
概要
最新の Salesforce アーキテクチャは、利便性ではなく、拡張性の戦略的な要件として非同期処理によって強化されつつあります。近年、データ量の急増、複数のタッチポイントを伴う複雑なインテグレーション、24 時間 365 日稼働する自律システムの台頭に取り組む企業が増えています。これらすべての要素により、アーキテクトは非同期ファーストのシステム設計に取り組むようになります。
Salesforce での非同期処理では、多くの場合、ガバナの制限と複雑さを考慮して設計する必要があります。これらの制限は、一括で安全で拡張可能なシステムを生成するのに役立つガードレールとアーキテクチャの制約として機能します。プラットフォームの制限は複雑さの管理に直接役立ちませんが、設計パターンを使用すると、リスクを軽減できます。Salesforce の内部では、新機能のフォワードテストや複雑なビジネスプロセスの自動化にプラットフォームの限界を押し広げています。任意のステップ数で非同期ジョブを実行するためのステップベースの非同期処理フレームワークを構築しました。各ステップは、共有ガバナンス制御と一元化されたログ記録による完全な操作の可視化により、個別に実行、再試行、再起動できます。このドキュメントでは、その主要なアーキテクチャコンポーネントの概要を説明します。キュー可能な Apex およびファイナライザー、スケジュール済みフロー、Apex カーソル、呼び出し可能なアクション、Slack とのインテグレーション。これらのコンポーネントを組み合わせることで、進化するエンタープライズニーズに適したモジュラー型で拡張性が高く、監視可能なアーキテクチャが提供されます。
重要ポイント
- 最新の Salesforce アーキテクチャでは、拡張性、耐障害性、運用の透明性を実現するために、非同期優先のアプローチを採用する必要があります。
- 複雑な作業を個々に実行可能なステップに分割することで、コアワークフローを再設計することなく、予測可能なパフォーマンス、より安全な再試行、チェックポイント、ロールバック、モジュールの進化を実現できます。
- このフレームワークは、モノリシックで経年劣化した一括処理ジョブ、チェーンされた非同期コール、深くネストされたフローに代わるスケーラブルな代替手段を提供し、プラットフォーム外でオーケストレーションすることなく Salesforce 内で水平に拡張する必要がある大規模ワークロード向けに構築されています。
- 確定的で観察可能な実行により、一元的なログとガバナンスを通じて、進行状況の追跡、SLA の監視、障害診断、監査レベルの透明性が確保されます。
- 長期にわたるビジネスプロセスの統合ガバナンス、コンプライアンス、分散状態制御など、エンタープライズ クラスの厳格さを実現するように設計されています。
プラットフォームのベストプラクティス
要件を確認する前に、次のようなフレームワークを使用する場合の推奨事項と推奨事項を次に示します。何よりも、どのシステムが唯一の情報源であるかを検討します。Salesforce 組織が外部データに最小限しか依存していないが、数百件から数百万件のレコードに拡張する必要がある場合は、ステップベースの非同期フレームワークを検討します。
このフレームワークは、次の場合に使用します。
- アクションを実行する情報のほとんど (またはすべて) が CRM にすでに存在します。
- 外部データをハーモナイズするための抽出変換負荷 (ETL) ジョブの維持にかかる先行コストまたは継続的なコストが高すぎる。
- 設定されたスケジュールで多数の Salesforce レコードの処理を延期する必要があります。
- 処理を個別のステップに分割できます。たとえば、階層またはツリーベースのレコードセットを作成できます。特に、データ量が階層またはツリーの下位にある場合に便利です。
次の場合は、このフレームワークを使用しないでください。
- レコードを作成または更新するには、すぐに再計算する必要があります。
- 外部システムでレコード更新の主データがホストされているため、インテグレーションが困難です。(Bulk API を使用して更新されたデータを Salesforce に転送することを検討してください)。
これらのプラクティスを念頭に置いて、要件を確認して構築を開始しましょう。
要件の内訳
問題ステートメントについて考えてみます。
毎日実行する必要があるジョブがある場合、特定のレコードが追加処理のために事前設定された条件を満たしているかどうかを確認します。その場合は、これらの処理ジョブを開始します。レコードの処理では、複数の外部システムからデータを取得して計算を実行する必要がある場合があります。ジョブのステップでは、処理済みのレコードを確認する準備が整ったことを Slack 経由でユーザーに通知する必要があります。また、最初の通知のラウンド後に設定可能な遅延に基づいて、ロール階層内のマネージャー以上のユーザーに通知をエスカレーションする必要があります。
この問題には複数の異なるステップが含まれ、それぞれ独立して発生する場合もあります。作業を分割する方法は多数あります。1 つのグルーピングを次に示します。
- スケジューラー。
- (処理の種別に関係なく) レコードを処理するステップインターフェースと具体的な実装。
- ステップを整理するプロセッサー。
- スケジューラによって呼び出される Apex 呼び出し可能。
- 通知部分。Apex Slack SDKを使用します。
- 「設定可能な遅延」という語句には複雑さが隠されています。この複雑さについては、この記事で後ほど説明します。
組み込みフレームワークの意見を示した図を次に示します。
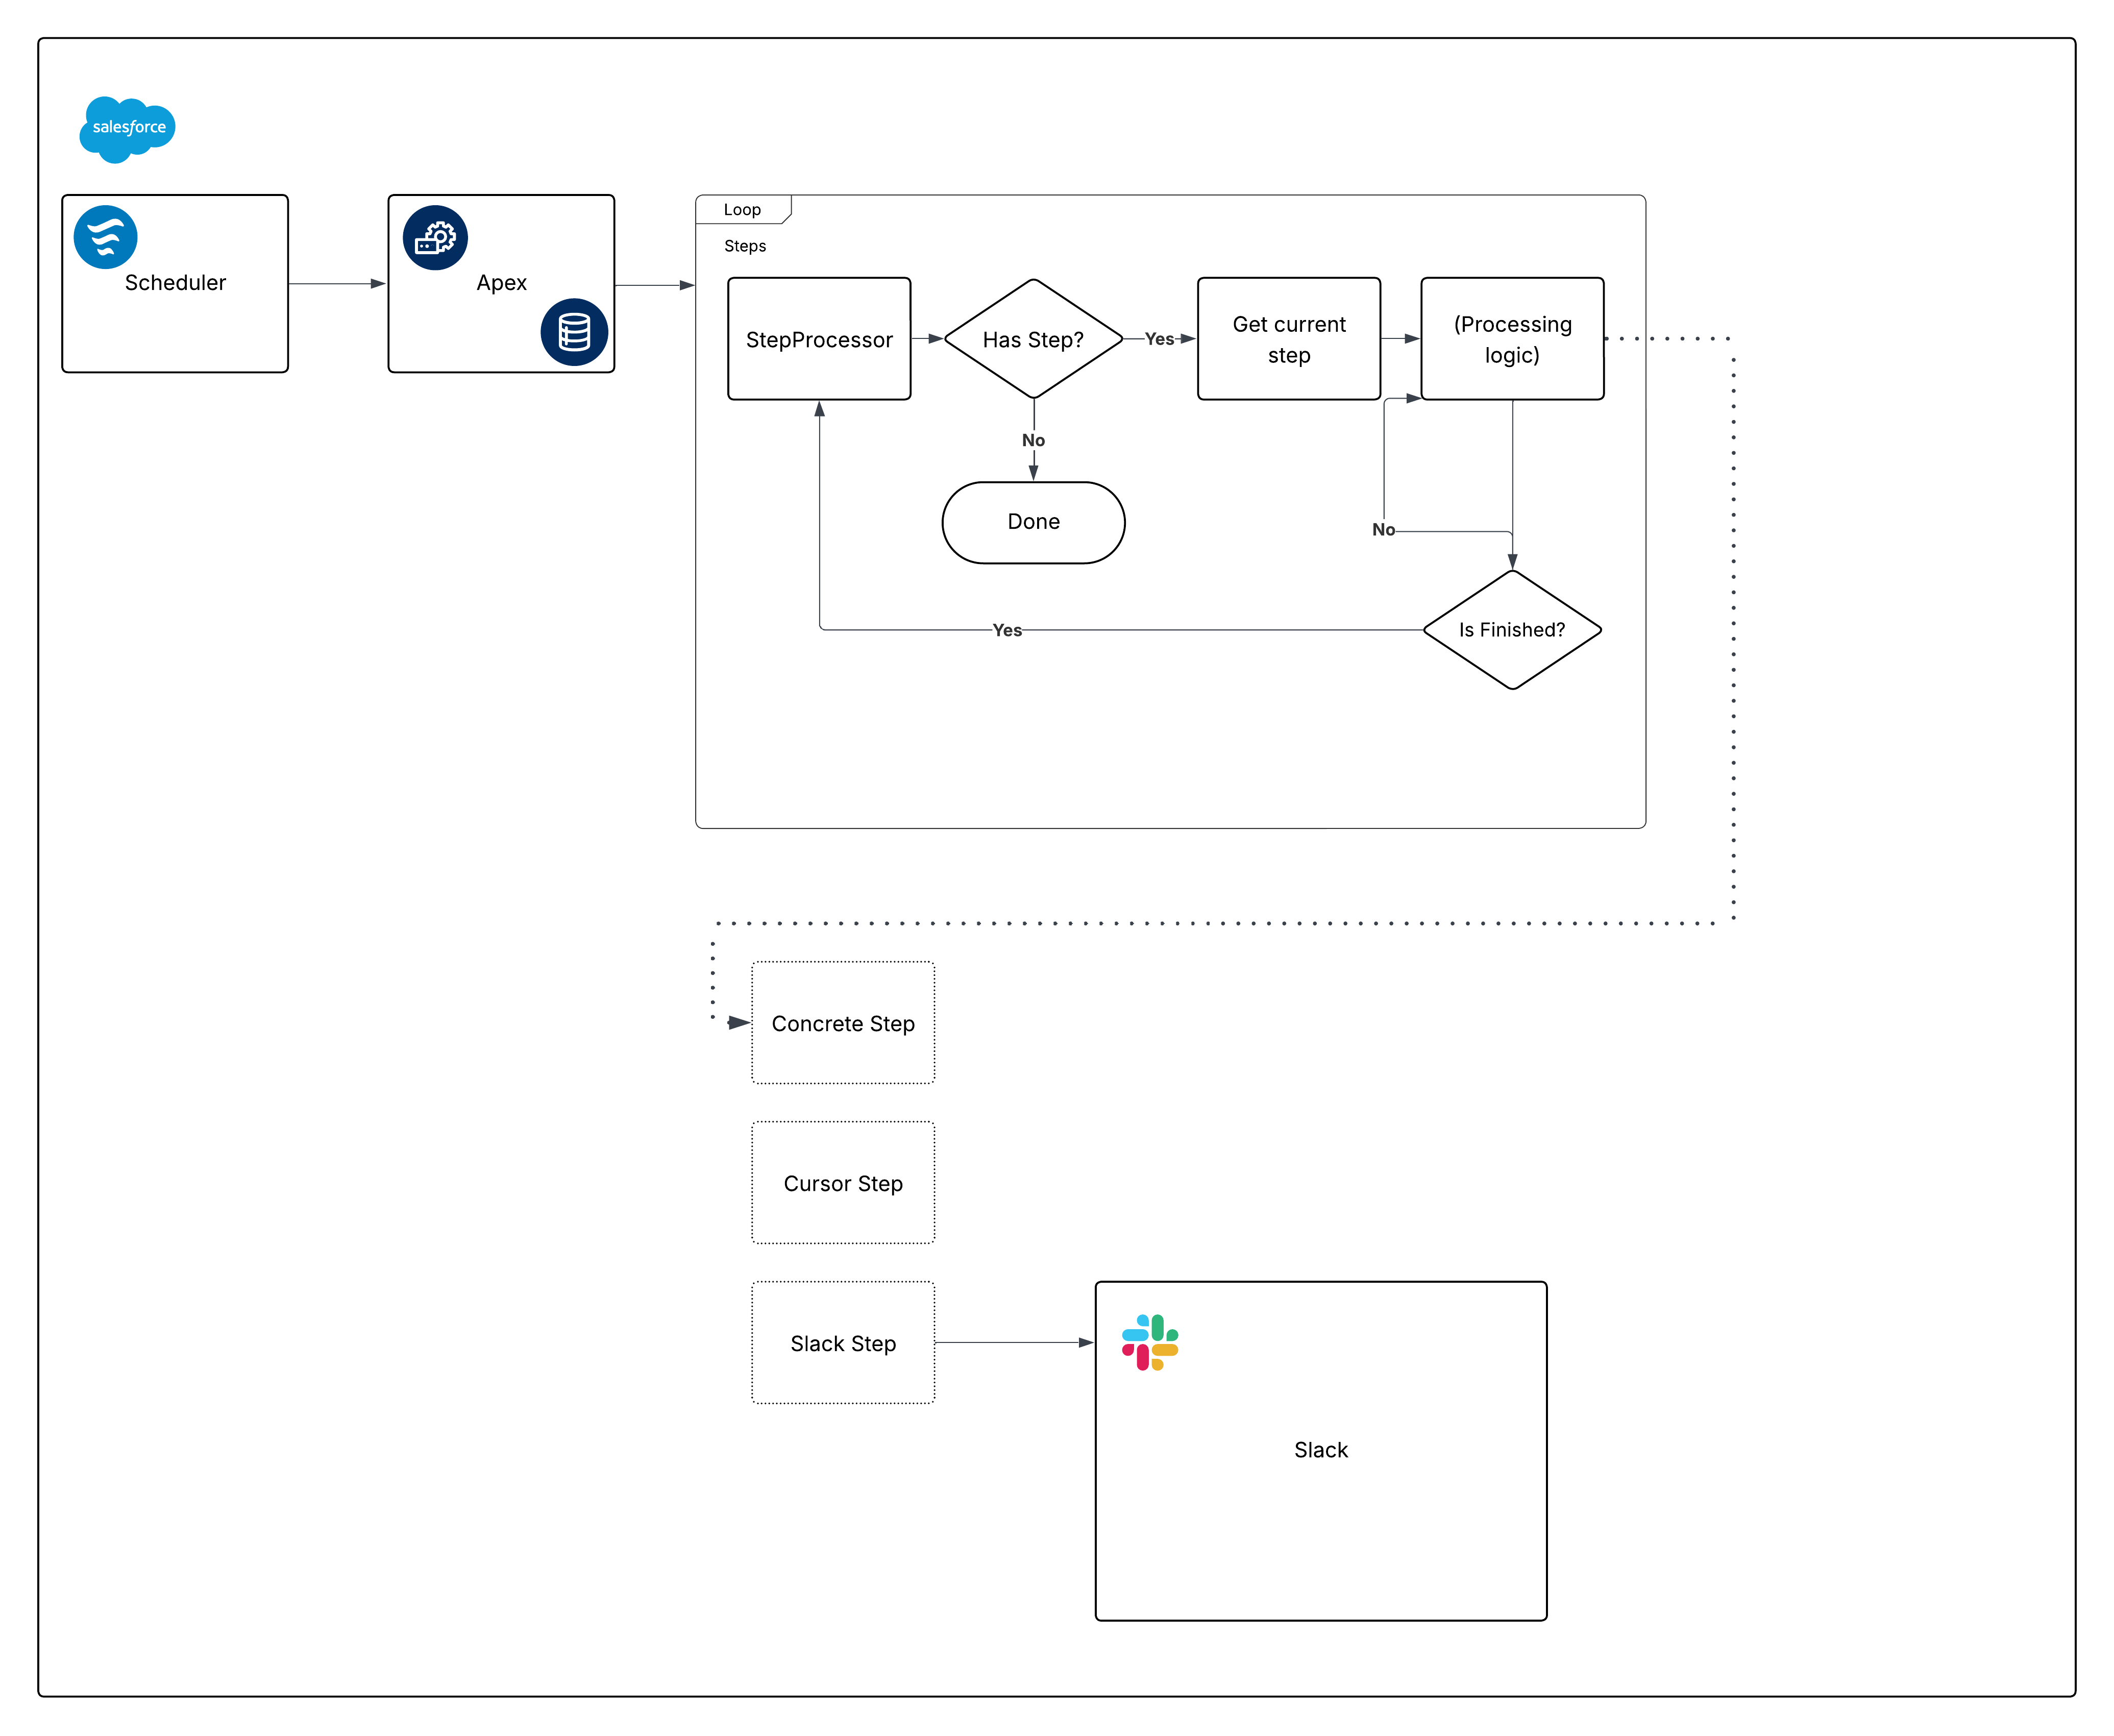 では、その図を分解して、ピースの作成を開始します。
スケジュール済みフローを使用したスケジュール
スケジュール済みフローには、スケジュールメカニズムとして次のような利点があります。
- スケジュール済みフローは、メタデータとしてパッケージ化してリリースできます。これは、Apex (または [スケジュール済みジョブ] ページ) でスケジュールされたジョブには適用されません。
- 待機要素は、コールアウトが必要なフレームワークにとって重要です。フローで使用すると、フレームワークの呼び出し可能部分でコールアウトが不要になります。
- スケジュールの粒度は要件を満たしています。スケジュール済みフローの最小間隔は毎日です。より高い頻度 (毎時など) が必要な場合は、この要件のスケジュール済みフローを再検討してください。
スケジュール済みフローを設定するときのもう 1 つの考慮事項は、環境管理です。Apex アクションを呼び出す前に、{!$Api.Enterprise_Server_URL_100}変数を評価する決定要素を追加します。これにより、UAT や本番など、意図した環境でのみジョブが実行されます。Sandbox は SDLC 中に頻繁に更新または新規作成されるため、このパターンは重要です。明示的な環境チェックを行わないと、フレームワークの実行が意図されていない環境でスケジュール済みフローが意図せずに実行される可能性があります。決定要素で contains 演算子を使用すると、今後の Sandbox の作成や URL の変更に対して設定が復元されます。
最後に、フレームワークで失敗をどのように捉えるかを検討します。フローでアクションをコールするときは、必ず障害パスを追加します。たとえば、Nebula Logger の「Add Log Entry」アクションに障害を配線できます。Nebula Logger はログをカスタムオブジェクトに書き込むため、ログデータは組織のストレージを消費します。デフォルトでは、ログは組織内で 14 日間保存され、その後クリーンアップされます。この保持期間は設定可能です。Nebula Logger はプラットフォームイベントを使用してログも公開するため、ログエントリはメインのデータ処理トランザクションから独立して保存されます。これにより、プライマリフローまたは Apex アクションがロールバックされた場合でも、障害を確実に捕捉できます。ログフレームワークの追加を検討する場合は、予想されるログ量と保持要件を評価する必要があります。
フローは次のようになります。
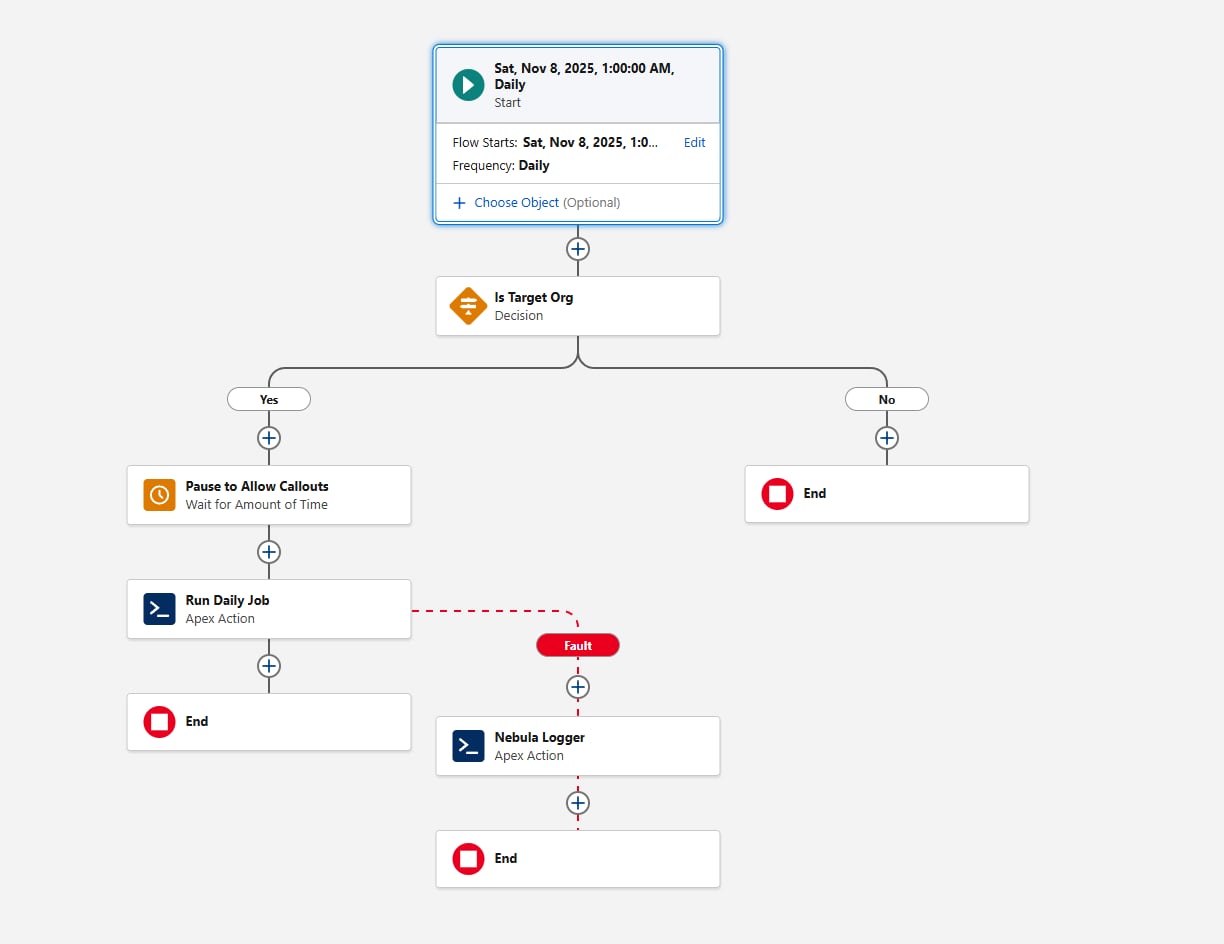
スケジュール要件が満たされた最初のApexコードに進みましょう。
ステップインターフェースの作成
Step インターフェイスを定義します。
 public interface Step {
  void execute();
  void finalize();
  String getName();
  Boolean shouldRestart();
}
この記事では、わかりやすくするために step インタフェースを外部クラスとして示します。フレームワーク自体は柔軟性が高く、すべてのステップ・クラスが同じインタフェースを参照していれば、チームは任意のApexパッケージ・パターンを使用してインタフェースとその実装を編成できます。
インターフェース内で定義されたメソッドについては、いくつかの注意事項があります。
executeは、現時点では引数なしで済みますが、順序が重要な場合にステップ間でデータをオーケストレーションするためにStateクラス(またはインターフェイス)を渡すと改善されます。getNameは、System.Type値ではなくString値を返す可能性があります。目的は、オーケストレーションレイヤーで他のプロパティを公開せずにステップ名を記録する方法を提供することです。
これらの要素がどのように組み合わされるかを示す最初の具体的な実装を次に示します。後で 1 つの例外を除いて、キュー可能 Apex を使用して Apex 内に非同期処理を実装することをお勧めします。通常、バッチ Apex は不要です (@future メソッドは使用しない)。Queueable Apex はすばやく開始でき、Apex カーソルを使用すると、バッチ Apex よりも多くの利点があります。
Apex カーソルのような実装
Apexカーソルは、従来のバッチApexモデルに代わる最新の機能を提供します。一括処理と同様に、カーソル実装ではレコードをチャンク (バッチあたり最大 2,000 件) で取得できます。ただし、カーソルでは 1 つのトランザクション内で複数の取得が許可されるため、大量の操作のスループットが大幅に向上します。
このフレームワークの一部としてカーソルを採用する場合、チームは現在のテストとモック可能性の制限を認識しておく必要があります。テストでのカーソルの動作は本番の動作とは異なる可能性があるため、カーソルの内部に依存しないようにテスト戦略を設計し、境界でオーケストレーションロジックを検証することが重要です。プラットフォームが進化するにつれて、次の領域は引き続き改善されますが、主要な指針は引き続き維持されます。カーソルを使用すると、多くの使用事例でバッチApexよりもパフォーマンスが向上し、オーケストレーションのオーバーヘッドが軽減されます。
システムが提供するカーソルと独自のコードの間に明確な境界を定義するには、Step インターフェースを実装するときにカーソルのような表現を作成することをお勧めします。次のコードについて考えてみます。
public inherited sharing abstract class CursorStep implements Step {
  private static final Integer MAX_CHUNK_SIZE = 2000;

  protected Cursor cursor;

  private Integer chunkSize = System.Limits.getLimitDMLRows();
  private Integer position = 0;

  protected abstract Cursor getCursor();
  protected abstract void innerExecute(List<SObject> records);

  public abstract String getName();

  public virtual CursorStep withChunkSize(Integer chunkSize) {
    this.chunkSize = chunkSize;
    return this;
  }

  public void execute() {
    this.cursor = this.cursor ?? this.getCursor();
    this.cursor.setFetchesPerTransaction(this.getFetchesPerTransaction());
    List<SObject> records = new List<SObject>();
    if (this.shouldAdvance()) {
      records = this.cursor.fetch(this.position, this.chunkSize);
      this.position += this.chunkSize;
    }
    this.innerExecute(records);
  }

  public virtual void finalize() {
    Logger.info('finished cursor step for ' + this.getName());
  }

  public virtual Boolean shouldRestart() {
    return this.position < this.cursor.getNumRecords();
  }

  protected virtual Integer getFetchesPerTransaction() {
    Integer maxRecordsPerFetchCall = 2000;
    if (this.chunkSize < maxRecordsPerFetchCall) {
      return this.chunkSize;
    }
    // Integer division rounds down
    // which is perfect for our use-case
    return this.chunkSize / maxRecordsPerFetchCall;
  }

  protected virtual Boolean shouldAdvance() {
    return true;
  }
}
Cursor クラスに注目してください。Apex カーソルはDatabase.Cursorのインスタンスですが、Cursor の実装により、カーソルの欠点を柔軟に回避できます。実装は次のようになります。
public virtual without sharing class Cursor {
  private static final Integer MAX_FETCHES_PER_TRANSACTION = Limits.getLimitFetchCallsOnApexCursor();

  @TestVisible
  private static Integer maxRecordsPerFetchCall = 2000;

  private Integer cursorNumRecords;
  private Integer fetchesPerTransaction = MAX_FETCHES_PER_TRANSACTION;
  private final Database.Cursor cursor;

  public Cursor(
    String finalQuery,
    Map<String, Object> bindVars,
    System.AccessLevel accessLevel
  ) {
    try {
      this.cursor = Database.getCursorWithBinds(finalQuery, bindVars, accessLevel);
    } catch (FatalCursorException e) {
      Logger.newEntry(
        System.LoggingLevel.WARN,
        'Error creating cursor. This can happen if there' +
          ' are no records returned by the query: ' + e.getMessage()
      );
    }
  }

  public Cursor setFetchesPerTransaction(Integer possibleFetchesPerTransaction) {
    // Handle accidental round downs from Integer division
    if (possibleFetchesPerTransaction == 0) {
      return this;
    }
    if (possibleFetchesPerTransaction > MAX_FETCHES_PER_TRANSACTION) {
      Logger.newEntry(
        System.LoggingLevel.DEBUG,
        'Fetches per transaction: ' +
          possibleFetchesPerTransaction +
          ' exceeded platform max fetches per transaction: ' +
          MAX_FETCHES_PER_TRANSACTION +
          ', defaulting to platform max'
      );
      possibleFetchesPerTransaction = MAX_FETCHES_PER_TRANSACTION;
    }
    this.fetchesPerTransaction = possibleFetchesPerTransaction;
    return this;
  }

  @SuppressWarnings('PMD.EmptyStatementBlock')
  protected Cursor() {
  }

  public virtual List<SObject> fetch(Integer start, Integer advanceBy) {
    if (this.getNumRecords() == 0) {
      Logger.newEntry(
        System.LoggingLevel.DEBUG,
        'Bypassing fetch call, no records to fetch'
      );
      return new List<SObject>();
    }
    Integer localStart = start;
    List<SObject> results = new List<SObject>();
    while (
      Limits.getFetchCallsOnApexCursor() < this.fetchesPerTransaction &&
      results.size() < this.getNumRecords() &&
      localStart < start + advanceBy
    ) {
      Integer actualAdvanceBy = this.getAdvanceBy(localStart, advanceBy);
      results.addAll(this.cursor?.fetch(localStart, actualAdvanceBy) ?? new List<SObject>());
      localStart += actualAdvanceBy;
    }
    return results;
  }

  public virtual Integer getNumRecords() {
    this.cursorNumRecords = this.cursorNumRecords ?? this.cursor?.getNumRecords() ?? 0;
    return this.cursorNumRecords;
  }

  protected Integer getAdvanceBy(Integer start, Integer advanceBy) {
    Integer possibleFetchSize = Math.min(advanceBy, this.getNumRecords() - start);
    if (possibleFetchSize > maxRecordsPerFetchCall) {
      Logger.newEntry(
        System.LoggingLevel.DEBUG,
        'Fetch size: ' +
          possibleFetchSize +
          ' exceeded platform max fetch size of ' +
          maxRecordsPerFetchCall +
          ', defaulting to max fetch size'
      );
      possibleFetchSize = maxRecordsPerFetchCall;
    } else if (possibleFetchSize < 0) {
      possibleFetchSize = 0;
    }
    return possibleFetchSize;
  }
}
この記事では、Apex クラスを参照するときに sharing 宣言を省略します。実際には、オブジェクトモデルと権限に準拠するために、最上位クラスで共有の有無に関係なく明示的に使用してください。
また、Cursorの実装はプラットフォーム Database.Cursorに委任され、その他のメリットについては次に説明します。
まず、対応するテストを次に示します。
@IsTest
private class CursorTest {
  @IsTest
  static void itCapsAdvanceByArgument() {
    String accountName = 'helloWorld!';
    insert new Account(Name = accountName);
    String query = 'SELECT Name FROM Account WHERE Name = :bindVar0';
    Map<String, Object> bindVars = new Map<String, Object>{ 'bindVar0' => accountName };

    Cursor instance = new Cursor(query, bindVars, System.AccessLevel.SYSTEM_MODE);

    Assert.areEqual(1, instance.getNumRecords());
    Assert.areEqual(accountName, instance.fetch(0, 1000).get(0).get('Name'));
    Assert.areEqual(1, System.Limits.getApexCursorRows());
  }

  @IsTest
  static void itCapsMaxRecordsPerFetchCall() {
    Cursor.maxRecordsPerFetchCall = 20;
    Integer oneMoreThanMaxFetch = Cursor.maxRecordsPerFetchCall + 1;

    List<Account> accounts = new List<Account>();
    for (Integer i = 0; i < oneMoreThanMaxFetch; i++) {
      accounts.add(new Account(Name = 'Fetch ' + i));
    }
    insert accounts;

    Exception ex;
    List<SObject> results;
    Cursor instance = new Cursor(
      'SELECT Id FROM Account',
      new Map<String, Object>(),
      System.AccessLevel.SYSTEM_MODE
    );
    try {
      results = instance.fetch(0, oneMoreThanMaxFetch);
    } catch (System.InvalidParameterValueException e) {
      ex = e;
    }

    Assert.areEqual(null, ex?.getMessage());
    Assert.areEqual(2, Limits.getFetchCallsOnApexCursor());
    Assert.areEqual(oneMoreThanMaxFetch, results.size());
  }

  @IsTest
  static void itFetchesMultipleTimesPerTransactionWhenMoreThanMaxFetch() {
    Cursor.maxRecordsPerFetchCall = 20;
    List<Account> accounts = new List<Account>();
    Set<String> expectedFetchNames = new Set<String>();
    for (Integer i = 0; i < Cursor.maxRecordsPerFetchCall + 1; i++) {
      String accountName = 'Fetch' + i;
      expectedFetchNames.add(accountName);
      accounts.add(new Account(Name = accountName));
    }
    insert accounts;

    Integer oneMoreThanMaxFetch = Cursor.maxRecordsPerFetchCall + 1;
    Cursor instance = new Cursor(
      'SELECT Name FROM Account',
      new Map<String, Object>(),
      System.AccessLevel.SYSTEM_MODE
    );
    List<SObject> results = instance.setFetchesPerTransaction(2).fetch(0, oneMoreThanMaxFetch);

    Assert.areEqual(Cursor.maxRecordsPerFetchCall + 1, results.size());
    Assert.areEqual(2, Limits.getFetchCallsOnApexCursor());
    Set<String> actuallyFetchedNames = new Set<String>();
    for (Account account : (List<Account>) results) {
      actuallyFetchedNames.add(account.Name);
    }
    Assert.areEqual(expectedFetchNames, actuallyFetchedNames);
  }

  @IsTest
  static void itFetchesMultipleTimesPerTransaction() {
    Cursor.maxRecordsPerFetchCall = 1;
    insert new List<Account>{ new Account(Name = 'One'), new Account(Name = 'Two') };

    Cursor instance = new Cursor(
      'SELECT Id FROM Account',
      new Map<String, Object>(),
      System.AccessLevel.SYSTEM_MODE
    )
      .setFetchesPerTransaction(2);
    List<SObject> results = instance.fetch(0, 2);

    Assert.areEqual(2, instance.getNumRecords());
    Assert.areEqual(2, results.size());
    results = instance.fetch(2, 1);
    Assert.areEqual(0, results.size());
  }

  @IsTest
  static void fetchesCorrectAmountOfRecords() {
    List<Account> accounts = new List<Account>();
    for (Integer i = 0; i < 10; i++) {
      accounts.add(new Account(Name = 'Fetch ' + i));
    }
    insert accounts;

    Cursor instance = new Cursor(
      'SELECT Id FROM Account',
      new Map<String, Object>(),
      System.AccessLevel.SYSTEM_MODE
    )
      .setFetchesPerTransaction(10);
    List<SObject> results = instance.fetch(0, 2);

    Assert.areEqual(2, results.size(), '' + results);
    Assert.areEqual(1, Limits.getFetchCallsOnApexCursor());
  }

  @IsTest
  static void doesNotExceedPlatformMaxFetch() {
    List<Account> accounts = new List<Account>();
    for (Integer i = 0; i < 101; i++) {
      accounts.add(new Account(Name = 'Fetch ' + i));
    }
    insert accounts;

    Test.startTest();
    Cursor instance = new Cursor(
        'SELECT Id FROM Account',
        new Map<String, Object>(),
        System.AccessLevel.SYSTEM_MODE
      )
      .setFetchesPerTransaction(100);
    Integer counter = 0;
    List<SObject> results;
    while (counter <= 100) {
      results = instance.fetch(counter, counter + 1);
      counter++;
    }
    Test.stopTest();

    Assert.areEqual(101, counter);
    Assert.areEqual(0, results.size());
  }
}
Cursorを仮想化することで、大規模なレコード・セットを繰り返す必要がない場合でも、具体的なCursorStepの実装をDatabase.Cursorなしで実行できます。これは、バッチApexでDatabase.QueryLocatorではなくSystem.Iterable<T>を返す場合と同様です。次に例を示します。
public abstract class CursorLikeImplementation extends CursorStep {
  private final Cursor cursorLike;

  public CursorLikeImplementation(List<SObject> previouslyRetrievedRecords) {
    this.cursorLike = new CursorLike(previouslyRetrievedRecords);
  }

  public override String getName() {
    return CursorLikeImplementation.class.getName();
  }

  public override Cursor getCursor() {
    return this.cursorLike;
  }

  private class CursorLike extends Cursor {
    private final List<SObject> records;

    public CursorLike(List<SObject> records) {
      super();
      this.records = records;
    }

    public override List<SObject> fetch(Integer position, Integer chunkSize) {
      // clone, to keep the underlying list type
      List<SObject> clonedRecords = this.records.clone();
      clonedRecords.clear();
      for (Integer i = position; i < this.getAdvanceBy(position, chunkSize); i++) {
        clonedRecords.add(this.records[i]);
      }
      return clonedRecords;
    }

    public override Integer getNumRecords() {
      return this.records.size();
    }
  }
}
このクラスも抽象クラスであるため、innerExecuteの具体的な実装はサブクラスに任せます。
CursorLike の内部サブクラスの代替法もあります。このようなステップの具体的なバージョンが他のガバナ制限で焼き付けられないことがわかっている場合は、CursorLike.fetch からthis.recordsを返し、親CursorStep.shouldRestart()を上書きして false を返すことができます。これにより、非同期トランザクションあたり12 MBのApexヒープ制限のみによって制限されたリストを反復処理できます。
その他の可能なステップベースの実装
カーソルベースの実装では、大量のデータをページングするときに十分な柔軟性が得られます。一方、Stepインターフェイスでは、あらゆる種類のステップを記述してカプセル化できる柔軟性があります。
フローベースのステップを考えてみましょう。
public virtual class FlowStep implements Step {
  private final Invocable.Action specificFlow;

  private Boolean shouldRestart = false;

  public FlowStep(String specificFlowName, Map<String, Object> inputs) {
    this.specificFlow = Invocable.Action.createCustomAction('flow', specificFlowName);
    this.specificFlow.setInvocations(new List<Map<String,Object>>{ inputs });
  }

  public void execute() {
    List<Invocable.Action.Result> results = this.specificFlow.invoke();
    for (Invocable.Action.Result result : results) {
      if (result.isSuccess()) {
        Map<String, Object> outputParams = result.getOutputParameters();
        Object potentialShouldRestartValue = outputParams.get('shouldRestart');
        // Flow does not enforce Booleans being initialized
        //  so a null check is sadly necessary here
        if (potentialShouldRestartValue != null) {
          this.shouldRestart = this.shouldRestart ||
           Boolean.valueOf(potentialShouldRestartValue);
        }
      } else {
        List<String> errorMessages = new List<String>();
        for (Invocable.Action.Error error : result.getErrors()) {
          errorMessages.add(
            'Error code: ' + error.getCode() +
            ', error message: ' + error.getMessage()
          );
        }
        Logger.error(
          'An error occurred within your auto-launched flow:\n' +
            String.join(errorMessages, '\n\t')
        );
      }
    }
  }

  public virtual void finalize() {
    Logger.info(this.getName() + ' finished processing');
  }

  public String getName() {
    return FlowStep.class.getName() + ':' + this.specificFlow.getName();
  }

  public Boolean shouldRestart() {
    return this.shouldRestart;
  }
}
フローでは Apex で定義されたタイプに準拠する出力パラメータを返すことができないため、使用前にshouldRestart出力パラメータが確認されます。
一部のステップは機能フラグが付けられている場合があります。含めるステップを決定するロジックを実装したり、無効化された機能に no-op ステップを使用したりできます。Null オブジェクトパターンは、オーケストレーションレイヤー内の複雑さを軽減する一般的な方法です。
@SuppressWarnings('PMD.EmptyStatementBlock')
public class NoOpStep implements Step {
  // The null object pattern is commonly implemented
  // as a singleton to reduce memory consumption
  public static final NoOpStep SELF {
    get {
      SELF = SELF ?? new NoOpStep();
    }
    private set;
  }

  public void execute() {
  }

  public void finalize() {
  }

  String getName() {
    return NoOpStep.class.getName();
  }

  Boolean shouldRestart() {
    return false;
  }
}
今では、多くのビルディングブロックで作業できます。ステップの反復を担当するオーケストレーションレイヤーを見てみましょう。
ステッププロセッサーの作成
プロセッサーはアーキテクチャの転換点となります。誰がどのステップをどこで初期化するかを決定する必要があります。次のオプションがあります。
- ビジネスロジックに対応付けるステップをプロセッサーで定義します。このオプションはシンプルですが、読みやすく拡張性に欠けます。
- カスタムメタデータ (CMDT) を使用して対応付けを定義します。メタデータリレーションフィールドでは、クラス名のスペルをビジネスプロセス設定と疎結合にする
ApexClassはサポートされません。項目を選択リストにしてその種別が存在することを検証 (Type.forName()またはApexClassを照会) することで、管理者のリスクを軽減できますが、CMDT レコードではトリガーがサポートされないため、検証は実行時に行われます。このルートはテスト可能ですが、システム管理者は本番でのみ CMDT レコードを作成できます。慎重に進めてください。 - レコードとの対応付けを定義します。システム管理者以外もステップを設定できますが、リリースが難しくなり、環境がドリフトする可能性があります。慎重に進め
Clean Code には、この特定の複雑さを処理する方法に関する有名な引用があります。
この問題の解決方法は、(オブジェクトを作成するための)
switchステートメントを抽象工場の地下に埋めて、誰にも見せないことです。
この点を考慮して、現在のステップ数は明確に定義されており、大きくなりすぎることはないため、ステッププロセッサーをステップの工場にすることもできます。これは、switch ステートメントの実行に Enum を使用できます。
public enum StepType {
   TYPE_ONE,
   TYPE_TWO,
   TYPE_THREE,
   TYPE_FOUR
   // etc ...
}
そして、私たちのStepProcessor:のために
public StepProcessor implements System.Queueable, System.Finalizer,
 Database.AllowsCallouts {
  private final List<Step> steps = new List<Step>();

  private Step currentStep;

  public StepProcessor setSteps(List<StepType> stepTypes) {
    for (StepType type : stepTypes) {
      switch on type {
        WHEN TYPE_ONE {
          this.addTypeOneSteps();
        }
        WHEN TYPE_TWO {
          this.addTypeTwoSteps();
        }
        // ... etc
      }
    }
    this.cleanSteps();
    return this;
  }

  public void execute(System.QueueableContext context) {
    this.currentStep = this.currentStep ?? this.steps.remove(0);
    if (context != null) {
      System.attachFinalizer(this);
      Logger.setAsyncContext(context);
    }
    Logger.info('Executing step ' + this.currentStep.getName());
    try {
      this.currentStep.execute();
    } catch (Exception e) {
      Logger.exception('Unexpected exception', e);
    }
    Logger.info('Finished executing step ' + this.currentStep.getName());
    Logger.saveLog();
  }

  public void execute(System.FinalizerContext context) {
    Logger.info('Executing finalizer for step ' + this.currentStep.getName());
    Logger.setAsyncContext(context);
    switch on context?.getResult() {
      when UNHANDLED_EXCEPTION {
        // see the note below about this logging paradigm
        Logger.warn(
          'Failed to run on step' + this.currentStep,
          context?.getException()
        );
      }
      when else {
        this.currentStep.finalize();
        if (this.currentStep.shouldRestart()) {
          this.kickoff();
        } else if (this.steps.isEmpty() == false) {
          this.currentStep = this.steps.remove(0);
          this.kickoff();
        } else {
          Logger.info('Finished executing steps');
        }
      }
    }
    Logger.info(
      'Finished executing finalizer for step ' +
        this.currentStep.getName()
    );
    Logger.saveLog();
  }

  public String kickoff() {
    return this.steps.isEmpty() ? null : System.enqueueJob(this);
  }

  private void cleanSteps() {
    for (Integer reverseIndex = this.steps.size() - 1;
      reverseIndex >= 0; reverseIndex--) {
      if (this.steps[reverseIndex] instanceof NoOpStep) {
        this.steps.remove(reverseIndex);
      }
    }
  }

  private void addTypeOneSteps() {
    this.steps.addAll(
      new List<Step> {
        new ExampleCursorStepOne(),
        new ExampleCursorStepTwo()
      }
    );
  }

  private void addTypeTwoSteps() {
    this.steps.addAll(
      new List<Step> {
        new FlowStep('
          ExampleInvocableName',
          new Map<String, Object>( 'exampleParameter' => true)
        ),
        new ExampleCursorStepThree()
      }
    );
  }
}
表示されたファクトリメソッド (addTypeOneSteps() など) は、機能のフラグ設定などの懸念事項を委任できます。cleanSteps() は、収集されたステップに対して 1 回チェックを実行し、「空の」ステップがないことを確認してから、実際に非同期にします。これは次のようになります。
private Step getStepOrDefault(String customPermissionName, Step defaultStep) {
  if (System.FeatureManagement.checkPermission(customPermissionName)) {
    return defaultStep;
  }

  return NoOpStep.SELF;
}
[スケジュール済みフロー] セクションで Nebula Logger に言及して以来、エラー処理については説明していません。これは、System.Finalizerを使用すると、各ステップで特定のエラー処理を追加することなく、すべてのエラー条件のログを包括的にカバーできるためです。各Stepは実行に焦点を絞りますが、単体テストで問題のあるパスがあれば記録して再スローします。これにより、安全な反復と本番レベルのアラートがサポートされます(すべてのWARNログとERRORログでNebula用Slack Loggerプラグインを使用)。
エラーログに関する 1 つの注意事項: ログメッセージにステップインスタンスを渡すと、ログに表示される内容のTrust性が想定されます。Apexクラスのデフォルト toString()には、すべての静的プロパティとインスタンス レベル プロパティがメッセージに含まれます。これは望ましいことですが、機密情報が漏洩する可能性もあります。ここではロギングとセキュリティは重視しませんが、一部のシステムでは、Step などのインターフェイスに準拠するために、toString()の上書きを強制することもあります。
 public interface Step {
  void execute();
  void finalize();
  String getName();
  Boolean shouldRestart();
  String toString();
}
このような方法では、各オブジェクト作成者に責任を負わせて、印刷を許可する内容を決定します。
ログ レベル:StepProcessor レベルでは、エラーでない最も高いレベルであるINFOが使用されます。アプリケーション内の詳細度が高くなると、それに応じてログレベルも低下します。個々のステップでは、概要レベルの情報に DEBUG を使用し、より詳細な出力用に FINE、FINER、FINEST を予約できます。ロギングは科学と同じくらい技術ですが、これらの原則に従うことでログの一貫性と有用性を保つことができます。
ステッププロセッサー内での追加の複雑さの処理
先に進む前に、ステッププロセッサーでステップを使用するロジックをホストするという決定について簡単に振り返ってみましょう。大規模なコードベースでは、StepProcessorを仮想または抽象にすることを検討し、サブクラスに特定のステップを特定させて、適切な懸念の分離を確立します。
Apex 呼び出し可能レイヤー
スケジューラは最終的に Apex を呼び出します。残りの設定が完了したら、「呼び出し可能な Apex」セクションで実行するステップを決定し、List<StepType>をプロセッサーに渡すことができます。
public class DailyJobExecutor {
  @InvocableMethod(label='Execute Daily Job')
  public static void executeJob() {
    Logger.info('Executing daily Job');

    List<StepType> correspondingTypes = new List<StepType>();
    // based on [business logic], determine which step types
    // should be included for any daily invocation

    if (correspondingTypes.isEmpty() == false) {
      try {
        new StepProcessor().setSteps(correspondingTypes).kickoff();
      } catch (Exception ex) {
        Logger.exception('Error starting job', ex);
      }
    }
  }

  Logger.saveLog();
}
これは、レコード、データ、またはロジックを使用して実行するステップ種別を決定するという、方程式の簡単な部分です。呼び出し可能なアクションは、他の場所で複雑さをカプセル化しているためシンプルです。また、予期しない例外から保護され、各ピースを個別に簡単にテストできるようになりました。
Slack への通話前の遅延の処理
Apex Slack SDK はこの記事の範囲外ですが、要件に関する潜在的な問題として、ロール階層の上位にあるユーザーへの設定可能な遅延に基づく通知を再確認する必要があります。書類上、これは単純であり、StepProcessorのSystem.enqueueJob(this)を(正しく)考慮する可能性があります。System.AsyncOptions では、この要件を満たすためにenqueueJobオーバーロードを使用するのが最初の傾向でした。
ただし、現時点では、System.AsyncOptions.MinimumQueueableDelayInMinutes 経由の最大遅延は 10 分です。要件は 120 分であるため、いくつかのオプションが残っています。ナイーブなアプローチは次のようになります。
public class ExampleDelayedNotifier implements Step {
  private final List<Slack.ChatPostMessageRequest> notifications = new List<Slack.ChatPostMessageRequest>();
  private final Slack.BotClient botClient = Slack.App
    .getAppByKey('some-slack-app-key')
    .getBotClientForTeam('slack team id');

  // account for the initial delay,
  // so 120 - 10 = 110
  private Integer delayMinutes = 110;

  public void execute() {
    if ( this.delayInMinutes > 0) {
      return;
    }

    Integer maximumAllowedCallouts = 100;
    while (this.notifications.isEmpty() == false && maximumAllowedCallouts > 0) {
      this.botClient.chatPostMessage(this.notifications.remove(0));
      maximumAllowedCallouts--;
    }
  }

  public void finalize() {
    this.delayInMinutes -= 10;
  }

  public String getName() {
    return ExampleDelayedNotifier.class.getName();
  }

  public Boolean shouldRestart() {
    return this.delayInMinutes > 0 || this.notifications.isEmpty() == false;
  }
}
実際には、遅延は設定駆動であるため、このクラスに遅延が渡されます。
遅延通知種別が 1 つしかないことが確実な場合を除き、この方法はお勧めしません。開始前に 11 個の追加非同期ジョブが実行されます (遅延が増加した場合はそれ以上)。そのコストは、1 つの作業で十分かもしれませんが、多くの作業では必要ありません。また、Step インタフェースにメソッドを追加して、各ステップで再起動までの待機時間をプロセッサーに指示できるようにする必要があります。これにより、ノイズが増加します。
次の 2 つの興味深い可能性が考えられます。
- ポーリングジョブがすでに適切な間隔でスケジュールされている場合、既存のジョブフレームワークに遅延ステップを挿入できます。また、指定した遅延が最大 15 分経過しても問題ありません(15 分は Apex でスケジュールされた CRON 式の最小更新間隔)。これは、呼び出し可能な Apex の例にほぼ一致し、代わりに Apex を介してスケジュールが実行されます。つまり、同じ
Stepベースのアーキテクチャを再利用して、[Start After]タイムスタンプに基づいてレコードを処理し、前に表示したStepType列挙値への選択リストまたは複数選択リストの対応付けに基づいて使用するステップを決定できます。 - または、追加の外部 Apex クラスを定義する場合は、
System.scheduleBatch()を使用して一括 Apex にフォールバックします(内部クラスをサポートする Queueable Apex とは異なり、一括 Apex クラスは外部クラスである必要があります)。
Batch Apexの例を考えてみましょう。一般的に、柔軟性と制御性のために Queueable Apex をお勧めしますが、これはバッチ Apex が依然として優位なケースの 1 つです。
public class DelayedNotifier implements Database.Batchable<Object> {
  private final StepProcessor processor = new StepProcessor();

  public Iterable<Object> start(Database.BatchableContext bc) {
    return new List<Object>();
  }

  @SuppressWarnings('PMD.EmptyStatementBlock')
  public void execute(Database.BatchableContext bc, Object scope) {
    // we don't need to actually do anything in execute,
    //  we just need to start up the processor in finish
  }

  public void finish(Database.BatchableContext bc) {
    try {
      // you can imagine Notifier as an elided,
      // simpler version of the naive implementation
      // we showed above, now only focused on sending messages
      this.processor.setSteps(new List<Step>{ new Notifier() }).kickoff();
    } catch (Exception ex) {
      Logger.exception('Unexpected error', ex);
    } finally {
      Logger.saveLog();
    }
  }
}
次に、StepProcessor で、前に示した addTypeOneSteps() メソッドがこの遅延ステップで更新されたとします。
public StepProcessor implements System.Queueable, System.Finalizer,
  Database.AllowsCallouts {
  // .... unchanged top of class elided

  private void addTypeOneSteps() {
    this.steps.addAll(
      new List<Step> {
        new ExampleCursorStepOne(),
        new ExampleCursorStepTwo(),
        new DelayedNotifierStep()
      }
    );
  }

  // ...

  private class DelayedNotifierStep implements Step {
    private final DelayedNotifier delayedNotifier = new DelayedNotifier();
    // again — in practice this value would also be passed in
    private final Integer delayInMinutes = 120;

    public void execute() {
      System.scheduleBatch(
        this.delayedNotifier,
        'Delayed notifier: ' + System.now().getTime(),
        this.delayInMinutes
      );
    }

    public void finalize() {
      Logger.debug('Nothing to finalize, batch scheduled');
    }

    public String getName() {
      return DelayedNotifierStep.class.getName();
    }

    public Boolean shouldRestart() {
      return false;
    }
  }
}
通常、この程度のフープジャンプはお勧めしませんが、このステップの遅延がもう 1 つの再利用可能なビルディングブロックになります。Queueable Apex で長い遅延が許可されるまでは、この方法は、この効果を生成する最も簡単な方法でもあります(ポーリング メカニズムを使用しない場合については後述)。
結論
要件を満たすためにオブジェクト指向設計を使用し、長期的な構築コストとメンテナンスコストのバランスを取りながら拡張できるシステムを作成しました。ステップの宣言とインスタンス化は最終的にStepProcessorでの位置を超える可能性がありますが、技術的な負債はほとんどありません。FlowStepを使用すると、システム管理者と開発者は、ノーコード ソリューションまたはプロコード ソリューションが最も合理的なタイミングを一緒に決定できます。
Apexのキュー可能フレームワーク内のSystem.Finalizer・インタフェースをNebula Loggerとともに使用することで、今後のステップで明示的なログ記録が欠落している場合でも、予期しない障害を警告する堅牢でテスト可能なシステムを構築しました。当社にとって、このシステムはコストと複雑さを軽減し、楽しく数字を計算できます。また、実際のワークロードでのApexカーソルの動作に関する貴重なインサイトが得られ、機能自体を改善しながらアプローチを改善できるようになりました。
ステップベースの非同期処理フレームワークフレームワークは、複雑で大量のワークロードをモジュール化された実行ステップに分解することで、プラットフォームの制約をエンジニアリング上のメリットに変換し、エンタープライズ規模の予測可能なパフォーマンス、可観測性、ガバナンスを実現します。ステップはシステム管理者と開発者の両方が設定でき、いずれの場合もステップ作成者は各ステップの拡張方法を心配することなく、プラットフォームの基本的なガバナ制限 (DML 行や取得されるクエリ行など) の遵守に集中できます。
Path Forward (パス転送)
エンタープライズ実装全体でこのパターンを運用して採用するには、アーキテクトは次の要件を満たす必要があります。
- 既存の自動化を評価して、非同期オーケストレーションがパフォーマンスの向上と可観測性の向上に役立つ領域を特定します。
- 明確な処理目標と個別の作成者ポイント(フロー、Apexなど)を使用して、大きなプロセスを個別に実行可能なステップに分割します。
- ステップ種別を定義してグループ化し、ビジネスユニット間でのステップの再利用と標準化を促進します。
- 新しいプロセスまたは既存の自動化を使用してアプローチをパイロットします。ステップ内で無料で見つけることができるエッジケースの数に驚くかもしれません。
著者について
James Simone は Salesforce のプリンシパルソフトウェアエンジニアであり、このプラットフォームで 10 年以上働いた経験があります。開発に移行する前はSalesforceのお客様であり、製品所有者でした。また、2019年からThe Joys Of ApexでSalesforceに関する技術的な詳細を執筆されています。以前にはSalesforce開発者ブログとSalesforceエンジニアリングブログでも記事を公開しています。