
| パターン種別 | モード/ツール | 利点 | 考慮事項 | 結果 |
|---|---|---|---|---|
| データ取り込み | リアルタイム:CDC サポートの取り込み API を介した 1 秒未満の遅延の取り込み。継続的なストリーミングパイプライン。 | - 即時インサイト -低レイテンシの運用およびパーソナライズの使用事例に最適 -イベント駆動型ワークフローをサポート |
- 高いコスト - 複雑なアーキテクチャ - 低レイテンシのソースシステムが必要 - 大量のソースにより過剰なストリーミングが発生し、パイプラインが飽和状態になる可能性がある - I/O集中型 オーバーヘッドを削減するための選択項目と絞り込みを考慮する |
Agentforce: リアルタイムの不正行為アラート、小売のパーソナライズ、運用アラート 分析: - 1 秒未満のダッシュボード、KPI 監視 コンプライアンス: - 規制対象のワークフローの顧客レコードの継続的な更新 |
| ストリーミング:ネイティブコネクタを使用して 1 ~ 3 分ごとにマイクロバッチを取り込み | - コストと新鮮さのバランス -リアルタイムよりもシンプルなアーキテクチャ -増分更新をサポート |
- 若干の遅延 - 重要な1秒未満の意思決定には適していない可能性がある -バッチサイズがメモリ/コンピューティングに影響する - I/O が中程度 -予測可能で反復的な更新パターンに最適 -処理負荷を軽減するためにウィンドウ集計を考慮する |
Agentforce: - タイムリーなキャンペーントリガー、ほぼ稼働中のエンゲージメント 分析: - レコメンデーションエンジン、ほぼ稼働中のダッシュボード コンプライアンス: - 監査機能を備えた頻繁な更新 |
|
| バッチ:コネクタまたは API を介してスケジュールされた大量の読み込み。オブジェクトストレージと ETL/ELT パイプラインをサポートします。 | -大規模なデータセットのコスト効率 - 実装が容易 - 履歴分析の信頼性 |
- データ遅延 - 時間的制約のある操作には不向き - 読み込みウィンドウ中にI/Oを集中 -大きなファイルでは、ネットワークのスループットがボトルネックになる可能性がある -履歴集計や規制対象のレポートワークフローに最適 |
Agentforce: - IT サポートチケット (Jira/ServiceNow)、集計されたワークフロー 分析: ・履歴分析、トレンド評価 苦情: - 規制レポート、患者/請求データの集計 |
|
| Zero Copy | Live Query:外部システムでの直接クエリ、読み取り時のスキーマ、データの重複なし | - 最大限の新鮮度 -最小限のストレージオーバーヘッド、リアルタイムの運用インサイトのサポート |
-ソースのパフォーマンスによる - クエリ量が多いと遅延に影響する可能性がある -述語プッシュダウンと集計を使用して I/O を最小限に抑えるクエリに最適 -大量のデータセットに対する絞り込まれていないクエリを回避する |
Agentforce: - ライブ活動に適応する動的ワークフロー 分析: - 運用ダッシュボード、ライブレポート コンプライアンス: - ソースでの行レベルセキュリティとマスキングを遵守 |
| Accelerated Query (Caching):統合クエリ用のキャッシュされたローカルコピー。15 分から 7 日の間で設定できます。最適化されたクエリ実行 | - 遅延を削減 - 繰り返しのライブクエリよりも低コスト - 頻繁なアクセスパターンのパフォーマンスを向上 |
キャッシュ管理が必要 -キャッシュ間隔によって停滞 - 頻度の高いクエリに最適 - 秒未満の判断には適していません。 |
Agentforce: - 迅速な意思決定のための事前集計されたエンゲージメント評価指標 分析: - BI ダッシュボード、セグメンテーション、分析レポート コンプライアンス: -監査ログを含む一貫した規制対象ダッシュボード |
|
| ファイルフェデレーション:オブジェクト ストアまたはレーク(S3、Iceberg、Google BigQuery、Redshift)内の大規模な履歴データセットへの直接アクセス。 | - 大規模なデータセットを処理する Data 360 の最小ストレージ -AI/MLワークロードをサポート |
- 参照のみ -クエリのパフォーマンスは外部システムのスループットによって異なる -バッチ処理が多く、スループット要件の厳しいジョブに最適化 - リアルタイムダッシュボードには適していません。 |
Agentforce: - (一般的ではない — バッチ処理が多い) 分析: -ML/AIトレーニング、履歴分析、ペタバイト規模のレポート コンプライアンス: -重複のない外部データセットへのアクセスを管理 |
 #### データ取り込み方法
データの取り込み方法は、データの取り込みに使用するコネクタによって異なります。さまざまな取り込み方法を提供するコネクタもあれば、バッチモードまたはストリーミングモードでのみ動作するコネクタもあります。「[Data 360:Data 360 コネクタとその使用可能な方法の完全なリストについては、Integrations and Connectors](https://help.salesforce.com/s/articleView?id=data.c360_a_sources_targets.htm&type=5) (インテグレーションとコネクタ) を参照してください。
- **リアルタイム**
- ストリーミングパイプラインまたは Change データキャプチャ (CDC) を使用した 1 秒未満の取り込み。
- 時間的制約のあるワークフロー (不正検出、パーソナライズ、運用ダッシュボード) に最適です。
- Data 360 内の変換と集計をプッシュして、下流の I/O を削減し、コンピューティングの使用状況を最適化します。増分 CDC を使用して、データの入れ替えを最小限に抑えます。
- **ストリーミング**
- 1 ~ 3 分おきに少しずつ取り込みます。
- キャンペーンオーケストレーション、ニアライブエンゲージメント、運用レポートに適した、新鮮さとコストのバランスの取れたソリューション。
- マイクロバッチを使用して、I/O スパイクを制御します。可能な場合はソースでデータを集計して、転送量を削減し、ストレージを最適化します。
- **バッチ (スケジュール済み負荷)**
- 大規模なデータセットの定期的な取り込み (毎時、毎日、毎週)。
- 履歴データセット、規制レポート、コンプライアンスの使用事例のコスト効率と信頼性。
- パフォーマンスとコストを最適化するために、ソースストレージと同じ領域でコンピューティングの局所性を確保します。
#### Architect Playbook (アーキテクトプレイブック)
- **データ取り込みの使用事例**
- **Customer 360統合プロファイルの生成:**顧客の ID と属性の一元化された情報源を構築します。
- **規制コンプライアンスデータセットの管理:**機密データのガバナンス、系統、監査可能性を適用します。
- **キャンペーンのオーケストレーションを一元化:**マーケティング、営業、サービスのすべてが一貫性のある信頼できるデータセットから実行されるようにします。
- **設計プラクティス**
- アーカイブレポートや定期的なスナップショットなど、履歴や低レイテンシーを必要とする場合にバッチ取り込みを推奨します。
- CDC またはストリーミング API を使用して、業務およびパーソナライズワークフローの新鮮さを維持し、ほぼリアルタイムの更新を保証します。
- データセット全体を再読み込みするのではなく、増分負荷を適用してコストと効率を最適化し、ストレージとコンピューティングの増加を制御します。
- 取り込みパイプラインをコンピューティングの局所性および増分処理に合わせて、ネットワーク I/O を削減します。Data 360 内で変換を適用して、未加工データを不必要に移動しないようにします。
- **コストに関する考慮事項**
- **リアルタイム取り込み:**コンピューティングとパイプラインのコストが最も高い。パーソナライズ、運用ダッシュボード、Agentforce駆動型アクションなど、価値が高く時間的制約のあるワークフローが妥当。
- **ストリーミング取り込み:**コンピューティングコストとストレージコストを中程度に抑えます。キャンペーンオーケストレーションや運用レポートなど、わずかな遅延を許容できる頻繁な更新に適しています。
- **バッチ取り込み:**コンピューティング コストの削減と予測可能なストレージ。履歴データセットや頻度の低い更新に最適です。特定のコネクタを使用して Salesforce 組織から一括処理データを取り込むことは無料です。
- **更新モード:**増分更新モードを選択すると、取り込みと計算の合計コストを削減できます。すべての取り込み種別で効率を最適化するために、可能な限り増分更新を使用することをお勧めします。
- コストは、ソースから Data 360 への I/O 量にも影響されます。バッチサイズ、パーティション、地域調整を最適化すると、転送コストが削減され、パフォーマンスが向上します。
- **業種シナリオ**
- **財務:**顧客 (KYC)、アンチマネーロンダリング (AML)、不正検出 (監査可能性とコンプライアンスが譲れない場合) を知るために必要なデータセットを取得します。
- **医療:**患者の ID 解決と HIPAA 準拠レコードの取り込みを使用して、安全で統合されたビューを実現します。
- **小売:**セグメンテーションとパーソナライズのために、POS、eコマース、ロイヤルティプログラムデータを統合プロファイルに統合
- **通信:**正規管理された登録者データを使用して、離脱防止と利用状況の分析をサポートします。
#### データ取り込み方法の決定条件
| 機能 | リアルタイム取り込み | ストリーミング取り込み | 一括取り込み |
|---|---|---|---|
| レイテンシと新鮮さ | 変更データキャプチャ (CDC) をサポートする取り込み API を介した 1 秒未満の遅延の取り込み。継続的なストリーミングパイプラインを提供します。低レイテンシの運用使用事例に最適です。 | ネイティブコネクタを使用して 1 ~ 3 分ごとにマイクロバッチを取り込みます。増分更新をサポートします。若干の遅延が予想されます。 | データ遅延が予想されます。スケジュールされた大量の読み込み。定期的な取り込み (毎時、毎日、毎週)。時間的制約のある操作には適していません。 |
| 主な使用事例 | 低レイテンシの運用およびパーソナライズの使用事例に最適です。時間的制約のあるワークフローに使用されます。イベント駆動型ワークフローをサポートします。リアルタイムの不正行為アラートと業務アラートに使用されます。 | 緊急度が中程度のプロセスに適しています。キャンペーンオーケストレーション、ニアライブエンゲージメント、運用レポートに使用されます。タイムリーなキャンペーントリガーに使用されます。 | 大規模なデータセットのコスト効率が高い。履歴分析の信頼性。履歴集計または規制対象のレポートワークフローに使用されます。履歴データセットや低速データセットに最適です。 |
| アーキテクチャの複雑さと I/O | 高コストで複雑なアーキテクチャ。低レイテンシのソースシステムが必要。I/O 集約型。大量のソースがあると、パイプラインが飽和する可能性があります。 | リアルタイムよりもシンプルなアーキテクチャ。I/O は中程度です。予測可能で反復的な更新パターンに最適です。バッチサイズはメモリ/コンピューティングに影響します。 | 実装が容易。読み込みウィンドウ中は I/O 集中型。大規模なバッチでは、ネットワークのスループットがボトルネックになる可能性があります。 |
| コストに関する考慮事項 | 最も高いコンピューティングコストとパイプラインコスト。価値が高く、時間的制約のあるワークフローでのみ有効です。 | コンピューティングコストとストレージコストを節減します。コストと新鮮さのバランスの取れたアプローチを提供します。わずかな遅延を許容できる頻繁な更新に適しています。 | コンピューティングコストの削減と予測可能なストレージ。履歴データセットや頻度の低い更新にお勧めします。Salesforce 内部パイプラインを介した取り込みは無料です。 |
| 設計プラクティス | 増分 CDC を使用して、データの入れ替えを最小限に抑えます。選択項目を絞り込んで使用し、オーバーヘッドを削減します。 | マイクロバッチを使用して、I/O スパイクを制御します。処理の負荷を軽減するために、ウィンドウ集計を検討します。 | これは、アーカイブレポートや定期的なスナップショットに使用します。コストを最適化するために、ソースストレージと同じ領域でコンピューティングの局所性を確保します。 |
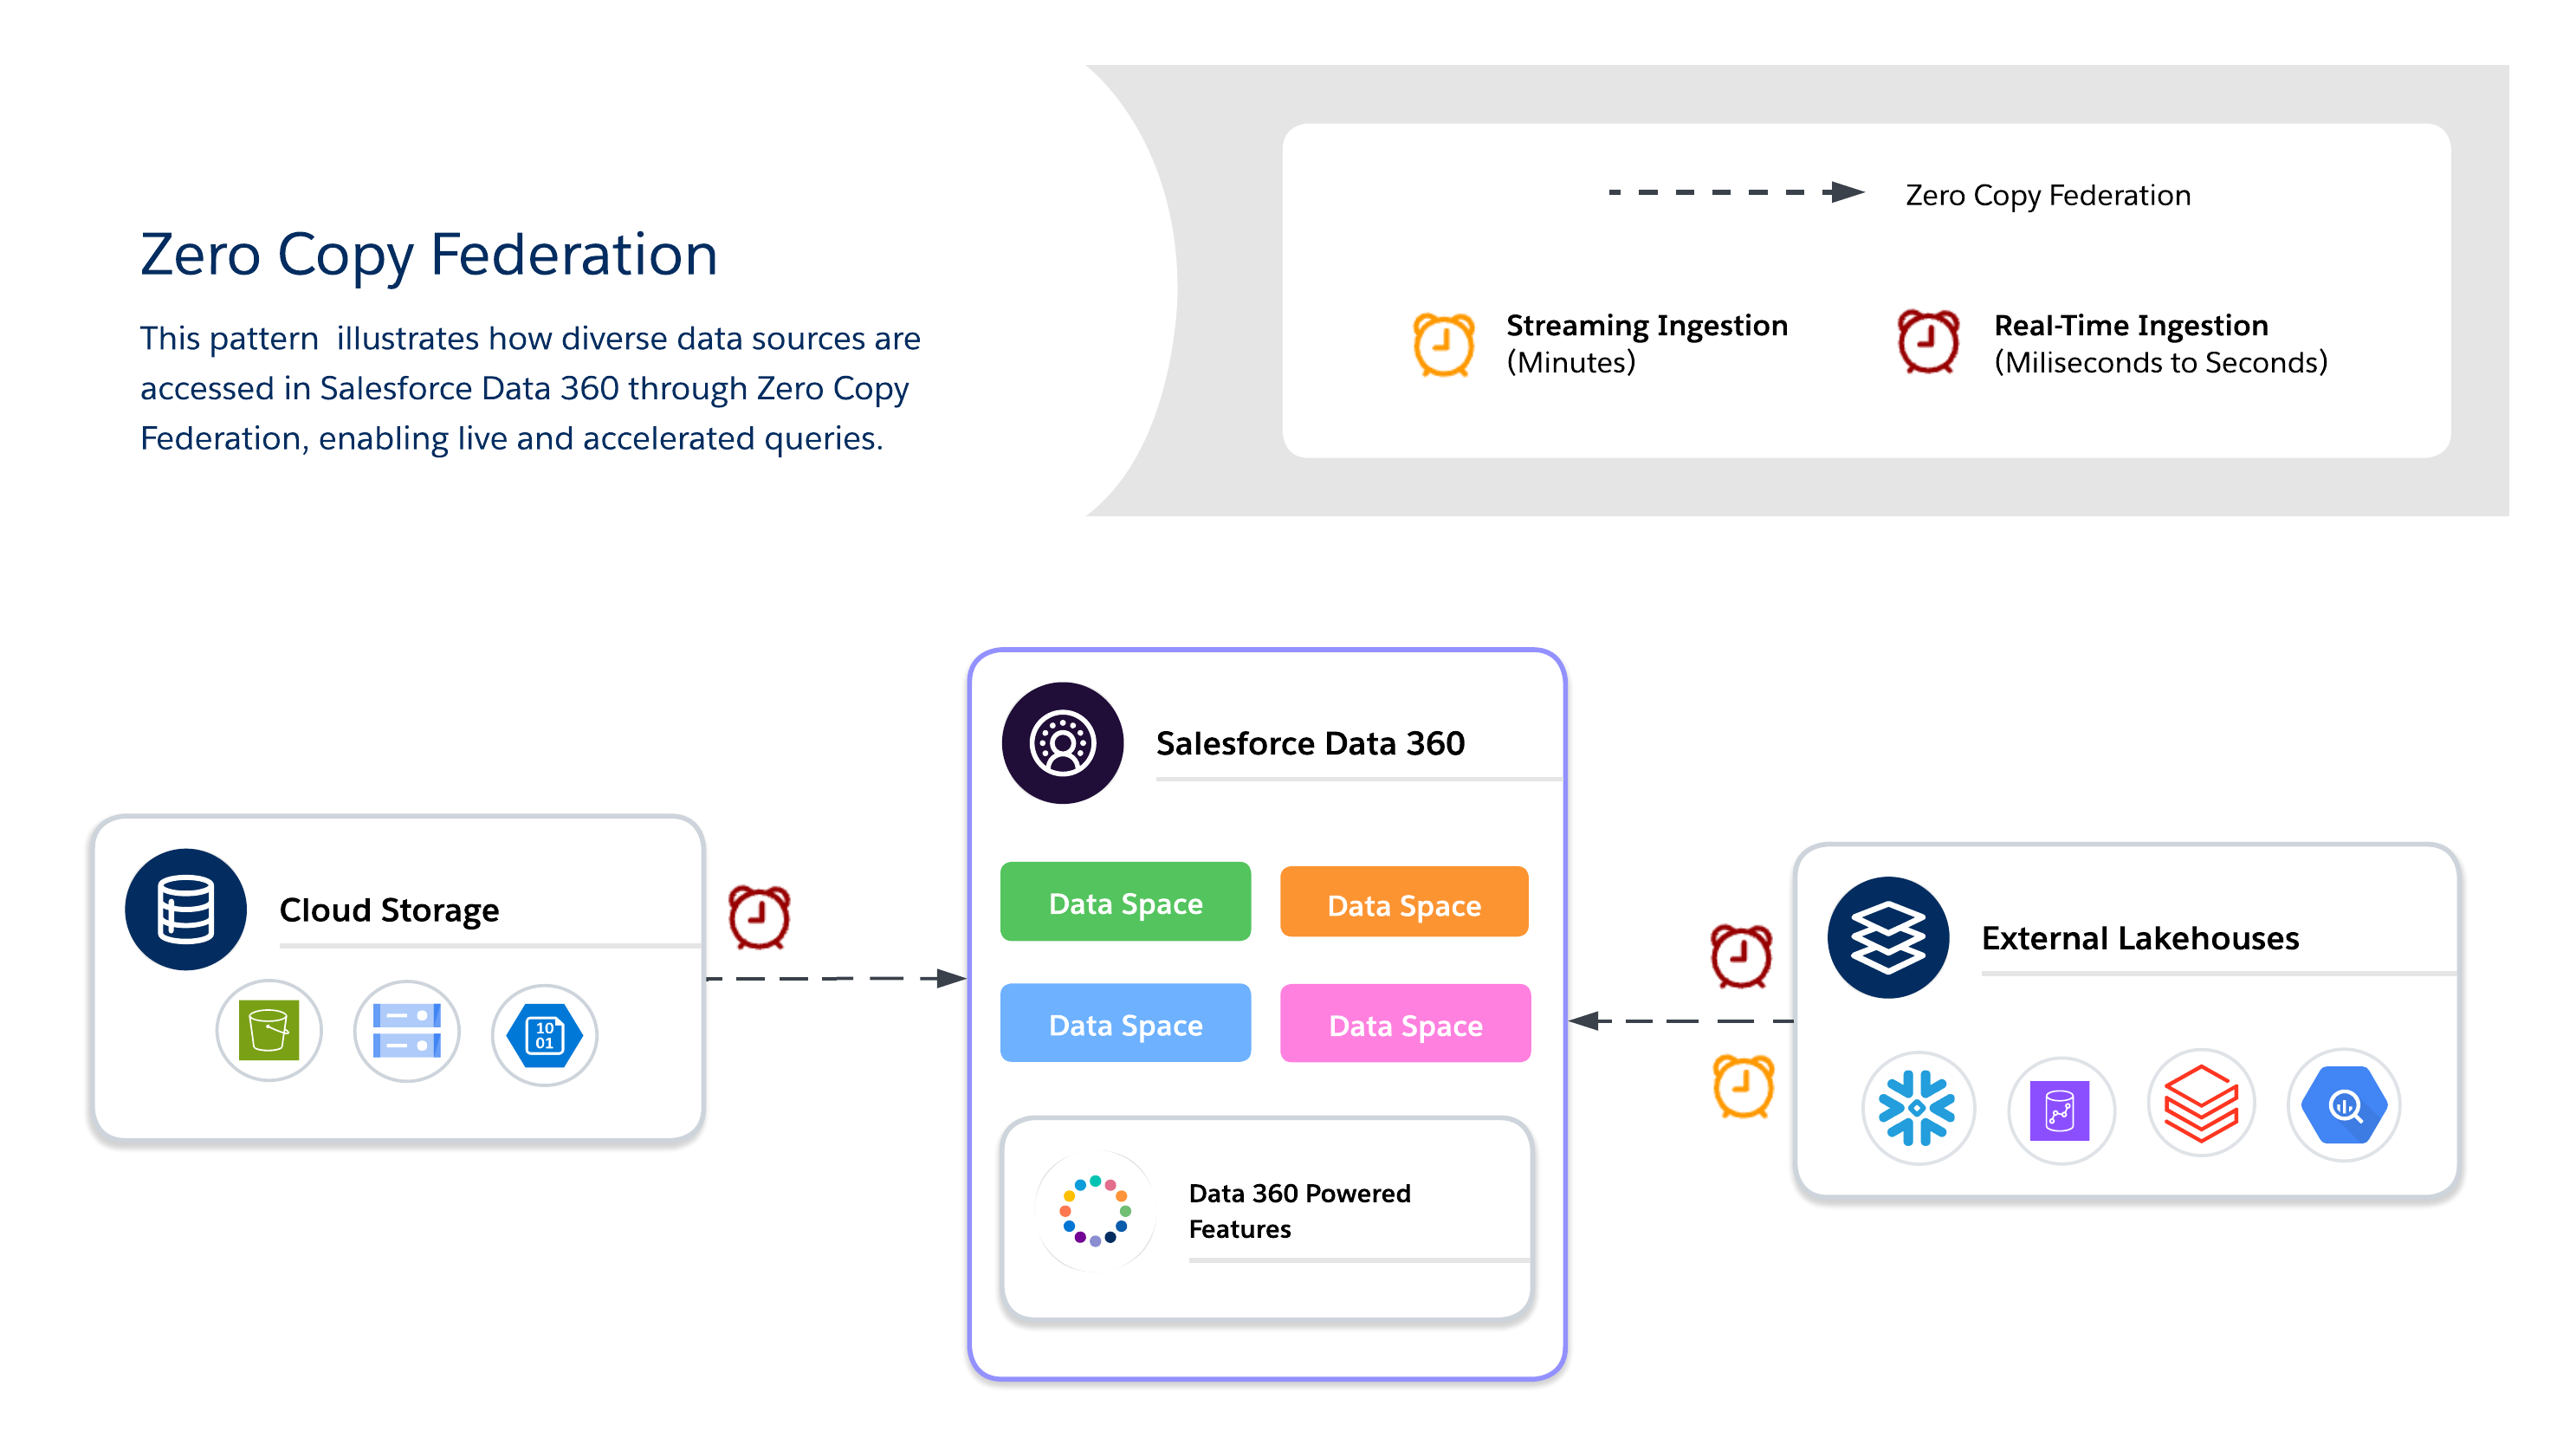 #### ゼロコピー方法
Zero Copy を使用する場合、アーキテクトは使用可能な 3 つのデータ統合方法のいずれかをさらに決定する必要があります。各方法には、新鮮さ、パフォーマンス、コストのトレードオフがあります。
- **Live Query**
- 外部システム (Snowflake、Google BigQuery、Redshift、Databricks など) に対してデータの重複なしで直接クエリを実行します。
- 述語と集計を押し下げられる場合に最適で、ネットワーク上のデータ移動を最小限に抑え、Salesforce Data 360 コンピューティングの I/O を削減します。
- リアルタイムのインサイトと低レイテンシの運用ダッシュボードに最適です。外部システムのパフォーマンスによって異なります。
- **キャッシュ (高速化されたクエリ)**
- Salesforce Data 360 に統合データのキャッシュコピーを一時的に保存します。
- 頻繁にアクセスされるデータセットの反復クエリコストと遅延を削減し、期間 (分~日) を設定可能。
- データが完全にコピーされたり、完全に管理されたりすることはありません。更新はソースからのスケジュールされた更新で管理されます。
- **ファイルフェデレーション**
- オブジェクトストアの大規模なデータセット (S3、Iceberg を使用する GCS など) への参照のみの直接アクセスを提供します。
- データを移動することなく、AI/ML ワークロード、履歴分析、ペタバイト規模のレポートに最適です。
- クエリのパフォーマンスは、オブジェクト形式、パーティショニング、ネットワーク I/O に大きく依存します。大規模なスキャンでは、最適化されていない場合、大量の I/O が生成される可能性があります。
#### Architect Playbook (アーキテクトプレイブック)
- **使用事例**
- **リアルタイムのパーソナライズと適応型ワークフロー:**顧客の行動の変化に応じて、動的な提案、おすすめ、Next Best Action を提供します。
- **ライブ ダッシュボードと運用分析:**ビジネスクリティカルなダッシュボードと KPI を外部倉庫から直接強化します。
- **大規模な外部データセットを使用したAI/MLモデルのトレーニング:**ファイルフェデレーションを使用して、データレークやデータウェアハウスからペタバイト規模のデータを移動せずに活用します。
- **業種シナリオ**
- **小売/メディア:**クリックストリームまたはコンテンツインタラクションデータを統合することで、パーソナライズされたおすすめとリアルタイムの顧客エンゲージメントを実現します。
- **財務:**機密データを重複させることなく外部倉庫を照会することで、ほぼリアルタイムで不正行為の検出とリスクスコアリングを実行します。
- **テクノロジー/エンタープライズ:**データセットが複数のシステムに存在するクロスクラウドレポート、IT サービスダッシュボード、運用分析をサポートします。
- **設計プラクティス**
- **Live Query**
- 新鮮さが重要な場合に、高 QPS で低遅延のクエリに使用します。
- 述語と集計を外部システムに転送して、ネットワーク上のデータの入れ替えを減らします。
- 大量のデータを不必要にスキャンするクエリは避け、パーティションプルーニングとフィルターを検討します。
- **ファイルフェデレーション**
- 取り込みなしでオブジェクトストアのペタバイト規模のデータセットにアクセスできます。
- オブジェクトストレージを Salesforce コンピューティングと同じクラウド領域に保持して、遅延と出力コストを最小限に抑えます。
- パーティション分割された列形式 (Parquet/ORC) とプッシュダウン検索条件を使用して、I/O とネットワーク転送を削減します。
- クエリと述語のプッシュダウンを活用して、ソースでデータを絞り込んで集計し、データの移動を減らします。
- I/O、遅延、コストが増加するため、必要時以外は地域間のデータアクセスは避けてください。
- **キャッシュ (高速化されたクエリ)**
- コストとパフォーマンスのバランスを取るために、頻繁にアクセスするデータセットをキャッシュします。
- 更新間隔を設定して、新鮮度とクエリコストのバランスを取ります。
- **コンプライアンス:**行レベルセキュリティ (RLS) を活用し、統合システム内でポリシーを直接マスキングすることで、ソースでガバナンスを適用します。以下は、プラットフォーム全体で統一的な RLS とマスキングを行うためのベストプラクティスです。
- **一元化されたエンタープライズ ID を使用します。**Salesforce Data 360 のユーザーとエンティティを、外部システムの ID に対応する一意の一元化されたエンタープライズ識別子に対応付けます。
- **セキュリティポリシーの調整:**対応付けられた ID に基づいて、統合システムの行レベルセキュリティとマスキングポリシーが適用されるようにします。これにより、外部データを照会するときのコンプライアンスが保持されます。
- **ID スキーマの標準化:**すべてのデータソースで ID 属性 (メール、ユーザー ID、顧客 ID など) の一貫性を維持し、不一致やアクセス違反を回避します。
- **コストに関する考慮事項**
- **ライブクエリ:**クエリごとの支払モデル — 外部 Lakehouse コンピューティングでコストが発生し、高い QPS で急増する可能性があります。コストの変動よりも価値の方が大きい、新鮮さを重視する使用事例に最適です。
- **高速化されたクエリ (キャッシュ):**ソースシステムへのヒットを減らすことで Live Query よりもクエリコストを削減しますが、キャッシュへの入力と更新のための一括処理データ取り込みのコストが増加します。頻繁にアクセスされるデータセットに最適です。
- **ファイルフェデレーション:**オブジェクトストアのデータとして最も安価なストレージオプション。ただし、クエリコストはファイルサイズ、パーティション分割、およびプルーニングによって異なります。ペタバイト規模の履歴データや一括データに最適です。
#### ゼロコピー方法の決定条件
| 決定ポイント | ライブクエリ | キャッシュ (高速化されたクエリ) | ファイルフェデレーション |
|---|---|---|---|
| データソースの場所 | 外部データレイクハウス (Snowflake、Google BigQuery、Redshift、Databricks)。 | 外部データレイクハウス (Snowflake、Google BigQuery、Redshift、Databricks) | オブジェクトストアまたはクラウドデータレイク (S3、ADLS、GCS)。多くの場合、Iceberg などのオープンテーブル形式が使用されます。 |
| 目的/使用事例 | 対話型の分析やリアルタイムダッシュボードに最適です。リアルタイムのパーソナライズと動的なワークフローに最適です。 | クエリが頻繁に発生するが、若干古い結果が許容される場合に最適です。BI ダッシュボードおよびセグメンテーションに適しています。 | 大規模なバッチ処理や AI/ML モデルのトレーニングに最適です。履歴分析やペタバイト規模のレポートに最適です。 |
| 新鮮さ/レイテンシ | 最大限の新鮮さ。クエリはリアルタイムで直接実行されます。1 秒未満の決定をサポートします。 | 若干古い結果でも問題ありません。新鮮度はキャッシュ間隔によって異なり、15 分から 7 日間の範囲で設定できます。 | バッチ負荷が高く、スループット要件の厳しいジョブに最適化されています。リアルタイムダッシュボードには適していません。 |
| アクセスパターン | 頻度の低いクエリやアドホッククエリに最適です。新鮮さが重要な高 QPS (1 秒あたりのクエリ数) で低遅延のクエリに使用します。 | 高頻度の読み取りシナリオに最適です。頻繁なアクセスパターンのパフォーマンスが向上します。 | 参照のみアクセス権。取り込みなしのペタバイト規模のデータセットに適しています。 |
| パフォーマンスの促進要因 | 外部ソースシステムのパフォーマンスに大きく依存します。述語と集計をソースにプッシュできる場合に最適化されます。 | 繰り返されるライブクエリよりも遅延が短縮されます。パフォーマンスは、キャッシュ管理と間隔によって異なります。 | パフォーマンスは、オブジェクト形式、パーティショニング、外部システムのスループットに大きく依存します。パーティション分割された列形式 (Parquet/ORC) を使用します。 |
| コストへの影響 | クエリ単位の支払モデル。外部 Lakehouse コンピューティングで発生するコスト。クエリ頻度が低い場合はコスト効率が高くなりますが、1 秒あたりのクエリ (QPS) 量が多いと経費が急増する可能性があります。 | 繰り返しのライブクエリよりも低コスト。外部ソースを繰り返し照会する必要がなくなります。キャッシュストレージと更新オーバーヘッドが追加されます。 | 最も安価なストレージオプション。クエリコストは、ファイルサイズとパーティション化によって異なります。 |
| 主な考慮事項 | 大量のデータを不必要にスキャンする絞り込まれていないクエリは避けてください。 | キャッシュ管理が必要です。秒未満の判断には適していません。 | クエリのパフォーマンスは、パーティショニングと述語プッシュダウンによる最適化に大きく依存します。 |
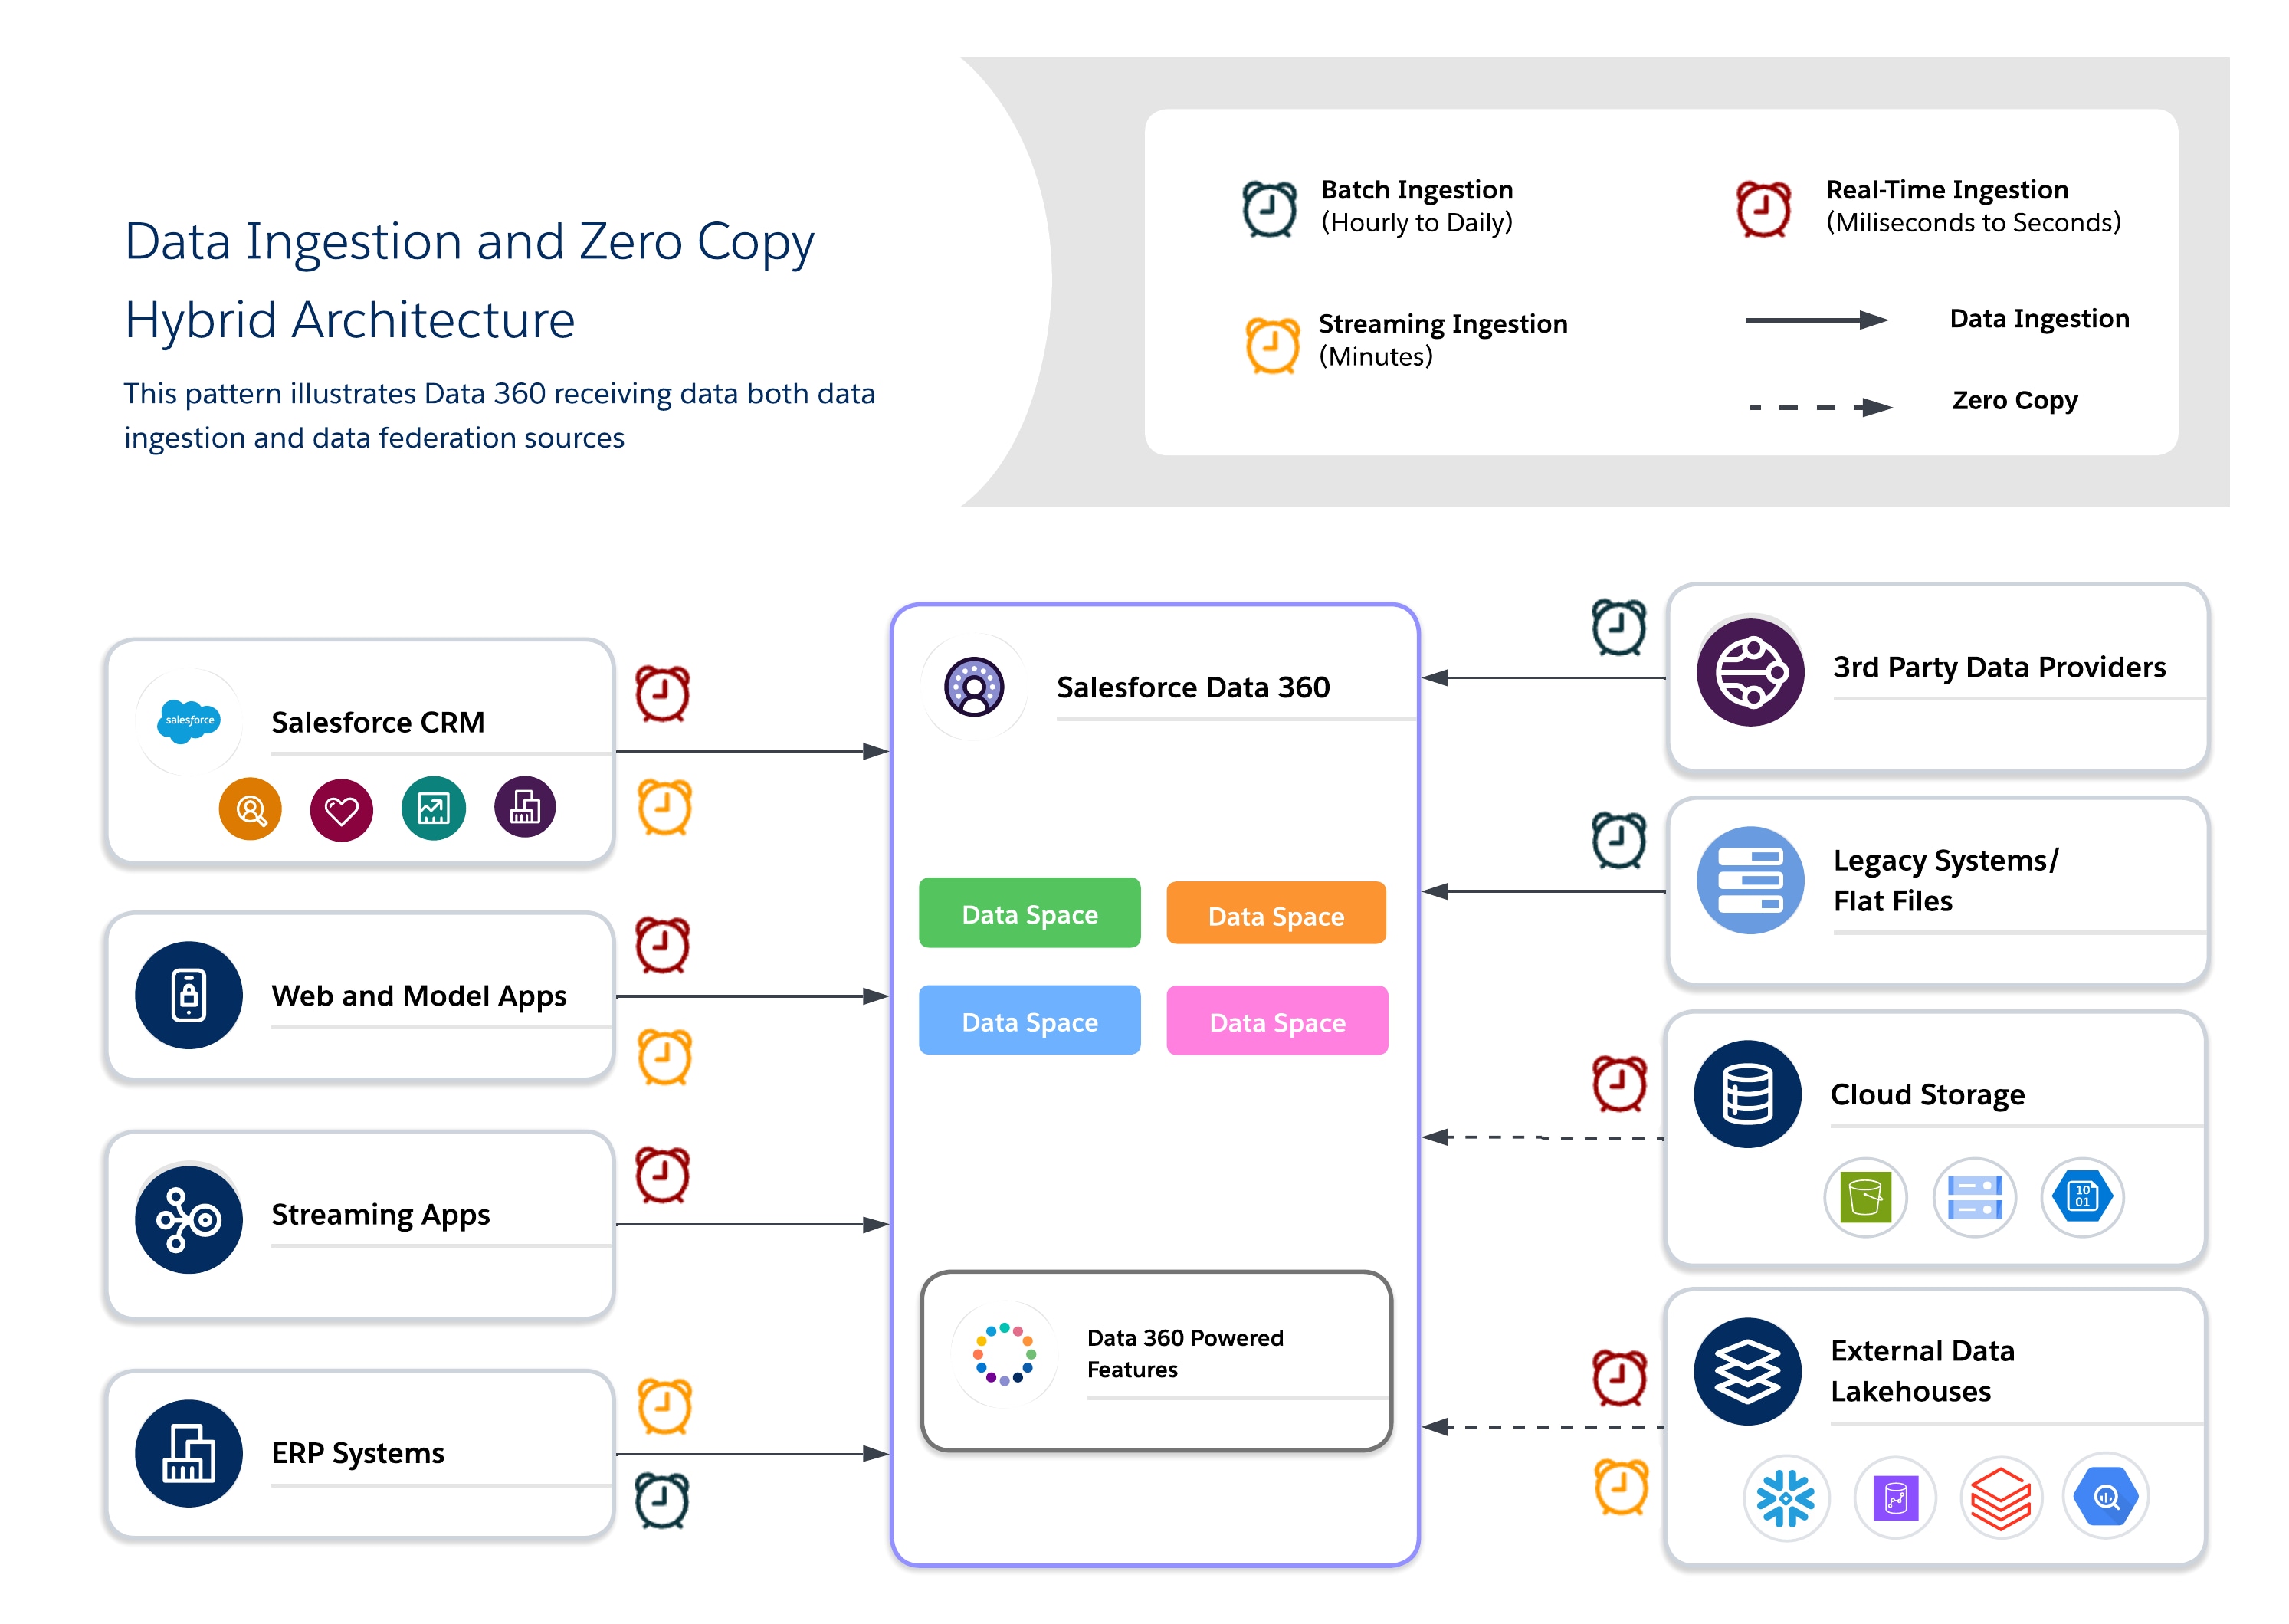 #### Architect Playbook (アーキテクトプレイブック)
- **使用事例**
- **オムニチャネルエンゲージメント:**過去の顧客データとリアルタイムの行動を組み合わせて、一貫性のあるコンテキスト対応環境を提供します。
- **AI/MLパイプライン:**選定された正規データセットでモデルをトレーニングしながら、外部ソースからの未加工またはリアルタイムのシグナルで強化します。
- **混在するコンプライアンスと俊敏性のニーズ:**機密データには厳格なガバナンスを適用し、運用の俊敏性については統合します。
- **業種シナリオ**
- **小売:**ID 解決とプロファイル統合には取り込みを使用し、リアルタイムの提案とパーソナライズには統合を使用します。
- **医療:**IoT デバイスストリームとセンサーデータを統合することでコンテキストをすぐに把握しながら、取り込みによってゴールデンの患者レコードを維持します。
- **金融サービス:**不正行為の検出とリスク監視のための外部クエリを統合しながら、規制対象データをコンプライアンスが管理されるレイクに取り込みます。
- **設計プラクティス**
- **取り込みを使用したアンカー ガバナンス:**価値の高いデータや規制対象のデータを正規モデルに取り込み、Trustとコンプライアンスを確保します。
- **新鮮さのための統合の使用:**外部レイクハウスで、重複のないリアルタイムまたは大規模なデータアクセスができるようにします。
- **バランスコストとパフォーマンス:**ワークロードをプロファイルして、取り込むものと統合するものを決定し、不要なストレージやクエリのコストを最小限に抑えます。
- **階層化されたガバナンスの適用:**統合システム独自のセキュリティ制御 (RLS、マスキングなど) を活用しながら、取り込まれたデータの一元的なガバナンスを適用します。
- ハイブリッドパイプラインを設計する場合、履歴データセットの増分取り込みを確認し、統合ソースに集計または絞り込みを転送して、I/O と計算の使用量を最適化します。
- **コストに関する考慮事項**
- コンプライアンスや重要なデータの取り込みと、新鮮さが必要な場合の統合を組み合わせて、総コストとパフォーマンスを最適化します。
- 取り込みと統合を混在させるときに、I/O とコンピューティングの配分を考慮します。クエリが繰り返されるソースシステムでの計算コストを削減するには、読み取り頻度が高く、頻繁にアクセスされる統合データセットのキャッシュ (Accelerated Query) を使用します。
## 使用事例決定ガイド
このロジックを適用する方法を示す一般的なアーキタイプを次に示します。
1. **「単一の情報源」のアーキタイプ:一元化と管理**
- **シナリオ:**グローバル企業全体に対して、コンプライアンスに準拠した統合 Customer 360 プロファイルを作成する必要があります。データはさまざまなシステムから取得され、GDPR と CCPA の厳格な規制に準拠する必要があり、すべてのマーケティングおよびサービスインタラクションの信頼できるソースとして機能します。
- **推奨パターン:****データ取り込み。**優先度は、Governance、Trust、Control です。Data 360 にデータを取り込むことが、ソースシステムから隔離された、完全に監査可能な正規プロファイルを作成する唯一の方法です。
2. **「リアルタイム インサイト」のアーキタイプ:移動せずに分析**
- **シナリオ:**データサイエンスチームは、Snowflake で絶えず更新される大量のトランザクションテーブルに対して探索クエリを実行する必要があります。同時に、エグゼクティブチームは、同じデータに基づいたライブ BI ダッシュボードを必要としています。毎日数ペタバイトのデータを移動すると、時間がかかりすぎる上にコストがかかります。
- **推奨パターン:****ゼロコピー統合。**優先事項は、スピード、俊敏性、大規模なコスト効率です。Zero Copy では、既存のデータウェアハウスの膨大な機能を活用して、データの重複によるオーバーヘッドや遅延を発生させることなくリアルタイムクエリを実行できます。
3. **「ハイブリッド インテリジェンス」のアーキタイプ:コアの管理、エッジの統合**
- **シナリオ:**データレイクからのリアルタイムの行動シグナル (Web サイトのクリックなど) を使用して、管理され、取り込まれた顧客プロファイルを強化したいと考えています。コアプロファイルの安定性は必要ですが、ライブデータの即時性は、その場のパーソナライズを強化するために必要です。
- **推奨パターン:****ハイブリッド アプローチ。**データ取り込みを使用して、顧客データの安定した管理されたコアを作成します。次に、ゼロコピーを使用して、揮発性のリアルタイムの「エッジ」データを統合し、クエリ時に結合して、最新の完全なビューを表示します。
## 進むべき道
エンタープライズデータ戦略は、もはや 1 つのインテグレーションパターンを選択することではなく、相互運用可能なデータエコシステム内で制御された柔軟性を構築することです。多くの場合、ビジネスニーズに基づいて各ソースデータシステムに適切なデータインテグレーション方法を選択することで、データ取り込みとデータ統合の両方の長所をブレンドしたハイブリッドアプローチが可能になります。
- コンプライアンス、ID 解決、運用ワークフローのために、ミッションクリティカルな管理データセットを Salesforce Data 360 に取り込みます。
- Zero Copy を使用してデータを統合することで、ストレージを重複させることなくライブ、探索、AI 駆動の分析を行うことができます。
Hyperforce上のSalesforce Data 360は、複数リージョンの復元性と拡張性を実現します。Icebergテーブルを備えたオープンな Lakehouse により、Snowflake、Databricks、S3 Icebergなどのプラットフォームとのコンピューティングの分離と相互運用性が実現し、真に相互運用性のあるマルチクラウドデータエコシステムのバックボーンが形成されます。
データエコシステムの進化に合わせて、新鮮さ、コスト、パフォーマンス、コンプライアンスを継続的にバランスさせ、アーキテクチャの俊敏性を維持します。取り込まれた管理データを統合アクセスで統合することで、プラットフォームを将来にわたって使用できます。これにより、クラウド、地域、ビジネスドメイン全体でリアルタイムインテリジェンス、AI の有効化、エンタープライズ規模のパーソナライズが可能になります。
汎用的なソリューションは、ほとんどのビジネスには適していません。最適な戦略では、適切なパターンを適切なビジネスドライバーに対応付けます。
## 著者について
Yugandhar Bora は、Salesforce のソフトウェアエンジニアリングアーキテクトで、Data & Intelligence アプリケーションプラットフォーム内のデータアーキテクチャを専門としています。データガバナンスと統合データモデルに焦点を絞ったエンタープライズアーキテクチャレビューボード (EARB) イニシアチブを主導しながら、自動化プラットフォームプロビジョニングソリューションに貢献しています。
Jan Fernando は、Salesforce のチーフアーキテクトオフィスのプリンシパルアーキテクトです。2012 年に Salesforce に入社し、スタートアップエコシステム時代から豊富な経験を積んできました。Office of the Chief Architect に入社する前は、プラットフォーム組織で 10 年以上にわたり、いくつかの主要なテクノロジー変革を率いていました。
## 概要
Salesforce Data 360は、Hyperforce上に構築されたデータ プラットフォームで、Salesforceと外部データを、すべての顧客またはアカウントの明確で完全、かつ信頼できる全方位的なビューに統合します。
合併や買収、地域の業務、職務の分離、または歴史的な理由により、多くの場合、企業は複数の Salesforce 組織を運営しています。アーキテクトは、1 つの自宅組織と複数組織のどちらを設定するかだけでなく、複数の独立した Data 360 インスタンスをプロビジョニングするか、Data Cloud One を使用して 1 つのインスタンスで組織を統合するか、Data 360 間のデータ共有 (Data 360 と Data 360 のデータ共有) を使用して独立した Data 360 インスタンス間でコラボレーションするかも決定する必要があります。これらの選択は、ガバナンス、コンプライアンス、コスト、レイテンシ、および組織の AI および組織間プラットフォーム機能の拡張能力に影響します。
Data 360 は、Data 360 ライセンスを受け取る本番組織で自動的にプロビジョニングされます。Data Cloud One は、1 つの自宅組織で Data 360 インスタンスをホストし、他の Salesforce 組織はコンパニオン組織として接続できるようにする Salesforce の複数組織の接続アーキテクチャです。Data 360 ライセンスを保持し、Data 360 ホーム組織となる組織の選択は、長期的な影響を伴う重要なアーキテクチャ上の決定です。
Salesforce Data 360のプロビジョニング方法は、アーキテクチャに関する基本的な決定事項です。これは、企業がどのように顧客データを統合し、ガバナンスを適用し、重要なプラットフォーム機能(特にAI、Agentforce、分析)を組織全体で有効にするかを決定するためです。組織のクラスターを 1 つの Data 360 に固定することで、統合されたデータモデル、一元化されたガバナンス、全社的な AI 準備が実現します。また、コンパニオン組織はデータがローカルにあるかのように共有メタデータと機能にアクセスできます。一方、規制、コンプライアンス、または自律性の要件によって一元化できない場合、Data 360 組織間のデータ共有により、これらのインスタンス間でゼロコピーで選択的なコラボレーションが可能になるため、複数の独立した Data 360 インスタンスが適しています。
建築家にとって、この決定は非常に重要です。データガバナンスを制御するユーザー、データが存在する場所、プラットフォーム機能の有効化方法、将来のインテグレーションと AI イニシアチブの拡張性を定義します。現在 Data 360 を使用していない組織でも、今後 Data 360 アクセスを追加する戦略を立てることで、アーキテクチャを将来に備えることが重要になる場合があります。Sales、Service、Marketing、Commerce、Industries、AgentforceにわたるSalesforceの機能は、Data 360上に構築されることが増えています。これらのプラットフォーム機能を使用する組織は、独自の Data 360 をプロビジョニングするか、共有の Data 360 にコンパニオン組織として接続する必要があります。
このガイドは、アーキテクトがシンプルさ、エンタープライズ全体の一貫性、コンプライアンス、拡張性のバランスを取るプロビジョニング戦略を設計するのに役立ちます。これにより、組織は自信を持ってData 360をCustomer 360、AI、クロス プラットフォームのイノベーションに活用できます。Data 360 をプロビジョニングする組織の選択方法、および Data Cloud One と Data 360 組織間のデータ共有の選択方法を決定し、Data 360 中心の未来にビジネスを進めるための強固な基盤を築くのに役立ちます。
---
## プロビジョニングに関する考慮事項
Data Cloud One と Data 360 組織間のデータ共有のどちらを選択するか、またはどの組織をホーム組織として指定するかなど、すべてのプロビジョニングの選択は、次の横断的な考慮事項に照らして評価する必要があります。
| 考慮事項 | 重要な理由 | シナリオの例 |
|---|---|---|
| データレジデンシーとコンプライアンス | データを保存および処理する場所を決定します。規制ルールでは、特定の地域または複数のインスタンスが必要になる場合があります。 | あるグローバル銀行は、GDPR に準拠するためにフランクフルトに地理的に配置された Salesforce 組織に Data 360 テナントをプロビジョニングし、米国部門用にバージニア州の組織に Data 360 テナントをプロビジョニングしました。 |
| ガバナンスとセキュリティ | Data 360 を所有および管理するのは誰ですか?ポリシーはビジネスユニットごとに一元管理するか、委任するか? | 強力な中央 IT を持つ多国籍企業が、Center of Excellence によって管理される専用の自宅組織を作成します。 |
| Autonomy vs.一元化 | リーダーによって、データの所有権が異なる場合があります。自律性では複数の Data 360 が、一元化では Data Cloud One が適しています。 | 独立した子会社を持つ持株会社では、各 BU が独自の Data 360 を実行できます。 |
| レイテンシとパフォーマンス | 特に、リージョン全体の Data 360 テナントに接続されているコンパニオン組織の場合、クエリ速度とエクスペリエンスに影響します。 | ロンドンの営業チームが米国の Data 360 テナントからデータを照会すると、遅延が大きくなる場合があります。 |
| インテグレーションの複雑さ | Data 360 テナントが増えると、パイプライン、API、ミドルウェアが増えます。統合により、統合が簡素化されます。 | ある小売業者は、Data Cloud One 設定に統合することで、10 個の ETL パイプラインを構築する必要がなくなります。 |
| ゼロコピーデータソース領域 | Zero Copy コネクタには、Data 360 を配置できるリージョンを制限するクロスリージョンアクセス要件がある場合があります。 | ある会社に AWS eu-west-1 リージョンの Snowflake インスタンスがあります。Zero Copy を使用して自分の地域の Data 360 にデータを統合できますが、Zero Copy を使用して米国地域の Data 360 に統合することはできません。 |
| プライベートコネクトのリージョン間の互換性 | 場合によっては、データソースが Data 360 テナントと同じリージョンにあるかどうかによってプライベートコネクトのサポートが異なる場合があります。 | aws-east-1 リージョンに、ゼロコピーで接続する Snowflake インスタンスがあります。Data 360 ホーム組織が同じリージョンにある場合のみ、プライベートコネクトネットワーク接続を確立できます。 |
| コストとライセンス | 各 Data 360 テナントのコストが増加します。より少ないインスタンスに統合することで、支出が最適化されます。 | あるヘルスケア事業者は、複数の独立した Data 360 インスタンスではなく Data Cloud One を採用してライセンスコストを削減します。 |
| 将来の拡張性 | 今日のプロビジョニングの選択肢は、成長の基盤となります。 | ある SaaS 会社は、1 つの Data 360 インスタンスから開始し、Salesforce 組織の子会社を買収して Data Cloud One に拡張する予定です。 |
| エンタープライズ全体のAI対応 | AI機能とAgentforceでは、すべての組織に接続されたData 360テナントが必要です。プロビジョニングの決定は、AI モデルが企業全体でどのようにトレーニングおよび有効化されるかに影響します。 | ある金融サービス会社は、データをData Cloud Oneに統合し、Einstein AIモデルがエンタープライズ全体の顧客データにアクセスできるようにします。 |
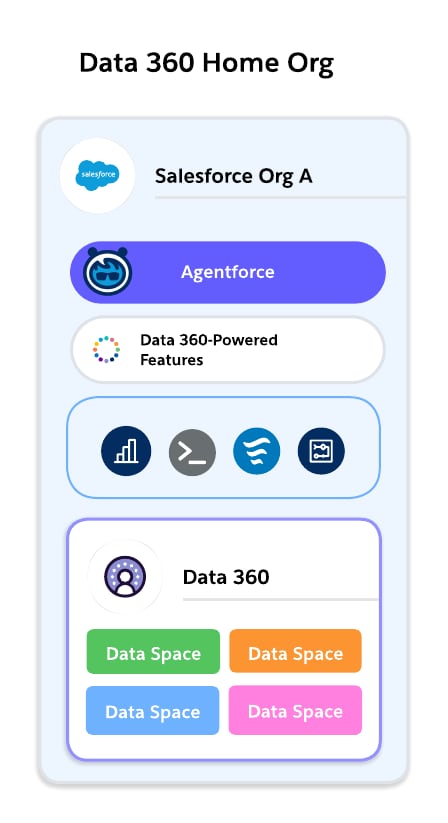 ホーム組織は、Data 360 インスタンスのアンカーです。ここで、
- Data 360 のストレージとコンピューティングは (プロビジョニング時に選択した地域で) 管理されます。
- 管理、ガバナンス、セキュリティポリシーが適用されます。
- データの取り込み、ハーモナイゼーション、ID解決、セグメンテーション、有効化が実行されます。
マルチ組織のシナリオでは、ホーム組織で他の Salesforce 「コンパニオン」組織の中央 Data 360 インスタンスを管理します。
ホーム組織が重要な理由:
- Data 360 インスタンスの地理的位置を決定します。
- Data 360 インスタンスの所有者と管理者を決定します。Data 360 ホーム組織の管理者は、Data 360 に取り込まれたすべてのデータにアクセスできます。
- Data Cloud One 設定でコンパニオン組織の接続を制御します。
- これにより、エンタープライズデータ戦略の基盤が確立されます。後で変更するのは困難で、中断を伴います。
### 1.2 決定:ホーム組織として既存の組織または新規組織
最初の大きな決定は、既存の本番組織で Data 360 をプロビジョニングするか、新しい専用組織を作成してホーム組織として機能させるかです。
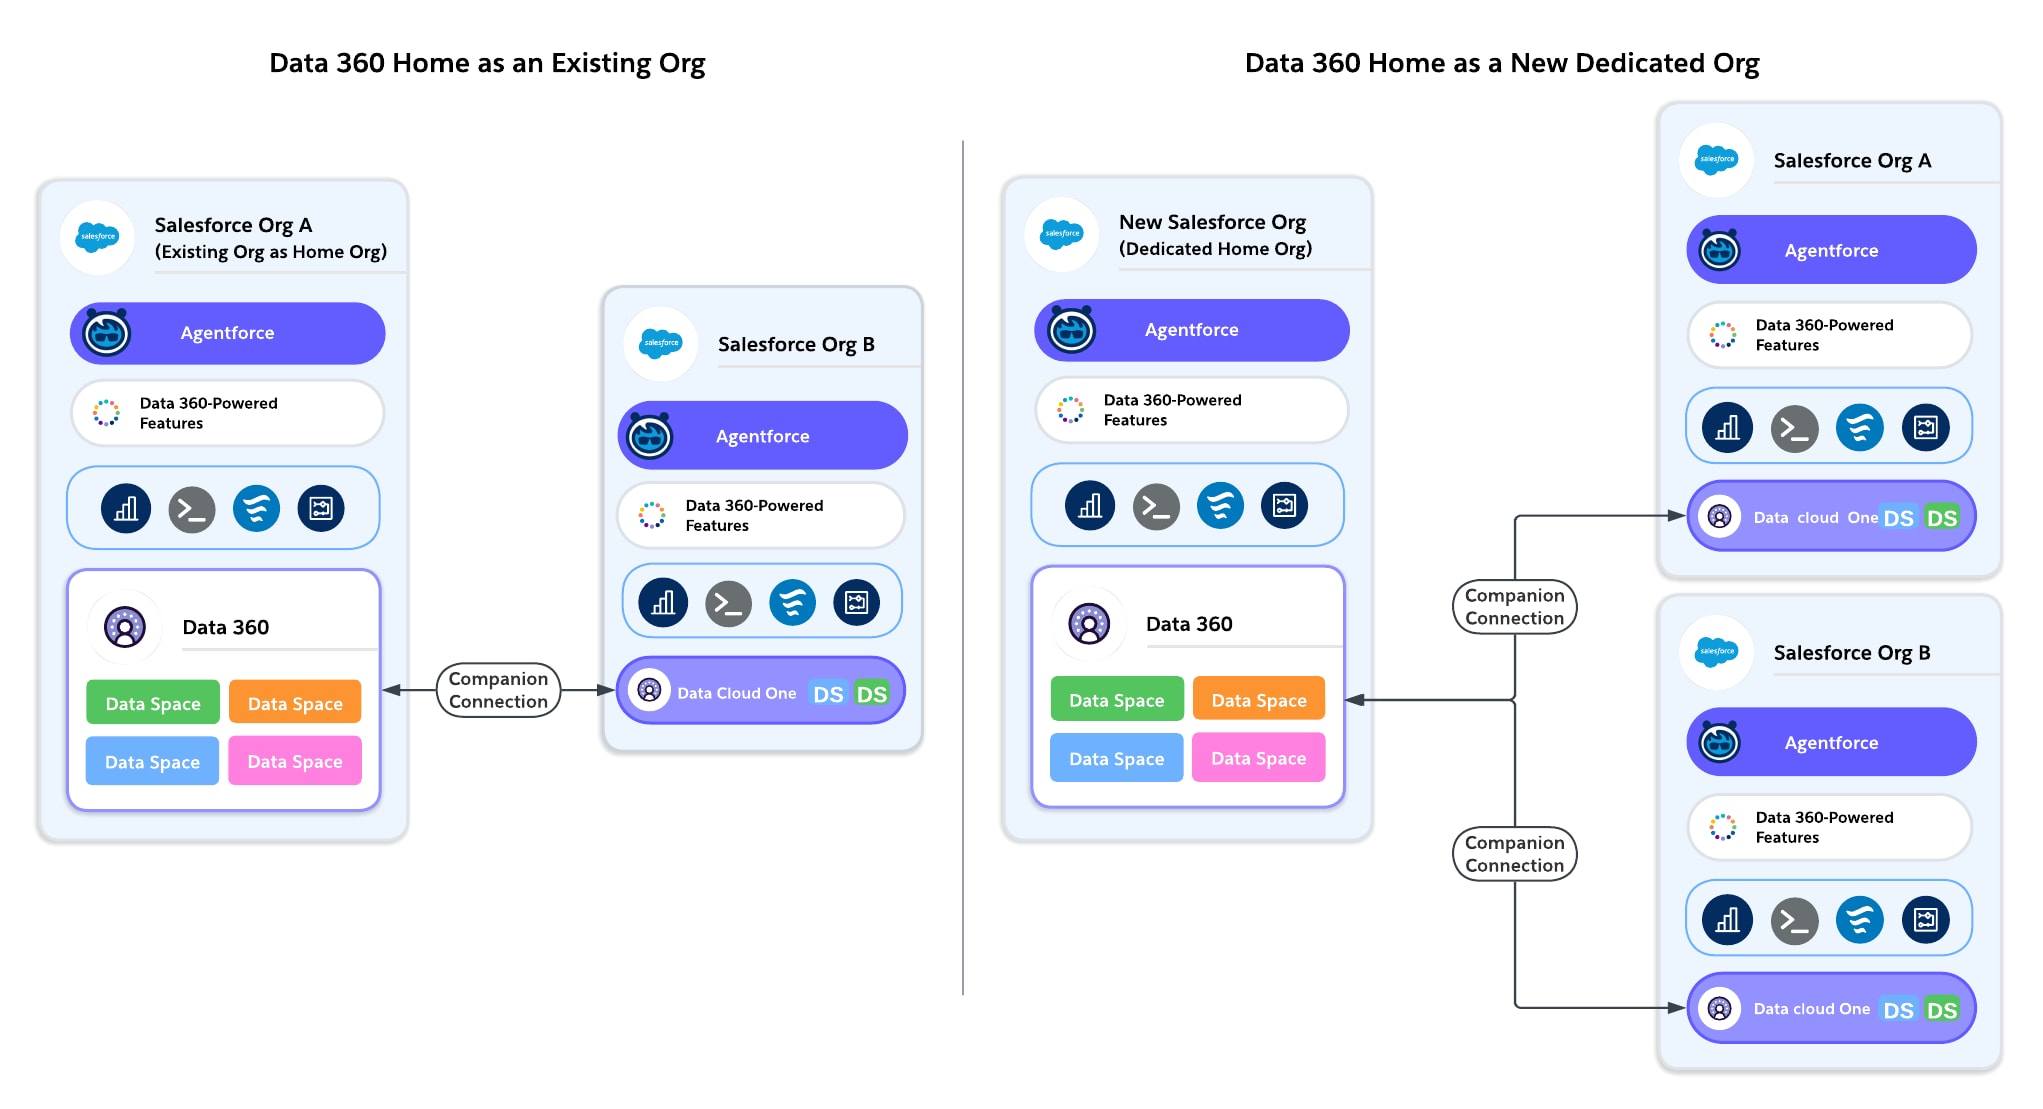 #### オプション A:既存の組織での Data 360 のプロビジョニング
**最適な用途:**1 つの Salesforce 組織を使用しているお客様、またはほとんどのビジネスが実行されている主要な一元化された組織をすでに使用している複数組織のお客様。
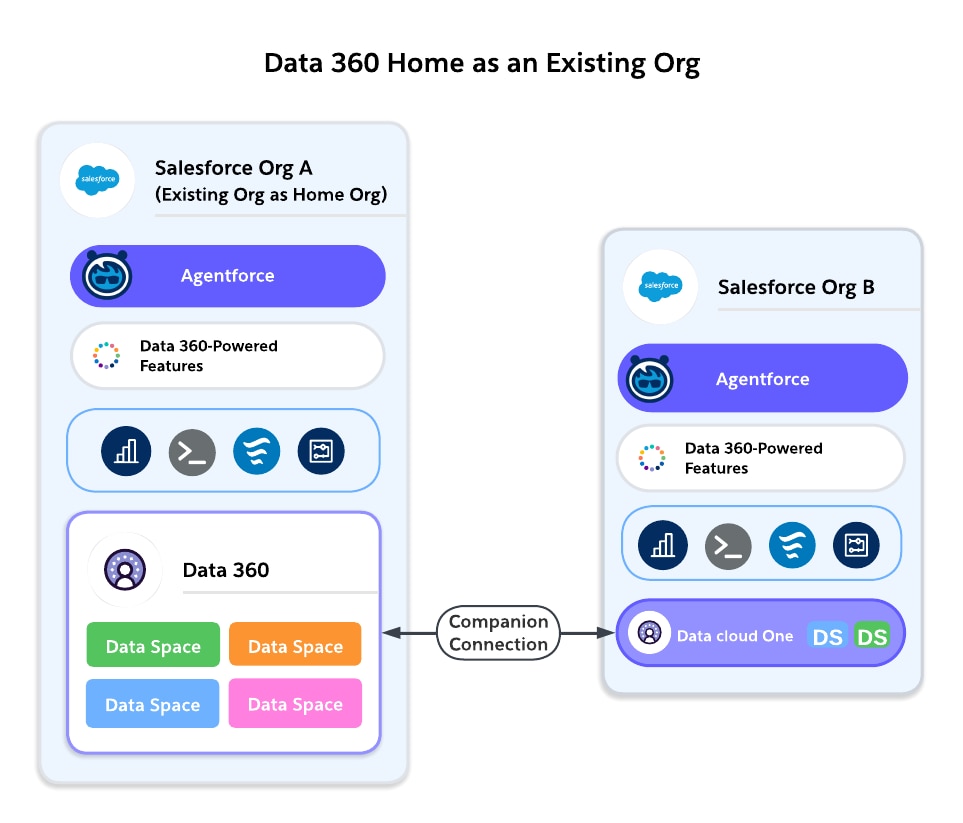 - **長所**:
- 最もシンプルなパス:Data 360 は、CRM データがすでに存在する場所でプロビジョニングされます。
- ローカルの営業、サービス、マーケティングデータにすぐにアクセスできます。
- 追加のインテグレーションは必要ありません。
- 管理するライセンスと環境が少ない。
- 早期導入、パイロット、本番での使用事例を加速します。
- **短所**:
- 既存の組織のガバナンスまたは技術的負債を継承する可能性がある。
- 「メイン組織」が 1 つも存在しない場合、1 つを選択すると所有権に関する議論が生じる可能性があります。
- 組織の場所に関連するパフォーマンス。企業全体のレジデンシーのニーズと一致しない場合があります。
- 複数のビジネスユニットで異なる組織を使用している場合、ローカルプロビジョニングを Data Cloud One と組み合わせないと断片化が発生する可能性があります。
**例:**
1 つの Salesforce 組織を持つ SaaS 会社は、顧客のサブスクリプションデータとサポートデータを統合するために、その組織に Data 360 をプロビジョニングします。
#### オプション B:新しい専用組織での Data 360 のプロビジョニング
**最適な用途:**複数の Salesforce 組織があり、1 つの主要組織で連携できないお客様、または強力な Center of Excellence (CoE) モデルを使用する企業。
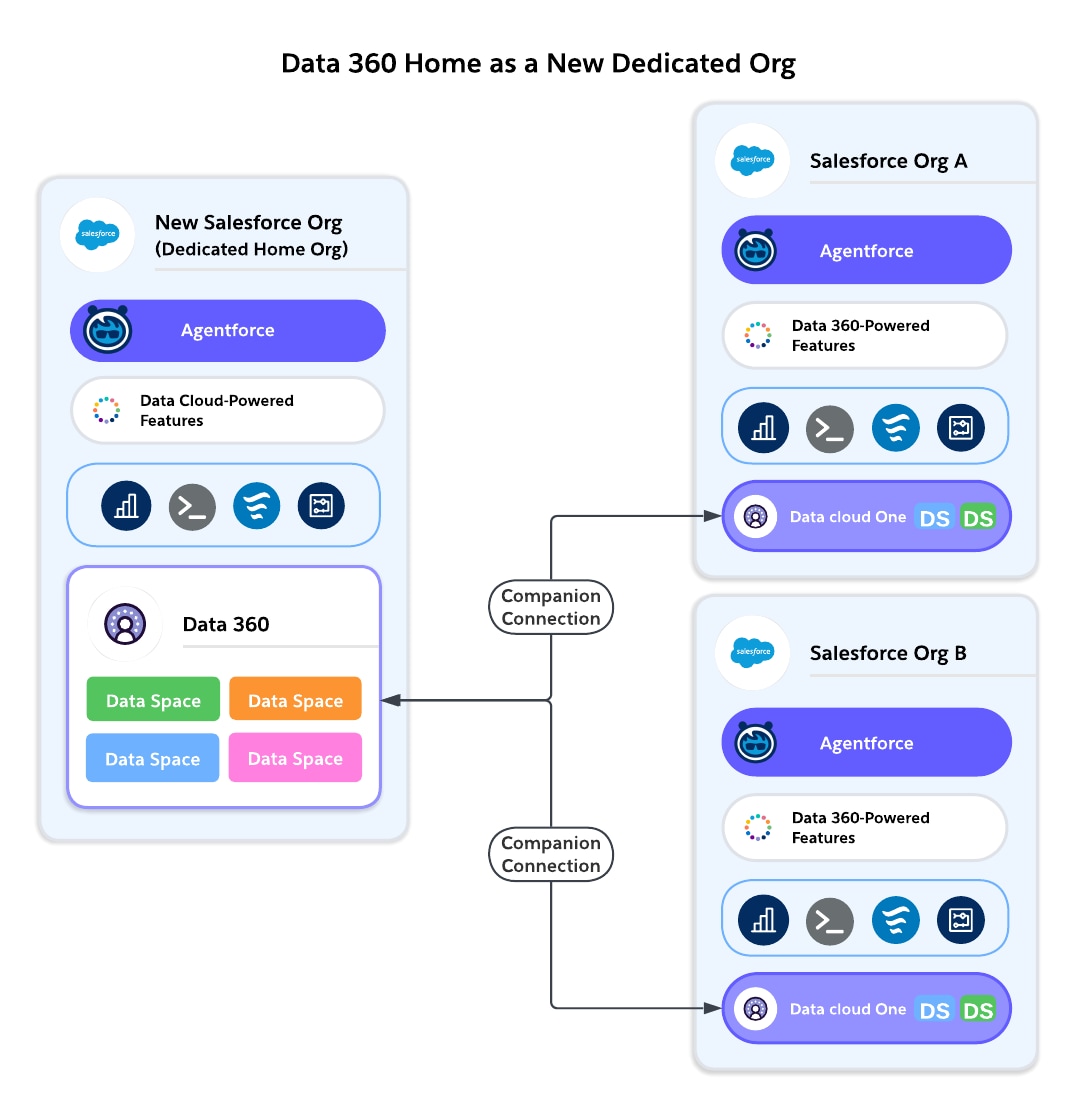 - **長所**:
- 継承された組織の複雑さがなく、ガバナンスを一から構築できます。
- 複数の基幹業務の一元管理。
- コンプライアンスのニーズに基づいて地域を柔軟に選択できます。
- 1 つのビジネスユニットに縛られず、中立的な「共有サービス」組織として機能します。
- 将来の Data Cloud One アーキテクチャ (複数のコンパニオン組織がある自宅組織) に合わせて設定します。
- **短所**:
- 顧客は、Data 360 をプロビジョニングする新しい Salesforce 組織のライセンスを取得する必要があります。
- Data Cloud One コンパニオン接続を介して組織を Data 360 に接続するには、追加のインテグレーションが必要です。
- 管理オーバーヘッド (ユーザー管理、セキュリティ、ID) を追加する場合があります。
- 既存の本番組織のプロビジョニングと比較して、タイム トゥ バリューが遅い。
**例:**
ある多国籍金融サービス会社は、Data 360 をプロビジョニングするための専用の自宅組織を作成します。すべてのビジネスユニット組織 (リテール、ウェルス、コマーシャルバンキング) は、Data Cloud One を介してコンパニオン組織として接続します。
#### 決定条件
| 考慮事項 | 在宅組織としての既存の組織 (優先デフォルト) | ホーム組織としての新規組織 (代替) |
|---|---|---|
| シンプルさ | 既存のユーザーとデータ構造に基づいて構築されているため、設定を迅速化できます。Data 360 はデフォルトでホーム組織と統合されています。 | 新しい Salesforce 組織のライセンスと設定、およびそれを管理するための追加の管理オーバーヘッドが必要です。 |
| Time-to-Value | ローカル CRM データの迅速な使用。 | 傾斜が遅い。インテグレーションが必要。 |
| ガバナンス | 既存の組織の基本ガバナンスモデル (既存のユーザーと権限セット) を継承します。組織がすでに中央にある場合は、これで問題ありません。 | ガバナンスのための白紙の状態。CoE 主導のモデルに最適です。 |
| コンプライアンス | 既存の組織の地域に関連付けられたレジデンシー。 | 既存の組織から独立した地域を柔軟に選択できます。 |
| Performance | ローカル CRM クエリで最高のパフォーマンス。 | コンパニオン組織の接続性 (他の組織と同じリージョンかクロスリージョンか) によって異なります。 |
| 将来の拡張性 | Data Cloud One と組み合わせると適切に機能します。間違った組織が選択されている場合、後で移行するのが困難です。 | 中立性を考慮して設計された Data Cloud One を使用して簡単に拡張できます。 |
| Cost (コスト) | 増分コストを削減。 | 環境の追加によるオーバーヘッドの増加。 |
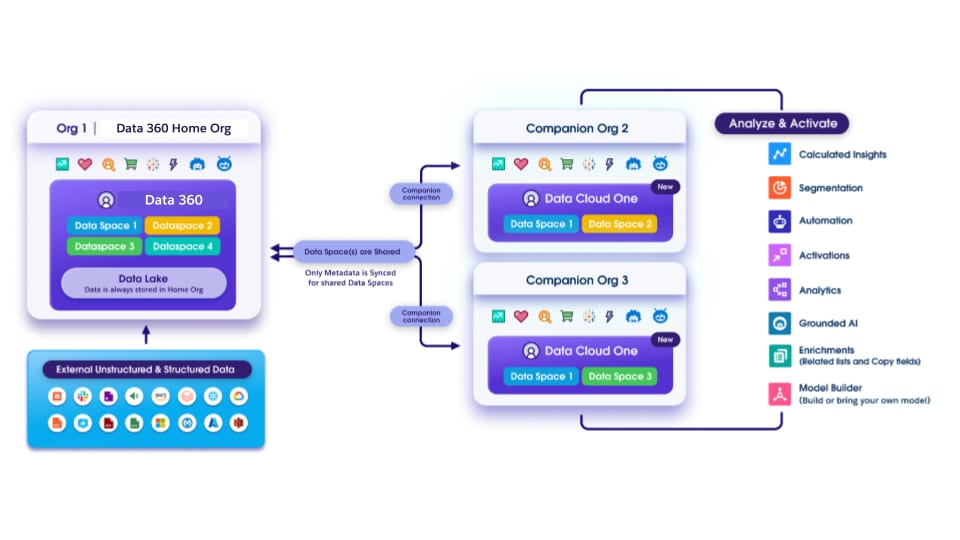 #### Data Cloud One のしくみ
| 機能 | ホーム組織 | コンパニオン組織 |
|---|---|---|
| Connect 設定コネクタ、データストリームの作成、データの取り込みまたは統合 | ✅ | ❌ |
| 調和と統合 データ変換と ID 解決の構築および実行 | ✅ | ❌ |
| データスペースと権限によるデータの保護のガバナンス | ✅ | ✅ |
| セグメントと予測 セグメント、インサイト、Einstein Studioモデルの構築 | ✅ | ✅ |
| Activate Everywhere Activations、データアクション | ✅ | ✅ |
| プラットフォーム機能プロンプトビルダー、フロー、レポート、強化など | ✅ | ✅ |
| Data 360対応機能 Prospecting Center、Sales CloudおよびService Cloudの機能、Agentforceなど | ✅ | ✅ |
| 考慮事項 | 複数の独立した Data 360 | 1 つの共有データ 360 (Data Cloud One) |
|---|---|---|
| 自律 | 各組織またはビジネスユニットの高い自律性。 | 一元化されたガバナンス、組織ごとの自律性の低下。 |
| コンプライアンス | 厳格な分離が必要な場合 (地域の法律など) に便利です。 | レジデンシーで集中管理が許可されている場合に最適です。 |
| Cost (コスト) | ライセンスコストと管理コストの増加。 | コスト効率が向上。多くの組織で 1 つのライセンスを使用できます。 |
| ガバナンス | 断片化。ポリシーは組織によって異なります。 | 組織全体で一元化された一貫したポリシー。 |
| データサイロ | 各組織には独自のビューがあり、Enterprise 360 はありません。 | 統合されたデータセット (重複なし)。 |
| AI/Analytics | 各組織のデータに制限されます。 | 精度が向上したエンタープライズ規模のモデル。 |
| 複雑さ | 管理するインスタンスが増え、インテグレーションも増えました。 | シンプルなアーキテクチャ、可動部品の削減。 |
| Performance | 組織内の使用事例に最適です。 | コンパニオン組織へのアクセスで遅延が発生する場合があります。 |
| 要素 | プラス面 | マイナス面 |
|---|---|---|
| データレジデンシー | コラボレーションを可能にしながら、地域の分離をサポートします。 | 複数の Data 360 を管理する必要はありません。 |
| データの複製 | ゼロコピー、オブジェクトの重複なし。 | 各データ共有に含めるオブジェクトを慎重に選択する必要があります。 |
| ガバナンス | 共有は明示的かつ慎重に行われます (オブジェクトレベル)。 | タグまたはポリシーフローはありません。対象組織はガバナンスを再適用する必要があります。 |
| 複雑さ | 一元化なしで選択的なコラボレーションを可能にします。 | 複数の Data 360 とデータ共有の管理が必要です。 |
| AI/Analytics | 地域の AI/分析が可能。インサイトを組織間で共有できます。 | データを意図的に共有しない限り、全社的な AI は使用されません。 |
| プラットフォーム機能 | 各組織の Data 360 対応機能は独立して実行されます。 | 自動共有なし — 慎重に設計しないと重複のリスクがあります。 |
| Cost (コスト) | ETL パイプラインの必要性を減らすことができる。 | ただし、複数の Data 360 のコストが発生します。データクエリとデータ共有のクレジットを消費します。 |
| 考慮事項 | Data Cloud One (マルチ組織に推奨) | Data 360 組織間でのデータ共有 |
|---|---|---|
| 一元化された情報源 | ✅ はい — すべての組織で同じ DC を共有します。 | ❌ いいえ — 各 Data 360 には独自のデータモデルがあります。 |
| コンプライアンス | レジデンシーで一元化が許可されている場合にのみ機能します。 | 居住法によって一元化が妨げられている場合に必要です。 |
| ガバナンス | 一元化された一貫性。 | 統合。オブジェクトレベルの共有を意図します。 |
| 複雑さ | 可動部品が少なく、シンプル。 | または複雑 — 設定データ共有と複数の Data 360 が必要です。 |
| AI/Analytics | エンタープライズ全体の AI モデル。 | 地域 AI。インサイトは選択的に共有できます。 |
| プラットフォーム機能 | Shared Data 360 では、すべての機能がホームとコンパニオンで一貫して動作します。 | 機能は Data 360 ごとに独立して実行されます。共有は明示的に行う必要があります。 |
|
Salesforce Lightning Platformは、従業員、自律型AIエージェント、会社のデータ、アプリケーションを単一の信頼できるシステムに統合し、生産性とカスタマー エクスペリエンスを向上させる包括的なAI駆動型プラットフォームです。Customer 360アプリケーション、Data Cloud、Slackを接続してエンドツーエンドの自動化を実現することで、「エージェント エンタープライズ」の作成を可能にします。 |
| アプローチ | 説明 | 必要なスキル | ライセンスと制限 |
|---|---|---|---|
| Queueable Apex | 実行時間の長いデータベース操作や外部 Web サービスのコールアウトが含まれるプロセスに使用します。Queueable Apex には、ジョブ ID、プリミティブ型以外の種別のサポート、ジョブのチェーンなどの機能があります。 | プロコード | ライセンス数によって制限が増加する可能性があります。 |
| Apex の一括処理 | レコードセットを分割して管理可能なチャンクで処理することで、数百万件のレコードが含まれる複雑で実行時間の長いプロセスを構築します。 | プロコード | ライセンス数によって制限が増加する可能性があります。 |
| スケジュール済み Apex | cron 式で定義されたスケジュールされた時間に Apex を実行します。cron 式を使用して Apex をスケジュールする動作は非同期プロセスですが、基盤となるコードはジョブの開始時に同期して実行されます。 | プロコード | ライセンス数によって制限が増加する可能性があります。 |
| Apex 継続コールアウト | 同期トランザクション コンテキストで実行されている Apex メソッドからコールアウトを実行します。 | プロコード | いいえ |
| 非同期パス (レコードトリガーフロー) | 独自の時間に実行する操作を実行します。フローをトリガーしたレコードに含まれていない関連レコードの値を更新したときに発生する混在 DML エラーを回避します。 | ローコード | ライセンスの数と種類によって制限が増加する可能性があります。 |
| スケジュール済みパス (確定後フロー) | トリガーイベント (レコードの作成、更新、削除など) 後の動的にスケジュールされた時間に実行します。 | ローコード | ライセンスの数と種類によって制限が増加する可能性があります。 |
| スケジュール済みフロー | 指定した時刻と繰り返し頻度 (毎日、毎週、または 1 回) でフローをバックグラウンドで実行し、レコードのバッチに対してアクションを実行します。 | ローコード | ライセンスの数と種類によって制限が増加する可能性があります。 |
| プラットフォームイベントトリガー | Salesforce を外部システムと疎結合し、Salesforce Platform 内の非同期コンポーネント間で通信します。 | ローコード + プロコード | 大規模プラットフォームイベントの使用事例にはアドオンライセンスが必要 |
| 変更データキャプチャ | データベーストランザクションがコミットされた後に、変更イベントを非同期で取得して処理します。 | プロコード | ベースラインの割り当てを超える拡張を行うには、アドオン ライセンスが必要です。 |
| Bulk API | 多数のレコードを非同期で挿入、更新、更新/挿入、クエリ、削除し、後で結果を処理します。 | プロコード | 制限があります。 |
| Lightning アクション | Lightning ページで、ユーザーにページの完全な更新を強制せずにサーバーとやりとりできるようにします。 | ローコード | いいえ |
| 必要なスキル | このガイドで説明されているツールには、コードが必要なものと、宣言的に設定できるものがあります。選択肢を検討するときに、チームメンバーのスキルセットについて考えます。最初の実装で (実装パートナーを介して) 開発者が対応可能であっても、将来ソリューションの変更が必要になる場合があります。メンテナンスチームに開発者がいない場合は、ローコードオプションが適しています。 |
| 適用されるプラットフォーム制限の種別 | 実行に適用される制限の種類を決定します。ソリューションを設計するときに、選択したアプローチのガバナ制限にトランザクションの量と頻度がどのように反映されるかを慎重に検討します。毎日実行される実行数を計算します。選択したツールに関連付けられた制限内に計算値が含まれていることを確認します。 |
| 遅延 | 処理の結果をプラットフォームでどの程度迅速に使用できるかを決定します。一部のアプローチでは、変更はほぼ即座に行われますが、別のアプローチでは数分から数時間かかる場合があります。 |
| 使用事例 | 説明 | First Choice Approach (第一選択肢アプローチ) | 根拠 |
|---|---|---|---|
| 高パフォーマンスのバッチ処理 | 何千、何百万ものレコードを効率的に処理する必要がある自動化 | Batch Apex | Batch Apex は、プラットフォームとのインタフェースと未フォーマット時の処理速度を実現する豊富な API を提供します。 |
| データ消去ジョブ | データをクリーンアップするために定期的またはオンデマンドで実行されるジョブ。たとえば、重複除外、住所検証、データ統合などがあります。 | Batch Apex | Batch Apex は、プラットフォームとのインタフェースと未フォーマット時の処理速度を実現する豊富な API を提供します。 |
| 夜間積み上げ集計ジョブ | 営業日の終わりに積み上げ集計データを計算するジョブ。 | Batch Apex | Batch Apex は、プラットフォームとのインタフェースと未フォーマット時の処理速度を実現する豊富な API を提供します。 |
| レコードトリガーロジック | レコードの更新に応じてロジックを実行します。 | 不特定 | コンパニオン決定ガイド「Record Triggered Events Automation」を参照してください。これには、キュー可能 Apex、バッチ Apex、スケジュール済み Apex、スケジュール済みフロー、非同期パスフロー、変更データキャプチャなどの非同期使用事例のディシジョンツリーが含まれます。 |
| オブジェクトグラフを使用した更新のカスケード | ユーザーの保存アクションをすばやく完了し、他のオブジェクトのカスケード更新を非同期で実行できるようにします。 | Queueable Apex | Queueable Apex には、更新のチェーンを一連の非同期トランザクションに分割するロジックを可能にする強力なチェーン機能があります。 |
| レコード固有のスケジュール済み処理 | レコードに固有の将来の動的な日付 (完了予定日の 3 日前など) での自動化。 | スケジュール済みパスを使用するフロー | スケジュール済みパスは、レコードのデータが変更された場合にプラットフォームが自動的にこれらのパスのスケジュール、キャンセル、再スケジュールを処理するため、フローに独自の強みを提供します。 |
| 複数の低速外部サービスの並列呼び出し | 同期実行中は、全体的な実行時間を最適化するために複数の外部サービスが並列で呼び出されます。 | Apex 継続コールアウト | 実行に時間がかかる複数のコールアウトを並列で実行できるようにすることで、作業の完了までの全体的な時間を最小限に抑えます。 |
| 外部システムからのレコードのデータ移行 | 外部システムから大量のレコードを Salesforce Platform に移動します。1 回限りのプロセスまたは定期的なスケジュールプロセス。 | Bulk API | これは、データ移行の最も効率的で制限の少ない方法です。 |
| 外部システムでの追加ロジックの実行 | プラットフォームのイベントを外部システムに通知し、そのシステムでイベントを非同期で処理できるようにする、ファイアーアンドフォーゲットパターン。 | プラットフォームイベントまたは変更データキャプチャ | pub-sub モデルはここで最適に機能し、準備が整ったら外部システムでイベントを処理できます。このパターンについての詳細は、「イベント駆動型アーキテクチャ」を参照してください。 |
| 考慮すべき領域 | よくある質問 |
|---|---|
| 既存のツールとランドスケープ | 既存の ESB または ETL ソリューションはありますか?関連するデータに規制要件またはコンプライアンス要件がありますか?統合しようとしているシステムはどこにありますか (クラウドまたは社内)? |
| データフロー (タイミング、予想されるユーザーエクスペリエンス、方向性) | データを同期または非同期で移動する必要がありますか? または一括処理/スケジュールできますか?データレプリケーションは必要か?どのようなシステムを情報源とすべきか?データソースは?対象目的地は?ユーザー操作は必要か?ユーザーはインテグレーションの結果を確認する必要がありますか?例外処理 (再試行、通知、失敗) に関するニーズは?システムはどの程度緊密に結合する必要がありますか? |
| 実装 | Salesforce 以外のシステムの作業レベルは?インテグレーションの提供を担当するチームは?顧客が好んで使用するツールは? |
| メンテナンス性 | インテグレーションを維持する必要があるチームは?現在どのようなスキルを持っているか?将来どのようなスキルが必要か?経時的な総所有コストは?ローコードツールまたはプロコードツールを使用してテスト、デバッグ、トラブルシューティングを行う能力はどの程度重要ですか? |
| データ量 | インテグレーションに含まれるデータ量は?大規模データボリューム(LDV)を使用する予定がありますか?一括変更の頻度は?シングルトン更新はどのような影響がありますか?発生する頻度は? |
| 制限 | データは複雑な変換を行う必要がありますか?複数のソースシステムのデータを結合する必要がありますか?インテグレーションはユーザーごとにどの程度の頻度で行われますか?合計ユーザー数は?一括データ読み込み (新規インスタンスの初期データ読み込みなど) を事前に計画していますか? |
| Salesforce から外部システムへ | 外部システムから Salesforce へ | 実行 | 必要な追加ライセンス | |
|---|---|---|---|---|
| Apex アクション | 利用可 | 利用可 | サーバー側 | いいえ |
| 変更データキャプチャ | 利用可 | 利用不可 | サーバー側 | いいえ* |
| カスタム Apex (REST および SOAP Web サービス) | 利用可 | 利用可 | サーバー側 | いいえ |
| 外部サービス | 利用可 | 利用不可 | サーバー側 | いいえ |
| Heroku Connect | 利用可 | 利用可 | サーバー側 | はい |
| Data 360 | 利用可 | 利用可 | サーバー側 | はい |
| MuleSoft Anypoint | 利用可 | 利用可 | サーバー側 | はい |
| ネイティブSalesforce API | 使用不可 | 利用可 | サーバー側 | いいえ |
| OmniScript | 利用可 | 利用可 | Client-Side*** | はい |
| OmniStudio インテグレーション手順 | 利用可 | 利用可 | サーバー側 | はい |
| アウトバウンドメッセージング | 理想的ではない | 使用不可 | サーバー側 | いいえ |
| プラットフォームイベント | 利用可 | 利用可 | サーバー側 | いいえ** |
| Salesforce Connect/外部オブジェクト | 利用可 | 利用可 | サーバー側 | はい |
| ガイダンス | ライセンス | タイミング | ボリューム & スケール | 配送およびメンテナンス | プライバシーとセキュリティ | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| 使用するケース | 追加ライセンス | 同期 (要求/応答) または非同期 (起動/忘れ) | 複数オブジェクトのサポート | LDV/Bulk | テストと導入** | デバッグ | 組み込みエラー処理/再試行動作 | 保存データを暗号化して使用 | 認証プロトコル | |
| 変更データキャプチャ | Salesforce で行われたレコードレベルの変更を外部システムに公開する必要があり、カスタムペイロードが不要な場合。 | 必須 | 非同期 | なし | なし | はい | プロコードツールの使用 | はい | あり | OAuth |
| 外部サービス | フロー、Apex、Einsteinボット、OmniStudioを使用してプロセスを調整する場合、外部システムAPIはOpenAPI仕様を使用して記述されます。 | 不要 | 同期 | あり | いいえ | あり | プロコードツールの使用 | いいえ | なし | 指定ログイン情報 |
| Heroku Connect | 双方向同期を使用してデータを拡張して Heroku のモバイルアプリケーションや他のアプリケーションを有効にし、データを Salesforce にも複製する場合。 | 必須 | 非同期 | はい | はい | 不可 | プロコードツールの使用 | はい | はい、Shield Connect を使用 | OAuth |
| OmniStudio インテグレーション手順 | ユーザー操作なしでデータを変換し、ブラウザーではなくサーバーで処理することでパフォーマンスを向上させる必要がある場合。 | 必須 | 両方 | はい | はい | はい | 宣言型サポート | はい | はい | 指定ログイン情報 |
| Salesforce Connect/外部オブジェクト | Salesforce UI にデータを表示し、データを外部システムに保存する場合。データは Salesforce に複製されません。 | 必須 | 同期 | いいえ | はい* | はい | プロコードツールと宣言型トレーサーを使用 | いいえ | なし | 指定ログイン情報 |
| *バージョン4.01より古いOdataアダプタには、コールアウト制限が適用されます。詳細については、「Odata Callout Rate Limit Considerations(Odataコールアウト レート制限に関する考慮事項)」を参照してください。**テストおよびリリースとは、より低い環境で構築し、メタデータAPI、パッケージ、または変更セットを使用して本番にリリースする機能のことです。 | ||||||||||
| ガイダンス | ライセンス | タイミング | ボリューム & スケール | 配送およびメンテナンス | プライバシーとセキュリティ | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| 使用するケース | 追加ライセンス | 同期 (要求/応答) または非同期 (起動/忘れ) | 複数オブジェクトのサポート | LDV/Bulk | テストと導入** | デバッグ | 組み込みエラー処理/再試行動作 | 保存データを暗号化して使用 | 認証プロトコル | |
| Apex アクション | Salesforce フローを使用して別のシステムへのコールアウトを自動化する場合。開発者は、フローで呼び出すことができる Apex クラスを作成したり、AppExchange から事前作成済みソリューションをダウンロードしたりできます。 | 不要 | 両方 | あり | いいえ | あり | プロコードツールの使用 | いいえ | あり | 複数 |
| イベントリレー | プラットフォームイベントと変更データキャプチャチャイベントを Salesforce から Amazon EventBridge に送信する必要がある場合。イベントリレーは AWS Eventbridge にのみ接続 | いいえ | 非同期 | はい | いいえ | はい | はい | はい | はい | HTTP/1.1 with TLS |
| アウトバウンドメッセージング | ワークフロールールによってトリガーされた受信が保証された、指定されたエンドポイントに HTTP(S) 経由で SOAP メッセージを送信する必要がある場合。 | 不要 | 非同期 | なし | なし | はい | 宣言型サポート | はい | あり | 双方向 TLS |
| プラットフォームイベント | Salesforce または外部システムでほぼリアルタイムの変更を行うために、カスタム定義の構造化されたペイロードが必要な場合。 | 必須ではありません* | 非同期 | はい | いいえ | はい | プロコードツールの使用 | はい | はい | OAuth |
| Salesforce Connect/外部オブジェクト(カスタムApexアダプタを使用) | Salesforce UI にデータを表示するが、Odata や GraphQL などの標準プロトコルを使用できない外部システムにデータを保存する場合。 | 必須 | 両方 | はい | はい | はい | プロコードツールの使用 | いいえ | なし | 複数 |
| Data 360 | 1 つのデータストアで異なるソースのデータをハーモナイズする場合、または他の Salesforce 組織や他の外部システムにデータを複製する場合。 | 必須 | 両方 | はい | はい | はい | はい | はい | はい | 複数 |
| ガイダンス | ライセンス | タイミング | ボリューム & スケール | 配送およびメンテナンス | プライバシーとセキュリティ | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| 使用するケース | 追加ライセンス | 同期 (要求/応答) または非同期 (起動/忘れ) | 複数オブジェクトのサポート | LDV/Bulk | テストと導入** | デバッグ | 組み込みエラー処理/再試行動作 | 保存データを暗号化して使用 | 認証プロトコル | |
| カスタムApex | ローコードツールで使用できない機能が必要な場合。 | 不要 | 両方 | はい | はい | あり | プロコードツールの使用 | いいえ | はい* | 複数 |
| 外部サービス | コードから外部システム API へのインテグレーションは、OpenAPI 仕様を使用して記述されます。 | 不要 | 同期 | あり | いいえ | はい | プロコードツールの使用 | いいえ | なし | 複数 |
| MuleSoft Anypoint | インテグレーションを構築、オーケストレーション、管理するために単一のエンタープライズクラスの統合ソリューションが必要な場合、従来のポイントツーポイントアーキテクチャを置き換える必要がある場合、API 管理サポートが必要な場合。 | 必須 | 両方 | はい | はい | はい | プロコードツールの使用 | いいえ | はい* | 複数 |
| ガイダンス | ライセンス | タイミング | ボリューム & スケール | 配送およびメンテナンス | プライバシーとセキュリティ | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| 使用するケース | 追加ライセンス | 同期 (要求/返信) または非同期 (起動/忘れ) | 複数オブジェクトのサポート | LDV/Bulk | テストと導入* | デバッグ | 組み込みエラー処理/再試行動作 | 保存データを暗号化して使用可能 | 認証プロトコル | |
| Heroku Connect | 双方向同期を使用してデータを拡張して Heroku のモバイルアプリケーションや他のアプリケーションを有効にし、データを Salesforce にも複製する場合。 | 必須 | 非同期 | はい | はい | 不可 | プロコードツールの使用 | はい | はい、Shield Connect を使用 | OAuth |
| OmniStudio インテグレーション手順 | ユーザー操作なしでサードパーティソースからデータをインポートおよび変換する必要がある場合。 | 必須 | 両方 | あり | あり | あり | 宣言型サポート | いいえ | はい | 指定ログイン情報 |
| Salesforce Connect/外部オブジェクト | Salesforce UI にデータを表示するが、データを Odata や GraphQL などの標準プロトコルを使用できる外部システムに保存する場合。 | 必須 | 同期 | はい | はい | はい | プロコードツールの使用 | いいえ | なし | 複数 |
| ガイダンス | ライセンス | タイミング | ボリューム & スケール | 配送およびメンテナンス | プライバシーとセキュリティ | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| 使用するケース | 追加ライセンス | 同期 (要求/返信) または非同期 (起動/忘れ) | 複数オブジェクトのサポート | LDV/Bulk | テストと導入** | デバッグ | 組み込みエラー処理/再試行動作 | 保存データを暗号化して使用可能 | 認証プロトコル | |
| プラットフォームイベント | Salesforce または外部システムでほぼリアルタイムの変更を行うために、カスタム定義の構造化されたペイロードが必要な場合。 | 必須ではありません* | 非同期 | はい | いいえ | はい | プロコードツールの使用 | はい | はい | OAuth |
| Salesforce Connect/外部オブジェクト(カスタムApexアダプタを使用) | Salesforce UI にデータを表示する必要があるが、Odata 2.0/4.0 プロトコルを使用できない外部システムにデータを保存する場合。 | 必須 | 両方 | はい | はい | はい | プロコードツールの使用 | いいえ | なし | 複数 |
| Data 360 | 1 つのデータストアで異なるソースのデータをハーモナイズする場合、または他の Salesforce 組織や他の外部システムにデータを複製する場合。Data 360 では、一部のプラットフォームで仮想化もサポートされています。 | 必須 | 両方 | はい | はい | はい | いいえ | はい | はい | 複数 |
| ガイダンス | ライセンス | タイミング | ボリューム & スケール | 配送およびメンテナンス | プライバシーとセキュリティ | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| 使用するケース | 追加ライセンス | 同期 (要求/返信) または非同期 (起動/忘れ) | 複数オブジェクトのサポート | LDV/Bulk | テストと導入**** | デバッグ | 組み込みエラー処理/再試行動作 | 保存データを暗号化して使用可能 | 認証プロトコル | |
| カスタム Apex REST および SOAP Web サービス | クロスオブジェクト処理やその他の複雑なロジックなど、ネイティブ API エンドポイントで提供される以上の機能が必要な場合。 | 不要 | 両方 | はい | はい | はい | プロコードツールの使用 | いいえ | はい*** | 複数 |
| MuleSoft Anypoint | インテグレーションを構築、オーケストレーション、管理するために単一のエンタープライズクラスの統合ソリューションが必要な場合、従来のポイントツーポイントアーキテクチャを置き換える必要がある場合、API 管理サポートが必要な場合。 | 必須 | 両方 | はい | はい | はい | プロコードツールの使用 | いいえ | はい*** | 複数 |
| ネイティブSalesforce API | REST API、SOAP API、Bulk API、GraphQL API、または gRPC を使用してインテグレーションを構築するために、より詳細な制御が必要な場合や、プロコードスキルセットがある場合。 | 必須ではありません* | 両方 | はい***** | はい | はい | プロコードツールの使用 | はい** | はい*** | 複数 |
| ガイダンス | Cost (コスト) | タイミング | ボリューム & スケール | 配送およびメンテナンス | プライバシーとセキュリティ | 実装するツール | |||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| 使用するケース | 追加ライセンス | 同期 (要求/応答) または非同期 (起動/忘れ) | 複数オブジェクトのサポート | LDV/Bulk | テストと導入* | デバッグ | 組み込みエラー処理/再試行動作 | 保存データを暗号化して使用 | 認証プロトコル | ローコード → プロコード | |
| Heroku Connect | Salesforce 組織間で双方向同期を使用してデータを拡張し、Heroku で実行されているモバイルアプリケーションやその他のアプリケーションからのデータへのアクセスも有効にする場合 | 必須 | 非同期 | はい | はい | いいえ | プロコードツールの使用 | はい | はい、Shield Connect を使用 | OAuth | ローコード |
| MuleSoft Anypoint | インテグレーションを構築、オーケストレーション、管理するために単一のエンタープライズクラスの統合ソリューションが必要な場合、従来のポイントツーポイントアーキテクチャを置き換える必要がある場合、API 管理サポートが必要な場合 | 必須 | 両方 | はい | はい | はい | プロコードツールの使用 | いいえ | はい** | 複数 | プロコード |
| ネイティブSalesforce API | Salesforce または Heroku Connect が使用できない場合や、より複雑な処理が必要な場合 | 不要 | 両方 | いいえ | あり | あり | プロコードツールの使用 | なし | はい** | 複数 | プロコード |
| 変更データキャプチャ | Salesforce で行われたレコードレベルの変更を外部システムに公開する必要があり、カスタムペイロードが不要な場合。 | 必須 | 非同期 | なし | なし | はい | プロコードツールの使用 | はい | はい | OAuth | |
| Salesforce Connect with Cross-Org Adapter (組織間アダプタを使用した Salesforce Connect) | ある組織のユーザーがデータ複製を使用せずに別の組織のレコードを表示または編集できるようにする場合 | 必須 | 非同期 | はい | はい | はい | プロコードツールの使用 | なし | なし | 複数 | ローコード |
| Data 360 | ある組織のユーザーが、Data 360 で複製されたデータを使用して別の組織のレコードを表示または編集できるようにする場合。 | 必須 | 両方 | はい | はい | はい | プロコードツールの使用 | はい | はい | 複数 | ハイブリッド |
|
Salesforce Platformは、従業員、自律型AIエージェント、会社のデータ、アプリケーションを単一の信頼できるシステムに統合し、生産性とカスタマー エクスペリエンスを向上させる包括的なAI駆動型プラットフォームです。Customer 360アプリケーション、Data Cloud、Slackを接続してエンドツーエンドの自動化を実現することで、「エージェント エンタープライズ」の作成を可能にします。 |
 |
MuleSoftは、オン プレミス環境とクラウド環境でアプリケーション、データ、デバイスを接続できるSalesforceの主要な統合プラットフォームです。MuleSoft は、システム全体のデータをロック解除し、拡張性の高いインテグレーションおよび自動化フレームワークを開発し、差別化された接続された環境を迅速に作成するためのプラットフォームを IT 部門に提供するプラットフォームです。 |
| 決定ポイント | ガイダンス |
|---|---|
| ほぼリアルタイムの通知 | 公開/登録、ファンアウト、ストリーミングなどのイベント駆動型アーキテクチャパターンは、複数のアプリケーションに状況の変更やレコードの更新をほぼリアルタイムで通知する必要があるシナリオで適切に機能する傾向にあります。 |
| 並列処理 | 公開/登録などのパターンは、大量のデータや非常に複雑なメッセージで処理の負荷を複数のシステムに分散する必要がある場合に適しています。 |
| 大量読み取り | [合格メッセージ] および [キュー] パターンは、組織で急増が発生し、生成されるメッセージの量が登録者の即時処理能力を超える可能性があるシナリオでよく使用されます。 |
| 大量書き込み | ストリーミングとキューイングのパターンは、生成されるメッセージ数が急増する多くのシナリオで適切に機能します。 |
| 異なるシステムへの同じデータの送信 | 公開/登録は、同じデータを複数のシステムに送信する必要がある組織にとってかなり一般的なソリューションですが、ここで説明するほとんどのパターンで対処できます。必ず詳細に確認して、最適な方法を見つけてください。 |
| 新しいシステムまたはデバイスの頻繁な導入 | 公開/登録、ストリーミング、および順番待ちパターンは、新しいシステムやデバイスが定期的に追加され、全体的な状況が変動する傾向があるシナリオに適しています。このシナリオでは、新しいシステムまたはデバイスは、イベントバスの登録者になるか、キューに関連付けられているだけで、メッセージの受信を開始できます。カスタムのポイントツーポイントインテグレーションは必要ありません。 |
| IoTデバイス | 通常、IoT デバイスは頻繁に更新を行い、一部のシナリオではメッセージの急増も発生するため、ストリーミングとキューイングのパターンは IT ランドスケープに統合すると適切に機能する傾向にあります。 |
| オフラインモバイルデバイスおよびシステム | 品質が低い、または存在しないインターネットアクセスや、メッセージが配信された時点でオフラインになっている可能性があるシステムで作業する必要があるモバイルデバイスは、キューに接続して、オンラインに戻ったら関連するメッセージを取得できるようにするキューパターンを利用できます。 |
| 決定ポイント | ガイダンス/質問 |
|---|---|
| ビジネス要件 | 「イベント駆動型アーキテクチャを使用するケース」セクション(#イベント駆動型アーキテクチャを使用するケース)に記載されている機能のいずれかに、本当にビジネスニーズがありますか? |
| 技術要件 | 設計しているインテグレーションは、データ仮想化、バッチ、要求/応答など、明らかに異なるパターンに適していますか?つまり、丸い穴に四角い釘をはめ込もうとしているのでしょうか。 |
| 人間が応答を待機する必要があるプロセス | 対象システムからの応答を待機する人間が含まれるインテグレーションは、非同期実行を目的として設計されており、応答時間を保証できないため、イベント駆動型アーキテクチャには適していません。技術的なソリューションを実装する前に、このようなプロセスが組織にとって最適かどうかを検討します。詳細は、「適切に設計されたプロセス設計」を参照してください (/docs/architect/ja-jp/well-architected/guide/automated#プロセス設計)。 |
| 頻繁に変更されないソースデータ | ソースシステムのデータの変更頻度が低すぎて定期的な更新で十分な場合は、イベント駆動型パターンではなく [バッチパターン] (https://developer.salesforce.com/docs/atlas.en-us.integration_patterns_and_practices.meta/integration_patterns_and_practices/integ_pat_batch_data_sync.htm) を使用してアーキテクチャを簡略化できます。 |
| 実装要件 | ソリューションに関与するシステムの大半はイベント駆動型アーキテクチャをサポートしていますか?イベント駆動型アーキテクチャをサポートしていないシステム (アップグレード、カスタマイズ、ミドルウェアなど) で使用するには何が必要ですか?これらの要件を満たすには、どの程度の努力が必要ですか? |
| メッセージ構造の安定性 | メッセージ構造の変更が必要になる頻度は?このような変更の影響を受けるシステムと、その修正プロセスは? |
| 組織ガバナンス | すべての関係者がメッセージ構造、トリガー、その他のアーキテクチャおよびプロセス関連の意思決定の変更について把握し、検討できるようにするためのガバナンス体制が確立されていますか? |
| 必須スキルセット | スタッフにイベント駆動型アーキテクチャの経験があり、サポート方法を理解しているか? |
| パターン | ほぼリアルタイム | 一意のメッセージコピー | 配送の保証 | メッセージサイズの削減 | データの変換 |
|---|---|---|---|---|---|
| 公開/登録 | ✓ | ✓ | ✓ | ||
| Fanout | ✓ | ✓ | ✓ | ||
| 合格メッセージ | ✓ | ✓ | ✓ | ✓ | |
| ストリーミング | ✓ | ✓ | ✓ | ||
| キューイング | ✓ | ✓ | ✓ |
| ツール | 説明 | 必須スキル | |
|---|---|---|---|
| MuleSoft | Anypoint Platform | API レイヤーを使用してデータインテグレーションを可能にするプラットフォーム。 | プロコード |
| Salesforce Pub/Sub コネクタ | Pub/Sub API のコネクタ。プラットフォームイベント、リアルタイムイベント監視イベント、変更データキャプチャを 1 つのインターフェースで公開および登録できます。 | プロコード | |
| MuleSoft Anypoint JMS Connector | Java Message Service (JMS) 仕様を実装するメッセージサービスのキューおよびトピックへのメッセージの送受信を可能にするコネクタ。 | プロコード | |
| MuleSoft Anypoint Apache Kafka Connector | Apache Kafka とエンタープライズアプリケーションおよびサービス間でデータを移動するためのコネクタ。 | プロコード | |
| MuleSoft Anypoint Solace Connector | JCSMP Java SDK を使用したネイティブ API インテグレーションを備えた Solace PubSub+ イベントブローカーのコネクタ | プロコード | |
| MuleSoft Anypoint MQ Connector | 顧客がアプリケーション間で高度な非同期メッセージングを実行できるようにするマルチテナントのクラウドメッセージングサービス。 | プロコード | |
| MuleSoft Anypoint MQTT Connector | MQTT (Message Queuing Telemetry Transport) v3.x プロトコルに準拠した MuleSoft 拡張機能。 | プロコード | |
| MuleSoft Anypoint AMQP Connector | アプリケーションが AMQP 0.9.1 準拠のブローカーを使用してメッセージを公開および消費できるようにするコネクタ。 | プロコード | |
| MuleSoft Anypoint Event-Driven (ASync) API | イベント駆動型 API をイベントレイヤー、チャネルレイヤー、トランスポートレイヤーに分割して公開をサポートする、業種に依存しない言語。 | プロコード | |
| MuleSoft Anypoint MQ | 顧客がアプリケーション間で高度な非同期メッセージングを実行できるようにするマルチテナントクラウドメッセージングサービス。 | プロコード | |
| MuleSoft Anypoint Data Streams | MuleSoft Anypoint 内で使用可能な、ストリーミングデータの公開および登録用のフレームワーク。 | プロコード | |
| Salesforce Platform | Heroku での Apache Kafka | Heroku プラットフォームに完全に統合された Apache Kafka をサービスとして提供する Heroku アドオン。 | プロコード |
| 変更データキャプチャ | Salesforce レコードへの変更を公開する変更イベントログ。変更には、新規レコードの作成、既存のレコードの更新、レコードの削除、レコードの復元などがあります。 | ローコードからプロコード | |
| 送信メッセージ | Salesforce 内で項目値が更新されるときに XML メッセージを外部エンドポイントに送信するアクション。 | ローコード | |
| プラットフォームイベント | カスタムイベントデータを含む安全でスケーラブルなメッセージ。 | ローコードからプロコード | |
| Pub/Sub API | プラットフォームイベント、変更データキャプチャチャイベント、リアルタイムイベントモニタリングイベントの登録を可能にする API。 | プロコード | |
| イベントリレー | プラットフォームイベントと変更データキャプチャチャイベントを Salesforce から Amazon EventBridge に送信できるようにします。イベントリレーは AWS Eventbridge にのみ接続します。 | ローコード | |
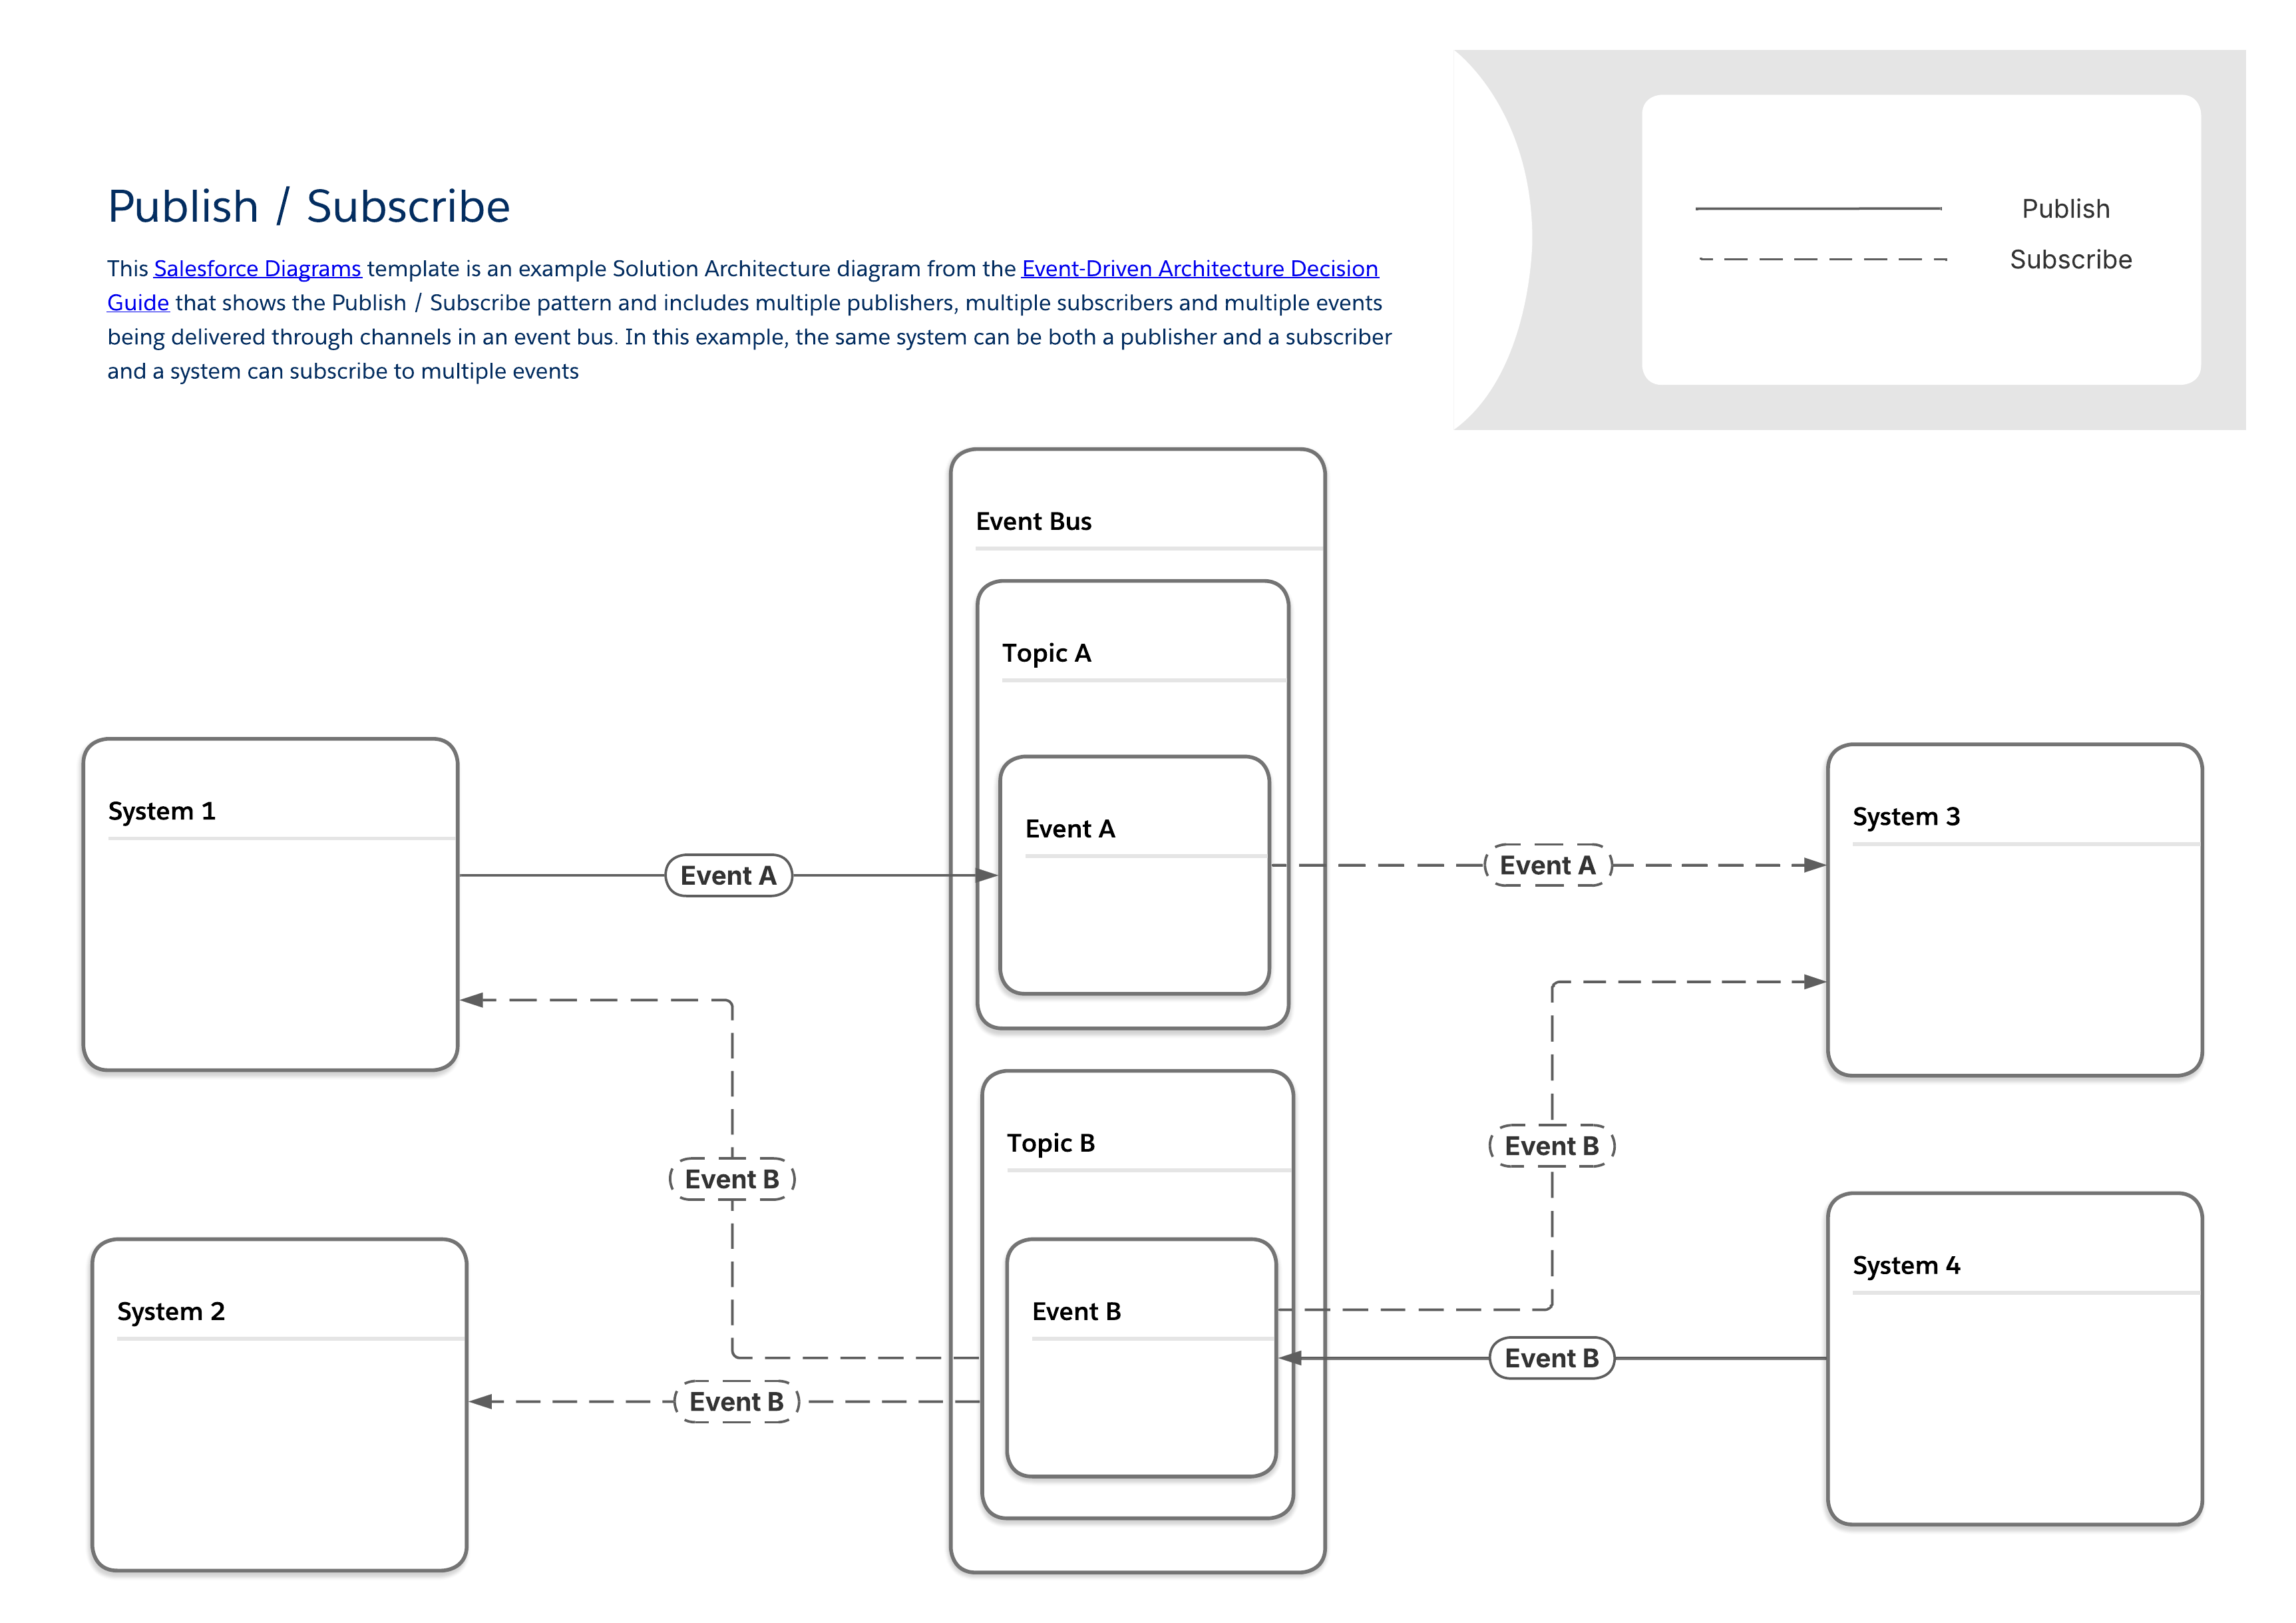 #### 公開/登録パターンに関連するツール
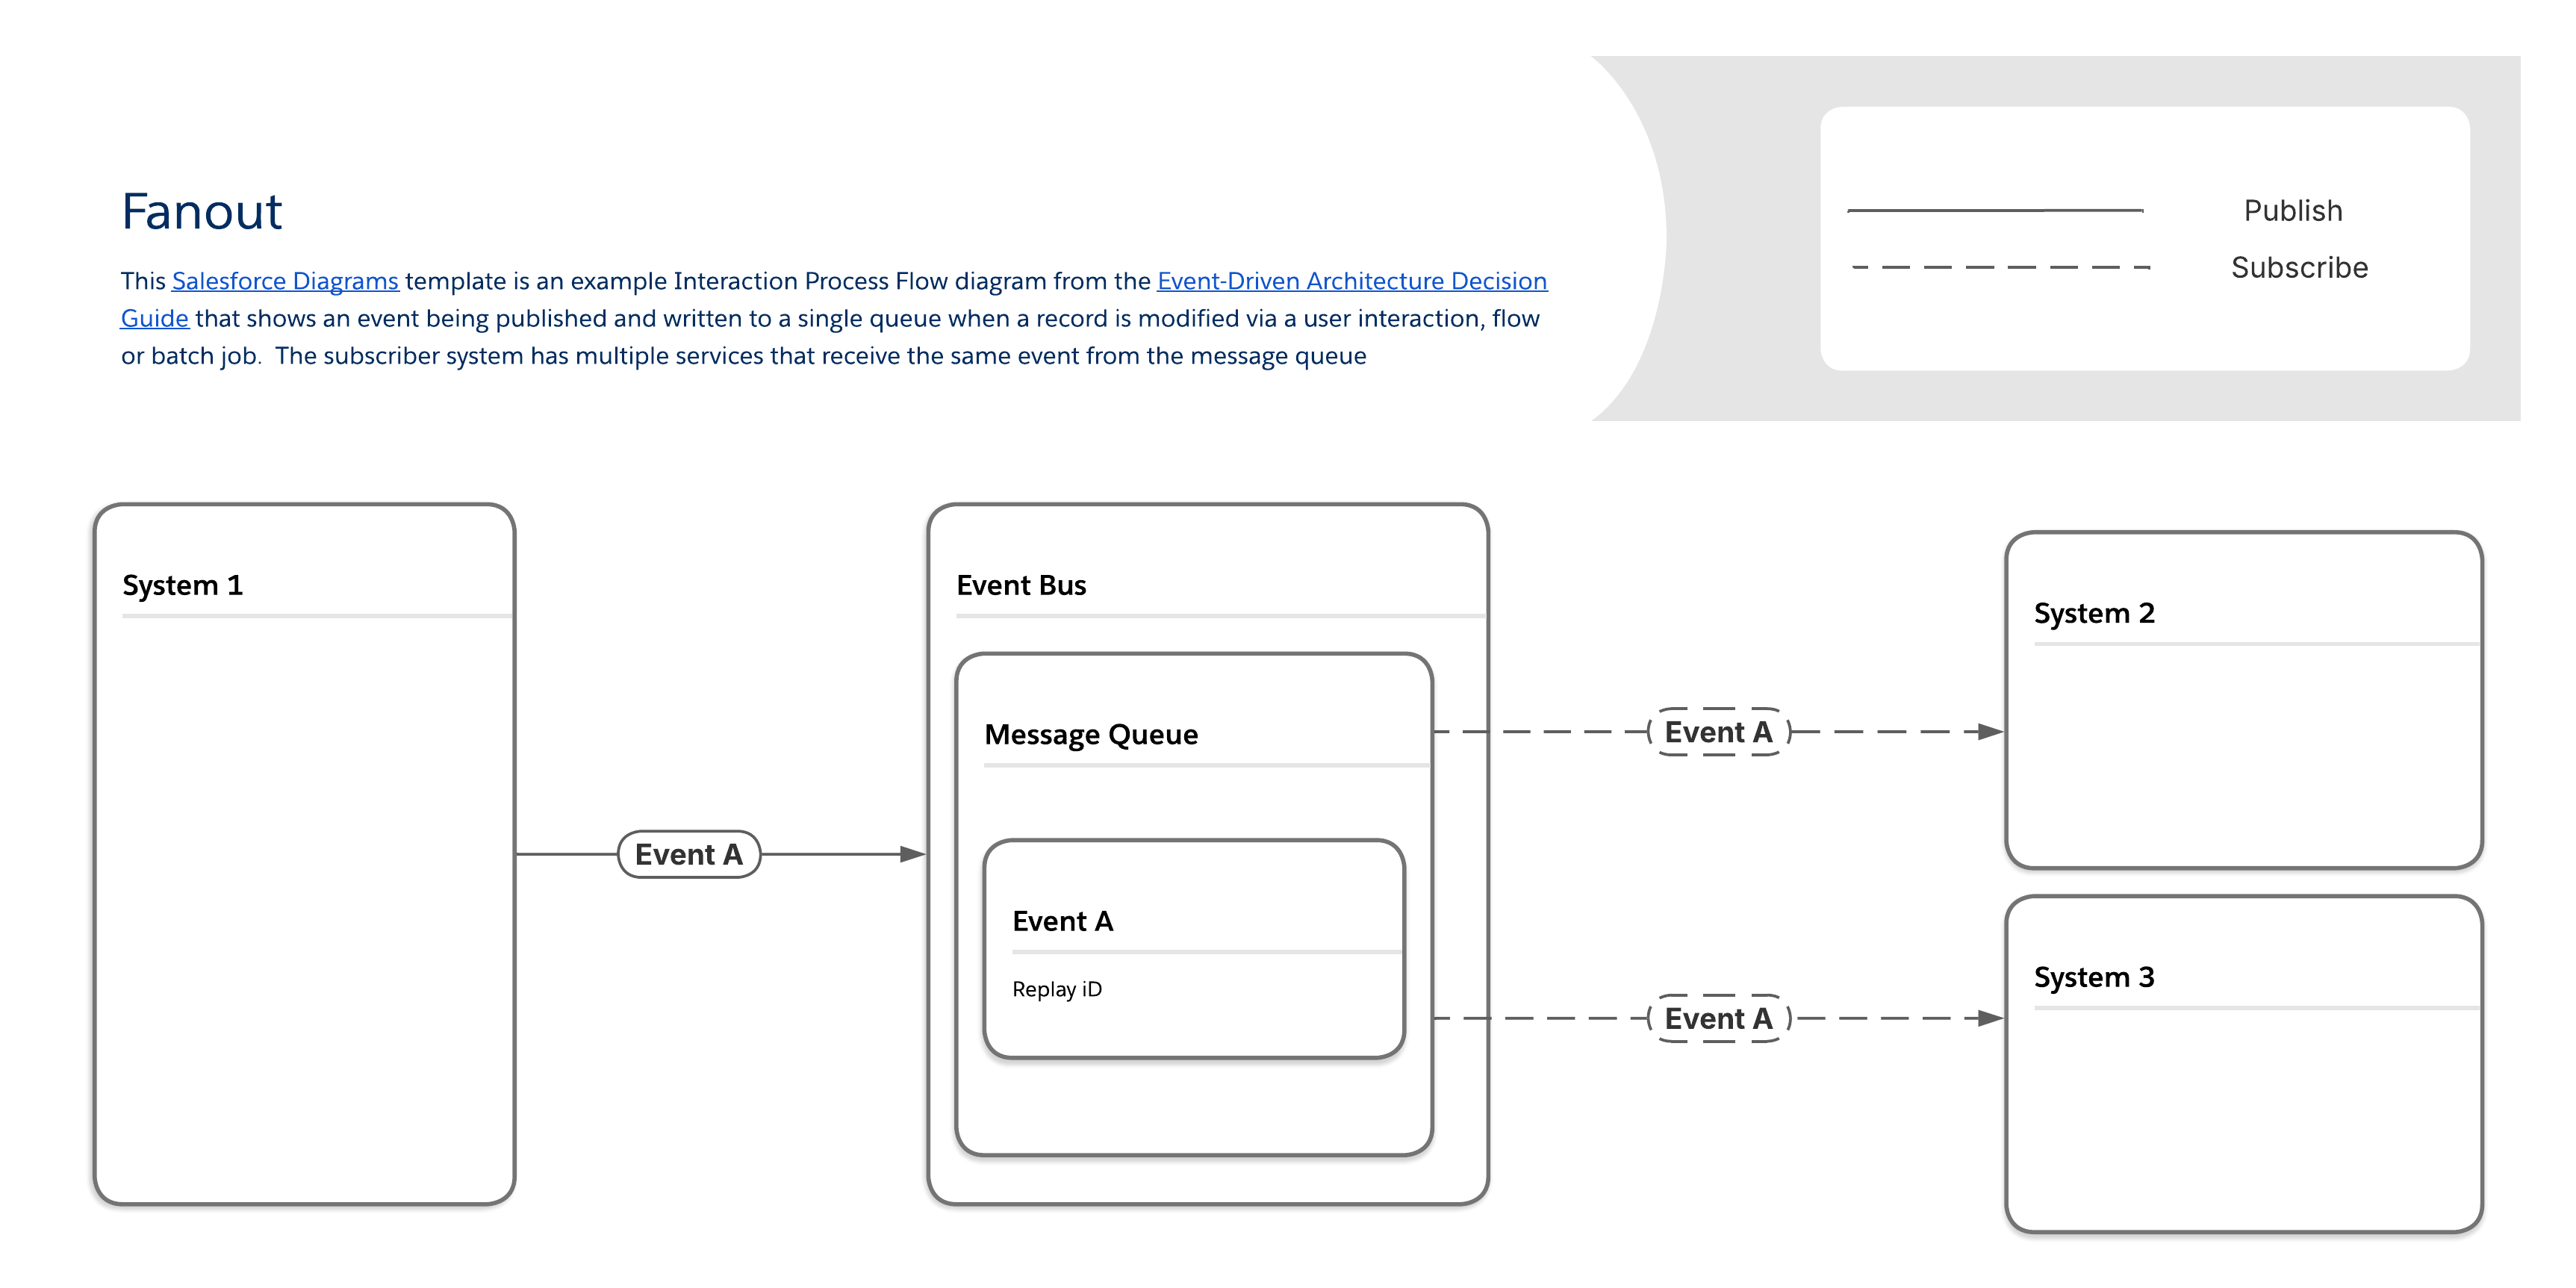 #### Fanout パターンに関連するツール
| イベントフローと動作 | ペイロードに関する考慮事項 | ||||||
|---|---|---|---|---|---|---|---|
| 使用可能なツール | 必須スキル | 公開方法 | 登録方法 | リプレイ期間 | ペイロード構造 | ペイロード制限 | |
| MuleSoft | MuleSoft Anypoint JMS Connector | プロコード | API | API | As Configured | ユーザー定義 | なし |
| Salesforce Pub/Sub コネクタ | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint Apache Kafka Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint Solace Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint MQ Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint MQTT Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint AMQP Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint MQ | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| Salesforce Platform | Heroku での Apache Kafka | プロコード | API、Heroku Postgres のレコード変更 | なし | 1 ~ 6 週間 | ユーザー定義 | ユーザー定義 |
| 変更データキャプチャ | ローコードからプロコード | レコードの変更 | Apex、API、Lightning Webコンポーネント(LWC) | 3 日 | 定義済み | 1 MB | |
| プラットフォームイベント | ローコードからプロコード | API、Apex、フロー | Apex、API、フロー、LWC | 3 日 | ユーザー定義 | 1 MB | |
| Pub/Sub API | プロコード | Pub/Sub APIまたはApex、API、フロー | Pub/Sub API | 3 日 | ユーザー定義 | 1 MB | |
| イベントリレー* | ローコード | プラットフォームイベント、変更データキャプチャチャ | API | 3 日 | ユーザー定義 | 1 MB | |
| *イベントリレーは AWS Eventbridge にのみデータを送信 | |||||||
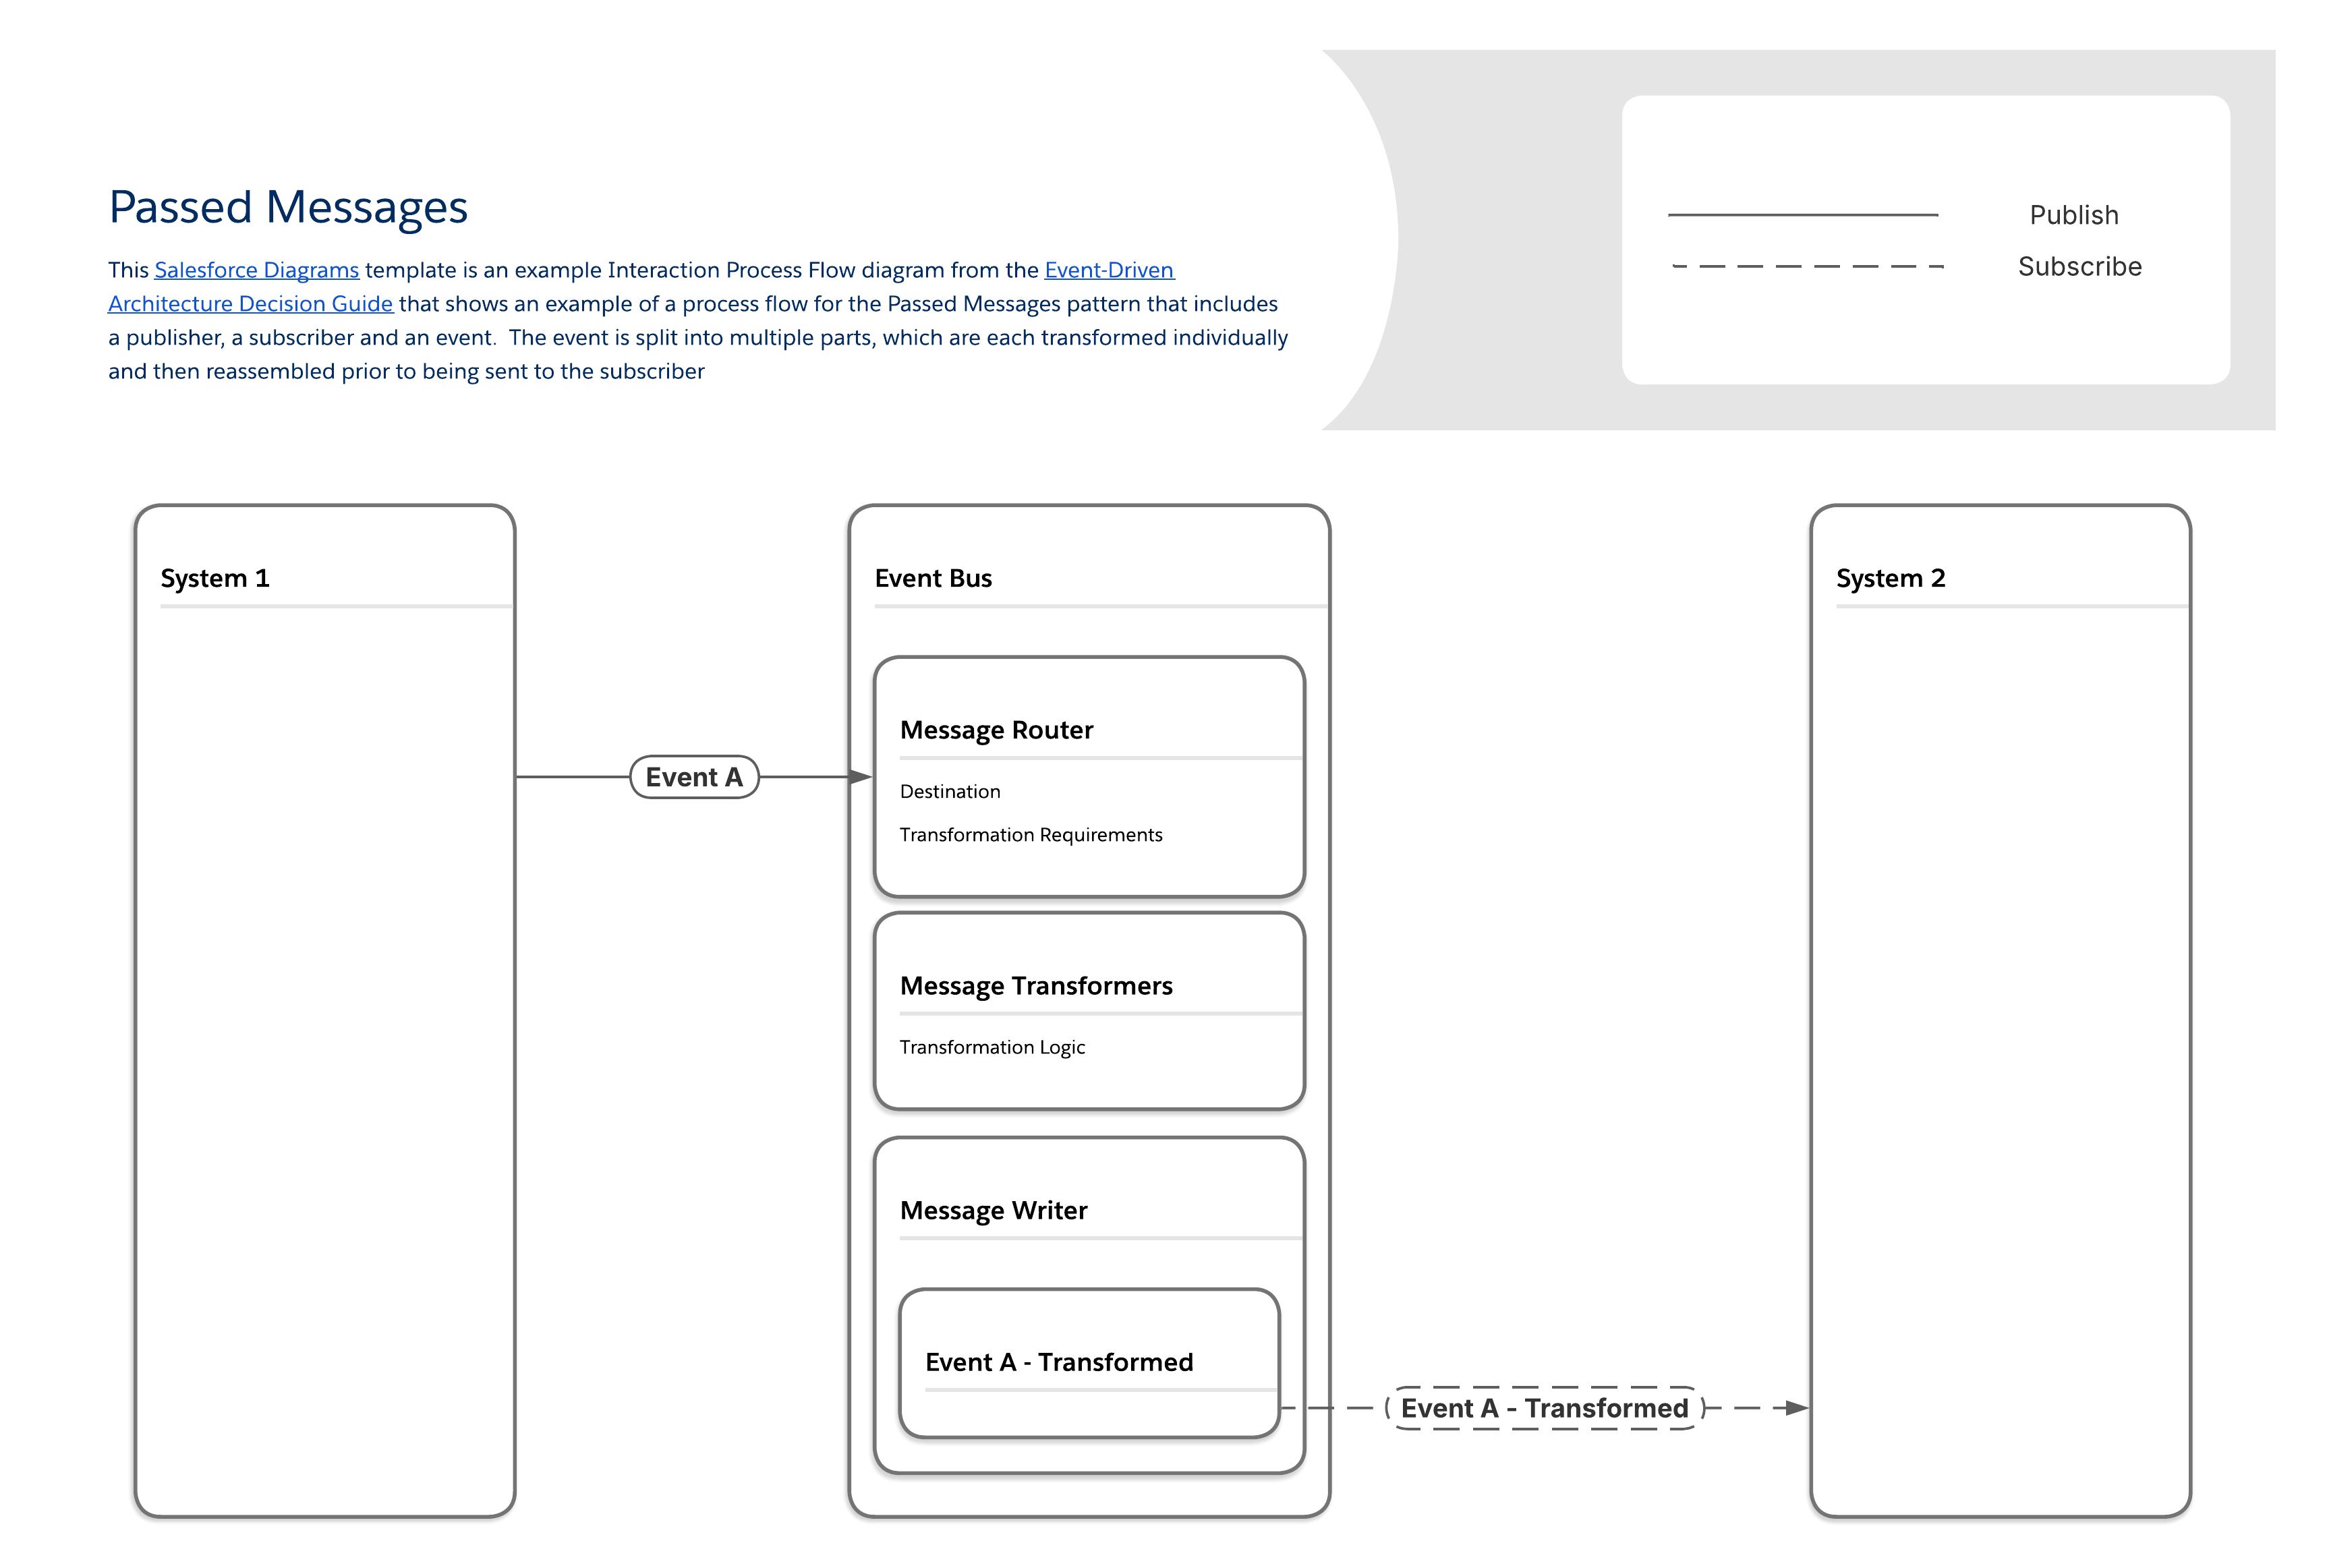 #### 合格メッセージパターンに関連するツール
| イベントフローと動作 | ペイロードに関する考慮事項 | ||||||
|---|---|---|---|---|---|---|---|
| 使用可能なツール | 必須スキル | 公開方法 | 登録方法 | リプレイ期間 | ペイロード構造 | ペイロード制限 | |
| MuleSoft | MuleSoft Anypoint Apache Kafka Connector | プロコード | API | API | As Configured | ユーザー定義 | なし |
| Salesforce Pub/Sub コネクタ | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| Salesforce Platform | Heroku での Apache Kafka | プロコード | API、Heroku Postgres のレコード変更 | なし | 1 ~ 6 週間 | ユーザー定義 | ユーザー定義 |
| 変更データキャプチャ | ローコードからプロコード | レコードの変更 | Apex、API、Lightning Webコンポーネント(LWC) | 3 日 | 定義済み | 1 MB | |
| プラットフォームイベント | ローコードからプロコード | API、Apex、フロー | Apex、API、フロー、LWC | 3 日 | ユーザー定義 | 1 MB | |
| Pub/Sub API | プロコード | Pub/Sub APIまたはAPI、Apexフロー | Pub/Sub API | 3 日 | ユーザー定義 | 1 MB | |
| イベントリレー* | ローコード | プラットフォームイベント、変更データキャプチャチャ | API | 3 日 | ユーザー定義 | 1 MB | |
| *イベントリレーは AWS Eventbridge にのみデータを送信 | |||||||
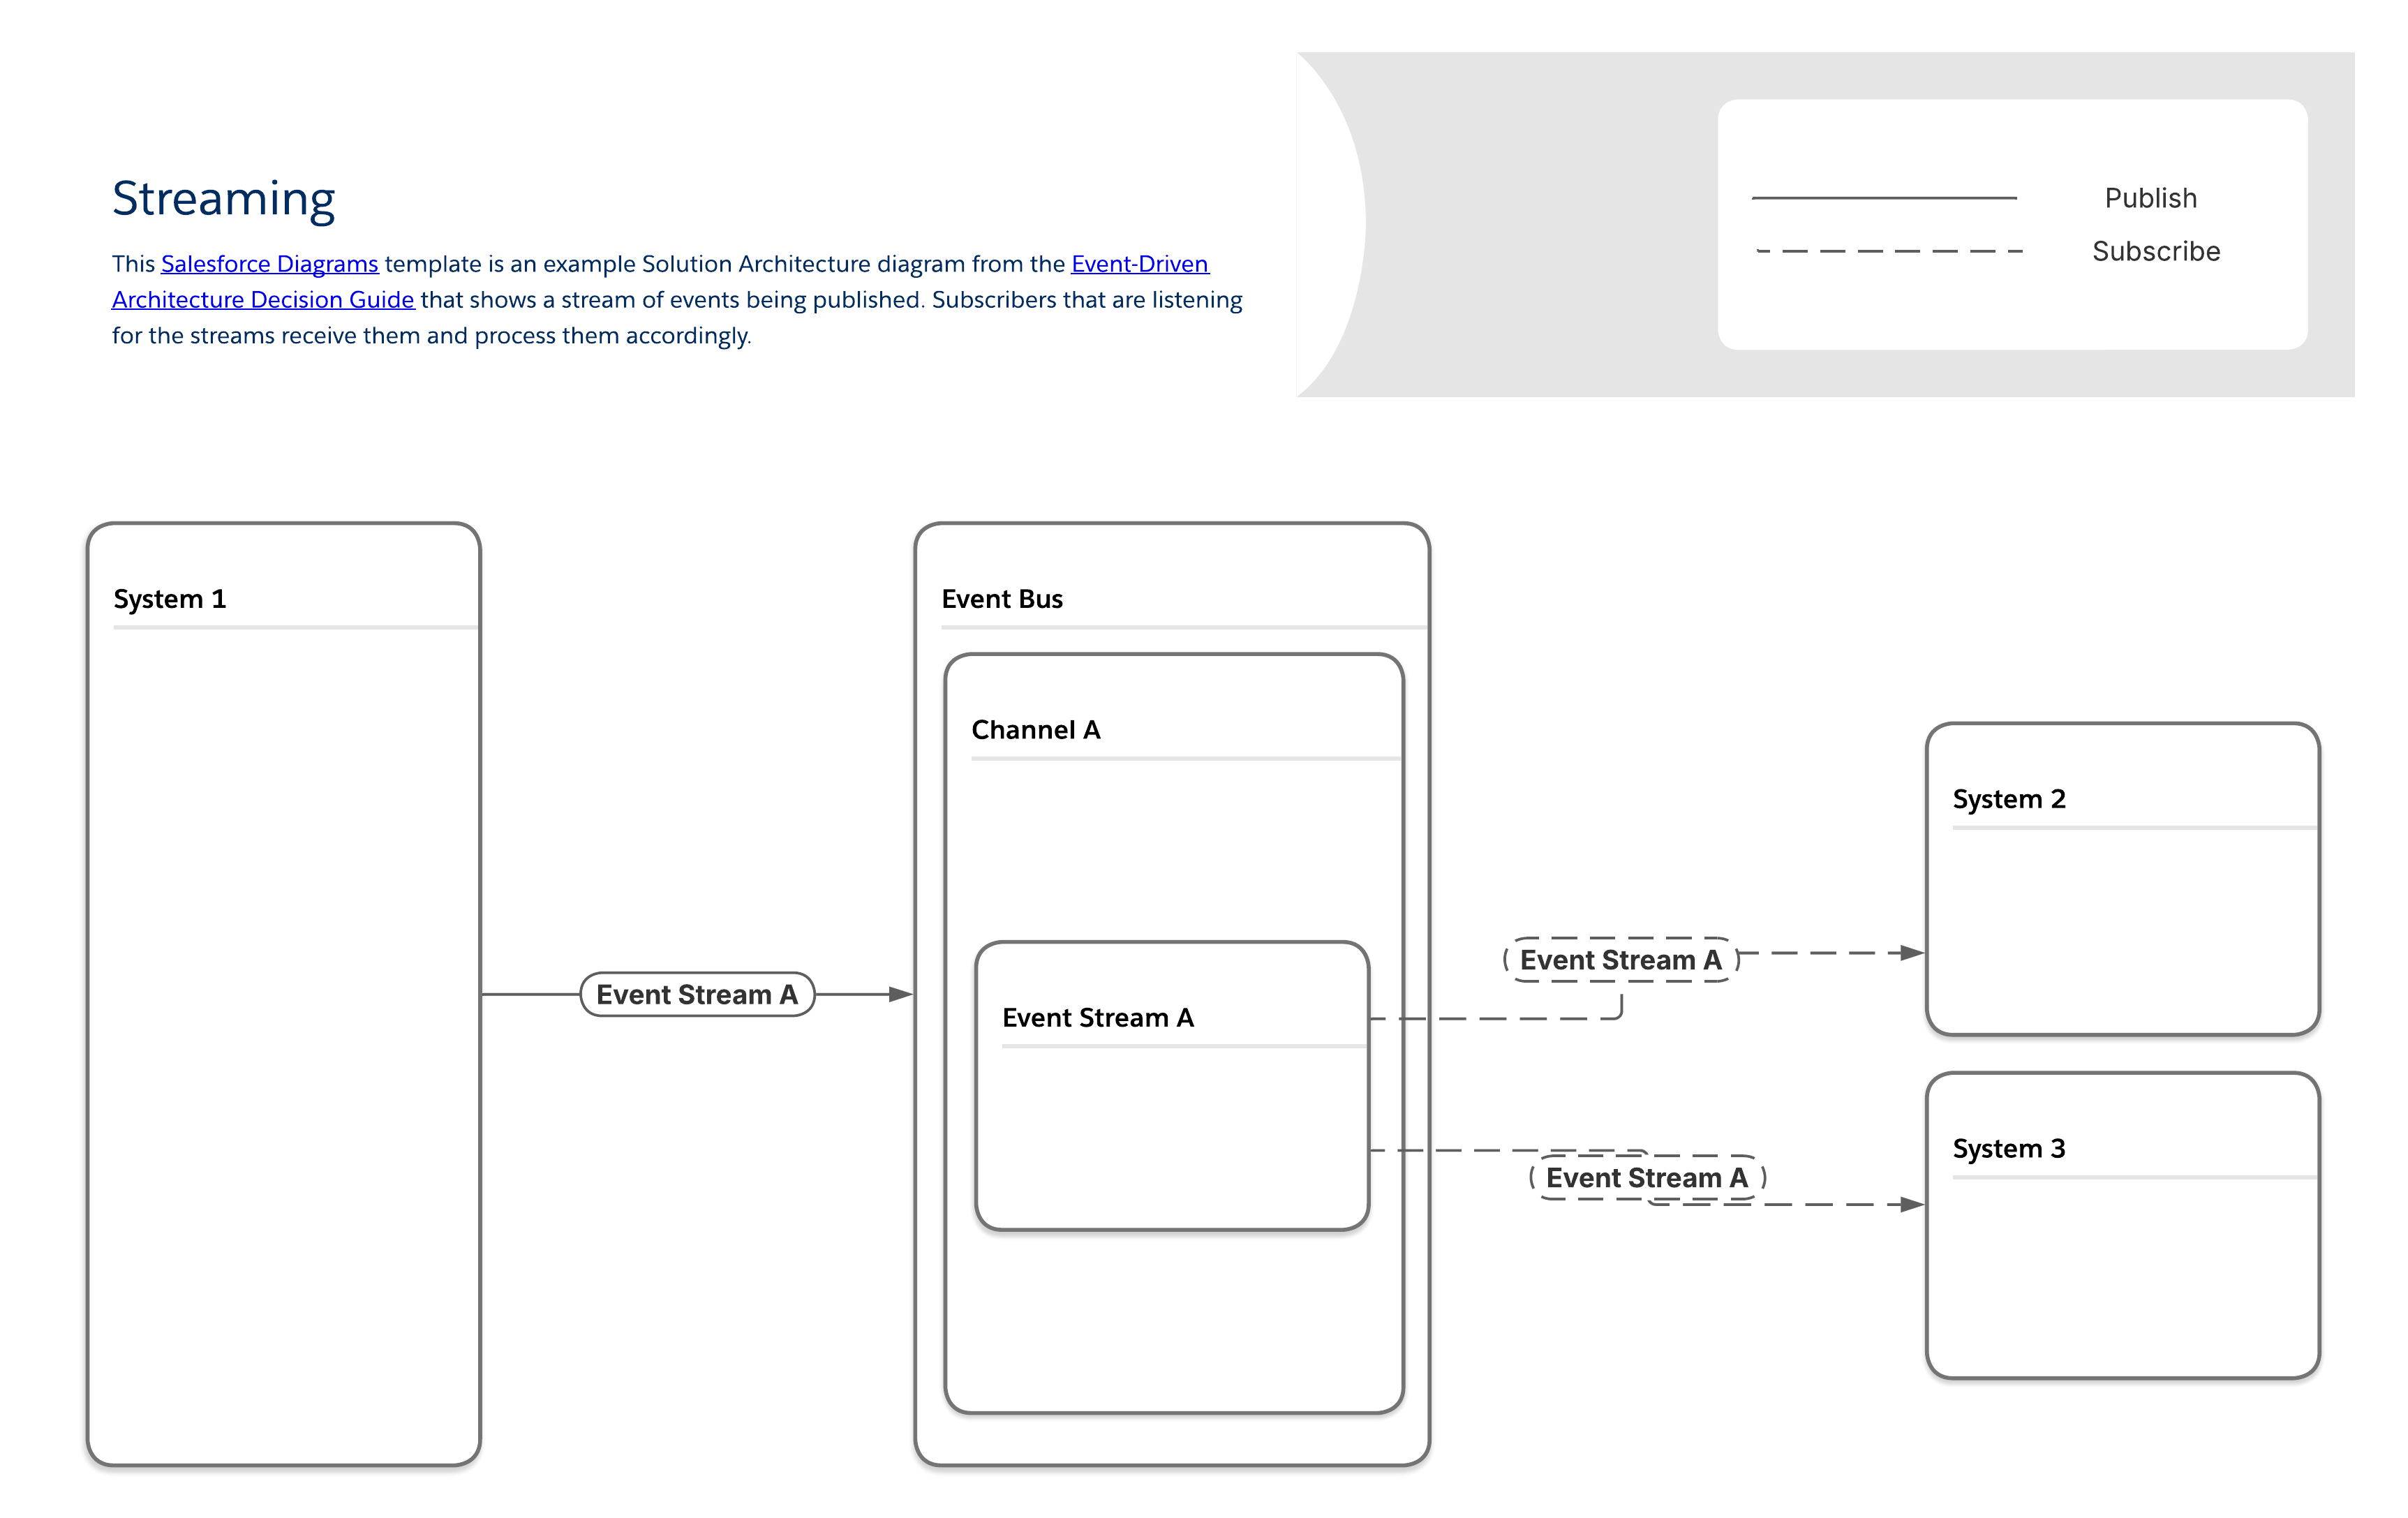 #### ストリーミングパターンに関連するツール
| イベントフローと動作 | ペイロードに関する考慮事項 | ||||||
|---|---|---|---|---|---|---|---|
| 使用可能なツール | 必須スキル | 公開方法 | 登録方法 | リプレイ期間 | ペイロード構造 | ペイロード制限 | |
| MuleSoft | MuleSoft Anypoint Data Streams | プロコード | API | API | As Configured | ユーザー定義 | なし |
| Salesforce Pub/Sub コネクタ | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint Apache Kafka Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| Salesforce Platform | Heroku での Apache Kafka | プロコード | API、Heroku Postgres のレコード変更 | なし | 1 ~ 6 週間 | ユーザー定義 | ユーザー定義 |
| Pub/Sub API | プロコード | Pub/Sub APIまたはAPI、Apexフロー | Pub/Sub API | 3 日 | ユーザー定義 | 1 MB | |
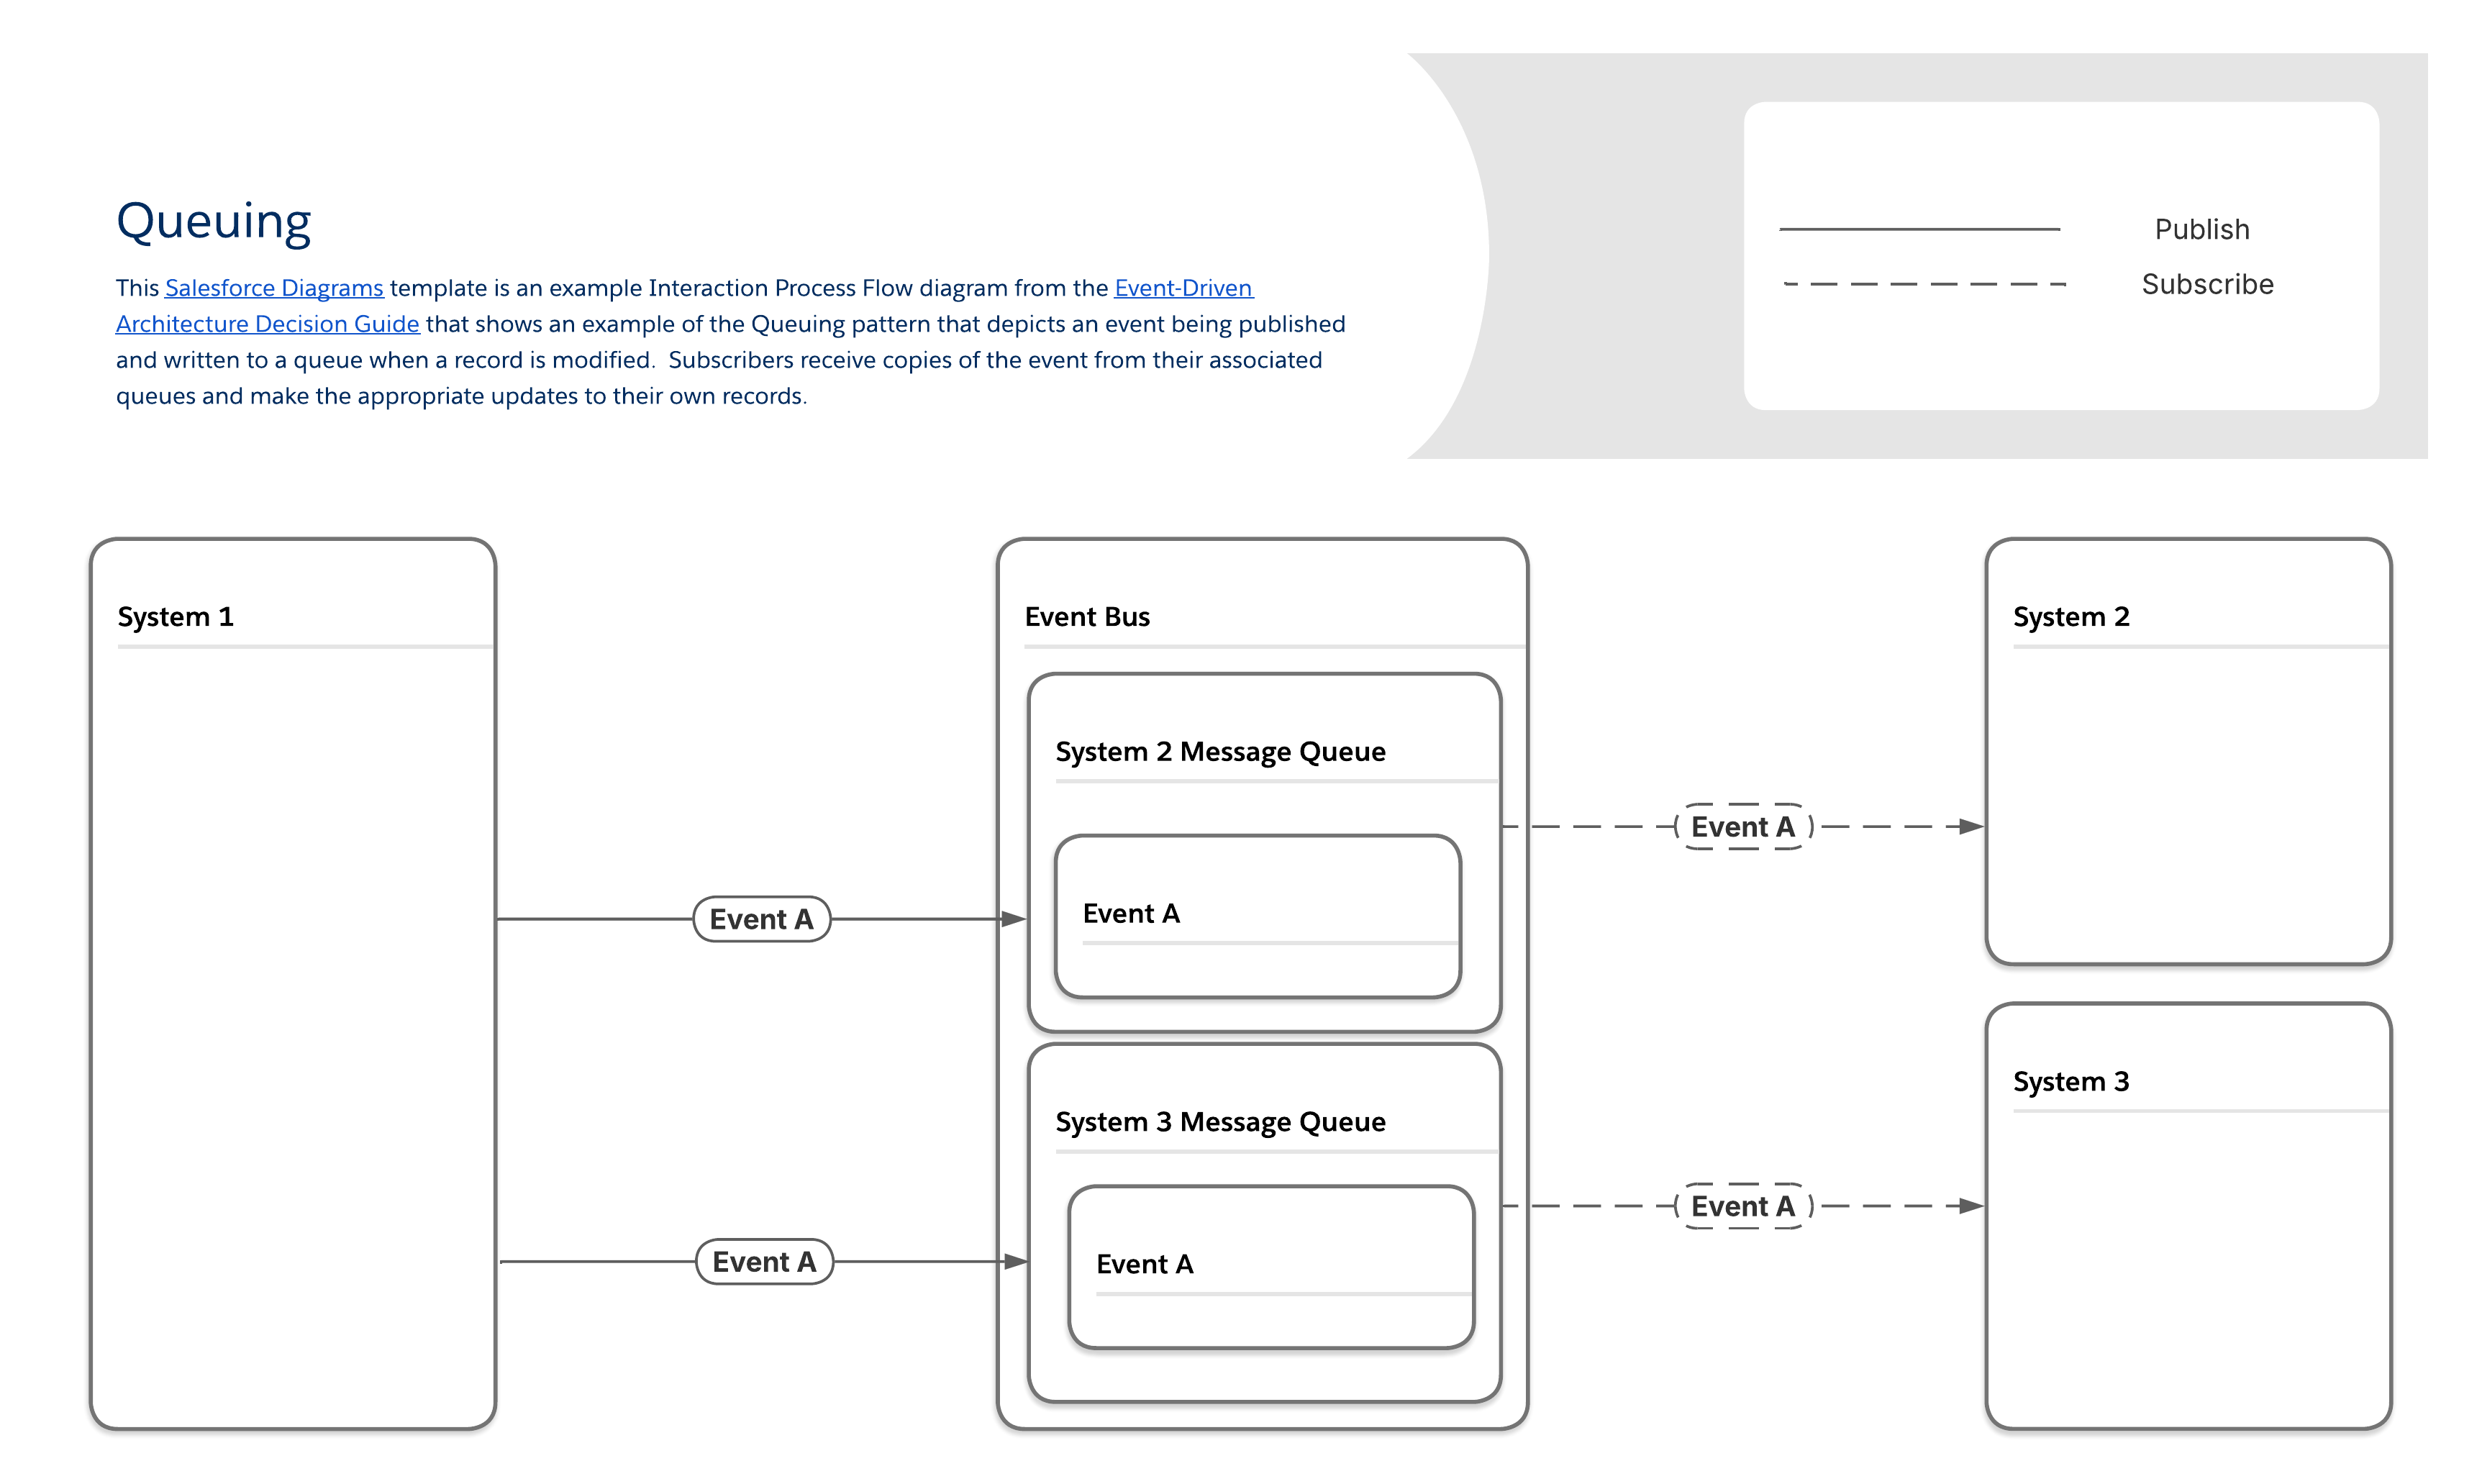 #### キューイングパターンに関連するツール
| イベントフローと動作 | ペイロードに関する考慮事項 | ||||||
|---|---|---|---|---|---|---|---|
| 使用可能なツール | 必須スキル | 公開方法 | 登録方法 | リプレイ期間 | ペイロード構造 | ペイロード制限 | |
| MuleSoft | MuleSoft Anypoint MQ | プロコード | API | API | As Configured | ユーザー定義 | なし |
| Salesforce Pub/Sub コネクタ | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint Apache Kafka Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint MQ Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint MQTT Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint AMQP Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| Salesforce Platform | Heroku での Apache Kafka | プロコード | API、Heroku Postgres のレコード変更 | なし | 1 ~ 6 週間 | ユーザー定義 | ユーザー定義 |
| 変更データキャプチャ | ローコードからプロコード | レコードの変更 | Apex、API、Lightning Webコンポーネント(LWC) | 3 日 | 定義済み | 1 MB | |
| プラットフォームイベント | ローコードからプロコード | API、Apex、フロー | Apex、API、フロー、LWC | 3 日 | ユーザー定義 | 1 MB | |
| Pub/Sub API | プロコード | Pub/Sub APIまたはAPI、Apex、フロー | Pub/Sub API | 3 日 | ユーザー定義 | 1 MB | |
| イベントリレー* | ローコード | プラットフォームイベント、変更データキャプチャチャ | API | 3 日 | ユーザー定義 | 1 MB | |
| *イベントリレーは AWS Eventbridge にのみデータを送信 | |||||||
| パターン | リソース |
|---|---|
| 公開/登録 | Salesforce の適切なアーキテクチャ - スループット Salesforce の適切なアーキテクチャ - データ処理 Salesforce の適切なアーキテクチャ - 相互運用性 ブログ投稿:イベントリレーを使用したアーキテクチャの効率化 ブログ投稿:Pub/Sub API正式リリースのお知らせ ブログ投稿:RESTful から EVENTful への移行 ブログ投稿:イベント駆動型アーキテクチャと AsyncAPI 仕様 動画:パターンの公開/登録のウォークスルー |
| Fanout | ブログ投稿:プラットフォームイベント配信制限内での作業方法 動画:Fanout Pattern Walkthrough (ファンアウトパターンウォークスルー) |
| 合格メッセージ | 動画:Passed Messages Pattern Walkthrough (合格メッセージパターンウォークスルー) |
| ストリーミング | ブログ投稿:Salesforce での大量の書き込みに対応する設計 動画:ストリーミングパターンウォークスルー ドキュメント:Mule アプリケーションでのストリーミング |
| キューイング | ブログ投稿:Salesforce での大量の書き込みに対応する設計 ブログ投稿:イベント API を使用した支払アーキテクチャの設計方法 動画:Queueing Pattern Walkthrough (キューイングパターンウォークスルー) |
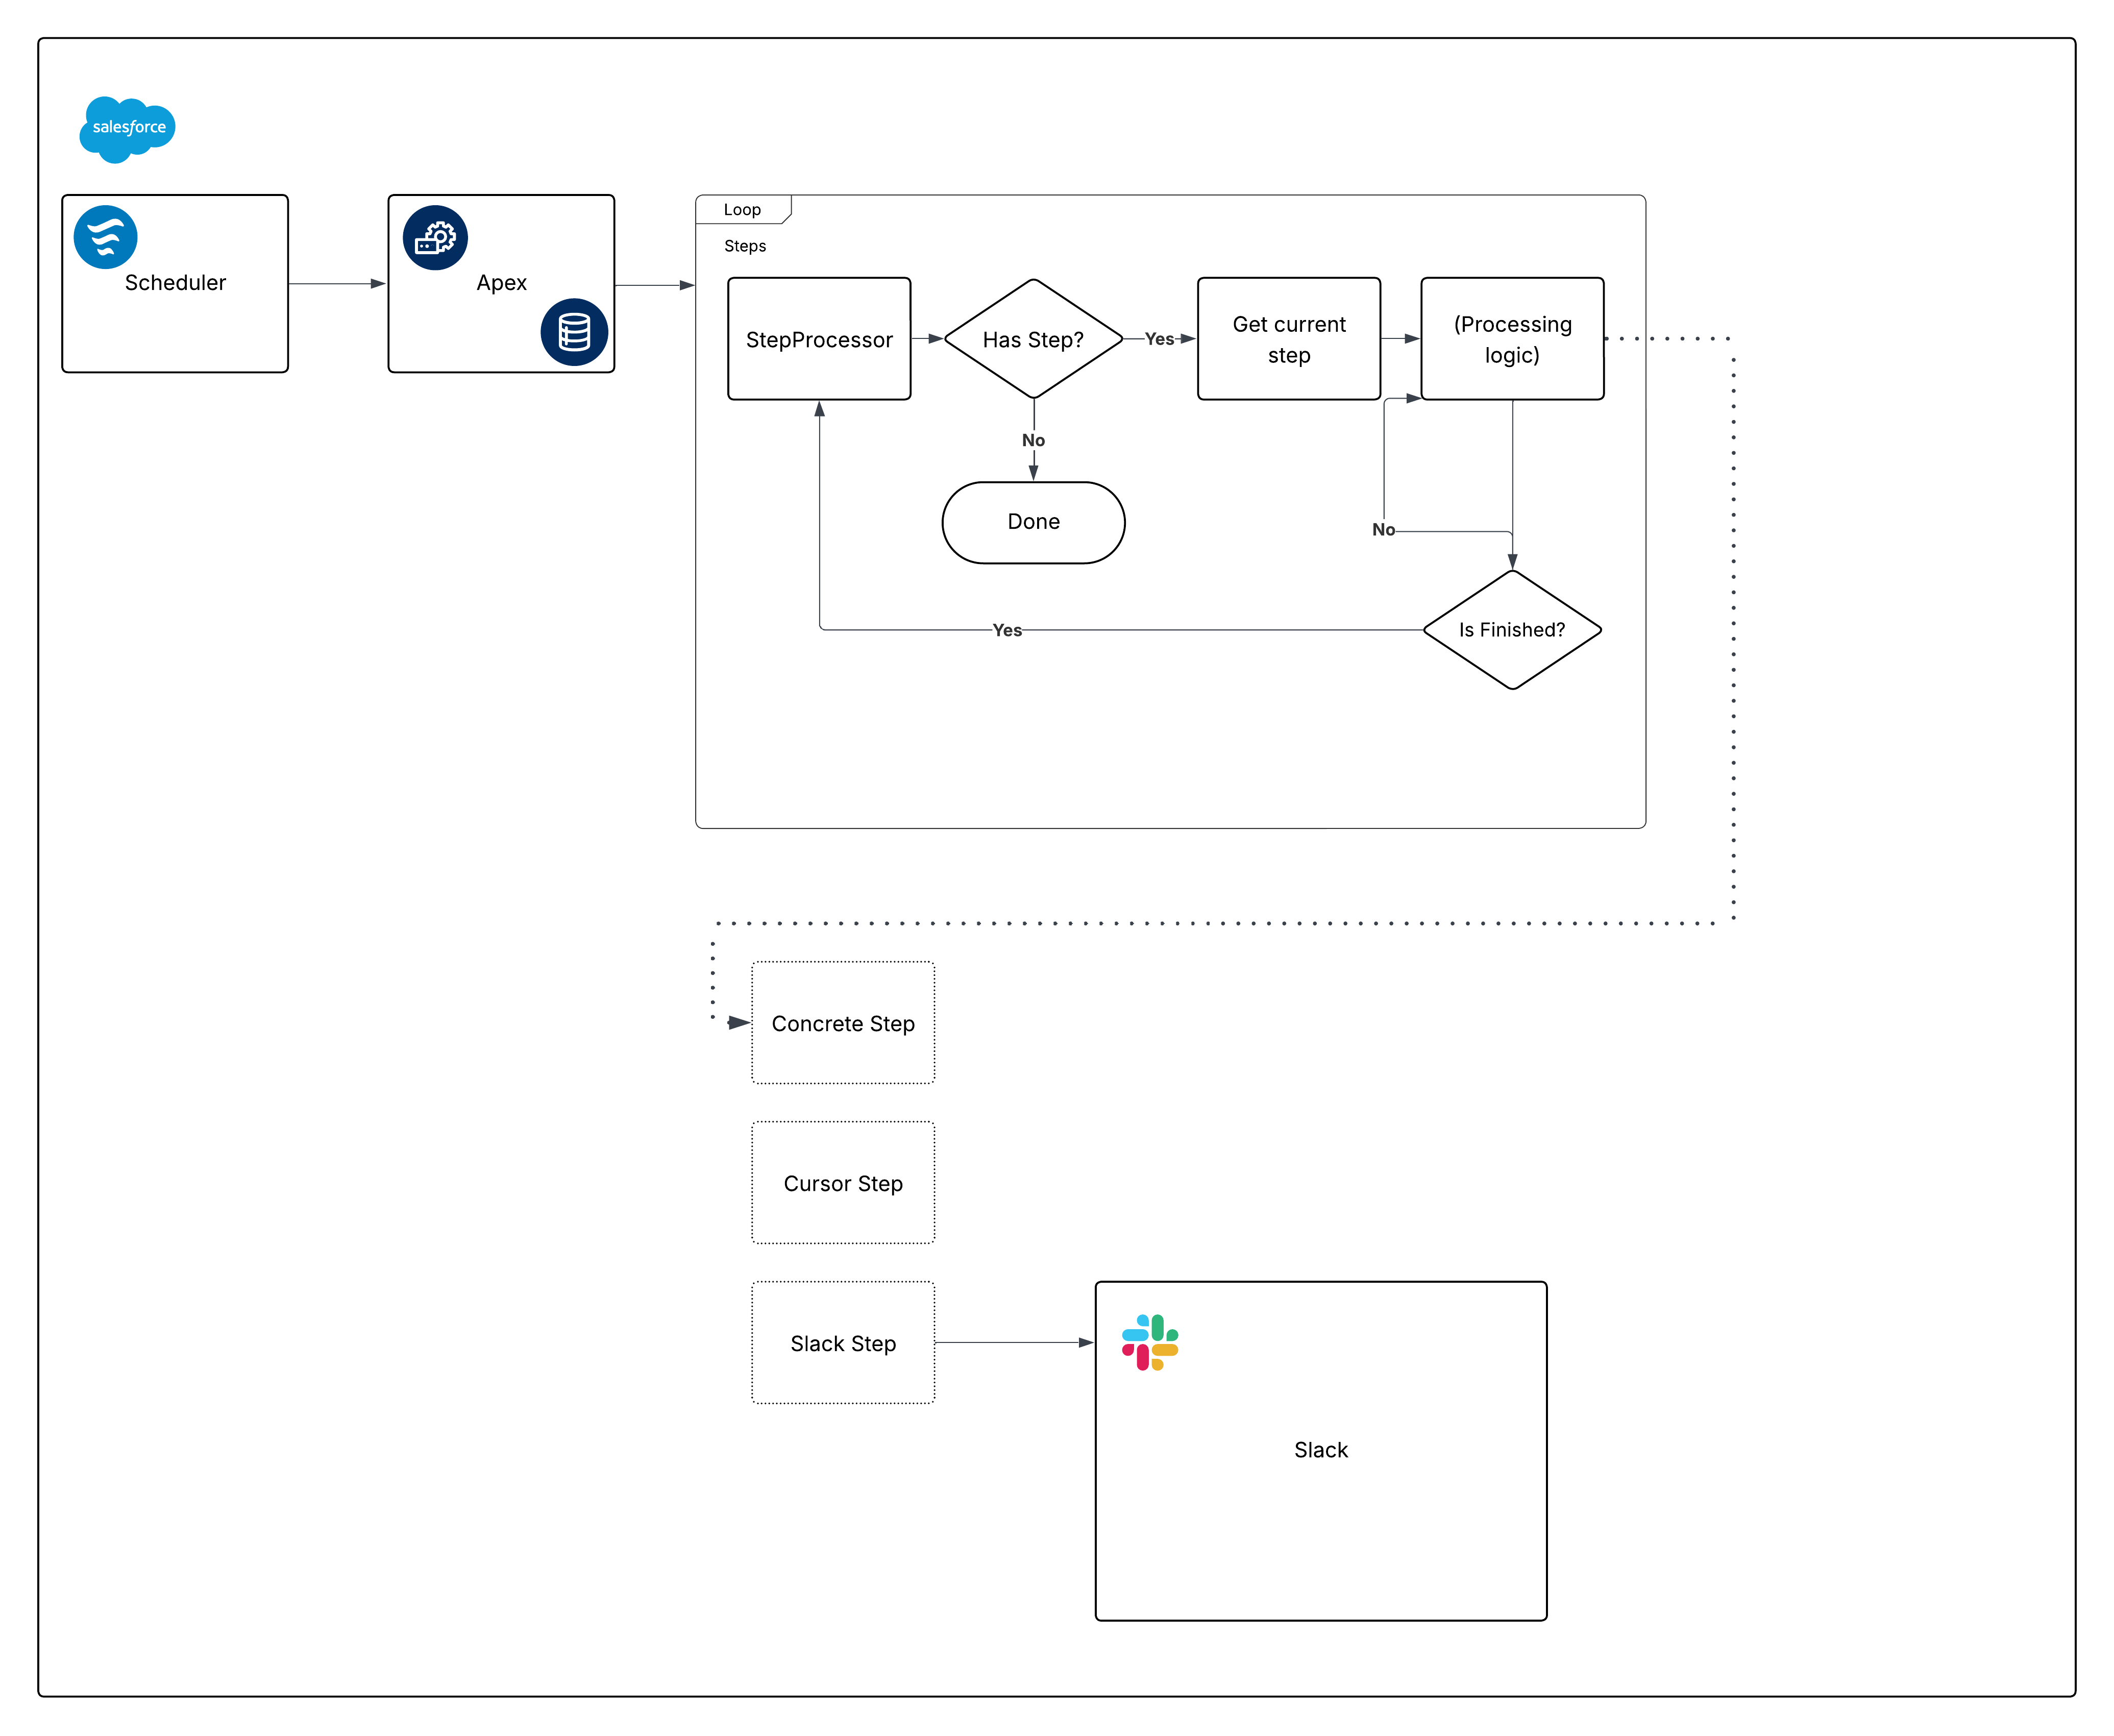 では、その図を分解して、ピースの作成を開始します。
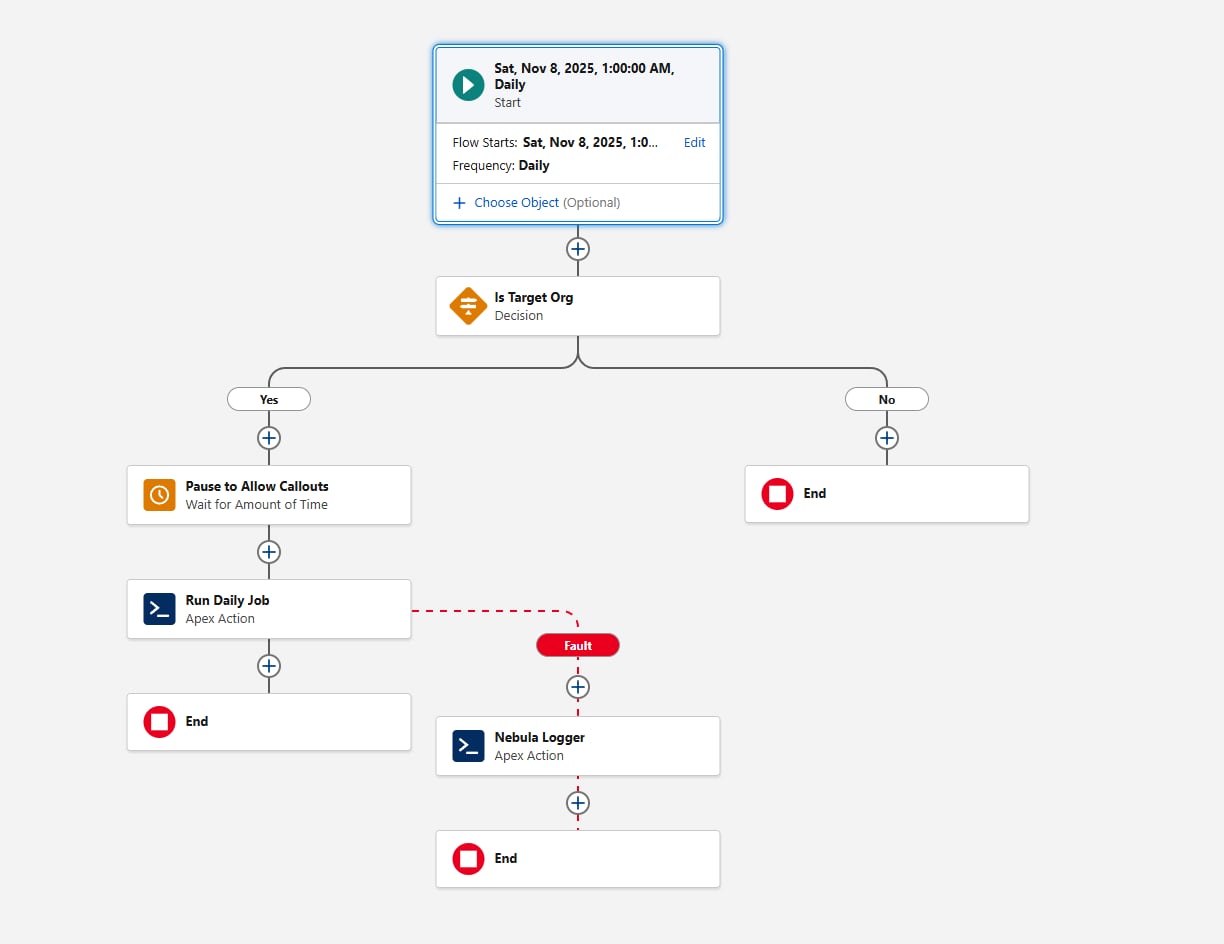
## スケジュール済みフローを使用したスケジュール
スケジュール済みフローには、スケジュールメカニズムとして次のような利点があります。
- スケジュール済みフローは、メタデータとしてパッケージ化してリリースできます。これは、Apex (または \[スケジュール済みジョブ] ページ) でスケジュールされたジョブには適用されません。
- 待機要素は、コールアウトが必要なフレームワークにとって重要です。フローで使用すると、フレームワークの呼び出し可能部分でコールアウトが不要になります。
- スケジュールの粒度は要件を満たしています。スケジュール済みフローの最小間隔は毎日です。より高い頻度 (毎時など) が必要な場合は、この要件のスケジュール済みフローを再検討してください。
スケジュール済みフローを設定するときのもう 1 つの考慮事項は、環境管理です。Apex アクションを呼び出す前に、`{!$Api.Enterprise_Server_URL_100}`変数を評価する決定要素を追加します。これにより、UAT や本番など、意図した環境でのみジョブが実行されます。Sandbox は SDLC 中に頻繁に更新または新規作成されるため、このパターンは重要です。明示的な環境チェックを行わないと、フレームワークの実行が意図されていない環境でスケジュール済みフローが意図せずに実行される可能性があります。決定要素で `contains` 演算子を使用すると、今後の Sandbox の作成や URL の変更に対して設定が復元されます。
最後に、フレームワークで失敗をどのように捉えるかを検討します。フローでアクションをコールするときは、必ず障害パスを追加します。たとえば、[Nebula Logger の](https://www.nebulalogger.com/)「Add Log Entry」アクションに障害を配線できます。Nebula Logger はログをカスタムオブジェクトに書き込むため、ログデータは組織のストレージを消費します。デフォルトでは、ログは組織内で 14 日間保存され、その後クリーンアップされます。この保持期間は設定可能です。Nebula Logger はプラットフォームイベントを使用してログも公開するため、ログエントリはメインのデータ処理トランザクションから独立して保存されます。これにより、プライマリフローまたは Apex アクションがロールバックされた場合でも、障害を確実に捕捉できます。ログフレームワークの追加を検討する場合は、予想されるログ量と保持要件を評価する必要があります。
フローは次のようになります。
 スケジュール要件が満たされた最初のApexコードに進みましょう。
## ステップインターフェースの作成
`Step` インターフェイスを定義します。
```java
public interface Step {
void execute();
void finalize();
String getName();
Boolean shouldRestart();
}
```
この記事では、わかりやすくするために `step` インタフェースを外部クラスとして示します。フレームワーク自体は柔軟性が高く、すべてのステップ・クラスが同じインタフェースを参照していれば、チームは任意のApexパッケージ・パターンを使用してインタフェースとその実装を編成できます。
インターフェース内で定義されたメソッドについては、いくつかの注意事項があります。
- `execute`は、現時点では引数なしで済みますが、順序が重要な場合にステップ間でデータをオーケストレーションするために`State`クラス(またはインターフェイス)を渡すと改善されます。
- `getName` は、`System.Type` 値ではなく`String`値を返す可能性があります。目的は、オーケストレーションレイヤーで他のプロパティを公開せずにステップ名を記録する方法を提供することです。
これらの要素がどのように組み合わされるかを示す最初の具体的な実装を次に示します。後で 1 つの例外を除いて、キュー可能 Apex を使用して Apex 内に非同期処理を実装することをお勧めします。通常、バッチ Apex は不要です (`@future` メソッドは使用しない)。Queueable Apex はすばやく開始でき、Apex カーソルを使用すると、バッチ Apex よりも多くの利点があります。
### Apex カーソルのような実装
[Apexカーソル](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_cursors.htm)は、従来のバッチApexモデルに代わる最新の機能を提供します。一括処理と同様に、カーソル実装ではレコードをチャンク (バッチあたり最大 2,000 件) で取得できます。ただし、カーソルでは 1 つのトランザクション内で複数の取得が許可されるため、大量の操作のスループットが大幅に向上します。
このフレームワークの一部としてカーソルを採用する場合、チームは現在のテストとモック可能性の制限を認識しておく必要があります。テストでのカーソルの動作は本番の動作とは異なる可能性があるため、カーソルの内部に依存しないようにテスト戦略を設計し、境界でオーケストレーションロジックを検証することが重要です。プラットフォームが進化するにつれて、次の領域は引き続き改善されますが、主要な指針は引き続き維持されます。カーソルを使用すると、多くの使用事例でバッチApexよりもパフォーマンスが向上し、オーケストレーションのオーバーヘッドが軽減されます。
システムが提供するカーソルと独自のコードの間に明確な境界を定義するには、`Step` インターフェースを実装するときにカーソルのような表現を作成することをお勧めします。次のコードについて考えてみます。
```java
public inherited sharing abstract class CursorStep implements Step {
private static final Integer MAX_CHUNK_SIZE = 2000;
protected Cursor cursor;
private Integer chunkSize = System.Limits.getLimitDMLRows();
private Integer position = 0;
protected abstract Cursor getCursor();
protected abstract void innerExecute(List