# tableau Tableau Desktop and Web Authoring (pro) - Full Documentation [跳转到主要内容](#main-content) # 将高级分析应用于视图(“分析”窗格) 从“分析”窗格中将参考线、盒形图、趋势线、预测和其他项拖入视图。通过单击左侧栏顶部的选项卡,可以在“数据”窗格与“分析”窗格之间切换。  Tableau Desktop“分析”窗格 在 Tableau Desktop 中,“分析”窗格、菜单或视图的上下文中提供了用于将分析对象添加到视图中的选项。举例来说,参考线和区间可在编辑轴时找到,而趋势线和预测可从“分析”菜单中找到。 在“分析”窗格中,能够拖放各个选项。 在 Web 上,大多数分析对象都可以从“分析”窗格中获得。 ## 向视图中添加分析对象 若要从“分析”窗格中添加项,请将该项拖入视图。将项目从“分析”窗格中拖出时,Tableau 将显示该项目的可能目标。选择范围因项类型和当前视图而异。 举一个简单的例子,放置目标区域将提供以下三个选项:  术语表、区和单元格定义了项的作用域:  对于更复杂的视图(例如,带有双轴的视图),Tableau 将显示如下放置目标区域:  如果将项放在放置目标区域顶部标题中的三个较大方框的其中一个方框中(例如,“表”方框),则会为每个轴添加单独的“带四分位点的中值”。  但如果将项放在与特定度量对齐的下面六个方框的任何一个方框中,则只会具有指定范围的对应轴上添加“带四分位点的中值”。 ## 从视图中删除分析对象 您可以通过单击“撤消”从视图中删除分析对象,也可以将该对象从视图中拖出以将其删除。 也可单击项并从工具提示中选择“移除”。 **注意**:某些“分析”窗格项(“带四分位点的中值”和“CI 为 95% 的平均值”)会同时添加参考线和参考分布。除非使用“撤消”,否则您将需要单独删除这些项。 ## 在视图中编辑分析对象 若要编辑通过“分析”窗格添加的项,请单击该项并从工具提示中选择“编辑”。有关其他编辑选项,请参见下面的“分析对象定义”下的特定项类型部分。 ## 分析对象定义 可从“分析”窗格中将以下项拖放到视图中。如果分析对象无法应用于视图中字段的当前配置,则该分析对象不可用。 ### 常量线 向视图添加一条或多条常量线。可以为特定度量、所有度量或日期维度添加常量线。在添加常量线时,Tableau 将显示一个“值”提示,您在其中指定常量的值:  在 Tableau Desktop 中,日期值的“值”提示是一个日历控件:  您可以单击生成的常量线,并选择“编辑”或“移除”。Tableau Desktop 中有第三个选项:设置格式。选择“编辑”可打开“编辑参考线”对话框。有关详细信息,请参见**参考线、参考区间、参考分布和参考箱**一文中的[编辑现有参考线、参考区间和参考分布](https://help.tableau.com/current/pro/desktop/zh-cn/reference_lines.htm#Edit_Existing_Reference_Lines_and_Bands)。在 Tableau Desktop 中编辑线的另一种方式是右键单击(在 Mac 上按住 Control 单击)相关轴并选择“编辑参考线”。 ### 平均线 向视图添加一条或多条平均线。可以为特定的度量或所有度量添加平均线。 您可以单击生成的平均线并选择其他聚合,例如“合计”或“总和”。您也可以选择“编辑”或“移除”。Tableau Desktop 中有第三个选项:设置格式。选择“编辑”可打开“编辑参考线”对话框。有关详细信息,请参见**参考线、参考区间、参考分布和参考箱**一文中的[编辑现有参考线、参考区间和参考分布](https://help.tableau.com/current/pro/desktop/zh-cn/reference_lines.htm#Edit_Existing_Reference_Lines_and_Bands)。在 Tableau Desktop 中编辑线的另一种方式是右键单击(在 Mac 上按住 Control 单击)相关轴并选择“编辑参考线”。 ### 带四分位点的中值 向视图添加一组或多组中值线及分布区间。可以为特定的度量或所有度量添加带四分位点的中值。 分布区间作为四分位点计算;中间两个四分位点带阴影。 可以单击生成的中值线或分布,并选择“编辑”或“移除”。Tableau Desktop 中有第三个选项:设置格式。必须单独对中值线和分布进行编辑、设置格式或移除。选择“编辑”可打开“编辑参考线”对话框。您必须单击分布区间的外边缘才能看到选项 — 在区间的中间单击没有效果。有关详细信息,请参见**参考线、参考区间、参考分布和参考箱**一文中的[编辑现有参考线、参考区间和参考分布](https://help.tableau.com/current/pro/desktop/zh-cn/reference_lines.htm#Edit_Existing_Reference_Lines_and_Bands)。在 Tableau Desktop 中编辑线或分布的另一种方式是:右键单击(在 Mac 上按住 Control 单击)相关的轴,并选择“编辑参考线”。子菜单将提供两个选择:“四分位点”和“中值”。 有关分布类型(包括四分位点)的信息,请参见[添加参考分布](https://help.tableau.com/current/pro/desktop/zh-cn/reference_lines.htm#Add_Reference_Distributions)一文中的**添加参考分布**。 ### 盒形图 向视图添加一个或多个盒形图。可以为特定的度量或所有度量添加盒形图。盒形图的作用域始终是单元格(绝不会是表或窗格)。 单击或将鼠标悬停在盒形图中的任何水平线上以查看有关须线、四分位点和中值的统计信息。 您也可以在单击某条线时选择“编辑”或“移除”。Tableau Desktop 中有第三个选项:设置格式。选择“编辑”可打开“编辑参考线”对话框。在 Tableau Desktop 中编辑盒形图的另一种方式是右键单击(在 Mac 上按住 Control 单击)相关轴并选择“编辑参考线”。 **注意**:在 Tableau Desktop 中,有两个在“分析”窗格中名为“盒形图”的项目。对于“汇总”部分的“盒形图”选项,Tableau 将为指定目标自动添加盒形图。对于“自定义”部分的“盒形图”选项,Tableau 将在您指定目标之后打开对话框。 ### 合计 向视图添加合计。添加合计时,放置选项是“小计”、“列总计”和“行总计”。 有关详细信息,请参见[在可视化项中显示合计](https://help.tableau.com/current/pro/desktop/zh-cn/calculations_totals_grandtotal_turnon.htm)。 若要移除合计,请单击相关列或行标题,并选择“移除”。 在 Tableau Desktop 中,在添加合计并通过工具提示设置聚合之后,您也可以单击合计列或行标题:  ### CI 为 95% 的平均值 添加一组或多组包含分布区间的平均线;分布区间按 95% 的置信区间配置。可以为特定的度量或所有度量添加这些项。 置信区间分布区间将总体平均值占时间 95% 的区域显示为阴影。 可以单击生成的平均线或分布,并选择“编辑”或“移除”。Tableau Desktop 中有第三个选项:设置格式。选择“编辑”可打开“编辑参考线”对话框。必须单独对平均线和分布进行编辑、设置格式或移除。您必须单击分布区间的外边缘才能看到选项 — 在区间的中间单击没有效果。在 Tableau Desktop 中编辑线或分布的另一种方式是:右键单击(在 Mac 上按住 Control 单击)相关的轴,并选择“编辑参考线”。子菜单将提供两个选择:“平均”和“95% 置信区间”。 您也可以通过将线和区间拖离视图来将它们移除。 ### CI 为 95% 的中值 添加一组或多组包含分布区间的中值线;分布区间按 95% 的置信区间配置。可以为特定的度量或所有度量添加这些项。 置信区间分布区间将总体中值占时间 95% 的区域显示为阴影。 可以单击生成的中值线或分布,并选择“编辑”、“设置格式”或“移除”。Tableau Desktop 中有第三个选项:设置格式。选择“编辑”可打开“编辑参考线”对话框。必须单独对中值线和分布进行编辑、设置格式或移除。您必须单击分布区间的外边缘才能看到选项 — 在区间的中间单击没有效果。在 Tableau Desktop 中编辑线或分布的另一种方式是:右键单击(在 Mac 上按住 Control 单击)相关的轴,并选择“编辑参考线”。子菜单将提供两个选择:“中值”和“95% 置信区间”。 您也可以通过将线和区间拖离视图来将它们移除。 ### 趋势线 向视图添加一条或多条趋势线。添加趋势线时,放置选项会识别在 Tableau 中可用的趋势线模型类型:“线性”、“对数”、“指数”和“多项式”。对于某些视图,这些选项只有一部分可用。 有关详细信息,请参见[趋势线模型类型](https://help.tableau.com/current/pro/desktop/zh-cn/trendlines_add.htm#modeltype)。 单击趋势线以将其移除或对其进行编辑,或者查看统计定义。您也可以通过将趋势线拖离视图来将其移除。 ### 预测 向视图添加预测。此选项仅在 Tableau Desktop 中可用 — 在 Web 上编辑视图时不可用。只有当视图中至少有一个度量时,才能进行预测。 不支持对基于多维数据源的视图进行预测。另外,视图不能包含以下任何内容: - 表计算 - 解聚的度量 - 百分比计算 - 总计或小计 - 使用聚合的日期值设置精确日期 包含 Null 值的时间系列也存在限制。 有关详细信息,请参见[预测](https://help.tableau.com/current/pro/desktop/zh-cn/forecasting.htm)。 若要移除、编辑或读取当前预测的说明,请转到“分析”菜单,然后选择“预测”。 ### 自定义参考线 可以为视图中的特定度量或所有度量添加参考线。 将参考线从“分析”窗格拖放到目标上后,Tableau 将自动打开一个编辑对话框。有关可用选项的信息,请参见**参考线、参考区间、参考分布和参考箱**一文中的[添加参考线](https://help.tableau.com/current/pro/desktop/zh-cn/reference_lines.htm#Add_a_Reference_Line)。若要稍后返回到到此对话框,请单击线并选择“编辑”。 ### 自定义参考区间 可以为视图中的特定度量或所有度量添加参考区间。 将参考区间从“分析”窗格拖放到目标上后,Tableau 将自动打开对话框。有关可用选项的信息,请参见[添加参考区间](https://help.tableau.com/current/pro/desktop/zh-cn/reference_lines.htm#Add_Reference_Bands)一文中的**添加参考区间**。若要稍后返回到此对话框,请单击区间,并选择“编辑”。单击参考区间的外边缘才能看到选项 — 在区间的中间单击没有效果。 ### 自定义分布区间 可以为视图中的特定度量或所有度量添加参考分布。 将参考分布从“分析”窗格拖放到目标上后,Tableau 将自动打开对话框。有关可用选项的信息,请参见[添加参考分布](https://help.tableau.com/current/pro/desktop/zh-cn/reference_lines.htm#Add_Reference_Distributions)一文中的**添加参考分布**。若要稍后返回到此对话框,请单击区间,并选择“编辑”。单击分布区间的外边缘才能看到选项 — 在区间的中间单击没有效果。 ### 自定义盒形图 在 Tableau Desktop 中(而不是在 Web 上编辑视图时),您可以将盒形图从“分析”窗格的拖放到目标上。(但请记住,在 Web 上,您可以通过“分析”窗格上的“汇总”部分添加盒形图。)当您从“自定义”部分拖出盒形图时,Tableau 将自动打开“编辑参考线、参考区间或参考箱”对话框。有关可用选项的信息,请参见[添加盒形图](https://help.tableau.com/current/pro/desktop/zh-cn/reference_lines.htm#Add_a_Box_Plot)一文中的**添加盒形图**。盒形图的作用域始终是单元格(绝不会是表或窗格)。 单击盒形图中的任何水平线以查看有关须线、四分位点和中值的统计信息。 若要稍后返回到此对话框,请单击区间,并选择“编辑”。 [跳转到主要内容](#main-content) # “前 N 个”和“其他”的集 如果收集了要可视化的大型数据集,您可能会发现,通过将显示的信息量限制为重要的记录子集,将可帮助您更有效地处理和回答有关数据的问题。 本文描述如何创建将客户分为两个动态组的交互式视图: - 前 N 名客户 - 所有其他客户 视图包括一个控件,用户可调整该控件来更改前几名客户组中包括的客户数。当用户更改数量时,视图将相应更新。 ### 集和支持的数据源 本文中介绍的用于创建前几名客户视图的方法使用集的“内/外”功能。 集是随 Tableau Desktop 版本 8.0 一起引入的。 对于实时连接,“内/外”功能需要关系数据源或多维数据源。 如果使用基于文件的数据源(例如 Microsoft Excel 工作簿或文本文件),您可以采用可用来创建集的数据提取。 ### 步骤 1:创建参数 1. 在 Tableau Desktop 中,打开一个新工作簿并连接到“Sample-Superstore”数据源。 2. 打开新工作表。 3. 在“数据”窗格中,单击右上角中的下拉箭头,并选择“创建参数”。 4. 在“创建参数”对话框中,执行以下操作: - 在“名称”文本框中,键入 Top Customers 2。 - 对于“数据类型”,选择“整数”。 - 对于“当前值”,键入 5。 - 对于“允许的值”,单击“范围”。 - 在“值范围”下,执行以下操作: - 单击“最小值”,并键入 5。 - 单击“最大值”,并键入 20。 - 单击“步长”,并键入 5。 此参数将与您在下一步中创建的“前 N 个”集结合使用,以快速调整视图中的“前 N 个”值。 ### 步骤 2:创建“前 N 名客户”集 1. 在“数据”窗格中,右键单击**“Customer Name”(客户名称)**维度,并选择**“创建”**\>**“集”**。 2. 在打开的“创建集”对话框中,执行以下操作: - 在**“名称”**文本框中,键入**“Top N Customers by Sales”**。 - 单击**“前”**选项卡。 - 选择**“按字段”**。 - 从字段下拉列表(类别)中,选择**“Sales”(销售额)**。 - 从聚合下拉列表中,选择**“总和”**。 - 完成后,单击**“确定”**。 ### 步骤 3:设置视图 1. 从“数据”窗格中的**“集”**下,将**“Top N Customers by Sales”(按销售额列出的前 N 名客户)**拖到**“行”**功能区。 2. 将**“Customer Name”(客户名称)**维度拖到**“行”**功能区,将其放在集的右侧。 3. 将**“Sales”(销售额)**度量拖到**“列”**功能区。 4. 在工具栏上,单击“降序排序”按钮  以确保集工作正常。  5. 在“数据”窗格中,右键单击**“Top N Customers by Sales”(按销售额列出的前 N 名客户)**,然后单击**“创建计算字段”**。 6. 在打开的“计算字段”对话框中,完成以下步骤: - 在**“名称”**文本框中,键入**“Subset Labels”**。 - 在**“公式”**文本框中,键入以下公式,为集中的客户创建动态标签: `IF [Top N Customers by Sales] THEN "Top " + str([Top Customers 2]) + " Customers" ELSE "Others" END` - 完成后,单击**“确定”**。 8. 从“数据”窗格中,将**“Subset Labels”(子集标签)**拖到**“行”**功能区,将其放在“前 N 个”集和**“Customer Name”(客户名称)**维度之间。 9. 在**“行”**功能区上,右键单击**“IN/OUT(Top N Customers by Sales)”**集,然后清除**“显示标题”**。 这将隐藏“内/外”标签,同时保留排序顺序,以使“前 N 个”子集始终出现在视图的顶部。 11. 从“数据”窗格中,将**“Top N Customers by Sales”(按销售额列出的前 N 名客户)**拖到**“标记”**卡上的**“颜色”**。  ### 步骤 4:将“前 N 个”集与动态参数合并 1. 在**“数据”**窗格中,右键单击**“Top N Customers by Sales”(按销售额列出的前 N 名客户)**,然后选择**“编辑集”**。 2. 在“编辑集”对话框中,执行以下操作: - 选择**“前”**选项卡。 - 单击值下拉菜单,并选择**“Top Customers 2”**参数。 - 单击**“确定”**。  这会将**“Top N Customers by Sales”**集链接到**“Top Customers 2”**动态参数,而不是链接到静态列表 10。 此参数将与您刚刚创建的“Top N Customers by Sales”集结合使用,以调整视图中的“前 N 个”值。 6. 在“数据”窗格中的“参数”下,右键单击**“Top Customers 2”**参数,并选择**“显示参数”**。 可通过使用出现在视图中的**“Top Customers 2”**参数来控制“前 N 个”值。  ## 用于改善视图功能的附加提示 下面是一些附加步骤,您可以执行这些步骤来使查看器在显示客户子集时更加灵活。 1. 从**“数据”**窗格下拉菜单中,选择**“创建参数”**。 2. 在打开的“创建参数”对话框中,执行以下操作: - 对于**“名称”**,键入**“Expand or Collapse”**。 - 对于**“数据类型”**,选择**“字符串”**。 - 对于**“允许的值”**,选择**“列表”**。 - 在**“值列表”**中,键入值**“Expand”**和**“Collapse”**。  - 完成后,单击**“确定”**。 4. 选择**“分析”**\>**“创建计算字段”**。 5. 在打开的“创建计算字段”对话框中,执行以下操作来创建一个计算,该计算使用您刚刚创建的参数。此计算使 Viewer(查看者)能够指定如何查看“其他”子集中的客户: - 对于**“名称”**,输入 **Customer Names Calc**。 - 在公式框中,键入以下公式,然后单击**“确定”**: `IF [Expand or Collapse]="Collapse" THEN IF [Top N Customers by Sales] THEN [Customer Name] ELSE "Others" END ELSE [Customer Name] END` 7. 在“数据”窗格中的“参数”下,右键单击**“Expand or Collapse”**参数,然后选择**“显示参数”**。 8. 从**“列”**功能区中,将**“SUM(Sales)”**度量拖到**“标记”**卡上的**“标签”**。 9. 从“数据”窗格中,将**“Customer Names Calc”(客户名称计算)**直接拖到**“行”**功能区的**“Customer Name”(客户名称)**字段上,使前者替代后者。  现在,您可以使用**“Expand or Collapse”(展开或折叠)**参数控件来查看前 N 名客户的名称列表,其余客户将汇总到单个**“其他”**条目中。  [跳转到主要内容](#main-content) # 预测描述 “描述预测”对话框描述了 Tableau 为您的可视化项计算的预测模型。 启用了预测后,您可通过选择“分析”> “预测”>“描述预测”打开此对话框。 “描述预测”对话框中的信息是只读的,不过,您可以单击“复制到剪贴板”,然后将屏幕内容粘贴到文档中。 “描述预测”对话框有两个选项卡:“摘要”选项卡和“模型”选项卡。 ## 描述预测 —“摘要”选项卡 “摘要”选项卡描述 Tableau 已创建的预测模型,以及 Tableau 在您的数据中发现的一般模式。 ### 用于创建预测的选项 此部分汇总了 Tableau 创建预测所用的选项。这些选项可由 Tableau 自动选取,也可在“预测选项”对话框中指定。 - 时间系列 - 用于定义时间系列的连续日期字段。在某些情况下,此值可能实际上不是日期。请参见[在视图中没有日期时进行预测](https://help.tableau.com/current/pro/desktop/zh-cn/forecast_no_date.htm)。 - 度量 — 估计值时使用的度量。 - 向前预测 — 预测的长度和日期范围。 - 预测依据 — 创建预测所用实际数据的日期范围。 - 忽略最后的周期数 — 实际数据末尾的周期数将被忽略,该数值用于确定预测数据显示的周期数。此值由“预测选项”对话框中的“忽略最后的周期数”选项决定。 - 季节模式 — Tableau 在数据中找到的季节周期的长度,如果在任何预测中都找不到季节周期,则为“无”。 ### 预测摘要表 对于预测的每个度量将显示一个摘要表,用来描述预测。如果使用维度将视图划分为多个窗格,则会在每个表中插入一列,用来指示维度。预测摘要表中的字段包括: - 初始 — 第一个预测周期的值和预测间隔。 - 相对于初始值的变化 — 第一个和最后一个预测估计点之间的差值。这两个点之间的间隔显示在列标题中。当值以百分比形式显示时,此字段会显示相对于第一个预测周期的百分比变化。 - 季节影响 — 这些字段将针对具有季节性(随时间变化的重复模式)的模型而显示。它们将显示实际值和预测值的合并时间系列中上一个完整季节周期的季节组件的高值和低值。季节组件表示相对于趋势的偏差,因此会围绕零值变化,并且在整个季节内的和值为零。 - 贡献 — 趋势和季节性对预测的贡献程度。这些值始终以百分比形式表示,且总和为 100%。 - 质量 — 指示预测与实际数据的相符程度。可能的值为 GOOD、OK 和 POOR。自然预测的定义为:下一周期的值估计将与当前周期的值相同。质量以与自然预测相比较的结果表示,例如,“OK”表示相比自然预测,预测误差更小;“GOOD”表示预测误差要小一半以上;而“POOR”则表示预测的误差更大。 ## 描述预测 —“模型”选项卡 “模型”选项卡提供了更详尽的统计信息以及预测下的霍尔特-温特斯指数平滑模型的平滑系数值。对于预测的每个度量将显示一个表,用来描述 Tableau 为该度量创建的预测模型。如果使用维度将视图划分为多个窗格,则会在每个表中插入一列,用来指示维度。表有以下部分: ### 模型 指定“级别”、“趋势”或“季节”组件是否是用于生成预测的模型的一部分。每个组件的值为以下值之一: - 无 - 模型中没有该组件。 - 累加 - 该组件存在,并且已添加到其他组件中以便创建整体预测值。 - 累乘 - 该组件存在,并且已与其他组件相乘以便创建整体预测值。 ### 质量指标 有一组值提供了关于模型质量的统计信息: #### **RMSE** 均方根误差:  #### **MAE** 平均绝对误差:  #### **MASE** 平均绝对标度误差:  MASE 测量误差量级与向前一期天真预测的误差量级的比率。天真预测法假定不管今天是什么值,明天都将是相同的值。因此,MASE 为 0.5 意味着您的预测的误差可能是天真预测误差的一半,这要优于 MASE 1.0,MASE 1.0 意味着您的预测并不比天真预测准确。由于这是为所有值定义的规范化统计数字并平均地衡量误差,因此是比较不同预测方法的质量的理想指标。 与更常用的 MAPE 指标相比,MASE 的优点在于:MASE 是为包含零的时间系列定义的,MAPE 则不是。此外,MASE 为误差赋予相等的权重,而 MAPE 为正误差和/或极值误差赋予更多权重。 #### **MAPE** 平均绝对百分比误差:  MAPE 测量误差量级与数据量级的百分比。因此,20% 的 MAPE 要优于 60% 的 MAPE。误差是模型估计的响应值与数据中每个说明性值的实际响应值之间的差异。由于这是一种规范化统计数据,因此可用于比较 Tableau 中计算的不同模型的质量。但是,对于某些比较,它可能不可靠,因为它对某些种类的误差设置的权重要大于其他误差。此外,对于包含零值的数据,其效果也不明确。 #### **AIC** Akaike 信息准则:  AIC 是一个模型质量度量,由 Hirotugu Akaike 开发,可对复杂模型进行罚分以防止过度拟合。在该定义中,_k_ 是估计参数的数量,包括初始状态,_SSE_ 是误差平方和。 #### 变量 在上面的定义,用到的变量如下:
| 变量 | 含义 |
| t | 时间系列中的周期的索引。 |
| n | 时间系列长度。 |
| m | 一个季节/循环中的周期数。 |
| A(t) | 周期为 t 时的时间系列的实际值。 |
| F(t) | 周期为 t 时的拟合值或预测值。 |
| 默认情况下排除的字段 | 排除理由 |
|---|---|
数据源中有超过 1000 个度量时,排除所有未可视化的度量。 数据源中有超过 1000 个维度时,排除所有未可视化的维度。 | 为超过 1000 个未可视化的度量或维度计算解释可能需要更长时间的计算时间,有时需要几分钟时间。默认情况下会为初始分析排除这些字段,但您可以选择包括这些字段以进行进一步分析。 在此情况下,您可能会看到一条通知,询问您是否希望“数据解释”功能考虑更多字段。单击通知链接以获取更多信息。单击“全部解释”以运行包含更多字段的分析。 |
| 使用几何图形、纬度或经度的字段 | 几何图形、纬度或经度本身永远不能是解释。将纬度或经度作为解释的原因极有可能是存在虚假的关联,而不是可能的解释。 |
| 具有高基数的维度(成员超过 500 的维度) | 高基数维度的计算时间较长。不会考虑将包含超过 500 个唯一值的维度用于分析。 |
| 组、数据桶或集 | 当前不支持。 |
| 表计算 | 当表计算的详细级别与视图不同时,无法对表计算进行分析。 |
| 无法求平均值的未可视化度量 | 无法求平均值的未可视化度量包括作为计算字段的度量,其中计算表达式包含聚合(添加到工作表时显示为 AGG() 字段)。 |
| 离散度量和连续维度 | 当前不支持。 |
| 隐藏字段 | 不可用。 |
| 包含错误的计算字段 | 不存在要分析的值。 |
此解释显示:
探索选项:
分析的后续步骤:
|
在此示例中,租用 463 小时的单个极端值导致总租用时间的总和高于预期的 613 小时。 造成如此高值的一个可能原因是,有人在归还自行车时忘记将自行车停靠。在这种情况下,作者可能希望排除此值以供将来分析。
| |
可视化差异本节显示:
探索选项:
分析的后续步骤:
| ![]()
在此示例中,当排除极端值 483 时,与视图中的其他标记相比,已分析标记不再高。其他标记现在会很突出。作者可能想要探索其他标记,以考虑为什么这些其他地点的自行车租赁时间更长。 |
此解释显示:
探索选项:
分析的后续步骤:
|
在此示例中,目标度量中的 null 值百分比显示为蓝色圆圈。 |
此解释显示:
探索选项:
分析的后续步骤:
|
在此示例中,针对“Ride Month”(骑行月)的每个值列出了“Trip Distance”(行程距离)的记录数,这是原始可视化项中的一个维度。八月的总行程距离值最高。 您可能会探索八月的行程距离值最高是否是因为八月的骑行次数更多,还是因为某些骑行时间更长导致行程距离最高。 |
此解释显示:
探索选项:
分析的后续步骤:
| ![]() 在此示例中,八月的平均行程距离与大多数月份相比并没有显著提高或降低。这表明八月的行程距离更高是因为八月的骑行次数更多,而不是人们的骑行时间更长。 |
此解释显示:
探索选项:
分析的后续步骤:
| ![]() 在此示例中,统计分析表明,许多次骑行来自 Back Bay 车站附近。请注意,“Station Neighborhood”(车站附近)是一个未可视化的维度,它与源可视化项的基础数据中的“Trip Distance”(行程距离)有某种关系。 |
此解释显示:
探索选项:
分析的后续步骤:
| ![]() 在这个例子中,统计分析表明,与整体评分相比,从南部车站和 MIT 骑行的次数更多,从 Charles Circle 和 Kendall 骑行的次数更少。 请注意,“Station Name”(车站名称)是一个未可视化的维度,它与源可视化项的基础数据中的“Trip Distance”(行程距离)有某种关系。 |
此解释显示:
探索选项:
分析的后续步骤:
| ![]() 在这个例子中,行程距离很长的一个可能原因是平均租用总时间也很长。 |
此解释显示:
探索选项:
分析的后续步骤:
| ![]() 在此示例中,很大比例的记录与阴天天气相关。因为数据是关于波士顿的自行车租赁,并且已分析标记是八月的行程距离,我们可以假设天气通常温暖潮湿。人们可能会在阴天更频繁地租用自行车,以避免炎热。八月也有可能有更多的阴天。 |
使用“数据解释”功能 | 作者工作簿和控制访问权限 |
| 类别 | 产品名称 | 销售额 |
| 家具 | 落地灯 | 96.00 美元 |
| 解释类型 | 评估 |
|---|---|
极端值 | 基于可视化标记的模型,极端值是离群值形式的聚合标记。如果所选标记位于数据预期值分布的尾部,则被视为包含极端值。 通过比较有极端值和无极端值的聚合标记来确定极端值。如果删除值后标记变得不那么让人惊讶,则它会得到较高的分数。 当标记具有极端值时,并不自动意味着它具有离群值,或者您应将这些记录从视图中排除。怎样选择由您根据分析自行决定。解释只是指出标记中一个有趣的极端值。例如,它可能会显示记录中一个输入错误的值,即一根香蕉的成本为 10 美元,而不是 10 美分。或者,它可能会显示一名特定销售人员在某个季度的表现特别出色。 |
记录数 | 记录数解释根据聚合计数对聚合总和进行建模;记录的平均值根据聚合平均值对其进行建模。模型对总和的解释越好,得分就越高。 此解释描述总和由于计数较高或较低或者平均值较高或较低而是否令人关注。 |
标记的平均值 | 这种类型的解释用于总和形式的聚合标记。它解释了标记是否与其他标记一致,因为就其聚合计数或平均值而言,注意关系 SUM(X) = COUNT(X) * AVG(X)。 此解释描述总和由于计数较高或较低或者平均值较高或较低而是否令人关注。 |
产生影响的维度 | 该解释根据未可视化维度的类别之间的细分对已分析标记的目标度量进行建模。分析平衡了模型的复杂性和对标记的解释程度。 非可视化维度是存在于数据源中,但当前未在视图中使用的维度。这种类型的解释用于总和、计算及平均值。 非可视化维度的模型是通过以下方式创建的:依据解释列的分类值将标记拆分,然后使用包括源可视化项中所有数据点的值构建模型。对于每一行,模型都会尝试恢复组成每个标记的各个组件。分析指明,与使用非可视化维度的值未知的模型相比,对与非可视化维度对应的组件进行建模然后加总时,模型是否能对标记进行更好的预测。 聚合维度解释探讨在没有任何条件的情况下可将标记值解释到怎样的程度。然后,模型会通过条件对作为可能解释的每一列的值进行限制。通过对解释列的分布进行条件限制,应该能进行更好的预测。 |
产生影响的度量 | 此解释根据这种未可视化的度量对标记建模,聚合为其跨可视化维度的平均值。非可视化度量是存在于数据源中,但当前未在视图中使用的度量。 产生影响的度量解释可以揭示未可视化度量与目标度量之间的线性或二次关系。 |
| 记录数 | 检索所花费的时间 |
|---|---|
100,000 | 1.7 分钟 |
250,000 | 4 分钟 |
500,000 | 8.5 分钟 |
| Library | LibraryID | Consortium Member | Private | Librarians | Library Technicians | Library Assistants |
Idle Hour Library | L-IHL | Yes | No | 53 | 61 | 16 |
The Bibliophile’s Shelves | L-BS | Yes | Yes | 4 | 3 | 0 |
Armchair Athanaeum | L-AA | No | Yes | 6 | 0 | 0 |
| Old Friend Library | L-OFL | Yes | No | 3 | 5 | 17 |
| Bide Awhile | L-BA | Yes | No | 9 | 20 | 6 |
| IndieUnBound | L-IUB | Yes | No | 7 | 2 | 47 |
Page Station Book Exchange | L-PS | No | Yes | 3 | 1 | 4 |
Actian Matrix* Alibaba AnalyticDB for MySQL‡ Alibaba Data Lake Analytics‡ Alibaba MaxCompute‡ Amazon Athena‡ Amazon Aurora for MySQL‡ Amazon EMR Hadoop Hive‡ Amazon Redshift‡ Apache Drill‡ Aster Database* Azure Data Lake Storage Gen2‡ Box‡ Cloudera Hadoop‡ Databricks‡ Datorama by Salesforce‡ Denodo‡ Dremio by Dremio‡ Dropbox‡ Esri 连接器‡ Exasol‡ | Google BigQuery**‡ Google BigQuery JDBC**‡ Google Cloud SQL‡ Google 云端硬盘‡ Impala‡ Kognito* Kyvos‡ Hortonworks Hadoop Hive IBM BigInsights IBM DB2‡ IBM PDA (Netezza)* Kyvos‡ MariaDB‡ MarkLogic* Microsoft Azure SQL Database‡ Microsoft Azure Synapse Analytics‡ Microsoft SQL Server‡ MonetDB* MongoDB BI Connector‡ MySQL‡ | OData‡ OneDrive‡ Oracle‡ Pivotal Greenplum Database‡ PostgreSQL‡ Progress OpenEdge* Presto‡ Qubole Presto‡ SAP HANA(仅适用于虚拟连接)‡ SAP Sybase ASE* SAP Sybase IQ* Salesforce‡ Sharepoint 列表‡ SingleStore(前身为 MemSQL)‡ Snowflake‡ Spark SQL‡ Teradata***‡ Vertica‡ |
Alibaba AnalyticsDB for MySQL‡ Alibaba Data Lake Analytics‡ Amazon Athena‡ Amazon Aurora for MySQL‡ Amazon EMR Hadoop Hive‡ Amazon Redshift‡ Apache Drill‡ Azure Data Lake Storage Gen2‡ Azure Synapse Analytics(兼容 SQL Server) Box‡ Cloudera Hadoop‡ Databricks‡ Datorama by Salesforce‡ Denodo‡ Dremio by Dremio‡ | Dropbox*‡ Esri 连接器‡ Exasol‡ Google BigQuery*‡ Google Cloud SQL(兼容 MySQL)‡§ Google 云端硬盘‡ Hortonworks Hadoop Hive Impala‡ Kyvos‡ MariaDB‡ Microsoft Azure SQL Database‡ Microsoft Azure Synapse Analytics‡ Microsoft SQL Server‡ MongoDB BI Connector‡ MySQL‡ | OData‡ OneDrive*‡ Oracle‡ Pivotal Greenplum Database‡ PostgreSQL‡ Presto‡ Qubole Presto‡ Salesforce‡ SAP HANA(仅适用于虚拟连接)‡ Sharepoint 列表‡ SingleStore(前身为 MemSQL)‡ Snowflake‡ Spark SQL‡ Teradata**‡ Vertica‡ |
Google 云端硬盘 OData |
| 名称 | 公式 |
| First Purchase Date(第一次购买日期) | {FIXED [Customer Name] : MIN([Order Date])} |
| Days Since First Purchase(自第一次购买后的天数) | DATETRUNC('day', [Order Date])-DATETRUNC('day', [First Purchase Date]) |
| bq-fetch-tasks | 使用 HTTP 获取数据时使用的并行后台任务数。默认值为 10。 |
| bq-large-fetch-rows | 要在每一批脱机查询中获取的行数。默认值为 50000。 |
| bq-fetch-rows | 要在每一批非脱机查询中获取的行数。默认值为 10000。 |
| bq-response-rows | 非脱机非分批查询中返回的行数。默认值为 10000。 |
| CAP_BIGQUERY_FORCE_SPOOL_JOB | 强制所有查询使用临时表方法。默认值为“no”。将值更改为“yes”以启用此属性。 |
Bill(账单) Bill Payment(账单付款) Credit Memo(贷项通知单) Deposit(保证金) | Estimate(估值) Invoice(发票) Journal Entry(日记账分录) Payment(付款) Purchase(采购) | Purchase Order(采购订单) Refund Receipt(退款收据) Sales Receipt(销售凭据) Vendor Credit(供应商贷项) |
| 公历 | ISO-8601 | 日历之间的差异 |
|---|---|---|
| 年 | ISOYEAR | ISO-8601 年始终从最接近 1 月 1 日的第一个星期一开始。这意味着一年可能会在 12 月 29 日和 1 月 4 日之间的任何时间开始。公历的年始终在 1 月 1 日开始。这可能会导致两个日历系统的年在这些日期前后会出现一些差异。每个 ISO-8601 年都是一个长年或短年,包含 52 周或 53 周,具体取决于 ISO-8601 年的开始时间。 |
| 季度 | ISOQUARTER | ISO-8601 的前三个季度总是有 13 周。最后一个季度有 13 周(短年)或 14 周(长年)。 |
| 月 | ISO-8601 基于周的日历不使用月。许多零售和财务系统将 ISO-8601 季度划分为三个 4-4-5 周的分段,但也存在其他“月”模式。这些可以使用计算来定义。请参见创建一个 4-4-5 日历。 | |
| 周数 | ISOWEEK | ISO-8601 基于周的日历中的所有周都正好是 7 天,并且从星期一开始。每一周都属于一年,不像公历允许周跨年延续。长年有 53 周,短年有 52 周。 |
| 日 | ISO-8601 基于周的日历不使用数字日(例如 14 日或 23 日)。 | |
| 平日 | ISOWEEKDAY | ISO-8601 平日总是从星期一开始,并以个位数表示。周一是 1,周二是 2,一直到周日的 7。 |
| 例如,下面是 JSON 文件的一个片段: | JSON 文件生成以下架构级别: |
![]() | ![]() |
| 记录数 | 检索所花费的时间 |
|---|---|
1,000 | 4.5 秒 |
10,000 | 45 秒 |
100,000 | 8 分钟 |
1,000,000 | 75 分钟 |
| SQL_ODBC_INTERFACE_CONFORMANCE | 当前未使用。 |
| SQL_SQL_CONFORMANCE | 整数位掩码。定义数据源符合 SQL 标准的级别:“1”代表入门级 SQL-92 符合性,“2”代表 FIPS 127-2 过渡,“4”代表中间,“8”代表完全符合。 |
| SQL_CATALOG_USAGE | 整数位掩码。定义可以在其中使用目录标识符的 SQL 语句。 |
| SQL_SCHEMA_USAGE | 整数位掩码。定义可以在其中使用架构标识符的 SQL 语句。 |
| SQL_AGGREGATE_FUNCTIONS | 整数位掩码。定义支持哪些标准 SQL 聚合形式。 |
| SQL_NUMERIC_FUNCTIONS | 整数位掩码。定义支持哪些 SQL 标量数值函数。 |
| SQL_STRING_FUNCTIONS | 整数位掩码。定义支持哪些 SQL 标量字符串函数。 |
| SQL_TIMEDATE_FUNCTIONS | 整数位掩码。定义支持哪些 SQL 标量日期/时间函数。 |
| SQL_TIMEDATE_ADD_INTERVALS | 整数位掩码。定义 TIMESTAMPADD 标量函数支持哪些日期/时间间隔。 |
| SQL_TIMEDATE_DIFF_INTERVALS | 整数位掩码。定义 TIMESTAMPDIFF 标量函数支持哪些日期/时间间隔。 |
| SQL_DATETIME_LITERALS | 整数位掩码。定义支持使用哪些 SQL-92 文本来表示 DATE/TIME 常量和 INTERVAL。 |
| SQL_SYSTEM_FUNCTIONS | 整数位掩码。定义对以下特殊 SQL 系统标量函数的支持:IFNULL、DBNAME 和 USERNAME。 |
| SQL_SQL92_VALUE_EXPRESSIONS | 整数位掩码。定义支持使用哪些逻辑函数来测试和处理值:CASE、CAST 和 NULLIF。 |
| SQL_SQL92_NUMERIC_VALUE_FUNCTIONS | 整数位掩码。定义哪些函数可以从非数值数据生成数值,其中包括:EXTRACT(用于日期/时间部分提取), CHAR_LENGTH, CHARACTER_LENGTH 和 POSITION(.. IN ..)。 |
| SQL_SQL92_STRING_FUNCTIONS | 整数位掩码。定义支持哪些字符串操作函数。 |
| SQL_SQL92_DATETIME_FUNCTIONS | 整数位掩码。定义支持使用哪些日期/时间操作函数来确定当前日期、时间或时间戳。 |
| SQL_OJ_CAPABILITIES | 整数位掩码。定义支持哪些类型的外部联接。 |
| SQL_SQL92_RELATIONAL_JOIN_OPERATORS | 整数位掩码。定义支持哪些类型的联接运算符,例如 INNER、OUTER。 |
| SQL_SQL92_PREDICATES | 整数位掩码。定义支持使用哪些谓词进行值的逻辑测试,例如 IS NULL、LIKE、IN。 |
| SQL_CONVERT_FUNCTIONS | 整数位掩码。定义支持使用哪些 ODBC 标量函数将一种数据类型转换 (CONVERT) 或强制转换 (CAST) 为或转换为另一种数据类型。 |
| SQL_CONVERT_TINYINT | 整数位掩码。确定使用 ODBC 标量函数 CONVERT 可以将此命名类型转换为哪些其他数据类型。 |
| SQL_CONVERT_SMALLINT | 整数位掩码。同上。 |
| SQL_CONVERT_INTEGER | 整数位掩码。同上。 |
| SQL_CONVERT_BIGINT | 整数位掩码。同上。 |
| SQL_CONVERT_REAL | 整数位掩码。同上。 |
| SQL_CONVERT_FLOAT | 整数位掩码。同上。 |
| SQL_CONVERT_DOUBLE | 整数位掩码。同上。 |
| SQL_CONVERT_CHAR | 整数位掩码。同上。 |
| SQL_CONVERT_VARCHAR | 整数位掩码。同上。 |
| SQL_CONVERT_LONGVARCHAR | 整数位掩码。同上。 |
| SQL_CONVERT_DECIMAL | 整数位掩码。同上。 |
| SQL_CONVERT_NUMERIC | 整数位掩码。同上。 |
| SQL_CONVERT_BIT | 整数位掩码。同上。 |
| SQL_CONVERT_GUID | 整数位掩码。同上。 |
| SQL_CONVERT_BINARY | 整数位掩码。同上。 |
| SQL_CONVERT_VARBINARY | 整数位掩码。同上。 |
| SQL_CONVERT_LONGVARBINARY | 整数位掩码。同上。 |
| SQL_CONVERT_DATE | 整数位掩码。同上。 |
| SQL_CONVERT_TIME | 整数位掩码。同上。 |
| SQL_CONVERT_TIMESTAMP | 整数位掩码。同上。 |
| SQL_CONVERT_INTERVAL_DAY_TIME | 整数位掩码。同上。 |
| SQL_CURSOR_COMMIT_BEHAVIOR | 短整数值。如果在为数据源提交时准备好的语句关闭,则为“0”。 |
| SQL_MAX_IDENTIFIER_LEN | 整数值。定义可在标识符中使用的最大字符数。Tableau 会为作为字符串终止符的一个额外字符留出空间。 |
| SQL_TXN_CAPABLE | 短整数值。如果数据源不支持事务,则为“0”。 |
| SQL_QUOTED_IDENTIFIER_CASE | 整数位掩码。 |
| SQL_COLUMN_ALIAS | 布尔值。"如果数据源支持对 SELECT 子句中列出的列使用别名,则为“Y”。 |
| SQL_IDENTIFIER_QUOTE_CHAR | 字符串值。指示可用于引用标识符的字符。由于连接自定义是 XML 文档,因此任何实体都必须正确编码。例如,双引号将为“"”。另外,假定此字符用作标识符两侧的开始和结束字符,因此要求使用“[]”括住标识符的一些数据源将不受支持。 |
| SQL_CATALOG_NAME_SEPARATOR | 字符值。指示在使用目录、架构或表名限定标识符时,标识符之间使用的分隔符。这通常是句点字符。 |
| SQL_SPECIAL_CHARACTERS | 字符串值。指示标识符字符串中允许的特殊字符。 |
| SQL_CATALOG_TERM | 字符串值。这是数据库目录的描述性词语,出现在此 ODBC 数据源的 Tableau 连接对话框中。 |
| SQL_SCHEMA_TERM | 字符串值。这是数据库架构的描述性词语,出现在此 ODBC 数据源的 Tableau 连接对话框中。 |
| SQL_TABLE_TERM | 字符串值。这是数据库表的描述性词语,出现在此 ODBC 数据源的 Tableau 连接对话框中。 |
| SQL_DRIVER_NAME | 字符串值。这是数据库 ODBC 驱动程序的名称。 |
| SQL_DRIVER_VER | 字符串值。这是 ODBC 驱动程序的版本号。 |
| SQL_DRIVER_ODBC_VER | 字符串值。这是驱动程序支持的 ODBC API 版本。 |
| SQL_ODBC_VER | 字符串值。这是 Windows ODBC Driver Manager 支持的 ODBC 版本。这应该不需要进行自定义。 |
| SQL_DBMS_NAME | 字符串值。这是数据库供应商的名称。 |
| SQL_DBMS_VER | 字符串值。这是数据库系统的版本。 |
| SQL_SERVER_NAME | 字符串值。这是数据库服务器的命名网络地址。 |
| SQL_USER_NAME | 字符串值。这是当前已验证用户的名称。 |
| 记录数 | 检索所花费的时间 |
|---|---|
50,662 条记录 | 3 分钟 17 秒 |
95,214 行 | 6 分钟 14 秒 |
194,679 行 | 12 分钟 55 秒 |
包括共享成员 无糖饮料在“Diet Drinks”分层结构及其相应的饮料分层结构列出。 | 不包括共享成员 无糖饮料仅在各饮料分层结构中列出一次。 |
![]() | |
![]() | ![]() | ![]() |
| 实时连接 | 数据提取连接 |
![]() | ![]() |
| 已隐藏别名 | 别名显示 |
![]() | ![]() |
| 记录数 | 检索所花费的时间 |
|---|---|
1,000 | 11 秒 |
10,000 | 2 分钟 |
100,000 | 18 分钟 |
| 特性和功能 | Tableau Desktop Public Edition | Tableau Desktop Free Edition | Tableau Desktop Professional Edition |
| 隐私和安全 | |||
| 在本地保存可视化项 | |||
| 自动恢复 | |||
| 在其他公共站点上发布或嵌入可视化项 | * 发布到 Tableau Public 后可用的嵌入选项 | ||
| 将可视化项发布到 Tableau Public | |||
| 将可视化项发布到 Tableau Cloud 或 Tableau Server | |||
| 与其他用户共享打包工作簿 | |||
| 实时数据刷新 | 受限数据刷新 (仅限 Google Drive。数据每 24 小时自动刷新一次) | ||
| 数据源 | 有限的数据源选项 (Google Drive、JSON 文件、Microsoft Excel 2007 或更高版本、OData、PDF、空间文件、统计文件、文本文件) | * 不支持 Tableau Cloud 或 Tableau Server 上的已发布数据源 | |
| 数据源行 | 1500 万行 | 无限 | 无限 |
| 云存储 | Tableau Public 上为 10GB | Tableau Cloud 和 Tableau Server(如果适用) | |
| 本地存储 |
| 视觉提示 | 描述 |
![]() | 工作簿直接连接到关系数据源或文件。 |
![]() | 工作簿连接到仍然引用基础数据的数据提取。 |
![]() | 工作簿连接到多维数据集(多维)数据源。在 Tableau 中,只支持 Windows 中的多维数据集数据源。 |
![]() | 工作簿连接到 Excel 表、子表或命名范围。 |
![]() | 工作簿连接到已发布到 Tableau Server 的数据源。 |
| 视觉提示 | 字段描述 |
![]() | 文本或字符串值。 |
![]() | 数值。 |
![]() | 日期值。 |
![]() | 日期和时间值。 |
![]() | 布尔值(True 或 False)。 |
| 地理数据。此图标还表示该字段已被分配地理角色。这些字段在构建地图视图时使用。请参见Tableau 中的地图和地理数据分析。 | |
| 来自自定义地理编码文件的地理数据。请参见Tableau 无法识别和在地图上绘制的地理编码位置。 | |
| 设置为图像角色的 URL。请参见将 Web 图像动态添加到工作表。 | |
![]() | 由数据源定义的计算。 |
![]() | 用户定义的集。请参见创建集。 |
![]() | 服务器命名集。 |
![]() | 作为动作结果而自动创建的集。请参见动作。 |
![]() | 已发布内容的用户筛选器。请参见在数据行级别限制访问权限。 |
![]() | 数字数据桶。请参见依据连续度量创建数据桶。 |
![]() | 组。请参见通过将数据分组来纠正数据错误或合并维度成员。 |
| 群集组。请参见在数据中查找群集。 | |
![]() | 关系分层结构。请参见创建分层结构。 |
![]() | 多维分层结构中的级别。大于 5 的级别显示时不带数字。 |
![]() | 包含一个或更多个字段的文件夹。文件夹用于组织“数据”窗格中的字段。请参见组织“数据”窗格。 |
![]() | 多维数据集(多维)数据源的属性。在 Tableau 中,只支持 Windows 中的多维数据集数据源。 |
![]() | 多维数据集(多维)数据源的可变属性。 |
| 该字段是数据混合的活动链接。请参见混合您的数据。 | |
| 该字段是数据混合的潜在链接。请参见混合您的数据。 | |
| 该字段不相关。请参见关于多事实关系数据模型。 | |
| 字段为拼接字段。请参见关于多事实关系数据模型。 | |
| 该字段已隐藏。单击即可取消隐藏该字段。请参见隐藏或取消隐藏字段。 |
| 视觉提示 | 描述 |
![]() | 功能区上的蓝色字段指示离散字段。大多数情况下,向功能区中添加维度会生成蓝色字段。蓝色字段是离散字段 — 它们包含的值数量有限。向功能区中添加蓝色字段会创建标题。有关详细信息,请参见标题。 |
![]() | 功能区上的绿色字段指示连续字段。大多数情况下,向功能区中添加度量会生成绿色字段。绿色字段是连续字段 — 它们包含的值数量无限。向功能区中添加绿色字段会创建轴。有关详细信息,请参见轴。 |
| 排序图标指示应用了计算或手动排序顺序的字段。请参阅在可视化项中对数据进行排序。 | |
![]() | 西格玛图标指示多维(多维数据集)数据源中的切片筛选器。请参见创建切片筛选器。 |
![]() | 维恩图图标指示集。请参见创建集。 |
![]() | 不相关图标表示该字段与可视化项中的至少一个其他字段不相关。请参见字段级相关性指标。 |
![]() | 相关图标表示该维度正在将不相关的字段拼接在一起。请参见字段级相关性指标。 |
![]() | 以斜体显示的字段名称表示筛选器是由某个动作生成和控制的。 |
![]() | 筛选器功能区上的灰色字段指示上下文筛选器。请参见使用上下文筛选器。 |
![]() | 三角形图标指示该字段为表计算。请参见使用表计算转换值。 |
![]() | 当字段是您可以下钻查询或汇总的分层结构的一部分时,将显示加号和减号控件。 |
![]() | 箭头图标指示正在为字段显示预测。此图标还用在“预测指示器”字段上,该字段是用于区分实际值和预测值的自动字段。请参见预测。 |
![]() | 带有橙色复选标记的数据源圆柱体表示该字段来自辅助数据源。请参见混合您的数据。 |
![]() | 该筛选器被分配到特定的工作表。 |
![]() | 该筛选器被分配到具有相同数据源的所有工作表。 |
![]() | 此字段与视图中的其他一个或更多个字段不兼容。 |
| 视觉提示 | 描述 |
![]() | 此字段应用于“标记”卡上的“颜色”。 |
![]() | 此字段应用于“标记”卡上的“大小”。 |
![]() | 此字段应用于“标记”卡上的“标签”。 |
![]() | 此字段应用于“标记”卡上的“形状”。 |
![]() | 此字段应用于“标记”卡上的“详细信息”。 |
![]() | 此字段应用于“标记”卡上的“工具提示”。 |
![]() | 此字段应用于“标记”卡上的“路径”。仅在从“标记”下拉菜单中选择了“线”或“多边形”标记类型时,路径才可用。 |
| 视觉提示 | 描述 |
![]() | 表单为工作表。 |
![]() | 表单为仪表板。 |
| 视觉提示 | 描述 |
| [文件名] | 橙色文本。字段是维度、度量或集。 |
| [参数].[参数名称] | 紫色文本。字段为参数。 Tableau 会添加前缀 [参数] 以避免参数与另一个字段同名时出现歧义 |
| [数据源].[字段名称] | 橙色文本。该字段源自辅助数据源。添加数据源名称作为前缀。 |
| Blue() | 蓝色文本。计算函数。 |
| CAP_CREATE_TEMP_TABLES | 如果 Tableau 可以创建某些复杂或优化的查询所需的临时表,则设置为“yes”。另请参见:CAP_SELECT_INTO。 |
| CAP_CONNECT_STORED_PROCEDURE | 设置为“yes”以允许对连接到存储过程的支持。 |
| CAP_FAST_METADATA | 如果有小型到中型的架构,请设置为“yes”。此功能控制 Tableau 在您连接时是否应立即枚举所有对象。将值设置为“yes”启用此功能,以便在创建新连接时改善性能。禁用此功能以允许搜索特定的架构或表格,而不是检索所有对象。可以通过使用空白字符串来搜索所有对象。9.0 及更高版本中提供了此功能。 |
| CAP_ISOLATION_LEVEL_READ_COMMITTED | 如果数据源支持,则设置为“yes”以强制事务隔离级别为 Read Committed。应只将 4 个事务隔离级别中的一个设置为“yes”。另请参见:CAP_SET_ISOLATION_LEVEL_VIA_SQL。 |
| CAP_ISOLATION_LEVEL_READ_UNCOMMITTED | 如果数据源支持,则设置为“yes”以强制事务隔离级别为 Read Uncommitted。应只将 4 个事务隔离级别中的一个设置为“yes”。此功能可以通过减少锁争用来提高速度,但可能会导致查询结果中的数据不完整或不一致。另请参见:CAP_SET_ISOLATION_LEVEL_VIA_SQL。 |
| CAP_ISOLATION_LEVEL_REPEATABLE_READS | 如果数据源支持,则设置为“yes”以强制事务隔离级别为 Repeatable Reads。应只将 4 个事务隔离级别中的一个设置为“yes”。另请参见:CAP_SET_ISOLATION_LEVEL_VIA_SQL。 |
| CAP_ISOLATION_LEVEL_SERIALIZABLE | 如果数据源支持,则设置为“yes”以强制事务隔离级别为 Serializable。应只将 4 个事务隔离级别中的一个设置为“yes”。这是一个非常保守的设置,它可以提高稳定性,但会降低性能。另请参见:CAP_SET_ISOLATION_LEVEL_VIA_SQL。 |
| CAP_JDBC_BIND_DETECT_ALIAS_CASE_FOLDING | 设置为“yes”以允许 Tableau 检测在结果集中报告仅使用大写或小写字符的字段名称而非预期字段名称的 JDBC 数据源并从该数据库源恢复。 |
| CAP_JDBC_EXPORT_DATA_BATCH | 设置为“no”以禁止使用 ODBC 批量操作进行数据插入。 |
| CAP_JDBC_METADATA_GET_INDEX_INFO | 设置为“no”以禁止读取索引信息。 |
| CAP_JDBC_METADATA_READ_FOREIGNKEYS | 设置为“no”以禁止读取外键元数据。 |
| CAP_JDBC_METADATA_READ_PRIMARYKEYS | 设置为“no”以禁止读取主键元数据。 |
| CAP_JDBC_METADATA_USE_RESULTSET_FOR_TABLE | 设置为“yes”以从 select * 查询的结果集中获取列元数据。在 Tableau 2020.4 及更高版本中可用。 |
| CAP_JDBC_QUERY_ASYNC | 设置为“yes”以在另一个线程上运行查询。 |
| CAP_JDBC_QUERY_CANCEL | 如果驱动程序可以取消查询,则设置为“yes”。 |
| CAP_JDBC_QUERY_DISABLE_AUTO_COMMIT | 设置为“yes”以在运行查询时禁用默认的自动提交模式。在 Tableau 2020.4 及更高版本中可用。 |
| CAP_JDBC_QUERY_FORCE_PREPARE | 设置为“yes”以始终在执行前准备查询。在 Tableau 2020.4 及更高版本中可用。 |
| CAP_JDBC_SUPPRESS_EMPTY_CATALOG_NAME | 设置为“yes”以忽略缺失的目录。 |
| CAP_JDBC_SUPPRESS_ENUMERATE_DATABASES | 设置为“yes”以禁用数据库枚举。 |
| CAP_JDBC_SUPPRESS_ENUMERATE_SCHEMAS | 设置为“yes”以禁用架构枚举。 |
| CAP_JDBC_METADATA_SUPPRESS_PREPARED_QUERY | 如果 CAP_JDBC_METADATA_USE_RESULTSET_FOR_TABLE 已启用,则将此功能设置为“yes”以禁用准备用于读取表元数据的查询。我们将执行用 where-false 子句封装的查询。 |
| CAP_JDBC_USE_ADAPTIVE_FETCH_SIZE | 设置为“yes”以使用 ResultSet 元数据来确定最佳提取大小。可能需要启用 CAP_JDBC_QUERY_FORCE_PREPARE 才能正常工作。在 Tableau 2020.4 及更高版本中可用。 |
| CAP_MULTIPLE_CONNECTIONS_FROM_SAME_IP | 设置为“no”以阻止 Tableau 创建到数据库的多个活动连接。这是一个保守的设置,它可以提高稳定性,但会降低性能。 |
| CAP_QUERY_BOOLEXPR_TO_INTEXPR | 如果 Tableau 必须将任何布尔表达式强制转换为整数值才能包括在结果集中,则设置为“yes”。 |
| CAP_QUERY_FROM_REQUIRES_ALIAS | 如果 FROM 子句必须为给定表提供别名,则设置为“yes”。 |
| CAP_QUERY_GROUP_ALLOW_DUPLICATES | 如果 SQL 查询无法在 GROUP BY 子句中包含重复的表达式(这很罕见),则设置为“no”。 |
| CAP_QUERY_GROUP_BY_ALIAS | 如果 SQL 聚合查询可以通过 SELECT 列表中的相应别名引用组合列(例如 GROUP BY "none_ShipCountry_nk"。 |
| CAP_QUERY_GROUP_BY_DEGREE | 如果 SQL 聚合查询可以通过每个列的序号位置引用组合列(例如 GROUP BY 2, 5),则设置为“yes”。另请参见:CAP_QUERY_SORT_BY_DEGREE |
| CAP_QUERY_HAVING_REQUIRES_GROUP_BY | 如果 Tableau 必须对具有 HAVING 子句但没有组合列的任何查询使用假分组字段,则设置为“yes”。 |
| CAP_QUERY_HAVING_UNSUPPORTED | 如果不支持 HAVING 的 SQL 语法,则设置为“yes”。Tableau 或许可以使用子查询解决此问题。另请参见:CAP_QUERY_SUBQUERIES。 |
| CAP_QUERY_INCLUDE_GROUP_BY_COLUMNS_IN_SELECT | 设置为“yes”以要求所有 GROUP BY 表达式还显示在 SELECT 表达式列表中。 |
| CAP_QUERY_JOIN_ACROSS_SCHEMAS | 如果 SQL 查询可以表示位于不同架构中的表之间的联接,则设置为“yes”。 |
| CAP_QUERY_JOIN_ASSUME_CONSTRAINED | 设置为“yes”以便即使在数据库表没有 FK-PK 关系的情况下也剔除内部联接。 |
| CAP_QUERY_JOIN_PUSH_DOWN_CONDITION_EXPRESSIONS | 设置为“yes”以便重写联接将 ON 子句条件简化为简单的标识符比较。 |
| CAP_QUERY_JOIN_REQUIRES_SCOPE | 如果 SQL 查询必须将每个联接子句用括号括起来以确保正确的计算顺序,则设置为“yes”。 |
| CAP_QUERY_JOIN_REQUIRES_SUBQUERY | 设置为“yes”以强制包括超过两个表的联接表达式由子查询构成。 |
| CAP_QUERY_NULL_REQUIRES_CAST | 如果数据源要求将所有 NULL 文本转换为显式数据类型,则设置为“yes”。 |
| CAP_QUERY_SELECT_ALIASES_SORTED | 如果 Tableau 必须对 SELECT 表达式施加确定顺序(按别名排序)以确保查询结果可以正确地与 Tableau 可视化项中的每个字段匹配,则设置为“yes”。只有随查询结果返回元数据时没有保留 SELECT 表达式的别名的数据源,才必须这么做。 |
| CAP_QUERY_SORT_BY_DEGREE | 如果 SQL 查询可以通过每个列的序号位置引用排序列(例如 ORDER BY 2, 5),则设置为“yes”。另请参见:CAP_QUERY_GROUP_BY_DEGREE。 |
| CAP_QUERY_SUBQUERIES | 如果数据源支持子查询,则设置为“yes”。 |
| CAP_QUERY_SUBQUERIES_WITH_TOP | 如果数据源支持子查询中的 TOP 或 LIMIT 行限制子句,则设置为“yes”。 |
| CAP_QUERY_SUBQUERY_DATASOURCE_CONTEXT | 设置为“yes”以使用子查询筛选的查询上下文来实施数据源筛选器。仅 Tableau 8.0 至 Tableau 9.3 中提供了此功能。 |
| CAP_QUERY_SUBQUERY_QUERY_CONTEXT | 设置为“yes”以强制 Tableau 使用上下文筛选器的子查询而非临时表或本地缓存的结果。 |
| CAP_QUERY_TOP_N | 如果数据源支持任何形式的行限制子句,则设置为“yes”。下面介绍了受支持的确切形式。 |
| CAP_QUERY_TOPSTYLE_LIMIT | 如果数据源使用 LIMIT 作为行限制子句,则设置为“yes”。 |
| CAP_QUERY_TOPSTYLE_ROWNUM | 如果数据源支持 ROWNUM 上的 Oracle 样式的筛选器作为行限制子句,则设置为“yes”。 |
| CAP_QUERY_TOPSTYLE_TOP | 如果数据源使用 TOP 作为行限制子句,则设置为“yes”。 |
| CAP_QUERY_USE_QUERY_FUSION | 设置为“no”以防止 Tableau 将多个单独的查询合并为一个合并的查询。为了优化性能,或者,如果数据库无法处理大型查询,请关闭此功能。此功能默认情况下已启用,并且在 Tableau 9.0 及更高版本中可用于除 Tableau 数据提取外的所有数据源。Tableau 9.0.6 中支持为 Tableau 数据提取使用此功能。 |
| CAP_SELECT_INTO | 如果 Tableau 可以从其他查询的结果集动态创建表,则设置为“yes”。另请参见:CAP_CREATE_TEMP_TABLES。 |
| CAP_SELECT_TOP_INTO | 如果 Tableau 在从查询结果集创建表时可以使用 TOP 或 LIMIT 行限制子句,则设置为“yes”。 |
| CAP_SET_ISOLATION_LEVEL_VIA_SQL | 设置为“yes”以强制 Tableau 使用 SQL 查询为数据源设置事务隔离级别。当 4 个 CAP_ISOLATION_LEVEL 功能中的任一个设置为“yes”时,CAP_SET_ISOLATION_LEVEL_VIA_SQL 必须设置为“yes”。 |
| CAP_STORED_PROCEDURE_PREFER_TEMP_TABLE | 设置为“yes”以使用临时表来支持存储过程结果集上的远程查询。 |
| CAP_STORED_PROCEDURE_REPAIR_TEMP_TABLE_STRINGS | 设置为“yes”以在元数据指明无宽度或非正宽度的情况下尝试计算实际字符串宽度。 |
| CAP_STORED_PROCEDURE_TEMP_TABLE_FROM_BUFFER | 设置为“yes”以通过整体缓冲的结果集填充临时表。 |
| CAP_STORED_PROCEDURE_TEMP_TABLE_FROM_NEW_PROTOCOL | 设置为“yes”以通过仅为此操作创建的单独协议填充临时表。 |
| CAP_SUPPRESS_DISCOVERY_QUERIES | 设置为“yes”以阻止 Tableau 检测各种子句的受支持的 SQL 语法。 |
| CAP_SUPPRESS_DISPLAY_LIMITATIONS | 设置为“yes”以抑制显示有关此数据源的限制的任何警告。 |
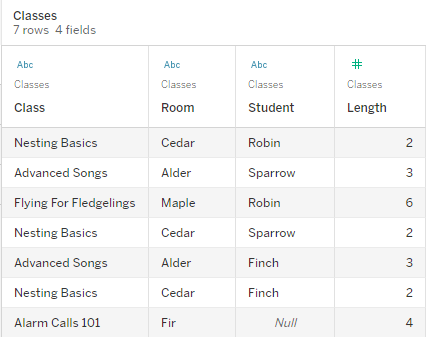
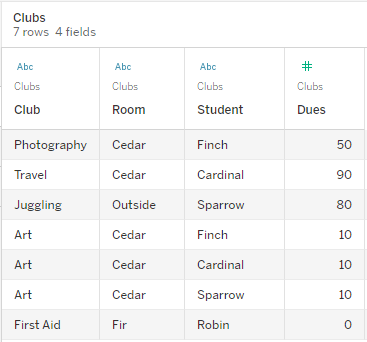
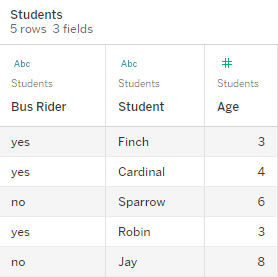
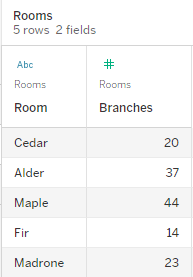
Classes(班级) | Clubs(俱乐部) | Students(学生) | Rooms(房间) |
![]() | ![]() | ![]() | ![]() |
字段:
| 字段:
| 字段:
| 字段:
|
不相关:交叉联接 | 拼接:中间内部联接的外部联接 |
![]() 一个可视化项,显示了“Classes”(班级)和“Clubs”(俱乐部)的交叉联接,其中行代表“Advanced Songs”(高级歌曲)/“Alarm Calls 101”(报警电话 101)/“Flying for Fledglings”(雏鸟飞行)/“Nesting Basics”(筑巢基础)与“Art”(艺术)/“First Aid”(急救)/“Juggling”(杂耍)/“Photography”(摄影)的每个组合。 | ![]() 一个可视化项,显示了学生-班级内部联接和以及学生-俱乐部内部联接的外部联接结果。并非所有班级和俱乐部的组合都有代表,并且没有班级的学生和俱乐部也有行。 |
| 语言 | 关键字 |
| 英语(英国和美国) | Year、Yr、Day、Day of Week、Week、Wk、Month、Quarter、Qtr、FY |
| 中文(简体) | 年, 天, 周中某天, 周, 月, 季度, 会计年度 |
| 中文(繁体) | 年, 天, 週中某天, 週, 月, 季, 會計年度 |
| 荷兰语 | Jaar、Jr、Dag、Dag Van De Week、Week、Wk, Maand、Kwartaal、Q, |
| 法语(加拿大和法国) | Année, Jour, Jour de la Semaine, Semaine, Mois, Trimestre, AF |
| 德语 | Jahr, Tag, Wochentag, Woche, Monat, Quartal, GJ |
| 意大利语 | Anno, Giorno, Giorno della Settimana, Settimana, Sett, Mese, Trimestre, Trim, AF |
| 日语 | 年, 日, 曜日, 週, 月, 四半期, 年度 |
| 朝鲜语 | 년, 일, 요일, 주, 월, 분기, 회계 연도 |
| 葡萄牙语 | Ano, Dia, Dia da Semana, Semana, Mês, Trimestre, AF |
| 西班牙语 | Año, Día, Día de la Semana, Semana, Mes, Trimestre, AF |
| 瑞典语 | År, Dag, Veckodag, Vecka, Månad, Kvartal, Räkenskapsåret |
| 泰语 | ปี, วัน, วันของสัปดาห์, สัปดาห์, เดือน, ไตรมาส, FY |
| CIF | FDA | MPI |
| DMA | FOB | MSA |
| DOB | FTE | SKU |
| EIN | KPI | UPC |
| ESP | LOB | URL |
| USD |
| 1st | as | down | of | th(数字后面的后缀) |
| 2nd | at | for | on | than |
| 3rd | but | in | off | the |
| a | by | inclu. | or | to |
| an | de | into | over | vs |
| and | da | la | per | with |
| 见解类型 | 定义 |
| 集中贡献 | 显示少数维度成员何时占对指标贡献的大部分(50% 或更多)。 |
| 主要驱动因素 | 显示与观察到的指标变化方向相同的变化最大的维度成员的值。 |
| 当前趋势 | 显示当前趋势以传达指标值的变化率、方向和波动。 |
| 趋势变化 | 显示与当前趋势显著不同的新趋势。这种见解传达了指标值的变化率、方向和波动。 |
| 排名靠后的促成因素 | 显示给定时间范围内指标的维度最低值。 |
| 主要贬损因素 | 显示与观察到的指标变化相反方向变化最大的维度成员的值。 |
| 意外值(异常值) | 显示给定时间范围内的指标值何时高于或低于基于该指标的历史观察结果的预期范围。 |
| 日期级别 | 转换为会计等效项时 |
|---|---|
| 年 | 反映会计年度。例如,如果“会计年度开始”设置为 4 月,日期“2004 年 6 月 1 日”的年份将显示为 FY 2005。 |
| 季度 | “季度”反映会计季度。例如,如果“会计年度开始”设置为 4 月,日期“2004 年 6 月 1 日”的季度将为 Q1。 |
| 月 | 行为没有任何更改。日历月与会计月相同。 |
| 日 | 行为没有任何更改。日历日与会计日相同。 |
| 小时 | 行为没有任何更改。日历小时与会计小时相同。 |
| 分钟 | 行为没有任何更改。日历分钟与会计分钟相同。 |
| 秒 | 行为没有任何更改。日历秒与会计秒相同。 |
| 周数 | “周数”反映会计周数。例如,如果“会计年度开始”设置为 4 月,日期“2004 年 4 月 1 日”的周数将为 1。 |
| 平日 | 行为没有任何更改。日历平日与会计平日相同。 |
| MM/YYYY | 行为没有任何更改。此日期格式始终显示日历日期,即使指定了会计年度也是如此。 |
| M/D/Y | 此日期格式始终显示日历日期,即使指定了会计年度也是如此。 |
| 日期部分或截断 | 使用会计日历时 |
| 年份日期部分 | “会计年度开始”设置为 4 月,日期“2004 年 6 月 1 日”的年份将显示为 FY 2005。 |
| 季度日期部分 | “会计年度开始”设置为 4 月,日期“2004 年 6 月 1 日”的季度将为 Q1。 |
| 周数日期部分 | “会计年度开始”设置为 4 月,日期“2004 年 4 月 1 日”的周数将为 1。 |
| 年份日期截断 | “会计年度开始”设置为 5 月,日期“2004 年 6 月 1 日”将变为 2004 年 5 月 1 日。 |
| 季度日期截断 | “会计年度开始”设置为 7 月,日期“2004 年 6 月 1 日”将变为 2004 年 4 月 1 日。 |
正确:“Invoices”(发票)和“Appointments”(预约)作为基表 | 错误:“Doctors”(医生)和“Patients”(患者)作为基表 |
![]() | ![]() |
基表 | 共享表 |
数据仓库架构中的事实表 | 数据仓库架构中的共享或一致维度表 |
具体到上下文或分析 (航班信息、能源使用情况) | 在不同上下文中保持一致的概念 (日期、地点) |
测量重量 | 主要维度 |
更新/事务性更频繁 (医疗预约、处方、生命体征) | 更稳定/持久 (医生、患者) |
具有外键字段 | 具有主键字段 |
基于事件 (课程表、作业成绩) | 基于实体 (学生,教室) |
| 部分 | 描述 | 示例 |
|---|---|---|
Prediction(预测) 预测反映使用案例的目标。 | 目标是最大化或最小化结果。例如,您的目标可能是最大限度地减少运输时间或最大限度地提高每批货物的平均销售收入。 |
|
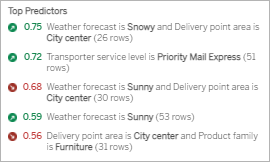
Top Predictors(首要预测因子) 对预测结果影响最大的条件,按大小递减。 | 条件是与字段关联的数据值。 预测因子由一个或两个条件组成。如果显示两个条件,则它们由 and 连接,代表这些条件的交集。 绿色(向上箭头)表示预测因子改善了预测结果。 红色(向下箭头)表示预测因子使预测结果恶化。 |
|
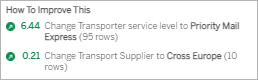
How To Improve This(如何改进这一点) 用户可以采取的改进预测结果的建议操作。 | 改进与用户可能控制的因素相关,例如送货方式或订阅者的会员级别。 |
|
| 对于 Tableau Desktop | 对于 Tableau Prep Builder | 对于 Tableau Server、Tableau Prep Conductor、Tableau Prep Flow Authoring |
|---|---|---|
|
|
|
| 适用于 Tableau Desktop | 对于 Tableau Prep Builder | 对于 Tableau Server |
|---|---|---|
|
|
|
| 适用于 Tableau Desktop | 对于 Tableau Prep Builder | 对于 Tableau Server、Tableau Prep Conductor、Tableau Prep Flow Authoring |
|---|---|---|
|
|
若要为 Prep 启用连接器,您还需要将 taco 添加到以下位置:
|
Tableau 中支持的 SRS/EPSG 代码: |
3857 - WGS 84/伪墨卡托投影 [默认] 4326 - WGS 84 4269 - NAD83 3824 - TWD97 3889 - IGRS 4019 - 基于 GRS 80 椭圆体的未知数据 4023 - MOLDREF99 4030 - 基于 WGS 84 椭圆体的未知数据 4031 - 基于 GEM 10C 椭圆体的未知数据 4046 - RGRDC 2005 4075 - SREF98 4081 - REGCAN95 4126 - LKS94 (ETRS89) 4130 - Moznet 4140 - NAD83(CSRS98) 4148 - Hartebeesthoek94 4151 - CHTRF95 4152 - NAD83(HARN) 4163 - Yemen NGN96 4166 - Korean 1995 4167 - NZGD2000 4170 - SIRGAS 1995 4171 - RGF93 4172 - POSGAR 4173 - IRENET95 4176 - 澳大利亚南极 4180 - EST97 4189 - REGVEN 4190 - POSGAR 98 4258 - ETRS89 4283 - GDA94 4319 - KUDAMS 4612 - JGD2000 4617 - NAD83(CSRS) 4619 - SWEREF99 4627 - RGR92 4640 - RRAF 1991 4645 - RGNC 1991 4659 - ISN93 4661 - LKS92 4667 - IKBD-92 4669 - LKS94 4670 - IGM95 4674 - SIRGAS 2000 4686 - MAGNA-SIRGAS 4687 - RGPF 4693 - Nakhl-e Ghanem 4694 - POSGAR 94 4702 - Mauritania 1999 4737 - Korea 2000 4742 - GDM2000 4747 - GR96 4749 - RGNC91-93 4755 - DGN95 4756 - VN-2000 4757 - SVY21 4758 - JAD2001 4759 - NAD83(NSRS2007) 4761 - HTRS96 4762 - BDA2000 4763 - Pitcairn 2006 4764 - RSRGD2000 4765 - Slovenia 1996 102100 - WGS 84 Web 墨卡托投影(辅助球面) |
| “数据解释”功能无法在使用以下各项的视图中运行: |
|
如果选择以下各项,“数据解释”功能将无法运行: |
|
| 当要用于解释的度量满足以下条件时,“数据解释”功能无法运行: |
|
当维度满足以下条件时,“数据解释”功能无法为其提供解释: |
|
| 如果您正在使用 Einstein Discovery,请选择“启用”。您的默认浏览器将打开,允许您授权与 Salesforce 的连接。连接后,转到帮助主题的Einstein Discovery部分以继续。 | 对于所有其他服务(Tabpy、Matlab 和 Rserve),将显示以下对话框。 |
![]() | ![]() |
| 可选参数 | 语法 | 描述 |
|---|---|---|
| maxMiddleValues | "maxMiddleValues": integer | 指定要在响应中返回的顶级预测因子的数量。 设置为整数。 只能与回归和二元分类模型一起使用。 |
| maxPrescriptions | "maxPrescriptions": integer | 指定要在响应中返回的最大改进数量。 设置为整数。 只能与回归和二元分类模型一起使用。 |
| showMultiClassProbabilities | "showMultiClassProbabilities": boolean | 选择是否显示多类分类模型的概率。 设置为 true 或 false。 只能与多类分类模型一起使用。 |
| 所有维度 | 子类 | 区域 |
|---|---|---|
![]() | ![]() | ![]() |
| 这 5 个标记将合并在一起,而其余标记将添加到“Other”类别中。 | 与三个子类中的任何一个关联的所有标记都将合并在一起,而所有其他标记将添加到“Other”类别中。 | 与四个区域中关联的所有标记都将合并在一起,而所有其他标记将添加到“Other”类别中。 |
| 发布自定义字体工作流程
则
|
如果 | 则 |
A- 工作簿是在 Tableau Desktop 中创建的。 | 您可以在工作簿中使用计算机上安装的任何字体。 |
B- 工作簿是使用 Web 制作创建的。 | 设置文本格式时,只有 Tableau Server 或 Tableau Cloud 上安装的字体才起作用。 |
C- 工作簿发布到 Tableau Server。 | 必须在所有服务器节点上安装任何自定义字体。 如果 Tableau Server 上未安装字体,则在发布时,未安装的字体将被替换为替代字体。 |
D- 工作簿发布到 Tableau Cloud。 | 仅显示 Tableau Cloud 支持的字体。 在发布时,工作簿中的任何不支持的字体将被替换为替代字体。有关支持的字体的列表,请参见知识库文章:字体未按预期显示。 |
问题 | 可能的解决方案 |
|---|---|
某些字体在视图中正确,但其他字体不正确。 | 当视图有许多标记时,服务器将在服务器端呈现标记,并将标记显示为静态图像。这可能会导致视图中的某些字体看起来与视图的其余部分不一致。若要解决此问题,请减少每个视图的标记数。 |
对于不同的查看者,字体上的间距看起来是不同的。 | 如果查看者在其计算机上安装了自定义字体,则查看者将看到正确显示的字体。但是,每个浏览器都使用略有不同的方法来呈现字体,因此不同浏览器之间的字体显示略有不同是正常的。 |
为查看者显示的字体不同。 | 如果查看者没有在其计算机上安装自定义字体,则工作簿中任何未安装的字体将被替换为浏览器选择的替代字体。 |
| 样式元素 | 描述 | 样式属性 | 输入类型 | 格式设置选择 |
|---|---|---|---|---|
| all | 设置整个工作簿的所有字体的格式。 | font-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。 |
| font-family | 字符串 | 最大长度为 50 个字符的字符串。 | ||
| worksheet | 设置工作表默认字体的格式。 | font-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。 |
| font-family | 字符串 | 最大长度为 50 个字符的字符串。 | ||
| font-size | 整数 | 最小值为 1,最大值为 99 的整数。 | ||
| worksheet-title | 设置工作表标题字体的格式 。 | font-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。 |
| font-family | 字符串 | 最大长度为 50 个字符的字符串。 | ||
| font-size | 整数 | 最小值为 1,最大值为 99 的整数。 | ||
| tooltip | 设置工具提示字体的格式。 | font-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。 |
| font-family | 字符串 | 最大长度为 50 个字符的字符串。 | ||
| font-size | 整数 | 最小值为 1,最大值为 99 的整数。 | ||
| dashboard-title | 设置仪表板标题的格式。 | font-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。 |
| font-family | 字符串 | 最大长度为 50 个字符的字符串。 | ||
| font-size | 整数 | 最小值为 1,最大值为 99 的整数。 | ||
| font-weight | 字符串 | 指定为 normal或 bold 的字符串。 | ||
| story-title | 设置故事标题字体的格式。 | font-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。 |
| font-family | 字符串 | 最大长度为 50 个字符的字符串。 | ||
| font-size | 整数 | 最小值为 1,最大值为 99 的整数。 | ||
| header | 设置标题字体的格式。 | font-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。 |
| font-family | 字符串 | 最大长度为 50 个字符的字符串。 | ||
| legend | 设置图例正文字体和背景颜色的格式。 | font-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。 |
| font-family | 字符串 | 最大长度为 50 个字符的字符串。 | ||
| font-size | 整数 | 最小值为 1,最大值为 99 的整数。 | ||
| background-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。此元素还支持两个附加数字以实现透明度,例如 #FF000080。 | ||
| legend-title | 设置所有工作表上的图例标题字体的格式。 | font-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。 |
| font-family | 字符串 | 最大长度为 50 个字符的字符串。 | ||
| font-size | 整数 | 最小值为 1,最大值为 99 的整数。 | ||
| filter | 设置所有工作表上的筛选器正文字体和背景颜色的格式。 | font-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。 |
| font-family | 字符串 | 最大长度为 50 个字符的字符串。 | ||
| font-size | 整数 | 最小值为 1,最大值为 99 的整数。 | ||
| background-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。此元素还支持两个附加数字以实现透明度,例如 #FF000080。 | ||
| filter-title | 设置所有工作表上的筛选器标题字体的格式。 | font-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。 |
| font-family | 字符串 | 最大长度为 50 个字符的字符串。 | ||
| font-size | 整数 | 最小值为 1,最大值为 99 的整数。 | ||
| parameter-ctrl | 设置所有工作表上的参数正文字体和背景颜色的格式。 | font-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。 |
| font-family | 字符串 | 最大长度为 50 个字符的字符串。 | ||
| font-size | 整数 | 最小值为 1,最大值为 99 的整数。 | ||
| background-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。此元素还支持两个附加数字以实现透明度,例如 #FF000080。 | ||
| parameter-ctrl-title | 设置所有工作表上的参数控件标题字体的格式。 | font-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。 |
| font-family | 字符串 | 最大长度为 50 个字符的字符串。 | ||
| font-size | 整数 | 最小值为 1,最大值为 99 的整数。 | ||
| highlighter | 设置所有工作表上的荧光笔正文字体和背景颜色的格式。 | font-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。 |
| font-family | 字符串 | 最大长度为 50 个字符的字符串。 | ||
| font-size | 整数 | 最小值为 1,最大值为 99 的整数。 | ||
| background-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。此元素还支持两个附加数字以实现透明度,例如 #FF000080。 | ||
| Highlighter-title | 设置所有工作表上的荧光笔控件标题字体的格式。 | font-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。 |
| font-family | 字符串 | 最大长度为 50 个字符的字符串。 | ||
| font-size | 整数 | 最小值为 1,最大值为 99 的整数。 | ||
| page-ctrl-title | 设置所有工作表上的页面卡标题字体的格式。 | font-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。 |
| font-family | 字符串 | 最大长度为 50 个字符的字符串。 | ||
| gridline | 设置视图上的网格线的格式。 | line-visibility | 字符串 | 指定为 on 或 off.的字符串。 |
| line-pattern | 字符串 | 指定为 dotted、dashed 或 solid 的字符串。 | ||
| line-width | 整数 | 最小值为 1,最大值为 99 的整数。 | ||
| line-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。此元素还支持两个附加数字以实现透明度,例如 #FF000080。 | ||
| zeroline | 设置视图上的零线的格式。 | line-visibility | 字符串 | 指定为 on 或 off.的字符串。 |
| line-pattern | 字符串 | 指定为 dotted、dashed 或 solid 的字符串。 | ||
| line-width | 整数 | 最小值为 1,最大值为 99 的整数。 | ||
| line-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。此元素还支持两个附加数字以实现透明度,例如 #FF000080。 | ||
| mark | 设置视图上的标记颜色的格式。 | mark-color | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。 |
| view | 设置视图的背景颜色的格式。 | 字符串 | 遵循十六进制颜色代码格式的字符串,例如 #FF0000。 |
| 选择工具 | 矩形 | 径向 | 套索 | 行驶时间 |
|---|---|---|---|---|
| 形状 | 矩形 | 圆形 | 自由格式路径 | 行驶时间多边形 |
| 基础 | 视觉边界 | 直线距离 | 视觉边界 | 行驶时间和路线 |
| 需要网络 | 否 | 否 | 否 | 是 |
| 扩展过去的视图 | 否 | 是 | 否 | 是 |
| 最深 | 指定应该按最精细级别执行计算。这是默认选项。 |
| 订单日期季度 | 指定应该按季度级别执行计算。 |
| 订单日期月份 | 指定应该按月份级别执行计算。
|
| Min | 字段的最小值。 |
| Max | 字段的最大值。 |
| Diff | 字段的最小和最大值之间的差。 |
| CntD | 数据中不同值(行)的数量。 |
销售额
| 产品目录
|
| 产品 ID | 产品名称 | 产品 ID | 销售额 | 交易日期 |
| 1 | 10 英寸平板电脑 | 1 | 100 | 2012 年 10 月 1 日 |
| 1 | 10 英寸平板电脑 | 1 | 2000 | 2012 年 10 月 2 日 |
| 2 | 智能手机 | 2 | 50 | 2012 年 9 月 30 日 |
| 3 | 台灯 | 3 | 10 | 2012 年 8 月 21 日 |
表 A 和表 X 不相关 | 表 B 和表 X 不相关 |
![]() | ![]() |
表 A 和表 S 相关 | 表 B 和表 S 相关(通过表 A) |
![]() | ![]() |
| 尚未相关 | 模糊相关 | 相关性性解析为单一树 | |
| 通过基础表 A 相关 | 通过基表 X 相关 | ||
![]() | ![]() | ![]() | ![]() |
拼接 | 解析不确定性 |
![]() 不相关的 FieldA 和 FieldX 通过 DimensionS 拼接 | ![]() 通过基表 A 定义的树评估 FieldS 和 FieldT |
| 基于共享属性并列不相关的字段 | 当有多个选项(模糊性或共享度量)时缩小要使用的关系路径,或当没有关系路径(尚不相关)时建立关系路径。 |
使用多基表逻辑来计算结果 | 使用单基表逻辑来计算结果 |
| 分析涉及不相关的表 | 分析涉及共享表 |
Classes(班级) | Clubs(俱乐部) | Students(学生) |
![]() | ![]() | ![]() |
字段:
| 字段:
| 字段:
|
| 已解决的问题 | 修复截止日期 |
数据提取 本地数据源(在工作簿中):尝试提取多事实关系数据源将出现“No such table”(没有这样的表)错误。 已发布数据源:提取已发布的多事实关系数据源似乎成功,但字段值可以交换。 |
如果您在 Tableau Desktop 或 Tableau Server 中仍然看到这些问题,请升级到 2024 年 7 月 24 日或更高版本。 |
EXCLUDE 详细级别表达式 仅当存在不相关字段时才应验证 INCLUDE LOD。然而,在相同条件下,EXCLUDE LOD 也可能被错误地标记为无效。 | |
嵌套用户计算 嵌套用户计算在具有多事实关系数据模型的已发布数据源中不可用。 |
一对一
示例:每辆车都有自己的车牌,车牌是特定于一辆汽车的。汽车与车牌的关系是一对一的。 请注意,即使汽车未注册或车牌号尚未分配给汽车,该差异也由引用完整性描述。汽车只能有一个车牌,车牌只能分配给一辆车,所以关联基数一直是一对一。 |
![]() |
一对多或多对一
示例:多名雇员同属于一名经理。员工与经理的关系是多对一的。经理与员工的关系是一对多的。 |
![]()
|
多对多
示例:一名演员出演多部电影,而一部电影有多名演员。演员与电影的关系是多对多的。在同一笔交易中可以购买多本书,也可以多次购买一本书。ISBN 与订单 ID 的关系是多对多的。 |
![]() |
| 关联 | 在合并来自不同详细级别的数据时使用。
|
| 联接 | 在需要在同一行结构上添加更多数据列时使用。
|
| 并集 | 在需要添加具有相同列结构的更多行数据时使用。
|
| 混合 | 在合并来自不同详细级别的数据时使用。
|
| 语法 | REGEXP_REPLACE(string, pattern, replacement) |
| 输出 | 字符串 |
| 定义 | 返回给定字符串的副本,其中正则表达式模式被替换字符串取代。 |
| 示例 | REGEXP_REPLACE('abc 123', '\s', '-') = 'abc-123' |
| 说明 | 此函数可用于文本文件、Hadoop Hive、Google BigQuery、PostgreSQL、Tableau 数据提取、Microsoft Excel、Salesforce、Vertica、Pivotal Greenplum、Teradata(版本 14.1 及更高版本)、Snowflake 和 Oracle 数据源。 对于 Tableau 数据提取,模式和替换字符串必须为常量。 |
| 语法 | REGEXP_MATCH(string, pattern) |
| 输出 | 布尔值 |
| 定义 | 如果指定的字符串的子字符串匹配正则表达式模式,则返回 true。 |
| 示例 | REGEXP_MATCH('-([1234].[The.Market])-','\[\s*(\w*\.)(\w*\s*\])')=true |
| 说明 | 此函数可用于文本文件、Google BigQuery、PostgreSQL、Tableau 数据提取、Microsoft Excel、Salesforce、Vertica、Pivotal Greenplum、Teradata(版本 14.1 及更高版本)、Impala 2.3.0(通过 Cloudera Hadoop 数据源)、Snowflake 和 Oracle 数据源。 对于 Tableau 数据提取,模式必须为常量。 |
| 语法 | REGEXP_EXTRACT(string, pattern) |
| 输出 | 字符串 |
| 定义 | 返回与正则表达式模式匹配的字符串部分。 |
| 示例 | REGEXP_EXTRACT('abc 123', '[a-z]+\s+(\d+)') = '123' |
| 说明 | 此函数可用于文本文件、Hadoop Hive、Google BigQuery、PostgreSQL、Tableau 数据提取、Microsoft Excel、Salesforce、Vertica、Pivotal Greenplum、Teradata(版本 14.1 及更高版本)、Snowflake 和 Oracle 数据源。 对于 Tableau 数据提取,模式必须为常量。 |
| 语法 | REGEXP_EXTRACT_NTH(string, pattern, index) |
| 输出 | 字符串 |
| 定义 | 返回与正则表达式模式匹配的字符串部分。子字符串匹配到第 n 个捕获组,其中 n 是给定的索引。如果索引为 0,则返回整个字符串。 |
| 示例 | REGEXP_EXTRACT_NTH('abc 123', '([a-z]+)\s+(\d+)', 2) = '123' |
| 说明 | 此函数可用于文本文件、PostgreSQL、Tableau 数据提取、Microsoft Excel、Salesforce、Vertica、Pivotal Greenplum、Teradata(版本 14.1 及更高版本)和 Oracle 数据源。 对于 Tableau 数据提取,模式必须为常量。 |
| Tableau Desktop | Tableau Prep Builder |
![]() | ![]() |
| 原因 | 方案 |
|---|---|
| 您没有正确的权限。 |
|
| 您无法访问完整数据。 |
|
| 工作簿数据源的密码未嵌入或不再有效。 |
|
| 数据没有位于正确的粒度级别。 |
|
| 不支持日期维度。 |
|
| 工作簿 | 数据源 |
|---|---|
|
|
| 版本 9.x 调色板名称 | 版本 9.x 十六进制值 |
|---|---|
Tableau 10 现在称为 Tableau Classic 10。
| <color-palette name="Classic 10" type="regular"> |
Tableau 10 Medium 现在称为 Tableau Classic Medium。
| <color-palette name="Classic 10 Medium" type="regular">
|
Tableau 10 Light
| <color-palette name="Classic 10 Light" type="regular">
|
Tableau 20 现在称为 Tableau Classic 20。
| <color-palette name="Classic 20" type="regular">
<color>#9edae5</color>
<color>#17becf</color>
<color>#dbdb8d</color>
<color>#bcbd22</color>
<color>#c7c7c7</color>
<color>#7f7f7f</color>
<color>#f7b6d2</color>
<color>#e377c2</color>
<color>#c49c94</color>
<color>#8c564b</color>
<color>#c5b0d5</color>
<color>#9467bd</color>
<color>#ff9896</color>
<color>#d62728</color>
<color>#98df8a</color>
<color>#2ca02c</color>
<color>#ffbb78</color>
<color>#ff7f0e</color>
<color>#aec7e8</color>
<color>#1f77b4</color>
|
Gray 5
替换为“Seattle Grays”。 | <color-palette name="Classic Gray 5" type="regular">
<color>#cfcfcf</color>
<color>#8f8782</color>
<color>#414451</color>
<color>#a5acaf</color>
<color>#60636a</color>
|
Color Blind 10
更新为“Color Blind”。 | <color-palette name="Classic Color Blind" type="regular">
|
Traffic Light
更新为“Traffic Light”。 | <color-palette name="Classic Traffic Light" type="regular">
|
Purple-Gray 6
已停用。 | <color-palette name="Classic Purple-Gray 6" type="regular">
|
Purple-Gray 12
更新为“Purple-Pink-Gray”。 | <color-palette name="Classic Purple-Gray 12" type="regular">
|
Green-Orange 6
已停用。 | <color-palette name="Classic Green-Orange 6" type="regular">
|
Green-Orange 12
更新为“Green-Orange-Teal”。 | <color-palette name="Classic Green-Orange 12" type="regular">
|
Blue-Red 6
已停用。 | <color-palette name="Classic Blue-Red 6" type="regular">
|
Blue-Red 12
更新为“Blue-Red-Brown”。 | <color-palette name="Classic Blue-Red 12" type="regular">
|
Cyclic
更新为“Hue Circle”。 | <color-palette name="Classic Cyclic" type="regular"> |
Green
已更新。 | <color-palette name="Classic Green" type="ordered-sequential">
|
Gray
已更新。 | <color-palette name="Classic Gray" type="ordered-sequential">
|
Blue
已更新。 | <color-palette name="Classic Blue" type="ordered-sequential">
|
Red
已更新。 | <color-palette name="Classic Red" type="ordered-sequential">
|
Orange
已更新。 | <color-palette name="Classic Orange" type="ordered-sequential">
|
Area Red
已停用。 | <color-palette name="Classic Area Red" type="ordered-sequential">
|
Area Green
已停用。 | <color-palette name="Classic Area Green" type="ordered-sequential">
|
Area Brown
已停用。 | <color-palette name="Classic Area-Brown" type="ordered-sequential">
|
Red-Green Diverging
已更新。 | <color-palette name="Classic Red-Green" type="ordered-diverging">
|
Red-Blue Diverging
已更新。 | <color-palette name="Classic Red-Blue" type="ordered-diverging">
|
Red-Black Diverging
已更新。 | <color-palette name="Classic Red-Black" type="ordered-diverging">
|
Area Red-Green Diverging
已停用。 | <color-palette name="Classic Area Red-Green" type="ordered-diverging"> |
Orange-Blue Diverging
已更新。 | <color-palette name="Classic Orange-Blue" type="ordered-diverging">
|
Green-Blue Diverging
已更新。 | <color-palette name="Classic Green-Blue" type="ordered-diverging">
|
Red-White-Green Diverging
已更新。 | <color-palette name="Classic Red-White-Green" type="ordered-diverging">
|
Red-White-Black Diverging
已更新。 | <color-palette name="Classic Red-White-Black" type="ordered-diverging">
|
Orange-White-Blue Diverging
已更新。 | <color-palette name="Classic Orange-White-Blue" type="ordered-diverging">
|
Red-White-Black Light
已停用。 | <color-palette name="Classic Red-White-Black Light" type="ordered-diverging">
|
Orange-White-Blue Light Diverging
已停用。 | <color-palette name="Classic Orange-White-Blue Light" type="ordered-diverging">
|
Red-White-Green Light Diverging
已停用。 | <color-palette name="Classic Red-White-Green Light" type="ordered-diverging">
|
Red-Green Light Diverging
已停用。 | <color-palette name="Classic Red-Green Light" type="ordered-diverging">
|
| 预测标记类型 | 预测区域显示方式 |
| 线 | 区间 |
| 形状、正方形、圆形、条形或饼形 | 须线 |
| F4 | 开始和停止向前播放 |
| SHIFT + F4 | 开始和停止向后播放 |
| Ctrl + . | 向前跳一页 |
| Ctrl + , | 向后跳一页 |
| F4 | 开始和停止向前播放 |
| Shift-F4 | 开始和停止向后播放 |
| Command-句号键 | 向前跳一页 |
| Command-逗号键 | 向后跳一页 |
| 您的数据 | 旧版连接 | 默认连接 |
|---|---|---|
| 文件名长度 | 不允许连接到文件名长度超过 64 个字符的文件。 | 文件名无长度限制。 |
| 文件名中的多个句点 | 不允许连接到文件名包含多个句点的文件。 | 文件名无句点限制。 |
| 文件中的列数 | 使用第一行中的字段数来确定文件中的列数。 | 扫描整个文件并使用行中最常见的字段数来确定文件中的列数。 |
| 标题行 | 不自动检测文件中的第一行是否为标题。 注意: 可以手动地指定文件中的第一行是标题。 | 自动检测文件中的第一行是否为标题。 注意: 可以手动地替代此检测。 |
| 空列 | 空列可见。 | 隐藏空列,因为它们不包含任何值。 |
| 您的数据 | 旧版连接 | 默认连接 |
|---|---|---|
| 字段名称中的字符数 | 字段名称被截断为 64 个字符。 | 字段名称中的字符数无限制。 |
| 字段名称中的特殊字符 | 在字段名称中不允许特殊字符。例如,引号和句点等特殊字符会被转换为数字符号。方括号会被转换为圆括号。 | 在字段名称中允许特殊字符。 |
| 字段名称中的前导和尾随空格 | 允许字段名称中的前导和尾随空格。 | 自动从列名称中删除字段名称中的前导和尾随空格。 |
| 重复的字段名称 | 对于重复的字段名称,将向字段名称附加索引编号。 例如,测试分数1。 | 对于重复的字段名称,将向字段名称附加一个空格和索引编号。 例如,测试分数 1。 |
| Excel 单元格格式 | 支持使用 Excel 中的“设置单元格格式”选项来配置的单元格格式。 | 不支持使用 Excel 中的“设置单元格格式”选项来配置的单元格格式。 |
| 货币值的精度 | 包含货币值的字段用四位数的最大精度来表示 | 表示全精度的货币值。 |
| 您的数据 | 旧版连接 | 默认连接 |
|---|---|---|
| 文件名中的特殊字符 | 在文件名中不允许特殊字符。 例如,句点等特殊字符会被转换为数字符号。 | 允许特殊字符。 |
| 标题字段名称中的字符 | 从标题字段名称中自动删除前导空格。 | 从标题字段名称中自动删除前导和尾随空格。 |
| 字符分隔符 | 仅将逗号识别为字段分隔符。 注意: 可以手动地替代此检测。 | 自动检测字段分隔符。 注意: 可以手动地替代此检测。 |
| 引号包围的文本 | 用于包围文本值的引号保持可见。 | 自动隐藏用于包围文本值的引号。 |
| ANSI 和 OEM 代码页 | 支持 ANSI 和 OEM 代码页。 | ANSI 和 OEM 代码页自动转换为跨平台兼容。 |
| BOM 代码页 | 不一致地支持 BOM 代码页。 | 支持 BOM 代码页。 |
| 数据类型检测 | 旧版连接 | 默认连接 |
|---|---|---|
| 列 | 列的数据类型由前 8 行确定。
注意: 在确定了表格中的列的数据类型后,无法更改该类型。 | 列的数据类型由前 10000 行的 95% 确定。
注意: 可以手动地替代此检测。 |
| 无时间的日期值 | 日期值被分配日期时间数据类型。 | 无时间的日期值被分配日期数据类型。有时间的日期值被分配日期时间数据类型。 |
| 数字值 | 所有数字值均表示为实数。 | 无小数点的数字值表示为整数。 |
| null 值 | 如果列包含 null 单元格,则列的数据类型自动指定为字符串数据类型。 | null 单元格不会影响数据类型的检测。 |
| 引用错误或空单元格 | 如果列包含出现引用错误的单元格或空单元格,则整列会被解释为字符串数据类型。 | 引用错误或没有值的单元格不会影响数据类型的检测。 |
| 替代数据类型的检测 | 在确定了表格中的列的数据类型后,无法更改该类型。 | 在自动检测后可以更改列的数据类型。 |
| 时间值精度 | 时间值的最小测量单位是整秒。 | 时间值的最小测量单位是小数形式的秒。 |
| DecimalSymbol 和 CurrencyDecimalSymbol schema.ini 值 | 可以识别 DecimalSymbol 和 CurrencyDecimalSymbol schema.ini 值。 | 可以识别 DecimalSymbol 和 CurrencyDecimalSymbol scheam.ini 值。但是,如果同时使用这两个值,则 DecimalSymbol 优先。 |
| 设置为文本格式的单元格 | 在使用 Excel 中的“设置单元格格式”选项将单元格的格式设置为文本时,列的数据类型被检测为字符串数据类型。 | 不支持使用 Excel 中的“设置单元格格式”选项来配置的单元格格式。 |
| Tableau Desktop 版本 | Web 版本 |
|
|
| Tableau Desktop 版本 | Web 版本 |
|
|
| 单独发布、 | 嵌入工作簿中 |
|---|---|
发布数据源是实现数据集中管理的一步。您可以创建专为最大程度减少数据源扩散并帮助用户找到适合其工作的正确数据而设计的策略。 | 每个嵌入的数据源具有单独的数据连接。 在任何给定的时间,每个人显示的内容都可能与其他人显示的内容不同(数据源扩散是常见现象)。 |
应该共享;可供要连接到的其他 Tableau 用户使用。 | 数据只能用于工作簿内部;无法供要连接到的其他 Tableau Desktop 用户使用。 |
如果没有内容管理和自助服务准则,看到一长列要连接的数据源可能会对依赖于数据完成工作的用户造成困惑,而且很难在服务器上进行管理。 | 用户创建自己的连接,并且准确地知道他们所获取的内容。 |
更改共享数据源的用户可能会不确定或不了解他们所做更改对连接的工作簿产生的影响。 | 更改数据需要打开工作簿,在其中您可以看到更改的结果。 |
即使数据源更改对已连接工作簿的影响已在规划之中,但更新这些已连接工作簿也非常繁琐。 | 同上所述;但是,如果多个工作簿使用类似的数据并且需要更新,则改为连接到发布的数据源可能是值得的。 |
数据提取可以按计划刷新。您为数据提取设置一个刷新计划,连接到该数据提取的所有工作簿始终会显示最新数据。 | 未刷新的嵌入式数据提取可用于及时显示快照。 如果想要使数据保持最新,则每个工作簿都必须有自己的刷新计划。 |
通常可帮助您在服务器或站点上优化性能。 | 当服务器包含连接到相同原始数据的多个工作簿,并且每个工作簿有其自己的刷新计划时,性能可能会受到影响。 |
| 限制 | 默认值 | 错误消息 | 检查时间 |
| 每个组合数据源的数据源 | 500 | 此组合数据源中的数据源太多。 | 打开或使用组合数据源,包括使用数据源加载工作簿。 |
| 总依赖项 | 100 | 不支持发布具有超过 100 个 PDS 依赖项的数据源。 | 您发布一个组合数据源。 |
| 嵌套深度 | 20 | 不支持发布包含超过 20 个嵌套层的数据源。 | 您发布一个组合数据源。 |
May2016
| June2016
| July2016
|
August2016
|
并集(具有空值)
|
| (包含已合并的列的)并集
|
| 普通颜色图例 | 颜色图例突出显示已启用 | |
![]() | ![]() |
| 地震日期时间 | ID | 震级 | 震级^10 | 纬度 | 经度 |
| 1/1/73 | centennial19730101114235 | 6.00000 | 17,488,747.04 | -35.570 | -15.427 |
| 1/2/73 | pde19730102005320300_66 | 5.50000 | 25,329,516.21 | -9.854 | 117.427 |
| 1/3/73 | pde19730103022942800_33 | 4.80000 | 6,492,506.21 | 1.548 | 126.305 |
| 1/4/73 | pde19730104003142000_33 | 4.50000 | 3,405,062.89 | 41.305 | -29.272 |
| 1/5/73 | pde19730105003948200_36 | 4.70000 | 5,259,913.22 | 0.683 | -80.018 |
| 1/6/73 | pde19730106061852300_83 | 4.90000 | 7,979,226.63 | -22.354 | -69.310 |
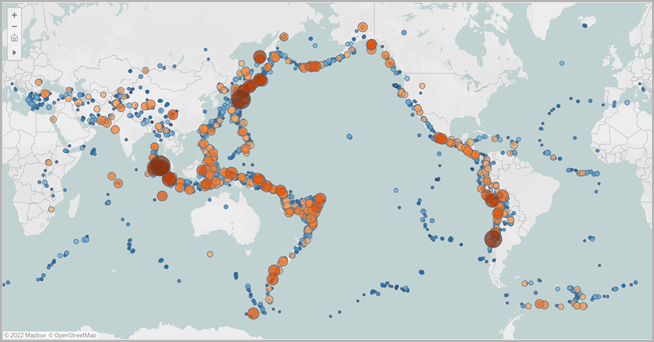
| “列”功能区: | 经度(连续度量,分配的经度地理角色) |
| “行”功能区: | 纬度(连续度量,分配的纬度地理角色) |
| 详细信息: | 一个或多个维度字段 |
| 大小: | 一个度量字段(聚合) |
| 标记类型: | 自动 |
| State(州/省/市/自治区) | 郡县 | Obesity Percent - 2012(肥胖百分比 - 2012 年) |
| 阿拉巴马州 | Autauga County(奥陶葛县) | 30.9000 |
| 阿拉巴马州 | Baldwin County(鲍德温县) | 26.7000 |
| 阿拉巴马州 | Barbour County(巴伯尔县) | 40.8000 |
| 阿拉巴马州 | Bibb County(比伯县) | 40.1000 |
| 阿拉巴马州 | Blount County(布朗特县) | 32.4000 |
| 阿拉巴马州 | Bullock County(布洛克县) | 44.5000 |
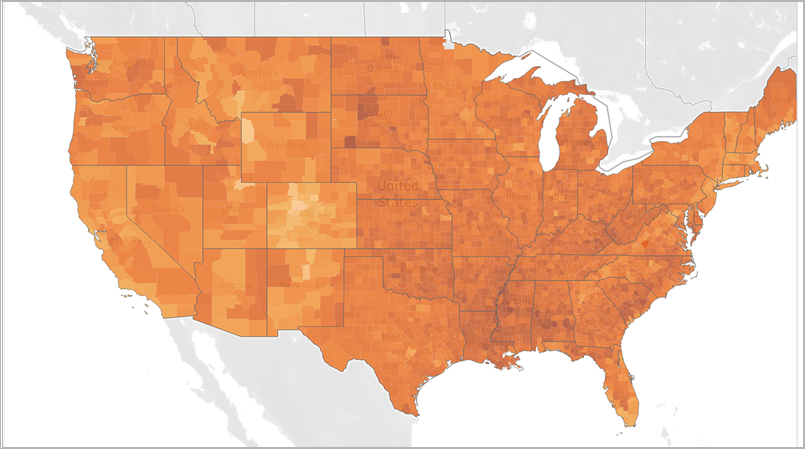
| “列”功能区: | 经度(连续度量,分配的经度地理角色) |
| “行”功能区: | 纬度(连续度量,分配的纬度地理角色) |
| 详细信息: | 一个或多个地理单元(已分配具有地理角色的维度) |
| 颜色: | 度量或维度 |
| 标记类型: | “自动”或“地图” |
| 线 | 线路组(路径 ID) | 点顺序 | Station | 纬度 | 经度 | 交通量 |
| 1 | 1 | 1 | 法国拉德芳斯区(新凯旋门) | 48.891934 | 2.237883 | 14,275,382 |
| 1 | 1 | 2 | 保防广场 | 48.887843 | 2.250442 | 9,843,051 |
| 1 | 1 | 3 | 讷伊桥 | 48.884509 | 2.259892 | 6,902,931 |
| 10 BOUCLE | 10 | 1 | 布洛涅-让-饶勒斯 | 48.842222 | 2.238836 | 3,847,782 |
| 10 BOUCLE | 10 | 2 | 奥特伊门 | 48.848074 | 2.258648 | 687,237 |
| 10 BOUCLE | 10 | 3 | 米歇尔-安热-奥特伊 | 48.847740 | 2.264297 | 2,222,709 |
| “列”功能区: | 经度(连续度量,分配的经度地理角色) |
| “行”功能区: | 纬度(连续度量,分配的纬度地理角色) |
| 详细信息: | “路径 ID”字段(离散维度) |
| 路径: | “Order”(订单)字段(连续维度) |
| 标记类型: | 线 |
| Origin-Destination | Station | Path ID | 纬度 | 经度 |
| Origin | BT-01 | BT-01_BT-01 | 47.61841 | -122.35101 |
| Destination | BT-01 | BT-01_BT-01 | 47.61841 | -122.35101 |
| Origin | BT-01 | BT-01_BT-03 | 47.61841 | -122.35101 |
| Destination | BT-03 | BT-01_BT-03 | 47.61576 | -122.34843 |
| Origin | BT-01 | BT-01_BT-04 | 47.61841 | -122.35101 |
| Destination | BT-04 | BT-01_BT-04 | 47.61613 | -122.34108 |
| Origin | BT-01 | BT-01_BT-05 | 47.61841 | -122.35101 |
| Destination | BT-05 | BT-01_BT-05 | 47.61303 | -122.34410 |
| Origin-Destination | 位置名称 | Path ID | 纬度 | 经度 |
| Origin | BT-01 | BT-01_BT-01 | 47.61841 | -122.35101 |
| Destination | BT-01 | BT-01_BT-01 | 47.61841 | -122.35101 |
| Origin | BT-01 | BT-01_BT-03 | 47.61841 | -122.35101 |
| Destination | BT-03 | BT-01_BT-03 | 47.61576 | -122.34843 |
| “列”功能区: | 经度(连续度量,分配的经度地理角色) |
| “行”功能区: | 纬度(连续度量,分配的纬度地理角色) |
| 详细信息: | “路径 ID”字段(离散维度) |
| 标记类型: | 线 |
| Storm Name(风暴名称) | Date(日期) | 纬度 | 经度 | Basin(盆地) | Wind Speed (kt)(风速 (kt)) |
| PAKHAR | 3/26/12 12:00:00 AM | 9.5000 | 115.700 | 西太平洋 | 0 |
| PAKHAR | 3/26/12 6:00:00 AM | 9.5000 | 115.400 | 西太平洋 | 0 |
| PAKHAR | 3/26/12 12:00:00 PM | 9.5000 | 115.100 | 西太平洋 | 0 |
| PAKHAR | 3/26/12 6:00:00 PM | 9.4000 | 114.800 | 西太平洋 | 0 |
| PAKHAR | 3/27/12 12:00:00 AM | 9.4000 | 114.500 | 西太平洋 | 0 |
| PAKHAR | 3/27/12 6:00:00 AM | 9.4000 | 114.300 | 西太平洋 | 35 |
| “列”功能区: | 经度(连续度量,分配的经度地理角色) |
| “行”功能区: | 纬度(连续度量,分配的纬度地理角色) |
| 详细信息: | 维度(每个路径的唯一 ID) |
| 路径: | 用于定义连接数据点的顺序的“Date”(日期)字段或顺序字段 |
| 标记类型: | 线 |
| 纬度 | 经度 |
| 32.2000 | -101.5000 |
| 38.5800 | -92.5800 |
| 41.2000 | -89.6800 |
| 39.2800 | -87.4000 |
| 41.7800 | -87.7800 |
| 39.5000 | -90.0800 |
| “列”功能区: | 经度(连续度量,分配的经度地理角色) |
| “行”功能区: | 纬度(连续度量,分配的纬度地理角色) |
| 标记类型: | 自动 |
简单地图
| 基于空间文件的地图
|
比例符号地图
| 点分布图
|
热图(密度图)
| 填充地图(面量图)
|
流程(路径)图
| 起点-终点地图
|
双轴(分层)地图
| 包含饼图的填充地图
|
| 组件 | 语法 | 示例 |
函数 | 有关如何为 Tableau 中的所有函数设置格式的示例,请参见Tableau 函数(按字母顺序)或Tableau 函数(按类别)。 |
|
字段 | 计算中的字段通常括在方括号 [ ] 中。 有关详细信息,请参见字段语法。 |
|
运算符 |
有关可在 Tableau 计算中使用的运算符类型以及这些运算符在公式中的执行顺序的信息,请参见运算符语法。 |
|
文本表达式 | 数字文本写为数字。 字符串文本带有引号。 日期文本带有 # 符号。 布尔文本写为 true 或 false。 Null 文本写为 Null。 有关详细信息,请参见文本表达式语法。 |
|
参数 | 计算中的参数应括在方括号 [ ] 中,就像字段一样。有关详细信息,请参阅创建参数。 |
|
注释 | 若要在计算中输入注释,请键入两个正斜杠 //。有关详细信息,请参见向计算中添加注释。 可以通过键入 /* 开始注释以及 */ 结束注释,从而添加多行注释。 |
|
| 地理角色 | 如果字段包含以下内容,则将此角色分配给字段: |
| 机场 | 国际航空运输协会 (IATA) 或国际民航组织 (ICAO) 机场代码。 |
| 地区代码(美国) | 美国电话区号;仅限数字。 |
| CBSA/MSA(美国) | 由美国行政管理和预算局定义的美国核心基础统计区域 (CBSA),包括大都市统计区域 (MSA)。可识别 CBSA/MSA 代码和名称。 |
| 城市 | 全世界人口达到或超过 15,000 人的城市。名称使用英语(英国英语和美国英语)、法语、德语、西班牙语、巴西葡萄牙语、日语、朝鲜语和中文(简体中文和繁体中文)显示。 |
| 国会选区(美国) | 美国国会选区。 |
| 国家/地区 | 全世界的国家、地区和领地。名称使用英语(英国或美国)、法语(加拿大和法国)、德语、西班牙语、巴西葡萄牙语、日语、朝鲜语、中文(简体中文繁体中文)、瑞典语和荷兰语显示。Tableau 还可识别 FIPS 10、ISO 3166-1 alpha 2 以及 ISO 3166-1 alpha 3。名称使用多种格式,包括长名称、短名称,以及各种缩写。 |
| 郡县 | 所选国家/地区的二级行政区域。例如,美国的郡/县、法国的 départements、德国的 kriese 等。 注意: 二级行政区域定义因国家/地区而异。在 Tableau 中,所有二级行政区域都使用“郡县”地理角色进行编码。有关详细信息,请参见 Tableau 支持用于构建地图视图的位置数据部分。 |
| NUTS 欧洲 | NUTS(地域统计单位命名法)1 – 3 级代码。支持代码和名称,包括同义词。 |
| 纬度 | 以十进制度数为单位的纬度。只能用于数字字段。 |
| 经度 | 以十进制度数为单位的经度。只能用于数字字段。 |
| 州/省/市/自治区 | 全世界范围的州/省/市/自治区,以及其他一级行政区域。名称使用英语(英国英语和美国英语)、法语、德语、西班牙语、巴西葡萄牙语、日语、朝鲜语和中文(简体中文和繁体中文)显示。注意: 某些名称只能使用其本地形式。 |
| 邮政编码 | 所选国家/地区的邮政编码。例如,美国的五位邮政编码、澳大利亚的四位邮政编码、德国的五位邮政编码等。有关详细信息,请参见 Tableau 支持用于构建地图视图的位置数据部分。 |
入门指南Viewer(查看者):我可以使用 Tableau Web 视图做些什么? | 浏览和管理内容 |
制作 Web 视图 | 分享和协作 |
| 嵌套 | 非嵌套 |
![]() | ![]() |
嵌套排序将单独考虑每个窗格,并按窗格对行进行排序。 “紫色”在排序后位于“织物”和“纸”的“绿色”的上方,但位于“油漆”的“绿色”的下方。 | 非嵌套排序考虑跨窗格的值,并且每个窗格的值顺序相同。 对于所有材料,“紫色”都位于“绿色”上方,因为在聚合中,“紫色”要高于“绿色”。 |
| 嵌套排序在窗格的上下文内看起来是正确的,但未传达有关值的总体比较情况的聚合信息。 | 非嵌套排序在单个窗格中可能看上去不正确,但总是能传达聚合值的总体比较情况。 |
| 默认情况下,通过轴进行排序会进行嵌套排序。 | 默认情况下,通过字段标题进行排序会进行非嵌套排序。 |
| 此工作簿主题... | 与以下 Tableau 版本关联... |
|---|---|
| 平滑 | 版本 10.x 及更高版本 |
| 清理 | 版本 8.0.x – 9.3.x |
| 现代 | 版本 3.5 – 7.0.x |
| 经典 | 版本 1.0 – 3.2 |
| 字段 | 包含该字段的原因 |
| Life Expectancy Female 和 Life Expectancy Male | 人们的寿命越长,就越有可能对在晚年外出旅游感兴趣。 |
| Population Urban | 在人口密度更大的地区进行服务营销更容易。 |
| Population 65+ | 目标群体是有时间和资金外出旅游的老年居民。 |
| TourismPerCapita | 这是您必须作为命名计算字段创建的度量。公式为:
Tourism Outbound 对某个国家/地区的居民每年花费在国际旅游上的资金(以美元为单位)进行聚合。但必须将这一总金额除以每个国家/地区的人口来确定每个居民花费在国际旅游上的平均金额。 |
| 顾客 | Contact | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
|
|
| Projector rental | 顾客 | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
|
|
| DATE('01/01/'+STR([Member since])) |
| 日期 | 保留类型 | 请求者 ID | ID | First name | Last name | 分支 | 成员开始日期 | Units borrowed | Fees | Suggested limit |
|---|---|---|---|---|---|---|---|---|---|---|
1/1/2000 | 单个 | 233445589 | 232502870 | Alan | Wang | North | 2000 | 1 | 0.00 | 15 |
| 1/1/2000 | 单个 | 233445589 | 233445589 | Fred | Suzuki | North | 2000 | 52 | 0.90 | 15 |
| 1/1/2000 | 单个 | 233445589 | 233445566 | Ashley | Garcia | 南部 | 2000 | 243 | 11.30 | 15 |
| 1/1/2000 | 单个 | 233445589 | 233448978 | John | Smith | North | 2000 | 36 | 3.50 | 15 |
| Tableau Desktop 版本 | Web 版本 |
|
|
| 日历系统 | 周数 | 年数 |
| 标准公历 | 1 | 2011 |
| ISO-8601 | 52 | 2010 |
| 注释 | 要使用的日历 | 示例格式字符串 |
| [Y] | ISO-8601 | ww[Y] yyyy[Y] |
| [y] | 标准公历 | ww[y] yyyy[y] |
| 格式字符串 | 设置化输出 |
| yyyy | 2013 |
| yyyy[Y] | 2014 |
| yyyy ww | 2014 1 |
| yyyy mm | 2013 12 |
| ww yyyy | 1 2014 |
| mm yyyy | 12 2013 |
| ww yyyy[y] | 1 2013 |
| mm yyyy[Y] | 12 2014 |
| yyyy mm ww | 2013 12 1 |
| mm yyyy ww | 12 2013 1 |
| ww mm yyyy | 1 12 2013 |
| ww mm yyyy[Y] | 1 12 2014 |
| ww yyyy mm | 1 2014 12(格式不明确) |
| ww yyyy[y] mm | 1 2013 12 |
| ww yyyy mm yyyy | 1 2014 12 2013 |
| ww yyyy yyyy mm | 1 2014 2013 12 |
| yyyy mm ww yyyy | 2013 12 1 2014 |
| 错误消息 | 注释 |
| 传递给 SCRIPT 函数的参数是不支持的类型。 | Tableau 只能将以下 Tableau 数据类型导出到 R:
|
| SCRIPT 函数返回了意外数量的结果。函数预期 %2 个值;返回了 %1 个值。 | 脚本结果必须是为所有行复制的长度为 1 的标量或矢量,或者长度等于 Tableau 结果表中的行数的矢量。 |
| 证书文件对指定的连接 (%1%2:%3) 无效。检查是否为服务器和客户端使用了相同的证书、证书文件未损坏并且日期有效。 | 验证用于连接到外部服务的证书的编码和格式正确无误。您必须使用有效的 PEM 编码 x509 证书(扩展名为 .crt)进行连接。 |
| SCRIPT 函数返回的结果是意外类型。 | 在收到无效数据类型时出现。Tableau 只能从 Rserve 服务器导入以下数据类型:
对于 TabPy,Tableau 只能导入以下数据类型:
如果结果为 null 或存在 Tableau 无法从外部服务器收集到说明的脚本执行错误,也会报告此错误。 |
| 与外部服务通信时出错。 | Tableau 在“try”外部函数内运行所有外部脚本。当“try”函数捕获计算错误时,会显示此错误以及外部服务生成的错误消息。 |
| 此外部服务连接不支持身份验证。请尝试在不指定密码的情况下进行连接。 | |
| 身份验证失败。请提供有效的外部服务用户名和密码。 | |
| 外部服务中启用的身份验证类型不受支持。 | 禁用外部服务身份验证或更改为纯文本密码身份验证。 |
| 未配置外部服务连接。请指定服务器名称并重试。 | 请参见使用分析扩展程序传递表达式。 |
| 计算“%1”包含一个需要内部服务连接的 SCRIPT_ 函数。请配置外部服务连接以启用自定义脚本。 | 请参见使用分析扩展程序传递表达式。 |
| 尝试发布的工作簿包含需要外部服务连接的 SCRIPT_ 函数。公共工作簿中不允许包含自定义脚本。 | 无法将包含外部服务脚本的公共工作簿发布到 Tableau Public。 |
| Tableau Public 不支持运行需要外部服务的自定义脚本。若要利用外部服务,请升级到 Tableau Desktop Professional Edition。 | “Tableau Public”(在此错误中)是指 Tableau Desktop Public。 |
| Tableau Reader 不支持运行需要外部服务的自定义脚本。若要利用外部服务,请升级到 Tableau Desktop Professional Edition。 | 无法在 Tableau Reader 中查看包含外部服务脚本的工作簿。 |
| 错误消息 | 注释 |
| 无法识别 Rserve 签名。 | Rserve 标头签名必须为“Rsrv”。 |
| 无法识别 Rserve 版本。 | Rserve 标头版本必须为“0103”。 |
| 无法识别 Rserve 协议。 | Rserve 标头协议必须为“QAP1”。 |
| 在连接到 R 时身份验证失败。 | Tableau 尝试向 Rserve 进行身份验证但失败。请确认您输入了有效密码。 |
| 参数/主体中的字节数不正确。 | |
| Tableau 读取的数据长度不等于标头承诺的长度。 | |
| 无法识别响应类型。 | 读取结果时的传输协议类型不是预期的 SEXP。 |
| <type>vector 过长。 | 用于测量从或向 Rserve 发送的数据长度的数字过大,可能指示协议标头已损坏。 |
| Rserve 命令无效。 | Tableau 可能错误地实施了 Rserve 协议。 |
服务器的响应是错误 << (uint32_t)status << 。有关详细信息,请参见 Rsrv.h。 | 各种错误条件记录在 Rsrv.h 中的注释中。 |
| 标头偏移过长。 | 这可能由于乱码标头与响应数据的偏移过大造成的。 |
| Rserve 套接字失败。 | 登录、脚本计算、读取挂起检查、结果读取或 Tableau 字段到 R 脚本参数赋值引发非标准异常。 |
| 外部服务使用不受支持的身份验证类型。 | 若要同时支持通过启用 SSL 的方式和明文方式连接到 Rserve 实例,Rserve 服务器管理员必须将以下条目添加到 Rserve 服务器上的 Rserve 配置文件中:
|
| RServe 上发生了加密系统错误。 | RServe 的加密系统发生错误。有关详细信息,请检查 RServe 日志。 |
| RServe 由于安全违规而发起关闭命令。 | RServe 由于安全违规而关闭了连接。有关详细信息,请检查 RServe 日志。 |
| 为安全连接设置了“外部服务配置”,但缺少证书。 | 建立与外部服务的安全连接时,需要上载您希望用于对此外部服务签名的证书。与未使用此证书签署的服务器的连接将被拒绝。这可确保仅将数据发送到受信任的服务器。 |
| 证书文件对指定的连接 (%1%2:%3) 无效。检查是否为服务器和客户端使用了相同的证书、证书文件未损坏并且日期有效 | 提供的证书对于此连接配置无效。检查以确定它是否与用于签署外部服务服务器的证书匹配、它是否为 PEM 编码,并且对于当天的日期有效。 |
| 外部服务连接证书无效 | 提供的证书无效。检查以确定证书是否为 PEM 编码,并且它对于当天的日期有效。 |
| 外部服务连接未能创建 SSL/TLS 上下文 | Tableau 未能为此给定外部服务配置初始化安全环境。检查以确定主机和端口是否正确,并且证书有效。 |
| 外部服务未能与 SSL/TLS 连接 | Tableau 未能建立与外部服务的安全连接。验证外部服务是否配置为支持安全连接,并且提供的证书是否与用于签署外部服务的证书匹配。 |
| 无法识别外部服务服务器协议 | 主机前面附带了 Tableau 无法识别或不支持的协议。如果连接到 RServe,则不需要任何协议。如果连接到 TabPy,则在建立明文连接时需要 HTTP 协议,在建立安全连接时需要 HTTPS 协议。 |
| 功能 | 多维数据集数据源的状态 |
| 动作 | 对于 Microsoft Analysis Services 连接,在多维数据集中定义的下钻操作在 Tableau 中不可用。 多维数据集数据源不接受来自关系数据源或其他多维数据集数据源的动作。 例如,假设您的工作簿包含三个视图,它们分别使用 MySQL 数据源、多维数据集数据源 A 和多维数据集数据源 B。使用 MySQL 数据源的视图中的动作将不会影响使用多维数据集数据源的视图,并且一个多维数据集数据源的视图中的动作不会影响另一个。但是,使用多维数据集数据源的视图中的动作将影响使用 MySQL 数据源的视图。 |
| 高级分析功能 | 多维数据集数据源不支持详细信息级别的表达式、趋势线、预测和群集。 |
| 聚合计算函数 | 多维数据集数据源已预先聚合,因此不支持聚合函数,例如 SUM()、AVG() 和 CNT()。可以使用表计算在 Tableau 中对多维数据集中的单元格级别结果执行聚合运算。 |
| 别名 | 多维数据集数据库的别名由多维数据集的设计员进行创建,并且可以通过从“数据”菜单中选择数据源,然后选择“别名文件”在 Tableau 中激活。请与数据库管理员联系,了解您的数据库是否有可用的别名。Microsoft Analysis Services 数据库不支持别名。 默认情况下,每个维度的每个成员的别名最初定义为原始成员名称。 |
| 数据桶 | 对于多维数据集数据源,“创建数据桶”命令无法用于度量。 然而,您可以写入一个使用多维数据集单元格结果并将它们放入数据桶中的计算。例如:
|
| 多维数据集 KPI 数据类型 | 连接到 Microsoft Analysis Services 后,在多维数据集中定义的任何 KPI 计算都不可用。 但是,您可以在 Tableau 中编写自己的 KPI 计算。也可以使用 Tableau 参数来创建非常灵活的 KPI 假设分析。有关详细信息,请参见显示关键进度指标。 |
| 多维数据集 Lag 函数 | 对于多维数据集数据源,您无法在 Tableau 计算编辑器中使用多维数据集 Lag 函数。您可以改用 Tableau 表计算来计算某些百分比和总计。有关详细信息,请参见使用表计算转换值。 或者,您可以使用计算成员直接在 Tableau 中使用 MDX Lag 函数。例如:
|
| 自定义多维表达式 (MDX) 语句 | 连接到多维数据集后,无法建立自定义 MDX 语句连接。需要在服务器上创建所有子多维数据集定义,方法是实施必要的多维数据集透视图、分区、维度或单元格安全性。 |
| 数据混合 | 在 Tableau 中,多维数据集数据源只能用作数据混合的主数据源。不能将它们用作辅助数据源。有关详细信息,请参见数据混合疑难解答。 |
| 日期维度 | 对于多维数据集数据源,日期维度通常组织为包含年、季度和月等级别的分层结构。此外,有些多维数据源还启用了时间智能,以便能够以不同方式来查看这些数据级别,例如月(按年)、月(按季度)、周末等。这些级别表示为分层结构的属性。有关详细信息,请参见日期和时间。 |
| 数据源筛选器 | 数据源筛选器无法用于多维数据集数据源。在 Tableau 中进行分析之前,必须先在多维数据集中定义所有字段值。 |
| 数据提取 | 您无法从大多数多维数据集数据源中创建数据提取。多维数据集和关系数据源具有不兼容的数据结构,这会导致在大多数情况下无法从多维数据集中提取数据并将其存储在关系数据源(例如数据引擎)中。 从 10.4 开始,您无需 Tableau 提供的特殊产品密钥也可创建 SAP BW 数据提取。有关 SAP BW 数据提取的支持和限制的信息,请参见SAP NetWeaver Business Warehouse。 |
| 筛选器 | 显示多维数据集维度的筛选器时,该维度的所有分层结构层都将包含在此筛选器中。例如:
您可以使用多维数据集属性作为筛选器,以只显示单个级别而不是分层结构。在“数据”窗格中,属性显示在“维度”部分中,并由此图标指明: 切片筛选器对多维数据集数据源的行为与对关系数据源的行为不同。有关详细信息,请参见创建切片筛选器。 某些维度筛选器卡选项不可用。例如,单值(下拉列表)、多个值(自定义列表)等。相反,视图中显示的维度筛选器会保留其分层外观,并且不能更改为特定的列表类型。您可以创建包含分层结构中的特定值的 Tableau 集,然后使用该集作为视图中具有预期筛选器选项的筛选器(在“数据”窗格中右键单击该集,然后单击“显示筛选器”)。 |
| 组 | 使用多维数据集数据源时,无法创建组。任何分组概念都应在多维数据集中预定义为维度属性或多维数据集组。 但是,可以使用计算成员直接在 Tableau 中编写多维表达式 (MDX) 以创建组。例如:
|
| 分层结构 | 对于多维数据集数据源,必须在分析之前在多维数据集中定义分层结构。 |
| 参数 | 对于多维数据集数据源,您无法使用参数值在 MDX 计算中筛选维度。 |
| 发布 | 使用多维数据集数据源的工作簿可以发布到 Tableau Server,但不支持直通连接。这意味着您不能使用此类数据源从 Tableau Server 建立连接。这还意味着您不能在 Tableau Server 中使用该数据源创建工作簿。有关详细信息,请参见 Tableau Server 帮助中的多维数据集数据源。 通过将多维数据集数据源发布到 Tableau Server,您可以将该数据源存储在服务器上。但是,要使用该数据源,您必须将其下载到 Tableau Desktop 并在本地使用它。 无法将使用多维数据集数据源的工作簿发布到 Tableau Cloud。 |
| 集 | 多维数据集数据源支持将数据筛选至所选成员及其所有下级的分层集。有关详细信息,请参见集示例。 |
| Tableau 字符串函数 | 对于多维数据集数据源,维度在计算编辑器中不可用。 但是,您可以使用计算成员在 Tableau 内编写 MDX 来操作维度值。例如:
|
| 类型转换 | 对于多维数据集数据源,某些类型转换函数在计算编辑器中不可用。通常,应在分析之前在多维数据集中定义数据类型转换。 尤其是,在 Tableau 中将多维数据集维度的数据类型更改为日期有时会提供不正确的信息。某些多维数据集维度支持此功能,具体情况视多维数据集中日期的格式设置方式而定。 您可以使用计算成员在 Tableau 中直接编写多维表达式 (MDX),以将多维数据集维度的数据类型更改为日期。例如:
|
| year(Order%20Date) | 整数 |
| quarter(Order%20Date) | 1 和 4 之间的整数 |
| month(Order%20Date) | 1 和 12 之间的整数 |
| day(Order%20Date) | 1 和 31 之间的整数 |
| hour(Order%20Date) | 整数 0-23 |
| minute(Order%20Date) | 整数 0-59 |
| second(Order%20Date) | 整数 0-59 |
| week(Order%20Date) | 整数 1-53 |
| my(Order%20Date) | 六位整数:YYYYMM |
| mdy(Order%20Date) | 八位整数:YYYYMMDD |
| 语法 | ASCII(string) |
| 输出 | 数字 |
| 定义 | 返回 <string> 的第一个字符的 ASCII 码。 |
| 示例 | ASCII('A') = 65 |
| 说明 | 这是 CHAR 函数的反函数。 |
| 语法 | CHAR(number) |
| 输出 | 字符串 |
| 定义 | 返回通过 ASCII 代码 <number> 编码的字符。 |
| 示例 | CHAR(65) = 'A' |
| 说明 | 这是 ASCII 函数的反函数。 |
| 语法 | CONTAINS(string, substring) |
| 输出 | 布尔值 |
| 定义 | 如果给定字符串包含指定子字符串,则返回 true。 |
| 示例 | CONTAINS("Calculation", "alcu") = true |
| 说明 | 另请参见逻辑函数 根据数据源的不同,CONTAINS 可能区分大小写。也就是说,对于某些数据源, |
| 语法 | ENDSWITH(string, substring) |
| 输出 | 布尔值 |
| 定义 | 如果给定字符串以指定子字符串结尾,则返回 true。会忽略尾随空格。 |
| 示例 | ENDSWITH("Tableau", "leau") = true |
| 说明 | 另请参见附加函数文档中支持的正则表达式。 |
| 语法 | FIND(string, substring, [start]) |
| 输出 | 数字 |
| 定义 | 返回子字符串在字符串中的索引位置,如果未找到子字符串,则返回 0。字符串中第一个字符的位置为 1。 如果添加了可选参数 |
| 示例 | FIND("Calculation", "alcu") = 2FIND("Calculation", "Computer") = 0FIND("Calculation", "a", 3) = 7FIND("Calculation", "a", 2) = 2FIND("Calculation", "a", 8) = 0 |
| 说明 | 另请参见附加函数文档中支持的正则表达式。 |
| 语法 | FINDNTH(string, substring, occurrence) |
| 输出 | 数字 |
| 定义 | 返回指定字符串内的第 n 个子字符串的位置,其中 n 由 occurrence 参数定义。 |
| 示例 | FINDNTH("Calculation", "a", 2) = 7 |
| 说明 | 所有数据源都不可使用 另请参见附加函数文档中支持的正则表达式。 |
| 语法 | LEFT(string, number) |
| 输出 | 字符串 |
| 定义 | 返回字符串最左侧一定 <number> 的字符。 |
| 示例 | LEFT("Matador", 4) = "Mata" |
| 说明 | 另请参见 MID 和 RIGHT。 |
| 语法 | LEN(string) |
| 输出 | 数字 |
| 定义 | 返回字符串长度。 |
| 示例 | LEN("Matador") = 7 |
| 说明 | 不要与空间函数 LENGTH 混淆。 |
| 语法 | LOWER(string) |
| 输出 | 字符串 |
| 定义 | 以全小写字符返回提供的 <string>。 |
| 示例 | LOWER("ProductVersion") = "productversion" |
| 说明 | 另请参见 UPPER 和 PROPER。 |
| 语法 | LTRIM(string) |
| 输出 | 字符串 |
| 定义 | 返回移除了所有前导空格的所提供的 <string>。 |
| 示例 | LTRIM(" Matador ") = "Matador " |
| 说明 | 另请参见 RTRIM。 |
| 语法 | MAX(expression) 或 MAX(expr1, expr2) |
| 输出 | 与参数相同的数据类型,或者,如果参数的任何部分为 null,则为 NULL 。 |
| 定义 | 返回两个参数(必须为相同数据类型)中的最大值。
|
| 示例 | MAX(4,7) = 7 |
| 说明 | 对于字符串
对于数据库数据源, 对于日期 对于日期, 作为聚合
作为比较
另请参见 |
| 语法 | (MID(string, start, [length]) |
| 输出 | 字符串 |
| 定义 | 返回从指定 如果添加了可选数字参数 |
| 示例 | MID("Calculation", 2) = "alculation"MID("Calculation", 2, 5) ="alcul" |
| 说明 | 另请参见附加函数文档中支持的正则表达式。 |
| 语法 | MIN(expression) 或 MIN(expr1, expr2) |
| 输出 | 与参数相同的数据类型,或者,如果参数的任何部分为 null,则为 NULL 。 |
| 定义 | 返回两个参数(必须为相同数据类型)中的最小值。
|
| 示例 | MIN(4,7) = 4 |
| 说明 | 对于字符串
对于数据库数据源, 对于日期 对于日期, 作为聚合
作为比较
另请参见 |
| 语法 | PROPER(string) |
| 输出 | 字符串 |
| 定义 | 返回所提供的 |
| 示例 | PROPER("PRODUCT name") = "Product Name"PROPER("darcy-mae") = "Darcy-Mae" |
| 说明 | 空格和非字母数字字符(如标点符号)被视为分隔符。 |
| 数据库限制 | PROPER 仅适用于某些平面文件和数据提取。如果您需要在不支持 PROPER 的数据源中使用 PROPER,请考虑使用数据提取。 |
| 语法 | REPLACE(string, substring, replacement |
| 输出 | 字符串 |
| 定义 | 在 <string> 中搜索 <substring> 并将其替换为 <replacement>。如果未找到 <substring>,则字符串保持不变。 |
| 示例 | REPLACE("Version 3.8", "3.8", "4x") = "Version 4x" |
| 说明 | 另请参见附加函数文档中的 REGEXP_REPLACE。 |
| 语法 | RIGHT(string, number) |
| 输出 | 字符串 |
| 定义 | 返回字符串最右侧一定 <number> 的字符。 |
| 示例 | RIGHT("Calculation", 4) = "tion" |
| 说明 | 另请参见 LEFT 和 MID。 |
| 语法 | RTRIM(string) |
| 输出 | 字符串 |
| 定义 | 返回移除了所有尾随空格的所提供的 <string>。 |
| 示例 | RTRIM(" Calculation ") = " Calculation" |
| 说明 | 另请参见 LTRIM 和 TRIM。 |
| 语法 | SPACE(number) |
| 输出 | 字符串(具体来说,只是空格) |
| 定义 | 返回由指定数量的重复空格组成的字符串。 |
| 示例 | SPACE(2) = " " |
| 语法 | SPLIT(string, delimiter, token number) |
| 输出 | 字符串 |
| 定义 | 返回字符串中的一个子字符串,并使用分隔符字符将字符串分为一系列标记。 |
| 示例 | SPLIT ("a-b-c-d", "-", 2) = "b"SPLIT ("a|b|c|d", "|", -2) = "c" |
| 说明 | 字符串将被解释为分隔符和标记的交替序列。因此,对于字符串
另请参见附加函数文档中支持的正则表达式。 |
| 数据库限制 | 可以为以下数据源类型使用拆分和自定义拆分命令:Tableau 数据提取、Microsoft Excel、文本文件、PDF 文件、Salesforce、OData、Microsoft Azure Market Place、Google Analytics(分析)、Vertica、Oracle、MySQL、PostgreSQL、Teradata、Amazon Redshift、Aster 数据、Google Big Query、Cloudera Hadoop Hive、Hortonworks Hive 和 Microsoft SQL Server。 某些数据源在拆分字符串时会有限制。请参见本主题后面的 SPLIT 函数限制。 |
| 语法 | STARTSWITH(string, substring) |
| 输出 | 布尔值 |
| 定义 | 如果 string 以 substring 开头,则返回 true。会忽略前导空格。 |
| 示例 | STARTSWITH("Matador, "Ma") = TRUE |
| 说明 | 另请参见附加函数文档中的 CONTAINS 以及支持的正则表达式。 |
| 语法 | TRIM(string) |
| 输出 | 字符串 |
| 定义 | 返回移除了前导和尾随空格的所提供的 <string>。 |
| 示例 | TRIM(" Calculation ") = "Calculation" |
| 说明 | 另请参见 LTRIM 和 RTRIM。 |
| 语法 | UPPER(string) |
| 输出 | 字符串 |
| 定义 | 以全大写字符返回提供的 <string>。 |
| 示例 | UPPER("Calculation") = "CALCULATION" |
| 说明 | 另请参见 PROPER 和 LOWER。 |
| 数据源 | 左/右约束 | 最大拆分数量 | 版本限制 |
| Tableau 数据提取 | 两侧 | 无限 | |
| Microsoft Excel | 两侧 | 无限 | |
| 文本文件 | 两侧 | 无限 | |
| Salesforce | 两侧 | 无限 | |
| OData | 两侧 | 无限 | |
| Google Analytics(分析) | 两侧 | 无限 | |
| Tableau 数据服务器 | 两侧 | 无限 | 在版本 9.0 中支持。 |
| Vertica | 仅左侧 | 10 | |
| Oracle | 仅左侧 | 10 | |
| MySQL | 两侧 | 10 | |
| PostgreSQL | 在版本 9.0 之前仅左侧;版本 9.0 及更高版本中为两侧 | 10 | |
| Teradata | 仅左侧 | 10 | 版本 14 及更高版本 |
| Amazon Redshift | 仅左侧 | 10 | |
| Aster Database | 仅左侧 | 10 | |
| Google BigQuery | 仅左侧 | 10 | |
| Hortonworks Hadoop Hive | 仅左侧 | 10 | |
| Cloudera Hadoop | 仅左侧 | 10 | 版本 2.3.0 中开始支持 Impala。 |
| Microsoft SQL Server | 两侧 | 10 | 2008 及更高版本 |
| 包括其他 | 不包括其他 |
|---|---|
![]() | ![]() |
| Runner | Action | Time |
|---|---|---|
| Amanda | Start | 9/3/2016 3:04 PM |
| Oscar | Start | 9/3/2016 3:04 PM |
| William | Start | 9/3/2016 3:04 PM |
| Amanda | End | 9/3/2016 3:25 PM |
| Oscar | End | 9/3/2016 3:21 PM |
| William | End | 9/3/2016 3:16 PM |
| 要求 | 描述 |
|---|---|
Salesforce 许可证 | 以下许可证之一:
这些许可证需要额外付费才能获得。 |
Salesforce 用户帐户 | 配置为访问 Einstein Discovery 的帐户。 如果您使用 Tableau 中的 Einstein Discovery 许可证,则必须为您的用户帐户分配“通过 Connect API 查看 Einstein Discovery 建议”系统权限。 如果您使用 Tableau CRM Plus 许可证或 Einstein Predictions 许可证:
若要配置用户帐户,请参见 Salesforce 帮助中的设置 Einstein Discovery。 |
管理员设置 | Salesforce 管理员将需要: |
| 要求 | 描述 |
|---|---|
Tableau 许可证和权限 | 需要配置 Einstein Discovery 仪表板扩展程序的作者需要允许他们编辑和保存工作簿的 Creator 或 Explorer 许可证和权限。 Creator、Explorer 和 Viewer(查看者)需要登录 Salesforce org 帐户才能访问 Tableau 中 Einstein Discovery 仪表板扩展程序中的预测。 |
Tableau 用户帐户 | 在 Tableau Cloud 和 Tableau Server 中,用户可以保存 Salesforce 用户帐户凭据及其 Tableau 用户帐户。 |
管理员设置 | Tableau Server 管理员需要为 OAuth 配置 Tableau Server(允许从 Tableau 中访问预测)。有关详细信息,请参见 Tableau Server 帮助中的配置 Einstein Discovery 集成。 为了让用户在已发布的表计算中看到预测,Tableau Server 管理员需要为站点启用分析扩展程序。有关详细信息,请参见 Tableau Server 帮助中的配置与分析扩展程序的连接。 有关 Tableau Server 配置的详细信息,请参见配置 Einstein Discovery 集成 (Tableau Server)。 有关 Tableau Cloud 配置的详细信息,请参见配置 Einstein Discovery 集成 (Tableau Cloud)。 |
| 产品名称 | 产品图像 URL | 产品销售额 |
| 平面 | https://img.example.com/flats.png | 12,118 |
| 高跟鞋 | https://img.example.com/highheels.png | 15,865 |
| 跑步鞋 | https://img.example.com/runningshoes.png | 14,200 |
| 坡跟鞋 | https://img.example.com/wedges.png | 8,665 |
| 计算 | 结果 |
RIGHT([Value], 4) | 8892 |
LEFT([Value], 4) | IGW8 |
LEFT(RIGHT([Value], 2) , 1) | 9 |
| 原始值 | 拆分字段值 |
| Zip-98102 | 98102 |
| Zip-98109 | 98109 |
| Zip-98119 | 98199 |
| Zip-98195 | 98195 |
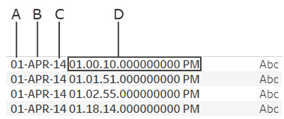
![]() | A:月中的天 B:月 C:年 D:小时、分钟、秒、毫秒、期间 |
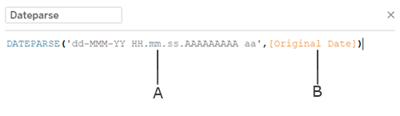
![]() | A:格式 B:字符串 |
| 日期部分 | 符号 | 示例输出 |
|---|---|---|
| 年 | yy y, yyyy Y | 26 2026 2026(用于基于年中某周的日历) |
| 年中的季度 | Q QQQ QQQQ | 2 02 Q2 第二季度 |
| 月 | M MM MMM MMMM | 9 09 9 月 九月 |
| 一年中的某周 | w、ww | 47 |
| 周中的天 | E, EE, EEE EEEE EEEEE | 周一 星期一 M |
| 月中的天 | d dd | 1、15 01、15 |
| 年中的天 (1-365) | D | 23、143 |
小时 (1-12) | h hh | 8 08 |
| 小时 (0-23) | H HH | 8 08 |
| 分钟 | m mm | 8 08 |
| 一分钟中的秒 | s ss | 5 05 |
| 小数秒 | S SS SSS SSSS | 2 23 235 2350 |
| 天中的毫秒 | A | 34532 |
| 期间(am/pm 标记) | a、aa、aaa | AM、am、PM |
| 时区 | z、zz、zzz zzzz Z、ZZ、ZZZ ZZZZ | PDT 太平洋夏令时 -0800 PST-08:00 |
| 操作 | 结果 |
| 将“Discount”(折扣)从度量转换为维度... | 销售额值不再依据折扣率聚合,从而会生成折线图(而不是散点图)。 |
| 将“Discount”(折扣)从连续转换为离散... | Tableau 将在视图底部显示标题,而不是连续轴。 |
| 参数 | 值 | 描述 | 示例 |
|---|---|---|---|
| 来源 (必需) | 字符串 | Tableau Server 或 Tableau Cloud 上指标的 URL。 | https://mycompany/#/metrics/1 |
link-target (HTML) linkTarget (JavaScript) (可选) | 字符串 | 查看者单击该指标时将被定向到的 URL。如果未指定目标,则嵌入的指标将链接到源 URL。 | http://example.com |