| Nome del prodotto | URL dell’immagine del prodotto | Vendite dei prodotti |
| Ballerine | https://img.example.com/flats.png | 12.118 |
| Tacchi alti | https://img.example.com/highheels.png | 15.865 |
| Scarpe da corsa | https://img.example.com/runningshoes.png | 14.200 |
| Zeppe | https://img.example.com/wedges.png | 8.665 |
| Aggregazione | Descrizione | Risultato per una misura contenente 1, 2, 2, 3 |
|---|---|---|
| Attributo | Restituisce il valore dell’espressione data se ha un solo valore per tutte le righe del gruppo, altrimenti visualizza un simbolo asterisco (*). I valori NULL vengono ignorati. Tale aggregazione è utile per l’aggregazione di una dimensione. Per impostare una misura nella vista in questa aggregazione, fai clic con il pulsante destro del mouse (Control-clic su Mac) sulla misura e scegli Attributo. Il campo cambia per visualizzare il testo ATTR:
| * |
| Dimensione | Restituisce tutti i valori univoci di una misura o di una dimensione. | 3 valori (1, 2, 3) |
| Somma | Restituisce la somma dei numeri in una misura. I valori NULL vengono ignorati. | 1 valore (8) |
| Media | Restituisce la media aritmetica dei numeri in una misura. I valori NULL vengono ignorati. | 1 valore (2) |
| Conteggio (valori univoci) | Restituisce il numero di valori univoci in una misura o in una dimensione. Quando applicato a una dimensione, Tableau crea una nuova colonna temporanea che rappresenta una misura perché il risultato di un conteggio è un numero. Puoi conteggiare numeri, date, valori booleani e stringhe. I valori NULL vengono ignorati in tutti i casi. Questa aggregazione non è disponibile per i seguenti tipi di cartelle di lavoro:
Se sei connesso a una cartella di lavoro che utilizza uno di questi tipi, Conteggio (valori univoci) non è disponibile e verrà visualizzato il messaggio “Richiede l’estrazione”. Per utilizzare questa aggregazione, estrarre i dati. Vedi Estrarre i dati. | 1 valore (3) |
| Minimo | Restituisce il numero più piccolo in una misura o in una dimensione continua. I valori NULL vengono ignorati. | 1 valore (1) |
| Massimo | Restituisce il numero più grande in una misura o nell’espressione data basata su un campione di popolazione. I valori NULL vengono ignorati. Restituisce un valore NULL se nel campione sono presenti meno di 2 membri che non sono NULL. Utilizza questa funzione se i tuoi dati rappresentano un campione della popolazione. | 1 valore (3) |
| Std. Dev (Pop.) | Restituisce la deviazione standard di tutti i valori dell’espressione data basata su una popolazione di parte. Suppone che i suoi argomenti siano costituiti dall’intera popolazione. Utilizza questa funzione per campioni di grandi dimensioni. | 1 valore (0,7071) |
| Varianza | Restituisce la varianza di tutti i valori dell’espressione data basata su un campione. I valori NULL vengono ignorati. Restituisce un valore NULL se nel campione sono presenti meno di 2 membri che non sono NULL. Utilizza questa funzione se i tuoi dati rappresentano un campione della popolazione. | 1 valore (0,6667) |
| Varianza (Pop.) | Restituisce la varianza standard di tutti i valori dell’espressione data basata su una popolazione di parte. Suppone che i suoi argomenti siano costituiti dall’intera popolazione. Utilizza questa funzione per campioni di grandi dimensioni. | 1 valore (0,5000) |
| Disaggregazione | Restituisce tutti i record dell’origine dati sottostante. Per disaggregare tutte le misure nella vista, seleziona Aggrega misure dal menu Analisi (per cancellare il segno di spunta). Tableau consente di visualizzare i dati in forma disaggregata (solo database relazionali). Quando i dati sono disaggregati, puoi visualizzare le singole righe dell’origine dati. Ad esempio, dopo aver scoperto che la somma delle vendite per le fasce di gomma è di 14.600 $, potresti voler visualizzare la distribuzione delle singole transazioni di vendita. Per rispondere a questa domanda, devi creare una vista che mostri singole righe di dati. Ciò significa che devi disaggregare i dati (consulta Come disaggregare i dati). Un altro modo per esaminare i dati disaggregati consiste nel visualizzare i dati sottostanti per tutte o parte di una vista. Per maggiori informazioni, consulta Visualizzare i dati sottostanti. | 4 valori (1, 2, 2, 3) |

| Tableau Desktop | Tableau Prep Builder |
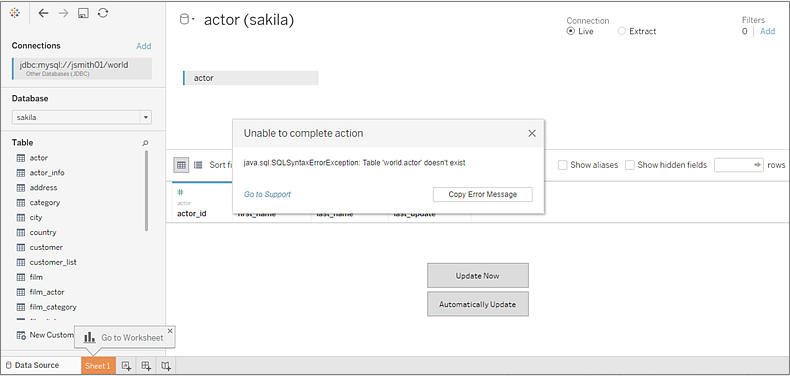 | 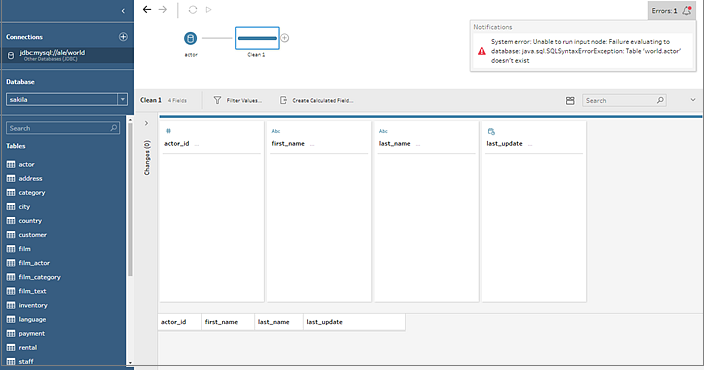 |
| Strumento di selezione | Rettangolo | Radiale | Lazo | Tempo di guida |
|---|---|---|---|---|
| Forma | Rettangolo | Cerchio | Percorso in formato libero | Poligono del tempo di guida |
| Base | Area delimitata visiva | Distanza in linea retta | Area delimitata visiva | Tempo di percorrenza e percorso |
| Rete obbligatoria | No | No | No | Sì |
| Estende la vista precedente | No | Sì | No | Sì |
| Numero di record | Tempo di recupero |
|---|---|
100.000 | 1,7 minuti |
250.000 | 4 minuti |
500.000 | 8,5 minuti |
| Posizione | Regione Hyperforce | Pod (nome del pod) | Indirizzo IP e intervallo dopo la migrazione a Hyperforce (In alternativa, cerca la regione Hyperforce in https://ip-ranges.salesforce.com/ip-ranges.json) | |
|---|---|---|---|---|
| Asia Pacifico | Australia | ap-southeast-2 | prod-apsoutheast-a | 141.163.192.0/23 |
| India | ap-south-2 | prod-in-a | 141.163.216.0/24 | |
Indonesia | ap-southeast-3 | prod-apsoutheast-c | 141.163.212.0/24 | |
Giappone | ap-northeast-1 | prod-apnortheast-a | 141.163.208.0/23 | |
Singapore | ap-southeast-1 | prod-apsoutheast-b | 141.163.196.0/23 | |
| Corea del Sud | ap-northeast-2 | prod-kr-a | 141.163.200.0/23 | |
| Canada | Québec | ca-central-1 | prod-ca-a | 155.226.152.0/23 |
| Europa | Germania | eu-central-1 | dub01 (DUB01) | 145.224.208.0/23 |
eu-west-1a (EW1A) | ||||
| Svizzera | eu-central-2 | prod-ch-a | 145.224.198.0/24 | |
| Regno Unito | eu-west-2 | prod-uk-a | 145.224.200.0/23 | |
| Stati Uniti - Ovest | Oregon | us-west-2 | 10ax (10AX) | 155.226.128.0/21 |
10ay (10AY) | ||||
10az (10AZ) | ||||
uw2b (UW2B) | ||||
prod-uswest-c | ||||
| Stati Uniti - Est | Virginia | us-east-1 | prod-useast-a | 155.226.144.0/22 |
prod-useast-b | ||||
us-east-1 (useast-1) | ||||
prod-useast-c | ||||
| Posizione | Regione Hyperforce | Pod (nome del pod) | Indirizzo IP precedente alla migrazione a Hyperforce | |
|---|---|---|---|---|
| Asia Pacifico | Australia | ap-southeast-2 | prod-apsoutheast-a | 3.25.37.32/28 |
Giappone | ap-northeast-1 | prod-apnortheast-a | 18.176.203.96/28 | |
| Canada | Québec | ca-central-1 | prod-ca-a | 3.98.24.208/28 |
| Europa | Germania Nota: in precedenza regione dell’Irlanda prima della migrazione a Hyperforce. | eu-central-1 | dub01 (DUB01) | 34.246.74.86 52.215.158.213 |
eu-west-1a (EW1A) | 34.246.62.141 34.246.62.203 | |||
| Regno Unito | eu-west-2 | prod-uk-a | 18.134.84.240/28 | |
| Stati Uniti - Ovest | Oregon | us-west-2 | 10ax (10AX) | 34.208.207.197 52.39.159.250 |
10ay (10AY) | 34.218.129.202 52.40.235.24 | |||
10az (10AZ) | 34.218.83.207 52.37.252.60 | |||
us-west-2b (UW2B) | 34.214.85.34 34.214.85.244 | |||
| Stati Uniti - Est | Virginia | us-east-1 | prod-useast-a | 3.219.176.16/28 |
prod-useast-b | 3.219.176.16/28 | |||
us-east-1 (useast-1) | 50.17.26.34 52.206.162.101 | |||
| Posizione | Regione Hyperforce | Pod (nome del pod) | Indirizzo e intervallo di indirizzi IP/ID VPCE | |
|---|---|---|---|---|
| Asia Pacifico | Australia | ap-southeast-2 | prod-apsoutheast-a | 141.163.192.0/23 |
| India | ap-south-2 | prod-in-a | 141.163.216.0/24 vpce-02e14aeeeccOa2eef | |
Indonesia | ap-southeast-3 | prod-apsoutheast-c | 141.163.212.0/24 | |
Giappone | ap-northeast-1 | prod-apnortheast-a | 141.163.208.0/23 | |
Singapore | ap-southeast-1 | prod-apsoutheast-b | 141.163.196.0/23 | |
| Corea del Sud | ap-northeast-2 | prod-kr-a | 141.163.200.0/23 vpce-053ebbbe86f5411ca | |
| Canada | Québec | ca-central-1 | prod-ca-a | 155.226.152.0/23 |
| Europa | Germania | eu-central-1 | dub01 (DUB01) | 145.224.208.0/23 vpce-091ff41bc3686e6e8 |
eu-west-1a (EW1A) | ||||
| Svizzera | eu-central-2 | prod-ch-a | 145.224.198.0/24 vpce-0fbf9d552ffbb6be2 | |
| Regno Unito | eu-west-2 | prod-uk-a | 145.224.200.0/23 | |
| Stati Uniti - Ovest | Oregon | us-west-2 | 10ax (10AX) | 155.226.128.0/21 vpce-090a7c76e361d5013 |
10ay (10AY) | ||||
10az (10AZ) | ||||
uw2b (UW2B) | ||||
prod-uswest-c | ||||
| Stati Uniti - Est | Virginia | us-east-1 | prod-useast-a | 155.226.144.0/22 vpce-0ea40e596e16259d1 |
prod-useast-b | ||||
us-east-1 (useast-1) | ||||
prod-useast-c | ||||
| Tabella di testo | L’aggiunta di una dimensione genera innanzitutto una tabella di testo (o cross-tab). Tutti i clic successivi nei campi determinano l’affinamento della tabella di testo. |
| Barre | Aggiungendo prima una misura e poi una dimensione si ottiene una vista a barre. Tutti i clic successivi producono un affinamento della vista a barre, a meno che non venga aggiunta una dimensione della data, nel qual caso la visualizzazione viene cambiata in una linea. |
| Linea | L’aggiunta di una misura e poi di una dimensione della data genera una vista lineare. Tutti i clic successivi producono un affinamento della vista lineare. |
| Linea continua | L’aggiunta di una dimensione continua e poi di una misura genera una vista lineare continua. Le dimensioni successive producono un perfezionamento della vista lineare continua. Le misure successive aggiungono assi quantitativi alla vista. |
| Dispersione | L’aggiunta di una misura e poi di un’altra misura genera una vista a dispersione. Le dimensioni successive danno origine ad un affinamento della vista a dispersione. Le misure successive creeranno una matrice di dispersione. |
| Mappe | L’aggiunta di un campo geografico genera una vista mappa con latitudine e longitudine come assi e il campo geografico nello spazio Livello di dettaglio. Le dimensioni successive aggiungono righe alla vista mentre le misure successive affinano ulteriormente la mappa aggiungendo la codifica delle dimensioni e del colore. |
| Metodo di evidenziazione | Vantaggi | Quando potresti utilizzarlo |
|---|---|---|
| Selezionare gli indicatori |
|
|
| Legende |
|
|
| Evidenziatore |
|
|
| Azioni (solo Tableau Desktop) |
|
|
| Passa il puntatore | Seleziona | Menu |
 |  |  |
| Se scegli questa opzione... | L’azione viene eseguita quando l’utente... |
|---|---|
| Passa il puntatore | Passa il puntatore del mouse su un indicatore nella vista. Questa opzione è ideale per le azioni di evidenziazione all’interno di una dashboard. |
| Seleziona | Fa clic su un indicatore nella vista. Questa opzione funziona correttamente per tutti i tipi di azioni. |
| Menu | Fa clic con il pulsante destro (Control-clic su Mac) su un indicatore selezionato nella vista, quindi fa clic su un’opzione in un menu delle informazioni. Questa opzione è particolarmente adatta per le azioni URL. |
| Non facilmente accessibile: troppi indicatori | Più accessibile: vista aggregata |
|---|---|
 |  |
|
|
| Non facilmente accessibile: troppo poco testo | Più accessibile: aggiunta di testo descrittivo per fornire contesto |
|---|---|
 |  |
|
|
| Non facilmente accessibile: troppo poco testo | Più accessibile: testo più descrittivo |
|---|---|
 |  |
|
|
| Non facilmente accessibile: utilizza il colore solo per differenziare gli indicatori | Più accessibile: utilizza il colore e la forma per differenziare gli indicatori |
|---|---|
 |  |
|
|
| Pubblicazione separata | Incorporazione nella cartella di lavoro |
|---|---|
La pubblicazione delle origini dati è un passaggio verso la centralizzazione della gestione dei dati. È possibile creare criteri adatti a ridurre al minimo la proliferazione delle origini dati e consentire agli utenti di trovare i dati appropriati per il loro lavoro. | Ogni origine dati incorporata dispone di una connessione distinta ai dati. Ciascuna possiede il potenziale di visualizzare qualcosa di diverso dall’altra in qualsiasi momento e la proliferazione dell’origine dati è diffusa. |
Finalizzata alla condivisione; diventa disponibile per gli altri utenti di Tableau che vogliono connettersi ad essa. | I dati sono disponibili solo all’interno della cartella di lavoro, gli altri utenti di Tableau Desktop non possono connettersi ad essi. |
Senza le linee guida di gestione del contenuto e self-service, vedere un lungo elenco di origini dati a cui connettersi può essere fonte di confusione per gli utenti che si basano sui dati per eseguire il proprio lavoro ed è più difficile da gestire nel server. | Gli utenti creano le proprie connessioni e sanno esattamente quali dati stanno ricevendo. |
Gli utenti che modificano un’origine dati condivisa potrebbero essere incerti o non consapevoli degli effetti che tali modifiche esercitano sulle cartelle di lavoro connesse. | La modifica dei dati richiede l’apertura della cartella di lavoro, in cui è possibile visualizzare il risultato della modifica. |
Anche se gli effetti delle modifiche all’origine dati sulle cartelle di lavoro connesse sono pianificati, l’aggiornamento di queste cartelle è complicato. | Come sopra; tuttavia, se più cartelle di lavoro utilizzano dati simili che devono essere aggiornati, potrebbe essere utile connettersi invece a un’origine dati pubblicata. |
Le estrazioni possono essere aggiornate in base a una pianificazione. È possibile configurare una pianificazione di aggiornamento per l’estrazione e tutte le cartelle di lavoro che si connettono a essa mostrano sempre i dati più recenti. | Le estrazioni incorporate che non sono aggiornate possono risultare utili per mostrare gli snapshot nel tempo. Se desideri mantenere i dati aggiornati, ogni cartella di lavoro deve avere la propria pianificazione di aggiornamento. |
In genere, è utile ottimizzare le prestazioni sul server o sul sito. | Le prestazioni potrebbero essere compromesse quando il server contiene più cartelle di lavoro che si connettono ai dati originali e ogni cartella di lavoro dispone di una propria pianificazione di aggiornamento. |
| Tipo di storia basata sui dati | Descrizione |
Modifiche nel tempo | Funzione: usa una cronologia per illustrare una tendenza. Discussioni aperte: perché si è verificato questo evento, oppure perché continua a verificarsi questo evento? Cosa possiamo fare per evitare che ciò accada? |
Drill-down | Funzione: imposta il contesto in modo che il pubblico capisca meglio cosa sta succedendo in una particolare categoria. Discussioni aperte: perché questa persona, luogo o cosa è diverso? In che modo è possibile confrontare le prestazioni di questa persona, luogo o cosa? |
Zoom all’indietro | Funzione: descrive come qualcosa che sta a cuore al pubblico faccia parte di un contesto più ampio. Discussioni aperte: in che modo è possibile confrontare qualcosa che ti sta cuore con un contesto più ampio? Quale effetto ha un’area in questo contesto più ampio? |
Contrasto | Funzione: mostra le differenze tra due o più argomenti. Discussioni aperte: perché questi elementi sono diversi? In che modo è possibile far sì che le prestazioni di A coincidano con quelle di B? Su quale area dovremmo concentrarsi e quale area invece va bene? |
Intersezioni | Funzione: evidenzia i cambiamenti importanti nel momento in cui una categoria supera un’altra. Discussioni aperte: qual è la causa di questi cambiamenti? Questi cambiamenti sono positivi o negativi? In che modo questi cambiamenti influiscono sugli altri aspetti del nostro piano? |
Fattori | Funzione: spiega una tematica suddividendola in tipologie o categorie. Discussioni aperte: c’è una particolare categoria sulla quale dovremmo porre maggiormente attenzione? Quanto incidono queste categorie sulla metrica che ci interessa? |
Anomalie | Funzione: mostra le anomalie o il punto in cui le cose sono diverse. Discussioni aperte: perché questo elemento è diverso? |


| Prima | Dopo |
|---|---|
 |  |
 |  |
| Predict_Sales_City | Predict_Sales_State | Predict_Sales_Region |
MODEL_QUANTILE(0.5,sum([Sales]), | MODEL_QUANTILE(0.5,sum([Sales]), | MODEL_QUANTILE(0.5,sum([Sales]), |
Fai doppio clic su un campo esistente per iniziare la modifica. |  |
| Puoi anche fare doppio clic su uno spazio vuoto o su una parte vuota di uno spazio per creare un nuovo calcolo. |  |
| Digita per aggiornare l’espressione oppure trascina i nuovi campi nell’espressione dal riquadro Dati o altrove nella vista. |  |
Premi INVIO, TAB o fai clic all’esterno dell’espressione per confermare l’espressione, chiudere il calcolo e aggiornare la vista. Premi CTRL+INVIO (o Comando + Invio su Mac) per confermare l’espressione e aggiornare la visualizzazione senza chiudere il calcolo. |  |
| Gregoriano | ISO-8601 | Differenze tra i calendari |
|---|---|---|
| Anno | ISOYEAR | Gli anni ISO-8601 iniziano sempre il primo lunedì più vicino al 1° gennaio. Quindi l’anno può iniziare tra il 29 dicembre e il 4 gennaio. Nei calendari gregoriani l’anno inizia sempre il 1° gennaio. Questo può causare qualche discrepanza negli anni tra i due sistemi di calendario quando ci si avvicina a quelle date. Ogni anno ISO-8601 è un anno lungo o corto, con 52 o 53 settimane a seconda di quando inizia. |
| Trimestre | ISOQUARTER | I primi tre trimestri dell’anno ISO-8601 hanno sempre 13 settimane. L’ultimo trimestre ha 13 settimane (in un anno breve) o 14 settimane (in un anno lungo). |
| Mese | Il calendario settimanale ISO-8601 non utilizza i mesi. Molti sistemi finanziari e di vendita al dettaglio dividono i trimestri ISO-8601 in tre segmenti di 4-4-5 settimane, sebbene esistano anche altri modelli "mensili" che possono essere definiti utilizzando i calcoli. Consulta Creare un calendario 4-4-5. | |
| Numero della settimana | ISOWEEK | Tutte le settimane nel calendario settimanale ISO-8601 hanno esattamente 7 giorni e iniziano di lunedì. Ogni settimana appartiene a un singolo anno, a differenza del calendario gregoriano che consente l’estensione delle settimane tra più anni. Gli anni lunghi hanno 53 settimane, gli anni corti hanno 52 settimane. |
| Giorno | Il calendario settimanale ISO-8601 non utilizza giorni numerici (come il 14 o il 23). | |
| Giorno della settimana | ISOWEEKDAY | I giorni feriali ISO-8601 iniziano sempre di lunedì e sono rappresentati da una sola cifra. Lunedì è 1, martedì è 2, fino a 7 per la domenica. |
| Campi esclusi per impostazione predefinita | Motivi per l’esclusione |
|---|---|
Tutte le misure non visualizzate quando sono presenti più di 1.000 misure nell’origine dati. Tutte le dimensioni non visualizzate quando sono presenti più di 1.000 dimensioni nell’origine dati. | L’elaborazione delle spiegazioni per più di 1.000 misure o dimensioni non visualizzate può richiedere più tempo, talvolta diversi minuti. Questi campi sono esclusi per impostazione predefinita durante l’analisi iniziale, ma puoi scegliere di includerli per ulteriori analisi. In questa situazione, potresti vedere un avviso che richiede se considerare più campi in Interpreta i dati. Fai clic sul collegamento nell’avviso per ottenere ulteriori informazioni. Fai clic su Interpreta tutto per eseguire un’analisi che includa più campi. |
| Campi che utilizzano la geometria, la latitudine o la longitudine | La geometria, la latitudine o la longitudine da sole non possono mai essere spiegazioni. È molto probabile che una spiegazione che coinvolga la latitudine o la longitudine sia dovuta a una correlazione spuria e non rappresenti una probabile spiegazione. |
| Dimensioni con una cardinalità elevata (dimensioni con più di 500 membri) | L’elaborazione delle dimensioni con una cardinalità elevata richiede più tempo. Le dimensioni con più di 500 valori univoci non verranno considerate per l’analisi. |
| Gruppi, raggruppamenti o insiemi | Attualmente non sono supportati. |
| Calcoli tabella | Non è possibile eseguire l’analisi dei calcoli tabella quando sono a un livello di dettaglio diverso da quello della vista. |
| Misure non visualizzate per cui non è possibile calcolare una media | Le misure non visualizzate per cui non è possibile calcolare una media includono le misure che sono campi calcolati in cui l’espressione di calcolo include aggregazioni (visualizzate come campi AGG() quando vengono aggiunte al foglio). |
| Misure distinte e dimensioni continue | Attualmente non sono supportati. |
| Campi nascosti | Non disponibili. |
| Campi calcolati con errori | Nessun valore presente da analizzare. |
Uno-a-uno
Esempio: ogni auto ha la propria targa e una targa è specifica per una singola auto. La relazione tra le auto e le targhe è di tipo uno-a-uno. Tieni presente che se un’auto non è registrata o un numero di targa non è ancora stato assegnato a un’auto, tale discrepanza è descritta dall’integrità referenziale. Un’auto può avere una sola targa e una targa può essere assegnata a una sola auto, quindi la cardinalità rimane uno-a-uno. |
 |
Uno-a-molti o molti-a-uno
Esempi: molti dipendenti hanno lo stesso manager. La relazione tra i dipendenti e il manager è di tipo molti-a-uno. La relazione tra il manager e i dipendenti è di tipo uno-a-molti. |

|
Molti-a-molti
Esempi: un attore compare in molti film e un film è interpretato da molti attori. La relazione tra attori e film è di tipo molti-a-molti. Più libri possono essere acquistati nella stessa transazione e un libro può essere acquistato più volte. La relazione tra codici ISBN e ID ordine è di tipo molti-a-molti. |
 |

| Tutte le dimensioni | Sottocategoria | Regione |
|---|---|---|
 |  |  |
| Si combinano i 5 indicatori, mentre gli indicatori restanti vengono aggiunti a una categoria "Altro". | Vengono combinati tutti gli indicatori associati a una delle tre sottocategorie, mentre i restanti vengono aggiunti a una categoria "Altro". | Vengono combinati tutti gli indicatori associati alle quattro regioni, mentre i restanti vengono aggiunti a una categoria "Altro". |
| Origine dati originale | Origine dati secondaria |
 |  |
| Tipo di spiegazione | Valutazione |
|---|---|
Valori estremi | I valori estremi sono indicatori aggregati che sono outlier, basati su un modello degli indicatori visualizzati. Si ritiene che l’indicatore selezionato contenga un valore estremo se è presente un valore di record nella coda di distribuzione dei valori previsti per i dati. Un valore estremo viene determinato confrontando l’indicatore aggregato con e senza il valore estremo. Se l’indicatore diventa meno sorprendente rimuovendo un valore, allora riceve un punteggio più alto. Se un indicatore contiene valori estremi, non significa automaticamente che si tratta di outlier o che devi escludere i record corrispondenti dalla vista. La scelta dipende da te, in base alla tua analisi. La spiegazione sta semplicemente evidenziando un valore estremo interessante nell’indicatore. Ad esempio, potrebbe rivelare un valore errato in un record in cui una banana costa 10 dollari invece di 10 centesimi. In un altro caso, potrebbe indicare che un particolare addetto alle vendite ha avuto un ottimo trimestre. |
Numero di record | La spiegazione del numero di record modella la somma aggregata in termini di conteggio aggregato, mentre il valore medio dei record la modella in termini di media aggregata. Quanto meglio il modello spiega la somma, tanto più alto è il punteggio. Questa spiegazione descrive se la somma è interessante perché il conteggio è alto o basso o perché la media è alta o bassa. |
Valore medio dell’indicatore | Questo tipo di spiegazione viene utilizzato per gli indicatori aggregati che sono somme. Spiega se l’indicatore è coerente con gli altri indicatori in termini di conteggio aggregato o media, sulla base della relazione SUM(X) = COUNT(X) * AVG(X). Questa spiegazione descrive se la somma è interessante perché il conteggio è alto o basso o perché la media è alta o bassa. |
Dimensioni rilevanti | Questa spiegazione modella la misura di destinazione dell’indicatore analizzato in termini di suddivisione tra categorie della dimensione non visualizzata. L’analisi bilancia la complessità del modello con l’efficacia con cui viene spiegato l’indicatore. Una dimensione non visualizzata è una dimensione che esiste nell’origine dati, ma che attualmente non viene utilizzata nella vista. Questo tipo di spiegazione viene utilizzato per le somme, i conteggi e le medie. Il modello per le dimensioni non visualizzate viene creato dividendo gli indicatori secondo i valori categorici della colonna delle spiegazioni, e costruendo poi un modello con il valore che include tutti i punti dati nella visualizzazione dell’origine. Per ogni riga, il modello tenta di recuperare ciascuno dei singoli componenti che hanno dato origine a ciascun indicatore. L’analisi indica se il modello prevede meglio l’indicatore se i componenti corrispondenti alla dimensione non visualizzata sono modellati e poi sommati, rispetto all’utilizzo di un modello in cui i valori della dimensione non visualizzata non sono noti. Le spiegazioni di dimensione aggregata esplorano come si possano spiegare bene i valori degli indicatori senza alcun condizionamento. Successivamente, il modello condiziona i valori per ogni colonna che rappresenta una spiegazione potenziale. Condizionare la distribuzione di una colonna esplicativa dovrebbe risultare in una previsione migliore. |
Misure rilevanti | Questa spiegazione modella l’indicatore in termini di questa misura non visualizzata, aggregata alla relativa media nelle dimensioni visualizzate. Una misura non visualizzata è una misura che esiste nell’origine dati, ma che attualmente non viene utilizzata nella vista. La spiegazione Misure rilevanti può rivelare una relazione lineare o quadratica tra la misura non visualizzata e la misura di destinazione. |
Classes | Clubs | Students | Rooms |
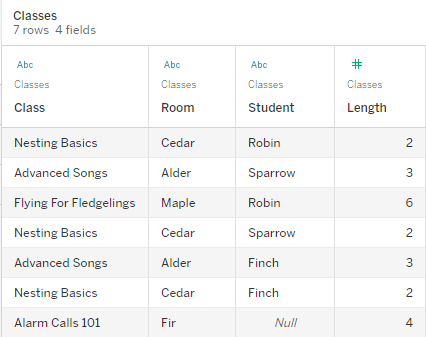 | 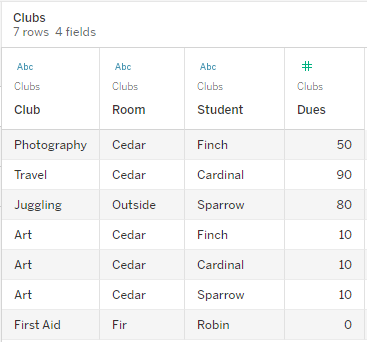 | 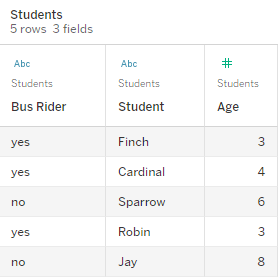 | 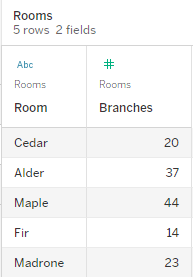 |
Campi:
| Campi:
| Campi:
| Campi:
|
Non correlata: cross join | Congiunta: join esterno di join interni intermedi |
 Una visualizzazione che mostra un cross join di Class e Club con righe per ogni combinazione di Advanced Songs/Alarm Calls 101/Flying for Fledglings/Nesting Basics with Art/First Aid/Juggling/Photography. |  Una visualizzazione che mostra i risultati di un join esterno dei join interni Student-Class e Student-Club. Non sono rappresentate tutte le combinazioni di classi e club e sono presenti righe per studenti e club senza classe. |
| Storia di esempio | Scomposizione della storia |
| Le prime due frasi utilizzano le funzioni di media e intervallo per scrivere i valori medio, massimo e minimo nel periodo preso in esame. |
| La terza frase riguarda le prestazioni complessive della misura nel periodo. Ad esempio, una frase può indicare se le vendite sono aumentate, diminuite o hanno avuto un andamento diverso durante un periodo specifico. |
| La quarta frase utilizza l’analisi della progressione. Questa frase esegue la scrittura del maggiore aumento e della maggiore diminuzione in base alla misura durante il periodo, utilizzando sia una base percentuale che una base assoluta. |
| Questa frase offre informazioni sulla correlazione. Questo tipo di informazioni analitiche esegue la scrittura di correlazioni significative tra diverse serie nei dati. |
| Questa frase offre informazioni relative al segmento. Questo tipo di informazioni analitiche esegue la scrittura di aumenti e diminuzioni significativi nel tempo. |
| Questa frase offre informazioni relative alla linea di tendenza. Questo tipo di informazioni analitiche esegue la scrittura di come le tendenze si adattano ai dati con una certa percentuale di confidenza e le linee di tendenza consentono di formulare previsioni basate sulle tendenze storiche. |
| Storia di esempio | Scomposizione della storia |
| La prima frase calcola il valore totale della misura. |
| La seconda frase esegue la scrittura dei driver della dimensione. In questo esempio, i driver della dimensione sono i prodotti che hanno contribuito maggiormente alle vendite totali. |
| La terza e la quarta frase analizzano la distribuzione dei dati. Vengono esaminate le medie, le mediane, la concentrazione dei dati (se presente) e l’asimmetria dei dati. Questo aiuta a identificare quanto sono equilibrate queste variabili raggruppate quando vengono confrontate tra loro. |
| Questa frase usa il clustering per eseguire la scrittura delle misure che possono essere raggruppate. Questo aiuta a identificare se sono presenti gruppi distinti che si distinguono nei dati. |
| La frase finale esegue la scrittura degli outlier significativi. |
| Storia di esempio | Scomposizione della storia |
| Le prime due frasi sono basate sull’analisi della regressione. La regressione mostra come una misura influisce su un’altra. Nella prima frase la storia ha identificato una relazione tra profitto e vendite. |
| La terza frase deriva dal clustering. L’analisi del clustering tenta di identificare i gruppi o i cluster chiave in tutte le variabili nei dati. |
| La quarta frase esegue la scrittura degli outlier, ovvero i valori significativamente al di sopra o al di sotto della media. |
| Le frasi rimanenti per le storie con grafici a dispersione utilizzano l’analisi dell’intervallo e della media per fornire informazioni. |
| Storia di esempio | Scomposizione della storia |
| La prima frase calcola il valore totale della misura. |
| La seconda frase esegue la scrittura dei driver. In questo esempio, i driver sono i segmenti che hanno contribuito maggiormente alle vendite totali. |
| L’ultima frase analizza la distribuzione dei dati. |
Snowflake usa Okta come provider di identità (IdP) predefinito, che fornisce i token di accesso e autentica le identità. Dovrai configurare le impostazioni in Snowflake e Okta per le funzionalità OAuth e Single Sign-On (SSO). In Okta, devi definire Okta come server di autenticazione OAuth e identificare Snowflake come risorsa OAuth. Segui i passaggi descritti in questo argomento della Guida di Snowflake: Configurazione di un provider di identità per Snowflake (in inglese). |  |
| 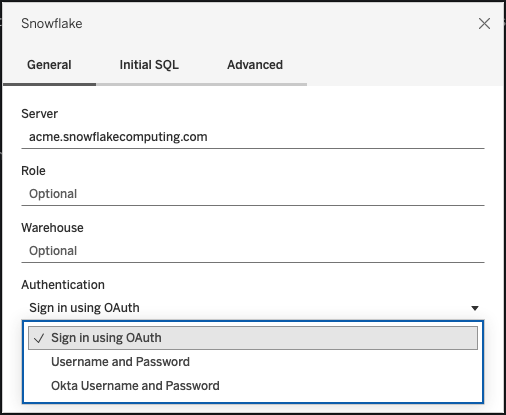 |
| Funzioni e funzionalità | Tableau Desktop Public Edition | Tableau Desktop Free Edition | Tableau Desktop Professional Edition |
| Privacy e sicurezza |  | | |
| Salvataggio delle visualizzazioni in locale | | | |
| Ripristino automatico | | | |
| Pubblicazione o incorporamento di visualizzazioni in altri siti pubblici |  * Opzioni di incorporamento disponibili dopo la pubblicazione su Tableau Public | | |
| Pubblicazione di visualizzazioni su Tableau Public | | | |
| Pubblicare visualizzazioni in Tableau Cloud o Tableau Server | | | |
| Condividere cartelle di lavoro compresse con altri utenti | | | |
| Aggiornamento dei dati live | Aggiornamento dei dati limitato (Solo Google Drive. I dati vengono aggiornati automaticamente una volta ogni 24 ore) | | |
| Origini dati | Opzioni per origini dati limitate (Google Drive, file JSON, Microsoft Excel 2007 o versione successiva, OData, PDF, file spaziali, file di statistiche, file di testo) | * Le origini dati pubblicate su Tableau Cloud o Tableau Server non sono supportate | |
| Righe dell’origine dati | 15 milioni di righe | Nessun limite | Nessun limite |
| Archiviazione cloud | 10 GB su Tableau Public | | Tableau Cloud e Tableau Server se applicabile |
| Archiviazione in locale | | | |
| Funzionalità | Combinazione dei dati | Geocodifica personalizzata |
| Tracciare la tua posizione in una vista mappa | Sì | Sì |
| Usare qualsiasi dato | Sì | No, solo file di testo |
| Aggiungere nuovi ruoli geografici | No | Sì |
| Aggiungere a un ruolo geografico esistente | No | Sì |
| Creare nuove gerarchie geografiche | No | Sì |
| Può essere riutilizzato per altre cartelle di lavoro | No | Sì |
| Novembre | Dicembre |
|---|---|
 |  |
| Ordini | Venditori |
|---|---|
 |  |
| Per Tableau Desktop | Per Tableau Prep Builder | Per Tableau Server |
|---|---|---|
|
|
|
| Per Tableau Desktop | Per Tableau Prep Builder | Per Tableau Server, Tableau Prep Conductor, Tableau Prep Flow Authoring |
|---|---|---|
|
|
Per abilitare il tuo connettore per Prep, devi anche aggiungere il tuo taco nelle seguenti posizioni:
|
| Per Tableau Desktop | Per Tableau Prep Builder | Per Tableau Server, Tableau Prep Conductor, Tableau Prep Flow Authoring |
|---|---|---|
|
|
|
| Modalità | Chi può accedere |
|---|---|
Modalità di visualizzazione | Gli utenti Viewer, Explorer e Creator di Tableau che dispongono dell’autorizzazione Esegui Interpreta i dati possono eseguire ed esplorare le spiegazioni di Interpreta i dati in modalità di visualizzazione. |
Modalità di modifica
| Gli utenti Creator di Tableau possono eseguire Interpreta i dati durante la modifica di una vista in Tableau Desktop, Tableau Cloud o Tableau Server. Gli utenti Explorer che dispongono dell’autorizzazione Esegui Interpreta i dati e delle autorizzazioni di modifica possono eseguire Interpreta i dati durante la modifica di una cartella di lavoro in Tableau Cloud o Tableau Server. Gli utenti Creator ed Explorer che dispongono delle autorizzazioni di modifica possono aprire nuovi fogli di lavoro per ulteriori analisi. Possono anche utilizzare le impostazioni di Interpreta i dati per controllare chi può usare Interpreta i dati e quali elementi è in grado di visualizzare. |
| Sintassi | DATE(expression) |
| Output | Data |
| Definizione | Restituisce una data con un numero, una stringa o un’espressione di data. |
| Esempio | DATE([Employee Start Date]) DATE("September 22, 2018") DATE("9/22/2018")DATE(#2018-09-22 14:52#) |
| Note | A differenza di DATEPARSE, non è necessario fornire un modello poiché DATE riconosce automaticamente molti formati di data standard. Tuttavia, se DATE non riconosce l’input, prova ad utilizzare DATEPARSE e a specificare il formato. MAKEDATE è un’altra funzione simile, ma MAKEDATE richiede l’input di valori numerici per anno, mese e giorno. |
| Sintassi | DATETIME(expression) |
| Output | Data e ora |
| Definizione | Restituisce data e ora con un numero, una stringa o un’espressione di data. |
| Esempio | DATETIME("April 15, 2005 07:59:00") = April 15, 2005 07:59:00 |
| Sintassi | FLOAT(expression) |
| Output | Numero in virgola mobile (decimale) |
| Definizione | Trasmette il proprio argomento come numero a virgola mobile. |
| Esempio | FLOAT(3) = 3.000 |
| Note | Vedi anche INT, che restituisce un numero intero. |
| Sintassi | INT(expression) |
| Output | Intero |
| Definizione | Trasmette il proprio argomento come numero intero. Per le espressioni, questa funzione tronca i risultati al numero intero più vicino allo zero. |
| Esempio | INT(8/3) = 2 INT(-9.7) = -9 |
| Note | Quando una stringa viene convertita in un numero intero, viene prima convertita in un numero a virgola mobile e poi arrotondata. Vedi anche FLOAT, che restituisce un numero decimale. |
| Sintassi | MAKEDATE(year, month, day) |
| Output | Data |
| Definizione | Restituisce un valore di data costruito a partire dall’anno, dal mese e dalla data numerici specificati. |
| Esempio | MAKEDATE(1986,3,25) = #1986-03-25# Tieni presente che i valori immessi erroneamente verranno regolati in una data come MAKEDATE(2020,4,31) = May 1, 2020 invece di restituire un messaggio di errore che dice che non esiste il 31 aprile. |
| Note | Disponibile per le estrazioni dei dati di Tableau. Verifica la disponibilità in altre origini dati. MAKEDATE richiede input numerici per le parti di una data. Se i tuoi dati sono una stringa che dovrebbe essere una data, prova la funzione DATE. DATE riconosce automaticamente molti formati di data standard. Se DATE non riconosce l’input, prova ad utilizzare DATEPARSE. |
| Sintassi | MAKEDATETIME(date, time) |
| Output | Data e ora |
| Definizione | Restituisce un valore data e ora che combina una data e un’ora. La data può essere una data, un valore data e ora o un tipo di stringa. L’ora deve essere un valore data e ora. |
| Esempio | MAKEDATETIME("1899-12-30", #07:59:00#) = #12/30/1899 7:59:00 AM#MAKEDATETIME([Date], [Time]) = #1/1/2001 6:00:00 AM# |
| Note | Questa funzione è disponibile solo per connessioni compatibili con MySQL (che per Tableau sono MySQL e Amazon Aurora). MAKETIME è una funzione simile disponibile per le estrazioni di dati Tableau e alcune altre origini dati. |
| Sintassi | MAKELINE(<Spatial Point1>,<Spatial Point2>) |
| Output | Oggetto spaziale geometria (linea) |
| Definizione | Genera un indicatore lineare tra due punti. |
| Esempio | MAKELINE(OriginPoint, DestinationPoint) MAKELINE( MAKEPOINT(OriginLat],[OriginLong]) , MAKEPOINT([DestinationLat],[DestinationLong] ) |
| Note | Utile per creare mappe di origine-destinazione o, con MAKEPOINT, per trasformare la latitudine e la longitudine in oggetti spaziali. |
| Sintassi | MAKEPOINT(<latitude>, <longitude>) |
| Output | Oggetto spaziale geometria (punto) |
| Definizione | Converte i dati delle colonne di latitudine e longitudine in oggetti spaziali. |
| Esempio | MAKEPOINT([AirportLatitude],[AirportLongitude]) |
| Note | Puoi utilizzare MAKEPOINT per abilitare spazialmente un’origine dati in modo che possa essere collegata con un file spaziale utilizzando un join spaziale. Per maggiori informazioni, consulta Creare un join dei file spaziali in Tableau. Per utilizzare MAKEPOINT, i dati devono contenere le coordinate di latitudine e longitudine. |
| Sintassi | MAKETIME(hour, minute, second) |
| Output | Data e ora. Vedi le note. |
| Definizione | Restituisce un valore di data costruito a partire da ore, minuti e secondi specificati. |
| Esempio | MAKETIME(14, 52, 40) = #1/1/1899 14:52:40# |
| Note | Poiché Tableau non supporta un tipo di dati ora, solo data e ora, l’output è un datetime. La parte di data del campo sarà 1/1/1899. Funzione simile a MAKEDATETIME, disponibile solo per connessioni compatibili con MYSQL. |
| Sintassi | STR(expression) |
| Output | Stringa |
| Definizione | Trasmette il proprio argomento come stringa. |
| Esempio | STR([ID]) |
 | A. Giorno del mese B. Mese C. Anno D. Ora, minuto, secondo, millisecondo, periodo |
 | A. Formato B. Stringa |
| Parte della data | Simbolo | Esempio di output |
|---|---|---|
| Anno | yy y, yyyy Y | 26 2026 2026 (utilizzato per i calendari basati su Settimana dell’anno) |
| Trimestre dell’anno | Q QQQ QQQQ | 2 02 Q2 2° trimestre |
| Mese | M MM MMM MMMM | 9 09 Set Settembre |
| Settimana dell’anno | w, ww | 47 |
| Giorno della settimana | E, EE, EEE EEEE EEEEE | Lu Lunedì M |
| Giorno del mese | d dd | 1, 15 01, 15 |
| Giorno dell’anno (1-365) | D | 23, 143 |
Ora (1-12) | h hh | 8 08 |
| Ora (0-23) | H HH | 8 08 |
| Minuto | m mm | 8 08 |
| Secondo di un minuto | s ss | 5 05 |
| Secondo frazionario | S SS SSS SSSS | 2 23 235 2350 |
| Millisecondi nel giorno | A | 34532 |
| Periodo (marcatore AM/PM) | a, aa, aaa | AM, am, PM |
| Fuso orario | z, zz, zzz zzzz Z, ZZ, ZZZ ZZZZ | PDT Ora legale del Pacifico -0800 PST-08:00 |
| Azione | Risultato |
| Conversione di Sconto da una misura in una dimensione... | I valori di vendita non sono più aggregati in base al tasso di sconto, pertanto viene generato un grafico a linee anziché in un grafico a dispersione. |
| Conversione di Sconto da continuo a distinto... | Tableau mostra le intestazioni nella parte inferiore della vista, anziché un asse continuo. |
| Relazione | Utilizza questa opzione per combinare dati con diversi livelli di dettaglio.
|
| Join | Utilizza questa opzione quando desideri aggiungere altre colonne di dati nella stessa struttura di righe.
|
| Unificazione | Utilizza questa opzione quando desideri aggiungere più righe di dati con la stessa struttura di colonne.
|
| Combinazione | Utilizza questa opzione per combinare dati con diversi livelli di dettaglio.
|
| Se la dimensione minima iframe è... | Verrà visualizzato il layout dispositivo... |
|---|---|
| 500 pixel o meno | Telefono |
| Tra 501 e 800 pixel | Tablet |
| Più di 800 pixel | Desktop |
| Min. | Valore minimo del campo. |
| Max | Valore massimo del campo. |
| Diff | Differenza tra i valori minimo e massimo del campo. |
| CntD | Numero di valori distinti (righe) nei dati. |
| Meno accessibile: contrasto basso | Più accessibile: contrasto più elevato |
 |  |
| Meno accessibile: troppi indicatori | Più accessibile: vista aggregata |
|---|---|

|  |
| Meno accessibile: troppi indicatori | Più accessibile: vista aggregata e raggruppata |
|---|---|
|  |
| Meno accessibile: indicatori non necessari | Più accessibile: indicatori non necessari rimossi |
|---|---|
|  |
| Non facilmente accessibile | Più accessibile: tavolozza discromatoptica e forme |
|---|---|
 |  |
| Meno accessibile: troppi indicatori | Più accessibile: meno indicatori nella vista |
|---|---|
|  |
| Stato | Provincia | Percentuale di obesità - 2012 |
| Alabama | Provincia di Autauga | 30,9000 |
| Alabama | Provincia di Baldwin | 26,7000 |
| Alabama | Provincia di Barbour | 40,8000 |
| Alabama | Provincia di Bibb | 40,1000 |
| Alabama | Provincia di Blount | 32,4000 |
| Alabama | Provincia di Bullock | 44,5000 |
| Spazio Colonne: | Longitudine (misura continua, ruolo geografico di longitudine assegnato) |
| Spazio Righe: | Latitudine (misura continua, ruolo geografico di latitudine assegnato) |
| Dettaglio: | Una o più unità geografiche (dimensioni con ruoli geografici assegnati) |
| Colore: | Misura o dimensione |
| Tipo di indicatore: | Automatico o Mappa |
| Linea | Gruppo di linee (ID percorso) | Ordine dei punti | Stazione | Latitudine | Longitudine | Traffico |
| 1 | 1 | 1 | La Défense (Grande Arche) | 48,891934 | 2,237883 | 14.275.382 |
| 1 | 1 | 2 | Esplanade de la Défense | 48,887843 | 2,250442 | 9.843.051 |
| 1 | 1 | 3 | Pont de Neuilly | 48,884509 | 2,259892 | 6.902.931 |
| 10 BOUCLE | 10 | 1 | Boulogne-Jean-Jaurès | 48,842222 | 2,238836 | 3.847.782 |
| 10 BOUCLE | 10 | 2 | Porte d’Auteuil | 48,848074 | 2,258648 | 687.237 |
| 10 BOUCLE | 10 | 3 | Michel-Ange-Auteuil | 48,847740 | 2,264297 | 2.222.709 |
| Spazio Colonne: | Longitudine (misura continua, ruolo geografico di longitudine assegnato) |
| Spazio Righe: | Latitudine (misura continua, ruolo geografico di latitudine assegnato) |
| Dettaglio: | Campo ID percorso (dimensione distinta) |
| Percorso: | Campo Ordine (dimensione continua) |
| Tipo di indicatore: | Linea |
| Origine-destinazione | Stazione | ID percorso | Latitudine | Longitudine |
| Origine | BT-01 | BT-01_BT-01 | 47,61841 | -122,35101 |
| Destinazione | BT-01 | BT-01_BT-01 | 47,61841 | -122,35101 |
| Origine | BT-01 | BT-01_BT-03 | 47,61841 | -122,35101 |
| Destinazione | BT-03 | BT-01_BT-03 | 47,61576 | -122,34843 |
| Origine | BT-01 | BT-01_BT-04 | 47,61841 | -122,35101 |
| Destinazione | BT-04 | BT-01_BT-04 | 47,61613 | -122,34108 |
| Origine | BT-01 | BT-01_BT-05 | 47,61841 | -122,35101 |
| Destinazione | BT-05 | BT-01_BT-05 | 47,61303 | -122,34410 |
| Origine-destinazione | Nome posizione | ID percorso | Latitudine | Longitudine |
| Origine | BT-01 | BT-01_BT-01 | 47,61841 | -122,35101 |
| Destinazione | BT-01 | BT-01_BT-01 | 47,61841 | -122,35101 |
| Origine | BT-01 | BT-01_BT-03 | 47,61841 | -122,35101 |
| Destinazione | BT-03 | BT-01_BT-03 | 47,61576 | -122,34843 |
| Spazio Colonne: | Longitudine (dimensione continua, ruolo geografico di longitudine assegnato) |
| Spazio Righe: | Latitudine (dimensione continua, ruolo geografico di latitudine assegnato) |
| Dettaglio: | Campo ID percorso (dimensione distinta) |
| Tipo di indicatore: | Linea |
| Data e ora del terremoto | ID | Magnitudo | Magnitudo ^10 | Latitudine | Longitudine |
| 01/01/1973 | centennial19730101114235 | 6,00000 | 17.488.747,04 | -35,570 | -15,427 |
| 02/01/1973 | pde19730102005320300_66 | 5,50000 | 25.329.516,21 | -9,854 | 117,427 |
| 03/01/1973 | pde19730103022942800_33 | 4,80000 | 6.492.506,21 | 1,548 | 126,305 |
| 04/01/1973 | pde19730104003142000_33 | 4,50000 | 3.405.062,89 | 41,305 | -29,272 |
| 05/01/1973 | pde19730105003948200_36 | 4,70000 | 5.259.913,22 | 0,683 | -80,018 |
| 06/01/1973 | pde19730106061852300_83 | 4,90000 | 7.979.226,63 | -22,354 | -69,310 |
| Spazio Colonne: | Longitudine (misura continua, ruolo geografico di longitudine assegnato) |
| Spazio Righe: | Latitudine (misura continua, ruolo geografico di latitudine assegnato) |
| Dettaglio: | uno o più campi dimensione |
| Dimensione: | un campo misura (aggregato) |
| Tipo di indicatore: | Automatico |
| Nome del temporale | Data | Latitudine | Longitudine | Bacino | Velocità del vento (kt) |
| PAKHAR | 26/03/2012 00:00:00 | 9,5000 | 115,700 | Pacifico occidentale | 0 |
| PAKHAR | 26/03/2012 06:00:00 | 9,5000 | 115,400 | Pacifico occidentale | 0 |
| PAKHAR | 26/03/2012 12:00:00 | 9,5000 | 115,100 | Pacifico occidentale | 0 |
| PAKHAR | 26/03/2012 18:00:00 | 9,4000 | 114,800 | Pacifico occidentale | 0 |
| PAKHAR | 27/03/2012 00:00:00 | 9,4000 | 114,500 | Pacifico occidentale | 0 |
| PAKHAR | 27/03/2012 6:00:00 | 9,4000 | 114,300 | Pacifico occidentale | 35 |
| Spazio Colonne: | Longitudine (misura continua, ruolo geografico di longitudine assegnato) |
| Spazio Righe: | Latitudine (misura continua, ruolo geografico di latitudine assegnato) |
| Dettaglio: | Dimensione (ID univoco per ogni percorso) |
| Percorso: | Campo data o ordine in base al quale definire l’ordine per il collegamento dei punti dati |
| Tipo di indicatore: | Linea |


| Latitudine | Longitudine |
| 32,2000 | -101,5000 |
| 38,5800 | -92,5800 |
| 41,2000 | -89,6800 |
| 39,2800 | -87,4000 |
| 41,7800 | -87,7800 |
| 39,5000 | -90,0800 |
| Spazio Colonne: | Longitudine (dimensione continua, ruolo geografico di longitudine assegnato) |
| Spazio Righe: | Latitudine (dimensione continua, ruolo geografico di latitudine assegnato) |
| Tipo di indicatore: | Automatico |
| Motivo | Scenari |
|---|---|
| Non disponi delle autorizzazioni corrette. |
|
| Non puoi accedere ai dati completi. |
|
| La password per l’origine dati della cartella di lavoro non è incorporata o non è più valida. |
|
| I dati non sono al livello corretto di granularità. |
|
| La dimensione della data non è supportata. |
|
| Nome della tavolozza nella versione 9.x | Valori esadecimali della versione 9.x |
|---|---|
Tableau 10 Ora nominato Tableau Classic 10.
| <color-palette name="Classic 10" type="regular"> |
Tableau 10 Medium Ora nominato Tableau Classic Medium.
| <color-palette name="Classic 10 Medium" type="regular">
|
Tableau 10 Light
| <color-palette name="Classic 10 Light" type="regular">
|
Tableau 20 Ora nominato Tableau Classic 20.
| <color-palette name="Classic 20" type="regular">
<color>#9edae5</color>
<color>#17becf</color>
<color>#dbdb8d</color>
<color>#bcbd22</color>
<color>#c7c7c7</color>
<color>#7f7f7f</color>
<color>#f7b6d2</color>
<color>#e377c2</color>
<color>#c49c94</color>
<color>#8c564b</color>
<color>#c5b0d5</color>
<color>#9467bd</color>
<color>#ff9896</color>
<color>#d62728</color>
<color>#98df8a</color>
<color>#2ca02c</color>
<color>#ffbb78</color>
<color>#ff7f0e</color>
<color>#aec7e8</color>
<color>#1f77b4</color>
|
Grigio 5
Sostituito con Grigi di Seattle. | <color-palette name="Classic Gray 5" type="regular">
<color>#cfcfcf</color>
<color>#8f8782</color>
<color>#414451</color>
<color>#a5acaf</color>
<color>#60636a</color>
|
Daltonica 10
Aggiornato come Daltonici. | <color-palette name="Classic Color Blind" type="regular">
|
Semaforo
Aggiornato comeSemaforo. | <color-palette name="Classic Traffic Light" type="regular">
|
Purple-Gray 6
Interrotto. | <color-palette name="Classic Purple-Gray 6" type="regular">
|
Purple-Gray 12
Aggiornato come Viola-Rosa-Grigio. | <color-palette name="Classic Purple-Gray 12" type="regular">
|
Green-Orange 6
Interrotto. | <color-palette name="Classic Green-Orange 6" type="regular">
|
Green-Orange 12
Aggiornato come Verde-Arancio-Verde acqua. | <color-palette name="Classic Green-Orange 12" type="regular">
|
Blue-Red 6
Interrotto. | <color-palette name="Classic Blue-Red 6" type="regular">
|
Blue-Red 12
Aggiornato come Blu-Rosso-Marrone. | <color-palette name="Classic Blue-Red 12" type="regular">
|
Ciclico
Aggiornato come Cerchio di tonalità. | <color-palette name="Classic Cyclic" type="regular"> |
Verde
Aggiornato. | <color-palette name="Classic Green" type="ordered-sequential">
|
Grigio
Aggiornato. | <color-palette name="Classic Gray" type="ordered-sequential">
|
Blu
Aggiornato. | <color-palette name="Classic Blue" type="ordered-sequential">
|
Rosso
Aggiornato. | <color-palette name="Classic Red" type="ordered-sequential">
|
Arancione
Aggiornato. | <color-palette name="Classic Orange" type="ordered-sequential">
|
Area rosso
Interrotto. | <color-palette name="Classic Area Red" type="ordered-sequential">
|
Area verde
Interrotto. | <color-palette name="Classic Area Green" type="ordered-sequential">
|
Area marrone
Interrotto. | <color-palette name="Classic Area-Brown" type="ordered-sequential">
|
Rosso-verde divergenti
Aggiornato. | <color-palette name="Classic Red-Green" type="ordered-diverging">
|
Roso-blu divergenti
Aggiornato. | <color-palette name="Classic Red-Blue" type="ordered-diverging">
|
Rosso-nero divergenti
Aggiornato. | <color-palette name="Classic Red-Black" type="ordered-diverging">
|
Area rosso-verde divergenti
Interrotto. | <color-palette name="Classic Area Red-Green" type="ordered-diverging"> |
Arancione-blu divergenti
Aggiornato. | <color-palette name="Classic Orange-Blue" type="ordered-diverging">
|
Verde-blu divergenti
Aggiornato. | <color-palette name="Classic Green-Blue" type="ordered-diverging">
|
Rosso-bianco-verde divergenti
Aggiornato. | <color-palette name="Classic Red-White-Green" type="ordered-diverging">
|
Rosso-bianco-nero divergenti
Aggiornato. | <color-palette name="Classic Red-White-Black" type="ordered-diverging">
|
Arancione-bianco-blu divergenti
Aggiornato. | <color-palette name="Classic Orange-White-Blue" type="ordered-diverging">
|
Chiaro rosso-bianco-nero
Interrotto. | <color-palette name="Classic Red-White-Black Light" type="ordered-diverging">
|
Chiaro arancione-bianco-blu divergenti
Interrotto. | <color-palette name="Classic Orange-White-Blue Light" type="ordered-diverging">
|
Chiaro rosso-bianco-verde divergenti
Interrotto. | <color-palette name="Classic Red-White-Green Light" type="ordered-diverging">
|
Chiaro rosso-verde divergenti
Interrotto. | <color-palette name="Classic Red-Green Light" type="ordered-diverging">
|


| Cartelle di lavoro | Origini dati |
|---|---|
|
|
| Crea barre verticali | Crea barre orizzontali |
 |  |
| Crea un semplice grafico a dispersione | Crea una matrice di grafici a dispersione |
 |  |
| Tipo di join | Risultato |
Inner
| Quando utilizzi un join interno per combinare tabelle, il risultato è una tabella che contiene valori che hanno corrispondenze in entrambe le tabelle. Quando un valore non corrisponde in entrambe le tabelle, viene eliminato completamente. |
Sinistro
| Quando utilizzi un join sinistro per combinare le tabelle, il risultato è una tabella che contiene tutti i valori della tabella di sinistra e le corrispondenze della tabella di destra. Quando un valore nella tabella di sinistra non ha una corrispondenza nella tabella di destra, viene visualizzato un valore NULL nella griglia di dati. |
Destro
| Quando utilizzi un join destro per combinare le tabelle, il risultato è una tabella che contiene tutti i valori della tabella di destra e le corrispondenze della tabella di sinistra. Quando un valore nella tabella di destra non ha una corrispondenza nella tabella di sinistra, viene visualizzato un valore NULL nella griglia di dati. |
Esterno completo
| Quando utilizzi un join esterno completo per combinare le tabelle, il risultato è una tabella che contiene tutti i valori di entrambe le tabelle. Quando un valore di una delle tabelle non ha una corrispondenza nell’altra tabella, viene visualizzato un valore NULL nella griglia di dati. |
| Unificazione
| Sebbene l’unificazione non sia un tipo di join, è un altro metodo per combinare due o più tabelle aggiungendo righe di dati da una tabella all’altra. In teoria, le tabelle unificate hanno lo stesso numero di campi e questi campi hanno nomi e tipi di dati corrispondenti. Per maggiori informazioni sull’unificazione, consulta Unificare i dati. |


| Non supportato. La tabella X ha due relazioni in entrata che provengono entrambe dalle tabelle a valle della tabella di base A | Supportato. Le tabelle S e T hanno entrambe più relazioni in entrata, ma ciascuna proviene da una tabella di base diversa. | Supportato. Anche se visivamente può sembrare che sia presente un ciclo, le relazioni in entrata sia per la tabella S che per la tabella T possono essere ricondotte a diverse tabelle di base. |
 |  |  |
 |  |
| Tipo di indicatore di previsione | Intervalli di previsione visualizzati tramite |
| Linea | Bande |
| Forma, quadrato, cerchio, barra o torta | Baffi |
Actian Matrix Alibaba AnalyticDB per MySQL‡ Alibaba Data Lake Analytics‡ Alibaba MaxCompute‡ Amazon Athena‡ Amazon Aurora per MySQL‡ Amazon EMR Hadoop Hive‡ Amazon Redshift‡ Apache Drill‡ Aster Database* Azure Data Lake Storage Gen2‡ Box‡ Cloudera Hadoop‡ Databricks‡ Datorama di Salesforce‡ Denodo‡ Dremio di Dremio‡ Dropbox‡ Connettore Esri‡ Exasol‡ | Google BigQuery**‡ Google BigQuery JDBC**‡ Google Cloud SQL‡ Google Drive‡ Impala‡ Kognito* Kyvos‡ Hortonworks Hadoop Hive IBM BigInsights IBM DB2‡ IBM PDA (Netezza)* Kyvos‡ MariaDB‡ MarkLogic* Database SQL di Microsoft Azure‡ Microsoft Azure Synapse Analytics‡ Microsoft SQL Server‡ MonetDB* Connettore MongoDB BI‡ MySQL‡ | OData‡ OneDrive‡ Oracle‡ Database Pivotal Greenplum‡ PostgreSQL‡ Progress OpenEdge* Presto‡ Qubole Presto‡ SAP HANA (solo per le connessioni virtuali)‡ SAP Sybase ASE* SAP Sybase IQ* Salesforce‡ Elenchi di SharePoint‡ SingleStore (in precedenza MemSQL)‡ Snowflake‡ Spark SQL‡ Teradata***‡ Vertica‡ |
Alibaba AnalyticsDB per MySQL‡ Alibaba Data Lake Analytics‡ Amazon Athena‡ Amazon Aurora per MySQL‡ Amazon EMR Hadoop Hive‡ Amazon Redshift‡ Apache Drill‡ Azure Data Lake Storage Gen2‡ Azure Synapse Analytics (compatibile con SQL Server) Box‡ Cloudera Hadoop‡ Databricks‡ Datorama di Salesforce‡ Denodo‡ Dremio di Dremio‡ | Dropbox*‡ Connettore Esri‡ Exasol‡ Google BigQuery*‡ Google Cloud SQL (compatibile con MySQL)‡§ Google Drive‡ Hortonworks Hadoop Hive Impala‡ Kyvos‡ MariaDB‡ Database SQL di Microsoft Azure‡ Microsoft Azure Synapse Analytics‡ Microsoft SQL Server‡ Connettore MongoDB BI‡ MySQL‡ | OData‡ OneDrive*‡ Oracle‡ Database Pivotal Greenplum‡ PostgreSQL‡ Presto‡ Qubole Presto‡ Salesforce‡ SAP HANA (solo per le connessioni virtuali)‡ Elenchi di SharePoint‡ SingleStore (in precedenza MemSQL)‡ Snowflake‡ Spark SQL‡ Teradata**‡ Vertica‡ |
Google Drive OData |
| Parte della data distinta | Troncamento della data continuo |
 |  |
| Livello data | Dopo la conversione a fiscale |
|---|---|
| Anno | Rispecchia l’anno fiscale. Ad esempio, se Inizio anno fiscale è impostato su aprile, l’anno per la data 1 giugno 2004 sarà visualizzato come FY 2005. |
| Trimestre | Il trimestre riflette il trimestre fiscale. Ad esempio, se Inizio anno fiscale è impostato su aprile, il trimestre per la data 1 giugno 2004 sarà Q1. |
| Mese | Nessuna modifica di comportamento. Il mese di calendario è uguale al mese fiscale. |
| Giorno | Nessuna modifica di comportamento. Il giorno del calendario corrisponde al giorno fiscale. |
| Ora | Nessuna modifica di comportamento. L’ora di calendario corrisponde all’ora fiscale. |
| Minuto | Nessuna modifica di comportamento. Il minuto di calendario è uguale al minuto fiscale. |
| Secondo | Nessuna modifica di comportamento. Il secondo di calendario è uguale al secondo fiscale. |
| Numero della settimana | Il numero della settimana riflette il numero della settimana fiscale. Ad esempio, se Inizio anno fiscale è impostato su aprile, il numero della settimana per la data 1 aprile 2004 sarà 1. |
| Giorno della settimana | Nessuna modifica di comportamento. Il calendario dei giorni feriali è lo stesso dei giorni feriali fiscali. |
| MM/YYYY | Nessuna modifica di comportamento. Questo formato di data mostra sempre le date del calendario, anche quando è stato assegnato un anno fiscale. |
| M/D/Y | Questo formato di data mostra sempre le date del calendario, anche quando è stato assegnato un anno fiscale. |
| Parte o troncamento della data | Quando si utilizza un calendario fiscale |
| Parte della data dell’anno | Inizio anno fiscale è impostato su aprile, l’anno per la data dell’1 giugno 2004 verrebbe quindi visualizzato come FY 2005. |
| Parte della data del trimestre | Inizio anno fiscale è impostato su aprile, il trimestre per la data 1 giugno 2004 sarebbe Q1. |
| Parte della data del numero della settimana | Inizio anno fiscale è impostato su aprile, il numero della settimana per la data 1 aprile 2004 sarà 1. |
| Troncamento della data dell’anno | Inizio anno fiscale è impostato su maggio, la data 1 giugno 2004 diverrebbe 1 maggio 2004. |
| Troncamento della data del trimestre | Inizio anno fiscale è impostato su luglio, la data 1 giugno 2004 diverrebbe 1 aprile 2004. |
 | Dimensione fissa (impostazione predefinita): la dashboard rimane della stessa dimensione, indipendentemente dalle dimensioni della finestra utilizzata per visualizzarla. Se la dashboard è più grande della finestra, diventa a scorrimento. Puoi scegliere da una dimensione preimpostata o specificare una dimensione personalizzata. Le dashboard di dimensione fissa consentono di specificare l’esatta posizione dei contenuti nella dashboard, che può essere utile in caso di presenza di oggetti mobili. Le dashboard pubblicate che utilizzano una dimensione fissa possono caricarsi più rapidamente in quanto è probabile che utilizzino una versione memorizzata nella cache sul server. Per altri suggerimenti relativi alle prestazioni, vedi Ottimizzare le prestazioni delle cartelle di lavoro. |
 | Intervallo: la dashboard viene ridimensionata tra dimensioni minime e massime specificate. Se la finestra utilizzata per visualizzare la dashboard è inferiore alle dimensioni minime, vengono visualizzate barre di scorrimento. Se invece è maggiore della dimensione massima, viene visualizzato uno spazio bianco. Utilizza questa impostazione quando stai progettando per due diverse dimensioni dello schermo che necessitano dello stesso contenuto e hanno forme simili, ad esempio le finestre del browser di piccole e medie dimensioni. L’impostazione Intervallo è adatta anche per le dashboard mobili con layout verticale. La larghezza può cambiare a seconda della larghezza del dispositivo mobile, ma l’altezza è fissa per lo scorrimento verticale. |
 | Automatica: la dashboard viene ridimensionata automaticamente per riempire la finestra utilizzata per visualizzarla. Utilizza questa impostazione se desideri che Tableau si occupi del ridimensionamento. Per ottenere risultati ottimali, utilizza un layout affiancato (anziché mobile) per la dashboard. Il dimensionamento automatico può generare risultati imprevedibili su schermi diversi, quindi usa questa impostazione con cautela se non sai dove verrà utilizzata la dashboard. Il rendering delle dashboard con dimensioni variabili deve essere eseguito per ogni richiesta del browser, il che può avere un impatto sulle prestazioni. |
Contenitore di layout orizzontale Le due viste sono disposte in un contenitore di layout orizzontale. | Contenitore di layout verticale Le tre viste sono disposte in un contenitore di layout verticale. |


| Con indicatore selezionato | Senza una selezione |
 |  |
| Layout affiancato | Layout mobile |
| Gli elementi affiancati non si sovrappongono, diventano parte di una griglia a strato singolo che si ridimensiona in base alle dimensioni generali della dashboard. | Gli elementi mobili possono essere sovrapposti ad altri oggetti. Nell’esempio seguente, una mappa si muove sopra le viste affiancate. |
 |  |
| Per ottenere risultati ottimali, assegna agli oggetti mobili una dimensione e una posizione fissa in una dashboard di dimensione fissa. |
| Dimensioni distinte |  |
| Dimensioni continue* |  |
| Misure distinte |  |
| Misure continue |  |
| Campo Quantità Continuo | Campo Quantità Discreto | |
 |  |
| Calcolo | Risultato |
RIGHT([Value], 4) | 8892 |
LEFT([Value], 4) | IGW8 |
LEFT(RIGHT([Value], 2) , 1) | 9 |
| Valore originale | Valori del campo diviso |
| Zip-98102 | 98102 |
| Zip-98109 | 98109 |
| Zip-98119 | 98199 |
| Zip-98195 | 98195 |
| Versioni precedenti | 2020.2 e versioni successive | |
|---|---|---|
 |  | |
| In Tableau 2020.1 e versioni precedenti, il modello di dati comprendeva solo il livello fisico | In Tableau 2020.2 e versioni successive, il modello di dati comprende due livelli: il livello logico e il livello fisico |
| Patrocinatore | Contatto | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
|
|
| Noleggio del proiettore | Patrocinatore | ||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
|
|
| DATE('01/01/'+STR([Member since])) |
| Data | Tipo di prenotazione | ID del richiedente | ID | Nome | Cognome | Ramo | Membro dal | Unità in prestito | Commissioni | Limite suggerito |
|---|---|---|---|---|---|---|---|---|---|---|
01/01/2000 | Individuale | 233445589 | 232502870 | Alan | Wang | Nord | 2000 | 1 | 0.00 | 15 |
| 01/01/2000 | Individuale | 233445589 | 233445589 | Fred | Suzuki | Nord | 2000 | 52 | 0.90 | 15 |
| 01/01/2000 | Individuale | 233445589 | 233445566 | Ashley | Garcia | Sud | 2000 | 243 | 11.30 | 15 |
| 01/01/2000 | Individuale | 233445589 | 233448978 | John | Smith | Nord | 2000 | 36 | 3.50 | 15 |
| I tuoi dati | Connessione legacy | Connessione predefinita |
|---|---|---|
| Lunghezza nome file | Non consente la connessione a un file il cui nome è più lungo di 64 caratteri. | Nessun limite di lunghezza per i nomi dei file. |
| Più punti nel nome del file | Non consente la connessione a un file il cui nome contiene più punti. | Nessun limite di punti per i nomi dei file. |
| Numero di colonne nel file | Utilizza il numero di campi presenti nella prima riga per determinare il numero di colonne nel file. | Esegue la scansione dell’intero file e utilizza il numero più comune di campi in una riga per determinare il numero di colonne nel file. |
| Righe intestazioni | Non rileva automaticamente se la prima riga del file è un’intestazione. Nota: puoi specificare manualmente che la prima riga del file è un’intestazione. | Verifica automaticamente se la prima riga del file è un’intestazione. Nota: puoi annullare manualmente il rilevamento. |
| Colonne vuote | Le colonne vuote sono visibili. | Le colonne vuote sono nascoste perché non contengono valori. |
| I tuoi dati | Connessione legacy | Connessione predefinita |
|---|---|---|
| Numero di caratteri nel nome del campo | I nomi dei campi sono troncati a 64 caratteri. | Nessun vincolo sul numero di caratteri in un nome di campo. |
| Caratteri speciali nei nomi dei campi | I caratteri speciali non sono consentiti nei nomi dei campi. Ad esempio, caratteri speciali come virgolette e punti vengono convertiti in simboli numerici. Le parentesi quadre vengono convertite in parentesi tonde. | I caratteri speciali sono consentiti nei nomi dei campi. |
| Spazi iniziali e finali nei nomi dei campi | Sono consentiti spazi iniziali e finali nei nomi dei campi. | Gli spazi iniziali e finali nei nomi dei campi vengono automaticamente rimossi dai nomi delle colonne. |
| Nomi dei campi duplicati | Per i nomi dei campi duplicati, al nome campo viene aggiunto un numero di indice. Ad esempio, Punteggi test1. | Per i nomi dei campi duplicati, al nome del campo vengono aggiunti uno spazio e un numero di indice. Ad esempio, Punteggi test 1. |
| Formattazione celle di Excel | Supporta la formattazione delle celle configurata utilizzando l’opzione Formatta celle di Excel. | Non supporta la formattazione delle celle configurata utilizzando l’opzione Formatta celle di Excel. |
| Precisione dei valori di valuta | I campi contenenti valori di valuta sono rappresentati con una precisione massima di quattro cifre | È rappresentata la precisione completa dei valori di valuta. |
| I tuoi dati | Connessione legacy | Connessione predefinita |
|---|---|---|
| Caratteri speciali nei nomi dei file | I caratteri speciali non sono consentiti nei nomi dei file. Ad esempio, i caratteri speciali come i punti vengono convertiti in simboli numerici. | Sono consentiti caratteri speciali. |
| Caratteri nei nomi dei campi di intestazione | Elimina automaticamente gli spazi iniziali dai nomi dei campi di intestazione. | Elimina automaticamente gli spazi iniziali e finali dai nomi dei campi di intestazione. |
| Separatori dei campi | Riconosce solo le virgole come separatori dei campi. Nota: puoi annullare manualmente il rilevamento. | Rileva automaticamente il separatore di campo. Nota: puoi annullare manualmente il rilevamento. |
| Testo racchiuso tra virgolette | Le virgolette utilizzate per racchiudere i valori di testo restano visibili. | Le virgolette utilizzate per racchiudere i valori di testo vengono nascoste automaticamente. |
| Pagine di codice ANSI e OEM | Sono supportate le pagine di codice ANSI e OEM. | Le pagine di codice ANSI e OEM vengono convertite automaticamente in modo che siano compatibili con piattaforme diverse. |
| Pagine di codice BOM | Supporta le pagine di codice BOM in modo non coerente. | Supporta le pagine di codice BOM. |
| Rilevamento del tipo di dati | Connessione legacy | Connessione predefinita |
|---|---|---|
| Colonne | Il tipo di dati di una colonna è determinato dalle prime 8 righe.
Nota: Dopo che il tipo di dati di una colonna della tabella è stato determinato, non può essere modificato. | Il tipo di dati di una colonna è determinato DAL 95% delle prime 10.000 righe.
Nota: puoi annullare manualmente il rilevamento. |
| Valori di data senza ora | Ai valori di data viene assegnato un tipo di dati di data e ora. | Ai valori di data senza ora viene assegnato un tipo di dati data. Ai valori di data con l’ora viene assegnato un tipo di dati data e ora. |
| Valori numerici | Tutti i valori numerici sono rappresentati come numeri reali. | I valori numerici senza decimali sono rappresentati come numeri interi. |
| Valori Null | Se una colonna contiene una cella Null, il tipo di dati per la colonna viene automaticamente definito come stringa di dati. | Le celle Null non influiscono sul rilevamento del tipo di dati. |
| Errori di riferimento o celle vuote | Se una colonna contiene celle con errori di riferimento o celle vuote, l’intera colonna viene interpretata come tipo di dati stringa. | Gli errori di riferimento o le celle senza valori non influiscono sul rilevamento del tipo di dati. |
| Annullare il rilevamento del tipo di dati | Dopo che il tipo di dati di una colonna della tabella è stato determinato, non può essere modificato. | Il tipo di dati di una colonna può essere modificato dopo il rilevamento automatico. |
| Precisione valore dell’ora | Il valore di tempo più piccolo corrisponde a pochi secondi. | Il valore di tempo più piccolo corrisponde a frazioni di secondi. |
| Valori schema.ini DecimalSymbol e CurrencyDecimalSymbol | Vengono riconosciuti entrambi i valori schema .ini DecimalSymbol e CurrencyDecimalSymbol. | Vengono riconosciuti i valori schema.ini DecimalSymbol e CurrencyDecimalSymbol. Se entrambi i valori vengono utilizzati, DecimalSymbol ha la precedenza. |
| Celle formattate come testo | Il tipo di dati di una colonna viene individuato come stringa quando le celle sono formattate come testo utilizzando l’opzione Formatta celle di Excel. | Non supporta la formattazione delle celle configurata utilizzando l’opzione Formatta celle di Excel. |
| Parametro | Descrizione | Esempio di valore restituito |
| TableauServerUser | Nome utente dell’utente corrente del server. Da utilizzare durante l’impostazione della rappresentazione sul server. Restituisce una stringa vuota se l’utente non ha effettuato l’accesso a Tableau Server. | rbianchi |
| TableauServerUserFull | Nome utente e dominio dell’utente del server corrente. Da utilizzare durante l’impostazione della rappresentazione sul server. Restituisce una stringa vuota se l’utente non ha effettuato l’accesso a Tableau Server. | domain.lan\rbianchi |
| TableauApp | Il nome dell’applicazione Tableau. | Tableau Desktop Professional Tableau Server |
| TableauVersion | La versione dell’applicazione Tableau. | 9.3 |
| WorkbookName | Il nome della cartella di lavoro Tableau. Utilizzare solo nelle cartelle di lavoro con un’origine dati incorporata. | Analisi finanziaria |
| Posizione del file di log | Esempio di record |
|---|---|
<percorso di installazione>\Tableau Server\data\tabsvc\log\vizqlserver <percorso di installazione>\Tableau Server\data\tabsvc\log\backgrounder <percorso di installazione>\Tableau Server\data\tabsvc\log\dataserver <percorso di installazione>\Tableau Server\data\tabsvc\log\vizportal | Found matching TDC 'C:\\ProgramData\\Tableau\\Tableau Server\\data\\tabsvc\\vizqlserver\\Datasources\\odbc-sqlite.tdc for class='genericodbc', vendor='SQLite', and driver='SQLite3 ODBC Driver' |
| Profitto vs. Vendite con aggregazione predefinita | Profitto vs. Vendite con aggregazione esplicita |
 |  |
| Versione Tableau Desktop | Versione Web |
|
|


| Sezione | Descrizione | Esempio |
|---|---|---|
Previsione La previsione riflette l’obiettivo del caso di utilizzo. | L’obiettivo è massimizzare o ridurre al minimo il risultato. Ad esempio, l’obiettivo può essere quello di ridurre al minimo i tempi di spedizione o massimizzare i ricavi medi di vendita per ogni spedizione. |
|
Predittori principali Condizioni che influenzano in modo più significativo il risultato previsto, in ordine di grandezza decrescente. | Una condizione è un valore di dati associato a un campo. Un predittore è costituito da una o due condizioni. Se vengono visualizzate due condizioni, queste vengono unite tramite and per rappresentare l’intersezione di tali condizioni. Verde (freccia verso l’alto) indica che il predittore migliora il risultato previsto. Rosso (freccia verso il basso) indica che il predittore peggiora il risultato previsto. |
|
Come migliorare Azioni consigliate che l’utente può intraprendere per migliorare il risultato previsto. | I miglioramenti sono associati a fattori su cui gli utenti possono avere il controllo, come il metodo di spedizione o il livello di iscrizione di un abbonato. |
|


| Nome | Formula |
| Prima data di acquisto | {FIXED [Nome cliente] : MIN([Data ordine])} |
| Giorni dal primo acquisto | DATETRUNC('day', [Data ordine])-DATETRUNC('day', [Prima data di acquisto]) |
| Dati originali | Aggregazione senza riporto | Aggregazione con riporto |
 |  |  |
| 10/31/2024 |
| 31/10/2024 |
10/12/2024 |
| 31 ottobre 2024 |
| 31 ottobre 2024 |
| 10 dicembre 2024 |
| 31 Oktober 2024 |
| 31 Oktober 2024 |
| 12 Oktober 2024 |
| NULL |
| 31 ottobre 2024 |
| 12 ottobre 2024 |
| 2024-10-31 |
| 2024-31-10 |
2024-12-10 |
| 2024-10-12 |
| 31 ottobre 2024 |
| NULL |
| 10 dicembre 2024 |
| 12 ottobre 2024 |
| Legenda dei colori normale | Evidenziazione legenda dei colori abilitata | |
 |  |
| Di seguito è illustrato un frammento di un file JSON: | Il file JSON genera questi livelli schema: |
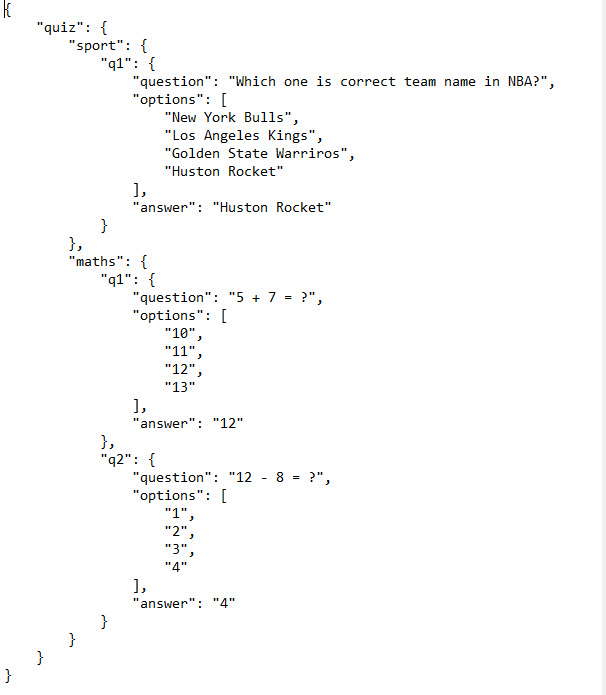 | 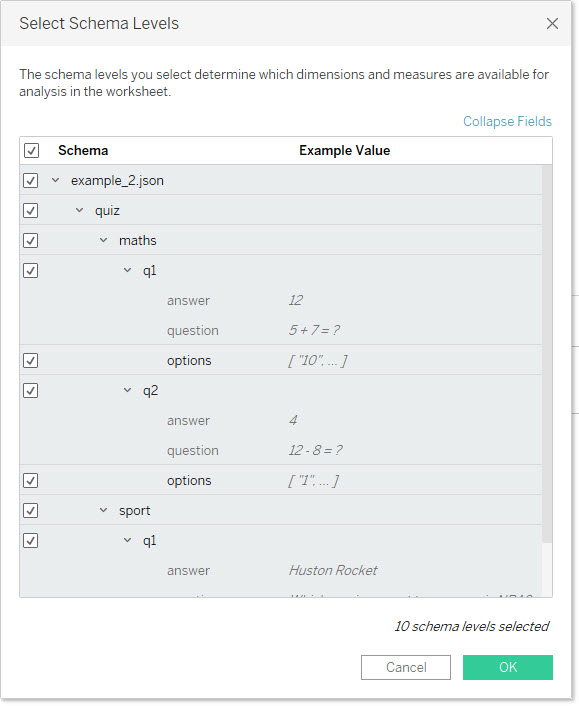 |
 |  |  |
| Frutta da origine dati A | Frutta da origine dati B | Frutta da origine dati C |
| Mele | Mele | Mele |
| Arance | Pompelmo | Pompelmo |
| Banane | Arance | Arance |
| Pere | Pomodori | |
| Banane |
| Frutta da origine dati A - Campo di origine | Frutta da origine dati B - Campo target | Frutta da origine dati C - Campo target |
| Mele | Mele | Mele |
| Arance | Arance | Arance |
| Banane | Banane |
| Variabile | Significato |
| t | Indice di un periodo in una serie temporale. |
| n | Lunghezza di una serie temporale. |
| m | Numero di periodi in una stagione/ciclo. |
| A(t) | Valore effettivo della serie temporale al periodo t. |
| F(t) | Valore adattato o di previsione al periodo t. |
| Simbolo | Descrizione |
| (:) | Separatore ora. In alcune impostazioni locali si utilizza un carattere diverso per rappresentare il separatore ora. In presenza di una formattazione dei valori temporali, il separatore ora divide le ore, i minuti e i secondi. Il carattere effettivo utilizzato come separatore ora nell’output formattato è determinato dalle impostazioni del sistema. |
| (/) | Separatore data. In alcune impostazioni locali viene utilizzato un carattere diverso per rappresentare il separatore data. In presenza di una formattazione dei valori della data, il separatore data divide il giorno, il mese e l’anno. Il carattere effettivo utilizzato come separatore data nell’output formattato è determinato dalle impostazioni del sistema. |
| c | Mostra la data come ddddd visualizza l’ora comettttt, in questo ordine. Visualizza solo le informazioni sulla data se non è presente una parte frazionaria per il numero seriale della data; mostra solo le informazioni sull’ora in assenza della parte intera. |
| d | Visualizza il giorno come numero senza zero iniziale (1-31). |
| dd | Visualizza il giorno come numero senza zero iniziale (01-31). |
| ddd | Visualizza il giorno come abbreviazione (Dom, Sab). |
| dddd | Visualizza il giorno come nome completo (Domenica, Sabato). |
| ddddd | Visualizza la data completa (compreso il giorno, il mese e l’anno), formattata in base all’impostazione del formato data breve del sistema. Il formato data breve predefinito è m/d/yy. |
| dddddd | Visualizza un numero seriale della data come data completa (incluso giorno, mese e anno) formattato in base all’impostazione della data estesa riconosciuta dal sistema. Il formato di data estesa predefinito è mmmm dd, yyyy. |
| aaaa | Come per dddd, solo che qui si tratta della versione localizzata della stringa. |
| w | Visualizza il giorno della settimana come numero (da 1 per domenica fino a 7 per sabato). |
| ww | Visualizza la settimana dell’anno come numero (1-54). |
| M | Visualizza il mese come numero senza zero iniziale (1 12). Se m segue immediatamente h o hh, viene visualizzato il minuto anziché il mese. |
| MM | Visualizza il mese come numero con zero iniziale (01-12). Se m segue immediatamente h o hh, viene visualizzato il minuto anziché il mese. |
| MMM | Visualizza il mese come abbreviazione (Gen-Dic). |
| MMMM | Visualizza il mese come nome intero del mese (Gennaio-Dicembre). |
| MMMMM | Visualizza il mese come abbreviazione con una singola lettera (G-D) |
| oooo | Come MMMM, ma localizzato. |
| q | Visualizza il trimestre dell’anno come numero (1-4). |
| y | Visualizza il giorno dell’anno come numero (1-366). |
| yy | Visualizza l’anno come un numero a 2 cifre (00-99). |
| yyyy | Visualizza l’anno come un numero a 4 cifre (100-9999). |
| h | Visualizza l’ora come numero senza zeri iniziali (0-23). |
| Hh | Visualizza l’ora come numero con zeri iniziali (00-23). |
| N | Visualizza il minuto come numero senza zeri iniziali (0 59). |
| Nn | Visualizza il minuto come numero con zeri iniziali (00 59). |
| S | Visualizza il secondo come numero senza zeri iniziali (0 59). |
| Ss | Visualizza il secondo come numero con zeri iniziali (00 59). |
| 000 | Visualizza i millisecondi. Utilizza un carattere punto come separatore prima di specificare i millisecondi. |
| t t t t t | Visualizza un’ora come tempo di completamento (compreso l’ora, il minuto e il secondo), formattato utilizzando il separatore ora definito dal formato ora riconosciuto dal sistema. Se è selezionata l’opzione zero iniziale e l’ora è antecedente alle 10:00, sia AM che PM, verrà visualizzato lo zero iniziale. Il formato ora predefinito è h:mm:ss. |
| AM/PM | Utilizza l’orologio con formato 12 ore e visualizza un simbolo AM maiuscolo con qualsiasi ora antecedente a mezzogiorno; mostra un simbolo PM minuscolo con ogni ora compresa tra mezzogiorno e le 11:59. |
| am/pm | Utilizza l’orologio con formato 12 ore e visualizza un simbolo AM minuscolo con qualsiasi ora antecedente a mezzogiorno; mostra un simbolo PM minuscolo con ogni ora compresa tra mezzogiorno e le 11:59. |
| A/P | Utilizza l’orologio con formato 12 ore e visualizza una lettera A maiuscola con qualsiasi ora antecedente a mezzogiorno; mostra una lettera P maiuscola con ogni ora compresa tra mezzogiorno e le 11:59. |
| a/p | Utilizza l’orologio con formato 12 ore e visualizza una lettera A minuscola con qualsiasi ora antecedente a mezzogiorno; mostra una lettera P minuscola con ogni ora compresa tra mezzogiorno e le 11:59. |
| AMPM | Utilizza l’orologio con formato 12 ore e visualizza il valore letterale stringa AM come definito dal sistema con qualsiasi ora antecedente a mezzogiorno; mostra il valore letterale stringa PM come definito dal sistema con ogni ora compresa tra mezzogiorno e le 11:59 PM. AMPM può essere maiuscolo o minuscolo, ma il maiuscolo/minuscolo della stringa visualizzata corrisponde alla stringa definita dalle impostazioni del sistema. Il formato predefinito è AM/PM. |
| Simbolo | Descrizione |
| g | Nome breve dell’epoca (ad esempio, H per l’era Heisei). |
| gg | Nome dell’epoca (ad esempio 平成). |
| ggg | Nome esteso dell’epoca (per il giapponese, corrisponde al nome standard dell’epoca). |
| e | Anno basato sull’epoca, come 1 per il primo anno di un’epoca. |
| ee | Anno basato sull’epoca, come 01 per il primo anno di un’epoca. Se c’è una sola cifra, l’anno basato sull’epoca avrà uno zero aggiunto all’inizio. |
| Parte della data | Simbolo | Esempio di output |
|---|---|---|
| Anno | yy y, yyyy Y | 26 2026 2026 (utilizzato per i calendari basati su Settimana dell’anno) |
| Trimestre dell’anno | Q QQQ QQQQ | 2 02 Q2 2° trimestre |
| Mese | M MM MMM MMMM | 9 09 Set Settembre |
| Settimana dell’anno | w, ww | 47 |
| Giorno della settimana | E, EE, EEE EEEE EEEEE | Lu Lunedì M |
| Giorno del mese | d dd | 1, 15 01, 15 |
| Giorno dell’anno (1-365) | D | 23, 143 |
Ora (1-12) | h hh | 8 08 |
| Ora (0-23) | H HH | 8 08 |
| Minuto | m mm | 8 08 |
| Secondo di un minuto | s ss | 5 05 |
| Secondo frazionario | S SS SSS SSSS | 2 23 235 2350 |
| Millisecondi nel giorno | A | 34532 |
| Periodo (marcatore AM/PM) | a, aa, aaa | AM, am, PM |
| Fuso orario | z, zz, zzz zzzz Z, ZZ, ZZZ ZZZZ | PDT Ora legale del Pacifico -0800 PST-08:00 |
| Unità di tempo | Note |
|---|---|
| Epoca | n/d |
| Anno | Tutti i simboli sono supportati nelle estrazioni .hyper, ad eccezione di “U”. Note:
|
| Mese | Tutti i simboli sono supportati nelle estrazioni .hyper, ad eccezione di “I”. Note:
|
| Settimana | Tutti i simboli sono supportati nelle estrazioni .hyper, ad eccezione di “W”. Note:
|
| Giorno | Note:
|
| Ora | Nelle estrazioni in formato .hyper sono supportati solo i simboli "h" e "H". Note:
|
| Minuto | Nota: diversamente da ICU, le estrazioni in formato .hyper non consentono l’inserimento di valori negativi in questo campo. I valori negativi causano un errore. |
| Secondo | Note:
|
| Trimestre | Nota: diversamente da ICU, le estrazioni in formato .hyper consentono solo valori compresi tra 1 e 4. Tutti gli altri valori causano un errore. |
| Giorno della settimana | Note:
|
| Periodo | n/d |
| Questo tema della cartella di lavoro... | È associato a queste versioni di Tableau... |
|---|---|
| Smooth | Versione 10.x e successiva |
| Clean | Versioni 8.0.x – 9.3.x |
| Modern | Versioni 3.5 – 7.0.x |
| Classic | Versioni 1.0 – 3.2 |
| Ruolo geografico | Assegnare questo ruolo a un campo se contiene: |
| Aeroporto | Codici aeroportuali IATA o ICAO. |
| Prefisso telefonico (Stati Uniti) | Prefissi telefonici degli Stati Uniti; solo numeri. |
| CBSA/MSA (Stati Uniti) | Le aree statistiche basate su core degli Stati Uniti (CBSA, Core Based Statistical Areas), che includono le aree metropolitane statistiche (MSA, Metropolitan Statistical Areas), definite dall’Ufficio per la gestione e il bilancio degli Stati Uniti. Codici e nomi CBSA/MSA sono riconosciuti. |
| Città | Le città mondiali con popolazione pari o superiore a 15.000 individui. I nomi sono in inglese (UK o US), francese, tedesco, spagnolo, portoghese brasiliano, giapponese, coreano e cinese (semplificato e tradizionale). |
| Distretto congressuale (Stati Uniti) | Distretti congressuali statunitensi. |
| Paese/Area | Paesi, regioni e territori internazionali. I nomi sono in inglese (UK o US), francese (Canada e Francia), tedesco, spagnolo, portoghese , brasiliano, giapponese, coreano, cinese (semplificato e tradizionale), svedese, thailandese e olandese. Tableau inoltre riconosce i codici FIPS 10, ISO 3166-1 alpha 2 e ISO 3166-1 alpha 3. I nomi sono inclusi in varie forme, tra cui quella estesa, breve e diverse abbreviazioni. |
| Provincia | Divisioni amministrative di secondo livello per alcuni Paesi selezionati. Ad esempio, contee statunitensi, départements francesi, kriese tedeschi ecc. Nota: le definizioni di divisione amministrativa di secondo livello variano in base al Paese. In Tableau, tutte le divisioni amministrative di secondo livello sono geocodificate con il ruolo geografico Provincia. Per maggiori informazioni, consulta la sezione Dati relativi alle posizione supportati da Tableau per la creazione di viste mappa. |
| NUTS Europa | Codici di livello 1-3 della nomenclatura delle unità territoriali statistiche NUTS (Nomenclature of Territorial Units for Statistics). Sono supportati codici e nomi, inclusi sinonimi. |
| Latitudine | Latitudine in gradi decimali. Disponibile solo per i campi numerici. |
| Longitudine | Longitudine in gradi decimali. Disponibile solo per i campi numerici. |
| Stato/regione | Stato, regione e altre divisioni amministrative internazionali di primo livello. I nomi sono in inglese (UK o US), francese, tedesco, spagnolo, portoghese brasiliano, giapponese, coreano e cinese (semplificato e tradizionale). Nota: alcuni nomi sono disponibili solo nel formato locale. |
| CAP | CAP e codici postali per Paesi selezionati. Ad esempio, i codici postali statunitensi a cinque cifre, i codici postali australiani a quattro cifre, i codici postali tedeschi a cinque cifre ecc. Per maggiori informazioni, consulta la sezione Dati relativi alle posizione supportati da Tableau per la creazione di viste mappa. |
| FORMATO NUMERO | OPZIONI FORMATO |
| Automatico: il formato viene selezionato automaticamente in base al formato specificato dall’origine dati o ai dati contenuti nel campo. | Nessuna. |
| Numero (standard): il formato si basa sulle impostazioni locali selezionate. | Impostazioni locali: il formato del numero varia in base alla posizione geografica selezionata. |
| Numero (personalizzato): il formato è personalizzato a tua scelta. | Posizioni decimali: il numero di cifre decimali da visualizzare. Valori negativi: come visualizzare i valori negativi. Unità: il numero viene visualizzato utilizzando le unità specificate.Ad esempio, se il numero è 20.000 e le unità sono migliaia, il numero sarà visualizzato come 20K. Prefisso/Suffisso: caratteri che precedono e seguono ogni numero visualizzato. Includi separatori migliaia: se il numero deve mostrare separatori ogni migliaia (esempio: 100.000 o 100000). |
| Valuta (standard): il formato e il simbolo della valuta si basano sulle impostazioni locali selezionate. | Impostazioni locali: il formato della valuta si basa sulla posizione geografica selezionata. |
| Valuta (personalizzata): il formato e il simbolo della valuta sono personalizzati a tua scelta. | Posizioni decimali: il numero di cifre decimali da visualizzare. Valori negativi: come visualizzare i valori negativi. Unità: il numero viene visualizzato utilizzando le unità specificate.Ad esempio, se il numero è 20.000 e le unità sono migliaia, il numero sarà visualizzato come 20K. Prefisso/Suffisso: caratteri che precedono e seguono ogni numero visualizzato. Includi separatori migliaia: se il numero deve mostrare separatori ogni migliaia (esempio: 100.000 o 100000). |
| Scientifico: i numeri vengono visualizzati in notazione scientifica. | Decimali: il numero di cifre decimali da visualizzare. |
| Percentuale: i numeri vengono visualizzati come percentuale con il simbolo percentuale.Il valore di 1 viene interpretato come 100% e 0 come 0%. | Decimali: il numero di cifre decimali da visualizzare. |
| Personalizza: il formato si basa interamente sulle opzioni di formato specificate. | Personalizza: digita il formato che desideri utilizzare, inclusi caratteri speciali (facoltativo).Per maggiori informazioni, consulta “Definire un formato numerico personalizzato” in questo argomento. |
| CASO DI UTILIZZO | SINTASSI DEL CODICE NUMERO | ESEMPIO DI OUTPUT |
| Mostra solo valori positivi | #,##; ; (nota uno spazio vuoto dopo il secondo e il terzo punto e virgola) | Valori positivi: 1.234 Valori negativi: (viene visualizzato solo lo spazio vuoto) Valori zero: (viene visualizzato solo lo spazio vuoto) |
| Mostra solo valori negativi | ;-#,##; | Valori positivi: (non viene visualizzato nulla) Valori negativi: -1.234 Valori zero: (non viene visualizzato nulla) |
| Mostra solo valori zero | ;;0; | Valori positivi: (non viene visualizzato nulla) Valori negativi: (non viene visualizzato nulla) Valori zero: 0 |
| Nascondi i valori zero | #,###;-#,###;; | Valori positivi: 1.234 Valori negativi: -1.234 Valori zero: (non viene visualizzato nulla) |
| Mostra i valori negativi tra parentesi | #,###;(#,###);; | Valori positivi: 1.234 Valori negativi: (1.234) Valori zero: (non viene visualizzato nulla) |
| Aggiungi un prefisso di carattere a un valore | $#,###.##;-$#,###.##;$0; | Valori positivi: $ 1.234,56 Valori negativi: -$ 1.234,56 Valori zero: $0 |
| Aggiungi un suffisso di carattere a un valore | #%;-#%;0%; | Valori positivi: 12% Valori negativi: -34% Valori zero: 0% |
| Aggiungi descrittori di testo | "$"#,#" Surplus";"$"-##" Carenza"; "$"0; | Valori positivi: eccedenza di $ 1.234 Valori negativi: carenza di $-1.234 Valori zero: $0 |
| FORMATO NUMERO | OPZIONI FORMATO |
| Automatico: il formato viene selezionato automaticamente in base al formato specificato dall’origine dati o ai dati contenuti nel campo. | Nessuna. |
| Numero (personalizzato): il formato è personalizzato a tua scelta. | Posizioni decimali: il numero di cifre decimali da visualizzare. Unità: il numero viene visualizzato utilizzando le unità specificate.Ad esempio, se il numero è 20.000 e le unità sono migliaia, il numero sarà visualizzato come 20K. Includi separatori: se il numero deve mostrare separatori ogni migliaia (esempio: 100.000 o 100000). |
| Valuta (personalizzata): il formato e il simbolo della valuta sono personalizzati a tua scelta. | Posizioni decimali: il numero di cifre decimali da visualizzare. Unità: il numero viene visualizzato utilizzando le unità specificate.Ad esempio, se il numero è 20.000 e le unità sono migliaia, il numero sarà visualizzato come 20K. Includi separatori: se il numero deve mostrare separatori ogni migliaia (esempio: 100.000 o 100000). |
| Percentuale (personalizzata): i numeri vengono visualizzati come percentuale con il simbolo percentuale.Il valore di 1 viene interpretato come 100% e 0 come 0%. | Posizioni decimali: il numero di cifre decimali da visualizzare. |
| Scientifico (personalizzato): i numeri vengono visualizzati nella notazione scientifica. | Posizioni decimali: il numero di cifre decimali da visualizzare. |
| Sintassi | MODEL_PERCENTILE(
|
| Definizione | Restituisce la probabilità (compresa tra 0 e 1) che il valore previsto sia minore o uguale all’indicatore osservato, definito dall’espressione di destinazione e da altri predittori. Questa è la funzione di distribuzione predittiva posteriore, anche nota come funzione di distribuzione cumulativa (CDF). |
| Esempio | MODEL_PERCENTILE( SUM([Sales]),COUNT([Orders])) |
| Sintassi | MODEL_QUANTILE(
|
| Definizione | Restituisce un valore numerico di destinazione all’interno dell’intervallo probabile definito dall’espressione di destinazione e da altri predittori, in corrispondenza di un quantile specificato. Questo è il quantile predittivo posteriore. |
| Esempio | MODEL_QUANTILE(0.5, SUM([Sales]), COUNT([Orders])) |
| Sintassi | REGEXP_REPLACE(string, pattern, replacement) |
| Output | Stringa |
| Definizione | Restituisce una copia della stringa data in cui la stringa sostitutiva prende il posto del modello dell’espressione regolare. |
| Esempio | REGEXP_REPLACE('abc 123', '\s', '-') = 'abc-123' |
| Note | Questa funzione è disponibile per le origini dati file di testo, Hadoop Hive, Google BigQuery, PostgreSQL, Estrazione dati Tableau, Microsoft Excel, Salesforce, Vertica, Pivotal Greenplum, Teradata (versione 14.1 e successive), Snowflake e Oracle. Per le estrazioni dei dati di Tableau, il modello e la stringa sostitutiva devono essere costanti. |
| Sintassi | REGEXP_MATCH(string, pattern) |
| Output | Booleano |
| Definizione | Restituisce true se una sottostringa della stringa specificata corrisponde al modello dell’espressione regolare. |
| Esempio | REGEXP_MATCH('-([1234].[The.Market])-','\[\s*(\w*\.)(\w*\s*\])')=true |
| Note | Questa funzione è disponibile per le origini dati file di testo, Google BigQuery, PostgreSQL, Estrazione dati Tableau, Microsoft Excel, Salesforce, Vertica, Pivotal Greenplum, Teradata (versione 14.1 e successive, Hadoop), Impala 2.3.0 (tramite origini dati Cloudera Hadoop), Snowflake e Oracle. Per le estrazioni dei dati di Tableau, il modello deve essere una costante. |
| Sintassi | REGEXP_EXTRACT(string, pattern) |
| Output | Stringa |
| Definizione | Restituisce la porzione di stringa che corrisponde al modello dell’espressione regolare. |
| Esempio | REGEXP_EXTRACT('abc 123', '[a-z]+\s+(\d+)') = '123' |
| Note | Questa funzione è disponibile per le origini dati file di testo, Hadoop Hive, Google BigQuery, PostgreSQL, Estrazione dati Tableau, Microsoft Excel, Salesforce, Vertica, Pivotal Greenplum, Teradata (versione 14.1 e successive), Snowflake e Oracle. Per le estrazioni dei dati di Tableau, il modello deve essere una costante. |
| Sintassi | REGEXP_EXTRACT_NTH(string, pattern, index) |
| Output | Stringa |
| Definizione | Restituisce la porzione di stringa che corrisponde al modello dell’espressione regolare. La porzione della stringa è abbinata al gruppo di acquisizione nth, dove n è l’indice dato. Se l’indice è 0, viene restituita l’intera stringa. |
| Esempio | REGEXP_EXTRACT_NTH('abc 123', '([a-z]+)\s+(\d+)', 2) = '123' |
| Note | Questa funzione è disponibile per le origini dati file di testo, PostgreSQL, Estrazione dati Tableau, Microsoft Excel, Salesforce, Vertica, Pivotal Greenplum, Teradata (versione 14.1 e successive) e Oracle. Per le estrazioni dei dati di Tableau, il modello deve essere una costante. |
| Sintassi | ATTR(expression) |
| Definizione | Restituisce il valore dell’espressione se ha un unico valore per tutte le righe. In caso contrario, restituisce un asterisco. I valori NULL vengono ignorati. |
| Sintassi | AVG(expression) |
| Definizione | Restituisce la media di tutti i valori nell’espressione. I valori NULL vengono ignorati. |
| Note | AVG può essere utilizzato solo con campi numerici. |
| Sintassi | COLLECT(spatial) |
| Definizione | Un calcolo aggregato che combina i valori nel campo dell’argomento. I valori NULL vengono ignorati. |
| Note | COLLECT può essere utilizzato solo con campi spaziali. |
| Sintassi | CORR(expression1, expression2) |
| Output | Numero da -1 a 1 |
| Definizione | Restituisce il coefficiente di correlazione di Pearson di due espressioni. |
| Esempio | example |
| Note | La correlazione di Pearson misura la relazione lineare tra due variabili. I risultati variano da -1 a +1 inclusi, dove 1 denota un’esatta relazione lineare positiva, 0 denota l’assenza di relazioni lineari tra la varianza e -1 è un’esatta relazione negativa. Il quadrato di un risultato CORR è equivalente al coefficiente di determinazione per un modello di linea di una tendenza lineare. Vedi Termini di modello di linee di tendenza lineare. Utilizzo con espressioni LOD con ambito tabella: Puoi utilizzare CORR per visualizzare la correlazione in una dispersione disaggregata utilizzando un’espressione Level of Detail con ambito tabella. Ad esempio: {CORR(Sales, Profit)}Con un’espressione Level of Detail, la correlazione viene eseguita su tutte le righe. Usando una formula come |
| Limitazioni del database |
Per altre origini dati, puoi ricorrere all’estrazione dei dati o all’utilizzo di |
| Sintassi | COUNT(expression) |
| Definizione | Restituisce il numero di voci. I valori NULL non vengono conteggiati. |
| Sintassi | COUNTD(expression) |
| Definizione | Restituisce il numero di elementi distinti in un gruppo. I valori NULL non vengono conteggiati. |
| Sintassi | COVAR(expression1, expression2) |
| Definizione | Restituisce la covarianza del campione di due espressioni. |
| Note | La covarianza quantifica il modo in cui due variabili cambiano insieme. Una covarianza positiva indica che le variabili tendono a muoversi nella stessa direzione, come quando in media valori più grandi di una variabile tendono a corrispondere a valori più grandi dell’altra variabile. Per normalizzare il calcolo della covarianza, la covarianza del campione utilizza il numero di punti dati non NULL n - 1 al posto di n, che viene invece utilizzato dalla covarianza della popolazione (disponibile con la funzione Se Il valore di |
| Limitazioni del database |
Per altre origini dati, puoi ricorrere all’estrazione dei dati o all’utilizzo di |
| Sintassi | COVARP(expression 1, expression2) |
| Definizione | Restituisce la covarianza della popolazione di due espressioni. |
| Note | La covarianza quantifica il modo in cui due variabili cambiano insieme. Una covarianza positiva indica che le variabili tendono a muoversi nella stessa direzione, come quando in media valori più grandi di una variabile tendono a corrispondere a valori più grandi dell’altra variabile. La covarianza della popolazione è la covarianza del campione moltiplicata per (n-1)/n, dove n è il numero totale di punti dati non NULL. Quando vi sono dati disponibili per tutte le voci di interesse, la covarianza della popolazione è la scelta appropriata, al contrario di quando è presente solo un sottoinsieme casuale di voci, nel qual caso risulta appropriata la covarianza del campione (con la funzione Se |
| Limitazioni del database |
Per altre origini dati, puoi ricorrere all’estrazione dei dati o all’utilizzo di |
| Sintassi | MAX(expression) oppure MAX(expr1, expr2) |
| Output | Stesso tipo di dati dell’argomento o NULL se qualsiasi parte dell’argomento è NULL. |
| Definizione | Restituisce il massimo dei due argomenti, che devono essere dello stesso tipo di dati.
|
| Esempio | MAX(4,7) = 7 |
| Note | Per le stringhe
Per le origini dati di database, Per le date Per le date, Come aggregazione
Come confronto
Vedi anche |
| Sintassi | MEDIAN(expression) |
| Definizione | Restituisce la mediana di un’espressione in tutti i record. I valori NULL vengono ignorati. |
| Note | MEDIAN può essere utilizzato solo con campi numerici. |
| Limitazioni del database |
Per altri tipi di origine dati, è possibile estrarre i dati in un file di estrazione per utilizzare questa funzione. Vedi Estrarre i dati. |
| Sintassi | MIN(expression) oppure MIN(expr1, expr2) |
| Output | Stesso tipo di dati dell’argomento o NULL se qualsiasi parte dell’argomento è NULL. |
| Definizione | Restituisce il minimo dei due argomenti, che devono essere dello stesso tipo di dati.
|
| Esempio | MIN(4,7) = 4 |
| Note | Per le stringhe
Per le origini dati di database, Per le date Per le date, Come aggregazione
Come confronto
Vedi anche |
| Sintassi | PERCENTILE(expression, number) |
| Definizione | Restituisce il valore percentile dell’espressione data corrispondente al valore <number> specificato. Il valore <number> essere compreso tra 0 e 1 (inclusi) e deve essere una costante numerica. |
| Esempio | PERCENTILE([Score], 0.9) |
| Limitazioni del database | Questa funzione è disponibile per le seguenti origini dati: connessioni non legacy Microsoft Excel e file di testo, estrazioni e tipi di origini dati di sola estrazione (ad esempio, Google Analytics, OData o Salesforce), origini dati Sybase IQ 15.1 e versioni successive, origini dati Oracle 10 e versioni successive, origini dati Cloudera Hive e Hortonworks Hadoop Hive, origini dati EXASolution 4.2 e versioni successive. Per altri tipi di origine dati, è possibile estrarre i dati in un file di estrazione per utilizzare questa funzione. Vedi Estrarre i dati. |
| Sintassi | STDEV(expression) |
| Definizione | Restituisce la deviazione statistica standard di tutti i valori dell’espressione data sulla base di un campione della popolazione. |
| Sintassi | STDEVP(expression) |
| Definizione | Restituisce la deviazione statistica standard di tutti i valori dell’espressione data sulla base di un campione parziale della popolazione. |
| Sintassi | SUM(expression) |
| Definizione | Restituisce la somma di tutti i valori nell’espressione. I valori NULL vengono ignorati. |
| Note | SUM può essere utilizzato solo con campi numerici. |
| Sintassi | VAR(expression) |
| Definizione | Restituisce la varianza statistica di tutti i valori dell’espressione data sulla base di un campione della popolazione. |
| Sintassi | VARP(expression) |
| Definizione | Restituisce la varianza statistica di tutti i valori dell’espressione data sulla base dell’intera popolazione. |
| Sintassi | DATE(expression) |
| Output | Data |
| Definizione | Restituisce una data con un numero, una stringa o un’espressione di data <expression>. |
| Esempio | DATE([Employee Start Date]) DATE("September 22, 2018") DATE("9/22/2018")DATE(#2018-09-22 14:52#) |
| Note | A differenza di
|
| Sintassi | DATEADD(date_part, interval, date) |
| Output | Data |
| Definizione | Restituisce la data <date> con il numero specificato <interval> aggiunto alla <date_part> di tale data. Ad esempio, aggiungendo tre mesi o 12 giorni a una data di inizio. |
| Esempio | Estendi tutte le date di scadenza di una settimana DATEADD('week', 1, [due date])Aggiungi 280 giorni alla data 20 febbraio 2021 DATEADD('day', 280, #2/20/21#) = #November 27, 2021# |
| Note | Supporta le date ISO 8601. |
| Sintassi | DATEDIFF(date_part, date1, date2, [start_of_week]) |
| Output | Intero |
| Definizione | Restituisce la differenza tra <date1> e <date2> espressa in unità di <date_part>. Ad esempio, sottraendo le date in cui una persona si è unita e ha lasciato un gruppo musicale, per scoprire la durata della sua permanenza nel gruppo. |
| Esempio | Numero di giorni tra 25 marzo 1986 e 20 febbraio 2021 DATEDIFF('day', #3/25/1986#, #2/20/2021#) = 12,751I mesi di permanenza di una persona in un gruppo musicale DATEDIFF('month', [date joined band], [date left band]) |
| Note | Supporta le date ISO 8601. |
| Sintassi | DATENAME(date_part, date, [start_of_week]) |
| Output | Stringa |
| Definizione | Restituisce <date_part> di <date> come una stringa. |
| Esempio | DATENAME('year', #3/25/1986#) = "1986"DATENAME('month', #1986-03-25#) = "March" |
| Note | Supporta le date ISO 8601. Un calcolo molto simile è DATEPART, che restituisce il valore della parte della data specificato come un numero intero continuo. Modificando gli attributi del risultato del calcolo (dimensione o misura, continuo o discreto) e la formattazione della data, i risultati di Una funzione inversa è DATEPARSE, che accetta un valore stringa e lo formatta come data. |
| Sintassi | DATEPARSE(date_format, date_string) |
| Output | Data |
| Definizione | L’argomento <date_format> descrive come viene disposto il campo <date_string>. A causa dei vari modi in cui può essere ordinato il campo string, <date_format> deve corrispondere esattamente. Per una spiegazione completa e dettagli di formattazione, consulta Convertire un campo in un campo di data. |
| Esempio | DATEPARSE('yyyy-MM-dd', "1986-03-25") = #March 25, 1986# |
| Note |
Le funzioni inverse che scompongono le date e restituiscono il valore delle loro parti, sono |
| Limitazioni del database |
|
| Sintassi | DATEPART(date_part, date, [start_of_week]) |
| Output | Intero |
| Definizione | Restituisce <date_part> di <date> come numero intero. |
| Esempio | DATEPART('year', #1986-03-25#) = 1986DATEPART('month', #1986-03-25#) = 3 |
| Note | Supporta le date ISO 8601. Un calcolo molto simile è Una funzione inversa è |
| Sintassi | DATETRUNC(date_part, date, [start_of_week]) |
| Output | Data |
| Definizione | Tronca la data <date> in base a quanto specificato da <date_part>. Questa funzione restituisce una nuova data. Ad esempio, quando si tronca una data che si trova a metà del mese a livello mensile, questa funzione restituisce il primo giorno del mese. |
| Esempio | DATETRUNC('day', #9/22/2018#) = #9/22/2018#DATETRUNC('iso-week', #9/22/2018#) = #9/17/2018#(il lunedì della settimana che contiene il giorno 22/9/2018) DATETRUNC(quarter, #9/22/2018#) = #7/1/2018# (il primo giorno del trimestre che contiene il giorno 22/9/2018) Nota: per settimana e settimana iso, entra in gioco |
| Note | Supporta le date ISO 8601. Non utilizzare Ad esempio, |
| Sintassi | DAY(date) |
| Output | Intero |
| Definizione | Restituisce il giorno della data <date> specificata come numero intero. |
| Esempio | Day(#September 22, 2018#) = 22 |
| Note | Vedi anche WEEK, MONTH, QUARTER, YEAR e gli equivalenti ISO. |
| Sintassi | ISDATE(string) |
| Output | Booleano |
| Definizione | Restituisce True se una determinata stringa <string> è una data valida. |
| Esempio | ISDATE(09/22/2018) = true ISDATE(22SEP18) = false |
| Note | L’argomento richiesto deve essere una stringa. ISDATE non può essere utilizzato per un campo con un tipo di dati data: il calcolo restituirà un errore. |
| Sintassi | ISOQUARTER(date) |
| Output | Intero |
| Definizione | Restituisce il trimestre basato sul calendario settimanale ISO-8601 della data <date> indicata come numero intero. |
| Esempio | ISOQUARTER(#1986-03-25#) = 1 |
| Note | Vedi anche ISOWEEK, ISOWEEKDAY, ISOYEAR e gli equivalenti non ISO. |
| Sintassi | ISOWEEK(date) |
| Output | Intero |
| Definizione | Restituisce la settimana basata sul calendario settimanale ISO-8601 della data <date> indicata come numero intero. |
| Esempio | ISOWEEK(#1986-03-25#) = 13 |
| Note | Vedi anche ISOWEEKDAY, ISOQUARTER, ISOYEAR e gli equivalenti non ISO. |
| Sintassi | ISOWEEKDAY(date) |
| Output | Intero |
| Definizione | Restituisce il giorno feriale basato sul calendario settimanale ISO-8601 della data <date> indicata come numero intero. |
| Esempio | ISOWEEKDAY(#1986-03-25#) = 2 |
| Note | Vedi anche ISOWEEK, ISOQUARTER, ISOYEAR e gli equivalenti non ISO. |
| Sintassi | ISOYEAR(date) |
| Output | Intero |
| Definizione | Restituisce l’anno basato sul calendario settimanale ISO-8601 della data <date> indicata come numero intero. |
| Esempio | ISOYEAR(#1986-03-25#) = 1,986 |
| Note | Vedi anche ISOWEEK, ISOWEEKDAY, ISOQUARTER e gli equivalenti non ISO. |
| Sintassi | MAKEDATE(year, month, day) |
| Output | Data |
| Definizione | Restituisce un valore di data costruito a partire dai valori <year>, <month> e <day> specificati. |
| Esempio | MAKEDATE(1986,3,25) = #1986-03-25# |
| Note | Nota: i valori immessi erroneamente verranno regolati in una data come Disponibile per le estrazioni dei dati di Tableau. Verifica la disponibilità in altre origini dati.
|
| Sintassi | MAKEDATETIME(date, time) |
| Output | Data e ora |
| Definizione | Restituisce un valore di data e ora che combina una data <date> e un’ora <time>. La data può essere una data, un valore data e ora o un tipo di stringa. L’ora deve essere un valore data e ora. |
| Esempio | MAKEDATETIME("1899-12-30", #07:59:00#) = #12/30/1899 7:59:00 AM#MAKEDATETIME([Date], [Time]) = #1/1/2001 6:00:00 AM# |
| Note | Questa funzione è disponibile solo per connessioni compatibili con MySQL (che per Tableau sono MySQL e Amazon Aurora).
|
| Sintassi | MAKETIME(hour, minute, second) |
| Output | Data e ora |
| Definizione | Restituisce un valore di data costruito a partire dai valori <hour>, <minute> e <second> specificati. |
| Esempio | MAKETIME(14, 52, 40) = #1/1/1899 14:52:40# |
| Note | Poiché Tableau non supporta un tipo di dati ora, ma solo data/ora, l’output è un valore data/ora. La parte di data del campo sarà 1/1/1899. Funzione simile a |
| Sintassi | MAX(expression) oppure MAX(expr1, expr2) |
| Output | Stesso tipo di dati dell’argomento o NULL se qualsiasi parte dell’argomento è NULL. |
| Definizione | Restituisce il massimo dei due argomenti, che devono essere dello stesso tipo di dati.
|
| Esempio | MAX(4,7) = 7 |
| Note | Per le stringhe
Per le origini dati di database, Per le date Per le date, Come aggregazione
Come confronto
Vedi anche |
| Sintassi | MIN(expression) oppure MIN(expr1, expr2) |
| Output | Stesso tipo di dati dell’argomento o NULL se qualsiasi parte dell’argomento è NULL. |
| Definizione | Restituisce il minimo dei due argomenti, che devono essere dello stesso tipo di dati.
|
| Esempio | MIN(4,7) = 4 |
| Note | Per le stringhe
Per le origini dati di database, Per le date Per le date, Come aggregazione
Come confronto
Vedi anche |
| Sintassi | MONTH(date) |
| Output | Intero |
| Definizione | Restituisce il mese della data <date> specificata come numero intero. |
| Esempio | MONTH(#1986-03-25#) = 3 |
| Note | Vedi anche DAY, WEEK, QUARTER, YEAR e gli equivalenti ISO |
| Sintassi | NOW() |
| Output | Data e ora |
| Definizione | Restituisce la data e l’ora correnti del sistema locale. |
| Esempio | NOW() = 1986-03-25 1:08:21 PM |
| Note |
Vedi anche Se l’origine dati è una connessione live, la data e l’ora di sistema potrebbero trovarsi in un altro fuso orario. Per maggiori informazioni su come affrontare questo problema, consulta la Knowledge Base. |
| Sintassi | QUARTER(date) |
| Output | Intero |
| Definizione | Restituisce il trimestre della data <date> specificata come numero intero. |
| Esempio | QUARTER(#1986-03-25#) = 1 |
| Note | Vedi anche DAY, WEEK, MONTH, YEAR e gli equivalenti ISO |
| Sintassi | TODAY() |
| Output | Data |
| Definizione | Restituisce la data corrente del sistema locale. |
| Esempio | TODAY() = 1986-03-25 |
| Note |
Vedi anche NOW, un calcolo simile che restituisce un valore data/ora invece di una data. Se l’origine dati è una connessione live, la data di sistema potrebbe trovarsi in un altro fuso orario. Per maggiori informazioni su come affrontare questo problema, consulta la Knowledge Base. |
| Sintassi | WEEK(date) |
| Output | Intero |
| Definizione | Restituisce la settimana della data <date> specificata come numero intero. |
| Esempio | WEEK(#1986-03-25#) = 13 |
| Note | Vedi anche DAY, MONTH, QUARTER, YEAR e gli equivalenti ISO |
| Sintassi | YEAR(date) |
| Output | Intero |
| Definizione | Restituisce l’anno della data <date> specificata come numero intero. |
| Esempio | YEAR(#1986-03-25#) = 1,986 |
| Note | Vedi anche DAY, WEEK, MONTH, QUARTER e gli equivalenti ISO |
| Formato | Tipo di dati | Valore |
| "25 marzo 1986" | Stringa | "25 marzo 1986" |
| #25/03/1986# | Data | #25/03/1986# |
| 25/03/1986 | Decimale a virgola mobile | 0.00006042 |
| 25/03/1986 | Intero | 1.958 |
| martedì 25 marzo 1986 | - | non valido |
| Sintassi | MODEL_PERCENTILE(
|
| Definizione | Restituisce la probabilità (compresa tra 0 e 1) che il valore previsto sia minore o uguale all’indicatore osservato, definito dall’espressione di destinazione e da altri predittori. Questa è la funzione di distribuzione predittiva posteriore, anche nota come funzione di distribuzione cumulativa (CDF). |
| Esempio | MODEL_PERCENTILE( SUM([Sales]),COUNT([Orders])) |
| Sintassi | MODEL_QUANTILE(
|
| Definizione | Restituisce un valore numerico di destinazione all’interno dell’intervallo probabile definito dall’espressione di destinazione e da altri predittori, in corrispondenza di un quantile specificato. Questo è il quantile predittivo posteriore. |
| Esempio | MODEL_QUANTILE(0.5, SUM([Sales]), COUNT([Orders])) |
| Sintassi | <expr1> AND <expr2> |
| Definizione | Esegue una congiunzione logica su due espressioni. Se entrambi i lati sono True, il test logico restituisce True. |
| Output | Booleano (True o False) |
| Esempio | IF [Season] = "Spring" AND "[Season] = "Fall" “Se sia (Season = Spring) e (Season = Fall) sono contemporaneamente True, viene restituito It’s the apocalypse and footwear doesn’t matter”. |
| Note | Spesso usato con IF e IIF. Vedi anche NOT e OR. Se entrambe le espressioni sono Se crei un calcolo in cui il risultato di un confronto Nota: l’operatore |
| Sintassi | CASE <expression>
|
| Output | Dipende dal tipo di dati dei valori <then>. |
| Definizione | Valuta l’espressione |
| Esempio | “Controlla il campo Season. Se il valore è Summer, restituisci Sandals. Se il valore è Winter, restituisci Boots. Se nessuna delle opzioni nel calcolo corrisponde a quanto indicato nel campo Season, restituisci Sneakers.” |
| Note | Utilizzato con WHEN, THEN, ELSE e END.
|
| Sintassi | CASE <expression>
|
| Definizione | Una parte facoltativa di un’espressione IF o CASE utilizzata per specificare un valore predefinito da restituire se nessuna delle espressioni testate è True. |
| Esempio | IF [Season] = "Summer" THEN 'Sandals' CASE [Season] |
| Note | Utilizzato con CASE, WHEN, IF, ELSEIF, THEN e END
|
| Sintassi | [ELSEIF <test2> THEN <then2>] |
| Definizione | Una parte facoltativa di un’espressione IF utilizzata per specificare condizioni aggiuntive oltre l’IF iniziale. |
| Esempio | IF [Season] = "Summer" THEN 'Sandals' |
| Note | Utilizzato con IF, THEN, ELSE e END
A differenza di |
| Definizione | Utilizzato per chiudere un’espressione IF o CASE. |
| Esempio | IF [Season] = "Summer" THEN 'Sandals' “Se Season = Summer, restituisci Sandals. In caso contrario, controlla l’espressione successiva. Se Season = Winter, restituisci Boots. Se nessuna delle espressioni è True, restituisci Sneakers.” CASE [Season] “Controlla il campo Season. Se il valore è Summer, restituisci Sandals. Se il valore è Winter, restituisci Boots. Se nessuna delle opzioni nel calcolo corrisponde a quanto indicato nel campo Season, restituisci Sneakers.” |
| Note |
| Sintassi | IF <test1> THEN <then1> |
| Output | Dipende dal tipo di dati dei valori <then>. |
| Definizione | Testa una serie di espressioni e restituisce il valore |
| Esempio | IF [Season] = "Summer" THEN 'Sandals' “Se Season = Summer, restituisci Sandals. In caso contrario, controlla l’espressione successiva. Se Season = Winter, restituisci Boots. Se nessuna delle espressioni è True, restituisci Sneakers.” |
| Note |
| Sintassi | IFNULL(expr1, expr2) |
| Output | Dipende dal tipo di dati dei valori <expr>. |
| Definizione | Restituisce |
| Esempio | IFNULL([Assigned Room], "TBD") “Se il campo Assigned Room non è Null, restituisci il relativo valore. Se il campo Assigned Room è Null, restituisci invece TBD.” |
| Note | Confronta con ISNULL. Vedi anche ZN. |
| Sintassi | IIF(<test>, <then>, <else>, [<unknown>]) |
| Output | Dipende dal tipo di dati dei valori nell’espressione. |
| Definizione | Controlla se una condizione è soddisfatta (<test>) e restituisce <then> se il test è True, <else> se il test è False e un valore facoltativo per <unknown> se il test è Null. Se il valore unknown facoltativo non è specificato, IIF restituisce Null. |
| Esempio | IIF([Season] = 'Summer', 'Sandals', 'Other footwear') “Se Season = Summer, restituisci Sandals. In caso contrario, restituisci Other footwear” IIF([Season] = 'Summer', 'Sandals', “Se Season = Summer, restituisci Sandals. In caso contrario, controlla l’espressione successiva. Se Season = Winter, restituisci Boots. Se nessuna delle due è True, restituisci Sneakers.” IIF('Season' = 'Summer', 'Sandals', “Se Season = Summer, restituisci Sandals. In caso contrario, controlla l’espressione successiva. Se Season = Winter, restituisci Boots. Se nessuna delle espressioni è True, restituisci Sneakers.” |
| Note |
In altre parole, nel calcolo seguente il risultato sarà Red, non Orange, perché l’espressione smette di essere valutata non appena A=A viene valutato come True:
|
| Sintassi | <expr1> IN <expr2> |
| Output | Booleano (True o False) |
| Definizione | Restituisce TRUE se qualsiasi valore in <expr1> corrisponde a qualsiasi valore in <expr2>. |
| Esempio | SUM([Cost]) IN (1000, 15, 200) “Il valore del campo Cost è 1000, 15 o 200?” [Field] IN [Set] “Il valore del campo è presente nell’insieme?” |
| Note | I valori in Vedi anche WHEN. |
| Sintassi | ISDATE(string) |
| Output | Booleano (True o False) |
| Definizione | Restituisce True se una stringa <string> è una data valida. L’espressione di input deve essere un campo stringa (di testo). |
| Esempio | ISDATE("2018-09-22")“La stringa 2018-09-22 è una data formattata correttamente?” |
| Note | Ciò che viene considerato una data valida dipende dalle impostazioni locali del sistema che valuta il calcolo. Ad esempio: Negli Stati Uniti:
Nel Regno Unito:
|
| Sintassi | ISNULL(expression) |
| Output | Booleano (True o False) |
| Definizione | Restituisce True se l’espressione |
| Esempio | ISNULL([Assigned Room]) “Il campo Assigned Room è Null?” |
| Note | Confronta con IFNULL. Vedi anche ZN. |
| Sintassi | MAX(expression) oppure MAX(expr1, expr2) |
| Output | Stesso tipo di dati dell’argomento o NULL se qualsiasi parte dell’argomento è NULL. |
| Definizione | Restituisce il massimo dei due argomenti, che devono essere dello stesso tipo di dati.
|
| Esempio | MAX(4,7) = 7 |
| Note | Per le stringhe
Per le origini dati di database, Per le date Per le date, Come aggregazione
Come confronto
Vedi anche |
| Sintassi | MIN(expression) oppure MIN(expr1, expr2) |
| Output | Stesso tipo di dati dell’argomento o NULL se qualsiasi parte dell’argomento è NULL. |
| Definizione | Restituisce il minimo dei due argomenti, che devono essere dello stesso tipo di dati.
|
| Esempio | MIN(4,7) = 4 |
| Note | Per le stringhe
Per le origini dati di database, Per le date Per le date, Come aggregazione
Come confronto
Vedi anche |
| Sintassi | NOT <expression> |
| Output | Booleano (True o False) |
| Definizione | Esegue una negazione logica su un’espressione. |
| Esempio | IF NOT [Season] = "Summer" “Se Season non è uguale a Summer, restituisci Don’t wear sandals. In caso contrario, restituisci Wear sandals.” |
| Note |
| Sintassi | <expr1> OR <expr2> |
| Output | Booleano (True o False) |
| Definizione | Esegue una disgiunzione logica su due espressioni. |
| Esempio | IF [Season] = "Spring" OR [Season] = "Fall" “Se (Season = Spring) o (Season = Fall) è True, restituisci Sneakers.” |
| Note | Spesso usato con IF e IIF. Vedi anche AND e NOT. Se una delle due espressioni è Se crei un calcolo che visualizza il risultato di un confronto Nota: l’operatore |
| Sintassi | IF <test1> THEN <then1>
|
| Definizione | Una parte richiesta di un’espressione IF, ELSEIF o CASE, utilizzata per definire quale risultato restituire se un valore o un test specifico è True. |
| Esempio | IF [Season] = "Summer" THEN 'Sandals' “Se Season = Summer, restituisci Sandals. In caso contrario, controlla l’espressione successiva. Se Season = Winter, restituisci Boots. Se nessuna delle espressioni è True, restituisci Sneakers.” CASE [Season] “Controlla il campo Season. Se il valore è Summer, restituisci Sandals. Se il valore è Winter, restituisci Boots. Se nessuna delle opzioni nel calcolo corrisponde a quanto indicato nel campo Season, restituisci Sneakers.” |
| Note |
| Sintassi | CASE <expression>
|
| Definizione | Una parte richiesta di un’espressione CASE. Trova il primo <value> che corrisponde a <expression> e restituisce il valore <then> corrispondente. |
| Esempio | CASE [Season] “Controlla il campo Season. Se il valore è Summer, restituisci Sandals. Se il valore è Winter, restituisci Boots. Se nessuna delle opzioni nel calcolo corrisponde a quanto indicato nel campo Season, restituisci Sneakers.” |
| Note | Utilizzato con CASE, THEN, ELSE e END.
CASE <expression> I valori con cui si confronta |
| Sintassi | ZN(expression) |
| Output | Dipende dal tipo di dati di <expression> oppure 0. |
| Definizione | Restituisce <expression> se non è Null, altrimenti restituisce zero. |
| Esempio | ZN([Test Grade]) “Se Test Grade non è Null, restituisci il relativo valore. Se Test Grade è Null, restituisci 0.” |
| Note |
Vedi anche ISNULL. |
| CASE | IF | IIF |
CASE [Region] | IF [Region] = 'West' THEN 1 | IIF([Region] = 'West', 1, |
La struttura CASE è molto semplice, facile da scrivere e interpretare. Tuttavia, l’espressione (in questo caso, [Region]) non può essere un’operazione logica, a differenza di IF o IIF. I valori Null vengono gestiti allo stesso modo per CASE e IF. | La struttura IF THEN consente più clausole ELSEIF, il che rende le valutazioni multiple molto più semplici rispetto a IIF. Gestione dei valori NULL: qualsiasi risultato sconosciuto (Null) viene gestito dalla stessa clausola ELSE dei risultati False. In questo caso, a qualsiasi regione diversa dalle quattro specificate (incluso Null) verrà assegnato il valore 5. | La struttura IIF gestisce i risultati sconosciuti in modo diverso rispetto ai risultati False e ha una sintassi diversa da IF. Il compromesso per la gestione specifica dei valori Null è l’annidamento, come nel caso precedente, che può essere complicato da scrivere e interpretare. Gestione dei valori NULL: a qualsiasi regione non Null diversa dalle quattro specificate verrà assegnato il valore 5, ma a un valore Null verrà assegnato 0. |
| Sintassi | ABS(number) |
| Output | Numero (positivo) |
| Definizione | Restituisce il valore assoluto del numero <number> dato. |
| Esempio | ABS(-7) = 7 Il secondo esempio restituisce il valore assoluto per tutti i numeri contenuti nel campo Budget Variance. |
| Note | Vedi anche SIGN. |
| Sintassi | ACOS(number) |
| Output | Numero (angolo in radianti) |
| Definizione | Restituisce l’arcocoseno (angolo) del numero <number> dato. |
| Esempio | ACOS(-1) = 3.14159265358979 |
| Note | La funzione inversa, COS, accetta come argomento l’angolo in radianti e restituisce il coseno. |
| Sintassi | ASIN(number) |
| Output | Numero (angolo in radianti) |
| Definizione | Restituisce l’arcoseno (angolo) del numero <number> dato. |
| Esempio | ASIN(1) = 1.5707963267949 |
| Note | La funzione inversa, SIN, accetta come argomento l’angolo in radianti e restituisce il seno. |
| Sintassi | ATAN(number) |
| Output | Numero (angolo in radianti) |
| Definizione | Restituisce l’arcotangente (angolo) di un numero <number> dato. |
| Esempio | ATAN(180) = 1.5652408283942 |
| Note | La funzione inversa, |
| Sintassi | ATAN2(y number, x number) |
| Output | Numero (angolo in radianti) |
| Definizione | Restituisce l’arcotangente (angolo) tra due numeri (x e y). Il risultato è in radianti. |
| Esempio | ATAN2(2, 1) = 1.10714871779409 |
| Note | Vedi anche ATAN, TAN e COT. |
| Sintassi | CEILING(number) |
| Output | Intero |
| Definizione | Arrotonda un numero <number> al numero intero più vicino di valore uguale o superiore. |
| Esempio | CEILING(2.1) = 3 |
| Note | Vedi anche FLOOR e ROUND. |
| Limitazioni del database |
|
| Sintassi | COS(number)L’argomento numerico è l’angolo in radianti. |
| Output | Numero |
| Definizione | Restituisce il coseno di un angolo. |
| Esempio | COS(PI( ) /4) = 0.707106781186548 |
| Note | La funzione inversa, Vedi anche |
| Sintassi | COT(number)L’argomento numerico è l’angolo in radianti. |
| Output | Numero |
| Definizione | Restituisce la cotangente di un angolo. |
| Esempio | COT(PI( ) /4) = 1 |
| Note | Vedi anche ATAN, TAN e PI. Per convertire un angolo da gradi in radianti, utilizza RADIANS. |
| Sintassi | DEGREES(number)L’argomento numerico è l’angolo in radianti. |
| Output | Numero (gradi) |
| Definizione | Converte un angolo da radianti in gradi. |
| Esempio | DEGREES(PI( )/4) = 45.0 |
| Note | La funzione inversa, Vedi anche |
| Sintassi | DIV(integer1, integer2) |
| Output | Intero |
| Definizione | Restituisce la parte intera di un’operazione di divisione, in cui <integer1> è diviso per <integer2>. |
| Esempio | DIV(11,2) = 5 |
| Sintassi | EXP(number) |
| Output | Numero |
| Definizione | Restituisce e innalzato alla potenza del numero <number> dato. |
| Esempio | EXP(2) = 7.389 |
| Note | Vedi anche LN. |
| Sintassi | FLOOR(number) |
| Output | Intero |
| Definizione | Arrotonda un numero <number> al numero più vicino di valore uguale o inferiore. |
| Esempio | FLOOR(7.9) = 7 |
| Note | Vedi anche CEILING e ROUND. |
| Limitazioni del database |
|
| Sintassi | HEXBINX(number, number) |
| Output | Numero |
| Definizione | Mappa una coordinata x, y alla coordinata x del contenitore esagonale più vicino. I contenitori hanno una lunghezza laterale di 1, quindi potrebbe essere necessario ridimensionare gli input in modo appropriato. |
| Esempio | HEXBINX([Longitude]*2.5, [Latitude]*2.5) |
| Note | HEXBINX e HEXBINY sono funzioni di creazione di contenitori e tracciato per contenitori esagonali. I contenitori esagonali sono un’opzione efficiente ed elegante per visualizzare i dati in un piano x/y come ad esempio una mappa. Poiché i contenitori sono esagonali, ogni contenitore si avvicina molto a un cerchio e riduce al minimo la variazione della distanza tra il punto dati e il centro del contenitore. Questo rende il clustering più accurato e informativo. |
| Sintassi | HEXBINY(number, number) |
| Output | Numero |
| Definizione | Mappa una coordinata x, y alla coordinata y del contenitore esagonale più vicino. I contenitori hanno una lunghezza laterale di 1, quindi potrebbe essere necessario ridimensionare gli input in modo appropriato. |
| Esempio | HEXBINY([Longitude]*2.5, [Latitude]*2.5) |
| Note | Vedi anche HEXBINX. |
| Sintassi | LN(number) |
| Output | Numero L’output è |
| Definizione | Restituisce il logaritmo naturale del numero <number>. |
| Esempio | LN(50) = 3.912023005 |
| Note | Vedi anche EXP e LOG. |
| Sintassi | LOG(number, [base])Se l’argomento base facoltativo non è presente, viene utilizzata la base 10. |
| Output | Numero |
| Definizione | Restituisce il logaritmo di un numero per la base data. |
| Esempio | LOG(16,4) = 2 |
| Note | Vedi anche POWER LN. |
| Sintassi | MAX(expression) oppure MAX(expr1, expr2) |
| Output | Stesso tipo di dati dell’argomento o NULL se qualsiasi parte dell’argomento è NULL. |
| Definizione | Restituisce il massimo dei due argomenti, che devono essere dello stesso tipo di dati.
|
| Esempio | MAX(4,7) = 7 |
| Note | Per le stringhe
Per le origini dati di database, Per le date Per le date, Come aggregazione
Come confronto
Vedi anche |
| Sintassi | MIN(expression) oppure MIN(expr1, expr2) |
| Output | Stesso tipo di dati dell’argomento o NULL se qualsiasi parte dell’argomento è NULL. |
| Definizione | Restituisce il minimo dei due argomenti, che devono essere dello stesso tipo di dati.
|
| Esempio | MIN(4,7) = 4 |
| Note | Per le stringhe
Per le origini dati di database, Per le date Per le date, Come aggregazione
Come confronto
Vedi anche |
| Sintassi | PI() |
| Output | Numero |
| Definizione | Restituisce la costante numerica pi greco: 3,14159... |
| Esempio | PI() = 3.14159 |
| Note | Utile per le funzioni trigonometriche che ricevono input in radianti. Vedi anche RADIANS. |
| Sintassi | POWER(number, power) |
| Output | Numero |
| Definizione | Eleva il numero <number> alla potenza <power> specificata. |
| Esempio | POWER(5,3) = 125 |
| Note | È inoltre possibile utilizzare il simbolo ^, ad esempio 5^3 = POWER(5,3) = 125 |
| Sintassi | RADIANS(number) |
| Output | Numero (angolo in radianti) |
| Definizione | Converte il numero <number> specificato da gradi in radianti. |
| Esempio | RADIANS(180) = 3.14159 |
| Note | La funzione inversa, DEGREES, accetta un angolo in radianti e restituisce l’angolo in gradi. |
| Sintassi | ROUND(number, [decimals]) |
| Output | Numero |
| Definizione | Arrotonda L’argomento facoltativo |
| Esempio | ROUND(1/3, 2) = 0.33 |
| Note | Alcuni database, come SQL Server, permettono di specificare una lunghezza negativa, dove -1 arrotonda il numero alle decine, -2 arrotonda alle centinaia e così via. Questo non è vero per tutti i database. Ad esempio, non è vero per Excel o Access.
|
| Sintassi | SIGN(number) |
| Output | -1, 0 o 1 |
| Definizione | Restituisce il segno di un numero <number>: i possibili valori restituiti sono -1 se il numero è negativo, 0 se il numero è zero o 1 se il numero è positivo. |
| Esempio | SIGN(AVG(Profit)) = -1 |
| Note | Vedi anche ABS. |
| Sintassi | SIN(number)L’argomento numerico è l’angolo in radianti. |
| Output | Numero |
| Definizione | Restituisce il seno di un angolo. |
| Esempio | SIN(0) = 1.0 |
| Note | La funzione inversa, Vedi anche |
| Sintassi | SQRT(number) |
| Output | Numero |
| Definizione | Restituisce la radice quadrata di un numero <number>. |
| Esempio | SQRT(25) = 5 |
| Note | Vedi anche SQUARE. |
| Sintassi | SQUARE(number) |
| Output | Numero |
| Definizione | Restituisce il quadrato di un numero <number>. |
| Esempio | SQUARE(5) = 25 |
| Note | Vedi anche SQRT e POWER. |
| Sintassi | TAN(number)L’argomento numerico è l’angolo in radianti. |
| Output | Numero |
| Definizione | Restituisce la tangente di un angolo. |
| Esempio | TAN(PI ( )/4) = 1.0 |
| Note | Vedi anche ATAN, ATAN2, COT e PI. Per convertire un angolo da gradi in radianti, utilizza RADIANS. |
| Sintassi | ZN(expression) |
| Output | Qualsiasi oppure 0 |
| Definizione | Restituisce l’espressione Utilizza questa funzione per sostituire i valori Null con zeri. |
| Esempio | ZN(Grade) = 0 |
| Note | Questa funzione è molto utile quando si utilizzano campi che possono contenere valori Null in un calcolo. Racchiudendo il campo con ZN, è possibile prevenire errori causati dal calcolo con i valori Null. |
| Sintassi | RAWSQL_BOOL("sql_expr", [arg1], …[argN]) |
| Output | Booleano |
| Definizione | Restituisce un risultato booleano da una data espressione SQL. |
| Esempio | RAWSQL_BOOL("%1 > %2", [Sales], [Profit])Nell’esempio, %1 è uguale a [Sales] e %2 è uguale a [Profit]. |
| Sintassi | RAWSQLAGG_BOOL("sql_expr", [arg1], …[argN]) |
| Output | Booleano |
| Definizione | Restituisce un risultato booleano da una data espressione SQL aggregata. |
| Esempio | RAWSQLAGG_BOOL("SUM( %1) >SUM( %2)", [Sales], [Profit]) Nell’esempio, %1 è uguale a [Sales] e %2 è uguale a [Profit]. |
| Sintassi | RAWSQL_DATE("sql_expr", [arg1], …[argN]) |
| Output | Data |
| Definizione | Restituisce un risultato data da un’espressione SQL specificata. |
| Esempio | RAWSQL_DATE("%1", [Order Date])In questo esempio, %1 è uguale a [Order Date]. |
| Sintassi | RAWSQLAGG_DATE("sql_expr", [arg1], …[argN]) |
| Output | Data |
| Definizione | Restituisce un risultato data da un’espressione SQL aggregata specificata. |
| Esempio | RAWSQLAGG_DATE("MAX(%1)", [Order Date])In questo esempio, %1 è uguale a [Order Date]. |
| Sintassi | RAWSQL_DATETIME("sql_expr", [arg1], …[argN]) |
| Output | Data e ora |
| Definizione | Restituisce un risultato data e ora da un’espressione SQL specificata. |
| Esempio | RAWSQL_DATETIME("%1", [Order Date])In questo esempio, %1 è uguale a [Order Date]. |
| Sintassi | RAWSQLAGG_DATETIME("sql_expr", [arg1], …[argN]) |
| Output | Data e ora |
| Definizione | Restituisce un risultato data e ora da un’espressione SQL aggregata specificata. |
| Esempio | RAWSQLAGG_DATETIME("MIN(%1)", [Order Date])In questo esempio, %1 è uguale a [Order Date]. |
| Sintassi | RAWSQL_INT("sql_expr", [arg1], …[argN]) |
| Output | Intero |
| Definizione | Restituisce come risultato un numero intero da una data espressione SQL. |
| Esempio | RAWSQL_INT("500 + %1", [Sales])In questo esempio, %1 è uguale a [Sales]. |
| Sintassi | RAWSQLAGG_INT("sql_expr", [arg1,] …[argN]) |
| Output | Intero |
| Definizione | Restituisce come risultato un numero intero da una data espressione SQL aggregata. |
| Esempio | RAWSQLAGG_INT("500 + SUM(%1)", [Sales])In questo esempio, %1 è uguale a [Sales]. |
| Sintassi | RAWSQL_REAL("sql_expr", [arg1], …[argN]) |
| Output | Numerico |
| Definizione | Restituisce un risultato numerico da un’espressione SQL specificata. |
| Esempio | RAWSQL_REAL("-123.98 * %1", [Sales])In questo esempio, %1 è uguale a [Sales] |
| Sintassi | RAWSQLAGG_REAL("sql_expr", [arg1,] …[argN]) |
| Output | Numerico |
| Definizione | Restituisce un risultato numerico da un’espressione SQL aggregata specificata. |
| Esempio | RAWSQLAGG_REAL("SUM( %1)", [Sales])In questo esempio, %1 è uguale a [Sales]. |
| Sintassi | RAWSQL_SPATIAL("sql_expr", [arg1], …[argN]) |
| Output | Spaziale |
| Definizione | Restituisce un risultato spaziale da un’espressione SQL specificata. |
| Esempio | RAWSQL_SPATIAL("%1", [Geometry])In questo esempio, %1 è uguale a [Geometria]. |
| Nota | Non esiste alcuna versione RAWSQLAGG di questa funzione. |
| Sintassi | RAWSQL_STR("sql_expr", [arg1], …[argN]) |
| Output | Stringa |
| Definizione | Restituisce una stringa da un’espressione SQL specificata. |
| Esempio | RAWSQL_STR("%1", [Customer Name])In questo esempio, %1 è uguale a [Nome cliente]. |
| Sintassi | RAWSQLAGG_STR("sql_expr", [arg1,] …[argN]) |
| Output | Stringa |
| Definizione | Restituisce una stringa da un’espressione SQL aggregata specificata. |
| Esempio | RAWSQLAGG_STR("AVG(%1)", [Discount])In questo esempio, %1 è uguale a [Sconto]. |
| Sintassi | AREA(Spatial Polygon, 'units') |
| Output | Numero |
| Definizione | Restituisce l’area della superficie totale di <spatial polygon>. |
| Esempio | AREA([Geometry], 'feet') |
| Note | Nomi delle unità supportate (devono essere racchiusi tra virgolette nel calcolo, ad esempio
|
| Sintassi | BUFFER(Spatial point, distance, 'units')
|
| Output | Geometria |
| Definizione | Per i punti spaziali, restituisce una forma poligonale centrata su Per le stringhe lineari, calcola i poligoni formati includendo tutti i punti entro il raggio di distanza dalla stringa lineare. Per i poligoni, calcola un poligono che è un valore interno (distanza negativa) o iniziale (distanza positiva) di ogni poligono specificato. |
| Esempio | BUFFER([Spatial Point Geometry], 25, 'mi') BUFFER(MAKEPOINT(47.59, -122.32), 3, 'km') BUFFER(MAKELINE(MAKEPOINT(0, 20),MAKEPOINT (30, 30)),20,'km')) |
| Note | Nomi delle unità supportate (devono essere racchiusi tra virgolette nel calcolo, ad esempio
|
| Sintassi | DIFFERENCE(Spatial, Spatial) |
| Output | Poligono spaziale |
| Definizione | Calcola le porzioni di regioni rimanenti quando tutte le regioni nel secondo argomento vengono ricavate dal primo argomento in aree sovrapposte.Scarta le regioni del secondo argomento nelle aree che non si sovrappongono. |
| Esempio | DIFFERENCE(Spatial Polygon1, Spatial Polygon2) |
| Note | Supporta poligoni e multipoligoni spaziali, punti o linee non spaziali. |
| Sintassi | DISTANCE(SpatialPoint1, SpatialPoint2, 'units') |
| Output | Numero |
| Definizione | Restituisce la misura della distanza tra due punti nell’unità <unit> specificata. |
| Esempio | DISTANCE([Origin Point],[Destination Point], 'km') |
| Note | Nomi delle unità supportate (devono essere racchiusi tra virgolette nel calcolo, ad esempio
|
| Limitazioni del database | Questa funzione può essere creata solo con una connessione live, ma continuerà a funzionare se l’origine dati viene convertita in un’estrazione. |
| Sintassi | INTERSECTION (spatial, spatial) |
| Output | Poligono |
| Definizione | Calcola e restituisce le porzioni delle regioni nel secondo argomento che si sovrappongono alle regioni nel primo argomento. |
| Esempio | INTERSECTION (Spatial Polygon1, Spatial Polygon2) |
| Note | Supporta poligoni e multipoligoni spaziali, punti o linee non spaziali. |
| Sintassi | INTERSECTS (geometry1, geometry2) |
| Output | Booleano |
| Definizione | Restituisce True o False per indicare se due geometrie si sovrappongono nello spazio. |
| Note | Combinazioni supportate: punto/poligono, linea/poligono e poligono/poligono. |
| Sintassi | LENGTH(geometry, 'units') |
| Output | Numero |
| Definizione | Restituisce la lunghezza del percorso geodetico della stringa o delle stringhe lineari in <geometry> utilizzando le unità <units> specificate. |
| Esempio | LENGTH([Spatial], 'metres') |
| Note | Il risultato è <NaN> se l’argomento della geometria non ha stringhe lineari, sebbene siano consentiti altri elementi. |
| Sintassi | MAKELINE(SpatialPoint1, SpatialPoint2) |
| Output | Geometria (linea) |
| Definizione | Genera un indicatore lineare tra due punti |
| Esempio | MAKELINE(MAKEPOINT(47.59, -122.32), MAKEPOINT(48.5, -123.1)) |
| Note | Utile per creare mappe di origine-destinazione. |
| Sintassi | MAKEPOINT(latitude, longitude, [SRID]) |
| Output | Geometria (punto) |
| Definizione | Converte i dati delle colonne Se viene aggiunto l’argomento facoltativo |
| Esempio | MAKEPOINT(48.5, -123.1) MAKEPOINT([AirportLatitude], [AirportLongitude]) MAKEPOINT([Xcoord],[Ycoord], 3493) |
| Note |
Puoi utilizzare |
| Sintassi | NO_CUTOUTS (spatial) |
| Output | Poligono spaziale corretto |
| Definizione | Restituisce un poligono spaziale corretto se l’interpretazione della terra piatta richiede l’inversione dei poligoni; in caso contrario, restituisce l’oggetto originale. |
| Note | I formati di file spaziali come Keyhole Markup Language (.kml) richiedono che i contorni dei poligoni seguano una direzione di coordinate specifica.Se un insieme di dati disegna i contorni al contrario, Tableau interpreta lo spazio esterno come forma. |
| Sintassi | OUTLINE(spatial polygon) |
| Output | Geometria |
| Definizione | Converte una geometria poligonale in stringhe lineari. |
| Note | Utile per creare un livello separato per un contorno a cui è possibile applicare uno stile diverso rispetto al riempimento. Supporta i poligoni all’interno di multipoligoni. |
| Sintassi | PARSE_WKT (String) |
| Output | Oggetto spaziale (geografia) |
| Definizione | Converte un campo stringa di testo contenente WKT (Well-Known Text) di entità geografiche (come punti, stringhe lineari o poligoni) in un valore spaziale. |
| Note | Si presuppone che le coordinate utilizzino la latitudine e la longitudine WGS-84.Per maggiori informazioni su WKT, consulta Rappresentazione WKT della geometria (in inglese). |
| Sintassi | SHAPETYPE(geometry) |
| Output | Stringa |
| Definizione | Restituisce una stringa che descrive la struttura della geometria spaziale <geometry>, ad esempio vuoto, punto, multipunto, stringa lineare, stringa lineare multipla, poligono, multipoligono, misto e non supportato. |
| Esempio | SHAPETYPE(MAKEPOINT(48.5, -123.1)) = "Point" |
| Sintassi | SYMDIFFERENCE(spatial, spatial) |
| Output | Geometria |
| Definizione | Calcola tutte le porzioni di regioni del secondo argomento che si sovrappongono alle regioni del primo argomento e le scarta da entrambi.Restituisce le porzioni rimanenti delle regioni da entrambi gli argomenti. |
| Esempio |
|
| Sintassi | UNION(spatial 1, [spatial 2]) |
| Output | Geometria |
| Definizione | Combina le geometrie spaziali dissolvendo i confini adiacenti o sovrapposti in un’unica geometria spaziale. |
| Note | Quando viene utilizzata con un argomento ( Se viene utilizzata con due argomenti ( Per punti e stringhe lineari, |
| Sintassi | VALIDATE(spatial geometry) |
| Output | Geometria |
| Definizione | Conferma la correttezza topologica della geometria nel valore spaziale.Se il valore non può essere utilizzato per l'analisi a causa di problemi quali l'intersezione del perimetro di un poligono, il risultato sarà NULL.Se la geometria è corretta, il risultato sarà la geometria originale. |
| Esempio |
|
| Sintassi | ASCII(string) |
| Output | Numero |
| Definizione | Restituisce il codice ASCII per il primo carattere di <string>. |
| Esempio | ASCII('A') = 65 |
| Note | È l’inversa della funzione CHAR. |
| Sintassi | CHAR(number) |
| Output | Stringa |
| Definizione | Restituisce il carattere codificato dal codice ASCII <number>. |
| Esempio | CHAR(65) = 'A' |
| Note | È l’inversa della funzione ASCII. |
| Sintassi | CONTAINS(string, substring) |
| Output | Booleano |
| Definizione | Restituisce true se la stringa data contiene la sottostringa specificata. |
| Esempio | CONTAINS("Calculation", "alcu") = true |
| Note | Vedi anche la funzione logica A seconda dell’origine dati, CONTAINS può applicare la distinzione tra maiuscole e minuscole. In altre parole, per alcune origini dati, |
| Sintassi | ENDSWITH(string, substring) |
| Output | Booleano |
| Definizione | Restituisce true se la stringa data termina con la sottostringa specificata. Gli spazi vuoti finali vengono ignorati. |
| Esempio | ENDSWITH("Tableau", "leau") = true |
| Note | Vedi anche le espressioni RegEx supportate nella documentazione sulle funzioni aggiuntive. |
| Sintassi | FIND(string, substring, [start]) |
| Output | Numero |
| Definizione | Restituisce la posizione dell’indice della sottostringa nella stringa oppure 0 se la sottostringa non viene trovata. Il primo carattere della stringa è la posizione 1. Se viene aggiunto l’argomento numerico facoltativo |
| Esempio | FIND("Calculation", "alcu") = 2FIND("Calculation", "Computer") = 0FIND("Calculation", "a", 3) = 7FIND("Calculation", "a", 2) = 2FIND("Calculation", "a", 8) = 0 |
| Note | Vedi anche le espressioni RegEx supportate nella documentazione sulle funzioni aggiuntive. |
| Sintassi | FINDNTH(string, substring, occurrence) |
| Output | Numero |
| Definizione | Restituisce la posizione dell’occorrenza n della sottostringa all’interno della stringa specificata, dove n è definito dall’argomento dell’occorrenza. |
| Esempio | FINDNTH("Calculation", "a", 2) = 7 |
| Note |
Vedi anche le espressioni RegEx supportate nella documentazione sulle funzioni aggiuntive. |
| Sintassi | LEFT(string, number) |
| Output | Stringa |
| Definizione | Restituisce il numero <number> di caratteri più a sinistra della stringa. |
| Esempio | LEFT("Matador", 4) = "Mata" |
| Note | Vedi anche MID e RIGHT. |
| Sintassi | LEN(string) |
| Output | Numero |
| Definizione | Restituisce la lunghezza della stringa. |
| Esempio | LEN("Matador") = 7 |
| Note | Da non confondere con la funzione spaziale LENGTH. |
| Sintassi | LOWER(string) |
| Output | Stringa |
| Definizione | Restituisce la stringa <string> in caratteri minuscoli. |
| Esempio | LOWER("ProductVersion") = "productversion" |
| Note | Vedi anche UPPER e PROPER. |
| Sintassi | LTRIM(string) |
| Output | Stringa |
| Definizione | Restituisce la stringa <string> con gli eventuali spazi iniziali rimossi. |
| Esempio | LTRIM(" Matador ") = "Matador " |
| Note | Vedi anche RTRIM. |
| Sintassi | MAX(expression) oppure MAX(expr1, expr2) |
| Output | Stesso tipo di dati dell’argomento o NULL se qualsiasi parte dell’argomento è NULL. |
| Definizione | Restituisce il massimo dei due argomenti, che devono essere dello stesso tipo di dati.
|
| Esempio | MAX(4,7) = 7 |
| Note | Per le stringhe
Per le origini dati di database, Per le date Per le date, Come aggregazione
Come confronto
Vedi anche |
| Sintassi | (MID(string, start, [length]) |
| Output | Stringa |
| Definizione | Restituisce una stringa a partire dalla posizione Se viene aggiunto l’argomento numerico facoltativo |
| Esempio | MID("Calculation", 2) = "alculation"MID("Calculation", 2, 5) ="alcul" |
| Note | Vedi anche le espressioni RegEx supportate nella documentazione sulle funzioni aggiuntive. |
| Sintassi | MIN(expression) oppure MIN(expr1, expr2) |
| Output | Stesso tipo di dati dell’argomento o NULL se qualsiasi parte dell’argomento è NULL. |
| Definizione | Restituisce il minimo dei due argomenti, che devono essere dello stesso tipo di dati.
|
| Esempio | MIN(4,7) = 4 |
| Note | Per le stringhe
Per le origini dati di database, Per le date Per le date, Come aggregazione
Come confronto
Vedi anche |
| Sintassi | PROPER(string) |
| Output | Stringa |
| Definizione | Restituisce la stringa |
| Esempio | PROPER("PRODUCT name") = "Product Name"PROPER("darcy-mae") = "Darcy-Mae" |
| Note | Anche gli spazi e i caratteri non alfanumerici, come la punteggiatura, sono trattati come separatori. |
| Limitazioni del database | PROPER è disponibile solo per alcuni file flat e nelle estrazioni. Se devi utilizzare PROPER in un’origine dati che altrimenti non lo supporta, valuta la possibilità di utilizzare un’estrazione. |
| Sintassi | REPLACE(string, substring, replacement |
| Output | Stringa |
| Definizione | Cerca in <string> provare <substring> e la sostituisce con <replacement>. Se <substring> non viene trovata, la stringa rimane inalterata. |
| Esempio | REPLACE("Version 3.8", "3.8", "4x") = "Version 4x" |
| Note | Vedi anche REGEXP_REPLACE nella documentazione sulle funzioni aggiuntive. |
| Sintassi | RIGHT(string, number) |
| Output | Stringa |
| Definizione | Restituisce il numero <number> di caratteri più a destra della stringa. |
| Esempio | RIGHT("Calculation", 4) = "tion" |
| Note | Vedi anche LEFT e MID. |
| Sintassi | RTRIM(string) |
| Output | Stringa |
| Definizione | Restituisce la stringa <string> con gli eventuali spazi finali rimossi. |
| Esempio | RTRIM(" Calculation ") = " Calculation" |
| Note | Vedi anche LTRIM e TRIM. |
| Sintassi | SPACE(number) |
| Output | Stringa (nello specifico, solo spazi) |
| Definizione | Restituisce una stringa composta dal numero specificato di spazi ripetuti. |
| Esempio | SPACE(2) = " " |
| Sintassi | SPLIT(string, delimiter, token number) |
| Output | Stringa |
| Definizione | Restituisce una sottostringa da una stringa, usando un carattere delimitatore per dividere la stringa in una sequenza di token. |
| Esempio | SPLIT ("a-b-c-d", "-", 2) = "b"SPLIT ("a|b|c|d", "|", -2) = "c" |
| Note | La stringa è interpretata come una sequenza alternata di delimitatori e token. Quindi per la stringa
Vedi anche le espressioni REGEX supportate nella documentazione sulle funzioni aggiuntive. |
| Limitazioni del database | I comandi di divisione e di divisione personalizzata sono disponibili per i tipi di origini dati seguenti: estrazioni dati Tableau, Microsoft Excel, file di testo, file PDF, Salesforce, OData, Microsoft Azure Market Place, Google Analytics, Vertica, Oracle, MySQL, PostgreSQL, Teradata, Amazon Redshift, Aster Data, Google Big Query, Cloudera Hadoop Hive, Hortonworks Hive e Microsoft SQL Server. Alcune origini dati impongono limiti per la divisione delle stringhe. Consulta le limitazioni della funzione SPLIT più avanti in questo argomento. |
| Sintassi | STARTSWITH(string, substring) |
| Output | Booleano |
| Definizione | Restituisce true se string inizia con substring. Gli spazi vuoti iniziali vengono ignorati. |
| Esempio | STARTSWITH("Matador, "Ma") = TRUE |
| Note | Vedi anche CONTAINS, oltre alle espressioni REGEX supportate nella documentazione sulle funzioni aggiuntive. |
| Sintassi | TRIM(string) |
| Output | Stringa |
| Definizione | Restituisce la stringa <string> specificata con gli spazi iniziali e finali rimossi. |
| Esempio | TRIM(" Calculation ") = "Calculation" |
| Note | Vedi anche LTRIM e RTRIM. |
| Sintassi | UPPER(string) |
| Output | Stringa |
| Definizione | Restituisce la stringa <string> in caratteri maiuscoli. |
| Esempio | UPPER("Calculation") = "CALCULATION" |
| Note | Vedi anche PROPER e LOWER. |
| Origine dati | Vincoli a sinistra/destra | Numero massimo di divisioni | Limiti di versione |
| Estrazione dati Tableau | Entrambi | Infinito | |
| Microsoft Excel | Entrambi | Infinito | |
| File di testo | Entrambi | Infinito | |
| Salesforce | Entrambi | Infinito | |
| OData | Entrambi | Infinito | |
| Google Analytics | Entrambi | Infinito | |
| Tableau Data Server | Entrambi | Infinito | Supportata nella versione 9.0. |
| Vertica | Solo a sinistra | 10 | |
| Oracle | Solo a sinistra | 10 | |
| MySQL | Entrambi | 10 | |
| PostgreSQL | A sinistra solo prima della versione 9.0; entrambi per la versione 9.0 e superiori. | 10 | |
| Teradata | Solo a sinistra | 10 | Versione 14 e successive |
| Amazon Redshift | Solo a sinistra | 10 | |
| Aster Database | Solo a sinistra | 10 | |
| Google BigQuery | Solo a sinistra | 10 | |
| Hortonworks Hadoop Hive | Solo a sinistra | 10 | |
| Cloudera Hadoop | Solo a sinistra | 10 | Impala supportato a partire dalla versione 2.3.0. |
| Microsoft SQL Server | Entrambi | 10 | 2008 e successive |
| Sintassi | FULLNAME( ) |
| Output | Stringa |
| Definizione | Restituisce il nome completo dell’utente corrente. |
| Esempio | FULLNAME( ) Restituisce il nome completo dell’utente che ha effettuato l’accesso, ad esempio “Hamlin Myrer”. [Manager] = FULLNAME( ) Se il responsabile “Hamlin Myrer” ha effettuato l’accesso, in questo esempio viene restituito TRUE solo se nel campo Responsabile nella vista è specificato “Hamlin Myrer”. |
| Note | Questa funzione controlla:
Filtri utente Se utilizzato come filtro, un campo calcolato come |
| Sintassi | ISFULLNAME("User Full Name") |
| Output | Booleano |
| Definizione | Restituisce |
| Esempio | ISFULLNAME("Hamlin Myrer") |
| Note | L’argomento Questa funzione controlla:
|
| Sintassi | ISMEMBEROF("Group Name") |
| Output | Booleano o Null |
| Definizione | Restituisce |
| Esempio | ISMEMBEROF('Superstars')ISMEMBEROF('domain.lan\Sales') |
| Note | L’argomento Se l’utente ha effettuato l’accesso a Tableau Cloud o Tableau Server, l’appartenenza al gruppo è determinata dai gruppi Tableau. La funzione restituirà TRUE se la stringa data è “Tutti gli utenti” La funzione Se viene apportata una modifica all’appartenenza al gruppo di un utente, la modifica nei dati basati sull’appartenenza al gruppo si riflette in una cartella di lavoro o in una vista con una nuova sessione. La sessione esistente rifletterà i dati non aggiornati. |
| Sintassi | ISUSERNAME("username") |
| Output | Booleano |
| Definizione | Restituisce TRUE se il nome dell’utente corrente corrisponde al nome utente specificato o FALSE se non corrisponde. |
| Esempio | ISUSERNAME("hmyrer") |
| Note | L’argomento Questa funzione controlla:
|
| Sintassi | USERDOMAIN( ) |
| Output | Stringa |
| Definizione | Restituisce il dominio dell’utente corrente. |
| Note | Questa funzione controlla:
|
| Sintassi | USERNAME( ) |
| Output | Stringa |
| Definizione | Restituisce il nome utente dell’utente corrente. |
| Esempio | USERNAME( ) Restituisce il nome dell’utente che ha effettuato l’accesso, ad esempio “hmyrer”. [Manager] = USERNAME( ) Se il responsabile “hmyrer” ha effettuato l’accesso, in questo esempio viene restituito TRUE solo se nel campo Responsabile nella vista è specificato “hmyrer”. |
| Note | Questa funzione controlla:
Filtri utente Se utilizzato come filtro, un campo calcolato come |
| Sintassi | USERATTRIBUTE('attribute_name') |
| Output | Stringa o Null |
| Definizione | Se Restituisce NULL se |
| Esempio | Supponiamo che “Region” sia l’attributo utente incluso nella risposta JWT o SAML e passato a Tableau. In qualità di autore della cartella di lavoro, puoi configurare la tua visualizzazione per filtrare i dati in base a una regione specifica. In tale filtro, puoi fare riferimento al seguente calcolo. [Region] = USERATTRIBUTE("Region")Quando User2 della regione occidentale visualizza la visualizzazione incorporata, Tableau mostra i dati appropriati solo per la regione occidentale. |
| Note | Puoi usare la funzione USERATTRIBUTEINCLUDES se prevedi che <'attribute_name'> restituisca più valori. |
| Sintassi | USERATTRIBUTEINCLUDES('attribute_name', 'expected_value') |
| Output | Booleano |
| Definizione | Restituisce
In caso contrario, restituisce |
| Esempio | Supponiamo che “Region” sia l’attributo utente incluso nella risposta JWT o SAML e passato a Tableau. In qualità di autore della cartella di lavoro, puoi configurare la tua visualizzazione per filtrare i dati in base a una regione specifica. In tale filtro, puoi fare riferimento al seguente calcolo. USERATTRIBUTEINCLUDES('Region', [Region])Se User2 della regione occidentale accede alla visualizzazione incorporata, Tableau controlla se l’attributo utente Region corrisponde a uno dei valori del campo [Region]. Se è true, la visualizzazione mostra i dati appropriati. Quando User3 della regione settentrionale accede alla stessa visualizzazione, non potrà visualizzare alcun dato perché non c’è corrispondenza con i valori del campo [Region]. |
| Tipo di contenuto | Conseguenza |
|---|---|
| Cartelle di lavoro, metriche, flussi e ruoli dati | Il contenuto viene eliminato definitivamente. Non è possibile annullare questa operazione. |
| Viste | La vista viene rimossa dal sito, tuttavia è ancora accessibile se si modifica o si scarica la cartella di lavoro. L’effetto è lo stesso che si avrebbe nascondendo la vista al momento della pubblicazione. Per maggiori informazioni, consulta Mostrare o nascondere fogli. |
| Progetti | Il progetto e qualsiasi contenuto di Tableau all’interno del progetto, viene eliminato in modo definitivo. Le risorse esterne vengono spostate nel Progetto predefinito per risorse esterne. In Tableau Server 2022.3 e versioni precedenti le risorse esterne sono irrilevanti perché non possono trovarsi in una cartella fin dall’inizio. |
| Raccolte | La raccolta viene eliminata in modo definitivo, ma gli elementi aggiunti alla raccolta non vengono eliminati. |
| bq-fetch-tasks | Numero di attività in background parallele da utilizzare durante il recupero dei dati tramite HTTP. Il valore predefinito è 10. |
| bq-large-fetch-rows | Numero di righe da recuperare in ogni batch per le query di spool. Il valore predefinito è 50000. |
| bq-fetch-rows | Numero di righe da recuperare in ogni batch per le query non di spool. Il valore predefinito è 10000. |
| bq-response-rows | Numero di righe restituite nelle query non di batch non di spool. Il valore predefinito è 10000. |
| CAP_BIGQUERY_FORCE_SPOOL_JOB | Forza tutte le query per utilizzare l’approccio tabella temp. Il valore predefinito è "No". Imposta il valore su "Sì" per attivare l’attributo. |
| Se la dimensione minima iframe è... | Verrà visualizzato il layout dispositivo... |
|---|---|
| 500 pixel o meno | Telefono |
| Tra 501 e 800 pixel | Tablet |
| Più di 800 pixel | Desktop |
| Parametro | Valori | Descrizione | Esempio |
|---|---|---|---|
| src (obbligatorio) | stringa | URL della metrica in Tableau Server o Tableau Cloud. | https://mycompany/#/metrics/1 |
link-target (HTML) linkTarget (JavaScript) (facoltativo) | stringa | URL a cui verranno indirizzati gli utenti se fanno clic sulla metrica. Se non viene specificata alcuna destinazione, la metrica incorporata si collegherà all’URL di origine. | http://example.com |
La tabella A e la tabella X non sono correlate | La tabella B e la tabella X non sono correlate |
 |  |
La tabella A e la tabella S sono correlate | La tabella B e la tabella S sono correlate (tramite la tabella A) |
 |  |
| Non ancora correlati | Correlati in modo ambiguo | Correlazione risolta in un unico albero | |
| Correlati tramite la tabella di base A | Correlati tramite la tabella di base X | ||
 |  |  |  |
Congiunzione | Risolvere l'incertezza |
 CampoA e CampoX non correlati congiunti da DimensioneS | CampoS e CampoT valutati attraverso l’albero definito dalla tabella di base A |
| Associa campi non correlati in base ad attributi condivisi | Restringe il percorso di relazione da utilizzare quando sono presenti più opzioni (ambiguità o misura condivisa) oppure stabilisce un percorso di relazione quando non ce n'era uno (non ancora correlato). |
Utilizza la logica con più tabelle di base per calcolare i risultati | Utilizza la logica con singole tabelle di base per calcolare i risultati |
| L’analisi coinvolge le tabelle non correlate | L’analisi coinvolge le tabelle condivise |
Classes | Clubs | Students |
 |  |  |
Campi:
| Campi:
| Campi:
|
| Problema risolto | Risolto a partire da |
Estrazioni Origine dati locale (in una cartella di lavoro): il tentativo di estrarre un’origine dati con relazioni multi-fatti genererà l’errore “Nessuna tabella di questo tipo”. Origine dati pubblicata: l’estrazione di un’origine dati con relazioni multi-fatti pubblicata sembra avere esito positivo, ma i valori dei campi possono essere scambiati. |
Se riscontri ancora questi problemi in Tableau Desktop o Tableau Server, esegui l'aggiornamento a una versione del 24 luglio 2024 o successiva. |
Espressioni Level of Detail EXCLUDE Solo le espressioni LOD INCLUDE dovrebbero essere convalidate in presenza di campi non correlati. Tuttavia, anche le espressioni LOD EXCLUDE potrebbero essere erroneamente contrassegnate come non valide nelle stesse condizioni. | |
Calcoli utente nidificati I calcoli utente nidificati non sono disponibili nelle origini dati pubblicate con un modello di dati con relazioni multi-fatti. |
| Library (Biblioteca) | LibraryID (ID biblioteca) | Consortium Member (Membro consorzio) | Private (Privata) | Librarians (Bibliotecari) | Library Technicians (Tecnici biblioteca) | Library Assistants (Assistenti biblioteca) |
Idle Hour Library | L-IHL | Sì | No | 53 | 61 | 16 |
The Bibliophile’s Shelves | L-BS | Sì | Sì | 4 | 3 | 0 |
Armchair Athanaeum | L-AA | No | Sì | 6 | 0 | 0 |
| Old Friend Library | L-OFL | Sì | No | 3 | 5 | 17 |
| Bide Awhile | L-BA | Sì | No | 9 | 20 | 6 |
| IndieUnBound | L-IUB | Sì | No | 7 | 2 | 47 |
Page Station Book Exchange | L-PS | No | Sì | 3 | 1 | 4 |
| requisito | description |
|---|---|
Licenza Salesforce | Una delle licenze seguenti:
Queste licenze sono disponibili a un costo aggiuntivo. |
Account utente di Salesforce | Account configurato per l’accesso a Einstein Discovery. Se utilizzi la licenza per Einstein Discovery in Tableau, all’account utente deve essere assegnata l’autorizzazione di sistema View Einstein Discovery Recommendations Via Connect API. Se utilizzi la licenza per Tableau CRM Plus o per Einstein Predictions:
Per configurare gli account utente, consulta Set Up Einstein Discovery nella Guida di Salesforce. |
Impostazioni dell’amministratore | Gli amministratori di Salesforce dovranno:
|
| requisito | description |
|---|---|
Licenza e autorizzazioni di Tableau | Gli autori che devono configurare l’estensione di dashboard Einstein Discovery avranno bisogno di una licenza Creator o Explorer e di autorizzazioni che consentano loro di modificare e salvare le cartelle di lavoro. Gli utenti Creator, Explorer e Viewer dovranno eseguire l’accesso all’account dell’organizzazione Salesforce per accedere alle previsioni nell’estensione di dashboard Einstein Discovery in Tableau. |
Account utente di Tableau | In Tableau Cloud e Tableau Server, gli utenti possono salvare le credenziali dell’account utente Salesforce insieme al proprio account utente Tableau. |
Impostazioni dell’amministratore | Gli amministratori di Tableau Server dovranno configurare Tableau Server per OAuth (consente l’accesso alle previsioni da Tableau). Per maggiori informazioni, consulta Configurare l’integrazione Einstein Discovery nella Guida di Tableau Server. Per consentire agli utenti di visualizzare le previsioni nei calcoli tabella pubblicati, gli amministratori di Tableau Server devono abilitare le estensioni di analisi per il sito. Per maggiori informazioni, consulta Configurare la connessione con le estensioni di analisi nella Guida di Tableau Server. Per maggiori informazioni sulla configurazione di Tableau Server, consulta Configurare l’integrazione di Einstein Discovery (Tableau Server). Per maggiori informazioni sulla configurazione di Tableau Cloud, consulta Configurare l’integrazione di Einstein Discovery (Tableau Cloud). |
Utilizzare Interpreta i dati | Creare cartelle di lavoro e controllare l’accesso |
| Categoria | Nome del prodotto | Vendite |
| Mobili | Lampada da terra | 96,00 $ |
Fattura Pagamento fattura Nota di credito Deposito | Stima Fattura Registrazione a giornale Pagamento Acquisto | Ordine di acquisto Ricevuta di rimborso Ricevuta di vendita Credito fornitore |
| Pulsante della barra degli strumenti | Descrizione |
|---|---|
 | Icona Tableau: passa alla pagina iniziale. Per maggiori informazioni, consulta Pagina iniziale. Nota: solo Tableau Desktop. |
 | Annulla: annulla l’operazione più recente nella cartella di lavoro. È possibile annullare un numero illimitato di volte, fino all’ultima volta in cui hai aperto la cartella di lavoro, persino dopo aver salvato. Per maggiori informazioni, consulta Annullare e ripetere. |
 | Ripeti: ripete l’ultima azione annullata con il pulsante Annulla. Puoi ripetere un numero illimitato di volte. |
 | Salva: in Tableau Desktop, salva le modifiche apportate alla cartella di lavoro. Per maggiori informazioni, consulta Salvare il lavoro. In Tableau Server o Tableau Cloud, fai clic su File > Salva o File > Salva con nome per salvare le modifiche. |
 | Nuova origine dati: in Tableau Desktop, apre il riquadro Connetti in cui è possibile creare una nuova connessione o aprirne una salvata. Per maggiori informazioni, consulta Connettersi ai dati. In Tableau Server o Tableau Cloud, apre la pagina Connetti a un’origine dati in cui puoi connetterti a un’origine dati pubblicata. Per maggiori informazioni, consulta Connessione alle origini dati pubblicate durante la progettazione Web. |
| Pausa aggiornamenti automatici: controlla se Tableau aggiorna la vista quando vengono apportate modifiche. Utilizza il menu a discesa per aggiornare automaticamente l’intero foglio oppure solo i filtri. Per maggiori informazioni, consulta Aggiornare i dati o sospendere gli aggiornamenti automatici. |
| Esegui aggiornamento: esegue una query manuale dei dati per aggiornare la vista con le modifiche quando vengono disattivati gli aggiornamenti automatici. Utilizza il menu a discesa per aggiornare l’intero foglio di lavoro oppure usa solo i filtri. Nota: solo Tableau Desktop. |
| Nuovo foglio di lavoro: crea un nuovo foglio di lavoro vuoto, usa il menu a discesa per creare un nuovo foglio di lavoro, una dashboard o una storia. Per maggiori informazioni, consulta Creare nuovi fogli di lavoro, dashboard o storie. |
| Duplica: crea un nuovo foglio di lavoro contenente la stessa vista del foglio corrente. Per maggiori informazioni, consulta Duplicare un foglio. |
| Cancella: cancella il foglio di lavoro corrente. Utilizza il menu a discesa per cancellare parti specifiche della vista, ad esempio filtri, formattazione, ridimensionamento e intervalli degli assi. |
 | Scambia: sposta i campi dallo spazio Righe allo spazio Colonne e viceversa. Questo pulsante esegue sempre lo scambio delle impostazioni Nascondi righe vuote e Nascondi colonne vuote. |
 | Ordinamento crescente: applica un ordinamento crescente del campo selezionato in base alle misure della vista. Per maggiori informazioni, consulta Ordinare i dati in una visualizzazione. |
 | Ordinamento decrescente: applica un ordinamento decrescente in base alle misure della vista. Per maggiori informazioni, consulta Ordinare i dati in una visualizzazione. |
 | Totali: è possibile calcolare totali complessivi e subtotali per i dati in una vista. Seleziona una delle seguenti opzioni:
Nota: solo su Tableau Server e Tableau Cloud. In Tableau Desktop, fai clic su Analisi > Totali. Per maggiori informazioni, consulta Mostra totali in una visualizzazione. |
| Evidenzia: attiva l’evidenziazione per il foglio selezionato. Utilizza le opzioni del menu a discesa per definire la modalità di evidenziazione dei valori. Per maggiori informazioni, consulta Pulsante Evidenzia della barra degli strumenti. |
 | Membri del gruppo: crea un gruppo unendo i valori selezionati. Quando sono selezionate più dimensioni, utilizza il menu a discesa per specificare se raggruppare su una dimensione specifica o su tutte. Per maggiori informazioni, consulta Correggere gli errori dei dati o combinare i membri della dimensione raggruppando i dati. Nota: solo Tableau Desktop. In Tableau Server e Tableau Cloud, crea i gruppi utilizzando il pulsante Membri del gruppo nelle informazioni. |
| Mostra etichette indicatore: passa dal mostrare al nascondere le etichette degli indicatori per il foglio corrente. Per maggiori informazioni, consulta Mostrare, nascondere e formattare le etichette degli indicatori. |
 | Correggi asse: passa da un asse bloccato che mostra solo un intervallo specifico a un asse dinamico che regola l’intervallo in base ai valori minimi e massimi nella vista. Per maggiori informazioni, consulta Modificare gli assi. Nota: solo Tableau Desktop. |
 | Formato della cartella di lavoro: apri Formato della cartella di lavoro per modificare l’aspetto dei tipi di carattere e dei titoli in ogni vista di una cartella di lavoro, specificando le impostazioni del formato a livello di cartella di lavoro, anziché a livello di foglio di lavoro. Nota: solo su Tableau Server e Tableau Cloud. In Tableau Desktop, fai clic su Formato > Cartella di lavoro. Per maggiori informazioni, consulta Formattare a livello di cartella di lavoro. |

| Adatta: specifica la modalità di ridimensionamento della vista nella finestra. Seleziona Standard, Adatta larghezza, Adatta altezza o Vista completa. Nota: questo menu non è disponibile nelle viste delle mappe geografiche. I comandi Dimensioni cella esercitano effetti diversi in base al tipo di vista. Per accedere al menu Dimensioni cella in Tableau Desktop, fai clic su Formato > Dimensioni cella. |
 | Mostra/Nascondi schede: mostra e nasconde schede specifiche in un foglio di lavoro. Dal menu a discesa puoi selezionare ogni scheda che vuoi nascondere o visualizzare. In Tableau Server e Tableau Cloud è possibile visualizzare e nascondere le schede solo in base a Titolo, Didascalia, Filtro ed Evidenziatore. |
 | Modalità presentazione: consente di passare da visualizzare tutto a nascondere tutto, ad eccezione della vista (ad esempio, spazi, barra degli strumenti, riquadro Dati ). Per maggiori informazioni, consulta Riorganizzare l’area di lavoro. Nota: solo Tableau Desktop. |
 | Scarica: usa le opzioni sotto Scarica per acquisire parti della tua vista da usare in altre applicazioni.
Nota: solo su Tableau Server e Tableau Cloud. |
 | Condividi la cartella di lavoro con altri utenti: pubblica la cartella di lavoro su Tableau Server o Tableau Cloud. Per maggiori informazioni, consulta Semplici passaggi per pubblicare una cartella di lavoro. Nota: solo Tableau Desktop. |
 | Mostra: ti consente di scegliere un tipo di vista evidenziando le tipologie che funzionano meglio con i tipi di campo dei tuoi dati. Una linea di contorno arancione mostra il tipo di grafico consigliato che corrisponde alla corrispondenza migliore per i tuoi dati. Per maggiori informazioni, consulta Utilizzare Mostra per avviare una vista. |


| Icona di avviso | Descrizione |
|---|---|
 | Indicatore annullamento query: quando annulli più query, viene visualizzato un indicatore per mostrare quante query sono ancora in esecuzione nel database, dunque stanno utilizzando le risorse. Quando annulli una query in Tableau, al database viene comunicato di interrompere l’elaborazione della query. Tuttavia, alcuni database non supportano l’annullamento (MS Excel, MS Access, Essbase, Microsoft Analysis Services 2000). Se annulli una query utilizzando uno di questi tipi di origini dati, la query viene abbandonata da Tableau, ma continua a utilizzare le risorse e rimane in esecuzione in background. Quando hai abbandonato alcune query, viene visualizzato un indicatore nell’angolo in basso a destra della cartella di lavoro, che riporta il numero di query ancora in esecuzione Nota: le origini dati di testo, di Microsoft Excel e di Microsoft Access potrebbero essere temporaneamente non disponibili dopo l’annullamento di una query, a causa di un blocco effettuato internamente. Potrebbe essere necessario attendere che la query abbandonata sia stata completata, prima di poter effettuare una nuova connessione. |
 | Avviso di precisione: alcuni campi sono più precisi nel database rispetto a quelli che può modellare Tableau. Quando aggiungi un campo a una vista contenente valori che presentano una maggiore precisione rispetto a ciò che Tableau può modellare, nell’angolo in basso a destra della barra di stato viene visualizzata un’icona Ad esempio, un valore nel database può avere 22 posizioni decimali, ma Tableau ne supporta solo fino a 15. Quando aggiungi questo campo alla vista, viene visualizzato un avviso di precisione. Se fai clic sull’avviso, è possibile leggere ulteriori dettagli, inclusi il numero di posizioni decimali che sono state troncate nella vista. Ricorda che la precisione dei dati visualizzati in Tableau sarà sempre dipendente dai dati del database. Se i valori del database eccedono le 15 posizioni decimali, quando li aggiungi alla vista, il valore viene troncato e viene visualizzato un avviso di precisione. Nota: le estrazioni di database relazionali utilizzano sempre il tipo Hyper a precisione doppia e non utilizzano mai il tipo Hyper numerico. Quindi, se crei un’estrazione di un database relazionale, ottieni solo 15 cifre di precisione. Puoi eseguire la scrittura sull’API Hyper e utilizzare il tipo numerico per ottenere fino a 18 cifre. Per informazioni correlate, consulta Tipi numerici nella documentazione dell’API Hyper. |
 | Indicatore di valori speciali: se i dati contengono valori Null, posizioni geografiche sconosciute, valori negativi o valori zero in un asse curvo, tali valori vengono mostrati con un indicatore nell’angolo inferiore destro della vista. Fai clic sull’indicatore per visualizzare le opzioni disponibili per la gestione di questi valori. Per maggiori informazioni su questo indicatore e su come gestire questi valori, consulta Gestione dei valori NULL e di altri valori speciali . |
| Versione Tableau Desktop | Versione Web |
|
|


| Versione Tableau Desktop | Versione Web |
|
|


| Spazio Colonne: | Longitudine (dimensione continua, ruolo geografico di longitudine assegnato) |
| Spazio Righe: | Latitudine (dimensione continua, ruolo geografico di latitudine assegnato) |
| Dettaglio: | Uno o più campi con molti punti dati sottostanti |
| Tipo di indicatore: | Densità |
| Numero di record | Tempo di recupero |
|---|---|
1.000 | 4,5 secondi |
10.000 | 45 secondi |
100.000 | 8 minuti |
1.000.000 | 75 minuti |
Tabella SQL Server
| Tabella Excel  |

| Livello logico | Livello fisico | |
|---|---|---|
| Noodle = Relazioni | Diagramma di Venn = Join | |
 |  | |
| Vista di primo livello di un’origine dati con più tabelle correlate. Questo è il livello logico. Le tabelle logiche possono essere combinate utilizzando le relazioni (noodle). Non usano i tipi di join. Si comportano come contenitori per le tabelle fisiche. | Fai doppio clic su una tabella logica per aprirla e visualizzare le relative tabelle fisiche. Le tabelle fisiche possono essere combinate utilizzando i join o le unioni. In questo esempio, la tabella logica Libro è composta da tre tabelle fisiche unite (Libro, Premio, Informazioni). |
| Origine dati del livello fisico | Origine dati del livello logico | |
|---|---|---|
| |
Origine dati primaria
| Origine dati secondaria
|
| Bassa intensità (50%) | Alta intensità (80%) |
 |  |
Righe vuote nascoste (impostazione predefinita) Jay non fa parte di nessun club, quindi non ci sono righe per lo studente Jay. Ogni riga ha un indicatore segnaposto (Abc). | Righe vuote visualizzate Jay non fa parte di nessun club, ma vengono visualizzate delle righe vuote, quindi c'è una riga per Jay senza alcun indicatore segnaposto (Abc). |
 |  |
| Opzioni etichetta in Tableau Desktop: Tutti | Opzione etichetta in Modifica Web: Min/Max |
 |  |
| Relazione | Join |
Utilizzando l’origine dati correlata:
| Utilizzando l’origine dati unita tramite join:
In questo caso, sembra che ci sia qualche problema con i numeri. |
| Numero di record | Tempo di recupero |
|---|---|
50,662 record | 3 minuti e 17 secondi |
95.214 righe | 6 minuti e 14 secondi |
194.679 righe | 12 minuti e 55 secondi |
Include membri condivisi Le bevande dietetiche sono elencate sia nella gerarchia Bevande dietetiche che nelle rispettive gerarchie delle bevande. | Non include membri condivisi Le bevande dietetiche sono elencate solo una volta nelle rispettive gerarchie delle bevande. |
 | |
| Nidificato | Non nidificato |
 |  |
Un ordinamento nidificato considera ogni riquadro in modo indipendente e ordina le righe per riquadro. Il colore viola viene posizionato sopra al verde per Tessuto e Carta, ma sotto al verde per Vernice. | Un ordinamento non nidificato considera il valore nei vari riquadri e presenta lo stesso ordine di valori per riquadro. Il colore viola viene posizionato sopra al verde per tutti i materiali in quanto, nella forma aggregata, il viola è superiore al verde. |
| Gli ordinamenti nidificati sono corretti nel contesto del riquadro, ma non forniscono informazioni aggregate sul confronto complessivo dei valori. | Gli ordinamenti non nidificati possono non essere corretti nel contesto di un singolo riquadro, ma indicano in modo coerente il modo in cui i valori aggregati modo coerente il modo in cui i valori aggregati si confrontano a livello complessivo. |
| L’ordinamento da un asse produce come risultato un ordinamento nidificato per impostazione predefinita. | L’ordinamento da un’etichetta di campo produce come risultato un ordinamento non nidificato per impostazione predefinita. |
| Limite | Valore predefinito | Messaggio di errore | Verificato quando |
| Origini dati per origine dati composta | 500 | Troppe origini dati in questa origine dati composta. | Apri o utilizzi un’origine dati composta, incluso il caricamento di una cartella di lavoro tramite l’origine dati. |
| Dipendenze totali | 100 | La pubblicazione di un’origine dati con più di 100 dipendenze di PDS non è supportata. | Pubblichi un’origine dati composta. |
| Profondità di nidificazione | 20 | La pubblicazione di un’origine dati con più di 20 livelli nidificati non è supportata. | Pubblichi un’origine dati composta. |
| Funzionalità | Stato per origini dati cubo |
| Azioni | Con le connessioni di Microsoft Analysis Services, le azioni di drill down definite nel cubo non sono disponibili in Tableau. Le origini dati dei cubi non accettano azioni da origini dati relazionali o da altre origini dati dei cubi. Ad esempio, supponiamo di disporre di una cartella di lavoro con una vista che utilizza un’origine dati MySQL, una seconda vista che utilizza un’origine dati cubo A, e una terza vista che utilizza un’origine dati cubo B. Le azioni nella vista che utilizza l’origine dati MySQL non influenzeranno le viste che utilizzano le origini dati cubo, mentre le azioni nella vista per un’origine dati cubo non influenzeranno l’altra. Tuttavia, le azioni nella vista che utilizzano le origini dati cubo A possono incidere sulla vista che utilizza l’origine dati MySQL. |
| Funzionalità avanzate di analisi | Il livello di dettaglio di espressioni, linee di tendenza, previsioni e clustering non sono supportati per le origini dati cubo. |
| Funzioni di calcolo aggregate | Le origini dati cubo sono preaggregate e quindi non supportano le funzioni di aggregazione, come SUM(), AVG(), e CNT().Puoi utilizzare i Calcoli tabella per eseguire operazioni di aggregazione sui risultati a livello di cella dal cubo in Tableau. |
| Alias | Gli alias per i database cubo vengono creati dal progettista del cubo e possono essere attivati in Tableau selezionando l’origine dati dal menu Dati e scegliendo il File Alias. Contatta l’amministratore del database per sapere se il database contiene degli alias. Gli alias non sono supportati dai database di Microsoft Analysis Services. Per impostazione predefinita, l’alias per ogni membro di ogni dimensione è inizialmente definito come il nome del membro originale. |
| Contenitori | Per le origini dati cubo, il comando Crea contenitore non è disponibile per le misure. Tuttavia, puoi scrivere un calcolo che prende i risultati della cella cubica e li sposta nel contenitore. Ad esempio:
|
| Tipo di dati KPI del cubo | Quando sei connesso a Microsoft Analysis Services, i calcoli KPI definiti nel cubo non sono disponibili. Tuttavia, puoi scrivere calcoli KPI personalizzati in Tableau. Puoi inoltre utilizzare i parametri Tableau per creare analisi di indicatori KPI di simulazione estremamente flessibili. Per maggiori informazioni, consulta Visualizzare gli indicatori chiave di prestazione. |
| Funzioni di ritardo del cubo | Per le origini dati cubo non puoi utilizzare funzioni di ritardo del cubo nell’editor di calcolo Tableau. Puoi invece utilizzare i calcoli della tabella di Tableau per calcolare determinate percentuali e totali. Per maggiori informazioni, consulta Trasformare i valori con i calcoli tabella. In alternativa, puoi utilizzare una funzione di ritardo MDX direttamente in Tableau utilizzando un membro calcolato. Ad esempio:
|
| Dichiarazioni su espressioni multidimensionali personalizzate (MDX) | Quando sei connesso a un cubo, non puoi stabilire una connessione a un’istruzione MDX personalizzata. Devi creare tutte le definizioni di sub-cubo sul server implementando le prospettive, le partizioni, le dimensioni o la sicurezza delle celle necessarie. |
| Combinazione di dati | Le origini dati cubo possono essere utilizzate solo come origini dati primarie per la combinazione dei dati in Tableau. Non puoi usarle come origini dati secondarie. Per maggiori informazioni, consulta Risoluzione dei problemi della combinazione dei dati. |
| Dimensioni della data | Per le origini dati cubo, le dimensioni della data sono generalmente organizzate in gerarchie contenenti livelli come ad esempio anno, trimestre e mese. Per alcune origini dati multidimensionali è inoltre abilitata la funzionalità di Business Intelligence per le gerarchie temporali, che rende possibile esplorare i livelli di dati in diversi modi ad esempio Mese per anno, Mese per trimestre, Fine settimana e così via. Questi livelli sono rappresentati come attributi della gerarchia. Per informazioni dettagliate, consulta Date e orari. |
| Filtri dell’origine dati | I filtri dell’origine dati non sono disponibili per le origini dati cubo. Devi definire tutti i valori dei campi nel cubo prima dell’analisi in Tableau. |
| Estrazioni | Non puoi creare estrazioni dalla maggior parte delle origini dati cubo. Le origini dati cubo e relazionali hanno strutture dati incompatibili, rendendo nella maggior parte dei casi impossibile estrarre i dati da un cubo e archiviarli in un’origine dati relazionale, ad esempio il motore di dati. A partire dal 10.4, puoi creare estrazioni SAP BW senza la necessità di uno speciale codice prodotto da Tableau. Per informazioni sul supporto e sui limiti delle estrazioni di SAP BW, consulta SAP NetWeaver Business Warehouse. |
| Filtri | Quando visualizzi un filtro per una dimensione del cubo, nel filtro vengono inclusi tutti i livelli della gerarchia. Ad esempio:
Puoi utilizzare gli attributi del cubo come filtri per visualizzare solo un singolo livello anziché una gerarchia. Nel riquadro Dati, gli attributi vengono visualizzati nella sezione Dimensioni e sono indicati da questa icona: I filtri di sezionamento si comportano in modo diverso con un’origine dati cubo rispetto a un’origine dati relazionale. Per maggiori informazioni, consulta Creare filtri di affettatura. Alcune opzioni della scheda di filtro dimensioni non sono disponibili. Ad esempio, valore singolo (menu a discesa), valori multipli (elenco personalizzato), ecc. Invece, i filtri dimensionali mostrati nella vista mantengono il loro aspetto gerarchico e non puoi modificarli in tipi di elenchi specifici. Puoi creare un gruppo Tableau contenente determinati valori dalla gerarchia e quindi utilizzarlo come filtro nella vista con le opzioni di filtro previste (fai clic con il pulsante destro del mouse sul set nel riquadro Dati, quindi fai clic su Mostra filtro. |
| Gruppi | Quando lavori con un’origine dati cubo non puoi creare gruppi. Qualsiasi concetto di raggruppamento deve essere predefinito nel cubo come attributi dimensionali o gruppi di cubi. Puoi tuttavia scrivere espressioni MDX (MDX) direttamente in Tableau utilizzando un membro calcolato per creare un gruppo. Ad esempio:
|
| Gerarchie | Per le origini dati cubo, le gerarchie devono essere definite nel cubo prima dell’analisi. |
| Parametri | Per le origini dati cubo, non puoi utilizzare valori di parametro per filtrare le dimensioni in un calcolo MDX. |
| Pubblicazione | Puoi pubblicare cartelle di lavoro che utilizzano l’origine dati cubo su Tableau Server, ma queste non supportano connessioni pass-through. Ciò significa che non puoi stabilire una connessione da Tableau Server utilizzando tale origine dati. Significa anche che non è possibile creare una cartella di lavoro utilizzando l’origine dati in Tableau Server. Per maggiori dettagli, consulta Origini dati cubo nella Guida di Tableau Server. La pubblicazione di un’origine dati cubo su Tableau Server offre la possibilità di archiviare l’origine dati sul server. Per utilizzare l’origine dati devi scaricarla su Tableau Desktop e utilizzarla localmente. Non puoi pubblicare le cartelle di lavoro che utilizzano l’origine dati cubo su Tableau Cloud. |
| Insiemi | Le origini dati cubo supportano gli insiemi gerarchici, che filtrano i dati ai membri selezionati e tutti i relativi discendenti. Per maggiori dettagli, consulta Esempi di insiemi. |
| Funzioni stringa Tableau | Con le origini dati cubo, le dimensioni non sono disponibili nell’editor di calcolo. Tuttavia, puoi scrivere MDX all’interno di Tableau utilizzando un membro calcolato per manipolare i valori dimensionali. Ad esempio:
|
| Tipi di conversione | Per le origini dati cubo, alcune funzioni di tipi di conversione non sono disponibili nell’editor di calcolo. Di norma, devi definite le conversioni del tipo di dati nel cubo prima dell’analisi. In particolare, la modifica del tipo di dati di una dimensione del cubo in una data in Tableau a volte fornisce informazioni errate. Questa funzione è supportata per alcune dimensioni cubo, in base alla modalità di formattazione delle date nel cubo. Puoi scrivere espressioni multidimensionali (MDX) direttamente in Tableau utilizzando un membro calcolato per modificare il tipo di dati di una dimensione cubo in una data. Ad esempio:
|
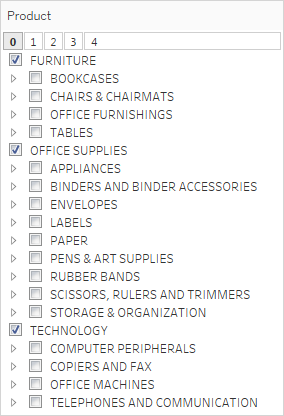

| Lingua | Parole chiave |
| Inglese (Regno Unito e Stati Uniti) | Year, Yr, Day, Day of Week, Week, Wk, Month, Quarter, Qtr, FY |
| Cinese (semplificato) | 年, 天, 周中某天, 周, 月, 季度, 会计年度 |
| Cinese (tradizionale) | 年, 天, 週中某天, 週, 月, 季, 會計年度 |
| Olandese | Jaar, Jr, Dag, Dag Van De Week, Week, Wk, Maand, Kwartaal, Q, |
| Francese (Canada e Francia) | Année, Jour, Jour de la Semaine, Semaine, Mois, Trimestre, AF |
| Tedesco | Jahr, Tag, Wochentag, Woche, Monat, Quartal, GJ |
| Italiano | Anno, Giorno, Giorno della Settimana, Settimana, Sett, Mese, Trimestre, Trim, AF |
| Giapponese | 年, 日, 曜日, 週, 月, 四半期, 年度 |
| Coreano | 년, 일, 요일, 주, 월, 분기, 회계 연도 |
| Portoghese | Ano, Dia, Dia da Semana, Semana, Mês, Trimestre, AF |
| Spagnolo | Año, Día, Día de la Semana, Semana, Mes, Trimestre, AF |
| Svedese | År, Dag, Veckodag, Vecka, Månad, Kvartal, Räkenskapsåret |
| Tailandese | ปี, วัน, วันของสัปดาห์, สัปดาห์, เดือน, ไตรมาส, FY |
| CIF | FDA | MPI |
| DMA | FOB | MSA |
| DOB | FTE | SKU |
| EIN | KPI | UPC |
| ESP | LOB | URL |
| USD |
| 1st | as | down | of | th (suffisso posto dopo un numero) |
| 2nd | at | for | on | than |
| 3rd | but | in | off | the |
| a | by | inclu. | or | to |
| an | de | into | over | vs |
| and | da | la | per | with |
| Origine dati | Supporto |
| Actian Vectorwise | Non supportato. |
| Amazon EMR Hadoop Hive | Supportato per Hive 0.13 e versioni successive. |
| Amazon Redshift | Supportato. |
| Aster Database | Supportato per la versione 4.5 e successive. |
| Cloudera Hadoop | Supportato per Hive 0.13 e versioni successive. |
| Cloudera Impala | Supportato per Impala 1.2.2 e versioni successive. |
| Cubi (origini dati multidimensionali) | Non supportato. |
| DataStax Enterprise | Non supportato. |
| EXASOL | Supportato. |
| Firebird | Supportato per la versione 2.0 e successive. |
| Generic ODBC | Limitato. In base all’origine dati specifica. |
| Google Big Query | Supportato per SQL standard, non supportato per SQL legacy. |
| Hortonworks Hadoop Hive | Supportato per Hive 0.13 e versioni successive. Nella versione 1.1 delle espressioni Level of Detail HIVE che producono cross join non sono affidabili. Il cross join si verifica quando non è presente un campo esplicito da unire. Ad esempio, per un’espressione Level of Detail |
| IBM BigInsights | Supportato. |
| IBM DB2 | Supportato per la versione 8.1 e successive. |
| MarkLogic | Supportato per la versione 7.0 e successive. |
| Microsoft Access | Non supportato. |
| Connessioni basate su Microsoft Jet (connettori legacy per Microsoft Excel, Microsoft Access e testo) | Non supportato. |
| Microsoft SQL Server | SQL Server 2005 e versioni successive. |
| MySQL | Supportato. |
| IBM PDA (Netezza) | Supportato per la versione 7.0 e successive. |
| Oracle | Supportato per la versione 9i e successive. |
| Actian Matrix (ParAccel) | Supportato per la versione 3.1 e successive. |
| Pivotal Greenplum | Supportato per la versione 3.1 e successive. |
| PostgreSQL | Supportato per la versione 7 e successive. |
| Progress OpenEdge | Supportato. |
| SAP HANA | Supportato. |
| SAP Sybase ASE | Supportato. |
| SAP Sybase IQ | Supportato per la versione 15.1 e successive. |
| Spark SQL | Supportato. |
| Splunk | Non supportato. |
| Estrazione dati Tableau | Supportato. |
| Teradata | Supportato. |
| Vertica | Supportato per la versione 6.1 e successive. |
| Parametro oggetto | Valori | Descrizione | Esempi |
|---|---|---|---|
dataDetails | no | Nasconde il pulsante Dettagli dei dati nella barra degli strumenti, che consente agli utenti di visualizzare i dettagli sui dati utilizzati in quella vista. | <param name='dataDetails' value='no' /> |
showDataDetails | yes | Se Tableau Catalog è abilitato, mostra la vista con il riquadro Dettagli dati aperto. | <param name='showDataDetails' value='yes' /> |
alerts | no | Nasconde il pulsante Avvisi nella barra degli strumenti, che consente agli utenti di creare avvisi basati sui dati. | <param name='alerts' value='no'/> |
customViews | no | Nasconde il pulsante Vista nella barra degli strumenti, che consente agli utenti di salvare le viste personalizzate. | <param name='customViews' value='no'/> |
device | desktop; tablet; phone | Se nella dashboard sono disponibili layout per dispositivi mobili, visualizza un layout specifico indipendentemente dalle dimensioni dello schermo. Se questo parametro non è impostato, Tableau Server o Tableau Cloud rileva le dimensioni dello schermo e carica il layout corrispondente. Per gli esempi, vedi Incorporare le dashboard. | <param name='device' value='phone'/> |
filter | stringa | Filtra i dati visualizzati quando si apre la vista. È inoltre possibile filtrare mediante i parametri URL. | <param name='filter' value='Team=Blue'/> |
host_url | stringa | Obbligatorio. Nome del server visualizzato nell’URL. | <param name='host_url' value='http://myserver.exampleco.com/'>
|
linktarget | stringa | Il nome della finestra di destinazione per i collegamenti ipertestuali esterni. | <param name="linktarget" value="_blank"/> |
load-order | numero | Quando sono incorporate più viste, determina l’ordine in cui vengono caricate nella pagina. Sono consentiti i numeri negativi. | <param name="load-order" value="2"/> |
mobile | yes | Visualizza filtri rapidi ottimizzati per il tocco per i dispositivi mobili. | <param
name='mobile' value='yes'/> |
name | stringa | Parametro oggetto obbligatorio, con questa struttura: [nome cartella di lavoro]/[nome foglio]/[nome vista personalizzata] Formatta i nomi delle viste personalizzate opzionali come segue: nome utente@dominio/[nome vista personalizzata] | <param name='name' value='ExampleCoSales/Sales'/>
|
:original_view | yes | Se il parametro name fa riferimento a una cartella di lavoro o a un URL di un foglio (e non si riferisce esplicitamente a una vista personalizzata), l’inclusione di questo parametro mostra la vista come originale. | <param name='filter' value=':original_view=yes'/> |
path(Solo su Tableau Server. Non applicabile a Tableau Cloud). | stringa | Solo per l’autenticazione attendibile, non può essere utilizzato con il parametro ticket. Sostituisce il valore del parametro name ed è utilizzato come URL. Per maggiori informazioni, consulta Visualizzare la vista con il ticket nella Guida dell’amministratore di Tableau Server. | <param name='path' value='trusted/Etdpsm_Ew6rJY-9kRrALjauU/views/workbookQ4/SalesQ4'/>
|
showShareOptions | true; false | Controlla se le opzioni di condivisione sono visualizzate in una vista incorporata. | <param name='showShareOptions' value='true' /> |
site_root | stringa | Obbligatorio. Il nome del sito. Il valore del sito predefinito è nullo (value=''). Se il tuo server è multisito e vuoi utilizzare l’autenticazione attendibile, consulta Visualizzare la vista con il ticket nella Guida di Tableau Server. | <param name='site_root' value='/#/Sales'/>
|
subscriptions | no | Nasconde il pulsante Sottoscrizioni nella barra degli strumenti, che consente agli utenti di impostare le sottoscrizioni e-mail così da ricevere snapshot delle viste a intervalli regolari. |
|
tabs | yes; no | Visualizza o nasconde le schede. | <param name='tabs' value='yes'/> |
ticket(Solo su Tableau Server. Non applicabile a Tableau Cloud). | stringa | Solo per l’autenticazione attendibile, non può essere utilizzato con il parametro oggetto path. Deve essere utilizzato con l’oggetto name per costruire l’URL di riscatto dei ticket attendibili. Per maggiori informazioni, consulta Visualizzare la vista con il ticket nella Guida di Tableau Server. | <param name='ticket' value='9D1ObyqDQmSIOyQpKdy4Sw==:dg62gCsSE0QRArXNTOp6mlJ5'/>
|
toolbar | yes; no; top | La barra degli strumenti viene visualizzata in basso per impostazione predefinita. La barra degli strumenti viene posizionata sopra la vista quando si imposta questo parametro su toped esclusa dalla vista incorporata quando viene configurato come no. | <param name='toolbar' value='top'/> |
tooltip | yes; no | Le informazioni vengono visualizzate per impostazione predefinita se si imposta questo parametro su no, ma vengono escluse dalla vista incorporata. | <param name='tooltip' value='no'/> |
| Parametro URL | Valori | Descrizione | Esempi |
|---|---|---|---|
:dataDetails | no | Nasconde il pulsante Dettagli dei dati nella barra degli strumenti, che consente agli utenti di visualizzare i dettagli sui dati utilizzati in quella vista. | http://tabserver/views/Date-Time/DateCalcs?:embed=yes&:dataDetails=no |
:showDataDetails | yes | Se Tableau Catalog è abilitato, mostra la vista con il riquadro Dettagli dati aperto. | http://tabserver/views/Date-Time/DateCalcs?:embed=yes&:showDataDetails=yes |
:alerts | no | Nasconde il pulsante Avvisi in una vista incorporata. | http://tabserver/views/Date-Time/DateCalcs?:embed=yes&:alerts=no |
:customViews | no | Opzione Ricorda le mie modifiche. | http://tabserver/views/Date-Time/DateCalcs?:embed=yes&:customViews=no |
:device | desktop; tablet; phone | Se nella dashboard sono disponibili layout per dispositivi mobili, visualizza un layout specifico indipendentemente dalle dimensioni dello schermo. Se questo parametro non è impostato, Tableau Server o Tableau Cloud rileva le dimensioni dello schermo e carica il layout corrispondente. Per gli esempi, vedi Incorporare le dashboard. | http://tabserver/views/sales/sales_dashboard?:device=tablet |
:display_count(Solo su Tableau Public) | yes | Mostra il numero totale di pageviews quando fai clic sul logo di Tableau in basso a sinistra. | https://public.tableau.com/en-us/s/gallery/what-emoji-say-about-music?:display_count=yes |
:embed | yes | Parametro URL obbligatorio. Nasconde l’area di spostamento superiore, unione migliore delle vista nella pagina Web. | http://tabserver/views/Date-Time/DateCalcs?:embed=yes |
:format | pdf; png | Visualizza una vista come file PDF o .png. | http://tabserver/views/Sales/Q2?:format=pdf |
:highdpi | false | Esegue il rendering di una vista utilizzando un DPI standard (punti per pollice) per schermi e dispositivi ad alta risoluzione. | http://tableauserver/views/Sales/Q2?:highdpi=false |
:linktarget | stringa | Il nome della finestra di destinazione per i collegamenti ipertestuali esterni. | http://tabserver/views/Date-Time/DateCalcs?:embed=yes&:linktarget=_blank |
:openid_hd | stringa | Utilizzato durante l’autenticazione con OpenID Connect. Specifica il dominio ospitato a cui appartiene un utente. Ad esempio, potresti utilizzare questa opzione se non desideri eseguire il rendering del riquadro di selezione del dominio. Utilizzato in combinazione con :openid_login_hint per specificare l’identificatore utente completo. | http://tabserver/views/Sales/Q2?:openid_hd=example.com |
:openid_login_hint | stringa | Utilizzato durante l’autenticazione con OpenID Connect. Specifica l’identificatore utente completo (indirizzo e-mail). Utilizzato in combinazione con :openid_hd per specificare il dominio ospitato a cui appartiene l’utente. | http://tabserver/views/Sales/Q2?:openid_login_hint=tara@example.com |
:record_performance(Solo su Tableau Server. Non applicabile a Tableau Cloud). | yes | Avvia una registrazione delle prestazioni di una vista. Aggiungi questo valore alla fine dell’URL, immediatamente prima dell’ID di sessione (:iid=<n>). Per maggiori informazioni, consulta Creare una registrazione delle prestazioni nella Guida di Tableau Server. | http://tabserver/views/Sales2013/Regions?:recordperformance=yes |
:refresh | yes | Esegue il rendering della vista utilizzando i dati più recenti di Tableau Server o Tableau Cloud. Per maggiori informazioni, consulta Aggiornare i dati o sospendere gli aggiornamenti automatici . Suggerimento: per aggiornare continuamente una vista nella sezione | http://tabserver/views/Date-Time/DateCalcs?:embed=yes&:refresh=yes |
:render | true; false; numero | Se il rendering sul lato client è abilitato (impostazione predefinita), impostare questa opzione come false per forzare il rendering sul lato server della sessione. L’impostazione di questa opzione su true forza il rendering sul lato client per la sessione.È possibile immettere un numero compreso tra 1 e 100 per impostare la soglia di complessità al di sopra della quale il rendering delle viste viene eseguito dal server. Per maggiori informazioni, consulta Informazioni sul rendering lato client nella Guida di Tableau Server. | http://tabserver/views/Date-Time/DateCalcs?:render=false |
:revert | all; filters; sorts; axes; shelves | Riporta l’elemento allo stato originale. | http://tabserver/views/Date-Time/DateCalcs?:embed=yes&:revert=all |
:showAppBanner | false | Nasconde l’intestazione "Apri in Tableau Mobile" nei Web browser mobili. | http://tabserver/views/Date-Time/DateCalcs?:embed=yes&:showAppBanner=false |
:showAskData | false | Nasconde il pulsante Chiedilo ai dati nella barra degli strumenti in una vista incorporata. Per impostazione predefinita, il pulsante Chiedilo ai dati è visualizzato. | http://tabserver/views/Date-Time/DateCalcs?:embed=yes&:showAskData=false |
:showShareOptions | true; false | Controlla se le opzioni di condivisione sono visualizzate in una vista incorporata. | http://tabserver/views/Date-Time/DateCalcs?:embed=yes&:showShareOptions=true |
:showVizHome(Solo su Tableau Public) | yes; no | Visualizza o nasconde l’interfaccia di navigazione del contenuto in Tableau Public. Imposta questa opzione su No quando incorpori le visualizzazioni in altre pagine Web. | https://public.tableau.com/en-us/s/gallery/what-emoji-say-about-music?:showVizHome=no |
:subscriptions | no | Nasconde il pulsante Sottoscrivi in una vista integrata. | http://tabserver/views/Date-Time/DateCalcs?:embed=yes&:subscriptions=no |
:tabs | yes; no | Visualizza o nasconde le schede. | http://tabserver/views/Date-Time/DateCalcs?:embed=yes&:tabs=no |
:toolbar | yes; no; top | Quando questo parametro non è impostato, la barra degli strumenti viene visualizzata per impostazione predefinita nella parte inferiore. Quando è selezionato no la barra degli strumenti è esclusa dalla vista incorporata. Quando è selezionato top la barra degli strumenti viene posizionata sopra la vista. | http://tabserver/views/Date-Time/DateCalcs?:embed=yes&:toolbar=no |
:tooltip | yes; no | Quando questo parametro non è impostato, le informazioni vengono visualizzate per impostazione predefinita in una vista. Se è impostato su no, le informazioni vengono escluse dalla vista incorporata. | http://tabserver/views/workbookQ4/SalesQ4?:embed=yes&:tooltip=no |
| Operatore | DIFFERENCE |
| Definizione | Calcola le porzioni di regioni rimanenti quando tutte le regioni nel secondo argomento vengono ricavate dal primo argomento in aree sovrapposte. Scarta le regioni del secondo argomento nelle aree che non si sovrappongono. |
| Esempio |
|

| Operatore | INTERSECTION |
| Definizione | Calcola e restituisce le porzioni delle regioni nel secondo argomento che si sovrappongono alle regioni nel primo argomento. |
| Esempio |
|

| Operatore | SYMDIFFERENCE |
| Definizione | Calcola tutte le porzioni di regioni del secondo argomento che si sovrappongono alle regioni del primo argomento e le scarta da entrambi. Restituisce le porzioni rimanenti delle regioni da entrambi gli argomenti. |
| Esempio |
|

| Operatore | UNION |
| Definizione | Unione monadica (un parametro) Sintassi:
Unione diadica (due parametri) Sintassi:
|
| Esempio |
|

| Versione Tableau Desktop | Versione Web |
|
|


| Versione Tableau Desktop | Versione Web |
|
|


| Se utilizzi Einstein Discovery, seleziona Abilita. Verrà aperto il browser predefinito, consentendoti di autorizzare la connessione a Salesforce. Dopo la connessione, passa alla sezione Einstein Discovery di questo argomento della Guida per continuare. | Per tutti gli altri servizi (Tabpy, Matlab e Rserve), verrà visualizzata la seguente finestra di dialogo. |
 | 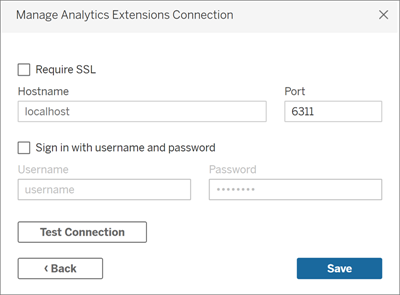 |
| Parametri facoltativi | Sintassi | Descrizione |
|---|---|---|
| maxMiddleValues | "maxMiddleValues": integer | Specifica il numero di predittori principali da restituire nella risposta. Impostato su un numero intero. Può essere utilizzato solo con i modelli di regressione e classificazione binaria. |
| maxPrescriptions | "maxPrescriptions": integer | Specifica il numero massimo di miglioramenti da restituire nella risposta. Impostato su un numero intero. Può essere utilizzato solo con i modelli di regressione e classificazione binaria. |
| showMultiClassProbabilities | "showMultiClassProbabilities": boolean | Scegli se mostrare le probabilità per un modello di classificazione multiclasse. Impostato su vero o falso. Può essere utilizzato solo con i modelli di classificazione multiclasse. |
| Gerarchia incorporata | Colonne da includere nel file con estensione .csv (in ordine di lettura) |
|---|---|
| Paese (Nome) | Paese (Nome) Latitudine Longitudine |
| Paese (Nome), Stato/regione | Paese (Nome) Stato/regione Latitudine Longitudine |
| Paese (Nome), Stato/regione, Città | Paese (Nome) Stato/regione Città Latitudine Longitudine |
| Paese (Nome), Stato/regione, Provincia | Paese (Nome) Stato/regione Provincia Latitudine Longitudine |
| Paese (Nome), CAP | Paese (Nome) CAP Latitudine Longitudine |
| Paese (nome), Prefisso telefonico | Paese (Nome) Prefisso telefonico Latitudine Longitudine |
| Paese (Nome), CBSA | Paese (Nome) CBSA Latitudine Longitudine |
| Normale | Chiaro | Scuro |
 |  |  |
| Strade | Esterni | Satellite |
 |  |  |
| Nome livello | Descrizione | presente nello stile mappa |
|---|---|---|
| Base | Mostra la mappa base che include le aree terrestri e le superfici acquatiche. | Tutti |
| Copertura del suolo | Ombreggia aree naturali e parchi per offrire maggiore profondità alla mappa. | Tutti tranne Satellite |
| Terreno | Visualizza un rilievo delle variazioni di elevazione verticale. | Tutti tranne Satellite |
| Costa | Visualizza le coste. | Chiaro, scuro, normale |
| Strade, superstrade, autostrade | Contrassegna strade e autostrade, nonché piccole vie cittadine. Questo livello include anche i nomi di strade e autostrade. | Tutti |
| Confini paesi/aree di colore chiaro | Mostra un contorno grigio chiaro per i confini di paesi/aree e i relativi nomi. | Chiaro, scuro, normale |
| Nomi paesi/aree di colore chiaro | Mostra i nomi di paesi e aree in grigio chiaro. | Chiaro, scuro, normale |
| Confini paesi/aree | Evidenzia i confini di paesi e aree in grigio più scuro. | Tutti |
| Nomi paesi/aree | Evidenzia i nomi di paesi e aree in grigio più scuro. | Tutti |
| Confini stati/regioni di colore chiaro | Mostra un contorno grigio chiaro per i confini di stati/regioni e i relativi nomi. | Chiaro, scuro, normale |
| Nomi stati/regioni di colore chiaro | Mostra i nomi di stati e regioni in grigio chiaro. | Chiaro, scuro, normale |
| Confini stati/regioni | Evidenzia i confini di stati e regioni in grigio più scuro. | Tutti |
| Nomi stati/regioni | Evidenzia i nomi di stati e regioni in grigio più scuro. | Tutti |
| Confini province | Evidenzia i confini amministrativi di secondo livello e i confini delle contee degli Stati Uniti. | Chiaro, scuro, normale |
| Nomi province | Evidenzia i nomi di amministrazioni di secondo livello e i nomi delle contee degli Stati Uniti. | Chiaro, scuro, normale |
| Confini CAP | Contrassegna i confini dei codici postali (CAP) per gli Stati Uniti e per alcuni paesi. Devi ingrandire per vedere questo livello. | Chiaro, scuro, normale |
| Etichette CAP | Mostra le etichette dei codici postali (CAP) per gli Stati Uniti e per alcuni paesi. Devi ingrandire per vedere questo livello. | Chiaro, scuro, normale |
| Confini prefissi telefonici | Contrassegna i confini dei prefissi telefonici degli Stati Uniti. Devi ingrandire per vedere questo livello. | Chiaro, scuro, normale |
| Etichette prefissi telefonici | Mostra le etichette per i prefissi telefonici degli Stati Uniti. Devi ingrandire per vedere questo livello. | Chiaro, scuro, normale |
| Confini aree metropolitane statunitensi (CBSA) | Contrassegna i confini delle aree statistiche metropolitane e delle aree micropolitane degli Stati Uniti. | Chiaro, scuro, normale |
| Etichette aree metropolitane statunitensi (CBSA) | Mostra le etichette per le aree statistiche metropolitane e le aree micropolitane degli Stati Uniti. | Chiaro, scuro, normale |
| Etichette acque | Mostra le etichette per i corpi idrici. | Tutti |
| Città | Mostra le etichette per le città. | Tutti |
| Punti di interesse | Visualizza etichette per punti di interesse come scuole, parchi, cimiteri, aziende ed edifici importanti. Questo livello dipende dal livello di zoom. | Tutti |
| Quartieri | Mostra le etichette per i quartieri delle città. Devi ingrandire per vedere questo livello. | Tutti |
| Stazioni metropolitane e ferroviarie | Visualizza i nomi delle stazioni metropolitane e ferroviarie. Devi ingrandire per vedere questo livello. | Tutti tranne Satellite |
| Sagome edifici | Mostra il contorno degli edifici, se disponibile. Devi ingrandire per vedere questo livello. | Satellite, Strade, Esterni |
| Numeri civici | Visualizza i numeri civici degli edifici, con e senza le sagome degli edifici. Devi ingrandire per vedere questo livello. | Strade, Esterni |
| Curve di livello | Visualizza le linee che indicano il cambiamento di elevazione verticale in metri. Questo livello dipende dal livello di zoom. | Esterni |
| Singolo database | Più database |
|
|
| Relazioni | Stabiliscono il potenziale per i join tra due tabelle in base ai campi correlati. Non uniscono i dati per creare una nuova tabella fissa. Durante l’analisi, eseguono automaticamente query sulle tabelle pertinenti utilizzando i join appropriati in base al contesto per generare una tabella di dati personalizzata per l’analisi. Mantengono il livello di dettaglio appropriato, non comportano perdite di dati, mantengono le aggregazioni appropriate e gestiscono i valori Null. Possono essere utilizzate in più origini dati pubblicate. |
| Join | Uniscono due tabelle di dati in base a una clausola di join e a un tipo di join per formare una nuova tabella di dati fissa. Spesso utilizzati per aggiungere nuove colonne di dati nella stessa struttura di righe di base. Possono causare una perdita di dati con alcuni tipi di join se i campi non sono presenti in tutte le tabelle. Possono causare la duplicazione dei dati se le tabelle hanno diversi livelli di dettaglio. |
| Unificazioni | Uniscono due o più tabelle di dati per formare una nuova tabella di dati fissa. Utilizzate per aggiungere (nuove righe di) dati nella stessa struttura di colonne di base. |
| Combinazioni | I dati rimangono separati. Tableau esegue query sulle origini dati in modo indipendente e visualizza i risultati insieme nella vista, in base ai campi di collegamento stabiliti per il foglio. Simulano il comportamento di un join a sinistra e possono filtrare i dati provenienti da origini dati secondarie. |
Vendite
| Catalogo prodotti
|
| ID prodotto | Nome del prodotto | ID prodotto | Importo vendite | Data transazione |
| 1 | Tablet da 10 pollici | 1 | 100 | 01/10/2012 |
| 1 | Tablet da 10 pollici | 1 | 2000 | 02/10/2012 |
| 2 | Smartphone | 2 | 50 | 30/09/2012 |
| 3 | Lampada da tavolo | 3 | 10 | 21/08/2012 |
Modello corretto: Invoices e Appointments come tabelle di base | Modello errato: Doctors e Patients come tabelle di base |
 |  |
Tabella di base | Tabella condivisa |
Tabelle dei fatti in uno schema di data warehouse | Tabelle delle dimensioni condivise o conformi in uno schema di data warehouse |
Specifica per il contesto o l’analisi (informazioni sul volo, consumo energetico) | Concetto coerente nei diversi contesti (data, posizione) |
Notevolmente dipendente dalle misure | Principalmente dipendente dalle dimensioni |
Aggiornata più frequentemente/transazionale (visite mediche, prescrizioni, parametri vitali) | Più stabile/durevole (medico, paziente) |
Con campi della chiave esterna | Con campi della chiave primaria |
Basata su eventi (orario delle lezioni, voto a un compito) | Basata su entità (studente, classe) |
| Include Altro | Non include Altro |
|---|---|
 |  |
| Incremento | Lambda | |
| Regressione ridge | Sì | Sì |
| Regressione lineare | Sì | Non applicabile |
| Interpreta i dati non può essere eseguito in viste che utilizzano: |
|
Interpreta i dati non può essere eseguito se selezioni: |
|
| Interpreta i dati non può essere eseguito quando la misura da utilizzare per una spiegazione: |
|
Interpreta i dati non può dare spiegazioni per una dimensione quando è: |
|
| Cella quadrata | Cella di testo |
 |  |
| CAP_CREATE_TEMP_TABLES | Imposta su "Sì" se Tableau può creare tabelle temporanee necessarie per determinate query complesse o ottimizzate. Vedi anche: CAP_SELECT_INTO. |
| CAP_CONNECT_STORED_PROCEDURE | Imposta su "Sì" per consentire il supporto per il collegamento a una stored procedure. |
| CAP_FAST_METADATA | Imposta su "Sì" se disponi di schemi di piccole o medie dimensioni. Questa funzionalità controlla se Tableau deve enumerare tutti gli oggetti immediatamente quando esegui la connessione. Imposta il valore su "Sì" per abilitare questa funzionalità per ottenere prestazioni migliori quando crei nuove connessioni. Disabilita questa funzionalità per consentire la ricerca di tabelle o schemi specifici anziché recuperare tutti gli oggetti. Puoi cercare tutti gli oggetti utilizzando una stringa vuota. Questa funzionalità è disponibile nella versione 9.0 e nelle versioni successive. |
| CAP_ISOLATION_LEVEL_READ_COMMITTED | Imposta su "Sì" per forzare il livello di isolamento delle transazioni su Leggi i dati sottoposti a commit in caso di supporto dell’origine dati. Solo uno dei quattro livelli di isolamento delle transazioni dovrebbe essere impostato su "Sì". Vedi anche: CAP_SET_ISOLATION_LEVEL_VIA_SQL, CAP_SET_ISOLATION_LEVEL_VIA_ODBC_API. |
| CAP_ISOLATION_LEVEL_READ_UNCOMMITTED | Imposta su "Sì" per forzare il livello di isolamento delle transazioni su Leggi i dati non sottoposti a commit in caso di supporto dell’origine dati. Solo uno dei quattro livelli di isolamento delle transazioni dovrebbe essere impostato su "Sì". Questa funzionalità può migliorare la velocità riducendo i conflitti di blocco, ma può generare dati parziali o non coerenti nei risultati delle query. Vedi anche: CAP_SET_ISOLATION_LEVEL_VIA_SQL, CAP_SET_ISOLATION_LEVEL_VIA_ODBC_API. |
| CAP_ISOLATION_LEVEL_REPEATABLE_READS | Imposta su "Sì" per forzare il livello di isolamento delle transazioni su Letture ripetibili in caso di supporto dell’origine dati. Solo uno dei quattro livelli di isolamento delle transazioni dovrebbe essere impostato su "Sì". Vedi anche: CAP_SET_ISOLATION_LEVEL_VIA_SQL, CAP_SET_ISOLATION_LEVEL_VIA_ODBC_API. |
| CAP_ISOLATION_LEVEL_SERIALIZABLE | Imposta su "Sì" per forzare il livello di isolamento delle transazioni su Serializzabile in caso di supporto dell’origine dati. Solo uno dei quattro livelli di isolamento delle transazioni dovrebbe essere impostato su "Sì". Si tratta di un’impostazione molto conservativa che può migliorare la stabilità a scapito delle prestazioni. Vedi anche: CAP_SET_ISOLATION_LEVEL_VIA_SQL, CAP_SET_ISOLATION_LEVEL_VIA_ODBC_API. |
| CAP_SET_ISOLATION_LEVEL_VIA_ODBC_API | Imposta su "Sì" per forzare l’impostazione da parte di Tableau del livello di isolamento delle transazioni per l’origine dati utilizzando l’API ODBC. CAP_SET_ISOLATION_LEVEL_VIA_ODBC_API deve essere impostato su "Sì" quando una delle quattro funzionalità di CAP_ISOLATION_LEVEL è stata impostata su "Sì". |
| CAP_SET_ISOLATION_LEVEL_VIA_SQL | Imposta su "Sì" per forzare l’impostazione da parte di Tableau del livello di isolamento delle transazioni per l’origine dati utilizzando una query ODBC. CAP_SET_ISOLATION_LEVEL_VIA_SQL deve essere impostato su "Sì" quando una delle quattro funzionalità di CAP_ISOLATION_LEVEL è stata impostata su "Sì". |
| CAP_MULTIPLE_CONNECTIONS_FROM_SAME_IP | Imposta su "No" per evitare che Tableau crei più di una connessione attiva al database. Si tratta di un’impostazione conservativa che può aumentare la stabilità a scapito delle prestazioni. |
| CAP_ODBC_BIND_DETECT_ALIAS_CASE_FOLDING | Imposta su "Sì" per consentire a Tableau di eseguire il rilevamento e il recupero da un’origine dati ODBC che riporta i nomi dei campi in un insieme di risultati utilizzando solo caratteri maiuscoli o minuscoli, invece dei nomi campo previsti. |
| CAP_ODBC_BIND_BOOL_AS_WCHAR_01LITERAL | Imposta su "Sì" per associare un tipo di dati booleano come WCHAR contenente valori "0" o "1". |
| CAP_ODBC_BIND_BOOL_AS_WCHAR_TFLITERAL | Imposta su "Sì" per associare un tipo di dati booleano come WCHAR contenente valori "t" o "f". |
| CAP_ODBC_BIND_FORCE_DATE_AS_CHAR | Imposta su "Sì" per fare in modo che il protocollo ODBC nativo di Tableau colleghi collegare i valori della data come CHAR. |
| CAP_ODBC_BIND_FORCE_DATETIME_AS_CHAR | Imposta su "Sì" per fare in modo che il protocollo ODBC nativo di Tableau colleghi il valore di data/ora come CHAR. |
| CAP_ODBC_BIND_FORCE_MAX_STRING_BUFFERS | Imposta su "Sì" per fare in modo che il protocollo ODBC nativo di Tableau utilizzi buffer di dimensioni massime (1 MB) per le stringhe invece delle dimensioni descritte dai metadati. |
| CAP_ODBC_BIND_FORCE_MEDIUM_STRING_BUFFERS | Imposta su "Sì" per fare in modo che il protocollo ODBC nativo di Tableau utilizzi buffer di dimensioni medie (1 K) per le stringhe invece delle dimensioni descritte dai metadati. |
| CAP_ODBC_BIND_FORCE_SMALL_STRING_BUFFERS | Imposta su "Sì" per fare in modo che il protocollo ODBC nativo di Tableau utilizzi buffer di piccole dimensioni per le stringhe invece delle dimensioni descritte dai metadati. |
| CAP_ODBC_BIND_FORCE_SIGNED | Imposta su "Sì" per forzare i numeri interi di associazione come firmati. |
| CAP_ODBC_BIND_PRESERVE_BOM | Imposta su "Sì" per preservare BOM quando presente nelle stringhe. Hive restituirà BOM e tratterà le stringhe che la contengono come entità distinte. |
| CAP_ODBC_BIND_SKIP_LOCAL_DATATYPE_UNKNOWN | Imposta su "Sì" per impedire al protocollo ODBC nativo di eseguire il binding a colonne con tipo di dati locale DataType::Unknown nei metadati previsti. |
| CAP_ODBC_BIND_SPATIAL_AS_WKT | Imposta su "Sì" per forzare il binding di dati spaziali come WKT (Well Known Text) |
| CAP_ODBC_BIND_SUPPRESS_COERCE_TO_STRING | Imposta su "Sì" per evitare che il protocollo ODBC nativo di Tableau associ dati che non sono stringhe come stringhe (ad esempio, richiedendo la conversione del driver). |
| CAP_ODBC_BIND_SUPPRESS_INT64 | Imposta su "Sì" per evitare che il protocollo ODBC nativo di Tableau utilizzi numeri interi a 64 bit per dati numerici di grandi dimensioni. |
| CAP_ODBC_BIND_SUPPRESS_PREFERRED_CHAR | Imposta su "Sì" per evitare che il protocollo ODBC nativo di Tableau preferisca un tipo di carattere diverso da quello predefinito del driver. |
| CAP_ODBC_BIND_SUPPRESS_PREFERRED_TYPES | Imposta su "Sì" per evitare che il protocollo ODBC nativo di Tableau associ tutti i dati in base al tipo di cavo preferito. Con questo insieme di funzionalità, Tableau esegue l’associazione solamente in base ai tipi di dati descritti dal driver ODBC tramite metadati. |
| CAP_ODBC_BIND_SUPPRESS_WIDE_CHAR | Imposta su "Sì" per evitare che il protocollo ODBC nativo di Tableau impedisca di associare alle stringhe una WCHAR. Saranno invece vincolati come array CHAR a byte singolo ed elaborati localmente per qualsiasi carattere UTF-8 contenuto all’interno. |
| CAP_ODBC_CONNECTION_STATE_VERIFY_FAST | Imposta su "Sì" per verificare se una connessione è interrotta con una chiamata veloce dell’API ODBC. |
| CAP_ODBC_CONNECTION_STATE_VERIFY_PROBE | Imposta su "Sì" per verificare se un collegamento è interrotto con una sonda forzata. |
| CAP_ODBC_CONNECTION_STATE_VERIFY_PROBE_IF_STALE | Imposta su "Sì" per verificare se un collegamento è interrotto con una sonda forzata solo è "ferma" (ovvero non utilizzata per circa 30 minuti). |
| CAP_ODBC_CONNECTION_STATE_VERIFY_PROBE_PREPARED_QUERY | Imposta su "Sì" per verificare se un collegamento è interrotto con una query preparata. |
| CAP_ODBC_CURSOR_DYNAMIC | Imposta su "Sì" per fare in modo che il protocollo ODBC nativo di Tableau imposti il tipo di cursore per tutte le dichiarazioni su Dinamico (scorrimento consentito, rileva righe aggiunte/rimosse/modificate). |
| CAP_ODBC_CURSOR_FORWARD_ONLY | Imposta su "Sì" per fare in modo che il protocollo ODBC nativo di Tableau imposti il tipo di cursore per tutte le dichiarazioni su Solo in avanti (scorrimento non consentito). |
| CAP_ODBC_CURSOR_KEYSET_DRIVEN | Imposta su "Sì" per fare in modo che il protocollo ODBC nativo di Tableau imposti il tipo di cursore per tutte le dichiarazioni su Basato su insieme di chiavi (scorrimento consentito, rileva le modifiche ai valori all’interno di una riga). |
| CAP_ODBC_CURSOR_STATIC | Imposta su "Sì" per forzare Tableau a impostare il tipo di cursore per tutte le dichiarazioni su Statico (scorrimento consentito, non rileva le modifiche). |
| CAP_ODBC_ERROR_IGNORE_FALSE_ALARM | Imposta su "Sì" per consentire al protocollo ODBC nativo di Tableau di ignorare le condizioni SQL_ERROR in cui SQLSTATE è "00000" (che significa "Nessun errore"). |
| CAP_ODBC_ERROR_IGNORE_SQLNODATA_FOR_COMMAND_QUERIES | Imposta su "Sì" per ignorare quando SQLExecDirect restituisce SQL_NO_DATA anche quando non sono previsti dati. |
| CAP_ODBC_EXPORT_ALLOW_CHAR_UTF8 | Imposta su "Sì" per consentire l’utilizzo di tipi di dati a carattere singolo per l’associazione di stringhe Unicode come UTF-8. |
| CAP_ODBC_EXPORT_BIND_FORCE_TARGET_METADATA | Imposta su "Sì" per forzare l’associazione per l’esportazione in base a tutti i metadati della tabella di destinazione invece dei metadati ODBC per la dichiarazione di inserimento parametrizzato. |
| CAP_ODBC_EXPORT_BIND_PREFER_TARGET_METADATA | Imposta su "Sì" per preferire l’associazione per l’esportazione in tipi specifici di metadati della tabella di destinazione invece dei metadati ODBC per la dichiarazione di inserimento parametrizzato. |
| CAP_ODBC_EXPORT_BUFFERS_RESIZABLE | Imposta su "Sì" per consentire la riallocazione dei buffer di esportazione dopo il primo batch per migliorare le prestazioni. |
| CAP_ODBC_EXPORT_BUFFERS_SIZE_FIXED | Imposta su "Sì" per ignorare la larghezza di una riga singola durante l’elaborazione delle righe totali da inserire contemporaneamente. |
| CAP_ODBC_EXPORT_BUFFERS_SIZE_LIMIT_512KB | Imposta su "Sì" per limitare i buffer di esportazione a 512 KB. Questa è un’impostazione non comune. |
| CAP_ODBC_EXPORT_BUFFERS_SIZE_MASSIVE | Imposta su "Sì" per forzare l’utilizzo di buffer di grandi dimensioni per l’inserimento. Se CAP_ODBC_EXPORT_BUFFERS_RESIZABLE non è impostato o disattivato, viene utilizzato un numero di righe fisso. |
| CAP_ODBC_EXPORT_BUFFERS_SIZE_MEDIUM | Imposta su "Sì" per forzare l’utilizzo di buffer di dimensioni medie per l’inserimento. Se CAP_ODBC_EXPORT_BUFFERS_RESIZABLE non è impostato o disattivato, viene utilizzato un numero di righe fisso. |
| CAP_ODBC_EXPORT_BUFFERS_SIZE_SMALL | Imposta su "Sì" per forzare l’utilizzo di buffer di piccole dimensioni per l’inserimento. Se CAP_ODBC_EXPORT_BUFFERS_RESIZABLE non è impostato o disattivato, viene utilizzato un numero di righe fisso. |
| CAP_ODBC_EXPORT_CONTINUE_ON_ERROR | Imposta su "Sì" per continuare l’inserimento dei dati nonostante gli errori. Alcune origini dati segnalano gli avvisi come errori. |
| CAP_ODBC_EXPORT_DATA_BULK | Imposta su "Sì" per consentire l’utilizzo di operazioni collettive ODBC per l’inserimento di dati. |
| CAP_ODBC_EXPORT_DATA_BULK_VIA_INSERT | Imposta su "Sì" per consentire l’utilizzo di operazioni collettive ODBC basate su query parametrizzate "INSERT INTO". |
| CAP_ODBC_EXPORT_DATA_BULK_VIA_ROWSET | Imposta su "Sì" per consentire l’utilizzo di operazioni collettive ODBC in base a un cursore dell’insieme di righe. |
| CAP_ODBC_EXPORT_FORCE_INDICATE_NTS | Imposta su "Sì" per forzare l’utilizzo dei buffer di indicatore per l’identificazione delle stringhe che terminano con NULL (NTS). |
| CAP_ODBC_EXPORT_FORCE_SINGLE_ROW_BINDING | Imposta su "Sì" per forzare l’utilizzo di una riga singola per associare i buffer di esportazione per l’inserimento dei dati. |
| CAP_ODBC_EXPORT_FORCE_SINGLE_ROW_BINDING_WITH_TIMESTAMPS | Imposta su "Sì" per forzare l’utilizzo di una riga singola per associare i buffer di esportazione quando si tratta di dati con timestamp. Questa operazione è necessaria per alcune versioni di Teradata. |
| CAP_ODBC_EXPORT_FORCE_STRING_WIDTH_FROM_SOURCE | Imposta su "Sì" per forzare l’utilizzo della larghezza della stringa di origine (dai metadati Tableau), sostituendo la larghezza della stringa di destinazione (dai metadati dei parametri di inserimento). |
| CAP_ODBC_EXPORT_FORCE_STRING_WIDTH_USING_OCTET_LENGTH | Imposta su "Sì" per forzare l’utilizzo della larghezza della stringa di origine dalla lunghezza dell’ottetto. |
| CAP_ODBC_EXPORT_SUPPRESS_STRING_WIDTH_VALIDATION | Imposta su "Sì" per evitare la convalida relativa alla larghezza della stringa di destinazione che può contenere le stringhe di origine più larghe. |
| CAP_ODBC_EXPORT_TRANSACTIONS_COMMIT_BATCH_MASSIVE | Imposta su "Sì" per eseguire il commit in batch di grandi dimensioni di dichiarazioni INSERT (~100.000). Può essere utile con l’associazione di esportazioni a riga singola. |
| CAP_ODBC_EXPORT_TRANSACTIONS_COMMIT_BATCH_MEDIUM | Imposta su "Sì" per eseguire il commit in batch di medie dimensioni di dichiarazioni INSERT (~50). Una singola dichiarazione può essere legata a più record. |
| CAP_ODBC_EXPORT_TRANSACTIONS_COMMIT_BATCH_SMALL | Imposta su "Sì" per eseguire il commit in batch di piccole dimensioni di dichiarazioni INSERT (~5). Una singola dichiarazione può essere legata a più record. |
| CAP_ODBC_EXPORT_TRANSACTIONS_COMMIT_BYTES_MASSIVE | Imposta su "Sì" per eseguire il commit in batch di grandi dimensioni di dati (~100 MB). |
| CAP_ODBC_EXPORT_TRANSACTIONS_COMMIT_BYTES_MEDIUM | Imposta su "Sì" per eseguire il commit in batch di medie dimensioni di dati (~10 MB). |
| CAP_ODBC_EXPORT_TRANSACTIONS_COMMIT_BYTES_SMALL | Imposta su "Sì" per eseguire il commit in batch di piccole dimensioni di dati (~1 MB). |
| CAP_ODBC_EXPORT_TRANSACTIONS_COMMIT_EACH_STATEMENT | Imposta su "Sì" per eseguire il commit dopo l’esecuzione di ogni dichiarazione INSERT. Una singola dichiarazione può essere legata a più record. |
| CAP_ODBC_EXPORT_TRANSACTIONS_COMMIT_INTERVAL_LONG | Imposta su "Sì" per eseguire il commit in intervalli lunghi di tempo trascorso (~100 secondi). |
| CAP_ODBC_EXPORT_TRANSACTIONS_COMMIT_INTERVAL_MEDIUM | Imposta su "Sì" per eseguire il commit in intervalli medi di tempo trascorso (~10 secondi). |
| CAP_ODBC_EXPORT_TRANSACTIONS_COMMIT_INTERVAL_SHORT | Imposta su "Sì" per eseguire il commit in intervalli brevi di tempo trascorso (~1 secondo). |
| CAP_ODBC_EXPORT_TRANSACTIONS_COMMIT_ONCE_WHEN_COMPLETE | Imposta su "Sì" per eseguire il commit solo una volta al termine dell’esportazione. |
| CAP_ODBC_EXPORT_TRANSLATE_DATA_PARALLEL | Imposta su "Sì" per utilizzare i cicli paralleli per convertire i DataValues Tableau in wire buffer durante l’esportazione. |
| CAP_ODBC_FETCH_ABORT_FORCE_CANCEL_STATEMENT | Imposta su "Sì" per annullare la gestione della dichiarazione all’interruzione di SQLFetch con un’eccezione di annullamento. |
| CAP_ODBC_FETCH_BUFFERS_RESIZABLE | Imposta su "Sì" per consentire la riallocazione dei buffer dopo il recupero per migliorare le prestazioni o gestire il troncamento dei dati. |
| CAP_ODBC_FETCH_BUFFERS_SIZE_FIXED | Imposta su "Sì" per ignorare la larghezza di una riga singola durante l’elaborazione delle righe totali da recuperare. |
| CAP_ODBC_FETCH_BUFFERS_SIZE_MASSIVE | Imposta su "Sì" per forzare l’utilizzo di buffer estesi. Se CAP_ODBC_FETCH_BUFFERS_SIZE_FIXED è abilitato, viene utilizzato un numero di righe fisso. |
| CAP_ODBC_FETCH_BUFFERS_SIZE_MEDIUM | Imposta su "Sì" per forzare l’utilizzo di buffer di dimensioni medie. Se CAP_ODBC_FETCH_BUFFERS_SIZE_FIXED è abilitato, viene utilizzato un numero di righe fisso. |
| CAP_ODBC_FETCH_BUFFERS_SIZE_SMALL | Imposta su "Sì" per forzare l’utilizzo di buffer di piccole dimensioni. Se CAP_ODBC_FETCH_BUFFERS_SIZE_FIXED è abilitato, viene utilizzato un numero di righe fisso. |
| CAP_ODBC_FETCH_CONTINUE_ON_ERROR | Imposta su "Sì" per consentire al protocollo ODBC nativo di Tableau di continuare a recuperare gli insiemi risultati nonostante gli errori (alcune origini dati segnalano gli avvisi come errori). |
| CAP_ODBC_FETCH_IGNORE_FRACTIONAL_SECONDS | Imposta su "Sì" per consentire al protocollo ODBC nativo di Tableau di ignorare la componente di secondi frazionari di un valore temporale quando si recuperano i dati dell’insieme di risultati delle query. Ciò è utile quando si lavora con le origini dati che non seguono la specifica ODBC per frazioni di secondo, che devono essere rappresentate come miliardesimi di secondo. |
| CAP_ODBC_FETCH_RESIZE_BUFFERS | Imposta su "Sì" per consentire al protocollo ODBC nativo di Tableau di ridimensionare automaticamente i buffer ed eseguire nuovamente il recupero se si è verificato il troncamento dei dati. |
| CAP_ODBC_FORCE_SINGLE_ROW_BINDING | Imposta su "Sì" per fare in modo che il protocollo ODBC nativo di Tableau utilizzi una riga singola per i trasferimenti degli insiemi di risultati invece del più efficiente recupero in blocco. |
| CAP_ODBC_IMPORT_ERASE_BUFFERS | Imposta su "Sì" per reimpostare il contenuto dei buffer di dati prima del recupero di ciascun blocco. |
| CAP_ODBC_IMPORT_TRANSLATE_DATA_PARALLEL | Imposta su "No" per disabilitare la decodifica dei dati locale in parallelo. |
| CAP_ODBC_METADATA_FORCE_LENGTH_AS_PRECISION | Imposta su "Sì" per fare in modo che il protocollo ODBC nativo di Tableau utilizzi la colonna "lunghezza" come precisione numerica. Questa è un’impostazione non comune. |
| CAP_ODBC_METADATA_FORCE_NUM_PREC_RADIX_10 | Imposta su "Sì" per fare in modo che il protocollo ODBC nativo di Tableau assuma che la precisione numerica sia riportata con sistema decimale. Questa è un’impostazione non comune. |
| CAP_ODBC_METADATA_FORCE_UNKNOWN_AS_STRING | Imposta su "Sì" per fare in modo che il protocollo ODBC nativo di Tableau tratti i tipi di dati sconosciuti come stringhe anziché ignorare la colonna associata. |
| CAP_ODBC_METADATA_FORCE_UTF8_IDENTIFIERS | Imposta su "Sì" per fare in modo che il protocollo tratti gli identificatori come UTF-8 durante la comunicazione con il driver. |
| CAP_ODBC_METADATA_SKIP_DESC_TYPE_NAME | Imposta su "Sì" per rimuovere la verifica dell’attributo SQL_DESC_TYPE_NAME con l’API SQLColAttribute. |
| CAP_ODBC_METADATA_STRING_LENGTH_UNKNOWN | Imposta su "Sì" per evitare che Tableau assegni la memoria in base alla lunghezza della stringa segnalata dal driver, che potrebbe non essere conosciuta o segnalata correttamente. Al suo posto, Tableau utilizzerà una lunghezza di stringa di dimensione fissa e, se necessario, eseguirà la riallocazione per gestire dati di stringa troppo grandi per il buffer di dimensione fissa. |
| CAP_ODBC_METADATA_STRING_TRUST_OCTET_LENGTH | Imposta su "Sì" per utilizzare la lunghezza dell’ottetto riportata dal driver per le stringhe invece di calcolarla a partire dal numero di caratteri. |
| CAP_ODBC_METADATA_SUPPRESS_EXECUTED_QUERY | Imposta su "Sì" per impedire l’esecuzione da parte di Tableau di una query come mezzo per la lettura dei metadati. Anche se Tableau include tipicamente una clausola di limitazione della riga in tali query di metadati (ad es. "LIMIT" o "WHERE 1=0"), ciò potrebbe non essere d’aiuto quando viene utilizzata con una connessione SQL personalizzata per sistemi di database con ottimizzatori di query scadenti. Nota che questa funzionalità potrebbe impedire l’individuazione corretta dei metadati di connessione da pare di Tableau. |
| CAP_ODBC_METADATA_SUPPRESS_PREPARED_QUERY | Imposta su "Sì" per impedire l’utilizzo da parte di Tableau di una query preparata come mezzo per la lettura dei metadati. Una query preparata è spesso il modo più rapido per leggere con precisione i metadati. Non tutti i sistemi di database tuttavia sono in grado di sono in grado di inviare report sui metadati per una query preparata senza che la query venga effettivamente eseguita. Nota che alcuni metadati, ad esempio da connessioni che utilizzano SQL personalizzato, non possono essere recuperati se questa funzionalità e CAP_ODBC_METADATA_METADATA_SUPPRESS_EXECUTED_QUERY sono entrambi impostati. |
| CAP_ODBC_METADATA_SUPPRESS_READ_IDENTITY_COLUMNS | Imposta su "No" per impedire la lettura dei metadati della colonna di identità. |
| CAP_ODBC_METADATA_SUPPRESS_SELECT_STAR | Imposta su "Sì" per impedire la lettura dei metadati utilizzando una query "seleziona *". |
| CAP_ODBC_METADATA_SUPPRESS_SQLCOLUMNS_API | Imposta su "Sì" per evitare che Tableau utilizzi API meno accurate e più vecchie per la lettura di metadati da origini dati ODBC. L’impostazione di questa capacità consente a Tableau di leggere i metadati emettendo una query completa "seleziona *", che è dispendiosa ma può consentire la connettività per origini dati estremamente limitate o instabili. |
| CAP_ODBC_METADATA_SUPPRESS_SQLFOREIGNKEYS_API | Imposta su "Sì" per impedire a Tableau di tentare di leggere i metadati che descrivono i vincoli delle chiavi esterne. Nonostante le semplici caratteristiche di questa API ODBC, alcuni driver potrebbero avere un comportamento instabile o produrre risultati imprecisi. L’impostazione di questa funzionalità può costringere Tableau a generare query meno efficienti con join multi-tabella. |
| CAP_ODBC_METADATA_SUPPRESS_SQLPRIMARYKEYS_API | Imposta su "Sì" per impedire a Tableau di leggere i metadati della chiave primaria utilizzando l’API SQLPrimaryKeys o una query equivalente. Questa funzionalità è disponibile in Tableau 9.1 e nelle versioni successive. |
| CAP_ODBC_METADATA_SUPPRESS_SQLSTATISTICS_API | Imposta su "Sì" per evitare la lettura di vincoli unici e stime di cardinalità delle tabelle utilizzando l’API SQLStatistics o una query equivalente. Questa funzionalità è disponibile in Tableau 9.0 e nelle versioni successive. |
| CAP_ODBC_QUERY_USE_PREPARE_PARAMETER_MARKER | Abilita questa opzione per utilizzare istruzioni preparate con indicatori di parametro anziché valori letterali. Si applica solo ai valori a virgola mobile, interi e stringa. |
| CAP_ODBC_REBIND_SKIP_UNBIND | Imposta su "Sì" per fare in modo che il protocollo ODBC nativo di Tableau riassoci direttamente una colonna e salti la rimozione dell’associazione, in modo da ridurre le chiamate dell’API ODBC quando si ridimensionano i buffer per il nuovo recupero dei dati troncati. |
| CAP_ODBC_SUPPORTS_LONG_DATA_BULK | Imposta su "Sì" se il driver può recuperare più righe di dati di tipo Long contemporaneamente. |
| CAP_ODBC_SUPPORTS_LONG_DATA_ORDERED | Imposta su "Sì" se il driver richiede che le colonne con dati di tipo Long seguano quelle con dati non di tipo Long. |
| CAP_ODBC_SUPPRESS_INFO_SCHEMA_STORED_PROCS | Imposta su "Sì" per evitare che vengano inviate query allo schema INFORMATION.SCHEMA quando si elencano le stored procedure. |
| CAP_ODBC_SUPPRESS_INFO_SCHEMA_TABLES | Imposta su "Sì" per impedire che le tabelle nello schema "information_schema" vengano restituite da EnumerateTables. |
| CAP_ODBC_SUPPRESS_PG_TEMP_SCHEMA_TABLES | Imposta su "Sì" per impedire che le tabelle nello schema "pg_temp" vengano restituite da EnumerateTables. |
| CAP_ODBC_SUPPRESS_PREPARED_QUERY_FOR_ALL_COMMAND_QUERIES | Imposta su "Sì" per eseguire direttamente tutti i comandi (vale a dire senza dichiarazioni preparate). |
| CAP_ODBC_SUPPRESS_PREPARED_QUERY_FOR_DDL_COMMAND_QUERIES | Imposta su "Sì" per eseguire i comandi DDL (ad es. CREATE TABLE) direttamente (vale a dire senza dichiarazioni preparate). |
| CAP_ODBC_SUPPRESS_PREPARED_QUERY_FOR_DML_COMMAND_QUERIES | Imposta su "Sì" per eseguire i comandi DML (ad es. INSERT INTO) direttamente (vale a dire senza dichiarazioni preparate). |
| CAP_ODBC_SUPPRESS_PREPARED_QUERY_FOR_NON_COMMAND_QUERIES | Imposta su "Sì" per eseguire direttamente tutte le query non di comandi (senza dichiarazioni preparate). |
| CAP_ODBC_SUPPRESS_SYS_SCHEMA_STORED_PROCS | Imposta su "Sì" per aggiungere esplicitamente lo schema "SYS" alle esclusioni di schema quando si elencano le stored procedure. |
| CAP_ODBC_TRANSACTIONS_COMMIT_INVALIDATES_PREPARED_QUERY | Imposta su "Sì" per indicare che una transazione invaliderà tutte le dichiarazioni preparate e chiuderà tutti i cursori aperti. |
| CAP_ODBC_TRANSACTIONS_SUPPRESS_AUTO_COMMIT | Imposta su "Sì" per evitare che il protocollo ODBC nativo utilizzi il comportamento predefinito di auto-committing per le transazioni in ODBC. Questa funzionalità non può essere utilizzata con CAP_ODBC_TRANSACTIONS_SUPPRESS_EXPLICIT_COMMIT. |
| CAP_ODBC_TRANSACTIONS_SUPPRESS_EXPLICIT_COMMIT | Imposta su "Sì" per impedire che il protocollo ODBC nativo gestisca esplicitamente le transazioni. Questa funzionalità non può essere utilizzata con CAP_ODBC_TRANSACTIONS_SUPPRESS_AUTO_COMMIT. |
| CAP_ODBC_TRIM_CHAR_LEAVE_PADDING | Imposta su "Sì" per lasciare spazio vuoto alla fine di un carattere o di un tipo di dati di testo. La maggior parte delle origini dati eliminerà automaticamente questo spazio vuoto, ma il comportamento dipende dal driver. |
| CAP_ODBC_TRIM_VARCHAR_PADDING | Imposta su "Sì" per fare in modo che il protocollo ODBC nativo di Tableau elimini gli spazi bianchi finali dalle colonne VARCHAR che il driver ha erroneamente inserito. |
| CAP_ODBC_UNBIND_AUTO | Imposta su "Sì" per fare in modo che il protocollo ODBC nativo di Tableau disaccoppi le colonne e ne rimuova automaticamente l’allocazione, in modo da ridurre le chiamate all’API ODBC. |
| CAP_ODBC_UNBIND_BATCH | Imposta su "Sì" per fare in modo che il protocollo ODBC nativo di Tableau disaccoppi le colonne e ne rimuova l’allocazione in un’unica operazione batch, in modo da ridurre le chiamate all’API ODBC. |
| CAP_ODBC_UNBIND_EACH | Imposta su "Sì" per fare in modo che il protocollo ODBC nativo di Tableau disaccoppi le colonne e ne rimuova l’allocazione singolarmente, il che può migliorare la stabilità. |
| CAP_ODBC_UNBIND_PARAMETERS_BATCH | Imposta su "Sì" per rimuovere l’allocazione di tutti i parametri in un’unica operazione batch. |
| CAP_ORACLE_SHOW_ALL_SYNONYM_OWNERS | Imposta su "Sì" per elencare tutti i proprietari nella vista all_synonyms per Oracle. Questa funzionalità è disponibile nella versione 9.0 e nelle versioni successive. |
| CAP_QUERY_BOOLEXPR_TO_INTEXPR | Imposta su "Sì" se Tableau deve forzare qualsiasi espressione booleana in modo che diventi un valore di numero intero per includerla in un insieme di risultati. |
| CAP_QUERY_FROM_REQUIRES_ALIAS | Imposta su "Sì" se la clausola FROM deve fornire un alias per la tabella specificata. |
| CAP_QUERY_GROUP_ALLOW_DUPLICATES | Imposta su "No" se le query SQL non possono contenere espressioni duplicate nella clausola GROUP BY (si tratta di una condizione non comune). |
| CAP_QUERY_GROUP_BY_ALIAS | Imposta su "Sì" se le query SQL con aggregazioni possono fare riferimento alle colonne di raggruppamento con il loro corrispondente alias nell’elenco SELECT, ad esempio GROUP BY "none_ShipCountry_nk". |
| CAP_QUERY_GROUP_BY_DEGREE | Imposta su "Sì" se le query SQL con aggregazioni possono fare riferimento alle colonne di raggruppamento in base alla posizione ordinale di ogni colonna, ad esempio GROUP BY 2, 5. Vedi anche: CAP_QUERY_SORT_BY_DEGREE |
| CAP_QUERY_HAVING_REQUIRES_GROUP_BY | Imposta su "Sì" se Tableau deve utilizzare un campo di raggruppamento artificiale per qualsiasi query che dispone di una clausola HAVING ma non di colonne di raggruppamento. |
| CAP_QUERY_HAVING_UNSUPPORTED | Imposta su "Sì" se la sintassi SQL per HAVING non è supportata. Tableau potrebbe essere in grado di aggirare questo problema utilizzando le subquery. Vedi anche: CAP_QUERY_SUBQUERIES. |
| CAP_QUERY_INCLUDE_GROUP_BY_COLUMNS_IN_SELECT | Imposta su "Sì" per richiedere che vengano visualizzate tutte le espressioni GROUP BY anche nell’elenco di espressioni SELECT. |
| CAP_QUERY_JOIN_ACROSS_SCHEMAS | Imposta su "Sì" se le query SQL possono esprimere join tra tabelle situate in schemi diversi. |
| CAP_QUERY_JOIN_ASSUME_CONSTRAINED | Imposta su "Sì" per ridurre i join interni anche se le tabelle del database non hanno relazioni FK-PK. |
| CAP_QUERY_JOIN_PUSH_DOWN_CONDITION_EXPRESSIONS | Imposta su "Sì" per riscrivere i join per semplificare le condizioni della clausola ON a semplici confronti tra gli identificatori. |
| CAP_QUERY_JOIN_REQUIRES_SCOPE | Imposta su "Sì" se le query SQL devono includere ogni clausola di join tra parentesi per garantire un corretto ordine di valutazione. |
| CAP_QUERY_JOIN_REQUIRES_SUBQUERY | Imposta su "Sì" per fare in modo che le espressioni di join che coinvolgono più di due tabelle vengano composte con le subquery. |
| CAP_QUERY_NULL_REQUIRES_CAST | Imposta su "Sì" se l’origine dati richiede che tutte le letterali NULL siano impostate su un tipo di dati esplicito. |
| CAP_QUERY_SELECT_ALIASES_SORTED | Imposta su "Sì" se Tableau deve imporre un ordine deterministico alle espressioni SELECT (ordinate per alias) per garantire che i risultati della query possano essere correttamente associati a ciascun campo della visualizzazione di Tableau. Questa operazione è necessaria solo per le origini dati che non mantengono gli alias delle espressioni SELECT durante la restituzione dei metadati con i risultati della query. |
| CAP_QUERY_SORT_BY_DEGREE | Imposta su "Sì" se le query SQL possono fare riferimento alle colonne di ordinamento in base alla posizione ordinale di ogni colonna, ad esempio ORDER BY 2, 5. Vedi anche: CAP_QUERY_GROUP_BY_DEGREE. |
| CAP_QUERY_SUBQUERIES | Imposta su "Sì" se l’origine dati supporta le subquery. |
| CAP_QUERY_SUBQUERIES_WITH_TOP | Imposta su "Sì" se l’origine dati utilizza TOP o LIMIT come clausola di limitazione della riga all’interno di una subquery. |
| CAP_QUERY_SUBQUERY_DATASOURCE_CONTEXT | Imposta su "Sì" per utilizzare il contesto della query filtrato da subquery per implementare i filtri dell’origine dati. Questa funzionalità è disponibile solo nelle versioni da Tableau 8.0 a Tableau 9.3. |
| CAP_QUERY_SUBQUERY_QUERY_CONTEXT | Imposta su "Sì" per forzare l’utilizzo da parte di Tableau di una subquery per i filtri di contesto invece di una tabella temporanea o di risultati memorizzati nella cache locale. |
| CAP_QUERY_TOP_0_METADATA | Imposta su "Sì" se l’origine dati è in grado di gestire una richiesta "TOP 0" per il recupero dei metadati. |
| CAP_QUERY_TOP_N | Imposta su "Sì" se l’origine dati supporta una qualsiasi forma di clausola di limitazione della riga. Di seguito sono descritte le forme esatte supportate. |
| CAP_QUERY_TOPSTYLE_LIMIT | Imposta su "Sì" se l’origine dati utilizza LIMIT come clausola di limitazione della riga. |
| CAP_QUERY_TOPSTYLE_ROWNUM | Imposta su "Sì" se l’origine dati supporta un filtro in stile Oracle o se utilizza ROWNUM come clausola di limitazione della riga. |
| CAP_QUERY_TOPSTYLE_TOP | Imposta su "Sì" se l’origine dati utilizza TOP come clausola di limitazione della riga. |
| CAP_QUERY_USE_QUERY_FUSION | Imposta su "No" per impedire a Tableau di combinare più query singole in un’unica query combinata. Disattiva questa funzionalità per ottimizzare le prestazioni o se il database non è in grado di elaborare query di grandi dimensioni. Questa funzionalità è abilitata per impostazione predefinita ed è disponibile in Tableau 9.0 e versioni successive per tutte le origini dati ad eccezione delle estrazioni dati Tableau. Il supporto di questa funzionalità per le estrazioni dati Tableau è disponibile in Tableau 9.0.6. |
| CAP_QUERY_WHERE_FALSE_METADATA | Imposta su "Sì" se l’origine dati è in grado di gestire un predicato "WHERE <false>" per il recupero dei metadati. |
| CAP_SELECT_INTO | Imposta su "Sì" se Tableau può creare una tabella in tempo reale dall’insieme di risultati di un’altra query. Vedi anche: CAP_CREATE_TEMP_TABLES. |
| CAP_SELECT_TOP_INTO | Imposta su "Sì" se Tableau può utilizzare una clausola TOP o LIMIT per creare una tabella da un insieme di risultati di una query. |
| CAP_STORED_PROCEDURE_PREFER_TEMP_TABLE | Imposta su "Sì" per utilizzare una tabella temporanea per supportare le query remote nell’insieme di risultati di stored procedure. |
| CAP_STORED_PROCEDURE_REPAIR_TEMP_TABLE_STRINGS | Imposta su "Sì" per tentare di calcolare le larghezze effettive delle stringhe se i metadati indicano una larghezza assente o una larghezza non positiva. |
| CAP_STORED_PROCEDURE_TEMP_TABLE_FROM_BUFFER | Imposta su "Sì" per popolare la tabella temporanea da un insieme di risultati con buffering nella sua interezza. |
| CAP_STORED_PROCEDURE_TEMP_TABLE_FROM_NEW_PROTOCOL | Imposta su "Sì" per popolare la tabella temporanea da un protocollo separato creato per questa sola operazione. |
| CAP_SUPPRESS_DISCOVERY_QUERIES | Imposta su "Sì" per impedire a Tableau il rilevamento della sintassi SQL supportata per una serie di clausole. |
| CAP_SUPPRESS_DISPLAY_LIMITATIONS | Imposta su "Sì" per non visualizzare gli avvisi relativi alle limitazioni per questa origine dati. |
| CAP_CREATE_TEMP_TABLES | Imposta su "Sì" se Tableau può creare tabelle temporanee necessarie per determinate query complesse o ottimizzate. Vedi anche: CAP_SELECT_INTO. |
| CAP_CONNECT_STORED_PROCEDURE | Imposta su "Sì" per consentire il supporto per il collegamento a una stored procedure. |
| CAP_FAST_METADATA | Imposta su "Sì" se disponi di schemi di piccole o medie dimensioni. Questa funzionalità controlla se Tableau deve enumerare tutti gli oggetti immediatamente quando esegui la connessione. Imposta il valore su "Sì" per abilitare questa funzionalità per ottenere prestazioni migliori quando crei nuove connessioni. Disabilita questa funzionalità per consentire la ricerca di tabelle o schemi specifici anziché recuperare tutti gli oggetti. Puoi cercare tutti gli oggetti utilizzando una stringa vuota. Questa funzionalità è disponibile nella versione 9.0 e nelle versioni successive. |
| CAP_ISOLATION_LEVEL_READ_COMMITTED | Imposta su "Sì" per forzare il livello di isolamento delle transazioni su Leggi i dati sottoposti a commit in caso di supporto dell’origine dati. Solo uno dei quattro livelli di isolamento delle transazioni dovrebbe essere impostato su "Sì". Vedi anche: CAP_SET_ISOLATION_LEVEL_VIA_SQL. |
| CAP_ISOLATION_LEVEL_READ_UNCOMMITTED | Imposta su "Sì" per forzare il livello di isolamento delle transazioni su Leggi i dati non sottoposti a commit in caso di supporto dell’origine dati. Solo uno dei quattro livelli di isolamento delle transazioni dovrebbe essere impostato su "Sì". Questa funzionalità può migliorare la velocità riducendo i conflitti di blocco, ma può generare dati parziali o non coerenti nei risultati delle query. Vedi anche: CAP_SET_ISOLATION_LEVEL_VIA_SQL. |
| CAP_ISOLATION_LEVEL_REPEATABLE_READS | Imposta su "Sì" per forzare il livello di isolamento delle transazioni su Letture ripetibili in caso di supporto dell’origine dati. Solo uno dei quattro livelli di isolamento delle transazioni dovrebbe essere impostato su "Sì". Vedi anche: CAP_SET_ISOLATION_LEVEL_VIA_SQL. |
| CAP_ISOLATION_LEVEL_SERIALIZABLE | Imposta su "Sì" per forzare il livello di isolamento delle transazioni su Serializzabile in caso di supporto dell’origine dati. Solo uno dei quattro livelli di isolamento delle transazioni dovrebbe essere impostato su "Sì". Si tratta di un’impostazione molto conservativa che può migliorare la stabilità a scapito delle prestazioni. Vedi anche: CAP_SET_ISOLATION_LEVEL_VIA_SQL. |
| CAP_JDBC_BIND_DETECT_ALIAS_CASE_FOLDING | Imposta su "Sì" per consentire a Tableau di eseguire il rilevamento e il recupero da un’origine dati JDBC che riporta i nomi dei campi in un insieme di risultati utilizzando solo caratteri maiuscoli o minuscoli, invece dei nomi campo previsti. |
| CAP_JDBC_EXPORT_DATA_BATCH | Imposta su "No" per disabilitare l’utilizzo di operazioni batch JDBC per l’inserimento di dati. |
| CAP_JDBC_METADATA_GET_INDEX_INFO | Imposta su "No" per disabilitare la lettura delle informazioni sull’indice. |
| CAP_JDBC_METADATA_READ_FOREIGNKEYS | Imposta su "No" per disabilitare la lettura dei metadati della chiave esterna. |
| CAP_JDBC_METADATA_READ_PRIMARYKEYS | Imposta su "No" per disabilitare la lettura dei metadati della chiave primaria. |
| CAP_JDBC_METADATA_USE_RESULTSET_FOR_TABLE | Imposta su "Sì" per ottenere i metadati delle colonne dall’insieme di risultati di una query select *. Disponibile in Tableau 2020.4 e versioni successive. |
| CAP_JDBC_QUERY_ASYNC | Imposta su "Sì" per eseguire le query su un altro thread. |
| CAP_JDBC_QUERY_CANCEL | Imposta su "Sì" se il driver può annullare le query. |
| CAP_JDBC_QUERY_DISABLE_AUTO_COMMIT | Imposta su "Sì" per disabilitare la modalità di commit automatico predefinita durante l’esecuzione della query. Disponibile in Tableau 2020.4 e versioni successive. |
| CAP_JDBC_QUERY_FORCE_PREPARE | Imposta su "Sì" per preparare sempre la query prima dell’esecuzione. Disponibile in Tableau 2020.4 e versioni successive. |
| CAP_JDBC_SUPPRESS_EMPTY_CATALOG_NAME | Imposta su "Sì" per ignorare un catalogo mancante. |
| CAP_JDBC_SUPPRESS_ENUMERATE_DATABASES | Imposta su "Sì" per disabilitare l’enumerazione dei database. |
| CAP_JDBC_SUPPRESS_ENUMERATE_SCHEMAS | Imposta su "Sì" per disabilitare l’enumerazione degli schemi. |
| CAP_JDBC_METADATA_SUPPRESS_PREPARED_QUERY | Se CAP_JDBC_METADATA_USE_RESULTSET_FOR_TABLE è abilitato, imposta questa funzionalità su "Sì" per disabilitare la preparazione della query utilizzata per leggere i metadati della tabella. L’esecuzione della query verrà racchiusa con una clausola where-false. |
| CAP_JDBC_USE_ADAPTIVE_FETCH_SIZE | Imposta su "Sì" per utilizzare i metadati di ResultSet per determinare la dimensione di recupero ottimale. Potrebbe richiedere l’abilitazione di CAP_JDBC_QUERY_FORCE_PREPARE per funzionare correttamente. Disponibile in Tableau 2020.4 e versioni successive. |
| CAP_MULTIPLE_CONNECTIONS_FROM_SAME_IP | Imposta su "No" per evitare che Tableau crei più di una connessione attiva al database. Si tratta di un’impostazione conservativa che può aumentare la stabilità a scapito delle prestazioni. |
| CAP_QUERY_BOOLEXPR_TO_INTEXPR | Imposta su "Sì" se Tableau deve forzare qualsiasi espressione booleana in modo che diventi un valore di numero intero per includerla in un insieme di risultati. |
| CAP_QUERY_FROM_REQUIRES_ALIAS | Imposta su "Sì" se la clausola FROM deve fornire un alias per la tabella specificata. |
| CAP_QUERY_GROUP_ALLOW_DUPLICATES | Imposta su "No" se le query SQL non possono contenere espressioni duplicate nella clausola GROUP BY (si tratta di una condizione non comune). |
| CAP_QUERY_GROUP_BY_ALIAS | Imposta su "Sì" se le query SQL con aggregazioni possono fare riferimento alle colonne di raggruppamento con il loro corrispondente alias nell’elenco SELECT, ad esempio GROUP BY "none_ShipCountry_nk". |
| CAP_QUERY_GROUP_BY_DEGREE | Imposta su "Sì" se le query SQL con aggregazioni possono fare riferimento alle colonne di raggruppamento in base alla posizione ordinale di ogni colonna, ad esempio GROUP BY 2, 5. Vedi anche: CAP_QUERY_SORT_BY_DEGREE |
| CAP_QUERY_HAVING_REQUIRES_GROUP_BY | Imposta su "Sì" se Tableau deve utilizzare un campo di raggruppamento artificiale per qualsiasi query che dispone di una clausola HAVING ma non di colonne di raggruppamento. |
| CAP_QUERY_HAVING_UNSUPPORTED | Imposta su "Sì" se la sintassi SQL per HAVING non è supportata. Tableau potrebbe essere in grado di aggirare questo problema utilizzando le subquery. Vedi anche: CAP_QUERY_SUBQUERIES. |
| CAP_QUERY_INCLUDE_GROUP_BY_COLUMNS_IN_SELECT | Imposta su "Sì" per richiedere che vengano visualizzate tutte le espressioni GROUP BY anche nell’elenco di espressioni SELECT. |
| CAP_QUERY_JOIN_ACROSS_SCHEMAS | Imposta su "Sì" se le query SQL possono esprimere join tra tabelle situate in schemi diversi. |
| CAP_QUERY_JOIN_ASSUME_CONSTRAINED | Imposta su "Sì" per ridurre i join interni anche se le tabelle del database non hanno relazioni FK-PK. |
| CAP_QUERY_JOIN_PUSH_DOWN_CONDITION_EXPRESSIONS | Imposta su "Sì" per riscrivere i join per semplificare le condizioni della clausola ON a semplici confronti tra gli identificatori. |
| CAP_QUERY_JOIN_REQUIRES_SCOPE | Imposta su "Sì" se le query SQL devono includere ogni clausola di join tra parentesi per garantire un corretto ordine di valutazione. |
| CAP_QUERY_JOIN_REQUIRES_SUBQUERY | Imposta su "Sì" per fare in modo che le espressioni di join che coinvolgono più di due tabelle vengano composte con le subquery. |
| CAP_QUERY_NULL_REQUIRES_CAST | Imposta su "Sì" se l’origine dati richiede che tutte le letterali NULL siano impostate su un tipo di dati esplicito. |
| CAP_QUERY_SELECT_ALIASES_SORTED | Imposta su "Sì" se Tableau deve imporre un ordine deterministico alle espressioni SELECT (ordinate per alias) per garantire che i risultati della query possano essere correttamente associati a ciascun campo della visualizzazione di Tableau. Questa operazione è necessaria solo per le origini dati che non mantengono gli alias delle espressioni SELECT durante la restituzione dei metadati con i risultati della query. |
| CAP_QUERY_SORT_BY_DEGREE | Imposta su "Sì" se le query SQL possono fare riferimento alle colonne di ordinamento in base alla posizione ordinale di ogni colonna, ad esempio ORDER BY 2, 5. Vedi anche: CAP_QUERY_GROUP_BY_DEGREE. |
| CAP_QUERY_SUBQUERIES | Imposta su "Sì" se l’origine dati supporta le subquery. |
| CAP_QUERY_SUBQUERIES_WITH_TOP | Imposta su "Sì" se l’origine dati utilizza TOP o LIMIT come clausola di limitazione della riga all’interno di una subquery. |
| CAP_QUERY_SUBQUERY_DATASOURCE_CONTEXT | Imposta su "Sì" per utilizzare il contesto della query filtrato da subquery per implementare i filtri dell’origine dati. Questa funzionalità è disponibile solo nelle versioni da Tableau 8.0 a Tableau 9.3. |
| CAP_QUERY_SUBQUERY_QUERY_CONTEXT | Imposta su "Sì" per forzare l’utilizzo da parte di Tableau di una subquery per i filtri di contesto invece di una tabella temporanea o di risultati memorizzati nella cache locale. |
| CAP_QUERY_TOP_N | Imposta su "Sì" se l’origine dati supporta una qualsiasi forma di clausola di limitazione della riga. Di seguito sono descritte le forme esatte supportate. |
| CAP_QUERY_TOPSTYLE_LIMIT | Imposta su "Sì" se l’origine dati utilizza LIMIT come clausola di limitazione della riga. |
| CAP_QUERY_TOPSTYLE_ROWNUM | Imposta su "Sì" se l’origine dati supporta un filtro in stile Oracle o se utilizza ROWNUM come clausola di limitazione della riga. |
| CAP_QUERY_TOPSTYLE_TOP | Imposta su "Sì" se l’origine dati utilizza TOP come clausola di limitazione della riga. |
| CAP_QUERY_USE_QUERY_FUSION | Imposta su "No" per impedire a Tableau di combinare più query singole in un’unica query combinata. Disattiva questa funzionalità per ottimizzare le prestazioni o se il database non è in grado di elaborare query di grandi dimensioni. Questa funzionalità è abilitata per impostazione predefinita ed è disponibile in Tableau 9.0 e versioni successive per tutte le origini dati ad eccezione delle estrazioni dati Tableau. Il supporto di questa funzionalità per le estrazioni dati Tableau è disponibile in Tableau 9.0.6. |
| CAP_SELECT_INTO | Imposta su "Sì" se Tableau può creare una tabella in tempo reale dall’insieme di risultati di un’altra query. Vedi anche: CAP_CREATE_TEMP_TABLES. |
| CAP_SELECT_TOP_INTO | Imposta su "Sì" se Tableau può utilizzare una clausola TOP o LIMIT per creare una tabella da un insieme di risultati di una query. |
| CAP_SET_ISOLATION_LEVEL_VIA_SQL | Imposta su "Sì" per forzare l’impostazione da parte di Tableau del livello di isolamento delle transazioni per l’origine dati utilizzando una query ODBC. CAP_SET_ISOLATION_LEVEL_VIA_SQL deve essere impostato su "Sì" quando una delle quattro funzionalità di CAP_ISOLATION_LEVEL è stata impostata su "Sì". |
| CAP_STORED_PROCEDURE_PREFER_TEMP_TABLE | Imposta su "Sì" per utilizzare una tabella temporanea per supportare le query remote nell’insieme di risultati di stored procedure. |
| CAP_STORED_PROCEDURE_REPAIR_TEMP_TABLE_STRINGS | Imposta su "Sì" per tentare di calcolare le larghezze effettive delle stringhe se i metadati indicano una larghezza assente o una larghezza non positiva. |
| CAP_STORED_PROCEDURE_TEMP_TABLE_FROM_BUFFER | Imposta su "Sì" per popolare la tabella temporanea da un insieme di risultati con buffering nella sua interezza. |
| CAP_STORED_PROCEDURE_TEMP_TABLE_FROM_NEW_PROTOCOL | Imposta su "Sì" per popolare la tabella temporanea da un protocollo separato creato per questa sola operazione. |
| CAP_SUPPRESS_DISCOVERY_QUERIES | Imposta su "Sì" per impedire a Tableau il rilevamento della sintassi SQL supportata per una serie di clausole. |
| CAP_SUPPRESS_DISPLAY_LIMITATIONS | Imposta su "Sì" per non visualizzare gli avvisi relativi alle limitazioni per questa origine dati. |
| SQL_ODBC_INTERFACE_CONFORMANCE | Attualmente non utilizzato. |
| SQL_SQL_CONFORMANCE | Bitmask intera. Definisce il livello di conformità dell’origine dati allo standard SQL: "1" per la conformità SQL-92 di livello base, "2" per la transizione FIPS 127-2, "4" per il livello intermedio e "8" per la piena conformità. |
| SQL_CATALOG_USAGE | Bitmask intera. Definisce le istruzioni SQL in cui è possibile utilizzare un identificatore di catalogo. |
| SQL_SCHEMA_USAGE | Bitmask intera. Definisce le istruzioni SQL in cui è possibile utilizzare un identificatore di schema. |
| SQL_AGGREGATE_FUNCTIONS | Bitmask intera. Definisce quali moduli di aggregazione standard SQL sono supportati. |
| SQL_NUMERIC_FUNCTIONS | Bitmask intera. Definisce le funzioni numeriche scalari SQL supportate. |
| SQL_STRING_FUNCTIONS | Bitmask intera. Definisce le funzioni di stringa scalari SQL supportate. |
| SQL_TIMEDATE_FUNCTIONS | Bitmask intera. Definisce le funzioni di data/ora scalari SQL supportate. |
| SQL_TIMEDATE_ADD_INTERVALS | Bitmask intera. Definisce quali intervalli di data/ora sono supportati con la funzione scalare TIMESTAMPADD. |
| SQL_TIMEDATE_DIFF_INTERVALS | Bitmask intera. Definisce quali intervalli di data/ora sono supportati con la funzione scalare TIMESTAMPDIFF. |
| SQL_DATETIME_LITERALS | Bitmask intera. Definisce quali letterali SQL-92 sono supportate per rappresentare le costanti DATA/ORA e gli INTERVALLI. |
| SQL_SYSTEM_FUNCTIONS | Bitmask intera. Definisce il supporto per speciali funzioni scalari del sistema SQL: IFNULL, DBNAME e USERNAME. |
| SQL_SQL92_VALUE_EXPRESSIONS | Bitmask intera. Definisce quali funzioni logiche sono supportate per testare e manipolare i valori: CASE, CAST e NULLIF. |
| SQL_SQL92_NUMERIC_VALUE_FUNCTIONS | Bitmask intera. Definisce quali funzioni possono produrre un valore numerico da dati non numerici, inclusi: EXTRACT (per l’estrazione della parte di data/ora), CHAR_LENGTH, CHARACTER_LENGTH e POSITION(.. IN ..). |
| SQL_SQL92_STRING_FUNCTIONS | Bitmask intera. Definisce le funzioni di manipolazione stringa supportate. |
| SQL_SQL92_DATETIME_FUNCTIONS | Bitmask intera. Definisce quali funzioni di manipolazione di data/ora sono supportate per determinare la data, l’ora o il timestamp corrente. |
| SQL_OJ_CAPABILITIES | Bitmask intera. Definisce il tipo di join esterno supportato. |
| SQL_SQL92_RELATIONAL_JOIN_OPERATORS | Bitmask intera. Definisce quali tipi di operatori JOIN sono supportati, ad esempio INNER, OUTER. |
| SQL_SQL92_PREDICATES | Bitmask intera. Definisce i predicati supportati per i test logici di valori, ad esempio IS NULL, LIKE, IN. |
| SQL_CONVERT_FUNCTIONS | Bitmask intera. Definisce le funzioni ODBC scalari supportate per la trasmissione o la conversione di un tipo di dati in un altro. |
| SQL_CONVERT_TINYINT | Bitmask intera. Determina in quali altri tipi di dati questo tipo di dati può essere convertito utilizzando la funzione scalare ODBC CONVERT. |
| SQL_CONVERT_SMALLINT | Bitmask intera. Come sopra. |
| SQL_CONVERT_INTEGER | Bitmask intera. Come sopra. |
| SQL_CONVERT_BIGINT | Bitmask intera. Come sopra. |
| SQL_CONVERT_REAL | Bitmask intera. Come sopra. |
| SQL_CONVERT_FLOAT | Bitmask intera. Come sopra. |
| SQL_CONVERT_DOUBLE | Bitmask intera. Come sopra. |
| SQL_CONVERT_CHAR | Bitmask intera. Come sopra. |
| SQL_CONVERT_VARCHAR | Bitmask intera. Come sopra. |
| SQL_CONVERT_LONGVARCHAR | Bitmask intera. Come sopra. |
| SQL_CONVERT_DECIMAL | Bitmask intera. Come sopra. |
| SQL_CONVERT_NUMERIC | Bitmask intera. Come sopra. |
| SQL_CONVERT_BIT | Bitmask intera. Come sopra. |
| SQL_CONVERT_GUID | Bitmask intera. Come sopra. |
| SQL_CONVERT_BINARY | Bitmask intera. Come sopra. |
| SQL_CONVERT_VARBINARY | Bitmask intera. Come sopra. |
| SQL_CONVERT_LONGVARBINARY | Bitmask intera. Come sopra. |
| SQL_CONVERT_DATE | Bitmask intera. Come sopra. |
| SQL_CONVERT_TIME | Bitmask intera. Come sopra. |
| SQL_CONVERT_TIMESTAMP | Bitmask intera. Come sopra. |
| SQL_CONVERT_INTERVAL_DAY_TIME | Bitmask intera. Come sopra. |
| SQL_CURSOR_COMMIT_BEHAVIOR | Valore intero breve. "0" se le dichiarazioni preparate sono chiuse al momento del commit per l’origine dati. |
| SQL_MAX_IDENTIFIER_LEN | Valore intero. Definisce il numero massimo di caratteri che possono essere utilizzati in un identificatore. Tableau lascia spazio per un carattere aggiuntivo come terminatore di stringa. |
| SQL_TXN_CAPABLE | Valore intero breve. "0" se l’origine dati non supporta la transazione. |
| SQL_QUOTED_IDENTIFIER_CASE | Bitmask intera. |
| SQL_COLUMN_ALIAS | Valore booleano. "Y" se l’origine dati supporta l’uso di alias per le colonne indicate nella clausola SELECT. |
| SQL_IDENTIFIER_QUOTE_CHAR | Valore della stringa. Indica il carattere che può essere utilizzato per gli identificatori delle offerte. Poiché la personalizzazione della connessione è un documento XML, qualsiasi entità deve essere correttamente codificata. Per esempio, le virgolette doppie saranno """. Inoltre, si presume che questo carattere funzioni come carattere di apertura e chiusura intorno agli identificatori, per cui alcune origini dati che richiedono "[]" per racchiudere gli identificatori non saranno supportate. |
| SQL_CATALOG_NAME_SEPARATOR | Valore di carattere. Indica il carattere separatore da utilizzare tra gli identificatori per qualificarli con un catalogo, uno schema o un nome tabella. Questo è in genere il carattere del periodo. |
| SQL_SPECIAL_CHARACTERS | Valore della stringa. Indica i caratteri speciali consentiti nelle stringhe di identificatore. |
| SQL_CATALOG_TERM | Valore della stringa. Questo è il termine descrittivo di un catalogo di database, che appare nella finestra di dialogo di connessione di Tableau per questa origine dati ODBC. |
| SQL_SCHEMA_TERM | Valore della stringa. Questo è il termine descrittivo di uno schema di database, che appare nella finestra di dialogo di connessione di Tableau per questa origine dati ODBC. |
| SQL_TABLE_TERM | Valore della stringa. Questo è il termine descrittivo di una tabella di database, che appare nella finestra di dialogo di connessione di Tableau per questa origine dati ODBC. |
| SQL_DRIVER_NAME | Valore della stringa. Nome del driver ODBC del database. |
| SQL_DRIVER_VER | Valore della stringa. Numero di versione del driver ODBC. |
| SQL_DRIVER_ODBC_VER | Valore della stringa. Versione dell’API ODBC supportata dal driver. |
| SQL_ODBC_VER | Valore della stringa. Versione di ODBC supportata da Windows ODBC Driver Manager. Non deve necessariamente essere personalizzato. |
| SQL_DBMS_NAME | Valore della stringa. Questo è il nome del fornitore del database. |
| SQL_DBMS_VER | Valore della stringa. Questa è la versione del sistema di database. |
| SQL_SERVER_NAME | Valore della stringa. Indirizzo di rete denominato del server di database. |
| SQL_USER_NAME | Valore della stringa. Nome dell’utente attualmente autenticato. |
| F4 | Avvia e arresta la riproduzione in avanti |
| SHIFT + F4 | Avvia e arresta la riproduzione indietro |
| Ctrl + . | Salta avanti di una pagina |
| Ctrl + , | Salta indietro di una pagina |
| F4 | Avvia e arresta la riproduzione in avanti |
| Maiusc+F4 | Avvia e arresta la riproduzione indietro |
| Comando + . | Salta avanti di una pagina |
| Comando + , | Salta indietro di una pagina |
 | Mostra pellicola: mostra i fogli come anteprime nella parte inferiore dell’area di lavoro. |
 | Mostra schede: mostra le schede del foglio nella parte inferiore dell’area di lavoro. |
 | Foglio precedente/successivo: consente di avanzare in avanti o indietro lungo i fogli di una cartella di lavoro. |
 | Passa a schermo intero/Esci da schermo intero: consente di passare dall’espansione della cartella di lavoro a schermo intero alla visualizzazione in una finestra e viceversa. |
| Esci dalla modalità Presentazione: riporta la cartella di lavoro alla visualizzazione dell’intera area di lavoro, inclusi i menu, la barra degli strumenti e il riquadro Dati. |
| Messaggio di errore | Suggerimento per la risoluzione |
| Non è possibile derivare una data continua a partire dai campi data nella vista. | La previsione richiede un campo data che può essere interpretato continuamente. Se il campo data non è esplicitamente continuo, è necessario che uno dei livelli di data inclusi sia Anno. Questo errore viene restituito se nella vista non sono presenti date o se le date nella vista non costituiscono una gerarchia completa (ad esempio, la data include Anno e Giorno ma non Mese) o se costituiscono una gerarchia non compatibile (ad esempio Anno, Settimana, Giorno). |
| La serie temporale è troppo breve per effettuare previsioni. | Espandi le serie temporali nella vista per includere più valori di data. Questo errore viene restituito se vi sono meno di quattro punti data dopo aver tagliato i periodi finali non affidabili o parziali che potrebbero falsare la previsione. |
| Non è possibile calcolare una previsione per una serie temporale con valori data NULL. | Elimina i valori NULL dal campo data o dai campi della vista, filtrando il campo data o utilizzando una granularità della data meno dettagliata (ad esempio, passando da mesi a trimestri). |
| Una previsione non può essere calcolata quando la vista contiene più campi datati distinti. | Questo errore si genera se nella vista sono presenti più campi data. Ad esempio, se Data ordine e Data spedizione sono nella stessa vista, la previsione non è supportata. |
| Il valore "Aggregato per" selezionato nelle opzioni di previsione non è compatibile con la visualizzazione. | La data nella vista deve essere compatibile con il valore di Aggregato per nella finestra di dialogo Opzioni di previsione. Ad esempio, se Aggregato per è definito in Settimane e la data della vista è definita in Mesi, si verifica questo errore. Modifica una delle date in modo che siano compatibili o imposta Aggregato per in Automatico. |
| Impossibile calcolare una previsione in quanto vi sono troppi valori mancanti. | Questo errore viene restituito se risulta mancante più del 40% dei dati. La selezione di Compila i valori mancanti con gli zeri nella finestra di dialogo Opzioni di previsione non risolve questo errore. Aggrega i dati a un livello di dettaglio superiore rimuovendo le dimensioni o cambiando il livello di data, ad esempio da "Settimane" a "Mesi". In caso contrario, devi modificare i dati di origine o utilizzare dati da un’origine diversa. |
| Nessuna misurazione da prevedere. | Questo errore viene restituito se nella vista non è presente alcuna misurazione da prevedere. Le misurazioni di previsione devono essere nello spazio Righe o Colonne, oppure nella scheda Indicatori. |
| La misurazione da prevedere deve essere un numero. | Alcune misurazioni non possono essere interpretate numericamente e quindi non possono essere previste. |
| Non è possibile calcolare una previsione per una dimensione. | Il valore da prevedere deve essere una misurazione e non una dimensione. |
| Sono presenti troppi dati per calcolare una previsione. | La previsione non è possibile quando il risultato ottenuto dalla query è troppo grande. Il limite è di circa 10.000 righe. Per correggere la previsione, aggrega il valore della serie temporale a un livello superiore (ad esempio, Mese anziché Settimana) o filtra i dati. |
| Non è possibile creare una previsione poiché i dati sono suddivisi in troppe righe, colonne o colori. | Semplifica la vista per risolvere l’errore filtrando o rimuovendo alcune delle dimensioni. |
| Non è possibile calcolare una previsione poiché la vista contiene calcoli della tabella. | Crea una versione della vista non contenenti calcoli della tabella. |
| Non è possibile calcolare una previsione poiché è presente una misurazione nello spazio Filtri. | Rimuovi le misurazioni dallo spazio Filtri. |
| Non è possibile calcolare una previsione poiché non è stata selezionata la voce Aggrega misure. | Aggrega misure è un’opzione del menu Analisi. Vedi Aggregazione di dati in Tableau e Come disaggregare i dati. |
| Non è possibile calcolare una previsione poiché la vista contiene calcoli percentuali. | Percentuale di è un’opzione del menu Analisi. Vedi Calcolo di Percentuali in Tableau. |
| Non è possibile calcolare una previsione poiché l’opzione Totali complessivi o Subtotali è abilitata. | Queste opzioni sono controllate dal comando Totali nel menu Analisi. Vedi Mostra totali in una visualizzazione. |
| Impossibile calcolare un modello moltiplicativo perché la misura da prevedere ha uno o più valori inferiori o uguali a zero. | Hai creato un modello personalizzato con Trend o Stagionalità impostati su Moltiplicativo. Modifica questo valore o imposta il Modello di previsione su Automatico. |
| Un modello con tendenza moltiplicativa e stagione additiva non è consentito perché numericamente instabile. | Hai creato un modello personalizzato configurato come descritto nel messaggio di errore. Modifica le impostazioni per il modello personalizzato o imposta il modello di previsione su Automatico. |
| Impossibile completare un modello stagionale perché la serie temporale è troppo breve. | Espandi le serie temporali nella vista per includere più valori di data. |
| Il modello moltiplicativo selezionato non può essere calcolato poiché alcuni dati sono troppo vicini allo zero rispetto al resto dei dati. | Hai creato un modello personalizzato configurato come descritto nel messaggio di errore. Modifica le impostazioni per il modello personalizzato o imposta il modello di previsione su Automatico. |
Origine dati primaria  | Origine dati secondaria  |
| Messaggio di errore | Commenti |
| Tipo non supportato passato come argomento alla funzione SCRIPT. | Tableau può solo esportare i seguenti tipi di dati in R:
|
| Numero inatteso di risultati restituito dalla funzione SCRIPT. Funzione prevista: sono stati restituiti i valori %2 e valori %1. | Il risultato dello script deve essere scalare o vettore di lunghezza che viene replicato per tutte le righe oppure un vettore di lunghezza uguale al numero di righe nella tabella dei risultati di Tableau. |
| File di certificato non valido per la connessione specificata (%1 %2:%3). Verifica che sia utilizzato lo stesso certificato sia per il server che per client, che il file di certificato non sia danneggiato e che contenga date valide. | Verifica che il certificato utilizzato per connettersi al servizio esterno sia codificato e formattato correttamente. Devi connetterti con un certificato con codifica PEM x509 valido con l’estensione .crt. |
| Il risultato restituito dalla funzione SCRIPT è di tipo imprevisto. | Si verifica quando viene ricevuto un tipo di dati non valido. Tableau può solo i tipi di dati seguenti da un server Rserve:
Per TabPy, Tableau può importare i seguenti tipi di dati:
Questo errore viene segnalato anche se il risultato è null o se è stato generato un errore di esecuzione dello script per cui Tableau non ha potuto ottenere una spiegazione dal server esterno. |
| Si è verificato un errore nella comunicazione con il servizio esterno. | Tableau esegue tutti gli script esterni all’interno della funzione "try". Questo errore viene visualizzato insieme a un messaggio di errore external-service-generated quando la funzione "try" rileva un errore di valutazione. |
| Questa connessione al servizio esterno non supporta l’autenticazione. Prova a collegarti senza specificare una password. | |
| Autenticazione non riuscita. Fornisci un nome utente e una password di servizio esterno validi. | |
| Nel servizio esterno viene attivato un tipo di autenticazione non supportato. | Disabilita l’autenticazione dei servizi esterni o passa all’autenticazione con password basata su testo semplice. |
| Nessuna connessione di servizio esterna configurata. Specifica un nome server e riprova. | Vedi Passare espressioni con le estensioni di analisi |
| Il calcolo '%1' contiene una funzione SCRIPT_ che richiede una connessione al servizio interno. Configura la connessione al servizio esterno per abilitare gli script personalizzati. | Vedi Passare espressioni con le estensioni di analisi |
| La cartella di lavoro che stai tentando di pubblicare contiene funzioni SCRIPT_ che richiedono una connessione al servizio esterno. Gli script personalizzati non sono consentiti nelle cartelle di lavoro pubbliche. | Non è possibile pubblicare cartelle di lavoro contenenti script di servizio esterni su Tableau Public. |
| Tableau Public non supporta l’esecuzione di script personalizzati che richiedono servizi esterni. Per usufruire dei servizi esterni, passa a Tableau Desktop Professional Edition. | Il "Tableau Public" di questo errore si riferisce a Tableau Desktop Public. |
| Tableau Reader non supporta l’esecuzione di script personalizzati che richiedono servizi esterni. Per usufruire dei servizi esterni, passa a Tableau Desktop Professional Edition. | Non è possibile visualizzare le cartelle di lavoro contenenti script di servizio esterni in Tableau Reader. |
| Messaggio di errore | Commenti |
| Firma Rserve non riconosciuta. | La firma dell’intestazione Rserve deve essere "Rsrv". |
| Versione Rserve non riconosciuta. | La versione dell’intestazione Rserve deve essere "0103". |
| Protocollo Rserve non riconosciuto. | Il protocollo di intestazione Rserve deve essere "QAP1". |
| Errore di autenticazione durante la connessione a R. | Tableau ha tentato di eseguire l’autenticazione con Rserve, ma ha avuto esito negativo. Verifica di aver immesso una password valida. |
| Numero di byte errato nel parametro/corpo. | |
| La lunghezza dei dati letti da Tableau non equivale alla lunghezza garantita dall’intestazione. | |
| Tipo di risposta non riconosciuto. | Il tipo di protocollo di trasporto durante la lettura di un risultato non era SEXP come previsto. |
| Vettore <type> eccessivamente lungo. | Numero irragionevolmente elevato che misura la lunghezza dei dati inviati a o da Rserve, che potrebbe indicare un’intestazione di protocollo danneggiata. |
| Comando Rserve non valido. | Tableau potrebbe avere erroneamente implementato il protocollo Rserve. |
La risposta del server è stata Errore << (uint32_t)status <<. Per maggiori informazioni, consulta Rsrv.h. | Le varie condizioni di errore sono documentate nei commenti di Rsrv.h. |
| Offset dell’intestazione eccessivamente lungo. | Ciò potrebbe essere dovuto a un’intestazione non corretta con un offset irragionevole ai dati di risposta. |
| Socket Rserve non riuscito. | Un’eccezione di accesso, un controllo in sospeso di lettura, la lettura di un risultato o un’assegnazione di un campo Tableau a un argomento script R ha sollevato un’eccezione non standard. |
| Il servizio esterno utilizza un tipo di autenticazione non supportato. | Per supportare l’esecuzione di connessioni sia abilitate SSL che in testo semplice a un’istanza di Rserve, l’amministratore del server Rserve deve aggiungere la voce seguente al file di configurazione Rserve nel server Rserve:
|
| Si è verificato un errore del sistema crittografico su RServe. | Si è verificato un errore con il sistema di crittografia di RServe. Per maggiori informazioni, vedere i log di RServe. |
| RServe ha avviato la chiusura a causa di una violazione della sicurezza. | RServe ha avviato la chiusura della connessione a causa di una violazione della sicurezza. Per maggiori informazioni, vedere i log di RServe. |
| La configurazione del servizio esterno è impostata per una connessione sicura, ma non dispone di un certificato. | Quando si stabilisce una connessione protetta a un servizio esterno, è necessario caricare il certificato con cui prevedi che il servizio esterno venga firmato. Le connessioni ai server non firmate da questo certificato verranno rifiutate. In questo modo si inviano solo i dati ai server attendibili. |
| File di certificato non valido per la connessione specificata (%1 %2:%3). Verifica che lo stesso certificato sia utilizzato sia per server sia per client, che il file di certificato non sia danneggiato e che contenga date valide | Il certificato fornito non è valido per questa configurazione della connessione. Verifica che corrisponda alla firma del certificato del server del servizio esterno, che presenti la codifica PEM e che sia valido per la data odierna. |
| Il certificato di connessione al servizio esterno non è valido | Il certificato fornito non è valido. Verifica che il certificato presenti la codifica PEM e che sia valido per la data odierna. |
| La connessione del servizio esterno non è riuscita a creare il contesto SSL/TLS | Tableau non è riuscito a inizializzare un ambiente sicuro per questa configurazione del Servizio esterno. Verifica che l’host e la porta siano corretti e che il certificato sia valido. |
| Non è stato possibile connettere il servizio esterno con SSL/TLS | Tableau non è riuscito a stabilire una connessione protetta al Servizio esterno. Verifica che il Servizio esterno sia configurato per supportare la connessione protetta e che il certificato fornito corrisponda a quello che ha fornito il Servizio esterno. |
| Il protocollo del server del servizio esterno non è riconosciuto | Un protocollo è stato aggiunto all’host che non è riconosciuto o supportato da Tableau. Se ti connetti a RServe, non è previsto alcun protocollo. Se ti connetti a TabPy, il protocollo HTTP è previsto quando si stabilisce una connessione di testo semplice e il protocollo HTTPS è previsto quando si stabilisce una connessione protetta. |
Tabella 1
| Tabella 2
|
| ID dipendente | Nome | Stipendio | Reparto | Data di noleggio | Organizzazione |
| 20107 | Rossi, Mario | 61.000 | Assistenza | 28/07/2015 | Operazioni |
| 20107 | Rossi, Mario | 61.000 | Vendite | 25/08/2016 | Operazioni |
| Prima | Dopo |
|---|---|
 |  |
| Runner | Action | Time |
|---|---|---|
| Amanda | Inizio | 9/3/2016 3:04 PM |
| Oscar | Inizio | 9/3/2016 3:04 PM |
| William | Inizio | 9/3/2016 3:04 PM |
| Amanda | End | 9/3/2016 3:25 PM |
| Oscar | End | 9/3/2016 3:21 PM |
| William | End | 9/3/2016 3:16 PM |
| Connessione live | Connessione dell’estrazione |
 |  |
| Alias nascosti | Alias visualizzati |
 |  |
Modifiche nel tempo
Argomenti correlati
|
Mostrare una modifica nel tempo di una misura è una delle categorie fondamentali delle visualizzazioni. Sono disponibili molte opzioni per esplorare le modifiche nel tempo, tra cui grafici a linee, a pendenza e a barre. Per mostrare la modifica nel tempo, devi conoscere il valore che prevedi di modificare e sapere come usare i campi di Data in Tableau. A quale domanda risponde questo grafico?
|
Correlazione
Argomenti correlati
|
Può capitare di avere due variabili e di cercare la relazione tra di esse. Potresti cercare, ad esempio, la relazione tra le dimensioni della classe e il tasso di raggiungimento del titolo scolastico oppure quanta capacità polmonare sta in relazione alla resistenza. Ricordate, tuttavia, che la correlazione non è sempre uguale al nesso di causalità. La correlazione può essere visualizzata con i grafici a dispersione o con le tabelle in evidenza ed è possibile utilizzare gli oggetti di analisi di Tableau per mostrare la forza della correlazione. A quali domande può rispondere questo grafico?
|
Magnitudo
Argomenti correlati
|
La magnitudo mostra la dimensione relativa o il valore di due o più elementi distinti. Se metti a confronto le vendite di aree diverse, devi osservare la magnitudo. I grafici di intensità includono grafici a barre, grafici a bolle in pacchetti e grafici a linee. A quali domande può rispondere questo grafico?
|
Deviazione
Argomenti correlati
|
I grafici di deviazione mostrano la variazione di un valore da una certa linea di base, ad esempio la media o la mediana. Utilizzeresti un grafico di deviazione per sapere quali elementi hanno ottenuto profitti insolitamente alti o bassi. Puoi usare grafici bullet, grafici a barre e grafici combinati per mostrare la deviazione. Puoi inoltre trovare il significato statistico della deviazione utilizzando un punteggio Z. A quali domande può rispondere questo grafico?
|
Distribuzione
Argomenti correlati
|
Quando cerchi di trovare la frequenza degli eventi all’interno di un popolo, ne stai osservando la distribuzione. Se desideri mostrare il numero di partecipanti a un sondaggio in base all’età o alla frequenza delle chiamate in arrivo in una giornata, un grafico di distribuzione può essere la scelta migliore. I grafici di distribuzione includono istogrammi, piramidi della popolazione, grafici di Pareto e diagrammi a scatola. A quali domande può rispondere questo grafico?
|
Classifica
Argomenti correlati
|
Può capitare che tu voglia non solo raffigurare la grandezza di alcuni valori ma anche la relativa classificazione di tutti i membri della dimensione. Utilizza un diagramma di classificazione per mostrare i dieci migliori venditori o per dimostrare le situazioni di prestazioni più basse del previsto. I grafici di classificazione in genere integrano calcoli Classificazione, set per Principali N o indicatori chiave di prestazione. A quali domande può rispondere questo grafico?
|
Relazione parte-tutto
Argomenti correlati
|
I grafici parte-tutto mostrano la quantità di un insieme rappresentata da un singolo componente. Ad esempio, se devi mostrare quanto ogni area contribuisca alle vendite complessive o i costi di spedizione per un singolo prodotto, utilizzerai un grafico parte-tutto. I grafici parte-tutto possono essere grafici a torta, grafici ad area, grafici a barre in pila o grafici ad albero. A quali domande può rispondere questo grafico?
|
Spaziale
Argomenti correlati
|
I grafici spaziali possono indicare con precisione la posizione e i modelli geografici dei tuoi dati. Sono esempi di grafici spaziali la rappresentazione dei terminal aeroportuali con il traffico pedonale più intenso o la mappa di tutte le vendite nel territorio nazionale. I grafici spaziali includono mappe colorate, mappe con ripartizione puntiforme, mappe dei simboli e mappe di densità. A quali domande può rispondere questo grafico?
|
Flusso
Argomenti correlati
|
I diagrammi di flusso possono essere mappe che trasmettono il movimento nel tempo, come i diagrammi di Sankey. Le mappe di flusso includono il percorso nel tempo e il percorso tra origine e grafici di destinazione. A quali domande può rispondere questo grafico?
|


| Componenti | Sintassi | Esempio |
Funzioni | Per esempi su come formattare tutte le funzioni in Tableau, consulta Funzioni di Tableau (in ordine alfabetico) o Funzioni di Tableau (per categoria). |
|
Campi | Un campo di un calcolo è spesso racchiuso tra parentesi quadre [ ]. Per maggiori informazioni, consulta Sintassi dei campi . |
|
Operatori |
Per informazioni sui tipi di operatori che puoi utilizzare nei calcoli Tableau e sull’ordine di esecuzione in una formula, consulta Sintassi degli operatori. |
|
Espressioni letterali | Le espressioni letterali numeriche vengono scritte come numeri. Le espressioni letterali stringa vengono scritte tra virgolette. Le espressioni letterali data vengono scritte con il simbolo #. Le espressioni letterali booleane vengono scritte come vere o false. Le espressioni letterali NULL vengono scritte come NULL. Per maggiori informazioni, consulta Sintassi delle espressioni letterali. |
|
Parametri | Un parametro in un calcolo è racchiuso tra parentesi quadre [ ], come un campo. Per maggiori informazioni, consulta Creare parametri. |
|
Commenti | Per inserire un commento in un calcolo, digita due barre //. Per maggiori informazioni, consulta Aggiungere commenti a un calcolo. È possibile aggiungere commenti su più righe digitando /* per iniziare il commento e */ per terminarlo. |
|