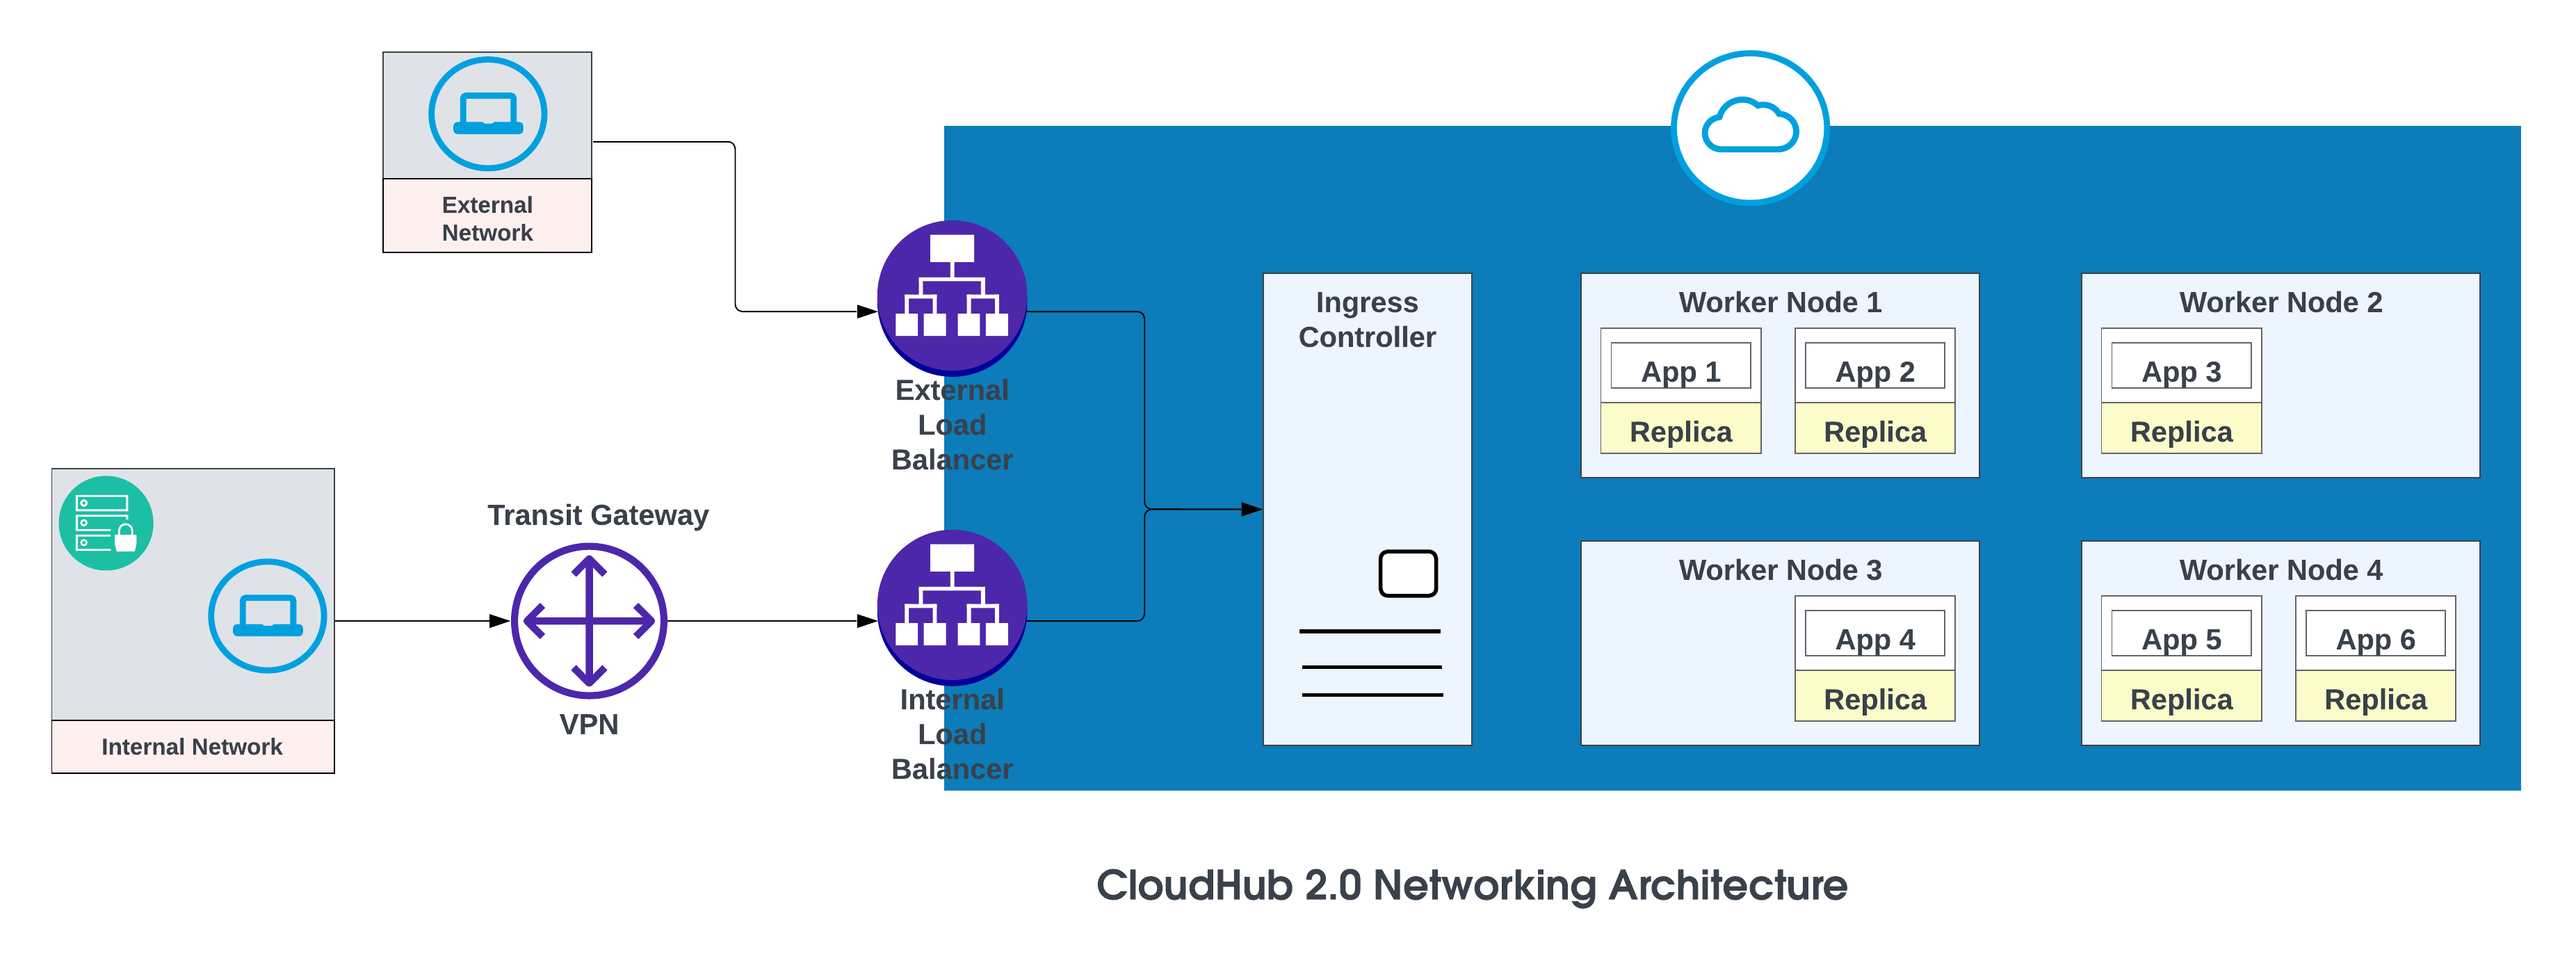
 CloudHub 2.0 網路結構的基本元件有:
- HTTP 負載平衡程式
- 模擬複本 DNS 記錄
- 私人空間
- 區域服務
如需詳細資料,請參閱 [CloudHub 2.0 網路結構](https://docs.mulesoft.com/cloudhub-2/ch2-networking-guide)。
**虛名網域**
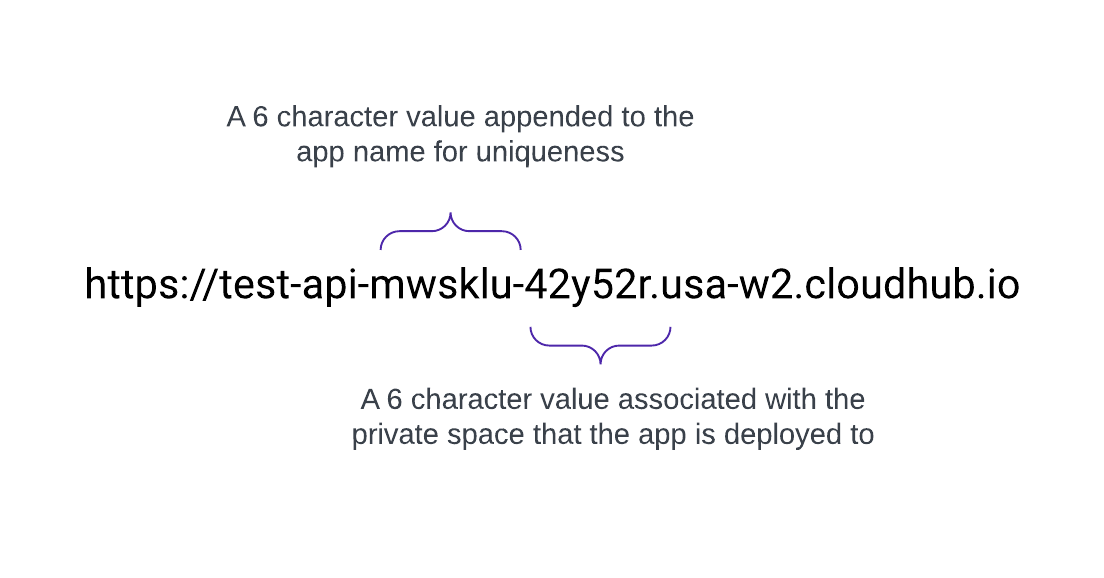
建立「私人空間」時,會收到格式為 \
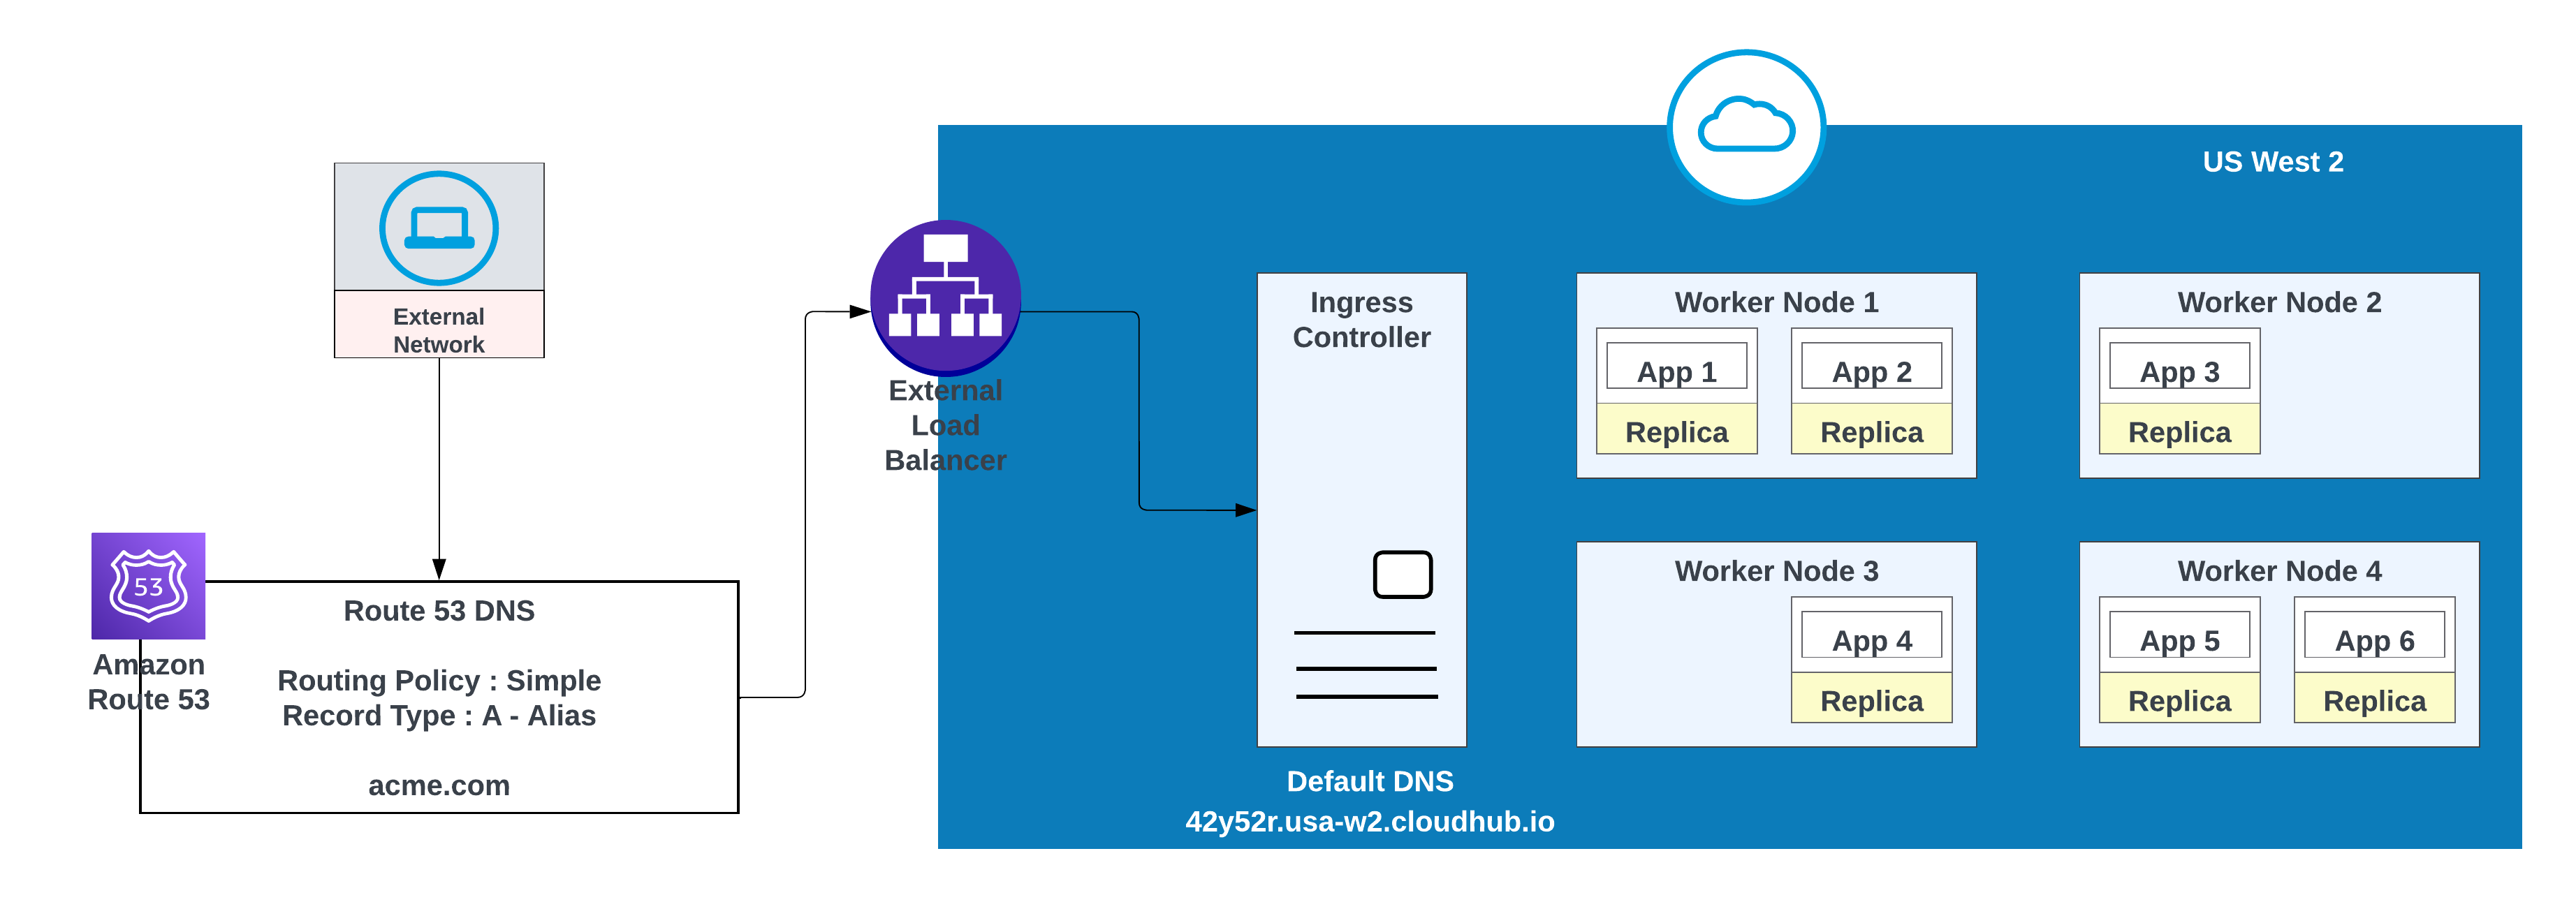
 CloudHub 2.0 也支援使用 TLS 內容和 DNS 記錄在「私人空間」內設定自訂或虛名網域。若要在「私人空間」的「執行階段管理員」中建立 TLS 內容,請上載公用憑證和私人金鑰,然後在應用程式設定中新增自訂端點以使用該網域。建立 DNS 記錄 (例如 CNAME),將您的虛名網域指向您私人空間的預設主機名稱。
例如,在 us-west-2 中部署的名為 test-api 應用程式,其預設 DNS 42y52r.usa-w2.cloudhub.io 的 API 端點為:
https://test-api-mwsklu-42y52r.usa-w2.cloudhub.io
此 URL 不使用虛名或自訂網域。若要使用 [acme.com](https://acme.com) 讓 API URL 顯示為 [https://test-api.acme.com](https://test-api.acme.com),請遵循以下步驟。
1. 使用公用和私人金鑰在執行階段管理員中建立 TLS 內容。
2. 在應用程式的設定中新增虛名網域,以使用該網域。
3. 在 AWS Route 53 中建立 DNS 記錄,並設定簡單的路由原則 (例如 CNAME),讓虛名網域解析為私人空間的預設主機名稱。
針對自訂網域,您可以透過路由原則使用 AWS Route 53 或任何其他全域 CDN 服務。在下圖中,AWS Route 53 會與「簡單」路由原則搭配使用。當公用 (外部) 網路中的取用者要求 acme.com 時,AWS 路由 53 會將要求路由至 MuleSoft 私人空間進入控制項。
 ## 失敗策略
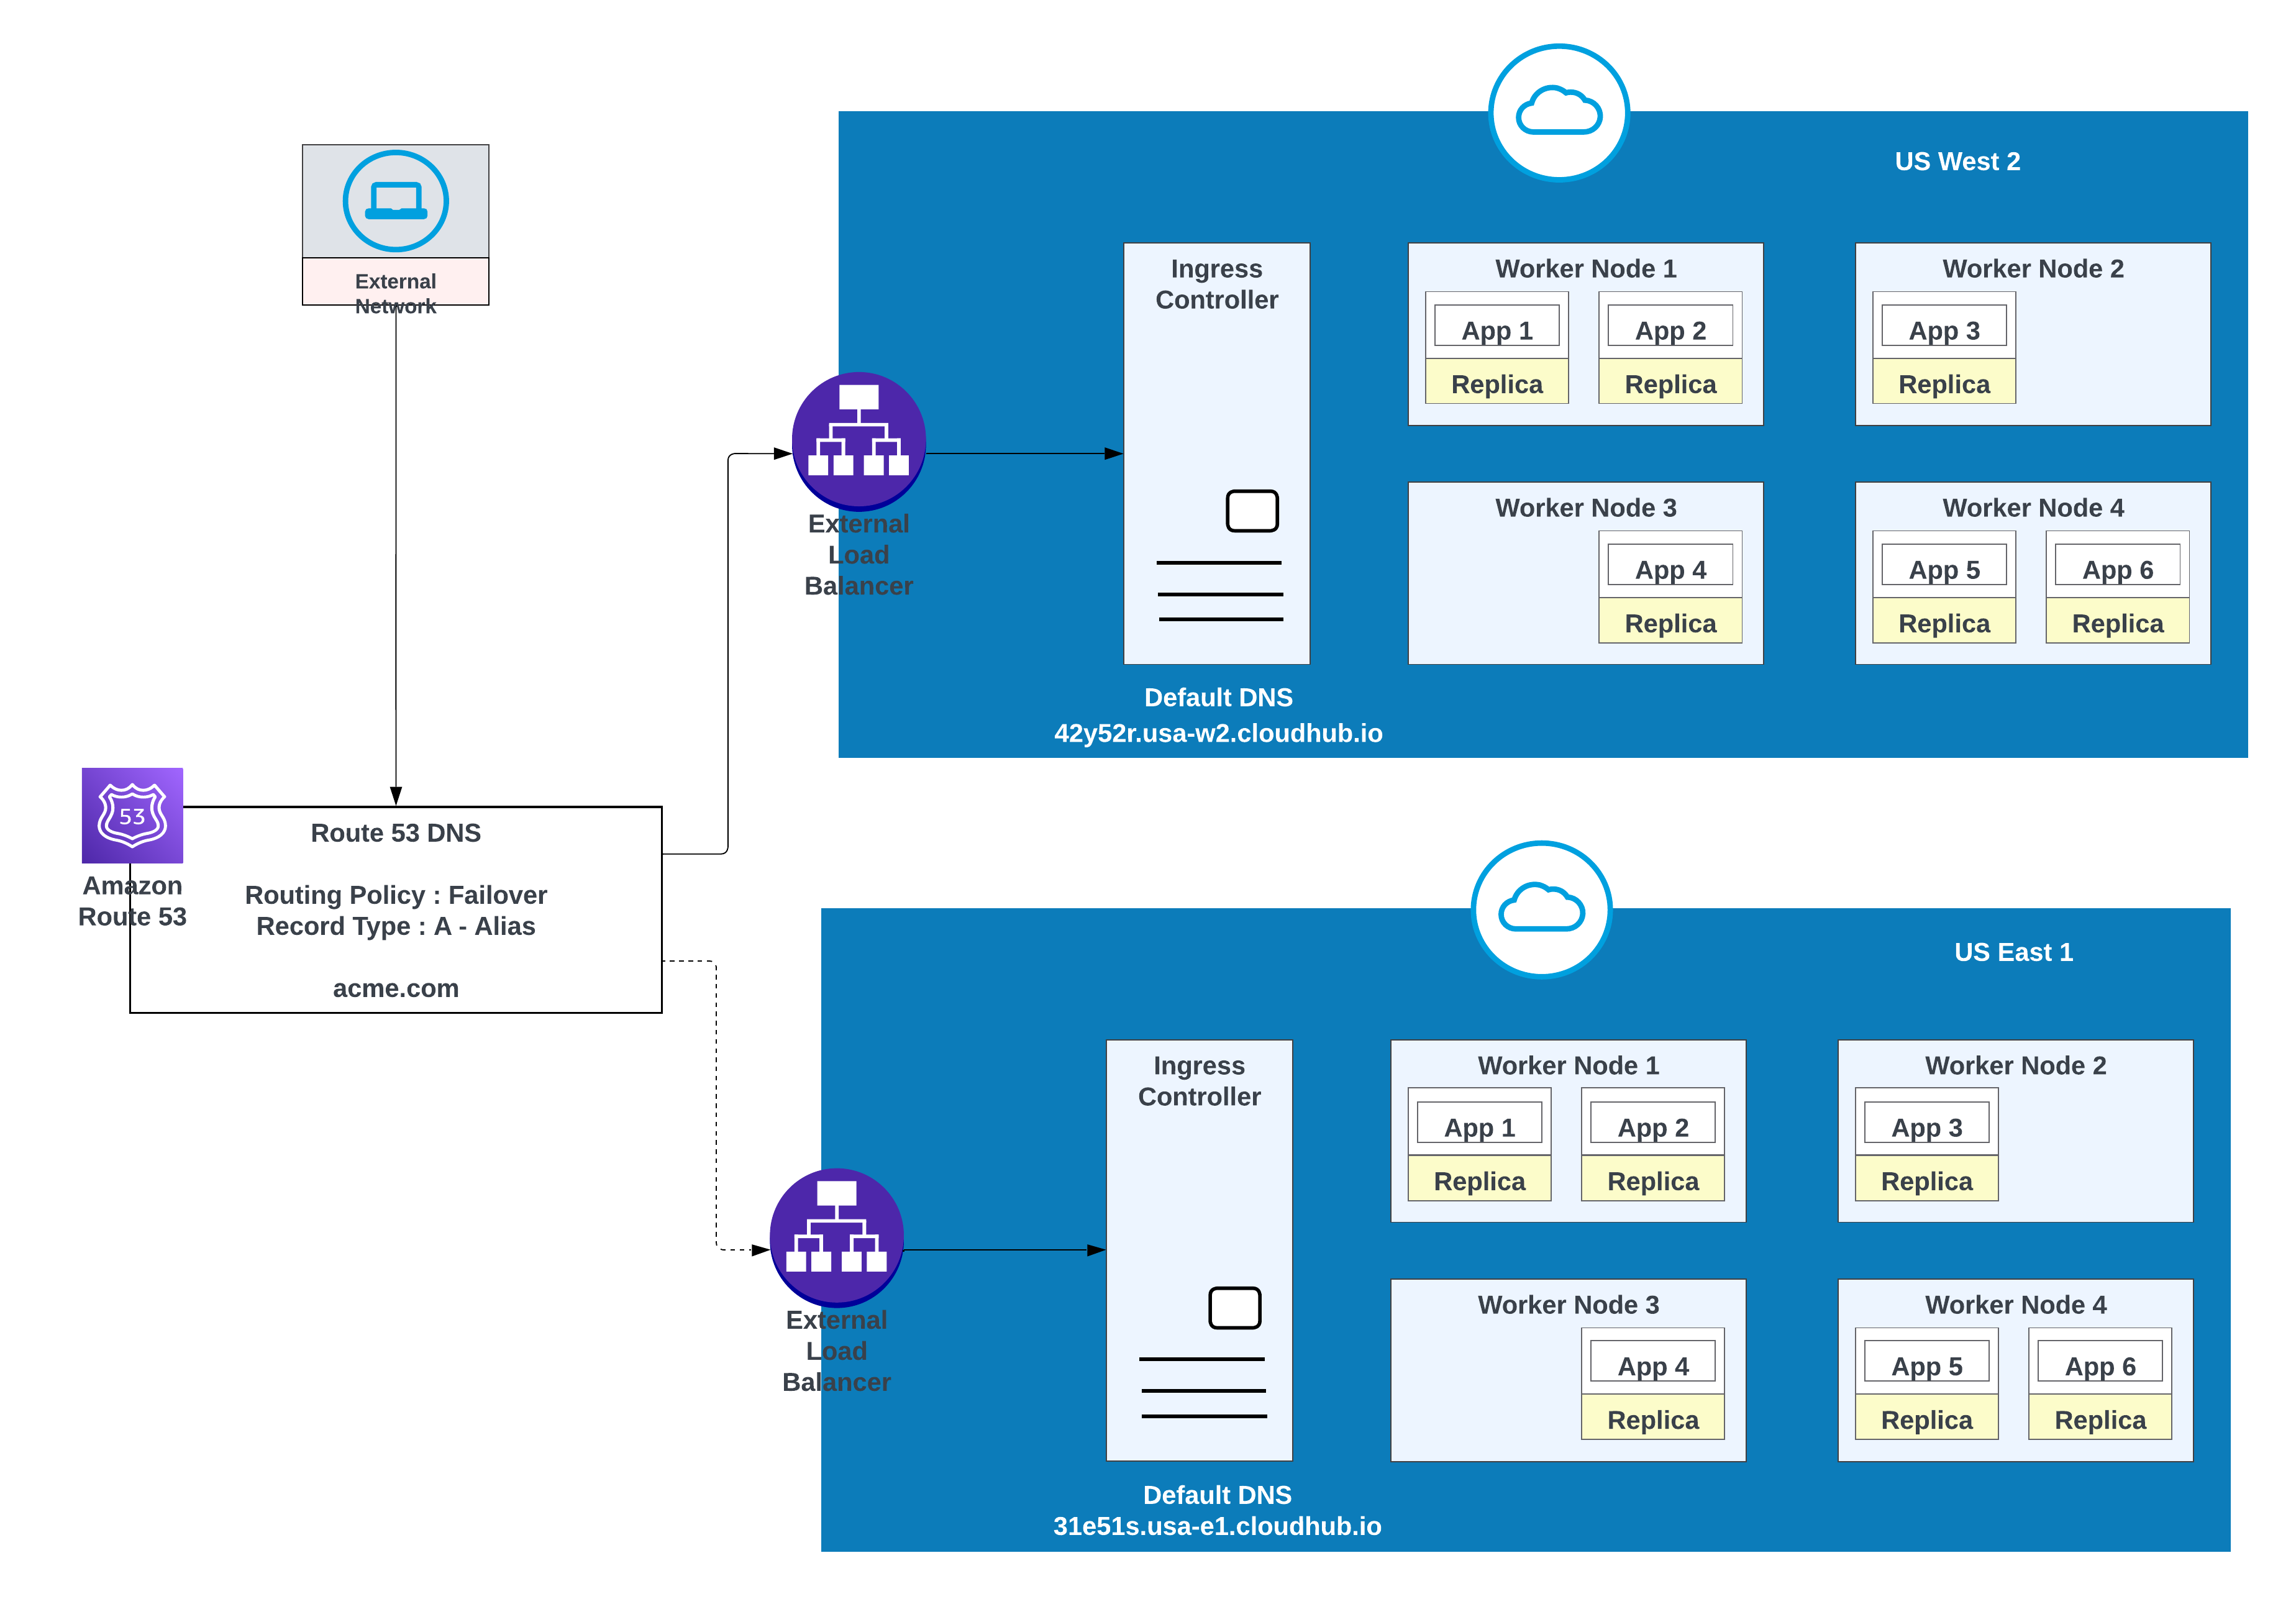
當應用程式需要故障切換時,請使用此選項:在主要區域 (例如,us-west-2) 中部署一個例項,並在次要區域 (例如,us-east-1) 中部署另一個例項。
盡可能在次要區域中使用現有環境;建立新環境需要額外的精力。
**部署在一個區域 (美國西部 2) 且失敗移至另一個區域 (美國東部 1) 的應用程式範例**
 | 記錄名稱 | 值/路由流量至 | 路由原則 | 健康檢查識別碼 |
| :------: | :-----------------------: | :------: | :------------: |
| acme.com | 42y52r.usa-w2.cloudhub.io | 失敗 | 31s3wseq121 |
| acme.com | 31e51s.usa-e1.cloudhub.io | 失敗 | 43e131s131sq |
在此組態中,AWS 路線 53 會將流量路由至美國西部 2 與美國東部 1 的私人空間進入控制項。使用健康檢查設定故障轉換路由原則。
## 高可用性與低延遲
如需縮短延遲與高可用性,請使用圖表中所述的部署策略。透過此策略,可在兩個區域部署應用程式 (此範例中為 us-west-2 與 us-east-1)。
使用 AWS Route 53 中的延遲路由原則,將要求路由至提供最低延遲的區域,同時保留高可用性。 AWS Route 53 中的「延遲」路由原則,可將要求路由至較低延遲仍具有高可用性的區域。
**在這兩個區域部署的應用程式 (美國西部 2 與美國東部 1) 以降低延遲和高可用性**
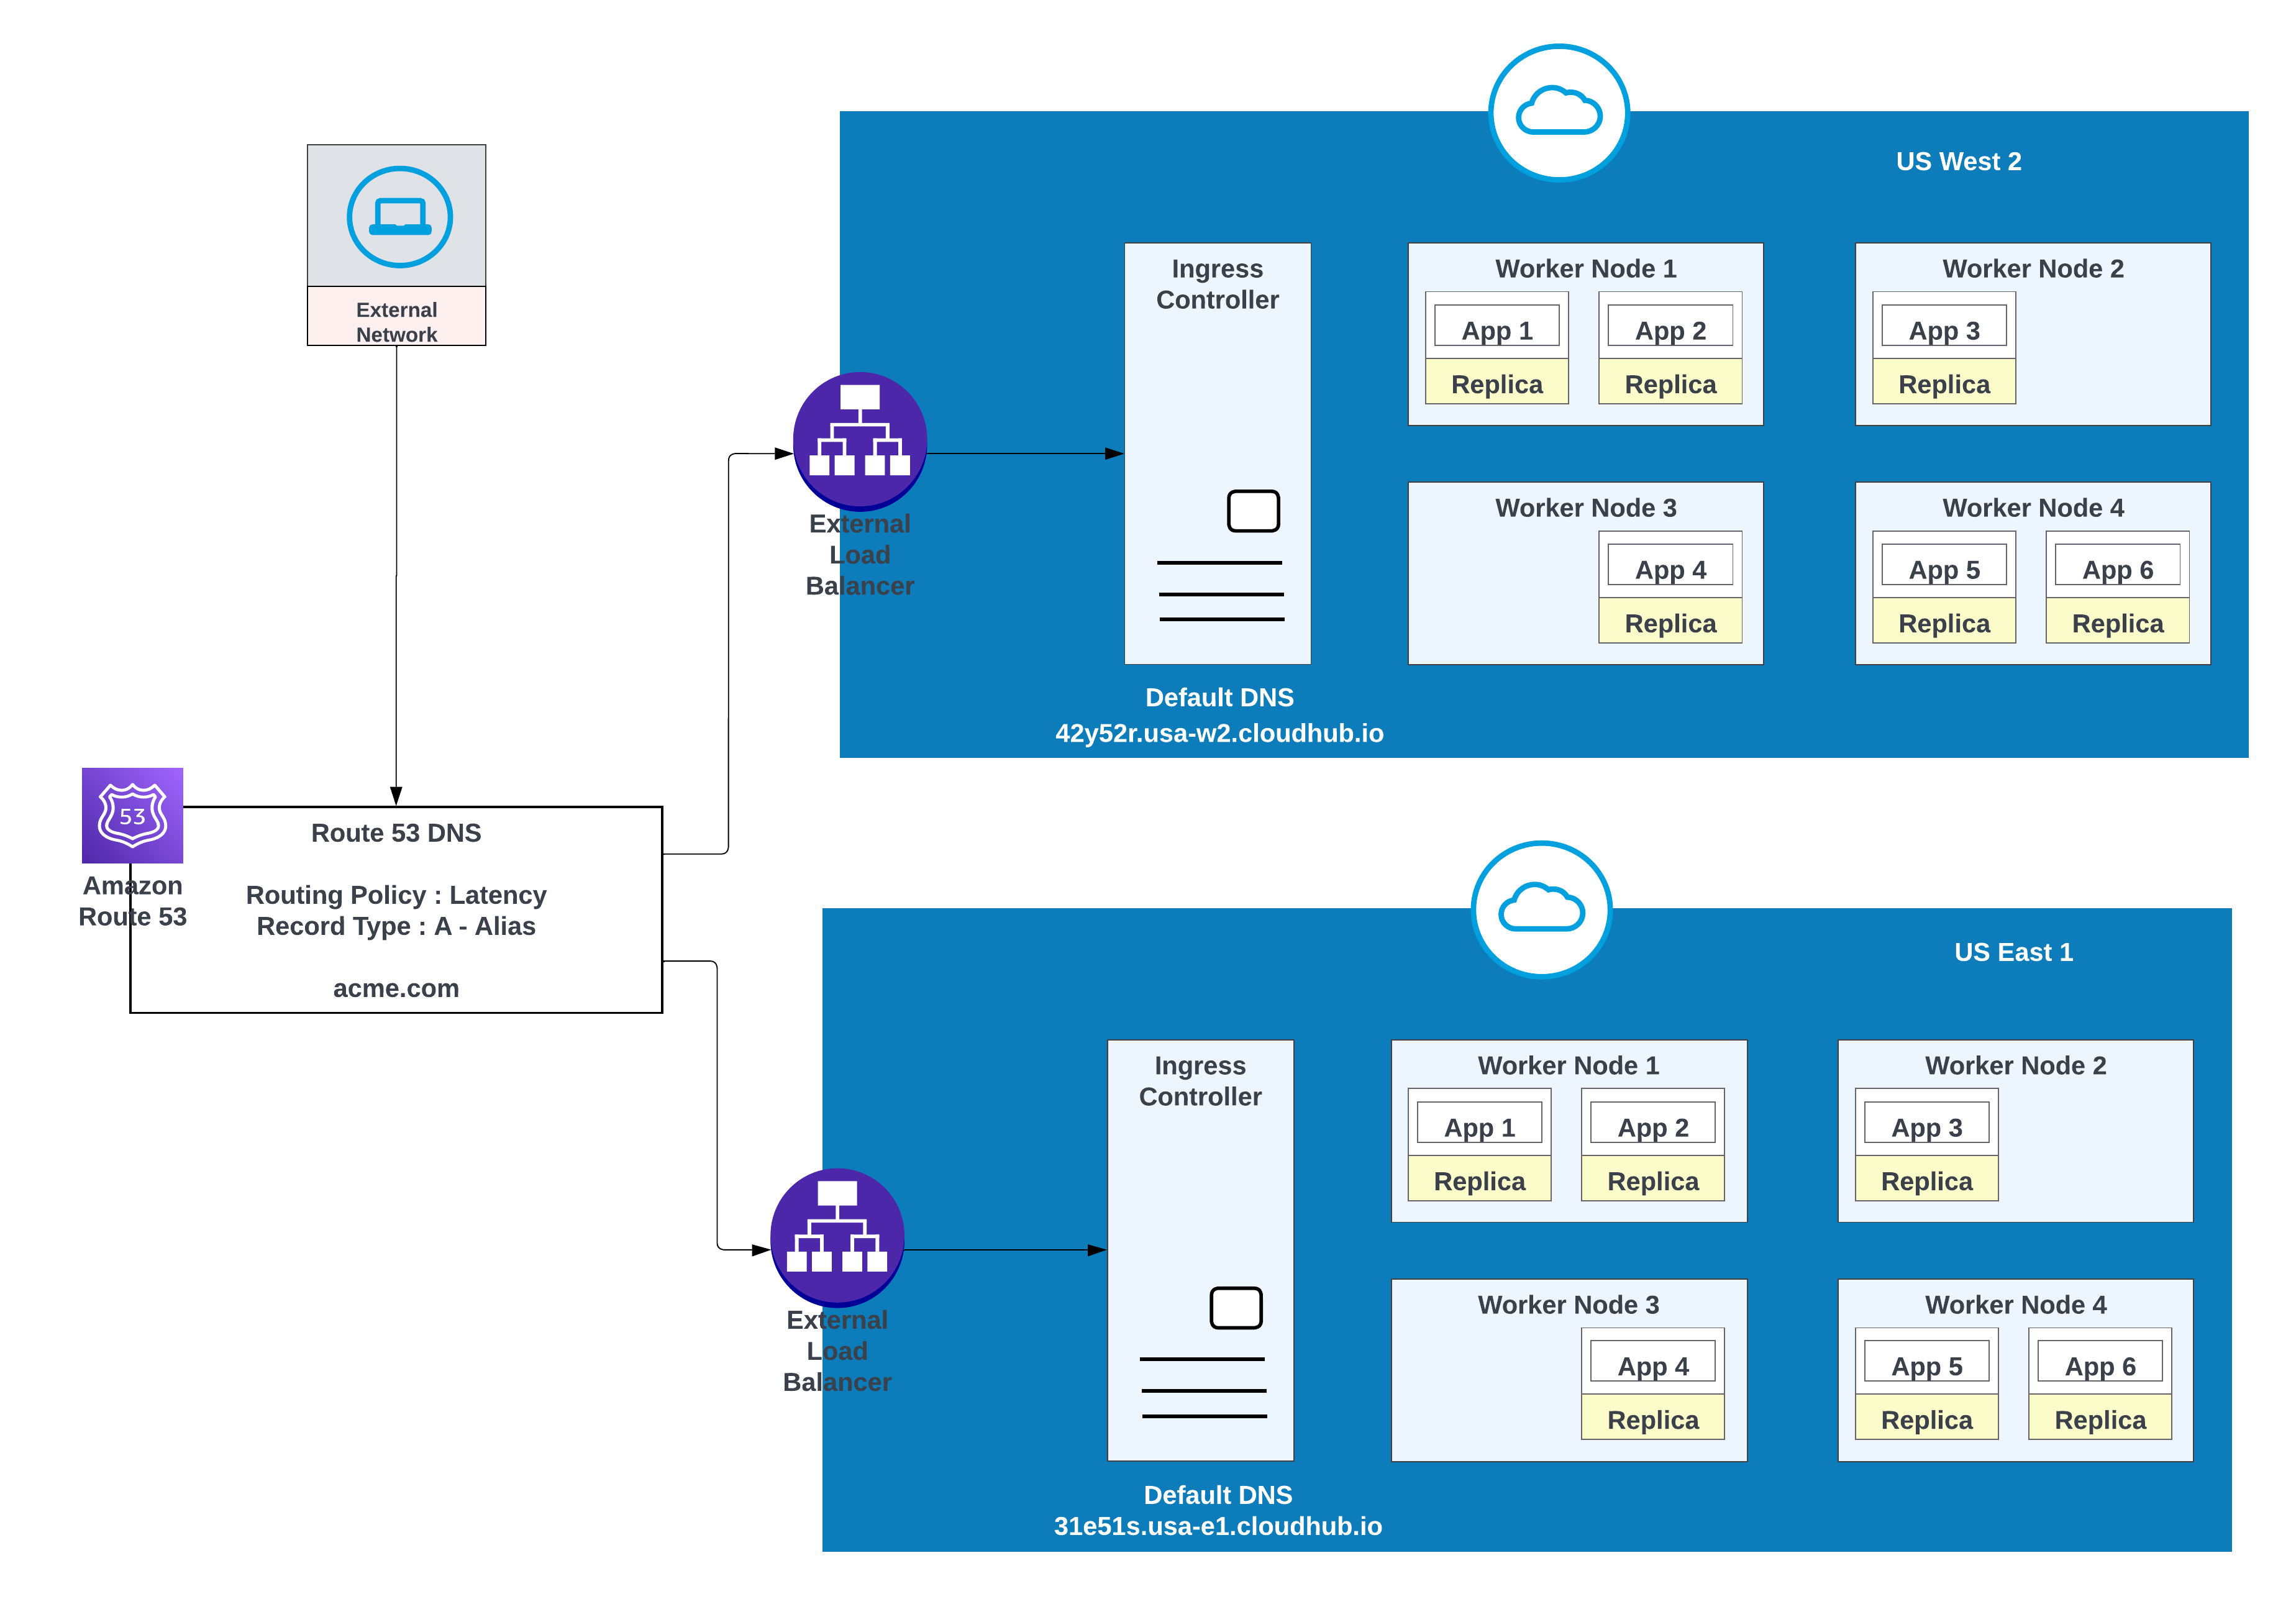 | 記錄名稱 | 值/路由流量至 | 路由原則 | 健康檢查識別碼 |
| :------: | :-----------------------: | :------: | :------------: |
| acme.com | 42y52r.usa-w2.cloudhub.io | 延遲性 | 31s3wseq121 |
| acme.com | 31e51s.usa-e1.cloudhub.io | 延遲性 | 43e131s131sq |
## 結論
MuleSoft CloudHub 2.0 為區域內彈性提供穩固的基礎,主要運用自動複本冗餘和智慧型負載平衡。在單一雲端區域內,使用多個複本部署應用程式可確保如果一個例項失敗,則其他例項可以立即接管工作量。整合型負載平衡程式可有效地將傳入流量分配至這些健康的複本,以儘量縮短停機時間並確保在正常營運條件下能夠持續提供服務。
不過,僅依賴此單一區域結構,即使是高冗餘的結構,也會造成廣泛的災難性區域中斷風險。歷程記錄已顯示,即使是最可靠且在技術上最先進的雲端提供者也容易受到影響整個地理區域的中斷事件。這些單一失敗點雖然罕見,但可能來自於各種事件,包括:
- 大規模的基礎結構事件
- 主要電源失敗
- 廣泛的網路中斷
因此,若要達成真正的高可用性 (HA) 和災害復原 (DR),則必須設計結構以超越單一區域模型的限制。建議的策略是跨多個地理不同區域部署。此區域間彈性可確保如果整個雲端區域因非預期的災害而無法使用,流量便可順暢地移轉至在個別且不受影響區域中執行的應用程式例項,以保證服務中斷最小並達到最大執行時間目標。
## 參照
[CloudHub 2.0 網路結構](https://docs.mulesoft.com/cloudhub-2/ch2-networking-guide)
[設定跨區域錯誤轉換的標準列](https://docs.mulesoft.com/mq/mq-failover)
[物件存放區 V2 部署區域](https://docs.mulesoft.com/object-store/osv2-faq#osv2-regions)
[您的物件商店部署區域](https://docs.mulesoft.com/object-store/osv2-faq#is-object-store-v2-persistent-in-the-same-region-as-the-worker)
## 關於作者
Gulal Kumar 是 Salesforce 的「軟體工程結構設計師」,專注於資料與整合結構。他在整合和 API、現代化計畫、安全性和 AIML 計畫方面擁有超過 20 年的經驗,提供豐富的專業知識。Gulal 一直致力於推進業務轉型計畫、增強安全性和彈性、促進傑出結構,並領導跨各種網域的 AIML 計畫。
Ajay Nagaraju 是 MuleSoft 的企業結構設計師和高級總監,在企業結構、系統整合和大規模數位轉型方面擁有超過 28 年的經驗。他負責跨財富 100 和財富 500 組織的複雜多百萬美元計畫架構和交付,並擁有 API 驅動連線、SOA、雲端技術和企業整合模式的深度專業知識。Ajay 已與執行領導階層密切合作,以現代化業務流程、資料平台和整合生態系統,並致力於建立可調整的結構、指導小組,並透過技術推動可測量的業務成果。
## 概觀
企業資料結構處於轉移點。組織必須同時支援即時 AI 系統、遵循日益嚴格的隱私權法規,並與無法共用原始資料的外部合作夥伴協同合作。這些需求會改變資料平台的設計方式。
以 ETL 銷售管道和集中式資料倉庫為基礎的傳統結構難以滿足這些需求。跨系統複製資料會增加延遲、成本和管治的複雜性。每個複本都會成為新的合規義務,進而複雜了在分散式環境之間的同意管理、刪除要求和強制執行原則。
為了解決這些挑戰,行業正轉向零複製、強制執行原則的協同合作模型。資料清除室已成為重要結構功能,讓多個組織能夠分析共用的訊號,而無須公開或轉移原始資料。計算在每個參與者的受管理網域內執行,而不是將資料移至集中環境,且只會傳回隱私權安全的結果。
此結構變更在各產業中越來越明顯。例如,WPP 收購行銷和廣告領域最大的 InfoSum,以反映清潔房間作為隱私保護協同合作基礎結構的日益重要性。金融機構使用它們來偵測跨機構的詐騙、零售商與消費者品牌協調促銷,以及醫療照護組織來分析跨提供者病患群組,而無須共用敏感的基礎記錄。
Salesforce Data 360 透過在 Hyperforce 上建立的零複製結構來實作此模型。資料會保留在其來源系統中,而聯合查詢會在執行階段強制執行隱私權、同意和落地原則。此方法可實現即時洞察、跨雲端協同合作和 AI 驅動的決策,而不會擴大資料複製所建立的風險面積。
此文件檢查資料清除室如何作為現代企業的基礎架構模式,同時支援 AI 創新、法規合規和大規模保護跨網域協同合作。
## 為什麼清潔房間現在很重要
若要瞭解資料清除空間為何為必要,企業結構設計師必須先面對舊版整合模型的結構性失敗。行業正在從單一集中的集中式資料存放庫轉換為去中心化聯邦生態系統。在此,系統會立即存取、管理和計算資料,而非實際移動資料。此排班不是增量。這是對傳統結構無法再吸收之規模、隱私權和靈活性的系統壓力直接回應。
### 在現代企業中重新定義資料整合
多年來,企業依賴以 ETL 為導向的結構,將 CRM、ERP 和數位系統的資料複製到集中化倉庫以進行報告和分析。此方法已證明對歷程記錄分析有效,但針對較慢的批次導向世界而設計。
隨著數位互動的加速和 AI 驅動系統的出現,此模型的限制變得更明顯。ETL 銷售管道本身為非同步,這表示洞察通常會在事件發生的幾個小時或幾天後到達。此類延遲與現代使用個案 (例如即時個人化、自適應決策,以及需要立即內容相關資料的 AI 系統) 不相容。
複製也導致管理與安全性越來越複雜。每個新的資料複本都需要額外的原則、監視和規範控制。在受監管的環境中,如「一般資料保護規則」(GDPR) 等架構需要組織在資料存在的所有位置管理刪除、同意和使用限制,這在多個系統之間重複資料集時是一個作業挑戰。
大規模而言,此重複會造成成本和營運負擔。組織會重複支付多個平台之間採取、儲存、安全性和處理的費用,而其他複本的邊際值則會減少。
因此,現代資料結構正轉向最小化資料移動並在來源上強制執行管治的模型。零複製整合與聯合資料存取權可讓組織產生洞察,而無須複製敏感資料集,為企業資料協同合作提供更可擴充、安全且符合原則的方法。
### 資料網格與資料紡織的出現
針對這些壓力,產業已在兩個互相互補的結構模式之間建立聯合:資料網格與資料紡織。它們共同代表從集中控制移至聯合的網域認知資料結構。
Data Mesh 會將資料擁有權去中心化至網域相符的小組,例如銷售、行銷或供應鏈。每個網域都會將其資料視為產品,並使用清楚定義的契約、品質標準和服務層級目標。此模型改善了責任與業務對齊方式,但在企業規模中,會針對跨網域的協調、互通性和一致的管治帶來新的挑戰。
Data Fabric 透過提供將去中心化網域繫結至一致系統的連接層來解決這些挑戰。其提供共用的中繼資料、通用語意、自動化原則強制執行、歷程和管治,讓資料能夠一致探索、存取和管理,而不需要將實體合併強制建立在單一儲存庫中。
「資料網格」與「資料紡織」共同建立聯合資料存取的基礎。然而,這些動作尚未解決一個關鍵的下一層問題:啟用跨網域和組織界限的安全、受管理協同合作,其中必須共同分析資料,而無須複製或公開。
### 清潔空間的策略樞紐分析
隨著企業資料變得越來越分散,以及隱私權法規越來越嚴格,組織面臨核心結構上的挑戰。他們如何在小組、合作夥伴和平台之間協同合作,而無須共用原始資料?傳統資料整合方法並未針對此層級的分佈或監管審查而設計,這在協同合作與合規之間產生了緊張的狀況。
此挑戰導致轉向資料清除室作為基礎結構功能。清除空間會將協同合作從資料傳輸移至受管理的運算。分析和 AI 工作負載不會複製或交換資料集,而是透過共用中繼資料在資料已存在的位置執行。系統會根據隱私權、同意和使用規則即時評估查詢,且只會傳回批准的彙總結果。
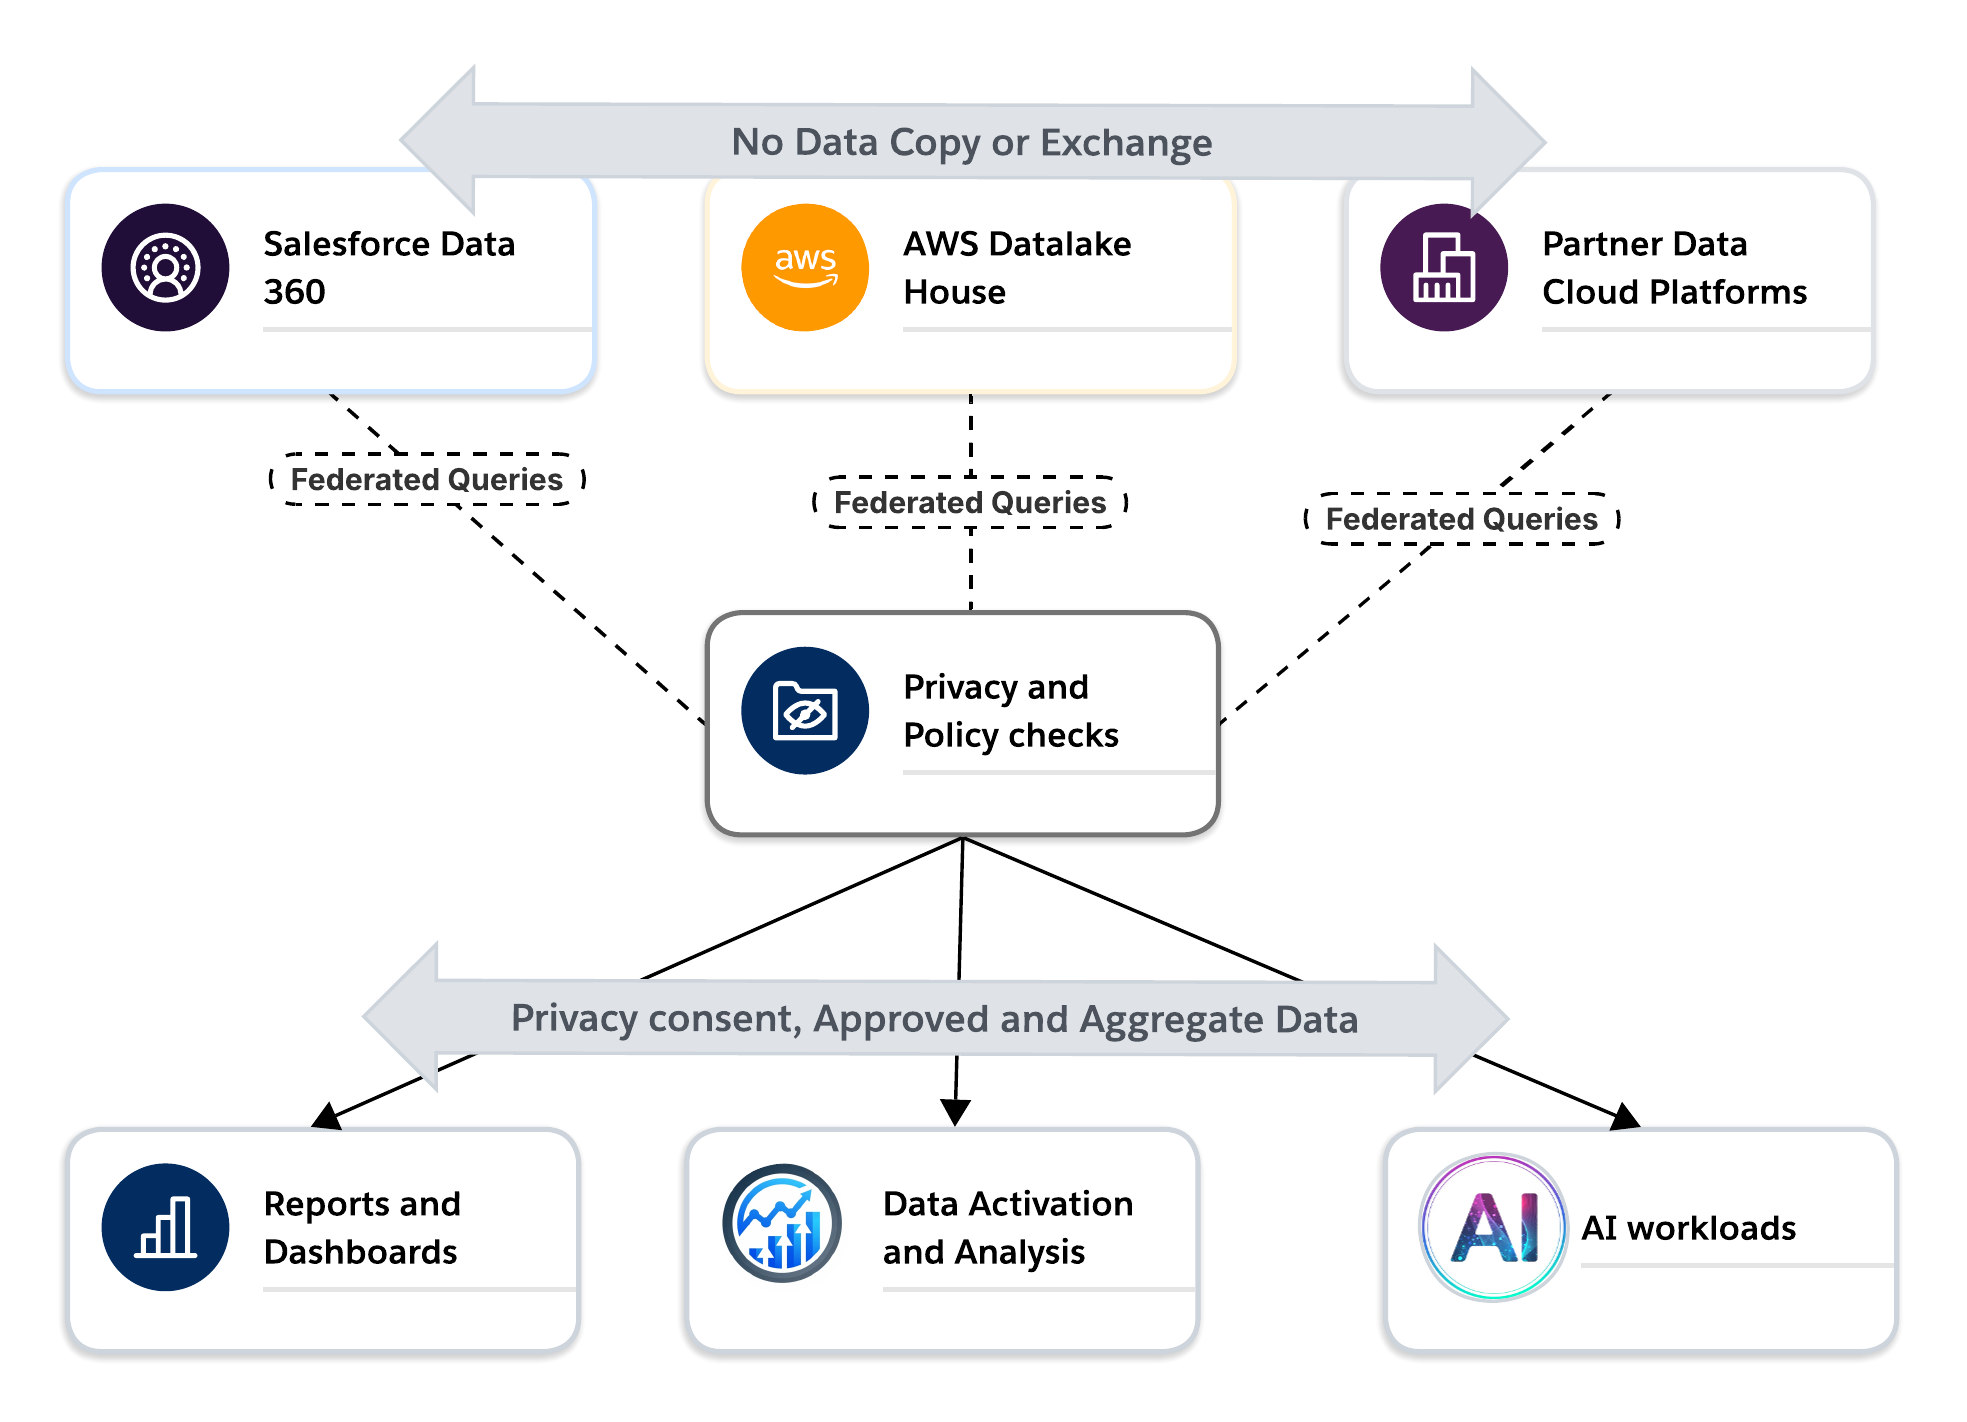 在此模型中,資料清除空間會作為現代資料結構的 Trust 邊界。它們允許組織與合作夥伴和子公司合作,而不失去對其資料的控制權、透過系統控制而非單獨原則強制執行隱私權和同意,並在遵循資料落地與合約限制的同時跨雲端作業。
針對啟用、分析和 AI 使用個案,清除房間可讓您安全地從外部資料產生洞察,而無須公開敏感資訊。它們可讓您從資料共用轉為信任的協同合作。針對「啟用」使用個案,清潔室可提供安全的方式來產生可直接啟用至允許目的地的受眾。所有這一切皆可在不向任何一方顯示任何個人可識別資訊 (PII) 的情況下達成。這會在企業資料結構中標示轉向點。資料清除室不再是利基工具。它們正在成為聯合、保留隱私權、 AI 準備資料平台的核心基礎結構。
## 利害關係人角色和技術護欄
成功的資料清除室結構是一種多介面系統,專為解決資料公用程式、安全性和速度的競爭壓力而設計。有三個主要角色,其特定的摩擦點必須由基本技術設計解決。
### 隱私權與合規專員 (風險降低人員)
隱私權與合規主管會使用資料清除室作為管治工具。他們的主要疑慮是合規性漂移,也就是外部協同合作環境無法強制執行與內部系統相同嚴格標準的風險。
- **破折點:**監管暴露 (GDPR、CCPA、DMA) 和「網路釣魚」攻擊,其中合作夥伴嘗試透過重複的細微查詢來三角形處理使用者的身分。
### 資料科學家與分析師 (公用程式最佳化工具)
資料科學家會將資料清除室視為進階建模的安全避境。他們的主要考量是公用程式的保留,確保隱私權措施不會使資料在統計上變成無用。
- **破折點:**對於機器學習 (ML)、類似建模和流失預估所需細微屬性的高度延遲和限制存取權。
### 行銷和業務使用者 (值實現者)
此角色專注於時間轉換為值 (TTV)。他們的疑慮是資料清除室專案通常會變成技術瓶頸,需要數週的資料工程支援。
- **破折點:**複雜的設定流程、手動資料清除,以及需要撰寫程式碼以取得簡單重疊結果的「空白頁面」問題。
### 「公司優先」個性人物模型
雖然傳統結構專注於在使用者層之前建立資料層,但我們的策略方法 (符合「業務優先」方法) 會反轉此模型。我們將無程式碼到按幾下方法的優先順序,讓業務使用者產生洞察並立即採取行動。
**「洞察動作」工作流程:**結構設計為已啟用工作區,而非作為被動儲存庫。透過提供使用個案範本 (例如區段重疊、啟用和行銷活動效能),我們可讓業務使用者提供自助式洞察。這可確保洞察 (例如最佳化類似區段) 可立即在整個行銷生態系統中啟用,而不需要資料工程師手動移動檔案。
**零複製聯合作為策略資產:**為了最大化 TTV,結構採用零複製邏輯。我們的結構會將查詢直接聯結至資料所在位置 (例如 Snowflake、BigQuery 或 Amazon S3),而非傳統 ETL 流程 (導致延遲與安全性風險)。這會將組織的現有資料投資轉為策略性資產,允許業務使用者即時對最新的資料採取行動,同時維持嚴格的管治並消除資料冗餘的成本。
## 金鑰資料 Clean Room 使用個案
資料清除空間在廣告中出現,是針對 Cookie 淘汰和隱私權法規的回應,但已超出測量範圍,進化為跨產業的客戶分析、受眾區隔和啟用使用個案。根據 2025 年「零售媒體狀態」報告,66% 的組織現在使用某些容量的潔淨空間,因為需要提供可測量業務成果的隱私權安全協同合作。
產業之間的模式一致:資料會與其擁有者保持聯繫、會管理運算,且只會共用隱私保護洞察。
### 行銷和廣告:測量不含第三方 Cookie
**挑戰:**行銷人員需要測量行銷活動的成效、避免重複的廣告呈現,並最佳化接觸率/頻率,但無法再依賴第三方 Cookie 或裝置識別碼。
**清潔室解決方案:**
- 廣告商提供雜湊的客戶或行銷活動曝光資料
- 發行者提供印象與參與訊號
- Clean room 會計算到達、頻率、歸屬和增益
- 啟用會透過未匯出原始資料的已批准平台進行
**業務成果:**清潔空間提供已結束迴圈歸屬,可將廣告呈現連結至實際交易、可區隔真實行銷活動提升的增量分析,以及跨管道的統一測量—傳統數位廣告無法提供的功能。
**行業證據:**測量是目前最為穩定的清潔室使用個案,主要媒體網路如 Pinterest、Disney 和 Paramount 建立自己的清潔室。
### 零售媒體和消費者包裝商品 (CPG):無須共用即獲利第一方資料
**挑戰:**CPG 品牌在零售媒體上花費大量錢,但缺乏對購買成果的可見性。零售商擁有豐富的銷售點資料,但在違反隱私權承諾的情況下無法將其公開。
**清潔室解決方案:**
- 零售商和 CPG 公司將零售位置的銷售點資料與行銷資料結合,以最佳化促銷活動
- 品牌提供雜湊的 CRM 或忠誠度識別碼
- 清潔房間連結對店內/線上購買的廣告公開
- 啟用會停留在零售商的媒體生態系統內
**業務成果:**
- 零售商在不銷售原始客戶資訊的情況下,將第一方資料獲利
- 顯示哪些行銷活動促進購買的品牌獲得已結束迴圈歸屬
- 零售媒體網路規模不受隱私風險影響
**行業證據:**如 Walmart 的 Luminate 和 Kroger Precision Marketing 等零售媒體網路提供乾淨的空間,協助 CPG 品牌分析客戶行為並使用零售商資料最佳化行銷策略。
### 金融服務:協同合作詐騙偵測
**挑戰:**詐騙網路跨機構運作,但由於 GLBA 等法規和新興隱私權法規,銀行無法公開共用客戶或交易資料。
**清潔室解決方案:**
- 多個銀行會將匿名資料集合,以識別指示詐騙的模式,例如異常的跨銀行活動
- 聯合分析或模型會跨共用詐騙訊號執行
- 沒有任何機構可看見其他機構的客戶層級資料
**業務成果:**
- 提早偵測跨機構詐騙模式
- 透過更豐富的訊號集減少假陽性
- 不集中敏感資料的法規合規性
**行業證據:**Experian 和 TransUnion 的金融服務解決方案提供清潔辦公室技術,讓銀行和保險商能夠針對詐騙偵測和風險評估進行協同合作,同時維持嚴格的資料隱私權控制。
### 醫療照護與生命科學:未公開病患資料的研究
**挑戰:**製藥公司需要藥品開發的實際病患成果,但資料位於受 HIPAA 及類似法規保護的醫院 EHR 系統中。
**清潔室解決方案:**
- 醫師和製藥研究人員可在清潔室內共用資料,以瞭解病患對治療的反應。
- 病患資料會保留在提供者環境中。
- 研究人員透過清潔室執行已批准的統計分析。
- 不同的隱私權會防止重新識別。
**業務成果:**
- 大規模的統計上有效的真實世界證據
- 透過將匿名化的病患資料與試用條件進行比對,尋找符合資格的候選項目,而不違反醫療照護隱私權法規,來簡化臨床試驗的病患招募
- 對有限的臨床試驗族群的相依性降低
**行業證據:**Datavant 等專注於醫療照護的清潔室提供符合 HIPAA 的環境,讓研究人員和醫療照護組織安全分析臨床試驗和藥物開發的病患資料。
### 跨產業模式:協同合作需求
除了這些主要使用個案之外,清潔室可啟用:
- **供應鏈最佳化:**製造商和供應商可協同合作來共用庫存詳細資料、生產排程和需求預測,進而在保護專屬資訊的同時啟用更佳的協調。
- **M&A 盡職調查:**當一個公司取得另一個公司時,盡職調查需要檢查財務預測和客戶資料庫,而無須直接共用敏感資訊;清潔空間會顯示如客戶區段對齊和合規性風險等洞察。
- **媒體與娛樂:**發行者向廣告商證明受眾的價值,同時保護訂閱者身分,啟用由信任度量支援的頂級 CPM,而非可能性目標
在 AdTech、零售、財務服務、醫療照護和媒體之間,Data Clean Rooms 已成為基礎 Trust 基礎結構。它們會啟用先前因隱私權、法規或競爭限制而遭到封鎖的高價值協同合作。清潔空間是可實現安全、受管理協同合作的**核心結構元件**,可解鎖洞察和獲利,而無須放棄資料控制或合規性。
## 資料清除室:信任資料協同合作的基礎
資料清除室是安全且受管理的環境,可讓多個對象產生共同洞察,而無須公開或交換原始資料。已批准的分析、AI 和啟用工作量不會複製資料集,而是會立即執行,且只會傳回符合原則的輸出。若啟用需要個人層級記錄,資料會直接傳送至預期的目的地,而不會向協同合作者公開。
在結構上,清潔空間會將協同合作從資料共用移至控制的運算。每個參與者都會保留其資料的保管權,而執行階段強制執行會管理查詢行為、輸出限制、同意和使用原則。
透過隱私權保護的識別碼對齊機制,進一步啟用協同合作,允許不同方的資料集進行關聯,而無須顯示基本識別碼—此功能會在本文件稍後詳細說明。
因此,資料清除室可作為以零複製聯合資料策略為基礎的隱私權監管、多雲端、 AI 驅動企業基礎結構。
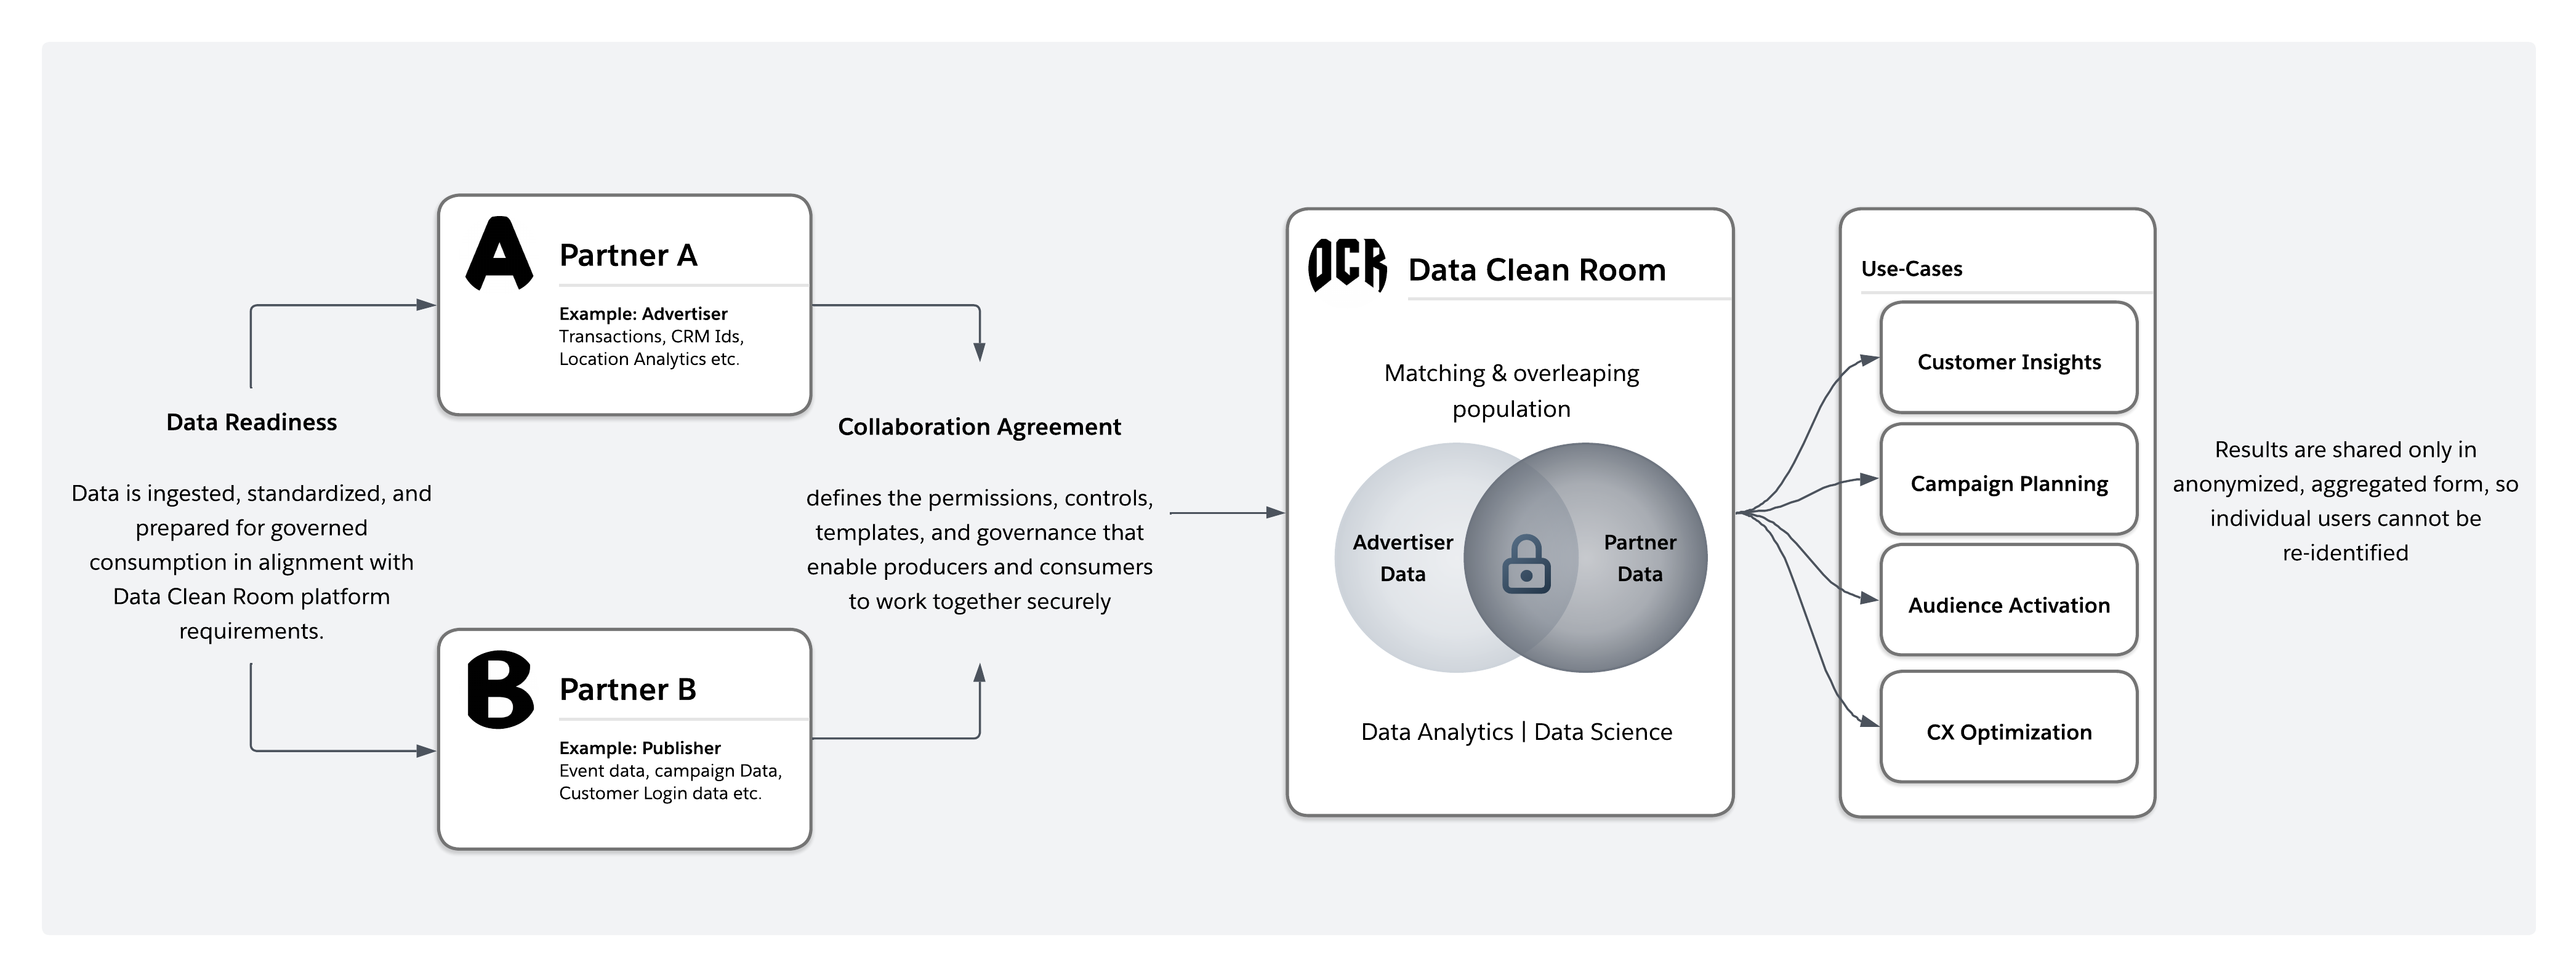 早期資料清除室遵循集中化「容器」模式。所有參與者都需要將資料複製到中立第三方環境以供分析。雖然此方法在概念上很簡單,但導致了顯著的摩擦。資料移動增加了延遲和成本、複雜的法律與合規合約,並強制組織放棄對敏感資料的直接控制。在受監管的產業中,這些權衡通常使協同合作變得不實用。
現代資料清除室已發展為散佈的聯合模式。資料會保留在擁有者的環境中,且會透過聯合查詢執行分析。清除室本身會作為監管層,來攔截每個查詢、在執行階段強制執行隱私權與原則控制,並僅傳回已批准的彙總輸出。
| 維度 | 傳統清潔室 (「容器」模式) | 現代清潔室 (散佈/聯邦模型) |
|---|---|---|
| 資料位置 | 資料會複製到集中化的第三方環境 | 資料會保留在擁有者的環境中 |
| 資料移動 | 需要資料集的實體傳輸與複製 | 沒有原始資料移動,查詢會立即執行 |
| 控制與保管 | 保管部分放棄至第三方平台 | 各方保留原始資料擁有權與保管權 |
| 結構模型 | 集中彙總 | 散佈的聯合計算 |
| 強制執行管治 | 資料移動後套用的原則 | 在查詢執行階段強制執行的原則 |
| 隱私模式 | 高度依賴契約與程序控制 | 透過執行階段控制項與彙總值以技術強制執行 |
| 延遲 | 由於採取和同步化而造成的延遲較高 | 延遲愈低,近乎即時聯合查詢 |
| 成本結構 | 更高的儲存、運送和重複成本 | 已減少重複,即會在資料所在處發生 |
| 合規性複雜性 | 由於跨境資料移動而造成的複雜法律協議 | 簡化合規性,因為資料不會離開來源邊界 |
| 延展性 | 調整規模需要更多的儲存空間和資料複製 | 透過散佈的計算進行調整,而不重複資料 |
| 受監管的產業適配 | 由於監護和居住考量而經常不實用 | 更符合主權、同意與監管限制 |
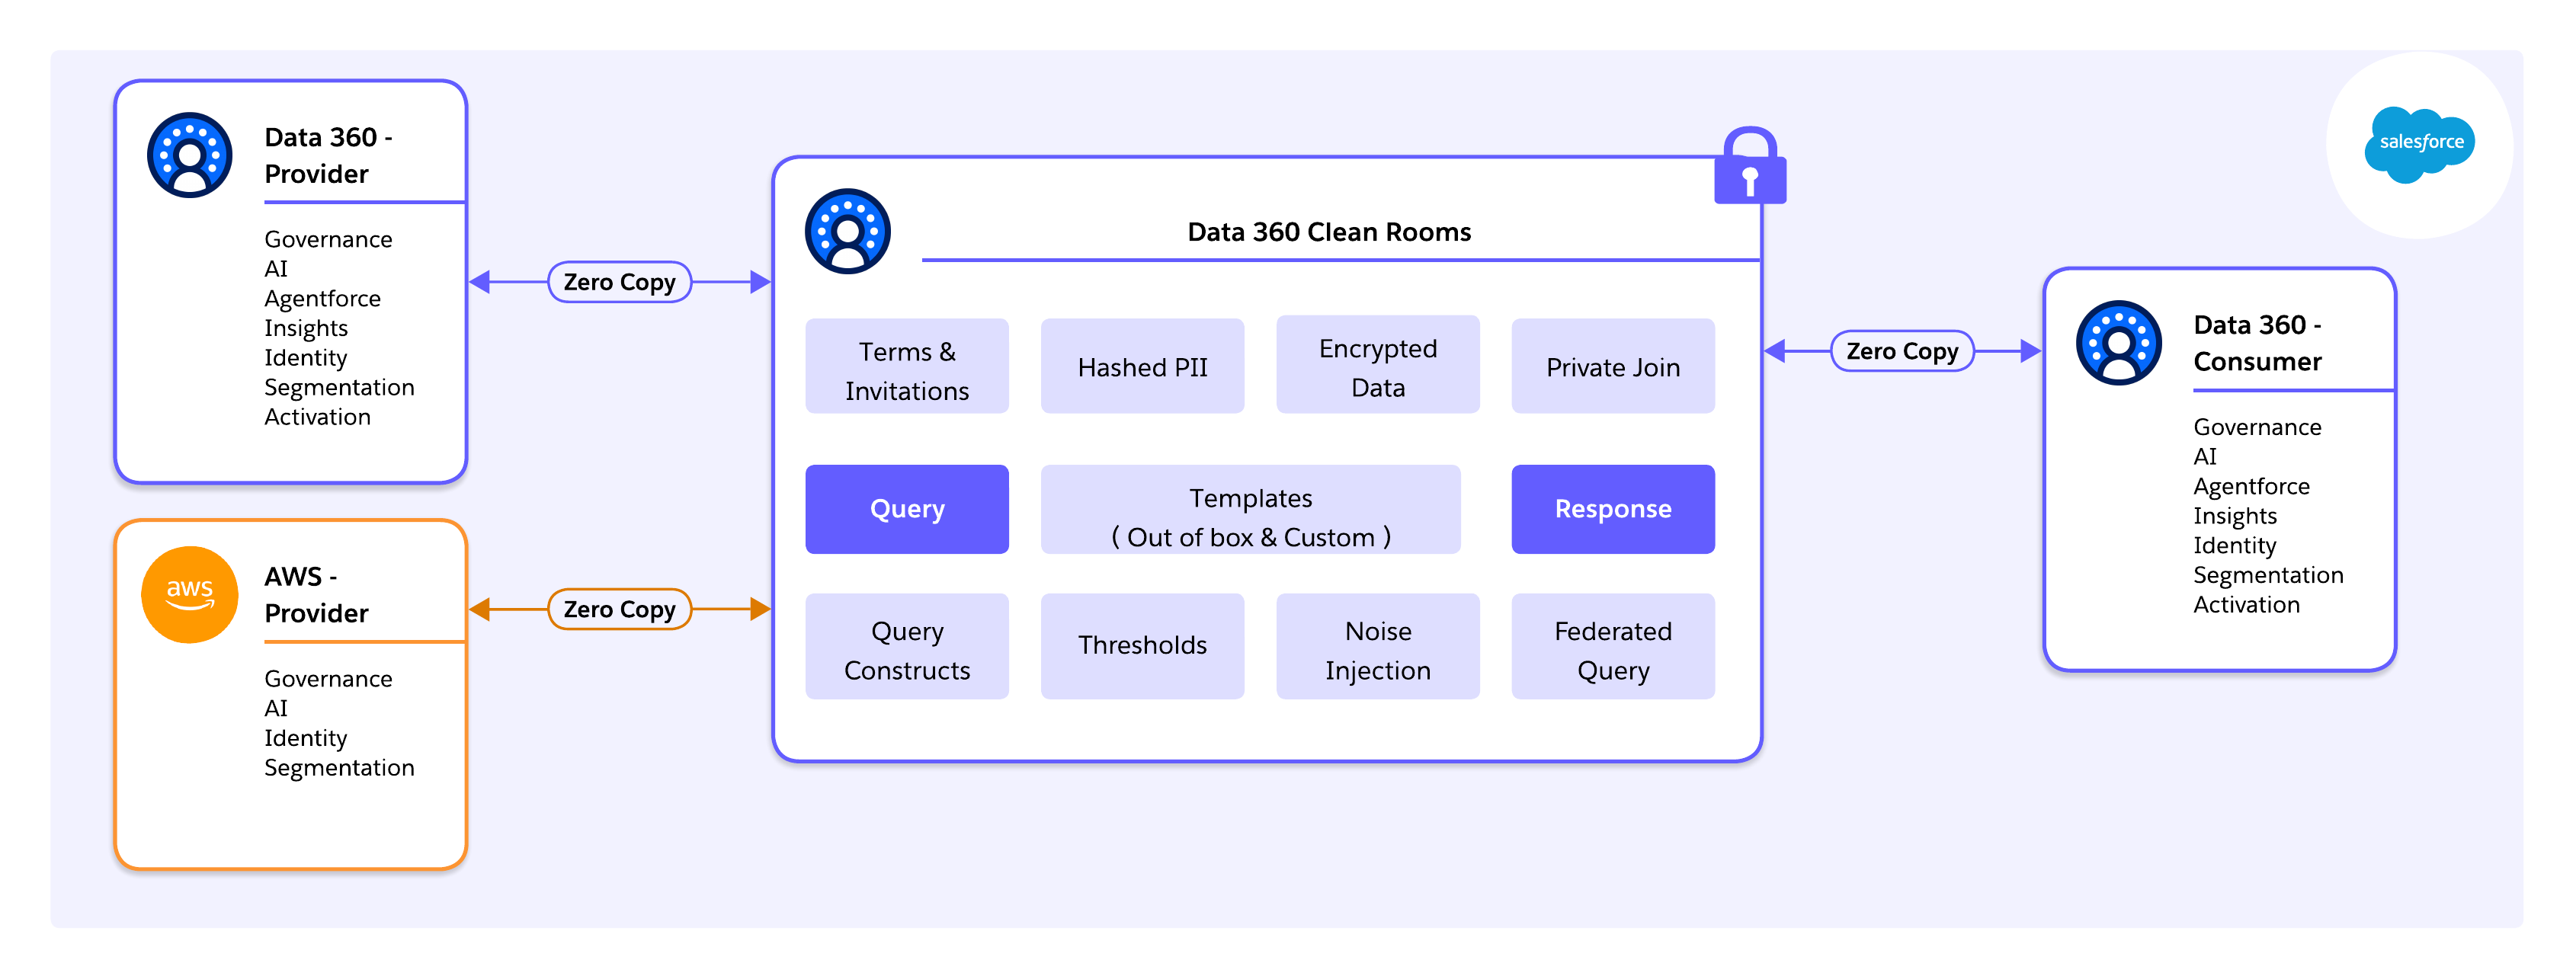 ### 可調整資料清除空間的平台基礎
在基礎結構層級上,Salesforce Data 360 會在 Hyperforce 上執行,這是 Salesforce 的雲端原生執行階段,該執行階段會在統一控制平面後抽象超規模資源 (AWS、Azure、GCP)。此結構可讓資料保持在區域內,以滿足主權與落地需求,同時在全域啟用受管理的清潔室作業。
重要的是,此基礎可實現跨雲端 Clean Room 協同合作,包括與 AWS Clean Rooms 的原生互通性。使用 Data 360 作為協調流程和管治層,企業可以與直接在 AWS 上作業的合作夥伴協同合作,而無須強制將資料移轉至 Salesforce 管理的儲存空間。查詢會推送至來源,隱私權規則會一致強制執行,且只有符合的彙總結果會在平台之間交換。
規範與 Trust 會在基礎結構與執行邊界強制執行,而非在應用程式層重新調整,為大規模的多重雲端多方協同合作提供永久的基礎。
### Data 360 從取用到啟用的銷售管道
Data 360 會實作可追蹤的端對端資料銷售管道,確保清潔室作業會執行在協調、受管理且具有身分認知的資料上,而不是在原始解壓。
關鍵階段包括:
- **連線**:透過立即可用的連接器、API、SDK、MuleSoft 或 0 複製連接器進行資料取用和虛擬化
- **持續**:以原生格式儲存原始資料 (Parquet/Iceberg)
- **協調**:對應至標準資料模型物件 (DMO),以取得一致聯結
- **統一**:身分解析建立金級記錄
- **衍生洞察**:已計算洞察會計算受管理邊界內的彙總度量
- **動作**:受管理輸出流向 Salesforce 組織、行銷平台、廣告網路、外部資料平台 **或其他清潔空間**,進而結束洞察轉動迴圈
此管道可確保清除房間會根據企業級資料運作,而非臨時取用。
### 原生整合與「點按非程式碼」
不同於需要個別佈建和 SQL 開發的獨立資料清除室平台,Salesforce 清除室原生內嵌在 Data 360 中。這可啟用 DMO、身分規則、同意模型和管治原則的重複使用,進而消除重複的安全性層級。
Salesforce 以範本為導向的清潔室模型是關鍵加速器,使用:
- **立即可用的範本**,可支援常見的協同合作模式,例如受眾重疊、抑制、接觸和提升度量。
- **自訂範本**允許結構設計師和進階使用者定義可重複使用的分析邏輯,以滿足產業特定或合作夥伴特定需求,而不暴露原始資料或原則複雜性。
此方法會將協同合作標準化,同時允許彈性,讓清潔空間擴充為可重複的企業功能,而非一次性的分析專案。
### 「金色路徑」:結束洞察動作迴圈
Data 360 會解決傳統清潔室常見的失敗模式:啟用缺口。其「金色路徑」架構可確保可以在清潔室內產生的洞察上立即採取行動,而無須匯出原始資料。
- **設定與探索**:合作夥伴會共用結構描述中繼資料,並利用範本在契約完成前評估可行性。
- **分析**:預先建置和自訂範本會驅動重疊分析、抑制、類似建模和增益度量,這些都會在受管理的邊界內執行。
- **啟用**:批准的區段會直接推送至 Marketing Cloud、廣告平台或合作夥伴系統,且只會共用彙總符合的結果。
範本會變成有意見的執行路徑,以確保協同合作可預測地從分析移至啟用。
## Salesforce Data 360 Clean Rooms 教學手冊
部署 Salesforce Data 360 Clean Room 不只是設定演練,而是跨越資料整備、管治設計、安全連線和作業監視的嚴謹結構工作流程。
### 步驟 1:定義協同合作使用個案 (從意圖開始)
在接觸資料或組態前,結構設計師必須清楚定義:
- 我們嘗試回答哪些問題?
- 預期成果為何? (例如重疊分析、增益度量、抑制、詐騙偵測)
- 需要什麼層級的彙總?
- 適用的法規或合約限制為何?
- 哪個啟用路徑會耗用結果?
瞭解協作者的目標會塑造後續的所有項目,例如聯結索引鍵、身分規則、管治水準和成本建模。Clean Rooms 是專為目的而建置的環境。您應該根據定義的分析目標來設計,而不是針對一般資料的曝光。
### 步驟 2:準備 Clean Room 協同合作的資料
必須先以結構和語意準備企業資料,才能開始協同合作。清除空間會強化基本資料的優勢與劣勢。放置垃圾,放置垃圾在此處是更為真實的。
**入院:**將 Salesforce CRM、Marketing Cloud、AWS S3 和 Google Cloud Storage 等來源系統連線至 Data 360。盡可能使用零複製連接器 (例如 Snowflake),以避免不必要的資料移動或重複。
**語意對應:**將資料串流對應至 Customer 360 資料模型。將重要欄位標準化,例如電話號碼 (E.164 格式)、國家/州代碼 (ISO 標準) 和電子郵件地址。不對齊方式 (例如,有一方使用「CA」,另一方使用「California」) 會無聲地失敗聯結並降低比對率。
**身分解析:**設定決定性 (完全符合) 和可能性 (模糊比對) 規則,以建立「統一個人」(金級記錄)。此統一實體是清除空間比對的基礎。
身分解析的品質會直接影響協同合作價值。比對準確度愈高,可增加重疊率、分析信賴,並減少假陰性。
### 步驟 3:佈建清潔室
一旦資料協調,則必須佈建清除空間本身,才能定義協同合作的邊界。
**授權驗證:**確認所有參與的組織都有必要的 Data 360 和 Clean Room 權益。
**資料空間範圍:**清除空間物件必須以特定資料空間為範圍。只有對應至該資料空間的物件才會對清潔室顯示。這可確保協同合作在邏輯上隔離,而不需要僅為清潔空間建立新的資料空間。
**定義監管規則:**執行查詢前,請以宣告的方式建立原則:
- 例如,每個輸出至少有 100 筆記錄的「**總計值」:**
- **聯結索引鍵:**例如 Email_Hash_SHA256
- **允許的作業:**僅彙總如 COUNT、SUM、AVG 等函數
- **明確限制:** 封鎖列層級匯出 (選取 \*)
管治規則會在執行階段強制執行,使隱私權與合規性系統層級內容而非程序指引。
### 步驟 4:建立安全的多方連線
清潔空間通常會跨越組織與平台界限。連線必須明確且嚴格控制。
**帳戶連結:**
- **Salesforce 對 Salesforce:**使用 Data Cloud One 或已批准的跨組織共用機制。
- **多雲案例:**啟用查詢前驗證區域對齊方式與落地。
**驗證和授權:**使用「最低權限原則」為專屬整合使用者設定以 OAuth 為基礎的存取權—將存取權嚴格限制為必要的資料空間,並避免管理權限。
安全性失敗通常是由整合使用者過度權限而非加密或平台控制的弱點所導致。
### 步驟 5:執行、監視和控制 Clean Room 工作量
啟用後,焦點會移至營運監督、查詢品質和成本管理。
**查詢執行:**分析師或工作流程會透過「已計算洞察」或批准的 SQL 介面執行重疊分析和彙總。所有查詢都會自動強制執行彙總值和隱私權控制。
**稽核與可追溯性:**Salesforce Data 360 清除空間以稽核資料模型物件 (DMO) 的形式提供稽核追蹤。此功能會收集查詢活動的相關中繼資料,包括執行查詢的人員、執行時間,以及套用的原則。「稽核 DMO」可啟用合規性報告、管治驗證和鑑識追溯性,以確保協同合作的隱私權安全且可檢閱。
**消耗監視:**Data Cloud 使用以耗用量為基礎的信用模型。主要驅動因素包括:
- 已處理的資料列 (例如,1 百萬個資料列 = 基準信用單位)
- 查詢複雜性
- 身分解析作業 (乘數較高)
- 採取批次 (乘數較低)
**Digital Wallet 與警示:**使用 Digital Wallet 追蹤即時耗用情況,並在 50、75 和 90% 值上設定警示。將高峰與特定工作量相關聯,以避免發生非預期成本。
請注意,零複製並不會消除計算成本。移除實體重複項目時,執行會在來源系統進行。結構設計師必須管理查詢模式、聯結選擇性及執行頻率,才能控制成本與效能。
## 監管、安全性和合規性
### 大規模建構 Trust 的清潔空間
在現代企業中,Trust 不會螺栓在資料清除室。這是結構成果。Salesforce Data 360 會持續自動強制執行管治、安全性和合規性,從原則驅動的環境轉為平台管理的系統。
無論協同合作是在 Salesforce 內部、跨合作夥伴或跨雲端,執行階段控制項 (已鎖定身分、稽核追蹤和不同的隱私權) 都會一致套用。
### 執行階段 Trust 與 Governance
結構設計師最重要的轉換是,在執行期間強制執行 Trust,而不是事先假設。Salesforce Data 360 透過數個核心平台控制項目達成此目標:
- **鎖定的身分:**合作夥伴存取權會以密碼編譯方式繫結至已驗證的 Salesforce 組織身分,以防止偽造或未經授權的參與。
- **稽核追蹤:**系統會記錄每個查詢、聯結、區段重疊和啟用,以確保完整的稽核性與法規合規性。
- **不同的隱私權:**結構上無法進行列層級檢查。輸出會進行彙總和統計定義。協作者只會看見隱私權安全的結果,例如達成度量或提升百分比,絕不看見個別交易或身分。
這些控制項會以數學保證和平台級強制執行取代合約 Trust,進而降低營運和法律風險。
### 透過 Einstein Trust 層管理 AI
隨著 AI 工作人員越來越多地與 Clean Room 資料互動,Salesforce 導入 Einstein Trust 層級。它會作為敏感企業資料與外部 LLM 之間的結構空白鎖。這可確保清除空間洞察可以安全地推動 AI 驅動的決策,而無須公開基本資料。
**重要功能:**
- **零資料保留:**傳送至 LLM 的資料是暫時的。模型提供者無法儲存提示或回應以進行訓練。
- **毒性語言偵測和 PII 遮蔽:**系統會自動掃描輸入和輸出,並根據在 Data 360 中設定的「資料遮蔽原則」遮蔽 PII。
### 透過資料空間與權限集進行邏輯隔離
**資料空間**在組織內提供邏輯隔離,且應符合法規、地理位置和合作夥伴關係的邊界,例如:
- 歐盟資料空間
- 北美資料空間
只有指派給資料空間的資料集才能在其清除空間中看見,以避免意外跨境曝光。
權限集可讓您精細地控制誰可以建立或管理清潔室、執行查詢或啟用區段。資料感知權限會在資料模型物件中強制執行欄位級限制—例如,行銷人員可能會看見區段名稱和受眾大小,但無法看見收入或健康指標。
系統會在語意層強制執行安全性,讓業務使用者無須持續的 IT 監督即可安全地進行自助式服務。
### 依設計規範與同意
同意訊號會透過 Data 360 自動移入至 Clean Room Execution。撤銷同意的使用者依預設會排除在分析和啟用之外,以確保系統會強制執行合規性,而非手動監督。
Salesforce Data 360 將監管、安全性和合規視為一流的結構基本概念,而非選用的附加元件。透過結合執行階段稽核性、鎖定身分、差異性隱私權、資料空間、認可身分解析和 Einstein Trust 層,企業可以在合作夥伴、多雲端系統和 AI 驅動的工作量之間擴充整個空間協同合作,而不會影響 Trust、隱私權或法規合規性。
## 結束與進展路徑
### 結構設計師的實作路徑
若要將資料清除室的完整價值納入,結構設計師必須將其視為核心結構基礎結構,而非孤立的分析工具。下列優先順序會定義實際且可調整的進展路徑:
**讓協同合作成為一流的結構考量:**外部資料協同合作應以與內部整合相同的嚴謹度進行設計。清除空間應與資料平台、整合層和 AI 系統一起內嵌在企業參考結構內,而非部署為臨時擴充。隨著互通性擴大 (例如,Data 360 清潔室與 AWS 清潔室整合,以及未來的跨清潔室相容性),結構設計師必須設計協同合作模式,以預期多平台生態系統而非單一廠商孤島。
**來源的預設隱私權設計**
資料流性的 **設計:**建築師應先考慮聯合與零複製存取權,而不必預設為粗型 ETL 和集中複製。將運算移至資料 (若適用) 可減少不必要的重複運算、降低成本,並保留事實來源完整性。「連接與複製」應該是意識的結構決策,而不是繼承的習慣。
**關閉洞察轉動作缺口:**在分析時停止的清潔空間無法提供業務價值。架構必須原生將清除空間輸出連線至啟用系統和 AI 工作流程。回饋意見迴圈、效能測量和下游執行必須從頭開始進行設計。
**準備工作人員企業:**隨著 AI 工作人員越來越多地使用企業資料,清潔室將作為控制的執行環境,工作人員可以在其中作業,而無須公開原始資料。將清潔空間策略與 AI 監管與 Trust 架構保持一致的結構設計師最適合此下一個階段。
### 結論
現代資料清除室代表企業資料結構的基本轉變。它們透過啟用無資料公開的協同合作來解決資料公用程式與隱私權之間的長期緊張局勢。
Salesforce Data 360 等結構示範此權衡不是「無論是」考量事項。透過透過零複製模式將資料儲存空間與啟用分離,並將增強隱私權技術直接嵌入執行,企業可以針對高價值分析進行協同合作,而無須放棄對其資料的控制權。隱私權從合約義務移至結構保固。
最重要的是,清潔房間會將靜態、隔離的資產資料轉換為受管理且可運作的資源。當原生連線至啟用和 AI 圖層時,洞察將不再停滯在顯示面板中。它們會直接流入決策、行銷活動和自發系統,進而在企業規模中關閉資料、動作和成果之間的迴圈。
## 關於作者
**Yugandhar Bora** 是 Salesforce 的「軟體工程結構設計師」,專門在「資料和情報應用程式」平台內進行資料結構。他負責領導企業結構審查委員會 (EARB) 計畫,專注於資料管理和統一資料模型,同時為自動平台佈建解決方案做出貢獻。
**Birendra Kumar Singh** 是 Salesforce 的技術人員主管成員,專門處理 Data 360 中的平台與資料結構。他是「啟用平台」的核心成員,並負責「清除室」計畫,專注於為 Data 360 客戶提供資料清除室基礎結構。
**Priyanka Kshirsagar** 是 Salesforce 的資深產品經理,負責領導 Data 360 Clean Rooms,這是她從頭開始建立的功能,讓企業客戶能夠在保護隱私權的環境中針對第一方資料進行協同合作。她為工作人員 AI 和 ML 技術支援的使用個案 (包括清潔室的類似建模和身分豐富) 推動了願景,並透過「一般可用性」和「層級 1 Dreamforce」啟動帶來產品。
## 概觀
Salesforce Data 360 會改變企業如何大規模連線、協調和啟用客戶資料。然而,其真正的優勢在於管理整個生命週期資料的安全性。此安全性參考結構提供保護 Data 360 環境的實際端對端藍圖。我們透過最低權限、零 Trust 設計和預設治理的核心原則達成此目標。
在其基礎上,Data 360 中的安全性是共用的責任模型。Salesforce 使用 ISO 27001、SOC 2 和「一般資料保護規則」(GDPR) 等全球標準來保護基礎架構、網路、加密服務、平台、合規性和應用程式本身。Salesforce 管理員透過定義存取權、強制執行隱私權和管理整合,以保護其組織在平台內的資料。這包括實作僅授與必要存取權的強式身分與存取管理 (IAM),強制執行雙因素驗證 (2FA),並遵循最低權限原則和企業與法規要求。
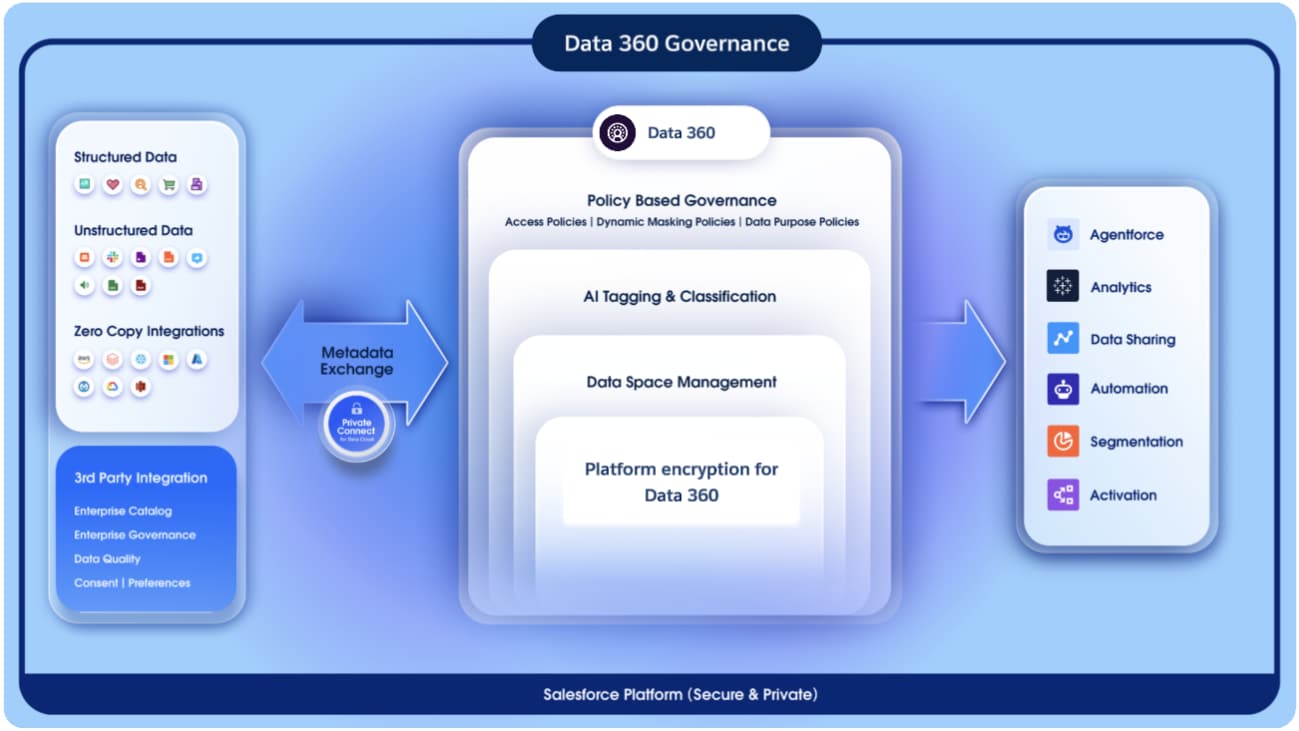
Data 360 Governance 可將這些層級的責任連結在一起,確保安全性和合規性保持一致。其可確保在整個流程中定義角色、原則、權限和資料處理規則,並持續強制執行,從取用到啟用。資料歷程、中繼資料分類和同意感知內建於每個物件和流程中。這會將監管從手動監督功能轉換為作業控制平面。
Salesforce 提供彈性的合規基礎,企業可在此基礎上保留其資料狀態、隱私權設定和整合界限的完整權限。他們共同建立安全性和管治架構,讓每個資料集、原則和使用者動作都可追蹤、一致且固定在 Trust 中。
Data 360 中的安全性超出靜態控制。其會內嵌在資料生命週期的每個階段中。從取用資料開始,系統便會根據企業原則加密、驗證和分類資料。統一並豐富後,會維護中繼資料歷程和同意屬性以確保負責。當針對業務或 AI 使用啟用洞察時,輸出流程會透過加密管道、強式驗證和授權、原則認知的管理和同意強制執行來受到保護,以確保資料從取用到啟用都保持值得信任、合規且安全。
## Data 360 的安全性基礎
### 在 Hyperforce 上建立
Salesforce Data 360 是完全以 Salesforce Hyperforce 結構為基礎的雲端原生資料平台,為全域作業提供安全、相容且可調整的基礎。
### 設計者保護基礎
- Hyperforce 會以內建功能提供安全性和合規性,而非附加元件。其提供一組通用的基礎控制項,這些控制項深度整合 Salesforce 平台與應用程式,確保從基礎結構到應用程式體驗的每個層級都以安全性、隱私權與合規性為核心設計。
- Data 360 會直接從 Hyperforce 的基礎控制繼承強大的存取控制、加密和法規合規架構。
- 此預設的安全模型可將漏洞降到最低,並簡化提供信任且合規的資料服務。
### 雲端原生結構
- Data 360 會在 Hyperforce (統一的雲端平台) 之上主控的專屬功能網域中執行,以確保隔離、效能和多租戶安全性。
- Data 360 使用微型服務結構,所有服務都會透過 Kubernetes 進行容器化和協調流程。
- Istio 服務網格套用零Trust的原則,可管理安全的服務間通訊,並提供流量管理、可觀察性和保單強制執行。
### 可調整和模組式部署
- Data 360 服務已佈建並使用 Salesforce 受管理的虛擬私人雲端 (VPC) 作業,以啟用區隔、有效控制和最佳化內部網路。
- 此結構支援水平延展性,確保 Data 360 可以處理位元組大小的資料處理工作量。
### 整合與擴充性
- Data 360 會顯示可與 Salesforce CRM 應用程式和其他資料來源整合的精確定義 API。
- 其支援第一方 (1P) 和以 Hyperforce 為基礎的 Salesforce CRM 組織,以確保跨環境的廣泛相容性。
- Data Cloud One 可讓客戶將多個 Salesforce CRM 組織與單一 Data 360 例項連線。
### 共用責任模型
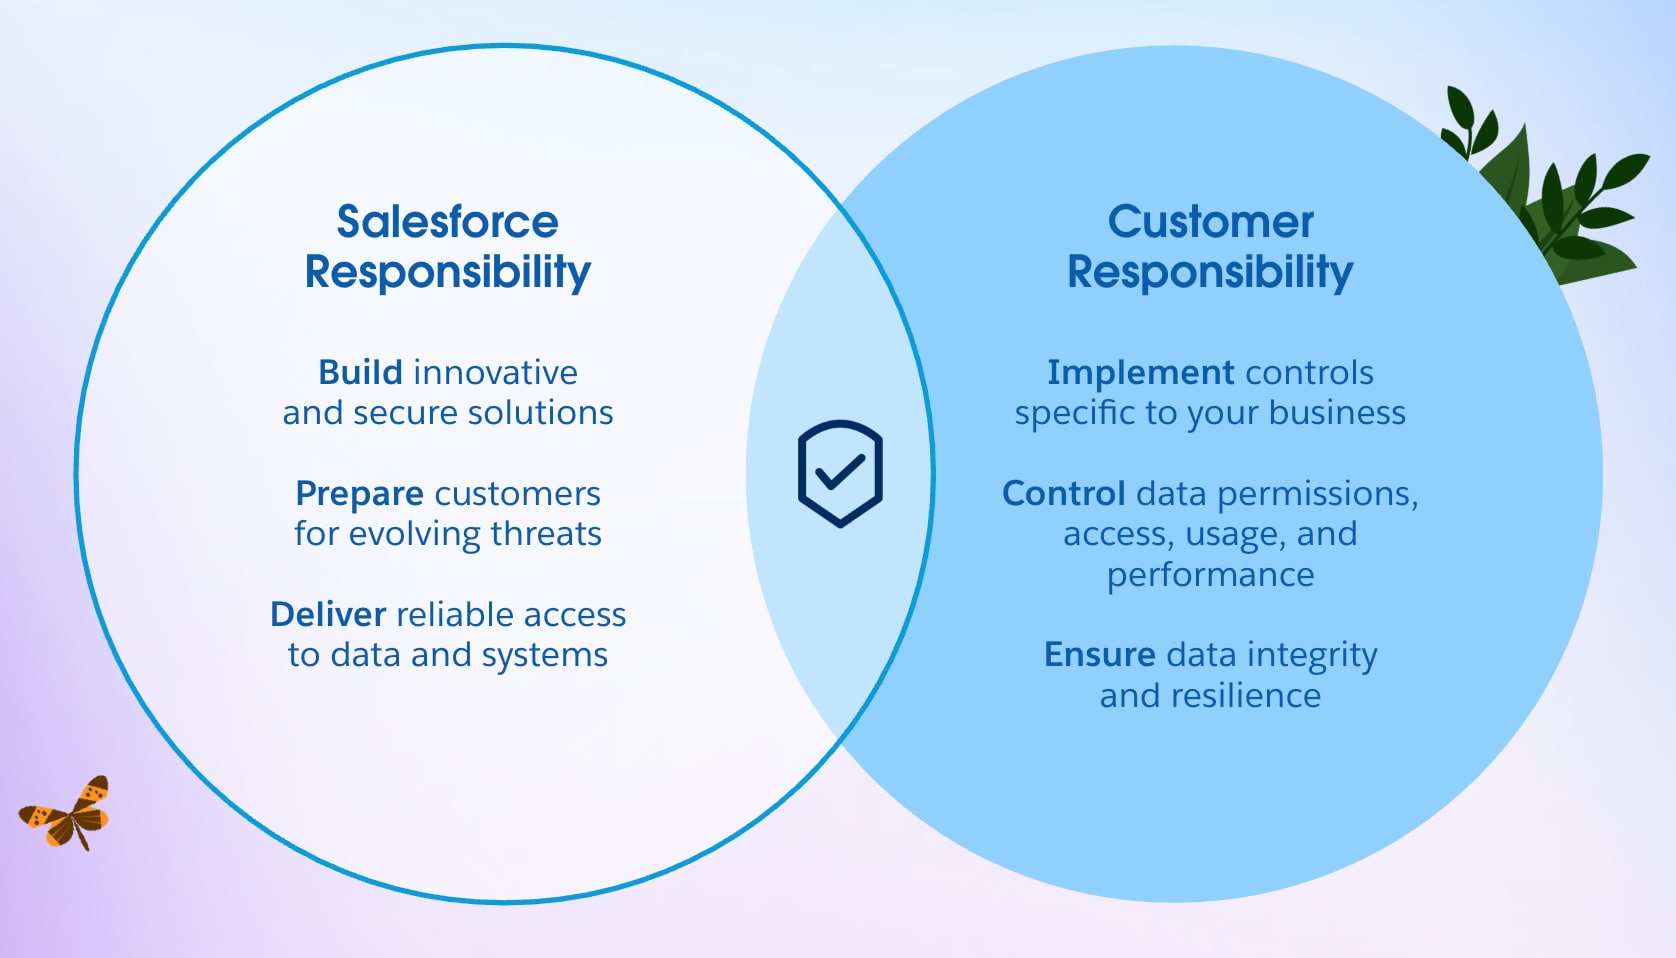
Salesforce Data 360 中的安全性在 [共用責任模型](https://compliance.salesforce.com/en/documents/a006e000010nW2FAAU)下運作,此架構也是主要雲端提供者 (例如 Amazon Web Services (AWS)、Microsoft Azure 和 Google Cloud) 所使用。
此模型定義明確的邊界:Salesforce 負責雲端安全**,**客戶負責雲端安全**。**瞭解和運作此區別對於維護彈性、合規性和安全資料生態系統而言至關重要。
 #### Salesforce:雲端安全性
Salesforce 負責保護及維護 Data 360 平台及其全域基礎結構的完整性。包括:
- **實體與環境安全性:**Hyperforce 託管在 AWS 基礎結構上,Amazon 會透過存取控制、監視和環境保護來委派其全球資料中心的保護責任。
- **網路和邊界防禦:**針對傳輸中 (TLS 1.2 及以上) 和靜態 (AES-256) 的所有流量,散佈式拒絕服務 (DDoS) 緩解、入侵偵測和加密。
- **平台強化與修補程式管理:**持續漏洞管理、修補程式部署和作業系統層級安全性基準。
- **規範與認證:**根據如 SOC 1/2/3、ISO 27001、ISO 27017、ISO 27018 等標準進行持續稽核,以及針對 GDPR 等架構做好準備。
這些控制項可確保 Data 360 平台保持安全、可靠且符合規範,讓客戶專注於業務邏輯和資料管理,而非基礎結構防禦。
#### 客戶:雲端安全性
客戶負責保護其 Salesforce Data 360 組織內的資料、組態和作業流程。責任的重要領域包括:
- **身分與存取管理 (IAM):**定義角色、強制執行多因素驗證 (MFA) 和單一登入 (SSO),並套用最低權限原則。
- **資料管理:**分類敏感資料、在需要時套用遮蔽,並強制執行物件、欄位和記錄級存取控制。
- **整合安全性:**使用已命名認證和外部認證,透過 OAuth 2.0、JSON Web 權杖 JWT 和其他驗證標準管理 API 存取。
- **監視與回應:**使用事件監視和稽核追蹤,並將記錄轉送至安全性資訊和事件管理 (SIEM) 系統以進行進階威脅偵測。
Salesforce 提供安全的基礎,但客戶可透過其組態、控制和警覺來決定其實際的安全狀態。
#### 人類中心的責任
安全性不只是技術建構,也是組織規範。Salesforce Data 360 中的資料保護可透過結構、作業和管治小組的協同合作來達成。
**企業應:**
- 持續檢閱並淘汰未使用或過度特權的帳戶。
- 使用程式碼和 CI/CD 管道等原則自動執行強制執行。
- 執行桌面演練,模擬事件,例如未經授權的資料啟用或洩漏,以增強回應整備。
Data 360 的效率並非僅依功能而定,而是依客戶負責執行功能的方式來調整。
#### 預設安全:主動安全性態勢
Salesforce Data 360 採用安全依預設的哲學,其是從反應性控制移至預防性設計。每個新的 Data 360 組織現在都會以「全部拒絕」狀態開始,從第一個部署強制執行零 Trust 原則。
#### 從反應性控制到預防性設計
在較舊的環境中,客戶繼承了權限的「允許所有」模式,以加速上線。雖然方便,但這會造成意外過度曝光和設定錯誤的風險。
新的安全依預設結構會反轉此方法:
- 沒有任何使用者或系統具有隱含存取權。
- 必須明確授與所有權限。
- 從第 0 天強制執行資料存取、整合與管治控制。
這會透過設計強制執行最低權限,大幅降低意外曝光或權限升級的風險。
#### 營運與管治影響
此模型具有技術與行為影響:
- 小組必須刻意規劃存取模型,使權限與合規性和業務界限保持一致。
- 監管會成為內建的設計需求,而不是後續的考量。
- 從一開始就定義資料的擁有權與責任。
針對仍在「全部允許」下運作的舊版 Data 360 組織,管理員必須手動縮小組態以符合新的基準,這是任何安全性現代化或 Data 360 成熟度計畫中的關鍵步驟。
#### Trust 由設計
透過預設為零存取權並要求明確的原則定義,Salesforce Data 360 建立Trust依據設計,這是企業資料安全性的基礎演進。
此方法可確保:
- 將未經授權的存取與資料洩漏風險降到最低。
- 會以結構方式強制執行監管架構,而非選擇性執行。
- 企業可在環境之間取得更可預測、更可稽核且更具彈性的安全性狀態。
基本上,安全性不再是您新增的功能。這是您從中開始的基礎。
## 身分與存取管理:資料的門戶
**Salesforce Data 360** 中的身分與存取管理 (IAM) 是第一個且最重要的防禦層。它會管理可以存取平台**的人員**,以及他們可以在內部執行**哪些**動作。實作良好的 IAM 架構是企業可保護其客戶資料並確保營運完整性的單一最強大控制項。
### 驗證:驗證「您是誰」
驗證會建立 **數位 Trust,**確認存取 Salesforce Data 360 的每個使用者、服務或外部系統都是合法的。
### 聯合身分管理
Data 360 支援使用 [**SAML 2.0**](https://help.salesforce.com/s/articleView?id=xcloud.sso_saml.htm&type=5)、OpenID Connect ([**OIDC**](https://help.salesforce.com/s/articleView?id=xcloud.sso_provider_openid_connect.htm&type=5)) 或跨網域身分管理 ([**SCIM**](https://help.salesforce.com/s/articleView?id=xcloud.identity_scim_overview.htm&type=5)) 系統等企業級身分提供者 (IdP) 的 **聯合驗證**,例如 [**Microsoft Entra ID (Azure AD)**](https://learn.microsoft.com/en-us/entra/identity/saas-apps/salesforce-tutorial)、[**Okta**](https://help.okta.com/en-us/content/topics/provisioning/salesforce/sfdc-provision.htm) 或 [**Ping Identity**](https://docs.pingidentity.com/configuration_guides/salesforce/config_saml_salesforce_pf.html)。
此聯合會將您的公司身分生命週期直接延伸至 Salesforce。當員工加入、轉移或離開公司時,其存取權會自動調整,進而減少孤立帳戶並改善合規性整備。
### 單一登入 (SSO)
透過 [**單一登入 (SSO)**](https://help.salesforce.com/s/articleView?id=xcloud.sso_about.htm&type=5),使用者可以使用其公司認證進行一次驗證,並取得 Salesforce 應用程式的安全存取權,而無須使用個別密碼。這可減少認證疲勞,並將密碼重複使用或網路釣魚的風險降到最低。
### 適應與條件式存取
身分提供者 (IdP) 會成為驗證決策的單一授權機構,強制執行多因素驗證 (MFA)、條件式存取和以風險為基礎的控制。驗證會從單一事件進化為持續評估 Trust,並根據使用者行為和內容進行回應。
聯合驗證提供:
- **集中強制執行原則:**系統會在所有 Salesforce 環境之間的一個位置管理驗證標準。
- **端對端可追溯性:**「統一稽核」追蹤會將每個動作連結回已驗證的身分。
- **以人為本的體驗:**無縫且安全的登入流程可讓小組專注於洞察,而非認證。
### 授權:定義「您可以執行的項目」
使用者驗證後,授權會定義他們可以存取、檢視或修改的內容。它會設定保護敏感資料並強制執行最低權限的作業邊界。
**最低權限原則 (PoLP):**每個使用者和系統只會獲得其工作功能所需的權限,而不會獲得任何權限。此原則會大幅限制認證遭入侵或設定錯誤所造成的潛在損害。
**以角色為基礎的存取控制 (RBAC):**Salesforce Data 360 使用權限集和權限集群組來指派符合業務角色的細微功能。例如:
- 「資料工程師」可在 Data 360 結構設計師權限集的協助之下,管理取用管道和轉換。
- 「行銷分析師」可在「Data 360 啟用管理員」權限集的協助下查詢協調資料,但無法變更模型。
- 「啟用管理員」可以執行輸出行銷活動,但無法透過「Data 360 啟用管理員」權限集的協助存取來源資料
存取權會集中管理且可稽核,以確保在整個資料生命週期中擁有責任。當與如 Entra ID、Okta 或 Ping Identity 等 IdP 整合時,存取原則會透過 SCIM 佈建和 SAML/SSO 聯邦順暢地延伸至整個企業。
### 瞭解 Data 360 中的標準角色和權限
Salesforce 提供預先定義的權限集,這些權限集會壓縮職責分隔和符合如 ISO 27001 等產業標準的最佳作法。
| 角色 | 主要責任 | 存取設計原則 |
|---|---|---|
| 系統管理員 | 環境設定、佈建和組態 | 沒有基本資料集的存取權 — 確保系統與資料控制區隔 |
| Data 360 結構設計師 | 資料取用、轉換、身分解析和建模 | 無法執行資料啟用以維護資料曝光邊界 |
| Data 360 啟用管理員 | 區段建立、管道管理和啟用 | 資料模型的唯讀存取權;沒有修改權限 |
| Data 360 使用者 | 耗用分析與洞察 | 唯讀;零修改權限 |
| Data 360 One 使用者 | 透過伴侶組織進行跨組織存取 | 由共用空間權限與範圍存取原則管理 |
 ### 控管計畫
Data 360 是根據監管優先的模型所建立,可確保每個資料互動皆符合原則、可稽核且符合,從採取到洞察啟用。管治會作為中心控制層級,管理在整個生命週期中如何探索、分類和保護資料。
此統一控制平面可確保:
- **資料存取權會根據內容授權**:只有正確的使用者可以根據正確的原則對正確的資料採取動作。
- **管治內嵌在語意與作業層**中,可確保資料建模方式與保護方式之間的一致性。
- 強制執行「**零信任」與「最低權限**」原則:在授與存取權之前即時評估身分、內容和原則。
透過此結構,Salesforce Data 360 會將管理從靜態權限管理轉換為動態、原則驅動的協調流程層。一種可持續適應內容、透過設計強制執行合規性,並在企業規模維持 Trust。
### 使用資料空間邏輯資料分隔
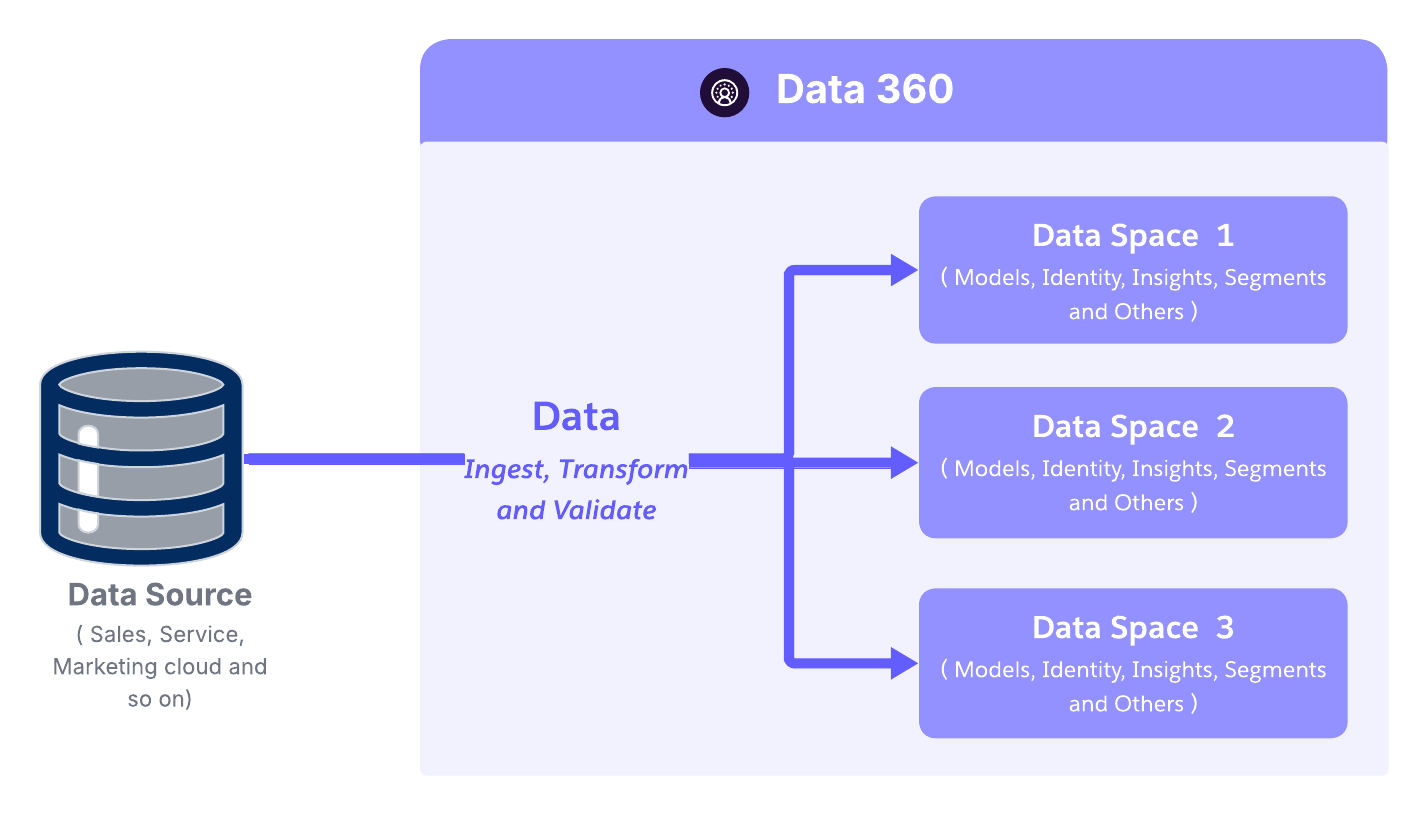
在巨集層級,資料空間提供企業資料網域的邏輯區隔與隔離,讓具有多品牌、多區域或多租戶作業模型的組織能夠在單一統一平台內管理資料。資料空間可與業務領域 (例如「銷售」、「行銷」或「客戶成功」) 或法規與地理邊界 (例如歐盟、美洲或亞太地區) 保持一致,讓管治與存取控制能夠反映組織的營運與合規結構,而無須分割基本資料平台。
- 每個資料空間都會作為虛擬邊界,定義使用者或小組可以看見或互動的資料集合。
- 系統會明確授與資料空間內的存取權,以確保沒有資料可視性的隱含權限或交叉污染。
- 這可啟用聯合擁有權:每個業務單位可獨立管理其領域,同時維持集中監督與合規。
透過設計,資料空間提供第一層的管治,建立企業資料集的結構清晰度和責任性。
 ### 從 RBAC 至 ABAC:移至內容授權
在 Salesforce Data 360 中,RBAC 和 ABAC 具有不同的但互補的用途,且會套用至平台的不同層級。
RBAC 主要用於平台和功能存取。它會管理可存取 Data 360 建構和功能 (例如資料空間、流程建立、管理功能和工具存取權) 的使用者。RBAC 透過權限和權限集實作,例如透過特定已啟用功能指派使用者對「資料空間」的存取權。
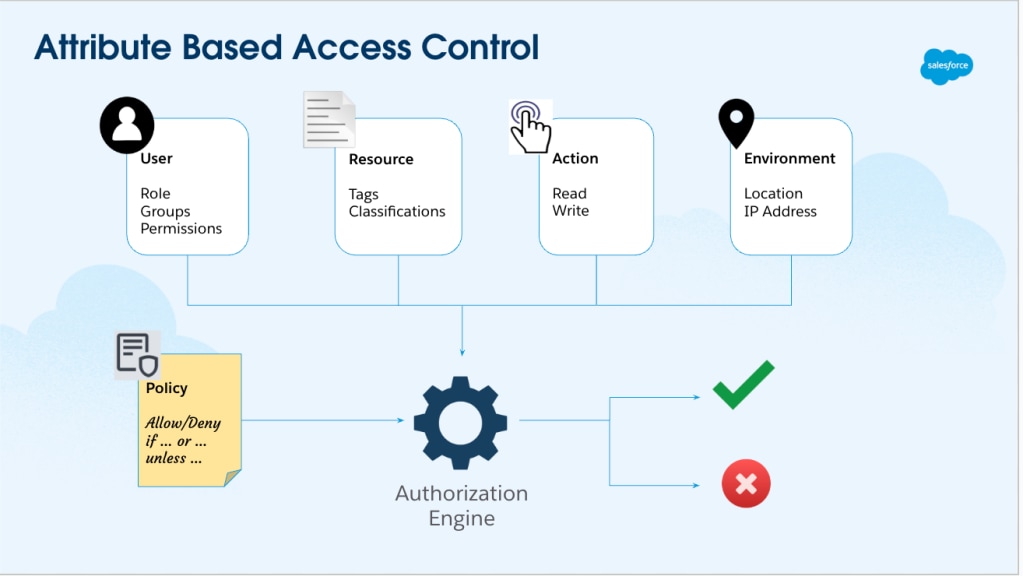
ABAC 用於強制執行資料存取。ABAC 原則完全負責決定可以存取哪些資料物件和屬性,包括物件級安全性 (OLS)、欄位級存取權和列層級限制。這些決策是在執行階段透過評估動作、使用者屬性和資源屬性來動態做出。
在 ABAC 中,權限會保持為模型的一部分,但原則本身會決定存取權,而非僅限角色。原則會評估內容,例如業務單位、區域、資料敏感度、用途或允許或拒絕存取的法規限制。
例如:
- RBAC 可讓使用者存取 Data 360 資料空間與分析功能。
- ABAC 會決定同一位使用者是否可以讀取特定客戶資料集、他們可以看見哪些列,以及哪些屬性會遭到遮蔽或限制。
此清除區隔可讓 Data 360 安全地調整規模:
- RBAC 提供平台功能與工作流程的控制存取權。
- ABAC 提供精細的原則驅動資料存取權,並符合規範、落地與資料保護需求。
這些動作會共同啟用受管理的資料民主化,而不會將平台權限與資料授權邏輯混合。
基本上,RBAC 會根據權限指派強制執行存取權,而 ABAC 會在內容中評估權限—結合動作、使用者和資源屬性,在整個 Salesforce Data 360 中提供自適應且精細的存取控制
### ABAC:多層級安全性階層
Salesforce Data 360 的精細存取控制中心是以屬性為基礎的存取控制 (ABAC),其由 CEDAR 原則語言提供技術支援。
不同於靜態以角色為基礎的權限,ABAC 會動態評估 _誰_ 要求存取權、他們嘗試存取的 _內容_,以及 _在哪些情況_ 下—確保每個資料互動皆符合企業原則和信任界限。
#### 動態保單評估
Data 360 的 ABAC 引擎會根據三個核心屬性類型的組合評估存取決策:
- **使用者屬性:**部門、位置、排放層級
- **資料屬性:**分類、敏感度 (PII、PHI、財務資料)、資料空間
此彈性原則驅動的模型可讓強制執行會隨著使用者角色、資料分類或營運條件的演變自動調整,這對於大型、分散式和受監管的企業而言至關重要。
 #### Salesforce Data 360 中的 ABAC 結構元件
Salesforce Data 360 會實作標準型「屬性型存取控制」(ABAC) 結構,並與行業最佳作法保持一致,以進行原則驅動的資料管理。其由三個主要功能元件所組成:
- **原則資訊點 (PIP) - 原則、增強型中繼資料和分類:**
- 包含原則定義本身,包括管理企業資料的資料存取、分類、遮蔽、保留和使用原則。
- 維護豐富的中繼資料,例如標記、分類、業務內容和端對端歷程。
- 使用 LLM 和 ML 驅動分類來自動標記敏感資料 (例如 PII.Email、PII.Phone、PHI)。
- 標記傳播可確保分類在資料歷程 (DLO → DLO → DMO) 中自動流動。
- 在整個轉換中保留敏感性和合規性。
- **原則決策點 (PDP)**:PDP 是解讀 CEDAR 原則的決策引擎。
- 從 PEP (使用者身分、要求中繼資料) 和 PIP 參照屬性中取用內容輸入。
- 以決定性方式評估原則,以提供一致、可解釋且可調整的存取決策。
- 支援即時與批次評估,即使在大量環境中也能確保效能與精確度。
- **原則執行點 (PEP)**:PEP 是執行階段強制執行授權決策的位置。
- 攔截所有互動管道的資料存取要求,例如 API、UI 查詢、CRM 增強或 GenAI 尋找增強產生 (RAG) 管道。
- 立即套用 PDP 結果,以確保每個查詢和提取皆符合企業存取原則。
PIP–PDP–PEP triad 會組成分散式監管架構,在所有 Data 360 服務和存取模式之間強制執行一致且以原則為基礎的控制。
請注意,Data 360 中的 [ABAC](https://help.salesforce.com/s/articleView?id=data.c360_a_policy_based_governance_dg.htm&type=5) 已設定,非已建立。結構設計師不會組合自訂控制平面或強制執行邏輯。而是會填入並連接三個原生結構元件,這些元件會共同運作為統一的管治架構。
在實際層級,實作遵循簡單的進度:分類資料、定義原則,並讓平台自動強制執行。設定後,存取控制會成為系統行為,而非手動或程序流程。
此分散式管治架構可確保在所有存取管道之間**一致強制執行原則**,進而在整個 Data 360 中建立統一的 Trust 界限。
#### 強制執行多層級原則
Data 360 的 ABAC 架構支援分層存取邊界,確保資料不僅在物件層級受到保護,而且在特定欄位和記錄內受到保護。
- **物件級安全性 (OLS)**:存取控制的最外部邊界。
管理整個資料結構的存取權,例如資料湖物件 (DLO) 或資料模型物件 (DMO)。
範例:授與 _客戶_物件的存取權,但不授與「_交易」_的存取權。
- **欄位級安全性 (FLS)**:控制物件內特定欄位的存取權。
範例:行銷使用者可以看見客戶名稱,但受限於檢視信用卡號碼或國家/地區識別碼。
- **記錄級安全性 (RLS)**:最精確的控制層。
決定使用者可檢視或修改資料集內的個別記錄。
範例:區域經理只能存取與其指派區域繫結的客戶資料。
- **動態資料遮蔽 (DDM):**啟用即時資料保護。補充 ABAC,DDM 會強制執行原則驅動的敏感資訊隱藏,而不會變更基本資料集。在查詢時,DDM 會根據使用者角色、內容或合規性規則自動遮蔽 PII 或財務資料等欄位。
- 敏感資料會在 UI 檢視、API 和 AI 工作流程之間保持受保護。
- 透過確保所有耗用層之間的一致遮蔽來減少資料洩漏風險。
- 維護稽核性。系統會在 Data 360 的管理架構內記錄並追蹤每個遮蔽的查詢。
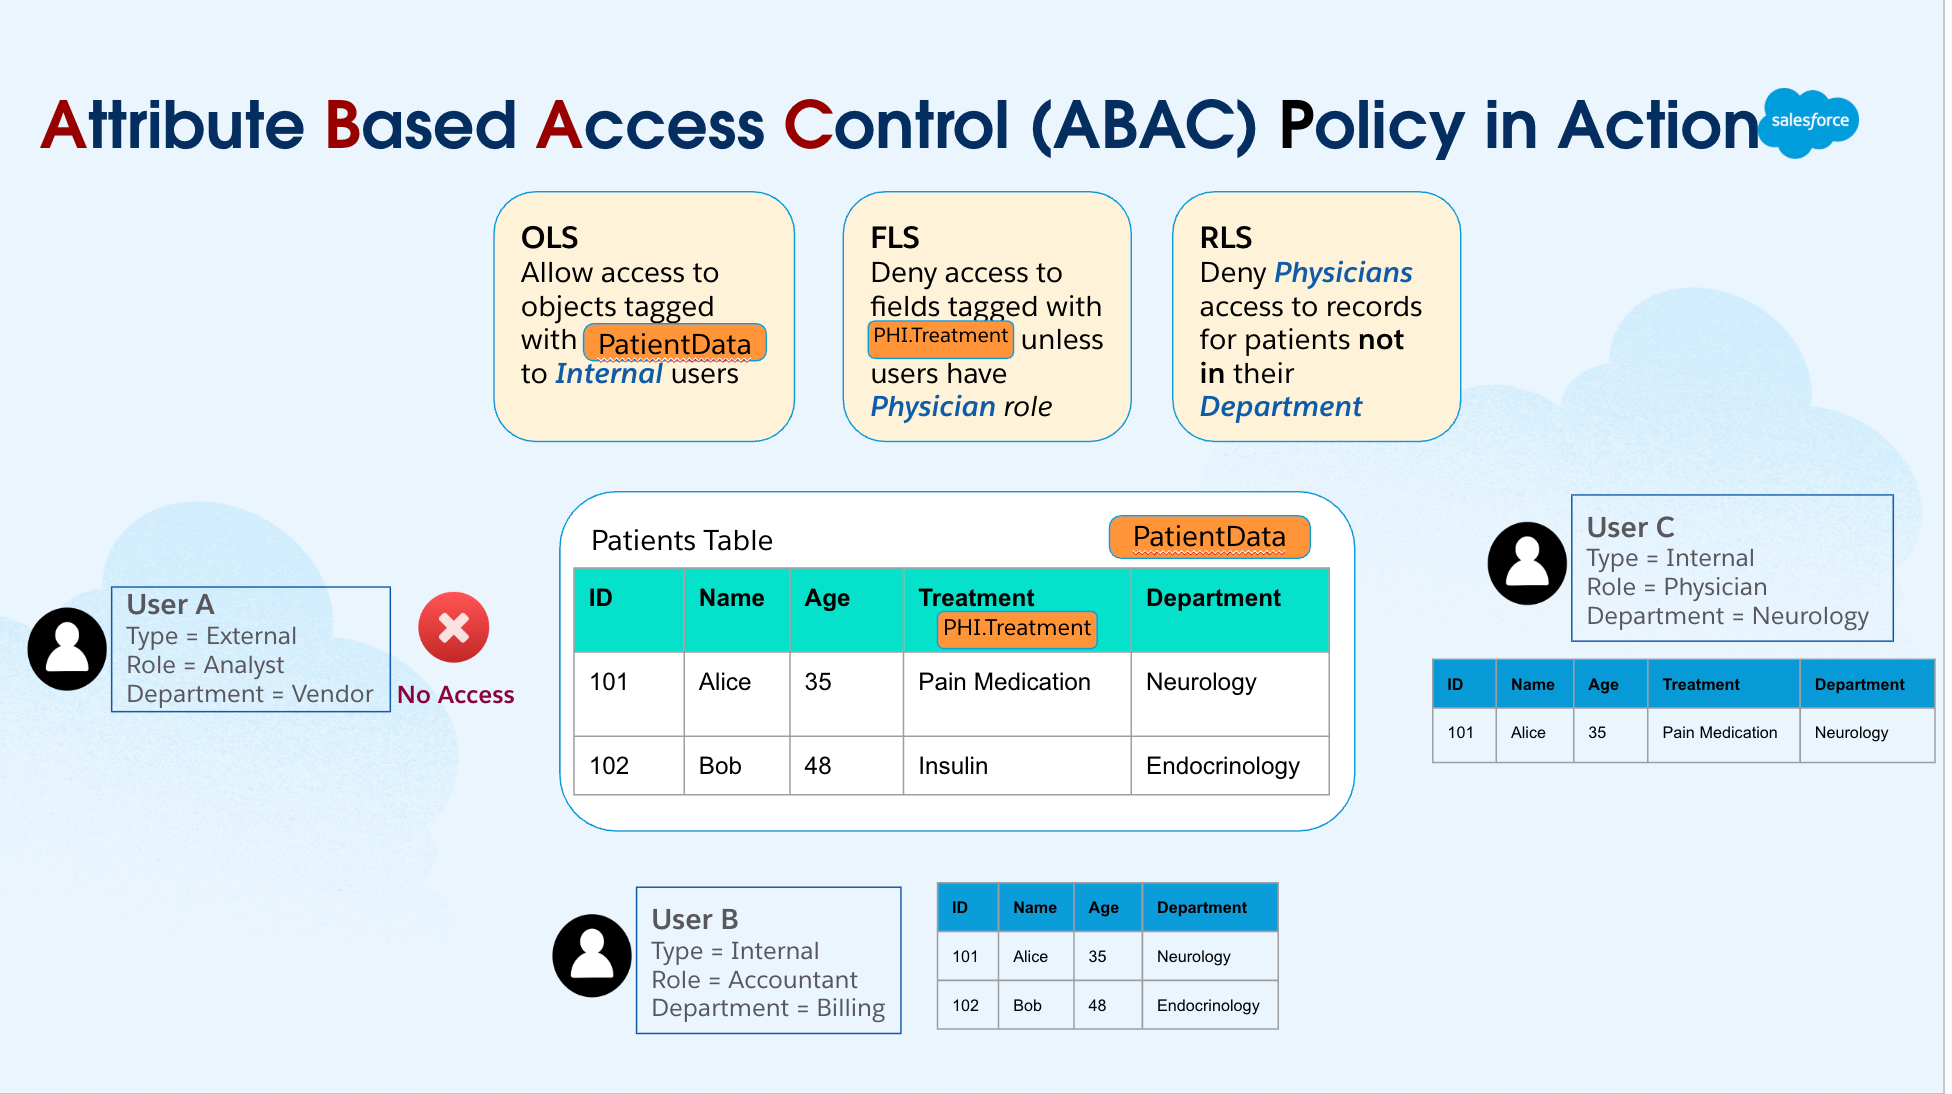 此結構會將存取控制從靜態權限模型轉換為動態且感知內容的原則結構。透過將 RBAC 的結構化簡單度與 ABAC 的內容深度結合,Salesforce Data 360 可達成:
- 在整個採取、調和和啟用之間一致強制執行原則。
- 根據資料、角色和合規性需求而發展的自適應管理。
- 在整個資料生命週期中整合 Trust 界限,從取用到 AI 啟用。
#### 與 Salesforce Platform 的深度整合
Salesforce Data 360 的監管模型原生內嵌在 Salesforce Platform 中,能夠統一營運與分析資料的安全性、合規性與存取控制。透過繼承 Salesforce 的核心身分識別與存取管理功能 (例如身分識別聯邦、權限集、集中原則編寫和平台加密),Data 360 會在雲端之間套用一致的 Trust 原則,而不會導入並列的管治堆疊。平台不會將隔離、授權和歷程視為個別的問題,而是將這些問題整合到跨越整個資料生命週期的單一認知執行 Trust 架構中。
在結構層級上,此管治架構由三個互補的層所組成:
- **資料空間**,可為資料隔離與監管區隔建立明確的邏輯界限
- **以屬性為基礎的存取控制 (ABAC)**,可根據身分、用途和資料屬性,啟用精細且感知內容的授權決策
- **語意歷程**,可在資料從採取移至洞察和啟用時保留業務意義、敏感性和可追溯性
他們共同建立一個可解釋存取決策、自動強制執行,且規範是連續的而非追溯的管治模式。結果是使管治不再是限制因素或後續考慮的平台。而是會變成啟用層,讓結構設計師能夠設計資料產品和 AI 驅動的工作流程,並確信系統本身會強制執行 Trust、隱私權與法規要求。
此組成方法可確保企業資料不僅保持可用性,還能負責任地採取行動—支援大規模洞察、啟用和自動化,而不會影響透明度、安全性或控制。
## 保護資料生命週期:從取用至啟用
在 AI 驅動的企業時代,保護資料並非一次性的事件,而是持續的程序,從資訊進入生態系統的那一刻開始,直到資料啟用供業務或 AI 使用為止。
Salesforce Data 360 內嵌在資料生命週期每個階段的安全性與管治控制項,確保資料完整性、機密性與 Trust 皆可保留,無論是從取用到洞察啟用。
### 保護基礎:靜態與傳輸中的加密
Salesforce Data 360 的保護模型核心是 Platform Encryption for Data 360 — 透明且高效能的加密架構,可保護靜態與傳輸中的資料,而不會影響可用性或延展性。
#### 靜態加密:儲存層安全性
Data 360 Data Lake 中保留的資料會在儲存層級進行**自動加密**,以確保即使發生實體或未經授權的存取,資料仍無法閱讀。重要功能包括:
- **透明資料湖加密:**系統會使用客戶管理金鑰 (CMK) 在儲存層加密資料湖中存在的所有資料。這可確保即使發生未經授權的實體儲存空間存取,資料仍會保持不可讀和無法解碼。
- **客戶管理金鑰 (CMK):**客戶可完全控制加密金鑰,這是金融服務、醫療照護和政府等受監管產業的重要功能。CMK 可實現細微的資料主權稽核、控制和證明,直接符合 GDPR、HIPAA 和 ISO 27001 等法規要求。
- **外部金鑰管理 (EKM):**透過「外部金鑰管理」,這是 Platform Encryption for Data 360 的功能,客戶將能夠使用儲存在客戶 AWS KMS 帳戶中的金鑰來加密 Data 360 中的資料。這可讓客戶更有彈性,同時確保 Data 360 中的資料安全且受保護。
- **自帶金鑰 (BYOK):**Data 360 現在以 CMK 和 EKM 為基礎,可讓客戶直接在 Salesforce 中上載自己的金鑰資料,以加密靜態資料和搜尋索引。此增強功能針對 PII、敏感、機密和專有資料提供額外一層的保護,而不需要客戶在 AWS KMS 中建立或管理金鑰。
- **金鑰輪換與生命週期管理:**金鑰輪換已妥善處理。新資料會使用新金鑰加密,而舊資料會保持原始金鑰加密,以避免停機或效能降低。此輪換機制可強化合規性,而不會造成營運中斷。
#### 傳輸中的加密:網路級安全性
Data 360 服務、API 和連接器之間傳輸的每個資料都會使用「傳輸層安全性」(TLS) 1.2 或更高版本來保護,進而提供端對端加密。
這可確保:
- 在傳輸期間無法攔截或變更資料。
- Salesforce 服務、信任連接器和客戶端點之間的通訊會保持私密且可驗證。
- 安全性會持續延伸至整合管道、調和流程、啟用工作流程和外部 API 整合。
透過結合客戶管理靜態加密與傳輸中的持續加密,Salesforce Data 360 可建立深度防禦結構,以保護客戶資料免受外部攻擊和內部基礎結構威脅。
### 在 Data 360 中保護系統對系統整合 (資料整合)
雖然加密和存取控制會保護 Salesforce Data 360 內的資料,但在整個系統之間安全地移動資料同樣重要。現代企業在多雲與混合式環境中運作,其中敏感資料會在 Salesforce、分析平台、外部 API 和資料湖之間流動。
為了解決此問題,Salesforce 設計了一個以已命名認證 (NC) 和外部認證 (EC) 為中心的安全整合架構,為安全連線提供以原則為導向且符合零 Trust 的基礎。
#### Salesforce 的安全整合架構
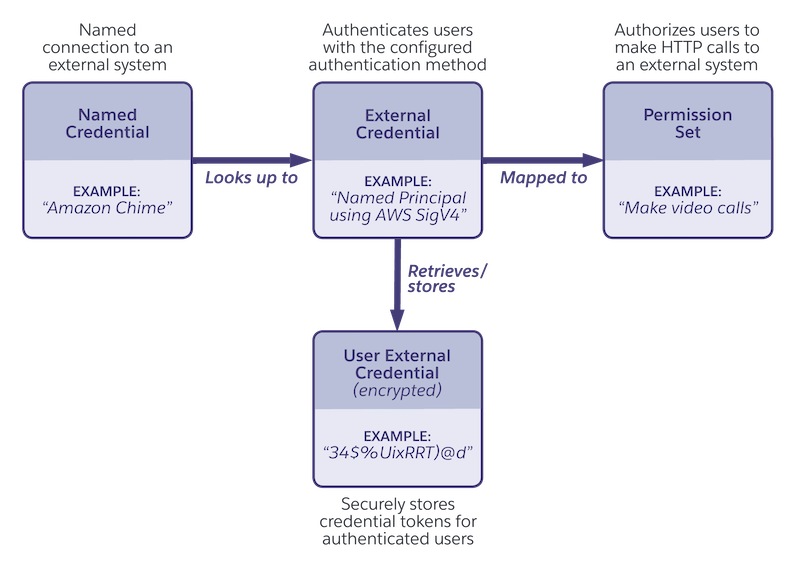
Salesforce 已建立強大的 **[安全整合架構](https://developer.salesforce.com/docs/platform/named-credentials/guide/get-started.html)**,以已命名認證 (NC) 和外部認證 (EC) 為中心。整體,它們會移除認證複雜性、強制執行最低權限存取權,並在所有整合之間啟用一致的驗證管理,而不會在程式碼或組態中顯示密碼。
此架構會抽出安全性複雜性、強制執行最佳作法,並針對所有外部連線建立一個以**原則為導向的控制平面**,以符合 Salesforce 的 **Zero Trust** 和 **security-by-design** 原則。
##### 已命名認證
已命名認證 (NC) 是 Salesforce 安全整合結構的基礎。它們提供定義外部端點及其驗證參數的陳述性集中機制,無須硬式編碼 Apex 程式碼或組態檔案中的使用者名稱、密碼或權杖等敏感認證。開發人員和管理員只需參照已命名認證別名 (例如,SnowflakeConnector_NC),Salesforce 會自動處理基本驗證和連線管理。
**結構與安全性優點:**
- **簡化維護:**NC 會將外部端點 URL 和驗證參數合併至單一受管理記錄。任何更新 (例如變更端點或輪換認證) 僅需要對 NC 記錄進行變更,以避免在環境之間重新部署程式碼或流程。
- **增強型安全性:**認證會安全地儲存在 Salesforce 的加密密碼存放區中,以避免在程式碼存放庫、組態檔案或記錄中顯示。驗證流程本身會在執行階段自動管理,進而減少人為錯誤和洩漏風險。
**合規性符合度:**將認證與業務邏輯分開可簡化資料保護法規 (例如 **GDPR、HIPAA 和 PCI DSS**) 的合規性。稽核員可以輕鬆驗證外部資料存取是否遵循企業安全性與管治原則。
- **略過遠端網站設定:**NC 會去除遠端網站設定的舊版需求,簡化組態和部署,特別是大規模或多環境企業實作。
 #### 外部認證
外部認證 (EC) 定義 Salesforce 在連線至外部服務時使用的驗證通訊協定和流程,有效回答「驗證方式」。單一 EC 可在共用相同驗證類型的多個 NC 中重複使用,進而促進組態重複使用和一致的安全性強制執行。
**支援的驗證通訊協定:**
- OAuth 2.0 (支援所有變體)
- JWT (JSON Web 權杖)
- 基本驗證
- AWS 簽章 v4
- 自訂驗證
- 無驗證 (適用於開放的 API 或公用端點)
外部認證與已命名認證的設計目的為清楚分隔工作。外部認證定義驗證的方式,指定用於連線至外部系統的驗證通訊協定、權杖類型和重新整理行為。另一方面,「已命名認證」會定義要連線的位置—端點 URL,以及要用於該連線的「外部認證」。此設計可確保驗證邏輯與端點組態保持分離,讓 Salesforce 能夠安全地支援多元整合通訊協定,同時在整個企業中維持集中且一致的認證管理。
### Data 360 連接器如何利用此架構
雖然 Data 360 的使用者介面會抽出大部分的基礎組態,但其原生連接器和資料串流經常利用「已命名認證和外部認證」架構。這表示,即使管理員透過引導式 UI 簡單地「新增資料連線」,Data 360 仍在背景中套用此標準化安全性模型。
結構影響:
- **統一安全性模型:**無論連線至外部資料庫、AWS S3 或企業 API,每個連接器都會受益於「已命名」和「外部認證」強制執行的相同加密、驗證和金鑰管理標準。
- **開發人員摘要:**開發人員與管理員無須手動處理驗證流程或認證輪替。Salesforce 會自動管理權杖生命週期、到期與重新整理。
- **一致的保單強制執行:**此架構可確保所有連接器皆遵循一致的驗證、稽核和記錄原則,這對於受監管產業中大規模的多來源摘要而言至關重要。
- **未來的擴充性:**隨著 Salesforce 增強其驗證堆疊 (例如,支援新的 OAuth 流程或 FIDO2 標準),這些改善會自動在所有連接器之間移入,而不需要重新產生或重新部署。
### Data 360 連接器安全性與監管
Salesforce Data 360 提供大量立即可用的連接器,可簡化來自各種來源的資料整合。這可讓企業有效率地合併和利用其資料。Salesforce 提供多種連接器類型,包括原生 Salesforce 連接器、雲端儲存連接器、資料庫連接器,以及應用程式和 API 連接器。除了提供的連接器外,也支援零 ETL 工具。Salesforce 連接器可讓 Salesforce 產品 (例如 Sales Cloud、Service Cloud 和 Marketing Cloud) 與 Data 360 順暢整合。此外,提供與雲端儲存體提供者的各種連接器,包括 Amazon S3、Google Cloud Storage 和 Azure Data Lake。Snowflake、Redshift 和 BigQuery 等資料庫的預先建置連接器可讓企業將現有的資料倉庫與 Data 360 連結。此外,Data 360 為各種第三方應用程式和 API (例如 Google 廣告、Facebook 廣告和其他行銷平台) 提供連接器。為了增強彈性,Data 360 會與如 MuleSoft 和 Informatica 等 ETL 工具整合。
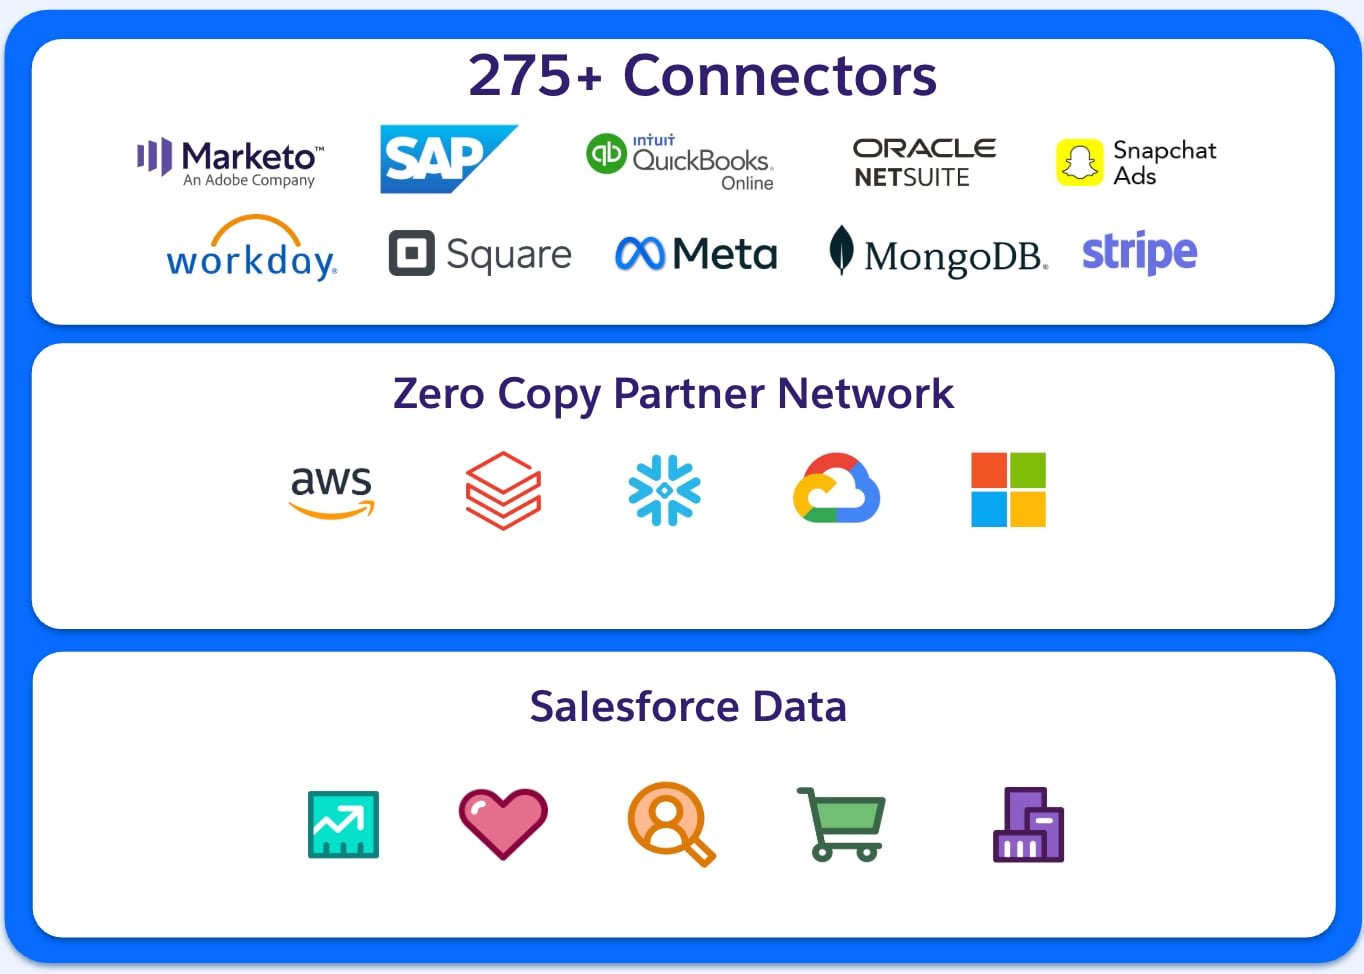 #### 資料安全性與 Salesforce Data 360 連接器
儲存在 Salesforce Data 360 中的資料安全性一直是許多 Data 360 相關對話的重點。作為 Salesforce 對深度防護安全性方法的承諾的一部分,同等重要性重點在於確保資料如何提取至 Data 360 環境。
Salesforce 瞭解企業在多元化的資料生態系統中運作,經常跨越多個雲端平台、儲存解決方案和分析工具。我們的 Data 360 連接器可作為這些環境之間的橋樑。連接器可實現安全、可調整且有效率的資料整合,同時維持 Salesforce 的高安全性標準。這些連接器可協助流程順暢,而不會影響完整性或隱私權。
Data 360 連接器安全性的三個基本元件有:
- **驗證/授權對應**:安全存取管理是資料安全性的基礎。不同的雲端連接器會使用不同的驗證和授權機制來驗證和控制使用者存取權。驗證可確保使用者或系統是合法的實體,而授權則可定義授與的存取層級。Salesforce 盡可能確保其連接器符合產業標準。
- **零複製 (ZETL) 功能的互通性**:資料重複會造成安全性和營運挑戰。這也會產生不必要的儲存成本、資料不一致,以及增加的風險曝光。Salesforce 的 Zero Extract、Transform 與 Load (ZETL) 方法可確保跨平台進行即時資料共用,而不需要實體資料複製。這表示資料可以保留在其原始環境中,同時仍可供處理、報告和分析使用。此外,這也會大幅減少攻擊面積,並增強對資料落地法律的潛在合規性。
- **資料聯合支援**:在今天的多雲環境中,組織需要全方位的資料存取權,而不需要不必要的資料移動。Data 360 連接器聯合資料模型支援檔案型和查詢型資料聯合,讓企業能夠即時利用外部資料來源。無論是存取結構化資料庫、半結構化記錄或非結構化檔案,Salesforce 的連接器都能確保資料在整個生命週期中保持安全。
Salesforce 旨在為客戶提供所需的透明度,以協助其瀏覽資料安全性和合規性的複雜性,即使是我們的整合也是如此。無論是與 AWS S3、Google Cloud Storage、Snowflake 或其他平台整合,我們的 Data 360 連接器都專為確保重要業務資料的Trust、透明度和控制而設計。
##### Salesforce Data 360 連接器安全性與驗證對應
| 連接器類型 | 連線類型支援 | 主要驗證類型 | 重要安全性層面與注意事項 |
|---|---|---|---|
| Salesforce CRM | 無 (內部) | 以工作階段為基礎 (內部) | 使用 Salesforce 強大的內部身分與存取管理 (IAM) 模型。所有資料都會在 Salesforce 基礎結構中傳輸和靜態加密。 |
| Marketing Cloud 參與 | 僅公用網際網路 | OAuth 2.0、使用者名稱/密碼 | 標準 OAuth 2.0 通訊協定用於安全驗證。資料會透過公用網際網路進行傳輸 (TLS) 加密。 |
| B2C Commerce | 僅公用網際網路 | OAuth 2.0 | 標準 OAuth 2.0。依賴安全的公用網際網路通訊協定 (TLS) 來傳輸資料。 |
| Web 與行動應用程式 | 僅公用網際網路 | API 金鑰、OAuth 2.0 | 經由 API (Cogestion API、Streaming API) 所採取的資料。透過 API 金鑰管理與標準 Web 通訊協定管理的安全性。 |
| Amazon S3 | 私人連線與公用 | IAM 角色、外部認證 | 支援 AWS PrivateLink 以安全、私人連線。公用連線使用安全認證。資料會在傳輸和靜態中加密 (S3 中的客戶管理金鑰為選用)。 |
| Snowflake | 私人連線與公用 | OAuth 2.0、私人金鑰驗證、使用者名稱/密碼 | 支援 VPC 私人連線 (AWS PrivateLink)。公用連線適用於安全驗證方法。資料可在 Snowflake 內使用客戶金鑰進行加密。 |
| Amazon Redshift | 私人連線與公用 | 使用者名稱/密碼、IAM 驗證 | 支援私人連線 (AWS PrivateLink)。公用連線使用標準安全性最佳作法。 |
| Microsoft Azure (Storage/SQL) | 僅公用網際網路 | SAS 權杖、OAuth 2.0、使用者名稱/密碼 | 連線依賴安全的 SAS 權杖或 OAuth 進行驗證。資料會透過加密管道 (TLS) 周遊公用網際網路。 |
| Google Cloud Storage (GCS) | 僅公用網際網路 | OAuth 2.0、服務帳戶 | 連線依賴安全的 OAuth 2.0。資料會透過加密管道 (TLS) 周遊公用網際網路。 |
| MuleSoft (API) | 僅公用網際網路 | OAuth 2.0、API 金鑰 | 透過 API 連線。系統會透過透過 MuleSoft Anypoint Platform 實作的標準 API 驗證和強大監管原則來管理安全性。 |
| 階段 | 機制 | 安全性/監管控制 |
|---|---|---|
| 啟用組態 | 在 Data 360 啟用設定中定義 | 透過已命名認證與外部認證保護 |
| 資料準備 | 已從 DMO 篩選並加入 | 已套用同意與隱私權中繼資料 |
| 輸出轉移 | 透過 TLS/私人連線加密 | 保單強制執行與認證抽取 |
| 外部遞送 | SFTP/雲端儲存空間/API | 存取控制與可稽核傳送 |
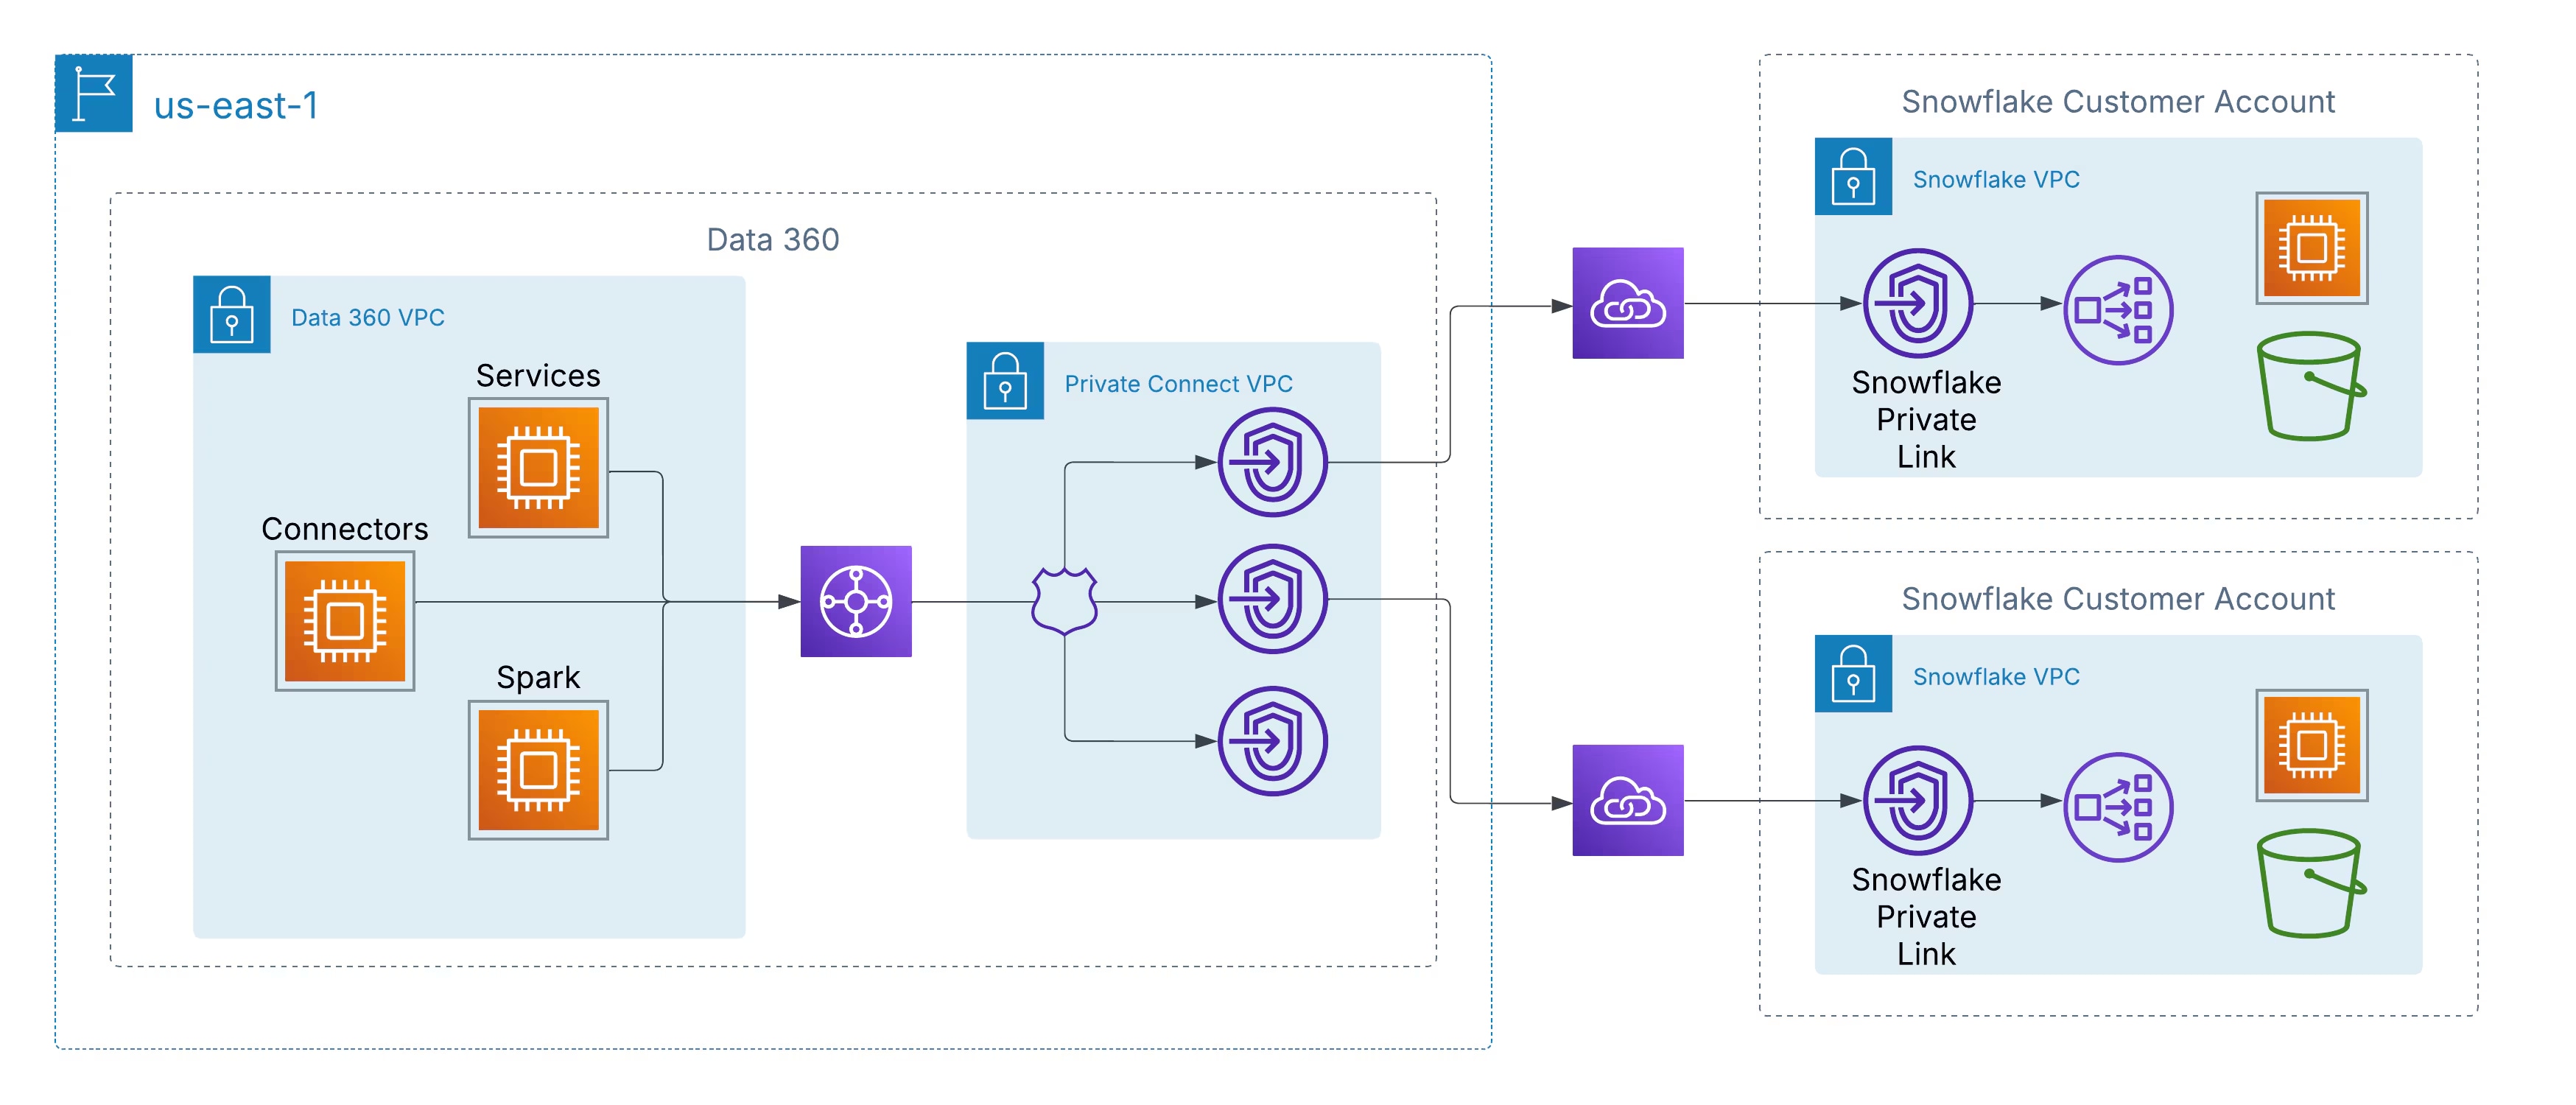 所有通訊都會保留在 AWS 架構內,使用私人 IP 位址和非可建立路線的網路路徑,從而消除傳輸中資料遭到截斷的風險,並符合嚴格的企業與法規安全性需求。
此結構可確保:
- **零網際網路曝光:**資料永不離開 AWS 私人網路。
- **私人 IP 通訊:**流量會保持隔離,且無法在外部處理。
- **合規對齊方式:**符合如 ISO 27001、SOC 2 和 FedRAMP 等安全性標準。
#### 私人互連:跨雲端擴充安全性
為了支援在多雲端環境中作業的客戶,Salesforce 透過「私人互連」,將相同的安全性原則延伸至 AWS 之外。此功能可在 Data 360 與在 Azure 或 Google Cloud 中主控的資料湖之間啟用跨雲端私人連線,維持私人路由、零網際網路周遊和僅限加密支柱流量的相同保證。
有兩種結構部署模型可供使用:
- **客戶管理的互連:**客戶可將其現有的私人網路電路 (例如 Azure ExpressRoute、Google Cloud Interconnect 或 Equinix Fabric) 直接與 Data 360 VPC 整合。
- **Salesforce 受管理的互連:**Salesforce 會佈建和管理跨雲端連結,以在客戶的目標雲端環境中公開專用服務端點,以進行整備式設定。
### 保護門:Salesforce Data 360 中的 API 安全性功能
Salesforce Data 360 是統一企業資料的強大平台,內建強大且多層級的安全性控制項。針對客戶,管理 API 安全性是全方位資料保護策略的重要部分,讓客戶能夠有效控制存取、管理整合和監視使用狀況。
以下是客戶可在 Salesforce Data 360 內設定、控制和管理 API 安全性的主要功能與功能。
#### 重要 API 安全性功能與功能
客戶可以利用數個內建的 Salesforce 功能來確保對其 Data 360 例項的 API 安全存取權:
##### 1\.強大的驗證和授權 (OAuth 2.0)
Salesforce 要求對其 Data 360 API 進行嚴格驗證,且 OAuth 2.0 是標準和建議通訊協定。
- **連線的應用程式**:客戶建立和設定「連線的應用程式」以管理外部應用程式存取。這是驗證和授與 Data 360 取用和查詢 API 存取權的主要機制。
- **OAuth 範圍**:管理員可以定義特定的 OAuth 範圍 (例如 cdp_ingest_api、api),以要求最低必要權限,並遵循最低權限原則。
- **多因素驗證 (MFA)**:您可以強制執行 Salesforce Authenticator 和其他 MFA 解決方案,進而增加重要的安全性層級,並確保只有已驗證的使用者可以存取系統,包括透過 API 登入。
##### 2\.細微存取控制與權限
客戶可以精細地控制哪些使用者和應用程式可以存取資料,以及他們可以執行的動作。
- **API 存取控制 (功能)**:此功能由 Salesforce 支援啟用後,可讓管理員明確批准可用於存取 API 的連線應用程式。系統會自動封鎖所有未批准的應用程式,大幅減少未經授權的資料解壓風險。
- **權限集與設定檔**:管理員透過使用者設定檔或專屬權限集指派「已啟用 API」權限來管理 API 存取權。這可確保使用者僅擁有與其工作功能相關的存取權。
- **以角色為基礎的存取控制 (RBAC)**:在 Data 360 中,客戶可以建立和管理以角色為基礎的存取控制原則,以定義資料存取層級 (物件、欄位和記錄級安全性),以確保整個平台的一致性與控制。
- **專屬整合使用者**:最佳作法建議為整合建立特定「僅 API」使用者,將其權限限制為僅限於 API 呼叫所需的權限,而非使用系統管理員帳戶。
##### 3\.網路安全性控制
- **IP 白名單/登入 IP 範圍**:客戶可以將 API 存取權限制為已定義的信任 IP 位址範圍。任何來自未批准 IP 範圍的登入嘗試都可遭到拒絕或要求進行驗證。
- **私人連線**:此功能建立在 AWS PrivateLink 上,可讓管理員管理敏感資料,而無須將端點公開至公用網際網路,從而消除對公開可見端點的攻擊風險。
- **傳輸和靜態加密**:所有資料都會在傳輸 (使用 TLS) 和靜態時加密,以保護敏感資訊免受未經授權的存取,即使遭到攔截也是如此。
##### 4\.監視、稽核和監管
可視性是安全性的關鍵。Salesforce 提供監視和稽核 API 活動的廣泛工具。
- **事件監視**:提供各種事件的近乎即時追蹤,包括 API 呼叫和登入嘗試。客戶可以使用此資料來稽核和建立交易安全性原則。
- **Security Center**:此功能提供所有 Salesforce 組織之間安全性狀況、合規性與管治度量的單一合併檢視,以簡化監視與管理。
- **欄位稽核追蹤**:協助客戶追蹤登入和欄位歷程記錄、監視設定變更,並處理稽核和資料保留合規義務。
- **資料管理功能**:包含資料標記與分類、強制執行原則和動態資料遮蔽,以確保在所有資料接觸點 (包括透過 API 存取的資料接觸點) 中套用一致的管治原則。
#### 設定與管理 API 安全性:客戶旅程
1. 啟用核心控制:從啟用組織範圍預設值 (例如 MFA 和 IP 限制) 開始。
2. 要求 API 存取控制:向 Salesforce 支援記錄個案,以在您的組織中啟用「API 存取控制」功能。
3. 設定連線的應用程式:為每個整合建立特定連線的應用程式,定義必要的 OAuth 範圍,並將其指派給授權的設定檔/權限集。
4. 實作最低權限:確定所有整合使用者都有「僅 API」權限和最少的資料存取權。
5. 監視和稽核:定期使用「事件監視與安全性中心」檢閱 API 用量、偵測異常,並執行漏洞評估。
6. 強制執行最佳作法:一律強制執行 TLS、安全地儲存重新整理權杖、輪替工作階段識別碼,以及驗證資料輸入。
透過利用這些強大的客戶可設定的功能,企業可以為 Salesforce Data 360 內的所有 API 互動維護安全且符合的環境。
### 合規性、稽核和持續監控
#### 服務可用性與資料落地
Salesforce Data 360 的設計目的為透過其地理散佈的部署模型,滿足全球資料落地與主權需求。此服務目前適用於多個受監管區域,包括美國、加拿大、巴西、德國、印度、澳大利亞和日本。
資料落地是透過將每個客戶的「核心組織」例項對應至最近對應的 Data 360 區域例項來決定。例如,位於美國或加拿大的核心組織會與美國區域內的 Data 360 例項配對,而歐盟內的核心組織會對應至德國主控的例項。同樣地,印度、澳大利亞、紐西蘭或新加坡的核心組織與在印度主控的 Data 360 例項相關聯。
Salesforce 的 Hyperforce 基礎結構是此模型的基礎,為地理資料控制、安全性隔離和法規合規提供基礎。Hyperforce 可確保客戶資料 (包括中繼資料、備份和衍生的資料集) 保持在定義的區域界限內。此架構可讓企業符合當地資料落地與合規性要求,例如 GDPR、FFIEC、HIPAA 及 APAC 與 EMEA 區域隱私權法規。
Salesforce 持續將 Data 360 的可用性擴展至其他 Hyperforce 區域,以符合不斷演進的全球隱私權標準、區域合規性需求,以及客戶對主權資料控制的期望。
#### 法規合規性啟用
Salesforce Data 360 的設計目的為協助企業符合嚴格的全球隱私權與法規需求,例如 GDPR 與 CCPA。平台提供管理「資料主題權利」(DSR) 的原生功能,包括資料存取、匯出和刪除 (「被遺忘權」),以確保在整個生命週期內遵循個人資料的處理方式。
雖然客戶保留合規性的最終責任,但 Salesforce 會根據如 CCPA 等法規作為經認證的「服務提供者」運作,提供平台層級控制、安全性保證和合約機制,讓組織能夠有效率且大規模地實作其合規架構。
#### 基礎 Trust:認證與證明
Trust 是 Salesforce 平台的基石,而該 Trust 是透過獨立驗證獲得的。Salesforce 擁有廣泛的全球安全性認證和證明組合,以示範其持續致力於保護客戶資料並維護最高標準的雲端安全性。
這些認證不只是核取方塊,它們代表嚴格的循環稽核,以驗證 Salesforce 安全性控制、流程和基礎結構的強大性和一致性。它們共同構成 Salesforce 基礎 Trust 模型的支柱。
**關鍵認證和證明包括:**
- **ISO/IEC 27001:**驗證 Salesforce 的全方位資訊安全性管理系統。
- **ISO/IEC 27017:**建立雲端特定安全性控制的最佳作法。
- **ISO/IEC 27018:**重點在於保護雲端中的個人可識別資訊 (PII)。
- **SOC 1、SOC 2 和 SOC 3:**確認 Salesforce 安全性與隱私權控制之設計與營運效率的獨立報告。
- **PCI DSS:**確保付款卡資訊的安全處理與儲存。
- **FedRAMP 高和 DoD 影響層級 4:**認證 Salesforce Government Cloud 供管理敏感性工作負載的美國聯邦機構使用。
透過維護此全方位的認證集,Salesforce 可讓客戶確信其資料是在符合 (且經常高於) 全球合規性和安全性期望的平台內管理的。
### 最大化可視性:Salesforce Data 360 中的記錄、監視和可觀察性
在今天的快速數位環境中,擁有客戶資料的全方位檢視至關重要,但擁有管理該資料之平台的全方位檢視同樣重要。Salesforce Data 360 提供強大的內建記錄、監視和可觀察性功能,可讓客戶確保資料品質、安全性和效能。
這些工具可協助您從反應性問題解決移至主動管理,確保 Data 360 實作的執行順利且有效率。
#### 主動威脅偵測和回應
安全性不會與預防結束,它會隨著警覺而發展。在不斷變化的威脅環境中,Salesforce 將進階平台監視功能與客戶管理的審查流程結合在一起,以確保主動且持續的保護。
Salesforce 提供可視性和威脅偵測的強大原生工具:
- 「**設定稽核追蹤」** 會收集完整的管理變更歷程記錄,協助小組追蹤組態或原則更新。
- **事件監視**可提供使用者行為、API 活動和資料存取模式的深入洞察。此遠端測試可與 **Security Information and Event Management (SIEM)** 解決方案順暢整合,以進行集中分析和關聯。
#### 1\.事件監視:組織的脈動
事件監視是 Salesforce Shield 產品的一部分,是追蹤 Salesforce 組織中詳細使用者活動和系統效能資料 (包括 Data 360 特定動作) 的中心。它會將廣泛的「事件」儲存到記錄檔案和物件中,以供您分析之用。
- **事件記錄檔 (ELF):**這些提供使用者活動和系統事件的細微詳細資料,可在短暫延遲後 (每小時或每天) 下載。您可以透過 API 或「事件記錄檔」瀏覽器存取最多 30 天的資料,並選擇匯出以供較長時間儲存。
- **即時事件監視:**針對立即洞察,即時事件會作為平台事件串流,可讓您近乎即時監視和偵測活動。這對安全性和效能至關重要,可讓您視需要立即採取行動。
- **Data 360 特定事件:**「事件監視」包含 Data 360 用量的特定事件類型,例如與 Data 360 頁面和資料相關的 Lightning 頁面檢視、Lightning 互動和「報告事件」。
- **與外部工具的整合:**Salesforce 可協助與受歡迎的第三方監視解決方案 (例如 Splunk、Datadog、New Relic 和 Sumo Logic) 順暢整合。您可以將「事件監視」資料串流或匯出至這些平台,以便合併整個技術堆疊的可觀察性。
#### 2\.效能監視與最佳化
瞭解 Data 360 實作的效能是獲得絕佳使用者體驗的關鍵。
- **Lightning Usage 應用程式:**此內建應用程式針對 Lightning Experience 中的 Data 360 頁面,提供效能度量的彙總檢視,例如頁面載入時間 (經歷頁面時間或 EPT) 和瀏覽器效能。
- **自訂報告與顯示面板:**您可以使用 Data 360 物件和「事件監視」資料建立自訂報告和顯示面板,包括使用稱為 Event Monitoring Plus 的免費 CRM Analytics 範本應用程式。這些視覺效果可協助您快速找出趨勢並找出績效瓶頸。
但技術本身並不夠。真正的彈性需要自動偵測和人力審查之間的紀律合作夥伴關係。自動警示可以呈現即時異常,但微妙或長期威脅 (例如有效使用者緩慢且未經授權的資料洩漏) 通常是透過定期稽核和趨勢分析最佳識別。
Salesforce 提供遠程測試、稽核記錄和整合關聯;客戶提供流程嚴謹、作業步調和內容特定情報。它們共同構成一種**深度防禦模型**,結合自動化、分析和人力監督,以在威脅變成事件之前偵測、調查和回應威脅。
### 推動明智的決策:Salesforce Data 360 中的報告、顯示面板、度量與通知
Salesforce Data 360 不僅用來統一您的客戶資料,還要讓資料變得聰明且可運作。此價值主張的核心部分為提供強大的報告、強大的顯示面板、深入的度量和即時通知功能。這些工具可讓客戶在熟悉的 Salesforce 環境中,根據統一資料監視資料狀況、追蹤效能並自動化動作。
#### 報告與顯示面板:您的資料視覺效果中心
Salesforce 的原生報告與顯示面板功能可順暢地延伸至 Data 360,讓您無須離開平台即可視覺化與分析統一資料。
#### 針對統一資料建立報告
您可以針對儲存在 Data 360 中的資料建立標準和自訂報告,包括來自各種來源的統一資料和已計算洞察。
- **標準與自訂報告類型:**Data 360 特別針對 Data 360 物件 (例如資料串流、區段、啟用、身分解析和已計算洞察) 導入新報告類型。這可讓您使用標準 Salesforce 報告產生器來查詢統一的資料。
- **粒子分析:**報告支援最多 10 列分組,允許更精細的區隔和詳細分析客戶屬性和趨勢。
- **公式和摘要:**您可以利用列層級公式和摘要公式來評估每個記錄或記錄群組,協助您在單一報告中追蹤詳細的度量和概況彙總摘要。
#### 整體檢視的動態顯示面板
顯示面板可在整個 Data 360 實作中以視覺化方式顯示主要度量與趨勢。
- **統一檢視:**在單一顯示面板中結合來自多個 Data 360 報告的資料,甚至可以將 Data 360 報告與標準 CRM 報告混合,以全方位檢視您的作業和客戶洞察。
- **可自訂小工具:**使用各種圖表類型 (長條圖、線條圖、圓餅圖、量表等) 和表格,有效顯示報告資料。
- **即時洞察:**您可以重新整理顯示面板以提供最新的資訊,以協助快速的資料驅動決策。
#### 度量與 KPI:測量成功
Data 360 可讓您定義和追蹤與業務目標相關的主要績效指標 (KPI)。這些項目可透過以下方式產生:
- **已計算洞察:**使用大量批次處理的資料建立強大度量。例如,計算如「平均客戶終身價值」或「已啟用契約收入總計」等度量,並在報告和顯示面板中使用這些度量或維度。
- **串流洞察:**近乎即時地從串流來源處理資料,以建立時間序列彙總,例如網站或行動參與資料。這些度量可以驅動立即協調流程和資料動作。
#### 通知與警示:掌握資訊並主動
Salesforce 提供強大的自動化和通知功能,以確保您瞭解 Data 360 中的重要事件或資料變更。
- **流程型通知:**您可以設定「流程流程」以根據 Data 360 物件 (例如「資料串流」、「區段」和「啟用」) 中的事件觸發動作並傳送通知。
- **自訂警示:**建立觸發電子郵件的自訂通知,或在符合特定條件時顯示在 Salesforce 通知 Bell 中。例如,如果資料串流失敗、身分解析規則發生錯誤,或金鑰度量超過某一特定值,您會收到警示。
- **事件通知服務 (ENS):**針對開發人員,API 第一個「事件通知服務」可讓外部系統在發生特定事件時接收通知,讓整個技術堆疊能夠順暢整合和即時回應。
- **資料動作:**您可以根據串流洞察觸發資料動作,這些動作可設定為傳送警示、叫用平台事件,或透過 Webhook 與其他 SaaS 應用程式整合。
透過利用這些全方位功能,Salesforce Data 360 客戶可以有效監視其資料生態系統、視覺化主要度量,並即時接收警示,以促進主動參與和卓越營運。
### 企業採用的策略性建議
企業規模採用 Salesforce Data 360 不需要技術啟用,而需要有意義且以安全性為第一的結構。下列策略性建議為 CTO 和企業結構設計師提供建立 Trust、彈性與合規性的藍圖,讓其在 Data 360 部署的每個層級中都能達到目標。
- **實作「安全依據設計」方法:**安全性不應改良,應該是基礎。從 Salesforce 的預設 _「全部拒絕」_ 原則開始,並視需要明確授與存取權。請先定義監管、原則和存取架構,再取用或啟用資料。從第一天開始建立安全性可消除隱藏曝光的風險,並簡化長期合規性。
- **強制執行強大的身分與存取管理 (IAM) 策略:**透過聯合 SSO 集中身分,並強制執行多因素驗證 (MFA),以減輕認證妥協。透過「登入 IP 範圍」限制存取權,並使用 Salesforce 的身分提供者 (IdP) 功能在使用者和整合之間建立端對端的責任。統一的 IAM 圖層可減少作業複雜度並強化您的驗證表面。
- **套用最低權限原則:**為了精確率而非便利性而設計角色。使用 Salesforce 的標準權限集作為工作分隔的基礎,確保使用者僅可存取必要項目。避免過度自訂權限 - 每個偏差都會增加維護負擔和非預期的存取風險。
- **建立多層資料管理架構:**使用「資料空間」依業務單位或品牌分隔資料,並使用物件、欄位和記錄級安全性 (OLS、FLS、RLS) 強制執行以屬性為基礎的存取控制 (ABAC)。使用「動態資料遮蔽」即時保護敏感資訊,而不會阻礙分析或可用性。此分層模型可確保在資料跨網域規模保持一致的管治。
- **策略地利用加密和安全整合:**針對敏感工作量,請使用客戶管理金鑰 (CMK) 部署「平台加密」,以維持對加密生命週期的主管權。使用「已命名認證」和「私人連線」來保護所有系統對系統整合的安全,以免除硬式編碼密碼,並確保所有流量都保持專用、合規和可稽核。
- **建立連續安全性作業計畫:**安全性並非與組態結束,它在作業規範上茁壯成長。透過事件記錄和存取追蹤的定期稽核檢閱來補充自動監視。建立專屬的安全性作業 (SecOps) 函數,以識別異常、調查威脅並驗證合規性。目標:及早偵測、快速回應,並持續改善狀態。
### 繼續路徑:建立彈性的信任 Data 360
建立安全且智慧企業的旅程並非透過部署結束,而是透過規範、設計和 Trust 來發展。Salesforce Data 360 提供結構基礎,但當組織將安全性、管治和情報運作為一個統一的動作時,即會出現真正的價值。
企業不應將 Data 360 視為另一個資料平台,而是作為安全且可組成的 Trust 層,以單一管治架構將資料、AI 和客戶參與連接在一起。透過採用 _安全依據設計_的理念、在每個層級強制執行最低權限,並將私人連線延伸至所有資料流程,組織可將合規從核取方塊轉換為競爭優勢。
下一步是持續現代化,將稽核自動化、保單強制執行和加密生命週期管理內嵌在日常作業中。隨著企業發展為代理 AI 驅動的架構,今天保護資料的相同原則將構成明天 AI 治理的支柱,確保每個模型、工作人員和決策都可解釋、注意原則,且設計上符合。
最終,Trust 會成為數位轉換的新貨幣。透過 Salesforce Data 360,企業可以自信地擴展其資料生態系統 — 瞭解每個位元組、每個連線和每個洞察都會以完整性保護、管理和啟用。
## 關於作者
**Krishna Chalamasandra** 是一位經驗豐富的網路安全專家,擁有 25 年以上的資訊安全技術與合規經驗。在 Salesforce,他是客戶的信任顧問,也是 CISO 組織內「安全性和合規性客戶Trust」功能的關鍵領導者。之前,Krishna 在思科工作了 10 年,領導了 IAM、網路安全性和 PKI 的安全性結構,並推動了關鍵認證,包括 ISO 27001、SOC 1–3、PCI、FedRAMP 和 FIPS 140-2。他還在 Novell 花了 8 年以上的時間,為全球受監管的客戶實作基礎架構層級控制,並支援複雜的安全審查。
**Yugandhar Bora** 是 Salesforce 的軟體工程結構設計師,專門在「資料與情報應用程式」平台內進行資料結構。他負責領導企業結構審查委員會 (EARB) 計畫,專注於資料管理和統一資料模型,同時為自動平台佈建解決方案做出貢獻。
## 概觀
現代 Salesforce 整合必須支援比簡單的資料交換更多。他們預期能夠提供即時客戶體驗、協調多個系統的動作,並在企業規模上可靠運作,同時符合嚴格的安全性和合規性需求。因此,選擇正確的整合方法是重要的結構決策,而非實作詳細資料。
請考量常見的企業案例。客戶在行動應用程式中完成購買,以觸發個人化優惠的即時資格檢查。同時,必須在 ERP 系統中記錄交易資料、在 Salesforce 中更新客戶屬性,以及將分析串流至資料湖—而不會導致延遲、資料重複或合規性風險。此類案例現在在現代 Salesforce 環境中很典型,Salesforce 很少獨立運作,且必須與更廣泛的應用程式與資料平台生態系統順暢整合。
此指南是為了協助結構設計師和開發人員以清晰且自信的方式設計這些整合。它不專注於點對點實作,而是呈現一組**已驗證的整合模式**,以處理循環的企業案例,例如流程協調流程、資料同步化和即時資料存取。每個模式都會強調架構意圖、權衡和執行模式,讓小組能夠做出明智的設計決策,以擴展和持續。
在此文件中,您會發現:
- 代表流程、資料和虛擬存取情況之間常見企業「階層類型」的整合模式
- 模式選取架構,可協助根據整合意圖和執行時間點找出正確的方法
- 關於可擴充性、彈性、管治和安全性考量事項的實際指引
- 從實際世界 Salesforce 與 Data 360 實作中所取得的最佳作法
此文件的目標是提供整合的共用結構語言,協助小組設計平衡效能、彈性和 Trust 的解決方案,同時與企業資料和管治策略保持一致。
### 目的與範圍
此文件適用於需要將企業中其他應用程式的資料與 Salesforce Data 360 (先前稱為 Data Cloud) 整合的設計師和結構設計師。此內容是 Salesforce 結構設計師和合作夥伴成功實作的精密精簡。
若要熟悉可用於大規模採用 Data 360 的整合功能和選項,請參閱下方的「模式摘要」和「模式選取指南」一節。結構設計師和開發人員在將資料互動專案納入 Data 360 的設計和實作階段期間,應考量這些模式詳細資料和最佳作法。
若正確實作,這些模式可讓您盡快進入生產環境,並擁有最穩定、可調整且無維護的應用程式集。Salesforce 自己的諮詢結構設計師會在結構審查期間使用這些模式作為參考點,並主動維護和改善模式。
與所有模式一樣,此內容涵蓋大部分的整合案例,但並非全部。例如,Salesforce 允許使用者介面 (UI) 整合,但此類整合超出此文件的範圍。
### 模式範本
每個整合模式皆遵循一致的結構。這可讓每個模式提供的一致資訊,並且更容易比較模式。
- **名稱**:此模式識別碼也表示模式中包含的整合類型。
- **內容:**模式處理的整體整合情況。「內容」提供使用者嘗試達成之目標的相關資訊,以及應用程式支援需求的行為。
- **問題:**以問題表示,這是模式設計要解決的案例。請閱讀此區段以瞭解模式是否適合您的整合案例。
- **力:**使所述情況難以解決的限制與狀況。
- **解決方案:**解決整合案例的建議方法。
- **草稿:**UML 順序圖表,顯示解決方案如何處理案例。
- **結果:**說明如何將解決方案套用至整合案例的詳細資料,以及其如何解決與該案例相關聯的障礙。此區段也包含因套用模式而可能發生的新挑戰。
- **側列:**與模式相關的其他區段,其中包含重要的技術問題、模式變化、模式特定的疑慮等。
- **範例:**描述如何在 Salesforce 實際案例中使用設計模式的實際世界案例。範例說明整合目標,以及如何實作模式以達成這些目標。
## 模式摘要
使用此表格作為此文件中所包含整合模式的目錄。
### 模式清單
| 模式層級1 | 模式層級2 | 模式 | 助理 |
|---|---|---|---|
| 資料入院模式--資料輸入 | 批次吸收模式 | 從雲端儲存裝置大量取用資料 | 系統會從企業雲端儲存來源 (例如 Amazon S3、Azure Blob 或 Google Cloud Storage) 將資料以大量原始資料批次 (例如交易或產品記錄) 的形式,將資料納入 Data 360。 |
| 從 Salesforce Cloud 大量資料取用 | Data 360 會從多個 Salesforce 組織 (例如 Sales Cloud、Service Cloud) 大量接收 CRM 資料,以建立統一的客戶設定檔。 | ||
| 串流和即時取用模式 | 事件驅動的使用者介於「Embase API--串流」中 | Data 360 會訂閱來自企業系統中接收連續事件裝載 (例如購買事件、IoT 遠端測試),以進行即時設定檔更新的串流取用端點。 | |
| 即時 Web 與行動裝置的行動行為 | Data 360 會透過 SDK 收集並處理即時網站和行動應用程式行為資料,以增強參與度量和個人化模型。 | ||
| 透過串流近乎即時的 CRM 同步化 | Data 360 會透過事件串流接收近乎即時的 CRM 資料更新 (例如連絡人、個案、機會變更),以維護持續同步的 Customer 360 檢視。 | ||
| 來自雲端傳訊平台—Kinesis 和 MSK 的事件串流 | Data 360 會直接從雲端事件平台 (例如 AWS Kinesis 或 Kafka (MSK)) 取用串流資料,以處理高頻率的作業或 IoT 事件。 | ||
| 零複製模式--輸入與輸出 | 輸入零複製--外部平台至 Data 360 | Data 360 會依需求透過「Zero Copy Capture」來查詢外部資料集 (例如 Snowflake、BigQuery),而不會實際地將資料移至 Salesforce。 | |
| 輸出零複製--Data 360 至外部平台 | 外部系統 (例如 Databricks 或 Tableau) 可透過「零複製輸出」連線存取 Data 360 中增強的區段和洞察,而不需要資料複製。 | ||
| 使用 Data Cloud One 整合多組織資料平台 | Data Cloud One 會在共用的中繼資料和語意模型下統一多個 Salesforce 組織和外部資料來源,提供一致的 Customer 360,而不會重複資料。 | ||
| 資料啟用模式--資料輸出 | 批次啟用模式 | 行銷和廣告平台的區段啟用 | Data 360 會將精密設計的客戶區段直接啟用至 Marketing Cloud、Meta、Google Ads 或其他廣告平台,以進行個人化行銷活動傳送 |
| 資料匯出至雲端儲存空間 | Data 360 會將統一或篩選的資料集 (例如同意的客戶記錄) 作為 CSV 或 Parquet 檔案匯出至企業雲端儲存空間,以供分析或合規歸檔。 | ||
| 隨選 API 式啟用 | 透過 Connect API 的自訂應用程式整合 | 外部應用程式會根據目前的客戶資料,在即時中叫用 Data 360 Connect API,以根據實際客戶的資料,從個性化動作 (例如忠誠度平衡檢查或 AI 優惠產生) 中提取或觸發個人化動作。自訂建置的 Web 或行動應用程式會透過 Connect REST API 安全地提取已協調的 Data 360 洞察,以在企業或合作夥伴 UI 中顯示。 | |
| 透過 Data Graph API 完成客戶設定檔檢索 | 系統會使用「資料圖表」API 提取客戶的統一設定檔,以傳回完全全方位檢視的預先聯結即時 JSON 表示,以進行決策或個人化。 | ||
| 即時資料動作 | 將客戶訊號轉換為立即動作的即時資料動作 | Data 360 會偵測及處理即時事件 (例如同意更新、購買觸發),並立即叫用連線的系統或 Salesforce 流程進行後續動作。Data 360 中的客戶活動訊號 (例如偵測到流失風險) 會觸發即時即時動作,例如更新 CRM、叫用 Einstein 評分或啟動保留旅程。 |
| 類型 | 時間 | 輸出考量事項 |
|---|---|---|
| 資料整合 | 非同步 | 行銷和廣告平台的區段啟用 |
| 程序/資料整合 | 同步 | 透過 Connect API 的自訂應用程式整合 透過 Data Graph API 完成客戶設定檔檢索 |
| 資料整合 | 同步 | 將客戶訊號轉換為立即動作的即時資料動作 |
| 虛擬整合 (使用零複製) | 非同步 | 輸出零複製--Data 360 至外部平台 |
| 虛擬整合 | 非同步 | 使用 Data Cloud One 整合多組織資料平台 |
| 類型 | 時間 | 輸入考量事項 |
|---|---|---|
| 資料整合 | 非同步 | 從雲端儲存裝置大量取用資料 從 Salesforce Cloud 大量資料取用 |
| 資料整合 | 非同步 | 來自雲端傳訊平台—Kinesis 和 MSK 的事件串流 透過串流近乎即時的 CRM 同步化 |
| 流程整合 | 同步 | 事件驅動的使用者介於「Embase API--串流」中 即時 Web 與行動裝置的行動行為 |
| 虛擬整合 | 非同步 | 輸入零複製--外部平台至 Data 360 |
| 期限 | 定義 |
|---|---|
| 事件處理 | 事件處理是指從來源系統或應用程式接收、路由和回應可識別的事件。中間軟體會透過識別目標端點、轉送事件,以及觸發必要業務動作 (例如記錄、重試或啟用下游服務) 來處理事件。在 Data 360 架構中,事件處理對於即時資料取用、啟用觸發和發佈/訂閱模式至關重要。事件可能源自外部系統 (Kafka、AWS Kinesis) 或 Salesforce Platform 事件,且由中介軟體或 Data 360 Event Bus 路由以供立即處理。 |
| 通訊協定轉換 | 通訊協定轉換允許使用不同的資料傳輸標準在系統之間進行通訊。中間軟體會將專屬或舊版通訊協定 (例如 AMQP、MQTT、FTP) 翻譯為支援的 Data 360 通訊協定 (REST、gRPC 或 HTTPS)。這可確保不同階層系統的互通性。由於 Data 360 不會原生處理通訊協定轉換,因此 middleware 會提供適應層,將訊息壓縮或轉換為 Data 360 API 格式,連接器可以進行解譯。 |
| 翻譯和轉換 | 翻譯和轉換可透過將一個資料格式或結構描述對應至另一個資料格式來確保互通性。Middleware 會執行這些轉換,使各種資料裝載 (CSV、XML、JSON) 與 Data 360 資料模型物件 (DMO) 和統一資料層物件 (UDLO) 保持一致。這包括清除、增強和套用以語意或基於本體的對應,然後再採取。雖然 Salesforce 提供如資料準備配方等轉換工具,但複雜轉換 (尤其是用於語意調和) 最適合在中介軟體中處理。 |
| 排隊和緩衝 | 以非同步訊息傳遞為依據,以確保彈性、分離的通訊。中介軟體平台 (例如 MuleSoft、Kafka 或 Azure Event Hub) 會提供永久的可在 Data 360 或下游系統忙碌或無法存取時暫時儲存資料。這可防止資料遺失,並支援近乎即時的快取或啟用重試。Data 360 支援串流移入和流程式輸出傳訊,但永久的排入和保證傳送通常由中介軟體處理。 |
| 同步傳輸通訊協定 | 同步傳輸通訊協定涉及封鎖、即時要求/回應作業。寄件者在繼續之前會等待回覆。在 Data 360 中,這些項目用於隨選 API 式啟用、即時增強或設定檔對應,其中立即需要回應。中間軟體可確保連線可靠性,並管理同步 Data 360 API 呼叫的重試或回復處理。 |
| 非同步傳輸通訊協定 | 非同步傳輸通訊協定支援非封鎖、分離的通訊,其中寄件者可繼續處理,而無須等待回應。中間軟體可處理批次啟用、串流移入和事件驅動啟用的非同步流程。這可實現高輸送量和彈性,這對於 Data 360 中的事件串流和近乎即時的資料取用模式而言至關重要。 |
| 中介路由 | 仲裁路由會定義系統之間的複雜訊息流程,確保正確的資料或事件到達正確的消費者。中介會作為中介者,根據規則、標題、內容或事件類型處理路由邏輯。在 Data 360 整合中,中介可確保來自多個系統的事件和設定檔更新正確路由至「資料取用 API」、啟用端點或外部取用者。這可簡化協調流程,並支援多系統資料同步化。 |
| 流程編程和服務協調流程 | 流程 koreography 和協調流程可協調多系統流程。koreography 支援以事件為導向的自動非同步流程,其中系統會根據沒有中央控制項的共用規則來執行動作。協調流程是集中管理的流程,可導向服務執行。在 Data 360 架構中,中介軟體可管理跨系統採取和啟用的協調流程,而 Salesforce 工作流程或「流程」可處理平台內的輕量型 koreography。建議在中介軟體層進行複雜協調流程 (需要交易協調或狀態管理)。 |
| 交易性 (加密、簽署、可靠傳送、交易管理) | 交易性可確保在整個系統之間有原子、一致、隔離且永久 (ACID) 的作業。Salesforce 和 Data 360 在其範圍內進行交易,但不支援跨外部系統的散佈交易。中間軟體可處理全域交易控制,包括加密、訊息簽署、回復、薪水和可靠傳送。針對關鍵任務的資料流程 (例如財務或同意更新),中介軟體可確保跨 Data 360 和外部系統的端對端完整性和復原。 |
| 路由 | 路由指定元件之間訊息或資料的控制流程。其可以標題、內容類型、優先順序或規則為基礎。中間軟體可處理涉及 Data 360 事件和啟用的路由邏輯,例如將豐富的受眾區段導向至不同的下游系統 (廣告平台、倉庫、CRM 應用程式)。雖然可在 Salesforce (Apex、流程) 內實作路由,但為了擴充性、彈性和管治,偏好使用中介軟體路由。 |
| 提取、轉換和載入 (ETL) | ETL 涉及從來源系統中提取資料、將其轉換為一致的結構描述,並將其載入至目標 (例如 Data 360)。中間軟體或 ETL 工具會處理這些作業,然後再移轉資料。Data 360 可以透過 API、連接器或大量取用管道接收 ETL 輸出,也支援變更資料擷取 (CDC) 以進行近乎即時的同步化。中間 ETL 流程對於整合舊版系統並確保資料品質在 Data 360 中統一之前至關重要。 |
| 長輪詢 | 長輪詢 (Comet 程式設計) 是維護系統之間開放通訊以進行即時更新的方法。用戶端會傳送要求,伺服器會保留要求直到事件發生為止,然後回應並重新開啟新的連線。Salesforce 會在串流 API 和 CometD/Bayeux 通訊協定中使用此功能,以進行以事件為導向的資料同步化。中間軟體可以訂閱這些事件,並將其轉送至 Data 360 以進行即時取用或啟用觸發,以確保跨企業系統的延遲最小。 |
| 解決方案 | 適合 | 註解 |
|---|---|---|
| 使用原生雲端儲存連接器 (Amazon S3、Google Cloud Storage、Azure Blob Storage) | 最佳 | 此為大規模、循環檔案型取用至 Data 360\ 的建議且最可靠模式。原生連接器可提供受管理驗證、結構描述對應,以及直接將資料安全移動至 Data 360 的資料湖物件 (DLO)。適用於排程的批次載入,其延遲不重要 (例如排程每小時或每日)。 |
| 處理大型資料集 (超出連接器限制) | 最適用於預先處理 | 每個連接器都會強制執行取用限制 (例如 S3:100,000 列或每個物件 50 GB)。針對較大的資料集,請實作 ETL 預先處理步驟,以將資料分割至低於下限的較小檔案/資料夾。接著,設定多個資料串流以並行地取用每個分割,然後在 Data 360 內使用批次資料轉換中的附加節點,將分割重新合併為統一的資料集。 |
| 安全性與管治 | 最佳 | 所有連接器都支援透過雲端原生方法 (IAM 角色、服務帳戶或存取金鑰) 進行安全驗證。如需額外控制,請透過雲端提供者的允許清單限制 Data 360 IP 範圍的存取權。資料傳輸會透過加密的管道進行,其中檔案會儲存在暫時安全的暫存層中,並且會在取用期間進行。 |
| 不使用時機 | 子最佳 | 此模式不適用於:
|
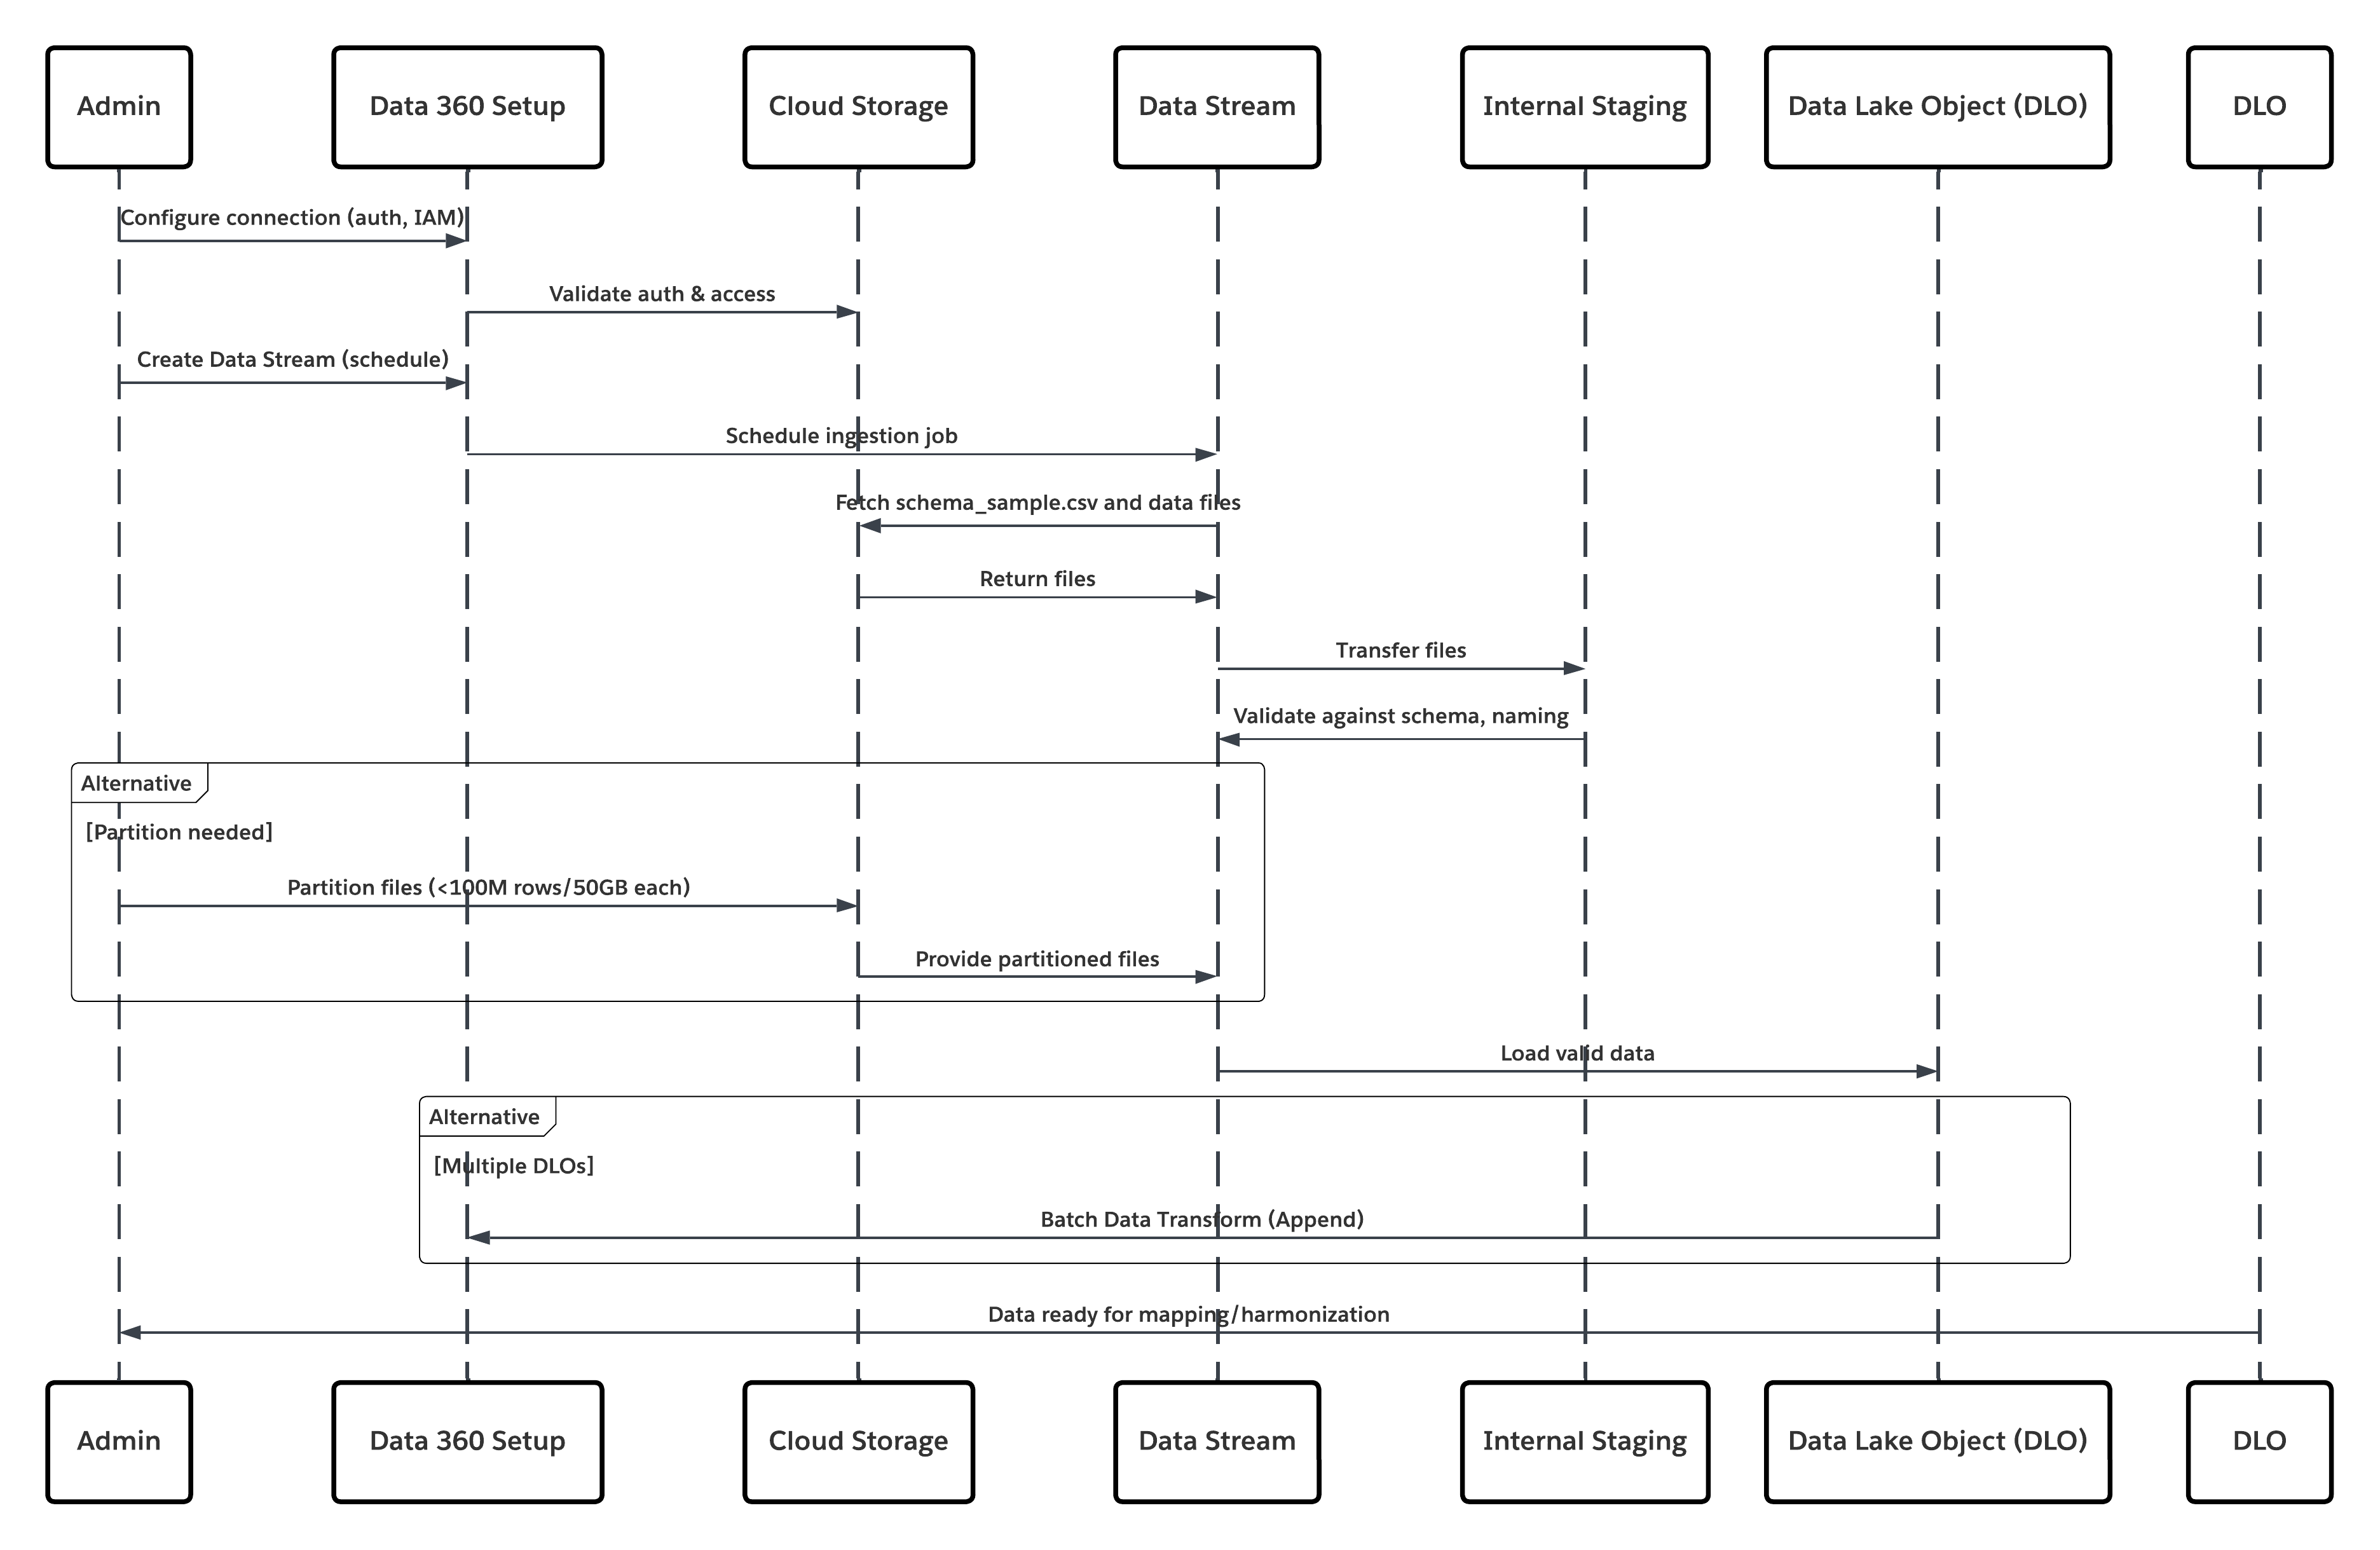 在此情況下:
- 管理員透過 Data 360 設定介面設定雲端儲存空間的連線 (指定驗證、分類詳細資料、IAM 角色和白名單)。
- 「Data Cloud 設定」介面會使用 Cloud Storage Platform 進行驗證,驗證認證和存取權。
- 管理員會在 Data 360 中建立資料串流,將資料串流連結至 Cloud Storage 中的物件/資料夾,並定義取用排程。
- 在排程觸發時,資料串流會從雲端儲存平台要求來源檔案 (例如 CSV、Parquet)。
- Cloud Storage Platform 會傳送檔案,包括必要的有效 schema_sample.csv 以及其他符合命名慣例的資料檔案。
- 「資料串流」會將檔案傳輸至 Data 360 內的內部暫存環境。
- Data 360 Pipeline 處理檔案:使用 schema_sample.csv 中的結構描述定義「驗證結構、欄位名稱」,並在超過取所值 (100 百萬列/每個檔案 50 GB) 時分配載入。如果偵測到大型檔案,則會在外部執行預先處理的分割步驟 (通知管理員以進行下一次執行)。
- 記錄會從暫存匯入至資料湖物件 (DLO)。
- 如果需要且資料已分割,請使用批次資料轉換中的 append 節點來結合多個 DLO。
- Data 360 會記錄成功/失敗、更新監視狀態,並表示資料已準備好進行對應、調和和統一。
##### 結果
此模式的應用程式可將結構化或非結構化檔案從企業雲端儲存平台安全、排程及大規模提取至 Data 360。此流程是自動化、可調整且彈性的,可將原始資料傳送至資料湖物件 (DLO),作為調和和對應至 Customer 360 資料模型的基礎。
###### 吸收機制
取用機制取決於在 Data 360 中定義的連接器和排程策略。
| 吸收機制 | 描述 |
|---|---|
| 本地雲端儲存連接器 (Amazon S3、GCS、Azure) | 建議直接從企業的雲端資料湖中,從 CSV 或 Parquet 格式的檔案採取。這些連接器支援增量與完整重新整理排程。例如,銀行可以設定從 S3 分類將客戶交易檔案每日同步至 DLO。 |
| 分割檔案策略 | 對於非常大的資料集 (超過 1 億列或每個物件 50 GB),資料會分割為較小的邏輯集 (例如依月份或區域)。系統會以個別的「資料串流」管理每個分割,之後再使用含附加節點的「批次資料轉換」來重新組合。 |
| 自動排程的同步化 | Data 360 提供一個陳述性排程器 (每小時、每日或自訂步調),此排程器會自動觸發取用工作,以確保資料新鮮無須手動介入。 |
| 連接器類型 | 端點需求 |
|---|---|
| Amazon S3 連接器 | 具有適當 IAM 原則和結構描述\_sample.csv 檔案的 S3 分類。 |
| Google Cloud Storage 連接器 | 具有統一命名慣例的服務帳戶認證和分類存取權。 |
| Azure Storage 連接器 | 存取金鑰或 SAS 權杖驗證;Blob 或資料夾結構必須遵循 Data 360 慣例。 |
| 解決方案區域 | 適合 | 註解/實作詳細資料 |
|---|---|---|
| 解決方案適合 | 最佳 | 在 Data 360\ 中使用原生 Salesforce CRM 連接器和 Marketing Cloud 參與連接器。從標準使用個案的「入門資料搭售方案」開始,並加速上線。針對自訂或網域特定的資料模型,使用手動串流自訂。 |
| 處理高度自訂的 CRM 例項 | 最佳使用對應工作坊 | 將「入門搭售方案」視為基準,並執行對應工作坊以識別:自訂物件與關係。公式或計算欄位。受管理封裝擴充。針對重型公式欄位,請在階段前 ETL 或 Data 360 轉換內計算值,以將來源組織的 API 負載降到最低。 |
| 不使用時機 | 子最佳情況 | 在下列情況中請避免使用此模式:您需要高頻頻率或即時事件 (請改用串流連接器、平台事件或零複製聯合)。來源組織的 API 容量有限,且無法在沒有節流或排程延遲的情況下維持已排程取用。 |
| 安全性與管治 | 必要控制 | 最低權限原則 - 使用具有最低讀取存取權的專屬整合使用者。請勿使用組織範圍管理員。 驗證—使用 OAuth 2.0 和連線的應用程式;定期輪替用戶端密碼並監視重新整理權杖的使用狀況。 稽核與可追蹤性 — 記錄所有採取執行、結構描述變更和連接器事件。將記錄轉送至 SIEM 或合規性系統以取得稽核整備。 資料分類 — 使用 CEDAR 原則,在取用後立即套用 PII/PHI 標記和以屬性為基礎的存取控制 (ABAC),以強制執行遮蔽、同意和下游合規。 |
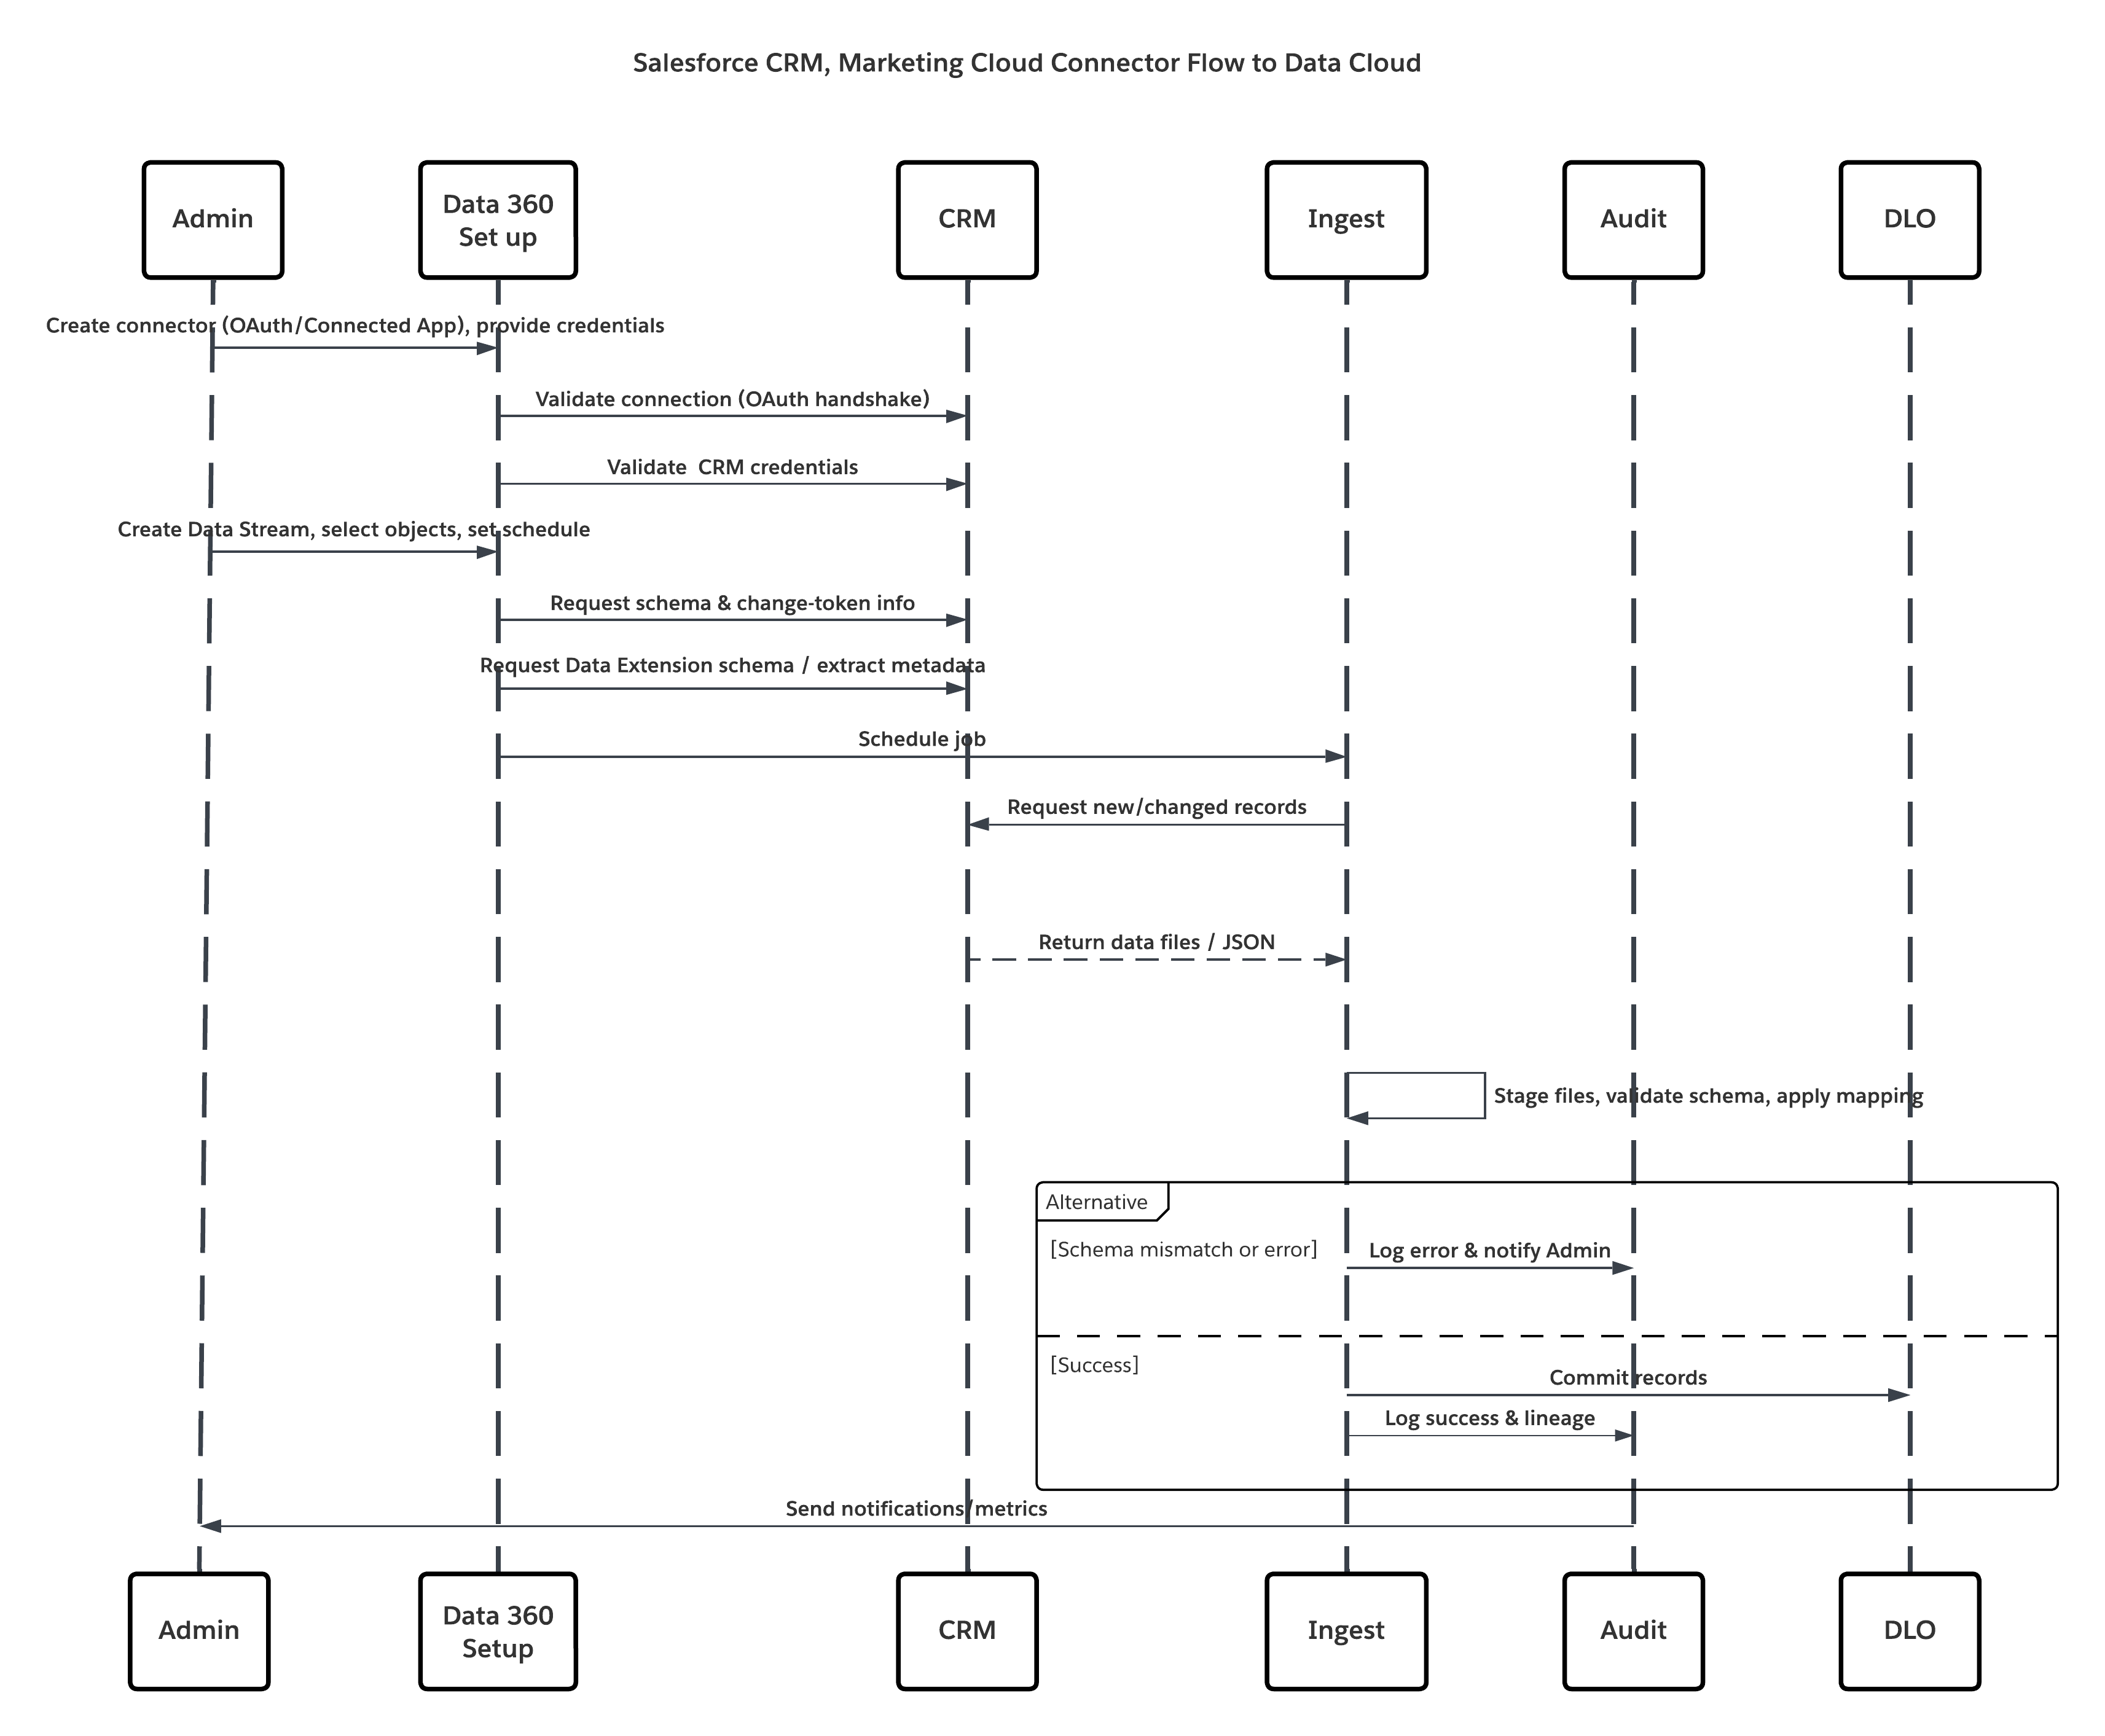 在此情況下:
- **管理員會佈建整合使用者**,並在來源組織中指派連接器權限集。
- **管理員會在 Data 360 設定中設定連接器** (透過 OAuth/連線應用程式連線至 Salesforce CRM 和 Marketing Cloud)。
- **管理員建立「資料串流」,**選取物件和「資料延伸模組」,選擇完整或差異重新整理,並設定排程。
- **排程執行時**,Data 360 會向來源要求結構描述和差異權杖。
- **來源系統會傳回記錄** (delta 或完整裝載)。Marketing Cloud 可能會傳送提取;CRM 可能會傳回 JSON/Query 結果。
- **Data 360 會在其內部安全暫存區域中暫存檔案**,並根據對應的結構描述進行驗證。
- **若驗證失敗**,會記錄錯誤、警示管理員,並停止認可。如果驗證成功,Data 360 會以原子方式將記錄認可至目標 DLO。
- **監視與稽核記錄**會以歷程、執行持續時間、列數和認證用量更新。若觸發的值或錯誤,則發出給管理員的警示。
##### 結果
核心客戶關係與行銷參與資料會作為「資料湖物件」(DLO) 來加以輸入至 Data 360。這會產生:
- 包含設定檔、個案、機會和電子郵件/參與度量的 **統一資料集**。
- **身分解析與建立「統一個人設定檔」的基礎** 。
- 下游調和、增強、AI 建模和啟用,同時保留管治與稽核能力的**營運整備**。
###### 吸收機制
取用機制取決於在 Data 360 中定義的連接器和排程策略。
| 機制 | 使用時機 |
|---|---|
| Salesforce CRM 連接器 (原生) | 最適用於標準/自訂 CRM 物件;支援完整和差異重新整理。 |
| Marketing Cloud 參與連接器 (原生) | 最適用於「資料延伸模組」、「傳送」與「追蹤」、提取;支援 full/delta 模式。 |
| 入門資料搭售方案 | 加速常見「銷售/服務/行銷」物件的上線。 |
| 自訂串流 + 預先處理 | 當需要複雜轉換或嚴重的結構描述正規化時使用。 |
| 連接器 | 端點需求 |
|---|---|
| Salesforce CRM 連接器 | 來源組織必須允許連線的應用程式、OAuth 權杖,以及具有讀取權限的專用整合使用者。 |
| Marketing Cloud 連接器 | Marketing Cloud API 認證或已安裝的封裝;「資料延伸模組」必須透過 Extracts/API 公開資料。 |
| 解決方案區域 | 適合 | 註解/實作詳細資料 |
|---|---|---|
| 解決方案適配 | 最適用於低延遲事件捕捉 | 針對推送單一事件或微批次,請使用 Data 360 Capture API (串流 JSON)。使用嚴格的 OAS 3.0 結構描述 (.yaml) 來設定接收 API 連接器。針對較大且較不頻繁的同步化使用大量 CSV。 |
| 處理結構描述變更 | 嚴格 / 受管理 | 結構描述會變更:更新 OAS .yaml、版本化連接器,並執行契約測試。如果產生者無法同時變更,請實作滾動結構描述移轉。 |
| 不使用時機 | 子最佳 | 如果需要預先處理 (例如:刪除重複、保證訂單等),或非常大的大量負載 (使用原生大量連接器或批次 ETL),則不理想。如果來源無法產生結構描述有效的裝載,或無法安全地驗證,請使用替代的方法。 |
| 安全與管治 | 必要 | 將 OAuth 2.0 與最低權限範圍、輪替金鑰、記錄權杖用量搭配使用。強制執行 TLS 1.2+,視需要驗證用戶端 IP,並確保裝載 PII 標記。所有事件都必須包含來源中繼資料 (來源、時間戳記、結構描述版本、無效金鑰)。 |
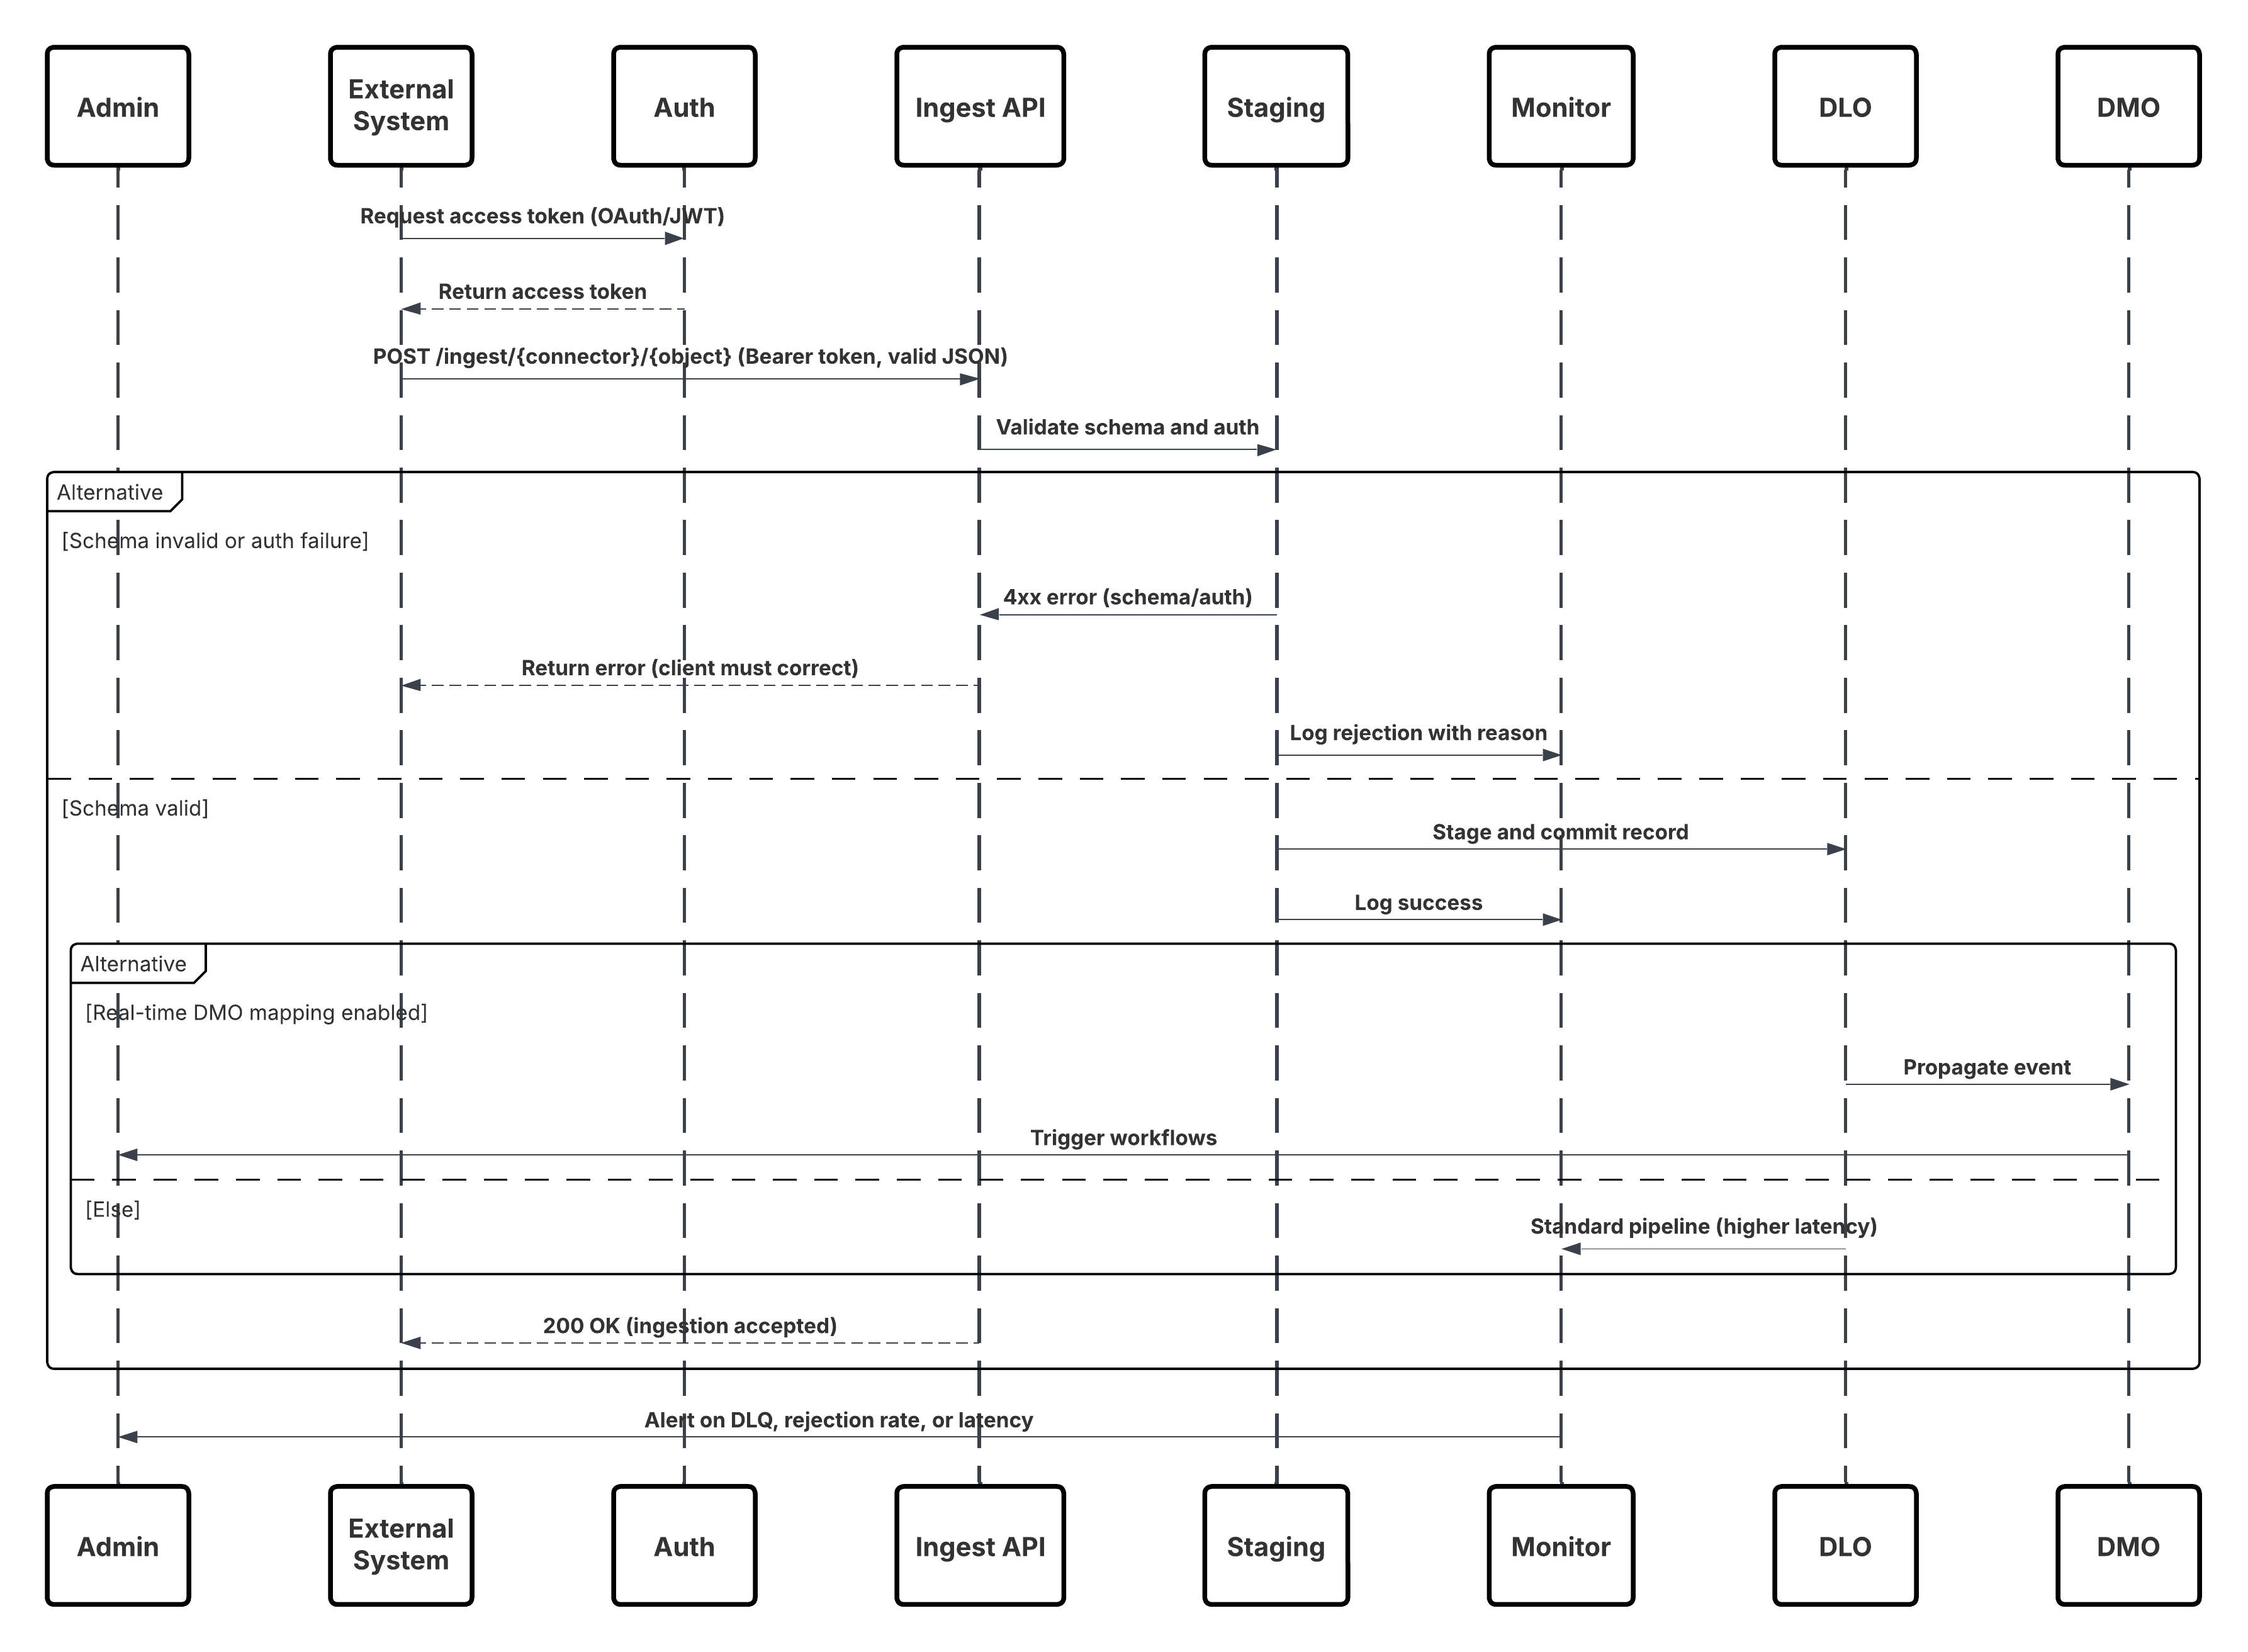 **在此情況下:**
- 外部系統從「驗證伺服器」要求透過 OAuth/JWT 進行驗證。
- Auth Server 會將存取權杖傳回至外部系統。
- 外部系統會透過授權與 JSON 裝載,將資料取用 POST 要求傳送至 Data 360 取用 API。
- 透過「暫存驗證」模組驗證要求結構描述和驗證。
- 結構描述/驗證失敗時:
- 傳回至外部系統的錯誤。
- 針對監視與警示記錄的拒絕。
- 成功驗證時:
- 暫存並認可至資料湖物件 (DLO) 的記錄。
- 已成功記錄進行監視。
- 若已啟用,則會將資料移入至觸發下游工作流程的即時資料圖表 (DMO)。
- 否則,會透過標準批次或較高延遲管道處理資料。
- 通訊 API 確認外部系統的成功。
- 監視元件會警示管理員無效字母、拒絕率或延遲問題。
##### 結果
外部事件資料會以較低的延遲將其採取至 Data 360 DLO。當目標 DMO 是即時圖表的一部分時,資料可用於立即區隔、工作人員工作流程、AI 模型和作業啟用。這可讓業務快速回應來自任何已連線系統的事件。
###### 吸收機制
取用機制取決於在 Data 360 中定義的連接器和排程策略。
| 機制 | 使用時機 |
|---|---|
| 串流 JSON (吸收 API) | 單一事件、微批次、行為事件、點擊串流、IoT 遙測—需要低延遲時。 |
| 大量 CSV (吸收 API 大量模式) | 縮短延遲需求的大型定期上載。 |
| 邊緣/中介 | 當您需要驗證、轉換、增強或比率限制時,請先使用,再推送至「採取 API」。 |
| 解決方案區域 | 適合 | 註解/實作詳細資料 |
|---|---|---|
| 以 SDK 為基礎的事件捕捉 | 最佳 | 部署 Salesforce Interactions SDK (Web) 或原生 SDK (行動裝置)。這些輕量型文件庫會將使用者互動以即時式方式加成序列,並附加中繼資料 (工作階段識別碼、時間戳記、內容)。 |
| 事件串流銷售管道 | 最佳 | 事件會透過安全的 HTTPS 傳送至 Marketing Cloud Personalization 的事件串流服務。此層可水平調整,並針對低延遲傳動 (<2s) 進行最佳化。 |
| Data 360 整合 | 最佳 | Data 360 的「個人化連接器」會訂閱串流摘要,以近乎即時的方式將每個事件提取至「資料湖物件」(DLO)。 |
| 資料模型對應 | 最佳作法 | 此將對應至 Customer 360 資料模型物件 (DMO)。這可讓您透過「身分解析」連結匿名與已知使用者。 |
| 即時圖表啟用 | 選用 / 建議 | 在即時圖表中包含對應的 DMO,以進行立即區隔,透過 Einstein 或 Agentforce 工作流程觸發個人化動作。 |
| 不使用時機 | 子最佳 | 以下情況下,此模式並不理想:來源資料為 Web 用戶端與事件 (請改用「取用 API」)。組織無法控制 Web/行動用戶端。不需要即時行為追蹤 (使用批次採取)。 |
| 處理結構描述變更 | 受管理的進化 | 事件結構描述會隨著新增互動而演進。SDK 應版本化事件定義。與舊版相容的變更 (新增選用欄位) 是安全的;中斷變更需要重新設定連接器和契約測試。 |
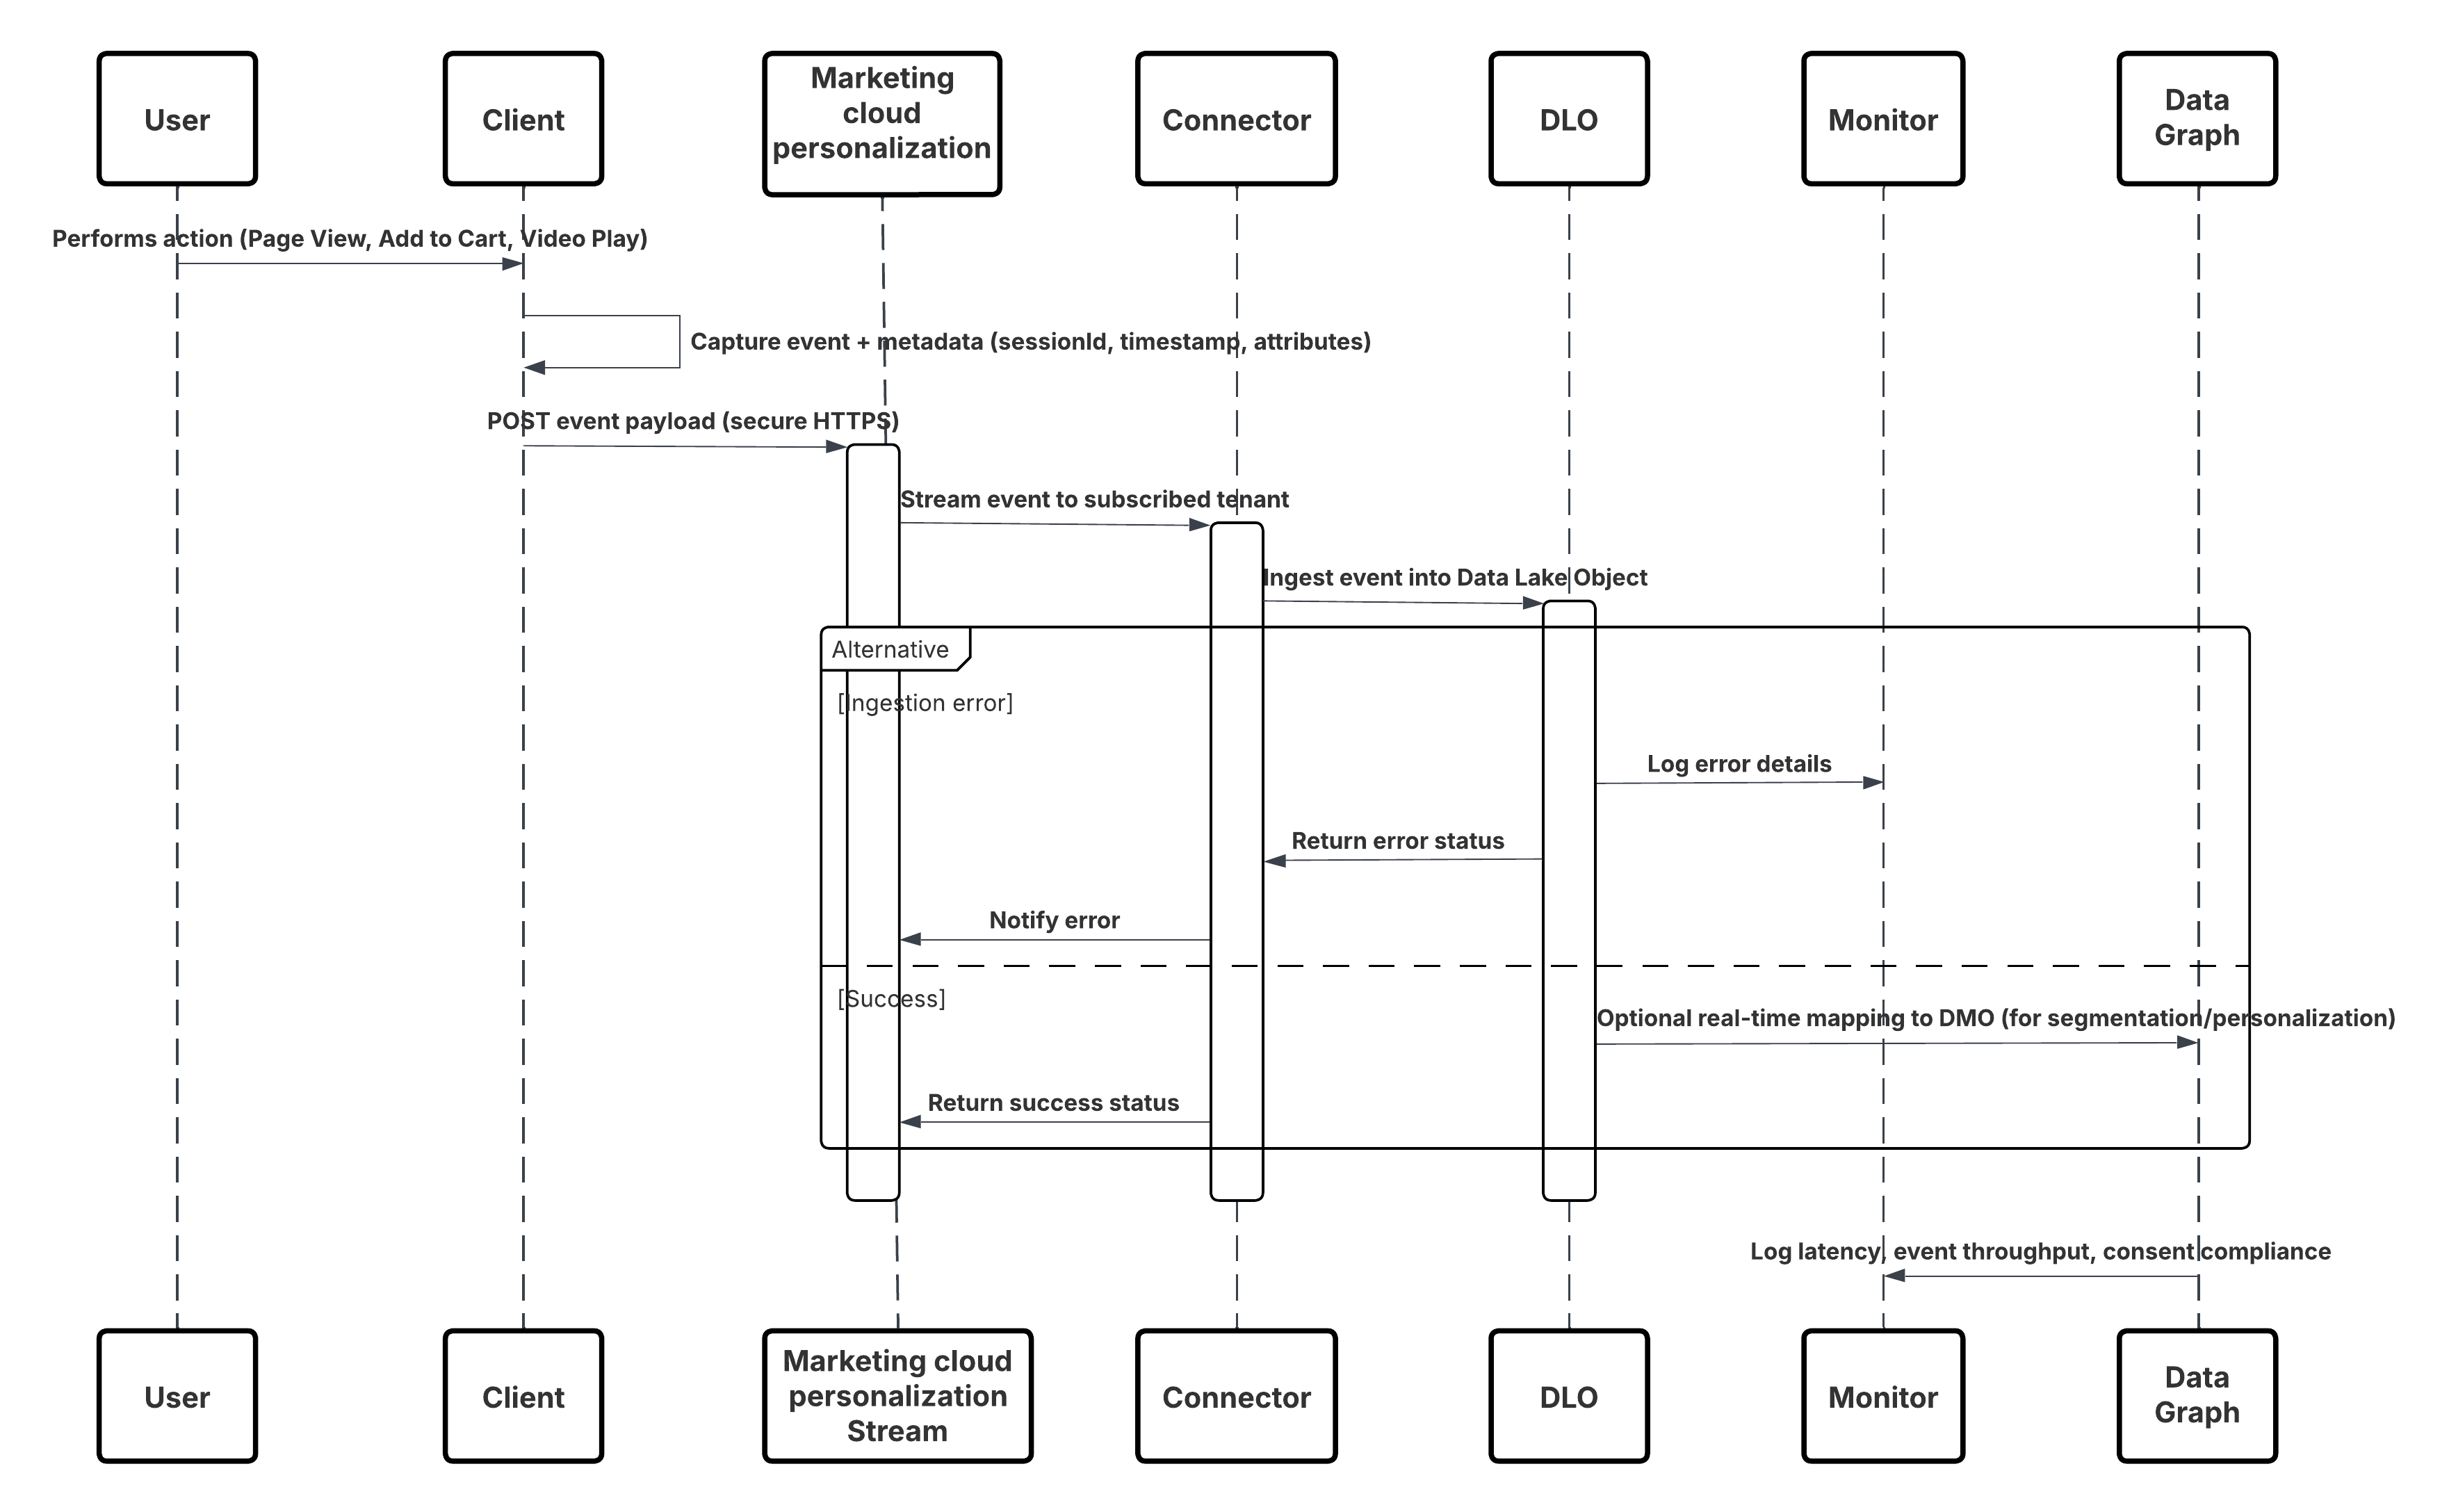 **在此情況下:**
- 在 Web 或行動管道中部署 SDK (使用者-互動捕捉)。
- 使用租戶識別碼、環境和同意控制來設定 SDK。
- 將捕取的 JSON 事件 (中繼資料 + 屬性) 串流至 Marketing Cloud 串流端點。
- 在「Data 360 設定」中,建立並設定租戶的「個人化連接器」。
- 在 Data 360 內將 DLO → DMO 對應至 DLO。
- 在即時圖表中啟用 DMO,以立即啟用。
- 監視延遲、結構描述合規性、同意標記、輸出、錯誤率。
- 部署至生產環境並持續監視。
##### 結果
從數位管道流入 Data 360 的行為事件連續低延遲串流。在秒數內,每個使用者動作都可用於即時區隔、預測建模或觸發個人化,以實現真正適應的客戶體驗。
###### 吸收機制
取用機制取決於在 Data 360 中定義的連接器和排程策略。
| 機制 | 使用時機 |
|---|---|
| Interactions SDK (Web) | 從網頁瀏覽器和 SPA 進行即時快照。 |
| Mobile SDK | 來自原生行動應用程式的即時快照。 |
| 個人化連接器 | Marketing Cloud 與 Data 360\ 之間的受管理訂閱。 |
| 即時圖表對應 | 在「區隔」、「Einstein」和「旅程」中啟用立即啟用。 |
| 解決方案區域 | 適合 | 註解/實作詳細資料 |
|---|---|---|
| CDC 式串流連接器 | 最佳 | 本地 Salesforce 機制;完全受管理,並與平台事件基礎結構整合。 |
| 事件訂閱與傳送 | 最佳 | Connector 會透過永久的重新執行識別碼訂閱 ChangeEvent 管道 (例如 /data/ContactChangeEvent)。 |
| 資料對應與結構描述演進 | 最佳作法 | 將串流裝載對應至對應的 DLO;在中繼資料中處理結構描述版本化,以避免發生中斷。 |
| 重複執行與錯誤復原 | 建議 | 使用重新執行識別碼和識別碼金鑰可避免重複並從暫時錯誤中復原。 |
| 混合模式 (串流 + 批次) | 選擇性 | 針對不支援的物件或初始大量載入,請使用與 CDC 串流組合使用批次取用。 |
| 不使用時機 | 子最佳 | 以下情況下,此模式可能為「子最佳」:來源物件未啟用 CDC。使用個案不需要即時更新 (批次足夠)。來源組織中的網路輸出受到限制或事件限制超過。 |
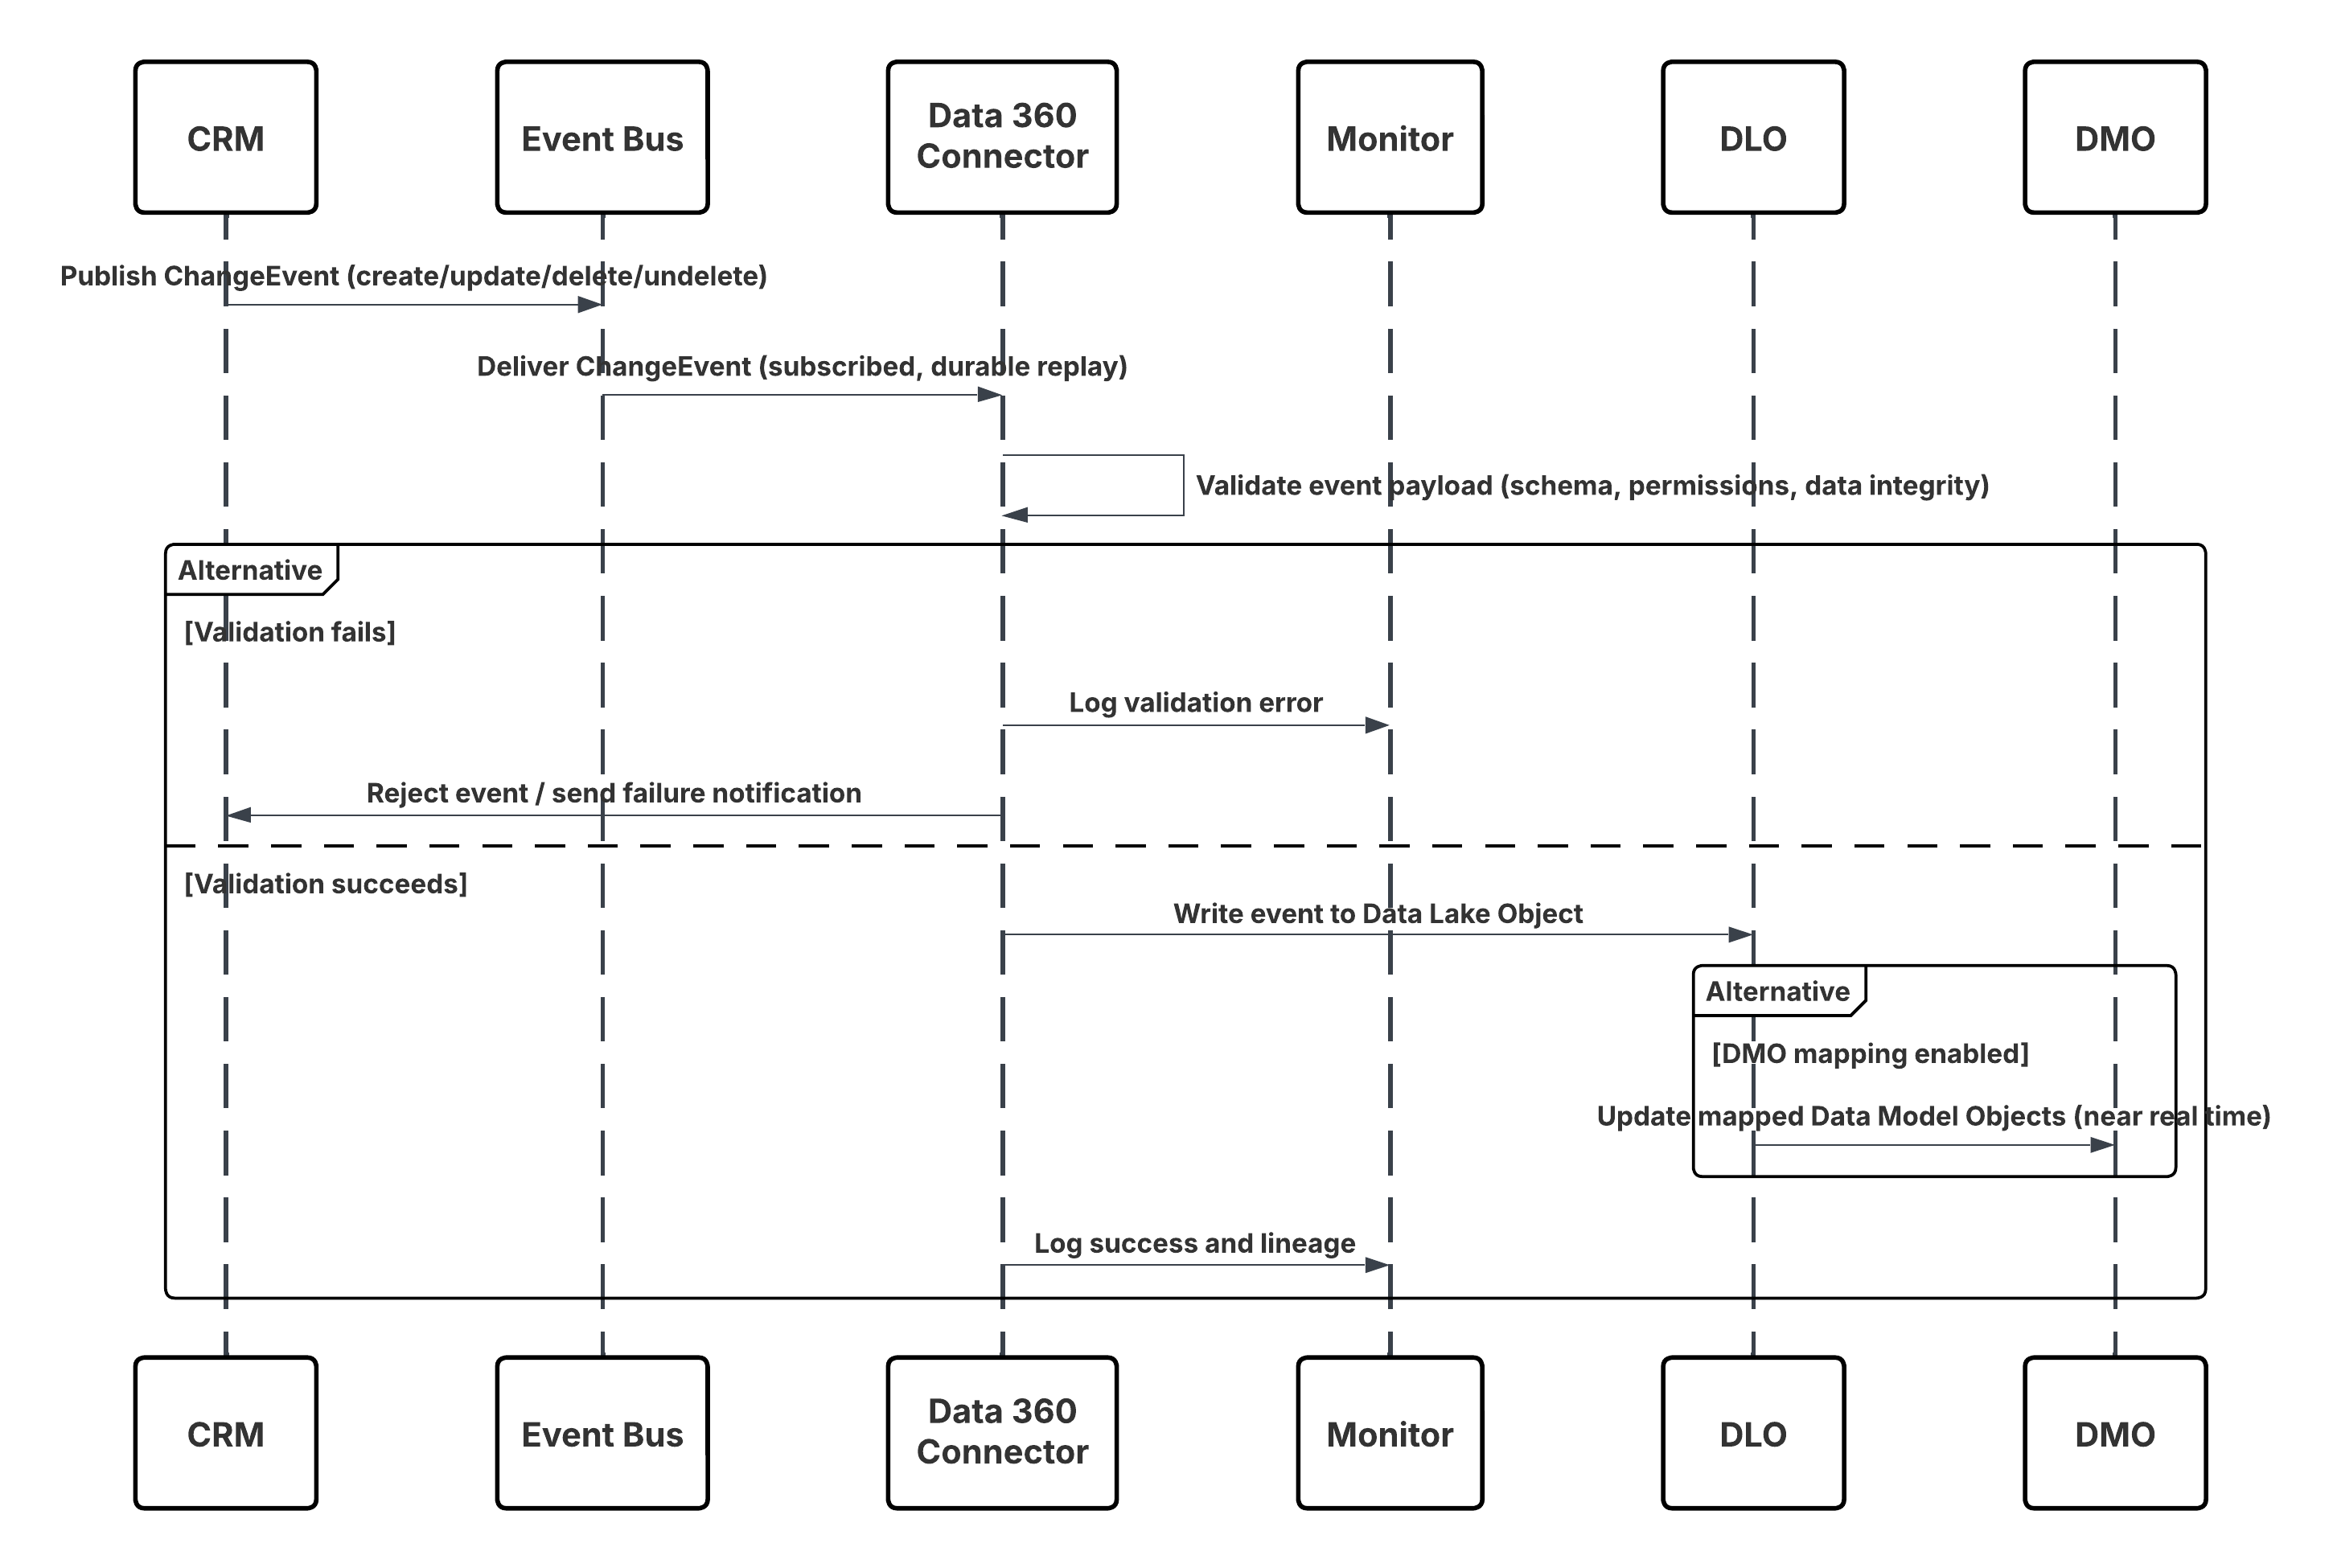 **在此情況下:**
- 變更會在 Salesforce CRM 中發生 (建立/更新/刪除/取消刪除)。
- CDC 會將 ChangeEvent 發佈至內部 Salesforce Event Bus。
- Data 360 CRM 連接器會使用永久的重新執行游標來訂閱 Event Bus。
- 系統會針對結構描述、權限和資料完整性驗證事件裝載。
- Data 360 會將驗證的事件寫入對應的 **資料湖物件 (DLO)**。
- 若已啟用,則對應的「**資料模型物件」(DMO)** 會以近乎即時的方式更新,進而加強區隔和啟用。
##### 結果
Data 360 會維持關鍵 CRM 資料的連續同步化鏡像。
這可啟用:
- 即時觸發 (例如建立「個案」時啟動 Journey)。
- 最新的區段 (例如,在帳戶狀態變更時將客戶移至「金級」區段)。
- 根據即時 CRM 內容更精確的分析和個人化。
###### 吸收機制
系統會原生透過已啟用「變更資料擷取」(CDC) 的 Salesforce CRM 連接器來管理此模式的採取機制。Data 360 會作為 CDC 事件串流的訂閱者,確保來源 CRM 組織與 Data 360 之間的可靠低延遲同步化。
| 機制 | 使用時機 |
|---|---|
| 透過 CDC 串流 (偏好) | 適用於需要近乎即時同步化的所有支援 Salesforce 標準和自訂物件。 |
| 混合模式 (CDC + 批次) | 適用於尚未啟用 CDC 的物件,或需要初始歷程記錄載入的物件。 |
| 重複執行訂閱模式 | 用於停機或部署後重新同步化。 |
| 錯誤隔離模式 | 適用於測試和驗證環境。 |
| 解決方案區域 | 適合 | 註解/實作詳細資料 |
|---|---|---|
| Kinesis 原生連接器 | 最佳 | 第一方與 AWS Kinesis 的整合;支援連續高輸送量。 |
| MSK 原生連接器 | 最佳 | 使用 OIDC 和金鑰型驗證支援的受管理 Kafka 採取。 |
| 結構描述對應與驗證 | 最佳作法 | 上載結構描述 (.json/.avro),定義事件結構;強制執行合併期間。 |
| IAM 組態 | 建議 | 將具有唯讀存取權的最低權限 IAM 角色指派給目標 Kinesis 串流或 MSK 主題。 |
| 私人網路路由 | 選擇性 | 設定 PrivateLink/VPC 端點以進行安全內部路由。 |
| 混合模式 (串流 + 批次) | 選擇性 | 使用串流進行差異處理,並針對回填或歷程記錄載入使用批次處理。 |
| 錯誤隔離模式 | 建議 | 將結構描述拒絕並將暫時錯誤路由至 DLQ 以供重新執行 |
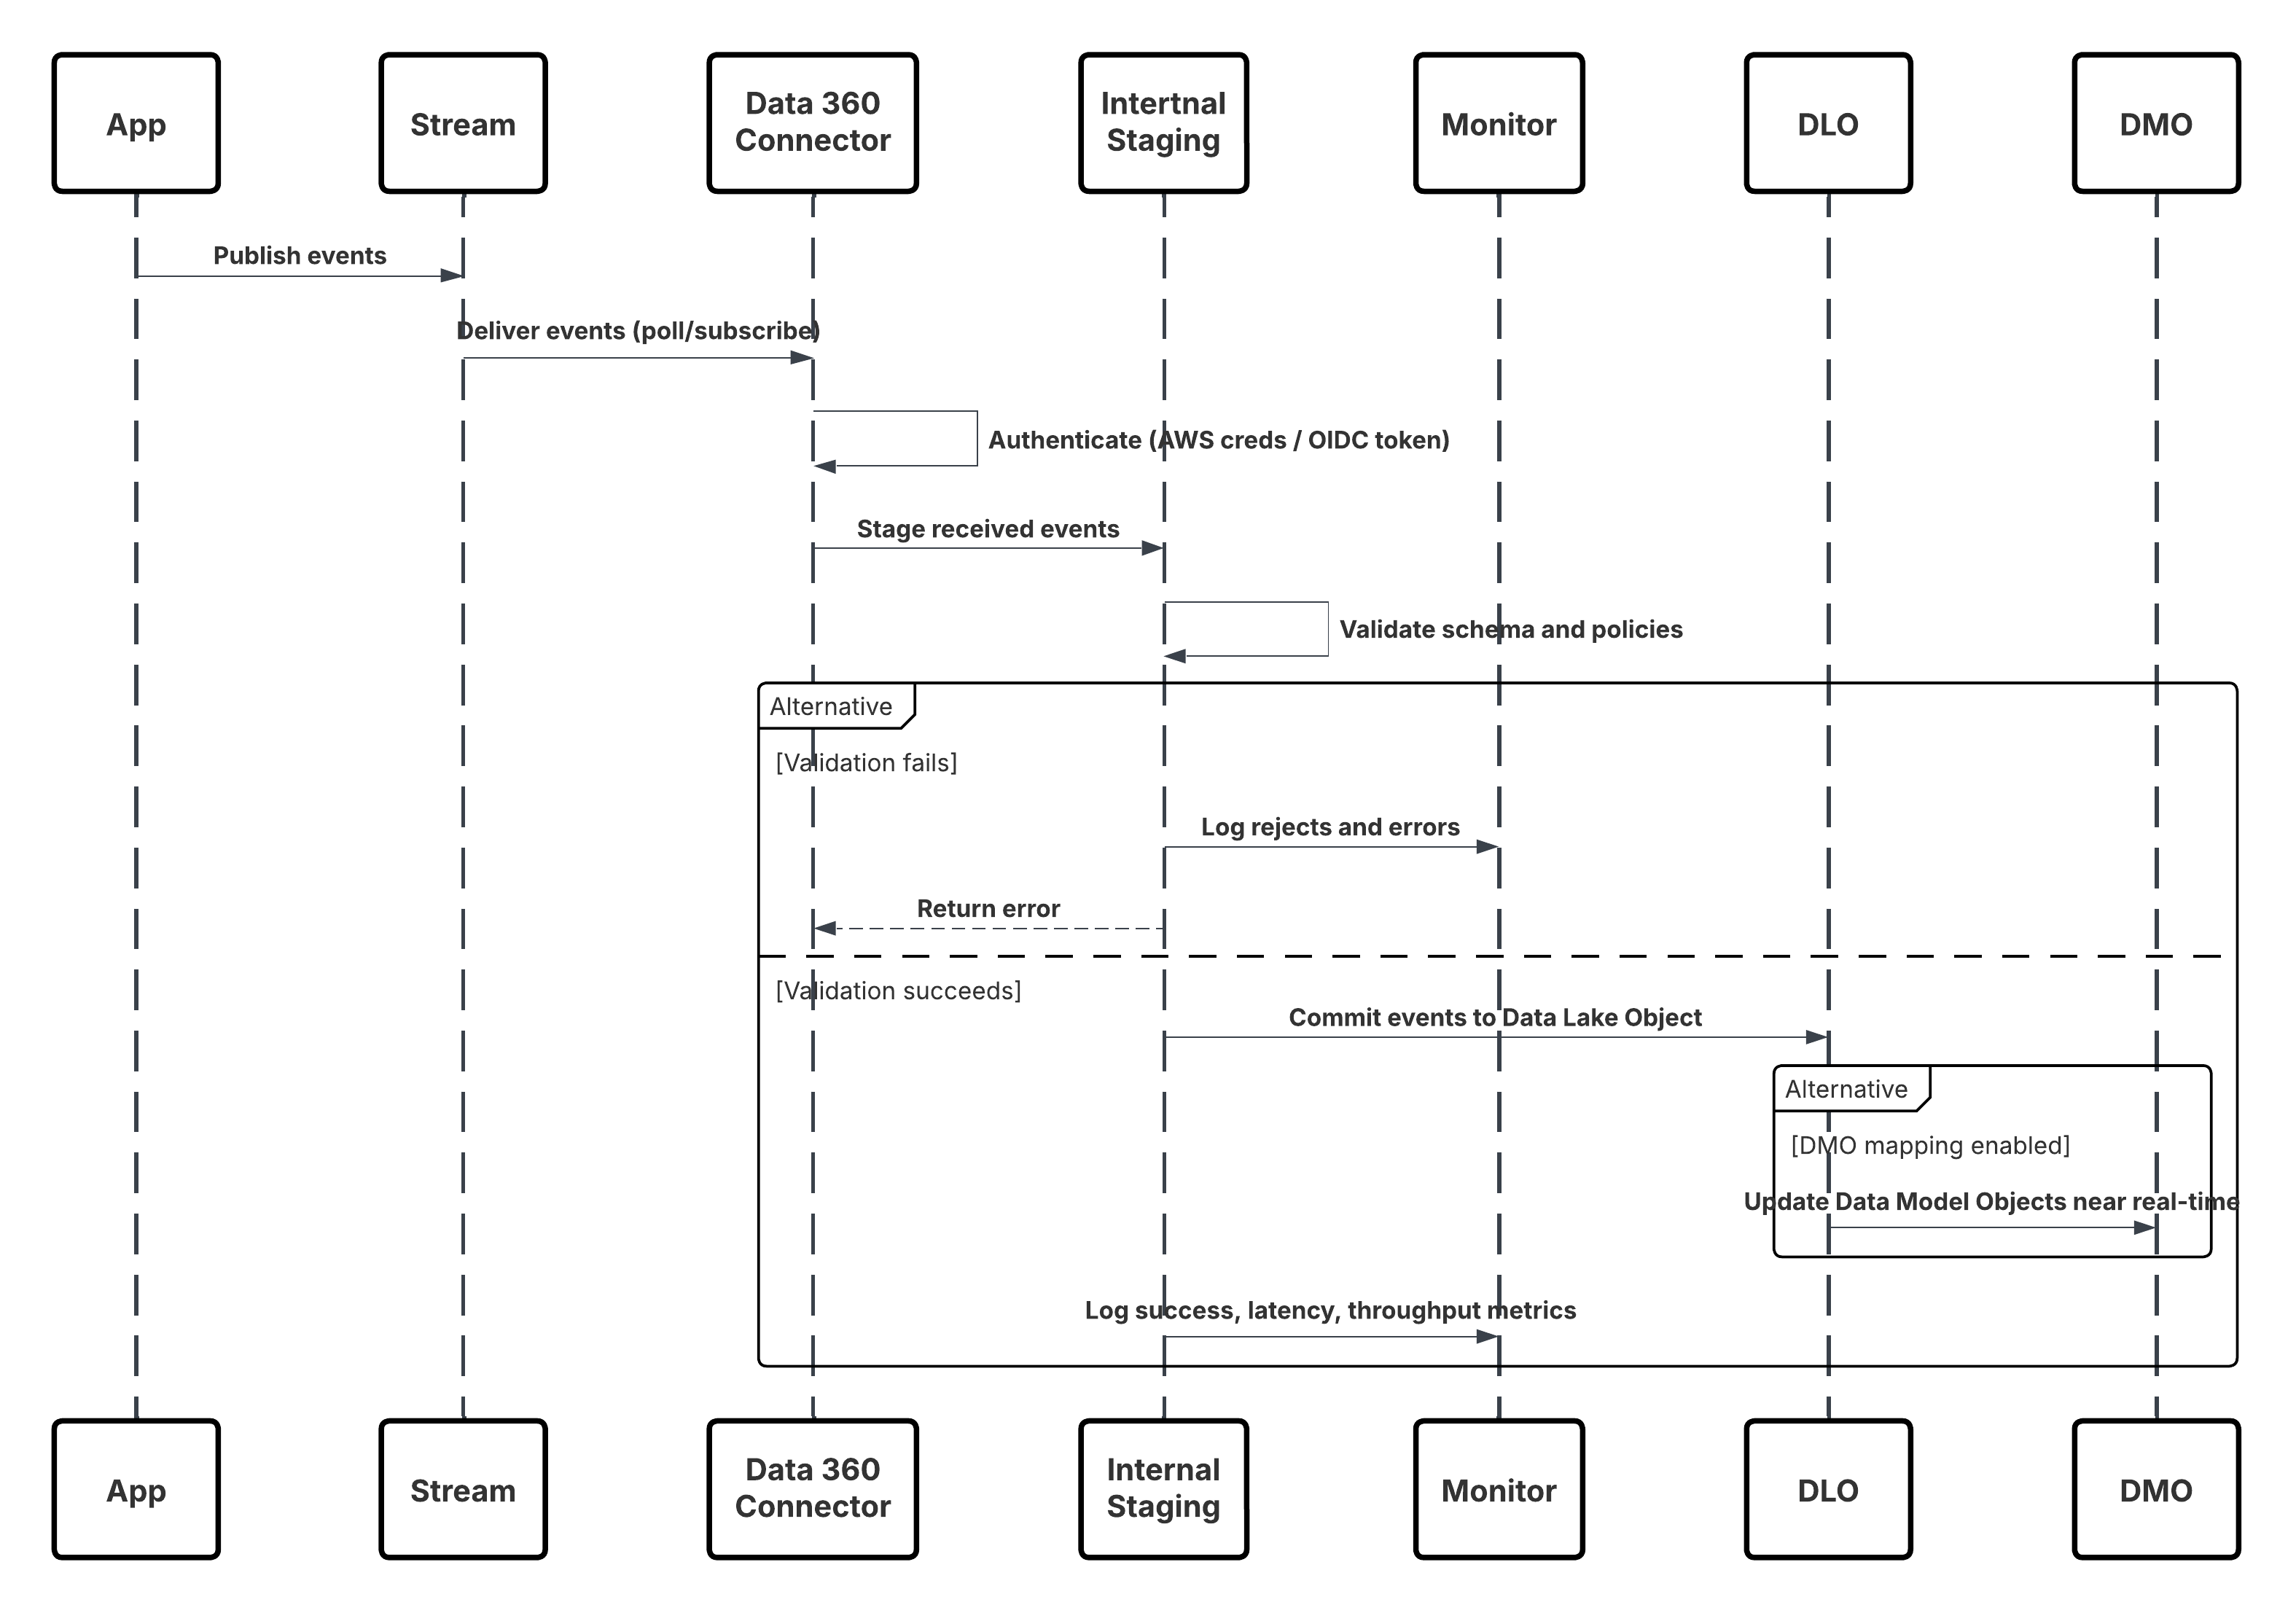 **在此情況下:**
- 應用程式或裝置會將事件發佈至 Kinesis 串流或 MSK 主題。
- Data 360 連接器會使用 AWS 認證或 OIDC 權杖進行驗證。
- 連接器會持續輪詢或訂閱串流。
- 事件會暫存、驗證結構描述與原則,然後認可至「資料湖物件」(DLO)。
- 若已對應,「資料模型物件」(DMO) 會近乎即時更新以供啟用。
- 「監視層」會追蹤度量、結構描述拒絕和延遲。
##### 結果
將結構化資料直接從 AWS Kinesis 或 MSK 連續、低延遲地提取至 Data 360。資料可立即用於:
- 身分解析
- 即時區段
- Einstein AI 啟用
- Agentforce 驅動的觸發
去除批次 ETL 的相依性,啟用與企業事件驅動設計一致的串流型結構。
###### 吸收機制
| 機制 | 使用時機 |
|---|---|
| Kinesis 連接器 (偏好) | 適用於 AWS 原生串流來源,此串流來源需要持續提取大量結構化資料。 |
| MSK 連接器 | 適用於在 Kafka 相容平台上執行事件銷售管道的組織。 |
| 混合式 (串流 + 批次) | 適用於與定期大量負載結合的增量事件。 |
| 解決方案區域 | 適合 | 註解/實作詳細資料 |
|---|---|---|
| Snowflake Zero Copy 連接器 | 最佳 | 第一方原生整合;透過 Snowflake 的資料共用或外部表格 API 建立即時查詢聯合。 |
| Databricks Zero Copy 連接器 | 最佳 | 支援在 Delta Lake 中直接即時存取表格/檢視;推送查詢會在 Databricks 執行階段中執行。 |
| 檔案聯合 (Apache Iceberg / Delta / Parquet) | 新增最佳作法 | Data 360 會直接從物件儲存空間讀取開啟的表格格式,而不需要外部運算相依性。大量資料集的理想選擇。 |
| 私人網路組態 | 建議 | 使用 Salesforce Private Connect 或 VPC 對等以取得安全的網路級聯合。 |
| 驗證與金鑰管理 | 最佳作法 | 透過定期輪替和儲存庫管理實作安全的金鑰型或 OAuth 型驗證。 |
| 結構描述註冊 | 必要 | Data 360 會取用外部結構描述,並將其對應至「外部資料湖物件」(外部 DLO)。 |
| 受管理中繼資料 | 建議 | 所有外部 DLO 都會繼承分類、同意和歷程中繼資料,以瞭解合規性。 |
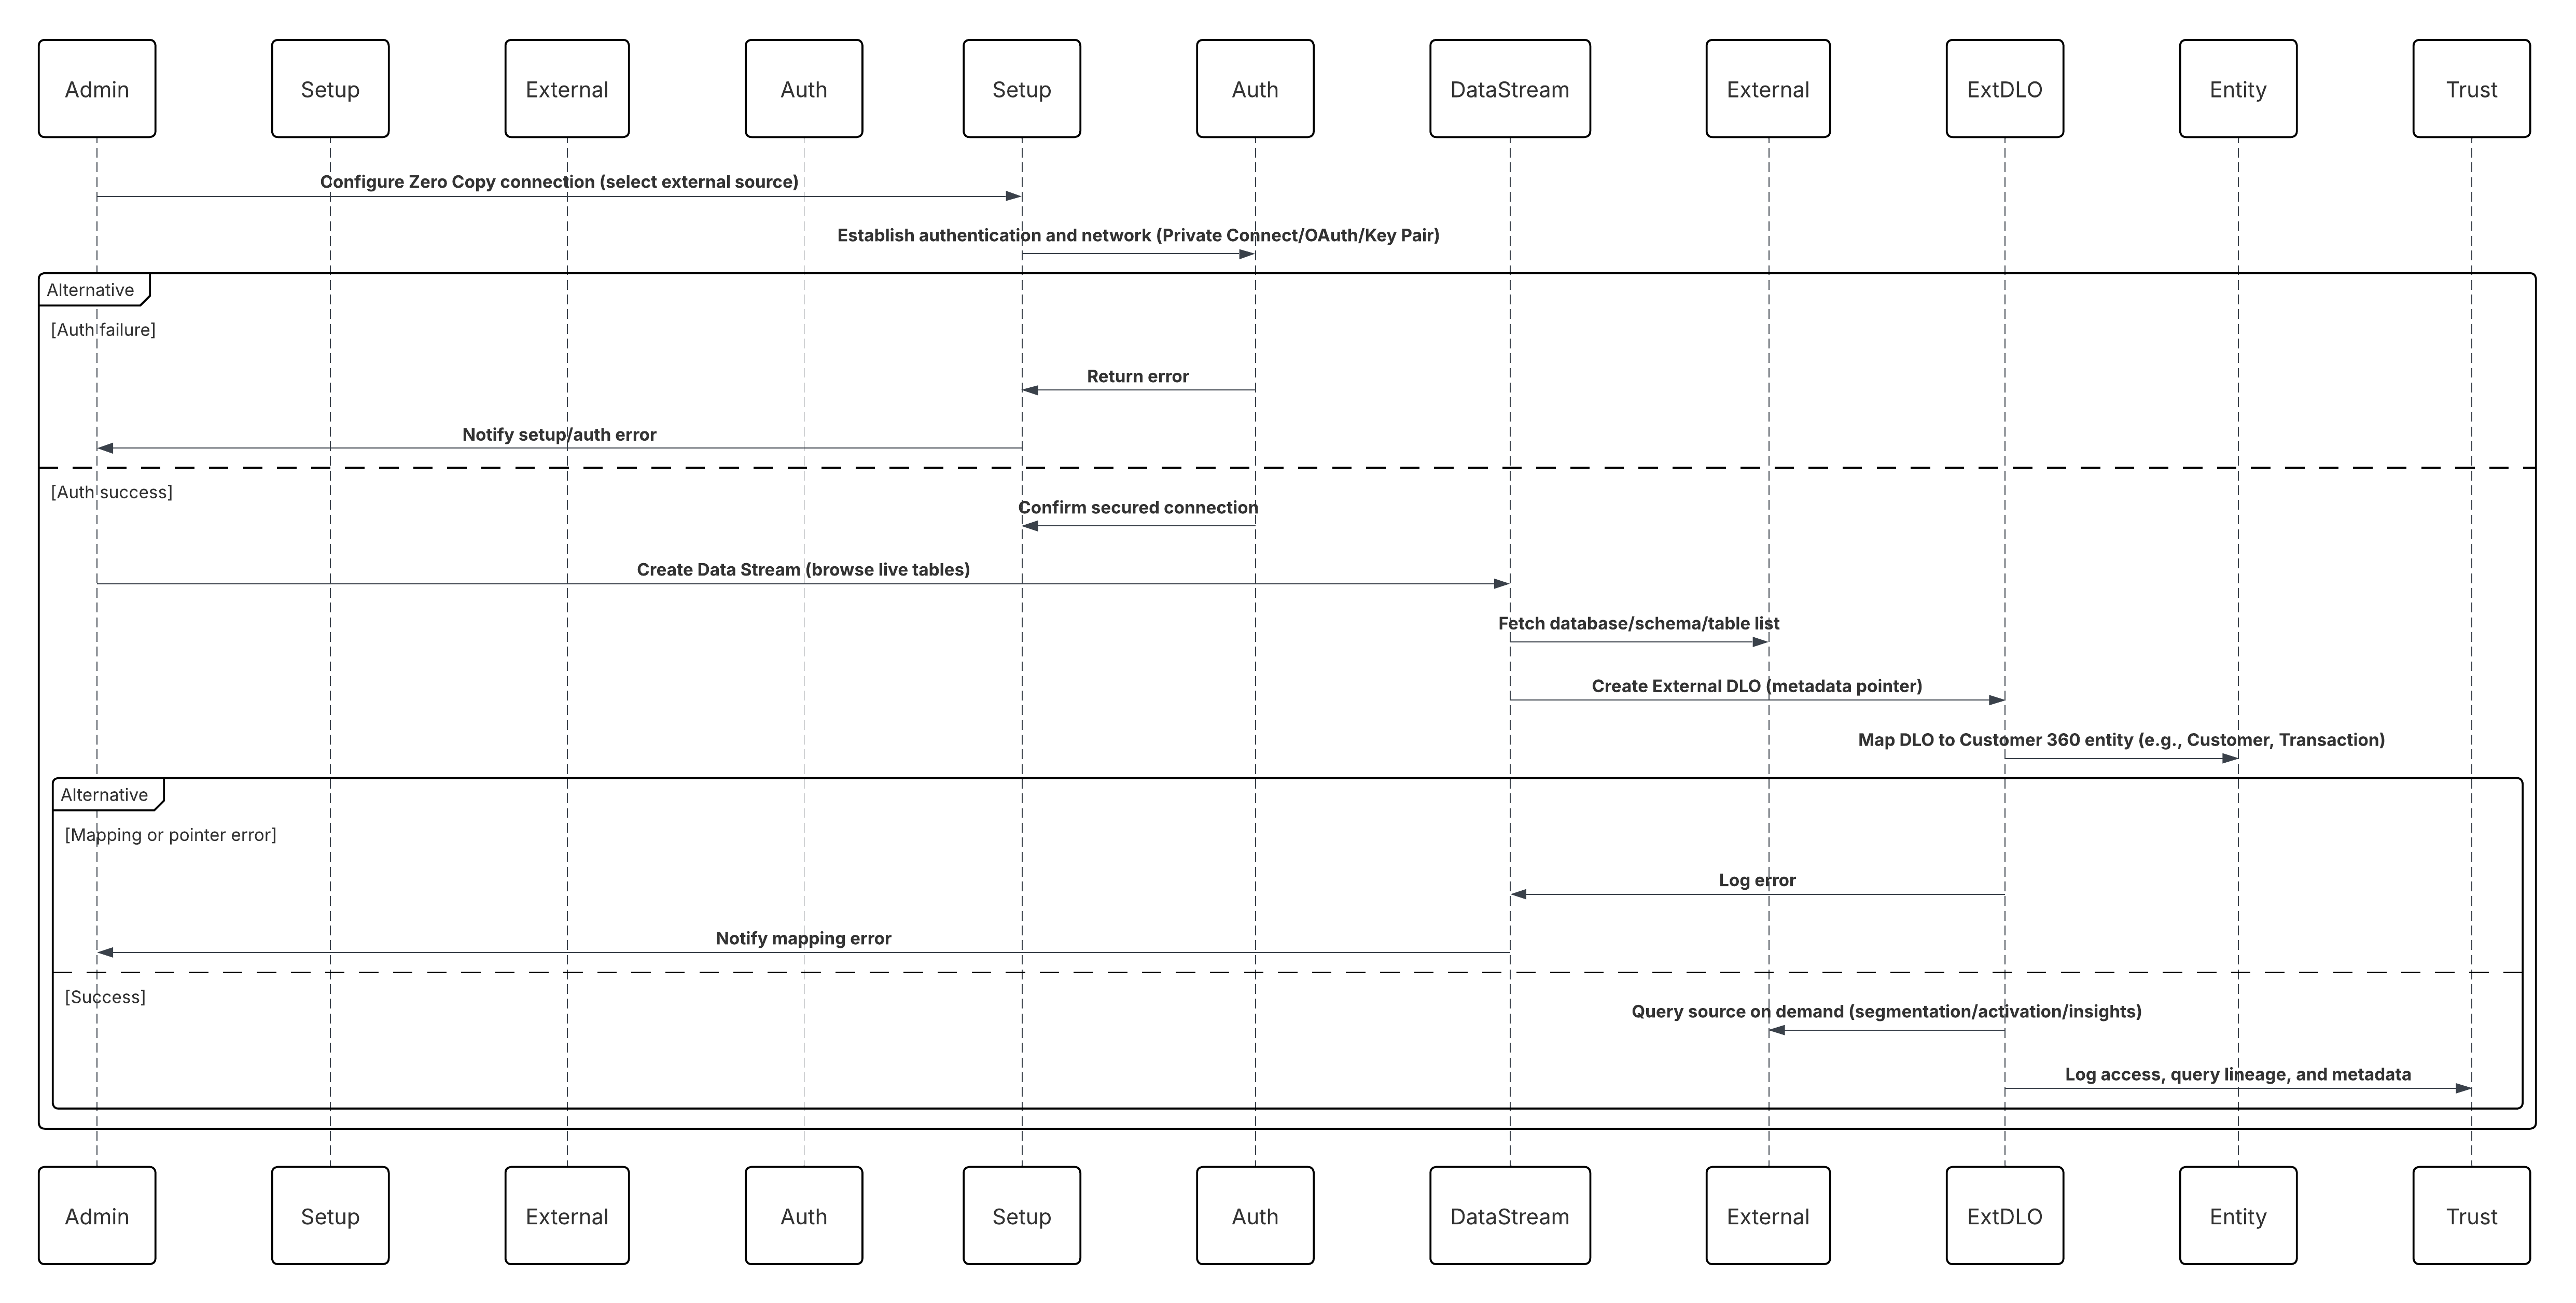 在此情況下:
- 管理員會在 Data 360 設定 (Snowflake、Databricks 或檔案聯合) 中設定「零複製」連線。
- 已建立安全驗證和網路路由 (私人連線/OAuth/金鑰配對)。
- 管理員建立「資料串流」,選取外部來源—瀏覽即時資料庫、結構描述和表格。
- Data 360 會建立外部 DLO (資料湖物件),即參照即時表或 Iceberg 檔案的中繼資料指標,而不是複製資料。
- 外部 DLO 會對應至 Customer 360 實體 (例如客戶、交易、產品)。
- Data 360 會在區隔、啟用或洞察計算期間查詢來源。
- 所有存取、查詢歷程和中繼資料都會在 Data 360 Trust 層內進行稽核。
##### 結果
- 外部資料會保留在 Snowflake、Databricks 或 S3 中—無 ETL、無重複,無額外儲存空間。
- Data 360 可取得企業規模資料的即時讀取存取權,以用於身分解析、已計算洞察和啟用。
- 組織可在其現有的管治、加密與合規架構下維持完整控制權。
- 此模式會啟用真正的「零複製」結構,結合本機存取的效能與聯合儲存空間的管理。
###### 通話機制
呼叫機制取決於用來實作此模式的解決方案。
| 機制 | 使用時機 |
|---|---|
| Snowflake Federation (偏好) | 適用於具有受管理企業資料倉庫的即時高效能查詢聯合。 |
| Databricks 聯邦 | 適用於使用 Delta 或 Parquet 支援資料集的統一分析與湖家環境。 |
| 檔案聯合 (Apache Iceberg / Delta Lake) | 適用於物件儲存空間中的大規模資料集,其中運算分離與成本最佳化十分重要。 |
| 混合模式 (零複製 + 接收) | 當歷程記錄資料需要一次性取用,但透過「零複製」存取即時資料時。 |
| 解決方案區域 | 適合 | 註解/實作詳細資料 |
|---|---|---|
| 資料共用建立 | 最佳 | 管理員在 Data 360 內建立「資料共用」,新增選取的 DMO 和 CIO (例如,「統一個人」、「客戶健康分數」)。 |
| 目標組態 | 最佳 | 建立「資料共用目標」,指定 Snowflake 或 Databricks 帳戶識別碼和驗證參數。 |
| 共用發佈 | 最佳作法 | 將「資料共用」連結至「資料共用目標」以安全發佈。 |
| 倉庫接受 | 必要 | 外部管理員接受共用,將共用物件作為倉庫中的唯讀檢視/表格具體化。 |
| 細微存取控制 | 建議 | 在 Data 360 內套用物件和以角色為基礎的權限;與倉庫層級以角色為基礎的存取控制保持一致。 |
| 聯合查詢存取權 | 最佳 | 分析師透過標準 SQL 查詢即時共用資料;聯結原生倉庫資料以供下游分析和 ML。 |
| 檔案聯合選項 | 選擇性 | 針對大型資料集,請利用以 Apache Iceberg 為基礎的聯合,以直接取得 S3 或 Delta Lake 讀取,而不需要計算相依性。 |
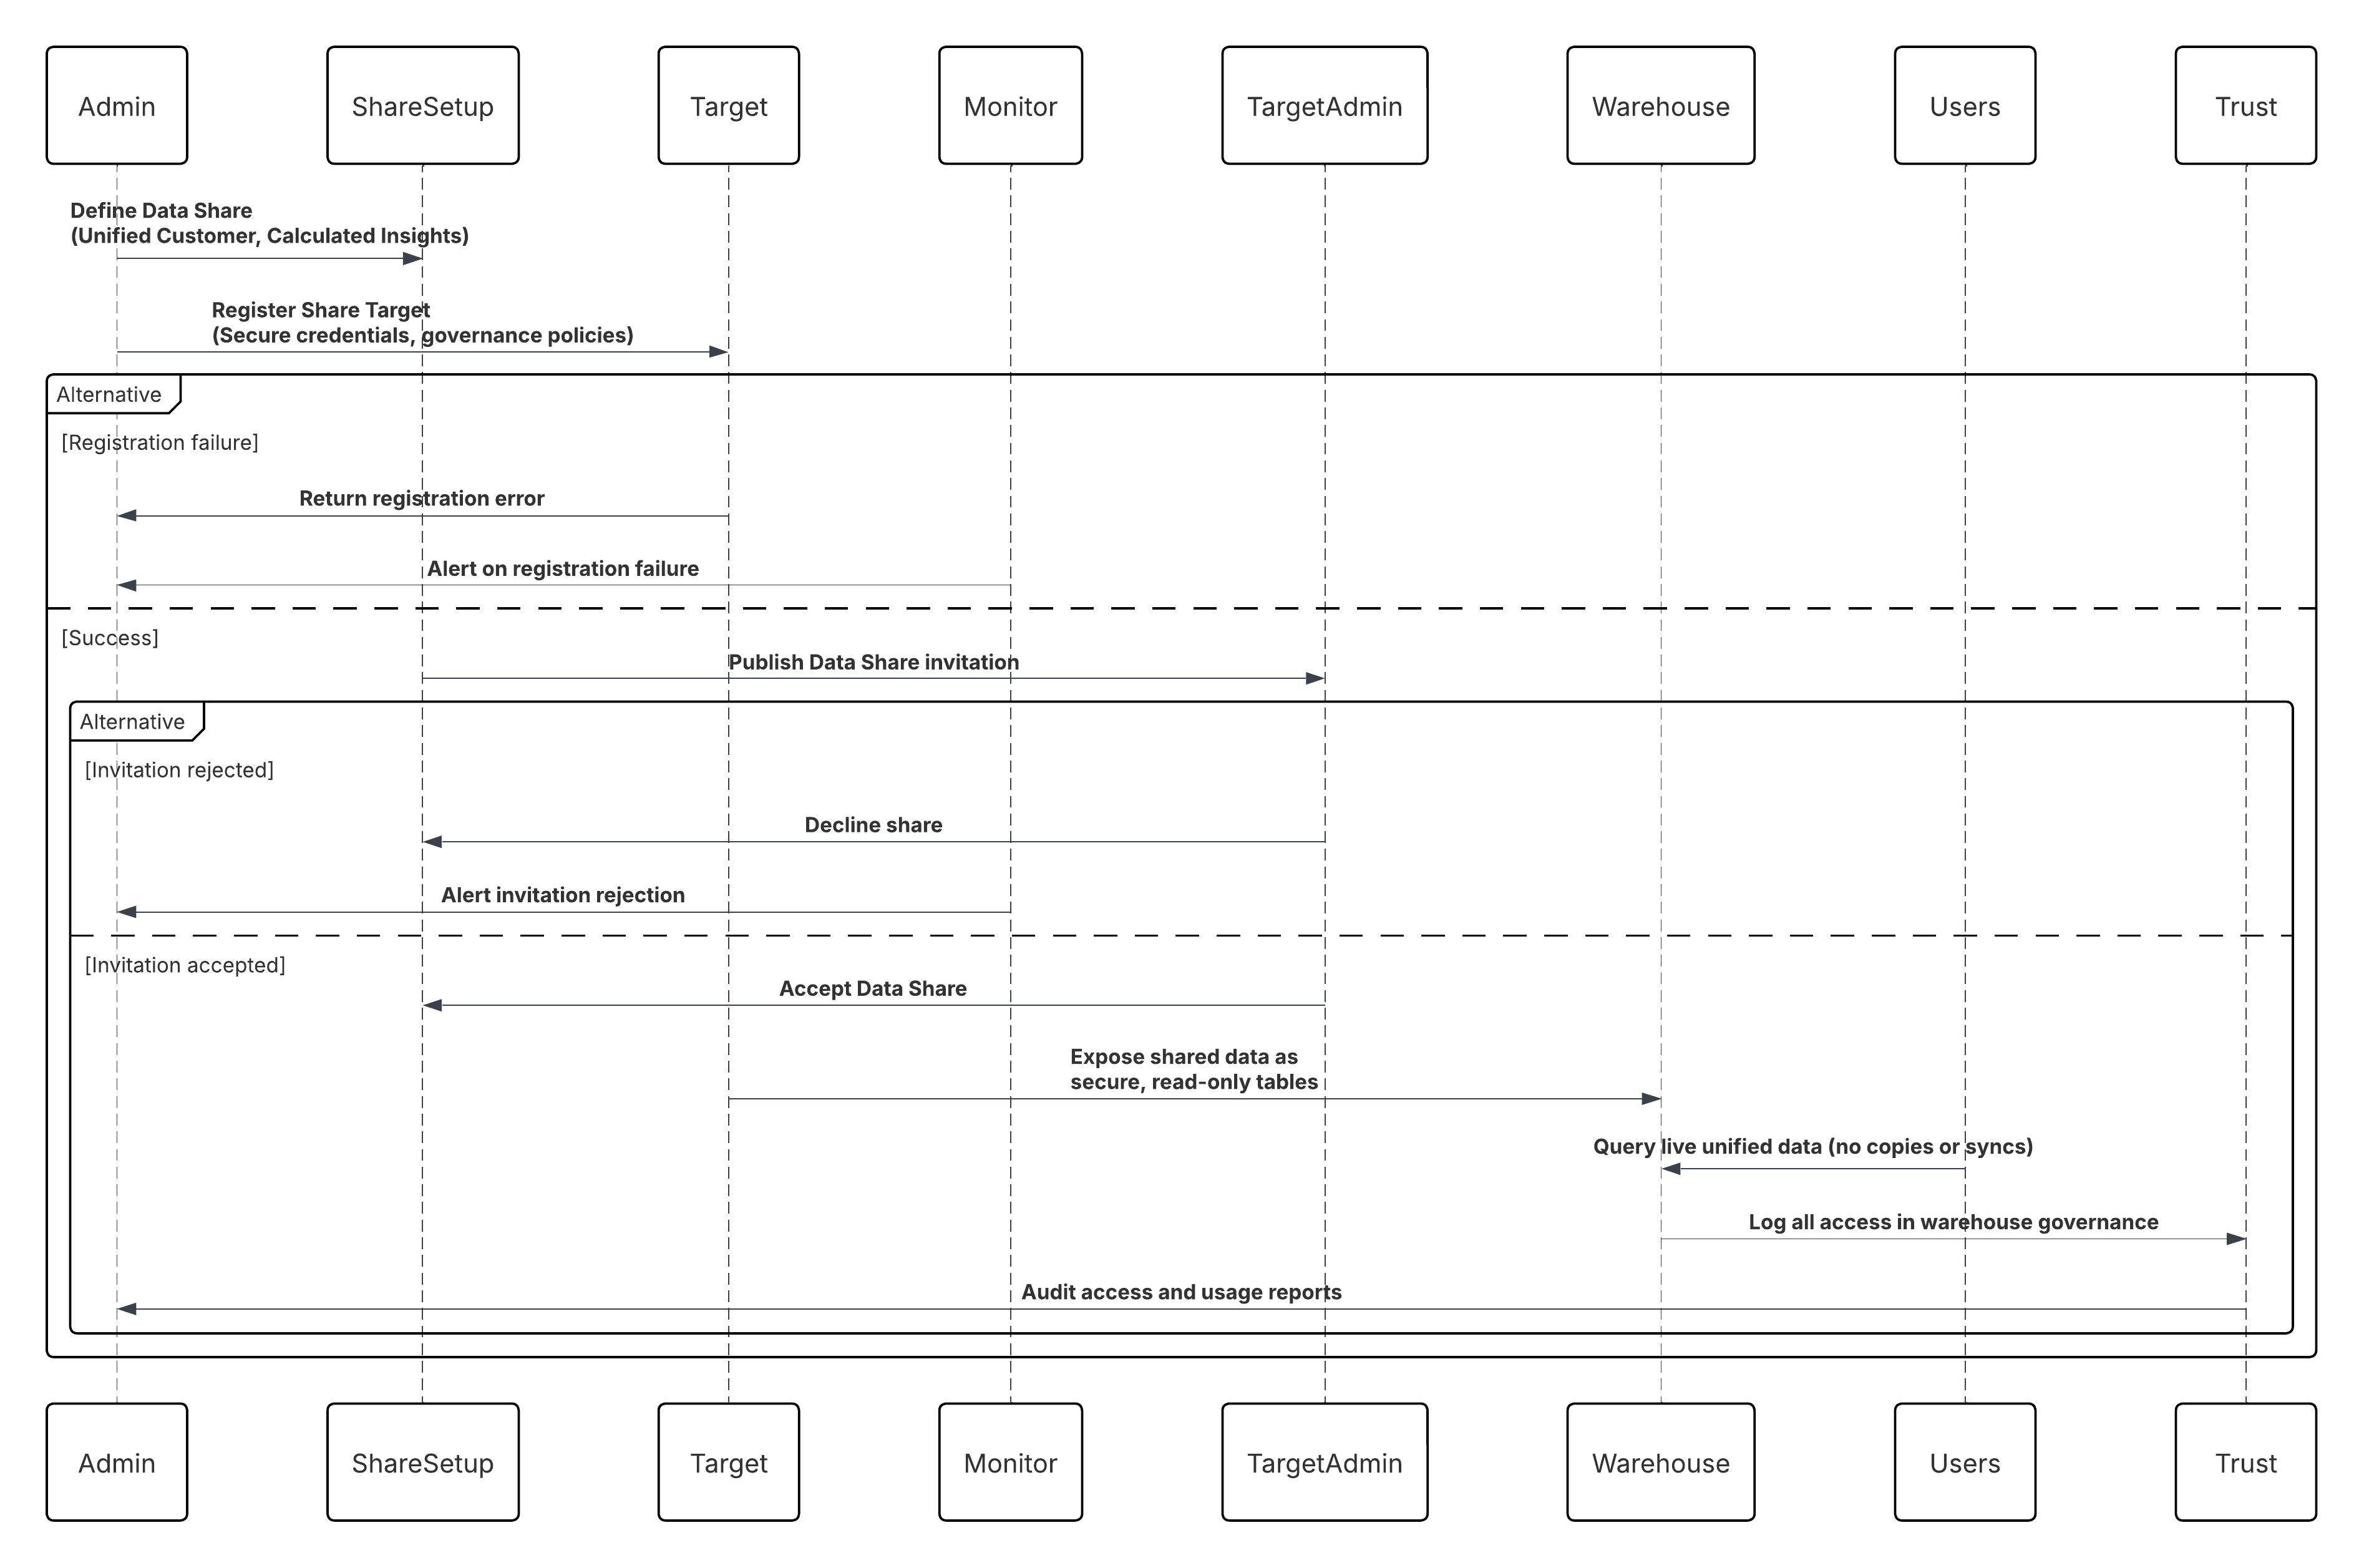 **在此情況下:**
- Data 360 管理員定義「資料共用」,包括「統一客戶」和「已計算洞察」物件。
- 使用安全認證和管治原則註冊「資料共用目標」(Snowflake 或 Databricks 帳戶)。
- Data 360 會發佈共用;Snowflake/Databricks 管理員會接受該共用。
- 共用的資料會在倉庫內顯示為安全且唯讀的表格。
- 分析師、BI 工具或 ML 管道會查詢即時且統一的客戶資料,而無須複製或同步化。
- 所有存取權都會在 Data 360 Trust 層與倉庫管理記錄中進行稽核。
##### 結果
- 外部倉庫可取得已協調 Data 360 資料的即時可查詢存取權。
- 去除反向 ETL 銷售管道,減少營運負擔和延遲。
- 直接在統一資料上啟用 AI/ML 訓練、預測建模和進階 BI。
- 維持零重複、強大的管治,以及安全的依設計存取控制。
- 完成雙向「零複製」迴圈,其中輸入聯合與輸出共用在單一管治模式下同時存在。
###### 通話機制
呼叫機制取決於用來實作此模式的解決方案。
| 機制 | 使用時機 |
|---|---|
| Snowflake 安全資料共用 (偏好) | 當您的企業倉庫是 Snowflake 且您需要對協調的 Data 360 資料集進行即時、受管理的存取,而不需要資料移動或重複時使用。適用於需要零延遲共用和原生歷程強制執行的分析、AI 和合規性導向工作量。 |
| Databricks Delta 共用 | 當下游取用者在 Databricks 或 Delta Lake 環境中作業,且需要透過開放的 Delta 共用通訊協定對統一或已啟用資料集的即時唯讀存取權時使用。 |
| 外部表格共用 (Apache Iceberg / Parquet) | 當維護物件儲存空間 (S3、ADLS 或 GCS) 中的開放格式結構,以及需要跨分析引擎 (例如 Athena、BigQuery 或 Snowflake-on-Iceberg) 進行互通、低成本共用時使用。 |
| 資料共用 API (程式設計存取權) | 當自訂應用程式或中介軟體 (例如 MuleSoft) 必須透過 API 安全地探索、訂閱或取用共用資料集時,使用以事件為基礎的重新整理通知和細微的存取控制。 |
| 混合共用 (零複製 + 輸出共用) | 實作雙向交換模式時使用—利用輸入資料的「零複製」和發佈洞察的「輸出資料共用」,確保跨企業資料層的語意與管治一致性。 |
| 解決方案區域 | 適合 | 註解/實作詳細資料 |
|---|---|---|
| 首頁組織佈建 | 最佳 | 將一個 Salesforce 組織指定為佈建 Data 360 的主要組織,這會成為中央資料存放庫和管治中心。 |
| 伴侶組織連線 | 最佳 | 透過 Data Cloud One 應用程式,設定從「主要組織」到一或多個「伴侶組織」的「伴侶連線」,無須自訂程式碼。 |
| 資料空間定義 | 最佳作法 | 定義「首頁組織」內的「資料空間」,以邏輯方式將資料分段 (例如零售、服務、行銷),並隔離存取邊界。 |
| 資料空間共用 | 最佳 | 明確地將選取的「資料空間」從「主要組織」共用至「伴侶組織」,以確保統一資料的以角色為基礎的受管理可視性。 |
| 存取組態 | 必要 | 在「伴侶組織」中,啟用 Data Cloud One 應用程式,並指派設定檔、洞察和區段存取權的使用者權限。 |
| 管治與保單控制 | 建議 | 集中在「首頁組織」中執行所有採取、身分解析和 Trust 組態,並維持端對端管理。 |
| 多組織同步化 | 最佳 | 「首頁組織」中的資料變更和已計算洞察會透過受管理的同步化管道,在「伴隨組織」之間即時反映。 |
| 混合式部署選項 | 選擇性 | 針對大型企業,多個「伴侶組織」可以連線至單一「首頁組織」,同時維護本機內容與合規性邊界。 |
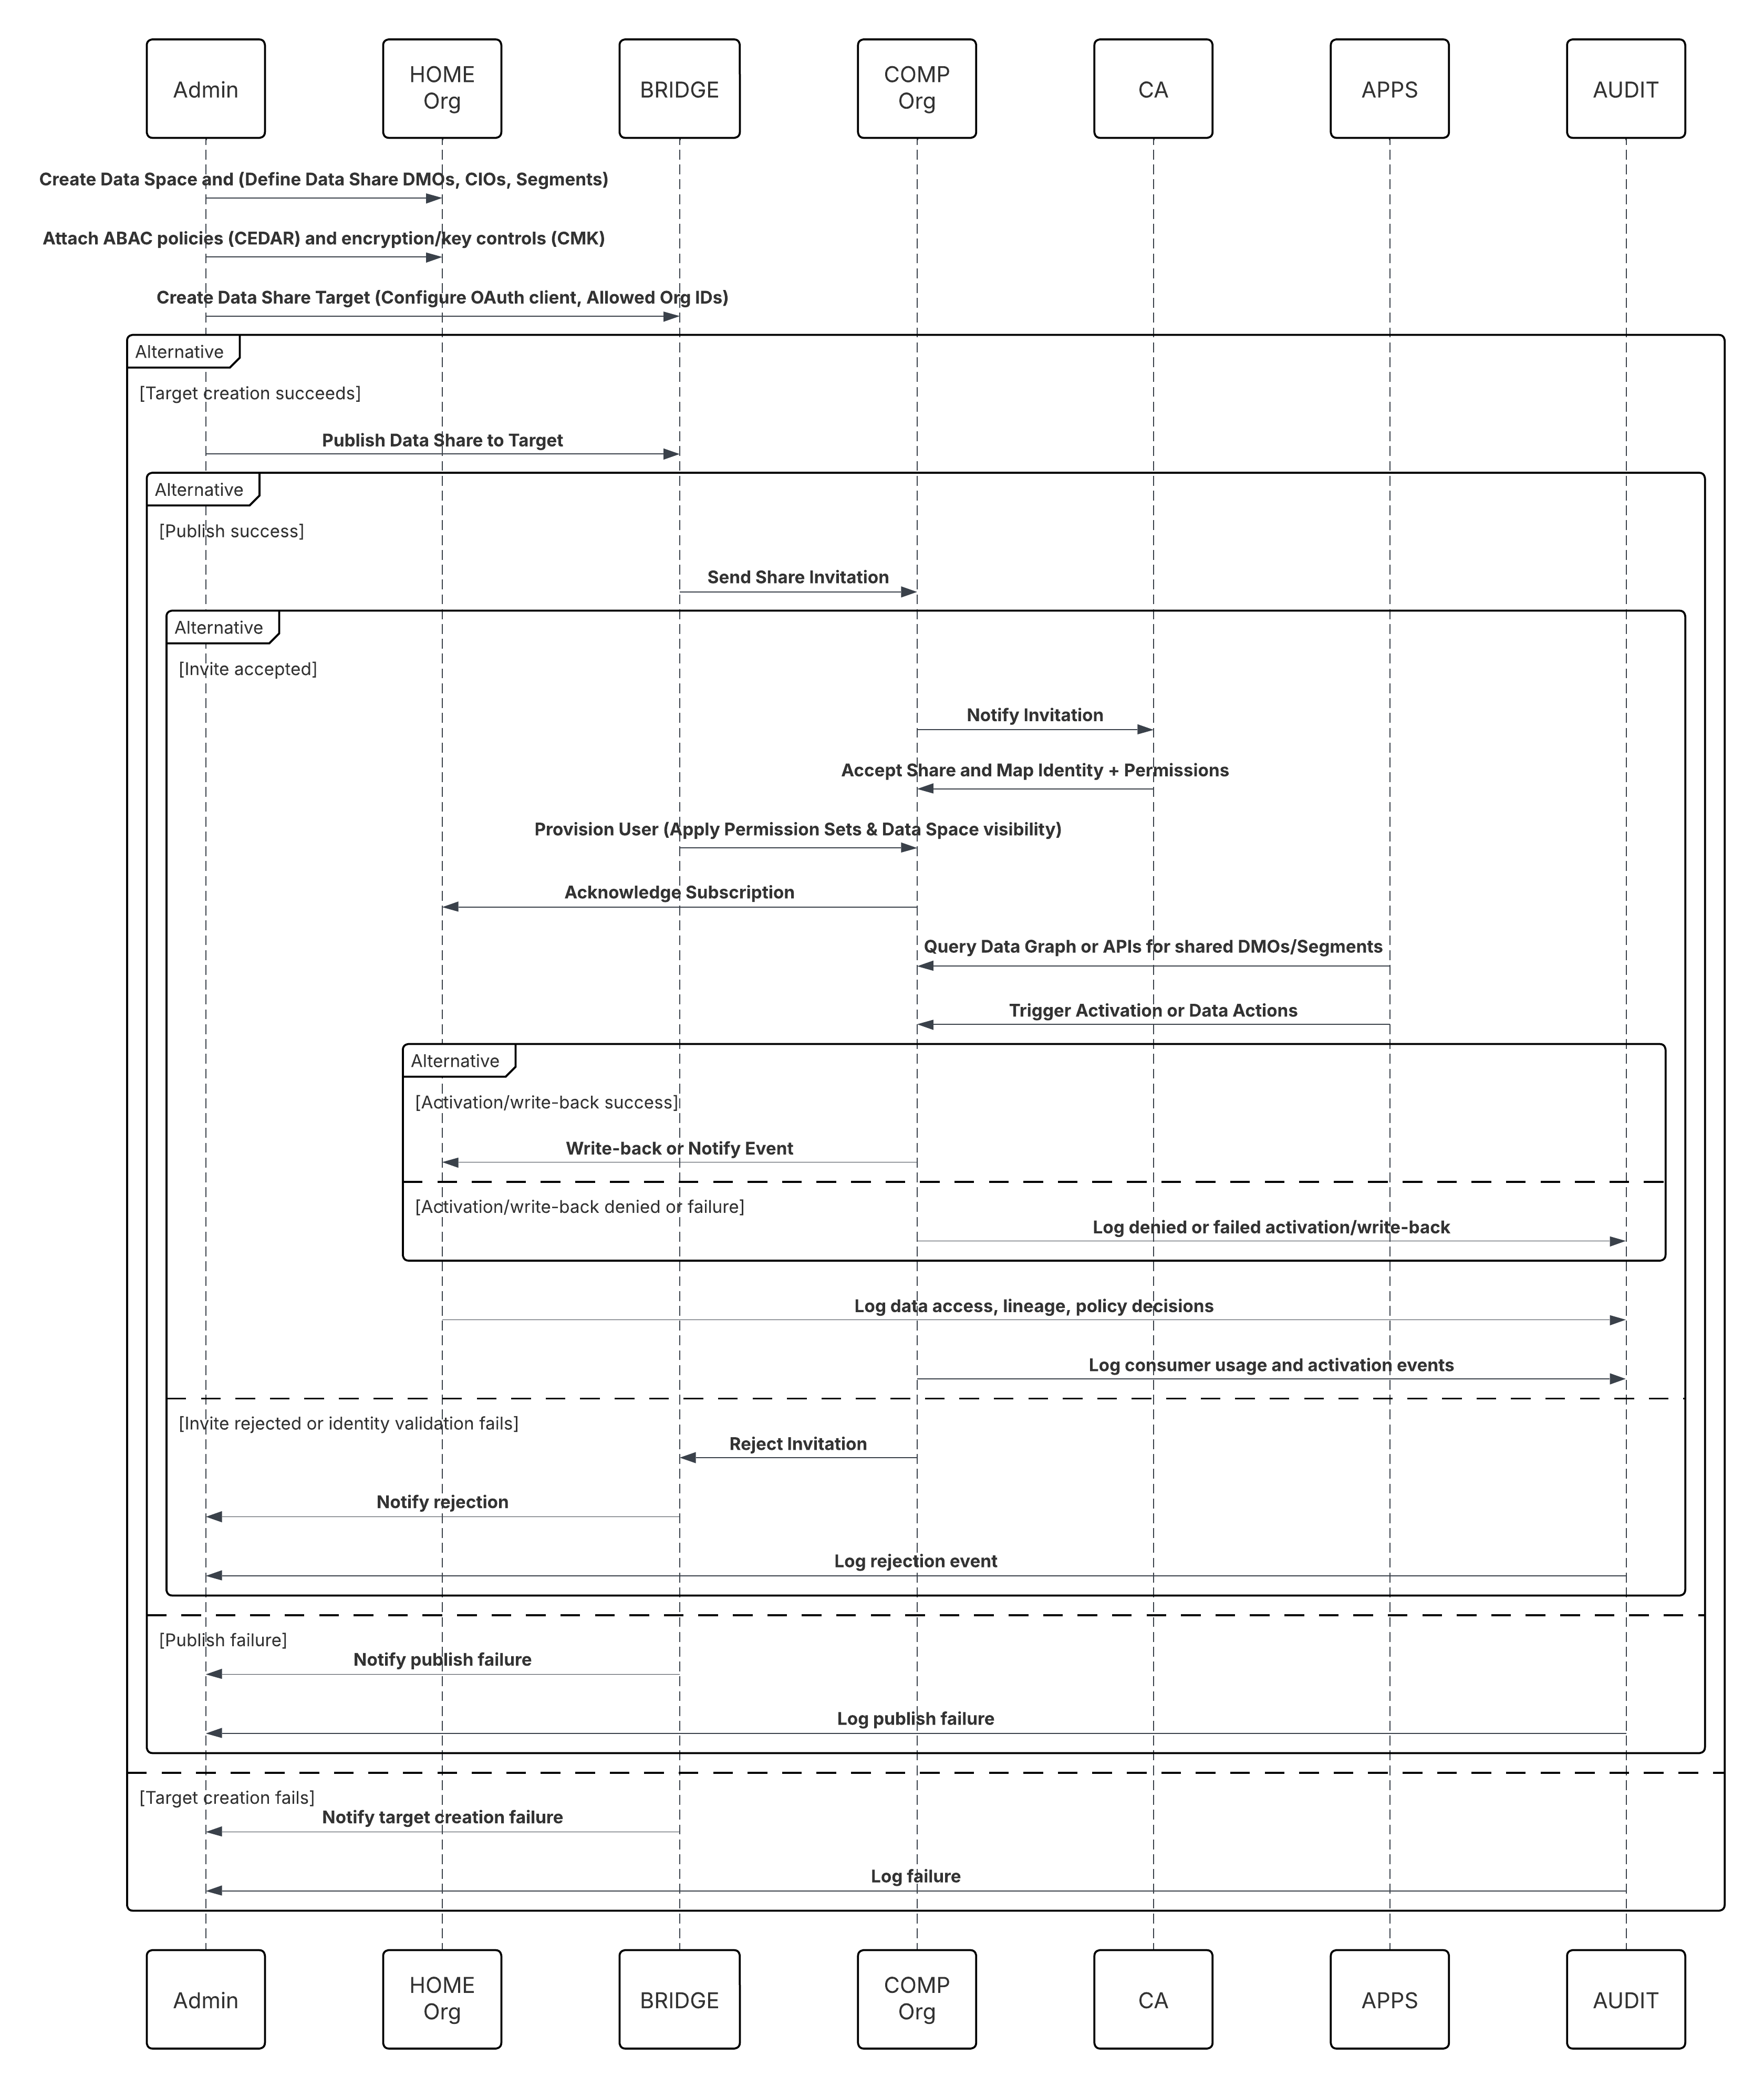 **在此情況下:**
- **首頁管理員**:建立「資料空間」並定義「資料共用」(選取 DMO/CIO、區段)。
- **首頁管理員**:為伴侶組織建立「資料共用目標」,並設定 Trust (OAuth 用戶端、允許的組織識別碼)。
- **首頁管理員**:將「資料共用」發佈至目標;附加 ABAC 原則 (CEDAR) 和加密/金鑰控制項 (如有需要,CMK)。
- **伴侶組織管理員**:接收邀請、驗證身分對應,並接受共用。
- **伴侶組織**:Data Cloud One Bridge 會佈建 Data Cloud One 使用者,並套用「權限集與資料空間」可視性。
- **伴隨組織應用程式 (流程 / Einstein / Apex)**:查詢資料圖表或呼叫 Data Cloud One API 以讀取共用的 DMO 或區段。
- **啟用**:伴侶組織會觸發啟用,或透過資料動作寫回 (若允許)。
##### 結果
- 所有已連線組織中客戶資料 (Customer 360) 的 **單一事實來源**—沒有冗餘的 Data 360 例項。
- **更快的評估時間**,伴隨組織只需要幾分鐘,才能存取統一資料和 Data 360 技術的功能,而不需要數週的自訂編碼。
- **受控制的資料共用。**只會共用授權的資料空間,以保留安全性和管治,同時啟用業務靈活性。
- 業務功能 (銷售、服務、行銷) 會在相同的統一資料基礎上運作,在整個企業中啟用一致的度量、啟用和洞察。
###### 通話機制
呼叫機制取決於用來實作此模式的解決方案。
| 機制 | 使用時機 |
|---|---|
| Data Cloud One 原生共用 (偏好) | 當多個 Salesforce 組織 (銷售、服務或 Industry Cloud) 需要直接從 Data 360\ 存取統一客戶資料的即時存取權時使用。這可免除複製,並啟用對金級記錄、區段和已計算洞察的零延遲存取權。 |
| 透過 Data Cloud One Bridge 進行組織對組織共用 | 當多個業務單位或子公司在個別的 Salesforce 組織中營運,但需要從中央 Data 360 例項共用對常見客戶資料和區段的存取權時使用。適用於維護獨立作業系統的多組織企業。 |
| Einstein 1 平台查詢 API | 當 Salesforce 應用程式、流程或 Einstein Copilot 必須以程式設計的方式查詢或啟用 Data 360 資料時使用。啟用將統一設定檔、度量或啟用結果即時提取至其他 Salesforce 應用程式,而無須批次匯出。 |
| 啟用至 Salesforce 管道 | 當 Data 360 資料 (區段、洞察或屬性) 必須啟用至 Marketing Cloud、Service Cloud 或 Commerce Cloud 以進行個人化、行銷活動執行或工作人員協助體驗時使用。 |
| 資料圖形存取權 (語意查詢層) | 當您需要透過 Salesforce 資料圖表對統一資料模型的語意層級存取權時使用—支援 Copilot、AI 工作流程和即時跨雲端分析,無須手動聯結或轉換。 |
| 解決方案區域 | 適合 | 註解/實作詳細資料 |
|---|---|---|
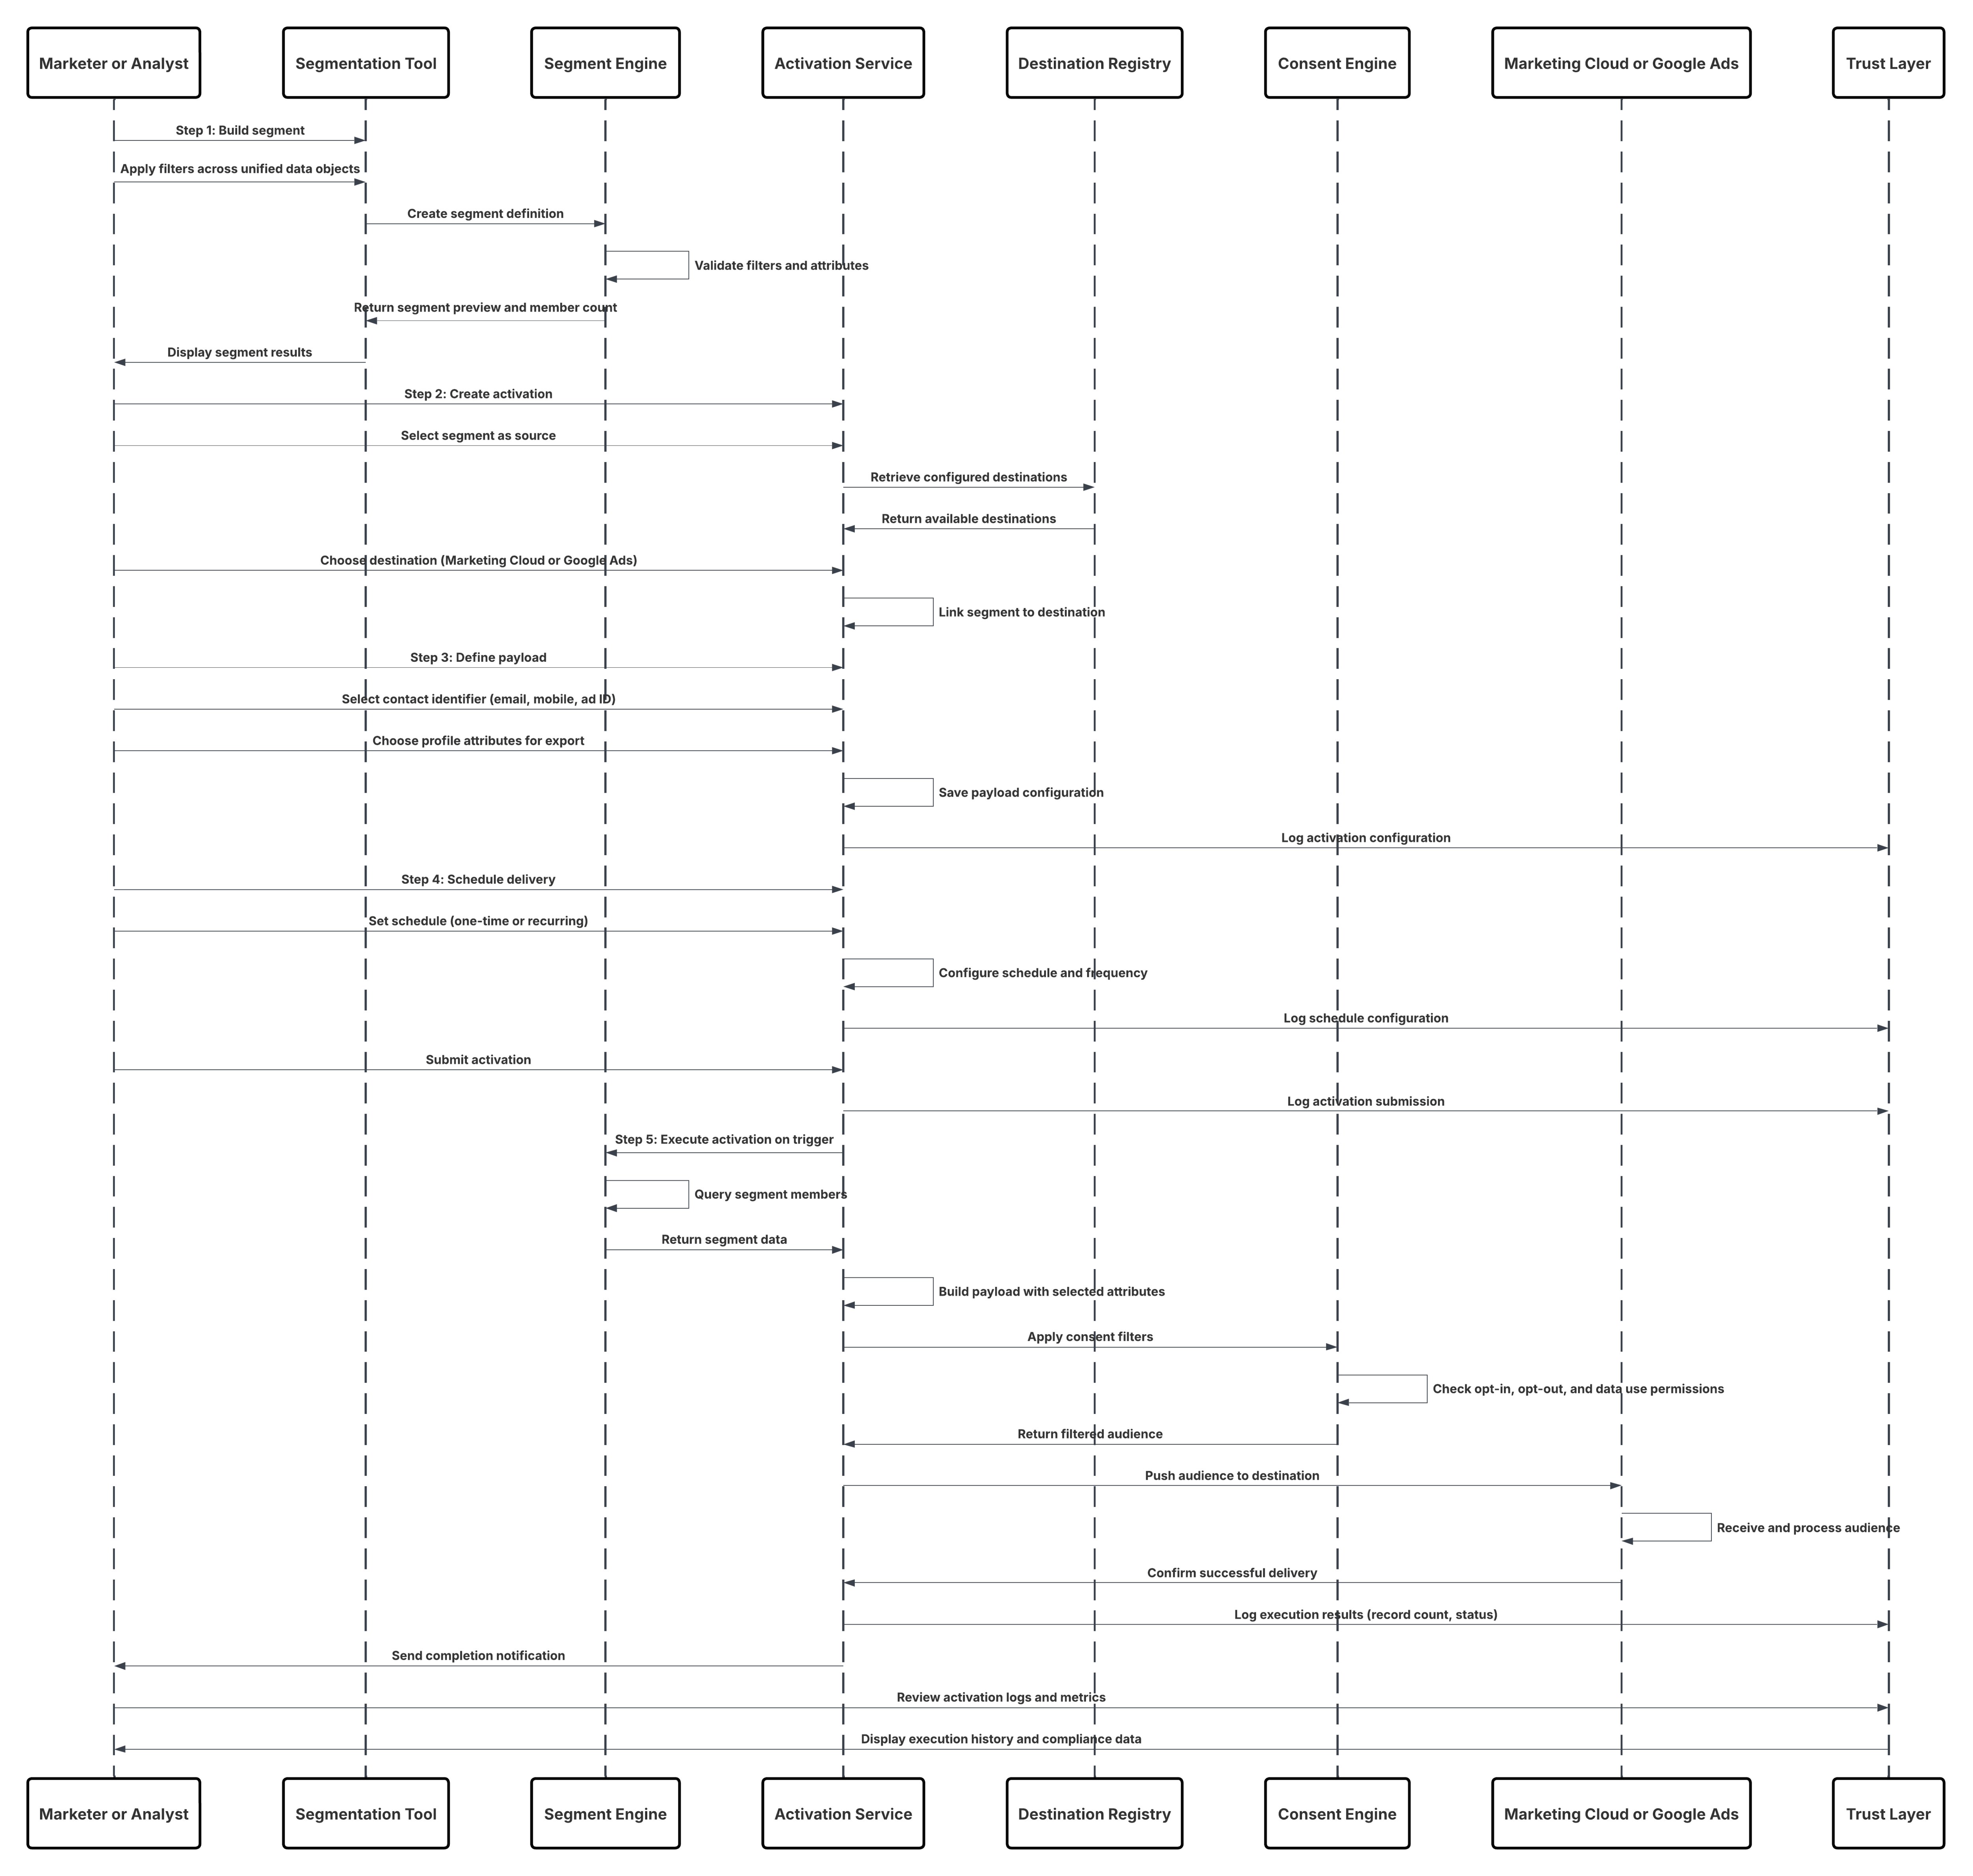
| 區段建立 | 最佳 | 行銷人員或分析師可透過套用任何資料模型物件 (DMO) 或已計算洞察物件 (CIO) 之間的篩選條件,在視覺區隔畫布中建立區段。這會定義啟用的目標受眾。 |
| 啟用設定 | 最佳 | 使用者建立啟用,並選取他們剛才建立的區段作為來源。這會定義 Data 360 要匯出至下游系統的受眾。 |
| 啟用目標選取 | 最佳作法 | 行銷人員會選取預先設定的啟用目標 (例如 Marketing Cloud、Google Ads、LinkedIn Ads)。每個目標都會使用驗證認證和欄位對應在 Data 360 中註冊。 |
| Payload 定義 | 必要 | 行銷人員透過選擇連絡人識別碼 (例如電子郵件、行動裝置、雜湊識別碼),並選取其他設定檔屬性 (例如名字、忠誠度等級或 CLV) 來增強目的地系統,來定義裝載。 |
| 排程和頻率 | 建議 | 可將啟用排程為執行一次,或循環執行 (例如每日或每週)。排程可確保下游受眾保持同步且處於最新狀態。 |
| 執行與匯出 | 最佳 | 當啟用工作執行時,Data 360 會查詢區段、收集選取的屬性、套用同意篩選條件,並將資料匯出至目標平台。針對 Marketing Cloud,這通常會導致建立或更新「共用資料延伸模組」。 |
| 管治與合規 | 必要 | Trust 層會強制執行結構描述驗證、同意中繼資料和原則控制,以確保符合資料保護與行銷法規 (例如 GDPR、CCPA)。 |
| 監視與稽核性 | 最佳作法 | 系統會在 Trust 層監視顯示面板中使用成功/失敗度量、執行記錄和歷程可視性來追蹤每個啟用執行,以啟用作業透明度和 SLA 保證。 |
 ##### 結果
- Data 360 的目標性、豐富的受眾區段可直接在下游行銷和廣告平台中使用。
- 受眾會自動重新整理並使用最新的統一客戶資料進行同步化,以維持即時行銷活動的相關性。
- 行銷人員可以使用這些已啟用的受眾作為 Marketing Cloud 旅程、電子郵件行銷活動或數位廣告平台 (例如 Google Ads、Meta 或 LinkedIn Ads) 中的自訂受眾的輸入來源。
- 每個啟用執行都會維持端對端歷程,確保 Data 360 與外部系統之間的合規性、可追蹤性和一致性。
- 業務使用者可以透過完整且信任的 Customer 360 檢視提供高度個人化的資料驅動體驗。
###### 通話機制
呼叫機制取決於目的地平台和啟用目標組態。
| 機制 | 使用時機 |
|---|---|
| Marketing Cloud 參與啟用 (偏好) | 在 Marketing Cloud 中執行需要動態區段、個人化屬性和即時更新的電子郵件或跨管道旅程時使用。Data 360 會直接匯出至「共用資料延伸模組」以啟用行銷活動。 |
| 廣告平台啟用 (Google Ads、LinkedIn Ads、Meta Ads) | 在廣告平台中啟用 Data 360 區段作為自訂受眾時,用於重新定位或類似建模。支援雜湊識別碼和認可傳送。 |
| CRM 啟用 (Sales 或 Service Cloud) | 將豐富的客戶資料、洞察或傾向分數分享給 CRM 使用者,以進行個人化的銷售參與或服務互動時使用。資料可透過「資料動作」或「統一設定檔元件」作為增強的記錄或洞察使用。 |
| 透過 MuleSoft 或 API 的外部啟用 | 當啟用需要到達非 Salesforce 系統 (例如忠誠度、電子商務或第三方資料倉庫) 時使用。MuleSoft 或 Data 360 啟用 API 可透過以事件為基礎的重新整理選項,確保安全且由原則管理的傳送。 |
| 混合式啟用 (批次 + 事件觸發) | 將排程的批次啟用與以事件為基礎的觸發結合時使用—針對如捨棄手推車或流失風險警示等敏感時間行銷活動啟用「永遠開啟」個人化。 |
| 解決方案區域 | 適合 | 註解/實作詳細資料 |
|---|---|---|
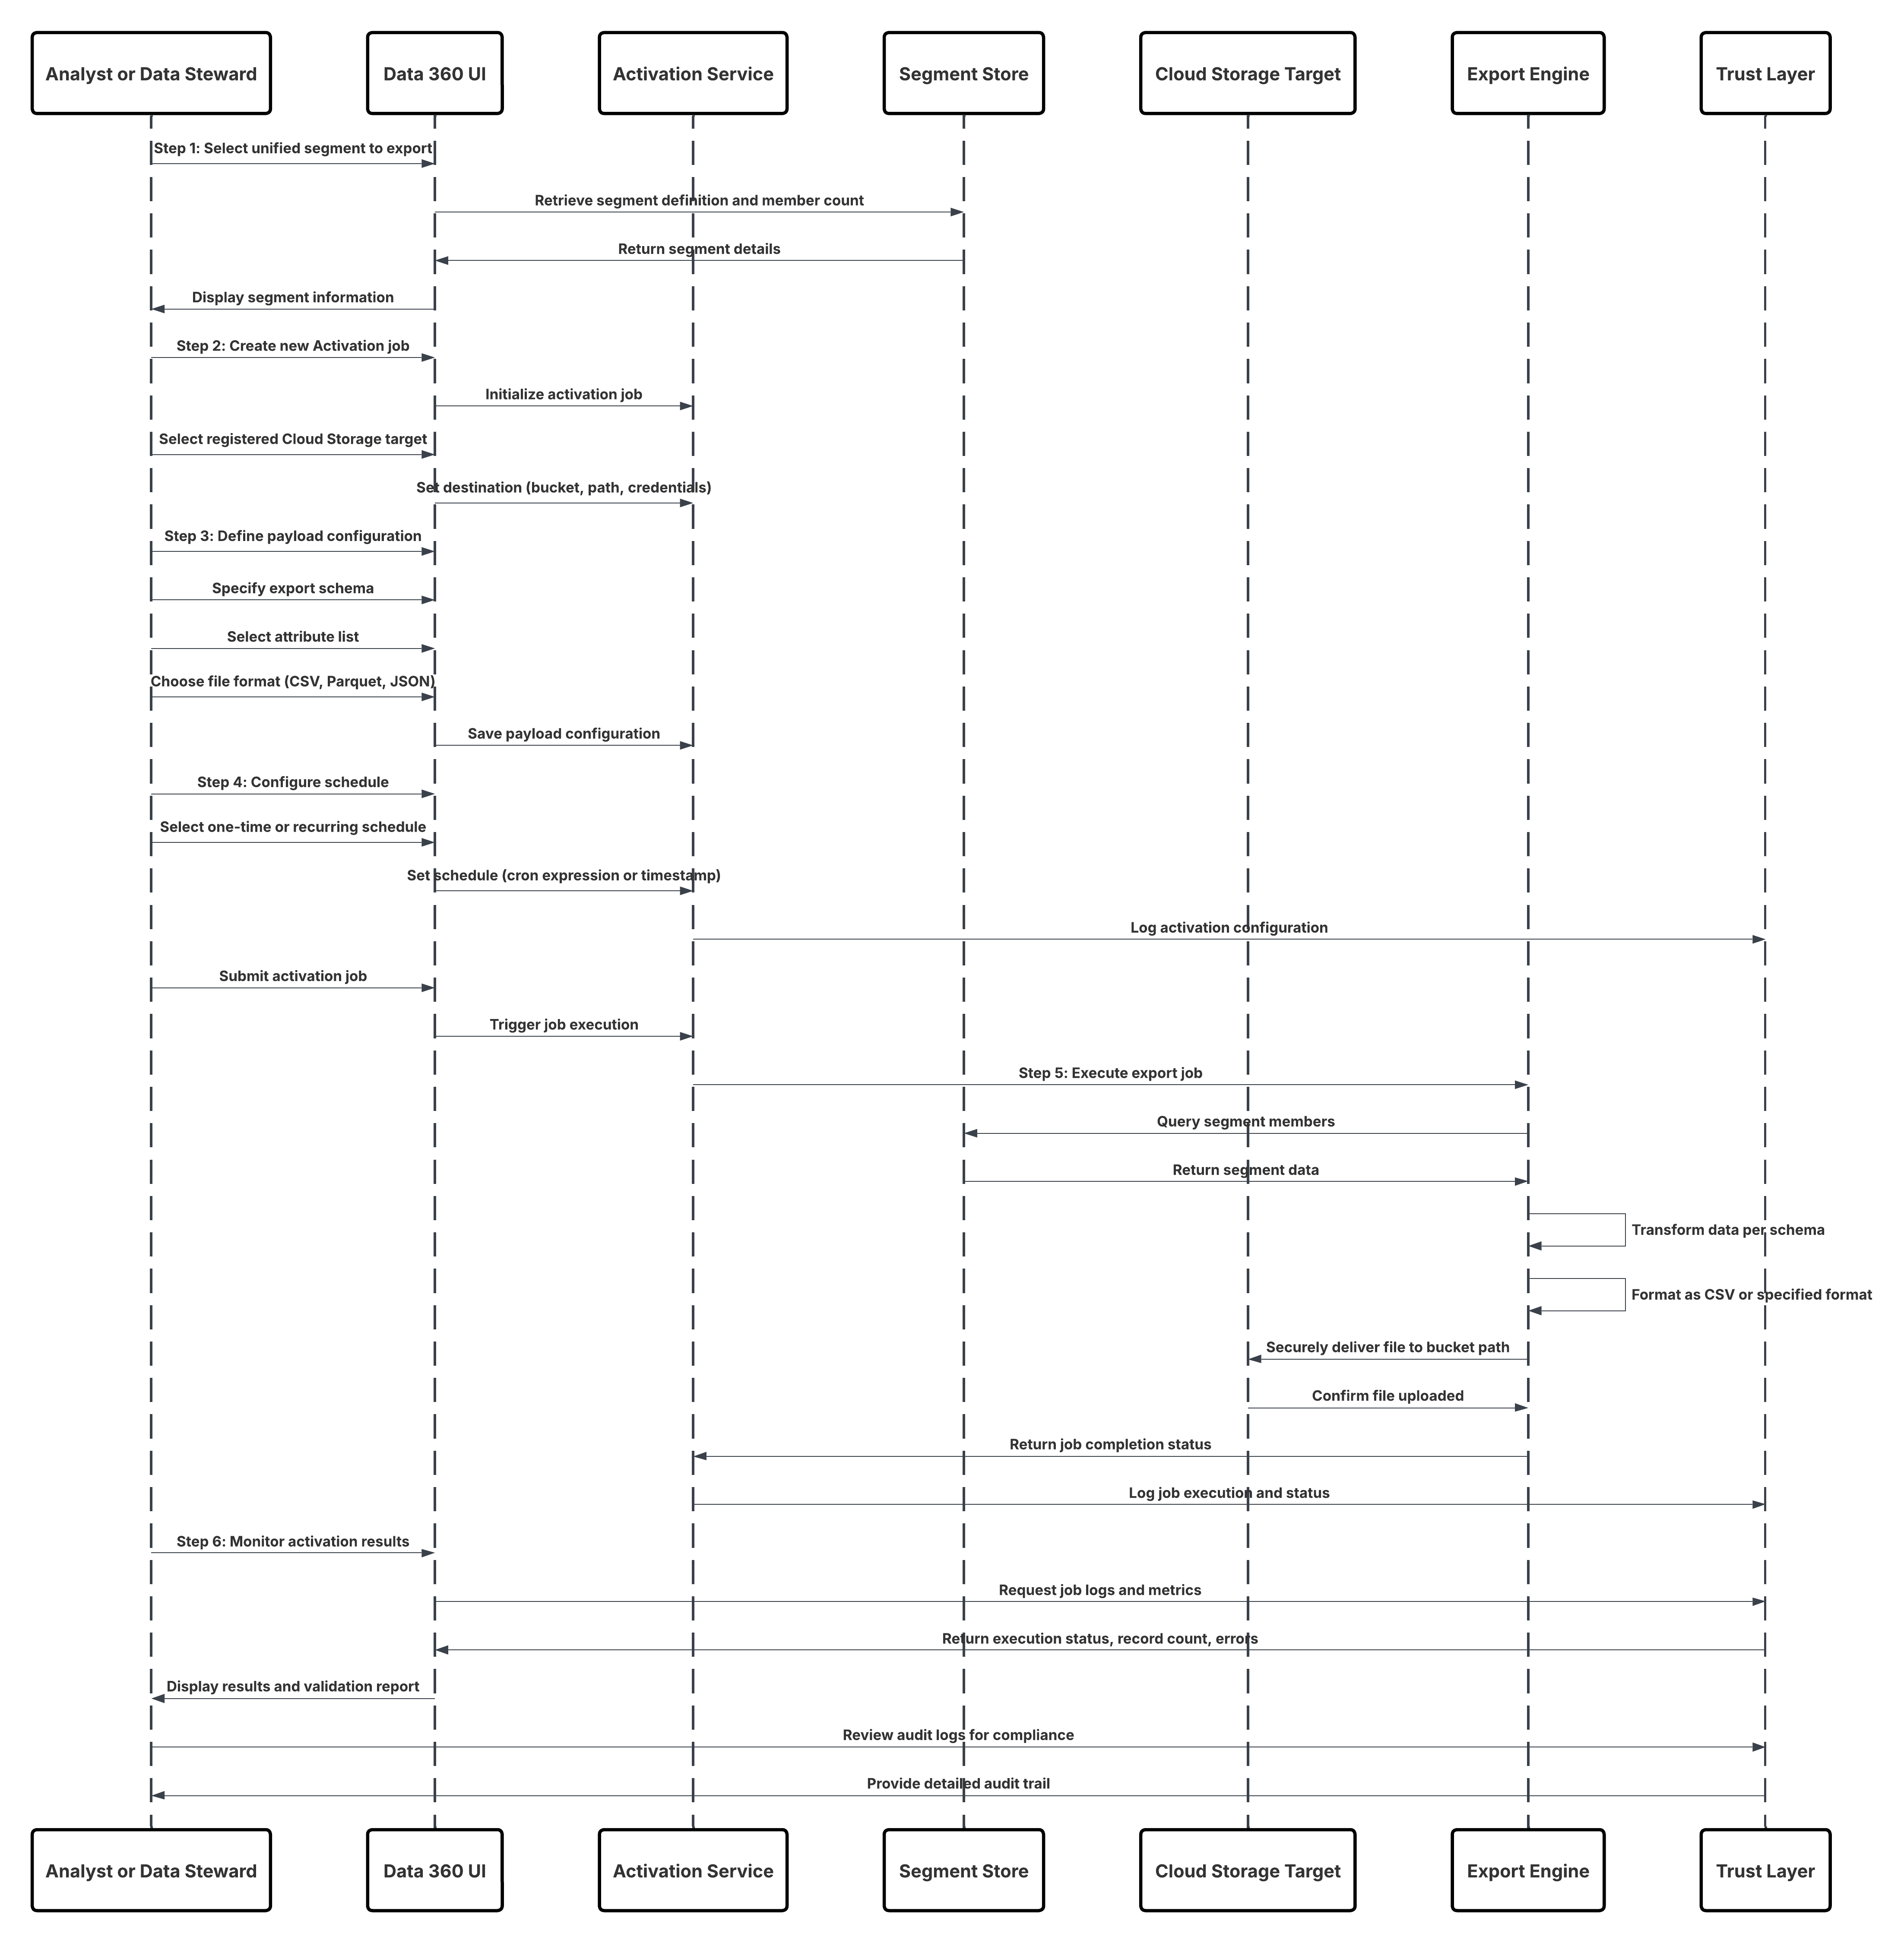
| 區段選取 | 最佳 | 分析師會在 Data 360\ 內選取現有的「區段」或「查詢」定義。區段會決定要匯出的記錄和屬性。 |
| 啟用設定 | 最佳 | 使用者建立新的「啟用」,選擇「區段」作為來源,並選擇「雲端儲存空間目標」(例如 S3) 作為目的地。 |
| 啟用目標組態 | 必要 | 管理員會使用認證、IAM 角色和輸出路徑預先設定目標。支援的格式包括 CSV、Parquet 和 JSON。 |
| Payload 定義 | 最佳作法 | 透過選取所需屬性 (例如識別碼、名稱、電子郵件、區域、同意標記) 來定義匯出結構描述。系統會強制執行屬性層級管理。 |
| 排程與頻率 | 建議 | 匯出可以排程在定義的步調 (每日、每週、每月) 上執行,也可以視需要手動觸發。 |
| 執行與遞送 | 最佳 | 在執行時,Data 360 會使用雲端提供者的 API 來查詢區段、編譯匯出檔案、加密檔案,並將其寫入設定的分類/資料夾。 |
| 管治與合規 | 必要 | Data 360 的 Trust 圖層可確保所有匯出皆遵循同意原則、結構描述驗證和合規性篩選條件。 |
| 監視與稽核性 | 最佳作法 | 系統會在包含狀態、執行記錄和歷程中繼資料的 Trust 圖層監視顯示面板中追蹤每個匯出。 |
 ##### 結果
- Data 360 的目標性、豐富的受眾區段可直接在下游行銷和廣告平台中使用。
- 受眾會自動重新整理並使用最新的統一客戶資料進行同步化,以維持即時行銷活動的相關性。
- 行銷人員可以使用這些已啟用的受眾作為 Marketing Cloud 旅程、電子郵件行銷活動或數位廣告平台 (例如 Google Ads、Meta 或 LinkedIn Ads) 中的自訂受眾的輸入來源。
- 每個啟用執行都會維持端對端歷程,確保 Data 360 與外部系統之間的合規性、可追蹤性和一致性。
- 業務使用者可以透過完整且信任的 Customer 360 檢視提供高度個人化的資料驅動體驗。
###### 通話機制
呼叫機制取決於目標雲端儲存平台和啟用組態。
| 機制 | 使用時機 |
|---|---|
| Amazon S3 啟用 | 在 AWS 上主控您的企業資料湖時使用。Data 360 會使用 IAM 角色或暫存認證直接寫入至 S3 分類,以確保安全且可調整的匯出。 |
| Azure Blob Storage 啟用 | 當您的組織在 Microsoft Azure 上作業時使用。Data 360 使用 SAS 權杖或服務主體將加密檔案寫入 Blob 容器。 |
| Google Cloud Storage (GCS) 啟用 | 當您的資料科學或分析工作量在 GCP 上執行時使用。Data 360 使用 OAuth 認證,以 CSV 或 Parquet 格式將檔案匯出至 GCS 分類。 |
| SFTP 或 External File Gateway | 當法規或舊版系統需要透過 SFTP 端點或企業管理的檔案傳輸平台安全傳送時使用。 |
| 混合式匯出 (檔案 + API) | 當下游應用程式需要分析的檔案型匯出,以及工作流程協調的 API 觸發 (例如 MuleSoft 流程) 時使用。 |
| 解決方案區域 | 適合 | 註解/實作詳細資料 |
|---|---|---|
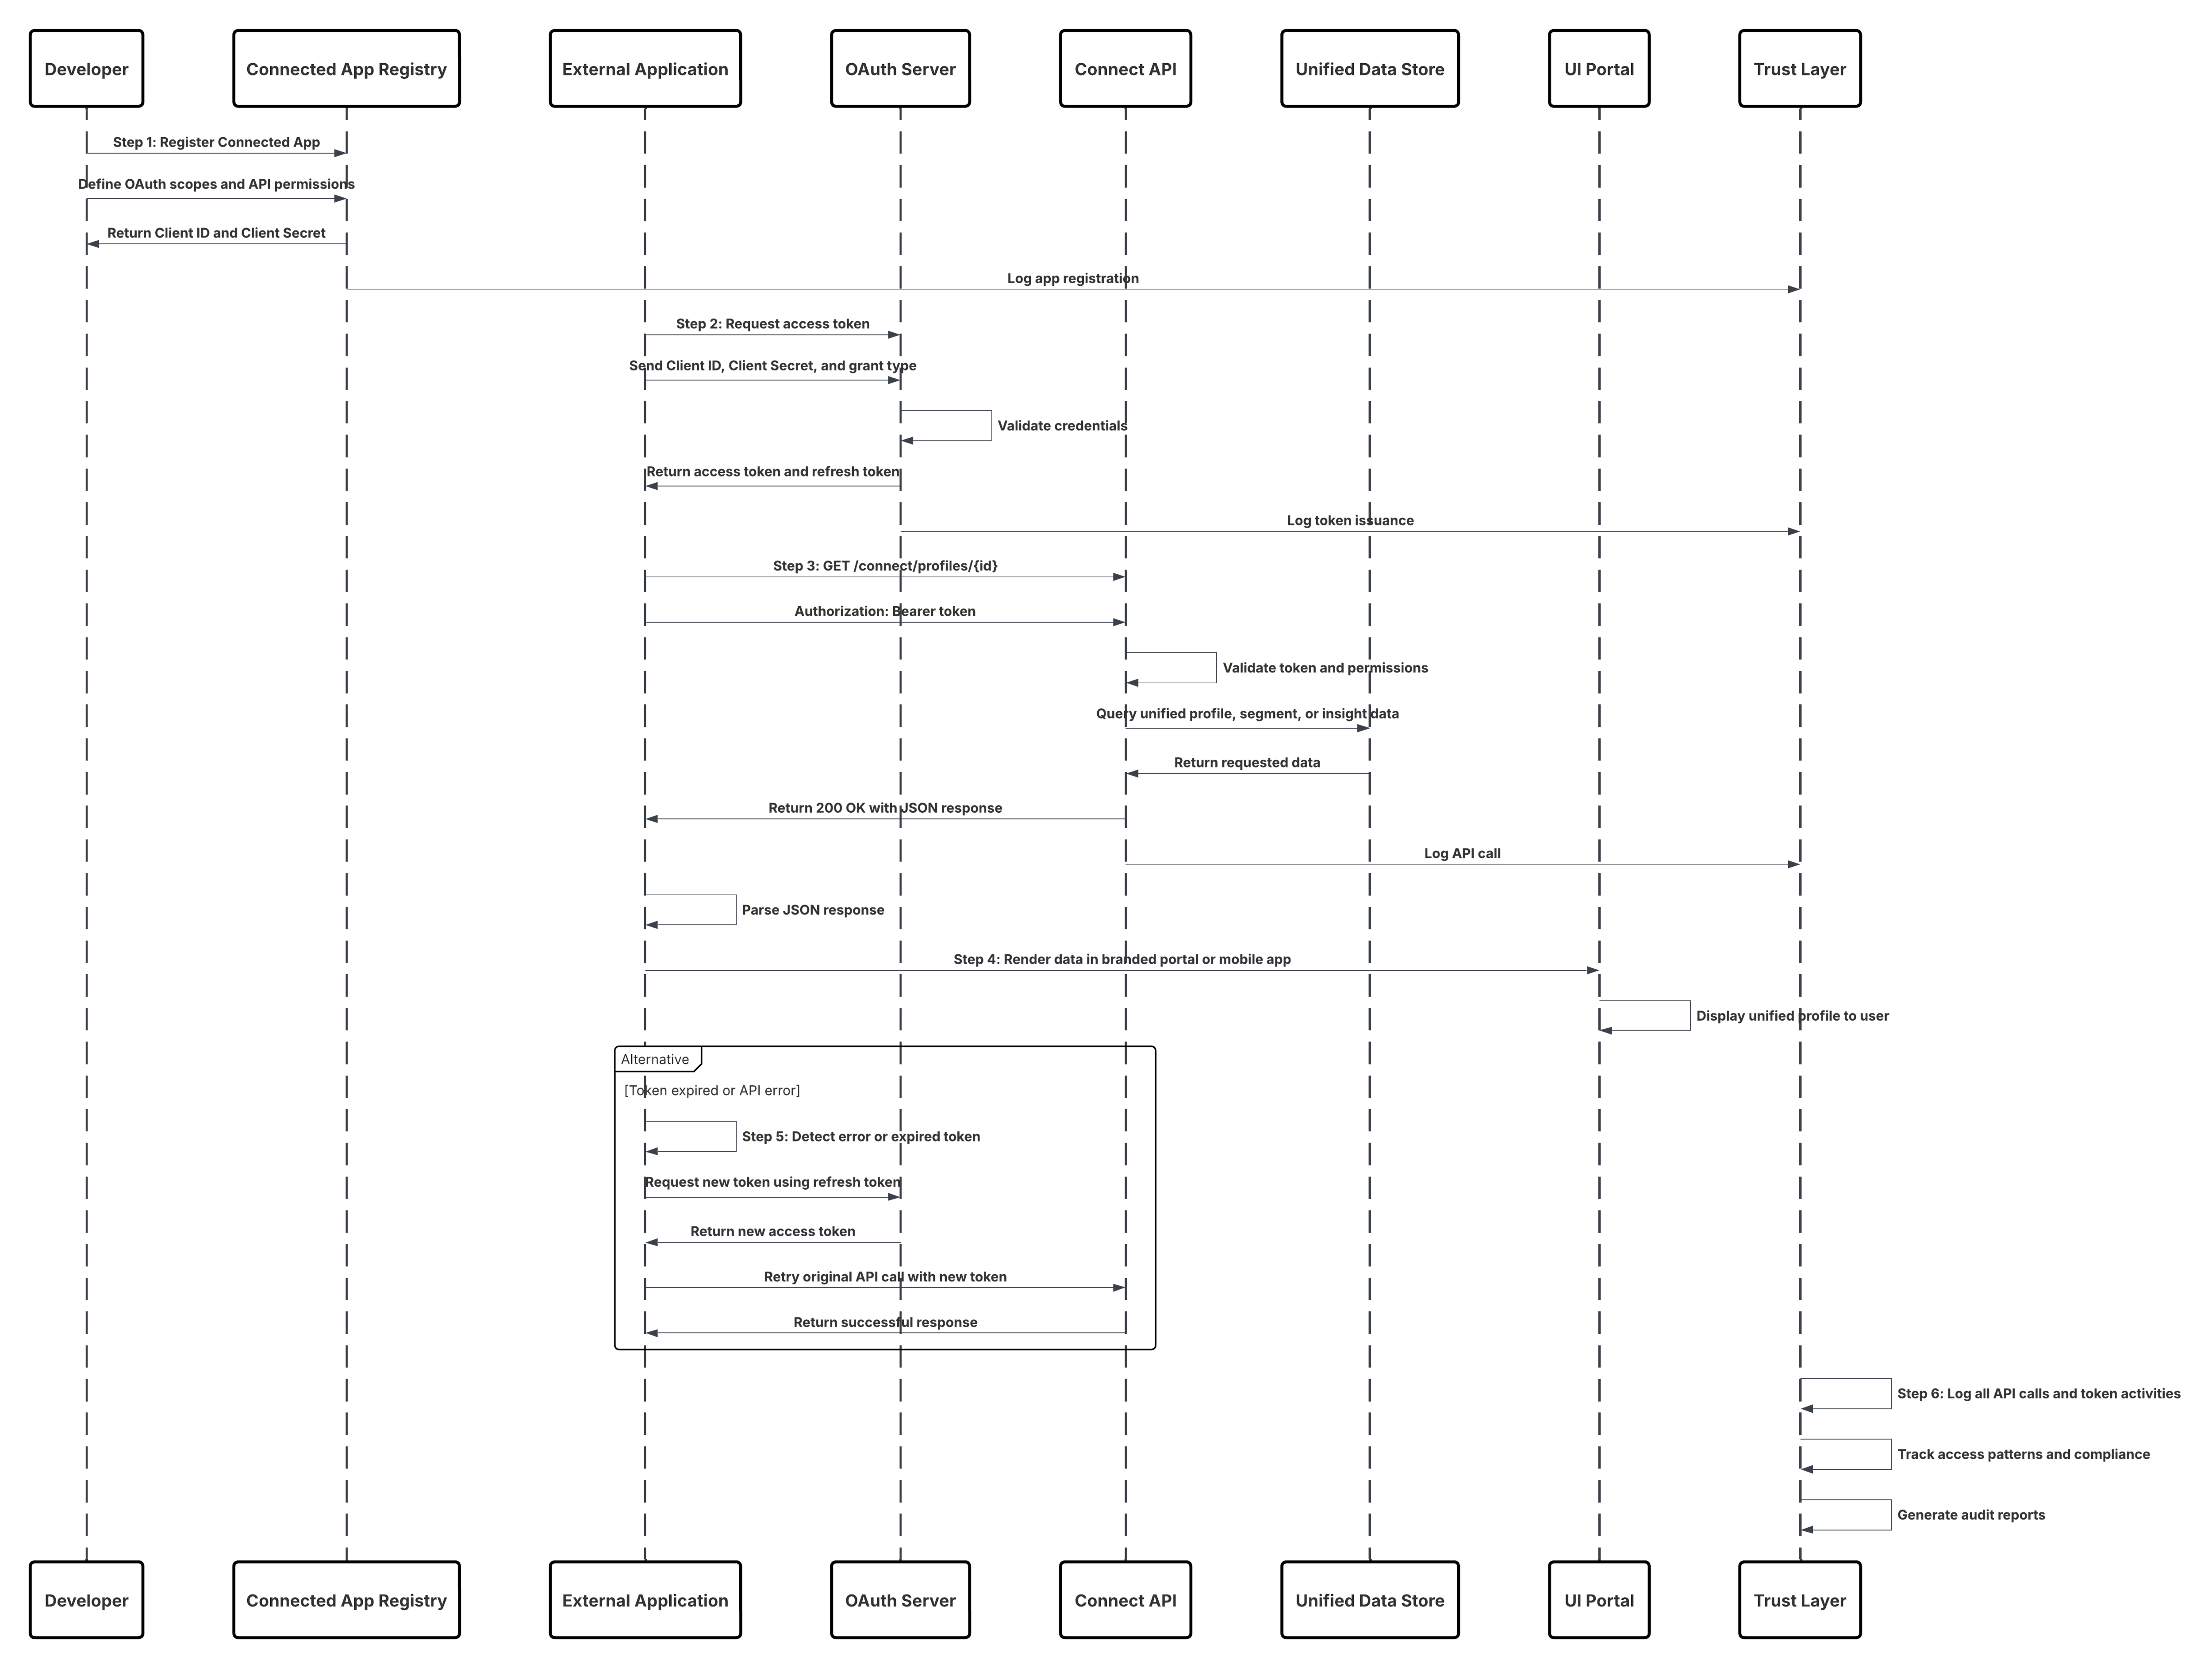
| 驗證與應用程式註冊 | 必要 | 在 Salesforce 中建立連線的應用程式以進行以 OAuth 2.0 為基礎的驗證。設定 Data 360 API 存取的範圍。 |
| 資料存取權 (設定檔、區段、洞察) | 最佳 | 使用 Connect API 端點 (/services/data/vXX.X/connect) 查詢已協調的 Data 360 資料、統一設定檔和已計算洞察。 |
| UI 整合 | 最佳 | 前端應用程式 (React、Angular、iOS、Android) 會呼叫 Connect API,以在顯示面板、入口網頁或行動介面中呈現 Data 360 資料。 |
| 資料圖表查詢 | 建議 | 將 Connect API 與 Data Graph API 結合,以取得簡化複雜聯結和關係的語意層級查詢。 |
| 即時重新整理 | 選擇性 | 將 Connect API 與 WebSocket 或串流擴充用於即時資料更新。 |
| 安全與管治 | 必要 | 使用 OAuth 範圍、Data 360 原則和 Trust 層稽核架構強制執行資料可視性。 |
 ##### 結果
開發人員可以建立與 Data 360 密切整合的安全自訂品牌應用程式。這些應用程式可以:
- 以即時方式呈現已協調的客戶設定檔和洞察。
- 透過統一 API 與 CRM 或自訂物件一起顯示 Data 360 資料。
- 透過 Trust 層運用一致的驗證、授權和稽核控制。
- 為業務使用者或合作夥伴提供流暢且受管理的跨體驗信任客戶智慧存取權。
##### 通話機制
呼叫機制取決於目標雲端儲存平台和啟用組態。
| 機制 | 使用時機 |
|---|---|
| 連線 REST API (偏好) | 建立需要以 UI 易用 JSON 格式即時存取 Data 360 資料的 Web、行動或第三方應用程式時使用。 |
| 資料圖形 API | 應用程式需要在多個物件之間執行語意層級查詢 (例如客戶 → 交易 → 行銷活動) 時使用。 |
| 查詢 API | 執行 SOQL 類似查詢時使用,以高精確度的方式提取協調的資料集。 |
| Einstein 1 平台 API | 在自訂 UI 中整合 AI 驅動洞察或 Copilot 產生的建議時使用。 |
| MuleSoft 或 Apex Gateway 包裝程式 | 當應用程式與 Connect API 之間需要額外協調流程、快取或強制執行原則時使用。 |
| 解決方案區域 | 適合 | 註解/實作詳細資料 |
|---|---|---|
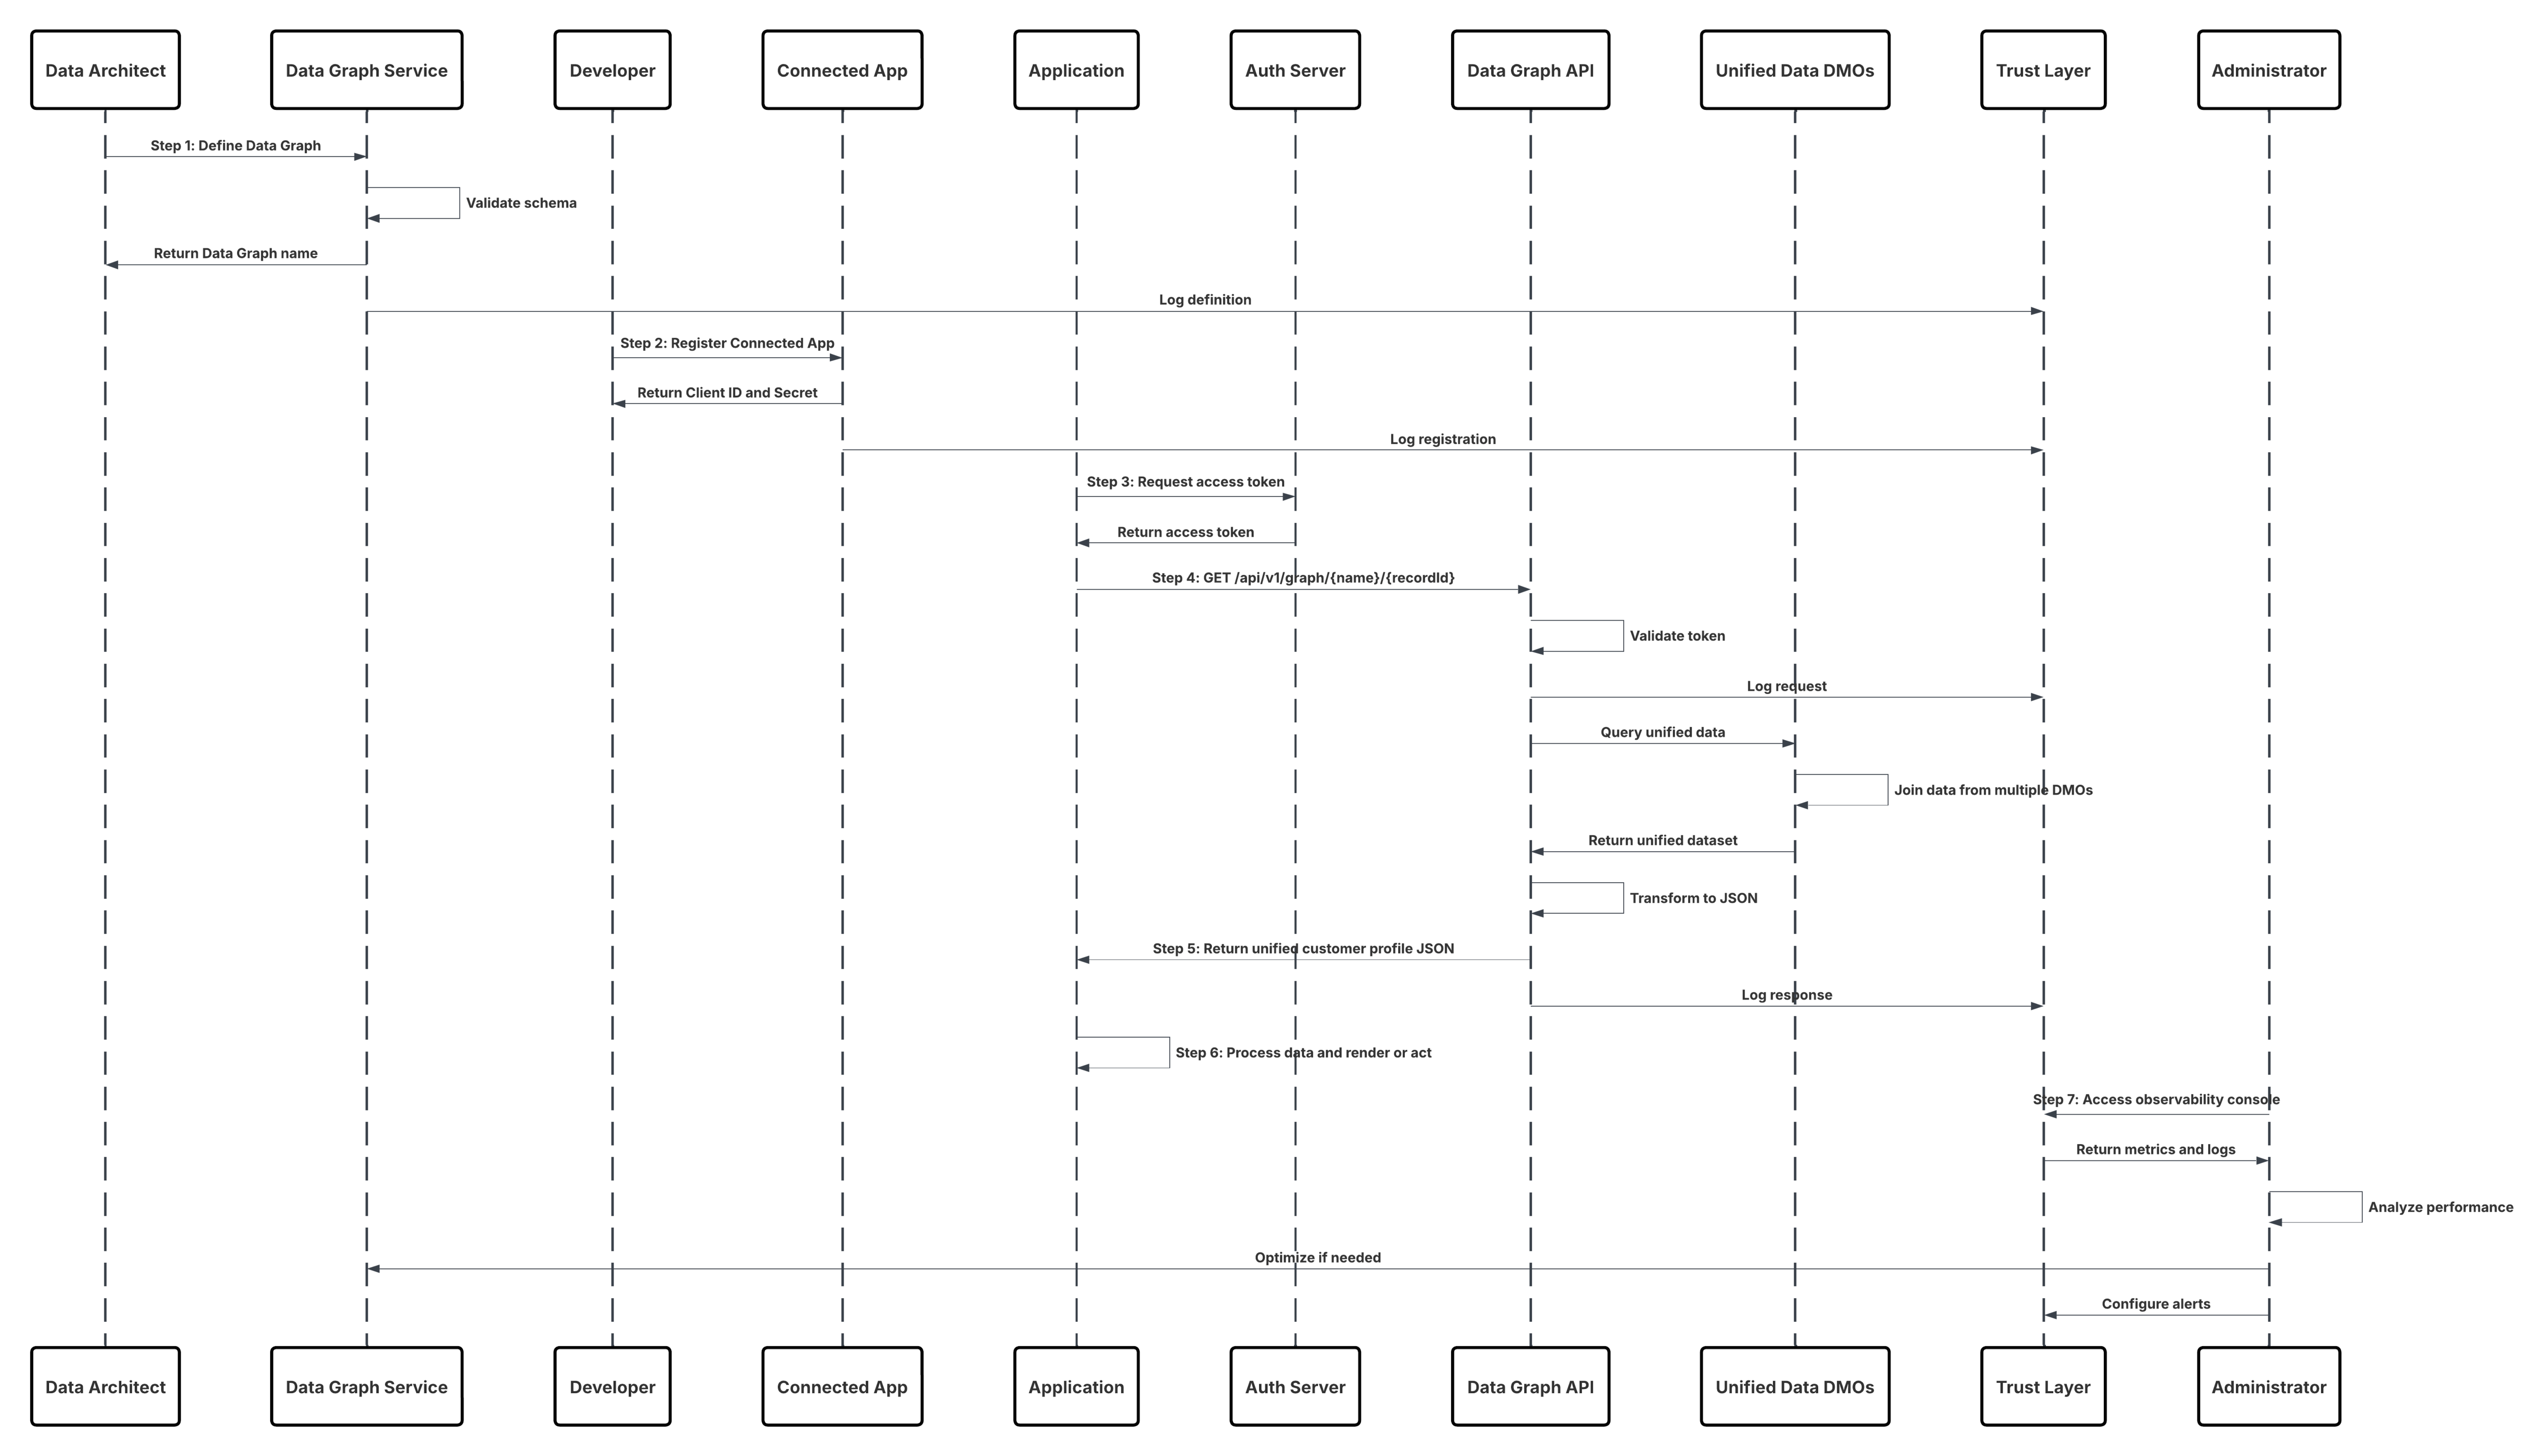
| 資料圖形定義 | 必要 | 結構設計師定義將多個 DMO 合併為單一語意實體的「資料圖表」(例如,UnifiedCustomerProfile)。 |
| 設定檔搜尋 | 最佳 | 應用程式會呼叫 GET /api/v1/dataGraph/{entity}/{id} 以依唯一識別碼或金鑰來檢取完整的反正規化設定檔。 |
| 即時參數用量 | 選擇性 | 附加 ?live=true 以強制重新計算,而非快取取用;適用於高價值決策。 |
| 驗證 | 必要 | 透過連線的應用程式使用 OAuth 2.0 來安全地驗證 API 呼叫。 |
| 回應剖析 | 最佳作法 | 應用程式會將 JSON 回應直接剖析至其 UI 或決策引擎,無須進一步聯結。 |
| 快取策略 | 建議 | 針對重複的設定檔對應,實作短期本機快取 (例如記憶體內或 CDN)。 |
| 監視與可觀察性 | 必要 | 使用 Trust 圖層顯示面板監視查詢效能、回應時間和原則符合度。 |
 ##### 結果
應用程式現在可以立即提取完整且預先加入的客戶設定檔,以支援即時互動,例如個人化、服務和決策自動化。
此模式可確保:
- 目前決策的子秒回應時間。
- 與 Data 360 語意模型相符的一致且受管理的資料提取。
- 簡化應用程式邏輯—無聯結,無結構描述協調。
- 可透過 Trust 層進行追蹤且符合的存取,以進行稽核和可觀察。
###### 通話機制
呼叫機制取決於目標雲端儲存平台和啟用組態。
| 機制 | 使用時機 |
|---|---|
| 資料圖形 API (偏好) | 可用於透過識別碼或金鑰即時快取完整且預先具體化的設定檔。 |
| 具有 live=true 的資料圖表 API | 用於需要最新資料的高價值使用個案 (例如詐騙偵測、即時優惠),接受略有較高的延遲。 |
| Connect API (回復) | 用於複合應用程式案例,其中將「資料圖形」,以及其他的 Salesforce 資料相結合。 |
| 查詢 API | 建構臨時查詢或分析讀取時使用,而非立即設定檔提取。 |
| MuleSoft API Proxy | 用於在透過企業門戶路由 Data Graph 呼叫或需要額外協調流程/強制執行原則時使用。 |
| 解決方案區域 | 適合 | 註解/實作詳細資料 |
|---|---|---|
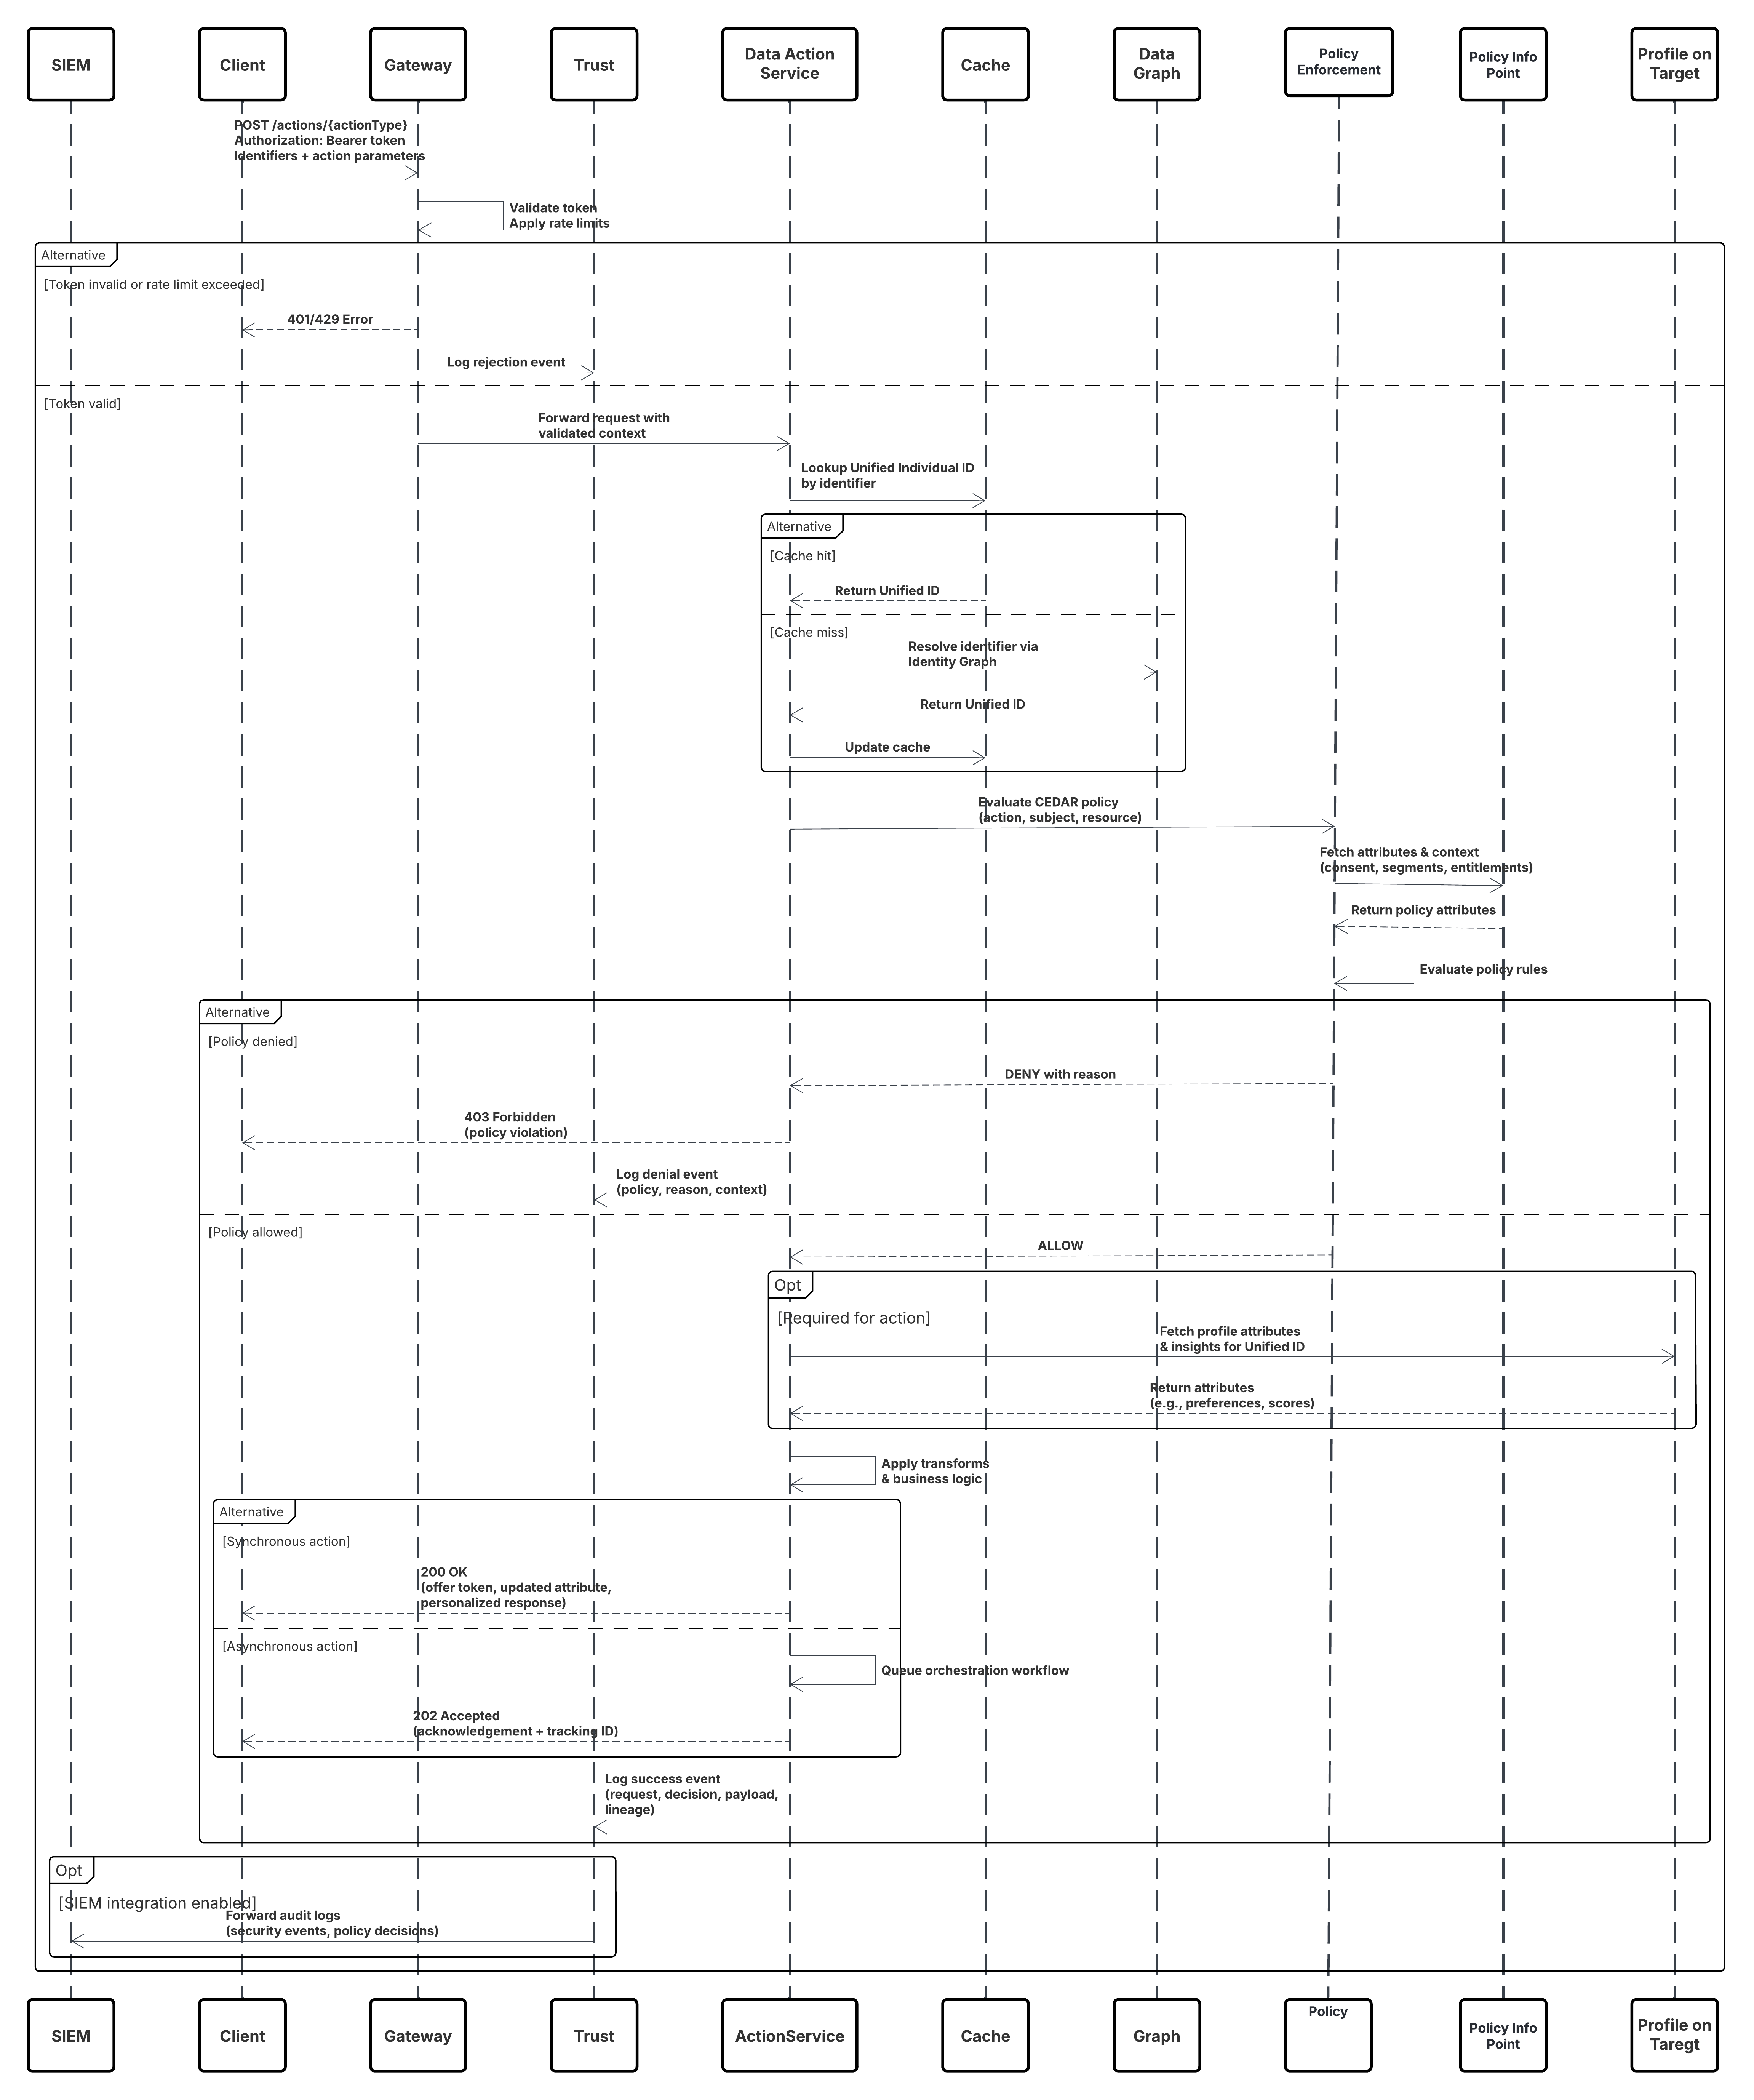
| 即時資料動作 | 最佳 | 顯示單一記錄讀/寫與動作觸發的端點。透過 OAuth/JWT 進行驗證。 |
| 身分解析 | 必要 | 將傳入識別碼 (email、externalId、cookie) 內嵌解析為「統一個人識別碼」。將決定性解析程式與快取搭配使用。 |
| 保單強制執行 (CEDAR) | 最佳作法 | 在要求時評估同意、ABAC 和遮蔽原則;拒絕或遮蔽每個原則決策的欄位。 |
| 邊緣/快取層級 | 建議 | 針對設定檔片段和已計算洞察使用短TTL 快取,以減少延遲;變更事件時失效。 |
| 輕量型轉換 | 建議 | 在動作路徑中套用簡單增強或已計算欄位;重量轉換應預先計算。 |
| 動作協調流程 | 最佳 | 支援複雜流程的同步單一步驟動作 (例如,傳回提供權杖) 和非同步協調流程 (queue \+ webhook)。 |
| 觀察性與追蹤 | 必要 | 將要求/回應、原則決策和歷程記錄到 Trust Layer/SIEM 以用於稽核和除錯。 |
| 比率限制與節流 | 必要 | 針對高流量時刻,強制執行用戶配額和優雅的降級策略。 |
 ##### 結果
- 應用程式會收到透過子秒到第二次延遲的統一設定檔讀/寫和動作觸發的原則管理即時存取權。
- 即時個人化、決策和作業工作流程 (例如,優惠、工作人員協助、庫存更新) 會啟用,而不會發生批次延遲。
- 所有動作皆可稽核、感知同意,並強制執行屬性層級遮蔽,以維護隱私權與合規性。
###### 通話機制
呼叫機制取決於目的地平台和啟用目標組態。
| 機制 | 使用時機 |
|---|---|
| RESTful 資料動作 API | 偏好用於需要同步設定檔讀取或動作回應的 Web/行動應用程式和中介軟體。 |
| gRPC / Binary RPC | 用於超低延遲的企業服務或具有永久連線的內部微型服務。 |
| GraphQL 單一記錄查詢 | 用於用戶端需要彈性選取欄位並想要最小化裝載時使用。 |
| 事件觸發的 Webhooks | 用於動作觸發下游流程 (例如開始旅程) 的非同步工作流程。 |
| 平台事件/PubSub | 用於多個系統必須回應單一動作事件的扇出案例。 |
| Edge SDK (用戶端 lib) | 用於快取設定檔片段並僅在需要時呼叫「資料動作 API」的低延遲用戶端。 |
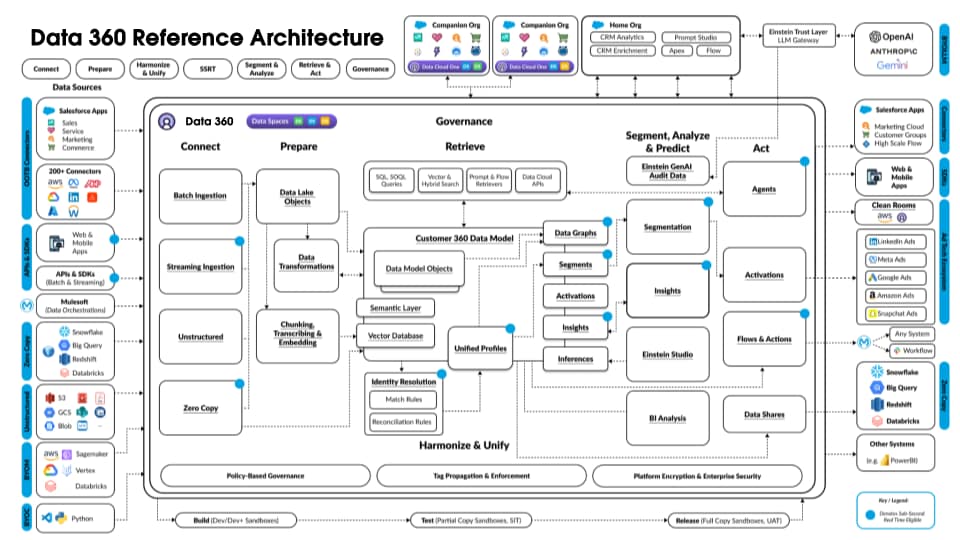 讓我們思考一下在 Data 360 上分層的假設 Agentforce Loan Agent,以描述結構流程範例。假設「貸款工作人員」是面向客戶的工作人員,客戶 (消費者) 可在此申請貸款並取得立即貸款批准。
Data 360 會依排程執行這些步驟,準備資料供「貸款工作人員」使用。
- Data 360 會從 CRM 取得結構化「客戶帳戶」資料,並將其儲存在資料湖中。
- Data 360 會處理非結構化公司貸款與財務保單資料。
- Data 360 會從外部資料來源 (例如 Snowflake) 聯合個人資料。
- Data 360 會轉換和模型化已採取和聯合的資料。
- Data 360 會建立與維護設定檔資料圖表。
每次客戶申請貸款時,都會執行這些動作。
- 客戶登入「貸款工作人員」,這會以即時層級開始客戶工作階段。客戶的統一設定檔會提取至即時層。
- 客戶透過提供必要資訊完成貸款申請。
- 客戶會將財務文件 (例如稅報單、投資、銀行對帳單) 上載至 Data 360 以進行非結構化資料處理。
- 系統會切分和向量化上載的資料 (產生內嵌),並建立索引 (關鍵字和向量)。
- 接著,客戶填寫貸款申請文件並將其上載。Data 360 會即時提取貸款金額與持續期間。
- 「貸款工作人員」會使用 Data 360 查詢,並使用設定檔和其他預先建立索引進行混合式搜尋,來提取相關財務資料。
- 「貸款工作人員」會啟用具有貸款資料和其他財務設定檔資料的「批准工作人員」,以做出貸款批准決策。
- 「貸款工作人員」會透過決策回應客戶。
- 系統也會將客戶與貸款工作人員之間的整個互動儲存在 Data 360 中。
上述範例提供用來建立 Agent 應用程式 (例如 Loan Agent) 的 Data 360 結構元件概觀。在下一個區段中,我們會描述 Data 360 結構的圖層與元件。
## Data 360 結構
在此區段中,我們將深入探討 Salesforce Data 360 的基礎建構區塊,從其強大的儲存模型開始,然後探索用於連線、提取和準備資料的機制。接著,我們會檢查結構化與非結構化資料的儲存、建模和處理方式,進而瞭解其調和、統一、提取和智慧啟用功能。
### Data 360 儲存空間
Salesforce Data 360 以分層但整合的儲存模型為基礎,此模型結合湖家與即時儲存的優勢。Lakehouse 圖層為大量歷程記錄與批次資料提供可調整且具成本效益的儲存空間,以啟用進階分析與機器學習使用個案。另一方面,即時儲存空間針對低延遲存取和高頻率更新最佳化,確保客戶互動、設定檔和參與訊號一律處於最新狀態。這些層級共同運作順暢,讓資料在歷程記錄與即時環境之間流暢移動,在統一的資料基礎中提供深度與立即性,以進行個人化、AI 和啟用。
#### 湖頭
Data 360 採用以 Iceberg/Parquet 為基礎的原生湖家結構,專為處理批次、串流和即時案例的大規模資料管理和處理而設計,支援結構化與非結構化資料,這對 AI 和分析應用程式至關重要。
在雲端式資料湖 (例如 Azure、AWS 或 GCP) 中,基本儲存單位是檔案,通常會組織成資料夾和階層。Lakehouse 透過導入更高層級的結構與語意抽象來增強此結構,以協助查詢和 AI/ML 處理等作業。主要抽象是具有中繼資料的表格,其中定義其結構和語意,並納入來自如 Iceberg 或 Delta Lake 等開放程式碼專案的元素,以及 Data 360 新增的其他語意層。
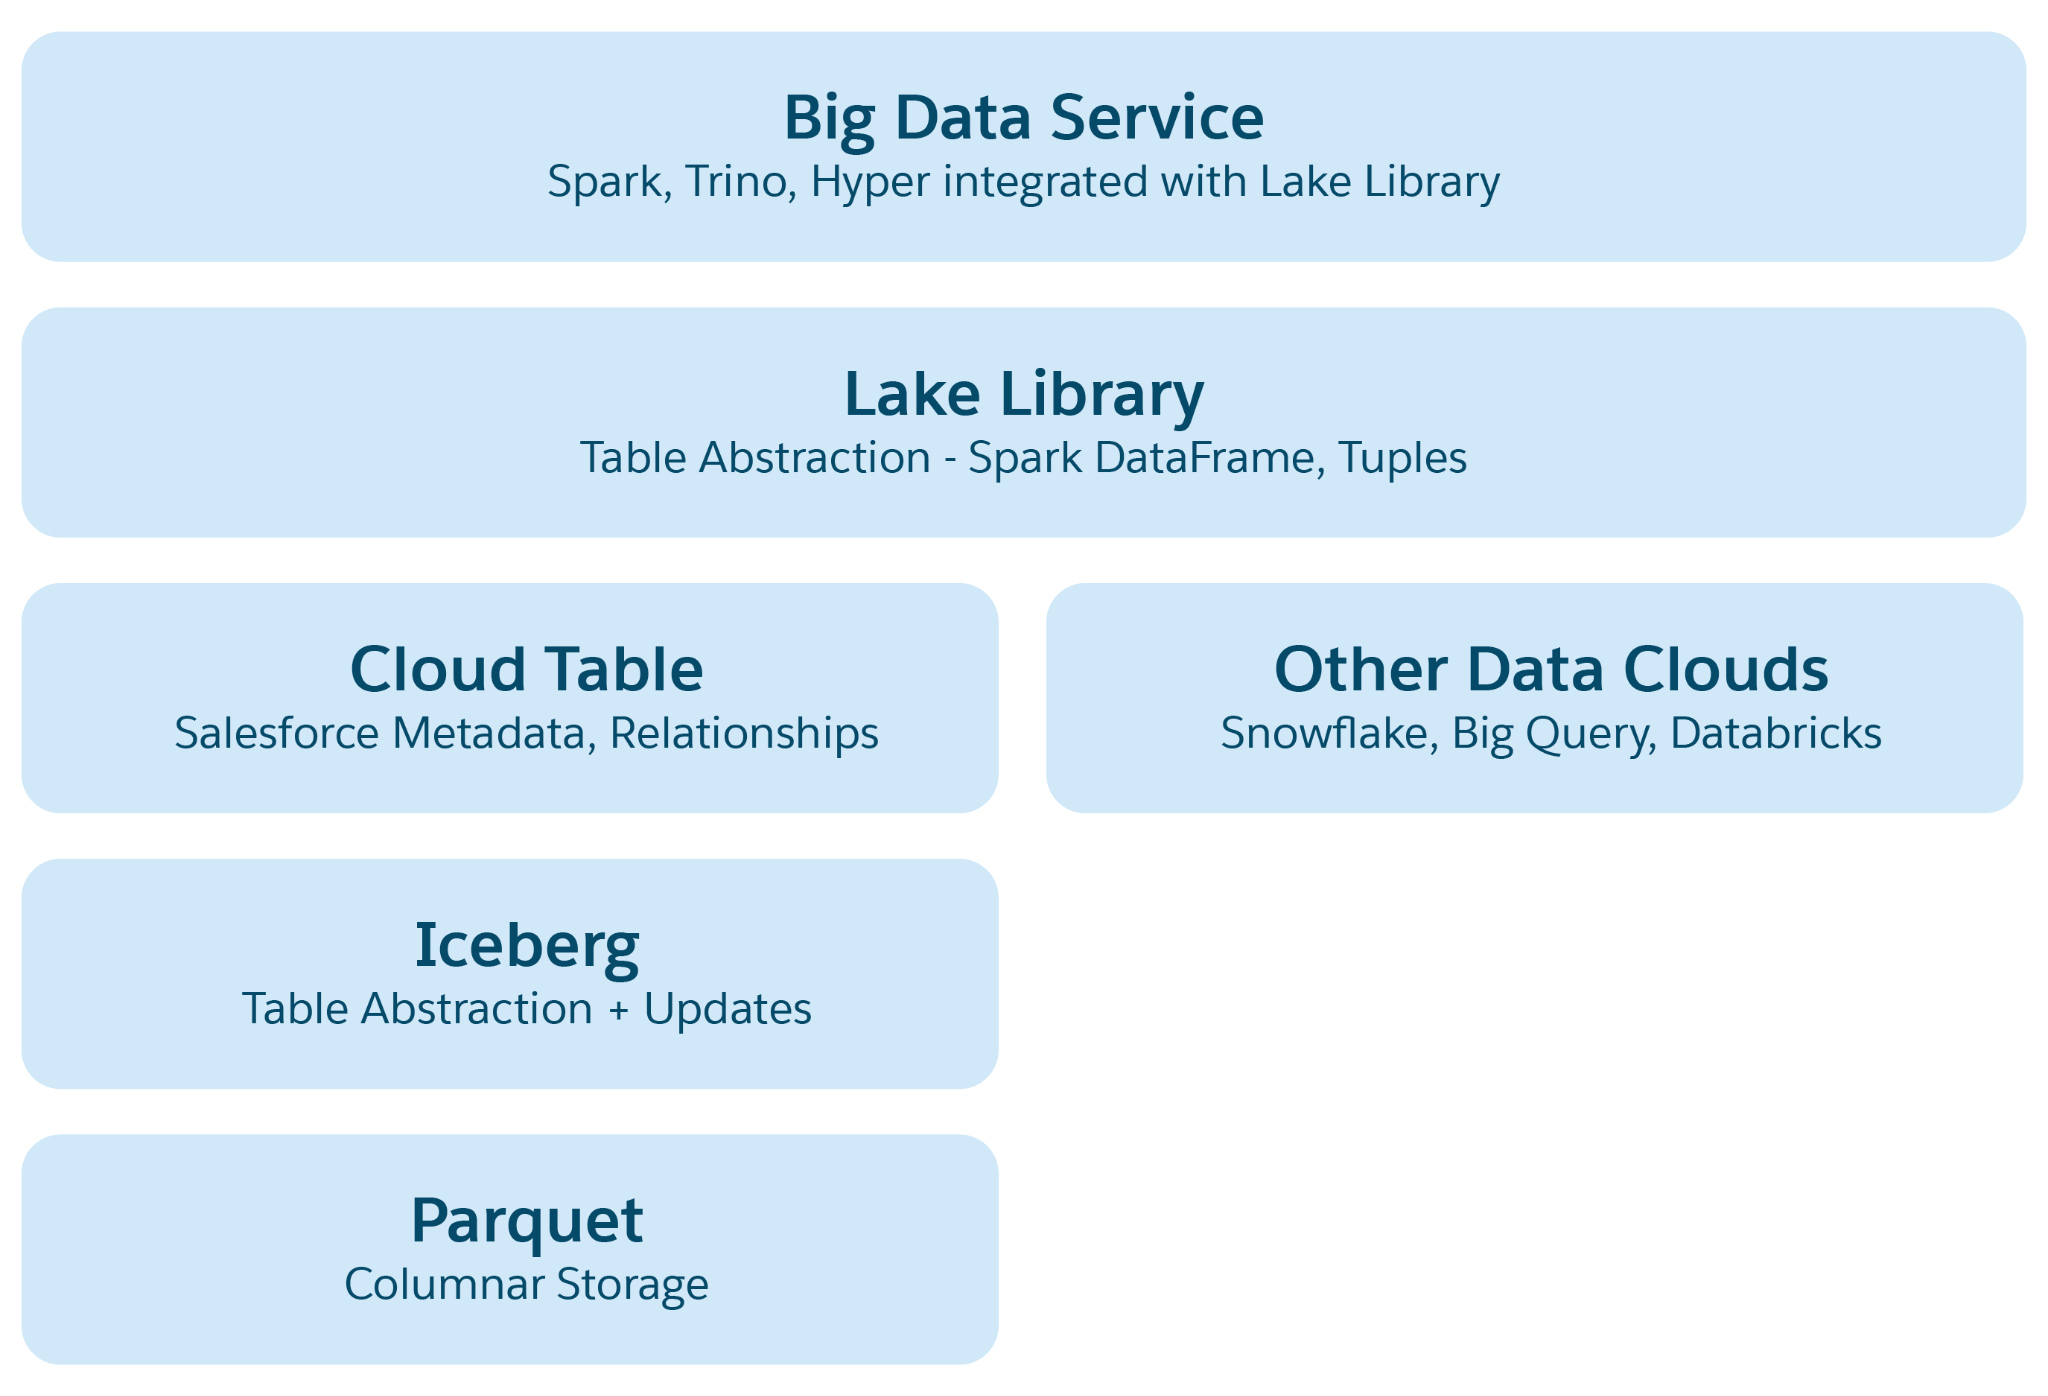 Lakehouse 中的抽象圖層:
1. **Parquet 檔案摘要**:在基礎上,儲存空間包含 Parquet 格式的資料湖檔案 (例如 AWS 中的 S3 或 Azure 中的 Blob)。來源表格的資料會儲存在多個分割區中,作為 Parquet 檔案,每個表格皆為這些檔案的集合。
2. **Iceberg 表格摘要**:表格會組織為資料夾,資料分割會在這些資料夾中儲存為 Parquet 檔案。對分割進行的修改會導致新的 Parquet 檔案成為快照。Iceberg 會管理每個表格的中繼資料檔案,詳細列出結構描述、分割規格和快照。
3. **Salesforce Cloud 表格摘要**:此層建立在 Iceberg 上,會新增如欄名稱與關係等語意中繼資料,以及如目標檔案大小與壓縮等組態。它會在各種平台 (例如 Snowflake 和 Databricks) 中摘要表格,藉此保護 Data 360 應用程式免受基本儲存平台的特定資訊。
4. **湖端存取庫**:此文件庫提供 Salesforce Cloud 表格的存取權、處理資料和中繼資料,並為應用程式開發人員摘要基本的儲存機制。
5. **大型資料服務抽象**:這包括處理架構 (例如 Hyper 用於查詢),以及處理任何雲端表格平台的 Spark。
#### 即時儲存空間
為了支援即時分析和代理應用程式,Data 360 使用低延遲商店增強了 Lakehouse 大型資料儲存空間。Data 360 即時層會在記憶體中處理即時訊號和參與資料。不過,由於以記憶體為基礎的儲存容量受到限制,因此無法符合所有資料,且可能無法即時完成處理。Data 360 新增低延遲存放區 (LLS),以移除此類限制,以啟用可調整的即時處理。
低延遲存放區是 Lakehouse 上的 petabyte 級 NVMe (SSD) 儲存層。並非所有的資料都需要保存在低延遲存放區中。這是永久的快取。大多數資料最終都會進入 Lakehouse 以取得長期保留。即時層中的工作階段中資料可以清洗至低延遲存放區,以便後續快速存取。例如,在工作人員對話中,最近的訊息可在記憶體中處理;舊的訊息可在低延遲存放區中清洗。如果需要先前的交談,則可以從低延遲商店在幾毫秒內存取該交談。以 NVMe 為基礎的儲存空間允許大量資料以毫秒延遲儲存和存取。資料可能會移至 Lakehouse 雲端儲存空間,以獲得長期的持續性。此外,Lakehouse 中實時處理或擴充即時體驗所需的資料會從低延遲存放區中提取並保留。例如,「客戶設定檔內容」會從「Lakehouse」預先提取或帶入,並在低延遲存放區中快取。此外,任何在工作階段處理期間即時處理所需的湖家物件和其他物件也可在低延遲存放區中快取。
Data 360 低延遲存放區會在具有記憶體 (SSD) Lakehouse 儲存層的真儲存階層上啟用「即時器」圖層,並在這些圖層之間順暢移轉資料。我們稍後會在此文件中討論 Data 360 Real Time 圖層。
### 資料組織
Salesforce Data 360 是針對標準化、協調和啟用所有客戶資料 (結構化與非結構化) 的設計,遵循嚴格的生命週期,將原始輸入轉換為統一的目前資料模型。
#### 資料生命週期與物件類型
生命週期著重於取得各種外部資料輸入,並將其建構為永久的已建模物件。模型化資料可協調為 Customer 360 統一設定檔。
**原始取用資料與初始轉換**
流程會從原始資料從來源系統 (CRM、行銷、檔案等) 進行原始資料。這包括完整的資料載入和持續變更事件 (delta),這些事件會受管理並與持久資料合併以維持目前狀態。
**內嵌轉換** (例如,修整、正規化、串連) 會立即套用於取用期間,以確保初步的資料品質和清理。
##### 資料湖物件 (DLO):持續層
**DLO** (資料湖物件) 形成 Data 360 中的核心永久性儲存層。它們會儲存乾淨且轉換的資料,並作為所有客戶資訊的組織、長期存放庫。
系統會將 **進階資料轉換** (例如聯結、彙總、已計算洞察) 套用至來源 DLO,以產生精密設計的新衍生 DLO。
透過 Zero Copy Data Federation 提供的資料會直接表示為 DLO。
**非結構化資料與中繼資料組織**
針對非結構化內容 (例如文字、媒體、文件),Data 360 會透過在名為「非結構化資料湖物件 (UDLO)」的特定 DLO 中,將其結構化中繼資料解壓縮並保留,以納入資料。
這些專用 DLO 會作為目錄表格運作,提供對應至非結構化資產的實體位置和內容。此功能可讓結構設計師將非結構化資料的中繼資料與其餘結構化客戶資料無縫建立關聯,進而啟用統一的查詢和調和。
##### 資料模型物件 (DMO):協調層級
**DMO** (資料模型物件) 代表最終、協調和結構化資料層。
它們是透過將 DLO 欄位 (來自來源、衍生和非結構化中繼資料 DLO) 對應至標準 Customer 360 資料模型來建立。
DMO 圖層可作為所有客戶資料的單一事實來源,在整個生態系統中啟用統一設定檔建立、區隔和啟用。
#### 資料空間:邏輯容器
資料空間是組織 Data 360 內所有資料和中繼資料 (包括所有 DLO (結構化與非結構化) 和 DMO) 的基礎邏輯容器。資料空間提供安全且隔離的資料處理與建模環境。
資料空間會作為邏輯與管治界限,透過分隔不同實體 (例如業務單位、區域或品牌) 的資料來啟用內部多租用,同時維持企業範圍的可視性、歷程和合規性,作為定義粗體粒紋存取控制的基礎。
資料空間內的隔離會在平台的多個層級強制執行:
- **資料層級隔離**:每個 DLO/DMO 都屬於單一資料空間,以確保查詢、轉換和物件對應不能跨越資料空間的邊界,除非有明確授權。
- **存取控制整合**:權限集原生繫結至資料空間,可控制讀取、寫入和管理作業。這可確保只有經過授權的使用者和服務才能存取資料空間內的物件、洞察和啟用。
- **管治與稽核**:資料空間內的所有作業都會使用企業級稽核追蹤來記錄,以啟用合規性、管理和法規報告的可追蹤性。
透過「權限集」管理存取權與權限,以確保細微可視性、控制更新,以及防止跨網域資料洩漏。透過將資料空間邊界與 Data 360 的安全性與管治結構整合,結構設計師可以自信地實作集中化與去中心化管治策略,同時在多個雲端與業務網域之間保持一致性。
#### 計算面板
Data 360 運算模組提供統一的層級來管理和執行所有大型資料工作負載,簡化基礎結構的複雜性。其核心元件是資料處理控制項 (DPC)。
DPC 是全方位、多工作量資料處理協調流程服務,可在各種雲端運算環境中提供「工作方式服務」(JaS) 功能。其會抽出基礎結構複雜性,並統一 Spark (在 EC2 上為 EMR,在 EKS 上為 EMR) 和 Kubernetes Resource Controller (KRC) 工作負載等架構的工作執行。透過作為集中控制平面門戶,DPC 可協調、排程和監視跨多個資料平面的工作,以確保可靠性、可擴充性、成本效率和一致的開發人員體驗。
DPC 的需求源自直接與如 EMR 等原生叢集管理系統互動的限制。
##### 基礎結構與雲端抽象
雖然 EMR 為叢集、工作和步驟提供 API,但仍會為用戶端小組負擔重要基礎結構管理工作,例如佈建、調整規模、效能調整和成本最佳化。DPC 透過針對工作提交提供簡化的平台層級 API,來解決此問題。它支援自動失敗處理、重試和動態負載平衡。透過以點和重點為基礎的節點提供成本效率。透過 TLS、PKI、IAM 隔離和自動修補功能提供強大的安全性。管理 Spark 和 EMR 執行階段版本升級,以提供效能改善、安全性修補程式和功能增強功能。
此外,DPC 提供一個統一的雲端無效介面,用於提交和管理資料工作,從基礎雲端基底 (AWS, future 提供者) 的複雜性和專屬 API 中抽取。這可確保用戶小組只會與常見的 Data 360 API 型工作提交介面互動,此工作介面會移除基本資源管理員 (例如 Kubernetes 和 YARN) 的複雜性。這可讓用戶小組透過簡單且統一的 API 提交 Spark 工作,而無須直接管理 pods、節點集區或 Spark 叢集組態。
手動調整 Spark 參數需要專業技能,而不正確的組態可能會導致工作執行速度變慢。DPC 小組集中此專業知識,提供最佳化組態以避免常見的效能問題。此專門的小組持續整合開放程式碼社群的 Knowledge,以確保在控制器管理的所有工作量之間提供最佳效能。
DPC 不僅限於 Spark;它支援廣泛的工作量陣列。這些包括:
- 即時處理工作量
- 「資料動作」功能的事件傳送
- 管理 Milvus (非結構化資料索引的向量資料庫)
- 低延遲儲存基礎結構
DPC 也利用 **Kubernetes Resource Controller (KRC)** 架構,其支援如 Trino for Query、Event Delivery for Data Actions、Data Extraction Jobs for Connectors 和即時處理等工作量。針對所有 KRC 工作負載,DPC 提供中心的「工作即服務」功能,在高層級工作抽象中處理運算佈建、部署和管理。
##### JaaS 優點與結構
DPC 提供的「工作方式服務」模型可確保符合成本效益且有彈性的工作處理管道。
使用者提供簡單的叢集規格,專注於所需的 CPU、記憶體、儲存空間、例項計數,以及用於叢集比對的「最小/最大」叢集計數和標記。接著,DPC 會自動管理抽象的基礎結構詳細資料,包括選取最佳 VM SKU、管理「例項車隊」,以及決定「核心」與「核心」比率。工作節點和管理隨選與。根據輸入找出例項。它也會處理 EMR 和元件版本管理和升級,而不會發生停機。
重要的是,DPC 本身支援多租用,其設計目的為瞭解並強制執行 Data 360 租用範圍邊界和資源分隔。其也透過強制執行 Salesforce 認證的電腦影像、管理服務特定 IAM 角色,以及保證傳輸和靜態加密來確保安全性和合規性。針對路由和容量控制,會使用「叢集標記」管理工作對叢集比對,以容量為基礎的路由會使用工作同時設定上限,以有效控制資源利用率。
Cloud Agnostic Client Experience 是核心優點,因為基本雲端環境的複雜性會對用戶端服務隱藏,讓他們能夠專注於純粹的業務邏輯。這可達成「雲端提供者抽象」的目標。最後,DPC 可啟用輕鬆的「使用狀況」和「成本追蹤」,允許依服務區隔叢集利用率和成本,以進行準確的會計。整體而言,DPC 採用可插入的結構,可讓新執行引擎 (例如 Flink、Ray) 和雲端基底 (GKE/Dataproc) 順暢整合,而無須向使用者顯示基礎結構詳細資料。此設計會將控制平面與執行層分離,以確保無論後端為何皆有一致的 API 與作業體驗。
### Data 360 中的資料處理:從原始至可操作
Data 360 可精簡及豐富原始資料,藉此彌補原始資訊與可運作業務耗用之間的差距。其透過準備複雜的資料以進行精密的啟用和分析,來補充資料物件生命週期。Data 360 支援各種處理類型,包括批次和串流資料轉換、批次和串流計算洞察、非結構化資料處理和身分解析。若要有效率地啟用這些多樣化的作業,特別是在近乎即時且跨大量資料集的作業中,需要精密機制才能有效處理資料變更。
#### 增量處理
若要達成高效率且近乎即時的資料處理,特別是使用 TB 大小的表格和數百萬個潛在更新的資料,Data 360 需要突破。需要一種方法,才能在資料變更時精確通知系統,然後有效識別哪些資料已變更,以便只處理相關更新,且僅在更新時處理。此挑戰導致兩種互補的創新:「儲存原生變更事件」(SNCE) 以在變更時通知,以及「變更資料摘要」(CDF) 以識別變更的項目。
##### 儲存原生變更事件 (SNCE)
SNCE 已將 Data 360 徹底改變為反應性且增量資料平台。此轉換涉及使用標準化事件格式和高流量訊息傳送系統,從主動輪詢資料湖移至被動監視原子認可事件。
每個對 Iceberg 表格的成功寫入作業 (INSERT、UPDATE、DELETE) 都會在目錄中原子交換表格目前中繼資料檔案指標。基礎物件儲存層 (例如 S3) 設定為每當新中繼資料快照寫入至表格目錄時,會發出原生通知事件 (例如 S3 事件)。
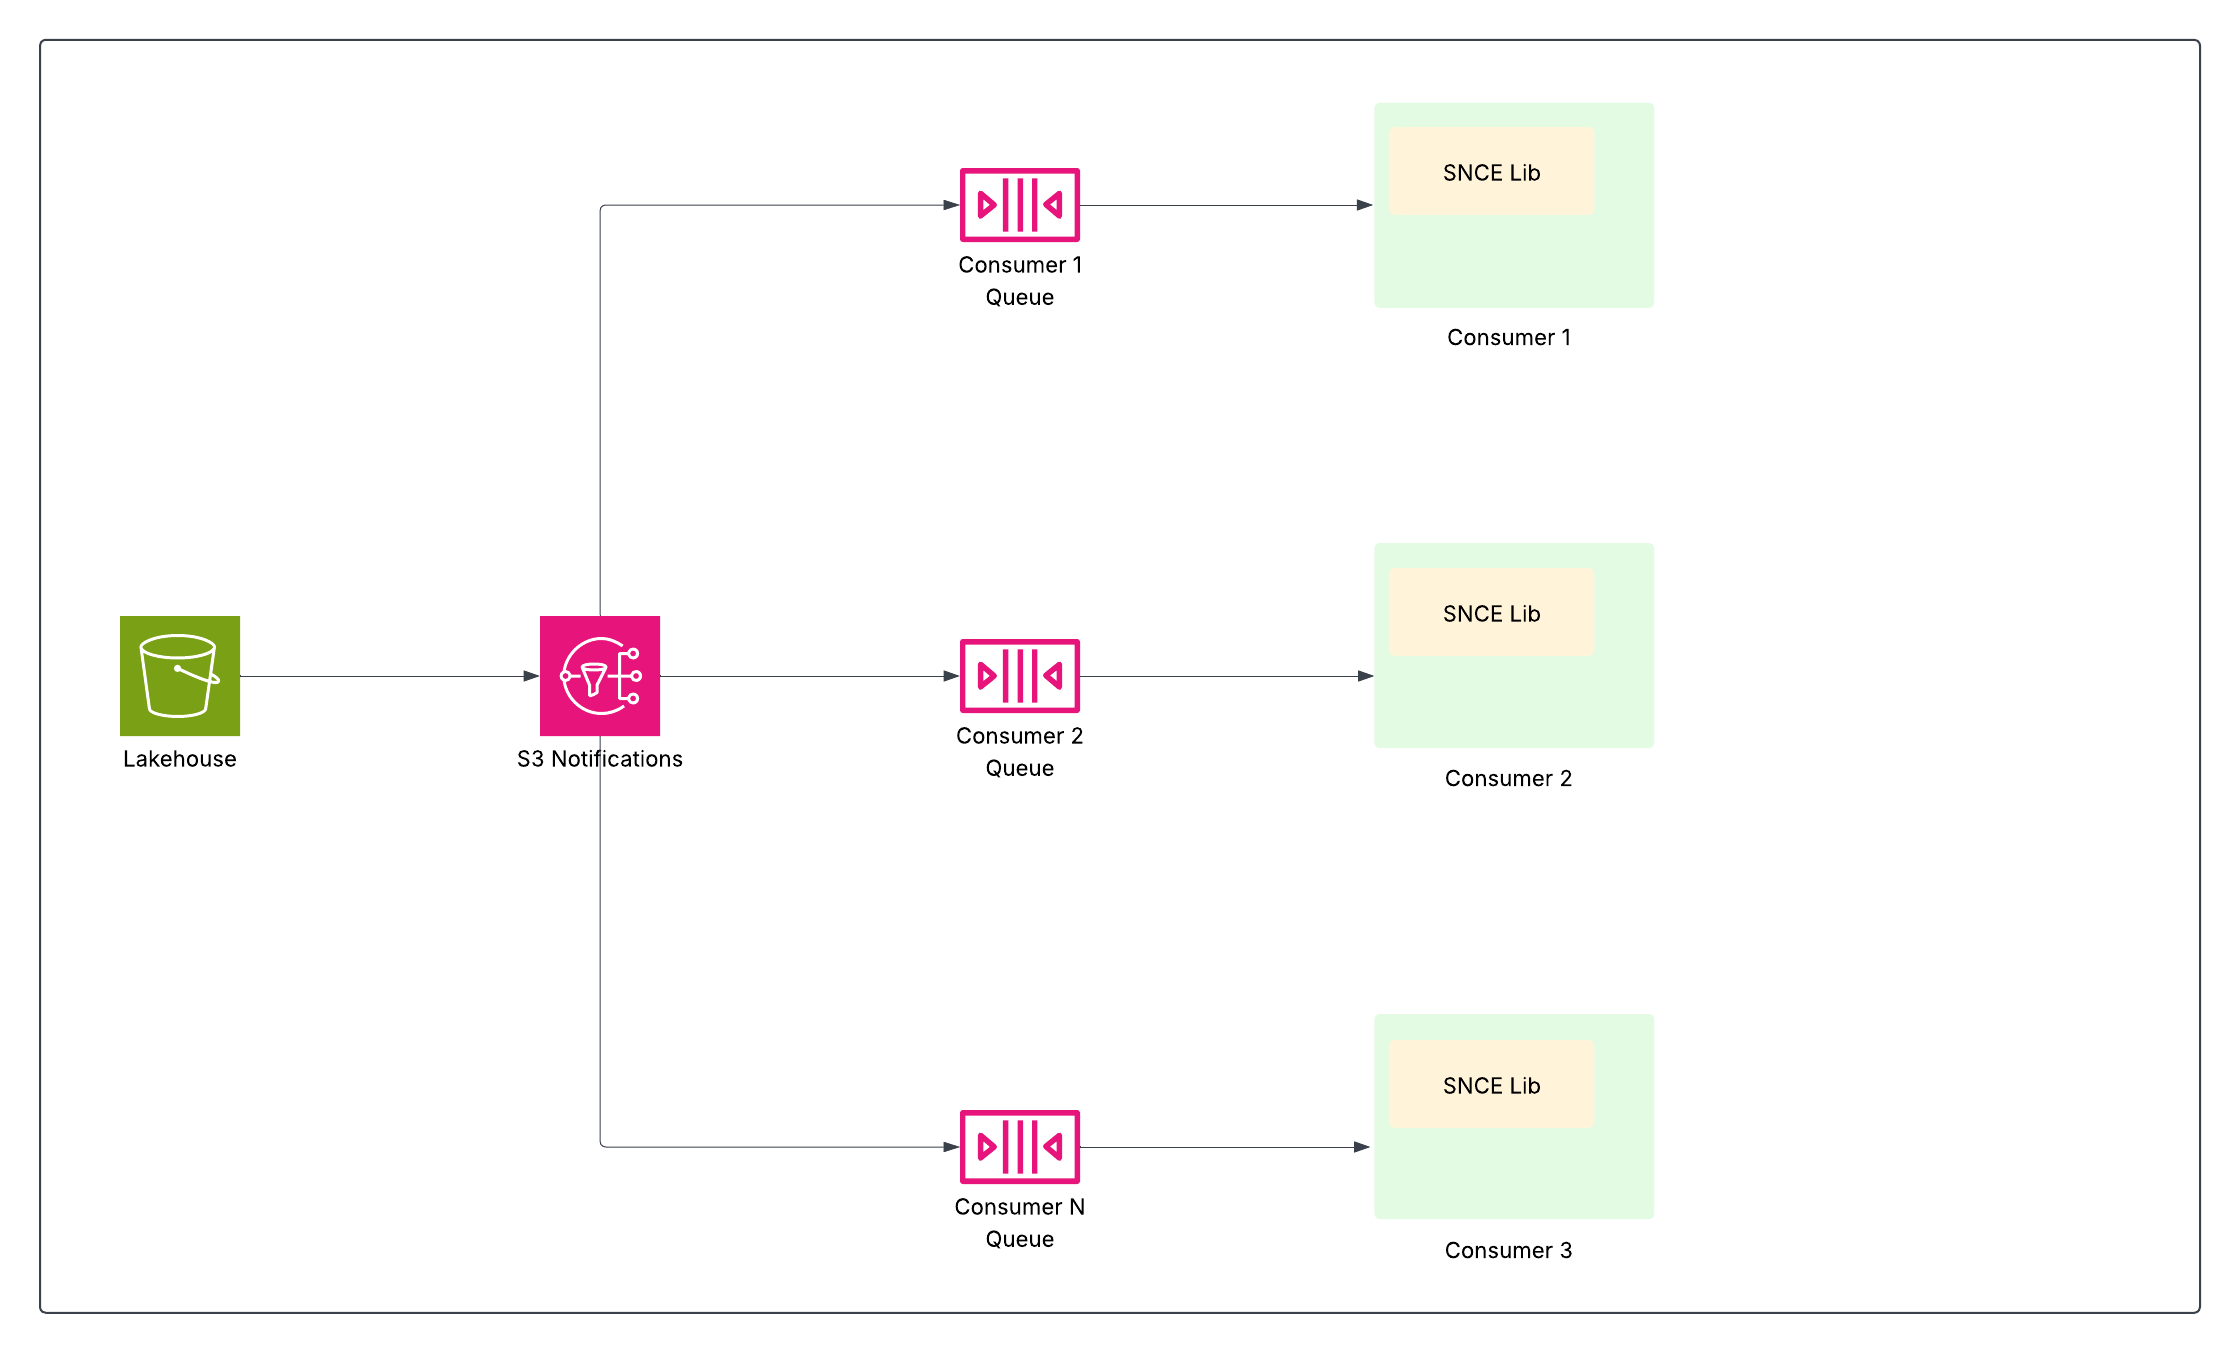 SNCE 程式庫提供用來取用這些事件的標準化方法,並可根據要求以快照中繼資料來增強這些事件。
這可讓下游資料銷售管道 (例如串流已計算洞察、身分解析和區隔) 僅在資料變更時訂閱並採取動作,進而避免成本高昂的完整表格掃描,大幅提升效率。
##### 變更資料摘要 (CDF)
以 SNCE 為基礎,「變更資料摘要」(CDF) 提供耗用變更及逐步處理變更的簡化機制。
CDF 利用 Iceberg 快照有效地產生變更串流。重要的是,Data 360 的最佳化 Iceberg 寫入器會將變更計算並維持為寫入作業本身的一部分,讓 CDF 產生效率高,並將額外的額外負擔降到最低。這可讓處理工作 (例如串流轉換或串流已計算洞察) 僅選擇性地處理已變更的記錄,避免耗費快照的差異計算。
此增量策略為大型資料集提供數個優點,包括節省成本、減少延遲和改善效率。它會啟用如串流轉換和增量身分解析等功能,進而導致更快的洞察、更可預測的系統負載、增強的效能和更低的營運費用。
### 連線、接收和準備
Data 360 透過原生對 Salesforce 產品的支援,提供強大取用功能,確保資料流程順暢。針對外部來源,其透過超過 270 個連接器、API、SDK 和 MuleSoft 提供廣泛的連線能力。此外,Data 360 具備零複製聯合功能,允許 BI 和分析,而不需要資料重複。
#### Data 360 連接器架構
Data 360 連接器架構 (DCF) 是大多數 Data 360 連線的基礎。其可透過統一結構來啟用採取、聯合和輸出。DCF 會定義建立和管理連接器的標準,從設定和管理的 UI 到中繼資料持續性、資料提取和傳送至 Lakehouse 或透過對外部來源的即時查詢。它也支援私人連線選項 (例如私人連結、VPN 和安全隧道),以確保在連線至客戶或合作夥伴環境時的企業級資料安全性和合規性。透過提供所有連接器的一致方法,DCF 可透過確保可擴充性、可靠性和安全整合,讓 Data 360 順暢連線至更廣泛的生態系統。
#### Data 360 連接器
Data 360 可提供對資料來源的廣泛生態系統強大連線,同時支援原生 Salesforce 產品和許多外部系統。此廣泛的連線對於統一隔離的企業資料,以及啟用 AI/ML 和 Agenttic 應用程式而言至關重要。
Data 360 原生或透過 MuleSoft、API 和 SDK 提供超過 270 個連接器,以支援其端對端資料銷售管道功能,包括批次、串流或即時提取。這些連接器可依其整合的來源系統類型廣泛分類。
**Salesforce 原生連接器**
這些連接器可確保 Salesforce 產品的原生資料流流順暢。
範例包括 Salesforce CRM、Data Cloud One、Marketing Cloud Engagement、Marketing Cloud Account Engagement 和 B2C Commerce 的連接器。
**外部應用程式與 SaaS**
各種業務應用程式和雲端服務的連接器允許從外部軟體平台提取資料。
範例包括 Adobe Marketo Engage、Microsoft Dynamics 365、Mailchimp 和 Airtable。
**資料庫與資料倉庫**
Data 360 可連線至各種關聯式和雲端式資料儲存平台。
範例包括 Amazon Redshift、Amazon DynamoDB、Amazon RDS (MySQL、PostgreSQL、Oracle)、Google BigQuery 和 Microsoft SQL Server。
**雲端物件儲存和檔案系統**
這些連接器會與結構化與非結構化資料的超大規模儲存解決方案整合。
範例包括 Amazon S3、Google Cloud Storage (GCS) 和 Azure Blob Storage。
**串流和傳訊服務**
處理連續即時資料串流的連接器對於以事件為導向的案例和即時處理而言至關重要。
範例為 Amazon Kinesis 連接器。
**整合平台**
MuleSoft Anypoint 連接器透過 Anypoint Exchange 將 Data 360 與更廣泛的應用程式和資料庫整合,藉此擴充 Data 360 的接觸範圍。
**非結構化資料與雲端物件儲存連接器**
這些連接器對於將非結構化資料 (缺少預先定義的模型資料) 採取和參照至關重要,以增強生成式 AI 功能。
所有這些連接器皆以 Data 360 連接器架構為基礎,提供一致的體驗。
#### 資料轉換
資料轉換是 Data 360 中的基礎結構元件,其設計目的為清除、增強原始資料,並將其塑造為符合 Customer 360 資料模型的正規化且可運作的資料資產。此流程對於資料調和、品質改善,以及確保資料已準備好供下游使用個案 (例如設定檔統一、區隔和啟用) 使用而言至關重要。轉換會利用來源資料湖物件 (DLO) 和資料模型物件 (DMO) 作為輸入,分別為新的 DLO 或 DMO 產生結果。
Data 360 提供兩種主要轉換範例以滿足不同的資料速度需求:批次資料轉換和串流資料轉換。
##### 批次資料轉換
「批次資料轉換」是針對根據定義的排程或隨選觸發進行大量處理而設計。此引擎已針對處理複雜且具有資源密集性的重新結構作業最佳化。
「批次轉換」流程使用視覺化低程式碼管道畫布進行設定,讓使用者定義多階段轉換邏輯。此引擎唯一支援對於標準資料模型對齊的重要複雜重組作業:資料結構與正規化。這包括樞紐 (將反正規化記錄拆分為多個正規化記錄) 和壓平 (將階層資料 (例如 JSON) 重新結構化為結構化表格)。系統的執行模式支援完整同步化 (處理所有記錄) 和高效率的增量處理模式。增量模式僅處理自上次成功執行後變更的記錄,以大幅減少處理時間和資源消耗。批次轉換適用於不需要即時更新的工作,例如定期彙總和複雜資料重新結構。
##### 串流資料轉換
串流資料轉換會在資料流入系統時,以近乎即時的方式持續且以增量方式處理資料,使其在低延遲使用個案中至關重要。
主要介面是 SQL 優先方法,其中的轉換會定義為 SQL SELECT 查詢,會根據記錄變更的傳入串流持續執行。此引擎支援核心轉換功能,包括資料清除和標準化 (例如,驗證 PII 和標準化資料格式),以及資料增強和合併 (使用聯結和聯結)。重要的是,其支援串流對應 JOIN,以針對靜態或緩慢變化的參考資料啟用即時資料增強和對應,以確保立即設定檔更新。為了最佳化服務成本,結構使用高密度 (HD) 工作設計,將單一租戶的多個串流轉換定義封裝到單一基礎運算工作中,最大化資源利用率。串流轉換對於如事件監視、立即個人化和即時設定檔更新等使用個案而言至關重要。
### 零複製資料聯合與資料共用
Data 360 透過支援「零複製」聯邦與資料共用來徹底改變資料管理,因此無須移動或重複資料。此功能可讓使用者順暢直接從各種外部來源存取資料,並與外部環境共用資料,大幅減少複雜性、降低儲存成本,並確保所有決策皆以最新的、最可靠的資訊為基礎。
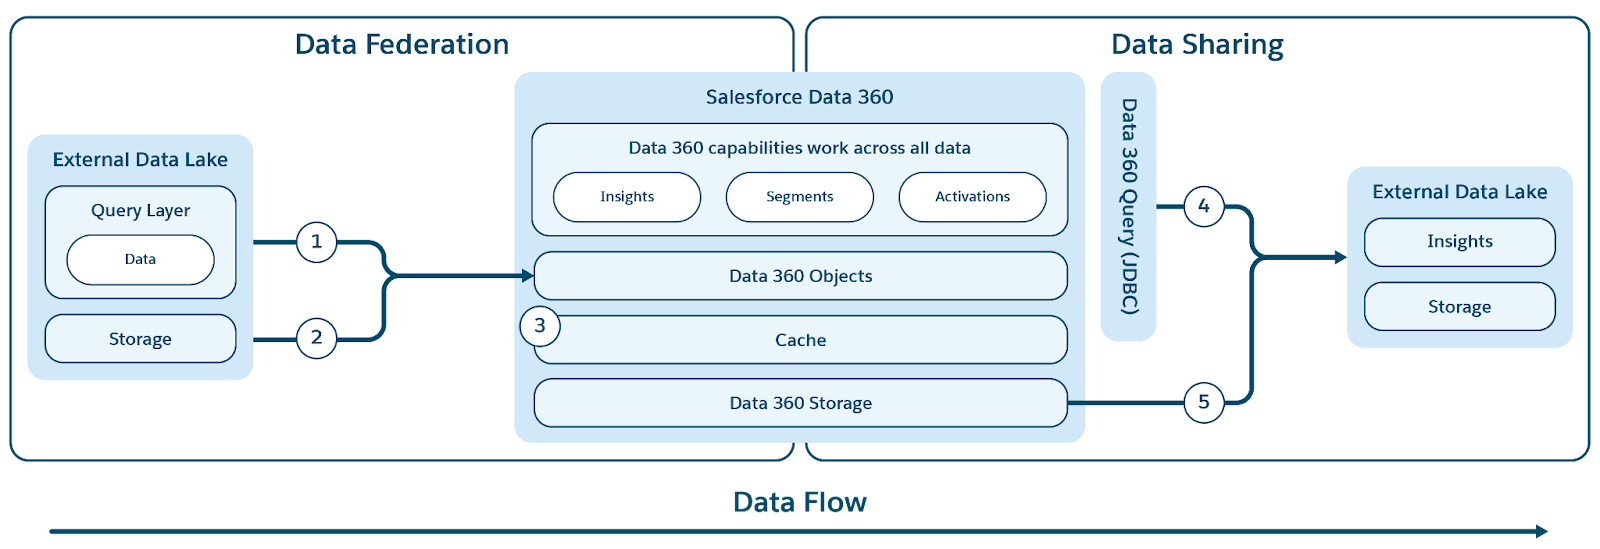 #### 資料聯合
Data 360 支援與外部資料倉庫 (Snowflake、Redshift)、湖家 (Google BigQuery、Databricks、Azure Fabric)、SQL 資料庫和許多其他來源的零複製聯合。其抽象層可讓您直接查詢外部資料,而無須重複,進而減少提取時間、儲存成本,並確保最新資訊。
Data 360 透過提供抽象化 Salesforce 和外部物件的統一中繼資料層,來簡化對外部和聯合資料的存取。這可讓整個 Salesforce 平台及其應用程式順暢地使用此資料。
Data 360 支援檔案和以查詢為基礎的聯合,以及即時查詢和存取加速,如圖所示。
標籤 (1) 和 (2) 說明 Data 360 的查詢 (包括即時查詢推送),以及從外部資料湖/倉庫/資料來源存取資料的檔案型同盟;標籤 (3) 醒目提示從外部資料湖/資料來源加速聯合存取。
##### 查詢聯合
Data 360 的聯合功能核心在於其查詢聯合層,可管理存取外部資料和執行智慧查詢推送的複雜流程 (如標籤 1 所示)。Data 360 使用 JDBC 通訊協定連線至來源,並從來源提取資料,並增強額外的邏輯以提升效率。「查詢聯合層」負責瞭解和翻譯不同的 SQL 方言,並找出要推送至外部系統的查詢最佳部分,以有效處理結果,並執行任何必要的進一步處理以衍生最終洞察。
###### 快取 (查詢加速)
針對增強型公用程式,Data 360 為其聯合功能提供選用的加速功能。
啟用「加速」時,Data 360 會快取聯合資料,以達到更快的存取和更低的成本,因為它會避免重複直接存取外部來源。此快取會視為加速層,並會逐步更新以快速反映外部來源資料中的任何變更,以確保加速檢視保持近乎即時。
##### 檔案聯合
Data 360 支援檔案型聯合 (以標籤 2 說明),用於從外部資料湖和來源存取資料。此零複製功能的技術基礎依賴標準化:基礎資料必須是 Apache Parquet 檔案格式,並使用 Apache Iceberg 表格格式。Data 360 可以聯合為公開「Iceberg REST 目錄」(IRC) 的任何來源,以取得中繼資料和儲存空間存取權,以確保流暢且受管理地存取位於平台外的檔案。
透過檔案型聯合,Data 360 計算會處理所有資料處理,因為其可直接存取基本儲存空間。這可消除查詢推送功能表和管理各種 SQL 方言的需求,這在查詢型聯合中通常是必要的。
除此之外,「零複製」功能也擴充至非結構化資料來源,例如超大規模儲存解決方案 (S3/GCS/Azure 儲存空間)、Slack 和 Google Drive,可由 Data 360 的非結構化處理管道存取。
#### 資料共用
Data 360 可協助與外部資料湖和倉庫共用其管理的以查詢為基礎與以檔案為基礎資料 (原始圖例內容中的標籤 4 和 5 說明)。
##### 以查詢為基礎的共用
針對以查詢為基礎的資料共用,Data 360 會使用外部引擎和應用程式來公開 JDBC 驅動程式,以安全地存取資料。此機制允許外部系統直接針對 Data 360 內的資料連線、驗證和執行即時查詢。
##### 檔案共用 (資料共用與 DaaS)
檔案式共用的主要機制包含兩個概念:資料共用和資料共用目標,其利用 DaaS (資料作為服務) API。
- 細微控制:資料共用概念可讓客戶精確定義要在外部共用的物件 (DLO、DMO、CIO 等),以防止非預期的資料曝光。
- 安全目標:它也會控制資料共用目標,確保資料僅可供明確授權的外部環境、帳戶或合作夥伴組織使用 (例如與特定 Redshift 或 Databricks 例項共用)。
DaaS API 提供安全且受管理的介面,讓外部引擎取用資料。其會授與基本中繼資料和基本表格儲存空間的存取權,同時保留所有 Data 360 語意。這可確保外部引擎以安全的方式,在一致且有意義的內容中存取資料。
### 私人連線
許多安全性敏感的客戶,特別是大型企業、受監管產業和公共部門組織,會限制對其資料湖的所有網際網路存取權,作為其安全性狀況的一部分。此原則對於合規性和降低風險而言至關重要,但也會防止 Salesforce Data 360 和 Agentforce 透過公用網際網路連線至這些環境。
大多數資料湖都會部署在超大規模環境中,例如 AWS、Azure 或 Google Cloud。由於 Data 360 本身在 AWS 上執行,因此存取在不同雲端提供者上主控的客戶資料湖需要跨雲端網路連線。若沒有略過公用網際網路的安全私人連線選項,客戶通常無法或不願意為依賴這些資料湖的使用個案採用 Data 360 或 Agentforce。
#### 私人連結
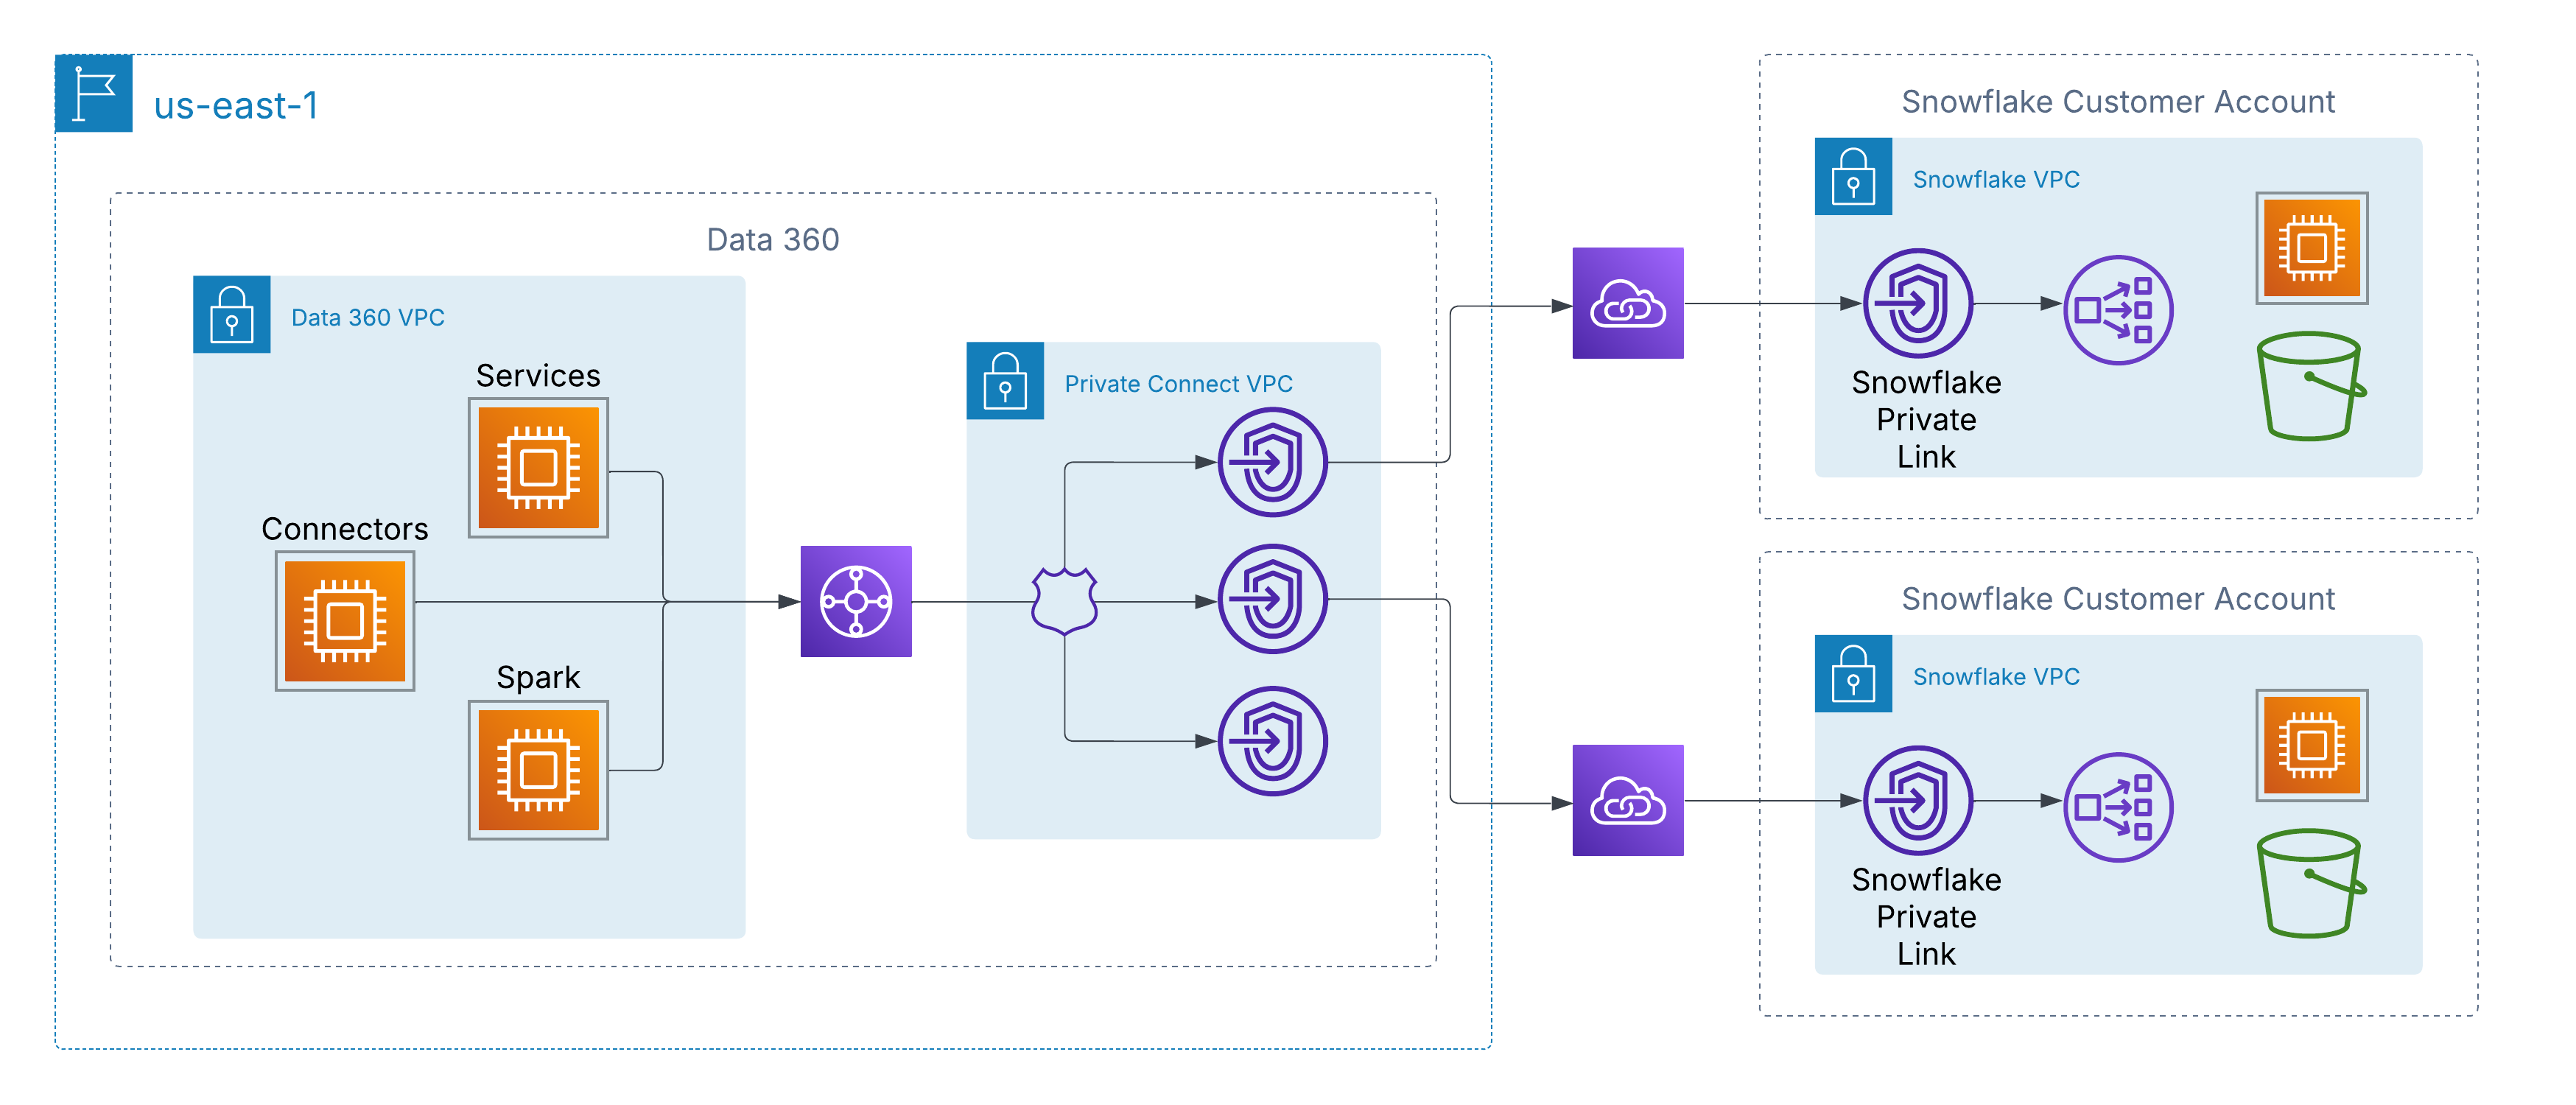 為了解決此問題,Data 360 支援跨雲端與客戶管理資料來源的專用網路層級連線。在 AWS 上,此功能透過 AWS PrivateLink 啟用,可讓 Data 360 直接連線至客戶提供的端點,無論是在其自己的帳戶內或在第三方資料湖環境 (例如 Snowflake) 中,而無須周遊公用網際網路。
此結構會使用私人 IP 位址和非可建立路線網路路徑,確保所有流量完全保留在 AWS 架構上,從而滿足嚴格的安全性和合規性需求,同時讓客戶資料的存取流暢。
#### 私人互連
針對具有多雲端結構的客戶,Data 360 透過跨雲端互連支援,將私人連線延伸至 AWS 之外。這可啟用從 Data 360 到 Azure 或 Google Cloud 中所主控資料湖和服務的安全、僅限後端網路路徑,並保留與 AWS PrivateLink 相同的原則—私人 IP 位址、非公用路由和零網際網路曝光。
客戶可以選擇兩種部署模型:
- **客戶管理的互連**:將現有私人電路 (例如 Azure ExpressRoute、Google Cloud Interconnect 或 Equinix Fabric) 直接與 Data 360 的 VPC 整合。
- **Salesforce 受管理的互連**:使用完全受管理的整合式連線,其中 Salesforce 會佈建和作業跨雲端連結,以在目標雲端中公開私人端點。
在這兩個模型中,體驗一致:Data 360 服務會在超級規模之間連線至外部資料來源,如同在本機一樣,無須周遊公用網際網路即可啟用安全的取用、啟用和查詢。
### Data 360 中的資料管理:Trust 與控制的基礎
針對企業結構設計師,強大的資料管理不只是合規性核取方塊,而是建立可信任、可調整且可運作客戶智慧的基礎支柱。Salesforce Data 360 以全方位的管治架構結構設計,可確保在整個資料生命週期中達到資料品質、安全性和法規要求。
Data 360 可作為集中式管治中心運作,確保完整且控制的管理所有資料,從原始摘要到已啟用的洞察。
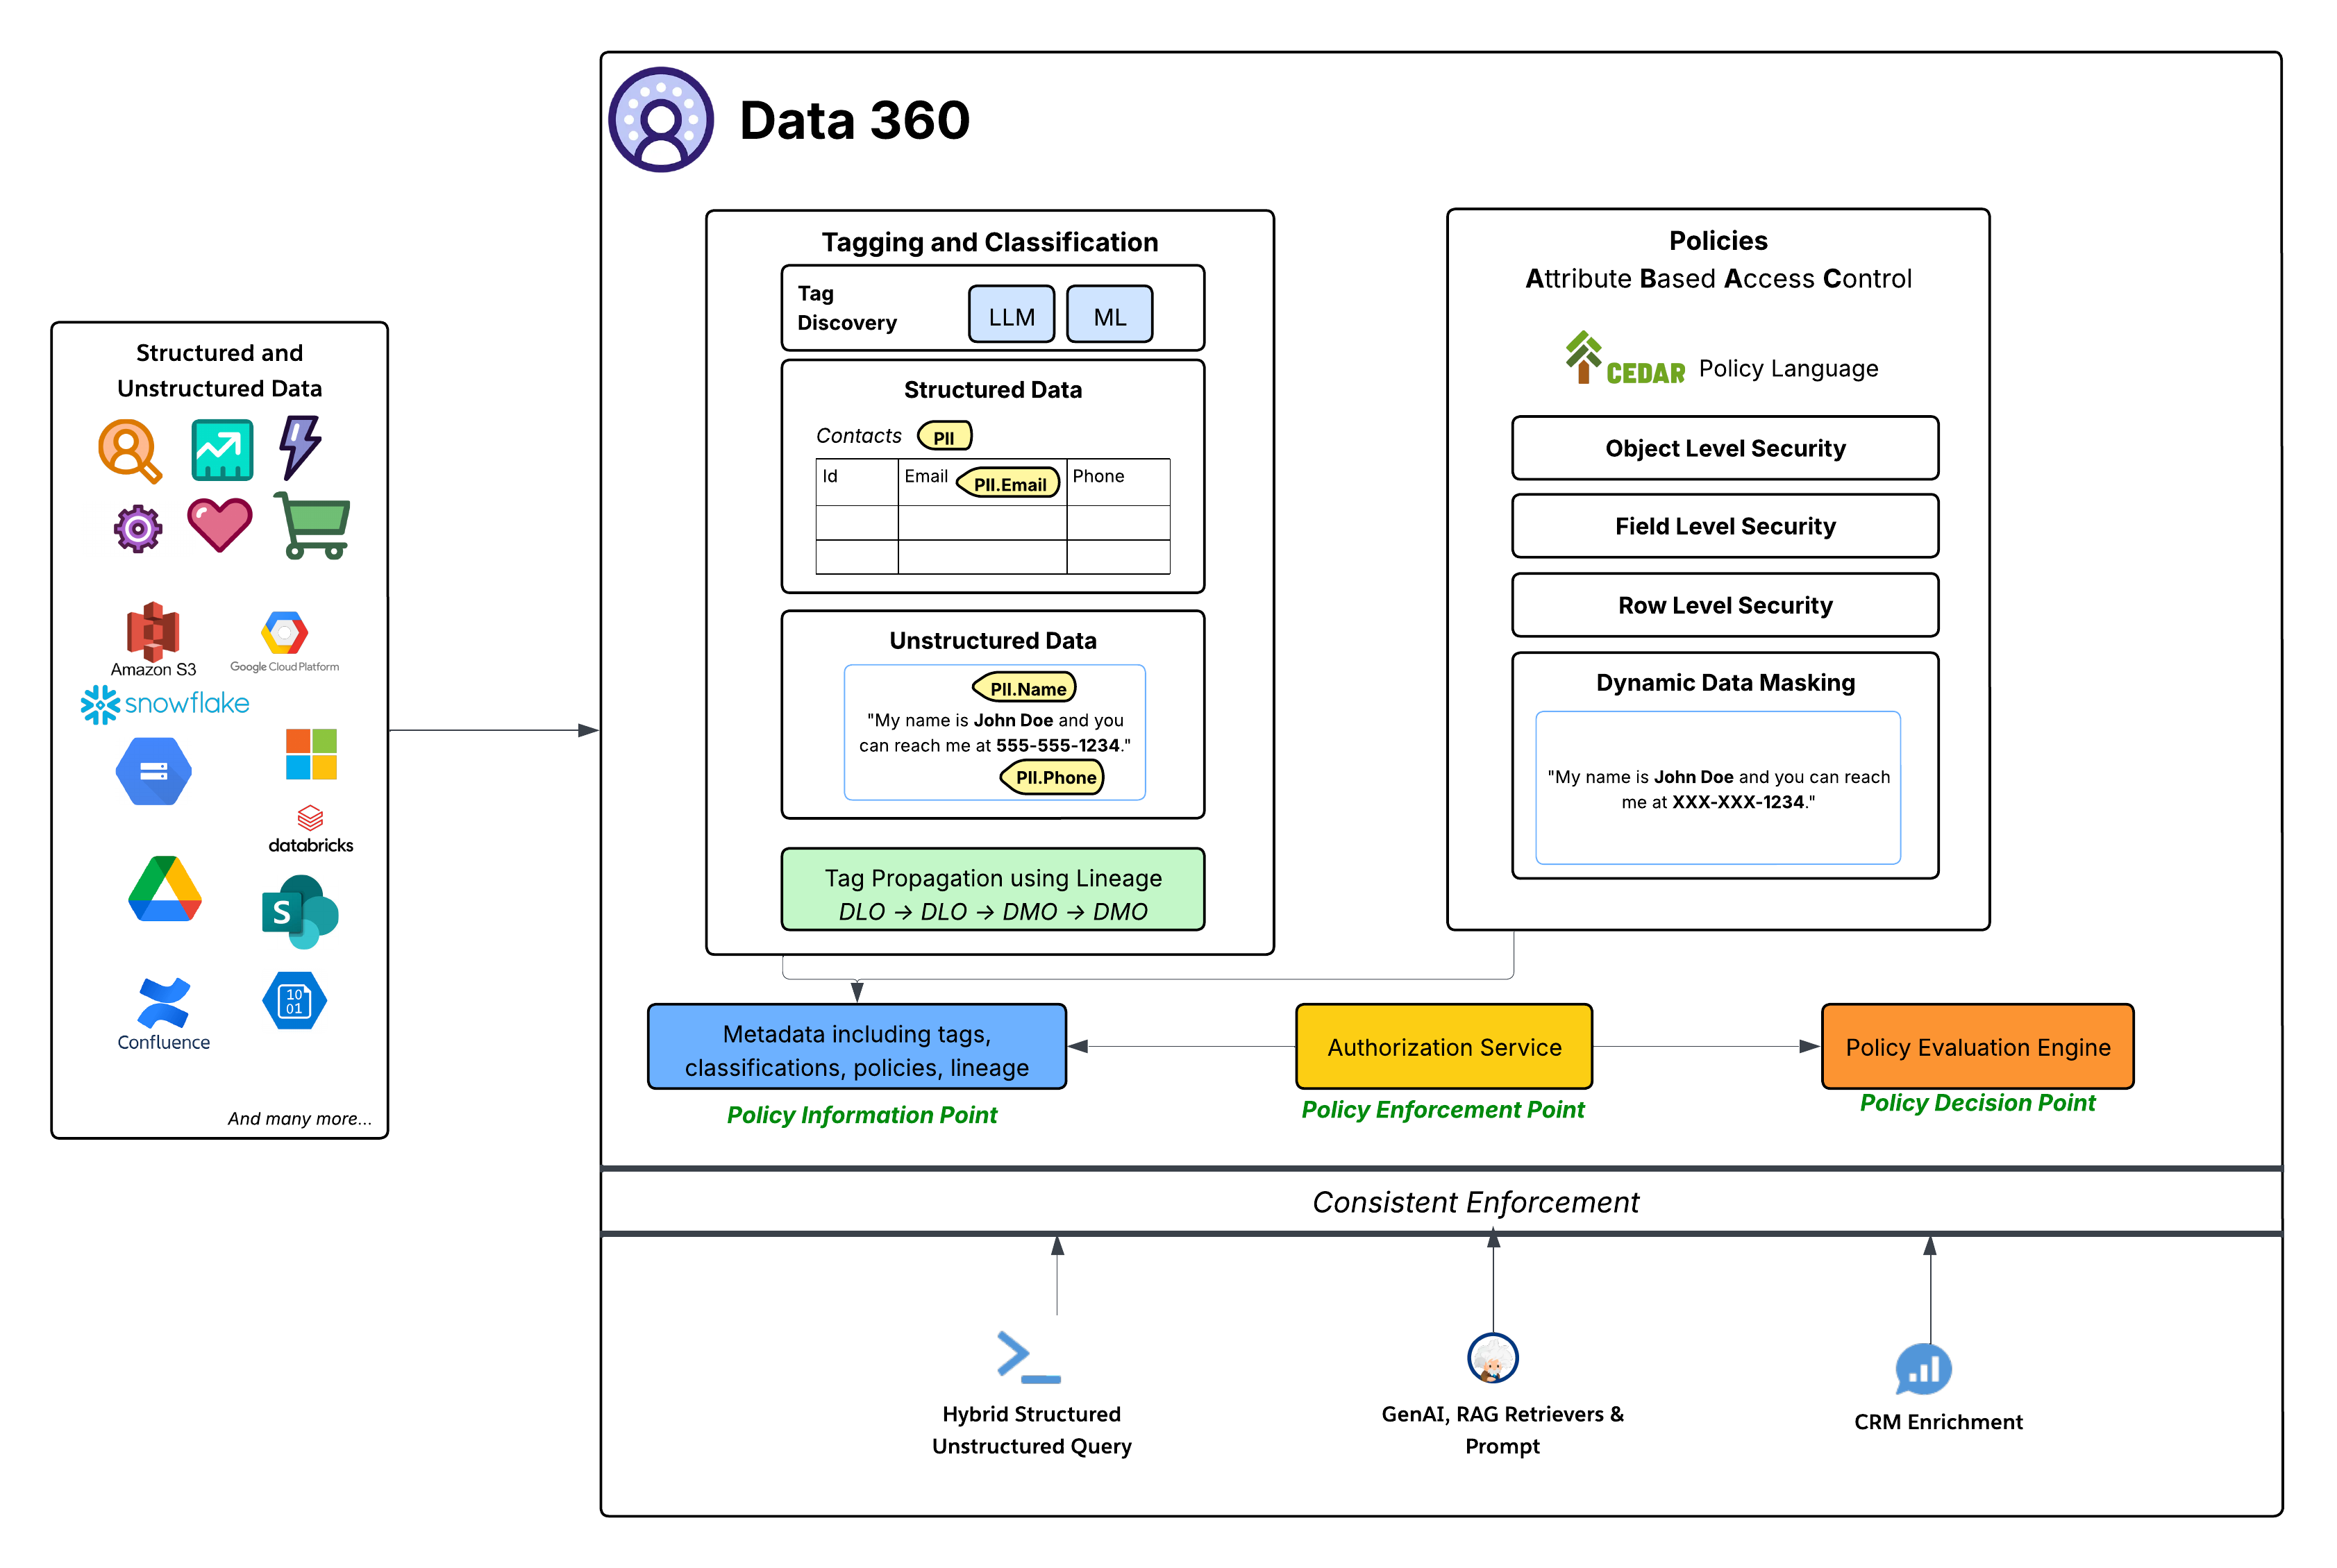 #### 進階存取控制:為什麼以屬性為基礎的存取控制 (ABAC)
雖然 dataspace 提供粗略的粒紋式存取控制,可決定資料空間內所有物件的存取權,但以 ABAC 為基礎的原則可提供資料空間內個別物件、欄位和列的細微粒紋式存取控制。Data 360 已採用「以屬性為基礎的存取控制」(ABAC) 作為微調存取控制的核心授權模型。與傳統「以角色為基礎的存取控制」(RBAC) 相比,此策略選擇提供卓越的彈性與延展性,這對於具有大量資料和各種存取需求的動態、複雜企業環境而言特別重要。ABAC 允許根據使用者的屬性 (例如部門、角色、位置)、資料 (例如 PII、敏感度、資料空間) 和環境 (例如當天時間) 進行存取決策,而不只是預先定義的角色。這可啟用高度細微且內容相關的存取原則,以在資料和使用者屬性變更時進行調整。
- **CEDAR 原則語言**:Data 360 的 ABAC 實作核心是使用 CEDAR 原則語言。此用途建立的正式原則語言提供定義複雜授權規則的精確且可驗證方法,確保原則是明確的,且可在規模上一致評估。
#### 監管結構:保單資訊、強制執行與決策點
Data 360 中的監管系統遵循標準且強大的 ABAC 結構:
- **標記、分類和原則編寫 (原則資訊點 - PIP)**:
- Data 360 提供自動標記和分類機制,利用 LLM (大型語言模型) 和 ML (機器學習) 來識別結構化資料 (例如連絡人表格) 和非結構化資料 (例如 Google Drive) 中的敏感資料種類 (例如 PII.Email、PII.Phone、PII.Name) 和其他用途建立的分類 (PHI、FinancialData)。
- 重要的是,「標記傳播」會沿著「資料歷程」(DLO -> DLO -> DMO) 進行,以確保分類會自動遵循資料轉換和衍生,從原始資料到協調的 DMO 圖層,以及透過從程序定義建立的衍生資料。
- 最後,原則編寫窗格提供簡單的體驗,可利用資料和使用者屬性為組織定義動態存取規則。
- 此豐富的中繼資料 (包括標記、分類、原則和歷程) 會摘要至「原則資訊點」(PIP)。
- **授權服務 (原則執行點 - PEP)**:
- 「授權服務」會作為「保單強制執行點」(PEP)。其會從各種耗用層 (混合結構化/非結構化查詢、GenAI RAG 取得器和提示、CRM 增強) 攔截所有資料存取要求,並諮詢「原則決策點」以判斷是否允許存取。
- **原則評估引擎 (原則決策點 - PDP)**:
- 此引擎會作為「保單決策點」(PDP)。它會從 PEP 取得存取要求內容,以及來自 PIP 的原則定義 (在 CEDAR 中) 和屬性,以做出權威權限的存取決策。
#### 重要原則強制執行與整合
- **細微安全性原則**:在 CEDAR 中定義的原則會強制執行各種安全性層級,包括:
- **物件級安全性**:根據與這些物件相關聯的標記,控制整個 DLO 或 DMO 的存取權。
- **欄位級安全性**:根據標記限制物件內特定敏感欄位的存取權。
- **列層級安全性**:篩選特定物件的資料,以根據使用者屬性僅顯示相關資料列。
- **動態資料遮蔽**:在存取點動態遮蔽特定資料 (根據標記),而不變更基本資料。這可確保敏感資訊受到保護,同時允許廣泛的公用程式。這適用於結構化資料中的遮蔽欄位,以及非結構化資料中的內容。
- **一致強制執行**:整個 ABAC 架構都能確保在所有 Data 360 耗用模式之間一致強制執行原則,無論是直接資料查詢、針對生成式 AI 應用程式 (RAG),或是透過相關清單增強 Salesforce CRM 體驗,例如。
- **與 Salesforce Platform 的深度整合**:Data 360 的監管功能會直接在 Salesforce 核心平台中定義與管理。此整合可讓管理員使用熟悉的 Salesforce 工具來管理存取原則、使用者身分和屬性管理,以確保整個 Salesforce 生態系統的統一與一致的管治層。
透過使用 CEDAR 原則建立此複雜的 ABAC 架構,Data 360 為結構設計師提供無可比擬的控制層級和彈性,確保客戶資料不僅可運作,而且在整個企業中也安全、合規且值得信賴。
### Data 360 加密:自帶金鑰
在各個產業中,組織正在加強對端對端資料安全性的重視,以確保防止資料洩漏、未經授權的存取、篡改或破壞。大多數資料平台 (包括今天的 Data 360) 使用廠商管理的加密金鑰來提供靜態加密。然而,企業 (尤其是受監管產業的企業) 越來越強制要求客戶為靜態與傳輸中的資料提供受管理加密功能。
此模型可讓公司控制自己的加密金鑰,以確保即使在平台層級缺口或未經授權存取的極少見情況下,資料仍會受到加密保護。若沒有客戶的專屬金鑰,則沒有任何實體 (包括平台提供者) 可以解密或重建資料,進而維持完全機密性和控制。
### 非結構化資料儲存與處理
Data 360 支援在整個資料提取、處理、索引和查詢機制中順暢地儲存和管理結構化 (表格)、半結構化 (JSON) 和非結構化資料。Data 360 支援文字以外的各種非結構化資料類型,包括音訊、視訊和影像,擴大資料處理和分析的範圍。下圖說明基礎的兩個側面 (取用與提取)。
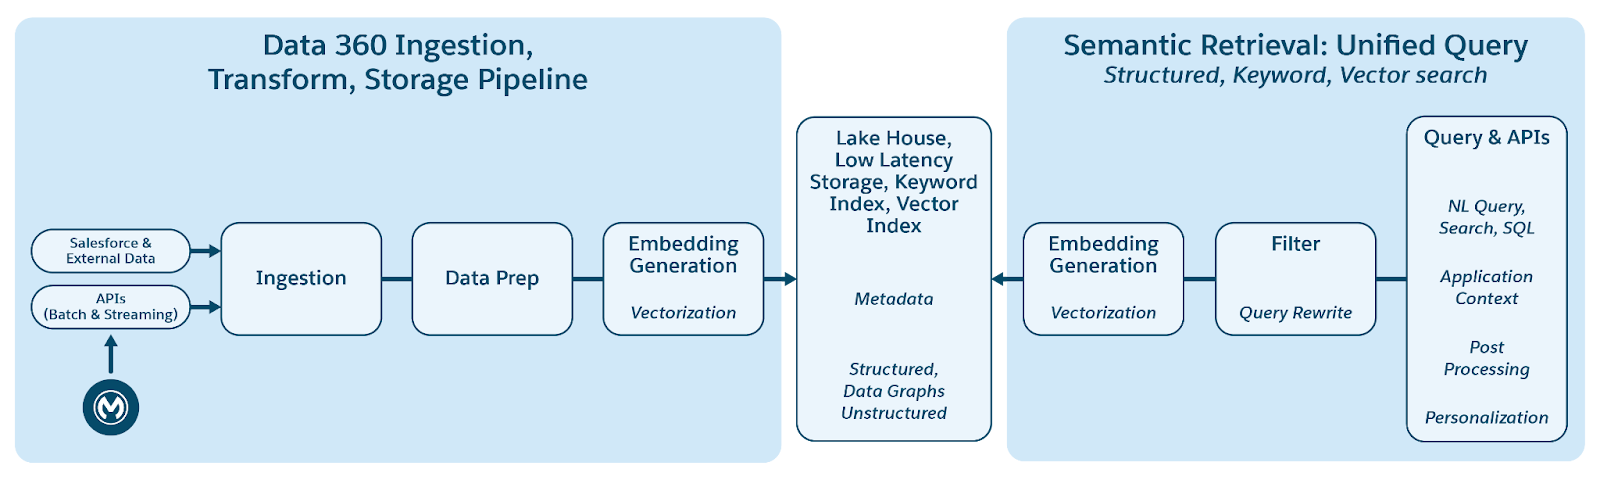 Data 360 會透過將資料儲存在資料欄中作為文字,或儲存在較大資料集的檔案中來管理非結構化資料。它支援非結構化內容的資料聯合,這允許整合和管理來自多個來源的資料。
接著會準備資料並切分、產生內嵌,並處理用於關鍵字索引和向量索引。Data 360 主控多個立即可用的可插入模型,用於分割和內嵌產生。Data 360 支援自動且可設定的音訊和視訊內容文字記錄,以供後續處理和編製索引。搜尋服務用於關鍵字索引。針對向量索引,Data 360 同時支援原生索引 (含 Hyper),並利用如開放原始碼 Milvus 等向量資料庫。Data 360 也會與 Salesforce 搜尋平台整合,以支援對非結構化資料的關鍵字索引。Data 360 中此類整合的多重模式索引可搜尋任何非結構化資料,如同在文件中稍後的「代理企業搜尋」一節中所討論。
Data 360 會提供要搜尋的 API 以取得。我們的超級型統一查詢可協助跨結構化、關鍵字索引和向量索引的集合查詢,維持嚴格的可視性和權限,進而增強 RAG 和搜尋。
#### 可延伸銷售管道
Data 360 的非結構化資料索引管道設計為模組化、可擴充的結構,包含五個核心階段:
1. 剖析
2. 預先處理
3. 切分
4. 後續處理
5. 內嵌
所有階段也支援以 LLM 為基礎的處理,可讓客戶提出自訂提示。預先處理與後續處理階段皆可包含多個連續步驟,讓複雜轉換有彈性的撰寫方式。每個階段皆完全以中繼資料為導向,無須變更程式碼即可順暢設定與擴充。
預先處理的範例包括作業,例如消除雜訊、語言正規化和影像瞭解 (光學字元辨識和標題),而後續處理階段可能包括中繼資料的增強、語意分組或進階技術,例如 Raptor 切分。
管道完全支援 Data 360 Code Extension,可讓客戶和內部小組在任何階段插入自訂邏輯。程式碼擴充元件是輕量型 Python 函數,其生命週期 (執行、調整規模和失敗處理) 由 Data 360 完全管理。此方法可確保可快速導入創新和網域特定處理,同時維持整個平台的營運一致性和管治。
##### 內容索引
針對使用非結構化處理來設定 RAG,有兩個關鍵因素:
1. **快速迭代**:能夠使用範例測試查詢快速驗證。
2. **角色特定的內容**:為耗用角色量身打造內容的容量。
「內容索引」是使用者易用的工具,專為解決這兩個方面而設計。此互動式 UI 由執行前述全部五個階段的即時 (RT) 管道提供技術支援。當需要時,管道會針對如內嵌產生和光學字元辨識 (OCR) 等工作使用 GPU。此外,其可讓客戶在部署組態以進行全方位內容處理之前,使用工作人員快速測試 RAG 管道。
##### 文件 AI
Data 360 文件 AI 可讓您從如發票、履歷、實驗室報告和購買訂單等文件中讀取及匯入非結構化或半結構化資料。此功能支援臨時互動式處理以及大量批次處理。這是可為客戶啟用業務流程自動化的關鍵功能。這是由人工智慧 (包括 LLM 和 ML 模型) 所支援。
### 企業Knowledge
企業擁有大量的 Knowledge 散佈在不同系統中,例如維基百科、檔案共用、內容管理系統、內部資料庫等。此分割使得員工 (尤其是服務工作人員和銷售代表) 和客戶難以快速且有效地找到相關資訊。主要問題包括:缺少所有 Knowledge 來源的單一統一搜尋體驗;不同來源的內容呈現與呈現不一致;缺乏跨系統散佈敏感資訊的存取管理;以及在核心業務工作流程中難以利用權威 Knowledge 來源 (例如,將相關文章附加至個案)。
Enterprise Knowledge 代表從更廣泛的企業資料集區中手動或自動精密設計的內容。手動精密設計涉及刻意的動作,例如建立 Salesforce Knowledge 文章,或在外部系統中開發 Knowledge,此知識便會接著被提取。我們預期自動化精密設計會利用流程 (例如 Salesforce 工作人員和轉換),這些流程會執行於已提取的資料上,以產生精簡且精密設計的圖層,進而可能混合結構化和非結構化內容。無論是手動或自動精密設計、在 Salesforce 內部或外部精密設計,此結果都是與原始資料不同的加值內容。
Enterprise Knowledge Hub 解決方案利用 Data 360 功能達成以下目標:
- **取用與儲存空間**:「CRM 連接器」正在取用 Salesforce Knowledge 文章,而資料連接器架構 (DCF) 非結構化連接器會從外部來源取用原始內容和中繼資料。內容會在 SFDrive 上對應至內容的來源特定非結構化資料湖物件 (UDLO) 中 (若為零複本,則為來源)。
- **調和與結構**:調和管道會處理 UDLO 和檔案資料,執行清除、正規化、增強 (NLP 等)、PII 遮蔽和轉換為已協調的中間格式,儲存在 SF Drive 和對應至其的已協調 UDLO (HUDLO)。
- **索引**:「非結構化銷售管道」(UDS) 會在協調的內容上觸發,且會為每個 HUDMO 設定搜尋索引。
- **消耗**:耗用應用程式包括搜尋、提取、呈現和連結至如「個案」等業務物件。系統會收集耗用應用程式的參與以提供用量分析 (例如點擊、檢閱等)。
### 已計算洞察
Data 360 中的已計算洞察 (CI) 可讓客戶從其資料定義和產生彙總度量。接著,這些度量會用於及時的客戶參與、分析、區隔和啟用。CIs 計算的彙總資料會寫入 Lakehouse,並以已計算洞察物件 (CIO) 表示。
已計算洞察有兩種主要類型:
- **批次已計算洞察**:針對複雜的大量資料彙總而設計,可定期計算度量 (例如每日或每週)。
- **串流洞察**:提供從即時事件資料產生度量和動作的能力,以便立即啟用低延遲的客戶參與。
已計算洞察是在資料模型物件 (DMO) 上定義,也可以在其他已計算洞察物件上定義。已計算洞察服務可管理批次和串流工作的協調流程。
批次與串流洞察計算都使用 Spark。主要差異在於串流洞察使用「Spark 結構化串流」,而批次 CI 使用定期排程的批次 Spark 工作執行。為了提高成本效率,已計算洞察服務會根據如來源資料物件的相依性和重疊等因素,將 CIs 組合在相同的批次 CI 工作或串流 CI 工作中進行計算。
SNCE 和 CDF 在「串流洞察」計算中扮演重要角色。
### 身分解析
身分解析負責將多個來源的不同資料轉換為單一的全方位「統一設定檔」。
務必瞭解統一設定檔並非「金級記錄」,且身分解析不會在統一設定檔時挑選成交值或覆寫任何現有資料。「統一設定檔」可作為一組金鑰,透過識別與相同實體相關的所有相符記錄,在一個資料來源內或跨多個來源,來解除鎖定來源資料。透過此資訊,您可以選取適合用於指定業務使用個案的來源系統資料。
身分解析可合併各種記錄類型,包括「個人」、「帳戶」和「家庭」。也可以用來將商機與現有帳戶進行比對。統一流程對於達成完整的 Customer 360 檢視,並在 B2C 和 B2B 案例中促進個人化即時參與至關重要。
身分解析銷售管道以可高度調整的雲端原生架構為基礎,專為持續處理大量資料而設計。此流程包含三個關鍵階段,依賴強大的搜尋索引來管理比對流程:
- **比對 (候選項目選取項目)**:比對流程的目標是搜尋可能屬於相同實體的記錄。系統會根據可自訂的規則集分析記錄,每個規則都包含一組條件,定義要在哪個嚴格層級比對的資料。為了有效地從資料存放區中提取潛在相符項目,系統會產生索引,以使用兩種技術尋找可能相符的記錄:
- **封鎖金鑰**:封鎖索引鍵是從記錄的資料和比對規則 (例如名稱的前幾個字母、正規化電話號碼等) 產生的值,可將可能類似的記錄分組在一起。每個記錄有多個封鎖索引鍵,這些索引鍵會編製索引並儲存為反向索引,以確保系統僅對小型記錄群組執行詳細比較,而非整個資料集。
- **本地敏感雜湊 (LSH)**:針對具有模糊比對的比對規則,會根據已訓練模型中的內嵌產生雜湊。
- **深度比對**:在候選項目選取步驟建立較小的潛在符合項目群組後,系統會開始更詳細的比較。在此階段中,AI 模型和進階演算法會分析每個記錄配對,以計算機率比對分數。此分數會透過智慧地比較經常包含拼字錯誤、變化或格式差異的欄位,來量化兩筆記錄參照相同實體的可能性。
- **叢集與統一**:從候選項目識別相符記錄後,這些記錄會分組為叢集。此流程重要包括解析傳動比對。例如,如果記錄 A 符合記錄 B,而記錄 B 符合記錄 C,則即使 A 與 C 從未直接比較,這三個記錄皆會連結至相同的叢集。這些完整叢集形成「統一設定檔」的基礎結構。此叢集流程可確保在單一永久識別碼下正確連結所有相關來源記錄。
- **協調**:系統會使用定義的協調規則 (例如,_最常見_、_最近_或 _來源優先順序_) 來評估來自所有叢集來源記錄的資料值,以便將設定檔資料摘要填入產生的「統一設定檔」。協調不會覆寫任何現有資料,因為所有來源資料皆可使用連結至統一設定檔的金鑰。
#### 身分解析類型
此結構支援多個實體類型的解析度,以滿足各種使用個案。
- **個人比對**:專注於建立「統一個人」設定檔,其會將所有已知個人識別碼 (電子郵件、電話號碼、忠誠度識別碼、Cookie) 連結至一個人員。
- **帳戶比對**:專注於建立「統一帳戶」設定檔,其會連結帳戶的相關資料。比對公司名稱時,引擎會在模糊比對時使用微調的模型。
- **家庭比對**:擴充比對邏輯,將「統一個人」記錄彙總到相關個人的群組中。
- **跨實體比對**:除了統一之外,身分解析也會使用相同的比對規則,在設定檔物件之間建立連結。例如,可使用「帳戶名稱」上的模糊比對,將「商機」連結至「帳戶」。
#### 近乎即時處理
為了確保「統一設定檔」一律為最新狀態,身分解析引擎使用近乎即時的時間結構運作。此雲端最佳化的結構專為持續處理而設計,以達到快速的處理時間。雖然處理速度會根據接收來源資料的方式而有所不同,但身分解析可每 15 分鐘處理一次的小批次變更。
#### 來源設定檔連結
系統會維護身分連結物件,這些物件會將每個來源記錄識別碼對應至其對應的「統一設定檔識別碼」。此基礎資料結構可讓引擎有效追蹤關係,並快速將變更和更新移入「統一設定檔」,確保客戶體驗 (例如網站個人化、 Next Best Action 建議和區隔) 始終利用最新的可用客戶資料。
### 區段
區隔是將統一的客戶設定檔轉換為可運作受眾的核心流程。此功能對於在整個行銷、商務和服務管道中提供個人化體驗而言至關重要。Salesforce Data 360 Segmentation 平台是針對大規模作業而設計。它會管理複雜的中繼資料,並使用包含數千個物件和關係的資料模型。平台支援複雜的規則、彙總式篩選條件和視窗式排名,同時確保以 petabyte 規模進行快速且可靠的計算。
#### 區隔類型與步調
Data 360 支援各種區段類型,以符合不同業務需求的速度、複雜性和階層:
1. **標準區段**:主要批次處理區段類型。其會依自訂排程發佈,其「標準發佈」步調至少為 12 小時至 24 小時,或較快的「快速發佈」步調為 1 到 4 小時,其針對最近參與資料最佳化。
2. **即時區段**:此區段會依需求完成,以毫秒為單位,以根據最近事件和設定檔資料立即採取動作。其針對立即個人化高度最佳化,但無法使用排除條件或巢狀區段。
3. **瀑布圖區段**:子區段的階層結構,用於將客戶的優先順序設定為單一且最有價值的區段 (如果其符合多個條件)。
4. **巢狀區段**:這允許重複使用現有區段作為新更具體區段的篩選條件 (基本區段的精簡),繼承父系區段的排程。
#### 區隔引擎:結構基礎知識
區隔引擎使用強大的雲端原生結構來確保速度、規模和彈性。
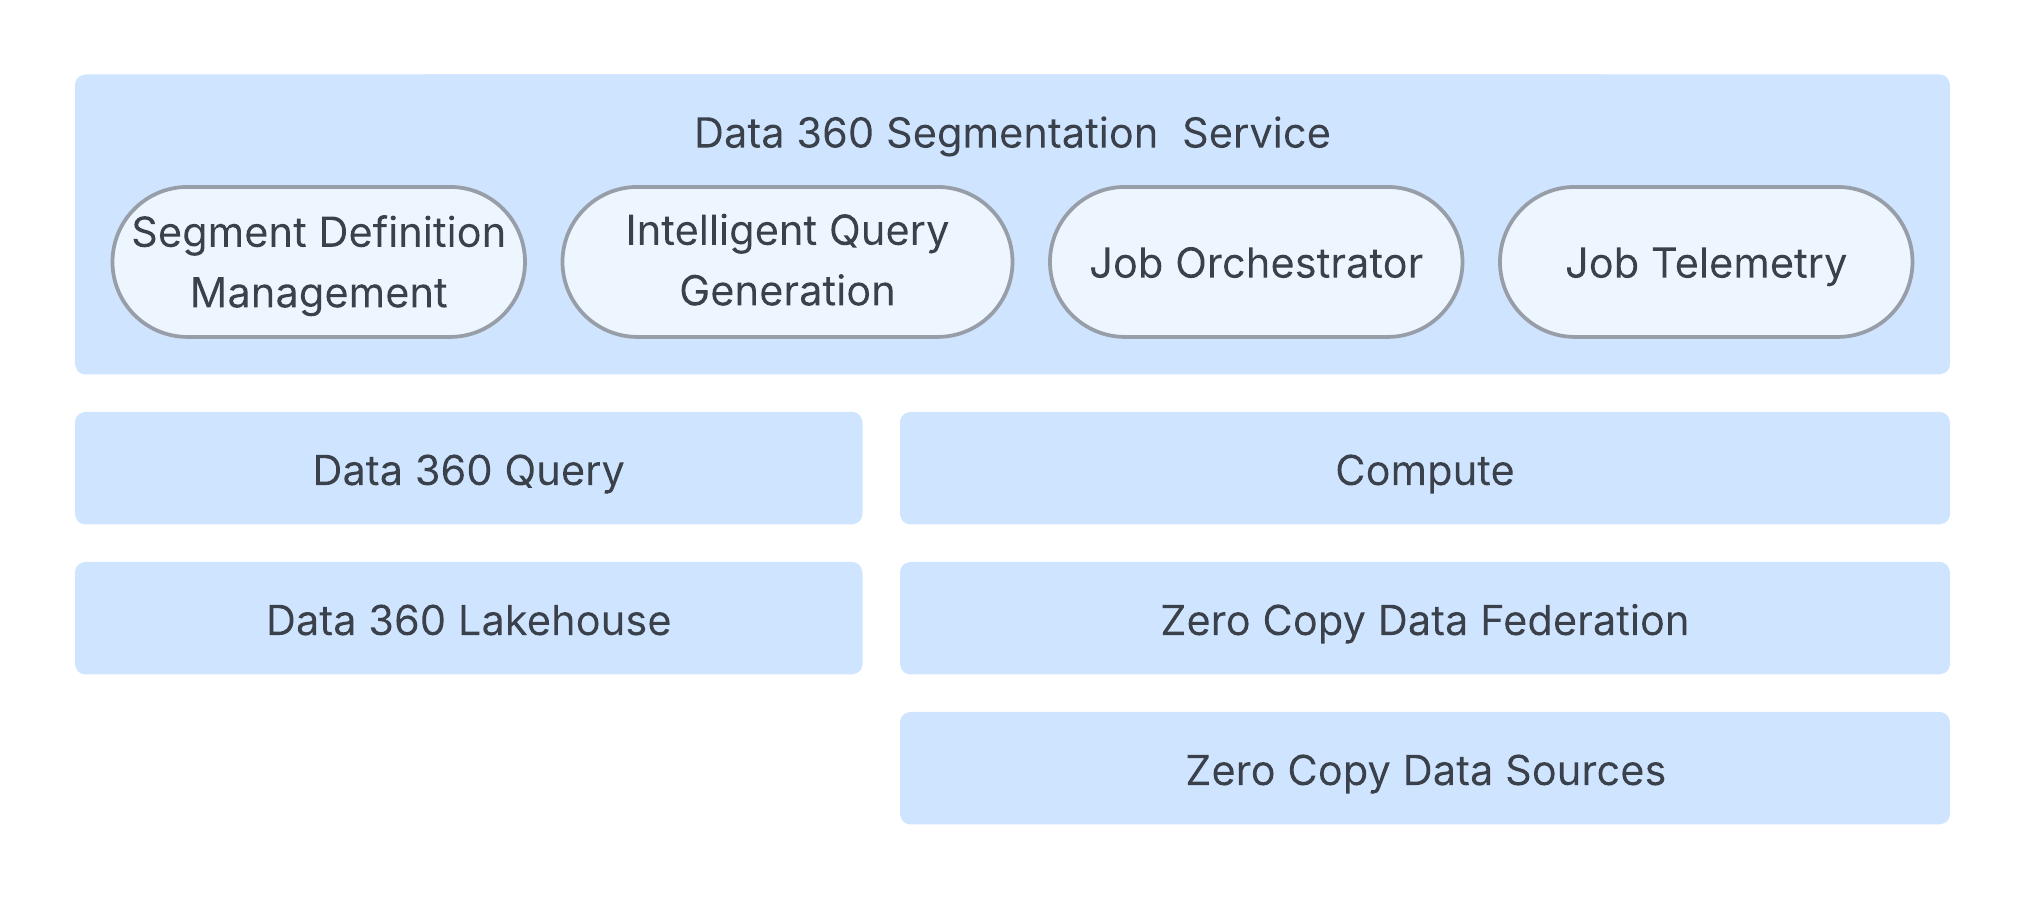 核心流程由工作協調流程服務管理,其可控制區段的生命週期,產生必要的工作組態並觸發執行。此協調流程層會在分割資料庫中維護狀態和中繼資料,以便擴充性。
雖然 Data 360 查詢會處理區隔計數計算,但 Spark 計算層負責計算實際的「區段」成員資格。Spark 應用程式會對大量客戶資料執行 Spark SQL 查詢。此資料可以位於 Data 360 Lakehouse、透過 Zero Copy 資料聯邦的外部系統,或兩者的組合。
系統透過智慧查詢產生高度最佳化,進而精簡基本的 Spark SQL 查詢。這包括智慧分割等技術,以將資料掃描降到最低,並消除冗餘子運算式。為了確保服務可靠性,結構有自適應資源管理功能,會根據工作量與複雜度動態調整運算資源。此外,系統會使用自適應持續時間和重試邏輯主動管理「SLO 符合度」。為了獲得快速的使用者體驗,加速區段計數會使用以取樣為基礎的方法,在建立區段期間提供快速大小估計值,避免完整執行查詢。
最後,透過全方位的 Spark 執行度量和自動化錯誤分類 (例如客戶端與系統問題),深度專注於可觀察性和根本原因歸因,大幅減少診斷時間並確保高度彈性的資料平台。
### 啟用
啟用是 Data 360 生命週期的關鍵最後一個步驟。其核心功能是將靜態、區隔且統一的客戶設定檔轉換為可運作且豐富的資料,並將此資料傳送至內部和外部端點 (例如 Marketing Cloud、Commerce Cloud 和 Adtech 平台)。此流程的設計目的為觸發個人化的客戶旅程和近乎即時的互動。其支援如相關屬性、啟用成員資格篩選、同意篩選、限制和排名等進階功能。
啟用針對外部傳送與管道合規性提供三種不同的方法:
- **批次啟用**:針對大量排程作業設計,例如大規模電子郵件行銷活動和廣告受眾重新整理。資料會透過將資料暫存至「安全內部分類」(雲端物件儲存) 或透過「安全檔案傳輸」來傳送,後面接著是目標系統起始的 API 採取流程。批次啟用可利用特殊重新整理模式 (增量) 來減少 Salesforce 合作夥伴傳送和處理的量。
- **串流啟用**:針對需要事件驅動自動化的近乎即時使用個案最佳化。傳送可透過傳送至目的地端點的直接 API 呼叫達成。
- **啟用觸發流程**:此高度平台化管道提供無程式碼/低程式碼方法,可將「受眾資料」與數百個已啟用客戶 API 的參與平台整合。啟用完成時,Data 360 會填入「受眾 DMO」,然後觸發「大規模流程」。「流程」引擎接著會耗用受眾資料,並利用如「外部服務」和「模擬輸出目的地」等平台功能來呼叫最終 API 型目的地。此方法會大幅減少上線新啟用目標所需的時間。
啟用會針對工作管理、分散式執行和監視使用與區隔相同的模式。這包括用於生命週期管理的工作協調流程服務和用於處理的運算層 (Spark) 原則,並依賴工作距離測量來瞭解效能可觀察性和服務層級目標 (SLO) 符合度。
除了這些項目之外,啟用還具有:
**啟用目標管理**會監視所有目的地端點的安全連線、認證和組態。這可保證資料格式和安全性通訊協定已標準化,確保可靠的輸出傳送至各種平台,包括 Marketing Cloud、Adtech 合作夥伴和其他外部應用程式。
啟用會為特定目標量身打造裝載。針對 Salesforce Marketing Cloud,這包括業務單位 (BU) 感知篩選、多重 EID 支援和交叉污染控制。
**「通訊管理」** 會作為門管,確保資料用量與通訊符合客戶偏好與法律需求。集中同意模式會統一所有客戶偏好設定,從全域選擇退出到管道和用途特定同意,並儲存在「統一個人設定檔」上。執行期間,平台會使用排除篩選來從最終裝載中自動移除不同意的個人,以嚴格執行這些原則。此外,系統會套用連絡點選取規則,以確保在傳輸任何資料之前,針對預期的管道使用單一、最合規且偏好的連絡點。此強制執行機制由基礎管理架構保護,此架構使用如動態資料遮蔽和存取控制等保護措施,以在整個啟用流程中保護敏感資料欄位。
### 統一查詢:流暢存取所有客戶資料
統一資料平台的真正價值在於其能夠輕鬆且一致地存取其所有資料資產,無論其來源或結構為何。Salesforce Data 360 的「統一查詢」功能精確設計,可提供此功能,從多元化資料存放區的基本複雜性中摘要以提供單一強大的查詢介面。
「統一查詢」層提供各種耗用模式的精密存取權:
- **混合結構化與非結構化查詢**:其提供廣泛的 SQL 支援,可順暢地查詢結構化資料和非結構化資料的結構化中繼資料。此功能透過表格函數增強運算子擴充性,可在文字、影像和空間類型之間啟用專用搜尋。
- **使用 Hyper 加速效能**:Data 360 利用高效能記憶體內引擎 Hyper 加速複雜的分析查詢和互動式顯示面板,透過大量資料集提供近乎即時的回應。
- **AI 與個人化的統一方法**:此統一存取權對於產生目標化和個人化結果至關重要,透過在豐富的企業資料中奠基 AI 模型,直接使用「取得增強型產生」(RAG) 來促進更精確的 LLM 回應。
- **與下游耗用整合**:其可作為 UI 驅動體驗、強大的 API、生成式 AI 工作流程和 CRM 增強的基礎資料存取層,以順暢地將資料連線至啟用。
透過提供單一、智慧且高效能的查詢介面,Data 360 的統一查詢可讓結構設計師建立敏捷、資料驅動的應用程式,以充分利用其完整的客戶資訊範圍。
### 資料動作
Data 360 是啟用的平台,支援針對資料事件啟用銷售管道。例如,重要事件 (例如客戶的帳戶餘額下降) 會觸發 Salesforce 流程來協調對應的動作。同樣地,主要度量的更新 (例如終身使用) 可以自動移入相關應用程式。
「資料動作」會使用儲存空間原生變更事件 (SNCE) 和變更資料摘要 (CDF) 持續監視變更的增量資料。系統會根據客戶設定的動作規則來評估此資料,例如到度值監視或狀態變更。符合這些規則時,會產生資料動作事件。此事件會以其他資訊 (例如客戶忠誠度狀態) 增強,並立即傳送至設定的目的地,例如 Salesforce 流程或外部應用程式,以觸發業務協調流程。
#### 客戶資料平台
Data 360 支援原生 CDP (Customer Data Platform) 功能,包括進階身分解析功能,以及建立統一個人識別碼和設定檔以及全方位參與歷程記錄。此平台擅長處理公司對公司 (B2B) 和公司對消費者 (B2C) 架構,透過支援使用完全和模糊比對規則的身分解析和身分圖,如上所述。這些身分圖以來自各種管道的參與資料來增強,這有助於建立含有寶貴分析洞察和區段的詳細設定檔圖表。
支援客戶設定檔的重要概念是資料圖形。Data 360 提供 JSON 格式的企業資料圖表,這是衍生自各種 Lakehouse 表格及其相互關係的反正規化物件。這包括由 CDP 建立的「設定檔」資料圖表,其中包含人員的購買和瀏覽歷程記錄、個案歷程記錄、產品用量和其他已計算洞察,且客戶和合作夥伴可以擴充。這些資料圖是針對特定應用程式量身打造,並透過提供相關的客戶或使用者內容來增強生成式 AI 提示準確度。Data 360 的即時圖層使用「設定檔」圖表進行即時個人化和區隔。我們會將「對話」、「工作階段」和「工作人員記憶體」作為資料圖包含的建模 Agentforce Context。
此外,CDP 可在不同平台之間 (例如 Salesforce 的 Marketing Cloud、Facebook 和 Google) 啟用有效的區隔和啟用。它會批次、近乎即時和即時處理客戶設定檔,以便立即進行決策和個人化。此功能可增強 B2C 和 B2B 案例中的互動,確保公司可以快速且準確地回應客戶的需求和行為。
### 即時層級
Data 360 的即時階層由 Data 360 CDP 支援,並針對即時使用個案擴充其概念。Data 360 的即時層設計為以毫秒延遲處理如網路和行動點擊串流、造訪、手推車資料和結帳等事件,以增強客戶體驗個人化。其會持續監視客戶參與度,並使用即時參與資料、區段和計算來更新 Customer 360 的客戶設定檔,以立即個人化。
例如,當消費者在購物網站上購買項目時,即時圖層會快速偵測並取用此事件、識別消費者,並以更新的終身支出資訊增強其設定檔。這可讓使用子秒的方式個人化其在網站上的體驗。此外,此層包含即時觸發和回應的功能,以根據客戶互動啟用立即動作。
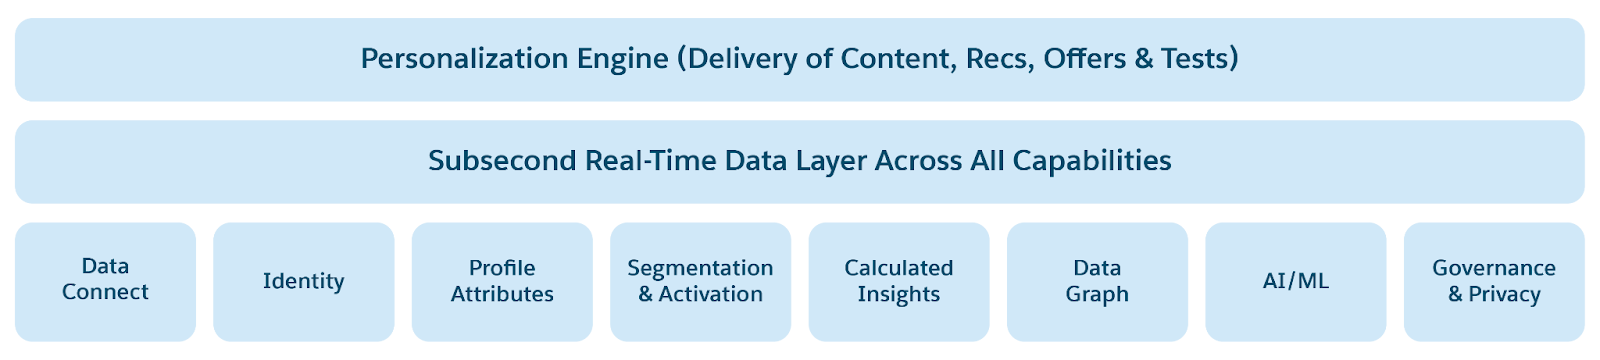 Sub-Second Real-Time 平台透過數個重要功能來強化此轉換:
1. **即時資料圖**:Customer 360 設定檔使用反正規化圖表建立,其中包含與品牌最相關的關鍵物件和欄位。這些資料圖可啟用即時資料處理,並在毫秒內提供可運作的內容和洞察
2. **即時採取和轉換**:從 Web 和行動來源以毫秒為單位的速度,來取用使用者事件和設定檔。
3. **即時身分解析**:在裝置之間合併客戶設定檔,立即統一未知與已知使用者。
4. **即時已計算洞察**:計算如終身價值 (LTV) 或使用者造訪歷程記錄等度量 (以毫秒為單位),以啟用「個人化」或「Web 的優惠」、「聊天機器人」或服務代理程式。
5. **即時區段**:隨時將受眾區隔,即時個人化訊息和互動。
6. **即時動作**:讓品牌能夠評估每個使用者參與,並透過 Salesforce 流程或其他相關的通訊管道採取行動。
在 Data 360 中,我們建立了包含即時管道、低延遲儲存和子秒資料處理層的新即時平台。隨著從 Web 和行動管道中快速取用互動式資料,其會經過一系列快速流程。
我們的 Web 與行動 SDK 和即時 API 會從 Web/行動應用程式收集資料 (在未來 Agenttic 互動中),並將其傳送至我們的指標伺服器。接著,系統會將此資料路由至「即時層」以進行毫秒處理,並將其路由至「Lakehouse 層」以與批次/串流資料整合。「即時」層會在使用者設定檔內容 (匿名或已登入) 中處理傳入即時資料,例如更新使用者總支出或終身價值等,以進行工作階段中即時個人化。「即時層」受主要記憶體和 NVme (SSD) 儲存空間支援,用於儲存即時資料和客戶設定檔。資料在「即時層」中後,會先經過下列流程,再更新為「即時資料圖表」:
- **簡易採取與轉換**:系統會為進一步的處理取用並轉換資料。
- **身分解析**:系統會套用完全符合比對規則,以將設定檔與所有現有比對規則集統一,因此資料感知專家不必特別為即時建立新的身分解析規則集。
- **已計算洞察**:系統會評估每個參與、執行如加總和毫秒計數等簡單計算,並在即時資料圖表中更新資料。
- **即時區段**:系統會評估每個參與資料,以判斷其是否符合已定義即時區段的條件,且使用者會以毫秒新增至合格區段。
- **即時動作和觸發**:系統會根據定義的規則評估每個參與,以在符合規則時,即時針對一系列目標觸發動作。
- **即時資料圖形與 API**:即時資料圖表 (也包含即時 API) 可讓品牌針對每個使用者提取更新後的 JSON 格式資料,以確保所有客戶互動皆以最新的資料通知。
#### 個人化
個人化就是瞭解要鎖定目標的人員、何時及何處傳送相關內容和建議、要說什麼以及什麼頻率。「個人化服務平台」可協調透過個人化體驗來最佳化目標達成率所做的決策。
**個人化服務**提供下列功能:
- 一致的模型集與解譯 Data 360 中設定檔、活動和資產資料的方式
- 平台整合的試驗 (A/B/n、多臂詐騙)
- 設計時間 (組態)、ML 訓練時間和執行階段 (ML 推斷) 的整合目標
- B2C 規模即時和批次互動支援 (匿名使用者、大量即時/互動式外部、大量內部批次)
- 透過 Data 360 驅動的 Analytics
- 整合其他廠商 AI 模型與服務的模式 (內部與外部)
- 整合至核心中繼資料生態系統 (PLATE 特性)
- 高價值 AI 驅動使用個案的 OOTB 實作 (具有各種 ML 演算法的建議/決策,包括促銷/內容選取、產品建議、定價決策等的內容違約)。
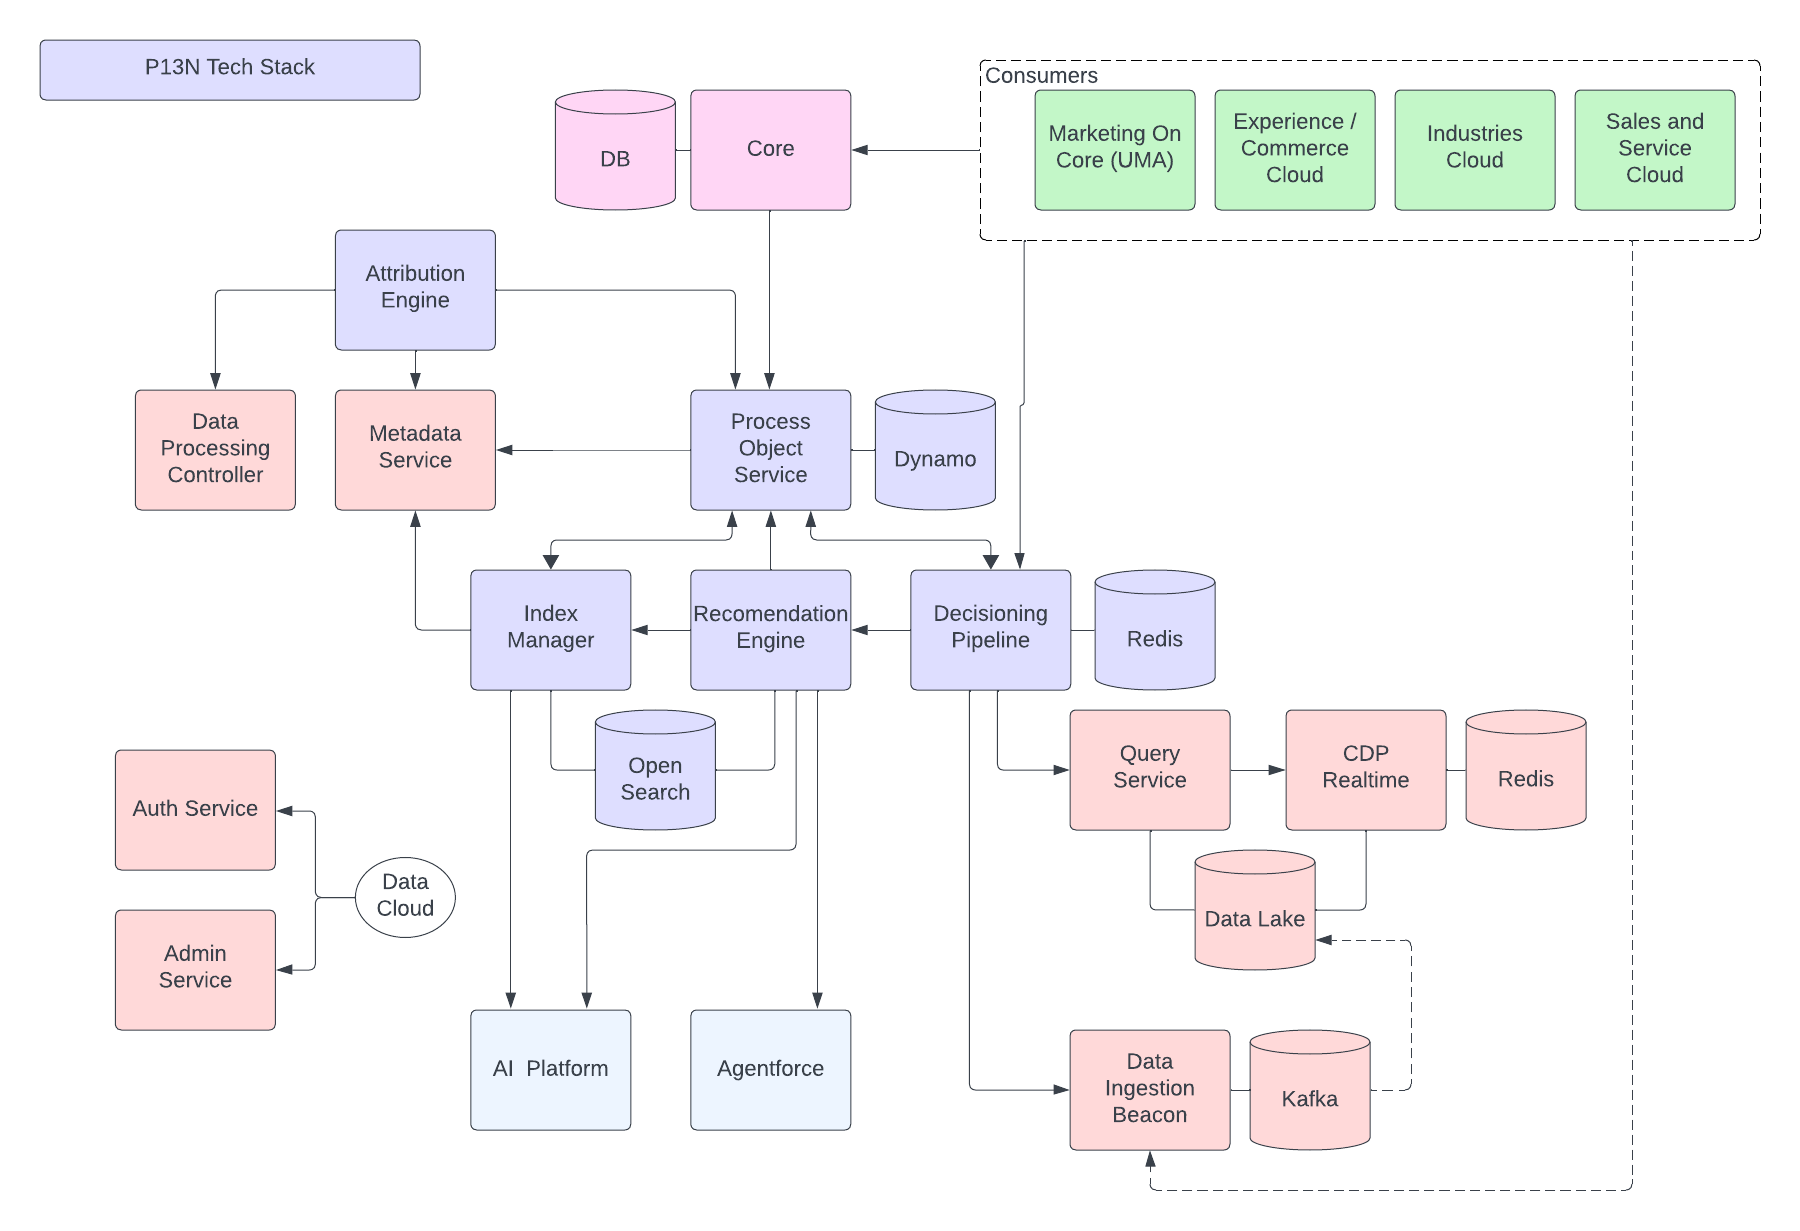 - **決策管道**
- 提供個人化決策的外部要求,包括設定檔擴充、試驗和建議。
- **建議引擎**
- 以規則或 ML 為基礎之建議的執行階段服務。
- **索引管理員**
- 管理/協調非同步流程的工作流程,包括建議模型的 ML 訓練
- **流程物件服務**
- 負責在核心與非核心之間同步化個人化中繼資料
- **歸屬引擎與試驗**
- 個人化建議的 Analytics 歸屬與試驗
### 工作人員企業搜尋
Data 360 專為支援新興工作人員體驗而設計為強大且豐富的平台。我們透過建立各種現有的 Data 360 服務,並透過與 Agentforce 的深度整合來達到這些功能。
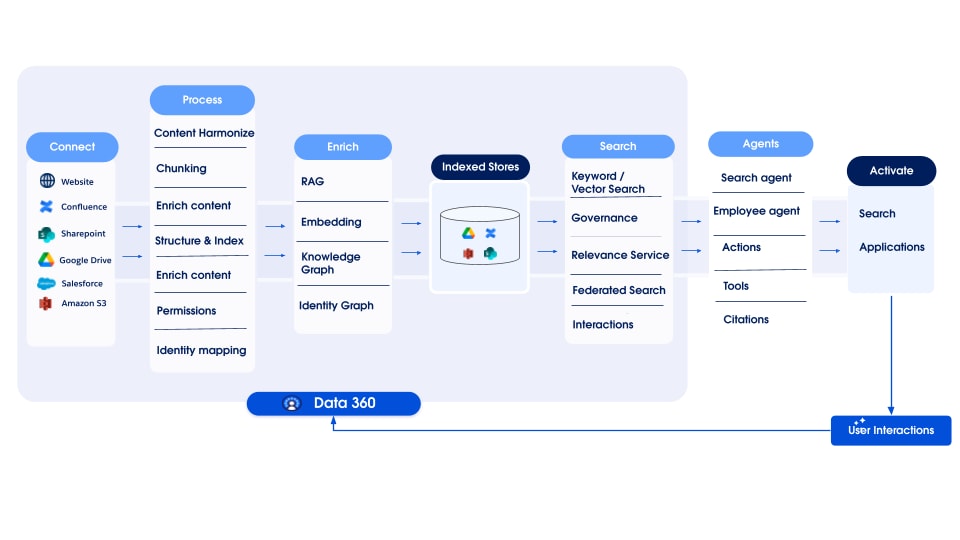 #### 利用 Data 360 的核心優勢
我們對「代理企業搜尋」的方法以下列原則為基礎:
- 企業資料會保存在隔離的服務或商店中,且具有存取所需的安全權限。能夠在維護來源權限的同時存取和處理此資料,對於確保 Trust 而言至關重要。
- 跨資料整體的跨排名和相關性可提供更好的結果,進而為工作人員體驗提供更好的內容。
為了提供這些體驗,「代理企業搜尋」以這些關鍵結構元件為基礎建立:
- **連接器**:Data 360 提供一組廣泛的連接器,讓您能夠從各種來源中存取和取用資料。
- **非結構化資料處理**:這是處理非表格內容的基礎,讓系統能夠從各種資料衍生意義和內容。
- **監管**:確保搜尋所耗用所有資料的企業級安全性、合規性和存取控制。針對簡單搜尋與工作人員體驗,支援來源可視性權限可確保只有已授權的使用者可以存取資料。為了確保快速取回,搜尋後端會在資料存取的最早階段原生評估和強制執行安全性權限。
- **統一檢索層**:為了解決隔離資料的挑戰,連接器會摘要為全方位「統一檢視」層。此圖層提供所有資料的單一存取點,無論其是否保留在透過聯合搜尋存取的外部系統中,或透過零複製與已提取資料的進階索引進行原生管理。
- **智慧查詢瞭解**:提取前,系統會使用 AI 技術支援的機制解讀使用者的意圖。除了內嵌用於語意向量比對的查詢表示外,它還可以重寫和展開以關鍵字為基礎的搜尋,以改善準確性。
- **混合式搜尋和進階查詢**:為了尋找最相關的資訊,平台會並列使用多個策略。混合式搜尋會在最佳化區塊的資料上,提供與語意向量搜尋相符的精確關鍵字,而「完整記錄」搜尋會同時檢取整個文件。兩者皆結合在一起,以確保語意相關性和完整的內容涵蓋範圍。
- **階層排名**:取得資料後,多階段階層排名結構會為每個來源和方法的結果進行評分、合併和重新排名。此流程會建立單一的統一清單,以呈現與使用者或工作人員最相關的資訊。
#### 工作人員搜尋應用程式
生成式 AI 將企業搜尋的主要消費者從人類使用者移至大型語言模型 (LLM)。Data 360 搜尋是從頭開始設計的,可提供這兩種服務。其已最佳化以處理來自工作人員的較長且更複雜的查詢,並傳回程式設計耗用與推理迴圈所需的完整內容結果。同時,系統可以處理人類使用者通常較短且經常不明確的查詢,提供如程式碼片段等功能,並醒目提示 UI 中的快速評估。
最終提供工作人員搜尋體驗結合以下兩種方法:
1. **直接搜尋結果**:應用程式可以使用以 Data 360 統一搜尋基礎建立的中繼資料驅動 API,顯示傳統的排名結果清單。
2. **代理、多輪對話回答**:代理回答透過與 Agentforce 的原生整合來實作。此對話體驗由主要工作人員驅動,主要工作人員可協調動作和查詢,並將所有資訊尋找工作委派給專門的內部搜尋工作人員。
此專門的「搜尋工作人員」已最佳化以用於取得企業資訊。它會使用推斷迴圈來制定並執行並列搜尋,以探索使用者要求的不同層面。它利用一組強大的工具,包括 Data 360 統一搜尋所有資料類型和結構化查詢語言,以從表格和實體中提取精確的資料。
透過此結構合併,Data 360 可讓您建立高智慧、感知內容且可運作的代理企業搜尋體驗。
### 使用自訂程式碼擴充 Data 360
擴充功能是 Salesforce Platform 中的關鍵功能。「程式碼延伸模組」可在 Data 360 中提供擴充功能,允許專業程式碼使用者直接在 Data 360 環境中執行自訂 Python 邏輯,以補充其豐富的陳述性與低程式碼功能。使用程式碼擴充功能,使用者可以安全地擴充 Data 360 核心功能,例如轉換和非結構化資料銷售管道 (自訂切分)。
我們的「程式碼延伸模組」設計優先考量彈性、安全性、效率和簡化的開發人員體驗。其支援兩個主要執行模型,每個模型皆為特定結構需求量身打造:
- **指令檔模型**:
- **目的**:適用於需要與 Data 360 Lakehouse 直接互動的全方位自訂邏輯。
- **功能**:客戶使用 Code Extension SDK 撰寫完整的 Python 指令檔,透過 SDK API 啟用 Lakehouse 的讀取與寫入存取權。適用於自訂/複雜資料準備或自訂資料操作的理想選擇。
- **隔離與安全性**:當指令檔存取 Lakehouse 時,其執行僅限於 Data 360 執行階段內的安全隔離環境,以防止其他程序或未經授權的系統存取遭到干擾。
- **函數模型**:
- **目的**:類似無伺服器函數,適用於從現有 Data 360 管道叫用的模組化無狀態計算 (例如「非結構化管道」中的自訂切分)。
- **功能**:客戶提供的函數會取得輸入、計算和傳回輸出。
- **隔離與安全性**:這些函數是為了嚴格的隔離而設計;它們沒有直接的 Lakehouse 存取權。其執行為 Sandbox、無狀態和資源限制,使其適合專注的無狀態處理步驟,確保安全性、可預測的執行,並將爆炸半徑降到最低。
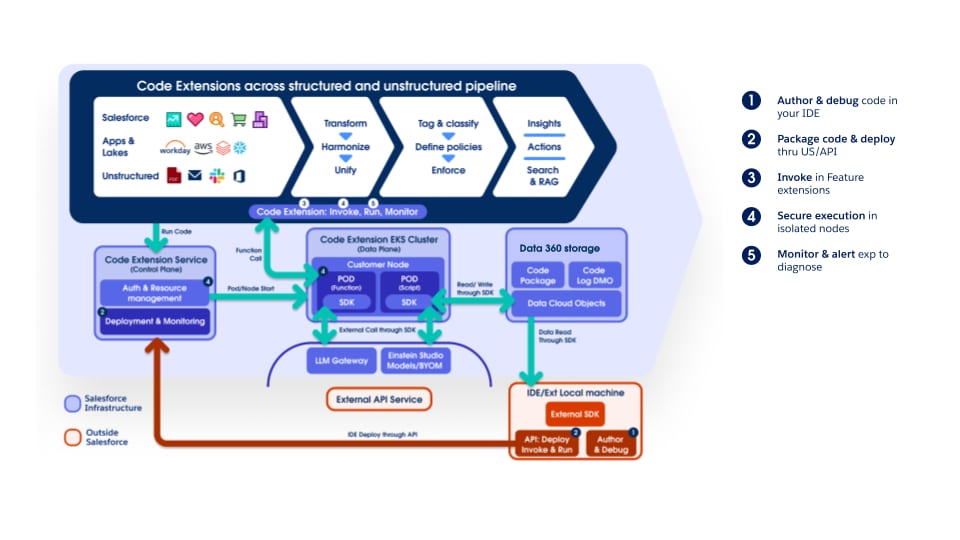 「指令檔」與「函數」模型都旨在安全執行客戶程式碼,防止某個租戶的程式碼影響其他租戶,或未經授權存取其他租戶資料、Salesforce 資源或外部資源。此安全性可透過層級式 (深度防禦) 結構來達成。此結構為每個租戶的自訂程式碼提供隔離執行環境,並納入各種護欄。其中包括 Kubernetes (K8s) 層級的邏輯隔離、網路隔離、執行階段 Sandbox 和最低權限權限,所有這些權限都會由作業監視和偵測和回應的事件回應整備補充。
#### 開發人員體驗與作業可視性
為了支援強大的開發生命週期,Code Extension 提供:
- **外部編寫與除錯**:開發人員可以在熟悉的環境 (例如 VSCode) 中建立和除錯 Python 程式碼,以利用 SDK。
- **彈性部署**:您可以使用 SDK 公用程式、Data 360 UI 或 API 來封裝和部署自訂程式碼,以啟用整合至 CI/CD。
**營運記錄**:詳細執行記錄的存取權可提供透明度,並協助在生產環境中進行疑難排解。
透過提供這些安全且彈性的程式碼擴充功能,Data 360 可讓結構設計師量身打造平台以滿足其最獨特且複雜的資料處理需求,真正強化其作為可擴充企業資料架構的角色。
### 透過自帶 AI 模型擴充 Data 360
隨著企業加速採用 AI,大多數都會維護不同的 ML 生態系統,包括 Amazon SageMaker、Google Vertex AI 和以 Python 為基礎的自訂環境,以主控推動任務關鍵預估的模型,例如信用風險評分、流失傾向、產品建議和 Next Best Action 決策。
傳統上,將這些外部模型整合至 Salesforce 需要自訂 API 圖層、ETL 管道或中間軟體協調流程,並導入資料重複、管治負擔、延遲和營運複雜性—這些挑戰與統一、合規和即時 Customer Data Platform (CDP) 願景衝突。
**自帶模型 (BYOM)**:透過 Einstein Studio in Data 360 提供,透過在 Salesforce 工作流程、Apex 邏輯和自動化工具中啟用直接叫用外部訓練的模型來解決這些挑戰,而無須移動或複製資料。透過零複製聯合,Data 360 會作為受管理的單一事實來源,以在外部端點公開協調的 Customer 360 資料來推斷。預估輸出會即時返回流程,以可調整的情報為業務流程提供動力。
BYOM 透過分離模型開發、受管理的資料和耗用層級,有效地清除資料科學與作業執行之間的差距。其可保留平台獨立性、減少整合複雜性、加速 AI 部署,並維持敏感資料的管理。
結構的運作方式如下:Data 360 提供統一的 Customer 360 資料基礎,而 Einstein Studio 會協調外部 ML 平台 (SageMaker、Vertex AI 或自訂端點) 的連線。外部模型會以即時、批次或串流模式執行推斷。Salesforce 圖層 (流程、Apex 和查詢 API) 會耗用輸出,以跨 Sales、Service、Marketing 和 Industry Cloud 提供個人化、自動化和分析洞察。
從企業的角度來看,BYOM 會提供:
- **資料完整性和管治**:去除未受控制的資料複本並強制遵循原則。
- **AI 民主化**:透過 Salesforce 工具讓非技術使用者可存取複雜模型。
- **時間對值的加速**:外部模型會立即在 Salesforce 程序內啟用。
- **延展性和混合式結構支援**:啟用 AI 工作量的多雲端部署。
- **準備未來的 AI 結構**:支援可編輯 AI 策略,將資料、模型和耗用層分離以獲得作業靈活性。
**自帶 LLM (BYO-LLM)**:提供相同的擴充機制,但適用於生成模型。透過啟用外部 LLM 的直接叫用,我們允許客戶在 Agentforce Platform 中使用外部 LLM,而非 Salesforce 提供的模型。針對企業,BYO-LLM 可:
- 存取微調的模型
- 目前未由 Salesforce 提供的模型整合
- 模型用於客戶提供的帳戶
### 資料協同合作
現代企業在具有兩個主要結構挑戰的複雜資料環境中運作:
1. **企業內區段**:大型組織經常利用多個 Salesforce 組織 (通常依區域、業務單位或歷程記錄取得區隔) 和許多其他資料系統。此分割會建立內部資料孤島,因此無法建立客戶的單一、信任且統一檢視,以便在整個業務中即時參與。挑戰是統一此資料,而不實際整合或複製所有系統中的資料,以確保監管保持不變。
2. **跨企業協同合作**:公司通常需要與合作夥伴和供應商共用資料,以進行聯合行銷、測量和業務情報。挑戰是啟用此協同合作,同時保護敏感、專屬的資料,並遵循如 GDPR 和 CCPA 等隱私權法規,以及競爭阻礙。
Salesforce Data 360 透過以共用存取與洞察原則為基礎的零複製、每個 Trust 設計架構來解決這些挑戰,而非移動或複製資料。
#### Data 360 協同合作機制
Salesforce Data 360 透過 Data Cloud One、Data 360 之間的資料共用和隱私權優先的資料清除空間,解決資料片段和協同合作的挑戰。這些解決方案可統一客戶資料、啟用安全資料交換,並提供保密洞察。透過零複製、 Trust 每個設計方法,組織可以開放資料潛力,以實現即時參與、增強合作夥伴關係和智慧決策。每個資料協同合作選項都有不同的用途。
##### 使用 Data Cloud One 進行內部企業啟用
Data Cloud One 是針對營運多個 Salesforce 組織的企業所提供的基礎結構解決方案。其用途超出簡單的資料共用範圍;其設計目的為建立單一信任的客戶檢視,並在整個組織中啟用完整的 Data 360 平台功能。
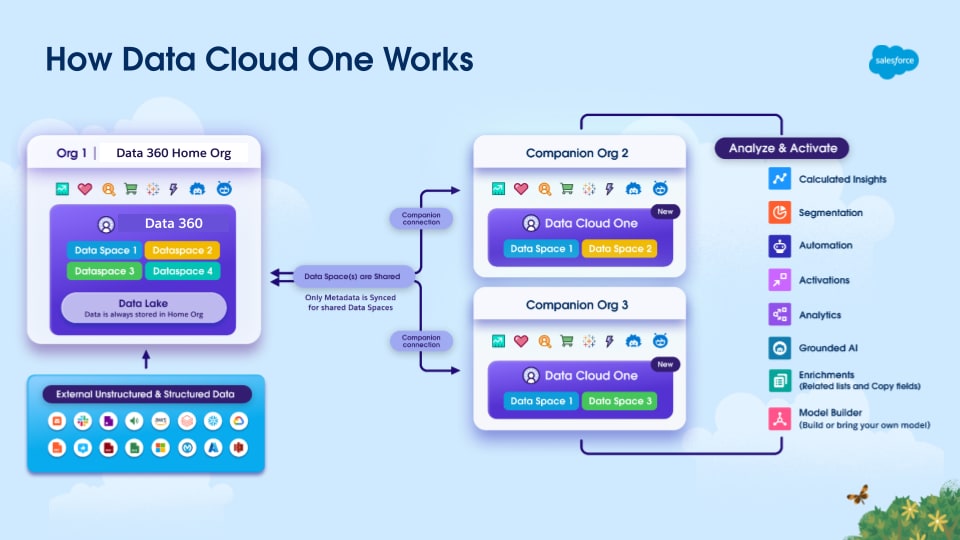 此機制著重於指定的 Home Org Data 360 例項,其會作為資料管理和建立統一客戶設定檔的中心授權機構。「首頁組織」是佈建 Data 360 的組織。Data 360 與其他 Salesforce 組織 (稱為「伴侶組織」) 之間建立 Data Cloud One 連線。作為 Data Cloud One 連線的一部分,Data 360 會與每個伴侶組織共用一或多個資料空間,以在每個共用資料空間中提供資料與中繼資料的存取權。這可透過零複製聯邦模型和跨組織中繼資料同步化來達成。
Data Cloud One 也允許「伴隨組織」利用「首頁組織」的 Data 360 例項,以滿足自己的啟用、個人化和情報需求。此策略對於消除內部資料分片,並確保所有業務單位根據相同、受管理且統一的客戶設定檔進行啟用至關重要,以最大化核心 Data 360 實作的 ROI。
##### Data 360 組織之間的資料共用
針對散佈內部環境 (無法完全集中化),以及與受信任的外部合作夥伴協同合作,Data 360-to Data 360 資料共用會連線獨立的 Data 360 例項。
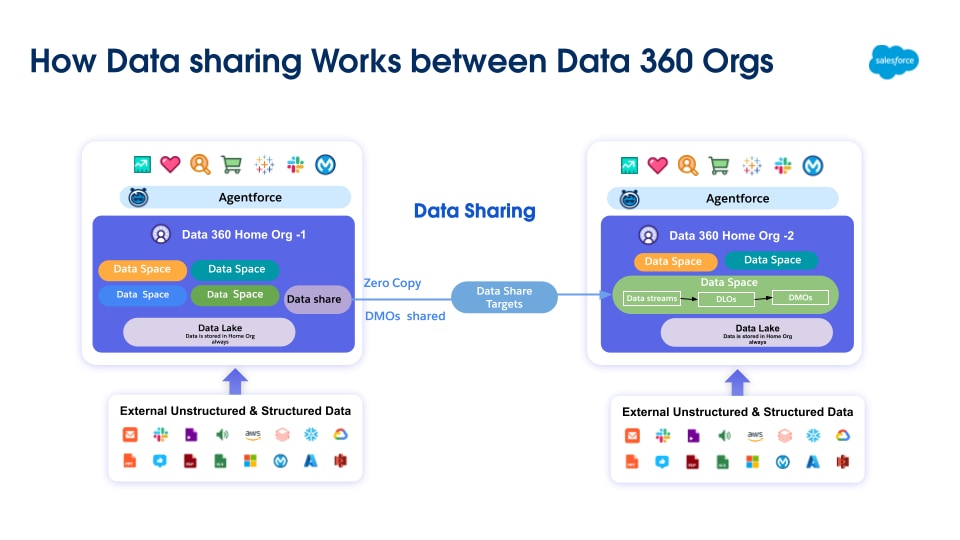 此零複製共用模式會在不同 Salesforce 組織上佈建的個別 Data 360 租戶之間建立連線,以安全地交換資料物件 (DLO、DMO 和 CIO)。連線後,整個資料物件會在 Data 360 收件者中可供存取。接著,收件者的 Data 360 管理員可以設定管治規則來管理此資料的使用者存取權。
##### 與 Data 360 Clean Room 合作的隱私權優先合作
當協同合作需要最高層級的隱私權與合規性時,或當競爭問題禁止共用原始資料時,Data 360 Clean Rooms 是結構上必要的。
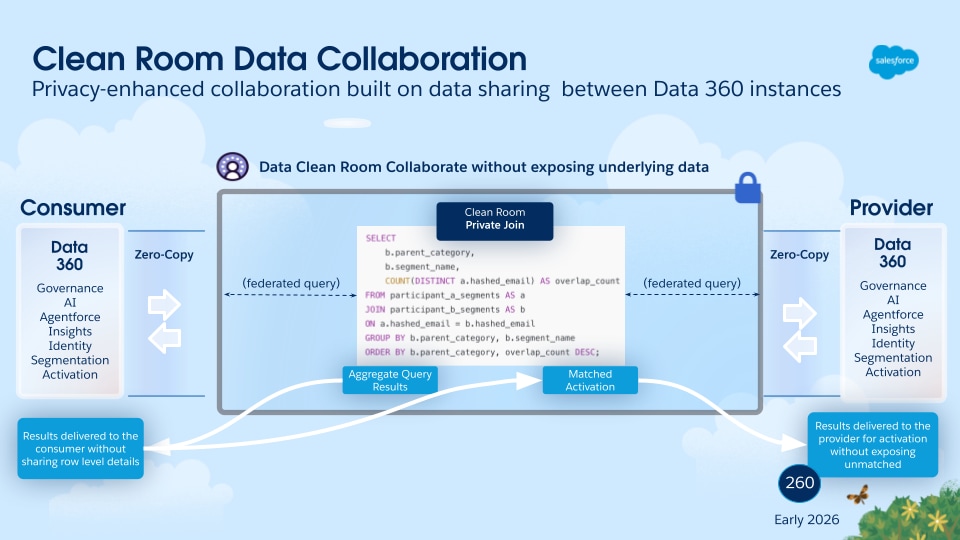 在結構上,Data 360 Clean Room 協同合作是建置在 Data 360-to-Data 360 資料共用所使用的零複製共用架構之上,但套用了額外層級的管治與運算限制。Data 360 Clean Room 提供安全且受控制的計算環境,讓使用者可以根據匿名金鑰加入其資料集。其核心目的是允許共同分析和洞察產生,而無須公開基本專屬資料。環境會強制執行嚴格且可程式設計的規則,例如最小彙總值和不可匯出的識別碼。這些規則可確保只衍生和共用已批准、增強隱私權和彙總洞察。這使得 Clean Rooms 對於跨平台行銷活動度量和敏感受眾重疊分析等使用個案至關重要。
## 結論:Salesforce Data 360:工作人員企業不可或缺的資料背景
Data 360 設計為智慧、可擴充且值得信賴的資料架構,以支援下一代 AI。其結構設計可解決分割資料的問題,讓組織能夠大規模統一、處理和啟用所有客戶資料,並使用「零複製資料聯合」確保效率。
其強大的「資料組織」可建立從 DLO (包含非結構化資料) 到 DMO 的協調檢視,這些檢視都會在分割資料空間內保護。Data 360 的靈活資料處理功能 (包括批次和串流轉換、已計算洞察、非結構化資料處理和身分解析) 由增量 SNCE 和 CDF 結構提供技術支援,可確保高效率、近乎即時的處理並大幅節省成本。
擴充功能由「程式碼延伸模組」結構提供,可透過指令檔或單獨的功能安全地啟用自訂 Python 邏輯,以滿足獨特的需求。此外,以含 CEDAR 原則的屬性型存取控制 (ABAC) 為基礎建立的全方位資料管理架構,可保證細微的安全性、動態資料遮蔽,以及所有資料耗用的一致強制執行。這會達到複雜的區隔和啟用功能,將統一的客戶設定檔轉換為動態的多管道參與策略,並具有即時回應性。
重要的是,Data 360 能夠統一廣泛、多元化的資料、透過統一查詢提供即時內容 (包括混合式結構化/非結構化搜尋和超級加速),並強制執行嚴格的管治,這對強化智慧 AI 工作人員而言至關重要。其提供必要的信任、新鮮且相關的資料,以奠基生成式 AI 工作流程 (RAG),並為 Agentforce 提供的工作人員提供多輪、以動作為導向的功能,以確保其精確且準確地作業。
透過提供一個未來的平台,讓來源資料轉換為可運作洞察,Data 360 可作為組織建立 Agent 客戶體驗的不可或缺的結構基礎。這是將客戶資料轉化為精密且個人化的客戶體驗的重要支柱,為現代組織帶來成功。
## 指南概觀
非同步處理可透過允許每個內容更高的限制來增加[延展性](/docs/architect/zh-tw/well-architected/guide/reliable#延展性)。非同步要求會在背景執行自己的執行緒,因此使用者可以在非同步工作在背景中執行時,繼續在用戶端執行工作。
Salesforce Lightning 平台提供各種非同步技術,可用來解決指定的使用個案。每個技術都有您在為每個使用個案選取方法時需要考量的優點與限制。
選擇實作技術時,請記住三個重要考量事項:
1. 非同步處理並非每個問題的最佳方法。嘗試將不直接需要使用者互動的任何程序視為非同步處理的良好候選項目,但有一些缺點。首先,非同步程序沒有 SLA,這表示不保證非同步程序會在設定的時間內完成。其次,沒有一致回應延遲的保證。如果非同步程序在特定時間內完成,則後續程序可能需要不同的時間完成。因此,即使使用者並未直接等待回應,如果您有後續的程序取決於回應,或您擔心過多回應時間可能導致您的資料與外部系統中的資料不同步,則非同步處理可能不適合您的案例。
2. 在 Salesforce Platform 上處理非同步要求的方式不同,因此請確保您選擇最佳方法。在 Salesforce Platform 上支援非同步處理的技術運作方式不同,有些技術是針對非常特定的使用個案所設計。
3. 如果技術在用戶端為非同步,則不一定表示所有端對端處理都會並行執行。視您所做的選擇而定,用戶端訊息有時仍會在伺服器端進行序列化。
如果您針對工作使用錯誤的技術或錯誤的技術組合,可能會發生取消非同步處理好處的非預期後果。本指南提供各種非同步使用個案的說明和建議,以及可能的缺點和反模式,以及這些建議的理由。它也會提供如何在 Salesforce Platform 上運作和監管各種非同步實作技術的洞察。
如果您要決定要使用的技術,則有一份專注的「[非同步處理決策指南」(](/docs/architect/zh-tw/decision-guides/guide/async-processing)Asynchronous Processing Decision Guide) 提供一般使用個案的快速對應至最適合的技術。
## 範疇中的產品
 |
Salesforce Lightning Platform 是一個全方位、 AI 驅動的平台,可將員工、獨立 AI 工作人員、公司資料和應用程式整合到一個可靠的系統中,以提升生產力與客戶體驗。透過連接 Customer 360 應用程式、Data Cloud 和 Slack 來進行端對端自動化,以便建立「真正的企業」。 |
 #### 公平使用
平台的公平使用機制會實作以層級為基礎的系統。系統會確保 Salesforce Platform 上的每個組織都會獲得指定訊息類型的處理時間,包括「未來」、「可排列」和「批次」訊息類型。如果某個組織在等待其他組織對相同訊息類型執行工作的同時,控制指定的訊息類型,則公平使用率演算法會減少組織可用於該特定訊息類型的執行緒數目。
 使用非同步 Apex 方法的好處是某些管理員限制 (例如 SOQL 查詢限制和堆疊大小限制) 較高。不過,請勿過度依賴這些方法。由於分配給非同步基礎結構的有限資源,因此使用 Future、Queueable 和批次 Apex 大量可能會導致處理延遲,這取決於合理使用與流程控制的限制。
#### 透過非同步 Apex 輸出呼叫的特殊考量事項
使用非同步 Apex 的輸出呼叫會計入非同步 Apex 限制。每日限制目前為 250,000 或 200 倍的適用使用者授權數目,視何者較大而定。此限制可能是大量使用個案的問題。如果您超過限制,您的非同步 Apex 工作及其相關聯的輸出呼叫將會失敗。
此外,由於平台有有限數量的非同步執行緒可供使用,因此透過非同步 Apex 的輸出整合有有限的延展性。大量輸出整合超過可用執行緒的數量可能會有較長的處理時間並導致延遲。
針對大量使用個案,請考慮這些替代方法。具有這些方法的 API 呼叫會計入每日 API 要求限制,此限制明顯高於每日非同步 Apex 限制。因此,這些方法更容易調整。不過,請注意,任何 CPU 可處理的同時要求數量仍有實體限制。
- **中介排程提取。**使用中介軟體以排程的方式提取資料,而非透過非同步 Apex 推送資料,以避免與大量輸出整合工作相關聯的延遲。中介軟體 (例如 MuleSoft Anypoint Platform) 可以同步方式使用原生 SOAP API 或 REST API,因此可能會導致少量延遲。中繼軟體也可以針對大量資料使用原生大量 API。
 - **透過平台事件通知提取中繼軟體。**您可以使用平台事件來執行輸出整合,而不是強制執行 Future、Queueable 或批次非同步 Apex。平台事件可以提供輸出資訊,或指示中介軟體工具透過原生 API 提取必要資訊並將其傳送至最終目的地。這些方法皆不受非同步 Apex 所需的延遲影響。不過,[平台事件限制](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_events_limits_default.htm)仍適用。
 #### 非同步 Apex 權衡
| 產品/方法 | 使用個案 | 所需技能 | 與用戶相關非同步 | 與伺服器不同步 | 強制執行平台限制的類型 |
|---|---|---|---|---|---|
| Apex Future 方法 | 我們建議您使用 Queueable Apex,而非 Apex future 方法。可排列的使用個案與未來方法相同,但提供額外優點。 | 專業程式碼 | 是 | 是 | 非同步 |
| 可排序的 Apex | 我們偏好此方法,而非未來方法。用於涉及長時間執行資料庫作業或外部 Web 服務呼叫的流程。Apex 提供比未來方法更多的優點,包括工作識別碼、支援非原始類型和工作鏈。 | 專業程式碼 | 是 | 是 | 非同步 |
| 已排程 Apex | 在由 Cron 運算式定義的排程時間執行 Apex。雖然透過 Cron 運算式排程 Apex 的動作是非同步的程序,但基本程式碼會在工作開始時同步執行。 | 專業程式碼 | 是 | 是 | 同步 |
| Apex 繼續呼叫 | 在同步交易內容中執行的 Apex 方法呼叫。 | 專業程式碼 | 是 | 是 | 同步 |
 透過 [認可後發佈](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_events_intro.htm)發佈至 Bus 的事件會依序傳送,且可以在個別的同步化內容中由觸發或流程大量處理。內容為同步,會強制執行所有同步管理員限制。請謹慎選擇平台事件觸發/流程批次大小,以避免達到限制。
| 產品/方法 | 使用個案 | 所需技能 | 與用戶相關非同步 | 與伺服器不同步 | 強制執行平台限制的類型 |
|---|---|---|---|---|---|
| 平台事件觸發 | 寬鬆將 Salesforce 與外部系統配對,並在非同步平台元件之間通訊。 | 低程式碼 + 專業程式碼 | 是 | 是 | 同步 |
| 產品/方法 | 使用個案 | 所需技能 | 與用戶相關非同步 | 與伺服器不同步 | 強制執行平台限制的類型 |
|---|---|---|---|---|---|
| 排程路徑 (認可流程後) | 在觸發事件後動態排程的時間執行。 | 低程式碼 | 是 | 是 | 非同步 |
| 非同步路徑 (記錄觸發流程) | 執行您要在自己的時間執行的作業,以避免混合的 DML 錯誤。 | 低程式碼 | 是 | 是 | 非同步 |
| 產品/方法 | 使用個案 | 所需技能 | 與用戶相關非同步 | 與伺服器不同步 | 強制執行平台限制的類型 |
|---|---|---|---|---|---|
| 輸出訊息 | 透過 SOAP 通訊協定近乎即時地與第三方系統共用資料 | 低程式碼 | 無 | 是 | 無 |
| 產品/方法 | 使用個案 | 所需技能 | 與用戶相關非同步 | 與伺服器不同步 | 強制執行平台限制的類型 |
|---|---|---|---|---|---|
| 電子郵件轉個案 | 根據傳入電子郵件中的值自動建立個案並填入個案欄位。 | 低程式碼 | 是 | 是* | 同步 |
| * 「電子郵件轉個案」會以同步和非同步的方式處理,但具有同步 Apex 限制 | |||||
| 產品/方法 | 使用個案 | 所需技能 | 與用戶相關非同步 | 與伺服器不同步 | 強制執行平台限制的類型 |
|---|---|---|---|---|---|
| 批次 Apex | 涉及數千筆記錄的複雜且長時間執行程序 | 專業程式碼 | 是 | 是 | 非同步 |
| 排程觸發流程 | 透過流程在指定時間和重複頻率,對背景中記錄的批次執行動作。 | 低程式碼 | 是 | 是 | 同步 |
| 大量 API | 以非同步方式插入、更新、更新插入、查詢或刪除許多記錄。 | 專業程式碼 | 是 | 是 | 非同步 |
 **探索:**「工作人員登錄」提供整個組織中所有 AI 工作人員與工具的集中型目錄。其可啟用內部建立、內嵌 SaaS 和外部資產的探索與重複使用。透過為所有工作人員資產提供單一事實來源,「工作人員登錄」可消除冗餘,並確保開發人員可以大規模利用現有功能。
**協調流程:**MuleSoft Agent Broker 是一種智慧路由解決方案,可動態將工作與最合適的工作人員或工具進行比對。由您選擇的 LLM 提供支援,其可協調工作人員和工具,以確保複雜的多步驟要求和業務流程以高度可靠性和可追蹤成果執行。
**政府:**[MuleSoft Agent Governance](https://www.mulesoft.com/platform/ai/ai-agent-governance) 利用「Flex Gateway」及其對 [模型內容通訊協定 (MCP)](https://www.mulesoft.com/platform/ai/model-context-protocol) 和 [Agent2Agent (A2A) 通訊協定](https://www.mulesoft.com/platform/ai/a2a-support)的支援。透過 Flex Gateway,企業可以對每個工作人員-工作人員和工作人員-工具互動強制執行安全性和合規性原則。
**觀察:**「工作人員視覺化工具」透過動態互動式工作人員互動地圖提供即時可觀察性。它會追蹤決策、監視系統健康狀況,以便持續最佳化並可靠監視整個工作人員生態系統。
工作人員 Fabric 擁有規格優先 (YAML) 方法,使用者可透過中繼資料描述元 (「YAML 檔案」) 定義工作人員網路。此 YAML 檔案對 MuleSoft 不明確,且會將工作人員網路的定義與其執行分離。
## 工作人員網路規格 (中繼資料描述元)
每個工作人員網路 (YAML) 都會使用其代理資產定義特定功能區域,包括其作業規則與原則。YAML 用於啟用四個「工作人員紡織」支柱:
1. 探索:使用現有的「工作人員資產」填入「工作人員登錄」,例如:
1. 跨各種平台部署的工作人員 (MuleSoft 或其他平台)
2. MCP 伺服器
3. LLM 提供者
2. 協調流程:建立協調工作人員經紀人
3. 控管:在資產上套用安全性與管治原則
4. 注意:定義並重複使用已定義資產的連線。此外,可觀察性和監視功能也可供工作人員網路使用。
### 編寫
使用者旅程會在 Anypoint Code Builder 中開始。使用名為「MuleSoft:「建立工作人員網路專案」以建立新專案。此指令會建立包含兩個檔案的新專案 (「工作人員網路」)。
- **agent-network.yaml:**此檔案定義多工作人員系統的組態,以透過外部工具 (透過 MCP) 與工作人員 (透過 A2A 通訊協定) 來協調 AI 工作人員。此格式提供用來定義工作人員功能、相依性和整合的陳述方式。
- **exchange.json:**所有工作人員網路專案也擁有 exchange.json 檔案。發佈工作人員網路資產後,此檔案包含 Anypoint Exchange 中可用的資產中繼資料。
您工作人員網路的開發遵循包含四個主要階段的標準軟體開發生命週期 (SDLC):
1. **環境設定:**設定執行階段環境與門戶
2. **專案建立與設計**:建立工作人員網路專案規格
3. **建立與發佈:**建立並發佈資產至工作人員登錄
4. **部署:**將工作人員網路部署或升級至指定的環境
建立專案並產生所需的 MuleSoft 應用程式和資產後,請使其可在 Exchange 中使用。在 Anypoint 程式碼產生器中,使用 **_“MuleSoft:可透過指令調色盤使用「發佈工作人員經紀人專案至換貨」_** 指令。
發佈步驟會將 YAML 檔案中的每個工作人員資產轉換為 A2A、MCP 或 LLM 規格,並將其發佈至 Exchange。
此外,系統會使用新的工作人員網路資產類型,將 YAML **發佈至** Exchange。您可以在「工作人員登錄使用者介面」中**檢視**此資產,並透過 Exchange API 進行**搜尋**。
### 範例
請參閱為企業定義工作人員網路的「[工作人員網路」檔案](https://docs.mulesoft.com/anypoint-code-builder/af-project-files)。此工作人員網路會啟用在 Salesforce、Stripe 之間的訂單履行網路,以及另一個訂單履行工作人員和庫存 MCP 伺服器,並透過單一保單管理的體驗。
- **探索**
將現有工作人員和工具 (例如 Salesforce、Stripe、訂單履行和庫存) 發佈為 Exchange 資產以供重複使用。此外還有一個版本化且可共用的訂單履行定義 (YAML),可針對角色、區域或子公司快速調整,而無須重新建立流程。
- **協調流程**
工作人員經紀人使用 LLM 將訂單履行流程拆分成一系列工作,例如驗證客戶詳細資料、配置庫存和計算運費。接著透過呼叫 MCP 和 A2A 工作人員來執行此工作流程,以確保在需要時要求人類即時批准。
- **政府**
Anypoint Flex Gateway 會強制執行驗證、最低權限存取權和護欄。API 管理員原則可確保在所有通話和資料交換之間的一致控制。
- **觀察**
監視和追蹤可讓您端對端瞭解進度、失敗和延遲。視覺效果會顯示哪些工作人員互動,以及發生瓶頸的位置。
- **信任與合規性**
集中認證、稽核追蹤和原則繼承支援安全性、隱私權和法規需求 (PII 處理、批准和職責分隔)。
此圖顯示在 YAML 中定義之工作人員網路 (中繼資料) 的不同節點。
 ## 工作人員登錄 (探索)
 - **目的**:換貨是工作人員、工具和其他資產的目錄。其主要目標是透過提供單一、受管理的目錄,以探索、精密設計和管理異質工作人員的生命週期來解決「工作人員擴展」。其可讓開發人員尋找並重複使用工作人員、平台擁有者維持可視性,並讓協調流程者探索功能。
- **依設計不同**:Anypoint Exchange 現在支援三個新資產:工作人員、MCP 和 LLM。Exchange 設計為通用型目錄,可註冊和管理任何類型的工作人員。其支援來自任何來源 (包括第三方、Agentforce 和自訂 MuleSoft 代理程式) 的 A2A 相容工作人員、MCP 伺服器和 LLM 提供者。
- **核心中繼資料**:每個註冊的資產都有固定的中繼資料基準集,包括「唯一名稱和版本」、「擁有權」和「發行者」。也會追蹤生命週期狀態 (開發、暫存、生產、已淘汰)。
- **探索**:
- **設計時間**:開發人員可以透過現有 Exchange UI 或使用 Anypoint 程式碼產生器中的 Vibes 進行自然語言搜尋來探索註冊的工作人員。
- **標記與分類**:您可以使用基本金鑰值標記系統,依類型 (工作人員、MCP、LLM、經紀人) 和網域 (例如 HR、天氣) 分類資產,以啟用動態連結、搜尋和選擇原則。
- **目錄**:儲存庫支援在組織內共用工作人員的私人與內部目錄模型。
- **視覺效果**:提供視覺工具來支援網路檢視,顯示單一資產的連線或整個組織中節點和連結的整個地圖,以及篩選功能。
工作人員網路中的經紀人可以參照儲存在 Anypoint Exchange 中的已註冊工作人員、MCP 伺服器和 LLM 提供者。但如果尚未註冊,則可在「工作人員網路」(YAML) 的中繼資料中宣告,並自動註冊。在此範例中,有多個工作人員、MCP 伺服器和 LLM 提供者會在 Anypoint Exchange 中宣告和註冊。
```
agents:
orders-agent:
label: Order Fulfilment Agent
metadata:
protocol: a2a
platform: OpenAI
salesforce-agent:
label: Salesforce Agent
metadata:
protocol: a2a
platform: OpenAI
stripe-agent:
label: Stripe Payment Agent
metadata:
protocol: a2a
platform: OpenAI
mcpServers:
inventory:
label: Inventory MCP
metadata:
transport:
kind: streamableHttp
path: /mcp
llmProviders:
open-ai:
label: OpenAI
description: OpenAI LLM Provider
metadata:
platform: OpenAI
```
## 工作人員經紀人 (協調流程)
 工作人員經紀人是智慧路由工作人員,可協調跨企業專門工作人員的工作委派。其由其用來完成工作的工作人員和 MCP 伺服器所定義。
經紀人是專門的工作人員,在發佈工作人員網路資產並由其他經紀人重複使用後顯示在 Anypoint Exchange 中。
經紀人是在 YAML 的 _經紀人_區段中定義的。定義的經紀人會以透明的方式「編譯」至應用程式,而不需要任何先前的 Mule Knowledge。此產生的應用程式會部署至 CloudHub 2.0 (CH2),並利用強大的 CH2 基礎結構。
這表示「工作人員經紀人」受益於 CloudHub 2.0 的已建立效能特性,包括其記錄和度量功能。作業層面,例如「營運成本」和「監視/警示/工具」,與任何其他工作量相同。
針對需要人力介入 (循環中的人) 的案例,系統會使用 MuleSoft 物件存放區來維護每個互動的狀態,此分散式解決方案專為在高度同時環境中有效管理狀態而設計。
經紀人定義由兩個區段組成:卡片與規格。
### 卡片
卡片區段遵循「[工作人員對工作人員 (A2A)」規格](https://a2a-protocol.org/v0.2.5/specification/)。其中包括描述經紀工作人員的契約、技能和能力。卡片 URL 會自動填入值 ${ingressgw.url}/broker-name。部署時,${ingressgw.url} 預留位置會自動取代為前置工作人員進入要求的 Anypoint Flex Gateway url。
### 規格
規格區段會設定經紀人的「來源程式碼」。在此,開發人員可以指定要使用的 LLM、指示、可用的工具、錯誤處理,以及最重要的是,可供此經紀人使用的各種工作人員和 MCP 工具。
**LLM 提供者**
此區段是每個經紀人的規格的一部分。這是服務區段中定義的其中一個 LLM 參照。我們可以選擇是否要在所有經紀人之間共用一個 LLM,或視需要讓不同的經紀人使用更適合其工作的 LLM。
經紀人可以指向 LLM 提供者。我們可以根據需求選擇這些提供者的模型。
```
llmProviders:
open-ai:
label: OpenAI
description: OpenAI LLM Provider
metadata:
platform: OpenAI
```
**指示**
此區段是選擇性的,您可以用來指定此經紀人工作人員特有的指示。這些指示通常專注於特定業務導向的疑慮。例如,想像一下客戶服務代理來協調客戶報告事件的管理:
```
instructions:
- |
You are an Incident Management Orchestrator Agent. Your primary responsibility is to coordinate the resolution of incidents reported by customers.
The process for incident management is:
1. Fetch Salesforce Case Details: Retrieve the latest critical case details for the given customer.
2. Fetch Entitlement Details: Obtain the customer's entitlement information.
3. Fetch On-Call Engineer: Identify the current on-call engineer for the incident.
4. Create Slack War Room and invite on-call engineer: Set up a Slack war room channel and invite the on-call engineer.
5. Summarize Actions: Provide a clear, human-readable summary of the steps performed, including information about the created slack channel and the on-call engineer assigned
```
請注意,不需要提供明確的指示,例如**「將提示分割為工作」或「選取最佳工具」**,因為經紀人會自行處理。這些指示僅在描述特定業務流程時才需要。
**工具組態**
工具可提供工作人員外部功能。只要經紀人需要存取外部系統 (不是其他工作人員,例如現有 API 或 SaaS 服務),便會連絡 MCP (模型內容通訊協定) 伺服器:
```
tools:
- mcp:
server: collaboration-mcp # MCP server reference
allowed: # Allowlist specific tools
- create_channel
- invite_user
```
MCP 伺服器會以交換資產的名稱參照。其連線詳細資料可在服務區段中指定。
依預設,經紀人可存取 MCP 伺服器中所有可用的工具。根據我們的觀察,最新的 LLM 只能處理每個內容的約 20 - 25 個工具,然後才能開始產生不準確情況 (或遺失內容)。因此,將可用的工具限制在所需的最低值通常是最佳作法。您可以透過允許的清單套用該篩選條件。
**工作人員連結**
此區段是整個定義中最重要的部分。連結區段可啟用工作人員之間的通訊和協調流程。這表示此經紀人依賴在此處連結的工作人員來執行適當的動作以完成使用者的目標。
```
links:
- agent:
ref:
name: orders-agent
- agent:
ref:
name: salesforce-agent
- agent:
ref:
name: stripe-agent
```
實際上,此區段定義協同合作的工作人員-網路。
## 彈性門戶 (管理)
 「工作人員管理」是「工作人員紡織」的重要支柱,是建立信任工作人員網路並確保安全性和合規性的基礎。
針對管治,您的私人空間中總共需要兩個「Flex Gateways」(1 個進入和 1 個出口)。
監管會建立必要的結構、控制項與證據,以安全地調整整個工作人員開發週期 (ADLC) 的規模。具體而言,管治會實作重要流程,例如工作人員認證、目錄、生命週期決策和執行階段原則的強制執行。
- **目錄:**
- 更換:支援記錄工作人員目的、擁有者、環境,以及資料與分類邊界。它也會向版本註冊功能、工具、資源、提示和外部相依性。
- **版本化與生命週期:**
- 在完成「工作人員開發生命週期」期間,記錄並管理工作人員、工具和資產的語意版本化。
- 版本化有助於管理工作人員淘汰時間表,並支援雙重執行 (若可能),以確保順利移轉。
- **保單強制執行**:
- 工作人員 AI 結構會擴大攻擊的表面 (對話介面、提示和如 MCP 等新通訊協定)。對任何元件的任何入侵都可能會導致多個提供如通訊協定、提示、API 或工具等元件的系統產生串聯式影響。
- 保護企業代理 AI 部署的安全性需要專門的方法,因為這些獨立且無法預測的環境本身會透過工作人員對工作人員的互動擴大攻擊範圍。儘管靜態系統的現有安全性工具十分重要,但它們本身已不再足夠。企業必須主動規劃和實作四個特定安全性解決方案,每個解決方案都會直接處理與工作人員 AI 相關聯的關鍵業務風險。
- Flex Gateway:所有 A2A 和 MCP 流量都會透過「Flex Gateway」進行路由,即使目標系統未受到保護,以確保原則會套用至每個端點。此路由對於保護工作人員通訊的安全性和與授權伺服器的整合而言至關重要。
- 原則搭售方案:使用者可以在執行之前定義預先定義原則的配套,並將其套用至工作流程,強制執行一組一致的安全性和作業原則。
- 保單類型:平台支援各種輸入與輸出原則,包括:
- A2A 原則:工作人員卡、PII 偵測器、提示裝飾者、結構描述驗證。
- MCP 原則:以屬性為基礎的存取控制、結構描述驗證、MCP 支援。
- LLM/AI 原則:AI 提示裝飾器、AI 提示保護器 (篩選有害內容)、AI 提示範本 (套用預先定義的範本)、AI 基本權杖比率限制。
- 遠端測試原則:A2A 和 MCP 遠端測試,可擴充記錄資料收集和匯出的「開放式遠端測試」解決方案。
- **記錄**:由於自動追蹤,工作人員網路的記錄可追蹤每個工作人員互動,說明行為並建立 Trust。
此範例描述訊息記錄的原則,此原則是使用工作人員網路中繼資料設定的。Orderfullfillment 經紀人是指稱為 Salesforce 工作人員的現有工作人員,且傳訊的原則是使用中繼資料來進行設定。請注意,工作人員 Fabric 會自動設定在「Flex Gateway」上「規格」區段下提及的所有原則。您不需要額外的步驟。
```
salesforce-agent-connection:
kind: agent
ref:
name: salesforce-agent
spec:
url: ${salesforce-agent.cardUrl}
policies:
- ref:
name: message-logging
namespace: 68ef9520-24e9-4cf2-b2f5-620025690913
configuration:
loggingConfiguration:
- itemName: "Payload"
itemData:
message: "#[payload]"
firstSection: true
secondSection: true
level: "INFO"
- itemName: "Headers"
itemData:
message: "#[attributes.headers]"
firstSection: true
secondSection: true
level: "INFO"
```
## 工作人員視覺化工具 (觀察)
 由於 LLM 工作人員與多重工作人員部署的非決定性性質與複雜性,因此可觀察性和監視十分重要。
- **基本記錄與追蹤**:透過記錄提供原因與工具執行追蹤。工作流程執行的記錄和追蹤可在執行階段管理員中檢視執行後。
- **度量**:在初始階段中,平台會發佈 a2a_total_calls 和 mcp_total_calls 作為具有標籤 (例如路徑、狀態、方法、工具) 的計數器,以判斷通話總數、成功和失敗。這些度量會使用「傳送者」(Flex Gateway) 的原生統計資料介面,最好透過現有原則 (例如 mcp_support_policy 和 a2a_agent_card_policy) 來從原則程式碼發佈。
- **增強型可觀察性 (未來)**:計畫包括在未來版本中使用「開放式遠端測量」來散佈追蹤。更進階的可觀察性包括:
- **詳細要求追蹤**:取得對要求的端對端可視性、包含提示、計畫者流程、叫用動作,以及與子工作人員的互動。
- **工作人員健康監視**:監視工作人員執行時間、回應延遲、輸送量、錯誤率,以及基本資源利用率 (CPU、記憶體、網路、GPU)。
- **多工作人員協調監視**:偵測工作人員對工作人員互動的成功和失敗率、偵測循環叫用模式 (迴圈),以及追蹤工作人員的度量,例如工作完成和叫用計數。
- **成本追蹤**:透過顯示面板和警示追蹤每個 LLM 呼叫的權杖用量和相關聯的成本,最好是每個工作人員。
- **認知追蹤**:收集並顯示工作人員工作階段的詳細追蹤,包括內部思考流程和所有工具呼叫,作為固定的稽核追蹤。
- **工作人員工作階段播放**:此 UI 允許以視覺方式逐步「重新執行」工作人員的認知追蹤,以進行深入除錯。
- **DAG 視覺效果**:針對複雜的多工作人員互動,提供工作人員工作流程執行的導向非循環圖 (DAG) 視覺效果。
「工作人員視覺化工具」用於識別工作人員網路的部分,並查看這些部分如何一起運作。
- 區分節點類型 (工作人員與 MCP 伺服器)。
- 檢視邊緣以查看已宣告與執行階段的互動。
- 使用圖層將檢視專注在特定環境上
- 開啟詳細資料卡以檢查節點的中繼資料和度量,以及存取記錄和追蹤
- 檢閱監管指標,例如「彈性門戶」保護和套用的原則。
[在此](https://docs.mulesoft.com/agent-visualizer/agent-visualizer-components)找到有關「工作人員視覺化程式」元件的詳細資料。
## 工作人員 Fabric:四個支柱
透過這四個支柱,MuleSoft Agent Fabric 可將安全性和控制延伸至具有內建管治的任何工作人員。其可利用新的通訊協定 (例如 A2A (工作人員對工作人員) 和 MCP (模型內容通訊協定) 來建立和擴充業務流程,讓工作人員隨時隨地採取行動。我們會將所有項目 (應用程式、資料和系統) 連接在一起,以在工作人員在整個業務中執行動作時賦予其能力和管理。智慧工具透過原生使用 AI 或帶入第三方 AI 工具來支援業務流程或 API 的建立和擴充。
不需要同時使用全部四個支柱,但建議使用。您可以視需要獨立選擇支柱。例如,您可以利用「工作人員紡織」進行註冊與管治,而無須使用協調流程層。同樣地,您可以使用經紀人協調透過其他平台管理的工作人員。
此圖顯示這四個元件之間的互動方式:
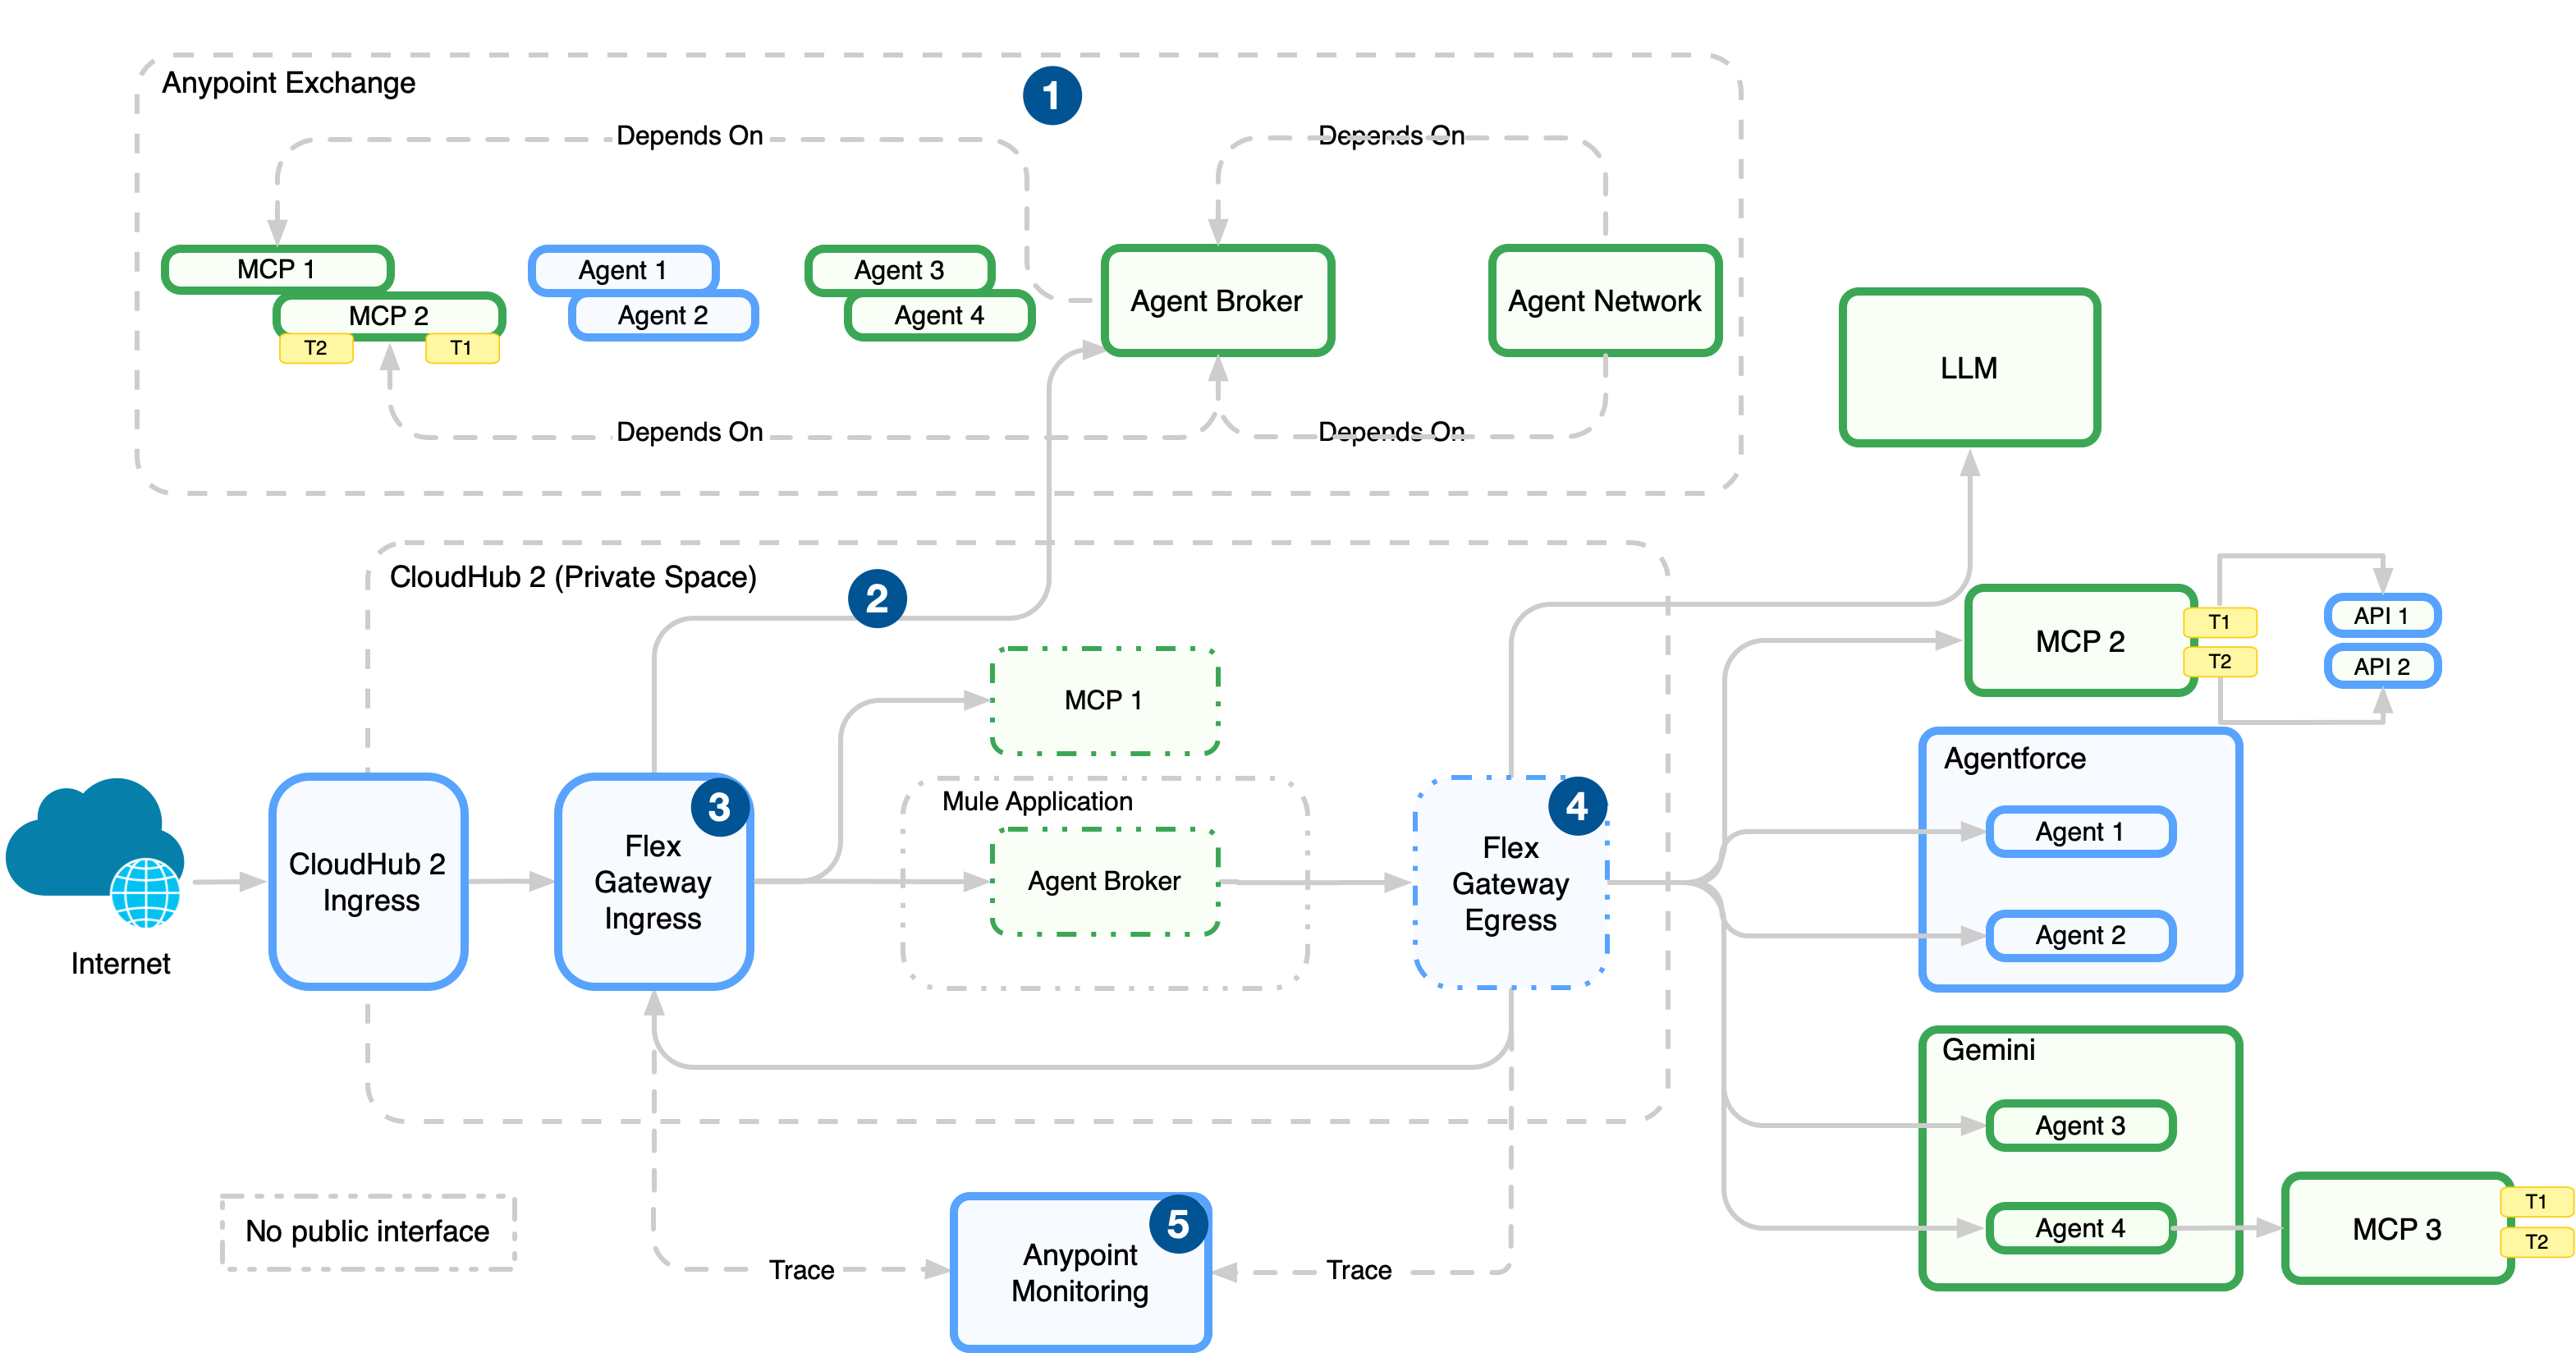 1. 在 Anypoint 程式碼產生器中的工作人員網路 YAML 中定義工作人員網路 (經紀人、工作人員、MCP 伺服器) 後,將工作人員資產發佈至 Anypoint Exchange 以供探索和重複使用。
2. 將工作人員資產部署至 CloudHub 2.0 (在執行階段管理員中管理)。
3. 使用進入 Flex Gateway (位於經紀人和 API 端點前方) 對網路的傳入流量強制執行原則。
4. 使用輸出 Flex Gateway 強制執行原則、管理連線和發出遠端測量資料。這是從經紀人和工作人員到外部服務的輸出路徑。
5. 在 Anypoint Monitoring 中從「Flex Gateway」和執行階段收集記錄、度量和追蹤。
## 工作人員協調流程設計模式
在平面且不受限制的結構中讓每個專門工作人員立即可供存取,並透過單一協調流程器來處理任何工作,藉此擁有每個可用 AI 資產的存取權。不過,此方法很快就會對整體系統的效率和可靠性產生負面影響。與套用至過多個別工具的原則一樣,許多工作人員選項對於中央**經紀人工作人員** (或協調員) 帶來顯著的雜訊和複雜性。此增加的複雜性直接導致經紀人決策的準確度 (為工作選取正確的工作人員) 和系統回應的決定性 (類似查詢的可預測一致成果) 都明顯下降。經紀人工作人員有效地遭受了選項瘫痪,導致路由速度變慢且較不可靠。
我們強烈主張建立「工作人員網路」結構的**多層階層方法**,而不是平面結構。此組織原則提供許多重要優點。首先,其本身有利於**可追蹤性和管理**。階層結構會反映已建立的組織最佳作法,讓您更容易稽核要求的流程、透過找出失敗層來除錯問題,以及管理特定工作人員或子網路的部署和淘汰。
其次,在強化這些工作人員的大型語言模型 (LLM) 內容中,階層對於**控制內容大小**而言非常有幫助。透過區隔工作人員橫向,任何指定層級的經紀工作人員只會考量位於其下方的有限工作人員組或子經紀人。此結構可防止主要協調流程將 _每個工作人員_的描述、功能和歷程記錄內容載入其工作記憶體,從而**避免**快速**超過** LLM 的內容視窗限制,並且**導致**成本和延遲。
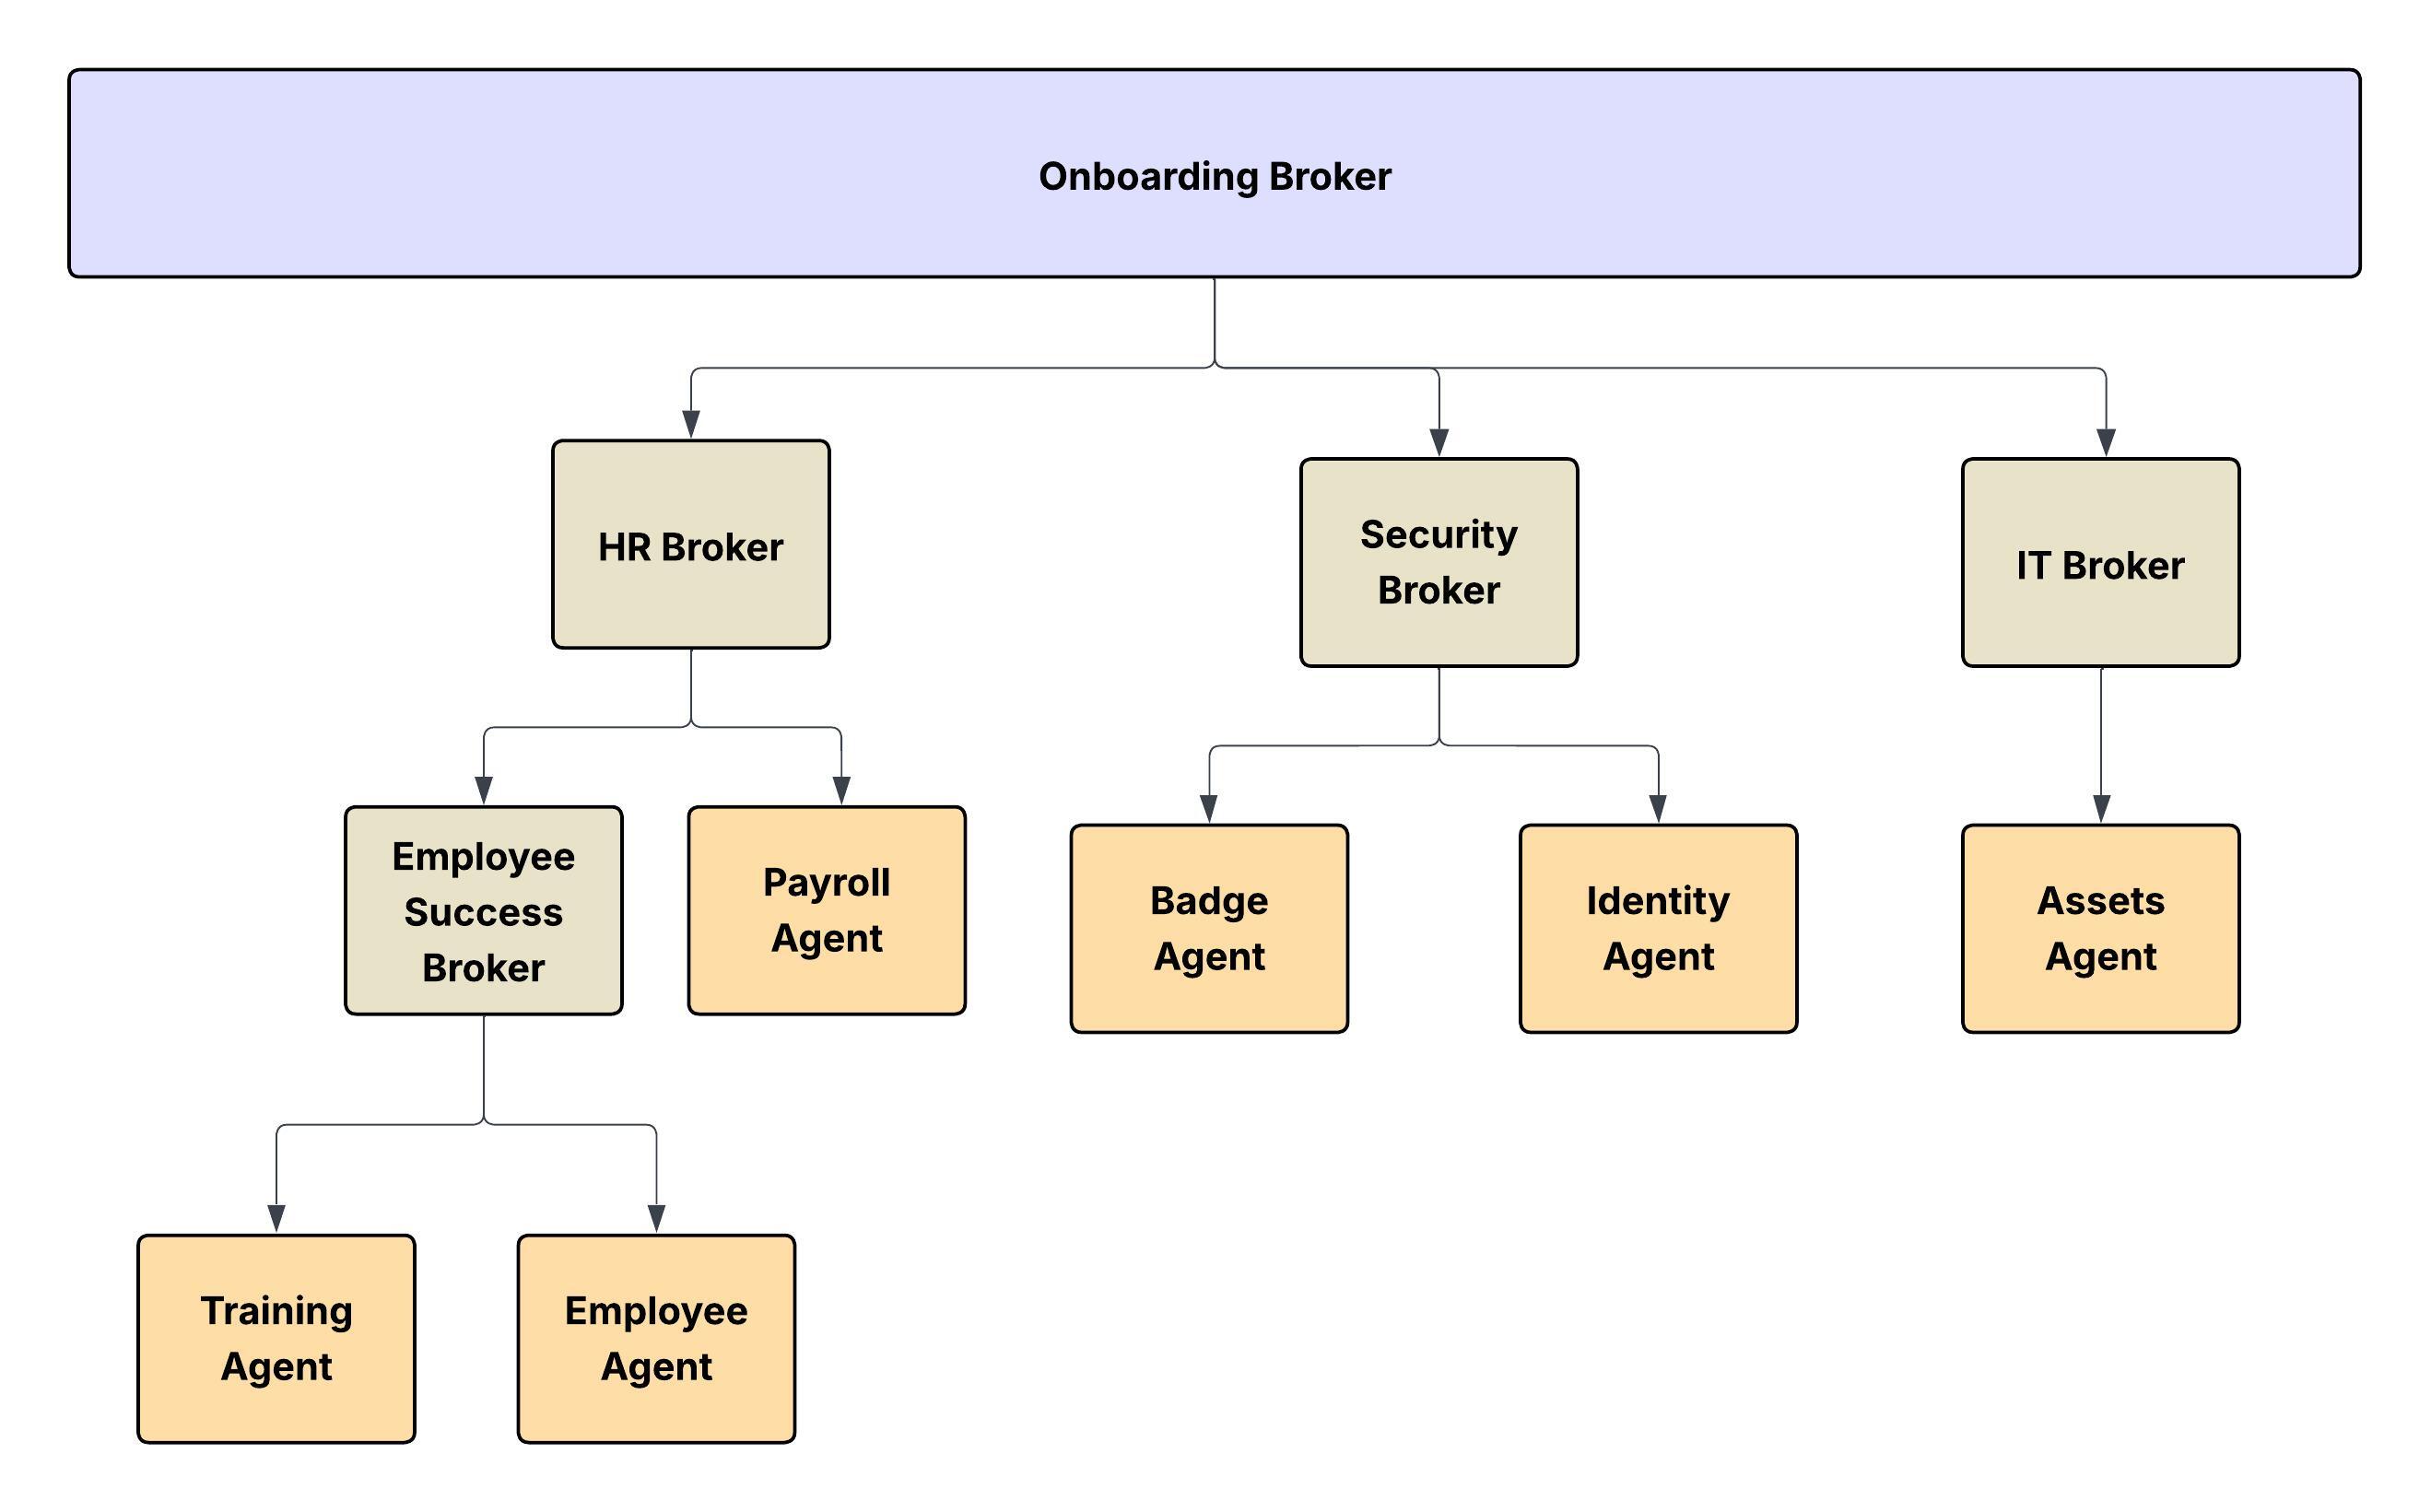 工作人員網路可透過多種方式實作。其中有兩個:
1. Conway 的法則 - 對應至真實世界階層結構的直覺方式。
2. 網域驅動的設計 - 更專注於業務網域
# 選項 1:使用真實世界階層結構對應
在階層組織中,通訊流程會垂直 (從經理到下屬) 且決策通常會集中。根據 Conway 法:
- 此類組織建立的系統或軟體結構也會有層級與階層。
- 每個小組都會傾向於設計反映其自身邊界與權限的子系統。
- 系統之間的介面會反映部門之間的通訊管道。
工作人員網路也可以根據 Conway 法則,以直覺的方式對應到大型企業的**真實世界階層結構**。
- **概念模型:**正如同公司具有不同的分部、部門和管理層級 (例如,C 套件、VP、董事、經理),在特定領域內運作的工作人員網路可以建模為平行組織圖表。
- **節點與頁面:**在此階層中:
- 樹狀結構的 **葉子**是 **專家工作人員**或 **MCP**。他們是執行實際工作的功能單位 (例如,「資料庫查詢工作人員」、「客戶驗證工作人員」、「情感分析工作人員」)。他們代表組織的個別參與者或工作單位。
- 階層中的 **所有其他節點** (包括根層和中間層) 是 **經紀人代理程式** (或子協調流程)。這些工作人員不會執行最終工作,但負責其特定網域或層級內的路由、委派、彙總和衝突解決。高層級經紀人將工作委派給「銷售網域經紀人」,這會將工作委派給「機會管理經紀人」,這會透過「機會狀態更新工作人員」(表格) 執行工作。
此結構可確保在本機管理複雜性、包含內容,且系統可預測且可靠地調整規模。您可以將新的專科工作人員導入組織樹狀結構的特定適當分支。
 請考慮數位人工的組織圖類似度。每個 YAML 檔案皆代表每個內部組織 (「員工成功」、「安全性」、「財務」等等)。在每個組織 (工作人員網路) 內,您可能擁有階層結構,工作人員可透過此結構協同合作、將工作分割成工作並指派。在上述圖表中,通訊流程從上到下。且假日並非僅限於一組經紀工作人員的耗用。
## 選項 2:網域驅動的設計和工作人員 AI 實作
根據人體組織圖表建模工作人員網路,可能需要經常重新架構,特別是在經常進行重新組織的公司中。替代方法是依功能領域組織工作人員。此分組可能需要跨越傳統的人類組織界限。例如,新員工上線涉及硬體和使用者提供的 IT 作業,而銷售動作需要作業和行銷。
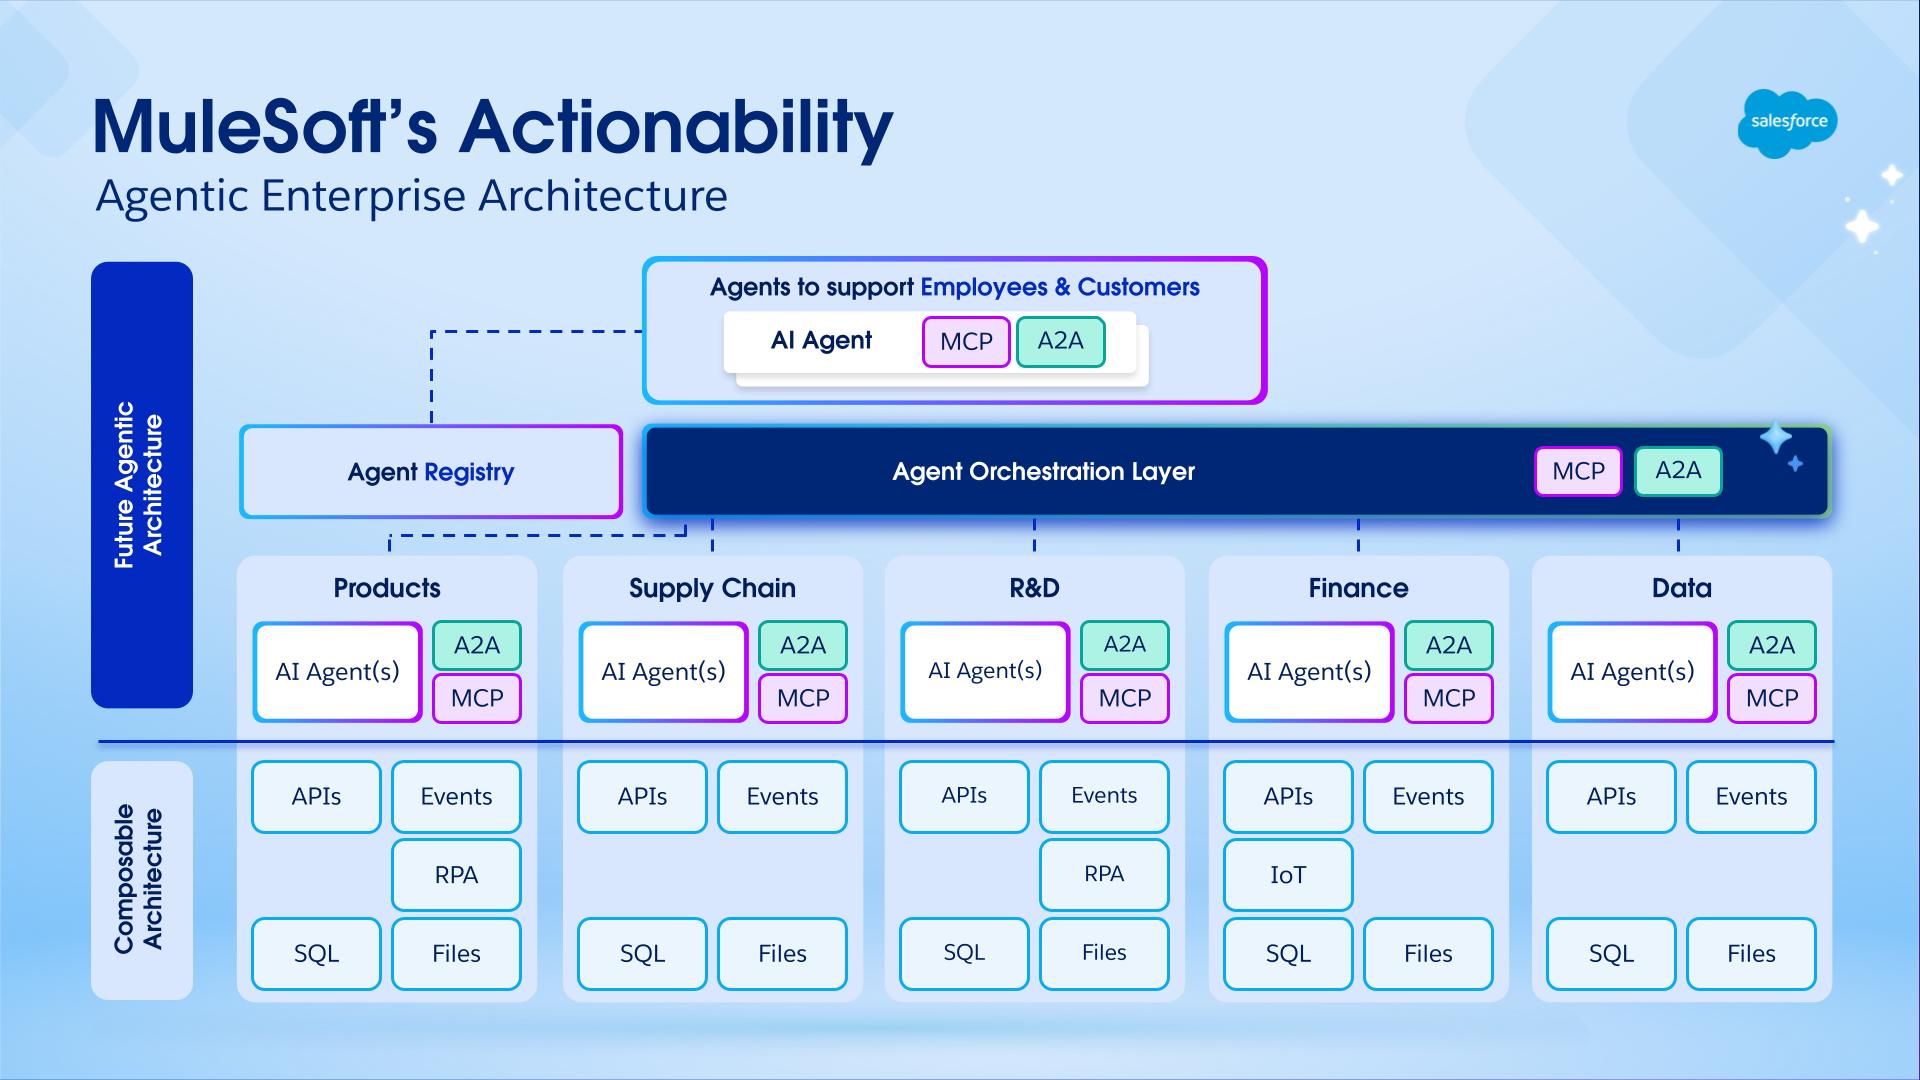 ## 關於作者
Nikhil Aggarwal 是 Salesforce 的主要結構設計師,負責 MuleSoft 和 Salesforce Automation Cloud 的結構設計。Nikhil 在提供大規模產品方面擁有超過 18 年的經驗,並對可調整結構、直覺式開發人員體驗和建立績效優良的小組有熱忱。在 Salesforce 之前,他曾在 Microsoft Power Platform、Dataverse 和 Office 365 中從概念到啟動領導多個計畫。他的工作持續構思現代企業在 AI 初期時代如何連線系統、自動化工作流程,以及發揮業務價值。
Mariano Gonzalez 於 2011 年開始加入 MuleSoft,專注於關鍵任務的分散式系統、整合、PaaS 和雲端運算。今天,Mariano 專注於推進 AI 平台,特別關注監管、協調流程、探索和可觀察性。Mariano 在 IT 產業工作超過 20 年,擔任軟體架構師和團隊領導者,在整個農業、能源、政府、IT、電信和內容管理行業中設計和提供 BPM、ERP 和整合解決方案。
Pedro Colunga 是 Salesforce 的軟體工程師結構設計師,專門處理 API 和中繼資料結構。專注於完整平台生命週期,Pedro 在定義組織如何與系統情報、語意和中繼資料驅動解決方案互動時扮演關鍵角色。Pedro 的 20 年職涯,其中包括企業經驗,涵蓋 Fuego、BEA Systems、Oracle 和 TekGenesis 等公司,此公司後來被 MuleSoft 收購,他一直在其中推動平台式架構,提供如 BPM、RAD 和整合等領域的深度專業知識。
Gulal Kumar 是 Salesforce 的「軟體工程結構設計師」,專注於資料與整合結構。他在整合和 API、現代化計畫、安全性和 AIML 計畫方面擁有超過 20 年的經驗,提供豐富的專業知識。Gulal 一直致力於推進業務轉型計畫、增強安全性和彈性、促進傑出結構,並領導跨各種網域的 AIML 計畫。
## 1\.簡介
二十多年前,Salesforce 開始了第一個多重租戶雲端平台,在該行業中建立了先例。此後,Salesforce 已發展為全方位的企業平台,能夠壓縮和自動化業務的關鍵層面,並為不同產業和區域的數十萬個企業和數百萬位使用者提供服務。Salesforce 也透過策略性收購增強了其 Customer360 產品套件。
過去幾年,市場、產業和技術環境的變化已導致我們在基礎 Salesforce Platform 中進行了一些深度轉型。這些包括:
- 出現大量投資基礎結構的公用雲端提供者。
- AI 的快速進展,包括機器學習、生成式 AI 和工作人員體驗。
- 跨產業和國家/地區的資料落地與法規需求增加。
- 快速增加規模處理即時資料和交易的需求。
- 更專注於網路安全、系統可用性、效能和彈性的需求。
- 客戶對整合套件的需求,其提供高度彈性、寬鬆連接且高度一致的結構。
針對這些變更,尤其是 AI 的地震轉變及其對業務的影響,Salesforce 已從頭開始全面轉型其平台,為下一代應用程式和客戶使用個案奠定基礎,同時維持我們的 Trust 目標。
在 Dreamforce 2024 發佈 Agentforce 及以下圖表,代表此廣泛努力的成果,涉及數千名 Salesforce Technology 和 Product 組織小組成員。目前,超過 95% 的客戶已轉換至此新平台。大多數客戶的成功移轉,包括具有最嚴苛工作負載的客戶,強調了工程師的創意,並重申 Salesforce 的核心價值「Trust」、「客戶成功」和「創新」。
自 Agentforce 啟動以來,Salesforce 持續引領在企業應用程式中使用 AI,並成為開發代理體驗的市場領導者,為現有和新業務功能提供即時對話式體驗。
在此白皮書中,與頂尖工程師協同合作,為瞭解主要技術轉型背後複雜性的建構人員提供詳細的探索。此論文會深入瞭解可讓平台延展、安全且準備好處理未來應用程式的基本結構增強功能,同時滿足客戶不斷變化的需求。建議您從「結構概觀」一節開始,以瞭解完整的全貌。讀者可以從此處依序繼續,或探索最感興趣的章節。
_Emin Gerba_
Salesforce _首席結構設計師_
 ## 2\.結構概觀
下列 Salesforce Platform 的架構原則能瞭解我們如何設計功能與功能的基礎與差異:
- **企業級 Trust**:Trust 是 Salesforce 的第一個價值,我們不僅優先處理服務的可用性和安全性,還建立存取控制、合規性和安全性功能,讓客戶能夠透過 Salesforce Platform 符合其合規性和安全性標準。
- **多租戶**:所有服務和基礎結構都建立為代管多個客戶。這為使用規模提供策略性模式,並針對可用性和安全性的常見高標準化,無論客戶的大小為何。
- **中繼資料驅動**:中繼資料是多重租戶服務可自訂方式的核心。我們的中繼資料可擴充,因此管理員和開發人員可以建立現有工作的基礎,並從 Salesforce 和生態系統合作夥伴的未來產品更新中獲益。
- **API 第一個:**Salesforce Platform 會排定豐富且一致的 API 組合優先順序,該組合涵蓋可透過 Salesforce 原生使用者介面執行的所有動作。這可讓開發人員和合作夥伴利用並重新撰寫平台的功能,以整合系統或建立新的使用者體驗。
- **開放與可互通**:Salesforce Platform 可整合至客戶的任何企業結構。我們設計 Salesforce Platform 以與其他雲端型和內部部署系統搭配使用,並為外部系統提供 API、工具和整合標準,以與 Salesforce Platform 整合。
- **工作人員:**Salesforce Platform 正在快速發展,成為整個應用程式套件中的優先工作人員。我們希望使用者能夠透過深度的工作人員對話體驗與 Salesforce 互動,讓他們能夠以越來越自然的方式完成工作並與其資料互動。
目前的 Salesforce Platform 代表自 Force.com Platform 2008 首展後 Salesforce 功能的最新階段。最近的金鑰轉換包括:
- 採用 Hyperforce 並轉為雲端式結構。
- 從單一結構演進至具有獨立服務的結構。
- 與傳統關聯式資料存放區一起,導入 Data 360 和 Lakehouse 技術。
- 深入整合 AI 技術、生成式和機器學習,以及在整個平台上演進至工作人員體驗。
這些變更已擴展並精簡平台的功能,而不會產生明顯的中斷,因為可讓 Salesforce 工程師以最少的客戶中斷的方式順暢地推進我們的技術。強大的抽象也持續是 Salesforce Platform 中簡化企業級軟體技術複雜性的關鍵,例如安全性、可用性和技術慣例,讓應用程式開發人員可以專注於解決其獨特挑戰。Salesforce Platform 的功能會在下方醒目提示:
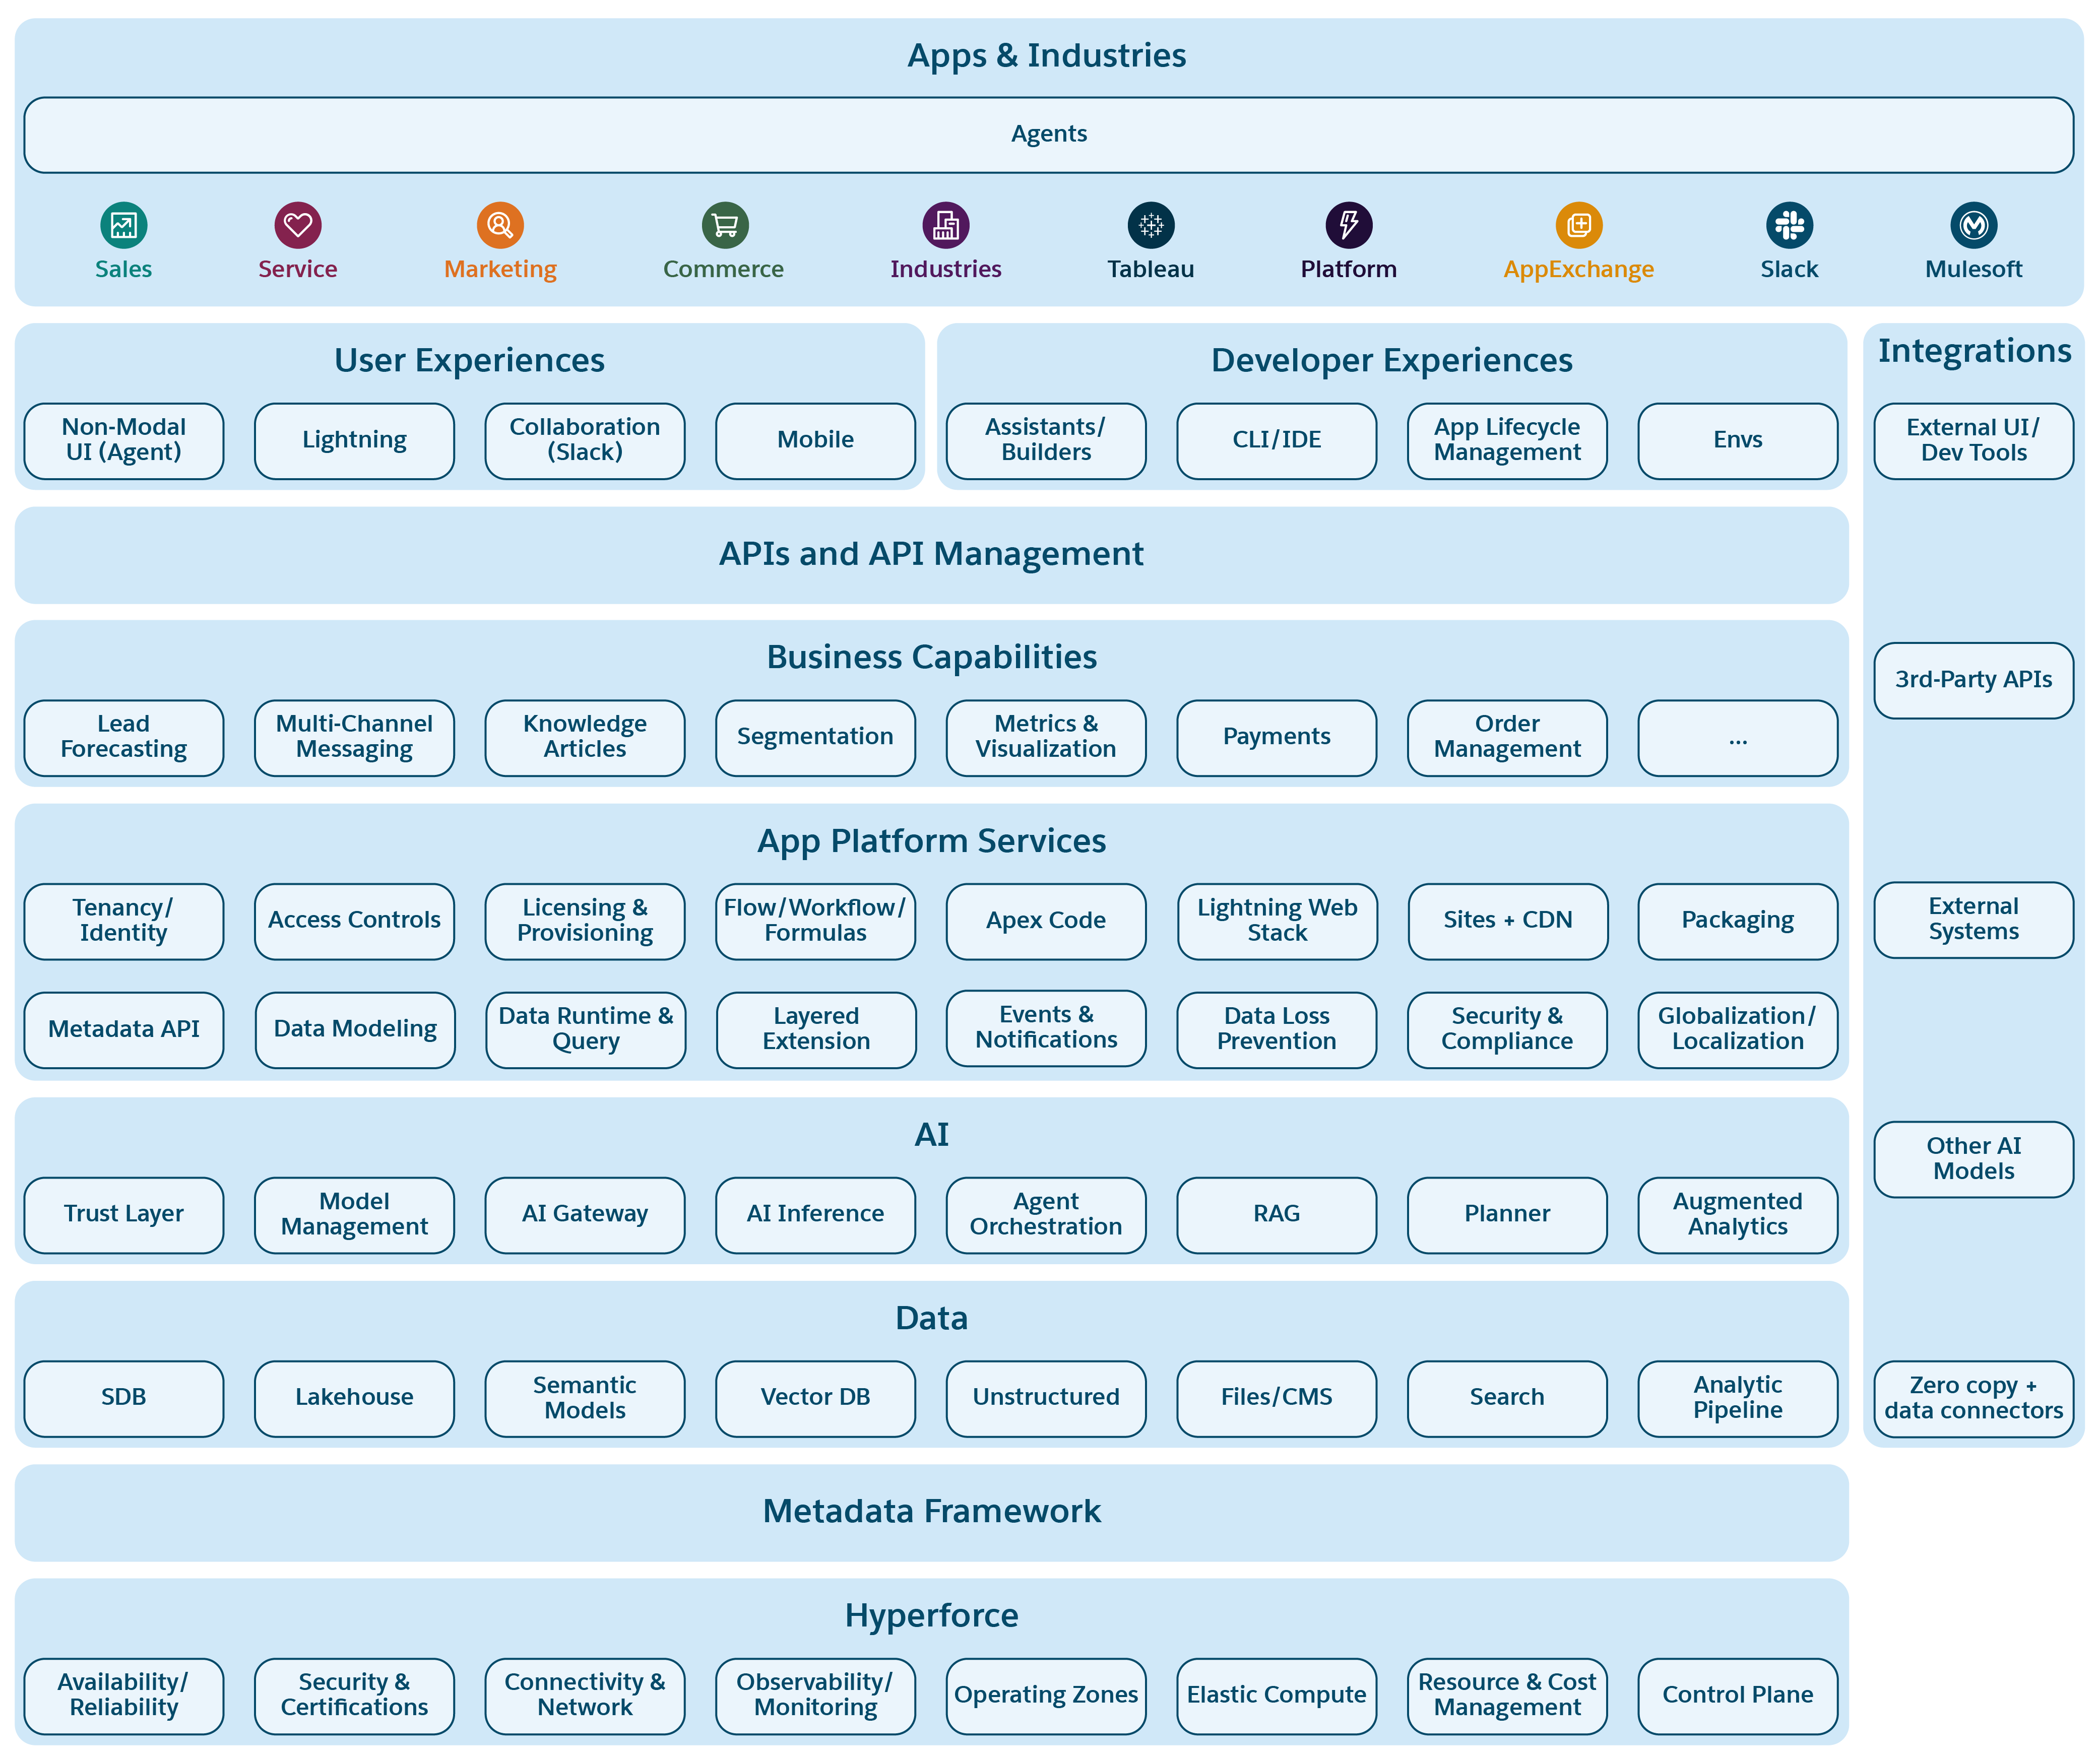 Salesforce Platform 會顯示成組成系統的一組圖層。每個圖層代表對於在平台上建立的應用程式而言十分重要的一組相關功能。每個圖層內的子方塊提供這些功能的說明範例。每個較低層的功能都會整合到上述所有層,以確保整個 Salesforce 應用程式套件的體驗一致且一致。
Salesforce Platform 體現過去 20 年所開發成熟技術平台的所有層級廣泛的工程轉型。這些變更由不斷發展的客戶需求和新技術所驅動,可支援新應用程式類型與解決方案。轉換互相連接,下層的變更會影響上層所有後續層的進化。
Salesforce Platform 結構為數個層級,每個層級皆為其全方位功能做出貢獻:
- **Hyperforce**:基礎基礎結構已從第一方資料中心發展為公用雲端提供者,並透過 Salesforce 技術增強,以確保安全、合規、高可用性且具成本效益的主控。
- **中繼資料架構**:提供可建立應用程式的穩定抽象,即使我們擁有且使用的技術也隨之發展。包含物件關係對應器、執行的指示性順序,以及將中繼資料定義與中繼資料驅動執行階段橋接的「核心」執行階段。
- **資料**:包含多租戶關聯式資料庫和 petabyte 級 Lakehouse,用於管理 Salesforce 和非 Salesforce 資料、支援非結構化資料和內容管理、進階搜尋、管治和分析處理功能。
- **AI**:使用基本、信任的 AI 技術建立資料層,利用預測和生成式 AI 強化代理體驗。
- **應用程式平台服務:**為 IT 管理員、開發人員和廠商提供建立和自訂應用程式的工具,提供意見抽象以簡化常見且複雜的工作。
- **業務能力**:提供各種功能以滿足各種業務需求,讓開發人員可以視需要量身打造應用程式。
- **API 與 API 管理**:確保透過格式正確的 API 可存取所有平台功能,進而促進服務與層級的相互依賴。
- **使用者和開發人員體驗**:提供使用者易用的使用者介面,以及從低程式碼到 Pro-code 的各種開發工具,可用於應用程式開發和自訂,並支援現代 AI 驅動的開發。
- **整合**:與任何企業結構整合,透過資料連接器、零複製資料整合和其他工具,與 Salesforce 和非 Salesforce 系統的相容性。
- **應用程式與產業**:提供以平台的整合功能為基礎的可自訂應用程式和產業特定解決方案套件,利用完整的下層功能,並使用深度整合的 AI 工作人員。
## 3\.Hyperforce
Salesforce 已開發全球資料中心基礎結構近 25 年,遠遠超過許多目前的超級規模和 IaaS 廠商。Hyperforce 是 Salesforce 基礎結構演進的目前產生,專為在全球多個公用雲端提供者之間作業而設計。
其量身打造以滿足客戶的彈性 B2C 規模、全域資料落地、增強型可用性、最上層安全性和法規合規性的需求。Hyperforce 會標準化所有 Salesforce 產品的基礎結構,以協助快速整合新收購。
Hyperforce 可確保 Salesforce Platform 的交付,進而在全球 20 多個地區快速部署新功能與應用程式、符合資料落地與法規合規性需求。
### 3.1 結構原則
在 Salesforce 轉換至 Hyperforce 期間,超級規模的服務、介面和合規性層級之間已識別出明顯的差異。為了為 Salesforce Platform 建立強大且可攜式的基礎,採用以下結構原則:
- **基礎結構代碼**:此原則利用網域驅動的結構,涉及基礎結構的陳述性編碼、建立固定的成品,以及使用如 Kubernetes 和 Service Mesh 等標準依需求自動化基礎結構。
- **零 Trust 安全性**:使用全方位防禦策略實作零信任安全性模型,包括身分管理、驗證、授權、網路隔離、最低權限安全性原則,以及傳輸與靜態資料的加密。
- **受管理服務**:此原則強調使用多租戶和多雲端服務,可增強跨不同基礎架構和環境 (例如商業、政府和空氣缺口系統) 的可攜性。
- **內建彈性**:任務關鍵服務分佈在多個「可用性區域」之間,以確保高可用性。資料會在「可用性」區域之間複製。服務也會以可用性層級標記,以管理服務層級目標和彈性規劃。
- **完全可觀察**:將所有服務整合至標準可觀察性平台以有效監視,其中包括記錄收集、度量收集、警示、分散式追蹤,以及如流量、錯誤率和資源利用率等服務作業的追蹤。
- **自動化作業**:這包括基礎結構生命週期的自動化管理和預測 AIOps (營運 AI),以維護服務品質、偵測和處理服務降級,以及偵測失敗。
- **自動刻度**:此原則著重於可擴展性和成本效益,可在不同規模之間提供營運彈性,而不會增加營運風險,從而摘要與雲端提供者相關的特定帳戶限制。
- **FinOps 感知**:公用雲端提供基礎結構靈活性,但可能導致成本增加的風險。我們在整個服務生命週期中採用以效率為導向的工程文化,而不會影響可用性、安全性和客戶 Trust。
這些原則可引導 Salesforce Hyperforce 平台的開發和作業,確保其在各種環境中保持適應性、安全性和效率。
### 3.2 基礎結構概念
Salesforce Platform 及其支援服務在 Hyperforce Foundation 上執行,其中包含多個 Hyperforce 例項。這些例項會策略地分配至各種國家,以符合客戶的地理位置和可用性偏好設定。為了符合嚴格的資料落地與作業需求,可選擇性地將一或多個 Hyperforce 例項分組並指定為「作業區域」。每個例項都會定期更新,以確保安全性、延展性和符合當地和法律標準。
Hyperforce 例項由多個 Hyperforce 功能領域例項所組成,這些例項是提供特定功能的服務叢集。基本功能網域提供安全性、驗證、記錄和監視等重要服務,這些服務對於其他 Hyperforce 服務至關重要。業務功能網域支援各種 Salesforce 產品,例如 Sales Cloud、Service Cloud 等,以協助其產品功能。
「功能領域」內的服務可以組織成「儲存格」,這是可調整且可重複的服務傳送單位。Hyperforce 儲存格會對應至傳統上稱為「Salesforce 例項」,其中一或多個 Salesforce 組織 (組織) 位於其中。儲存格是刻度單位以及強爆炸半徑邊界。超級儲存格提供多個儲存格的邏輯分組,以限定由於跨儲存格共用服務而導致的更大爆炸半徑。一個功能領域中可以有多個超級儲存格。儲存格與超級儲存格可讓 Hyperforce 在功能領域內水平調整規模,同時強大控制爆炸半徑的大小。
每個 Hyperforce 例項都會對應至一個「可用性區域」,這是所有公用雲端基礎結構中找到的概念,且能夠獨立於所有其他 Hyperforce 例項運作。Hyperforce 例項中的所有任務關鍵服務與資料都會散佈並複製在至少三個「可用性區域」之間,以達到錯誤容忍度與穩定性。此外,資料備份會複製到其他適當的 Hyperforce 例項,以達成業務連續性和法規合規性。
Hyperforce 基礎結構會隨著建立或重新整理新的 Hyperforce 例項和儲存格而持續發展。系統會將客戶與 Hyperforce 實體詳細資料的變更隔離。所有外部可見的客戶端點皆可透過穩定且安全的 Salesforce「我的網域」(例如,acme.my.salesforce.com),以安全地將流量路由至目前的資料和服務位置來存取。輸出流量 (例如郵件、網路呼叫) 最適合使用如「網域金鑰識別郵件」(DKIM) 和 mTLS 等安全機制來實作,以確保客戶的內部部署基礎結構不會硬式編碼 Salesforce 基礎結構的實體詳細資料,例如可能隨時間變更的 IP 位址。
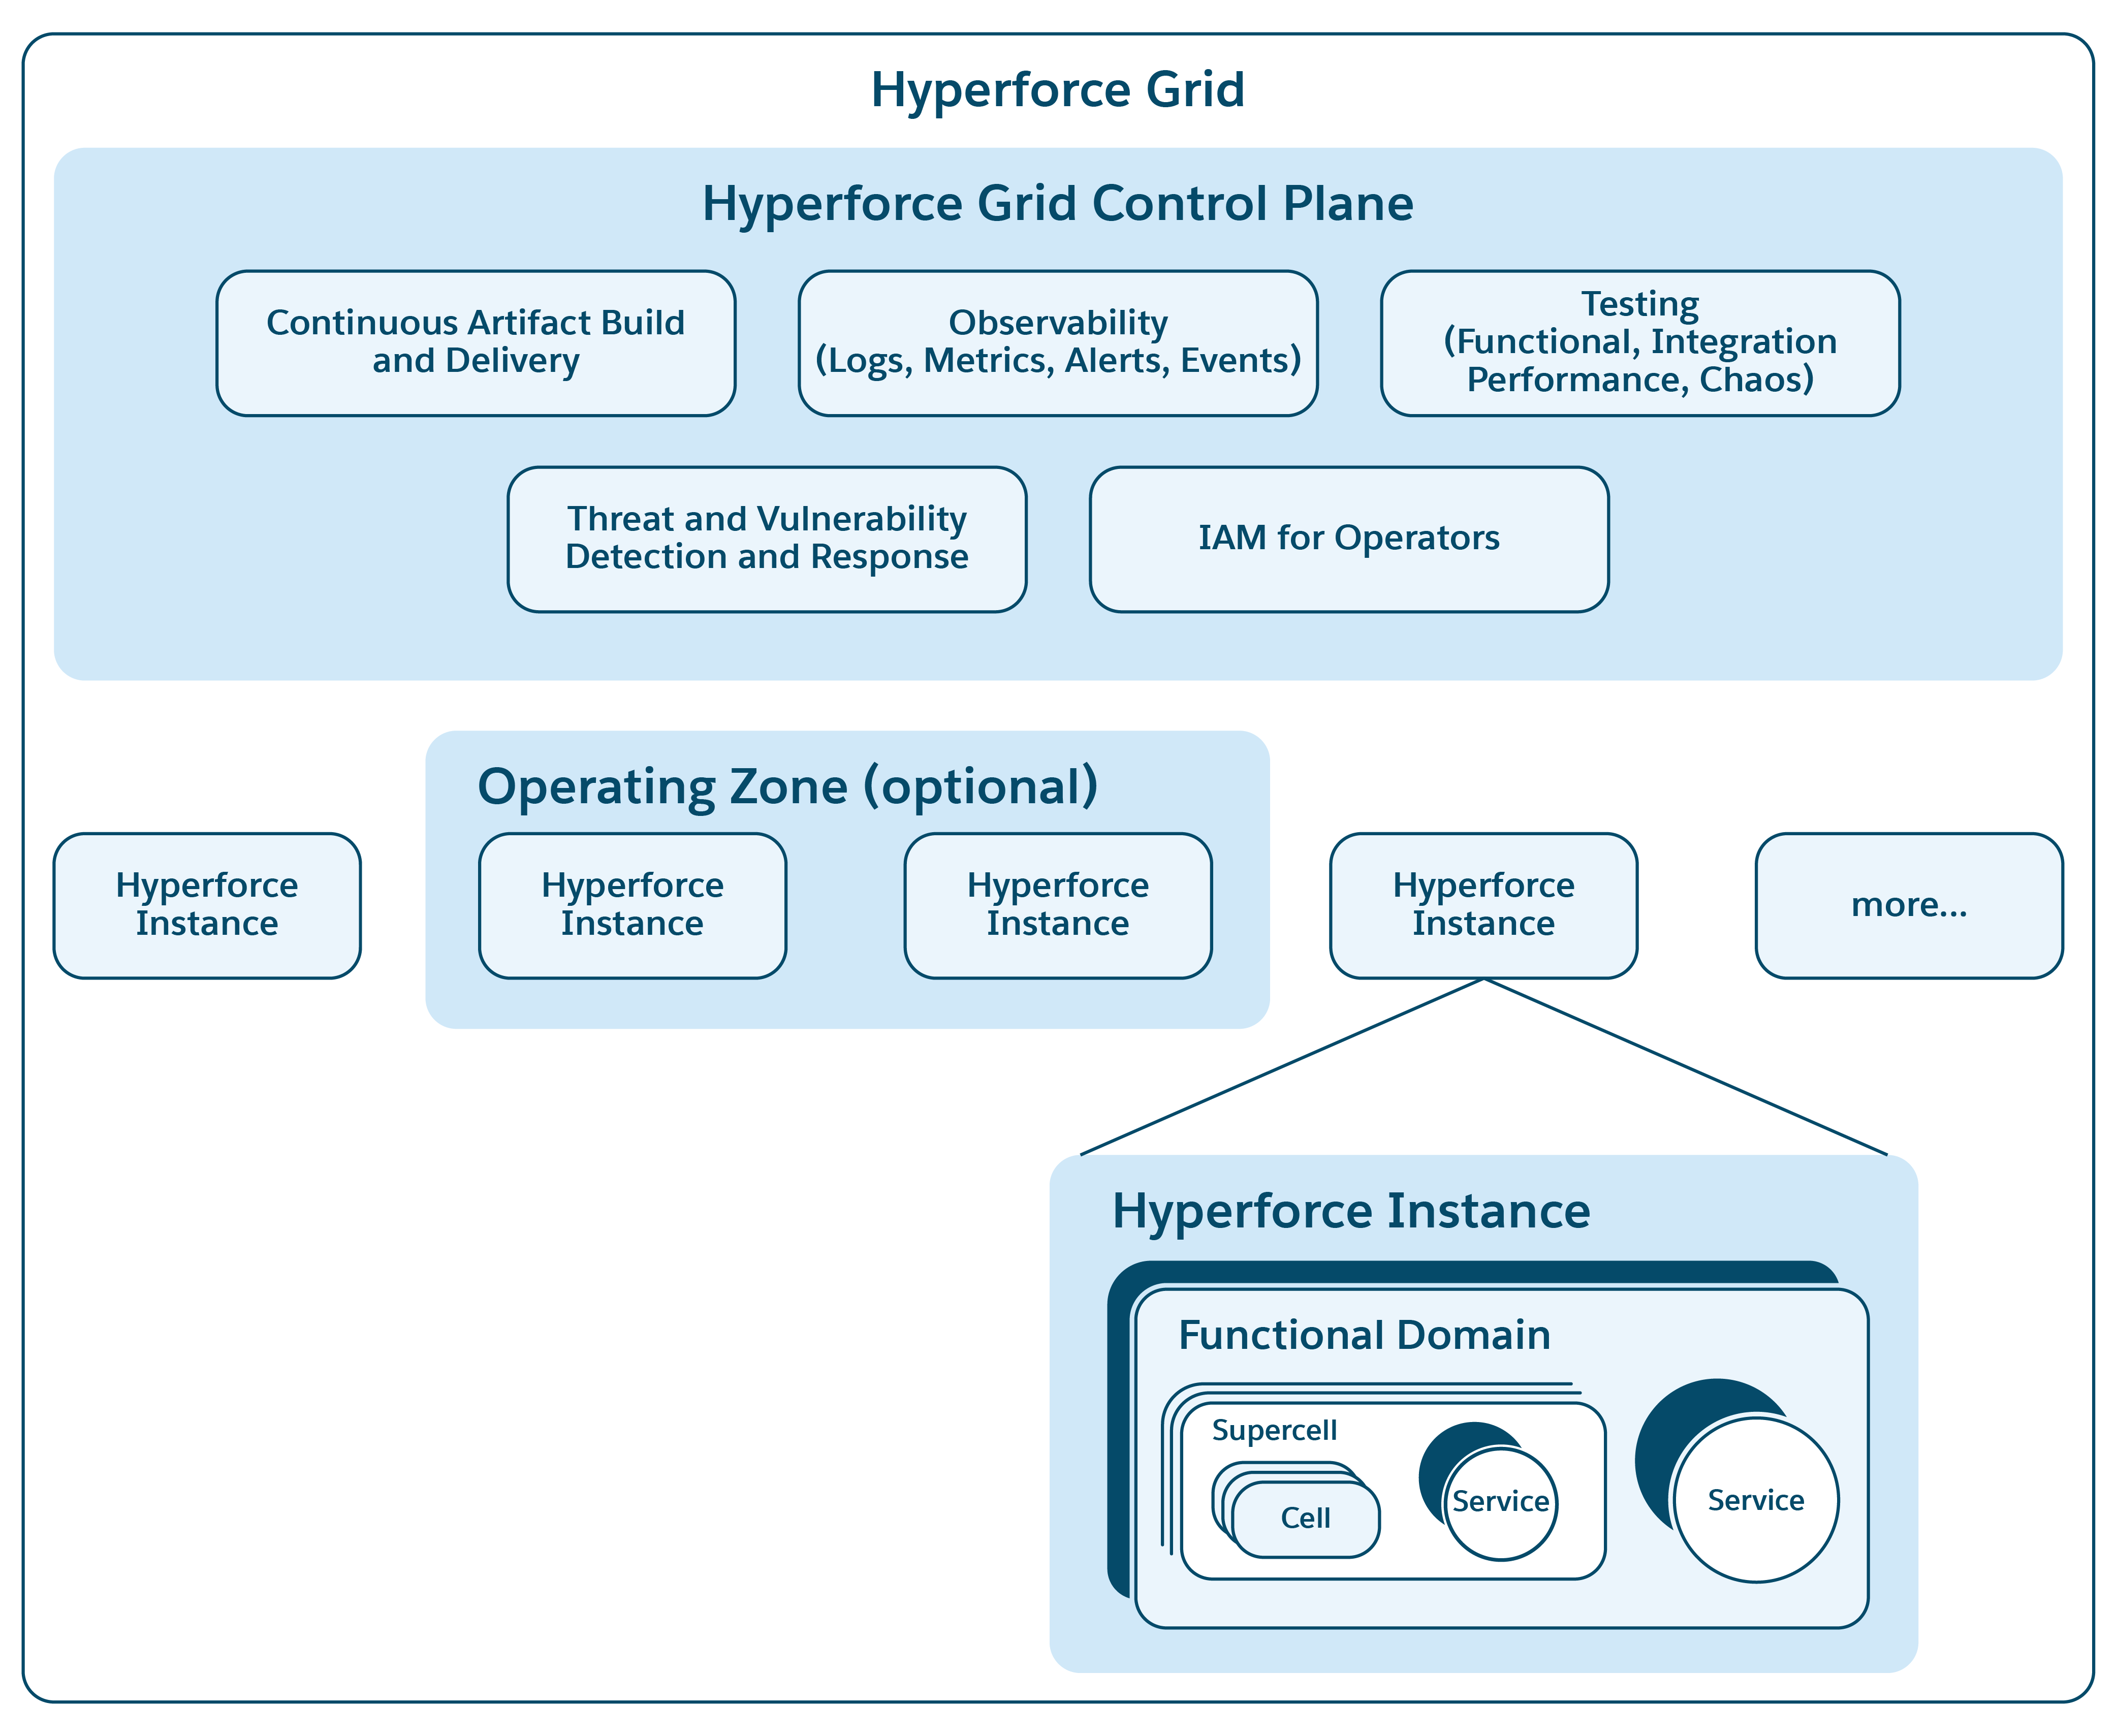 ### 3.3 網路安全性
Hyperforce 功能網域的設計採用強大的安全措施。每個網域都會在邊界受到保護且隔離,網域內的服務會分隔為專屬帳戶以增加安全性。服務之間的通訊可透過 Service Mesh 或類似的通訊協定安全地進行。流量管理由檢查、路由和將必要控制項 (例如斷電器或比率限制) 套用至所有傳入和傳出流量的輸入和輸出管道來處理。
Hyperforce 功能領域內的服務會分組為「安全性群組」,只有邊緣群組中的服務才會對公用網際網路公開。執行階段安全性原則會強制執行不同安全性群組之間的通訊規則,並遵循最低權限原則來確保服務僅具有必要的存取權。
每個地理區域都有 Hyperforce Edge 功能領域,可終止傳輸層安全性,並使用可程式設計的 Web 應用程式防火牆原則來預先處理威脅。這可確保僅合法流量到達 Hyperforce 端點,同時維持安全且有效的客戶體驗。此外,Hyperforce 例項之間的內部網路連結受到嚴格控制,且包含個人可識別資訊的所有記錄資料都會匿名化,以遵循 GDPR 標準。
### 3.4 Hyperforce 網格控制平面
Hyperforce 網格包含多個共用相同控制平面的 Hyperforce 例項,其設計目的是在適當的情況下隔離敏感工作負載。其可確保所有客戶或系統資料、平台中繼資料或跨網格監視資料的零洩漏。「控制平面」包含冗餘的 Hyperforce 例項,這些例項主控建立、管理和監視面向客戶的 Hyperforce 例項所需的基本服務。
所有 Hyperforce 服務的服務和基礎結構程式碼是在專屬的控制平面功能領域中安全開發,使用來源程式碼管理、持續整合、測試和成品建立服務。在將產生的程式碼封裝至標準化且數位簽署的容器,並儲存在影像登錄中之前,系統會掃描其威脅和漏洞。程式碼部署由 Hyperforce 連續傳送系統中的授權管道處理,而部署權限僅限於授權的小組和運算子。Airgapped Control Plane 會處理此類環境中必要的其他保護措施。
身分與存取管理 (IAM) 服務會強制執行及時批准,以限制存取持續時間與動作,而稽核追蹤會監視所有活動,並提供即時偵測系統,以找出任何可疑活動並予以警示。
### 3.5 Hyperforce 成本管理
當 Salesforce 從第一方資料中心將服務轉移至公用雲端上的 Hyperforce 時,重新整理預算建立、成本視覺化和資源最佳化策略十分重要。
我們的成本管理方法不僅僅是減少成本,它是一種策略性流程,可區分旨在成長的產品和穩定的產品。其計畫以耗用量為基礎的定價和利潤,以維護產品可用性,並符合我們 Trust 的核心價值。公用雲端帳戶以階層方式組織,並連結至特定產品和主管。詳細的服務層級資源標記,以組織中繼資料豐富,可協助找出個別微型服務的成本。Tableau 和 Slack 之類的工具與進階預測工具一起,用於為主管和小組提供成本、預測和預算分析的即時資料,藉此為未來財務規劃帶來信心。
為了確保最佳化成本管理,Salesforce 採用「計算節省計畫」、「現有容量」和「隨選容量預留」(ODCR),以保證所需容量。這些預留會透過進階時間序列預測和自訂顯示面板進行管理,以允許人力監督和決策。針對單位交易成本減少 (處理定義業務交易量的成本) 設定可達成的目標是推動改善的有效策略。Hyperforce 單位成本探索器工具可讓小組分析和管理單位成本趨勢、將成本歸屬於特定服務,並識別新的改善機會。Salesforce Cloud 最佳化指數 (或「COIN」分數) 會根據儲蓄機會的動態清單來評估服務,以激勵服務小組維持最佳的資源效率。
在我們對永續性的堅定承諾中,我們積極致力於減少碳足跡,並設定特定目標來減少我們的單位「服務碳」,即與執行工作相對的排放量度量。
## 4\.企業級 Trust
安全性和可用性是企業級平台的重要基礎層面,對於維護客戶 Trust 而言至關重要。在 Salesforce 中,這些控制項是 Salesforce Platform 的整體,會透過共用的服務和軟體架構自動強制執行。此內建方法可確保個別系統受益,而不需要額外的工作。
管理並持續增強跨數千個服務和數百個小組的此廣泛的安全性和可用性控制,這是一項重大挑戰。不過,這十分重要,因為忽略小詳細資料可能會導致安全性缺口或系統中斷。
### 4.1 安全性
Hyperforce 是安全且符合的基礎結構平台,支援使用進階安全性功能開發和部署服務。其提供強大的存取控制、資料加密和安全性標準合規性。Salesforce 遵循 40 多個安全性和合規性標準,例如 PCI/DSS、GDPR、HIPAA、FedRamp 等。
重要安全性原則包括 Zero Trust Architecture (ZTA) 和端對端加密,以確保在所有處理階段中保護客戶資料。Salesforce 遵循安全性標準和最佳作法,從安全軟體開發生命週期到生產作業,以及強大的應用程式級安全性作法來減輕潛在威脅。
#### 零 Trust 結構 (ZTA)
ZTA 網路安全性範例可確保所有使用者、裝置和服務連線都經過驗證、授權和持續驗證,無論位置為何。ZTA 和公用金鑰基礎結構 (PKI) 對於現代網路安全而言至關重要,可建立 Trust 邊界和安全通訊,而無須依賴周邊安全性。
然而,PKI 部署通常會忽略憑證撤銷與監管在根憑證授權機構中的重要性。Salesforce 的憑證撤銷實作強大且可調整,支援端對端 PKI 安全性。
此外,Hyperforce 透過服務之間的共同傳輸層安全性強制執行 ZTA,為使用者使用以角色為基礎的存取控制,使用短期私人金鑰和及時存取權。
#### 端對端加密
Salesforce Platform 透過將 TLS 與完美的前置密碼加密套件搭配使用來確保傳輸中的資料受到保護,這可在資料在使用者裝置與 Salesforce 服務之間的網路之間以及 Salesforce 基礎結構網域內移動時保護資料的安全。
針對靜態資料,Salesforce Platform 採用硬體安全模組支援的金鑰管理系統。在其多租戶平台中,每個租戶都會獲派唯一的加密金鑰,以防止租戶之間的任何金鑰交叉。
通訊和加密的安全性取決於產生金鑰或隨機資料的 entropy。瞭解密碼編譯通訊協定因可預測的金鑰產生而導致的攻擊漏洞,Salesforce Platform 透過針對所有金鑰產生流程從多個來源取得 entropy,來減輕此風險。我們利用由雲端服務提供者啟用的各種處理器中可用的記憶體加密功能,來增強對冷啟動攻擊的保護。
#### 安全軟體開發生命週期
Salesforce 擁有自訂的 JDK,可符合許多合規性標準,例如聯邦資訊處理標準 (FIPS),從而減少開發人員和操作人員自行進行合規性工作的需求,藉此簡化流程。此自訂不僅有助於避免如 XML 外部實體插入 (XXE) 等風險,還可增強 Salesforce 的加密靈活性,並視需要交換加密策略的能力。它允許將不符合的程式碼 (無論是內部開發或從開放式存放庫取得來源) 轉換為符合 FIPS 的程式碼,而不需要進行完整的重寫,從而減少開發小組的工作量,並維持遵循依預設的安全設計原則。
此外,Salesforce 已將保護措施整合至安全軟體開發生命週期 (SSDL),以納入架構來對抗跨網站指令檔 (XSS)、要求偽造 (CSRF) 和 SQL 插入等漏洞。
已實作以角色型存取控制項 (RBAC) 增強的集中密碼管理系統,以保護服務與使用者存取權的安全。此外,系統會使用程式碼掃描工具,藉由來源程式碼管理系統避免意外在生產環境中顯示機密。
#### Hyperforce 作業安全性功能
網路釣魚仍然是組織的重大威脅,導致 Salesforce 根據數個業界最佳作法 (包括 CISA (Cybersecurity and Infrastructure Security Agency) Zero Trust 原則) 實作防網路釣魚的多因素驗證 (MFA)。這包括具有生產存取權之員工的硬體支援金鑰,以及可控制雲端服務提供者帳戶存取權的安全核心。
為了維持強大的安全性狀況,Salesforce 已將安全性控制標準化,並將雲端原生安全性服務整合至 Hyperforce,提供增強的可視性、威脅偵測和保單強制執行。全方位的安全性資訊和事件管理系統已用於即時監視、警示和報告,全面的漏洞管理計畫和雲端安全性狀態管理工具支援此功能,可持續識別、評估和修復漏洞。
此外,網頁應用程式防火牆會篩選和監視 HTTP 流量,以防範各種攻擊,並使用一系列網路安全性工具,包括防火牆、入侵偵測和預防系統、虛擬私人網路和端點偵測和回應工作人員,以提供持續監視和威脅偵測。網路區隔和微區段實作以將攻擊面積降到最低,並包含潛在缺口。
Salesforce 也已開發並實作針對 Hyperforce 獨特挑戰量身打造的強大事件應變計畫,其中包含識別、容納和緩解安全性事件的預先定義程序,以確保快速且有效地回應潛在的安全性威脅。
### 4.2 可用性
Salesforce 管理需要高可用性的任務關鍵客戶工作量。我們的高可用性策略包含各種組織層面,例如服務擁有權模型、事件管理和營運檢閱。策略的關鍵技術元素包括監視結構、AI 驅動的作業自動化,以及生產變更的自動化安全機制。
#### 可用性結構標準
為了持續在數千個服務之間達到高可用性,三步驟方法可大規模管理技術風險。
首先,建立可用性結構標準,定義最佳作法,例如:
- 透過自動故障轉換進行的 **冗餘**。為了處理大型雲端型系統遇到的持續失敗,Salesforce 使用高層級的冗餘性、完全自動化故障偵測,以及針對完整和部分故障的流暢自動復原來建立其服務。
- **限制爆炸半徑**。失敗_將會_發生,因此小組使用意圖的爆炸半徑上限設計其所有服務,以限制失敗的影響。最經典且可見的範例為 Hyperforce 儲存格 (fka Pod)。
- **分割失敗**。防止失敗在系統的獨立單位之間散佈和複雜。服務之間容錯的 API 呼叫是防止分散式系統中串聯失敗的關鍵模式。在過程中,小組會仔細平衡分割與冗餘。
- **自動調整**。若要在沒有效能降級的情況下提供無法預測的負載,請自動快速調整和緩慢縮減,而不需依賴由資源的飽和點 (例如 CPU、記憶體或等級深度) 觸發的慢速、錯誤的人類運算子。
- **快速回復**。我們會針對所有服務以分鐘為單位設定回復目標,並在生產前環境中自動測試回復,方法是將前往、上往和後往再次作為預設作業。小組廣泛使用功能標記來進行更快、更精確的緊急切換和首展。
- **保護接收 API 呼叫**的所有服務。負載流失、租戶公平限制、網路應用程式防火牆和複雜的 7 層保護會部署在系統的所有層級,從我們直接向網際網路公開的最遠邊界服務,到小組內部最深層的服務,這些服務可能會在更高層級的通話服務中遭到錯誤攻擊。
- **寬鬆相依性**。服務之間的相依性設計為盡可能軟性,讓其獨立失敗或成功。快取是此處最常見的模式之一 - 下游相依性通常會造成過時的結果,足以繼續運作。
- **偏好非同步通訊**。服務之間的非同步、經紀通訊會將這些服務彼此分離,並緩衝服務之間的負載高峰。
- **使 API 呼叫容錯**。為了容忍部分失敗和暫時網路問題,我們使用數種模式:逾時與期限、斷電和反向重試。我們盡可能偏好非封鎖通話,以限制資源消耗和封鎖。在建立時與整合測試時,會使用結構描述層級 linting 強制執行上一期與下一期相容性。
- **管理服務配額與限制**。小組會設定其服務車隊的配額和限制,例如 IP 位址、磁碟 IOps 或指定 Kubernetes 叢集的容量。小組會集中彙總、監視和警示這些配額和限制的使用情況,以避免即將到來的限制在執行階段影響系統。
其次,多層檢查模型可確保服務符合這些標準。這包括自動混沌測試、掃描和偵測反模式,以及與資深結構設計師一起進行結構審查,以找出自動化未解決的問題。
第三,解決方案已整合至 Hyperforce 以便符合這些標準。這包括自動遠端測量收集、預設冗餘和故障切換機制,以及如負載流失和 DDoS 防禦等內建保護,這些都會依預設為個別服務啟用。
#### 監視與可觀察性
Salesforce 處理大量遠端測量資料,包括度量、記錄、事件和追蹤,而傳統監視解決方案無法隨時有效管理。
為了解決此問題,Salesforce 開發了全方位的可觀察性系統,此系統會與其軟體開發生命週期、作業和支援功能整合。此系統為工程和客戶支援小組提供統一體驗,同時滿足規模需求並降低第三方軟體的授權成本。
Salesforce 的度量基礎結構以 OpenTSDB 和 HBase 為基礎,支援大規模收集、儲存和即時查詢時間序列資料。非即時使用個案使用 Trino 和 Iceberg,每分鐘處理超過 20 億個度量,以提供 CPU 利用率、記憶體用量和要求率的洞察。針對記錄管理,Salesforce 使用 Splunk 進行強大的索引與搜尋功能。Apache Druid 支援對大規模事件資料進行即時採取和分析,這對瞭解使用者互動和系統事件至關重要。透過 OpenTelemetry 和 ElasticSearch 管理跨微型服務的散佈追蹤,協助識別特定延遲和失敗點。
Salesforce 也已實作「應用程式效能監視」(APM) 基礎結構,此基礎結構會與其資料收集和遠端測量商店的技術堆疊整合。此應用程式自動儀表可簡化資料收集,並確保服務之間的一致距離測量。APM 的統一顯示面板可建立各種資料類型的關聯,進而增強工程師監視效能、診斷問題,以及透過凝聚式介面最佳化系統的能力。
透過標準化可觀察性工具,Salesforce 會使用散佈式追蹤,在服務之間連結不同的距離測試類型。這會建立全方位的服務相依性圖表,將整個服務生態系統視覺化,並以細微細微度追蹤要求。此功能對於找出問題、識別瓶頸,以及支援 AI 驅動的功能 (例如異常偵測、預測分析和自動修復) 而言至關重要。
#### AIOps 工作人員
為了增加事件解決時間,我們已開發 AI 作業 (AIOps) 工作人員,此工作人員會自動代表人類操作員偵測、分級和修復事件,但只會介入少數個案。AIOps 工作人員是可調整的多個工作人員反應性工具組,專為協助開發複雜且反應性工作人員型系統而設計。其功能高度模組化,可使用各種工具增強功能。其設計目的為隨著工作人員數目增加而有效率地調整規模。重要功能包括反應性結構,可讓工作人員動態回應其環境中的變更;工具增強功能,可讓工具輕鬆整合以擴充工作人員功能;以及可插入的規劃模組,可透過插入不同的規劃模組來自訂工作人員的規劃策略。
使用我們 Merlion 程式庫 (由我們 AI 研究小組開發的公開開放程式碼程式庫) 的進階機器學習模型,為 91% (撰寫時) 的核心 CRM 產品事件完成主動快速偵測。Merlion 是一組機器學習模型,例如「隔離森林」、「統計資料」、「隨機森林」和長期短期記憶 (LSTM) 神經網路,可近乎即時地處理系統產生的廣泛遠距測量資料。
79% 的事件 (撰寫時) 會由工作人員的動作自動解決。我們的 AIOps 工作人員可以處理和分級資料向量,例如記錄、設定檔、診斷、時間序列和服務特定成品,以建議補救動作。AIOps 工作人員控制項與計畫者可選擇具有特定技能的工作人員,以在生產環境中執行動作。
針對需要人力參與的剩餘事件,AIOps 工作人員會有效地將未解決的問題分級至適當的服務小組。透過使用內部微調的模型 XGenOps 智慧地瞭解每個事件的性質和內容,此模型會針對如問題記錄、事件、JFR 和記錄等作業資料集進行訓練,以確保將其導向具有必要專業知識的小組。這會為每週節省超過 2800 小時的工程時間,減輕工程師分級未解決問題的需求。
#### 持續部署
為了管理每週執行近 250,000 筆生產變更中斷的風險,系統會使用完全自動的部署系統來強制執行安全變更作法,進而消除人力錯誤。現有系統無法足夠調整或自訂,導致開發更量身打造的解決方案。
自訂連續部署系統遵循業界標準的藍色/綠色部署策略,透過多個層級確保安全:
- 每個變更的必要測試證據。
- 變更的初始 Canary 測試。
- 具有控制爆炸半徑的暫存部署。
- 部署階段之間的浸水與健康檢查。
- 緩解與現有暫停和事件的衝突。
此外,已將連續整合系統最佳化,以執行數百萬個 AI 選取的測試,以啟用快速發行,同時減少迴歸風險。
## 5\.中繼資料架構
Salesforce Platform 的核心結構原則是中繼資料驅動的設計。Salesforce 工程師建立多重租戶服務和資料存放區。平台上的每個應用程式實際上都是中繼資料集合,可量身打造個別客戶如何利用這些多重租戶服務。這就是為什麼 Salesforce Platform 的常見行銷片語為「透過中繼資料存取所有一切」。
平台會強調結構化與強型中繼資料。此中繼資料會作為客戶體驗與基本 Salesforce 基礎結構與實作之間的抽象層。此方法可增強應用程式的可用性和品質。例如,客戶不會使用 SQL 結構描述定義和查詢,而是透過 Salesforce 物件 (sObject) API 與結構化中繼資料 (例如實體、欄位和記錄) 互動。此設計可讓平台整合新的資料儲存技術,或修改現有的資料儲存技術,而不需要重新撰寫應用程式,進而支援持續開發的最佳作法。
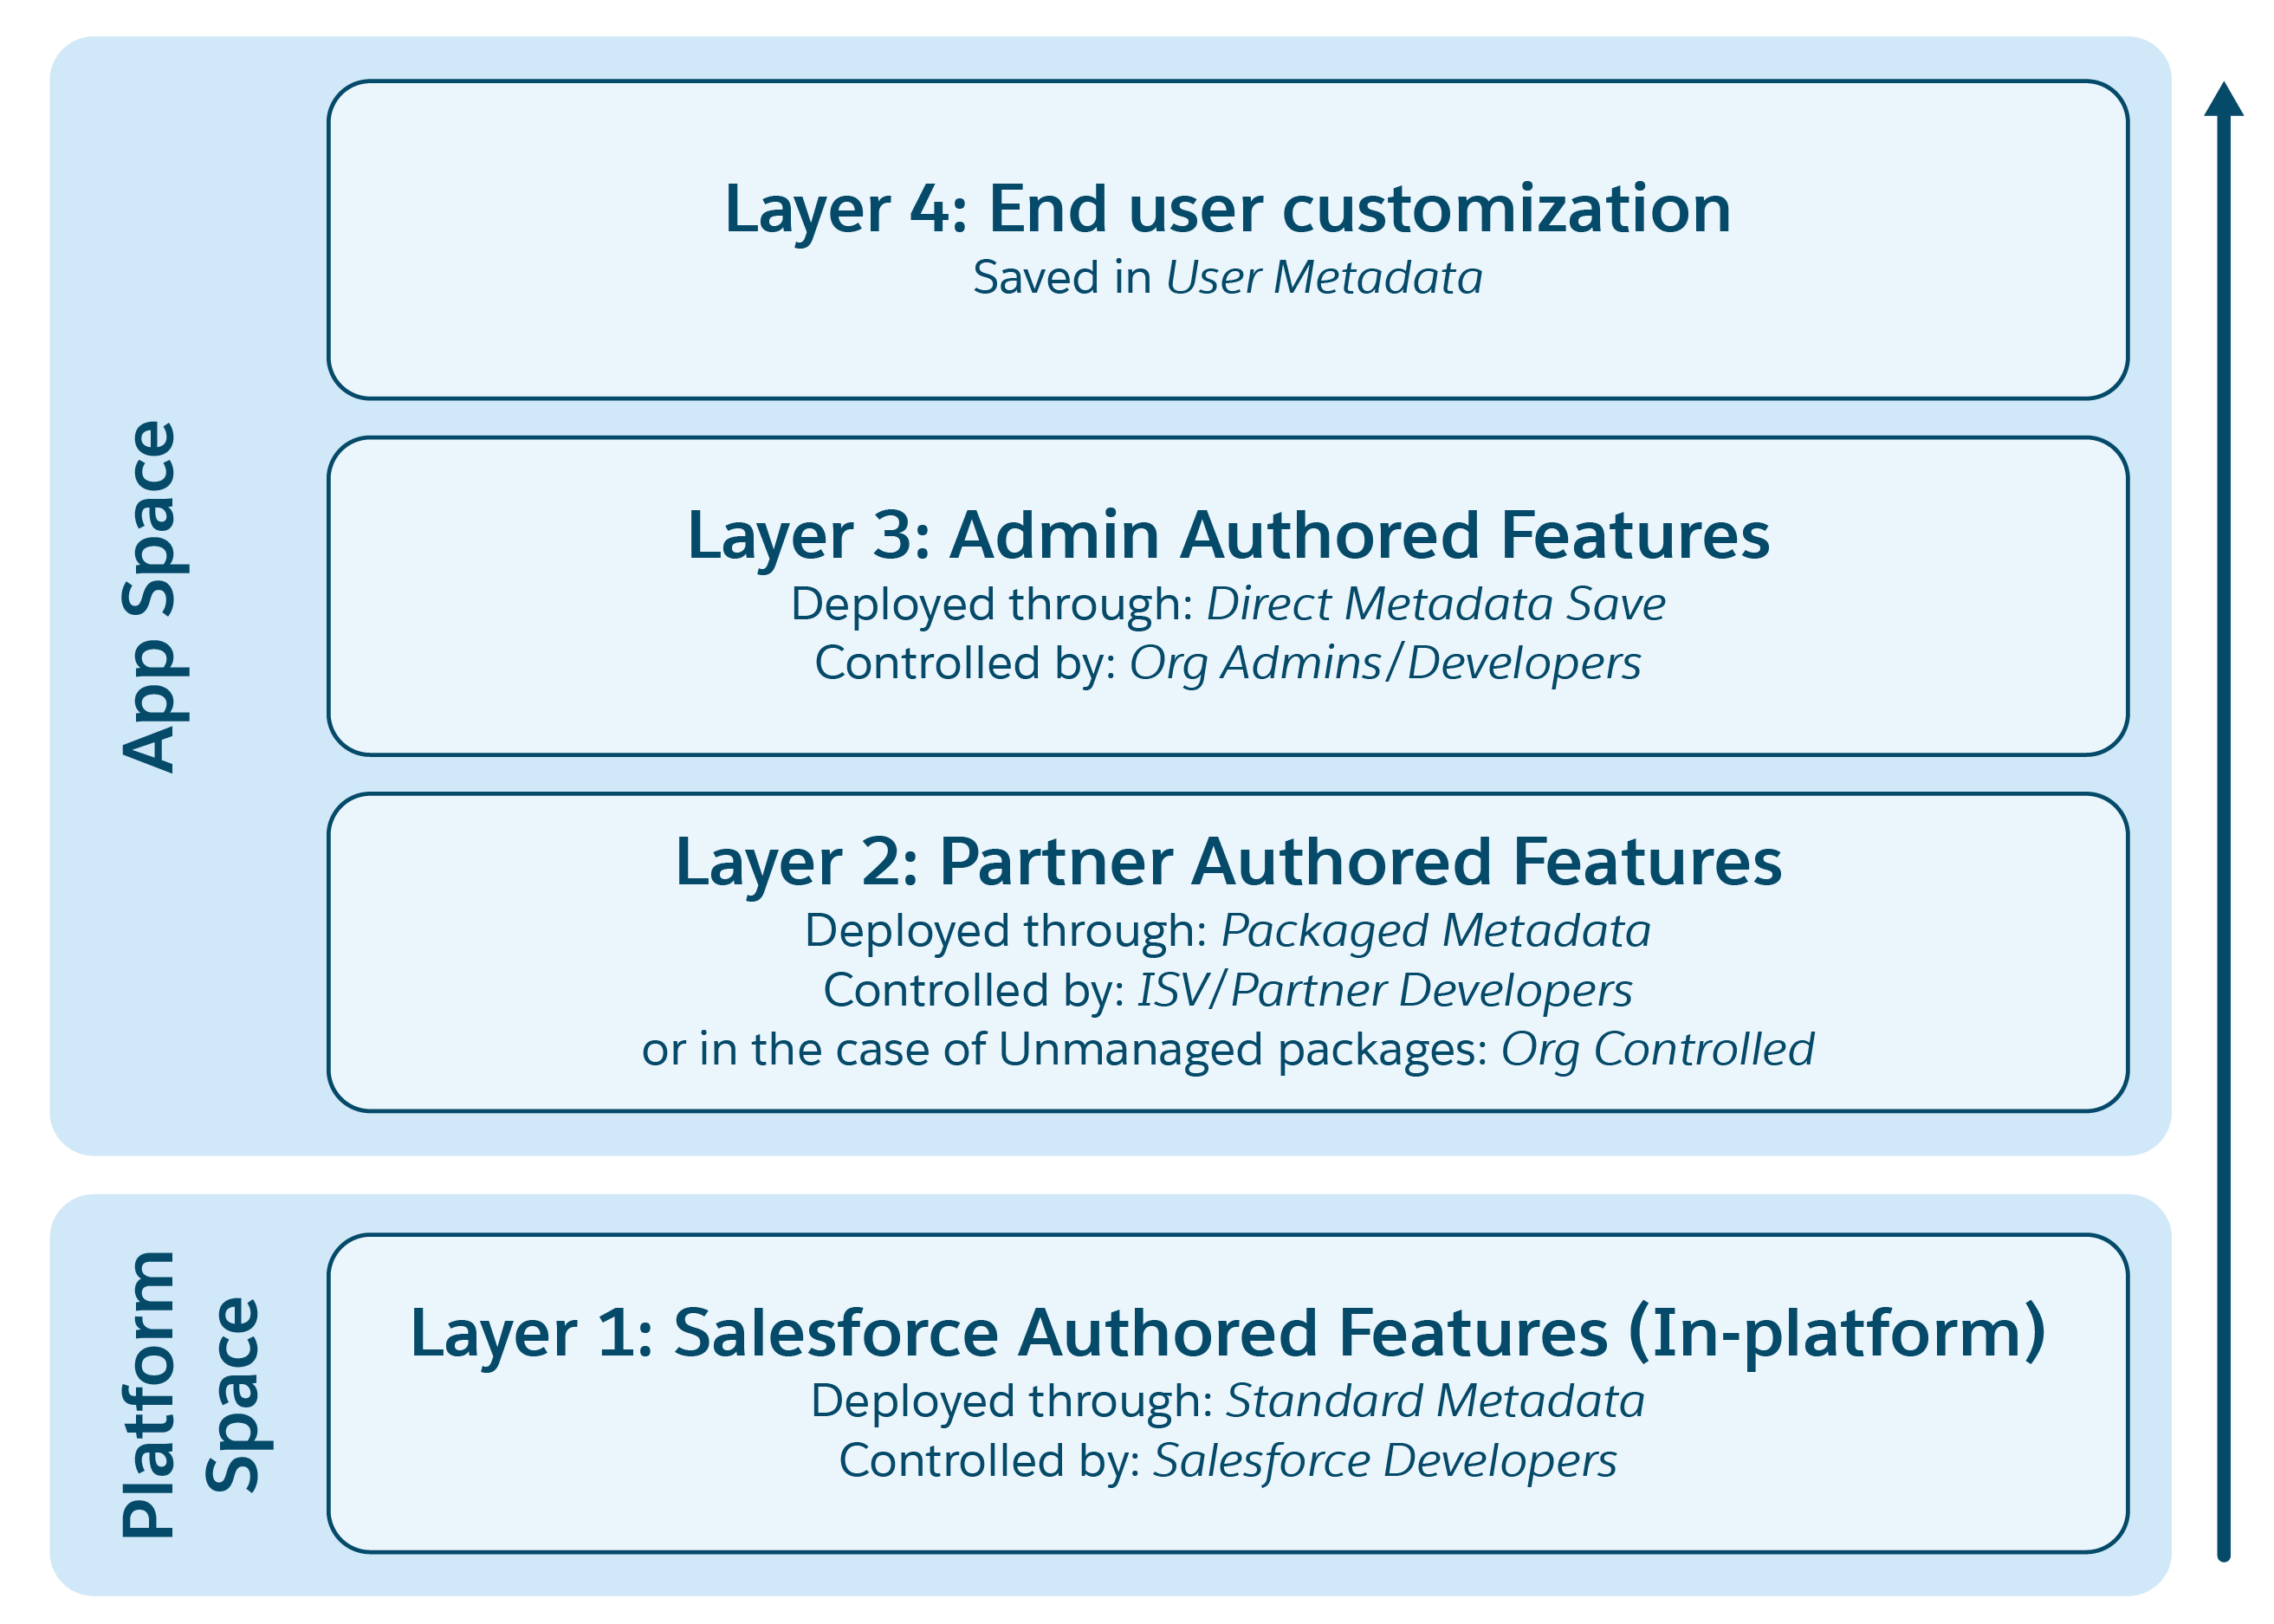 Salesforce Platform 結構具有「層級擴充」方法,支援建立和擴充應用程式的四個關鍵角色:
- **Salesforce Engineering:**小組會開發如 Sales Cloud 和 Service Cloud 等原生應用程式,這些應用程式會透過廣泛的版本流程在所有服務和執行階段中部署。這些應用程式透過授權與佈建機制可供所有租戶使用。
- **外部合作夥伴**:獨立軟體廠商 (ISV) 和其他合作夥伴可以擴充 Salesforce 建立的中繼資料,以建立價值新增的解決方案,例如 Sales Cloud 資料模型上的結構描述擴充,或 Service Cloud 個案記錄的其他驗證規則。他們可以封裝這些解決方案以散佈給多位客戶。
- **組織特定的 IT 管理員和開發人員**:他們可以自訂其應用程式,超出 ISV 提供的範圍,量身打造解決方案以滿足獨特的業務挑戰,例如專屬或區域特定的流程。
- **個別使用者**:一般使用者可以個人化其應用程式體驗,例如變更清單檢視中的資料欄順序或設定預設索引標籤。
每個角色都可以在相同的應用程式上獨立迭代,方法是確保較低層不取決於較高層中的角色變更,並維護強大版本與舊版相容性契約。
醒目提示「層級擴充」概念的一項功能是「記錄儲存執行順序」,可確保所有四個層級的商業邏輯皆依預測順序套用。這允許由組織管理員或 IT 開發人員判定的更具體、較高層級的業務邏輯,在儲存記錄期間適當覆寫 Salesforce 或外部合作夥伴可能提供的較低層級邏輯。
此外,平台的中繼資料架構使用「核心」執行階段,以及具有內建多重租戶的專屬物件-關聯式對應器 (ORM),連線至關聯式資料庫。此核心執行階段會啟用共用記憶體狀態、參考完整性驗證和交易認可,以排定應用程式穩定性的優先順序並增強應用程式部署的可靠性。結構不斷演進,以支援應用程式複雜性的規模不斷增加。例如,截至 2025 年 10 月,Salesforce 已定義超過 85,000 個實體,客戶已定義超過 3 億個自訂實體。
在過去,核心執行階段主控大部分的平台與應用程式功能。Salesforce Platform 目前的結構現在包含數百個獨立的中繼資料驅動服務。核心執行階段仍是應用程式中繼資料的單一記錄系統,利用單一結構的獨特優點來進行中繼資料管理。相關中繼資料會同步化至獨立服務中的本機快取,為應用程式執行階段提供多元化的可調整服務陣列。
## 6\.資料
資料是組織的重要資產,且 Hyperforce 為其在 Salesforce 的儲存空間提供可靠的基礎。關鍵挑戰是以針對應用程式最佳化公用程式的方式儲存資料。Salesforce Platform 透過配合各種儲存和存取需求來轉換資料層。它有效平衡成本、讀/寫速度、儲存容量和資料類型,以滿足各種需求。
隨著 AI 和分析日益塑造企業應用程式,資料已成為樞紐元素。其重要性在於其能夠啟用 AI 和分析來學習、分析、決策和自動化流程。
資料源自「記錄系統」(SOR) 資料庫,滿足公司的作業需求。接著會透過各種轉換轉換至大型資料平台,這些平台對於強化 AI 和分析驅動的應用程式至關重要。
有效管理資料 (從交易資訊到分析洞察) 對於獲取價值和支援複雜的應用程式至關重要。Salesforce Database (SalesforceDB) 是管理 SOR 資料的首要交易資料庫,而 Data 360 是強大的大型資料平台,可增強 AI 和分析功能。
### 6.1 交易資料庫
交易資料與中繼資料對於 Salesforce Platform 至關重要。SalesforceDB 是專為 Salesforce 的多租戶工作負載而設計的現代雲端原生關聯式資料庫,類似於主要提供者的其他雲端資料庫,但具有 Salesforce 結構的自訂功能。其會擴充 PostgreSQL、分開運算和儲存空間,並利用 Kubernetes 和雲端儲存空間,透過租戶特定功能 (例如加密和 Sandbox) 增強作業。
SalesforceDB 處理所有交易 CRM 資料,每月超過 1.1 萬億筆交易,以及 Data 360 和相關服務的中繼資料。其主要目標是透過永續性、可用性、效能和安全性來確保 Trust;針對大型客戶進行規模調整;並促進簡化且可靠的雲端作業。其透過將計算與儲存層分開的設計、固定的分散式儲存系統,以及記錄結構化合併樹狀目錄資料存取,來達到這些目標。這可啟用進階功能,例如儲存空間中每個租戶資料的加密,以及有效率的 Sandbox 與移轉。
#### 結構概觀
SalesforceDB 服務結構會跨三個可用性區域執行,且會在這些區域之間複製運算和儲存空間,以確保即使遺失任何節點或整個區域,系統仍可供使用。所有服務都會在 Kubernetes 中執行,以啟用自動失敗復原和服務部署。
為了提供高層級的永續性和可用性,SalesforceDB 的最終記錄系統是雲端儲存空間,如同 AWS 的 S3。系統會在此雲端儲存層級管理如歸檔和跨區域複寫等作業。儲存物件是固定的,進而增強資料散佈和複製以獲得高可用性。
由於雲端儲存空間的延遲高,因此 SalesforceDB 會使用儲存空間快取來存取資料。這些快取是散佈式儲存系統,可在節點叢集中維護儲存物件的暫時複本,以確保資料庫所需的複製性和持續性。個別快取用於交易記錄儲存和資料檔案儲存。
SQL 計算層級由三個不同可用性區域中的主要資料庫叢集和兩個待處理叢集所組成。主要叢集會處理所有資料庫修改,而待處理叢集僅會處理查詢作業。
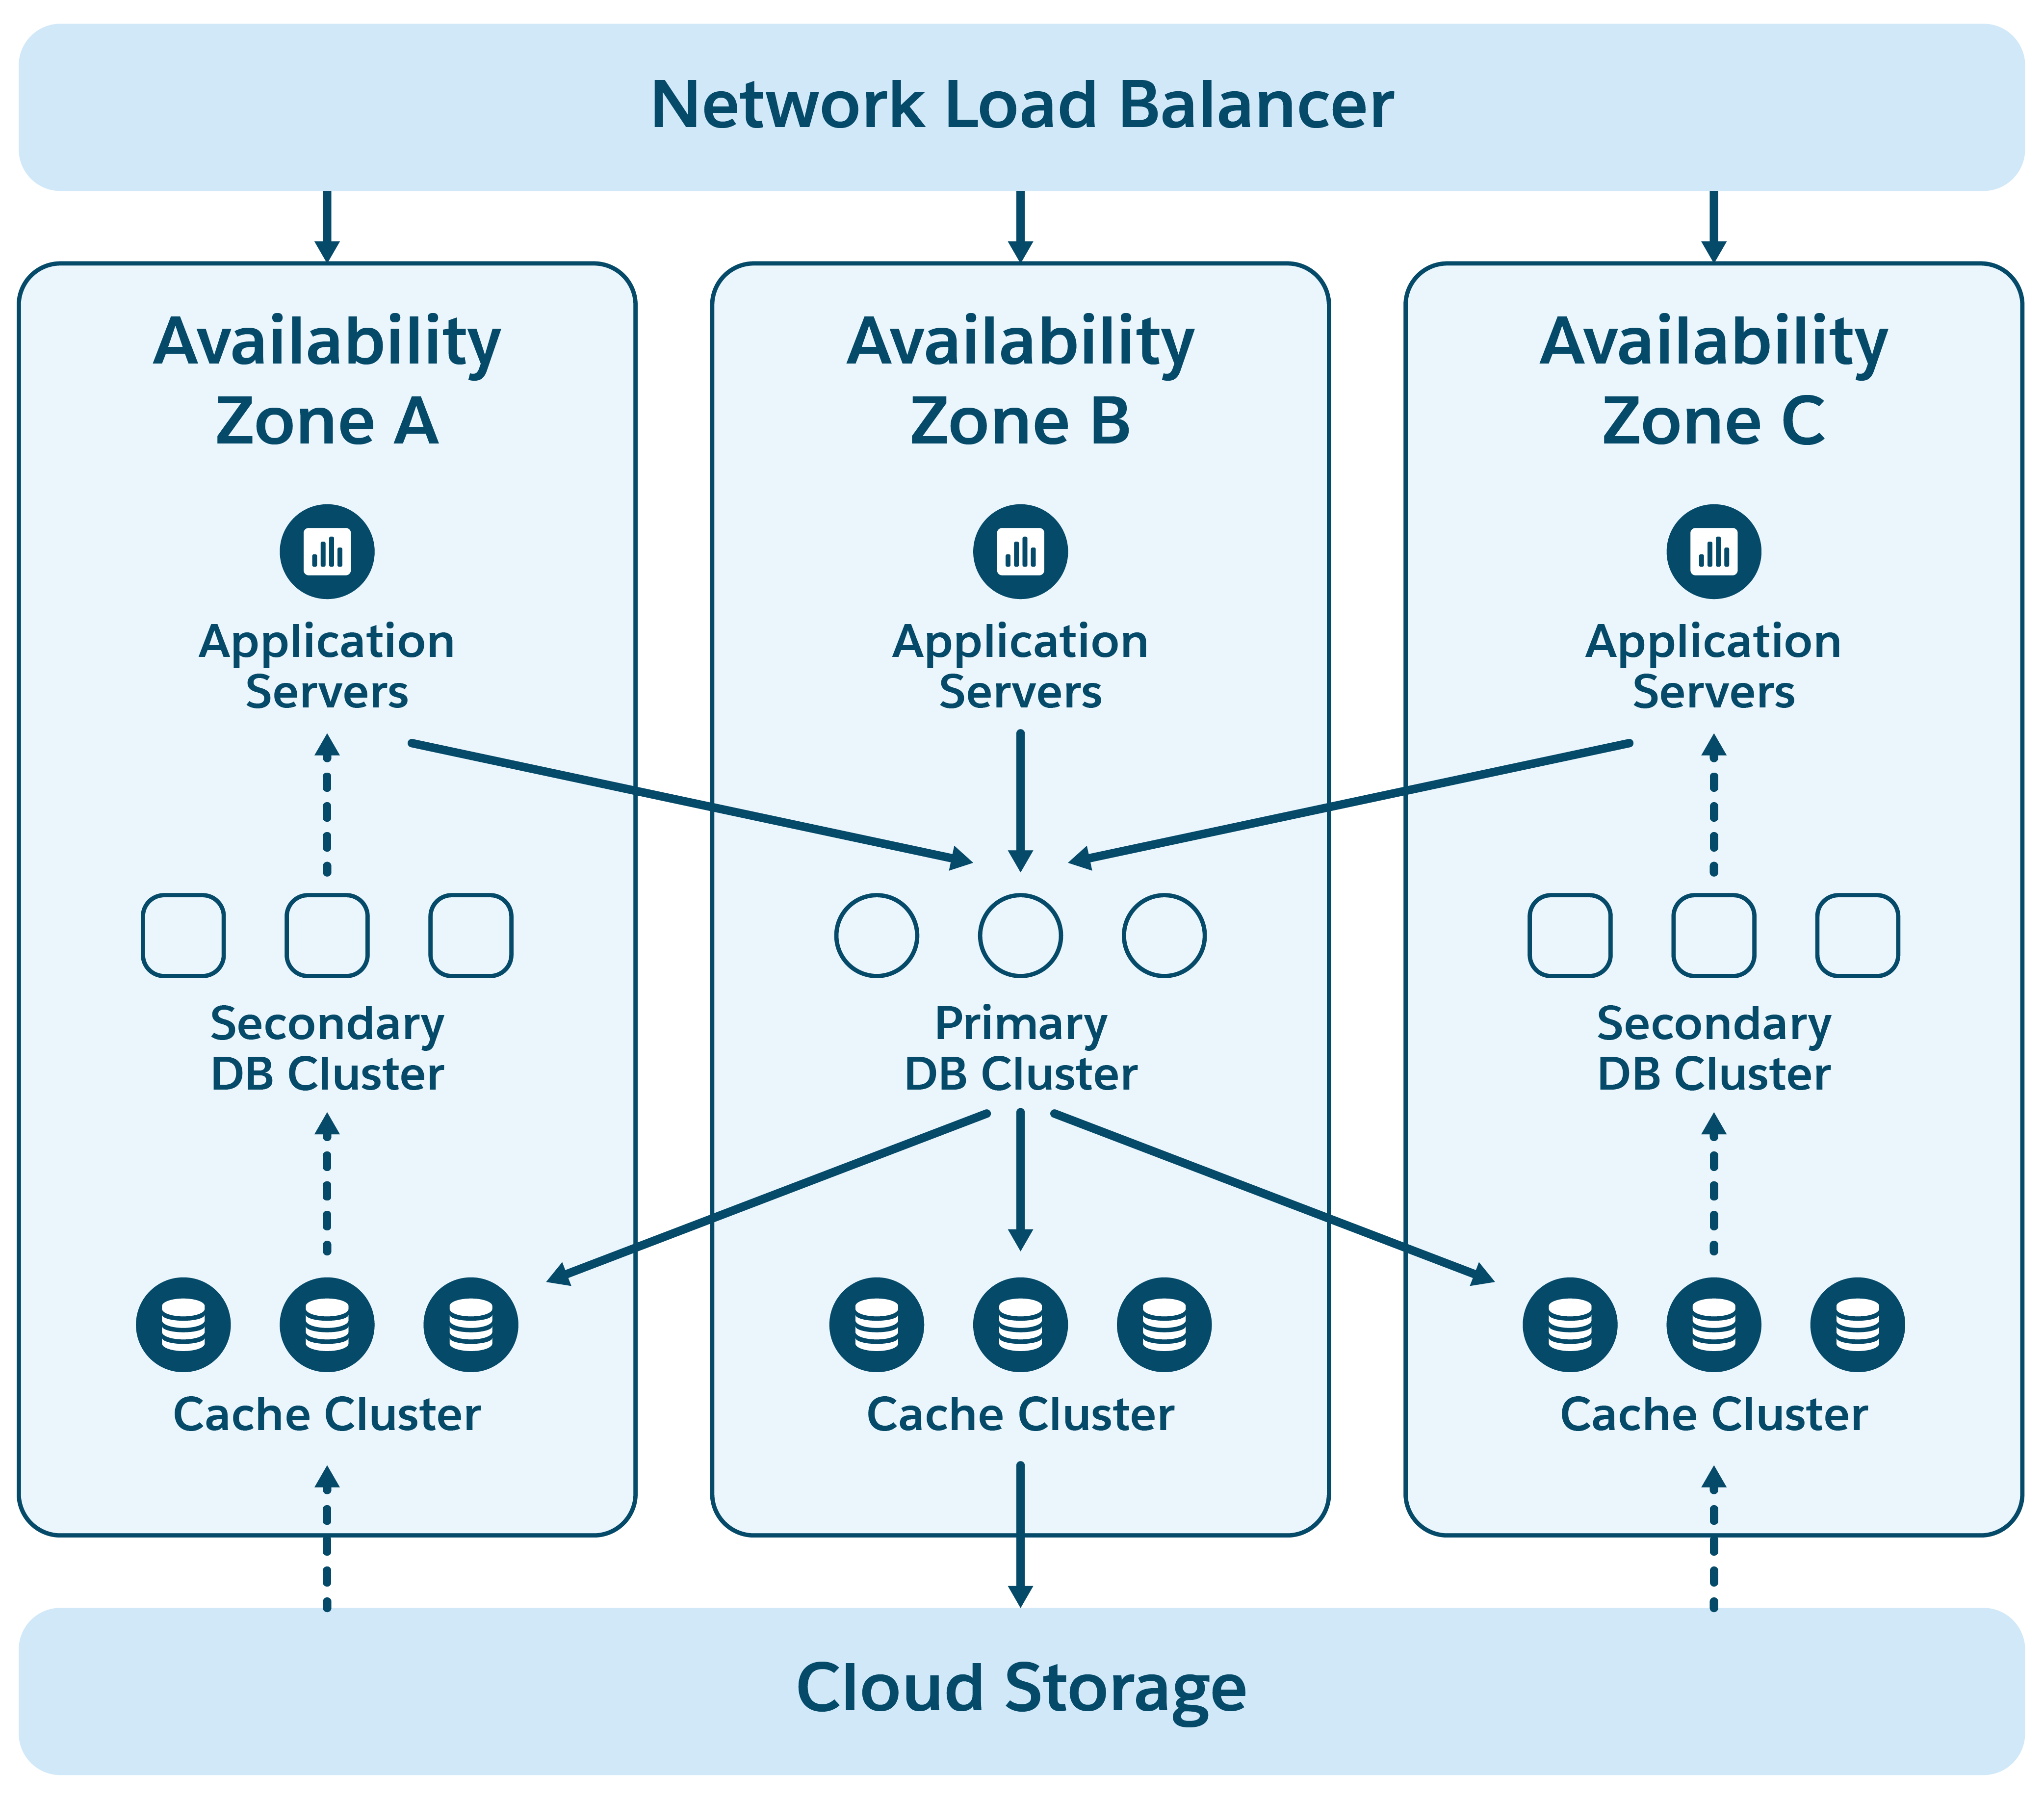 #### LSM 儲存空間與存取權
SalesforceDB 使用記錄結構化合併樹狀目錄 (LSM) 資料結構,其中的變更一開始會記錄在交易記錄中,並累積在記憶體中。接著,系統會將認可的變更集合寫入至金鑰排序的資料檔案,這些檔案會定期合併並壓縮以最佳化儲存效率。
此結構可有效消除直接更新儲存空間之資料庫中常見的同時更新問題。透過使用 LSM 方法,SalesforceDB 支援重要功能,例如固定的儲存空間,使其成為管理 Salesforce 工作負載的強大解決方案。
#### 固定的儲存空間
儲存空間中的資料是固定的;一旦資料檔案寫入並顯示,便不會變更。交易記錄僅限附加,可簡化資料存取模式並增強可靠性。此結構支援非協調讀取、簡化備份、提升擴展性,並促進儲存空間虛擬化,使其適合雲端環境。
#### 可用性與永續性
SalesforceDB 中的交易會跨多個可用性區域認可,這可確保即使節點或區域失敗也不會遺失資料。如果發生失敗,則會在機中中止交易,並成功復原認可的交易。由於失敗不會遺失認可的資料,因此會自動移轉至新節點。
叢集管理軟體會透過監視配額和管理擁有權轉移來自動處理故障。此流程不僅在緊急狀況下使用,而且在定期修補期間也會定期使用,進而透過持續使用提升系統的可靠性。一般使用者通常不會注意到簡短的資料庫重新啟動,以維持流暢的使用者體驗。
Salesforce 每年會進行三個主要的結構描述更新,每週會進行較小的結構描述更新。SalesforceDB 提供零停機結構描述作業,讓這些更新能夠在不影響客戶的情況下完成。
#### 記錄系統
我們的交易資料庫會作為客戶資料的主要存放庫,該資料庫會在多個可用性區域之間快取,並儲存在雲端中。每個資料區塊都會使用固定的檢查總和來保護,並由儲存層與資料庫引擎驗證。資料庫會執行歷程追蹤來偵測任何異常變更或遺漏版本,並在索引與基準表之間執行持續的一致性檢查。
為了保護勒索程式,資料庫會封存在不同帳戶下方的個別儲存空間中,包括完整與增量交易記錄備份。這些備份會定期透過還原測試流程進行驗證。此外,雲端基礎結構已預先設定,但未啟用,可視需要管理資料還原要求。
#### 刻度
每個 Salesforce 組織都存放在 Hyperforce 儲存格中,其中包含 SalesforceDB 服務。此設定允許透過 Hyperforce 結構建立新的儲存格來快速全域調整,且可輕鬆在儲存格之間切換流量以管理負載。不過,隨著客戶的工作量和業務需求增加,單一資料庫例項的容量可能會不足。
為了解決此問題,SalesforceDB 針對儲存和運算層級使用水平調整結構。雲端儲存空間幾乎沒有限制,快取圖層會自動調整規模以符合需求。此外,可透過新增更多資料庫運算節點來展開運算層級,以有效率地從共用的固定儲存空間中讀取,而不需要協調。此方法可讓 SalesforceDB 達成符合或高於領先商業叢集資料庫結構的擴充性,而不需要特殊的網路或硬體。
#### 多重租賃
Salesforce 是一種多租戶應用程式,單一資料庫可在其中主控多個租戶。每個表格記錄都包含租戶識別碼來區分其擁有權,且透過 Salesforce 應用程式層新增的自動查詢述詞來維護租戶隔離。
SalesforceDB 針對此模型量身打造,支援租戶特定的 DDL、中繼資料和執行階段流程,進而增強可靠性、效能和安全性。其會將每列租戶模型的低負擔與每個資料庫結構描述的效率結合在一起。
在 SalesforceDB 中,租戶識別碼是多租戶表格中主要索引鍵的一部分,可在 LSM 資料結構中依租戶將資料叢集,進而提升存取效率。此設定不僅可協助有效率的資料存取和每個租戶加密,還可簡化租戶資料管理。由於精簡的中繼資料結構,租戶可以輕鬆複製或移動,但中繼資料調整程度最低。
### 6.2 Data 360 與 Data Lake
AI、分析和資料功能在現代企業中至關重要。企業已經投資於成熟的大型資料平台,例如 Snowflake、Databricks、BigQuery 和 Redshift。然而,許多
由於資料孤立、缺少 AI 處理、資料過時或現有業務流程中的閒置,因此客戶無法從其資料中衍生業務價值。將客戶資料集中化為單一事實來源,並透過客戶參與的單一檢視,對於業務而言至關重要,但由於資料分割和系統管理的複雜性,也具有挑戰性。Salesforce 透過將資料、AI 和 CRM 整合至虛擬循環,以生成式 AI 和機器學習洞察為驅動,並以資料為驅動,以促進客戶的整體檢視。
SalesforceDB 針對結構化資料的高效能交易工作量進行最佳化,而 AI 和分析工作量需要處理來自各種來源的大量非結構化資料,並執行複雜的查詢和批次處理。為了滿足這些需求,Salesforce 開發了 Data 360,此平台的設計目的為破壞資料孤立區、安全且有效率地統一、儲存和處理資料,支援 AI 和分析需求,並啟用即時企業作業。
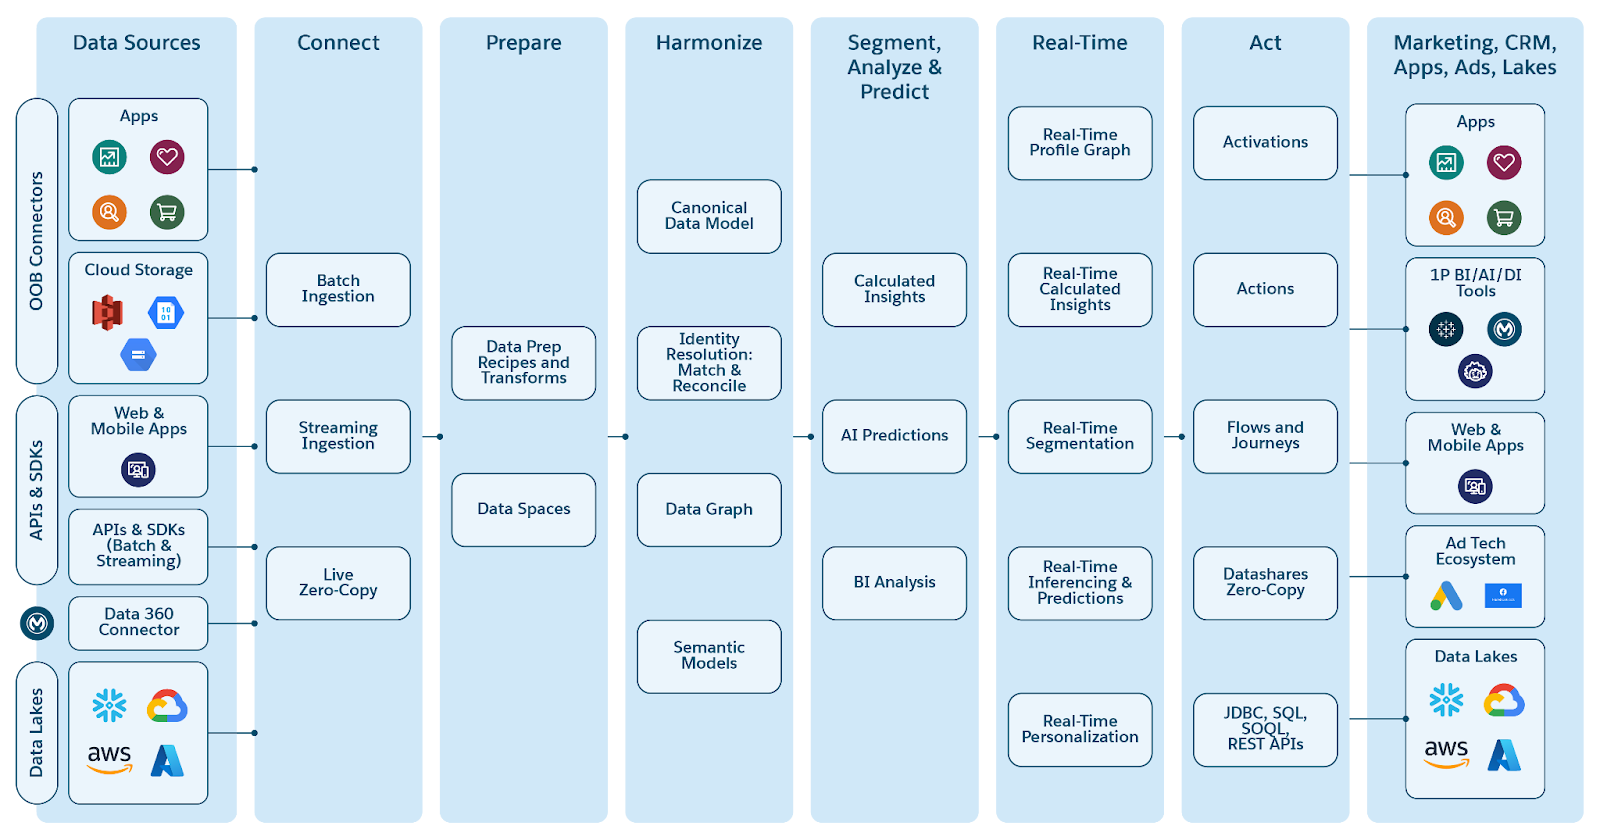 Data 360 以 Hyperforce 為基礎,作為 AI 和 Analytics 的基礎平台,提供:
- 整合的基礎結構和無程式碼平台,可透過連線來合併資料孤立區
- 即時與近乎即時的資料快取
- 零複製聯合
- 資料清除、準備和形塑以供處理
- 結構化與非結構化資料的統一查詢服務
- 針對洞察產生開發分析和 AI/ML 模型
- 資料觸發動作與啟用
- 支援生成式 AI retrieve 擴充產生 (RAG)
- 全方位原則型監管
Data 360 結構支援數個元件與功能,概述於下方。
#### 連線、轉換和調和
Data 360 針對批次、近乎即時和即時的資料處理,支援來自各種結構化與非結構化資料來源的高效的採取管道。Data 360 採取服務的運作方式為 Extract-Load-Transform (ELT) 模式,針對低延遲而設計,且適用於 B2C 級數。近乎即時的來源涵蓋詳細的產品使用狀況,即即將進行即時取用包含 API 和互動串流。一旦獲取,資料便會大量轉換,以準備、協調 (例如統一各種連絡類型),並將其建模以進行有效的查詢、分析和 AI 應用程式。平台也包含各種可供使用的協調資料模型。
Data 360 可與 Sales Cloud、Service Cloud、Marketing Cloud 和 Commerce Cloud 等 Salesforce 應用程式順暢整合。此外,其為外部資料來源提供數百個連接器,以確保資料整合順暢。
#### 大型資料湖
Data 360 採用以 Iceberg/Parquet 為基礎的原生湖家結構,專為處理批次、串流和即時案例的大規模資料管理和處理而設計。此結構結構支援結構化與非結構化資料,對於 AI 與分析應用程式而言十分重要。
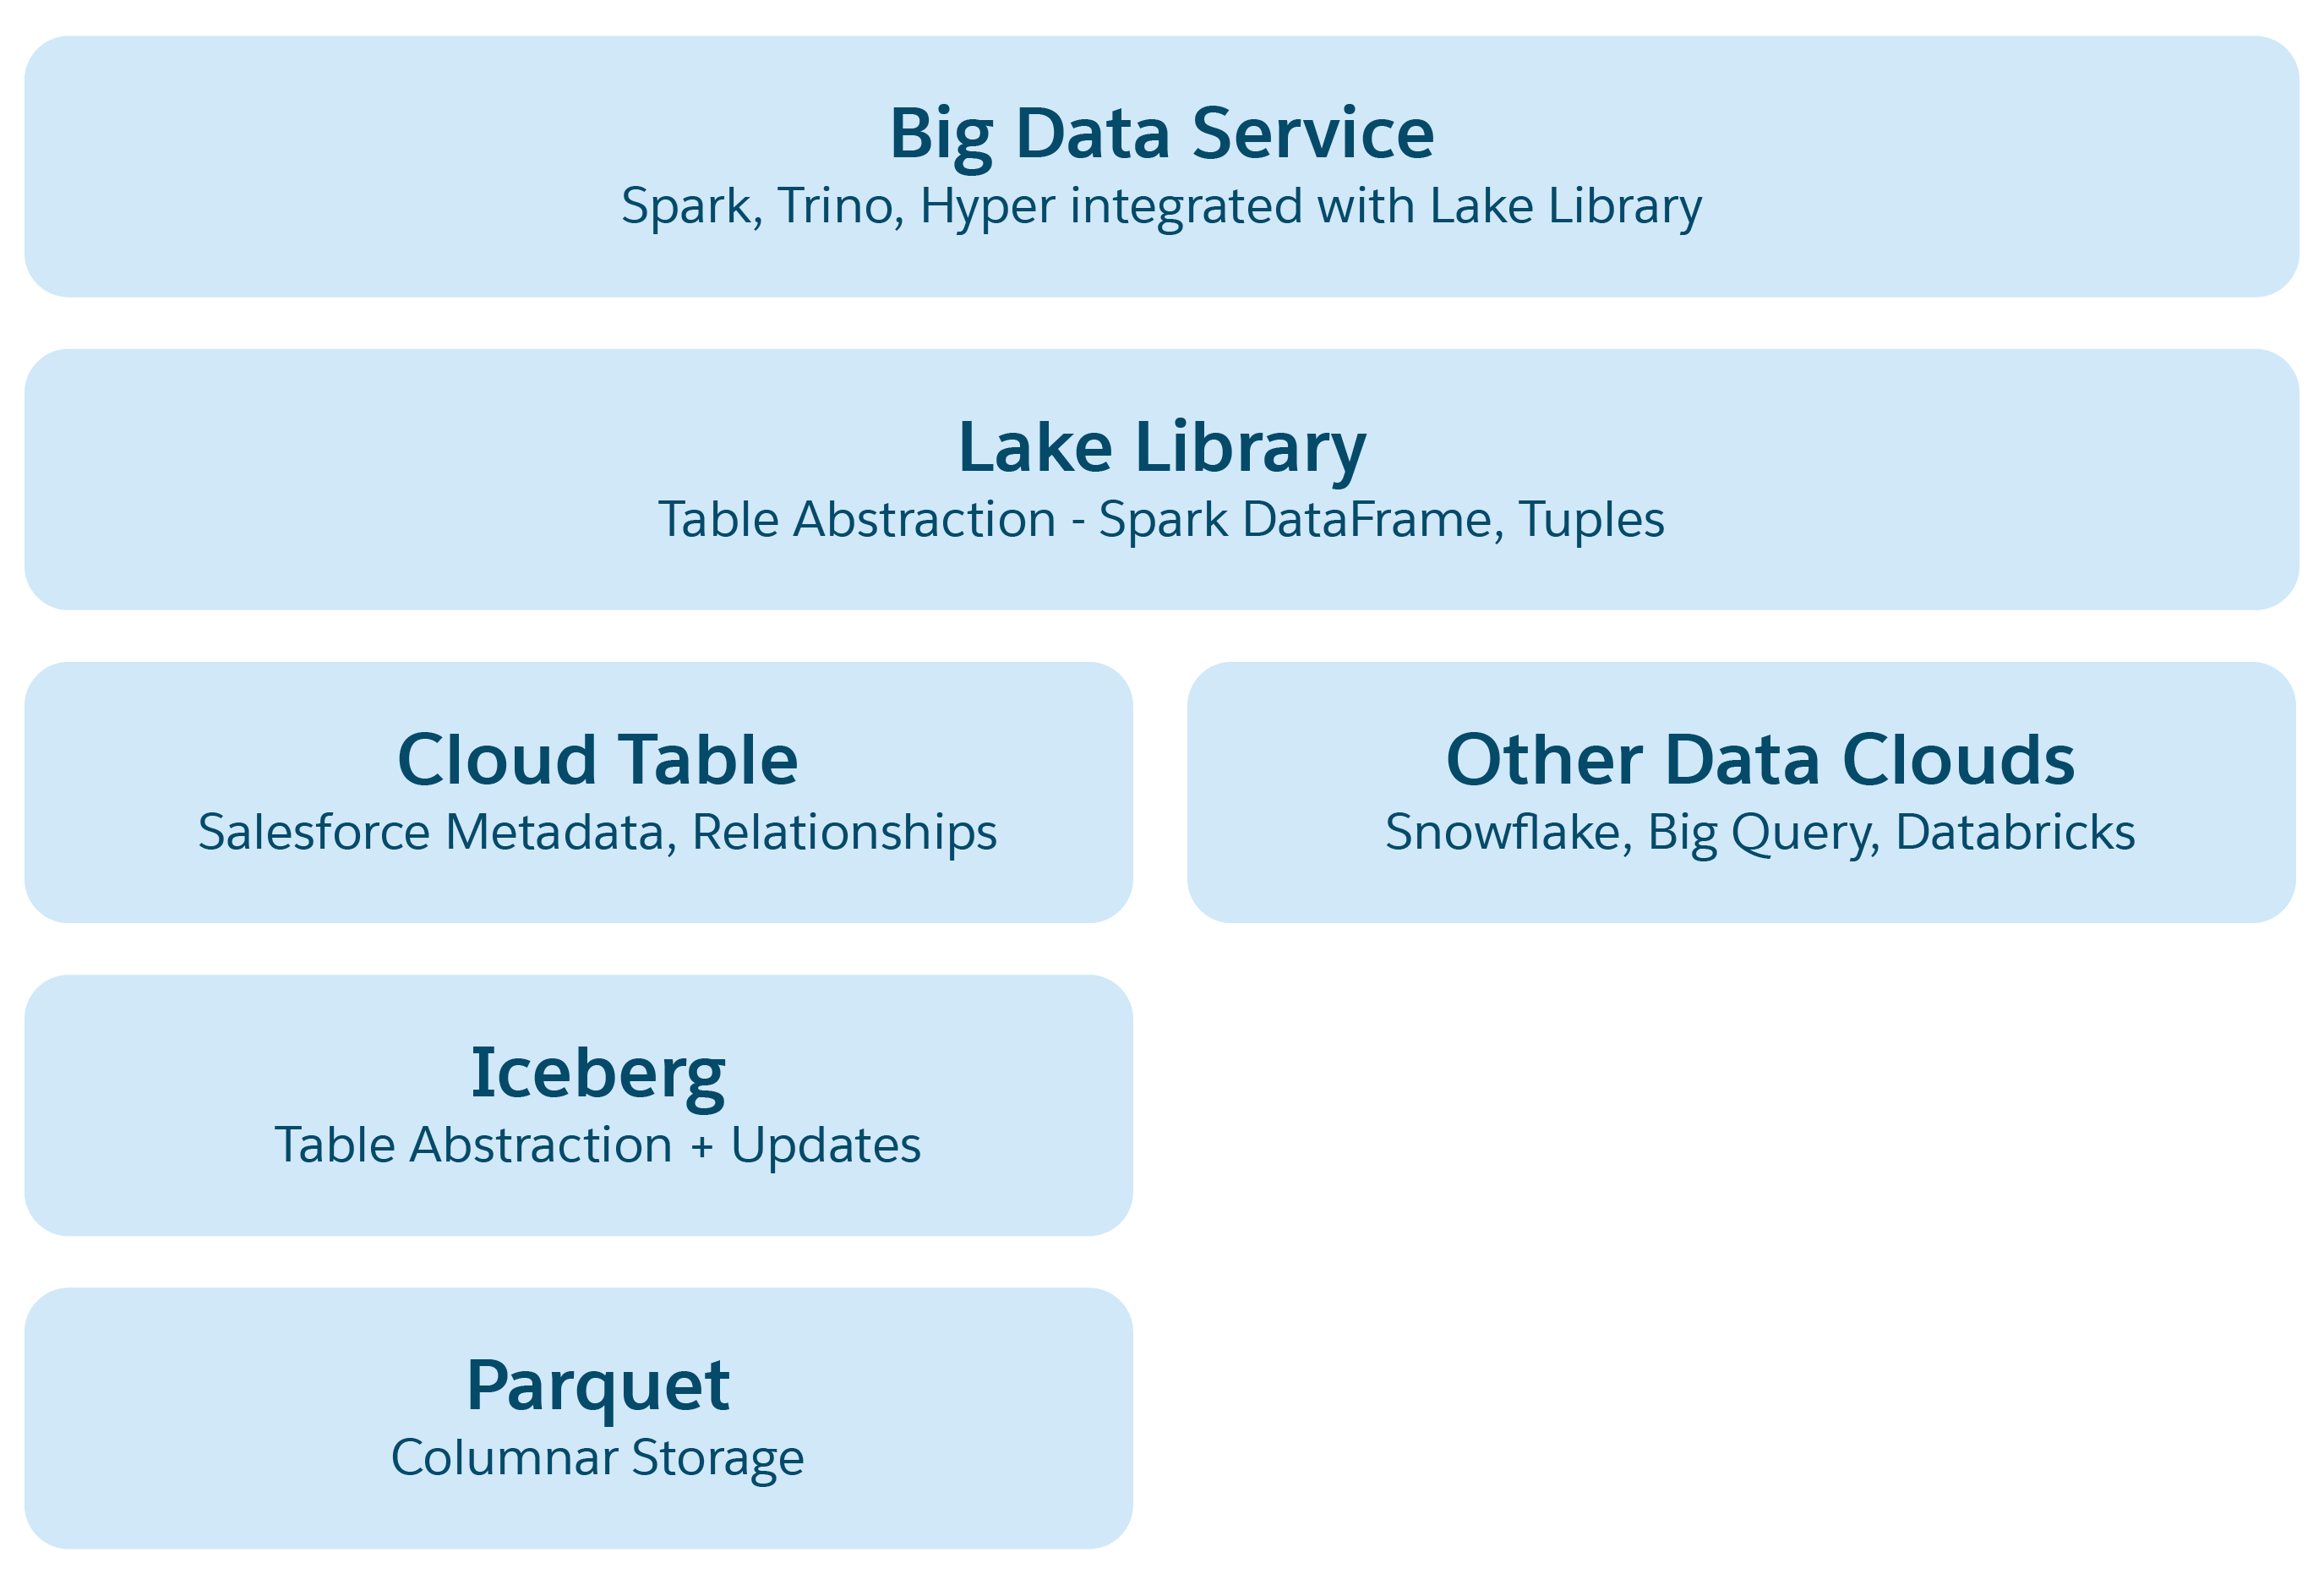 在雲端式資料湖 (例如 Azure、AWS 或 GCP) 中,基本儲存單位是檔案,通常會組織成資料夾和階層。此湖舍透過導入更高層級的結構與語意抽象,以協助查詢和 AI/ML 處理等作業來增強此結構。主要抽象是具有中繼資料的表格,其中定義其結構和語意,並納入來自如 Iceberg 或 Delta Lake 等開放程式碼專案的元素,以及 Data 360 新增的其他語意層。
湖中抽象層:
- **Parquet 檔案摘要**:在基礎上,儲存空間包含 Parquet 格式的資料湖檔案 (例如 AWS 中的 S3 或 Azure 中的 Blob)。來源表格的資料會儲存在多個分割區中,作為 Parquet 檔案,每個表格皆為這些檔案的集合。
- **Iceberg 表格摘要**:表格會組織為資料夾,資料分割會在這些資料夾中儲存為 Parquet 檔案。對分割進行的修改會導致新的 Parquet 檔案成為快照。Iceberg 會管理每個表格的中繼資料檔案,詳細列出結構描述、分割規格和快照。
- **Salesforce Cloud 表格摘要**:此層建立在 Iceberg 上,會新增如欄名稱與關係等語意中繼資料,以及如目標檔案大小與壓縮等組態。它會在各種平台 (例如 Snowflake 和 Databricks) 中摘要表格,藉此保護 Data 360 應用程式免受基本儲存平台的特定資訊。
- **湖端存取庫**:此文件庫提供 Salesforce Cloud 表格的存取權、處理資料和中繼資料,並為應用程式開發人員摘要基本的儲存機制。
- **大型資料服務抽象**:這包括處理架構,例如 Trino 與 Hyper 用於查詢,以及處理任何雲端表格平台的 Spark。
Data 360 Lakehouse 支援 B2C 級度、即時採取、處理、結構描述強制執行與進化、快照,並使用開放式儲存格式。
#### 即時儲存空間
為了支援即時分析和代理應用程式,Data 360 會以額外的「低延遲存放區」(LLS) 增強湖庫的大型資料儲存空間。Data 360 的即時處理層會分析記憶體中的即時訊號和參與資料。由於以記憶體為基礎的儲存容量受到限制,因此無法一次處理所有資料。Data 360 會新增此 LLS 來移除此類限制,並啟用可調整的即時處理。
「低延遲商店」是位元組級 NVMe (SSD) 儲存層的湖頭。這是一種永久的快取—大多數的資料最終都會進入湖庫,以保持長期持續性。即時層中的工作階段中資料可以清洗至低延遲存放區,以便後續快速存取。例如,在工作人員對話中,最近的訊息可在記憶體中處理;舊的訊息可填入至 LLS。如果需要先前的交談,則可在 LLS 的幾毫秒內存取該交談。NVMe 型儲存空間允許大量資料以毫秒延遲儲存和存取。資料可能會前往湖莊,以持續持續。
此外,即時處理或擴充即時體驗所需的湖庫資料也會從 LLS 中提取並保存在其中。例如,客戶設定檔內容會從湖中預先提取或帶入,並在 LLS 中快取。此外,任何在工作階段處理期間即時處理所需的湖家物件和其他物件也可以在 LLS 中快取。LLS 透過記憶體、SSD 和湖家儲存層,在實際儲存階層上啟用即時層級,並在每個儲存層之間順暢移轉資料。
Data 360 也提供安全性的強大支援,包括具有客戶管理金鑰的租戶層級加密 (TLE),以及其管治技術的隱私權與合規性。核心是以屬性為基礎的存取控制 (ABAC) 支援,其會根據與實體、作業和環境因素相關的屬性,動態評估存取權。此系統支援任意與必要存取控制。
補充 ABAC,詳細的資料分類系統會依敏感度和用途將資料分類,進而增強合規性、風險管理和事件回應。ABAC 與此分類系統共同提供全方位的資料管理,確保安全且有效管理 Data 360 內的資料。
#### 中繼資料驅動
Data 360 透過 AppExchange 與 Salesforce Platform 深度整合,以取得中繼資料、封裝、擴充性、使用者體驗和應用程式散佈。客戶可以定義和管理湖畔串流和表格的中繼資料,就像其他 Salesforce 中繼資料一樣。每個資料物件 (包括聯合或外部表格) 都會以 Salesforce 物件表示,並且模型化為 Data 360 中資料儲存支援的虛擬實體。開發人員可以用來在 Salesforce Platform 上建立應用程式。
#### 零複製聯合與擴充性
Data 360 廣泛支援零複製聯合,允許使用者與外部資料倉庫 (例如 Snowflake 和 Redshift)、湖庫 (例如 Google BigQuery、Databricks 和 Azure Fabric),以及 SQL 資料庫和各種檔案類型 (包括 Excel) 整合。Data 360 支援檔案和以查詢為基礎的聯合,以及即時查詢和存取加速,如圖所示。標籤 (1) 和 (2) 說明 Data 360 的查詢 (包括即時查詢推送),以及從外部資料湖/倉庫/資料來源存取資料的檔案型同盟;標籤 (3) 醒目提示從外部資料湖/資料來源加速聯合存取。標籤 (4) 和 (5) 說明從 Data 360 與外部資料湖/倉庫的查詢和檔案式共用資料。功能也延伸至非結構化資料來源,例如 Slack 和 Google Drive,可由 Data 360 的非結構化處理管道存取。此外,Data 360 可協助從外部來源聯合的 Salesforce 物件和資料存取,讓您能夠在整個 Salesforce 平台與應用程式中存取此類資料。
#### 客戶資料平台 (CDP)
Data 360 整合具有進階身分解析功能的 CDP,建立統一個人識別碼和設定檔,以及全方位的參與歷程記錄。此平台擅長處理公司對公司 (B2B) 和公司對消費者 (B2C) 架構,並支援使用精確和模糊比對規則的身分圖。這些身分圖以來自各種管道的參與資料來增強,這有助於建立含有寶貴分析洞察和區段的詳細設定檔圖表。
此外,CDP 可在不同平台之間 (例如 Salesforce 的 Marketing Cloud、Facebook 和 Google) 啟用有效的區隔和啟用。它會批次、近乎即時和即時處理客戶設定檔,以便立即進行決策和個人化。此功能可增強 B2C 和 B2B 案例中的互動,確保公司可以快速且準確地回應客戶的需求和行為。
#### 資料圖
Data 360 提供 JSON 格式的企業資料圖表,這是衍生自各種湖家表格及其相互關係的反正規化物件。這包括由 CDP 建立的「設定檔」資料圖表,其中包含人員的購買和瀏覽歷程記錄、個案歷程記錄、產品用量和其他已計算洞察,且客戶和合作夥伴可以擴充。這些資料圖是針對特定應用程式量身打造,並透過提供相關的客戶或使用者內容來增強生成式 AI 提示準確度。
此外,已有計畫擴充這些資料圖,以納入將衍生 Knowledge (例如從非結構化資料中解壓縮的實體和關係) 的 Knowledge 圖表。Data 360 的即時圖層使用「設定檔」圖表進行即時個人化和區隔。
#### 即時層級
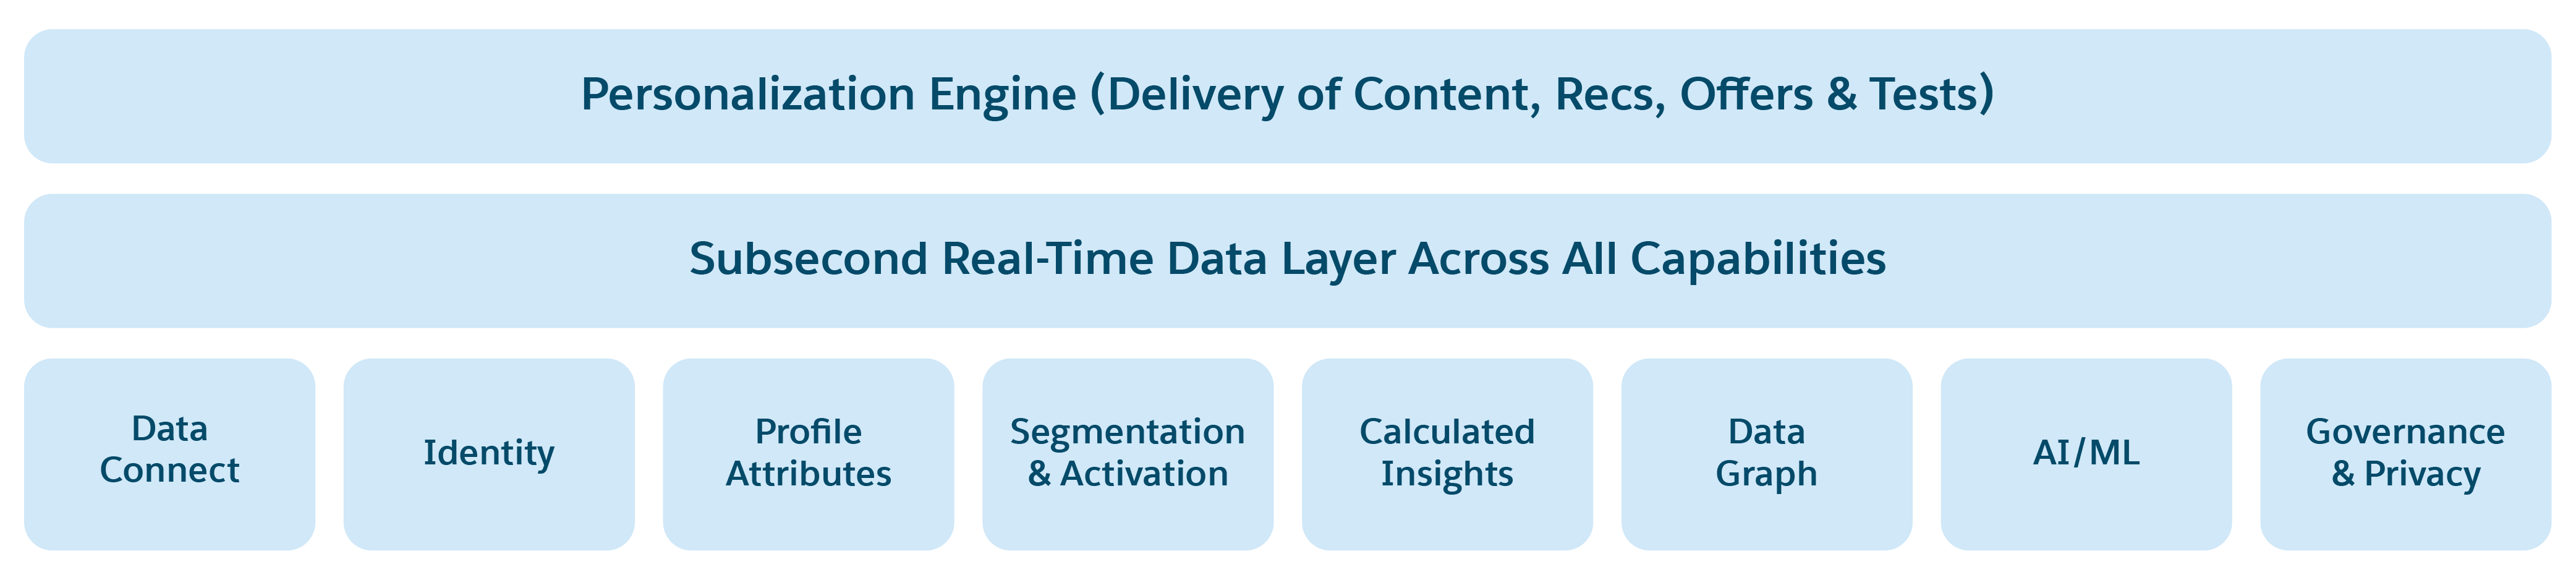 Data 360 的即時層設計為以毫秒延遲處理如網路和行動點擊串流、造訪、手推車資料和結帳等事件,以增強客戶體驗個人化。它會持續監視客戶參與度,並使用即時參與資料、區段和計算來更新 CDP 的客戶設定檔,以立即個人化。
例如,當消費者在購物網站上購買項目時,即時圖層會快速偵測並取用此事件、識別消費者,並以更新的終身支出資訊增強其設定檔。這可讓使用子秒的方式個人化其在網站上的體驗。此外,此層包含即時觸發和回應的功能,以根據客戶互動啟用立即動作。
#### 個人化
個人化是瞭解要作為目標的角色、提供相關內容和建議的時間和位置、要說什麼以及頻率。Data 360 的「個人化服務平台」功能是協調流程,用於透過個人化體驗做出決策以最佳化目標達成。此平台提供下列功能:
- 一致的模型集與解譯 Data 360 中設定檔、活動和資產資料的方式。
- 平台整合的實驗 (例如 A/B/n 或多臂詐騙決策)。
- 透過組態、ML 訓練時間和執行階段 (ML 推斷) 整合設計階段的目標。
- B2C 級度、即時和批次互動支援 (匿名使用者、大量即時/互動式外部、大量內部批次)。
- 透過 Data 360 驅動的 Analytics。
- 整合其他廠商 AI 模型和服務 (內部與外部) 的模式。
- 高價值 AI 驅動使用個案的 OOTB 實作 (使用各種 ML 演算法的建議和決策,包括促銷/內容選取、產品建議和定價決策的內容違反)。
#### 資料動作
Data 360 是啟用的平台,支援針對資料事件啟用銷售管道。例如,重要事件 (例如客戶的帳戶餘額下降) 會觸發 Salesforce 流程來協調對應的動作。同樣地,主要度量的更新 (例如終身使用) 可以自動移入相關應用程式。
#### 資料計算模組
Data 360 具備彈性調整的計算叢集,可有效處理處理工作。其針對多重租戶和專屬運算環境提供強大的管理。此外,其提供 Spark 和 SQL 的受管理支援。BYOC (自帶運算/程式碼) 功能支援多種程式設計語言,包括 Java、Python 和 Spark,允許整合自訂轉換、模型 (包括 LLM) 和函數,進而增強擴充性。
Data 360 Compute Fabric 提供稱為「資料處理控制器」(DPC) 的統一層,可管理與執行所有大型資料工作量。DPC 是全方位、多工作量資料處理協調流程服務,可在各種雲端運算環境中提供「工作方式服務」(JaS) 功能。其會抽出基礎結構複雜性,並統一 Spark (在 EC2 上為 EMR,在 EKS 上為 EMR) 和 Kubernetes Resource Controller (KRC) 工作負載等架構的工作執行。透過作為集中控制平面門戶,DPC 可協調、排程和監視跨多個資料平面的工作,以確保可靠性、可擴充性、成本效率和一致的開發人員體驗。
#### 統一查詢
Data 360 的查詢服務提供進階查詢功能,透過 Trino 和 Hyper 為結構化與非結構化資料提供廣泛的 SQL 支援。其透過「表格功能」增強運算子擴充功能,允許跨文字、影像、空間和其他非結構化資料類型進行多樣的搜尋作業。這些功能會與關聯性作業無縫整合,例如選取客戶記錄。此統一方法可產生目標化和個人化結果,藉此使用 RAG 促進更精確的 LLM 回應。
#### 非結構化資料處理
Data 360 支援在整個資料提取、處理、索引和查詢機制中順暢地儲存和管理結構化 (表格)、半結構化 (JSON) 和非結構化資料。Data 360 支援文字以外的各種非結構化資料類型,包括音訊、視訊和影像,擴大資料處理和分析的範圍。下圖說明基礎的兩個側面 (取用與提取)。
Data 360 會透過將資料儲存在資料欄中作為文字,或儲存在較大資料集的檔案中來管理非結構化資料。它支援非結構化內容的資料聯合,這允許整合和管理來自多個來源的資料。
Data 360 的非結構化資料索引管道設計為模組化、可擴充的結構,包含五個核心階段:剖析、預先處理、切分、後續處理和內嵌。接著接著是關鍵字和向量索引。「預先處理」範例包含如消除雜訊、語言正規化和影像瞭解 (光學字元辨識) 的作業,而「後續處理」階段可能包含中繼資料的增強、語意分組或進階技術 (例如切分)。
Data 360 提供多個立即可用且可插入的模型,用於分割和內嵌產生。Data 360 中的資料銷售管道完全支援程式碼擴充,允許客戶和內部小組在任何階段插入自訂邏輯。這些階段也支援以 LLM 為基礎的處理,可讓客戶視需要定義自己的提示。
針對索引,Data 360 支援使用搜尋服務進行關鍵字索引,以及使用 Milvus (開放原生矢量索引) 進行向量索引。針對使用非結構化處理來設定 RAG,Data 360 利用內容索引來啟用使用範例測試查詢的快速迭代和快速驗證,並使用設定為根據取用角色或使用者量身打造的角色特定內容。
Data 360 的 Document AI 功能支援從如發票、履歷、實驗室報告和購買訂單等文件讀取和匯入非結構化或半結構化資料。此功能支援臨時互動式處理,以及大量批次處理。這是可為客戶啟用業務流程自動化的關鍵功能。
#### 語意層
Data 360 具有無周邊語意層,其中包含 API,其設計目的為增強業務語意和 AI/ML 驅動的分析,類似於 Tableau Next。此層包含語意資料建模服務,以業務分類 (例如度量和度量) 來增強傳統分析模型。
其語意查詢服務使用陳述性語言與這些模型互動,將查詢翻譯為 SQL,以從 Data 360 內的原生和聯合資料來源存取資料。
此整合可協助擴充且互動式的分析探索、報告和顯示面板,與第三方視覺效果工具相容。
#### 資料管理
Data 360 可作為集中式管治中心運作,確保所有資料 (無論是原始入門到已啟用的洞察) 均以完整且控制的方式管理。Data 360 已採用「以屬性為基礎的存取控制」作為其核心授權模型。ABAC 允許存取決策以使用者的屬性 (部門、角色、位置)、資料 (個人資訊、敏感度、資料空間) 和環境 (例如當天時間) 為基礎,而非預先定義的角色。這可啟用高度細微且內容相關的存取原則,以在資料和使用者屬性變更時進行調整。Data 360 的 ABAC 實作核心是使用 CEDAR 原則語言。此用途建立、開放原始碼的正式原則語言提供定義複雜授權規則的精確且可驗證方法,確保原則是無歧義的,且可以一致大規模評估。
管治生命週期包含關於保單資訊、強制執行和決策點的關鍵功能:
- **標記與分類 (原則資訊點):**資料會識別並以重要屬性增強。Data 360 提供自動標記和分類機制,利用探索、LLM 和機器學習,在結構化與非結構化資料中識別敏感資料種類 (例如電子郵件、電話、名稱等個人可識別資訊)。
- **授權服務 (原則強制執行點):**此服務會從各種耗用層 (混合結構化/非結構化查詢、RAG 提取器和提示,以及 CRM 增強) 攔截所有資料存取要求,並諮詢「原則決策點」以判斷是否允許存取。
- **原則評估引擎 (原則決策點):**此引擎會從「保單強制執行點」中取得存取要求內容,以及來自「保單資訊點」的原則定義 (在 CEDAR 中) 和屬性,以做出權威的存取決策。
ABAC 架構搭配 CEDAR 原則提供控制和彈性,確保客戶資料不僅可運作,而且在整個企業中安全、合規且值得信賴。
### 6.3 資料快取
快取對於快速存取常用資料而言至關重要。Salesforce 在整個 Salesforce Platform 中使用許多快取,包括在核心應用程式伺服器、SalesforceDB 和 Edge 中。Salesforce Platform 與應用程式需要可調整且具有租戶認知的快取解決方案,其延遲率低且輸送量高。此解決方案必須允許 Salesforce 工程師控制快取的內容及時間長度,以確保其資料不會遭系統雜訊或其他客戶資料的外洩。以 Redis 為基礎的 Salesforce 受管理快取服務 Vegacache 針對多重型、多租戶和公用雲端環境量身打造。它已廣泛由 Salesforce 服務使用,且可透過 Apex 程式語言 API 供平台開發人員存取。目前在 Hyperforce 中大規模作業,Vegacache 每天處理超過 2 萬億個要求,回應時間低於毫秒。
在透過 Service Mesh 存取的 Kubernetes 容器中執行的 Vegacache 例項會跨多個「可用性區域」部署,以平衡資料可用性和延遲。它會根據系統載入自動調整規模,以確保資料可用性和時段訂單保留。Vegacache 可為每個客戶提供保證快取大小,並針對雜亂的鄰居提供保護,並透過複製的資料儲存空間抵禦基礎結構失敗。
針對 Salesforce Platform 開發人員,Vegacache 可讓開發人員快取 Apex 物件和 SOQL 資料庫查詢結果,從 SalesforceDB 中消除不必要的資料提取來減少 CPU 用量和延遲。它支援 Put()、Get() 和 Delete() 作業,讓常用的物件可供輕鬆存取。
### 6.4 非同步資料處理
Salesforce 本機支援非同步資料流程與結構,以增強工作流程的彈性、彈性與延展性。
Salesforce 工程師先利用訊息排列來分離大量與大型資料流程,以及協調獨立系統之間的流程。透過平台功能 (例如大量 API 查詢或非同步 Apex) 從外部開發人員中提取這些訊息的列。Salesforce Platform 接著導入以記錄組織的事件串流,其建立在內部受管理 Apache Kafka 叢集的強大傳訊基礎結構上。這已啟用以發佈/訂閱互動模型的以事件為基礎結構,並將其作為「平台事件」製作給外部開發人員。
這兩種技術皆持續為在平台上建立的應用程式和解決方案,這些技術均持續具有高度運用,特別是因為這些技術利用更多在獨立執行階段上主控的功能、雲端和外部系統。透過版本化事件結構描述通訊可針對不同的執行階段啟用獨立的軟體開發生命週期。透過事件將系統分離,也有助於管理負載高峰和個別執行階段的彈性/規模,以支援更高的整體彈性與應用程式可用性。
### 6.5 企業搜尋
Salesforce 的搜尋功能對於從全域搜尋到生成式 AI 之間的應用程式而言至關重要,因此會面臨構成我們結構方法的獨特挑戰:
- **刻度**:我們的雲端原生搜尋解決方案支援數十萬個客戶和數百萬個租戶,專為大規模設計,同時保持成本效益。
- **客戶多元性**:Salesforce 跨不同產業的多元化客戶庫,由於平台的廣泛自訂,涉及許多物件類型與欄位,因此具有獨特且複雜的搜尋需求。
- **操作性**:搜尋解決方案必須具有彈性且高可用性,支援資料落地、租戶生命週期營運 (例如區域移轉和 Sandboxing),並且在租戶之間保持低索引延遲並保持公平。
- **規模相關性**:提升搜尋結果的相關性以符合各種使用者查詢十分重要,特別是因為我們將相關性演算法調整為適用於各種租戶、資料類型和搜尋案例。
- **AI 與語意功能**:搜尋支援「機器學習」與生成式 AI,特別是「取得增強型產生」(RAG) 和「代理搜尋」。
- **流暢整合**:為了確保使用者體驗一致,Salesforce 的搜尋技術會與更廣泛的 Salesforce Platform 深度整合,包括中繼資料模型和 AI/資料服務。
Salesforce 的雲端原生解決方案 SeaS (搜尋即服務) 以 Solr (開放程式碼散佈搜尋引擎) 為基礎。Salesforce 已大幅擴充和最佳化 Solr 以符合我們獨特的挑戰,並將其與 Salesforce 應用程式和平台深度整合,並納入語意技術來增強 AI 應用程式和搜尋相關性。
SeaS 採用計算/儲存空間分隔結構,允許跨節點可調整的索引分佈,並在失敗期間重新平衡跨區域的負載和可用性。其提供自動分割和調整片段大小、零停機升級,以及如複本閒置載入和歸檔等最佳化功能,以滿足稀有的索引。
此結構也包含針對大量欄位最佳化的低層級索引實作、自動完成、拼字修正和自帶金鑰加密。Hyperforce 搜尋基礎結構在全球管理約 6,000 個 Solr 節點,使用每個區域中的多個獨立叢集 (Hyperforce 儲存格),以平衡成本與控制,自動根據載入、網域和類型放置用戶端索引。
Salesforce 的搜尋相關性管道採用學習排名技術,適應客戶的多元需求,並支援如結果排名等功能。其中也包含來自使用者查詢和過去互動的實體預估。相關性模型會透過從使用者互動中學習並透過 A/B 測試評估來持續精簡,進而增強搜尋結果的準確度。此流程也透過 Knowledge 轉移支援 AI 應用程式的入門模型。
堆疊納入用於語意搜尋和 AI 應用程式的向量搜尋引擎,並與 Data 360 整合以取得生成式 AI 功能。這包括資料轉換的全方位管道、混合式搜尋支援、可設定的排名目錄,例如 Deep Fusion Ranker 和 Autodrop,以篩選出低相關性搜尋結果。
當生成式 AI 將搜尋服務的主要消費者從人類使用者移至使用 LLM 時,Salesforce 搜尋堆疊會調整以尋找並傳回針對此程式設計耗用最佳化的結果,處理較長且更複雜的查詢,並傳回更具描述性的結果,例如區塊。這支援新的「工作人員搜尋」功能,其中 Agentforce 工作人員使用推理迴圈來利用搜尋來完成複雜工作。
Salesforce 的搜尋功能涵蓋各種內容,包括全域搜尋、對應、搜尋答案、社群搜尋、相關清單、設定、行動和生成式 AI 應用程式。透過將「搜尋」堆疊與 Salesforce 中繼資料系統和 UI 生態系統緊密整合,以順暢支援標準與自訂物件,達到此廣泛的功能。
此外,與 Data 360 整合可透過無程式碼組態增強資料物件的搜尋功能,並允許在資料銷售管道內撰寫搜尋功能,例如在 SQL 查詢中包含搜尋陳述式。「搜尋」堆疊利用 Data 360 豐富連接器生態系統 (例如 Google Drive 認可連接器) 來提供完整的企業搜尋功能。此整合可延伸至 AI 平台,讓搜尋查詢在提示詞產生器中以取得基礎,以及在工作人員搜尋中作為 retrievers 使用。
## 7\.AI 與 Agentforce
AI 已重新塑造技術環境,Salesforce Platform 具有整合且豐富的資料層,使 Salesforce 能夠為客戶提供有影響力的 AI 體驗。Salesforce 將近十年前開始 AI 轉型,並且自 2013 年以來一直在領先該領域,專注於研究、道德和產品開發,讓企業能夠解決複雜的問題並推動成長。
Salesforce 利用「創新」的核心價值,引入 Einstein 預測式 AI,讓企業能夠使用全方位的 AI 技術工具套件 (例如 Einstein 預估產生器和 AI 機器人) 來分析資料、自動化程序、瞭解客戶,並最佳化作業。隨著生成式 AI 的崛起,Salesforce 啟動 Agentforce,這是一個平台,可合併預測和生成模型,以提供進階 AI 功能,同時優先處理資料隱私權。
隨著最近的 Agentforce 3.0 推出,其以 Python 為基礎,具有以事件為導向的架構,Salesforce 透過內建對話歷程記錄、端對端工作階段追蹤、語音支援和自訂推理引擎 (自帶計畫者) 功能等功能導入增強的彈性,以啟用更可調整、可自訂且智慧的多人代理程式系統。
### 7.1 核心 AI 原則
Agentforce 遵循以下核心原則:
- **資料安全性與道德**:排定資料保護、合規性和道德 AI 原則的優先順序。
- **透明度與可解釋性**:提供 AI 產生輸出的清楚瞭解與驗證。
- **彈性和自訂性**:針對特定需求和產業量身打造 AI 應用程式。
- **流暢整合**:與 Salesforce CRM 和其他系統整合。
- **延展性**:處理大規模部署,並提供即時 AI 體驗。
- **智慧且一致的體驗**:透過連線的資料和內容相關的瞭解,提供個人化、擴充和自動化的體驗。
- **全方位觀察性:**提供 AI 工作人員互動的深入可視性和監視,以使用 Agentforce 互動探索器主動最佳化和微調工作人員。
### 7.2 結構概觀
 AI 堆疊包含數個關鍵元件:
- **AI 平台**:此平台層負責管理、訓練和微調用於預測和生成應用程式的 AI 模型。其提供立即可用的 (OOTB) 服務、Trust服務和基礎模型,用於訓練、測試和對模型執行推斷。此外,其支援您自己的預測和生成模型整合,讓您在平台內提供自訂模型。
- **AI 基礎服務**:其中包括 AI Gateway、回饋意見架構、RAG、工作人員協調流程、工作人員評估和理由服務,可協助將業務應用程式與 AI 堆疊整合。
- **AI 技術支援的使用者和工作人員體驗**:Salesforce 透過其雲端服務提供專業 AI 技術支援的應用程式。客戶也可以使用平台的任何元件 (例如流程、Apex 或甚至 Lightning Web 元件 (LWC)) 來建立自訂體驗,以將 AI 技術支援的體驗流暢整合到其工作流程和業務流程中。
- **Agentforce Studio**:此元件包含如工作人員產生器、提示詞產生器、測試中心和模型產生器等工具,專為建立生成式與預測式 AI 體驗而設計。其提供開發/訓練、測試和調整 AI 模型的端對端支援。「下一代編寫」增強這些功能,其設計目的為透過改善的 UX 與 SFDX 相容性,簡化和加速 AI 工作人員建立。
### 7.3 基礎元件
#### Agentforce Trust 圖層
 Agentforce Trust 圖層適用於選定的使用個案,透過提供強大的功能來協助保護生成式 AI 應用程式中的客戶資料:
- **資料隱私權**:強大的遮蔽與隱私權控制可保護外部 AI 模型無法存取敏感資訊。
- **安全性**:確保安全的資料處理環境,並防止未經授權的存取。
- **信任**:維持客戶對資料的控制權,無需協力廠商 AI 儲存或使用。
- **護欄:**強制執行工作人員行為標準,並減輕 LLM 的固有不確定性,驗證工作人員持續遵循預先定義的指示和工作流程。
- **準確性**:使用相關 Salesforce 資料將 AI 輸出增強至提示。
- **內容仲裁**:提供內容前後仲裁、敏感資訊的可自訂資料遮蔽 (PII/PCI/PHI),以及大型語言模型 (LLM) 回應的毒性分類。
#### Agentforce AI Gateway
AI Gateway 提供存取和管理各種 LLM 和預測模型的統一介面。它會作為 Salesforce 與 LLM 世界之間的橋樑,從不同 LLM 提供者和客戶自己的預測 AI 模型的複雜程度中解析,並提供與其互動的一致方式。Agentforce AI Gateway 可與多個 LLM 提供者整合,讓客戶可以選擇最適合其需求的模型,並納入強大的資料安全措施,以協助管理與使用不同 LLM 相關聯的成本。
「回饋意見服務」是收集、分析、測量和利用使用者回饋意見的元件,以重新訓練和精簡 AI 模型。其在 Salesforce Platform 中持續改善 AI 驅動的功能至關重要。
#### 取得增量產生 (RAG)
RAG 是一種重要技術,可使用生成式 AI 增強搜尋功能,進而提供更具資訊且準確的回應。Agentforce 平台利用廣泛的 Salesforce Data 360 和整合的「向量資料庫」,以便針對使用者的查詢,快速提取相關資料。接著此資料會作為 LLM 的基礎,以產生最佳回應。
此外,此方法透過在回應中包含來源資料來提升回應速度和使用者 Trust。RAG 廣泛用於 Agentforce 平台,特別是用於如 Agentforce for Service 和 適用於銷售的 Agentforce 等應用程式,強調其如何呈現這些使用個案的相關資訊。
### 7.4 Agentforce 平台
隨著 AI 模型進步,開發工作人員以自動化需要推理的工作是下一個步驟。這些工作人員會作為智慧助理,能夠以自然語言瞭解和回應查詢,讓使用者為各種工作設計、測試和部署查詢。此系統的重要元件為「計畫者服務」,其功能如下:
- **解譯使用者要求**:它會分析使用者的輸入來決定意圖。
- **建立計畫**:其會制定結構化計畫以滿足使用者的需求。
- **啟動動作**:它會透過直接或透過其他服務起始動作來執行計畫。
「計畫者服務」會協調流程,透過管理和執行必要步驟,確保工作人員有效地滿足使用者要求。
#### Agentforce
Agentforce 是建立工作人員的平台,可讓客戶和 ISV 為如「服務工作人員」和「銷售工作人員」等應用程式建立自動化 AI 工作人員。這些工作人員可以以自然、人類似的方式處理和回應客戶查詢,處理廣泛的業務工作,並為企業和其客戶帶來重大益處。
工作人員的工作流程包括:
- **啟用**:工作人員由預先定義的條件觸發,例如客戶在各種管道之間的要求。
- **瞭解與回應**:其會使用「自然語言處理」(NLP) 來掌握客戶的查詢、意圖和情感,然後諮詢 Salesforce 的 Knowledge 庫或其他資料來源以建立適當的回應。
- **處理複雜性**:如果遇到複雜問題或需要人力監督,工作人員可以順利將互動轉交給人力工作人員。
- **持續學習**:工作人員會從每個互動中學習,並持續增強回應和整體效能。
#### Agentforce Studio
Agentforce Studio 提供低程式碼平台,可讓客戶將 AI 整合至其 Salesforce 應用程式和工作流程,使 AI 技術可供資料科學家以外的使用者存取。
Studio 的主要功能包括:
- **模型產生器**:允許建立或匯入符合特定業務需求的 AI 模型。
- **提示詞產生器**:無程式碼/低程式碼工具,可協助建立和管理生成式 AI 提示,以簡單的介面增強使用者體驗,以建立、測試和部署提示。
- **工作人員產生器**:讓客戶和 ISV 可以開發自訂的對話和自發工作人員。
- **測試中心**:支援模型、提示和工作人員的測試,這對確保高品質 AI 應用程式和最佳化效能和成本效益至關重要,同時增強決定性回應和使用者體驗品質。
Agentforce 結合預測式與生成式 AI,利用 Salesforce Platform 和 Data 360 的統一中繼資料架構,提供智慧、個人化且有效的業務解決方案。
### 7.5 下一個進化:Agentforce 3.0
為了滿足生成式 AI 市場的日益加速需求,包括推理的快速進步、可調整多工作人員系統的需求,以及轉向多型式介面,Salesforce 正使用 Agentforce 3.0 來發展其架構。此新一代平台以數項重要進度為基礎:
- **非同步、以事件為導向的結構:**Agentforce 3.0 以增強型事件驅動架構的 Python 基礎為基礎。這可啟用非同步且可高度調整的工作人員實作,改善效能並為工作人員可透過事件通訊的複雜、多工作人員使用個案奠定基礎。
- **多重模式語音功能:**除了文字式互動之外,Agentforce 3.0 引進語音支援作為主要模式。此架構與電話服務供應商和 WebRTC Gateways 整合,以處理即時音訊串流。新服務管理音訊轉換為文字 (ASR) 和文字轉換為音訊 (TTS),為自動化連絡中心等使用個案啟用自然對話式語音體驗。
- **Agentforce 指令檔和決定性:**以狀態機器為基礎的截斷機制,可限制明確定義結構內工作人員行為,以確保一致的執行路徑。這可啟用決定性圖表、提供強大的狀態管理以防止記憶體遺失,並促進條件式和 LLM 決定的處理,從而確保重要業務流程的工作人員動作可預測且一致。
## 8\.應用程式平台服務
Salesforce Platform 的應用程式生態系統以其跨「應用程式平台服務」、「API」、「使用者體驗」和「開發人員體驗」層級的功能整合而不同。「應用程式平台服務」是用於在 Salesforce Platform 上建立和自訂大多數應用程式的常見功能,而業務功能通常更為解決方案特定。
### 8.1 重要功能
應用程式生態系統以五個關鍵功能為基礎,其可引導應用程式開發程序。
- **租戶**:這涉及在多重租戶服務內邏輯分隔資料和中繼資料,讓已驗證的使用者存取特定的資料和功能。當客戶在註冊時收到 Salesforce 組織時,最能看見此項目。
- **實體**:代表資料庫表格的實體由類似表格欄的欄位所組成。實體和欄位中繼資料包含資料建模的屬性,例如資料類型和 API 名稱,以及功能屬性,例如實體是否為可查詢或可寫入。此抽象,而非直接操作資料存放區本身,可讓 Salesforce 順暢導入和切換儲存技術,而不需要 IT 開發人員進行更新,以確保持續應用程式功能。
- **存取控制**:這些控制項會根據使用者身分與特定原則,規範使用者對資料與功能的存取權。原則由規則和功能切換而成,並管理可存取的實體、欄位和功能。系統會在「權限集」中共用原則和權限,並透過將權限集指派給使用者身分授與存取權。
- **分層延伸模組**:如先前所述,這支援由不同角色 (包括 Salesforce 工程師、外部合作夥伴、IT 管理員和一般使用者) 獨立開發中繼資料和應用程式,並由結構化儲存訂單和中繼資料命名空間協助。
- **封裝**:此功能允許在 Salesforce 租戶之間配套和散佈中繼資料,以簡化應用程式的更新和散佈流程,而不需要重新建立。
除了這些關鍵功能之外,應用程式平台服務還包括:
- **資料執行階段與查詢**:支援在多個專用資料存放區之間建立、更新、刪除和查詢資料等作業。可透過 Salesforce 工程師使用的內部抽象,或透過面向客戶的「Salesforce 物件」或 sObject 慣例,直接在資料存放區上執行資料作業的結構支援資料規模與效能的範圍。
- **流程/工作流程/公式**:使用低程式碼工具定義和執行業務邏輯和驗證規則。
- **Apex 程式碼**:應用程式邏輯的專業程式碼語言,原生整合至平台資料執行階段和 API。
- **雲端原生基礎結構服務:**Heroku 為開發人員提供使用產業程式設計語言和架構的強大環境,以建立、部署和管理與平台資料和事件整合的應用程式。
- **事件與通知**:管理觸發和以事件為基礎的協調流程。
- **全球化**:提供多國語言與多國應用程式的支援。
- **授權與佈建**:處理平台功能與應用程式的購買與管理存取權。
- **Lightning Web 堆疊**:允許使用結構化中繼資料 (例如版面配置和標準 Web 技術) 自訂視覺介面。
- **網站 + CDN**:確保低延遲和高流量的 Web 體驗,包括未經驗證的使用者。
- **安全性和合規性**:提供符合特定組織安全性和規範需求的工具和控制項。
- **資料遺失防止**:包含資料備份、還原和封存的功能。
### 8.2 雲端應用程式平台
Salesforce Platform 透過 Heroku 提供一套工具和功能,讓開發人員能夠使用他們選擇的程式設計語言和架構,在雲端中建立、執行和管理應用程式。Heroku 受管理的雲端應用程式平台提供應用程式執行階段、資料存放區、傳訊排隊和事件系統,作為可調整的服務,以建立 Salesforce 應用程式的擴充功能。
在 Heroku 上執行的應用程式擁有 Salesforce 功能、客戶資料和業務邏輯的完整套件存取權,以及與第三方系統和服務連線的能力。透過 Heroku,開發人員可以專注於提供價值,而不必因基礎結構上的疑慮而擔心。
## 9\.自動化
自動化是讓應用程式具有動態性,對於重要的業務流程數位轉型而言至關重要。
Salesforce 流程自動化是為了解決客戶面臨的關鍵挑戰,包括組織規模的簡化和高效率業務流程需求。這些挑戰通常涉及需要過度手動工作的工作流程,導致效率不佳且營運成本較高。客戶尋找可將這些流程自動化、最小化手動人工,並維持一致性和準確性的解決方案。
重要問題是缺少使用者易用的工具,允許非技術使用者設計和實作沒有廣泛編碼技能的業務流程。此外,也需要可安全、可調整且順暢地與現有自動 Salesforce 工作整合的解決方案,例如資料輸入、批准、通知和複雜的多步驟流程。
Salesforce 流程自動化透過提供可建立自動化工作流程的強大但直覺式平台來滿足這些需求。其可讓使用者透過可供技術與非技術使用者存取的視覺介面建立及自訂流程,進而自動化重複的工作、強制執行業務規則,並簡化 Salesforce 生態系統內的流程。
針對需要複雜協調流程與交易資料互動的自動化,Salesforce 提供 Apex 作為撰寫業務邏輯的 Pro-code 語言。
### 9.1 流程自動化結構與功能
**視覺邏輯產生器**:客戶和 ISV 使用 Flow Builder (拖放介面) 來建立流程自動化流程,而無須撰寫程式碼。此視覺工具適用於所有技術層級,可讓業務分析師和管理員輕鬆設計複雜的自動化。
Flow Builder 可讓客戶建立多功能的流程,這些流程可在核心流程引擎支援的各種環境中運作:
- **記錄觸發**:流程會在記錄更新或表單提交時啟用,並根據客戶動作啟用資料修改、驗證和工作流程起始。
- **已排程或以事件為導向的流程**:這些流程可依預先決定的排程運作,或在特定事件之後觸發,並可對外部服務進行呼叫。
- **畫面流程**:針對包含表單、畫面和其他互動元素的引導式逐步流程,提供使用者介面,用於資料輸入、疑難排解或上線等工作。
- **協調流程**:管理與整合多步驟流程,以協助處理複雜作業。
離線流程引擎無須與 Salesforce 應用程式伺服器連線即可執行。離線流程可為 Field Service 行動使用個案提供自動化功能。「大規模流程引擎」可強化行銷流程。其提供 B2C 級度,可同時處理大量長時間執行流程。
所有使用個案和環境都透過 Flow Builder 中的統一中繼資料模型增強,其支援適用於所有流程自動化流程的各種強大邏輯元素:
- **進階邏輯與條件**:使用者可以將決策元素、迴圈和等候條件等複雜邏輯整合到其工作流程中,以便處理複雜的業務案例。
- **資料管理與轉換**:Flow Builder 可讓您從各種來源 (包括 Web 服務、Salesforce 組織和 Data 360) 來啟用資料採取、轉換和管理。它支援全方位的資料作業,例如建立、更新、刪除和查詢記錄。
### 9.2 在整個 Salesforce Platform 中自動化
Salesforce 流程自動化可與其他 Salesforce 產品和第三方系統順暢整合,確保應用程式之間的資料流程順暢,以取得業務流程和客戶互動的統一檢視。其支援各種整合方法,例如 API、網路呼叫和 MuleSoft 連接器。
Salesforce 中的「外部服務」與 MuleSoft 連線可讓外部 API 連線,並在 Salesforce 流程自動化內利用其資料。註冊 API 結構描述可建立可叫用動作,以順暢整合至流程,進而協助透過外部資料來源自動化流程。MuleSoft 的強大整合功能可確保 Salesforce 與其他應用程式之間的資料流流順暢,消除資料孤立區,並提供業務流程的統一檢視。
**Agentforce 整合**:Salesforce 流程自動化利用 Agentforce 來透過智慧決策增強工作流程。它會使用 AI 洞察來自動將商機導向至適當的銷售代表,或根據客戶行為起始量身打造的行銷活動,進而透過新增智慧提升自動化的效率。
**平台同步化**:Salesforce 流程自動化與其他 Salesforce 產品 (例如 Sales Cloud、Service Cloud、Commerce Cloud 和 Marketing Cloud) 順暢整合。此整合可讓組織自動化各種部門的流程,進而提升營運效率。例如,當透過 Marketing Cloud 表單提交客戶投訴時,工作流程會在 Service Cloud 中自動產生支援個案。
### 9.3 使用 Apex 自動化 Pro-Code
Apex 是強大的物件導向程式語言,可讓開發人員在 Salesforce 平台上撰寫自訂業務邏輯並執行複雜作業。此平台一直是我們平台的核心,目前平台每月處理超過 350 億個 Apex 交易 (截至 2025 年 10 月)。
Apex 用於開發廣泛的自訂功能和深入整合至 Salesforce 平台,包括:
- **以觸發為基礎的自動化**:實作在插入、更新或刪除記錄之前或之後執行的複雜自動化。這允許複雜的資料驗證、相關記錄更新,以及根據特定資料變更叫用其他程序。
- **網路服務:**建立與外部系統的自訂整合,並從 Apex 呼叫 REST 或 SOAP API。
- **自訂使用者介面**:使用 Visualforce 和 Lightning Web 元件 (LWC) 建立高度自訂的使用者介面和體驗,其中 Apex 會作為後端控制器來處理資料操作和業務邏輯。
- **自訂 API:**開發人員可以使用 Apex REST 和 Apex SOAP 將自訂邏輯公開為 API,讓外部系統以程式設計的方式與 Salesforce 資料和程序互動。
- **非同步處理**:透過未來的方法、可排列的 Apex 和排程的 Apex 非同步執行長時間執行或具有資源密集性的工作。這可讓長時間執行的作業在背景中卸載和處理,進而改善使用者體驗和系統效能。
- **已排程 Apex:**開發人員可以使用 Apex Scheduler 排程 Apex 類別在特定時間執行,以進行定期工作,例如夜間資料同步、報告產生和維護活動。
## 10\.使用者體驗
Salesforce Platform 上的「使用者體驗」功能可讓使用者透過瀏覽器型 Lightning 應用程式、Experience 網站、行動原生、以 AI 為導向、協同合作 UX 或使用 Lightning Out 內嵌元件的各種部署選項與應用程式互動。
### 10.1 Lightning 設計系統
Salesforce Lightning Design System (SLDS) 是一種全方位設計架構,可透過 Salesforce 的設計原則,促進建立一致且可存取的使用者介面,為所有產品提供一致的使用者體驗。其可讓 Salesforce 工程師、客戶和合作夥伴建立在整個 Salesforce 生態系統中的原生應用程式。
設計系統的主要功能包括:
- **設計模式**:針對常見設計挑戰提供經過驗證的解決方案,提供版面配置、資料呈現和使用者互動的原則,以確保一致的使用者體驗。
- **樣式勾點**:代表設計決策的 CSS 變數,例如色彩、列印、間距和大小,以確保應用程式之間的一致性。
- **Lightning 型元件庫**:可重複使用的 UI 元件集合,例如按鈕、表單元素和瀏覽元素,遵循 Salesforce 的設計原則,協助快速且有效率地開發。
- **無障礙**:內建的無障礙功能與原則可確保所有元件均可供身心障礙的個人使用,並遵循標準,例如網路內容無障礙指導方針 (WCAG)。
- **回應式版面配置**:彈性的網格系統與版面配置指導方針,可讓應用程式順暢地適應不同的裝置與螢幕大小。
- **工具**:支援元件衛生、反模式減少和設計系統管理的工具、資源和技術集合。
SLDS 架構持續發展以支援更豐富的樣式綁架和更深入的自訂功能,讓元件可以重複使用,同時仍可自訂以符合獨特的品牌標識和主題需求。我們的設計系統願景是讓 Salesforce 快速、簡單且吸引人使用 AI。
### 10.2 Lightning Web 堆疊
Salesforce 的瀏覽器型介面稱為 Lightning,提供一致的 UI 容器和中繼資料驅動的 UI 架構,以及針對 Salesforce 工程師、IT 管理員、開發人員和合作夥伴快速開發具有一致 Salesforce 外觀的 UI 的技術集合,以及可讓您完全控制重新設計和重新品牌標識的擴充點。Lightning Web 堆疊包含數種技術:
- **Lightning Web 元件**:以 HTML 和 JavaScript 建立的自訂 Web 元件,遵循 W3C Web 標準。
- **Lightning Web 安全性**:虛擬化引擎,可在瀏覽器中管理 JavaScript 程式碼,確保符合 Salesforce 第三方程式碼的安全性標準。
- **Lightning 資料服務**:專為與伺服器端資料有效互動而設計的架構。
- **Lightning Web Runtime**:確保在各種用戶端之間呈現高效且一致的 UI。
Salesforce 工程已納入先前 UI 技術的經驗,並為 Web 標準內文做出貢獻,進而影響標準型元件實作的開發。例如,Salesforce 會繼續成為約 20 個 W3C 工作群組的成員。Lightning Web 元件和 Lightning Web 堆疊符合這些產業標準,進而降低開發人員的複雜性。
### 10.3 行動裝置
行動裝置持續是使用者與 Salesforce 應用程式互動的成長且重要介面。
Salesforce 提供原生行動應用程式,因此所有以瀏覽器為基礎的 Lightning 應用程式無須撰寫新程式碼即可成為行動應用程式。Salesforce 也提供各種工具、SDK 和功能,以建立針對裝置最佳化的完全自訂原生應用程式。這些包括:
- **Mobile SDK**:適用於跨行動作業系統開發人員的 Procode 介面,可簡化與驗證、工作階段/權杖管理、Salesforce API 等的整合。
- **行動原生執行階段**:讓開發人員能夠使用 iOS 和 Android 技術,以動態方式在執行階段呈現的中繼資料驅動原生體驗,同時利用裝置上的功能。
- **品牌**:允許透過 Mobile Publisher 銷售管道自訂行動應用程式的美感,以將 Salesforce 行動應用程式轉換為客戶品牌應用程式。
- **離線功能**:確保不一致或沒有網際網路連線的流暢應用程式功能。
行動自訂架構 (MCF) 透過提供易於使用和廣泛的自訂選項,大幅增強原生 Salesforce 行動應用程式的開發。主要優點包括:
- **中繼資料驅動方法**:MCF 利用可從視覺產生器、一般存放庫和 Salesforce 主控的資源來源的中繼資料,以建立針對特定需求量身打造的動態且可調整的使用者體驗。
- **試驗和最佳化**:架構支援具有不同版面配置的執行階段實驗,協助進行持續參與最佳化和使用者體驗精簡。
- **擴充性**:針對彈性的設計,MCF 允許將自訂元件整合至核心中繼資料架構,增強功能與靈活性。
- **可組合的使用者體驗**:MCF 利用最新的 iOS 和 Android 技術,支援組合可重複使用的元件,例如按鈕、清單和卡片,以建立複雜的使用者介面。
- **執行階段自訂**:MCF 可啟用即時 UI 自訂和實驗,促進更個人化且吸引人的使用者體驗。
當在行動裝置上使用應用程式時,離線和低連線情況是令人擔憂的問題。行動技術堆疊會排定建立可能為離線優先之應用程式的優先順序。重要功能包括:
- **快取第一個體驗**:專注於快取資料以供離線使用,以確保高效能與安全性。使用者互動也會以離線呈現原則為考量而設計。
- **快取管理**:讓快取保持相關且更新,即使離線也是如此。
- **共用快取**:針對原生與混合式畫面使用單一快取,以促進流暢的離線體驗。
Nimbus 是平台的生產就緒解決方案,可簡化混合式應用程式開發人員存取裝置功能的流程。傳統上,將 JavaScript 與行動原生程式碼之間的間隔橋接為一項複雜的工作。不過,透過 Nimbus,開發人員現在可以充分利用行動裝置的潛力,而無須深入瞭解低階程式碼。重要功能包括:
- **寬存取權**:提供與各種裝置功能的流暢整合,例如相機、麥克風、地理位置和 LiDAR。
- **標準化介面**:提供存取裝置功能的一致方法。
- **混合式應用程式整合**:啟用混合式應用程式以充分利用裝置功能。
- **有效開發**:簡化應用程式開發流程,減少複雜性。
隨著 AI 持續改變 Salesforce 應用程式的可行性,Salesforce 也透過運用內部裝置、工作特定 AI 模型以及雲端型解決方案來提供不同的使用者體驗:
- **小型語言模型 (SLM):**這些功能可在行動裝置上有效率且成本低的執行。
- **隱私權與安全性:**確保使用者隱私權,並維持與伺服器型模型相似的 Trust 和安全性層級。
- **離線功能:**在低連線環境中有效運作,啟用離線使用個案。
- **聲音:**最先進的語音對文字、自然文字對語音和發言者直方模型現在會在裝置上原生執行,提供高度忠實的語音互動,並提供完整的隱私權和零延遲。
### 10.4 AI 與協同合作
自然語言的非模型使用者介面以及與我們應用程式的多輪互動的頻率將持續增加。未來開發預期會增強模型、裝置功能與應用程式之間的整合,透過更直覺的語音與文字介面改善使用者互動。裝置內度量集合也會允許根據使用者偏好進行個人化調整。
所有使用者 (包括人類與工作人員) 都需要協同合作,才能利用自動化與人力監督的組合優勢。對於涉及組織員工和其客戶的複雜業務互動而言,此協同合作特別重要。Slack 可作為 Salesforce Platform 中的主要工具,透過針對特定討論主題量身打造的直接傳訊和多使用者管道,協助進行此互動。這些討論可以從使用者建立的自發對話,到以使用者工作流程內特定資料為中心的結構化對話,例如解決重要客戶問題的詳細 Slack 訊息討論串。
在未來,Salesforce Platform 計畫增強目前由 Slack 提供的協同合作體驗。此擴充的目的是充分利用平台的廣泛功能,豐富使用者在數位工作區內互動與協同合作的方式。
## 11\.開發人員體驗
平台上的「開發人員體驗」功能提供建立、自訂、測試和部署應用程式的工具,透過專業程式碼方法專注於低程式碼的範圍,確保所有技能層級的開發人員均有平等的機會。
- **低程式碼工具**:這些項目包括資料模型的「結構描述產生器」、「業務規則的流程」和適用於 UI 自訂的 AppBuilder,其設計目的為透過操作結構化中繼資料並使用業務解決方案的語言來簡化開發程序,而非技術概念和語法。
- **Pro-Code 工具**:針對需要更豐富且複雜自訂的開發人員,平台提供如 Salesforce 程式碼產生器 (雲端型 IDE) 等工具,以及進階編碼和元件建立的命令列介面 (CLI) 和 API。開發人員可以利用 Heroku 部署、管理和最佳化應用程式的解決方案,以其選擇的語言撰寫程式碼。
- **整合開發環境**:Salesforce 生態系統支援低程式碼和專業程式碼工具之間的流暢整合,以及使用產業標準工具在雲端內和本機進行一致開發。
- **應用程式週期管理 (ALM)**:提供與生產環境分開開發的各種 Sandbox 組織,包括初始開發的臨時組織,以及針對類似生產的資料和規模進行測試的完整 Sandbox 組織。
### 11.1 開發人員適用的 AI
AI 和「開發人員助理」正在簡化和加速建立高效率且高品質的應用程式,藉此改變開發人員體驗。在 Salesforce,我們的 AI 研究和開發人員體驗小組不斷重複並探索如何透過代理推理,將預測和生成式 AI 轉換為強大的開發人員工作人員。這些開發人員工作人員會原生整合開發人員已使用的工具,例如 VS Code、Code Builder、指令行、DevOps Center 和 Code Analyzer,使其更具相關性和影響力。
我們在程式碼分析方面取得重大進展,以識別 Apex 程式碼中的防模式和熱點,然後提供可改善其實作的重要建議。所識別的問題通常會浪費運算資源,且通常會導致大規模事件。這是在 2024 年 1 月啟動為 ApexGuru 洞察。
在啟動後的第一年,超過 2,800 個 Salesforce 組織使用 ApexGuru 分析並改善其 Salesforce 實作。已成功實作超過 22,000 個建議,進而每週節省 28,000 個 CPU 小時。此增強不僅可提升績效,還可透過每週減少 135 公斤的 CO2 排放量來為環境永續性做出貢獻,以符合我們「永續性」的核心價值與減少碳排放的承諾。
我們也將 AI 整合至 Pro-Code 開發人員工具和功能,以改善 Developer Productivity。在 2024 年製作為「適用於開發人員的 Agentforce」,開發人員可以在 Visual Studio 程式碼和程式碼產生器中的 Salesforce Extension 套件中存取這些新功能。這些擴充功能可啟用:
- 開發人員撰寫和產生 Apex 和 Lightning Web 元件 (JavaScript、CSS、HTML) 的內嵌程式碼建議。
- Apex 和 Lightning Web 元件的程式碼說明和文件產生。
- Apex 單元測試程式碼產生。
- IDE 中獨特的多輪聊天體驗,可處理代碼產生、說明和文件的多個回應。
- Lightning Web 元件最佳化。
- 具有人類可讀 YAML 中繼資料的工作人員產生,包括工作人員測試和除錯功能。
截至 2025 年 10 月,每月超過 42,000 名開發人員主動使用此技術,並接受了 17,6 百萬行程式碼。此全方位套件可確保靈活、整合且有效率的開發環境,滿足 Salesforce Platform 內的各種開發需求。AI 開發人員工具也增強了跨多個外部和 Salesforce 建立模型的結構,可為指定的使用個案選擇最有效且最有效率的模型。
### 11.2 MCP 支援和 AI 輔助編碼
「模型內容通訊協定」(MCP) 是一種開放標準,專為允許 AI 工作人員安全且一致地與任何工具或資料來源互動而設計。Salesforce 會將 MCP 支援原生整合至 Salesforce 開發人員工具組,以協助可存取整個企業功能與工具的工作人員。包括:
- **本機 MCP 伺服器:**本機 MCP 伺服器可讓開發人員在部署至生產環境之前,輕鬆建立、測試和除錯其本機 IDE 中的代理整合,進而大幅提升生產力。本機 MCP 伺服器提供組織互動和開發工作流程的專用工具,例如行動開發、無障礙測試、Aura 到 LWC 移轉,以及代理 DevOps。本機 MCP 伺服器也包含與工作人員邏輯和 LLM 的整合,以進一步讓開發人員以自然語言以反覆方式「Vibe Code」應用程式。
- **適用於 Salesforce API 的自訂 MCP 伺服器:**開發人員現在可以安全地將 Salesforce API、Data 360 物件和自動化流程公開為 MCP「工具」。這會將整個 Salesforce Platform 轉變為任何外部 AI 工作人員或應用程式的豐富、可信任且可探索的功能集,並完成細微的存取控制,以及新以耗用量為基礎的獲利模式的潛力。
- **原生外部 MCP 連線:**開發人員也可以安全地管理與符合 MCP 標準的外部伺服器連線。這可讓開發人員建立可跨企業工作的工作人員。
## 12\.應用程式套件
我們的應用程式雲端 (包括 Sales Cloud、Service Cloud、Marketing Cloud、Revenue Cloud 和 Commerce Cloud) 是以 Salesforce Platform 為基礎,提供領先的業務功能,並撰寫應用程式套件來推動客戶成功。重要功能包括:
- **流暢整合**:深度整合,並設計為在整個客戶旅程中一致運作,並確保在整個客戶接觸點之間的資料和流程順暢,以增強客戶體驗。
- **端對端自訂性**:我們的應用程式建立在我們的平台上,提供廣泛的自訂選項,從無程式碼到專業程式碼,以便精確量身打造客戶需求。
- **進階 AI 功能**:透過我們的 Agentforce 工作人員,提供工作人員協助與工作人員獨立的互動式管道型工作流程。整合預測和生成式 AI,透過自動化、預測分析和個人化使用者體驗提升效率,提供可採取動作的洞察和建議。
- **即時資料處理**:利用 Data 360 進行即時資料存取與分析,並支援根據最新資訊及時且明智的決策。這可在快速的環境中增強回應和靈活性。
- **統一資料與分析**:將各種資料來源整合至集中式平台,以提供一致且全方位的資料檢視,提供準確的分析並改善決策。
- **增強型安全性和合規性**:具備強大的安全性和合規性工具,可保護敏感資料並符合法規標準。
- **消費者級使用者體驗**:提供直覺式、使用者易用的介面,讓應用程式在裝置、管道和強制回應之間可供存取並有效執行。
- **可靠性**:確保最低的停機時間和延展性,以支援任務和關鍵性作業,包括緊急服務和關鍵交通系統。
- **彈性延展性**:建立在 Hyperforce 上,支援增加資料和使用者互動量,而不會犧牲效能或服務成本。
- **持續改善**:定期整合創新以增強功能,而不會中斷現有作業。
Salesforce 致力於透過整合平台的功能,以此白皮書中所述的基礎技術為基礎,進一步推進其應用程式。此轉換由一組關鍵優先順序所引導,這些優先順序會塑造 Salesforce 應用程式套件的設計和開發。
### 12.1 規模與效能
我們的應用程式小組專注於效能與延展性,利用進階效能實驗室使用合成資料建立我們生產環境的精確複本。此設定允許大量模擬並列使用者旅程,以確保每個新功能均經過全面的效能測試,並評估其影響。當發現執行階段瓶頸時,我們會動態調整比率限制和其他措施,以保護系統運作狀況,同時收集資料來推動解決方法。
我們的系統專為水平調整而設計,以有效利用公用雲端的彈性。自動檢查可確保更新或增強項目不會對效能造成負面影響。我們採用預測自動量表,主動管理系統負載,不僅反應增加的需求,還會事先預期並調整。
自動調整對透過減少未使用的容量來最小化服務成本而言至關重要。我們會密切監控系統執行成本,識別並處理自動調整規模或資源使用的任何效率不佳。雖然成本效率很重要,但我們優先考慮可靠的應用程式傳送,選擇快速縮減及緩慢縮放的自動量表,以維持客戶的 Trust,即使產生更高的成本也是如此。
### 12.2 流暢整合
#### 常見資料模型
資料模型是 Salesforce 所有業務作業的基礎,會影響業務功能、API、瀏覽、UI 顯示,以及可建立的報告。它們是平台功能的整體。
我們的應用程式套件在 Sales Cloud、Service Cloud、Revenue Cloud、Commerce Cloud、Marketing Cloud 和 Industries Cloud 中共用常見的資料模型。這對我們的整合套件有貢獻,提供一致的行為與互通性,並清楚說明升級與擴充的路徑。
例如,跨所有 Cloud 的「帳戶」與「產品」實體共用可讓 Marketing Cloud 和 Sales Cloud 中的使用者交換資料、中繼資料、UI 元件和業務邏輯。此整合有助於拆分孤立群體並促進跨部門協同合作。
#### 虛擬資料平台
所有 Salesforce Cloud 之間的通用資料模型會大幅增強整合,但可能無法滿足所有複雜的合作夥伴整合需求。Data 360 常用資料模型透過將共用資料模型優點延伸至超出 Salesforce 標準資料界限,以容納更廣泛的整合案例,進而擴展此功能。
#### 分層擴充性
Salesforce 的中繼資料架構允許各種群組 (例如工程小組、ISV、合作夥伴、管理員和一般使用者) 在不同的擴充性層級內自訂和展開其應用程式,而無須互相干擾。此結構支援可調整的環境,其中某個群組的修改不會中斷其他群組,以維護系統完整性。
「架構」的最佳範例為統一知識產品,該產品將所有 Knowledge 來源整合到資料湖中。此設定包含語意層級與取得器,可增強 Sales Cloud、Service Cloud、Revenue Cloud、Marketing Cloud 和 Commerce Cloud 中的預測和生成式 AI 功能。其會納入與現有結構化 Knowledge 模型連結的非結構化與半結構化 Knowledge 資料模型。
此外,「架構」會使用中繼資料定義資料類型之間的自訂關係,以協助進階查詢產生。這可讓應用程式小組建立可自訂的應用程式,這些應用程式可利用此全方位的 Knowledge 庫,而 ISV、合作夥伴和客戶可以透過修改中繼資料關係或針對特定業務使用個案開發自訂取得器來進一步增強應用程式功能。
#### 增強通用資料平台
客戶資料會安全地儲存在各種平台 (例如 SalesforceDB 和 Data 360) 中,且會標準化和正規化,無論其結構化或非結構化格式為何。這可透過稱為 sObject 的統一格式確保一致的資料處理,其支援所有客戶資料之間的一致資料平台。
此標準化可為所有資料作業啟用單一 API、為 Apex 中的觸發啟用統一介面,以及使用「流程」建立自訂工作流程。它也支援 Tableau Next,允許自訂資料檢視並與生成式 AI 工具 (例如提示詞產生器) 整合,以根據客戶資料產生智慧回應。
此外,Salesforce 應用程式會與各種資料存放區整合,以增強產品內的業務流程彈性。例如,在 Marketing Cloud 中,流程用於管理多重接觸客戶體驗,以及使用預先設計的範本或建立自訂流程的選項,這些流程會根據基本客戶資料整合行銷與其他業務流程。
### 12.3 共用業務功能
應用程式利用並增強如身分解析、內容協調流程、個人化、分析、LLM Gateway 和 Reasoning Services 等共用服務,以實現快速的創新和傳遞。這些服務支援即時資料處理、AI 驅動洞察和豐富的使用者體驗,提供全方位的客戶檢視。
優點包括透過智慧自動化和預測分析改善效率、可擴充資料和使用者互動的延展性,以及強大的安全性和合規性。平台的自訂功能可讓組織快速適應不斷變化的需求,進而促進成長和卓越的營運。
「應用程式層級」的創新由 Salesforce Platform 和個別應用程式推動,強化 Salesforce 生態系統並將應用程式建立為業界領導者。
### 12.4 多管道與管道最佳化
Salesforce 應用程式的設計目的為滿足各種平台的使用者,包括 Web、行動、電子郵件、SMS、WhatsApp 和其他管道。它們會最佳化每個管道的原生功能,以增強使用者體驗和效率。
功能包括 Salesforce Field Service 使用者的多月離線功能、瀏覽器推送通知,以及 Lightning Service Console 中服務工作人員的寬螢幕版面配置,以及商務購物者的高效能店面和副試用版。
中繼資料平台可確保 Salesforce、其合作夥伴和客戶可以立即立即立即使用這些功能。
### 12.5 快速提供創新
Salesforce 的基礎服務、平台和共用業務功能可讓應用程式快速適應市場轉變和技術趨勢,以便快速提供創新。例如,隨著生成式 AI 的出現,Salesforce 迅速利用現有的 AI 服務,例如 NLP Trust 層級和意圖偵測,將提示範本納入 Universal Communications Platform。此整合可增強產品的傳訊和電話功能,進而促進更多個人用戶端連線。
跟隨自動 AI 的趨勢,Salesforce 啟動 Agentforce,此解決方案利用這些現有的投資,以有效率地透過工作人員自動化業務使用個案,而無須從頭開始建立。
### 12.6 應用程式套件路徑
我們已在 Salesforce Platform 上重新建立 Marketing Cloud、Revenue Cloud 和 Commerce Cloud,讓這些 Cloud 能夠共用相同的基礎結構、平台、中繼資料、資料、AI、UI 元件和業務邏輯,同時受益於 Salesforce Platform 的完整功能。例如,我們已採用來自 Revenue Cloud 的功能和內嵌核心功能,例如以限制為基礎的組態器、定價引擎和目錄管理,使其成為可跨套件使用的基本服務。這也可讓我們順暢整合所有雲端,Commerce Cloud 和 Marketing Cloud 提供的功能會成為其他應用程式可利用的共用業務功能的一部分。這是我們提供的整合應用程式套件願景。
Salesforce Platform 的旅程已導致開發整合應用程式套件,將 Sales Cloud、Service Cloud、Marketing Cloud、Revenue Cloud 和 Commerce Cloud 結合為一個統一的解決方案。此套件自 Salesforce Starter Edition 起可供使用,在一個綜合的封裝中提供多管道拓展、客戶關係管理和業務洞察。無論選擇的版本為何,使用者都可以存取 Sales Cloud、Service Cloud、Marketing Cloud 和 Commerce Cloud 的核心功能,以確保跨所有層級的一致體驗。
## 13\.產業特定解決方案
Salesforce Industries 的 Financial Services、Health、Life Sciences、Media、Energy and Utilities、Manufacturing、Auto、Consumer Goods、Retail、Net Zero、Public Sector、Education 和 Nonprofit 產品擴充了我們的應用程式產品和平台,以提供量身打造的解決方案,滿足產業的獨特挑戰。其透過納入產業特有的工作流程、合規性度量和資料模型,來簡化作業並提升生產力。
Industries 產品組合已在 Salesforce Platform 上重建,以實現跨垂直的可組合性。客戶現在可以將一或多個產業功能組合為量身打造的解決方案,利用共用的中繼資料、API 和業務服務。此方法會平衡垂直區分與平台一致性,確保在各種法規與業務環境中具有適應性和規模。
### 13.1 分層結構方法
我們的產品使用分層結構。基礎是 Salesforce Platform 和 Sales Cloud 和 Service Cloud 等水平應用程式,作為所有產業解決方案的基礎。為此,Salesforce 已新增值新增的常用服務,可增強多數產業內嵌的可重複使用元件。範例包括數位自動化、時間表、動作計畫等功能。在此層之上,有一個可重複使用的業務邏輯層,會壓縮水平功能,例如回饋意見管理、CPQ (config、price、question) 和服務管理。
頂端層有專為符合特定產業需求量身打造的網域特定自訂項目,並利用基礎平台增強擴充性與效率。例如,在製造垂直,此設定透過準確的預測最佳化生產規劃。在生命科學部門中,其提供製藥銷售小組行動離線解決方案,可有效管理工作流程和樣品處理,同時遵循各種地理法規需求。
### 13.2 產業特定功能
**信任的 AI 傑出**:我們信任的生成式 AI 解決方案提供產業特有的 AI 功能。其中包括工作人員和提示工程,可協助在如醫療照護、生命科學和金融服務等產業中進行低程式碼/無程式碼自動化和數位化。此外,如文件/文字挖掘和摘要等功能可滿足處理大量資料的產業需求,進而協助瞭解資訊和洞察。
自訂的工作人員可增強工作人員和客戶之間的三向溝通,進而加速解決方案。Salesforce Platform 的 Trust 層級可協助跨產業遵循所有規範與法規標準。
**含法規合規性和安全性的資料、洞察和情報**:Salesforce Industries 提供全方位的全方位檢視,其中包含嚴格的資料隱私權、共用和安全措施,以符合特定產業法規,例如 GDPR、HIPAA 和 FedRamp。Salesforce 整合來自各種來源的資料,以實現合規性和安全性,並使用如租戶資料加密的 Shield Encryption BYOK (自帶金鑰) 等額外功能增強這些解決方案。
**提升的使用者體驗**:Salesforce Industries 強調根據產業特定需求量身打造的流暢使用者體驗,以增強使用者旅程。這包括如「可動作資源中心」、Experience Cloud 範本和 OmniStudio 型解決方案等工具。
**數位化、整合和上線**:Salesforce Industries 透過低程式碼到無程式碼解決方案提供數位化、整合和上線,為新客戶運用如「流程」和 Omnistudio 等工具,並為現有 CRM 系統提供移轉解決方案。透過 MuleSoft 提供的連接器簡化與外部系統和資料的整合。Salesforce 也包含產業特定的服務流程,例如 Retail Banking 的爭議管理。
**行動和離線**:Salesforce Industries 提供 Salesforce 行動應用程式和 Field Service 行動應用程式的強大網域特定支援。針對需要進階離線支援的高專業網域,產業提供以 Salesforce Mobile SDK 為基礎建立的自訂行動應用程式。
**通用業務功能**:Salesforce Industries 建立在通用業務功能的基礎上,實現一致性和生產力,同時為業界獨特的需求量身打造解決方案,例如銀行和醫院的不同約會預訂系統。Salesforce 與更廣泛的 Salesforce 生態系統整合,提供整體的 Customer 360 檢視,使其成為 Salesforce 產品套件的重要部分。
## 14\.Analytics
多年來,Analytics 和業務情報 (BI) 平台市場已為一般使用者推廣視覺自助式服務和 AI 驅動的自動洞察,以協助他們更快速地做出更資料驅動的決策。然而,我們知道並非每個人都看到了由於幾個挑戰而實現:
- **中斷連線洞察**:洞察未整合至使用者的工作流程中,這使得不易對洞察採取行動,儘管洞察有可能為決策提供資訊。
- **資料超載和孤立狀況**:資料持續快速成長且保持分割,導致混亂和安全性風險。組織面臨混亂的自助式資料環境與受限制且受管治良好的資料環境之間的困境。
- **不信任資料**:資料的擴展和分片化已經破壞了使用者對從公司資料衍生洞察的 Trust。
- **缺少可組合性**:工作流程中有顯著的可組合性和重複使用缺少,強制使用者重複工作,且沒有明確的獲利方式。
Tableau Next 的設計目的為透過透過新的協同合作方式來將業務使用者和資料專業人員聯結在一起,以擴大視覺分析週期,這一切皆透過 AI 增強。它會透過 Salesforce Platform 提供及時且值得信賴的度量和洞察,以協助對可運作洞察的普遍存取。
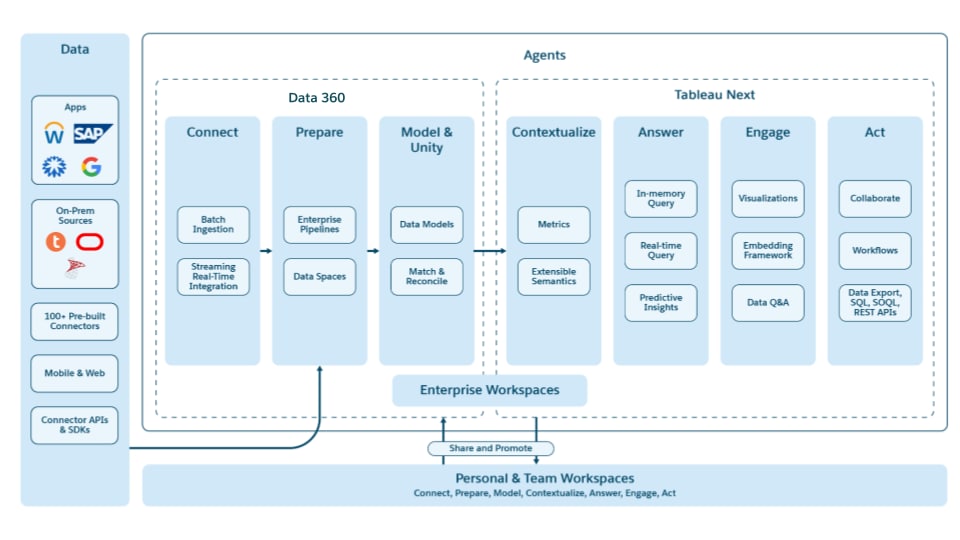 Tableau Next 透過以下方式解決這些挑戰:
- 針對從資料連線到動作之間連線的體驗,建立開放、可編輯的 API 優先平台。提供開發的工具、豐富分析應用程式的可組合元件,以及管理其封裝與散佈的功能。
- 以 AI 為核心,能夠提供內容相關洞察,以及可讓資料專業人員有效檢閱和驗證以確保 Trust 的工具。
- 使用 Tableau Semantics 作為通用語意層,在受控制但彈性的生態系統內快速、自助式和受管理的資料分析。
- 透過 Data 360 提供即時雲端規模的資料功能,以供信任、可調整和受管理的資料存取。
- 為開發人員提供豐富的環境和市場,以建立和獲利應用程式。
- 整合核心智慧,將組織語意和 Knowledge 的強大功能提供給可提供您能力的工作人員。
- 排定Trust的優先順序,讓您能夠透過直接控制資料、分析、工作人員工作量和部署,讓您對其活動和效率有信心。
- 利用協同合作作為一流的設計原則,並與 Slack 以及您組織的任何其他協同合作工具進行深度且豐富的整合。
### 14.1 頂級 Analytics 體驗
Tableau Next 透過提供開放式平台來增強功能並整合體驗,以建立 Tableau 在資料分析工具中的領導地位。重要功能包括:
- **豐富資料視覺效果**:利用 Tableau 的 VizQL 技術進行擴充的視覺分析。
- **協同合作、受管理工作區**:提供分析工作的統一介面,與 Slack 整合以進行即時協同合作。
- **受信任、受管理的資料**:在安全環境中支援具有結構化促銷路徑的自助式服務分析,以進行全域管理。
- **進階度量編寫**:讓分析師能夠在整個組織中有效率地建立和重複使用 KPI,以促進一致性和可靠性。
### 14.2 Agentic Analytics
Tableau Next 以 Agentforce 作為基礎結構建構為基礎,增強 Tableau Next 提供高連線、信任且協同合作 AI 技術的資料工具的能力。
- **BI 工具**:提升資料工作人員的自助式服務分析效率,專注於資料準備和視覺與語意中繼資料的精密設計。
- **內容相關體驗**:將資料洞察、體驗和透明 AI 帶入大多數組織的工作環境 (例如 Slack)。
- **Agentforce 結構**:建立在 Agentforce 堆疊上,在進階代理程式結構上為 Tableau Next 提供豐富的內容。
- **語意目錄**:提供用於管理中繼資料、歷程和搜尋的集中系統,以在 Tableau Next 使用者之間啟用共用體驗。
- **共用與產生的中繼資料**:在全方位生態系統中,協助在自助式服務分析與受管理內容之間順暢進行工作流程。
- **動作架構**:透過預先封裝、人類策劃或產生的工作流程取得洞察以採取行動。
- **個人化洞察**。瞭解您的資料偏好設定、您的角色等等 (以您允許的程度),以立即為您帶來高度內容相關聯且個人化的資料洞察。
- **主動洞察**。智慧地探索資料生態系統,尋找您感興趣的統計位置,同時主動瞭解變更的驅動因素、如何處理變更,並建議採取作為後續步驟的動作。
- **信任的資料工作人員**。讓您成為資料工作人員的驅動因素,能夠透過整合的體驗建立和調整應用程式。它也提供您測試工具,以預先評估資料變更及其對工作人員準確性和效率的影響。
### 14.3 整合解決方案驅動的業務使用者體驗
Tableau Next 透過各種平台 (例如 Slack 與 Salesforce) 以及如 Tableau Pulse 等新分析功能 (全部可透過代理體驗存取) 來增強業務使用者體驗,以簡化分析參與。重要層面包括:
- **協同合作**:以信任的分析為中心,其可協助跨不同分析元件的互動,並將驗證工具整合到使用者的工作流程中。
- **脈衝度量**:與傳統分析師建立的顯示面板相比,提供精密設計和自動化洞察的效率更高。
- **AI 驅動的體驗**:使用 AI 來減少進階分析的技術專業知識需求,協助確保決定性中繼資料與受管理資料的可靠性。
- **多角色洞察傳遞**:允許業務使用者與分析師協同合作,以取得系統提供洞察的 Knowledge 和 Trust。
- **深度整合**:建立在共用中繼資料和資料平台上,提供不同系統和體驗的可組合性,以允許促銷、資料流程和不同角色的可組合性,以協助彼此檢閱和完成工作。
### 14.4 Tableau 語意
Tableau 語意層可作為原始資料與使用者解譯之間的關鍵橋樑,簡化資料分析、決策和應用程式開發,並增強 AI 驅動的內容與提取。重要功能包括:
- **整合中繼資料管理**:支援自助式服務與受管理中繼資料,透過結構化路徑促進臨時分析,以成為組織的單一事實來源。
- **Tableau 的最佳功能**:包含多邏輯物件支援、模型可組合性、共用維度、複雜地理空間階層和時間建模。
- **多元化資料與分析**:協助連結非結構化與結構化資料,例如將以影像為基礎的產品種類與結構化銷售資料相關聯,以及納入來自半結構化產品檢閱的情感分析。
- **Salesforce Platform 整合**:建立統一的事實來源,協助在應用程式之間的一致業務語意和流暢整合,以及支援各種使用者體驗和使用個案的綜合中繼資料模型。
- **工作人員情報**:語意層是工作人員獲得智慧的關鍵領域之一,不僅能瞭解支援您業務的資料和中繼資料,還能瞭解定義其語意,包括針對您組織量身打造的更深入描述和偏好設定。
### 14.5 整合的工作流程與可操作洞察
Tableau Next 提供增強資料驅動決策和信任自動化的整合解決方案,其中包含簡單動作、預先定義的「流程」、排程和 API 整合。重要元件包括:
- **標準化、智慧型業務動作**:協助公司內的緊急與內容特定的通訊,這相當重要但複雜。
- **預先定義和產生的流程排程**:透過可信任但可驗證的靜態與動態產生流程來啟用臨時與已排程動作。
- **Agentforce**:支援 AI 驅動的資料對話與互動,讓使用者能夠使用洞察,並執行與傳統 UI 中類似的動作,包括其業務應用程式內部與外部,並透過對話簡化。
### 14.6 可組合開發人員平台
Tableau Next 提供一個可編輯的開發人員平台,其中包含無程式碼、低程式碼和專業程式碼選項,可用於應用程式開發,全都利用 Data 360 上的 Tableau 語意。主要供應項目包括:
- **預先封裝的產業/智慧應用程式**:提供符合特定產業需求的範本化和可自訂分析應用程式。
- **第三方與 ISV 申請**:支援建立動態和互動式應用程式以用於分析、產業特定和自訂用途。
- **市場與交易所**:允許 ISV 和開發人員在最大且最信任的業務應用程式開發生態系統內封裝和散佈其應用程式。
### 14.7 深度協同合作
Tableau Next 針對業務使用者和資料專業人員設計,可促進資料瞭解的協同合作方式。無論是技術或非技術,所有小組成員都可以檢閱彼此的資料洞察,從業務使用者到資料專家。此外,這些洞察不限於 BI 平台內的瀏覽器索引標籤。
作為 BI 平台,Tableau Next 為:
- **跨平台可組合**。無論您檢視洞察的平台為何,洞察都會以相同的方式呈現。此一致性是視覺化處理資料時的基礎設計原則。
- **與 Slack 深度整合**。與 Slack 整合的開發確保了目前市場上最直覺式且沉浸式的協同合作資料體驗之一。
- **開啟任何工具**。在我們高度統一的平台上套用我們的 API 優先原則,可確保整合可延伸至其他協同合作和第三方工具,進而在整個過程中保留豐富的功能。
## 15\.整合
雖然 Salesforce Platform 提供全方位的整合功能組合,可解決廣泛的數位挑戰,但許多客戶在一段時間內透過使用各種供應商和技術開發的企業結構內運作。
現代企業面對系統整合和業務流程自動化的挑戰,這通常會導致資料孤立和效率不佳。Salesforce 整合平台利用 MuleSoft 的強大功能,透過協助快速開發和增強自動化流程來解決這些問題。其可確保流暢的系統連線、增強資訊流程,並支援跨不同平台的決策,進而降低人工成本和自動化成本。此層對於建立、管理、管理和監視 Salesforce 服務與其他自訂或第三方服務之間的整合而言至關重要。
系統透過 API 定義,其用途為:
- 從重要系統 (例如 ERP、客戶和帳單系統,以及專屬資料庫) 存取資料。
- 協助資料互動與整合,協助消除資料孤立。
- 將業務內容新增至由系統和流程 API 管理的資料和程序。
為了有效溝通,會使用以下方式描述 API:
- 立即同步交換的 OpenAPI 規格 (OAS)
- 非同步、以事件為導向的通訊
- 用於結構化模型-內容互動的模型內容通訊協定 (MCP)
- 直接工作人員對工作人員整合的工作人員對工作人員 (A2A) 通訊協定。
Salesforce 整合層提供強大的功能,可整合和管理任何系統,進而增強與 Salesforce 資料、AI 和應用程式功能的連線,無論系統是 Salesforce 的原生系統還是來自其他提供者。
複雜整合需要進階轉換,且需要強大的工具,包括通用連線、API 管理與管治、建立整合工作負載的整合開發環境 (IDE),以及可部署、管理和監督這些整合的執行階段平台,以及可觀察性平台,以提供對這些整合的端對端可視性。
為了進一步加速整合流程,我們提供加速器和產業特有的範本,以編碼常見的整合模式和需求。
### 15.1 與 Salesforce 的整合模式
兩個主要的整合模式可處理 Salesforce 與更廣泛生態系統之間的資料與流程流程:輸出整合與輸入整合。
**將 Salesforce 連線至外部系統 (輸出):**此模式涉及源自 Salesforce 的流程,可存取外部系統中的資料或觸發動作。
- **安全端點管理 (已命名認證):**「已命名認證」提供安全且集中化的位置以儲存端點和驗證詳細資料。應用程式和自動化會參照邏輯名稱,而平台會處理驗證生命週期的複雜性。
- **宣告整合 (外部服務):**針對提供標準 OpenAPI 規格的外部系統,管理員可以使用「外部服務」以宣告的方式註冊 API。接著平台會處理規格,使服務的作業在如「流程」等工具中自動可作為原生動作,或在 Apex 中可作為原生物件使用。
- **複雜系統整合 (MuleSoft)**:針對缺少現代化介面的系統,MuleSoft 會建立可重複使用的標準 API 圖層。這會移除舊版複雜性,並將內部部署資料和流程帶入 Salesforce 生態系統。
- **即時資料存取 (外部物件):**將外部系統中的表格呈現為 Salesforce 資料模型內的虛擬物件,讓外部資料無須複製即可透過標準查詢和 UI 元件存取。
- **中央產能管理 (統一 API 目錄):**「統一 API 目錄」是集中化的存放庫,也是所有 API 規格及其相關聯中繼資料 (例如其位置與安全性通訊協定) 的單一事實來源。無論資料或商業邏輯位於何處,都可在整個 Salesforce 生態系統中進行探索、安全連線,並組成強大的新應用程式和自動化。
- **自訂 Pro-Code 邏輯 (Apex REST):**開發人員可以公開以 Apex 撰寫作為 REST API 和動作的自訂業務邏輯。此動作便可作為「流程」中的步驟或 AI 工作人員的工具使用。
**將外部系統連線至 Salesforce (輸入):**此模式可讓外部系統和應用程式連線至 Salesforce Platform,以存取資料、觸發業務邏輯和協調流程。此功能以經過驗證的企業級 API 為基礎,以大量規模運作。自 2025 年 10 月起:
- 查詢 API (SOQL) 每天處理超過 50 億個要求。
- REST API 每天從外部系統提供近 5 億個呼叫,使用量比去年增加 30%。
- 「大量 API」每日為大規模資料作業處理數十億筆記錄。
此已驗證的可靠性和規模可支援下列功能:
- **統一 API 體驗:**透過一致端點結構 (api.salesforce.com) 統一所有 Salesforce 功能的存取權,因此開發人員無須為每個產品學習不同的模式或驗證流程。
- **全方位、專用建立的 API 組合:**此平台提供針對特定需求量身打造的多元化 API 集合,包括適用於交易作業的 REST 和 SOAP API、適用於大量資料處理的大量 API、適用於事件驅動應用程式的 Pub/Sub API,以及專用產品或自訂 Apex API。
- **工作人員整合的未來整備:**透過如 MCP 等標準,客戶可以安全地將其 Salesforce 資料和動作公開為外部 AI 工作人員的「工具」,將 Salesforce 例項轉換為數位人力可擴充的技能集。
### 15.2 工作人員與 MCP 的整合
除了針對資料與程序整合建立的輸入與輸出模式以外,工作人員時代的新模式正在出現。Salesforce Platform 正在實作全方位 MCP 策略,將其定位為 AI 技術支援服務的消費者與提供者。此雙向方法可實現工作人員的互通性,讓企業能夠順暢地將 Salesforce 資料和功能與 AI 工作人員和工具的漸進生態系統整合,同時維持企業級安全性和管治。
**Salesforce 作為 MCP 用戶端:**工作人員可以智慧且動態地利用外部系統和 API 作為 MCP 用戶端。此功能可讓組織將 Agentforce 的接觸範圍延伸至超出 Salesforce 界限,協調任何系統的動作,無論其擁有現代 API 或需要透過 MuleSoft 連線至舊版系統或 RPA 機器人。透過熟悉的陳述性主題式設定體驗處理組態,無須自訂開發即可快速整合。合作夥伴提供 MCP 伺服器的簡化探索機制可進一步簡化外部功能的整合。透過大規模堆疊來摘要外部連線的複雜性,企業可以快速將 Agentforce 與其更廣泛的技術環境整合。
**Salesforce 作為 MCP 伺服器:**作為 MCP 伺服器,平台會將其邏輯和資產 (包括標準 REST API、自訂端點、可叫用動作和流程) 公開為可探索的外部工作人員「工具」。透過陳述性介面,客戶和 ISV 可以建立和設定自己的自訂 MCP 伺服器,將功能精密設計為專為獨特業務流程量身打造的工具集合。這會延伸至 MCP 提示,建立與平台的「提示範本」功能的自然同步,並允許組織將其對提示工程的投資提供給任何外部 AI 系統。
此功能由多層安全性模型管理:
- **應用程式控制:**外部用戶端應用程式建構可讓管理員強大控制哪些外部工作人員應用程式可以存取其 Salesforce 組織。
- **範圍權限:**驗證會透過細微的 OAuth 範圍增強,讓驗證的工作人員能夠精確追蹤並強制執行的動作。
- **核心平台授權:**這些新控制項是建立在 Salesforce 強大的授權模型之上,包括記錄存取控制項、實體和欄位級權限,以及在「設定檔」和「權限集」中定義的其他權限。
ISV 和合作夥伴也可以封裝和散佈 MCP 伺服器組態,以在整個 Salesforce 生態系統中快速部署 AI 整合。
### 15.3 通用連線
Salesforce 對通用連線的現代方法是「_解譯連線_」,這是以中繼資料為中心的方法,可針對無須程式設計的任何使用個案開發可在任何平台 (MuleSoft、Flow 或 Data 360) 中執行的連接器。中繼資料模型會瞭解如何連線至遠端服務以驗證要求、建模傳回的資料、建立查詢、瀏覽結果,以及接收事件 (觸發) 以自動化流程。
針對未使用 HTTP 型 API 的系統,Salesforce 提供數百個預先建置的連接器和完整的 SDK 以建立自訂連接器。針對沒有任何 API 存取權的系統,Salesforce 提供「機器人流程自動化」(RPA),此機器人流程自動化會使用工作人員自動化通常由人類執行的重複的以規則為基礎工作。這些工作可能包括資料輸入、交易處理,以及回應簡單的客戶服務查詢。Salesforce 提供「智慧文件處理」(IDP) 以利用 AI 來自動從各種文件類型 (例如發票、契約和表單) 提取、分類和處理資料。無論資訊為何,Salesforce 都會提供一種自動化方式,以便在該資訊中取得和操作資訊。
隨著 AI 的最近進步,Salesforce 提供建構區塊,可在組織中快速啟用工作人員功能:
- **模型內容通訊協定 (MCP) 連接器**可讓組織快速將其 API 顯示為 MCP 工具,並讓工作人員輕鬆使用 API 和資源的探索。
- **工作人員對工作人員 (A2A) 連接器**可讓組織透過為工作人員提供 A2A 通訊協定支援來標準化工作人員對工作人員的通訊。每個工作人員 (網域中的功能專家) 都可以探索客戶的查詢,並將其委派給最適合網域的工作人員。
- **推斷連接器**透過提供 LLM 呼叫、向量內嵌和搜尋、RAG 尋找和 MCP 工具支援,提供建構區塊來從頭開始建立工作人員。
### 15.4 API 管理
MuleSoft 的 API 管理透過 Anypoint API Manager 提供全方位平台,可在任何部署環境中設計、保護、管理、監視和調整 API 和微型服務。無論平台為何,組織都可以使用一致的企業級控制項和洞察,從單一玻璃窗格管理其 API 和微型服務,並透過從部署到版本化進行的集中管理。重要功能包括:
- **Anypoint Flex Gateway** 是應用程式層 API 門戶,可管理和保護 API,在 HTTP/S 層級套用比率限制、快取、驗證、授權、威脅防護、監視和記錄的原則。這是一個輕量型、高效能、以「傳送者」為基礎的門戶,針對以微型服務為基礎的分散式環境設計,並建構以順暢整合 DevOps 和 CI/CD 工作流程,同時在任何環境中提供企業安全性和管理性,同時支援輸入與輸出原則。
- **API 警示**可讓組織為其 API 定義和監視特定的值或條件,以偵測異常或不需要的行為。範例包括當回應時間超過限制 (例如 60 秒)、時間範圍中要求數量過高、傳回某些 HTTP 回應碼,或發生原則違規時的警示。
- **API Analytics** 可讓您瞭解 API 如何使用,以及其執行的效能。Analytics 顯示面板可讓組織追蹤和檢視概況度量、逐層細分至圖表、建立和自訂顯示面板和報告,以瞭解使用趨勢、原則違規、回應時間、要求/回應代碼等。
### 15.5 下一代整合開發環境
MuleSoft Anypoint Code Builder (ACB) 是我們新一代的 IDE,專為 API 和整合開發而設計,提供現代化的統一體驗,並使用 VS Code 作為後端。
- **統一開發環境:**將整個 API 和整合開發流程合併到一個工具中,支援非同步 API、OAS 和 RAML API、管治規則集、低程式碼流程畫布、預先建置連接器,以及整合的測試和部署選項。此外,ACB 透過智慧型內容相關建議支援除錯、疑難排解和持續維護。
- **工作人員開發經驗:**在整個應用程式開發生命週期中提供工作人員體驗。核心是 MuleSoft MCP Server,可啟用工作人員整合開發。MuleSoft MCP Server 提供強大的工具,可從自然語言產生 API 規格和整合、建立資料轉換、管理 MuleSoft Exchange 中的資產,以及管理應用程式和 API 原則。MuleSoft MCP Server 工具可讓使用者在任何以 VS 程式碼為基礎的 AI 程式碼編輯器 (包括游標、Windsurf 等) 中進行 API 規格和整合開發。
- **AI 整合:**MuleSoft 使用 MuleSoft 主題中心來增強整合開發,其可將 API 呼叫轉換為 Agentforce 動作以供企業系統存取。Agentforce 連接器會將自然語言自動化內嵌在整合中。「推斷連接器」可安全整合外部 LLM 提供者,在 MuleSoft 應用程式中啟用 AI 驅動的邏輯。組織可以使用這些組合的功能來建立智慧型、適應式的整合。
### 15.6 執行階段平台
MuleSoft 的「執行階段平台」提供跨環境執行 MuleSoft 應用程式、API 和整合的彈性部署選項。組織可以選擇最符合其營運、合規性和延展性需求的執行階段模型,同時透過 Anypoint Platform 維持一致的管理與管治。此彈性可確保應用程式可靠近資料來源執行、遵循區域法規,並根據需求順暢調整規模。
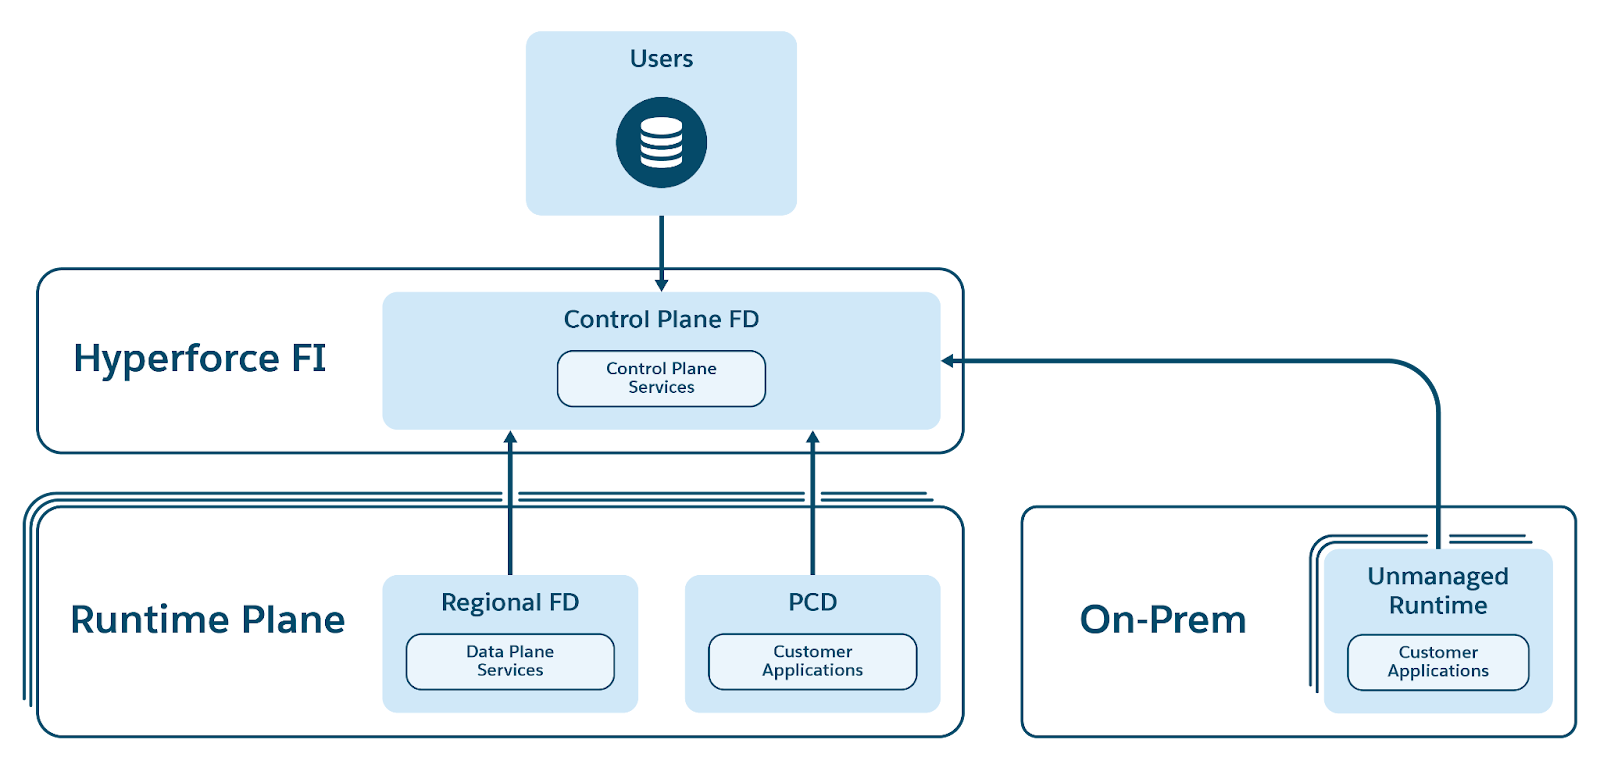 重要主控選項包括:
- **雲端:**MuleSoft 的完整受管理多租戶整合平台即服務 (iPaaS),可減少基礎結構管理的負擔。CloudHub 2.0 提供彈性調整、高可用性和零停機部署/升級,以及內建的可觀性需求和合規性認證。開發人員可以專注於建立 API 和整合,而 MuleSoft 可管理執行階段基礎結構,確保企業級安全性、可靠性和高可用性。
- **混合:**針對需要自行主控應用程式以獲得更多控制的組織,MuleSoft 提供「執行階段布料」,此容器服務可在 Kubernetes 或虛擬電腦之間自動部署和協調 MuleSoft 執行階段。其支援水平調整、零停機部署、內建安全性控制項,以及簡化的叢集管理。
- **Private Cloud Edition (PCE):**MuleSoft 的私人雲端版本提供完全自我管理的內部部署版 Anypoint Platform (包括「控制」和「執行階段計畫」),讓組織能夠符合嚴格的法規、資料落地與安全性需求。這可讓大型企業維持基礎結構的完整控制權,同時仍能受益於 Anypoint Platform 的統一整合和 API 管理功能。
### 15.7 可觀察性
MuleSoft 提供全方位可觀察性解決方案,可提供任何部署模型之間 API、整合和應用程式的端對端可視性。無論工作量執行的位置為何,可觀察性功能都是一致的,提供環境的統一檢視。MuleSoft 藉由即時和歷程記錄的遠端測量資料,讓組織能夠在整個應用程式網路中更快速地偵測、分析和解決生產問題。可觀察性資料可在 Anypoint Platform 內原生檢視,也可以透過 OpenTelemetry 匯出至客戶偏好的 APM,以允許與現有監視生態系統順暢整合。這可讓組織主動強化基礎結構彈性,並改善關鍵任務應用程式的可靠性。
MuleSoft 透過兩個主要供應項目提供可觀察性:
- **Anypoint Monitoring** 是內建於 Anypoint Platform 中的目前市內可觀察性解決方案。其提供立即可用的可自訂顯示面板,用於監視應用程式健康狀況、記錄管理的進階記錄搜尋,以及在發生定義值或異常時通知小組的警示功能。
- **Integration Intelligence** 是針對 MuleSoft 重新設計並在 Salesforce Platform 上原生建立的新一代 AI 優先的可觀察性平台。此產品使用 Data 360 作為遠程測量資料的統一資料層、Tableau Semantics 作為可信任的語意層,以啟用智慧且可運作的洞察、Tableau Concierge 以達成 AI 輔助的疑難排解,以及 Tableau Next Dashboards 來提供互動式的視覺化介面,將多個豐富的資料視覺效果整合到單一的凝聚式檢視中。Tableau Next 也可讓客戶在含有可觀察性功能的語意資料模型之上建立自訂顯示面板。
此堆疊也會強化以工作人員為中心的追蹤,讓客戶能完全透明地瞭解非決定性的端對端工作人員叫用路徑,讓他們可以觀察工作人員在每個中間步驟中工作的狀況,讓使用者能更快找到失敗的根本原因,並找出任何效能瓶頸。
## 16\.生態系統與 AppExchange
Salesforce 生態系統範例為平台的強大功能。「系統整合者」(SI) 和諮詢合作夥伴透過開發、設定和最佳化複雜的 Salesforce 解決方案來支援客戶。獨立軟體廠商 (ISV) 會在平台上建立創新應用程式和解決方案,然後客戶可以將其安裝到其 Salesforce 組織中。這些 ISV 應用程式可在 Salesforce 於 2006 年啟動的應用程式商店 AppExchange 上使用,截至 2025 年 10 月,此商店已擁有超過 10,000 個應用程式,已安裝了超過 14.3 百萬個應用程式。
為了協助客戶瀏覽廣泛的市場並探索相關應用程式,AppExchange 搜尋體驗已在 2025 年重新架構,以利用 Data 360。Salesforce Data 360 的向量搜尋功能與傳統關鍵字比對一起運作,透過瞭解使用者的意圖,從語意上提供更相關的結果。最終願景是將此基礎與 Agentforce 平台整合,以實現完全具代理性的「詢問任何項目」介面,讓客戶能夠以對話方式描述其業務挑戰,以接收高度個人化的解決方案建議。
AppExchange 透過涉及程式碼分析器、安全性掃描器和參考實作指南的嚴格審查流程來確保高品質的解決方案,這些都與 Salesforce 密切合作。此平台也為 ISV 提供授權管理工具,以量身打造應用程式授權和獲利,並支援各種定價模型,包括以使用者為基礎和以耗用量為基礎的選項。
「中繼資料驅動的平台」原則可讓 ISV 擴充 Salesforce 的原生應用程式和中繼資料,進而簡化資料模型、業務邏輯和使用者介面的開發。Salesforce Platform 支援各式各樣的解決方案,從產業特定的應用程式到使用如 Lightning Web Components for UI 和 Apex Code for business logic 等技術的高度自訂品牌應用程式。
「封裝」的概念對於在各種 Salesforce 組織之間散佈這些應用程式而言至關重要。封裝涉及將中繼資料序列化為可由任何 Salesforce 客戶安裝的成品,其使用針對跨各種環境的中繼資料管理所設計的基礎技術。封裝的獨特層面是允許在開發人員不知道的環境中進行安裝。
為了增強控制和安全性,封裝內的「管理性」功能可讓 ISV 安全升級應用程式的部分,因為其他人無法依賴這些部分,同時允許客戶擁有和管理其他部分。例如,ISV 可以將某些中繼資料 (例如自訂設定) 設定為「受管理」,讓客戶無法看見並無法編輯,進而避免客戶環境中斷。受管理封裝包含這些可管理性控制項,而未受管理封裝會將已部署的中繼資料視為客戶建立,且無法在部署後升級。
自 AppExchange 和 Salesforce Platform 成立以來,建立和安裝封裝的數量和複雜度都大幅增加。為滿足這些需求,平台在 2020 年推出第二代封裝結構。此新結構增強受管理封裝的模組性、改善版本化彈性、允許命名空間共用,並支援陳述性相依性,包括軟體開發生命週期中的其他進階項目。封裝部署結構也有數個明顯的增強功能,以提高效率和規模,例如決定哪些中繼資料已變更,以及僅部署差異值。
新產品與功能的開發的重要度量,就是其與封裝的相容性和準備好使用 ISV。平台強調其功能可供合作夥伴快速使用,讓 Salesforce 生態系統有效利用 Salesforce Platform 的創新潛力,並超越 Salesforce 的立即可用產品。不過,這是一個持續投資的領域,以確保 Salesforce 內部開發人員可以使用本文件中描述的所有功能,而 ISV 開發人員也可以使用。
此外,Heroku Marketplace 和 Slack Marketplace 提供各種協力廠商整合和附加元件,可增強 Salesforce 應用程式的功能。Heroku Marketplace 提供其他應用程式功能的工具和服務,以及改善開發人員建立、部署和管理應用程式的方式。Slack Marketplace 提供整合,可簡化工作流程並改善 Salesforce 環境內的協同合作。
## 17\.Salesforce 上的 Salesforce
根據核心價值「客戶成功」的精神,Salesforce 會在 Salesforce Platform 上作為所有應用程式和服務的「客戶零件」,盡可能在內部利用面向客戶的產品。這可提供明顯優點:
- **嚴格的產品測試**:透過每日使用產品套件,Salesforce 員工可讓平台面對真實的挑戰,增強產品品質並識別改善的區域。
- **精密產品**:內部使用的立即回饋意見可快速精簡功能和可用性,以及快速識別和解決任何錯誤,進而在發行時更符合客戶需求的產品。
- **深度產業專長**:各種功能的內部使用可讓 Salesforce 深入瞭解特定產品和產業的挑戰,特別是在高科技產業中。
- **增強的客戶同理心**:使用平台的直接體驗可讓員工進一步瞭解並處理客戶的難題。
- **行銷和銷售洞察**:每日產品用量會告知銷售和行銷策略,協助量身打造平台以滿足客戶的需求。
- **更強大的行銷策略**:成功的內部實作可讓 Salesforce 自信地將套件作為經過驗證的解決方案進行行銷。
此外,所有用於生產的軟體更新一開始會部署至專屬的「Salesforce on Salesforce」Hyperforce 例項,作為暫存部署流程的一部分。自 2020 年 8 月起,此例項已成功主控 Salesforce 的工程小組組織 GUS,以及 Salesforce 的 CRM 作業,以展示 Hyperforce 對於任何客戶的穩健性和整備性。此策略可讓內部小組在對外部客戶進行生產部署之前,先測試並顯示任何問題。
Salesforce Technology 組織已完全採用 Agentforce 作為在整個 SDLC 中提升生產力與品質的內部平台。這不僅允許我們透過及早偵測和減輕程式錯誤來改善傳送給客戶的程式碼品質,也讓我們能夠根據一手內部回饋意見快速重複處理工作人員體驗。
## 18\.大規模提供轉換
自從 Salesforce 於 1999 年成立以來,Salesforce 經歷了多個技術轉型。不過,涉及 Salesforce Platform 的轉換特別重要,因為其規模和實作變更的速度快速。此轉換需要所有主要結構元件的同時演進,才能達成整合的平台。為了確保此轉換會反覆進行,並對利害關係人和創新者造成最小干擾,Salesforce Technology 組織也必須發展其工程和產品交付作法。
Salesforce Technology 組織是一個大型且多元化的團隊,由位於 14 個不同國家/地區超過 20 個地點的 2500 個團隊組成。此群組大規模運作,每週提供超過 200 個產品版本,並實作 250,000 個系統變更。根據更廣泛的公司精神,Technology 群組以五個核心價值觀為導向:Trust、客戶成功、創新、平等與永續性。這些值是塑造群組策略、引導其執行,以及影響每日決策的一部分。
Salesforce Engineering 360 架構遵循核心價值,為工程小組提供動作導向的顯示面板和對其作業的全方位洞察,為組織內的標準和最佳作法設定明確的期望。此整體檢視涵蓋各種關鍵領域,包括可用性、安全性、合規性、品質、無障礙性、Developer Productivity、敏捷產品開發和成本效率。為了提供這些洞察,架構會處理來自數百個內部工程系統 (例如安全性系統、生產健康記錄、程式碼存放庫、開發環境、CI/CD 和發行/工作規劃和追蹤系統) 的數十億筆記錄,這些都以 Salesforce Platform 為基礎,並使用 Agentforce、Data 360、Tableau 和 Slack 的最新創新。
Salesforce Technology 組織根據此和其他資料,利用 AI 和代理技術來加速生產力。我們每日有超過 10,000 位內部 AI 工具的啟用使用者,並已建立超過 100 個 AI 工作人員作為內部 AgentExchange 計畫的一部分,進一步促進整個組織的生產力改善。
由於我們的首要 Trust 價值,因此服務擁有權深深植根於我們的工程文化中。每個服務和產品的設計不僅符合,而且超出與可用性和事件管理度量 (例如偵測時間 (TTD) 和還原時間 (TTR) 相關的「服務層級目標」(SLO)。我們對變更管理、發行整備和問題管理的方法遵循高標準。安全性已整合至「安全開發生命週期」的每個階段,並遵循安全依預設原則。透過「敏捷測試方法」來排定品質與效能的優先順序,其中包含 CI/CD 管道內數百萬個自動測試的單元、功能、整合和負載/規模測試。
在結構上,我們專注於開發共用功能以增強杠杆率和效率,進而改善品質。例如,我們已在 Hyperforce 中開發受管理服務,以滿足如運算和資料管理等多樣化的需求,讓產品小組專注於產品創新,而中央小組在安全性、可用性和成本效益方面增強這些服務。
我們的作業具有敏捷性,可促進向客戶提供創新。超過 3000 個小組的每個小組都可以使用 Scrum 或看板來實作敏捷架構。整個組織的產品開發規劃會以各種時間表結構化,包括策略方向的 3 年長期計畫,後面是年度執行計畫,進一步細分為 4 個月的產品發行計畫,這些計畫會告知每兩週的衝刺計畫。透過多個版本車輛部署產品、功能和錯誤修正,以滿足各種客戶需求,包括三個主要年度版本、雙週版本和每日版本。
由於規模,因此生產力十分重要。我們利用 SPACE 架構有效度量測生產力,並得到 Engineering 360 系統提供的全方位度量集支援。我們也專注於改善內部開發人員的工具和體驗,以簡化開發生命週期,投資於代理體驗和 AI、工作流程、建立工具、開發設定、更安全的發行和安全性服務可帶來顯著好處。
## 19\.結論
總之,Salesforce Platform 在過去五年內經歷了驚人的轉型,從領先的多重租戶雲端平台發展為受信任、整合、代理和資料支援的平台,其可在所選區域中提供一組應用程式和服務。此演變是由應對新興挑戰的需求所驅動,例如公用雲端提供者的崛起、法規需求的增加,以及生成式 AI 和機器學習的進步。
引入 Hyperforce、Data 360 和 Agentforce 可大幅增強平台的功能,確保平台在保持 Trust 與可靠性時仍處於創新前沿。大多數客戶成功移轉至此新平台,強調了我們工程師的創造力與專心。
隨著我們持續創新並適應不斷變化的市場需求,Salesforce Platform 適合支援新一代應用程式和客戶使用個案,重申我們對客戶成功與卓越技術的承諾。
## 簡介
此文件提供一種概觀,描述企業在未來 3-5 年內需要的 IT 架構,才能充分掌握工作人員的價值;其中概述支援大規模部署 AI 工作人員所需的 IT 轉型。目標是提供策略指引和參考結構,以協助 CIO、CDO 和 IT 主管計畫其成為工作人員企業的旅程。
強大的 AI 模型可建立工作人員人力,能夠感知環境、推理資料、進行自主決策、執行工作,以及與人類工作人員有效協同合作。此新人力在創新、生產力和靈活性方面承諾會逐步改變,為專案關係人和客戶創造價值。若要實現此願景,組織必須經歷業務和 IT 轉型,才能成為「代理企業」。
## 工作人員企業的業務能力
今天,傳統企業面臨的營運效率低落是由於資訊孤立區、員工埋在手動工作中、組織結構中的激勵不一致,以及策略與成果之間的反饋意見迴圈。這些問題會導致客戶體驗未最佳化、流程效率低下,以及缺少成長機會。
Agentic Enterprise 透過將智慧 AI 工作人員的數位人力與人力工作人員整合,以克服這些限制。透過此新的 AI 增強型人力,組織可以透過數種新業務功能來促進創新以促進成長、促進傑出營運,並建立企業彈性。
**促進創新的新業務能力:**
- 增強的人工生產力:AI 工作人員的速度、規模和隨時可用性可讓企業自動化重複工作,並讓人類工作人員專注於更有價值且更有創意的工作。
- 適應性能力改善:由於可以觀察 AI 工作人員的邏輯,因此他們可以動態學習並部署新技能,讓企業能夠持續改善績效以達成業務目標,並快速適應新的市場機會。
_動作範例 — 在金融服務中創新客戶體驗:_財富管理公司可以使用 AI 工作人員重新建立其用戶參與模式。工作人員會自主監視產品組合、識別用戶檢閱的關鍵時刻,並為顧問準備通話前計畫,並在出現新聞時調整計畫。這可讓人類顧問大規模提供主動且個人化的客戶體驗,強化關係並發現新機會。
**保護及確保組織彈性的新業務功能:**
- 彈性人力容量:企業可以快速擴大其滿足因變更的業務條件而導致工作量激增的能力,而不需要增加完全人力勞動力的成本和延遲。
- 預測作業彈性:AI 工作人員的 24/7 性質使其能夠自動即時預測、建模和降低營運、合規性和安全性風險,確保企業維持客戶和利害關係人的Trust。
_動作中的範例 — 保護客戶資料:_大型企業可以部署 AI 資料管理工作人員來掃描法規環境以瞭解資料隱私權法規的變更、在企業資料集中探索和分類敏感資訊,然後套用適當的管治原則。工作人員可以檢閱資料存取要求,並將例外情況路由至人工分析師以供檢閱,進而降低合規性風險,同時允許以信任的方式使用資料。
**最佳化卓越營運的新業務功能:**
- 自動流程執行:數位人力可以以機器速度全天候執行複雜的多步驟工作 (以人為本),有效率地降低成本並調整流程規模。
- 跨界協調流程:AI 工作人員可以跨越通常限制人力工作人員的資訊和獎勵孤立區,進而促進跨部門流程的靈活性。
_動作範例 — 最佳化零售行銷漏斗圖:_零售行銷小組可以部署 AI 工作人員,以加速其行銷活動流程,以回應新的消費者趨勢。工作人員可以產生行銷計畫、與行銷、產品和銷售小組協同合作以供檢閱,然後自動建立數位附屬資料並跨多個管道執行,根據即時回饋意見動態調整行銷活動。
## 工作人員企業的 IT 結構
### 傳統 IT 結構的限制
企業的 IT 結構可使用圖層建構來描述。圖層會邏輯地將相關技術功能分組,並促進結構化推理,但不一定意味著特定實作或圖層應以單一或更異質的方式設計的程度。在此圖層檢視 (圖 1) 中,傳統 IT 結構包含五個主要圖層:基礎結構、資料、整合、應用程式和體驗。「安全性」與「IT 作業」兩個跨層可跨這些層,以確保監管、監視和保護。
傳統的 IT 結構是針對企業智慧所屬的範例所設計,其中人類工作人員在應用程式中採取行動來存取資料、套用業務邏輯、促進協同合作和執行工作流程。這並非針對 AI 工作人員可以針對先前由人類完成 (或完全未完成) 的特定使用個案進行推理和採取動作的範例所設計,同時人類會監督 AI 工作人員並專注於更具創意和不明確的工作。
 雖然傳統結構目前可能支援 AI 工作人員的子規模部署,但無法完全提供上述「代理企業」的業務功能。實現這些功能需要針對廣泛部署強大的 AI 工作人員而設計的 IT 結構,其可處理廣泛的使用個案,而非僅限於鎖定窄使用個案的有限部署。
AI 工作人員將在未來 5 年內持續改善,且 IT 結構必須演進,才能實現更強大且智慧 AI 工作人員的價值,才能成為未來的證明。首先,工作人員會隨著基本 AI 模型 (例如多重模式 LLM) 和工作人員的認知結構發展 (例如多步驟規劃、工作分解等) 變得更有智慧。其次,AI 工作人員會透過改善的記憶體、自我反射功能,以及從回饋意見學習的能力,來改善學習和適應能力。第三,AI 工作人員將能夠更有效地與其他工作人員、工具和資料互動,如開放技術標準的快速發展生態系統所示 (例如「模型內容通訊協定」、「Agent2Agent」等)。雖然這三種技術趨勢能夠讓 AI 工作人員在執行更抽象且複雜的工作時變得更強大,但也會對今天的 IT 結構帶來許多挑戰。
首先,AI 工作人員基本上依賴 AI 模型 (由內部開發與外部取得),這些模型會快速演進,且需要複雜、共用且標準化的 AI/ML 模型管理。今天,AI 模型會針對應用程式中的特定使用個案開啟,而非作為可重複使用的共用功能,並使用常見的訓練、部署、管治和風險管理工具。在未來,企業將需要能夠針對各種代理程式使用個案使用不同的 AI 模型,這些個案需要工具,讓工作人員能夠根據業務內容交換基礎模型 (例如基礎模型與網域特定的較小型模型)。這需要使用統一的生命週期工具來管理內部開發或主控的 AI 模型,以確保一致性、可重複使用性、可調整性和效率。同樣地,存取外部主控的 AI 模型需要企業範圍控制架構,以確保最佳效能、安全性、合規性、可用性和可靠性。
其次,AI 工作人員具有不同的調整模式和作業需求,例如主控、開發、推理、學習、記憶體管理和作業,這需要工作人員的個別和專屬架構邊界。將此功能直接內嵌在今天的靜態與決定性應用程式結構中,會導致不必要的結構複雜性和風險。此外,AI 工作人員應透過標準化介面或傳訊系統與現有應用程式互動,以進行即時互動。
第三,AI 工作人員必須能夠考慮不同的資料集,並彼此協同合作,通常在隔離的應用程式堆疊之間進行合作,但在今天的結構中,沒有通用的語意功能可讓這些工作人員共用瞭解以考慮不同的資料集。因此,雖然單一用途工作人員可以成功部署,但將工作人員調整為對複雜的跨坐落機工作進行大量作業仍會很困難且有風險。
最後,目前的企業 IT 結構缺乏協調、最佳化和管理端對端業務流程的有效方式,其中包含由更強大的工作人員執行的動態工作流程,這將增強,在某些情況下會取代人類在該流程中扮演的角色。今天,利用自動化工具來管理線性決定性工作流程,這些工作流程通常遵循預先定義的順序,以流程特定的語言記錄,並依賴不常變更的靜態邏輯。AI 技術可以增強某些線性流程 (例如,使用 ML 模型而非硬式編碼業務規則來計算貸款批准值),但大多數關鍵業務流程的策略與執行層面仍會保持動態且彈性的本質。如開發行銷策略、解決複雜的客戶問題或潛在客戶等工作具有明確的目標 (客戶滿意度、個案解決速度等),但不遵循固定的預先定義執行順序。
目前,傳統企業主要依賴人類來協調和執行這些複雜的業務流程 (例如設定策略和管理複雜的計畫)。隨著 AI 工作人員在未來 3-5 年內持續發展 (更高的智慧、學習和互動能力),其自主執行此類動態流程的能力將大幅擴大,導致複雜性和整合挑戰遠超出現有整合和自動化工具的功能。AI 工作人員的適應性和動態性質,強烈需要新的協調流程功能,以確保企業層級控制、全方位可見度,並與企業範圍策略目標一致一致,特別是在管理包含 AI 工作人員、人類、自動化工具和其他決定性系統的複雜、長時間且多步驟的工作流程方面。
「代理企業」的 IT 結構透過流暢整合人力工作人員、AI 工作人員和決定性系統,為智慧動作建立平台。此架構可讓人體和 AI 工作人員能夠動態存取並利用來自多元資料來源的統一企業 Knowledge,並以語意內容豐富,以有效執行與策略業務目標一致的複雜工作流程和流程。一組隔離平台和點數解決方案的現有 IT 架構將演進為一組可編輯應用程式服務、語意和資料工具,以及由新智慧型業務流程協調流程工具監督和管理的 AI 工作人員網路。
此結構可讓工作人員在其個別範圍內感知、推理和採取行動、在業務領域內部和跨領域工作,並持續學習、改善和調整。這需要專注於可靠機制的設計,以存取資料和 Knowledge (語意理解)、彈性且標準化的通訊通訊通訊通訊協定和介面 (例如工作人員對工作人員、工作人員對決定性系統,以及工作人員對人類),以及批判性地協調工作人員、人類、自動化工具和決定性系統之間的工作流程和流程。
### 結構原則
為了實現智慧動作平台的結構願景,建議使用下列設計原則作為最佳作法:
- **複合性和模組性:**使用標準化介面將結構元素設計為模組化元件,以快速且動態地組合工作人員功能、工作流程和人力面向的面板。排定清楚的介面契約和抽象的優先順序,讓 AI 工作人員能有最大的彈性撰寫工作流程。
- **資料和語意優先:**透過共用語意瞭解,以確保資料的完整、準確、快速、安全且符合成本效益的存取權,讓工作人員能夠有效地在隔離系統之間思考。這需要將資料 (和中繼資料) 視為產品,並使用工具來確保品質、歷程、管治和存取,以及提供跨工作人員和人類共用的語意瞭解。
- **內嵌的 IT 與業務觀察性:**在整個結構內嵌端對端監視、追蹤、評估和可解釋性功能,以深入瞭解工作人員的推理、行為、系統互動,以及對業務 KPI 的影響,以便持續最佳化工作人員的績效。這包括成本最佳化 (FinOps)、永續性度量和營運距離測量,同時維持 Trust、合規性和負責任的資源消耗。由於 AI 工作人員本身並非決定性,因此可觀察性對於確保 AI 工作人員能夠以人力監督的信任、合規和可稽核方式運作至關重要。
- ** Trust 整體:**根據工作人員工作的意圖 (資料存取、動作等) 強制執行動態細微權限,並實作包括紅色團隊、自動 CVE 掃描、漏洞偵測和風險型驗證控制的全方位安全性作法。由於工作人員能夠以機器速度作業,因此造成階層化風險,因此需要更精確且動態的控制。確保所有 AI 產生的輸出 (來自工作人員或模型) 會在使用或傳送前根據已定義的合規性、安全性、毒性和偏差原則進行嚴格驗證,需要記錄和可解釋性機制,並具有 AI 決策、動作、內容和預估的可驗證稽核追蹤。
- **人力監督工作人員優先:**讓 AI 工作人員成為解決業務使用個案的預設工具,以排除其他考量事項 (例如成本、技術適配),並設計可供代理程式工作流程存取的 IT 系統。這包括人類監視、介入和覆寫工作人員流程任何步驟的能力。如果工作人員對決策的信賴低於預先程式設計的值,則工作人員需要自我反射功能才能主動尋求人力指引。
- **反應性與多模式互動:**啟用結構以支援所有互動類型之間的全方位工作人員叫用和回應機制,包括工作人員對工作人員通訊協定、人類多型模式輸入 (語音、文字、視覺)、業務事件、系統訊號和串流資料。啟用以事件為導向與即時處理功能,以確保工作人員可以從任何來源或格式回應任何及時訊號。
- **AI 整備基礎結構:**確保基礎結構可以使用內建冗餘來彈性調整,以處理波動式 AI 工作負載,並將 ML/LLM 銷售管道整合至資料與應用程式結構,同時維持資料落地需求的合規性。
- **開放生態系統:**優先使用開放標準、通訊協定和正確定義的介面 (API、事件),以利用技術生態系統來優先處理互通性並避免技術鎖定。
## 結構層級
若要成功啟用及擴大工作人員轉換,企業必須超出僅限增強目前層級的範圍;企業必須考慮明確引進四個額外的結構層級 (圖 2) 專為滿足 AI 工作人員需求而設計。
**工作人員層**專門開發和管理 AI 工作人員,其中包含如規劃、推理、記憶、工具利用率、狀態管理和生命週期控制等認知功能。此層可滿足 AI 工作人員的獨特技術與作業需求、透過標準化通訊協定確保跨應用程式和資料存放區的互通性,並促進工作人員對工作人員協同合作。現有的應用程式層將演進為應用程式服務,並為工作人員工作流程動態撰寫。
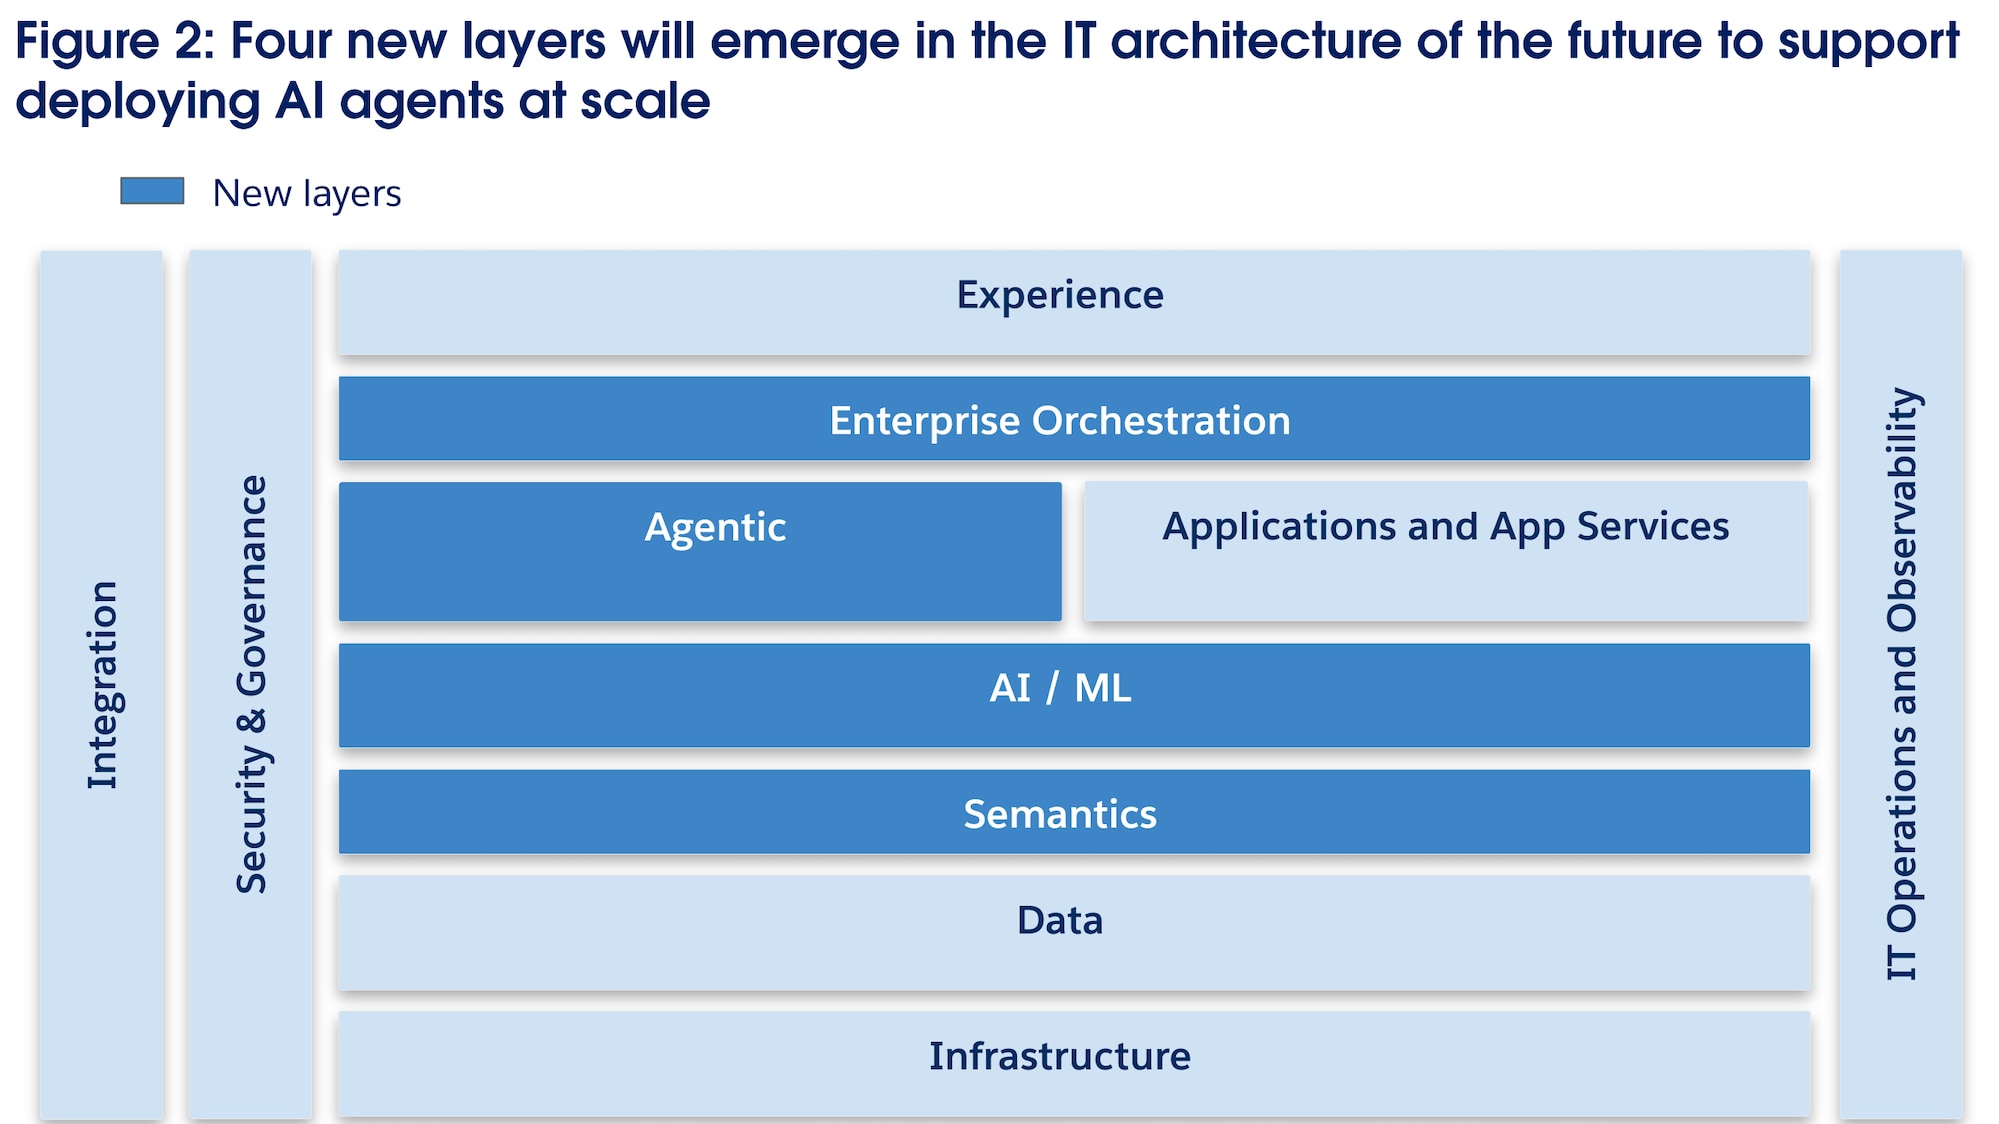 導入了「**語意層級」,**以解決原始企業資料與 AI 工作人員所需語意瞭解之間的中斷。它會明確編碼和管理業務實體、概念、定義和相互關係,建立企業本質和表示業務 Knowledge,以啟用共用的語意瞭解,以支援執行更高層級工作的更複雜多工作人員工作流程。除了資料目錄之外,「語意層」會將自然語言查詢轉換為針對特定資料存放區精確的查詢、協調結果,並為工作人員傳回內容更豐富的回答。與此同時,現有的「資料層」會透過採用集中化湖舍來統一,同時透過 AI 整備的資料架構來擴大資料存取權,以支援資料網格作業模型原則。
**AI/ML 層級**集中管理企業 AI 功能,包括大型語言模型、大型動作模型和網域特定的 ML 模型,同時處理在整個生命週期內開發的 AI 模型,以及對外部 AI 服務的控制存取/使用。不同於傳統結構,其中 AI 模型內嵌在應用程式內,此層會將 AI 模型建立為企業中的一流元件和共用服務。其著重於企業控制的 AI 功能 (非外部廠商提供的 AI 功能)。此層提供企業中各種工作人員和其他 AI 工作量的情報,並使用標準化 Trust、安全性、合規性和部署機制。
**企業協調流程層**是功能性抽象,用於協調、管理和最佳化跨越 AI 工作人員、人類、自動化工具和決定性系統的複雜、多步驟工作流程和業務流程。此層利用混合協調流程模型,讓個別工作人員和系統使用如 MCP 和 A2A 等開放通訊協定,自行處理本機編譯的工作,同時提供整個流程的集中端對端監督和協調。為了實作混合協調流程模型,此層以機器可讀取的語意豐富格式呈現關鍵業務流程,這些流程會定義業務流程的決定性步驟 (在設計時間內建模) 和動態步驟 (由工作人員在執行階段內決定),進而為管理和最佳化建立流程模型基礎。
傳統上,以機器可讀取的形式,人力驅動業務流程的大部分仍保持不記錄或無法存取。然而,AI 工作人員活動的詳細可觀察性,包括其工作和動作的豐富資料和中繼資料,可讓您將動態、先前非結構化工作與決定性線性工作流程整合,以建立全方位的流程模型。詳細的流程文件會捕捉先前看不到的工作相互依存性和執行路徑,讓企業能夠持續最佳化營運效率、有效解決瓶頸,並系統將工作人員識別的最佳作法編碼為可重複使用的企業範圍手冊。這會產生個別流程的整體數位雙子,並在調整規模時產生整個企業。
例如,複雜的流程 (例如執行全方位銷售策略或上線新員工) 涉及許多相互依存的步驟,其中協調流程層可以確保適當的人力參與層級 (例如例外處理)、 AI 工作人員的受限自主性,以及強制遵循。在這些流程中,由上到下協調流程層可增加可預測性和管治性、持續追蹤和評估主要績效指標 (KPI)、確保工作流程和回復邏輯的交易完整性,並維持工作流程每個階段的可視性,以確保與整體業務目標保持一致。為了實作此功能,此層會從安全性和管治層 (透過原則代碼) 和儲存在「語意層」中的業務目標和 KPI 中取用原則、規則和護欄。考慮到 AI 驅動互動的獨立性和快速性質,僅依賴去中心化編程會造成策略不一致或違規的風險,特別是在長時間執行多步驟工作流程中。混合協調流程方法透過將企業範圍業務規則、合規性檢查和原則強制執行直接內嵌在複雜工作流程中,以減輕這些風險,並將人力監督整合至關重要連接點。
這些 11 個層的每個都會以安全、信任且有效的方式,為大規模部署 AI 工作人員提供特定功能,以釋放代理 AI 的完整潛力,以轉變工作在企業中的完成方式。下一節概述圖層的功能、由於 AI 工作人員崛起而產生的新變更,以及其關鍵技術功能。
### 體驗層級
**函數:**「體驗層」可作為人體使用者的主要介面,藉此在多個裝置之間捕獲輸入 (文字、語音、視覺) 並提供內容相關的回應,以啟用多模式互動。它會將使用者意圖順暢地傳送至「工作人員層」以採取行動,同時提供動態 UI 和視覺效果,以便在工作人員工作流程中進行人類升級和批准。
**與今天有何不同:**AI 會使用自然語言處理、內容感知和主動式決策支援來增強以 GUI 為基礎的傳統介面。AI 工作人員能夠主動起始互動,在所有管道和強制回應之間提供個人化即時的建議。
**關鍵技術功能:**
- **對話式 AI 與數位助理:**依預設啟用 UX 來功能 AI 協助以支援人類使用者。
- **屬性與透明度 UI:**讓回應可在使用者介面中解釋,例如顯示引號、檔案/系統的來源,以及決策的方法/理由。
- **主動與環境通知服務:**讓工作人員能夠根據使用者的目前內容,在最適當的管道和尺寸規格上主動向使用者推送洞察或警示。
- **Omnichannel 體驗:**透過旅程連續性,為所有管道提供流暢、一致且統一的體驗,其中對話與工作會跟隨人員,而非應用程式。
- **多重強制回應功能:**允許人類透過文字、語音、影像、觸控、視訊和 AR/VR 與工作人員和應用程式互動,讓工作人員以最有效率的方式瞭解和呈現資訊。
- **內容感知個人化與動態使用者介面:**啟用上下文感知的即時 (時間、位置、使用者動作) 使用者體驗,以啟用個人化,包括立即產生 UI。
### 工作人員層級
**函數:**「工作人員層」可作為在企業中執行工作的預設執行階段,其中 AI 工作人員可使用應用程式和應用程式服務層和資料層中的工具來動態組合工作流程,從體驗層中拆分工作並執行工作。AI 工作人員的組態狀態會儲存在此層中並受管理。系統會針對特定工作例項化工作人員,並在之後停用特定工作人員例項。此實作可讓工作人員一律根據離線最佳化從最新的組態狀態叫用 (使用 AI/ML、可觀察性和協調流程層的功能)。此層負責 AI 工作人員的全方位生命週期管理、協調和管治。
**與今天有何不同:**此層會出現今天目前不同的試用版集和有限的工作人員部署。雖然存在以規則為基礎的機器人,但很少有大規模部署的適應性、非決定性和目標導向軟體程式。
**關鍵技術功能:**
- **工作人員執行階段環境:**管理 AI 工作人員的生命週期、執行和資源配置。
- **工作人員週期管理套件:**包含開發架構、開發和測試工具,以及工作人員活動和版本控制的管理系統。
- **工作人員推理引擎:**認知架構,可讓工作人員拆分目標、規劃並決定要用於解決複雜問題的工具。
- **工作人員記憶體和內容存放區:**允許工作人員例項取回和維護先前互動的相關內容,以確保一致性和個人化。
- **工作人員互通性通訊協定:**工作人員對工作人員通訊 (A2A) 的標準化介面,以及工作人員與外部系統的介面 (例如透過模型內容通訊協定)。
- **工具登錄:**精密設計的一組內部和外部支援的工具,供工作人員叫用以完成特定工作。
- **工作人員登錄:**預先建置 AI 解決方案與工作人員的精密設計生態系統,支援探索和功能比對。
- **散佈的工作人員強制執行原則:**允許工作人員在採取動作前自行檢查合規性,以啟用企業範圍的管理。
- **工作人員自我反應與調整架構:**提供機制讓工作人員分析自己的績效,並在人類批准後觸發改善或對自己建議修改。
### AI/ML 圖層
**函數:**此層會作為集中式情報中心運作,提供 AI 模型作為「工作人員層」(和應用程式) 所要取用的共用服務集,以透過內建的安全架構和監視技術強化其推理和決策能力。
**與今天有何不同:**傳統上,AI 模型內嵌在特定應用程式中。在 Agenttic Enterprise 的 IT 架構中,AI/ML 圖層將是一流的集中式服務集,可支援許多應用程式和工作人員,支援從開發到大規模即時服務的整個模型生命週期。
**關鍵技術功能:**
- **預先建置基礎模型:**針對各種資料訓練的大型 ML 模型,能夠執行各種一般工作。
- **取得增強產生 (RAG):**以 AI 為中心的管道,此管道會在企業特有的資料中奠基基礎模型,以改善準確度並減少幻覺。
- **AI Trust、Safety & Governance Hub:**整合至模型生命週期的工具套件,以強制執行負責 AI 原則,例如偏差偵測、可解釋性和安全監視。
- **Model Gateway:**作為所有模型推斷要求單一進入點的路由引擎,可管理對各種內部和外部模型的呼叫,以最佳化成本、效能和合規性。
- **模型開發工作台:**資料科學家的整合開發環境,其中包含資料預先處理、模型訓練和試驗的工具。
- **MLO 與生命週期自動化銷售管道:**機器學習的 CI/CD 引擎,可自動化模型從訓練到部署和淘汰的端對端生命週期。
- **模型提供與推斷執行階段:**可調整且低延遲的環境,可將訓練的模型部署為安全的 API 端點,以供即時使用。
- **模型與資產登錄:**所有 AI/ML 資產 (包括模型、資料集和來源程式碼) 的集中版本控制儲存庫,可確保可複製性和稽核性。
- **合成資料產生與管理:**產生與管理合成資料的工具,可維持實際資料的統計內容,而無須顯示敏感資訊。
### 企業協調流程層級
**函數:**「企業協調流程層」是代理企業中端對端工作的控制平面。其可確保工作人員工作流程與互動遵循企業目標與管治原則。它會取用來自其他層的可觀察性遠距測量,以建立全方位的業務流程模型,以根據從「語意層」所繪製的 KPI 進行最佳化。此層會為重要工作流程的 AI 工作人員每個新例項提供共用內容和長時間執行記憶體。
**與今天有何不同:**此層可透過建立機器可讀的模型來統一對業務流程的可視性,這些模型會同時捕捉結構化決定性步驟,以及人類和工作人員執行的非結構化動態工作。它會透過程式設計方式將業務目標和規範規則編碼為限制,進而超越現今以人為本的協同合作與管治模型,進而控制工作人員。
**關鍵技術功能:**
- **混合式工作流程執行引擎:**執行「混合協調流程模型」的核心執行階段,提供集中監督,同時允許進行本機工作人員編程。
- **流程管理與限制引擎:**即時管理服務,會取用陳述性業務規則、原則和限制,並套用至所有機上流程。
- **共用記憶體與內容管理:**可供工作流程中所有執行動作的使用者存取的共用記憶體層,可維持多個步驟的連續性和一致性。
- **Process Modeling Studio:**設計時環境,用於建立和管理機器可讀取、語意豐富的流程模型,這些模型會定義決定性與動態、目標導向的步驟。
- **流程最佳化和模擬:**建構業務流程數位模擬以進行進階分析、What-if 模擬和預測最佳化的功能。
- **流程探索與健康監視:**針對流程運作狀況的業務度量來報告,此模型與即時資料。
- **數位雙流程建模:**即時工作流程的即時鏡像,用於測試、模擬變更和最佳化,而不會影響生產環境。
### 應用程式與應用程式服務層級
**函數:**此層會將現有的業務應用程式功能公開為可組合且模組化工具和服務,供工作人員使用。其也可作為簡報執行階段,以將工作人員功能內嵌在使用者體驗中。應用程式會繼續是記錄的系統,但會重新設計為工作人員的「無周邊」功能。
**與今天有何不同:**應用程式將從單一 UI 發展為「後端服務」,工作人員可以透過 API 和事件動態呼叫。此層會以原生方式與 AI 工作人員和模型整合,而代碼產生 LLM 的擴充將導致自訂工作人員建立的微型應用程式數目增加。
**關鍵技術功能:**
- **模組化應用程式服務:**從傳統應用程式中拆分的業務邏輯,發佈為機器可讀取的動作供工作人員呼叫。
- **工作人員內嵌 SDK:**可讓開發人員安全地將工作人員直接內嵌至應用程式 UI 的工具組與文件庫。
- **動態 UI 產生服務:**允許 AI 工作人員根據使用者內容即時產生或修改 UI 元件的服務。
- **AI 原生 UI 架構:**前端架構設計的內建支援可處理 AI 驅動的 UI,例如管理概率資料和串流文字回應。
- **工作人員導入的參與系統:**透過視覺元件納入 AI 工作人員功能的企業生產力與協同合作應用程式。
- **AI 增強型低程式碼/無程式碼應用程式開發:**讓使用者和工作人員使用自然語言與提示建立自訂應用程式和服務的工具。
- **工作人員使用的應用程式護欄:**工作人員用量的應用程式端控制,例如比率限制、範圍權限和距離測量。
### 語意層
**函數:**「語意層」提供整個企業資料和 Knowledge 的統一瞭解,讓人類和 AI 工作人員能夠一致解讀資訊並採取行動。它使用 Knowledge 表示工具 (例如本體與 Knowledge 圖表) 將自然語言查詢翻譯為精確且感知內容的資料查詢。
**與今天有何不同:**雖然現今的企業擁有不同的中繼資料存放區,但「代理企業」的 IT 結構需要一個集中式的企業 Knowledge Graph (EKG),可將跨網域的資料與明確定義的語意關係連結。這為 AI 工作人員提供豐富的內容,以執行複雜的推理,為一組技術功能建立需求,以強化跨多個功能領域的 Knowledge 圖表。
**關鍵技術功能:**
- **中繼資料服務:**提供描述性中繼資料,包括資料歷程、擁有權和分類。
- **業務詞彙與分類管理:**可讓業務使用者定義和同意標準業務詞彙的工具。
- **語意模型管理:**可供 Knowledge 工程師建立、管理及管理語意模型與本文的工作台。
- **企業 Knowledge 圖表 (EKG):**企業本文的執行階段例項,可儲存和對應業務實體之間的關係。
- **中繼資料取用與調和引擎:**從各種來源系統填入與維護「企業 Knowledge 圖表」的自動化管道。
- **語意查詢引擎**:解譯自然語言查詢,並根據 EKG 建構結構化查詢,以從各種來源提取資料。
- **語意原因引擎:**從 EKG 分析與衍生隱含 Knowledge 和隱藏關係。
### 資料層
**函數:**「資料層」是事實的基礎來源,可管理並提供安全且受管理的所有企業資料存取權,讓「語意層」可供解譯、AI/ML 層用於訓練、用於交易的應用程式,以及工作人員用於推理。
**與今天有何不同:**「資料層」會發展為更統一、即時且以管治為中心,通常以雲端規模資料湖為中心。其必須處理更大的資料量和資料種類,並從批次導向處理轉為即時串流,以支援反應性工作人員。資料管理和品質對於防止不良資料產生瑕疵 AI 輸出而言,更重要。
**關鍵技術功能:**
- **VectorDB:**專為儲存和查詢高維度向量內嵌最佳化的專用資料庫,對於 RAG 而言十分重要。
- **智慧分析資料銷售管道:**一種自動化中繼資料驅動的服務,用於在「資料層」(ETL/ELT),以用於資料採取、轉換和載入。
- **企業資料湖:**結構化、半結構化和非結構化資料的集中存放庫,針對分析和 AI 工作量最佳化。
- **零複製資料聯合與搜尋:**無須實體資料移動,即可在多個商店之間存取、查詢和搜尋資料的技術。
- **自然語言對 SQL:**將自然語言查詢轉換為 SQL 的技術。
- **企業資料目錄與探索服務:**整個企業中所有資料資產的集中式可搜尋庫存。
- **主要與參考資料管理 (MDM):**管理重要業務實體 (例如客戶和產品) 的「金級記錄」。
- **自適應資料品質服務:**使用 AI 來自動即時偵測及修復資料品質問題的連續監控服務。
- **資料契約:**資料產生者與消費者之間的機器可讀取協定,指定資料交換的結構描述、語意和 SLA。
- **AI 專用資料存放區:**針對特定 AI 使用個案設計的資料庫,例如時間序列或圖形資料庫。
- **AI-Ready Data Fabric:**邏輯資料解壓縮層,提供跨不同實體系統資料的統一虛擬化檢視。
- **即時資料處理:**可持續在機器速度處理和分析多重模式資料串流的功能。
### 基礎結構層級
**函數:**「基礎結構層」可固定所有其他層級,提供以彈性且符合成本效益的方式大規模執行 AI 和工作人員工作負載所需的計算、儲存、網路和雲端功能。
**與今天有何不同:**AI 工作量需要更高的延展性和彈性,才能處理工作人員系統的可能性性質。基礎結構必須支援快速佈建、專業硬體 (例如 GPU),以及低延遲的高輸送網路流量,以進行工作人員之間的通訊。
**關鍵技術功能:**
- **基礎結構代碼:**透過 CI/CD 部署管道自動化基礎結構佈建和管理。
- **混合式與多雲端 AI 基礎結構:**為生成式 AI 工作量利用公用雲端彈性與專用基礎結構。
- **AI 最佳化的計算、儲存和網路:**根據 AI 工作量變數需求,動態配置和調整基礎結構資源規模。
- **邊緣 AI 基礎結構:**針對具有獨特延遲或隱私權需求的使用個案,讓 AI 模型與工作人員部署在網路邊緣。
- **自我修復基礎結構:**使用 AI 管理系統復原而無須手動輸入,以確保高可用性。
- **永續 AI 計算:**降低 AI 工作量對環境影響的能源效率方法。
- **成本與碳感知自動調整:**使用 FinOps 和永續性訊號來促進產能的調整和放置。
### 整合層
**函數:**「整合層」可透過 API、事件、通訊協定和中間軟體作為所有系統 (舊版與新版) 的通用通訊架構,以確保工作人員可以無縫探索和與服務、資料和工具互動。
**與今天有何不同:**整合必須演進以支援 AI 工作人員的動態、多對多通訊模式,而不只是處理少數已知系統之間預先決定的靜態互動。它需要即時資料處理,且必須容納工作人員之間的臨時探索與協同合作。
**關鍵技術功能:**
- **作業資料連線管道:**自動結構描述對應、資料轉換和工作流程產生的 AI 輔助工具,包括 API 導向、以事件為導向和反向 ETL 功能。
- **自適應 API 管理與服務網格:**可透過適應性強制執行工作人員原則,動態註冊、探索和管理服務的 API 門戶和服務網格技術。
- **語意 Knowledge 轉接器:**整合元件,可在工作人員和應用程式之間提供共用詞彙和資料模型,以一致解譯資料。
- **事件驅動的整合布料:**高流量、低延遲傳訊和串流支柱,可啟用分離的非同步通訊。
- **工作人員通訊協定 Gateway:**可讓工作人員安全探索工具和觸發動作,以將 MCP 橋接至內部 API 和事件的 MCP 服務門戶。
- **可組合功能目錄與市集:**所有企業功能 (API、服務、工作人員技能、模型和資料集) 的集中管理型目錄,以語意中繼資料為依需求組成加上註釋。
### IT 作業與可觀察性層
**函數:**此層可監視和管理工作人員和整個系統的健康與營運績效 (可觀察性內嵌原則),透過產生洞察來提供透明度和控制,以便對企業代理人力進行稽核、除錯、可解釋性、成本和資源最佳化。
**與今天有何不同**:由於 AI 工作人員在機器速度發生錯誤的風險,因此此層變得更加重要。其必須擴展至基礎結構監視之外,以包含獨立工作人員的不可預測行為,需要新類型的距離測量和瞭解語意正確性的能力,而不只是技術效能。
**關鍵技術功能:**
- **即時監視與可觀察性平台:**持續收集整個 IT 環境中的記錄、度量和追蹤,以及 ML 度量與工作人員行為的擴充功能。
- **FinOps 與 Cloud 成本管理:**負責監視、分析和最佳化與 AI 和工作人員工作量相關聯的基礎結構成本。
- **工作人員與 ML 特定監視:**在固定的稽核追蹤中記錄工作人員執行的每個步驟,並持續設定工作人員行為,以偵測與已建立規則的偏差。
- **AIOps、事件和變更管理:**使用 AI/ML 預估潛在的 IT 問題、識別根本原因,並建立補救工作流程。
- **已結束學習回饋意見迴圈:**將工作人員的可觀察性遠距測量整合回 MLOps 管道,啟用自動模型重新訓練或提示調整。
- **語意觀察性引擎:**將可觀察性與關聯式語意層整合,以便偵測工作人員行為中的語意異常。
### 安全性與管治層級
**目的:**此層可透過保護企業資產免受威脅、管理風險,以及確保符合法規需求,將 Trust 與安全性內嵌在整個結構中。其中包含身分管理、威脅偵測、GRC 和 AI 特定的安全性措施。
**與今天有何不同:**安全性層級必須演進以處理 AI 模型和工作人員呈現的新攻擊面,例如提示插入和模型中毒。身分與存取管理必須從靜態、以角色為基礎的控制項移至動態、以意圖為基礎的權限,這些權限會即時授與,並在使用後立即撤銷。
**關鍵技術功能:**
- **LLM 輸入/輸出安全性和護欄:**在提示和回應時間套用企業護欄,以封鎖不安全的內容、PII 洩漏和洩漏。
- **使用 AI 驗證的 Zero Trust 結構:**透過 AI 式行為分析增強的持續驗證,並根據工作人員的特定工作提供細微且及時的存取權。
- **工作人員安全性架構:**微調的權限模型、監視有害行為和控制機制,可安全中斷工作人員活動。
- **AI 模型安全性:**內含模型生命週期各階段的深度防禦策略,可保護您免受中毒、提取和敵對攻擊。
- **隱私權保留 AI:**技術,例如聯合學習和不同的隱私權,以保護敏感資料。
- **AI 增強型 GRC:**使用 AI 工作人員來持續監視 IT 結構與控制項的合規性。
- **原則代碼引擎:**以陳述性、機器可讀的格式定義業務規則和規範限制的單一事實來源,可設定工作人員行為的護欄。
- **連續紅組:**AI 模型和工作人員的自動持續反對測試,可在攻擊者利用漏洞之前識別漏洞。
## 工作人員企業的參照結構藍圖
轉換為「代理企業」需要透過設定技術基礎,同時建立具體的業務價值來遵循多階段過程 (請參閱下方圖 3)。雖然精確的藍圖取決於企業的策略、文化、AI 管治模型和 IT 結構起點,但大多數組織應採用分階段式方法,以作為持續 IT 投資的推動因素,其範圍、複雜性和價值創造日益增長。Salesforce 的「[工作人員成熟度模型」](https://www.salesforce.com/news/stories/agentic-maturity-model/)為企業提供一個有用的成熟度層級架構,可用於策略化其轉換,概述工作人員的能力如何從基本資訊提取 (層級 1) 成長到協調更複雜的多網域 (層級 2 與 3) 和多工作人員工作流程 (層級 4)。若要成功完成這些階段,IT 結構必須以協調的方式發展,並在每個階段針對不同層級的架構進行目標投資,以滿足 AI 工作人員更複雜且價值更高的部署需求。針對每個成熟度層級,系統會透過投資原因,識別跨 11 個結構層級所需的特定技術功能。
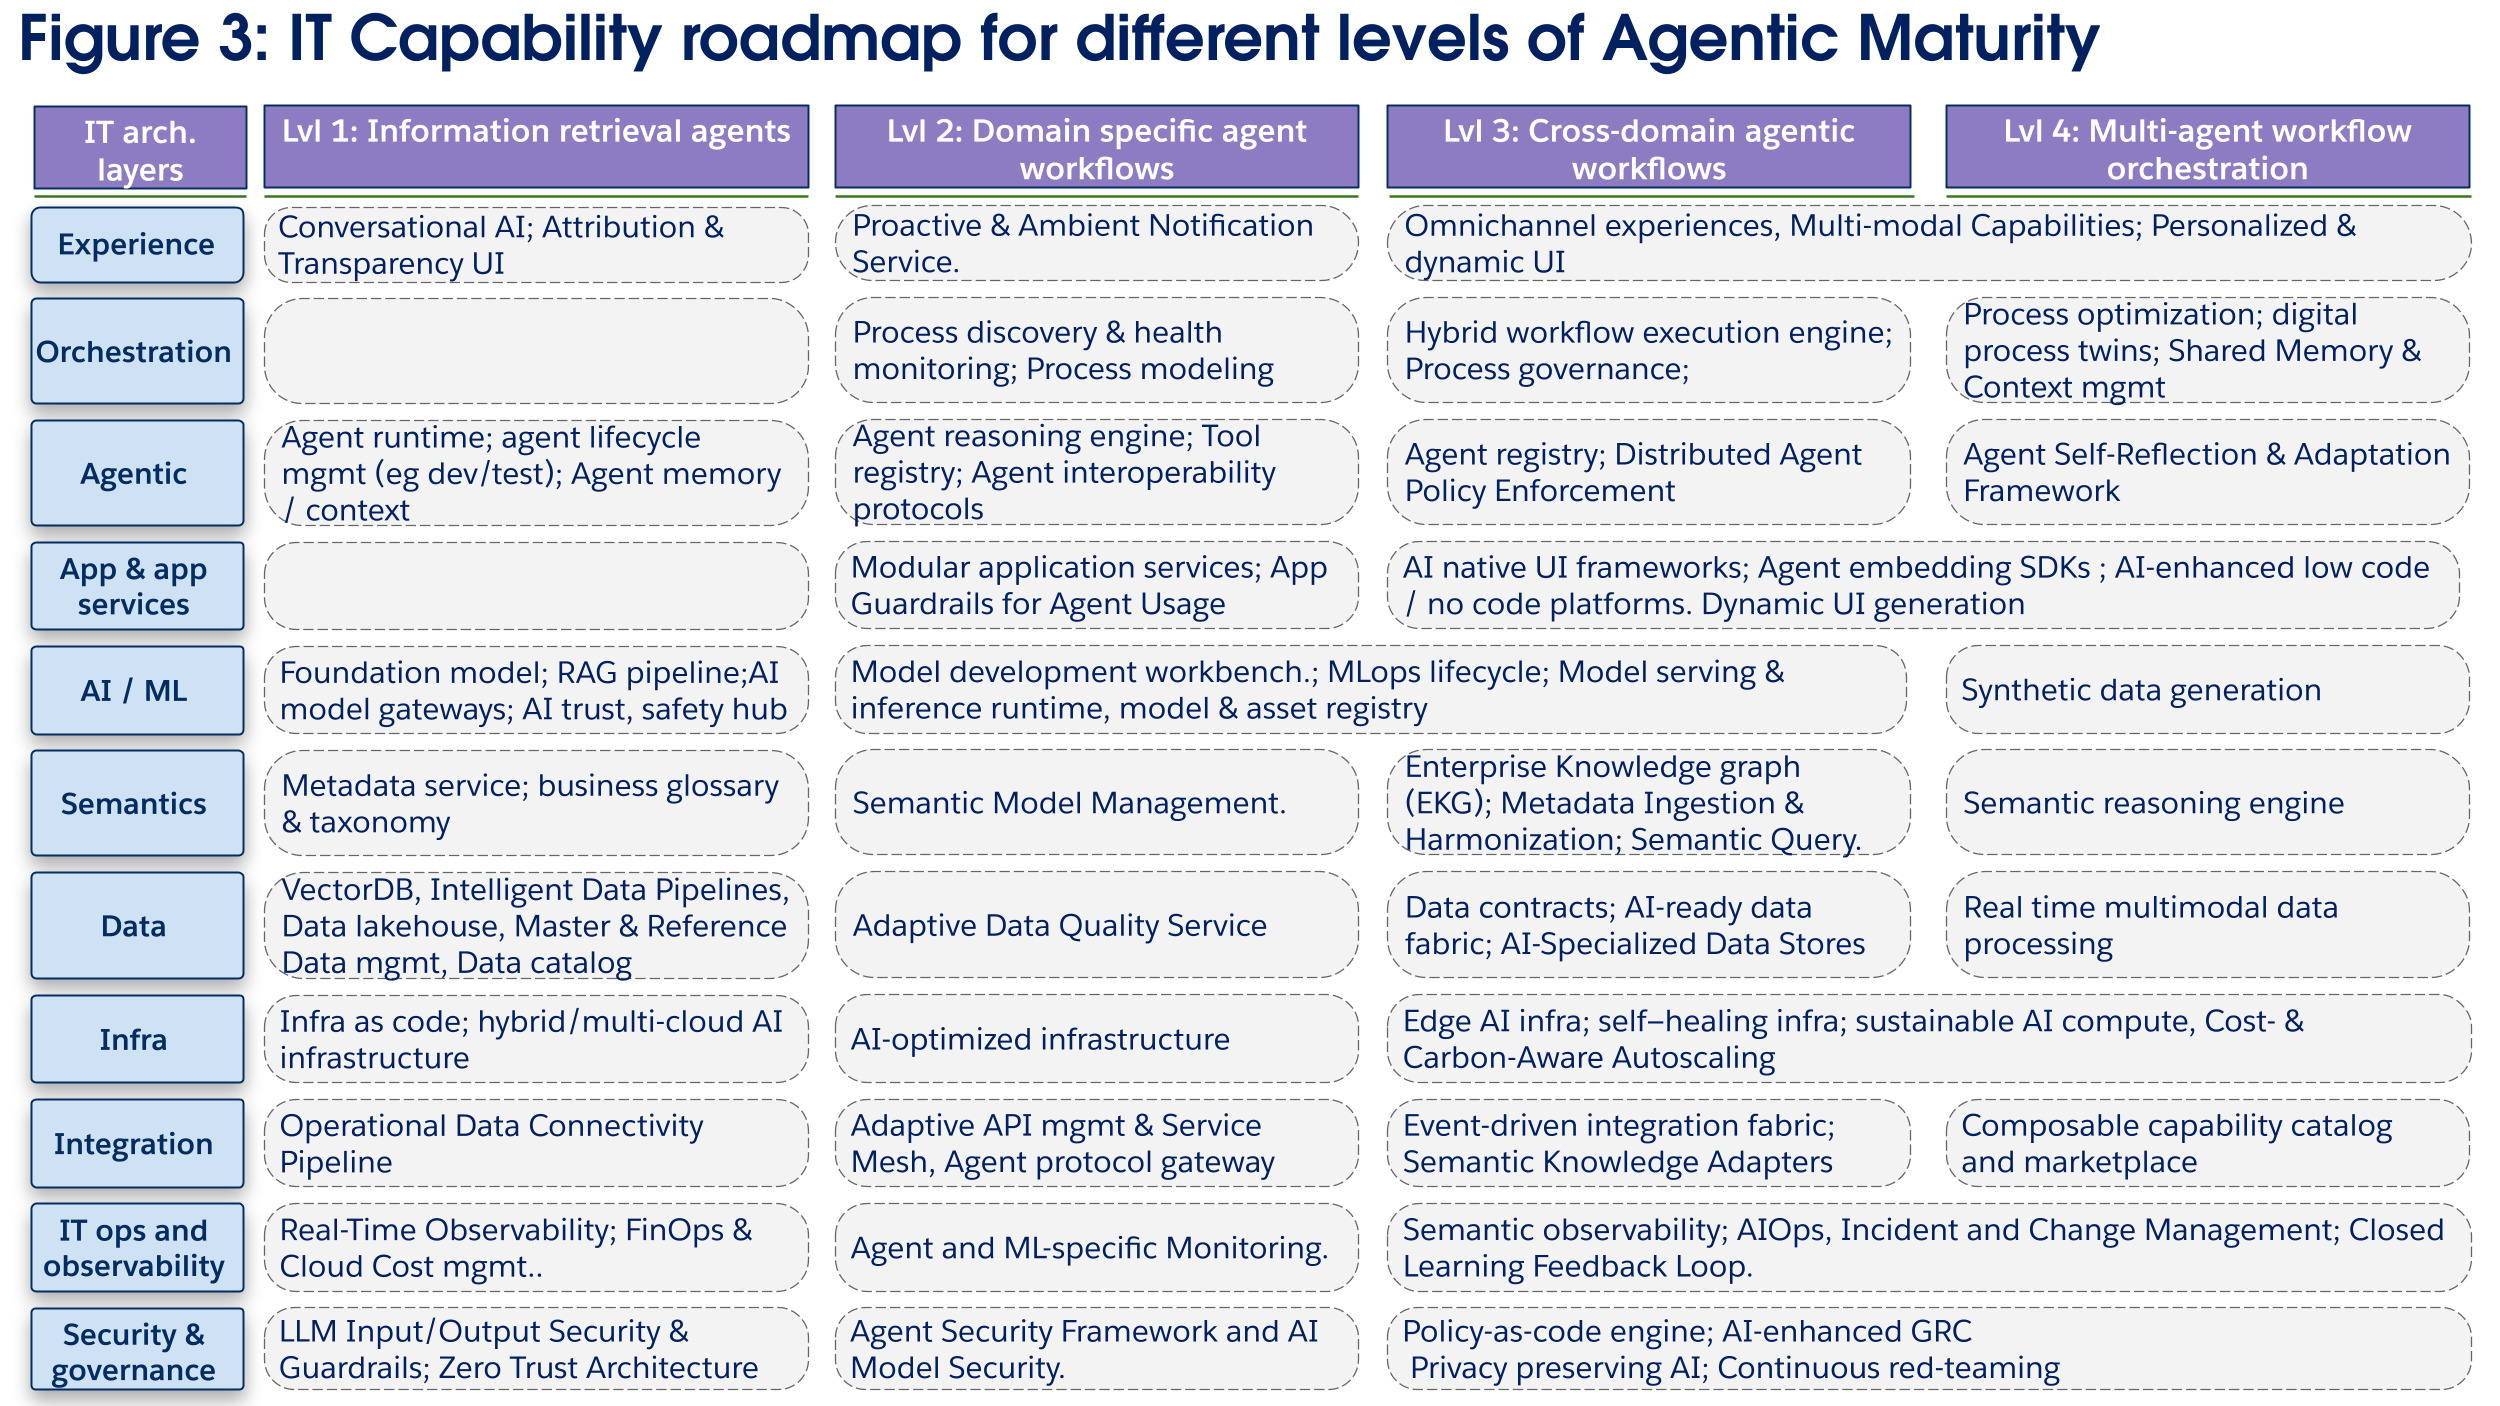 **成熟度層級 1:資訊取得工作人員**
**業務目標與值:透過提供可信任的對話介面來查詢企業 Knowledge,來提升人類工作人員的生產力。**主要值在於增加人類的能力,而不是取代它們。這些工作人員會藉由提取資訊和建議動作來協助人類。
**結構焦點:**重點在於建立安全、可靠的資料基礎,以及需要的基本 AI 元件,以取得資訊。從第一天開始,管理與可觀察性對建立使用者 Trust 和控制成本至關重要。
**關鍵技術投資 (圖 4:**
在此階段,IT 應專注於建立可靠的資料對工作人員銷售管道和其他基礎功能。**資料層**中的技術 (例如 **VectorDB**) 對於啟用可強化資訊提取工作人員的提取擴充產生 (RAG) 技術至關重要。這與集中式 **AI/ML 層**相結合,其中包含可安全且以成本控制的方式存取基礎模型的「**模型門戶**」,以及可監視不安全輸出並確保合規性的 **AI Trust、Safety & Governance Hub**。**語意****層級**中的**主要資料管理**和**業務詞彙**對於工作人員的準確資訊而言至關重要。需要工作人員執行階段和生命週期功能,以確保在此階段建立的工作人員可以針對未來使用個案進行修改和擴充。為了提供價值並建立使用者信任,**體驗層**必須納入「**歸屬與透明度」UI**,其可透過顯示引號和其資訊來源,讓工作人員回應可供說明。基本可觀察性和安全性投資 (例如**零** **信任**) 必須開始實作,才能為未來工作人員部署設定階段。
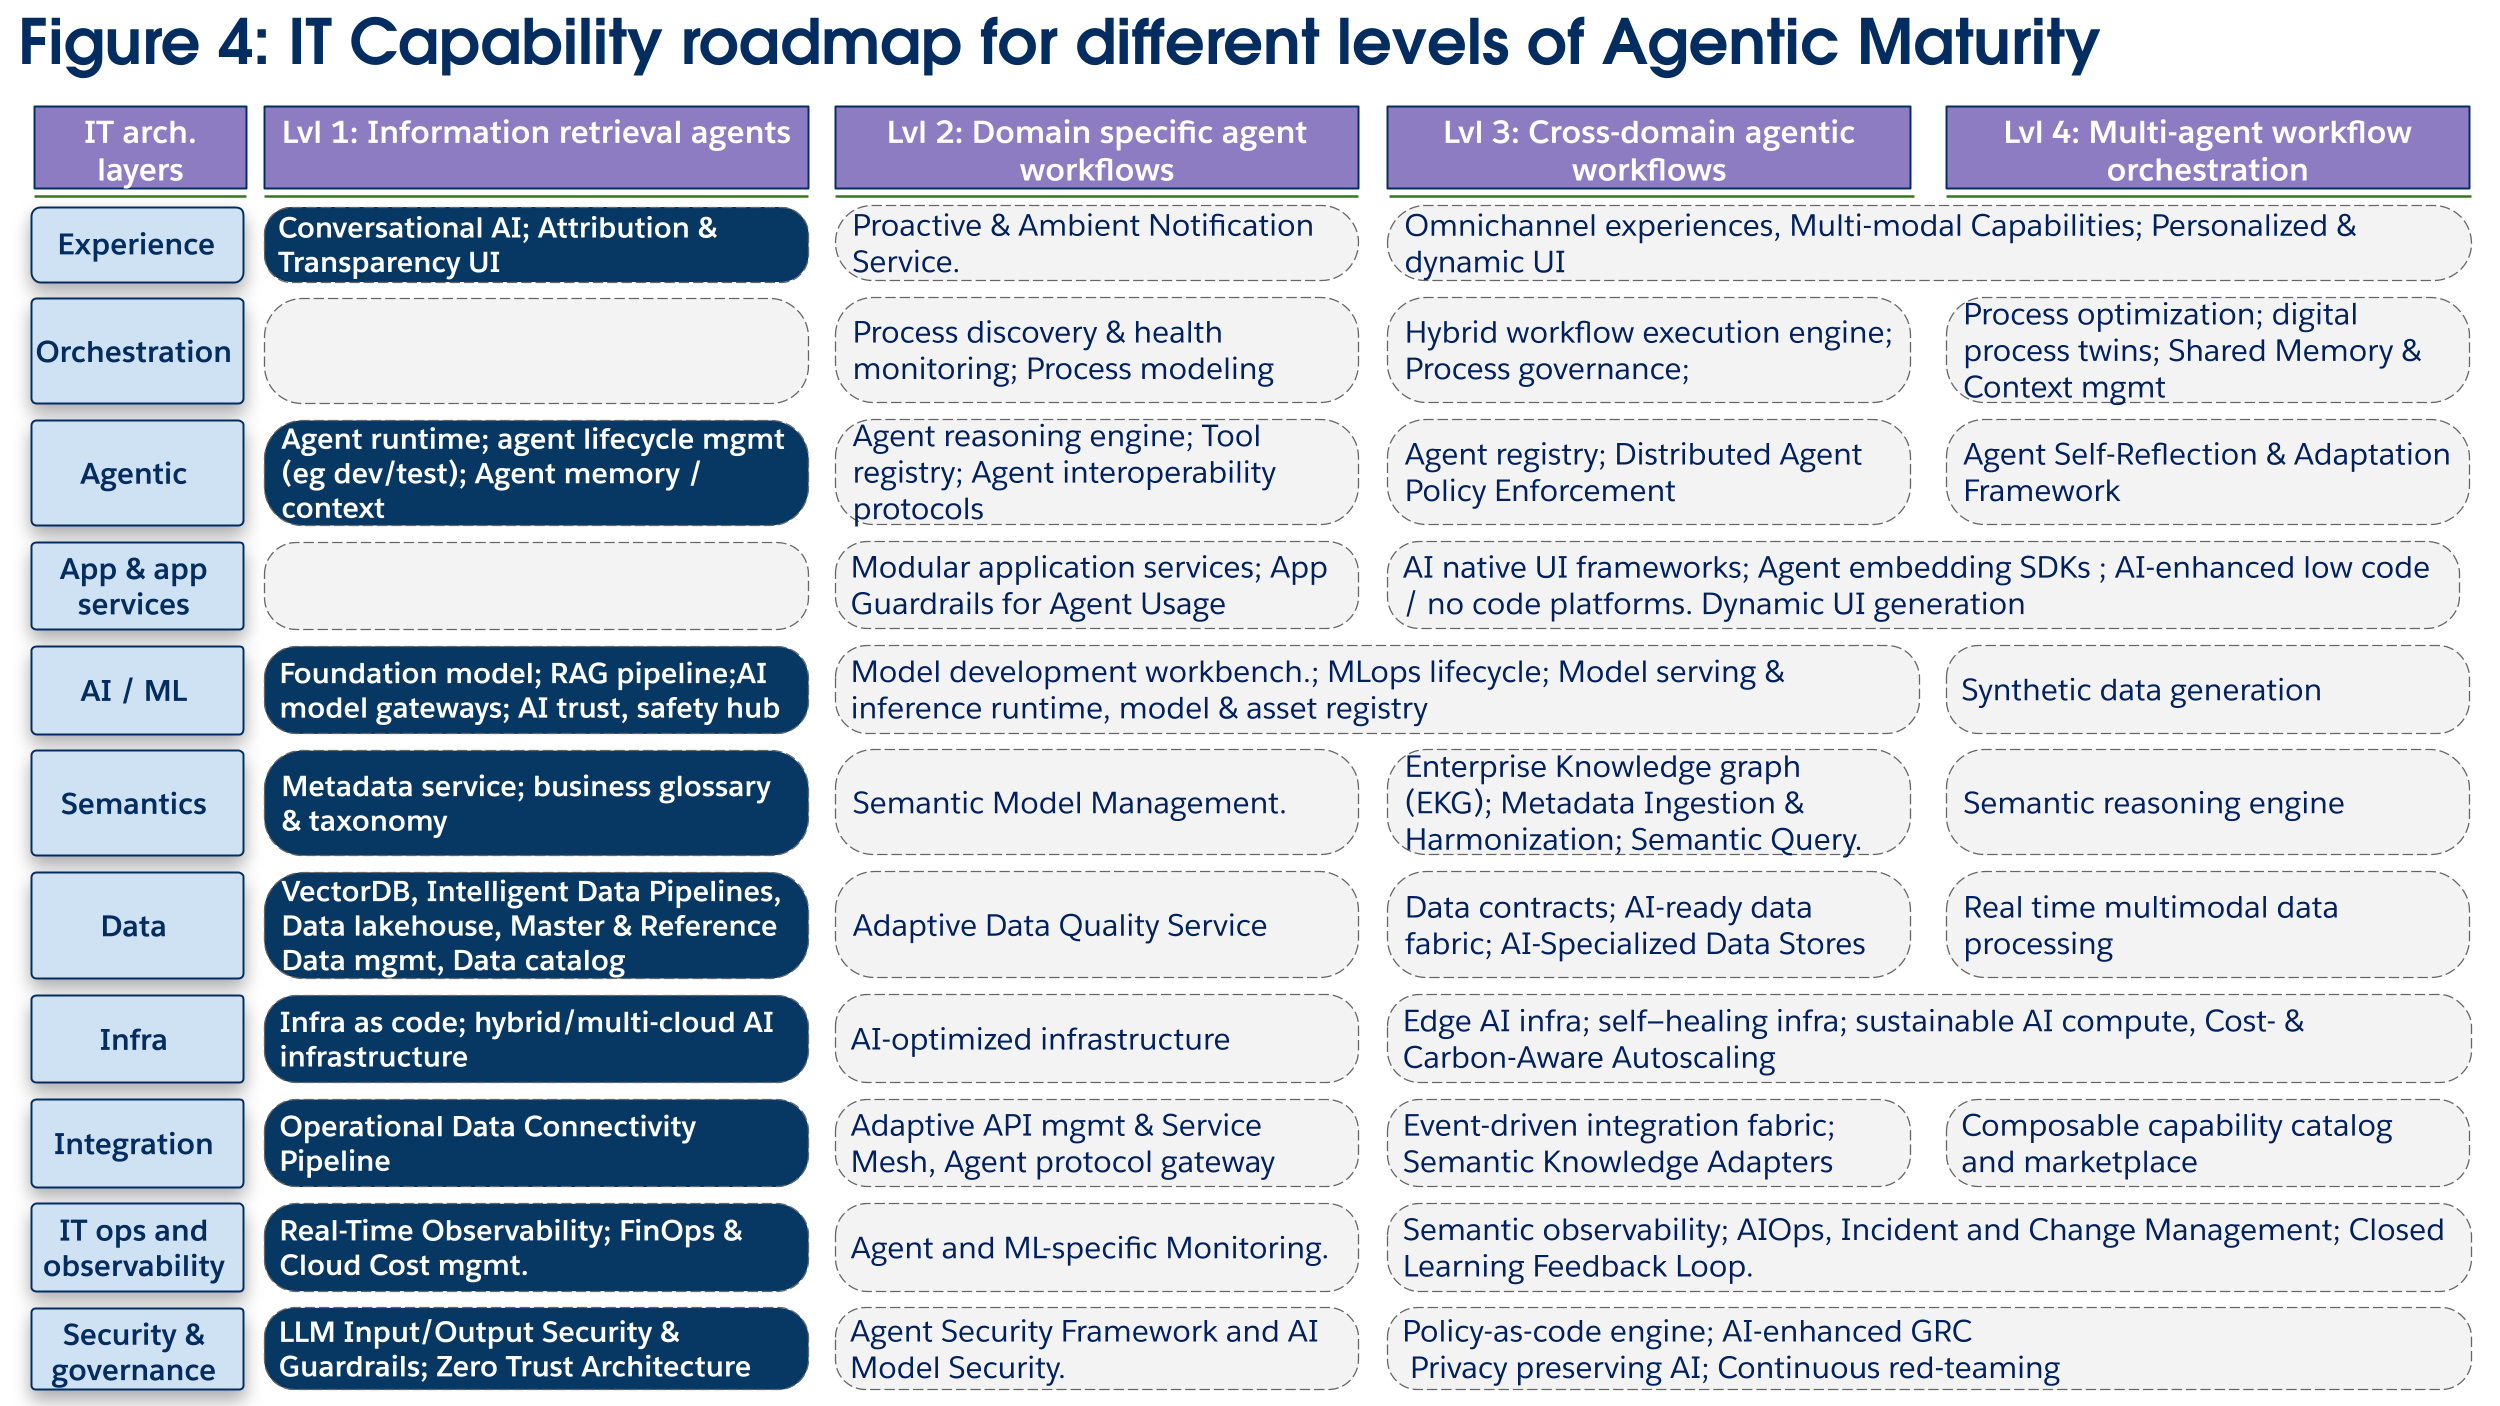 **成熟度層級 2:簡單協調流程,單一網域工作人員**
**業務目標與值:在單一業務網域中自動化例行工作並協調低複雜度的工作流程。**這可改善營運效率並減少手動工作,讓人力工作人員專注於更高價值的活動。
**結構焦點:**關鍵的結構性轉換是從唯讀的資料提取到執行動作。這需要開始更長的旅程來模組化應用程式功能 (通常會顯示為 API),讓工作人員能夠存取,為工作人員動作實作強大的安全性,並建立語意與 AI 開發功能來增強 AI 工作人員的智慧。
**關鍵技術投資 (圖 5:**
主題投資著重於讓 AI 工作人員能夠透過適當的管治來採取行動。**應用程式和應用程式服務層級**正在進行重大變更,因為單一型業務邏輯會分解為可供工作人員呼叫的 **模組式應用程式服務** (API)。這些項目由 **應用程式護欄** 保護,以防止工作人員在系統中壓倒,並與可觀察性工具整合。若要強化這些工作人員,必須對工作人員的推理、工具通訊協定 (例如 MCP) 和 **註冊**進行投資。這會引入新的風險,使專屬的工作 **人員安全性架構和 AI 模型和工作人員監視功能** 對管治和安全性至關重要。最後,企業可以開始針對自訂模型擴充其 AI/ML 功能,以便這些工作人員處理網域特定工作。
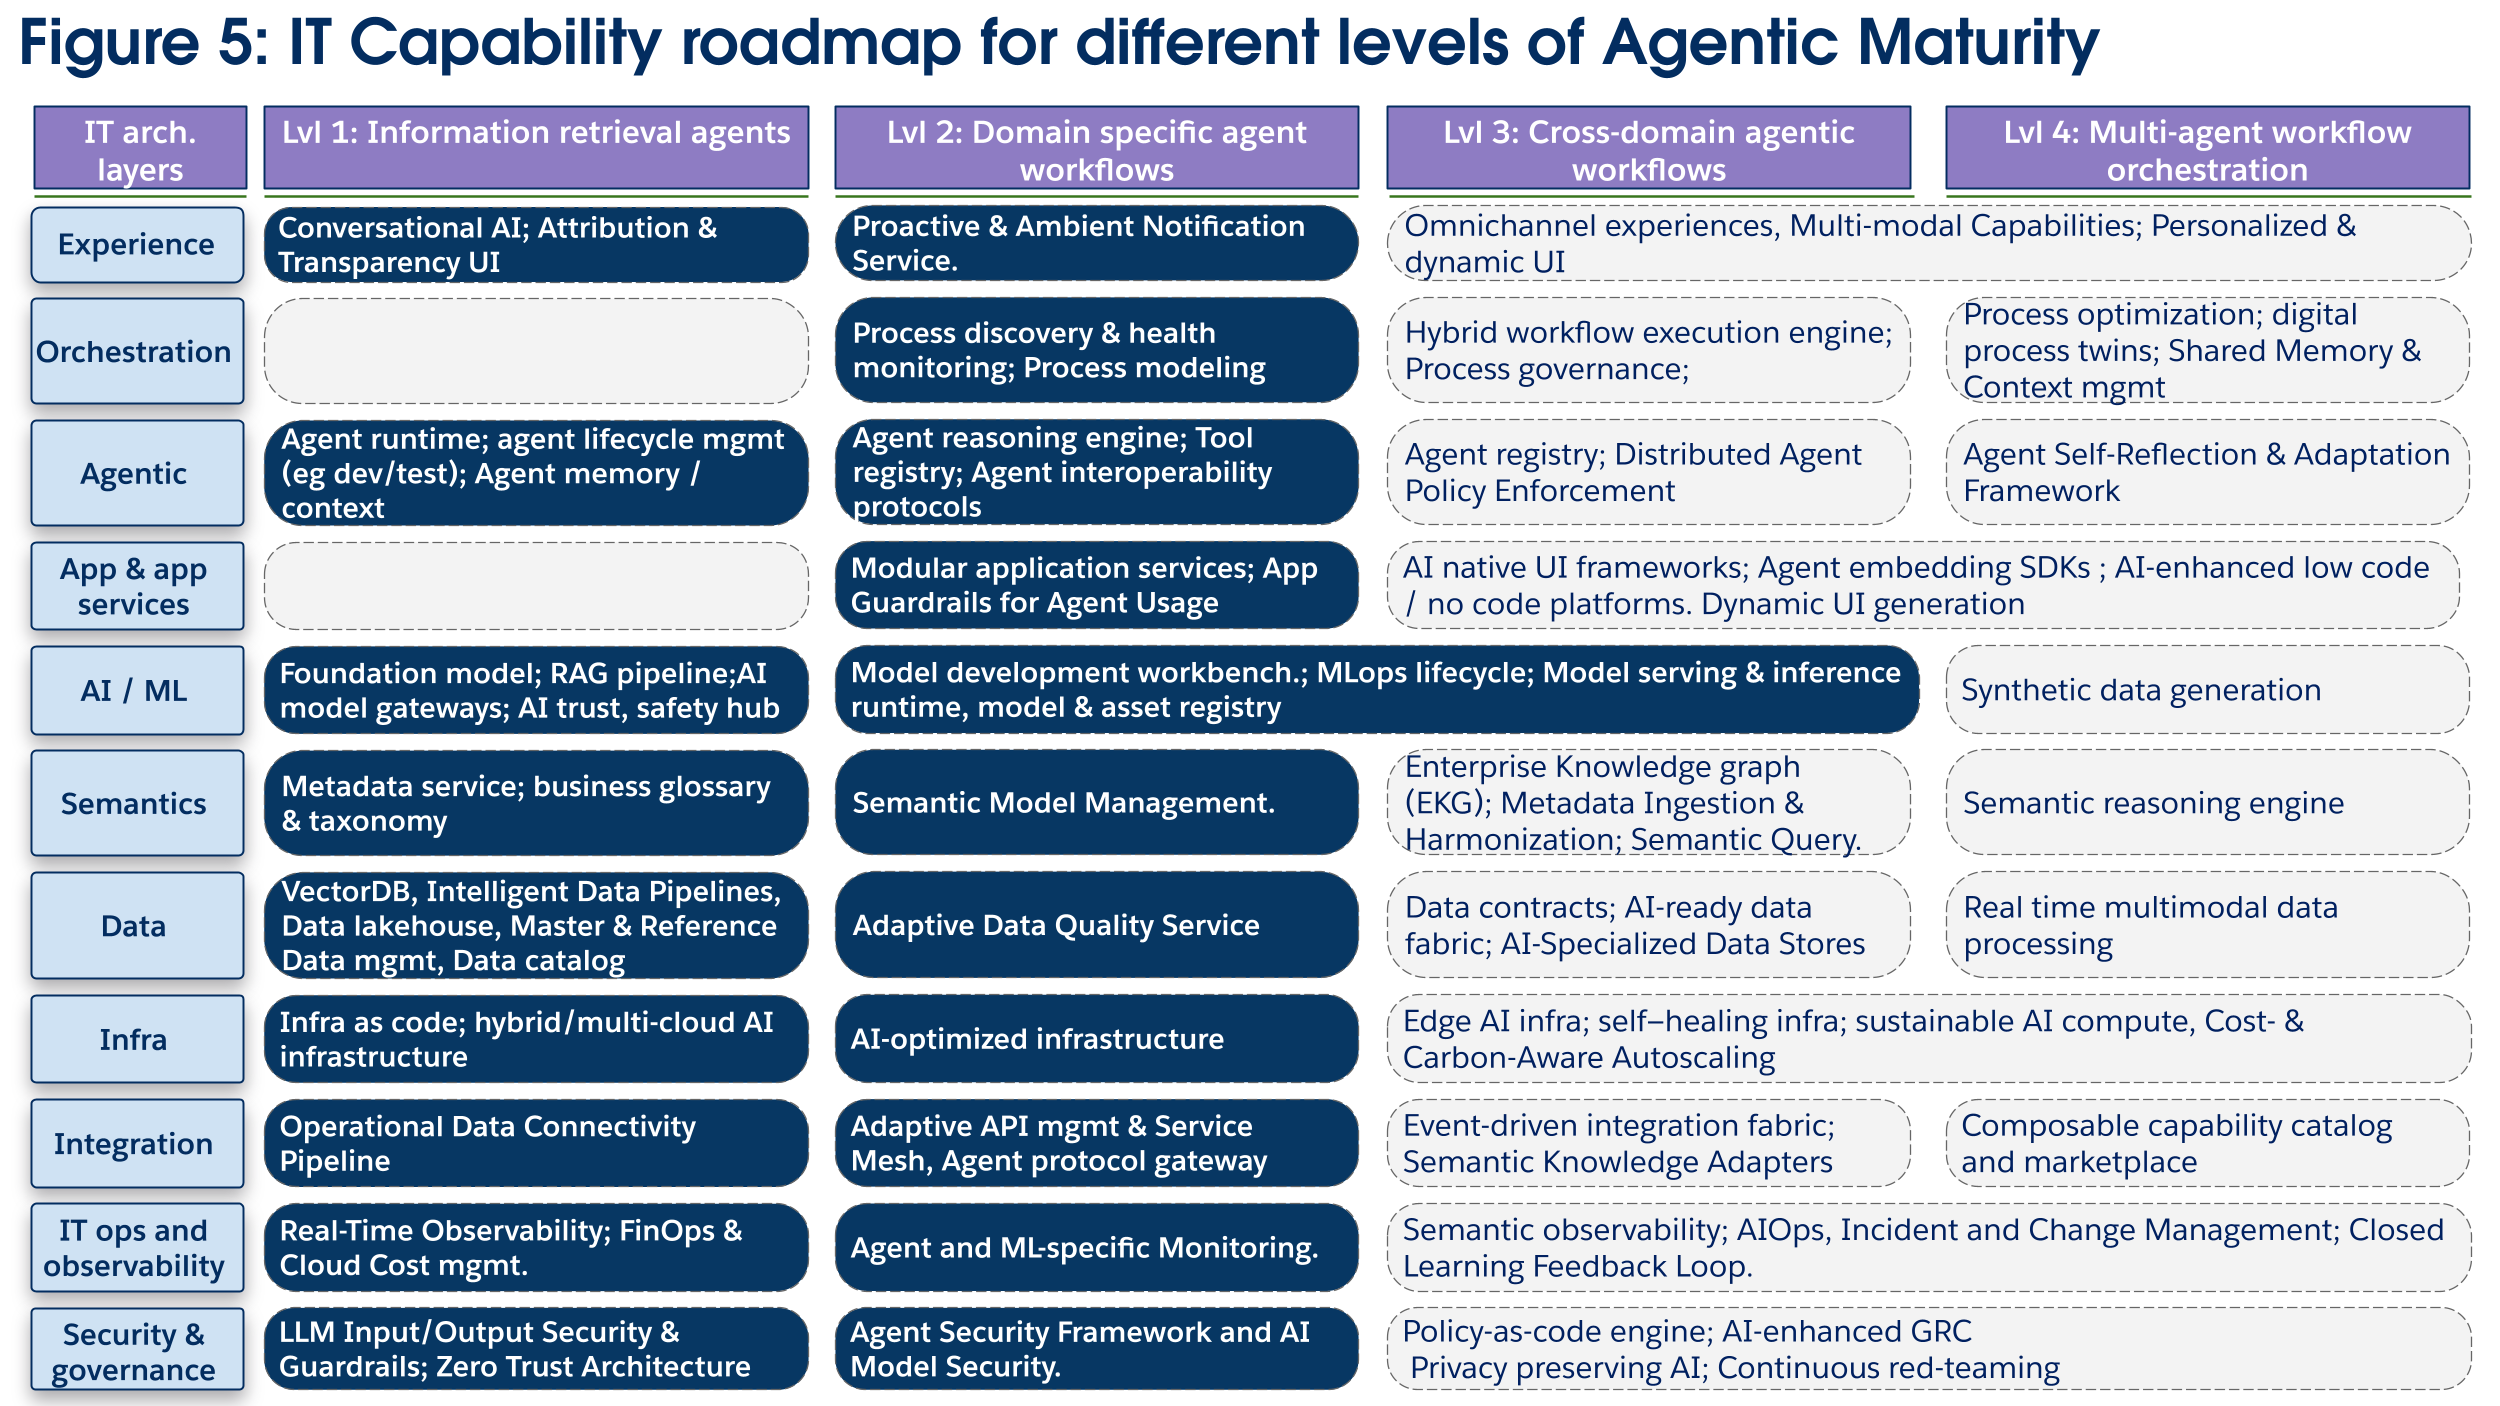 **成熟度層級 3:多網域協調流程工作人員**
**業務目標與值:****自動化跨越組織與功能界限的複雜端對端業務流程** (例如「報價現金」、「商機轉換訂單」)。價值在於拆分孤島、加速流程週期時間,以及最佳化業務內的整個價值鏈。隨著組織阻礙開始崩潰,而人類開始更專注於監督 AI 工作人員,人類工作人員生產力可能會有更高的步驟變化。
**結構焦點:**結構現在必須支援跨部門技術問題。跨企業的共用語意瞭解、用於管理的集中協調流程引擎,以及分離的事件驅動整合結構,會成為重要啟用因素。
 **關鍵技術投資 (圖 6):**
技術投資在主題上著重於跨人類、工作人員和決定性系統組織企業規模的流程。**企業協調流程層級**會變成投資的焦點,需要「**混合式工作流程執行引擎**」來協調活動,以及「**流程管理與限制引擎」**來對運作中流程強制執行業務規則和合規性原則,因為工作人員在跨網域工作,通常具有不同的原則和語意定義。只有具備 **企業 Knowledge 圖表 (EKG)** 的成熟「**語意層級**」才能達成此跨網域協調,其可建立對業務實體跨網域關係的共用瞭解。**整合層**必須演進以包含「**事件驅動整合模組**」,其使用串流支柱來分離系統,並啟用長時間執行企業流程的典型彈性非同步通訊。由於這些工作流程的價值較高,以及相關的風險,因此在安全性和監視方面進行的額外投資變得十分重要 (例如**AIOps、policy-as-code**)。最後,必須進一步投資於「應用程式和服務層」(例如**已啟用 AI 的 LCNC、更動態且多強制**模式的使用者體驗),因為人類使用者開始監視和與更有能力的 AI 工作人員協同合作。
**成熟度層級 4:多工作人員、多網域協調流程**
**業務目標與值:重新設計並最佳化跨網域的業務作業,以推動生產力與效率的步驟變更。**此階段會移至建立企業的整體數位模擬 (數位雙子),以在主要業務流程和工作流程之間持續改善和策略性規劃。
**結構焦點:**最後階段著重於啟用工作人員之間動態、新興的協同合作。這需要進階工作人員對工作人員 (A2A) 通訊通訊通訊協定、工作人員自助式學習功能、進一步投資於成熟「協調流程」、「資料」和「語意」層,以及完全動態和自我修復的基礎結構,以支援隨著工作人員在整個企業規模擴大而增長的動態 AI 工作量需求。
 **關鍵技術投資 (圖 7):**
主題投資著重於建立自我改善的自發系統。在「**工作人員層級」中**,「**工作人員自我反應與調整架構」** 提供機制讓工作人員分析自己的效能記錄並觸發改善。**IT 作業和可觀察性層級**支援此學習,其會實作「**已結束學習回饋迴圈」(Closed Learning Feedback Loop**),以自動將可觀察性資料摘要回 MLOps 銷售管道以進行模型重新訓練,這也可以利用合成資料產生來進一步最佳化模型效能。隨著在各部門部署工作人員的網路,以及持續的應用程式模組化工作,在安全性以及至關重要的可**編譯功能型錄**方面進行進一步的投資,因此工作人員必須動態撰寫功能,以解決更抽象且高價值的工作。這些流程全部透過新的「**數位雙流程建模」功能進行協調和最佳化,**此功能使用即時資料建立模擬以進行「What-If」分析和預測最佳化,讓企業安全地測試和部署新的代理部署。
**結論**
「工作人員企業」的藍圖會透過 IT 結構演變執行。企業結構設計師將是此轉換的關鍵驅動因素,並與業務和 IT 中的其他合作夥伴一起推動必要的關鍵投資決策,以便組織從「代理企業」的新業務能力中實現價值。
## 關於此白皮書
**企業代理程式結構與設計模式**為多代理程式結構的可能性帶來結構,識別並醒目提示 AI 代理程式的新功能如何結合在一起,以提供可靠、可重複、可調整且可管理的代理程式解決方案。我們從「物件導向」程式設計的「設計模式」中獲取靈感,並列出可結合和擴充的模式,以解決在代理技術之前置於以傳統決定性技術為基礎的業務系統範圍之外的許多令人興奮的挑戰。
在討論多重工作人員結構的邏輯後,我們介紹了許多代理模式,從利用自然語言處理來判斷使用者意圖的簡單模式,到提供工作人員之間關注分隔的多重代理模式,到 UX Agent 模式,這些模式可將代理理由帶入呈現方式和與系統、資訊和內容的互動。
## 您會從此文件中得到什麼?
首先,您將得到工作人員的新思維方式 - 工作人員作為元件、工作人員作為編輯者、工作人員作為執行動作的使用者、工作人員作為協作者,最重要的是,在更大結構內的使用者以意圖並在其個別的關注範圍內採取行動。
您將取得所需的指標,以構思豐富的工作人員解決方案,這些解決方案可跨越使用者旅程,並提供有意義的工作人員體驗,這是前所未有的體驗。
此文件的初始區段提供 muti-agent 結構的理由。請參閱以下內容以進一步瞭解多工作人員結構所帶來的挑戰和機會。
以下是工作人員模式的定義和描述,從簡單到複雜,涵蓋支援互動的模式、專科工作人員的模式、背景作業的模式,以及長時間執行模式。每個模式都包含實作模式的主要元件圖表,以及使用狀況與代表使用個案的建議。
最後,附錄包含這些模式結合為支援更大代理體驗的整體代理解決方案的範例,例如支援「客戶服務」或「經紀人銷售」。請參閱此區段以瞭解豐富的工作人員體驗如何利用工作人員和動作層級的疑慮分解和分隔,以在互動層級推動重複使用,其中共用工作人員支援內部和外部部部門成員,同時使用輔助模式和自動模式。
## 1\.多工作人員系統結構
企業結構設計師將生成式 AI 整合至其生態系統時,必須解決一組常見的設計問題:
- 需要多少工作人員?
- 工作人員如何互動?
- 工作人員與人類之間的人工分工為何?
- 這些元件如何組合成一致的系統?
此文件提供設計和建立工作人員解決方案的模式方法。
*單一型*工作人員是大多數代理解決方案的起點。工作人員 (更具體地說,Agentforce 工作人員) 是跨各種主題的成員。針對常見使用個案,從單一工作人員開始。
隨著您的組織成長,多工作人員結構是偏好的方法。相較於單一工作人員系統,*多工作人員結構*可提供更大的規模、控制和彈性。
多工作人員結構提供以下主要優點:
- **效能與複雜性解析提高**:由多個專門工作人員組成的系統提供增強的功能,並簡化指示符合度。
- **模組化與擴充性**:可更輕鬆地新增、取代、修改和測試個別工作人員,進而提升靈活性。
- **彈性與錯誤容忍度**:單一元件失敗不會影響整個系統,進而提升整體彈性。
- **去中心化管理**:疑難排解與管理可與特定工作人員及其對應的應用程式分隔,進而簡化維護與監督。
 ## 2\.核心結構原則
將多重工作人員結構合理化從將核心結構原則投影到工作人員的功能和結構上開始。產生的多重工作人員結構便是核心系統設計和系統結構原則的表達,並與 AI 技術的獨特「粒紋」保持一致。
驅動此結構的關鍵原則包括:
- 透過拆分管理複雜性
- 透過分離提升彈性並減少脆弱性
- 透過程式碼重複使用改善可靠性和效率
- 透過限制任何一個工作人員的關注範圍來提升工作人員的可靠性
- 透過模組化和擴充性改善系統維護和進化
- 透過專長簡化工作人員管理與當責
不同於更原始的工作人員結構 (例如,專注於以 LLM 作為核心結構建構的結構),*Agentforce 從一開始就針對多工作人員協調流程*而設計。多工作人員協調流程以 Atlas Reasoning 引擎和代理程式推理為基礎,可在代理程式回應內建立動態且有效的程式設計路徑,以大幅擴大為使用者體驗 (UX) 提供廣泛且深度代理程式擴充的能力。
在 Agentforce 中,這些金鑰開放、可互通的通訊協定和 Salesforce 產品可啟用此類型的協調:
- **Agentforce** 提供「工作人員」子系統,可壓縮工作人員的所有關鍵元素:主題、指示、動作、護欄、內容、叫用、輸出、執行詳細資料、記錄等。
- **動作**:提供存取資料、通話流程、叫用外部系統和呼叫其他工作人員的勾點。
- **Data 360**:提供資料虛擬化層,以將特定、個人化內容帶給工作人員 (利用 Data 360 的統一設定檔和金鑰鏈,從整個企業中提取特定資訊)。
針對跨企業的工作人員,或存取工作人員或資源,我們支援:
- **模型內容通訊協定 (MCP)**: 是安全通訊層,可將工作人員與企業工具、資料和 Knowledge 連線,以確保內容準確性。
- **工作人員對工作人員 (A2A) 通訊協定**:是一種標準化工作人員之間委派的協定,可在系統、組織和廠商之間啟用安全且受管理的協調。
這些原則提供建立可調整、可管理協調式情報系統的基礎。
### 其他考量事項
強大的代理解決方案需要對非功能需求的明確方法,以實現有效的技術傳遞:
- 安全性與管治 (身分與存取管理、資料隱私權、資料安全性和威脅建模)。
- 可觀察性和監視 (散佈式追蹤、集中化記錄、度量和顯示面板)。
- 作業與生命週期管理 (規格、測試個案產生、測試、回饋意見、持續學習、淘汰)。
這些是建立「企業代理程式」解決方案的關鍵結構考量事項,並未涵蓋在此白皮書中;不過,這些考量事項將會在未來的發佈中處理。
## 3\.企業工作人員分類
若要管理企業範圍內的工作人員環境,結構設計師必須透過兩個互補的透鏡來分類工作人員:技術功能與業務影響。
### 3.1 功能角色分類
此分類會分類工作人員在結構內可能採用的功能角色。
- **Channel/UX 角色**:定義互動模式 (例如「無周邊」、「提示」、「聊天與訊息」或「AI 受管理工作區」)。
- **專家角色**:壓縮深度網域 Knowledge (例如,網域專家、Knowledge 主管、助理或計畫者)。
- **公用程式服務角色**:執行離散的交易工作 (例如產生、摘要、轉換或組態)。
- **維護與主動服務角色**:專注於資料健康與品質 (例如精密設計、合規性、資料品質或資料豐富)。
- **長時間執行角色**:管理一段時間內的流程 (例如服務台、專案經理、護理人員或監視者/警示員)。
## 4\.工作人員地圖範本
為了協助清楚設計和溝通,「**工作人員地圖」** 是描述工作人員解決方案的標準範本。它會定義特定設計模式內的關鍵實體、系統和互動。
以下是工作人員地圖範本元件:
- **使用者層級**定義系統中的人力執行動作的使用者 (例如客戶、已驗證員工 (SF-Users) 和未經驗證員工)。
- **工作人員層級**描述必要的工作人員、顯示的模式、彼此之間的關係,以及用於實現特定模式的指示。
- **內容/動作**是工作人員管理或存取的資源、功能或動作。
- **來源**是工作人員連線的基礎資料、應用程式、Knowledge 庫和其他系統。
附錄 A 和 B 會在「工作人員地圖範本」中示範其組成,以說明系統層級的工作人員模式。
## 5\.工作人員模式架構
在 Salesforce,我們使用工作人員模式的文件庫來組織並提供可靠且可預測的工作人員解決方案。這些模式是解決常見結構問題的藍圖。
它們分為四個主要種類:
- **互動模式**:專注於工作人員參與和使用者體驗 (UX)。
- **專家/工作人員模式**:壓縮特定網域內的深度 Knowledge 或特定技能。
- **公用事業與資料管理模式**:執行支援其他工作人員或流程的特定且經常可重複的工作。
- **長時間執行模式**:管理在延長期間內發生的流程和工作流程,包含多個步驟。
下列區段詳細說明每個種類的主要模式。每個模式描述皆提供「**概觀**」、「**輸出類型**」、「**模式使用指南**」、「**代表使用個案**」和「**解決方案圖表**」,以及對應至「**Salesforce 工作人員成熟度標題**」。
## 6\.互動模式
*互動模式*是重點在工作人員參與和使用者體驗的基礎設計。
### 接待員模式
- **概觀**:*Greeter 模式*是一種簡單且易於實作的模式,使用自然語言來決定使用者的意圖。接著會將使用者路由至適當的人工工作人員。
- **輸出類型**:轉移/升級至下一個資源。
- **業務價值**:協助客戶順暢且有效率地開始連絡,同時為服務提供者最大化意圖解析和內容收集。
- **模式使用指南**:將工作人員設定為品牌管道的主要參與資源。根據使用者意圖提供與路由指示配對的品牌、產品和服務指示。工作人員會收集並摘要提供熱門轉送的意圖。
- **代表使用個案**:想像一下使用聊天機器人來呈現選項功能表的網頁,使用者必須先按一下所有選項,才能路由至人類。為了改善後端辦公室的生產力與效率,聊天機器人通常會使用複雜且複雜的工作路徑與互動。這會導致客戶的「填入、選擇和按一下」疲勞情境,如果客戶的內容位於可用功能表選項之外,這通常會導致挫折。將傳統聊天機器人取代為使用自然語言互動的 _Agent Front Door_,可減輕負擔並提供類似人類的互動。
- **Agentforce 配方**:
- Agentforce 服務代理:[建立服務代理程式](https://trailhead.salesforce.com/content/learn/projects/quick-start-build-your-first-agent-with-agentforce)
- 封裝的服務代理有支援轉移的可設定的轉移功能:
- 人力工作人員
- AI 工作人員
- 外部工作人員
- 包含程式碼範例的產業特定模式
- **圖表**:
 - **Salesforce 工作人員成熟度**:層級 1 (或層級 0 (如果您使用具有內建轉移和升級的立即可用服務代理程式)
### 操作員模式
- **概觀**:*運算子模式*會透過將要求路由至適當的專家工作人員或人類,並在需要時進行協商,以建立在 *Greeter 模式*上。
- **輸出類型**:轉移/轉移至下一個資源。
- **模式使用指南**:將品牌和服務特定指示與根據意圖傳送使用者的位置指示配對。定義升級資源,可能是人類或其他工作人員。
- **代表使用個案**:針對人類或 AI 代表高度專長的案例,使用「_工作人員前門_」。
- **圖表**:
 - **Salesforce 工作人員成熟度**:層級 2
### 協調流程模式
- **概觀**:*Orchestrator 模式*會管理 AI 工作人員「群集」。接收使用者要求時,會將說話方式傳遞給一或多個專家工作人員,然後彙總使用者的回應。不同於「_運算子」模式_,其仍是第一個接觸點 (POC)。
- **輸出類型**:整理並準備來自工作人員的工作回應。
- **模式使用指南**:設定為主要參與者。為每個支援工作人員工作人員 (例如,優先順序者或網域 SME) 提供指示,讓協調員能夠將說話方式轉送給他們。
- **代表使用個案**:使用「_協調流程模式_」作為工作人員的前門,協助可能需要在每個對話中討論多個主題的客戶,這需要多位工作人員的解決方案和一致的互動。在多系統結構中,請考量「*協調流程模式」,*以協調跨系統的回應,並透過外部工作人員的協同合作。
- **圖表**:
 - **Salesforce 工作人員成熟度**:層級 3
### 接聽者/摘要模式
- **概觀**:*聆聽者/摘要模式*會在交談流程期間呈現內容與洞察。*聆聽者*會在每次交談輪數期間觸發,以尋找並顯示員工的相關資訊。
- **輸出類型**:根據對話提供相關內容,其可進行格式化以取得效果 (例如,進行比較或醒目提示關鍵點)。
- **模式使用指南**:將「接聽者」附加至以輪數為基礎的管道 (例如聊天、語音或 SMS)。定義每個主題區域的主題。工作人員會耗用文字記錄、識別主題,並叫用動作以搜尋並將相關內容張貼至員工的執行摘要。
- **代表使用個案**:使用 _Universal Assistant_ 協助「客戶服務」或「銷售代表」。
- **圖表**:
 - **Salesforce 工作人員成熟度**:層級 3
### 工作區 (Radar O'Reilly) 模式
- **概觀**:*工作區 (Radar O’Reilly) 模式*會在交談流程中管理回應式單一玻璃 UX。其會處理每種說話方式,以使用相關內容更新 UX 的部分。
- **輸出類型**:提供位於大單一玻璃窗檢視內 Portlet 中的相關內容。
- **模式使用指南**:*協調流程*工作人員會將說話方式傳遞給一套「*主題」*工作人員。每個「主題」工作人員都會評估陳述式,以判定是否需要 UX 更新。如果是,則會將動態更新推送至對應的 LWC。
- **代表使用個案**:此功能類似進階工作人員門。
- **圖表**:
 - **Salesforce 工作人員成熟度**:層級 3
## 7\.專家模式
*專家模式*會壓縮特定領域中的深度 Knowledge 或技能,且通常由 *互動模式*協調。
### 回答機器人模式
- **概觀**:*Answerbot 模式*是自助式服務的有效模式,使用 GenAI 來判斷自然語言以供 Knowledge 提取,而不只是關鍵字。
- **輸出類型**:對支援資料的摘要 Knowledge 與參照/引號。
- **模式使用指南**:組織並取用可靠的來源資料 (例如 Knowledge 存放區或常見問題) 來設定工作人員。在公司網站或內部入口網頁中放置工作人員。監視問題以識別和處理 Knowledge 缺口。
- **代表使用個案**:在公司網站上協助自然語言搜尋、與 HR 優惠機器人互動,並為所有部門成員提供自助式元件。
- **圖表**:
 - **Salesforce 工作人員成熟度**:層級 1
### 網域 SME 模式
- **概觀**:*網域 SME 模式*是一種基礎模式,可為業務領域 (例如「訂單」或「索賠」) 提供自然語言前端。
- **輸出類型**:提供與網域相關的內容、主題、資料和格式資訊。
- **模式使用指南**:使用此模式壓縮主題或業務網域。設定具有執行適當 CRUD 作業能力的工作人員。透過「[_互動」模式_](/docs/architect/zh-tw/fundamentals/guide/enterprise-agentic-architecture#6互動模式)提供這些工作人員 (例如 - 協調流程或聆聽者)。
- **代表使用個案**:保留業務資料網域、提供「訂單工作人員」或「庫存工作人員」,以及為業務網域提供代理介面。
- **圖表**:
 - **Salesforce 工作人員成熟度**:層級 2
### 查詢模式
- **概觀**:*查詢者模式*是 SME 工作人員,可針對主題進行查詢,以組合來自多個來源的內容以回答問題。利用的關鍵工作人員功能是透過人類在閱讀和內建內容後所使用的方式,在內容內文中提取內容並連線概念的能力。此模式可減輕「捲動椅整合」的需求。
- **輸出類型**:提供問題的回答。
- **模式使用指南**:它通常設定為主控台小工具,連線至使用者的目前內容,讓他們可以直接提出問題。也會與 Knowledge 資源搭配使用,例如常見問題、原則和產品目錄。將「*查詢器」模式*與標準提示配對,以將常見的回答調整為常見問題。
- **代表使用個案**:作為契約助理工作人員使用;受益查詢助理或多工作人員模式 (例如「接聽者」或「工作區」) 的專家工作人員工作人員。
- **圖表**:
 - **Salesforce 工作人員成熟度**:層級 2
### 優先順序規格模式
- **概觀**:*優先順序規格模式*用於根據定義的目標排序一組工作或工作物件。其利用 GenAI 進行質性分析、非結構化資料分析或跨多個資料網域的整合分析。
- **輸出類型**:提供生成洞察。
- **模式使用指南**:使用自然語言描述排定優先順序所需的品質。使用一組可選取的選項將工作人員奠基。與「聆聽者」模式結合,以在工作流程中建立回應式「Next Best Action」。
- **代表使用個案**:作為長時間執行或多工作人員模式中的 _Next Best Action_ 產生器或專門工作人員工作人員使用。
- **圖表**:
 - **Salesforce 工作人員成熟度**:層級 2
## 8\.公用程式與資料模式
*公用程式模式*會執行支援其他工作人員或流程的特定可重複工作。
### 發電機模式
- **概觀**:*產生器模式*是從現有輸入和標準建立新內容 (例如個案摘要或電子郵件草稿) 的基本模式。它通常會作為提示進行實作,並可能內嵌在其他工作人員內。
- **輸出類型**:提供符合要求格式和意圖的產生內容。
- **模式使用指南**:*產生器模式*可在大多數其他模式內或作為獨立模式使用。內容可透過要求、執行期間的加水或其他增強步驟提供。
- **代表使用個案**:提供個案摘要、電子郵件草稿、Knowledge 文章或 QBR 的建議/回應。
- **圖表**:
 - **Salesforce 工作人員成熟度**:層級 1
### 資料主管模式
- **概觀**:*資料管理員模式*是自發的背景模式,會將工作人員步驟導入資料作業,以確保一致的資料品質、合規性和增強。
- **輸出類型**:儲存前提供更新的記錄和資料欄位。
- **模式使用指南**:透過在儲存資料前新增記錄觸發流程的資料管理員,以在建立資料時內嵌資料品質。協助確保一致地套用分類、摘要和州/省資料。
- **代表使用個案**:確保一致的「披薩追蹤器」樣式更新、豐富帳戶資料,並消除不相符的郵遞區號和地址。
- **圖表**:
 - **Salesforce 工作人員成熟度**:層級 2
### Zen Data Gardener 模式
- **概觀**:*Zen Data Gardener 模式*是一種已排程的背景模式,用於整理和標準化資料,利用低成本的推理來驗證、增強和對應其他未連線資料網域的資料。
- **輸出類型**:提供更新的記錄和/或資料管理工作。
- **模式使用指南**:使用模式來啟用定期的資料檢閱和驗證。針對變慢的資料,請以緩慢的步調排程工作人員 (例如,每月)。與 [資料管理員模式](/docs/architect/zh-tw/fundamentals/guide/enterprise-agentic-architecture#資料主管模式)結合,以提供潛在和追溯的資料品質作業。
- **代表使用個案**:確保已銷售的福利與索賠系統之間的對齊方式,以及根據國家登錄定期驗證經紀人授權。
- **圖表**:
 - **Salesforce 工作人員成熟度**:層級 4
### 設定工具模式
- **概觀**:*Configurer 模式*會從自然語言需求產生組態成品 (例如 SQL/SOQL、JSON 和 CSV)。也可以反向執行,以根據需求驗證現有組態。
- **輸出類型**:提供更新的記錄、資料管理工作,或建立問題/錯誤以進行修正。
- **模式使用指南**:使用特定標準、原則或範例將工作人員奠基。使用如契約或產品規格等來源來設定建立需求。將 *Configurer 模式*連線至目標系統以推送產生的組態。
- **代表使用個案**:產生健康保險產品的產品組態記錄,並驗證健康提供者的契約/付款條款。
- **圖表**:
 - **Salesforce 工作人員成熟度**:層級 4
### 評判與評審模式
- **概觀**:*法官與陪審員模式*的設計目的為使用「陪審員」工作人員集合,以及評估回應的一致性,以確保回應在實質上一致且有基礎。
- *「組合方式」*內嵌在 Agentforce 和 Atlas Reasoning 引擎中,以解決回應的真實性和相關性。當高準確度至關重要時,*評判與評審模式*會建立此功能。
- _資料奠基_ (例如「在這些記錄/文件中尋找您的答案」) 和 _提示工程_ (例如「只有在這些記錄中找到答案時才傳回」或「根據此外部來源驗證您的答案」) 是最小化幻覺的有效方法。
- **輸出類型**:提供生成洞察。
- **模式使用指南**:強烈需要一致且奠基的生成性輸出時使用。*法官工作人員*會編譯基礎提示,並將其傳遞給兩個以上的 _陪審工作人員_,然後法官會評估回應。為獲得最佳結果,請針對每個「Juror」工作人員使用不同的模型 (例如,一個來自 OpenAI,另一個來自 Anthropic)。
- **代表使用個案**:提供高度忠實且以實情為基礎的回應,以儘量減少幻覺。
- **圖表**:
 - **Salesforce 工作人員成熟度**:層級 2
### 模型模式模型
- **概觀**:*模型模式模式*利用多個專家工作人員來產生廣泛的觀點,然後便會取得共識。不同於 [Judge 與 Jury 模式](/docs/architect/zh-tw/fundamentals/guide/enterprise-agentic-architecture#評判與評審模式),此模式包含多個觀點以增強豐富性。
- 當具有不同檢視點 (POV) 的專家模型時,此模式也稱為「專家面板」模式,且點選時會很有幫助。
- 不同於「判斷者和陪審員」模式,其意圖是確保工作人員回應在常見的「事實」上融合,*模型模式模式*透過利用工作人員環境中的多元性來擴大回應的範圍。
- 此模式假設有其他工作人員具有不同的 POV。例如,在多組織、多工作人員環境或跨技術堆疊具有多個廠商提供工作人員的環境中,*模型模式模式*提供整合多個 POV 的結構。
- 考慮此模式時,也請考慮其他通常較輕量型方法:
- 請指定多個提示,讓系統運作為提示集合,而不是定義多個專家工作人員。
- 透過存取內容上適當資料的動作來利用「奠基」。
- **輸出類型**:提供生成洞察。
- **模式使用指南**:*彙總器*工作人員的角色是根據模型工作人員傳回的重要概念,建立並傳回豐富的 POV。「模型工作人員」會根據其唯一的 POV 決定回應。
- **代表使用個案**:在可能受益於合併不同觀點以增加回應品質的情況下使用。
例如,多系統代理程式環境,其中特權工作人員 (例如,_ERP 工作人員_) 可能具有有價值且無法存取的 POV。
- **圖表**:
 - **Salesforce 工作人員成熟度**:層級 2
## 9\.長時間執行流程模式
*長時間執行流程模式*可管理在長時間內發生的流程,且涉及多個步驟和執行動作的使用者。
### 專案管理員模式
- **概觀**:*Project Manager 模式*是監督長期執行專案的複雜模式。它會協調活動、追蹤完成狀況、通知使用者,並向利害關係人呈現專案狀態。
- **輸出類型**:有多個輸出 (例如個案、工作、狀態更新和通知)。
- **模式使用指南**:作為傘模式來支援定期、重複的多步驟活動。*Project Manager 模式*會取得專案的輸入範本/大綱 (包括工作、角色和相依性),然後例項化個案和活動,並將其指派給使用者。
- **代表使用個案**:用於帳戶安裝管理和企業銷售參與。
- **圖表**:
 - **Salesforce 工作人員成熟度**:層級 4
## 10\.企業協調流程結構類型
模式描述工作人員的角色,而 *協調結構類型*會定義工作人員車隊協同合作方式的系統層級藍圖。這些原型可說明 _Agentforce_ 作為協調流程腦的角色,以及 _MuleSoft_ 作為通用連接器與轉接器的角色。
**結構類型 1:SOMA (單一組織、多位工作人員)**
- **定義**:多個工作人員可在使用共用管理與資料的 Salesforce 組織內進行協同合作。
- **結構流程**:在 Agentforce 中,*上司工作人員*會作為單一前門,將要求路由至組織內的 _專家工作人員_。針對外部功能,工作人員使用具有 MuleSoft 的 _Agentforce MCP Client_ 作為非 MCP 啟用 API 的 MCP 包裝程式。
- **重要考量事項**:此模式會在 Salesforce 中集中協調流程邏輯 (類似於 CRM 內容和 Data 360),以保留統一的管治、身分、權限和可觀察性。
**結構類型 2:MOMA (多組織、多位工作人員)**
- **定義**:工作人員可跨多個 Salesforce 組織協同合作,這需要跨資料與權限界限安全協調。
- **結構流程**:一個組織中的「*上司工作人員」*透過標準化 _工作人員對工作人員 (A2A)_ 通訊協定,將工作委派給另一個組織中的工作人員。此接觸可確保組織層級 Trust、使用者身分驗證流程和共用對話內容。
- **重要考量事項**:此模式可保留組織自主性,同時啟用企業範圍的工作流程,為複雜的多組織主體中一致的工作提供基礎。
**序列類型 3:多廠商 A2A (Salesforce 主導的協調流程)**
- **定義**:Salesforce 中的「*上司工作人員」*會透過 A2A 通訊協定,協調 Salesforce 原生工作人員與來自其他廠商 (例如 Google/Vertex 或 LangGraph) 的工作。
- **結構流程**:*上司工作人員*會處理要求並協調計畫,透過 A2A 通訊協定叫用內部和外部廠商工作人員。針對不適用於 A2A 的外部系統,_MuleSoft_ 可以公開「輕量型工作人員面向」,其會包覆現有工具並與 A2A 通訊。
- **重要考量事項**:此階層類型透過使用 A2A 來產生清潔且可管理的組成,無需個別的協調流程層級,讓協調流程大腦保持靠近 CRM 和 Data 360。
**序列類型 4:多廠商 A2A (MuleSoft 導向的協調流程)**
- **定義**:協調流程是從非 Salesforce 進入點起始,這需要中立外部協調流程者來執行推理和路由。
- **結構流程**:外部系統中的 *UI 工作人員*會將要求轉送至協調流程服務 (概念化為 _MuleSoft Conductor_),該服務會解讀意圖並規劃工作。接著,司機會使用 A2A 將通話路由至廠商工作人員,包括適用於 CRM 或服務動作的 Agentforce 工作人員。
- **重要考量事項**:此模式適用於在結構上偏好中立協調流程的非 Salesforce 進入點。它會將 UX 保持在網域系統中,同時將推理、管治、原則和可觀察性集中在 MuleSoft 中。
## 11\.解決方案組合:撰寫模式
這些個別模式和協調流程結構類型是設計為可組成端對端解決方案的結構建構區塊。「工作人員解決方案地圖」用於視覺化這些元件如何連接。
- 適用於醫療照護提供者的「_成員服務解決方案」_ 是 SOMA 結構類型的標準實作。其使用適用於匿名使用者的 Answerbot、已驗證成員的 _Orchestrator_,以及多個 _網域 SME 工作人員_ (例如「個案」、「索賠」和「福利」) 來處理特定要求。
- *B2C 經紀人入口網頁*是一種複雜的組成,使用入口網頁 *協調流程*工作人員為 RFP 流程叫用長時間執行的 _專案管理員工作人員_,進而使用 _無周邊_、*資料管理員*和 *詢問者工作人員*進行後端辦公室資料作業。
## 12\.結論
工作人員設計模式方法提供建立強大、可調整且可維護的企業 AI 系統所需的結構規律。透過細分複雜性並促進模組化,這些模式可讓結構設計師提供可靠且可預測的工作人員解決方案。
協調流程結構類型的選擇是根據使用者工作的位置、內容所在位置,以及企業如何管理人類、工作人員和系統之間的互動而做的策略性決定。透過瞭解建立工作人員之間的區別並協調工作人員,以及利用如 _MCP_ 和 _A2A_ 等開放式通訊協定,結構設計師可以從建立獨立機器人以外,改為設計一個凝聚式、受管理且分散式的企業推理系統。此方法提供共用語言和一組可重複使用的藍圖,以建立永續的代理架構。
## 附錄:解決方案對應和系統結構
此附錄提供工作人員模式如何組成為系統層級解決方案的具體範例。
### 附錄 A:基本模式組成範例
此圖說明如何將五個基本模式連接在一起,以建立常見的客戶服務工作流程。
 1. **Answerbot**:匿名使用者提出問題,由 Knowledge 型工作人員處理。
2. **操作員**:員工的問題由「運算子」分級,該運算子會欄位交談,並將其傳送給更專業的工作人員。
3. **協調流程**:器已驗證的使用者 (SF 使用者) 會與協調器互動,協調多個工作人員以處理潛在的多面向查詢。
4. **網域 SME**:專家工作人員 (例如「HR 工作人員」或「福利工作人員」) 會由協調流程器叫用,以執行主題事項更新並檢取特定資料。
5. **發電機**:公用程式工作人員用於在互動完成後摘要帳戶詳細資料或總結個案。
### 附錄 B:工作人員解決方案地圖 - 成員服務
此解決方案對應詳細說明「成員服務」使用個案的代理結構,示範多個模式的組成。
- **使用者設定檔**:解決方案提供三種不同的使用者類型:匿名使用者、已驗證成員和 SF 使用者 (例如,人類 CSR)。
- **互動模式**:_Answerbot_ 會處理匿名「尋找文件」查詢,而 Orchestrator (工作人員前門) 會管理已驗證的使用者查詢。*聆聽者/摘要模式*可協助 SF 使用者。
- **網域工作人員重複使用**:專用 _網域 SME 工作人員_ (例如「個案工作人員」、「索賠工作人員」或「福利工作人員」) 可在不同的互動流程中重複使用。
- **自動與輔助**:系統結合了 _獨立工作人員_ (以導向使用者互動) 和 _輔助工作人員_ (以增加人體 CSR)。
- **資料來源**:此結構整合了公用和企業資料來源的混合,並廣泛使用 _Data 360_ 和 _MuleSoft_ 來進行連線。
 ### 附錄 C:系統結構 - 連絡中心
此圖說明「連絡中心」中「輔助 AI」解決方案的邏輯結構,並組織成功能層。
- **協調流程工作人員**:管理不同角色 (例如匿名、外部成員或 CSR) 的使用者體驗,並協調整體互動流程。
- **工作人員**:*多個 SME 工作人員*專注於核心業務領域,例如 Knowledge、個案/索賠/福利和提供者目錄。_Next Best Action_ 工作人員也包含在內。
- **公用程式工作人員**:執行特定可重複使用的工作,例如翻譯、個案總結和通話摘要。
整合與核心系統:整個代理程式系統透過跨平台整合層連線至非結構化資料資源、結構化資料資源和核心企業系統。
- **監管**:監管層提供工作人員所使用 LLM/SLM 的可觀察性、評估和管理。
 ### 附錄 D:工作人員解決方案地圖 - 經紀人入口網頁
此解決方案對應詳細說明 B2B 健康保險經紀人入口網頁的複雜且長期執行中工作人員互動。此模型包含一個 _入口網頁代理程式_ (_協調程式_),可協助經紀人完成多個步驟的旅程 (例如提交 RFP 並接收提案)。此協調流程會叫用一個 *專案管理員*工作人員,該工作人員接著會針對後端辦公室資料品質和轉換協調數個無周邊工作人員,例如 RFP Extractor、普查轉換和資料管理員。
 ### 附錄 E:系統結構 - B2C 經紀人工作人員
此圖表顯示 B2C Broker 解決方案的邏輯結構,其示範與「連絡中心」類似的分層方法。其中包含不同使用者角色的 _協調流程工作人員_、可重複使用的關鍵網域 (例如 Knowledge、成員服務或佣金) 的 _Worker 工作人員_,以及翻譯和摘要等特定功能的 _公用程式工作人員_。
 ### 附錄 F:系統結構 - 提供者契約
此圖顯示「提供者契約」解決方案的邏輯結構。*協調流程*工作人員管理完整的互動、*工作人員*在網域內管理特定的意圖 (例如,承包中 SME 工作人員),以及 *公用事業*工作人員執行離散的工作,例如比較契約或產生洞察。
 ### 附錄 G:互動模式摘要表格
下表摘要列出數個關鍵互動模式、一般使用者體驗和主要結構目的。
| 模式 | 使用者體驗 (UX) | 目的 |
|---|---|---|
| 接待員 | 以轉換文字 (聊天、語音、SMS 等) 結尾為回應者將互動轉移給人類 | 這是用來判斷使用者意圖的簡單模式,然後將使用者路由至適當的人工工作人員。 |
| 操作員 | 以轉換文字 (聊天、語音、SMS 等) 結尾為回應者將互動轉移給人類或專家工作人員 | 這會用來將要求路由至適當的混合工作人員。此模式以「接待員」為基礎,可協商意圖,然後將互動轉移給專業的人類或 AI 工作人員。 |
| 協調流程 | 使用回應者收集並彙總專家工作人員回應,並將其傳送至 UX 的逐步轉換文字 (聊天、語音、SMS 等) | 這用於協調受管理 AI 工作人員「群集」,其會在進行時回應交談。「協調流程」工作人員會將每一輪的文字傳遞給一或多個專家工作人員,然後彙總每個工作人員的回應。 |
| 回答機器人 | 提示與回應 | 這是使用 Knowledge 資源、常見問題、原則等來形成回應的自然語言介面。 |
| 查詢者 | 提示與回應 | 這是一種自然語言介面,用於在特定網域或區域中提出問題。 |
| 接聽者 / 摘要 | 以協調流程模式結尾並摘要線性摘要的逐步轉換文字 (聊天、語音、SMS 等) | 這可用來呈現對話流程中的內容和洞察。 |
| 工作區 (Radar O'Reilly) | 以自適應式的單一玻璃窗格上門顯示畫面結尾的逐步轉換文字 (聊天、語音、SMS 等) | 這用於在對話流程中管理回應式的單窗式 UX。 |
 已建立的 API 導向連線三層式方法 (系統、流程和 Experience API) 提供結構化工作人員可採取動作的強大架構。
- **系統 API** 為基本記錄系統提供一致、安全且抽象的介面。它們會將工作人員與後端通訊協定和資料模型的複雜性分離,以確保所有工作人員動作都會在受管理且可靠的端點上執行。
- **流程 API** 會壓縮複雜的多步驟業務邏輯。工作人員不需要瞭解建立銷售訂單、檢查庫存或起始出貨後的複雜協調流程。他們可以使用流程 API (例如「流程訂單」),而無須處理基本複雜性。流程 API 提供安全、交易且可稽核的機制讓工作人員執行業務流程,進而大幅減少工作人員所需的推理,並確保持續強制執行業務規則。
- **Experience API** 以傳統設計為提供特定 UI 應用程式 (例如「訂單管理應用程式」),但也可以重新用作工作人員的內容豐富動作。這可提供工作人員執行指定工作的必要資訊,而不需要對下游系統進行多次呼叫。
## **1\.生成式建立:加速開發可供工作人員使用的資產**
為了滿足對工作人員就緒工具和功能的日益增加需求,企業必須加速開發構成可組合基礎的 API 和整合。_MuleSoft_ 透過將生成式 AI 直接內嵌在開發生命週期中來解決這個挑戰,這會建立一個使用 AI 的虛擬週期,以建立其他工作人員所耗用的高品質資產。
### **1.1 MuleSoft Vibes**
針對開發人員,[MuleSoft Vibes](https://www.mulesoft.com/platform/api/anypoint-code-builder/announcing-mulesoft-vibes) 會自動化整合開發中最重複的層面,並為整個軟體開發生命週期提供統一的代理介面,以作為智慧合作夥伴。透過 [Anypoint 程式碼產生器](https://docs.mulesoft.com/anypoint-code-builder/)中的 MuleSoft Vibes,開發人員可以與由[受信任的 _Einstein AI 銷售管道_](https://blogs.mulesoft.com/automation/how-mulesoft-turns-generative-output-into-value/)支援的生成功能互動,進而讓 AI 輔助開發流程順利且有效率。此管道 (_推斷圖表執行服務 (IGES)_) 是用於達成高品質結果的多階段流程。其中包含奠基、驗證、錯誤修正和嚴格評估。
 - _MuleSoft Vibes_ 中的「[**產生流程」**](https://blogs.mulesoft.com/dev-guides/einstein-for-acb/) 功能以 _Agentforce AI_ 架構為基礎。它會將自然語言商業邏輯 (使用者提示) 轉換為功能式 Mule 應用程式。*IGES 銷售管道*包含以下步驟:
- **對話歷程記錄摘要:**LLM 會分析目前的提示和使用者的先前訊息,以建立摘要提示,該提示會收集使用者意圖和對話歷程記錄。此合併的提示可改善後續資料提取與產生步驟的準確度。
- **從向量資料庫的流程語意取得:**系統會從上一個步驟取得摘要提示,並針對包含 200 個以上連接器、7,000 個以上連接器作業和 7,000 個以上範例程式碼片段的向量資料庫執行語意搜尋。其會使用準確的資料,以取得最相關的連接器、作業和程式碼範例,以奠基產生程序,並確保輸出符合 MuleSoft 的廣泛連接器生態系統。由於 MuleSoft 是連接器和作業的業界標準,因此此基礎可為模型提供一般 LLM 缺少的豐富內容和網域準確度。
- **增量:**接著,系統會結合摘要的提示,以結合所取的內容和對話歷程記錄訊息。此擴大提示可引導 LLM 減少幻覺。其中也包含防止產生有毒內容的指示。
- **流程產生:**此步驟利用 _Einstein AI LLM_ 模型,以根據提供的內容與範例產生原始 XML 程式碼。這是產生管道的核心步驟。
- **後續處理與驗證:**後端處理器和驗證程式會檢查程式碼以確保語法正確,並使用有效的連接器作業,而個別的毒性檢查會標記有害的內容。
- **多步驟錯誤修正:**如果所有的初始產生無效,自動錯誤修正機制會分析錯誤訊息以偵測模式。接著,會將提示與豐富的錯誤訊息和修正中繼資料一起重新提交至 LLM。
- **設定檔案產生:**此步驟會解壓縮相關連接器中繼資料、增強提示,並將其傳送至 LLM 以產生準確的連接器組態。最後,所有 POM 和 XML 命名空間都會使用每個相依性的最新版本來決定性地產生,進而消除幻覺並確保一致性。
- [**DataWeave 轉換產生**](https://blogs.mulesoft.com/dev-guides/dataweave-generative-transformation/)**:**資料轉換通常是整合開發的最耗時部分。_MuleSoft Vibes_ 使用與產生 _Mule Flow XML_ 類似的多步驟方法來處理此流程。
- **意圖原因:**LLM 會分析使用者輸入和輸出資料樣本,以自然語言推斷和說明概況轉換邏輯。此步驟會將使用者的目標與提示中可能提供的文字資料值分開。
- **DataWeave 語意尋找:**為了尋找與語意最相關的 DataWeave 函數文件和完整的轉換範例,系統會使用上一個步驟產生的提示作為向量資料庫的查詢。這會讓產生流程以高品質且經過驗證的資訊為基礎。
- **增量:**系統會將取用的函數和範例與原始使用者提示結合在一起,為後續 LLM 呼叫建立感內容的指示集,這會影響 LLM 的行為以減少幻覺。
- **DataWeave 產生:**此步驟利用 LLM 模型產生 DataWeave 轉換指令檔,並根據提供的內容與範例提供隨附的說明。這是產生管道的核心步驟。
- 系統會根據兩個特定度量評估產生的指令檔:有效性和正確性。\*\*\*\*指令檔必須編譯而不含語法錯誤 (有效性),並在使用範例輸入 (正確性) 執行時產生預期的輸出。
- **多步驟錯誤修正:**如果初始驗證失敗,則此外掛程式會識別錯誤種類,並在產生的指令檔中修正問題。此精簡有助於改善系統的整體成功率與準確性。
- **最終後續處理與驗證** 來自錯誤修正模組的已更正指令檔會經過重新驗證流程,以確保其在語法上有效且在功能上正確。在將輸出傳送回使用者之前,此最終品質門可確保輸出精確且可靠。
- [**API 規格**](https://docs.mulesoft.com/anypoint-code-builder/api-ai-create-spec) **和 [文件產生](https://docs.mulesoft.com/exchange/generating-documentation-with-ai):**開發人員可以透過以自然語言描述所需的 API,產生完全驗證的 _OpenAPI (OAS)_ 或 _RAML_ 規格。_MuleSoft Vibes_ 會提取提示 (其中包含資源、方法、安全性架構和參數的詳細資料),並產生有效且語法正確的 API 定義。產生後,其可以在 *Anypoint Exchange 中*建立 API 文件,其中涵蓋從驗證到端點詳細資料和錯誤處理的所有內容,以免開發人員執行這些繁琐的工作類型。
- **AI 輔助的 MUnit 產生:**針對由自發工作人員耗用的資產,品質保證至關重要。_MuleSoft Vibes_ 可協助直接從 Mule 流程程程式碼產生 MUnit 測試個案。這有助於模擬外部相依性和判斷式,並識別常見的測試缺口,進而大幅減少達到高測試範圍和確保整合邏輯可靠性的手動工作。
### **1.2 MuleSoft Your Way**
開發人員在其偏好的環境中成長。這就是為什麼 _MuleSoft_ 會在他們所在的位置與開發人員會面,這可讓他們在自己選擇的 AI IDE 中建立整合。[MuleSoft 的模型內容通訊協定 (MCP) 伺服器](https://www.npmjs.com/package/@mulesoft/mcp-server)將開發、部署和管理功能公開為 MCP 工具,任何以 VS 程式碼為基礎的 AI 原生 IDE (例如 Cursor、Windsurf 或 Trae) 都可以使用這些功能來使用自然語言與 _Anypoint Platform_ 互動。
透過將其核心 IDE 功能封裝到 [標準 VS 程式碼擴充](https://marketplace.visualstudio.com/items?itemName=salesforce.mule-dx-extension-pack)中,_MuleSoft _ 會將其工具與品牌的 IDE 範本分離,這可讓開發工具對 IDE 進行反射。此結構選項不必與 IDE 的快速進化競爭,而是允許 MuleSoft 的開發工具在現代 AI 技術支援的 IDE 生態系統中保持相容且可供存取。
## **2\.啟用可操作性:將 API 轉換為工作人員的工具**
在「代理企業」中,擁有可編輯 API 的強大基礎是必要的,但不足。下一個重要步驟是確保 AI 工作人員可以探索、瞭解並叫用這些資產。這需要以特別針對工作人員通訊設計的開放標準為基礎建立的「可操作層」。_MuleSoft_ 為兩個主要的新通訊協定提供企業級工具:
- 工作人員對系統互動的 **MCP**
- 工作人員對工作人員互動的 **A2A**
 ### **2.1 模型內容通訊協定 (MCP)**
_MCP_ 迅速成為工作人員對工具通訊的業界標準,這與 Web 服務的 _REST_ 變得類似。_MCP_ 可讓 AI 工作人員動態探索系統的功能、瞭解其輸入和輸出,並叫用以執行動作,而不需要預先程式設計或硬式編碼邏輯。
[MuleSoft MCP 連接器](https://docs.mulesoft.com/mcp-connector/latest/)允許將任何實作為 Mule 應用程式的 API 發佈為 MCP 伺服器。由於 _MuleSoft_ 為幾乎每個主要企業系統 (例如 SaaS、舊版和資料庫) 提供數百個預先建置的連接器,因此會立即將組織的 API 和應用程式轉換為一組可供工作人員使用的工具。專為在 SAP 中檢查庫存所設計的 API、在 Salesforce 中處理新商機的流程,或透過 _MuleSoft_ 連線的自訂應用程式,皆可使用 *MCP 連接器*作為原子受管理工具提供給 AI 工作人員。
### **2.2 工作人員對工作人員通訊協定 (A2A)**
雖然 _MCP_ 在階層式、工作人員叫用工具互動方面表現優異,但複雜的業務流程通常需要多個專門工作人員的協同合作。_工作人員對工作人員 (A2A)_ 通訊協定是新興的開放標準,其設計目的為協助點對點通訊,可啟用複雜的多工作人員工作流程。
MuleSoft 對 A2A 的支援可讓企業設計和建置進階系統,其管理與可靠性等級與其預期的 API 相同。[MuleSoft A2A 連接器](https://docs.mulesoft.com/a2a-connector/latest/)可讓開發人員輕鬆將任何工作人員公開為 A2A 伺服器,或從 Mule 應用程式叫用任何 A2A 相容的工作人員。例如,抵押貸款申請流程可能會跨「信用檢查工作人員」、「文件簽署工作人員」和「法規合規工作人員」協調,每個工作人員會探索並根據需要叫用其他人員的功能,以繼續進行申請。
透過為 MCP 和 A2A 提供強大的企業級工具,MuleSoft 支援建立由直接工作人員對系統互動 (透過 MCP 工具) 和工作人員對工作人員 (A2A) 互動組成的彈性生態系統。無論 AI 環境如何發展,此方法都會將 _MuleSoft_ 視為連接所有形式代理通訊的基礎。
## **3\.MuleSoft Agent Fabric:工作人員企業的中部神經系統**
當企業採用工作人員 AI 時,不可避免地會面臨工作人員擴展的挑戰。為了防止變成混亂,需要專屬的協調流程層。[MuleSoft Agent Fabric](https://docs.mulesoft.com/agent-fabric/) ([示範](https://www.youtube.com/watch?v=GAqwPie16ic)) 是全方位的結構解決方案,專為面對此挑戰而設計。它提供一個集中式的管理計畫,可探索、管理、協調和觀察 AI 工作人員的整個網路,無論其建立的位置或作業方式為何。_MuleSoft Agent Fabric_ 作為企業數位人力的「空中流量控制器」,將分割、隔離的工作人員集合轉換為一個凝聚力、安全且高效能的情報網路。
_MuleSoft Agent Fabric_ 以四個整合的支柱為基礎,涵蓋工作人員作為一流企業資產的完整生命週期管理。
### **3.1 工作人員登錄 (探索)**
任何受管理生態系統的基礎就是可探索性。*工作人員註冊處*作為企業內每個工作人員資產的通用集中型目錄。這包括自訂建立的工作人員、內嵌在 SaaS 應用程式的工作人員、公開舊版系統的 MCP 伺服器,以及適用於工作人員間協同合作的 A2A 端點。透過提供單一事實來源,*工作人員註冊處*可透過防止小組建立冗餘功能,並讓人類開發人員和其他 AI 工作人員能夠動態尋找和大規模重複使用現有資產來解決重要探索問題。
 *工作人員登錄*是以 _Anypoint Exchange_ 為基礎,並新增三種新資產類型:工作人員、MCP 伺服器和 LLM。它會收集這些資產的相關資訊,包括 MCP 工具、傳輸通訊協定和工作人員卡片,以及工作人員與 MCP 伺服器和使用工具之間的相依性。開發人員可以直接在註冊表內建立及管理資產。他們也可以在建立新協調流程時,以程式設計的方式探索並重複使用 MuleSoft Vibes 內的現有資產 (透過 _MuleSoft MCP Server 的_ search_asset 工具)。這可讓開發人員取得瞭解和取用這些資產所需的所有資訊。
### **3.2 工作人員經紀人 (協調流程)**
一旦可探索資產,必須協調資產,才能執行實用工作。*工作人員經紀人*是一種協調流程服務,可執行多步驟業務流程。其使用可設定的 LLM 解譯高層級工作並產生對應的工作流程。*工作人員經紀人*會動態探索、排序並叫用完成這些流程所需的工作人員和工具。
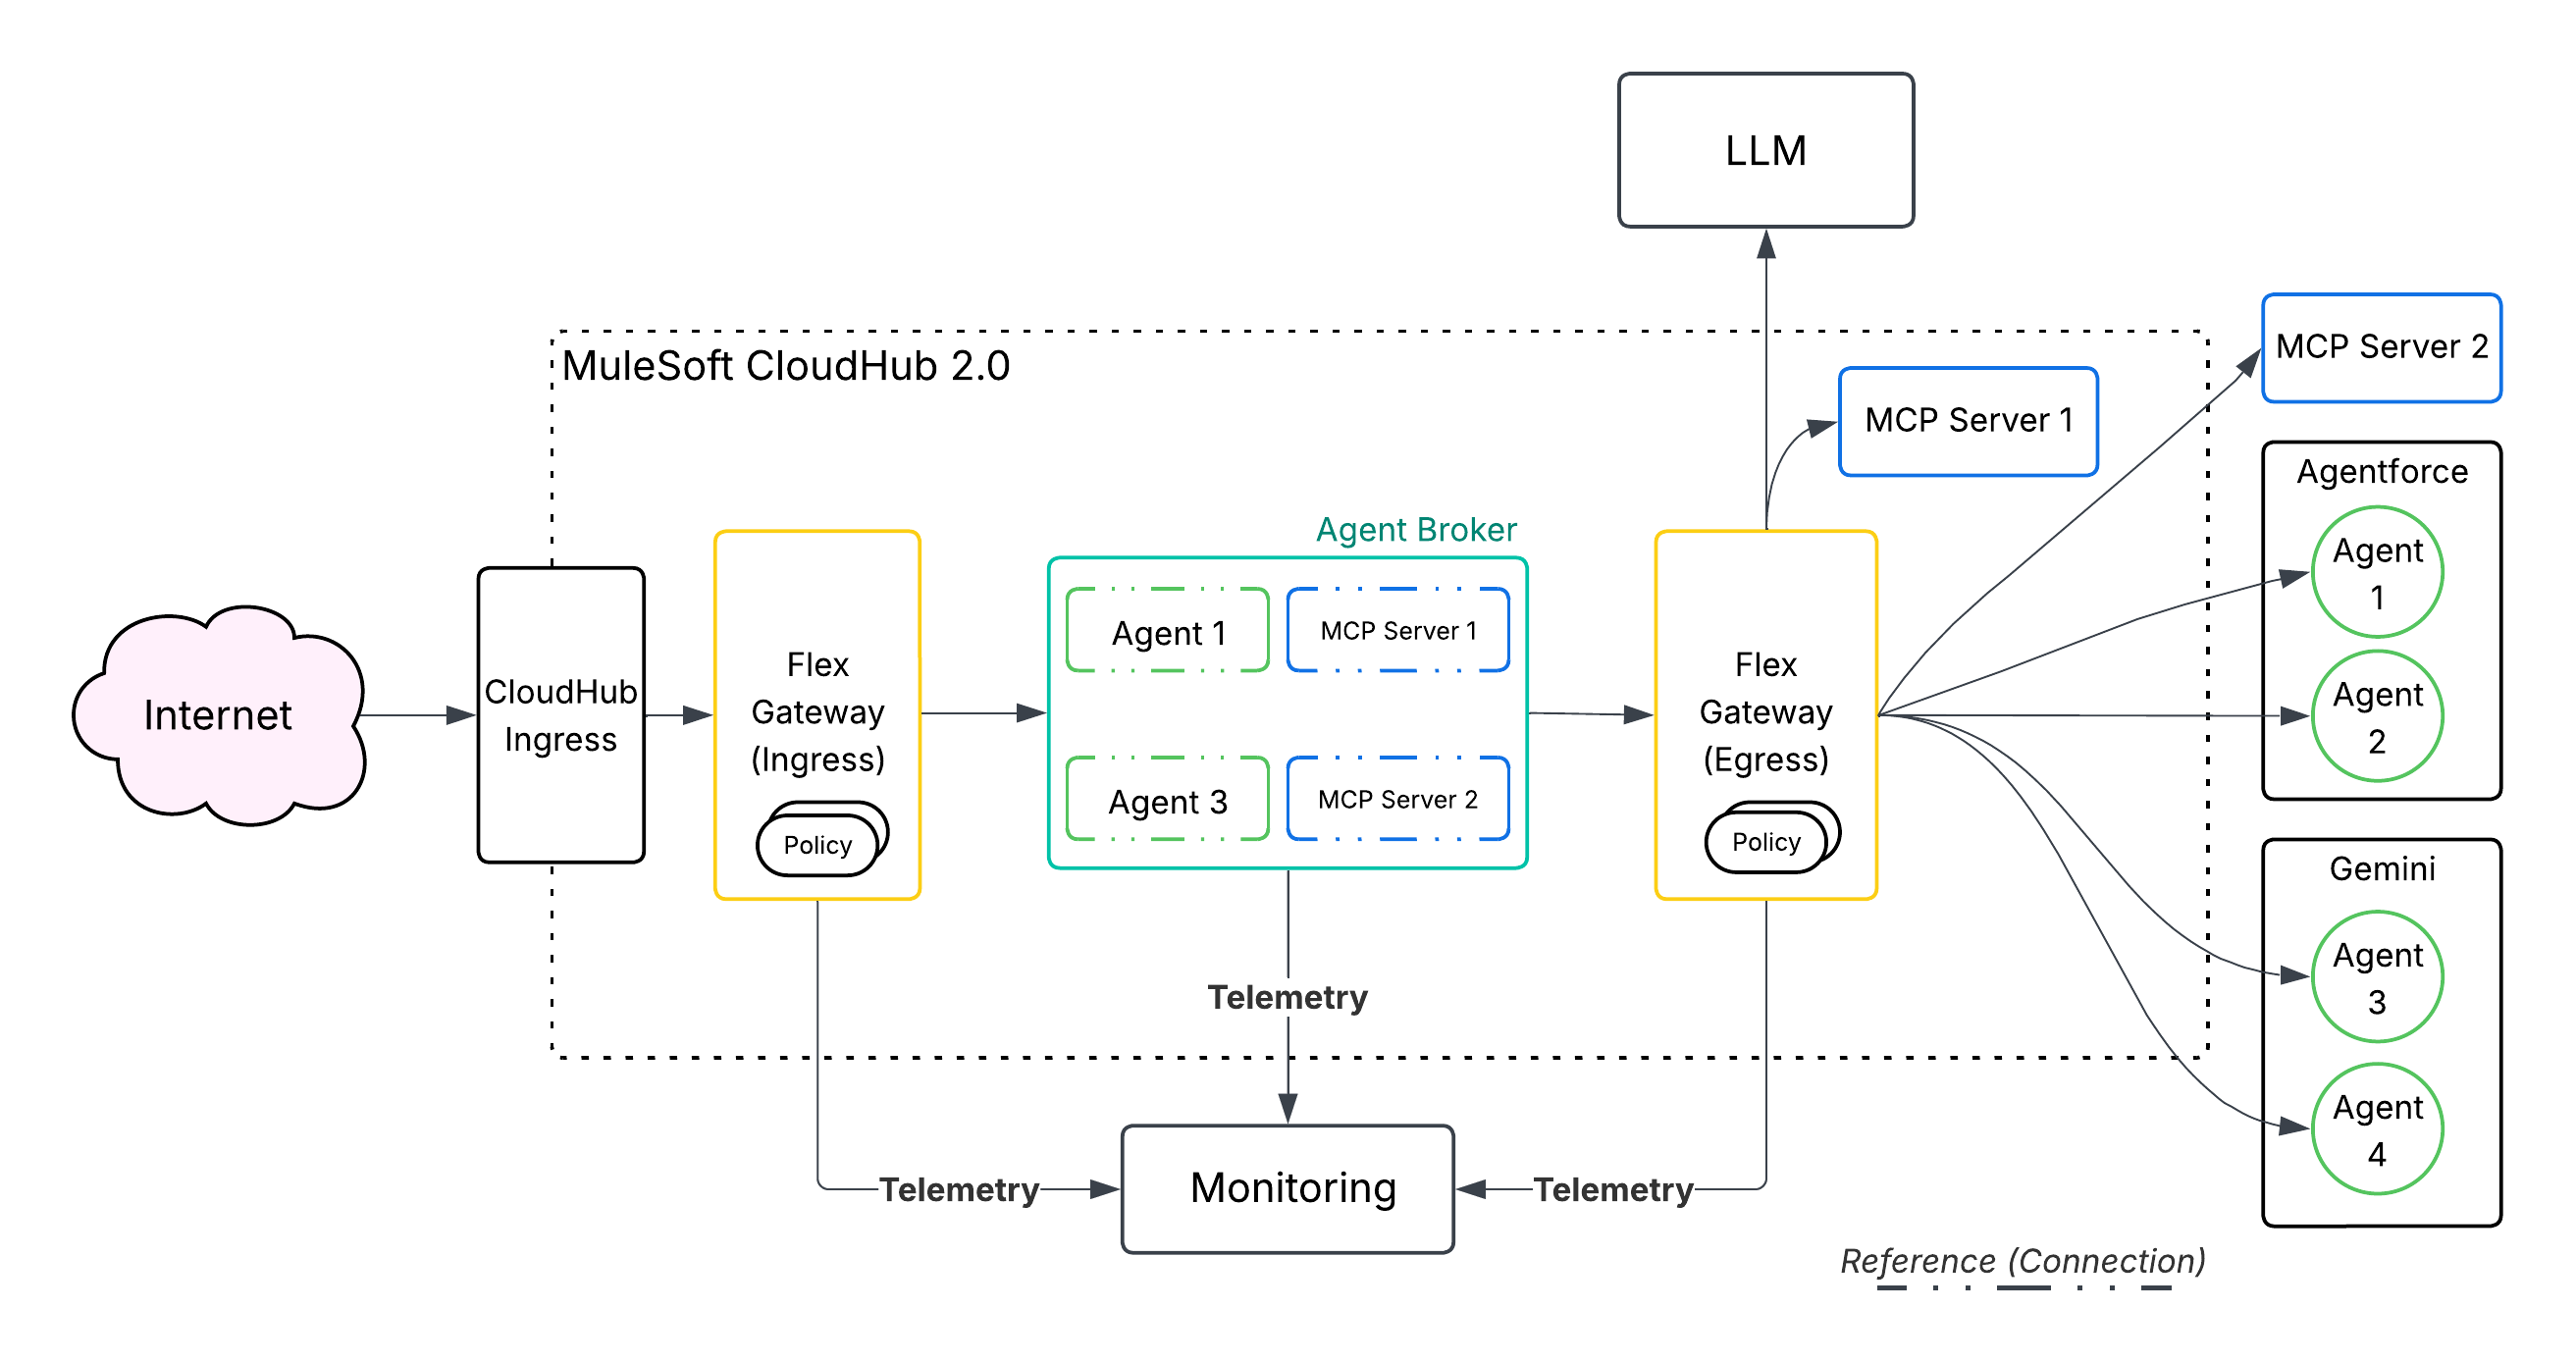 透過工具的 _MCP_ 和工作人員的 _A2A_ 通訊協定來管理連線。這可讓系統將工作人員組織到業務特定的網域 (例如「供應鏈」或「財務」),並在所有網域之間路由工作。單一自然語言提示 (例如「上線員工」) 會分成一系列由不同工作人員或工具在多個後端系統之間執行的離散動作。「工作人員經紀人協調流程」包括:
- **動態協調流程模式:**這是「工作人員迴圈」模式,可決定子工作,並在最適合的工作人員和工具之間協調工作,以達成整體目標。利用此模式,可建立 [協同合作工作人員](/docs/architect/zh-tw/fundamentals/guide/agentic-patterns#15-協同合作工作人員-工作人員群集)來解決複雜的使用個案 (例如,[處理複雜的服務升級](/docs/architect/zh-tw/fundamentals/guide/agentic-patterns#35-協同合作工作人員使用個案複雜服務升級))。
- **LLM 強化的理由:**使用 LLM 解譯自然語言目標並產生執行計畫,進而去除硬式編碼的嚴格工作流程邏輯。
- **可設定的 LLM 模型:**允許開發人員指定要使用的 LLM 模型,其可控制成本、效能和功能。
- **自然語言開發:***工作人員經紀人*邏輯可透過 _MuleSoft Vibes_ 使用自然語言來定義。
- **觀察性:**_Anypoint Monitoring_ 會在部署時提供記錄和追蹤,以協助使用者瞭解和除錯工作人員經紀人的推理,以及與 _MCP_ 工具和 _A2A_ 工作人員的互動。
- **受管理部署:**_Agent Broker_ 是容器化應用程式,受 _Mule Runtime_ 支援,可管理部署的可用性和延展性。
### **3.3 MCP 與 A2A 的 Flex Gateway (管理)**
_Anypoint Flex Gateway_ 是技術上強制執行特定原則的機制。_MuleSoft Agent Fabric_ 利用 _Anypoint Flex Gateway_ 來[保護、檢查和管理透過 _MCP_ 和 _A2A_ 通訊協定發生的每個代理互動](https://docs.mulesoft.com/gateway/latest/flex-agent-secure)。這可讓組織將一組豐富的企業級[原則](https://docs.mulesoft.com/gateway/latest/flex-agent-policies)套用至所有工作人員流量,以確保每個動作在執行前皆安全、合規且可稽核。若要安全且負責任地擴大 AI 採用,這些護欄十分重要。
| 保單名稱 | 通訊協定 | 描述 |
| :---------------------------------------- | :------- | :----------------------------------------------------------------------------------------------------------------------------- |
| **JWT 驗證原則/用戶端識別碼強制執行原則** | A2A、MCP | **JWT 驗證原則/用戶端識別碼強制執行原則**會透過僅限制對已驗證來電者的存取權,來保護 _A2A_ 工作人員和 _MCP_ 伺服器的安全。 |
| **結構描述驗證** | A2A、MCP | **結構描述驗證**可確保傳入的工作人員要求符合 _A2A_ 或 _MCP_ 規格,以防止錯誤格式化的流量。 |
| **A2A PII 偵測器** | A2A | **A2A PII 偵測器**會識別要求和回應中的「_個人可識別資訊」(PII)_,並啟用記錄或封鎖以符合合規性需求。 |
| **A2A 提示裝飾器** | A2A | **A2A Prompt Decorator** 會將自訂內容或指示注入傳送給工作人員的提示,以指引其行為並強制執行護欄。 |
| **以 MCP 屬性為基礎的存取控制** | MCP | **MCP 屬性型存取控制**會根據使用者屬性 (例如「層級」、「IP」或「JWT」宣告」) 來控制對 _MCP_ 伺服器公開特定工具和資源的存取權。 |
| **SSE 記錄** | A2A、MCP | 「**SSE 記錄」** 會記錄工作人員通訊協定用於全方位稽核和追蹤性的「_伺服器傳送事件」(SSE)_ 串流內容。 |
| **比率限制與點數控制** | A2A、MCP | **比率限制和尖端控制**會強制執行要求限制,藉此保護後端工作人員和系統免受流量激增和拒絕服務攻擊。 |
| **A2A 工作人員卡** | A2A | **A2A 工作人員卡片**會重寫工作人員卡片 URL,以確保透過受管理的 Flex Gateway 例項正確佈建所有流量。 |
**工作人員通訊協定的企業管理原則**
除了管理輸入要求之外,_Anypoint Flex Gateway_ 也會管理工作人員與外部服務 (例如,_MCP_ 伺服器和工具或其他工作人員) 的所有傳出連線和要求。包括:
- **登入:**提供集中化的可觀察點,以監視和記錄所有用於稽核和疑難排解的輸出工作人員要求。
- **安全性:**透過檢查輸出流量來防止敏感資料洩漏。
- **驗證:**透過從單一點套用輸出驗證機制 (包括 API 金鑰、OAuth 和 ClientId/ClientSecret) 來管理外部系統的認證。
_Anypoint Flex Gateway_ [**Policy Development Kit (PDK**)](https://docs.mulesoft.com/pdk/latest/policies-pdk-overview) 可讓使用者在立即可用的原則不符合特定需求時建立自訂原則。透過使用 _PDK_,開發人員可以使用 _Rust_ 程式設計語言撰寫原則邏輯,並將其編譯為 _WebAssembly (WASM)_ 模組。接著將獨立模組載入至 _Anypoint Flex Gateway_,以直接在 API 邊緣強制執行唯一的安全性規則、自訂資料轉換或專門的整合邏輯。這可為獨特或複雜的使用個案提供強大且高效能的方法,以擴充通道功能。
以下是 _PDK_: 的四個重要元件
- **Anypoint CLI PDK 外掛程式:**此外掛程式會建立 _PDK_ 專案,並將編譯的原則上載至 _Exchange_。它也會產生一個 _Makefile_,透過提供一組明確的指令來建立和管理原則來簡化開發程序。
- **原則範本:**建立新專案時,_PDK_ 會產生基本的架構或範本。此結構包含成功編譯原則所需的所有必要檔案和組態,這為開發人員提供自訂邏輯的起點。
- **SDK 建立工具:**這些工具會摘要基本 _Envoy_ Proxy 以事件為導向的複雜結構。透過使用反應器和執行器模式,_SDK_ 提供簡單的線性編碼方法。這有助於降低複雜性、改善除錯,並降低開發人員的學習曲線。
- **原則管理:**[MuleSoft MCP Server](https://docs.mulesoft.com/mulesoft-mcp-server/reference-mcp-tools) 提供 _MCP_ 工具,協助使用者管理自訂原則生命週期。這些工具的範例包括:
- get_flex_gateway_policy_example
- manage_api_instance_policy
- manage_flex_gateway_policy_project
### **3.4 工作人員視覺化程式 (觀察)**
 *工作人員視覺化程式*提供完整工作人員網路的即時動態地圖,將 AI 互動的「黑盒」變成可完全觀察的系統。結構設計師和作業小組可以使用「_工作人員視覺化工具_」來檢閱工作人員的連線方式、追蹤其決策流程、監視其健康與效能,以及識別相依性。此層級的可視性對於最佳化效能、有效地疑難排解失敗、偵測瓶頸,以及對已部署的工作人員建立信任至關重要。
## **4\.Salesforce Platform 統一**
### **4.1 API 目錄與主題中心**
*MuleSoft API 目錄*和 *主題中心*的設計目的為改善如何探索、使用和管理 API,特別是與 _Agentforce_ 搭配使用。
所有設計和發佈的 _MuleSoft_ API 都可以透過 _Salesforce Platform_ 中的 [API 目錄](https://help.salesforce.com/s/articleView?id=platform.api_catalog.htm&type=5)進行探索和取用。*API 目錄*作為集中化存放庫,將組織的所有 API (從 _MuleSoft_、_Salesforce_、_Heroku_ 和其他雲端) 統一到單一檢視。這可讓開發人員和管理員輕鬆探索、瞭解和重複使用現有 API,方法是讓其能夠用於自動化 (例如,_Agentforce_、_Flow_ 和 _Apex_)。
Agentforce 的 [MuleSoft:「主題中心」](https://blogs.mulesoft.com/news/mulesoft-for-agentforce-topic-center/)可讓開發人員在設計時定義 Agentforce **Topics** 和 **Actions** 中繼資料,以根據特定業務使用個案來建構其 API。包括:
- **動作**,這是工作人員可執行的工作
- **指示**,可引導工作人員瞭解如何套用特定動作
透過[新增此語意層級](https://docs.mulesoft.com/anypoint-code-builder/ai-enabling-api-project-topic-center),_「主題中心_」可讓 API 可理解且可供 _Agentforce_ 使用,以確保其能夠有效地與企業系統互動。
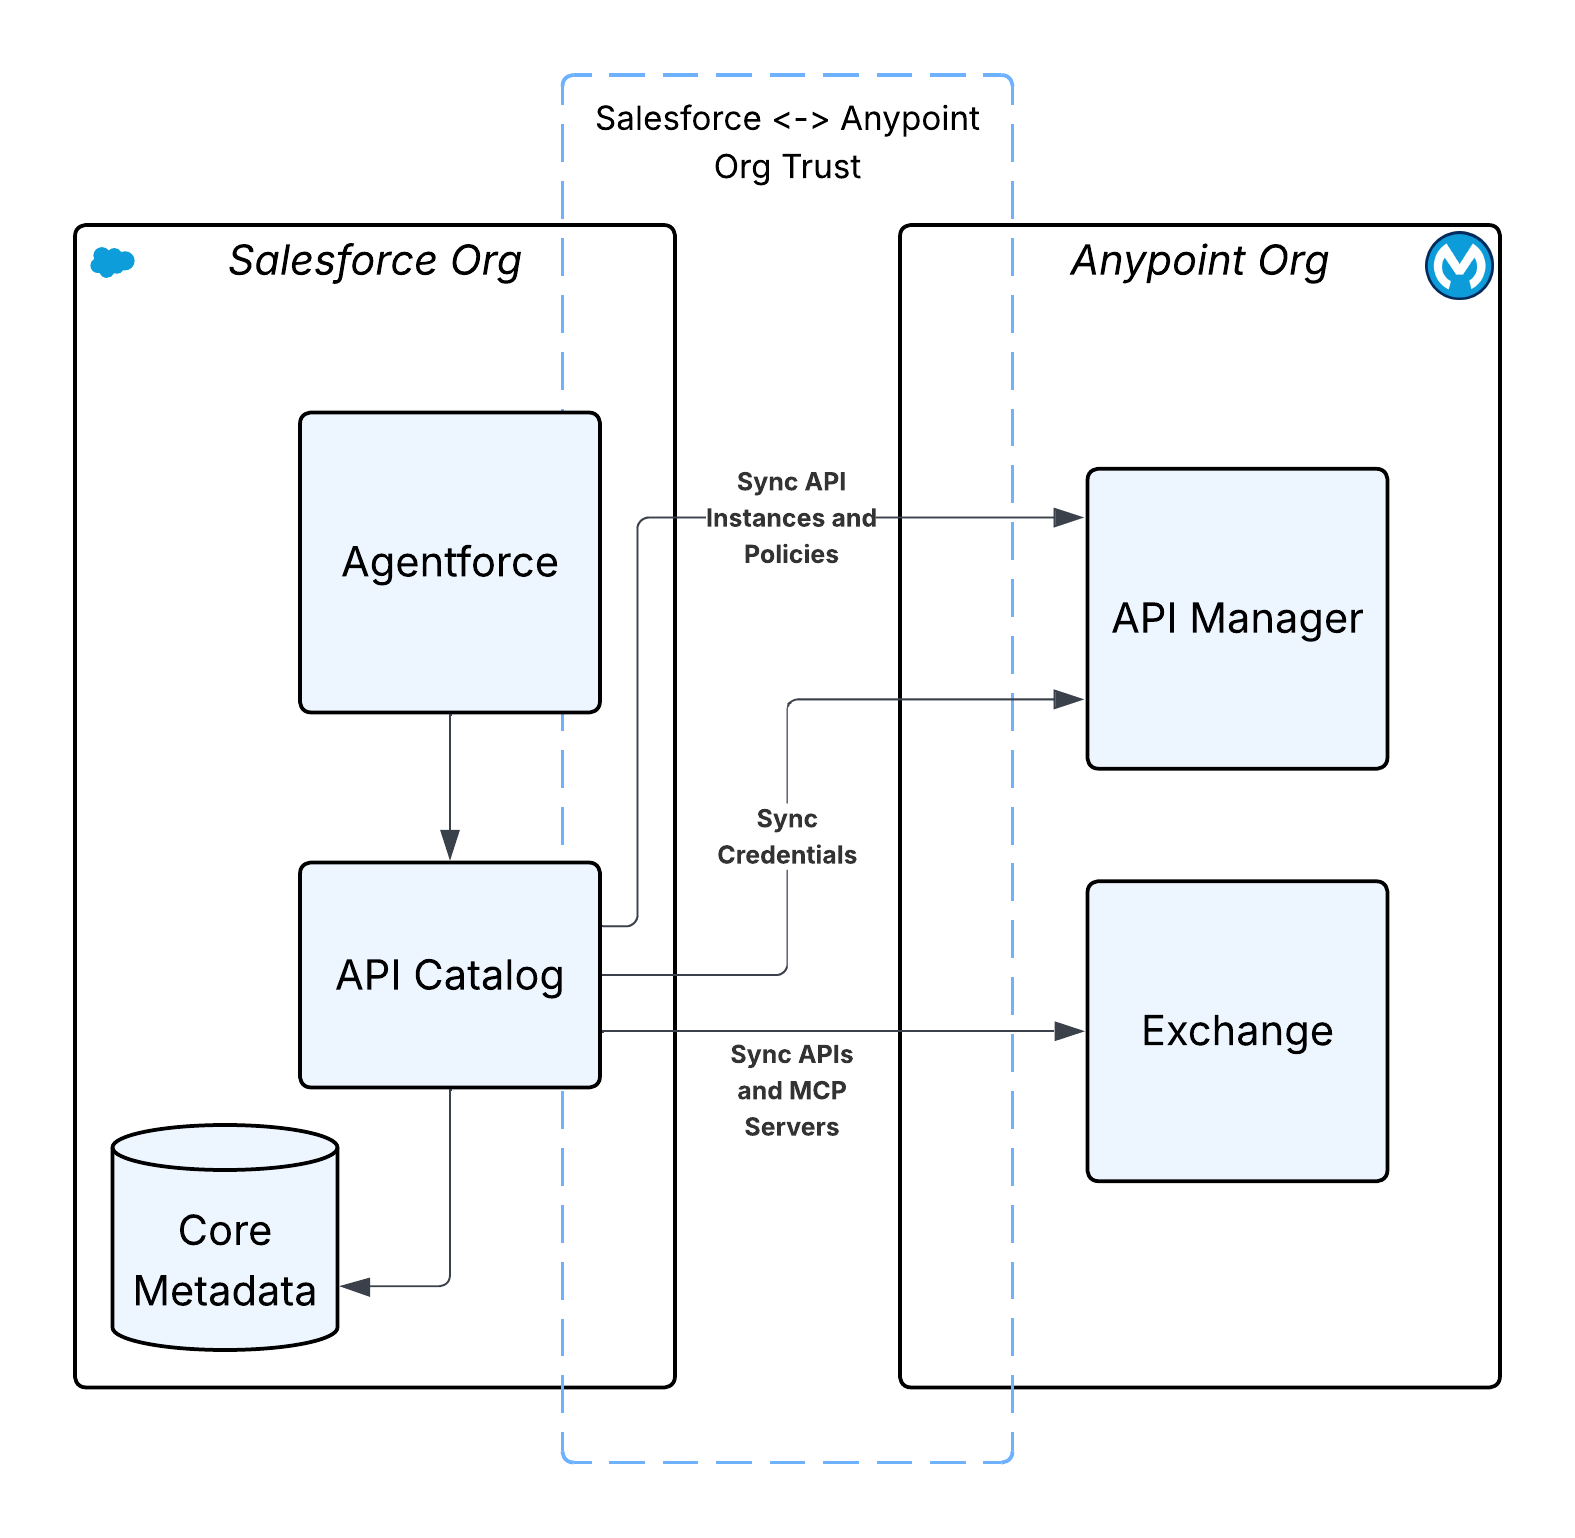 ### **4.2 Agentforce Gateway**
_Agentforce Gateway_ 是一個集中式的管治層,專為管理及保護擴充中 _Agentforce_ 生態系統內的互動而設計。由於 _Agentforce_ 透過如 _MCP_ 等通訊協定與其他第三方 API 和工具整合,因此 _Agentforce Gateway_ 的主要功能是針對由 _Agentforce_ 起始的所有輸出流量強制執行原則 (例如比率限制和工具限制),並稽核所有傳出要求。
_Agentforce Gateway_ 利用現有的 _MuleSoft_ API 監管原則引擎,原生內建於 _Salesforce Platform_ 中。此以 *傳送者*為基礎的原則引擎會攔截工作人員流量、套用設定的原則 (例如,以屬性為基礎的存取控制和配額限制),以及管理驗證和授權,而不需要客戶安裝額外的大門基礎結構。
 ### **4.3 整合情報**
部署受管理的工作人員網路是里程碑成就。然而,這會帶來新的「第二天」作業挑戰。它需要增強層級的作業情報,才能監視、測量和疑難排解動態分散式自發執行動作的系統。最終的結構願景是系統,其中 AI 不僅用於執行業務流程,還用於監視、管理和修復其執行基礎結構。
*MuleSoft 的*整合智慧願景利用更廣泛的 _Salesforce_ 生態系統的強大功能,為整合架構和代理程式網路的效能提供深入且可自訂的洞察。透過在 **Salesforce Data 360 中** (即可觀察性的新增標準) 在「[OpenTelemetry (OTEL)」合規](https://opentelemetry.io/)資料中,組織可以建立整個地圖的記錄、度量和追蹤統一存放庫。透過預先建置的顯示面板和自訂視覺效果,您可以在 **Tableau 中**檢視此資料,以取得 API 效能、工作人員互動模式和整體系統健康狀況的詳細洞察。
 此系統有三個關鍵元件:
1. **入院:**其為從各種 _Mule_ 應用程式、*工作人員經紀人*和 _Flex Gateways_ 收集及處理遙測資料的集中進入點。其會執行結構描述驗證、資料正規化和篩選,以維護各種應用程式的資料品質和一致性。此外,它也會在取用管道中強制執行控制 (例如驗證、加密、租戶公平性和比率限制)。
2. **儲存空間:**高流量串流工作會以 _Data 360_ 執行,此工作會讀取來自多租戶 _Kafka_ 主題的資料,並將其轉換為 _OTEL_ 格式。接著,OTEL 資料會認可至在 *Lakehouse 中*的 _TelemetryTraceSpan_、_TelemetryLogs_ 和 _TelemetryMetrics DMO_ 中租戶的 _Data 360_。
3. **視覺化/耗用:**透過在 *Data 360 中*提供的遠端測量資料,客戶可以透過 _Tableau Next_ 使用預先建置或自訂顯示面板來檢閱系統狀態並取得洞察。客戶也可以利用 [Tableau Concierge](https://help.salesforce.com/s/articleView?id=analytics.tua_metric_questions.htm&type=5),這是 _Tableau Next_ 中預先建置的代理分析技能,可讓使用者以自然語言詢問相距測量資料的相關問題,並透過視覺效果接收可靠且可運作的回答。客戶也可以將資料匯出至現有的 _應用程式效能管理 (APM)_ 系統 (例如,_DynaTrace_、_Datadog_、_Splunk_ 等)。
## **結論**
轉換至「代理企業」不只是 IT 升級,而是基本的結構轉換點。AI 工作人員的分片化、隔離部署是營運混亂、陰影 IT 和無法管理技術債務的直接路徑。唯一的永續發展路徑是透過統一且可組合的結構。_MuleSoft Agent Fabric_ 以經過驗證的 API 導向連線基礎為基礎,提供管理新數位人力所需的「中央神經系統」。其提供探索、協調流程、企業級監管和端對端可觀察性的關鍵功能。這是我們超越 AI 實驗的方式,開始建構真正智慧、自動和安全的企業,將自主潛力轉換為具體、受管理的業務成果。
## **技術指南與參考**
- [開始使用 Anypoint 程式碼產生器](https://docs.mulesoft.com/anypoint-code-builder/start-acb)
- Einstein for Anypoint Code Builder 的 [技術指南:生成流程](https://blogs.mulesoft.com/dev-guides/einstein-for-acb/)
- [DataWeave 生成轉換 Deep Dive:快速資料轉換的 AI 創新](https://blogs.mulesoft.com/dev-guides/dataweave-generative-transformation/)
- [使用 MuleSoft Dev Agent 建立 API 規格](https://docs.mulesoft.com/anypoint-code-builder/api-ai-create-spec)
- [使用 Einstein 生成式 AI 產生 API 文件](https://docs.mulesoft.com/exchange/generating-documentation-with-ai)
- [MuleSoft MCP 伺服器概觀](https://docs.mulesoft.com/mulesoft-mcp-server/)
- [MuleSoft MCP 伺服器工具](https://docs.mulesoft.com/mulesoft-mcp-server/reference-mcp-tools)
- [MCP 連接器](https://docs.mulesoft.com/mcp-connector/latest/)
- [A2A 連接器](https://docs.mulesoft.com/a2a-connector/latest/)
- [開始使用工作人員面板](https://docs.mulesoft.com/agent-fabric/learning-map-agent-fabric)
- [使用 Flex Gateway 保護工作人員的互動](https://docs.mulesoft.com/gateway/latest/flex-agent-secure)
- [Flex Gateway 工作人員原則](https://docs.mulesoft.com/gateway/latest/flex-agent-policies)
- [Flex Gateway Policy Development Kit (PDK) 概觀](https://docs.mulesoft.com/pdk/latest/policies-pdk-overview)
- [Salesforce 的 MuleSoft API 目錄](https://help.salesforce.com/s/articleView?id=platform.api_catalog.htm&type=5)
- [為主題和工作人員動作啟用 API 專案](https://docs.mulesoft.com/anypoint-code-builder/ai-enabling-api-project-topic-center)
- [使用 Tableau 下一步](https://help.salesforce.com/s/articleView?id=analytics.tua_consume.htm&type=5)
- [OpenTelemetry](https://opentelemetry.io/)
- [模型內容通訊協定](https://modelcontextprotocol.io/docs/getting-started/intro)
- [Agent2Agent (A2A) 通訊協定](https://a2a-protocol.org/latest/)
## 關於作者
Nikhil Aggarwal 是 Salesforce 的主要結構設計師,負責 MuleSoft 和 Salesforce Automation Cloud 的結構設計。Nikhil 在提供大規模產品方面擁有超過 18 年的經驗,並對可調整結構、直覺式開發人員體驗和建立績效優良的小組有熱忱。在 Salesforce 之前,他在 Microsoft Power Platform、Dataverse 和 Office 365 中從概念到啟動領導多個計畫。他的工作繼續構思現代企業在 AI 初期時代如何連線系統、自動化工作流程,以及發揮業務價值。
## 摘要
軟體的模式正在從直接操作轉為目標導向的委派。此轉換的最前沿是 AI 工作人員—能夠瞭解、推理及代表使用者採取動作的自主智慧實體。此白皮書提供 AI 工作人員主要類型的技術探索:對話、主動、環境、自發和協同合作。它定義每個類型、呈現特定的「客戶關係管理」(CRM) 使用個案,並提供在 Salesforce _Agentforce_ Platform 上建立這些工作人員的結構藍圖,以及利用 Flow、Apex、Data 360、Agent2Agent (A2A) 通訊和模型內容通訊協定 (MCP) 互通性的技術範例。
## 第一章:AI 工作人員的分類
AI 工作人員是一種系統,可認知其環境並採取行動以達成特定目標。雖然此概念並非新概念,但功能強大的大型語言模型 (LLM) 已強化其功能。我們可以根據工作人員的主要作業模式和互動來分類工作人員。
### 1.1 對話工作人員
**定義:**對話工作人員是最常見的工作人員類型。它們以反應性的要求回應方式運作,主要透過自然語言介面 (文字或語音)。其核心功能是瞭解使用者的意圖並提供相關回應,無論是回答問題、提取資訊或執行簡單指令。
**重要性:**對話工作人員是組織的數位前門。他們在處理精確定義且重複性的工作方面表現出色,從而釋放人力資源。其成效的測量方式是能夠快速且準確地解決使用者意圖,並代表使用者採取行動。
 ### 1.2 主動工作人員
**定義:**不同於等待提示的對話工作人員,主動工作人員會作為警覺的觀察者。它們是由系統內的特定事件、資料變更或預先定義的條件所觸發。觸發時,他們會執行工作或起始工作流程,而不需要直接使用者互動。
**重要性:**主動工作人員會將系統從被動式資料存放庫轉換為業務流程的主動參與者。它們會在機會和風險出現時識別,讓企業能夠即時對重要訊號採取行動。
 ### 1.3 環境工作人員
**定義:**環境工作人員是主動工作人員的特定類型,會在使用者工作流程的背景中持續作業,而不需要明確指令。使用者通常會從其動作中獲益,而不會意識到其作業,因為其設計目的在於增強人力功能,同時維持較低的設定檔。
**重要性:**環境工作人員的目標是透過自動化日常的「工作相關工作」,來降低使用者的認知負擔。透過流暢整合至員工每日使用的工具,以自動收集和建構資訊,進而提升流程效率。
 ### 1.4 獨立工作人員
**定義:**獨立工作人員代表複雜性大幅上升。系統會為他們提供高階目標,並能夠獨立規劃並執行一系列步驟以達成該目標。他們可以思考、做出決策,甚至從動作中學習,以隨著時間改善績效。
**重要性:**這是與真正的數位員工最接近的地方。您可以將複雜的多步驟目標 (例如「本季在製造行業中產生 50 個新的合格商機」) 委派給自發工作人員,並信任其制定並執行計畫以達成目標。
 ### 1.5 協同合作工作人員 (工作人員群集)
**定義:**協同合作工作人員通常稱為「工作人員群集」,是專門工作人員的集合,這些工作人員共同解決的問題過於複雜,無法讓任何單一工作人員處理。「協調器」或「主要」工作人員通常會拆分大型工作、將子工作委派給適當的專門工作人員,然後將其輸出同步化。強大的 Agent2Agent (A2A) 通訊協定可達成此目標。
**重要性:**此方法反映人類的小組。透過細分複雜的問題,每個專門工作人員都可以運用其獨特的技能:一個專注於資料分析、另一個專注於客戶通訊,第三個專注於系統整合,進而提供更強大且全方位的解決方案。
 ## 第 2 章:Agentforce 結構模式
探索 AI 工作人員的分類後,仍有一個關鍵問題:我們如何結合這些元素,以有效且可靠地解決實際的業務問題?本章透過提供常見工作人員設計模式的儲存庫來回答該問題。每個模式都是對循環挑戰的已驗證解決方案,針對從簡單、單一用途的工作人員到複雜、協同合作的工作人員群組提供的一切藍圖。
### 2.1 對話工作人員模式
對話工作人員通常是組織 AI 功能的前門。其定義的能力是參與狀態豐富、多輪對話的能力,作為使用者執行工作及使用自然語言提取資訊的主要介面。此區段提供兩個建立對話工作人員的必要配方,每個配方都專為特定管道量身打造:一個用於傳訊用戶端的快速互動交換,另一個用於電子郵件的結構化非同步性質。
對話工作人員的智慧衍生自對話工作人員在正確時間存取正確資料並考量正確資料的能力。此模式依賴複雜的資料基礎,連線至客戶記錄、Knowledge 文章和業務分析。[第 4 章提供這些整合的完整可重複使用配方:整合模式](#第-4-章工作人員的整合模式)。
#### 2.1.a 對話工作人員:互動式傳訊用戶端模式
**問題**
客戶可跨許多數位管道參與**,並期望立即、內容相關且智慧回應。**傳統聊天機器人是以**指令檔**或為**資料盲目,**這會導致個人化不佳、早期升級至人類,以及高服務成本。
**內容**
- 您的組織具有多管道數位參與 (WhatsApp、SMS、Slack 和 Salesforce Experience Cloud)。
- 您組織的客戶會以[多國語言](https://help.salesforce.com/s/articleView?id=ai.service_agent_considerations.htm&type=5)與您的組織互動。
- 您的組織需要使用下列工作人員來擴大服務和銷售工作流程:
- 從即時信任的客戶資料提取
- 遵循護欄與規範要求
- 僅在必要時升級至人力工作人員
 **關鍵元件**
- **管道抽象:**Service Cloud 增強型聊天 (先前稱為「應用程式內和 Web 傳訊」) 可讓工作人員透過單一體驗跨多個管道通訊。
- **Agentforce 服務代理:**工作人員的行為與目標由下列元件定義。
- **主題與指示:**定義直接使用者互動的工作人員角色和對話用途。這包括其核心任務 (例如「您是解決客戶支援問題的專家」)、維持同情和專業語氣的指示,以及有關授權處理的查詢範圍的清晰護欄。
- **動作:**服務導向動作是工作人員用來即時診斷和解決客戶問題的工具。這些工具的設計目的為執行如檢查訂單狀態、搜尋 Knowledge 庫中的解決方案,或直接從對話介面建立新的支援個案等工作。
- **護欄:**護欄會作為一組可設定的規則和執行階段檢查,以限制工作人員的行為。作為安全層,可攔截提示、驗證工作人員建議的動作,並篩選其最終回應,以防止有害內容、強制執行業務規則,並確保工作人員在其指定的範圍內作業。
- **提示範本:**透過 Data 360 RAG Retrievers 的合併欄位或語意資料,動態填入即時 CRM 資料的可重複使用範本。這些範本可讓工作人員產生相關聯的品牌內容,而 Einstein Trust 層會在將指示傳送至 LLM 之前安全地遮蔽敏感資訊。
- **Data 360**
- Data 360 元件 (包括 DLO、DMO、向量存放區和 RAG 提取器) 為工作人員提供所有相關企業資料的統一檢視,從結構化客戶記錄到非結構化 Knowledge 文章,以確保回應準確且以內容為基礎。
- **Service Cloud**
- **CRM 資料:**將工作人員連線至完整的個案歷程記錄,提供帳戶詳細資料、連絡人記錄和權益的關鍵內容
- **「Live Agent」(即時工作人員):**支援升級並路由至已插入完整對話內容的人工服務代表
**互動**
1. 您組織的客戶透過管道開始交談。
2. 訊息會路由至 **Agentforce,**這會決定範圍 (主題) 並套用護欄。
3. AI 會使用 **提示範本**撰寫回應,而流程或 Apex 可能會觸發後端邏輯。
4. 系統會透過 RAG retriever 從 **Data 360 物件、向量存放區和 CRM** 提取內容。
5. AI 會傳回內容相關回答。
6. 如果 AI 無法解決,則對話會升級至 **Service Cloud 即時工作人員。**
**貿易**
| 層面 | 收益 | 成本 |
|---|---|---|
| 回應速度 | 隨時開啟的立即回覆 | 複雜查詢的 2+ 秒延遲 |
| 準確性 | 透過 RAG 以實際資料為基礎 | 需要精密設計且最新的向量商店 |
| 延展性 | 近乎無限同時對話 | 必須透過快取、合格和篩選來最佳化成本 |
| 彈性 | 處理開放式查詢 | 需要精密的提示工程 |
| 人性觸控 | 人力服務代表僅處理複雜的個案 | 若升級值錯誤,客戶感到沮喪 |
| 對話多元性 | 需要不同的 Knowledge、技能和工具的大量意圖 | 需要持續主題與指示調整以最佳化準確性和延遲性 |
 **關鍵元件**
- **電子郵件管道:**處理收集輸入訊息、剖析其內容和附件,以及維護討論串連性以啟用非同步對話。
- **Agentforce SDR 工作人員:**工作人員的行為與目標由下列元件定義。
- **主題與指示:**定義工作人員透過交談來參與並使輸入商機合格的任務。這包括瞭解潛在客戶需求、收集關鍵資格資料 (例如預算、授權和時間表) 的指示,以及引導對話進行明確的後續步驟,例如排程與帳戶主管的會議。
- **動作:**可讓工作人員管理商機生命週期的專用銷售動作。這些工具的設計目的為執行核心 SDR 工作,例如增強商機資料、傳送範本後續追蹤電子郵件,或與行事曆系統整合以預訂探索通話。
- **護欄:**護欄會作為一組可設定的規則和執行階段檢查,以限制工作人員的行為。作為安全層,可攔截提示、驗證工作人員建議的動作,並篩選其最終回應,以防止有害內容、強制執行業務規則,並確保工作人員在其指定的範圍內作業。
- **提示範本:**透過 Data 360 RAG Retrievers 的合併欄位或語意資料,動態填入即時 CRM 資料的可重複使用範本。這些範本可讓工作人員產生相關聯的品牌內容,而 Einstein Trust 層會在將指示傳送至 LLM 之前安全地遮蔽敏感資訊。
- **Data 360**
- Data 360 元件 (包括 DLO、DMO、向量存放區和 RAG 提取器) 為工作人員提供所有相關企業資料的統一檢視,從結構化客戶記錄到非結構化 Knowledge 文章,以確保回應準確且以內容為基礎。
- **Sales Cloud**
- **CRM 資料:**將工作人員連線至完整的個案歷程記錄,提供帳戶詳細資料、連絡人記錄和權益的關鍵內容
- **排程客戶和 SDR 之間的會議:**SDR Live Agent 轉移可設定為使用「工作」和「會議排程」(後續動作) 設定即時會議。
- **活動記錄:**由於 SDR 工作人員的互動,便可捕捉事件、工作和電子郵件活動,並將其與商機、帳戶和機會相關聯。
**互動**
1. 客戶透過管道傳送及接收電子郵件,該管道會路由至 Agentforce。
2. Agentforce 會套用主題、動作和護欄來剖析意圖。
3. Agentforce 使用增強 CRM 和 Data 360 內容的提示範本來撰寫內容回應草稿。
4. 多輪電子郵件對話會持續直到解決方案或原則指導方針為止。
5. 針對合格的商機,Agentforce 會排程會議並更新 CRM。
6. 如果意圖超過 AI 範圍,則 Agentforce 會針對人力服務代表回應升級至 Sales Cloud SDR。
**貿易**
| 層面 | 收益 | 成本 |
|---|---|---|
| 回應速度 | <5 分鐘的第一個回應 (相對)。8–24 小時) | 與電話相比,個人化的初始拓展程度較低 |
| SDR 容量 | 商機涵蓋範圍增加 2–5 倍 | 遺失早期建立關係的接觸點 |
| 資格一致性 | 非同步取得預算、授權、需求和時程表 (BANT) 涵蓋範圍 | 可能會遺漏細微的訊號 |
| 內容準確性 | RAG 確保最新資訊 | 需要精密設計的銷售產品和啟用程式庫。多輪可能很繁琐 |
| 會議轉換 | 大幅提升轉換 | 某些會議的商機品質低 (若有 BANT 間隙) |
| 成本效率 | 比人類 SDR 更具成本效益 | 開發和維護成本 |
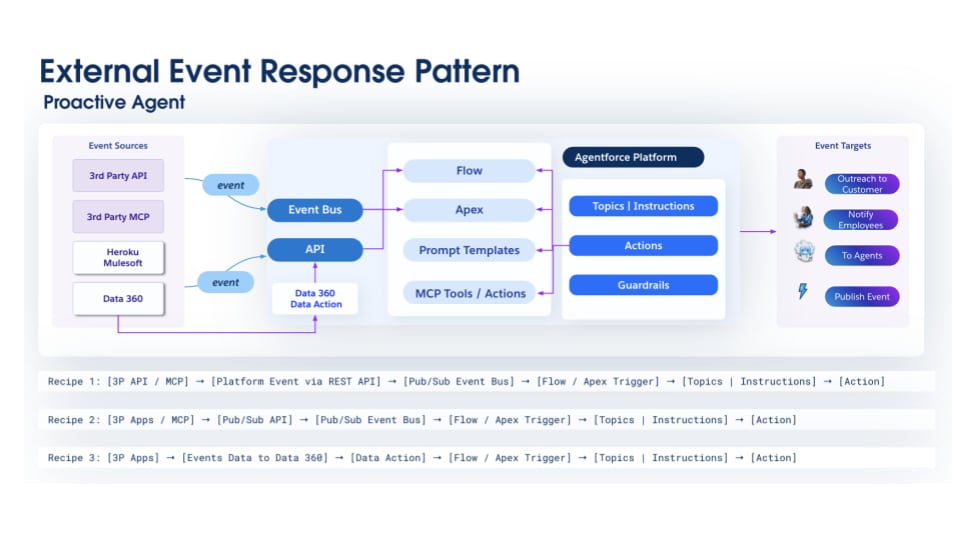 **關鍵元件**
- **事件來源**
- 「資料動作」會在將外部資料提取至 Data 360 後觸發事件
- 可透過 Salesforce Pub/Sub API 將事件傳送至 Salesforce 的第三方或 Salesforce Heroku MCP 伺服器
- 可透過 Salesforce Pub/Sub API 傳送事件通知的外部應用程式
- **選擇性中介:**轉換的 MuleSoft 或 Data 360
- **Agentforce 工作人員:**工作人員的行為與目標由下列元件定義。
- **主題與指示:**指定工作人員的核心任務及其觸發,包括定義其主要目標 (例如「監視所有高優先順序個案並防止 SLA 缺口」)。包含工作人員應傾聽以起始工作的特定事件或資料條件
- **動作:**為回應外部事件而設計的事件觸發和排程動作。雖然這些動作會針對例行工作自主執行,但通常會包含協調涉及人類介入的工作流程的功能,並將其升級至使用者以供檢閱、批准或處理需要人類判斷的情境。
- **護欄:**護欄會作為一組可設定的規則和執行階段檢查,以限制工作人員的行為。作為安全層,可攔截提示、驗證工作人員建議的動作,並篩選其最終回應,以防止有害內容、強制執行業務規則,並確保工作人員在其指定的範圍內作業。
- **提示範本:**透過 Data 360 RAG Retrievers 的合併欄位或語意資料,動態填入即時 CRM 資料的可重複使用範本。這些範本可讓工作人員產生相關聯的品牌內容,而 Einstein Trust 層會在將指示傳送至 LLM 之前安全地遮蔽敏感資訊。
- **Data 360**
- Data 360 元件 (包括 **DLO 和 DMO),**可儲存事件資料,[由外部系統產生並傳送至 salesforce](https://developer.salesforce.com/docs/data/data-cloud-int/guide/c360-a-create-eventbusconnector-data-stream.html),以轉換和建立串流或即時洞察
- **已計算、串流和即時洞察**可提供工作人員與客戶相關的立即資料。這可啟用預防性問題解決方案,緩解升級。**資料圖**主動呈現來自不同資料來源的關係和洞察,以便及早偵測與客戶參與、活動和設定檔相關的模式或異常。
- **Data 360 向量存放區和 RAG** 提取器為工作人員提供所有相關企業資料和非結構化 Knowledge 文章的統一檢視,確保回應準確且以內容為基礎。
- **事件目標**
- 主動通知員工或連絡客戶
- 可延伸至工作人員 (請參閱 [環境工作人員](#23-環境工作人員模式)和[自動工作人員](#25-自動工作人員模式)模式)
**互動**
1. 外部系統發生明顯的變更。
2. 外部系統會透過 API (建立平台事件) 或 Pub/Sub API 來發送事件並將其發佈至 Salesforce Event Bus,或將事件資料串流至 Data 360。
3. 觸發事件的訂閱者。觸發流程。
4. 流程會呼叫具有事件資料的「[工作人員動作](https://help.salesforce.com/s/articleView?id=platform.automate_flow_ref_elements_actions_generate_ai_agent_response.htm&type=5)」。工作人員決定正確的動作方式並執行。
5. 結果是觸發的通知或工作流程。通知會在協同合作工具 (例如 Slack) 中傳送給使用者。也會產生工作或事件。此外,動作會呼叫外部系統。因此,事件不會遺失,但會主動執行、訊號和動作,從而移除人類的負擔或複雜的自動化來探索。
**貿易**
| 層面 | 收益 | 成本 |
|---|---|---|
| 即時整合 | 事件會在秒內觸發動作。 | API 進入複雜性 (合作夥伴 SLA 變異性) |
| 智慧回應 | 使用 CRM 和外部內容進行 AI 強化的決策 | 增強會增加延遲和過時的資料 (例如異常事件)。 |
| 寬鬆配對 | 與 Salesforce 邏輯無關的外部系統 | 非同步處理最終會導致一致性。 |
| 延展性 | 處理突發事件 | API 限制、事件儲存成本 |
| 雙向 | Salesforce 可以回應外部系統。 | 外部 API 相依性、失敗情況 |
| 安全性 | 已簽署的已驗證事件,外部系統的最低 (或零) 權限存取權 | 重複執行保護、金鑰輪換和營運負擔 |
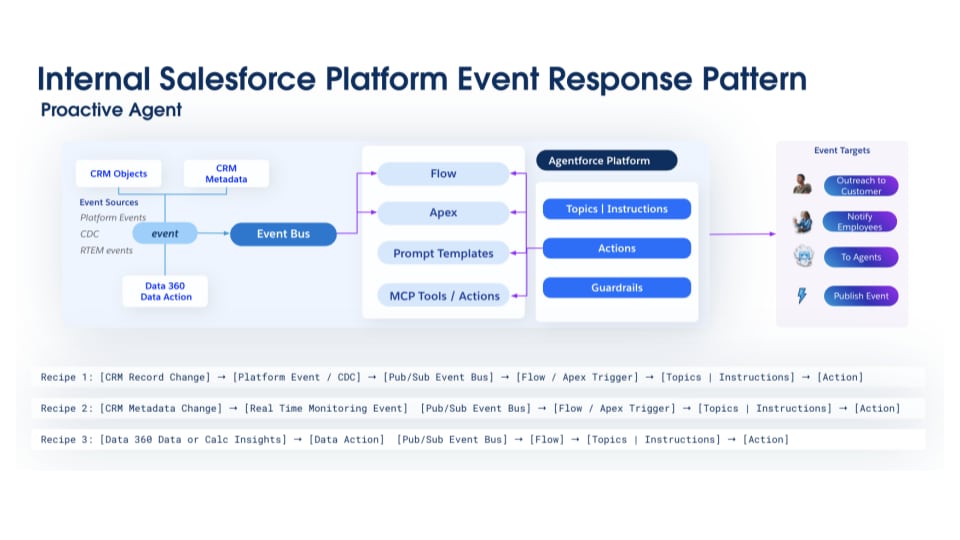 **關鍵元件**
- **事件來源層**
- 來自低層級平台活動的 CRM 資料、平台事件、變更 資料擷取 (CDC) 資料和即時事件監視 (RTEM) 資料
- **Data 360**
- Data 360 元件 (包括 **DLO 和 DMO),**可儲存事件資料,[由 CRM 或平台事件產生](https://developer.salesforce.com/docs/data/data-cloud-int/guide/c360-a-create-eventbusconnector-data-stream.html)、轉換和建立串流或即時洞察
- **已計算、串流和即時洞察**可提供工作人員與系統中客戶、員工活動或中繼資料變更相關的立即相關資料。這可啟用預防性問題解決方案,緩解升級。此即時情況感知可讓工作人員針對管治與合規性作業輸出提供及時介入。
- **資料圖**會主動呈現來自不同資料來源的關係和洞察,以便及早偵測與客戶參與、活動和設定檔相關的模式或異常。
- **Data 360 向量存放區和 RAG** 提取器為工作人員提供所有相關企業資料和非結構化 Knowledge 文章的統一檢視,確保回應準確且以內容為基礎。
- **Agentforce 工作人員:**工作人員的行為與目標由下列元件定義。
- **主題與指示:**指定工作人員根據 Salesforce 內的資料變更,強制執行業務規則和自動化流程的任務。它會定義工作人員的目標 (例如「在到達協商階段之前,請確保所有機會都透過主要連絡人更新」),以及該工作人員觸發的特定記錄建立、欄位更新等等。
- **動作:**為回應內部 Salesforce 事件而設計的事件觸發和排程動作。雖然這些動作會針對例行工作自主執行,但通常會包含協調涉及人類介入的工作流程的功能,並將其升級至使用者以供檢閱、批准或處理需要人類判斷的情境。
- **護欄:**護欄會作為一組可設定的規則和執行階段檢查,以限制工作人員的行為。作為安全層,可攔截提示、驗證工作人員建議的動作,並篩選其最終回應,以防止有害內容、強制執行業務規則,並確保工作人員在其指定的範圍內作業。
- **提示範本:**透過 Data 360 RAG Retrievers 的合併欄位或語意資料,動態填入即時 CRM 資料的可重複使用範本。這些範本可讓工作人員產生相關聯的品牌內容,而 Einstein Trust 層會在將指示傳送至 LLM 之前安全地遮蔽敏感資訊。
- **事件目標**
- 主動通知員工或連絡客戶。
- 可擴充以呼叫其他工作人員 (請參閱 [環境 AI](#23-環境工作人員模式) 和 [自動 AI](#25-自動工作人員模式) 模式)
**互動**
1. 在內部系統內發生明顯變更,例如 CRM 記錄更新、中繼資料修改,或從 Data 360 觸發的資料動作。
2. 內部系統會透過 API (建立平台事件) 或 Pub/Sub API 來發送事件並將其發佈至 Salesforce Event Bus,或將事件資料串流至 Data 360。
3. 事件的訂閱者會觸發並啟用流程或 Apex。
4. 已啟用的流程或 Apex 會呼叫「[工作人員動作](https://help.salesforce.com/s/articleView?id=platform.automate_flow_ref_elements_actions_generate_ai_agent_response.htm&type=5)」。
5. 結果是觸發的通知或工作流程。通知會在協同合作工具 (例如 Slack) 中傳送給使用者。也會產生工作或事件。此外,動作會呼叫外部系統。
6. 因此,事件不會遺失,但會主動執行、訊號和動作,從而移除人類的負擔或複雜的自動化來探索。
**貿易**
| 層面 | 收益 | 成本 |
|---|---|---|
| 即時整合 | 事件會在秒內觸發動作。 | 更多圖層可能會造成簡易事件處理的延遲。 |
| 智慧回應 | 使用 CRM 和外部內容進行 AI 強化的決策 | 增強會增加延遲和過時的資料 (例如,訂單外事件)。 |
| 寬鬆配對 | Fan out (更多訂閱者) 與可擴充 | 非同步處理會導致訂閱者之間最終一致。 |
| 延展性 | 處理突發事件 | API 限制 |
| 安全性 | 平台提供的 Trust 圖層 | 非可協商的營運額外支出 |
| 層面 | 收益 | 成本 |
|---|---|---|
| 視窗大小 | 小型時段—延遲較低,訓練速度更快 | 也較少內容,準確度較低 |
| 處理模式 | 即時呈現立即助理機會。 | 資源密集 |
| 串流解析度 | 高品質音訊和影片能更準確,但會增加延遲。 | 更多儲存空間與運算 |
| 保留期間 | 大量資料可用於訓練和合規性。 | 更高的儲存成本,可能導致雜訊 |
| 多重強制回應 | 更豐富的內容,全方位的瞭解 | 同步化複雜性 |
| 環境 | 可為人類使用者提供一致的支援 | 隱私權/保單強制執行 |
| 層面 | 收益 | 成本 |
|---|---|---|
| 範圍 | 廣泛的活動涵蓋範圍,工作人員可在不同的強制回應 (電子郵件、行事曆、應用程式頁面) 中共用內容 | 計算成本 |
| 智慧自動化 | 可以是模組,並擴充至完全自主 AI,並可將人類排除在清除原則的迴圈之外 | 更多工作人員評估。產生假陽性或錯誤的風險,可能會在合理的時間範圍內無法偵測到 |
| 截斷複雜性 | 可受益於即時分析。例如,可以偵測詐騙或威脅,並防止交易發生 | 需要同步化工作人員與人力工作流程 |
| 內容深度 | 更深入的內容可帶來智慧決策 | 必須為內容完整 |
| 工作人員自動 | 無周邊工作人員在背景中工作,而不提示使用者,因此會減少摩擦 | 工作人員決策的透明度愈低,稽核追蹤愈多 |
| 多工作人員 | 無周邊工作人員可以共同合作,形成專門工作人員 | 無周邊協調流程與額外複雜度 |
| 層面 | 收益 | 成本 |
|---|---|---|
| 本地協同合作面向 | 工作人員可以參與,並立即為人類的工作流程做出貢獻 | 使用者採用需要額外的訓練和啟用 |
| 雙向內容共用 | 工作人員可以呈現並與所有人共用內容,使資訊可供所有人使用。 | 意圖非對稱敏感資訊需要額外的保護措施。 |
| 協同合作 | 工作人員可啟用即時協同合作,提供立即的回饋意見和更快的解決時間。 | 更快的解析度表示可能導致疲勞的人類在排隊中工作更積極 |
| 專長 | 網域特定工作人員提供高價值的協助。 | 已增加界限內容需求與網域特定性。適應變更的複雜度 |
| 可觀察性 | 提供邏輯、稽核追蹤、工作人員評估建立 Trust | 已增加遠端測試成本 |
| 層面 | 收益 | 成本 |
|---|---|---|
| 速度 | 工作人員會以小時到天完成工作,而非以週到月完成工作 | 需要自主工作人員作業的啟用 |
| 自治 | 工作人員在沒有人力介入的情況下達成完整執行 | 執行期間介入有限且成本高 |
| 延展性 | 工作人員可輕鬆調整規模 | 必須建立比率限制,以防止資源遭到鎖定。 |
| 一致性 | 工作人員透過護欄遵循原則 | 新案例處理需要檢查以確保取得正確的結果。 |
| 成本 | 工作人員避免在迴圈中使用人類 | 建立流程十分昂貴 |
| 人力資源 | 工作人員釋出重要和專家資源 | 專家缺乏經歷的可視性,減少識別流程改善的能力 |
| 品質控制 | 可監視和檢閱 | 如果未立即發現工作人員錯誤,則補救成本很高 |
| 準確性 | 工作人員可以使用內容與原則做出正確的決定。 | 必須精密設計與維護內容與資料,以移除任何不明確或延遲。 |
-
設定對話工作人員。
設定增強型聊天 → 建立服務代理程式 → 定義支援訂單主題 → 建立「取得訂單」動作 ↓ 新增輸出升級 Omni-Channel 流程 ← 建立升級主題 ← 新增動作至主題 ← 建立「取得狀態」動作 ↓ 發佈工作人員 - 設定增強型聊天作為 Jane 的聊天進入點,讓 Jane 可以在網頁中開啟 Agentforce 視窗。
- 啟用 Agentforce 並在 Agentforce Builder 中建立服務代理,以處理對話並觸發自訂動作。
- 使用描述和 指示定義「支援訂單」主題,讓工作人員能自然辨識「我的最新訂單在哪裡?」。
-
定義具有描述的「升級」主題,以升級為服務代表。
- 建立並啟用輸出 Omni-Channel 流程。
- 將它新增至產生器中的「連線」索引標籤,以使用升級訊息進行升級。
-
設定 Omni-Channel。
設定 Omni-Channel → 在指示中定義升級規則 → 設定優先順序與容量 → 測試和驗證 - 當 AI 工作人員無法解決查詢時,啟用流暢升級至人力服務工作人員。設定 Omni-Channel 路由以將聊天指派給服務代表,並針對內容轉移完整文字記錄。
- 將升級邏輯整合至 Agentforce 指示和升級動作,讓工作人員知道何時轉移複雜個案。透過 Omni Supervisor 管理路由優先順序與容量。
- 測試完整體驗:Jane 會開啟聊天,工作人員會問候她、識別她的訂單、提取寄送資料,並在需要人力介入時順暢升級 (另請參閱啟用增強型事件記錄)。
-
設定資料整合。
對應內容資料 → 建立 MuleSoft API 認證 → 註冊 MuleSoft 外部服務 - 透過已驗證的聊天或聊天前表單,透過 Jane 的 Salesforce 內容來讓工作人員對應其連絡人和訂單記錄。
- 使用外部認證和已命名認證將 Salesforce 安全連線至 MuleSoft 寄送 API 以進行驗證。
- 如果 MuleSoft 公開 OpenAPI 規格,請將其 註冊為外部服務,讓 Flow 和工作人員能夠以宣告的方式呼叫。
-
設定非結構化資料整合。
- 從「設定」中建立新資料庫。將其命名為「訂單與寄送原則」。
- 新增包含寄送原則例外的保單文件 PDF。
- 文件會在背景自動切分、編製索引,並準備好可供使用。
-
設定捨棄的手推車事件,以在 VIP 客戶 John 捨棄手推車時觸發。
建立自訂「連絡人」欄位 → 定義新平台事件 - 建立包含「連絡人識別碼」、「手推車值」、「手推車上次更新日期時間」和「手推車詳細資料」之 欄位的
Cart_Abandoned__e 平台事件。 - 設定捨棄事件:使用 Commerce Cloud,針對 Checkout 事件通知建立平台事件。當手推車Checkout工作階段狀態處於中介狀態,且工作階段逾時於值之後,便會偵測到捨棄。或者,如果您的電子商務是外部系統,請使用下列 任何方法將事件發佈至 Salesforce:流程、Apex、Salesforce API 或 Pub/Sub API。
- 在「連絡人」物件中,建立新欄位
Customer_Tier__c ,其中包含選項清單值標準 、頂級 和VIP 。
- 建立包含「連絡人識別碼」、「手推車值」、「手推車上次更新日期時間」和「手推車詳細資料」之 欄位的
-
在 Data 360 中設定非結構化資料取用: 透過 Amazon S3 將來自文件存放庫的折扣原則文件新增至 Data 360。
建立 AWS S3 認證 → 建立新的 S3 資料串流 → 設定與部署串流 → 建立搜尋索引 ↓ Test retrieve 函數 ← 設定與部署索引 - 建立外部認證以存取 S3:針對 IAM 使用者建立新的存取金鑰和密碼集,或針對 IdP 建立新的 IAM 亞馬遜資源名稱 (ARN)。
- 建立新的 S3 資料串流:在「資料串流」索引標籤上,建立資料串流「原則文件串流」,選取 S3 來源、選擇 PDF 檔案類型、設定重新整理頻率、對應中繼資料欄位 (檔案名稱與大小),然後部署。
- 資料串流完成後,建立搜尋索引:針對切分、E5-large-v2 內嵌模型和混合式搜尋類型,使用通訊通行徑,然後部署索引。
- 測試建立的取用函數。
-
設定「VIP 手推車復原」工作人員。
從範本建立工作人員 → 新增復原 VIP 手推車主題 → 新增主題指示 → 建立 Slack 警示動作 ↓ 新增動作至主題 ← 建立旅程註冊動作 ← 建立折扣優惠動作 ← 建立手推車復原工作 - 從 Agentforce 員工工作人員範本建立工作人員。
- 新增新主題「復原 VIP 手推車」,其中描述此工作人員為 VIP 客戶處理高價值手推車捨棄。
- 新增主題指示以驗證 VIP 狀態、使手推車符合資格、通知 Slack 中的帳戶管理員、建議折扣優惠,並在手推車復原電子郵件旅程中註冊客戶。
- 建立動作與工作。
- 警示帳戶管理員動作:傳送主動 Slack 通知
- 復原捨棄的手推車工作,指派給包含手推車詳細資料的經理
- 「取得折扣優惠」動作:分析原則與先前購買歷程記錄。建立具有奠基的提示範本、參照提示範本中的取用函數,然後使用資料。
- 註冊「復原旅程」動作:透過 API 註冊 Marketing Cloud 復原旅程,並收集所有訂閱者資料和從工作人員產生的折扣優惠電子郵件訊息。
- 將動作新增至主題。
- 使用 Marketing Cloud 中的範本 建立 VIP 客戶手推車復原旅程,或 建立新的旅程。
-
連線平台事件以呼叫工作人員。
建立事件觸發流程 → 訂閱平台事件 → 新增工作人員可叫用動作 → 將事件資料傳送給工作人員 - 建立新的平台事件觸發流程,VIP Cart Abandonment Recovery。
- 選取流程應訂閱的「手推車已捨棄」事件。
- 在 Flow Builder 中設定自訂工作人員可叫用動作,然後選取「VIP 手推車復原」工作人員。傳送要求來為客戶起始 VIP 捨棄手推車復原,並傳送平台事件裝載。
| 客戶捨棄手推車 | → | Commerce Cloud 發佈事件 | → | 平台事件觸發流程 | → | 流程叫用員工工作人員 |
| ↓ | ||||||
| 折扣優惠的分析 | ← | 為經理建立工作 | ← | Slack 中的警示管理員 | ← | 工作人員執行復原主題 |
| ↓ | ||||||
| 在旅程中註冊客戶 | → | 客戶兌換優惠 | → | 工作人員分析成果以取得回饋意見 |
-
設定「銷售通話即時回應」工作人員。
從範本建立工作人員 → 新增協助通話主題 → 新增主題指示 → 建立文字稿分析動作 ↓ 新增動作至主題 ← 建立 Slack 洞察動作 ← 建立產品規格動作 - 從 Agentforce 員工工作人員範本建立工作人員。
- 新增新主題「協助通話」,其中包含此工作人員傾聽即時文字記錄、瞭解意圖,並協助處理產品資料的描述。
- 新增主題指示以剖析文字記錄、提取產品規格,以及傳送 Slack 訊息。
- 建立動作。
- 分析通話文字記錄動作:分析即時接收的通話文字記錄資料,並解壓縮關鍵問題或動作
- 「取得產品規格」動作:查詢產品 Knowledge 文章
- 將 Slack 洞察傳送給「內部」使用者
- 將動作新增至主題。
-
設定「產品 Knowledge」資料庫。
建立新資料庫 → 新增Knowledge文章 → 系統區塊與索引 → 生效中的陸地程式庫 - 從「設定」中建立新資料庫。將其命名為「Product Knowledge」。
- 新增包含產品資訊的Knowledge文章。
- 文件會在背景自動切分、編製索引,並準備好可供使用。
- 在「取得產品規格」動作中使用奠基。
-
透過 Pub/Sub API 將即時文字稿發佈至 Salesforce。
伺服器接收音訊文字稿 → 伺服器發佈平台事件 - 建立平台事件
Transcript_Segment__e ,其中包含欄位呼叫識別碼 、序列 、發言者 、區段開始時間 、區段結束時間 、持續時間 和文字記錄資料 。 - 在您的訊號伺服器中 (請參閱先決條件區段),當您從音訊接收文字記錄後,請透過
Transcript_Segment__e 事件立即發佈資料。您可以使用下列 任何方法將事件發佈至 Salesforce:流程、Apex、Salesforce API 或 Pub/Sub API。
- 建立平台事件
-
訂閱已發佈
Transcript_Segment__e 事件的 Wire 流程。建立事件觸發流程 → 訂閱文字稿事件 → 新增工作人員可叫用動作 → 將裝載傳送給工作人員 ↓ 工作人員傳送 Slack DM - 建立新的平台事件觸發流程「探索通話洞察」。
- 選取流程應訂閱的
Transcript_Segment__e 事件。 - 在 Flow Builder 中設定自訂工作人員可叫用動作,然後選取「銷售通話即時回應」工作人員。傳送事件裝載以路由至「協助通話」主題。從主題衍生問題後,問題會傳送至「取得產品規格」動作以取得回答。
- 系統會編譯最後的回答,並透過 Slack DM 立即傳送給使用者。
| 使用者開始縮放通話 | → | 伺服器文字記錄與發佈 | → | 流程叫用回應工作人員 | → | 工作人員查詢Knowledge庫 |
| ↓ | ||||||
| Analytics 限定工作人員績效 | ← | 工作人員編譯通話摘要 | ← | 工作人員繼續聆聽 | ← | 工作人員傳送 Slack DM |
-
設定多工作人員結構。
研究工作人員收集情報 → 資格工作人員評分商機 → SDR 工作人員開始拓展 - 研究工作人員:透過 MuleSoft 查詢 Data 360 與外部來源
- 資格工作人員:排定優先順序、評分和增強商機
- SDR 工作人員:取得商機指派、執行拓展、追蹤和排程會議。使用 Agentforce Analytics for SDR 工作人員監視 SDR 工作人員的活動和進度。
-
探索並取用新的公司資料。
建立新資料空間 → 採取 Salesforce CRM 資料 → Ingest ZoomInfo data → 採取供應商資料庫資料 - 設定名為「Sales and Marketing」的新「資料空間」。此新的資料空間將容納獨立工作人員所需的所有資料。
- 使用 Salesforce 連接器將「商機」、「帳戶」、「連絡人」和「機會 CRM」資料流入至資料空間。
- 設定 ZoomInfo 的 Data 360 連接器。將資料流入至 Data 360 Sales 和 Marketing 資料空間。
- 設定 Anypoint Salesforce Data 360 連接器以連線至供應商資料庫,並將資料提取至 Data 360。
-
設定平台事件以起始無周邊「研究」和「資格」工作人員。
建立新平台事件 - 建立一個新的
AgentGoal__e 平台事件,其中的欄位目標 會捕捉人類使用者的概況目標。
- 建立一個新的
-
設定「目標協調流程」工作人員,這是對話式 AI 工作人員,會接收使用者的目標並將其協調至其他工作人員。
從範本建立工作人員 → 新增剖析目標主題 → 新增主題指示 → 建立目標事件動作 ↓ 新增動作至主題 - 從 Agentforce 員工工作人員範本建立工作人員。
- 新增新主題「剖析目標」,說明此工作人員瞭解目標意圖,且可以視需要呼叫其他工作人員。
- 新增主題指示來剖析目標,並將事件觸發給其他工作人員。
- 建立「目標」事件,
AgentGoal__e 。
-
設定由協調工作人員觸發的「商機研究和資格」工作人員。
建立「研究」主題 → 建立重複動作 → 建立商機增強動作 → 建立商機評分動作 ↓ 新增動作至主題 ← 建立商機資格動作 - 建立具有描述「在區域或州中研究新商機」的潛在客戶研究主題。
- 建立動作。
- 複製商機 Apex 動作:對照現有客戶檢查和驗證新商機
- 增強商機 Apex 動作,其使用提示範本:查看非結構化行銷洞察和供應商資料庫資料,以增強商機資料
- 「評分商機」動作:使用更新的商機資料主動為商機評分
- 使商機符合工作人員資格動作:根據評分指派使商機符合 SDR 工作人員資格的參數
-
設定 Agentforce SDR 工作人員以執行拓展、商機培養和會議排程。
從範本建立 SDR 工作人員 → 設定工作人員Knowledge庫 → 設定工作人員電子郵件設定 → 設定商機指派規則 ↓ 定義合格商機條件 - 使用預先設定的 Lead Nurture Agent 範本,從「設定」頁面建立新的 SDR 工作人員。設定電子郵件設定和商機指派規則,選取「商機」物件或「連絡人」物件,並定義指派規則的合格條件 (量度商機分數和新商機)。
- 透過設定工作人員、指派權限,以及設定步調和指派規則,設定 Agentforce 商機培養。
- 為 SDR 工作人員設定必要 Knowledge,以回答問題。
-
設定新流程以訂閱已發佈的
AgentGoal__e 事件。建立事件觸發流程 → 訂閱工作人員目標事件 → 新增工作人員可叫用動作 - 建立名為「將目標路由至工作人員」的新平台事件觸發流程。
- 選取流程應訂閱的工作人員目標事件。
- 在 Flow Builder 中設定自訂工作人員可叫用動作,然後選取「商機研究和資格」工作人員。
| 使用者指派高階目標 | → | 協調流程工作人員建立事件 | → | 流程將目標路由至工作人員 | → | 研究工作人員合格商機 |
| ↓ | ||||||
| 使用分析監視工作人員 | ← | SDR 工作人員排程會議 | ← | SDR 工作人員開始拓展 |
- 設定增強型聊天作為客戶的聊天進入點,讓他們可以在網頁中開啟 Agentforce 視窗。
-
設定 Agentforce 帳單工作人員,這是無周邊專門工作人員,可接受訂單或發票並執行帳單查詢。
從範本建立工作人員 → 定義帳單查詢主題 → 建立自訂流程動作 → 新增動作至主題 - 啟用 Agentforce 並從 Agentforce 員工代理程式範本建立「員工代理程式」。
- 定義主題「帳單查詢」,其描述為「調查發票不一致、付款問題和帳單錯誤」。
- 新增自訂流程動作「檢查發票不一致」,輸入「
發票號碼 」、「客戶識別碼 」和「日期範圍 」,以及輸出「不一致金額 」、「根本原因 」和「受影響的交易 」。
- 新增自訂流程動作「檢查發票不一致」,輸入「
-
設定 Agentforce Logistics Agent,無周邊專門工作人員可驗證出貨、追蹤出貨和檢查庫存。
從範本建立工作人員 → 定義「寄送驗證」主題 → 建立自訂流程動作 → 新增動作至主題 - 啟用 Agentforce 並從 Agentforce 員工代理程式範本建立「員工代理程式」。
- 定義主題:「寄送驗證」,其中包含驗證發票寄送的描述。
- 新增自訂流程動作「驗證寄送詳細資料」,輸入「
發票號碼 」、「客戶識別碼 」和「日期範圍 」,以及輸出「已寄送零件 」、「日期 」和「庫存狀態 」。
- 新增自訂流程動作「驗證寄送詳細資料」,輸入「
-
設定 Agentforce 佈建工作人員,這是可驗證佈建和服務狀態的無周邊專門工作人員。
從範本建立工作人員 → 定義服務檢查主題 → 建立自訂流程動作 → 新增動作至主題 - 啟用 Agentforce 並從 Agentforce 員工代理程式範本建立「員工代理程式」。
- 定義主題「服務檢查」與描述以驗證服務連線和帳戶狀態。
- 新增自訂「流程」動作「驗證服務」,輸入「
客戶識別碼 」和「資產識別碼 」,以及輸出「服務狀態 」和「服務例外原因 」。
- 新增自訂「流程」動作「驗證服務」,輸入「
-
將「帳單」、「物流」和「佈建」工作人員公開為 A2A 伺服器,並在「工作人員註冊」中予以註冊。
透過 MuleSoft 公開工作人員 → 在註冊表中註冊工作人員 - 若 Agentforce 工作人員沒有直接 A2A 支援,則 MuleSoft 連接器可用來將 工作人員 API 公開為 A2A 伺服器。
- 在 工作人員登錄中註冊這些 A2A 伺服器。
- 使用 Anypoint Agent Fabric 協調工作人員。
- MuleSoft Agent Broker 可協助根據工作人員卡中提及的工作人員功能,協調跨平台的任何工作人員。
-
設定 Agentforce 說明工作人員,此對話式 AI 工作人員會與客戶互動、評估複雜度,並與多個專門工作人員協調以解決問題。
建立服務代理程式 → 定義「調查」主題 → 建立通知動作 → 定義協調流程主題 ↓ 定義升級主題 ← 「建立」 「建立個案」動作 ← 建立 Call Agent 動作 ← 建立工作人員協調流程 ↓ 建立 Omni-Channel 流程 → 升級的連線流程 - 啟用 Agentforce 並在 Agentforce Builder 中建立服務代理,以處理對話並觸發自訂動作。
- 定義主題「服務調查」,其中包含描述和指示,讓工作人員能自然識別具有多個同時問題的複雜主題。
- 建立自訂工作人員動作。
- 「狀態通知」動作可確認問題並提供進度更新
- 建立自訂工作人員動作。
- 定義可透過動作呼叫其他工作人員的協調流程主題。
- 建立呼叫「流程」動作的「通話工作人員」動作。「流程」動作有數個工作人員動作,並可起始每個無周邊工作人員:帳單工作人員、物流工作人員和佈建工作人員。
- 建立建立個案、新增詳細資料和設定狀態的「建立個案」動作。
- 定義具有描述的「升級」主題,以升級為服務代表。
- 建立並啟用輸出 Omni-Channel 流程。
- 將它新增至「工作人員」中的「連線」索引標籤,以使用升級訊息進行升級。
| Agentforce 說明工作人員 | → | MuleSoft 工作人員經紀人 | → | 帳單工作人員為 A2A 伺服器 | → | 作為 A2A 伺服器的 Logistics Agent |
| ↓ | ||||||
| 協助工作人員得到回應 | ← | 經紀人彙總回應 | ← | 採購工作人員作為 A2A 伺服器 |
| 客戶開始聊天 | → | 客戶狀態為多個問題 | → | 工作人員調查訂單詳細資料 | → | 協調流程呼叫專家工作人員 |
| ↓ | ||||||
| 協調流程會同步化解決方案 | ← | 佈建工作人員找到問題 | ← | 物流工作人員確認錯誤 | ← | 帳單工作人員發現不一致 |
| ↓ | ||||||
| 工作人員升級為服務代表 | → | 提供解決方案的服務代表 | → | 系統工作人員執行工作 | → | 工作人員更新與結束個案 |
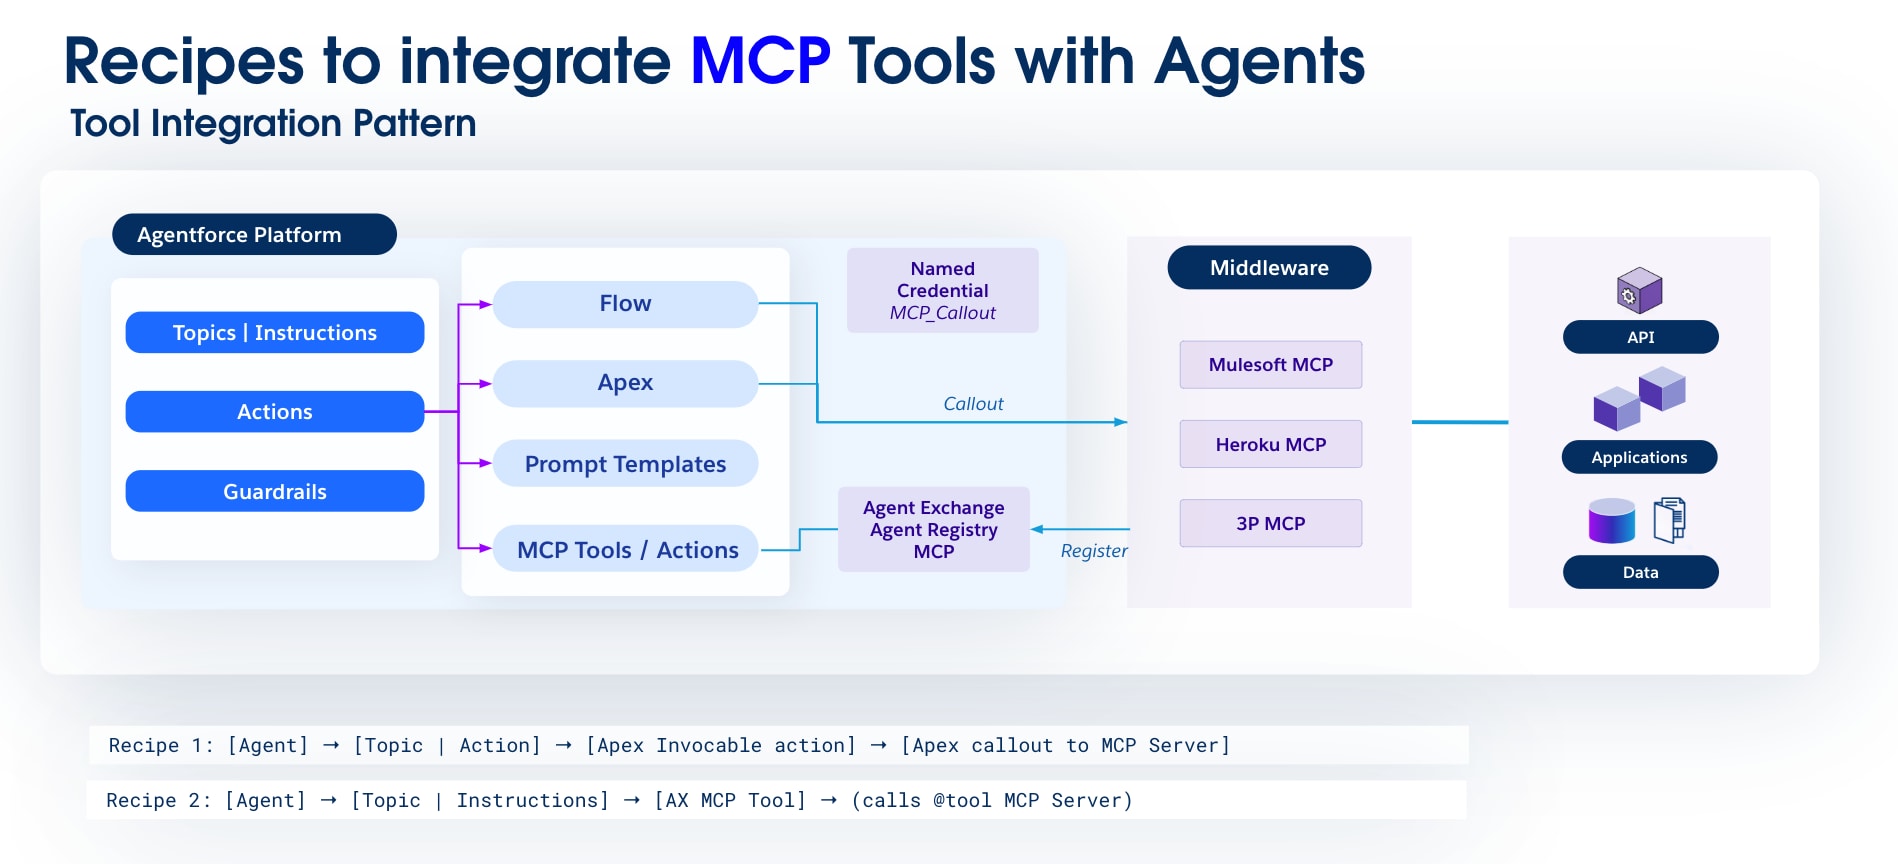 **配方 1:\*\***使用 MCP 啟用外部工具\*\*
**問題**
組織在混合舊版 ERP 和現代 SaaS 上執行,但與工作人員整合這些組織很困難,因為沒有共同的通訊協定—每個工具都有自己的 API、驗證和資料模型。開發人員最終會為每個工具建立和維護自訂點對點連接器,進而產生脆弱、無法調整且成本高昂的整合。
**模式**
工作人員透過結構化動作叫用外部工具 (透過 MCP 公開),讓其能夠使用 Salesforce 平台以外的專用工具。
**內容**
- 工作人員會作為 Salesforce 平台外存在的一組工具的 Proxy。
- 這些外部工具可能有不同的 API、驗證機制和資料格式。
- 需要標準化通訊協定,才能讓工作人員與這些外部工具之間順暢地互動。
- 重複使用性是關鍵考量因素,因為多個工作人員可能會將相同的外部工具用於不同的用途。
**互動**
1. **觸發:**使用者要求或 Agentforce 內部的內部事件需要使用外部工具。
2. **意圖採取動作:**Agentforce Agent 會識別意圖,並判定需要外部 MCP 型工具。
3. **計畫者 (內部):**Agentforce 工作人員的計畫者會根據設定的指示和可用的工具選取適當的 MCP 工具或動作。
4. **執行:**Agentforce Agent 會將 MCP 相容要求傳送至外部 MCP 伺服器 (例如,透過 Apex 呼叫傳送至 MuleSoft 端點,接著路由至外部 MCP 伺服器)。
5. **外部處理:**外部 MCP 伺服器會處理要求、與基本外部應用程式互動,並準備 MCP 相容的回應。
6. **結果**:外部 MCP 伺服器會將回應傳回給 Agentforce Agent。
7. **後續追蹤:**Agentforce Agent 會處理回應、更新其內部狀態,然後繼續工作或提供回饋意見給使用者。
**貿易**
| 層面 | 收益 | 成本 |
|---|---|---|
| 彈性 | 存取各種外部功能 | MCP 伺服器/整合層的初始開發 |
| 模組性 | 工作人員功能與外部工具分離 | 需要謹慎的 API 設計與版本化 |
| 延展性 | 使用外部系統的延展性 | 外部系統的效能會變成相依性 |
| 標準化 | 標準化通訊協定 (MCP) | 採用和/或包裝 |
| 安全性 | 外部存取的集中安全性 | 管理外部系統的認證和存取原則 |
| 永續性 | 更新外部工具不需要工作人員變更。MCP 可以表示變更 | 經常變更的成本 |
| 層面 | 收益 | 成本 |
|---|---|---|
| 速度 | 一個工具呼叫 | 更多監管負擔 |
| 效能與安全性 | 安全重試 | 實作以支援除錯與無效 |
| 延展性 | 可輕鬆調整規模 | 連線費用 |
| 一致性 | 清楚明確 | 原子 |
| 安全性 | 可實作護欄與原則。 | 作業負擔對串聯原則的變更 |
| 可觀察性 | 關聯與稽核可供作業使用。 | 已增加遠端測試成本 |
| 層面 | 收益 | 成本 |
|---|---|---|
| 速度 | 多個散佈作業的一次呼叫 | 開發和營運負擔 |
| 效能與安全性 | 安全重試/SAGA 支援 | 複雜性 |
| 延展性 | 可輕鬆調整規模、可為非同步 | 非同步的最終一致性 |
| 安全性 | API 圖層中的原則 | 作業負擔對串聯原則的變更 |
| 可觀察性 | 可用於追蹤的關聯性與稽核 | 已增加遠端測試成本 |
| 層面 | 收益 | 成本 |
|---|---|---|
| 資料移動 | 無;零複本 | 計算成本 |
| 延遲性 | 從天數或週數到近乎即時 | SLA |
| 延展性 | 無限制資料量 | 計算成本 |
| 層面 | 收益 | 成本 |
|---|---|---|
| 延遲性 | 可用 (以秒為單位) | 計算與實作成本 |
| 連接 | 產生者獨立於消費者。 | 較難除錯與追蹤 |
| 延展性 | 可以調整 | 限制 |
| 訂購 | 增量內容建立 | 訂單外抵達 |
| 值 | 近乎即時洞察 | 監管與合規性概況 |
| 層面 | 收益 | 成本 |
|---|---|---|
| 準確性 | 更高的Trust (以引號為基礎的回答) | 文件精密設計與衛生 |
| 提取 | 處理自然語言與關鍵字 | 更多儲存空間,精力調整 |
| 安全性 | 可強制執行特權存取 | 執行階段超額、快取複雜度 |
| 切分 | 更佳的相關性 | 更多預先處理與調整 |
| 版本化 | 篩選過期的Knowledge | 維護與管治成本 |
| 層面 | 收益 | 成本 |
|---|---|---|
| 準確性 | 更高的Trust (以可驗證關係為基礎的回答) | 資料調和和圖表建模工作 |
| 提取 | 處理複雜的關聯性查詢 | 對於非常大的圖表,圖表周遊的計算成本很高 |
| 安全性 | 可以根據關係強制執行特權存取權 | 執行階段負擔,複雜存取控制 |
| 內容深度 | 豐富且完整的實體與其連線的瞭解 | 針對圖表最佳化的更多預先處理與調整 |
| 永續性 | 關係的集中化資料模型 | 持續讓 DMO 符合不斷變化的業務需求 |
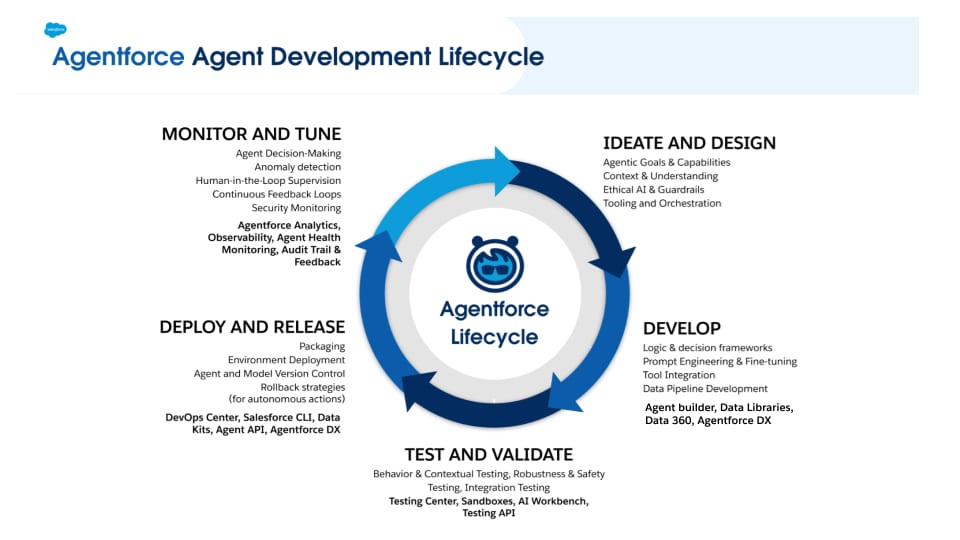 本章說明 Agentforce 如何 **在單一統一平台中支援 ADLC 的各個階段。**
#### 階段 1:計畫與設計
##### 計畫
計畫階段是 ADLC 的基礎階段,其中會針對工作人員制定初始願景與需求。它涉及深入瞭解問題、識別潛在解決方案,以及概述工作人員的核心功能。
透過定義主要屬性來啟動工作人員的計畫流程:
1. **目標/目標**:清楚定義工作人員的主要目標。計畫要解決的特定問題為何,或計畫要完成的工作為何?工作人員應為哪些人員服務?這應該是簡要且可測量的陳述式,可引導整個開發程序。
2. **角色**:為工作人員開發詳細的角色。這包括定義其身分、通訊樣式,以及其在與使用者或其他系統互動時要扮演的角色。考量其語氣、形式層級,以及在預期內容中有效的任何特定特性。
3. **模式**:識別並連結至相關的工作人員模式和實作策略。這涉及可告知工作人員結構和行為的結構設計或最佳作法。「Salesforce Agentforce 上的[工作人員模式與實作:「技術白皮書](/docs/architect/zh-tw/fundamentals/guide/agentic-patterns)」作為此步驟的重要資源,提供 Salesforce 平台和 Agentforce 上有效工作人員設計的洞察。
##### 設計
設計階段會將概念從計畫轉換為工作人員建構的詳細藍圖。這涉及定義工作人員的結構、使用者流程、互動模型,以及如主題、工具和護欄等技術規格。
在設計階段期間,您會為工作人員的建構建立詳細藍圖,其中包括:
- **工作人員設計**:概述工作人員的內部結構,包括其元件、模組及其互動方式。這可能涉及定義 Knowledge 庫、組態和邏輯來控制工作人員行為、自然語言處理 (NLP) 元件,以及與其他系統的整合點。
- **使用者流程/互動設計**:對應完整的使用者旅程和工作人員的互動。定義對話流程、決策樹狀結構、錯誤處理和回饋意見機制,以建立直覺式且有效的體驗。
- **技術規格**:記錄工作人員的技術非功能需求,例如效能度量、延展性考量事項、安全性通訊協定和整合規格。
- **原型與模型**:建立工作人員介面和互動的視覺呈現或互動原型。這允許提早測試和回饋意見,協助在開始全規模開發前限定設計。
- **資料**:決定工作人員需要的資料類型與來源時,請識別工作人員必須存取的資料集、API、資料庫和存放庫。針對 Agentforce,請專注於作為內容提供的資料、結構化或非結構化,以及即時或批次資料。Agentforce 平台與 Data 360 進行深度整合,可讓您使用 Salesforce CRM 和其他來源的結構化與非結構化資料。非結構化內容可以原生地針對 RAG 分割和編製索引。MuleSoft 可讓您連線至外部系統。
- **工具**:識別工作人員必須執行的動作。使用 Agentforce 動作公開可達成業務目標的工具。這些動作利用現有的 Salesforce 資產,例如透過提示詞產生器、MuleSoft、Apex、Flow 和 API 使用 OpenAPI 規格的提示。任何「可叫用動作」可整合至 Agentforce 並由工作人員使用,使所有熟悉的 Salesforce 開發工具可立即作為 Agentforce 動作使用。
- **工作人員輸入資料**:在傳統 SDLC 中,會精確指定輸入。在 ADLC 中,輸入通常是自然、非決定性的自由格式說話方式。收集預期會產生適當回應的代表說話方式。
#### 階段 2:開發
開發階段著重於將在「計畫」和「設計」階段中決定的已定義工作人員目的、能力和作業範圍轉換為新的 Agentforce Agent。
為了協助開發人員建立工作人員,Agentforce 同時提供 **Agent Builder** 和 **Agentforce 開發人員體驗 (AFDX)。**這些基礎工具可作為建構和設定工作人員的主要環境。
- **工作人員產生器**提供 UI 體驗,用於定義工作人員的核心功能。
- **AFDX** 提供程式設計介面,可用於自訂和與其他系統整合。
開發和建立工作人員包含下列可使用「工作人員產生器」或 AFDX 執行的步驟:
1. **定義個性人物**:工作人員設計的關鍵層面是建立獨特的角色。這涉及設定:
- **工作人員描述**:工作人員角色的詳細描述、目標,以及其設計要處理的特定客戶服務工作。
- **語調**:工作人員的溝通風格、同理程度,以及其需要遵循的任何特定品牌指導方針。
2. **定義工作人員主題與動作**:若要讓工作人員更精密且能夠處理各種工作,將其功能分成不同的主題,並使用對應的動作是非常重要的。
- **主題**:每個主題都可以使用獨特的指示與工具集,以專門工作人員的方式進行概念化。
- **模組結構。**主題的模組化方法可提供更大的組織與延展性。透過定義多個主題,工作人員可以處理更廣泛的複雜案例陣列。例如,工作人員可能會有「訂單管理」、「常見問題」(FAQ)、「技術支援」和「帳單查詢」的個別主題。
- **主題指示 (護欄)**:每個主題都隨附作為護欄的特定指示,定義工作人員可在該主題中討論或執行的範圍。這些指示可防止工作人員偏離主題或提供不相關的資訊。它們也有助於維持回應的一致性和準確性。
- **動作**:主題也具備「工具」,代表工作人員可以採取的動作。這些工具可以是:
- **資訊動作**:從 Knowledge 庫或外部系統提取資料以回答查詢。
- **交易動作**:代表使用者執行動作,例如下單、更新客戶記錄或起始退款流程。這些動作通常會與其他系統整合 (例如 CRM、ERP)。
#### 階段 3:測試和驗證
評估 AI 工作人員的效能與可靠性時,測試人員通常會遇到一系列可能降低使用者體驗的挑戰。這些問題涵蓋從誤解使用者意圖到無法正確執行工作。
##### 常見的工作人員失敗案例
建立強大的工作人員需要瞭解其如何與何處會失敗。下表將在工作人員生命週期期間遇到的常見問題分類,從邏輯錯誤到 Knowledge 不良。使用此作為開發期間的策略指南,以及測試期間的檢查清單,以確保工作人員不僅具有功能,而且對一般使用者來說也是可靠且直覺的。這些失敗情況應協助您定義測試個案。
| 種類 | 描述 | 失敗範例 |
|---|---|---|
| 主題分類 | 工作人員無法正確識別使用者的意圖或目標。 |
|
| 回應品質 | 工作人員回覆的內容、準確性和格式失敗。 |
|
| 動作執行 | 工作人員在嘗試執行特定功能或工作時失敗。 |
|
| 護欄與指示 | 工作人員違反預先定義的規則、限制或對話界限。 |
|
| 取得Knowledge | 工作人員無法從其 Knowledge 庫取得和呈現資訊。 |
|
| 結構化指引 | 工作人員努力引導使用者完成多步驟流程。 |
|
| 資料湖物件/資料模型物件 | 描述 |
|---|---|
| AIAgentSession | 與一或多個 AI 工作人員連續互動的整體容器。 |
| AIAgentSessionParticipant | 參與 AIAgentSession 的實體 (人類或 AI)。 |
| AIAgentInteraction | 工作階段內的區段。它通常會從使用者的要求開始,並在 AI 工作人員對該要求提供回應時結束。 |
| AIAgentInteractionStep | 在互動期間執行以滿足使用者的要求的離散動作或作業。 |
| AIAgentInteractionMessage | 由使用者提供或由 AI 工作人員在工作階段期間產生的單一通訊。 |
 ##### 說話方式分析
「說話方式分析」會顯示 Agentforce (預設) 使用者如何使用工作人員、他們要求的內容,以及工作人員是否能夠處理這些要求。這些可自訂的報告可協助您限定主題與動作,讓工作人員更有效且準確地回應。
 ##### Agentforce Python SDK:使用 Data 360 整合監視
工作人員 SDK 實作使用 Data 360 Python 連接器的進階監視與分析、建立 Salesforce Data 360 的連線、查詢工作人員效能度量,以及建立全方位監視顯示面板。
系統會追蹤回應時間、成功率、使用者滿意度和成本度量,以提供工作人員最佳化的可採取動作洞察。
```py
# Data 360 Python Connector Integration
from salesforce_cdp_connector import SalesforceCDPConnector
# Initialize Data 360 Connector
cdp_connector = SalesforceCDPConnector(
client_id='your_client_id',
client_secret='your_client_secret',
username='your_username@example.com',
password='your_password'
)
# Query agent performance data
performance_data = cdp_connector.query("""
SELECT timestamp, response_time_ms, success_rate, user_satisfaction
FROM AgentPerformanceMetrics
WHERE agent_id = 'Coral_Cloud_Resorts_Resort_Manager'
""")
# Create monitoring dashboard
def create_monitoring_dashboard(performance_data):
fig = go.Figure()
fig.add_trace(go.Scatter(
x=performance_data['timestamp'],
y=performance_data['response_time_ms'],
mode='lines+markers'
))
return fig
```
##### Agentforce DX:工作人員監視
此實作使用標準 AFDX 指令搭配 CLI 型工作人員管理,讓工作人員掌握平台變更的最新資訊,並納入使用者回饋意見以持續改善。
```zsh
# List all agents and their status
sf agent list --target-org "production-org"
# Get detailed agent information
sf agent get \
--api-name "Resort_Manager" --target-org "production-org"
# Activate agent if needed
sf agent activate --api-name "Resort_Manager" --target-org "production-org"
# Query agent performance data
sf data query \
--query "SELECT Id, Name, Status, LastModifiedDate FROM BotDefinition WHERE DeveloperName = 'Resort_Manager'" \
--target-org "production-org"
```
```python
# AgentforceDX Dashboard Creation (Similar to Agent SDK)
import pandas as pd
import plotly.graph_objects as go
from salesforce_cdp_connector import SalesforceCDPConnector
# Initialize Data 360 Connector for AgentforceDX
cdp_connector = SalesforceCDPConnector(
client_id='your_client_id',
client_secret='your_client_secret',
username='your_username@example.com',
password='your_password'
)
# Query agent performance data from Data 360
performance_data = cdp_connector.query("""
SELECT timestamp, agent_id, response_time_ms, success_rate, user_satisfaction
FROM AgentPerformanceMetrics
WHERE agent_id = 'Resort_Manager'
AND timestamp >= CURRENT_DATE - 30
ORDER BY timestamp DESC
""")
```
如需使用工作人員 SDK 和 AFDX 的 ADLC 實作,請參閱 [此處的](https://github.com/akshatasawant9699/ADLC_Whitepaper) GitHub 存放庫。
## 最佳作法
掌握工作人員開發生命週期需要遵循一組核心原則,以確保效率、可靠性和策略一致性。下列指導方針會將 ADLC 每個階段的重要教訓合併為結構設計師和開發人員的策略架構。
**1\.規劃和計畫**
此初始階段著重於使工作人員的目標與業務目標保持一致,並確保其建立在堅實的基礎上。
- **排定業務影響的優先順序**:從直接將潛在使用個案對應至策略業務目標開始。使用優先順序矩陣來評分其潛在影響,並從具有明確 KPI 的單一、專注使用個案開始。
- **及早參與利害關係人**:收集有關難題的洞察,並確保對齊。
- **利用資料洞察**:工作人員與其資料相同。使用 Data 360 探索可用的結構化與非結構化資料,以通知工作人員的內容與功能。檢閱現有報告和顯示面板,以識別可通知您使用個案選取的目前趨勢。
- **使用計畫架構**:將結構化計畫方法套用至集意和精簡潛在應用程式,例如設計思維或 SWOT 分析。
**2\.建立工作人員**
此階段涵蓋建立高績效且高效率的工作人員的最佳作法。
- **避免過多主題**:限制主題數目,以降低建立可能讓工作人員混淆之類似或重疊主題的風險。
- **將指示與提示保持精簡**:使用直接、簡單的語言,並提供範例說話方式來有效引導工作人員。
- **杠杆變數與決定性動作**:使用這些工具可引導工作人員的行為,並最佳化其效能以取得更可預測的成果。
- **讓動作輸出保持簡短**:請確保工作人員的回應簡短且精確。較長的輸出使用更多內容,產生速度較慢。
- **最佳化速度的動作**:設計流程和 Apex 類別以傳回最少的必要資料。盡可能透過預先處理來產生回應所需的動作減少。
- **定義清除範圍**:撰寫適當的動作描述、指示和範圍,以防止工作人員針對超出範圍的問題呼叫 RAG (Retrieval-Augmented Generation)。
- **謹慎使用混合搜尋**:僅在絕對必要時使用混合搜尋,因為這會對延遲造成負面影響。
**3\.測試、監視和調整**
此反覆階段對於精簡工作人員準確性和效能而言至關重要。
- **建立測試流程**:遵循一致的測試週期:
1. **執行批次測試**:執行一組全方位的測試。
2. **檢視分數/錯誤**:分析效能度量並識別失敗。
3. **檢查失敗**:檢查每個失敗列以瞭解不一致。
4. **更新工作人員**:對工作人員或其評估資料進行必要調整。
- **檢閱工作階段追蹤資訊**:使用「工作階段追蹤資料模型」和 Agentforce Interaction Explorer,在發現問題或非預期行為時執行根本原因分析。根據資訊調整工作人員,並繼續重複處理工作人員。
## 結論
*工作人員開發生命週期*代表傳統軟體開發原則的關鍵演進,針對智慧型自發系統的時代而設計。
- **進化,而非取代**:「工作人員開發生命週期」會延伸並增強傳統的「應用程式生命週期管理」,而不會加以取代。
- **資料為一流公民**:資料在工作人員開發中扮演更為動態且中心的角色。
- **專業工具與技能**:需要新工具和資料科學、ML 工程和工作人員開發之間更廣泛的專門技能。
- **持續學習**:工作人員開發會增加系統本身的持續*學習*和*調整*。
- **未來影響**:工作人員 AI 承諾會進一步自動化和最佳化複雜的 IT 作業和軟體開發工作流程。
## 簡介
Salesforce 共用模式是貴組織提供安全應用程式資料存取權的必要元素。因此,正確建立共用模式,以符合您目前和未來資料存取需求十分重要。在此文件中,我們將檢閱資料無障礙元件、共用模型使用個案和實際客戶共用解決方案,並提供一些疑難排解原則。
### 預期受眾與先決條件
此文件適用於進階系統管理員和結構設計師。若要瞭解這些概念,您必須具備 Salesforce 安全性和共用模式的實際 Knowledge。此指南的先決條件為:
- [Salesforce 說明:共用設定](https://help.salesforce.com/s/articleView?id=sf.managing_the_sharing_model.htm)
- [Trailhead 模組:資料安全性](https://trailhead.salesforce.com/en/content/learn/modules/data_security)
- [針對企業規模設計記錄存取權](https://developer.salesforce.com/docs/atlas.en-us.draes.meta/draes/draes_preface.htm)
- [Salesforce 結構良好 - 安全](/docs/architect/zh-tw/well-architected/guide/secure)
### 不涵蓋資料存取權
本指南著重於用來控制標準和自訂物件記錄級存取權的主要功能。本指南未涵蓋的主題包括:
- 資料夾存取權
- 內容存取權
- Chatter 存取權
- Knowledge 庫存取權
- 計畫、問題/回答存取權
- 行動資料無障礙
## 資料存取類型
記錄級安全性可讓您將某些物件記錄的存取權授與使用者,但不授與其他物件記錄的存取權。如同大多數應用程式,資料存取從使用者開始。應用程式必須先知道使用者是誰,才能提供存取權。針對 Salesforce,使用者類型不同,且有時存取層級會因類型而有所不同。我們不會檢閱每個授權類型的每個屬性,而是將在此專注於對資料存取有顯著影響的感興趣屬性。記錄擁有權與完整存取權為同義詞且可互換,為使用者提供記錄的最高層級存取權。
### 使用者與授權
**_大量使用者_**
大量使用者 (包括具有「客戶社群」、「大量客戶入口網頁」和「已驗證的網站」授權類型的使用者) 不會利用共用模式,因為其授權類型不支援角色。這些授權擁有自己的共用模式,可依外部索引鍵比對使用者 (持有授權) 和帳戶和連絡人對應的資料。管理員可以建立共用集或共用群組,以授與大量使用者記錄的存取權。
**_Chatter Free 與 Chatter External 授權_**
Chatter Free 和 Chatter External 授權不遵循標準共用模式。這些授權沒有 CRM 記錄 (標準或自訂物件) 和「內容」功能的存取權,且不支援角色,因此沒有共用。
針對此文件的其餘部分,我們假設 Salesforce 使用者類型使用完整共用模式。請參閱「[使用者授權」,](https://help.salesforce.com/apex/HTViewHelpDoc?id=users_understanding_license_types.htm)以取得每個可用授權類型的詳細資訊。
### 元件
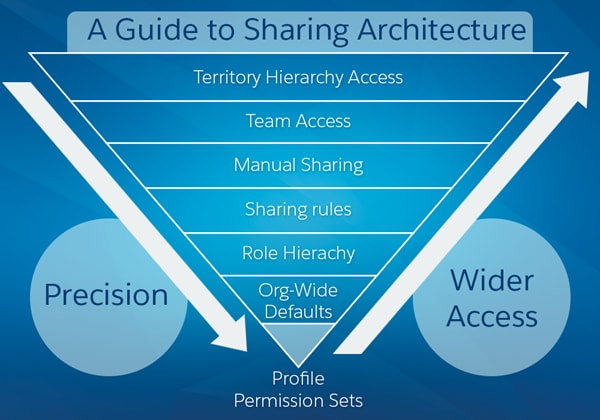
**_設定檔和權限集_**
設定檔和權限集透過決定使用者可看見的資料類型,以及他們是否可以編輯、建立或刪除記錄,來提供物件級安全性。針對每個物件,「檢視所有」和「修改所有」權限會忽略共用規則和設定,讓管理員能夠快速將存取權授與整個組織中與指定物件相關聯的記錄。這些權限通常是「檢視所有資料」和「修改所有資料」管理權限的偏好替代項目,允許使用者檢視或修改所有應用程式和資料。
設定檔和權限集也會控制欄位級安全性,這會決定使用者可存取之每個物件中的欄位。例如,物件可以有 20 個欄位,但可設定欄位級安全性,以防止使用者看見 20 個欄位中的五個。
強烈建議您使用權限集和權限集群組,而非設定檔來管理使用者的物件權限。由於您可以重複使用較小的權限集建構區塊,因此您可以避免為每個使用者和工作功能建立數十個甚至數百個設定檔。
**_記錄擁有權與排隊_**
每個記錄都必須是由單一使用者或某列人的擁有。擁有者可根據擁有者設定檔的「物件設定」來存取記錄。例如,如果擁有者的設定檔具有物件的「建立」和「讀取」權限,但沒有「編輯」或「刪除」權限,則擁有者可以為物件建立記錄,並查看新記錄。不過,擁有者將無法編輯或刪除記錄。階層較高的使用者 (角色或區域範圍) 會繼承與其標準物件下屬相同的資料存取權。如果下屬擁有唯讀存取權,則角色階層中位於其上層的使用者也會如此。此存取權適用於使用者擁有的記錄,以及與其共用的記錄。
查詢可協助您排定優先順序、分配記錄,並將其指派給共用工作負載的小組。在角色階層中較高層級的排行榜成員和使用者可以從清單檢視存取排行榜,並取得列中記錄的擁有權。
如果單一使用者擁有 10,000 筆以上的記錄,最佳作法是:
- 擁有者的使用者記錄不應在角色階層中保留角色。
- 如果擁有者的使用者記錄必須保留角色,請將角色置於角色階層本身分支中的階層頂端。
請 [參閱 Salesforce 結構良好 - 可靠以](/docs/architect/zh-tw/well-architected/guide/reliable#資料量) 取得詳細資訊。
**_組織範圍預設值_**
組織範圍共用設定指定使用者對每個其他記錄擁有的預設存取層級。您可以使用組織範圍共用設定將資料鎖定至限制最嚴格的層級。使用其他記錄級安全性和共用工具來選擇性地將存取權授與其他使用者。例如,使用者擁有讀取和編輯機會的物件級權限,且組織範圍共用設定為「唯讀」。依預設,這些使用者可以讀取所有機會記錄,但無法編輯任何記錄,除非他們擁有記錄或獲授與其他權限。
您可以將組織範圍預設設定從一個設定變更為另一個設定 (「私人」變更為「由父系控制」,再變更為「私人」)。不過,這些變更需要共用重新計算,且視量而定,可能會造成較長的處理時間。
僅針對自訂物件,您可以設定「使用階層賦予存取權」設定。如果未勾選 (預設值已勾選),則在角色階層中較高的使用者無法繼承存取權。此設定可在組織範圍預設設定中找到。
**_角色階層_**
角色階層代表使用者或一組使用者需要的資料存取層級。角色階層可確保管理員一律可存取與其員工相同的資料,無論組織範圍預設設定為何。角色階層不必完全符合您的組織圖表。相反地,階層中的每個角色應呈現使用者或使用者群組需要的資料存取層級。
在 Spring ’21 或更新版本中建立的 Salesforce 組織中,您最多可以建立 5,000 個角色。在 Spring ’21 之前建立的組織中,您最多可以建立 500 個角色,也可以連絡 Salesforce 客戶支援以增加此限制。最佳作法是將內部角色數目保持在 25,000 個,並將外部角色數目保持在 100,000 個。
最佳作法是將角色階層保持在階層中不超過 10 個層級的分支。
當使用者的角色變更時,系統會評估任何相關的共用規則,以視需要更正存取權。位於相同角色的對等者並不保證他們可存取彼此的資料。
建模角色階層從瞭解組織的結構開始。這通常是從從頂端開始,從瞭解經理的範圍建立。CEO 監督整個公司。CEO 通常擁有直接報告,然後可依業務單位 (銷售或支援) 或地理區域 (EMEA、APAC) 分段。接著該人員會擁有可進一步區隔的直接報告等等。雖然這聽起來很像 HR 組織圖表,但建模資料存取時,請專注於資料存取設定,並考量 HR 報告。
重疊一律是階層中的困難部分。如果他們在自己的分行中,則需要共用規則、小組或區域範圍管理才能取得所需的存取權。如果它們折疊至階層,可能會產生報告影響。
花時間設定角色階層是很重要的,因為它是共用模式的基礎層面之一。
| 角色階層使用個案 |
| ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| 管理存取權—經理能夠看見和執行其下屬可以看見和執行的任何動作。 |
| 管理報告—報告以階層方式累計的能力,讓階層中較高層級的人員看見的資料比位於其下層的人員多。 |
| 組織分行之間的區隔 - 不同的業務單位不需要看見彼此的資料;在階層中,您可以定義個別分行,讓您可以區隔業務單位內的可視性,同時將可視性向上滾動至這些單位之上的主管層級。 |
| 角色內的區隔 - 在許多組織/應用程式中,所有扮演相同角色的使用者不一定會看見彼此的資料。擁有階層角色可讓您定義「分葉」節點,其中所有資料都基本為專用,且仍可將該資料累計至可全部查看的父系角色。 |
**_公用群組_**
公用群組是個別使用者、角色、區域範圍等的集合,所有使用者皆具有共同功能。公用群組可包含:
- 使用者
- 客戶入口網頁使用者
- 合作夥伴使用者
- 角色
- 角色和內部下屬
- 角色、內部和入口網頁下屬
- 入口網頁角色
- 入口網頁角色和下屬
- 區域範圍
- 區域範圍和下屬
- 其他公用群組 (巢狀群組)
群組可以嵌套 (將群組 A 嵌套至群組 B),但無法嵌套超過五個層級。巢狀會因為群組成員資格計算而影響群組維護和績效。最佳作法是將組織的公用群組總數保持在 100,000 個。
| 公用群組使用個案 |
| -------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| 當您需要將存取權提供給任意的人員群組時,您可以建立公用群組來收集他們,然後使用其他共用工具將必要的存取權授與群組。僅群組成員資格不會提供資料存取權。 |
| 群組也可以在彼此內部嵌套,因此可讓巢狀群組取得與其所包含群組相同的存取權。這可建立較小的臨時階層,這些階層不一定會與角色或區域範圍階層互動。如果「群組 A」是「群組 B」的成員,則「群組 A」的成員將擁有與「群組 B」成員相同存取層級的存取權,以存取與「群組 B」成員共用的資料。 |
| 群組也能夠保護在群組中共用的資料,使其無法供在群組成員之上的角色階層的人員存取。這項動作 (以及處理記錄擁有者及其管理階層的存取權) 允許建立可共用高度機密資訊的群組—資料只會供群組成員存取,而組織中的其他人則無法存取。這可透過使用「使用階層賦予存取權」設定來完成。 |
**_擁有者共用規則_**
以擁有者為基礎的共用規則允許組織範圍預設設定和角色階層的例外,讓其他使用者能夠存取他們不擁有的記錄。擁有者共用規則僅以記錄擁有者為基礎。
以連絡人擁有者為基礎的共用規則不適用於私人連絡人,或與帳戶無關聯的連絡人。
每個物件的共用規則總數限制為 300。
| 擁有者共用規則使用個案 |
| --------------------------------------------------------------------------------------------------------------------------------------------------------- |
| 以角色為基礎的矩陣管理或重疊情況:服務中的人員必須能夠看見某些「銷售」資料,但他們居住在階層的不同分支中,因此您可以建立規則來在不同分支的角色之間共用資料。 |
| 將資料存取權提供給擁有相同角色或區域範圍的對等者。 |
| 將資料存取權提供給其他使用者群組 (公用群組、入口網頁、角色、區域範圍)。擁有記錄的分組成員可以與其他分組的成員共用。 |
**_條件式共用規則_**
條件式共用規則會根據記錄的欄位值 (條件) 提供記錄的存取權。如果符合條件 (一或多個欄位值),則會為規則建立共用記錄。記錄擁有權並非考量事項。
每個物件的條件式與來賓使用者共用規則限制為 50。
| 條件式共用規則使用個案 |
| --------------------------------------------------- |
| 根據記錄上的欄位值,將資料存取權提供給使用者或群組。 |
**_來賓使用者共用規則_**
來賓使用者共用規則是條件式共用規則的特殊類型,用於將記錄存取權授與未經驗證的來賓使用者。每個物件的條件式與來賓使用者共用規則限制為 50。
> **警告:**來賓使用者共用規則類型會將存取權授與沒有登入認證的來賓使用者。透過建立來賓使用者共用規則,您可將所有符合共用規則條件之記錄的立即且無限制存取權授與任何人。若要保護 Salesforce 資料的安全,並授與來賓使用者其所需的存取權,請考量建立此類共用規則的所有使用個案和涵義。實作您認為適用於資料敏感性的安全性控制。針對根據預設設定的此變更,將資料向未經驗證的使用者公開時,Salesforce 概不負責。
| 來賓使用者共用規則使用個案 |
| ---------------------------------------- |
| 將資料存取權提供給未經驗證的來賓使用者。 |
**_手動共用_**
有時候,無法定義需要特定記錄集存取權的一致使用者群組。記錄擁有者或具有足夠權限的其他使用者 (例如系統管理員) 可以使用手動共用,將讀取與編輯權限授與沒有其他存取權的使用者。手動共用並非自動化,例如組織範圍共用設定、角色階層或共用規則。但這可讓記錄擁有者與必須看見記錄的使用者彈性共用記錄。
當記錄擁有者變更,或當授與的共用存取權未授與物件其組織範圍共用預設存取層級以外的額外存取權時,系統會移除手動共用。這也適用於以程式設計的方式建立的手動共用。
手動共用記錄會定義為將列原因設為手動共用的共用記錄。
所有具有設定為 *手動共用的*列原因的共用記錄 (標準和自訂物件) 都可以透過物件版面配置上的 **_共用_**按鈕編輯和刪除,即使共用記錄是以程式設計的方式建立。
| 手動共用使用個案 |
| ------------------------------------------------------------------------- |
| 讓使用者能夠將目前記錄的存取權 (唯讀或讀/寫) 授與其他使用者、群組或角色。 |
**_小組_**
小組是使用者群組,可共同處理帳戶、銷售機會或個案。記錄擁有者可以為其擁有的每個記錄建立小組。記錄擁有者會新增小組成員,並指定每個小組成員對於記錄的存取層級。某些小組成員可以擁有唯讀存取權,而其他小組成員則擁有讀/寫存取權。
只有擁有者、階層較高的人員和管理員可以新增小組成員,並為成員提供更多存取權。具有讀/寫存取權的小組成員可以新增已擁有與小組相關聯記錄存取權的其他成員。小組成員無法為其提供額外存取權。
在應用程式中建立小組成員會建立兩個記錄:小組記錄和相關聯的共用記錄。如果您以程式設計的方式建立小組成員,則必須同時管理小組記錄和相關聯的共用記錄。每個記錄僅有一個小組 (帳戶、機會或個案)。如果需要多個小組,請根據您的特定需求考慮區域範圍管理或程式設計共用
| 小組使用個案 |
| ---------------------------------------------------------------------------------------------------------------------------------------------------------- |
| 讓使用者能夠將存取權 (唯讀或讀/寫) 授與單一使用者群組 (小組)。 |
| 如果小組是由外部管理,例如透過外部佣金或區域範圍管理系統,則整合可以用來管理帳戶小組。外部系統中的區域範圍管理可以與 Salesforce 中的小組解決方案一致的狀況。 |
| 帳戶小組可以管理帳戶的多個擁有者。 |
| 單一使用者群組 (小組) 需要機會記錄的唯讀或讀/寫存取權。(機會小組) |
**_區域範圍階層_**
使用「企業區域範圍管理」時,您可以設定區域範圍階層,以顯示模型的區域範圍結構,並作為其主要互動點。如果已啟用企業區域範圍管理,您必須管理角色階層與區域範圍階層。如需詳細資訊,請參閱 Salesforce 說明中的 [企業區域範圍管理](https://help.salesforce.com/articleView?id=sf.tm2_intro.htm)。
**_Apex 受管理共用_**
當資料存取需求無法以任何其他方式達成時,Apex 受管理共用 (也稱為程式設計共用) 可讓您使用程式碼建立精密且動態的共用設定。
如果您以程式設計的方式建立共用記錄,且使用立即可用的列原因 (_手動共用_),則您可以在應用程式中使用「 **_共用_** 」按鈕來維護此共用記錄。共用記錄受限於具有手動共用列原因 (例如在擁有者轉移時刪除) 的所有規則。
您也可以為自訂物件建立自己的 Apex 共用原因,以追蹤使用者或使用者群組的記錄原因,並簡化共用記錄的更新與刪除所需的編碼。
如需詳細資訊,請先檢閱使用 Apex [共用記錄](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_bulk_sharing_creating_with_apex.htm),再考慮使用程式設計共用。
| Apex 受管理共用使用個案 |
| -------------------------------------------------------------------- |
| 沒有其他共用方法 (宣告) 符合資料存取需求。 |
| 使用者存取指派的現有外部事實系統將持續推動存取並與 Salesforce 整合。 |
| 使用原生共用元件的效能不佳。(通常適用於非常大的資料量) |
| 自訂物件的小組功能。 |
**_限制規則_**
在您的資料存取組態中,您可能會想要防止使用者看見可能包含敏感資料或只是對其工作沒有必要的記錄。您可以使用限制規則來允許使用者僅存取符合您所指定條件的記錄。當限制規則套用至使用者時,會根據您指定的條件篩選透過組織範圍預設值、共用規則和其他共用機制授與使用者存取權的記錄。限制規則的運作方式與此主題中討論的共用元件相反;而不是向使用者開放存取權,而是進一步限制。
限制規則適用於自訂物件、外部物件、契約、事件、工作、時間表和時間表項目。您可以在 Enterprise 和 Developer Edition 中為每個物件建立最多兩個啟用中的限制規則,在 Performance 和 Unlimited Edition 中為每個物件建立最多五個啟用中的限制規則。限制規則適用於下列 Salesforce 功能:
- 清單檢視
- 對應
- 相關清單
- 報告
- 搜尋
- SOQL
- SOSL
| 限制規則使用個案 |
| ----------------------------------------------------------------------------- |
| 您想讓特定使用者僅看見特定記錄集。 |
| 簡化使用敏感或機密資訊控制記錄存取權。 |
| 若要讓契約、工作和事件的存取權真正為私人,因為使用組織範圍預設值可能難以達成。 |
**_隱含共用_**
隱含共用會自動執行。您無法將其關閉或開啟,這是應用程式的原生功能。換句話說,隱含共用並非可設定的設定,但對於任何結構設計師而言,此設定十分重要。當使用者可存取該帳戶的子系機會、個案或連絡人時,父系隱含共用會提供父系記錄 (僅限帳戶) 的存取權。Salesforce 擁有資料存取原則,此原則會指出使用者是否可以看見連絡人 (或機會、個案或訂單),則使用者會隱含地看見相關聯的帳戶。子系隱含共用是將帳戶子系記錄的存取權提供給帳戶擁有者。此存取權是在角色階層中擁有者的角色中定義的。子系隱含共用僅適用於連絡人、機會和個案物件 (帳戶的子系)。建立角色時,可為每個子物件提供的存取層級為「檢視」、「編輯」和「無」存取權。透過設定為「檢視」,帳戶擁有者可以隱含地查看相關聯的物件記錄 (連絡人、機會或個案)。透過設定為「編輯」,帳戶擁有者可以隱含地修改相關聯的物件 (連絡人、機會或個案)。
隱含共用不適用於自訂物件。
## 客戶實作實例
沒有適合所有 Salesforce 組織的共用模式。嘗試建構最佳共用模式時,每個組織都有不同的需求和挑戰。使用最適當的資料存取元件以符合組織的共用需求十分重要。下列情況是嘗試建構共用模式時常見的挑戰。
### 透過客戶主要系統在外部管理小組指派
| **需求或挑戰** | **解決方案** |
| ---------------------------------------------------------------------------------------------------------------------------------------- | -------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| 立即可用的兩個項目:一個地理涵蓋範圍區的銷售經理也想要存取另一個地理涵蓋範圍區來協助。 | 擁有者共用規則:此處適用擁有者共用規則,因為這些是邊緣個案,而非規則。如果擁有者共用規則提供的存取權超過實際需要,也可接受,因為這是一位經理,即受信任的個人。 |
| 以國家為基礎的營運使用者需要存取所有國家銷售資料。 | 擁有者共用規則:共用規則的常見用途是在不同部門 (銷售以外) 需要銷售資料的存取權時。 |
| 帳戶上有至少 80% 的「核心 4」小組 (帳戶主管、內部銷售代表、銷售顧問、技術銷售代表)。帳戶小組指派的記錄系統為外部。帳戶一律只有一個小組。 | 小組:由於每個帳戶一律只有一個小組,即使有許多具有不同角色的不同成員,帳戶小組功能仍能滿足此需求。 |
| 小組管理員的存取權必須與其下屬相同。 | 角色階層:角色階層可允許經理存取其下屬的資料,藉此解決此需求。 |
| 指派的帳戶小組不可修改。 | 小組:此需求實際上未透過帳戶小組功能完成。不過,也不應防止您繼續使用帳戶小組。不過,有許多方法可以鎖定小組。針對此個案,會使用移除帳戶小組版面配置。 |
| 必須有「好友」功能,讓當某人病退或休假時,可以在休假期間存取並涵蓋沒有帳戶或機會標準存取權的人員。 | 小組:「好友」可以只是在完成此需求的小組中扮演的角色。然而,挑戰來自先前的需求,其中「小組」不能為可修改。唯一的解決方案是擁有一組可以修改小組的人員,以在必要時建立好友角色。 |
| 當交易需要自訂解決方案時,其他人員 (不一定屬於銷售組織) 必須擁有交易的存取權。 | 小組:「機會小組」的標準使用方式,透過手動將新成員新增至「機會小組」(透過相關清單完成)。如果您一律知道應新增的人員,也可以透過觸發完成。在此個案中,這是依機會的機會。 |
### 立即可用的區域範圍管理
| **需求或挑戰** | **解決方案** |
| ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | -------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| 來自兩個不同業務單位 (零售銷售和再行銷) 的兩個不同機會小組需要相同帳戶記錄的存取權。他們必須共用連絡人並掌握帳戶上的所有活動。這兩個業務單位擁有自己的階層和累計。 | 區域範圍管理:思考此需求的最佳方法是具有階層的兩個分支,其結構可能不同。區域範圍管理的理由是,這兩個不同分行的兩個層級 (兩個層級具有成員 = 該業務單位的機會小組) 都需要帳戶的存取權。雖然您可以使用「小組」概念完成此需求,但這太細微了。銷售區隔不是在帳戶層級,而是在階層中。 |
| 有個別的業務開發人員群組已獲指派,且需要存取特定機會小組 (區域範圍) 的特定帳戶。業務開發人員是機會小組的共用資源,這表示可將每個業務開發人員指派給一或多個機會小組的一個或多個帳戶。 | 區域範圍管理:由於這是一群使用者 (或小組),且每個業務開發小組可能因帳戶而有所不同,且由於需要其他原因管理區域範圍,因此最有可能的方法是建立代表這些業務開發小組的子區域範圍或個別分支。 |
| 有一些非佣金型銷售支援角色需要一次性存取帳戶。 | 小組:需求的關鍵部分為「一次性」。這表示會根據帳戶在帳戶基礎上完成,因此帳戶小組會原生提供。 |
| 信用部門需要指定業務單位所有帳戶的存取權。 | 擁有者共用規則:這是針對指定業務單位,一組使用者在整個板上都必須看見所有內容的情況。此需求可透過群組所屬角色的共用規則、群組所屬角色階層的分支 (角色和下屬),甚至是公用群組來完成。區域範圍管理:您也可以將信用部門建模為具有指定業務單位相同邏輯的區域範圍來完成此需求。 |
| 管理員必須擁有與其下屬相同的存取權。 | 角色階層:角色階層可允許經理存取其下屬的資料,藉此解決此需求。 |
## 考量事項
### 企業區域範圍管理實作考量事項
- 角色階層會發生什麼狀況?
- 如果您同時使用區域範圍階層,則角色階層不會有任何影響。不過,如果您同時使用以區域範圍為基礎的預測和以角色為基礎的預測,則必須管理兩個階層。在此情況下,建議您使用角色階層來建模 HR 報告結構,然後使用區域範圍階層來建模實際的銷售階層。區域範圍階層最適用於建模矩陣報告結構,其中有人可以向多個經理報告。
如果您未同時使用以區域範圍為基礎的預測和以角色為基礎的預測,則只能使用區域範圍階層作為銷售階層。在此情節下,最好盡可能簡化或壓平階層。
我們不建議讓角色階層與區域範圍階層相同,因為這會造成不必要的共用活動。
- 您是否仍可使用小組?
- 是。不過,如果您可以滿足區域範圍階層內的存取需求 (例如重疊),則最好在其中執行,而非使用小組。您已經維護多個階層 (角色和區域範圍),因此在嘗試盡可能保持簡單時,請僅在沒有其他現有共用元件符合需求時實作小組。
### 其他考量事項
- 重新對齊和重新指派
- 有兩種變更會發生—角色、小組或區域範圍的成員資格,以及階層的結構。成員資格變更通常會每日發生,甚至每小時發生一次。階層結構 (重新對齊) 變更通常較不常見 (每季、每半年或每年),且可能需要資源。必須考量變更量,以及每個變更會造成的串聯變更數目。根據基本規則,請讓結構變更不會超過每季發生一次,且所有大量變更 (大量或大量變更) 都會經過良好規劃、測試和協調。
- 大量資料
- 無論您是為初始首展建立模型,或是計畫重新對齊方式變更,您都必須嚴重考量資料量。效能可能會變成因素的某些值,因此強烈建議在生產之前在 Sandbox 中測試您的變更。此測試也會提供您變更所需時間的基準。
如果您擁有超過 2 百萬個帳戶,且已實作小組或「企業區域範圍管理」,則特別必須注意績效。這些是複雜的共用模式元件,可產生大量共用記錄,進而長時間執行交易。
- 延後共用計算
- 如果您有使用共用且具有大量記錄的物件 (例如超過 2 百萬個帳戶),且您必須進行大量變更 (例如需要階層變更的每季重新對齊),則 Salesforce 客戶支援可以啟用功能來延後自動共用計算。原生而言,對於角色階層、區域範圍階層、群組、共用規則、使用者角色、小組成員資格或記錄擁有權的每個個人變更都會起始自動共用計算。進行大量變更時,會造成數個自動共用重新計算開始。透過暫時暫停這些重新計算,您便能夠進行變更,然後一次完成所有共用計算。此方法通常更有效率且更能執行大量變更。
- 資料和擁有權概觀
- 資料誤差定義為具有許多子系記錄的一些父系記錄。當少數帳戶擁有許多連絡人、機會或個案時,這些偏差可能會對您造成傷害。我們開始看見績效降級的比率為 1:10,000。最佳作法是盡可能將比率保持在其上 (偏好較低)。
擁有權誤差與資料誤差類似,但我們指的是擁有物件多個記錄的單一使用者、角色或群組。如同資料誤差,這也會導致長時間執行交易,進而在發生變更時導致效能降低。擁有者與記錄數的建議比率也為 1:10,000。
如果單一使用者擁有 10,000 筆以上的記錄,最佳作法是:
- 擁有者的使用者記錄不應在角色階層中保留角色。
- 如果擁有者的使用者記錄必須保留角色,請將角色置於角色階層本身分支中的階層頂端。
- 帳戶階層對資料存取權的影響
- 許多人在實作帳戶階層時會做出不良假設。他們假設可存取父系帳戶的使用者也可以存取子系帳戶。兩個記錄之間只有一個父系/子系關係的簡單事實並不會驅動存取。雖然角色階層與區域範圍階層會以此方式運作,但帳戶階層則不會。
## 疑難排解
完成共用模型結構後,您可能會受到使用者看見或看不見記錄的原因的挑戰。通常,您不會聽到使用者何時可以看到他們不應該看到的內容,但如果需要,您可以看到每個具有記錄存取權的使用者以及其原因。
更困難且可能更常見的挑戰是使用者看不見記錄的原因。您建立的安全性層級會決定您從何處開始。如果您熟悉共用模式,則您可能會知道哪個元件應提供存取權,且可以從中開始。但如果您對共用模式較不熟悉,請從角色階層開始,並將每個圖層取回,以決定哪些圖層應提供存取權。以下是疑難排解流程。
1. 確認使用者具有存取物件的權限。
2. 識別看不到記錄的使用者角色並記下。
3. 識別記錄角色的擁有者並記下。
4. 檢閱角色階層,並確認這兩個角色位於兩個不同的分支中 (應該是)。
5. 現在您必須檢閱物件的共用規則,並確定沒有授與使用者存取權的規則。視需要也可在公用群組中尋找。使用者可能已排除在共用規則的群組之外,或者建立新共用規則以授與使用者存取權是否合理?此選擇取決於您嘗試維護的結構,並適用於擁有者共用規則與條件式共用規則。
6. 如果您使用小組,該使用者是否應在該記錄的小組中?如何維護小組,以及缺口如何發生?
7. 如果使用手動共用,則使用者可能因為記錄擁有者變更而失去存取權。手動共用會在擁有權變更時遭到捨棄。手動共用也可使用「**共用」**按鈕移除。
8. 如果您使用的是企業區域範圍管理,使用者是否缺少其中一個區域範圍?維護區域範圍成員資格的位置為何,以及缺口如何發生?或者,可能不會將記錄指派至使用者所屬的區域範圍。
9. 如果您要建立程式設計共用,且有條件可在程式碼中建立共用,請檢閱程式碼以瞭解為何忽略此使用者。
每天,[數以萬計的企業和數百萬的使用者](https://www.salesforce.com/customer-stories/)使用 Salesforce Platform 提供的應用程式在雲端中營運業務。為什麼平台如此成功?為什麼您可以 Trust 支援您的業務?平台為您類似的公司提供哪些獨特好處?
此技術簡報說明 Salesforce Platform 如何使用其獨特的雲端計算軟體結構,為一般使用者提供可靠、可調整且易於自訂的體驗。閱讀本簡要說明後,您將更瞭解讓 Salesforce Platform 成為您業務應用程式引人注目的選擇的基礎技術。
## 平台概觀
Salesforce Platform 是成功的雲端計算平台和相關應用程式生態系統的重要範例。自千禧年開始,此平台一直是下列項目的基礎:
- 許多常見使用個案 (例如銷售和客戶服務) 的熱門[業務應用程式](http://www.salesforce.com/products/)
- 適用於更專業使用個案 (例如財務和醫療照護) 的 [產業特定應用程式](https://www.salesforce.com/solutions/industries/)
- 數百萬個唯一使用個案的 [自訂應用程式和應用程式擴充](https://www.salesforce.com/products/platform/overview/)
在很大程度上,Salesforce Platform 非常成功且受歡迎,因為其獨特的軟體結構支援易於建立、使用、自訂和擴充的應用程式,具有卓越的[效能和可靠性](http://trust.salesforce.com/trust/)。平台的軟體結構核心是其多租戶中繼資料驅動的設計。
| 預先查詢選擇性測量 | 撰寫最終資料庫存取查詢,強制執行... | |
| 使用者 | 篩選 | |
| 低 | 低 | ... 巢狀迴圈聯結,使用使用者可看見的列檢視來駕駛 |
| 低 | 高 | ... 使用與 filter 相關的索引 |
| 高 | 低 | ... 排序雜湊聯結,使用 MT_DATA 駕駛 |
| 高 | 高 | ... 使用索引相關篩選條件 |
| 模式 | 案例 |
|---|---|
| 遠端流程叫用—要求與回覆 | Salesforce 會在遠端系統上叫用程序、等待該程序完成,然後根據遠端系統的回應追蹤狀態。 |
| 遠端流程叫用—觸發與忘記 | Salesforce 會在遠端系統中叫用程序,但不會等待程序完成。相反地,遠端流程會接收並確認要求,然後將控制退回至 Salesforce。 |
| 批次資料同步化 | 系統會建立或重新整理儲存在 Lightning 平台中的資料,以反映外部系統的更新,以及從 Lightning 平台將變更傳送至外部系統時。任一方向的更新都會以批次方式進行。 |
| 遠端呼叫 | 儲存在 Salesforce Platform 中的資料會由遠端系統建立、取用、更新或刪除。 |
| 根據資料變更更新 UI | 由於 Salesforce 資料的變更,因此必須自動更新 Salesforce 使用者介面。 |
| 資料虛擬化 | Salesforce 會即時存取外部資料。這可消除在 Salesforce 中保留資料的需求,然後在 Salesforce 與外部系統之間協調資料。 |
| 層面 | 描述 |
|---|---|
| 類型 | 指定整合的樣式:程序、資料或虛擬。
|
| 時間 | 指定整合的樣式:程序、資料或虛擬。
|
| 類型 | 時間 | 考量的主要模式 |
|---|---|---|
| 流程整合 | 同步 | 遠端流程叫用—要求與回覆 |
| 流程整合 | 非同步 | 遠端流程叫用—觸發與忘記 |
| 資料整合 | 同步 | 遠端流程叫用—要求與回覆 |
| 資料整合 | 非同步 | 根據資料變更更新 UI |
| 虛擬整合 | 同步 | 資料虛擬化 |
| 類型 | 時間 | 考量的主要模式 |
|---|---|---|
| 流程整合 | 同步 | 遠端呼叫 |
| 流程整合 | 非同步 | 遠端呼叫 |
| 資料整合 | 同步 | 遠端呼叫 |
| 資料整合 | 非同步 | 批次資料同步化 |
| 期限 | 定義 |
|---|---|
| 事件處理 | 事件處理是指在指定收件者 (「處理常式」) 處接收可識別的事件。事件處理涉及的關鍵流程包括:
請記住,事件處理常式最終可以將事件轉送給事件消費者。 此功能與中介軟體的常見用途可以延伸至包含受歡迎的「發佈/訂閱」或「pub/sub」功能。在發佈/訂閱案例中,中介軟體會將要求或訊息路由至已啟用資料事件發行者的已啟用資料事件訂閱者。這些具有已啟用接聽者的取用者便可在發佈事件時取回事件。 在使用中介軟體的 Salesforce 整合中,中介軟體層會假設控制事件處理。它會收集所有相關事件,無論同步或非同步,並管理對所有端點 (包括 Salesforce) 的散佈。 或者,您可以透過 Salesforce 企業傳訊平台透過將 Event Bus 與平台事件搭配使用來達成此功能。 |
| 通訊協定轉換 | 通訊協定轉換通常是軟體應用程式,可將一個裝置的標準或專屬通訊協定轉換為適合其他裝置的通訊協定,以達成互通性。 在中介軟體環境中,特定目標系統的連線可能受通訊協定的限制。在此情況下,必須將訊息格式轉換為目標系統的格式,或將其壓縮在目標系統的格式內,以便在該處提取裝載。這也稱為隧道。 Salesforce 不支援原生通訊協定轉換,因此會假設中介軟體層或端點符合任何此類需求。 |
| 翻譯和轉換 | 轉換是將一個資料格式對應至另一個資料格式的功能,以確保整合的各種系統之間的互通性。通常,流程需要重新格式化路線中的訊息,以符合寄件者或收件者的需求。在更複雜的情況下,一個應用程式可以傳送其原生格式的訊息,而兩個以上的其他應用程式可以每個接收其原生格式的訊息複本。 中介程式翻譯和轉換工具通常包含為舊版或其他非標準端點建立服務面向的功能。這些服務面向允許這些端點顯示為可供服務定址。 使用 Salesforce 整合時,會假設中介軟體層或端點符合任何此類需求。 資料轉換可在 Apex 中進行編碼,但基於維護與效能考量事項,我們不建議進行編碼。 |
| 排隊與緩衝 | 截排和緩衝通常依賴非同步訊息傳遞,而非要求回應結構。在非同步的系統中,當目的地程式忙碌或連線能力遭到破壞時,訊息會提供暫時儲存空間。此外,大多數非同步中介軟體系統都會提供永久的儲存空間來備份訊息排列。 非同步訊息流程的主要優點是,如果接收者應用程式因任何原因而失敗,則傳送者可以繼續不受影響。傳送的訊息只會累積在訊息中,以便在收訊者重新啟動時稍後處理。 Salesforce 僅提供以工作流程為基礎的輸出傳訊形式明確排入功能。若要為其他整合案例 (包括協調流程、流程編程和服務品質) 提供真實的訊息排入,則需要中介解決方案。 |
| 同步傳輸通訊協定 | 同步傳輸通訊協定是指支援活動的通訊協定,其中「來電者中的單一執行緒傳送要求訊息、封鎖等候回覆訊息,然後處理回覆...等待回應的要求執行緒表示只有一個待處理的要求,或此要求的回覆管道為此執行緒專用。」 |
| 非同步傳輸通訊協定 | 非同步傳輸通訊協定是指支援活動的通訊協定,其中「來電者中的一個執行緒會傳送要求訊息,並為回覆設定回呼。個別的執行緒會聆聽回覆訊息。當回覆訊息到達時,回覆討論線索會叫用適當的回呼,這會重新建立來電者的內容並處理回覆。此方法可讓多個未完成要求共用單一回覆討論串。」 |
| 仲裁路由 | 仲裁路由是從元件到元件的複雜訊息「流程」規格。例如,許多以中介軟體為基礎的解決方案都取決於訊息列系統。雖然某些實作允許由傳訊層本身提供路由邏輯,但其他實作依賴用戶端應用程式來提供路由資訊或允許兩種範例混合。在這種複雜的情況下,中介軟體的仲裁可簡化開發、整合和驗證。 computerator [中介者] 可以確保將正確的訊息傳送給正確的消費者。」 |
| 流程 koreography 和服務協調流程 | 流程 koreography 和服務協調流程是「服務組成」的每種形式,其中會協調任何數量的端點和功能。
koreography 與服務協調流程之間的差異為:
您可以在 Salesforce 工作流程中或使用 Apex 中建立部分業務流程的 koreography。由於 Salesforce 逾時值和管理員限制,因此建議在中介軟體層中實作所有複雜協調流程,特別是在需要真正交易處理的解決方案中。 |
| 交易性 (加密、簽署、可靠傳送、交易管理) | 交易性可以定義為支援全域交易的能力,其中包含針對每個必要資源的所有必要作業。交易性意味著支援所有四個 ACID 屬性 (原子性、一致性、隔離性、永續性),其中原子性會保證工作單位 (交易) 的全部或無成果。
雖然 Salesforce 本身為交易,但無法參與 Salesforce 外部起始的散佈交易或交易。因此,假設針對需要複雜且多系統交易的解決方案,會在中介軟體層中實作交易性和相關聯的回復/補償機制。 |
| 路由 | 路由可定義為指定從元件到元件的複雜訊息流程。在現代服務型解決方案中,此類訊息流程可根據數個條件,包括標題、內容類型、規則和優先順序。
使用 Salesforce 整合時,會假設中介軟體層或端點符合任何此類需求。訊息路由可在 Apex 中進行編碼,但基於維護與效能考量事項,我們不建議進行編碼。 |
| 解壓縮、轉換和載入 | 解壓縮、轉換和載入 (ETL) 是指涉及下列項目的程序:
Salesforce 現在也支援 Change 資料擷取這是發佈代表變更 Salesforce 記錄的變更事件。透過 Change 資料擷取,用戶端或外部系統會接收 Salesforce 記錄的近乎即時變更。透過此資訊,用戶端或外部系統可以同步化外部資料存放區中的對應記錄。 |
| 長輪詢 | 長輪詢也稱為 Comet 程式設計,會模擬從伺服器到用戶端的資訊推送。與一般投票類似,用戶端會從伺服器連線並要求資訊。然而,當資訊無法使用時,伺服器不會傳送空白回應,而是保留要求並等待資訊可用 (事件發生)。接著,伺服器會將完整回應傳送至用戶端。接著,用戶立即重新要求資訊。用戶端持續與伺服器保持連線,因此一律等待收到回應。如果伺服器逾時,則用戶端會再次連線並重新開始。 Salesforce Streaming API 使用 Bayeux 通訊協定和 CometD 進行長輪詢。
|
| 解決方案 | 適合 | 註解 |
|---|---|---|
| 外部服務叫用 REST API 呼叫 | 最佳 | 外部服務可讓您以宣告的方式叫用外部主控的服務 (無須程式碼)。符合下列條件時,最適合使用此功能:
|
| Salesforce Lightning—Lightning 元件或頁面會起始同步 Apex REST 或 SOAP 呼叫。</ 如果遠端端點造成高度延遲回應的風險 (請參閱此處適用限制的最新限制文件),則建議使用非同步呼叫 (也稱為繼續),以避免達到同步 Apex 交易管理員限制。 |
最佳 | Salesforce 可讓您取用 WSDL 並產生產生的 Proxy Apex 類別。此類別提供呼叫遠端服務所需的邏輯。 Salesforce 也可讓您使用標準 GET、POST、PUT 和 DELETE 方法叫用 HTTP (REST) 服務。 Lightning 頁面上的使用者起始動作接著會呼叫 Apex 控制項動作,然後執行此 Proxy Apex 類別以執行遠端呼叫。Lightning 頁面需要自訂 Salesforce 應用程式。 |
| 從 Salesforce 資料變更叫用的同步觸發會執行非同步 Apex SOAP 或 HTTP 呼叫。 | 子最佳 | 您可以使用 Apex 觸發程序,根據記錄資料變更執行自動化。 Apex Proxy 類別可以使用 Apex 觸發來作為 DML 作業的結果執行。不過,從觸發內容中進行的所有呼叫必須從起始事件非同步執行。因此,此整合問題不建議使用此解決方案。此解決方案更適用於「遠端流程叫用—觸發與忘記」模式。 |
| 批次 Apex 工作會執行同步 Apex SOAP 或 HTTP 呼叫。 | 子最佳 | 您可以從批次工作撥打遠端系統的電話。此解決方案允許從 Salesforce 中的遠端系統批次遠端流程執行和處理回應。不過,指定的批次對通話數量有限制。如需詳細資訊,請參閱 管理員限制。 指定的批次執行可以執行多個交易內容 (通常為 200 筆記錄的間隔)。管理員限制會針對每個交易內容重設。 |
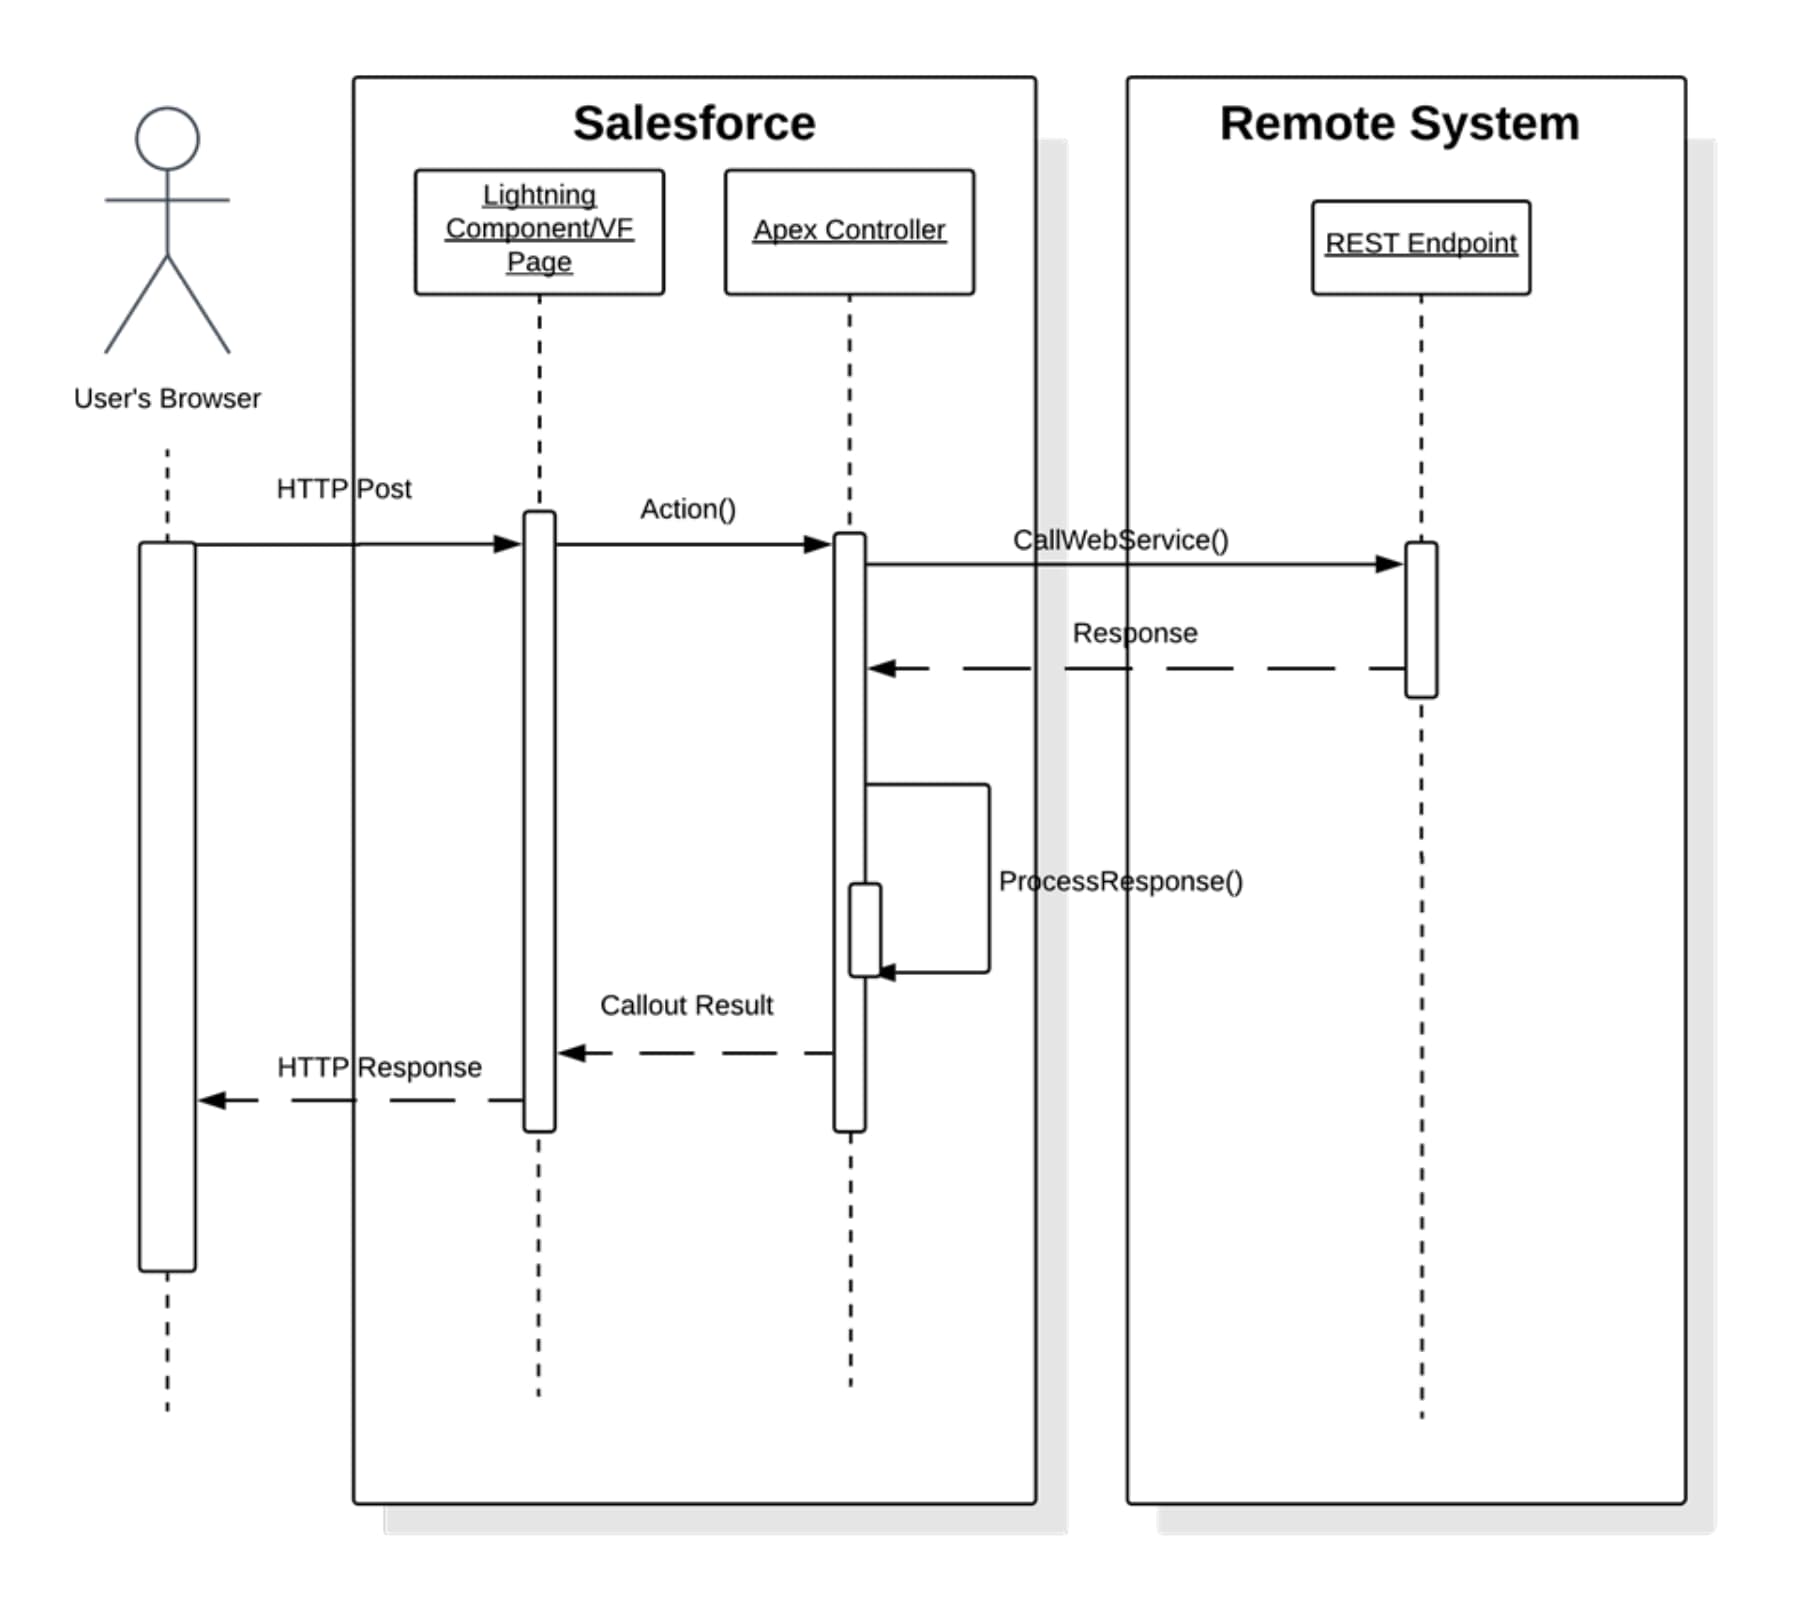 下載圖表
在此情況下: - 系統會在 Lightning 頁面上起始動作 (例如按一下按鈕)。 - 瀏覽器 (在 Lightning 元件中透過用戶端控制項) 會執行 HTTP POST,進而在對應的 Apex 控制項上執行動作。 - 控制器會叫用遠端 Web 服務的實際呼叫。 - 遠端系統的回應會傳回至 Apex 控制項。控制器會視需要處理回應、更新 Salesforce 中的資料,並重新呈現頁面。 在必須追蹤後續狀態的情況下,遠端系統會傳回儲存在 Salesforce 記錄中的唯一識別碼。 **結果** 套用與此模式相關的解決方案可允許事件起始的遠端流程叫用,其中 Salesforce 處理處理。 **呼叫機制** 呼叫機制取決於用來實作此模式的解決方案。
| 通話機制 | 描述 |
|---|---|
| 流程中內嵌的增強型外部服務 Lightning 元件或 Apex 控制項 |
用於觸發遠端流程作為涉及使用者介面的端對端流程的一部分,且結果必須在 Salesforce 記錄中顯示或更新。例如,將信用卡付款提交至外部付款管道,以及付款結果會立即傳回並向使用者顯示。 |
| Apex 觸發 | 主要用於使用 DML 初始事件中的 Apex 呼叫來叫用遠端程序。如需此呼叫機制的詳細資訊,請參閱模式 遠端流程叫用—觸發與忘記。 |
| Apex 批次類別 | 用於批次叫用遠端程序。如需此呼叫機制的詳細資訊,請參閱模式 遠端流程叫用—觸發與忘記。 |
| 解決方案 | 端點考量事項 |
|---|---|
| Apex HTTP 呼叫 | 端點必須能夠接收 HTTP 呼叫。Salesforce 必須能夠透過公用網際網路存取端點。針對私人和安全的通訊,Salesforce 現在也已開始透過 Hyperforce 平台安全地支援 Salesforce 私人連線。請參閱 Salesforce Private Connect 以取得詳細資料。
您可以使用 Apex HTTP 呼叫,使用標準 GET、POST、PUT、DELETE 和 PATCH 方法呼叫 REST 服務。 |
| Apex SOAP 呼叫 | 端點必須能夠接收 HTTP 呼叫。Salesforce 必須能夠透過公用網際網路存取端點。針對私人和安全的通訊,Salesforce 現在也已開始透過 Hyperforce 平台安全地支援 Salesforce 私人連線。請參閱 Salesforce Private Connect 以取得詳細資料。
此解決方案需要遠端系統與 Salesforce 支援的標準相容。撰寫時,Salesforce 針對 Apex SOAP 呼叫支援的 Web 服務標準為:
|
- Salesforce 會儲存遠端系統遠端記錄的主要或唯一替代金鑰。
- 遠端系統會儲存 Salesforce 唯一記錄識別碼或其他唯一的替代金鑰。
| 主要 | 系統 描述 |
|---|---|
| Salesforce | 遠端系統會儲存 Salesforce RecordId 或記錄中的其他唯一替代金鑰。 |
| 遠端系統 | 遠端流程的呼叫會從應用程式傳回唯一金鑰,而 Salesforce 會將該金鑰值儲存在唯一記錄欄位中。 |
- 涉及複雜流程邏輯的業務流程和規則協調流程
- 將通話及其在多個系統之通話之間的結果彙總
- 轉換輸入與輸出訊息
- 跨多個系統的呼叫維護交易完整性
| 財產 | 必要 | 理想 | 不需要 |
|---|---|---|---|
| 事件處理 | X | ||
| 通訊協定轉換 | X | ||
| 翻譯和轉換 | X | ||
| 排隊與緩衝 | X | ||
| 同步傳輸通訊協定 | X | ||
| 非同步傳輸通訊協定 | X | ||
| 仲裁路由 | X | ||
| 流程 koreography 和服務協調流程 | X | ||
| 交易性 (加密、簽署、可靠傳送、交易管理) | X | ||
| 路由 | X | ||
| 解壓縮、轉換和載入 | X | ||
| 長輪詢 | X |
- Salesforce 會從 Apex Proxy 類別中取用帳單帳戶服務 WSDL。
- 透過從自訂 Apex 控制器或外部服務傳送至外部 Web 服務的客戶資訊,執行 Apex Proxy 類別。
- 自訂控制器接著會剖析來自 Apex 呼叫的傳回值,並將該資訊儲存在 salesforce 物件上。
- 系統會使用儲存在 Salesforce 帳戶物件上的帳戶號碼來追蹤客戶的狀態。
- 來電者後續處理回覆訊息
- 遠端系統的呼叫是否需要 Salesforce 等待回應,才能繼續處理?對遠端系統的呼叫是同步還是非同步?
- 如果遠端系統的通話為同步,Salesforce 是否需要將回應作為通話相同交易的一部分處理?
- 訊息大小是否小?
- 整合是否以特定事件 (例如按一下 Salesforce 使用者介面中的按鈕) 或以 DML 為基礎的事件為基礎?
- 保證從 Salesforce 傳送訊息至遠端系統是否為必要條件?
- 遠端系統是否能夠參與 Salesforce 指定契約的契約優先整合?在某些解決方案變體 (例如輸出傳訊) 中,Salesforce 會指定遠端系統端點實作的契約。
- 端點或企業服務匯流 (ESB) 是否支援長輪詢?
- 陳述性組態方法是否優先於自訂 Apex 開發?在此情況下,如平台事件等解決方案優先於 Apex 呼叫。
| 解決方案 | 適合 | 註解 |
|---|---|---|
| 流程驅動的平台事件 | 最佳 | 以宣告的方式建立流程以實作平台事件。建議的解決方案是在從插入或更新事件叫用遠端程序時。 平台事件是您應用程式傳送和接收以採取進一步動作的事件訊息 (或通知)。平台事件可簡化傳達變更和回應變更的流程,而無須撰寫複雜邏輯。一或多個訂閱者可以聆聽同一個事件並執行動作。 例如,軟體系統可以傳送事件,其中包含印表機墨水盒的相關資訊。訂閱者可以訂閱事件來監視印表機墨水層級,並下單來取代具有較低墨水層級的墨水盒。 外部應用程式可以透過 CometD 訂閱管道來聆聽事件訊息。平台應用程式 (例如 Lightning 元件) 也可以透過 CometD 訂閱事件訊息。您也可以在此使用以 gRPC 和 HTTP/2 為基礎的 Salesforce PubSub API。 Salesforce 也支援「平台事件觸發流程」,有效建立使用 Flow Builder 介面的接聽者。當特定平台事件訊息發佈至 Salesforce Event Bus 時,此類型的流程會自動啟動。 |
| Pub/Sub API | 最佳 | Pub/Sub API 是外部消費者使用 Event Bus 事件的建議方式。 gRPC 型 Pub/Sub API:
平台事件在 Salesforce 中定義後,便可供內部與外部消費者使用。 |
| 變更 資料擷取 | 最佳 | Change 資料擷取 (CDC) 會發佈 Salesforce 記錄中對應建立、更新、刪除和取消刪除作業變更的事件。在 Salesforce 中啟用 Change 資料擷取 (CDC) 是純粹的陳述性程序,不需要 Apex 程式碼。 通知訊息會傳送至事件匯流,用戶端可使用 Pub/Sub API 或 Apex 觸發來訂閱該匯流。以事件為導向的系統可簡化分散式企業系統之間的通訊、增加延展性,並提供即時資料。 例如,如果訂單資訊位於 ERP 系統與 Salesforce 中,您可以將訂單變更事件從 Salesforce 串流至整合應用程式。接著應用程式會同步化 ERP 系統中的變更 |
| Omnistudio 整合程序 | 良好 | 使用 Omnistudio 整合程序,以宣告的方式自動化 Salesforce 與外部第三方應用程式之間的資料互動。「整合程序」會處理複雜的資料轉換、API 呼叫和以事件為導向的自動化,並可在單一伺服器呼叫中執行多個動作。 當執行期間不需要使用者互動,且您想要:
請查看更多關於「整合程序」的詳細資料。 |
| 自訂驅動的平台事件 | 良好 | 與流程驅動的平台事件類似,但事件是由 Apex 觸發或類別所建立。您可以使用 Apex 或 API 來發佈及取用平台事件。 平台事件會透過 Apex 觸發與 Salesforce 平台整合。觸發是 Salesforce 平台上聆聽事件訊息的事件取用者。 當外部應用程式使用 API 或原生 Salesforce 應用程式使用 Apex 發佈事件訊息時,會觸發該事件的觸發。觸發會執行動作以回應事件通知。 |
| 流程驅動的輸出傳訊 | 適合 | 此類型整合的建議解決方案是在從插入或更新事件叫用遠端程序時。Salesforce 提供流程驅動的輸出傳訊功能,可將 SOAP 訊息傳送至 Salesforce 中插入或更新作業觸發的遠端系統。這些訊息會以非同步方式傳送,且獨立於 Salesforce 使用者介面。 輸出訊息會傳送至特定遠端端點。遠端服務必須能夠參與 Salesforce 提供契約的契約優先整合。 收到訊息時,如果遠端服務未以正向確認的方式回應,Salesforce 會重試傳送訊息,提供一種保證傳送的形式。 |
| 起始 Apex SOAP 或 HTTP 非同步呼叫的自訂 Lightning 元件 | 子最佳 | 此解決方案通常用於以使用者介面為基礎的案例,但需要自訂。此外,解決方案必須處理程式碼中訊息的保證傳遞。 與使用 Lightning 元件與 Apex 呼叫指定之「遠端流程叫用」—「要求與回覆」 模式解決方案類似。不同之處在於在此模式中,Salesforce 不會等待要求完成,然後再將控制權授與使用者。 接收訊息後,遠端系統會回應並指示已收到訊息,然後以非同步方式處理訊息。遠端系統會在處理訊息前先將控制回 Salesforce,因此 Salesforce 不需要等待處理完成。 |
| Apex 觸發使 Apex SOAP 或 HTTP 非同步呼叫 | 子最佳 | 您可以使用 Apex 觸發程序,根據記錄資料變更執行自動化。 Apex Proxy 類別可以使用 Apex 觸發來作為 DML 作業的結果執行。不過,從觸發內容進行的所有通話必須以非同步方式執行。 |
| Apex 觸發使 Apex SOAP 或 HTTP 非同步呼叫 | 子最佳 | 可從批次工作執行遠端系統的呼叫。此解決方案允許批次遠端流程執行,以及從 Salesforce 中的遠端系統處理回應。不過,指定批次內容的通話數目有限制。如需詳細資訊,請參閱「Salesforce 開發人員限制與配置快速參考」。
|
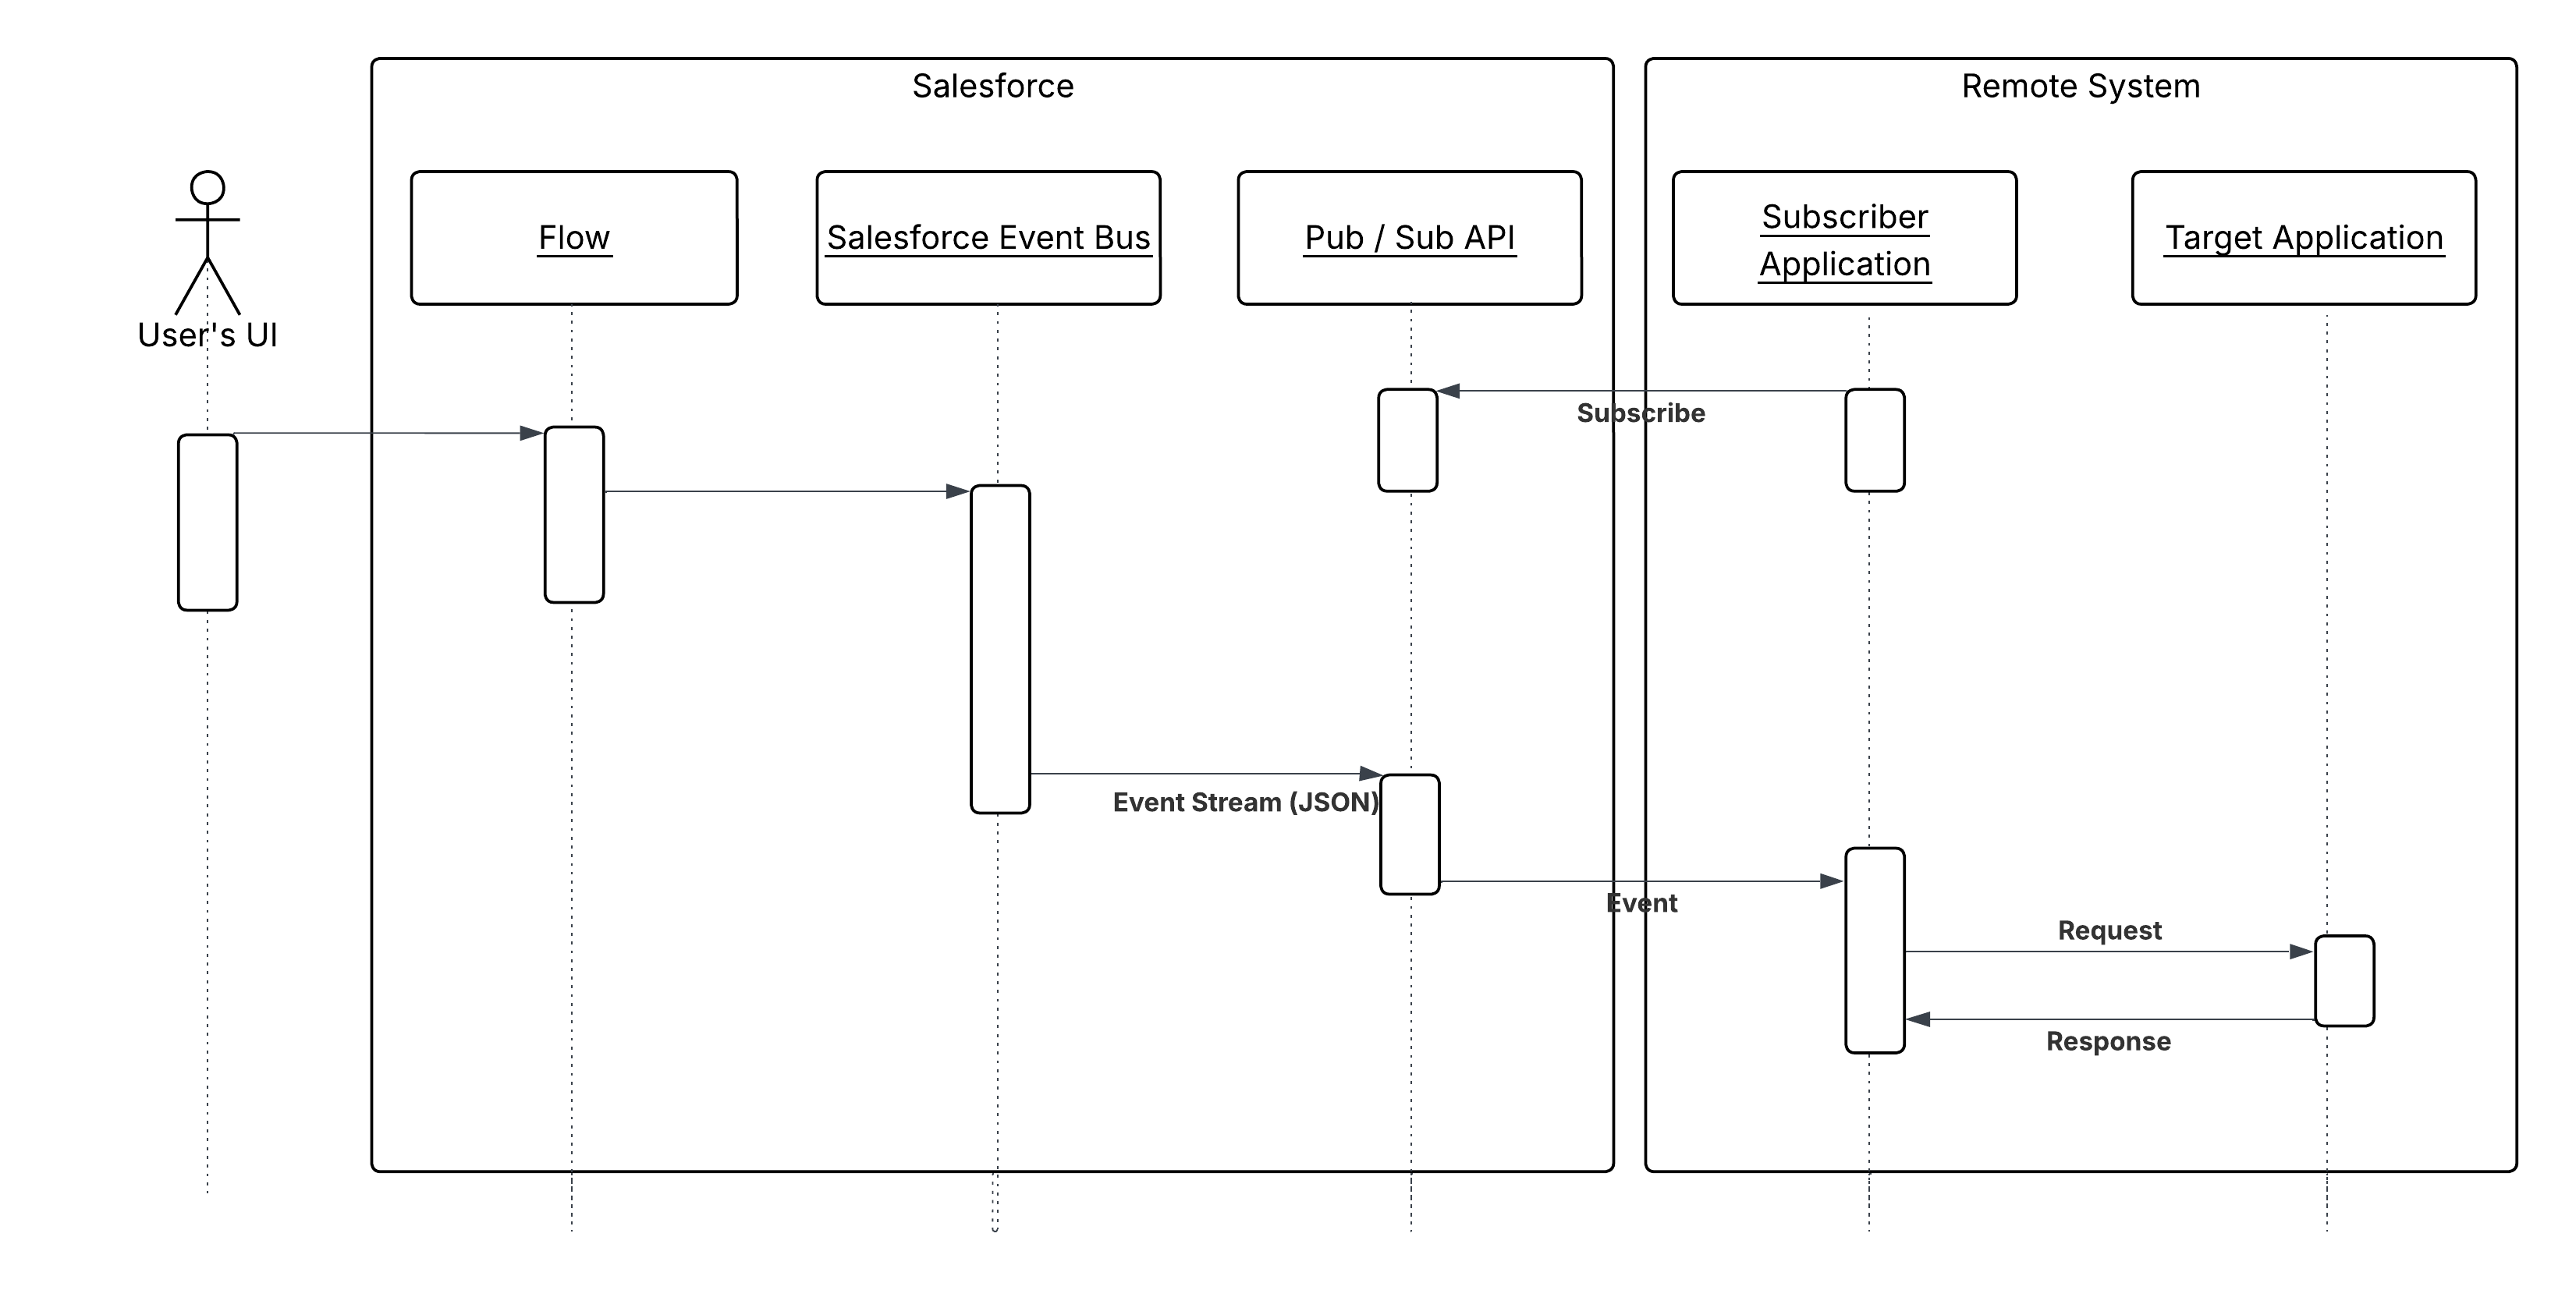 下載圖表
在此情況下:
- 遠端系統訂閱平台事件。
- 更新或插入會在 Salesforce 中指定的記錄集上發生。
- Salesforce 流程會在符合一組條件時觸發。
- 此流程會建立平台事件。
- 遠端接聽者會接收事件訊息,並將訊息放置在本機排隊上。
- 將訊息轉送至遠端應用程式以供處理。
- 使用者介面–起始的遠端流程叫用,可在其中向一般使用者顯示交易結果
- DML 事件起始的遠端流程叫用,其中呼叫流程可處理交易結果
| 通話機制 | 描述 |
|---|---|
| 流程 | 用於流程驅動和自訂驅動的解決方案。事件會觸發 Salesforce 流程,然後可發佈平台事件以供遠端系統訂閱。 |
| Pub / Sub API | Pub/Sub API 提供發佈和訂閱平台事件的單一介面,包括即時事件監視事件,以及變更資料擷取事件。根據 gRPC 和 HTTP/2,Pub/Sub API 可有效發佈並以 Apache Avro 格式傳送二進位事件訊息。 |
| 變更 資料擷取 | Salesforce Change 資料擷取 會發佈變更事件,其代表對 Salesforce 記錄進行的變更。變更包括建立新記錄、更新現有記錄、刪除記錄,以及取消刪除記錄。 |
| Lightning 元件與 Apex 控制項 | 用於使用 Apex 呼叫非同步地叫用遠端程序。 |
| 流程驅動的輸出傳訊 | 僅用於輸出傳訊解決方案。建立與更新 DML 事件會觸發 Salesforce 工作流程規則,然後將訊息傳送至遠端系統。 |
| Apex 觸發 | 用於觸發驅動的平台事件和遠端程序的叫用,使用來自 DML 初始事件的 Apex 呼叫。 |
| Apex 批次類別 | 用於在批次模式中叫用遠端程序。 |
| 解決方案 | 錯誤處理和復原策略 |
|---|---|
| 流程 |
|
| Apex 呼叫 |
|
| Change 資料擷取 (CDC) / Platform 事件 |
|
| 解決方案 | 安全性考量事項 |
|---|---|
| Apex 呼叫 | 對遠端系統的呼叫必須維護要求的機密性、完整性和可用性。以下是此模式中使用 Apex SOAP 和 HTTP 呼叫的特定安全性考量事項。
|
| Change 資料擷取 (CDC) / Platform 事件 | 針對平台事件,訂閱的外部系統必須能夠驗證 Salesforce Streaming API。 平台事件符合在 Salesforce 組織中設定的現有安全性模型。若要訂閱事件,使用者需要事件實體的讀取存取權。若要發佈事件,使用者需要事件實體的「建立」權限。 |
| 解決方案 | 端點考量事項 |
|---|---|
| Apex SOAP 呼叫 | 端點必須能夠透過 HTTP 處理 Web 服務呼叫。Salesforce 必須能夠透過公用網際網路存取端點。此解決方案需要遠端系統與 Salesforce 支援的標準相容。撰寫時,Salesforce 針對 Apex SOAP 呼叫支援的 Web 服務標準為:
|
| Apex HTTP 呼叫 | 端點必須能夠接收 HTTP 呼叫,且可由 Salesforce 透過公用網際網路存取。 Apex HTTP 呼叫可用於使用標準 GET、POST、PUT 和 DELETE 方法呼叫 RESTful 服務。 |
| Change 資料擷取 (CDC) / Platform 事件 |
|
- Salesforce 會儲存遠端系統遠端記錄的主要或唯一替代金鑰。
- 遠端系統會儲存 Salesforce 唯一記錄識別碼或其他唯一的替代金鑰。
| 主要 | 系統 描述 |
|---|---|
| Salesforce | 遠端系統必須將 Salesforce RecordId 或其他唯一的替代金鑰儲存在 Salesforce 記錄中。 |
| 遠端系統 | Salesforce 必須將唯一識別碼的參照儲存在遠端系統中。由於流程為非同步,因此儲存此唯一識別碼不能是原始交易的一部分。 Salesforce 必須在呼叫遠端流程中提供唯一識別碼。接著遠端系統必須回電 Salesforce,以使用 Salesforce 唯一識別碼,以使用遠端系統唯一識別碼更新 Salesforce 中的記錄。 回呼會在遠端應用程式中包含特定狀態處理,以儲存 Salesforce 唯一識別碼,讓該交易在處理完成時用於回呼,或將 Salesforce 唯一識別碼儲存在遠端系統的記錄上。 |
| 解決方案 | 考量事項 |
|---|---|
| Apex 呼叫 | 在某些情況下,此模式所指定的解決方案需要使用中介軟體或讓 Salesforce 呼叫複合服務來實作數個最適合的複雜整合案例。這些情況包括:
|
| Change 資料擷取 (CDC) / Platform 事件 | 由於事件的靜態陳述性質,因此無法在 Salesforce 中執行複雜的整合案例,例如彙總、協調流程或轉換。遠端系統或中介軟體必須處理下列類型的作業。 |
| OmniStudio 整合程序 | 「整合程序」(OmniStudio) 提供伺服器端無狀態協調流程,可協調多個後端服務,同時執行複雜的陳述性資料轉換。 「整合程序」會鏈結如「HTTP 動作」、「DataRaptor Extract/Transform/Load」、「設定值」、「迴圈/If」和「矩陣」查詢等步驟,以正規化、增強、彙總和對應 UI 契約與不同 API 之間的裝載。 它們支援強大的執行階段控制,例如條件式分支、分頁、逾時、重試、部分失敗處理和繼續錯誤,以及效能最佳化,例如伺服器端快取和回應形塑。 IP 可從 OmniScript 同步叫用,或透過 REST 無周邊叫用,以啟用可重複使用的版本化「整合面向」,以隱藏管道的後端複雜性。 |
| 解決方案 | 可靠傳訊考量事項 |
|---|---|
| Apex 呼叫 | Salesforce 不會明確支援可靠的傳訊通訊協定 (例如,WS-ReliableMessaging)。我們建議接收 Salesforce 訊息的遠端端點實作可靠的傳訊系統,例如 JMS 或 MQ。此系統可確保完整端對端保證傳送至最終處理訊息的遠端系統。不過,此系統不會保證從 Salesforce 傳送至呼叫的遠端端點。 必須透過對 Salesforce 的自訂來處理保證傳送。除了自訂重試邏輯外,必須實作特定的技術,例如從遠端端點處理正向確認。 |
| Change 資料擷取 (CDC) / Platform 事件 | 「平台事件」會嘗試透過在 Event Bus 中暫時保留事件訊息來提供可靠的傳訊。訂閱者可以使用事件訊息的「重新執行識別碼」,透過從 Event Bus 重新播放訊息來追蹤遺漏的事件訊息。 Event Bus 是分散式系統,且沒有與交易資料庫相同的保固。因此,Salesforce 無法為事件發佈要求提供同步回應。事件會加以排入和緩衝,Salesforce 會嘗試以非同步方式發佈事件。在極少數情況下,事件訊息可能不會在初始或後續嘗試期間存在於散佈系統中。這表示事件不會傳送給訂閱者,且無法復原。 |
| 財產 | 必要 | 理想 | 不需要 |
|---|---|---|---|
| 事件處理 | X | ||
| 通訊協定轉換 | X | ||
| 翻譯和轉換 | X | ||
| 排隊與緩衝 | X | ||
| 同步傳輸通訊協定 | X | ||
| 非同步傳輸通訊協定 | X | ||
| 仲裁路由 | X | ||
| 流程 koreography 和服務協調流程 | X | ||
| 交易性 (加密、簽署、可靠傳送、交易管理) | X | ||
| 路由 | X | ||
| 解壓縮、轉換和載入 | X | ||
| 長輪詢 | X (在平台事件中為必要) |
- 「認可後發佈」可讓事件訊息僅在交易成功認可後發佈。如果訂閱者依賴發佈交易認可的資料,請選取此選項。例如,程序會發佈事件訊息並建立工作記錄。系統會觸發訂閱事件的第二個程序,並預期會找到工作記錄。選擇此行為的另一個原因是當您不想要在交易失敗時發佈事件訊息時。
- 「立即發佈」可在發佈呼叫執行時發佈事件訊息。如果您想要發佈事件訊息,無論交易是否成功,請選取此選項。如果發行者與訂閱者是獨立的,且訂閱者不依賴發行者認可的資料,請選擇此選項。例如,立即發佈行為適用於用於記錄的事件。透過此選項,訂閱者可能會在發行者交易認可資料之前收到事件訊息。
- 只能實作陳述性開發。
- 機會轉換為訂單後,您不需要訂單編號的立即通知。
- 組織擁有支援 CometD 通訊協定的 ESB,且能夠訂閱平台事件。
- 建立流程以起始平台事件 (例如,當機會狀態變更為「結束成交」時)。
- 建立發佈機會詳細資料的新平台事件。
- ESB 會使用 CometD 通訊協定訂閱 Salesforce Platform 事件。
- ESB 會收到一或多個通知,指出機會要轉換為訂單。
- ESB 會將訊息轉送至後端 ERP 系統,以便建立訂單。
- 在 ERP 系統中建立訂單後,個別的執行緒會使用 SessionId 作為驗證權杖回呼至 Salesforce。此回呼會以訂單編號和狀態更新機會。您可以使用記錄的模式解決方案來執行此回呼,例如 Salesforce Platform 事件、Salesforce SOAP API、REST API 或 Apex Web 服務。
- 實作非同步叫用的遠端程序
- 端對端保證傳送
- 後續回呼至 Salesforce 以更新記錄的狀態
- 從目前的 CRM 系統中解壓縮和轉換帳戶、連絡人和機會,並將資料載入至 Salesforce (初始資料匯入)。
- 每週 (進行中) 從遠端系統將客戶的帳單資料解壓縮、轉換和載入至 Salesforce。
- 每週 (進行中) 從 Salesforce 解壓縮客戶活動資訊,並將其匯入內部部署資料倉庫。
- 資料是否應儲存在 Salesforce 中?若否,則結構設計師可以並應考慮其他整合選項 (例如,遮罩)。
- 如果資料應儲存在 Salesforce 中,是否應針對遠端系統中的事件重新整理資料?
- 資料是否應依排程重新整理?
- 資料是否支援主要業務流程?
- 是否有受 Salesforce 中此資料可用性影響的分析 (報告) 需求?
| 解決方案 | 適合 | 資料主要資料 | 註解 |
|---|---|---|---|
| 透過第三方 ETL 工具複製 | 最佳 | 遠端系統 | 外部系統需要將大量資料傳送至 Salesforce 的位置,請利用協力廠商 ETL 工具,讓您能夠對來源資料執行變更資料擷取。 工具會回應來源資料集中的變更、轉換資料,然後呼叫 Salesforce 大量 API 來核發 DML 陳述式。如果記錄數目較少,則也可以使用 Salesforce REST API 來實作此動作。 |
| 透過第三方 ETL 工具複製 | 良好 | Salesforce | 利用協力廠商 ETL 工具,讓您針對 ERP 和 Salesforce 資料集執行變更日期資料擷取。 在此解決方案中,Salesforce 是資料來源,您可以使用個別資料列的時間/狀態資訊來查詢資料並篩選目標結果集。這可透過使用大量 API 2.0 或標準 REST API (如果記錄數量較少) 來實作。 |
| 資料匯入精靈和 Data Loader | 適合 | Salesforce/外部系統 | 「資料匯入精靈」和 Data Loader 可用來匯入、匯出和移轉資料。雖然 Data Loader 指令也可以指令檔,以自動匯入和匯出資料,但指令行介面僅適用於 Windows。這些工具都不是資料整合策略的建議基礎。他們應改為補充您的資料管理與維護策略。 如需 Data Loader 的詳細資訊,請參閱 此處。 |
| 遠端呼叫 | 子最佳 | 遠端系統 | 遠端系統可以使用其中一個 API 呼叫 Salesforce,並在發生時對資料執行更新。不過,這會造成兩個系統之間有大量的持續流量。 應更重視錯誤處理和鎖定。此模式可能會造成持續更新,這可能會影響一般使用者的效能。 |
| 遠端流程叫用 | 子最佳 | Salesforce | Salesforce 可能會呼叫遠端系統,並在發生時對資料執行更新。不過,這會造成兩個系統之間有大量的持續流量。 應更重視錯誤處理和鎖定。此模式可能會造成持續更新,這可能會影響一般使用者的效能。 |
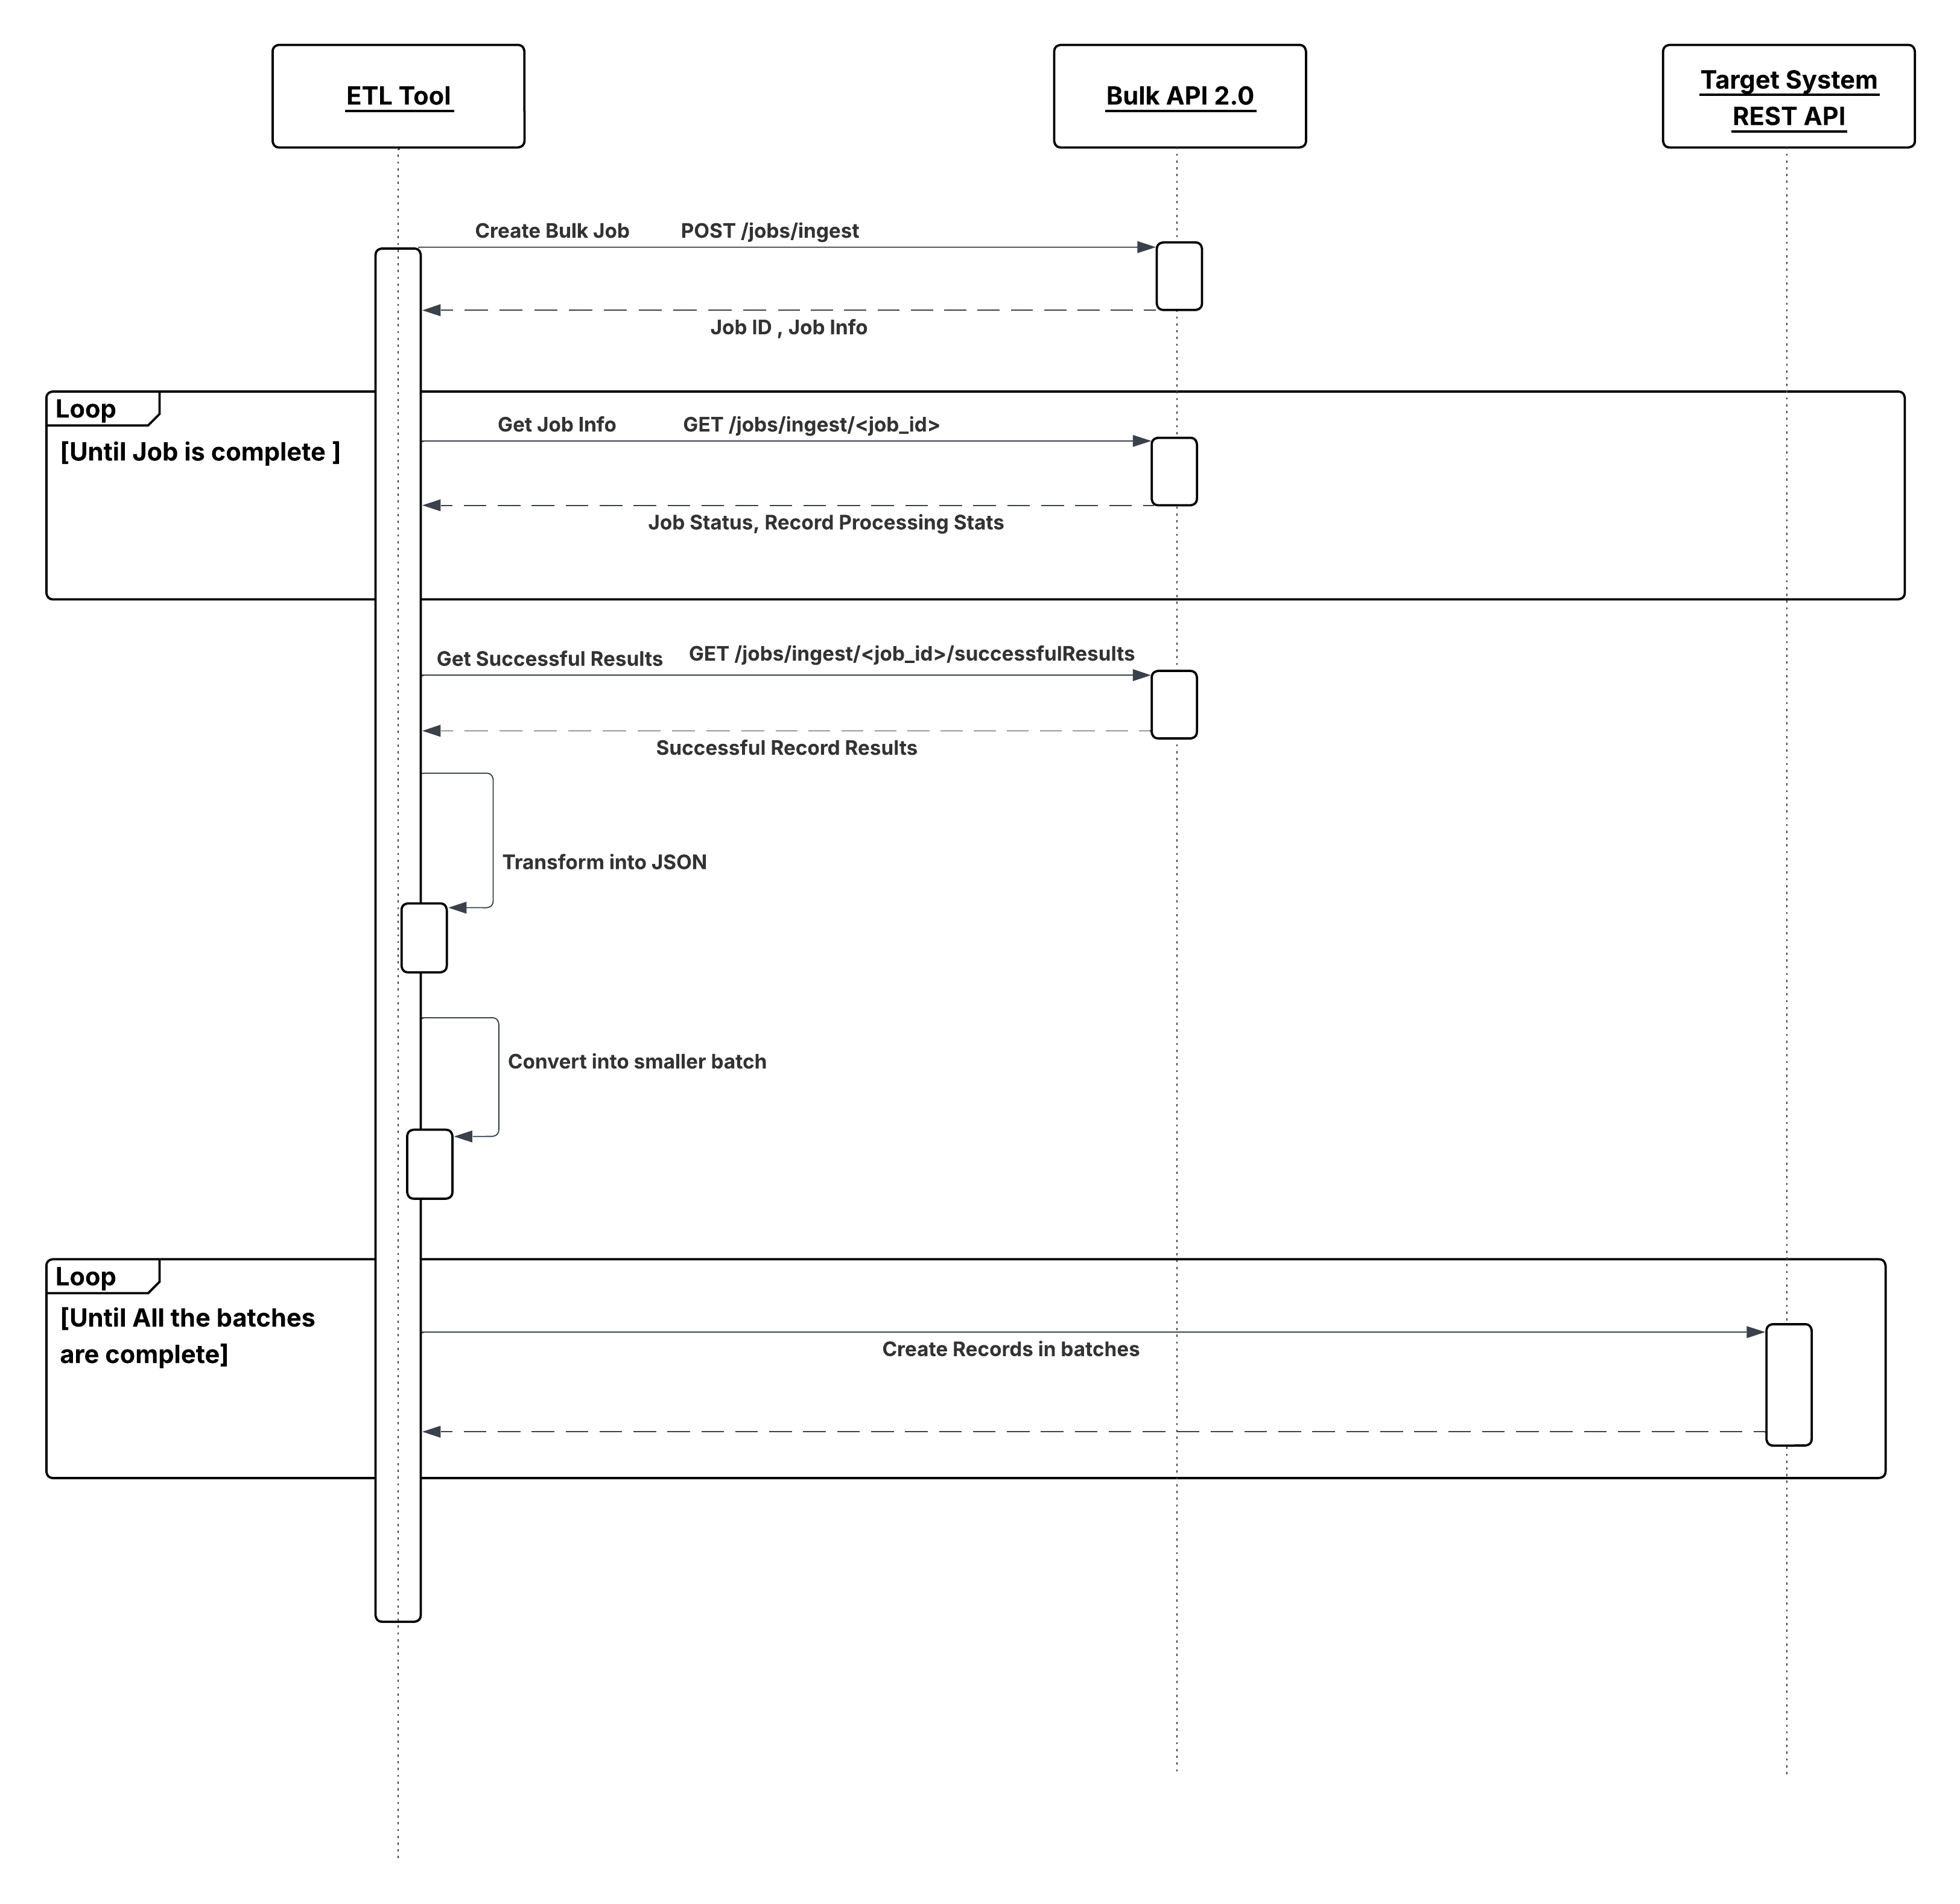 下載圖表
下圖說明近乎即時的事件後續同步化,其中 Salesforce 是資料主要資料。
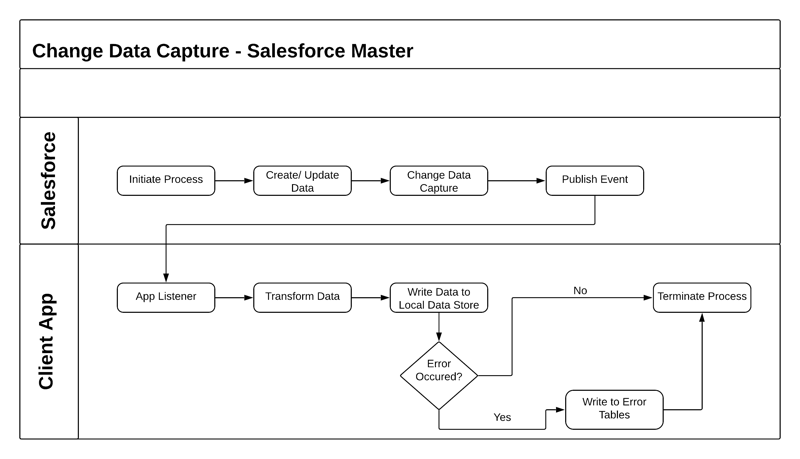 **結果**
您可以在下列情況下將外部來源的資料與 Salesforce 整合:
- 外部系統是資料主要資料—Salesforce 是單一來源系統或多個系統所提供資料的取用者。在此情節下,在將資料匯入 Salesforce 之前,擁有彙總資料的資料倉庫或資料 Mart 很常見。
- Salesforce 是資料主要資料—Salesforce 是特定實體的記錄系統,Salesforce Change 資料擷取 用戶端應用程式可以通知 Salesforce 資料的變更。
- 在來源資料集上實作變更資料擷取。
- 在中間的內部部署資料庫中實作一組支援的資料庫結構 (稱為控制表格)。
- 閱讀控制表以判斷工作的上次執行階段,並取用其他所需的控制值。
- 使用上述控制值作為篩選條件,並查詢來源資料集。
- 套用預先定義的處理規則,包括驗證、增強等等。
- 使用 ETL 工具的可用連接器/轉換功能來建立目的地資料集。
- 將資料集寫入至 Salesforce 物件。
- 如果處理成功,請更新控制表格中的控制值。
- 如果處理失敗,請使用可啟用重新啟動與結束的值更新控制表格。
- 將 ETL 工作鏈結並排序,以提供一致的流程。
- 使用兩個系統中的主要索引鍵比對傳入資料。
- 使用特定的 API 方法來僅取用更新的資料。
- 如果在「主要 - 詳細資料」或對應關係中匯入子系記錄,請使用來源的父系金鑰將匯入的資料分組,以避免鎖定。例如,如果您要匯入連絡人資料,請務必依父系帳戶金鑰將連絡人資料分組,以便在一個 API 呼叫中載入單一帳戶的連絡人數目上限。無法分組匯入的資料通常會導致在 API 呼叫內容中載入第一個連絡人記錄,而該帳戶的後續連絡人記錄會失敗。
- 任何匯入後處理 (例如觸發) 都應只選擇性地處理資料。
- 如果您的案例涉及大量資料,請遵循此 Trailhead 模組中的最佳作法 使用大量資料進行部署的最佳作法 .
| 錯誤位置 | 錯誤處理與復原策略 |
|---|---|
| 使用 Change 資料擷取 從 Salesforce 讀取 |
|
| 使用第三方 ETL 系統從 Salesforce 讀取 |
|
| 寫入 Salesforce |
|
| 外部主要系統 | 錯誤應根據主要系統的最佳作法處理。 |
- 需要至少具有「僅 API」使用者權限的 Lightning 平台授權,才能允許已驗證的 API 存取 Salesforce API。
- 我們建議使用標準加密來保護密碼存取的安全。
- 當呼叫 Salesforce API 時,請使用 HTTPS 通訊協定。您也可以視需要透過內部部署安全性解決方案將流量代理至 Salesforce API。
- Salesforce 不會維護特定使用者編輯記錄的狀態。
- 讀取時,它會記錄資料的取用時間。
- 如果使用者更新記錄並予以儲存,Salesforce 會檢查其他使用者是否在同時間更新記錄。
- 如果記錄已更新,則系統會通知使用者已進行更新,且使用者應在繼續進行其更新的過程中,先取回記錄的最新版本。
| 財產 | 必要 | 理想 | 不需要 |
|---|---|---|---|
| 事件處理 | X | ||
| 通訊協定轉換 | X | ||
| 翻譯和轉換 | X | ||
| 排隊與緩衝 | X | ||
| 同步傳輸通訊協定 | X | ||
| 非同步傳輸通訊協定 | X | ||
| 仲裁路由 | X | ||
| 流程 koreography 和服務協調流程 | X | ||
| 交易性 (加密、簽署、可靠傳送、交易管理) | X | ||
| 路由 | X | ||
| 解壓縮、轉換和載入 | X | ||
| 長輪詢 | X (Salesforce Change 資料擷取 需要) |
- 類似 Cron 的排程器會執行批次工作,將潛在客戶指派給使用者和小組。
- 批次工作執行並更新資料後,ETL 工具會使用變更資料擷取來識別這些變更。ETL 工具會從資料存放區彙總變更。
- ETL 連接器使用 Salesforce REST API 將變更載入至 Salesforce。
- 遠端呼叫 Salesforce 的目的為使用以事件為導向的結構通知 Salesforce 在外部發生的事件嗎?或者是為了對特定記錄執行 CRUD 作業?如果您使用以事件為導向的結構,則事件產生者 (遠端程序) 會與 Salesforce 事件取用者分離。
- 對 Salesforce 的呼叫是否需要遠端流程等待回應,才能繼續處理?遠端呼叫至 Salesforce 一律為同步要求回應,雖然遠端流程可能會捨棄回應,如果其不需要模擬非同步呼叫。
- 每個交易是否會針對單一 Salesforce 物件或多個相關物件進行作業?
- 訊息的格式為何 (例如,SOAP 或 REST,或兩者皆透過 HTTP)?
- 訊息大小是否相對較小或較大?
- 如果遠端系統支援 SOAP,則遠端系統是否能夠參與契約優先方法,其中 Salesforce 會規定契約嗎?此為使用 SOAP API (提供預先定義的 WSDL) 時所需。
- 是否需要交易處理?
- 您對 Salesforce 中自訂的容忍程度為何?
| 解決方案 | 適合 | 註解 |
|---|---|---|
| 複合 API | 最佳 | Salesforce 提供基本上是 REST API 的複合 API,並支援複合要求。遠端系統可將其用於:
同步 API—在進行 API 呼叫後,遠端用戶端應用程式會等待,直到收到服務的回應為止。 交易/認可行為—依預設,如果某些記錄標記為錯誤,則複合 API 不會允許部分成功。您可以將「全部或無所有一切」標記為 false 來變更,這將允許部分成功。 錯誤處理:適當的錯誤處理應檢查回應內文,而不只是 HTTP 狀態代碼。複合端點會以 200 HTTP 狀態代碼回應,即使在回應內文中顯示其中一個子要求失敗且交易必須回復。 |
| REST API | 最佳 | 無障礙—Salesforce 提供遠端系統可用來:
同步 API—在進行 API 呼叫後,遠端用戶端應用程式會等待,直到收到服務的回應為止。 REST API 遵循根據登入使用者的設定檔在 Salesforce 中設定的物件級和欄位級安全性。 REST 會將資源 (實體/物件) 顯示為 URI,並使用 HTTP 動詞定義這些資源的 CRUD 作業。不同於 SOAP,REST API 不需要預先定義的契約、使用 XML 和 JSON 進行回應,且有寬鬆的輸入。REST API 輕量型,提供與 Salesforce 互動的簡單方法。其優點包括輕鬆整合與開發,且是與行動應用程式和 Web 應用程式搭配使用的絕佳選擇。 交易/認可行為—依預設,會將每個記錄視為個別交易,並分別認可。一個記錄變更失敗不會導致其他記錄變更回復。此行為可以變更為「全部或無」行為。使用 REST API 複合資源,在一個 API 呼叫中進行一系列更新。 大量資料—任何包含超過 2,000 筆記錄的資料作業均是「大量 API 2.0」成功準備、執行及管理使用「大量」架構非同步工作流程的理想候選項目。 |
| 大量 API 2.0 | 大量作業最佳 | 大量 API 2.0 是 Salesforce 的現代化、簡化的 API,用於處理大規模資料作業。REST 型大量 API 2.0 提供程式設計選項,可在您的 Salesforce 組織中非同步地插入、更新插入、查詢或刪除大型資料集。當您需要將大量資料載入 Salesforce 或對組織的資料執行大量查詢時,其設計目的為效率。 不同於大量 API 1.0,「大量 API 2.0」一律會並列處理批次,且不支援序列模式。這表示:
「大量 API 2.0」中的每個批次都會作為其自己的交易處理。這表示:
雖然 SOAP API 也可以用於處理大量記錄,但當資料集包含數十萬到數百萬筆記錄時,其會變得較不最佳。這是由於其相對高負擔和較低的效能特性。
|
| Pub/Sub API | 最佳 |
Pub/Sub API 是外部發行者在 Event Bus 上發佈事件的建議方式。 Pub/Sub API 是 gRPC 型 API,允許外部系統發佈平台事件。Pub/Sub API:
平台事件在 Salesforce 中定義後,便可供內部與外部消費者使用。 |
| 平台事件 | 最佳 |
平台事件的定義方式與您定義 Salesforce 物件的方式相同。平台事件可以使用不同的機制發佈,例如 REST API、大量 API 和 SOAP API。
透過 REST API 發佈事件與建立 Salesforce 記錄相同。 端點格式:POST /services/data/vXX.X/sobjects/EventName__e/
透過大量 API,僅支援建立和插入作業。批次內的事件會在批次工作處理時非同步地發佈至 Salesforce Event Bus。 由於「平台事件」是 SObject,因此支援標準 SOAP API 作業。 |
| SOAP API | 適合 |
無障礙—Salesforce 提供 SOAP API,可讓遠端系統用於:
同步 API—在進行 API 呼叫後,遠端用戶端應用程式會等待,直到收到服務的回應為止。不支援對 Salesforce 進行非同步呼叫。 產生的 WSDL—Salesforce 針對遠端系統提供兩個 WSDL:
安全性—執行 SOAP API 的用戶端必須具有有效的登入並取得工作階段,才能執行任何 API 呼叫。API 遵循根據登入使用者的設定檔在 Salesforce 中設定的物件級和欄位級安全性。 交易/認可行為—依預設,如果某些記錄標記為錯誤,則每個 API 呼叫都允許部分成功。這可以變更為「全部或無所有一切」行為,如果發生任何錯誤,則所有結果都會回復。無法跨多個 API 呼叫來跨越交易。若要克服此限制,單一 API 呼叫可能會影響多個物件。 |
| Apex Web 服務 | 子最佳 |
Apex 類別方法可作為 Web 服務方法向外部應用程式公開。此方法是 SOAP API 的替代方法,通常僅在必須符合下列其他需求時使用。
使用 Apex Web 服務的好處必須根據需要在 Salesforce 中維護的其他程式碼加權。 不適用於平台事件,因為在消費者處的交易預先插入邏輯不適用於 以事件為導向的結構。若要通知 Salesforce 組織事件已發生,請使用 SOAP API、REST API 或大量 API 2.0。 |
| Apex REST 服務 | 子最佳 |
Apex 類別可以公開為對應至特定 URI 且具有定義的 HTTP 動詞 (例如 POST 或 GET) 的 REST 資源。
您可以使用 REST API 複合資源,在單一交易中執行多個更新。 不同於 SOAP,用戶端不需要耗用服務定義/契約 (WSDL) 並產生用戶端停用。遠端系統只需要能夠形成 HTTP 要求並處理傳回的結果 (XML 或 JSON)。 不適用於平台事件,因為在消費者處的交易預先插入邏輯不適用於 以事件為導向的結構。若要通知 Salesforce 組織事件已發生,請使用 SOAP API、REST API 或大量 API 2.0。 |
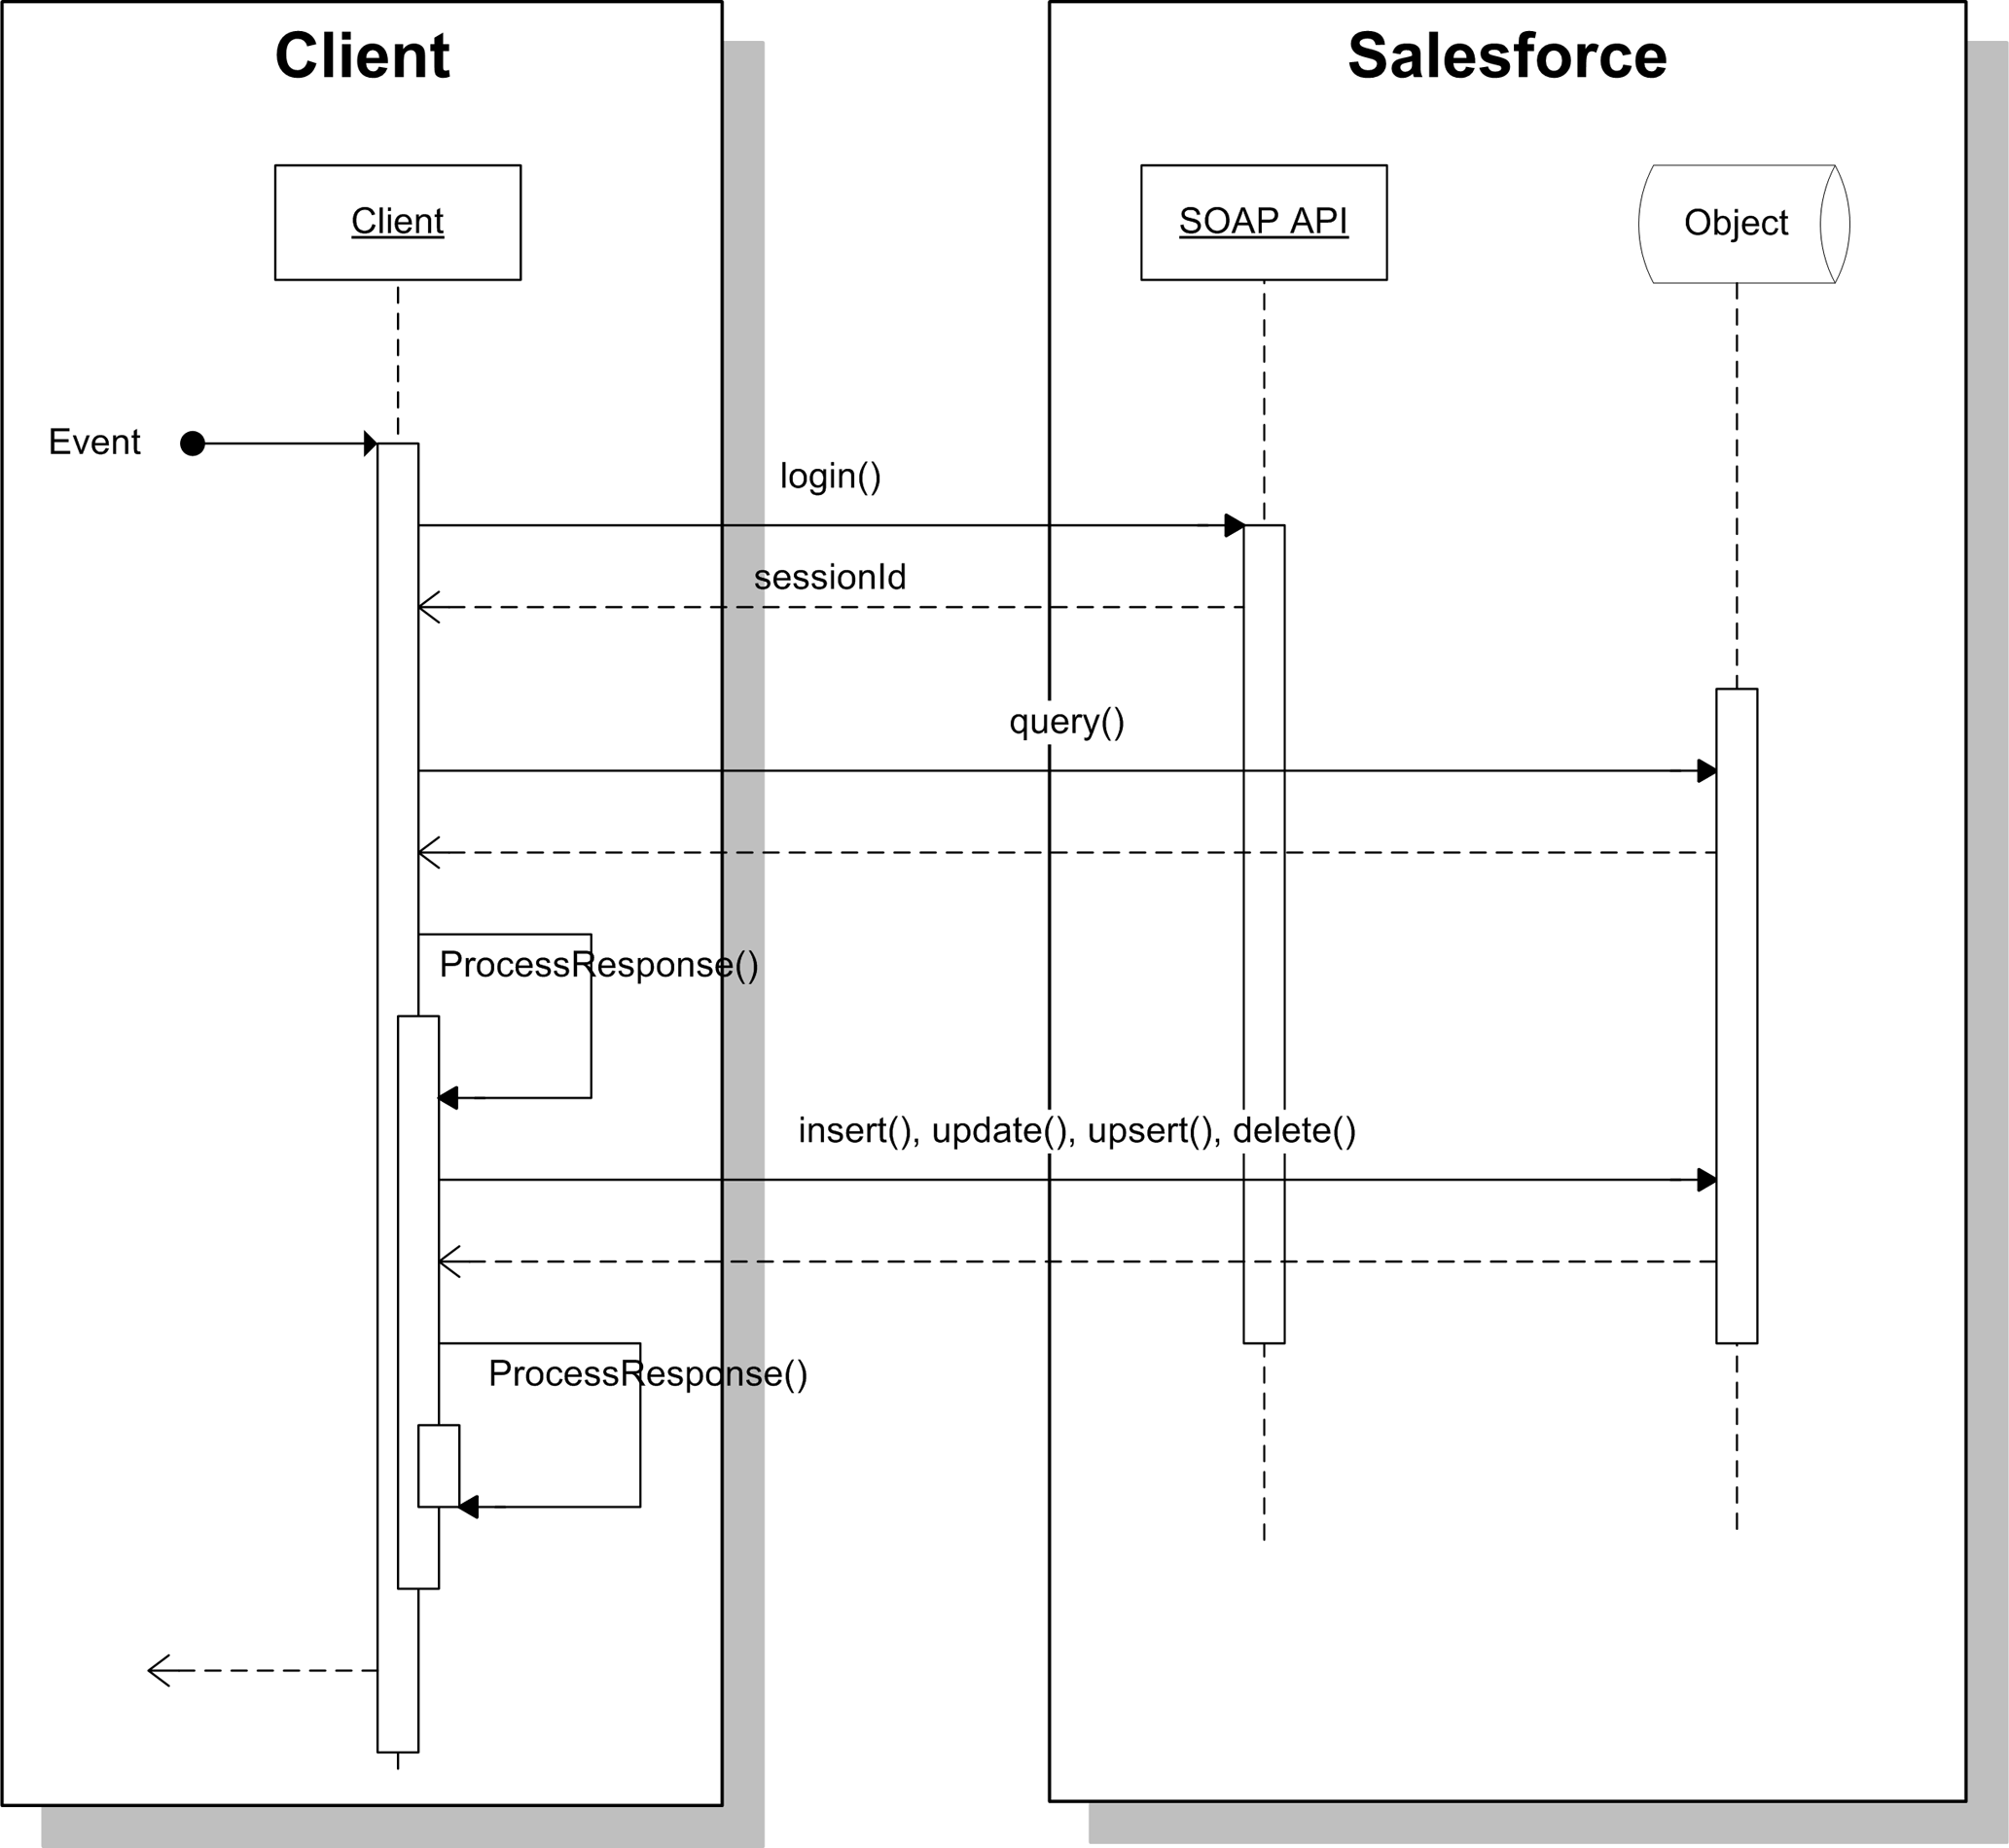 _透過 REST API 通知 Salesforce 事件的遠端系統_
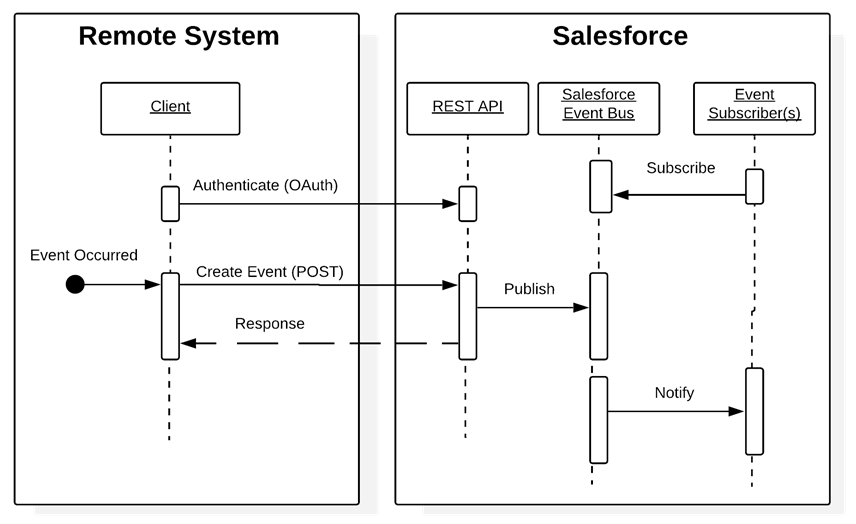 **結果**
在以事件為導向的結構中,遠端系統會使用 SOAP API、REST API 或大量 API 2.0 呼叫至 Salesforce 以將事件發佈至 Salesforce Event Bus。發佈事件會通知所有訂閱者。事件訂閱者可以位於 Salesforce Platform (例如流程或 Lightning 元件) 的 Apex 觸發。事件訂閱者也可以是 Salesforce Platform 的外部使用者,例如 CometD 訂閱者。
當直接使用 Salesforce 物件時,與此模式相關的解決方案允許:
- 遠端系統會呼叫 Salesforce API 來查詢資料庫並執行單一物件作業 (建立、更新、刪除等)。
- 可呼叫 Salesforce REST API 複合資源的遠端系統,以執行一系列物件作業。
- 遠端系統可呼叫可支援多物件交易作業和自訂前/後處理邏輯的自訂建立 Salesforce API (服務)。
| 呼叫機制 | 描述 |
|---|---|
| SOAP API | 遠端系統使用 Salesforce Enterprise 或合作夥伴 WSDL 產生用戶端固體,進而用來叫用標準 SOAP API。 |
| REST API | 遠端系統必須先進行驗證,才能存取任何 Apex REST 服務。遠端系統可以使用 OAuth 2.0 或使用者名稱和密碼驗證。在任一情況下,用戶端必須以適當的值設定授權 HTTP 標頭 (可透過 SOAP API 的登入呼叫取得 OAuth 存取權杖或工作階段識別碼)。 接著,遠端系統會產生具有適當動詞的 REST 叫用 (HTTP 要求),並處理傳回的結果 (支援 JSON 和 XML 資料格式)。 |
| Apex Web 服務 | 遠端系統會耗用自訂的 Apex Web 服務 WSDL,以產生用戶端固體,進而用於叫用自訂 Apex Web 服務。 |
| Apex REST 服務 | 根據 REST API,系統會使用 @RestResource、@HttpGet 和 @HttpPost 註釋來定義資源 URI 和適用的動詞。 |
| 大量 API 2.0 | 「大量 API 2.0」是以 REST 為基礎的 API,因此會套用與 REST API 相同的呼叫機制。 |
| 叫用流程的 REST API | 使用 REST API 呼叫自訂可叫用動作端點以叫用自動啟動流程。 |
- 錯誤處理—所有遠端呼叫方法 (標準或自訂 API) 都需要遠端系統來處理任何後續錯誤,例如逾時和重試的管理。中間軟體可用來提供錯誤處理與復原的邏輯。
- 復原—如果服務品質需求規定該機制,則必須建立自訂重試機制。在此情況下,確保設計特性完全相符十分重要。平台事件可讓訂閱者使用重新執行識別碼,在發佈這些訊息後的特定期間內提取訊息。
| 解決方案 | 安全性考量事項 |
|---|---|
| SOAP API | alesforce 支援 Secure Sockets Layer v3 (SSL) 和 Transport Layer Security (TLS) 通訊協定。加密的金鑰長度必須至少為 128 位元。 遠端系統必須使用有效的認證登入,才能取得工作階段識別碼。如果遠端系統已具有有效的工作階段識別碼,則可以呼叫 API,而無須明確登入。這會用於此文件稍早說明的回呼模式,其中先前的 Salesforce 輸出訊息包含工作階段識別碼和記錄識別碼以供後續使用。 我們建議呼叫 SOAP API 的用戶端快取並重複使用工作階段識別碼以最大化效能,而非為每個呼叫取得新的工作階段識別碼。 |
| REST API | 我們建議遠端系統建立 OAuth Trust 以進行授權。接著,可以使用 HTTP 動詞對特定資源進行 REST 呼叫。您也可以使用可能以其他方式取得的有效工作階段識別碼進行 REST 呼叫 (例如,透過呼叫 SOAP API 或透過輸出訊息提供), 我們建議呼叫 REST API 的用戶端快取並重複使用工作階段識別碼以最大化效能,而非為每個呼叫取得新的工作階段識別碼。 |
| Apex Web 服務 | 我們建議遠端系統建立 OAuth Trust 以進行授權。 |
| Apex REST 服務 | 我們建議遠端系統建立 OAuth Trust 以進行授權。 |
| 大量 API 2.0 | 我們建議遠端系統建立 OAuth Trust 以進行授權。 |
- 工作階段逾時—如果根據 Salesforce 組織的工作階段逾時設定沒有活動,則工作階段逾時。
- 查詢逾時—每個 SOQL 查詢的個別逾時限制為 120 秒。
| 解決方案 | 通訊類型 | 限制 |
|---|---|---|
| SOAP API 或 REST API | 同步 |
|
| 大量 API 2.0 | 非同步 | 「大量 API 2.0」已針對非同步匯入和匯出大型資料集進行最佳化。 任何包含超過 2,000 個記錄的資料作業都是「大量 API 2.0」成功準備、執行及管理使用「大量」架構的非同步工作流程的理想候選項目。記錄少於 2,000 個的工作應涉及 REST (例如複合) 或 SOAP 中「大量處理」的同步呼叫。 提交批次要求和相關聯的資料時,大量 API 2.0 為同步。資料的實際處理會以非同步方式進行。如需有關 API 和批次處理限制的詳細資訊,請參閱「限制」。 |
| 解決方案 | 端點考量事項 |
|---|---|
| SOAP API | 遠端系統必須能夠根據 Salesforce 預先定義的訊息格式,實作可呼叫 Salesforce SOAP API 的用戶端。 遠端系統 (用戶端) 必須參與契約優先實作,其中契約由 Salesforce 提供 (例如,Enterprise 或合作夥伴 WSDL)。 |
| REST API | 遠端系統必須能夠實作叫用 Salesforce (定義的 REST 服務) 並處理 XML 或 JSON 結果的 REST 用戶端。 |
| Apex Web 服務 | 遠端系統必須能夠實作可叫用預先定義格式 SOAP 訊息的用戶端,如 Salesforce 所定義。 遠端系統必須參與程式碼優先實作,其中契約會在實作 Apex Web 服務後由 Salesforce 提供。每個 Apex Web 服務都有自己的 WSDL。 |
| Apex REST 服務 | 套用與 REST API 相同的端點考量事項。 |
- Salesforce 會儲存遠端系統遠端記錄的主要或唯一替代金鑰。
- 遠端系統會儲存 Salesforce 唯一記錄識別碼或其他唯一的替代金鑰。在此同步模式中處理整合索引鍵有特定考量事項。
| 主要 | 系統 描述 |
|---|---|
| Salesforce | 在此情節下,遠端系統會儲存 Salesforce RecordId 或記錄中的其他唯一替代金鑰。 |
| 遠端系統 | 在此情節下,Salesforce 會將唯一識別碼的參照儲存在遠端系統中。由於程序為同步,因此金鑰可以使用外部識別碼欄位作為相同交易的一部分提供。 |
| 解決方案 | 考量事項 |
|---|---|
| SOAP API 或 REST API | SOAP API 和 REST API 提供物件的簡單交易。複雜的整合案例 (例如彙總、協調流程和轉換) 無法在 Salesforce 中執行。這些情況必須由遠端系統或中介軟體處理,而中介軟體是偏好的方法。 |
| Apex Web 服務或 Apex REST 服務 | 自訂 Web 服務可提供跨物件功能、自訂邏輯和更複雜的交易支援。應謹慎使用此解決方案,且您應一律考量中介軟體是否適合任何轉換、協調流程和錯誤處理邏輯。 |
| 解決方案 | 限制 |
|---|---|
| SOAP API、REST API 和自訂 Apex API |
|
| 大量 API 2.0 | 請參閱 資料量側列以取得詳細資訊。 |
| 平台事件 |
|
| 財產 | 必要 | 理想 | 不需要 |
|---|---|---|---|
| 事件處理 | X | ||
| 通訊協定轉換 | X | ||
| 翻譯和轉換 | X | ||
| 排隊與緩衝 | X | ||
| 同步傳輸通訊協定 | X | ||
| 非同步傳輸通訊協定 | X | ||
| 仲裁路由 | X | ||
| 流程 koreography 和服務協調流程 | X | ||
| 交易性 (加密、簽署、可靠傳送、交易管理) | X | ||
| 路由 | X | ||
| 解壓縮、轉換和載入 | X (適用於大量/批次) |
- PMS 可以參與契約優先整合,其中 Salesforce 會提供契約,而 PMS 會作為 Salesforce 服務的用戶端 (消費者) (透過企業或合作夥伴 WSDL 定義)。
- Salesforce 中不應該有自訂開發。
- 在 Salesforce 中定義平台事件,以包含來自 PMS 的通知資料。
- 建立由印表機事件通知觸發的流程。流程會更新印表機資產並建立訂單 (使用自動啟動流程)。
- 下載 Enterprise 或合作夥伴 WSDL,並將其提供給遠端系統。
- 從 Enterprise 或合作夥伴 WSDL 建立用戶端設定檔。
- 使用整合使用者的認證來驗證 Salesforce (透過 OAuth Web 伺服器或承載者權杖流程)。
- 在印表機狀態事件時,PMS 會呼叫 API 以建立印表機狀態平台事件 (包含印表機用量統計資料)。Salesforce Event Bus 會通知流程訂閱者和所有其他訂閱者。
- Salesforce 同步 API 用戶端 (消費者) 實作。
- 回呼至 Salesforce 以發佈平台事件 (符合先前涵蓋的要求/回覆平台事件模式)。
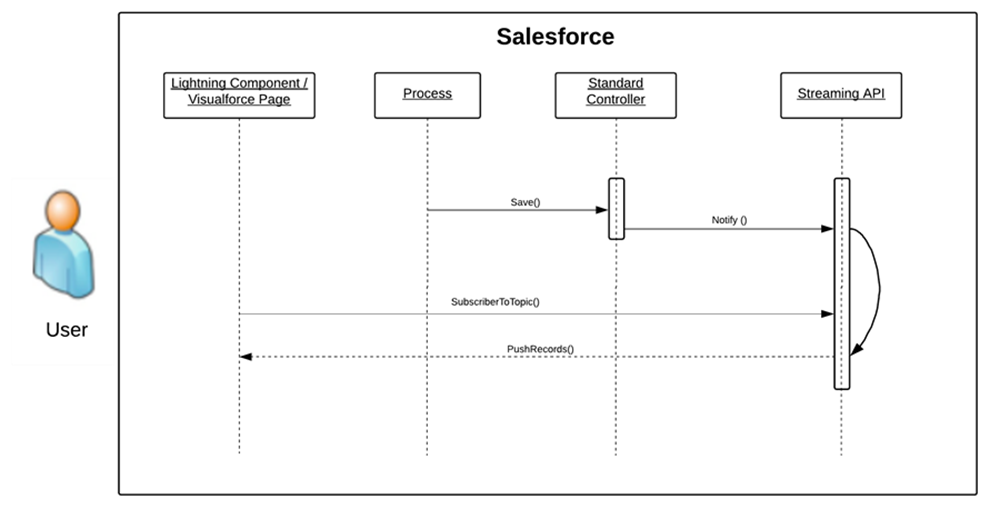 **結果**
**福利**
套用與此模式相關的解決方案具有下列優點:
- 無須撰寫自訂輪詢機制
- 無須使用者起始的回饋意見迴圈
- 不保證傳送通知。
- 不保證通知的順序。
- 大量 API 所做的記錄變更不會產生通知。
- 建立 Apex 觸發 PushTopic,當個案儲存為「已結束」且「解決方式」為「成功」時,傳送平台事件。
- 建立可供客戶服務經理使用的自訂使用者介面。此使用者介面訂閱 Event Bus 以取用平台事件。
- 在自訂使用者介面中實作邏輯,顯示該經理客戶服務代表產生的警示。
- 您想要在 Salesforce 中建立陳述式/點選輸出整合或 UI 模擬?
- 您是否有大量不想要複製到 Salesforce 組織中的資料?
- 您是否需要一次存取少量遠端系統資料?
- 您是否需要即時存取最新資料?
- 您是否將資料儲存在雲端或後端辦公系統中,但想要在 Salesforce 組織中顯示或處理該資料?
- 您是否有資料落地考慮要將特定類型的資料儲存在 Salesforce 中?
| 解決方案 | 適合 | 註解 |
|---|---|---|
| Salesforce Connect | 最佳 | 使用 Salesforce Connect 可從外部來源存取資料以及您的 Salesforce 資料。從 SAP、Microsoft、Oracle 和其他雲端型系統 (例如 Snowflake) 等系統即時提取資料,而無須在 Salesforce 中複製資料。 Salesforce Connect 會將外部系統中的資料表對應至您組織中的外部物件。外部物件與自訂物件類似,但其會對應至 Salesforce 組織外部的資料。Salesforce Connect 使用與外部資料的即時連線,讓外部物件始終處於最新狀態。存取外部物件會從外部系統即時提取資料。 Salesforce Connect 可讓您:
|
| 要求與回覆 | 子最佳 |
使用 Salesforce Web 服務 API 進行臨時資料要求,以存取及更新外部系統資料。此解決方案包含下列方法:
使用 Salesforce SOAP API。自訂頁面或按鈕會以同步方式起始 Apex REST/SOAP 呼叫。在 Salesforce 中,您可以取用 WSDL 並產生產生的 Proxy Apex 類別。此類別提供呼叫遠端服務所需的邏輯。頁面上的使用者起始動作接著會呼叫執行此 Proxy Apex 類別的 Apex 控制項動作來執行遠端呼叫。頁面需要 Salesforce 應用程式的自訂。 使用 Salesforce REST API。自訂頁面或按鈕會以同步方式起始 Apex HTTP 呼叫 (REST 服務)。在 Salesforce 中,您可以使用標準 GET、POST、PUT 和 DELETE 方法叫用 HTTP 服務。 如需此解決方案的詳細資訊,請參閱 遠端流程叫用—要求與回覆。 |
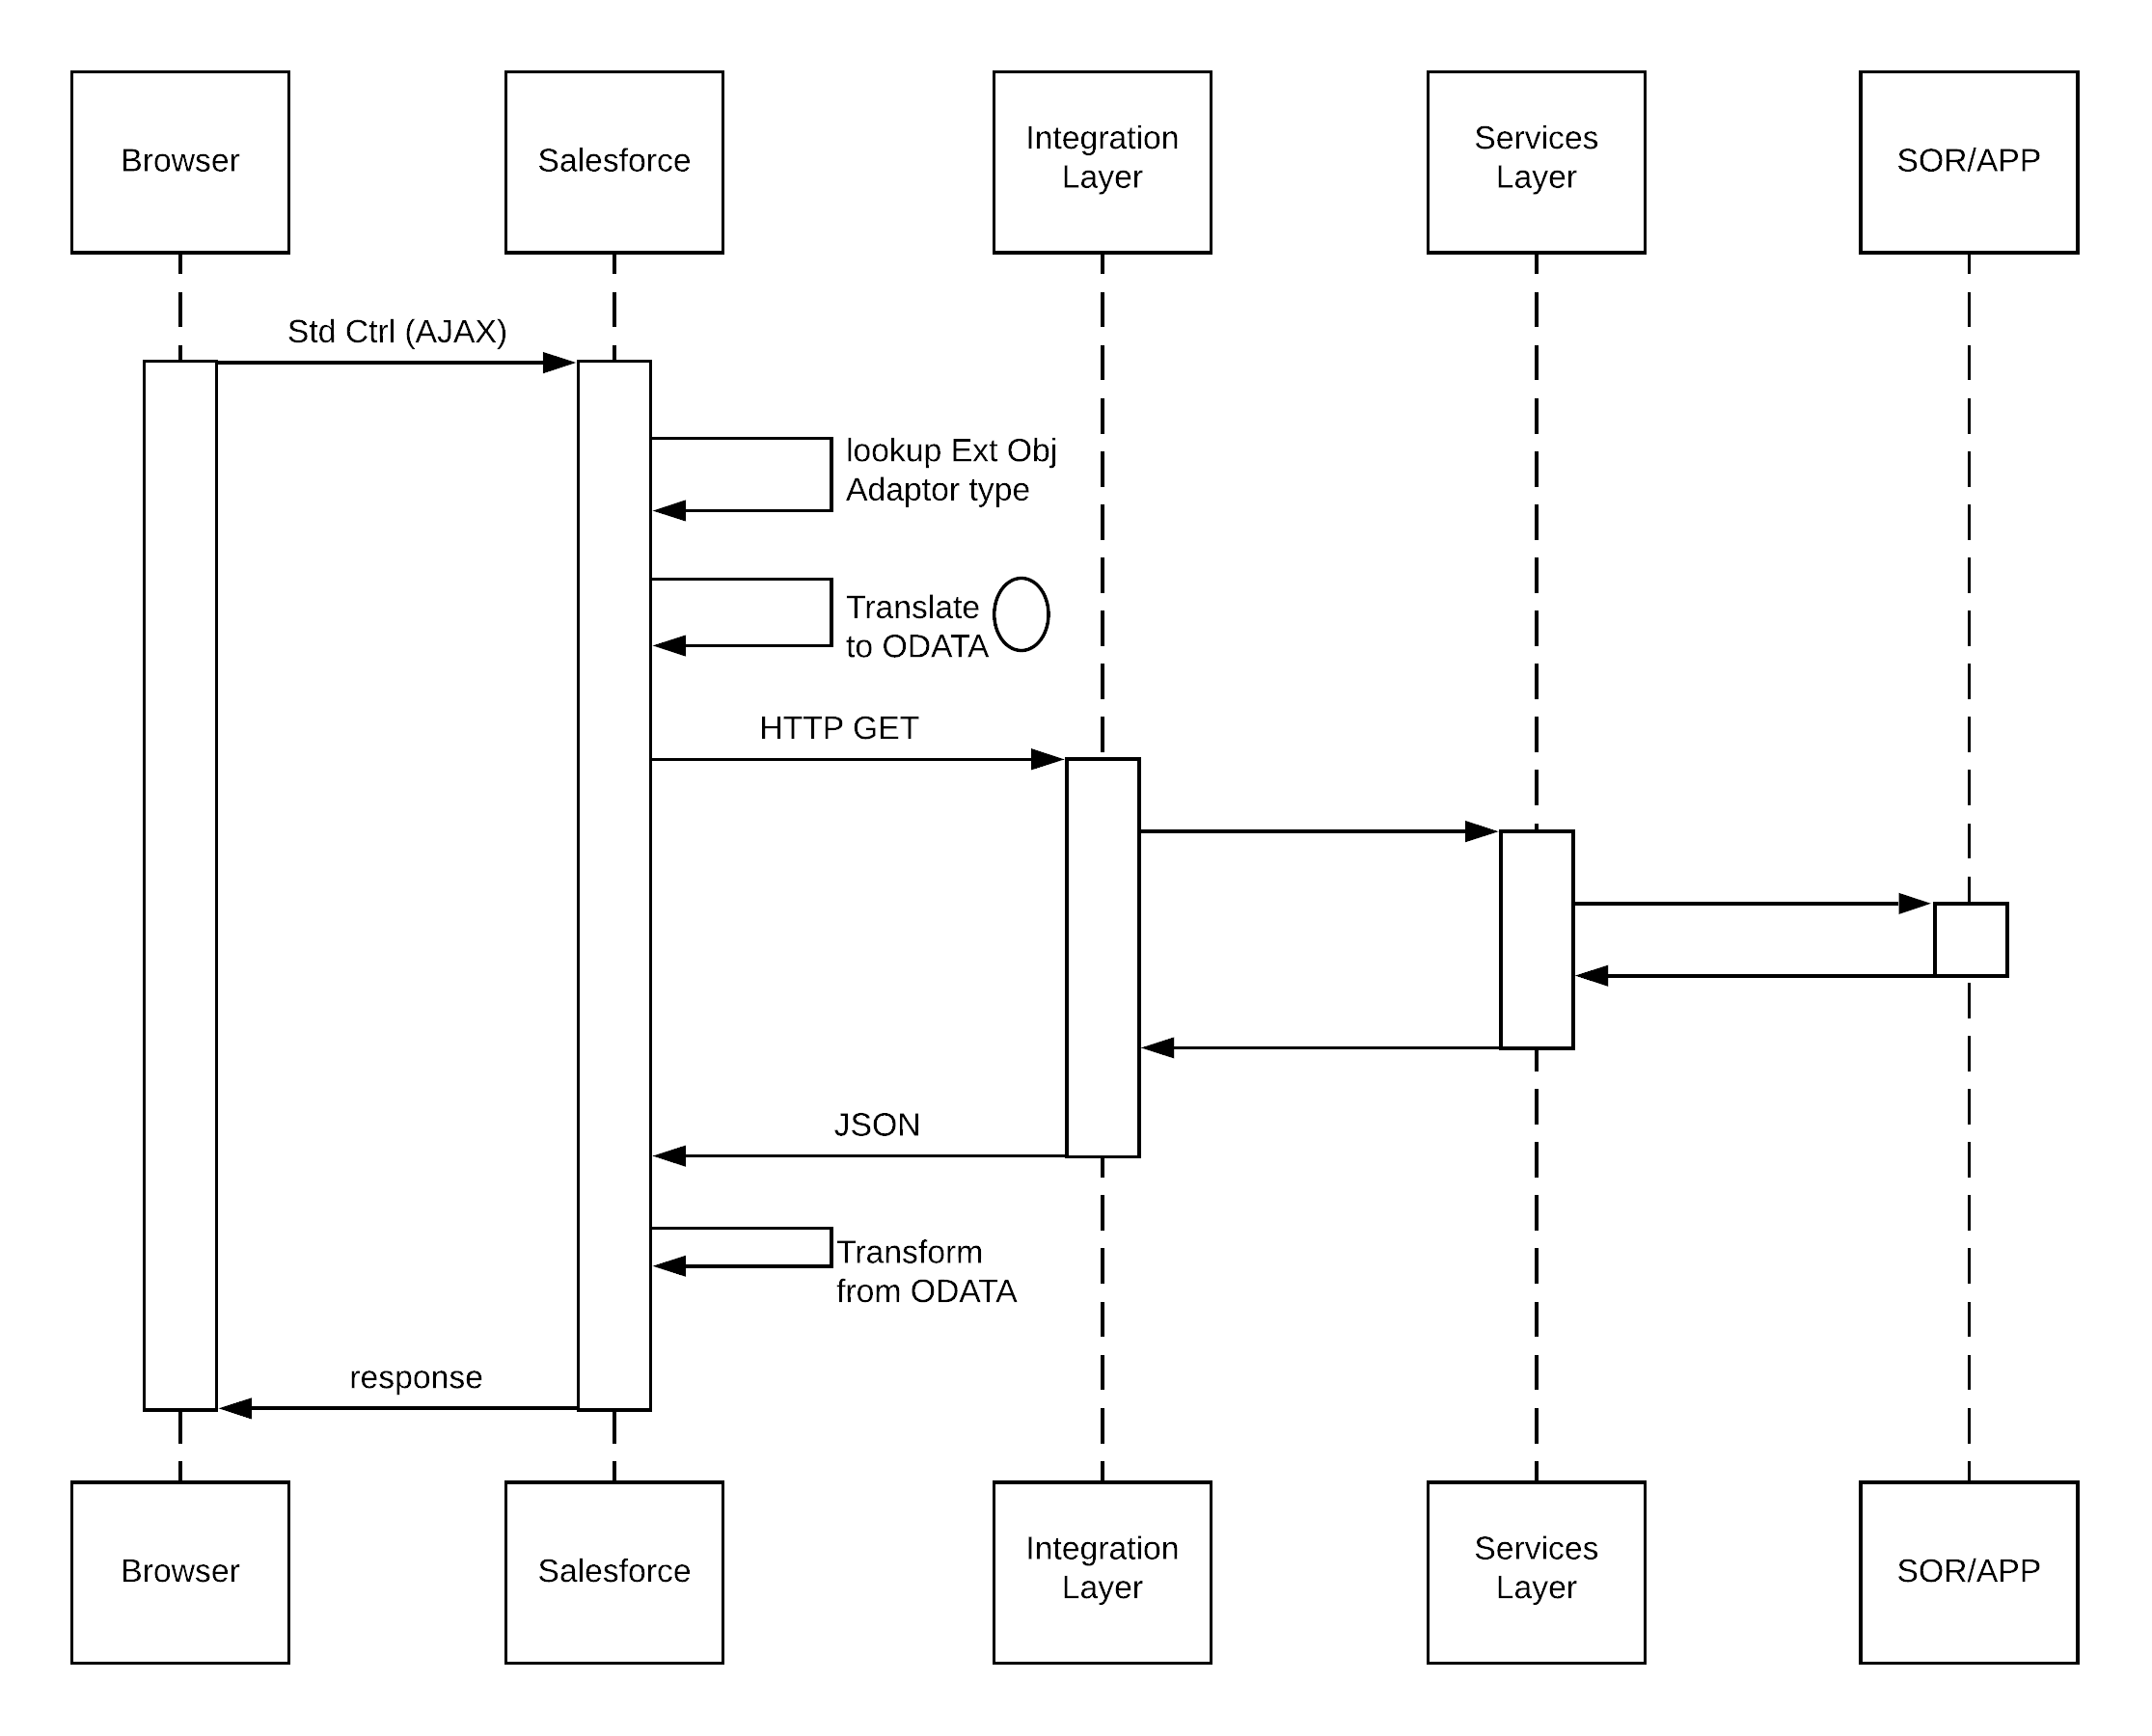 在此情況下:
- 瀏覽器會執行 AJAX 呼叫,進而在對應的外部物件轉接器上執行動作。
- 轉接器會將動作翻譯為 Odata 要求,並透過整合和服務層向遠端系統提出 HTTP GET 要求。
- 遠端系統會透過整合與服務層級將 JSON 回應傳回至 Salesforce。
- 回應會從 Odata 翻譯為外部物件,並呈回瀏覽器。
| 通話機制 | 描述 |
|---|---|
| 外部物件 | Salesforce Connect 會將 Salesforce 外部物件對應至外部系統中的資料表。Salesforce Connect 會依需求即時存取資料,而非將資料複製到您的組織。即使資料儲存在您的組織之外,Salesforce Connect 仍提供與 Lightning 平台的流暢整合。外部物件適用於 Salesforce 工具,例如全域搜尋、對應關係、記錄摘要和 Salesforce 行動應用程式。外部物件也可供 Apex、SOSL、SOQL 查詢、Salesforce API,以及透過中繼資料 API、變更集和封裝的部署使用。 |
| 照明元件 | 用於觸發遠端流程作為涉及使用者介面的端對端流程的一部分,且結果必須在 Salesforce 記錄中顯示或更新。例如,可將信用卡付款提交至外部付款的流程,並立即傳回向使用者顯示的付款結果。從使用者介面事件觸發的整合通常需要建立自訂 Lightning 元件。 |
- 此解決方案不會耗用 Salesforce 中的資料儲存空間。
- 使用者不必擔心在外部系統與 Salesforce 之間定期同步化資料。
- 可透過 Odata 或跨組織轉接器,或透過自訂 Apex 轉接器使用最少程式碼,快速達成的陳述性設定。
- 使用者可以存取外部資料,其功能與外部物件形式的自訂物件大致相同。
- 能夠使用全域搜尋在連線的外部系統中執行聯合搜尋。
- 能夠執行從雲端和內部部署來源存取外部資料的報告。請參閱下方的報告考量事項。
- 外部物件的行為與自訂物件類似,但外部物件無法使用某些功能。如需詳細資訊,請參閱 Salesforce Connect 的 Salesforce 相容性考量事項。
- 外部物件會影響報告效能。如需詳細資訊,請參閱 Salesforce Connect 的 報告考量事項。
- 如需使用 Salesforce Connect 轉接器的其他考量事項,請參閱 Salesforce Connect—所有轉接器的考量事項。
- 如果您考慮使用跨組織轉接器,請參閱 Salesforce Connect—跨組織轉接器的考量事項。
- 如果您考慮使用 OData 轉接器,請參閱 Salesforce Connect—OData 2.0 與 4.0 轉接器的考量事項。
- 如果您考慮使用自訂 Apex 轉接器,請參閱 Salesforce Connect—自訂轉接器的考量事項。
- 通常會從使用者介面叫用要求,因此程序不能讓使用者等待。
- 視外部系統的可用性和連線而定,可能需要很長的時間才會取回外部資料。Salesforce 具有可設定的 120 秒逾時上限值,可等待外部系統的回應。
- 遠端流程的完成應及時執行,並在 Salesforce 逾時限制內及使用者期望內完成。
| 解決方案 | 端點考量事項 |
|---|---|
| Salesforce Connect | Odata API — 使用開放式資料通訊協定存取儲存在 Salesforce 之外的資料。外部資料必須透過 Odata 產生者公開。 其他 API—當其他可用的轉接器不適合您的需求時,請使用 Apex 連接器架構來開發您自己的自訂轉接器。自訂轉接器可以從任何來源取得資料。例如,某些資料可透過呼叫從網際網路中提取,而其他資料則可透過程式設計方式進行操作甚至產生。 連線至 Salesforce — 使用 Lightning 平台 REST API 存取儲存在其他 Salesforce 組織中的資料。 透過中介軟體連線 透過中間軟體連線—Salesforce Connect 合作夥伴生態系統已與 Salesforce 密切合作,確保其中間軟體門戶從服務中公開 OData 端點,以便 Salesforce 無須撰寫額外程式碼即可與其連線。 |
| 要求與回覆 | Apex SOAP 呼叫 - 端點必須能夠透過 HTTP 接聽網路服務通話。 Apex HTTP 呼叫 - 端點必須能夠接收 HTTP 呼叫。 您可以使用 Apex HTTP 呼叫,使用標準 GET、POST、PUT 和 DELETE 方法呼叫 RESTful 服務 |
- Salesforce 會儲存遠端記錄的主要或唯一替代金鑰。
- 遠端系統會儲存 Salesforce 唯一記錄識別碼或其他唯一的替代金鑰。在此同步模式中處理整合索引鍵有特定考量事項。
| 主要系統 | 描述 |
|---|---|
| Salesforce | 遠端系統會儲存 Salesforce 記錄識別碼或記錄中的其他唯一替代金鑰。 |
| 遠端系統 | 遠端流程的呼叫會從應用程式傳回唯一金鑰,而 Salesforce 會將該金鑰值儲存在唯一記錄欄位中。 |
- 將通話及其在多個系統之通話之間的結果彙總
- 轉換輸入與輸出訊息
- 跨多個系統的呼叫維護交易完整性
- Salesforce 與外部系統之間的其他流程協調流程活動
| 財產 | 必要 | 理想 | 不需要 |
|---|---|---|---|
| 事件處理 | X | ||
| 通訊協定轉換 | X | ||
| 翻譯和轉換 | X | ||
| 排隊與緩衝 | X | ||
| 同步傳輸通訊協定 | X | ||
| 非同步傳輸通訊協定 | X | ||
| 仲裁路由 | X | ||
| 流程 koreography 和服務協調流程 | X | ||
| 交易性 (加密、簽署、可靠傳送、交易管理) | X | ||
| 路由 | X | ||
| 解壓縮、轉換和載入 | X | ||
| 長輪詢 | X |
| 關係 | 允許的子物件 | 允許的父系物件 | 比對記錄的父系欄位 |
|---|---|---|---|
| 對應 | 標準、自訂、外部 | 標準、自訂 | 18 個字元的 Salesforce 記錄識別碼 |
| 外部對應 | 標準、自訂、外部 | 外部 | 外部識別碼標準欄位 |
| 間接對應 | 外部 | 標準、自訂 | 選取具有「外部識別碼」和「唯一」屬性的自訂欄位 |
- 使用 Odata 端點設定外部資料來源。您的遠端應用程式可能包含對 Odata 的原生支援。針對其他應用程式,主要整合廠商 (例如 Dell Boomi、Informatica、Jitterbit、MuleSoft 和 Progress Software) 已在 Salesforce Connect 上與 Salesforce 合作建立轉接器。
- 直接或透過中介軟體解決方案,將 Salesforce Connect 指向 Odata 端點。
- 將您的外部資料庫表格與 Salesforce 中的外部物件同步化。當使用者存取包含這些外部物件資料的頁面時,Salesforce Connect 會對後端應用程式進行即時呼叫。
| 行為 | 資料 | 中繼資料 |
|---|---|---|
| 從生產環境複製到 Sandbox 環境 | 否* | 是 |
| 依中繼資料 API 移轉 | 否 | 是** |
| 依資料載入移轉 | 是 | 否 |
| 可包含在封裝中 | 否 | 是** |
| 計入資料儲存限制 | 是 | 否 |
| *完整複製和部分複製 Sandbox 允許從生產組織複製資料。 **某些中繼資料類型無法與中繼資料 API 和/或封裝搭配使用。您可以在「中繼資料涵蓋範圍報告」中找到例外狀況。 |
||