---
schema_version: "1"
id: c66cb0e7ac137b8c08e6bb5f5ef51c916014ea399fdc3d5a082db5d6dda24101
title: CloudHub 2.0 高可用性和灾难恢复
collection: architect
version: next
locale: zh-cn
portal_url: https://docs.salesforce.com/architect/next/zh-cn/fundamentals/guides/cloudhub-high-availability.md
canonical_url: https://staging.architect.salesforce.com/docs/architect/zh-cn/fundamentals/guide/cloudhub-high-availability.html
source_site: staging.architect.salesforce.com
content_type: documentation
content_hash: 0d313602abe4e612aab0539787d25b74fdae769262675f738e82b4426a39316f
products:
  - 基本知识
  - Architect Site Content Repo
updated_at: 2026-03-01T00:00:00Z
---
## 概览

本文档概述了将应用程序部署到 CloudHub 2.0 以满足高可用性和灾难恢复要求的当前选项。它以美国地区为例，可以应用到其他地区。

CloudHub 2.0 是一个完全受管的云原生集成平台，通过自动化部署、扩展和管理 MuleSoft API 和云中的集成，消除了基础设施开销。这是 MuleSoft 的现代云部署平台，运行在 Amazon AWS 基础设施上。

## 灾难恢复要求

在大多数情况下，CloudHub 2.0 提供的默认高可用性 (HA) 和灾难恢复 (DR) 就足够了。CloudHub 2.0 在区域一级提供 HA 和 DR(有关详细信息,请参阅 [CloudHub 2.0 中断场景](#cloudhub-20-outage-scenarios) ) 。[CloudHub 2.0 关键注意事项](#cloudhub-20-关键注意事项)部分提供了有关 CloudHub-2.0 支持的 HA 和 DR 的更多详细信息。

要求设计超出 CloudHub 2.0 默认可用性的条件包括：

- 应用程序需要确保在灾难场景中不会丢失数据（例如，Amazon 的一个地区即将宕机）。
- 应用程序取决于对象存储，如果部署区域停机，需要确保连续性。

## 假设

- 后端系统配置为等效可用性。CloudHub 2.0 有时可以通过队列或类似的机制提供可靠性，但是无论集成是实时的还是异步的，后端系统都必须支持同等级别的 HA 和 DR。
- 当 AWS 区域级停机影响后端系统时，它们的恢复被假定与 CloudHub 2.0 恢复并行运行。
- 专用空间设置在多个区域完成。

## 超出范围

本指南中的设计选项侧重于在整个 AWS 可用性区域或区域不可用时，适用于 CloudHub 2.0 中应用程序可用性的解决方案。

本指南并**未**涉及这些恢复场景，但会在相关之处指出影响：

- 恢复在 Anypoint CloudHub 之外管理和配置的后端系统、应用程序、数据库、网络组件和数据中心，无论是本地还是云中。
- 恢复 CloudHub 2.0 与客户专用数据中心之间的 VPN 链路（例如，IPsec 隧道和 VPN 网关）。本指南中的一些灾难恢复选项可能会部分解决这些情况。
- 当 IP 允许列表用于集成时，在灾难恢复期间对 MuleSoft 出口 IP 的更改。本指南中的一些灾难恢复选项可能会部分解决这些情况。
- 客户解决方案中使用的外部消息传递系统，无论是由 MuleSoft（例如 Anypoint MQ）还是其他供应商（例如 AWS MSK 或 Heroku Kafka）提供。

## CloudHub 2.0 关键注意事项

在评估 CloudHub 2.0 的[灾难恢复要求](#灾难恢复要求)时，请考虑这些关键注意事项。

**CloudHub 2.0 对 AWS 区域可用性的依赖**

- CloudHub 2.0 在 AWS 上运行；其可用性与 AWS 区域相关。
- 部署和应用程序可用性按地区组织。这些区域对应于 AWS 区域。

如果整个 AWS 区域出现故障，该区域的应用程序将不可用，并且不会自动复制到其他地方。

**应用程序高可用性 (HA) 和副本管理**

- 当硬件出现故障时，CloudHub 2.0 会自动在同一区域内重新部署应用程序，但是具有单个副本的应用程序可能会遇到停机。
- 默认情况下，具有多个副本的应用程序部署在单独的可用性区域中，跨区域提供高可用性。
- 如果单个副本应用程序的可用性区域失败，该应用程序将自动进入同一区域中的另一个可用性区域。

**美国东部地区特定影响**

- 在美国东部地区停机时：
  - CloudHub 2.0 管理 UI 和部署 REST 服务不可用，无法部署新应用程序。
  - 在大多数失败情况下，其他地区的应用程序不受影响。这些应用程序继续正常运行；但在停机期间，通过控制平面的监控和管理功能将不可用。
  - Core CloudHub 2.0 模块（例如应用程序设置）在美国东部维护，因此无法在中断期间编辑设置。

**监控和警报**

- 通过 [status.mulesoft.com](http://status.mulesoft.com) 配置可用性区域或区域级别故障的提醒。
- 在 CloudHub 2.0 之外使用单独的健康检查和警报机制，以便在副本失败或应用程序停止响应时通知团队。

**数据持久性 (Object Store V2)**

- 对象存储 V2 绑定到*首次*部署应用程序的区域。
- 如果您将应用程序移到其他区域，Object Store V2 会保留在原始区域，以避免数据丢失。
- 如果部署对象存储 V2 的区域失败，对象存储不可用。

**入口控制器和专用空间**

- CloudHub 2.0 的入口控制器在地区级别上高度可用。
- 在共享空间中，如果一个区域出现故障，另一个区域的入口控制器仍然可用，但只能为部署在该区域的应用程序提供服务。
- 在专用空间中，如果某个区域出现故障，其他区域的入口控制器将不可用，除非预先在那里设置。
- 专用空间设置是区域性的；如果区域失败，专用空间将不可用，除非已设置其他区域。

## CloudHub 2.0 Outage Scenarios

### 副本/可用性区域/区域中断

#### Salesforce 责任

| 组件状态           | Salesforce 责任                                                                                                                                                                                                |
| ------------------ | :------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **向下复制**       | **操作**:如果当前可用性区域有问题，CloudHub 2.0 会自动在不同可用性区域中重新启动副本。但应用程序将离线，直到新副本完全启动。**条件**:默认配置。**花费的时间**:大约 2-15 分钟，取决于应用程序复杂性和副本大小。 |
| **可用性区域缩小** | **操作**:与副本关闭相同。**条件**:默认配置。**花费的时间**:与副本关闭相同。**通知**:与副本关闭相同。                                                                                                           |
| **区域缩小**       | **操作**:没有自动恢复。必须进行故障转移设计。                                                                                                                                                                  |

#### 客户责任

| 组件状态           | 客户责任                                                                                                                                                                                                                     |
| ------------------ | :--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **向下复制**       | **通知**:使用内置于 API 中的心跳机制执行定期健康检查。**缓解**:将应用程序部署到同一区域的多个副本。**测试/模拟：**通过 MuleSoft 支持提出工单，他们将支持故障转移测试，以检查新副本是否在 1 到 15 分钟内在不同的 AZ 中旋转。  |
| **可用性区域缩小** | **通知**:与副本关闭相同。**缓解**:将应用程序部署到同一区域或不同区域的多个副本。**测试/模拟：**AZ Down 场景难以模拟。它需要 MuleSoft 工程的参与来支持可能的测试场景。                                                        |
| **区域缩小**       | **通知**:与副本关闭相同。另请访问 [https://status.aws.amazon.com](https://status.aws.amazon.com) 查看状态更新。**缓解**:和 AZ Down 一样灾难恢复应急计划：不同区域 2 个具有相同配置的专用空间。**测试/模拟：**和 AZ Down 一样 |

### VPN 网关和入口控制器中断

#### Salesforce 责任

| 组件状态                       | Salesforce 责任                                                                                                                                                                                                                   |
| :----------------------------- | :-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **VPN 网关关闭**               | **复制状态**:正在运行，但无法连接到内部托管的可通过 VPN 隧道访问的任何资源。**操作**:没有自动恢复。必须进行故障转移设计。                                                                                                         |
| **入口控制器（共享空间）关闭** | **复制状态**:入口控制器是一个具有多个实例的集群设置，类似于应用程序副本。如果应用程序副本失败，将创建新副本并自动启动。如果一个入口控制器实例失败，应用程序将通过另一个实例保持可用。如果整个入口控制器停机，该区域将被视为停机。 |
| **入口控制器（专用空间）关闭** | **副本状态：**与共享空间中的入口控制器相同。                                                                                                                                                                                      |

#### 客户责任

| 组件状态                   | 客户责任                                                                                                                                                                                                                                            |
| :------------------------- | :-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| VPN 网关关闭               | **通知**:使用内置于 API 中的心跳机制执行定期健康检查。**缓解**:CloudHub 2.0 VPN 网关通过具有隧道间自动故障切换的双隧道架构支持高可用性；客户必须配置此模式。**测试/模拟：**VPN 网关关闭场景难以模拟。需要 MuleSoft 工程的参与来支持可能的测试场景。 |
| 入口控制器（共享空间）关闭 | **通知**:与 VPN 网关关闭相同。**缓解**:与区域缩小相同。将应用程序迁移到其他区域的备用或活动空间。**测试/模拟：**与 VPN 网关关闭相同。                                                                                                               |
| 入口控制器（专用空间）关闭 | **通知**:与 VPN 网关关闭相同。**缓解**:与区域缩小相同。与 AWS Route 53（或等效）配置协调，将应用程序迁移到其他区域的备用或活动专用空间。**测试/模拟：**与 VPN 网关关闭相同。                                                                        |

### 对象存储和持久队列

**概述平台服务关闭场景 – 对象商店**

<table>
  <thead>
    <tr>
      <th colspan="1"></th>
      <th>内存中对象存储</th>
      <th>持久对象存储 v2</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>数据位置</strong></td>
      <td>仅本地到应用程序。</td>
      <td>在首次部署 MuleSoft 应用程序的同一区域中。</td>
    </tr>
    <tr>
      <td><strong>跨副本共享？</strong></td>
      <td>没有</td>
      <td>是</td>
    </tr>
    <tr>
      <td><strong>应用程序中的对象存储恢复</strong></td>
      <td>数据丢失；应用程序重新启动、新部署或副本失败时，所有内存中数据丢失。</td>
      <td>数据不会丢失。除非删除应用程序。</td>
    </tr>
    <tr>
      <td><strong>区域内的对象商店恢复</strong></td>
      <td>数据丢失（与以上相同）。</td>
      <td>数据不会丢失（与以上相同）。</td>
    </tr>
    <tr>
      <td><strong>区域恢复</strong></td>
      <td>与以上相同。</td>
      <td>数据不可用。即使使用主动-主动灾难恢复配置，对象存储也仅在原始部署区域中可用。</td>
    </tr>
    <tr>
      <td><strong>缓解</strong></td>
      <td>为区域恢复外部化数据。</td>
      <td>在原始部署区域可用时，数据仍可用。对于跨区域 HA 或 DR，将对象存储外部的数据外部化。</td>
    </tr>
  </tbody>
</table>

## 高可用性与灾难恢复

**高可用性** (HA) 是衡量系统在系统组件出现故障时保持可访问性的能力。通常，HA 通过在系统中内置多个级别的容错和/或负载平衡功能来实现。它通常是主动-主动配置，对业务服务的影响有限或没有影响。

**灾难恢复** (DR) 是在自然(如洪水、龙卷风、地震或火灾)或人为(如电源故障、服务器故障或配置错误)灾害发生后，系统恢复到先前可接受状态的过程。DR 通常是主动-被动配置，并对业务服务造成一些影响。

## CloudHub 2.0 中的区域可用性

如果希望在 AWS 区域故障时减少区域高可用性或区域灾难恢复对业务的影响，请在 MuleSoft CloudHub 2.0 中设计解决方案时考虑以下几点：

- CloudHub 2.0 副本和相关功能（专用空间、入口控制器和 Anypoint MQ 目标）特定于地区。
- 如果整个 AWS 区域出现故障，该区域中的所有副本和相关服务将不可用。
- 在区域恢复时，配置也会恢复；您必须重新启动应用程序。
- 如果美国东部区域出现故障， Anypoint 平台服务（例如，访问管理和运行时管理器）也将不可用。
- MuleSoft 为平台服务提供 99.95% 的可用性 SLA，包括区域内主动-主动配置中的 CloudHub 2.0 副本；有关当前详细信息，请参考最新的 MuleSoft Cloud 产品 SLA。
- CloudHub 2.0 不支持开箱即用的多区域 HA 或 DR；可用性仅在单个区域内提供。

## 通用设计指南

无论您选择哪种设置，这些设计指南都适用。

**多区域专用空间设置**

以下部分中描述的所有选项都需要将应用程序部署在单独的区域中。只有在灾难发生之前提前完成专用空间设置的情况下，才可能做到这一点。因为专用空间设置是区域性的，所以灾难恢复策略需要至少两个专用空间（每个区域一个）和一个将流量切换到适当 VPN 端点的机制。

**区域内的高可用专用空间设置**

当区域内的专用空间出现故障时，CloudHub 2.0 不会提供自动故障切换。解决方法是跨多个环境的主动-被动设置，这需要：

- 在专用空间上配置多个 VPN 网关。
- 在 CloudHub 2.0 区域中建立单独的环境，每个环境都有自己的专用空间。
- 将其中一个环境指定为被动环境（其中应用程序最初未部署，但在主要专用空间出现故障时启动）。

如果高可用性设置没有 VPN 网关作为单点故障是一个硬性要求，那么部署到两个区域是最好的选择。在这种情况下，VPN 网关故障可以通过将受影响区域故障切换到已经配置了专用空间的替代区域来解决。

**零消息丢失**

要在整个区域出现故障时实现零消息丢失，应用程序必须防止数据丢失并解决以下几点：

- 使用外部消息传递来实现消息的可靠性。
- 确保对象存储不用于本质上属于事务性的临时事务数据。如果首次部署 MuleSoft 应用程序的部署区域出现故障，对象存储将不可用。
- 在对象存储读取或写入操作失败时，将所有对象存储访问权限封装在单独的流或部分中，该流或部分将继续运行，以处理异常和行为。

**注意**在大多数情况下，灾难恢复要求不需要确保在发生灾难时消息零丢失，并且需要确保数据丢失小于给定时间段的数据价值（例如 1 小时）。

**保持集成无国籍**

作为一般设计原则，确保集成本质上是无国籍的始终非常重要。这意味着在各种客户端调用或执行之间没有共享的事务信息（在计划服务的情况下）。如果由于系统限制，一些数据必须由中间件维护，它应该保存在外部存储中，例如数据库或消息队列中，而不是 MuleSoft 基础设施或内存中。重要的是要注意，当我们进行扩展时，特别是在云中，每个副本的状态和资源应该独立于其他副本。该模型可确保更好的性能、可扩展性和可靠性。

## 多区域部署的其他灾难恢复注意事项

**网络和流量管理**

- 区域可用性需要虚域；它们充当跨区域所有入口控制器的全局 DNS。
- **全局负载平衡器**在主要和灾难恢复区域专用空间之间路由流量。客户提供此组件；使用 AWS Route 53 或带有路由策略的全局 CDN，以路由跨区域的流量。
- 使用自定义虚域在主要和 DR 区域中配置入口控制器。
- 计划和维护防火墙规则和 VPN 隧道，以便从主要和灾难恢复区域专用空间访问内部部署应用程序。
- **TLS 证书维护**必须覆盖主要和灾难恢复区域中的专用空间，以实现无缝恢复。

**应用程序部署和配置**

- **应用程序名称**在各区域必须唯一。例如，CI/CD 漏斗可以在部署前将区域名称（或区域代码）附加到应用程序名称，以保持主要和灾难恢复区域之间的唯一性。
- 配置 CI/CD 漏斗，将应用程序部署到主要和灾难恢复区域，以便所有应用程序在两个区域中都可用。

**基础设施和容量**  
当所有基础设施方面的主要和灾难恢复区域容量相同时，性能最佳。当这些基础设施方面不完全相同时，性能会下降。

**数据持久性和存储**

- **持久性存储**必须在两个区域之间定期同步。客户负责存储复制；MuleSoft 不提供。主区域和灾难恢复区域中的 VPC 之间可以有一个共享存储，但是共享存储必须高度可用，否则会成为两个区域的单点故障。
- **Object Store V2** 是区域性的，仅在首次部署 Mule 应用程序的区域中可用。如果应用程序移到其他区域，对象存储 V2 会保留在原始区域，以避免数据丢失。将其他持久存储用于多区域灾难恢复策略。

**测试和操作程序**

采用正式的 DR 测试策略，并定期运行 DR 演练。对于主动-主动灾难恢复，使用金丝雀部署策略来验证这两个区域。

**性能和服务级别协议 (SLA)**

可能会出现一些性能下降，因为灾难恢复区域可能比主要区域离最终用户或后端系统更远。定义 DR SLA 并将其传达给利益相关者。

**恢复模式行为（上下文备注）**

在主动-主动模式中，从主要区域到 DR 区域专用空间的故障切换非常快：全局负载平衡器检测到主要区域不健康，并将流量路由到健康 (DR) 区域。在主动-被动模式中，您必须在发生灾难时将应用程序部署到灾难恢复区域专用空间。

## 区域可用性选项

有 3 种选项可以实现更高的灾难恢复级别可用性：

[**主动-主动配置**](https://docs.mulesoft.com/cloudhub-2/ch2-ha-dr#use-case-1-active-active-configuration)

主动-主动设置基于分布在各区域的活动工作人员，使用外部负载平衡器在两个实例之间路由流量。

[**暖备配置**](https://docs.mulesoft.com/cloudhub-2/ch2-ha-dr#use-case-2-warm-standby-configuration)  
主动-被动设置将基于一个区域中的积极员工和另一个区域中消极的员工。被动区域将在需要时启动。

被动区域的一些元素必须保持活动状态，以便进行故障切换，或预先设置，包括专用空间、VPN 和过境网关附件。

[**冷备用配置**](https://docs.mulesoft.com/cloudhub-2/ch2-ha-dr#use-case-3-cold-standby-configuration)

如上所述，副本和入口控制器在故障转移时通过完全自动化的 DevOps 流程在第二个区域中配置。被动区域的一些元素需要保持活动状态，以便进行故障转移，包括专用空间、VPN 和传输网关附件。

## 适用于高可用性的虚域

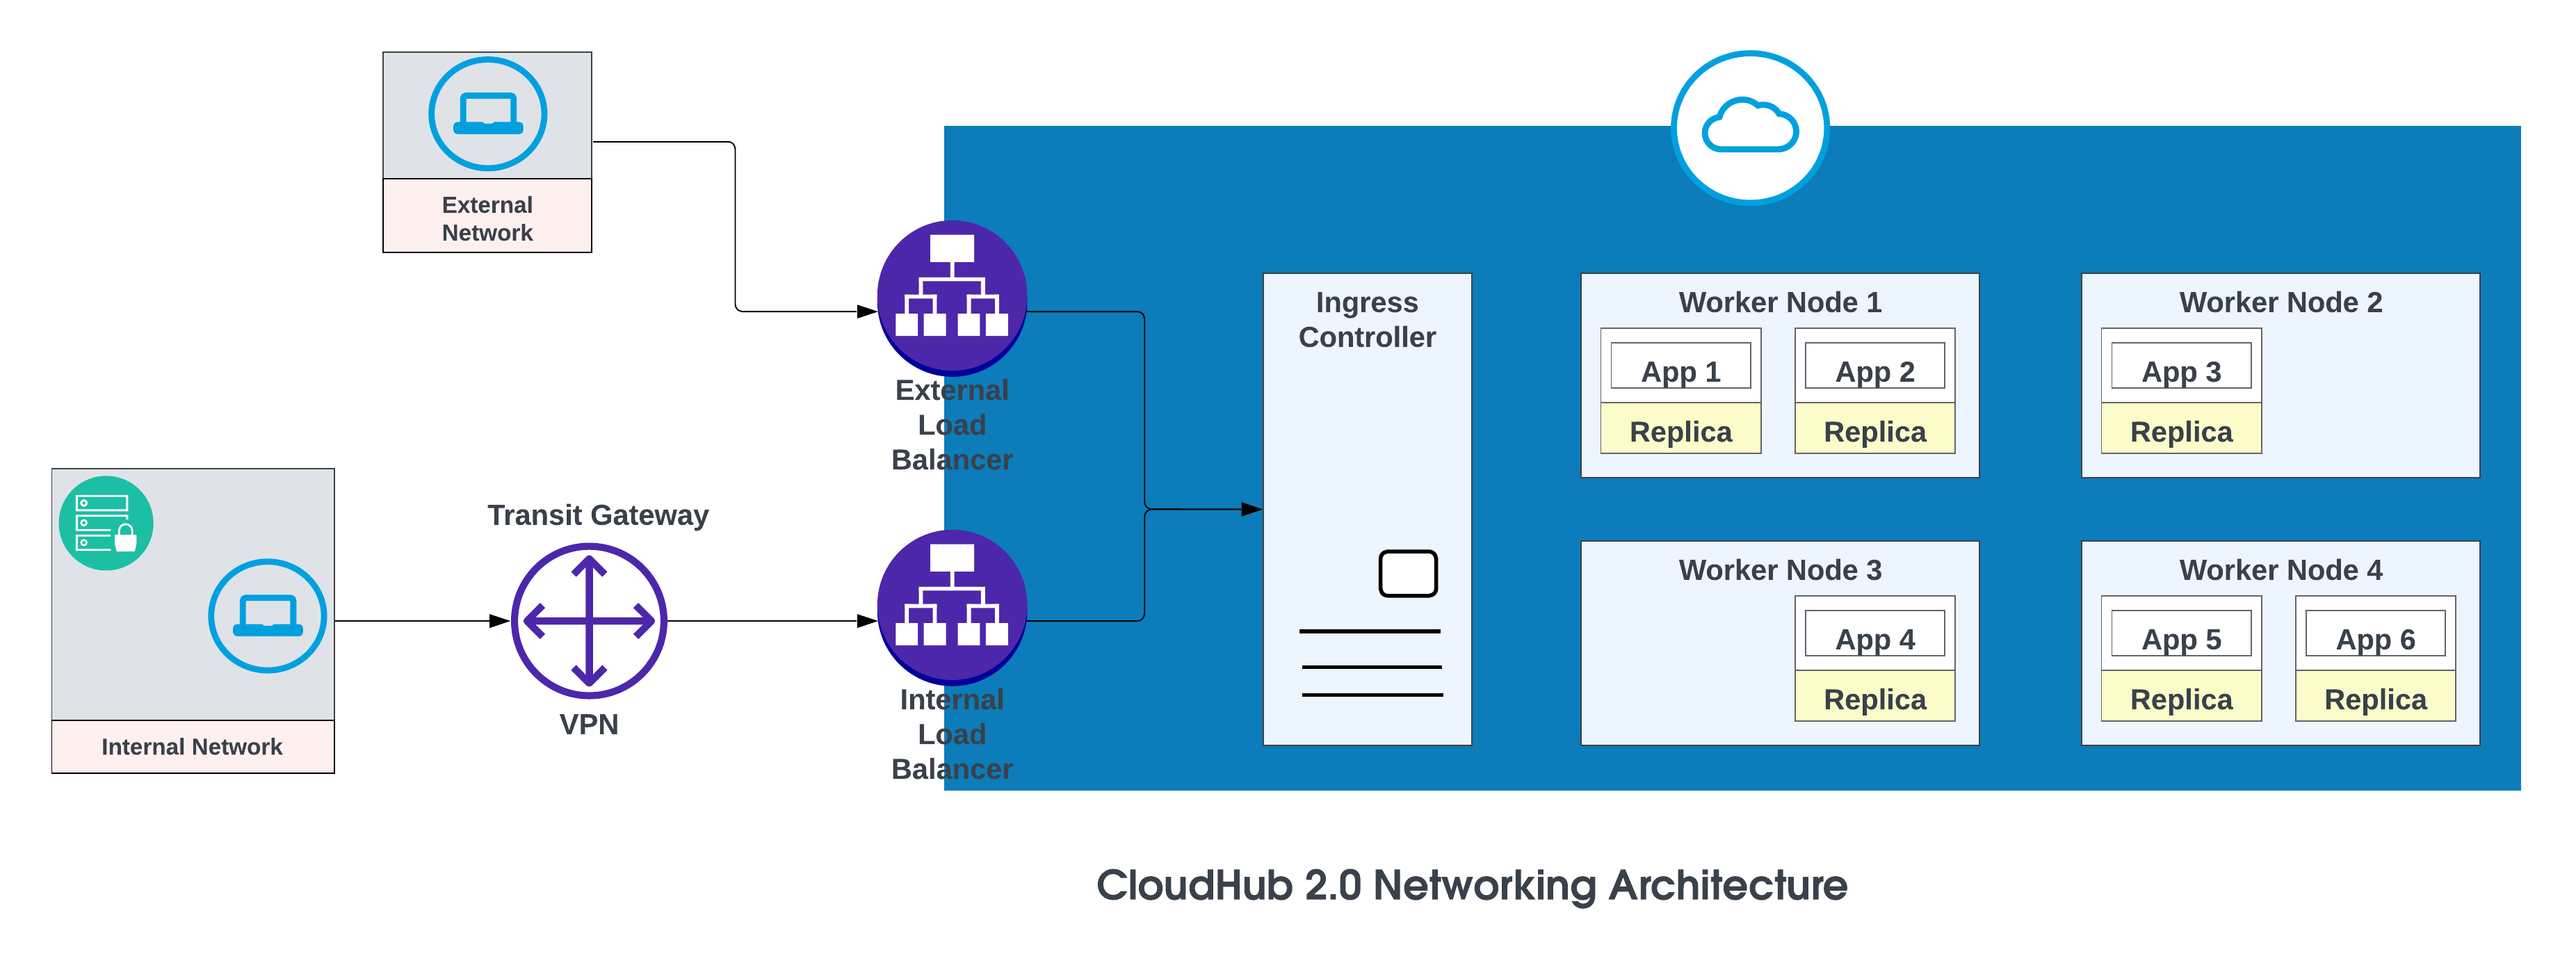
<img style="border:1px solid #e5e5e5;margin:2rem 0rem" src="https://architect.salesforce.com/ns-assets/mulesoft-ch-ha-dr/ch-ha-and-dr-networking-arch.png" alt="CloudHub 2.0 网络架构">

CloudHub 2.0 网络架构的基本组件是：

- HTTP 负载平衡器
- Mule 副本 DNS 记录
- 专用空间
- 区域服务

有关更多详细信息，请查看 [CloudHub 2.0 网络架构](https://docs.mulesoft.com/cloudhub-2/ch2-networking-guide)。

**虚域**

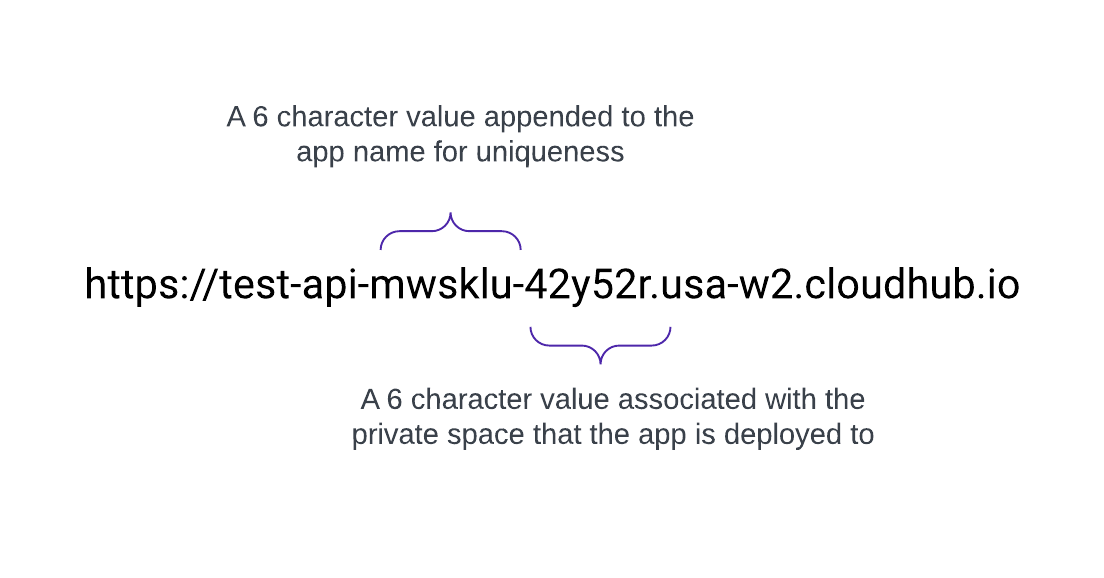
创建专用空间时，它会收到 DNS 目标名称，格式为：\<space-id\>.\<region\>.cloudhub.io。在该专用空间中部署名为 test-api 的应用程序时，其端点将遵循以下格式：

<img style="border:1px solid #e5e5e5;margin:2rem 0rem" src="https://architect.salesforce.com/ns-assets/mulesoft-ch-ha-dr/ch-ha-and-dr-default-dns.png" alt="端点格式">

CloudHub 2.0 还支持自定义或虚域，方法是使用 TLS 上下文和 DNS 记录在专用空间中配置它们。要在专用空间的运行时管理器中创建 TLS 上下文，请上传公共证书和私钥，然后在应用程序的设置中添加自定义端点以使用该域。创建 DNS 记录（例如 CNAME），将虚域指向专用空间的默认主机名。

例如，在 us-west-2 中部署的名为 test-api 的应用程序（默认 DNS 为 42y52r.usa-w2.cloudhub.io）的 API 端点为：

https://test-api-mwsklu-42y52r.usa-w2.cloudhub.io

此 URL 不使用虚域或自定义域。要使用 [acme.com](https://acme.com) 使 API URL 显示为 [https://test-api.acme.com](https://test-api.acme.com)，请执行以下步骤。

1. 使用公钥和私钥在运行时管理器中创建 TLS 上下文。
2. 在应用程序的设置中添加虚域，以使用该域。
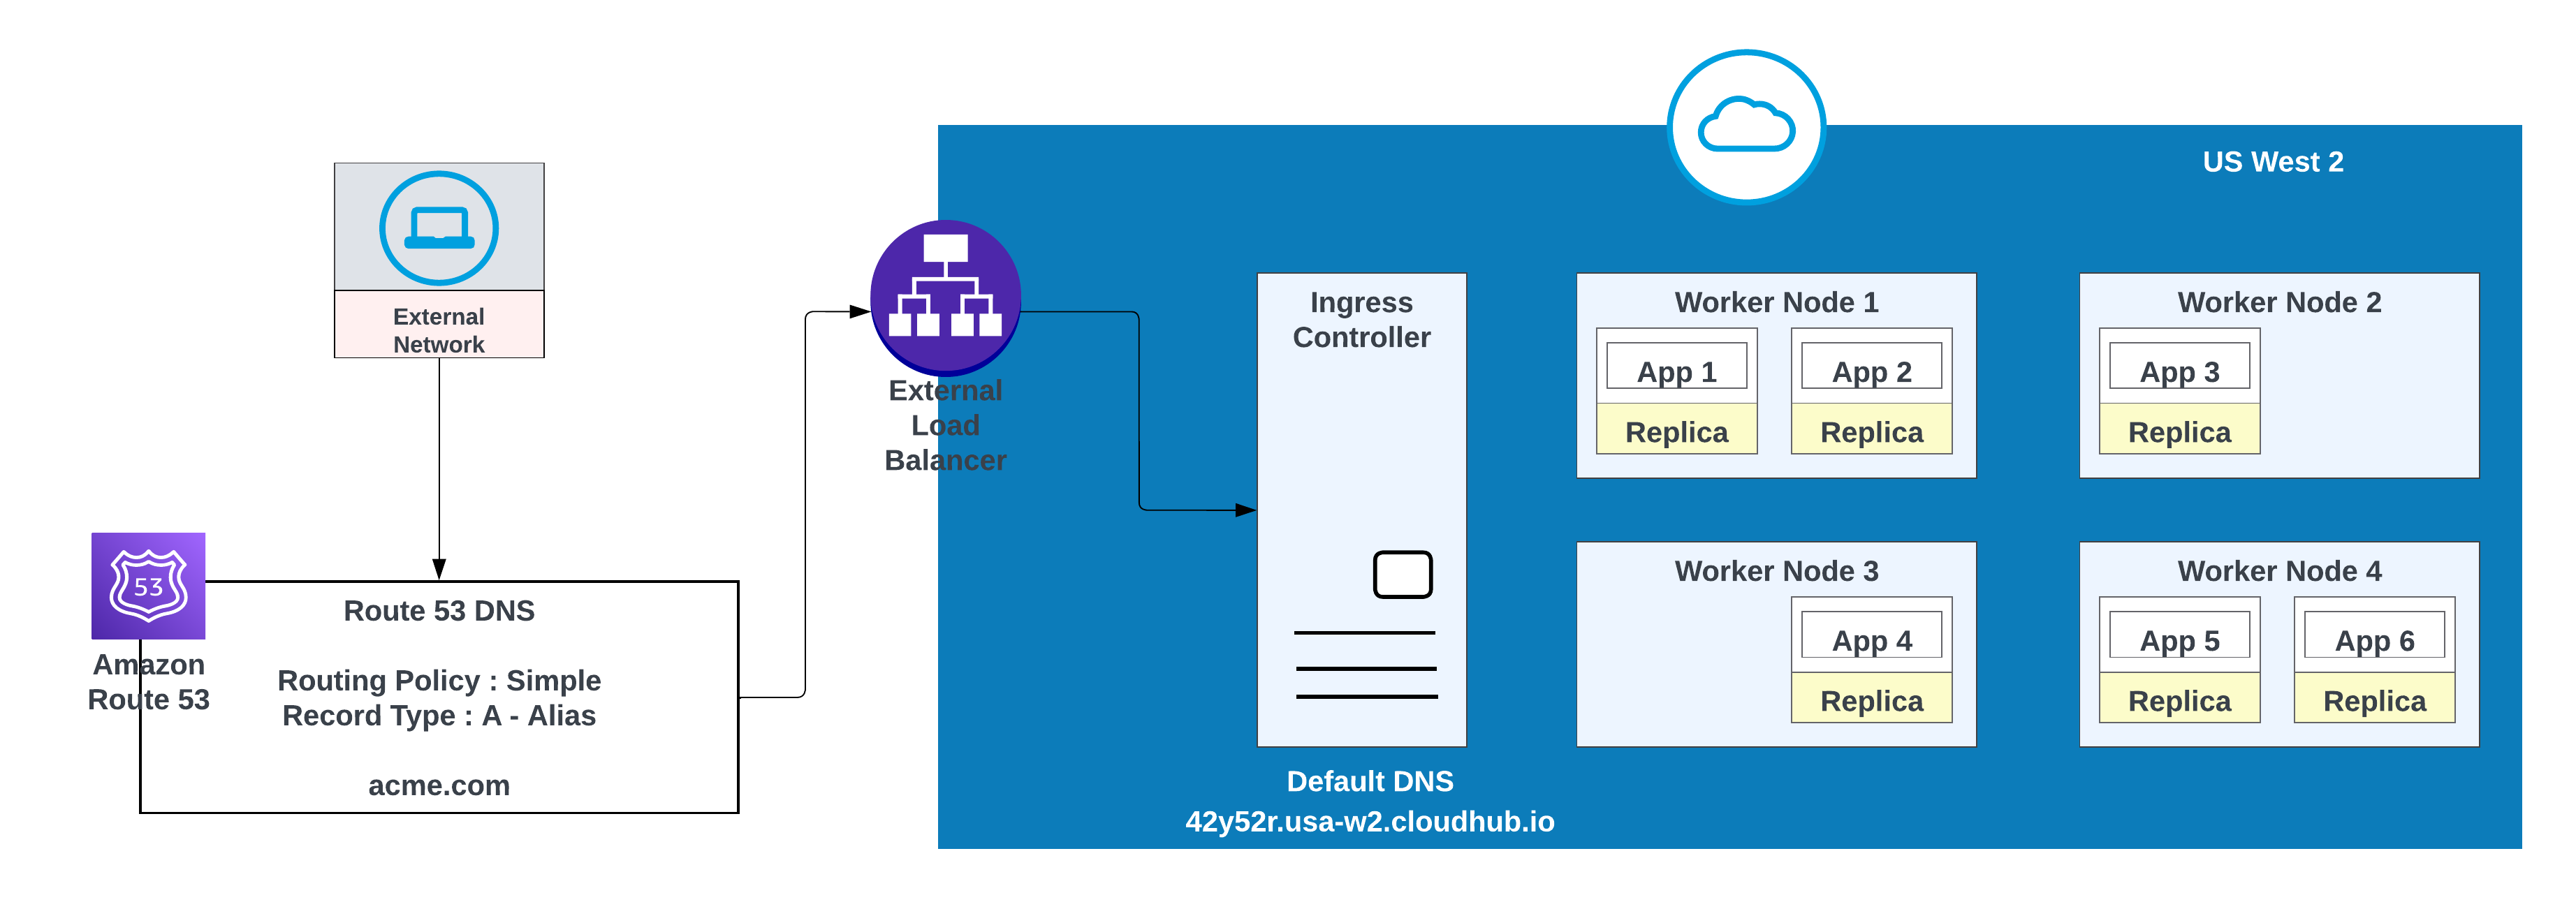
3. 在 AWS 路由 53 中创建 DNS 记录，并配置简单的路由策略（例如 CNAME），以便虚域解析为专用空间的默认主机名。

对于自定义域，您可以使用 AWS Route 53 或任何其他具有路由策略的全局 CDN 服务。在下图中，AWS Route 53 与“简单”路由策略一起使用。当来自公共（外部）网络的使用者请求 acme.com 时，AWS 路由 53 会将请求路由到 MuleSoft 专用空间入口控制器。

<img style="border:1px solid #e5e5e5;margin:2rem 0rem" src="https://architect.salesforce.com/ns-assets/mulesoft-ch-ha-dr/ch-ha-and-dr-global-load-balancer.png" alt="包含自定义域路由策略的 CDN 示例">

## 故障切换策略

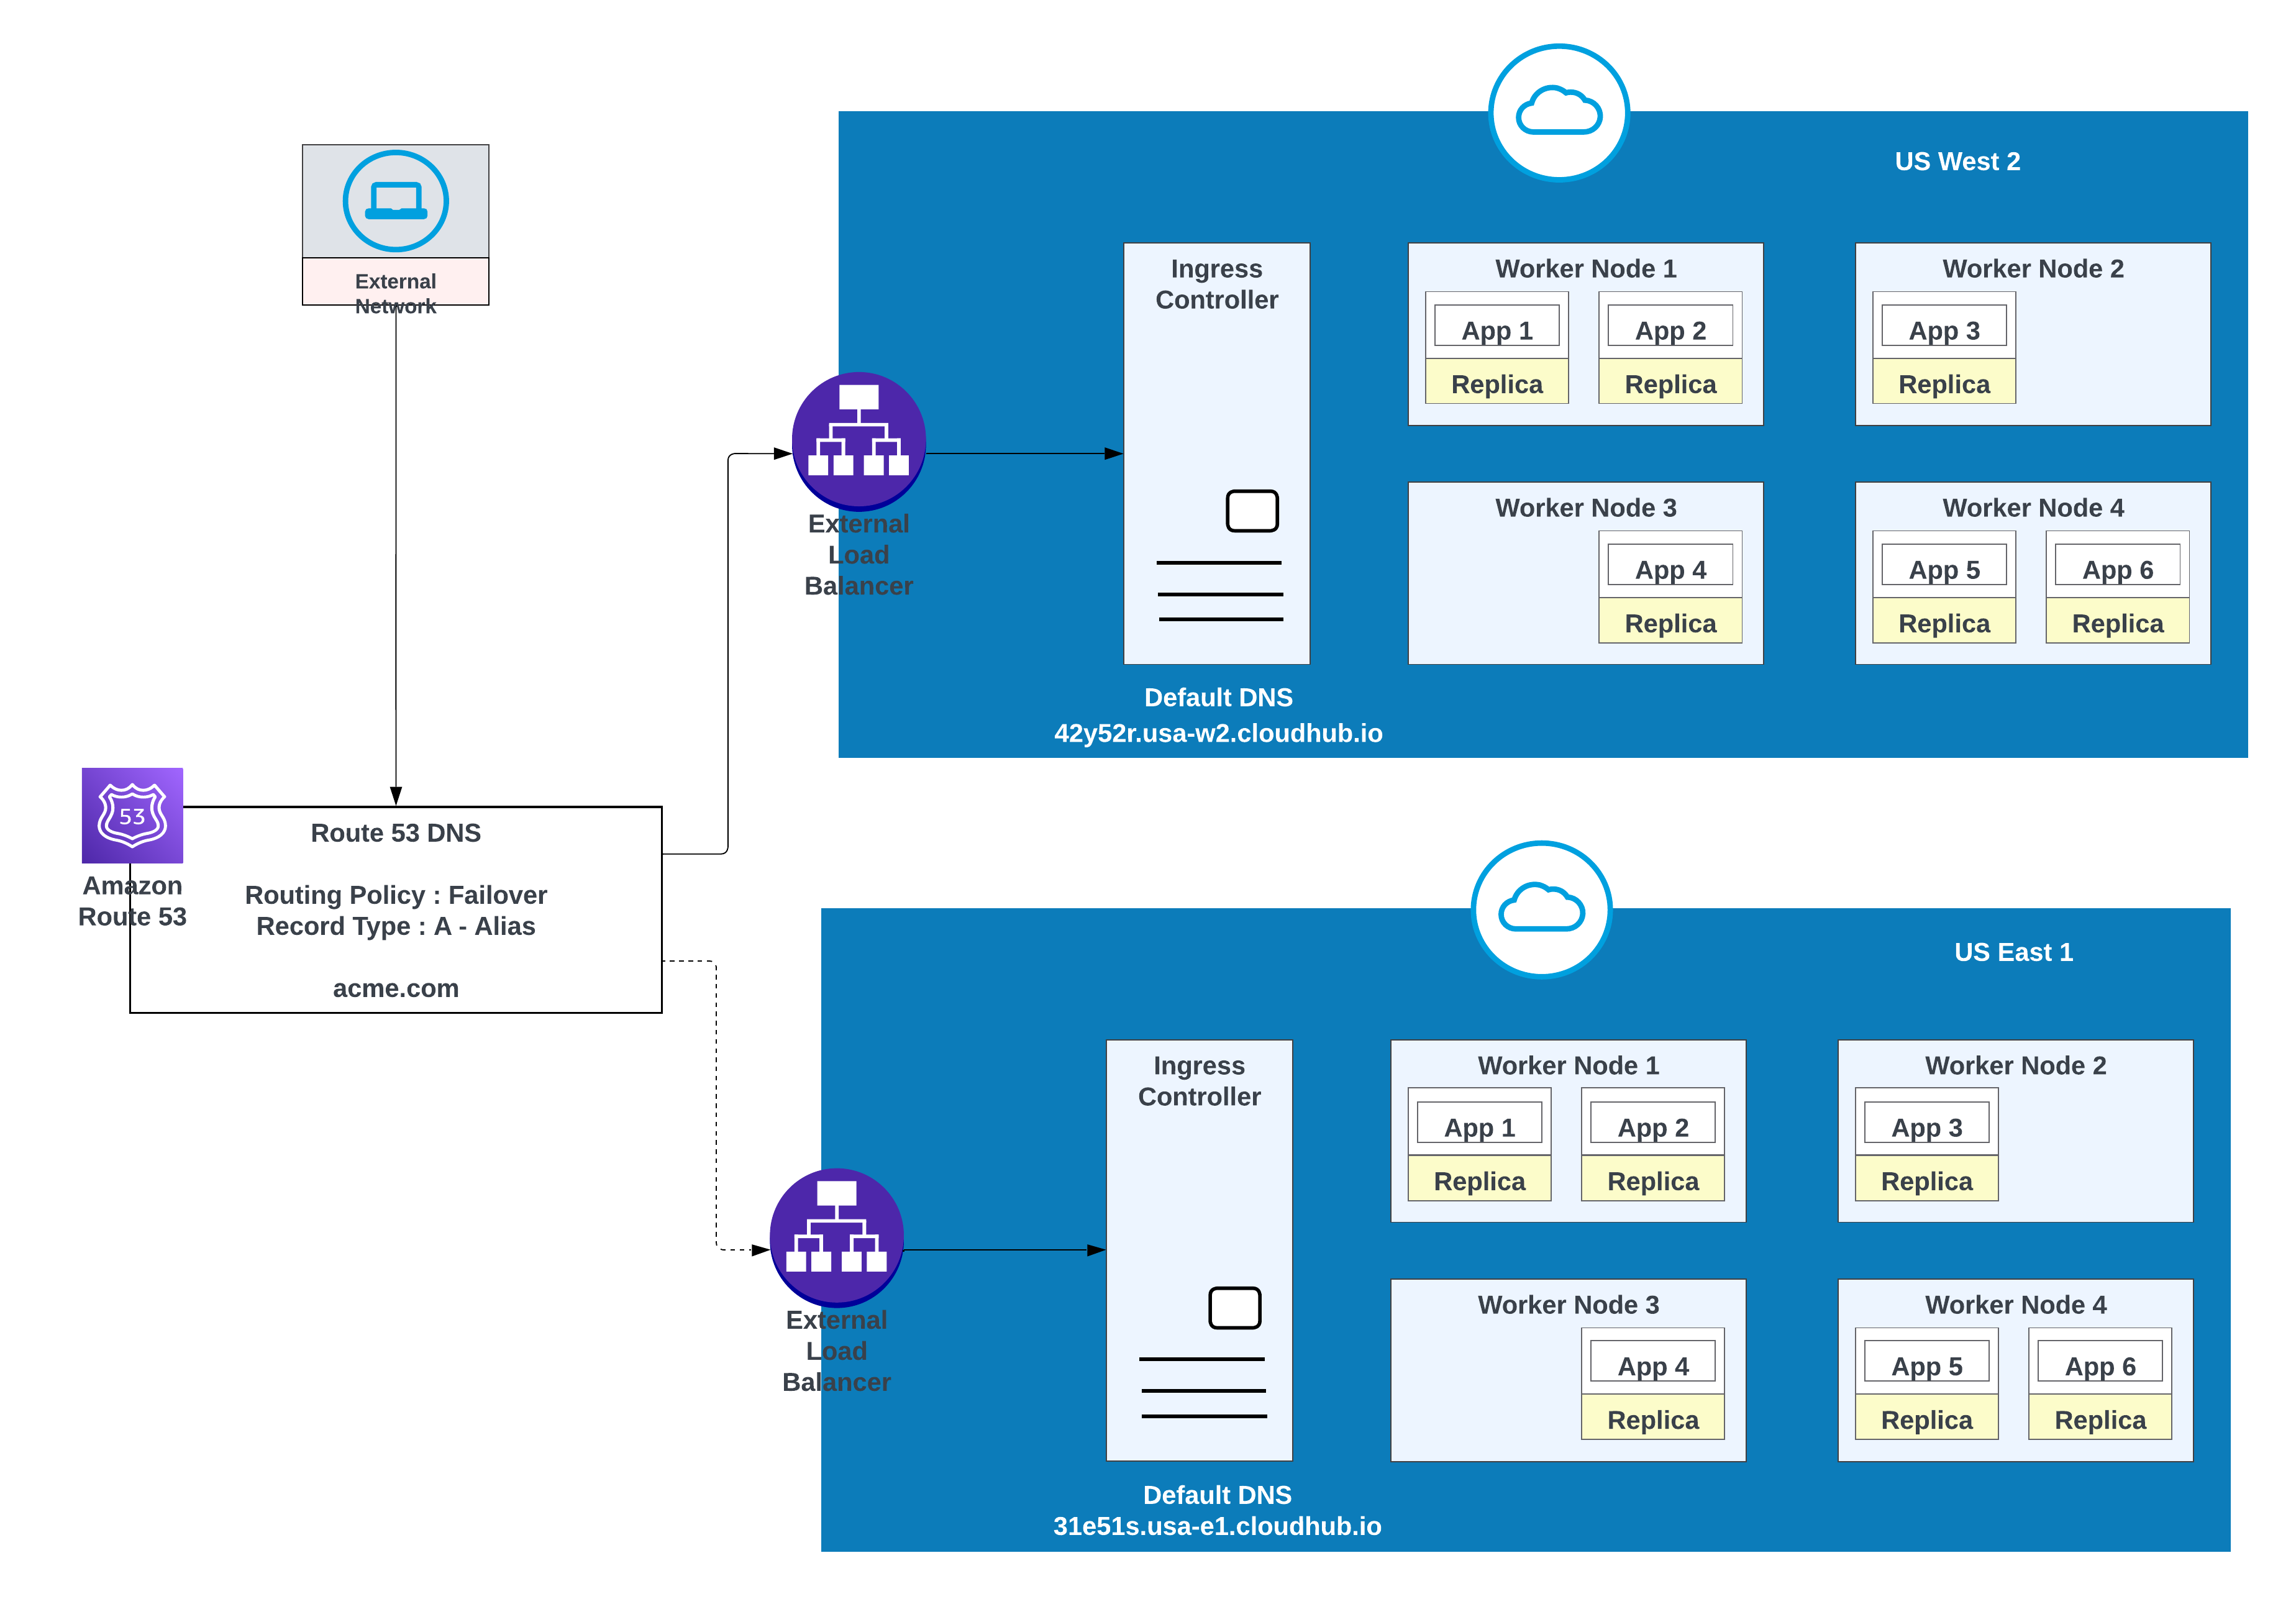
在应用程序需要故障切换时使用此选项：在主要区域（例如 us-west-2）部署一个实例，在次要区域（例如 us-east-1）部署另一个实例。

尽可能使用次要区域的现有环境；创建新环境需要额外努力。

**在一个区域（美国西部 2）部署的应用程序示例，故障转移到另一个区域（美国东部 1）**

<img style="border:1px solid #e5e5e5;margin:2rem 0rem" src="https://architect.salesforce.com/ns-assets/mulesoft-ch-ha-dr/ch-ha-and-dr-failover-across-regions.png" alt="多区域部署的故障转移示例">

| 记录名称 |       流量值/路由到       | 路由策略 | 健康检查 ID  |
| :------: | :-----------------------: | :------: | :----------: |
| acme.com | 42y52r.usa-w2.cloudhub.io | 故障转移 | 31s3wseq121  |
| acme.com | 31e51s.usa-e1.cloudhub.io | 故障转移 | 43e131s131sq |

在此配置中，AWS Route 53 将流量路由到美国西部 2 和美国东部 1 的专用空间的入口控制器。故障转移路由策略配置了健康检查。

## 高可用性和低延迟

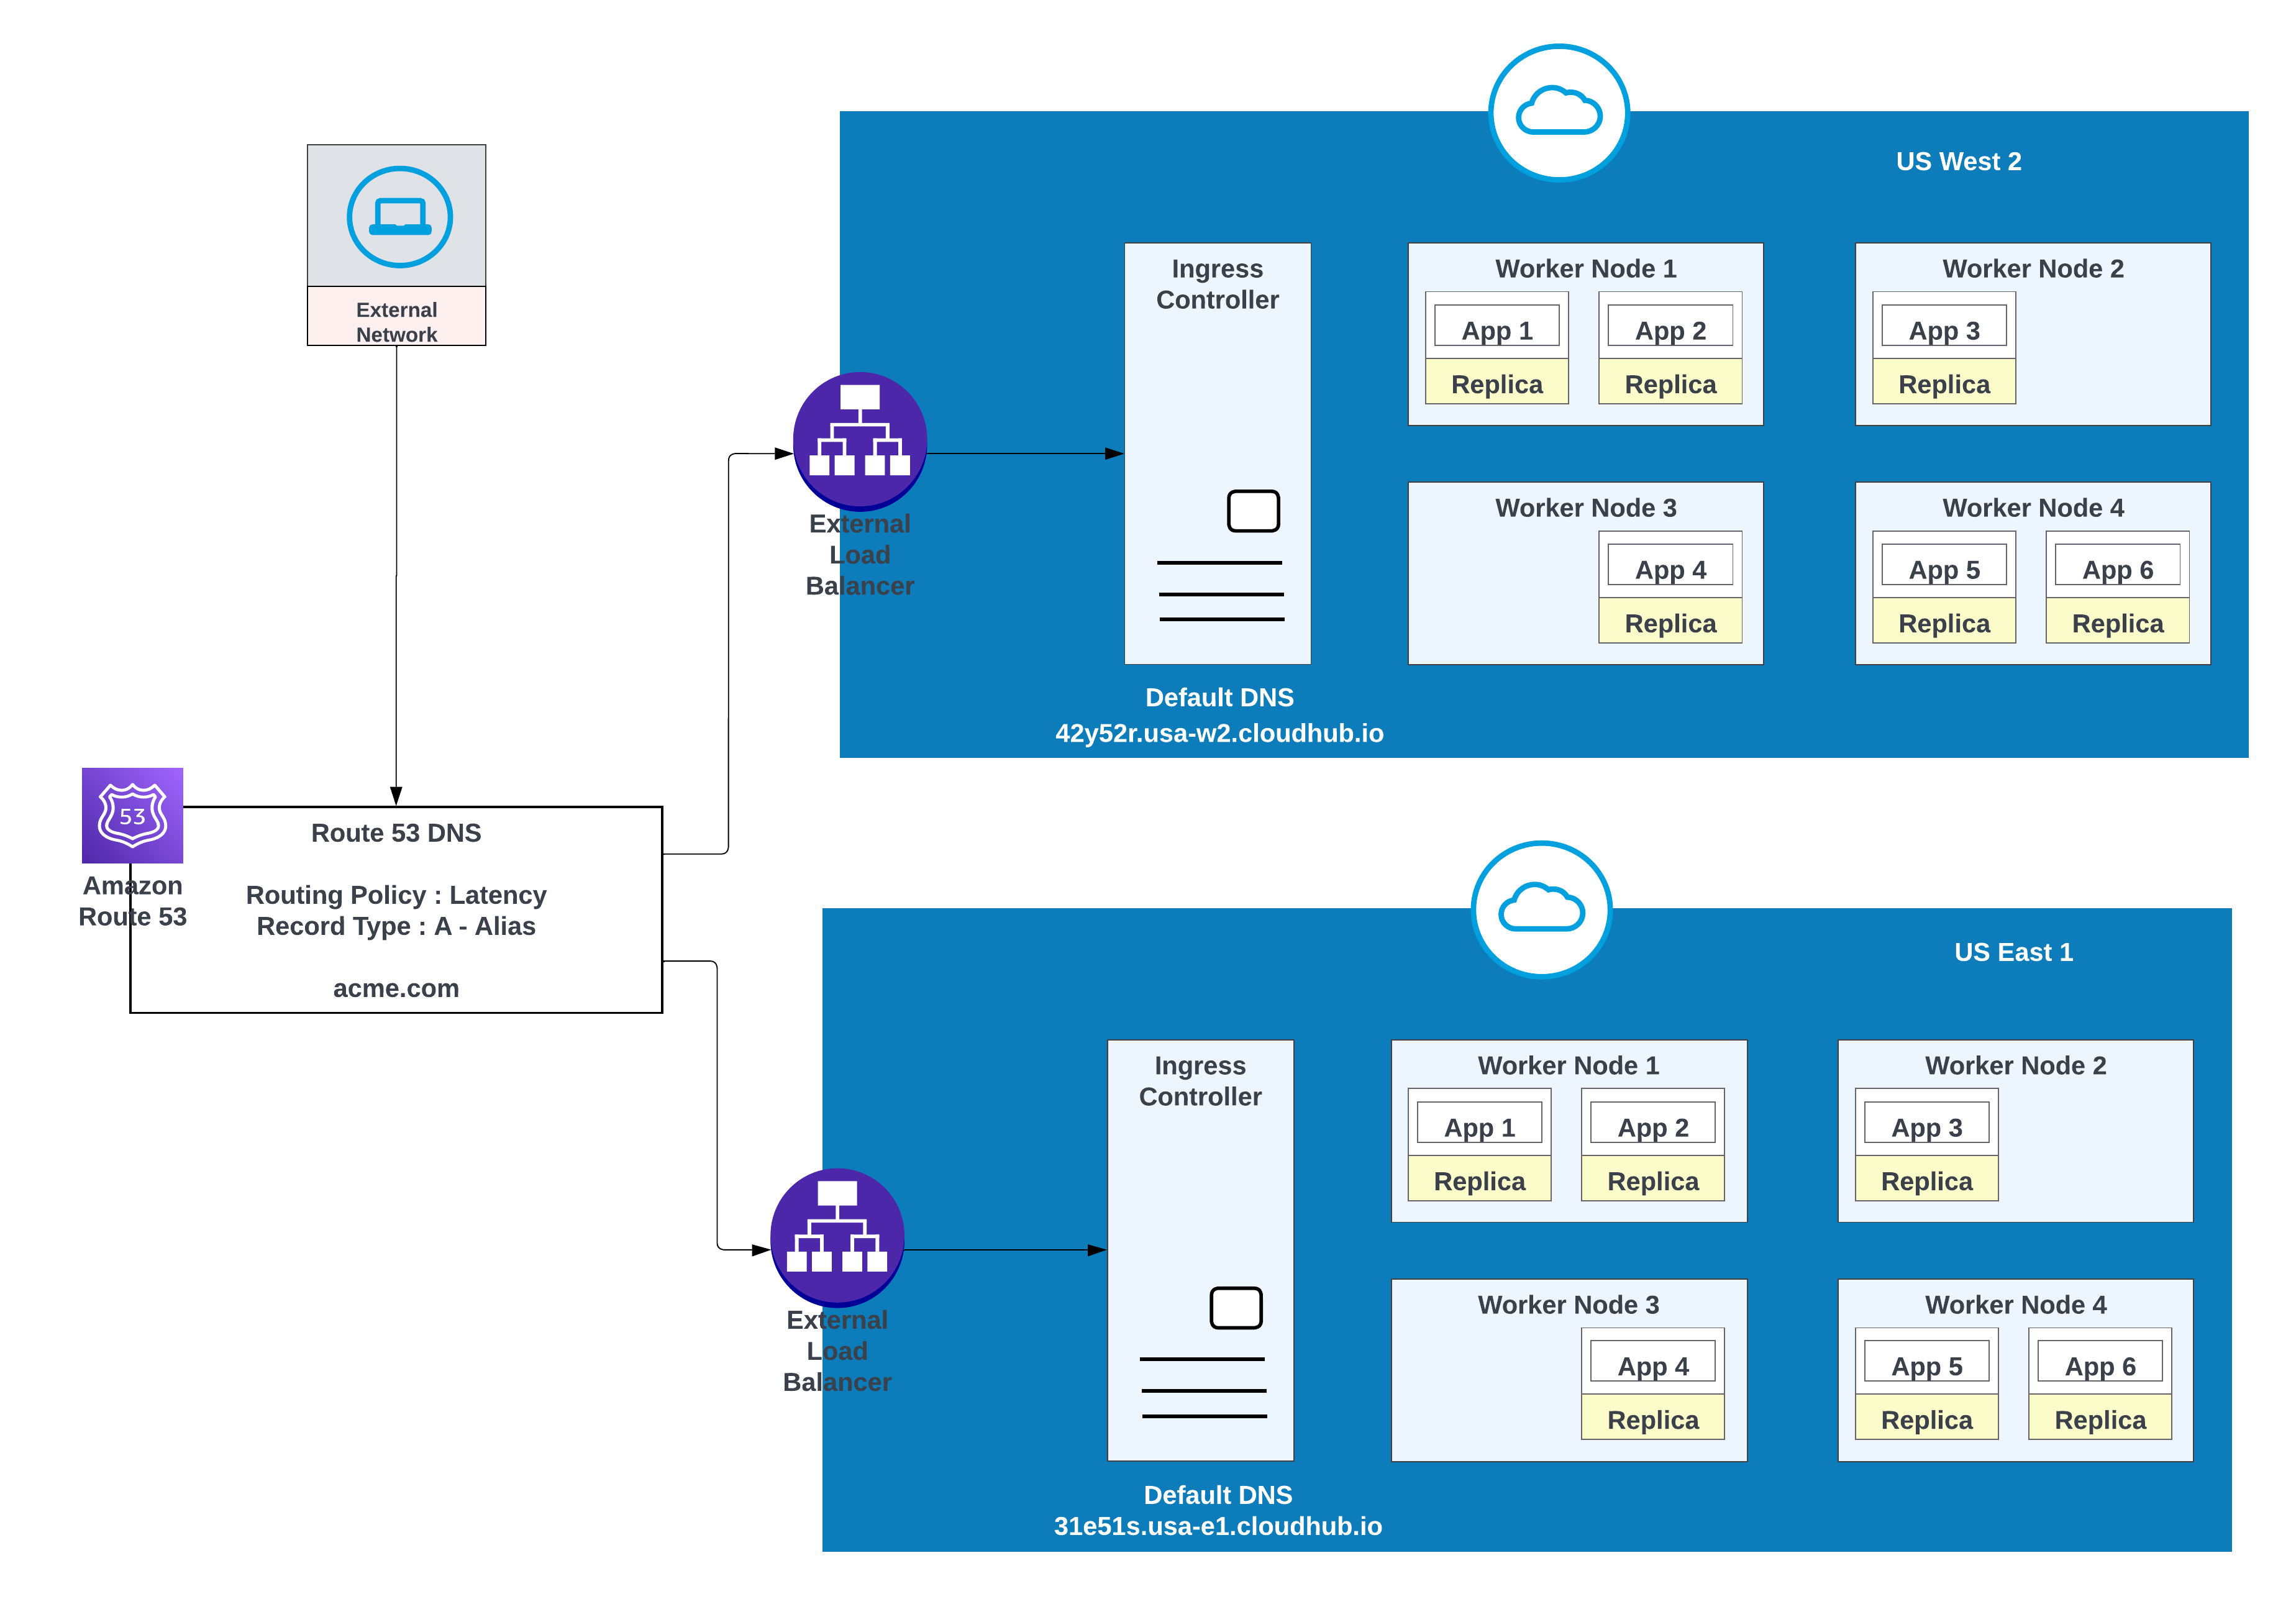
为了获得更低的延迟和高可用性，请使用图中描述的部署策略。使用此策略，应用程序可以部署在两个区域（在本例中是 us-west-2 和 us-east-1）。

使用 AWS 路由 53 中的延迟路由策略，将请求路由到提供最低延迟的区域，同时保持高可用性。 AWS 路由 53 中的“延迟”路由策略，将请求路由到仍然具有高可用性的较低延迟。

**在两个地区(美国西部 2 和美国东部 1)部署的应用程序，可实现更低的延迟和高可用性**

<img style="border:1px solid #e5e5e5;margin:2rem 0rem" src="https://architect.salesforce.com/ns-assets/mulesoft-ch-ha-dr/ch-ha-and-dr-latency-based-routing.png" alt="高可用性和低延迟示例">

| 记录名称 |      值/将流量路由到      | 路由策略 | 健康检查 ID  |
| :------: | :-----------------------: | :------: | :----------: |
| acme.com | 42y52r.usa-w2.cloudhub.io |   延迟   | 31s3wseq121  |
| acme.com | 31e51s.usa-e1.cloudhub.io |   延迟   | 43e131s131sq |

## 结论

MuleSoft CloudHub 2.0 为区域内的弹性提供了坚实的基础，主要利用了自动化的副本冗余和智能负载平衡。在单个云区域中，部署具有多个副本的应用程序可确保如果一个实例失败，其他实例可以立即接管工作负载。集成的负载平衡器有效地在这些健康的副本之间分配传入流量，最大限度地减少停机时间，并确保在正常操作条件下的持续服务可用性。

然而,完全依赖这种单一区域架构,即使这种架构具有高冗余性,也很有可能出现大范围的灾难性区域中断。历史表明，即使是最可靠、技术最先进的云提供商，也容易受到破坏性事件的影响，从而影响整个地理区域。这些单点故障虽然罕见，但可能由各种事件引起，包括：

- 大规模基础设施事件
- 主要电源故障
- 广泛的网络中断

因此，为了实现真正的高可用性 (HA) 和灾难恢复 (DR)，架构的设计必须超越单区域模式的限制。推荐的策略是跨多个地理位置不同的区域进行部署。这种区域间弹性确保了如果整个云区域由于意外灾难而不可用，流量可以无缝地故障切换到在单独的、不受影响的区域运行的应用程序实例，从而保证最少的服务中断并实现最大的正常运行时间目标。

## 引用

[CloudHub 2.0 网络架构](https://docs.mulesoft.com/cloudhub-2/ch2-networking-guide)

[为标准队列配置跨区域故障切换](https://docs.mulesoft.com/mq/mq-failover)

[对象存储 V2 部署区域](https://docs.mulesoft.com/object-store/osv2-faq#osv2-regions)

[您的对象商店部署区域](https://docs.mulesoft.com/object-store/osv2-faq#is-object-store-v2-persistent-in-the-same-region-as-the-worker)

## 关于作者

Gulal Kumar 是 Salesforce 的软件工程架构师，专注于数据和集成架构。他在集成和 API、现代化计划、安全和 AIML 计划方面拥有超过 20 年的经验，拥有丰富的专业知识。Gulal 一直致力于推进业务转型计划，增强安全性和弹性，促进架构卓越性，并领导各个领域的 AIML 计划。

Ajay Nagaraju 是 MuleSoft 的企业架构师和高级总监，在企业架构、系统集成和大规模数字转型方面拥有超过 28 年的经验。他曾领导财富 100 强和财富 500 强组织中数百万美元的复杂计划的架构和交付，在 API 引导的连接、SOA、云技术和企业集成模式方面拥有深厚的专业知识。Ajay 与管理层领导密切合作,以实现业务流程、数据平台和集成生态系统的现代化,并热衷于构建可扩展的架构、指导团队和通过技术推动可衡量的业务成果。