# architect 决策指南 (decision-guides) - Full Documentation ## 概览 企业通常会将数据同时存储在 Salesforce 和其他外部数据湖中,例如 Snowflake、Google BigQuery、数据块、Redshift 或 Amazon S3 等云存储。对于希望充分利用数据能力的公司来说,这种在不同源系统中的数据孤立构成了挑战。 致力于跨多个数据湖汇集数据的架构师面临着关于如何最好地集成这些数据的关键架构决策。Data 360 为数据集成提供了多个选项,其中每个选项都有不同的利弊。 本指南提供了一个框架来评估在集成数据时哪种模式最适合您对延迟、成本、可扩展性、治理和复杂性的要求,帮助您选择何时使用数据接收、零复制数据联合或混合方法。该指南还将帮助您在不同数据摄取和数据联合方法之间进行选择,每种方法都满足不同的需求。 将外部数据湖库与 Data 360 集成需要仔细考虑数据新鲜度、治理和漏斗效率之间的权衡。例如,使用 Zero Copy 数据联合实时查询可以最大限度地提高数据的新鲜度,但随着您通过网络移动更多数据,可能会降低漏斗效率。因此,对于大多数真实世界的实施,多云湖滨生态系统中的摄取和联合是最佳路径。这种混合方法确保了可扩展的、受管的、可互操作的架构,它无缝支持实时个性化和欺诈检测等低延迟操作工作负载,以及监管报告和历史趋势分析等分析工作负载。本决策指南将帮助您了解如何浏览这些权衡,并选择正确的策略。 ## 外卖 - **数据接收:**将数据复制到 Salesforce Data 360,创建受管的规范数据模型。当您需要: - **建立一个全面的 Customer 360:**将不同的源统一并转换为一个受信任的简档。 - **满足严格的监管合规性:**创建可审计的集中副本,其中数据访问和谱系可以严格控制。 - **零复制联盟:**无重复地实时查询外部源,实现实时个性化、实时仪表板和快速源入门。您必须权衡两个主要选项: - **实时和缓存(加速查询):**最适合对 Snowflake、Google BigQuery、Redshift 或数据块等外部数据平台中的数据进行交互式分析和实时仪表板。通过将处理推送到源系统,避免缓慢、昂贵的数据重复。 - **文件联合:**最适合云数据湖中数据的大规模批处理和 AI 模型训练 (S3、ADLS)。通过直接查询开放表格式的文件,解锁 ETL 和数据科学工作负载的海量数据集,避免代价高昂和接收缓慢。 - **混合模型:**将统一简档的接收与联合进行融合以获得新鲜感,支持全方位参与、Agentforce 驱动的操作和 AI/ML 培训。 ### 重要注意事项 - **混合架构:**通常需要混合数据摄取和数据联合。 - 将关键数据的数据摄取用于规范数据模型和核心治理。 - 通过 Zero Copy 聚合所有其他数据,以最大限度地减少构建和维护接收数据漏斗的操作开销。 - **数据摄取频率很重要:**根据业务价值、延迟需求和操作复杂性选择频率。 - 将实时用于对时间敏感的工作流(个性化、实时仪表板、Agentforce 操作)。 - 对于中等紧急流程(市场活动、运营报表),近乎实时。 - 历史或低速数据集的批次。 - **将联盟模式与延迟和性能匹配:**选择最适合您的访问模式以及对新鲜度、性能和成本的要求。 - 将实时查询用于低延迟至关重要的操作仪表板和实时个性化。 - 当查询频繁但稍微过时的结果可以接受时,使用缓存(加速查询),以平衡性能和成本。 - 将文件联合用于大规模、吞吐量繁重的分析或批处理工作负载,非常适合历史数据集或时间不太敏感的数据集。 - **将治理与数据驻留要求保持一致:** - 在集中治理至关重要的地方使用接收。 - 在可接受的分散治理时使用联合,同时在外部源强制执行严格的治理。Zero Copy 遵守源级策略,例如行级安全性 (RLS) 和数据屏蔽。 - **优先考虑高价值工作流的接收:**有选择地将摄取应用于关键流程,例如身份解析、监管报告和操作激活。 - **成本和复杂性推动决策:**实时摄取可能既昂贵又复杂。架构师应权衡加入、存储和转换数据的成本与直接通过 Zero Copy 查询数据的成本。 选择正确的集成模式 — 数据接收、零复制或混合方法 — 直接影响多云平台的延迟、治理、运营效率和成本。此决策决定了如何可靠、大规模地提供实时见解、AI 驱动的激活和个性化参与。 ## 产品比较 此表对 Salesforce Data 360 中的数据接收和零复制模式进行了技术比较,重点关注功能、权衡和好处,以及企业用例和结果。架构师可以将其作为参考,以设计平衡性能、成本和合规性的混合多云数据平台。
模式类型 模式/工具 好处 注意事项 结果
数据摄取 实时:通过 CDC 支持的摄取 API 进行亚秒级延迟摄取。连续流漏斗。 - 即时见解
- 非常适合低延迟操作和个性化用例
- 支持事件驱动的工作流
- 成本高
- 复杂架构
- 需要低延迟源系统
- 高用量源会导致过多的流导致漏斗饱和
- I/O 密集型
- 考虑选择性字段和筛选以减少开销
Agentforce:
- 实时欺诈警报、零售个性化、运营警报
Analytics:
- 亚秒级仪表板、KPI 监控
合规性:
- 持续更新受管工作流的客户记录
流:通过本机连接器每 1-3 分钟进行微批处理摄取 - 平衡成本和新鲜度
- 架构比实时更简单
- 支持增量更新
- 略微延迟
- 可能不适合重要的次秒决策
- 批处理大小影响内存/计算
- I/O 中等
- 最适合可预测的重复更新模式
- 考虑窗口聚合以减少处理负载
Agentforce:
- 及时的市场活动触发器,近乎实时的参与
Analytics:
- 推荐引擎,近实时仪表板
合规性:
- 具有可审计性的频繁更新
批次:通过连接器或 API 计划大批量加载。支持对象存储和 ETL/ELT 漏斗。 - 经济高效地处理大规模数据集
- 易于实施
- 适用于历史分析
- 数据延迟
- 不适用于时间敏感的操作
- 在加载窗口期间 I/O 密集型
- 网络吞吐量可能成为大文件的瓶颈
- 最适合历史聚合或受监管的报表工作流
Agentforce:
- IT 支持票证 (Jira/ServiceNow)、聚合工作流
Analytics:
- 历史分析、趋势评估
投诉:
- 监管报告、患者/索赔数据聚合
零复制 实时查询:对外部系统的直接查询;读取时的模式;没有数据重复 - 最大新鲜度
- 最小的存储开销;支持实时操作见解
- 取决于源性能
- 高查询量会影响延迟
- 非常适合具有谓词下拉和聚合的查询,以最小化 I/O
- 避免对大规模数据集进行未筛选的查询
Agentforce:
- 适应实时活动的动态工作流
Analytics:
- 操作仪表板、实时报告
合规性:
- 在源位置遵守行级安全性和屏蔽
加速查询(缓存):为联合查询缓存本地副本。从 15 分钟到 7 天可配置。优化查询执行 - 减少延迟
- 成本低于重复的实时查询
- 提高频繁访问模式的性能
- 需要缓存管理
- 过时取决于缓存间隔
- 最适合高频查询
- 不适合次秒决策
Agentforce:
- 用于快速决策的预聚合参与度量
Analytics:
- BI 仪表板、细分、分析报告
合规性:
- 与审计日志一致的受管仪表板
文件联合:直接访问对象商店或湖泊中的大型历史数据集(S3、Iceberg、Google BigQuery、Redshift)。 - 处理大规模数据集
- Data 360 中的最小存储
- 支持 AI/ML 工作负载
- 只读
- 查询性能取决于外部系统吞吐量
- 针对批量繁重、吞吐量密集型作业优化
- 不适用于实时仪表板
Agentforce:
-(非典型 — 批量繁重)
Analytics:
- ML/AI 培训、历史分析、PB 级报告
合规性:
- 对外部数据集的受管访问,没有重复
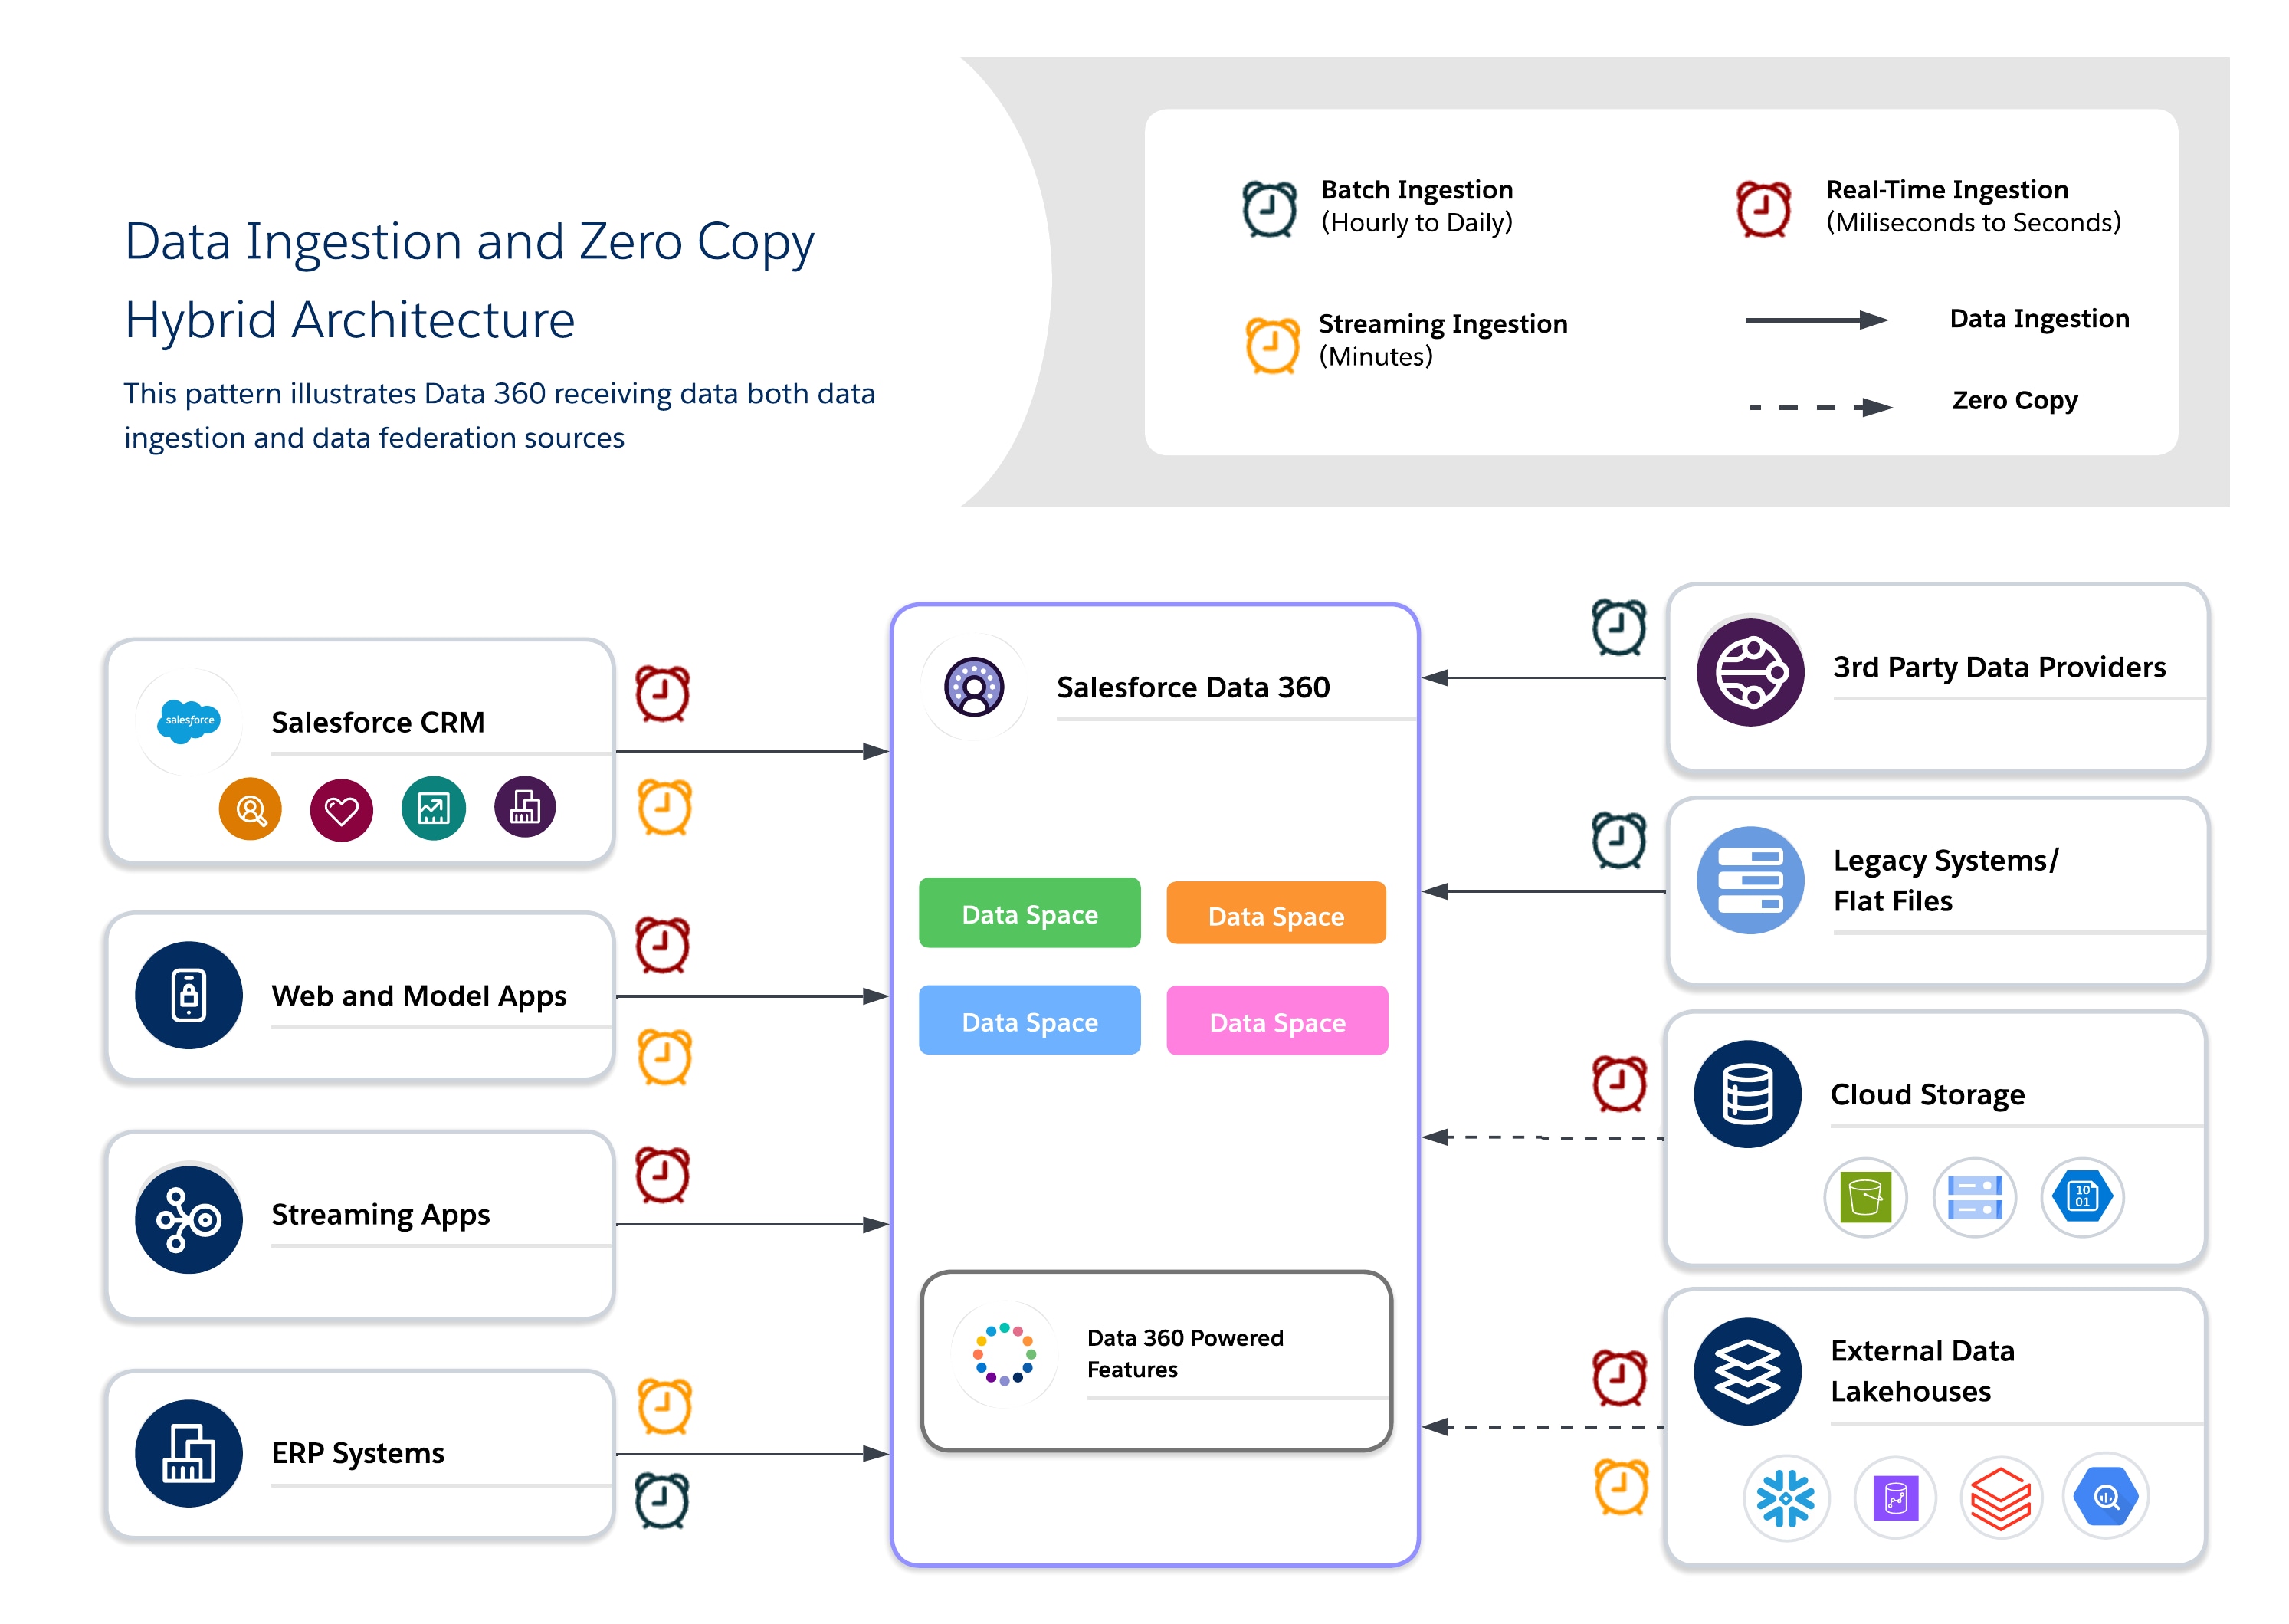
## Data 360 集成模式 ### 数据摄取 通过数据接收,数据被物理复制到 Data 360 中并完全受管,这与数据保留在源位置的 Zero Copy 不同。在 Data 360 中计算转换,这允许集中治理和审计。 #### 数据摄取用例 使用数据接收在 Salesforce Data 360 中存储规范的受管数据集,以实现合规性和运营控制。在需要完全控制、审计和可追溯性时使用摄取。非常适合集中式计算和治理至关重要的受监管或高价值工作流。 摄取最适合为身份解析、监管报告、任务关键型 AI 驱动的工作流和客户参与构建可信基础。 数据摄取概览 #### 数据摄取方法 数据接收方法因您使用的连接器接收数据而异。一些连接器提供多种接收方法,而其他连接器仅以批处理或流模式运行。请参阅[数据 360:Data 360 连接器及其可用方法的完整列表的集成和连接器](https://help.salesforce.com/s/articleView?id=data.c360_a_sources_targets.htm&type=5)。 - **实时** - 使用流漏斗或变更数据捕获 (CDC) 进行亚秒级接收。 - 最适合对时间敏感的工作流(欺诈检测、个性化、操作仪表板)。 - 在 Data 360 中推送转换和聚合,以减少下游 I/O 并优化计算使用。使用增量 CDC,以最大限度地减少数据重组。 - **流** - 每 1-3 分钟以较小的增量摄取一次。 - 平衡新鲜度和成本,适合市场活动编排、近乎实时的参与和运营报告。 - 使用微型批处理来控制 I/O 峰值。如果可能,在源位置聚合数据,以减少传输量并优化存储。 - **批次(计划加载)** - 定期接收大型数据集(每小时、每天、每周)。 - 对于历史数据集、监管报告和合规用例,经济高效且可靠。 - 确保计算位置与源存储位于同一区域,以实现性能和成本优化。 #### 架构师行动手册 - **数据接收的用例** - **生成 Customer 360 统一简档:**为客户身份和属性构建单一的真实来源。 - **维护监管合规数据集:**为敏感数据强制执行治理、谱系和可审计性。 - **集中市场活动编排:**确保市场营销、销售和服务全部从一致、可信的数据集运行。 - **设计实践** - 支持批量接收,以满足历史或低延迟容忍的需求,例如归档报告或定期快照。 - 使用 CDC 或流 API 保持操作和个性化工作流的新鲜度,确保近乎实时的更新。 - 通过应用增量加载而不是重新加载整个数据集来控制存储和计算增长,以优化成本和效率。 - 将接收漏斗与计算位置和增量处理保持一致,以减少网络 I/O。在 Data 360 中应用转换,以避免不必要地移动原始数据。 - **成本注意事项** - **实时摄取:**最高的计算和漏斗成本;适合高价值、时效性高的工作流,例如个性化、操作仪表板或 Agentforce 驱动的操作。 - **流接收:**适中计算和存储成本;适用于容忍轻微延迟的频繁更新,例如市场活动编排或运营报告。 - **批量摄取:**更低的计算成本、可预测的存储;最适合历史数据集或低频更新。使用特定连接器从 Salesforce 组织免费接收批处理数据。 - **刷新模式:**选择增量刷新模式可以减少总摄取和计算成本。我们建议尽可能使用增量刷新来优化所有摄取类型的效率。 - 从源到 Data 360 的 I/O 量也会影响成本。优化批次大小、分区和区域对齐降低了转移成本,并提高了性能。 - **行业场景** - **财务:**引入了解客户 (KYC)、反洗钱 (AML) 和欺诈检测所需的数据集,其中可审计性和合规性是不容置疑的。 - **医疗保健:**将摄取用于患者身份解析和符合 HIPAA 的记录,实现安全、统一的视图。 - **零售:**将销售点 (POS)、电子商务和忠诚计划数据整合到统一简档中,以实现细分和个性化 - **电信:**使用规范、受管订阅者数据,支持流失预防和使用情况分析。 #### 数据摄取方法决策条件
功能 实时摄取 流摄取 批量摄取
延迟和新鲜度 通过支持变更数据捕获 (CDC) 的接收 API 进行亚秒级延迟接收。提供连续的流漏斗。最适合低延迟操作用例。 通过本机连接器,每 1-3 分钟进行一次微批量摄取。支持增量更新。预计会略有延迟。 预计数据延迟。计划的大批量加载。定期摄取(每小时、每天、每周)。不适合时间敏感的操作。
主要用例 非常适合低延迟操作和个性化用例。用于对时间敏感的工作流。支持事件驱动的工作流。用于实时欺诈警报和操作警报。 适用于中等紧急流程。用于市场活动编排、近乎实时的参与和运营报告。用于及时的市场活动触发器。 经济高效地处理大规模数据集。适用于历史分析。用于历史聚合或受监管的报表工作流。最适合历史或低速数据集。
架构复杂性和 I/O 高成本和复杂的架构。需要低延迟源系统。I/O 密集型。高用量源会导致漏斗饱和。 架构比实时更简单。I/O 中等。最适合可预测的重复更新模式。批次大小会影响内存/计算。 易于实施。在加载窗口期间 I/O 密集型。网络吞吐量可能成为大批量的瓶颈。
成本注意事项 最高的计算和漏斗成本。仅适用于高价值、对时间敏感的工作流。 降低计算和存储成本。提供平衡的成本与新鲜度方法。适用于容忍轻微延迟的频繁更新。 降低计算成本和可预测的存储。建议用于历史数据集或低频更新。通过 Salesforce 内部漏斗接收是免费的。
设计实践 使用增量 CDC,以最大限度地减少数据重组。筛选并使用选择性字段以减少开销。 使用微型批处理来控制 I/O 峰值。考虑窗口聚合,以减少处理负载。 对于归档报告或定期快照,更喜欢这样做。确保计算位置与源存储位于同一区域,以实现成本优化。
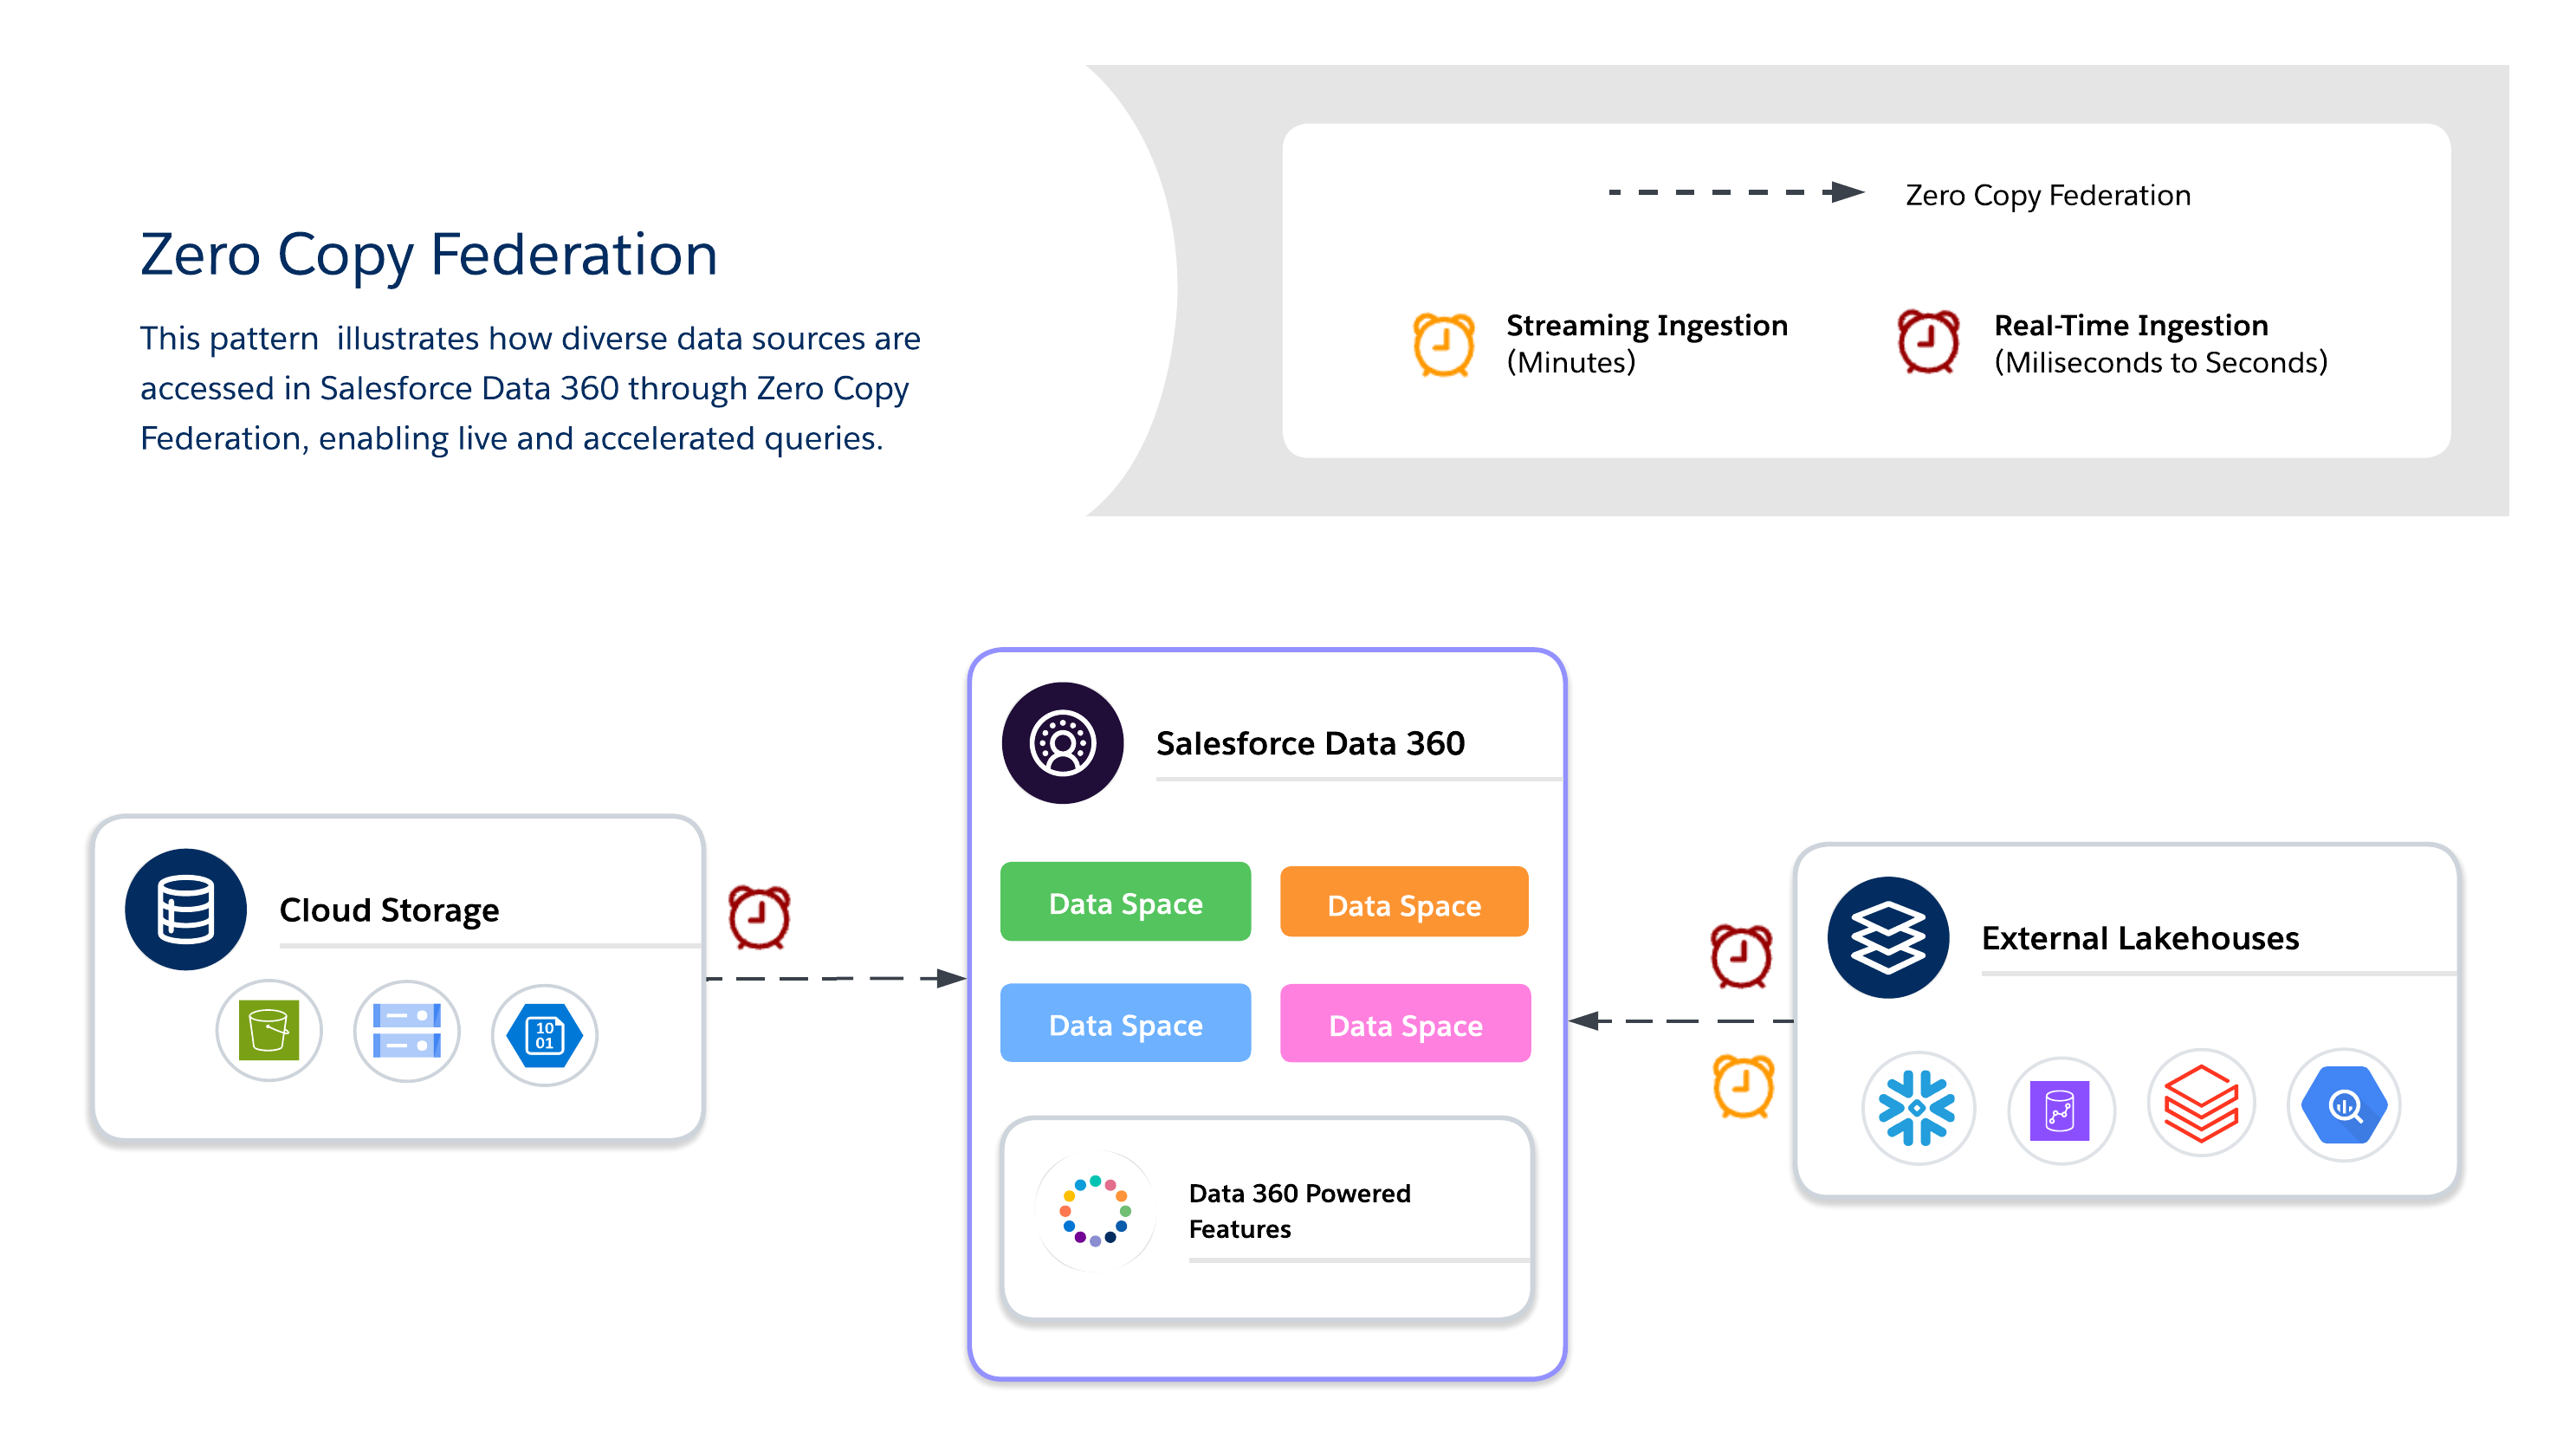
### 零复制数据联合 #### 零复制用例 使用 Zero Copy 对外部系统进行实时查询,没有数据重复,实现了对大型或临时数据集的灵活性、新鲜性和可扩展访问。它最适合实时仪表板、探索性分析、AI/ML 模型训练和直接通过 Salesforce Data 360 进行实时客户参与。 零复制数据联盟概览 #### 零复制方法 在使用 Zero Copy 时,架构师必须进一步决定三种可用的数据联合方法,其中每种方法在新鲜度、性能和成本之间都有其自己的权衡。 - **实时查询** - 直接针对外部系统(Snowflake、Google BigQuery、Redshift、数据块等)运行查询,没有数据重复。 - 在谓词和聚合可以推送时最佳,最大限度地减少数据通过网络的移动,并减少 Salesforce Data 360 计算上的 I/O。 - 最适合实时见解和低延迟操作仪表板。取决于外部系统的性能。 - **缓存(加速查询)** - 在 Salesforce Data 360 中临时存储聚合数据的缓存副本。 - 通过可配置的持续时间(几分钟到几天),降低频繁访问数据集的重复查询成本和延迟。 - 数据不会永久复制或完全管理;新鲜度通过源的定期刷新进行管理。 - **文件联合** - 提供对对象存储中大规模数据集的直接、只读访问(例如,S3、带 Iceberg 的 GCS)。 - 最适合 AI/ML 工作负载、历史分析和 PB 级报表,无需移动数据。 - 查询性能在很大程度上取决于对象格式、分区和网络 I/O。如果不进行优化,大扫描可能会产生大量的 I/O。 #### 架构师行动手册 - **用例** - **实时个性化和自适应工作流:**随着客户行为的变化,提供动态优惠、推荐和 Next Best Action。 - **实时仪表板和运营分析:**直接从外部仓库为关键业务仪表板和 KPI 提供支持。 - **使用大型外部数据集进行 AI/ML 模型训练:**使用文件联合利用来自数据湖和仓库的 PB 级数据,而无需移动它。 - **行业场景** - **零售/媒体:**通过整合点击流或内容交互数据,启用个性化推荐和实时客户参与。 - **财务:**通过查询外部仓库,在不复制敏感数据的情况下,近乎实时地运行欺诈检测和风险评分。 - **技术/企业:**支持数据集驻留在多个系统中的跨云报表、IT 服务仪表板和运营分析。 - **设计实践** - **实时查询** - 当新鲜度至关重要时,用于高 QPS、低延迟查询。 - 将谓词和聚合推送到外部系统,以减少通过网络进行的数据重组。 - 避免不必要地扫描大量数据的查询;考虑分区修剪和筛选。 - **文件联合** - 在不摄取的情况下访问对象存储中的 PB 级数据集。 - 将对象存储保持在与 Salesforce 计算相同的云区域中,以最大限度地减少延迟和出口成本。 - 使用分区域列格式 (Parquet/ORC) 和下拉筛选器,以减少 I/O 和网络传输。 - 利用查询和谓词下推在源位置筛选和聚合数据,减少数据移动。 - 除非必要,否则避免跨区域数据访问,因为这会增加 I/O、延迟和成本。 - **缓存(加速查询)** - 缓存频繁访问的数据集,以平衡成本和性能。 - 配置刷新间隔,以平衡新鲜度和查询成本。 - **合规性:**通过直接在联盟系统中利用行级安全性 (RLS) 和屏蔽策略,在源头强制执行治理。以下是跨平台统一 RLS 和屏蔽的最佳实践。 - **使用集中企业 ID:**将 Salesforce Data 360 中的用户和实体映射到与外部系统中的身份相对应的唯一的集中企业标识符。 - **调整安全策略:**确保根据映射的身份应用联合系统中的行级安全性和屏蔽策略。这保留了查询外部数据时的合规性。 - **标准化身份模式:**在所有数据源中保持一致的身份属性(电子邮件、用户 ID、客户 ID 等),以避免不匹配和访问违规。 - **成本注意事项** - **实时查询:**按查询付费模式 - 外部 Lakehouse 计算会产生成本,并可能因高 QPS 而激增。最适合价值大于成本变化率的新鲜度关键用例。 - **加速查询(缓存):**通过减少对源系统的点击,降低了与实时查询相比的查询成本,但增加了填充和刷新缓存的批处理数据接收成本。最适合频繁访问的数据集。 - **文件联合:**对象存储中最便宜的存储选项作为数据,但查询成本取决于文件大小、分区和修剪。最适合 PB 级别的历史数据或批量数据。 #### 零复制方法决策条件
决策点 实时查询 缓存(加速查询) 文件联合
数据源位置 外部数据湖库(Snowflake、Google BigQuery、Redshift、数据块)。 外部数据湖库(Snowflake、Google BigQuery、Redshift、数据块) 对象存储或云数据湖(S3、ADLS、GCS),通常使用 Open Table 格式,例如 Iceberg。
目的/用例 非常适合交互式分析和实时仪表板。最适合实时个性化和动态工作流。 最适合查询频繁但结果稍显过时的情况。适用于 BI 仪表板和细分。 最适合大规模批处理和 AI/ML 模型训练。非常适合历史分析和 PB 级报表。
新鲜度/延迟 最大新鲜度;查询直接实时运行。支持亚秒决策。 稍微过时的结果可以接受。新鲜度取决于缓存间隔,可从 15 分钟到 7 天进行配置。 针对批量繁重、吞吐量密集型作业进行优化。不适合实时仪表板。
访问模式 最适合不频繁或临时查询。用于新鲜度至关重要的高 QPS(每秒查询)、低延迟查询。 最适合高频读取场景。提高频繁访问模式的性能。 只读访问权限。适用于没有摄取的 PB 级数据集。
性能驱动因素 高度依赖于外部源系统的性能。在谓词和聚合可以推送到源时优化。 与重复的实时查询相比,减少延迟。性能取决于缓存管理和间隔。 性能在很大程度上取决于对象格式、分区和外部系统吞吐量。使用分区域列格式 (Parquet/ORC)。
所涉费用 按查询付费模式。外部 Lakehouse 计算会产生成本。对于不频繁的查询来说很经济高效,但是费用可能会因为每秒查询量 (QPS) 高而激增。 成本低于重复的实时查询。减少重复查询外部源的需要。添加缓存存储和刷新开销。 最便宜的存储选项。查询成本取决于文件大小和分区。
关键注意事项 避免不必要地扫描大量数据的未筛选查询。 需要缓存管理。不适合亚秒决策。 查询性能在很大程度上取决于通过分区和谓词下推进行优化。
### 混合方法 混合架构使架构师能够在 Data 360 中锚定关键数据集以实现集中治理,同时利用联合查询来实现新鲜度、减少重复以及对大型外部数据集的可扩展访问。这种方法平衡了 I/O、计算位置、成本和合规性要求。 #### 混合用例 通过将数据接收和零复制结合起来,使用混合方法实现平衡的治理、新鲜度和运营效率,以提供实时、可操作的见解。将摄取用于需要可追溯性、RLS 和屏蔽的高价值受监管数据集,并将联合用于新鲜度和性能至关重要的短暂或高用量数据集。 混合方法概览 #### 架构师行动手册 - **用例** - **全方位参与:**将历史客户数据与实时行为相结合,以提供一致的上下文感知体验。 - **AI/ML 漏斗:**在策划的规范数据集上训练模型,同时使用来自外部源的原始或实时信号来丰富它们。 - **合规性和灵活性混合需求:**对敏感数据应用严格的治理,但应结合使用,以确保操作灵活性。 - **行业场景** - **零售:**将接收用于身份解析和简档统一;将接收用于实时优惠和个性化。 - **医疗保健:**通过摄取维护黄金级患者记录,同时为即时上下文提供 IoT 设备流和传感器数据。 - **金融服务:**将受监管的数据引入合规监管的湖泊,同时整合外部查询,以进行欺诈检测和风险监控。 - **设计实践** - **带摄取的锚治理:**将高价值或受监管的数据引入规范模型,以确保 Trust 和合规性。 - **使用新鲜度联盟:**允许外部湖库提供实时或大规模数据访问,而不会重复。 - **平衡成本与性能:**简档工作负载,以决定接收的内容与联合的内容,从而最大限度地减少不必要的存储或查询成本。 - **应用分层治理:**对接收的数据实施集中治理,同时利用联合系统自身的安全控制(例如,RLS、屏蔽)。 - 在设计混合漏斗时,请确保增量接收历史数据集,并将聚合或筛选器推送到聚合源,以优化 I/O 和计算使用。 - **成本注意事项** - 在需要新鲜度时,通过将合规或关键数据的摄取与联合相结合,优化总成本和性能。 - 在混合摄取和联合时,考虑 I/O 和计算分配。要降低重复查询源系统的计算成本,请对高读取、频繁访问的联合数据集使用缓存 (加速查询)。 ## 用例决策指南 以下是说明如何应用此逻辑的常见原型。 1. **"单一真理源"原型:集中和治理** - **场景:**您需要为整个全球企业构建合规、统一的 Customer 360 简档。数据来自十几个不同的系统,必须遵守严格的 GDPR 和 CCPA 法规,并将作为所有营销和服务交互的可信来源。 - **推荐模式:****数据摄取。**优先级是治理、Trust 和控制。将数据引入 Data 360 是创建与源系统隔离的完全可审计的规范简档的唯一方法。 2. **“实时见解”原型:分析而不移动** - **场景:**数据科学团队需要对 Snowflake 中不断更新的大规模事务表运行探索性查询。同时,您的执行团队需要由相同数据支持的实时 BI 仪表板。每天移动 PB 级数据太慢,成本太高。 - **推荐模式:****零复制联盟。**首要任务是大规模的速度、灵活性和成本效益。Zero Copy 允许您利用现有数据仓库的巨大功能进行实时查询,而没有数据重复的开销和延迟。 3. **"混合智能"原型:管理核心,聚合边缘** - **场景:**您想要使用来自数据湖的实时行为信号(例如网站点击)来丰富您的受管、接收的客户简档。您需要核心简档的稳定性,但实时数据的即时性支持即时个性化。 - **推荐模式:****混合方法。**使用数据摄取来创建客户数据的稳定和受管核心。然后,使用 Zero Copy 将易失性的实时“边缘”数据联合在一起,并在查询时将其联接在一起,以获得完整的最新视图。 ## 前进之路 企业数据策略不再是选择单一的集成模式,而是在可交互的数据生态系统中构建可控的灵活性。根据业务需求为每个源数据系统选择正确的数据集成方法通常会导致一种混合方法,这种方法结合了数据接收和数据联合的优点。 - 将关键任务受管数据集引入 Salesforce Data 360,以实现合规性、身份解析和运营工作流。 - 通过 Zero Copy 聚合数据,以实现实时、探索性和 AI 驱动的分析,而不会复制存储。 Hyperforce 上的 Salesforce Data 360 提供多区域弹性和可扩展性。 带有冰山表格的开放式 Lakehouse 支持计算分离,并与 Snowflake、Databricks 和 S3 Iceberg 等平台交互,从而构成了真正可交互的多云数据生态系统的主干。 随着数据生态系统的发展,不断平衡新鲜度、成本、性能和合规性,以保持架构灵活性。通过将接收的受管数据与联合访问统一起来,让您的平台面向未来。这支持跨云、地区和业务域的实时智能、AI 激活和企业级个性化。 一刀切的解决方案不适合大多数企业。最佳策略将正确的模式映射到正确的业务驱动因素。 ## 关于作者 Yugandhar Bora 是 Salesforce 的软件工程架构师,专门从事数据和智能应用平台中的数据架构。他领导企业架构审查委员会 (EARB) 专注于数据治理和统一数据模型的举措,同时为自动化平台配置解决方案做出贡献。 Jan Fernando 是 Salesforce 首席架构师办公室的首席架构师。他于 2012 年加入 Salesforce,在创业生态系统中积累了丰富的经验。在加入首席架构师办公室之前,他曾在 Platform 组织中工作了十多年,领导了多项关键技术变革。 # Data 360 决策指南入门 本节提供有关 Salesforce Data 360 的关键架构决策的实用指导,包括配置策略、多组织连接和集成模式。使用这些指南来设计和实施有效的数据架构,统一客户数据并支持 AI 支持的功能。 --- ## Data 360 配置 [Data 360 配置](/docs/architect/zh-cn/decision-guides/guide/data-360-provisioning)涵盖了配置 Salesforce Data 360 时的基本决策: - **主页组织选择**:决定是否在现有生产组织中配置 Data 360,或创建专用组织,考虑治理、合规性和价值实现时间。 - **多组织策略**:在多个独立的 Data 360 实例或使用 Data Cloud One 进行选择,以统一多个 Salesforce 组织,从而平衡自治、合规性和成本。 - **Data Cloud One 架构**:通过跨组织的集中治理、元数据共享和功能奇偶性,启用多个同伴组织共享单个 Data 360 实例。 - **Data 360 组织之间的数据共享**:将独立实例之间的零复制数据共享用于区域合规、业务部门协作或联合执行仪表板。 - **配置注意事项**:数据驻留、治理模型、延迟、集成复杂性、成本和 AI 在企业范围内部署就绪方面的因素。 帮助架构师设计配置策略,以确保 Customer 360、AI 和跨平台创新的简单性、企业一致性、合规性和可扩展性。 --- ## Data 360 互操作性 [Data 360 互操作性](/docs/architect/zh-cn/decision-guides/guide/data-360-interoperability)为将 Data 360 与外部平台和数据湖集成提供了一个框架: - **数据接收模式**:实时、流和批量接收,用于创建适用于 Customer 360、合规性和集中治理的受管规范数据集。 - **零复制数据联合**:实时查询、加速查询(缓存)和文件联合方法,可在没有重复的情况下实时访问外部系统,从而实现个性化、仪表板和 AI/ML 工作负载。 - **混合方法**:将核心数据集的受管接收与零复制联合相结合,以实现新鲜性和可扩展性,支持全方位参与、Agentforce 驱动的操作和企业分析。 - **决策框架**:评估延迟、成本、可扩展性、治理和复杂性方面的权衡,以选择每个数据源的正确集成模式。 - **架构师行动手册**:金融、医疗、零售和电信场景的特定于行业的指导、设计实践和成本注意事项。 指导架构师平衡数据新鲜度、治理和漏斗效率,构建支持运营和分析工作负载的可扩展、可互操作、AI 就绪的数据架构。 ## 概览 Salesforce Data 360 是基于 Hyperforce 构建的数据平台,它将 Salesforce 和外部数据统一到每个客户或客户的清晰、完整和可信的 360 度视图中。 由于并购、区域运营、功能分离或历史原因,企业通常运营多个 Salesforce 组织。架构师必须不仅在单个家庭组织还是多组织配置之间做出决定,而且还要决定是否配置多个独立的 Data 360 实例,使用 Data Cloud One 在一个实例下统一组织,或者使用 Data 360 之间的数据共享(Data 360 到 Data 360 数据共享)在独立的 Data 360 实例之间协作。这些选择会影响治理、合规性、成本、延迟以及组织扩展 AI 和跨组织平台功能的能力。 Data 360 会在获得 Data 360 许可证的任何生产组织中自动配置。Data Cloud One 是 Salesforce 的多组织连接架构,允许单个家庭组织托管 Data 360 实例,而其他 Salesforce 组织作为同伴组织连接。选择哪个组织持有 Data 360 许可证,从而成为 Data 360 主页组织,是一个具有长期后果的关键架构决策。 您如何配置 Salesforce Data 360 是一个基本的架构决策,因为它决定了企业如何在组织中统一客户数据、实施治理以及启用关键的平台功能,特别是 AI、Agentforce 和分析。将组织集群锚定到单个 Data 360 提供了统一的数据模型、集中的治理和企业范围的 AI 就绪性,同时使同伴组织能够访问共享的元数据和功能,就像数据在本地一样。相反,当监管、合规或自治要求阻止集中时,多个独立的 Data 360 实例是合适的,Data 360 组织之间的数据共享支持这些实例之间的选择性零复制协作。 对于架构师,此决策至关重要。它定义了谁控制数据治理,数据驻留在哪里,如何启用平台功能,以及未来集成和 AI 倡议可以如何顺利扩展。即使对于目前没有 Data 360 的组织,通过制定未来添加 Data 360 访问权限的策略来验证您的架构也很重要。Sales、Service、Marketing、Commerce、Industry 和 Agentforce 中的 Salesforce 功能越来越多地构建在 Data 360 上。想要使用这些平台功能的组织必须配置自己的 Data 360 或连接到作为伴随组织的共享 Data 360。 本指南帮助架构师设计配置策略,平衡简单性、企业范围的一致性、合规性和可扩展性,确保组织可以自信地利用 Data 360 进行 Customer 360、AI 和跨平台创新。这将帮助您决定如何选择在哪个组织上配置 Data 360,以及如何在 Data Cloud One 和 Data 360 组织之间的数据共享之间进行选择,从而帮助奠定坚实的基础,将您的业务推向以 Data 360 为中心的未来。 --- ## 配置注意事项 每个配置选择 — 无论是选择 Data Cloud One 还是 Data 360 组织之间的数据共享,或者将哪个组织指定为家庭组织 — 都应该根据这些交叉注意事项进行评估:
注意事项 为何如此重要 示例场景
数据驻留与合规 确定数据的存储和处理位置。监管规则可能需要特定区域或多个实例。 一家全球银行在位于法兰克福的 Salesforce 组织中配置了一个 Data 360 租户,以满足 GDPR 合规性要求,并在弗吉尼亚州的一个组织中为其美国分部配置了另一个租户。
治理和安全 谁拥有和管理 Data 360?保单是集中管理还是按业务部门委派? 一家拥有强大中央 IT 的跨国公司创建了由卓越中心管理的专用家庭组织。
自主与集中 不同的领导可能需要单独的数据所有权。自治支持多个 Data 360;集中支持 Data Cloud One。 拥有独立子公司的控股公司允许每个业务部门运行自己的 Data 360。
延迟和性能 影响查询速度和体验,特别是对于跨区域连接到 Data 360 租户的同伴组织。 伦敦的销售团队从美国的 Data 360 租户查询数据时,可能会看到更高的延迟。
集成复杂性 更多 Data 360 租户 = 更多漏斗、API 和中间件。整合简化了集成。 零售商通过整合到 Data Cloud One 配置中,避免了构建 10 个 ETL 漏斗。
零复制数据源区域 Zero Copy 连接器可能有跨区域访问要求,限制 Data 360 可以位于哪些区域。 一家公司在 AWS eu-west-1 地区拥有 Snowflake 实例。他们可以使用 Zero Copy 将数据合并到他们区域的 Data 360,但无法使用 Zero Copy 合并到美国区域的 Data 360。
专用连接跨区域兼容性 在某些情况下,专用连接支持取决于数据源是否与 Data 360 租户位于同一区域。 一家公司在 aws-east-1 地区有一个 Snowflake 实例,他们希望通过零复制来连接。如果 Data 360 家庭组织位于同一区域,他们只能建立专用连接网络连接。
成本和许可 每个 Data 360 租户都会增加成本。整合为更少的实例可以优化支出。 医疗保健提供商通过采用 Data Cloud One 而不是多个独立的 Data 360 实例来降低许可成本。
未来可扩展性 今天的配置选择为增长奠定了基础。 SaaS 公司从单个 Data 360 实例开始,但计划在通过 Salesforce 组织收购子公司时扩展到 Data Cloud One。
企业级 AI 就绪 AI 功能和 Agentforce 需要在每个组织中连接 Data 360 租户。配置决策会影响 AI 模型在整个企业中的训练和激活方式。 一家金融服务公司在 Data Cloud One 中统一数据,因此其 Einstein AI 模型可以访问企业范围内的客户数据。
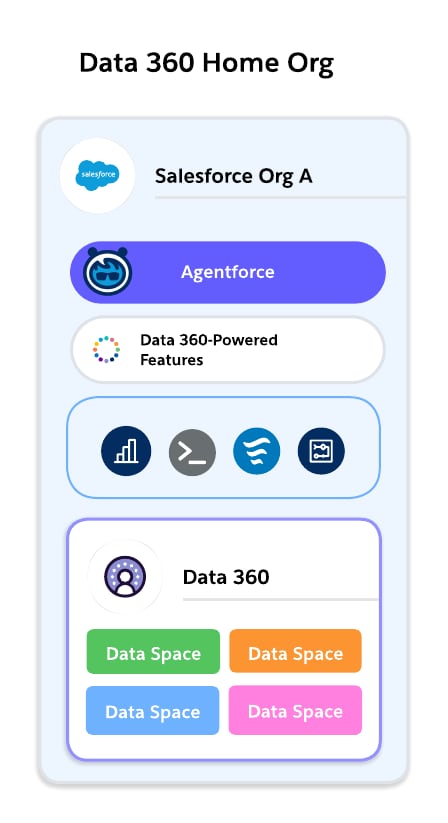
### 重要注意事项 --- ## 第 1 部分:配置数据 360 – 选择家庭组织 ### 1.1 什么是 Data 360 家庭组织? 在您购买 Data 360 许可证时,Data 360 实例将在与该许可证关联的 Salesforce 组织中配置。该组织称为 Data 360 主页组织。 显示 Data 360 主页组织的决策图 主页组织是 Data 360 实例的锚。它位于: - 管理 Data 360 存储和计算(在配置时选择的区域)。 - 应用管理、治理和安全策略。 - 执行数据接收、协调、身份解析、细分和激活。 在多组织场景中,家庭组织管理其他 Salesforce "Companion" 组织的中央 Data 360 实例。 家庭组织为何重要: - 它决定了 Data 360 实例的地理位置。 - 它确定谁拥有和管理您的 Data 360 实例。Data 360 主页组织中的管理员可以访问接收到 Data 360 中的所有数据。 - 它控制 Data Cloud One 配置中的同伴组织连接。 - 它为您的企业数据策略奠定了基础 — 稍后更改它很困难,并且具有破坏性。 ### 1.2 决策:现有组织或新组织作为主页组织? 第一个主要决策是在现有生产组织中配置 Data 360,还是创建新的专用组织作为家庭组织。 将现有组织与新组织显示为主页组织的决策图 #### 选项 A:在现有组织中配置 Data 360 **最适合:**拥有单个 Salesforce 组织的客户,或已经拥有主要集中组织(大部分业务都在其中运行)的多组织客户。 显示现有组织中 Data 360 配置的图表 - **优点**: - 最简单的路径:Data 360 配置在您的 CRM 数据已经存在的地方。 - 立即访问本地销售、服务和市场营销数据。 - 无需额外集成。 - 需要管理的许可证和环境更少。 - 加速早期采用、试点和生产用例。 - **缺点**: - 可能继承现有组织的治理或技术债务。 - 如果不存在单个“主要组织”,选择一个组织可能会引起所有权辩论。 - 绩效与组织的位置相关;可能与企业范围的驻留需求不一致。 - 如果多个业务部门使用不同的组织,如果不与 Data Cloud One 配对,本地配置可能会导致碎片化。 **示例:** 一个拥有 Salesforce 组织的 SaaS 公司在该组织中配置 Data 360,以统一客户订阅和支持数据。 #### 选项 B:在新的专用组织中配置 Data 360 **最适合:**拥有多个 Salesforce 组织且无法在单个主要组织上保持一致的客户,或拥有强大卓越中心 (CoE) 模式的企业。 显示 Data 360 在新的专用组织中配置的图表 - **优点**: - 治理清晰,没有继承的组织复杂性。 - 跨多个业务线的集中控制。 - 根据合规需求灵活选择地区。 - 充当中立的“共享服务”组织,不与一个业务部门绑定。 - 为未来的 Data Cloud One 架构(具有多个配套组织的家庭组织)设置。 - **缺点**: - 客户必须获得新 Salesforce 组织的许可证,才可以配置 Data 360。 - 通过 Data Cloud One 配套连接,将组织连接到 Data 360 需要额外的集成。 - 可能会增加管理开销(用户管理、安全性、身份)。 - 与现有生产组织中的配置相比,价值实现时间更慢。 **示例:** 一家跨国金融服务公司创建了一个专门的家庭组织来配置 Data 360。所有业务部门组织(零售、财富、商业银行)都通过 Data Cloud One 作为配套组织连接。 #### 决策条件
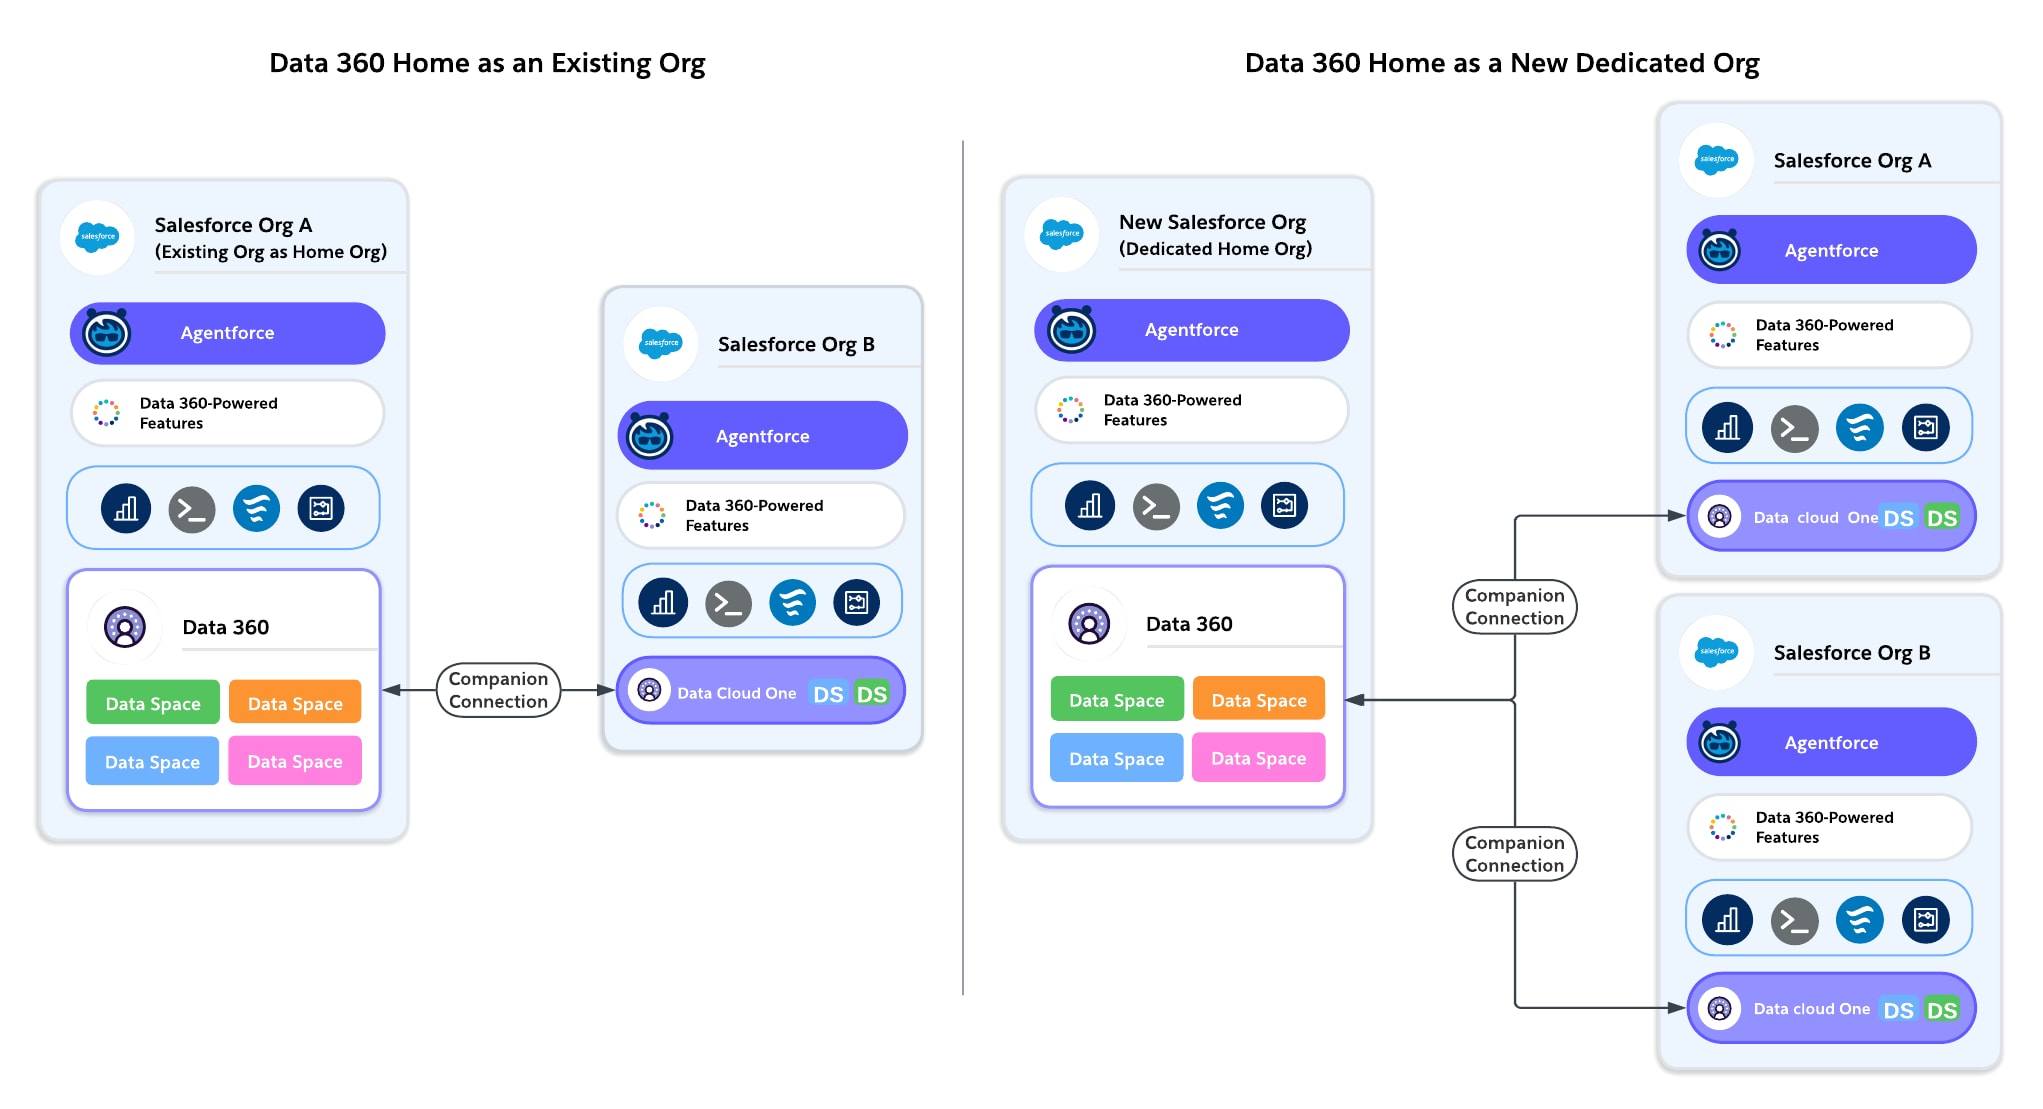
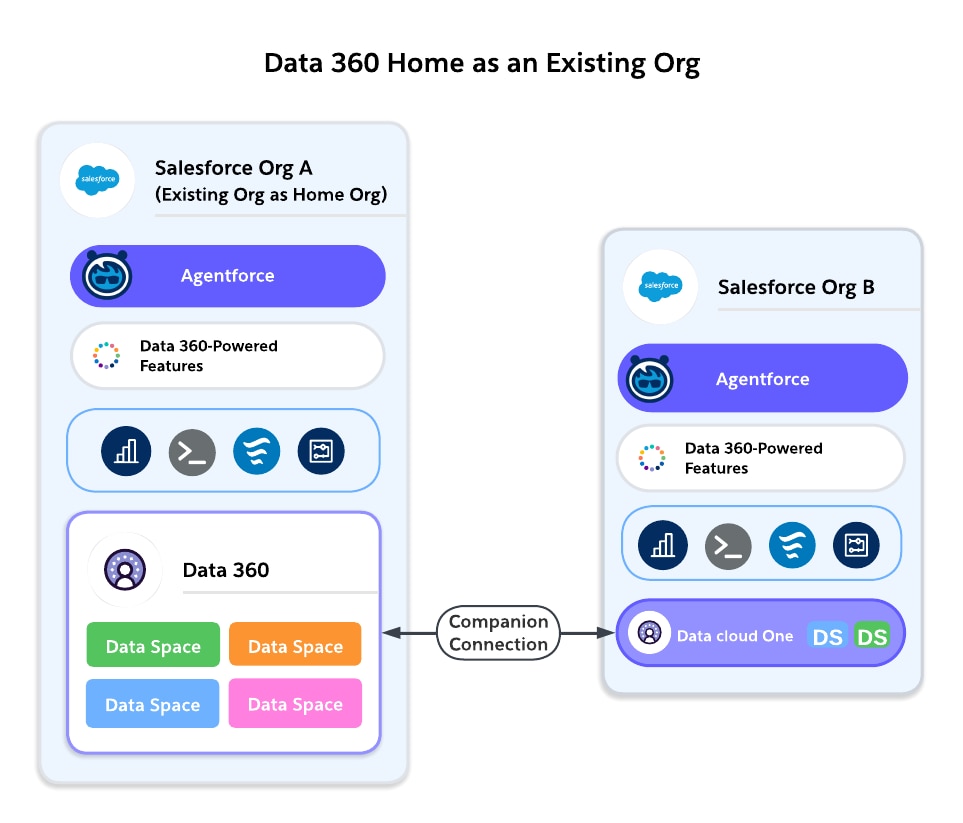
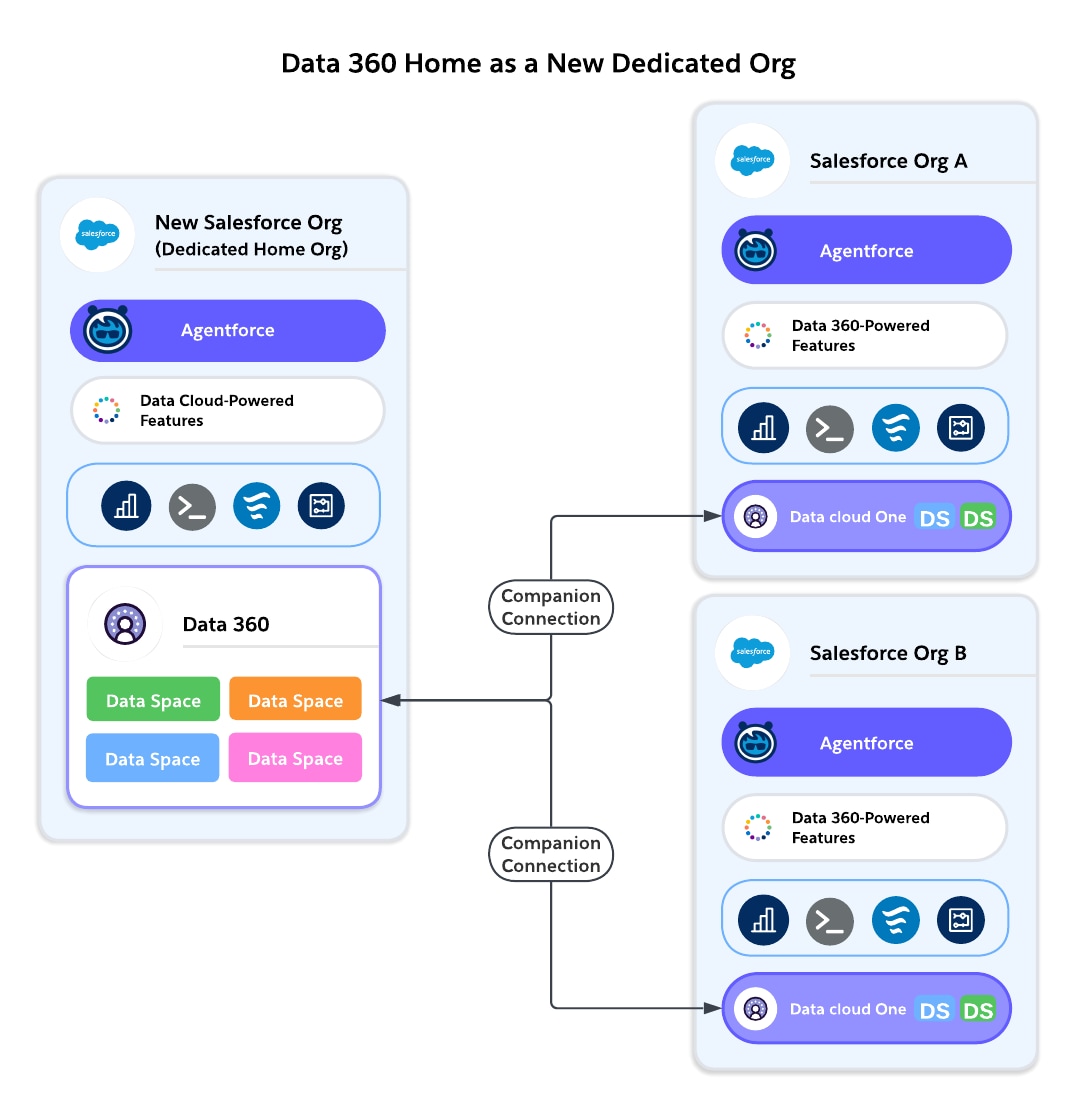
注意事项 作为主页组织的现有组织(首选默认值) 作为主页组织的新组织(替代)
简单性 构建现有用户和数据结构,以加快设置;默认情况下,Data 360 与 Home Org 集成。 需要新 Salesforce 组织的许可和设置,以及额外的管理开销来管理它。
价值实现时间 立即使用本地 CRM 数据。 需要更慢的坡道集成。
治理 继承现有组织的基本治理模型 - 现有用户和权限集。如果组织已经处于中心位置,这可能没问题。 清晰的治理模式;是 CoE 主导的模式的理想选择。
合规性 与现有组织区域绑定的驻留。 灵活选择独立于现有组织的区域。
性能 本地 CRM 查询的最佳性能。 取决于同伴组织的连通性,无论是与其他组织的同一区域还是跨区域。
未来可扩展性 如果与 Data Cloud One 配对,效果很好;如果选择错误组织,以后更难以转换。 使用 Data Cloud One 轻松扩展;专为中立设计。
成本 降低增量成本。 来自其他环境的较高开销。
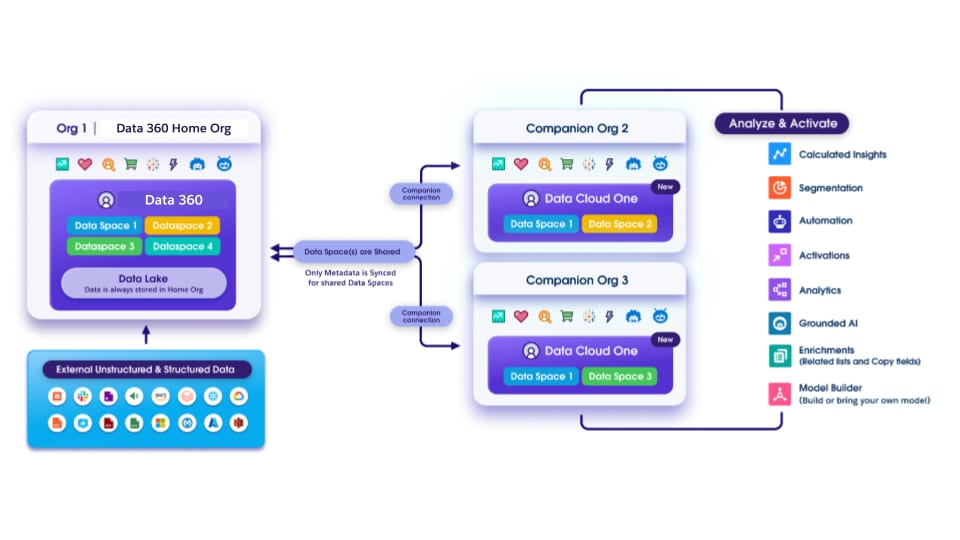
### 1.3 建议 作为一般原则,赞成使用现有的主要组织作为您的家庭组织,以最大限度地减少初始工作并加快采用。仅当您的长期治理或合规战略需要时,才创建新的专用家庭组织。对于拥有卓越中心 (COE) 的大型企业来说,创建新的专用家庭组织是常见的选择。 **单个组织环境** 在现有生产组织中配置 Data 360。这最大限度地提高了简单性和即时价值。它避免了不必要的集成开销。 **多个组织环境** 倾向于选择一个主要组织(通常是您大部分业务所在的组织,或已经作为您的集中 CRM 的组织)作为家庭组织。这降低了复杂性,最大限度地减少了设置工作,并允许您快速实现 Data 360 的价值。使用现有的主要组织还避免了管理新环境的成本和集成工作。 **何时考虑新的专用家庭组织** 如果您的组织拥有强大的卓越中心 (CoE),并希望治理独立于业务部门组织。如果由于合规性或组织限制,没有一个现有组织适合。在这些情况下,创建新的家庭组织提供了灵活性和中立性,但价值实现时间变慢。 --- ## 第 2 部分:多组织策略和 Data Cloud One ### 2.1 多组织挑战 企业通常运营多个 Salesforce 组织,这不是边缘个案,而是常规。截至 2024 年 2 月,约有 19000 个 Salesforce 客户已经运行了多个 Salesforce 组织。 为什么会发生这种情况? - **收购和合并:**新收购的公司自带 Salesforce 实例。 - **区域行动:**欧盟、北美、亚太地区等地区的单独组织,通常满足数据驻留法。 - **职能分离:**不同的业务部门(例如 Retail Banking、 Wealth Management、 Insurance)保持自己的组织自治。 - **监管或安全隔离:**出于合规性原因,某些行业要求组织具有逻辑上不同的特性。 - **历史/技术原因:**随着时间的推移,客户会有机地累积多个组织。 每个原因单独有意义,但它们共同造成了数据的碎片化。如果没有统一层,每个组织只有部分客户视图。 架构挑战:如何在遵守合规性、治理和自治要求的同时,将跨组织的数据统一到单一的真实来源? --- ### 2.2 什么是 Data Cloud One? Data Cloud One 是 Salesforce 的多组织连接架构,允许多个 Salesforce 组织共享一个 Data 360 实例。它是具有多个 Salesforce 组织的企业的推荐模式。 在任何 Data Cloud One 群集中,一个 Salesforce 组织被指定为托管 Data 360 实例的家庭组织。其他 Salesforce 组织作为同伴组织连接,使用来自家庭组织 Data 360 的统一数据和元数据。 显示 Data Cloud One 架构的图表 #### Data Cloud One 的工作方式
  1. 数据接收和统一(家庭组织)
  2. 数据空间架构
  3. 元数据共享
    同伴组织从家庭组织接收元数据定义,包括数据模型对象 (DMO)、统一简档模式、计算见解、细分等。这些资产在同伴组织中本地显示,如同本地资产,但实际上与家庭组织相关联。
  4. 在家组织中要完成的工作与同伴组织
  5. 家庭组织和伴侣组织之间的功能访问权限不同。同伴组织无法接收或统一数据,需要依赖家庭组织进行接收、建模和统一。同伴组织可以访问 Data 360 数据,以支持 Data 360 支持的平台功能,他们可以在共享的可信数据上创建本地见解、细分和流。在未来的愿景中,他们还可以访问激活功能。
    功能 主页组织 同伴组织
    连接 配置连接器、创建数据流、接收或联合数据 ✅ ❌
    协调和统一 构建并运行数据转换和身份解析 ✅ ❌
    使用数据空间和权限管理安全数据 ✅ ✅
    细分和预测构建细分、见解和 Einstein Studio 模型 ✅ ✅
    激活随处激活、数据操作 ✅ ✅
    平台功能提示生成器、流、报表、丰富等 ✅ ✅
    数据 360 支持功能 勘探中心、销售和 Service Cloud 功能、Agentforce 等 ✅ ✅
  6. 平台功能奇偶性
    从用户和生成器的角度来看,一旦元数据被共享,在使用 Salesforce 平台功能方面,主页和同伴组织之间有一些功能差异。支持的功能列表可在 Data 360 功能 中找到。
  7. 消耗模型
    所有同伴组织活动(查询、细分运行、Data 360 触发的流、AI 使用、Einstein Trust 层日志等)都会消耗来自家庭组织的 Data 360 信用。消费流单向流动:根据家庭组织的信用分配,对信用进行集中、计费和跟踪。但您可以深入了解每个个人组织在 Digital Wallet 中使用的信用数量。
  8. 设计原理:水平构造
    Data Cloud One 设计为 Salesforce 平台的水平结构,与 Sandbox 非常相似。目标是 Salesforce 的每个新功能版本都可以在家庭和伴侣组织中使用,无需额外设置。这确保了 Data Cloud One 不仅仅是数据架构的选择,而且是 Salesforce 平台未来的基础元素。
--- ### 2.3 决策:多个独立数据 360 与一个共享 Data 360 (Data Cloud One) 拥有多个组织的企业必须选择在其生态系统中定位 Data 360 的方式和位置。他们是想要在每个组织中配置独立的 Data 360,还是使用 Data Cloud One 将组织统一到一个家庭组织下? #### 选项 A:多个独立数据 360 每个 Salesforce 组织配置自己的 Data 360 实例。 **优点**: - **自治**:每个业务部门或区域控制自己的 Data 360。 - 每个组织内的**简单性**:治理、安全和自定义已本地化。 - **监管合规**:在需要严格监管分离时非常有用(例如,数据不得跨越边界)。 **缺点**: - **数据孤岛:**Customer 360 不能跨组织实现。 - **成本较高**:每个实例都需要许可、管理和集成。客户最终会多次接收相同的源数据,以便在多个不同的组织中实现完整的 C360 视图。 - **重复工作:**必须在每个 Data 360 中重复身份解析、细分和丰富。 #### 选项 B:一个共享数据 360(Data Cloud One 群集) 单个 Data 360 在家庭组织中配置,其他 Salesforce 组织作为同伴组织连接。 **优点**: - **单一真相来源 (SSOT):**所有组织共享相同的统一数据模型。 - **成本效率:**只有一个 Data 360 许可证和基础设施需要管理。 - **统一治理:**策略、安全性和合规性控制集中应用。 - **跨组织丰富:**同伴组织可以访问统一的简档、见解和细分。 - **AI 就绪:**企业范围的数据集支持更好地训练和激活 AI 模型。 - **未来证明:**添加新的同伴组织很简单;不需要新的 Data 360。 **缺点**: - **其他准备:**需要规划组织到家庭的组织连接。 - **延迟注意事项:**不同地区的同伴组织可能会看到查询变慢。 - **复杂治理:**如果每个组织都有非常不同的自定义需求,那么细粒度治理可能很复杂。 #### 选项 C:多个 Data Cloud One 群集 在某些情况下,治理、合规性或其他业务需求会使将每个组织群集在一起不切实际。这可能会导致需要实施一个混合解决方案,其中企业操作几个 Data 360,每个都是不同同伴组织集群的家庭组织。 #### 示例: 跨国公司在多个地区拥有 Salesforce 组织,包括欧洲、美国和亚洲。为了遵守区域数据驻留条例,他们为每个单独的区域配置了一个 Data 360。 #### 决策条件
注意事项 多个独立数据 360 一个共享 Data 360 (Data Cloud One )
自治 每个组织或业务部门的高度自主权。 集中管理,每个组织的自主权更少。
合规性 在需要严格分离时非常有用(例如,区域法律)。 当驻留允许集中时,效果最佳。
成本 更高的许可和管理成本。 更具成本效益;一个许可证适用于多个组织。
治理 分散;每个组织的策略不同。 跨组织的集中、一致的策略。
数据仓 每个组织都有自己的视图;没有 Enterprise 360。 统一数据集,无重复。
AI/Analytics 仅限于每个组织的数据。 具有更好准确性的企业范围模型。
复杂性 要管理的实例更多,集成更多。 更简单的架构,更少的移动部件。
性能 最适合组织内用例。 同伴组织访问权限可能会引入延迟。
--- ### 2.4 建议 **首选模式:****Data Cloud One** 默认设置为具有多组织企业连接的同伴组织的单个家庭组织。 这将创建企业范围的 Customer 360,简化治理,并优化成本。 **何时使用多个 Data 360:** 仅在合规、驻留或组织自治严格要求时。例如,如果欧洲业务由于监管而必须与美国业务完全分开。 **如何在 Data Cloud One 中选择家庭组织:** 从考虑其中一个主要组织开始 — 通常是大部分业务运行的地方。在此配置 Data 360 可以最大限度地减少复杂性,并最大限度地提高早期价值。 仅当现有组织不适用时,才考虑创建由卓越中心团队管理的专用家庭组织。 **概况:** 在多组织环境中,最大限度地减少 Data 360 的数量。青睐 Data Cloud One 作为默认模式,以减少重复、启用 AI 就绪并简化治理。 --- ## 第 3 部分:多个 Data 360 和 Data 360 组织之间的数据共享 ### 3.1 什么是 Data 360 组织之间的数据共享? 虽然 Data Cloud One 是大多数企业的推荐方法,但在某些情况下,客户可能需要配置多个 Data 360 实例。一旦存在多个 Data 360,它们之间的统一不会自动。 Data 360 到 Data 360 数据共享使客户能够在 Data 360 实例之间共享特定对象,而无需重复或自定义漏斗。它是一种零复制元数据共享机制,旨在跨 Data 360 协作。 #### 工作方式 - 每个 Data 360 都在自己的家庭组织中配置。 - 管理员可以创建数据共享 — 一组他们想要共享的特定对象。 - 对选定数据的访问权限与目标组织的 Data 360 共享,其中的对象显示为本地定义。基础数据保留在源 Data 360 中;仅共享访问权限。 - 标记不共享。只有原始对象可用;目标组织必须根据需要重新应用任何治理、操作或 AI 标记。 #### 与 Data Cloud One 的关键区别 - 在 Data Cloud One 中,多个配套组织共享一个 Data 360 实例。平台功能(Agentforce、潜在客户中心、Tableau Next 等)都在相同的基础数据上运行,从而确保了一致性。 - 在 Data 360 组织之间使用数据共享时,每个组织都有自己的 Data 360。组织 A 和组织 B 中的 Agentforce 等功能各自在本地实例上独立运行。不会自动进行共享 — 必须创建有意的数据共享,以便仅在特定对象上协作。 --- ### 3.2 Data 360 组织之间数据共享的用例 **区域合规性:** 一家跨国零售商在欧盟配置了一个 Data 360,在美国配置了另一个 Data 360。Data 360 到 Data 360 数据共享允许公司汇总见解(例如,忠诚度 KPI),以便与美国总部共享,同时原始数据保持本地状态。 **业务部门协作:** 一个企业集团为零售和保险运行单独的 Data 360。Data 360 之间的数据共享允许用户访问单个权威数据源,而无需移动或复制。通过 Data 360 组织之间的数据共享,保险组织接收零售的“高价值客户”细分,以进行有针对性的交叉销售活动。 **并购:** 母公司通过自己的 Data 360 收购子公司。通过两个实例来管理,保留短期数据孤岛可以保留数据安全和 SSOT 完整性。同时,在两个 Data 360 实例之间共享数据允许在迁移期间进行必要的协作。 **联合主管仪表板:** 一家跨大陆的跨国公司为每个地区配置单个 Data 360。主管需要联合季度绩效视图。每个区域 Data 360 都与“主管组织”共享汇总的计算见解,从而实现企业范围的报告。 #### Data 360 组织之间数据共享的优缺点
系数 优点 缺点
数据驻留 支持区域分离,同时支持协作。 不会消除管理多个 Data 360 的需要。
数据复制 零复制;没有对象的重复。 需要有意选择要包含在每个数据共享中的对象。
治理 共享是明确和有意的(对象级)。 没有标记或策略流;目标组织必须重新应用治理。
复杂性 支持选择性协作,无需集中。 需要管理多个 Data 360 和数据共享。
AI/Analytics 可能的区域 AI/分析;见解可在组织之间共享。 没有企业范围的 AI,除非有意共享数据。
平台功能 每个组织的 Data 360 支持的功能独立运行。 没有自动共享 — 如果不仔细设计,就有重复风险。
成本 可能会减少对 ETL 漏斗的需求。 仍会产生多个 Data 360 的成本。消耗数据查询和数据共享的信用。
#### 决策条件
注意事项 Data Cloud One(多组织首选) Data 360 组织之间的数据共享
单一真相来源 ✅ 是 — 所有组织共享相同的 DC。 ❌ 否 — 每个 Data 360 都有自己的数据模型。
合规性 仅在驻留允许集中时有效。 当居住法阻止集中时需要。
治理 集中、一致。 聚合;有意的对象级共享。
复杂性 移动零件更少,更简单。 ore complex — 需要配置数据共享和多个 Data 360。
AI/Analytics 企业范围的 AI 模型。 区域 AI;见解可以有选择地共享。
平台功能 共享数据 360 意味着所有功能在家庭 + 伴侣中一致工作。 功能在每个 Data 360 中独立运行;共享必须明确。
### 3.3 最佳实践 **如果您的企业有多个 Data 360:** - 使用 Data 360 组织之间的数据共享进行跨组织协作,而不是构建自定义漏斗或复制数据。 - 通过创建数据共享并将其授予目标组织来共享特定对象(DMO、计算见解、细分)。 - 请注意,标记不是共享的 — 接收组织必须重新应用标记(例如,治理、分类、AI 丰富)。 **何时使用 Data 360 组织之间的数据共享:** - 满足防止集中化的法规要求。 - 保持业务部门的自主权,同时启用选择性协作。 - 跨多个区域提供联合主管仪表板。 - 弥补无法立即整合的并购情况。 **精心设计** 共享必须是有意的,并且特定于对象。避免“过度共享” - 使数据共享与业务和合规需求保持一致。将 Data 360 到 Data 360 数据共享视为联合策略,而不是 Data Cloud One 的替代。 --- ## 汇总
  1. 每个组织都应计划对 Data 360 的访问权限
  2. 考虑企业范围,而不是逐个组织
  3. 最小化数据孤岛
  4. 如果您必须运行多个 Data 360,请谨慎设计
  5. 尽早规划治理和所有权
  6. 避免短期快捷方式
这些配置选择至关重要,因为 Salesforce 平台正在向 Data 360 优先模型发展,其中从客户细分到 AI 客服人员基础训练的每个功能都将依赖于它。您今天做出的决策将为您的企业如何有效地统一客户数据、您如何迅速地采用新的 Salesforce 功能以及您如何自信地在整个业务中扩展 AI 奠定基础。要取得成功,您必须谨慎配置,最大限度地减少重复,与合规要求保持一致,谨慎管理,并着眼于长远。归根结底,配置 Data 360 是将数据、AI 和 CRM 作为一个统一的平台协同工作的第一步。 # ## 关于作者 Kunal Goyal 是 Salesforce 的产品管理总监,专注于提高 Data 360 中的多组织架构和可扩展性。自 2017 年以来,他领导了多项以跨组织协作和多租户系统设计为中心的计划和产品。Kunal 是 Data 360 最佳实践架构潜在客户之一,也是 Data Cloud One、设置、配置和管理员体验的产品所有者。 Erin Wagner Tidwell 是 Data 360 的主要技术作者和内容设计师。她自 2013 年以来一直在 Salesforce。她致力于通过清晰、一致和准确的技术文档和应用程序内通信,使 Data 360 更容易理解和使用。 Yugandhar Bora 是 Salesforce 的软件工程架构师,专门从事数据和智能应用平台中的数据架构。他领导企业架构审查委员会 (EARB) 专注于数据治理和统一数据模型的举措,同时为自动化平台配置解决方案做出贡献。 Samarpan Jain 是 Salesforce 的首席架构师,专门从事 Commerce Cloud、平台集成和跨组织架构。作为 Salesforce 任职时间最长的员工之一,他领导的关键计划包括政府客户的数据驻留合规性和 Data 360 使用归因系统。 ## 指南概览 本指南将帮助您评估 Salesforce 平台上异步处理要求的正确方法。它解释了每种方法,详细描述了每种方法的优势和局限性。大多数方法与产品功能保持一致,但一些方法协调使用多个功能。该指南包含用例,以突出显示何时使用每种方法。 异步处理为您的架构提供了两大好处。首先,它提高了可扩展性,因为异步进程具有更高的调控器限制。第二,异步请求在自己的线程中执行,因此用户可以在后台执行异步任务时执行其他工作。 请注意,本指南仅侧重于在 Salesforce Platform 中选择异步处理技术。[资源部分](#资源)列出了有助于您的决策过程的其他资源。 ## 本指南范围内的产品
Salesforce 平台 Salesforce Lightning 平台是一个人工智能驱动的综合平台,将员工、自主人工智能客服人员、公司数据和应用程序统一到一个可信的系统中,以提高生产率和客户体验。它通过连接 Customer 360 应用程序、Data Cloud 和 Slack 来实现端到端自动化,从而支持创建“代理企业”。
本文档未涵盖其他生态系统中的技术,例如 MuleSoft、Informatica、Commerce Cloud、Tableau 和 Marketing Cloud。 ## 外卖 - **在使用异步处理之前,请确保您的用例适合该模式。**异步模式没有 SLA,受多个调控器机制的约束,可以根据许可证定义容量限制,并且由于分配给 Salesforce Platform 中的异步基础设施的资源的有限性,可能会导致处理延迟。当用户在继续工作之前需要系统的响应时,请在使用异步处理时考虑这些限制。 - **与 Salesforce 异步处理不是满足无限扩展需求的解决方案。**Salesforce 平台不会无限扩展,异步模式会受到限制。异步处理使用线程,线程包含 CPU 执行指令流所需的上下文信息。线程可以并行运行。任何 CPU 中的可用线程数量有限,因此平台拥有尽可能高效地使用可用线程的机制。平台的[流控制机制](/docs/architect/zh-cn/fundamentals/guide/async-fundamentals#流控制)可以防止组织消耗过多线程并对其他组织产生负面影响。平台的[公平使用算法](/docs/architect/zh-cn/fundamentals/guide/async-fundamentals#公平使用)还控制组织对每个特定消息类型可用的线程数量。 - **考虑可能导致极端负载的事件。**在设计异步流程时,请确保可以预测地管理工作负荷高峰和平静。请考虑您的实施如何处理意外事件,例如断电,并设计保护措施来减轻数据丢失或功能损失。 ## 产品比较 此表概述了可用于 Salesforce 异步处理的工具。参考此表,查看每个工具在决策过程中的主要特征。有关为您的架构选择正确工具的帮助,请参见[用例](#用例)和[决策点](#决策点)。
方法 描述 所需技能 许可证和限制
Queueable Apex 用于涉及长时间运行的数据库操作或外部 Web 服务标注的进程。Queueable Apex 提供作业 ID、支持非原始类型和作业链接等功能。 赞成代码 许可证的数量可以增加限制。
Batch Apex 通过划分记录集并将其处理为可管理的块,构建涉及数百万条记录的复杂、长时间运行的流程。 赞成代码 许可证的数量可以增加限制。
计划 Apex 在 Cron 表达式定义的计划时间执行 Apex。虽然通过 Cron 表达式计划 Apex 的行为是一个异步过程,但底层代码会在作业开始时同步执行。 赞成代码 许可证的数量可以增加限制。
Apex 继续标注 从同步事务上下文中运行的 Apex 方法执行标注。 赞成代码 没有
异步路径(记录触发的流) 执行您想要自行运行的操作。避免在更新相关记录上的值时出现混合 DML 错误,该值不是触发流的记录的一部分。 低代码 许可证的数量和类型可以增加限制。
计划路径(提交流后) 在触发事件后的动态计划时间执行,例如在创建、更新或删除记录时。 低代码 许可证的数量和类型可以增加限制。
计划流 在指定的时间以重复的频率(每天、每周或一次)在后台执行流,以便对一批记录执行操作。 低代码 许可证的数量和类型可以增加限制。
平台事件触发器 将 Salesforce 与外部系统松耦合,并在 Salesforce Platform 中的异步组件之间进行通信。 低代码 + 专业代码 高用量平台事件用例需要加载项许可证
变更数据捕获 提交数据库事务后,异步捕获和处理变更事件。 赞成代码 要扩展到基准分配以上,需要加载项许可证。
批量 API 异步插入、更新、更新插入、查询或删除许多记录,稍后处理结果。 赞成代码 是有限制的。
Lightning 操作 允许 Lightning 页面与服务器交互,而不强制用户完全刷新页面。 低代码 没有
## 决策点 此表包含您在决定使用哪个异步工具时需要考虑的要点概览。
所需技能 本指南概述的一些工具需要代码,而其他工具可以声明性地配置。在您考虑选项时,请考虑团队成员拥有的技能集。请记住,即使开发人员可用于您的初始实施(例如通过实施合作伙伴),您可能需要在未来修改您的解决方案。如果维护团队缺少开发人员,低代码选项可能更适合。
强制执行的平台限制的类型 确定适用于执行的限制类型。在设计解决方案时,请仔细考虑每天事务的数量和频率将如何计入所选方法的调控器限制。计算每天将发生的执行次数。确保计算值在与您选择的工具相关联的限制范围内。
延迟 确定处理结果在平台中的可用速度。对于某些方法,更改几乎会立即生效,而对于其他方法,更改可能是几分钟或几小时。
## 用例 当您选择异步处理的工具时,请先评估贵组织的要求和可用资源。您的目标是选择一种或几种工具,这些工具可以最大限度地减少实施和维护成本,但仍可确保可扩展性,并最大限度地减少违反限制的可能性。此目标取决于之前概述的技术注意事项,以及团队的组成。 考虑 Salesforce 中的异步订购流程。保存订单时,它会触发一条消息给外部仓库管理系统,其中包含关于如何包装和运送商品的特殊说明。下订单的用户不需要仓库管理系统立即响应,因此请求可以异步发送。异步处理允许用户继续工作,而无需等待响应。 对于此用例,您可以考虑使用 Apex 实施。只有当您的团队中有可以维护您的专业代码解决方案的 Apex 开发人员时,这种方法才有效。否则,声明性方法更有意义。此外,请记住,不同的[限制](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_gov_limits.htm)集适用于不同的工具。 此表列出了最左侧列中的常见用例,然后是描述。*第一选择*列提供了用于满足此类用例的最典型方法,以及第一选择方法的基本原理。将此用作分析的起点 - First Choice 方法可能有局限性,不适用于您的用例。
用例 描述 首选方法 理由
高性能批处理 任何必须高效处理数千或数百万条记录的自动化 批量 Apex Batch Apex 提供了丰富的 API 来与平台交互,并提高原始速度。
数据清理作业 定期或按需运行的清理数据的作业。示例包括重复数据消除、地址验证或数据整合。 批量 Apex Batch Apex 提供了丰富的 API 来与平台交互,并提高原始速度。
夜间汇总作业 在工作日结束时计算累计数据的作业。 批量 Apex Batch Apex 提供了丰富的 API 来与平台交互,并提高原始速度。
记录触发的逻辑 执行逻辑以响应记录更新。 不同 请查看我们的相关决策指南 - 记录触发事件自动化。它包括异步用例的决策树,包括 Queueable Apex、Batch Apex、Scheduled Apex、Scheduled Flow、异步路径流和变更数据捕获。
通过对象图级联更新 允许用户的保存操作快速完成,延迟到其他对象的级联更新以异步运行。 可排队 Apex Queueable Apex 具有强大的链接功能,支持逻辑将更新链分为一系列异步事务。
特定于记录的计划处理 未来特定于记录的动态日期的自动化(例如,结束日期前 3 天)。 具有计划路径的流 计划的路径为流提供了独特的优势,因为如果记录的数据发生变化,平台会自动处理这些路径的计划、取消和重新计划。
并行调用多个缓慢的外部服务 在同步执行期间,并行调用多个外部服务,以优化整体执行时间。 Apex 继续标注 允许多个运行缓慢的标注并行运行,可以最大限度地减少完成工作的总时间。
记录从外部系统的数据迁移 将大量记录从外部系统移到 Salesforce Platform。一次性或定期计划的进程。 批量 API 这是最高效、最方便的数据迁移方法。
在外部系统上执行其他逻辑 将平台上的事件通知给外部系统,然后允许该系统异步处理该事件的触发-忘记模式。 平台事件或变更数据捕获 pub-sub 模型最适合这里,并允许外部系统在准备就绪时处理事件。有关此模式的更多详细信息,请参见事件驱动架构。
用例表是每个用例的最合适的方法指南。但您需要验证 First Choice 技术是否适合您用例的特定需求。特别是,确定所选方法是否可以遵守贵组织的调控器限制。 在您为用例确定了候选方法后,[异步处理基本指南](/docs/architect/zh-cn/fundamentals/guide/async-fundamentals)可以帮助全面检查解决方案。 ## 资源 这些额外资源可以帮助您的决策过程: - 深入了解每种平台异步技术:[异步处理基础知识](/docs/architect/zh-cn/fundamentals/guide/async-fundamentals) - 为记录触发器选择 Apex 和流:[记录触发的事件自动化](/docs/architect/zh-cn/decision-guides/guide/record-triggered) - 有关异步集成模式的信息:[事件驱动架构](/docs/architect/zh-cn/decision-guides/guide/event-driven) ## 指南概览 有多种方式可以在 Salesforce 和外部系统之间访问、同步和共享数据。但并非所有工具都适合您的特定项目。本指南介绍了 Salesforce 提供的数据集成工具。它还为特定用例下最合适的工具(或工具组合)提供了建议,以及特定场景下应避免的工具指南。 本决策指南侧重于涉及 Salesforce 的数据级集成。具体而言,它涵盖了以下数据集成用例: - Salesforce 到外部系统 - Salesforce 的外部系统 - Salesforce 组织到 Salesforce 组织 这些只是 Salesforce Architects 面临的集成挑战的一部分,因此我们计划添加更多决策指南,重点关注事件驱动的集成,使用流程集成建立有效的面向客户或员工的工作流等。最后,必须指出,此处描述的许多工具和方法可用于解决更广泛的企业中的集成挑战,但这种使用超出了本指南的范围。 ### 外卖 - **避免不必要的数据复制。**除非数据绝对需要驻留在 Salesforce 中,否则请考虑使用 Salesforce Connect 进行数据虚拟化。贵组织中的数据越多,最终将导致数据量越大,从而对[性能](/docs/architect/zh-cn/well-architected/guide/reliable#性能)产生不利影响,并增加技术债务。如果您的数据已经驻留在 Salesforce 中,并且您需要它位于外部系统中,请避免将其复制到外部系统,除非绝对必要。相反,让外部系统通过 Salesforce API 访问数据。 - **使用 MuleSoft 或其他 Enterprise Service Bus (ESB) 或 Extract-Transform-Load (ETL) 解决方案(如果可用)作为现有环境的一部分。**由于这些工具旨在帮助支持数据迁移和转换,因此它们通常具有强大的功能,使您能够在整个企业中重复使用集成,保持更强的治理,并集中管理集成。在本指南中,在推荐 MuleSoft Anypoint 时,请考虑现有 ESB/ETL 解决方案是否足够。 - **使用 Data 360 和 Data Cloud One 协调来自不同来源的数据。**通过 Customer 360 数据模型、身份解析、数据联合和其他功能,Data 360 会将 Salesforce 和其他外部系统的数据整合到客户的统一视图中。借助 [Data Cloud One](/docs/architect/zh-cn/fundamentals/guide/data360_integration_patterns_and_practices.html#unified-multi-org-data-platform-with-data-cloud-one),其他 Salesforce 组织中的用户可以安全地访问通过数据空间从 Data 360 虚拟共享的数据。 - 使用 **Data 360 操作和激活在组织之间移动数据。**将数据从不同的组织接收到 Data 360 后,数据[操作和激活](/docs/architect/zh-cn/fundamentals/guide/data360_integration_patterns_and_practices.html#data-activation-patterns--data-outbound)可以将数据同步到另一个组织。这种方法对于与 Marketing Cloud 组织的集成非常有用。 - 使用 **MuleSoft Anypoint** 提取和移动数据 MuleSoft Anypoint 可用于使用连接 API 和数据图 API 从 Data 360 中提取数据,并将其移动到其他 Salesforce 组织。如果没有 Data 360,当需要在组织之间移动数据而不在 Data 360 中复制时,也可以使用 MuleSoft Anypoint。 - **如果您选择使用出站消息传递构建,请谨慎小心。**Salesforce 将继续在现有功能容量范围内支持出站消息传递,但不打算对此技术进行进一步投资。 - **对于所有集成,始终建议使用具有“仅 API”简档的集成用户许可证。**Salesforce 还建议使用外部客户端应用程序(支持连接的应用程序或 SOAP 登录)作为所有集成的适当允许的 AuthN 和 AuthZ 模式。 ## 选择数据集成工具的常见注意事项 在深入了解可用的数据集成工具之前,在选择工具时,请记住一些常见注意事项非常重要。与架构的典型情况一样,没有针对每个业务挑战的规范性答案。如果您在做出集成选择时说了“这取决于”这个词,那么您就找对地方了。
要考虑的区域 常见问题
现有工具和环境 是否有现有的 ESB 或 ETL 解决方案?涉及的数据是否有监管或合规要求?您尝试集成的系统位于何处(在云中或本地)?
数据流(时间、预期用户体验、方向性) 数据是否需要同步、异步移动,或者是否可以批量/计划?是否需要数据复制?什么系统应该是真理的来源?什么是数据源?什么是目标目的地?是否需要用户交互?用户是否需要查看集成的结果?异常处理(重试、通知、失败)的需求是什么?系统的紧密耦合程度如何?
实施 对于非 Salesforce 系统,工作级别是多少?哪些团队负责交付集成?他们更喜欢使用哪些工具?
可维护性 哪些团队需要维护集成?他们目前拥有哪些技能?他们未来需要哪些技能?随着时间的推移,总拥有成本是多少?使用低代码或专业代码工具进行测试、调试和故障排除的能力有多重要?
数据量 集成涉及多少数据?您是否将使用大数据量 (LDV)?批量更改的频率如何?单一版本更新会产生什么影响?多久发生一次?
限制 数据是否需要进行复杂的转换?数据是否需要从几个源系统合并?每个用户多久集成一次?总共有多少用户?您是否预先计划了批量数据加载(例如:新实例的初始数据加载)?
## 产品比较 以下是可用于数据集成的工具的高级概览,以及开始评估每个选项的一些注意事项。以下部分包括深入的用例和有关这些工具功能的详细信息。
从 Salesforce 到外部系统 从外部系统到 Salesforce 执行 需要其他许可证
Apex 操作 可用 可用 服务器端 没有
变更数据捕获 可用 不可用 服务器端 否*
Custom Apex(REST和SOAP Web Services) 可用 可用 服务器端 没有
外部服务 可用 不可用 服务器端 没有
Heroku Connect 可用 可用 服务器端 是
Data 360 可用 可用 服务器端 是
MuleSoft Anypoint 可用 可用 服务器端 是
本地 Salesforce API 不可用 可用 服务器端 没有
Omniscript 可用 可用 客户端*** 是
OmniStudio 集成程序 可用 可用 服务器端 是
出站消息 不理想 不可用 服务器端 没有
平台事件 可用 可用 服务器端 否**
Salesforce Connect/外部对象 可用 可用 服务器端 是
[\* 高用量变更数据捕获事件用例所需的加载项](https://developer.salesforce.com/docs/atlas.en-us.change_data_capture.meta/change_data_capture/cdc_allocations.htm) [\*\*高用量平台事件用例需要加载项](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_event_limits.htm) \*\*\*适用于业务逻辑可以在 Web 浏览器中运行的场合。 列图例: - **可用**:适用于大多数用例 - **不理想**:可能,但请考虑替代工具 - **不可用**:未来 12 个月内没有支持的计划 ### 将数据移入和移出 Salesforce 可能涉及的其他工具: 还有其他工具可以支持数据层集成的某些方面,但决不能被认为是解决集成问题的主要手段。现在,让我们快速看看这些工具。 **Lightning Web 组件**通常用于流程整合,但它们可以使用 JavaScript 功能进行标注,因此数据可能参与这些交易。 **Salesforce Flow**可用于通过外部服务或 Apex 操作编排外部标注。Salesforce 流本身不被视为独立的数据集成工具。 **数据导入向导和数据**加载器可用于同步、导入和迁移数据。虽然 Data Loader 命令也可以编写脚本来自动导入和导出数据,但[命令行界面](https://developer.salesforce.com/docs/atlas.en-us.dataLoader.meta/dataLoader/command_line_intro.htm)仅适用于 Windows,这两个工具都不是数据集成策略的推荐基础。相反,使用它们来补充您的数据管理和维护策略。 [**Salesforce CLI**](https://developer.salesforce.com/docs/atlas.en-us.sfdx_cli_reference.meta/sfdx_cli_reference/cli_reference_force_data.htm) 数据命令可用于操作贵组织中的记录。命令可用于帮助您使用批量 API 和 SObject Tree Save API 导入和导出数据,并使用 REST API 对单个记录执行简单的 CRUD 操作。Salesforce CLI 本身不被视为独立的数据集成工具。 **OmniStudio 数据映射**器可用作声明性 ETL 工具,以在 Salesforce 对象和 JSON 数据结构之间移动数据。虽然为每个数据映射器接口自动创建 REST 接口,提供将数据从外部系统移动到 Salesforce 对象的声明性方式,但数据映射器独立版不是数据集成策略的推荐基础。数据映射器操作在 OmniStudio 集成程序中可用。 [**Dataloader.io**](http://dataloader.io/) 是另一个适用于 Salesforce 的数据加载器工具,由 MuleSoft Anypoint 平台提供支持,允许您快速安全地导入、导出和删除企业无限量的数据。Dataloader.io 不是数据集成策略的推荐基础。 ## Salesforce 到外部系统(出站集成) 对于来自 Salesforce 的出站集成,您可以考虑不同类型的工具:低代码、专业代码或混合。以下部分提供了每种工具类型的指导,并提供示例解决方案。 - [出站集成的低代码工具](#salesforce-出站集成的低代码工具) - [出站集成的混合工具](#salesforce-出站集成的混合工具) - [适用于出站集成的专业代码工具](#适用于-salesforce-出站集成的专业代码工具) ### Salesforce 出站集成的低代码工具
指导 许可 时间 体积和规模 交付和维护 隐私和安全
何时使用 其他许可证 同步(请求/回复)或异步(火灾/忘记) 多对象支持 LDV/批量 测试和部署** 调试 内置错误处理/重试行为 可与静态加密的数据一起使用 身份验证协议
变更数据捕获 当您需要将 Salesforce 中所做的记录级更改发布到外部系统并且不需要自定义负载时。 必填 异步 没有 没有 是 使用专业代码工具 是 是 OAuth
外部服务 当您使用 Flow、Apex、Einstein 机器人或 OmniStudio 来编排进程时,使用 OpenAPI 规范来描述外部系统 API。 不需要 同步 是 没有 是 使用专业代码工具 没有 N/A 命名凭据
Heroku Connect 当您希望通过双向同步来扩展您的数据,以便在 Heroku 上启用移动和其他应用程序,并且您想要将数据也复制到 Salesforce 中时。 必填 异步 是 是 没有 使用专业代码工具 是 是,通过 Shield Connect OAuth
OmniStudio 集成程序 当您需要在没有用户交互的情况下转换数据,并通过在服务器而不是浏览器上处理来提高性能时。 必填 两者 是 是 是 声明性支持 是 是 命名凭据
Salesforce Connect/外部对象 当您希望数据显示在 Salesforce UI 中,但希望数据存储在外部系统中时。数据不会复制到 Salesforce。 必填 同步 没有 是* 是 使用专业代码工具和声明性跟踪器 没有 N/A 命名凭据
*Odata 适配器在版本 4.01 之前受标注限制。有关更多详细信息,请参阅 Odata 标注率限制注意事项。** 测试和部署是指在较低的环境中构建并通过元数据 API、软件包或更改集部署到生产环境的能力。
### 用例:使用低代码工具的出站集成 > 赢得业务机会后,需要在公司的 ERP 系统或订单管理系统中创建相关产品的订单。 **变更数据捕获** 随着业务机会记录的更新,变更数据捕获发布包含对象更新的变更事件。变更事件通过 CometD 连接(或通过 MuleSoft 连接器)在客户一侧消耗,并用于更新客户的 ERP 或订单管理系统。可以丰富变更事件,以始终包含集成所需的外部记录 ID 或来自对象(例如区域)的其他数据。多个对象的变更事件流可以合并到*渠道中*,以简化订阅和流处理(因此您可以订阅和处理一个流,而不是多个流 ) 。 **外部服务** 如果您的 Web 服务支持 OpenAPI 2.0 或 3.0 规范,您可以在 Salesforce 中将操作和服务公开为外部服务。当业务机会的阶段更改为“已赢得”时,API 操作(例如创建订单)可以在使用 Flow Builder 构建的流中调用为可调用操作。 **Heroku Connect** Heroku Connect 通常用于保持 Heroku Postgres 数据库和 Salesforce 同步。如果客户使用 Heroku Postgres 作为其真相来源交易存储,您可以使用 Heroku Connect 将记录和更改从 Salesforce 同步到 Heroku Postgres。从那里,您可以使用 Heroku 串流连接器将这些更改发布到 Apache Kafka,并作为事件发送到下游应用程序,包括 ERP 或订单管理系统。 **OmniStudio 集成程序** 提交订单时,编排流程的 Omniscript 可以将订单详细信息发布到 ERP 或 MuleSoft 连接器。帖子可以直接由 Omniscript(客户端)执行,也可以通过集成程序(服务器端)间接执行。如果 ERP 系统抛出验证错误,Omniscript UI 必须通知用户,如有必要,为用户翻译和上下文化错误。 **Salesforce Connect/外部对象** 您可以在 Salesforce 中创建记录触发的流,在业务机会阶段更改为“已赢得”时将记录插入相关外部对象。由于这是一[个混合事务](https://help.salesforce.com/articleView?id=000328873&type=1&mode=1),为了避免错误,请在业务机会更新和相关外部对象插入之间添加零秒的暂停元素,以便在开始新事务上下文之前关闭一个事务上下文。 ### Salesforce 出站集成的混合工具
指导 许可 时间 体积和规模 交付和维护 隐私和安全
何时使用 其他许可证 同步(请求/回复)或异步(火灾/忘记) 多对象支持 LDV/批量 测试和部署** 调试 内置错误处理/重试行为 可与静态加密的数据一起使用 身份验证协议
Apex 操作 当您希望通过 Salesforce 流自动调出另一个系统时。开发人员可以编写流可以调用的 Apex 类,或者您可以从 AppExchange 下载预构建的解决方案。 不需要 两者 是 没有 是 使用专业代码工具 没有 是 多个
事件中继 当您需要从 Salesforce 发送平台事件并将数据捕获事件更改为 Amazon EventBridge 时。事件中继仅连接到 AWS Eventbridge 没有 异步 是 没有 是 是 是 是 带 TLS 的 HTTP/1.1
出站消息 当工作流规则触发时,您需要通过 HTTP(S) 向指定的端点发送 SOAP 消息,并保证接收。 不需要 异步 没有 没有 是 声明性支持 是 是 双向 TLS
平台事件 当您需要自定义的结构化负载来近乎实时地更改 Salesforce 或外部系统时。 不需要* 异步 是 没有 是 使用专业代码工具 是 是 OAuth
Salesforce Connect/外部对象(带有自定义 Apex 适配器) 当您希望数据显示在 Salesforce UI 中,但希望数据存储在无法使用 Odata 或 GraphQL 等标准协议的外部系统中时。 必填 两者 是 是 是 使用专业代码工具 没有 N/A 多个
Data 360 当您想要在一个数据存储中协调来自不同来源的数据时,或者您想要将数据复制到其他 Salesforce 组织或其他外部系统。 必填 两者 是 是 是 是 是 是 多个
[\*](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_event_limits.htm) 高用量用例必填。 \*\*测试和部署是指在较低的环境中构建并通过[元数据 API](https://developer.salesforce.com/docs/metadata-coverage/)、软件包或更改集部署到生产环境的能力。 ### 用例:使用混合工具的出站集成 > 赢得业务机会后,需要在公司的 ERP 或订单管理系统中创建相关产品的订单。 **Apex 操作**基于业务机会状态的记录触发的流程可以在赢得业务机会时自动触发。该流执行可调用操作,该操作使用外部标注将订单提交到订单管理系统或 ERP 解决方案。Apex 批处理和队列机制处理高用量提交和多站点订单。 **出站消息传递** [在设置出站消息](https://developer.salesforce.com/docs/atlas.en-us.api.meta/api/sforce_api_om_outboundmessaging_setting_up.htm)传递后,您可以定义由业务机会更新触发的工作流规则,通过 HTTP(S) 向托管监听器的指定端点 URL 发送 SOAP 消息。消息将包含创建出站消息时指定的字段。如果对象中的信息在通知排队后但在发送前发生变化,则只有更新后的信息将被传递,消息将保留在队列中,直到发送成功,或直到它们存在 24 小时。24 小时后,消息将从队列中删除。如果 ERP 系统需要其他数据,您可以在出站消息中传递 sessionId,以便外部系统可以发出回调请求。 **平台事件** 您可以定义包含自定义负载的平台事件,其中包含在外部系统中创建记录所需的数据。因为平台事件不会在记录更改时自动发布,所以当业务机会的阶段更改为“已赢得”时,您必须通过 Apex、Salesforce Flow 或 Process Builder 发布事件。外部服务使用 CometD(或 MuleSoft 连接器)监听平台事件渠道,并在外部系统中创建适当的记录。 **Salesforce Connect/外部对象(带有自定义 Apex 适配器)**基于 Salesforce Connect/外部对象的解决方案并不完全适合纯粹需要数据同步的用例。但是,此解决方案可以应用于 Salesforce 中的用户需要查看外部系统的数据并可能与外部系统进行交互,并且数据无法在 Salesforce 中复制的情况。如果企业资源规划或订单管理系统不支持 Odata 或 GraphQL 协议,那么开发团队可以使用 [Apex 连接器框架](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_connector_start.htm)编写 Apex 类来处理通过支持的协议与外部系统的通信。 **Data 360** 基于 Data 360 的解决方案非常适合我们需要在一个数据存储中协调来自不同来源的数据的用例。当我们需要将数据从一个 Salesforce 组织复制到多个 Salesforce 组织或使用 Data 360 作为数据中心的其他外部系统时,也可以使用它。在源组织中赢得并更新业务机会时,业务机会数据将同步到 Data 360,其中可以使用不同的机制(例如操作、激活和 API)在其他系统中复制,包括 Salesforce 组织。同样,业务机会可以转诊,而无需使用 Data Cloud One 在其他 Salesforce 组织中复制数据。但是,Data Cloud One 不支持非 Salesforce 平台。 ### 适用于 Salesforce 出站集成的专业代码工具
指导 许可 时间 体积和规模 交付和维护 隐私和安全
何时使用 其他许可证 同步(请求/回复)或异步(火灾/忘记) 多对象支持 LDV/批量 测试和部署** 调试 内置错误处理/重试行为 可与静态加密的数据一起使用 身份验证协议
Custom Apex 当您需要的功能多于低代码工具时。 不需要 两者 是 是 是 使用专业代码工具 没有 是* 多个
外部服务 使用 OpenAPI 规范描述了从代码与外部系统 API 的集成。 不需要 同步 是 没有 是 使用专业代码工具 没有 N/A 多个
MuleSoft Anypoint 当您需要单个企业级统一解决方案来构建、编排和管理您的集成时;当您需要替换传统的点对点架构时;或者当您需要 API 管理支持时。 必填 两者 是 是 是 使用专业代码工具 没有 是* 多个
\* 启用 Shield Platform Encryption 会改变某些行为,有关更多详细信息,请参阅 [General Shield Platform Encryption 注意事项](https://help.salesforce.com/articleView?id=sf.security_pe_considerations_general.htm&type=5)。 \*\*测试和部署是指在较低的环境中构建并通过[元数据 API](https://developer.salesforce.com/docs/metadata-coverage/)、软件包或更改集部署到生产环境的能力。 ### 用例:使用 Pro-Code 工具进行出站集成 > 赢得业务机会后,需要在公司的 ERP 或订单管理系统中创建相关产品的订单。 **Custom Apex** 您可以在业务机会上创建 Apex 触发器和触发器处理程序,当业务机会的阶段更改为“已赢得”时,对企业资源规划或订单管理系统进行标注。请注意,如果您从触发器或在执行 DML 操作后进行标注,则必须使用注释为未来或可排队的方法。触发器中的标注会在标注的整个生命周期内保持数据库连接打开。所有 Apex 代码都受 [Apex 调控器和 API 限制](https://developer.salesforce.com/docs/atlas.en-us.salesforce_app_limits_cheatsheet.meta/salesforce_app_limits_cheatsheet/salesforce_app_limits_overview.htm)的约束,这些限制不断修订。 **外部服务** 如果公司的外部 ERP 或订单管理系统通过 OpenAPI 规范定义,则可以简化对将来方法或可排队作业中执行的服务的标注。注册的外部服务可以直接从 Apex 调用,而无需编写模板代码。在示例中,外部服务可以处理创建订单的标注。 **MuleSoft Anypoint** MuleSoft Anypoint 提供企业级 API 管理。MuleSoft Anypoint 可以创建 API,以便为 Salesforce 和许多其他企业系统启用对数据的读取(和/或写入)访问。有[许多预构建连接器](https://www.mulesoft.com/platform/cloud-connectors)可以简化实施,公司也可以创建和发布自己的连接器。这些 API 可以通过灵活的安全策略部署在 Anypoint 中,支持集中管理和治理。只要 API 的大小适合其峰值利用率(以 vCores 衡量),事务量就没有限制。 ## 外部系统数据到 Salesforce(入站集成) 对于 Salesforce 的入站集成,您可以考虑不同类型的工具:低代码、专业代码或混合。以下部分提供了每种工具类型的指导,并提供示例解决方案。 - [适用于入站集成的低代码工具](#适用于-salesforce-入站集成的低代码工具) - [适用于入站集成的混合工具](#适用于-salesforce-入站集成的混合工具) - [适用于入站集成的专业代码工具](#适用于-salesforce-入站集成的专业代码工具) ### 适用于 Salesforce 入站集成的低代码工具
指导 许可 时间 体积和规模 交付和维护 隐私和安全
何时使用 其他许可证 同步(请求/回复)或异步(火灾/忘记) 多对象支持 LDV/批量 测试和部署* 调试 内置错误处理/重试行为 可与静态加密的数据一起使用 身份验证协议
Heroku Connect 当您希望通过双向同步来扩展您的数据,以便在 Heroku 上启用移动和其他应用程序,并且您想要将数据也复制到 Salesforce 中时。 必填 异步 是 是 没有 使用专业代码工具 是 是,通过 Shield Connect OAuth
OmniStudio 集成程序 当您需要在没有用户交互的情况下从第三方来源导入和转换数据时。 必填 两者 是 是 是 声明性支持 没有 是 命名凭据
Salesforce Connect/外部对象 当您希望数据显示在 Salesforce UI 中,但希望数据存储在可以使用 Odata 或 GraphQL 等标准协议的外部系统中时。 必填 同步 是 是 是 使用专业代码工具 没有 N/A 多个
\*测试和部署是指在较低的环境中构建并通过[元数据 API](https://developer.salesforce.com/docs/metadata-coverage/)、软件包或更改集部署到生产环境的能力。 ### 用例:使用低代码工具的入站集成 > 联系人会在组织的 ERP 系统中更新。此联系信息需要在 Salesforce 中更新。 **Heroku Connect** Heroku Connect 通常用于保持 Heroku Postgres 数据库和 Salesforce 同步。除非 ERP 系统使用 Heroku Postgres 作为其交易存储,否则此用例是不可能的。如果它使用 Heroku Postgres,则在 Postgres 表中所做的更改可以使用 Heroku Connect 同步到 Salesforce 中的对象。 **OmniStudio 集成程序** 在 ERP 系统更新联系人记录后,可以通过数据映射器生成的 REST API 调用带有数据映射器加载操作和响应操作的 OmniStudio 集成程序。首先,数据映射加载操作发送 JSON 或 XML 负载,用于根据外部 ID 字段或通过[更新插入密钥](https://trailhead.salesforce.com/content/learn/modules/omnistudio-data-tools-and-internal-data/build-an-integration-procedure-with-conditional-dataraptor-loads?trail_id=build-guided-experiences-with-omnistudio)更新插入联系人记录。如果 JSON 中的简单响应是预期的全部,响应操作可以从以前的操作发回任何相关信息来指示成功或失败。如果 ERP 系统需要特定响应,则数据映射器转换或提取操作可用于生成具有附加功能的 JSON 或 XML 响应,以声明性地包含联系人记录更新在触发器中生成的数据。此场景的主要挑战是并发:同时多次调用更新同一联系人记录将导致问题,因为 API 直接存在于 Salesforce 中。 本用例不建议使用 **Salesforce Connect/外部对象** Salesforce Connect 和外部对象,因为场景特别需要在 Salesforce 中进行数据复制。如果您预先存在与 ERP 集成的 Salesforce Connect,您可以配置 Odata 4.0 连接器,以支持外部变更数据捕获(如果 ERP 可以支持变更数据捕获)。此外,您必须在 Salesforce 中配置,以使用发布/订阅 API 订阅来自 ERP 的变更流。 ### 适用于 Salesforce 入站集成的混合工具
指导 许可 时间 体积和规模 交付和维护 隐私和安全
何时使用 其他许可证 同步(请求/回复)或异步(火灾/忘记) 多对象支持 LDV/批量 测试和部署** 调试 内置错误处理/重试行为 可与静态加密的数据一起使用 身份验证协议
平台事件 当您需要自定义的结构化负载来近乎实时地更改 Salesforce 或外部系统时。 不需要* 异步 是 没有 是 使用专业代码工具 是 是 OAuth
Salesforce Connect/外部对象(带有自定义 Apex 适配器) 当您需要数据显示在 Salesforce UI 中,但希望数据存储在无法使用 Odata 2.0/4.0 协议的外部系统中时。 必填 两者 是 是 是 使用专业代码工具 没有 N/A 多个
Data 360 当您想要在一个数据存储中协调来自不同来源的数据,或者您想要从其他 Salesforce 组织或其他外部系统复制您的数据时。Data 360 还支持一些平台的虚拟化。 必填 两者 是 是 是 没有 是 是 多个
\* 高用量用例需要[加载项](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_event_limits.htm)。 \*\*测试和部署是指在较低的环境中构建并通过[元数据 API](https://developer.salesforce.com/docs/metadata-coverage/)、软件包或更改集部署到生产环境的能力。 ### 用例:使用混合工具的入站集成 > 联系人会在组织的 ERP 系统中更新。此联系信息需要在 Salesforce 中更新。 当联系人记录在 ERP 中更新时,外部系统中的**自定义代码**会发布平台事件。Salesforce 中的触发器、进程或流可以订阅平台事件,并在处理事件时更新相应的 Salesforce 对象。平台事件可能只是作为客户 ERP 系统中发生变化的信号,不包含任何数据,或者可能包含更新 Salesforce 对象所需的实际数据。 **Salesforce Connect/外部对象(带有自定义 Apex 适配器)**该解决方案不适用于需要数据复制的用例。如果您需要 Salesforce 中的用户查看来自外部系统的信息,而该外部系统又不支持 Odata 或 GraphQL 等标准协议,则此解决方案适用。请参阅[用例:出站整合使用混合工具](#用例使用混合工具的出站集成)作为 Apex 自定义适配器的用例示例。 **Data 360** 当联系人在外部系统(例如 ERP)中更新时,可以使用现成的连接器或使用 API 和专业代码工具(例如 MuleSoft)将联系人更新同步到 Data 360。联系人也可以使用零复制机制在 Data 360 中引用(适用于一些平台)。一旦数据在 Data 360 中可用,可以使用不同的现成集成机制将数据同步到其他 Salesforce 组织。可以使用 Data Cloud One 引用访问数据。使用激活和其他 API,使用现成的连接器,或者借助 MuleSoft Anypoint 平台等专业代码工具,也可以复制数据。 ### 适用于 Salesforce 入站集成的专业代码工具
指导 许可 时间 体积和规模 交付和维护 隐私和安全
何时使用 其他许可证 同步(请求/回复)或异步(火灾/忘记) 多对象支持 LDV/批量 测试和部署**** 调试 内置错误处理/重试行为 可与静态加密的数据一起使用 身份验证协议
Custom Apex REST & SOAP Web Services 当您需要比本地 API 端点提供的功能更多的功能时,例如跨对象处理或其他复杂逻辑。 不需要 两者 是 是 是 使用专业代码工具 没有 是*** 多个
MuleSoft Anypoint 当您需要单个企业级统一解决方案来构建、编排和管理您的集成时;当您需要替换传统的点对点架构时;或者当您需要 API 管理支持时。 必填 两者 是 是 是 使用专业代码工具 没有 是*** 多个
本地 Salesforce API 当您需要更多的控制或拥有专业代码技能来通过 REST API、SOAP API、批量 API 或 GraphQL API 或 gRPC 构建集成时。 不需要* 两者 是****** 是 是 使用专业代码工具 是** 是*** 多个
\*适用 [API 请求限制和分配](https://developer.salesforce.com/docs/atlas.en-us.salesforce_app_limits_cheatsheet.meta/salesforce_app_limits_cheatsheet/salesforce_app_limits_platform_api.htm)。 \*\*批量 API 具有重试行为的各个方面,一些 API 通过 allOrNone 设置提供*回滚*保护(例如,请查看复合和集合请求中的 [allOrNone 参数](https://developer.salesforce.com/docs/atlas.en-us.api_rest.meta/api_rest/resources_composite_allornone.htm)) \*\*\*启用 Shield Platform Encryption 会更改某些行为,有关详细信息,请参阅[一般 Shield Platform Encryption 注意事项](https://help.salesforce.com/articleView?id=sf.security_pe_considerations_general.htm&type=5)。 \*\*\*\*测试和部署是指在较低的环境中构建并通过[元数据 API](https://developer.salesforce.com/docs/metadata-coverage/)、软件包或更改集部署到生产的能力。 \*\*\*\*\*复合 API 支持多对象。 ### 用例:使用 Pro-Code 工具进行入站集成 > 联系人会在组织的 ERP 系统中更新。此联系信息需要在 Salesforce 中更新。 **自定义 Apex REST 和 SOAP Web Services**您可以使用 Apex 代码创建 Web Services,该代码可对联系人对象执行 CRUD(创建、读取、更新、删除)操作。此服务将通过 SOAP 或 REST 从外部系统 (ERP) 调用。 **MuleSoft Anypoint** MuleSoft Anypoint 的目的是提供企业级 API 管理。MuleSoft Anypoint 提供了一[套大型预构建连接器](https://www.mulesoft.com/platform/cloud-connectors),您可以使用这些连接器与许多 ERP 系统集成,包括 SAP、Oracle EBS、Oracle ERP 和 NetSuite。您可以创建流来监听这些 ERP 系统中的事件(在本例中,是在创建新联系人时)。在流开始时,将使用 Salesforce 连接器创建新的联系人记录(或更新联系人记录(如果联系人已存在)。此外,如果复制事务涉及将联系人整合至其他系统,也可以与其他系统集成。如果需要,您可以使用映射和转换语言 (DataWeave) 在多个不同的系统中执行复杂的逻辑和计算。针对这些系统的身份验证可以通过许多不同的身份验证机制完成,例如基本身份验证和 OAuth。只要流的大小适合其峰值利用率(以 vCores 衡量),事务量就没有限制。 **本地 Salesforce API** 当 ERP 系统中的更新事务完成时(或紧随其后 ) , 您可以通过 SOAP API 对联系人对象执行更新插入操作,或者对 Salesforce 组织中的联系人 sObjects REST API 执行[补丁](https://developer.salesforce.com/docs/atlas.en-us.api_rest.meta/api_rest/dome_update_fields.htm)。 ## Salesforce 到 Salesforce 集成 Salesforce 至 Salesforce 产品已达到其使用寿命。Salesforce 到 Salesforce 使合作伙伴能够轻松地向联合客户销售和支持,但 Salesforce 将投资为其他工具带来更多创新。下一步,建议在 Salesforce 组织之间共享数据时采用以下方法。 ### 跨 Salesforce 组织的数据集成工具
指导 成本 时间 体积和规模 交付和维护 隐私和安全 实施工具
何时使用 其他许可证 同步(请求/回复)或异步(火灾/忘记) 多对象支持 LDV/批量 测试和部署* 调试 内置错误处理/重试行为 可与静态加密的数据一起使用 身份验证协议 低代码 → 专业代码
Heroku Connect 当您希望通过 Salesforce 组织之间的双向同步来扩展您的数据,并且还支持从在 Heroku 上运行的移动和其他应用程序访问数据时 必填 异步 是 是 没有 使用专业代码工具 是 是,通过 Shield Connect OAuth 低代码
MuleSoft Anypoint 当您需要单个企业级统一解决方案来构建、编排和管理您的集成时;当您需要替换传统的点对点架构时;或者当您需要 API 管理支持时 必填 两者 是 是 是 使用专业代码工具 没有 是** 多个 Pro 代码
本地 Salesforce API 当 Salesforce 或 Heroku Connect 不可选或您需要更复杂的处理时 不需要 两者 没有 是 是 使用专业代码工具 没有 是** 多个 Pro 代码
变更数据捕获 当您需要将 Salesforce 中所做的记录级更改发布到外部系统并且不需要自定义负载时。 必填 异步 没有 没有 是 使用专业代码工具 是 是 OAuth
带跨组织适配器的 Salesforce Connect 当您希望一个组织中的用户在不复制数据的情况下查看或编辑不同组织中的记录时 必填 异步 是 是 是 使用专业代码工具 N/A N/A 多个 低代码
Data 360 当您希望一个组织中的用户查看或编辑具有在 Data 360 中复制的数据的不同组织中的记录时。 必填 两者 是 是 是 使用专业代码工具 是 是 多个 混合
\*测试和部署是指在较低的环境中构建并通过[元数据 API](https://developer.salesforce.com/docs/metadata-coverage/)、软件包或更改集部署到生产的能力 \*\* 启用 Shield Platform Encryption 会更改某些行为,更多详细信息请参阅 [General Shield Platform Encryption 注意事项](https://help.salesforce.com/articleView?id=sf.security_pe_considerations_general.htm&type=5)。 _平台事件对于将数据从一个 Salesforce 组织集成到另一个组织来说不是最佳选择,因为它们不能在组织之间“监听”同一个事件。自定义 Apex 也不是这类整合的推荐方法。_ ### 用例:连接多个 Salesforce 组织 > 大型企业跨多个业务部门 (BU) 运营。每个业务部门都有自己的 Salesforce 组织。单个客户与企业的多个业务部门打交道,因此在多个组织中拥有客户和业务机会数据。企业需要访问单个组织中所有业务部门的所有客户和业务机会数据的聚合视图。 _注意:根据 [Takeaway #1](#外卖),以下所有解决方案都旨在进行最少的数据复制。_ 使用现成的 Salesforce 连接器,可以将来自不同 Salesforce 组织的 **Data 360** 客户和业务机会数据接收到 Data 360 中。它们也可以汇总和协调(如果需要)。在 Data 360 中聚合数据后,可以使用 Data Cloud One 在其他 Salesforce 组织中访问它,而无需数据复制。 **Heroku Connect** 对于每个业务部门的单个组织,您可以使用 Heroku Connect 将更改从 Salesforce 同步到单个 Heroku Postgres 数据库中。在这种情况下,不会启用双向同步,只会从 Salesforce 同步到 Postgres。然后,在 Heroku Connect 中,您可以启用 Odata 提供商,并选择要在需要聚合视图的 Salesforce 组织中显示为外部对象的表。从 Salesforce 中,您可以定义指向 Heroku 中的 Odata 提供商的外部数据源。 **MuleSoft Anypoint** MuleSoft Anypoint 提供企业级 API 管理。可以配置 MuleSoft Anypoint API,以便它使用具有多个组织连接的 Salesforce 连接器从多个相关的 Salesforce 组织读取信息。MuleSoft 流可以查询不同的 Salesforce 组织,并返回特定的结构,如果需要,该结构可以通过其他第三方信息来增强或丰富。当调用 API 时,它将进行所有正确的 Salesforce 组织标注(在本例中查询客户和业务机会信息),以便消费者可以处理数据(可能是 UI)。针对这些系统的身份验证可以通过多种身份验证机制完成,包括基本身份验证和 OAuth。只要流的大小适合其峰值利用率(以 vCores 或 Core 衡量),事务量就没有任何限制。 **本地 Salesforce API** 查询操作可以发布到每个感兴趣的组织,特别是通过 Salesforce 批量 API 2.0,它非常适合高效地提取数千条记录。您可以分别检索每个组织的查询结果,并根据客户需求通过自定义应用程序或中间件进行聚合。 具有跨组织适配器的 **Salesforce Connect** Salesforce Connect 跨组织适配器不太适合这种情况,因为来自远程组织的客户或业务机会都将作为*不同*的对象出现在中央组织中。例如,无法为所有组织中的所有业务机会的金额相加。 **跨组织选择性更新场景:**使用 Salesforce 组织 A 的销售人员需要在组织 A 工作时查看和更新 Salesforce 组织 B 的个案数据,并将个案评论添加到 Salesforce 组织 B 的父级个案。数据不得复制到组织 A。 **Heroku Connect** 您可以使用上述*数据聚合场景*中描述的相同方法。但是,您必须通过 Odata 连接器在外部对象上启用 CRUD,并将更改写回 Heroku Postgres。 **MuleSoft Anypoint** MuleSoft Anypoint 提供企业级 API 管理。您可以使用上述*数据聚合场景*中描述的相同方法。 **本地 Salesforce API** 使用命名凭据并调用本地 Salesforce API,以读取和更新相关 Salesforce 组织中的数据。组件必须设计为显示数据。 具有跨组织适配器的 **Salesforce Connect** 通过 [Salesforce 跨组织适配器](https://help.salesforce.com/articleView?id=sf.xorg_adapter_about.htm&type=5)支持在外部对象中查看数据(以及在外部对象上启用 CRUD 的情况下编辑数据)的能力。外部对象之间也支持关系,因此您可以链接到外部对象中的父级个案。但是,创建关系现在是一个手动过程,您将现有的数据类型转换为关系数据类型。此外,为了更有效地处理个案,在 Service Cloud 中实施的优化不会级联到远程组织。Salesforce 强烈建议测试跨组织适配器,并评估用例使用外部对象与标准对象时的权衡。 **跨组织数据同步**:当客户的客户在组织的一个业务部门 Salesforce 组织中更新时,其他 Salesforce 组织的客户对象需要更新,以保持一致的客户信息。 **Data 360** Data 360 可用于从一个组织到另一个 Salesforce 组织的数据复制。一个 Salesforce 组织的客户数据可以使用现成的 Salesforce 连接器接收到 Data 360。我们可以使用数据激活机制,例如批量激活、近乎实时的数据操作或基于 API 的激活,还可以将数据从 Data 360 移动到 Salesforce 组织。 **Heroku Connect** 您可以使用上述*数据聚合场景*中描述的相同方法。但是,您必须启用双向同步,并且您不再需要启用 Salesforce Connect,因为当对 Postgres 表进行更改时,双向同步将使所有组织保持最新状态。 **MuleSoft Anypoint** MuleSoft Anypoint 提供企业级 API 管理。您可以在 MuleSoft Anypoint 中使用流设计器[配置 Mule 应用程序](https://docs.mulesoft.com/design-center/about-designing-a-mule-application),以监听标准和自定义对象事件,从而在 Salesforce 中启动自动启动的流。当触发 Mule 应用程序时,它可以调用 Anypoint Connector for Salesforce 来与任意数量的 Salesforce 组织通信。在此用例中,当在一个 Salesforce 组织中更新客户记录时,Mule 应用程序可以更新相关 Salesforce 组织中的客户记录。每个相关的 Salesforce 组织在 MuleSoft 的整体应用程序流中都会内置一个唯一的更新步骤。针对这些系统的身份验证可以通过各种身份验证机制完成,包括基本身份验证和 OAuth。只要流的大小适合其峰值利用率(以 vCore 或 Core 衡量),事务量就不会受到限制。 **本地 Salesforce API** [复制 API](https://developer.salesforce.com/docs/atlas.en-us.api.meta/api/sforce_api_guidelines_datareplication.htm) (getUpdated、getDeleted 操作) 可用于跨组织同步数据,但不建议使用此方法。 带跨组织适配器的 **Salesforce Connect** 您可以使用记录触发的流和外部对象来保持一些数据在 Salesforce 组织之间同步。例如,更新组织 A 中的客户记录会触发流,然后更新客户外部对象上的匹配记录,并将这些更新写入组织 B 中的客户记录。这需要正确使用流语义,以避免[混合 DML 事务](https://help.salesforce.com/articleView?id=000328873&type=1&mode=1)。此外,请记住,组织 B 中的验证规则和流将以与 REST/SOAP API 更改时相同的方式触发。 ## 结束语 请记住本指南,并在计划涉及 Salesforce 的新数据集成时参考。了解您可用的选项的全部范围,以及它们如何与您的特定用例相适应始终是一个好主意。 ### 告诉我们您的想法 帮助我们确保发布与您最相关的内容。[参加我们的调查](https://sfdc.co/J0cWb),提供有关此内容的反馈,并告诉我们您接下来想要看到的内容。 # 为事件驱动的架构使用正确的工具和模式 ## 概览 事件驱动的架构支持事件的高效生产和消费,这些事件传达系统或应用程序状态的变化。这些架构支持系统与支持流程之间的灵活连接,以及跨系统工作的近乎实时的更新。虽然事件驱动架构的优势显而易见,但实施细节并不总是那么清晰。在事件驱动的架构模式中,需要考虑哪些功能?这些模式解决哪些具体问题?解决方案有哪些特殊注意事项,解决这些问题的最佳模式是什么? 本指南介绍了在使用 Salesforce 技术时用于构建最佳事件驱动架构的模式。它还讨论了 Salesforce 提供的事件工具,并为一些用例提供了工具推荐。有关涉及 Salesforce 的数据级集成的信息,请参阅[数据集成决策指南](/docs/architect/zh-cn/decision-guides/guide/data-integration)。 ## 外卖 - **对于不需要同步响应请求的流程,使用事件驱动的架构。**本指南中概述的模式旨在实现数据的一致性、可扩展性和重用,这有助于随着贵组织的应用程序环境的发展,将技术债务保持在最低水平。(有关更多信息,请查看[结构合理 - 吞吐量](/docs/architect/zh-cn/well-architected/guide/reliable#吞吐量)。) - **如果 MuleSoft 或其他企业服务总线 (ESB) 解决方案是现有环境的一部分,请尽可能使用它。**这些解决方案专为支持事件驱动的架构模式而构建,具有强大的功能,使您能够在整个企业中重复使用集成。 - **将发布/订阅 API 用于任何未来的发布/订阅模式,而不是使用其他 API(包括流 API)构建自己的事件处理器。**现在,发布/订阅 API 已普遍可用,请将其用于任何新的发布/订阅模式。在可行时,计划使用其他平台 API(例如串流 API 或自定义 Apex 服务)将现有事件通信迁移到发布/订阅 API。 - **平台事件和变更数据捕获(CDC)是发布需要其他系统使用的记录和字段变更的首选机制。**我们不建议将 PushTopic 和通用事件用于新实施。Salesforce 将继续在当前功能范围内支持 PushTopic 和通用事件,但不打算对此技术进行进一步投资。 ## 范围内的产品
Salesforce 平台 Salesforce 平台是一个 AI 驱动的综合平台,将员工、自主 AI 客服人员、公司数据和应用程序统一到一个可信的系统中,以提高生产率和客户体验。它通过连接 Customer 360 应用程序、Data Cloud 和 Slack 来实现端到端自动化,从而支持创建“代理企业”。
MuleSoft MuleSoft 是 Salesforce 领先的集成平台,使组织能够跨本地和云环境连接应用程序、数据和设备。MuleSoft 是一个平台,它为 IT 提供了平台来解锁系统之间的数据,开发可扩展的集成和自动化框架,并快速创建差异化的连接体验。
## 决策点 事件驱动架构 (EDA) 推荐用于需要近乎实时通知、分配高用量或复杂消息的处理负载以及集成需要通过排队实现连接弹性的系统(例如 IoT 和移动设备)的场景。然而,不应为需要即时、同步人工响应的进程实施 EDA,因为它们专为异步执行而设计。如果源数据更改频率如此之低,以至于批处理等简单模式就足够了,那么它们也不适合。 ### 何时使用事件驱动的架构 以下是一些通常非常适合事件驱动架构的常见场景:
决策点指导
近乎实时通知事件驱动的架构模式(例如发布/订阅、扇出和流)通常在多个应用程序需要近乎实时地通知状态更改或记录更新的情况下工作良好。
并行处理发布/订阅等模式往往适用于大量数据或高度复杂的消息需要在多个系统之间分配处理负载的场景。
高用量读取传递的消息和队列模式通常用于组织遇到激增的情况,并且正在生成的消息量可能超出订阅者立即处理它们的能力。
高用量写入流和队列模式在许多组织遇到消息生成数量激增的场景中效果良好。
将相同数据发送到不同系统虽然对于需要将相同数据发送到多个系统的组织来说,发布/订阅往往是相当常见的解决方案,但它可以通过本文涵盖的大多数模式来解决。请确保详细查看它们,以找到最合适的。
频繁引入新系统或设备发布/订阅、流和队列模式通常适用于总体情况变化不定的场景,并定期添加新的系统和设备。在这种情况下,新系统或设备只需要成为事件总线的订阅者或与队列相关联,就可以开始接收消息,而无需自定义点对点集成。
IoT 设备因为 IoT 设备通常提供频繁更新,并且在某些情况下也会生成大量消息,所以当将它们集成到 IT 环境中时,流和队列模式往往很好用。
离线移动设备和系统对于需要在互联网接入质量低或根本不存在或在消息传递时可能离线的系统中工作的移动设备,他们将受益于队列模式,该模式使他们能够连接到他们的队列并在他们重新在线时检索任何相关的消息。
大多数大型组织都拥有复杂的 IT 环境,这些环境包含具有不同功能的系统组合。您的组织可能或很可能拥有不支持事件驱动集成的传统系统。您可能也有事件驱动的集成没有意义的用例,即使系统将支持它们(例如,第三方的 SFTP 文件传输)。如果您退一步看贵组织的整体 IT 环境,您很可能会像其他架构解决方案一样,采用混合模式来支持不同的场景。当您决定将事件驱动作为集成的首选方法时,请将其视为工具箱中的另一个工具。它可以而且应该在正确的场景中使用,但它不是强加给每个系统的方法。制定全面的集成策略将帮助您确定本指南中描述的模式何时适用或不适用。 ### 何时不使用事件驱动的架构 许多场景需要事件驱动的架构,而在某些情况下,事件驱动的架构可以工作,即使它们不是最合适的架构。但在某些情况下,根本不应该使用事件驱动的架构。以下是一些决策点问题,可帮助您识别这些情况:
决策点指导/要问的问题
业务需求对于[何时使用事件驱动的架构](#何时使用事件驱动的架构)部分中描述的任何功能,是否有真正的业务需求?
技术要求您正在设计的集成是否明显适合不同的模式,例如数据虚拟化、批处理或请求/回复?换句话说,您是在尝试将方形钉子放入圆形孔中吗?
需要人类等待响应的进程任何涉及人类等待目标系统响应的集成都不适合事件驱动的架构,因为它们专为异步执行而设计,不能保证响应时间。在实施技术解决方案之前,请考虑这样的流程是否是您的组织的最佳选择。有关更多信息,请查看[设计良好 - 流程设计](/docs/architect/zh-cn/well-architected/guide/automated#流程设计)。
不经常更改源数据如果源系统中的数据变化如此频繁,以至于定期更新足够,您很可能会通过使用[批处理模式](https://developer.salesforce.com/docs/atlas.en-us.integration_patterns_and_practices.meta/ integration_patterns_and_practices/integ_pat_batch_data_sync.htm)而不是事件驱动的模式来简化您的架构。
实施要求解决方案涉及的大多数系统是否支持事件驱动的架构?将事件驱动的架构与不支持它们的系统一起使用(例如,升级、自定义或中间件)需要什么?满足这些要求需要付出什么程度的努力?
消息结构稳定性您的消息结构需要多久更改一次?哪些系统将受此更改的影响,修复过程是什么?
组织治理您是否拥有治理结构来确保所有相关方了解并能够权衡消息结构、触发器和其他与架构和流程相关的决策的变化?
所需技能集您的员工是否拥有事件驱动架构的经验,他们是否知道如何支持它们?
## 用例 事件驱动的架构模式多种多样。一些是通用模式,可以应用于除事件驱动之外没有任何特殊要求的用例;例如,请参见[架构良好 - 交互](/docs/architect/zh-cn/well-architected/guide/composable#交互性)性。其他模式适用于此处讨论的特定用例,例如涉及大量数据的集成,或需要更长的消息保留时间的场景。 ### 模式概览 下表比较了本文档中概述的模式的属性。当您需要确定给定用例的潜在模式时,将其用作快速参考。
模式近乎实时唯一消息副本保证交货减小消息大小转换数据
发布/订阅✓✓✓
扇出✓✓✓
传递的消息✓✓✓✓
流✓✓✓
排队✓✓✓
### 适用于事件驱动架构的工具 Salesforce 提供多种工具,以帮助您解决事件驱动的用例。此表包含可用工具的高级概览。
工具描述所需技能
MuleSoftAnypoint 平台使用 API 层实现数据集成的平台。赞成代码
Salesforce 发布/订阅连接器发布/订阅 API 连接器,它为发布和订阅平台事件、实时事件监控事件和变更数据捕获事件提供了单一界面。赞成代码
MuleSoft Anypoint JMS 连接器连接器,允许向实施 Java 消息服务 (JMS) 规范的任何消息服务的队列和主题发送和接收消息。赞成代码
MuleSoft Anypoint Apache Kafka 连接器用于在 Apache Kafka 和企业应用程序和服务之间移动数据的连接器。赞成代码
MuleSoft Anypoint Solace 连接器使用 JCSMP Java SDK 与本地 API 集成的 Solace PubSub+ 事件经纪人连接器赞成代码
MuleSoft Anypoint MQ 连接器一种多租户云消息传递服务,使客户能够在他们的应用程序之间执行高级异步消息传递。赞成代码
MuleSoft Anypoint MQTT 连接器符合 MQTT(消息队列遥测传输)v3.x 协议的 MuleSoft 扩展。赞成代码
MuleSoft Anypoint AMQP 连接器一种连接器,可让您的应用程序使用符合 AMQP 0.9.1 标准的代理发布和使用消息。赞成代码
MuleSoft Anypoint 事件驱动 (ASync) API与行业无关的语言,通过将事件驱动的 API 分为事件、渠道和传输层,支持发布它们。赞成代码
MuleSoft Anypoint MQ多租户云消息传递服务,可让客户在应用程序之间执行高级异步消息传递。赞成代码
MuleSoft Anypoint Data StreamsMuleSoft Anypoint 中可用于发布和订阅流数据的框架。赞成代码
Salesforce 平台Apache Kafka on HerokuHeroku 加载项,将 Apache Kafka 作为服务提供,并将平台完全集成到 Heroku 平台。赞成代码
变更数据捕获更改事件日志,发布对 Salesforce 记录的更改。更改包括创建新记录、更新现有记录、删除记录和取消删除记录。低代码到专业代码
出站消息在 Salesforce 中更新字段值时,向外部端点发送 XML 消息的操作。低代码
平台事件包含自定义事件数据的安全和可扩展的消息。低代码到专业代码
发布/订阅 API支持订阅平台事件、变更数据捕获事件和/或实时 Event Monitoring 事件的 API。赞成代码
事件中继允许将平台事件和变更数据捕获事件从 Salesforce 发送到 Amazon EventBridge。请注意,事件中继仅连接到 AWS Eventbridge。低代码
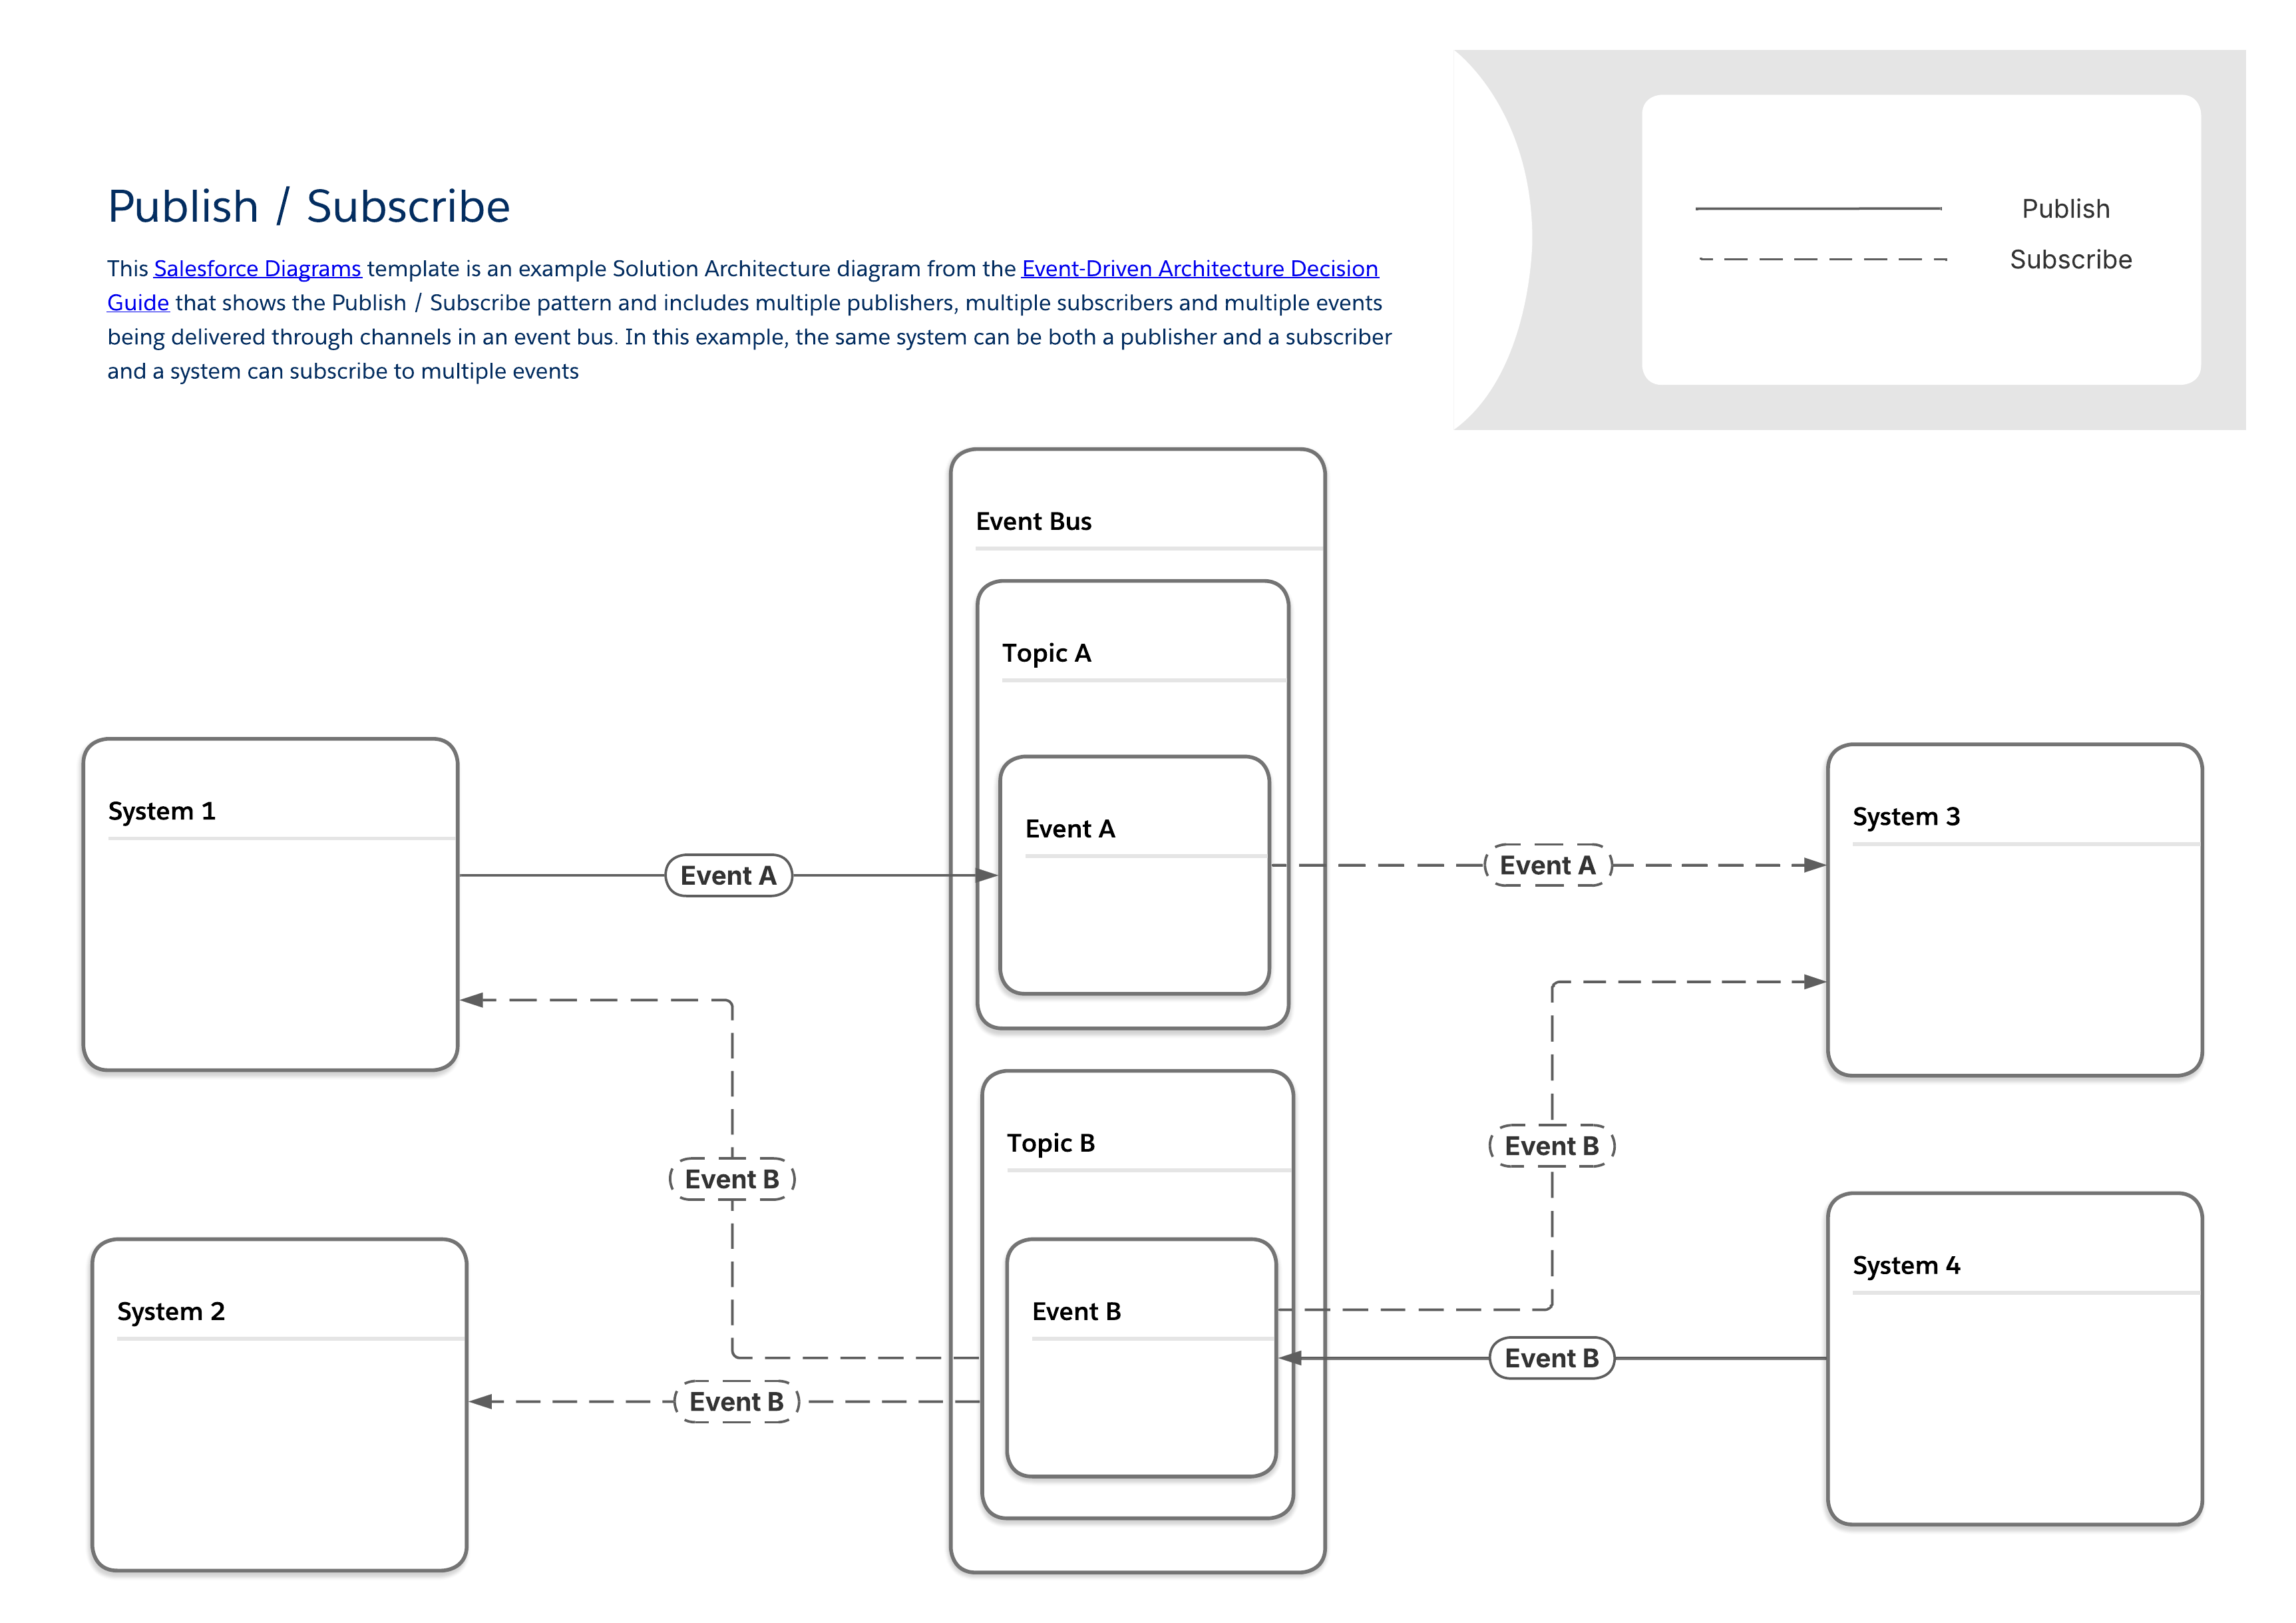
### 发布/订阅 当关键记录在核心应用程序中改变状态时(例如,订单的状态从“正在处理”变为“已发货”),多个其他系统可能需要近乎实时的通知来执行各自的任务。当这些更改的数量很大并且消息很复杂时,就会产生特定的业务需求,这使得传统的点对点集成变得繁重和难以维护。为每个依赖应用程序建立脆弱的自定义连接会导致技术债务,并抑制组织快速扩展的能力。需要一种强大的集成方法来管理这些频繁的数据同步,而无需将源系统直接耦合到每个消耗系统。 #### 发布/订阅模式 下图描述了典型的发布/订阅模式,多个发布者和订阅者通过事件总线共享数据。这种基本模式构成了本指南其余部分中可以找到的更具体的模式的基础。该模式的一些关键特征是: - 发布者和订阅者之间没有直接联系。发布者只需向事件总线发送消息,事件总线便会将它们广播到任何其他想要监听它们的系统。 - 同一系统可以是发布者和订阅者。 - 系统可以发布或订阅多种类型的事件。 - 与本指南中的所有模式一样,发布/订阅模式属于通用集成模式类别,称为远程过程调用 (RPI),或简称[为"触发并忘记 " 。](/docs/architect/zh-cn/fundamentals/guide/integration-patterns#远程进程调用--触发并忘记) 此 2 级图表显示了发布/订阅模式的示例,该模式包括多个发布者、多个订阅者和通过事件总线中的渠道传递的多个事件。在此模式中,同一系统可以同时是发布者和订阅者,系统可以订阅多个事件。 #### 与发布/订阅模式相关的工具
事件流和行为有效载荷注意事项
可用工具所需技能发布方式订阅方式重放期间有效载荷结构有效载荷限制
MuleSoftAnypoint 平台赞成代码APIAPI已配置用户定义无
Salesforce 发布/订阅连接器赞成代码APIAPI已配置用户定义无
MuleSoft Anypoint JMS 连接器赞成代码APIAPI已配置用户定义无
MuleSoft Anypoint Apache Kafka 连接器赞成代码APIAPI已配置用户定义无
MuleSoft Anypoint Solace 连接器赞成代码APIAPI已配置用户定义无
MuleSoft Anypoint MQ 连接器赞成代码APIAPI已配置用户定义无
MuleSoft Anypoint MQTT 连接器赞成代码APIAPI已配置用户定义无
MuleSoft Anypoint AMQP 连接器赞成代码APIAPI已配置用户定义无
MuleSoft Anypoint 事件驱动 (ASync) API赞成代码APIAPI已配置用户定义无
MuleSoft Anypoint MQ赞成代码APIAPI已配置用户定义无
Salesforce 平台Apache Kafka on Heroku赞成代码API,Heroku Postgres 中的记录更改N/A ⁇ 周用户定义用户定义
变更数据捕获低代码到专业代码记录更改Apex、API、Lightning Web 组件 (LWC)3 天预定义1 MB
出站消息*低代码流和工作流规则N/A24 小时用户定义每条消息 100 条通知
平台事件低代码到专业代码API、Apex、流Apex、API、Flow、LWC3 天用户定义1 MB
发布/订阅 API赞成代码发布/订阅 API 或 API、Apex、流发布/订阅 API3 天用户定义1 MB
事件中继**低代码平台事件、变更数据捕获API3 天用户定义1 MB
*Salesforce 将继续在当前功能范围内支持出站消息,但不打算对此技术进一步投资。**事件中继仅连接到 AWS Eventbridge
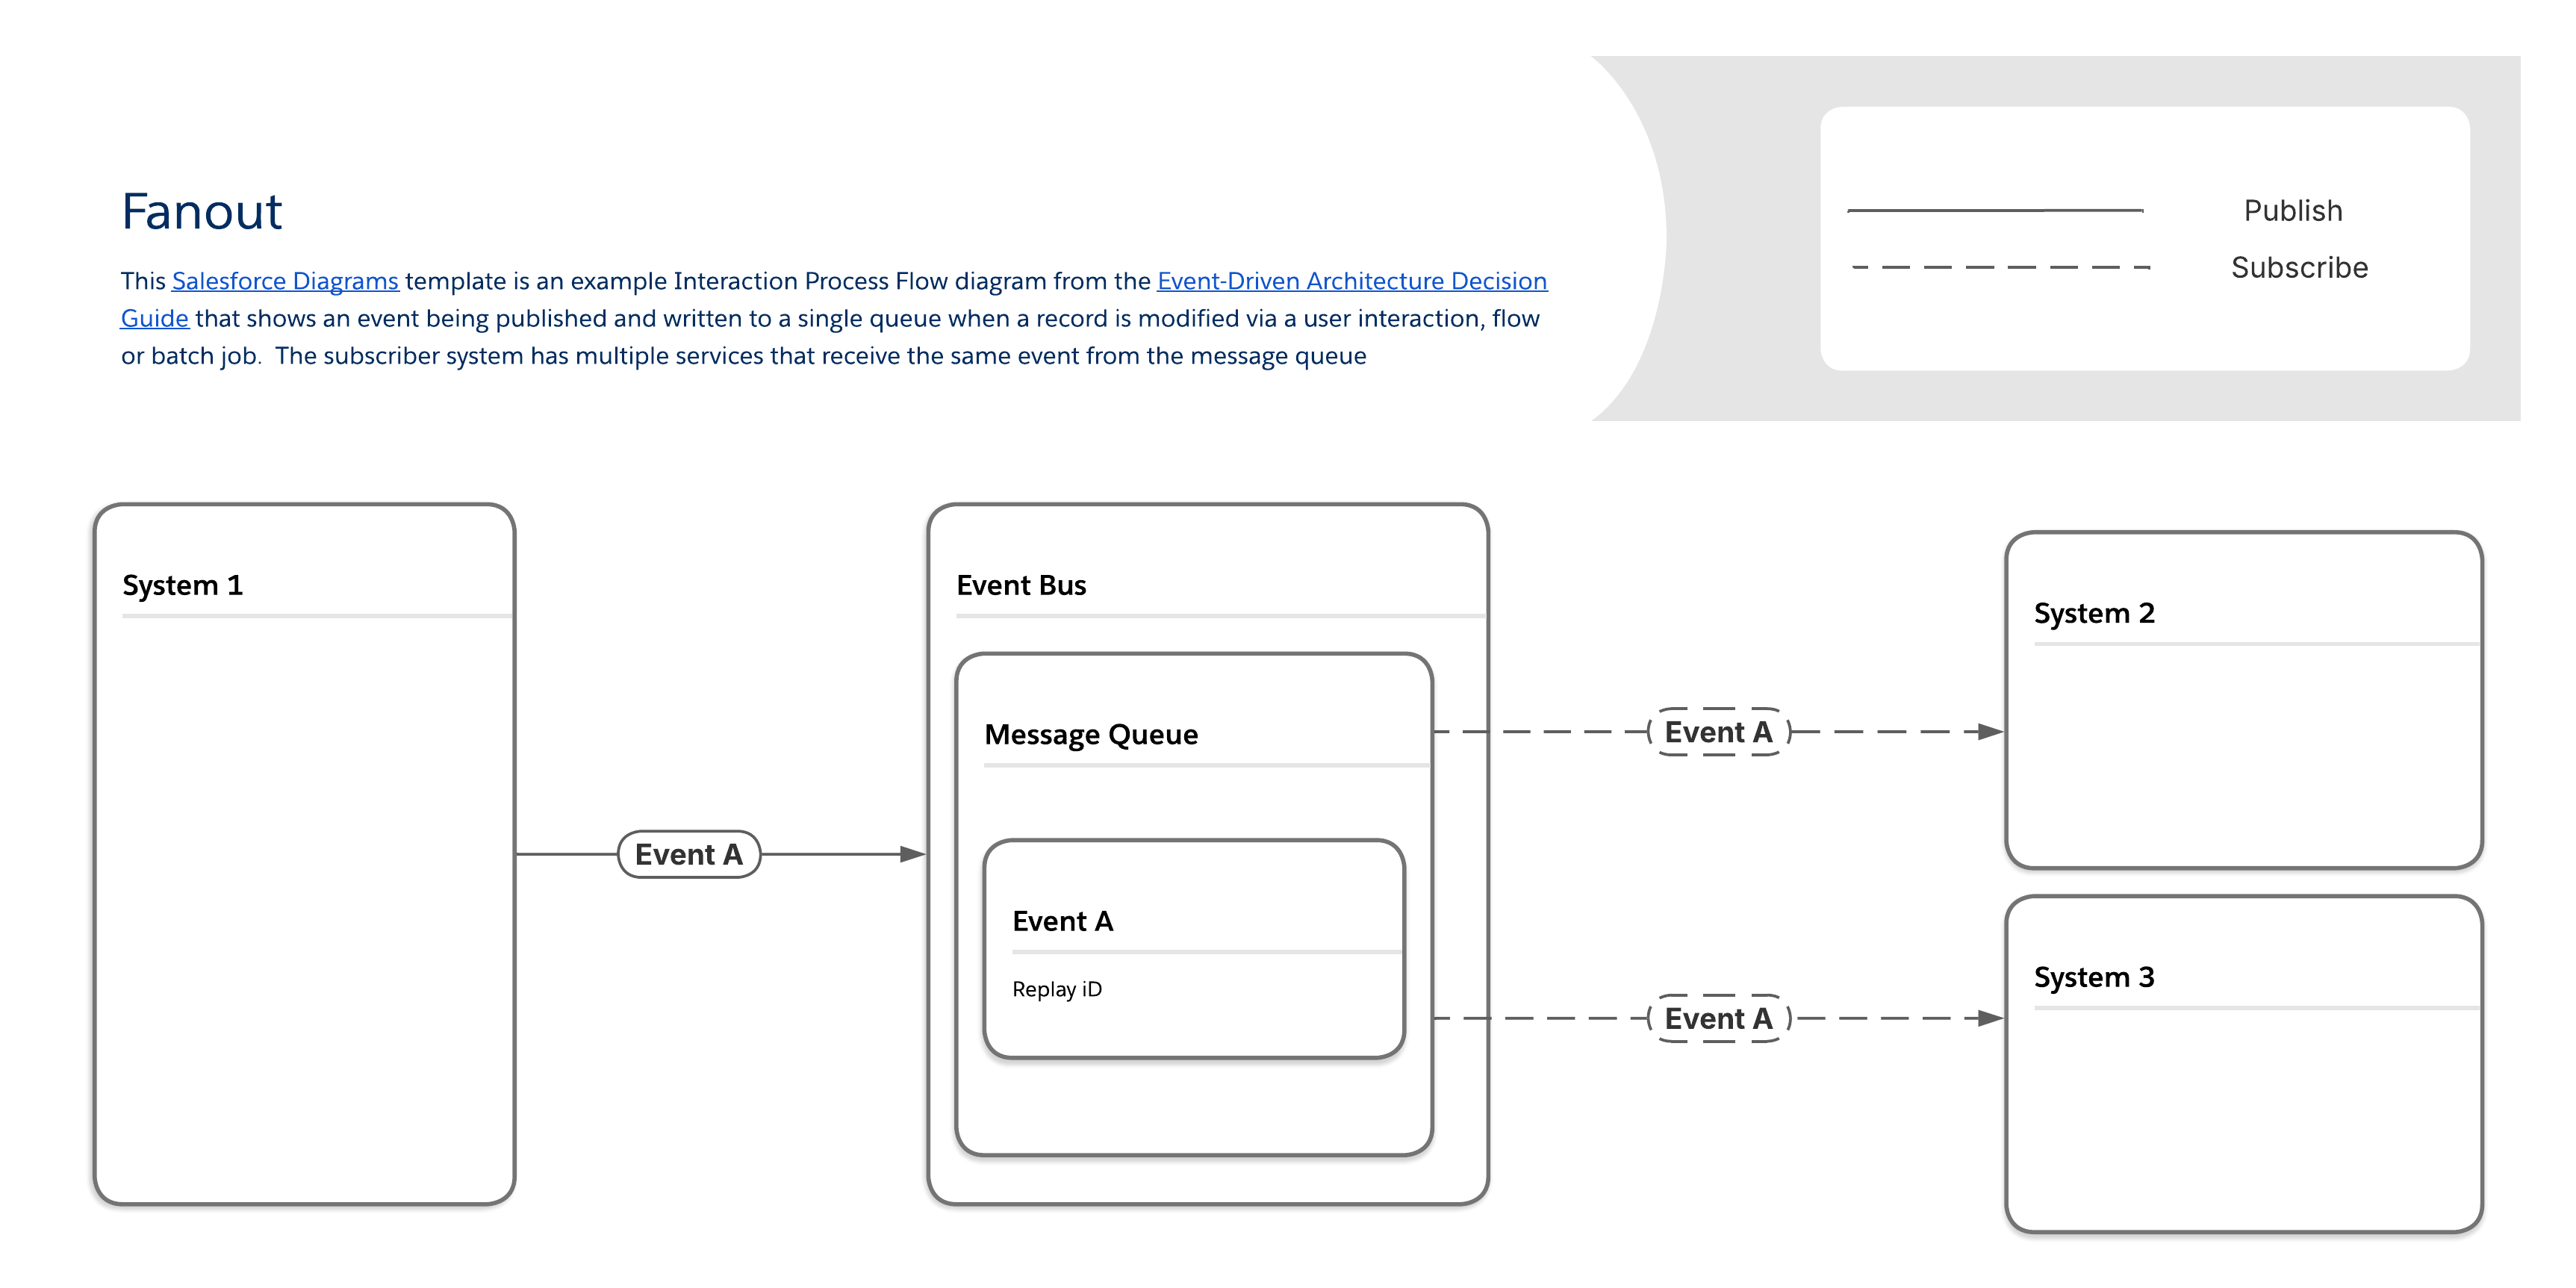
### 扇出 当组织需要向大量客户端应用程序发送即时更新时,例如向移动设备发送推送通知或短信,为每个单个收件人创建唯一传输的传统流程会很快成为可扩展性瓶颈。在这种情况下,核心业务需求是同时将单个信息(例如客户提醒或重要服务变更通知)快速、高性能地分发到多个端点应用程序。满足此要求的简化方法包括通过单个队列路由所有消息,该队列充当所有消耗系统的事件信息中心点。这种方法通过消除对许多单独消息副本的管理来提高性能。 #### 扇出模式 通过扇出模式,消息通过单个消息队列传递到一个或多个目的地(即监听客户端或订阅者)。订阅者从队列中检索相同的消息,而不是他们自己的唯一副本。(请注意,虽然这会提高性能,但也会增加验证特定订阅者是否收到消息的难度。) 此 3 级文档和实施图显示了扇出模式的示例。它描述了当通过用户交互、流或批处理作业修改记录时,正在发布和写入单个队列的事件。订阅者系统有多个服务从消息队列接收相同的事件。 #### 与扇出模式相关的工具
事件流和行为有效载荷注意事项
可用工具所需技能发布方式订阅方式重放期间有效载荷结构有效载荷限制
MuleSoftMuleSoft Anypoint JMS 连接器赞成代码APIAPI已配置用户定义无
Salesforce 发布/订阅连接器赞成代码APIAPI已配置用户定义无
MuleSoft Anypoint Apache Kafka 连接器赞成代码APIAPI已配置用户定义无
MuleSoft Anypoint Solace 连接器赞成代码APIAPI已配置用户定义无
MuleSoft Anypoint MQ 连接器赞成代码APIAPI已配置用户定义无
MuleSoft Anypoint MQTT 连接器赞成代码APIAPI已配置用户定义无
MuleSoft Anypoint AMQP 连接器赞成代码APIAPI已配置用户定义无
MuleSoft Anypoint MQ赞成代码APIAPI已配置用户定义无
Salesforce 平台Apache Kafka on Heroku赞成代码API,Heroku Postgres 中的记录更改N/A ⁇ 周用户定义用户定义
变更数据捕获低代码到专业代码记录更改Apex、API、Lightning Web 组件 (LWC)3 天预定义1 MB
平台事件低代码到专业代码API、Apex、流Apex、API、Flow、LWC3 天用户定义1 MB
发布/订阅 API赞成代码发布/订阅 API 或 Apex、API、流发布/订阅 API3 天用户定义1 MB
事件中继*低代码平台事件、变更数据捕获API3 天用户定义1 MB
*事件中继仅将数据发送到 AWS Eventbridge
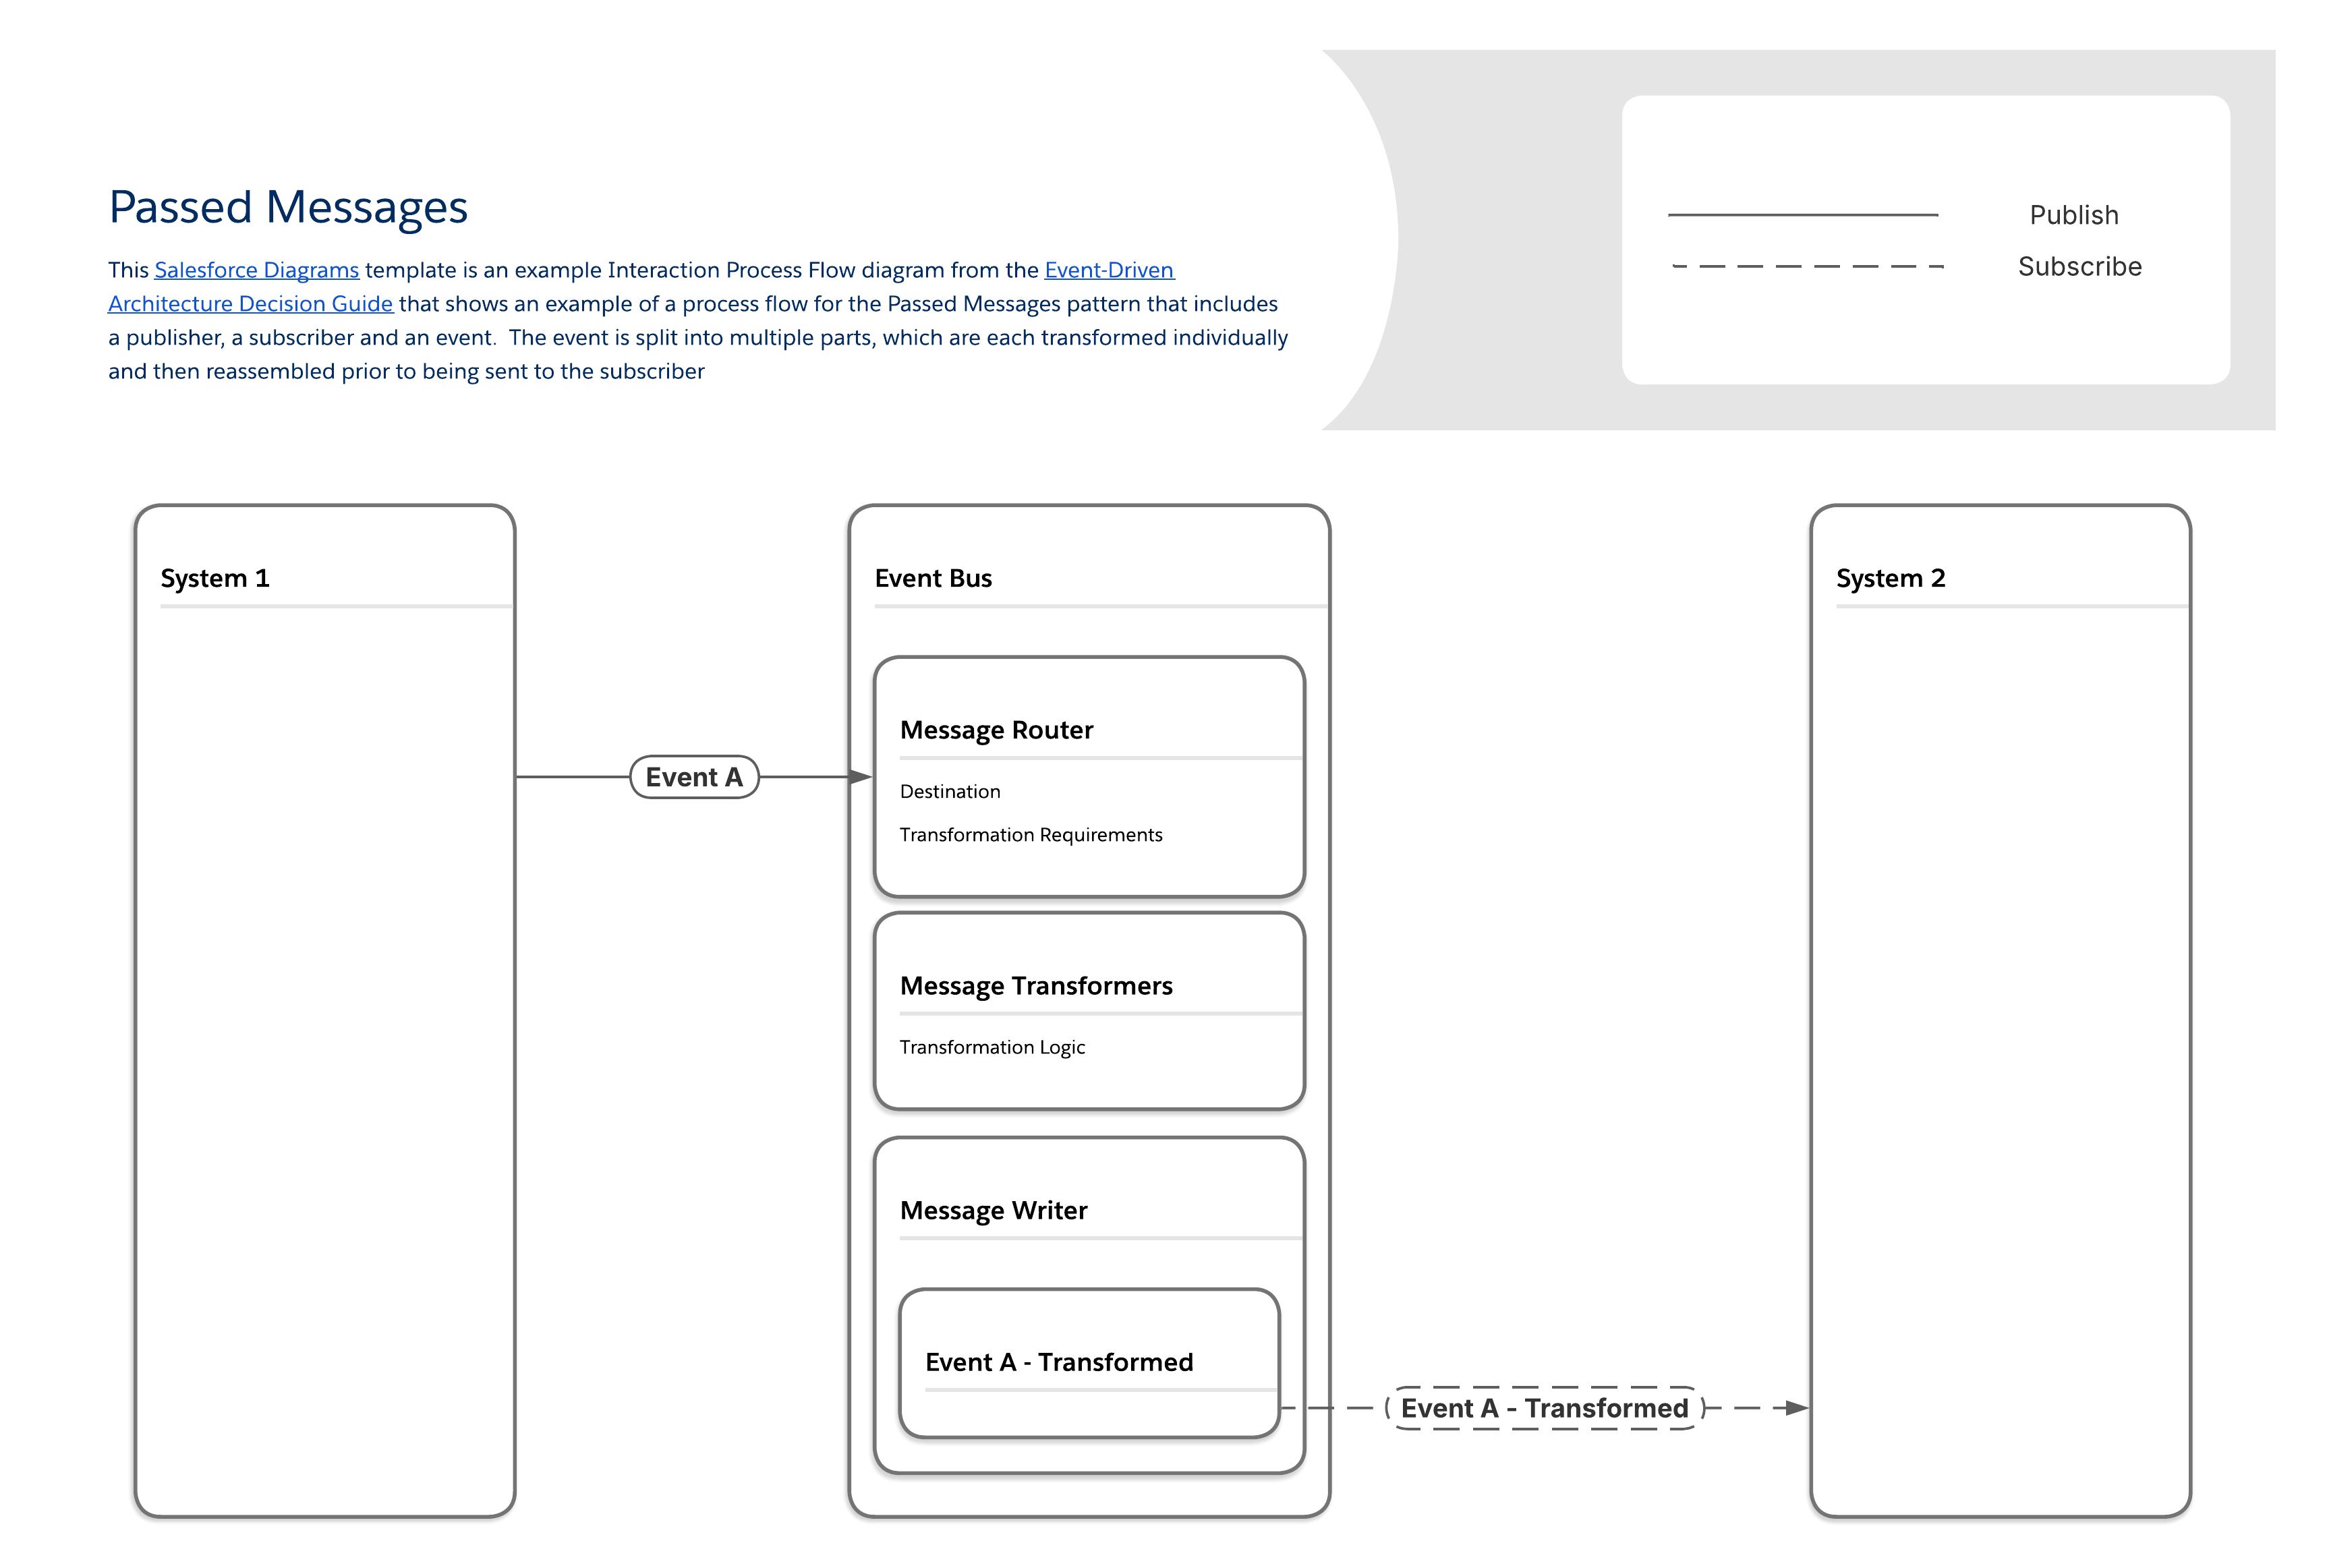
### 传递的消息 一些事件场景的特点是大量消息涌入,有可能超出同步和转换流程的工作量,或者具有处理和转换事件数据所需的复杂、多步骤逻辑。 一些示例包括: - **季节性用量高峰:**当在线零售商选择的产品处于“季节性”时,他们会遇到销量高峰。当大量客户同时进行购买时,生成的事件数量可能会暂时超出同步和转换流程的工作量。有关更多信息,请查看[架构良好 - 数据处理](/docs/architect/zh-cn/well-architected/guide/automated#数据处理)。 - **个案或索赔管理:**基于服务的公司在停机期间可能会遇到个案或索赔数量的激增。 - **复杂数据转换:**需要复杂逻辑来转换消息的组织通常担心事件的生成速度比转换速度快。 #### 传递的消息模式 这种模式解决了消息生成速度超过转换速度的挑战。它确保可以可靠地处理大量消息和所需的数据操纵,将流消息平台和消息处理逻辑细分为专用组件。 “传递的消息”模式的工作方式是将消息处理逻辑划分为多个组件: - 一个组件处理消息路由,确定所需的转换和最终目的地。 - 一组单独的组件处理不同的消息转换层(例如,字段映射、对象关系等)。 - 最后一个组件会写入最终的修改消息。 此 3 级文档和实施图显示了传递的消息模式的流程示例,该模式包括发布者、订阅者和消息。消息被分成多个部分,这些部分被单独转换,然后在发送给订阅者之前被重新组合。 #### 与传递的消息模式相关的工具
事件流和行为有效载荷注意事项
可用工具所需技能发布方式订阅方式重放期间有效载荷结构有效载荷限制
MuleSoftMuleSoft Anypoint Apache Kafka 连接器赞成代码APIAPI已配置用户定义无
Salesforce 发布/订阅连接器赞成代码APIAPI已配置用户定义无
Salesforce 平台Apache Kafka on Heroku赞成代码API,Heroku Postgres 中的记录更改N/A ⁇ 周用户定义用户定义
变更数据捕获低代码到专业代码记录更改Apex、API、Lightning Web 组件 (LWC)3 天预定义1 MB
平台事件低代码到专业代码API、Apex、流Apex、API、Flow、LWC3 天用户定义1 MB
发布/订阅 API赞成代码发布/订阅 API 或 API、Apex 流发布/订阅 API3 天用户定义1 MB
事件中继*低代码平台事件、变更数据捕获API3 天用户定义1 MB
*事件中继仅将数据发送到 AWS Eventbridge
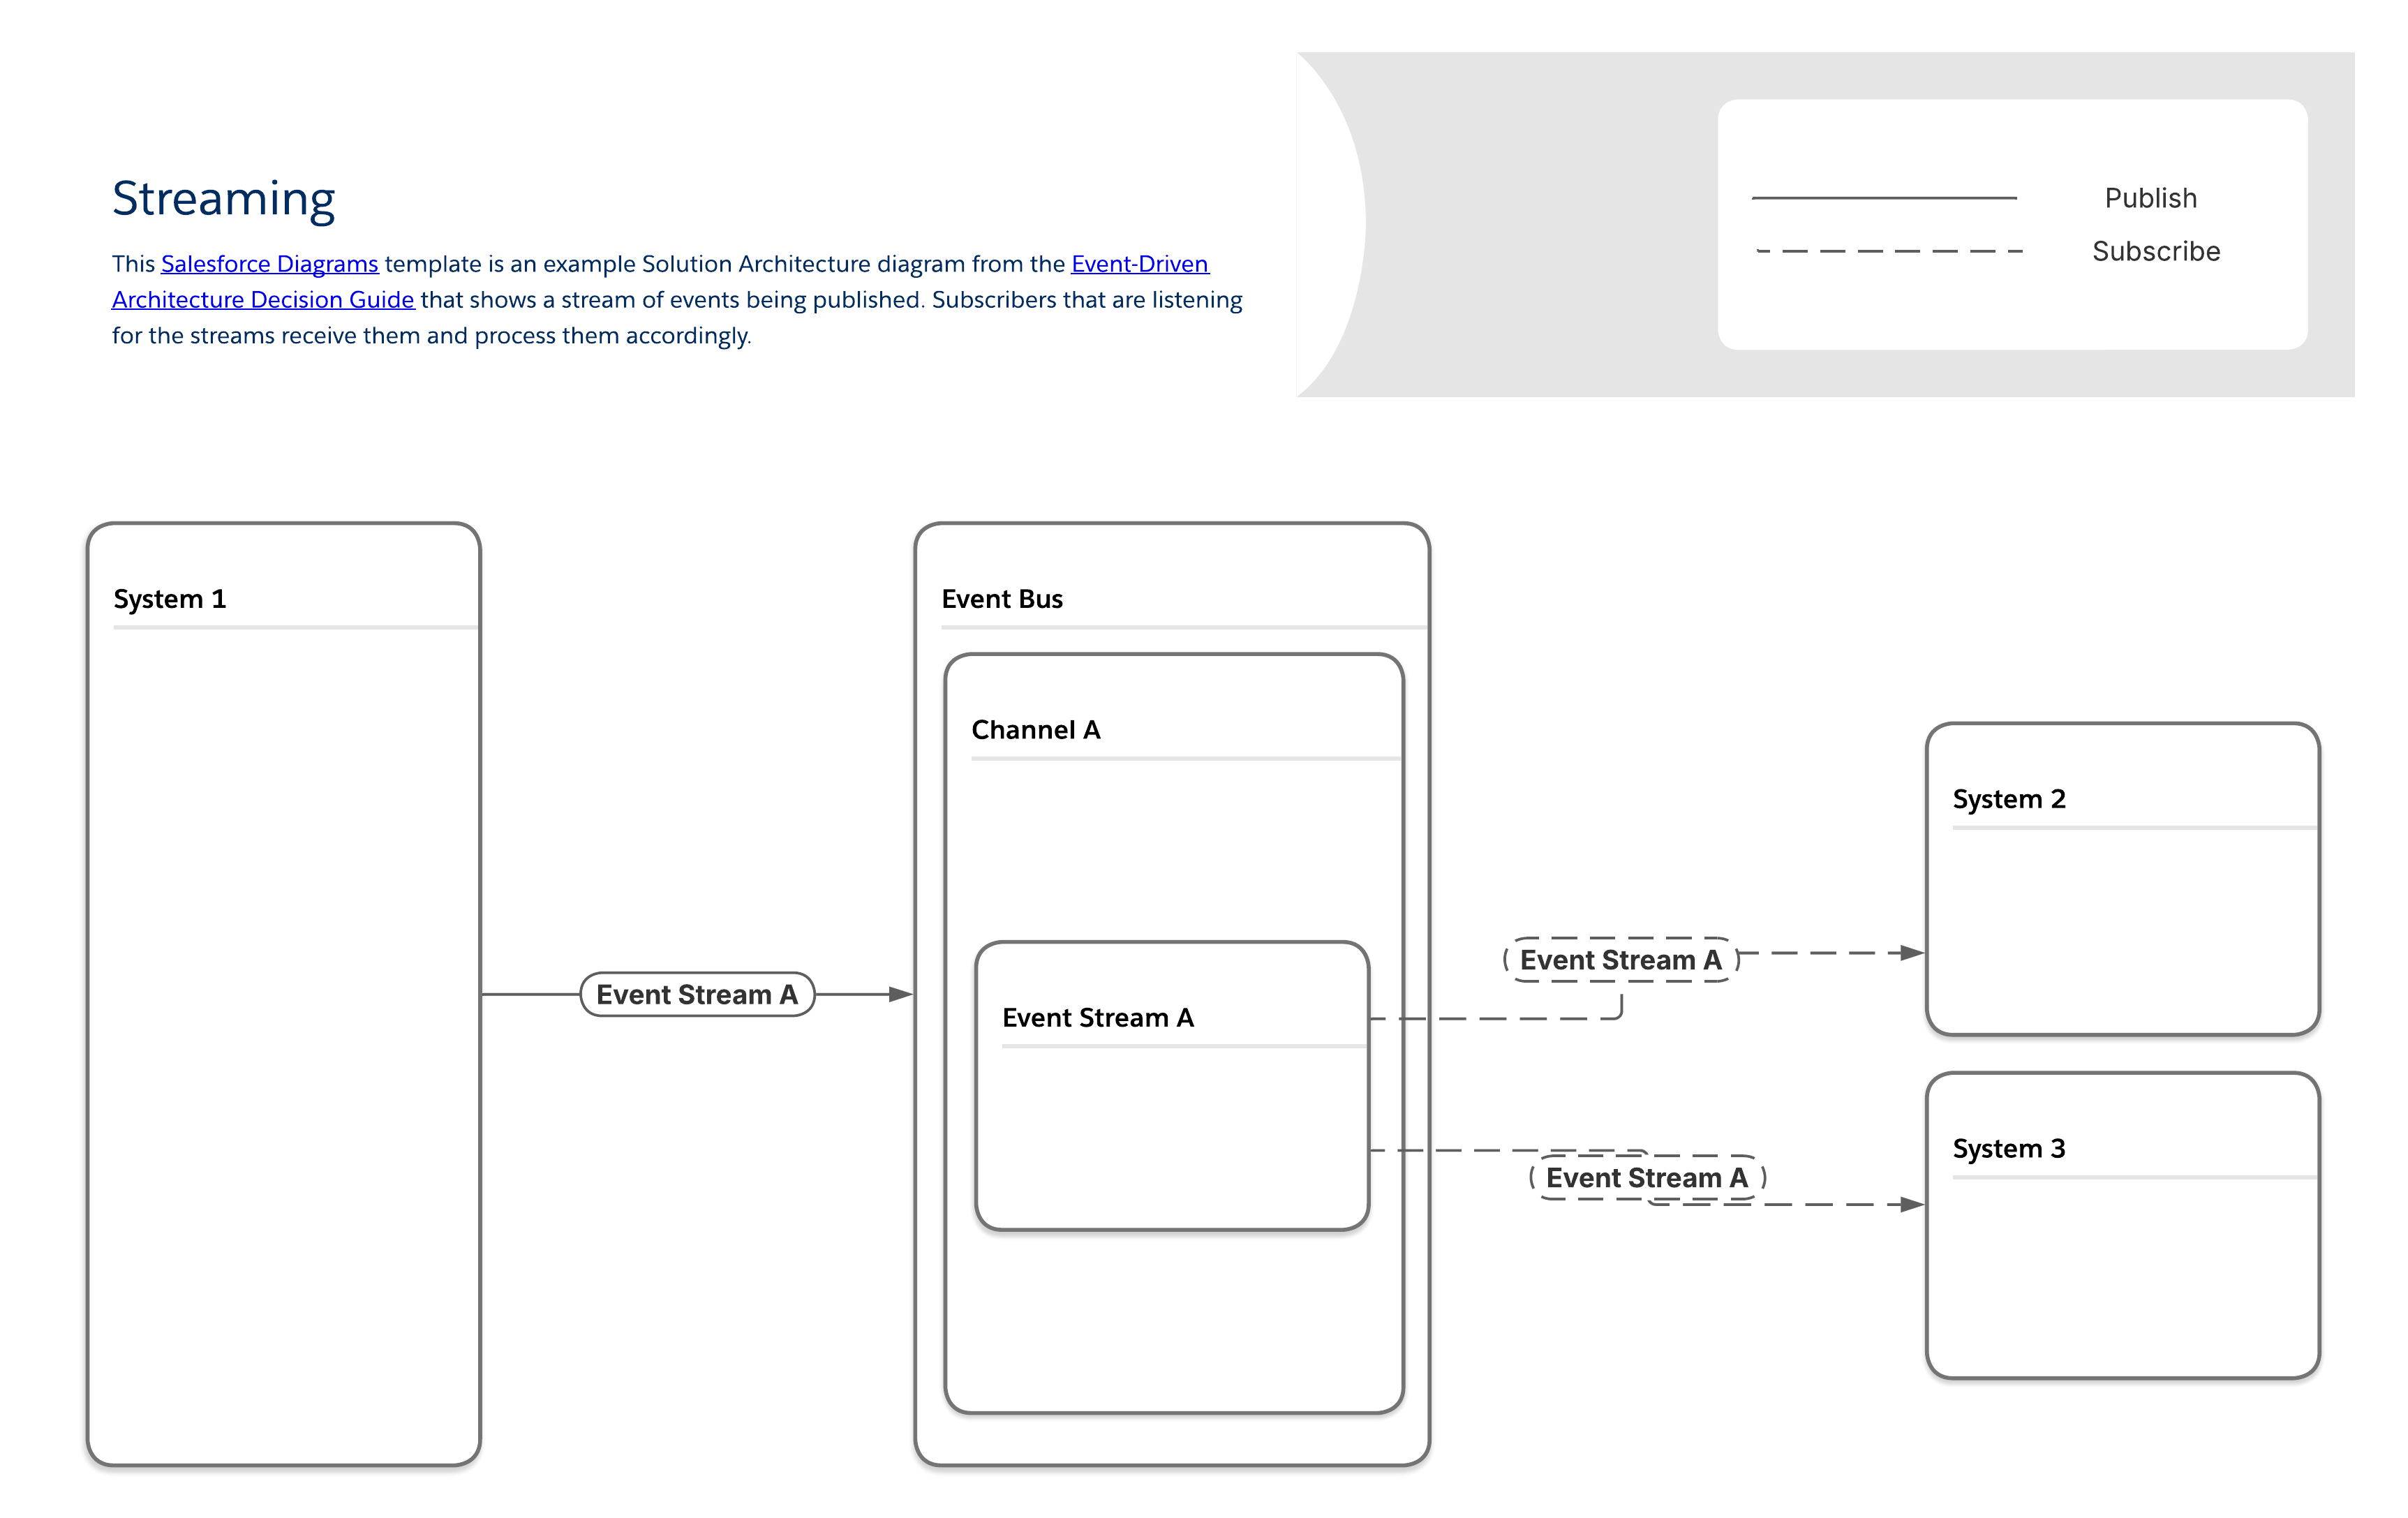
### 流 一些生产者会生成连续的事件流。一个常见的例子是媒体流,它涉及自然作为离散事件发生的用户交互。多个系统必须同时对相同的用户行为做出反应,而不会阻止核心流体验。 考虑音乐流平台的事件。这些可能包括: - 跟踪开始/暂停/跳过的事件 - 监听带有时间戳的会话事件 - 播放列表创建/修改事件 - 社交共享事件 - 下载离线收听 #### 流模式 在流模式中,订阅者访问每个事件流,并按照接收的确切顺序处理事件。每个消息流的唯一副本被发送给每个订阅者,使得能够交付订阅者特定的内容,并确定哪些订阅者收到了哪些流。 此 3 级文档和实施图显示了描述正在发布的事件流的流模式的示例。正在监听流的订阅者接收它们并相应地处理它们。 #### 与流模式相关的工具
事件流和行为有效载荷注意事项
可用工具所需技能发布方式订阅方式重放期间有效载荷结构有效载荷限制
MuleSoftMuleSoft Anypoint Data Streams赞成代码APIAPI已配置用户定义无
Salesforce 发布/订阅连接器赞成代码APIAPI已配置用户定义无
MuleSoft Anypoint Apache Kafka 连接器赞成代码APIAPI已配置用户定义无
Salesforce 平台Apache Kafka on Heroku赞成代码API,Heroku Postgres 中的记录更改N/A ⁇ 周用户定义用户定义
发布/订阅 API赞成代码发布/订阅 API 或 API、Apex 流发布/订阅 API3 天用户定义1 MB
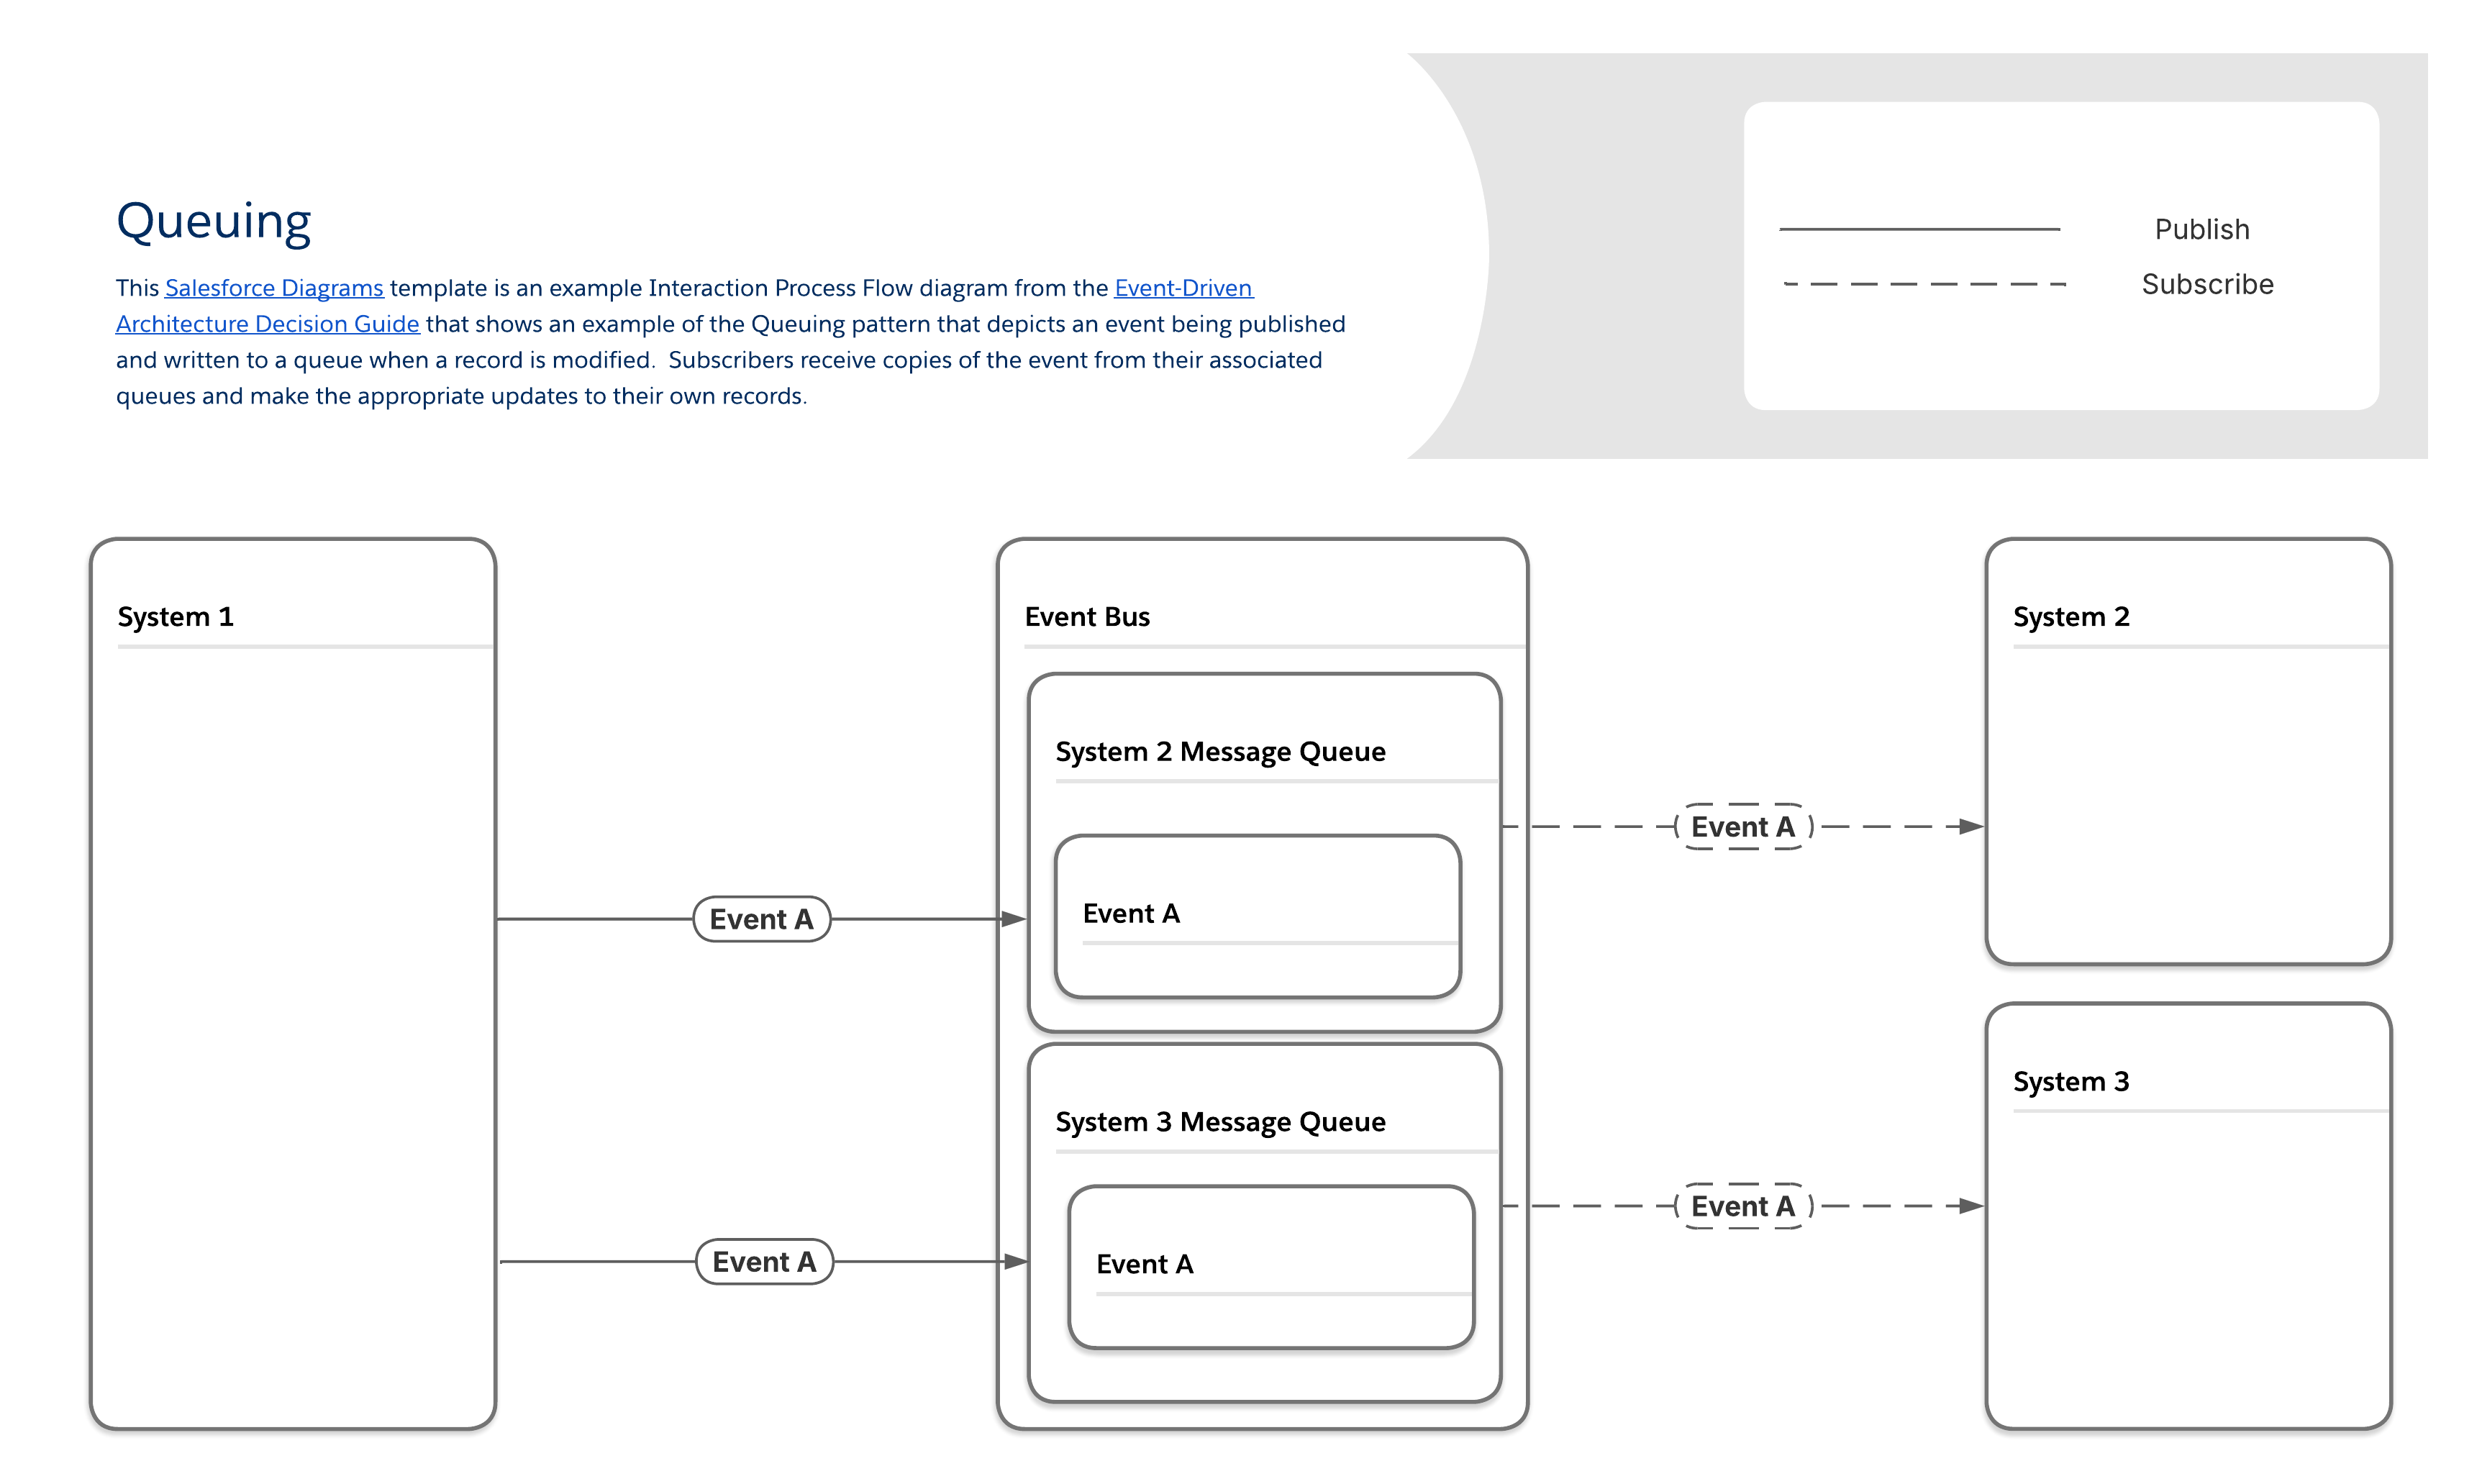
#### 流事件订单管理 为使流有意义,所有事件及其关联消息需要以正确的顺序显示。如果您从不同系统获取流中的数据,您需要将其他排序逻辑作为设计过程的一部分。 ### 排队 排队用例无处不在。示例包括: - **互联网连接质量低:**对于拥有移动设备的团队需要在低质量或断断续续的互联网接入区域工作的现场服务组织或其他组织,排队将从中受益,因为这些设备上的应用程序可以连接到他们的队列,并在恢复连接时检索任何相关的消息。 - **消息缓冲:**当消息量偶尔超过订阅者的处理能力,并且增加的延迟不会造成其他问题时,队列可以是存储过量消息和防止数据丢失的缓冲。 - **运输管理:**需要监控车队的物流组织可以使用此模式近乎实时地查看每辆车行驶的路线,并确保司机尽可能高效。 - **IoT 设备:**制造商通常使用可生成快速数据流的系统,而这些流会对其他系统产生下游影响。此模式可用于识别跨多个系统的灾难性故障发生之前需要人为干预的事件序列。 #### 队列模式 在队列模式中,生产者将消息发送到队列,队列保存消息,直到订阅者检索它们。大多数消息队列遵循先进先出 (FIFO) 顺序,并在检索后删除每条消息。每个订阅者都有一个唯一的队列,这需要额外的设置步骤,但可以保证发送,并确定哪些订阅者收到了哪些消息。 此 3 级文档和实施图显示了队列模式的示例,该模式描述了在修改记录时正在发布和写入队列的事件。订阅者从他们的关联队列接收事件的副本,并对他们自己的记录进行适当的更新。 #### 与队列模式相关的工具
事件流和行为有效载荷注意事项
可用工具所需技能发布方式订阅方式重放期间有效载荷结构有效载荷限制
MuleSoftMuleSoft Anypoint MQ赞成代码APIAPI已配置用户定义无
Salesforce 发布/订阅连接器赞成代码APIAPI已配置用户定义无
MuleSoft Anypoint Apache Kafka 连接器赞成代码APIAPI已配置用户定义无
MuleSoft Anypoint MQ 连接器赞成代码APIAPI已配置用户定义无
MuleSoft Anypoint MQTT 连接器赞成代码APIAPI已配置用户定义无
MuleSoft Anypoint AMQP 连接器赞成代码APIAPI已配置用户定义无
Salesforce 平台Apache Kafka on Heroku赞成代码API,Heroku Postgres 中的记录更改N/A ⁇ 周用户定义用户定义
变更数据捕获低代码到专业代码记录更改Apex、API、Lightning Web 组件 (LWC)3 天预定义1 MB
平台事件低代码到专业代码API、Apex、流Apex、API、Flow、LWC3 天用户定义1 MB
发布/订阅 API赞成代码发布/订阅 API 或 API、Apex、流发布/订阅 API3 天用户定义1 MB
事件中继*低代码平台事件、变更数据捕获API3 天用户定义1 MB
*事件中继仅将数据发送到 AWS Eventbridge
#### 内存和存储管理 由于队列模式的异步性质,在消息添加到队列和检索消息之间可能会有很长的延迟。队列需要内存或存储空间来保存消息,因此它们不能无限增长,这意味着如果队列中有足够的消息,无限期离线的订阅者可能会导致失败。如果订阅者处理时间过长,导致队列中累积大量消息,则消息缓冲会产生相同效果。为了降低这些风险,请对所有消息队列的存储要求进行透彻的分析,如有必要,还可以设计一些流程,以便在消息未在规定时间内检索到或到达预定的卷时清除和禁用队列。 ## 非功能注意事项 ### 从点对点集成迁移 即使您完全相信事件驱动的架构适合您的组织,您也可能从已经拥有大量点对点集成的环境开始。为项目获得资金以一次替换所有集成可能很困难,甚至可能无法直接将事件驱动的架构与一些原有系统一起使用。在这些场景中,您可以通过先转换最关键业务的应用程序,然后在其他系统在未来项目中更新或替换时转换它们,从而采取增量方法迁移到更松散耦合的架构。此方法可轻松将新应用程序添加到事件总线,并使您的整体 IT 环境保持可扩展性和弹性,因为系统会随着时间的推移不断添加。 ### 松耦合系统中的权衡 作为架构师,我们知道每个架构都有权衡。事件驱动的架构也不例外。虽然充满松散耦合的系统的环境具有高可扩展性和弹性,但也需要考虑一些权衡: - **整体集成策略:**无论您决定使用什么工具和模式,重要的是从创建如何在贵组织环境中的各种系统之间共享数据的策略开始。此策略应包括贵组织的数据目标、如何共享数据和使用的模式,以及数据源、目标、结构、所有权和访问权限要求。 - **支持原有系统:**贵组织可能拥有根本不支持事件驱动架构模式的原有系统。虽然可以构建解决方法(例如,通过订阅事件并将输出通过不同的数据传输方式发送到目标系统的过程),但在这种情况下,您可能要考虑其他集成方法。 - **消息的结构更改:**一旦发布者和订阅者之间定义并商定了初始消息结构,就很难更改,特别是如果订阅者是外部的。有几种方法可以解决这个问题。您可以使用版本化端点,但请确保为每个版本定义并传达清晰的生命周期,这样开发人员就不必同时维护太多的版本。如果 Heroku 上的 Apache Kafka 是您的环境的一部分,您也可以考虑模式注册表或类似工具,但请确保您的环境中的其他系统也支持它(并使用它)。 - **发布者和订阅者之间缺乏可见性:**在大多数事件驱动的架构模式中,发布者不知道他们的订阅者的状态。因此,如果发布者在所有订阅者离线时发送关键消息,消息可能永远不会被传递。您可以通过使用重放功能或为所有关键消息添加在单独服务器上运行的冗余订阅者来解决这个问题。 - **性能瓶颈:**随着事件驱动架构的扩展,如果太多发布者试图同时向太多的订阅者发送消息,事件总线会成为消息传递的瓶颈。您可以通过增加分配给事件总线的内存和处理资源来解决这个问题,或者通过使用多个事件总线来并行处理不同类型的消息。 ## 相关最佳实践 ### 实施事件驱动的架构 在实施事件驱动的架构之前,请首先考虑您是否真正需要使用一个架构。上一节描述了非常适合每个事件驱动架构模式的常见业务场景。您也可以在[架构良好 - 交互](/docs/architect/zh-cn/well-architected/guide/composable#交互性)性中阅读更多信息。查看实施事件驱动架构时需要考虑的挑战,以确定您想到的模式是否最适合您的特定用例。 请注意,虽然本指南涵盖的大多数场景涉及集成,但事件驱动的架构也可用于在单个 Salesforce 组织中发送消息,例如,通过使用平台事件。在设计将平台事件用作内部消息传递系统的流程时,请确保记住任何适用的[事件分配限制](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_event_limits.htm)。 ### 避免反模式 通常,围绕事件驱动架构的反模式来自将事件用作 Salesforce 组织内部通信的解决方法。常见的反模式包括: - **从与相同事件对象关联的 Apex 触发器发布事件:**这将导致无限的触发器循环。 - **在 DML 交易完成之前从 Apex 发布事件:**如果事务失败并回滚,任何具有“立即发布”发布行为的已发布事件都不会包含在回滚行为中。 - **在流中发布事件以编排后续自动化:**在多个自动化之间协调逻辑的最佳方式是使用[子流](https://developer.salesforce.com/docs/atlas.en-us.salesforce_vpm_implementation_guide.meta/salesforce_vpm_implementation_guide/vpm_designer_elements_subflow.htm)或 [Flow Orchestrator](https://help.salesforce.com/s/articleView?id=sf.orchestrator_flow_orchestrator.htm)。 - **创建运行时依赖性:**不要发布事件来促进软件包之间的通信,而不采取适当[步骤](https://medium.com/salesforce-architects/5-anti-patterns-in-package-dependency-design-and-how-to-avoid-them-87bb50331cb8)来消除运行时依赖性。 - **不必要的大负载:**在提出请求时,最好在负载中发送和接收尽可能少的数据。用户的每个操作都可能产生多个请求,重要的是要高效地处理这些请求。发送超过必要的数据会导致传输速度变慢和处理时间增加。 - **对应用程序事件的非选择性处理:**在多个组件监听应用程序事件时,开发人员应确保事件处理程序仅在实际需要和有用时执行。例如,在 Lightning 控制台中,选项卡中包含的未聚焦组件仍可以监听,即使它们不可见。开发人员可以使用各种技术,例如将后台实用程序项目用作唯一侦听器,或调用 getEnclosingTabId() 来确定组件的此实例是否包含在聚焦选项卡中,以确保每个事件仅在预期时处理。 - **错误使用平台事件发布行为:**平台事件有两种发布行为 — 立即发布和提交后发布。将实时平台事件用于记录等用例非常有用,在这些用例中,您希望发布记录事件,而不管事务是否成功并提交。但是,对于实时平台事件,请非常谨慎地使用“立即发布”。订阅者可以在相同事务中消耗事件,并导致行锁定或其他竞争条件。 ### 设计有效事件 在实施事件驱动的架构时,成功的关键之一是为事件本身的设计方式设置标准。具体情况因贵组织的用例而异,但以下是一些一般指导原则: - **确定事件负载的最佳结构。**虽然较小的消息大小减少了处理时间,但用大量消息轰炸订阅者会导致性能瓶颈。您可能需要迭代负载大小和结构,以找到正确的平衡。MuleSoft 和类似的 ESB 工具提供了在与事件相关联的消息中设计自定义负载的能力,这可以帮助您可视化数据结构,以提高订阅者侧的性能。(有关更多信息,请查看[架构良好 - API 管理](/docs/architect/zh-cn/well-architected/guide/composable#api-管理)。) - **端到端地思考您的流程。**请确保您没有创建任何“无止境的循环”场景,一旦集成推出,这可能很难跟踪。例如,两个系统会在更新记录时发布事件,同时监听彼此的事件,并在处理时触发其他已发布事件。 您可以通过向两个系统添加逻辑来修复这种类型的反模式,以确保由于事件被消耗而导致的更改不会导致发布新事件。您还应确保记录所有事件、关联触发器以及可能受影响的下游系统。在设计会议期间,将此文档用作参考,以帮助尽早捕捉无休止的循环和类似场景。(有关更多信息,请查看[结构合理 - 流程设计](/docs/architect/zh-cn/well-architected/guide/automated#流程设计)。) - **跨系统使用通用命名约定。**一致的命名约定是所有软件开发的最佳实践,包括事件驱动的架构。花时间记录事件名称、结构、关联对象和错误处理流程的一组标准,以确保跨系统的一致性。(有关更多信息,请查看[设计标准](/docs/architect/zh-cn/well-architected/guide/intentional#设计标准)。) ## 资源
模式资源
发布/订阅Salesforce 精心设计 - 吞吐量
Salesforce 精心设计 - 数据处理
Salesforce 架构良好 - 交互性
博客帖子:通过事件中继实现架构效率
博客帖子:宣布发布/订阅 API 正式可用
博客帖子:从 RESTful 迁移到 eventful
博客帖子:事件驱动的架构和 AsyncAPI 规范
视频:发布/订阅模式逐步解说
扇出博客帖子:如何在平台事件交付限制内工作
视频:扇出模式逐步解说
传递的消息视频:传递的消息模式逐步解说
流博客帖子:在 Salesforce 中设计高用量写入
视频:流模式逐步解说
文档:在 Mule 应用程序中流式传输
排队博客帖子:在 Salesforce 中设计高用量写入
博客帖子:如何使用事件化 API 设计付款架构
视频:队列模式逐步解说
## 概览 现代 Salesforce 架构越来越多地由异步处理提供支持;异步处理不是为了方便,而是规模的战略要求。近年来,我们看到越来越多的公司面临着数据量激增、涉及多个接触点的复杂集成以及全天候运行的自主系统的兴起等问题。所有这些因素都推动架构师设计异步优先的系统。 Salesforce 上的异步处理通常意味着围绕调控器限制和复杂性进行设计。这些限制充当防护栏和架构约束,有助于生产批量安全的、可扩展的系统。虽然没有平台限制直接用于管理复杂性,但[设计模式](https://refactoring.guru/design-patterns)可以帮助降低这方面的风险。在内部,Salesforce 通常会推动平台向前发展,以测试新功能并自动化复杂的业务流程。我们构建了一个基于步骤的异步处理框架,用于运行具有任意数量步骤的异步作业。通过集中日志记录,每个步骤都可以独立运行、重试和重新启动,并具有共享治理控制和完全操作可见性。本文档概述了其主要架构组件:可排队 Apex 和最终确定器、计划流、Apex 光标、可调用操作以及与 Slack 的集成。这些组件共同提供了一个适合不断发展的业务需求的模块化、可扩展和可观察的架构。 ## 重要外卖 - 现代 Salesforce 架构应采用异步优先的方法,以实现规模、弹性和运营透明度。 - 将复杂工作分解为独立可执行的步骤可实现可预测的性能、更安全的重试、检查点、回滚和模块化演进,而无需重新设计核心工作流。 - 该框架提供了对整体式和老化批处理作业、链式异步调用和深度嵌套流的可扩展替代方案,并专为必须在 Salesforce 中水平扩展而没有平台外编排的高用量工作负载构建。 - 确定性和可观察的执行通过集中的日志记录和治理来确保进度跟踪、SLA 监控、故障诊断和审计级透明度。 - 设计用于企业级严格性,包括跨长时间运行的业务流程的统一治理、合规性和分布式状态控制。 ## 平台最佳实践 在查看要求之前,以下是何时使用类似框架的一些注意事项。首先,请考虑哪个系统是真理的唯一来源。如果您的 Salesforce 组织对外部数据的依赖最少,但需要从数百条记录扩展到数百万条记录,请考虑基于步骤的异步框架。 如果满足以下条件**,请**使用此框架: - 大部分(或所有)要处理的信息已经存在于您的 CRM 中。 - 维护提取转换加载 (ETL) 作业以协调外部数据的前期或持续成本太高。 - 您需要推迟按既定计划处理大量 Salesforce 记录。 - 您可以将处理分解为离散的步骤。例如,您可以创建一组层次结构或基于树的记录,特别是如果数据量向下扇出层次结构或树。 如果出现以下情况**,请勿**使用此框架: - 创建或更新记录需要立即重新计算。 - 集成具有挑战性,因为外部系统托管记录更新的主要数据。(考虑使用批量 API 将更新的数据推送到 Salesforce。) 请记住这些实践,让我们回顾一下我们的要求并开始构建。 ## 细分要求 考虑问题陈述: > 给定需要每天运行的作业,请检查某些记录是否满足预先建立的标准,以便进一步处理。如果是,则启动这些处理作业。处理记录可能意味着从多个外部系统提取数据以执行计算。作业中的步骤应通过 Slack 通知人员已处理记录已准备好进行审核。步骤还应根据第一轮通知后的可配置延迟,将通知上报到角色层次结构中的经理和上级。 此问题涉及几个不同的步骤,其中一些步骤可以相互独立发生。拆分工作有很多方法。以下是一组: - 计划程序。 - 处理记录的步骤界面和具体实施(无论处理类型如何)。 - 组织步骤的处理器。 - 计划程序调用的 Apex 可调用。 - 通知部分。我们使用 [Apex Slack SDK](https://developer.salesforce.com/docs/platform/salesforce-slack-sdk/guide/overview.html)。 - “可配置的延迟”短语隐藏着一些复杂性。我们将在本文后面回顾这种复杂性。 以下是构建框架的意见图: 显示流程调度器、Apex 异步处理和不同可能步骤实施的结构图 现在,分解该图表,并开始构建各个部分。 ## 使用计划流计划 计划流作为计划机制提供了几个优势: - 计划流可以打包并部署为元数据。对于通过 Apex(或通过计划作业页面)计划的作业,情况并非如此。 - “等待”元素对于需要标注的框架至关重要。通过在流中使用它,在框架的可调用部分中不需要标注。 - 计划粒度满足要求:计划流的最小间隔是每天。如果您需要更高的频率(例如每小时),请重新考虑此要求的计划流。 配置计划流时的另一个注意事项是环境门控。在调用 Apex 操作前,添加评估`{!$Api.Enterprise_Server_URL_100}`变量的决策元素。这确保了作业仅在预期的环境中运行,例如 UAT 和生产。这种模式很重要,因为 Sandbox 在 SDLC 期间经常刷新或新创建,如果没有明确的环境检查,计划流可能会无意中在框架不打算运行的环境中执行。在决策元素中使用 `contains` 运算符会使设置适应未来的 Sandbox 创建或 URL 更改。 最后,考虑框架应如何捕获失败。在流调用任何操作时,请始终添加错误路径;例如,您可以将错误连接到 [Nebula Logger 的](https://www.nebulalogger.com/)“添加日志条目”操作。星云日志记录器将日志写入自定义对象,因此客户应了解日志数据会消耗组织存储 — 默认情况下,日志会在组织中存储 14 天,然后进行清理;此保留期可配置。星云日志记录器还使用平台事件发布日志,因此日志条目独立于主要数据处理事务保存 — 这将确保捕获失败,即使主要流或 Apex 操作回滚。在考虑添加日志记录框架时,客户应评估预期的日志量和保留要求。 以下是流的外观: 包含决定是否运行的决策元素、允许标注的暂停元素以及随星云记录器故障路径一起调用的 Apex 可调用操作的计划流 现在,让我们继续讨论 Apex 代码的第一部分,满足计划要求。 ## 创建步骤界面 定义`Step`界面: ```java public interface Step { void execute(); void finalize(); String getName(); Boolean shouldRestart(); } ``` 对于本文,为清楚起见,`step`界面显示为外部类。框架本身是灵活的 — 只要所有步骤类引用相同的界面,团队就可以使用他们喜欢的任何 Apex 打包模式来组织界面及其实施。 关于在我们的界面中定义的方法,有一些需要注意的事项: - `execute` 目前虽然没有参数,但在我们传递`State`类(或接口)以在顺序重要时在步骤之间编排数据时有所改进。 - `getName` 可以返回`System.Type`值,而不是`String`。目标是为编排层提供一种在不公开其他属性的情况下记录步骤名称的方法。 以下是第一个具体实施,显示了这些组件如何相互配合。除了稍后的一个例外,我们建议使用可排队 Apex 在 Apex 中实施异步处理;批量 Apex 通常是不必要的(不鼓励使用`@future`方法)。Queueable Apex 启动迅速,通过 Apex 光标,与批处理 Apex 相比有许多优势。 ### Apex 类似光标的实施 [Apex 光标](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_cursors.htm)为传统的批量 Apex 模型提供了现代替代方案。与批处理相似,光标实施可以分块获取记录(每批最多 2,000 条)。但是,光标允许在单个事务中进行多次提取,从而为大批量操作提供了更高的吞吐量。 当将光标作为此框架的一部分时,团队应该了解当前的测试和可模拟性限制。测试中的光标行为可能与生产行为不同,因此重要的是设计测试策略,避免依赖光标内部,而是在边界处验证编排逻辑。随着平台的发展,这些领域将继续改进,但核心指导仍然是:与批处理 Apex 相比,光标在许多用例中提供了更高的性能和更低的编排开销。 要定义系统提供的光标和您自己的代码之间的明确边界,我们建议在实施`Step`界面时创建类似光标的表示。考虑以下代码: ```java public inherited sharing abstract class CursorStep implements Step { private static final Integer MAX_CHUNK_SIZE = 2000; protected Cursor cursor; private Integer chunkSize = System.Limits.getLimitDMLRows(); private Integer position = 0; protected abstract Cursor getCursor(); protected abstract void innerExecute(List records); public abstract String getName(); public virtual CursorStep withChunkSize(Integer chunkSize) { this.chunkSize = chunkSize; return this; } public void execute() { this.cursor = this.cursor ?? this.getCursor(); this.cursor.setFetchesPerTransaction(this.getFetchesPerTransaction()); List records = new List(); if (this.shouldAdvance()) { records = this.cursor.fetch(this.position, this.chunkSize); this.position += this.chunkSize; } this.innerExecute(records); } public virtual void finalize() { Logger.info('finished cursor step for ' + this.getName()); } public virtual Boolean shouldRestart() { return this.position < this.cursor.getNumRecords(); } protected virtual Integer getFetchesPerTransaction() { Integer maxRecordsPerFetchCall = 2000; if (this.chunkSize < maxRecordsPerFetchCall) { return this.chunkSize; } // Integer division rounds down // which is perfect for our use-case return this.chunkSize / maxRecordsPerFetchCall; } protected virtual Boolean shouldAdvance() { return true; } } ``` 请注意`Cursor`类。Apex 光标是`Database.Cursor`的实例,但我们的`Cursor`实施使我们对光标的缺点具有灵活性。以下是实施: ```java public virtual without sharing class Cursor { private static final Integer MAX_FETCHES_PER_TRANSACTION = Limits.getLimitFetchCallsOnApexCursor(); @TestVisible private static Integer maxRecordsPerFetchCall = 2000; private Integer cursorNumRecords; private Integer fetchesPerTransaction = MAX_FETCHES_PER_TRANSACTION; private final Database.Cursor cursor; public Cursor( String finalQuery, Map bindVars, System.AccessLevel accessLevel ) { try { this.cursor = Database.getCursorWithBinds(finalQuery, bindVars, accessLevel); } catch (FatalCursorException e) { Logger.newEntry( System.LoggingLevel.WARN, 'Error creating cursor. This can happen if there' + ' are no records returned by the query: ' + e.getMessage() ); } } public Cursor setFetchesPerTransaction(Integer possibleFetchesPerTransaction) { // Handle accidental round downs from Integer division if (possibleFetchesPerTransaction == 0) { return this; } if (possibleFetchesPerTransaction > MAX_FETCHES_PER_TRANSACTION) { Logger.newEntry( System.LoggingLevel.DEBUG, 'Fetches per transaction: ' + possibleFetchesPerTransaction + ' exceeded platform max fetches per transaction: ' + MAX_FETCHES_PER_TRANSACTION + ', defaulting to platform max' ); possibleFetchesPerTransaction = MAX_FETCHES_PER_TRANSACTION; } this.fetchesPerTransaction = possibleFetchesPerTransaction; return this; } @SuppressWarnings('PMD.EmptyStatementBlock') protected Cursor() { } public virtual List fetch(Integer start, Integer advanceBy) { if (this.getNumRecords() == 0) { Logger.newEntry( System.LoggingLevel.DEBUG, 'Bypassing fetch call, no records to fetch' ); return new List(); } Integer localStart = start; List results = new List(); while ( Limits.getFetchCallsOnApexCursor() < this.fetchesPerTransaction && results.size() < this.getNumRecords() && localStart < start + advanceBy ) { Integer actualAdvanceBy = this.getAdvanceBy(localStart, advanceBy); results.addAll(this.cursor?.fetch(localStart, actualAdvanceBy) ?? new List()); localStart += actualAdvanceBy; } return results; } public virtual Integer getNumRecords() { this.cursorNumRecords = this.cursorNumRecords ?? this.cursor?.getNumRecords() ?? 0; return this.cursorNumRecords; } protected Integer getAdvanceBy(Integer start, Integer advanceBy) { Integer possibleFetchSize = Math.min(advanceBy, this.getNumRecords() - start); if (possibleFetchSize > maxRecordsPerFetchCall) { Logger.newEntry( System.LoggingLevel.DEBUG, 'Fetch size: ' + possibleFetchSize + ' exceeded platform max fetch size of ' + maxRecordsPerFetchCall + ', defaulting to max fetch size' ); possibleFetchSize = maxRecordsPerFetchCall; } else if (possibleFetchSize < 0) { possibleFetchSize = 0; } return possibleFetchSize; } } ``` 对于本文的其余部分,我们在引用 Apex 类时省略了 `sharing` 声明。在实践中,请确保顶级类明确使用,无论是否共享,以符合您的对象模型和权限。 另请注意,我们的`Cursor`实施委派到平台`Database.Cursor`,下面将讨论其他好处。 首先,以下是相应的测试: ```java @IsTest private class CursorTest { @IsTest static void itCapsAdvanceByArgument() { String accountName = 'helloWorld!'; insert new Account(Name = accountName); String query = 'SELECT Name FROM Account WHERE Name = :bindVar0'; Map bindVars = new Map{ 'bindVar0' => accountName }; Cursor instance = new Cursor(query, bindVars, System.AccessLevel.SYSTEM_MODE); Assert.areEqual(1, instance.getNumRecords()); Assert.areEqual(accountName, instance.fetch(0, 1000).get(0).get('Name')); Assert.areEqual(1, System.Limits.getApexCursorRows()); } @IsTest static void itCapsMaxRecordsPerFetchCall() { Cursor.maxRecordsPerFetchCall = 20; Integer oneMoreThanMaxFetch = Cursor.maxRecordsPerFetchCall + 1; List accounts = new List(); for (Integer i = 0; i < oneMoreThanMaxFetch; i++) { accounts.add(new Account(Name = 'Fetch ' + i)); } insert accounts; Exception ex; List results; Cursor instance = new Cursor( 'SELECT Id FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ); try { results = instance.fetch(0, oneMoreThanMaxFetch); } catch (System.InvalidParameterValueException e) { ex = e; } Assert.areEqual(null, ex?.getMessage()); Assert.areEqual(2, Limits.getFetchCallsOnApexCursor()); Assert.areEqual(oneMoreThanMaxFetch, results.size()); } @IsTest static void itFetchesMultipleTimesPerTransactionWhenMoreThanMaxFetch() { Cursor.maxRecordsPerFetchCall = 20; List accounts = new List(); Set expectedFetchNames = new Set(); for (Integer i = 0; i < Cursor.maxRecordsPerFetchCall + 1; i++) { String accountName = 'Fetch' + i; expectedFetchNames.add(accountName); accounts.add(new Account(Name = accountName)); } insert accounts; Integer oneMoreThanMaxFetch = Cursor.maxRecordsPerFetchCall + 1; Cursor instance = new Cursor( 'SELECT Name FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ); List results = instance.setFetchesPerTransaction(2).fetch(0, oneMoreThanMaxFetch); Assert.areEqual(Cursor.maxRecordsPerFetchCall + 1, results.size()); Assert.areEqual(2, Limits.getFetchCallsOnApexCursor()); Set actuallyFetchedNames = new Set(); for (Account account : (List) results) { actuallyFetchedNames.add(account.Name); } Assert.areEqual(expectedFetchNames, actuallyFetchedNames); } @IsTest static void itFetchesMultipleTimesPerTransaction() { Cursor.maxRecordsPerFetchCall = 1; insert new List{ new Account(Name = 'One'), new Account(Name = 'Two') }; Cursor instance = new Cursor( 'SELECT Id FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ) .setFetchesPerTransaction(2); List results = instance.fetch(0, 2); Assert.areEqual(2, instance.getNumRecords()); Assert.areEqual(2, results.size()); results = instance.fetch(2, 1); Assert.areEqual(0, results.size()); } @IsTest static void fetchesCorrectAmountOfRecords() { List accounts = new List(); for (Integer i = 0; i < 10; i++) { accounts.add(new Account(Name = 'Fetch ' + i)); } insert accounts; Cursor instance = new Cursor( 'SELECT Id FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ) .setFetchesPerTransaction(10); List results = instance.fetch(0, 2); Assert.areEqual(2, results.size(), '' + results); Assert.areEqual(1, Limits.getFetchCallsOnApexCursor()); } @IsTest static void doesNotExceedPlatformMaxFetch() { List accounts = new List(); for (Integer i = 0; i < 101; i++) { accounts.add(new Account(Name = 'Fetch ' + i)); } insert accounts; Test.startTest(); Cursor instance = new Cursor( 'SELECT Id FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ) .setFetchesPerTransaction(100); Integer counter = 0; List results; while (counter <= 100) { results = instance.fetch(counter, counter + 1); counter++; } Test.stopTest(); Assert.areEqual(101, counter); Assert.areEqual(0, results.size()); } } ``` 通过将`Cursor`虚拟化,当具体的`CursorStep`实施不需要迭代大型记录集时,它们可以在没有`Database.Cursor`的情况下运行,类似于在批处理 Apex 中返回`System.Iterable`而不是`Database.QueryLocator`。以下是示例: ```java public abstract class CursorLikeImplementation extends CursorStep { private final Cursor cursorLike; public CursorLikeImplementation(List previouslyRetrievedRecords) { this.cursorLike = new CursorLike(previouslyRetrievedRecords); } public override String getName() { return CursorLikeImplementation.class.getName(); } public override Cursor getCursor() { return this.cursorLike; } private class CursorLike extends Cursor { private final List records; public CursorLike(List records) { super(); this.records = records; } public override List fetch(Integer position, Integer chunkSize) { // clone, to keep the underlying list type List clonedRecords = this.records.clone(); clonedRecords.clear(); for (Integer i = position; i < this.getAdvanceBy(position, chunkSize); i++) { clonedRecords.add(this.records[i]); } return clonedRecords; } public override Integer getNumRecords() { return this.records.size(); } } } ``` 请注意,由于该类也是抽象的,因此它将`innerExecute`的具体实施留给子类。 `CursorLike` 内部子类也有另一种选择。如果您知道像这样的步骤的具体版本不会通过其他调控器限制,您可以从 `CursorLike.fetch` 返回 `this.records` 并覆盖父`CursorStep.shouldRestart()`以返回 false。这允许您迭代仅受每个异步事务 12 MB 的 Apex 堆限制限制的列表。 ### 其他可能的基于步骤的实施 在分页大量数据时,我们基于光标的实施为我们提供了很大的灵活性。同时 , `Step` 界面让我们可以灵活地描述和封装各种步骤。 考虑基于流的步骤: ```java public virtual class FlowStep implements Step { private final Invocable.Action specificFlow; private Boolean shouldRestart = false; public FlowStep(String specificFlowName, Map inputs) { this.specificFlow = Invocable.Action.createCustomAction('flow', specificFlowName); this.specificFlow.setInvocations(new List>{ inputs }); } public void execute() { List results = this.specificFlow.invoke(); for (Invocable.Action.Result result : results) { if (result.isSuccess()) { Map outputParams = result.getOutputParameters(); Object potentialShouldRestartValue = outputParams.get('shouldRestart'); // Flow does not enforce Booleans being initialized // so a null check is sadly necessary here if (potentialShouldRestartValue != null) { this.shouldRestart = this.shouldRestart || Boolean.valueOf(potentialShouldRestartValue); } } else { List errorMessages = new List(); for (Invocable.Action.Error error : result.getErrors()) { errorMessages.add( 'Error code: ' + error.getCode() + ', error message: ' + error.getMessage() ); } Logger.error( 'An error occurred within your auto-launched flow:\n' + String.join(errorMessages, '\n\t') ); } } } public virtual void finalize() { Logger.info(this.getName() + ' finished processing'); } public String getName() { return FlowStep.class.getName() + ':' + this.specificFlow.getName(); } public Boolean shouldRestart() { return this.shouldRestart; } } ``` 因为流不能返回符合 Apex 定义类型的输出参数,所以我们在使用前要检查`shouldRestart`输出参数。 一些步骤可能会带有标记。您可以实施逻辑来决定要包含哪些步骤,或者对禁用的功能使用禁止步骤。[空对象模式](https://refactoring.guru/introduce-null-object)是降低编排层复杂性的常见方法: ```java @SuppressWarnings('PMD.EmptyStatementBlock') public class NoOpStep implements Step { // The null object pattern is commonly implemented // as a singleton to reduce memory consumption public static final NoOpStep SELF { get { SELF = SELF ?? new NoOpStep(); } private set; } public void execute() { } public void finalize() { } String getName() { return NoOpStep.class.getName(); } Boolean shouldRestart() { return false; } } ``` 我们现在有很多构件可以使用。让我们看看负责迭代步骤的编排层。 ## 创建步骤处理器 处理器是架构中的转折点。我们必须决定由谁定义初始化哪些步骤,以及在哪里初始化。选项包括: - 让处理器定义哪些步骤映射到业务逻辑。此选项简单,但在可读性方面扩展性较差。 - 使用自定义元数据 (CMDT) 定义映射。元数据关系字段不支持`ApexClass`,这会将类名称拼写松散地耦合到业务流程设置中。通过将字段设置为选项列表并验证类型是否存在(`Type.forName()`或查询`ApexClass`),您可以降低管理员风险,但由于 CMDT 记录不支持触发器,验证将在运行时进行。此路线可测试,但管理员仍只能在生产中创建 CMDT 记录,请谨慎操作。 - 使用记录定义映射。非管理员可以配置步骤,但部署会变得更加困难,环境也会发生变化。小心行事。 [Clean Code](https://www.oreilly.com/library/view/clean-code-a/9780136083238/) 中有句名言介绍了如何处理这一特殊的复杂性: > 这个问题的解决方案是埋在抽象工厂的地下室中\[用于制作对象的]`switch`语句,永远不要让任何人看到它。 请谨记这一点,因为我们当前的步骤数量定义明确,并且不太可能增长得太大,所以步骤处理器也可以成为步骤的工厂。这可以使用枚举来驱动 switch 语句: ```java public enum StepType { TYPE_ONE, TYPE_TWO, TYPE_THREE, TYPE_FOUR // etc ... } ``` 然后为了我们的`StepProcessor`: ```java public StepProcessor implements System.Queueable, System.Finalizer, Database.AllowsCallouts { private final List steps = new List(); private Step currentStep; public StepProcessor setSteps(List stepTypes) { for (StepType type : stepTypes) { switch on type { WHEN TYPE_ONE { this.addTypeOneSteps(); } WHEN TYPE_TWO { this.addTypeTwoSteps(); } // ... etc } } this.cleanSteps(); return this; } public void execute(System.QueueableContext context) { this.currentStep = this.currentStep ?? this.steps.remove(0); if (context != null) { System.attachFinalizer(this); Logger.setAsyncContext(context); } Logger.info('Executing step ' + this.currentStep.getName()); try { this.currentStep.execute(); } catch (Exception e) { Logger.exception('Unexpected exception', e); } Logger.info('Finished executing step ' + this.currentStep.getName()); Logger.saveLog(); } public void execute(System.FinalizerContext context) { Logger.info('Executing finalizer for step ' + this.currentStep.getName()); Logger.setAsyncContext(context); switch on context?.getResult() { when UNHANDLED_EXCEPTION { // see the note below about this logging paradigm Logger.warn( 'Failed to run on step' + this.currentStep, context?.getException() ); } when else { this.currentStep.finalize(); if (this.currentStep.shouldRestart()) { this.kickoff(); } else if (this.steps.isEmpty() == false) { this.currentStep = this.steps.remove(0); this.kickoff(); } else { Logger.info('Finished executing steps'); } } } Logger.info( 'Finished executing finalizer for step ' + this.currentStep.getName() ); Logger.saveLog(); } public String kickoff() { return this.steps.isEmpty() ? null : System.enqueueJob(this); } private void cleanSteps() { for (Integer reverseIndex = this.steps.size() - 1; reverseIndex >= 0; reverseIndex--) { if (this.steps[reverseIndex] instanceof NoOpStep) { this.steps.remove(reverseIndex); } } } private void addTypeOneSteps() { this.steps.addAll( new List { new ExampleCursorStepOne(), new ExampleCursorStepTwo() } ); } private void addTypeTwoSteps() { this.steps.addAll( new List { new FlowStep(' ExampleInvocableName', new Map( 'exampleParameter' => true) ), new ExampleCursorStepThree() } ); } } ``` 显示的工厂方法,例如 `addTypeOneSteps()`,可以委派功能标记等关注;`cleanSteps()` 对收集的步骤执行一次性检查,以确保在真正异步之前没有任何“空”步骤。这可能看起来像这样: ```java private Step getStepOrDefault(String customPermissionName, Step defaultStep) { if (System.FeatureManagement.checkPermission(customPermissionName)) { return defaultStep; } return NoOpStep.SELF; } ``` 自从在“计划流”部分提到星云记录器以来,我们没有讨论过错误处理。这是因为 `System.Finalizer` 允许我们全面记录所有错误条件,而无需在每个步骤中添加特定的错误处理。每个`Step`侧重于运行,而我们记录并重新抛出任何不愉快的路径,以便它们在单元测试中出现。这支持安全迭代和生产级警报(对所有 WARN 和 ERROR 日志使用 [Slack Logger 星云](https://github.com/jongpie/NebulaLogger/tree/main/nebula-logger/plugins/slack)插件 ) 。 有关错误日志记录的一个注意事项:将步骤实例传递到日志消息中,假设对日志中可见的内容有一定程度的 Trust。Apex 类的默认`toString()`包括消息中的所有静态和实例级属性。这可能是可取的 — 也可能泄露敏感信息。虽然日志记录和安全性不是这里的重点,但是请注意对于一些系统,遵守像 `Step` 这样的界面也可能涉及强制覆盖`toString()`。 ```java public interface Step { void execute(); void finalize(); String getName(); Boolean shouldRestart(); String toString(); } ``` 这种方法让每个对象创建者负责决定允许打印的内容,这可能是可取的。 在日志记录级别:在`StepProcessor`级别,我们使用 `INFO`,即最高的非错误级别。随着您在应用程序中变得越来越细,日志级别应该相应地降低。单个步骤可能会将`DEBUG`用于高级信息,并将`FINE`、`FINER`和`FINEST`保留给越来越详细的输出。记录既是一门艺术,也是一门科学,但遵循这些原则有助于保持日志的一致性和有用性。 ### 在步骤处理器中处理其他复杂性 在继续之前,让我们简要地考虑一下让我们的步骤处理器托管使用步骤的逻辑的决定。在大型代码库中,考虑使`StepProcessor`成为虚拟或抽象的,并让子类确定具体步骤来建立适当的关注点分离。 ## Apex 可调用图层 计划程序最终会调用 Apex。在其余设置完成后,可调用 Apex 部分可以决定哪些步骤应运行并将`List`传递给处理器: ```java public class DailyJobExecutor { @InvocableMethod(label='Execute Daily Job') public static void executeJob() { Logger.info('Executing daily Job'); List correspondingTypes = new List(); // based on [business logic], determine which step types // should be included for any daily invocation if (correspondingTypes.isEmpty() == false) { try { new StepProcessor().setSteps(correspondingTypes).kickoff(); } catch (Exception ex) { Logger.exception('Error starting job', ex); } } } Logger.saveLog(); } ``` 这是等式的简单部分 — 使用记录、数据或逻辑来确定要运行哪个步骤类型。可调用操作很简单,因为我们在其他地方封装了复杂性。我们还防止了意外异常,并使每个部分易于单独测试。 ## 在调用 Slack 之前处理延迟 [Apex Slack SDK](https://developer.salesforce.com/docs/platform/salesforce-slack-sdk/guide/overview.html)超出了本文的范围,但需求中的一个潜在障碍值得重新审视:根据可配置的延迟通知角色层次结构中的上级人员。从纸面上讲,这很简单,您可能(正确地)考虑在`StepProcessor`中`System.enqueueJob(this)`。对于 [System.AsyncOptions](https://developer.salesforce.com/docs/atlas.en-us.apexref.meta/apexref/apex_class_System_AsyncOptions.htm),我们最初倾向于使用`enqueueJob`过载来满足这一要求。 但目前通过`System.AsyncOptions.MinimumQueueableDelayInMinutes`的最大延迟为 10 分钟。因为要求是 120 分钟,所以还有一些选项。一种幼稚的方法可能看起来像这样: ```java public class ExampleDelayedNotifier implements Step { private final List notifications = new List(); private final Slack.BotClient botClient = Slack.App .getAppByKey('some-slack-app-key') .getBotClientForTeam('slack team id'); // account for the initial delay, // so 120 - 10 = 110 private Integer delayMinutes = 110; public void execute() { if ( this.delayInMinutes > 0) { return; } Integer maximumAllowedCallouts = 100; while (this.notifications.isEmpty() == false && maximumAllowedCallouts > 0) { this.botClient.chatPostMessage(this.notifications.remove(0)); maximumAllowedCallouts--; } } public void finalize() { this.delayInMinutes -= 10; } public String getName() { return ExampleDelayedNotifier.class.getName(); } public Boolean shouldRestart() { return this.delayInMinutes > 0 || this.notifications.isEmpty() == false; } } ``` 实际上,延迟会传递到该类,因为延迟是配置驱动的。 除非您确定只有一个延迟通知类型,否则我们不建议使用这种方法。在开始之前,它会烧掉 11 个额外的异步作业(或者更多,如果延迟增加)。对于一个工作来说,这个成本可能还不错 — 对许多人来说不是。您还需要向`Step`界面添加方法,以便每个步骤可以告诉处理器在重新启动之前需要等待多长时间,这会增加噪音。 这给我们留下了两个有趣的可能性: - 如果您已经以适当的时间间隔计划了轮询作业,您可以将延迟的步骤插入到现有作业框架中。指定的延迟在 15 分钟后到达(15 分钟是 Apex 计划 CRON 表达式的最小刷新间隔),您也应该可以。这大致匹配可调用 Apex 示例;计划改为通过 Apex 执行。换句话说,您可以重复使用相同的基于 `Step` 的架构来根据“开始于”时间戳处理记录,并根据选项列表或映射到之前显示的`StepType`枚举值的多选选项列表决定使用哪些步骤。 - 或者,如果您愿意定义额外的外部 Apex 类,请回到使用`System.scheduleBatch()`的批处理 Apex(与支持内部类的 Queueable Apex 不同,批处理 Apex 类必须是外部类)。 考虑批处理 Apex 示例。虽然我们通常建议使用 Queueable Apex 来实现灵活性和控制性,但这是 Batch Apex 仍然占主导地位的一个情况: ```java public class DelayedNotifier implements Database.Batchable { private final StepProcessor processor = new StepProcessor(); public Iterable start(Database.BatchableContext bc) { return new List(); } @SuppressWarnings('PMD.EmptyStatementBlock') public void execute(Database.BatchableContext bc, Object scope) { // we don't need to actually do anything in execute, // we just need to start up the processor in finish } public void finish(Database.BatchableContext bc) { try { // you can imagine Notifier as an elided, // simpler version of the naive implementation // we showed above, now only focused on sending messages this.processor.setSteps(new List{ new Notifier() }).kickoff(); } catch (Exception ex) { Logger.exception('Unexpected error', ex); } finally { Logger.saveLog(); } } } ``` 然后,在`StepProcessor`中,假设之前显示的`addTypeOneSteps()`方法使用此延迟步骤进行更新: ```java public StepProcessor implements System.Queueable, System.Finalizer, Database.AllowsCallouts { // .... unchanged top of class elided private void addTypeOneSteps() { this.steps.addAll( new List { new ExampleCursorStepOne(), new ExampleCursorStepTwo(), new DelayedNotifierStep() } ); } // ... private class DelayedNotifierStep implements Step { private final DelayedNotifier delayedNotifier = new DelayedNotifier(); // again — in practice this value would also be passed in private final Integer delayInMinutes = 120; public void execute() { System.scheduleBatch( this.delayedNotifier, 'Delayed notifier: ' + System.now().getTime(), this.delayInMinutes ); } public void finalize() { Logger.debug('Nothing to finalize, batch scheduled'); } public String getName() { return DelayedNotifierStep.class.getName(); } public Boolean shouldRestart() { return false; } } } ``` 虽然我们通常不会建议这么多的跳转,但这个步骤延迟会成为另一个可重用的构建块。在 Queueable Apex 中允许更长的延迟之前,这也是产生这种效果的最简单方法(如讨论的那样,没有轮询机制)。 ## 结论 我们使用面向对象的设计来满足要求,并创建了一个系统来扩展,同时平衡长期的建筑和维护成本。虽然步骤声明和实例化最终可能会超出其在`StepProcessor`中的地位,但几乎没有额外的技术债务。通过`FlowStep`,管理员和开发人员可以共同决定何时无代码或专业代码解决方案最有意义。 通过在 Apex 可排队框架中使用`System.Finalizer`界面以及星云日志记录器,我们构建了一个强大的可测试系统,即使未来的步骤缺乏明确的日志记录,也能提醒我们意外的失败。对于我们来说,这个系统很高兴地压缩了数字,降低了成本和复杂性。它还为我们提供了有关 Apex 光标在实际工作负载下的行为的宝贵见解,帮助我们在改进功能的同时完善了我们的方法。 通过将复杂的高用量工作负载分解为模块化执行步骤,基于步骤的异步处理框架框架将平台约束转化为工程优势,实现了企业级的可预测性能、可观察性和治理。管理员和开发人员都可以设置步骤,无论哪种情况,步骤作者都可以安全地专注于遵守基本平台调控器限制(例如 DML 行和检索的查询行),而不必担心如何扩展每个步骤。 ## 前进路径 为了在企业实施中操作和采用这种模式,架构师应该: - **评估现有自动化**,确定异步编排可帮助改善性能和增强可观察性的领域。 - 将**大型进程细分**为离散的、独立可执行的步骤,具有明确的处理目标和离散的作者点(例如 Flow 或 Apex)。 - **定义和分组步骤类型**,以加速步骤重用和跨业务部门的标准化。 - 通过新流程或现有自动化**试用该方法**。您可能会惊讶地发现,在步骤中免费找到多少边缘个案,关心您的内置日志记录和可观察性! ## 关于作者 James Simone 是 Salesforce 的首席软件工程师,拥有十多年的平台工作经验。在进入开发阶段之前,他是 Salesforce 的客户和产品所有者,自 2019 年以来一直在 [The Joys Of Apex](https://www.joysofapex.com/) 中撰写有关 Salesforce 的技术文章。他之前在 [Salesforce 开发人员博客](https://developer.salesforce.com/content-archive?authors=James%20Simone&content-type=Blogs&language=English)和 [Salesforce 工程博客](https://engineering.salesforce.com/author/james-simone/)上发表了文章。 ## 指南概览 想要在 Salesforce 平台上构建表单?您有多个选项,跨越整个低代码到专业代码的连续体。代表低代码的是 Lightning 应用程序生成器中的动态表单和 Flow Builder 中的屏幕流。在连续体的中间挂出的是使用 LWC 扩展屏幕流和使用 OmniStudio 构建面向客户的表单的能力。代表 pro-code 的是 LWC 框架及其不断增长的基组件库。 选项很好,但您如何确定哪个选项(或哪个组合)是正确的选项?这就是本指南的作用所在。 ## 重要外卖 - **外卖 #1:在为 Lightning 页面构建创建/编辑/查看布局时,使用动态表单。**您可能会注意到本指南的对比表中缺少页面布局。下一步,配置记录详细信息页面的推荐方法是在 Lightning 应用程序生成器中使用动态表单。有关我们为何不期望进一步增强它们的更多信息,请查看[页面布局](#页面布局)部分。 - **外卖 #2:如果您需要仅为一个对象构建创建或编辑表单,请从 Lightning 页面和动态表单开始。**这是在 Salesforce 平台上构建表单的最简单方法。它还提供了一些额外的功能,例如控制字段可见性的能力。如果您的要求更高,请继续阅读。屏幕流、OmniStudio 或 Lightning Web 组件 (LWC) 可能更适合。 - **外卖 #3:如果您正在构建多页面表单或向导,并且没有严格的 UX 或品牌化要求,请从屏幕流开始。**屏幕流为编排多个表单提供了线性导航框架。您可以使用 LWC 构建您自己的框架以在表单之间导航,但我们建议让 Flow 为您完成繁重的工作,这样您就可以专注于表单本身,而不是担心[表单状态](/docs/architect/zh-cn/well-architected/guide/engaging#表格)。 - **外卖 #4:如果您需要*在表单后*添加其他逻辑或操作,请使用屏幕流、OmniStudio 或 LWC。**所有这三个工具都为您的解决方案提供了实现更多功能的方法,而不仅仅是创建或编辑单个记录。“更多”可能是更高级的逻辑,例如分支或迭代,也可能是更多操作,例如与外部系统集成、发送电子邮件或将通知推送到用户的移动应用程序。 - **外卖 #5:有复杂的 UX 要求吗?需要动态处理可见性以外的内容?使用 LWC 或 Omniscript。**如果您的要求可以通过简单的主题化和基于列的布局来实现,您可以直接在低代码生成器中构建表单。为了获得对表单样式的更精细的控制,您需要 LWC 的最终灵活性。如果您是行业客户,需要像素级完美品牌化,或者拥有复杂的层次结构数据,请使用 OmniStudio,这将允许您构建能够处理复杂业务逻辑和数据转换的消费者等级表单。 - **外卖 #6:如果您需要测试自动化,请从 Lightning Web 组件开始。**您可以为任何 LWC 编写单元测试,无论您计划将其嵌入何处。这使您能够创建更强大的测试策略,其中包括具有多个记录的批量测试和消极测试。有关创建测试的更多信息,请[参阅 Salesforce 架构良好 - 测试策略](/docs/architect/zh-cn/well-architected/guide/resilient#测试策略),这将帮助您了解表单与功能和非功能需求的一致性。 请记住,您的选择不必是要么/要么 - 您可以组合多个选项的功能。例如,如果您同时需要 Flow 的内置导航系统和 LWC 提供的完整样式灵活性,请将它们一起使用。 ## 使用 Salesforce 构建表单的工具 下表概述了可用于使用 Salesforce 构建表单的工具,以及所需的技能和许可证注意事项。稍后,我们将深入了解每个工具支持的特定功能,以及如何在基于点击的工具和基于代码的工具之间进行选择(以及何时组合):
所需技能 其他许可证要求
动态表单 低代码 没有
屏幕流 低代码 没有
OmniStudio 低代码 + 专业代码 需要行业软件包
屏幕流 + Lightning Web 组件 低代码 + 专业代码 没有
Lightning Web组件 Pro 代码 没有
## 决策点概览 下表概述了在选择产品时需要考虑的决策点,以及您应该问自己的每个问题。在本指南的其余部分中,我们将更深入地探讨每个主题。
对象影响 确定您的表单是针对单个对象还是需要对多个对象进行操作。
表单范围和导航 确定表单上的所有字段是否逻辑上适合一个屏幕,或者用户是否应该能够在多个屏幕之间导航。
位置 确定您想要嵌入表单的位置,该位置的范围可以从 Salesforce 应用程序中的某个位置到移动应用程序,甚至是外部网站。
控制器 确定用户与您的表单交互时需要在后台执行的操作或逻辑,包括数据转换和与外部系统的集成。
验证 确定您是否有 Salesforce 提供的标准系统级验证之外的任何其他输入验证要求。
安全性 确定您的表单是否应该在执行某些操作之前检查用户的访问权限,您是否想要控制谁可以访问表单,以及您是否想要控制表单可以嵌入的位置。
交互设计 确定应在表单中触发动态响应的交互或条件类型。
样式 确定所需样式和 CSS 的复杂程度。
布局 根据所需列数、选项卡、折叠和显示重复数据块的能力,确定表格的布局要求。
翻译 确定表单是否需要本地化为其他语言。
UI 测试自动化 确定 DevOps 流程是否需要对表单进行自动化单元测试或自动化端到端测试
度量 确定您想要跟踪表单使用情况的方式,包括页面视图、在表单上花费的时间、完成率和成功率
打包和部署 确定在构建表单后您想要如何分发或部署表单。
以下是我们在对比表中使用的术语及其定义: - **可用:**基本注意事项工作正常。 - **不理想:**可以工作,但不是最佳工具。 - **路线图:**预计未来 12 个月内的支持(2025 年 6 月)。 - **未来**:未来 12 个月之后的支助估算。 - **不可用:**未来 12 个月内没有计划支持此功能。 ## 决策点逐步解说 如承诺的那样,让我们开始深入了解动态表单、屏幕流、OmniStudio、带有嵌入式 LWC 的屏幕流以及 LWC 框架本身之间的各种比较点和功能差异。 ### 对象影响 如果您的表单针对单个 Salesforce 对象操作,我们正在比较的任何工具都将正常工作。对于跨对象或与对象无关的表单,事情会变得有点复杂。我们所说的对象无关是指不映射到任何 Salesforce 对象的输入。也许您的表单代表您将发送到外部服务的数据结构,例如 Stripe 或 DocuSign。或者,您可能正在使用表单中的多个输入来计算值,然后将该值提交到数据库。 #### 要问的问题: - 表单将针对哪些对象操作? - 是只有一个对象还是有多个对象? - 您是否正在使用特定对象(即客户、联系人、业务机会、潜在客户和个案),或者您的表单是否需要与其他对象一起使用?
单个对象 跨对象 对象不可知性
动态表单 可用 可用 不可用
屏幕流 可用 可用 可用
OmniStudio 可用 可用 可用
屏幕流 + LWC 可用 可用 可用
LWC 可用 可用 可用
对于跨对象和与对象无关的表单,Flow 和 OmniStudio 都是可靠的选项。流屏幕中可用的组件本质上是不可知的,因此您可以选择在后台如何处理这些数据。例如,使用在一个表单中输入的数据在后台创建多个记录,或使用这些数据执行其他操作,例如生成 Chatter 帖子、发送 Slack 消息、发送电子邮件或连接到外部服务。 对于简单个案,使用现有 LWC 组件,例如 Lightningrecord-form,可以是降低提供强大解决方案所需代码的简单方法。但是,对于涉及多个对象的场景,Flow 为所有对象提供了全面的控制,开发人员无需遍历复杂的关系和依赖性。 OmniStudio 将事情向前推进了一步,并且是完全对象不可知的 — 它将用户看到的形式与基础数据模型分开。相反,OmniStudio 会操纵基础 JSON,然后使用[数据映射器](https://help.salesforce.com/s/articleView?id=sf.os_dataraptors.htm&type=5)和[集成程序](https://help.salesforce.com/s/articleView?id=sf.os_omnistudio_integration_procedures_48334.htm&type=5)等工具映射到 Salesforce 对象(或外部数据)。数据映射器和集成程序是将 OmniStudio 表单与 Salesforce 内部和外部数据连接起来的两个关键组件。使用拖放元素,您可以在外部系统中使用复杂的层次结构数据,然后根据数据需要的位置转换数据以满足您的需求。它们还允许您使用公式对数组或数据列表执行数学和逻辑,就像 Apex。 [OmniStudio Integrations_OmniStudio Integrations_](/docs/architect/zh-cn/reference-diagrams/guide/omnistudio-integrations) ### 表单范围和导航 如果您可以从单个屏幕表单获取所有用户输入,请从动态表单开始。但是,虽然记录页面中的动态表单可以使用路径功能来松散地表示业务流程中的各个阶段,但它可能不适合大多数用例。 #### 要问的问题: - 您需要一个屏幕,还是用户需要在多个屏幕之间导航以完成任务? - 您是否希望您的用户看到他们在填写表单过程中走多远的可视化描述? - 您的用户是否需要按特定顺序填写每个屏幕上的信息,或者他们是否应该可以根据需要在屏幕之间来回移动?
单屏幕 多屏幕表单 进度指示器 在步骤/屏幕之间跳转导航
动态表单 可用 不可用 可用 不可用
屏幕流 可用 可用 可用 不可用
OmniStudio 可用 可用 可用 可用
屏幕流 + LWC 可用 可用 可用 可用
LWC 可用 不理想 不理想 不理想
如果您需要比动态表单更多的功能,那么在 Flow、OmniStudio 和 LWC 之间的选择将取决于其他一些问题: - 团队拥有哪些技能?对于管理工作量较大的组织,我们建议从流开始。如果您有行业解决方案,您的团队已经熟悉 OmniStudio,并且您的项目有严格的 UX 要求,请从 OmniStudio 开始。 - 是否可以在表格底部显示导航栏?如果屏幕流和 Omniscript 导航体验不理想,请转向 LWC。 - 表格后面需要做什么?如果您需要管理员配置行为,请构建流或 Omniscript(用于更改字段标签等基本更改)。否则,对于复杂的多对象关系,构建 Omniscript 或 LWC。 - 如果您选择 Flow 或 OmniStudio,您可能需要构建 LWC 来实现正确的 UX。如果您已经在构建 LWC 来正确设计表单样式,请考虑将[该组件嵌入流](https://developer.salesforce.com/docs/platform/lwc/guide/use-flow-embed-component.html)是否过度。 另一方面,如果您的解决方案看起来像向导,用户可以在多个屏幕之间导航,请考虑 Flow 或 OmniStudio。Flows 和 OmniStudio 带有内置导航模型,因此您无需构建和维护相互串联的 LWC。导航是线性的,具有向前移动操作、向后移动操作和保存表单以供以后使用的机制。如果符合您的目的,您也可以使用非线性导航构建表单。有关使用屏幕流的重要示例,请查看 Salesforce Labs 中的[数字商店审计](https://appexchange.salesforce.com/appxListingDetail?listingId=a0N3A00000FMkOtUAL)软件包。 OmniStudio 提供了关键的导航优势,因为它提供了来自标准导航的进度指示器,在表单中显示了“步骤”。此步骤视图自动显示用户在给定多步骤表单中的位置。与流不同,它允许用户通过单击表单的各个步骤在屏幕之间“跳转”。 无论您是构建单屏幕还是多屏幕表单,请确保您的表单已[简化](/docs/architect/zh-cn/well-architected/guide/engaging#表格),以便用户轻松导航。 ### 位置 如果您在标准 Lightning 记录页面中嵌入表格,我们正在比较的任何工具都可以使用,但需要说明的是,动态表格目前仅在桌面上可用。但是,如果您正在寻找一种允许用户从其他位置访问表单的体验,您可能需要考虑其他选项。 #### 要问的问题: - 用户是否需要通过桌面、移动设备或两者访问表单? - 用户是否应该能够通过实用程序栏从应用程序的任何地方访问表单? - 您是否希望使用快速操作,以便用户无需离开当前页面即可填写表单? - 您的表单是否需要在外部网站上可用?
Lightning 记录页面 Lightning 主页或应用程序页面 Aura Experience Cloud 站点 LWR Experience Cloud 站点 嵌入式 Snap-In 实用程序栏 特定于对象的操作 全局操作 Salesforce 移动应用程序** Field Service Mobile Mobile SDK 外部站点和应用程序 自定义 LWC
动态表单 可用 不可用 不可用 不可用 不可用 不可用 不可用 不可用 可用 不可用 不可用 不可用 不可用
屏幕流 可用 可用 可用 可用 可用 可用 可用 路线图 可用 可用*** 不可用 路线图 可用
OmniStudio 可用 可用 可用 不可用 不可用 可用 不可用 不可用 可用 不可用 不可用 可用 可用
屏幕流 + LWC 可用 可用 可用 可用 可用 可用 可用 路线图 可用 不可用 不可用 不理想 可用
LWC 可用 可用 可用 可用 可用 可用 路线图 路线图 可用 路线图 路线图 可用 可用
*流可以嵌入 LWR Experience Cloud 站点,但您需要记住一些注意事项。
**Salesforce 移动应用程序支持流和 LWC,但 Salesforce 移动应用程序不支持您可以嵌入流和 LWC 的所有方式。例如,移动设备支持特定于对象的操作,但实用程序栏项目不支持。
***Field Service 移动应用程序不支持许多最新的流功能,因为它是从旧的流引擎和屏幕流运行时设计的 - 它有特殊的修改,可以离线工作。
由于动态表单需要记录上下文,因此仅在 Lightning 记录页面中受支持。但是,Experience Cloud 页面不支持动态表单。存在此限制,因为 Experience Cloud 不使用动态表单依赖的基础框架:Lightning 页面。我们正在根据 Experience Cloud 中对动态表单的请求进行评估。 您可以构建需要记录上下文的流或全局工作的流。因此,您可以在各种位置嵌入流。对于记录上下文流,这可能是 Lightning 记录页面、Experience Cloud 记录页面、特定于对象的操作或操作和推荐部署。对于全局流,这可能是实用程序栏、其他 Lightning 或体验生成器页面、Snap 单元或外部应用程序。流目前不支持作为全局操作,但作为解决方法,您可以将流封装在 Aura 组件中。 OmniStudio 允许您构建可组合的 FlexCard 和 Omniscript,您可以将它们放在几乎任何可以放置流的地方。但是,虽然它们可以组合,但不能打包。 LWC 支持高度的可重用性,因为您正在通过跨 Salesforce、社区甚至开源项目的元数据创建可与目标关联的组件。LWC 组件也可以通过 [Lightning Out](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lightning_out) 嵌入您自己的网站。 外部站点上的 Lightning Out 外部站点上的 Lightning Out [\_\_](/docs/architect/zh-cn/reference-diagrams/guide/lightning-out-on-external-sites) 目前,Lightning Web 组件不支持作为快速操作(特定于对象或全局),但作为解决方法,您可以在 Aura 组件中封装 LWC(与流相似)。LWC 组件也可以通过[Lightning -flow](https://developer.salesforce.com/docs/component-library/bundle/lightning-flow/documentation)组件启动流。 OmniStudio 擅长通过 OmniOut 功能向外部站点公开内容。通过 OmniStudio 和 OmniOut,您可以将 Omniscript 表单和 FlexCard 组件编译为标准组件,并在第三方站点或应用程序中将它们运行在平台外。 今天,Mobile SDK 模板不支持本指南涵盖的任何表单技术。如果移动软件开发工具包对用例至关重要,您最好在您的移动应用程序中本地构建表单或构建 Visualforce 页面,同时牢记 Salesforce 精心设计的[外形规格](/docs/architect/zh-cn/well-architected/guide/engaging#外形规格)指南。 **路线图备注:**Mobile SDK 团队正在积极致力于支持 Visualforce 页面中的 LWC。 ### 控制器 如果您需要使用表单中的值来创建或更新记录,动态表单是完美的选择。对于任何其他功能,您需要利用 Flow、OmniStudio 或 LWC。这些功能可能包括决策或迭代层,或者使用表单中的输入生成 Slack 帖子或电子邮件。 #### 要问的问题: - 您想要在后台执行哪些操作或逻辑? - 您的数据模型是否包含层次结构数据? - 您的表单是否需要在单个事务中或跨多个事务完成操作? - 是否需要与外部系统集成? - 您对可重用性和模块化的要求是什么?
日志和操作 层次结构数据管理 在一个事务中操作 跨多个事务操作 集成 模块化设计和重用 打包
动态表单 不可用 不可用 不可用 不可用 不可用 不可用 可用
屏幕流 可用 路线图 可用 可用 可用 可用 可用
OmniStudio 可用 可用 可用 可用 可用 可用 不可用
屏幕流 + LWC 可用 可用 可用 可用 可用 可用 可用
LWC 可用 可用 可用 可用 可用 可用 可用
Flow 提供了发布到 Slack、发送电子邮件和与 Quip 文档交互的标准操作,因此您无需编写这些操作的代码。通过使用与[用户界面 API](https://developer.salesforce.com/docs/atlas.en-us.uiapi.meta/uiapi/ui_api_get_started.htm) 交互的线路适配器,LWC 提供了与单个记录和相关对象的丰富交互。当使用 [getListInfoByName](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/reference_get_list_info_by_name.html) 的线时,LWC 也可以与多个记录交互。 [LWC 通过有线适配器交互_Lightning Web 组件通过有线适配器交互_](/docs/architect/zh-cn/reference-diagrams/guide/lightning-web-components-interaction-via-wire-adapters) 如上所述,OmniStudio 使用集成程序和数据映射器轻松获取和转换 Salesforce 外部和内部的数据。由于您可以使用大量无代码函数,它在平展和扩展具有各种关系的数据集方面大放异彩。 **路线图备注:**Flow 将很快支持更新插入记录集合以及管理层次结构数据的功能。 Flow、OmniStudio 和 LWC 都与 Apex 集成,因此无论选择哪种解决方案,您都可以轻松弥合任何差距。例如,如果您需要从 LWC 筛选记录,您可以始终使用 Apex 的线适配器来创建复杂的 SOQL 查询。如果您被基于点击的数据趋势所左右,请考虑将 Flow 或 OmniStudio 作为 Apex 控制器的可行替代方案,以满足服务器端需求。 此处的第二个问题是,您是想要立即提交操作,还是将它们推迟到表单的特定部分。如果您使用的是多页表单,这尤其相关。流可轻松组合来自多个表单(流屏幕)的输入,并在向导(流)中稍后使用它们来执行一些操作。事实上,我们建议以这种方式设计流 — 在结束时执行操作 — 以防用户在屏幕之间来回切换,更改答案。 #### 控制操作 事务和[管理者限制](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_gov_limits.htm)是 Salesforce 平台上的一种生活方式。如果您的用例相当简单,那么控制特定操作发生在什么事务中就不那么重要。但是,在少数用例中,您可能想要将多个操作合并为一个[事务](/docs/architect/zh-cn/fundamentals/guide/architecture-basics#交易),而不是在多个事务中执行它们。一些示例: - **回滚或不回滚**:这就是问题所在。假设您的表单在后台创建多个记录。如果第三个记录无法创建,前两个记录是否应该回滚?如果每个操作相互独立,请随意在单独的事务中执行。但如果它们有依赖性,并且您希望其中一个的失败也回滚另一个,请在单个事务中实施它们。如果您的表单在流中,您可以使用错误路径中的回滚元素来回滚事务并确保数据完整性。 - **对调控器限制的下游影响**:特别是当您的表单创建或更新记录时,请考虑该操作的下游影响。根据此记录更改,将触发哪些进程、工作流规则、流触发器、Apex 触发器或保存订单中的其他项目?这些集体更改如何影响该事务中消耗的调控器限制?如果特定记录更改将导致大量影响限制的下游更改,请考虑将该记录更改隔离到自己的事务中。 - **批处理**:即使在 UI 上下文中,您可能需要一起批量处理多个更新。假设您的多屏幕表单迭代一大组记录。与其在每个屏幕后提交记录更新,不如等到您收集了所有记录的更新,然后提交一个请求来更新所有记录。 当您使用动态表单创建或编辑记录时,您只执行过一次操作,并且该操作始终是新交易的开始。 在构建屏幕流时,您可以显著控制给定事务中会发生什么。屏幕和本地操作充当事务之间的边界。以下是如何在屏幕流架构中管理事务的高级摘要。 1. 最终用户与屏幕交互,然后单击**下一步**。 2. 客户端向带有输入的 API 发布请求。 3. API 收到请求,并打开事务和数据库连接。然后,API 调用流引擎来调用请求。 4. 流引擎接管并遵循流定义中的相应路径,直到它到达屏幕或本地操作节点。然后,引擎向 API 返回有关该节点的信息。 5. API 创建包含要呈现的下一个屏幕的详细信息的响应对象,并将该对象返回到客户端。此时,提交数据库更改(提示[执行保存订单](/docs/architect/zh-cn/fundamentals/guide/architecture-basics#数据库操作)),并关闭数据库连接和事务。 6. 客户端使用 API 响应呈现下一个屏幕,供用户交互。 7. 从步骤 1 重复。 换句话说,屏幕会“破坏”交易。发生这种情况时,提交任何等待批准的操作或 DML,关闭之前的事务,并开始新的事务。
多屏幕流 正确的设计 — 您将哪些操作分组到给定的事务中 — 是您的决定。让我们来复习一些示例。
具有单独事务的屏幕流
在左侧,您可以看到跨多个屏幕收集输入的流,然后在一个事务中执行几个操作。
右侧的流会在单独的事务中执行每个操作。
流团队最近引入了一个新元素:如果单个操作在一系列数据库操作中失败,回滚记录元素使您能够回滚整个事务。
包含多个创建记录的屏幕流

假设您有一个创建记录、更新记录,然后创建更多记录的流,如右侧下一个流所示。
在这种情况下,如果前两个元素成功,最后一个元素失败,前两个 DML 操作仍会创建和更新这些记录,而第三个不会。
带回滚的屏幕流
通过使用“回滚记录”元素,您可以确保如果所有三个操作必须同时进行,整个事务将被回滚,如左侧的最终流所示。 有关更多详细信息,请查看[事务中的流](https://help.salesforce.com/articleView?id=flow_concepts_transaction.htm)和[事务中的流](https://help.salesforce.com/articleView?id=flow_concepts_bulkification.htm)批量化。Salesforce Well-Architected 的自动化部分也会在[数据处理](/docs/architect/zh-cn/well-architected/guide/automated#数据处理)中对此进行更深入的介绍。 您从 LWC 控制事务的能力取决于 LWC 用来执行操作的底层服务。如果您正在使用 Lightning 记录表单基础组件,基础操作(创建或更新记录)将在提交表单后立即在独立事务中发生。 通常,这些规则适用: - 每个 UI API 调用都被隔离到自己的事务中。 - 如果您需要在单个事务中执行多个操作,请将输入发送到服务器端技术,例如 Apex 控制器或流。该技术的常规事务规则适用。 #### 外部集成 Flow、OmniStudio 和 LWC 都支持平台事件(适用于[事件驱动架构](/docs/architect/zh-cn/decision-guides/guide/event-driven))和 API 集成。除了自定义 Apex 代码之外,Flow 和 OmniStudio 都支持集成 API 的声明性机制。 如果您需要连接到 MuleSoft API 或 RPA 机器人,请使用 MuleSoft 服务。这将生成外部服务。 [通过 MuleSoft 进行外部集成 通过 MuleSoft API 和 RPA 机器人进行*外部集成*](/docs/architect/zh-cn/reference-diagrams/guide/external-integrations-via-mulesoft-apis-and-rpa-bots) 如果 API 具有 OpenAPI 模式,请创建外部服务。 [通过 OpenAPI 进行外部集成 通过 OpenAPI 模式与 API 进行*外部集成*](/docs/architect/zh-cn/reference-diagrams/guide/external-integrations-to-apis-with-openapi-schemas) 否则,使用流中的 HTTP 标注功能或 OmniStudio 中的 HTTP 操作。流的 HTTP 标注由外部服务提供支持。 [通过 HTTP 的外部集成 _通过 HTTP 的外部集成_](/docs/architect/zh-cn/reference-diagrams/guide/external-integrations-via-http) OmniStudio 具有丰富的集成功能,可以通过集成程序调用外部系统,并使用数据映射器转换数据。(有关更多信息,请查看[对象影响](#对象影响)) 无论您是通过自定义 Apex 还是外部服务实施,标注都是标注。以下是您需要了解的内容。 1. 标注可能需要很长时间。 2. 当同步执行标注时,它会在数据库事务打开时执行。 3. 如果您有等待批准的数据库操作,Salesforce 不会让您保持数据库事务打开。 请记住的主要限制是所谓的**_脏事务_**的危险,即您执行创建、更新或删除操作,然后在同一事务中执行标注。不允许此模式,因为以上注意事项 #3;当然,存在此模式是因为注意事项 #1 和 #2。 在流中,您可以通过打破事务来解决此限制。请谨记,屏幕和本地操作会重新引入浏览器上下文,从而中断事务。虽然您可以在使用外部标注时使用屏幕和本地操作,但我们建议在可调用的高级设置中启用事务控制。事务控制是可调用操作的功能,允许您在调出前自动结束事务。您可以通过在调用操作的高级部分中选择始终启动新事务来启用事务控制。 通过标注的外部集成 使用 LWC 时,标注对事务的影响不那么复杂。一般来说,您将使用 Lightning 数据服务 (LDS) 执行数据操作,然后使用 Apex 控制器进行外部标注。这种设计保护您免受脏事务的影响,因为 LDS 调用在与 Apex 标注分开的事务中隔离。 _有关 Apex 标注、外部服务和一般数据集成能力的深入指导,请参阅数据与 Salesforce 集成[架构师指南](/docs/architect/zh-cn/decision-guides/guide/data-integration)。_ #### 可重用性和模块化 动态表单不支持重用。每个动态表单都绑定到特定对象的特定 Lightning 记录页面(尽管您可以将该 Lightning 记录页面分配给多个应用程序、简档等)。 如同您可以编写用于跨多个其他组件的库、实用程序和组件一样,在通过**_子流_**创建流时,您可以应用类似的设计模式。将流保存在更小、更模块化的存储桶中,然后使用子流元素从其他流调用它们。如果您的设计需要它,您可以构建一个流,它既是独立的,又是另一个流的子流。 OmniStudio 本质上是为模块化而构建的。数据映射器、Omniscript、FlexCard 和集成程序都是独立构建的,可以互换工作。最重要的是,FlexCard 可以构建为可嵌入其他 LWC、Omniscript、记录页面和 Experience Cloud 站点的 LWC 组件。 屏幕流、Omniscript 和 LWC 都可以构建用于重复使用,并嵌入到各种位置,包括外部站点和 Lightning Out 应用程序。当您将解决方案设计成可[组合](/docs/architect/zh-cn/well-architected/guide/composable)时,您会获得额外的好处,例如适应性和稳定性。 ### 验证 用于创建或更新记录的所有技术都遵守系统级验证 — 无论是经典验证规则还是内置于 Apex 触发器的自定义验证。无论您使用什么技术执行记录更改,每个更改都会经过保存顺序。这意味着,除了验证规则之外,记录更改由任意数量的保存前或保存后流、触发器、升级规则、分配规则等处理。如果您尚未这样做,请确保添加书签并熟悉 Apex 的[执行顺序](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_triggers_order_of_execution.htm)。 #### 要问的问题: - 除了系统级验证之外,您的表单是否有其他要求? - 您是否需要在表单中动态将字段设置为必填或只读?
遵守系统级验证 特定于此表单的自定义字段级验证 自定义字段级验证
动态表单 可用 不可用 不可用
屏幕流 可用 不可用 路线图
OmniStudio 可用 可用 可用
屏幕流 + LWC 可用 可用 可用
LWC 可用 可用 可用
流屏幕或 Omniscript 步骤上的输入本质上是未绑定的,因此表单本身不会本地遵守与特定对象关联的系统级验证。但无论您使用什么值来创建或更新记录,它们都由保存订单处理,这意味着它们通过对象的系统级验证。但请注意,并非所有屏幕流组件都支持输入验证。从 Summer '24 开始,不支持输入验证的剩余屏幕组件是单选按钮、选项列表、多选选项列表、复选框组和选择查找。 就像页面布局一样,动态表单允许您在页面级别设置要求和只读状态。但您无法覆盖系统级设置。 流为自定义表单输入的验证提供了灵活性。虽然一些检查在客户端执行(例如标记缺少必填字段或不兼容的值),但客户端验证不会阻止用户尝试导航。真正的验证发生在服务器上。当用户单击**下一步**时,流会将输入发送到服务器进行验证。如果任何输入返回无效,导航将被阻止,并显示适当的错误。服务器通过检查来验证输入: 1. 输入的要求设置,或输入的值是否与基础数据类型兼容。 2. 对该输入的自定义验证:一些标准组件(复选框、币种、日期、日期/时间、长文本区域、数字、密码和文本)支持每个屏幕的自定义验证。提供布尔值公式表达式和错误消息,以便在不满足公式表达式时显示。 3. 对基础组件的自定义验证:如果您正在为流构建自定义 LWC,请将自己的验证码添加到 validate() 方法中。 OmniStudio 具有丰富的错误和验证处理功能,可通过[设置错误](https://help.salesforce.com/s/articleView?id=sf.os_set_errors_in_an_omniscript.htm&type=5)操作与[条件视图](https://help.salesforce.com/s/articleView?id=sf.os_conditionally_display_elements_using_the_conditional_view_property.htm&type=5)和[消息](https://help.salesforce.com/s/articleView?id=sf.os_display_messages_in_omniscripts_19551.htm&type=5)传递组件组合使用。 在 LWC 侧,大多数基本组件执行自己的客户端验证。例如,Lightningrecord-form 遵守系统级要求,但不遵守页面级要求。对于自定义组件,您可以 Build Your Own 验证机制。 需要用户输入数据的字段应尽早出现在您的表单中。在提交表单之前,尽可能验证客户端的用户输入。有关简化表单的更多最佳实践,请查看 Salesforce 精心设计 - 参与中的[表单](/docs/architect/zh-cn/well-architected/guide/engaging#表格)指导。 ### 安全性 一般来说,安全性是一个复杂的主题,当涉及到构建表单时,有一些您可能甚至没有想到的注意事项。在基础级别,您需要确保表单在正确的上下文中运行,并且用户拥有使用其基础数据所需的权限。但除此之外,您可能还希望采取额外的措施,从富文本字段中删除潜在的恶意代码或 URL,阻止某些用户访问表单,或者对管理员未来可能嵌入表单的位置类型进行限制。在选择工具之前,请确保彻底记录您的安全要求。Salesforce 结构良好的[安全策略模板](/docs/architect/zh-cn/resources/guide/security-policy-template)包含此类文档的指导说明。 #### 要问的问题: - 在执行某些操作之前,表单是否应该检查用户的访问权限? - 您是否应对用户输入进行消毒? - 是否要控制谁可以访问表单? - 是否要控制表格的嵌入位置?
提升用户权限 控制谁拥有访问权限 限制允许的位置
动态表单 不可用 可用 不可用
屏幕流 可用 可用 不可用
OmniStudio 不可用 可用 不可用**
屏幕流 + LWC 可用 可用 不可用
LWC 可用* 可用 可用
*需要 Apex
**虽然 Omniscript 不能有一组指定的目标位置,但 FlexCard 可以。
#### 提升用户权限 在**_用户上下文_**中运行时,Salesforce 会强制执行一系列访问权限检查,包括根据贵组织的共享规则验证字段级安全性、CRUD 权限和记录访问权限。因此,例如,用户只有在能够更新个案、适当的字段级安全性和访问有关记录时,才能运行个案更新表单。但如果您希望用户在使用*您*的表单时能够执行特定操作,而不是通过任何其他表单或交互,该怎么办?这就是**_系统上下文_**的来源。 系统上下文是在会话期间提升运行用户权限的一种方式,这样用户就不需要更新个案对象的访问权限来成功完成您的个案更新表单。这对于未经身份验证的社区尤其有用。不要授予来宾用户潜在的危险功能,而是将您的表单设置为在系统上下文中运行。 当然,系统上下文是一把双刃剑,您应该只在必要时使用它。当表格在系统上下文中运行时,每个 CRUD 操作都会绕过对象和字段级安全性和共享,而不仅仅是您关心的具体操作。另请注意,系统上下文对 Salesforce 认为操作者是谁没有影响,即您在上次修改人字段中看到的名称。对于表单执行的每个操作,例如个案更新,操作者是运行用户,即使表单在不同的上下文中运行。 动态表单、Omniscript 和 LWC 始终在用户上下文中运行,并且无法覆盖此行为。 默认情况下,屏幕流在用户上下文中运行,但您可以将其设置为在系统上下文中运行。流是否应授予对所有数据的访问权限,或是否仍应强制执行共享等记录级访问权限,由您自行决定。 - 如果您在系统上下文中运行的流中嵌入 Lightning 组件,流不会覆盖组件的上下文。如果您需要绕过用户访问检查,我们建议使用该流执行这些操作,并将适当的数据传入或传出 Lightning 组件。一些现成的组件(例如查找)无法在系统上下文中运行。 - 如果流调用 Apex 操作,还有一些细微差别需要了解。如果 Apex 类设置为继承共享,则无论流设置为什么,它都会在具有共享的系统上下文中运行。如果类没有显式共享声明,则无论流设置为什么,它都会在系统上下文中运行,而不会共享。如果类设置为“共享”或“不共享”,则会执行此操作并覆盖流的上下文。 **使用 Experience Cloud 站点查询系统上下文中的记录:** 如果您在 Experience Cloud 站点的系统上下文中运行流,**特别是未经**身份验证的流,我们建议在获取记录元素中仅存储特定字段。当您使用流并将获取记录元素的结果传递到子流、可调用操作或 Lightning 组件时,可以通过浏览器的开发人员工具检查该对象中的所有字段。这可能会使字段对您可能不打算使用的 Experience Cloud 站点用户可用。通过在“获取记录”元素中指定特定字段,即使启用了系统上下文,您也可以确保仅公开正确的字段。 请注意,Omniscript 逻辑在客户端运行,这使得攻击者能够修改 Omniscript 的预期执行*情况,并*使用浏览器的开发人员工具查看对集成程序、数据映射程序和 Apex 方法调用的响应。当您使用 Omniscript 时,我们建议尽可能在服务器端执行业务逻辑,并在通过 [@InvocableMethod 注解](https://help.salesforce.com/s/articleView?id=sf.os_integration_procedure_invocation_55721.htm&type=5)公开的任何 Apex 方法上实施输入验证规则。 **消毒输入:** 要保护您的组织免受不良行为者的攻击,也请考虑输入消毒。假设您在可公开访问的表单上有一个输入,可以映射到贵组织的富文本字段。您可能要考虑自动化,删除可能隐藏恶意 URL 的任何 HTML。通常,在表单级别实施此消毒并不理想,因为您可以让任意数量的源写入这些字段。我们建议创建快速字段更新流(保存前)或使用对象上的现有 Apex 触发器,以删除或修改可能在表单中输入的任何潜在 HTML。 **_最佳实践:_** - _除非您需要提升运行用户对特定操作的访问权限,否则将流保留在默认上下文中运行。_ - 出于安全原因,_避免在系统上下文中为来宾用户运行流。相反,创建分配给 Experience Cloud 站点来宾用户简档的具有有限字段访问权限的权限集。_ - _在 Experience Cloud 站点的系统上下文运行流中查询记录时,仅将您需要的字段存储在获取记录元素或可调用操作中。_ - _如果流执行各种操作,但并非所有操作都需要提升访问权限,请使用子流隔离应在系统上下文中运行的操作。_ - _如果您计划在外部网页中嵌入表格,请考虑使用快速字段更新流或 Apex 触发器对用户输入进行消毒,以删除 HTML,如果它们最终将映射到富文本字段,以防止恶意行为者的任何潜在网络钓鱼攻击。_ #### 其他备注: - 默认情况下,Omniscript、FlexCard 和 LWC 在用户上下文中运行。 - 默认情况下,LWC 在用户上下文中运行,流在用户上下文中运行,但您可以在 Apex 控制器中覆盖它。 - 通过 UI API 执行的操作在用户上下文中运行。 - 通过 Apex 控制器执行的操作取决于该类。要在系统模式下执行这些操作,请将 Apex 类设置为共享或不共享。 #### 访问控制 如果您需要控制谁可以访问您的表单,您可以经常查看嵌入表单的容器。例如,您可以将 Lightning 页面分配到可用于特定应用程序、记录类型或简档。如果表单中的某些输入敏感,请使用可见性规则进一步控制向谁显示什么;此功能适用于动态表单和屏幕流。 您可以将[流限制](https://help.salesforce.com/articleView?id=flow_distribute_security.htm)为特定简档或权限集,如同您可以限制为 Apex 类或 Visualforce 页面。默认情况下,流不受限制,这意味着任何具有运行流用户权限的用户都可以运行它们。 如果您正在使用 OmniStudio,您可以配置 [Apex 类权限检查](https://help.salesforce.com/s/articleView?id=sf.os_add_an_apex_class_permissions_checker_1.htm&type=5)器,以确保用户需要明确访问 Apex 类,该类管理从 Omniscript、Flexcard、Classic Card 或 REST API 调用的远程操作。 - 注意 Apex 类权限检查默认为新创建的脚本启用。但必须为任何现有脚本手动启用 - 另请注意,Apex 类权限检查仅适用于 Apex 类。我们建议也为[集成程序和数据映射](https://help.salesforce.com/s/articleView?id=sf.os_security_for_dataraptors_and_integration_procedures_48147.htm&type=5)程序设置简档级权限。 有关来宾用户权限的更多详细信息和最佳实践,请参阅: - [来宾用户记录访问最佳实践](https://www.learnexperiencecloud.com/s/article/Guest-User-Record-Access-Development-Best-Practices#Pattern6) - [开发安全站点:经过身份验证的用户和来宾用户](https://developer.salesforce.com/docs/atlas.en-us.communities_dev.meta/communities_dev/communities_dev_security_authenticated_and_guest_users.htm) **_最佳实践:_** - _如果您向来宾用户公开流,请仅授予来宾用户简档对所需流的访问权限。虽然可以将运行流添加到来宾用户简档,但我们认为这是一种有风险的做法。_ - _请特别小心在系统上下文中操作的流。我们强烈建议将这些流限制为特定用户组,因为他们拥有更少的制衡措施来保护您的数据。_ - _确保在来宾用户社区中运行 Apex 的任何 Omniscript 在 Apex 类定义中都有"共享"。_ - _在您的来宾用户简档中,只分配您希望来宾用户能够调用的 Apex 类,否则您就有无意中向来宾用户公开其他业务逻辑的风险。_ 对于 LWC,您可以检查运行用户的权限分配,以确认他们是否有特定的标准或自定义权限。您可以直接从 JavaScript 导入 Salesforce 权限,从 @salesforce/userPermission 和 @salesforce/customPermission 范围模块导入。或者,您可以使用 Apex 检查相同内容。 #### 嵌入控制 Lightning Web 组件仅在作为有效[目标](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.reference_configuration_tags)添加时在指定位置可用。例如,您可以使组件在记录页面上可用,而不可用作实用程序栏项目。 激活屏幕流后,它可在支持屏幕流的所有位置使用,而不论您是否希望它在所有位置可用。也就是说,Flow Builder 支持多种类型的具有屏幕的流。面包和黄油类型是屏幕流,但也有一些其他专用类型仅限于特定位置。例如,Field Service 移动应用程序仅支持 Field Service 移动流(您猜对了)。联系人请求流也是如此,只有 Experience Cloud 支持。 无论流类型如何,创建流的个人无法控制流的嵌入位置。该流将在支持该流类型的每个位置可用。 如果您正在使用 Salesforce Industries,在 Omniscript 方面需要稍作说明:虽然您不能为 Omniscript 本身指定目标,但您可以为要嵌入其中的 FlexCard 指定一个目标。 ### 交互设计 静态表单已成为历史。今天,重要的是要动态更新表单,使其具有适合该用户的属性和值,这一次是这个地方。让我们讨论一下 Salesforce 的表单构建工具在这方面可能实现的功能。 #### 要问的问题: - 哪些类型的交互或条件应触发表单中的动态响应? - 在填写表单时,是否需要在后台执行屏幕外操作? - 您是否需要将字段设置为可见、必填、只读或禁用,或者根据表单输入更改格式?
执行屏幕外数据操作 条件值和计算 条件可见性 条件要求 条件格式化 条件只读状态 有条件禁用状态
动态表单 不可用 不可用 可用 不可用 路线图 不可用 不可用
屏幕流 可用 可用** 可用 可用* 不可用 可用** 可用**
OmniStudio 可用 可用 可用 可用 可用 可用 可用
屏幕流 + LWC 可用 可用 可用 可用 可用 可用 可用
LWC 可用 可用 可用 可用 可用 可用 可用
*仅限于使用资源选择器而不是静态复选框的组件
**受限 Beta
由于反应性屏幕,屏幕流交互性现已成为现实。反应性允许流屏幕上的单个组件相互通信 - 使屏幕流无限强大。 **执行屏幕外数据操作:**屏幕流提供了一种声明性方法,通过屏幕操作在同一屏幕上获取数据。屏幕操作允许您在屏幕的任何更改或用户单击操作按钮组件时触发自动启动的流。然后,您可以将这些自动启动流的结果映射到同一个屏幕,使用户无需导航到另一个屏幕。 LWC 提供了全套的有线适配器,允许您访问 Salesforce 数据以动态填充表格组件中的数据,并使开发人员能够通过 Apex 控制器更新、删除和创建记录。 [Lightning Web 组件屏幕外数据操作_Lightning Web 组件屏幕外数据操作_](/docs/architect/zh-cn/reference-diagrams/guide/lightning-web-components-off-screen-data-operations) **可见性:**可见性可在所有表单构建工具中动态控制。动态表单、Flow Builder 和 OmniStudio 通过组件可见性功能来解决这个问题。这样,您可以根据表单上的其他值或用户是否在移动设备上来声明性地显示或隐藏字段。 - 通过动态表单,可视性可以根据记录字段值、通过查找字段相关的记录和外形规格来控制。 - 通过流,您可以将可见性规则基于屏幕上的其他输入,以及流中较早填充的其他资源,例如公式或其他记录中的值。 - **基于设备的规则:**从一开始并不明显,但是您可以使用公式来显示或隐藏用户在移动设备上的特定字段。编写检查 \$User.UIThemeDisplayed 全局变量值的流公式。如果值为 Theme4t,则用户在 Salesforce 移动应用程序上。 - **评估其他资源:**手动变量和公式引用仅在服务器上评估。因此,当屏幕首次呈现时,该资源拥有的值是它将拥有的值,直到您导航到另一个屏幕。在导航中,流运行时向流引擎(服务器)提交请求,并获取手动变量和公式的最新值。如果您希望可见性规则在用户通过单个屏幕时更新(例如,模糊),请确保您仅引用屏幕上其他组件的值。 - 使用 OmniStudio,您可以通过设置条件视图属性来有条件地显示或隐藏组件。但是,您不能为输入添加多个条件视图属性。 **条件输入状态:**如果您需要动态控制任何其他属性,例如字段是必填、禁用还是只读,您有几个选项。正如预期的那样,LWC 为您提供了对输入状态的完整反应性控制。通过反应性屏幕流组件,您可以动态控制组件属性,例如只读、禁用和支持它的标准组件所需的属性,而 OmniStudio 支持组件特定的全部属性。如果您的要求要求您需要流,并且组件不支持特定属性状态,您可以创建可嵌入的 LWC 来实现动态输入状态。 如果您需要动态控制任何其他属性,例如某个字段是必填字段还是只读字段,您短期内的最佳方法是拥有完全控制权的 LWC。如果您有如何处理模糊或点击的定制要求,这尤其如此。 屏幕流中的反应性 LWC:在构建能够对屏幕流上的其他组件做出反应和进行更改的 LWC 时,请参考本 [LWC 屏幕流最佳实践](https://developer.salesforce.com/blogs/2023/02/lwc-best-practices-for-screen-flows)指南,以确保您的组件很好地集成到流运行时引擎中,并按预期在未来工作。
标准事件处理(模糊、聚焦) 自定义事件处理
动态表单 不可用 不可用
屏幕流 不可用 不可用
OmniStudio 不可用 可用*
屏幕流 + LWC 可用 可用
LWC 可用 可用
*OmniStudio 标准运行时不支持发布/订阅,但支持 Windows postMessage
现在,对于自定义事件。如果您的一些输入或整个表单需要与页面中的其他内容通信,LWC 是您的唯一选择。 - 要在相同 DOM 树中通信,请使用 [**CustomEvent 界面**](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.events)。 - 要在 DOM 之间通信 请使用[**Lightning Messaging Service**](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.use_message_channel) - 如果目标容器[不支持](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.use_message_channel_considerations) Lightning 消息传递服务,请使用**发布/子模块**。 #### 其他资源 - 有关更多详细信息,请查看 _Lightning Web 组件开发指南_ 中的[与事件通信](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/events)和[跨 DOM 通信](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.events_pubsub)。 - 对于 OmniStudio,请从 Lightning Web 组件咨询[与 Omniscript 通信。](https://help.salesforce.com/s/articleView?id=sf.os_communicate_with_omniscript_from_a_lightning_web_component_18222.htm&type=5) ### 样式 为了提供最佳用户体验,您需要确保您的表单样式与嵌入表单的其他应用程序或站点一致。实现这一点意味着从使用 Salesforce 提供的标准模板到创建完全利用设计中的每个像素来提供更清晰的外观的自定义 CSS 的一切。 #### 要问的问题: - 您想要的样式和 CSS 有多复杂? - 您是否需要自定义的像素级完美样式,或者是否适合标准主题?
直接样式 组织和体验生成器主题 像素完美样式
动态表单 不可用 可用 不可用
屏幕流 不可用 可用 路线图
OmniStudio 可用* 不可用 可用
屏幕流 + LWC 不可用 可用 可用
LWC 不可用 可用 可用
*仅限Flex 卡
FlexCard 是本指南涵盖的唯一产品,使您能够直接在工具中声明性地控制您正在构建的 UI 的样式和布局,无论是边距和填充、排字、颜色等。 动态表单和流都遵守声明性主题特征。如果您需要控制 [Salesforce 主题](https://help.salesforce.com/articleView?id=brand_your_org_in_lightning_experience.htm&mode=1)、[体验生成器品牌](https://help.salesforce.com/articleView?id=community_designer_brandsets.htm)集或 [LWR Experience Cloud 站点](https://developer.salesforce.com/docs/atlas.en-us.exp_cloud_lwr.meta/exp_cloud_lwr/brand_overview.htm)支持的内容之外的内容,请考虑编程解决方案。 对于喜欢使用 CSS 的团队,您有几个选择: - 流和 LWC 继承[标准设计令牌](https://developer.salesforce.com/docs/atlas.en-us.lightning.meta/lightning/tokens_standard.htm)。 - Omniscript 和 FlexCard 包括对可自定义设计系统的支持:[纽波特](https://help.salesforce.com/s/articleView?id=sf.os_customize_omniscripts_and_flexcards_with_the_newport_design_system.htm&type=5) - 使用 LWC,您可以编写自己的组件,并完全控制它们的 HTML 和 CSS。 只要有可能,我们建议使用主题和设计系统,以便您的外观始终一致地应用于所有内容。 提醒:您可在流中嵌入 Lightning 组件。因此,如果您需要对表单的外观进行像素级完美控制,但想要使用流的其他好处,例如导航模型,您可以充分利用这两个方面。同样的原则适用于 Omniscript 和 FlexCard。 ### 布局 选择良好的布局对于设计简化的表单至关重要,这些表单支持快速高效的数据输入并提高数据完整性。有关此主题的更多信息,请查看 [Salesforce 结构合理 - 表单](/docs/architect/zh-cn/well-architected/guide/engaging#表格)。 #### 要问的问题: - 您如何利用表单布局优化用户体验? - 您如何以让用户更容易将新数据输入到表单的方式向用户显示现有数据?
2 列 4 列 超过 4 列 重复数据块 选项卡容器 折叠容器
动态表单 可用 不可用 不可用 不可用 可用 可用
屏幕流 可用 可用 不可用 可用 不可用 可用
OmniStudio 可用 可用 可用 可用 可用* 可用
屏幕流 + LWC 可用 可用 可用 可用 可用 可用
LWC 可用 可用 可用 可用 可用 可用
*如果将数据嵌入 Omniscript 中的 FlexCard,可以使用选项卡
动态表单支持两列布局,并可以分为带有字段的单个部分。这些部分可以放在选项卡和折叠等组件中,以创建易于使用和组织有序的布局。 流可以选择使用“部分”组件呈现。通过部分,您可以在流屏幕上添加最多四列和任意数量的部分。该组件也会响应屏幕宽度,因此可在更小的屏幕上工作。最后,它使您能够对整个部分应用条件可见性,从而更容易对该部分中的多个字段批量应用可见性。流部分还支持列标题,并提供类似折叠的体验,用户可以单击标签折叠整个部分。 Omniscript 具有用于显示字段和数据的各种布局选项。您可以创建最多 12 列的数据部分,包括有条件折叠的折叠琴。 使用 LWC,您可以使用 Lightning-form 和支持 Lightning-字段来控制布局。唯一的布局限制是那些来自 HTML/CSS 的限制。Lightningrecord-form 遵守相关页面布局中的部分配置;例如,如果部分在页面布局中是两列,则它在该组件中是两列。 ### 翻译 如果您的表单将由不同地区的用户或讲不同语言的用户访问,您需要确保您将用于构建表单的工具将满足本地化要求。有关其他指导和建议,请查看 [Salesforce 架构良好 - 本地化](/docs/architect/zh-cn/well-architected/guide/compliant#本地化)。特别是对于表单,本地化要求通常涉及将文本元素翻译成其他语言。 #### 要问的问题: - 您的表单是否将在多个国家或地区使用? - 表格中的文本是否需要本地化为其他语言?
在生成器中输入的标签 代码中的标签
动态表单 可用* 不可用
屏幕流 可用 可用
OmniStudio 可用 可用
屏幕流 + LWC 可用 可用
LWC 不可用 可用
*仅限字段部分标题
如果您已本地化自定义字段,动态表单将遵循这些翻译的标签。动态表单还遵守您在 Lightning 应用程序生成器中分配给组件标签和属性的[自定义标签](https://help.salesforce.com/s/articleView?id=platform.lightning_page_components_use_expressions_for_labels.htm&type=5)。 借助翻译工作台的功能,Flow 支持翻译所有标准和自定义屏幕组件面向用户的标签。您可以本地化这些屏幕组件的标签、帮助文本和错误消息:文本、长文本区域、数字、货币、复选框、单选按钮、选项列表、多选选项列表、复选框组、密码、日期和日期/时间。 没有现成的操作的内置翻译支持,例如发送电子邮件或发布到 Chatter。但是,有一个解决方法!如果您使用[自定义标签](https://help.salesforce.com/articleView?id=cl_about.htm)定义翻译的标签,您可以在 Flow Builder 中配置时在操作或组件中引用该自定义标签。创建引用自定义标签的流公式,并在流的适当位置引用该公式。 Omniscript 使用自定义标签进行翻译。请参考[此帮助文档](https://help.salesforce.com/s/articleView?id=sf.os_create_multi_language_omniscripts.htm),以使 Omniscripts 准备好使用多种语言。 接下来是 LWC。如果在翻译工作台中配置了相关对象的字段、帮助文本和验证消息,则某些基本组件会自动继承它们的翻译(例如:Lightning)。 如果需要在代码中引入新颖的可翻译标签,自定义标签仍然是无名英雄。声明您需要的自定义标签,然后从 @salesforce/label 范围模块将其导入组件。 ### UI 测试自动化 有几个端到端的测试自动化工具可用(例如 Selenium),这将允许您模拟用户如何与您的表单交互。您可以为任何标准或自定义 UI 编写这些测试,包括 Lightning 页面和屏幕流。但是,重要的是要注意,这些类型的测试不能验证正在执行的每种方法的输出。请确保在考虑 UI 测试自动化的要求时考虑这一点。 #### 要问的问题: - 是否需要对表单进行自动化测试? - 您需要执行什么类型的测试? - 测试自动化需要什么级别的粒度?
单元测试 端到端自动化
动态表单 不可用 可用*
屏幕流 不可用 可用*
OmniStudio 可用* 可用*
屏幕流 + LWC 可用* 可用*
LWC 可用 可用
*需要代码
考虑您对 UI 测试自动化的要求。 **单元测试**支持与行业标准 CI/CD 系统和工具一起使用的更精细的自动化和验证,可以测试组件的业务逻辑、JavaScript 控制器和输出。仅使用低代码,您将无法自行编写测试,但 Salesforce 会严格测试我们的端到端产品。 如果组件的方法足够复杂,以至于您想要单独测试,请将这些方法放入专用 JavaScript 文件中。这样,您可以使用类似 `import { sort } from 'c/utils';` 的东西将它们导入 LWC 和 Jest 测试。 有关您在 Salesforce 上构建端到端自动化的各种选项的比较,请参见 [UI 测试自动化](https://developer.salesforce.com/blogs/2020/01/ui-test-automation-on-salesforce.html)。其中包括何时使用 ISV 的无代码解决方案、Build Your Own 自定义测试自动化解决方案或使用 Selenium WebDriver 或 WebdriverIO 等开源测试框架的注意事项。这些解决方案适用于 Salesforce 中的任何 UI 交互,无论是 Lightning 页面中的动态表单、实用程序栏中的屏幕流,还是快速操作中的流中的 LWC。 ### 度量 在将表单部署到生产环境后,您需要确保表单得到有效使用。根据您的用例,这可能意味着从简单地跟踪填写的次数到用户在提交信息之前填写的时间。在选择工具之前,请确保确定您想要跟踪的 KPI。 #### 要问的问题: - 是否需要跟踪表单的使用情况? - 哪些 KPI 将决定您的表单是否得到有效使用?
页面视图 在表单上花费的时间 跟踪表单完成情况 跟踪成功率
动态表单 可用** 不可用 不可用 不可用
屏幕流 可用 可用* 可用 可用
OmniStudio 可用 可用* 可用 可用
屏幕流 + LWC 可用 可用* 可用 可用
LWC 可用** 可用* 可用 可用
*在启用基于软件包的 OmniStudio 运行时可用
** 可通过跟踪父 Lightning 页面使用情况获得
如果您需要跟踪表单的整体使用情况和采用情况,请从低代码工具开始。动态表单和屏幕流都可以使用现成的自定义报表类型进行跟踪,尽管您将从屏幕流跟踪报表中获得更大的粒度。如果您需要跟踪 LWC 的使用情况,现成可用性取决于您使用该 LWC 的位置。如果在 Lightning 页面上,任何可用于跟踪 Lightning 页面使用情况的内容都会适用于 LWC。嵌入流的 LWC 也是如此。 动态表单本身不是现成的,尽管您可以通过 [Lightning 使用对象](https://help.salesforce.com/articleView?id=lex_usage_reports.htm)跟踪父 Lightning 页面的使用情况。要跟踪标准 Lightning 页面,请使用按页面度量划分的 _Users with Lightning Usage_ 自定义报表类型。在自定义 Lightning 页面上也是如此,请使用按 FlexiPage 度量划分的 _Users with Lightning Usage_ 自定义报表类型。 对于跟踪特定表单的采用情况(而不仅仅是它所在的页面),Flow 会为您提供帮助。使用“示例流报表:屏幕流”,回答以下问题: - 此表单的完成率如何?它是否被很好地采用? - 用户完成此表单需要多长时间? - 用户在哪个屏幕上花费的时间最多? - 用户多久向后导航一次? - 错误多久发生一次? 如果标准报表不符合您的需求,请使用*屏幕流*报表类型进行复制以自行更改或从头开始构建 Your Own。 如果您正在使用基于软件包的 Omniscript 运行时,您可以使用 [OmniStudio for Vlocity 跟踪服务](https://help.salesforce.com/s/articleView?id=sf.os_vlocity_tracking_service.htm&type=5)。此服务跟踪任何类型的事件。例如,您可以跟踪完成 Omniscript 中的步骤所需的时间,以确定流程改进。OmniStudio 团队在标准 OmniStudio 中支持此服务的路线图上。 要跟踪未嵌入屏幕流、Omniscript 或 Lightning 页面的 LWC,没有现成的选项。您可以使用 Apex 构建自定义解决方案。 ### 打包和部署 当您需要将您的解决方案部署到更高的环境中进行测试或部署到生产中时,您可能习惯于使用更改集或 DevOps Center 来这样做。这些部署选项完全支持动态表单、流和 LWC。OmniStudio 需要一个单独的工具:[IDX 工作台](https://help.salesforce.com/s/articleView?language=en_US&id=sf.os_idx_workbench_desktop_application.htm&type=5)。 #### 要问的问题: - 您计划如何部署表单? - 您的表单会分发到多个 Salesforce 组织吗?
第一代受管软件包 (1GP) 第二代受管软件包 (2GP) 解锁的软件包 更改集 DevOps Center
动态表单 可用 可用 可用 可用 可用
屏幕流 可用 可用 可用 可用 可用
OmniStudio 不可用 不可用 不可用 不可用* 不可用*
屏幕流 + LWC 可用 可用 可用 可用 可用
LWC 可用 可用 可用 可用 可用
*使用 IDX 工作台将 OmniStudio 解决方案部署到其他组织。
如果您是 ISV 或合作伙伴,并计划打包解决方案以在 AppExchange 上分发,我们建议首先查看动态表单、流和 LWC。OmniStudio 不支持打包。 ## 其他主题 ### 将低代码导航到专业代码连续体 本指南的重点是帮助您了解动态表单、屏幕流、OmniStudio 和 LWC 可实现哪些功能和自定义级别。在高级别: 低代码到专业代码连续
- LWC 是构建表单最可自定义和最强大的选项,但它的防护设施最少。您可以确保[安全](/docs/architect/zh-cn/well-architected/guide/secure)性和可[扩展性](/docs/architect/zh-cn/well-architected/guide/reliable#可扩展性)的方式构建组件。 - 动态表单最不灵活,但出错的机会要少得多。 - Flow 和 OmniStudio 位于中间位置 - 比动态表单强大,但在 LWC 级别上不太强大。同样,它们的防护栏比动态表单少,但比自定义代码更难打破。 如果多个工具适合账单,决定哪个工具适合您的团队。其他[架构师决策指南](/decision-guides)介绍了做出决策时需要考虑的其他方面。 我们在这里不赘述每个方面的详细信息,但我们将针对本文档正在评估的特定工具解释它们。 **专业技能**:您的团队对您正在比较的工具拥有多少专业知识?有多少制造商精通并熟悉 LWC 或 JavaScript?谁是 Flow Builder 的专家或表示有兴趣浸泡脚趾的制造商呢?一般来说,动态表单和流技能更容易为构建表单的更多人获得。动态表单是最具声明性的表单构建工具,并且始终比流更容易学习。也就是说,流团队致力于尽可能降低标准。在复杂性方面,OmniStudio 位于 Flow 和 LWC 之间,并提供强大的表单构建功能。 **交付委派**:仅仅因为您的一些要求要求需要 LWC,并不意味着您的整个解决方案需要使用 LWC 构建。请考虑如何模块化构建解决方案,例如,需要 LWC 的部分已编码,不需要在低代码解决方案中构建的部分已编码。这样做可以最大限度地提高多元化团队的效率,并确保每个人正在解决适合其专业的问题。 现在,让我们谈谈流和 LWC。借助反应性屏幕组件,屏幕流组件现在可以在同一屏幕上相互交谈,为架构师、管理员和开发人员解锁全新的工具箱。开发人员现在可以创建有针对性的模块化组件,可以在整个组织中重复使用,提高团队每个人的工作效率。开发人员可以专注于解决新的挑战,并通过使用标准和自定义流组件的组合来实现表单动态来节省时间。在 Flow 中使用反应性组件时,在构建表单时,将 Flow 和 LWC 混合在一起再合适不过了。 **可维护性和长期所有权**:如果您有多步骤表单,最好从 Flow 或 Flow 和 LWC 的组合开始。如果您有一个低代码团队在维护解决方案,请考虑如何使解决方案尽可能适合该受众的配置和扩展。无论您选择哪种工具,都可以将您的解决方案组织成可[组合](/docs/architect/zh-cn/well-architected/guide/composable)单元,以提高可维护性和稳定性。 ### 页面布局 下一步,配置记录详细信息页面的推荐方法是在 Lightning 应用程序生成器中使用 Lightning 页面的动态表单。我们已经很长时间没有改进页面布局了,这一趋势将继续。以下是原因: - 动态表单更灵活 – 您可以将字段和部分直接放在 Lightning 应用程序生成器中的任何位置,您可以在其中利用部分、选项卡和折叠。如同您在 Lightning 页面上使用组件一样,您可以控制字段和部分的可见性,而无需定义多个页面布局或记录类型。 - 使用折叠和选项卡组件,您可以限制初始显示的字段数量。猜猜这意味着什么?更快的页面加载时间。 - Lightning 页面的布局管理更简单,因为您可以从 Lightning 应用程序生成器管理有关页面的一切内容,无论是页面内容还是哪些用户有权访问页面。无需在页面布局中进行更新,即可在 Lightning 页面中进行更改。更何况,借助可见性规则的强大功能,您无需创建多个页面(或页面布局)来控制谁可以在何时看到哪些字段。这也意味着您只需要为用户分配 Lightning 页面,而不是同时分配 Lightning 页面和页面布局。 我们建议尽可能使用动态表单,并仅在必要时返回页面布局。一如既往,我们欢迎在[意见交流中](https://ideas.salesforce.com/s/)就对您的组织最具影响力的改进提供反馈。 ### 性能 与动态表单、屏幕流、OmniStudio 和 LWC 相关的任何性能注意事项都集中在这些技术本身所基于的框架上。那些基于 LWC(当然,除了 LWC)的公司将优于那些基于 Aura 的公司。LWC 框架提供了更好的性能,因为核心功能是在 Web 引擎中本地实施的,而不是通过框架抽象在 JavaScript 中实施的。如果您不熟悉,请阅读[此博客文章](https://developer.salesforce.com/blogs/2018/12/introducing-lightning-web-components.html)。 早在 2019 年,我们就做了一[个案例研究](https://developer.salesforce.com/blogs/2019/06/case-study-dreamhouse-gains-speed-by-switching-to-lwc.html),比较了 Aura 和 LWC 中相同功能的性能。由于将 Dreamhouse 从 Aura 转换为 LWC,不仅开发体验与当前的 Web 前端开发标准和模式更加一致,而且性能也显著提高。实验室测量显示,在相同两个页面上,冷缓存的增益范围为 **2.4% 至 24.7%**,热缓存的增益范围为 **31.83% 至** **63.32%**。 现在,我们的表单技术正在使用哪个框架?换句话说,哪些形式的技术受益于这种卓越的性能? - 动态表单集成在 Lightning 页面元数据中,它建立在使用 LWC 堆栈的基础上,这将使我们能够实施一些请求已久的功能。作为性能奖励,动态表单使用渐进式渲染,这可以改善具有大量字段的页面的页面加载时间。 - 屏幕流构建在 LWC 上,除了两个现成的组件之外,大多数单独的现成的组件现在都转换为 LWC:文件上传和图像。虽然流团队将流运行时客户端转换为 LWC 及其大部分组件,但客户仍然需要将 Aura 屏幕组件转换为 LWC。不仅如此,Salesforce 仅支持屏幕流中新反应性组件框架中的 LWC 组件。有一个优秀的 Trailhead 模块解释了如何做到这一点:适用于 Aura 开发人员的 [Lightning Web 组件](https://trailhead.salesforce.com/en/content/learn/modules/lightning-web-components-for-aura-developers)。不用说:如果您正在考虑为屏幕流或任何其他容器构建自定义组件,请始终使用 LWC。 - OmniStudio 有几个版本可用。如果您是长期客户,您可能正在使用 Angular。我们鼓励所有新客户从基于 LWC 的 Omniscript 和 FlexCard 开始,并鼓励现有客户迁移到 Angular。 - LWC 基于...LWC of course.这是免费赠品。 ## 结束语 作为架构师,深入了解所有可用的选项以及如何将它们应用于特定的用例非常重要。对于在 Salesforce 上构建表单,选项范围从低代码(在 Lightning 应用程序生成器中使用动态表单、在 Flow Builder 中使用屏幕流,在 OmniStudio 中使用 Omniscript)到专业代码(使用 LWC 框架),中间是屏幕流或 Omniscript 和 LWC 的组合。请记住本指南,并在您计划在 Salesforce 上构建或重新设计表单时将其作为参考。如果您正在寻找有关如何设计简化和帮助表单的指导,请咨询 [Salesforce Well-Architected:参与](/docs/architect/zh-cn/well-architected/guide/engaging)。 ### 告诉我们您的想法 帮助我们确保发布与您最相关的内容:[参加我们的调查](https://forms.gle/FCFCES6vsRbKv4E29),提供对这些内容的反馈,并告诉我们您接下来想要看到的内容。 # 开始使用平台决策指南 本节提供有关 Salesforce Platform 功能的关键架构决策的实用指导。它涵盖了异步处理、记录触发的事件、表单构建、事件驱动的架构和基于步骤的异步框架,以帮助架构师设计可扩展、可维护和高性能的平台解决方案。 --- ## 异步处理 [异步处理](/docs/architect/zh-cn/decision-guides/guide/async-processing)提供了 Salesforce 中异步操作工具和方法的指导: - **异步处理工具**:比较可排队 Apex、计划 Apex、平台事件触发器、变更数据捕获、计划路径(提交流后)和异步路径(记录触发的流),并提供有关适当用例的指导。 - **服务器端异步处理**:长时间运行的数据库操作、外部标注和大批量记录处理的模式。 - **客户端异步处理**:可在浏览器或移动应用程序中执行的 Apex 继续标注和客户端异步处理等技术。 - **决策框架**:考虑用例验证、可扩展性、了解事务何时真正异步、监控和处理极端负载事件。 - **最佳实践和反模式**:正确使用指南,包括出站集成、监控和避免常见陷阱。 使架构师能够实施可扩展、可靠且可维护的异步模式,避免影响性能的陷阱。 --- ## 建筑表单 [构建表单](/docs/architect/zh-cn/decision-guides/guide/build-forms)指导架构师了解 Salesforce 表单构建选项: - **表单构建工具**:动态表单、屏幕流、OmniStudio、屏幕流与 Lightning Web 组件 (LWC) 和 LWC 的比较,包括技能和许可注意事项。 - **决策框架**:考虑对象影响、表单范围、导航、位置(应用程序、移动设备、Web)、UX 和测试自动化。 - **工具选择指导**:从简单记录布局到多页面向导和面向客户的品牌表单的推荐。 - **组合模式**:组合工具的指导,例如,屏幕流导航与 LWC 样式。 - **高级功能**:深入了解功能和限制,为工具选择提供信息。 帮助架构师为其特定的 UX、功能和集成要求选择合适的表单构建方法。 --- ## 事件驱动的架构 [事件驱动架构](/docs/architect/zh-cn/decision-guides/guide/event-driven)提供了 Salesforce 事件工具和模式的全面指南: - **夜间工具**:平台事件、变更数据捕获、发布/订阅 API、MuleSoft Anypoint、串流 API 和集成注意事项的概述。 - **事件驱动的模式**:包括各种事件驱动的用例的发布/订阅、扇出、传递的消息、流和队列模式。 - **与 MuleSoft 集成**:将 Anypoint 连接器(Pub/Sub、JMS、Kafka、Solace、MQ、MQTT、AMQP)用于企业架构。 - **平台事件和变更数据捕获**:关于发布记录和字段更改的首选机制的指导,以及从 PushTopic/Generic 事件迁移。 - **实施模式**:可扩展性、一致性、错误处理和监控的最佳实践。 使架构师能够设计可扩展的、近乎实时的事件驱动的系统,有效地连接多个系统。 --- ## 基于步骤的异步框架 [基于步骤](/docs/architect/zh-cn/decision-guides/guide/step-based-async-framework)的异步框架为模块化、可扩展的异步作业处理提供了一个框架: - **框架架构**:组件包含 Queueable Apex、Finalizer、Slack 集成、Apex 游标、可调用操作。 - **基于步骤的处理**:将工作分为独立的步骤,这些步骤可以通过共享治理和操作可见性来运行、重试和重新启动。 - **实施指导**:步骤界面、步骤处理器、Apex 可调用层、延迟处理和通知的模式。 - **最佳实践**:当大部分信息存在于 CRM 中时,对于高用量工作负载以及层次结构或基于树的记录处理,推荐使用;关于何时不使用的指导。 - **企业级功能**:治理、合规性、分布式状态、进度跟踪、SLA 监控、故障诊断和审计级日志记录。 为架构师提供了一种可扩展的替代整体批处理作业和链式异步调用的方法,支持高用量 Salesforce 工作负载,并具有完全的操作透明度。 --- ## 记录触发的自动化 [记录触发自动化](/docs/architect/zh-cn/decision-guides/guide/record-triggered)为在 Salesforce 平台上设计记录触发自动化提供了框架: - **工具选择**:在自动化密度(低、中、高)和密度选择矩阵的指导下,何时使用记录触发的流与 Apex 触发器。 - **自动化密度**:如何评估自动化数量、记录量和依赖性蔓延,以选择流、混合流(使用可调用 Apex 的流)或 Apex 触发器。 - **切入点和治理**:每个 Salesforce 对象一个入口点;入口条件、递归控制和有序执行指南。 - **异步调用**:何时以及如何从记录触发的流或 Apex 调用异步进程,并谨慎小心错误处理和调控器限制。 - **最佳实践**:批量化模式、混合流-Apex 设计,并避免触发器自动化中的常见陷阱。 使架构师能够设计符合平台标准的可扩展、可维护和高性能的记录触发自动化。 ## 概览 Salesforce 平台不断推进其自动化架构,以满足复杂业务流程的需求。早期版本 — 工作流规则和进程构建器 — 提供了事件驱动逻辑的初始步骤,扩展了事件驱动逻辑的自动化功能,并将覆盖范围扩大到更广泛的构建者。 这种演变最终形成了以两个互补支柱为中心的高性能整合架构:记录触发的流和 Apex 触发器。本文档提供了在设计触发器自动化时做出明智决策的框架和指南。 ## 范围内的产品
流 Salesforce Flow 是一款功能强大的点击式自动化工具,可让用户使用 Flow Builder 直观地构建复杂的业务流程、屏幕和逻辑,而无需编写代码。它自动化数据更新、发送电子邮件和指导用户等任务,并通过屏幕流(用户交互)和触发的流(记录/计划的事件)等类型提供灵活性。
Apex Salesforce Apex 是适用于 Salesforce 平台的专有的、面向对象的编程语言,与 Java 相似,用于构建自定义业务逻辑、自动化流程并将核心 CRM 功能扩展到声明性工具之外。
## 外卖 在 Salesforce Platform 上构建可扩展、可维护和高性能的记录触发自动化需要一种有章可循的、以架构为导向的方法。Flow 和 Apex 之间的选择,以及每个流的实施,都遵循一套明确的原则。这些要点总结了这些原则,并作为现代自动化设计的基本规则。 - **根据 Salesforce 对象自动化密度,为作业选择合适的工具。** - 将 Salesforce 对象的记录触发流用于**低密度**自动化。 - 使用可调用 Apex 扩充记录触发的流逻辑,以实现**中等密度**的自动化。 - 对 Salesforce 对象使用 Apex 触发器实现**高密度**自动化。 - **在触发异步进程时要谨慎小心。** 无论您是在记录触发的流中调用异步进程,还是从 Apex 将可排队作业排队,此规则都适用。虽然这种模式对卸载工作很有诱惑力,但它会引入复杂的错误处理场景,并增加达到调控器限制的风险。 - **每个 Salesforce 对象使用一个入口点。** 对于给定的 Salesforce 对象,使用一个机制作为自动化的入口点。尝试避免将 Flow 和 Apex 触发器混合为同一对象的入口点。 ## 决策点 ### 声明性实施与编程实施 Flow 和 Apex 共享一组共同的基本功能。每个工具都可以查询记录、执行条件逻辑、分配变量并执行 DML 操作,例如创建、更新和删除记录 — 按照指定顺序运行。 但是,这种功能重叠并不意味着这些工具可以互换。架构选择不是关于任务_是否_可以完成,而是_如何_完成以及对性能、可扩展性和可维护性的长期影响。Flow 在声明清晰度和实施速度方面表现优异,可实现简单流程,而 Apex 提供了复杂解决方案所需的精细控制和原始功能。 ### 自动化密度 **自动化密度**是对特定 Salesforce 对象施加的负载。它作为一种启发式方法来确定对象的最优实施。随着自动化密度的增长,违反事务限制的可能性也越来越大。 通过检查数量和复杂性的三个特定维度来计算自动化密度: - **自动化数量:**在单个数据操作语言 (DML) 事件期间执行的唯一自动化元数据条目(流、触发器操作等)的原始数量。 - **记录量:**通过 API 加载或繁重批处理处理的每个事务记录,其中性能变得至关重要。 - **依赖性蔓延:**初始 CRUD 操作触发的下游 DML 操作的评测。它量化了一个更新层叠到相关对象更新的图表深度(例如,个案 → 客户 → 联系人 → 自定义汇总)。 自动化密度尺寸 随着 Salesforce 应用程序的范围和复杂性的增长,请提交到单个主要入口点 — 记录触发的流或 Apex 触发器。避免在单个 Salesforce 对象上跨多个机制划分自动化,因为这会导致可维护性差和治理分散。 ### 密度选择矩阵 使用此矩阵来确定 Salesforce 对象所需的架构标准。 - **记录触发流**是低自动化密度的首选解决方案。它提供了功能和可访问性的平衡,是直接且相互独立的自动化的理想选择。 - **混合模式(带有可调用 Apex 的记录触发流)**对于复杂性不断上升的中等密度自动化来说是一个强大和可维护的选择。这种模式使团队能够在声明性流中维护有序的编排,同时将计算繁重的操作委托给 Apex,平衡可访问性和性能。 - **Apex触发器**为支持高密度自动化奠定了坚实的建筑基础。Apex 的性能、粒度控制、面向对象的抽象和多态性更适合管理这些场景的复杂性和规模。
密度级别 自动化数量 数据量(批次大小) 依赖性蔓延 架构标准
低 < 15
自动化
标准
用户驱动的 UI 交互或少量 API 加载(1–200 条记录)
离散
独立逻辑。同一对象或相关对象上的 0–1 下游 DML 操作。
记录触发的流
中等 15–30
自动化
审核
标准批处理(逻辑需要谨慎批量化)
夫妻
父/子级更新 2-4 个下游 DML 操作。递归风险
混合模式
流 + 可调用 Apex
高 > 30
自动化
高
具有批量 API 加载的大数据量(2,000 – 10,000 多条记录)
复杂和递归
深度依赖图(5+ 下游 DML 操作)。三角形递归循环的风险
Apex 触发器元数据框架
真实世界的架构决策要求您共同权衡自动化密度的所有维度。为给定的 Salesforce 对象选择自动化机制时,请考虑潜在的未来范围。 此外,考虑每日 DML 操作总数,因为 Salesforce 在多租户环境中强制实施共享资源管理,并[限制管理者](https://developer.salesforce.com/docs/atlas.en-us.salesforce_app_limits_cheatsheet.meta/salesforce_app_limits_cheatsheet/salesforce_app_limits_platform_apexgov.htm),以防止失控自动化独占共享资源。每日 DML 用量大的 Salesforce 对象需要谨慎的自动化选择。例如,CPU 时间(60,000 毫秒)和堆大小(12 MB)的异步限制高于同步限制。此外,组织范围内的异步执行 24 小时限制(计算为 250,000 次,或用户许可证的 200 倍)需要在架构设计中考虑每日总 DML,以避免运行时异常。 ## 产品比较 记录触发的流是平台用于记录触发自动化的首要声明性工具。Flow 的易用性和内置平台保障使团队能够轻松构建可扩展的可靠解决方案。这是大多数在 Salesforce 平台上构建解决方案的团队的理想选择。 Apex 是平台的专有强类型面向对象编程语言。将 Apex 用于具有高自动化密度的 Salesforce 对象,以及需要高性能、复杂逻辑或精细事务控制的用例。 为了有助于决策过程,此矩阵提供了关键架构功能之间流和 Apex 的直接比较。
功能 记录触发的流 Apex 触发器
交付和维护速度 推荐
Flow Builder 的可视用户界面允许管理员和其他声明性生成器创建和修改自动化,比编写、测试和部署 Apex 代码更快。此界面使更广泛的团队成员能够提供业务价值,并减少对简单任务的专业开发人员资源的依赖。
需要专业知识
Apex 需要具备适当技能的软件开发人员来实施、测试和维护代码。
模块化 可用
默认情况下,记录触发的流是模块化的。团队不是单一逻辑,而是针对特定要求构建离散流,并使用流触发器资源管理器一起编排它们。这种模块化实现了隔离修改和简单扩展,大大降低了长期拥有成本。
可用
Apex 按设计分为功能模块。每个 Apex 类旨在实施单个功能模块。
可见性和治理 推荐
流的可视性提供了业务逻辑的直观表示。流触发器资源管理器提供对象上所有流的综合视图,使架构师和管理员更容易理解、治理和排除故障,而无需阅读代码。
需要专业知识
使用元数据框架来组织触发器是有利的,但是 Apex 需要纪律严明的开发团队来保持代码的组织性和可维护性。
高性能批量数据处理 不推荐
在处理复杂逻辑或大数据量时,达到调控器限制的风险更高。
推荐
Apex 代码的执行更接近平台的核心服务,并为开发人员提供了对查询优化、数据处理和算法效率的增强控制。这将带来更好的性能和规模,特别是在涉及大量数据的复杂场景中。
强大的逻辑和数据结构 可用
流转换元素可以帮助完成一些复杂的处理任务。但是,Flow 缺少本地地图和设置数据结构,使得复杂的数据处理很麻烦,计算效率低下。
推荐
Apex 提供对映射、设置和程序循环的完整访问权限,以实现高效、批量安全的数据操纵。Apex 作为一种全功能编程语言,也提供对复杂逻辑结构、数据结构和设计模式的访问权限,有助于以可维护和有效的方式解决复杂的业务问题。Apex 包含丰富的高级函数标准库(例如 BusinessHours、Crypto),目前这些函数在声明性工具中不可用。
交易控制 不可用
对于部分事务提交或回滚,流不提供对“Database.savepoint”、“Database.rollback”或部分成功的 DML 操作的访问权限。
可用
Apex 提供了对事务完整性和复杂错误恢复场景的全面精细控制。
电子邮件分发 推荐
从记录触发的流发送预配置的电子邮件提醒简单且可扩展。自定义电子邮件提醒可以在运行时创建和分发。自定义电子邮件受每日电子邮件发送限制。
可用
Apex 可以生成并发送自定义电子邮件消息。从 Apex 发送的所有电子邮件都受每日电子邮件发送限制。
应用平台保障 推荐
流包含内置保护,例如自动批量化和自动重试。这些保障措施提高了价值实现的速度,并防止了否则需要复杂的手动编码的性能缺陷。
需要手动实施
批量化等保护措施必须明确编码(例如,管理集合和避免循环内的 SOQL)。自动重试不是触发器的本机功能,需要复杂的自定义逻辑来实现。
异步处理 可用
对于需要在异步路径中单独交易的自动化,流提供了简单的机制。这些自动化受每日限制。
可用
Apex 通过解耦触发器订阅者处理的变更数据捕获和可排队事件实现完全控制。
计划处理 推荐
流的计划路径提供了独特而强大的计划功能(例如,“在结束日期前 3 天触发”)。如果记录的数据发生变化,此功能包括自动取消和重新计划。这些自动化受每日限制。
不可用
Apex 触发器无法通过自动取消本地计划特定于记录的时间事件。虽然存在计划的 Apex,但它是一种根本不同的机制,它在特定时间运行,并且在作为触发器的一部分处理单个记录的过程中不会被计划。
订单和编排 可用
流触发器资源管理器允许管理员为同一对象上的多个流定义相对执行顺序。
可用
触发器框架提供了对自动化精确顺序的精细控制。
相同记录字段更新 可用(保存前)
记录触发的流是在初始 DML 提交之前更新触发记录的最高性能的声明性选项。
可用(保存前)
Apex 以最少的开销提供最高性能的产品。
跨对象 CRUD 可用(保存后)
流适用于简单、低复杂性的跨对象 DML 操作。
可用(保存后)
Apex 为跨对象 DML 操作提供了对重复数据消除、错误处理和性能的卓越控制。
昂贵的重复数据消除 可用
Flow 擅长通过自动批量化来消除冗余查询和 DML 语句。但是,状态不能在不同流触发器之间或在一个事务中同一流的多次调用之间缓存或共享。在极端性能场景中,此限制可能变得很重要。
推荐
Apex 提供了对昂贵操作进行重复数据消除的机制。开发人员可以使用静态属性和变量的事务缓存和使用平台缓存的平台级缓存来存储和重用数据。这些技术对于减少事务调控器限制(例如 SOQL 查询)的消耗,并确保高性能和可扩展性非常重要。
自定义错误处理 可用
CustomError 元素可以阻止保存操作并向用户显示消息。
推荐
addError() 方法提供了灵活的字段级和条件错误消息。
## 用例 ### 最适合的推荐 此表根据提供的功能,为通用用例提供了通用“最适合”推荐。最终,您将考虑其他注意事项,以得出最适合特定场景的方案,例如本文档_相关最佳实践_部分包含的方案。在那里,您将了解有关 Flow 和 Apex 的特定组合何时提供最佳方法的更多信息。
用例 描述 最适合 理由
高性能批处理 任何必须高效处理数千条记录的自动化 Apex Apex 为与平台的接口和原始速度提供了丰富的 API。
复杂数据处理 需要高级数据操作的场景 Apex Apex 提供在流中本地不可用的数据结构,例如映射和集,对于编写高效的批量安全代码至关重要。
交易控制 控制机制,例如保存点、回滚和部分提交 Apex Apex 提供对 Database.savepoint 和 Database.rollback 等机制的访问权限,并能够处理部分成功的 DML 操作。
复杂的自定义验证 记录中多个字段之间的数据验证 Apex 虽然流可以阻止使用“CustomError”元素保存,但它并非在所有流类型中可用,包括子流。Apex addError() 方法提供了多个特定于字段的错误消息,可以在触发器处理期间随时添加到记录中。
简单流程中的适度复杂逻辑 中等复杂性的逻辑和数据操纵,由标准高级函数库简化,作为不复杂流程的一部分发生 流 + Apex 记录触发的流充当编排层,而高复杂性操作封装在可调用 Apex 中。
简单到中等复杂的逻辑 低到中等复杂性的数据操纵,对主数据和相关数据对象进行触发器更新 流 流通常是转到选项,因为它基于声明性模型,使管理员和开发人员都可以访问它。
通知和出站消息 发送出站电子邮件和消息 流 流使发送电子邮件提醒和记录更改的出站消息变得容易和高度可扩展。
计划处理 未来动态日期的自动化(例如,结束日期前 3 天) 流 计划的路径为流提供了独特的优势,因为如果记录的数据发生变化,平台会自动处理这些路径的计划、取消和重新计划。
### 可扩展处理:深度异步用例 可扩展性是设计实施时的一个关键考虑因素。当记录触发的自动化的业务逻辑变得复杂、长时间运行或涉及高数据量时,Salesforce 平台的核心调控器限制将成为架构约束。批量数据更新、复杂 API 标注或繁重计算等操作会增加违反限制的风险,例如总 CPU 时间或单个数据库事务中 DML 语句的数量。由于限制异常而导致同步触发器失败,将导致用户的整个保存事务回滚,从而导致用户体验不佳和潜在的数据丢失。这种内在风险要求一种架构模式来卸载复杂的工作。 在这种情况下,异步自动化变得至关重要。使用异步机制,架构师可以有效地将长时间运行或高用量的工作与主要的同步记录保存事务分离开来。快速可靠地保存完成,而繁重的处理被委托给一个单独的平台管理的事务,该事务稍后执行。解耦提高了稳定性,防止了事务失败,对于构建可扩展的企业应用程序至关重要。该平台为此提供了几种专用工具,每种工具在可靠性、体积和复杂性方面都有不同的好处和利弊权衡。 ### 流的异步路径 记录触发的流中的异步运行路径为“触发并忘记”异步逻辑提供了最简单的机制。在原始记录保存事务成功提交到数据库后,此路径将在单独的事务中执行。 - **理想用例**:这非常适合不需要立即执行或自定义错误处理的任务。示例包括发送电子邮件通知、创建跟进任务或对外部系统进行简单的标注。 - **限制**:此机制与其他异步流采访共享相同的每日调控器限制。它并非设计用于极高用量的处理。 ### 变更数据捕获 (CDC) 变更数据捕获 (CDC) 是一种高吞吐量、可扩展和弹性的模式,用于处理高用量场景中记录变更触发的异步逻辑。在此模型中,触发器的唯一责任是同步保存记录。然后,平台发布详细的事件消息,其中包含记录对高用量事件总线的更改。单独的专用 Apex 触发器订阅此变更事件。它执行复杂的、长时间运行的或异步的工作。 - **福利**:此模式将异步进程与初始用户事务分离。异步处理中的失败不会导致用户的记录保存回滚。该模式还提供了多个内部订阅者或外部系统可以使用的持久事件流,事件可以重放长达 72 小时,提供了强大的弹性。 - **限制**:CDC事件消息不包含记录的先前状态——相当于Apex`Trigger.oldMap`。事件负载包含新字段值,但不包含更改的值。这使得实施基于特定状态转换的逻辑具有挑战性(例如,仅在`Status__c`从“待处理”更改为“已批准”时运行)。您可以通过在事件订阅者中查询对象的字段历史来缓解这种情况,但这会增加过程的复杂性,并且字段历史跟踪可能对特定感兴趣的字段不可用。这可能会限制您可以卸载到 CDC 的自动化类型。 默认情况下,CDC 可以在最多五个 Salesforce 对象上启用。需要更多资源的组织可以购买一个加载项许可证,以消除此限制并增加事件交付分配。 ### 来自触发器的可排队 Apex 直接从触发器将可排队 Apex 作业排队应被视为一种风险模式,仅在需要 Apex 提供的控制(例如,对于复杂的逻辑或自定义重试机制)时使用,CDC 不是一个可行的选项。 如果需要 Queueable Apex,实施必须包含适当的保护措施: - **限制检查**:在尝试添加其他作业之前,代码必须检查事务中已经排队的作业数量。 ``` if (Limits.getQueueableJobs() < Limits.getLimitQueueableJobs()) { ... } ``` - **上下文感知**:代码必须检测它是否在异步上下文中运行,例如批处理作业 (`System.isBatch()`),并修改它的行为以遵守该上下文中更严格的每个事务一个作业的限制。 ### 触发的异步 Apex 的限制注意事项 从同步触发器调用异步 Apex 会产生稳定性风险。为了防止组织级的影响(例如,超出限制),这种模式需要严格的设计和测试。 - 异步 Apex 执行的每日限制(`Batch`、`Queueable`、`@Future`)在整个组织中共享(通常是 250,000 个或根据用户许可证计算)。20000 条记录的批量数据加载将导致触发器在 200 条块中执行,从而产生 100 个单独的触发器调用 — 即使批量大小少于 200 条记录,也会更多。如果每次调用都对异步作业进行排队,则单个数据加载的每日限制可能会消耗很大一部分。这种消耗可能会耗尽异步资源的其他关键业务流程。 - 将作业排队的调控器限制因上下文而异。从 UI 中的用户操作触发的触发器(_同步_事务)中,最多可以将 50 个可排队作业排队。然而,从在批处理 Apex 类的`execute`方法(_异步_事务)中触发的触发器中,只能将一个可排队作业排队。不考虑这种差异是一个常见和关键的故障点,会导致大型数据操作期间的`LimitException`错误。 - 直接从触发器上下文调用可计划 Apex (`System.schedule`) 或批处理 Apex (`Database.executeBatch`) 构成反模式。这些方法并非设计用于从触发器上下文调用。这样做将导致异步 Apex 分配的快速消耗,从而导致限制异常。 ### 选择正确的异步模式 每个异步机制在性能、调控器限制和可靠性方面都有特定的权衡。使用此决策树作为指南,帮助您导航这些选项,并为用例选择正确的机制。 异步模式决策树 ### 计划作业替代项 如流程图所示,当您面临大量 DML 操作但无法使用变更数据捕获时(可能由于对象限制),最佳的架构选择通常是完全避免触发器调用的过程。 相反,请考虑使用计划的进程。这可以是计划的流或计划的 Apex。所需步骤是: 1. 在同步触发器中执行简单的低成本更新。例如,将`Status__c`字段设置为“待处理”,或插入低成本相关记录,例如 Chatter 帖子,以表示该记录需要处理。 2. 创建定期运行的已计划作业,即已计划流或已计划 Apex,例如每 15 分钟或每小时运行一次。 3. 让计划作业查询处于待处理状态的所有记录,在受控的高用量上下文中执行复杂逻辑,然后在处理时更新记录。 此模式将繁重的处理与用户的同步保存完全分离,不受触发器触发批次的每个事务一个作业的限制,并为非实时需求提供了高度可扩展和可管理的解决方案。 如果计划作业的延迟对业务需求来说是不可接受的,并且您仍然被限制使用 CDC 或触发器触发的可排队,这表明架构不匹配。此时,必须考虑不同的机制。重新评估核心应用程序设计可能会导致某些结论,例如: - 购买加载项以删除 CDC 对象限制。 - 从根本上说,确定近乎实时的处理是否真正是“必须拥有的”,或者计划作业的延迟是否是平台稳定性的可接受的折衷方案,是业务需求的挑战。 ## 非功能注意事项 ### 复杂性 实施的复杂程度是解决方案总拥有成本的一部分,也是其适应不断变化的业务需求的能力的一部分。如果不遵循最佳实践,复杂性会影响任何实施。在本文档的“_相关最佳实践_”部分中,提出了降低解决方案复杂性的建议,包括以下模式: - 混合模式:适用于流中复杂逻辑的可调用 Apex - 使用 Apex 触发器的元数据框架 - 超大流量与多个流 ### 流程和标准 文档与自动化本身同样重要。它不仅确保可维护性,而且对于 AI 和基于客服人员的工具也至关重要。文档有助于您了解和管理业务流程。 **在流中** - 为所有元素和变量建立一致的命名约定。 - 使用流的描述字段来解释其整体目的、触发条件和预期结果。 - 在每个单个元素上使用描述字段(例如,`Get Records`、`Action`、`Transform`)。这种做法是传达意图的最佳方式。它对于可调用操作和子流尤其重要,其中描述是解释操作执行的复杂逻辑的主要位置。 **在 Apex** - 清晰评论您的代码,以解释逻辑背后的_原因_,而不仅仅是_什么_。 - 如果使用元数据驱动的框架,请确保您的元数据记录包含并填充人类可读的描述字段,以解释每个处理程序类的功能及其应运行的时间。 DevOps 和源控制是成熟开发生命周期的一部分。始终使用源控制工具,例如适用于 Salesforce 项目的 Git。Apex 类和 Salesforce 流都是定义业务逻辑的元数据,必须对其进行版本化和管理。 在记录触发的自动化管理的上下文中,现代 DevOps 漏斗提供了基本的好处。 - **自动质量检查:**[Salesforce 代码分析](https://developer.salesforce.com/docs/platform/salesforce-code-analyzer/overview)器等工具可以配置为在您的漏斗中自动运行。静态分析可以在升级之前检测这两种自动化工具中的问题模式,并标记出流循环中效率低下的`Get Records`元素或 Apex for 循环中的`SOQL`查询等问题,这些都是性能下降的常见原因。 - **回归预防:**随着自动化密度的增长,对一个流或 Apex 类的更改可能会对同一对象上的其他自动化产生意想不到的后果。确保新流版本不会破坏现有 Apex 逻辑的最可靠方式是强大的 DevOps 测试策略,其中针对任何建议的更改运行自动 Apex 测试(反之亦然)。 - **协作和可见性:**源控制是“真理的单一来源”。它允许管理员和开发人员并行处理相同对象的自动化。它还提供了宝贵的审计跟踪:当生产过程中断时,您可以立即看到_谁_更改了自动化,他们_何时_更改的,以及他们为_什么_更改它 — — 通过提交消息。 对于管理员和开发人员混合的团队,[DevOps Center](https://help.salesforce.com/s/articleView?id=platform.devops_center_overview.htm&type=5)提供了统一的界面来帮助编排所有这些步骤,使团队中的每个人都可以访问可扩展的、基于源代码控制的开发流程。 文档和 DevOps 的这一组合纪律确保了贵组织的长期运行状况和维护性,这将使关注您的每位架构师和管理员受益。 ## 相关最佳实践 以上决策指南最适合在计划实施前使用。它旨在帮助您为您的用例选择最佳产品。在产品选择后,了解您的实施的现有最佳实践非常重要。 ### 利用混合模式:适用于流中复杂逻辑的可调用 Apex _每个对象一_个工具原则对于管理高密度自动化至关重要,但请勿将其解释为纯声明性或纯编程堆栈之间的二元选择。更有效和可维护的架构模式利用了混合模型:将记录触发的流定位为编排层,同时将高复杂性操作封装在可调用 Apex 中。 混合模式图 #### 编排图层:流 记录触发的流充当业务流程的编排层。它拥有准入条件和执行上下文(_什么_和_什么时候_)。通过在此层中保留决策逻辑和路由,架构的进程拓扑保持透明,并通过流触发器资源管理器进行管理,防止代码中的关键业务逻辑被模糊。 #### 复杂组件:可调用 Apex 复杂组件的一个常见示例是实施个案记录的服务级别协议 (SLA) 计算。由于 BusinessHours 对象及其相关逻辑(对于排除非工作时间和假期的准确计算至关重要)无法在流中本地访问,因此使用专用 Apex 类。该类通常命名为 `ServiceLevelAgreementCalculator`,它使用单个静态方法设计,并使用 `@InvocableMethod` 注解,以计算经过的工作时间,确定 SLA 是“目标内”还是“已违反”,并返回结构化输出。这种方法在 Apex 中封装了复杂的高性能逻辑,同时允许它无缝执行并集成到记录触发流的声明性编排层中。 一旦定义了 Apex `ServiceLevelAgreementCalculator`类,它就可以在记录触发的流中使用: 这种模式表明关切事项严格分离。声明层用于管理事务生命周期和编排,而代码用于高复杂性的执行。通过将代码视为功能实用程序而不是基础,我们平衡了性能和可维护性。 #### 混合模式的关键收益 **模块化**:该决策偏离了在整个流程中使用 Apex 或 Flow 的奇异性。相反,该架构将复杂的逻辑封装成离散的、批量安全的和可独立测试的单元。这些单元充当声明层消耗的可重用组件,确保自动化规模,而不会使架构设计复杂化。 可**重用性**:逻辑与触发器事件分离。设计良好的代码单元(例如`InvocableMethod`)仅编写一次,但会在多个入口点之间使用:记录触发的流、屏幕流或外部集成。这种代码重用消除了冗余开发。 可**维护性**:流程流逻辑在声明性流中保持可见和可管理。这种集中极大地减少了调试开销,并确保系统的执行顺序是确定性和透明的。 #### 混合模式的限制和权衡 虽然使用流中可调用 Apex 的混合模型功能强大,但并非一刀切的方法。在致力于混合解决方案之前,架构师必须了解特定的限制和权衡。 - **无保存前支持**:这是最重要的限制。可调用操作仅在保存后上下文中可用(操作和相关记录的流)。它们不能在高性能保存前上下文中使用(用于快速字段更新的流)。因此,此模式不能用于委派相同记录字段更新。在保存前流或上下文 Apex 触发器中使用本机流元素执行高性能工作。 - **无取消删除后支持:**记录触发的流目前不支持取消删除后的上下文。如果 Salesforce 对象有在从回收站恢复记录时运行自动化的业务需求,Apex 触发器是唯一的解决方案。 - **高用量场景下的性能开销:**从流运行时到 Apex 运行时的过渡不是零成本操作。虽然通常速度很快,但从流的运行时进入可调用操作的操作在计算上不如完全在 Apex 触发器内的本地执行快。对于大多数中等密度的自动化,这种微型开销对于提高可访问性来说微不足道,值得权衡。但是,对于极端高性能、高用量的场景,纯 Apex 仅框架将具有原始计算速度优势。 ### 传统自动化的策略 虽然自动化密度启发式为更新的绿地架构提供了明确的指导,但企业 Salesforce 环境的现实往往更加细微。在成熟的组织中,通常可以找到在相同 Salesforce 对象上运行的记录触发流和 Apex 触发器。此场景与之前解释的混合模式不同:这里,流和 Apex 触发器不是耦合的,也不是设计为一起工作的。 这种共存往往是平台功能不断发展或传统技术债务的结果。虽然这是允许的操作状态,但架构师必须将其视为计算权衡,而不是最终状态。 零散的编配造成了巨大的治理和维护开销,使得开发、测试和事件处理活动相互脱节且繁琐。这导致解决时间 (TTR) 和操作复杂性增加。 - 对于新的 Salesforce 对象,坚持自动化密度原则作为主要指南。 - 对于具有混合足迹、双 Apex 触发器和记录触发的流入口点的现有 Salesforce 对象,评估密度,然后架构师重构到可维护的混合状态。 - 对于低密度,将 Apex 触发器重构为记录触发的流,并指定执行顺序,将它们带到单个自动化入口点。 - 对于中等密度,使用正确的执行顺序将复杂的超大流重构为流子集。仅在绝对必要时引入 Apex 触发器,例如在取消删除上下文后支持。 - 为获得高密度,最好实施 Apex 触发器。 ### 使用 Apex 触发器的元数据框架 随着组织在 Salesforce 平台上的业务流程的成熟,记录触发的自动化的数量和复杂性不可避免地会增加。一个基本的最佳实践是维持_每个 Salesforce 对象一个_ Apex 触发器。此规则至关重要,因为平台不保证同一事件同一对象上多个触发器的执行顺序。这种限制会导致非确定性行为、竞争条件和难以调试的问题。 然而,遵守_单触发器_原则带来了一个架构挑战:如何以可维护、可扩展的方式管理和编排从该单一入口点调用的所有业务逻辑。 #### Classic 触发器处理器的限制 此架构的第一个演变是 Classic 触发器处理器模式。在这种方法中,单个 Apex 触发器将其所有逻辑委托给相应的处理程序类(例如,`OpportunityTriggerHandler`)。此方法将逻辑与触发器文件分开,并为开发人员提供对处理器类方法(例如 `afterInsert()`)中执行顺序的确定性控制。 虽然是一种改进,但这种模式通常会导致单片处理器类。随着时间的推移,随着更多业务需求的添加,该类会变得很大,难以管理,并且难以单独测试。所有单个流程的执行顺序都在一个方法中硬编码,这使得类容易出现合并冲突,从而大大增加了大型企业环境中的治理和维护开销。 #### 解决方案:元数据驱动的触发器框架 为了解决模块化和编排的核心问题,架构师转向了**元数据驱动触发框架**。这是一次重大的架构飞跃,将自动化逻辑本身与_如何_和_何时_运行的配置分离开来。 该框架基于三个关键优势: - **分区:**不是单个处理器类,而是将核心业务逻辑分解为小的原子 Apex 类(例如,`RecalculateAccountValues`类或`NotifySalesLeads`类),每个类都遵守_单一责任原则_。这种模块化使得逻辑更容易单独测试、调试和理解。 - **顺序和编排:**执行订单不再在 Apex 中硬编码。相反,它由配置记录进行声明性定义,通常存储在自定义元数据类型中(例如,`TriggerAction__mdt`)。这允许管理员通过修改元数据记录来重新排序、添加或删除自动化操作,这不需要部署或代码更改。 - **绕过功能:**该框架提供了标准化的精细旁路功能。每个自动化操作都可以通过其元数据记录配置为全局关闭,或者通过引用自定义权限来绕过特定的管理用户。 然后,对象的单个 Apex 触发器仅用作动态调度人员。它不包含业务逻辑,而是实例化一个中心`MetadataTriggerHandler`类。该处理器查询自定义元数据记录,以动态确定执行顺序,并按照规定的顺序调用正确的原子 Apex 类。自动化被统一在一个透明和可治理的层下。 ### 在事务中重复开销操作 在强大的框架中使用 Apex 的一个重要好处是通过消除冗余工作来管理事务状态和优化性能的能力。随着逻辑的累积,保存订单中的不同自动化通常会独立执行相同的昂贵操作,消耗宝贵的调控器限制,并增加 DML 操作时间。 该框架旨在用两个主要策略来解决这个问题: - **共享状态管理:**在单个 Apex 事务的范围内,静态属性和变量被用来缓存数据。这确保了昂贵的操作(例如配置设置的`SOQL`查询)仅执行一次,即使在触发器的不同记录或阶段中多次调用自动化逻辑。事务限制的消耗大大减少。 - **平台缓存利用率:**要超越简单的事务内缓存,请使用平台缓存来避免查询整个数据库的某些数据。这种受管的内存缓存非常适合检索非原始的、在代码库中频繁读取的、在整个事务过程中不可变的数据(例如简档、角色、工作时间)。使用 `Cache.CacheBuilder` 界面,系统首先检查缓存,并仅在数据不存在时执行数据库查询,从而最大限度地提高性能和可扩展性。 ### 对相同记录更新使用保存前 当您的自动化只需要更改启动事务的记录上的字段值时,请始终使用保存前更新。这适用于流中的快速字段更新(在保存前运行)和 Apex 触发器中的上下文前逻辑(插入前、更新前)。 无论使用哪种工具,此模式都是有效的,因为它避免了第二次 DML 操作和递归保存周期。在提交到数据库_之前_,对内存中的记录进行更改,并作为原始事务的一部分保存。消除了第二次保存的开销,否则将重新执行整个保存订单并再次启动所有自动化。 ### 防止不受控制的递归 不受控制的递归是更新后触发器中常见的陷阱,其中触发器的逻辑执行 DML 更新,进而导致同一触发器再次触发。这将创建一个无限循环,并最终以调控器限制异常结束。虽然静态布尔标记或处理的记录 ID 集合历来用于防止这种递归,但更精确和更强大的模式是通过比较记录本身的新版本和旧版本之间的字段值来把逻辑关起来。 仅在特定兴趣领域实际发生变化时执行逻辑。这防止触发器在同一事务中的后续 DML 操作上运行其逻辑,其中关键数据保持不变。 #### 控制记录触发流中的递归 在记录触发的流中,通过将流设置为仅在更新记录以满足条件要求时运行,防止不受控制的递归: 控制记录触发流中的递归 如果您在流中选择使用准入条件公式,您可以通过将`$Record`全局变量(代表新值)与`$RecordPrior`全局变量(代表保存前的原始值)进行比较来防止失控递归。例如,要确保流仅在业务机会的金额字段已更改时运行,请在准入条件中使用: ``` $Record.Amount != $Record__Prior.Amount ``` #### 在 Apex 中控制递归 将新版本记录 `Trigger.new` 中的字段值与旧版本记录 `Trigger.oldMap` 中的字段值进行比较,以查看您是否发生了您正在寻找的特定更改。这种方法确保自动化是幂等的,并且只在必要时运行,提高了系统的效率,防止了灾难性的递归循环。 ### 绕过自动化 架构良好的 Salesforce 组织需要一致可靠的机制来绕过自动化。这不是可选功能,而是维护数据完整性和启用管理任务的核心操作要求。 对于一些场景,旁路框架至关重要: - 在加载大量数据时,触发每个记录的触发器会显著减慢进程,导致限制异常,并创建错误的相关记录和通知。旁路允许干净高效地插入数据。 - 集成用户可能需要同步来自外部记录系统的数据。当更改来自另一个系统时,通常为用户发起的更改触发的自动化(例如,发送电子邮件、创建任务)可能是不可取的或多余的。 - 管理员或支持人员可能需要对记录执行更正更新。绕过机制允许他们在不触发标准业务自动化的情况下进行这些更改,这可能会产生意想不到的后果。 **自定义权限**:实施旁路逻辑的现代可扩展标准是自定义权限。这些方法优于旧方法有几个原因: - **灵活性:**自定义权限可以通过权限集分配给用户。这种做法符合现代 Salesforce 安全和访问模型,允许精细和灵活的分配。绕过可以授予特定用户,甚至可以临时授予特定到期日期/时间。 - **可维护性:**使用自定义权限可以避免将简档或用户硬编码到自动化逻辑中。如果用户的角色发生变化或新简档需要绕过访问权限,则更改是简单的权限集分配,而不是需要部署的代码或流修改。 - **可扩展性:**自定义权限为管理复杂用户群中的异常提供了一个可扩展的框架。它们可以通过权限集、权限集组或简档分配给用户。它们与权限集或简档的关联也可以在源元数据中表示。 **实施模式**:将一致的绕过模式应用于组织中的所有记录触发的自动化。 **绕过记录触发的流**:绕过流的最有效方法是完全阻止它运行。通过将条件添加到流的准入条件来实现这一点。 - 在记录触发的流的开始元素中,将条件要求设置为公式评估为真。 - 在公式生成器中,使用 `$Permission` 全局变量包含自定义权限的检查。将检查与您现有的准入条件结合起来。 - 公式模式: ``` ( ) && NOT($Permission.Bypass_This_Flow) ``` - 此模式确保流仅在用户_未_分配指定自定义权限时运行。此检查甚至在创建流采访之前执行,使其成为性能最好的方法。 **绕过 Apex 触发器框架**:在 Apex 中,将绕过逻辑直接集成到元数据驱动的触发器框架中,允许精细控制。 - `TriggerAction__mdt`自定义元数据类型应包含文本字段,例如 `BypassPermission__c`。 - 在 `MetadataTriggerHandler` 类中,在动态执行操作之前,代码应读取此字段中的值。 - 如果填充字段,处理程序会使用 `FeatureManagement.checkPermission()` 方法确定当前运行用户是否拥有指定的自定义权限。 - 如果 `checkPermission()` 返回真,处理程序会跳过该特定操作,并继续序列中的下一个操作。 - 此模式功能强大,因为它允许全局绕过(如果所有`TriggerAction__mdt`记录引用相同权限)和精细的每个操作绕过(如果不同记录引用不同权限,或一些记录根本没有绕过权限)。 ### 超大流量与多个流 将对象的所有自动化整合到单个大型流中是一种反模式。合并为一个流与将逻辑拆分为多个条件良好的流不会对性能产生重大影响。最重要的性能提升来自: - 使用保存前流进行相同记录字段更新。 - 编写精确的条目条件,以确保流排除在不会影响特定用例的更改上运行。 [流触发器浏览](https://trailhead.salesforce.com/content/learn/modules/record-triggered-flows/meet-flow-trigger-explorer)器允许您为对象上的每个流分配顺序值,保证顺序执行。 流触发器资源管理器 ## 资源
Apex 流 操作
# 集成决策指南入门 本节提供了为 Salesforce 选择正确数据集成工具和方法的实用指导。它涵盖了出站集成、入站集成和跨组织场景,帮助架构师设计和实施平衡性能、可维护性和成本的数据层集成。 --- ## 与 Salesforce 的数据集成 [数据集成 Salesforce](/docs/architect/zh-cn/decision-guides/guide/data-integration) 提供了 Salesforce 数据集成工具和最佳实践的全面概述: - **集成工具环境**:Salesforce 数据集成工具概述,包括低代码、混合和专业代码选项,以及针对特定用例选择正确工具的指导。 - **出站集成**:将数据从 Salesforce 发送到外部系统的方法,包括变更数据捕获、外部服务、Heroku Connect、OmniStudio 集成程序、Salesforce Connect、MuleSoft Anypoint 和自定义 Apex 解决方案。 - **入站集成**:将外部数据导入 Salesforce 的方法,以及关于数据复制与虚拟化以及何时使用每个工具的指导。 - **跨组织集成**:Salesforce 组织之间共享数据的推荐方法,包括 MuleSoft Anypoint、Heroku Connect、本地 Salesforce API、变更数据捕获和使用跨组织适配器的 Salesforce Connect,包括替换原有 Salesforce 到 Salesforce 实施的指导。 - **决策框架**:选择集成工具的关键注意事项,例如现有工具和环境、数据流要求(时间、方向性、预期用户体验)、实施复杂性、可维护性、数据量和平台限制。 使架构师能够为每个场景选择正确的集成工具和模式,最大限度地减少不必要的数据复制,利用现有的 ESB/ETL 解决方案,并确保符合企业架构原则的可扩展、可维护的集成。