# architect Guias de decisão (decision-guides) - Full Documentation # Usar as ferramentas e os padrões certos para arquiteturas conduzidas por evento ## Visão geral As arquiteturas conduzidas por evento dão suporte à produção e ao consumo eficientes de eventos, que comunicam alterações de estado do sistema ou do aplicativo. Essas arquiteturas permitem conexões flexíveis entre sistemas e dão suporte a processos e atualizações quase em tempo real que funcionam entre sistemas. Embora seja fácil ver as vantagens de arquiteturas conduzidas por evento, os detalhes da implementação nem sempre são tão claros. Quais recursos você precisa considerar em padrões de arquitetura conduzidos por evento? Quais problemas específicos esses padrões solucionam? Quais considerações especiais se aplicam às suas soluções e quais são os padrões ideais para lidar com elas? Este guia apresenta padrões usados para criar arquiteturas ideais conduzidas por evento ao trabalhar com tecnologias do Salesforce. Ele também discute ferramentas de controle disponíveis no Salesforce e fornece recomendações de ferramentas para uma seleção de casos de uso. Para obter informações sobre integrações em nível de dados envolvendo o Salesforce, consulte nosso [Guia de decisão de integração de dados](/docs/architect/pt-br/decision-guides/guide/data-integration). ## Capturas - **Use arquiteturas conduzidas por evento para processos que não exigem respostas síncronas a solicitações.** Os padrões descritos neste guia são projetados para consistência de dados, escalabilidade e reutilização, o que ajuda a manter o débito técnico a um mínimo conforme o panorama de aplicativos da sua organização evolui. (Consulte [Bem-arquitetado - taxa de transferência](/docs/architect/pt-br/well-architected/guide/reliable#transmissão) para obter mais informações.) - **Se o MuleSoft ou outra solução Enterprise Service Bus (ESB) fizer parte do seu panorama existente, use-o sempre que possível.** Essas soluções são projetadas para dar suporte a padrões de arquitetura conduzidos por evento e têm recursos poderosos que permitem reutilizar integrações em toda a sua empresa. - **Use a API Pub/Sub para qualquer padrão de publicação/assinatura futuro em vez de criar seus próprios manipuladores de evento usando outras APIs, incluindo a API de streaming.** Agora que a API Pub/Sub está disponível ao público em geral, use-a para qualquer novo padrão de publicação/assinatura. Planeje migrar as comunicações de evento existentes usando outras APIs de plataforma, como a API de streaming ou serviços do Apex personalizados, para a API Pub/Sub quando for viável. - **Os eventos de plataforma e a Captura de dados de alteração (CDC) são os mecanismos preferidos para publicar alterações de registro e campo que precisam ser consumidas por outros sistemas.** Não recomendamos usar PushTopic e eventos genéricos para novas implementações. A Salesforce continuará oferecendo suporte a eventos genéricos e PushTopic nos recursos funcionais atuais, mas não planeja fazer mais investimentos nessa tecnologia. ## Produtos no escopo
Plataforma Salesforce A Plataforma Salesforce é uma plataforma abrangente baseada em IA que une funcionários, agentes de IA autônomos, dados da empresa e aplicativos em um único sistema confiável para aumentar a produtividade e a experiência do cliente. Ele permite a criação de uma "empresa ativa" conectando aplicativos Customer 360, Data Cloud e Slack para automação completa.
MuleSoft O MuleSoft é a plataforma de integração líder da Salesforce que permite que as organizações conectem aplicativos, dados e dispositivos em ambientes locais e na nuvem. O MuleSoft é uma plataforma que dá aos TI as plataformas para desbloquear dados entre sistemas, desenvolver estruturas de integração e automação escalonáveis e criar experiências diferenciadas e conectadas rapidamente.
## Pontos de decisão Arquiteturas conduzidas por evento (EDAs) são recomendadas para cenários que exigem notificações quase em tempo real, distribuição de carga de processamento para mensagens de alto volume ou complexas e integração de sistemas como IoT e dispositivos móveis que exigem resiliência de conectividade por meio de fila. No entanto, os EDAs não devem ser implementados para processos que exigem respostas humanas síncronas imediatas, pois são projetados para execução assíncrona. Eles também não são adequados se os dados de origem mudarem com tanta frequência que um padrão mais simples, como processamento em lote, seria suficiente. ### Quando usar uma arquitetura conduzida por evento Aqui estão vários cenários comuns que geralmente são adequados para uma arquitetura conduzida por evento:
Ponto de decisãoDiretrizes
Notificações quase em tempo realOs padrões de arquitetura conduzidos por evento, como publish/subscribe, fanout e streaming, tendem a funcionar bem em cenários em que vários aplicativos precisam ser notificados sobre alterações de status ou atualizações de registro quase em tempo real.
Processamento paraleloPadrões como publicar/assinar tendem a funcionar bem em cenários em que grandes volumes de dados ou mensagens altamente complexas exigem a distribuição da carga de processamento entre vários sistemas.
Leitura de alto volumeOs padrões de Mensagens passadas e Enfileiramento são comumente usados em cenários em que as organizações têm surtos, e o volume de mensagens que estão sendo produzidas pode exceder a capacidade dos assinantes de processá-los imediatamente.
Gravações de alto volumeOs padrões de streaming e enfileiramento funcionam bem em muitos cenários em que as organizações têm aumento no número de mensagens produzidas.
Enviar os mesmos dados para diferentes sistemasEmbora a publicação/assinatura tende a ser uma solução bastante comum para organizações que precisam enviar os mesmos dados para vários sistemas, ela pode ser tratada pela maioria dos padrões abordados aqui. Certifique-se de revisá-los em detalhes para encontrar o melhor ajuste.
Introdução frequente de novos sistemas ou dispositivosOs padrões de publicar/assinar, transmitir e enfileirar tendem a funcionar bem para cenários em que o panorama geral tende a estar em fluxo, com novos sistemas e dispositivos sendo adicionados regularmente. Nesse cenário, um novo sistema ou dispositivo simplesmente precisa se tornar um assinante do barramento de evento ou associado a uma fila para começar a receber mensagens, em vez de exigir uma integração de ponto a ponto personalizada.
Dispositivos de IoTComo os dispositivos de IoT geralmente fornecem atualizações frequentes e também podem gerar uma onda de mensagens em alguns cenários, os padrões de streaming e enfileiramento tendem a funcionar bem ao integrá-los a um panorama de TI.
Dispositivos e sistemas móveis offlineDispositivos móveis que precisam trabalhar em áreas com acesso à Internet de baixa qualidade ou não existente ou sistemas que podem estar offline no momento em que as mensagens são entregues se beneficiarão do padrão de enfileiramento, que permite que eles se conectem às filas e recuperem todas as mensagens relevantes quando estiverem online novamente.
A maioria das organizações grandes tem paisagens de TI complexas que têm uma combinação de sistemas com diferentes recursos. É possível ou provável que sua organização tenha sistemas legados que não oferecem suporte a integrações conduzidas por evento. Você também pode ter casos de uso em que integrações conduzidas por evento não fazem sentido, mesmo que os sistemas tenham suporte para elas (por exemplo, transferências de arquivos SFTP de terceiros). Se você dar um passo para trás e olhar para o panorama de TI da sua organização como um todo, provavelmente, como acontece com outras soluções de arquitetura, você usará uma mistura de padrões para dar suporte a diferentes cenários. Quando você decidir tornar o evento conduzido sua abordagem preferida para integrações, pense nela como outra ferramenta na sua caixa de ferramentas. Ele pode e deve ser usado nos cenários certos, mas não é uma abordagem a ser imposta a todos os sistemas. O desenvolvimento de uma estratégia de integração abrangente ajudará a determinar quando os padrões descritos neste guia podem ou não ser adequados. ### Quando não usar uma arquitetura conduzida por evento Muitos cenários exigem arquiteturas conduzidas por evento, e em alguns cenários, as arquiteturas conduzidas por evento funcionarão mesmo que não sejam as mais adequadas. Porém, em alguns cenários, arquiteturas conduzidas por evento simplesmente não devem ser usadas. Aqui estão algumas perguntas do ponto de decisão para ajudá-lo a identificar estes cenários:
Ponto de decisãoOrientação/perguntas a fazer
Requisitos operacionaisHá uma necessidade comercial genuína para alguma das funcionalidades descritas na seção [Quando usar uma arquitetura conduzida por evento](#quando usar-uma arquitetura conduzida por evento)?
Requisitos técnicosA integração que você está projetando é um ajuste óbvio para um padrão diferente, como virtualização de dados, lote ou solicitação/resposta? Em outras palavras, você está tentando caber um pino quadrado em um buraco redondo?
Processos que exigem que os seres humanos aguardem respostasQualquer integração que envolva uma espera humana por uma resposta do sistema de destino não é adequada para arquiteturas conduzidas por evento, pois elas são projetadas para execução assíncrona e não podem garantir um tempo de resposta. Considere se processos como esse são ideais para sua organização antes de implementar soluções técnicas. Consulte [Well-Architected – Process Design](/docs/architect/pt-br/well-architected/guide/automated#design-de-processos) para obter mais informações.
Alteração frequente dos dados de origemSe os dados no seu sistema de origem mudarem com tanta frequência que atualizações periódicas sejam suficientes, você provavelmente poderá simplificar sua arquitetura usando [patrons em lote](https://developer.salesforce.com/docs/atlas.en-us.integration_patterns_and_practices.meta/integration_patterns_and_practices/integ_pat_batch_data_sync.htm) em vez de padrões conduzidos por evento.
Requisitos de execuçãoA maioria dos sistemas envolvidos em sua solução oferece suporte a arquiteturas conduzidas por evento? O que seria necessário para usar arquiteturas conduzidas por evento com os sistemas que não oferecem suporte a elas (por exemplo, upgrades, personalizações ou middleware)? Que nível de esforço seria necessário para cumprir esses requisitos?
Estabilidade da estrutura de mensagensCom que frequência suas estruturas de mensagens precisarão mudar? Quais sistemas serão afetados por essa alteração e qual será o processo de remediação?
Governança organizacionalVocê tem uma estrutura de governança em vigor para garantir que todas as partes interessadas sejam informadas e possam considerar alterações em estruturas de mensagens, acionadores e outras decisões relacionadas a arquitetura e processo?
Habilidades necessáriasSua equipe tem experiência com arquiteturas conduzidas por evento e sabe como dar suporte a elas?
## Casos de uso Há uma variedade de padrões de arquitetura conduzidos por evento. Alguns são padrões de finalidade geral que podem ser aplicados em casos de uso que não têm requisitos especiais além de serem conduzidos por evento; por exemplo, consulte [Bem-Arquiteto - Interoperabilidade](/docs/architect/pt-br/well-architected/guide/composable#interoperabilidade). Outros padrões são aplicáveis aos casos de uso específicos discutidos aqui, como integrações que envolvem grandes volumes de dados ou cenários que exigem retenção de mensagens mais longa. ### Padrões em uma visão geral A tabela abaixo compara os atributos dos padrões descritos neste documento. Use-o como uma referência rápida quando precisar identificar possíveis padrões para um determinado caso de uso.
PadrãoQuase em tempo realCópia de mensagem únicaEntrega de garantiaReduzir o tamanho da mensagemTransformar dados
Publicar/Assinar✓✓✓
Fanout✓✓✓
Mensagens passadas✓✓✓✓
Streaming✓✓✓
Enfileiramento✓✓✓
### Ferramentas para arquitetura conduzida por evento O Salesforce oferece várias ferramentas para ajudá-lo a lidar com seus casos de uso conduzidos por evento. Esta tabela contém uma visão geral de alto nível das ferramentas disponíveis.
FerramentaDescriçãoHabilidades necessárias
MuleSoftAnypoint PlatformPlataforma que habilita a integração de dados usando camadas de APIs.Código profissional
Conector de Pub/Sub do SalesforceConector para a API Pub/Sub, que fornece uma única interface para publicar e assinar eventos de plataforma, eventos de monitoramento de evento em tempo real e eventos de captura de dados de alteração.Código profissional
MuleSoft Anypoint JMS ConnectorConector que habilita o envio e o recebimento de mensagens para filas e tópicos para qualquer serviço de mensagens que implementa a especificação Java Message Service (JMS).Código profissional
MuleSoft Anypoint Apache Kafka ConnectorConector para mover dados entre o Apache Kafka e aplicativos e serviços corporativos.Código profissional
Conector do MuleSoft Anypoint SolaceUm conector para agentes de evento Solace PubSub+ com integração de API nativa usando o SDK Java JCSMPCódigo profissional
MuleSoft Anypoint MQ ConnectorUm serviço de mensagens na nuvem de vários locatários que permite que os clientes realizem mensagens assíncronas avançadas entre seus aplicativos.Código profissional
Conector MQTT do MuleSoft AnypointUma extensão do MuleSoft em conformidade com o protocolo v3.x MQTT (Transporte de telemetria de enfileiramento de mensagem).Código profissional
Conector do MuleSoft Anypoint AMQPUm conector que permite que seu aplicativo publique e consuma mensagens usando um agente em conformidade com AMQP 0.9.1.Código profissional
API acionada por evento (ASync) do MuleSoft AnypointIdioma agnóstico do setor que dá suporte à publicação de APIs conduzidas por evento separando-as em camadas de evento, canal e transporte.Código profissional
MuleSoft Anypoint MQServiço de mensagens de nuvem multilocatário que permite que os clientes realizem mensagens assíncronas avançadas entre seus aplicativos.Código profissional
MuleSoft Anypoint Data StreamsEstrutura disponível no MuleSoft Anypoint para publicar e assinar dados de streaming.Código profissional
Salesforce PlatformApache Kafka on HerokuComplemento do Heroku que fornece o Apache Kafka como um serviço com integração de plataforma completa à plataforma Heroku.Código profissional
Captura de dados de alteraçãoRegistro de eventos de alteração, que publica alterações em registros do Salesforce. As alterações incluem a criação de um novo registro, atualizações em um registro existente, exclusão de um registro e cancelamento da exclusão de um registro.Baixo código para Pro-code
Mensagens de saídaAções que enviam mensagens XML a pontos de extremidade externos quando os valores de campo são atualizados no Salesforce.Código baixo
Eventos de plataformaMensagens seguras e escalonáveis que contêm dados de evento personalizados.Baixo código para Pro-code
Pub/Sub APIAPI que habilita assinaturas para eventos de plataforma, eventos de Captura de dados de alteração e/ou eventos de Monitoramento de evento em tempo real.Código profissional
Retransmissões de eventoPermite que eventos de plataforma e eventos de captura de dados de alteração sejam enviados do Salesforce para o Amazon EventBridge. Observe que as Retransmissões de evento se conectam apenas ao AWS Eventbridge.Código baixo
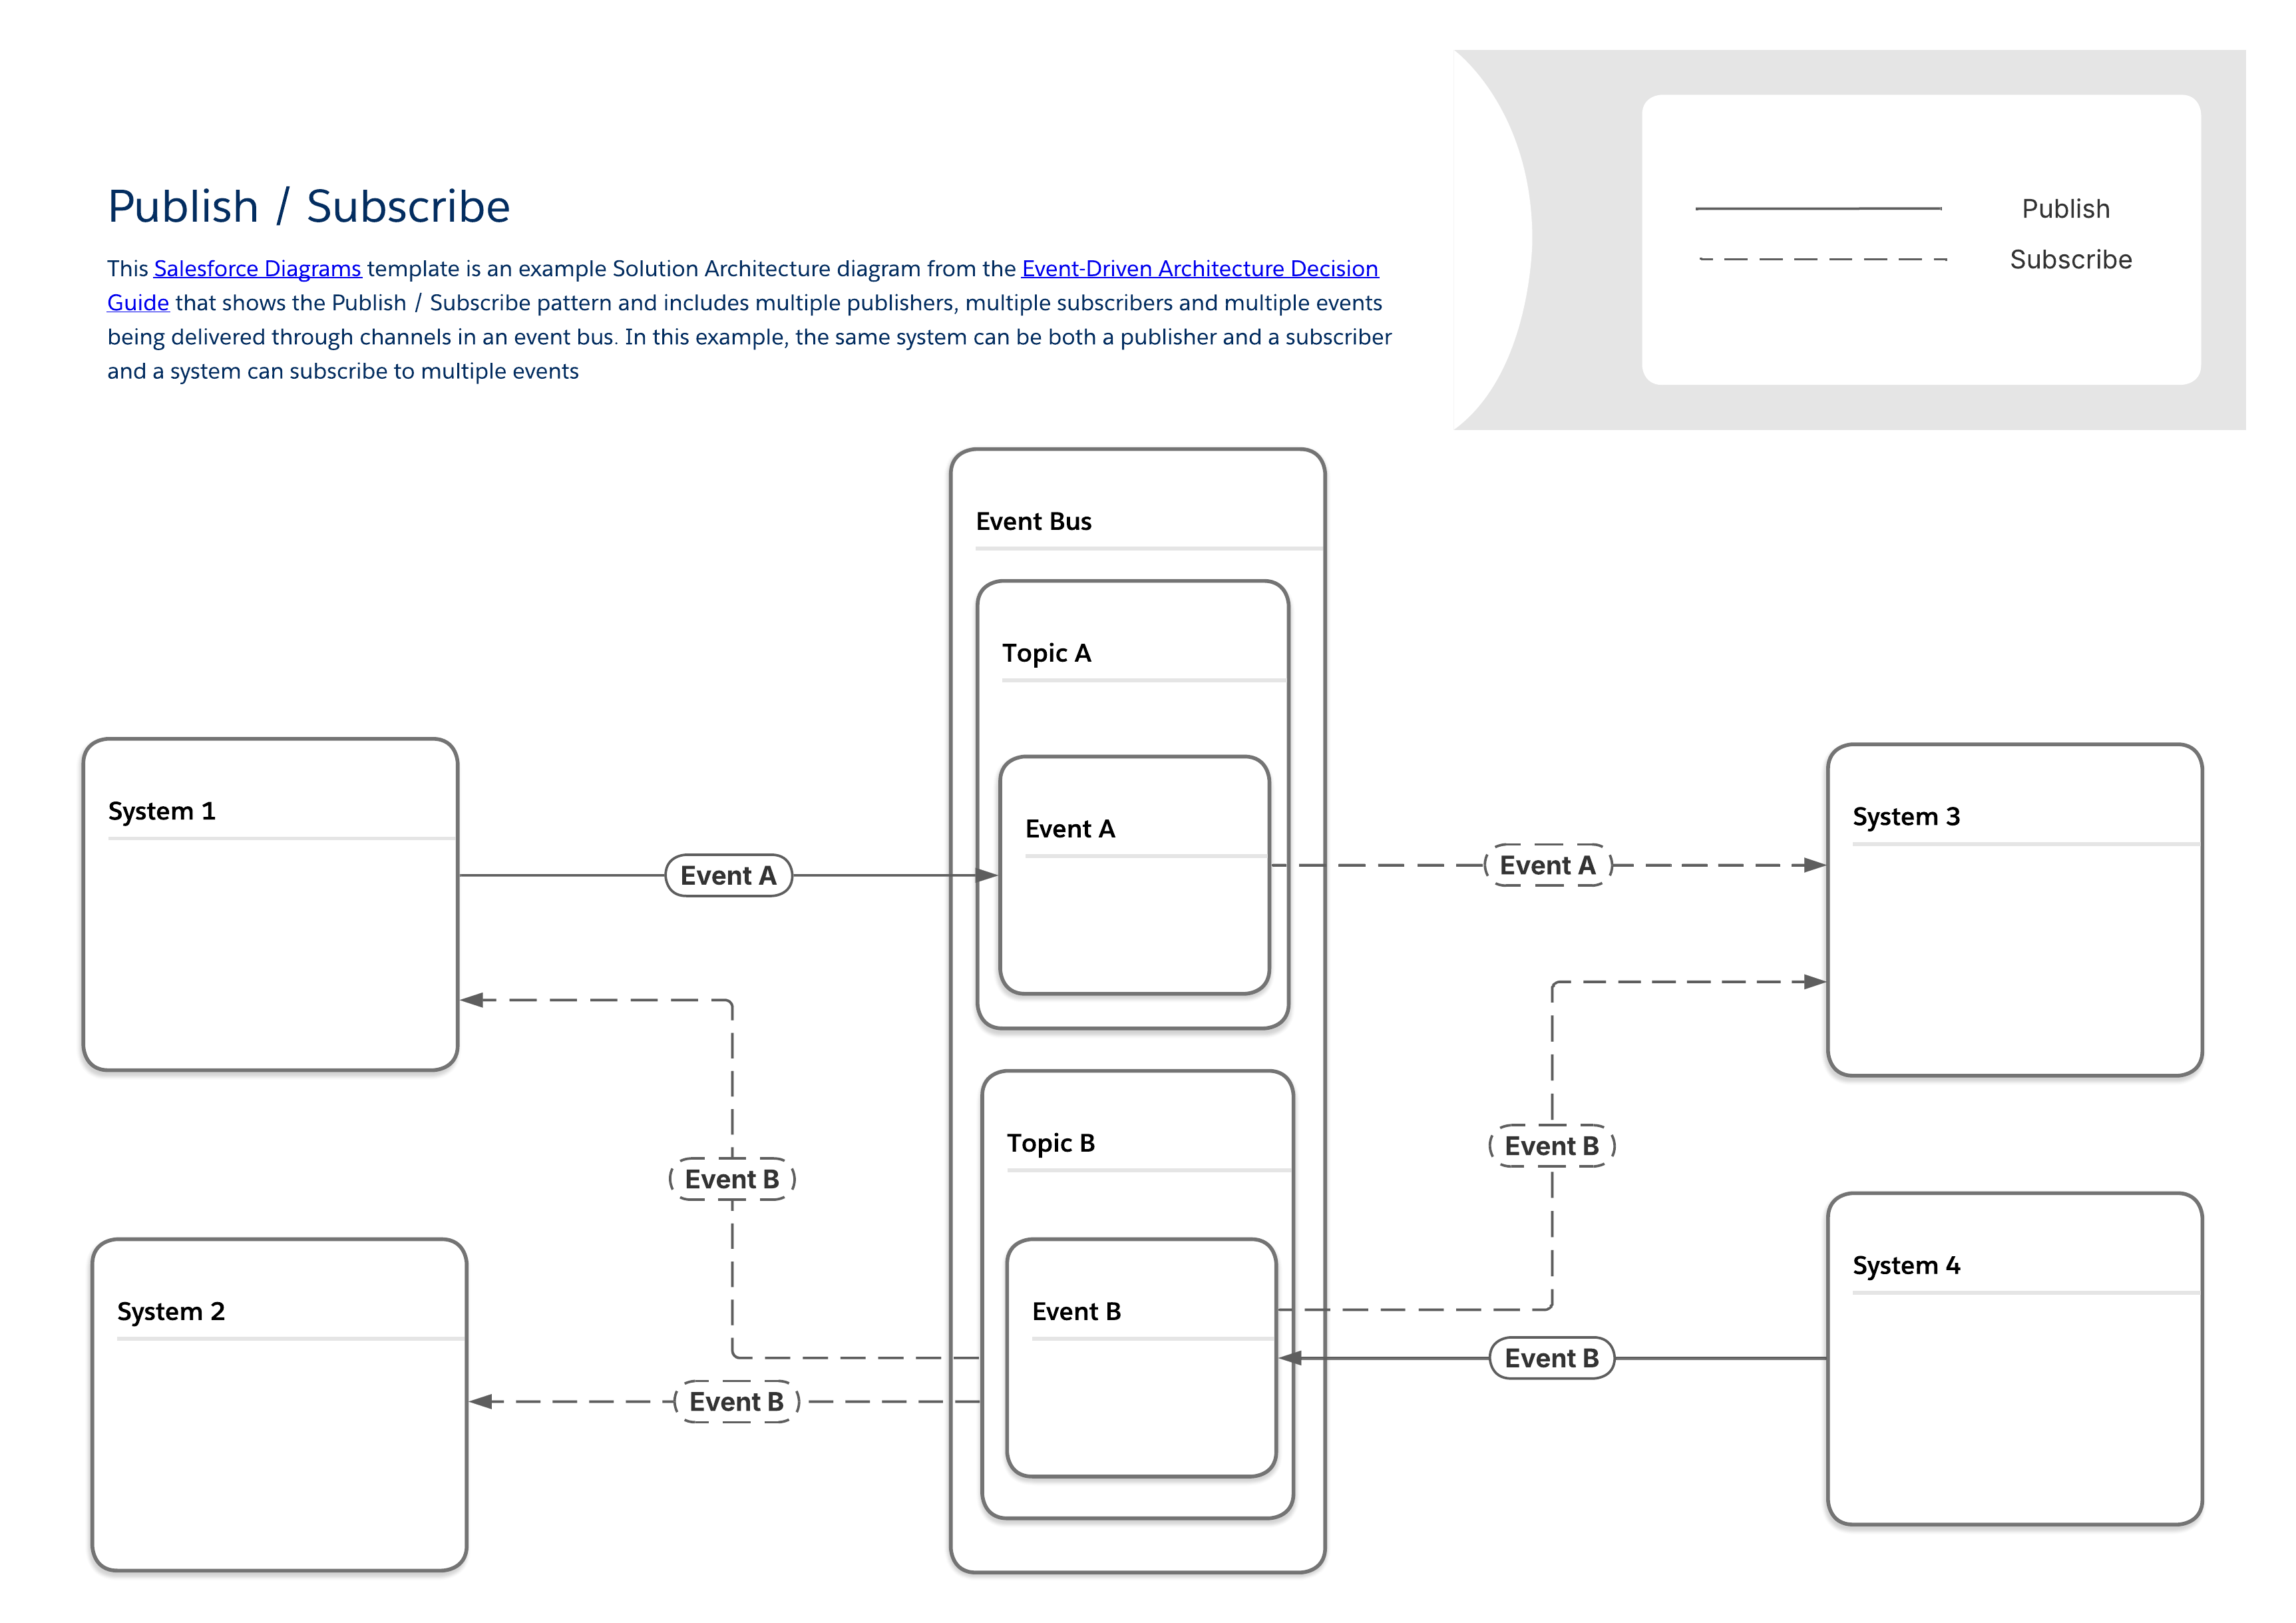
### Publicar/Assinar Quando um registro crítico muda de estado em um aplicativo principal, por exemplo, o status de um pedido muda de "Processando" para "Enviado", vários outros sistemas provavelmente precisam de uma notificação quase em tempo real para realizar suas respectivas tarefas. Uma necessidade de negócios específica surge quando o volume dessas alterações é alto e as mensagens são complexas, tornando as integrações de ponto a ponto tradicionais pesadas e difíceis de manter. Estabelecer conexões frágeis e personalizadas para cada aplicativo dependente leva a débitos técnicos e impede a capacidade da organização de escalar rapidamente. É necessária uma abordagem de integração robusta para gerenciar essas sincronizações de dados frequentes sem acoplar o sistema de origem diretamente a cada sistema consumidor. #### O padrão Publicar/Assinar O diagrama abaixo mostra um padrão de publicação/assinatura típico com vários editores e assinantes compartilhando dados por meio de um barramento de evento. Esse padrão fundamental forma a base para os padrões mais específicos que podem ser encontrados em todo o restante deste guia. Algumas características principais desse padrão são: - Não há conexão direta entre editores e assinantes. Os editores simplesmente enviam mensagens para um barramento de evento, que as transmite para qualquer outro sistema que queira escutá-las. - O mesmo sistema pode ser um editor e um assinante. - Os sistemas podem publicar ou assinar vários tipos de eventos. - Como acontece com todos os padrões neste guia, o padrão publish / subscribe se enquadra em uma categoria geral de padrão de integração conhecida como invocação de procedimento remoto (RPI) ou simplesmente ["apagar e esquecer".](/docs/architect/pt-br/fundamentals/guide/integration-patterns#chamada-de-processo-remoto--atirar-e-esquecer) Este diagrama de Nível 2 mostra um exemplo do padrão publish/subscribe que inclui vários editores, vários assinantes e vários eventos sendo entregues por meio de canais em um barramento de eventos.Nesse padrão, o mesmo sistema pode ser um editor e um assinante e um sistema pode assinar vários eventos. #### Ferramentas relevantes para o padrão Publicar/Assinar
Fluxo e comportamento de eventoConsiderações sobre carga útil
Ferramentas disponíveisHabilidades necessáriasPublicar viaAssinar viaPeríodo de repetiçãoEstrutura de carga útilLimites de carga útil
MuleSoftAnypoint PlatformCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
Conector de Pub/Sub do SalesforceCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
MuleSoft Anypoint JMS ConnectorCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
MuleSoft Anypoint Apache Kafka ConnectorCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
Conector do MuleSoft Anypoint SolaceCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
MuleSoft Anypoint MQ ConnectorCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
Conector MQTT do MuleSoft AnypointCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
Conector do MuleSoft Anypoint AMQPCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
API acionada por evento (ASync) do MuleSoft AnypointCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
MuleSoft Anypoint MQCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
Salesforce PlatformApache Kafka on HerokuCódigo profissionalAPIs, alterações de registro no Heroku PostgresN/A1 a 6 semanasUsuário definidoUsuário definido
Captura de dados de alteraçãoBaixo código para Pro-codeAlterações de registroApex, APIs, Componentes da Web Lightning (LWC)3 diasPredefinido1 MB
Mensagens de saída*Código baixoRegras de fluxo e fluxo de trabalhoN/A24 horasUsuário definido100 notificações por mensagem
Eventos de plataformaBaixo código para Pro-codeAPIs, Apex, FluxoApex, APIs, Flow, LWC3 diasUsuário definido1 MB
Pub/Sub APICódigo profissionalAPI ou APIs Pub/Sub, Apex, FluxoAPI Pub/Sub3 diasUsuário definido1 MB
Retransmissões de evento**Código baixoEventos de plataforma, Captura de dados de alteraçãoAPI3 diasUsuário definido1 MB
*A Salesforce continuará oferecendo suporte a mensagens de saída nos recursos funcionais atuais, mas não planeja fazer investimentos adicionais nessa tecnologia. **Retransmissões de evento conectam-se apenas ao AWS EventBridge
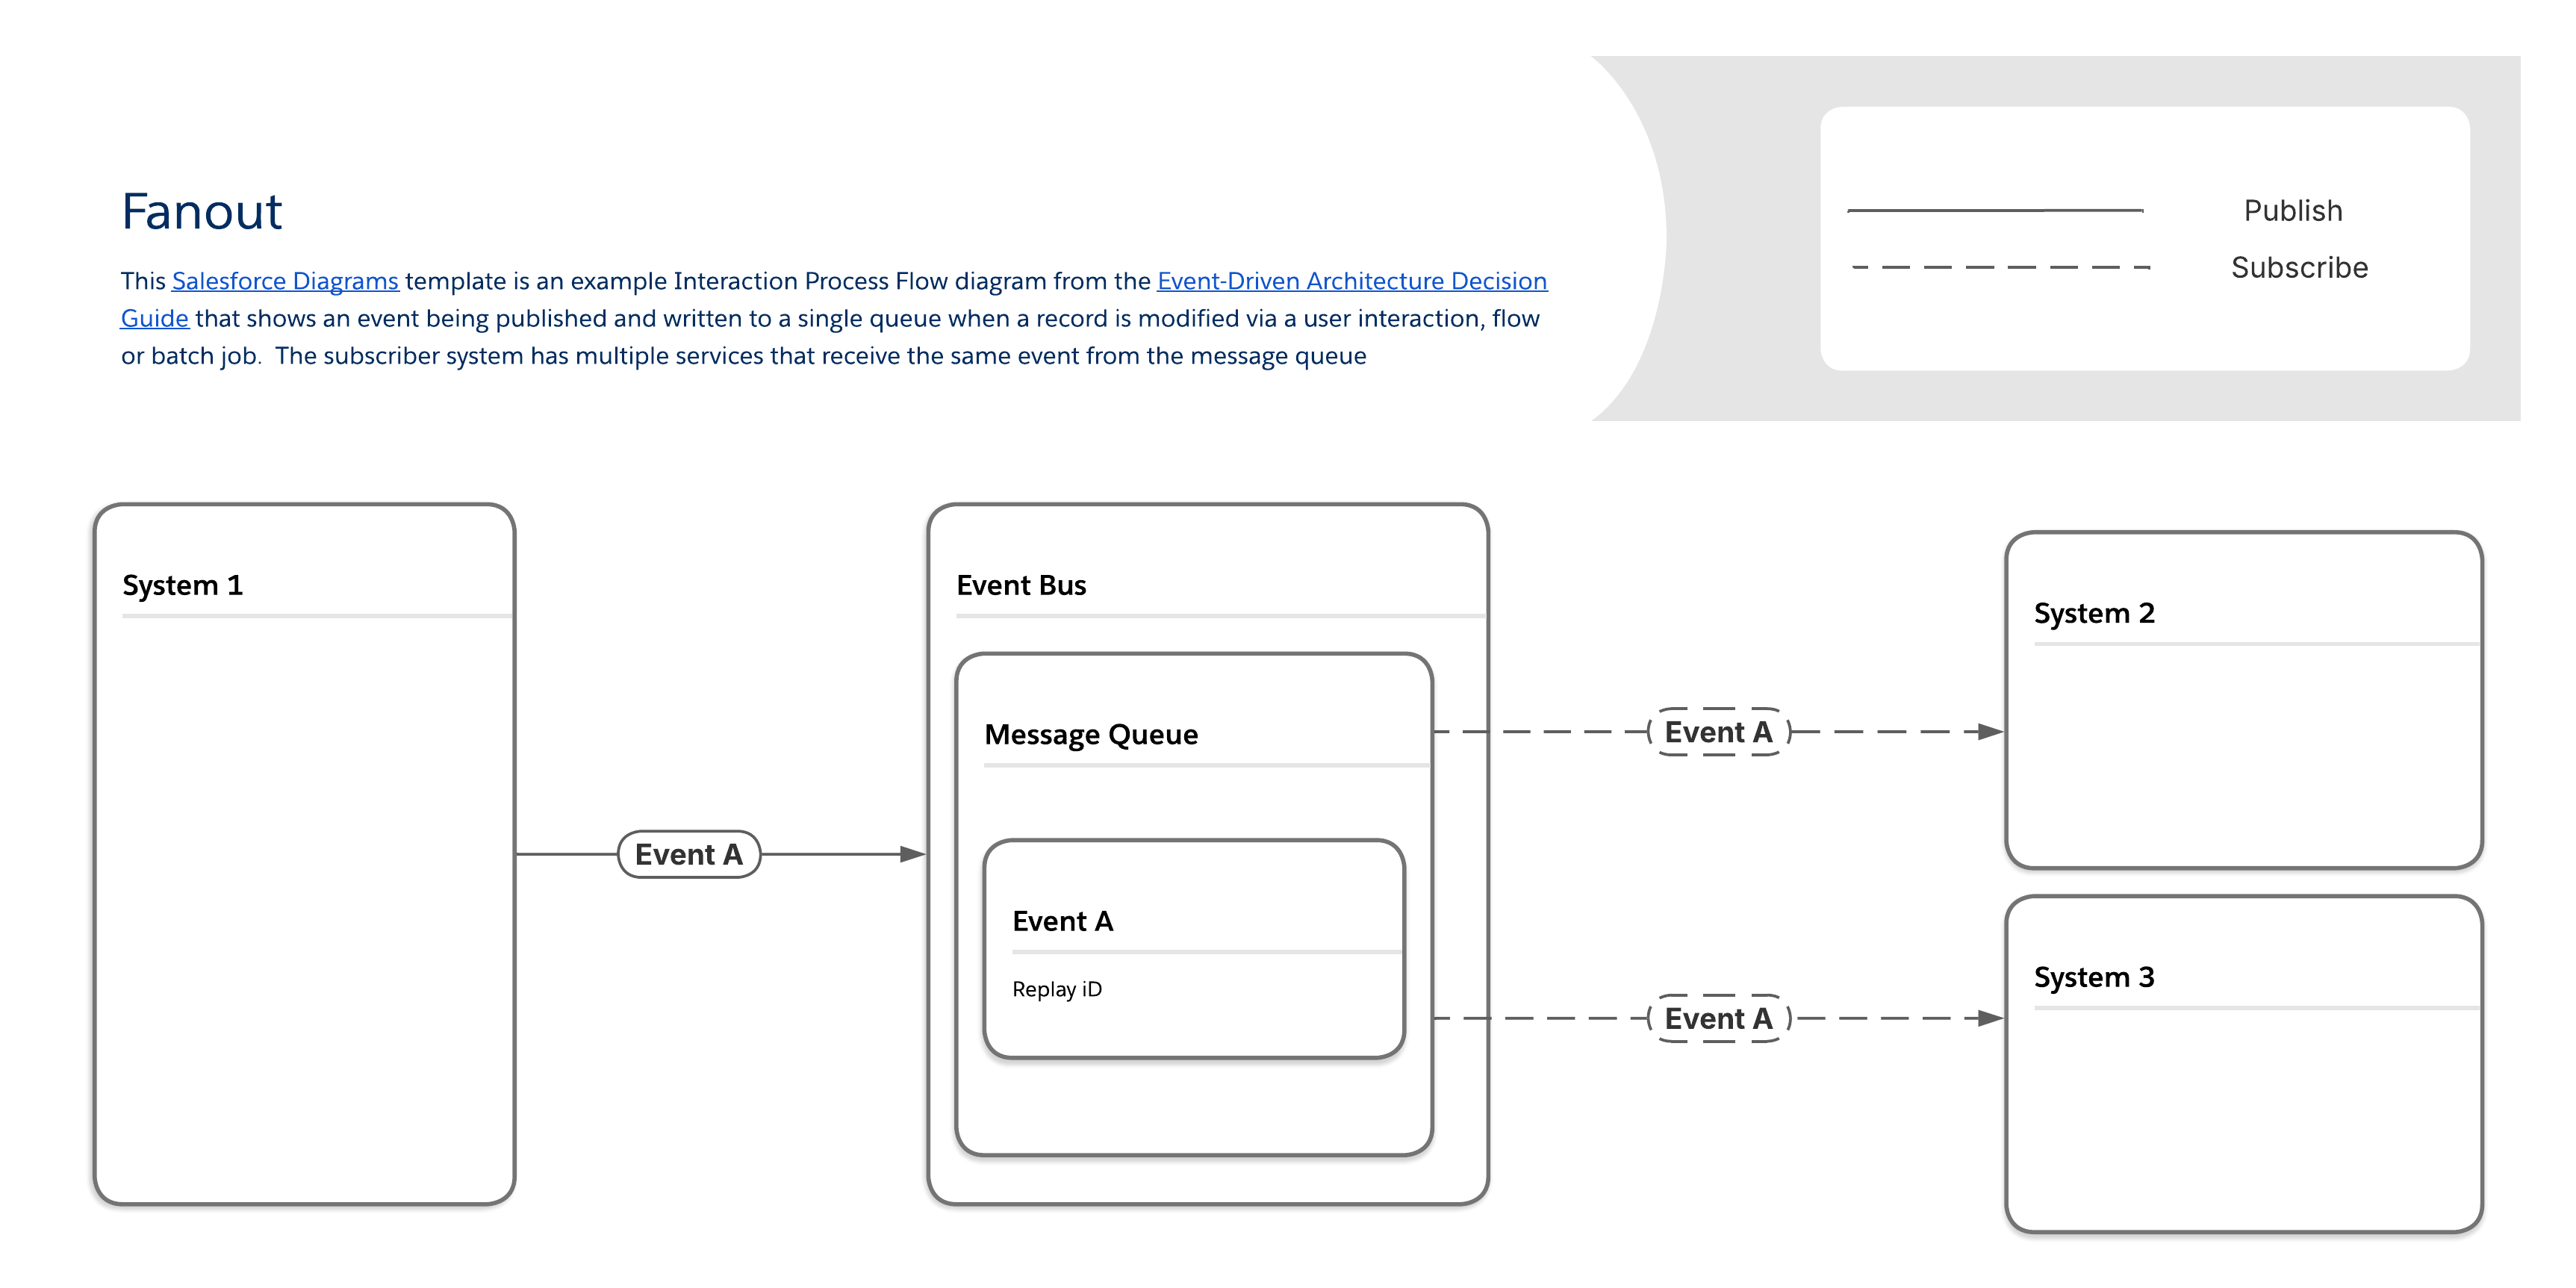
### Fanout Quando uma organização precisa enviar atualizações instantâneas a um grande número de aplicativos clientes, como notificações por push ou mensagens SMS para dispositivos móveis, o processo tradicional de criar transmissões exclusivas para cada destinatário se torna rapidamente um gargalinho de escalabilidade. A necessidade de negócio principal, neste caso, é a distribuição rápida e de alto desempenho de uma única informação, como um alerta de conta ou um aviso de alteração crítica de serviço, para vários aplicativos de ponto de extremidade simultaneamente. Uma abordagem simplificada para cumprir esse requisito envolve rotear todas as mensagens por uma única fila, que atua como o ponto central de informações de evento para todos os sistemas de consumo. Essa abordagem melhora o desempenho eliminando a necessidade de gerenciar muitas cópias de mensagem separadas. #### O padrão do Fanout Com o padrão de efusão, as mensagens são entregues para um ou vários destinos (ou seja, escutando clientes ou assinantes) por meio de uma única fila de mensagens. Os assinantes recuperam a mesma mensagem da fila, em vez de sua própria cópia exclusiva. (Observe que, embora isso melhore o desempenho, também pode tornar mais difícil verificar se um assinante específico recebeu ou não a mensagem.) Esse diagrama de implementação e documentação de Nível 3 mostra um exemplo do padrão do fanout. Ele mostra um evento sendo publicado e gravado em uma única fila quando um registro é modificado por meio de uma interação do usuário, fluxo ou trabalho em lote. O sistema do assinante tem vários serviços que recebem o mesmo evento da fila de mensagens. #### Ferramentas relevantes para o padrão do Fanout
Fluxo e comportamento de eventoConsiderações sobre carga útil
Ferramentas disponíveisHabilidades necessáriasPublicar viaAssinar viaPeríodo de repetiçãoEstrutura de carga útilLimites de carga útil
MuleSoftMuleSoft Anypoint JMS ConnectorCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
Conector de Pub/Sub do SalesforceCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
MuleSoft Anypoint Apache Kafka ConnectorCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
Conector do MuleSoft Anypoint SolaceCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
MuleSoft Anypoint MQ ConnectorCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
Conector MQTT do MuleSoft AnypointCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
Conector do MuleSoft Anypoint AMQPCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
MuleSoft Anypoint MQCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
Salesforce PlatformApache Kafka on HerokuCódigo profissionalAPIs, alterações de registro no Heroku PostgresN/A1 a 6 semanasUsuário definidoUsuário definido
Captura de dados de alteraçãoBaixo código para Pro-codeAlterações de registroApex, APIs, Componentes da Web Lightning (LWC)3 diasPredefinido1 MB
Eventos de plataformaBaixo código para Pro-codeAPIs, Apex, FluxoApex, APIs, Flow, LWC3 diasUsuário definido1 MB
Pub/Sub APICódigo profissionalAPI Pub/Sub ou Apex, APIs, FluxoAPI Pub/Sub3 diasUsuário definido1 MB
Retransmissões de evento*Código baixoEventos de plataforma, Captura de dados de alteraçãoAPI3 diasUsuário definido1 MB
*Retransmissões de evento enviam dados apenas para o AWS EventBridge
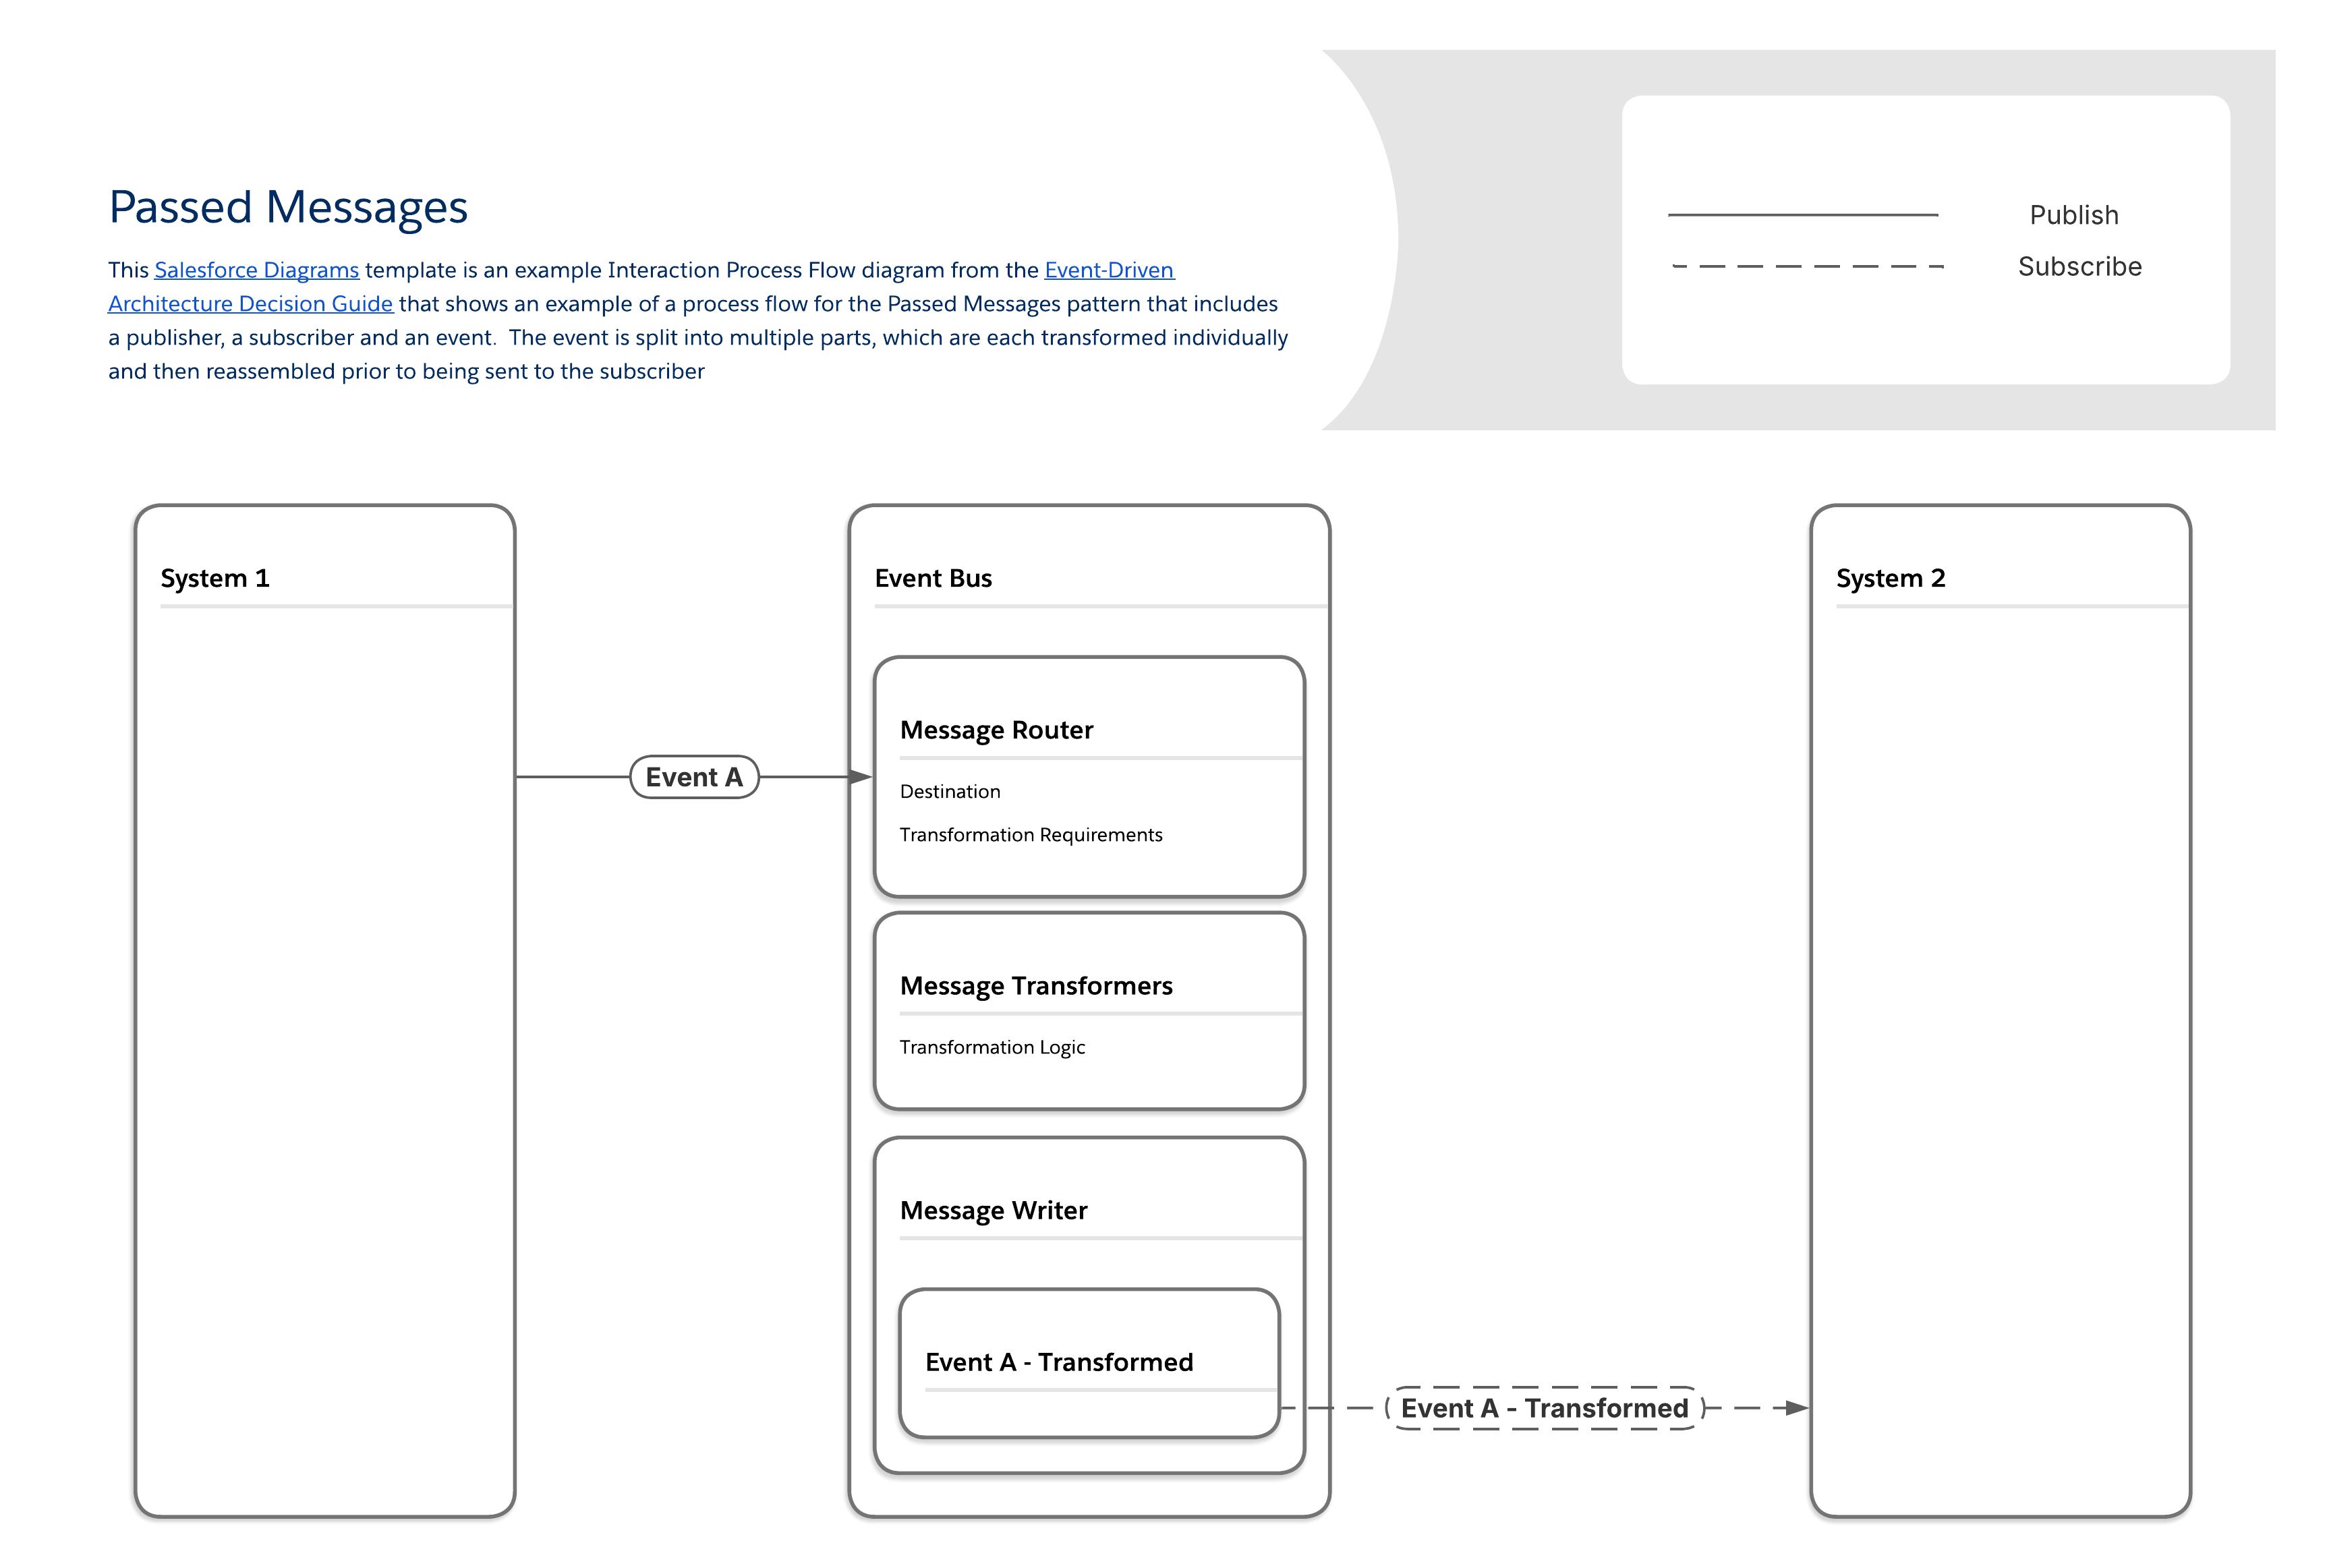
### Mensagens passadas Alguns cenários de evento são caracterizados por um influxo significativo de volume de mensagens que ameaça sobrecarregar a capacidade dos processos de sincronização e transformação ou por uma lógica complexa de várias etapas necessária para processar e transformar dados de evento. Alguns exemplos incluem: - **Picos sazonais de volume:** Pode haver picos de volume que os varejistas online veem quando uma seleção de seus produtos está "na temporada". Quando grandes números de clientes estão fazendo compras ao mesmo tempo, o número de eventos gerados pode exceder temporariamente a capacidade dos processos de sincronização e transformação. Consulte [Well-Architected – Data Handling](/docs/architect/pt-br/well-architected/guide/automated#tratamento-de-dados) para obter mais informações. - **Gerenciamento de caso ou reivindicações:** As empresas baseadas em serviço podem enfrentar aumentos no número de casos ou reivindicações durante interrupções. - **Transformações de dados complexas:** Organizações que exigem lógica complexa para transformar mensagens costumam se preocupar com eventos sendo gerados mais rapidamente do que podem ser transformados. #### O padrão de mensagens passadas Esse padrão lida com o desafio de as mensagens serem geradas mais rapidamente do que podem ser transformadas. Ele garante que grandes volumes de mensagens e manipulações de dados necessárias possam ser tratadas com confiança, incorporando uma plataforma de mensagens de streaming e segmentando a lógica de processamento de mensagens em componentes dedicados. O padrão de Mensagens passadas funciona segmentando a lógica de processamento de mensagens em vários componentes: - Um componente lida com o roteamento de mensagens, determinando as transformações necessárias e o destino final. - Um conjunto separado de componentes lida com diferentes camadas de transformação de mensagem (por exemplo, mapeamentos de campo, relacionamentos de objeto etc.). - O último componente grava a mensagem final modificada. Esse diagrama de implementação e documentação de Nível 3 mostra um exemplo de um fluxo de processo para o padrão de mensagens passadas que inclui um editor, um assinante e uma mensagem.A mensagem é dividida em várias partes, que são transformadas individualmente e então montadas novamente antes de serem enviadas ao assinante. #### Ferramentas relevantes para o padrão de mensagens passadas
Fluxo e comportamento de eventoConsiderações sobre carga útil
Ferramentas disponíveisHabilidades necessáriasPublicar viaAssinar viaPeríodo de repetiçãoEstrutura de carga útilLimites de carga útil
MuleSoftMuleSoft Anypoint Apache Kafka ConnectorCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
Conector de Pub/Sub do SalesforceCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
Salesforce PlatformApache Kafka on HerokuCódigo profissionalAPIs, alterações de registro no Heroku PostgresN/A1 a 6 semanasUsuário definidoUsuário definido
Captura de dados de alteraçãoBaixo código para Pro-codeAlterações de registroApex, APIs, Componentes da Web Lightning (LWC)3 diasPredefinido1 MB
Eventos de plataformaBaixo código para Pro-codeAPIs, Apex, FluxoApex, APIs, Flow, LWC3 diasUsuário definido1 MB
Pub/Sub APICódigo profissionalAPI ou APIs Pub/Sub, Fluxo do ApexAPI Pub/Sub3 diasUsuário definido1 MB
Retransmissões de evento*Código baixoEventos de plataforma, Captura de dados de alteraçãoAPI3 diasUsuário definido1 MB
*Retransmissões de evento enviam dados apenas para o AWS EventBridge
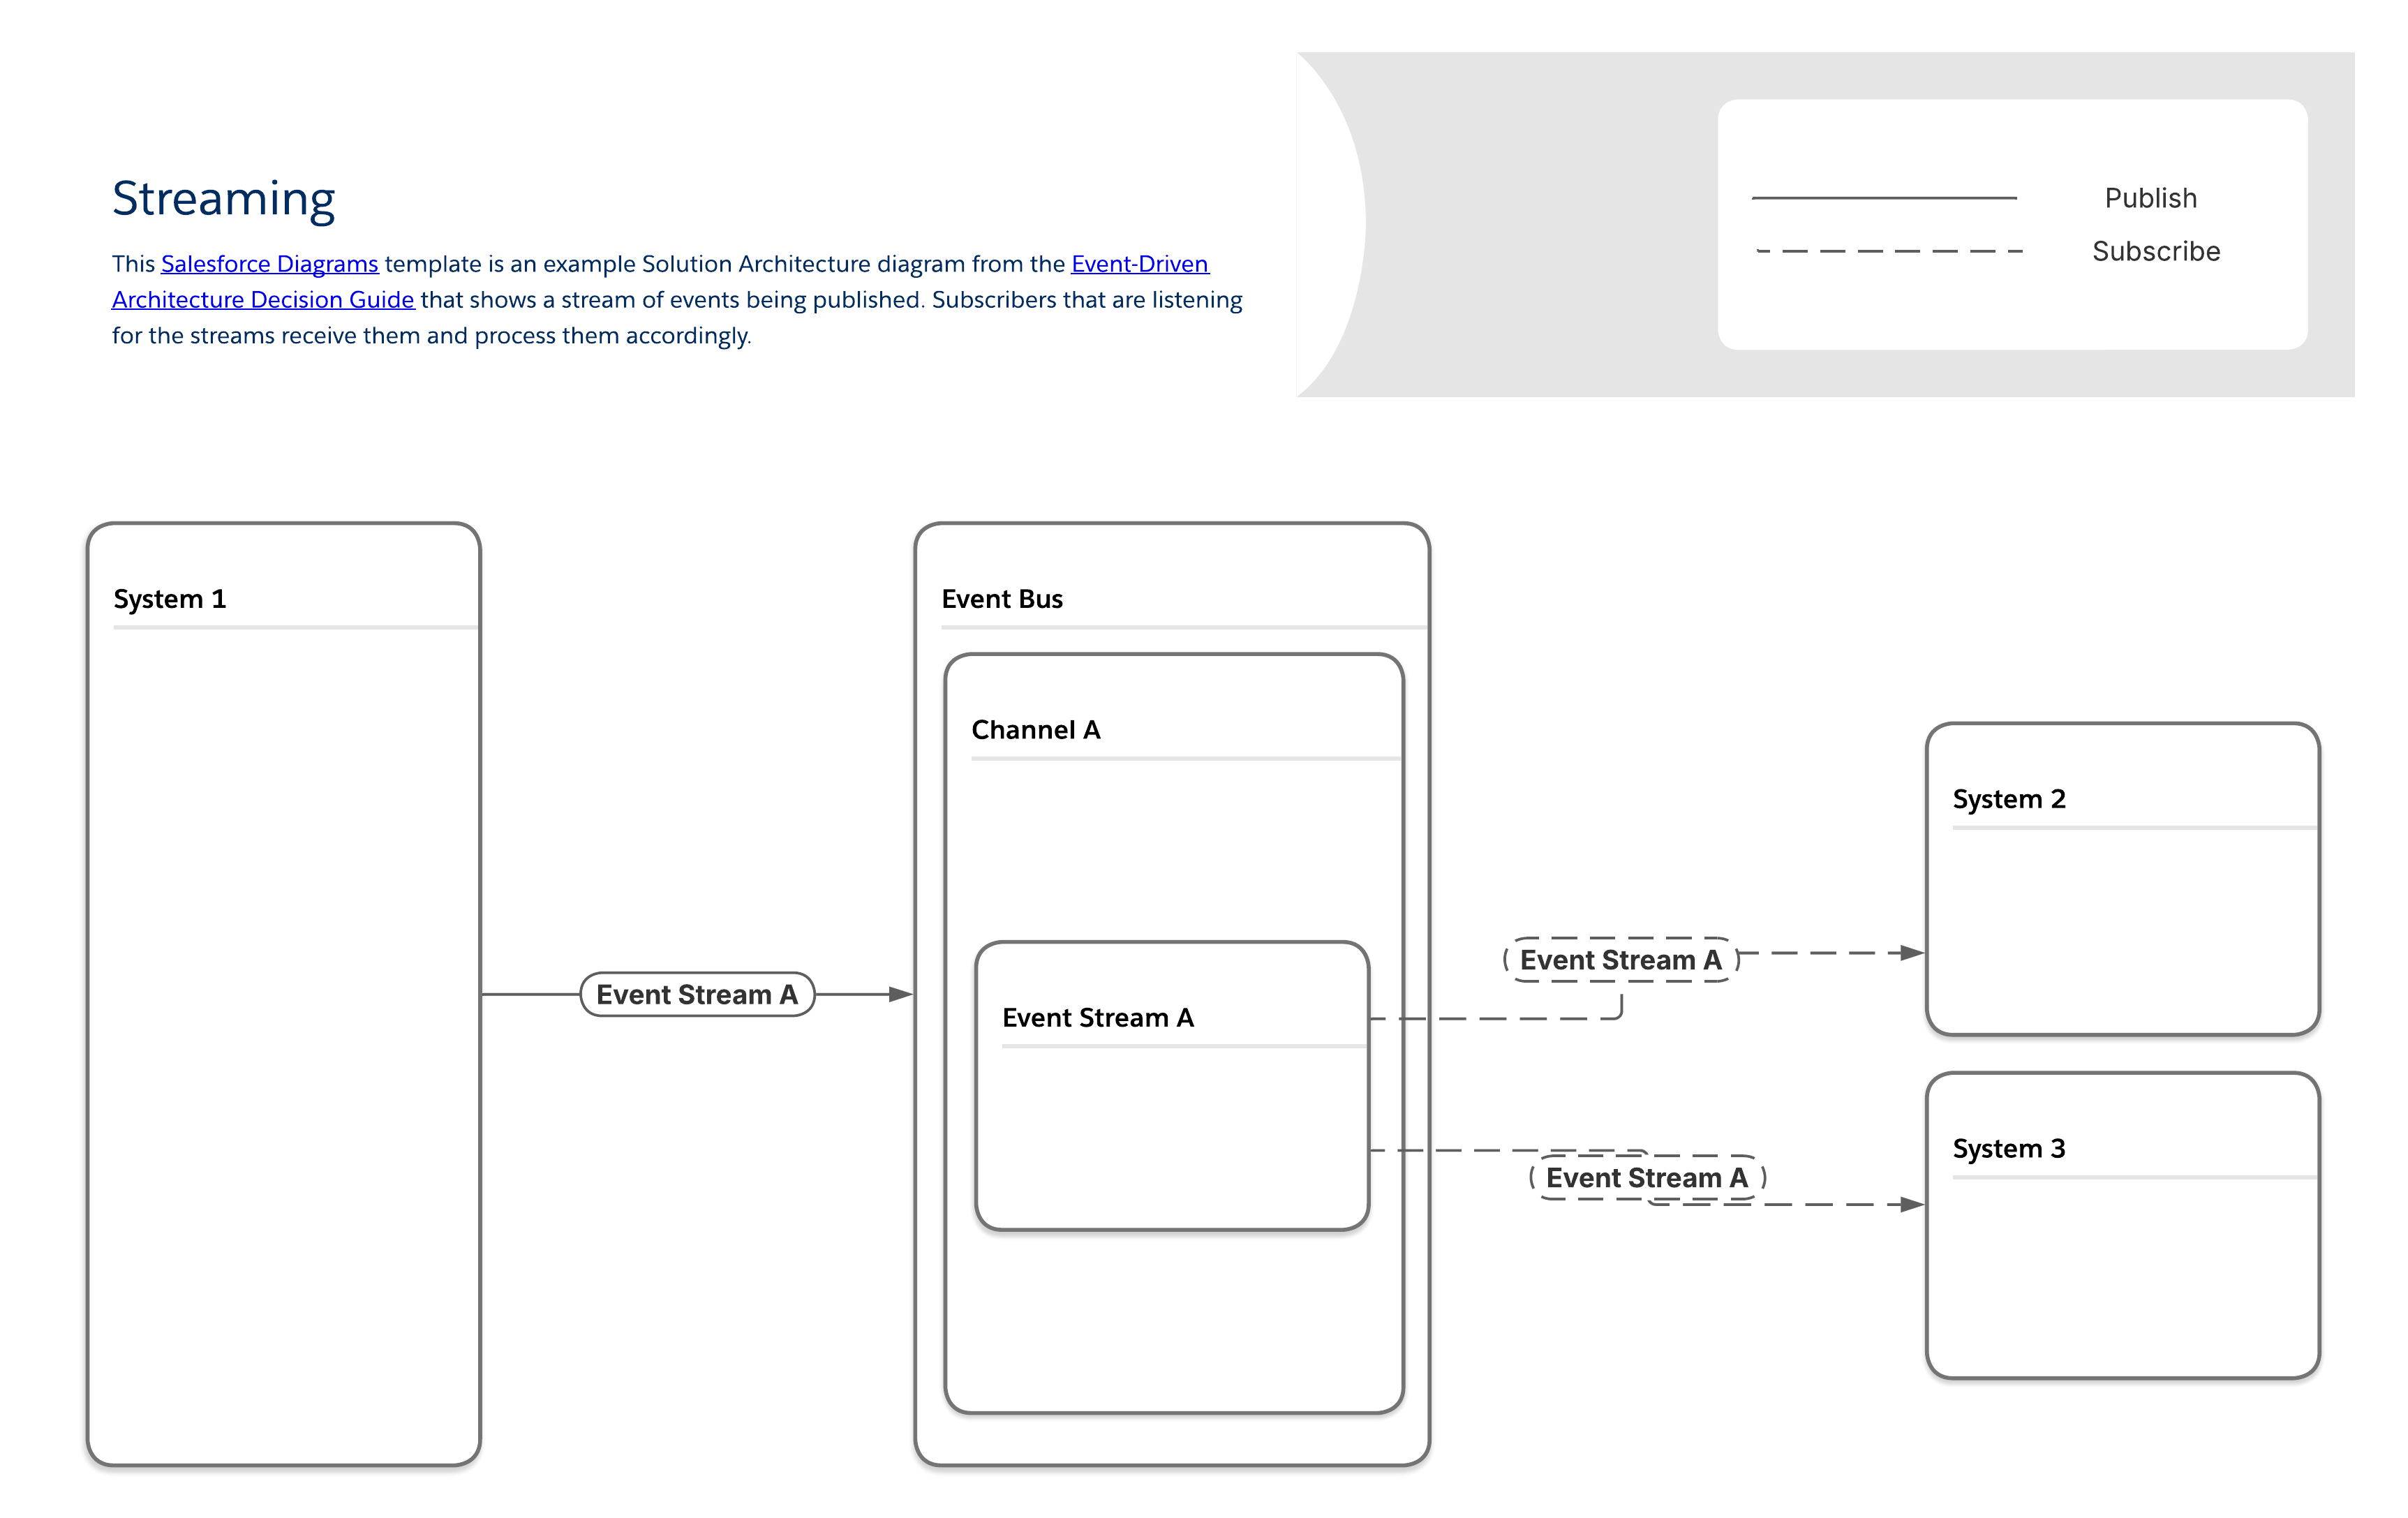
### Streaming Alguns produtores geram um fluxo contínuo de eventos. Um exemplo comum é o streaming de mídia, que envolve interações do usuário que ocorrem naturalmente como eventos separados. Vários sistemas devem reagir ao mesmo comportamento do usuário simultaneamente sem bloquear a experiência de streaming principal. Considere os eventos para uma plataforma de streaming de música. Essas podem incluir: - Rastrear eventos iniciados/pausados/pularam - Eventos de sessão de escuta com carimbos de data e hora - Eventos de criação/modificação da lista de reprodução - Eventos de compartilhamento social - Download para escuta offline #### O padrão de streaming No padrão de streaming, os assinantes acessam cada fluxo de evento e processam os eventos na ordem exata em que são recebidos. Cópias únicas de cada fluxo de mensagens são enviadas a cada assinante, tornando possível entregar conteúdo específico do assinante e identificar quais assinantes recebem quais fluxos. Esse diagrama de implementação e documentação de Nível 3 mostra um exemplo do padrão de streaming que mostra um fluxo de eventos sendo publicados, que os assinantes que estão ouvindo os fluxos recebem e processam de acordo. #### Ferramentas relevantes para o padrão de streaming
Fluxo e comportamento de eventoConsiderações sobre carga útil
Ferramentas disponíveisHabilidades necessáriasPublicar viaAssinar viaPeríodo de repetiçãoEstrutura de carga útilLimites de carga útil
MuleSoftMuleSoft Anypoint Data StreamsCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
Conector de Pub/Sub do SalesforceCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
MuleSoft Anypoint Apache Kafka ConnectorCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
Salesforce PlatformApache Kafka on HerokuCódigo profissionalAPIs, alterações de registro no Heroku PostgresN/A1 a 6 semanasUsuário definidoUsuário definido
Pub/Sub APICódigo profissionalAPI ou APIs Pub/Sub, Fluxo do ApexAPI Pub/Sub3 diasUsuário definido1 MB
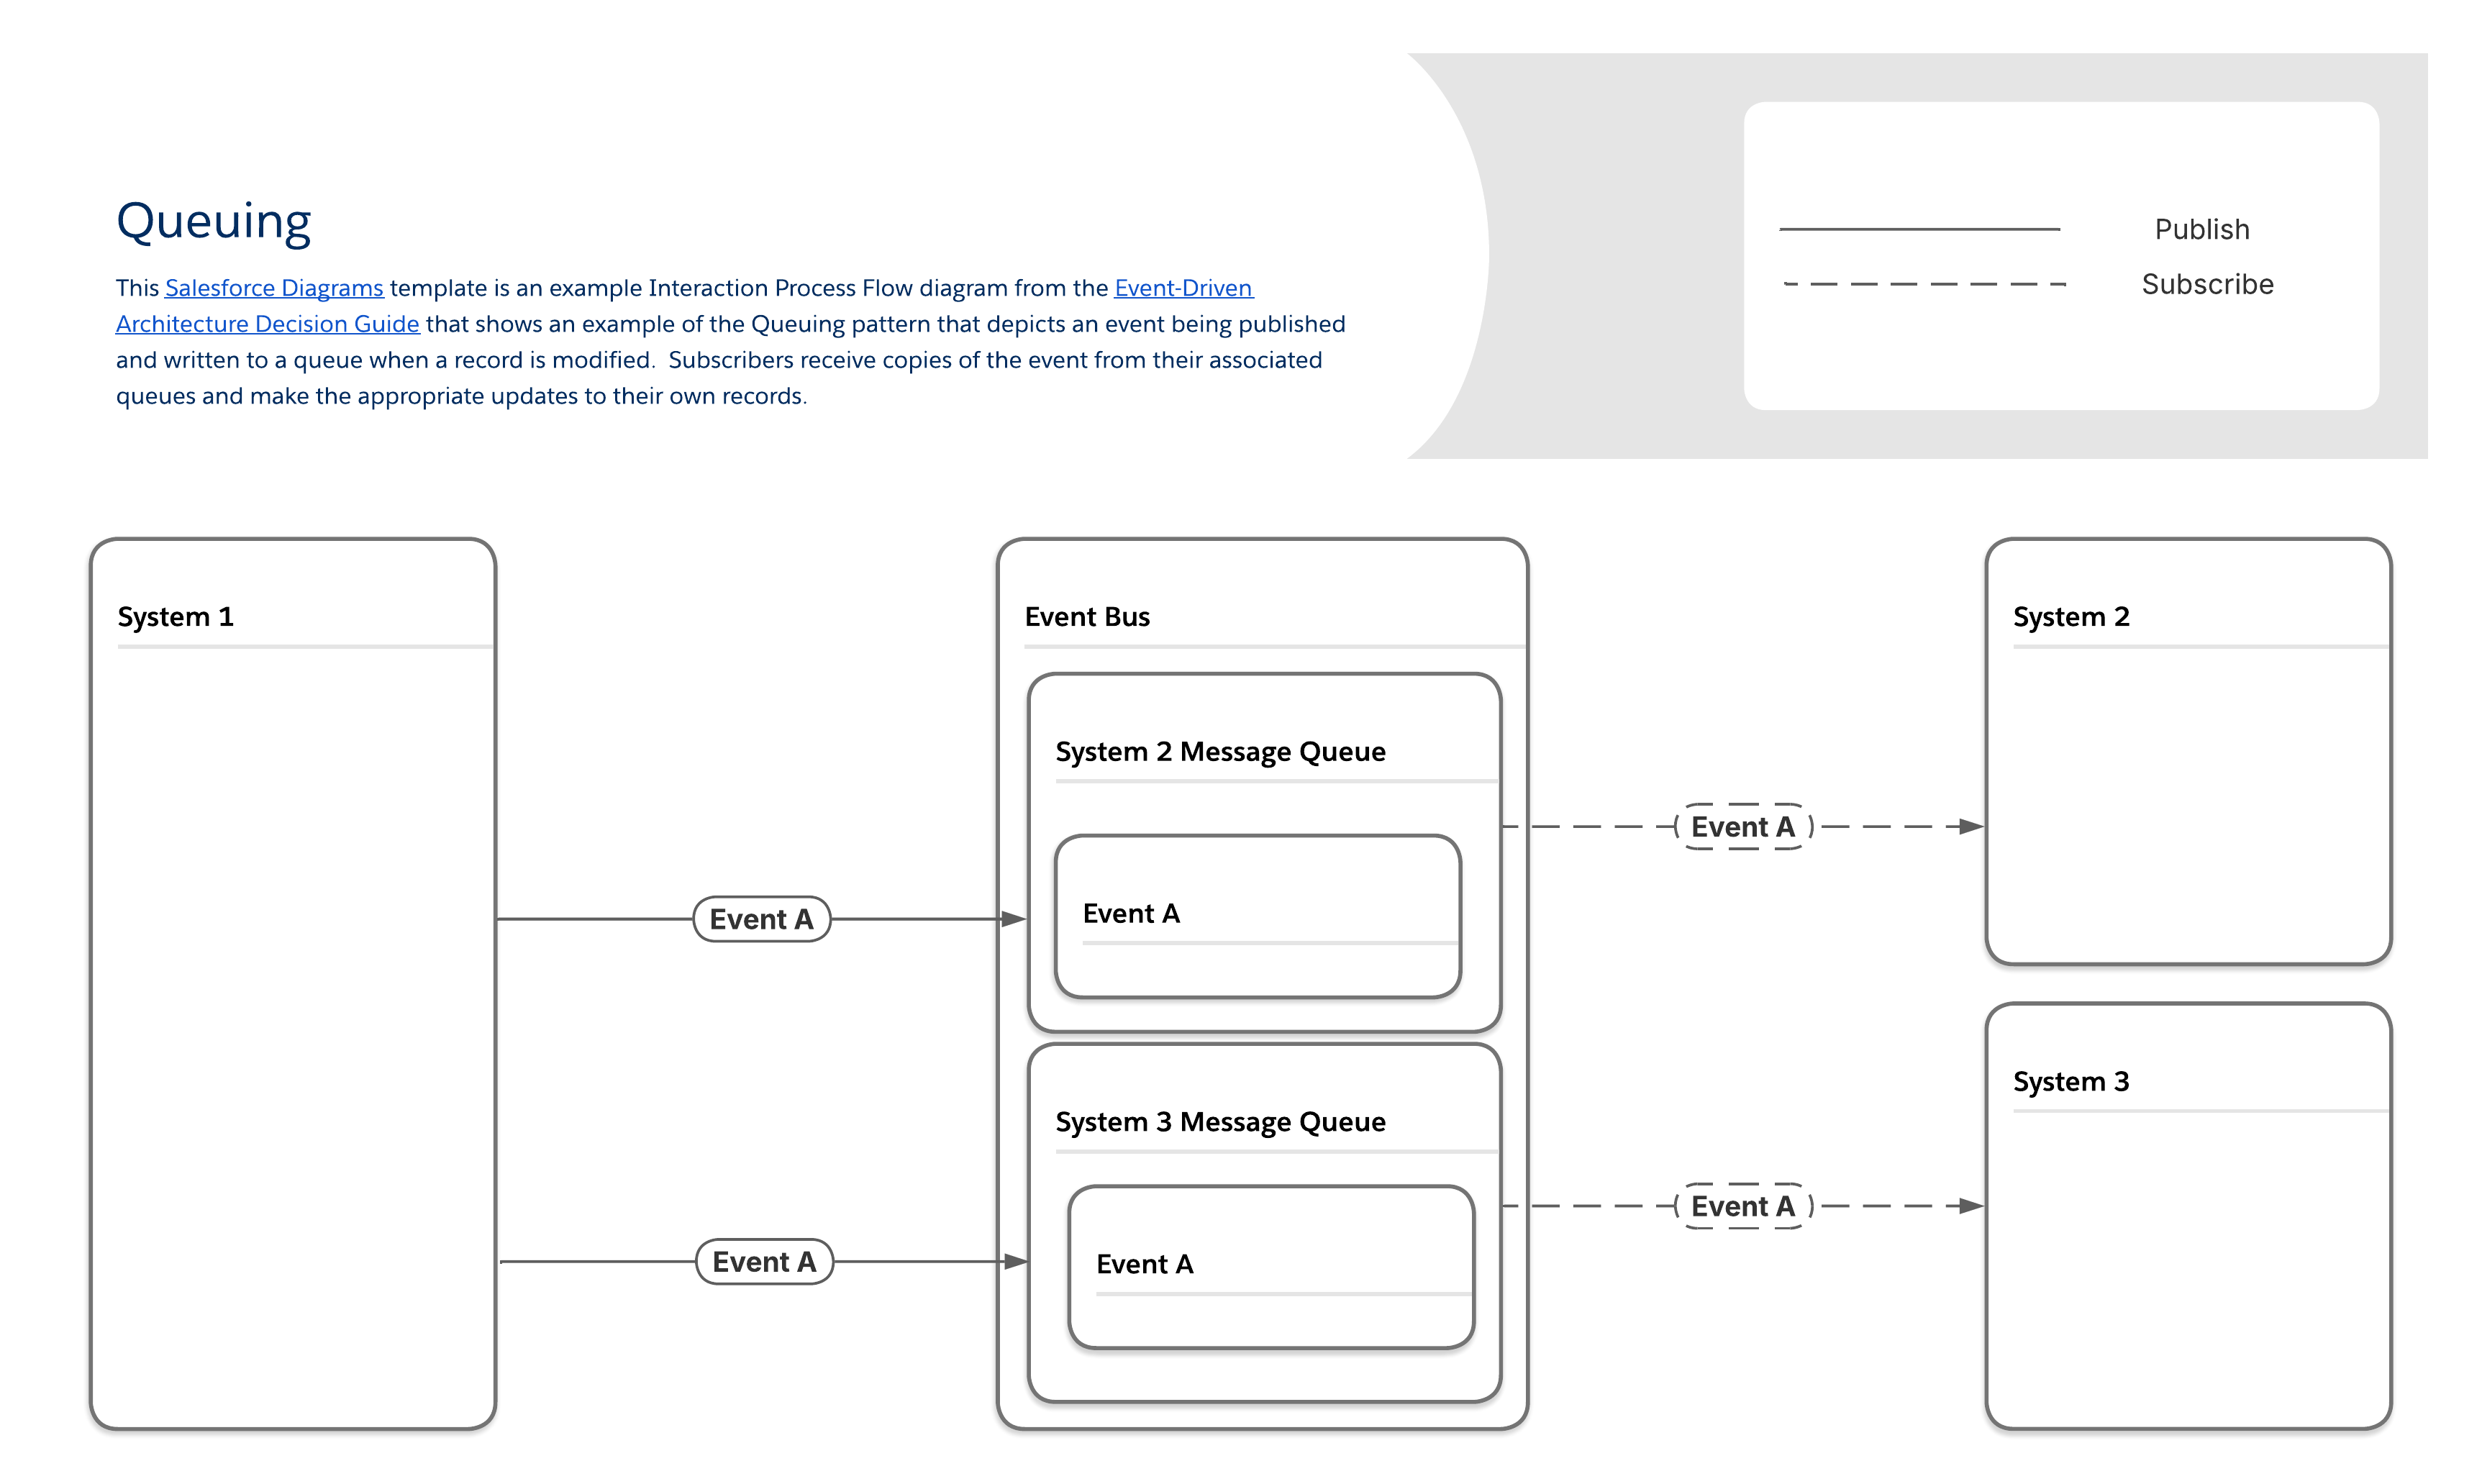
#### Gerenciamento de pedido de evento transmitido Para que um fluxo faça sentido, todos os seus eventos e suas mensagens associadas precisam estar na ordem correta. Se você originar os dados em um fluxo de sistemas diferentes, precisará incorporar lógica de pedido adicional como parte do processo de design. ### Fila Os casos de uso de enfileiramento são onipresentes. Os exemplos incluem: - **Conexões de internet de baixa qualidade:** Organizações de serviço de campo ou outras organizações em que as equipes com dispositivos móveis precisam trabalhar em áreas com acesso à Internet de baixa qualidade ou intermitente se beneficiam do enfileiramento, pois os aplicativos nesses dispositivos podem se conectar às filas e recuperar todas as mensagens relevantes quando a conectividade é restaurada. - **Buffering de mensagem:** Quando o volume de mensagens ocasionalmente excede a capacidade de processamento de um assinante e a latência aumentada não cria problemas adicionais, as filas podem ser uma margem para armazenar mensagens em excesso e evitar a perda de dados. - **Gerenciamento de transporte:** Organizações de logística que precisam monitorar suas frotas podem usar esse padrão para visualizar as rotas que cada veículo está seguindo quase em tempo real e garantir que os motoristas estejam sendo o mais eficientes possível. - **Dispositivos de IoT:** Os fabricantes costumam usar sistemas que geram fluxos de dados rápidos, e esses fluxos podem ter efeitos a jusante em sistemas adicionais. Esse padrão pode ser usado para identificar sequências de eventos que exigem intervenção humana antes que ocorram falhas catastróficas em vários sistemas. #### O padrão de enfileiramento No padrão de enfileiramento, os produtores enviam mensagens para filas, que mantêm as mensagens até que os assinantes as recuperem. A maioria das filas de mensagens segue a ordem de primeira entrada e primeira saída (FIFO) e exclui todas as mensagens após a recuperação. Cada assinante tem uma fila exclusiva, que exige etapas de configuração adicionais, mas permite garantir a entrega e identificar quais assinantes receberam quais mensagens. Esse diagrama de implementação e documentação de Nível 3 mostra um exemplo do padrão de enfileiramento que mostra um evento sendo publicado e gravado em uma fila quando um registro é modificado.Os assinantes recebem cópias do evento de suas filas associadas e fazem as atualizações apropriadas em seus próprios registros. #### Ferramentas relevantes para o padrão de enfileiramento
Fluxo e comportamento de eventoConsiderações sobre carga útil
Ferramentas disponíveisHabilidades necessáriasPublicar viaAssinar viaPeríodo de repetiçãoEstrutura de carga útilLimites de carga útil
MuleSoftMuleSoft Anypoint MQCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
Conector de Pub/Sub do SalesforceCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
MuleSoft Anypoint Apache Kafka ConnectorCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
MuleSoft Anypoint MQ ConnectorCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
Conector MQTT do MuleSoft AnypointCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
Conector do MuleSoft Anypoint AMQPCódigo profissionalAPIsAPIsConfiguradoUsuário definidoNenhum
Salesforce PlatformApache Kafka on HerokuCódigo profissionalAPIs, alterações de registro no Heroku PostgresN/A1 a 6 semanasUsuário definidoUsuário definido
Captura de dados de alteraçãoBaixo código para Pro-codeAlterações de registroApex, APIs, Componentes da Web Lightning (LWC)3 diasPredefinido1 MB
Eventos de plataformaBaixo código para Pro-codeAPIs, Apex, FluxoApex, APIs, Flow, LWC3 diasUsuário definido1 MB
Pub/Sub APICódigo profissionalAPI ou APIs Pub/Sub, Apex, FluxoAPI Pub/Sub3 diasUsuário definido1 MB
Retransmissões de evento*Código baixoEventos de plataforma, Captura de dados de alteraçãoAPI3 diasUsuário definido1 MB
*Retransmissões de evento enviam dados apenas para o AWS EventBridge
#### Gerenciamento de memória e armazenamento Devido à natureza assíncrona do padrão de enfileiramento, pode haver um longo atraso entre a adição de uma mensagem a uma fila e a recuperação dessa mensagem. As filas exigem memória ou espaço de armazenamento para conter suas mensagens, portanto, elas não podem crescer indefinidamente, o que significa que um assinante que está offline indefinidamente pode causar uma falha se mensagens suficientes se acumularem na fila. O buffering de mensagens poderá ter o mesmo efeito se os tempos de processamento do assinante ficarem longos demais, fazendo com que grandes volumes de mensagens se acumulem nas filas. Para mitigar esses riscos, realize uma análise completa dos requisitos de armazenamento para todas as filas de mensagens e, se necessário, projete processos que limparão e desabilitarão as filas se as mensagens não forem recuperadas dentro de um tempo definido ou quando atingirem um volume predeterminado. ## Considerações não funcionais ### Migração de integrações de ponto a ponto Mesmo que você esteja totalmente convencido de que uma arquitetura orientada por evento é a melhor para sua organização, pode estar começando com uma paisagem que já tem um grande número de integrações de ponto a ponto. Obter financiamento para um projeto para substituir todas as suas integrações de uma só vez pode ser difícil e talvez nem sequer seja possível usar uma arquitetura conduzida por evento diretamente com alguns sistemas legados. Nesses cenários, você pode adotar uma abordagem incremental para migrar para uma arquitetura mais solta, convertendo primeiro os aplicativos mais críticos para os negócios, então convertendo outros sistemas conforme eles são atualizados ou substituídos em projetos futuros. Essa abordagem facilita a adição de novos aplicativos ao barramento de eventos e permite que sua paisagem de TI geral permaneça escalonável e resiliente à medida que os sistemas continuam sendo adicionados ao longo do tempo. ### Compromissos em sistemas soltos Como arquitetos, sabemos que toda arquitetura vem com desvantagens. Uma arquitetura conduzida por evento não é exceção. Embora uma paisagem repleta de sistemas soltos seja altamente escalonável e resiliente, há algumas vantagens a serem consideradas também: - **Estratégia global de integração:** Independentemente das ferramentas e padrões que você decide usar, é importante começar criando uma estratégia para como os dados serão compartilhados entre os vários sistemas no panorama da sua organização. Essa estratégia deve incluir as metas da sua organização para seus dados, como os dados podem ser compartilhados e padrões usados, além de fontes de dados, destinos, estruturas e requisitos de propriedade e acesso. - **Suporte para sistemas legados:** Sua organização pode ter sistemas legados que simplesmente não oferecem suporte a padrões de arquitetura conduzidos por evento. Embora seja possível criar soluções alternativas (por exemplo, com um processo que atua como um passo a passo assinando eventos e então enviando a saída para o sistema de destino por meio de um meio diferente de transferência de dados), talvez você queira considerar outros métodos de integração neste caso. - **Alterações estruturais em mensagens:** Depois que a estrutura da mensagem inicial é definida e acordada entre editores e assinantes, pode ser difícil alterar, principalmente se os assinantes forem externos. Há várias maneiras de lidar com esse problema. Você pode usar pontos de extremidade com controle de versão, mas certifique-se de definir e comunicar um ciclo de vida claro para cada versão para que seus desenvolvedores não tenham que manter muitas versões simultaneamente. Se o Apache Kafka no Heroku fizer parte da sua paisagem, você também poderá considerar um registro de esquema ou uma ferramenta semelhante, mas certifique-se de que os outros sistemas na sua paisagem também dêem suporte a ele (e o usem). - **Falta de visibilidade entre editores e assinantes:** Na maioria dos padrões de arquitetura conduzidos por evento, os editores não estão cientes do status de seus assinantes. Portanto, se um editor enviar uma mensagem crítica enquanto todos os assinantes estiverem offline, talvez a mensagem nunca seja entregue. Você pode resolver esse problema usando a funcionalidade de reprodução ou adicionando assinantes redundantes que são executados em servidores separados para todas as mensagens críticas. - **Botões de desempenho:** À medida que uma arquitetura conduzida por evento cresce, o barramento de evento pode se tornar um gargalos para a entrega de mensagens se ele ficar sobrecarregado com muitos editores tentando enviar mensagens a muitos assinantes ao mesmo tempo. Você pode lidar com isso aumentando os recursos de memória e processamento alocados ao barramento de evento ou usando vários barramentos de evento para processar diferentes tipos de mensagens em paralelo. ## Melhores práticas relacionadas ### Implementar arquiteturas conduzidas por evento Antes de implementar uma arquitetura conduzida por evento, considere se você realmente precisa usar uma no primeiro lugar. A seção anterior descreve cenários de negócios comuns que são adequados a cada padrão de arquitetura conduzida por evento. Você também pode ler mais em [Well-Architected - Interoperability](/docs/architect/pt-br/well-architected/guide/composable#interoperabilidade). Revise os desafios a serem considerados ao implementar Arquiteturas conduzidas por evento para determinar se os padrões que você tem em mente são mais adequados para seus casos de uso específicos. Observe que, embora a maioria dos cenários abordados neste guia envolva integrações, as arquiteturas conduzidas por evento também podem ser usadas para enviar mensagens em uma única organização do Salesforce por meio do uso de eventos de plataforma, por exemplo. Lembre-se de quaisquer [limites de alocação de evento](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_event_limits.htm) aplicáveis ao projetar processos que usam eventos de plataforma como um sistema de mensagens interno. ### Evitando antipadrões Frequentemente, antipadrões em arquiteturas conduzidas por evento vêm do uso de eventos como uma solução alternativa para comunicações internas em uma organização do Salesforce. Antipadrões comuns incluem: - **Publicar eventos de acionadores do Apex associados ao mesmo objeto de evento:** Isso resultará em um loop de acionador infinito. - **Publicar eventos do Apex antes da conclusão de uma transação DML:** Se uma transação falhar e reverter, quaisquer eventos publicados que tenham o comportamento Publicar publicação imediata não serão incluídos no comportamento de reversão. - **Publicar eventos no Fluxo para orquestrar a automação subsequente:** A melhor maneira de coordenar a lógica entre várias automações é usar [subfluxos](https://developer.salesforce.com/docs/atlas.en-us.salesforce_vpm_implementation_guide.meta/salesforce_vpm_implementation_guide/vpm_designer_elements_subflow.htm) ou [Flow Orchestrator](https://help.salesforce.com/s/articleView?id=sf.orchestrator_flow_orchestrator.htm). - **Criando dependências de tempo de execução:** Não publique eventos para facilitar a comunicação entre pacotes sem tomar as [etapas](https://medium.com/salesforce-architects/5-anti-patterns-in-package-dependency-design-and-how-to-avoid-them-87bb50331cb8) adequadas para eliminar as dependências de tempo de execução. - **Cargas úteis desnecessariamente grandes:** Ao fazer solicitações, é melhor enviar e receber a menor quantidade possível de dados na carga útil. Cada ação de um usuário pode potencialmente gerar várias solicitações, e é importante que elas sejam processadas de maneira eficiente. Enviar mais dados do que o necessário pode contribuir para desacelerar o transporte e aumentar o tempo de processamento. - **Manuseio não seletivo de eventos de solicitação:** Quando há vários componentes ouvindo um evento de aplicativo, os desenvolvedores devem garantir que o manipulador de evento seja executado apenas quando for realmente desejado e útil. Por exemplo, no Console do Lightning, os componentes contidos em guias que não estão focalizadas ainda podem estar ouvindo, embora não estejam visíveis. Um desenvolvedor pode usar várias técnicas, como usar um item de utilitário em segundo plano como o único ouvinte ou chamar getEnclosingTabId() para determinar se essa instância do componente está delimitada na guia focada para garantir que cada evento seja tratado apenas quando ele for pretendido. - **Usando o comportamento de publicação de Eventos de plataforma incorretamente:** Os Eventos de plataforma têm dois comportamentos de publicação: Publicar imediatamente e Publicar após confirmação. Pode ser útil usar eventos de plataforma em tempo real para casos de uso, como Registro, em que você deseja publicar o evento de registro independentemente de a transação ser bem-sucedida ou confirmada. No entanto, use Publicar imediatamente com muito cuidado com eventos de plataforma em tempo real. Os eventos podem ser consumidos por assinantes na mesma transação e causar bloqueios de linha ou outras condições de corrida. ### Projetar eventos efetivos Ao implementar uma arquitetura conduzida por evento, uma das chaves para o sucesso é definir padrões para como os eventos em si são projetados. Os detalhes variarão dependendo dos casos de uso da sua organização, mas aqui estão algumas diretrizes gerais: - **Determine a estrutura ideal para suas cargas úteis de evento.** Embora tamanhos menores de mensagem reduzam os tempos de processamento, bombardear assinantes com volumes enormes de mensagens pode causar gargalos de desempenho. Talvez seja necessário iterar em seus tamanhos e estruturas de carga útil para encontrar o saldo certo. O MuleSoft e ferramentas ESB semelhantes oferecem a capacidade de projetar cargas úteis personalizadas nas mensagens associadas aos seus eventos, o que pode ajudá-lo a visualizar estruturas de dados para melhorar o desempenho no lado do assinante. (Consulte [Good-Architected – API Management](/docs/architect/pt-br/well-architected/guide/composable#gerenciamento-de-api) para obter mais informações.) - **Pense em seus processos de ponta a ponta.** Certifique-se de que você não esteja criando cenários de "loop infinito", que podem ser difíceis de rastrear depois que as integrações forem implementadas. Um exemplo disso seria dois sistemas que publicam eventos quando os registros são atualizados, ao mesmo tempo que escutam os eventos uns dos outros, que acionam eventos publicados adicionais quando são processados. Você pode corrigir esse tipo de antipadrão adicionando lógica a ambos os sistemas que garante que as alterações feitas como resultado de um evento sendo consumido não resultem na publicação de um novo evento. Você também deve documentar todos os seus eventos, seus acionadores associados e os sistemas a jusante que podem ser afetados. Use esta documentação como referência durante sessões de design para ajudar a capturar loops intermináveis e cenários semelhantes o mais cedo possível. (Consulte [Bem-Arquiteto - Projeto de processo](/docs/architect/pt-br/well-architected/guide/automated#design-de-processos) para obter mais informações.) - **Usar convenções de nomenclatura comuns entre sistemas.** Convenções de nomenclatura consistentes são uma prática recomendada para todo o desenvolvimento de software, incluindo arquiteturas conduzidas por evento. Reserve tempo para documentar um conjunto de padrões para nomes de evento, estruturas, objetos associados e processos de tratamento de erros para garantir a consistência entre sistemas. (Consulte [Bem-Arquiteto - Padrões de Design](/docs/architect/pt-br/well-architected/guide/intentional#padrões-de-design) para obter mais informações.) ## Recursos
PadrãoRecursos
Publicar/AssinarSalesforce bem-construído - taxa de transferência
Salesforce bem-construído - Tratamento de dados
Salesforce bem-construído - Interoperabilidade
Blog Post: Alcance eficiência arquitetônica com retransmissões de evento
Blog Post: Anúncio da API Pub/Sub disponível ao público em geral
Blog Post: Mudar de RESTful para EVENTFUL
Blog Post: Arquiteturas conduzidas por evento e a especificação da AsyncAPI
Vídeo: Publicar / Assinar guia passo a passo do padrão
FanoutBlog Post: Como trabalhar dentro dos limites de entrega de eventos da plataforma
Vídeo: Guia passo a passo do padrão do Fanout
Mensagens passadasVídeo: Guia passo a passo do padrão de mensagens passadas
StreamingBlog Post: Projetar gravações de alto volume no Salesforce
Vídeo: Guia passo a passo do padrão de streaming
Documentação: Streaming em aplicativos Mule
FilaBlog Post: Projetar gravações de alto volume no Salesforce
Blog Post: Como projetar arquiteturas de pagamento com APIs com evento
Vídeo: Guia passo a passo do padrão de enfileiramento
## Visão geral A Salesforce Platform avançou continuamente sua arquitetura de automação para atender às demandas de processos de negócios complexos. Gerações anteriores, as Regras de fluxo de trabalho e o Criador de processos, forneciam as etapas iniciais na lógica conduzida por evento, expandindo os recursos de automação para lógica conduzida por evento e ampliando o alcance para uma gama mais ampla de criadores. Essa evolução culminou em uma arquitetura consolidada de alto desempenho centrada em dois pilares complementares: Fluxo acionado por registro e acionadores do Apex. Este documento fornece a estrutura e as diretrizes para tomar decisões fundamentadas ao projetar automações de acionador. ## Produtos no escopo
Fluxo O Fluxo Salesforce é uma ferramenta avançada de automação de apontar e clicar que permite aos usuários criar processos comerciais complexos, telas e lógica visualmente usando o Flow Builder, sem escrever código. Ele automatiza tarefas como atualizações de dados, envio de emails e orientação de usuários, oferecendo flexibilidade por meio de tipos como Fluxos de tela (interação do usuário) e Fluxos acionados (eventos de registro/agendamento).
Apex O Salesforce Apex é uma linguagem de programação proprietária e orientada a objetos para a plataforma Salesforce, semelhante a Java, usada para criar lógica de negócios personalizada, automatizar processos e estender as principais funcionalidades do CRM além das ferramentas declarativas.
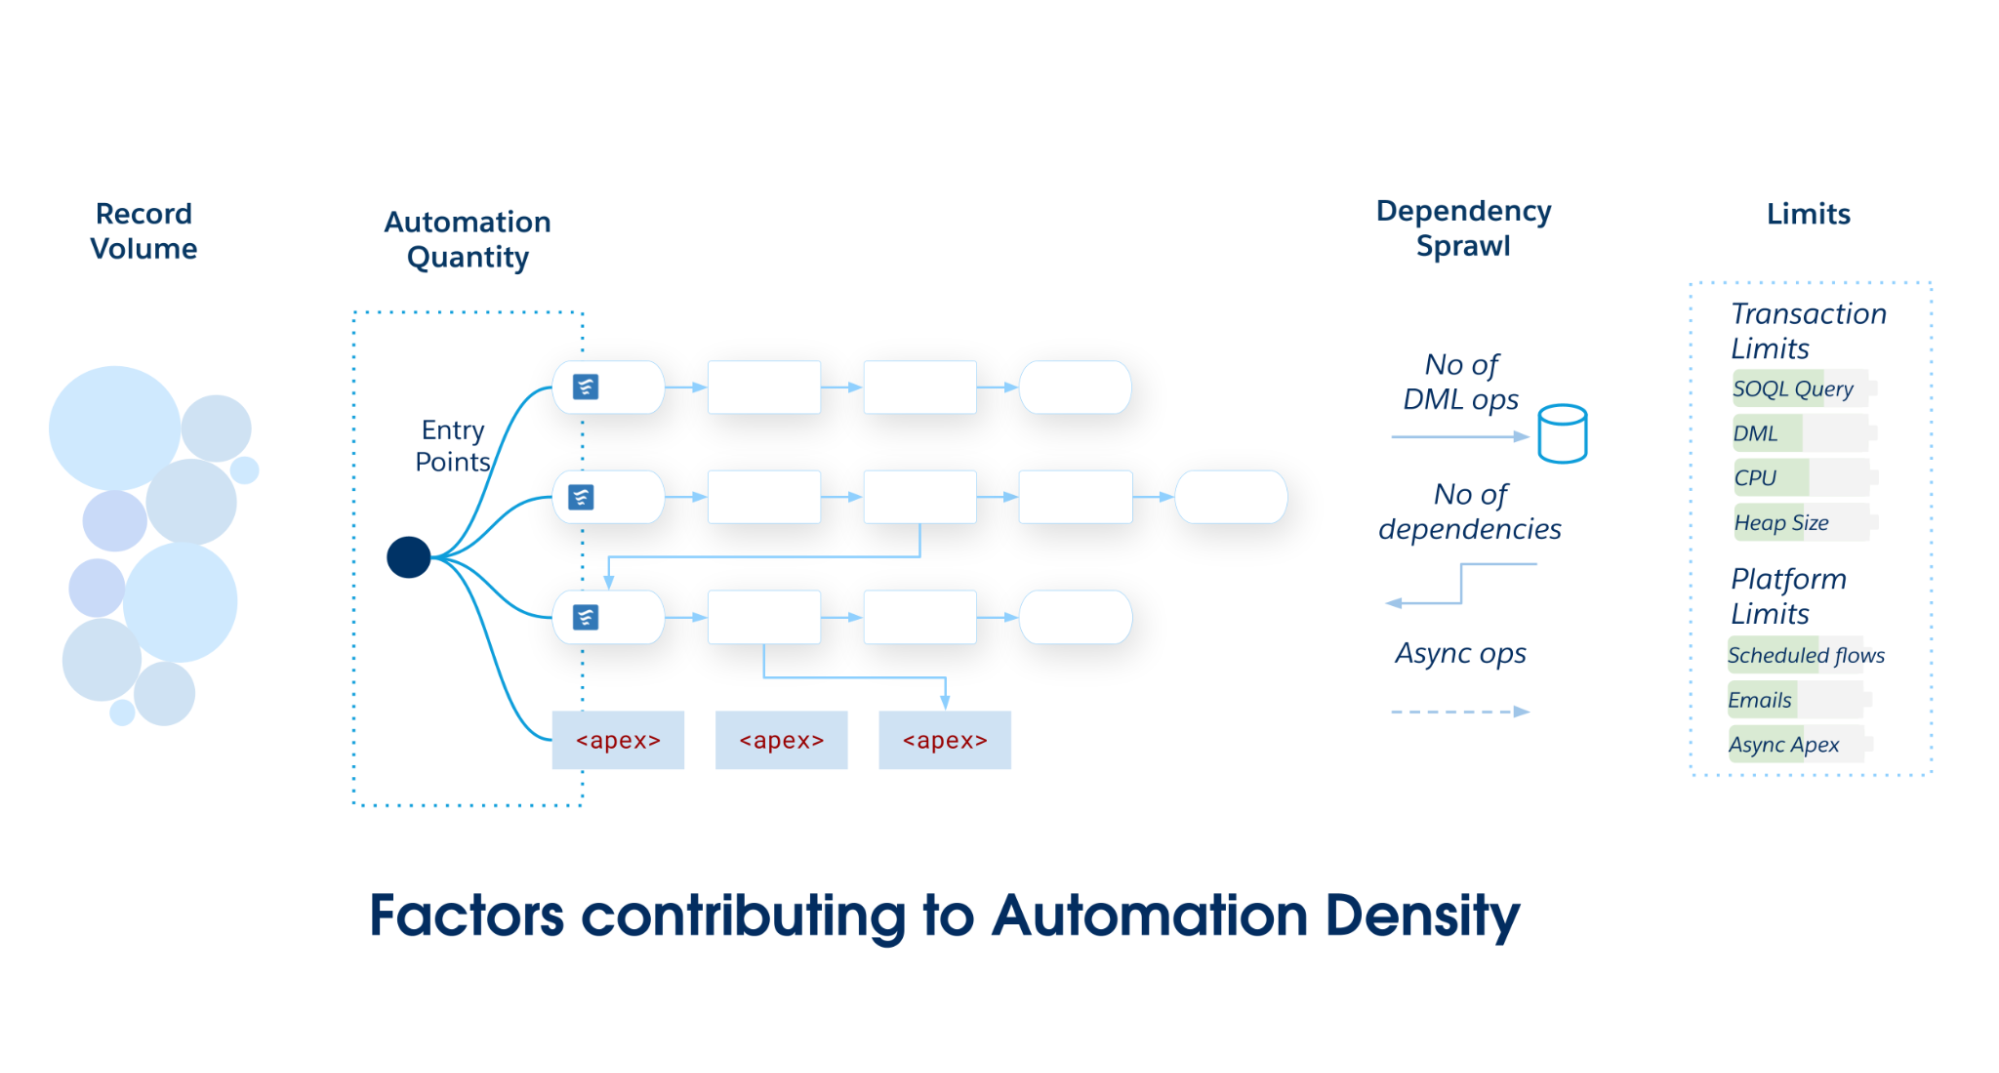
## Capturas A criação de automação acionada por registro escalonável, mantida e de desempenho no Salesforce Platform requer uma abordagem disciplinada e orientada por arquitetura. A escolha entre o Fluxo e o Apex, e a implementação de cada um, é guiada por um conjunto claro de princípios. Esses pontos resumem esses princípios e servem como as regras fundamentais para o design de automação moderna. - **Escolha a ferramenta certa para o trabalho com base na densidade de automação do Salesforce Object.** - Use o Fluxo acionado por registro para objetos do Salesforce para automações de **baixa densidade**. - Aumente a lógica de fluxo acionado por registro com o Apex invocável para automações de **densidade média**. - Use acionadores do Apex para objetos do Salesforce para automações de **alta densidade**. - **Tome cuidado ao acionar processos assíncronos.** Essa regra se aplica se você está invocando processos assíncronos em um fluxo acionado por registro ou enfileirando um trabalho enfileirável do Apex. Embora esse padrão possa ser tentador para descarregar o trabalho, ele pode introduzir cenários complexos de tratamento de erros e aumentar o risco de atingir os limites do regulador. - **Use um ponto de entrada por objeto do Salesforce.** Para um determinado Objeto do Salesforce, use um mecanismo como seu ponto de entrada para automação. Tente evitar misturar acionadores de Fluxo e Apex como pontos de entrada para o mesmo Objeto. ## Pontos de decisão ### Implementação declarativa versus programática O Fluxo e o Apex compartilham um conjunto comum de recursos fundamentais. Cada ferramenta pode consultar registros, executar lógica condicional, atribuir variáveis e realizar operações DML, como criar, atualizar e excluir registros, sequenciados para execução em uma ordem especificada. No entanto, essa sobreposição funcional não implica que as ferramentas sejam intercambiáveis. A escolha da arquitetura não é sobre _se_ uma tarefa pode ser realizada, mas sobre _como_ ela é realizada e quais são as implicações a longo prazo para o desempenho, a escalabilidade e a capacidade de manutenção. O Fluxo se destaca em clareza declarativa e velocidade de implementação para processos simples, enquanto o Apex fornece o controle granular e a potência bruta necessárias para soluções complexas. ### Densidade de automação A **densidade de automação** é a carga colocada em um objeto do Salesforce específico. Ele serve como uma heurística para determinar a implementação ideal do objeto. Conforme a densidade de automação aumenta, aumenta a probabilidade de violar limites transacionais. Calcule a densidade de automação inspecionando três dimensões específicas de volume e complexidade: - **Quantidade de automação:** O número bruto de entradas de metadados de automação exclusivas (fluxos, ações de acionador e assim por diante) que são executadas durante um único evento de Linguagem de manipulação de dados (DML). - **Volume de registro:** Os registros por transação processados por meio de carregamentos de API ou processamento em lote pesado, em que o desempenho se torna crítico. - **Despansão da dependência:** Uma medida das operações de DML a jusante acionadas pela operação CRUD inicial. Ele quantifica a profundidade do gráfico em que uma atualização se encaixa em atualizações em objetos relacionados (por exemplo, caso → conta → contato → totalização personalizada). Dimensões de densidade de automação Conforme o escopo e a complexidade do seu aplicativo Salesforce aumentam, confirme-se com um único ponto de entrada principal: Fluxo acionado por registro ou Acionadores do Apex. Evite particionar automações entre vários mecanismos em um único objeto do Salesforce, pois isso leva à má capacidade de manutenção e à fragmentação da governança. ### A matriz de seleção de densidade Use essa matriz para determinar o padrão de arquitetura necessário para seu objeto do Salesforce. - O **Fluxo acionado por registro** é a solução preferida para baixa densidade de automação. Ele oferece um equilíbrio de poder e acessibilidade ideal para automações diretas e independentes umas das outras. - **O padrão híbrido (Fluxo acionado por registro com Apex invocável)** é uma escolha poderosa e manejável para automações de média densidade com complexidade crescente. Esse padrão permite que as equipes mantenham a coreografia ordenada no Fluxo declarativo enquanto delegam operações pesadas em computação ao Apex, equilibrando acessibilidade e desempenho. - Os acionadores **Apex** fornecem os blocos de construção necessários para uma base arquitetônica sólida para suportar automações de alta densidade. O desempenho, o controle granular e a abstração e o polimorfismo orientados a objetos do Apex são mais adequados para gerenciar a complexidade e a escala desses cenários.
Nível de densidade Quantidade de automação Volume de dados (tamanho do lote) Sprawl de dependência Padrão arquitetônico
Baixo < 15
Automações
Padrão
Interações de interface do usuário orientadas pelo usuário ou cargas de API pequenas (1 a 200 registros)
Discreto
Lógica independente. 0 a 1 operações de DML a jusante no mesmo objeto ou em um objeto relacionado.
Fluxo acionado por registro
Médio 15–30
Automações
Moderar
Processamento em lote padrão (com lógica que requer massificação cuidadosa)
Acoplado
Pai/filho atualiza de 2 a 4 operações de DML a jusante. Risco de recursão
Padrão híbrido
Fluxo + Apex invocável
Alto > 30
Automações
Alto
Grandes volumes de dados com carregamentos de API em massa (2.000 a 10.000 registros)
Complexo e Recursivo
Gráfico de dependência profunda (5 operações DML a jusante). Risco de loops de recursão triangular
Apex Trigger Metadata Framework
As decisões de arquitetura do mundo real exigem que você pondera todas as dimensões da densidade de automação coletivamente. Considere o possível escopo futuro ao selecionar um mecanismo de automação para um determinado objeto do Salesforce. Além disso, considere o número total diário de operações de DML, pois o Salesforce impõe o gerenciamento compartilhado de recursos em um ambiente de vários locatários e os [limites de governador](https://developer.salesforce.com/docs/atlas.en-us.salesforce_app_limits_cheatsheet.meta/salesforce_app_limits_cheatsheet/salesforce_app_limits_platform_apexgov.htm) para evitar que as automações de fuga monopolizem recursos compartilhados. Objetos do Salesforce com alto volume diário de DML exigem seleção de automação cuidadosa. Por exemplo, limites assíncronos para tempo de CPU (60.000 ms) e tamanho de heap (12 MB) são maiores que limites síncronos. Além disso, o limite de 24 horas para toda a organização em execuções assíncronas (calculado como 250 mil, ou 200 vezes suas licenças de usuário) exige a consideração do DML diário total em seu design arquitetônico para evitar exceções de tempo de execução. ## Comparação de produto O Fluxo acionado por registro é a principal ferramenta declarativa da plataforma para automação acionada por registro. A facilidade de uso do fluxo e as proteções de plataforma integradas permitem que as equipes criem facilmente soluções escalonáveis e confiáveis. É a escolha ideal para a maioria das equipes criando soluções na plataforma Salesforce. Apex é a linguagem de programação proprietária da plataforma, fortemente tipada e orientada a objetos. Use Apex para objetos do Salesforce com alta densidade de automação e para casos de uso que exigem alto desempenho, lógica sofisticada ou controle granular sobre transações. Para ajudar no processo de tomada de decisão, esta matriz fornece uma comparação direta de Fluxo e Apex entre os principais recursos de arquitetura.
Capacidade Fluxo acionado por registro Acionador do Apex
Velocidade de entrega e manutenção Recomendado
A interface de usuário visual do Flow Builder permite que administradores e outros criadores declarativos criem e modifiquem automações mais rapidamente do que escrever, testar e implementar Apex code. Essa interface permite que uma gama mais ampla de membros da equipe ofereça valor comercial e reduza a dependência de recursos de desenvolvedor especializados para tarefas simples.
Requer conhecimento
O Apex exige que desenvolvedores de software habilitados para implementar, testar e manter o código.
Modularidade Disponível
Fluxos acionados por registro são modulares por padrão. Em vez de lógica monolítica, as equipes criam fluxos separados para requisitos específicos e os coreografam juntas usando o Explorador do Acionador de fluxo. Essa modularidade permite a modificação isolada e a extensão simples, reduzindo significativamente o custo de propriedade de longo prazo.
Disponível
O Apex é dividido em módulos funcionais por design. Cada classe do Apex tem como objetivo implementar um único módulo de funcionalidade.
Visibilidade e governança Recomendado
A natureza visual do Fluxo fornece uma representação intuitiva da lógica de negócios. O Explorador do acionador de fluxo fornece uma visualização consolidada de todos os fluxos em um objeto, tornando mais fácil para arquitetos e administradores entenderem, governarem e solucionarem problemas sem lerem código.
Requer conhecimento
Usar uma estrutura de metadados para organizar acionadores é vantajoso, mas o Apex exige uma equipe de desenvolvimento disciplinada para manter o código organizado e mantido.
Processamento de dados em massa de alto desempenho Não recomendado
Há um maior risco de atingir os limites do controlador ao lidar com lógica complexa ou grandes volumes de dados.
Recomendado
O Apex code é executado mais próximo dos serviços centrais da plataforma e oferece aos desenvolvedores um controle aprimorado sobre a otimização de consultas, o tratamento de dados e a eficiência algorítmica. Isso resulta em melhor desempenho e escala, especialmente em cenários complexos que envolvem grandes volumes de dados.
Lógica robusta e estruturas de dados Disponível
O Elemento Transformação de Fluxo pode ajudar com algumas tarefas complexas de processamento. No entanto, o Fluxo não tem estruturas de dados Mapear e Definir nativas, tornando o processamento de dados complexo complicado e computacionalmente ineficiente.
Recomendado
O Apex oferece acesso total a loops Map, Set e Programmatic para manipulação de dados altamente eficiente e segura em massa. Como uma linguagem de programação com recursos completos, o Apex também oferece acesso a construções lógicas complexas, estruturas de dados e padrões de design que podem ajudar a resolver problemas de negócios complexos de forma mantida e eficiente. O Apex inclui uma rica biblioteca padrão de funções avançadas (por exemplo, BusinessHours, Crypto) que atualmente não estão disponíveis em ferramentas declarativas.
Controlo da transação Não disponível
O fluxo não fornece acesso a operações de DML `Database.savepoint`, `Database.rollback` ou parcialmente bem-sucedidas para confirmações ou reversões de transações parciais.
Disponível
O Apex fornece controle completo e granular sobre a integridade da transação e cenários complexos de recuperação de erros.
Distribuição de email Recomendado
Enviar alertas por email pré-configurados de um fluxo acionado por registro é fácil e escalonável. Alertas por email personalizados podem ser elaborados e distribuídos no tempo de execução. Emails personalizados estão sujeitos a limites diários de envio de email.
Disponível
O Apex pode gerar e enviar mensagens de email personalizadas. Todos os emails enviados do Apex estão sujeitos aos limites diários de envio de email.
Aplicando salvaguardas de plataforma Recomendado
O fluxo inclui proteções integradas, como massificação automática e novas tentativas automáticas. Essas proteções aumentam a velocidade de valorização e impedem armadilhas de desempenho que exigem codificação manual complexa.
Implementação manual necessária
Proteções como massificação devem ser codificadas explicitamente (por exemplo, gerenciar coleções e evitar SOQL dentro de loops). As novas tentativas automáticas não são nativas de acionadores e exigem a implementação de uma lógica personalizada complexa.
Processamento assíncrono Disponível
O Fluxo oferece mecanismos fáceis para automações que exigem uma transação separada em um caminho assíncrono. Essas automações estão sujeitas a limites diários.
Disponível
O Apex permite o controle total por meio da Captura de dados de alteração e eventos enfileiráveis que são tratados por um assinante de acionador desacoplado.
Processamento agendado Recomendado
Os caminhos agendados do fluxo fornecem uma funcionalidade de agendamento exclusiva e eficiente (por exemplo, "desligar 3 dias antes da data de fechamento"). Essa funcionalidade inclui cancelamento automático e reagendamento se os dados do registro mudarem. Essas automações estão sujeitas a limites diários.
Não disponível
Um acionador do Apex não pode agendar nativamente um evento temporal específico do registro com cancelamento automático. Embora o Apex agendado exista, é um mecanismo fundamentalmente diferente que é executado em um horário específico e não é agendado durante o processamento de um registro individual como parte de um acionador.
Ordenamento e coreografia Disponível
O Explorador do acionador de fluxo permite que os administradores definam uma ordem de execução relativa para vários fluxos no mesmo objeto.
Disponível
Uma estrutura de acionador fornece controle granular sobre a ordem exata das automações.
Atualizações de campo de mesmo registro Disponível (antes de salvar)
O Fluxo acionado por registro é a opção declarativa de melhor desempenho para atualizar o registro acionador antes da confirmação DML inicial.
Disponível (antes de salvar)
O Apex oferece o melhor desempenho com pouca sobrecarga.
CRUD de objeto cruzado Disponível (depois de salvar)
O fluxo é adequado para operações de DML de objeto cruzado simples e de baixa complexidade.
Disponível (depois de salvar)
O Apex oferece controle superior sobre a remoção de duplicação, o tratamento de erros e o desempenho para operações DML entre objetos.
Deduplicação de cálculos caros Disponível
O fluxo se destaca na eliminação de consultas redundantes e instruções DML por meio de massificação automática. No entanto, o estado não pode ser armazenado em cache ou compartilhado entre diferentes acionadores de fluxo ou entre várias invocações do mesmo fluxo em uma transação. Essa limitação pode se tornar importante em cenários de desempenho extremo.
Recomendado
O Apex fornece mecanismos para desduplicar operações caras. Os desenvolvedores podem aproveitar o armazenamento em cache transacional usando propriedades e variáveis estáticas e o armazenamento em cache no nível da plataforma usando o Cache da plataforma para armazenar e reutilizar dados. Essas técnicas são importantes para reduzir o consumo de limites de controlador transacional, como consultas SOQL, e garantir alto desempenho e escalabilidade.
Tratamento de erros personalizados Disponível
O elemento CustomError pode bloquear uma operação de salvamento e exibir uma mensagem ao usuário.
Recomendado
O método addError() fornece mensagens de erro condicionais e em nível de campo flexíveis.
## Casos de uso ### Recomendações de melhor ajuste Esta tabela fornece recomendações gerais de "melhor ajuste" para casos de uso gerais com base nos recursos apresentados. Finalmente, você considerará considerações adicionais para chegar a um melhor ajuste para seus cenários específicos, como aqueles incluídos na seção _Melhores práticas relacionadas_ deste documento. Lá, você aprenderá mais sobre quando uma determinada combinação de Fluxo e Apex fornece a melhor abordagem.
Caso de uso Descrição Melhor ajuste Racionalidade
Processamento em lote de alto desempenho Qualquer automação que precise processar milhares de registros de maneira eficiente Apex O Apex fornece APIs avançadas para interface com a plataforma e velocidade bruta.
Processamento de dados complexo Cenários que exigem manipulação de dados avançada Apex O Apex fornece estruturas de dados, como Mapa e Conjunto, que não estão disponíveis nativamente no Fluxo e podem ser essenciais para escrever um código de alto desempenho e seguro em massa.
Controle transacional Controlar mecanismos como pontos de salvamento, reversões e confirmações parciais Apex O Apex fornece acesso a mecanismos como Database.savepoint e Database.rollback e tem a capacidade de processar operações DML parcialmente bem-sucedidas.
Validação personalizada sofisticada Validação de dados em vários campos em um registro Apex Embora o Fluxo possa impedir uma gravação com o elemento `CustomError', ele não está disponível em todos os tipos de fluxo, incluindo subfluxos. O método Apex addError() fornece várias mensagens de erro específicas do campo que podem ser adicionadas a um registro a qualquer momento durante o processamento do acionador.
Lógica moderadamente complexa em um processo simples Lógica e manipulação de dados de complexidade moderada, simplificada por uma biblioteca padrão de funções avançadas, que ocorre como parte de um processo não complicado Fluxo + Apex O Fluxo acionado por registro atua como a camada de orquestração, enquanto operações de alta complexidade são encapsuladas no Apex invocável.
Lógica simples a moderadamente complexa Manipulação de dados de baixa a moderada complexidade, com atualizações de acionador para os objetos de dados primários e relacionados Fluxo O fluxo costuma ser a opção recomendada, pois é baseado em um modelo declarativo que o torna acessível a administradores e desenvolvedores.
Notificações e mensagens de saída Enviar emails e mensagens de saída Fluxo O fluxo torna o envio de alertas por email e mensagens de saída em alterações de registro fácil e altamente escalonável.
Processamento agendado Automação em uma data futura e dinâmica (por exemplo, três dias antes de uma data de fechamento) Fluxo Os caminhos agendados fornecem um poder exclusivo ao Fluxo, pois a plataforma gerencia automaticamente o agendamento, o cancelamento e o reagendamento desses caminhos se os dados do registro mudarem.
### Processamento dimensionável: Casos de uso assíncronos em profundidade A escalabilidade é uma consideração crítica ao projetar sua implementação. Quando a lógica de negócios de uma automação acionada por registro se torna complexa, de longa duração ou envolve grandes volumes de dados, os limites principais do controlador da Salesforce Platform se tornam uma restrição arquitetônica. Operações como atualizações de dados em massa, chamadas de API complexas ou cálculos pesados aumentam o risco de violar limites, como o tempo total de CPU ou o número de instruções DML em uma única transação de banco de dados. Uma falha em um acionador síncrono devido a uma exceção de limite fará com que toda a transação de salvamento do usuário seja revertida, resultando em má experiência do usuário e possível perda de dados. Esse risco inerente exige um padrão arquitetônico para descarregar trabalho complexo. A automação assíncrona se torna essencial nesse caso. Usando mecanismos assíncronos, os arquitetos podem efetivamente desconectar o trabalho de longa duração ou de alto volume da transação de salvamento de registro síncrona principal. Salva com rapidez e confiabilidade, enquanto o processamento pesado é delegado a uma transação gerenciada por plataforma separada que é executada mais tarde. A desacoplamento melhora a estabilidade, evita falhas de transação e é essencial para criar aplicativos corporativos dimensionáveis. A plataforma oferece várias ferramentas especializadas para isso, cada uma com benefícios e compensações distintos em termos de confiabilidade, volume e complexidade. ### Caminho assíncrono do fluxo O caminho Executar de modo assíncrono em um fluxo acionado por registro fornece o mecanismo mais simples para lógica assíncrona "apagar e esquecer". Esse caminho é executado em uma transação separada depois que a transação de salvamento de registro original foi confirmada com sucesso no banco de dados. - **Caso de uso ideal**: Isso é adequado para tarefas que não exigem execução imediata ou tratamento de erros personalizados. Exemplos incluem enviar uma notificação por email, criar uma tarefa de acompanhamento ou fazer uma chamada simples para um sistema externo. - **Limitações**: Esse mecanismo compartilha os mesmos limites de controlador diários de outras entrevistas de fluxo assíncronas. Ele não foi projetado para processamento de alto volume. ### Captura de dados de alteração (CDC) A Captura de dados de alteração (CDC) é um padrão de alto rendimento, escalonável e resiliente para lidar com lógica assíncrona acionada por uma mudança de registro em cenários de alto volume. Nesse modelo, a única responsabilidade do acionador é salvar o registro de modo síncrono. A plataforma então publica uma mensagem de evento detalhada que contém as alterações do registro em um barramento de evento de alto volume. Um acionador do Apex dedicado separado assina esse evento de alteração. Ele realiza trabalhos complexos, de longa duração ou assíncronos. - **Benefício**: Esse padrão desconecta o processo assíncrono da transação do usuário inicial. Uma falha no processamento assíncrono não fará com que o salvamento do registro do usuário seja revertido. O padrão também fornece um fluxo de eventos durável que vários assinantes internos ou sistemas externos podem consumir, e os eventos podem ser repetidos por até 72 horas, proporcionando uma forte resiliência. - **Limitações**: As mensagens de evento CDC não contêm o estado anterior do registro, o equivalente a um `Trigger.oldMap` do Apex. A carga útil do evento inclui os novos valores de campo, mas não os valores dos quais ele mudou. Isso torna difícil implementar lógica com base em uma transição de estado específica (por exemplo, executar apenas se o `Status__c` mudou de "Pensando" para "Aprovado"). Você pode mitigar isso consultando o histórico de campo do objeto no assinante do evento, mas isso aumenta a complexidade do processo e o rastreamento de histórico de campo pode não estar disponível para o campo específico de interesse. Isso pode limitar os tipos de automação que você pode descarregar para a CDC. Por padrão, o CDC pode ser habilitado em no máximo cinco objetos do Salesforce. As organizações que precisam de mais podem comprar uma licença complementar que remova esse limite e aumenta as alocações de entrega de eventos. ### Apex enfileirável de um acionador Encolher um trabalho do Apex enfileirável diretamente de um acionador deve ser considerado um padrão arriscado, usado apenas quando o controle fornecido pelo Apex é necessário (por exemplo, para lógica complexa ou mecanismos de repetição personalizados), e o CDC não é uma opção viável. Se o Apex enfileirável for necessário, a implementação deverá incluir salvaguardas adequadas: - **Verificações de limite**: O código deve verificar o número de trabalhos já enfileirados na transação antes de tentar adicionar outro. ``` if (Limits.getQueueableJobs() < Limits.getLimitQueueableJobs()) { ... } ``` - **Contextualização**: O código deve detectar se está sendo executado em um contexto assíncrono, como um trabalho em lote (`System.isBatch()`), e modificar seu comportamento para cumprir o limite mais rígido de um trabalho por transação nesse contexto. ### Considerações de limite para o Apex assíncrono acionado A invocação do Apex assíncrono de um acionador síncrono introduz riscos de estabilidade. Para evitar o impacto no nível da organização (por exemplo, exceder limites), esse padrão requer um design e testes rigorosos. - O limite diário para execuções assíncronas do Apex (`Batch`, `Queueable`, `@Future`) é compartilhado entre a organização (geralmente 250.000 ou um cálculo baseado em licenças de usuário). Um carregamento de dados em massa de 20 mil registros fará com que um acionador seja executado em blocos de 200, resultando em 100 invocações de acionador separadas, ainda mais se o tamanho do lote em massa for inferior a 200 registros. Se cada chamada enfileirar um trabalho assíncrono, uma parte significativa do limite diário de um único carregamento de dados poderá ser consumida. Esse consumo pode prejudicar outros processos de negócios críticos de recursos assíncronos. - Os limites do controlador para enfileirar trabalhos são drasticamente diferentes dependendo do contexto. A partir de um acionador acionado por uma ação do usuário na interface do usuário (uma transação _síncrona_), até 50 trabalhos enfileiráveis podem ser enfileirados. No entanto, a partir de um acionador acionado no método de `execute` de uma classe do Apex em lote (uma transação _assíncrona_), apenas um trabalho enfileirável pode ser enfileirado. Não levar em conta essa diferença é um ponto de falha comum e crítico, levando a erros de `LimitException` durante operações de dados grandes. - Chamar Apex programável (`System.schedule`) ou Apex em lote (`Database.executeBatch`) diretamente de um contexto de acionador constitui um antipadrão. Esses métodos não foram projetados para serem chamados do contexto do acionador. Isso levará a um consumo rápido da alocação assíncrona do Apex, resultando em exceções de limite. ### Escolher o padrão assíncrono certo Cada mecanismo assíncrono tem compensações específicas em relação ao desempenho, limites do controlador e confiabilidade. Use essa árvore de decisão como guia para ajudá-lo a navegar por essas opções e escolher o mecanismo certo para seu caso de uso. Árvore de decisão de padrão assíncrono ### A alternativa de trabalho agendado Como o fluxograma indica, quando você está enfrentando operações de DML de alto volume, mas não pode usar a Captura de dados de alteração (talvez devido a limites de objeto), a melhor escolha arquitetônica é muitas vezes evitar um processo invocado por acionador completamente. Em vez disso, considere usar um processo agendado. Isso pode ser um Fluxo agendado ou Apex agendado. As etapas necessárias são: 1. Realize uma atualização simples e de baixo custo no acionador síncrono. Por exemplo, defina um campo de `Status__c` como "processamento pendente" ou insira um registro relacionado a baixo custo, como uma publicação do Chatter, para indicar que o registro precisa ser processado. 2. Crie um trabalho agendado, seja um fluxo agendado ou Apex agendado, que é executado periodicamente, como a cada 15 minutos ou a cada hora. 3. Tenha a consulta de trabalho agendada para todos os registros no estado pendente, execute a lógica complexa em um contexto controlado e de alto volume e atualize os registros conforme processados. Esse padrão desconecta totalmente o processamento pesado do salvamento síncrono do usuário, não está sujeito ao limite de um trabalho por transação de um lote acionado pelo acionador e fornece uma solução altamente escalonável e regulável para requisitos não em tempo real. Se a latência de um trabalho agendado não for aceitável para os requisitos de negócios e você ainda estiver impedido de usar o CDC ou uma fila acionada pelo acionador, isso indicará uma incompatibilidade arquitetônica significativa. Nesse ponto, diferentes mecanismos devem ser considerados. Reavaliar o design do aplicativo principal pode levar a determinadas conclusões, como: - Comprar o complemento para remover limites de objeto da CDC. - Desafiar fundamentalmente o requisito de negócios para determinar se o processamento quase em tempo real é realmente um "must-have" ou se a latência de um trabalho agendado é uma compensação aceitável para a estabilidade da plataforma. ## Considerações não funcionais ### Complexidade O nível de complexidade em uma implementação faz parte do custo total de propriedade de uma solução, bem como sua capacidade de se adaptar a mudanças nos requisitos de negócios. A complexidade pode afetar qualquer implementação se as práticas recomendadas não forem seguidas. Na seção Práticas recomendadas _relacionadas_ deste documento, há recomendações para reduzir a complexidade da sua solução, incluindo estes padrões: - Padrão híbrido: Apex invocável para lógica complexa no fluxo - Usando uma estrutura de metadados para acionadores do Apex - Mega-fluxos vs. Vários fluxos ### Processos e padrões A documentação é tão importante quanto a automação em si. Não apenas garante a capacidade de manutenção, mas também é essencial para IA e ferramentas baseadas em agente. A documentação ajuda você a entender e gerenciar seus processos de negócios. **Em fluxo** - Estabeleça uma convenção de nomenclatura consistente para todos os elementos e variáveis. - Use o campo Descrição do fluxo para explicar seu propósito geral, critérios de acionador e resultado pretendido. - Use o campo Descrição em cada elemento individual (por exemplo, `Get Records`, `Action`, `Transform`). Essa prática é a melhor maneira de transmitir a intenção. É especialmente importante para ações e subfluxos invocáveis, em que a descrição é o principal lugar para explicar a lógica complexa realizada pela ação. **No Apex** - Comente seu código claramente para explicar o _porquê_ por trás de sua lógica, não apenas o _o quê_. - Se estiver usando uma estrutura conduzida por metadados, garanta que seus registros de metadados incluam e preencham um campo de Descrição legível por humanos para explicar o que cada classe de manipulador faz e quando ela deve ser executada. DevOps e controle de origem fazem parte de um ciclo de vida de desenvolvimento maduro. Sempre use uma ferramenta de controle de código-fonte, como Git para projetos do Salesforce. As classes do Apex e os Fluxos do Salesforce são metadados que definem sua lógica de negócios e devem ser controlados e gerenciados com controle de versão. No contexto do gerenciamento de automações acionadas por registro, um pipeline DevOps moderno oferece benefícios essenciais. - **Verificações de qualidade automatizadas:** Ferramentas como o [Salesforce Code Analyzer](https://developer.salesforce.com/docs/platform/salesforce-code-analyzer/overview) podem ser configuradas para ser executadas automaticamente em seu pipeline. A análise estática pode detectar padrões problemáticos em ambas as ferramentas de automação antes de serem promovidas, sinalizando problemas como elementos de `Get Records` ineficientes dentro de um loop de Fluxo ou consultas de `SOQL` dentro de um loop do Apex, que são causas comuns de degradação do desempenho. - **Prevenção de regressão:** Conforme sua densidade de automação aumenta, uma mudança para um Fluxo ou classe do Apex pode ter consequências indesejadas para outras automações no mesmo objeto. Uma estratégia de teste DevOps robusta, em que os testes automatizados do Apex são executados em relação a qualquer alteração proposta, é a maneira mais confiável de garantir que uma nova versão do Fluxo não quebre a lógica do Apex existente (e vice-versa). - **Colaboração e visibilidade:** O controle de origem é a "única fonte da verdade". Permite que administradores e desenvolvedores trabalhem em automação para o mesmo objeto em paralelo. Ele também fornece uma trilha de auditoria inestimável: quando um processo de produção é interrompido, você pode ver instantaneamente _quem_ mudou a automação, _quando_ mudou e — através de mensagens de compromisso — _por que_ mudou. Para equipes com uma combinação de administradores e desenvolvedores, o [DevOps Center](https://help.salesforce.com/s/articleView?id=platform.devops_center_overview.htm&type=5) fornece uma interface unificada para ajudar a organizar todas essas etapas, tornando um processo de desenvolvimento escalonável e baseado em controle de código-fonte acessível a todos na equipe. Essa disciplina combinada de documentação e DevOps garante a integridade e a manutenção de longo prazo da sua organização, o que beneficiará todos os arquitetos e administradores que o seguem. ## Melhores práticas relacionadas O guia de decisão acima é melhor usado antes de planejar sua implementação. Ele tem como objetivo ajudá-lo a escolher o melhor produto para seus casos de uso. Após a seleção do produto, é importante entender as práticas recomendadas existentes para sua implementação. ### Explorar o padrão híbrido: Apex invocável para lógica complexa no fluxo O princípio _Uma ferramenta por objeto_ é crucial para gerenciar a automação de alta densidade, mas não o interprete como uma escolha binária entre uma pilha puramente declarativa ou puramente programática. Um padrão arquitetônico mais eficaz e mantido aproveita um modelo híbrido: posicione o Fluxo acionado por registro como a camada de orquestração, encapsulando operações de alta complexidade no Apex invocável. Diagrama de padrão híbrido #### A Camada de orquestração: Fluxo O Fluxo acionado por registro serve como a camada de orquestração para o processo de negócios. Ele é o proprietário dos critérios de entrada e do contexto de execução (o _o que_ e _quando_). Ao reter a lógica de decisão e o roteamento nessa camada, a topologia de processo da arquitetura permanece transparente e gerenciável por meio do Explorador do acionador de fluxo, impedindo que a lógica de negócios crítica seja ocultada no código. #### O componente complexo: Apex invocável Um exemplo comum de um componente complexo é a implementação de cálculos de Acordo de nível de serviço (SLA) para registros de Caso. Como o objeto BusinessHours e sua lógica relacionada, essenciais para cálculos precisos que excluem horas de trabalho e feriados, não estão acessíveis nativamente no Fluxo, uma classe do Apex dedicada é usada. Essa classe, muitas vezes chamada de algo como `ServiceLevelAgreementCalculator`, é projetada com um único método estático, anotado com `@InvocableMethod`, para calcular o horário comercial decorrido, determinar se o SLA é "Dentro da meta" ou "Fechado" e retornar uma saída estruturada. Essa abordagem encapsula a lógica complexa e de alto desempenho no Apex, ao mesmo tempo que permite que ela seja executada e integrada na camada de orquestração declarativa de um fluxo acionado por registro. Depois que a classe `ServiceLevelAgreementCalculator` do Apex for definida, ela estará disponível para uso em um fluxo acionado por registro: Esse padrão demonstra uma separação rígida das preocupações. A camada declarativa é usada para gerenciar o ciclo de vida da transação e a orquestração enquanto o código é usado para execução de alta complexidade. Ao tratar o código como um utilitário funcional em vez da base, equilibramos o desempenho e a capacidade de manutenção. #### Principais ganhos com o padrão híbrido **Modularidade**: A decisão afasta-se da singularidade de usar o Apex ou o Fluxo para todo o processo. Em vez disso, a arquitetura encapsula a lógica complexa em unidades separadas, seguras em massa e testáveis de modo independente. Essas unidades funcionam como componentes reutilizáveis consumidos pela camada declarativa, garantindo as escalas de automação sem complicar o design arquitetônico. **Reusabilidade**: A lógica é desacoplada do evento de acionador. Uma unidade de código bem projetada (como uma `InvocableMethod`) é escrita uma vez, mas aproveitada em vários pontos de entrada: Fluxos acionados por registro, fluxos de tela ou integrações externas. Essa reutilização de código elimina o desenvolvimento redundante. **Manutenção**: A lógica de fluxo de processo permanece visível e gerenciável no Fluxo declarativo. Essa centralização reduz drasticamente a sobrecarga de depuração e garante que a ordem de execução do sistema seja determinista e transparente. #### Limitações e compensações do padrão híbrido Embora o modelo híbrido de usar o Apex invocável do fluxo seja poderoso, não é uma abordagem unidimensional. Os arquitetos devem estar cientes das limitações e compensações específicas antes de se comprometerem com uma solução híbrida. - **Nenhum suporte antes de salvar**: Esta é a limitação mais crítica. Ações invocáveis estão disponíveis apenas no contexto após salvar (fluxos para ações e registros relacionados). Eles não podem ser usados no contexto de alto desempenho antes de salvar (fluxos para atualizações de campo rápido). Portanto, esse padrão não pode ser usado para delegar atualizações de campo do mesmo registro. Faça esse trabalho de alto desempenho usando elementos de Fluxo nativos em um fluxo antes de salvar ou em um acionador do Apex antes do contexto. - **Sem suporte após a exclusão cancelada:** Atualmente, o Fluxo acionado por registro não oferece suporte ao contexto após a exclusão cancelada. Se um objeto do Salesforce tiver um requisito de negócio para executar a automação quando um registro for restaurado da lixeira, um acionador do Apex será a única solução. - ** Sobrecarga de desempenho em cenários de alto volume:** A transição do tempo de execução do Fluxo para o tempo de execução do Apex não é uma operação de custo zero. Embora geralmente seja rápido, o ato de cair em uma Ação invocável do tempo de execução do Fluxo não é tão rápido computacionalmente quanto a execução nativa que permanece inteiramente dentro de um acionador do Apex. Para a maioria das automações de média densidade, essa sobrecarga é uma compensação insignificante e útil para a maior acessibilidade. No entanto, para cenários de alto desempenho e alto volume, uma estrutura somente do Apex terá uma vantagem de velocidade de computação bruta. ### Estratégias para automação legada Embora a heurística de densidade de automação forneça orientação definitiva para uma arquitetura de greenfield mais recente, a realidade dos ambientes corporativos do Salesforce costuma ser mais detalhada. Em organizações maduras, é comum encontrar fluxos acionados por registro e acionadores do Apex que operam no mesmo objeto do Salesforce. Este cenário é diferente do padrão híbrido explicado anteriormente: aqui, os fluxos e acionadores do Apex não estão acoplados nem projetados para trabalharem juntos. Essa coexistência geralmente é resultado de funcionalidades de plataforma em evolução ou débito técnico legado. Embora esse seja um estado operacional tolerado, os arquitetos devem tratá-lo como uma compensação calculada em vez de um estado final. A orquestração fragmentada gera uma sobrecarga significativa de governança e manutenção, tornando as atividades de desenvolvimento, teste e tratamento de incidentes desagrupadas e complicadas. Isso leva a um maior Tempo para resolução (TTR) e complexidade operacional. - Para novos objetos do Salesforce, siga o princípio de densidade de automação como o guia principal. - Para Objetos do Salesforce existentes com uma pegada híbrida e acionador Apex duplo e pontos de entrada de fluxo acionados por registro, avalie a densidade e, em seguida, arquite para o refator para um estado híbrido mantido. - Para baixa densidade, o Apex refator aciona fluxos acionados por registro e especifica a ordem de execução, levando-os a um único ponto de entrada de automação. - Para densidade média, o complexo do refator faz megafluxos em um subconjunto de fluxos com a ordem de execução certa. Introduza acionadores do Apex apenas quando absolutamente necessário, por exemplo, para dar suporte após a exclusão de contexto cancelada. - Para alta densidade, implemente acionadores do Apex. ### Usando uma estrutura de metadados para acionadores do Apex Conforme os processos de negócios de uma organização na Salesforce Platform amadurecem, o volume e a complexidade da automação acionada por registro aumentam inevitavelmente. Uma prática recomendada fundamental é manter _um acionador do Apex por objeto do Salesforce_. Essa regra é crítica porque a plataforma não garante a ordem de execução de vários acionadores no mesmo objeto para o mesmo evento. Essa limitação pode levar a comportamentos não deterministas, condições de corrida e problemas de depuração difíceis. No entanto, aderir ao princípio de _um acionador_ introduz um desafio arquitetônico: como gerenciar e orquestrar toda a lógica de negócios invocada desse ponto de entrada único de uma maneira mantida e escalonável. #### As limitações dos manipuladores do acionador clássico A primeira evolução dessa arquitetura foi o padrão do Manipulador de acionador clássico. Nesta abordagem, o acionador Apex único delega toda a sua lógica a uma classe de manipulador correspondente (por exemplo, `OpportunityTriggerHandler`). Esse método separa a lógica do arquivo de acionador e fornece aos desenvolvedores controle determinístico sobre a ordem de execução dentro dos métodos da classe manipuladora (por exemplo, `afterInsert()`). Embora seja uma melhoria, esse padrão geralmente leva a classes de manipulador monolíticas. Ao longo do tempo, à medida que mais requisitos de negócios são adicionados, a classe se torna grande, difícil de gerenciar e difícil de testar em isolamento. A ordem de execução de todos os processos individuais é codificada em um único método, tornando a classe propensas a conflitos de mesclagem, aumentando dramaticamente a sobrecarga de governança e manutenção em um ambiente corporativo grande. #### A solução: Uma estrutura do acionador conduzida por metadados Para resolver os problemas centrais da modularidade e da orquestração, os arquitetos mudam para uma **Quadro do acionador conduzido por metadados**. Este é um salto arquitetônico significativo que separa a própria lógica de automação da configuração de _como_ e _quando_ ela é executada. Essa estrutura é baseada em três principais vantagens: - **Particionamento:** Em vez de uma única classe de manipulador, a lógica de negócios principal é dividida em classes do Apex pequenas e atômicas (por exemplo, uma classe de `RecalculateAccountValues` ou uma classe de `NotifySalesLeads`), com cada classe aderindo ao _Princípio de Responsabilidade Única_. Essa modularidade facilita o teste, a depuração e a compreensão da lógica isoladamente. - **Ordem e coreografia:** A ordem de execução não é mais codificada no Apex. Em vez disso, é definido declarativamente por registros de configuração, geralmente armazenados em um tipo de metadados personalizado (por exemplo, `TriggerAction__mdt`). Isso permite que os administradores reordene, adicione ou remova ações de automação simplesmente modificando um registro de metadados, o que não requer uma implantação ou alteração de código. - **Funcionalidade de bypass:** A estrutura fornece uma funcionalidade de desvio granular padronizada. Cada ação de automação pode ser configurada por meio de seu registro de metadados para ser desativada globalmente ou ignorada para usuários administrativos específicos referenciando uma permissão personalizada. O acionador Apex único para o objeto então serve apenas como um supervisor dinâmico. Ele não contém lógica de negócios, mas instancia uma classe central de `MetadataTriggerHandler`. Esse manipulador consulta os registros de metadados personalizados para determinar dinamicamente a sequência de execução e invocar as classes atômicas Apex corretas na ordem prescrita. A automação é unificada sob uma única camada transparente e governável. ### Removendo operações caras na transação Uma vantagem importante do uso do Apex em uma estrutura robusta é a capacidade de gerenciar o estado transacional e otimizar o desempenho eliminando o trabalho redundante. Conforme a lógica se acumula, é comum que diferentes automações no pedido de salvamento executem de modo independente as mesmas operações caras, consumindo limites valiosos do regulador e aumentando o tempo de operação de DML. A estrutura é arquitetada para lidar com isso com duas estratégias principais: - **Gerenciamento de estado compartilhado:** No escopo de uma única transação do Apex, propriedades estáticas e variáveis são aproveitadas para armazenar dados em cache. Isso garante que uma operação cara, como uma consulta de `SOQL` para uma configuração de configuração, seja executada apenas uma vez, mesmo que a lógica de automação seja invocada várias vezes em diferentes registros ou fases do acionador. O consumo dos limites transacionais é significativamente reduzido. - **Utilização de cache da plataforma:** Para ir além do simples armazenamento em cache dentro da transação, use o cache da plataforma para evitar consultar todo o banco de dados para determinados dados. Esse cache gerenciado na memória é ideal para recuperar dados que não sejam primitivos, sejam lidos com frequência na base de códigos e sejam imutáveis ao longo de uma transação (por exemplo, perfis, papéis, horário comercial). Usando a interface de `Cache.CacheBuilder`, o sistema verifica o cache primeiro e realiza a consulta de banco de dados apenas se os dados não estiverem presentes, maximizando o desempenho e a escalabilidade. ### Usar antes de salvar para atualizações de mesmo registro Sempre use uma atualização antes de salvar quando sua automação precisar apenas alterar os valores de campo no registro que inicia a transação. Isso se aplica tanto a atualizações de campo rápido no Fluxo (que são executadas antes de salvar) quanto à lógica antes do contexto nos Acionadores do Apex (antes da inserção, antes da atualização). Esse padrão tem desempenho, independentemente da ferramenta usada, pois evita uma segunda operação DML e um ciclo de salvamento recursivo. As alterações são feitas no registro na memória _antes_ de ele ser vinculado ao banco de dados e são salvas como parte da transação original. A sobrecarga de um segundo salvamento, que, caso contrário, reexecutaria todo o pedido de salvamento e acionaria toda a automação novamente, é eliminada. ### Evitando recursão não controlada A recursão não controlada é uma armadilha comum em acionadores após a atualização, em que a lógica de um acionador realiza uma atualização de DML que, por sua vez, faz o mesmo acionador ser disparado novamente. Isso cria um loop infinito que termina com uma exceção de limite do regulador. Embora sinalizadores booleanos estáticos ou coleções de IDs de registro processados tenham sido usados historicamente para evitar essa recursão, um padrão mais preciso e robusto é criar a lógica por meio da comparação de valores de campo entre as versões novas e antigas do próprio registro. Execute a lógica apenas se um campo específico de interesse tiver realmente mudado. Isso impede que o acionador execute sua lógica em operações de DML subsequentes na mesma transação em que os dados críticos permanecem inalterados. #### Controlar a recursão no fluxo acionado por registro Em um fluxo acionado por registro, evite a recursão não controlada definindo o fluxo para ser executado apenas quando o registro for atualizado para atender aos requisitos de condição: Controlando a recursão no fluxo acionado por registro Se você optar por usar uma fórmula de critérios de entrada em seu fluxo, poderá evitar a recursão de escape comparando a variável global `$Record` (que representa os novos valores) com a variável global `$RecordPrior` (que representa os valores originais antes do salvamento). Por exemplo, para garantir que um fluxo seja executado apenas se o campo Valor em uma oportunidade tiver sido alterado, use isto nos critérios de entrada: ``` $Record.Amount != $Record__Prior.Amount ``` #### Controlando a recursão no Apex Compare os valores de campo da nova versão do registro, `Trigger.new`, com os valores de campo da versão antiga do registro, `Trigger.oldMap`, para ver se a alteração específica que você está procurando ocorreu. Essa abordagem garante que a automação seja idempotente e seja executada apenas quando necessário, tornando o sistema mais eficiente e evitando loops recursivos catastróficos. ### Ignorar automação Uma organização do Salesforce bem arquitetada requer um mecanismo consistente e confiável para contornar a automação. Esse não é um recurso opcional, mas um requisito operacional essencial para manter a integridade dos dados e habilitar tarefas administrativas. Uma estrutura de desvio é essencial para alguns cenários: - Ao carregar grandes volumes de dados, acionar acionadores para cada registro pode desacelerar drasticamente o processo, causar exceções de limite e criar registros relacionados e notificações incorretos. Um desvio permite que os dados sejam inseridos de maneira limpa e eficiente. - Um usuário de integração pode precisar sincronizar dados de um sistema externo de registro. A automação que normalmente é acionada para uma alteração iniciada pelo usuário (por exemplo, enviar um email, criar uma tarefa) pode ser indesejável ou redundante quando a alteração se origina de outro sistema. - Os administradores ou a equipe de suporte podem precisar realizar atualizações corretivas em registros. Um mecanismo de ignorar permite que eles façam essas alterações sem acionar a automação de negócios padrão, o que pode ter consequências indesejadas. **Permissões personalizadas**: O padrão moderno e escalonável para implementar a lógica de desvio é permissões personalizadas. Esses métodos são superiores aos métodos mais antigos por diversos motivos: - **Flexibilidade:** As permissões personalizadas podem ser atribuídas aos usuários por meio de conjuntos de permissões. Essa prática está alinhada ao moderno modelo de segurança e acesso do Salesforce, permitindo uma atribuição granular e flexível. Um desvio pode ser concedido a um usuário específico ou mesmo temporariamente com uma data/hora de expiração específica. - **Manutenção:** O uso de permissões personalizadas evita que perfis de codificação permanente ou usuários entrem na lógica de automação. Se o papel de um usuário mudar ou um novo perfil precisar ignorar o acesso, a alteração será uma simples atribuição de Conjunto de permissões, não uma modificação de código ou fluxo que exija uma implantação. - **Escalabilidade:** As permissões personalizadas fornecem uma estrutura dimensionável para gerenciar exceções em uma base de usuários complexa. Eles podem ser atribuídos a usuários por meio de conjuntos de permissões, grupos de conjuntos de permissões ou perfis. Sua associação a um conjunto de permissões ou perfil também é representável nos metadados de origem. **Padrões de implementação**: Aplique um padrão de desvio consistente a todas as automações acionadas por registro na organização. **Pular um fluxo acionado por registro**: A maneira mais eficiente de ignorar um fluxo é impedi-lo de ser executado. Isso é feito adicionando uma condição aos critérios de entrada do fluxo. - No elemento Iniciar do fluxo acionado por registro, defina Requisitos da condição como Fórmula avaliada como verdadeira. - No construtor de fórmula, incorpore uma verificação para a permissão personalizada usando a variável global `$Permission`. Combine a verificação com seus critérios de entrada existentes. - Padrão de fórmula: ``` ( ) && NOT($Permission.Bypass_This_Flow) ``` - Esse padrão garante que o fluxo seja executado somente se o usuário _não_ tiver a permissão personalizada especificada atribuída. Essa verificação é realizada antes mesmo da criação da entrevista de fluxo, tornando-a a abordagem com melhor desempenho. **Excluindo uma estrutura de acionador do Apex**: No Apex, integre a lógica de desvio diretamente na estrutura de acionador orientada por metadados, permitindo um controle granular. - O tipo de metadados personalizados `TriggerAction__mdt` deve incluir um campo de texto, por exemplo, `BypassPermission__c`. - Na classe `MetadataTriggerHandler`, antes de executar uma ação dinamicamente, o código deve ler o valor desse campo. - Se o campo for preenchido, o manipulador usará o método `FeatureManagement.checkPermission()` para determinar se o usuário em execução atual tem a permissão personalizada especificada. - Se `checkPermission()` retornar verdadeiro, o manipulador ignora essa ação específica e avança para a próxima na sequência. - Esse padrão é poderoso porque permite tanto um bypass global (se todos os registros de `TriggerAction__mdt` referenciarem a mesma permissão) quanto um bypass granular por ação (se diferentes registros referenciarem permissões diferentes ou se alguns não tiverem permissão de bypass). ### Mega-fluxos vs. Vários fluxos É um antipadrão consolidar toda a automação de um objeto em um único megafluxo maciço. Consolidar em um fluxo versus dividir a lógica em vários fluxos bem condicionados não tem um impacto significativo no desempenho. Os ganhos de desempenho mais significativos vêm de: - Usar fluxos antes de salvar para atualizações de campo do mesmo registro. - Escrever condições de entrada precisas para garantir que os fluxos sejam excluídos da execução em alterações que não afetam seu caso de uso específico. O [Flow Trigger Explorer](https://trailhead.salesforce.com/content/learn/modules/record-triggered-flows/meet-flow-trigger-explorer) permite atribuir um valor de ordem a cada fluxo em um objeto, garantindo uma ordem de execução sequencial. Explorador de acionadores de fluxo ## Recursos
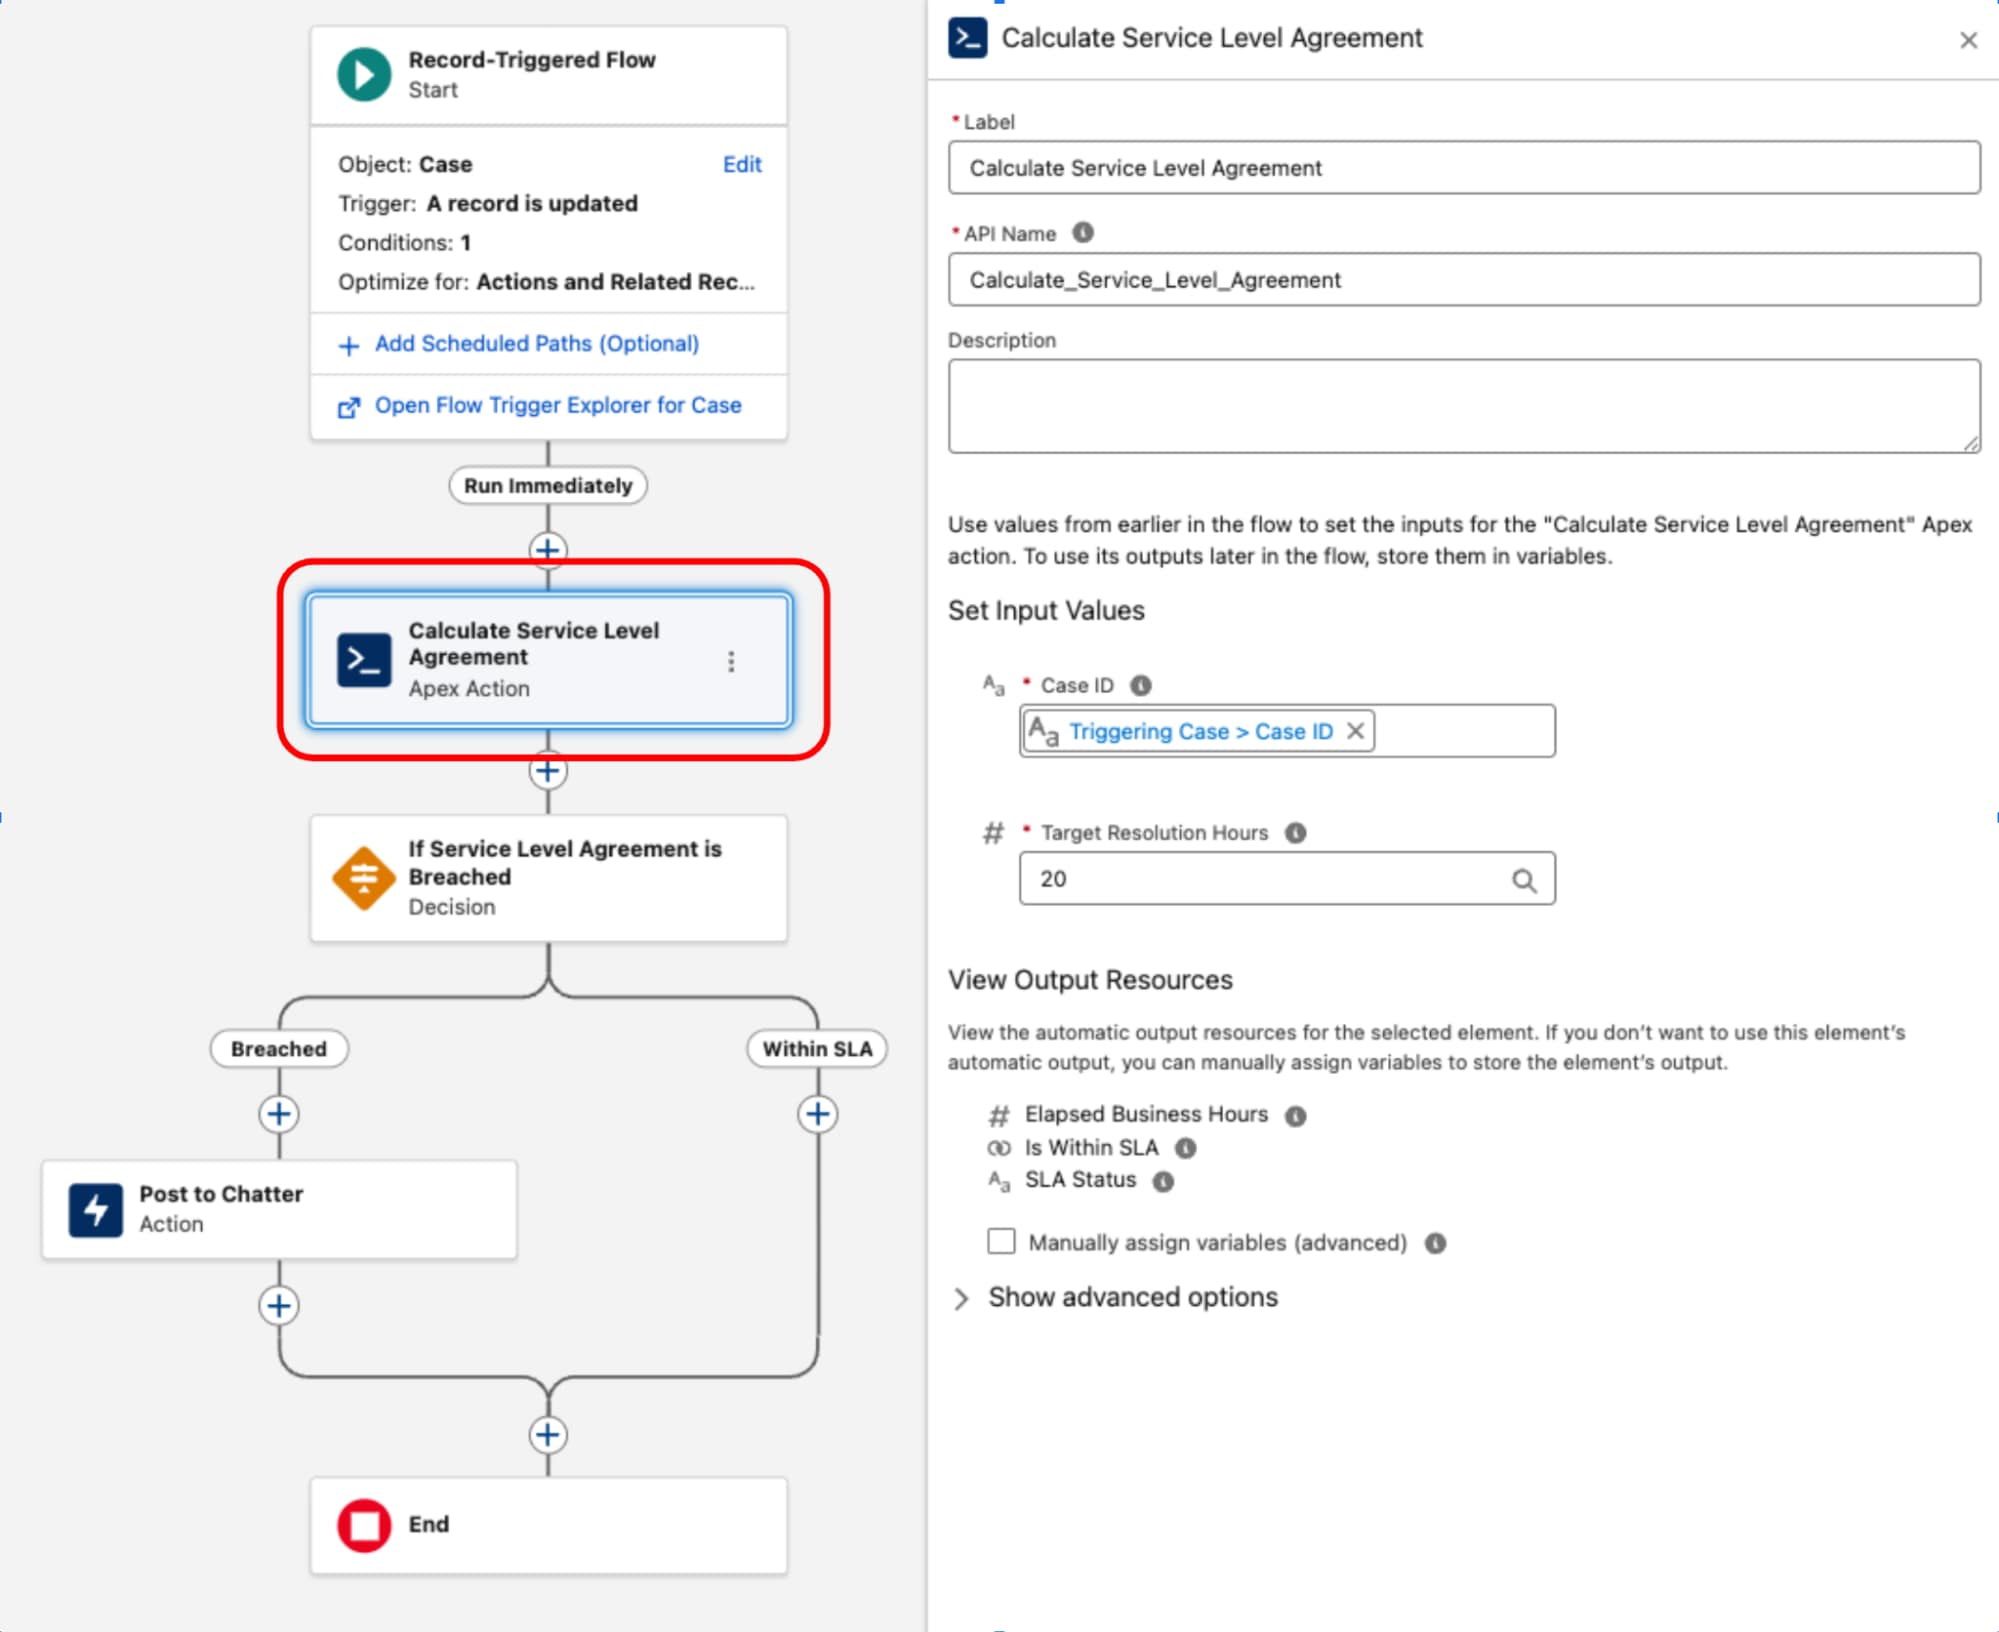
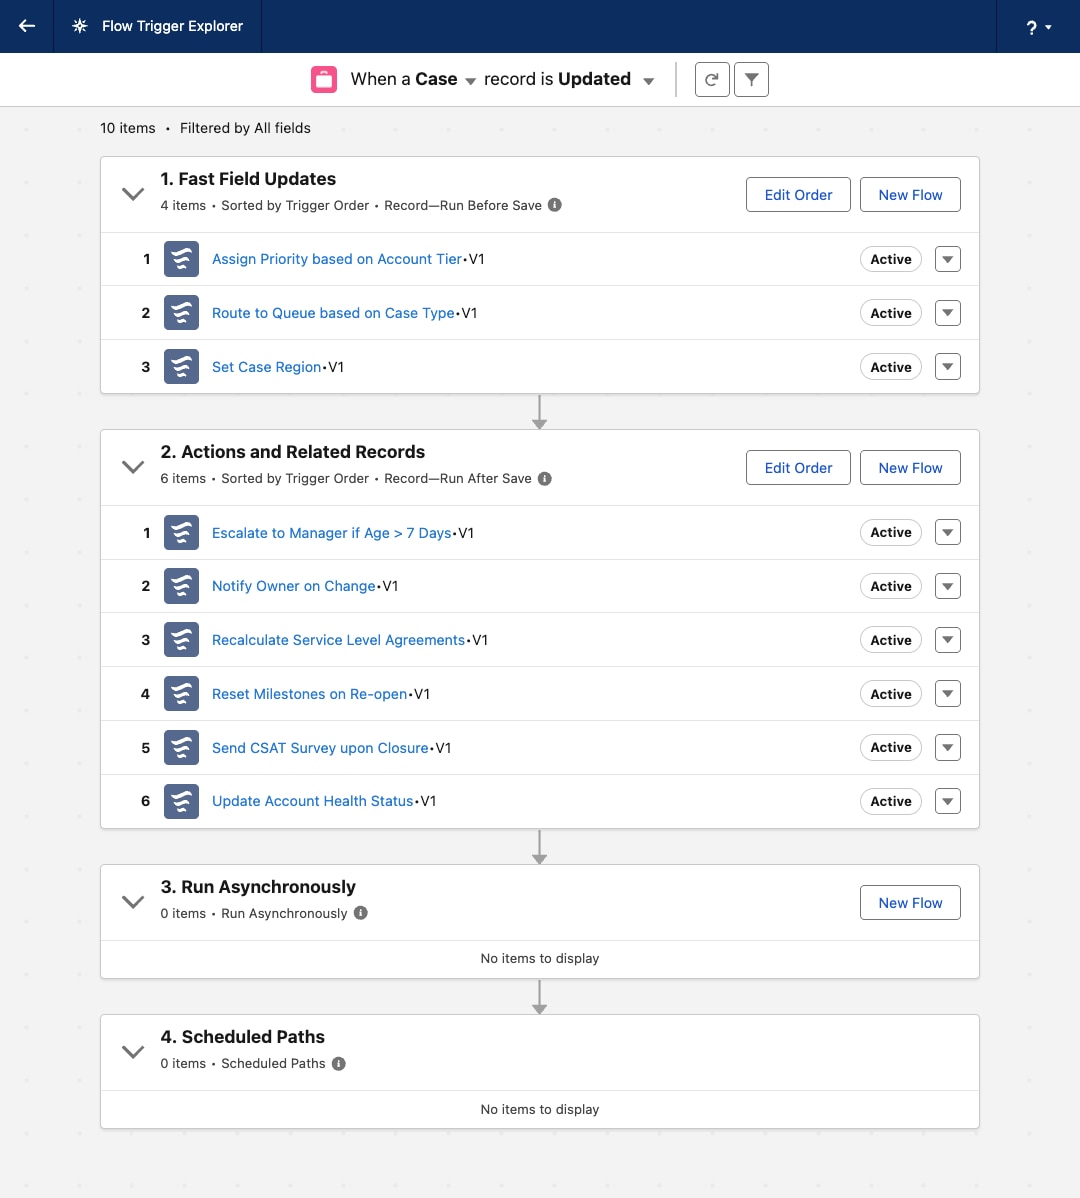
Apex Fluxo Operações
## Visão geral As arquiteturas modernas do Salesforce são cada vez mais alimentadas por processamento assíncrono; não como uma conveniência, mas como um requisito estratégico de escala. Nos últimos anos, vimos mais e mais empresas enfrentando volumes de dados crescentes, integrações complexas que envolvem vários pontos de contato e o surgimento de sistemas autônomos que funcionam 24 horas por dia, 7 dias por semana. Todas essas coisas levam os arquitetos a projetar sistemas assíncronos em primeiro lugar. O processamento assíncrono no Salesforce geralmente significa projetar em torno dos limites e da complexidade do controlador. Esses limites atuam como proteções e restrições arquitetônicas que ajudam a produzir sistemas escalonáveis e seguros em massa. Embora nenhum limite de plataforma sirva diretamente para gerenciar a complexidade, os [padrões de design](https://refactoring.guru/design-patterns) podem ajudar a mitigar o risco nessa frente. Interna, o Salesforce frequentemente aprofunde os limites da plataforma para testar novos recursos e automatizar processos comerciais complexos. Criamos uma Estrutura de processamento assíncrono baseada em etapas para executar trabalhos assíncronos com um número arbitrário de etapas. Cada etapa pode ser executada, tentada novamente e reiniciada de modo independente com controles de governança compartilhados e visibilidade operacional total por meio de registro centralizado. Este documento descreve os principais componentes arquitetônicos: Apex enfileirável e finalizadores, fluxo agendado, cursores do Apex, ações invocáveis e integrações com o Slack. Juntos, esses componentes fornecem uma arquitetura modular, escalonável e observável adequada para necessidades empresariais em evolução. ## Principais transferências - As arquiteturas modernas do Salesforce devem adotar uma abordagem assíncrona primeiro para alcançar escala, resiliência e transparência operacional. - Dividir trabalho complexo em etapas executáveis de modo independente habilita desempenho previsível, novas tentativas mais seguras, pontuação de verificação, reversão e evolução modular sem reengenhar fluxos de trabalho principais. - A estrutura fornece uma alternativa escalonável a trabalhos em lote monolíticos e antigos, chamadas assíncronas encadeadas e fluxos profundamente aninhados, e é criada para cargas de trabalho de alto volume que devem ser dimensionadas horizontalmente dentro do Salesforce sem orquestração fora da plataforma. - A execução determinística e observável garante rastreamento de progresso, monitoramento de SLA, diagnóstico de falha e transparência em nível de auditoria por meio de registro e governança centralizados. - Projetado para rigor de nível corporativo, incluindo governança unificada, conformidade e controle de estado distribuído em processos de negócios de longa duração. ## Melhores práticas de plataforma Antes de revisar os requisitos, aqui estão algumas considerações sobre quando usar uma estrutura como esta. Acima de tudo, considere qual sistema é a única fonte da verdade. Se sua organização do Salesforce depender minimamente de dados externos, mas precisar escalar de centenas a milhões de registros, considere uma estrutura assíncrona baseada em etapas. Use essa estrutura **se**: - A maioria (ou todas) das informações com base nas quais realizar ações já existe em seu CRM. - O custo inicial ou contínuo de manter um trabalho de Extrair carga de transformação (ETL) para harmonizar dados externos é muito alto. - Você precisa adiar o processamento de um grande número de registros do Salesforce em uma agenda definida. - Você pode dividir o processamento em etapas separadas. Por exemplo, você pode criar um conjunto hierárquico ou baseado em árvore de registros, especialmente se o volume de dados passar pela hierarquia ou pela árvore. **Não** use essa estrutura se: - Criar ou atualizar registros requer recálculo imediato. - A integração é um desafio porque os sistemas externos hospedem dados primários para atualizações de registro. (Considere enviar dados atualizados por push ao Salesforce com a API em massa.) Considerando essas práticas, vamos revisar nossos requisitos e começar a criar. ## Quebrar os requisitos Considere a instrução de problema: > Para um trabalho que precisa ser executado diariamente, verifique se determinados registros cumprem critérios predefinidos para processamento adicional. Se eles fizerem isso, inicie esses trabalhos de processamento. Processar registros pode significar extrair dados de vários sistemas externos para realizar cálculos. As etapas nos trabalhos devem notificar as pessoas por meio do Slack de que os registros processados estão prontos para revisão. As etapas também devem escalar as notificações para gerentes e superiores na hierarquia de papéis com base em um atraso configurável após a primeira rodada de notificações. Esse problema envolve várias etapas diferentes, algumas das quais podem ocorrer independentemente uma da outra. Há muitas maneiras de dividir o trabalho. Aqui está um agrupamento: - O agendador. - A interface da etapa e as implementações concretas que processam registros (independentemente do tipo de processamento). - O processador que organiza as etapas. - O Apex invocável chamado pelo agendador. - A parte da notificação. Usamos o [Slack SDK do Apex](https://developer.salesforce.com/docs/platform/salesforce-slack-sdk/guide/overview.html). - Há alguma complexidade oculta na frase "delay configurable". Revisaremos essa complexidade mais adiante neste artigo. Aqui está um diagrama definido para a estrutura integrada: Diagrama arquitetônico mostrando o agendador de fluxo, processamento assíncrono do Apex e diferentes implementações de etapas possíveis Agora, divida esse diagrama e comece a criar as peças. ## Agendamento com fluxo agendado O Fluxo agendado oferece várias vantagens como mecanismo de agendamento: - Fluxos agendados podem ser empacotados e implementados como metadados. Isso não se aplica a trabalhos agendados por meio do Apex (ou pela página Trabalhos agendados). - O elemento Aguardar é crítico para estruturas que exigem chamadas. Ao usá-lo no Fluxo, as chamadas não são necessárias na parte Invocável da estrutura. - A granularidade do agendamento atende aos requisitos: o intervalo mínimo para Fluxos agendados é diário. Se você precisar de uma frequência maior (por exemplo, por hora), reconsidere Fluxo agendado para esse requisito. Outra consideração ao configurar o Fluxo agendado é o encaminhamento de ambiente. Antes de invocar a ação do Apex, adicione um elemento Decisão que avalie a variável `{!$Api.Enterprise_Server_URL_100}`. Isso garante que o trabalho seja executado apenas nos ambientes pretendidos, como UAT e Produção. Esse padrão é importante porque os sandboxes são atualizados com frequência ou recém-criados durante o SDLC, e sem uma verificação de ambiente explícita, um Fluxo agendado pode ser executado inadvertidamente em ambientes em que a estrutura não deve ser executada. Usar o operador `contains` no elemento Decisão torna a configuração resiliente a futuras criações de sandbox ou alterações de URL. Por fim, considere como a estrutura deve capturar falhas. Sempre adicione um caminho de falha quando o Fluxo chamar qualquer Ação; por exemplo, você pode encaminhar falhas à ação "Adicionar entrada de registro" do [Nebula Logger](https://www.nebulalogger.com/). Como o Nebula Logger grava registros em objetos personalizados, os clientes devem estar cientes de que os dados de registro consomem o armazenamento da organização. Por padrão, os registros são armazenados por 14 dias em uma organização e, em seguida, são limpos. Esse período de retenção é configurável. O Nebula Logger também usa os Eventos da plataforma para publicar registros, de modo que as entradas do registro são salvas independentemente da transação principal de processamento de dados – isso garante que as falhas sejam capturadas mesmo que a ação principal do Fluxo ou do Apex seja revertida. Os clientes devem avaliar os requisitos de retenção e volume de registros esperados ao considerar a adição de uma estrutura de registro. Esta é a aparência do Fluxo: O Fluxo agendado contendo um elemento Decisão para executar ou não, um elemento Pausar para permitir chamadas e a ação Invocável do Apex chamada junto com o caminho de falha do Nebula Logger. Vamos passar para as primeiras partes do Apex code com o requisito de agendamento agora atendido. ## Criação de uma interface de etapa Defina uma interface de `Step`: ```java public interface Step { void execute(); void finalize(); String getName(); Boolean shouldRestart(); } ``` Para este artigo, a interface de `step` é mostrada como uma classe externa para maior clareza. A estrutura em si é flexível – as equipes podem organizar a interface e suas implementações usando qualquer padrão de empacotamento do Apex que preferem, desde que todas as classes de Etapa façam referência à mesma interface. Há alguns aspectos a serem considerados sobre os métodos definidos em nossa interface: - `execute`, embora sem argumento no momento, melhora quando passamos uma classe de `State` (ou interface) para orquestrar dados entre etapas quando a ordem importa. - Os `getName` podem retornar um valor de `System.Type` em vez de um `String`. A meta é dar à camada de orquestração uma maneira de registrar nomes de etapa sem expor outras propriedades. Esta é a primeira implementação concreta para mostrar como essas peças se encaixam. Com uma exceção, recomendamos usar o Apex enfileirável para implementar processamento assíncrono no Apex; o Apex em lote normalmente não é necessário (e os métodos de `@future` são desencorajados). O Apex enfileirável é iniciado rapidamente e, com os Cursores do Apex, tem muitas vantagens em relação ao Apex em lote. ### Uma implementação semelhante a cursor do Apex Os [Cursores do Apex](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_cursors.htm) oferecem uma alternativa moderna ao modelo Apex em lote tradicional. De modo semelhante ao processamento em lote, uma implementação de cursor pode buscar registros em blocos (até 2.000 por lote). No entanto, os cursores permitem várias busca em uma única transação, permitindo uma taxa de transferência significativamente maior para operações de grande volume. Ao adotar cursores como parte dessa estrutura, as equipes devem estar cientes das limitações atuais de teste e simulação. Como o comportamento do cursor em testes pode ser diferente do comportamento de produção, é importante projetar estratégias de teste que evitem depender de elementos internos do cursor e validar a lógica de orquestração nos limites. Conforme a plataforma evolui, essas áreas continuarão melhorando, mas a orientação principal permanece: Os cursores proporcionam um desempenho maior e uma sobrecarga de orquestração reduzida em comparação ao Apex em lote para muitos casos de uso. Para definir um limite claro entre o cursor fornecido pelo sistema e seu próprio código, recomendamos criar uma representação semelhante ao cursor ao implementar a interface de `Step`. Considere este código: ```java public inherited sharing abstract class CursorStep implements Step { private static final Integer MAX_CHUNK_SIZE = 2000; protected Cursor cursor; private Integer chunkSize = System.Limits.getLimitDMLRows(); private Integer position = 0; protected abstract Cursor getCursor(); protected abstract void innerExecute(List records); public abstract String getName(); public virtual CursorStep withChunkSize(Integer chunkSize) { this.chunkSize = chunkSize; return this; } public void execute() { this.cursor = this.cursor ?? this.getCursor(); this.cursor.setFetchesPerTransaction(this.getFetchesPerTransaction()); List records = new List(); if (this.shouldAdvance()) { records = this.cursor.fetch(this.position, this.chunkSize); this.position += this.chunkSize; } this.innerExecute(records); } public virtual void finalize() { Logger.info('finished cursor step for ' + this.getName()); } public virtual Boolean shouldRestart() { return this.position < this.cursor.getNumRecords(); } protected virtual Integer getFetchesPerTransaction() { Integer maxRecordsPerFetchCall = 2000; if (this.chunkSize < maxRecordsPerFetchCall) { return this.chunkSize; } // Integer division rounds down // which is perfect for our use-case return this.chunkSize / maxRecordsPerFetchCall; } protected virtual Boolean shouldAdvance() { return true; } } ``` Observe a aula de `Cursor`. Os cursores do Apex são instâncias de `Database.Cursor`, mas nossa implementação de `Cursor` nos dá flexibilidade em torno das falhas dos cursores. Aqui está a implementação: ```java public virtual without sharing class Cursor { private static final Integer MAX_FETCHES_PER_TRANSACTION = Limits.getLimitFetchCallsOnApexCursor(); @TestVisible private static Integer maxRecordsPerFetchCall = 2000; private Integer cursorNumRecords; private Integer fetchesPerTransaction = MAX_FETCHES_PER_TRANSACTION; private final Database.Cursor cursor; public Cursor( String finalQuery, Map bindVars, System.AccessLevel accessLevel ) { try { this.cursor = Database.getCursorWithBinds(finalQuery, bindVars, accessLevel); } catch (FatalCursorException e) { Logger.newEntry( System.LoggingLevel.WARN, 'Error creating cursor. This can happen if there' + ' are no records returned by the query: ' + e.getMessage() ); } } public Cursor setFetchesPerTransaction(Integer possibleFetchesPerTransaction) { // Handle accidental round downs from Integer division if (possibleFetchesPerTransaction == 0) { return this; } if (possibleFetchesPerTransaction > MAX_FETCHES_PER_TRANSACTION) { Logger.newEntry( System.LoggingLevel.DEBUG, 'Fetches per transaction: ' + possibleFetchesPerTransaction + ' exceeded platform max fetches per transaction: ' + MAX_FETCHES_PER_TRANSACTION + ', defaulting to platform max' ); possibleFetchesPerTransaction = MAX_FETCHES_PER_TRANSACTION; } this.fetchesPerTransaction = possibleFetchesPerTransaction; return this; } @SuppressWarnings('PMD.EmptyStatementBlock') protected Cursor() { } public virtual List fetch(Integer start, Integer advanceBy) { if (this.getNumRecords() == 0) { Logger.newEntry( System.LoggingLevel.DEBUG, 'Bypassing fetch call, no records to fetch' ); return new List(); } Integer localStart = start; List results = new List(); while ( Limits.getFetchCallsOnApexCursor() < this.fetchesPerTransaction && results.size() < this.getNumRecords() && localStart < start + advanceBy ) { Integer actualAdvanceBy = this.getAdvanceBy(localStart, advanceBy); results.addAll(this.cursor?.fetch(localStart, actualAdvanceBy) ?? new List()); localStart += actualAdvanceBy; } return results; } public virtual Integer getNumRecords() { this.cursorNumRecords = this.cursorNumRecords ?? this.cursor?.getNumRecords() ?? 0; return this.cursorNumRecords; } protected Integer getAdvanceBy(Integer start, Integer advanceBy) { Integer possibleFetchSize = Math.min(advanceBy, this.getNumRecords() - start); if (possibleFetchSize > maxRecordsPerFetchCall) { Logger.newEntry( System.LoggingLevel.DEBUG, 'Fetch size: ' + possibleFetchSize + ' exceeded platform max fetch size of ' + maxRecordsPerFetchCall + ', defaulting to max fetch size' ); possibleFetchSize = maxRecordsPerFetchCall; } else if (possibleFetchSize < 0) { possibleFetchSize = 0; } return possibleFetchSize; } } ``` Para o restante deste artigo, omitimos as declarações de `sharing` ao fazer referência a classes do Apex. Na prática, garanta que as classes de nível superior sejam usadas explicitamente com ou sem compartilhamento para estar de acordo com seu modelo de objeto e permissões. Observe também que nossa implementação de `Cursor` delega para a plataforma `Database.Cursor`, com benefícios adicionais discutidos a seguir. Primeiro, aqui estão os testes correspondentes: ```java @IsTest private class CursorTest { @IsTest static void itCapsAdvanceByArgument() { String accountName = 'helloWorld!'; insert new Account(Name = accountName); String query = 'SELECT Name FROM Account WHERE Name = :bindVar0'; Map bindVars = new Map{ 'bindVar0' => accountName }; Cursor instance = new Cursor(query, bindVars, System.AccessLevel.SYSTEM_MODE); Assert.areEqual(1, instance.getNumRecords()); Assert.areEqual(accountName, instance.fetch(0, 1000).get(0).get('Name')); Assert.areEqual(1, System.Limits.getApexCursorRows()); } @IsTest static void itCapsMaxRecordsPerFetchCall() { Cursor.maxRecordsPerFetchCall = 20; Integer oneMoreThanMaxFetch = Cursor.maxRecordsPerFetchCall + 1; List accounts = new List(); for (Integer i = 0; i < oneMoreThanMaxFetch; i++) { accounts.add(new Account(Name = 'Fetch ' + i)); } insert accounts; Exception ex; List results; Cursor instance = new Cursor( 'SELECT Id FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ); try { results = instance.fetch(0, oneMoreThanMaxFetch); } catch (System.InvalidParameterValueException e) { ex = e; } Assert.areEqual(null, ex?.getMessage()); Assert.areEqual(2, Limits.getFetchCallsOnApexCursor()); Assert.areEqual(oneMoreThanMaxFetch, results.size()); } @IsTest static void itFetchesMultipleTimesPerTransactionWhenMoreThanMaxFetch() { Cursor.maxRecordsPerFetchCall = 20; List accounts = new List(); Set expectedFetchNames = new Set(); for (Integer i = 0; i < Cursor.maxRecordsPerFetchCall + 1; i++) { String accountName = 'Fetch' + i; expectedFetchNames.add(accountName); accounts.add(new Account(Name = accountName)); } insert accounts; Integer oneMoreThanMaxFetch = Cursor.maxRecordsPerFetchCall + 1; Cursor instance = new Cursor( 'SELECT Name FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ); List results = instance.setFetchesPerTransaction(2).fetch(0, oneMoreThanMaxFetch); Assert.areEqual(Cursor.maxRecordsPerFetchCall + 1, results.size()); Assert.areEqual(2, Limits.getFetchCallsOnApexCursor()); Set actuallyFetchedNames = new Set(); for (Account account : (List) results) { actuallyFetchedNames.add(account.Name); } Assert.areEqual(expectedFetchNames, actuallyFetchedNames); } @IsTest static void itFetchesMultipleTimesPerTransaction() { Cursor.maxRecordsPerFetchCall = 1; insert new List{ new Account(Name = 'One'), new Account(Name = 'Two') }; Cursor instance = new Cursor( 'SELECT Id FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ) .setFetchesPerTransaction(2); List results = instance.fetch(0, 2); Assert.areEqual(2, instance.getNumRecords()); Assert.areEqual(2, results.size()); results = instance.fetch(2, 1); Assert.areEqual(0, results.size()); } @IsTest static void fetchesCorrectAmountOfRecords() { List accounts = new List(); for (Integer i = 0; i < 10; i++) { accounts.add(new Account(Name = 'Fetch ' + i)); } insert accounts; Cursor instance = new Cursor( 'SELECT Id FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ) .setFetchesPerTransaction(10); List results = instance.fetch(0, 2); Assert.areEqual(2, results.size(), '' + results); Assert.areEqual(1, Limits.getFetchCallsOnApexCursor()); } @IsTest static void doesNotExceedPlatformMaxFetch() { List accounts = new List(); for (Integer i = 0; i < 101; i++) { accounts.add(new Account(Name = 'Fetch ' + i)); } insert accounts; Test.startTest(); Cursor instance = new Cursor( 'SELECT Id FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ) .setFetchesPerTransaction(100); Integer counter = 0; List results; while (counter <= 100) { results = instance.fetch(counter, counter + 1); counter++; } Test.stopTest(); Assert.areEqual(101, counter); Assert.areEqual(0, results.size()); } } ``` Ao tornar as `Cursor` virtuais, as implementações de `CursorStep` concretas podem operar sem uma `Database.Cursor` quando não precisam de iterar um grande conjunto de registros, semelhante a retornar uma `System.Iterable` em vez de uma `Database.QueryLocator` no Apex em lote. Aqui está um exemplo: ```java public abstract class CursorLikeImplementation extends CursorStep { private final Cursor cursorLike; public CursorLikeImplementation(List previouslyRetrievedRecords) { this.cursorLike = new CursorLike(previouslyRetrievedRecords); } public override String getName() { return CursorLikeImplementation.class.getName(); } public override Cursor getCursor() { return this.cursorLike; } private class CursorLike extends Cursor { private final List records; public CursorLike(List records) { super(); this.records = records; } public override List fetch(Integer position, Integer chunkSize) { // clone, to keep the underlying list type List clonedRecords = this.records.clone(); clonedRecords.clear(); for (Integer i = position; i < this.getAdvanceBy(position, chunkSize); i++) { clonedRecords.add(this.records[i]); } return clonedRecords; } public override Integer getNumRecords() { return this.records.size(); } } } ``` Observe que, como essa classe também é abstrata, ela deixa a implementação concreta de `innerExecute` para subclasses. Há também uma alternativa à subclasse interna `CursorLike`. Se você souber que versões concretas de uma etapa como esta não passarão pelos outros limites do regulador, poderá retornar `this.records` de `CursorLike.fetch` e substituir o `CursorStep.shouldRestart()` pai para retornar falso. Isso permite que você itere em uma lista limitada apenas pelo limite de heap do Apex de 12 MB por transação assíncrona. ### Outras implementações baseadas em etapa possíveis Nossa implementação baseada em cursor nos dá muita flexibilidade ao paginar em grandes quantidades de dados. A interface de `Step`, entretanto, nos dá a flexibilidade de descrever e encapsular passos de todos os tipos. Considere uma etapa baseada em fluxo: ```java public virtual class FlowStep implements Step { private final Invocable.Action specificFlow; private Boolean shouldRestart = false; public FlowStep(String specificFlowName, Map inputs) { this.specificFlow = Invocable.Action.createCustomAction('flow', specificFlowName); this.specificFlow.setInvocations(new List>{ inputs }); } public void execute() { List results = this.specificFlow.invoke(); for (Invocable.Action.Result result : results) { if (result.isSuccess()) { Map outputParams = result.getOutputParameters(); Object potentialShouldRestartValue = outputParams.get('shouldRestart'); // Flow does not enforce Booleans being initialized // so a null check is sadly necessary here if (potentialShouldRestartValue != null) { this.shouldRestart = this.shouldRestart || Boolean.valueOf(potentialShouldRestartValue); } } else { List errorMessages = new List(); for (Invocable.Action.Error error : result.getErrors()) { errorMessages.add( 'Error code: ' + error.getCode() + ', error message: ' + error.getMessage() ); } Logger.error( 'An error occurred within your auto-launched flow:\n' + String.join(errorMessages, '\n\t') ); } } } public virtual void finalize() { Logger.info(this.getName() + ' finished processing'); } public String getName() { return FlowStep.class.getName() + ':' + this.specificFlow.getName(); } public Boolean shouldRestart() { return this.shouldRestart; } } ``` Como os Fluxos não podem retornar parâmetros de saída que correspondam a um tipo definido pelo Apex, verificamos um parâmetro de saída de `shouldRestart` antes de usá-lo. Algumas etapas podem ser sinalizadas por recurso. Você pode implementar lógica para decidir quais etapas incluir ou usar uma etapa no-op para um recurso desabilitado. O [padrão de objeto nulo](https://refactoring.guru/introduce-null-object) é uma maneira comum de reduzir a complexidade dentro da camada de orquestração: ```java @SuppressWarnings('PMD.EmptyStatementBlock') public class NoOpStep implements Step { // The null object pattern is commonly implemented // as a singleton to reduce memory consumption public static final NoOpStep SELF { get { SELF = SELF ?? new NoOpStep(); } private set; } public void execute() { } public void finalize() { } String getName() { return NoOpStep.class.getName(); } Boolean shouldRestart() { return false; } } ``` Agora temos vários blocos de construção com os quais trabalhar. Vamos dar uma olhada na camada de orquestração responsável pela iteração entre etapas. ## Criando um processador de etapa O processador é um ponto de inflexão na arquitetura. Devemos decidir quem define quais etapas serão inicializadas e onde. As opções incluem: - Peça para o processador definir quais etapas são mapeadas para a lógica de negócios. Essa opção é simples, mas tem uma escala ruim para legibilidade. - Defina o mapeamento com Metadados personalizados (CMDT). Os campos Relacionamento de metadados não oferecem suporte a `ApexClass`, o que combina facilmente a ortografia de nomes de classe à configuração do seu processo de negócios. Você pode reduzir o risco administrativo tornando o campo uma lista de opções e validando o tipo existente (`Type.forName()` ou consultando `ApexClass`), mas como os registros CMDT não suportam acionadores, a validação ocorre no tempo de execução. Essa rota é testável, mas os administradores ainda podem criar registros CMDT apenas em produção. Continue com cuidado. - Defina o mapeamento com registros. Não administradores podem configurar etapas, mas as implementações ficam mais difíceis e os ambientes podem se desviar. Prossiga com cuidado. Há uma famosa citação do [Código Limpo](https://www.oreilly.com/library/view/clean-code-a/9780136083238/) sobre como lidar com essa parte específica da complexidade: > A solução para esse problema é enterrar a declaração de `switch` [para fazer objetos] no porão de uma fábrica abstrata, e nunca deixar ninguém vê-la. Com isso em mente, e como nosso número atual de etapas é bem definido e provavelmente não crescerá demais, o processador de etapas também pode ser a fábrica das etapas. Isso pode usar uma enumeração para conduzir a instrução switch: ```java public enum StepType { TYPE_ONE, TYPE_TWO, TYPE_THREE, TYPE_FOUR // etc ... } ``` E então pela nossa `StepProcessor`: ```java public StepProcessor implements System.Queueable, System.Finalizer, Database.AllowsCallouts { private final List steps = new List(); private Step currentStep; public StepProcessor setSteps(List stepTypes) { for (StepType type : stepTypes) { switch on type { WHEN TYPE_ONE { this.addTypeOneSteps(); } WHEN TYPE_TWO { this.addTypeTwoSteps(); } // ... etc } } this.cleanSteps(); return this; } public void execute(System.QueueableContext context) { this.currentStep = this.currentStep ?? this.steps.remove(0); if (context != null) { System.attachFinalizer(this); Logger.setAsyncContext(context); } Logger.info('Executing step ' + this.currentStep.getName()); try { this.currentStep.execute(); } catch (Exception e) { Logger.exception('Unexpected exception', e); } Logger.info('Finished executing step ' + this.currentStep.getName()); Logger.saveLog(); } public void execute(System.FinalizerContext context) { Logger.info('Executing finalizer for step ' + this.currentStep.getName()); Logger.setAsyncContext(context); switch on context?.getResult() { when UNHANDLED_EXCEPTION { // see the note below about this logging paradigm Logger.warn( 'Failed to run on step' + this.currentStep, context?.getException() ); } when else { this.currentStep.finalize(); if (this.currentStep.shouldRestart()) { this.kickoff(); } else if (this.steps.isEmpty() == false) { this.currentStep = this.steps.remove(0); this.kickoff(); } else { Logger.info('Finished executing steps'); } } } Logger.info( 'Finished executing finalizer for step ' + this.currentStep.getName() ); Logger.saveLog(); } public String kickoff() { return this.steps.isEmpty() ? null : System.enqueueJob(this); } private void cleanSteps() { for (Integer reverseIndex = this.steps.size() - 1; reverseIndex >= 0; reverseIndex--) { if (this.steps[reverseIndex] instanceof NoOpStep) { this.steps.remove(reverseIndex); } } } private void addTypeOneSteps() { this.steps.addAll( new List { new ExampleCursorStepOne(), new ExampleCursorStepTwo() } ); } private void addTypeTwoSteps() { this.steps.addAll( new List { new FlowStep(' ExampleInvocableName', new Map( 'exampleParameter' => true) ), new ExampleCursorStepThree() } ); } } ``` Os métodos de fábrica mostrados, como o `addTypeOneSteps()`, podem delegar preocupações como a sinalização de recursos; o `cleanSteps()` realiza uma verificação única das etapas coletadas para garantir que não haja etapas “vazias” antes de ir realmente assíncrono. Isso pode se parecer com isto: ```java private Step getStepOrDefault(String customPermissionName, Step defaultStep) { if (System.FeatureManagement.checkPermission(customPermissionName)) { return defaultStep; } return NoOpStep.SELF; } ``` Não discutimos o tratamento de erros desde a menção ao Nebula Logger na seção Fluxo agendado. Isso ocorre porque o `System.Finalizer` permite que o registro de todas as condições de erro seja abrangido sem adicionar tratamento de erros específico em cada etapa. Cada `Step` se concentra na corrida, enquanto registramos e recuperamos caminhos infelizes para que apareçam em testes de unidade. Isso dá suporte à iteração segura e ao alerta em nível de produção (usando o plug-in [Slack Logger para Nebula](https://github.com/jongpie/NebulaLogger/tree/main/nebula-logger/plugins/slack) para todos os logs WARN e ERROR). Uma nota sobre o registro de erros: passar a instância da etapa para mensagens de log assume um nível de Trust no que fica visível nos logs. A `toString()` padrão para classes do Apex inclui todas as propriedades estáticas e no nível da instância na mensagem. Isso pode ser desejável ou pode vazar informações confidenciais. Embora o registro e a segurança não sejam o foco aqui, observe que, para alguns sistemas, a adesão a uma interface como `Step` também pode envolver forçar uma substituição para `toString()`. ```java public interface Step { void execute(); void finalize(); String getName(); Boolean shouldRestart(); String toString(); } ``` Esse método coloca a responsabilidade de cada criador de objeto decidir o que é permitido imprimir, o que pode ser desejável. Nos níveis de desmatamento: no nível da `StepProcessor`, utilizamos o `INFO`, o nível mais elevado sem erros. Conforme você fica mais granular no aplicativo, os níveis de registro devem diminuir de acordo. As etapas individuais podem usar `DEBUG` para informações de alto nível, com `FINE`, `FINER` e `FINEST` reservados para resultados cada vez mais detalhados. Registrar é tanto uma arte quanto uma ciência, mas seguir esses princípios ajuda a manter os registros consistentes e úteis. ### Manipulação de complexidade adicional no processador de etapa Antes de avançar, vamos refletir brevemente sobre a decisão de fazer com que nosso processador de etapas hospede a lógica para a qual as etapas são usadas. Em uma grande base de códigos, considere tornar as `StepProcessor` virtuais ou abstratas e faça com que as subclasses identifiquem etapas específicas para estabelecer uma separação adequada das preocupações. ## A Camada invocável do Apex O agendador eventualmente chama o Apex. Com o restante da configuração concluída, a seção Apex invocável pode decidir quais etapas devem ser executadas e passar o `List` para o processador: ```java public class DailyJobExecutor { @InvocableMethod(label='Execute Daily Job') public static void executeJob() { Logger.info('Executing daily Job'); List correspondingTypes = new List(); // based on [business logic], determine which step types // should be included for any daily invocation if (correspondingTypes.isEmpty() == false) { try { new StepProcessor().setSteps(correspondingTypes).kickoff(); } catch (Exception ex) { Logger.exception('Error starting job', ex); } } } Logger.saveLog(); } ``` Esta é uma parte simples da equação: usando registros, dados ou lógica para determinar quais tipos de etapa executar. A Ação invocável é simples porque encapsulamos a complexidade em outro lugar. Também protegemos contra exceções inesperadas e facilitamos o teste de cada peça em isolamento. ## Lidar com atrasos antes de chamar o Slack O [Apex Slack SDK](https://developer.salesforce.com/docs/platform/salesforce-slack-sdk/guide/overview.html) está além do escopo deste artigo, mas um possível problema dos requisitos é revisitar: notificar as pessoas para cima na hierarquia de papéis com base em um atraso configurável. No papel, isso é simples, e você pode (corretamente) considerar a `System.enqueueJob(this)` na `StepProcessor`. Com o [System.AsyncOptions](https://developer.salesforce.com/docs/atlas.en-us.apexref.meta/apexref/apex_class_System_AsyncOptions.htm), nossa inclinação inicial era usar a sobrecarga de `enqueueJob` para satisfazer esse requisito. Por enquanto, no entanto, o atraso máximo via `System.AsyncOptions.MinimumQueueableDelayInMinutes` é de 10 minutos. Como o requisito é de 120 minutos, restam algumas opções. Uma abordagem ingénua pode se parecer com esta: ```java public class ExampleDelayedNotifier implements Step { private final List notifications = new List(); private final Slack.BotClient botClient = Slack.App .getAppByKey('some-slack-app-key') .getBotClientForTeam('slack team id'); // account for the initial delay, // so 120 - 10 = 110 private Integer delayMinutes = 110; public void execute() { if ( this.delayInMinutes > 0) { return; } Integer maximumAllowedCallouts = 100; while (this.notifications.isEmpty() == false && maximumAllowedCallouts > 0) { this.botClient.chatPostMessage(this.notifications.remove(0)); maximumAllowedCallouts--; } } public void finalize() { this.delayInMinutes -= 10; } public String getName() { return ExampleDelayedNotifier.class.getName(); } public Boolean shouldRestart() { return this.delayInMinutes > 0 || this.notifications.isEmpty() == false; } } ``` Na prática, o atraso seria passado para essa classe porque o atraso é conduzido por configuração. Não recomendamos essa abordagem, a menos que você tenha certeza de que haverá apenas um tipo de notificação atrasada. Ele executa 11 trabalhos assíncronos adicionais antes do início (ou mais, se o atraso aumentar). Esse custo pode ser bom para um trabalho, não para muitos. Você também precisaria adicionar um método à interface de `Step` para que cada etapa possa dizer ao processador quanto tempo esperar antes de reiniciar, o que aumenta o ruído. Isso nos deixa com duas possibilidades interessantes: - Você poderá inserir a etapa atrasada na estrutura de trabalho existente se já tiver um trabalho de pesquisa agendado em um intervalo adequado. Você também deve estar certo com o atraso especificado atingindo até 15 minutos mais tarde (15 minutos é o intervalo mínimo de atualização para uma expressão CRON agendada pelo Apex). Isso corresponde aproximadamente ao exemplo do Apex invocável; o agendamento é realizado por meio do Apex. Em outras palavras, você pode reutilizar a mesma arquitetura baseada em `Step` para processar registros com base em um carimbo de data e hora "Iniciar após" e decidir quais etapas usar com base em um mapeamento de lista de opções ou de lista de opções de seleção múltipla de volta aos valores de enumeração de `StepType` mostrados anteriormente. - Como alternativa, se você se sentir à vontade definindo uma classe do Apex externa extra, volte para o Apex em lote (ao contrário do Apex enfileirável, que suporta classes internas, as classes do Apex em lote devem ser classes externas) usando o `System.scheduleBatch()`. Considere o exemplo do Apex em lote. Embora geralmente recomendamos o Apex enfileirável para flexibilidade e controle, este é um caso em que o Apex em lote ainda domina: ```java public class DelayedNotifier implements Database.Batchable { private final StepProcessor processor = new StepProcessor(); public Iterable start(Database.BatchableContext bc) { return new List(); } @SuppressWarnings('PMD.EmptyStatementBlock') public void execute(Database.BatchableContext bc, Object scope) { // we don't need to actually do anything in execute, // we just need to start up the processor in finish } public void finish(Database.BatchableContext bc) { try { // you can imagine Notifier as an elided, // simpler version of the naive implementation // we showed above, now only focused on sending messages this.processor.setSteps(new List{ new Notifier() }).kickoff(); } catch (Exception ex) { Logger.exception('Unexpected error', ex); } finally { Logger.saveLog(); } } } ``` E então, na `StepProcessor`, imagine que o método `addTypeOneSteps()` mostrado anteriormente seja atualizado com esta etapa atrasada: ```java public StepProcessor implements System.Queueable, System.Finalizer, Database.AllowsCallouts { // .... unchanged top of class elided private void addTypeOneSteps() { this.steps.addAll( new List { new ExampleCursorStepOne(), new ExampleCursorStepTwo(), new DelayedNotifierStep() } ); } // ... private class DelayedNotifierStep implements Step { private final DelayedNotifier delayedNotifier = new DelayedNotifier(); // again — in practice this value would also be passed in private final Integer delayInMinutes = 120; public void execute() { System.scheduleBatch( this.delayedNotifier, 'Delayed notifier: ' + System.now().getTime(), this.delayInMinutes ); } public void finalize() { Logger.debug('Nothing to finalize, batch scheduled'); } public String getName() { return DelayedNotifierStep.class.getName(); } public Boolean shouldRestart() { return false; } } } ``` Embora geralmente não recomendássemos esse tipo de salto, esse atraso de etapa se torna outro bloco de criação reutilizável. Até que atrasos mais longos sejam permitidos no Apex enfileirável, também representa a maneira mais fácil de produzir esse efeito (sem um mecanismo de consulta, como discutido). ## Conclusão Usamos o design orientado a objetos para atender aos requisitos e criamos um sistema que será dimensionado enquanto equilibra o custo de construção e manutenção de longo prazo. Embora a declaração de etapas e a instanciação possam, por fim, ultrapassar o seu lugar na `StepProcessor`, há pouca dívida técnica adicional aqui. Com a `FlowStep`, administradores e desenvolvedores podem decidir juntos quando as soluções sem código ou pro-código fazem mais sentido. Usando a interface de `System.Finalizer` na estrutura Queueable do Apex, juntamente com o Nebula Logger, criamos um sistema robusto e testável que nos alerta sobre falhas imprevistas, mesmo que as etapas futuras não tenham registro explícito. Para nós, esse sistema está felizmente aumentando os números e reduzindo o custo e a complexidade. Ele também nos deu percepções valiosas sobre o comportamento dos cursores do Apex sob cargas de trabalho reais, ajudando-nos a refinar nossa abordagem enquanto melhora o próprio recurso. Ao dividir cargas de trabalho complexas de alto volume em etapas de execução modulares, a estrutura de Estrutura de processamento assíncrono baseada em etapas transforma restrições de plataforma em vantagens de engenharia, permitindo desempenho previsível, observabilidade e governança em escala corporativa. As etapas podem ser configuradas por administradores e desenvolvedores, e em ambos os casos, os autores de etapas podem se concentrar com segurança em observar os limites básicos do controlador de plataforma (como linhas DML e linhas de consulta recuperadas) sem precisar se preocupar com a escala de cada etapa. ## Caminho para frente Para operacionalizar e adotar esse padrão em implementações corporativas, os arquitetos devem: - **Avaliar as automações existentes** para identificar áreas em que a orquestração assíncrona pode ajudar a melhorar o desempenho e melhorar a visibilidade. - **Divida grandes processos** em etapas separadas e executáveis de forma independente com metas de processamento claras e pontos de autor separados (como Fluxo ou Apex). - **Defina e agrupe tipos de etapas** para acelerar a reutilização de etapas e a padronização entre unidades de negócios. - **Pilote a abordagem** com novos processos ou automações existentes. Você pode se surpreender ao encontrar quantos casos de ponta você encontra gratuitamente dentro de etapas, cuidando de seu registro integrado e capacidade de observação! ## Sobre o autor James Simone é engenheiro de software principal na Salesforce e tem mais de uma década de experiência trabalhando na plataforma. Ele era um cliente da Salesforce — e proprietário do produto — antes de se mudar para o desenvolvimento, e está escrevendo detalhes técnicos sobre o Salesforce desde 2019 no [The Joys Of Apex](https://www.joysofapex.com/). Ele publicou artigos anteriormente no [blog Salesforce Developer](https://developer.salesforce.com/content-archive?authors=James%20Simone&content-type=Blogs&language=English) e também [no blog Salesforce Engineering](https://engineering.salesforce.com/author/james-simone/). ## Visão geral do guia Está procurando criar formulários no Salesforce Platform? Você tem várias opções, abrangendo todo o continuum de código baixo para código profissional. Representam formulários dinâmicos no Criador de aplicativo Lightning e fluxos de tela no Flow Builder. A vantagem no meio do continuum é a capacidade de estender fluxos de tela com LWCs e criar formulários voltados para o cliente com o OmniStudio. E representando o código profissional é a estrutura do LWC e sua biblioteca crescente de componentes básicos. As opções são ótimas, mas como determinar qual (ou qual combinação) é a opção certa? É aí que esse guia entra. ## Principais transferências - **Takeaway #1: Ao criar layouts de criação/editação/visualização para páginas do Lightning, use Formulários dinâmicos.** Talvez você observe que os layouts de página estão ausentes nas tabelas de comparação neste guia. Para avançar, a maneira recomendada de configurar páginas de detalhes de registro é usar Formulários dinâmicos no Criador de aplicativo Lightning. Consulte a seção Layouts de [página](#layouts-de-página) para obter mais informações sobre por que não esperamos aprimorá-los ainda mais. - **Takeaway #2: Se você precisar criar um formulário de criação ou edição para exatamente um objeto, comece com páginas do Lightning e Formulários dinâmicos.** Esta é a maneira mais simples de criar formulários na plataforma Salesforce. Ele também fornece algumas funcionalidades adicionais, como a capacidade de controlar a visibilidade do campo. Se seus requisitos forem mais avançados, continue lendo. Fluxo de tela, OmniStudio ou Componentes da Web Lightning (LWC) podem ser mais adequados. - **Takeaway #3: Se você estiver criando um formulário de várias páginas ou um assistente e não tiver requisitos rígidos de usuário ou identidade visual, comece com um Fluxo de tela.** Os Fluxos de tela fornecem uma estrutura de navegação linear para orquestrar vários formulários juntos. Você poderia usar o LWC para criar sua própria estrutura para navegar entre formulários, mas recomendamos deixar o Fluxo fazer o trabalho duro para você, para que você possa se concentrar nos formulários em si, em vez de se preocupar com o [estado do formulário](/docs/architect/pt-br/well-architected/guide/engaging#formulários). - **Takeaway #4: Se precisar de lógica ou ações adicionais _por trás do formulário_, use um Fluxo de tela, OmniStudio ou LWC.** Todas as três ferramentas oferecem maneiras de sua solução fazer mais do que criar ou editar um único registro. Essa "mais" pode ser uma lógica mais avançada, como ramificação ou iteração, ou pode ser mais ações, como integração a sistemas externos, envio de emails ou envio de notificações por push ao aplicativo móvel de um usuário. - **Takeaway # 5: Você tem requisitos de UX sofisticados? Precisa lidar dinamicamente com mais do que visibilidade? Use o LWC ou o OmniScript.** Se seus requisitos puderem ser atendidos com temas simples e layouts baseados em coluna, você poderá criar seus formulários diretamente em um criador de código baixo. Para ter um controle mais detalhado sobre o estilo do formulário, você precisará da flexibilidade máxima do LWC. Se você for um cliente de Indústrias e precisar de uma identidade visual perfeita para pixels ou tiver dados hierárquicos complexos, use o OmniStudio, que permitirá criar formulários de classificação de consumidor que podem lidar com lógica de negócios e transformações de dados complexas. - **Takeaway #6: Se você precisar de automação de teste, comece com Componentes da Web Lightning.** Você pode escrever testes de unidade para qualquer LWC, não importa onde você planeja integrá-lo. Isso lhe permite criar uma estratégia de teste mais robusta, que pode incluir testes em massa com vários registros e testes negativos. [Consulte Salesforce Well-Architected – Testing Strategy](/docs/architect/pt-br/well-architected/guide/resilient#estratégia-de-teste) para obter mais informações sobre a criação de testes que o ajudarão a ver o quão bem seus formulários estarão alinhados aos seus requisitos funcionais e não funcionais. Lembre-se de que sua escolha não precisa ser um ou dois. Você pode combinar o poder de várias opções. Por exemplo, se você precisar do sistema de navegação integrado do Fluxo e da flexibilidade de estilo total que o LWC oferece, use-os juntos. ## Ferramentas para criar formulários com o Salesforce A tabela abaixo descreve as ferramentas disponíveis para criar formulários com o Salesforce, junto com suas habilidades necessárias e considerações de licença. Posteriormente, analisaremos mais detalhadamente os recursos específicos com suporte para cada ferramenta, bem como como escolher entre ferramentas baseadas em clique e ferramentas baseadas em código (e quando combiná-las):
Habilidades necessárias Requisitos de licença adicionais
Formulários dinâmicos Código inferior Não
Fluxo de tela Código inferior Não
OmniStudio Código inferior + Código profissional Requer pacote de Indústrias
Fluxo de tela + Componentes da Web Lightning Código inferior + Código profissional Não
Componentes da Web Lightning Código profissional Não
## Pontos de decisão em uma visão geral A tabela abaixo contém uma visão geral dos pontos de decisão a serem considerados ao fazer suas seleções de produto, junto com perguntas que você deve se fazer sobre cada uma. Vamos aprofundar-nos em cada um desses tópicos ao longo do restante deste guia.
Impacto do objeto Determine se seu formulário operará em um único objeto ou precisa operar em vários objetos.
Escopo e navegação do formulário Determine se todos os campos no formulário caberão de modo lógico em uma única tela ou se os usuários deverão poder navegar entre várias telas.
Local Identifique o(s) local(s) em que deseja integrar o formulário, que pode variar de um local dentro de um aplicativo Salesforce a um aplicativo móvel ou até mesmo a um site externo.
Controlador Identifique as ações ou lógica que precisam ser realizadas nos bastidores enquanto os usuários estão interagindo com seu formulário, incluindo transformações de dados e integrações com sistemas externos.
Validação Determine se você tem ou não requisitos adicionais de validação de entrada que vão além da validação no nível do sistema padrão fornecida pelo Salesforce.
Segurança Determine se o formulário deve verificar o acesso do usuário antes de realizar determinadas operações, se você deseja controlar quem pode acessar o formulário e se deseja controlar onde o formulário pode ser integrado.
Design de interação Identifique os tipos de interações ou condições que devem acionar respostas dinâmicas no seu formulário.
Estilização Determine o nível de sofisticação para o estilo e o CSS desejados.
Layout Identifique os requisitos de layout do formulário em termos do número necessário de colunas, guias, acordeões e a capacidade de exibir blocos de dados repetidos.
Tradução Determine se o formulário precisará ser localizado para outros idiomas.
Automação de testes de UI Determine se seus processos DevOps exigirão que seu formulário seja submetido a testes de unidade automatizados ou a testes de ponta a ponta automatizados
Metricas Identifique as maneiras como você gostaria de rastrear o uso do formulário, incluindo visualizações de página, quantidade de tempo gasto no formulário, taxas de conclusão e taxas de sucesso
Empacotamento e implantação Determine como você deseja distribuir ou implementar seu formulário após ele ter sido criado.
Estes são os termos que usamos nas tabelas de comparação junto com suas definições: - **Disponível:** Funciona bem com considerações básicas. - **Não ideal:** Pode funcionar, mas não é a ferramenta ideal. - **Roadmap:** Suporte estimado nos próximos doze meses (june de 2025). - **Futuro**: Estimado para suporte além dos próximos doze meses. - **Não disponível:** Não há planos de dar suporte a esse recurso nos próximos doze meses. ## Guias passo a passo do ponto de decisão Conforme prometido, vamos começar um aprofundamento em uma variedade de pontos de comparação e diferenças funcionais entre Formulários dinâmicos, Fluxos de tela, OmniStudio, Fluxos de tela com LWCs integrados e a estrutura do LWC em si. ### Impacto do objeto Se seu formulário opera em um único objeto do Salesforce, qualquer uma das ferramentas que estamos comparando funcionará. As coisas ficam um pouco mais complicadas com formulários entre objetos ou agnósticos a objetos. Por objeto agnóstico, entendemos entradas que não são mapeadas para nenhum objeto do Salesforce. Talvez seu formulário represente uma estrutura de dados que você enviará a um serviço externo, como Stripe ou DocuSign. Ou talvez você esteja usando várias entradas no formulário para calcular um valor e, em seguida, confirmar esse valor no banco de dados. #### Perguntas a fazer: - Em relação a quais objetos o formulário operará? - É apenas um objeto ou há vários objetos? - Você está trabalhando com objetos específicos (por exemplo, Conta, Contato, Oportunidade, Lead e Caso) ou seu formulário precisará funcionar com outros objetos também?
Objeto único Objeto cruzado Agnóstico do objeto
Formulários dinâmicos Disponível Disponível Não disponível
Fluxo de tela Disponível Disponível Disponível
OmniStudio Disponível Disponível Disponível
Fluxo de tela + LWC Disponível Disponível Disponível
LWC Disponível Disponível Disponível
Para formulários entre objetos e agnósticos a objetos, o Fluxo e o OmniStudio são opções sólidas. Os componentes disponíveis nas telas de fluxo são agnósticos por natureza, assim, você pode escolher o que fazer com esses dados nos bastidores. Por exemplo, use os dados inseridos em um formulário para criar vários registros nos bastidores ou use os dados para realizar outras ações, como gerar publicações do Chatter, enviar mensagens do Slack, enviar emails ou conectar-se a serviços externos. Para casos simples, usar componentes do LWC existentes, como Lightning, pode ser uma maneira simples de reduzir o código necessário para fornecer uma solução robusta. No entanto, para cenários em que vários objetos estão envolvidos, o Fluxo fornece um controle abrangente para todos os objetos e elimina a necessidade de os desenvolvedores atravessarem relacionamentos e dependências complexos. O OmniStudio avança um passo e é completamente agnóstico ao objeto, separando a forma que um usuário vê do modelo de dados subjacente. Em vez disso, o OmniStudio manipula o JSON subjacente que é mapeado para objetos do Salesforce (ou dados externos) usando ferramentas como o [Mapeador de dados](https://help.salesforce.com/s/articleView?id=sf.os_dataraptors.htm&type=5) e [Procedimentos de integração](https://help.salesforce.com/s/articleView?id=sf.os_omnistudio_integration_procedures_48334.htm&type=5). O Mapeador de dados e os Procedimentos de integração são dois componentes importantes na conexão de seus formulários do OmniStudio com dados internos e externos ao Salesforce. Usando elementos de arrastar e soltar, você pode trabalhar com dados hierárquicos complexos em um sistema externo e então transformar os dados conforme suas necessidades, dependendo de onde os dados precisam ir. Eles também permitem que você use fórmulas para realizar matemática e lógica em matrizes ou listas de dados, assim como no Apex. [Integrações do OmniStudio_Integrações do OmniStudio_](/docs/architect/pt-br/reference-diagrams/guide/omnistudio-integrations) ### Escopo e navegação do formulário Se você puder obter todas as suas entradas de usuário de um formulário de tela única, comece com Formulários dinâmicos. No entanto, embora Formulários dinâmicos em páginas de registro possam usar o recurso Caminho para representar os vários estágios em seu processo de negócios, talvez não se adapte à maioria dos casos de uso. #### Perguntas a fazer: - Você precisa de uma única tela ou o usuário precisará navegar entre várias telas para concluir uma tarefa? - Você deseja que seus usuários vejam uma descrição visual de quanto tempo eles estão no processo de preencher seu formulário? - Seus usuários precisarão preencher as informações em cada tela em uma ordem específica ou deverão poder alternar entre as telas conforme necessário?
Tela única Formulário de várias telas Indicadores de progresso Navegação rápida entre etapas/tela
Formulários dinâmicos Disponível Não disponível Disponível Não disponível
Fluxo de tela Disponível Disponível Disponível Não disponível
OmniStudio Disponível Disponível Disponível Disponível
Fluxo de tela + LWC Disponível Disponível Disponível Disponível
LWC Disponível Não ideal Não ideal Não ideal
Se você precisar de mais funcionalidades do que o que os Formulários dinâmicos oferecem, a escolha entre Fluxo, OmniStudio e LWC também dependerá de algumas outras perguntas: - Quais habilidades sua equipe tem? Para uma organização mais pesada em administração, recomendamos começar com o Fluxo. Se você tiver soluções de Indústrias, sua equipe já estiver familiarizada com o OmniStudio e seu projeto tiver requisitos de UX rígidos, comece com o OmniStudio. - Está OK para exibir uma barra de navegação na parte inferior do formulário? Se o fluxo de tela e a experiência de navegação do OmniScript forem UX indesejável, aponte para o LWC. - O que precisa acontecer por trás do formulário? Se você precisar que o comportamento seja configurável por um administrador, crie um fluxo ou, para alterações básicas, como alterar rótulos de campo, um OmniScript. Caso contrário, para relacionamentos complexos de vários objetos, crie um OmniScript ou LWC. - Se você escolher o Fluxo ou o OmniStudio, poderá precisar criar um LWC de qualquer forma para obter a UX certa. Se você já estiver criando um LWC para estilizar seu formulário corretamente, considere se a [integração desse componente em um fluxo](https://developer.salesforce.com/docs/platform/lwc/guide/use-flow-embed-component.html) é excessiva. Por outro lado, se sua solução parecer um assistente, em que o usuário navega entre várias telas, considere Fluxo ou OmniStudio. Os fluxos e o OmniStudio vêm com um modelo de navegação integrado, de modo que você não precisa criar e manter LWCs agrupados. A navegação é linear, com ações avançadas, ações retroativas e um mecanismo para salvar o formulário para mais tarde. Você também pode criar um formulário com navegação não linear se for adequado às suas finalidades. Para obter um ótimo exemplo do uso de fluxos de tela, confira o pacote de [auditoria da loja digital](https://appexchange.salesforce.com/appxListingDetail?listingId=a0N3A00000FMkOtUAL) da Salesforce Labs. O OmniStudio oferece uma vantagem de navegação principal fornecendo indicadores de progresso da navegação padrão que detecta "etapas" no formulário. Esse modo de exibição de etapa exibe automaticamente onde um usuário está em um determinado formulário de várias etapas. Diferentemente do Fluxo, ele permite que os usuários "saltem" entre as telas clicando em várias etapas do formulário. Não importa se você está criando formulários de tela única ou de várias telas, certifique-se de que seus formulários estejam [simplificados](/docs/architect/pt-br/well-architected/guide/engaging#formulários) para que sejam fáceis de navegar para seus usuários. ### Local Se você estiver incorporando um formulário em uma página de registro do Lightning padrão, qualquer uma das ferramentas que estamos comparando funcionará, com a advertência de que, no momento, o recurso Formulários dinâmicos está disponível apenas no desktop. No entanto, se você estiver procurando fornecer uma experiência que permita aos usuários acessar formulários de outros locais, talvez seja necessário considerar opções alternativas. #### Perguntas a fazer: - Os usuários precisarão de acesso ao formulário por desktop, dispositivo móvel ou ambos? - Os usuários devem poder acessar o formulário de qualquer lugar no seu aplicativo por meio de uma barra de utilitários? - Deseja usar ações rápidas para que os usuários possam preencher seu formulário sem precisar sair da página em que estão? - Seu formulário precisa estar disponível em um site externo?
Página de registro do Lightning Página inicial do Lightning ou página de aplicativo Sites do Experience Cloud do Aura Sites do Experience Cloud do LWR Snap-ins integrados Barra de utilitários Ação específica do objeto Ação global Aplicativo Salesforce móvel** Field Service Mobile SDK móvel Sites e aplicativos externos LWC personalizado
Formulários dinâmicos Disponível Não disponível Não disponível Não disponível Não disponível Não disponível Não disponível Não disponível Disponível Não disponível Não disponível Não disponível Não disponível
Fluxo de tela Disponível Disponível Disponível Disponível Disponível Disponível Disponível Roteiro Disponível Disponível*** Não disponível Roteiro Disponível
OmniStudio Disponível Disponível Disponível Não disponível Não disponível Disponível Não disponível Não disponível Disponível Não disponível Não disponível Disponível Disponível
Fluxo de tela + LWC Disponível Disponível Disponível Disponível Disponível Disponível Disponível Roteiro Disponível Não disponível Não disponível Não ideal Disponível
LWC Disponível Disponível Disponível Disponível Disponível Disponível Roteiro Roteiro Disponível Roteiro Roteiro Disponível Disponível
*Os fluxos podem ser integrados a sites do LWR Experience Cloud, mas têm considerações que você precisa ter em mente.
** Há suporte para fluxos e LWCs no aplicativo Salesforce móvel, mas o aplicativo Salesforce móvel não oferece suporte a todos os modos de integração de fluxos e LWCs. Por exemplo, ações específicas de objeto têm suporte em dispositivos móveis, mas itens da barra de utilitários não.
***O aplicativo Field Service Mobile não oferece suporte a muitos dos recursos de Fluxo mais recentes, pois é projetado com base em um mecanismo de fluxo mais antigo e tempo de execução de fluxo de tela. Ele tem modificações especiais para funcionar offline.
Como eles exigem contexto de registro, os Formulários dinâmicos têm suporte apenas em páginas de registro do Lightning. No entanto, não há suporte para Formulários dinâmicos em páginas do Experience Cloud. Essa limitação está em vigor porque o Experience Cloud não usa a estrutura subjacente à qual os Formulários dinâmicos dependem: Páginas do Lightning. Estamos avaliando isso com base nas solicitações de Formulários dinâmicos no Experience Cloud. Você pode criar fluxos que exigem um contexto de registro ou fluxos que funcionam globalmente. Assim, você pode integrar fluxos em vários locais. Para fluxos contextuais de registro, isso pode ser uma página de registro do Lightning, uma página de registro do Experience Cloud, uma ação específica de objeto ou uma implantação de Ações e recomendações. Para o fluxo global, isso pode ser a barra de utilitários, outras páginas do Lightning ou do Criador de experiências, um Snap ou um aplicativo externo. Atualmente, não há suporte para fluxos como ações globais, mas como uma solução alternativa, você pode quebrar o fluxo em um componente do Aura. O OmniStudio permite criar FlexCards e OmniScripts composíveis que você pode colocar em praticamente qualquer lugar em que possa colocar um fluxo. No entanto, embora sejam compostos, eles não são empacotáveis. O LWC oferece suporte a um alto grau de reutilizabilidade, pois você está criando componentes que podem ser associados a metas por meio de metadados no Salesforce, em Comunidades e até mesmo em projetos de código aberto. Os componentes do LWC também podem ser integrados dentro do seu próprio site por meio do [Lightning Out](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lightning_out). [Lightning Out em sites externos_ Lightning Out em sites externos_](/docs/architect/pt-br/reference-diagrams/guide/lightning-out-on-external-sites) Atualmente, não há suporte para componentes da Web Lightning como ações rápidas (objeto específico ou global), mas como solução alternativa, você pode colocar um LWC em um componente do Aura (como pode fazer com fluxos). Os componentes do LWC também podem iniciar fluxos com o componente [Lightning-Flow](https://developer.salesforce.com/docs/component-library/bundle/lightning-flow/documentation). O OmniStudio se destaca em expor conteúdo a seus sites externos por meio do recurso OmniOut. Com o OmniStudio e o OmniOut, você pode compilar seus formulários do OmniScript e componentes do FlexCard em componentes padrão e executá-los fora da plataforma em sites ou aplicativos de terceiros. Nenhuma das tecnologias de formulário abordadas neste guia tem suporte oficial em modelos do Mobile SDK hoje. Se o Mobile SDK for essencial para seu caso de uso, é melhor criar seu formulário nativamente em seu aplicativo móvel ou criar uma página do Visualforce, mantendo a orientação do Salesforce Well-Archived [form factor](/docs/architect/pt-br/well-architected/guide/engaging#fator-de-forma) em mente. **Nota do roteiro:** A equipe do Mobile SDK está trabalhando ativamente em dar suporte a LWCs em páginas do Visualforce. ### Controlador Os Formulários dinâmicos são perfeitos se você precisar usar os valores em seu formulário para criar ou atualizar um registro. Para quaisquer recursos além disso, você precisará aproveitar o Fluxo, o OmniStudio ou o LWC. Esses recursos podem incluir uma camada de decisão ou iteração, ou a geração de publicações ou emails do Slack usando as entradas do formulário. #### Perguntas a fazer: - Que ações ou lógica você deseja que sejam realizadas nos bastidores? - Seu modelo de dados contém dados hierárquicos? - Seu formulário precisará concluir suas operações em uma única transação ou entre várias transações? - Você precisa se integrar a sistemas externos? - Quais são seus requisitos para reutilizabilidade e modularidade?
Registrar e ações Gerenciamento de dados hierárquico Operar em uma transação Operar entre várias transações Integração Design e reutilização modulares Empacotamento
Formulários dinâmicos Não disponível Não disponível Não disponível Não disponível Não disponível Não disponível Disponível
Fluxo de tela Disponível Roteiro Disponível Disponível Disponível Disponível Disponível
OmniStudio Disponível Disponível Disponível Disponível Disponível Disponível Não disponível
Fluxo de tela + LWC Disponível Disponível Disponível Disponível Disponível Disponível Disponível
LWC Disponível Disponível Disponível Disponível Disponível Disponível Disponível
O Fluxo oferece ações padrão para publicar no Slack, enviar emails e interagir com documentos do Quip, para que você não precise escrever código para essas operações. O LWC oferece interações avançadas com registros únicos e objetos relacionados através do uso de adaptadores de conexão que interagem com a [API Interface do usuário](https://developer.salesforce.com/docs/atlas.en-us.uiapi.meta/uiapi/ui_api_get_started.htm). O LWC também pode interagir com vários registros ao usar o cabo para [getListInfoByName](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/reference_get_list_info_by_name.html). [Interação LWC via adaptadores de conexão_ Componentes da Web Lightning Interação via adaptadores de conexão_](/docs/architect/pt-br/reference-diagrams/guide/lightning-web-components-interaction-via-wire-adapters) Como mencionado acima, o OmniStudio usa Procedimentos de integração e o Mapeador de dados para capturar e transformar facilmente dados externos e internos no Salesforce. Ele brilha em nivelar e expandir conjuntos de dados com vários níveis de relacionamentos graças a várias funções sem código que você pode usar. **Nota do roteiro:** O fluxo logo dará suporte à capacidade de inserir e atualizar coleções de registros, bem como gerenciar dados hierárquicos. O Fluxo, o OmniStudio e o LWC integram-se ao Apex para que você possa fechar facilmente qualquer lacuna na solução escolhida. Por exemplo, se você precisar filtrar registros de um LWC, sempre poderá usar o adaptador de conexão para Apex para criar consultas SOQL complexas. Se você estiver preocupado com a história baseada em cliques, considere o Fluxo ou o OmniStudio como alternativas viáveis a um controlador do Apex para suas necessidades no lado do servidor. Uma pergunta secundária aqui é se você deseja confirmar ações imediatamente ou adiá-las para uma parte específica do formulário. Isso é especialmente relevante se você estiver em um formulário de várias páginas. O fluxo torna fácil combinar entradas de vários formulários (tela de fluxo) e usá-las muito mais tarde no assistente (fluxo) para realizar algumas operações. Na verdade, recomendamos projetar fluxos dessa maneira (realizar ações no fim) caso o usuário volte e avance entre as telas, alterando suas respostas. #### Controlar operações Transações e [limites de governador](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_gov_limits.htm) são um modo de vida na Salesforce Platform. Se o seu caso de uso for bastante simples, talvez não seja tão importante controlar em qual transação uma determinada operação ocorre. No entanto, há alguns casos de uso em que você pode querer combinar várias operações em uma única [transação](/docs/architect/pt-br/fundamentals/guide/architecture-basics#transações) em vez de realizá-las entre várias transações. Alguns exemplos: - **Para reverter ou não reverter**: Essa é a pergunta. Digamos que seu formulário crie vários registros nos bastidores. Se a criação do terceiro registro falhar, os dois primeiros registros deverão ser revertidos? Se cada uma de suas ações for independente uma da outra, sinta-se à vontade para executá-las em transações separadas. No entanto, se forem dependentes e você quiser que a falha de um também reverta os outros, implemente-os em uma única transação. Se o formulário estiver em Fluxo, você poderá usar o elemento Reverter em um caminho de falha para reverter sua transação e garantir a integridade dos dados. - **Impacto a jusante nos limites do regulador**: Especialmente quando seu formulário cria ou atualiza um registro, considere quais são as implicações a jusante dessa operação. Quais processos, regras de fluxo de trabalho, acionadores de fluxo, acionadores do Apex ou outros itens na ordem de salvamento serão acionados com base nessa alteração de registro? Como essas alterações coletivas afetam os limites do controlador que são consumidos nessa transação? Se uma alteração de registro em particular resultar em muitas alterações a jusante que afetam seus limites, considere isolar essa alteração de registro em sua própria transação. - **Processamento em lote**: Mesmo em um contexto de UI, talvez seja necessário colocar várias atualizações em lote juntas. Digamos que seu formulário de várias telas itere em um grande grupo de registros. Em vez de confirmar uma atualização de registro após cada tela, aguarde até coletar as atualizações de todos os registros e envie uma solicitação para atualizar todos os registros. Quando você usa Formulários dinâmicos para criar ou editar um registro, está realizando apenas uma operação e essa operação é sempre o início de uma transação líquida e nova. Ao criar um fluxo de tela, você tem controle significativo sobre o que acontece em uma determinada transação. Telas e ações locais atuam como limites entre transações. Aqui está um resumo de alto nível de como as transações são gerenciadas na arquitetura de fluxo de tela. 1. O usuário final interage com uma tela e clica em **Avançar**. 2. O cliente publica uma solicitação à API com as entradas. 3. A API recebe a solicitação e uma conexão de banco de dados e transação é aberta. A API então chama o mecanismo de Fluxo para invocar a solicitação. 4. O mecanismo de Fluxo assume e segue o caminho adequado na definição de fluxo, até atingir um nó de Tela ou Ação local. O mecanismo então retorna informações sobre esse nó para a API. 5. A API cria um objeto de resposta que contém os detalhes da próxima tela a ser renderizada e retorna esse objeto ao cliente. Nesse ponto, as alterações de banco de dados são confirmadas (cue a execução do [pedido de salvar](/docs/architect/pt-br/fundamentals/guide/architecture-basics#manipulação-de-banco-de-dados)) e a conexão de banco de dados e a transação são fechadas. 6. O cliente usa a resposta da API para renderizar a próxima tela com a qual o usuário interage. 7. Repita a etapa 1. Em outras palavras, as telas "quebram" transações. Quando isso acontece, qualquer ação pendente ou DML é confirmado, a transação anterior é fechada e uma nova transação é iniciada.
Fluxo de múltiplas telas O design certo – que operações você agrupa em uma determinada transação – é sua chamada. Vamos analisar alguns exemplos.
fluxo de tela com transações separadas
À esquerda, você pode ver um fluxo que coleta entradas em várias telas e, em seguida, executa várias ações em uma transação.
O fluxo à direita realiza cada operação em uma transação separada.
A equipe de Fluxo lançou recentemente um novo elemento: O elemento Reverter registros permite que você reverta uma transação inteira se uma única operação falhar em uma série de operações de banco de dados.
Fluxo de tela com vários registros de criação

Suponha que você tenha um fluxo que crie registros, atualize registros e crie mais registros, conforme ilustrado no próximo fluxo à direita.
Nesse cenário, se os dois primeiros elementos forem bem-sucedidos e o último falhar, as duas primeiras operações DML ainda criarão e atualizarão esses registros, enquanto o terceiro não.
Fluxo de tela com reversão
Ao usar o elemento Reverter registros, você pode garantir que toda a transação seja revertida se todas as três operações precisarem ocorrer em conjunto, conforme visto no fluxo final à esquerda. Para obter mais detalhes, consulte [Fluxos em transações](https://help.salesforce.com/articleView?id=flow_concepts_transaction.htm) e [Multiplicação de fluxo em transações](https://help.salesforce.com/articleView?id=flow_concepts_bulkification.htm). A seção Automatizado do Salesforce Well-Architected também aprofunde-se sobre isso em [Manuseio de dados](/docs/architect/pt-br/well-architected/guide/automated#tratamento-de-dados). Sua capacidade de controlar a transação de um LWC se resume aos serviços subjacentes que o LWC está usando para realizar suas operações. Se você estiver usando o componente de base Lightning, a operação subjacente (criar ou atualizar o registro) acontecerá em uma transação independente assim que o formulário for enviado. Em geral, estas regras se aplicam: - Cada chamada à API da IU é isolada em sua própria transação. - Se você precisar realizar várias operações em uma única transação, envie as entradas para uma tecnologia no lado do servidor, como um controlador do Apex ou um fluxo. As regras de transação normais para essa tecnologia se aplicam. #### Integrações externas O Fluxo, o OmniStudio e o LWC oferecem suporte a eventos de plataforma (para a [arquitetura orientada por evento](/docs/architect/pt-br/decision-guides/guide/event-driven)) e integrações de API. Além do Apex code personalizado, o Fluxo e o OmniStudio oferecem suporte a mecanismos declarativos para integrar uma API. Se precisar se conectar a uma API ou bot de RPA do MuleSoft, use os Serviços do MuleSoft. Isso gera um Serviço externo. [Integrações externas por meio da MuleSoft_ Integrações externas por meio de APIs da MuleSoft e Bots de RPA_](/docs/architect/pt-br/reference-diagrams/guide/external-integrations-via-mulesoft-apis-and-rpa-bots) Se a API tiver um esquema OpenAPI, crie um Serviço externo. [Integrações externas via OpenAPI_Integrações externas a APIs com esquemas OpenAPI_](/docs/architect/pt-br/reference-diagrams/guide/external-integrations-to-apis-with-openapi-schemas) Caso contrário, use o recurso Chamada HTTP no Fluxo ou Ação HTTP no OmniStudio. A chamada HTTP do fluxo é habilitada por Serviços externos. [Integrações externas via HTTP_Integrações externas via HTTP_](/docs/architect/pt-br/reference-diagrams/guide/external-integrations-via-http) O OmniStudio oferece um conjunto avançado de recursos de integração que podem chamar sistemas externos com Procedimentos de integração e transformar os dados com o Data Mapper. (Consulte [impacto de objeto](#impacto-do-objeto) para obter mais informações) Independentemente de você implementá-lo com Apex personalizado ou um serviço externo, uma chamada é uma chamada. Isto é o que você precisa saber. 1. Uma chamada pode levar muito tempo. 2. Quando uma chamada é executada de modo síncrono, ela é realizada enquanto uma transação de banco de dados está aberta. 3. O Salesforce não permitirá que você mantenha uma transação de banco de dados aberta se tiver operações de banco de dados pendentes. A principal limitação a ter em mente é o perigo das chamadas **_transações sujas_**, onde você executa uma operação de criação, atualização ou exclusão e, em seguida, na mesma transação, executa uma chamada. Esse padrão não é permitido devido à consideração no 3 acima, que, claro, existe devido às considerações no 1 e no 2. No Fluxo, você pode contornar essa limitação interrompendo a transação. Lembre-se de que as telas e as ações locais reintroduzem o contexto do navegador, o que interrompe a transação. Embora você possa usar telas e ações locais ao trabalhar com chamadas externas, recomendamos habilitar o Controle de transação em configurações avançadas invocáveis. O Controle de transação é um recurso de ações invocáveis que permite encerrar automaticamente a transação antes de uma chamada ser feita. Você pode habilitar o Controle de transação selecionando Sempre iniciar uma nova transação na seção Avançado de uma ação invocada. Integrações externas por meio de chamadas O impacto das chamadas na transação é menos complicado com o LWC. Em geral, você realizará suas operações de dados usando o Lightning Data Service (LDS) e, em seguida, usará um controlador do Apex para fazer a chamada externa. Esse design protege você contra transações sujas, pois a chamada do LDS é isolada em sua própria transação separada da chamada do Apex. _Para obter orientações mais detalhadas sobre chamadas do Apex, serviços externos e recursos de integração de dados em geral, consulte o [Guia do arquiteto para integração de dados com o Salesforce](/docs/architect/pt-br/decision-guides/guide/data-integration)._ #### Reusabilidade e modularidade Formulários dinâmicos não oferecem suporte à reutilização. Cada Formulário dinâmico é vinculado a uma página de registro do Lightning específica para um objeto específico (embora você possa atribuir essa página de registro do Lightning a vários aplicativos, perfis etc.). Assim como você pode escrever bibliotecas, utilitários e componentes destinados a serem usados em vários outros componentes, você pode aplicar padrões de design semelhantes ao criar fluxos com o poder de **_subfluxos_**. Salve seus fluxos em grupos menores e mais modulares e, em seguida, chame-os de outros fluxos usando o elemento Subfluxo. Se o seu design exigir isso, você poderá criar um fluxo que seja independente e seja útil como um subfluxo de outro. O OmniStudio foi criado inerentemente para modularidade. Mapeadores de dados, OmniScripts, FlexCards e Procedimentos de integração são criados de modo independente e podem funcionar de modo intercambiável. Além disso, FlexCards podem ser criados como componentes do LWC que podem ser integrados a outros LWCs, OmniScripts, páginas de registro e sites do Experience Cloud. Fluxos de tela, OmniScripts e LWCs podem ser criados para reutilização e incorporados em vários locais, incluindo sites externos e aplicativos do Lightning Out. Quando você projeta suas soluções para serem [composíveis](/docs/architect/pt-br/well-architected/guide/composable), obtém vantagens adicionais como adaptabilidade e estabilidade. ### Validação Todas as tecnologias usadas para criar ou atualizar um registro seguem a validação no nível do sistema, sejam elas regras de validação clássicas ou validação personalizada integrada em um acionador do Apex. Independentemente da tecnologia usada para realizar uma alteração de registro, todas as alterações passam pelo pedido de salvamento. Isso significa que, além das regras de validação, a alteração de registro é processada por qualquer número de fluxos antes ou depois de salvar, acionadores antes ou depois, regras de escalação, regras de atribuição e muito mais. Se ainda não tiver feito isso, certifique-se de marcar como favorito e familiarizar-se com a [ordem de execução](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_triggers_order_of_execution.htm) do Apex. #### Perguntas a fazer: - Seu formulário tem requisitos adicionais além da validação no nível do sistema? - Você precisará definir campos como obrigatórios ou somente leitura dinamicamente no formulário?
Respeitar validação no nível do sistema Validação em nível de campo personalizada específica para este formulário Validação em nível de campo personalizada
Formulários dinâmicos Disponível Não disponível Não disponível
Fluxo de tela Disponível Não disponível Roteiro
OmniStudio Disponível Disponível Disponível
Fluxo de tela + LWC Disponível Disponível Disponível
LWC Disponível Disponível Disponível
As entradas em uma tela de fluxo ou etapa do OmniScript são por natureza não vinculadas, portanto, o formulário em si não adere nativamente à validação no nível do sistema associada a um objeto específico. No entanto, quaisquer valores que você use para criar ou atualizar registros serão processados pelo pedido de salvamento, o que significa que passam pela validação no nível do sistema do objeto. Observe, porém, que nem todos os componentes de fluxo de tela oferecem suporte à validação de entrada. A partir da versão Summer '24, os componentes da tela restantes que não oferecem suporte à validação de entrada são Botões seletores, Lista de opções, Lista de opções de seleção múltipla, Grupo de caixas de seleção e Pesquisa de opção. Assim como os layouts de página, os Formulários dinâmicos permitem definir a obrigatoriedade e o estado somente leitura no nível da página. No entanto, não é possível substituir as configurações no nível do sistema. O fluxo oferece flexibilidade para personalizar a validação nas entradas de um formulário. Embora algumas verificações sejam realizadas no cliente (como sinalizar campos obrigatórios ausentes ou valores incompatíveis), nenhuma validação no lado do cliente impede que o usuário tente navegar. A validação real acontece no servidor. Quando um usuário clica em **Avançar**, o Fluxo envia as entradas para o servidor para validação. Se alguma entrada for retornada como inválida, a navegação será bloqueada e o erro adequado será exibido. O servidor valida as entradas verificando: 1. A configuração de obrigatoriedade da entrada ou se o valor inserido é compatível com o tipo de dados subjacente. 2. Validação personalizada nessa entrada: Vários componentes padrão (Caixa de seleção, Moeda, Data, Data/hora, Área de texto longo, Número, Senha e Texto) oferecem suporte à validação personalizada por tela. Forneça uma expressão de fórmula booleana e uma mensagem de erro para ser exibida quando a expressão da fórmula não for atendida. 3. Validação personalizada no componente subjacente: Se você estiver criando um LWC personalizado para um fluxo, adicione seu próprio código de validação ao método validate(). O OmniStudio oferece processamento de erros avançados e validação por meio da ação [Definir erro](https://help.salesforce.com/s/articleView?id=sf.os_set_errors_in_an_omniscript.htm&type=5) em combinação com as Visualizações [condicionais](https://help.salesforce.com/s/articleView?id=sf.os_conditionally_display_elements_using_the_conditional_view_property.htm&type=5) e o componente [Mensagens](https://help.salesforce.com/s/articleView?id=sf.os_display_messages_in_omniscripts_19551.htm&type=5). No lado do LWC, a maioria dos componentes de base realiza suas próprias validações no lado do cliente. Por exemplo, Lightning respeita a obrigatoriedade no nível do sistema, mas não a obrigatoriedade no nível da página. Para seus componentes personalizados, você pode Build Your Own mecanismos de validação. Os campos que exigem que os usuários insiram dados devem aparecer mais cedo nos formulários. Sempre que possível, valide as entradas do usuário no lado do cliente antes do envio dos formulários. Para obter mais práticas recomendadas para simplificar seus formulários, consulte a orientação de [formulários](/docs/architect/pt-br/well-architected/guide/engaging#formulários) no Salesforce Well-Architected – Engaging. ### Segurança A segurança é um tópico complexo em geral e, quando se trata de criar formulários, há uma série de considerações sobre as quais você pode nem ter pensado. No nível fundamental, você quer garantir que o formulário esteja sendo executado no contexto correto e que os usuários tenham as permissões necessárias para trabalhar com os dados subjacentes. Porém, além disso, você também pode tomar medidas extras para remover códigos ou URLs potencialmente mal-intencionados de campos de rich text, impedir que determinados usuários possam acessar o formulário ou colocar limitações nos tipos de locais em que os administradores possam integrar o formulário no futuro. Documente cuidadosamente seus requisitos de segurança antes de escolher uma ferramenta. O modelo de [política de segurança](/docs/architect/pt-br/resources/guide/security-policy-template) bem criado do Salesforce contém diretrizes para esse tipo de documentação. #### Perguntas a fazer: - O formulário deve verificar o acesso do usuário antes de realizar determinadas operações? - Você deve limpar as entradas do usuário? - Deseja controlar quem pode acessar o formulário? - Deseja controlar onde o formulário pode ser integrado?
Elevar permissões de usuário Controlar quem tem acesso Restringir locais permitidos
Formulários dinâmicos Não disponível Disponível Não disponível
Fluxo de tela Disponível Disponível Não disponível
OmniStudio Não disponível Disponível Não disponível**
Fluxo de tela + LWC Disponível Disponível Não disponível
LWC Disponível* Disponível Disponível
*Requer Apex
**Enquanto os OmniScripts não podem ter um conjunto especificado de locais de destino, os FlexCards podem.
#### Elevar permissões de usuário Quando algo é executado no **_contexto do usuário_**, o Salesforce impõe uma série de verificações de acesso, incluindo a verificação da segurança em nível de campo, permissões CRUD e acesso ao registro com base nas regras de compartilhamento da sua organização. Por exemplo, os usuários só poderão executar um formulário de atualização de caso se tiverem a capacidade de atualizar casos, a segurança em nível de campo adequada e o acesso ao registro em questão. Mas e se você quiser que os usuários possam realizar uma operação específica quando estiverem usando _o seu_ formulário, mas não por meio de qualquer outro formulário ou interação? É aí que entra o **_contexto do sistema_**. O contexto do sistema é uma maneira de elevar as permissões do usuário em execução para a duração da sessão, de modo que o usuário não precise, por exemplo, de Acesso de atualização ao objeto Caso para concluir com sucesso o formulário de atualização de caso. Isso é especialmente útil para comunidades não autenticadas. Em vez de conceder aos usuários convidados habilidades potencialmente perigosas, defina seu formulário para ser executado no contexto do sistema. É claro que o contexto do sistema é uma espada dupla e você deve usá-la apenas quando necessário. Quando um formulário é executado no contexto do sistema, cada única operação CRUD ignora a segurança e o compartilhamento em nível de objeto e de campo, não apenas a operação específica que importa. Observe também que o contexto do sistema não tem relação com quem o Salesforce considera como o ator, o nome que você vê no campo Última modificação feita por. Para cada operação que seu formulário executa, como a atualização de caso, o ator é o usuário em execução mesmo que o formulário seja executado em um contexto diferente. Formulários dinâmicos, OmniScripts e LWCs sempre são executados no contexto do usuário e não há maneira de substituir esse comportamento. Os fluxos de tela são executados no contexto do usuário por padrão, mas você pode defini-los para serem executados no contexto do sistema. É sua escolha se o fluxo deve conceder acesso a todos os dados ou se ele ainda deve impor acesso em nível de registro, como compartilhamento. - Se você integrar um componente do Lightning a um fluxo executado no contexto do sistema, o fluxo não substituirá o contexto do componente. Se você precisar ignorar verificações de acesso do usuário, recomendamos usar o fluxo para realizar essas operações e passar os dados apropriados para dentro ou para fora do componente do Lightning. Alguns componentes prontos para uso (como Pesquisa) não podem funcionar no contexto do sistema. - Se o seu fluxo chamar ações do Apex, haverá mais algumas nuances a entender. Se a classe do Apex estiver definida como herdado compartilhamento, ela será executada no contexto do sistema com compartilhamento, independentemente do fluxo ser definido. Se a classe não tiver uma declaração de compartilhamento explícita, ela será executada no contexto do sistema sem compartilhamento, não importa para que o fluxo esteja definido. Se a classe estiver definida como com compartilhamento ou sem compartilhamento, ela fará isso e substituirá o contexto do fluxo. **Pesquisar registros no contexto do sistema com sites do Experience Cloud:** Se você estiver executando um fluxo no contexto do sistema em um site do Experience Cloud, **especialmente não autenticado**, recomendamos armazenar apenas campos específicos nos elementos Obter registros. Quando você está trabalhando com o Fluxo e passa os resultados de um elemento Obter registros para um subfluxo, ação invocável ou componente do Lightning, todos os campos desse objeto podem ser inspecionados por meio das ferramentas de desenvolvedor do navegador. Isso pode tornar os campos disponíveis aos usuários do site do Experience Cloud que você não deseja. Ao especificar campos específicos nos elementos Obter registros, você pode garantir que apenas os campos certos sejam expostos mesmo com o contexto do sistema ativado. Observe que a lógica OmniScript é executada no lado do cliente, o que permite aos invasores modificar a execução esperada de um OmniScript _e_ visualizar respostas a procedimentos de integração, mapeadores de dados e chamadas de método do Apex usando as ferramentas de desenvolvedor do navegador. Quando você estiver usando o OmniScript, recomendamos executar a lógica de negócios no lado do servidor sempre que possível e implementar regras de validação de entrada em qualquer método do Apex exposto por meio de uma anotação [@InvocableMethod](https://help.salesforce.com/s/articleView?id=sf.os_integration_procedure_invocation_55721.htm&type=5). **Entradas de saneamento:** Para proteger sua organização contra atores ruins, considere também a limpeza de entrada. Suponha que você tenha uma entrada em um formulário acessível ao público que possa ser mapeada para um campo de rich text na sua organização. Talvez você queira considerar a automação que remova qualquer HTML que possa ocultar URLs mal-intencionados. Em geral, não é ideal implementar essa limpeza no nível do formulário, pois você pode ter qualquer quantidade de origens gravando nesses campos. Recomendamos criar um Fluxo de atualização de campo rápido (antes de salvar) ou usar um Acionador do Apex existente no objeto para remover ou modificar qualquer HTML potencial que possa ser inserido no formulário. **_Práticas recomendadas:_** - _Deixe os fluxos em execução no contexto padrão, a menos que você precise elevar o acesso do usuário em execução para uma operação específica._ - _Evite executar fluxos no contexto do sistema para usuários convidados por motivos de segurança. Crie conjuntos de permissões com acesso a campo limitado atribuído ao perfil de usuário convidado do site do Experience Cloud._ - _Ao consultar registros em fluxos de execução de contexto do sistema em sites do Experience Cloud, armazene apenas os campos necessários no elemento Obter registros ou Ações invocáveis._ - _Se um fluxo executar várias operações e nem todas elas exigirem acesso elevado, use subfluxos para isolar as operações que devem ser executadas no contexto do sistema._ - _Se você planeja integrar um formulário a uma página da Web externa, considere limpar as entradas do usuário para remover HTML usando um Fluxo de atualização rápida de campo ou Apex Trigger se elas forem eventualmente mapeadas para campos de rich text para evitar possíveis ataques de phishing de atores ruins._ #### Notas adicionais: - OmniScripts, FlexCards e LWCs são executados no contexto do usuário por padrão. - Os LWCs são executados no contexto do usuário por padrão e os fluxos são executados no contexto do usuário, mas você pode substituir isso em um controlador do Apex. - As operações realizadas por meio da API da IU são executadas no contexto do usuário. - As operações realizadas por meio de um controlador do Apex dependem dessa classe. Para realizar essas operações no modo de sistema, defina a classe do Apex como with sharing ou without sharing. #### Controle de acesso Se você precisar de controle sobre quem pode acessar seu formulário, costuma procurar o contêiner no qual o formulário está integrado. Por exemplo, você pode atribuir páginas do Lightning para que estejam disponíveis para determinados aplicativos, tipos de registro ou perfis. Se determinadas entradas em seu formulário forem confidenciais, use regras de visibilidade para controlar ainda mais o que é exibido a quem; esse recurso se aplica tanto a Formulários dinâmicos quanto a fluxos de tela. Você pode [restringir um fluxo](https://help.salesforce.com/articleView?id=flow_distribute_security.htm) a determinados perfis ou conjuntos de permissões, assim como uma classe do Apex ou uma página do Visualforce. Por padrão, os fluxos não são restritos, o que significa que qualquer usuário com a permissão de usuário Executar fluxos pode executá-los. Se você estiver usando o OmniStudio, poderá configurar um verificador de permissões de classe do [Apex](https://help.salesforce.com/s/articleView?id=sf.os_add_an_apex_class_permissions_checker_1.htm&type=5) para garantir que os usuários precisem de acesso explícito à classe do Apex que administra a ação remota chamada de um OmniScript, FlexCard, Classic Card ou API REST. - Observação As verificações de permissão da classe do Apex estão habilitadas por padrão para scripts recém-criados. No entanto, eles precisam ser habilitados manualmente para quaisquer scripts existentes - Observe também que as verificações de permissão de classe do Apex se aplicam apenas a classes do Apex. Recomendamos configurar permissões no nível do perfil para [Procedimentos de integração e Mapeadores de dados](https://help.salesforce.com/s/articleView?id=sf.os_security_for_dataraptors_and_integration_procedures_48147.htm&type=5) também. Para obter mais detalhes e práticas recomendadas sobre permissões de usuário convidado, consulte: - [Práticas recomendadas de acesso ao registro do usuário convidado](https://www.learnexperiencecloud.com/s/article/Guest-User-Record-Access-Development-Best-Practices#Pattern6) - [Desenvolver sites seguros: Usuários autenticados e convidados](https://developer.salesforce.com/docs/atlas.en-us.communities_dev.meta/communities_dev/communities_dev_security_authenticated_and_guest_users.htm) **_Práticas recomendadas:_** - _Se você estiver expondo um fluxo a usuários convidados, conceda ao perfil de usuário convidado acesso apenas aos fluxos de que ele precisa. Embora seja possível adicionar Fluxos de execução ao perfil de usuário convidado, consideramos que isso é uma prática arriscada._ - _Seja especialmente cuidadoso com fluxos que operam no contexto do sistema. Recomendamos enfaticamente que você restrinja esses fluxos a um conjunto específico de usuários, pois eles têm menos verificações e saldos em vigor para proteger seus dados._ - _Qualquer OmniScript que execute Apex em uma comunidade de usuários convidados deve ter "com compartilhamento" na definição da classe do Apex._ - _No perfil de Usuário convidado, atribua apenas as classes do Apex que você deseja que os usuários convidados possam chamar ou corra o risco de expor inadvertidamente lógica de negócios adicional aos usuários convidados._ Para LWCs, você pode verificar as atribuições de permissão do usuário em execução para confirmar se ele tem uma permissão padrão ou personalizada específica. Diretamente de JavaScript, você pode importar permissões do Salesforce dos módulos com escopo @salesforce/userPermission e @salesforce/customPermission. Ou você pode usar o Apex para verificar o mesmo. #### Controle de integração Os componentes da Web Lightning só estão disponíveis em um determinado local quando foram adicionados como um [alvo](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.reference_configuration_tags) válido. Por exemplo, você pode tornar um componente disponível em páginas de registro e não disponível como um item da barra de utilitários. Depois que um fluxo de tela é ativado, ele fica disponível em todos os locais em que os fluxos de tela têm suporte, independentemente de você querer que ele esteja disponível em todos os lugares ou não. Dito isto, o Flow Builder oferece suporte a vários tipos de fluxos que têm telas. O tipo de pizza é Fluxo de tela, mas há alguns outros tipos especializados restritos a locais específicos. Por exemplo, o aplicativo Field Service Mobile oferece suporte apenas a fluxos do Field Service Mobile, você adivinhou. O mesmo se aplica a Fluxos de solicitação de contato, que têm suporte apenas no Experience Cloud. Independentemente do tipo de fluxo, o indivíduo que está fazendo o fluxo não tem controle sobre onde o fluxo pode ser integrado. O fluxo estará disponível em todos os locais com suporte para esse tipo de fluxo. Se você estiver usando o Salesforce Industries, há um pequeno aviso quando se trata do OmniScript: Embora não seja possível especificar um destino para um OmniScript em si, você pode especificar um para os FlexCards que talvez queira integrar a ele. ### Design da interação Formulários estáticos são algo do passado. Hoje, é tudo sobre atualizar dinamicamente o formulário com as propriedades e valores certos para esse usuário, dessa vez, neste local. Vamos falar sobre o que é possível nessa veia para as ferramentas de criação de formulário do Salesforce. #### Perguntas a fazer: - Quais tipos de interações ou condições devem acionar respostas dinâmicas no seu formulário? - Você precisará executar operações fora da tela em segundo plano conforme seu formulário está sendo preenchido? - Você precisará definir campos como visíveis, obrigatórios, somente leitura ou desabilitados ou alterar a formatação com base em entradas de formulário?
Executar operações de dados fora da tela Valores condicionais e cálculos Visibilidade condicional Requisito condicional Formatação condicional Estado somente leitura condicional Estado condicional desabilitado
Formulários dinâmicos Não disponível Não disponível Disponível Não disponível Roteiro Não disponível Não disponível
Fluxo de tela Disponível Disponível** Disponível Disponível* Não disponível Disponível** Disponível**
OmniStudio Disponível Disponível Disponível Disponível Disponível Disponível Disponível
Fluxo de tela + LWC Disponível Disponível Disponível Disponível Disponível Disponível Disponível
LWC Disponível Disponível Disponível Disponível Disponível Disponível Disponível
*Limitado a componentes que usam um seletor de recurso e não uma caixa de seleção estática
**Beta limitado
A interatividade do Fluxo de tela agora é uma realidade graças às telas reativas. A reatividade permite que componentes individuais em uma tela de fluxo se comuniquem entre si, tornando os fluxos de tela infinitamente mais poderosos. **Executar operações de dados fora da tela:** Fluxos de tela oferecem uma abordagem declarativa para buscar dados na mesma tela por meio de Ações de tela. Ações de tela podem permitir que você acione fluxos iniciados automaticamente em qualquer alteração na tela ou quando um usuário clica em um componente Botão de ação. Você então pode mapear os resultados desses fluxos iniciados automaticamente para a mesma tela, eliminando a necessidade de os usuários navegarem para outra tela. O LWC oferece uma gama completa de adaptadores de conexão que permitem acessar dados do Salesforce para preencher dados nos componentes do formulário dinamicamente e permite que os desenvolvedores atualizem, excluam e criem registros por meio de controladores do Apex. [Componentes da Web Lightning Operações de dados off-screen _Componentes da Web Lightning Operações de dados off-screen_](/docs/architect/pt-br/reference-diagrams/guide/lightning-web-components-off-screen-data-operations) **Visibilidade:** A visibilidade pode ser controlada dinamicamente em todas as ferramentas de criação de formulário. Formulários dinâmicos, Flow Builder e OmniStudio lidam com isso com recursos de visibilidade do componente. Com isso, você pode mostrar ou ocultar campos declarativamente com base em outros valores no formulário ou se o usuário está em um dispositivo móvel ou não. - Com Formulários dinâmicos, a visibilidade pode ser controlada com base em valores de campo de registro, registros relacionados por meio de campos de pesquisa e formato. - Com o Fluxo, você pode basear uma regra de visibilidade em outras entradas na tela, bem como em outros recursos preenchidos anteriormente no fluxo, como fórmulas ou valores de outros registros. - **Regras baseadas em dispositivo:** Não é óbvio desde o início, mas você pode usar uma fórmula para mostrar ou ocultar um determinado campo quando o usuário estiver em um dispositivo móvel. Escreva uma fórmula de fluxo que verifique o valor da variável global \$User.UIThemeDisplayed. Se o valor for Theme4t, o usuário estará no aplicativo Salesforce móvel. - **Avaliação de outros recursos:** Referências de variável manual e de fórmula são avaliadas apenas no servidor. Assim, qualquer valor que o recurso tenha quando a tela for renderizada pela primeira vez será o valor que ele terá até você navegar para outra tela. Na navegação, o tempo de execução do fluxo envia uma solicitação ao mecanismo de fluxo (o servidor) e retorna os valores mais recentes das fórmulas e variáveis manuais. Se você espera que sua regra de visibilidade seja atualizada à medida que o usuário passa por uma única tela (por exemplo, onblur), faça referência apenas a valores dos outros componentes na tela. - Com o OmniStudio, você pode mostrar ou ocultar componentes condicionalmente configurando uma Propriedade de visualização condicional. No entanto, não é possível adicionar mais de uma propriedade de visualização condicional para uma entrada. **Estados de entrada condicional:** Se você precisar controlar dinamicamente qualquer outra propriedade, como se um campo é obrigatório, desabilitado ou somente leitura, você tem algumas opções. Conforme esperado, o LWC oferece controle reativo total sobre seu estado de entrada. Com componentes reativos do Fluxo de tela, você pode controlar dinamicamente atributos de componente como Somente leitura, Desabilitado e Obrigatório para componentes padrão que dão suporte a ele, enquanto o OmniStudio oferece suporte a todo o espectro de atributos específicos do componente. Se os seus requisitos ditarem que você precisa do Fluxo e o componente não oferecer suporte a um estado de atributo específico, você poderá criar um LWC integrável para obter um estado de entrada dinâmico. Se você precisar controlar dinamicamente qualquer outra propriedade, como se um campo é obrigatório ou somente leitura, sua melhor aposta no curto prazo é o LWC, em que você tem controle total. Isso é especialmente verdadeiro se você tiver requisitos personalizados para lidar com onblur ou onclick. LWCs reativos em fluxos de tela: Ao criar LWCs que podem reagir e alterar outros componentes em um fluxo de tela, consulte este guia [LWC Best Practices for Screen Flows](https://developer.salesforce.com/blogs/2023/02/lwc-best-practices-for-screen-flows) para garantir que seus componentes se integram bem no mecanismo de tempo de execução de fluxo e funcionem como esperado no futuro.
Manipulação de evento padrão (onblur, onfocus) Manipulação de evento personalizado
Formulários dinâmicos Não disponível Não disponível
Fluxo de tela Não disponível Não disponível
OmniStudio Não disponível Disponível*
Fluxo de tela + LWC Disponível Disponível
LWC Disponível Disponível
*O Tempo de execução padrão do OmniStudio não oferece suporte a Pub/Sub, mas oferece suporte a Windows postMessage
Agora para eventos personalizados. Se algumas das suas entradas ou todo o formulário precisarem se comunicar com outra coisa na página, o LWC será sua única opção. - Para se comunicar dentro da mesma árvore DOM, use a [**interface CustomEvent**](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.events). - Para se comunicar no DOM, use o [**Lightning Messaging Service**](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.use_message_channel). - Se o Lightning Messaging Service [não tiver suporte](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.use_message_channel_considerations) para seu contêiner de destino, use o **módulo pub/sub**. #### Recursos adicionais - Para obter mais detalhes, consulte [Comunicar com eventos](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/events) e [Comunicar no DOM](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.events_pubsub) no Guia do desenvolvedor de _componentes da Web Lightning_. - Para o OmniStudio, consulte [Comunicar com OmniScript a partir de um Componente da Web Lightning.](https://help.salesforce.com/s/articleView?id=sf.os_communicate_with_omniscript_from_a_lightning_web_component_18222.htm&type=5) ### Estilização Para proporcionar a melhor experiência do usuário, você precisará garantir que o estilo do formulário seja consistente com o restante do aplicativo ou site em que ele está integrado. Realizar isso pode significar qualquer coisa, desde a utilização de modelos padrão fornecidos pelo Salesforce até a criação de CSS personalizado que utiliza totalmente cada pixel no design para proporcionar uma aparência mais nítida. #### Perguntas a fazer: - Quão sofisticado é o estilo e o CSS desejados? - Você precisa de um estilo personalizado perfeito para pixels ou está bem com temas padrão?
Estilização direta Temas de organização e do Criador de experiências Estilização perfeita para pixels
Formulários dinâmicos Não disponível Disponível Não disponível
Fluxo de tela Não disponível Disponível Roteiro
OmniStudio Disponível* Não disponível Disponível
Fluxo de tela + LWC Não disponível Disponível Disponível
LWC Não disponível Disponível Disponível
*Apenas cartões flexíveis
O FlexCards é o único produto coberto neste guia que permite controlar declarativamente o estilo e o layout da interface do usuário que você está criando na ferramenta diretamente, sejam elas as margens e o preenchimento, a tipografia, as cores etc. Tanto Formulários dinâmicos quanto fluxos respeitam os recursos de tema declarativo. Se você precisar de controle além do suporte para [Temas do Salesforce](https://help.salesforce.com/articleView?id=brand_your_org_in_lightning_experience.htm&mode=1), [Conjuntos de identidade visual do Criador de experiências](https://help.salesforce.com/articleView?id=community_designer_brandsets.htm) ou [Sites do Experience Cloud do LWR](https://developer.salesforce.com/docs/atlas.en-us.exp_cloud_lwr.meta/exp_cloud_lwr/brand_overview.htm), considere uma solução programática. Para equipes que se sentem à vontade ao trabalhar com CSS, você tem algumas opções: - Fluxos e LWCs herdam [tokens de design padrão](https://developer.salesforce.com/docs/atlas.en-us.lightning.meta/lightning/tokens_standard.htm). - OmniScripts e FlexCards incluem suporte para um sistema de design personalizável: [Newport](https://help.salesforce.com/s/articleView?id=sf.os_customize_omniscripts_and_flexcards_with_the_newport_design_system.htm&type=5). - Com o LWC, você pode escrever seus próprios componentes e controlar totalmente o HTML e o CSS para eles. Sempre que possível, recomendamos usar temas e sistemas de design para que sua aparência seja aplicada de modo consistente em todo o conteúdo. Lembrete: Você pode integrar componentes do Lightning em fluxos. Portanto, se você precisar de controle perfeito por pixel sobre a aparência do seu formulário, mas quiser usar os outros benefícios de fluxos, como o modelo de navegação, poderá ter o melhor dos dois mundos. O mesmo princípio se aplica a OmniScripts e FlexCards. ### Layout Escolher um bom layout é crucial para projetar formulários simplificados que permitem uma entrada de dados rápida e eficiente e aumentam a integridade dos dados. Consulte [Salesforce Well-Architected - Formulários](/docs/architect/pt-br/well-architected/guide/engaging#formulários) para obter mais informações sobre este tópico. #### Perguntas a fazer: - Como você pode utilizar o layout do formulário para otimizar as experiências do usuário? - Como apresentar dados existentes a seus usuários de uma maneira que facilite a inserção de novos dados nos formulários?
2 colunas 4 colunas Além de quatro colunas Repetindo blocos de dados Contêineres de guia Contêineres de acordeão
Formulários dinâmicos Disponível Não disponível Não disponível Não disponível Disponível Disponível
Fluxo de tela Disponível Disponível Não disponível Disponível Não disponível Disponível
OmniStudio Disponível Disponível Disponível Disponível Disponível* Disponível
Fluxo de tela + LWC Disponível Disponível Disponível Disponível Disponível Disponível
LWC Disponível Disponível Disponível Disponível Disponível Disponível
*As guias podem ser usadas ao integrar dados em um FlexCard em um OmniScript
Os Formulários dinâmicos oferecem suporte a layouts de duas colunas e podem ser divididos em seções individuais com campos. Essas seções podem ser colocadas em componentes como guias e acordeões para criar layouts organizados e fáceis de usar. Os fluxos também podem ser renderizados usando o componente Seção. Com seções, você pode adicionar até quatro colunas e quantas seções quiser na tela de fluxo. O componente também é responsivo à largura da tela, assim, ele pode funcionar em telas menores. Por fim, ele permite aplicar a visibilidade condicional a toda a seção, facilitando a aplicação em massa de visibilidade a vários campos dentro da seção. Seções de fluxo também dão suporte a cabeçalhos de coluna e oferecem uma experiência semelhante a acordeão em que os usuários podem recolher toda a seção clicando no rótulo. Os OmniScripts apresentam uma variedade de opções de layout para exibir campos e dados. Você pode criar seções de dados com até 12 colunas, incluindo acordeões condicionalmente recolhíveis. Com o LWC, você pode usar Lightning\[edit|view]-form e o campo Lightning-\[input|output] com suporte para controlar o layout. As únicas restrições de layout são as do HTML/CSS. Lightning respeita a configuração da seção no layout de página associado; por exemplo, se uma seção for de duas colunas no layout de página, ela será de duas colunas nesse componente. ### Tradução Se o formulário for acessível por usuários em diferentes regiões ou que falam diferentes idiomas, você precisará garantir que a ferramenta que estiver usando para criá-lo cumpra os requisitos de localização. Consulte [Salesforce Well-Architected – Localização](/docs/architect/pt-br/well-architected/guide/compliant#localização) para obter orientações e recomendações adicionais. No caso de formulários especificamente, os requisitos de localização geralmente envolvem a tradução de elementos de texto para outros idiomas. #### Perguntas a fazer: - Seu formulário será usado em mais de um país ou região? - O texto no formulário precisa ser localizado para outros idiomas?
Rótulos inseridos no Criador Rótulos no código
Formulários dinâmicos Disponível* Não disponível
Fluxo de tela Disponível Disponível
OmniStudio Disponível Disponível
Fluxo de tela + LWC Disponível Disponível
LWC Não disponível Disponível
*Apenas cabeçalhos da seção de campo
Se você tiver localizado seus campos personalizados, esses rótulos traduzidos serão respeitados em Formulários dinâmicos. O recurso Formulários dinâmicos também respeita [os rótulos personalizados que você atribuiu aos rótulos e atributos de componente](https://help.salesforce.com/s/articleView?id=platform.lightning_page_components_use_expressions_for_labels.htm&type=5) no Criador de aplicativo Lightning. Com o poder do Workbench de tradução, o Fluxo oferece suporte à tradução de rótulos voltados para o usuário para todos os componentes de tela padrão e personalizados. Você pode localizar o rótulo, o texto de ajuda e a mensagem de erro destes componentes da tela: Texto, Área de texto longo, Número, Moeda, Caixa de seleção, Botões seletores, Lista de opções, Lista de opções de seleção múltipla, Grupo de caixas de seleção, Senha, Data e Data/hora. Não há suporte integrado para tradução para ações prontas para uso, como Enviar email ou Publicar no Chatter. No entanto, há uma solução alternativa! Se você definir os rótulos traduzidos com um [rótulo personalizado](https://help.salesforce.com/articleView?id=cl_about.htm), poderá fazer referência a esse rótulo personalizado na ação ou no componente ao configurá-lo no Flow Builder. Crie uma fórmula de fluxo que faça referência ao rótulo personalizado e faça referência a essa fórmula nos locais apropriados em seu fluxo. Os OmniScripts usam rótulos personalizados para traduções. Consulte [este documento de ajuda](https://help.salesforce.com/s/articleView?id=sf.os_create_multi_language_omniscripts.htm) para preparar seus OmniScripts em vários idiomas. Agora para o LWC. Determinados componentes de base herdam automaticamente traduções dos campos do objeto associado, texto de ajuda e mensagens de validação se tiverem sido configurados no Workbench de tradução (por exemplo: Lightning). Se você precisar introduzir novos rótulos traduzíveis no seu código, os rótulos personalizados ainda serão o herói não escrito. Declare o rótulo personalizado necessário e importe-o para seu componente do módulo no escopo @salesforce/label. ### Automação de teste de IU Há várias ferramentas de automação de teste completas disponíveis (por exemplo, Selenium), que permitem simular como o usuário interage com seu formulário. Você pode escrever esses testes para qualquer interface de usuário padrão ou personalizada, incluindo páginas do Lightning e fluxos de tela. No entanto, é importante observar que esses tipos de testes não podem verificar as saídas de cada método que está sendo realizado. Certifique-se de levar isso em conta ao pensar nos seus requisitos para automação de teste de interface do usuário. #### Perguntas a fazer: - Você precisa de testes automatizados para seu formulário? - Quais tipos de testes você precisa realizar? - De que nível de granularidade você precisa em suas automações de teste?
Testes de unidade Automação de ponta a ponta
Formulários dinâmicos Não disponível Disponível*
Fluxo de tela Não disponível Disponível*
OmniStudio Disponível* Disponível*
Fluxo de tela + LWC Disponível* Disponível*
LWC Disponível Disponível
*Requer código
Considere seus requisitos para automação de teste da IU. Os **testes de unidade** permitem uma automação e validação mais granulares que funcionam com os sistemas e ferramentas CI/CD padrão do setor, que podem testar a lógica de negócios dos componentes, seu controlador JavaScript e suas saídas. Ao usar exclusivamente com baixa codificação, você não poderá realizar testes de autoautoria, mas o Salesforce testa rigorosamente nossas ofertas completas. Se os métodos do seu componente forem complexos o suficiente para que sejam testados individualmente, coloque-os em arquivos JavaScript dedicados. Dessa forma, você pode importá-los para um LWC e para um teste Jest com algo como `import { sort } from 'c/utils';`. Consulte [Automação de teste de UI no Salesforce](https://developer.salesforce.com/blogs/2020/01/ui-test-automation-on-salesforce.html) para obter uma comparação das várias opções disponíveis para criar automação completa no Salesforce. Incluem considerações sobre quando usar uma solução sem código de um ISV, Build Your Own solução de automação de teste personalizada ou usar uma estrutura de teste de código aberto como Selenium WebDriver ou WebdriverIO. Essas soluções são válidas para qualquer interação da IU no Salesforce, seja um Formulário dinâmico em uma página do Lightning, um fluxo de tela em uma barra de utilitários ou um LWC em um fluxo em ação rápida. ### Métricas Depois de implementar seu formulário em um ambiente de produção, você vai querer garantir que ele esteja sendo usado de modo eficaz. Dependendo do seu caso de uso, isso pode significar qualquer coisa, desde simplesmente rastrear o número de vezes que ele foi preenchido até a quantidade de tempo que os usuários passam preenchendo-o antes de enviar suas informações. Identifique os KPIs que deseja rastrear antes de escolher uma ferramenta. #### Perguntas a fazer: - Você precisa rastrear o uso do seu formulário? - Quais KPIs determinam se seu formulário está sendo usado de modo eficaz?
Exibições de página Tempo gasto no formulário Rastrear conclusão do formulário Rastrear a taxa de sucesso
Formulários dinâmicos Disponível** Não disponível Não disponível Não disponível
Fluxo de tela Disponível Disponível* Disponível Disponível
OmniStudio Disponível Disponível* Disponível Disponível
Fluxo de tela + LWC Disponível Disponível* Disponível Disponível
LWC Disponível** Disponível* Disponível Disponível
*Disponível quando o Tempo de execução do OmniStudio baseado em pacote está habilitado
** Disponível ao rastrear o uso de página pai do Lightning
Se precisar rastrear o uso geral e a adoção do formulário, comece com as ferramentas de baixa codificação. Tanto Formulários dinâmicos quanto Fluxos de tela podem ser rastreados usando tipos de relatório personalizados prontos para uso, embora você obtenha mais granularidade dos relatórios de rastreamento de Fluxo de tela. Se você precisar rastrear o uso de um LWC, a disponibilidade pronta para uso dependerá de onde você está usando esse LWC. Se estiver em uma página do Lightning, tudo o que estiver disponível para rastrear o uso da página do Lightning será aplicado ao seu LWC. A mesma história se aplica a LWCs integrados a fluxos. Os formulários dinâmicos não podem ser rastreados prontos para uso, embora você possa rastrear o uso da página pai do Lightning por meio de [objetos de uso do Lightning](https://help.salesforce.com/articleView?id=lex_usage_reports.htm). Para rastrear as páginas padrão do Lightning, use o tipo de relatório personalizado _Usuários com uso do Lightning por métricas de página_. Para o mesmo em páginas personalizadas do Lightning, use o tipo de relatório personalizado _Usuários com uso do Lightning por métricas FlexiPage_. Para rastrear a adoção do seu formulário específico (não apenas a página em que ele está), o Fluxo tem você coberto. Use o "Relatório de fluxo de amostra: Fluxos de tela" para responder a perguntas como: - Qual é a taxa de conclusão para esse formulário? Está sendo bem adotado? - Quanto tempo os usuários levam para preencher esse formulário? - Em qual tela os usuários passam mais tempo? - Com que frequência os usuários navegam para trás? - Com que frequência ocorrem erros? Se o relatório padrão não atender às suas necessidades, clone-o para fazer suas próprias alterações ou Build Your Own do zero usando o tipo de relatório _Fluxos de tela_. Se você estiver usando o tempo de execução do OmniScript baseado em pacote, poderá utilizar o [Serviço de rastreamento do OmniStudio para Vlocity](https://help.salesforce.com/s/articleView?id=sf.os_vlocity_tracking_service.htm&type=5). Esse serviço rastreia qualquer tipo de evento. Por exemplo, você pode rastrear o tempo que leva para concluir as etapas em um OmniScript para identificar melhorias no processo. Está no roteiro da equipe do OmniStudio para dar suporte a esse serviço no OmniStudio padrão. Para rastrear o mesmo para um LWC que não esteja integrado a um fluxo de tela, OmniScript ou página do Lightning, não há opção pronta para uso. Você pode criar uma solução personalizada usando o Apex. ### Empacotamento e implantação Quando você precisa implantar sua solução em ambientes mais altos para testes ou implantação em produção, pode ser usado para usar conjuntos de alterações ou DevOps Center para fazer isso. Formulários dinâmicos, fluxos e LWCs têm suporte total nessas opções de implantação. O OmniStudio requer uma ferramenta separada: [IDX Workbench](https://help.salesforce.com/s/articleView?language=en_US&id=sf.os_idx_workbench_desktop_application.htm&type=5). #### Perguntas a fazer: - Como você planeja implementar seu formulário? - Seu formulário será distribuído para mais de uma organização do Salesforce?
Pacotes gerenciados de primeira geração (1GP) Pacotes gerenciados de segunda geração (2GP) Pacotes desbloqueados Conjuntos de alterações DevOps Center
Formulários dinâmicos Disponível Disponível Disponível Disponível Disponível
Fluxo de tela Disponível Disponível Disponível Disponível Disponível
OmniStudio Não disponível Não disponível Não disponível Não disponível* Não disponível*
Fluxo de tela + LWC Disponível Disponível Disponível Disponível Disponível
LWC Disponível Disponível Disponível Disponível Disponível
*Use o Workbench do IDX para implementar soluções do OmniStudio em outras organizações.
Se você for um ISV ou parceiro que planeja empacotar sua solução para distribuição no AppExchange, recomendamos procurar primeiro Formulários dinâmicos, Fluxos e LWCs. O OmniStudio não oferece suporte a empacotamento. ## Tópicos adicionais ### Navegar do Continuum de baixo código para o Continuum de pro code Este guia foi focado em ajudá-lo a entender qual funcionalidade e nível de personalização é possível com Formulários dinâmicos, fluxos de tela, OmniStudio e LWC. Em um nível alto: Contínuo de baixo código para pro código
- O LWC é a opção mais personalizável e robusta para criar um formulário, mas tem o menor número de proteções em vigor. Cabe a você criar um componente de uma maneira que garanta a [segurança](/docs/architect/pt-br/well-architected/guide/secure) e a [escalabilidade](/docs/architect/pt-br/well-architected/guide/reliable#escalabilidade). - Formulários dinâmicos são os menos flexíveis, mas há muito menos oportunidades para erros. - O Fluxo e o OmniStudio estão em algum ponto no meio, mais poderosos que Formulários dinâmicos, mas não no nível do LWC. No mesmo token, eles têm menos proteções do que Formulários dinâmicos, mas são mais difíceis de quebrar do que o código personalizado. Se várias ferramentas caberem à conta, a decisão será sobre qual ferramenta é a certa para sua equipe. Outros [Guia de Decisão de Arquiteto](/decision-guides) apresentam aspectos adicionais a serem considerados ao tomar essa decisão. Não vamos entrar nos detalhes de cada um desses aspectos aqui, mas vamos interpretá-los para as ferramentas específicas que este documento está avaliando. **Habilidades especiais**: Quanto conhecimento sua equipe tem nas ferramentas que você está comparando? Quantos criadores conhecem bem o LWC ou JavaScript? Que tal criadores que são especialistas no Flow Builder ou que manifestaram interesse em detalhar? Geralmente, as habilidades de fluxo e formulários dinâmicos são mais alcançáveis para uma população mais ampla de pessoas que criam formulários. Formulários dinâmicos são a ferramenta de criação de formulário mais declarativa e sempre serão mais fáceis de aprender do que o Fluxo. Dito isto, a equipe do Fluxo está comprometida em manter essa barra o mais baixa possível. Em termos de complexidade, o OmniStudio fica em algum ponto entre o Fluxo e o LWC e oferece superpoderes significativos de criação de formulário. **Delegation of Delivery**: Apenas porque alguns de seus requisitos exigem o LWC não significa que toda a sua solução precisa ser criada com o LWC. Considere como você pode criar sua solução de modo modular, de modo que as peças que exigem LWC sejam codificadas e as peças que não são criadas em uma solução de baixa codificação. Fazer isso maximiza a eficiência de uma equipe diversificada e garante que cada indivíduo esteja resolvendo problemas apropriados para sua especialização. Agora vamos falar sobre Fluxo e LWC. Com Componentes de tela reativos, os componentes de fluxo de tela agora podem conversar entre si na mesma tela, desbloqueando uma nova cesta de ferramentas para arquitetos, administradores e desenvolvedores. Os desenvolvedores agora podem criar componentes modulares que podem ser reutilizados em toda a organização, aumentando a produtividade para todos na equipe. Os desenvolvedores podem se concentrar em resolver novos desafios e economizar tempo usando uma combinação de componentes de Fluxo padrão e personalizados para alcançar o dinamismo da forma. Com componentes reativos no Fluxo, nunca houve um momento mais adequado para combinar Fluxo e LWC ao criar seus formulários. **Manutenção e propriedade de longo prazo**: Se você tiver um formulário de várias etapas, é uma boa ideia começar com Fluxo ou uma combinação de Fluxo e LWC. Se você tiver uma equipe com pouco código mantendo a solução, pense em como tornar a solução o mais configurável e extensível possível para esse público. Seja qual for a ferramenta que você escolher, organize sua solução em unidades [compostables](/docs/architect/pt-br/well-architected/guide/composable) para melhorar a manutenção e a estabilidade. ### Layouts de página Avançando, a maneira recomendada de configurar páginas de detalhes de registro é Formulários dinâmicos no Criador de aplicativo Lightning usando páginas do Lightning. Há muito tempo que não temos layouts de página aprimorados e essa tendência continuará. Este é o motivo: - Os Formulários dinâmicos são mais flexíveis: você pode colocar campos e seções onde quiser diretamente no Criador de aplicativo Lightning, onde você pode aproveitar seções, guias e acordeões. Assim como você pode fazer com componentes na página do Lightning, você pode controlar a visibilidade de seus campos e seções sem definir vários layouts de página ou tipos de registro. - Com os componentes Acordeão e Guia, você pode restringir a quantidade de campos exibidos inicialmente. Adivinha o que isso significa? Tempos de carregamento de página mais rápidos. - O gerenciamento de layout é mais simples com páginas do Lightning, pois você pode gerenciar tudo sobre suas páginas no Criador de aplicativo Lightning – seja o conteúdo da página ou quais usuários têm acesso à página. Não é mais necessário fazer atualizações no layout de página para fazer uma alteração na página do Lightning. Sem mencionar que, com o poder das regras de visibilidade, você não precisa mais criar várias páginas (ou layouts de página) para controlar quem vê quais campos quando. Isso também significa que você só precisa atribuir aos usuários uma página do Lightning em vez de atribuir uma página do Lightning e um layout de página. Recomendamos usar Formulários dinâmicos sempre que possível e voltar aos layouts de página apenas quando necessário. Como sempre, recebemos feedback no [Idea Exchange](https://ideas.salesforce.com/s/) sobre as melhorias que teriam maior impacto na sua organização. ### Desempenho Qualquer consideração de desempenho relacionada a Formulários dinâmicos, fluxos de tela, OmniStudio e LWC se concentra na estrutura em que essas próprias tecnologias se sentem. As baseadas no LWC (além, claro, de um LWC) terão um desempenho superior às baseadas no Aura. A estrutura do LWC oferece um desempenho melhor porque os principais recursos são implementados nativamente em mecanismos da Web em vez de em JavaScript por meio de abstrações de estrutura. Se você não está familiarizado, dê uma leitura a [este post](https://developer.salesforce.com/blogs/2018/12/introducing-lightning-web-components.html). Em 2019, realizamos um [case study](https://developer.salesforce.com/blogs/2019/06/case-study-dreamhouse-gains-speed-by-switching-to-lwc.html) comparando o desempenho da mesma funcionalidade no Aura versus no LWC. Como resultado da conversão do DreamHouse do Aura para o LWC, não apenas a experiência de desenvolvimento estava muito mais alinhada aos padrões e padrões de desenvolvimento de front-end da Web atuais, mas os ganhos de desempenho eram significativos. As medições de laboratório mostraram ganhos na faixa de **2,4% a 24,7%** para cache frio e ganhos na faixa de **31,83% a** **63,32%** para cache quente nas mesmas duas páginas. Agora, qual estrutura nossas tecnologias de formulário estão usando? Em outras palavras, quais tecnologias de forma se beneficiam desse desempenho superior? - O recurso Formulários dinâmicos, que está integrado aos metadados das páginas do Lightning, é construído sobre uma base que usa a pilha do LWC, que nos permitirá implementar alguns recursos muito solicitados. Como um bônus de desempenho, os Formulários dinâmicos usam renderização progressiva, o que resulta em um tempo de carregamento de página aprimorado para páginas com um grande número de campos. - Os Fluxos de tela são criados no LWC com a maioria dos componentes individuais prontos para uso agora convertidos no LWC, com a exceção de dois componentes prontos para uso: Upload de arquivo e imagem. Embora a equipe do Fluxo tenha convertido o cliente de tempo de execução de fluxo para o LWC, bem como a maioria de seus componentes, os clientes ainda precisam converter seus componentes da tela do Aura para o LWC. Além disso, o Salesforce oferece suporte apenas a componentes do LWC na nova estrutura de componente reativo em fluxos de tela. Existe um excelente módulo do Trailhead que explica como fazer isso: Componentes da Web do [Lightning para desenvolvedores do Aura](https://trailhead.salesforce.com/en/content/learn/modules/lightning-web-components-for-aura-developers). É evidente que: Se você estiver pensando em criar um componente personalizado para um fluxo de tela ou qualquer outro contêiner, sempre vá para o LWC. - Há algumas versões do OmniStudio disponíveis. Se você for um cliente de longa data, poderá estar usando Angular. Incentivamos todos os novos clientes a começar com OmniScripts e FlexCards baseados em LWC e para que os clientes atuais migrem do Angular. - O LWC é baseado em... LWC, claro. Este é um prêmio gratuito. ## Observações de fechamento Como um arquiteto, é importante ter uma compreensão sólida de todas as opções disponíveis para você e como aplicá-las em seu caso de uso específico. Para criar formulários no Salesforce, as opções variam de baixo código (usando Formulários dinâmicos no Criador de aplicativo Lightning, Fluxos de tela no Flow Builder e OmniScripts no OmniStudio) a pro-código (usando a estrutura LWC), com uma combinação de fluxos de tela ou OmniScripts e LWC no meio. Lembre-se deste guia e use-o como referência ao planejar criar ou reprojetar formulários no Salesforce. Se você está procurando orientação sobre como criar formulários simplificados e úteis, consulte [Salesforce Well-Architected: Engraçado](/docs/architect/pt-br/well-architected/guide/engaging). ### Diga-nos o que você pensa Ajude-nos a garantir que estejamos publicando o que é mais relevante para você: [pegue nossa pesquisa](https://forms.gle/FCFCES6vsRbKv4E29) para fornecer feedback sobre esse conteúdo e diga-nos o que você gostaria de ver em seguida. ## Visão geral do guia Há várias maneiras de acessar, sincronizar e compartilhar dados entre o Salesforce e sistemas externos. Porém, nem todas as ferramentas são adequadas para seu projeto específico. Este guia apresenta o panorama das ferramentas de integração de dados disponíveis no Salesforce. Ele também oferece recomendações para as ferramentas (ou combinações de ferramentas) mais adequadas para um determinado caso de uso, bem como orientações sobre ferramentas para evitar em cenários específicos. Este guia de decisão foca integrações no nível de dados envolvendo o Salesforce. Especificamente, ele abrange os seguintes casos de uso de integração de dados: - Salesforce para sistemas externos - Sistemas externos para o Salesforce - Organização do Salesforce para organização do Salesforce Esses são apenas um subconjunto dos desafios de integração que os Arquitetos do Salesforce enfrentam, assim, planejamos adicionar mais guias de decisão focados na integração conduzida por evento, criar fluxos de trabalho eficazes voltados para o cliente ou para o funcionário usando a integração de processos e assim por diante. Por fim, é importante observar que muitas das ferramentas e abordagens descritas aqui podem ser usadas para resolver desafios de integração em toda a empresa, mas esses usos estão além do escopo deste guia. ### Capturas - **Evite replicação desnecessária de dados.** A menos que os dados absolutamente precisem residir no Salesforce, considere a virtualização de dados com o Salesforce Connect. Mais dados em sua organização resultam em maiores volumes de dados, o que pode afetar negativamente o [desempenho](/docs/architect/pt-br/well-architected/guide/reliable#desempenho) e aumentar o débito técnico. Se seus dados já residem no Salesforce e você precisar deles em um sistema externo, evite copiá-los para um sistema externo, a menos que seja absolutamente necessário. Em vez disso, permita que o sistema externo acesse os dados por meio das APIs do Salesforce. - **Use o MuleSoft ou outras soluções Enterprise Service Bus (ESB) ou Extract-Transform-Load (ETL), se disponíveis e parte de sua paisagem existente.** Como essas ferramentas são criadas para ajudar a dar suporte à migração e à transformação de dados, elas geralmente têm recursos poderosos que permitem reutilizar integrações em toda a empresa, manter uma governança mais forte e centralizar o gerenciamento de integrações. Neste guia, sempre que o MuleSoft Anypoint for recomendado, considere se sua solução ESB/ETL existente será suficiente. - **Harmonize dados de diferentes origens com o Data 360 e o Data Cloud One.** Por meio do Modelo de Dados Customer 360, resolução de identidade, federação de dados e outros recursos, o Data 360 consolida dados do Salesforce e outros sistemas externos em uma visão unificada do seu cliente. Com o [Data Cloud One](/docs/architect/pt-br/fundamentals/guide/data360_integration_patterns_and_practices.html#unified-multi-org-data-platform-with-data-cloud-one), os usuários em outras organizações do Salesforce podem acessar com segurança dados compartilhados virtualmente no Data 360 por meio de espaços de dados. - Mova dados entre organizações usando **ações e ativações do Data 360.** Depois que os dados são ingeridos de diferentes organizações no Data 360, as [ações e ativações de](/docs/architect/pt-br/fundamentals/guide/data360_integration_patterns_and_practices.html#data-activation-patterns--data-outbound) dados podem sincronizar os dados com outra organização. Essa abordagem pode ser muito útil para integrações com organizações do Marketing Cloud. - Extraia e mova dados usando o **MuleSoft Anypoint.** O MuleSoft Anypoint pode ser usado para extrair dados do Data 360 usando a API do Connect e a API do Data Graph e movê-los para outra organização do Salesforce. Sem o Data 360, o MuleSoft Anypoint também pode ser usado quando os dados precisam ser movidos entre organizações sem serem replicados no Data 360. - **Tome cuidado se você optar por criar com Mensagens de saída.** A Salesforce continuará oferecendo suporte a Mensagens de saída dentro das capacidades funcionais atuais, mas não planeja fazer mais investimentos nessa tecnologia. - **A licença de usuário de integração com o perfil "apenas API" é sempre recomendada para todas as integrações.** A Salesforce também recomenda usar Aplicativos cliente externos (em favor de aplicativos conectados ou login SOAP) como os padrões AuthN e AuthZ devidamente autorizados para todas as integrações. ## Considerações comuns sobre a escolha de ferramentas de integração de dados Antes de se aprofundar nas ferramentas de integração de dados disponíveis, é importante ter em mente algumas considerações comuns ao escolher uma ferramenta. Como acontece com a arquitetura, não há uma resposta prescritiva para todos os desafios de negócios. Se você tiver pronunciado as palavras "depende" ao fazer escolhas de integração, está no lugar certo.
Área a considerar Perguntas comuns
Ferramentas e paisagem existentes Existe uma solução de ETL ou ESB existente? Os dados envolvidos têm requisitos regulatórios ou de conformidade? Onde estão os sistemas que você está tentando integrar (na nuvem ou no local)?
Fluxo de dados (tempo, experiência do usuário esperada, direcionalidade) Os dados precisam se mover de modo síncrono, assíncrono ou podem ser agendados/loteados? A replicação de dados é obrigatória? Qual sistema deve ser a fonte da verdade? Qual é a origem de dados? Qual é o destino? A interação do usuário é obrigatória? O usuário precisa ver o resultado da integração? Quais são as necessidades quanto ao gerenciamento de exceções (retomar, notificar, falhar)? Qual deve ser o nível de acoplamento dos sistemas?
Implementação Qual é o nível de esforço para sistemas que não sejam do Salesforce? Quais equipes são responsáveis por fornecer integrações? Que ferramentas eles preferem usar?
Manutenção Que equipes deverão manter a integração? Quais habilidades eles têm no momento? De quais habilidades eles precisarão no futuro? Qual é o custo total de propriedade ao longo do tempo? Qual é a importância da capacidade de testar, depurar e solucionar problemas com ferramentas de código baixo ou profissional?
Data Volume Quantos dados estão envolvidos na integração? Você estará trabalhando com grandes volumes de dados (LDV)? Com que frequência as alterações ocorrerão em massa? Que tipo de impacto as atualizações do singleton terão? Com que frequência eles ocorrerão?
Limites Os dados precisarão passar por uma transformação complexa? Os dados precisam ser combinados de vários sistemas de origem? Com que frequência uma integração ocorrerá por usuário? Quantos usuários no total? Você planejou com antecedência para carregamentos de dados em massa (por exemplo: carregamento inicial de dados para uma nova instância)?
## Comparação de produto Esta é uma visão geral de alto nível das ferramentas disponíveis para integração de dados e algumas considerações para começar a avaliar cada opção. As seções a seguir incluem casos de uso aprofundados e detalhes sobre os recursos dessas ferramentas.
Do Salesforce para sistema externo Do sistema externo para o Salesforce Execução Licença adicional necessária
Ações do Apex Disponível Disponível Lado do servidor Não
Captura de dados de alteração Disponível Não disponível Lado do servidor Não*
Apex personalizado (Serviços da Web REST e SOAP) Disponível Disponível Lado do servidor Não
Serviços externos Disponível Não disponível Lado do servidor Não
Heroku Connect Disponível Disponível Lado do servidor Sim
Data 360 Disponível Disponível Lado do servidor Sim
MuleSoft Anypoint Disponível Disponível Lado do servidor Sim
APIs nativas do Salesforce Não disponível Disponível Lado do servidor Não
OmniScript Disponível Disponível Parte do cliente*** Sim
Procedimento de integração do OmniStudio Disponível Disponível Lado do servidor Sim
Mensagens de saída Não ideal Não disponível Lado do servidor Não
Eventos de plataforma Disponível Disponível Lado do servidor Não**
Salesforce Connect/Objetos externos Disponível Disponível Lado do servidor Sim
[\*Adição necessária para casos de uso de evento de captura de dados de alteração de alto volume](https://developer.salesforce.com/docs/atlas.en-us.change_data_capture.meta/change_data_capture/cdc_allocations.htm) [\*\*Adição necessária para casos de uso de evento de plataforma de alto volume](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_event_limits.htm) \*\*\* Adequado em situações em que é normal que a lógica de negócios seja executada no navegador da Web. Legenda da coluna: - **Disponível**: funciona bem para a maioria dos casos de uso - **Não Ideal**: possível, mas considere uma ferramenta alternativa - **Não disponível**: não há planos de suporte nos próximos doze meses ### Outras ferramentas que podem estar envolvidas na movimentação de dados para dentro e para fora do Salesforce: Há outras ferramentas que podem dar suporte a alguns aspectos de uma integração de camada de dados, mas não devem ser consideradas um meio primário de resolver problemas de integração. Vamos dar uma olhada rápida nessas ferramentas agora. Os **Componentes da Web Lightning** são normalmente usados para integrações de processos, mas podem fazer chamadas usando a funcionalidade JavaScript, portanto, os dados podem estar envolvidos nessas transações. O **Fluxo do Salesforce** pode ser usado para orquestrar chamadas externas com Serviços externos ou Ações do Apex. O Salesforce Flow por si só não é considerado uma ferramenta de integração de dados independente. O Assistente de **importação de dados e o Data Loader** podem ser usados para sincronizar, importar e migrar dados. Embora os comandos do Data Loader também possam ser scriptados para automatizar a importação e exportação de dados, a [interface de linha de comando](https://developer.salesforce.com/docs/atlas.en-us.dataLoader.meta/dataLoader/command_line_intro.htm) é somente para Windows e nenhuma dessas ferramentas é uma base recomendada para uma estratégia de integração de dados. Em vez disso, use-os para complementar sua estratégia de manutenção e gerenciamento de dados. Os comandos de dados [**Salesforce CLI**](https://developer.salesforce.com/docs/atlas.en-us.sfdx_cli_reference.meta/sfdx_cli_reference/cli_reference_force_data.htm) podem ser usados para manipular registros em sua organização. Os comandos estão disponíveis para ajudá-lo a importar e exportar dados com a API em massa e a API de salvamento de árvore de SObject e realizar operações CRUD simples em registros individuais com a API REST. O Salesforce CLI por si só não é considerado uma ferramenta de integração de dados independente. O **OmniStudio Data Mapper** pode ser usado como uma ferramenta ETL declarativa para mover dados entre objetos do Salesforce e estruturas de dados JSON. Embora uma interface REST seja criada automaticamente para cada interface do Data Mapper, fornecendo uma maneira declarativa de mover dados de sistemas externos para objetos do Salesforce, o Data Mapper independente não é uma base recomendada para uma estratégia de integração de dados. As ações do Mapeador de dados estão disponíveis em Procedimentos de integração do OmniStudio. [**Dataloader.io**](http://dataloader.io/) é outra ferramenta de carregamento de dados para o Salesforce habilitada pela Anypoint Platform da MuleSoft que permite importar, exportar e excluir de forma rápida e segura quantidades ilimitadas de dados para a sua empresa. O Dataloader.io não é uma base recomendada para uma estratégia de integração de dados. ## Salesforce para sistemas externos (integração de saída) Para integrações de saída do Salesforce, você pode considerar diferentes tipos de ferramentas: low-code, pro-code ou hybrid. As seções a seguir fornecem orientação para cada um desses tipos de ferramenta e oferecem soluções de amostra. - [Ferramentas de baixo código para integrações de saída](#ferramentas-de-baixa-codificação-para-integrações-de-saída-do-salesforce) - [Ferramentas híbridas para integrações de saída](#ferramentas-híbridas-para-integrações-de-saída-do-salesforce) - [Ferramentas pro-código para integrações de saída](#ferramentas-de-código-profissional-para-integrações-de-saída-do-salesforce) ### Ferramentas de baixa codificação para integrações de saída do Salesforce
Diretrizes Licenciamento Tempo Volume e escala Entrega e manutenção Privacidade e segurança
Quando usar Licença adicional Sincronizar (solicitação/resposta) ou assíncrono (ativar/esquecer) Suporte para vários objetos LDV/Bulk Teste e implantação** Depuração Comportamento de retry/tratamento de erro integrado Pode ser usado com dados criptografados em repouso Protocolo de autenticação
Captura de dados de alteração Quando você precisa publicar alterações no nível do registro feitas no Salesforce em um sistema externo e não precisa de uma carga útil personalizada. Obrigatório Assíncrono Não Não Sim Com ferramentas de código profissional Sim Sim OAuth
Serviços externos Quando você está orquestrando um processo usando o Fluxo, o Apex, Bots do Einstein ou OmniStudio e as APIs do sistema externo são descritos usando especificações OpenAPI. Não necessário Sincronizar Sim Não Sim Com ferramentas de código profissional Não N/A Credenciais nomeadas
Heroku Connect Quando você deseja estender seus dados com sincronização bidirecional para habilitar aplicativos móveis e outros no Heroku e deseja que os dados também sejam replicados ao Salesforce. Obrigatório Assíncrono Sim Sim Não Com ferramentas de código profissional Sim Sim, por meio do Shield Connect OAuth
Procedimento de integração do OmniStudio Quando você precisa transformar dados sem interação com o usuário e melhorar o desempenho processando no servidor, em vez do navegador. Obrigatório Ambos Sim Sim Sim Suporte declarativo Sim Sim Credenciais nomeadas
Salesforce Connect/Objetos externos Quando você deseja que os dados apareçam na IU do Salesforce, mas que os dados sejam armazenados em um sistema externo. Os dados não são replicados para o Salesforce. Obrigatório Sincronizar Não Sim* Sim Com ferramentas de código profissional e um rastreador declarativo Não N/A Credenciais nomeadas
*Adaptadores OData mais antigos que a versão 4.01 estão sujeitos a limites de chamada. Consulte Considerações sobre o limite de taxa de chamada OData para obter mais detalhes. ** Teste e implantação refere-se à capacidade de criar em um ambiente inferior e implantar por meio da API de metadados, pacotes ou conjuntos de alterações para produção.
### Caso de uso: Integração de saída usando ferramentas de baixa codificação > Quando as oportunidades são ganhas, um pedido para os produtos associados precisa ser criado no sistema ERP ou no sistema de gerenciamento de pedidos da empresa. **Captura de dados de alteração** À medida que os registros de Oportunidade são atualizados, a Captura de dados de alteração publica eventos de alteração que contêm as atualizações dos objetos. Os eventos de alteração são consumidos do lado do cliente por meio de uma conexão CometD (ou por meio de um conector do MuleSoft) e usados para atualizar o sistema de gerenciamento de pedido ou ERP do cliente. Os eventos de alteração podem ser aprimorados para sempre incluir IDs de registro externos ou outros dados do objeto (como região) necessários para a integração. Fluxos de evento de alteração para vários objetos podem ser combinados em _canales_ para simplificar o processamento de assinatura e fluxo (para que você possa assinar e processar um fluxo em vez de muitos). **Serviços externos** Se você tiver um serviço da Web compatível com a especificação OpenAPI 2.0 ou 3.0, poderá expor as operações e serviços como um Serviço externo no Salesforce. As operações da API (por exemplo, criar pedido) podem ser chamadas como uma Ação invocável em um fluxo criado com o Flow Builder quando o estágio da oportunidade for alterado para "Ganho". **Heroku Connect** O Heroku Connect geralmente é usado para manter um banco de dados Heroku Postgres e o Salesforce sincronizados. Se o cliente usar o Heroku Postgres como sua loja transacional de origem da verdade, você poderá sincronizar os registros e as alterações do Salesforce para o Heroku Postgres usando o Heroku Connect. De lá, você pode usar os Conectores de streaming do Heroku para publicar essas alterações no Apache Kafka e enviá-las como eventos para aplicativos downstream, incluindo o ERP ou o sistema de gerenciamento de pedidos. **Procedimento de Integração do OmniStudio** Quando um pedido é enviado, o OmniScript que orquestra o processo pode publicar os detalhes do pedido em um conector ERP ou MuleSoft. A publicação pode ser executada diretamente pelo OmniScript (do lado do cliente) ou indiretamente por meio de um Procedimento de integração (do lado do servidor). Se o sistema ERP gerar um erro de validação, a IU do OmniScript deverá notificar o usuário e, se necessário, traduzir e contextualizar o erro para o usuário. **Salesforce Connect/Objetos externos** Você pode criar um fluxo acionado por registro no Salesforce que insere um registro nos objetos externos relacionados quando o estágio da oportunidade for alterado para "Ganho". Uma vez que essa é uma [transação mista](https://help.salesforce.com/articleView?id=000328873&type=1&mode=1), para evitar erros, adicione um elemento de pausa por zero segundos entre a atualização de Oportunidade e a inserção de objetos externos relacionados para que você feche um contexto de transação antes de iniciar uma nova. ### Ferramentas híbridas para integrações de saída do Salesforce
Diretrizes Licenciamento Tempo Volume e escala Entrega e manutenção Privacidade e segurança
Quando usar Licença adicional Sincronizar (solicitação/resposta) ou assíncrono (ativar/esquecer) Suporte para vários objetos LDV/Bulk Teste e implantação** Depuração Comportamento de retry/tratamento de erro integrado Pode ser usado com dados criptografados em repouso Protocolo de autenticação
Ações do Apex Quando você deseja automatizar chamadas para outro sistema por meio do Salesforce Flow. Um desenvolvedor pode escrever uma classe do Apex que um fluxo pode invocar ou você pode baixar uma solução predefinida do AppExchange. Não necessário Ambos Sim Não Sim Com ferramentas de código profissional Não Sim Vários
Retransmissões de evento Quando você precisar enviar eventos de plataforma e alterar eventos de captura de dados para o Amazon EventBridge do Salesforce. As retransmissões de evento se conectam apenas ao AWS Eventbridge Não Assíncrono Sim Não Sim Sim Sim Sim HTTP/1.1 com TLS
Mensagens de saída Quando você precisa enviar mensagens SOAP por HTTP(S) para um ponto de extremidade designado com recebimento garantido quando acionado por uma regra de fluxo de trabalho. Não necessário Assíncrono Não Não Sim Suporte declarativo Sim Sim TLS bidirecional
Eventos de plataforma Quando você precisa de uma carga útil personalizada e estruturada para alterações quase em tempo real no Salesforce ou em um sistema externo. Não necessário* Assíncrono Sim Não Sim Com ferramentas de código profissional Sim Sim OAuth
Objetos externos do Salesforce Connect (com adaptadores personalizados do Apex) Quando você deseja que os dados apareçam na interface do usuário do Salesforce, mas que os dados sejam armazenados em um sistema externo que não possa usar protocolos padrão como OData ou GraphQL. Obrigatório Ambos Sim Sim Sim Com ferramentas de código profissional Não N/A Vários
Data 360 Quando você deseja harmonizar dados de diferentes origens em um repositório de dados ou replicar seus dados para outras organizações do Salesforce ou para outros sistemas externos. Obrigatório Ambos Sim Sim Sim Sim Sim Sim Vários
[\*Adição](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_event_limits.htm) necessária para casos de uso de grande volume. \*\*Teste e implantação refere-se à capacidade de criar em um ambiente inferior e implantar por meio da [API de metadados](https://developer.salesforce.com/docs/metadata-coverage/), pacotes ou conjuntos de alterações para produção. ### Caso de uso: Integração de saída usando ferramentas híbridas > Quando as oportunidades são ganhas, um pedido para os produtos associados precisa ser criado no ERP ou no sistema de gerenciamento de pedidos da empresa. **Ações do Apex** Um fluxo acionado por registro com base no estado da oportunidade pode ser acionado automaticamente quando uma oportunidade é ganha. O fluxo executa uma ação invocável que usa uma chamada externa para enviar o pedido ao sistema de gerenciamento de pedidos ou à solução ERP. Envios de alto volume e pedidos de vários sites são processados por mecanismos de lote e fila do Apex. **Mensagens de saída** Depois de [configurar as mensagens de saída](https://developer.salesforce.com/docs/atlas.en-us.api.meta/api/sforce_api_om_outboundmessaging_setting_up.htm), você pode definir uma regra de fluxo de trabalho acionada pela atualização de oportunidade para enviar uma mensagem SOAP por HTTP(S) para um URL de ponto final especificado que hospeda o ouvinte. A mensagem conterá os campos especificados quando a mensagem de saída foi criada. Se as informações no objeto mudarem depois que a notificação for colocada na fila, mas antes de ela ser enviada, somente as informações atualizadas serão entregues e as mensagens permanecerão na fila até o envio ser bem-sucedido ou até que tenham 24 horas. Após 24 horas, as mensagens são eliminadas da fila. Se o sistema ERP precisar de dados adicionais, você poderá passar o sessionId em mensagens de saída para que o sistema externo possa fazer uma solicitação de retorno. **Eventos de plataforma** Você pode definir um evento de plataforma que inclua a carga útil personalizada com os dados necessários para criar os registros no sistema externo. Como os Eventos de plataforma não são publicados automaticamente na mudança de registro, você deve publicar o evento por meio do Apex, do Salesforce Flow ou do Criador de processos quando o estágio da oportunidade for alterado para "Ganho". Um serviço externo escuta o canal de evento da plataforma usando CometD (ou um conector do MuleSoft) e cria os registros apropriados no sistema externo. **Objetos externos do Salesforce Connect (com adaptadores do Apex personalizados)** Uma solução baseada em objetos externos do Salesforce Connect não é perfeitamente adequada para um caso de uso que exija sincronização de dados. No entanto, essa solução pode se aplicar a casos em que os usuários no Salesforce precisam ver e possivelmente interagem com dados do sistema externo e os dados não podem ser replicados no Salesforce. Se o ERP ou o sistema de gerenciamento de pedidos não suportam protocolos OData ou GraphQL, a equipe de desenvolvimento pode usar o [Apex Connector Framework](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_connector_start.htm) para escrever classes do Apex que lidam com a comunicação com o sistema externo por meio de um protocolo compatível. **Data 360** Uma solução baseada no Data 360 é perfeitamente adequada para casos de uso em que precisamos de dados harmonizados de diferentes fontes em um único repositório de dados. Ele também pode ser usado quando precisamos replicar dados de uma organização do Salesforce para várias organizações do Salesforce ou para outros sistemas externos usando o Data 360 como um data hub. Quando uma oportunidade é ganha e atualizada na organização de origem, os dados da oportunidade são sincronizados com o Data 360, onde podem ser replicados em outros sistemas, incluindo organizações do Salesforce, usando diferentes mecanismos, como ações, ativações e APIs. Da mesma forma, uma oportunidade pode ser referenciada sem replicar os dados em outras organizações do Salesforce usando o Data Cloud One. No entanto, o Data Cloud One não oferece suporte a plataformas que não sejam do Salesforce. ### Ferramentas de código profissional para integrações de saída do Salesforce
Diretrizes Licenciamento Tempo Volume e escala Entrega e manutenção Privacidade e segurança
Quando usar Licença adicional Sincronizar (solicitação/resposta) ou assíncrono (ativar/esquecer) Suporte para vários objetos LDV/Bulk Teste e implantação** Depuração Comportamento de retry/tratamento de erro integrado Pode ser usado com dados criptografados em repouso Protocolo de autenticação
Apex personalizado Quando você precisa de mais funcionalidade do que está disponível em ferramentas com pouco código. Não necessário Ambos Sim Sim Sim Com ferramentas de código profissional Não Sim* Vários
Serviços externos A integração do código a APIs do sistema externo é descrita usando especificações OpenAPI. Não necessário Sincronizar Sim Não Sim Com ferramentas de código profissional Não N/A Vários
MuleSoft Anypoint Quando você precisa de uma única solução unificada de nível corporativo para criar, orquestrar e gerenciar suas integrações; quando precisa substituir uma arquitetura de ponto a ponto legada; ou quando precisa de suporte de gerenciamento de API. Obrigatório Ambos Sim Sim Sim Com ferramentas de código profissional Não Sim* Vários
\* A ativação da Shield Platform Encryption altera determinados comportamentos, consulte [Considerações gerais sobre a Shield Platform Encryption](https://help.salesforce.com/articleView?id=sf.security_pe_considerations_general.htm&type=5) para obter mais detalhes. \*\*Teste e implantação refere-se à capacidade de criar em um ambiente inferior e implantar por meio da [API de metadados](https://developer.salesforce.com/docs/metadata-coverage/), pacotes ou conjuntos de alterações para produção. ### Caso de uso: Integração de saída usando ferramentas de código profissional > Quando as oportunidades são ganhas, um pedido para os produtos associados precisa ser criado no ERP ou no sistema de gerenciamento de pedidos da empresa. **Apex personalizado** Você pode criar um acionador do Apex e manipuladores de acionador na Oportunidade que fazem uma chamada para o sistema de gerenciamento de ERP ou pedido quando o estágio da oportunidade é alterado para "Ganho". Observe que, se você fizer chamadas de um acionador ou depois de realizar uma operação DML, deverá usar um método anotado como futuro ou enfileirável. Uma chamada em um acionador mantém a conexão do banco de dados aberta pela vida útil da chamada. Todo o Apex code é vinculado aos limites [de API e controlador do Apex](https://developer.salesforce.com/docs/atlas.en-us.salesforce_app_limits_cheatsheet.meta/salesforce_app_limits_cheatsheet/salesforce_app_limits_overview.htm), que são revisados continuamente. **Serviços externos** Se o ERP externo ou sistema de gerenciamento de pedidos da empresa for definido por meio de uma especificação OpenAPI, as chamadas a esses serviços que são realizadas no futuro método ou trabalho enfileirável poderão ser simplificadas. Os serviços externos registrados podem ser chamados diretamente do Apex sem precisar escrever código de caldeira. No exemplo, a chamada para criar o pedido pode ser processada pelo serviço externo. **MuleSoft Anypoint** O MuleSoft Anypoint fornece gerenciamento de API de nível corporativo. O MuleSoft Anypoint pode criar APIs para habilitar o acesso de leitura (e/ou gravação) a dados para o Salesforce e muitos outros sistemas corporativos. Há [muitos conectores pré-construídos disponíveis](https://www.mulesoft.com/platform/cloud-connectors) para simplificar a implementação, e as empresas também podem criar e publicar seus próprios conectores. Essas APIs podem ser implementadas no Anypoint com políticas de segurança flexíveis, com suporte para gerenciamento centralizado e governança. Não há restrições ao volume de transações, desde que a API tenha sido dimensionada adequadamente para sua utilização máxima (como medida em vCores). ## Dados de sistemas externos para o Salesforce (integração de entrada) Para integrações de entrada ao Salesforce, você pode considerar diferentes tipos de ferramentas: de código baixo, de código profissional ou híbrido. As seções a seguir fornecem orientação para cada um desses tipos de ferramenta e oferecem soluções de amostra. - [Ferramentas de baixo código para integrações de entrada](#ferramentas-de-baixa-codificação-para-integrações-de-entrada-ao-salesforce) - [Ferramentas híbridas para integrações de entrada](#ferramentas-híbridas-para-integrações-de-entrada-ao-salesforce) - [Ferramentas pro-código para integrações de entrada](#ferramentas-de-código-profissional-para-integrações-de-entrada-ao-salesforce) ### Ferramentas de baixa codificação para integrações de entrada ao Salesforce
Diretrizes Licenciamento Tempo Volume e escala Entrega e manutenção Privacidade e segurança
Quando usar Licença adicional Sincronizar (solicitar/responder) ou assíncrono ( disparar/esquecer) Suporte a vários objetos LDV/Bulk Teste e implantação* Depuração Comportamento de retry/tratamento de erro integrado Pode ser usado com dados criptografados em repouso Protocolo de autenticação
Heroku Connect Quando você deseja estender seus dados com sincronização bidirecional para habilitar aplicativos móveis e outros no Heroku e deseja que os dados também sejam replicados ao Salesforce. Obrigatório Assíncrono Sim Sim Não Com ferramentas de código profissional Sim Sim, por meio do Shield Connect OAuth
Procedimento de integração do OmniStudio Quando você precisa importar e transformar dados de fontes de terceiros sem interação com o usuário. Obrigatório Ambos Sim Sim Sim Suporte declarativo Não Sim Credenciais nomeadas
Salesforce Connect/Objetos externos Quando você deseja que os dados apareçam na interface do usuário do Salesforce, mas que os dados sejam armazenados em um sistema externo que possa usar protocolos padrão como OData ou GraphQL. Obrigatório Sincronizar Sim Sim Sim Com ferramentas de código profissional Não N/A Vários
\*Teste e implantação refere-se à capacidade de criar em um ambiente inferior e implantar por meio da [API de metadados](https://developer.salesforce.com/docs/metadata-coverage/), pacotes ou conjuntos de alterações para produção. ### Caso de uso: Integração de entrada usando ferramentas de baixa codificação > Um contato é atualizado no sistema ERP da organização. Essas informações de contato precisam ser atualizadas no Salesforce. **Heroku Connect** O Heroku Connect geralmente é usado para manter um banco de dados Heroku Postgres e o Salesforce sincronizados. A menos que o sistema ERP use o Heroku Postgres como loja de transações, esse caso de uso não será possível. Se ele usa o Heroku Postgres, as alterações feitas nas tabelas do Postgres podem ser sincronizadas com objetos no Salesforce usando o Heroku Connect. **Procedimento de integração do OmniStudio** Depois que o sistema ERP atualiza o registro de contato, um Procedimento de integração do OmniStudio com uma Ação de carregamento do Data Mapper e uma Ação de resposta pode ser chamado por meio da API REST gerada pelo Data Mapper. Primeiro, uma ação Carregar do Data Mapper envia uma carga útil JSON ou XML, que é usada para inserir e atualizar os registros de contato com base em um campo de ID externo ou por meio de uma [chave de inserção e atualização](https://trailhead.salesforce.com/content/learn/modules/omnistudio-data-tools-and-internal-data/build-an-integration-procedure-with-conditional-dataraptor-loads?trail_id=build-guided-experiences-with-omnistudio). Se uma resposta simples no JSON for tudo o esperado, uma Ação de resposta poderá enviar de volta qualquer informação relevante das ações anteriores para indicar sucesso ou falha. Se o sistema ERP espera uma resposta específica, uma Ação de extração ou Transformação do mapeador de dados pode ser usada para gerar uma resposta JSON ou XML com recursos adicionais para incluir de modo declarativo dados que foram gerados em acionadores pela atualização de registro de contato. O principal desafio com esse cenário é a simultaneidade: Várias chamadas para atualizar o mesmo registro de contato ao mesmo tempo causarão problemas, pois a API existe diretamente no Salesforce. **Salesforce Connect / Objetos externos** Salesforce Connect e objetos externos não são recomendados para este caso de uso, pois o cenário exige especificamente a replicação de dados no Salesforce. Se você tiver uma integração preexistente do Salesforce Connect integrada ao ERP, poderá configurar o conector OData 4.0 para dar suporte à captura de dados de alteração externa se o ERP puder dar suporte à captura de dados de alteração. Além disso, você deve configurar no Salesforce para assinar o fluxo de alteração no ERP usando a API Pub/Sub. ### Ferramentas híbridas para integrações de entrada ao Salesforce
Diretrizes Licenciamento Tempo Volume e escala Entrega e manutenção Privacidade e segurança
Quando usar Licença adicional Sincronizar (solicitar/responder) ou assíncrono ( disparar/esquecer) Suporte a vários objetos LDV/Bulk Teste e implantação** Depuração Comportamento de retry/tratamento de erro integrado Pode ser usado com dados criptografados em repouso Protocolo de autenticação
Eventos de plataforma Quando você precisa de uma carga útil personalizada e estruturada para alterações quase em tempo real no Salesforce ou em um sistema externo. Não necessário* Assíncrono Sim Não Sim Com ferramentas de código profissional Sim Sim OAuth
Objetos externos do Salesforce Connect (com adaptadores personalizados do Apex) Quando você precisa que os dados apareçam na interface do usuário do Salesforce, mas deseja que os dados sejam armazenados em um sistema externo que não possa usar os protocolos OData 2.0/4.0. Obrigatório Ambos Sim Sim Sim Com ferramentas de código profissional Não N/A Vários
Data 360 Quando você deseja harmonizar dados de diferentes origens em um repositório de dados ou replicar seus dados de outras organizações do Salesforce ou para outros sistemas externos. O Data 360 também oferece suporte à virtualização para algumas plataformas. Obrigatório Ambos Sim Sim Sim Não Sim Sim Vários
- [Adição](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_event_limits.htm) necessária para casos de uso de grande volume. \*\*Teste e implantação refere-se à capacidade de criar em um ambiente inferior e implantar por meio da [API de metadados](https://developer.salesforce.com/docs/metadata-coverage/), pacotes ou conjuntos de alterações para produção. ### Caso de uso: Integração de entrada usando ferramentas híbridas > Um contato é atualizado no sistema ERP da organização. Essas informações de contato precisam ser atualizadas no Salesforce. **O código personalizado de Eventos de plataforma** em um sistema externo publica um Evento de plataforma quando o registro de contato é atualizado no ERP. Um acionador, processo ou fluxo no Salesforce pode assinar o evento de plataforma e atualizar os objetos do Salesforce correspondentes quando um evento é processado. O Evento de plataforma pode funcionar simplesmente como um sinal de que uma alteração ocorreu no sistema ERP do cliente sem conter nenhum dado ou pode conter os dados reais necessários para atualizar o objeto do Salesforce. **Objetos externos do Salesforce Connect (com adaptadores do Apex personalizados)** Esta solução não é aplicável a um caso de uso que exija replicação de dados. Essa solução é aplicável se você precisar que os usuários no Salesforce vejam informações de um sistema externo que não deve ou não pode ser replicado no Salesforce e o sistema externo não pode dar suporte a protocolos padrão como OData ou GraphQL. Consulte Caso de [uso: Integração de saída usando ferramentas híbridas](#caso-de-uso-integração-de-saída-usando-ferramentas-híbridas) para um exemplo de caso de uso para um adaptador personalizado do Apex. Quando um contato é atualizado em sistemas externos, como ERP, as atualizações de contato podem ser sincronizadas com o Data 360 usando conectores prontos para uso ou usando APIs e ferramentas de código profissional, como MuleSoft.\*\*\*\* O contato também pode ser referenciado no Data 360 usando o mecanismo de cópia zero (disponível com algumas plataformas). Depois que os dados estiverem disponíveis no Data 360, diferentes mecanismos de integração prontos para uso poderão ser usados para sincronizar os dados com outras organizações do Salesforce. Os dados podem ser acessados por referência usando o Data Cloud One. Os dados também podem ser replicados usando ativações e outras APIs usando conectores prontos para uso ou com a ajuda de ferramentas de código profissional, como a MuleSoft Anypoint Platform. ### Ferramentas de código profissional para integrações de entrada ao Salesforce
Diretrizes Licenciamento Tempo Volume e escala Entrega e manutenção Privacidade e segurança
Quando usar Licença adicional Sincronizar (solicitar/responder) ou assíncrono ( disparar/esquecer) Suporte a vários objetos LDV/Bulk Testar e implementar**** Depuração Comportamento de retry/tratamento de erro integrado Pode ser usado com dados criptografados em repouso Protocolo de autenticação
Serviços da Web REST e SOAP do Apex personalizados Quando você precisa de mais funcionalidades do que as fornecidas pelos pontos de extremidade de API nativos, como processamento de objetos cruzados ou outra lógica complexa. Não necessário Ambos Sim Sim Sim Com ferramentas de código profissional Não Sim*** Vários
MuleSoft Anypoint Quando você precisa de uma única solução unificada de nível corporativo para criar, orquestrar e gerenciar suas integrações; quando precisa substituir uma arquitetura de ponto a ponto legada; ou quando precisa de suporte de gerenciamento de API. Obrigatório Ambos Sim Sim Sim Com ferramentas de código profissional Não Sim*** Vários
APIs nativas do Salesforce Quando você precisa de mais controle ou tem um conjunto de habilidades de código profissional para criar integrações por meio da API REST, da API SOAP, da API em massa ou de APIs GraphQL ou gRPC. Não necessário* Ambos Sim***** Sim Sim Com ferramentas de código profissional Sim** Sim*** Vários
\*Limites e alocações de [solicitação de API](https://developer.salesforce.com/docs/atlas.en-us.salesforce_app_limits_cheatsheet.meta/salesforce_app_limits_cheatsheet/salesforce_app_limits_platform_api.htm) se aplicam. \*\*As APIs em massa têm aspectos de comportamento de nova tentativa e várias APIs oferecem proteção _de reversão_ por meio da configuração allOrNone (por exemplo, consulte [parâmetros allOrNone em Solicitações compostas e de coleta](https://developer.salesforce.com/docs/atlas.en-us.api_rest.meta/api_rest/resources_composite_allornone.htm)) \*\*\* A ativação da Shield Platform Encryption altera determinados comportamentos, consulte [Considerações gerais sobre a Shield Platform Encryption](https://help.salesforce.com/articleView?id=sf.security_pe_considerations_general.htm&type=5) para obter mais detalhes. \*\*\*\*Teste e implantação refere-se à capacidade de criar em um ambiente inferior e implantar por meio da [API de metadados](https://developer.salesforce.com/docs/metadata-coverage/), pacotes ou conjuntos de alterações para produção. \*\*\*\*\*As APIs compostas têm suporte para vários objetos. ### Caso de uso: Integração de entrada usando ferramentas de código profissional > Um contato é atualizado no sistema ERP da organização. Essas informações de contato precisam ser atualizadas no Salesforce. **Serviços personalizados do Apex REST e SOAP Web Services** Você pode criar um serviço da Web usando o Apex code que poderia executar operações CRUD (criar, ler, atualizar, excluir) no objeto Contato. Esse serviço será chamado por SOAP ou REST do sistema externo (o ERP). **MuleSoft Anypoint** A intenção do MuleSoft Anypoint é fornecer gerenciamento de API de nível empresarial. O MuleSoft Anypoint oferece um [grande conjunto de conectores predefinidos](https://www.mulesoft.com/platform/cloud-connectors) que você pode usar para integrar com muitos sistemas ERP, incluindo SAP, Oracle EBS, Oracle ERP e NetSuite. Você pode criar um fluxo para ouvir eventos nesses sistemas ERP (neste caso, quando um novo contato é criado). Quando o fluxo é iniciado, ele usa o conector do Salesforce para criar um novo registro de Contato (ou atualizar um caso o contato já exista). Além disso, é possível integrar-se a outros sistemas se a transação de replicação envolver a sindicação do contato em outros sistemas. Se necessário, você pode usar a linguagem de mapeamento e transformação (DataWeave) para realizar lógica e cálculos complexos à medida que as informações fluem entre vários sistemas diferentes. A autenticação com esses sistemas pode ser feita por meio de vários mecanismos de autenticação diferentes, como Autenticação básica e OAuth, entre outros. Não há restrições ao volume de transações, desde que o fluxo tenha sido dimensionado adequadamente para sua utilização máxima (medido em vCores). **APIs nativas do Salesforce** À medida que (ou imediatamente após) a transação de atualização no sistema ERP é concluída, você pode realizar uma operação de inserção e atualização no objeto Contato por meio da API SOAP ou realizar um [PATCH](https://developer.salesforce.com/docs/atlas.en-us.api_rest.meta/api_rest/dome_update_fields.htm) na API REST de sObjects de contato na organização do Salesforce. ## Integrações do Salesforce para Salesforce O produto Salesforce para Salesforce chegou ao fim da sua vida útil. O Salesforce para Salesforce facilitou para parceiros que trabalham juntos venderem e oferecerem suporte a clientes conjuntos, mas a Salesforce vai investir em trazer mais inovação para outras ferramentas. Avançando, as seguintes abordagens são recomendadas para compartilhar dados entre organizações do Salesforce. ### Ferramentas para integração de dados em organizações do Salesforce
Diretrizes Custo Tempo Volume e escala Entrega e manutenção Privacidade e segurança Ferramentas a implementar
Quando usar Licença adicional Sincronizar (solicitação/resposta) ou assíncrono (ativar/esquecer) Suporte para vários objetos LDV/Bulk Teste e implantação* Depuração Comportamento de retry/tratamento de erro integrado Pode ser usado com dados criptografados em repouso Protocolo de autenticação Código baixo → Código profissional
Heroku Connect Quando você deseja estender seus dados com sincronização bidirecional entre organizações do Salesforce e também habilitar o acesso aos dados de dispositivos móveis e outros aplicativos em execução no Heroku Obrigatório Assíncrono Sim Sim Não Com ferramentas de código profissional Sim Sim, por meio do Shield Connect OAuth Código inferior
MuleSoft Anypoint Quando você precisa de uma única solução unificada de nível corporativo para criar, orquestrar e gerenciar suas integrações; quando precisa substituir uma arquitetura de ponto a ponto legada; ou quando precisa de suporte para gerenciamento de API Obrigatório Ambos Sim Sim Sim Com ferramentas de código profissional Não Sim** Vários Código profissional
APIs nativas do Salesforce Quando o Salesforce ou o Heroku Connect não são uma opção ou você precisa de processamento mais complexo Não necessário Ambos Não Sim Sim Com ferramentas de código profissional Não Sim** Vários Código profissional
Captura de dados de alteração Quando você precisa publicar alterações no nível do registro feitas no Salesforce em um sistema externo e não precisa de uma carga útil personalizada. Obrigatório Assíncrono Não Não Sim Com ferramentas de código profissional Sim Sim OAuth
Salesforce Connect com adaptador entre organizações Quando você deseja que os usuários em uma organização visualizem ou editem registros em uma organização diferente sem replicação de dados Obrigatório Assíncrono Sim Sim Sim Com ferramentas de código profissional N/A N/A Vários Código inferior
Data 360 Quando você deseja que os usuários em uma organização visualizem ou editem registros em uma organização diferente com dados replicados no Data 360. Obrigatório Ambos Sim Sim Sim Com ferramentas de código profissional Sim Sim Vários híbrido
\*Teste e implantação refere-se à capacidade de criar em um ambiente inferior e implantar por meio da [API de metadados](https://developer.salesforce.com/docs/metadata-coverage/), pacotes ou conjuntos de alterações para produção \*\* A ativação da Shield Platform Encryption altera determinados comportamentos, consulte [Considerações gerais sobre a Shield Platform Encryption](https://help.salesforce.com/articleView?id=sf.security_pe_considerations_general.htm&type=5) para obter mais detalhes. Os eventos de _plataforma não são ideais para integrar dados de uma organização do Salesforce a outra, pois não podem "escutar" entre organizações para o mesmo evento. O Apex personalizado também não é uma abordagem recomendada para esse tipo de integração._ ### Caso de uso: Conectar várias organizações do Salesforce > Uma grande empresa opera em várias unidades de negócios (BUs). Cada BU tem sua própria organização do Salesforce. Um único cliente lida com várias unidades de negócios da empresa e, portanto, tem dados de conta e oportunidade em várias organizações. A empresa precisa acessar uma visualização agregada de todos os dados de Conta e Oportunidade em todas as BUs em uma só organização. _Nota: Todas as soluções abaixo são projetadas para a menor quantidade de replicação de dados, de acordo com a [Takeaway #1](#capturas)._ Dados de conta e oportunidade do **Data 360** de diferentes organizações do Salesforce podem ser ingeridos no Data 360 usando conectores prontos para uso do Salesforce. Eles também podem ser agregados e harmonizados (se necessário). Depois que os dados são agregados no Data 360, eles podem ser acessados em outras organizações do Salesforce usando o Data Cloud One sem replicação de dados. **Heroku Connect** Para cada organização individual da BU, você pode usar o Heroku Connect para sincronizar alterações do Salesforce em um único banco de dados Heroku Postgres. Nesse cenário, a sincronização bidirecional não está habilitada, apenas a sincronização do Salesforce para o Postgres. Então, no Heroku Connect, você pode habilitar o provedor OData e selecionar as tabelas que deseja expor como objetos externos na organização do Salesforce em que deseja uma visualização agregada. No Salesforce, você define uma origem de dados externa apontando para o provedor OData no Heroku. **MuleSoft Anypoint** O MuleSoft Anypoint fornece gerenciamento de API de nível corporativo. Uma API do MuleSoft Anypoint pode ser configurada para ler informações de várias organizações relacionadas do Salesforce usando o conector do Salesforce com várias conexões às organizações. O fluxo do MuleSoft pode consultar as diferentes organizações do Salesforce e retornar uma estrutura específica aprimorada ou aprimorada com outras informações de terceiros, se necessário. Quando a API é invocada, ela fará todas as chamadas adequadas da organização do Salesforce (neste exemplo, consultando informações de Conta e Oportunidade) para que os dados possam ser processados pelo consumidor (provavelmente uma UI). A autenticação com esses sistemas pode ser feita por meio de vários mecanismos de autenticação, incluindo autenticação básica e OAuth. Não há restrições ao volume de transações, desde que o fluxo tenha sido dimensionado adequadamente para sua utilização máxima (medido em vCores ou Cores). As operações de consulta **nativas das APIs do Salesforce** podem ser emitidas a cada uma das organizações de interesse, principalmente por meio da API em massa 2.0 do Salesforce, que é adequada para extrair de forma eficiente milhares de registros. Você pode recuperar os resultados da consulta de cada organização individualmente e agregá-los com um aplicativo personalizado ou middleware conforme os requisitos do cliente. **Salesforce Connect com adaptador entre organizações** O adaptador entre organizações do Salesforce Connect não é adequado nesse cenário, pois as contas ou oportunidades de organizações remotas aparecerão na organização central como objetos _diferentes_. Por exemplo, não há maneira de somar um total geral para os valores de todas as oportunidades em todas as organizações. **Scenário de atualizações seletivas entre organizações:** Um vendedor, usando a organização do Salesforce A, precisa visualizar e atualizar dados de caso da organização do Salesforce B e adicionar comentários de caso ao caso pai na organização do Salesforce B enquanto trabalha na organização A. Os dados não devem ser replicados à organização A. **Heroku Connect** Você pode usar a mesma abordagem descrita no _scenário de agregação de dados_ acima. No entanto, você deve habilitar o CRUD no objeto externo por meio do conector OData e gravar as alterações de volta no Heroku Postgres. **MuleSoft Anypoint** O MuleSoft Anypoint fornece gerenciamento de API de nível corporativo. Você pode usar a mesma abordagem descrita no _Scenário de agregação de dados_ acima. As APIs **nativas do Salesforce** usam credenciais nomeadas e invocam as APIs nativas do Salesforce para ler e atualizar dados na organização do Salesforce relacionada. Um componente deve ser projetado para exibir os dados. **Salesforce Connect com adaptador entre organizações** A capacidade de visualizar dados em um objeto externo (e editar os dados se você tiver o CRUD habilitado no objeto externo) é suportada por meio do [adaptador entre organizações do Salesforce](https://help.salesforce.com/articleView?id=sf.xorg_adapter_about.htm&type=5). Há suporte para relacionamentos entre objetos externos para que você possa vincular ao caso pai no objeto externo. No entanto, criar relacionamentos hoje é um processo manual em que você converte um tipo de dados existente em um tipo de dados de relacionamento. Além disso, as otimizações feitas no Service Cloud para trabalhar com Casos com mais eficiência não passam em cascata para a organização remota. A Salesforce recomenda enfaticamente testar o adaptador entre organizações e avaliar as vantagens de trabalhar com objetos externos vs. objetos padrão para seu caso de uso. **Sincronização de dados entre organizações**: Quando uma conta de um cliente é atualizada em uma das organizações do Salesforce da unidade de negócios da organização, os outros objetos da Conta da organização do Salesforce precisam ser atualizados para manter informações de conta consistentes. O Data 360 **do Data 360** pode ser usado para replicação de dados de uma organização para outra organização do Salesforce. Os dados da conta de uma organização do Salesforce podem ser ingeridos no Data 360 usando conectores prontos para uso do Salesforce. Podemos usar mecanismos de ativação de dados, como ativação em lote, ações de dados quase em tempo real ou ativações baseadas em API, bem como mover os dados do Data 360 para a organização do Salesforce. **Heroku Connect** Você pode usar a mesma abordagem descrita no _scenário de agregação de dados_ acima. No entanto, você deve habilitar a sincronização bidirecional e não precisa mais habilitar o Salesforce Connect, pois a sincronização bidirecional manterá todas as organizações atualizadas quando forem feitas alterações na tabela do Postgres. **MuleSoft Anypoint** O MuleSoft Anypoint fornece gerenciamento de API de nível corporativo. Você pode [configurar um aplicativo do Mule](https://docs.mulesoft.com/design-center/about-designing-a-mule-application) com o Designer de fluxo no MuleSoft Anypoint para ouvir eventos de objeto padrão e personalizados para iniciar um fluxo iniciado automaticamente no Salesforce. Quando o aplicativo Mule é acionado, ele pode invocar o Conector do Anypoint para Salesforce para se comunicar com qualquer número de organizações do Salesforce. Nesse caso de uso, quando um registro de Conta é atualizado em uma organização do Salesforce, o aplicativo Mule pode atualizar registros de Conta nas organizações relacionadas do Salesforce. Cada organização do Salesforce relacionada teria uma etapa de atualização exclusiva integrada ao fluxo de aplicativo geral no MuleSoft. A autenticação com esses sistemas pode ser feita por meio de vários mecanismos de autenticação, incluindo autenticação básica e OAuth. Não há restrições ao volume de transações, desde que o fluxo tenha sido dimensionado adequadamente para sua utilização máxima (medido em vCores ou Cores). **APIs nativas do Salesforce** A [API de replicação](https://developer.salesforce.com/docs/atlas.en-us.api.meta/api/sforce_api_guidelines_datareplication.htm) (operações getUpdated, getDeleted) pode ser usada para sincronizar dados entre organizações, mas essa abordagem não é recomendada. **Salesforce Connect com adaptador entre organizações** Você pode usar fluxos acionados por registro e objetos externos para manter alguns dados sincronizados entre as organizações do Salesforce. Por exemplo, atualizar um registro de conta na Organização A aciona um fluxo que então atualiza o registro correspondente no objeto externo Conta, que grava essas atualizações no registro da conta na Organização B. Isso exige o uso adequado da semântica do fluxo para evitar [transações DML mistas](https://help.salesforce.com/articleView?id=000328873&type=1&mode=1). Além disso, lembre-se de que as regras de validação e os fluxos na organização B serão acionados da mesma maneira que quando as alterações forem feitas por nossas APIs REST/SOAP. ## Observações de fechamento Lembre-se deste guia e consulte-o quando estiver planejando uma nova integração de dados envolvendo o Salesforce. Sempre é uma boa ideia entender todo o escopo de opções disponíveis para você e como elas podem se ajustar ao seu caso de uso específico. ### Diga-nos o que você pensa Ajude-nos a garantir que estejamos publicando o que é mais relevante para você. [Pegue nossa pesquisa](https://sfdc.co/J0cWb) para fornecer feedback sobre esse conteúdo e nos diga o que você gostaria de ver em seguida. ## Visão geral As empresas costumam armazenar dados tanto no Salesforce quanto em outros data lakes externos, como Snowflake, Google BigQuery, Databricks, Redshift ou armazenamento em nuvem, como o Amazon S3. Esse silonamento de dados em diferentes sistemas de origem apresenta um desafio para as empresas que querem aproveitar todo o poder de seus dados. Os arquitetos que trabalham para unir dados entre vários data lakes enfrentam decisões arquitetônicas importantes sobre como integrar melhor esses dados. O Data 360 oferece várias opções para integração de dados, cada uma oferecendo diferentes prós e contras. Este guia fornece uma estrutura para avaliar qual padrão atende melhor aos seus requisitos de latência, custo, escalabilidade, governança e complexidade ao integrar dados, ajudando você a escolher quando usar ingestão de dados, federação de dados de Cópia zero ou uma abordagem híbrida. O guia também o ajudará a selecionar entre diferentes métodos de ingestão de dados e federação de dados, cada um dos quais preenche uma necessidade diferente. Integrar data lakehouses externos ao Data 360 requer uma consideração cuidadosa das compensações entre a atualidade dos dados, a governança e a eficiência do pipeline. Por exemplo, usar as consultas ativas de federação de dados do Zero Copy maximizam a atualidade dos dados, mas podem reduzir a eficiência do pipeline à medida que você move mais dados pela rede. Portanto, para a maioria das implementações do mundo real, uma combinação de ingestão e federação em um ecossistema de lakehouse de várias nuvens é o caminho ideal. Essa abordagem híbrida garante uma arquitetura escalonável, governada e interoperável que dá suporte perfeitamente a cargas de trabalho operacionais de baixa latência, como personalização em tempo real e detecção de fraudes, e cargas de trabalho analíticas, como relatórios regulatórios e análise de tendências históricas. Este guia de decisão vai ajudá-lo a entender como navegar por essas compensações e selecionar a estratégia certa. ## Capturas - **Ingestão de dados:** Copia dados para o Salesforce Data 360, criando modelos de dados canônicos gerenciados. Ideal quando você precisa: - **Criar um Customer 360 abrangente:** Unifique e transforme origens distintas em um único perfil confiável. - **Satisfazer a rigorosa conformidade regulatória:** Crie uma cópia auditável centralizada em que o acesso aos dados e a linhagem possam ser controlados de perto. - **Federação de cópia zero:** Consulta origens externas em tempo real sem duplicação, habilitando personalização em tempo real, painéis ativos e integração de origem rápida. Duas opções principais com compensações que você deve equilibrar: - **Ativo e cache (consulta acelerada):** Melhor para análise interativa e painéis em tempo real em dados que estão em plataformas de dados externas, como Snowflake, Google BigQuery, Redshift ou Databricks. Evita duplicação de dados lenta e dispendiosa enviando o processamento para o sistema de origem. - **Federação de arquivos:** Melhor para processamento em lote em grande escala e treinamento de modelo de IA em dados em seu data lake de nuvem (S3, ADLS). Evita ingestões caras e lentas consultando diretamente arquivos em formatos de tabela abertos, desbloqueando conjuntos de dados massivos para ETL e cargas de trabalho de ciência de dados. - **Modelo híbrido:** Combine ingestão para Perfis unificados com federação para frescura, suporte ao engajamento do Omni-Channel, ações conduzidas pelo Agentforce e treinamento de IA/ML. ### Considerações importantes - **Arquitetura híbrida:** Geralmente, é necessário combinar a ingestão de dados e a federação de dados. - Use a Ingestão de dados em dados críticos para modelos de dados canônicos e governança principal. - Federar todos os outros dados por meio da Cópia zero para minimizar a sobrecarga operacional de criar e manter os pipelines de dados de ingestão. - **A frequência de ingestão de dados importa:** Escolha a frequência com base no valor dos negócios, nas necessidades de latência e na complexidade operacional. - Use em tempo real para fluxos de trabalho urgentes (personalização, painéis ativos, ações Agentforce). - Quase em tempo real para processos moderadamente urgentes (campanhas, relatórios operacionais). - Lote para conjuntos de dados históricos ou de baixa velocidade. - **Combine o padrão de federação com latência e desempenho:** Escolha o que melhor corresponde aos seus padrões de acesso e aos requisitos de frescura, desempenho e custo. - Use a Consulta ativa para painéis operacionais e personalização em tempo real em que baixa latência seja crítica. - Use o armazenamento em cache (consulta acelerada) quando as consultas forem frequentes, mas os resultados levemente obsoletos forem aceitáveis, o que equilibra o desempenho e o custo. - Use a federação de arquivos para análises em grande escala e de alto rendimento ou cargas de trabalho em lote, ideais para conjuntos de dados históricos ou menos sensíveis ao tempo. - **Alinhar a governança aos requisitos de residência de dados:** - Use a ingestão quando a governança centralizada for crítica. - Use federação quando a governança descentralizada for aceitável, ao mesmo tempo que você impõe uma governança rígida na origem externa. A Cópia zero respeita políticas em nível de origem, como segurança em nível de linha (RLS) e mascaramento de dados. - **Priorizar ingestão para fluxos de trabalho de alto valor:** Aplique a ingestão de modo seletivo a processos críticos, como resolução de identidade, relatórios regulatórios e ativação operacional. - **Custo e complexidade levam a decisão:** A ingestão em tempo real pode ser cara e complexa. Os arquitetos devem ponderar o custo de integração, armazenamento e transformação de dados em relação ao custo de consultá-los diretamente por meio do Zero Copy. Escolher o padrão de integração certo (Ingestão de dados, Cópia zero ou abordagem híbrida) afeta diretamente a latência, a governança, a eficiência operacional e o custo em plataformas de várias nuvens. Essa decisão determina como percepções em tempo real, ativação conduzida por IA e engajamento personalizado podem ser entregues de forma confiável e em escala. ## Comparação de produto Esta tabela fornece uma comparação técnica dos padrões de Ingestão de dados e Cópia zero no Salesforce Data 360, focando recursos, compensações e benefícios, junto com casos de uso e resultados corporativos. Os arquitetos podem usar isso como referência para projetar plataformas de dados de várias nuvens híbridas que equilibram desempenho, custo e conformidade.
Tipo de padrão Modo/ferramenta Benefícios Considerações Resultados
Ingestão de dados Em tempo real: Ingestão de latência de menos de um segundo por meio de APIs de ingestão com suporte para CDC. Pipelines de streaming contínuo. - Insights imediatos
- Ideal para casos de uso operacionais e de personalização de baixa latência
- Dá suporte a fluxos de trabalho conduzidos por evento
- Custo alto
- Arquitetura complexa
- Requer sistemas de origem de baixa latência
- Origens de alto volume podem causar streaming excessivo que leva a pipelines saturados
- Intensivo de I/O
- Considere campos seletivos e filtragem para reduzir a sobrecarga
Agentforce:
- Alertas de fraude em tempo real, personalização do varejo, alertas operacionais
Analytics:
- Painéis de subsegundo, monitoramento de KPI
Conformidade:
- Atualizações contínuas de registro do cliente para fluxos de trabalho regulados
Streaming: Ingestão de microlote a cada 1 a 3 minutos por meio de conectores nativos - Custo equilibrado vs. frescura
- Arquitetura mais simples do que em tempo real
- Dá suporte a atualizações incrementais
- Baixa latência
- Pode não ser adequado para decisões críticas em menos de um segundo
- O tamanho do lote afeta a memória/compute
- A I/O é moderada
- Melhor para padrões de atualização repetidos e previsíveis
- Considere a agregação com janelas para reduzir a carga de processamento
Agentforce:
Acionadores de campanha oportunos, engajamento quase ativo
Analytics:
- Mecanismos de recomendação, painéis quase ativos
Conformidade:
- Atualizações frequentes com capacidade de auditoria
Lote: Cargas de grande volume agendadas por meio de conectores ou APIs. Suporta o armazenamento de objetos e pipelines ETL/ELT. - Eficiente para conjuntos de dados massivos
- Fácil de implementar
- Confiável para análise histórica
- Latência de dados
- Não é adequado para operações que exigem tempo
- Intensidade de I/O durante janelas de carregamento
- A taxa de transferência de rede pode se tornar um gargalos para arquivos grandes
- Melhor para agregação de histórico ou fluxos de trabalho de relatórios regulados
Agentforce:
- Pedidos de suporte de TI (Jira/ServiceNow), fluxos de trabalho agregados
Analytics:
- Análise histórica, avaliação de tendências
Reclamação:
- Relatórios regulatórios, agregação de dados de pacientes/reivindicações
Zero Copy Consulta ao vivo: Consultas diretas em sistemas externos; esquema-on-read; sem duplicação de dados - Máxima frescura
- Sobrecarga mínima de armazenamento; dá suporte a percepções operacionais em tempo real
- Dependendo do desempenho de origem
- O alto volume de consultas pode afetar a latência
- Ideal para consultas com push-down de predicado e agregação para minimizar I/O
- Evite consultas não filtradas em conjuntos de dados massivos
Agentforce:
- Fluxos de trabalho dinâmicos adaptados à atividade ativa
Analytics:
- Painéis operacionais, relatórios ativos
Conformidade:
- Respeita a segurança e o mascaramento no nível da linha na origem
Consulta acelerada (cache): cópias locais armazenadas em cache para consultas federadas. Configurável de 15 minutos a 7 dias. Execução de consulta otimizada - Reduz a latência
- Custo menor do que consultas ativas repetidas
- Melhora o desempenho para padrões de acesso frequente
- Gerenciamento de cache obrigatório
- A permanência depende do intervalo de cache
- Melhor para consultas de alta frequência
- Não é adequado para tomada de decisão em menos de um segundo
Agentforce:
- Métricas de engajamento pré-agregadas para uma rápida tomada de decisão
Analytics:
- Painéis de BI, segmentação, relatórios analíticos
Conformidade:
- Painéis regulados consistentes com registros de auditoria
Federação de arquivos: Acesso direto a grandes conjuntos de dados históricos em lojas de objetos ou lagos (S3, Iceberg, Google BigQuery, Redshift). - Lida com conjuntos de dados em escala enorme
- Armazenamento mínimo no Data 360
- Dá suporte a cargas de trabalho de IA/ML
- Somente leitura
- O desempenho da consulta depende da taxa de transferência do sistema externo
- Otimizada para trabalhos pesados em lote com alta taxa de transferência
- Não é adequado para painel em tempo real
Agentforce:
- (Não típico – lote pesado)
Analytics:
- Treinamento em ML/IA, análise histórica, relatórios em escala de petabyte
Conformidade:
- Acesso controlado a conjuntos de dados externos sem duplicação
## Padrões de integração do Data 360 ### Ingestão de dados Com a ingestão de dados, os dados são copiados fisicamente para o Data 360 e totalmente controlados, diferentemente do Zero Copy em que os dados permanecem na origem. O cálculo de transformações acontece no Data 360, que permite a governança e a auditoria centralizadas. #### Casos de uso de ingestão de dados Use a ingestão de dados para armazenar conjuntos de dados canônicos e gerenciados no Salesforce Data 360 para conformidade e controle operacional. Use a ingestão quando controle total, auditoria e rastreabilidade forem necessários. Ideal para fluxos de trabalho regulados ou de alto valor em que computação e governança centralizadas são essenciais. A ingestão é melhor para criar uma base confiável para resolução de identidade, relatórios regulatórios e fluxos de trabalho conduzidos por IA críticos para a missão e engajamento do cliente. Visão geral da ingestão de dados #### Métodos de ingestão de dados Os métodos de ingestão de dados variam dependendo do conector que você usa para ingerir seus dados. Alguns conectores oferecem uma variedade de métodos de ingestão, enquanto outros operam apenas no modo de lote ou streaming. Consulte [Data 360: Integrações e conectores](https://help.salesforce.com/s/articleView?id=data.c360_a_sources_targets.htm&type=5) para uma lista completa de conectores do Data 360 e seus métodos disponíveis. - **Em tempo real** - Ingestão de subsegundo usando pipelines de streaming ou Captura de dados de alteração (CDC). - Melhor para fluxos de trabalho que exigem tempo (detecção de fraudes, personalização, painéis operacionais). - Envie por push transformações e agregações no Data 360 para reduzir as I/O a jusante e otimizar o uso de computação. Use a CDC incremental para minimizar o desvio de dados. - **Streaming** - Ingestão a cada 1 a 3 minutos em pequenos incrementos. - Equilibra frescura e custo, adequado para orquestração de campanha, engajamento quase ativo e relatórios operacionais. - Use microlotes para controlar picos de I/O. Agregue dados na origem, se possível, para reduzir volumes de transferência e otimizar o armazenamento. - **Lote (cargas agendadas)** - Ingestão periódica de conjuntos de dados grandes (horário, diário, semanal). - Custo e confiabilidade para conjuntos de dados históricos, relatórios regulatórios e casos de uso de conformidade. - Garanta a localidade de computação na mesma região que o armazenamento de origem para otimização de desempenho e custo. #### Manual do arquiteto - **Casos de uso para ingestão de dados** - **Gerar perfis unificados do Customer 360:** Crie uma única fonte da verdade para identidade e atributos do cliente. - **Manter conjuntos de dados de conformidade regulatória:** Impor governança, lineagem e capacidade de auditoria para dados confidenciais. - **Orquestração de campanha centralizada:** Garantir que marketing, vendas e serviço funcionem com base em conjuntos de dados consistentes e confiáveis. - **Práticas de design** - Favorecer a ingestão em lote para necessidades históricas ou com baixa tolerância de latência, como relatórios de arquivamento ou instantâneos periódicos. - Use as APIs de streaming ou CDC para manter a atualidade dos fluxos de trabalho operacionais e de personalização, garantindo atualizações quase em tempo real. - Controle o armazenamento e o crescimento de computação aplicando cargas incrementais, em vez de recarregar conjuntos de dados inteiros, para otimizar o custo e a eficiência. - Alinhe os pipelines de ingestão com localidade de computação e processamento incremental para reduzir as I/O de rede. Aplique transformações dentro do Data 360 para evitar mover dados brutos desnecessariamente. - **Considerações de custo** - **Ingestão em tempo real:** Os maiores custos de computação e pipeline; justificados para fluxos de trabalho de alto valor e urgentes, como personalização, painéis operacionais ou ações conduzidas pelo Agentforce. - **Ingestão de streaming:** Moderar os custos de computação e armazenamento; adequado para atualizações frequentes que podem tolerar pequenos atrasos, como orquestração de campanha ou relatórios operacionais. - **Ingestão de lote:** Menos custos de computação, armazenamento previsível; melhor para conjuntos de dados históricos ou atualizações de baixa frequência. A ingestão de dados em lote de organizações do Salesforce usando determinados conectores é gratuita. - **Modo de atualização:** Selecionar o modo Atualização incremental reduz os custos totais de ingestão e computação. Recomendamos usar atualização incremental sempre que possível para otimizar a eficiência em todos os tipos de ingestão. - O custo também é afetado pelo volume de I/O da origem para o Data 360. Otimizar tamanhos de lote, partições e alinhamento regional reduz os custos de transferência e melhora o desempenho. - **Cenários da indústria** - **Finanças:** Ingira conjuntos de dados necessários para conhecer seu cliente (KYC), Anti-Lavagem de Dinheiro (AML) e detecção de fraudes, em que a auditoria e a conformidade não são negociáveis. - **Saúde:** Use a ingestão para resolução de identidade do paciente e registros em conformidade com HIPAA, habilitando visualizações seguras e unificadas. - **Retail:** Consolidar dados de ponto de vendas (POS), comércio eletrônico e programa de fidelidade em perfis unificados para segmentação e personalização - **Telecom:** Dê suporte à prevenção de rotatividade e à análise de uso com dados canônicos de assinante regulamentados. #### Critérios de decisão do método de ingestão de dados
Recurso Ingestão em tempo real Ingestão de streaming Ingestão em lote
Latency e frescura Ingestão de latência de subsegundo por meio de APIs de ingestão com suporte para Captura de dados de alteração (CDC). Fornece pipelines de streaming contínuos. Melhor para casos de uso operacionais de baixa latência. Ingestão de microlote a cada 1 a 3 minutos por meio de conectores nativos. Dá suporte a atualizações incrementais. É esperada uma pequena latência. A latência de dados é esperada. Cargas de grande volume agendadas. Ingestão periódica (horária, diária, semanal). Não é adequado para operações que exigem tempo.
Casos de uso primários Ideal para casos de uso operacionais e de personalização de baixa latência. Usado para fluxos de trabalho urgentes. Dá suporte a fluxos de trabalho conduzidos por evento. Usado para alertas de fraude em tempo real e alertas operacionais. Adequado para processos moderadamente urgentes. Usado para orquestração de campanha, engajamento quase ativo e relatórios operacionais. Usado para acionadores de campanha oportunos. Eficiente para conjuntos de dados massivos. Confiável para análise histórica. Usado para agregação de histórico ou fluxos de trabalho de relatórios regulados. Melhor para conjuntos de dados históricos ou de baixa velocidade.
Complexidade arquitetônica e I/O Arquitetura complexa e de alto custo. Requer sistemas de origem de baixa latência. Intensivo de I/O. Origens de alto volume podem causar pipelines saturados. Arquitetura mais simples do que em tempo real. O I/O é moderado. Melhor para padrões de atualização repetidos e previsíveis. O tamanho do lote afeta a memória/compute. Fácil de implementar. Intensivo de I/O durante janelas de carregamento. A taxa de transferência de rede pode se tornar um gargalos para lotes grandes.
Considerações de custo Custos de pipeline e computação mais altos. Justificado apenas para fluxos de trabalho de alto valor e urgentes. Moderar os custos de computação e armazenamento. Fornece uma abordagem de custo equilibrado versus frescura. Adequado para atualizações frequentes que podem tolerar pequenos atrasos. Menos custos de computação e armazenamento previsível. Recomendado para conjuntos de dados históricos ou atualizações de baixa frequência. A ingestão por meio de pipelines internos do Salesforce é gratuita.
Práticas de design Use a CDC incremental para minimizar o desvio de dados. Filtre e use campos seletivos para reduzir a sobrecarga. Use microlotes para controlar picos de I/O. Considere a agregação com janelas para reduzir a carga de processamento. Favorecer isso para relatórios de arquivamento ou instantâneos periódicos. Certifique-se de que a localidade de computação esteja na mesma região que o armazenamento de origem para otimização de custo.
### Federação de dados de cópia zero #### Casos de uso de cópia zero Use o Zero Copy para consulta em tempo real de sistemas externos sem duplicação de dados, permitindo agilidade, frescura e acesso escalonável a conjuntos de dados grandes ou temporários. É melhor para painéis ativos, análise exploratória, treinamento de modelo de IA/ML e engajamento do cliente em tempo real diretamente por meio do Salesforce Data 360. Visão geral da Federação de dados de cópia zero #### Métodos de cópia zero Ao usar o Zero Copy, os arquitetos devem decidir ainda mais entre três métodos de federação de dados disponíveis, cada um oferecendo seus próprios prós e contras entre frescura, desempenho e custo. - **Consulta ativa** - Executa consultas diretamente em sistemas externos (Snowflake, Google BigQuery, Redshift, Databricks etc.) sem duplicação de dados. - Otimizado quando predicados e agregações podem ser enviados para baixo, minimizando a movimentação de dados na rede e reduzindo o E/S no computador do Salesforce Data 360. - Melhor para percepções em tempo real e painéis operacionais de baixa latência. Dependendo do desempenho do sistema externo. - **Cache (consulta acelerada)** - Armazena temporariamente cópias em cache de dados federados no Salesforce Data 360. - Reduz os custos de consulta repetida e a latência para conjuntos de dados acessados com frequência, com duração configurável (minutos a dias). - Os dados não são copiados permanentemente nem totalmente controlados; a atualidade é gerenciada por meio de atualizações agendadas da origem. - **Federação de arquivos** - Fornece acesso direto somente leitura a conjuntos de dados em grande escala em lojas de objetos (por exemplo, S3, GCS com iceberg). - Melhor para cargas de trabalho de IA/ML, análise histórica e relatórios em escala de petabytes sem mover dados. - O desempenho da consulta depende muito do formato do objeto, do particionamento e das I/O de rede. As verificações grandes podem gerar I/O substanciais se não forem otimizadas. #### Manual do arquiteto - **Casos de uso** - **Personalizar em tempo real e fluxos de trabalho adaptáveis:** Entregue ofertas dinâmicas, recomendações e próximas melhores ações conforme o comportamento do cliente muda. - **Painéis ativos e análise operacional:** Aprimore painéis e KPIs essenciais para os negócios diretamente de armazéns externos. - **Trenamento de modelo de IA/ML com grandes conjuntos de dados externos:** Aproveite dados em escala de petabytes de data lakes e armazéns usando federação de arquivos sem movê-los. - **Cenários da indústria** - **Retail/Media:** Habilite recomendações personalizadas e engajamento do cliente em tempo real federando dados de interação de conteúdo ou fluxo de cliques. - **Finanças:** Execute a detecção de fraudes e a pontuação de risco quase em tempo real consultando armazéns externos sem duplicar dados confidenciais. - **Tech/Enterprise:** Dê suporte a relatórios entre nuvens, painéis de serviço de TI e análise operacional em que os conjuntos de dados residem em vários sistemas. - **Práticas de design** - **Consulta ativa** - Use para consultas de alta QPS e baixa latência quando a frescura for crítica. - Envie por push predicados e agregações para o sistema externo para reduzir o desvio de dados na rede. - Evite consultas que verificam volumes de dados enormes desnecessariamente; considere cortar partições e filtros. - **Federação de arquivos** - Acesse conjuntos de dados em escala de petabytes em lojas de objetos sem ingestão. - Mantenha o armazenamento de objeto na mesma região de nuvem que a computação do Salesforce para minimizar os custos de latência e saída. - Use formatos particionados em coluna (Parquet/ORC) e filtros de menu suspenso para reduzir a transferência de I/O e rede. - Aproveite a consulta e o menu suspenso de predicado para filtrar e agregar dados na origem, reduzindo a movimentação dos dados. - Evite o acesso a dados entre regiões, a menos que necessário, pois isso aumenta o E/S, a latência e os custos. - **Cache (consulta acelerada)** - Armazene em cache conjuntos de dados acessados com frequência para equilibrar custo e desempenho. - Configure intervalos de atualização para equilibrar a frescura versus o custo da consulta. - **Conformidade:** Imponha a governança na origem aproveitando a segurança em nível de linha (RLS) e mascarando políticas diretamente em sistemas federados. Aqui estão as práticas recomendadas para RLS uniforme e mascaramento entre plataformas. - **Usar um ID corporativo centralizado:** Mapeie usuários e entidades no Salesforce Data 360 para um identificador corporativo único e centralizado que corresponda a identidades em sistemas externos. - **Align Políticas de segurança:** Garanta que a segurança em nível de linha e as políticas de mascaramento em sistemas federados sejam aplicadas com base na identidade mapeada. Isso preserva a conformidade ao consultar dados externos. - **Padronizar esquemas de identidade:** Mantenha atributos de identidade consistentes (email, ID do usuário, ID do cliente etc.) em todas as fontes de dados para evitar incompatibilidades e violações de acesso. - **Considerações de custo** - **Consulta ao vivo:** Modelo de pagamento por consulta – os custos se acumulam no cálculo externo do lakehouse e podem aumentar com QPS alto. Melhor para casos de uso críticos de frescura em que o valor é maior que a variabilidade de custo. - **Consulta acelerada (cache):** Reduz o custo da consulta em comparação à Consulta ativa reduzindo as consultas ao sistema de origem, mas aumenta os custos de ingestão de dados em lote para preenchimento e atualização do cache. Melhor para conjuntos de dados acessados com frequência. - **Federação de arquivos:** Opção de armazenamento mais barata como dados na Loja de objetos, mas os custos de consulta dependem do tamanho do arquivo, do particionamento e da redução. Melhor para dados históricos ou em massa em escala de petabytes. #### Critérios de decisão do método de cópia zero
Ponto de decisão Consulta ativa Armazenamento em cache (consulta acelerada) Federação de arquivos
Local da fonte de dados Lagos de dados externos (Snowflake, Google BigQuery, Redshift, Databricks). Lagos de dados externos (Snowflake, Google BigQuery, Redshift, Databricks) Armazéns de objetos ou data lakes de nuvem (S3, ADLS, GCS), geralmente usando formatos de tabela abertos, como IceBerg.
Objetivo/Caso de uso Ideal para análise interativa e painéis em tempo real. Melhor para personalização em tempo real e fluxos de trabalho dinâmicos. Melhor para quando as consultas são frequentes, mas os resultados levemente obsoletos são aceitáveis. Adequado para painéis de BI e segmentação. Melhor para processamento em lote em grande escala e treinamento de modelo de IA/ML. Ideal para análise histórica e relatórios em escala de petabytes.
Freshness/Latency Máxima atualidade; as consultas são executadas diretamente em tempo real. Dá suporte à tomada de decisão em subsegundo. Resultados levemente obsoletos são aceitáveis. A atualidade depende do intervalo de cache, configurável de 15 minutos a 7 dias. Otimizada para trabalhos pesados em lote com alta taxa de transferência. Não é adequado para painel em tempo real.
Padrão de acesso Melhor para consultas infrequentes ou ad-hoc. Use para consultas de QPS alto (consulta por segundo), de baixa latência em que a frescura é crítica. Melhor para cenários de leitura de alta frequência. Melhora o desempenho para padrões de acesso frequente. Acesso somente leitura. Adequado para conjuntos de dados em escala de petabytes sem ingestão.
Drivers de desempenho Altamente dependente do desempenho do sistema de origem externo. Otimizado quando predicados e agregações podem ser enviados para baixo para a origem. Reduz a latência em comparação a consultas ativas repetidas. O desempenho depende do gerenciamento de cache e do intervalo. O desempenho depende muito do formato do objeto, do particionamento e da taxa de transferência do sistema externo. Use formatos particionados em colunas (Parquet/ORC).
Implicações dos custos Modelo Pagar por consulta. Os custos se acumulam no computador de lakehouse externo. Custo-benefício para consultas pouco frequentes, mas as despesas podem aumentar com alto volume de consultas por segundo (QPS). Custo menor do que consultas ativas repetidas. Reduz a necessidade de consultar a origem externa repetidamente. Adiciona armazenamento em cache e sobrecarga de atualização. Opção de armazenamento mais barata. Os custos de consulta dependem do tamanho e do particionamento do arquivo.
Consideração principal Evite consultas não filtradas que verificam volumes de dados enormes desnecessariamente. Requer gerenciamento de cache. Não é adequado para tomada de decisão em menos de um segundo. O desempenho da consulta depende fortemente da otimização por meio de particionamento e menu suspenso de predicado.
### Abordagem híbrida As arquiteturas híbridas permitem que os arquitetos ancorem conjuntos de dados críticos no Data 360 para governança centralizada enquanto aproveitam consultas federadas para atualização, redução da duplicação e acesso escalonável a conjuntos de dados externos grandes. Essa abordagem balanceia os requisitos de I/O, localidade de computação, custo e conformidade. #### Casos de uso híbridos Use uma abordagem híbrida para uma governança equilibrada, frescura e eficiência operacional combinando ingestão de dados e cópia zero para fornecer percepções acionáveis em tempo real. Use a ingestão para conjuntos de dados regulados de alto valor em que rastreabilidade, RLS e mascaramento são necessários e federação para conjuntos de dados efetivos ou de alto volume em que a atualização e o desempenho são essenciais. Visão geral da abordagem híbrida #### Manual do arquiteto - **Casos de uso** - **Engajamento do Omni-Channel:** Combine dados históricos do cliente com comportamento em tempo real para proporcionar experiências consistentes sensíveis ao contexto. - **Pipelines de IA/ML:** Treine modelos em conjuntos de dados canônicos selecionados enquanto os aprimora com sinais brutos ou em tempo real de fontes externas. - **Necessidades de conformidade e agilidade mistas:** Aplique uma governança rígida a dados confidenciais, mas federar para agilidade operacional. - **Cenários da indústria** - **Retail:** Use ingestão para resolução de identidade e unificação de perfil; federar para ofertas e personalização em tempo real. - **Saúde:** Mantenha registros do paciente dourados por meio de ingestão enquanto federa fluxos de dispositivo de IoT e dados de sensor para contexto imediato. - **Serviços financeiros:** Ingira dados regulados em um lago de conformidade enquanto federa consultas externas para detecção de fraudes e monitoramento de risco. - **Práticas de design** - **Ancora governança com ingestão:** Ingira dados de alto valor ou regulados em modelos canônicos para garantir Trust e conformidade. - **Use Federação para frescura:** Permita que os lagos externos forneçam acesso a dados em tempo real ou em grande escala sem duplicação. - Custo do **saldo vs. Desempenho:** Faça o perfil das cargas de trabalho para decidir o que ingerir vs. federar, minimizando custos desnecessários de armazenamento ou consulta. - **Aplicar governança em camadas:** Imponha a governança centralizada para dados ingeridos enquanto aproveita os próprios controles de segurança dos sistemas federados (por exemplo, RLS, mascaramento). - Ao projetar pipelines híbridos, garanta a ingestão incremental para conjuntos de dados históricos e envie agregações ou filtros por push para fontes federadas para otimizar o uso de I/O e computação. - **Considerações de custo** - Otimize o custo total versus o desempenho combinando a ingestão de dados críticos ou de conformidade com a federação quando a atualização for necessária. - Considere a distribuição de I/O e computação ao combinar ingestão e federação. Para reduzir o custo de computação em sistemas de origem de consultas repetidas, use o armazenamento em cache (consulta acelerada) para conjuntos de dados federados de alta leitura acessados com frequência. ## Usar o Guia de decisão de caso Abaixo estão os arquetípicos comuns que ilustram como aplicar essa lógica. 1. **O Arquétipo da "Fonte Única da Verdade": Centralizar e governar** - **Cenário:** Você precisa criar perfis unificados e compatíveis do Customer 360 para toda a sua empresa global. Os dados vêm de uma dúzia de sistemas diferentes, devem cumprir normas rigorosas de GDPR e CCPA e servirão como a fonte confiável para todas as interações de marketing e serviço. - **Padrão recomendado:** **Ingestão de dados.** A prioridade é governança, Trust e controle. Ingerir os dados no Data 360 é a única maneira de criar um perfil canônico totalmente auditável que seja isolado dos sistemas de origem. 2. **O Arquiteto de Insights em tempo real: Analisar sem se mover** - **Cenário:** Sua equipe de ciência de dados precisa executar consultas exploratórias em uma tabela de transações massiva e constantemente atualizada no Snowflake. Ao mesmo tempo, sua equipe executiva quer um painel de BI ativo habilitado pelos mesmos dados. Mover petabytes de dados por dia é muito lento e caro. - **Padrão recomendado:** **Federação de cópia zero.** A prioridade é velocidade, agilidade e custo-benefício em escala. A Cópia zero permite que você aproveite o enorme poder do seu armazém de dados existente para consultas em tempo real sem o sobrecarregamento e a latência da duplicação de dados. 3. **O Arquétipo de Inteligência Híbrida: Governar o núcleo, Federar a borda** - **Cenário:** Você deseja aprimorar seus perfis de cliente administrados e ingeridos com sinais comportamentais em tempo real (como cliques no site) de um data lake. Você precisa da estabilidade do perfil principal, mas da imediatez dos dados ativos para habilitar a personalização no momento. - **Padrão recomendado:** **Uma abordagem híbrida.** Use a Ingestão de dados para criar o núcleo estável e governado dos dados do cliente. Em seguida, use a Cópia zero para federar os dados de "frente" em tempo real e voláteis, unindo-os no tempo da consulta para uma visualização completa atualizada por segundo. ## O caminho para frente A estratégia de dados corporativos não é mais sobre escolher um único padrão de integração, é sobre arquitetar flexibilidade controlada em um ecossistema de dados interoperável. Selecionar o método de integração de dados certo para cada sistema de dados de origem com base nas necessidades de negócios geralmente leva a uma abordagem híbrida que combina os pontos fortes da ingestão de dados e da federação de dados.: - Ingira conjuntos de dados governados essenciais para a missão no Salesforce Data 360 para conformidade, resolução de identidade e fluxos de trabalho operacionais. - Federar dados por meio do Zero Copy para análise ativa, exploratória e conduzida por IA sem armazenamento duplicado. O Salesforce Data 360 no Hyperforce proporciona resiliência e escalabilidade multi-região. O lakehouse aberto com tabelas de iceberg permite a separação de computação e a interoperabilidade com plataformas como Snowflake, Databricks e S3 Iceberg, formando a espinha dorsal de um ecossistema de dados multi-nuvem verdadeiramente interoperável. Conforme os ecossistemas de dados evoluem, equilibre continuamente a atualidade, o custo, o desempenho e a conformidade para manter a agilidade arquitetônica. Proteja sua plataforma para o futuro unificando dados ingeridos e controlados com acesso federado. Isso habilita a inteligência em tempo real, a ativação de IA e a personalização em escala corporativa em nuvens, regiões e domínios de negócios. Soluções unidimensionais adequadas a todos não são adequadas à maioria das empresas. A estratégia ideal mapeia o padrão certo para o motor de negócios certo. ## Sobre os autores Yugandhar Bora é um arquiteto de engenharia de software na Salesforce, especializado em arquitetura de dados na plataforma de Aplicativos de dados e inteligência. Ele lidera iniciativas do Conselho de revisão de arquitetura corporativa (EARB) focadas na governança de dados e modelos de dados unificados, ao mesmo tempo que contribui para soluções de provisionamento de plataforma automatizadas. Jan Fernando é um arquiteto principal no escritório do arquiteto principal no Salesforce. Ele entrou para a Salesforce em 2012, trazendo uma vasta experiência de seu tempo no ecossistema de startup. Antes de ingressar no Escritório do Arquiteto Chefe, ele passou mais de uma década na organização da plataforma, onde liderou várias transformações tecnológicas importantes. # Introdução aos guias de decisão da plataforma Esta seção fornece orientação prática para tomar decisões arquitetônicas essenciais sobre os recursos da Salesforce Platform. Ele abrange processamento assíncrono, eventos acionados por registro, criação de formulário, arquitetura orientada por evento e estruturas assíncronas baseadas em etapa para ajudar os arquitetos a projetar soluções de plataforma dimensionáveis, manejáveis e de alto desempenho. --- ## Processamento assíncrono O [Processamento assíncrono](/docs/architect/pt-br/decision-guides/guide/async-processing) fornece orientação sobre ferramentas e abordagens para operações assíncronas no Salesforce: - **Ferramentas de processamento assíncrono**: Comparação de Apex enfileirável, Apex agendado, acionadores de evento de plataforma, captura de dados de alteração, caminho agendado (depois de fluxos de confirmação) e caminho assíncrono (fluxos acionados por registro), com orientação sobre casos de uso apropriados. - **Processamento assíncrono no lado do servidor**: Padrões para operações de banco de dados de execução longa, chamadas externas e processamento de registro de grande volume. - **Processamento assíncrono do lado do cliente**: Técnicas como Chamadas de continuação do Apex e processamento assíncrono no lado do cliente que podem ser executadas em navegadores ou aplicativos móveis. - **Quadro de Decisão**: Considere a validação de caso de uso, a escalabilidade, a compreensão de quando as transações são verdadeiramente assíncronas, o monitoramento e o tratamento de eventos de carga extrema. - **Práticas recomendadas e antipadrões**: Orientação para o uso adequado, incluindo integrações de saída, monitoramento e evitar armadilhas comuns. Permite que os arquitetos implementem padrões assíncronos escalonáveis, confiáveis e mantidos, evitando armadilhas que comprometem o desempenho. --- ## Formulários de construção O [Building Forms](/docs/architect/pt-br/decision-guides/guide/build-forms) orienta os arquitetos sobre as opções de criação de formulário do Salesforce: - **Fórmulas de construção**: Comparação de Formulários dinâmicos, Fluxo de tela, OmniStudio, Fluxo de tela com Componentes da Web Lightning (LWC) e LWC, incluindo habilidades e considerações de licenciamento. - **Quadro de Decisão**: Considere o impacto do objeto, o escopo do formulário, a navegação, o local (aplicativo, dispositivo móvel, Web), a UX e a automação de teste. - **Orientação de seleção de ferramentas**: Recomendações de layouts de registro simples a assistentes de várias páginas e formulários voltados para o cliente com marca. - **Padrões de combinação**: Orientação para combinar ferramentas, por exemplo, navegação de Fluxo de tela com estilo do LWC. - **Recursos avançados**: Aprofunde-se em recursos e limitações para informar a escolha de ferramentas. Ajuda os arquitetos a selecionar a abordagem de criação de formulário certa para seus requisitos de UX, funcional e de integração específicos. --- ## Arquitetura conduzida por evento A [Arquitetura conduzida por evento](/docs/architect/pt-br/decision-guides/guide/event-driven) fornece um guia abrangente para ferramentas e padrões do Salesforce Eventing: - **Ferramentas para Eventos**: Visão geral de Eventos de plataforma, Captura de dados de alteração, API Pub/Sub, MuleSoft Anypoint, API de streaming e considerações de integração. - **Padrões conduzidos por evento**: Inclui padrões de publicação/assinatura, efetuação, mensagens passadas, streaming e enfileiramento para vários casos de uso conduzidos por evento. - **Integração com MuleSoft**: Usar conectores do Anypoint (Pub/Sub, JMS, Kafka, Solace, MQ, MQTT, AMQP) para arquiteturas empresariais. - **Eventos de plataforma e captura de dados de alteração**: Orientação sobre mecanismos preferenciais para publicar alterações de registro e campo, com migração de Eventos PushTopic/Generic. - **Padrões de implementação**: Práticas recomendadas para escalabilidade, consistência, tratamento de erros e monitoramento. Permite que os arquitetos projetem sistemas escalonáveis conduzidos por evento quase em tempo real que conectam vários sistemas de modo eficiente. --- ## Estrutura assíncrona baseada em etapas O [Step-Based Async Framework](/docs/architect/pt-br/decision-guides/guide/step-based-async-framework) fornece uma estrutura para processamento de trabalho assíncrono modular e escalável: - **Arquitetura de estrutura**: Os componentes incluem Apex enfileirável, finalizadores, fluxo agendado, cursores do Apex, ações invocáveis e integrações do Slack. - **Processamento baseado em etapas**: Divide o trabalho em etapas independentes que podem ser executadas, tentadas novamente e reiniciadas com governança compartilhada e visibilidade operacional. - **Orientação de Aplicação**: Padrões para interface de etapa, Processador de etapa, Camada invocável do Apex, tratamento de atraso e notificações. - **Práticas recomendadas**: Recomendado quando a maioria das informações existe no CRM, para cargas de trabalho de alto volume e processamento de registro hierárquico ou baseado em árvore; orientação sobre quando não usar. - **Recursos empresariais**: Governança, conformidade, estado distribuído, rastreamento de progresso, monitoramento de SLA, diagnóstico de falha e registro em nível de auditoria. Fornece aos arquitetos uma alternativa escalonável a trabalhos em lote monolíticos e chamadas assíncronas encadeadas, oferecendo suporte a cargas de trabalho do Salesforce de alto volume com transparência operacional total. --- ## Automação acionada por registro A [Automação acionada por registro](/docs/architect/pt-br/decision-guides/guide/record-triggered) fornece a estrutura para projetar a automação acionada por registro na Salesforce Platform: - **Seleção de ferramentas**: Quando usar o Fluxo acionado por registro versus acionadores do Apex, guiado pela densidade de automação (baixo, médio, alto) e pela matriz de seleção de densidade. - **Densidade de automação**: Como avaliar a quantidade de automação, o volume de registros e a disseminação de dependência para escolher Fluxo, fluxo híbrido (Fluxo com Apex invocável) ou acionadores do Apex. - **Ponto de entrada e governança**: Um ponto de entrada por objeto do Salesforce; orientação sobre condições de entrada, controle de recursão e execução ordenada. - **Invocação assíncrona**: Quando e como invocar processos assíncronos de fluxos acionados por registro ou Apex, com cuidado em relação ao tratamento de erros e limites do regulador. - **Práticas recomendadas**: Padrões para massificação, design de Fluxo híbrido – Apex e evitar armadilhas comuns na automação do acionador. Permite que os arquitetos projetem automação acionada por registro dimensionável, manejável e de desempenho alinhada aos padrões de plataforma. # Introdução aos guias de decisão de integração Esta seção fornece orientação prática para escolher as ferramentas e abordagens de integração de dados certas para o Salesforce. Ele abrange integrações de saída, integrações de entrada e cenários organizacionais cruzados, ajudando os arquitetos a projetar e implementar integrações de camada de dados que balanceiam desempenho, capacidade de manutenção e custo. --- ## Integração de dados com o Salesforce A [Integração de dados com o Salesforce](/docs/architect/pt-br/decision-guides/guide/data-integration) apresenta uma visão geral abrangente das melhores práticas e ferramentas de integração de dados do Salesforce: - **Paisagem de ferramentas de integração**: Visão geral das ferramentas de integração de dados do Salesforce, incluindo opções de código baixo, híbridas e de código profissional, com orientação sobre a seleção da ferramenta certa para casos de uso específicos. - **Integrações de saída**: Métodos para enviar dados do Salesforce para sistemas externos, incluindo captura de dados, Serviços externos, Heroku Connect, Procedimentos de integração do OmniStudio, Salesforce Connect, MuleSoft Anypoint e soluções personalizadas do Apex. - **Integrações de entrada**: Abordagens para trazer dados externos para o Salesforce, com orientação sobre replicação de dados versus virtualização e quando usar cada ferramenta. - **Integrações entre organizações**: Métodos recomendados para compartilhar dados entre organizações do Salesforce, incluindo MuleSoft Anypoint, Heroku Connect, APIs nativas do Salesforce, Captura de dados de alteração e Salesforce Connect com adaptador entre organizações, incluindo orientação para substituir implementações legadas do Salesforce para Salesforce. - **Quadro de Decisão**: Considerações importantes para selecionar ferramentas de integração, como ferramentas e paisagem existentes, requisitos de fluxo de dados (tempo, direcionalidade, experiência do usuário esperada), complexidade da implementação, capacidade de manutenção, volume de dados e limites da plataforma. Permite que os arquitetos escolham as ferramentas e os padrões de integração certos para cada cenário, minimizando a replicação de dados desnecessária, aproveitando soluções ESB/ETL existentes e garantindo integrações dimensionáveis e manejáveis alinhadas aos princípios da arquitetura corporativa. # Introdução aos guias de decisão do Data 360 Esta seção fornece orientação prática para tomar decisões arquitetônicas essenciais sobre o Salesforce Data 360, incluindo estratégias de provisionamento, conectividade de várias organizações e padrões de integração. Use esses guias para projetar e implementar arquiteturas de dados eficientes que unificam dados do cliente e habilitam recursos desenvolvidos com IA. --- ## Provisionamento do Data 360 O [Data 360 Provisioning](/docs/architect/pt-br/decision-guides/guide/data-360-provisioning) abrange decisões fundamentais ao provisionar o Salesforce Data 360: - **Home Organização Seleção**: Decida se deseja provisionar o Data 360 em uma organização de produção existente ou criar uma organização dedicada, considerando a governança, a conformidade e o tempo de valorização. - **Estratégia de várias organizações**: Escolha entre várias instâncias independentes do Data 360 ou use o Data Cloud One para unificar várias organizações do Salesforce, equilibrando a autonomia, a conformidade e o custo. - **Arquitetura Data Cloud One**: Habilite várias organizações parceiras para compartilhar uma única instância do Data 360 com governança centralizada, compartilhamento de metadados e paridade de recursos entre organizações. - **Compartilhamento de dados entre organizações do Data 360**: Use o compartilhamento de dados de cópia zero entre instâncias independentes para conformidade regional, colaboração da unidade de negócios ou painéis executivos federados. - **Considerações sobre provisionamento**: Fatores na residência de dados, modelos de governança, latência, complexidade da integração, custo e prontidão de IA para implantações corporativas. Ajuda os arquitetos a projetar estratégias de provisionamento que garantem simplicidade, consistência corporativa, conformidade e escalabilidade para Customer 360, IA e inovação entre plataformas. --- ## Interoperabilidade do Data 360 A [Interoperabilidade do Data 360](/docs/architect/pt-br/decision-guides/guide/data-360-interoperability) fornece uma estrutura para integrar o Data 360 a plataformas externas e data lakes: - **Padrões de ingestão de dados**: Tempo real, streaming e ingestão em lote para criar conjuntos de dados canônicos gerenciados ideais para Customer 360, conformidade e governança centralizada. - **Federação de dados de cópia zero**: Consultas ao vivo, consultas aceleradas (cache) e métodos de federação de arquivos para acessar sistemas externos em tempo real sem duplicação, habilitando personalização, painéis e cargas de trabalho de IA/ML. - **Abordagem híbrida**: Combine ingestão governada para conjuntos de dados principais com federação de cópia zero para atualização e escalabilidade, com suporte para engajamento do Omni-Channel, ações conduzidas pelo Agentforce e análise corporativa. - **Quadro de Decisão**: Avalie compensações em latência, custo, escalabilidade, governança e complexidade para selecionar o padrão de integração certo por fonte de dados. - **Architect Playbooks**: Diretrizes específicas do setor, práticas de design e considerações de custo para cenários financeiros, de saúde, de varejo e de telecomunicações. Orienta os arquitetos no equilíbrio entre a atualidade dos dados, a governança e a eficiência do pipeline para criar arquiteturas de dados escalonáveis, interoperáveis e prontas para IA que dão suporte a cargas de trabalho operacionais e analíticas. ## Visão geral do guia Este guia vai ajudá-lo a avaliar a abordagem certa para seus requisitos de processamento assíncronos na Salesforce Platform. Ele explica cada abordagem, detalhando os pontos fortes e as limitações de cada uma. A maioria das abordagens está alinhada a um recurso de produto, mas algumas abordagens usam vários recursos em coordenação. O guia inclui casos de uso para destacar quando usar cada abordagem. O processamento assíncrono oferece dois benefícios importantes para sua arquitetura. Primeiro, ele aumenta a escalabilidade porque os processos assíncronos têm limites de controlador maiores. Segundo, as solicitações assíncronas são executadas em seus próprios threads para que os usuários possam fazer outro trabalho enquanto as tarefas assíncronas são executadas em segundo plano. Observe que este guia se concentra exclusivamente na escolha de uma tecnologia de processamento assíncrona na Salesforce Platform. Outros recursos para ajudar seu processo de decisão são listados na [seção Recursos](#recursos). ## Produtos no escopo deste guia
Plataforma Salesforce A Salesforce Lightning Platform é uma plataforma abrangente baseada em IA que une funcionários, agentes de IA autônomos, dados da empresa e aplicativos em um único sistema confiável para aumentar a produtividade e a experiência do cliente. Ele permite a criação de uma "empresa ativa" conectando os aplicativos Customer 360, o Data Cloud e o Slack para automação completa.
Este documento não abrange tecnologias em outros ecossistemas, como MuleSoft, Informatica, Commerce Cloud, Tableau e Marketing Cloud. ## Capturas - **Antes de usar o processamento assíncrono, certifique-se de que seus casos de uso se encaixam no padrão.** Os padrões assíncronos não têm SLA, estão sujeitos a vários mecanismos de controlador, podem ter limites de capacidade definidos com base no licenciamento e podem causar atrasos de processamento devido à natureza finita dos recursos alocados à infraestrutura assíncrona na Salesforce Platform. Considere essas limitações ao usar processamento assíncrono em cenários em que um usuário precisa de uma resposta do sistema antes de continuar o trabalho. - **O processamento assíncrono com o Salesforce não é uma solução para necessidades de escala ilimitadas.** A Salesforce Platform não é dimensionada de modo infinito e os padrões assíncronos estão sujeitos a limitações. O processamento assíncrono usa threads, que contêm as informações contextuais de que uma CPU precisa para executar um fluxo de instruções. Os threads podem ser executados em paralelo. O número de threads disponíveis em qualquer CPU é limitado, portanto, a plataforma tem mecanismos em vigor para usar seus threads disponíveis da maneira mais eficiente possível. O [mecanismo de controle de fluxo](/docs/architect/pt-br/fundamentals/guide/async-fundamentals#controle-de-fluxo) da plataforma impede que as organizações consumam fitas demais e afetem negativamente outras organizações. O [algoritmo de uso justo](/docs/architect/pt-br/fundamentals/guide/async-fundamentals#uso-justo) da plataforma também controla o número de threads que uma organização tem disponíveis para cada tipo de mensagem específico. - **Tome em conta os eventos que podem causar cargas extremas.** Ao projetar processos assíncronos, certifique-se de que eles possam gerenciar de modo previsível picos e lacunas da carga de trabalho. Considere como sua implementação lida com eventos inesperados, como falhas de energia, e projete proteções que mitiguem a perda de dados ou a perda de funcionalidade. ## Comparação de produto Esta tabela descreve as ferramentas disponíveis para processamento assíncrono com o Salesforce. Consulte esta tabela para revisar as principais características de cada ferramenta durante o processo de tomada de decisão. Consulte [Usar casos](#casos-de-uso) e [pontos de decisão](#pontos-de-decisão) para obter ajuda na escolha das ferramentas certas para sua arquitetura.
Abordagem Descrição Habilidades necessárias Licenças e limites
Apex enfileirável Use para processos que envolvem operações de banco de dados de execução longa ou chamadas de serviço da Web externo. O Apex enfileirável oferece recursos como IDs de trabalho, suporte para tipos não primitivos e encadeamento de trabalho. Código profissional O número de licenças pode aumentar os limites.
Apex de lote Crie processos complexos de longa duração que envolvem milhões de registros dividindo seu conjunto de registros e processando-o em partes gerenciáveis. Código profissional O número de licenças pode aumentar os limites.
Apex agendado Execute o Apex em um horário agendado definido por uma expressão cron. Embora o ato de agendar o Apex por meio da expressão cron seja um processo assíncrono, o código subjacente é executado de forma síncrona quando o trabalho é iniciado. Código profissional O número de licenças pode aumentar os limites.
Chamadas de continuação do Apex Execute chamadas de métodos do Apex em execução em um contexto de transação síncrona. Código profissional Não
Caminho assíncrono (fluxos acionados por registro) Execute uma operação que você deseja executar em seu próprio horário. Evite erros DML mistos que ocorram quando você atualiza um valor em um registro relacionado que não faz parte do registro que acionou um fluxo. Código baixo O número e o tipo de licenças podem aumentar os limites.
Caminho agendado (depois de fluxos de confirmação) Execute em um horário dinamicamente agendado após um evento acionador, como quando um registro é criado, atualizado ou excluído. Código baixo O número e o tipo de licenças podem aumentar os limites.
Fluxos agendados Execute um fluxo em segundo plano em um horário especificado e com uma frequência repetida (diária, semanal ou uma vez) para realizar ações em um lote de registros. Código baixo O número e o tipo de licenças podem aumentar os limites.
Acionadores de evento de plataforma Combine o Salesforce com sistemas externos e se comunique entre componentes assíncronos dentro da Salesforce Platform. Código inferior + Código profissional Uma licença complementar é necessária para casos de uso de evento de plataforma de alto volume
Captura de dados de alteração Capture e processe eventos de alteração de modo assíncrono após a transação do banco de dados ser confirmada. Código profissional Uma licença complementar é necessária para escalar acima da alocação de linha de base.
API em massa Insira, atualize, insira e atualize, consulte ou exclua muitos registros de modo assíncrono e processe os resultados mais tarde. Código profissional Há limites.
Ações do Lightning Permita que as páginas do Lightning interajam com o servidor sem forçar os usuários a atualizar completamente a página. Código baixo Não
## Pontos de decisão Esta tabela contém uma visão geral dos pontos a serem considerados ao decidir qual ferramenta assíncrona usar.
Habilidades necessárias Algumas das ferramentas descritas neste guia exigem código, enquanto outras podem ser configuradas declarativamente. Ao considerar suas opções, pense nos conjuntos de habilidades que os membros da sua equipe têm. Lembre-se de que, mesmo que os desenvolvedores estejam disponíveis para sua implementação inicial (por meio de um parceiro de implementação, por exemplo), talvez você precise modificar suas soluções no futuro. Se a sua equipe de manutenção não tiver desenvolvedores, uma opção com pouco código poderá ser mais adequada.
Tipo de limites de plataforma aplicados Determine o tipo de limite que se aplica à execução. Conforme você projeta suas soluções, pense cuidadosamente em como o volume e a frequência das transações contam para os limites do regulador para a abordagem escolhida a cada dia. Calcule o número de execuções que ocorrerão a cada dia. Certifique-se de que os valores calculados estejam dentro dos limites associados às ferramentas selecionadas.
Latency Determine a rapidez com que os resultados do processamento estarão disponíveis na plataforma. Para algumas abordagens, as alterações serão quase imediatas, enquanto para outras podem ser minutos ou horas.
## Casos de uso Ao selecionar uma ferramenta para processamento assíncrono, primeiro avalie os requisitos e os recursos disponíveis da sua organização. Sua meta é selecionar a ferramenta ou ferramentas que minimizam os custos de implementação e manutenção, mas ainda garantem a escalabilidade e minimizam a probabilidade de violações de limite. Essa meta depende das considerações técnicas descritas anteriormente, bem como da composição da sua equipe. Considere um processo de pedido assíncrono no Salesforce. Quando um pedido é salvo, ele aciona uma mensagem para um sistema de gerenciamento de armazém externo com instruções especiais sobre como empacotar e enviar um item. O usuário que faz o pedido não precisa de uma resposta imediata do sistema de gerenciamento de armazém, portanto, a solicitação pode ser enviada de modo assíncrono. O processamento assíncrono permite que o usuário continue seu trabalho sem esperar uma resposta. Para esse caso de uso, você pode considerar implementar com Apex. Essa abordagem funcionará apenas se você tiver desenvolvedores do Apex em sua equipe que possam manter sua solução de código profissional. Caso contrário, uma abordagem declarativa faz mais sentido. Lembre-se também de que diferentes conjuntos de [limites](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_gov_limits.htm) se aplicam a diferentes ferramentas. Esta tabela lista casos de uso comuns na coluna mais à esquerda, seguidos por uma descrição. A coluna _Primeira escolha_ fornece a abordagem mais típica usada para satisfazer esse caso de uso, junto com a justificação para a abordagem Primeira escolha. Use isso como ponto de partida em sua análise. A abordagem Primeira opção pode ter limitações que não funcionarão para seu caso de uso.
Caso de uso Descrição Abordagem de primeira escolha Racionalidade
Processamento em lote de alto desempenho Qualquer automação que precise processar milhares ou milhões de registros de maneira eficiente Lote Apex O Apex em lote fornece APIs avançadas para interface com a plataforma e velocidade bruta.
Trabalho de limpeza de dados Um trabalho que é executado de rotina ou sob demanda que limpa dados. Exemplos incluem desduplicação, verificação de endereço ou consolidação de dados. Lote Apex O Apex em lote fornece APIs avançadas para interface com a plataforma e velocidade bruta.
Trabalho de totalização noturna Trabalho que calcula os dados de totalização no fim de um dia útil. Lote Apex O Apex em lote fornece APIs avançadas para interface com a plataforma e velocidade bruta.
Lógica acionada por registro Execute a lógica em resposta a uma atualização de registro. Varia Consulte nosso guia de decisão de companheiro, Automação de eventos acionados por registro. Inclui uma árvore de decisão para casos de uso assíncronos, incluindo Apex enfileirável, Apex em lote, Apex agendado, Fluxo agendado, Fluxos de caminho assíncrono e Captura de dados de alteração.
Atualizações em cascata por meio de um gráfico de objeto Permite que a ação de salvar de um usuário seja concluída rapidamente, adiando atualizações em cascata a outros objetos para execução assíncrona. Apex enfileirável O Apex enfileirável tem recursos poderosos de encadeamento que permitem que a lógica divida uma cadeia de atualizações em uma série de transações assíncronas.
Processamento agendado específico do registro Automação em uma data dinâmica futura específica do registro (por exemplo, três dias antes de uma data de fechamento). Fluxo com um caminho agendado Os caminhos agendados fornecem um poder exclusivo ao Fluxo, pois a plataforma gerencia automaticamente o agendamento, o cancelamento e o reagendamento desses caminhos se os dados do registro mudarem.
Invocando vários serviços externos lentos em paralelo Durante uma execução síncrona, vários serviços externos são chamados em paralelo para otimizar o tempo de execução geral. Chamadas de continuação do Apex Permitir que várias chamadas de execução lenta sejam executadas em paralelo minimiza o tempo geral para concluir o trabalho.
Migração de dados de registros de um sistema externo Mova grandes quantidades de registros para a Salesforce Platform de um sistema externo. Um processo único ou agendado regularmente. Bulk API Essa é a abordagem mais eficiente e amigável para a migração de dados.
Executar lógica adicional em um sistema externo Padrão de foco e esquecimento de notificar um sistema externo de um evento na plataforma, então permitindo que esse sistema processe o evento de modo assíncrono. Eventos de plataforma ou captura de dados de alteração Um modelo pub-sub funciona melhor aqui e permite que o sistema externo processe o evento quando ele estiver pronto. Consulte Arquitetura conduzida por evento para obter mais detalhes sobre esse padrão.
A tabela Casos de uso é um guia para a abordagem mais adequada para cada caso de uso. No entanto, você precisará validar o quão bem a tecnologia Primeira escolha atende às necessidades específicas do seu caso de uso. Em particular, determine se a abordagem escolhida pode cumprir os limites do controlador para sua organização. Depois de identificar uma abordagem candidata para seu caso de uso, o [Guia de Fundamentos de Processamento Assíncrono](/docs/architect/pt-br/fundamentals/guide/async-fundamentals) pode ajudar a verificar totalmente a solução. ## Recursos Estes recursos adicionais podem ajudar no processo de decisão: - Aprofunde-se em cada uma das tecnologias assíncronas da plataforma: [Fundamentos do processamento assíncrono](/docs/architect/pt-br/fundamentals/guide/async-fundamentals) - Escolher entre Apex e Fluxo para acionadores de registro: [Automação de eventos acionados por registro](/docs/architect/pt-br/decision-guides/guide/record-triggered) - Informações sobre padrões de integração assíncronos: [Arquitetura orientada por evento](/docs/architect/pt-br/decision-guides/guide/event-driven) ## Visão geral O Salesforce Data 360 é uma plataforma de dados baseada no Hyperforce que unifica dados do Salesforce e externos em uma visão clara, completa e confiável de 360 graus de cada cliente ou conta. As empresas costumam operar várias organizações do Salesforce devido a fusões e aquisições, operações regionais, separação funcional ou por motivos históricos. Os arquitetos devem decidir não apenas entre uma organização de origem única e uma configuração de organizações múltiplas, mas também se devem provisionar várias instâncias independentes do Data 360, usar o Data Cloud One para unificar organizações em uma única instância ou colaborar entre instâncias independentes do Data 360 usando o compartilhamento de dados entre os Data 360 (compartilhamento de dados do Data 360 para Data 360). Essas escolhas afetam a governança, a conformidade, o custo, a latência e a capacidade da organização de escalar recursos de plataforma entre organizações e IA. O Data 360 é provisionado automaticamente em qualquer organização de produção que receba uma licença do Data 360. O Data Cloud One é a arquitetura de conectividade de várias organizações do Salesforce que permite que uma única organização inicial hospede a instância do Data 360, enquanto outras organizações do Salesforce se conectam como organizações de companheiro. A escolha de qual organização possui a licença do Data 360 e, portanto, se torna uma organização inicial do Data 360 é uma decisão arquitetônica crítica com consequências de longo prazo. Como você provisionar o Salesforce Data 360 é uma decisão arquitetônica fundamental porque determina como a empresa unifica dados do cliente, impõe governança e habilita recursos críticos da plataforma, especialmente IA, Agentforce e análise, em toda a organização. Ancorar um grupo de organizações em um único Data 360 fornece um modelo de dados unificado, governança centralizada e prontidão de IA corporativa, ao mesmo tempo que permite que organizações parceiras acessem metadados e recursos compartilhados como se os dados fossem locais. Por outro lado, várias instâncias independentes do Data 360 são adequadas quando requisitos regulatórios, de conformidade ou de autonomia impedem a centralização, com o Compartilhamento de dados entre organizações do Data 360 habilitando a colaboração seletiva de cópia zero entre essas instâncias. Para os arquitetos, essa decisão é crítica. Ela define quem controla a governança de dados, onde os dados residem, como os recursos da plataforma são habilitados e como futuras integrações e iniciativas de IA podem ser dimensionadas sem problemas. Mesmo para organizações que não têm o Data 360 no momento, pode ser importante preparar sua arquitetura para o futuro desenvolvendo uma estratégia para adicionar acesso ao Data 360 no futuro. Os recursos do Salesforce em Vendas, Serviço, Marketing, Comércio, Indústrias e Agentforce são criados cada vez mais no Data 360. As organizações que desejam usar esses recursos de plataforma devem provisionar o próprio Data 360 ou conectar-se a um Data 360 compartilhado como organizações companheiras. Este guia ajuda os arquitetos a projetar uma estratégia de provisionamento que equilibra simplicidade, consistência em toda a empresa, conformidade e escalabilidade, garantindo que a organização possa aproveitar com confiança o Data 360 para Customer 360, IA e inovação entre plataformas. Ele vai ajudá-lo a decidir como selecionar em quais organizações você provisionará o Data 360 e como escolher entre o Data Cloud One e o Compartilhamento de dados entre as Organizações do Data 360, ajudando a estabelecer uma base firme que promova seu negócio em um futuro centrado no Data 360. --- ## Considerações sobre provisionamento Todas as opções de provisionamento, quer se trate de escolher entre o Data Cloud One e o compartilhamento de dados entre organizações do Data 360, ou qual organização designar como a Organização inicial, devem ser avaliadas com base nestas considerações abrangentes:
Consideração Por que é importante Cenários de exemplo
Residência de dados e conformidade Determina onde os dados são armazenados e processados. Regras regulatórias podem exigir regiões específicas ou várias instâncias. Um banco global provisiona um locatário do Data 360 em uma organização do Salesforce geograficamente localizada em Frankfurt para conformidade com o GDPR e outro em uma organização na Virgínia para sua divisão dos EUA.
Governança e segurança Quem é proprietário e administra o Data 360? As políticas devem ser gerenciadas centralmente ou delegadas por unidade de negócios? Uma multinacional com TI central forte cria uma organização residencial dedicada gerenciada por um Centro de excelência.
Autonomia vs. Centralização Diferentes líderes podem querer uma propriedade separada dos dados. A autonomia favorece vários Data 360s; a centralização favorece o Data Cloud One. Uma empresa de holding com subsidiárias independentes permite que cada BU execute seu próprio Data 360.
Latência e desempenho Impacta a velocidade de consulta e a experiência, especialmente para Organizações de companheiro conectadas a um locatário do Data 360 entre regiões. Uma equipe de vendas em Londres que consulta dados de um locatário do Data 360 nos EUA pode ver uma latência maior.
Complexidade de integração Mais locatários do Data 360 = mais pipelines, APIs e middleware. A consolidação simplifica a integração. Um varejista evita criar 10 pipelines ETL consolidando-os em uma configuração do Data Cloud One.
Região da fonte de dados de cópia zero Os conectores de Cópia zero podem ter requisitos de acesso entre regiões que limitam em quais regiões seu Data 360 pode estar localizado. Uma empresa tem uma instância do Snowflake na região eu-west-1 da AWS. Eles podem usar o Zero Copy para federar dados em um Data 360 em sua região, mas não podem usar o Zero Copy para federar em um Data 360 na região dos EUA.
Compatibilidade entre regiões do Private Connect Em alguns casos, o suporte para Conexão privada depende de se a fonte de dados está na mesma região que o locatário do Data 360. Uma empresa tem uma instância do Snowflake na região aws-east-1 à qual deseja se conectar por meio de cópia zero. Eles só poderão estabelecer uma conexão de rede de Conexão privada se a organização inicial do Data 360 estiver na mesma região.
Custo & Licenciamento Cada locatário do Data 360 aumenta o custo. Consolidar em menos instâncias otimiza o gasto. Um provedor de saúde reduz os custos de licenciamento adotando o Data Cloud One em vez de várias instâncias independentes do Data 360.
Escalabilidade futura As opções de provisionamento hoje estabelecem a base para o crescimento. Uma empresa de SaaS começa com uma única instância do Data 360, mas planeja expandir-se para o Data Cloud One à medida que adquire subsidiárias com organizações do Salesforce.
Prontidão de IA corporativa Os recursos de IA e Agentforce exigem um locatário do Data 360 conectado em cada organização. As decisões de provisionamento afetam como os modelos de IA são treinados e ativados em toda a empresa. Uma empresa de serviços financeiros unifica dados no Data Cloud One para que seus modelos de IA do Einstein tenham acesso a dados de clientes em toda a empresa.
### Considerações importantes
  • O provisionamento está vinculado à licenciamento: O Data 360 é provisionado na organização em que a licença do Data 360 é comprada e a região é determinada pelo local da organização no momento do provisionamento.
  • Mantenha suas opções abertas planejando o Data 360 mesmo que não precise dele agora. As decisões tomadas agora podem facilitar seu caminho se você implementar o Data 360 para habilitar recursos de plataforma como Agentforce mais tarde.
  • Clientes de organização única: Provisione o Data 360 em sua organização de produção existente para obter o tempo para o valor mais rápido.
  • Clientes de várias organizações: Minimize a complexidade criando o menor número possível de instâncias do Data 360, idealmente usando a configuração do Data Cloud One.
  • Múltiplas instâncias do Data 360 devem ser usadas apenas quando exigido por conformidade, residência ou autonomia organizacional. Nesses casos, use o compartilhamento de dados entre organizações do Data 360 para habilitar a colaboração segura.
  • Fonte de dados de cópia zero: Fique atento às regiões com suporte para várias nuvens públicas e fontes de dados do Zero Copy. Além disso, determine se a conexão privada é necessária para sua condição de segurança se conectar a essas fontes de dados e se há suporte para conexões na região ou entre regiões.
  • Governança e autonomia são conceitos centrais: decidir se o Data 360 deve ser gerenciado centralmente (modelo do Centro de Excelência) ou se as linhas de negócios individuais precisam de instâncias separadamente gerenciadas do Data 360.
--- ## Seção 1: Provisionamento do Data 360 – Escolher a organização inicial ### 1.1 O que é uma organização do Data 360 Home? Quando você compra uma licença do Data 360, a instância do Data 360 é provisionada na organização do Salesforce associada a essa licença. Essa organização é chamada de Organização do Data 360 Home. Diagrama de decisão mostrando a organização inicial do Data 360 A organização inicial é a âncora para sua instância do Data 360. É onde: - O armazenamento e a computação do Data 360 são gerenciados (na região selecionada no provisionamento). - Políticas de administração, governança e segurança são aplicadas. - A ingestão de dados, harmonização, resolução de identidade, segmentação e ativação são realizadas. Em cenários de várias organizações, a organização inicial gerencia a instância central do Data 360 para outras organizações "companheiras" do Salesforce. Por que a organização residencial é importante: - Ele determina a localização geográfica da sua instância do Data 360. - Ele determina quem é proprietário e administra sua instância do Data 360. Os administradores da sua organização inicial do Data 360 podem acessar todos os dados ingeridos no Data 360. - Ele controla as conexões da organização de companheiro em uma configuração do Data Cloud One. - Ela estabelece a base para sua estratégia de dados corporativos. Alterá-la posteriormente é difícil e disruptiva. ### 1.2 Decisão: Organização existente ou nova organização como a organização inicial? A primeira decisão importante é provisionar o Data 360 em uma organização de produção existente ou criar uma nova organização dedicada para atuar como a Organização inicial. Diagrama de decisão mostrando a organização existente vs. nova organização como organização inicial #### Opção A: Provisionar o Data 360 em uma organização existente **Funciona melhor para:** Clientes com uma única organização do Salesforce ou clientes de várias organizações que já têm uma organização centralizada importante em que a maioria dos negócios é executada. Diagrama mostrando o provisionamento do Data 360 em organização existente - **Prós**: - Caminho mais simples: O Data 360 é provisionado onde seus dados do CRM já estão. - Acesso imediato aos dados locais de Vendas, Serviço e Marketing. - Nenhuma integração adicional necessária. - Menos licenças e ambientes para gerenciar. - Acelera a adoção antecipada, pilotos e casos de uso de produção. - **Cons**: - Pode herdar a governança ou o débito técnico da organização existente. - Se não existir uma única "organização principal", a seleção de uma poderá criar debates de propriedade. - Desempenho vinculado ao local da organização; pode não estar alinhado às necessidades de residência corporativas. - Se várias unidades de negócios usarem organizações diferentes, o provisionamento local poderá levar à fragmentação se não for combinado ao Data Cloud One. **Exemplo:** Uma empresa de SaaS com uma organização do Salesforce provisiona o Data 360 nessa organização para unificar dados de assinatura e suporte do cliente. #### Opção B: Provisionar o Data 360 em uma organização nova e dedicada **Funciona melhor para:** Clientes com várias organizações do Salesforce que não podem se alinhar em uma única organização principal ou empresas com um forte modelo de Centro de excelência (CoE). Diagrama mostrando o provisionamento do Data 360 em uma nova organização dedicada - **Prós**: - Limpe o quadro para governança, sem complexidades da organização herdadas. - Controle centralizado em várias linhas de negócios. - Flexibilidade para escolher uma região com base nas necessidades de conformidade. - Atua como uma organização de "atendimento compartilhado" neutra, não vinculada a uma unidade de negócios. - Configure para a arquitetura futura do Data Cloud One (Organização inicial com várias organizações parceiras). - **Cons**: - Os clientes devem licenciar uma nova organização do Salesforce na qual provisionar o Data 360. - Integração adicional necessária para conectar a organização a um Data 360 por meio de uma conexão de companheiro do Data Cloud One. - Pode adicionar sobrecarga administrativa (gerenciamento de usuários, segurança, identidade). - Tempo para obter valor mais lento em comparação ao provisionamento em uma organização de produção existente. **Exemplo:** Uma empresa multinacional de serviços financeiros cria uma organização inicial dedicada para provisionar o Data 360. Todas as organizações da unidade de negócios (Retail, Wealth, Commercial Banking) se conectam como organizações de companheiro por meio do Data Cloud One. #### Critérios de decisão
Consideração Organização existente como organização inicial (padrão preferencial) Nova organização como organização residencial (alternativa)
Simplicidade Cria na estrutura de dados e usuário existente para uma configuração mais rápida; o Data 360 é integrado por padrão à organização Início. Requer licenciamento e configuração da nova organização do Salesforce e sobrecarga administrativa adicional para gerenciá-la.
Tempo para valor Uso imediato de dados locais do CRM. Rampa mais lenta; integração necessária.
Governance Herda o modelo de governança básico da organização existente: usuários e conjuntos de permissões existentes. Isso pode ser bom se a organização já é central. Quadro limpo para governança; ideal para modelos conduzidos por CoE.
Conformidade Residência vinculada à região da organização existente. Flexibilidade para selecionar uma região independente das organizações existentes.
Desempenho Melhor desempenho para consultas de CRM locais. Dependendo da conectividade da organização companheira, esteja ela na mesma região ou entre regiões para as outras organizações.
Escalabilidade futura Funciona bem se combinado com o Data Cloud One; é mais difícil alternar mais tarde se a organização errada for escolhida. Escala facilmente com o Data Cloud One ; projetado para neutralidade.
Custo Custo incremental menor. Sobrecarga maior de ambientes adicionais.
### 1.3 Recomendações Como um princípio geral, favorecer o uso de uma organização principal existente como sua organização inicial para minimizar o esforço inicial e acelerar a adoção. Crie uma nova organização inicial dedicada somente se sua estratégia de governança ou conformidade de longo prazo precisar. Criar uma nova organização residencial dedicada é uma escolha comum para empresas maiores com um Centro de excelência (COE). **Entorno da organização única** Provisione o Data 360 em sua organização de produção existente. Isso maximiza a simplicidade e o valor imediato. Evita sobrecargas de integração desnecessárias. **Entorno de várias organizações** Prefira selecionar uma das suas principais organizações, geralmente aquela em que a maioria dos seus negócios é executada, ou a organização que já atua como seu CRM centralizado, para atuar como a Organização inicial. Isso reduz a complexidade, minimiza o trabalho de configuração e permite que você perceba o valor do Data 360 rapidamente. Usar uma organização principal existente também evita o custo e o esforço de integração de gerenciar um novo ambiente. **Quando considerar uma nova organização residencial dedicada** Se sua organização tiver um forte Centro de excelência (CoE) e quiser uma governança separada das organizações da unidade de negócios. Se nenhuma organização existente for adequada devido a conformidade ou restrições organizacionais. Nesses casos, criar uma nova organização Início oferece flexibilidade e neutralidade, mas com um tempo de valor mais lento. --- ## Seção 2: Estratégia de várias organizações e Data Cloud One ### 2.1 O desafio de várias organizações As empresas costumam operar várias organizações do Salesforce, e isso não é um caso de ponta, mas a norma. Desde fevereiro de 2024, aproximadamente 19 mil clientes do Salesforce já executam mais de uma organização do Salesforce. Por que isso acontece? - **Adquisições e fusões:** As empresas recém-adquiridas trazem suas próprias instâncias do Salesforce. - **Operações regionais:** Organizações separadas para a UE, América do Norte, Ásia-Pacífico etc., geralmente para cumprir as leis de residência de dados. - **Separação funcional:** Diferentes unidades de negócios (por exemplo, Retail Banking, Wealth Management, Insurance) mantêm suas próprias organizações para autonomia. - **Isolamento regulamentar ou de segurança:** Determinados setores exigem organizações lógicamente distintas por motivos de conformidade. - **Motivos históricos/técnicos:** Ao longo do tempo, os clientes acumulam organicamente várias organizações. Cada motivo faz sentido individualmente, mas juntos eles criam fragmentação de dados. Sem uma camada unificadora, cada organização tem apenas uma visualização parcial do cliente. O desafio arquitetônico: Como unificar dados entre organizações em uma única fonte da verdade enquanto respeita os requisitos de conformidade, governança e autonomia? --- ### 2.2 O que é o Data Cloud One? O Data Cloud One é a arquitetura de conectividade de várias organizações do Salesforce que permite que várias organizações do Salesforce compartilhem uma única instância do Data 360. É o padrão recomendado para empresas com várias organizações do Salesforce. Em qualquer cluster do Data Cloud One, uma organização do Salesforce é designada como a Organização inicial, que hospeda a instância do Data 360. Outras organizações do Salesforce se conectam como organizações de companheiro, consumindo os dados unificados e metadados do Data 360 da organização inicial. Diagrama mostrando a arquitetura Data Cloud One #### Como o Data Cloud One funciona
  1. Ingestão de dados e unificação (Organização inicial)
    • Todas as configurações de ingestão de dados (Salesforce CRM, origens externas, streaming, lote) ocorrem apenas na organização inicial.
    • O locatário do Data 360 vinculado à organização Home realiza a resolução de identidade, harmonização, modelagem e unificação em perfis do Customer 360 confiáveis.
    • Administração, políticas de governança, marcação e mascaramento do Data 360 são aplicados centralmente na organização inicial.
  2. Arquitetura de espaço de dados
    • Na organização inicial, os dados são organizados em Espaços de dados, que atuam como contêineres lógicos para dados, metadados e processos.
    • As empresas podem criar espaços de dados para marcas, regiões ou linhas de negócios.
    • Compartilhamento de espaço de dados: Na organização inicial, espaços de dados específicos são compartilhados seletivamente com organizações de companheiro. Isso garante que apenas os dados relevantes (e metadados associados) fluam para as organizações certas.
  3. Compartilhamento de metadados
    Organizações parceiras recebem definições de metadados da organização inicial, incluindo objetos de modelo de dados (DMOs), esquema de perfil unificado, insights calculados, segmentos e muito mais. Eles aparecem nativamente dentro da Organização de companheiro como se fossem ativos locais, mas na verdade estão vinculados à Organização inicial.
  4. Trabalhos a serem feitos na organização domiciliar vs. Organizações de companheiro
  5. O acesso ao recurso difere entre organizações Início e Companheiro. Organizações parceiras não podem ingerir nem unificar dados e contam com a Organização inicial para ingestão, modelagem e unificação. Organizações parceiras podem acessar dados do Data 360 para aprimorar recursos de plataforma desenvolvidos com o Data 360 e podem criar percepções, segmentos e fluxos locais com base nos dados compartilhados e confiáveis. Na visão futura, eles também podem acessar recursos de ativação.
    Capacidade Organização residencial Organização de companheiro
    Conectar Configurar conectores, criar fluxos de dados, ingerir ou federar dados ✅ ❌
    Harmonizar e unificar Criar e executar transformações de dados e resolução de identidade ✅ ❌
    Gerenciar Dados seguros com permissões e espaço de dados ✅ ✅
    Criar segmentos, percepções e modelos do Einstein Studio Segmentar e prever ✅ ✅
    Ativar Everywhere Ativações, ações de dados ✅ ✅
    Criador de prompts, fluxos, relatórios, enriquecimento, e muito mais da plataforma ✅ ✅
    Centro de prospecção baseado em Data 360, recursos de Sales e Service Cloud, Agentforce e muito mais ✅ ✅
  6. Paridade de recursos da plataforma
    Da perspectiva de usuários e criadores, depois que os metadados são compartilhados, há algumas diferenças funcionais entre organizações Início e Companheiro em termos de uso de recursos da Salesforce Platform. A lista de recursos com suporte pode ser encontrada em Recursos do Data 360 em Organizações Companion.
    • Os recursos de plataforma do Salesforce, como Fluxos, Relatórios, Criador de prompts, painéis e outras ferramentas nativas da plataforma, funcionam nas Organizações Início e Companion assim que os metadados estiverem disponíveis.
    • Os recursos habilitados para o Data 360, como Agentforce, o Prospecting Center, os recursos do Sales Cloud Einstein e os recursos de IA do Service Cloud, também funcionam perfeitamente em organizações Início e Companion. Alguns recursos podem estar no caminho certo para alcançar a compatibilidade completa, mas a meta geral é ter a paridade de recursos entre organizações Início e Companheiro para todos os recursos entre nuvens que dependem do Data 360.
  7. Modelo de consumo
    Todas as atividades da organização companheira (consultas, execuções de segmento, fluxos acionados pelo Data 360, uso de IA, registro da Camada de Trust do Einstein etc.) consomem créditos do Data 360 da organização inicial. O consumo flui de uma só maneira: os créditos são centralizados, faturados e rastreados em relação à alocação de crédito da organização de origem. No entanto, você pode detalhar para ver quantos créditos cada organização individual usou na Digital Wallet.
  8. Princípio de design: Estrutura horizontal
    O Data Cloud One é projetado como uma construção horizontal da plataforma Salesforce, semelhante a sandboxes. A meta é que cada novo recurso lançado no Salesforce funcione nas organizações Início e Companheiro sem configuração adicional. Isso garante que o Data Cloud One não seja apenas uma opção de arquitetura de dados, mas um elemento fundamental da Salesforce Platform no futuro.
--- ### 2.3 Decisão: Vários Data 360s independentes vs. Um Data 360 compartilhado (Data Cloud One) Empresas com várias organizações devem escolher como e onde localizar o Data 360 em seu ecossistema. Eles querem provisionar Data 360s independentes em cada organização ou usar o Data Cloud One para unificar organizações em uma única organização Início? #### Opção A: Vários Data 360s independentes Cada organização do Salesforce provisiona sua própria instância do Data 360. **Prós**: - **Autonomia**: Cada unidade de negócios ou região controla o próprio Data 360. - **Simplicidade** em cada organização: Governança, segurança e personalizações são localizadas. - **Conformidade regulatória**: Útil quando a separação regulatória rígida é necessária (por exemplo, os dados não devem cruzar fronteiras). **Cons**: - **Silos de dados:** O Customer 360 não pode ser alcançado entre organizações. - **Custo maior**: Cada instância requer licenciamento, administração e integração. Os clientes acabam ingerindo os mesmos dados de origem várias vezes para obter uma visualização completa do C360 em várias organizações diferentes. - **Trabalho duplicado:** A resolução, a segmentação e o aprimoramento de identidade devem ser repetidos em cada Data 360. #### Opção B: Um cluster compartilhado do Data 360 (Data Cloud One Cluster) Um único Data 360 é provisionado em uma organização Início, com outras organizações do Salesforce conectadas como Organizações de companheiro. **Prós**: - **Fonte Única da Verdade (SSOT):** Todas as organizações compartilham o mesmo modelo de dados unificado. - **Eficiência de custo:** Somente uma licença do Data 360 e uma infraestrutura para gerenciar. - **Governação unificada:** Políticas, segurança e controles de conformidade são aplicados centralmente. - **Enriquecimento entre organizações:** Organizações de companheiro podem acessar perfis, percepções e segmentos harmonizados. - **Prontidão de IA:** Conjunto de dados corporativo permite um treinamento e ativação melhores de modelos de IA. - **Prova futura:** Adicionar novas Organizações de companheiro é simples; não há necessidade de novos Data 360s. **Cons**: - **Preparação adicional:** Requer planejamento para a conectividade da organização organizacional. - **Considerações de latência:** Organizações parceiras em diferentes regiões podem ver consultas mais lentas. - **Governação complexa:** Se cada organização tiver necessidades de personalização muito diferentes, a governança detalhada poderá ser complexa. #### Opção C: Vários clusters do Data Cloud One Em alguns casos, governança, conformidade ou outros requisitos de negócios podem tornar imprático agrupar todas as organizações. Isso pode levar à necessidade de implementar uma solução híbrida na qual a empresa opera vários Data 360s, cada um dos quais é a organização inicial para um cluster diferente de Organizações de companheiro. #### Exemplo: Uma corporação multinacional tem organizações do Salesforce em várias regiões, incluindo Europa, EUA e Ásia. Para cumprir as normas de residência de dados regionais, eles fornecem um Data 360 para cada região separada. #### Critérios de decisão
Consideração Vários Data 360s independentes Um Data 360 compartilhado (Data Cloud One )
Autonomia Alta autonomia para cada organização ou unidade de negócios. Governança centralizada, menos autonomia por organização.
Conformidade Útil quando a separação rígida é necessária (por exemplo, leis regionais). Funciona melhor quando a residência permite a centralização.
Custo Custos de licenciamento e administrador maiores. Mais econômico; uma licença para muitas organizações.
Governance Fragmentado; as políticas diferem por organização. Políticas centralizadas e consistentes entre organizações.
Silos de dados Cada organização tem sua própria visualização; nenhum do Enterprise 360. Conjunto de dados unificado, sem duplicação.
IA/Analytics Limitado aos dados de cada organização. Modelos corporativos com maior precisão.
Complexidade Mais instâncias para gerenciar, mais integrações. Arquitetura mais simples, menos peças móveis.
Desempenho Melhor para casos de uso organizacionais. O acesso à organização de companheiro pode introduzir latência.
--- ### 2.4 Recomendações **Padrão preferencial:** **Data Cloud One** Padrão para uma única organização Início com organizações de companheiro conectadas para empresas de várias organizações. Isso cria um Customer 360 corporativo, simplifica a governança e otimiza o custo. **Quando usar vários Data 360s:** Somente se a conformidade, a residência ou a autonomia organizacional o exigirem estritamente. Por exemplo, se as operações europeias precisarem permanecer totalmente separadas das operações dos EUA devido à regulamentação. **Como escolher a organização Início no Data Cloud One:** Comece considerando uma das suas principais organizações, geralmente onde a maioria dos negócios é executada. O provisionamento do Data 360 lá pode minimizar a complexidade e maximizar o valor antecipado. Somente se nenhuma organização existente for adequada, considere criar uma organização residencial dedicada gerenciada por uma equipe do Centro de excelência. **Princípio geral:** Em ambientes de várias organizações, minimize o número de Data 360s. Favorecer o Data Cloud One como padrão para reduzir a duplicação, habilitar a prontidão de IA e simplificar a governança. --- ## Seção 3: Vários Data 360s e compartilhamento de dados entre organizações do Data 360 ### 3.1 O que é compartilhamento de dados entre organizações do Data 360? Embora o Data Cloud One seja a abordagem recomendada para a maioria das empresas, há cenários em que os clientes podem precisar provisionar várias instâncias do Data 360. Quando há vários Data 360s, a unificação entre eles não é automática. O compartilhamento de dados do Data 360 para Data 360 permite que os clientes compartilhem objetos específicos entre instâncias do Data 360 sem duplicação ou pipelines personalizados. É um mecanismo de compartilhamento de metadados de cópia zero projetado para colaboração entre os Data 360s. #### Como funciona - Cada Data 360 é provisionado em sua própria organização inicial. - Os administradores podem criar um compartilhamento de dados, um agrupamento de objetos específicos que desejam compartilhar. - O acesso aos dados selecionados é compartilhado com o Data 360 de uma organização de destino, em que os objetos aparecem como se fossem definidos localmente. Os dados subjacentes permanecem no Data 360 de origem; apenas o acesso é compartilhado. - As marcas não são compartilhadas. Somente os objetos brutos são disponibilizados; a organização de destino deve reaplicar quaisquer marcas de governança, operacionais ou de IA conforme necessário. #### Diferença principal em relação ao Data Cloud One - No Data Cloud One, várias organizações companheiras compartilham uma única instância do Data 360. Os recursos da plataforma (Agentforce, Prospecting Center, Tableau Next, etc.) são executados nos mesmos dados subjacentes, garantindo a consistência. - Ao usar o compartilhamento de dados entre organizações do Data 360, cada organização tem seu próprio Data 360. Recursos como Agentforce na organização A e na organização B funcionam separadamente em sua instância local. Nenhum compartilhamento ocorre automaticamente; compartilhamentos de dados deliberados devem ser criados para colaborar apenas em objetos específicos. --- ### 3.2 Casos de uso para compartilhamento de dados entre organizações do Data 360 **Conformidade regional:** Um varejista multinacional fornece um Data 360 na UE e outro nos EUA. O compartilhamento de dados do Data 360-to-Data 360 permite que a empresa agregue percepções (por exemplo, KPIs de fidelidade) para serem compartilhadas com a sede dos EUA enquanto os dados brutos permanecem locais. **Colaboração da unidade de negócios:** Um conglomerado executa Data 360s separados para varejo e seguro. O compartilhamento de dados entre o Data 360s permite que os usuários acessem uma única fonte de dados autônoma sem mover nem copiar. Com Com o compartilhamento de dados entre organizações do Data 360, a organização de Seguro recebe o segmento "Cliente de alto valor" do varejo para campanhas de venda cruzada direcionadas. **Fusões e aquisições:** Uma matriz adquire uma subsidiária com seu próprio Data 360. Com duas instâncias para gerenciar, manter silos de dados de curto prazo preserva a segurança dos dados e a integridade de SSOT. Ao mesmo tempo, o compartilhamento de dados entre duas instâncias do Data 360 permite a colaboração necessária durante a transição. **Painéis executivos federais:** Uma distribuição multinacional entre continentes provisiona Data 360s individuais por região. Os executivos querem uma visualização de desempenho trimestral federada. Cada Data 360 regional compartilha percepções calculadas agregadas com uma "Organização executiva", habilitando relatórios corporativos. #### Prós e contras do compartilhamento de dados entre organizações do Data 360
Fator Prós Contras
Residência de dados Dá suporte à separação regional enquanto ativa a colaboração. Não elimina a necessidade de gerenciar vários Data 360s.
Duplicação de dados Cópia zero; nenhuma duplicação de objetos. Requer seleção deliberada de objetos para inclusão em cada compartilhamento de dados.
Governance O compartilhamento é explícito e deliberado (no nível do objeto). Sem marcas ou fluxo de políticas; a organização de destino deve reaplicar a governança.
Complexidade Ativa a colaboração seletiva sem centralização. Requer o gerenciamento de vários Data 360s e compartilhamentos de dados.
IA/Analytics IA/análise regional possível; as percepções podem ser compartilhadas entre organizações. Nenhuma IA corporativa, a menos que os dados sejam compartilhados intencionalmente.
Recursos da plataforma Os recursos desenvolvidos com o Data 360 de cada organização são executados de modo independente. Sem compartilhamento automático – risco de duplicação se não for projetado com cuidado.
Custo Pode reduzir a necessidade de pipelines de ETL. Ainda ocorre o custo de vários Data 360s. Consome créditos para consultas de dados e compartilhamento de dados.
#### Critérios de decisão
Consideração Data Cloud One (preferencial para várias organizações) Compartilhamento de dados entre organizações do Data 360
Fonte Única da Verdade ✅ Sim – todas as organizações compartilham o mesmo DC. ⚡ Não – cada Data 360 tem seu próprio modelo de dados.
Conformidade Funciona apenas quando a residência permite a centralização. Necessário quando as leis de residência impedem a centralização.
Governance Centralizado, consistente. Federado; compartilhamentos deliberados no nível do objeto.
Complexidade Menos peças móveis, mais simples. complexo – requer compartilhamentos de dados de configuração e vários Data 360s.
IA/Analytics Modelos de IA corporativa. IA regional; as percepções podem ser compartilhadas de modo seletivo.
Recursos da plataforma O Data 360 compartilhado significa que todos os recursos funcionam de modo consistente em Início + Companheiros. Os recursos são executados de forma independente em cada Data 360; o compartilhamento deve ser explícito.
### 3.3 Melhores práticas **Se sua empresa tiver vários Data 360s:** - Use o compartilhamento de dados entre organizações do Data 360 para colaborar entre elas, em vez de criar pipelines personalizados ou duplicar dados. - Compartilhe objetos específicos (DMOs, Insights calculados, Segmentos) criando Compartilhamentos de dados e concedendo-os a organizações de destino. - Esteja ciente de que as marcas não são compartilhadas – a organização receptora deve reaplicar as marcas (por exemplo, governança, classificação, aprimoramento de IA). **Quando usar o Compartilhamento de dados entre organizações do Data 360:** - Para cumprir requisitos regulatórios que impedem a centralização. - Para manter a autonomia da unidade de negócios enquanto habilita a colaboração seletiva. - Para fornecer painéis executivos federados em várias regiões. - Para conectar cenários de mesclagem e compra em que a consolidação não é possível imediatamente. **Designe cuidadosamente** O compartilhamento deve ser deliberado e específico do objeto. Evite "sobrepartilhamento" – alinhe os compartilhamentos de dados às necessidades de negócios e conformidade. Trate o compartilhamento de dados do Data 360-to-Data 360 como uma estratégia de federação, não como uma substituição do Data Cloud One. --- ## Resumo
  1. Todas as organizações devem planejar o acesso ao Data 360
    • No futuro, todos os recursos da Salesforce Platform, do Sales Cloud e do Service Cloud até o Agentforce, exigem a conectividade do Data 360. Cada organização deve hospedar uma organização do Data 360 Home ou ser uma organização de companheiro conectada por meio do Data Cloud One.
  2. Pense em toda a empresa, não organização por organização
    • Evite decisões unilaterais de linha de negócios tomadas isoladamente.
    • O provisionamento deve ser decidido de modo coletivo, idealmente por uma arquitetura corporativa ou conselho de governança de dados. Sempre antecipe as necessidades futuras de IA e análise, que dependem de conjuntos de dados amplos e unificados.
  3. Minimizar silos de dados
    • Favorecer o provisionamento do Data 360 em uma organização principal existente para simplificação e velocidade.
    • Em ambientes de várias organizações, o Data Cloud One é o padrão para unificar organizações sob um Data 360.
    • Provisione vários Data 360s apenas se for estritamente necessário para conformidade, residência ou autonomia organizacional.
  4. Projete deliberadamente se precisar executar vários Data 360s
    • Configure o compartilhamento de dados entre organizações do Data 360 para colaboração, não pipelines de ETL personalizados.
    • Compartilhe objetos específicos (DMOs, Insights calculados, Segmentos) por meio de compartilhamentos de dados.
    • Lembre-se: as marcas não são compartilhadas e o consumo é faturado para a organização de origem.
  5. Planejar governança e responsabilidade antecipadamente
    • Decida se o Data 360 será gerenciado centralmente (modelo do Centro de excelência) ou delegado a linhas de negócios. Defina papéis para administradores, equipes de segurança e leads de conformidade.
    • Evite ambiguidade: a propriedade pouco clara é uma fonte comum de atrito.
  6. Evite atalhos de curto prazo
    • Não ative vários Data 360s para POCs sem um plano de longo prazo. Isso cria um trabalho de consolidação disruptivo mais tarde.
    • Em vez disso, alinhe pilotos e implantações iniciais à sua estratégia de provisionamento corporativo.
Essas escolhas de provisionamento são essenciais porque a Salesforce Platform está evoluindo para um modelo Data 360 First, em que todos os recursos, da segmentação do cliente à fundamentação do agente de IA, dependem dele. As decisões que você toma hoje estabelecerão a base para a eficiência com que sua empresa unifica dados do cliente, a rapidez com que você pode adotar novos recursos do Salesforce e a escala de IA confiável em seus negócios. Para ter sucesso, você deve provisionar com cuidado, minimizar a duplicação, alinhar-se aos requisitos de conformidade, governar deliberadamente e pensar em longo prazo. Por fim, o provisionamento do Data 360 é a primeira etapa para que dados, IA e CRM funcionem juntos como uma plataforma coesa. # ## Sobre os autores Kunal Goyal é diretora de gerenciamento de produto na Salesforce, focada em avançar a arquitetura e a escalabilidade de várias organizações no Data 360. Desde 2017, ele liderou várias iniciativas e produtos centrados na colaboração entre organizações e no design de sistemas de vários locatários. Kunal é um dos leads de Arquitetura de melhores práticas do Data 360 e o proprietário do produto para experiências de configuração, provisionamento e administrador do Data Cloud One. Erin Wagner Tidwell é redatora técnica principal e designer de conteúdo para o Data 360. Ela está no Salesforce desde 2013. Ela está dedicada a tornar o Data 360 mais fácil de entender e usar com documentação técnica clara, consistente e precisa e comunicação no aplicativo. Yugandhar Bora é um arquiteto de engenharia de software na Salesforce, especializado em arquitetura de dados na plataforma de Aplicativos de dados e inteligência. Ele lidera iniciativas do Conselho de revisão de arquitetura corporativa (EARB) focadas na governança de dados e modelos de dados unificados, ao mesmo tempo que contribui para soluções de provisionamento de plataforma automatizadas. Samarpan Jain é um arquiteto principal na Salesforce especializado em Commerce Cloud, integração de plataforma e arquitetura entre organizações. Um dos funcionários mais antigos da Salesforce, ele lidera iniciativas importantes, incluindo conformidade de residência de dados para clientes do governo e sistemas de atribuição de uso do Data 360.