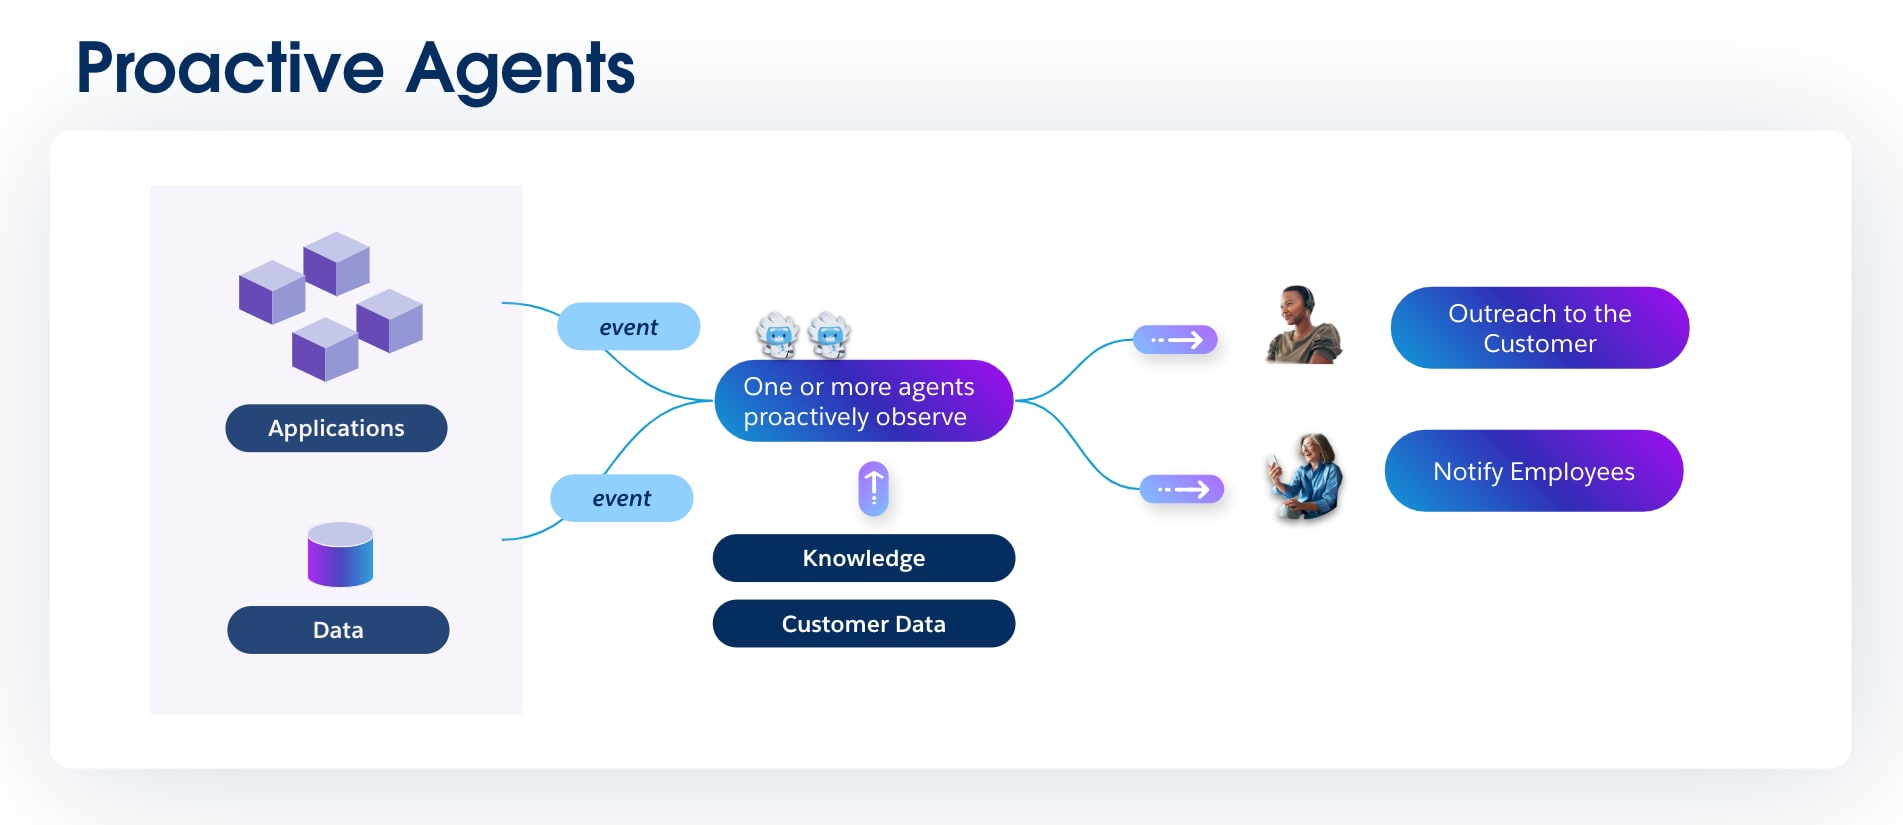
 ### 1.2 사전 예방적 에이전트
**정의:** 프롬프트를 기다리는 대화 에이전트와 달리 사전 예방적 에이전트는 주의적인 관찰자 역할을 합니다. 특정 이벤트, 데이터 변경 또는 시스템 내에서 미리 정의된 조건에 의해 트리거됩니다. 트리거되면 직접 사용자 상호 작용 없이 과업을 실행하거나 워크플로를 시작합니다.
**중요:** 사전 예방적 에이전트는 데이터의 패시브 리포지토리에서 비즈니스 프로세스의 활성 참가자로 시스템을 변환합니다. 이를 통해 발생할 때 기회 및 위험을 식별하여 비즈니스가 중요한 신호에 따라 실시간으로 조치를 취할 수 있습니다.
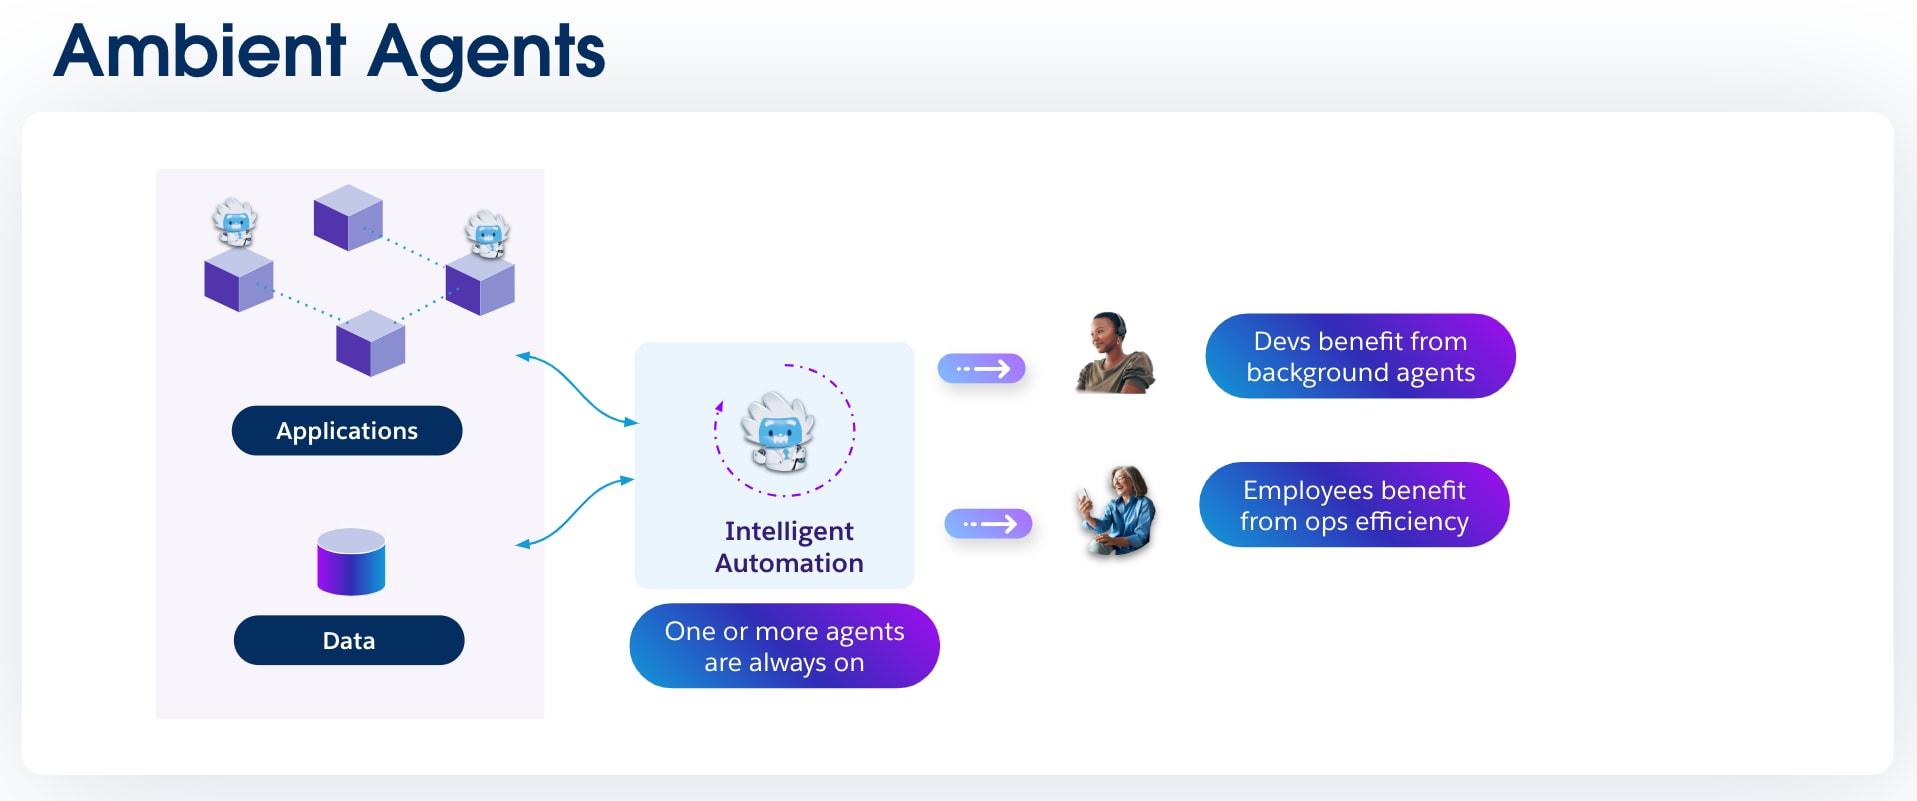
 ### 1.3 환경 에이전트
**정의:** 환경 에이전트는 명시적 명령 없이 사용자의 워크플로 백그라운드에서 연속적으로 작업하는 특정 유형의 사전 예방적 에이전트입니다. 사용자는 작업을 의식하지 않고 작업을 활용하는 경우가 많습니다. 사용자는 낮은 프로필을 유지하면서 인적 역량을 늘리도록 설계되었기 때문입니다.
**중요:** 환경 에이전트의 목표는 일상적인 "작업 관련 작업"을 자동화하여 사용자의 인지 부하를 줄이는 것입니다. 직원이 매일 사용하는 도구에 원활하게 통합하여 자동으로 정보를 수집하고 구조화하여 프로세스를 더욱 효율적으로 만듭니다.
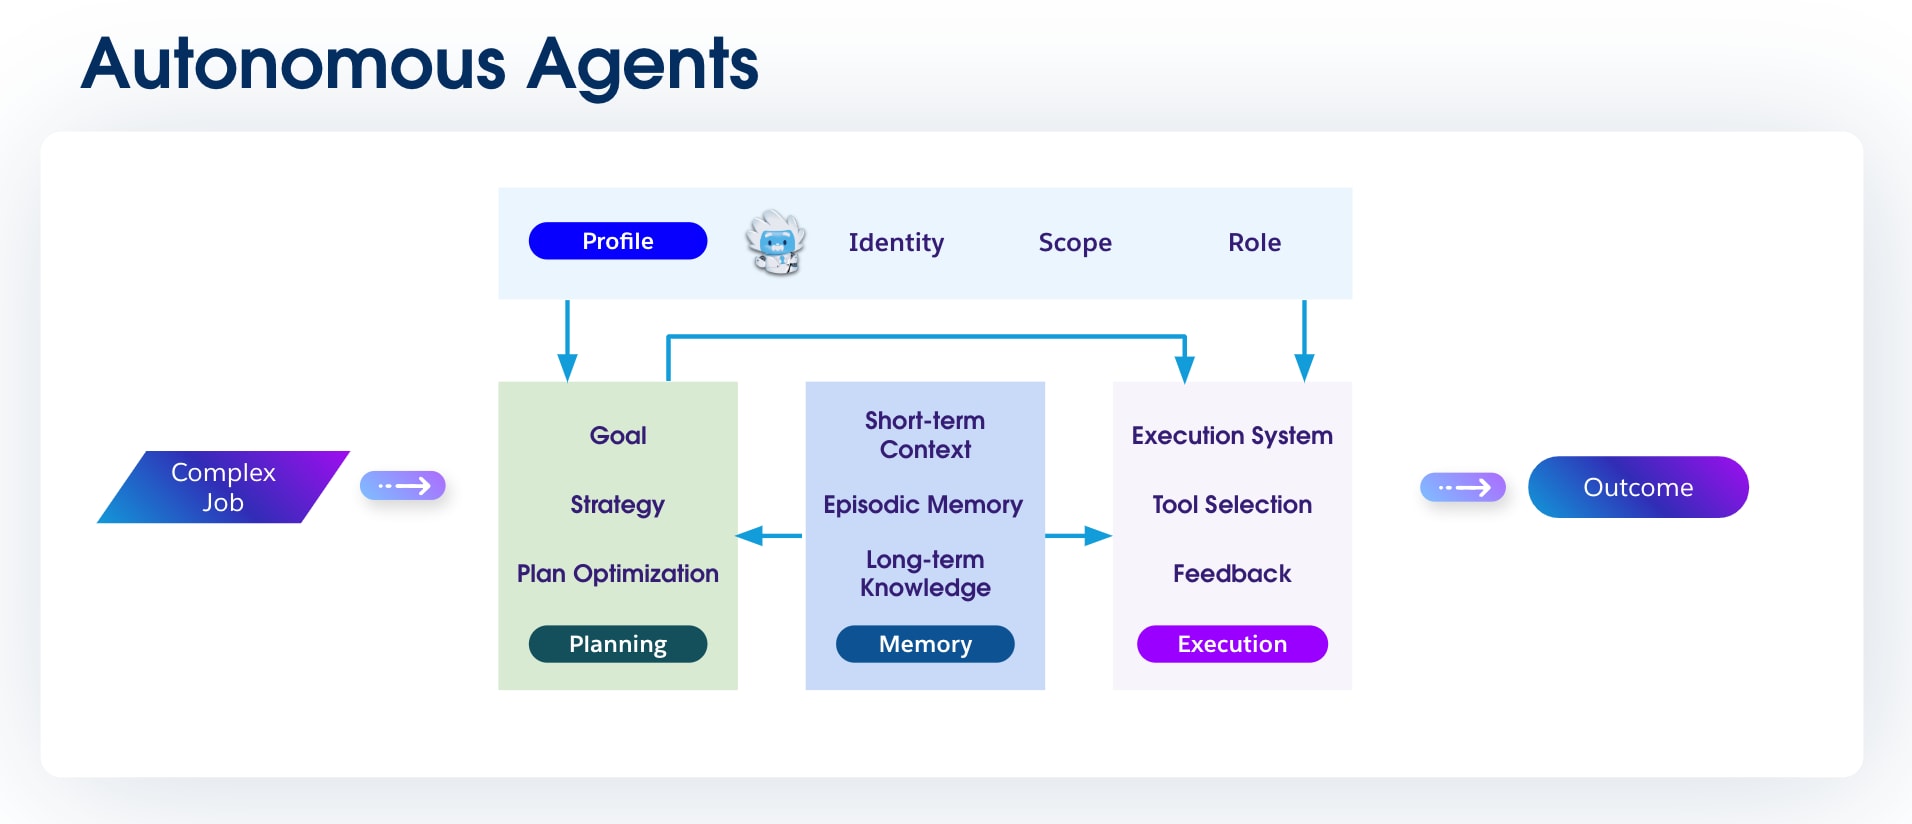
 ### 1.4 자율 에이전트
**정의:** 자율 에이전트는 복잡성에서 상당한 발전을 의미합니다. 상위 수준 목표가 부여되며 해당 목표를 달성하기 위한 단계 순서를 독립적으로 계획하고 실행할 수 있습니다. 시간에 따라 성과를 향상하기 위해 사안을 정리하고 결정을 내릴 수 있으며, 작업에서 배울 수도 있습니다.
**중요:** 이는 실제 디지털 직원과 가장 가까운 곳입니다. 자율 에이전트에게 복잡한 다단계 목표(예: "이 분기에 제조 부문에서 50명의 새 적격 리드 생성")를 위임받을 수 있으며, 이를 달성하기 위한 계획을 수립하고 실행할 수 있습니다.
 ### 1.5 공동 작업 에이전트(에이전트 스워밍)
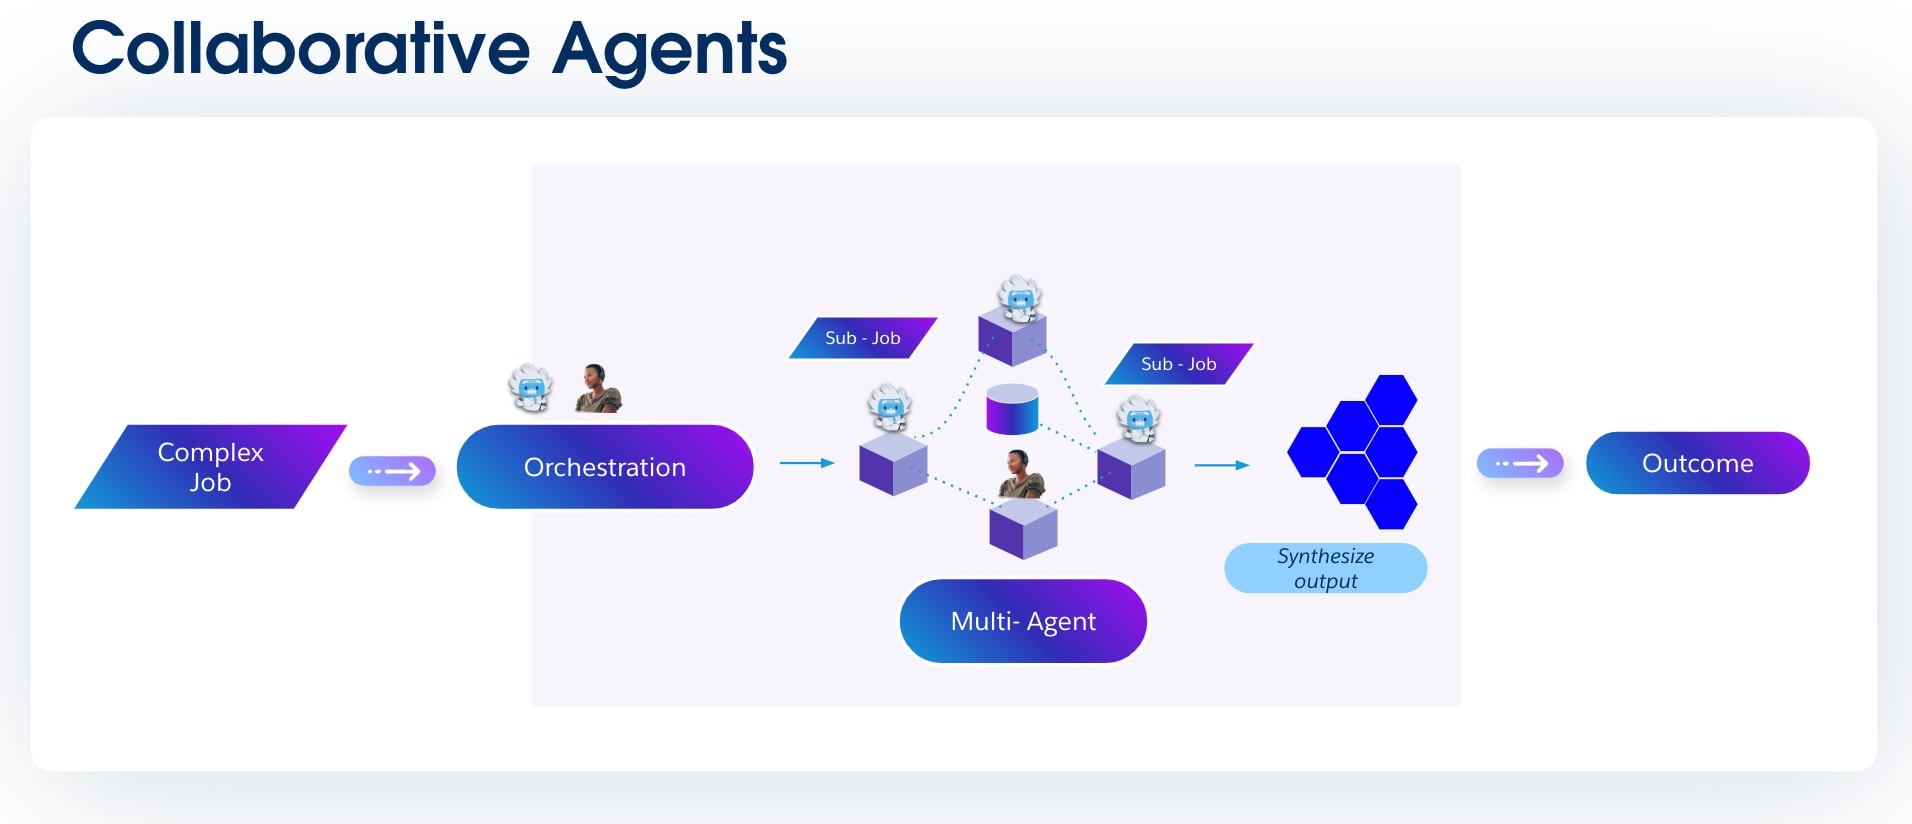
**정의:** 공동 작업 에이전트(일반적으로 "에이전트 집합"이라고도 함)는 단일 에이전트가 처리하기에 너무 복잡한 문제를 해결하기 위해 함께 작업하는 전문 에이전트의 모음입니다. "오케스트레이터" 또는 "마스터" 에이전트는 대규모 과업을 분해하고 적절한 전문 에이전트에게 하위 과업을 위임한 다음, 출력을 합성하는 경우가 많습니다. 강력한 Agent2Agent(A2A) 커뮤니케이션 프로토콜이 이 작업을 수행합니다.
**중요:** 이 접근 방식은 인간 팀을 반영합니다. 복잡한 문제를 파악함으로써 각 전문 에이전트는 데이터 분석, 고객 커뮤니케이션, 시스템 통합을 전문으로 하는 고유한 기술을 활용하여 보다 강력하고 포괄적인 솔루션을 구축할 수 있습니다.
 ## 장 2: Agentforce 아키텍처 패턴
AI 에이전트의 분류를 탐색한 후 중요한 질문은 다음과 같습니다. 이러한 요소를 결합하여 실제 비즈니스 문제를 효율적이고 신뢰할 수 있게 해결하는 방법 이 장에서는 공통의 에이전트 디자인 패턴 리포지토리를 제공하여 해당 질문에 대한 답변을 제공합니다. 각 패턴은 단순한 단일 목적 에이전트에서 복잡하고 공동 작업하는 에이전트 집합에 이르는 모든 사항에 대한 청사진을 제공하는 반복적인 문제에 대한 입증된 솔루션입니다.
### 2.1 대화 에이전트 패턴
대화 에이전트는 조직의 AI 기능에 대한 프런트 도어가 되는 경우가 많습니다. 이는 사용자가 과업을 수행하고 자연어를 사용하여 정보를 검색하는 기본 인터페이스로 작동하는 상태가 있는 다중 전환 대화 상자에 참여하는 기능에 따라 정의됩니다. 이 섹션에는 대화 에이전트를 구축하기 위한 두 가지 필수 레시피가 나와 있으며, 각각 특정 채널에 맞게 조정되며, 하나는 Messaging 클라이언트의 빠르고 대화형 교환을 위한 레시피이고 다른 하나는 이메일의 구조화되고 비동기적인 특성을 위한 레시피입니다.
대화 에이전트의 인텔리전스는 적시에 올바른 데이터에 액세스하고 이유를 설명할 수 있는 능력에서 파생됩니다. 이 패턴은 고객 기록, Knowledge 기사 및 비즈니스 분석에 연결되는 정교한 데이터 기반에 의존합니다. 이러한 통합에 대한 완전한 재사용 가능한 레시피는 [장 4에서 확인할 수 있습니다. 통합 패턴](#장-4-에이전트를-위한-통합-패턴)
#### 2.1.a 대화 에이전트: 대화형 Messaging 클라이언트 패턴
**문제**
고객은 많은 디지털 채널을 통해 참여하고 **즉시, 상황별, 지능형 응답을 기대합니다.** 기존의 채팅봇은 **스크립트** 또는 **데이터 블라인드**로 인해 개인 설정이 부족하고 인간에 대한 초기 에스컬레이션 및 높은 서비스 비용이 발생합니다.
**컨텍스트**
- 조직에 다중 채널 디지털 참여(WhatsApp, SMS, Slack, Salesforce Experience Cloud)가 있습니다.
- 조직의 고객이 [다중 언어로](https://help.salesforce.com/s/articleView?id=ai.service_agent_considerations.htm&type=5) 조직과 상호 작용합니다.
- 조직에서 다음을 수행하는 에이전트를 사용하여 서비스 및 세일즈 워크플로를 강화해야 합니다.
- 신뢰할 수 있는 실시간 고객 데이터에서 가져오기
- 가드 레일 및 규정 준수 요구 사항 준수
- 필요한 경우에만 에이전트에게 에스컬레이션
 **핵심 구성 요소**
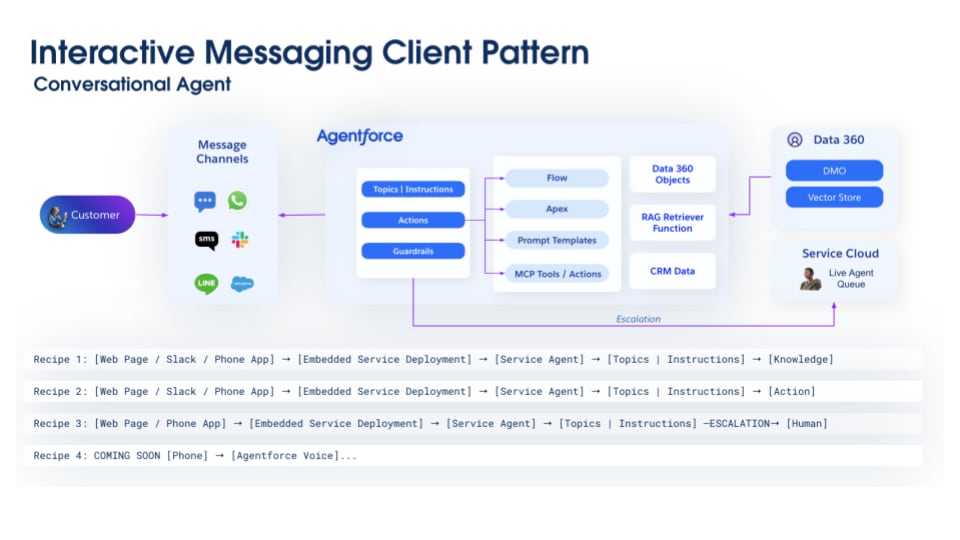
- **채널 추상:** Service Cloud 고급 채팅(기존의 앱 내 및 웹 Messaging)을 사용하면 에이전트가 단일 환경을 통해 여러 채널에서 커뮤니케이션할 수 있습니다.
- **Agentforce 서비스 에이전트:** 에이전트의 동작 및 목적은 다음 구성 요소에 의해 정의됩니다.
- **주제 및 지침:** 직접 사용자 상호 작용을 위한 에이전트의 개인 정보 및 대화 목적을 정의합니다. 여기에는 핵심 임무(예: "고객 지원 문제 해결 전문가임"), 공감하고 전문적인 어조를 유지하는 지침, 처리할 권한이 있는 문의 범위에 대한 명확한 가드 레일이 포함됩니다.
- **작업:** 에이전트가 고객 문제를 실시간으로 진단하고 해결하는 데 사용하는 도구인 서비스 중심 작업입니다. 이러한 도구는 주문 상태 확인, Knowledge 자료에서 솔루션을 검색 또는 대화 인터페이스에서 직접 새로운 지원 사례를 만드는 등의 작업을 수행하도록 설계되었습니다.
- **가드레일:** 가드 레일은 구성 가능한 규칙 및 런타임 검사 집합으로 작동하여 에이전트의 동작을 제한합니다. 프롬프트를 가로채고, 에이전트의 제안된 작업을 확인하고, 최종 응답을 필터링하여 유해한 콘텐츠를 방지하고, 비즈니스 규칙을 적용하고, 에이전트가 지정된 범위 내에서 작업하는지 확인할 수 있는 안전 계층 역할을 합니다.
- **프롬프트 템플릿:** 병합 필드 또는 Data 360 RAG Retriever의 시맨틱 데이터를 통해 실시간 CRM 데이터로 동적으로 채워지는 재사용 가능한 템플릿입니다. 이러한 템플릿을 사용하면 에이전트가 컨텍스트에 맞는 브랜드 콘텐츠를 생성할 수 있으며 Einstein Trust Layer는 지침이 LLM에 전송되기 전에 민감한 정보를 안전하게 마스킹합니다.
- **Data 360**
- DLO, DMO, 벡터 저장소 및 RAG 검색기를 비롯한 Data 360 구성 요소는 에이전트에게 구조화된 고객 레코드에서 비정형 Knowledge 기사에 이르기까지 모든 관련 엔터프라이즈 데이터의 통합된 보기를 제공하므로 응답이 정확하고 상황에 맞게 기반합니다.
- **Service Cloud**
- **CRM 데이터:** 에이전트를 전체 사례 내역에 연결하여 계정 세부 사항, 연락처 레코드, 권리에 대한 중요 컨텍스트 제공
- **Live Agent 대기열:** 전체 대화 컨텍스트가 주입된 인사 서비스 담당자에게 에스컬레이션 및 라우팅 지원
**상호 작용**
1. 조직의 고객이 채널을 통해 대화를 시작합니다.
2. 메시지가 범위(주제)를 결정하고 가드 레일을 적용하는 **Agentforce**로 라우팅됩니다.
3. AI는 **프롬프트 템플릿을** 사용하여 응답을 작성하고, Flow 또는 Apex는 백엔드 논리를 트리거할 수 있습니다.
4. 컨텍스트는 RAG 검색기를 통해 **Data 360 객체, 벡터 저장소 및 CRM**에서 검색됩니다.
5. AI는 상황별 답변을 반환합니다.
6. AI가 해결할 수 없는 경우 대화가 **Service Cloud Live Agent로 에스컬레이션됩니다.**
**상환**
 **핵심 구성 요소**
- **이메일 채널:** 인바운드 메시지 수집, 콘텐츠 및 첨부 파일 구문 분석, 스레드 연속성 유지를 처리하여 비동기식 대화를 활성화합니다.
- **Agentforce SDR 에이전트:** 에이전트의 동작 및 목적은 다음 구성 요소에 의해 정의됩니다.
- **주제 및 지침:** 대화를 통해 인바운드 리드를 참여시키고 자격을 부여하는 에이전트의 임무를 정의합니다. 여기에는 잠재 고객의 요구를 이해하고, 주요 자격 데이터(예: 예산, 권한, 타임라인)를 수집하고, 계정 담당자와의 회의 예약과 같은 명확한 다음 단계로 대화를 안내하는 지침이 포함됩니다.
- **작업:** 에이전트가 리드 수명 주기를 관리할 수 있는 특수 세일즈 작업입니다. 해당 도구는 리드 데이터 보강, 템플릿 기반 팔로우업 이메일 보내기 또는 캘린더 시스템과 통합하여 검색 통화를 예약하는 등 핵심 SDR 과업을 실행하도록 설계되었습니다.
- **가드레일:** 가드 레일은 구성 가능한 규칙 및 런타임 검사 집합으로 작동하여 에이전트의 동작을 제한합니다. 프롬프트를 가로채고, 에이전트의 제안된 작업을 확인하고, 최종 응답을 필터링하여 유해한 콘텐츠를 방지하고, 비즈니스 규칙을 적용하고, 에이전트가 지정된 범위 내에서 작업하는지 확인할 수 있는 안전 계층 역할을 합니다.
- **프롬프트 템플릿:** 병합 필드 또는 Data 360 RAG Retriever의 시맨틱 데이터를 통해 실시간 CRM 데이터로 동적으로 채워지는 재사용 가능한 템플릿입니다. 이러한 템플릿을 사용하면 에이전트가 컨텍스트에 맞는 브랜드 콘텐츠를 생성할 수 있으며 Einstein Trust Layer는 지침이 LLM에 전송되기 전에 민감한 정보를 안전하게 마스킹합니다.
- **Data 360**
- DLO, DMO, 벡터 저장소 및 RAG 검색기를 비롯한 Data 360 구성 요소는 에이전트에게 구조화된 고객 레코드에서 비정형 Knowledge 기사에 이르기까지 모든 관련 엔터프라이즈 데이터의 통합된 보기를 제공하므로 응답이 정확하고 상황에 맞게 기반합니다.
- **Sales Cloud**
- **CRM 데이터:** 에이전트를 전체 사례 내역에 연결하여 계정 세부 사항, 연락처 레코드, 권리에 대한 중요 컨텍스트 제공
- **고객과 SDR 간의 회의 예약:** SDR Live Agent 핸드오프를 구성하여 과업 및 회의 예약(다음 작업)을 사용하여 실시간 회의를 설정할 수 있습니다.
- **활동 로깅:** 이벤트, 과업 및 이메일 활동을 수집하고 SDR 에이전트 상호 작용의 결과로 리드, 계정 및 기회에 연결합니다.
**상호 작용**
1. 고객이 채널을 통해 이메일을 보내고 받는 경우 Agentforce 라우팅됩니다.
2. Agentforce 주제, 작업 및 가드 레일을 적용하여 의도를 구문 분석합니다.
3. Agentforce CRM 및 Data 360 컨텍스트로 보강된 프롬프트 템플릿을 사용하여 상황별 응답 초안을 작성합니다.
4. 다중 전환 이메일 대화는 해결 또는 정책 지침에 도달할 때까지 계속됩니다.
5. 자격을 갖춘 리드의 경우 Agentforce 회의를 예약하고 CRM을 업데이트합니다.
6. 의도가 AI 범위를 초과할 경우 Agentforce Sales Cloud SDR로 에스컬레이션하여 인사 서비스 담당자 응답을 합니다.
**상환**
 **핵심 구성 요소**
- **이벤트 소스**
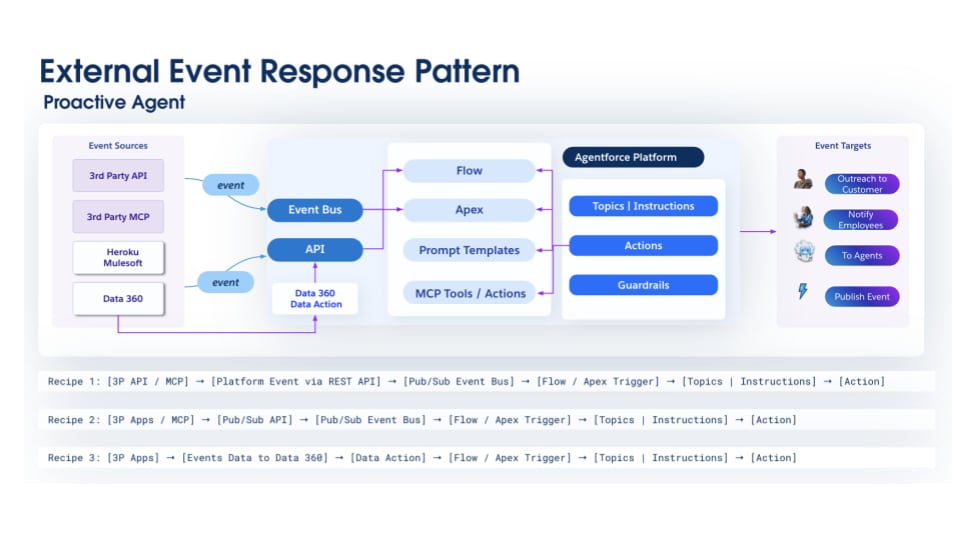
- 외부 데이터가 Data 360에 수집된 후 데이터 작업 트리거 이벤트
- Salesforce Pub/Sub API를 통해 Salesforce에 이벤트를 전송할 수 있는 타사 또는 Salesforce Heroku MCP 서버
- Salesforce Pub/Sub API를 통해 이벤트 알림을 보낼 수 있는 외부 응용 프로그램
- **옵션 미들웨어:** 변환용 MuleSoft 또는 Data 360
- **Agentforce 에이전트:** 에이전트의 동작 및 목적은 다음 구성 요소에 의해 정의됩니다.
- **주제 및 지침:** 기본 목표 정의(예: "우선 순위가 높은 모든 사례 모니터링 및 SLA 위반 방지")를 포함하여 에이전트의 핵심 임무 및 트리거를 지정합니다. 에이전트가 과업을 시작하기 위해 듣어야 하는 특정 이벤트 또는 데이터 조건이 포함됩니다.
- **작업:** 외부 이벤트에 응답하도록 설계된 이벤트 트리거형 및 예약된 작업입니다. 이러한 작업은 일상적인 과업에 대해 자동으로 작동하지만, 경우에 따라 사람이 개입하는 워크플로를 오케스트레이션하고 사용자에게 에스컬레이션하여 사람의 판단이 필요한 시나리오를 검토, 승인 또는 처리할 수 있습니다.
- **가드레일:** 가드 레일은 구성 가능한 규칙 및 런타임 검사 집합으로 작동하여 에이전트의 동작을 제한합니다. 프롬프트를 가로채고, 에이전트의 제안된 작업을 확인하고, 최종 응답을 필터링하여 유해한 콘텐츠를 방지하고, 비즈니스 규칙을 적용하고, 에이전트가 지정된 범위 내에서 작업하는지 확인할 수 있는 안전 계층 역할을 합니다.
- **프롬프트 템플릿:** 병합 필드 또는 Data 360 RAG Retriever의 시맨틱 데이터를 통해 실시간 CRM 데이터로 동적으로 채워지는 재사용 가능한 템플릿입니다. 이러한 템플릿을 사용하면 에이전트가 컨텍스트에 맞는 브랜드 콘텐츠를 생성할 수 있으며 Einstein Trust Layer는 지침이 LLM에 전송되기 전에 민감한 정보를 안전하게 마스킹합니다.
- **Data 360**
- **DLO 및 DMO를** 포함한 Data 360 구성 요소로 외부 시스템에서 [생성한 이벤트 데이터를 Salesforce](https://developer.salesforce.com/docs/data/data-cloud-int/guide/c360-a-create-eventbusconnector-data-stream.html)로 전송하여 스트리밍 또는 실시간 인사이트를 변환 및 구축
- **계산된 스트리밍 및 실시간 정보**는 에이전트에게 고객에 대한 즉각적이고 관련된 데이터를 제공합니다. 이를 통해 예방적 문제 해결을 수행하여 에스컬레이션을 완화할 수 있습니다. **데이터 그래프는** 서로 다른 데이터 소스의 관계와 통찰력을 사전에 표시하여 고객 참여, 활동 및 프로필과 관련된 패턴이나 변칙을 조기에 감지할 수 있습니다.
- **Data 360 벡터 저장소 및 RAG** 검색기는 에이전트에게 모든 관련 엔터프라이즈 데이터 및 비정형 Knowledge 기사의 통합된 보기를 제공하므로 응답이 정확하고 상황에 맞게 기반합니다.
- **이벤트 목표**
- 직원에게 사전에 알리거나 고객에게 연락
- 에이전트로 확장 가능 ([Ambient Agent](#23-환경-에이전트-패턴) 및 [Autonomous Agent](#25-자율-에이전트-패턴) 패턴 참조)
**상호 작용**
1. 외부 시스템에서 중요한 변경 사항이 발생합니다.
2. 외부 시스템에서 이벤트를 발송하고 API(플랫폼 이벤트 만들기) 또는 Pub/Sub API를 통해 Salesforce 이벤트 버스에 게시하거나 이벤트 데이터가 Data 360으로 스트리밍됩니다.
3. 이벤트 구독자가 트리거됩니다. 플로가 트리거됩니다.
4. 플로에서 이벤트 데이터가 포함된 [에이전트 작업](https://help.salesforce.com/s/articleView?id=platform.automate_flow_ref_elements_actions_generate_ai_agent_response.htm&type=5)을 호출합니다. 에이전트가 올바른 작업 경로를 결정하고 실행합니다.
5. 결과는 알림 또는 트리거 중인 워크플로입니다. 알림은 공동 작업 도구(예: Slack)에서 사용자에게 전달됩니다. 과업 또는 이벤트도 생성됩니다. 또한 작업에서 외부 시스템을 호출할 수 있습니다. 따라서 이벤트는 손실되지 않지만 사전에 실행, 신호, 조치가 이루어지므로 인적 오버헤드 또는 복잡한 자동화를 제거합니다.
**상환**
 **핵심 구성 요소**
- **이벤트 소스 레이어**
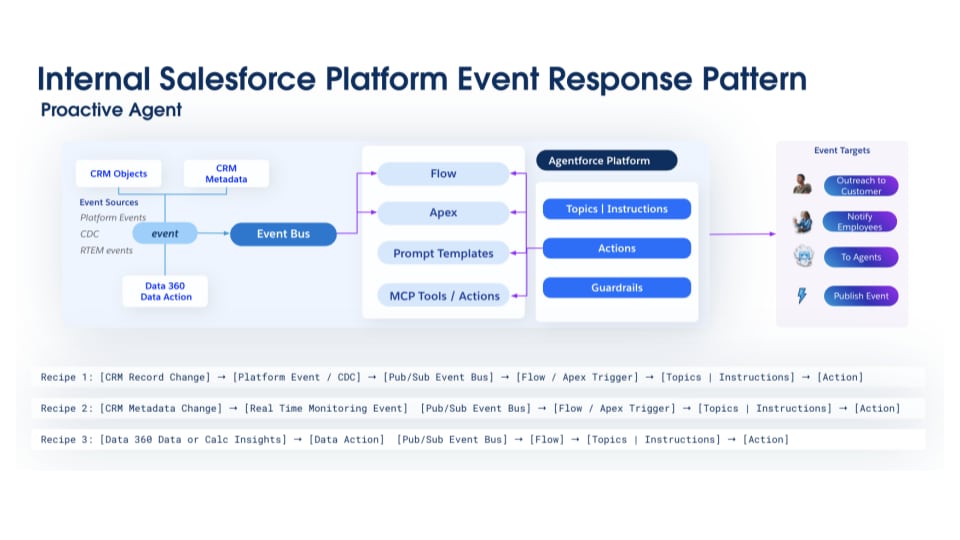
- CRM 데이터, 플랫폼 이벤트, 변경 데이터 수집(CDC) 데이터 및 저급 플랫폼 활동의 실시간 이벤트 모니터링(RTEM) 데이터
- **Data 360**
- [CRM 또는 플랫폼 이벤트에서 생성된](https://developer.salesforce.com/docs/data/data-cloud-int/guide/c360-a-create-eventbusconnector-data-stream.html) 이벤트 데이터를 저장하고 스트리밍 또는 실시간 인사이트를 변환 및 구축하는 **DLO 및 DMO를** 비롯한 Data 360 구성 요소
- **계산된 스트리밍 및 실시간 인사이트는** 에이전트에게 고객, 직원 활동 또는 시스템의 메타데이터 변경 사항에 대한 즉각적이고 관련된 데이터를 제공합니다. 이를 통해 예방적 문제 해결을 수행하여 에스컬레이션을 완화할 수 있습니다. 이 실시간 상황 인식을 통해 에이전트가 시기적절한 거버넌스 및 규정 준수 운영 처리량에 대한 중재를 제공할 수 있습니다.
- **데이터 그래프는** 서로 다른 데이터 소스의 관계와 통찰력을 사전에 표시하여 고객 참여, 활동 및 프로필과 관련된 패턴이나 변칙을 조기에 감지할 수 있습니다.
- **Data 360 벡터 저장소 및 RAG** 검색기는 에이전트에게 모든 관련 엔터프라이즈 데이터 및 비정형 Knowledge 기사의 통합된 보기를 제공하므로 응답이 정확하고 상황에 맞게 기반합니다.
- **Agentforce 에이전트:** 에이전트의 동작 및 목적은 다음 구성 요소에 의해 정의됩니다.
- **주제 및 지침:** Salesforce 내에서 데이터 변경 사항을 기반으로 비즈니스 규칙을 적용하고 프로세스를 자동화하는 에이전트의 임무를 지정합니다. 에이전트의 목표(예: "협상 단계에 도달하기 전에 모든 기회가 기본 연락처로 업데이트되도록 하십시오")와 에이전트를 트리거하는 특정 레코드 만들기, 필드 업데이트 등을 정의합니다.
- **작업:** 내부 Salesforce 이벤트에 응답하도록 설계된 이벤트 트리거형 및 예약된 작업입니다. 이러한 작업은 일상적인 과업에 대해 자동으로 작동하지만, 경우에 따라 사람이 개입하는 워크플로를 오케스트레이션하고 사용자에게 에스컬레이션하여 사람의 판단이 필요한 시나리오를 검토, 승인 또는 처리할 수 있습니다.
- **가드레일:** 가드 레일은 구성 가능한 규칙 및 런타임 검사 집합으로 작동하여 에이전트의 동작을 제한합니다. 프롬프트를 가로채고, 에이전트의 제안된 작업을 확인하고, 최종 응답을 필터링하여 유해한 콘텐츠를 방지하고, 비즈니스 규칙을 적용하고, 에이전트가 지정된 범위 내에서 작업하는지 확인할 수 있는 안전 계층 역할을 합니다.
- **프롬프트 템플릿:** 병합 필드 또는 Data 360 RAG Retriever의 시맨틱 데이터를 통해 실시간 CRM 데이터로 동적으로 채워지는 재사용 가능한 템플릿입니다. 이러한 템플릿을 사용하면 에이전트가 컨텍스트에 맞는 브랜드 콘텐츠를 생성할 수 있으며 Einstein Trust Layer는 지침이 LLM에 전송되기 전에 민감한 정보를 안전하게 마스킹합니다.
- **이벤트 목표**
- 직원을 사전에 알리거나 고객에게 연락합니다.
- 다른 에이전트를 호출할 수 있도록 확장 가능 ([환경 AI](#23-환경-에이전트-패턴) 및 [자율 AI](#25-자율-에이전트-패턴) 패턴 참조)
**상호 작용**
1. CRM 레코드 업데이트, 메타데이터 수정 또는 Data 360에서 트리거된 데이터 작업 등 내부 시스템 내에서 중요한 변경 사항이 발생합니다.
2. 내부 시스템에서 이벤트를 발송하고 API(플랫폼 이벤트 만들기) 또는 Pub/Sub API를 통해 Salesforce 이벤트 버스에 게시하거나 이벤트 데이터가 Data 360으로 스트리밍됩니다.
3. 이벤트 구독자가 트리거되고 플로 또는 Apex 활성화합니다.
4. 활성화된 플로 또는 Apex가 [에이전트 작업](https://help.salesforce.com/s/articleView?id=platform.automate_flow_ref_elements_actions_generate_ai_agent_response.htm&type=5)을 호출합니다.
5. 결과는 알림 또는 트리거 중인 워크플로입니다. 알림은 공동 작업 도구(예: Slack)에서 사용자에게 전달됩니다. 과업 또는 이벤트도 생성됩니다. 또한 작업에서 외부 시스템을 호출할 수 있습니다.
6. 따라서 이벤트는 손실되지 않지만 사전에 실행, 신호, 조치가 이루어지므로 인적 오버헤드 또는 복잡한 자동화를 제거합니다.
**상환**
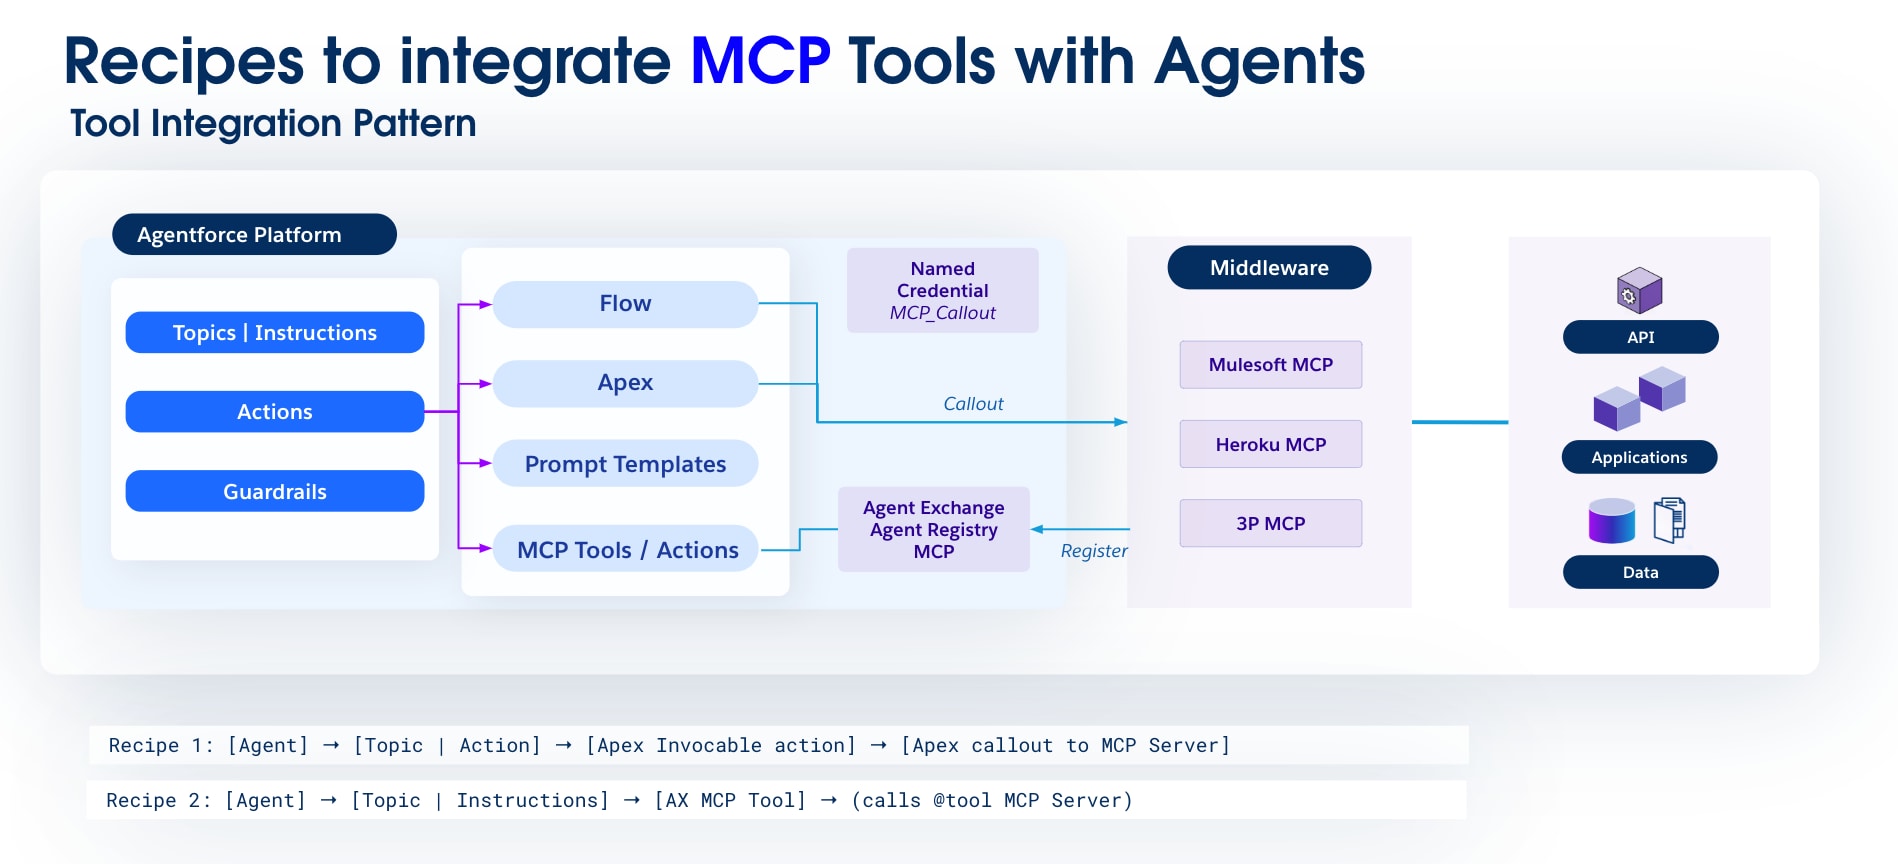 **레시피 1:** **MCP로 외부 도구 활성화**
**문제**
조직은 기존 ERP 및 현대 SaaS의 혼합으로 실행되지만, 공통 프로토콜이 없으므로 에이전트와 통합하기가 어렵습니다. 각 도구에는 자체 API, 인증, 데이터 모델이 있습니다. 개발자는 모든 도구에 대한 사용자 정의 지점 간 커넥터를 구축하고 유지 관리하여 취약하고 확장할 수 없으며 비용이 많이 드는 통합을 생성합니다.
**패턴**
에이전트가 구조화된 작업을 통해 외부 도구(MCP를 통해 노출됨)를 호출하여 Salesforce Platform 외부에서 특수 도구를 사용할 수 있습니다.
**컨텍스트**
- 에이전트는 Salesforce Platform 외부에 있는 도구의 집합에 대한 프록시 역할을 합니다.
- 해당 외부 도구에는 다양한 API, 인증 메커니즘, 데이터 형식이 있을 수 있습니다.
- 에이전트와 해당 외부 도구 간의 원활한 상호 작용을 활성화하려면 표준화된 커뮤니케이션 프로토콜이 필요합니다.
- 여러 에이전트가 서로 다른 목적으로 동일한 외부 도구를 활용할 수 있으므로 재사용성이 매우 중요합니다.
**상호 작용**
1. **트리거:** 사용자 요청 또는 Agentforce 내부 이벤트는 외부 도구를 사용해야 합니다.
2. **작업 의도:** Agentforce 에이전트는 의도를 식별하고 외부 MCP 기반 도구가 필요한지 결정합니다.
3. **플래너(내부):** Agentforce Agent의 플래너는 구성된 지침 및 사용 가능한 도구를 기반으로 적절한 MCP 도구 또는 작업을 선택합니다.
4. **실행:** Agentforce Agent는 외부 MCP 서버에 MCP 호환 요청을 보냅니다(예: Apex 콜아웃을 통해 MuleSoft 엔드포인트로 라우팅하여 외부 MCP 서버로).
5. **외부 처리:** 외부 MCP 서버가 요청을 처리하고, 기본 외부 응용 프로그램과 상호 작용하며, MCP 호환 응답을 준비합니다.
6. **결과**: 외부 MCP 서버가 Agentforce Agent에 응답을 반환합니다.
7. **후속 조치:** Agentforce 에이전트가 응답을 처리하고 내부 상태를 업데이트한 후 과업을 계속 진행하거나 사용자에게 피드백을 제공합니다.
**상환**
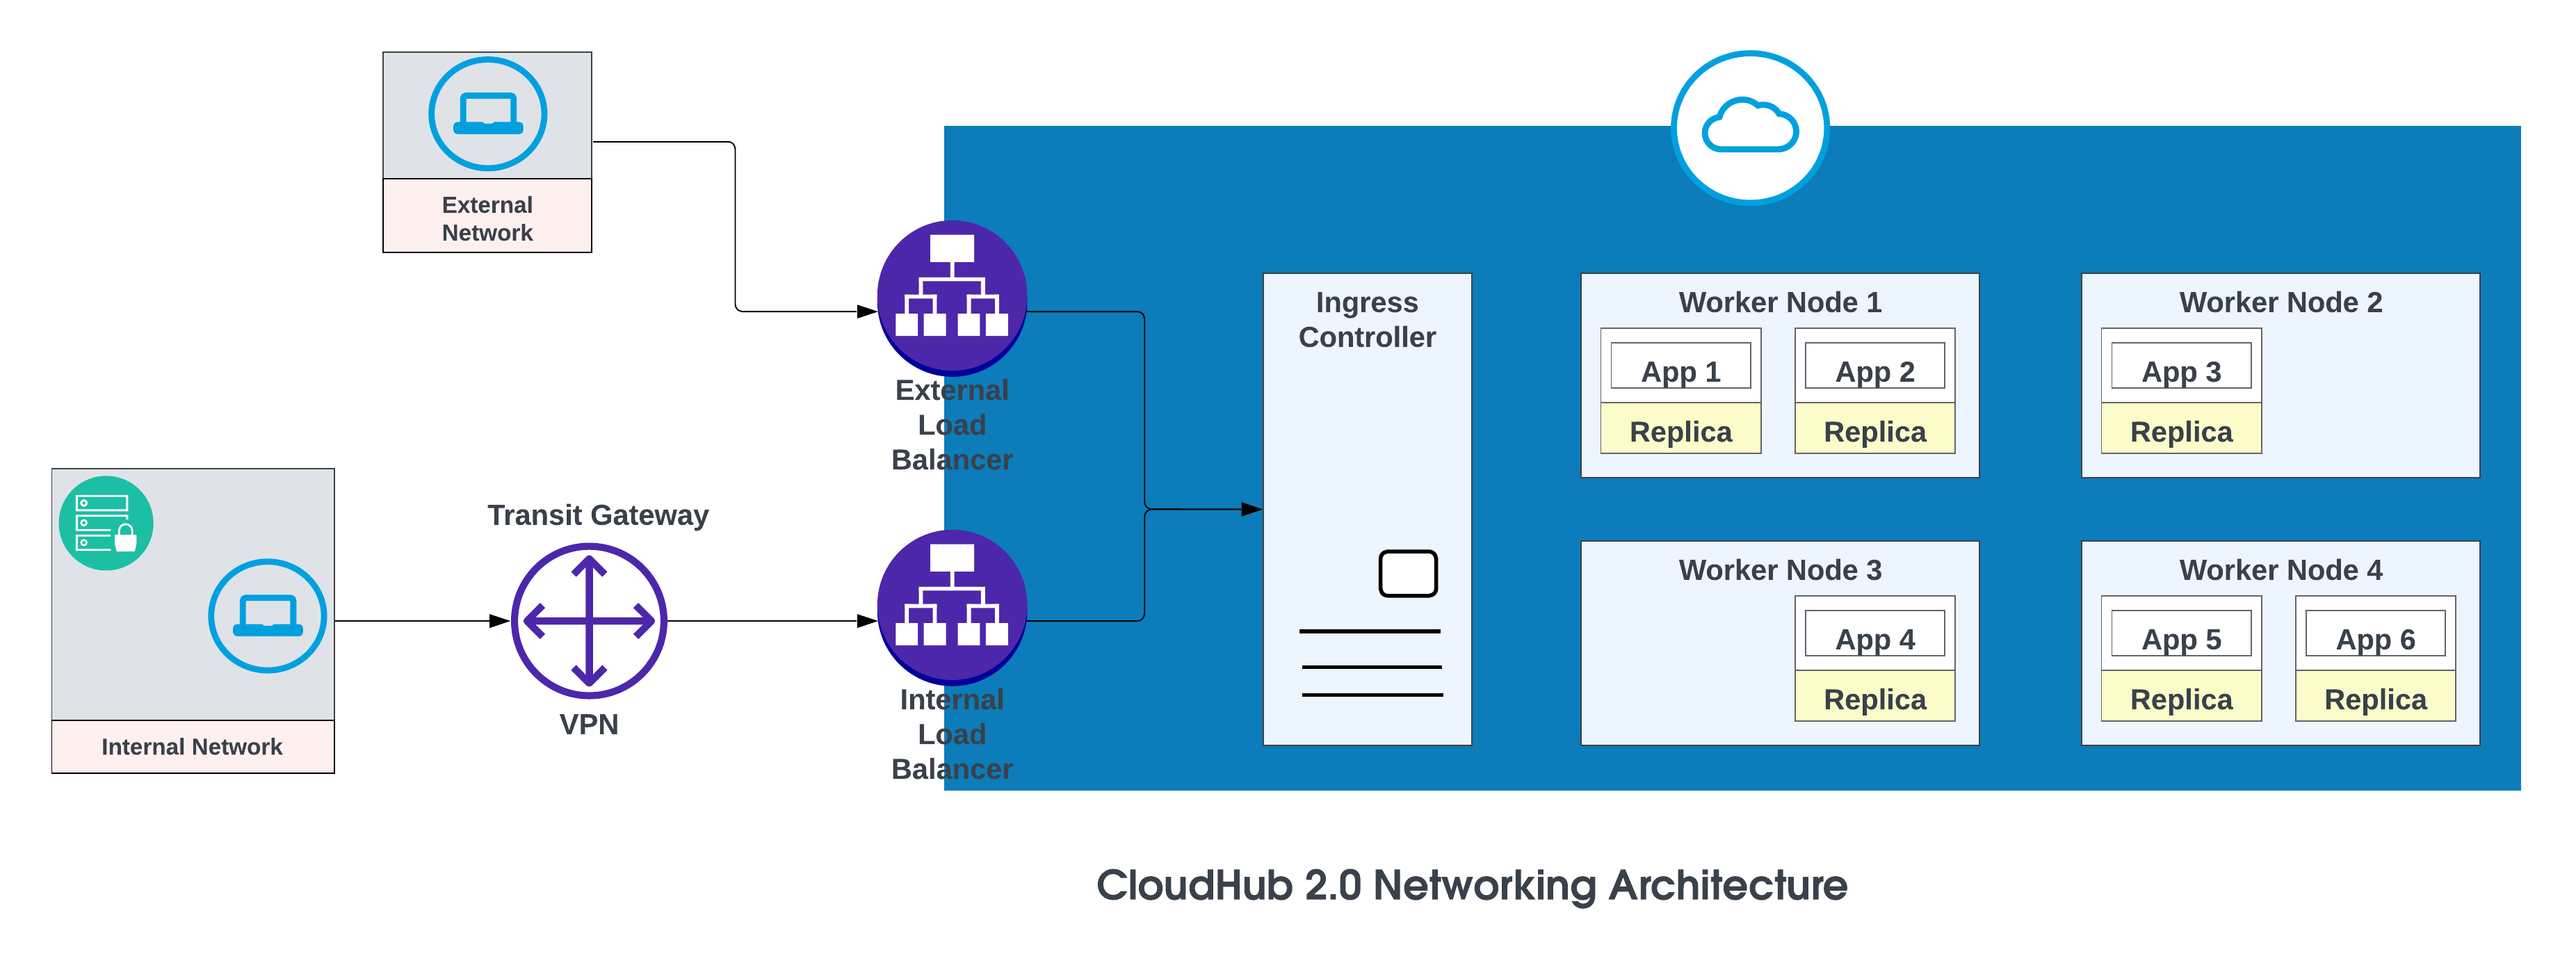 CloudHub 2.0 네트워킹 아키텍처의 기본 구성 요소는 다음과 같습니다.
- HTTP 로드 밸런서
- 복제본 DNS 레코드 모음
- 비공개 공간
- 지역 서비스
자세한 내용은 [CloudHub 2.0 네트워킹 아키텍처](https://docs.mulesoft.com/cloudhub-2/ch2-networking-guide)를 참조하십시오.
**Vanity 도메인**
비공개 공간이 생성되면 \
 CloudHub 2.0은 TLS 컨텍스트 및 DNS 레코드를 사용하여 비공개 공간 내에서 사용자 정의 또는 비활성 도메인을 구성하여 지원합니다. 비공개 공간의 런타임 관리자에서 TLS 컨텍스트를 만들려면 공개 인증서 및 비공개 키를 업로드한 다음, 응용 프로그램의 설정에 사용자 정의 끝점을 추가하여 해당 도메인을 사용합니다. 비공개 공간의 기본 호스트 이름을 비공개 공간 도메인을 가리키는 DNS 레코드(예: CNAME)를 만듭니다.
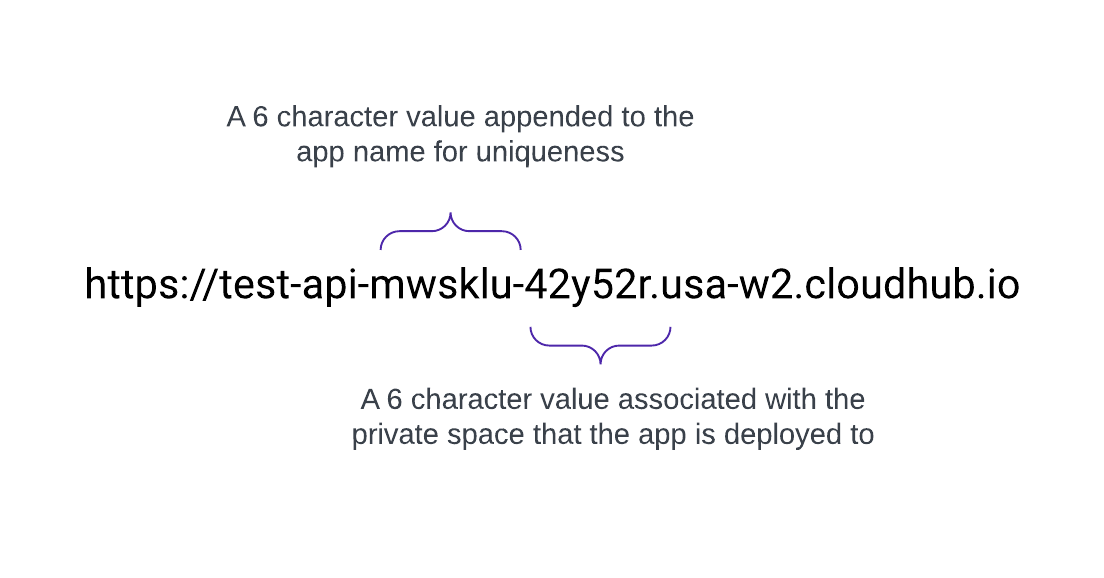
예를 들어, 기본 DNS 42y52r.usa-w2.cloudhub.io를 사용하여 us-west-2에 배포된 test-api라는 응용 프로그램의 API 끝점은 다음과 같습니다.
https://test-api-mwsklu-42y52r.usa-w2.cloudhub.io
이 URL은 배너리 또는 사용자 정의 도메인을 사용하지 않습니다. API URL이 [https://test-api.acme.com](https://test-api.acme.com)으로 표시되도록 [acme.com을](https://acme.com) 사용하려면 다음 단계를 수행합니다.
1. 공개 및 비공개 키를 사용하여 런타임 관리자에서 TLS 컨텍스트를 만듭니다.
2. 응용 프로그램의 설정에 유휴 도메인을 추가하여 해당 도메인을 사용합니다.
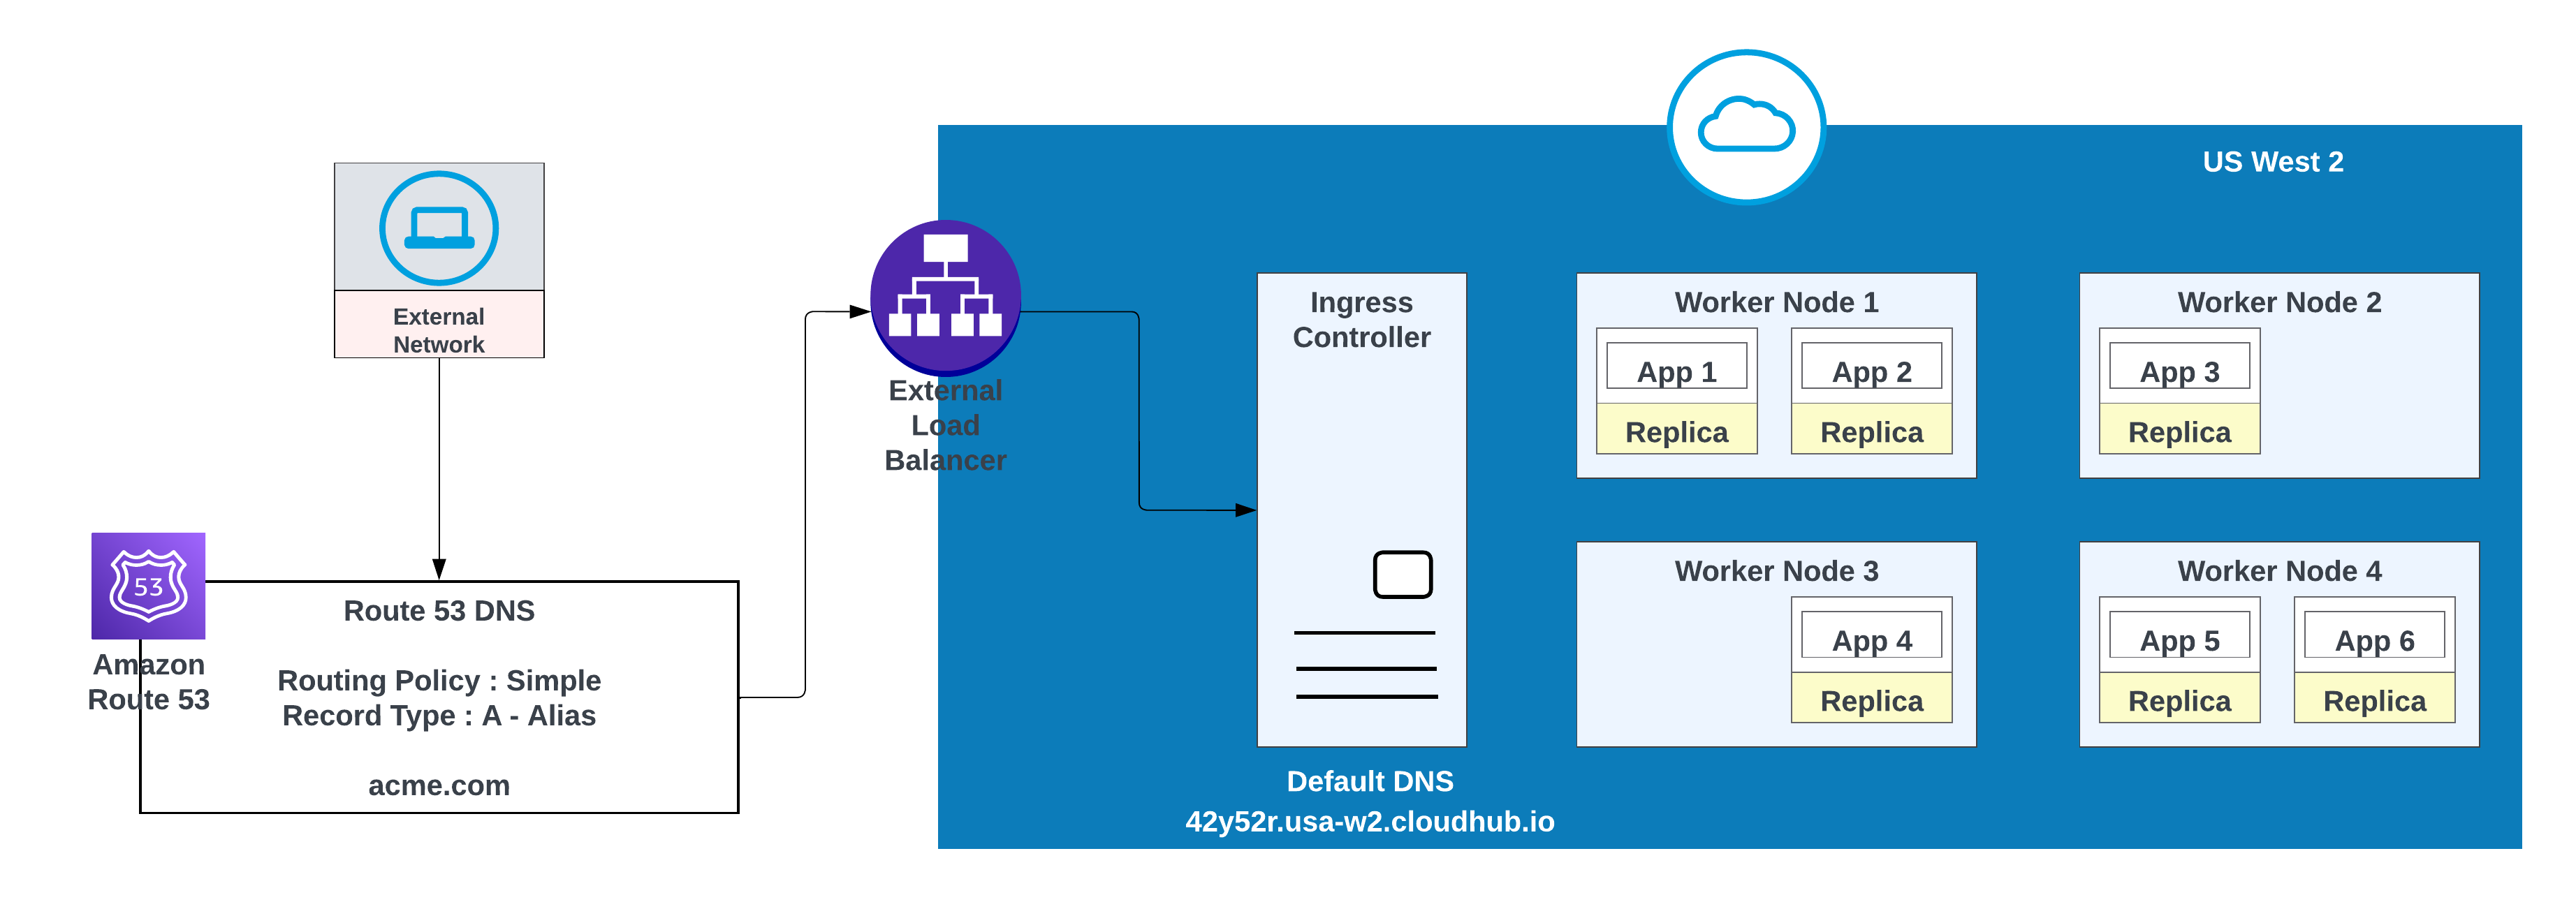
3. AWS 경로 53에서 DNS 레코드를 만들고 간단한 라우팅 정책(예: CNAME)을 구성하여 공백 도메인이 비공개 공간의 기본 호스트 이름으로 확인됩니다.
사용자 정의 도메인의 경우 라우팅 정책과 함께 AWS Route 53 또는 기타 모든 글로벌 CDN 서비스를 사용할 수 있습니다. 아래 다이어그램에서 AWS 경로 53는 "간단한" 라우팅 정책과 함께 사용됩니다. 공개(외부) 네트워크의 소비자가 acme.com을 요청하면 AWS 경로 53가 MuleSoft 비공개 공간 진입 컨트롤러로 요청을 라우팅합니다.
 ## 페일오버 전략
응용 프로그램에 페일오버가 필요한 경우 이 옵션을 사용합니다. 기본 영역(예: us-west-2)에서 하나의 인스턴스와 보조 영역(예: us-east-1)에서 다른 인스턴스를 배포합니다.
가능한 경우 보조 지역의 기존 환경을 사용하십시오. 새 환경을 만들려면 추가 노력이 필요합니다.
**다른 지역으로 페일오버된 한 지역(미국 서부 2)에 배포된 앱의 예(미국 동부 1)**
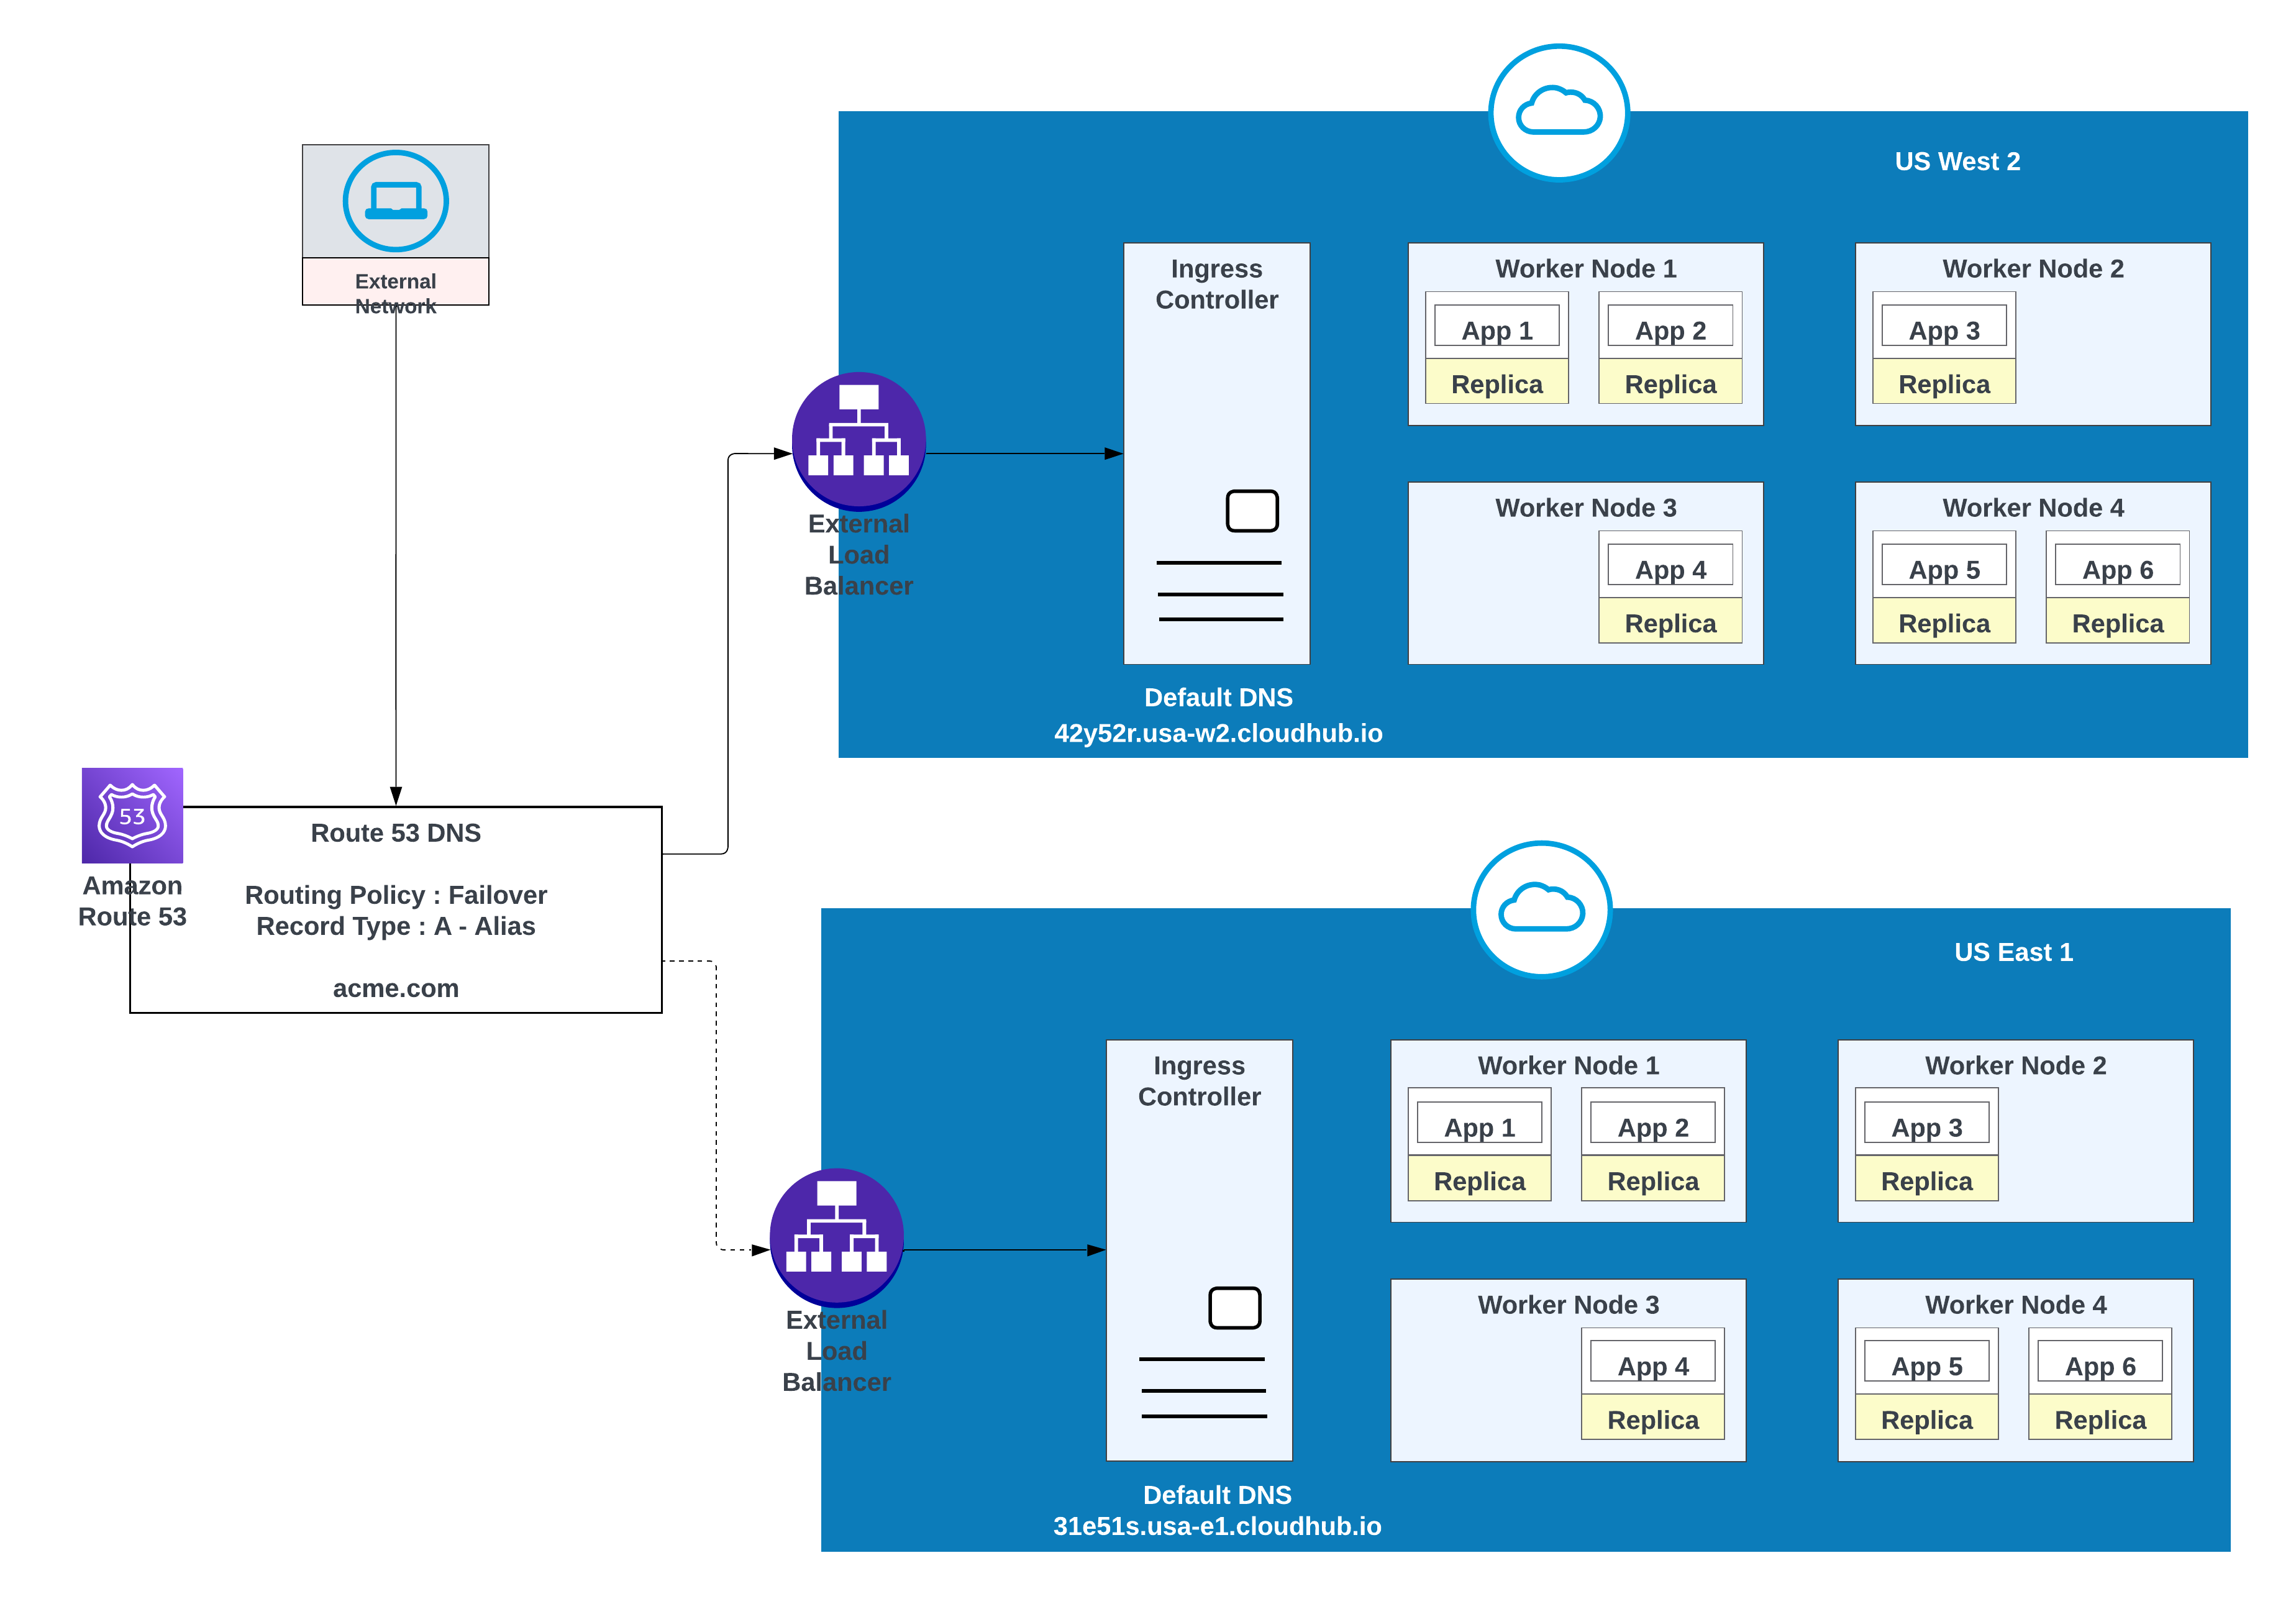 | 레코드 이름 | 값/경로 트래픽 대상 | 라우팅 정책 | 상태 확인 ID |
| :---------: | :-----------------------: | :---------: | :----------: |
| acme.com | 42y52r.usa-w2.cloudhub.io | 페일오버 | 31s3wseq121 |
| acme.com | 31e51s.usa-e1.cloudhub.io | 페일오버 | 43e131s131sq |
이 구성에서 AWS 경로 53는 미국 서부 2 및 미국 동부 1의 비공개 공간에 대한 입력 컨트롤러로 트래픽을 라우팅합니다. 상태 확인을 사용하여 페일오버 라우팅 정책이 구성됩니다.
## 고가용성 및 낮은 대기 시간
대기 시간과 고가용성을 줄이려면 다이어그램에 설명된 배포 전략을 사용하십시오. 이 전략을 사용하면 두 지역(이 예에서는 us-west-2 및 us-east-1)에서 앱을 배포할 수 있습니다.
AWS 경로 53의 대기 시간 라우팅 정책을 사용하여 높은 가용성을 유지하면서 가장 낮은 대기 시간을 제공하는 지역으로 요청을 라우팅합니다. AWS 경로 53의 "대기 시간" 라우팅 정책은 여전히 높은 가용성이 있는 낮은 대기 시간에 대한 요청을 라우팅합니다.
**애플리케이션 두 지역 모두에 배포(미국 서부 2개 및 미국 동부 1개)로 낮은 지연 시간 및 높은 가용성을 제공합니다.**
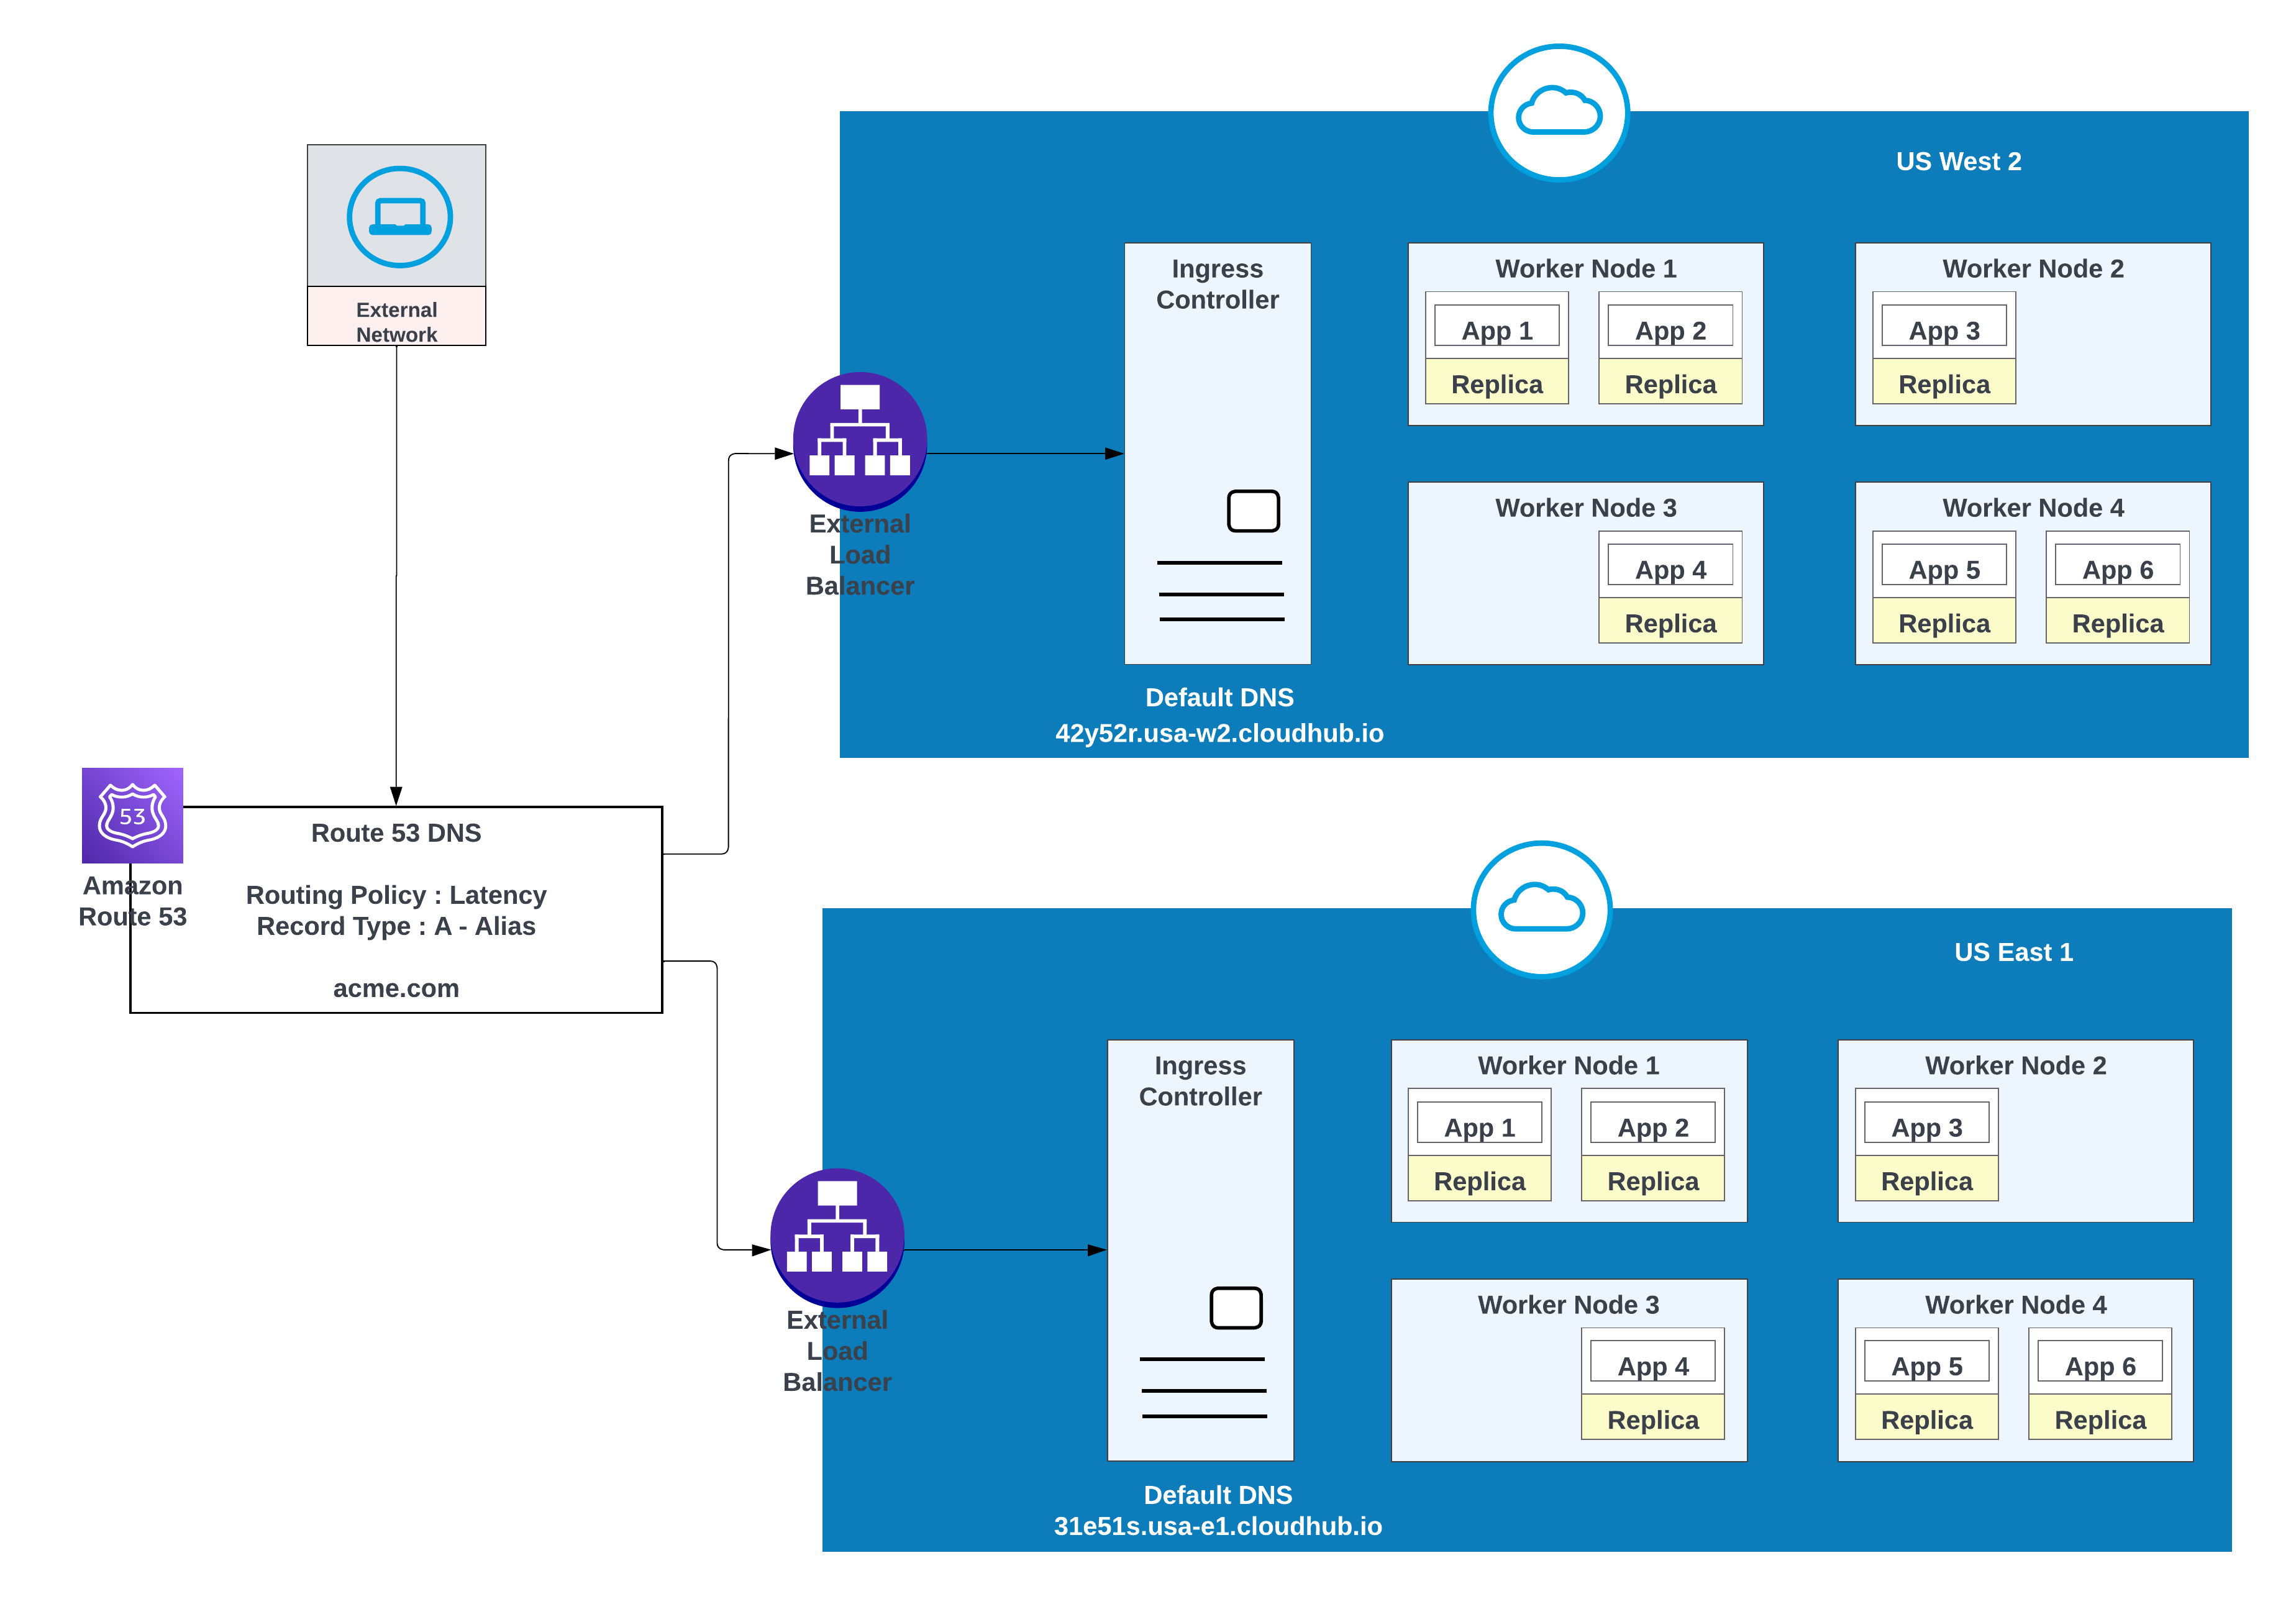 | 레코드 이름 | 값/교통량 라우팅 대상 | 라우팅 정책 | 상태 확인 ID |
| :---------: | :-----------------------: | :---------: | :----------: |
| acme.com | 42y52r.usa-w2.cloudhub.io | 대기 시간 | 31s3wseq121 |
| acme.com | 31e51s.usa-e1.cloudhub.io | 대기 시간 | 43e131s131sq |
## 결론
MuleSoft CloudHub 2.0은 기본적으로 자동 복제 중복 및 지능형 로드 밸런싱을 활용하여 지역 내 복원에 견고한 기반을 제공합니다. 단일 클라우드 지역 내에서 복제본이 여러 개 있는 응용 프로그램을 배포하면 하나의 인스턴스가 실패할 경우 다른 인스턴스가 작업 부하를 즉시 차단할 수 있습니다. 통합 로드 밸런처는 정상적인 복제본 전체에서 수신 트래픽을 효율적으로 배포하여 가동 중지 시간을 최소화하고 정상적인 운영 조건에서 지속적인 서비스 가용성을 보장합니다.
그러나 이 중복성이 높은 단일 영역 아키텍처에만 의존하는 경우에도 광범위하고 재해적인 지역 중단의 상당한 위험이 있습니다. 역사적으로 가장 신뢰할 수 있고 기술적으로 고급 클라우드 공급자도 전체 지리적 지역에 영향을 미칠 수 있는 중단 사고에 취약하다는 사실을 알 수 있습니다. 드물지만 이러한 단일 실패는 다음을 포함한 다양한 이벤트로 인해 발생할 수 있습니다.
- 대규모 인프라 사고
- 주요 전원 장애
- 광범위한 네트워크 중단
따라서 진정한 고가용성(HA) 및 재해 복구(DR)를 달성하려면 단일 지역 모델의 제한 사항을 초과하도록 아키텍처를 설계해야 합니다. 권장하는 전략은 여러 지리적으로 구별되는 지역에 대한 배포입니다. 이 지역 간 복원 기능을 통해 예기치 않은 재해로 인해 전체 클라우드 영역을 사용할 수 없게 되면 별도의 영향을 받지 않는 영역에서 실행되는 응용 프로그램 인스턴스에 대한 트래픽이 원활하게 실패하여 서비스 중단을 최소화하고 가동 시간 목표를 극대화할 수 있습니다.
## 참조
[CloudHub 2.0 Networking Architecture](https://docs.mulesoft.com/cloudhub-2/ch2-networking-guide)
[표준 대기열에 대한 지역 간 장애 복구 구성](https://docs.mulesoft.com/mq/mq-failover)
[개체 저장소 V2 배포 지역](https://docs.mulesoft.com/object-store/osv2-faq#osv2-regions)
[개체 저장소 배포 지역](https://docs.mulesoft.com/object-store/osv2-faq#is-object-store-v2-persistent-in-the-same-region-as-the-worker)
## 작성자 정보
Gulal Kumar는 데이터 및 통합 아키텍처에 중점을 둔 Salesforce의 소프트웨어 엔지니어링 아키텍처입니다. 통합 및 API, 현대화 프로그램, 보안, AIML 이니셔티브 분야에서 20년 이상의 경험을 보유한 그는 풍부한 전문 지식을 제공합니다. Gulal은 비즈니스 전환 이니셔티브를 발전시키고, 보안 및 복원 능력을 향상하고, 아키텍처 우수성을 촉진하고, 다양한 도메인 전반에 걸쳐 AIML 이니셔티브를 선도하기 위해 노력하고 있습니다.
Ajay Nagaraju는 엔터프라이즈 아키텍처, 시스템 통합, 대규모 디지털 변환 분야에서 28년 이상의 경험을 보유한 MuleSoft의 엔터프라이즈 아키텍처 및 선임 디렉터입니다. 그는 Fortune 100대 기업과 Fortune 500대 기업에서 복잡한 수백만 달러의 프로그램에 대한 아키텍처 및 전달을 이끌었으며 API 기반 연결, SOA, 클라우드 기술, 엔터프라이즈 통합 패턴에 대한 깊은 전문 지식을 보유하고 있습니다. Ajay는 비즈니스 프로세스, 데이터 플랫폼, 통합 생태계를 현대화하기 위해 경영진과 긴밀한 파트너 관계를 맺고 있으며, 기술을 통해 확장 가능한 아키텍처를 구축하고, 팀을 멘토링하고, 측정 가능한 비즈니스 결과를 촉진하는 데 열정적입니다.
## 개요
엔터프라이즈 데이터 아키텍처가 변화하는 시점입니다. 조직은 실시간 AI 시스템을 동시에 지원하고, 점점 엄격해지는 개인정보보호 규정을 준수하고, 원시 데이터를 공유할 수 없는 외부 파트너와 공동 작업을 수행해야 합니다. 이러한 요구 사항은 데이터 플랫폼이 설계되는 방식을 근본적으로 변경하고 있습니다.
ETL 파이프라인 및 중앙 집중식 데이터 웨어하우스를 기반으로 구축된 기존 아키텍처는 이러한 요구 사항을 충족하는 데 어려움을 겪고 있습니다. 시스템 전체에서 데이터를 복제하면 대기 시간, 비용, 거버넌스 복잡성이 증가합니다. 각 복사본은 새로운 규정 준수 의무가 되어 배포된 환경에서 동의 관리, 삭제 요청, 정책 시행이 복잡해집니다.
이러한 문제를 해결하기 위해 업계는 정책에 따라 제로 카피 공동 작업 모델로 전환하고 있습니다. 데이터 정리 룸은 주요 아키텍처 기능으로 등장하여 여러 조직에서 원시 데이터를 노출하거나 전송하지 않고도 공유 신호를 분석할 수 있습니다. 데이터를 중앙 집중화된 환경으로 이동하는 대신 계산이 각 참가자의 관리 도메인 내에서 실행되고 개인 정보 보호에 안전한 결과만 반환됩니다.
이 아키텍처 변화는 산업 전반에서 점점 더 눈에 띄고 있습니다. 예를 들어, 마케팅 및 광고 분야에서 가장 큰 회사인 WPP가 InfoSum을 인수한 것은 개인 정보 보호 안전 공동 작업을 위한 인프라로서 청결한 공간이 점점 더 중요하다는 사실을 반영합니다. 금융 기관은 이를 사용하여 기관 전체에서 사기를 감지하고 소매업체는 소비자 브랜드와 프로모션을 조율하며 헬스케어 조직은 민감한 기본 레코드를 공유하지 않고 교차 제공자 환자 코호트를 분석합니다.
Salesforce Data 360은 Hyperforce 구축된 제로 카피 아키텍처를 통해 이 모델을 운영합니다. 데이터는 소스 시스템에 남아 있지만 연합 쿼리는 런타임 시 개인 정보 보호, 동의, 보존 정책을 적용합니다. 이 접근 방식은 데이터 복제로 인해 생성되는 위험 영역을 확장하지 않고 실시간 인사이트, 클라우드 간 공동 작업, AI 중심 의사 결정을 지원합니다.
이 문서에서는 데이터 정리 룸이 현대 엔터프라이즈의 기본 아키텍처 패턴으로 작동하는 방식을 검토하여 AI 혁신, 규제 준수, 안전한 도메인 간 공동 작업을 동시에 대규모로 지원합니다.
## 지금 중요한 방 정리 이유
데이터 정리 공간이 필요한 이유를 이해하려면 엔터프라이즈 설계자가 먼저 기존 통합 모델의 구조적 실패를 해결해야 합니다. 업계는 중앙 집중식 단독 데이터 리포지토리에서 분산화된 연합된 에코시스템으로의 결정적인 전환을 거칩니다. 여기에서 데이터는 물리적으로 이동하는 대신 액세스, 관리, 계산됩니다. 이 교대 근무는 증분이 아닙니다. 이는 기존 아키텍처에서 더 이상 흡수할 수 없는 규모, 개인 정보 보호, 민첩성과 관련된 시스템적 압박에 대한 직접적인 대응입니다.
### 현대 엔터프라이즈에서 데이터 통합 재정의
수년간 기업은 보고 및 분석을 위해 CRM, ERP, 디지털 시스템의 데이터를 중앙 창고로 복사하는 ETL 기반 아키텍처에 의존했습니다. 이 접근 방식은 내역 분석에 효과적이었지만 더 느린 배치 지향 환경을 위해 고안되었습니다.
디지털 상호 작용이 가속화되고 AI 기반 시스템이 등장함에 따라 이 모델의 제한 사항이 더욱 명확해졌습니다. ETL 파이프라인은 본질적으로 비동기식이므로 이벤트가 발생한 후 몇 시간 또는 며칠 후 인사이트가 도착하는 경우가 많습니다. 이러한 대기 시간은 실시간 개인 설정, 적응형 의사 결정, 즉각적인 컨텍스트 데이터가 필요한 AI 시스템과 같은 현대 사용 사례와 점점 더 불일치합니다.
또한 복제는 증가하는 거버넌스 및 보안 복잡성을 도입합니다. 각각의 새 데이터 사본에는 추가 정책, 모니터링, 규정 준수 제어가 필요합니다. 규제된 환경에서 GDPR(일반 데이터 보호 규정)와 같은 프레임워크에서 조직은 데이터가 존재하는 모든 위치에서 삭제, 동의, 사용 제한을 관리해야 합니다. 이는 여러 시스템에서 데이터 집합이 복제되는 경우 운영상의 문제입니다.
이 중복은 규모에 따라 비용 및 운영 오버헤드가 복합됩니다. 조직은 여러 플랫폼에서 수집, 저장소, 보안, 처리 비용을 반복적으로 지불하고, 추가 사본의 여백 값은 하락합니다.
따라서 현대 데이터 아키텍처는 데이터 이동을 최소화하고 소스에 직접 관리를 적용하는 모델로 전환하고 있습니다. 제로 카피 통합 및 연합 데이터 액세스를 사용하면 조직이 민감한 데이터 집합을 복제하지 않고 인사이트를 생성하여 엔터프라이즈 데이터 공동 작업에 더욱 확장 가능하고 안전하며 정책에 부합하는 접근 방식을 제공할 수 있습니다.
### 데이터 메쉬 및 데이터 패브릭의 출현
이러한 압박에 대응하기 위해 업계는 두 가지 보완적인 아키텍처 패러다임, 즉 데이터 메쉬 및 데이터 패브릭. 모두 중앙 집중식 제어에서 통합된 도메인 인식 데이터 아키텍처로의 전환을 나타냅니다.
데이터 메쉬는 데이터 소유권을 세일즈, 마케팅 또는 공급망과 같은 도메인 지정 팀으로 분산합니다. 각 도메인은 계약, 품질 표준, 서비스 수준 목표가 명확하게 정의된 제품으로 데이터를 처리합니다. 이 모델은 회계 및 비즈니스 정렬을 개선하지만, 엔터프라이즈 규모에서 도메인 전반의 조정, 상호 운용성, 일관된 거버넌스와 관련된 새로운 문제를 제기합니다.
Data Fabric은 분산된 도메인을 일관된 시스템에 바인딩하는 연결 계층을 제공하여 이러한 문제를 해결합니다. 공유 메타데이터, 일반적인 의미론, 자동 정책 적용, 계보, 거버넌스를 제공하므로 물리적 통합을 단일 리포지토리로 강제 적용하지 않고 데이터를 지속적으로 검색, 액세스, 관리할 수 있습니다.
데이터 메쉬와 데이터 패브릭은 함께 연합 데이터 액세스를 위한 기반을 마련합니다. 그러나 데이터를 복사하거나 노출하지 않고 공동으로 분석해야 하는 도메인 및 조직 범위 전반에 걸쳐 안전하고 관리되는 공동 작업을 활성화하는 중요한 차선 문제를 해결하지 못합니다.
### 방 청소 전략 피벗
엔터프라이즈 데이터가 더욱 분산되고 개인정보보호 규정이 더욱 엄격해지므로 조직은 핵심적인 아키텍처 문제에 직면하게 됩니다. 원시 데이터를 공유하지 않고 팀, 파트너, 플랫폼에서 공동 작업을 수행하는 방법은 무엇입니까? 기존 데이터 통합 접근 방식은 이 수준의 배포 또는 규제 심사에 맞춰 설계되지 않았으므로 공동 작업과 규정 준수 간의 긴장이 발생했습니다.
이 과제로 인해 데이터 정리 룸이 기본 아키텍처 기능으로 바뀌었습니다. 정리 룸은 데이터 전송에서 관리 계산으로의 공동 작업을 이동시킵니다. 데이터 집합을 복사하거나 교환하는 대신 분석 및 AI 워크로드가 메타데이터를 공유하여 이미 존재하는 위치에서 실행됩니다. 개인정보보호, 동의, 사용 규칙에 대해 쿼리가 실시간으로 평가되고, 승인된 집계된 결과만 반환됩니다.
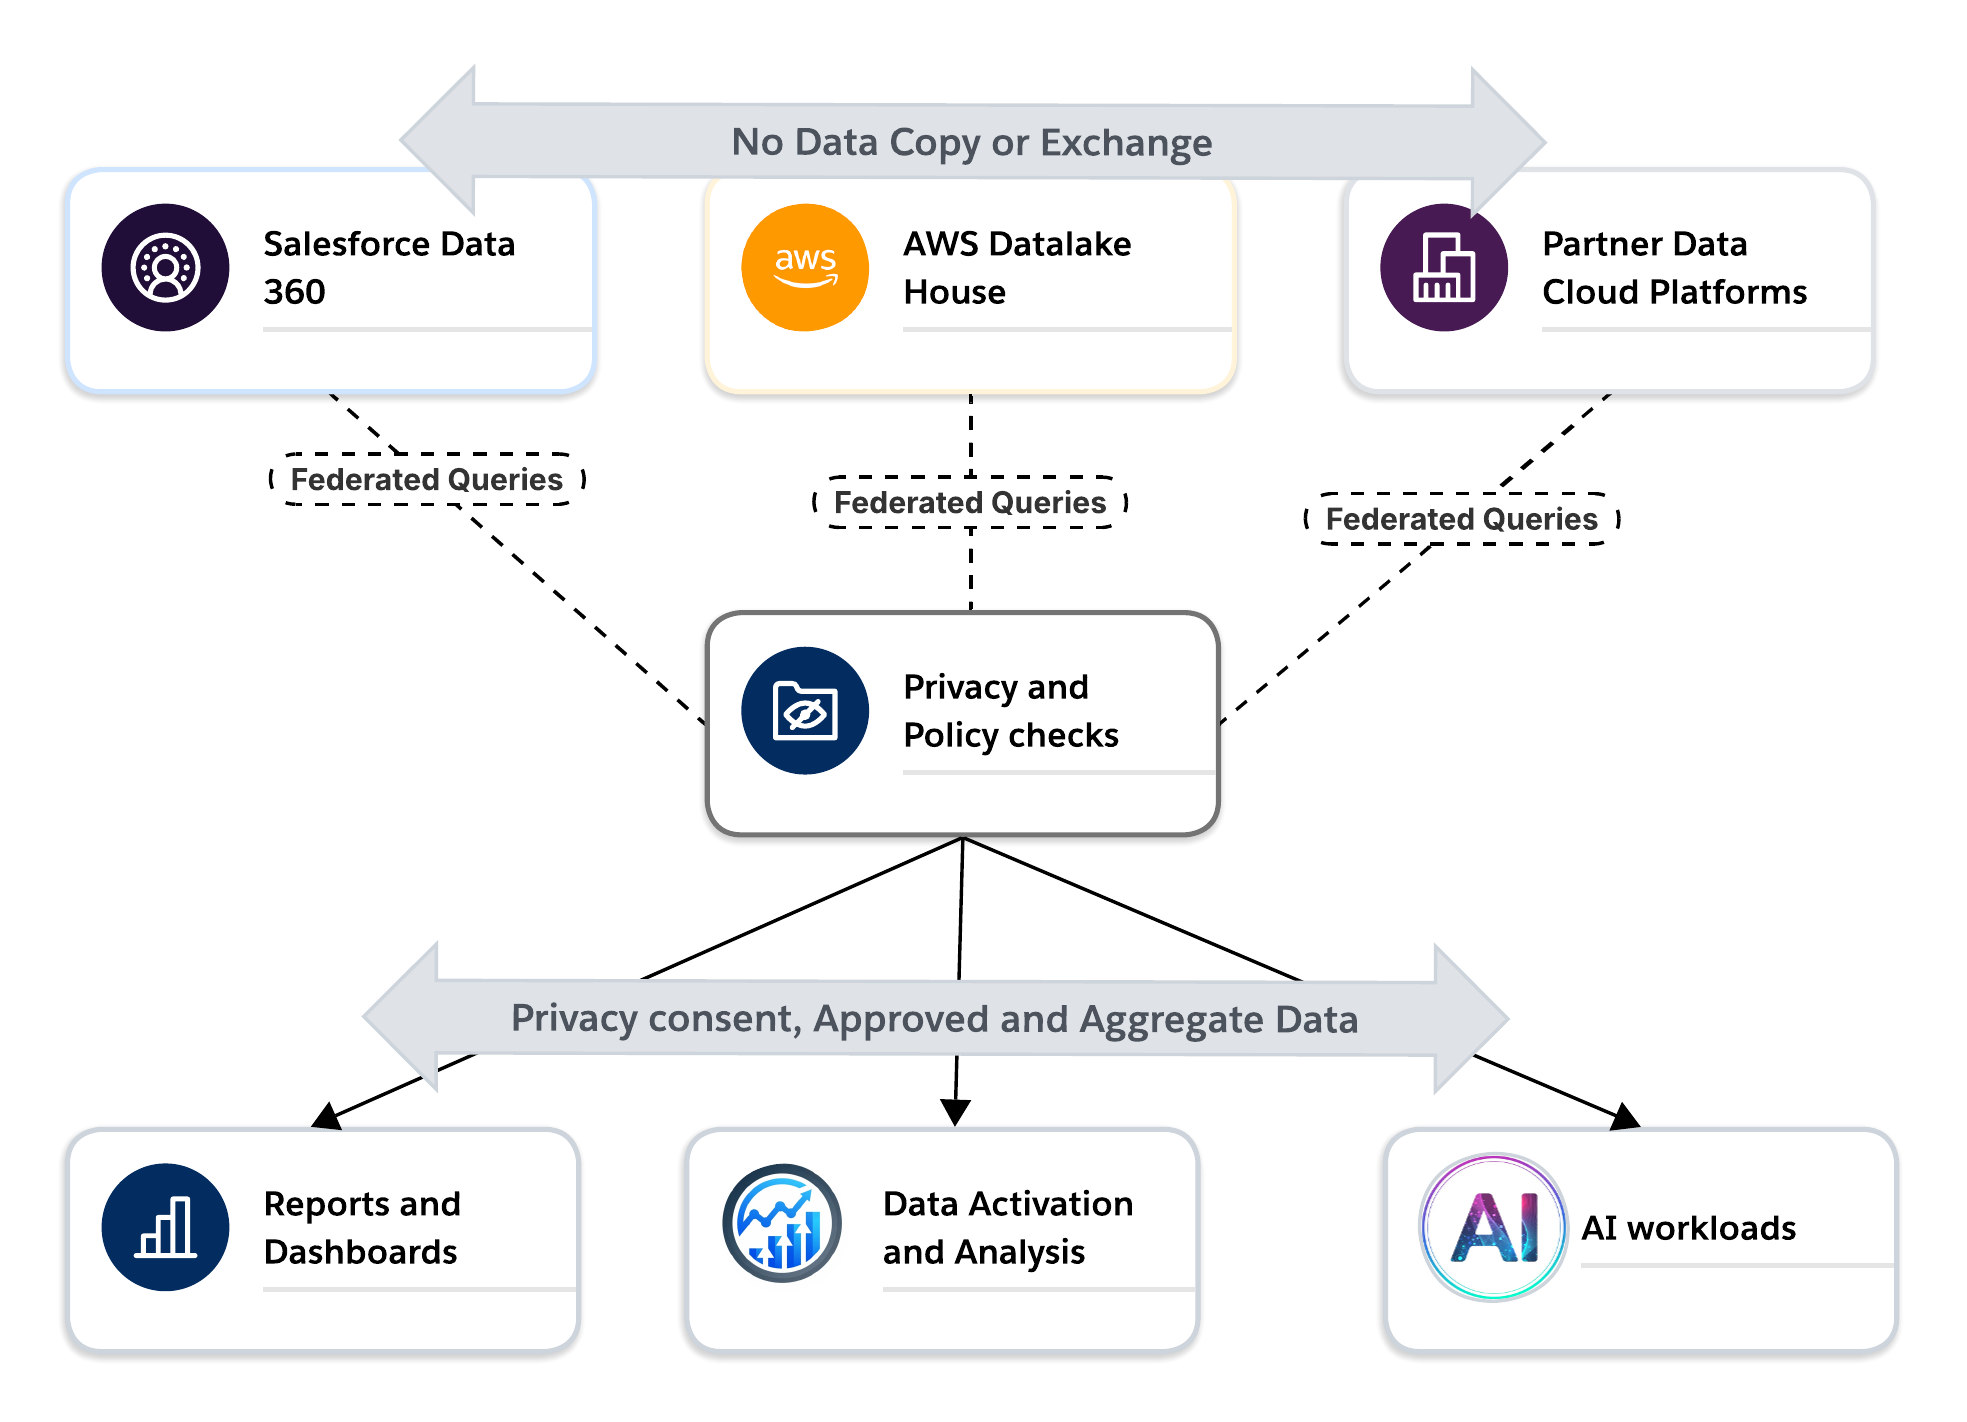 이 모델에서는 데이터 클린 룸이 현대 데이터 아키텍처의 Trust 경계로 작동합니다. 이를 통해 조직이 데이터를 제어하지 않고 파트너 및 자회사와 협력하고, 정책이 아닌 시스템 제어를 통해 개인정보보호 및 동의를 적용하고, 데이터 보존 및 계약 제한을 존중하면서 클라우드 전반에서 운영할 수 있습니다.
활성화, 분석, AI 사용 사례의 경우 클린 룸은 민감한 정보를 노출하지 않고도 외부 데이터에서 인사이트를 생성할 수 있는 안전한 방법을 제공합니다. 데이터 공유에서 신뢰할 수 있는 공동 작업으로 전환할 수 있습니다. 활성화 사용 사례의 경우 정리 룸은 허용된 대상으로 바로 활성화할 수 있는 대상 그룹을 생성하는 안전한 방법을 제공합니다. 이 모든 작업은 당사자에게 개인 식별 정보(PII)를 노출하지 않고 수행됩니다. 이는 엔터프라이즈 데이터 아키텍처의 전환점입니다. 데이터 정리 룸은 더 이상 틈새 도구가 아닙니다. 이는 연합, 개인 정보 보호, AI 지원 데이터 플랫폼의 핵심 인프라가 되고 있습니다.
## 이해당사자 페르소나 및 기술 가드 레일
성공적인 데이터 정리 룸 아키텍처는 데이터 유틸리티, 보안 및 속도의 경쟁적 압력을 해결하도록 설계된 다중 인터페이스 시스템입니다. 기본 기술 설계에서 고유한 마찰 지점을 해결해야 하는 3개의 기본 개인 정보가 있습니다.
### 개인정보 보호 및 규정 준수 담당자(위험 완화자)
개인정보 보호 및 규정 준수 담당자는 데이터 정리 룸을 거버넌스 도구로 사용합니다. 이들의 주된 우려는 규정 준수 드리프트이며, 외부 공동 작업 환경이 내부 시스템과 동일한 엄격한 표준을 적용하지 못할 위험입니다.
- **마찰점:** 규제 노출(GDPR, CCPA, DMA) 및 파트너가 반복적인 세분화된 쿼리를 통해 사용자의 ID를 삼각화하려고 하는 "피싱" 공격
### 데이터 과학자 및 분석가(유틸리티 최적화 프로그램)
데이터 과학자는 데이터 정리실을 고급 모델링을 위한 안전한 장소로 간주합니다. 이들의 주된 관심사는 유틸리티 보존이며, 개인 정보 보호 조치로 인해 데이터가 통계적으로 유용하지 않게 만들 수 있습니다.
- **마찰점:** 대기 시간이 길고 기계 학습(ML), 유사 모델링, 이탈 예측에 필요한 세분화된 특성에 대한 액세스가 제한됩니다.
### 마케팅 및 비즈니스 사용자(가치 실현자)
이 개인 정보는 TTV(Time to Value)에만 초점을 맞춥니다. 데이터 정리 룸 프로젝트는 종종 데이터 엔지니어링 지원이 수주일 필요로 하는 기술적인 지체 지점이 됩니다.
- **마찰점:** 복잡한 설정 프로세스, 수동 데이터 정리, 단순한 결과 겹침을 얻기 위해 코드를 작성해야 하는 "빈 페이지" 문제
### "비즈니스 우선" 페르소나 모델
기존 아키텍처는 사용자 레이어보다 먼저 데이터 레이어를 구축하는 데 중점을 두지만 "비즈니스 우선" 메서드와 일치하는 전략적 접근 방식은 이 모델을 반전합니다. 비즈니스 사용자가 인사이트를 생성하고 즉각적인 조치를 취할 수 있도록 코드 없음 접근 방식을 클릭 몇 번으로 우선 적용합니다.
**"인사이트-작업" 워크플로:** 아키텍처는 패시브 리포지토리가 아닌 활성 작업 영역으로 설계되었습니다. 사용 사례 템플릿(예: 세그먼트 겹침, 활성화, 캠페인 성과)을 제공하여 비즈니스 사용자가 셀프 서비스 인사이트를 만들 수 있습니다. 이렇게 하면 데이터 엔지니어가 파일을 수동으로 이동할 필요 없이 최적화된 유사 세그먼트와 같은 인사이트를 마케팅 에코시스템 전반에서 즉시 활성화할 수 있습니다.
**전략적 자산으로서의 제로 카피 연합:** TTV를 극대화하기 위해 아키텍처는 0-copy 논리를 채택합니다. 대기 시간 및 보안 위험이 발생하는 기존 ETL 프로세스 대신 아키텍처는 데이터가 있는 위치(예: Snowflake, BigQuery 또는 Amazon S3)에 쿼리를 직접 연합합니다. 이렇게 하면 조직의 기존 데이터 투자가 전략적 자산으로 전환되므로 비즈니스 사용자는 엄격한 관리를 유지하고 데이터 중복 비용을 없애는 동시에 실시간으로 최신 데이터에 대해 조치를 취할 수 있습니다.
## 핵심 데이터 정리 룸 사용 사례
데이터 정리 룸은 쿠키 중단 및 개인정보보호 규정에 대한 응답으로 광고에 등장했지만, 측정 이상으로 산업 전반의 고객 분석, 대상 그룹 세분화, 활성화 사용 사례로 발전했습니다. 2025년 리테일 미디어 상태 보고서에 따르면, 현재 조직의 66%가 일부 용량의 청결한 공간을 사용하고 있으며, 측정 가능한 비즈니스 결과를 제공하는 개인 정보 보호 보호 협업이 필요합니다.
패턴은 섹터 전체에서 일관되며, 데이터는 소유자와 유지되고, 계산이 관리되고, 개인 정보 보호에 안전한 인사이트만 공유됩니다.
### 마케팅 및 광고: 타사 쿠키 없이 측정
**도전:** 마케터는 캠페인 효과를 측정하고 중복 광고 인상을 피하고 도달률/주기를 최적화해야 하지만 더 이상 타사 쿠키 또는 장치 식별자를 사용하지 않아도 됩니다.
**클린 룸 솔루션:**
- 광고주가 해시된 고객 또는 캠페인 노출 데이터 제공
- 게시자가 인상 및 참여 신호 제공
- 클린 룸은 도달, 빈도, 귀속, 리프트를 계산합니다.
- 원시 데이터 내보내기가 없는 승인된 플랫폼을 통해 활성화
**비즈니스 결과:** 정리 룸은 실제 트랜잭션에 광고 인사이트를 연결하는 마감 루프 속성을 제공하고, 진정한 캠페인 리프트를 격리하는 증분성 분석을 제공하며, 기존 디지털 광고에서 제공할 수 없는 채널 전반의 통합 측정을 제공합니다.
**산업 증거:** 측정은 Pinterest, Disney, Paramount와 같은 주요 미디어 네트워크가 자체 깔끔한 공간을 만드는 현재 가장 확립된 청정실 사용 사례입니다.
### 리테일 미디어 및 Consumer Packaged Goods(CPG): 공유하지 않고 자사 데이터 수익성 조성
**도전:** CPG 브랜드는 리테일 미디어에 많은 비용을 지출하지만 구매 결과에 대한 가시성이 부족합니다. 소매업체는 풍부한 세일즈 지점 데이터를 소유하지만 개인정보보호 서약을 위반하지 않아도 노출할 수 없습니다.
**클린 룸 솔루션:**
- 소매업체 및 CPG 회사가 리테일 위치의 세일즈 지점 데이터와 마케팅 데이터를 결합하여 프로모션 활동 최적화
- 해시된 CRM 또는 충성도 식별자를 제공하는 브랜드
- 매장 내/온라인 구매에 대한 청소 공간 링크 광고 노출
- 활성화는 소매업체의 미디어 에코시스템 내에 유지됩니다.
**비즈니스 결과:**
- 소매업체는 원시 고객 정보를 판매하지 않고 자사 데이터를 활용
- 구매를 촉진한 캠페인을 표시하는 브랜드의 마감 루프 특성 얻기
- 개인 정보 보호 위험 없이 소매 미디어 네트워크 확장
**산업 증거:** Walmart의 Luminate 및 Kroger Precision Marketing와 같은 소매 미디어 네트워크는 CPG 브랜드가 소매업체 데이터를 사용하여 고객 동작을 분석하고 마케팅 전략을 최적화하는 데 도움이 되는 깔끔한 공간을 제공합니다.
### 금융 서비스: 공동 작업 사기 감지
**도전:** 사기 네트워크는 기관 전체에서 운영되지만 GLBA와 같은 규정 및 새로운 개인정보 보호법으로 인해 은행이 고객 또는 트랜잭션 데이터를 공개적으로 공유할 수 없습니다.
**클린 룸 솔루션:**
- 여러 은행이 익명화된 데이터를 공유하여 비정상적인 크로스 뱅크 활동과 같은 사기를 나타내는 패턴을 식별합니다.
- 연합 분석 또는 모델이 공유 사기 신호에서 실행됩니다.
- 다른 기관의 고객 수준 데이터를 볼 수 없는 경우
**비즈니스 결과:**
- 신속한 교차 기관 사기 패턴 감지
- 풍부한 신호 집합을 통한 위양성 감소
- 중요한 데이터를 중앙 집중화하지 않고 규정 준수
**산업 증거:** Experian 및 TransUnion의 금융 서비스 솔루션은 은행 및 보험사가 엄격한 데이터 프라이버시 제어를 유지하면서 사기 감지 및 위험 평가에 대해 공동 작업할 수 있는 청결한 공간 기술을 제공합니다.
### 의료 및 생명 과학: 환자 데이터 노출 없이 연구
**도전:** 제약 회사는 의약품 개발을 위해 실제 환자 결과가 필요하지만, 데이터는 HIPAA 및 유사한 규정에 의해 보호되는 병원 EHR 시스템에 있습니다.
**클린 룸 솔루션:**
- 의사와 의약품 연구자는 클린 룸 내에서 데이터를 공유하여 환자가 치료에 어떻게 반응하는지 알아봅니다.
- 환자 데이터는 제공자 환경 내에 남아 있습니다.
- 연구자는 클린 룸을 통해 승인된 통계 분석을 실행합니다.
- 개인 정보 차이로 인해 재확인되지 않습니다.
**비즈니스 결과:**
- 통계적으로 유효한 대규모 실제 증거
- 익명화된 환자 데이터와 평가 기준을 일치시키고 헬스케어 프라이버시 법률을 위반하지 않고 적격한 후보를 찾는 방식으로 임상 시험을 위한 환자 채용을 간소화
- 제한된 임상 평가 집단에 대한 종속성 감소
**산업 증거:** Datavant와 같은 헬스케어 중심의 청소실은 연구자 및 헬스케어 조직이 임상 시험 및 의약품 개발을 위해 환자 데이터를 안전하게 분석할 수 있는 HIPAA 준수 환경을 제공합니다.
### 산업 간 패턴: 공동 작업 명령
해당 기본 사용 사례 외에도 정리실은 다음을 활성화합니다.
- **공급망 최적화:** 제조업체 및 공급업체는 재고 세부 사항, 생산 일정, 수요 예측을 공유하기 위해 공동 작업을 수행하여 독점 정보를 보호하면서 더 나은 조율을 할 수 있습니다.
- **M&A Due Diligence:** 한 회사가 다른 회사를 인수하면 철저한 주의에 따라 민감한 정보를 직접 공유하지 않고 금융 예상 및 고객 데이터베이스를 검사해야 하며, 정리실은 고객 세그먼트 정렬 및 규정 준수 위험과 같은 인사이트를 드러냅니다.
- **미디어 및 엔터테인먼트:** 게시자가 광고주에게 대상 그룹 가치를 입증하면서 구독자 ID를 보호하여 확률적 타겟팅 대신 신뢰할 수 있는 측정으로 지원되는 프리미엄 CPM을 활성화합니다.
AdTech, 소매, 금융 서비스, 의료 및 미디어에서 Data Clean Rooms는 기본 Trust 인프라스트럭처가 되었습니다. 이전에는 개인정보보호, 규제 또는 경쟁 제약으로 차단된 중요한 공동 작업을 활성화합니다. 깨끗한 공간은 데이터 제어 또는 규정 준수를 포기하지 않고 통찰력과 수익을 확보하는 안전하고 관리되는 공동 작업을 가능하게 하는 **핵심 아키텍처 구성 요소**입니다.
## 데이터 정리 룸: 신뢰할 수 있는 데이터 공동 작업의 기반
데이터 정리 룸은 여러 당사자가 원시 데이터를 노출하거나 교환하지 않고도 공동 인사이트를 생성할 수 있는 안전하고 관리되는 환경입니다. 데이터 집합을 복제하는 대신 승인된 분석, AI, 활성화 워크로드가 실행되고 정책 준수 출력만 반환됩니다. 활성화 시 개별 수준 레코드가 필요한 경우 데이터는 공동 작업 당사자에게 노출되지 않고 의도한 대상으로 바로 전달됩니다.
아키텍처적으로 깔끔한 공간은 데이터 공유에서 제어 계산으로 공동 작업을 전환합니다. 각 참가자는 데이터 보관권을 유지하고 런타임 적용은 쿼리 동작, 출력 제약, 동의, 사용 정책을 관리합니다.
개인 정보 보호 식별자 정렬 메커니즘을 통해 공동 작업이 더욱 활성화되어 있으며, 이 문서의 나중에 자세히 설명된 기능은 기본 식별자를 노출하지 않고 다른 당사자의 데이터 집합을 연관시킬 수 있습니다.
따라서 데이터 정리 룸은 제로 카피, 연합 데이터 전략을 기반으로 운영하는 개인 정보 보호 규제, 멀티 클라우드, AI 중심 엔터프라이즈의 기본 인프라로 작동합니다.
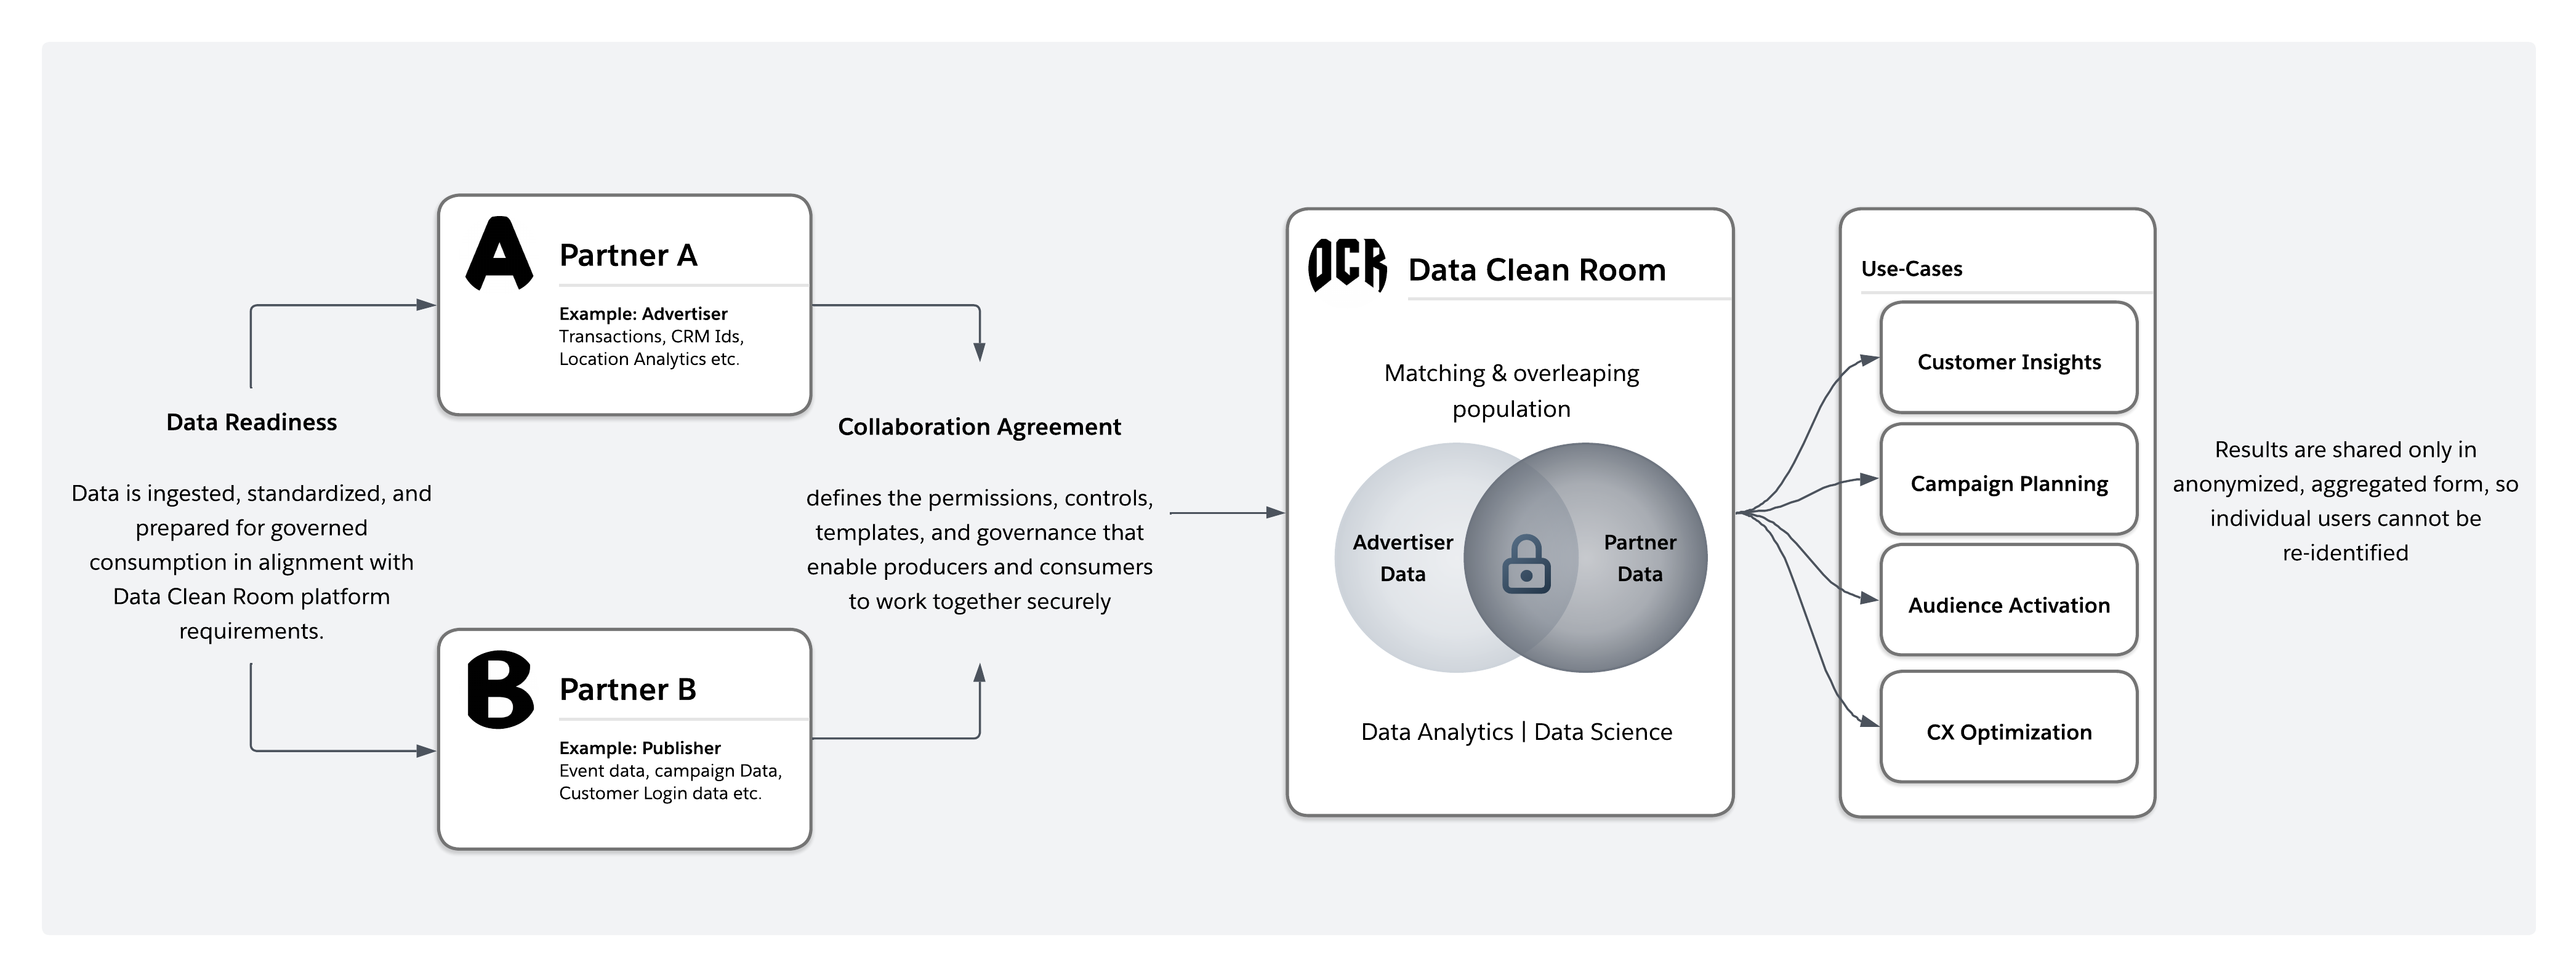 초기 데이터 정리 룸은 중앙 집중식 "번커" 모델을 따랐습니다. 모든 참가자는 분석을 위해 데이터를 중립 타사 환경에 복사해야 했습니다. 이 접근 방식은 개념이 간단하지만 상당한 마찰이 발생했습니다. 데이터 이동으로 인해 대기 시간 및 비용이 증가하고 법적 및 규정 준수 협약이 복잡해지고 조직이 민감한 데이터의 직접적인 제어를 포기하게 되었습니다. 규제화된 산업에서는 이러한 제약으로 인해 공동 작업이 실용적이지 않은 경우가 많습니다.
현대 데이터 정리 룸은 배포된 연합 모델로 발전했습니다. 데이터는 소유자의 환경에 남아 있으며, 통합 쿼리를 통해 분석이 실행됩니다. 클린 룸 자체는 각 쿼리를 가로채고 실행 시 개인 정보 및 정책 제어를 적용하며 승인된 집계된 출력만 반환하는 거버넌스 계층 역할을 합니다.
| 차원 | 일반 클린 룸("번커" 모델) | 현대 클린 룸(배포/연합 모델) |
|---|---|---|
| 데이터 위치 | 데이터가 중앙 집중식 타사 환경에 복사됨 | 소유자의 환경에 데이터 유지 |
| 데이터 이동 | 데이터 집합의 물리적 전송 및 복제 필요 | 원시 데이터 이동 없음, 쿼리가 실행됩니다. |
| 관리 및 보관 | 보관이 부분적으로 타사 플랫폼에 포기됨 | 각 당사자가 보유한 원시 데이터 소유권 및 관리 |
| 아키텍처 모델 | 중앙 집중식 집계 | 배포된 연합 계산 |
| 거버넌스 집행 | 데이터 이동 후 적용되는 정책 | 쿼리 실행 시 적용되는 정책 |
| 개인 정보 보호 모델 | 계약 및 절차 제어에 크게 의존 | 런타임 제어 및 집계 임계값을 통해 기술적으로 적용 |
| 대기 시간 | 수집 및 동기화로 인한 대기 시간 증가 | 대기 시간이 낮아 실시간 연합 쿼리 근처 |
| 비용 구조 | 높은 저장소, 전송, 중복 비용 | 중복 감소, 데이터가 있는 위치에서 계산 발생 |
| 규정 준수 복잡성 | 교차 국경 데이터 이동으로 인한 복잡한 법적 계약 | 데이터가 소스 경계에서 나가지 않으므로 규정 준수 단순화 |
| 확장성 | 확장하려면 추가 저장소 및 데이터 복제가 필요합니다. | 데이터 중복 없이 배포된 계산을 통해 확장 |
| 규제 산업적 적합성 | 보관 및 보존 문제로 인해 비실용적인 경우가 많습니다. | 주체권, 동의, 규제 제약에 더 잘 부합 |
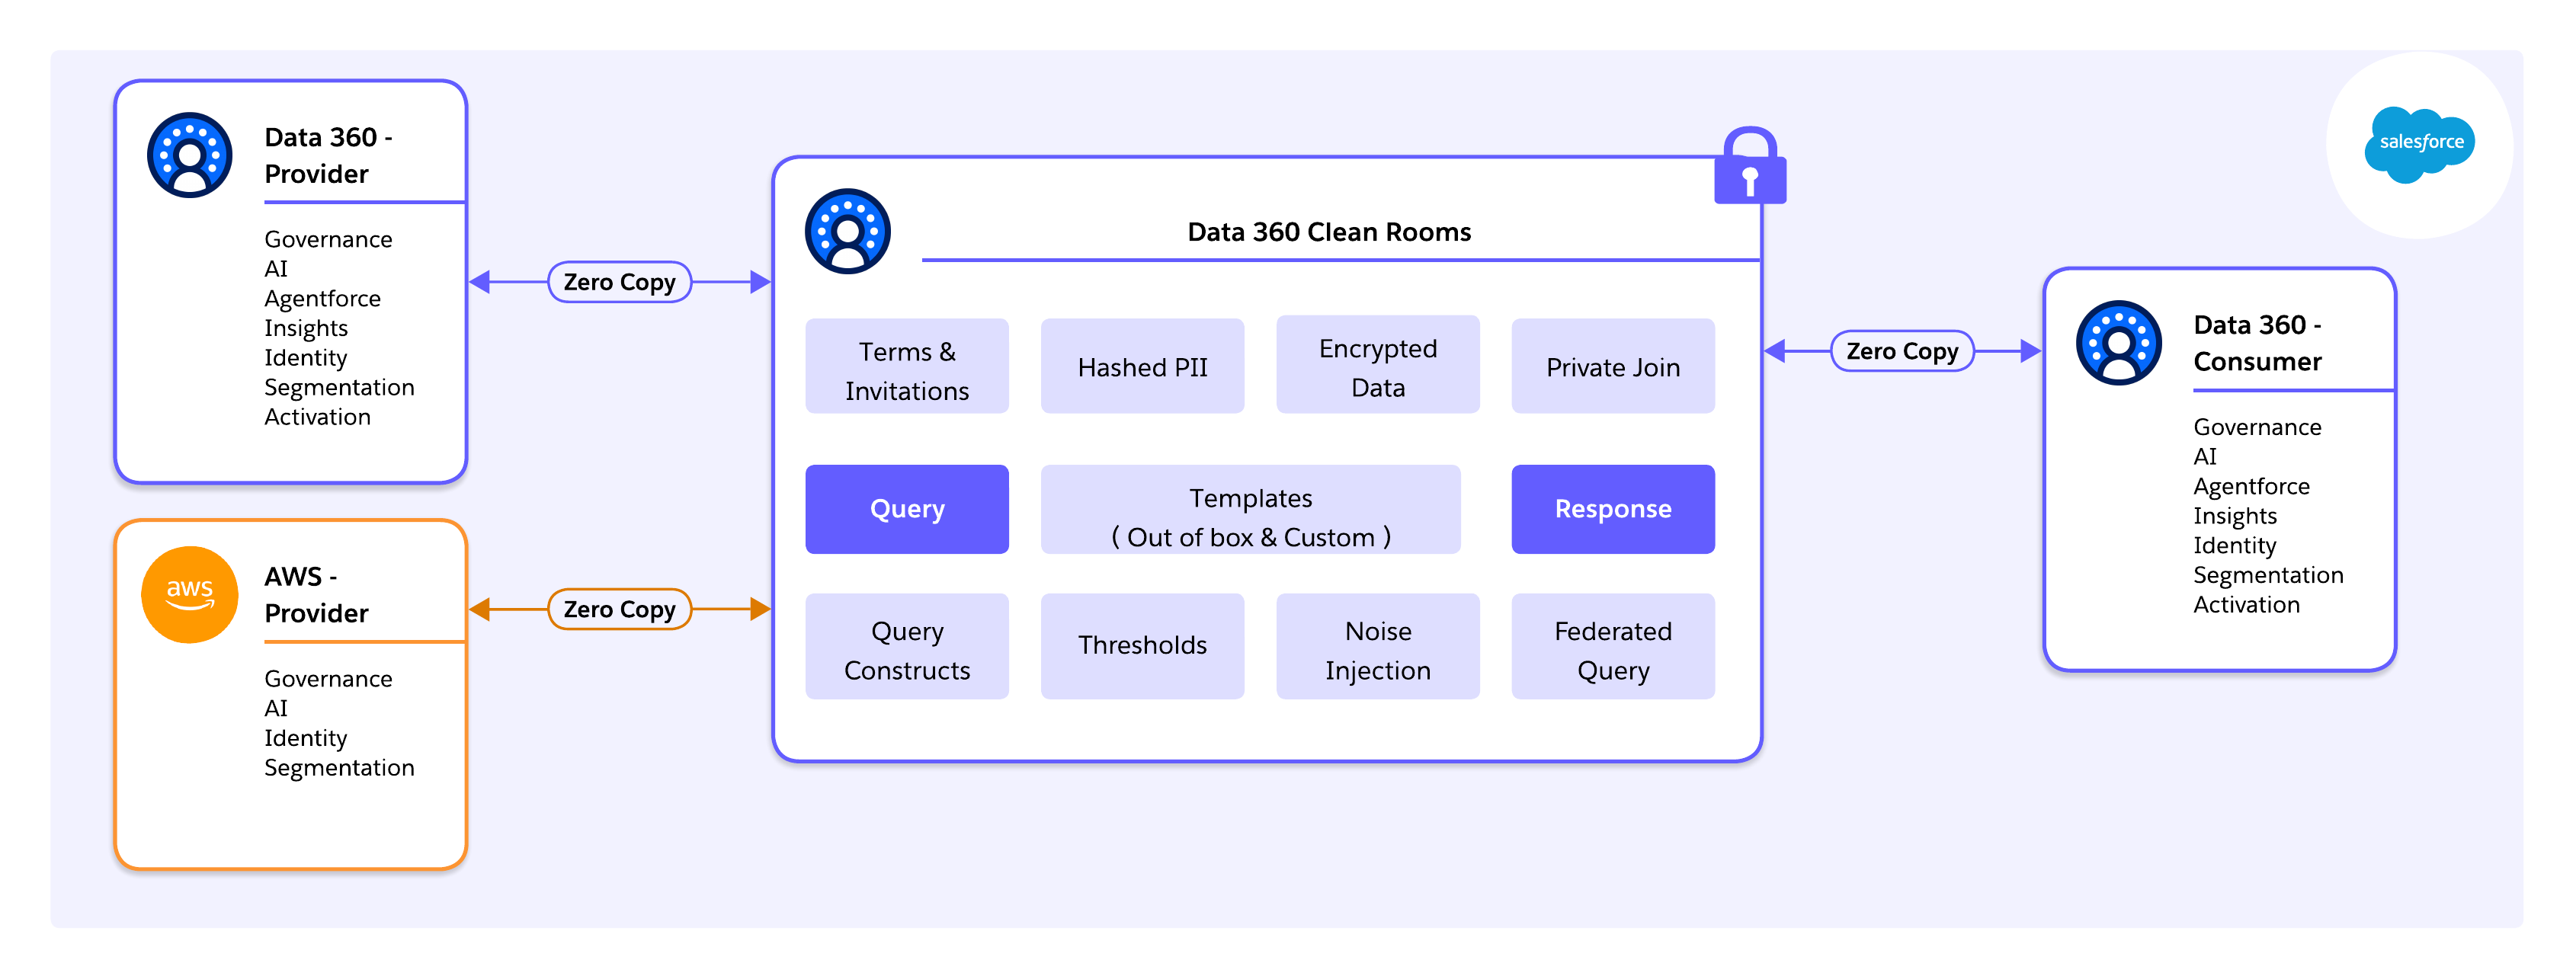 ### 확장 가능한 데이터 정리 룸을 위한 플랫폼 기반
인프라 레이어에서 Salesforce Data 360은 통합 제어 플레인 뒤에 대규모 리소스(AWS, Azure, GCP)를 추상하는 Salesforce의 클라우드 네이티브 런타임인 Hyperforce 실행됩니다. 이 아키텍처를 사용하면 데이터가 지역 내에 유지되어 주체권 및 보존 요구 사항을 충족하는 동시에 전 세계적으로 정리 실 운영을 지원할 수 있습니다.
중요한 점은 이 파운데이션을 통해 AWS Clean Rooms와의 네이티브 상호 운용성을 비롯한 클라우드 간 클린 룸 공동 작업을 수행할 수 있습니다. Data 360을 오케스트레이션 및 거버넌스 계층으로 사용하면 Salesforce에서 관리하는 저장소로 데이터를 강제로 마이그레이션하지 않고 AWS에서 직접 작업하는 파트너와 공동 작업할 수 있습니다. 쿼리가 소스로 푸시되고 개인정보 보호 규칙이 일관되게 적용되며, 규정을 준수하고 집계된 결과만 플랫폼 간에 교환됩니다.
규정 준수 및 Trust 응용 프로그램 계층에서 세분화되지 않고 인프라 및 실행 경계에서 적용되므로 대규모로 멀티 클라우드, 다자간 공동 작업을 위한 견고한 기반을 제공합니다.
### 수집에서 활성화까지의 Data 360 파이프라인
Data 360은 추적 가능한 종단간 데이터 파이프라인을 구현하여 정리실 작업이 원시 추출이 아닌 조화되고 관리되는 ID 인식 데이터를 통해 실행되도록 합니다.
주요 단계는 다음과 같습니다.
- **연결**: 기본 커넥터, API, SDK, MuleSoft 또는 제로 카피 커넥터를 통한 데이터 수집 및 가상화
- **유지**: 원시 데이터를 네이티브 형식으로 저장(Parquet/Iceberg)
- **조화**: 정합성 있는 조인을 위해 정규 데이터 모델 개체(DMO)에 매핑
- **통합**: ID 확인을 통해 골든 레코드 생성
- **인사이트 도출**: 계산된 인사이트는 관리된 경계 내에서 집계된 메트릭을 계산합니다.
- **작업**: Salesforce 조직, 마케팅 플랫폼, 광고 네트워크, 외부 데이터 플랫폼 **또는 기타 클린 룸**에 대한 관리 출력 흐름으로 인사이트-작업 루프를 닫습니다.
이 파이프라인을 통해 깔끔한 룸이 특별 추출이 아닌 엔터프라이즈급 데이터에서 작동합니다.
### 기본 통합 및 "Clicks-Not-Code"
별도의 프로비저닝 및 SQL 개발이 필요한 독립형 데이터 정리 룸 플랫폼과 달리 Salesforce 정리 룸은 Data 360에 기본적으로 포함되어 있습니다. 이를 통해 DMO, ID 규칙, 동의 모델, 거버넌스 정책을 재사용하여 중복 보안 계층을 제거할 수 있습니다.
Salesforce의 템플릿 기반 정리 공간 모델은 다음을 사용하는 핵심 가속 요소입니다.
- 대상 그룹 중복, 압축, 도달, 리프트 측정과 같은 일반적인 공동 작업 패턴을 지원하는 **사용 가능한 템플릿**입니다.
- 설계자 및 고급 사용자가 원시 데이터 또는 정책 복잡성을 노출하지 않고 업계별 또는 파트너별 요구에 맞게 재사용 가능한 분석 논리를 정의할 수 있는 **사용자 지정 템플릿**입니다.
이 접근 방식은 유연성을 유지하면서도 공동 작업을 표준화하여 일회성 분석 프로젝트가 아닌 반복 가능한 엔터프라이즈 기능으로 클린 룸을 확장할 수 있도록 합니다.
### "골든 경로" - 인사이트 작업 루프 마감
Data 360은 일반적인 청정실의 일반적인 실패 모드인 활성화 격차를 해결합니다. Golden Path 프레임워크는 원시 데이터를 내보내지 않고 클린 룸 내에서 생성된 인사이트를 즉시 조치할 수 있도록 합니다.
- **설정 및 검색**: 파트너는 스키마 메타데이터를 공유하고 템플릿을 활용하여 계약이 완료되기 전에 실행 가능성을 평가합니다.
- **분석**: 사전 구축된 사용자 정의 템플릿은 겹침 분석, 일시 보류, 유사 모델링, 리프트 측정을 구동하며, 모두 관리 경계 내에서 실행됩니다.
- **활성화**: 승인된 세그먼트는 Marketing Cloud, 광고 플랫폼 또는 파트너 시스템에 직접 푸시되며, 통합된 규정 준수 결과만 공유됩니다.
템플릿이 의견이 지정된 실행 경로가 되므로 공동 작업이 분석에서 활성화까지 예측 가능한 방식으로 이동됩니다.
## Salesforce Data 360 Clean Rooms용 플레이북
Salesforce Data 360 Clean Room 배포는 단순한 구성 연습이 아니라 데이터 준비, 거버넌스 설계, 보안 연결, 운영 모니터링을 포괄하는 규제화된 아키텍처 워크플로입니다.
### 1단계: 공동 작업 사용 사례 정의(의도로 시작)
데이터 또는 구성을 다루기 전에 설계자가 다음을 명확하게 정의해야 합니다.
- 답변하려는 질문은 무엇입니까?
- 예상되는 결과는 무엇입니까?(예: 겹침 분석, 리프트 측정, 억제, 사기 감지)
- 어떤 수준의 집계가 필요합니까?
- 적용되는 규제 또는 계약상의 제약은 무엇입니까?
- 결과를 사용하는 활성화 경로는 무엇입니까?
공동 작업자의 목표를 이해하면 조인 키, ID 규칙, 거버넌스 임계값, 비용 모델링과 같은 다음과 같은 모든 사항이 결정됩니다. 정리 룸은 용도로 구축된 환경입니다. 일반 데이터 노출이 아닌 정의된 분석 목표를 중심으로 설계해야 합니다.
### 2단계: Clean Room 공동 작업을 위한 데이터 준비
공동 작업을 시작하려면 먼저 엔터프라이즈 데이터를 구조적으로, 의미적으로 준비해야 합니다. 정리 룸은 기본 데이터의 강점과 약점 모두를 증폭합니다. 여기에는 휴지통이 들어오고 휴지통이 나옵니다.
**수입:** Salesforce CRM, Marketing Cloud, AWS S3, Google Cloud Storage와 같은 소스 시스템을 Data 360에 연결합니다. 가능한 경우 데이터를 불필요하게 이동하거나 중복하지 않도록 제로 카피 커넥터(예: Snowflake)를 사용하십시오.
**세맨틱 매핑:** 데이터 스트림을 Customer 360 데이터 모델에 매핑합니다. 전화 번호(E.164 형식), 국가/시/도 코드(ISO 표준), 이메일 주소와 같은 주요 필드를 표준화합니다. 정렬이 잘못되면(예: "CA"를 사용하는 한 당사자와 "캘리포니아"를 사용하는 다른 당사자) 조인이 자동으로 실패하고 일치율이 낮아질 수 있습니다.
**ID 확인:** 결정적(정확히 일치) 및 확률적( 퍼지 일치) 규칙을 구성하여 통합 개인(골든 레코드)을 만듭니다. 이 통합 엔티티는 정리 룸 일치를 위한 표면입니다.
ID 확인의 품질은 공동 작업 가치에 직접적으로 영향을 미칩니다. 일치 정확도가 높으면 겹침률, 분석 신뢰도 향상되고 거짓 음수가 줄어듭니다.
### 3단계: 클린 룸 프로비저닝
데이터가 조화되면 공동 작업 경계를 정의하기 위해 클린 룸 자체를 프로비저닝해야 합니다.
**라이센스 검증:** 모든 참가 조직에 필요한 Data 360 및 정리 공간 권한이 있는지 확인합니다.
**데이터 공간 범위 지정:** 정리 공간 개체는 특정 데이터 공간에 대한 범위를 지정해야 합니다. 해당 데이터 공간에 매핑된 개체만 클린 룸에 표시됩니다. 이를 통해 깔끔한 공간에 대해서만 새 데이터 공간을 만들 필요 없이 논리적으로 공동 작업을 분리할 수 있습니다.
**거버넌스 규칙 정의:** 쿼리를 실행하기 전에 선언적으로 정책을 설정합니다.
- **집계 임계값:** 예를 들어 출력당 최소 100개의 레코드
- **결합 키:** 예를 들어, Email_Hash_SHA256
- **허용되는 작업:** COUNT, SUM, AVG와 같은 집계 함수만
- **명시 제한:** 블록 행 수준 내보내기(선택 \*)
거버넌스 규칙은 실행 시 적용되므로 절차 지침이 아닌 개인 정보 보호 및 규정 준수 시스템 수준 속성을 만듭니다.
### 4단계: 보안 다자간 연결 설정
정리 룸은 조직 및 플랫폼 경계에 걸쳐 있습니다. 연결은 명시적이고 엄격하게 제어되어야 합니다.
**계정 연결:**
- **Salesforce-Salesforce:** Data Cloud One 또는 승인된 교차 조직 공유 메커니즘을 사용합니다.
- **다중 클라우드 시나리오:** 쿼리가 활성화되기 전에 지역 정렬 및 상주를 확인합니다.
**인증 및 인증:** 최소 권한 원칙을 사용하여 전용 통합 사용자에 대한 OAuth 기반 액세스를 구성합니다. 필요한 데이터 공간에 대한 액세스를 엄격하게 제한하고 관리 권한을 피합니다.
보안 실패는 암호화 또는 플랫폼 제어의 약점이 아닌 권한이 지나친 통합 사용자로 인해 발생하는 경우가 많습니다.
### 5단계: 정리실 작업 부하 실행, 모니터링, 제어
활성화되면 운영 감독, 쿼리 품질, 비용 관리에 대한 교대 근무에 초점을 맞춥니다.
**쿼리 실행:** 분석가 또는 워크플로는 계산된 인사이트 또는 승인된 SQL 인터페이스를 통해 겹침 분석 및 집계를 수행합니다. 모든 쿼리에서 집계 임계값 및 개인 정보 보호 제어가 자동으로 적용됩니다.
** 감사 및 추적 가능성 :** Salesforce Data 360 정리 룸은 감사 데이터 모델 개체(DMO) 형태로 감사 내역을 제공합니다. 이렇게 하면 쿼리를 실행한 사람, 실행 시기, 적용된 정책 등 쿼리 활동에 대한 메타데이터가 수집됩니다. 감사 DMO는 규정 준수 보고, 거버넌스 검증, 포렌식 추적 가능성을 활성화하여 공동 작업이 개인 정보 보호 및 검토 가능하도록 합니다.
**소모 모니터링:** Data Cloud는 소비 기반 신용 모델을 사용합니다. 핵심 동인:
- 처리된 행(예: 1M 행 = 기준 신용 단위)
- 쿼리 복잡성
- ID 확인 작업(높은 승수)
- 배치 수집(하위 승수)
**Digital Wallet 및 경고:** Digital Wallet 사용하여 실시간 소비를 추적하고 50%, 75% 및 90% 임계값에서 경고를 구성합니다. 급증과 특정 작업 부하를 연결하여 예기치 않은 비용을 피합니다.
제로 카피는 계산 비용을 절감하지 않습니다. 물리적 중복이 제거되는 동안 소스 시스템에서 실행이 발생합니다. 설계자는 쿼리 패턴, 조인 선택성, 실행 주기를 관리하여 비용 및 성능을 제어해야 합니다.
## 거버넌스, 보안, 규정 준수
### 대규모 Trust 위한 깔끔한 공간 설계
현대 엔터프라이즈에서는 Trust 데이터 정리 공간에 고정되지 않습니다. 이는 아키텍처 결과입니다. Salesforce Data 360은 지속적으로 자동으로 거버넌스, 보안, 규정 준수를 적용하여 정책 중심 환경에서 플랫폼 관리 시스템으로 깔끔한 공간을 전환합니다.
실행 시간 제어(잠긴 ID, 감사 추적, 차이 프라이버시)는 Salesforce 내, 파트너 간 또는 클라우드 간에 공동 작업이 발생하는지 여부와 상관없이 일관되게 적용됩니다.
### Execution-Time Trust 및 거버넌스
아키텍처에게 가장 중요한 변화는 사전에 가정하지 않고 실행 중에 Trust 적용되는 것입니다. Salesforce Data 360은 다음과 같은 여러 핵심 플랫폼 제어를 통해 이를 달성합니다.
- **잠긴 ID:** 파트너 액세스는 확인된 Salesforce 조직 ID와 암호화 방식으로 연결되어 스푸핑 또는 무단 참여를 방지합니다.
- ** 감사 내역:** 모든 쿼리, 조인, 세그먼트 겹침, 활성화가 로그되어 완전한 감사 가능성 및 규정 준수를 위해 기록됩니다.
- **다른 개인 정보 보호:** 행 수준 검사는 구조적으로 불가능합니다. 출력이 집계되고 통계적으로 경계됩니다. 공동작업자는 개인 트랜잭션이나 ID가 아닌 달성률 또는 리프트율과 같은 개인 정보 보호에 안전한 결과만 볼 수 있습니다.
이러한 제어는 계약 Trust 수학적 보증 및 플랫폼 수준 적용으로 대체하여 운영 및 법적 위험을 줄입니다.
### Einstein Trust 계층을 통한 AI 거버넌스
AI 에이전트가 Clean Room 데이터와 점점 더 상호 작용함에 따라 Salesforce는 Einstein Trust 레이어를 도입합니다. 중요한 엔터프라이즈 데이터와 외부 LLM 간의 아키텍처 공급 장치 역할을 합니다. 그러면 깔끔한 공간 인사이트가 기본 데이터를 노출하지 않고 AI 기반 의사 결정을 안전하게 강화할 수 있습니다.
** 핵심 기능:**
- **데이터 보존 제로:** LLM에 전송되는 데이터는 간단합니다. 모델 공급자는 교육을 위해 프롬프트 또는 응답을 저장할 수 없습니다.
- **독성 언어 탐지 및 PII 마스킹:** 입력 및 출력이 자동으로 스캔되고 Data 360에 구성된 데이터 마스킹 정책에 따라 PII가 마스킹됩니다.
### 데이터 공간 및 권한 집합을 통한 논리적 격리
**데이터 공간**은 조직 내에서 논리적으로 격리되며, 다음과 같은 규제, 지리 및 파트너십 경계에 맞춰야 합니다.
- EU 데이터 공간
- 북미 데이터 공간
데이터 공간에 할당된 데이터 집합만 클린 룸 내에 표시되므로 우발적인 교차 경계 노출이 방지됩니다.
권한 집합은 정리된 공간을 만들거나 관리하거나, 쿼리를 실행하거나, 세그먼트를 활성화할 수 있는 사람을 정밀하게 제어합니다. 데이터 인식 권한은 데이터 모델 개체 내에서 필드 수준 제한을 적용합니다. 예를 들어 마케터는 세그먼트 이름과 대상 그룹 크기를 볼 수 있지만 수입 또는 건강 지표는 볼 수 없습니다.
보안은 시맨틱 계층에서 적용되므로 지속적인 IT 감독 없이 비즈니스 사용자에게 안전한 셀프 서비스를 제공할 수 있습니다.
### 설계를 통한 규정 준수 및 동의
동의 신호는 Data 360을 통해 자동으로 정리실 실행으로 전파됩니다. 동의를 취소하는 사용자는 기본적으로 분석 및 활성화에서 제외되므로 규정을 수동으로 적용하지 않고 시스템에서 규정을 준수합니다.
Salesforce Data 360은 관리, 보안, 규정 준수를 옵션 추가 기능이 아닌 최상위 아키텍처 기본값으로 취급합니다. 실행 시간 감사 가능성, 잠긴 ID, 차별화된 개인 정보 보호, 데이터 공간, 동의 인식 ID 확인 및 Einstein Trust 계층을 결합하여 파트너, 멀티 클라우드 시스템, AI 기반 워크로드 간의 클린 룸 공동 작업을 확장할 수 있으며, 이는 Trust, 개인 정보 보호 또는 규정 준수에 영향을 미치지 않고도 가능합니다.
## 결론 및 진행 경로
### 설계자를 위한 실용적인 진행 경로
데이터 정리 룸의 가치를 모두 수집하려면 설계자가 격리된 분석 도구가 아닌 핵심 아키텍처 인프라로 처리해야 합니다. 다음 우선 순위는 실용적이고 확장 가능한 경로를 정의합니다.
**공동 작업을 최상의 건축 문제로 만들기 :** 외부 데이터 공동 작업은 내부 통합과 같은 엄격함으로 설계해야 합니다. 정리 공간은 데이터 플랫폼, 통합 계층 및 AI 시스템과 함께 엔터프라이즈 참조 아키텍처 내에 포함되어야 하며, 특별 확장으로 배포되지 않아야 합니다. 상호 운용성이 확대되면(예: Data 360 클린 룸과 AWS 클린 룸 통합 및 향후 교차 룸 호환성) 설계자는 단일 공급업체가 아닌 다중 플랫폼 생태계를 예상하는 공동 작업 패턴을 설계해야 합니다.
**소스에서 기본적으로 개인정보보호 설계**
데이터 유동성 **설계: **기본값이 큰 ETL과 중앙 복제를 사용하는 대신 아키텍처는 먼저 통합 및 제로 복제 액세스를 고려해야 합니다. 데이터로 계산을 전환하면(해당하는 경우) 불필요한 중복을 줄이고 비용을 절감하며 신뢰할 수 있는 소스 무결성을 유지할 수 있습니다. "연결 및 복사"는 상속된 습관이 아닌 의도한 아키텍처 결정이어야 합니다.
**인사이트-작업 간격 닫기 :** 분석 시 중지하는 정리실은 비즈니스 가치를 제공하지 못합니다. 아키텍처는 활성화 시스템 및 AI 워크플로에 정리 공간 출력을 기본적으로 연결해야 합니다. 사용자 의견 루프, 성능 측정, 다운스트림 실행은 처음부터 설계해야 합니다.
**에이전트 엔터프라이즈 준비 :** AI 에이전트가 점점 더 많은 엔터프라이즈 데이터를 사용하므로 클린 룸은 에이전트가 원시 데이터를 노출하지 않고 작업할 수 있는 제어 실행 환경으로 작동합니다. 클린 룸 전략과 AI 거버넌스 및 Trust 프레임워크를 조율하는 아키텍처는 다음 단계에 가장 적합합니다.
### 결론
현대 데이터 정리 룸은 엔터프라이즈 데이터 아키텍처의 근본적인 변화입니다. 데이터 노출 없이 공동 작업을 활성화하여 데이터 유틸리티와 개인 정보 보호 간의 오래된 긴장을 해결합니다.
Salesforce Data 360과 같은 아키텍처는 이 제약이 "또는" 고려 사항이 아니라는 사실을 보여줍니다. 데이터 저장소를 활성화에서 제로 복사 패턴으로 분리하고 개인 정보 보호 향상 기술을 실행에 직접 포함하여 기업은 데이터 제어를 포기하지 않고도 중요한 분석에 대한 공동 작업을 수행할 수 있습니다. 개인 정보 보호는 계약상 의무에서 아키텍처 보증으로 이동합니다.
무엇보다 클린 룸은 정적이고 사일로된 자산의 데이터를 실천 가능한 관리 자원으로 변환합니다. 활성화 및 AI 레이어에 기본적으로 연결되면 더 이상 대시보드에서 인사이트가 중단되지 않습니다. 이를 통해 결정, 캠페인 및 자율 시스템에 직접 유입되어 데이터, 작업, 결과 간에 엔터프라이즈 규모의 루프를 닫습니다.
## 작성자 정보
**Yugandhar Bora는** Salesforce의 소프트웨어 엔지니어링 아키텍처로, 데이터 및 인텔리전스 애플리케이션 플랫폼 내 데이터 아키텍처를 전문으로 합니다. 그는 데이터 거버넌스 및 통합 데이터 모델에 초점을 맞춘 EARB(Enterprise Architecture Review Board) 이니셔티브를 이끌고 자동화된 플랫폼 프로비저닝 솔루션에 기여합니다.
**Birendra Kumar Singh는** Salesforce의 Data 360 내에서 플랫폼 및 데이터 아키텍처를 전문으로 하는 주요 기술 직원입니다. 활성화 플랫폼의 핵심 구성원이며 Data 360 고객에게 데이터 정리 공간 인프라를 제공하는 데 중점을 둔 청소 공간 이니셔티브를 이끌고 있습니다.
Salesforce의 수석 제품 관리자인 **Priyanka Kshirsagar는** Data 360 Clean Rooms를 선도하며, 엔터프라이즈 고객이 개인 정보를 보호하는 환경에서 자사 데이터에 대해 공동 작업할 수 있도록 처음부터 구축한 기능입니다. 클린 룸에서 유사 모델링 및 ID 보강 등 에이전트 AI 및 ML 기반 사용 사례에 대한 비전을 구동하고 일반 가용성 및 계층 1 Dreamforce 출시를 통해 제품을 도입했습니다.
# Data 360 및 통합 시작하기
이 섹션에서는 데이터 플랫폼을 구성하고 Salesforce를 엔터프라이즈 시스템과 통합하는 방법을 설명합니다. 이러한 기사는 통합 데이터 아키텍처를 구축하고 Salesforce를 광범위한 기술 에코시스템과 연결하기 위한 필수 Knowledge 제공합니다.
## Data 360 아키텍처
[Data 360 아키텍처](/docs/architect/ko-kr/fundamentals/guide/data-360-architecture)는 AI 기반의 미래를 위해 설계된 Salesforce의 차세대 데이터 플랫폼을 소개합니다. 이 포괄적인 가이드는 다음을 다룹니다.
- **현대 데이터 플랫폼 아키텍처**: Data 360은 AI/ML, 분산된 데이터, 클라우드 호수, 비정형 데이터, Knowledge 관리 및 실시간 처리 기능을 통합합니다.
- **설계 원칙**: 개방성, 상호 운용성, 다중 모델 저장소, 메타데이터 중심 설계, 실시간 하이브리드 처리, 지능형 데이터, 거버넌스, 일대다 테넌스
- **핵심 차별화 요소**: Snowflake, Databricks, BigQuery, Redshift와 연합하여 기존 투자 중복 없이 Customer 360 확장합니다.
- **사용 사례 및 기능**: 실시간 인사이트, 자율적인 의사 결정, 구조화된 데이터 및 비정형 데이터에 대한 통합 액세스를 지원합니다.
이 문서는 엔터프라이즈 설계자 및 CTO가 에이전트 엔터프라이즈 시대의 데이터 전략을 계획하는 데 필수적이며, 전략 지침과 Data 360 아키텍처에 대한 기술적 심층 분석을 모두 제공합니다.
## 통합 패턴
[통합 패턴](/docs/architect/ko-kr/fundamentals/guide/integration-patterns)은 Salesforce Platform을 기업의 다른 애플리케이션과 통합하는 방법을 포괄적으로 설명합니다. 이 문서에서는 다음을 제공합니다.
- **패턴 기반 접근법**: 성공적인 Salesforce 구현에서 파생된 일반적인 시나리오의 통합 패턴입니다.
- **모형 선택 가이드**: 특정 통합 시나리오에 적합한 패턴을 선택하는 매트릭스입니다.
- **통합 모범 사례**: 안정적이고 확장 가능하며 유지 관리 가능한 통합을 빠르게 구축하는 팁
- **전체적인 적용 범위**: 실시간 동기화, 배치 처리, 데이터 마이그레이션, 이벤트 중심 아키텍처에 대한 패턴입니다.
이 문서는 Salesforce와 다른 엔터프라이즈 응용 프로그램을 통합해야 하는 아키텍처 및 개발자를 위해 고안되었습니다. Salesforce의 자체 컨설팅 아키텍처는 이러한 패턴을 아키텍처 검토 시 참조 지점으로 사용하므로 이 가이드는 통합 아키텍처에 대한 권위 있는 가이드입니다.
---
다음 두 기사는 함께 작동하여 Data 360을 사용하여 최신 데이터 플랫폼을 구성하는 방법과 Salesforce를 기존 엔터프라이즈 시스템과 효과적으로 통합하는 방법을 모두 이해할 수 있습니다. Data 360 아키텍처부터 데이터 플랫폼 기능을 이해한 다음 통합 패턴을 살펴보고 더 광범위한 기술 에코시스템과 Salesforce를 연결하는 방법을 알아봅니다.
## 개요
Salesforce Data 360은 기업이 고객 데이터를 대규모로 연결, 조화, 활성화하는 방법을 전환합니다. 그러나 데이터가 수명 주기 전반에 걸쳐 얼마나 안전하게 관리되는지에 대한 강점이 있습니다. 이 보안 참조 아키텍처는 Data 360 환경을 보호하기 위한 실용적인 종단간 청사진을 제공합니다. 최소 권한, 제로 Trust 설계, 기본 거버넌스의 핵심 원칙을 통해 이를 달성합니다.
Data 360의 보안은 기본적으로 공유 책임 모델입니다. Salesforce는 ISO 27001, SOC 2, GDPR(일반 데이터 보호 규정)와 같은 글로벌 표준을 사용하여 인프라, 네트워크, 암호화 서비스, 플랫폼, 규정 준수 및 응용 프로그램 자체를 보호합니다. Salesforce 관리자는 액세스를 정의하고 개인정보보호를 적용하고 통합을 관리하여 플랫폼 내에서 조직의 데이터를 보호합니다. 이 작업에는 필요한 액세스 권한만 부여하는 강력한 ID 및 액세스 관리(IAM) 구현, 2단계 인증(2FA) 적용, 최소 권한 및 엔터프라이즈 및 규제 요구 사항 준수 원칙이 포함됩니다.
Data 360 거버넌스는 이러한 책임 계층을 연결하여 보안 및 규정 준수 수준을 유지합니다. 역할, 정책, 권한 및 데이터 처리 규칙이 수집에서 활성화에 이르기까지 전체 프로세스에서 정의되고 지속적으로 적용되도록 합니다. 데이터 계보, 메타데이터 분류, 동의 인식은 모든 개체 및 프로세스에 내장되어 있습니다. 이렇게 하면 관리가 수동 감독 기능에서 운영 제어 플레인으로 전환됩니다.
Salesforce는 기업이 데이터 조치, 개인 정보 보호 설정, 통합 경계에 대한 완전한 권한을 유지하는 탄력적이고 규정을 준수하는 기반을 제공합니다. 함께 모든 데이터 집합, 정책 및 사용자 작업이 추적 가능하고 일관되며 Trust 기반하는 보안 및 거버넌스 패브릭을 만듭니다.
Data 360의 보안은 정적 제어 이상으로 확장됩니다. 데이터 수명 주기의 모든 단계에 포함되어 있습니다. 데이터가 수집되는 순간부터 암호화, 확인, 엔터프라이즈 정책에 따라 분류됩니다. 통합되고 보강되므로 메타데이터 계보와 동의 특성이 유지되어 책임을 보장합니다. 비즈니스 또는 AI 사용을 위해 인사이트가 활성화되면 암호화된 채널, 강력한 인증 및 권한 부여, 정책 인식 거버넌스, 동의 적용을 통해 아웃바운드 플로가 보호되므로 데이터가 수집에서 활성화까지 신뢰할 수 있고 규정을 준수하며 안전하게 유지됩니다.
## Data 360의 보안 기반
### Hyperforce 구축됨
Salesforce Data 360은 전적으로 Salesforce의 Hyperforce 아키텍처를 기반으로 구축된 클라우드 네이티브 데이터 플랫폼으로 글로벌 운영을 위한 안전하고 규정 준수 가능하고 확장 가능한 기반을 제공합니다.
### Secure-by-Design 기반
- Hyperforce 추가 기능이 아닌 내장형 기능으로 보안 및 규정 준수를 제공합니다. Salesforce의 플랫폼 및 응용 프로그램 전체에 깊이 통합된 공통의 기본 제어 집합을 제공하여 인프라에서 앱 환경에 이르기까지 모든 계층이 보안, 개인 정보 보호, 규정 준수에 중점을 두고 설계되도록 합니다.
- Data 360은 Hyperforce 기본 제어에서 직접 강력한 액세스 제어, 암호화, 규제 준수 프레임워크를 상속합니다.
- 이 security-by-default 모델은 취약성을 최소화하고 신뢰할 수 있는 규정 준수 데이터 서비스를 간소화합니다.
### 클라우드 네이티브 아키텍처
- Data 360은 격리, 성능 및 다중 테넌트 보안을 보장하는 통합 클라우드 플랫폼인 Hyperforce 상단에 호스팅되는 전용 기능 도메인 내에서 실행됩니다.
- Data 360은 마이크로서비스 아키텍처를 사용하며, 모든 서비스가 Kubernetes를 통해 컨테이너화되고 오케스트레이션됩니다.
- 제로 Trust 원칙을 적용하는 Istio 서비스 메쉬는 안전한 서비스 간 커뮤니케이션을 관리하고 트래픽 관리, 관찰 가능성, 정책 집행을 제공합니다.
### 확장 가능한 모듈식 배포
- Data 360 서비스는 Salesforce 관리 가상 사설 클라우드(VPC)로 프로비저닝되고 운영되므로 분리, 효율적인 제어, 최적화된 내부 네트워킹이 가능합니다.
- 아키텍처는 가로 확장성을 지원하므로 Data 360은 페타바이트 규모의 데이터 처리 워크로드를 처리할 수 있습니다.
### 통합 및 확장성
- Data 360은 Salesforce CRM 응용 프로그램 및 기타 데이터 소스와 통합하기 위해 잘 정의된 API를 노출합니다.
- 첫 번째 당사자(1P) 및 Hyperforce 기반 Salesforce CRM 조직을 모두 지원하므로 다양한 환경 간의 호환성을 보장합니다.
- Data Cloud One을 사용하면 고객이 여러 Salesforce CRM 조직을 단일 Data 360 인스턴스에 연결할 수 있습니다.
### 공유 책임 모델
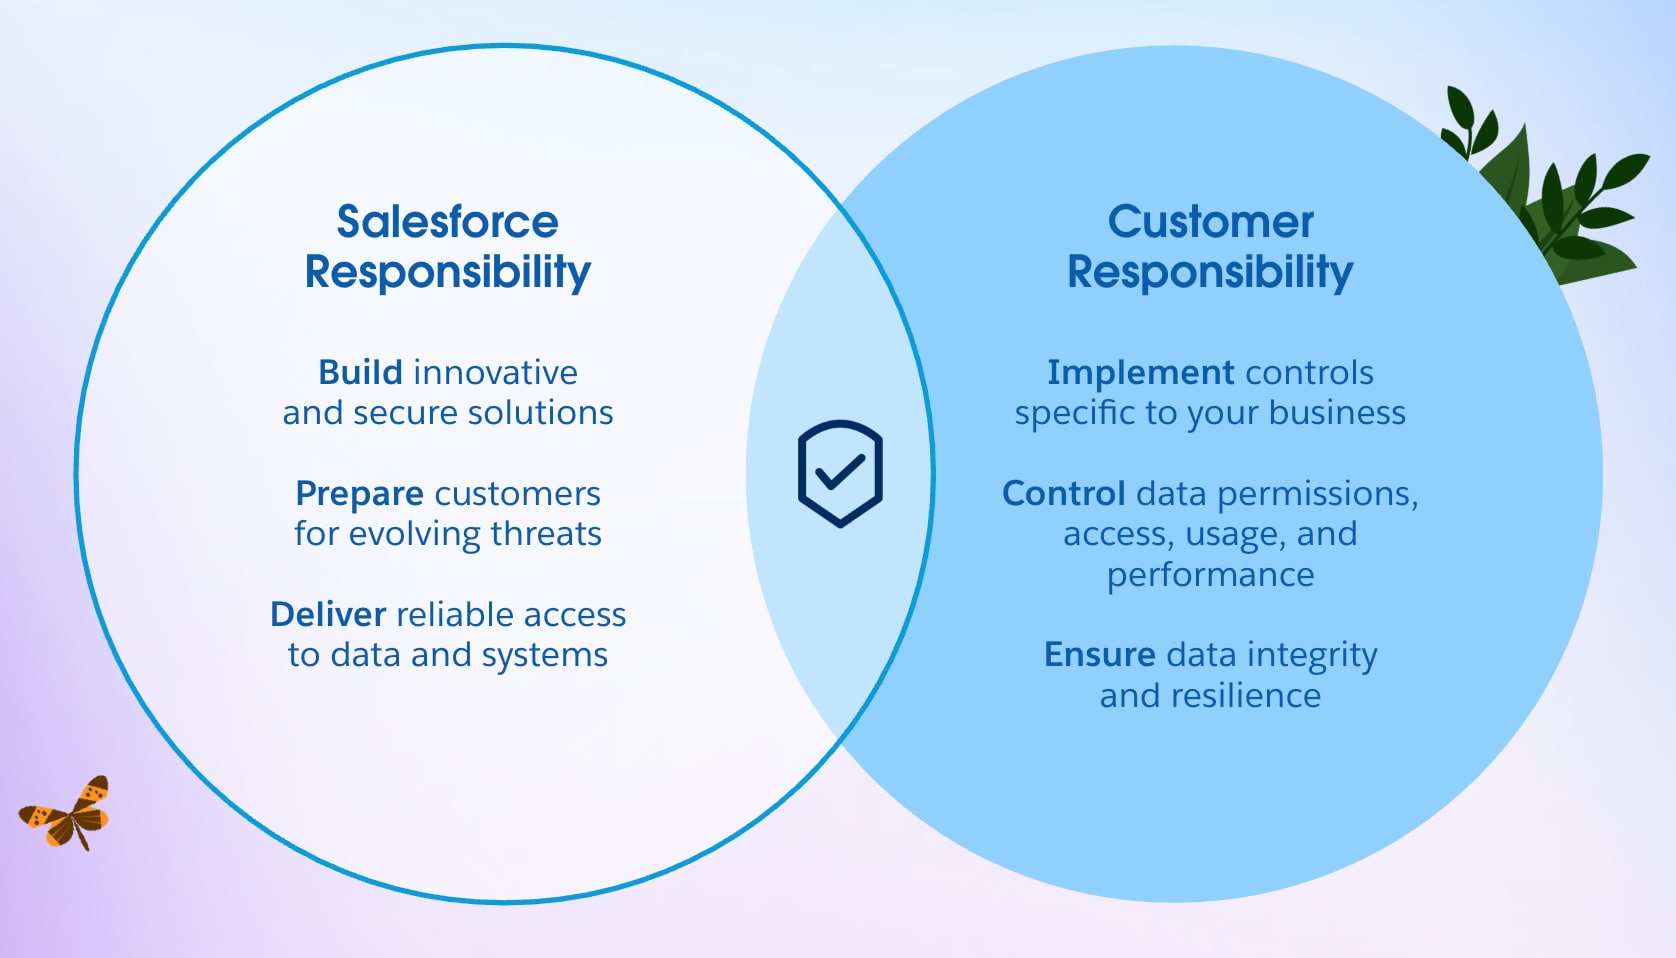
Salesforce Data 360의 보안은 Amazon Web Services(AWS), Microsoft Azure 및 Google Cloud와 같은 선도적인 클라우드 공급업체에서도 사용되는 프레임워크인 [공유 책임 모델](https://compliance.salesforce.com/en/documents/a006e000010nW2FAAU)에 따라 작동합니다.
이 모델은 명확한 경계를 정의합니다. Salesforce는 클라우드 보안을 담당하며 고객은 클라우드의 보안을 담당합니다.******** 이 구분을 이해하고 운영하려면 복원 가능하고 규정을 준수하며 안전한 데이터 에코시스템을 유지하는 것이 중요합니다.
 #### Salesforce: 클라우드 보안
Salesforce는 Data 360 플랫폼 및 해당 글로벌 인프라의 무결성을 보호하고 유지할 책임이 있습니다. 여기에는 다음이 포함됩니다.
- **물리적 및 환경 보안:** Hyperforce AWS 인프라에서 호스팅되며 Amazon은 액세스 제어, 감시, 환경 보안을 통해 글로벌 데이터 센터를 보호할 책임을 위임받습니다.
- **네트워크 및 경계 방어:** 운송 중(TLS 1.2 이상) 및 유휴 중(AES-256)의 모든 트래픽에 대한 DDoS(Distributed Denial of Service) 완화, 침입 감지, 암호화
- **플랫폼 경화 및 패치 관리:** 지속적인 취약성 관리, 패치 배포, OS 수준 보안 기준
- **규격 준수 및 인증:** SOC 1/2/3, ISO 27001, ISO 27017, ISO 27018, GDPR 등 프레임워크에 대한 준비도와 같은 표준에 대한 지속적인 감사
이러한 제어를 통해 Data 360 플랫폼이 안전하고 신뢰할 수 있으며 규정을 준수할 수 있으므로 고객은 인프라 보호 대신 비즈니스 논리 및 데이터 관리에 집중할 수 있습니다.
#### 고객: 클라우드의 보안
고객은 Salesforce Data 360 조직 내에서 데이터, 구성, 운영 프로세스를 안전하게 보호할 책임이 있습니다. 주요 책임 영역은 다음과 같습니다.
- **ID 및 액세스 관리(IAM):** 역할을 정의하고 다단계 인증(MFA) 및 싱글사인온(SSO)을 적용하거나 최소 권한 원칙을 적용합니다.
- **데이터 거버넌스:** 중요한 데이터를 분류하고 필요한 경우 마스킹을 적용하거나 개체, 필드, 레코드 수준 액세스 제어를 적용합니다.
- **통합 보안:** 명명된 자격 증명 및 외부 자격 증명을 사용하여 OAuth 2.0, JSON 웹 토큰 JWT, 기타 인증 표준을 통해 API 액세스를 관리합니다.
- **모니터링 및 대응:** 이벤트 모니터링 및 감사 추적을 사용하고 고급 위협 감지를 위해 보안 정보 및 이벤트 관리(SIEM) 시스템에 로그를 전달합니다.
Salesforce는 보안 기반을 제공하지만 고객은 구성을 통해 실제 보안 조치를 결정합니다.
#### 사람 중심의 책임
보안은 단순히 기술 구조가 아니라 조직 분야입니다. Salesforce Data 360의 데이터 보호는 아키텍처, 운영, 거버넌스 팀 간의 공동 작업을 통해 달성됩니다.
**기업은 다음을 수행해야 합니다.**
- 사용되지 않거나 과도한 권한이 있는 계정을 지속적으로 검토하고 사용 중지합니다.
- 정책을 코드 및 CI/CD 파이프라인으로 사용하여 적용을 자동화합니다.
- 무단 데이터 활성화 또는 필터링과 같은 사고를 시뮬레이션하여 대응 준비를 강화합니다.
Data 360의 효율성은 기능만으로 확장되는 것이 아니라 고객이 운영하는 방식에 따라 확장됩니다.
#### Secure-by-Default: 사전 예방적 보안 조치
Salesforce Data 360은 반응형 제어에서 예방적 설계로 전환하는 기본값별 보안 철학을 채택합니다. 모든 새로운 Data 360 조직은 나중에 개방하고 강화하는 대신 이제 "모두 거부" 상태로 시작하여 첫 배포부터 Zero Trust 원칙을 적용합니다.
#### 반응형 제어에서 예방 설계로 이동
이전 환경에서는 고객이 더 빠른 온보딩을 위해 허용 "모두 허용" 모델을 상속했습니다. 편리하지만, 실수로 초과 노출 및 잘못된 구성으로 인해 발생할 위험이 있습니다.
새 security-by-default 아키텍처는 다음 접근 방식을 반대로 합니다.
- 사용자 또는 시스템에 암시적 액세스 권한이 없습니다.
- 모든 권한은 명시적으로 부여되어야 합니다.
- 데이터 액세스, 통합, 거버넌스 제어는 0일부터 적용됩니다.
이렇게 하면 설계에 따라 최소 권한이 적용되어 실수로 노출되거나 권한 에스컬레이션될 위험이 크게 줄어듭니다.
#### 운영 및 거버넌스 영향
이 모델은 기술 및 행동에 모두 영향을 미칩니다.
- 팀은 권한을 규정 준수 및 비즈니스 경계에 맞춰 액세스 모델을 의도적으로 계획해야 합니다.
- 거버넌스는 사후 고려 사항이 아닌 기본 설계 요구 사항이 됩니다.
- 데이터의 소유권 및 책임은 처음부터 정의됩니다.
"모두 허용" 아래에서 계속 작동하는 레거시 Data 360 조직의 경우 관리자가 구성을 수동으로 조율하여 보안 현대화 또는 Data 360 성숙도 프로그램의 중요한 단계인 새로운 기준에 부합해야 합니다.
#### 설계를 통한 Trust
Salesforce Data 360은 기본적으로 0 액세스 권한을 지정하고 명시적인 정책 정의를 요구함으로써 엔터프라이즈 데이터 보안의 기본적인 발전인 Trust by Design을 구축합니다.
이 접근 방식은 다음을 보장합니다.
- 무단 액세스 및 데이터 누출 위험이 최소화됩니다.
- 거버넌스 프레임워크는 선택적으로 적용되지 않고 구조적으로 적용됩니다.
- 엔터프라이즈는 더욱 예측 가능하고 감사 가능하며 복원성이 뛰어난 환경 보안 조치를 취합니다.
기본적으로 보안은 더 이상 추가하는 기능이 아닙니다. 시작하는 기초입니다.
## ID 및 액세스 관리: 데이터에 대한 게이트웨이
**Salesforce Data 360**의 IAM(ID 및 액세스 관리)은 가장 중요한 방어 계층입니다. 플랫폼에 액세스할 수 있는 사람과 내부에서 수행할 수 있는 작업을 **누가** 수행할 수 있는지 규제합니다**.** 잘 구현된 IAM 프레임워크는 고객 데이터를 보호하고 운영 무결성을 보장하기 위해 엔터프라이즈에서 보유하고 있는 가장 강력한 단일 제어입니다.
### 인증: "당사자" 확인
인증은 Salesforce Data 360에 액세스하는 모든 사용자, 서비스 또는 외부 시스템이 합법적임을 확인하는 **디지털 Trust를** 설정합니다.
### 연합 ID 관리
Data 360은 [**Microsoft Entra ID(Azure AD)**](https://learn.microsoft.com/en-us/entra/identity/saas-apps/salesforce-tutorial), [**Okta**](https://help.okta.com/en-us/content/topics/provisioning/salesforce/sfdc-provision.htm) 또는 [**Ping Identity를**](https://docs.pingidentity.com/configuration_guides/salesforce/config_saml_salesforce_pf.html) 사용하는 [**SAML 2.0**](https://help.salesforce.com/s/articleView?id=xcloud.sso_saml.htm&type=5), OpenID Connect([**OIDC**](https://help.salesforce.com/s/articleView?id=xcloud.sso_provider_openid_connect.htm&type=5)) 또는 교차 도메인 ID 관리([**SCIM**](https://help.salesforce.com/s/articleView?id=xcloud.identity_scim_overview.htm&type=5)) 시스템과 같은 엔터프라이즈급 ID 공급자(IdP)와 함께 **연합 인증**을 지원합니다.
이 연합은 회사 ID 수명 주기를 Salesforce로 직접 확장합니다. 직원이 회사에 가입, 이사 또는 탈퇴하면 액세스가 자동으로 조정되어 고아 계정을 줄이고 규정 준수 준비도를 향상합니다.
### 싱글사인온(SSO)
[**SSO(Single Sign-On)**](https://help.salesforce.com/s/articleView?id=xcloud.sso_about.htm&type=5)를 사용하면 사용자가 회사 자격 증명을 사용하여 한 번만 인증하고 별도의 암호 없이 Salesforce 애플리케이션에 안전하게 액세스할 수 있습니다. 이렇게 하면 자격 증명 피로가 줄어들고 암호 재사용 또는 피싱으로 인한 위험이 최소화됩니다.
### 적응형 및 조건부 액세스
ID 공급자(IdP)는 인증 결정을 내릴 수 있는 단일 기관이 되어 다단계 인증(MFA), 조건부 액세스, 위험 기반 제어를 적용합니다. 인증은 단일 이벤트에서 사용자 동작 및 컨텍스트에 맞춰 지속적인 Trust 평가로 발전합니다.
연합 인증은 다음을 제공합니다.
- **중앙 집중식 정책 집행:** 인증 표준은 모든 Salesforce 환경 전반에서 한 곳에서 관리됩니다.
- **단계별 추적 가능:** 통합 감사 내역은 모든 작업을 다시 확인된 ID에 연결합니다.
- **인간 중심 경험:** 마찰 없이 안전한 로그인 프로세스를 통해 팀이 자격 증명이 아닌 인사이트에 집중할 수 있습니다.
### 인증: "할 수 있는 사항" 정의
사용자가 확인되면 권한 부여가 사용자가 액세스, 보기 또는 수정할 수 있는 항목을 정의합니다. 중요한 데이터를 보호하고 최소 권한을 적용하는 운영 경계를 설정합니다.
**최소 권한 원칙(PoLP):** 모든 사용자와 시스템에게는 업무에 필요한 권한만 부여되며 그 외에는 부여되지 않습니다. 이 원칙은 자격 증명 저하 또는 잘못된 구성으로 인한 잠재적인 손상을 대폭 제한합니다.
**역할 기반 액세스 제어(RBAC):** Salesforce Data 360은 권한 집합 및 권한 집합 그룹을 사용하여 비즈니스 역할에 맞춰 세분화된 기능을 할당합니다. 예:
- 데이터 엔지니어는 Data 360 아키텍처 권한 집합을 사용하여 수집 파이프라인 및 변환을 관리할 수 있습니다.
- 마케팅 분석가는 조화된 데이터를 쿼리할 수 있지만 Data 360 활성화 관리자 권한 집합을 통해 모델을 변경할 수 없습니다.
- 활성화 관리자는 아웃바운드 캠페인을 실행할 수 있지만 Data 360 활성화 관리자 권한 집합의 도움을 받아 소스 데이터에 액세스할 수 없습니다.
액세스는 중앙에서 관리하고 감사할 수 있으므로 데이터 수명 주기 전반에 걸쳐 책임을 보장할 수 있습니다. Entra ID, Okta 또는 Ping Identity와 같은 IdP와 통합된 경우 액세스 정책은 SCIM 프로비저닝 및 SAML/SSO 연합을 통해 엔터프라이즈 전체에서 원활하게 확장됩니다.
### Data 360의 표준 역할 및 권한 이해
Salesforce는 업무 분리 및 ISO 27001과 같은 업계 표준 준수에 대한 모범 사례를 캡슐화하는 사전 정의된 권한 집합을 제공합니다.
| 역할 | 기본 책임 | 액세스 설계 원칙 |
|---|---|---|
| 시스템 관리자 | 환경 설정, 프로비저닝, 구성 | 기본 데이터 집합에 대한 액세스 권한 없음 - 시스템 및 데이터 제어 간 분리 보장 |
| Data 360 아키텍트 | 데이터 수집, 변환, ID 확인, 모델링 | 데이터 노출 경계를 유지하기 위해 데이터 활성화를 수행할 수 없음 |
| Data 360 활성화 관리자 | 세그먼트 만들기, 채널 관리, 활성화 | 데이터 모델에 대한 보기 전용 액세스, 수정 권한 없음 |
| Data 360 사용자 | 분석 및 인사이트 사용 | 읽기 전용, 수정 권한 없음 |
| Data 360 One User | 동료 조직을 통한 Cross-org 액세스 | 공유 공간 권한 및 범위 지정 액세스 정책에 따라 관리 |
 ### 제어 플레인으로 거버넌스
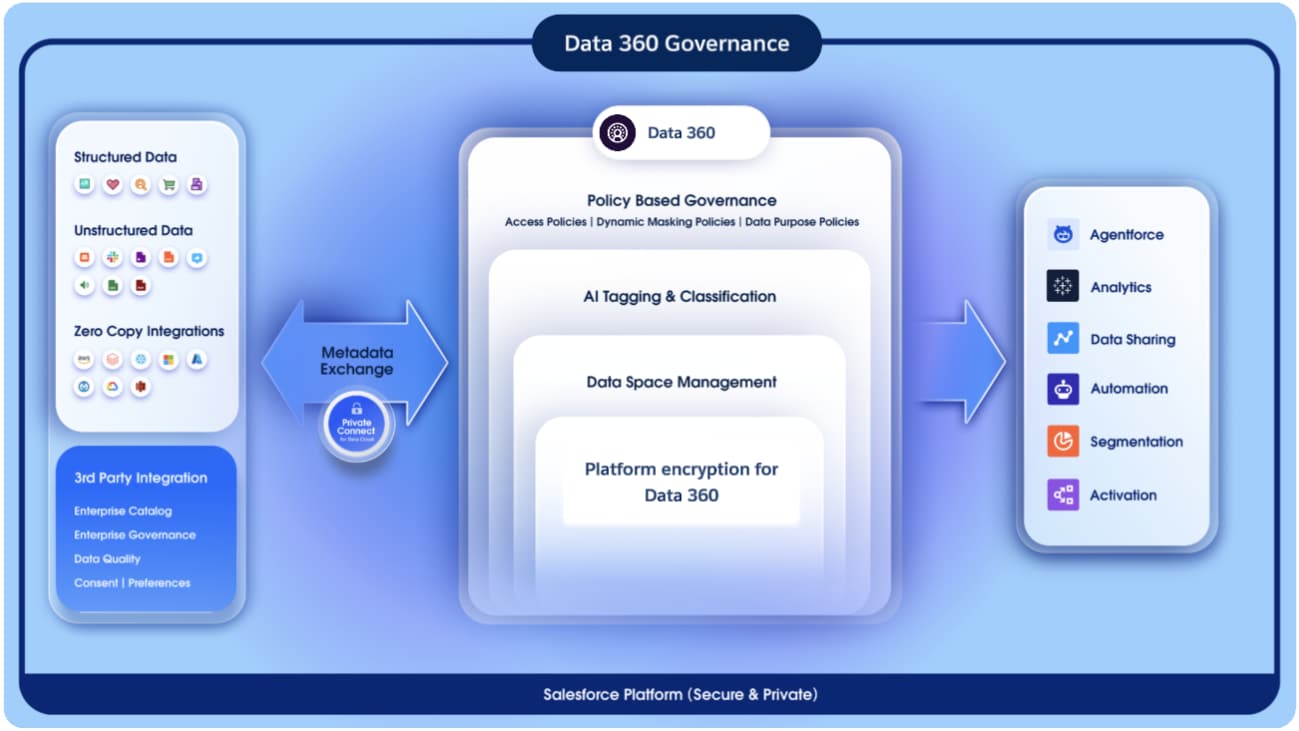
Data 360은 거버넌스 우선 모델을 기반으로 설계되어 데이터 수집에서 인사이트 활성화에 이르기까지 모든 데이터 상호 작용이 정책 인식, 감사 가능, 규정을 준수하도록 합니다. 거버넌스는 수명 주기 전반에 걸쳐 데이터가 검색, 분류, 보호되는 방식을 관리하는 중앙 제어 플레인 역할을 합니다.
이 통합 제어 플레인은 다음을 보장합니다.
- **데이터 액세스는 컨텍스트에 따라 허가됩니다**. 올바른 사용자만 올바른 정책에 따라 올바른 데이터에 대해 조치를 취할 수 있습니다.
- **거버넌스가 시맨틱 및 운영 계층에 모두 포함되어 있어** 데이터가 모델링되는 방식과 데이터가 보호되는 방식 간 일관성을 보장합니다.
- **Zero Trust 및 Least Privilege** 원칙이 적용됩니다. 여기서 액세스 권한을 부여하기 전에 ID, 컨텍스트 및 정책이 실시간으로 평가됩니다.
이 아키텍처를 통해 Salesforce Data 360은 정적 권한 관리에서 동적 정책 중심 오케스트레이션 계층으로 관리를 전환합니다. 컨텍스트에 지속적으로 적응하고 설계하여 규정 준수를 적용하며 엔터프라이즈 규모에서 Trust 유지합니다.
### 데이터 공간을 사용한 논리적 데이터 분리
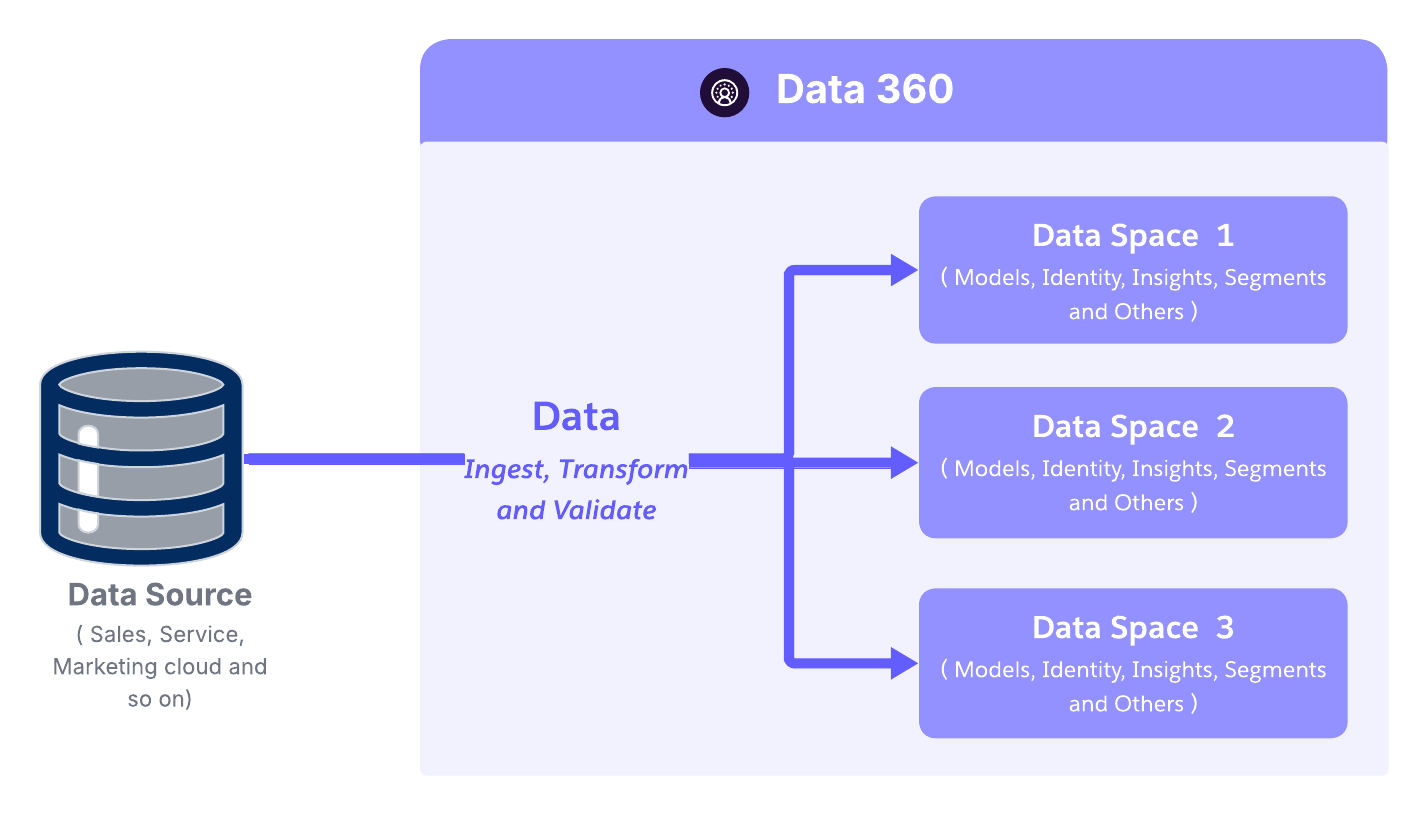
매크로 수준에서 데이터 공간은 엔터프라이즈 데이터 도메인의 논리적 분리 및 격리를 제공하므로 다중 브랜드, 다중 지역 또는 다중 테넌트 운영 모델을 사용하는 조직이 단일 통합 플랫폼 내에서 데이터를 관리할 수 있습니다. 데이터 공간은 비즈니스 도메인(예: 세일즈, 마케팅 또는 고객 성공) 또는 규제 및 지리적 경계(예: EU, AMER 또는 APAC)에 맞출 수 있으므로 관리 및 액세스 제어가 기본 데이터 플랫폼을 조각화하지 않고 조직의 운영 및 규정 준수 구조를 반영할 수 있습니다.
- 각 데이터 공간은 가상 경계 역할을 하며, 사용자 또는 팀에서 볼 수 있거나 상호 작용할 수 있는 데이터 컬렉션을 정의합니다.
- 데이터 공간 내에서 명시적으로 액세스 권한이 부여되어 암시적 권한 또는 데이터 가시성의 교차 오염이 발생하지 않습니다.
- 이렇게 하면 연합 소유권이 활성화됩니다. 각 사업부는 중앙 집중식 감독 및 규정 준수를 유지하면서 도메인을 독립적으로 관리할 수 있습니다.
설계를 통해 데이터 공간은 첫 번째 계층의 거버넌스를 제공하므로 엔터프라이즈 데이터 집합 전반에 걸쳐 명확성과 책임성을 구축할 수 있습니다.
 ### RBAC에서 ABAC로: 컨텍스트 인가로 이동
Salesforce Data 360에서 RBAC 및 ABAC는 고유하지만 보완적인 목적으로 사용되며 플랫폼의 여러 계층에 적용됩니다.
RBAC는 주로 플랫폼 및 기능 액세스에 사용됩니다. 데이터 공간, 프로세스 만들기, 관리 기능, 툴링 액세스와 같은 Data 360 구조 및 기능에 액세스할 수 있는 사용자를 관리합니다. RBAC는 권한 및 권한 집합을 통해 구현됩니다(예: 특정 기능이 활성화된 데이터 공간에 대한 사용자 액세스 권한 할당).
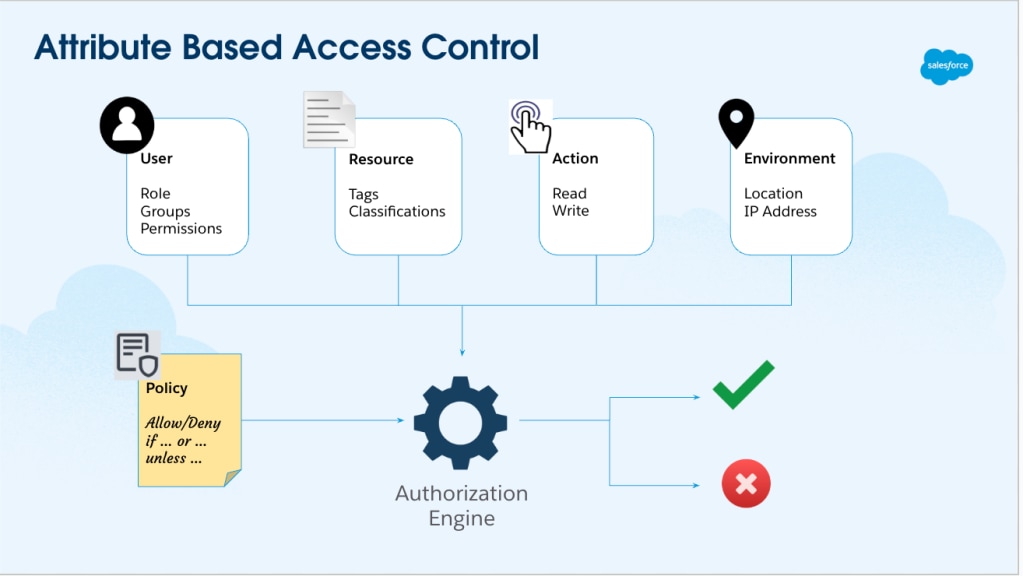
ABAC는 데이터 액세스 적용에 사용됩니다. ABAC 정책은 개체 수준 보안(OLS), 필드 수준 액세스, 행 수준 제약을 비롯한 데이터 개체 및 특성에 액세스할 수 있는 사람을 결정할 책임이 있습니다. 이러한 결정은 런타임 시 작업, 사용자 특성, 자원 특성을 평가하여 동적으로 이루어집니다.
ABAC에서는 권한이 모델의 일부로 유지되지만 정책 자체가 역할만이 아닌 액세스를 결정합니다. 정책은 사업부, 지역, 데이터 민감도, 사용 목적 또는 규제 제약과 같은 컨텍스트를 평가하여 액세스를 허용하거나 거부합니다.
예:
- RBAC를 사용하면 사용자가 Data 360 데이터 공간 및 분석 기능에 액세스할 수 있습니다.
- ABAC는 동일한 사용자가 특정 고객 데이터 집합을 읽을 수 있는지 여부, 볼 수 있는 행, 마스킹되거나 제한되는 특성을 결정합니다.
이 명확한 구분을 통해 Data 360은 안전하게 확장할 수 있습니다.
- RBAC는 플랫폼 기능 및 워크플로에 대한 제어된 액세스를 제공합니다.
- ABAC는 규정 준수, 보존 및 데이터 보호 요구 사항에 부합하는 섬세한 정책 중심 데이터 액세스를 제공합니다.
함께 플랫폼 권한과 데이터 권한 부여 논리를 혼동하지 않고 관리 데이터의 민주화를 활성화합니다.
기본적으로 RBAC는 권한 할당을 기반으로 액세스를 적용하고 ABAC는 컨텍스트에서 권한을 평가합니다. 작업, 사용자, 리소스 특성을 결합하여 Salesforce Data 360 전체에서 적응형 세분화된 액세스 제어를 제공합니다.
### ABAC: 다단계 보안 계층
Salesforce Data 360의 세분화된 액세스 제어의 핵심은 CEDAR 정책 언어로 구동되는 특성 기반 액세스 제어(ABAC)입니다.
정적 역할 기반 권한과 달리 ABAC는 액세스 권한을 요청하는 _개인_, 액세스하려는 _개인_, _어떤 조건 하에서_ 액세스하는 것을 동적으로 평가하여 모든 데이터 상호 작용이 엔터프라이즈 정책 및 Trust 경계에 부합하는지 확인합니다.
#### 동적 정책 평가
Data 360의 ABAC 엔진은 세 가지 핵심 특성 유형의 조합을 기반으로 액세스 결정을 평가합니다.
- **사용자 속성:** 부서, 위치, 허용 수준
- **데이터 속성:** 분류, 민감도(PII, PHI, 금융 데이터), 데이터 공간
이 유연한 정책 중심 모델을 사용하면 적용이 사용자 역할, 데이터 분류 또는 운영 조건이 발전함에 따라 자동으로 조정되며, 이는 대규모, 배포 및 규제된 기업에 필수적입니다.
 #### Salesforce Data 360의 ABAC 아키텍처 구성 요소
Salesforce Data 360은 정책 중심 데이터 거버넌스에 대한 업계 모범 사례에 부합하는 표준 기반 특성 기반 액세스 제어(ABAC) 아키텍처를 구현합니다. 세 가지 기본 기능 구성 요소로 구성됩니다.
- **정책 정보 지점(PIP) - 정책, 보강된 메타데이터 및 분류:**
- 데이터 액세스, 분류, 마스킹, 보존, 엔터프라이즈 데이터를 관리하는 사용 정책 등 정책 정의 자체를 포함합니다.
- 태그, 분류, 비즈니스 컨텍스트, 종단간 계보와 같은 보강된 메타데이터를 유지합니다.
- LLM 및 ML 기반 분류를 활용하여 중요한 데이터에 자동으로 태그를 지정합니다(예: PII.Email, PII.Phone, PHI).
- 태그 전파는 데이터 계보를 따라 분류가 자동으로 흐름을 보장합니다(DLO → DLO → DMO).
- 변환 전반에서 민감도 및 규정 준수 유지
- **정책 결정 지점(PDP)**: PDP는 CEDAR 정책을 해석하는 결정 엔진입니다.
- PEP(사용자 ID, 요청 메타데이터)의 컨텍스트 입력을 수집하고 PIP의 참조 특성을 수집합니다.
- 결정적으로 정책을 평가하여 일관되고 설명 가능하며 확장 가능한 액세스 결정을 내립니다.
- 실시간 및 배치 평가를 모두 지원하므로 대용량 환경에서도 성능과 정밀도를 보장합니다.
- **Policy Enforcement Point(PEP)**: PEP는 런타임 시 인가 결정이 적용되는 위치입니다.
- API, UI 쿼리, CRM 보강 또는 GenAI 검색 증가 생성(RAG) 파이프라인과 같은 모든 상호 작용 채널 전반의 데이터 액세스 요청을 가로채웁니다.
- 모든 쿼리 및 검색이 엔터프라이즈 액세스 정책을 준수하도록 PDP 결과를 즉시 적용합니다.
PIP-PDP-PEP 삼각형은 함께 분산된 거버넌스 패브릭을 형성하여 모든 Data 360 서비스 및 액세스 모드에 일관된 정책 기반 제어를 적용합니다.
중요한 점은 Data 360의 [ABAC](https://help.salesforce.com/s/articleView?id=data.c360_a_policy_based_governance_dg.htm&type=5)가 구성되었으며 구축되지 않았습니다. 설계자는 사용자 정의 제어 플레인 또는 적용 논리를 어셈블하지 않습니다. 대신 통합 거버넌스 패브릭으로 함께 작동하는 세 가지 기본 아키텍처 구성 요소를 채우고 연결합니다.
실제 수준에서 구현은 데이터를 분류하고 정책을 정의하고 플랫폼에서 자동으로 적용할 수 있도록 하는 간단한 진행 상황을 따릅니다. 구성되면 액세스 제어가 수동 또는 절차 프로세스가 아닌 시스템 동작이 됩니다.
이 분산된 거버넌스 패브릭은 모든 액세스 채널에서 **일관된 정책 적용**을 보장하므로 Data 360 전체에 통합된 Trust 경계가 생성됩니다.
#### 다단계 정책 적용
Data 360의 ABAC 프레임워크는 계층화된 액세스 경계를 지원하므로 데이터가 개체 수준에서뿐만 아니라 특정 필드 및 레코드 내에서도 보호됩니다.
- **오브젝트 수준 보안(OLS)**: 액세스 제어의 가장 외부 경계입니다.
데이터 레이크 개체(DLO) 또는 데이터 모델 개체(DMO)와 같은 전체 데이터 구조에 대한 액세스를 관리합니다.
예: _트랜잭션_이 아닌 _고객_ 개체에 대한 액세스 권한 부여
- **필드 수준 보안(FLS)**: 개체 내 특정 필드에 대한 액세스를 제어합니다.
예: 마케팅 사용자는 고객 이름을 볼 수 있지만 신용 카드 번호 또는 국가 식별자를 볼 수 없습니다.
- **레코드 수준 보안(RLS)**: 가장 세분화된 제어 레이어입니다.
사용자가 보거나 수정할 수 있는 데이터 집합 내의 개별 레코드를 결정합니다.
예: 지역 관리자는 할당된 지역과 연결된 고객 데이터에만 액세스할 수 있습니다.
- **동적 데이터 마스킹(DDM) :** 실시간 데이터 보호를 활성화합니다. ABAC를 보완하는 DDM은 기본 데이터 집합을 변경하지 않고 중요한 정보에 대한 정책 중심 난독화를 적용합니다. 쿼리 시간에 DDM은 사용자 역할, 컨텍스트 또는 규정 준수 규칙을 기반으로 PII 또는 금융 데이터와 같은 필드를 자동으로 마스킹합니다.
- 중요한 데이터는 UI 보기, API, AI 워크플로 전반에서 보호됩니다.
- 모든 소비 계층에서 일관된 마스킹을 보장하여 데이터 누출 위험을 줄입니다.
- 감사 가능성을 유지합니다. 마스킹된 모든 쿼리는 Data 360의 거버넌스 프레임워크 내에서 기록되고 추적할 수 있습니다.
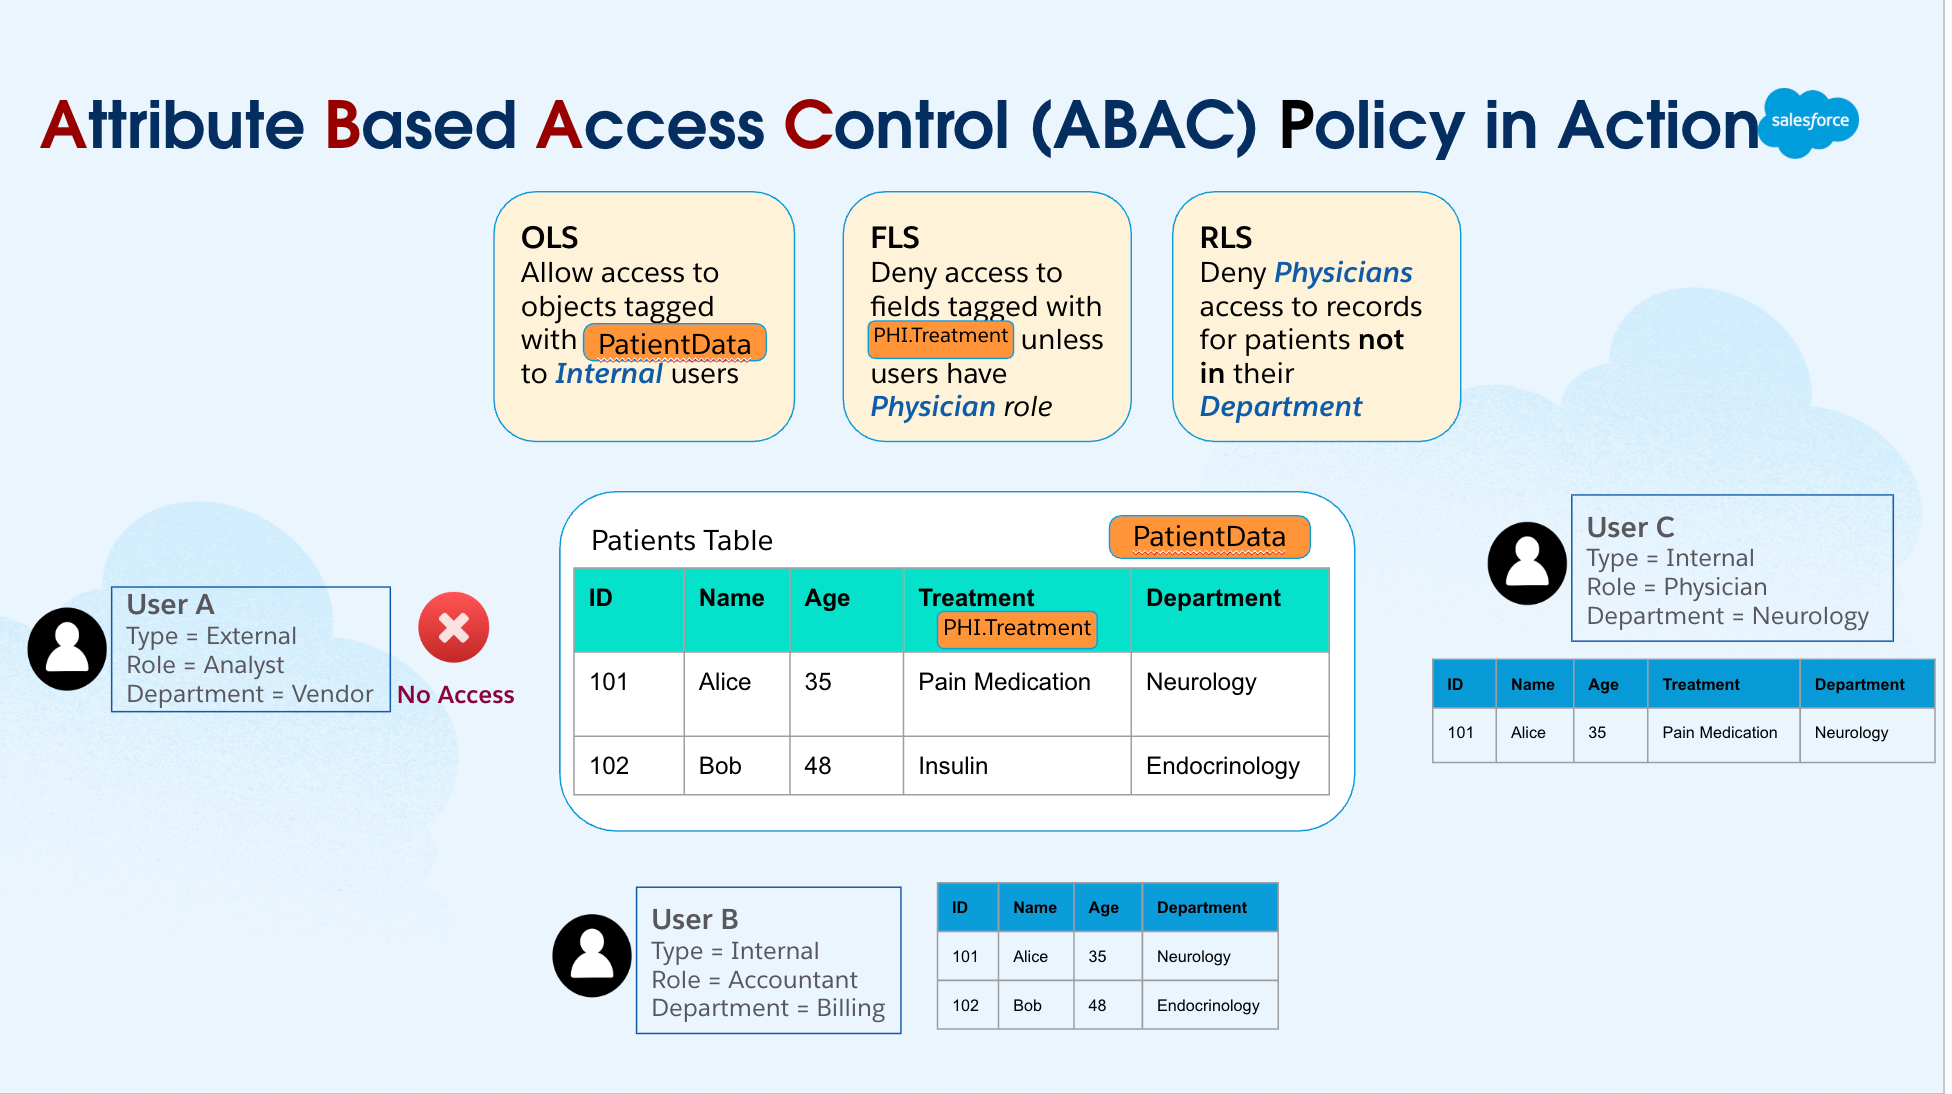 이 아키텍처는 정적 권한 모델에서 동적 컨텍스트 인식 정책 패브릭으로 액세스 제어를 변환합니다. RBAC의 구조화된 단순성과 ABAC의 컨텍스트 깊이를 결합하여 Salesforce Data 360은 다음을 달성합니다.
- 수집, 조합 및 활성화 전반에서 일관된 정책 적용
- 데이터, 역할, 규정 준수 요구 사항에 따라 발전하는 적응형 거버넌스입니다.
- 데이터 수명 주기 전체에 걸쳐 통합된 Trust 경계 — 수집에서 AI 활성화까지.
#### Salesforce Platform과 딥 통합
Salesforce Data 360의 거버넌스 모델은 Salesforce Platform 내에 기본적으로 내장되어 운영 데이터와 분석 데이터 모두에서 통합된 보안, 규정 준수, 액세스 제어를 지원합니다. ID 연합, 권한 집합, 중앙 집중식 정책 작성 및 플랫폼 암호화 등 Salesforce의 핵심 ID 및 액세스 관리 기능을 상속함으로써 Data 360은 병렬 관리 스택을 도입하지 않고 클라우드 전체에 일관된 Trust 정책을 적용합니다. 분리, 권한 부여 및 계보를 별도의 문제로 다루는 대신 플랫폼은 이를 전체 데이터 수명 주기를 가리키는 단일 실행 인식 Trust 조직에 통합합니다.
구조적 수준에서 이 거버넌스 패브릭은 함께 작동하는 세 가지 보완 계층으로 구성됩니다.
- 데이터 분리 및 규제 세분화에 대한 명확한 논리적 경계를 설정하는 **데이터 공간**
- **Attribute-Based Access Control(ABAC)** \- ID, 목적 및 데이터 속성을 기반으로 섬세하고 컨텍스트에 맞는 인가 결정을 내릴 수 있습니다.
- 데이터가 수집에서 인사이트 및 활성화로 이동하는 동안 비즈니스 의미, 민감성 및 추적성을 유지하는 **세맨틱 계보**
함께 액세스 결정이 설명 가능하고, 적용이 자동이며, 규정 준수는 소급이 아닌 연속적인 거버넌스 모델을 만듭니다. 결과적으로 더 이상 제한 요소가 아닌 거버넌스를 고려해야 하는 플랫폼이 생깁니다. 대신 설계자는 데이터 제품 및 AI 기반 워크플로를 설계하여 시스템 자체에서 Trust, 개인 정보 보호 및 규제 요구 사항이 적용되는 것을 확신할 수 있게 해줍니다.
이 구성 접근 방식을 사용하면 엔터프라이즈 데이터가 유용할 뿐 아니라 책임 있게 실행할 수 있어 투명성, 보안 또는 제어가 저하되지 않고 대규모 인사이트, 활성화, 자동화를 지원합니다.
## 데이터 수명 주기 보호: 수집에서 활성화까지
AI 기반 엔터프라이즈의 시대에서 데이터 보안은 일회성 이벤트가 아니라 비즈니스 또는 AI 사용을 위해 활성화되는 시점부터 정보를 보호하는 지속적인 프로세스입니다.
Salesforce Data 360은 데이터 수명 주기의 모든 단계에 보안 및 거버넌스 제어 기능을 포함하여 데이터 무결성, 기밀성, Trust 수집에서 인사이트 활성화까지 유지합니다.
### 보호 기본 사항: 암호화 상태 유지 및 운송 중
Salesforce Data 360의 보호 모델의 핵심은 Data 360용 플랫폼 암호화입니다. 투명하고 고성능 암호화 프레임워크로서 사용성이나 확장성을 저하하지 않고 데이터를 유휴 상태 및 전송 중에도 보호합니다.
#### 암호화 상태 유지: 저장소 레이어 보안
Data 360 Data Lake에 남아 있는 데이터는 **저장소 계층에서 자동으로 암호화됩니다**. 따라서 실제 또는 무단 액세스가 발생할 경우에도 데이터가 읽을 수 없습니다. 주요 기능은 다음과 같습니다.
- **투명 데이터 레이크 암호화:** 데이터 레이크에 유지되는 모든 데이터는 고객 관리 키(CMK)를 사용하여 저장소 계층에서 암호화됩니다. 이를 통해 물리적 저장소에 대한 무단 액세스가 발생해도 데이터는 읽을 수 없고 암호화할 수 없습니다.
- **고객 관리 키(CMK):** 고객은 암호화 키를 완벽하게 제어할 수 있습니다. 이는 금융 서비스, 헬스케어, 정부와 같은 규제된 산업에 매우 중요한 기능입니다. CMK는 GDPR, HIPAA, ISO 27001과 같은 규제 요구 사항에 직접 부합하여 데이터 독립성에 대한 세부 감사, 제어, 증거를 지원합니다.
- **외부 키 관리(EKM) :** Data 360용 플랫폼 암호화 기능인 외부 키 관리를 사용하면 고객의 AWS KMS 계정에 저장된 키를 사용하여 Data 360의 데이터를 암호화할 수 있습니다. 이를 통해 고객은 Data 360의 데이터를 안전하고 보호하면서 더욱 유연하게 작업할 수 있습니다.
- **자신의 키 가져오기 (BYOK):** CMK 및 EKM을 기반으로 구축된 Data 360을 사용하면 고객이 Salesforce 내에서 직접 자체 키 자료를 업로드하여 데이터를 암호화하고 검색 색인을 유지할 수 있습니다. 이 개선 사항은 고객이 AWS KMS에서 키를 만들거나 관리할 필요 없이 PII, 민감한, 기밀, 독점 데이터에 대한 추가 보호 계층을 제공합니다.
- **키 회전 및 수명 주기 관리:** 키 순환은 정상적으로 처리됩니다. 새 데이터는 새 키로 암호화되지만 이전 데이터는 원래 키로 암호화된 상태로 남아 가동 중지 시간 또는 성능 저하를 방지합니다. 이 순환 메커니즘은 운영 중단 없이 규정 준수를 강화합니다.
#### 운송 중 암호화: 네트워크 수준 보안
Data 360 서비스, API, 커넥터 간에 전송되는 모든 데이터는 TLS(Transport Layer Security) 1.2 이상을 사용하여 보호되므로 이동 중에 전체 암호화를 제공합니다.
이를 통해 다음이 가능합니다.
- 전송 중에는 데이터를 가로채거나 변경할 수 없습니다.
- Salesforce 서비스, 신뢰할 수 있는 커넥터, 고객 끝점 간의 통신은 비공개로 유지되고 확인할 수 있습니다.
- 보안은 수집 파이프라인, 조합 프로세스, 활성화 워크플로 및 외부 API 통합에 걸쳐 지속적으로 확장됩니다.
고객이 유지하는 암호화를 전송 중 지속적인 암호화와 결합하여 Salesforce Data 360은 외부 공격 및 내부 인프라 위협으로부터 고객 데이터를 보호하는 심층적인 방어 아키텍처를 만듭니다.
### Data 360에서 시스템 간 통합(데이터 통합) 보호
암호화 및 액세스 제어는 Salesforce Data 360 내에서 데이터를 보호하지만, 시스템 전반에서 데이터 이동을 안전하게 유지하는 것도 중요합니다. 현대 엔터프라이즈는 Salesforce, 분석 플랫폼, 외부 API, 데이터 레이크 간에 민감한 데이터가 흐르는 다중 클라우드 및 하이브리드 환경에서 운영합니다.
이를 해결하기 위해 Salesforce는 명명된 자격 증명(NC) 및 외부 자격 증명(EC)을 중심으로 하는 보안 통합 프레임워크를 설계하였으며, 이를 통해 정책 중심의 안전한 연결을 위한 제로 Trust 기반의 기반을 제공합니다.
#### Salesforce의 보안 통합 프레임워크
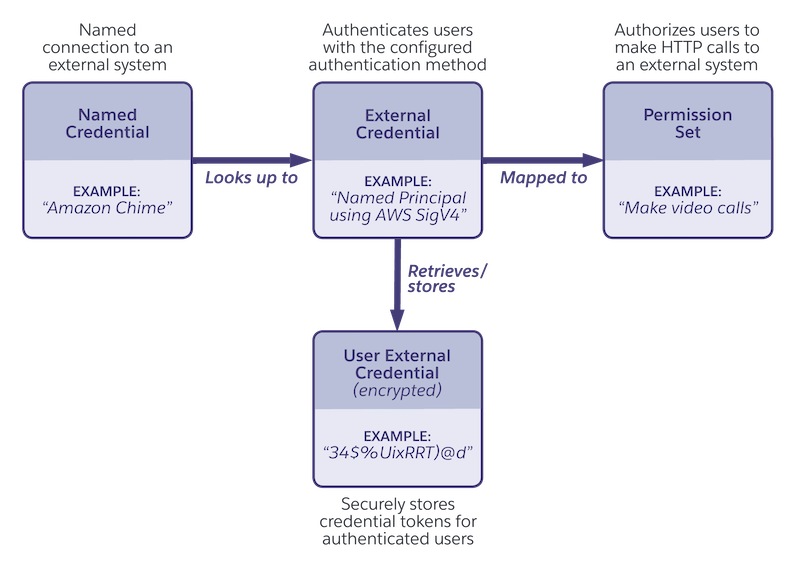
Salesforce는 명명된 자격 증명(NC) 및 외부 자격 증명(EC)을 중심으로 강력한 **[보안 통합 프레임워크를](https://developer.salesforce.com/docs/platform/named-credentials/guide/get-started.html)** 설계했습니다. 모두 함께 자격 증명 복잡성을 추상하고 최소 권한 액세스를 적용하며 코드 또는 구성에서 암호를 노출하지 않고 모든 통합 전반에서 일관된 인증 관리를 활성화합니다.
이 프레임워크는 보안 복잡성을 추상화하고, 모범 사례를 적용하며, Salesforce의 **Zero Trust** 및 **Security by Design** 원칙에 부합하는 모든 외부 연결에 대한 **정책 중심 제어 계획**을 수립합니다.
##### 명명된 자격 증명
명명된 자격 증명(NC)은 Salesforce의 보안 통합 아키텍처의 핵심입니다. 이를 통해 외부 엔드포인트와 인증 매개 변수를 정의할 수 있는 선언적이고 중앙 집중식 메커니즘을 제공하므로 Apex 코드 또는 구성 파일에서 사용자 이름, 암호 또는 토큰과 같은 민감한 자격 증명을 하드 코딩할 필요가 없습니다. 대신 개발자 및 관리자가 명명된 자격 증명 별칭(예: SnowflakeConnector_NC)을 참조하기만 하면 Salesforce에서 기본 인증 및 연결 관리를 자동으로 처리합니다.
**아키텍처 및 보안 이점:**
- **간소화된 유지 보수:** NC는 외부 끝점 URL 및 인증 매개 변수를 단일 관리 레코드에 통합합니다. 끝점 변경 또는 자격 증명 순환과 같은 모든 업데이트는 NC 레코드에 대해서만 변경해야 하므로 환경 전반에서 코드 또는 플로를 재배포하지 않아도 됩니다.
- **고급 보안:** 자격 증명은 Salesforce의 암호화된 암호 저장소에 안전하게 저장되므로 코드 리포지토리, 구성 파일 또는 로그에 노출되지 않습니다. 인증 프로세스 자체는 런타임 시 자동으로 관리되므로 인적 오류 및 누출 위험이 줄어듭니다.
**규정 준수:** 자격 증명과 비즈니스 논리를 분리하면 데이터 보호 규정(예: **GDPR, HIPAA 및 PCI DSS)**의 준수를 간소화할 수 있습니다. 감사자는 외부 데이터 액세스가 엔터프라이즈 보안 및 거버넌스 정책을 준수하는지 쉽게 확인할 수 있습니다.
- **원격 사이트 설정 우회:** NC는 원격 사이트 설정에 대한 기존 요구 사항을 없애고, 특히 대규모 또는 다중 환경 엔터프라이즈 구현의 경우 구성을 간소화하고 배포합니다.
 #### 외부 자격 증명
외부 자격 증명(EC)은 Salesforce가 외부 서비스에 연결할 때 사용하는 인증 프로토콜 및 플로를 정의하며, "인증 방법"에 효과적으로 답변합니다. 단일 EC는 동일한 인증 유형을 공유하는 여러 NC에서 재사용할 수 있으므로 구성 재사용 및 일관된 보안이 적용됩니다.
**지원되는 인증 프로토콜:**
- OAuth 2.0(모든 변형 지원)
- JWT(JSON 웹 토큰)
- 기본 인증
- AWS Signature v4
- 사용자 정의 인증
- 인증 없음(열려 있는 API 또는 공개 끝점의 경우)
외부 자격 증명 및 명명된 자격 증명은 명확한 업무 분리에 맞춰 설계되었습니다. 외부 자격 증명은 외부 시스템에 연결하기 위한 인증 프로토콜, 토큰 유형, 새로 고침 동작을 지정하여 인증하는 방법을 정의합니다. 반면 명명된 자격 증명은 연결할 위치( 끝점 URL 및 해당 연결에 사용할 외부 자격 증명)를 정의합니다. 이 설계를 통해 인증 논리와 끝점 구성이 분리된 상태로 유지되므로 Salesforce는 기업 전체에서 중앙 집중식으로 일관된 자격 증명 관리를 유지하면서 다양한 통합 프로토콜을 안전하게 지원할 수 있습니다.
### Data 360 커넥터가 이 프레임워크를 활용하는 방법
Data 360의 사용자 인터페이스는 기본 구성의 대부분을 추상하지만, 네이티브 커넥터 및 데이터 스트림에서 명명된 자격 증명 및 외부 자격 증명 프레임워크가 자주 활용됩니다.이로 인해 관리자가 안내 UI를 통해 단순히 "데이터 연결 추가"하는 경우에도 Data 360은 계속해서 이 표준화된 보안 모델을 적용합니다.
아키텍처 영향:
- **통합 보안 모델:** 외부 데이터베이스, AWS S3 또는 엔터프라이즈 API에 대한 모든 커넥터는 명명된 자격 증명 및 외부 자격 증명에 적용되는 동일한 암호화, 인증, 키 관리 표준을 활용합니다.
- **개발자 요약:** 개발자 및 관리자는 인증 플로 또는 자격 증명 순환을 수동으로 처리할 필요가 없습니다. Salesforce는 토큰 수명 주기, 만료, 새로 고침을 자동으로 관리합니다.
- **일관적인 정책 시행:** 이 프레임워크를 통해 모든 커넥터가 일관된 인증, 감사, 로깅 정책을 준수하므로 규제된 산업에서 대규모 다중 소스 수집에 매우 중요합니다.
- **향후 확장성:** Salesforce가 인증 스택을 향상할 때(예: 새로운 OAuth 플로 또는 FIDO2 표준 지원) 이러한 개선 사항은 재배치 또는 재배포 없이 모든 커넥터에 자동으로 전파됩니다.
### Data 360 커넥터 보안 및 거버넌스
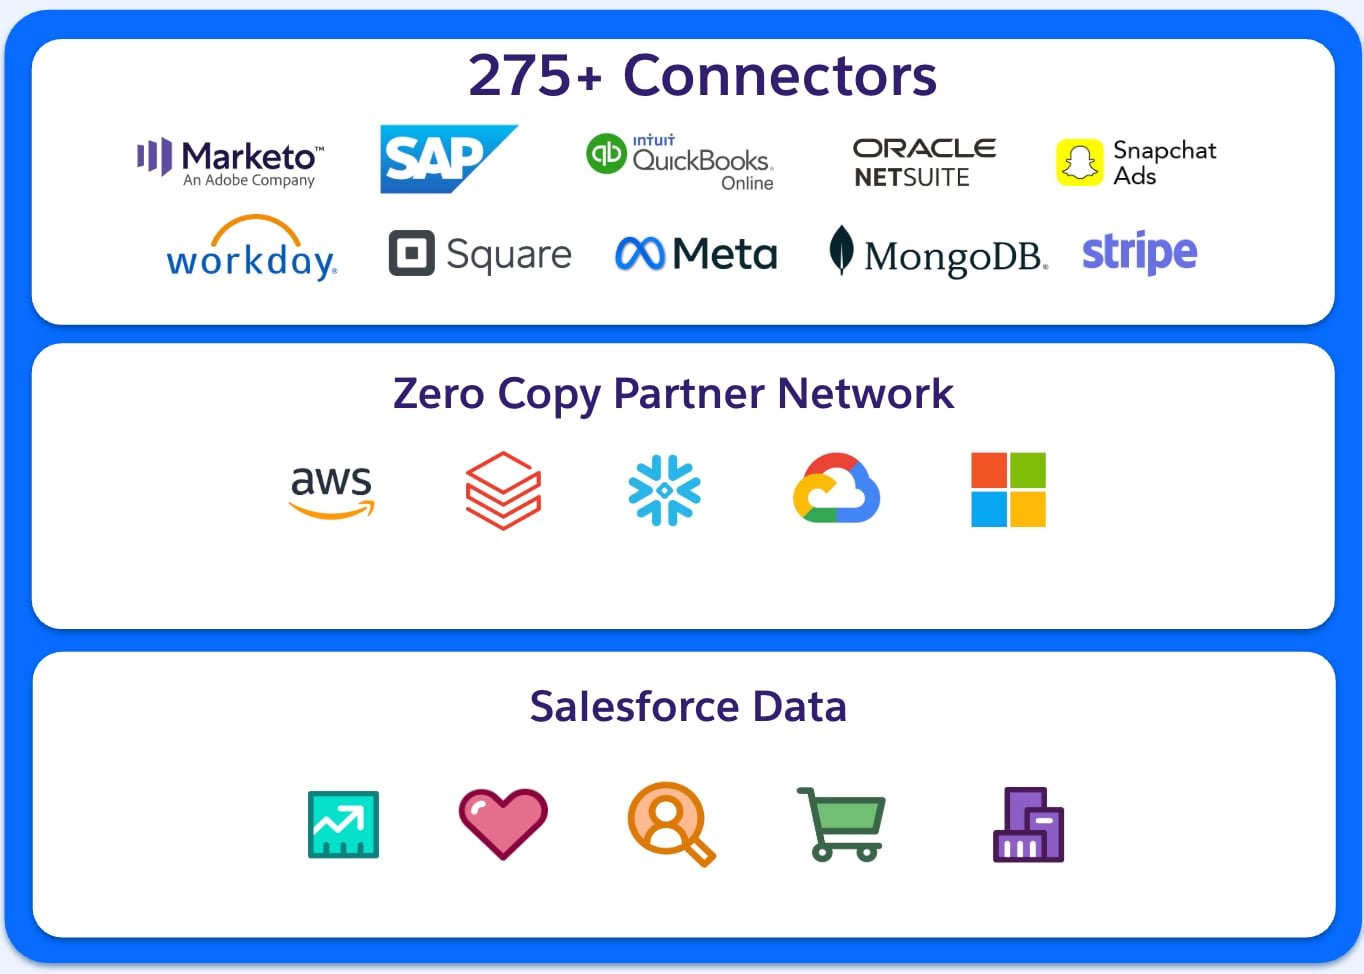
Salesforce Data 360은 다양한 소스의 데이터 통합을 간소화하는 대규모 기본 커넥터 제품군을 제공합니다. 이렇게 하면 기업이 데이터를 효율적으로 통합하고 활용할 수 있습니다. Salesforce는 네이티브 Salesforce 커넥터, 클라우드 저장소 커넥터, 데이터베이스 커넥터, 응용 프로그램 및 API 커넥터를 비롯한 여러 커넥터 유형을 제공합니다. 제공되는 커넥터 외에도 0 ETL 도구도 지원됩니다. Salesforce 커넥터를 사용하면 Sales Cloud, Service Cloud, Marketing Cloud와 같은 Salesforce 제품을 Data 360과 원활하게 통합할 수 있습니다. 또한 Amazon S3, Google Cloud Storage, Azure Data Lake 등 클라우드 저장소 공급자에 대한 다양한 커넥터가 제공됩니다. Snowflake, Redshift, BigQuery와 같은 데이터베이스의 사전 빌드 커넥터를 사용하면 엔터프라이즈에서 기존 데이터 웨어하우스를 Data 360과 연결할 수 있습니다. 또한 Data 360은 Google 광고, Facebook 광고 및 기타 마케팅 플랫폼과 같은 다양한 타사 응용 프로그램 및 API에 대한 커넥터를 제공합니다. Data 360은 유연성을 높이기 위해 MuleSoft 및 Informatica와 같은 ETL 도구와 통합됩니다.
 #### 데이터 보안 및 Salesforce Data 360 커넥터
Salesforce Data 360에 저장된 데이터의 보안은 많은 Data 360 관련 대화에서 가장 중요합니다. Salesforce의 방어 심층 보안 접근 방식에 대한 약속의 일환으로 Data 360 환경에 데이터가 수집되는 방어 방식도 동일하게 중요합니다.
Salesforce는 여러 클라우드 플랫폼, 스토리지 솔루션 및 분석 도구를 포함하는 다양한 데이터 에코시스템에서 비즈니스를 운영한다는 사실을 인식합니다. Data 360 커넥터는 다음 환경 간의 교량 역할을 합니다. 커넥터는 Salesforce의 높은 보안 표준을 유지하면서 안전하고 확장 가능하며 효율적인 데이터 통합을 지원합니다. 이러한 커넥터는 무결성 또는 개인 정보 보호를 저하하지 않고 원활한 데이터 흐름을 지원합니다.
Data 360 커넥터 보안의 세 가지 필수 구성 요소는 다음과 같습니다.
- **인증/권한 부여 매핑**: 보안 액세스 관리는 데이터 보안의 기본 사항입니다. 다양한 클라우드 커넥터는 다양한 인증 및 권한 부여 메커니즘을 사용하여 사용자 액세스를 확인하고 제어합니다. 인증은 사용자 또는 시스템이 합법적인 엔티티인지 확인하고, 인증은 부여되는 액세스 수준을 정의합니다. Salesforce는 가능한 경우 커넥터가 업계 표준을 활용하도록 합니다.
- **제로 복제본(ZETL) 기능 상호 운용성**: 데이터 중복은 보안 및 운영상의 문제를 야기합니다. 또한 불필요한 저장소 비용, 데이터 불일치, 증가된 위험 노출이 있습니다. Salesforce의 ZETL(Zero Extract, Transform, Load) 접근 방식을 사용하면 물리적 데이터 복제 없이 플랫폼 전반에서 실시간 데이터 공유를 수행할 수 있습니다. 즉, 데이터는 처리, 보고, 분석을 위해 계속 액세스할 수 있지만 원래 환경 내에 남아 있을 수 있습니다. 또한 이는 공격 표면을 크게 줄이고 데이터 보존 법률에 대한 잠재적인 규정 준수를 향상합니다.
- **데이터 연합 지원**: 오늘날의 멀티 클라우드 환경에서는 불필요한 데이터 이동 없이 조직에 포괄적인 데이터 액세스가 필요합니다. Data 360 커넥터 연합 데이터 모델은 파일 기반 및 쿼리 기반 데이터 연합을 모두 지원하므로 엔터프라이즈에서 외부 데이터 소스를 실시간으로 활용할 수 있습니다. 구조화된 데이터베이스, 세미 구조화 로그 또는 구조화되지 않은 파일에 액세스하는지 여부와 상관없이 Salesforce의 커넥터를 사용하면 데이터가 수명 주기 전체에 걸쳐 안전하게 유지됩니다.
Salesforce는 통합을 통해도 데이터 보안 및 규정 준수의 복잡성을 탐색하는 데 필요한 투명성을 고객에게 제공하려고 합니다. AWS S3, Google Cloud Storage, Snowflake 또는 기타 플랫폼과의 통합 여부와 상관없이 Data 360 커넥터는 중요한 비즈니스 데이터에 대한 Trust, 투명성 및 제어를 보장하도록 설계되었습니다.
##### Salesforce Data 360 커넥터 보안 및 인증 매핑
| 커넥터 유형 | 연결 유형 지원 | 기본 인증 유형 | 주요 보안 측면 및 참고 사항 |
|---|---|---|---|
| Salesforce CRM | N/A(내부) | 세션 기반(내부) | Salesforce의 강력한 내부 ID 및 액세스 관리(IAM) 모델을 사용합니다. 모든 데이터는 전송 중이며 Salesforce 인프라 내에서 암호화됩니다. |
| Marketing Cloud 참여 | 공용 인터넷만 해당 | OAuth 2.0, 사용자 이름/암호 | 표준 OAuth 2.0 프로토콜은 보안 인증에 사용됩니다. 데이터는 공용 인터넷을 통해 전송(TLS) 시 암호화됩니다. |
| B2C Commerce | 공용 인터넷만 해당 | OAuth 2.0 | 표준 OAuth 2.0입니다. 데이터 전송을 위해 보안 공용 인터넷 프로토콜(TLS)에 의존합니다. |
| 웹 및 모바일 앱 | 공용 인터넷만 해당 | API 키, OAuth 2.0 | API( 수집 API, 스트리밍 API)를 통해 수집된 데이터입니다. API 키 관리 및 표준 웹 프로토콜을 통해 보안을 관리합니다. |
| Amazon S3 | 비공개 연결 및 공개 | IAM 역할, 외부 자격 증명 | 안전한 비공개 연결을 위해 AWS PrivateLink를 지원합니다. 공개 연결은 보안 자격 증명을 사용합니다. 데이터는 전송 중 및 유지 중에 암호화됩니다(S3의 고객 관리 키 옵션). |
| Snowflake | 비공개 연결 및 공개 | OAuth 2.0, 비공개 키 인증, 사용자 이름/암호 | VPC 비공개 연결(AWS PrivateLink)을 지원합니다. 공개 연결은 보안 인증 메서드와 함께 사용할 수 있습니다. Snowflake 내에서 고객 키를 사용하여 데이터를 암호화할 수 있습니다. |
| Amazon Redshift | 비공개 연결 및 공개 | 사용자 이름/암호, IAM 인증 | 비공개 연결 지원(AWS PrivateLink). 공개 연결은 표준 보안 모범 사례를 사용합니다. |
| Microsoft Azure(스토리지/SQL) | 공용 인터넷만 해당 | SAS 토큰, OAuth 2.0, 사용자 이름/암호 | 연결은 인증을 위해 보안 SAS 토큰 또는 OAuth에 의존합니다. 데이터는 암호화된 채널(TLS)을 통해 공용 인터넷을 탐색합니다. |
| Google Cloud Storage(GCS) | 공용 인터넷만 해당 | OAuth 2.0, 서비스 계정 | 연결은 보안 OAuth 2.0에 의존합니다. 데이터는 암호화된 채널(TLS)을 통해 공용 인터넷을 탐색합니다. |
| MuleSoft(API) | 공용 인터넷만 해당 | OAuth 2.0, API 키 | API를 통해 연결됩니다. 보안은 MuleSoft Anypoint Platform을 통해 구현된 표준 API 인증 및 강력한 거버넌스 정책을 통해 관리됩니다. |
| 단계 | 메커니즘 | 보안/거버넌스 제어 |
|---|---|---|
| 활성화 구성 | Data 360 활성화 설정에 정의됨 | 명명된 자격 증명 및 외부 자격 증명을 통해 보호 |
| 데이터 준비 | DMO에서 필터링 및 조인됨 | 동의 및 개인 정보 메타데이터 적용 |
| 아웃바운드 전송 | TLS/Private Connect를 통해 암호화됨 | 정책 적용 및 자격 증명 추상 |
| 외부 배송 | SFTP/클라우드 저장소/API | 제어 및 감사 가능한 배달 액세스 |
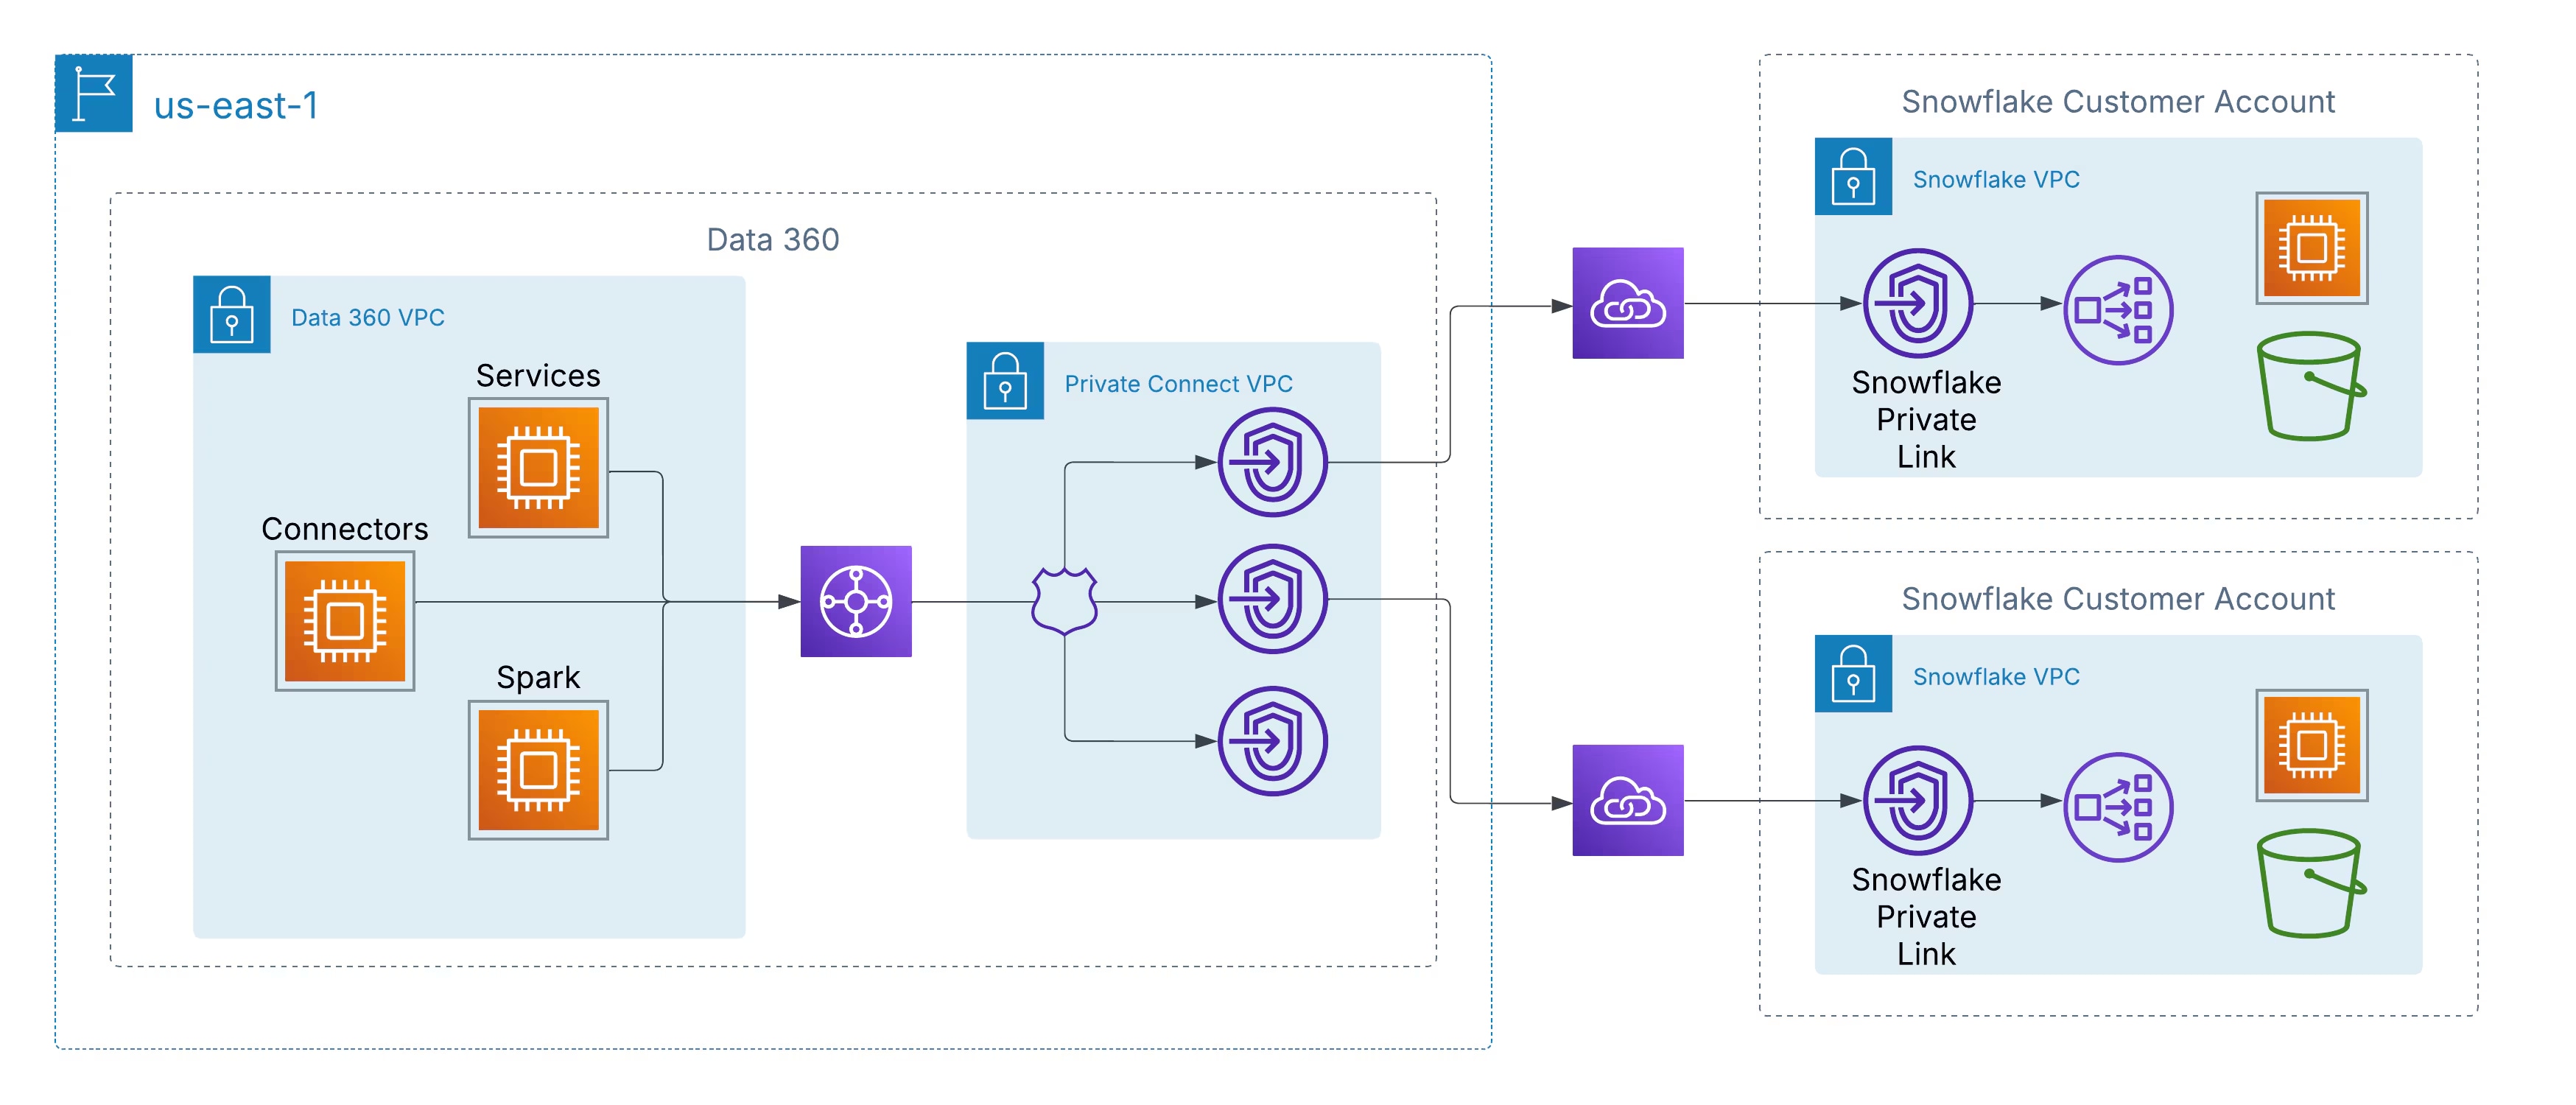 모든 커뮤니케이션은 비공개 IP 주소 지정 및 라우팅할 수 없는 네트워크 경로를 사용하여 AWS 백본 내에 유지되므로 전송 중인 데이터 중복 위험을 없애고 엄격한 엔터프라이즈 및 규제 보안 요구 사항을 충족할 수 있습니다.
이 아키텍처는 다음을 보장합니다.
- **제로 인터넷 노출:** 데이터는 AWS 비공개 네트워크를 벗어나지 않습니다.
- **개인 IP 통신:** 트래픽은 격리되고 외부에서 처리할 수 없습니다.
- **규정 준수:** ISO 27001, SOC 2, FedRAMP 등 보안 표준을 충족합니다.
#### 비공개 상호 연결: 클라우드 전체 보안 확장
다중 클라우드 환경에서 작업하는 고객을 지원하기 위해 Salesforce는 비공개 상호 연결을 통해 AWS 외에도 동일한 보안 원칙을 확장하고 있습니다. 이 기능을 사용하면 Data 360과 Azure 또는 Google Cloud에서 호스팅되는 데이터 레이크 간의 클라우드 간 비공개 연결을 활성화하여 비공개 라우팅, 인터넷 이동 제로, 암호화된 백본 전용 트래픽과 동일한 보증을 유지할 수 있습니다.
두 가지 아키텍처 배포 모델을 사용할 수 있습니다.
- **고객 관리형 상호 연결:** 고객은 Azure ExpressRoute, Google Cloud Interconnect 또는 Equinix Fabric과 같은 기존의 비공개 네트워크 회로를 Data 360 VPC와 직접 통합합니다.
- **Salesforce 관리형 상호 연결:** Salesforce는 클라우드 간 링크를 프로비저닝 및 관리하여 고객의 대상 클라우드 환경에서 비공개 서비스 끝점을 노출하여 턴키 설정을 수행합니다.
### 포트 보안: Salesforce Data 360의 API 보안 기능
엔터프라이즈 데이터를 통합하기 위한 강력한 플랫폼인 Salesforce Data 360은 강력하고 다층적인 보안 제어를 통해 구축되어 있습니다. 고객의 경우 API 보안 관리는 포괄적인 데이터 보호 전략의 중요한 부분으로써 액세스를 효과적으로 제어하고 통합을 관리하며 사용량을 모니터링할 수 있습니다.
다음은 Salesforce Data 360 내에서 고객이 API 보안을 설정, 제어, 관리할 수 있는 주요 기능 및 기능입니다.
#### 핵심 API 보안 기능 및 기능
고객은 몇 가지 내장 Salesforce 기능을 활용하여 Data 360 인스턴스에 대한 안전한 API 액세스를 보장할 수 있습니다.
##### 1\. 강력한 인증 및 권한 부여(OAuth 2.0)
Salesforce는 Data 360 API에 대한 엄격한 인증을 요구하며 OAuth 2.0은 표준 및 권장 프로토콜입니다.
- **연결된 앱**: 고객은 외부 응용 프로그램 액세스를 관리하기 위해 연결된 앱을 만들고 구성합니다. 이는 Data 360 수집 및 쿼리 API에 대한 액세스 권한을 인증하고 부여하는 기본 메커니즘입니다.
- **OAuth 범위**: 관리자는 최소 권한 원칙에 따라 특정 OAuth 범위를 정의할 수 있습니다(예: cdp_ingest_api, api).
- **다단계 인증(MFA)**: Salesforce Authenticator 및 기타 MFA 솔루션을 적용하여 필수 보안 계층을 추가하고 API 로그인을 통해서만 인증된 사용자가 시스템에 액세스할 수 있도록 합니다.
##### 2\. 세분화된 액세스 제어 및 권한
고객은 데이터에 액세스할 수 있는 사용자 및 응용 프로그램과 수행할 수 있는 작업을 정밀하게 제어할 수 있습니다.
- **API 액세스 제어(기능)**: Salesforce 지원에서 이 기능을 활성화하면 관리자가 API에 액세스하는 데 사용할 수 있는 연결된 앱을 명시적으로 승인할 수 있습니다. 승인되지 않은 모든 앱은 자동으로 차단되므로 무단 데이터 추출 위험이 크게 줄어듭니다.
- **권한 집합 및 프로필**: 관리자는 사용자 프로필 또는 전용 권한 집합을 통해 "API 사용 가능" 권한을 할당하여 API 액세스를 관리합니다. 이렇게 하면 사용자에게 직무와 관련된 액세스 권한만 부여됩니다.
- **역할 기반 액세스 제어(RBAC)**: Data 360 내에서 고객은 역할 기반 액세스 제어 정책을 만들고 관리하여 데이터 액세스 수준(개체, 필드, 레코드 수준 보안)을 정의하여 플랫폼 전체에서 일관성을 유지하고 제어할 수 있습니다.
- **전담 통합 사용자**: 모범 사례는 시스템 관리자 계정을 사용하지 않고 API 호출에 필요한 권한만으로 제한하는 통합을 위해 특정 "API 전용" 사용자를 만드는 것이 좋습니다.
##### 3\. 네트워크 보안 컨트롤
- **IP 화이트리스트/로그인 IP 범위**: 고객은 API 액세스를 정의된 신뢰할 수 있는 IP 주소의 범위로 제한할 수 있습니다. 승인되지 않은 IP 범위의 로그인 시도가 거부되거나 확인을 위해 제기될 수 있습니다.
- **개인 연결**: AWS PrivateLink에 구축된 이 기능을 사용하면 관리자가 공개 인터넷에 끝점을 노출하지 않고 민감한 데이터를 관리하여 공개적으로 표시되는 끝점에 대한 공격 위험을 없앨 수 있습니다.
- **교통 및 휴무 중 암호화**: 모든 데이터는 전송 중(TLS 사용) 및 미사용 중에 암호화되어 가로채기된 경우에도 민감한 정보를 무단 액세스로부터 보호합니다.
##### 4\. 모니터링, 감사, 거버넌스
가시성은 보안의 핵심입니다. Salesforce는 API 활동을 모니터링 및 감사하기 위한 광범위한 도구를 제공합니다.
- **이벤트 모니터링**: API 호출 및 로그인 시도를 포함하여 다양한 이벤트를 거의 실시간으로 추적합니다. 고객은 감사를 위해 이 데이터를 사용하고 트랜잭션 보안 정책을 만들 수 있습니다.
- **보안 센터**: 이 기능은 모든 Salesforce 조직의 보안 상태, 규정 준수, 거버넌스 메트릭에 대한 단일 통합 보기를 제공하므로 모니터링 및 관리를 간소화합니다.
- **현장 감사 내역**: 고객이 로그인 및 필드 내역을 추적하고 설정 변경 사항을 모니터링하거나 감사 및 데이터 보존 준수 의무를 해결할 수 있습니다.
- **데이터 거버넌스 기능**: 데이터 태그 지정 및 분류, 정책 적용, 동적 데이터 마스킹을 포함하여 API를 통해 액세스되는 데이터 접점을 포함하여 모든 데이터 접점을 통해 일관된 거버넌스 정책이 적용되도록 합니다.
#### API 보안 설정 및 관리: 고객 여정
1. 핵심 컨트롤 활성화: 먼저 MFA 및 IP 제한과 같은 조직 전체 기본값을 활성화합니다.
2. API 액세스 제어 요청: Salesforce 지원에 사례를 기록하여 조직에서 "API 액세스 제어" 기능을 활성화합니다.
3. 연결된 앱 구성: 각 통합에 대해 특정 연결된 앱을 만들어 필수 OAuth 범위를 정의하고 권한이 있는 프로필/권한 집합에 할당합니다.
4. 최소 권한 구현: 모든 통합 사용자에게 "API 전용" 권한 및 최소한의 데이터 액세스 권한이 있는지 확인합니다.
5. 모니터링 및 감사: 이벤트 모니터링 및 보안 센터를 정기적으로 사용하여 API 사용을 검토하고, 변칙을 감지하고, 취약성 평가를 수행합니다.
6. 모범 사례 적용: 항상 TLS를 적용하고, 새로 고침 토큰을 안전하게 저장하고, 세션 ID를 순환하고, 데이터 입력을 확인합니다.
고객이 구성할 수 있는 이러한 강력한 기능을 활용함으로써 기업은 Salesforce Data 360 내의 모든 API 상호 작용에 대해 안전하고 규정을 준수하는 환경을 유지할 수 있습니다.
### 규정 준수, 감사, 지속적인 모니터링
#### 서비스 가용성 및 데이터 보존
Salesforce Data 360은 지리적으로 분산된 배포 모델을 통해 글로벌 데이터 보존 및 주권 요구 사항을 충족하도록 설계되었습니다. 현재 미국, 캐나다, 브라질, 독일, 인도, 오스트레일리아, 일본을 포함한 여러 규제 지역에서 서비스를 사용할 수 있습니다.
데이터 보존은 각 고객의 핵심 조직 인스턴스를 가장 가까운 해당 Data 360 지역 인스턴스에 매핑하여 결정합니다. 예를 들어 미국 또는 캐나다에 위치한 핵심 조직은 미국 지역 내의 Data 360 인스턴스와 페어링되고, 유럽 연합 내의 핵심 조직은 독일에서 호스팅되는 인스턴스에 매핑됩니다. 마찬가지로 인도, 오스트레일리아, 뉴질랜드 또는 싱가포르의 핵심 조직은 인도에서 호스팅되는 Data 360 인스턴스와 연결됩니다.
Salesforce의 Hyperforce 인프라스트럭처는 이 모델을 기반으로 지리적 데이터 제어, 보안 격리, 규정 준수에 대한 기초를 제공합니다. Hyperforce 메타데이터, 백업, 파생 데이터 집합 등 고객 데이터가 정의된 지역 범위 내에 유지되도록 합니다. 이 아키텍처를 사용하면 기업이 APAC 및 EMEA 전역의 GDPR, FFIEC, HIPAA, 지역 개인정보보호법 등 현지 데이터 보존 및 규정 준수 요구 사항을 충족할 수 있습니다.
Salesforce는 지속적으로 Data 360의 가용성을 추가 Hyperforce 지역으로 확장하여 변화하는 글로벌 개인 정보 보호 표준, 지역 규정 준수 요구 사항 및 주체 데이터 제어에 대한 고객 기대에 부합합니다.
#### 규제 준수 활성화
Salesforce Data 360은 GDPR 및 CCPA와 같은 엄격한 글로벌 개인 정보 보호 및 규제 요구 사항을 충족할 수 있도록 설계되었습니다. 플랫폼은 데이터 액세스, 내보내기, 삭제("잊혀질 권리")를 포함하여 데이터 주체 권리(DSR)를 관리하는 기본 기능을 제공하여 수명 주기 전반에 걸쳐 개인 데이터를 규정 준수로 처리합니다.
고객은 규정 준수에 대한 최종 책임을 지지만 Salesforce는 CCPA와 같은 규정에 따라 인증된 "서비스 공급자"로 운영하며, 조직이 규정 준수 프레임워크를 효율적이고 대규모로 구현할 수 있는 플랫폼 수준 제어, 보안 보증, 계약 메커니즘을 제공합니다.
#### Foundational Trust: 인증서 및 증명서
Trust Salesforce 플랫폼의 핵심이며, 독립적인 검증을 통해 Trust 얻을 수 있습니다. Salesforce는 고객 데이터를 보호하고 가장 높은 클라우드 보안 표준을 준수하기 위한 지속적인 노력을 보여주는 광범위한 글로벌 보안 인증 및 증명서 포트폴리오를 유지합니다.
해당 인증은 단순한 확인란이 아니라 Salesforce의 보안 제어, 프로세스, 인프라의 강도와 일관성을 확인하는 엄격하고 반복적인 감사를 나타냅니다. 이들은 함께 Salesforce의 기본 Trust 모델의 기초를 형성합니다.
**핵심 인증서 및 증명서에는 다음이 포함됩니다.**
- **ISO/IEC 27001:** Salesforce의 포괄적인 정보 보안 관리 시스템을 확인합니다.
- **ISO/IEC 27017:** 클라우드별 보안 제어에 대한 모범 사례를 설정합니다.
- **ISO/IEC 27018:** 클라우드에서 개인 식별 정보(PII)를 보호하는 데 중점을 둡니다.
- **SOC 1, SOC 2, SOC 3:** Salesforce 보안 및 개인 정보 보호 제어의 설계 및 운영 효과를 확인하는 독립 보고서입니다.
- **PCI DSS:** 결제 카드 정보를 안전하게 처리하고 저장합니다.
- **FedRAMP 높은 & DoD 영향 레벨 4:** 중요한 워크로드를 관리하는 미국 연방 기관에서 사용할 수 있도록 Salesforce Government Cloud를 인증합니다.
Salesforce는 이 포괄적인 인증 집합을 유지하여 고객에게 전역 규정 준수 및 보안 기대치를 충족하고 종종 초과하는 플랫폼 내에서 데이터를 관리할 수 있는 자신감을 제공합니다.
### 가시성 극대화: Salesforce Data 360에서 로깅, 모니터링, 관찰 가능
오늘날의 빠른 디지털 환경에서 고객 데이터를 포괄적으로 파악하는 것이 중요하지만, 해당 데이터를 관리하는 플랫폼을 포괄적으로 파악하는 것도 중요합니다. Salesforce Data 360은 고객이 데이터 품질, 보안, 성능을 보장할 수 있는 강력하고 내장형 로깅, 모니터링, 관찰 기능을 제공합니다.
이러한 도구를 사용하면 반응형 문제 해결에서 사전 예방 관리로 전환하여 Data 360 구현을 원활하고 효율적으로 실행할 수 있습니다.
#### 사전 예방적 위협 감지 및 대응
보안은 예방으로 끝나지 않고 주의에 따라 발전합니다. 지속적으로 변화하는 위협 환경에서 Salesforce는 고급 플랫폼 모니터링 기능과 고객이 관리하는 검토 프로세스를 결합하여 사전 예방적이고 지속적인 보호를 보장합니다.
Salesforce는 가시성 및 위협 감지를 위한 강력한 기본 도구를 제공합니다.
- **설정 감사 내역**은 관리 변경 사항의 전체 내역을 캡처하여 팀이 구성 또는 정책 업데이트를 추적할 수 있도록 지원합니다.
- **이벤트 모니터링**은 사용자 동작, API 활동 및 데이터 액세스 패턴에 대한 자세한 정보를 제공합니다. 이 텔레메트리는 중앙 집중식 분석 및 상관 관계를 위한 **보안 정보 및 이벤트 관리(SIEM)** 솔루션과 원활하게 통합할 수 있습니다.
#### 1\. 이벤트 모니터링: 조직의 자가
Salesforce Shield 제품의 일부인 이벤트 모니터링은 Salesforce 조직의 사용자 활동 및 시스템 성능 데이터(Data 360별 작업 포함)를 추적할 수 있는 중앙 허브입니다. 분석을 위해 광범위한 "이벤트"를 로그 파일 및 개체에 수집합니다.
- **Event Log Files(ELF):** 짧은 지연 후(시간별 또는 매일) 다운로드할 수 있는 사용자 활동 및 시스템 이벤트에 대한 세부 사항을 제공합니다. API 또는 이벤트 로그 파일 브라우저를 통해 최대 30일 동안 데이터에 액세스할 수 있으며, 장기 보관을 위해 내보내는 옵션이 있습니다.
- **실시간 이벤트 모니터링:** 즉각적인 인사이트를 위해 실시간 이벤트는 플랫폼 이벤트로 스트리밍되므로 거의 실시간으로 활동을 모니터링하고 감지할 수 있습니다. 이는 보안 및 성능에 매우 중요하므로 필요한 경우 즉시 조치를 취할 수 있습니다.
- **Data 360 특정 이벤트:** 이벤트 모니터링에는 Data 360 페이지 및 데이터와 관련된 Lightning 페이지 보기, Lightning 상호 작용 및 보고 이벤트와 같은 Data 360 사용에 고유한 이벤트 유형이 포함됩니다.
- **외부 도구와의 통합:** Salesforce는 Splunk, Datadog, New Relic, Sumo Logic과 같은 인기 타사 모니터링 솔루션과 원활하게 통합할 수 있습니다. 이벤트 모니터링 데이터를 해당 플랫폼으로 스트리밍하거나 내보내 전체 기술 스택에서 관찰 가능성을 통합할 수 있습니다.
#### 2\. 성능 모니터링 및 최적화
Data 360 구현의 성능을 파악하는 것이 우수한 사용자 환경의 핵심입니다.
- **Lightning 사용 응용 프로그램:** 이 내장형 앱은 Lightning Experience Data 360 페이지에 대해 페이지 로드 시간(기존 페이지 시간 또는 EPT) 및 브라우저 성능과 같은 성능 메트릭의 집계 보기를 제공합니다.
- **사용자 정의 보고서 및 대시보드:** Event Monitoring Plus라는 무료 CRM Analytics 템플릿 기반 앱을 사용하여 Data 360 개체 및 이벤트 모니터링 데이터를 사용하여 사용자 정의 보고서 및 대시보드를 구축할 수 있습니다. 이러한 시각화를 통해 추세를 파악하고 성능 지체 지점을 빠르게 식별할 수 있습니다.
그러나 기술만으로는 충분하지 않습니다. 진정한 복원을 위해서는 자동 감지 및 인적 검토 간의 훈련된 파트너십이 필요합니다. 자동화된 경고는 실시간으로 변칙을 표시할 수 있지만 유효한 사용자가 느리고 무단으로 데이터를 추출하는 등 미세하거나 장기적인 위협은 정기 감사 및 추세 분석을 통해 가장 잘 식별할 수 있습니다.
Salesforce는 Telemetry, 감사 로그, 통합 후크를 제공합니다. 고객은 프로세스 엄격성, 운영 케이던스, 컨텍스트별 인텔리전스를 가져옵니다. 이 모델은 함께 자동화, 분석 및 인적 감독을 결합하여 사고가 발생하기 전에 위협을 감지, 조사, 대응하는 **무세한 방어 모델**을 형성합니다.
### 정보에 근거한 결정: Salesforce Data 360의 보고서, 대시보드, 메트릭, 알림
Salesforce Data 360은 단순히 고객 데이터를 통합하는 것이 아니라 해당 데이터를 지능적이고 실행 가능한 상태로 만드는 것입니다. 이 가치 제안의 핵심 부분은 강력한 보고, 강력한 대시보드, 통찰력 있는 메트릭, 실시간 알림 기능을 제공하는 것입니다. 이러한 도구를 사용하면 고객이 익숙한 Salesforce 환경 내에서 통합 데이터를 기반으로 데이터 상태를 모니터링하고 성능을 추적하고 작업을 자동화할 수 있습니다.
#### 보고서 및 대시보드: 데이터 시각화 허브
Salesforce의 기본 보고 및 대시보드 기능은 Data 360으로 원활하게 확장되므로 플랫폼을 벗어나지 않고 통합 데이터를 시각화하고 분석할 수 있습니다.
#### 통합 데이터에 대한 보고서 작성
다양한 소스의 통합 데이터 및 계산된 인사이트를 포함하여 Data 360에 저장된 데이터에 대한 표준 및 사용자 정의 보고서를 만들 수 있습니다.
- **표준 및 사용자 정의 보고서 유형:** Data 360은 데이터 스트림, 세그먼트, 활성화, ID 확인, 계산된 인사이트와 같은 Data 360 개체에 특별히 적용되는 새 보고서 유형을 도입합니다. 이렇게 하면 표준 Salesforce 보고서 빌더를 사용하여 통합 데이터를 쿼리할 수 있습니다.
- **분자 분석:** 보고서는 최대 10개의 행 그룹화를 지원하므로 고객 특성 및 추세를 세부적으로 세분화하고 분석할 수 있습니다.
- **수식 및 요약:** 행 수준 및 요약 수식을 활용하여 각 레코드 또는 레코드 그룹을 평가하여 단일 보고서 내에서 자세한 메트릭 및 상위 수준 집계 요약을 추적할 수 있습니다.
#### 전체 보기를 위한 동적 대시보드
대시보드는 Data 360 구현 전반의 주요 메트릭 및 추세를 시각적으로 표시합니다.
- **통합 보기:** 단일 대시보드에서 여러 Data 360 보고서의 데이터를 결합하거나 Data 360 보고서를 표준 CRM 보고서와 혼합하여 운영 및 고객 인사이트를 포괄적으로 파악할 수 있습니다.
- **사용자 정의 가능 위젯:** 다양한 차트 유형(바, 선, 원형, 게이지 등) 및 테이블을 사용하여 보고서 데이터를 효과적으로 표시합니다.
- **실시간 인사이트:** 대시보드를 새로 고쳐 최신 정보를 제공하여 신속한 데이터 중심 의사 결정에 도움이 됩니다.
#### 메트릭 및 KPI: 성공 측정
Data 360을 사용하면 비즈니스 목표와 관련된 핵심 성과 지표(KPI)를 정의하고 추적할 수 있습니다. 다음을 통해 생성할 수 있습니다.
- **계산된 인사이트:** 대용량 배치로 처리된 데이터를 사용하여 강력한 메트릭을 만듭니다. 예를 들어, "평균 고객 수명 가치" 또는 "총 활성 계약 매출액"과 같은 메트릭을 계산하고 보고서 및 대시보드에서 치수 또는 측정값으로 사용합니다.
- **스트리밍 인사이트:** 스트리밍 소스의 데이터를 거의 실시간으로 처리하여 웹 사이트 또는 모바일 참여 데이터와 같은 시계열 집계를 구축합니다. 해당 메트릭은 즉각적인 오케스트레이션 및 데이터 작업을 유도할 수 있습니다.
#### 알림 및 경고: 정보 및 사전 예방적 유지
Salesforce는 Data 360 내에서 중요한 이벤트 또는 데이터 변경 사항을 파악할 수 있도록 강력한 자동화 및 알림 기능을 제공합니다.
- **플로 기반 알림:** 프로세스 플로를 설정하여 데이터 스트림, 세그먼트, 활성화와 같은 Data 360 개체의 이벤트를 기반으로 작업을 트리거하고 알림을 보낼 수 있습니다.
- **사용자 정의 경고:** 특정 조건이 충족되면 이메일을 트리거하거나 Salesforce 알림 벨에 표시되는 사용자 정의 알림을 만듭니다. 예를 들어, 데이터 스트림이 실패하거나, ID 확인 규칙에 오류가 발생하거나, 키 메트릭이 특정 임계값을 넘을 경우 경고를 받을 수 있습니다.
- **Event Notification Service(ENS):** 개발자의 경우 API 우선 이벤트 알림 서비스를 사용하면 외부 시스템에서 특정 이벤트가 발생할 경우 알림을 수신할 수 있으므로 기술 스택 전체에서 원활한 통합 및 실시간 반응이 가능합니다.
- **데이터 작업:** 스트리밍 인사이트를 기반으로 웹후크를 통해 알림을 보내거나 플랫폼 이벤트를 호출하거나 다른 SaaS 응용 프로그램과 통합하도록 구성할 수 있는 데이터 작업을 트리거할 수 있습니다.
Salesforce Data 360 고객은 이러한 포괄적인 기능을 활용하여 데이터 에코시스템을 효과적으로 모니터링하고, 주요 메트릭을 시각화하고, 적시에 알림을 수신하여 사전 예방적 참여와 운영 우수성을 높일 수 있습니다.
### 엔터프라이즈 채택을 위한 전략적 권장 사항
엔터프라이즈 규모에서 Salesforce Data 360을 도입하려면 기술적인 활성화 이상이 필요하며, 의도한 보안 우선적인 아키텍처가 필요합니다. 다음 전략적 권장 사항은 CTO 및 엔터프라이즈 아키텍처에게 Data 360 배포의 모든 계층에서 Trust, Resilience 및 Compliance를 구축할 수 있는 로드맵을 제공합니다.
- **“Secure-by-Design” 접근 방식 구현:** 보안은 세분화되지 않아야 하며 기본이어야 합니다. Salesforce의 기본 _"모두 거부"_ 정책으로 시작하고 필요에 따라 명시적으로 액세스 권한을 부여합니다. 데이터를 수집하거나 활성화하기 전에 거버넌스, 정책, 액세스 프레임워크를 정의합니다. 첫날부터 보안을 구축하면 숨겨진 노출 위험을 없애고 장기적인 규정을 간소화할 수 있습니다.
- **강력한 ID 및 액세스 관리(IAM) 전략 적용:** 연합 SSO를 통해 ID를 중앙 집중화하고 다단계 인증(MFA)을 적용하여 자격 증명 저하를 완화합니다. 로그인 IP 범위별로 액세스를 제한하고 Salesforce의 ID 공급자(IdP) 기능을 사용하여 사용자 및 통합 전반에서 종단간 책임을 설정합니다. 통합 IAM 레이어는 운영 복잡성을 줄이고 인증 표면을 강화합니다.
- **최소 권한 원칙 적용 :** 간편함이 아닌 정밀도를 위해 역할을 설계합니다. Salesforce의 표준 권한 집합을 업무 분리 기반으로 사용하여 사용자가 필요한 사항에만 액세스할 수 있도록 합니다. 권한 과도한 사용자 정의 방지 - 각 편차로 서비스 점검 오버헤드와 의도하지 않은 액세스 위험이 증가합니다.
- **다중 계층 데이터 거버넌스 프레임워크 설정:** 데이터 공간을 사용하여 사업부 또는 브랜드별로 데이터를 분리하고 개체, 필드, 레코드 수준 보안(OLS, FLS, RLS)을 사용하여 특성 기반 액세스 제어(ABAC)를 적용합니다. 동적 데이터 마스킹을 사용하여 분석 또는 유용성을 방해하지 않고 실시간으로 민감한 정보를 보호합니다. 이 계층형 모델은 데이터가 도메인 전반에서 확장될 때 거버넌스를 일관적으로 유지합니다.
- **전략적으로 암호화 및 보안 통합 활용:** 중요한 워크로드의 경우 고객 관리 키(CMK)를 사용하여 플랫폼 암호화를 배포하여 암호화 수명 주기 전반에 걸쳐 주체권을 유지합니다. 명명된 자격 증명 및 비공개 연결을 사용하여 모든 시스템 간 통합을 보호하여 하드 코딩된 암호를 제거하고 모든 트래픽이 비공개로 유지되고 규정을 준수하며 감사할 수 있도록 합니다.
- **연속적인 보안 운영 프로그램 구축:** 보안은 구성으로 끝나지 않으며 운영 규칙에 따라 번창합니다. 이벤트 로그 및 액세스 내역을 정기적으로 감사하여 자동 모니터링을 보완합니다. 전용 보안 운영(SecOps) 기능을 구축하여 변칙을 식별하고, 위협을 조사하고, 규정 준수 여부를 검증합니다. 목표: 조기에 감지하고 신속하게 응답하며 지속적으로 자세를 개선합니다.
### 앞으로의 경로: 복원 가능하고 신뢰할 수 있는 Data 360 구축
안전하고 지능적인 엔터프라이즈로의 여정은 배포로 끝나지 않으며, 규칙, 설계, Trust 통해 발전합니다. Salesforce Data 360은 아키텍처 기반을 제공하지만 조직이 보안, 거버넌스, 인텔리전스를 하나의 통합 운동으로 운영할 때 진정한 가치가 나타납니다.
기업은 Data 360을 다른 데이터 플랫폼으로 다루는 것이 아니라 데이터, AI, 고객 참여를 하나의 거버넌스 프레임워크에 연결하는 안전하고 구성 가능한 Trust 레이어로 다루어야 합니다. _안전한 디자인_ 철학을 채택하고 모든 계층에서 최소 권한을 적용하고 모든 데이터 흐름에 대한 개인 연결을 확장함으로써 조직은 규정 준수를 확인란에서 경쟁 우위로 전환합니다.
다음 단계는 감사 자동화, 정책 적용, 암호화 수명 주기 관리를 일상적인 운영에 포함하는 지속적인 현대화입니다. 엔터프라이즈가 에이전트적인 AI 기반 아키텍처로 진화함에 따라 오늘날 데이터를 보호하는 동일한 원칙이 내일 AI 거버넌스의 기초를 형성하므로 모든 모델, 에이전트, 결정이 설계에 따라 설명 가능하고 정책을 인지하며 규정을 준수합니다.
결국 Trust 디지털 변환의 새로운 통화가 됩니다. Salesforce Data 360을 사용하면 모든 바이트, 모든 연결, 모든 인사이트가 무결하게 보호, 관리, 활성화됨을 알고 기업이 데이터 에코시스템을 확장할 수 있습니다.
## 작성자 정보
**Krishna Chalamasandra는** 정보 보안 기술 및 규정 준수 분야에서 25년 이상의 경험을 가진 숙련된 사이버 보안 전문가입니다. Salesforce에서 그는 고객에게 신뢰할 수 있는 자문자이자 CISO 조직 내의 보안 및 규정 준수 고객 Trust 기능의 주요 리더입니다. 이전에는 Krishna가 10년 동안 Cisco에서 IAM, 네트워크 보안, PKI의 보안 아키텍처를 선도하고 ISO 27001, SOC 1–3, PCI, FedRAMP, FIPS 140-2를 비롯한 주요 인증을 실행했습니다. 또한 Novell에서 8년 이상 인프라 수준 제어를 구현하고 규제가 있는 글로벌 고객을 위한 복잡한 보안 검토를 지원했습니다.
**Yugandhar Bora는** Salesforce의 소프트웨어 엔지니어링 아키텍처로, 데이터 및 인텔리전스 애플리케이션 플랫폼 내 데이터 아키텍처를 전문으로 합니다. 그는 데이터 거버넌스 및 통합 데이터 모델에 초점을 맞춘 EARB(Enterprise Architecture Review Board) 이니셔티브를 이끌고 자동화된 플랫폼 프로비저닝 솔루션에 기여합니다.
## 컨텍스트
데이터 플랫폼은 30년 이상 발전해 왔습니다. 처음에는 온 프레미스, 중앙 집중식, 구조화된(주로 관계형) 운영/OLTP 데이터베이스가 산업에 주도했습니다. 이는 주로 분석 처리에 사용되었으며 관계적이고 중앙 집중 상태로 유지된 데이터 웨어하우스 OLAP/Big Data 플랫폼을 포함하도록 확장되었습니다. 클라우드 저장소는 데이터 웨어하우스, 레이크하우스, 분류된 저장소와 같은 분산된 아키텍처를 구동했습니다. 그러나 운영 플랫폼과 분석 플랫폼은 별도로 유지되었습니다. 오늘날 클라우드 컴퓨팅과 AI 혁명은 데이터 플랫폼 아키텍처를 근본적으로 변경하고 있습니다.
엔터프라이즈는 이미 Snowflake, Databricks, BigQuery, Redshift와 같은 성숙한 Big Data 플랫폼에 투자하고 있습니다. 그러나 이러한 플랫폼은 데이터 분산으로 사용됩니다. 고객은 비즈니스 플로 및 응용 프로그램 내에서 직접 데이터에 대한 작업을 수행할 수 없으므로 데이터에서 비즈니스 가치를 도출하지 않습니다. 이러한 솔루션에는 생성형 에이전트 AI 처리가 없고 실시간으로 데이터 액세스를 제공할 수 없으므로 고객 참여 시점 및 기타 업계 최고의 기능에서 AI 중심 개인 설정을 제공할 수 없습니다.
데이터 플랫폼의 미래는 통합, 유연성, 액세스 가능성, 개방형 데이터 인프라스트럭처로 특징이 있습니다. 이 새로운 아키텍처는 GPU, 대용량 메모리, NVMe SSD, 클라우드 저장소 등 최신 계산 및 저장소 추세를 기반으로 구축되어 클라우드 컴퓨팅 및 AI와 통합됩니다. 실시간 인사이트를 제공하고, 자율 의사 결정을 강화하며, 실시간 신청을 구동할 수 있습니다. 여기에는 에이전트 AI, 예측 AI, 분석, 실시간 대규모 OLTP 데이터베이스, 데이터 레이크, 호수의 증가가 포함됩니다. 이러한 최신 데이터 플랫폼은 단순성, 확장성, 민첩성, 성능, 보안, 가용성, 비용 효율성을 위해 설계되었습니다.
### 차세대 데이터 플랫폼 아키텍처의 핵심 추세
다음 데이터 추세는 차세대 데이터 플랫폼 아키텍처를 구동합니다.
- **AI, 기계 학습 및 핵심 분석**: 에이전트 AI의 발전은 데이터 플랫폼 개발, 배포, 사용/액세스를 근본적으로 변경합니다. 에이전트 AI는 대화/쿼리 의도를 이해하고, 워크플로를 계획하고, 생성하고, 의사 결정을 자동화합니다. 에이전트 계획 및 결정, 실시간 대화 모델링, 데이터 플랫폼에서 중요한 개인 설정 지원을 개인 설정하기 위해 에이전트(단기 및 장기) 메모리는 대화 내역에서 구성됩니다. 에이전트는 데이터 거버넌스(예: 보안, 규정 준수, Trust), 성능(예: 동시성, 처리량 및 대기 시간에 대한 자동 확장), 페일오버 및 가용성, 관찰 가능성 및 유지 관리 등 운영 "능력"을 자동화하는 데 도움을 줄 것입니다. AI 기반 분석, 예측, 분석 Q/A용 자연어 처리(NLP), 구조화되지 않은 데이터(PDF, 이미지, 오디오, 비디오와 같은 텍스트)에 대한 분석이 표준 상태가 되므로 기업은 다양한 데이터 소스에서 자세한 인사이트를 파생할 수 있습니다.
- **데이터 분산 하지만 데이터 액세스 통합**: 에이전트는 인사이트를 파생하고 결정을 내리고 비즈니스 활동을 자동화하기 위해 엔터프라이즈 데이터가 필요합니다. 데이터는 엔터프라이즈에서, 서로 다른 응용 프로그램 및 데이터 플랫폼에서 기본적으로 분산됩니다. 그러나 엔터프라이즈 내부 및 엔터프라이즈 외부의 파트너와 서로 다른 사업부에서 사일로를 원활하게 통합하는 것은 쉽지 않습니다. 데이터 통합은 소스에서 데이터를 수집하거나 데이터 소스와 통합하여 데이터를 공유하고, 분석 및 AI 처리를 위한 데이터 준비, 조합 및 모델링의 원시 데이터를 공유하고, CTS가 낮은 수준으로 데이터를 효율적으로 액세스할 수 있도록 대규모로 데이터를 저장하고 관리하며, 다양한 쿼리 및 분석 메커니즘과 도구를 통해 데이터를 액세스하고, 기본 스토리지 및 데이터 액세스 플랫폼과 깊이 통합합니다.
- **Cloud-based Open LakeHouses**: 클라우드 기반 빅 데이터(OLAP) 플랫폼은 오픈 파일 형식(Parquet) 및 테이블 형식(Iceberg)을 채택하여 데이터 연합(데이터 입력) 및 공유(데이터 출력)을 활성화하고 있습니다.
- **비정형 데이터 처리**: 생성형 AI의 출현, 발전, 채택으로 인해 기업은 대용량 텍스트 문서, 오디오 기록, 비디오 녹음, 기타 미디어를 구성하는 데이터의 엔터프라이즈 장부에서 가치 있는 인사이트와 비즈니스 가치를 파생하기 시작합니다. 청크, 벡터화, 시맨틱 검색 및 Knowledge 그래프를 포함한 비정형 데이터 처리는 이러한 통찰력을 가능하게 합니다. RAG(검색 증강 생성) 및 CAG(캐시 증강 생성)와 같은 기술이 데이터의 본문 전체에서 빠르고 에이전트적인 검색의 메인스트림 동인으로 바뀌고 있습니다.
- **Knowledge 관리**: Knowledge 원시 콘텐츠 자체(문서, 기사, 비디오)를 벗어납니다. 이는 의미를 파생하고 메타데이터를 큐레이팅하고 컨텍스트에 배치하여 조직 또는 엔터프라이즈 전반에서 콘텐츠에 대한 공유 이해를 개발하여 해당 콘텐츠의 증가를 나타냅니다. Knowledge 자체는 일반적으로 구조화되어 있습니다. Knowledge 관리에는 컨텐츠 관리, Knowledge 추출, 그래프와 같은 모델을 통한 표현, 탐색이 포함됩니다.
- ** 풍부한 데이터 액세스**: 풍부한 데이터 액세스는 최종 사용자, 비즈니스 사용자, 관리자, 분석가를 비롯한 다양한 페르소나가 데이터, 분석, AI 도구에 액세스할 수 있어야 함을 의미합니다. 액세스 가능성은 앙상블 쿼리(관계, 키워드, 시맨틱 쿼리 포함), 자연어-SQL(NL2SQL) 쿼리, 실시간 액세스 등과 같은 메커니즘을 통해 달성됩니다.
- **실시간 처리**: 에이전트 응용 프로그램은 현재 상태를 기반으로 새로운 이벤트, 개인 설정 응답 및 작업을 기반으로 실시간 결정을 내리며, 이를 통해 실시간 데이터에 액세스, 처리, 조치를 취해야 합니다. 실시간 처리를 위해 최신 데이터(데이터 대기 시간) 및 대화형 액세스(액세스 대기 시간)가 필요합니다. 이러한 데이터 및 액세스 대기 시간에는 기본 데이터 플랫폼이 운영 및 분석 매장에서 최신 데이터 액세스, 낮은 대기 시간 액세스(지점 조회 및 쿼리) 처리, 높은 데이터 규모, 높은 처리량을 지원해야 합니다.
- **데이터 보안, 거버넌스 및 거주**: 에이전트 및 대화형 AI는 응용 프로그램 UI를 간소화하므로 소비자에서 직원, 기타 AI 에이전트에 이르기까지 모든 사람이 음성 또는 서면 자연어를 사용하여 응용 프로그램과 대화식으로 상호 작용할 수 있습니다. 에이전트 응용 프로그램에 대해 저장 및 모델링해야 하는 중요한 고객 및 개인 데이터는 정확하게 정의된 액세스 및 공유 정책을 통해 보호 및 관리해야 합니다. 점점 더 많은 고객이 해당 국가 또는 지역의 데이터 보존을 요구하는 규정을 준수해야 하며, 특히 정부에 속하거나 정부와 작업을 수행하는 고객을 대상으로 합니다.
Salesforce Data 360은 향후 데이터 추세를 해결하기 위해 고안되었습니다. Data 360은 엔터프라이즈 전반에서 사일로 데이터를 통합하여 조직에서 데이터를 저장, 모델링, 처리하여 분석, AI, 기계 학습, 에이전트 응용 프로그램을 활성화할 수 있도록 지원하는 클라우드 네이티브 메타데이터 기반 데이터 플랫폼입니다.
이 문서는 엔터프라이즈 설계자 및 CTO를 위한 필수 가이드입니다. Data 360의 아키텍처, 기능, 설계 원리, 사용 사례를 자세히 설명합니다. Data 360 아키텍처의 기본 사항을 프라이머로 소개한 다음, 다중 조직 전략, 보안, 거버넌스 및 개인 정보 보호, 실시간 활성화, 데이터 정리 룸 등 기존 데이터 플랫폼과의 상호 운용성과 같은 주요 차별화 요소에 대한 일련의 심층 분석을 진행합니다.
## 설계 원칙
Salesforce Data 360은 엔터프라이즈 데이터를 실시간으로 실행하고 신뢰할 수 있도록 하는 핵심 원칙 집합을 기반으로 설계되었습니다.
- **개방성 및 상호 운용성**: 다중 클라우드 에코시스템을 위해 구축됩니다. 중복 없이 Snowflake, Databricks, BigQuery, Redshift와 같은 데이터 플랫폼을 통합하여 기존 투자를 유지하면서 Customer 360 확장합니다.
- **스토리지-계산 분리**: 스토리지 및 처리(배치, 스트리밍, 대화형)를 독립적으로 확장합니다. 대용량 고성능 워크로드에 유연성과 효율성을 제공합니다.
- **다중 모델 스토리지 및 처리**: 텍스트, 이미지 오디오, 비디오와 같은 구조화된 다양한 비정형 데이터 유형을 지원합니다. 효율적인 저장소, 실시간 및 배치 처리, 확장 가능한 색인화, 통합 검색, 쿼리 및 분석을 제공합니다.
- **메타데이터 중심 설계**: 응용 프로그램은 코드가 아닌 메타데이터로 정의됩니다. 메타데이터는 최상위 자산으로 취급되므로 Salesforce Platform에 통합된 거버넌스, 유연성, 심층 통합이 가능합니다.
- **실시간 하이브리드 프로세싱**: 일괄 처리 및 분석 워크로드와 함께 대기 시간이 낮은 쿼리 및 즉각적인 의사 결정을 지원합니다.
- **인텔리전트 및 액티브 데이터**: 지속적으로 인사이트를 수집, 분석하고 비즈니스 워크플로에 직접 푸시합니다. 최신 컨텍스트를 사용하여 코드 없음, 하위 코드, 프로 코드, AI 중심 자동화를 지원합니다.
- **설계를 통한 거버넌스 및 개인 정보 보호**: 계보, 액세스 제어, 보존, 데이터 암호화, 규정 준수가 내장되어 있습니다. 모든 계층에서 Trust 및 규제 신뢰가 강화됩니다.
- **일대다 테넌시**: 중앙 집중식 Data 360 조직은 Customer 360 신뢰할 수 있는 단일 소스로 작동하며, Salesforce 고객이 광범위하게 사용하는 다중 조직 Salesforce 환경을 원활하게 지원합니다.
이러한 원칙은 Data 360이 데이터를 실시간으로 열고 지능적으로 실행할 수 있도록 합니다.
### 원칙에서 기능으로 이동
Salesforce Data 360은 현재 데이터 추세를 해결하는 설계 원칙을 기반으로 구축된 최신 데이터 플랫폼입니다. 아키텍처 기능을 통해 엔터프라이즈 데이터가 신뢰할 수 있고 통합되며 안내 원칙에 따라 실시간으로 실행할 수 있습니다.
- **Cloud-Native Foundation**: 변경할 수 없는 마이크로서비스 기반 인프라가 있는 Hyperforce 실행되며, AWS와 같은 Hypercaler에 배포됩니다. 탄력적인 확장, 제로 Trust 보안, 지속적인 제공, 글로벌 규정 준수 제공
- **Salesforce(핵심) 메타데이터 기반**: 메타데이터는 모든 Salesforce 응용 프로그램에서 즉시 사용할 수 있도록 설계, 모델링, Salesforce 메타데이터로 저장됩니다. 해당 메타데이터는 완전히 ACID 준수 RDBMS에 저장됩니다. 거버넌스, 수명 주기 일관성, Salesforce Lightning Platform과의 깊은 통합을 보장합니다.
- **레이크하우스 저장소**: 스키마 진화, 시간 이동, 대용량 업데이트를 지원하는 창고 거버넌스와 데이터 레이크 규모를 결합하는 아파치 아이세버그 및 Parquet에 구축됩니다. Data 360은 최신 개방형 표준을 사용하는 대규모 저장소와 배치 및 이벤트 중심 워크로드에 대한 풍부한 변환 및 데이터 처리 기능을 사용하여 구조화 및 비정형 데이터를 저장, 모델, 처리합니다.
- **유연한 수집이 가능한 엔드 투 엔드 데이터 파이프라인**: 수집, 준비, 모델링, 통합, 분석, 활성화와 같은 전체 수명 주기를 포함하여 분할된 포인트 솔루션에 대한 의존도를 줄입니다. 배치, 거의 실시간, 270개 이상의 커넥터 및 MuleSoft를 사용하여 스트리밍을 지원합니다. ELT 우선 접근 방식은 다운스트림 변환 유연성과 함께 빠른 데이터 가용성을 제공합니다.
- **Open frameworks 및 Federation과 엔터프라이즈 데이터 상호 운용성**: Snowflake, Databricks, BigQuery, Redshift를 사용하여 양방향 Zero Copy 연합을 사용하여 엔터프라이즈 전반에 걸쳐 실로 데이터를 통합하여 데이터 마이그레이션 또는 중복을 방지합니다.
- **데이터 분류, 모델링 및 조직**: Data 360은 데이터를 원시 수집 데이터, 정리 및 저장된 데이터, SSOT(단일 신뢰 소스)라고 하는 일반적인 정보 스키마에 따라 모델링된 데이터로 구성합니다. 이러한 SSOT 개체는 SDM(시맨틱 데이터 모델) 및 기타 큐레이팅된 응용 프로그램별 모델을 정의하는 기반입니다.
- 개방형 시맨틱 쿼리 API를 사용하여 확장 가능한 분석을 위한 **내장형 시맨틱 데이터 모델링**, Tableau Next를 구동하고 애플리케이션별 분석을 활성화합니다.
- 구조화된 데이터, 비정형 데이터 및 그래프 데이터에서 통합된 Data 360 SQL 쿼리를 지원하는 **고성능 SQL 쿼리 엔진**입니다.
- **낮은 대기 시간 데이터 저장소**: 응답 시간이 밀리초인 핫 데이터의 키 값 저장소입니다. 실시간으로 개인 설정 및 이벤트 중심 시나리오를 활성화합니다. 고객 참여 데이터를 실시간으로 수집하고 처리합니다. ID, 상호 작용 및 대화를 신뢰할 수 있는 단일 Customer 360 프로필 및 컨텍스트 그래프로 통합합니다.
- 비정형 데이터 저장, 청크, 내장형 생성(벡터화), 메타데이터 추출(확대), 요약, 인덱싱, Knowledge 추출, 지능형 문서 처리, 단기 및 장기(대화) 메모리 생성 등을 위한 유연하고 확장 가능한 지원을 위한 **비정형 데이터 처리 파이프라인**입니다.
- 빠른 검색 및 에이전트 검색, RAG, Knowledge 추출, 에이전트 메모리 파생 등과 같은 정확하고 효율적인 비정형 데이터 액세스를 위한 **네이티브 키워드, 벡터 및 하이브리드 인덱싱**
- AI/ML 및 Agenttic 애플리케이션을 활성화하기 위한 **프로필, 개인 설정, 컨텍스트 서비스**
- 계보 추적, 데이터 마스킹, 데이터 보존, 규정 준수 및 Trust 보증을 위한 모든 계층의 **내장형 거버넌스 및 보안**
- **Elastic Compute Fabric**: Kubernetes 기본 다중 테넌트 계산 패브릭입니다. 배포된 처리용 Spark 및 SQL 워크로드용 하이퍼를 실행합니다. 다양한 작업에서 유연하게 확장하고 신뢰할 수 없는 코드를 실행할 수 있는 격리를 지원합니다.
모든 작업은 Salesforce의 클라우드 파운데이션인 Hyperforce 실행됩니다. Hyperforce 다음을 제공합니다.
- 암호화, 격리 및 최소 권한 정책이 포함된 **Zero Trust 보안**
- 다중 지역 배포를 통한 **복구성** Salesforce Data 360은 Hyperforce 다중 지역 복원 및 플랫폼 수준 오류 허용 기능을 활용할 수 있지만, 진정한 엔터프라이즈급 재해 복구(DR)에는 모든 종속된 에코시스템 전반에서 재생 가능한 수집 파이프라인, 복제, 메타데이터 구동 재활용과 같은 주요 기능을 갖춘 모든 데이터 플랫폼과 유사한 더 광범위한 아키텍처가 필요합니다.
- 내장된 모니터링, 메트릭 및 추적 기능을 갖춘 **관찰 가능성**
- **자동 조정 및 FinOps 인지도**를 통해 비용 과도 없이 효율성 향상
Data 360은 기존 엔터프라이즈 투자를 대체하지 않습니다. 대신 Data 360은 이미 신뢰하고 관리하고 실행 가능한 데이터를 만들어 가장 중요한 위치에서 실시간으로 AI 중심 참여를 제공합니다. 단, Salesforce는 외부 데이터를 포함한 모든 엔터프라이즈 데이터를 (Salesforce) 메타데이터 구동 개체로 전환하고 에이전트 응용 프로그램을 활성화하여 검색, 의사 결정, 조치를 취합니다.
다음 그림은 Data 360 참조 아키텍처를 보여줍니다.
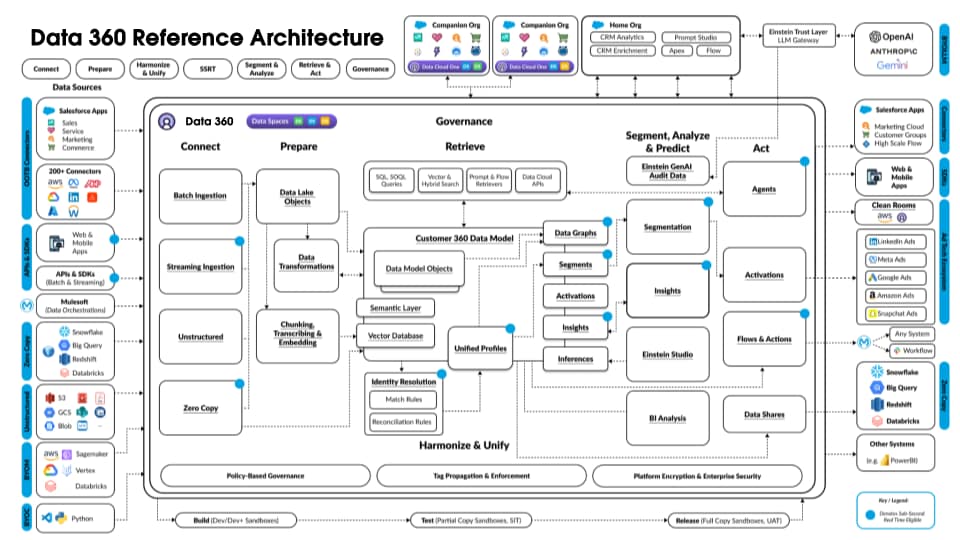 Data 360에 계층화된 가정적인 Agentforce Loan Agent를 고려하여 예제 아키텍처 흐름을 설명해 보겠습니다. 대출 에이전트가 고객(소비자)이 대출을 신청하고 즉시 대출 승인을 받을 수 있는 고객 대면 에이전트라고 가정해 보겠습니다.
Data 360은 해당 단계를 예약된 대로 수행하여 대출 에이전트가 사용할 데이터를 준비합니다.
- Data 360은 CRM에서 구조화된 고객 계정 데이터를 수집하고 데이터 레이크에 저장합니다.
- Data 360은 비정형 회사 대출 및 재무 증권 데이터를 처리합니다.
- Data 360은 Snowflake와 같은 외부 데이터 소스의 개인 데이터를 연합합니다.
- Data 360은 수집 및 연합 데이터를 변환하고 모델링합니다.
- Data 360은 프로필 데이터 그래프를 구축하고 유지합니다.
고객이 대출을 신청할 때마다 다음 작업이 수행됩니다.
- 고객이 대출 에이전트에 로그인하면 고객 세션이 실시간 레이어로 시작됩니다. 고객의 통합 프로필이 실시간 레이어로 가져옵니다.
- 고객이 필수 정보를 제공하여 대출 신청을 완료합니다.
- 고객이 비정형 데이터 처리를 위해 세금 반환, 투자, 은행 내역서와 같은 금융 문서를 Data 360에 업로드합니다.
- 업로드된 데이터는 청크되고 벡터화됩니다(포함 생성), 색인(키워드 및 벡터)이 생성됩니다.
- 그런 다음, 고객이 대출 신청 문서를 작성하고 업로드합니다. Data 360은 대출 금액 및 기간을 실시간으로 추출합니다.
- 대출 에이전트는 Data 360 쿼리 및 프로필 및 기타 사전 생성된 색인에서 하이브리드 검색을 사용하여 관련 금융 데이터를 검색합니다.
- 대출 에이전트가 대출 데이터 및 기타 금융 프로필 데이터를 사용하여 승인 에이전트를 활성화하여 대출 승인 결정을 내립니다.
- 대출 에이전트가 결정으로 고객에게 응답합니다.
- 고객과 대출 에이전트 간의 전체 상호 작용도 Data 360에 수집 및 저장됩니다.
위 예에서는 대출 에이전트와 같은 에이전트 응용 프로그램을 구축하는 데 사용되는 Data 360 아키텍처 구성 요소의 개요를 제공합니다. 다음 섹션에서는 Data 360 아키텍처 계층 및 구성 요소에 대해 설명합니다.
## Data 360 아키텍처
이 섹션에서는 Salesforce Data 360의 기본 빌딩 블록을 자세히 살펴보고, 견고한 스토리지 모델부터 이후에 데이터 연결, 수집, 준비 메커니즘을 살펴봅니다. 그런 다음, 구조화된 데이터와 비정형 데이터가 어떻게 저장되고, 모델링되고, 처리되는지 살펴보고, 조합, 통합, 검색 및 지능형 활성화 기능을 이해할 수 있습니다.
### Data 360 저장소
Salesforce Data 360은 레이크하우스의 강점과 실시간 저장소를 결합하는 계층화된 통합형 스토리지 모델을 기반으로 구축됩니다. 레이크하우스 레이어는 대량의 내역 및 배치 데이터에 확장 가능한 비용 효율적인 저장소를 제공하므로 고급 분석 및 기계 학습 사용 사례를 지원합니다. 반면 실시간 저장소는 대기 시간이 낮은 액세스 및 고주기 업데이트에 최적화되어 고객 상호 작용, 프로필, 참여 신호가 항상 최신 상태로 유지됩니다. 이러한 계층은 함께 원활하게 작동하므로 데이터가 내역 및 실시간 컨텍스트 간에 원활하게 이동하여 개인 설정, AI, 활성화를 위한 통합 데이터 파운데이션에서 심도와 즉각성을 모두 제공할 수 있습니다.
#### 레이크하우스
Data 360은 AI 및 분석 응용 프로그램에 매우 중요한 구조화된 데이터와 비정형 데이터를 모두 지원하는 배치, 스트리밍, 실시간 시나리오의 대규모 데이터 관리 및 처리를 처리하도록 설계된 Iceberg/Parquet 기반의 네이티브 레이크하우스 아키텍처를 갖추고 있습니다.
Azure, AWS 또는 GCP와 같은 클라우드 기반 데이터 레이크에서 기본 저장소는 일반적으로 폴더 및 계층으로 구성된 파일입니다. Lakehouse는 쿼리 및 AI/ML 처리와 같은 작업을 쉽게 수행할 수 있도록 더 높은 수준의 구조적 및 의미적 추상화를 도입하여 이 구조를 강화합니다. 기본 추상은 구조 및 의미론을 정의하는 메타데이터가 포함된 테이블이며, Data 360에서 추가 의미론 레이어를 추가하여 아이세버그 또는 델타 레이크와 같은 오픈 소스 프로젝트의 요소를 통합합니다.
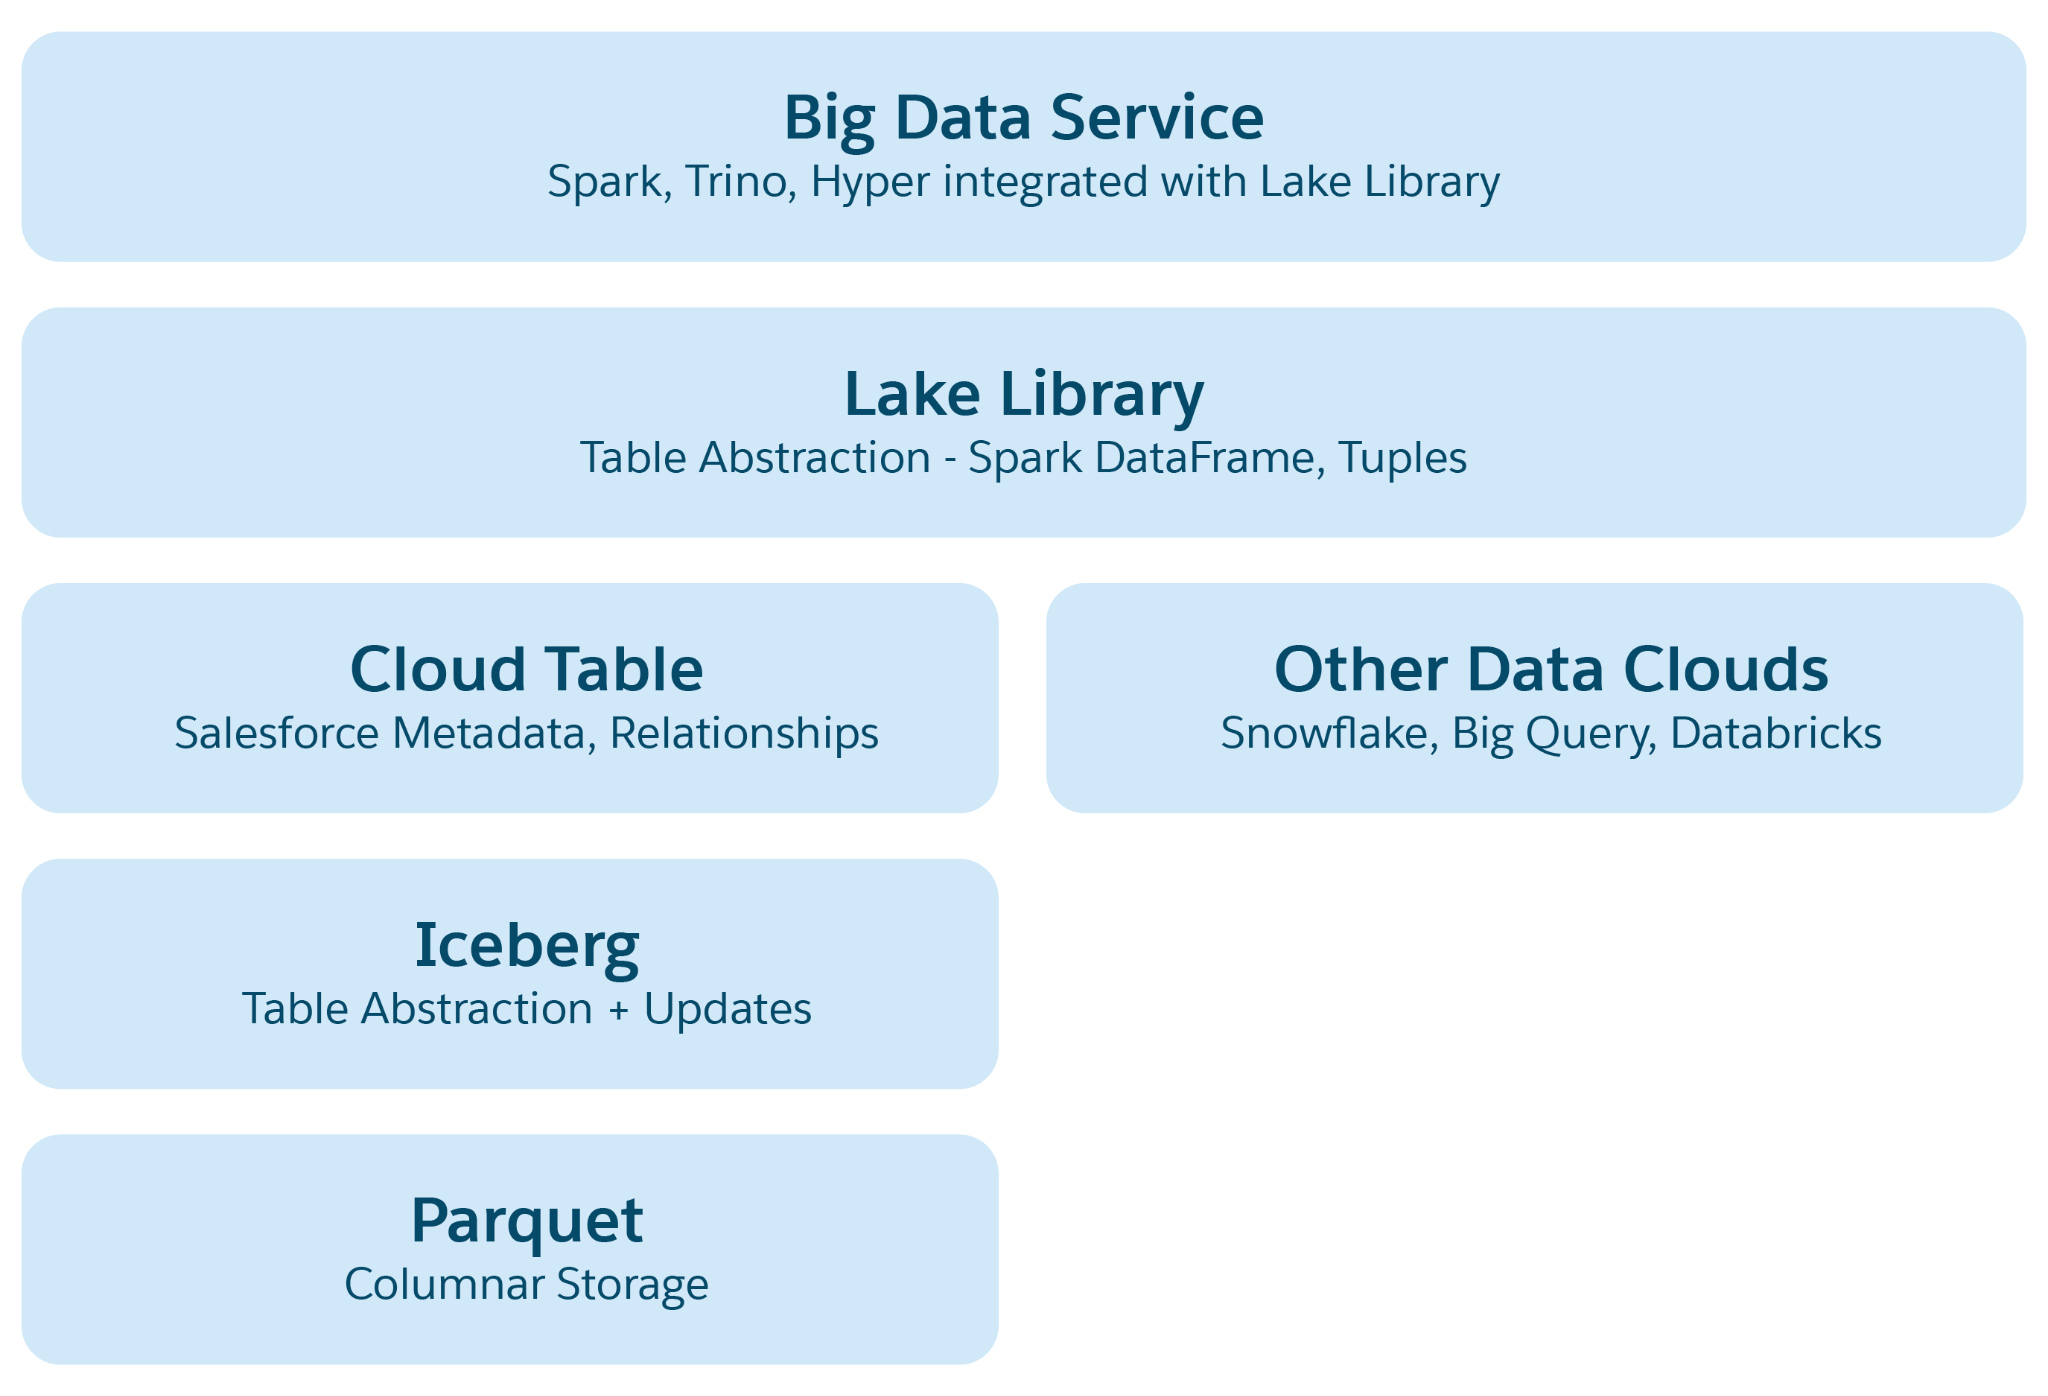 레이크하우스의 추상 레이어:
1. **Parquet 파일 요약**: 기본적으로 저장소는 Parquet 형식의 데이터 레이크 파일(예: AWS의 S3 또는 Azure의 Blob)으로 구성됩니다. 소스 테이블의 데이터는 여러 파티션에서 Parquet 파일로 저장되며, 각 테이블은 해당 파일의 모음입니다.
2. **Iceberg Table Abstraction**: 테이블은 폴더로 구성되며, 데이터 파티션은 해당 폴더 내에 Parquet 파일로 저장됩니다. 파티션을 수정하면 새 Parquet 파일이 스냅샷으로 표시됩니다. Iceberg는 스키마, 파티션 사양, 스냅샷을 자세히 설명하는 각 테이블의 메타데이터 파일을 관리합니다.
3. **Salesforce Cloud 테이블 요약**: 이 레이어는 아이스버그에서 구축되며, 대상 파일 크기 및 압축과 같은 구성과 함께 열 이름 및 관계와 같은 의미 있는 메타데이터를 추가합니다. Snowflake 및 Databricks와 같은 다양한 플랫폼에서 테이블을 추상화하여 기본 스토리지 플랫폼 세부 사항으로부터 Data 360 응용 프로그램을 보호합니다.
4. **레이크 액세스 도서관**: 이 라이브러리는 Salesforce Cloud 테이블에 대한 액세스 권한을 제공하며, 데이터와 메타데이터를 모두 처리하고 응용 프로그램 개발자의 기본 저장 메커니즘을 추상합니다.
5. **Big Data Service Abstraction**: 여기에는 쿼리용 하이퍼와 같은 처리 프레임워크 및 모든 클라우드 테이블 플랫폼에서 처리하는 Spark가 포함됩니다.
#### 실시간 저장소
실시간 분석 및 에이전트 응용 프로그램을 지원하기 위해 Data 360은 레이크하우스의 대용량 데이터 저장소를 낮은 대기 시간 저장소로 늘립니다. Data 360 실시간 레이어는 메모리에서 실시간 신호 및 참여 데이터를 처리합니다. 그러나 메모리 기반 저장 용량이 제한되어 모든 데이터가 적합하지 않으며 실시간으로 처리를 수행할 수 없습니다. Data 360은 이러한 제한 사항을 제거하기 위해 낮은 대기 시간 저장소(LLS)를 추가하여 확장 가능한 실시간 처리를 활성화합니다.
저 대기 시간 저장소는 레이크하우스의 페타바이트 규모 NVMe(SSD) 저장소 계층입니다. 일부 데이터는 저 대기 시간 저장소에 보관할 필요가 없습니다. 견고한 캐시입니다. 대부분의 데이터는 결국 Lakehouse로 이동하여 장기간 유지됩니다. 실시간 레이어의 세션 내 데이터는 후속 빠른 액세스를 위해 저 대기 시간 저장소로 플러시할 수 있습니다. 예를 들어 에이전트 대화에서 메모리에 최근 메시지를 처리할 수 있으며, 오래된 메시지는 저 대기 시간 저장소로 플러시할 수 있습니다. 이전 대화가 필요한 경우 저 대기 시간 매장에서 몇 밀리초 이내에 액세스할 수 있습니다. NVMe 기반 저장소를 사용하면 대량의 데이터를 밀리초 대기 시간으로 저장하고 액세스할 수 있습니다. 데이터는 Lakehouse 클라우드 저장소로 이동하여 장기간 유지될 수 있습니다. 또한 실시간 처리에 필요한 레이크하우스의 데이터 또는 실시간 경험을 늘리기 위해 필요한 데이터가 가져와 저지연 매장에 보관됩니다. 예를 들어 고객 프로필 컨텍스트가 미리 가져오거나 레이크하우스에서 가져와 지연 시간이 낮은 매장에 캐시됩니다. 또한 세션 내 처리 시 실시간 처리에 필요한 레이크하우스 개체 및 기타 개체는 저 대기 시간 저장소에서도 캐시할 수 있습니다.
Data 360 낮은 대기 시간 저장소는 데이터가 해당 레이어 간에 원활하게 마이그레이션되는 메모리(SSD) 레이크하우스 저장소 레이어를 사용하는 실제 저장소 계층의 실시간 타이머 레이어를 활성화합니다. 이 문서에서는 나중에 Data 360 실시간 레이어에 대해 설명합니다.
### 데이터 조직
Salesforce Data 360은 원시 입력을 통합된 현재 데이터 모델로 전환하는 엄격한 수명 주기에 따라 모든 고객 데이터(정형 및 비정형)를 표준화, 조화, 활성화하도록 설계되었습니다.
#### 데이터 수명 주기 및 개체 유형
수명 주기는 다양한 외부 데이터 입력을 가져오고 모델링된 영구 개체로 구조화하는 데 중점을 둡니다. 모델링된 데이터를 Customer 360 통합 프로파일로 조화할 수 있습니다.
**초고 수집 데이터 및 초기 변형**
프로세스는 소스 시스템(CRM, 마케팅, 파일 등)에서 그대로 수집된 원시 데이터로 시작합니다. 전체 데이터 로드 및 지속적인 변경 이벤트(델타)가 포함되며, 현재 상태를 유지하기 위해 영구 데이터와 관리 및 병합됩니다.
**인라인 변환**(예: 트림, 정규화, 연결)은 수집 중에 즉시 적용되어 예비 데이터 품질과 순결을 보장합니다.
##### 데이터 레이크 개체(DLO): 영구 레이어
**DLO**(데이터 레이크 개체)는 Data 360 내의 핵심 영구 저장 계층을 구성합니다. 깨끗하고 변환된 데이터를 저장하고 모든 고객 정보를 위한 구성된 장기 리포지토리로 사용합니다.
소스 DLO에 **고급 데이터 변환**(예: 조인, 집계, 계산된 인사이트)이 적용되어 새로 고도로 큐레이팅된 파생 DLO를 생성합니다.
Zero Copy 데이터 연합을 통해 사용할 수 있도록 지정된 데이터는 DLO로 직접 표시됩니다.
**비정형 데이터 및 메타데이터 조직**
구조화되지 않은 콘텐츠(텍스트, 미디어, 문서)의 경우 Data 360은 구조화되지 않은 데이터 레이크 개체(UDLO)라는 특정 DLO 내에서 구조화된 메타데이터를 추출하고 유지하여 데이터를 통합합니다.
이러한 전문화된 DLO는 디렉터리 테이블로 작동하여 구조화되지 않은 자산의 실제 위치 및 컨텍스트에 대한 지도를 제공합니다. 이 기능을 사용하면 아키텍처가 구조화되지 않은 데이터의 메타데이터를 구조화된 고객 데이터의 나머지 데이터와 원활하게 연결하여 통합 쿼리 및 조합 가능합니다.
##### 데이터 모델 개체(DMO): 조화된 레이어
**DMO**(데이터 모델 객체)는 최종, 조화된 구조화된 데이터 레이어를 나타냅니다.
이 필드는 소스, 파생 및 비정형 메타데이터 DLO의 DLO 필드를 표준 Customer 360 데이터 모델에 매핑하여 생성됩니다.
DMO 레이어는 모든 고객 데이터에 대한 신뢰할 수 있는 단일 소스로 작동하여 광범위한 에코시스템 전반에서 통합 프로필 생성, 세분화, 활성화를 지원합니다.
#### 데이터 공간: 논리 컨테이너
데이터 공간은 모든 DLO(정형 및 비정형) 및 DMO를 포함하여 Data 360 내의 모든 데이터 및 메타데이터를 구성하기 위한 기본 논리 컨테이너입니다. 데이터 공간은 데이터 처리 및 모델링을 위한 안전하고 분리된 환경을 제공합니다.
데이터 공간은 논리적 경계와 거버넌스 경계 역할을 하며, 비즈니스 단위, 지역 또는 브랜드와 같은 고유한 엔티티에 대한 데이터를 분리하여 내부 다중 자산을 가능하게 하며, 엔터프라이즈 전체의 가시성, 계보, 규정 준수를 유지하면서 대규모 세분화된 액세스 제어를 정의하는 기반이 됩니다.
데이터 공간 내의 격리는 플랫폼의 여러 계층에 적용됩니다.
- **데이터 레벨 격리**: 각 DLO/DMO는 단일 데이터 공간에 속하므로 쿼리, 변환, 개체 매핑이 명시적으로 승인되지 않는 한 데이터 공간 경계를 넘을 수 없습니다.
- **액세스 제어 통합**: 권한 집합은 기본적으로 데이터 공간에 연결되어 있어 읽기, 쓰기, 관리 작업을 제어할 수 있습니다. 이렇게 하면 권한이 있는 사용자 및 서비스만 데이터 공간 내의 개체, 인사이트, 활성화에 액세스할 수 있습니다.
- **거버넌스 및 감사**: 데이터 공간 내의 모든 작업은 엔터프라이즈급 감사 추적을 사용하여 기록되므로 규정 준수, 관리, 규제 보고에 대한 추적 가능성이 활성화됩니다.
권한 집합을 통해 액세스 및 권한이 관리되어 세부적인 가시성, 제어 업데이트, 교차 도메인 데이터 누출 방지를 보장합니다. 데이터 공간 경계를 Data 360의 보안 및 거버넌스 아키텍처와 통합함으로써 설계자는 여러 클라우드 및 비즈니스 도메인에서 일관성을 유지하면서 중앙 집중식 및 분산형 거버넌스 전략을 모두 확신할 수 있습니다.
#### 패브릭 계산
Data 360 계산 패브릭은 모든 주요 데이터 작업 부하를 관리하고 실행할 수 있는 통합된 계층을 제공하여 기본 인프라 복잡성을 간소화합니다. 핵심 구성 요소는 데이터 처리 컨트롤러(DPC)입니다.
DPC는 다양한 클라우드 컴퓨팅 환경에서 Job-as-a-Service(JaS) 기능을 제공하는 포괄적인 다중 작업 부하 데이터 처리 오케스트레이션 서비스입니다. 이는 인프라 복잡성을 추상하고 Spark(EC2의 EMR 및 EKS의 EMR) 및 Kubernetes 리소스 컨트롤러(KRC) 워크로드와 같은 프레임워크에 대한 작업 실행을 통합합니다. 중앙 집중식 제어 플레인 게이트웨이로 사용되므로 DPC는 여러 데이터 플레인에서 작업을 오케스트레이션, 예약 및 모니터링하여 신뢰성, 확장성, 비용 효율성, 일관된 개발자 환경을 보장합니다.
DPC의 필요성은 EMR과 같은 기본 클러스터 관리 시스템과 직접 상호 작용하는 제한으로 인해 발생합니다.
##### 인프라 및 클라우드 추상
EMR은 클러스터, 과업 및 단계에 대한 API를 제공하지만, 프로비저닝, 확장, 성능 조정, 비용 최적화와 같은 중요한 인프라 관리 과업을 클라이언트 팀에 부담으로 합니다. DPC는 작업 제출을 위한 간소화된 플랫폼 수준 API를 제공하여 이를 해결합니다. 자동 오류 처리, 재시도, 동적 로드 밸런싱을 지원합니다. 빈팩, 스팟 및 Graviton 기반 노드를 통해 비용 효율성을 제공합니다. TLS, PKI, IAM 격리 및 자동 패치를 통해 강력한 보안을 제공합니다. 성능 향상, 보안 패치 및 기능 향상을 제공하기 위해 Spark 및 EMR 런타임 버전 업그레이드를 관리합니다.
또한 DPC는 데이터 작업을 제출하고 관리할 수 있는 클라우드와 무관한 통합 인터페이스를 제공하며, 기본 클라우드 기반의 복잡성과 독점 API(AWS, future provider)를 추상화합니다. 이렇게 하면 클라이언트 팀이 Kubernetes 및 YARN과 같은 기본 리소스 관리자의 복잡성을 추상하는 공통 Data 360 API 기반 작업 제출 인터페이스와만 상호 작용할 수 있습니다. 이렇게 하면 클라이언트 팀이 팟, 노드 풀 또는 Spark 클러스터 구성을 직접 관리할 필요 없이 간단하고 통합된 API를 통해 Spark 작업을 제출할 수 있습니다.
수동으로 Spark 매개 변수를 조정하려면 전문 기술이 필요하며, 잘못된 구성으로 인해 작업 실행이 느려질 수 있습니다. DPC 팀은 이 전문 지식을 중앙 집중화하여 일반적인 성능 문제를 방지하기 위한 최적화된 구성을 제공합니다. 이 전문 팀은 컨트롤러가 관리하는 모든 작업 부하에서 최적의 성능을 보장하기 위해 오픈 소스 커뮤니티의 Knowledge 지속적으로 통합합니다.
DPC는 Spark로 제한되지 않으며 광범위한 워크로드 배열을 지원합니다. 다음은 포함됩니다.
- 실시간 처리 워크로드
- 데이터 작업에 대한 이벤트 배달 기능
- Milvus 관리(구형화되지 않은 데이터 색인화를 위한 벡터 데이터베이스)
- 저 대기 시간 스토리지 인프라
DPC는 또한 **Kubernetes 리소스 컨트롤러(KRC)** 프레임워크를 활용하여 Trino for Query, Event Delivery for Data Actions, Data Extraction Jobs for Connectors, 실시간 처리와 같은 워크로드를 지원합니다. 모든 KRC 워크로드에 대해 DPC는 중앙 Job-as-a-Service 기능을 제공하며, 고급 작업 추상에서 컴퓨팅 프로비저닝, 배포, 관리를 처리합니다.
##### JaaS 혜택 및 아키텍처
DPC에서 제공하는 Job-as-a-Service 모델은 비용 효율적이고 복원성이 뛰어난 작업 처리 파이프라인을 보장합니다.
사용자는 클러스터 일치에 필요한 CPU, 메모리, 저장소, 인스턴스 수, 최소/최대 클러스터 수 및 태그에 초점을 맞춘 간단한 클러스터 사양을 제공합니다. 그러면 DPC가 최적의 VM SKU 선택, 인스턴스 플리트 관리, 핵심 대비 비율 결정 등 추상 인프라 세부 사항을 자동으로 관리합니다. 과업 노드 및 주문형 관리 vs. 입력을 기반으로 인스턴스를 찾습니다. 또한 가동 중지 시간 없이 EMR 및 구성 요소 버전 관리 및 업그레이드를 처리합니다.
중요한 점은 DPC가 기본적으로 Data 360 테넌시 경계 및 자원 분리를 이해하고 적용하도록 설계된 멀티테넌스를 지원합니다. 또한 Salesforce 인증 기계 이미지를 적용하고 서비스별 IAM 역할을 관리하며 운송 중 및 유휴 중 모두 암호화를 보장하여 보안 및 규정 준수를 보장합니다. 라우팅 및 수용력 제어의 경우 클러스터 태그를 사용하여 작업-클러스터 일치가 관리되고 수용력 기반 라우팅은 최대 작업 동시 설정을 사용하여 자원 활용도를 효과적으로 제어합니다.
클라우드 무시적 클라이언트 환경은 클라이언트 서비스에서 기본 클라우드 환경의 복잡성을 숨기므로 비즈니스 논리에만 집중할 수 있으므로 핵심적인 이점입니다. 이를 통해 클라우드 공급자 추상화의 목표를 달성할 수 있습니다. 마지막으로 DPC를 사용하면 사용량 및 비용을 쉽게 추적할 수 있으므로 클러스터 사용량 및 비용을 서비스별로 세분화하여 정확한 계산을 수행할 수 있습니다. 전체적으로 DPC는 플러그 가능한 아키텍처를 따르므로 새로운 실행 엔진(예: Flink, Ray) 및 클라우드 기반(GKE/Dataproc)을 사용자에게 기본 인프라 세부 사항을 노출하지 않고 원활하게 통합할 수 있습니다. 이 설계는 실행 계층에서 제어 플레인을 분리하여 백엔드와 상관없이 일관된 API 및 운영 환경을 보장합니다.
### Data 360의 데이터 처리: 원시에서 실천 가능한 상태로 변경
Data 360은 원시 데이터를 세분화하고 보강하여 원시 정보와 실천 가능한 비즈니스 소비 사이의 격차를 줄입니다. 정교한 활성화 및 분석을 위해 복잡한 데이터를 준비하여 데이터 개체 수명 주기를 보완합니다. Data 360은 배치 및 스트리밍 데이터 변환, 배치 및 스트리밍 계산된 인사이트, 비정형 데이터 처리, ID 확인 등 다양한 처리 유형을 지원합니다. 특히 대규모 데이터 집합에서 거의 실시간으로 다양한 작업을 효율적으로 수행하려면 데이터 변경 사항을 효과적으로 처리하는 정교한 메커니즘이 필요합니다.
#### 증분 처리 지원
특히 테라바이트 크기의 테이블과 수백만 개의 잠재적인 업데이트를 사용하여 거의 실시간으로 효율적인 데이터 처리를 수행하려면 Data 360에 혁신적인 작업이 필요했습니다. 데이터가 변경될 때 정확하게 시스템에 알림을 보내고 관련 업데이트만 업데이트될 때만 처리되도록 변경된 데이터를 효율적으로 식별해야 했습니다. 이 과제로 인해 다음과 같은 두 가지 혁신이 보완되었습니다. 변경 사항이 발생하면 알리는 기본 변경 이벤트(SNCE)를 저장하고 변경된 사항을 식별하는 데이터 피드(CDF)를 저장합니다.
##### 저장소 네이티브 변경 이벤트(SNCE)
SNCE는 Data 360을 반응형 증분 데이터 플랫폼으로 근본적으로 변경했습니다. 이 교대 근무는 표준화된 이벤트 형식 및 고처리량 메시지 전달 시스템을 사용하여 데이터 레이크의 적극적인 폴링에서 원자 커밋 이벤트를 수동으로 모니터링하는 것으로 전환됩니다.
Iceberg 테이블에 대해 성공적으로 쓰기 작업(삽입, 업데이트, 삭제)을 수행하면 카탈로그에서 테이블의 현재 메타데이터 파일 포인터를 원자로 교체할 수 있습니다. 기본 개체 저장소 계층(S3)은 테이블의 디렉터리에 새 메타데이터 스냅샷이 작성될 때마다 S3 이벤트와 같은 기본 알림 이벤트를 전송하도록 구성됩니다.
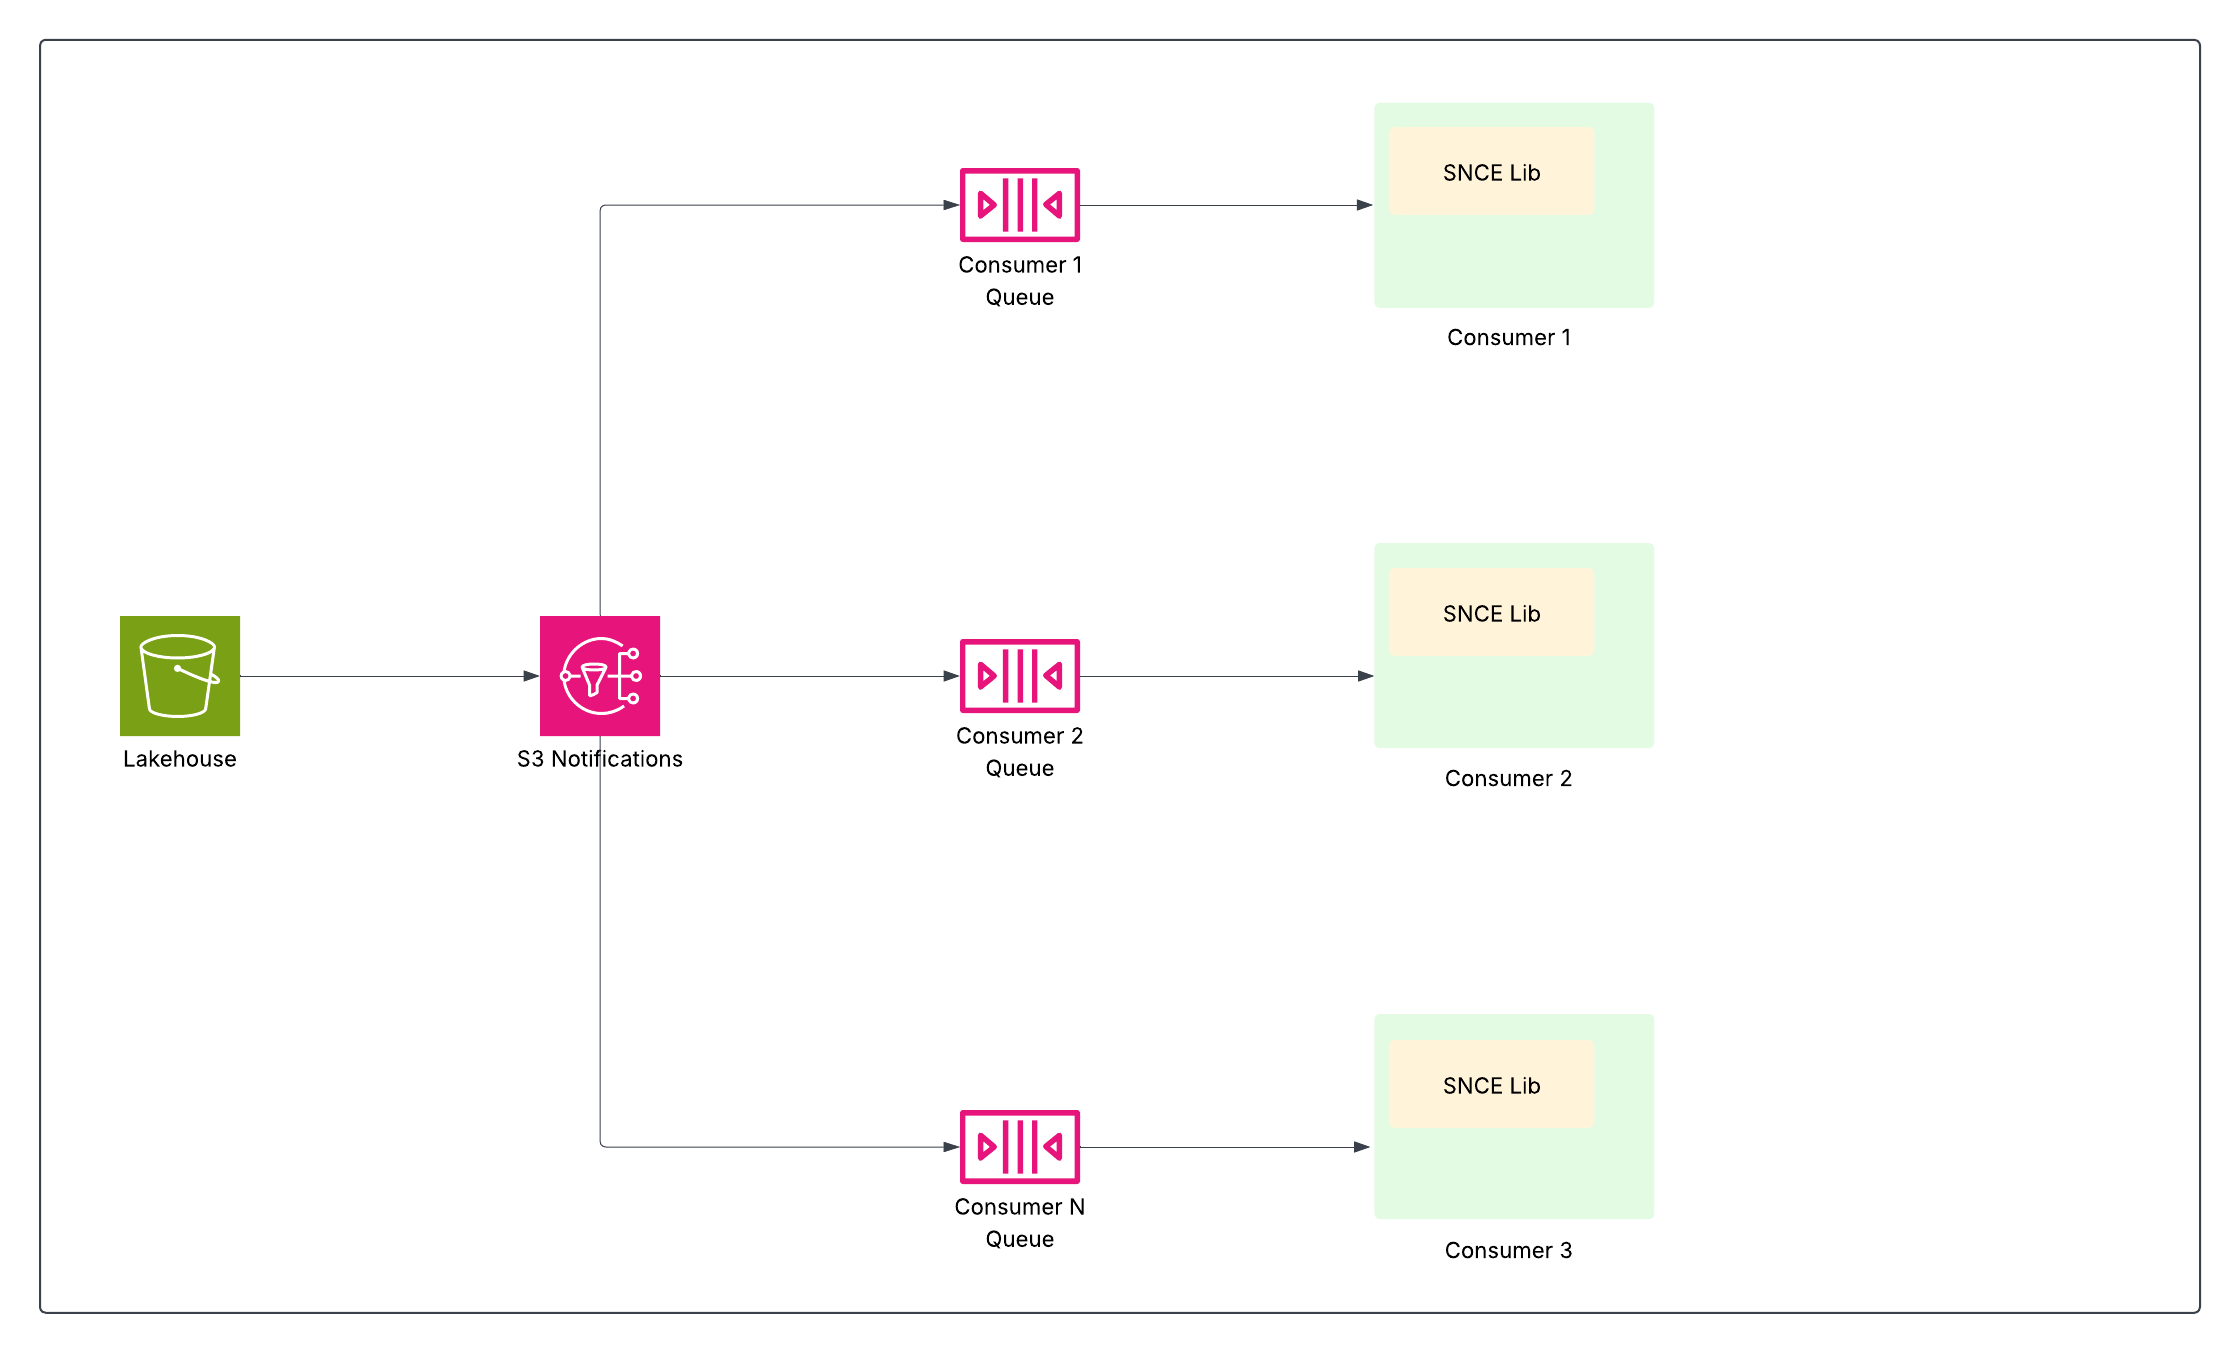 SNCE 라이브러리는 해당 이벤트를 사용하기 위한 표준화된 방법을 제공하며 요청 시 스냅샷 메타데이터로 보강할 수도 있습니다.
이렇게 하면 다운스트림 데이터 파이프라인(스트리밍 계산된 인사이트, ID 확인, 세분화 등)이 데이터가 변경된 경우에만 구독하고 조치를 취할 수 있으므로 비용이 많이 드는 전체 테이블 스캔을 피하여 효율성을 크게 높일 수 있습니다.
##### 데이터 피드 변경(CDF)
SNCE를 기반으로 하는 변경 데이터 피드(CDF)는 변경 사항을 소비하고 증분적으로 처리하는 간소화된 메커니즘을 제공합니다.
CDF는 Iceberg 스냅샷을 활용하여 변경 사항 스트림을 효율적으로 생성합니다. 중요한 점은 Data 360의 최적화된 아이스버그 작성기가 쓰기 작업 자체의 일부로 변경 사항을 계산하고 유지하므로 CDF 생성이 매우 효율적이고 추가 오버헤드가 최소화됩니다. 이렇게 하면 처리 작업(스트리밍 변환 또는 스트리밍 계산된 인사이트 등)이 변경된 레코드만 선택적으로 처리하여 비용이 많이 드는 스냅샷 다름 계산을 피할 수 있습니다.
이 증분 전략은 비용 절감, 대기 시간 단축, 효율성 향상 등 대규모 데이터 집합에 몇 가지 이점을 제공합니다. 스트리밍 변환 및 증분 ID 확인과 같은 기능을 활성화하여 더 빠른 인사이트, 더 예측 가능한 시스템 로드, 향상된 성능, 운영 비용을 줄일 수 있습니다.
### 연결, 수집, 준비
Data 360은 Salesforce 제품에 대한 기본 지원과 함께 강력한 수집 기능을 제공하여 원활한 데이터 흐름을 보장합니다. 외부 소스의 경우 270개가 넘는 커넥터, API, SDK, MuleSoft를 통해 광범위한 연결을 제공합니다. 또한 Data 360은 0-copy 연합을 사용하므로 데이터 중복 없이 BI 및 분석을 수행할 수 있습니다.
#### Data 360 커넥터 프레임워크
Data 360 커넥터 프레임워크(DCF)는 대부분의 Data 360 연결을 위한 기반입니다. 통합 아키텍처를 통해 수집, 연합, 추출을 활성화합니다. DCF는 설정 및 관리용 UI에서 메타데이터 지속성, 데이터 추출, 레이크하우스로 전달 또는 외부 소스에 대한 실시간 쿼리를 통해 커넥터 구축 및 관리에 대한 표준을 정의합니다. 또한 비공개 링크, VPN, 보안 터널 등 비공개 연결 옵션을 지원하여 고객 또는 파트너 환경에 연결할 때 엔터프라이즈급 데이터 보안 및 규정 준수를 보장합니다. 모든 커넥터에서 일관된 접근 방식을 제공함으로써 DCF는 확장성, 신뢰성, 안전한 통합을 보장하여 Data 360을 더 광범위한 에코시스템에 원활하게 연결할 수 있도록 지원합니다.
#### Data 360 커넥터
Data 360은 광범위한 데이터 소스 에코시스템에 강력한 연결을 제공하며 네이티브 Salesforce 제품과 다양한 외부 시스템을 모두 지원합니다. 이 광범위한 연결은 사일로 엔터프라이즈 데이터를 통합하고 AI/ML 및 에이전트 응용 프로그램을 활성화하는 데 매우 중요합니다.
Data 360은 MuleSoft, API, SDK를 통해 또는 기본적으로 270개가 넘는 커넥터를 제공하여 배치, 스트리밍 또는 실시간 수집을 통해 종단간 데이터 파이프라인 기능을 지원합니다. 이러한 커넥터는 통합하는 소스 시스템 유형별로 광범위하게 범주화할 수 있습니다.
**Salesforce 기본 커넥터**
이러한 커넥터는 Salesforce 제품의 원활한 기본 데이터 흐름을 보장합니다.
Salesforce CRM, Data Cloud One, Marketing Cloud Engagement, Marketing Cloud Account Engagement, B2C Commerce의 커넥터를 예로 들 수 있습니다.
**외부 애플리케이션 및 SaaS**
다양한 비즈니스 응용 프로그램 및 클라우드 서비스의 커넥터를 사용하면 외부 소프트웨어 플랫폼에서 데이터를 수집할 수 있습니다.
예를 들어 Adobe Marketo Engage, Microsoft Dynamics 365, Mailchimp, Airtable이 있습니다.
**데이터베이스 및 데이터 웨어하우스**
Data 360은 다양한 관계형 및 클라우드 기반 데이터 저장소 플랫폼에 연결됩니다.
예로는 Amazon Redshift, Amazon DynamoDB, Amazon RDS(MySQL, PostgreSQL, Oracle), Google BigQuery, Microsoft SQL Server가 있습니다.
**클라우드 개체 저장소 및 파일 시스템**
이러한 커넥터는 구조화된 데이터와 비정형 데이터 모두를 위한 대규모 스토리지 솔루션과 통합됩니다.
예로는 Amazon S3, Google Cloud Storage(GCS), Azure Blob Storage가 있습니다.
**스트리밍 및 메시징 서비스**
연속 실시간 데이터 스트림을 처리하는 커넥터는 이벤트 중심 시나리오 및 실시간 처리에 매우 중요합니다.
Amazon Kinesis 커넥터를 예로 들 수 있습니다.
**통합 플랫폼**
MuleSoft Anypoint 커넥터는 Anypoint Exchange를 통해 더 광범위한 응용 프로그램 및 데이터베이스와 Data 360의 도달 범위를 확장합니다.
**비정형 데이터 및 클라우드 개체 저장소 커넥터**
이러한 커넥터는 생성형 AI 기능을 강화하기 위해 구조화되지 않은 데이터(사전 정의된 모델이 없는 데이터)를 수집하고 참조하는 데 중요합니다.
모든 커넥터는 일관된 환경을 제공하는 Data 360 커넥터 프레임워크에 구축되어 있습니다.
#### 데이터 변환
데이터 변환은 Data 360의 기본 아키텍처 구성 요소로, 원시 수집된 데이터를 정리, 보강하고 Customer 360 데이터 모델에 맞춰 정규화된 실행 가능한 데이터 자산으로 형성하도록 설계되었습니다. 이 프로세스는 데이터 조합, 품질 향상 및 프로필 통합, 세분화 및 활성화와 같은 다운스트림 사용 사례에 대한 데이터 준비가 필수적입니다. 변환은 소스 데이터 레이크 개체(DLO) 및 데이터 모델 개체(DMO)를 모두 입력으로 활용하여 각각 새로운 DLO 또는 DMO에 대한 결과를 생성합니다.
Data 360은 서로 다른 데이터 속도 요구 사항인 배치 데이터 변환 및 스트리밍 데이터 변환을 해결하기 위한 두 가지 기본 변환 패러다임을 제공합니다.
##### 배치 데이터 변환
배치 데이터 변환은 정의된 일정 또는 주문형 트리거를 기반으로 대용량 처리를 위해 고안되었습니다. 이 엔진은 복잡하고 자원 집약적인 재구축 작업을 처리하기 위해 최적화되어 있습니다.
배치 변환 프로세스는 사용자가 다단계 변환 논리를 정의할 수 있는 시각적 하위 코드 파이프라인 캔버스를 사용하여 구성됩니다. 이 엔진은 정규 데이터 모델 정렬에 중요한 복잡한 재구성 작업(데이터 구조화 및 정규화)을 고유하게 지원합니다. 여기에는 피벗(비정규화된 레코드를 여러 정규화된 레코드로 분해) 및 평면화(JSON과 같은 계층적 데이터를 구조화된 테이블로 재구축)가 포함됩니다. 시스템의 실행 모드는 전체 동기화(모든 레코드 처리) 및 고효율 증분 처리 모드를 모두 지원합니다. 증분 모드는 마지막으로 성공적으로 실행된 이후에 변경된 레코드만 처리하여 처리 시간과 리소스 소비를 크게 줄입니다. 배치 변환은 정기적 집계 및 복잡한 데이터 재구축과 같이 실시간 업데이트가 필수적이지 않은 과업에 적합합니다.
##### 데이터 변환 스트리밍
스트리밍 데이터 변환은 시스템에 흐르는 동안 거의 실시간으로 데이터를 지속적으로 증분적으로 처리하므로 대기 시간이 낮은 사용 사례에 필수적으로 적용됩니다.
기본 인터페이스는 변환이 수신되는 레코드 변경 스트림에 대해 지속적으로 실행되는 SQL SELECT 쿼리로 정의되는 SQL 우선 접근 방식입니다. 이 엔진은 데이터 정리 및 표준화(예: PII 확인 및 데이터 형식 표준화) 및 데이터 보강 및 병합(조인 및 조인 사용) 등 핵심 변환 기능을 지원합니다. 중요하게 스트리밍 조회 JOIN을 지원하여 정적 또는 느리게 변경되는 참조 데이터에 대한 실시간 데이터 보강 및 조회를 활성화하여 즉시 프로필 업데이트를 보장합니다. 서비스 비용을 최적화하기 위해 아키텍처는 단일 테넌트에 대한 여러 스트리밍 변환 정의를 단일 기본 컴퓨팅 작업으로 패키징하는 고밀도(HD) 작업 설계를 사용하여 자원 활용도를 극대화합니다. 스트리밍 변환은 이벤트 모니터링, 즉각적인 개인 설정, 실시간 프로필 업데이트와 같은 사용 사례에 필수적입니다.
### 데이터 연합 및 데이터 공유 제로 카피
Data 360은 Zero Copy 연합 및 데이터 공유를 지원하여 데이터 관리를 혁신화하므로 데이터를 이동하거나 복제할 필요가 없습니다. 이 기능을 사용하면 사용자가 다양한 외부 소스에서 데이터에 원활하게 직접 액세스하고 외부 환경과 데이터를 공유하여 복잡성을 크게 줄이고 저장소 비용을 절감하며 모든 결정을 최신의 신뢰할 수 있는 정보를 기반으로 합니다.
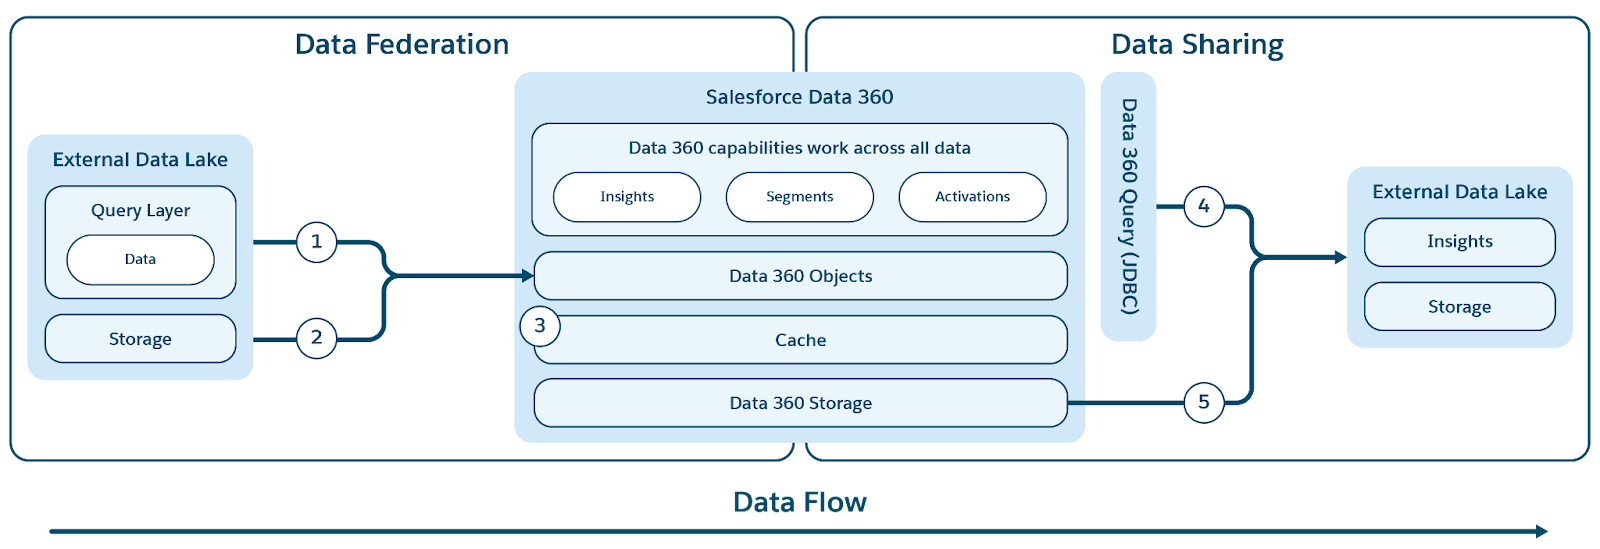 #### 데이터 연합
Data 360은 외부 데이터 웨어하우스(Snowflake, Redshift), 레이크하우스(Google BigQuery, Databricks, Azure Fabric), SQL 데이터베이스 및 기타 여러 소스와 함께 0-copy 연합을 지원합니다. 추상 레이어를 사용하면 중복 없이 외부 데이터를 직접 쿼리할 수 있으므로 수집 시간과 저장소 비용을 줄이고 최신 정보를 확보할 수 있습니다.
Data 360은 Salesforce 및 외부 개체를 모두 추상하는 통합 메타데이터 레이어를 제공하여 외부 및 연합 데이터에 대한 액세스를 간소화합니다. 이렇게 하면 전체 Salesforce Platform 및 응용 프로그램이 이 데이터를 원활하게 사용할 수 있습니다.
Data 360은 파일 및 쿼리 기반 연합을 모두 지원하며, 그림에 표시된 대로 실시간 쿼리 및 액세스 가속화가 가능합니다.
레이블(1) 및(2)은 외부 데이터 레이크/웨어하우스/데이터 소스에서 데이터에 액세스하기 위한 Data 360의 쿼리(실시간 쿼리 푸시다운 포함) 및 파일 기반 연합을 보여주며, 레이블(3)은 외부 데이터 레이크/데이터 소스에서 연합된 액세스 가속화를 강조합니다.
##### 쿼리 연합
Data 360의 연합 기능의 핵심은 외부 데이터에 액세스하고 지능형 쿼리 푸시다운을 수행하는 복잡한 프로세스를 관리하는 쿼리 연합 계층에 있습니다( 레이블 1에 표시). Data 360은 효율성을 향상하기 위해 추가 논리로 향상된 JDBC 프로토콜을 사용하여 소스에서 데이터를 연결하고 검색합니다. 쿼리 연합 계층은 다양한 SQL 방언을 이해하고 번역하고 최적의 쿼리 부분을 외부 시스템으로 푸시하여 효율적으로 처리하고 결과를 검색하고 최종 인사이트를 도출하기 위해 필요한 모든 추가 처리를 수행할 책임이 있습니다.
###### 캐싱(쿼리 가속화)
고급 유틸리티의 경우 Data 360은 연합 기능에 대한 가속 기능(옵션)을 제공합니다.
Acceleration이 활성화되면 Data 360이 연합 데이터를 캐시하여 외부 소스에 대한 반복적인 직접 액세스를 방지하여 더 빠른 액세스 및 비용을 절감합니다. 이 캐시는 가속화 레이어로 취급되며 외부 소스 데이터의 변경 사항을 빠르게 반영하도록 증분적으로 업데이트되므로 가속 보기가 실시간에 가깝게 유지됩니다.
##### 파일 통합
Data 360은 외부 데이터 레이크 및 소스의 데이터에 액세스하기 위한 파일 기반 연합(레이블 2로 표시)을 지원합니다. 이 제로 카피 기능의 기술적 기반은 표준화에 의존합니다. 기본 데이터는 Apache Parquet 파일 형식이어야 하며 Apache Iceberg 테이블 형식을 사용해야 합니다. Data 360은 메타데이터 및 저장소 액세스를 위해 IRC(Iceberg REST Catalog)를 노출하는 모든 소스로 연합하여 플랫폼 외부에 있는 파일에 원활하고 관리되는 액세스를 보장할 수 있습니다.
파일 기반 연합을 사용하면 Data 360 컴퓨팅이 기본 저장소에 직접 액세스하므로 모든 데이터 처리를 처리합니다. 이렇게 하면 쿼리 기반 연합에 종종 필요한 다양한 SQL 방언을 쿼리 푸시다운하고 관리할 필요가 없습니다.
또한 Zero Copy 기능은 Data 360의 비정형 처리 파이프라인에서 액세스할 수 있는 대규모 스토리지 솔루션(S3/GCS/Azure 스토리지), Slack 및 Google Drive 등 비정형 데이터 소스에도 확장됩니다.
#### 데이터 공유
Data 360은 원래 그림 컨텍스트에서 레이블 4 및 5로 표시된 외부 데이터 레이크 및 창고와 관리하는 데이터의 쿼리 기반 및 파일 기반 공유를 쉽게 수행합니다.
##### 쿼리 기반 공유
쿼리 기반 데이터 공유의 경우 Data 360은 데이터에 대한 보안 액세스를 얻을 수 있는 외부 엔진 및 응용 프로그램을 사용하여 JDBC 드라이버를 노출합니다. 이 메커니즘을 사용하면 외부 시스템이 Data 360 내의 데이터에 대해 직접 실시간 쿼리를 연결, 인증, 실행할 수 있습니다.
##### 파일 기반 공유(데이터 공유 및 DaaS)
파일 기반 공유를 위한 기본 메커니즘은 DaaS(Data as a Service) API를 활용하는 두 가지 개념인 데이터 공유 및 데이터 공유 대상을 포함합니다.
- 세분화된 제어: 데이터 공유 개념을 사용하면 고객이 외부에서 공유되는 개체(DLO, DMO, CIO 등)를 정확하게 정의하여 의도하지 않은 데이터 노출을 방지할 수 있습니다.
- 보안 대상: 또한 데이터 공유 대상을 제어하여 명시적으로 승인된 외부 환경, 계정 또는 파트너 조직(예: 특정 Redshift 또는 Databricks 인스턴스와 공유)만 데이터를 사용할 수 있도록 합니다.
DaaS API는 외부 엔진이 데이터를 소비할 수 있도록 안전하고 관리되는 인터페이스를 제공합니다. 모든 Data 360 시맨틱을 유지하면서 필수 메타데이터 및 기본 테이블 저장소에 대한 액세스 권한을 부여합니다. 이렇게 하면 외부 엔진이 일관되고 의미 있는 컨텍스트에서 안전한 방식으로 데이터에 액세스할 수 있습니다.
### 비공개 연결
특히 대기업, 규제된 산업, 공공 부문 조직 등 많은 보안에 민감한 고객이 보안 조치의 일부로 데이터 레이크에 대한 모든 인터넷 액세스를 제한합니다. 이 정책은 규정 준수 및 위험 감소에 필수적이지만 Salesforce Data 360 및 Agentforce 공개 인터넷을 통해 해당 환경에 연결되지 않도록 방지합니다.
대부분의 데이터 레이크는 AWS, Azure 또는 Google Cloud와 같은 하이퍼스케일러 환경에 배포됩니다. Data 360 자체가 AWS에서 실행되므로 다른 클라우드 공급자에서 호스팅되는 고객 데이터 레이크에 액세스하려면 클라우드 간 네트워크 연결이 필요합니다. 공개 인터넷을 우회하는 안전한 비공개 연결 옵션이 없으면 고객이 이러한 데이터 레이크에 의존하는 사용 사례에 Data 360 또는 Agentforce 채택할 수 없거나 원하지 않는 경우가 많습니다.
#### 비공개 링크
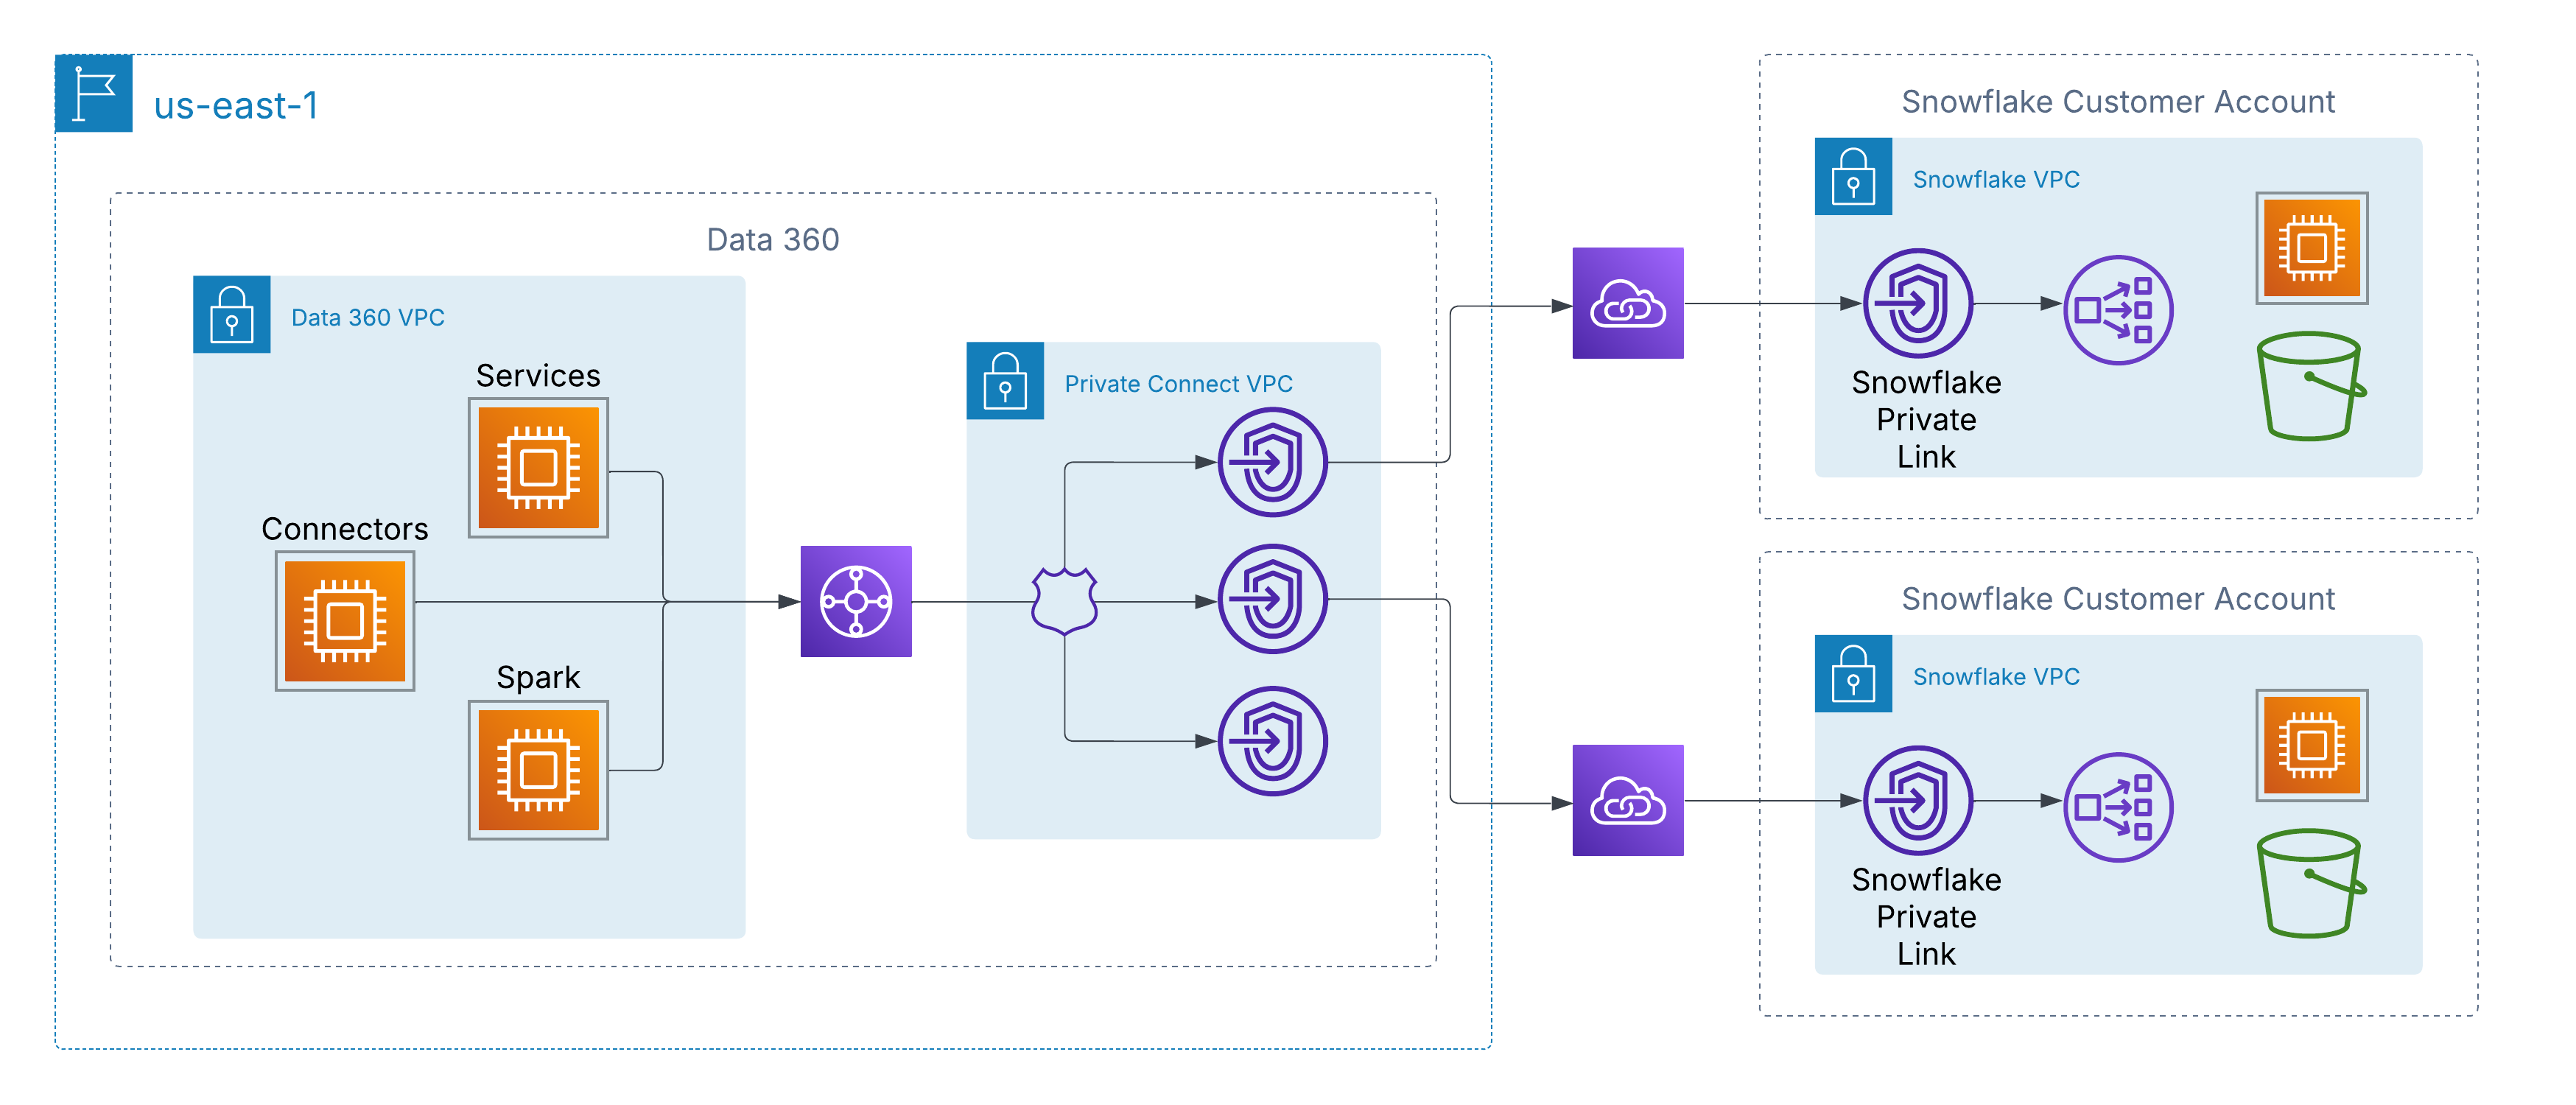 이를 해결하기 위해 Data 360은 클라우드 전반에서 고객이 관리하는 데이터 소스에 대한 비공개 네트워크 수준 연결을 지원합니다. AWS에서는 AWS PrivateLink를 통해 활성화되며, 이를 통해 Data 360은 공개 인터넷을 이동하지 않고 자체 계정 또는 타사 데이터 레이크 환경(예: Snowflake) 내에서 고객 프로비저닝 끝점에 직접 연결할 수 있습니다.
이 아키텍처는 비공개 IP 주소 지정 및 라우팅할 수 없는 네트워크 경로를 사용하여 모든 트래픽이 AWS 백본에 남아 있어 엄격한 보안 및 규정 준수 요구 사항을 충족하며 고객 데이터에 원활하게 액세스할 수 있도록 합니다.
#### 비공개 상호 연결
다중 클라우드 아키텍처를 사용하는 고객의 경우 Data 360은 클라우드 간 상호 연결 지원을 통해 AWS 이상의 비공개 연결을 확장합니다. 이를 통해 Data 360에서 Azure 또는 Google Cloud에서 호스팅되는 데이터 레이크 및 서비스로의 보안 백본 전용 네트워크 경로를 활성화하고 AWS PrivateLink와 동일한 원칙(비공개 IP 주소 지정, 비공개 라우팅, 인터넷 노출 제로)을 유지할 수 있습니다.
고객은 두 가지 배포 모델 중에서 선택할 수 있습니다.
- **고객 관리형 상호 연결**: Azure ExpressRoute, Google Cloud Interconnect 또는 Equinix Fabric과 같은 기존의 비공개 회로를 Data 360의 VPC와 직접 통합합니다.
- **Salesforce 관리형 상호 연결**: Salesforce가 클라우드 간 링크를 프로비저닝하고 운영하는 완전 관리형 턴키 연결을 사용하여 대상 클라우드에 비공개 끝점을 노출합니다.
두 모델 모두 환경이 일관적입니다. Data 360 서비스는 하이퍼스케일러를 통해 로컬처럼 외부 데이터 소스에 연결하여 공개 인터넷을 이동하지 않고도 안전하게 수집, 활성화, 쿼리를 수행할 수 있습니다.
### Data 360의 데이터 거버넌스: Trust 및 제어 기반
엔터프라이즈 아키텍처의 경우 강력한 데이터 거버넌스는 단순히 규정 준수 확인란이 아니라 신뢰할 수 있고 확장 가능하며 실행 가능한 고객 인텔리전스 구축하는 기본 기둥입니다. Salesforce Data 360은 전체 데이터 수명 주기 전반에 걸쳐 데이터 품질, 보안, 규제 요구 사항 준수를 보장하는 포괄적인 거버넌스 프레임워크로 구성되어 있습니다.
Data 360은 중앙 집중화된 거버넌스 허브 역할을 하므로 원시 수집에서 활성화된 인사이트까지 모든 데이터가 무결하고 제어적으로 관리됩니다.
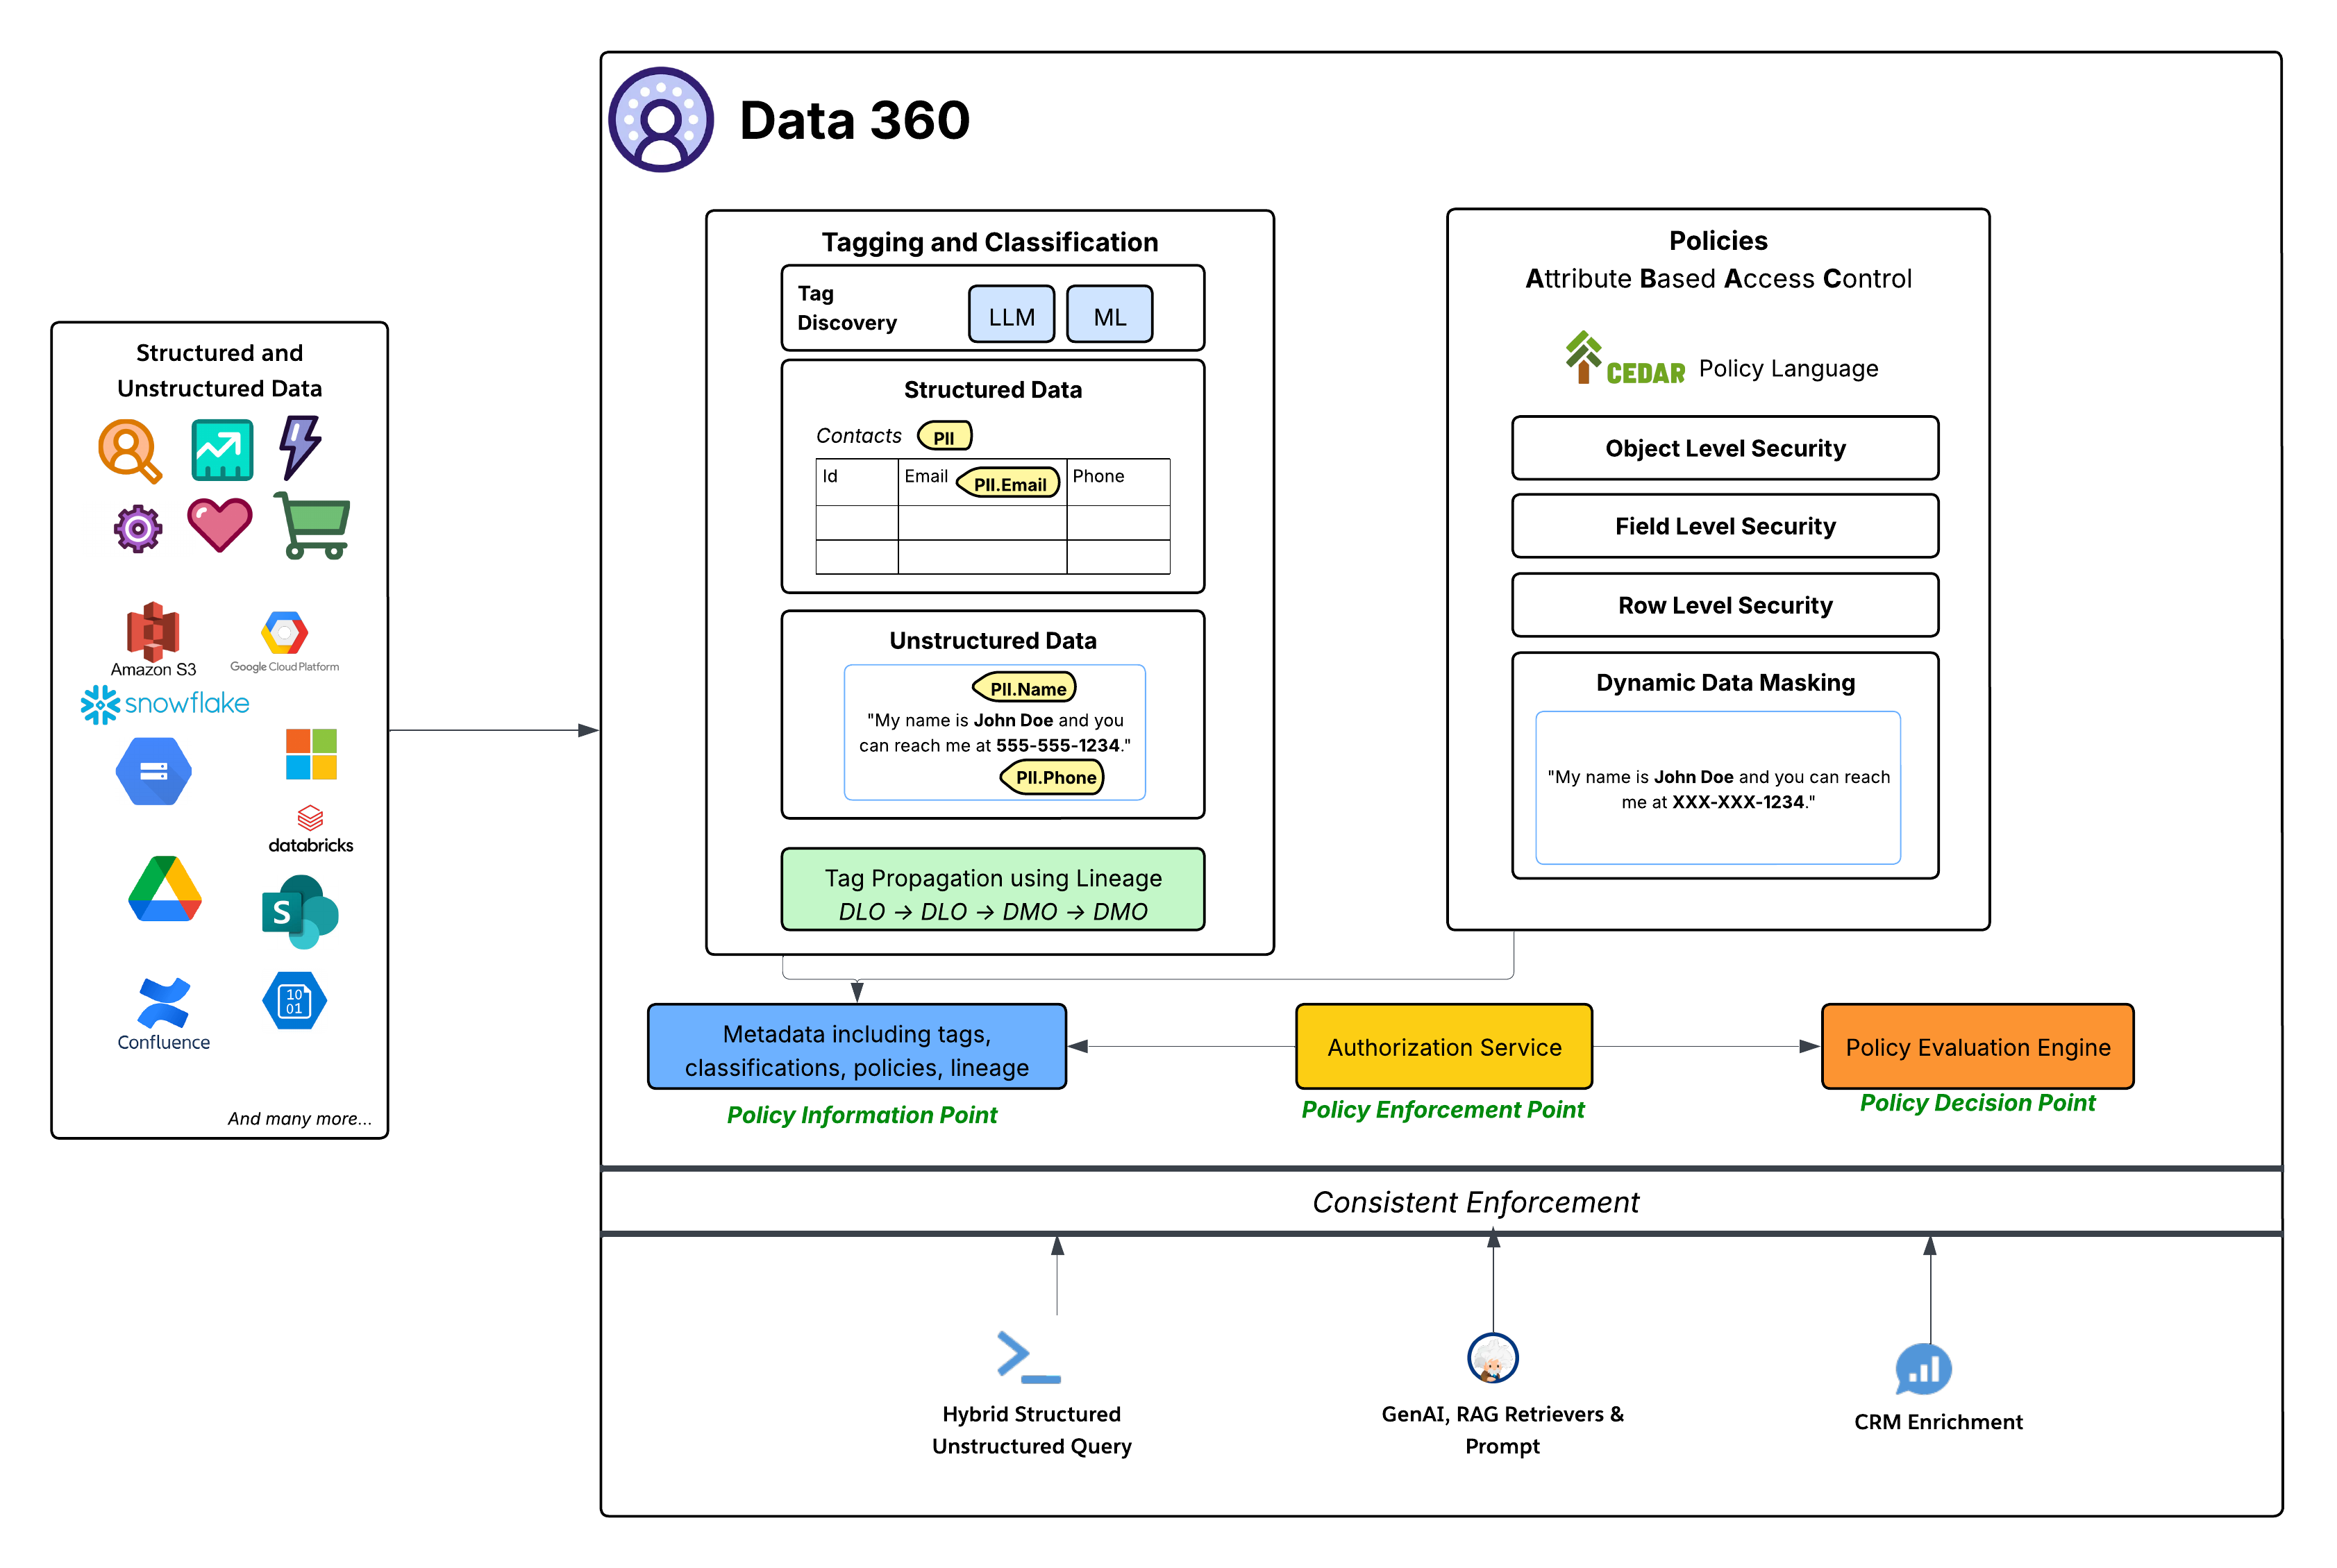 #### 고급 액세스 제어: 특성 기반 액세스 제어(ABAC)
데이터 공간은 데이터 공간 내의 모든 개체에 대한 액세스 권한을 결정하는 대규모 세분화된 액세스 제어를 제공하지만 ABAC 기반 정책은 데이터 공간 내의 개별 개체, 필드 및 행에 대한 정밀 세분화된 액세스 제어를 제공합니다. Data 360은 세분화된 액세스 제어를 위한 핵심 권한 부여 모델로 특성 기반 액세스 제어(ABAC)를 채택했습니다. 이 전략적 선택은 대용량 데이터와 다양한 액세스 요구 사항이 있는 동적이고 복잡한 엔터프라이즈 환경에서 특히 중요한 기존 RBAC(역할 기반 액세스 제어)와 비교하여 탁월한 유연성과 확장성을 제공합니다. ABAC를 사용하면 미리 정의된 역할이 아닌 사용자의 특성(예: 부서, 역할, 위치), 데이터(예: PII, 민감도, 데이터 공간), 환경(예: 일과 시간)을 기반으로 액세스 결정을 내릴 수 있습니다. 이를 통해 데이터 및 사용자 특성 변경에 따라 적응하는 매우 세분화되고 상황에 맞는 액세스 정책을 사용할 수 있습니다.
- **CEDAR 정책 언어**: Data 360의 ABAC 구현의 핵심은 CEDAR 정책 언어 사용입니다. 이 목적에 따라 구축된 공식 정책 언어는 복잡한 권한 부여 규칙을 정의하는 정확하고 확인 가능한 방법을 제공하므로 정책이 명확하고 규모에 따라 일관되게 평가할 수 있습니다.
#### 거버넌스 아키텍처: 정책 정보, 적용, 결정 사항
Data 360 내의 거버넌스 시스템은 강력하고 표준 ABAC 아키텍처를 준수합니다.
- **태그 지정, 분류 및 정책 작성(정책 정보 지점 - PIP)**:
- Data 360은 LLM(대규모 언어 모델) 및 ML(기계 학습)을 활용하여 민감한 데이터 범주(예: PII.Email, PII.Phone, PII.Name) 및 기타 용도 구축 분류(PHI, FinancialData)를 구조화된 데이터(예: 연락처 테이블) 및 구조화되지 않은 데이터(예: Google Drive) 모두에서 식별하는 자동화된 태그 지정 및 분류 메커니즘을 제공합니다.
- 중요하게, 태그 전파는 데이터 계보(DLO -> DLO -> DMO)를 따라 발생하므로 분류가 원시 수집된 데이터에서 조화된 DMO 레이어까지 프로세스 정의에서 생성된 파생 데이터를 통해 데이터 변환 및 파생을 자동으로 따릅니다.
- 마지막으로 정책 작성 창은 데이터 및 사용자 특성을 활용하여 조직에 대한 동적 액세스 규칙을 정의하는 간단한 환경을 제공합니다.
- 이 보강된 메타데이터(태그, 분류, 정책, 계보 포함)는 정책 정보 지점(PIP)에 피드됩니다.
- **승인 서비스(정책 집행 지점 - PEP)**:
- 인가 서비스는 정책 집행 지점(PEP) 역할을 합니다. 다양한 소비 계층(하이브리드 구조화/비정형 쿼리, GenAI RAG 검색기 및 프롬프트, CRM 보강)의 모든 데이터 액세스 요청을 가로채고 정책 결정 지점과 상담하여 액세스 허용 여부를 결정합니다.
- **정책 평가 엔진(정책 결정 지점 - PDP)**:
- 이 엔진은 정책 결정 지점(PDP) 역할을 합니다. 권한 있는 액세스 결정을 내리기 위해 PEP의 액세스 요청 컨텍스트와 정책 정의(CEDAR) 및 PIP의 특성을 가져옵니다.
#### 핵심 정책 적용 및 통합
- **전체 보안 정책**: CEDAR에 정의된 정책은 다음을 포함하여 다양한 보안 수준을 적용합니다.
- **개체 수준 보안**: 해당 개체와 연결된 태그를 기반으로 전체 DLO 또는 DMO에 대한 액세스를 제어합니다.
- **현장 수준 보안**: 태그를 기반으로 개체 내 특정 민감한 필드에 대한 액세스를 제한합니다.
- **Row Level Security**: 특정 개체의 데이터를 필터링하여 사용자 특성을 기반으로 관련 행만 표시합니다.
- **동적 데이터 마스킹**: 기본 데이터를 변경하지 않고 액세스 지점에서 특정 데이터(태그 기반)를 동적으로 마스킹합니다. 이렇게 하면 민감한 정보가 보호되지만 광범위한 유틸리티를 제공할 수 있습니다. 이는 구조화된 데이터의 마스킹 필드와 비정형 데이터의 콘텐츠에 적용됩니다.
- **일관적인 적용**: 전체 ABAC 프레임워크는 다이렉트 데이터 쿼리, 생성형 AI 응용 프로그램(RAG) 검색 또는 관련 목록을 통해 Salesforce CRM 환경 보강 등 모든 Data 360 소비 패턴에서 정책을 일관적으로 적용합니다.
- **Salesforce Platform과의 심층적 통합**: Data 360의 거버넌스 기능은 Salesforce 핵심 플랫폼 내에서 직접 정의 및 관리됩니다. 이 통합을 통해 관리자는 익숙한 Salesforce 도구를 사용하여 액세스 정책, 사용자 ID, 특성 관리를 관리하여 전체 Salesforce 에코시스템에서 일관된 통합 관리 계층을 보장할 수 있습니다.
CEDAR 정책을 사용하여 이 정교한 ABAC 프레임워크를 구축함으로써 Data 360은 설계자에게 탁월한 수준의 제어 및 유연성을 제공하여 고객 데이터가 실행 가능한 것뿐만 아니라 안전하고 규정을 준수하며 기업 전체에서 신뢰할 수 있도록 합니다.
### Data 360 암호화: 자체 키 가져오기
산업 전반에서 조직은 데이터 누출, 무단 액세스, 변경 또는 파괴로부터 보호하기 위해 종단간 데이터 보안에 더욱 강조하고 있습니다. 현재 Data 360을 포함한 대부분의 데이터 플랫폼은 공급업체에서 관리하는 암호화 키를 사용하여 암호화를 유지합니다. 그러나 기업(특히 규제된 섹터에 속하는 기업)은 사용 중인 데이터와 전송 중인 데이터 모두에 대해 고객이 관리하는 암호화 기능을 점점 더 요구하고 있습니다.
이 모델을 사용하면 회사에서 자체 암호화 키를 제어하여 플랫폼 수준 위반 또는 무단 액세스가 발생할 가능성이 높지 않은 경우에도 데이터가 암호화 방식으로 보호됩니다. 고객의 독점 키가 없으면 플랫폼 공급자를 포함한 어떠한 엔티티도 데이터를 해독하거나 재구성할 수 없으므로 전체 기밀성을 유지하고 제어할 수 있습니다.
### 비정형 데이터 저장소 및 처리
Data 360은 데이터 수집, 처리, 색인화, 쿼리 메커니즘 전반에서 원활하게 구조화(테이블), 세미 구조화(JSON), 비정형 데이터의 저장 및 관리를 지원합니다. Data 360은 오디오, 비디오, 이미지 등 텍스트 외에도 다양한 비정형 데이터 유형을 지원하여 데이터 처리 및 분석 범위를 넓힙니다. 아래 그림은 기초 교육의 양면( 수집 및 검색)을 보여줍니다.
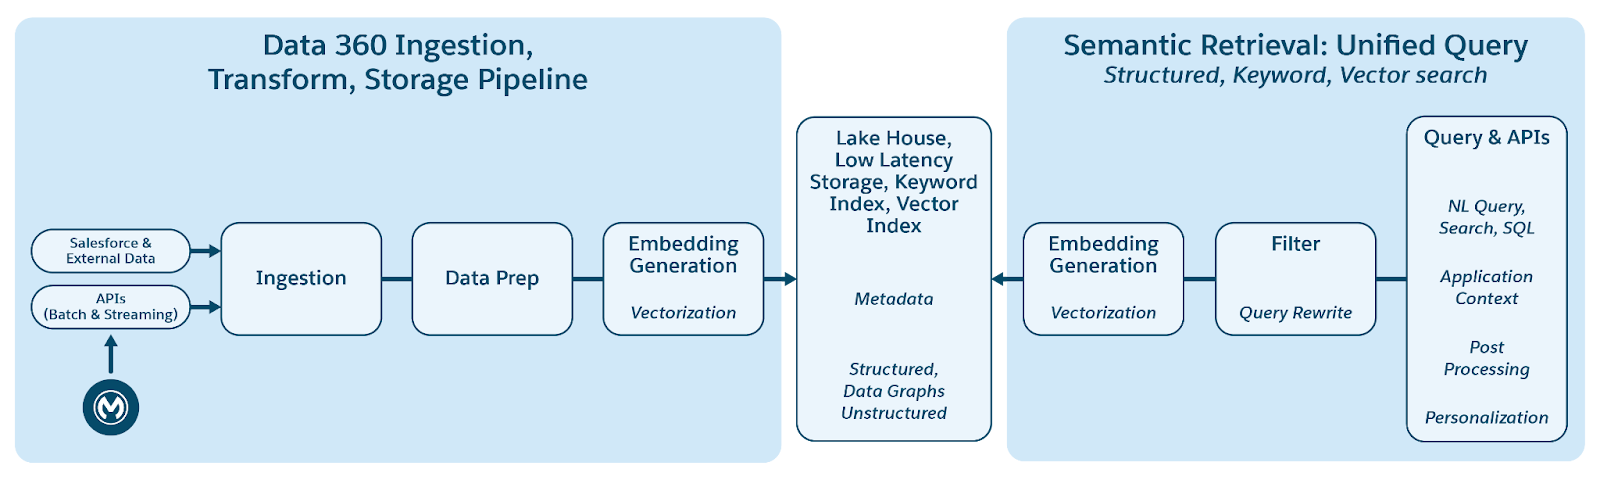 Data 360은 열에 텍스트로 저장하거나 더 큰 데이터 집합의 파일에 저장하여 비정형 데이터를 관리합니다. 구조화되지 않은 콘텐츠에 대한 데이터 연합을 지원하므로 여러 소스의 데이터를 통합하고 관리할 수 있습니다.
그런 다음, 데이터가 준비 및 청크되고, 임베딩이 생성되고, 키워드 색인화 및 벡터 색인화를 위해 처리됩니다. Data 360은 청크 및 임베딩 생성을 위한 여러 개의 기본 및 플러그 가능한 모델을 호스팅합니다. Data 360은 후속 처리 및 색인화를 위해 자동화되고 구성 가능한 오디오 및 비디오 콘텐츠 기록을 지원합니다. 검색 서비스는 키워드 색인화에 사용됩니다. 벡터 색인화의 경우 Data 360은 네이티브 색인화(하이퍼 사용)를 모두 지원하며 오픈 소스 Milvus와 같은 벡터 데이터베이스도 활용합니다. 또한 Data 360은 Salesforce Search 플랫폼과 통합되어 비정형 데이터에 대한 키워드 색인화를 지원합니다. Data 360에서 통합된 다중 모달 색인화를 사용하면 문서의 나중에 있는 에이전트 엔터프라이즈 검색 섹션에 설명된 대로 구조화되지 않은 데이터를 검색할 수 있습니다.
검색을 위해 Data 360은 검색을 위한 API를 제공합니다. 하이퍼 기반 통합 쿼리는 구조화된 키워드 색인 및 벡터 색인 전반에서 쿼리 집합을 쉽게 수행하여 엄격한 가시성과 권한을 유지하여 RAG 및 검색을 향상합니다.
#### 확장 가능한 파이프라인
Data 360의 비정형 데이터 색인화 파이프라인은 5가지 핵심 단계인 모듈식 확장 가능한 아키텍처로 설계되었습니다.
1. 구문 분석
2. 사전 처리
3. 청크
4. 후처리
5. 포함
모든 스테이지에서 고객이 사용자 정의 프롬프트를 제시할 수 있는 LLM 기반 처리를 지원합니다. 사전 처리 및 사후 처리 단계 모두 여러 순차 단계를 포함할 수 있으므로 복잡한 변환을 유연하게 작성할 수 있습니다. 각 스테이지는 완전히 메타데이터 기반이므로 코드를 변경하지 않고 원활하게 구성을 수행하고 확장할 수 있습니다.
사전 처리의 예에는 소음 제거, 언어 정규화, 이미지 이해(광학 문자 인식 및 캡션)와 같은 작업이 포함되며, 사후 처리는 메타데이터 보강, 시맨틱 그룹화 또는 Raptor 청크와 같은 고급 기술을 포함할 수 있습니다.
파이프라인은 Data 360 코드 확장을 완전히 지원하므로 고객 및 내부 팀이 모든 단계에서 사용자 정의 논리를 연결할 수 있습니다. 코드 확장 구성 요소는 실행, 확장, 오류 처리 등 수명 주기가 Data 360에서 완전히 관리되는 경량 Python 함수입니다. 이 접근 방식을 통해 플랫폼 전반에서 운영 일관성 및 거버넌스를 유지하면서 혁신 및 도메인별 처리를 신속하게 도입할 수 있습니다.
##### 컨텍스트 색인화
구조화되지 않은 처리를 사용하여 RAG를 설정하려면 다음과 같은 두 가지 중요한 요인이 중요합니다.
1. **빠른 반복**: 샘플 테스트 쿼리를 사용하여 신속하게 확인할 수 있는 기능
2. **개인별 콘텐츠**: 소비하는 개인 정보에 맞게 조정된 콘텐츠를 구성하는 수용력입니다.
컨텍스트 색인화는 이러한 두 측면을 모두 해결하기 위해 고안된 사용자에게 친숙한 도구입니다. 이 대화형 UI는 이전에 설명된 5개의 단계를 모두 실행하는 실시간(RT) 파이프라인에서 제공됩니다. 파이프라인은 생성 및 OCR(광학 문자 인식)과 같은 과업에 필요한 경우 GPU를 활용합니다. 또한 고객은 포괄적인 콘텐츠 처리를 위한 구성을 배포하기 전에 에이전트와 함께 RAG 파이프라인을 빠르게 테스트할 수 있습니다.
##### 문서 AI
Data 360 문서 AI를 사용하면 인보이스, 이력서, 실습 보고서, 구매 주문과 같은 문서에서 비정형 또는 반정형 데이터를 읽고 가져올 수 있습니다. 이 기능은 특별 대화형 처리와 대량 배치 처리를 지원합니다. 이는 고객의 비즈니스 프로세스 자동화를 지원하는 핵심 기능입니다. 이는 LLM 및 ML 모델을 비롯한 인공 지능에 의해 제공됩니다.
### 엔터프라이즈 Knowledge
엔터프라이즈는 Wiki, 파일 공유, 콘텐츠 관리 시스템, 내부 데이터베이스 등 다양한 시스템에 분산된 광범위한 Knowledge 보유하고 있습니다. 이 조각화로 인해 직원(특히 서비스 에이전트 및 세일즈 담당자) 및 고객이 빠르고 효율적으로 관련 정보를 찾기 어려워집니다. 주요 문제: 모든 Knowledge 소스에 걸쳐 단일하고 통합된 검색 경험이 없음; 다른 소스의 콘텐츠를 일관되게 표시하고 렌더링하지 않음; 시스템 간에 분산된 민감한 정보에 대한 액세스 관리가 없음; 핵심 비즈니스 워크플로 내에서 권위 있는 Knowledge 소스를 활용하는 어려움 (예: 사례에 관련 기사를 첨부).
엔터프라이즈 Knowledge 더 광범위한 엔터프라이즈 데이터 풀에서 수동 또는 자동으로 선별된 콘텐츠를 나타냅니다. 수동 큐레이션은 Salesforce Knowledge 기사를 만들거나 외부 시스템 내에서 Knowledge 개발하는 등 의도적인 조치와 함께 수행되며, 이를 통해 수집됩니다. 수집된 데이터를 통해 실행되는 Salesforce 에이전트 및 변환과 같은 프로세스를 활용하여 정교하고 선별된 레이어를 생성하고 잠재적으로 구조화된 콘텐츠와 구조화되지 않은 콘텐츠를 혼합하는 자동화된 큐레이션을 예상합니다. 수동으로 또는 자동으로, Salesforce 내부 또는 수집 전 외부로 선별되었는지 여부와 상관없이 결과는 원시 데이터와 별도의 추가 가치 콘텐츠입니다.
Enterprise Knowledge Hub 솔루션은 Data 360 기능을 활용하여 다음과 같은 작업을 수행합니다.
- **수입 및 저장**: CRM Connector는 Salesforce Knowledge 기사를 수집하고, 데이터 커넥터 프레임워크(DCF) 비정형 커넥터는 외부 소스의 원시 콘텐츠와 메타데이터를 수집합니다. 콘텐츠가 소스별 비정형 데이터 레이크 개체(UDLO)에 수집되어 SFDrive의 콘텐츠(또는 0 복제의 경우 소스)에 매핑됩니다.
- **조합 및 구조화**: 조합 파이프라인은 UDLO 및 파일 데이터를 처리하여 정리, 정규화, 보강(NLP 등), PII 마스킹 및 SF 드라이브에 저장된 조화된 중간 형식으로 변환하고 이를 매핑하는 조화된 UDLO(HUDLO)를 수행합니다.
- **인덱싱**: 조화된 콘텐츠에서 비정형 파이프라인(UDS)이 트리거되고 각 HUDMO에 대해 검색 색인이 구성됩니다.
- **소비**: 사용되는 응용 프로그램에는 사례와 같은 비즈니스 개체에 대한 검색, 검색, 렌더링, 링크가 포함됩니다. 응용 프로그램 소비 참여는 사용량 분석(예: 클릭, 검토 등)을 제공하기 위해 수집됩니다.
### 계산된 인사이트
Data 360의 계산된 인사이트(CI)를 사용하면 고객이 데이터에서 집계된 메트릭을 정의하고 생성할 수 있습니다. 그러면 해당 메트릭이 적시에 고객 참여, 분석, 세분화, 활성화에 사용됩니다. CI가 계산한 집계 데이터는 Lakehouse에 기록되고 계산된 인사이트 개체(CIO)로 표시됩니다.
계산된 인사이트에는 다음과 같은 두 가지 주요 유형이 있습니다.
- **배치 계산된 인사이트**: 메트릭을 정기적으로 계산할 수 있는 복잡한 대용량 데이터 집계(예: 매일 또는 매주)를 위해 설계되었습니다.
- **스트리밍 인사이트**: 실시간 이벤트 데이터에서 메트릭 및 작업을 생성할 수 있는 기능을 제공하여 지연 시간이 낮은 즉각적인 고객 참여를 지원합니다.
계산된 인사이트는 데이터 모델 개체(DMO)에 정의되며, 다른 계산된 인사이트 개체에서도 정의할 수 있습니다. 계산된 인사이트 서비스는 배치 및 스트리밍 작업의 오케스트레이션을 모두 관리합니다.
배치 및 스트리밍 인사이트 계산 모두 Spark를 사용합니다. 스트리밍 인사이트는 Spark 구조 스트리밍을 활용하고 배치 CI는 정기적으로 예약된 배치 Spark 작업을 사용하여 실행됩니다. 비용 효율성을 위해 계산된 인사이트 서비스는 종속성 및 소스 데이터 개체의 겹침과 같은 요소를 기반으로 동일한 배치 CI 작업 또는 스트리밍 CI 작업에서 함께 계산할 CIs를 그룹화합니다.
SNCE 및 CDF는 스트리밍 인사이트 계산에 중요한 역할을 합니다.
### ID 확인
ID 확인은 여러 소스의 서로 다른 데이터를 하나의 포괄적인 통합 프로필로 변환합니다.
통합 프로필은 "골든 레코드"가 아니며, ID 확인은 프로필을 통합하는 동안 수주 값을 선택하거나 기존 데이터를 재정의하지 않는다는 점을 이해해야 합니다. 통합 프로필은 단일 데이터 소스 또는 여러 소스에서 동일한 엔티티와 관련된 일치하는 모든 레코드를 식별하여 소스 데이터의 잠금을 해제하는 키 집합 역할을 합니다. 이 정보를 사용하면 해당 비즈니스 사용 사례에 사용할 올바른 소스 시스템 데이터를 선택할 수 있습니다.
ID 확인은 개인, 계정 및 가구를 포함하여 다양한 레코드 유형을 통합할 수 있습니다. 리드를 기존 계정에 연결하는 데도 사용할 수 있습니다. 통합 프로세스는 전체 Customer 360 뷰를 달성하고 B2C 및 B2B 시나리오 모두에서 맞춤형 실시간 참여를 유도하는 데 필수적입니다.
ID 확인 파이프라인은 대용량 데이터를 지속적으로 처리하도록 설계된 확장성이 높은 클라우드 네이티브 프레임워크를 기반으로 구축됩니다. 이 프로세스에는 세 가지 핵심 단계가 포함되어 있으며, 강력한 검색 색인 의존하여 일치 프로세스를 관리합니다.
- **일치(선택 후보)**: 일치 프로세스의 목표는 동일한 엔티티에 속할 수 있는 레코드를 검색하는 것입니다. 레코드는 사용자 정의 가능한 규칙 집합에 대해 분석되며, 각 규칙에는 특정 엄격도 수준에서 일치시킬 데이터를 정의하는 기준 집합이 포함됩니다. 데이터 저장소에서 잠재적 일치 항목을 효율적으로 검색하기 위해 다음 두 가지 방법을 사용하여 가능한 일치하는 레코드를 찾는 색인을 생성합니다.
- **차단 키**: 차단 키는 잠재적으로 유사한 레코드를 함께 그룹화하기 위해 레코드의 데이터 및 일치 규칙(예: 이름의 처음 몇 자, 정규화된 전화 번호 등)에서 생성된 값입니다. 각 레코드에는 색인화되고 역 색인으로 저장되는 여러 개의 차단 키가 있으므로 시스템에서 전체 데이터 집합이 아닌 소규모 레코드 그룹에 대한 자세한 비교만 수행합니다.
- **Locality Sensitive Hashing(LSH)**: 퍼지 일치가 있는 일치 규칙의 경우 교육된 모델의 내장형을 기반으로 해시가 생성됩니다.
- **딥 매칭**: 후보 선택 단계가 잠재적 일치 항목의 더 작은 그룹을 생성하면 시스템에서 더 자세한 비교를 시작합니다. 이 단계에서 AI 모델 및 고급 알고리즘은 각 레코드 쌍을 분석하여 확률적 일치 점수를 계산합니다. 이 점수는 자주 오타, 변형 또는 형식 차이를 포함하는 필드를 지능적으로 비교하여 두 레코드가 동일한 엔티티를 참조할 가능성을 수량화합니다.
- **클러스터링 및 통합**: 후보에서 일치하는 레코드를 식별하면 클러스터로 그룹화됩니다. 이 프로세스에는 중요하게 전달 일치 확인이 포함됩니다. 예를 들어 레코드 A가 레코드 B와 일치하고 레코드 B가 레코드 C와 일치하는 경우 A와 C가 직접 비교되지 않은 경우에도 세 가지가 모두 동일한 클러스터에 연결됩니다. 이러한 전체 클러스터는 통합 프로필의 기본 구조를 구성합니다. 이 클러스터링 프로세스를 통해 모든 관련 소스 레코드가 단일 지속 식별자 아래에 올바르게 연결됩니다.
- **조정**: 모든 클러스터링된 소스 레코드의 데이터 값은 정의된 조정 규칙(예: _가장 자주 사용되는_ 규칙, _가장 최근_ 사용 또는 _소스 우선 순위_)을 사용하여 결과 통합 프로필을 프로필 데이터의 발췌으로 작성합니다. 조정은 통합 프로필에 연결된 키를 사용하여 모든 소스 데이터를 사용할 수 있으므로 기존 데이터를 덮어쓰지 않습니다.
#### ID 확인 유형
아키텍처는 다양한 사용 사례를 처리하기 위해 여러 엔티티 유형의 해결을 지원합니다.
- **개별 일치**: 하나의 개인에 알려진 모든 개인 식별자(이메일, 전화 번호, 충성도 ID, 쿠키)를 연결하는 통합 개인 프로필을 만드는 데 중점을 둡니다.
- **계정 일치**: 계정에 대한 데이터를 연결하는 통합 계정 프로필 만들기에 중점을 둡니다. 회사 이름을 일치시키는 경우 엔진이 퍼지 일치 시 정밀 조정된 모델을 사용합니다.
- **가구 일치**: 일치 논리를 확장하여 통합 개인 레코드를 관련 개인의 그룹으로 집계합니다.
- **Cross Entity Matching**: 통합 외에도 ID 확인은 동일한 일치 규칙을 사용하여 프로필 개체 간 링크를 생성합니다. 예를 들어, 계정 이름에서 퍼지 일치를 사용하여 리드를 계정에 연결할 수 있습니다.
#### 거의 실시간 처리
통합 프로필이 항상 최신 상태로 유지되도록 ID 확인 엔진은 거의 실시간 아키텍처로 작동합니다. 이 클라우드 최적화 아키텍처는 지속적인 처리를 위해 고급 처리 시간을 달성하도록 설계되었습니다. 처리 속도는 소스 데이터가 수신되는 방식에 따라 다르지만, ID 확인을 통해 15분마다 작은 변경 사항 배치를 처리할 수 있습니다.
#### 소스 프로필 연결
시스템에서 모든 소스 레코드 ID를 해당하는 통합 프로필 ID에 매핑하는 ID 링크 개체를 유지합니다. 이 기본 데이터 구조를 사용하면 엔진이 관계를 효율적으로 추적하고 통합 프로필에 변경 사항 및 업데이트를 빠르게 전파하여 웹 사이트 개인 설정, Next Best Action 권장 사항, 세분화와 같은 고객 환경이 항상 최신 사용 가능한 고객 데이터를 활용할 수 있도록 합니다.
### 세분화
세분화는 통합 고객 프로필을 실천 가능한 대상 그룹으로 전환하는 핵심 프로세스입니다. 이 기능은 마케팅, 상거래, 서비스 채널 전반에서 맞춤형 환경을 제공하는 데 매우 중요합니다. Salesforce Data 360 세분화 플랫폼은 대규모 작업을 위해 고안되었습니다. 수천 개의 개체 및 관계로 구성된 데이터 모델을 사용하여 복잡한 메타데이터를 관리합니다. 플랫폼은 복잡한 규칙, 집계 기반 필터, 윈도우 기반 순위를 모두 지원하며 페타바이트 규모에서 빠르고 신뢰할 수 있는 계산을 보장합니다.
#### 세분화 유형 및 케이던스
Data 360은 다양한 세그먼트 유형을 지원하여 속도, 복잡성, 계층에 대한 고유한 비즈니스 요구 사항을 충족합니다.
1. **표준 세그먼트**: 배치 처리된 기본 세그먼트 유형입니다. 최소 12시간~24시간의 표준 게시 케이던스 또는 최근 참여 데이터에 최적화된 1시간~4시간의 빠른 빠른 게시 케이던스를 사용하여 사용자 정의 가능한 일정에 따라 게시합니다.
2. **실시간 세그먼트**: 이 세그먼트는 최신 이벤트 및 프로필 데이터를 기반으로 즉각적인 조치를 취할 수 있도록 주문형 작업을 밀리초 단위로 완료합니다. 즉각적인 개인 설정에 최적화되었지만, 제외 기준 또는 중첩된 세그먼트를 활용할 수 없습니다.
3. **폭포 구간**: 고객이 여러 기준에 맞는 경우 고객의 우선 순위를 가장 중요한 단일 세그먼트로 지정하는 데 사용되는 하위 세그먼트의 계층 구조입니다.
4. **Nested Segment**: 이렇게 하면 기존 세그먼트를 더 구체적인 새로운 세그먼트(기본 세그먼트의 세분화)의 필터로 재사용할 수 있으며, 상위 세그먼트의 일정을 상속할 수 있습니다.
#### 세분화 엔진: 아키텍처 기본 사항
세분화 엔진은 속도, 규모, 복원 능력을 보장하는 강력한 클라우드 네이티브 아키텍처에서 작동합니다.
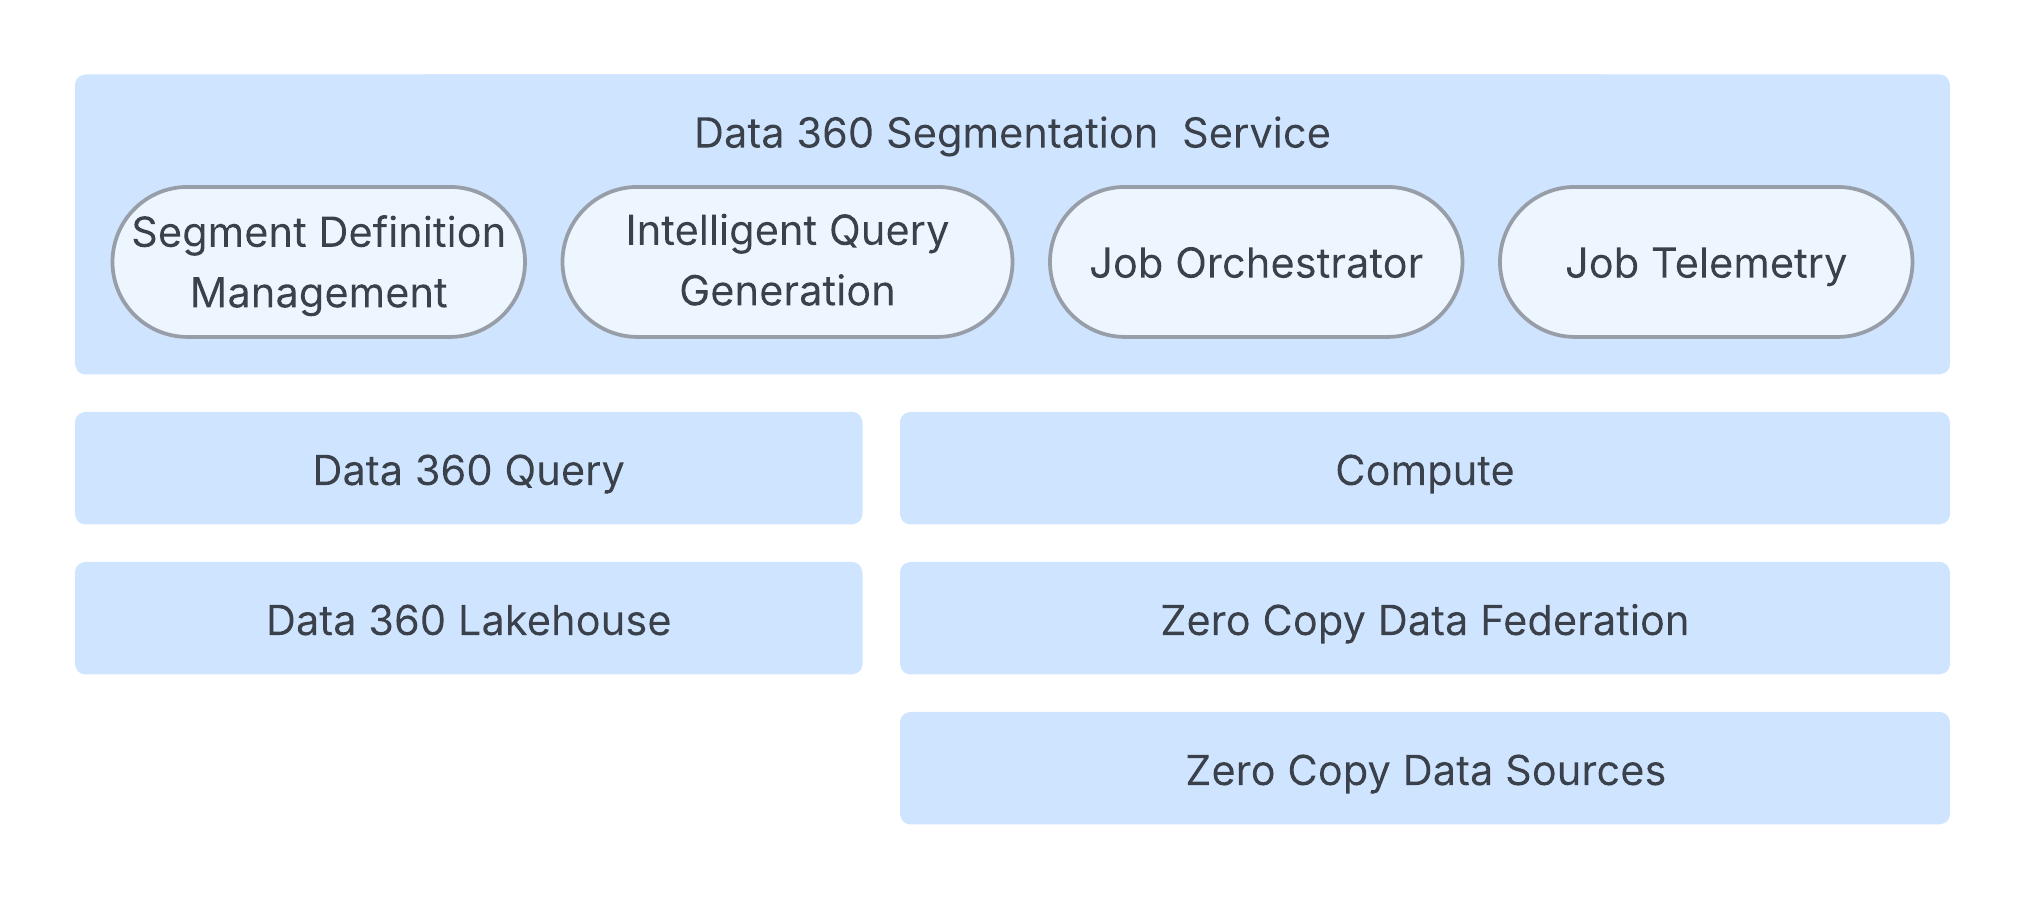 핵심 프로세스는 세그먼트의 수명 주기를 제어하여 필수 작업 구성을 생성하고 실행을 트리거하는 작업 오케스트레이션 서비스에 의해 관리됩니다. 이 오케스트레이션 레이어는 확장성을 위해 분할된 데이터베이스에서 상태 및 메타데이터를 유지합니다.
Data 360 쿼리는 세분화 개수 계산을 처리하지만 Spark 계산 계층은 실제 세그먼트 멤버십을 계산할 책임이 있습니다. Spark 응용 프로그램은 광범위한 고객 데이터에 대해 Spark SQL 쿼리를 실행합니다. 이 데이터는 Data 360 레이크하우스, Zero Copy 데이터 연합을 통한 외부 시스템 또는 둘 모두의 조합에 있을 수 있습니다.
인텔리전트 쿼리 생성을 통해 시스템이 매우 최적화되어 기본 Spark SQL 쿼리를 세분화합니다. 여기에는 데이터 스캔을 최소화하고 중복 하위 표현식을 제거하는 지능형 파티션 자르기와 같은 기법이 포함됩니다. 서비스 신뢰성을 보장하기 위해 아키텍처는 작업 부하 크기 및 복잡성을 기반으로 계산 자원을 동적으로 조정하는 어댑티브 자원 관리를 제공합니다. 또한 SLO 준수는 적응형 기간 및 재시도 논리를 사용하여 사전에 관리됩니다. 빠른 사용자 환경을 위해 가속 세그먼트 수는 샘플링 기반 접근 방식을 사용하여 세그먼트를 만드는 동안 빠른 크기 예측을 제공하므로 전체 쿼리가 실행되지 않습니다.
마지막으로 포괄적인 Spark 실행 메트릭과 자동화된 오류 분류(예: 고객 측 및 시스템 문제)를 통해 관찰 가능성 및 근본 원인 특성에 중점을 두고 진단 시간을 크게 단축하고 복원성이 높은 데이터 플랫폼을 보장합니다.
### 활성화
활성화는 Data 360 수명 주기의 중요한 마지막 단계입니다. 핵심 기능은 정적이고 세분화된 통합 고객 프로필을 실천 가능한 보강 데이터로 변환하고 이 데이터를 내부 및 외부 끝점(예: Marketing Cloud, Commerce Cloud, Adtech 플랫폼)에 전달하는 것입니다. 이 프로세스는 맞춤형 고객 여정과 실시간에 가까운 상호 작용을 트리거하기 위해 고안되었습니다. 관련 특성, 활성화 멤버십 필터링, 동의 필터링, 제한, 순위와 같은 고급 기능을 지원합니다.
활성화는 외부 전달 및 채널 규정 준수를 위한 세 가지 고유한 방법을 제공합니다.
- **배치 활성화**: 대규모 이메일 캠페인 및 광고 대상 그룹 새로 고침과 같은 대용량 예약된 작업을 위해 고안되었습니다. 데이터는 보안 내부 버킷(클라우드 개체 저장소)에 스테이징하거나 보안 파일 전송을 통해 전달된 다음, 대상 시스템에서 시작한 API 수집 프로세스를 통해 전달됩니다. 배치 활성화는 특수 새로 고침 모드(증분)를 사용하여 Salesforce 파트너에게 전송 및 처리되는 볼륨을 줄일 수 있습니다.
- **스트리밍 활성화**: 이벤트 중심 자동화가 필요한 거의 실시간 사용 사례에 최적화됩니다. 배달은 대상 끝점에 전송된 직접 API 호출을 통해 이루어집니다.
- **활성화 트리거 플로**: 이 고도로 플랫폼화된 채널은 대상 그룹 데이터를 수백 개의 고객 API가 활성화된 참여 플랫폼과 통합하기 위한 코드가 없는/하위 코드 접근 방식을 제공합니다. 활성화가 완료되면 Data 360이 대상 그룹 DMO를 채운 다음, 대규모 플로를 트리거합니다. 이후 플로 엔진은 대상 그룹 데이터를 사용하고 외부 서비스 및 Mule 아웃바운드 대상과 같은 플랫폼 기능을 활용하여 최종 API 기반 대상에 호출합니다. 이 방법은 새 활성화 타겟을 온보딩하는 데 필요한 시간을 크게 줄입니다.
활성화는 작업 관리, 배포된 실행, 모니터링에 대해 세분화와 동일한 패턴을 사용합니다. 여기에는 수명 주기 관리를 위한 작업 오케스트레이션 서비스의 원리와 처리를 위한 계산 계층(Spark)이 포함되며 성능 관찰 가능성 및 서비스 수준 목표(SLO) 준수에 대한 작업 Telemetry를 사용합니다.
이 외에도 활성화에는 다음과 같은 기능이 있습니다.
**활성화 대상 관리**는 모든 대상 끝점의 보안 연결, 자격 증명 및 구성을 감독합니다. 데이터 형식 및 보안 프로토콜이 표준화되어 Marketing Cloud, Adtech 파트너, 기타 외부 응용 프로그램 등 다양한 플랫폼에 신뢰할 수 있는 아웃바운드 전달을 보장합니다.
활성화하면 페이로드가 특정 대상에 맞게 조정됩니다. Salesforce Marketing Cloud의 경우 사업부(BU) 인식 필터링, 다중 EID 지원, 교차 관개 제어가 포함됩니다.
**커뮤니케이션 거버넌스**는 고객의 선호도 및 법적 요구 사항을 준수하는 데이터 사용 및 통신을 보장합니다. 중앙 집중식 동의 모델은 전역 수신 거부에서 채널 및 목적별 동의에 이르기까지 모든 고객 기본 설정을 통합하며 통합 개인 프로필에 저장됩니다. 실행하는 동안 플랫폼은 제외 필터링을 사용하여 최종 페이로드에서 동의하지 않는 개인을 자동으로 제거하여 이러한 정책을 엄격하게 적용합니다. 또한 시스템에서 연락관 선택 규칙을 적용하여 데이터를 전송하기 전에 의도한 채널에 대해 가장 규정을 준수하고 선호하는 단일 연락관을 사용합니다. 이 적용 메커니즘은 동적 데이터 마스킹 및 액세스 제어와 같은 보호 조치를 채택하여 활성화 프로세스 전반에서 중요한 데이터 필드를 보호하는 기본 거버넌스 프레임워크에 의해 보호됩니다.
### 통합 쿼리: 모든 고객 데이터에 원활한 액세스
통합 데이터 플랫폼의 진정한 가치는 원본 또는 구조에 관계없이 모든 데이터 자산에 간편하고 일관된 액세스를 제공하는 기능에 있습니다. Salesforce Data 360의 통합 쿼리 기능은 이를 제공하기 위해 정확하게 설계되었으며, 다양한 데이터 저장소의 기본 복잡성을 추상하여 강력한 단일 쿼리 인터페이스를 제공합니다.
통합 쿼리 레이어는 다양한 소비 패턴에 대한 정교한 액세스를 제공합니다.
- **하이브리드 구조화 및 비정형 질의**: 구조화된 데이터와 구조화되지 않은 데이터의 구조화된 메타데이터를 모두 원활하게 쿼리할 수 있는 광범위한 SQL 지원을 제공합니다. 테이블 함수를 통한 연산자 확장성이 향상되어 텍스트, 이미지, 공간 유형 전반에 걸쳐 특수 검색이 가능합니다.
- **Hyper로 성능 가속화**: 고성능 메모리 내 엔진인 Hyper를 활용하는 Data 360은 복잡한 분석 쿼리 및 대화형 대시보드를 가속화하여 대규모 데이터 집합에서 거의 즉각적인 응답을 제공합니다.
- **AI 및 개인 설정에 대한 통합 접근법**: 이 통합 액세스는 표적화된 맞춤형 결과를 생성하는 데 매우 중요하며, 풍부한 엔터프라이즈 데이터에 AI 모델을 기반으로 RAG(검색 증분 생성)를 사용하여 더욱 정밀한 LLM 응답을 직접 지원합니다.
- **다운스트림 소비와의 통합**: 이는 UI 구동 환경, 강력한 API, 생성형 AI 워크플로, CRM 보강을 위한 기본 데이터 액세스 계층으로서 데이터를 활성화에 원활하게 연결합니다.
Data 360의 통합 쿼리는 지능적이고 고성능의 단일 쿼리 인터페이스를 제공하여 설계자가 고객 정보의 전체 스펙트럼을 최대한 활용하는 민첩한 데이터 중심 응용 프로그램을 구축할 수 있도록 지원합니다.
### 데이터 작업
Data 360은 데이터 이벤트에 대한 파이프라인 활성화를 지원하는 활성 플랫폼입니다. 예를 들어, 고객의 계정 잔고가 떨어지는 등 중요한 이벤트가 Salesforce 플로를 트리거하여 해당 작업을 오케스트레이션할 수 있습니다. 마찬가지로 평생 소비와 같은 주요 메트릭에 대한 업데이트가 관련 응용 프로그램에 자동으로 전파될 수 있습니다.
데이터 작업은 저장소 네이티브 변경 이벤트(SNCE) 및 변경 데이터 피드(CDF)를 사용하여 변경 사항에 대한 증분 데이터를 지속적으로 모니터링합니다. 이 데이터는 임계값 모니터링 또는 상태 변경과 같은 고객이 구성한 작업 규칙에 대해 평가됩니다. 해당 규칙이 충족되면 데이터 작업 이벤트가 생성됩니다. 이 이벤트는 추가 정보(예: 고객 충성도 상태)로 보강되고 Salesforce 플로 또는 외부 응용 프로그램과 같은 구성된 대상으로 즉시 전송되어 비즈니스 오케스트레이션을 트리거합니다.
#### 고객 데이터 플랫폼
Data 360은 고급 ID 확인 기능과 포괄적인 참여 내역과 함께 통합 개인 식별자 및 프로필 생성과 같은 기본 CDP(고객 데이터 플랫폼) 기능을 지원합니다. 이 플랫폼은 위에 설명된 것처럼 정확한 일치 규칙과 퍼지 일치 규칙을 모두 사용하는 ID 확인 및 ID 그래프를 지원하여 B2B(B2B) 및 B2C(B2C) 프레임워크를 모두 처리하는 데 숙련되어 있습니다. 이러한 ID 그래프는 다양한 채널의 참여 데이터로 보강되므로 중요한 분석 인사이트 및 세그먼트가 포함된 자세한 프로필 그래프를 작성하는 데 도움이 됩니다.
고객 프로필을 지원하는 핵심 컨셉은 데이터 그래프입니다. Data 360은 다양한 레이크하우스 테이블 및 상호 관계에서 파생된 비정규화 개체인 JSON 형식의 엔터프라이즈 데이터 그래프를 제공합니다. 여기에는 개인의 구매 및 탐색 내역, 사례 내역, 제품 사용, 기타 계산된 인사이트를 포괄하는 CDP에서 만든 "프로필" 데이터 그래프가 포함되며 고객 및 파트너가 확장할 수 있습니다. 해당 데이터 그래프 특정 응용 프로그램에 맞게 조정되며 관련 고객 또는 사용자 컨텍스트를 제공하여 생성형 AI 프롬프트 정확성을 향상합니다. Data 360의 실시간 레이어는 프로필 그래프를 활용하여 실시간 개인 설정 및 세분화를 수행합니다. 대화, 세션, 에이전트 메모리를 데이터 그래프 포함하는 Agentforce 컨텍스트 모델링을 예상합니다.
또한 CDP를 사용하면 Salesforce의 Marketing Cloud, Facebook, Google 등 다양한 플랫폼에서 효과적으로 세분화 및 활성화할 수 있습니다. 즉시 의사 결정을 내리고 개인 설정을 할 수 있도록 배치, 거의 실시간, 실시간으로 고객 프로필을 처리합니다. 이 기능은 B2C 및 B2B 시나리오 모두에서 상호 작용을 강화하여 비즈니스가 고객의 요구와 행동에 빠르고 정확하게 대응할 수 있도록 합니다.
### 실시간 레이어
Data 360의 실시간 레이어는 Data 360 CDP에서 지원되며 실시간 사용 사례에 대한 개념을 확장합니다. Data 360의 실시간 레이어는 웹 및 모바일 클릭 스트림, 방문, 장바구니 데이터, 결제와 같은 이벤트를 밀리초 대기 시간으로 처리하도록 설계되어 고객 경험 개인 설정을 향상합니다. 고객 참여를 지속적으로 모니터링하고 Customer 360 고객 프로필을 실시간 참여 데이터, 세그먼트, 계산을 사용하여 즉시 개인 설정합니다.
예를 들어, 소비자가 쇼핑 웹 사이트에서 항목을 구매하면 실시간 레이어가 이 이벤트를 빠르게 감지 및 수집하고, 소비자를 식별하고, 업데이트된 평생 지출 정보로 프로필을 보강합니다. 이를 통해 사이트에서 몇 초 이내에 환경을 개인 설정할 수 있습니다. 또한 이 계층에는 실시간 트리거 및 응답 기능이 포함되어 있어 고객 상호 작용을 기반으로 즉각적인 조치를 취할 수 있습니다.
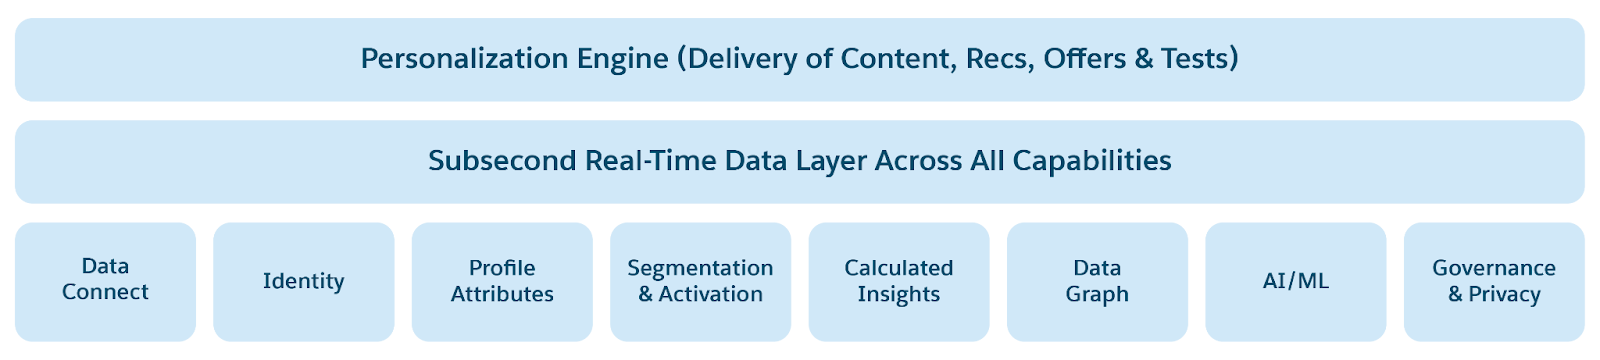 Sub-Second Real-Time 플랫폼은 다음과 같은 몇 가지 주요 기능을 통해 이 변환을 제공합니다.
1. **실시간 데이터 그래프**: Customer 360 프로필은 브랜드와 가장 관련된 주요 객체 및 필드를 포함하는 비정규화 그래프를 사용하여 작성됩니다. 해당 데이터 그래프 실시간 데이터 처리를 지원하고 실행 가능한 콘텐츠 및 인사이트를 밀리초 이내에 전달합니다.
2. **실시간 수집 및 변환**: 웹 및 모바일 소스에서 사용자 이벤트 및 프로필을 밀리초 단위로 수집합니다.
3. **실시간 ID 확인**: 장치 전체에서 고객 프로필을 병합하여 알 수 없는 사용자와 알려진 사용자를 즉시 통합합니다.
4. **실시간 계산된 인사이트**: 수명 값(LTV) 또는 사용자 방문 내역과 같은 메트릭을 밀리초 단위로 계산하여 웹, ChatBot 또는 서비스 에이전트 개인 설정 또는 제안을 활성화합니다.
5. **실시간 세분화**: 즉시 대상 그룹을 세분화하여 메시지 및 상호 작용을 실시간으로 개인 설정합니다.
6. **실시간 작업**: 브랜드가 모든 사용자 참여를 평가하고 Salesforce 플로 또는 기타 관련 커뮤니케이션 채널을 통해 조치를 취할 수 있도록 합니다.
Data 360에서 실시간 파이프라인, 낮은 대기 시간 저장소, 초초 미만 데이터 처리 계층이 포함된 새로운 실시간 플랫폼을 구축했습니다. 웹 및 모바일 채널에서 빠른 대화형 데이터가 수집되므로 일련의 빠른 프로세스를 거칩니다.
웹 및 모바일 SDK 및 실시간 API는 향후 에이전트 상호 작용에서 웹/모바일 응용 프로그램의 데이터를 수집하고 비콘 서버로 보냅니다. 이 데이터는 실시간 레이어로 라우팅되어 밀리초 처리하고 배치/스트림 데이터와 통합하기 위해 레이크하우스 레이어로 라우팅됩니다. 실시간 레이어는 세션 내, 실시간 개인 설정을 위해 사용자 총 지출 또는 평생 가치 등 사용자 프로필(익명 또는 로그인됨)의 컨텍스트에서 들어오는 실시간 데이터를 처리합니다. 실시간 레이어는 실시간 데이터 및 고객 프로필을 저장하기 위해 기본 메모리 및 NVme(SSD) 저장소에서 지원됩니다. 데이터가 실시간 레이어에 있으면 실시간 데이터 그래프로 업데이트하기 전에 다음 프로세스를 거칩니다.
- **단순 수집 및 변형**: 추가 처리를 위해 데이터가 수집되고 변환됩니다.
- **ID 확인**: 정확히 일치 규칙은 프로필과 모든 기존 일치 규칙 집합을 통합하기 위해 적용되므로 데이터 인식 전문가는 특별히 실시간으로 새 ID 확인 규칙 집합을 만들 필요가 없습니다.
- **계산된 인사이트**: 모든 참여가 평가되고, 합계 및 밀리초 단위의 개수와 같은 간단한 계산이 실행되고, 데이터가 실시간 데이터 그래프로 업데이트됩니다.
- **실시간 세그먼트**: 모든 참여 데이터가 평가되어 정의된 실시간 세그먼트에 대한 기준을 충족하는지 여부를 판단하고 사용자가 밀리초 단위로 적합한 세그먼트에 추가됩니다.
- **실시간 작업 및 트리거**: 정의된 규칙에 대해 모든 참여가 평가되어 규칙이 밀리초 이내에 충족될 때 실시간으로 다양한 대상에 대한 작업을 트리거합니다.
- **실시간 데이터 그래프 및 API**: 실시간 API도 포함된 실시간 데이터 그래프를 사용하면 브랜드가 각 사용자에 대해 업데이트된 JSON 형식 데이터를 검색하여 모든 고객 상호 작용에 최신 데이터로 정보를 제공할 수 있습니다.
#### 개인 설정
개인 설정은 대상을 지정할 사람, 관련 콘텐츠 및 권장 사항을 전달할 시기 및 위치, 언급할 내용 및 빈도를 파악하는 것입니다. 개인 설정 서비스 플랫폼은 맞춤형 환경을 통해 목표 달성률을 최적화하기 위해 결정되는 사항의 오케스트레이터입니다.
**개인화 서비스**는 다음 기능을 제공합니다.
- Data 360에서 프로필, 활동, 자산 데이터를 해석하는 일관된 모델 집합 및 방법
- 플랫폼 통합 실험(A/B/n, 다중 암 밴디트)
- 설계 시간(구성), ML 교육 시간 및 런타임 시 목표 통합(ML 추론)
- B2C 확장 실시간 및 배치 상호 작용 지원(익명 사용자, 대화형 실시간 외부 대량, 대용량 내부 배치)
- Data 360을 통한 Analytics 구동
- 다른 당사자(내부 및 외부)의 AI 모델 및 서비스 통합 패턴
- 핵심 메타데이터 에코시스템에 통합(PLATE 특성)
- 가치가 높은 AI 중심 사용 사례의 OOTB 구현(프로모션/콘텐츠 선택, 제품 권장 사항, 가격 책정 결정 등을 위한 컨텍스트 범주 등 다양한 ML 알고리즘을 사용하는 권장 사항/결정)
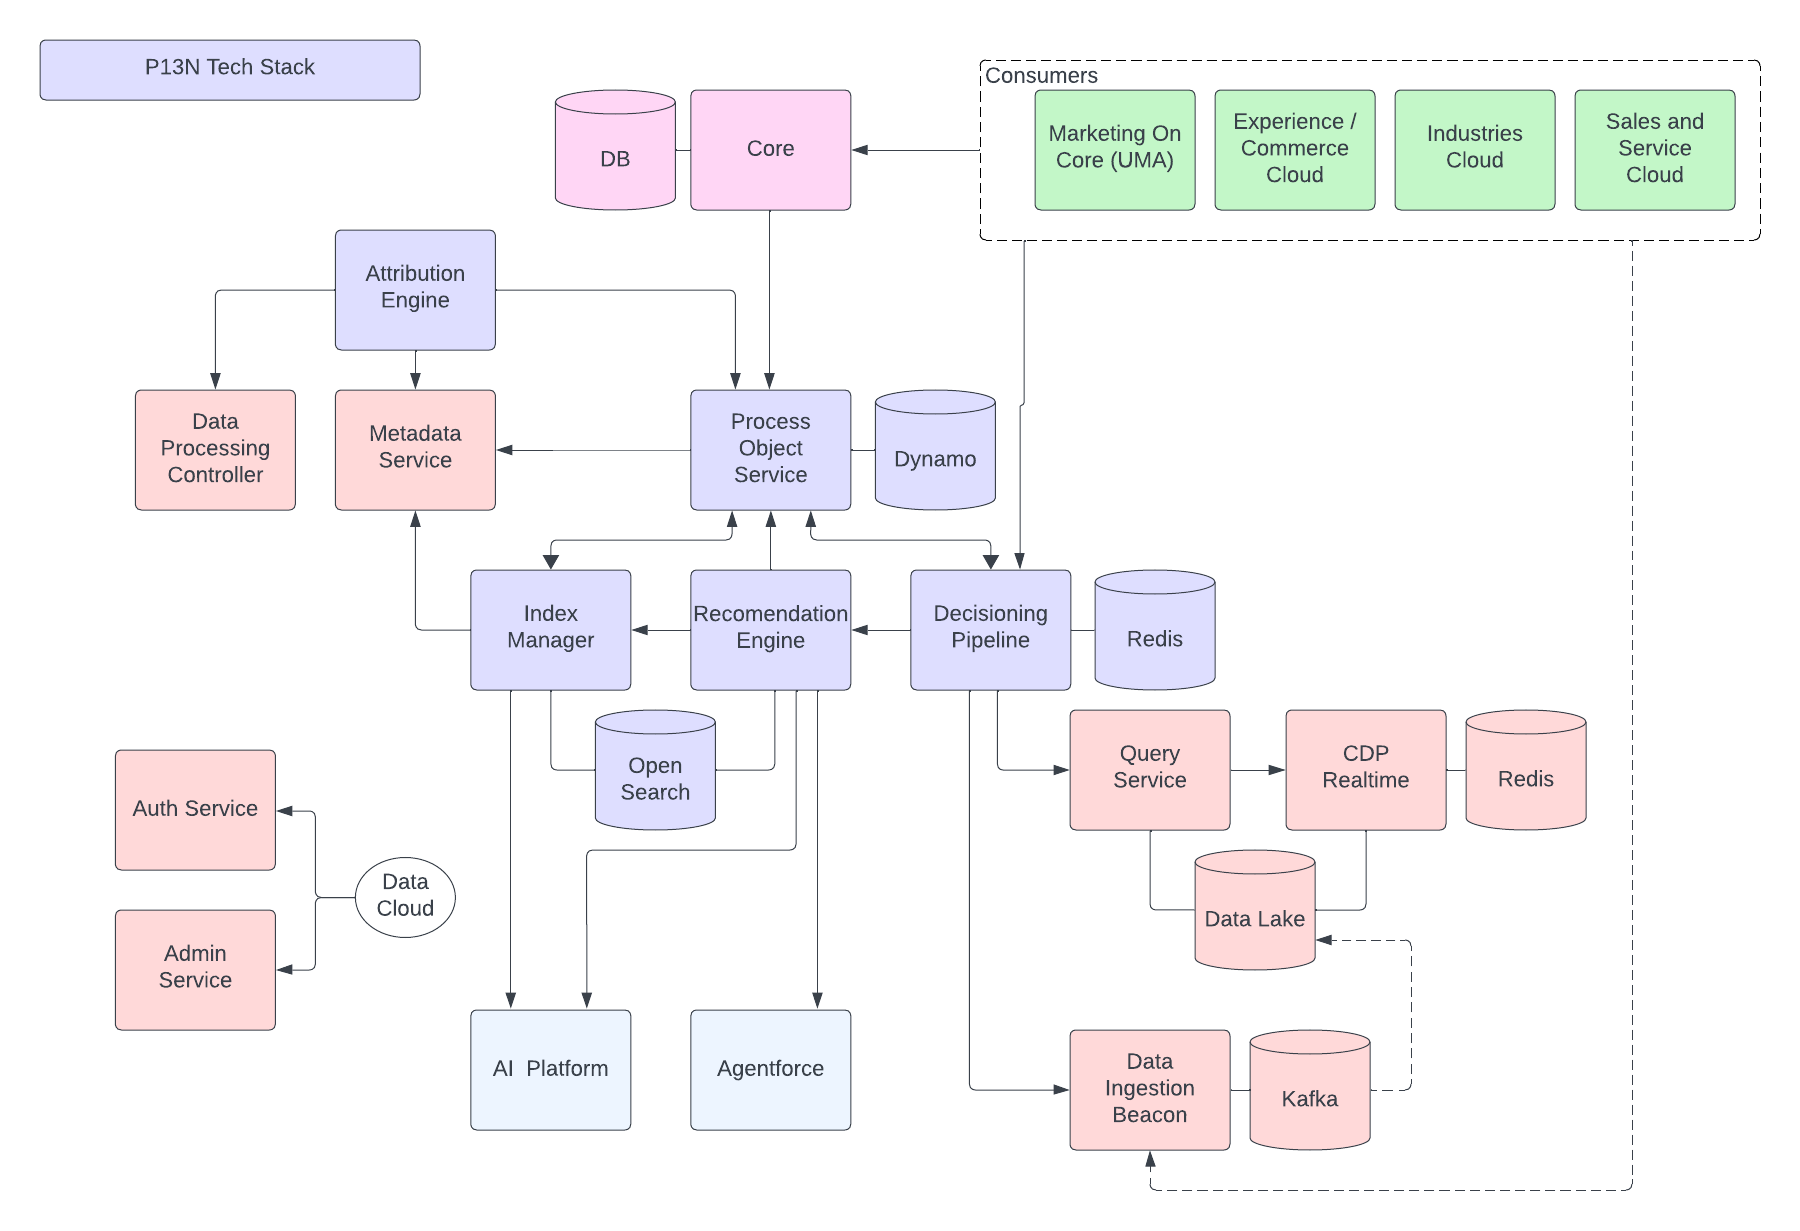 - **결정 파이프라인**
- 프로필 증가, 실험, 권장 사항 등 개인 설정 결정에 대한 외부 요청을 제공합니다.
- **권장 사항 엔진**
- 규칙 또는 ML 기반 권장 사항의 런타임 서비스.
- **인덱스 관리자**
- 권장 모델용 ML 교육 등 비동기 프로세스에 대한 워크플로 관리/오케스트레이션
- **프로세스 개체 서비스**
- 핵심 및 비핵심 간 개인 설정 메타데이터 동기화 책임자
- **속성 엔진 및 실험**
- 개인 설정 권장 사항의 Analytics 특성 및 실험
### 에이전트 엔터프라이즈 검색
Data 360은 특별히 신규 에이전트 환경을 지원하기 위해 강력하고 풍부한 플랫폼으로 설계되었습니다. 다양한 기존 Data 360 서비스를 기반으로 구축하고 Agentforce 긴밀하게 통합하여 이러한 기능을 달성합니다.
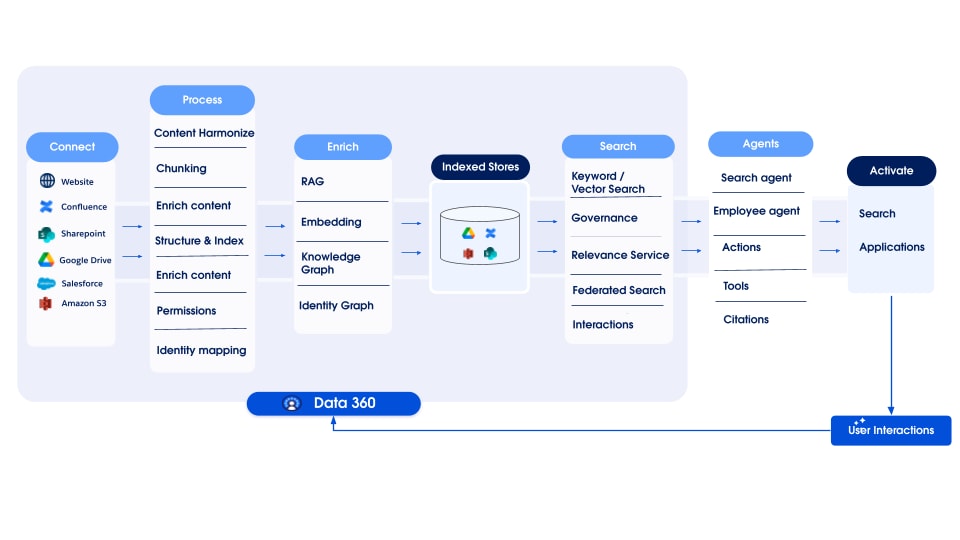 #### Data 360의 핵심 강점 활용
에이전트 엔터프라이즈 검색에 대한 접근 방식은 다음 원칙을 기반으로 합니다.
- 엔터프라이즈 데이터는 액세스에 필요한 보안 권한이 있는 사일로 서비스 또는 매장에 보관됩니다. 소스 권한을 유지하면서 이 데이터에 액세스하고 처리하는 기능은 Trust 보장하는 데 있어 매우 중요합니다.
- 전체 데이터의 순위 및 관련성을 통해 더 나은 결과를 얻을 수 있으므로 에이전트 환경에 더 나은 컨텍스트를 제공할 수 있습니다.
해당 환경을 제공하기 위해 에이전트 엔터프라이즈 검색은 다음 핵심 아키텍처 구성 요소를 기반으로 구축됩니다.
- **커넥터**: Data 360에서 사용할 수 있는 광범위한 커넥터 집합을 사용하면 다양한 소스에서 데이터에 액세스하고 데이터를 수집할 수 있습니다.
- **비정형 데이터 처리**: 이는 비테이블 형식 콘텐츠를 처리하는 데 기본이므로 시스템에서 다양한 데이터에서 의미와 컨텍스트를 도출할 수 있습니다.
- **거버넌스**: 검색에서 사용되는 모든 데이터에 대해 엔터프라이즈급 보안, 규정 준수, 액세스 제어를 보장합니다. 소스 가시성 권한을 지원하면 간단한 검색 및 에이전트 환경 모두에서 권한이 있는 사용자만 데이터에 액세스할 수 있습니다. 신속한 검색을 위해 보안 권한이 가장 빠른 데이터 액세스 단계에서 검색 백엔드에서 기본적으로 평가되고 적용됩니다.
- **통합 검색 계층**: 사일로 데이터의 문제를 해결하기 위해 커넥터가 포괄적인 통합 검색 계층에 피드됩니다. 이 레이어는 연합 검색을 통해 액세스된 외부 시스템에 남아 있거나 0-copy 및 수집된 데이터의 고급 색인을 통해 기본적으로 관리되는지 여부와 상관없이 모든 데이터에 단일 액세스 지점을 제공합니다.
- **인텔리전트 쿼리 이해**: 검색 전에 시스템에서 AI 기반 메커니즘을 사용하여 사용자 의도를 해석합니다. 시맨틱 벡터 일치에 대한 쿼리 표현을 포함하는 것 외에도 키워드 기반 검색을 다시 작성하고 확장하여 정확도를 향상할 수 있습니다.
- **하이브리드 검색 및 고급 쿼리**: 가장 관련성이 높은 정보를 찾기 위해 플랫폼은 여러 전략을 동시에 사용합니다. 하이브리드 검색은 최적화된 데이터 청크에서 시맨틱 벡터 검색과 일치하는 정확한 키워드를 제공하고, 전체 레코드 검색은 전체 문서를 동시에 검색합니다. 두 가지 모두 시맨틱한 관련성과 전체 콘텐츠 적용 범위를 모두 보장하기 위해 결합됩니다.
- **계층 순위**: 데이터를 검색하면 다단계 계층 순위 아키텍처가 모든 소스 및 메서드의 결과에 점수를 매기고 병합하고 순서를 변경합니다. 이 프로세스는 사용자 또는 에이전트에 가장 관련성이 높은 정보를 표시하는 단일 통합 목록을 만듭니다.
#### 에이전트 검색 응용 프로그램
생성형 AI는 엔터프라이즈 검색의 기본 소비자를 인간 사용자에서 대규모 언어 모델(LLM)으로 전환하고 있습니다. Data 360 Search는 모두 제공되도록 처음부터 설계되었습니다. 에이전트의 더 길고 복잡한 쿼리를 처리하고 프로그래밍 사용 및 추론 루프에 필요한 풍부한 컨텍스트 결과를 반환하도록 최적화되어 있습니다. 동시에 시스템은 인간 사용자에 대해 일반적으로 사용되는 빈번하고 모호한 쿼리를 처리하여 UI에서 빠른 평가를 위해 코드 조각 및 강조 표시와 같은 기능을 제공할 수 있습니다.
에이전트 검색 환경의 최종 전달은 두 가지 접근 방식을 결합합니다.
1. **직접 검색 결과**: 응용 프로그램은 Data 360 통합 검색 기반에 구축된 메타데이터 기반 API를 사용하여 순위가 지정된 결과의 기존 목록을 표시할 수 있습니다.
2. **자동 대화형 답변**: Agentforce와 네이티브 통합을 통해 구현됩니다. 이 대화 환경은 작업 및 쿼리를 오케스트레이션하는 기본 에이전트가 구동하여 모든 정보 검색 과업을 내부 검색 에이전트에 위임합니다.
이 전문 검색 에이전트는 엔터프라이즈 정보 검색에 최적화되어 있습니다. 이는 논리 루프를 사용하여 병렬 검색을 수립하고 실행하여 사용자의 요청의 다양한 패싯을 탐색합니다. 모든 데이터 유형에 대한 Data 360 통합 검색 및 구조화된 쿼리 언어 등 강력한 도구 집합을 활용하여 테이블 및 엔티티에서 정확한 데이터를 검색합니다.
이 아키텍처 합성을 통해 Data 360은 맥락에 맞는 매우 지능적인 실행 가능한 에이전트 엔터프라이즈 검색 환경을 만들 수 있습니다.
### 사용자 정의 코드로 Data 360 확장
확장성은 Salesforce Platform의 핵심 기능입니다. 코드 확장은 Data 360에서 확장성을 제공하므로 프로 코드 사용자가 Data 360 환경 내에서 직접 사용자 정의 Python 논리를 실행할 수 있으므로 서식 있는 선언적 및 하위 코드 기능을 보완합니다. 코드 확장을 사용하면 사용자가 변환 및 비정형 데이터 파이프라인(사용자 정의 청크)과 같은 Data 360 핵심 기능을 안전하게 확장할 수 있습니다.
코드 확장 설계는 유연성, 보안, 효율성, 간소화된 개발자 환경에 우선 순위를 두고 있습니다. 각각 특정 아키텍처 요구에 맞게 조정된 두 가지 기본 실행 모델을 지원합니다.
- **Script 모델**:
- **목적**: Data 360 레이크하우스와 직접 상호 작용해야 하는 포괄적인 사용자 정의 논리의 경우
- **기능**: 고객은 코드 확장 SDK를 사용하여 전체 파이썬 스크립트를 작성하여 SDK API를 통해 Lakehouse에 대한 읽기 및 쓰기 액세스를 활성화합니다. 사용자 정의/복합 데이터 준비 또는 맞춤형 데이터 조작에 이상적입니다.
- **격리 및 보안**: 스크립트가 레이크하우스에 액세스하는 동안 실행은 Data 360 런타임 내에서 안전하고 분리된 환경으로 제한되어 다른 프로세스 또는 무단 시스템 액세스를 방지합니다.
- ** 기능 모델**:
- **목적**: 기존 Data 360 파이프라인에서 호출된 모듈식 상태가 없는 계산의 경우(예: 비정형 파이프라인의 사용자 정의 청크) 서버리스 함수와 유사합니다.
- **기능**: 고객이 제공하는 함수는 입력을 가져오고, 계산하고, 출력을 반환합니다.
- **격리 및 보안**: 해당 기능은 엄격한 격리로 설계되었으며, 레이크하우스에 직접 액세스할 수 없습니다. 실행은 Sandbox, 상태가 없는 상태, 자원 제약이므로 중점을 두고 상태가 없는 처리 단계에 적합하며, 보안, 예측 가능한 실행, 폭발 반경 최소화를 보장합니다.
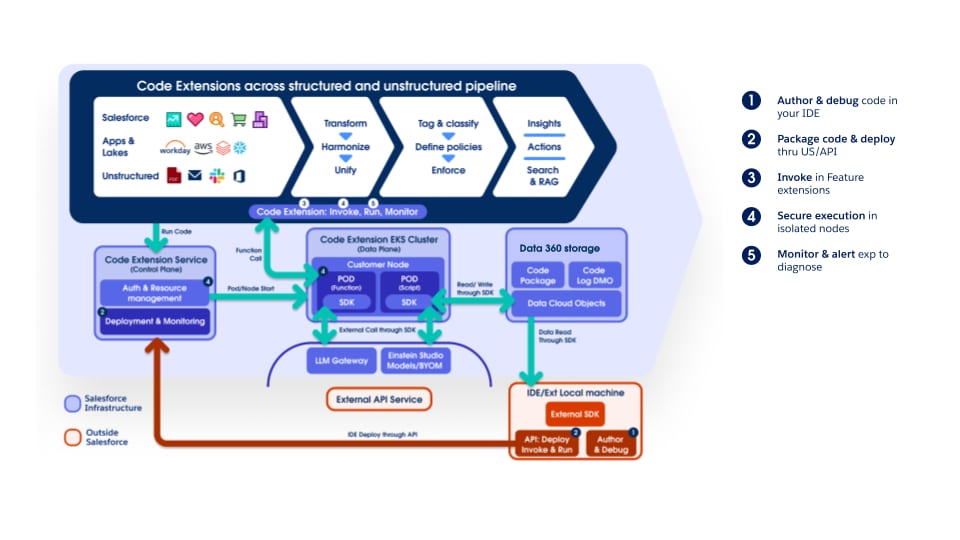 스크립트 및 함수 모델 모두 고객 코드를 안전하게 실행하여 한 테넌트의 코드가 다른 테넌트에 영향을 미치거나 다른 테넌트의 데이터, Salesforce 자원 또는 외부 자원에 대한 무단 액세스를 방지합니다. 이 보안은 계층화된 (보조 방어) 아키텍처를 통해 달성됩니다. 이 아키텍처는 다양한 가드 레일을 통합하여 각 테넌트의 사용자 정의 코드에 대해 분리된 실행 환경을 제공합니다. 여기에는 Kubernetes(K8s) 수준의 논리적 격리, 네트워크 격리, 런타임 Sandbox, 최소 권한 권한이 모두 포함되며, 감지 및 응답을 위한 운영 모니터링 및 사고 응답 준비가 보완됩니다.
#### 개발자 경험 및 운영 가시성
강력한 개발 수명 주기를 지원하기 위해 코드 확장은 다음을 제공합니다.
- **외부 작성 및 디버깅**: 개발자는 SDK를 활용하여 VSCode와 같은 친숙한 환경에서 Python 코드를 작성하고 디버그할 수 있습니다.
- **유연한 구축**: 사용자 정의 코드는 SDK 유틸리티, Data 360 UI 또는 API를 사용하여 패키지화하고 배포하여 CI/CD에 통합할 수 있습니다.
**작업 로그**: 자세한 실행 로그에 대한 액세스는 투명성을 제공하고 프로덕션에서 문제 해결에 도움이 됩니다.
Data 360은 이러한 안전하고 유연한 코드 확장 기능을 제공함으로써 설계자가 가장 고유하고 복잡한 데이터 처리 요구 사항에 맞게 플랫폼을 조정할 수 있도록 지원하여 확장 가능한 엔터프라이즈 데이터 패브릭 역할을 강화할 수 있습니다.
### 자체 AI 모델을 가져와 Data 360 확장
기업이 AI 채택을 가속화함에 따라 대부분 Amazon SageMaker, Google Vertex AI, 사용자 정의 Python 기반 환경 등 이기종 ML 에코시스템을 유지하며, 신용 위험 점수 매기기, 이탈 성향, 제품 추천, Next Best Action 결정과 같은 미션 크리티컬 예측을 촉진하는 모델을 호스팅합니다.
일반적으로 이러한 외부 모델을 Salesforce에 통합하려면 사용자 정의된 API 계층, ETL 파이프라인 또는 미들웨어 오케스트레이션이 필요하며 데이터 중복, 거버넌스 오버헤드, 대기 시간, 운영 복잡성이 도입되어 통합, 규정 준수, 실시간 고객 데이터 플랫폼(CDP) 비전과 충돌하는 문제입니다.
**Bring Your Own Model (BYOM)**: Data 360의 Einstein Studio를 통해 제공되며 데이터를 이동하거나 복제하지 않고 Salesforce 워크플로, Apex 논리 및 자동화 도구 내에서 외부에서 교육된 모델을 직접 호출할 수 있도록 지원함으로써 이러한 과제를 해결합니다. 제로 카피 연합을 통해 Data 360은 관리되는 단일 진실 소스로 작동하며, 외부 엔드포인트에서 추론할 수 있도록 조화된 Customer 360 데이터를 노출합니다. 예측 출력이 실시간으로 다시 흐르므로 비즈니스 프로세스에 확장 가능한 인텔리전스를 제공합니다.
BYOM은 모델 개발, 관리 데이터, 소비 계층을 분리하여 데이터 과학 및 운영 실행 간의 격차를 효과적으로 해소합니다. 플랫폼 독립성을 유지하고, 통합 복잡성을 줄이고, AI 배포를 가속화하며, 중요한 데이터에 대한 거버넌스를 유지합니다.
아키텍처는 다음과 같이 작동합니다. Data 360은 통합된 Customer 360 데이터 파운데이션을 제공하고 Einstein Studio는 외부 ML 플랫폼(SageMaker, Vertex AI 또는 사용자 정의 엔드포인트)에 대한 연결을 오케스트레이션합니다. 외부 모델은 실시간, 배치 또는 스트리밍 모드에서 추론을 실행합니다. Salesforce 계층(플로, Apex, 쿼리 API)은 출력을 사용하여 세일즈, 서비스, 마케팅, 산업 클라우드 전체에서 맞춤형, 자동화된 분석 인사이트를 제공합니다.
엔터프라이즈 관점에서 BYOM은 다음을 제공합니다.
- **데이터 무결성 및 거버넌스**: 제어되지 않는 데이터 사본을 제거하고 정책 준수를 적용합니다.
- **AI 민주화**: Salesforce 도구를 통해 비기술 사용자가 복잡한 모델에 액세스할 수 있도록 합니다.
- **Time-to-Value 가속화**: 외부 모델은 Salesforce 프로세스 내에서 즉시 활성화됩니다.
- **확장성 및 하이브리드 아키텍처 지원**: AI 워크로드의 다중 클라우드 배포를 활성화합니다.
- **미래에 적합한 AI 아키텍처**: 운영 유연성을 위해 구성 가능한 AI 전략을 지원하고 데이터, 모델, 소비 계층을 분리합니다.
**자신의 LLM 가져오기 (BYO-LLM)**: 생성형 모델의 경우에도 동일한 확장성 메커니즘을 제공합니다. 외부 LLM의 직접 호출을 활성화함으로써 고객은 Salesforce에서 제공하는 모델 대신 Agentforce Platform에서 해당 모델을 사용할 수 있습니다. 엔터프라이즈의 경우 BYO-LLM은 다음을 허용합니다.
- 정밀 조정된 모델에 액세스
- 현재 Salesforce에서 제공하지 않는 모델의 통합
- 고객이 제공한 계정의 모델 사용
### 데이터 공동 작업
현대 기업은 두 가지 주요 아키텍처 문제인 복잡한 데이터 환경 내에서 운영합니다.
1. **기업 내 분할**: 대규모 조직은 여러 Salesforce 조직(주로 지역, 사업부 또는 내역 인수별로 세분화됨)과 다양한 기타 데이터 시스템을 자주 활용합니다. 이러한 조각화로 인해 내부 데이터가 사라지므로 비즈니스 전반에서 실시간 참여를 위해 신뢰할 수 있는 단일하고 통합된 고객 보기를 설정할 수 없습니다. 모든 시스템에서 물리적으로 통합하거나 복제하지 않고 이 데이터를 통합하여 거버넌스를 그대로 유지하는 과제입니다.
2. **기업 간 협업**: 회사는 공동 마케팅, 측정, 비즈니스 인텔리전스를 위해 파트너 및 공급업체와 데이터를 공유해야 하는 경우가 많습니다. 중요한 독점 데이터를 보호하고 GDPR 및 CCPA와 같은 개인정보보호 규정을 준수하며 경쟁 장벽을 보호하면서 이러한 공동 작업을 활성화하는 것이 문제입니다.
Salesforce Data 360은 데이터를 이동하거나 복제하지 않고 액세스 및 인사이트를 공유하는 원칙에 기반한 제로 복제, Trust by Design 프레임워크를 통해 이러한 과제를 해결합니다.
#### Data 360 공동 작업 메커니즘
Salesforce Data 360은 Data Cloud One, Data 360 간 데이터 공유, 프라이버시 우선 데이터 정리 룸을 사용하여 데이터 조각화 및 공동 작업 문제를 해결합니다. 이러한 솔루션은 고객 데이터를 통합하고, 안전한 데이터 교환을 활성화하며, 개인 정보를 보호하는 인사이트를 제공합니다. 제로 카피, Trust by Design 접근 방식을 통해 조직은 실시간 참여, 향상된 파트너십, 지능형 의사 결정을 위한 데이터 잠재력을 확보할 수 있습니다. 이러한 각 데이터 공동 작업 옵션은 서로 다른 목적으로 사용됩니다.
##### Data Cloud One을 통한 내부 엔터프라이즈 활성화
Data Cloud One은 여러 Salesforce 조직을 운영하는 엔터프라이즈를 위한 기본 아키텍처 솔루션입니다. 단순한 데이터 공유를 벗어나 신뢰할 수 있는 단일 고객 보기를 구축하고 전체 조직에서 전체 Data 360 플랫폼 기능을 활성화하도록 설계되었습니다.
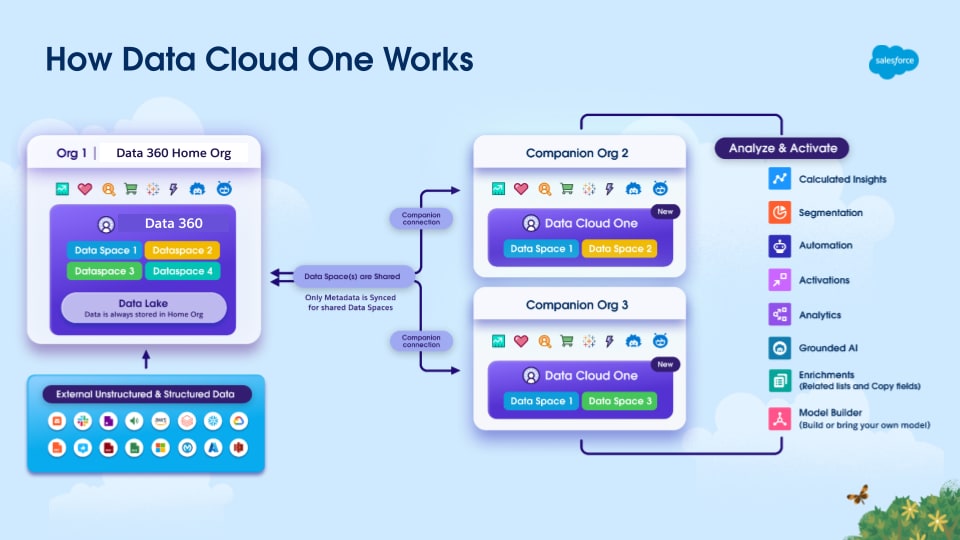 이 메커니즘은 데이터 관리 및 통합 고객 프로필 구축을 위한 중앙 기관 역할을 하는 지정된 홈 조직 Data 360 인스턴스에 중점을 두고 있습니다. 홈 조직은 Data 360이 프로비저닝되는 조직입니다. Data 360과 다른 Salesforce 조직 간에 동료 조직이라는 Data Cloud One 연결이 설정됩니다. Data Cloud One 연결의 일부로 Data 360은 각 동료 조직과 하나 이상의 데이터 공간을 공유하여 각 공유 데이터 공간의 데이터와 메타데이터에 모두 액세스할 수 있습니다. 이는 제로 카피 연합 모델 및 교차 조직 메타데이터 동기화를 통해 이루어집니다.
Data Cloud One을 사용하면 동료 조직이 자체 활성화, 개인 설정, 인텔리전스 요구에 맞게 홈 조직의 Data 360 인스턴스를 활용할 수도 있습니다. 이 전략은 내부 데이터 분할을 없애고 모든 사업부가 같은 관리 및 통합 고객 프로필에 대해 활성화되어 핵심 Data 360 구현의 ROI를 극대화하는 데 필수적입니다.
##### Data 360 조직 간 데이터 공유
분산된 내부 환경(완전한 중앙 집중화가 불가능한 경우) 및 신뢰할 수 있는 외부 파트너와의 공동 작업을 위해 Data 360-to-Data 360 데이터 공유는 독립 Data 360 인스턴스를 연결합니다.
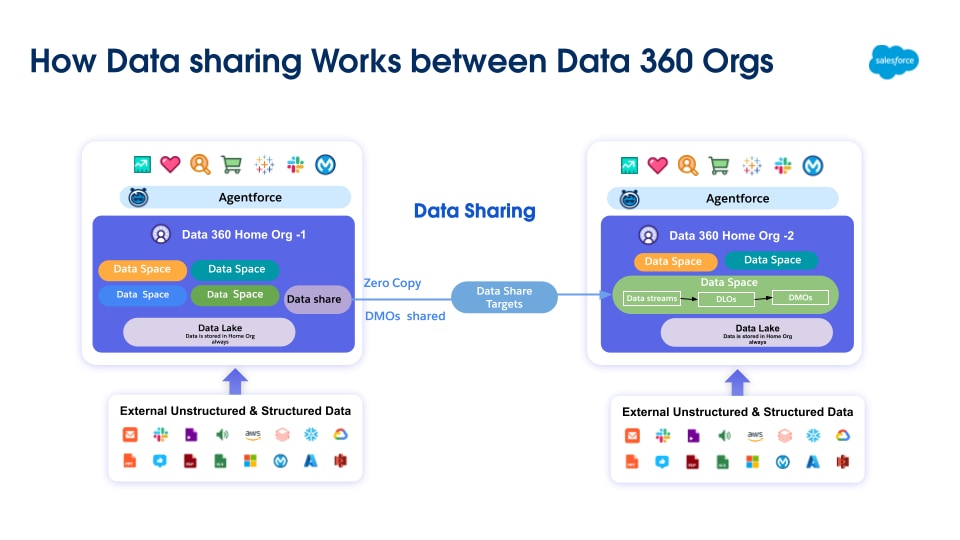 이 제로 카피 공유 모델은 데이터 개체(DLO, DMO, CIO)를 안전하게 교환하기 위해 다른 Salesforce 조직에서 프로비저닝된 별도의 Data 360 테넌트 간 연결을 설정합니다. 연결되면 수신자 Data 360에서 전체 데이터 개체에 액세스할 수 있습니다. 그러면 수신자 Data 360의 관리자가 이 데이터에 대한 사용자 액세스를 관리하는 거버넌스 규칙을 설정할 수 있습니다.
##### Data 360 Clean Room 공동 작업을 통한 개인정보 보호-첫 번째 공동 작업
공동 작업 시 가장 높은 수준의 개인 정보 보호 및 규정 준수가 필요하거나 경쟁 문제로 인해 원시 데이터 공유가 금지되는 경우 Data 360 Clean Rooms는 아키텍처에 따라 필수 항목입니다.
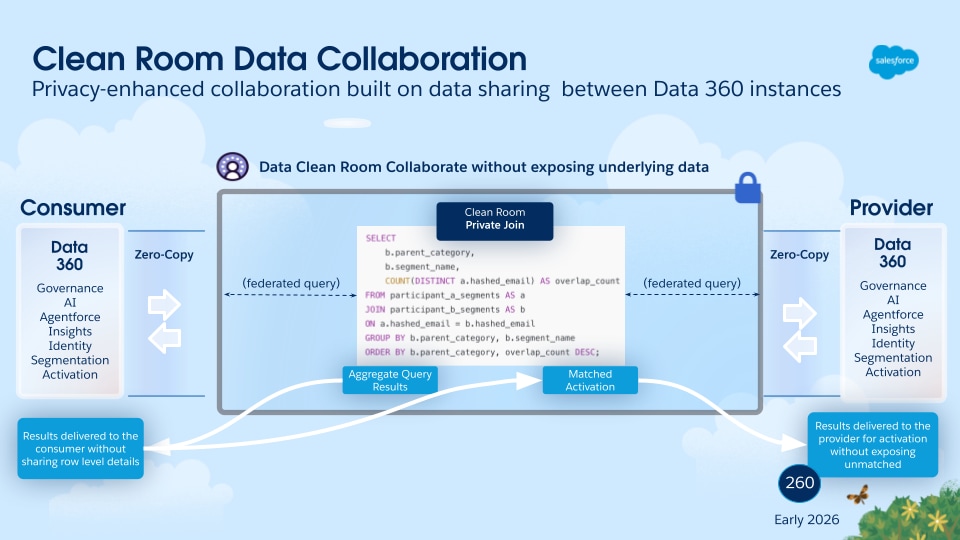 아키텍처적으로 Data 360 Clean Room 공동 작업은 Data 360-to-Data 360 데이터 공유에 사용되는 제로 카피 공유 프레임워크의 상단에 구축되었지만 추가적인 관리 계층 및 계산 제약이 적용됩니다. Data 360 Clean Room은 당사자가 익명화된 키를 기반으로 데이터 집합을 조인할 수 있는 안전하고 제어되는 컴퓨팅 환경을 제공합니다. 핵심적인 목적은 기본 독점 데이터를 노출하지 않고도 공동 분석 및 인사이트 생성을 허용하는 것입니다. 환경은 최소 집계 임계값 및 내보내기가 불가능한 식별자와 같은 프로그래밍 가능한 엄격한 규칙을 적용합니다. 이러한 규칙을 통해 승인된 개인 정보 보호 및 집계된 인사이트만 파생 및 공유됩니다. 이를 통해 클린 룸은 플랫폼 간 캠페인 측정 및 민감한 대상 겹침 분석과 같은 사용 사례에 필수적으로 적용됩니다.
## 결론: Salesforce Data 360: 에이전트 엔터프라이즈의 필수 데이터 백본
Data 360은 차세대 AI를 구동하는 데 필요한 지능적이고 확장 가능하며 신뢰할 수 있는 데이터 패브릭으로 설계되었습니다. 아키텍처 설계는 분할된 데이터의 문제를 해결하여 조직에서 효율성을 보장하기 위해 Zero Copy Data Federation을 사용하여 모든 고객 데이터를 대규모로 통합, 처리, 활성화할 수 있도록 합니다.
강력한 데이터 조직은 DLO(정형화되지 않은 데이터 포함)에서 DMO로의 조화된 보기를 설정하며, 모두 분할된 데이터 공간 내에서 보호됩니다. 배치 및 스트리밍 변환, 계산된 인사이트, 비정형 데이터 처리, ID 확인 등 Data 360의 다양한 데이터 처리 기능은 증분 SNCE 및 CDF 아키텍처에 의해 제공되므로 효율적이고 실시간에 가까운 처리를 수행하고 상당한 비용을 절감할 수 있습니다.
확장성은 코드 확장 아키텍처에서 제공되며, 고유한 요구 사항에 대해 스크립트 또는 분리된 함수를 통해 사용자 정의 파이썬 논리를 안전하게 활성화합니다. 또한 CEDAR 정책과 함께 특성 기반 액세스 제어(ABAC)를 기반으로 구축된 포괄적인 데이터 거버넌스 프레임워크는 세분화된 보안, 동적 데이터 마스킹, 모든 데이터 사용 전반에 걸쳐 일관된 적용을 보장합니다. 이는 정교한 세분화 및 활성화 기능으로 끝나고, 통합 고객 프로필을 실시간 반응형 동적 다중 채널 참여 전략으로 전환합니다.
중요한 점은 Data 360이 광범위하고 다양한 데이터를 통합하고, 통합 쿼리를 통해 실시간 컨텍스트를 제공하는 기능(하이브리드 구조화/비정형 검색 및 하이퍼 가속 포함), 엄격한 관리를 적용하는 기능이 지능형 AI 에이전트를 강화하는 데 매우 중요합니다. Agentforce 지원 에이전트의 생성형 AI 워크플로(RAG)를 기반으로 신뢰할 수 있고 신선하고 관련성이 높은 데이터를 제공하고 다중 전환 작업 지향 기능을 제공하므로 정확하고 정확하게 작동합니다.
소스 데이터가 실천 가능한 인사이트로 변환되는 미래 보장 플랫폼을 제공함으로써 Data 360은 에이전트 고객 경험을 구축하는 조직에 필수 아키텍처 기반 역할을 합니다. 이는 고객 데이터를 현대 조직의 성공을 촉진하는 정교하고 맞춤형 고객 경험으로 전환하는 중요한 기초입니다.
## 개요
현대 Salesforce 통합은 간단한 데이터 교환 이상을 지원해야 합니다. 실시간 고객 환경을 구동하고 여러 시스템에서 조치를 조율하며 엄격한 보안 및 규정 준수 요구 사항을 충족하면서 엔터프라이즈 규모에서 안정적으로 운영할 수 있습니다. 따라서 올바른 통합 접근 방식을 선택하는 것은 구현 세부 사항이 아닌 중요한 아키텍처 결정입니다.
일반적인 엔터프라이즈 시나리오를 고려하십시오. 고객이 모바일 앱에서 구매를 완료하여 맞춤형 제안에 대한 실시간 자격 검사를 트리거합니다. 동시에 트랜잭션 데이터는 ERP 시스템에 기록되고, 고객 특성이 Salesforce에서 업데이트되고, 분석이 대기 시간, 데이터 중복 또는 규정 준수 위험을 유발하지 않고 데이터 레이크로 스트리밍되어야 합니다. 이와 같은 시나리오는 Salesforce가 분리된 상태에서 작동하는 경우가 거의 없으며 더 광범위한 응용 프로그램 및 데이터 플랫폼 에코시스템과 원활하게 통합해야 하는 현대 Salesforce 환경에서 일반적입니다.
이 가이드는 설계자 및 개발자가 명확하고 자신 있게 통합을 설계할 수 있도록 지원합니다. 지점 간 구현에 초점을 맞추지 않고 반복되는 엔터프라이즈 시나리오(예: 프로세스 오케스트레이션, 데이터 동기화, 실시간 데이터 액세스)를 해결하는 **확인된 통합 패턴**을 소개합니다. 각 패턴은 아키텍처 의도, 제약, 실행 모델을 강조하여 팀이 확장하고 지속되는 정보에 근거한 설계 결정을 내릴 수 있습니다.
이 문서 내에서 다음을 찾을 수 있습니다.
- 프로세스, 데이터, 가상 액세스 시나리오에서 일반적인 엔터프라이즈 "상위 유형"을 나타내는 통합 패턴
- 통합 의도 및 실행 타이밍을 기반으로 올바른 접근 방식을 식별하는 데 도움이 되는 패턴 선택 프레임워크
- 확장성, 복원력, 거버넌스, 보안 고려 사항에 대한 실용 지침
- 실제 Salesforce 및 Data 360 구현에서 얻은 모범 사례
이 문서의 목표는 통합을 위한 공유 아키텍처 언어를 제공하는 것입니다. 이를 통해 팀이 엔터프라이즈 데이터 및 거버넌스 전략에 맞춰 성능, 유연성, Trust 균형을 맞추는 솔루션을 설계할 수 있습니다.
### 목적 및 범위
이 문서는 엔터프라이즈의 다른 응용 프로그램의 데이터를 Salesforce Data 360(기존의 Data Cloud)과 통합해야 하는 디자이너 및 아키텍처를 위한 것입니다. 이 콘텐츠는 Salesforce 아키텍처 및 파트너가 성공적으로 구현한 수많은 구현 내용의 추출입니다.
Data 360의 대규모 채택에 사용할 수 있는 통합 기능 및 옵션을 숙지하려면 아래의 패턴 요약 및 패턴 선택 가이드 섹션을 참조하십시오. 설계자 및 개발자는 Data 360에 대한 데이터 상호 작용 프로젝트의 설계 및 구현 단계에서 해당 패턴 세부 사항 및 성공 사례를 고려해야 합니다.
올바르게 구현되면 해당 패턴을 사용하면 가능한 한 빠르게 프로덕션으로 이동하고 가능한 한 안정적이고 확장 가능하며 유지보수 없이 애플리케이션 집합을 사용할 수 있습니다. Salesforce의 자체 컨설팅 아키텍처는 이러한 패턴을 아키텍처 검토 시 참조 지점으로 사용하고 적극적으로 유지 및 개선합니다.
모든 패턴과 마찬가지로 이 콘텐츠는 대부분의 통합 시나리오에 적용되지만 전부는 적용되지 않습니다. 예를 들어 Salesforce에서 사용자 인터페이스(UI) 통합을 허용하는 경우, 이러한 통합은 이 문서의 범위를 벗어납니다.
### 패턴 템플릿
각 통합 패턴은 일관된 구조를 따릅니다. 이렇게 하면 각 패턴에 제공되는 정보가 일관되고 패턴을 더 쉽게 비교할 수 있습니다.
- **이름**: 패턴에 포함된 통합 유형을 나타내는 패턴 식별자입니다.
- **컨텍스트:** 패턴이 해결하는 전체 통합 시나리오입니다. 컨텍스트는 사용자가 달성하려는 작업과 응용 프로그램이 요구 사항을 지원하기 위해 동작하는 방법에 대한 정보를 제공합니다.
- **문제:** 질문으로 표현하면 패턴이 해결하도록 설계된 시나리오입니다. 이 섹션을 읽어 패턴이 통합 시나리오에 적합한지 이해하십시오.
- **Forces:** 설명된 시나리오를 해결하기 어려운 제약 및 상황입니다.
- **솔루션:** 통합 시나리오를 해결하는 권장 방법입니다.
- **스케치:** 솔루션이 시나리오를 해결하는 방식을 보여주는 UML 순서 다이어그램
- **결과:** 통합 시나리오에 솔루션을 적용하는 방법과 해당 시나리오와 관련된 힘을 해결하는 방법에 대한 세부 사항을 설명합니다. 이 섹션에는 패턴 적용으로 인해 발생할 수 있는 새로운 문제도 포함되어 있습니다.
- **사이드바:** 주요 기술 문제, 패턴 변형, 패턴별 문제 등을 포함하는 패턴과 관련된 추가 섹션입니다.
- **예:** 실제 Salesforce 시나리오에서 디자인 패턴이 사용되는 방식을 설명하는 실제 시나리오입니다. 이 예에서는 통합 목표 및 해당 목표를 달성하기 위해 패턴을 구현하는 방법을 설명합니다.
## 패턴 요약
이 표를 이 문서에 포함된 통합 패턴의 목차로 사용합니다.
### 패턴 목록
| 패턴 수준1 | 패턴 수준2 | 패턴 | 보조 |
|---|---|---|---|
| 데이터 수집 패턴--데이터 인바운드 | 배치 수집 패턴 | 클라우드 스토리지에서 대량 데이터 수집 | 데이터는 Amazon S3, Azure Blob 또는 Google Cloud Storage와 같은 엔터프라이즈 클라우드 저장소 소스에서 대량의 원시 데이터 배치(예: 트랜잭션 또는 제품 로그) 형태로 Data 360으로 수집됩니다. |
| Salesforce Cloud에서 대량 데이터 수집 | Data 360은 여러 Salesforce 조직(예: Sales Cloud, Service Cloud)에서 CRM 데이터를 대량으로 수신하여 통합 고객 프로필을 구축합니다. | ||
| 스트리밍 및 실시간 수집 패턴 | 수집 API를 통한 이벤트 중심 수집--스트리밍 | Data 360은 실시간 프로필 업데이트를 위해 엔터프라이즈 시스템에서 연속 이벤트 페이로드(예: 구매 이벤트, IoT Telemetry)를 수신하는 스트리밍 수집 끝점을 구독합니다. | |
| 실시간 웹 및 모바일 동작 수집 | Data 360은 SDK를 통해 실시간 웹 사이트 및 모바일 앱 동작 데이터를 수집 및 처리하여 참여 메트릭 및 개인 설정 모델을 강화합니다. | ||
| 스트리밍을 통한 거의 실시간 CRM 동기화 | Data 360은 이벤트 스트림을 통해 CRM 데이터 업데이트(예: 연락처, 사례, 기회 변경)를 거의 실시간으로 수신하여 지속적으로 동기화된 Customer 360 보기를 유지합니다. | ||
| 클라우드 메시징 플랫폼에서 이벤트 스트림 수집--Kinesis 및 MSK | Data 360은 AWS Kinesis 또는 Kafka(MSK)와 같은 클라우드 이벤트 플랫폼에서 직접 스트리밍 데이터를 사용하여 고주파 운영 또는 IoT 이벤트를 처리합니다. | ||
| 제로 복제 패턴--인바운드 및 아웃바운드 | 인바운드 제로 복제--Data 360에 대한 외부 플랫폼 | Data 360은 물리적으로 데이터를 Salesforce로 이동하지 않고도 Zero Copy 수집을 통해 요청 시 외부 데이터 집합(예: Snowflake, BigQuery)을 쿼리합니다. | |
| Outbound Zero Copy--외부 플랫폼에 대한 Data 360 | Databricks 또는 Tableau와 같은 외부 시스템은 데이터 복제 없이 Zero Copy 아웃바운드 연결을 통해 Data 360의 보강 세그먼트 및 인사이트에 액세스합니다. | ||
| Data Cloud One을 통합한 다중 조직 데이터 플랫폼 | Data Cloud One은 공유 메타데이터 및 시맨틱 모델 아래 여러 Salesforce 조직과 외부 데이터 소스를 통합하여 데이터 중복 없이 일관된 Customer 360 제공합니다. | ||
| 데이터 활성화 패턴--데이터 아웃바운드 | 배치 활성화 패턴 | 마케팅 및 광고 플랫폼에 대한 세그먼트 활성화 | Data 360은 맞춤형 캠페인 전달을 위해 Marketing Cloud, Meta, Google Ads 또는 기타 광고 플랫폼에 직접 선별된 고객 세그먼트를 활성화합니다. |
| 클라우드 저장소로 데이터 내보내기 | Data 360은 분석 또는 규정 준수 보관을 위해 통합 또는 필터링된 데이터 집합(예: 동의된 고객 레코드)을 CSV 또는 Parquet 파일로 엔터프라이즈 클라우드 저장소로 내보냅니다. | ||
| 요청형 API 기반 활성화 | Connect API를 통한 맞춤형 응용 프로그램 통합 | 외부 응용 프로그램은 Data 360 Connect API를 실시간으로 호출하여 현재 고객 데이터를 기반으로 개인 설정된 작업(예: 충성도 잔고 확인 또는 AI 제안 생성)을 검색하거나 트리거합니다.사용자 정의된 웹 또는 모바일 응용 프로그램은 Connect REST API를 통해 조화된 Data 360 인사이트를 안전하게 검색하여 엔터프라이즈 또는 파트너 UI 내에 표시합니다. | |
| 데이터 그래프 API를 통한 전체 고객 프로필 검색 | 시스템에서 데이터 그래프 API를 사용하여 고객의 통합 프로필을 검색하여 결정 또는 개인 설정을 위해 전체 360° 보기의 사전 결합된 실시간 JSON 표현을 반환합니다. | ||
| 실시간 데이터 작업 | 실시간 데이터 동작 고객 신호를 즉각적인 동작으로 전환 | Data 360은 실시간 이벤트(예: 동의 업데이트, 구매 트리거)를 감지 및 처리하고 연결된 시스템 또는 Salesforce 플로를 즉시 호출하여 다운스트림 작업을 수행합니다.Data 360의 고객 활동 신호(예: 이탈 위험 감지)는 CRM 업데이트, Einstein 점수 호출 또는 보존 여정을 시작하는 등 즉시 실시간 작업을 트리거합니다. |
| 유형 | 시기 | 아웃바운드 고려 사항 |
|---|---|---|
| 데이터 통합 | 비동기식 | 마케팅 및 광고 플랫폼에 대한 세그먼트 활성화 |
| 프로세스/데이터 통합 | 동기식 | Connect API를 통한 맞춤형 응용 프로그램 통합 데이터 그래프 API를 통한 전체 고객 프로필 검색 |
| 데이터 통합 | 동기식 | 실시간 데이터 동작 고객 신호를 즉각적인 동작으로 전환 |
| 가상 통합(zero Copy 사용) | 비동기식 | Outbound Zero Copy--외부 플랫폼에 대한 Data 360 |
| 가상 통합 | 비동기식 | Data Cloud One을 통합한 다중 조직 데이터 플랫폼 |
| 유형 | 시기 | 인바운드 고려 사항 |
|---|---|---|
| 데이터 통합 | 비동기식 | 클라우드 스토리지에서 대량 데이터 수집 Salesforce Cloud에서 대량 데이터 수집 |
| 데이터 통합 | 비동기식 | 클라우드 메시징 플랫폼에서 이벤트 스트림 수집--Kinesis 및 MSK 스트리밍을 통한 거의 실시간 CRM 동기화 |
| 프로세스 통합 | 동기식 | 수집 API를 통한 이벤트 중심 수집--스트리밍 실시간 웹 및 모바일 동작 수집 |
| 가상 통합 | 비동기식 | 인바운드 제로 복제--Data 360에 대한 외부 플랫폼 |
| 기간 | 정의 |
|---|---|
| 이벤트 처리 | 이벤트 처리는 소스 시스템 또는 응용 프로그램에서 식별 가능한 항목의 수신, 라우팅, 응답을 나타냅니다. 중간웨어는 대상 끝점을 식별하고, 이벤트를 전달하고, 필수 비즈니스 작업(예: 로깅, 재시도 또는 다운스트림 서비스 활성화)을 트리거하여 이벤트를 처리합니다. Data 360 아키텍처에서 이벤트 처리는 실시간 데이터 수집, 활성화 트리거, 게시/구독 패턴에 매우 중요합니다. 이벤트는 외부 시스템(Kafka, AWS Kinesis) 또는 Salesforce Platform 이벤트에서 생성될 수 있으며, 즉시 처리하기 위해 미들웨어 또는 Data 360 이벤트 버스에서 라우팅됩니다. |
| 프로토콜 변환 | 프로토콜 변환을 사용하면 다른 데이터 전송 표준을 사용하여 시스템 간에 통신할 수 있습니다. 중간웨어는 독점 또는 레거시 프로토콜(예: AMQP, MQTT, FTP)을 지원되는 Data 360 프로토콜(REST, gRPC 또는 HTTPS)으로 변환합니다. 이렇게 하면 이기종 시스템 전체에서 상호 운용성이 보장됩니다. Data 360은 기본적으로 프로토콜 변환을 처리하지 않으므로 미들웨어는 메시지를 Data 360 API 형식으로 캡슐화하거나 변환하고 커넥터가 해석할 수 있는 조정 레이어를 제공합니다. |
| 번역 및 변환 | 번역 및 변환은 하나의 데이터 형식 또는 스키마를 다른 데이터 형식에 매핑하여 상호 운용성을 보장합니다. 중간웨어는 이러한 변환을 수행하여 다양한 데이터 페이로드(CSV, XML, JSON)를 Data 360 데이터 모델 개체(DMO) 및 통합 데이터 레이어 개체(UDLO)에 맞춥니다. 수집 전 시맨틱 또는 본체 기반 매핑 정리, 보강, 적용이 포함됩니다. Salesforce는 Data Prep Recipes와 같은 변환 도구를 제공하지만, 복잡한 변환(특히 시맨틱 조합)은 미들웨어에서 처리하는 것이 가장 좋습니다. |
| 대기열 및 버퍼링 | 대기열 및 완충은 복원 가능한 분리된 통신을 보장하기 위해 비동기식 메시지 전달에 의존합니다. MuleSoft, Kafka 또는 Azure 이벤트 허브 등 중간웨어 플랫폼은 Data 360 또는 다운스트림 시스템이 사용 중이거나 액세스할 수 없는 경우 데이터를 일시적으로 저장하는 영구 대기열을 제공합니다. 이를 통해 데이터 손실을 방지하고 거의 실시간 수집 또는 활성화 재시도를 지원합니다. Data 360은 스트리밍 수집 및 플로 기반 아웃바운드 메시지를 지원하지만, 지속적인 대기열 및 보증 배달은 일반적으로 미들웨어에서 처리됩니다. |
| 동기식 전송 프로토콜 | 동기식 전송 프로토콜에는 차단, 실시간 요청/응답 작업이 수반됩니다. 진행하기 전에 발신자가 회신을 기다립니다. Data 360에서는 요청 시 API 기반 활성화, 실시간 보강 또는 즉시 응답이 필요한 프로필 조회에 사용됩니다. 중간웨어는 연결 신뢰성을 보장하고 동기식 Data 360 API 호출에 대한 재시도 또는 대체 처리를 관리합니다. |
| 비동기식 전송 프로토콜 | 비동기식 전송 프로토콜은 배송자가 응답을 기다리지 않고 계속 처리하는 차단되지 않은 분리된 통신을 지원합니다. 중간웨어는 배치 활성화, 스트리밍 수집, 이벤트 중심 활성화를 위한 비동기 플로를 처리합니다. 이를 통해 Data 360에서 이벤트 스트리밍 및 거의 실시간 데이터 수집 패턴에 매우 중요한 처리량과 복원을 높일 수 있습니다. |
| 중재 라우팅 | 중재 라우팅은 시스템 간 복잡한 메시지 플로를 정의하여 올바른 데이터 또는 이벤트를 올바른 소비자에게 제공합니다. 중간웨어는 중재자 역할을 하며 규칙, 머리글, 콘텐츠 또는 이벤트 유형을 기반으로 라우팅 논리를 처리합니다. Data 360 통합에서 중재를 통해 여러 시스템의 이벤트 및 프로필 업데이트가 데이터 수집 API, 활성화 끝점 또는 외부 소비자에게 제대로 라우팅됩니다. 이렇게 하면 오케스트레이션을 간소화하고 다중 시스템 데이터 동기화를 지원합니다. |
| 프로세스 작전 및 서비스 오케스트레이션 | 프로세스 통합 및 오케스트레이션은 다중 시스템 프로세스를 좌표합니다. 단계는 중앙 컨트롤러 없이 공유 규칙을 기반으로 작업하는 자동 비동기 이벤트 중심 플로를 지원합니다. 오케스트레이션은 서비스 실행을 안내하는 중앙에서 관리하는 플로입니다. Data 360 아키텍처에서 미들웨어는 시스템 전반에서 수집 및 활성화를 위한 오케스트레이션을 관리하고 Salesforce 워크플로 또는 플로는 플랫폼 내에서 가벼운 통합을 처리합니다. 중간웨어 계층에서 트랜잭션 조정 또는 상태 관리를 필요로 하는 복잡한 오케스트레이션을 사용하는 것이 좋습니다. |
| 트랜잭션성(암호화, 서명, 신뢰할 수 있는 전달, 트랜잭션 관리) | 트랜잭션성은 시스템 전반에서 원자적, 일관적인, 분리된, 내구성 있는(ACID) 작업을 보장합니다. Salesforce 및 Data 360은 경계 내에서 트랜잭션이지만 외부 시스템에서 배포된 트랜잭션은 지원하지 않습니다. 중간웨어는 암호화, 메시지 서명, 롤백, 보상, 신뢰할 수 있는 전달 등 글로벌 트랜잭션 제어를 처리합니다. 미션에 중요한 데이터 플로(예: 재무 또는 동의 업데이트)의 경우 미들웨어는 Data 360 및 외부 시스템 전반에서 종단간 무결성 및 복구를 보장합니다. |
| 라우팅 | 라우팅은 구성 요소 간에 메시지 또는 데이터의 제어 플로를 지정합니다. 머리글, 콘텐츠 유형, 우선 순위 또는 규칙을 기반으로 할 수 있습니다. 중간웨어는 Data 360과 관련된 이벤트 및 활성화에 대한 라우팅 논리를 처리합니다(예: 다양한 다운스트림 시스템(Ad Platform, 웨어하우스, CRM 앱)으로 보강된 대상 세그먼트 이동). 라우팅은 Salesforce(Apex, 플로) 내에서 구현할 수 있지만, 확장성, 유연성 및 거버넌스에 따라 미들웨어 라우팅이 선호됩니다. |
| Extract, Transform, and Load(ETL) | ETL은 소스 시스템에서 데이터를 추출하고 일관된 스키마로 변환한 후 대상(예: Data 360)에 로드하는 과정입니다. 데이터 수집 전에 Middleware 또는 ETL 도구가 이러한 작업을 처리합니다. Data 360은 API, 커넥터 또는 대량 수집 파이프라인을 통해 ETL 출력을 수신할 수 있으며, 실시간 동기화를 위해 CDC(Change 데이터 수집 지원합니다. 중간웨어 ETL 프로세스는 레거시 시스템을 통합하고 Data 360에서 통합하기 전에 데이터 품질을 보장하는 데 필수적입니다. |
| 긴 폴링 | 긴 폴링(혜성 프로그래밍)은 실시간 업데이트를 위해 시스템 간의 개방형 통신을 유지하는 방법입니다. 클라이언트가 요청을 보내고 서버가 이벤트가 발생할 때까지 요청을 유지한 후 응답하고 새 연결을 다시 엽니다. Salesforce는 이벤트 중심 데이터 동기화를 위해 스트리밍 API 및 CometD/Bayeux 프로토콜에서 이를 사용합니다. 중간웨어는 해당 이벤트를 구독하고 Data 360에 전달하여 실시간 수집 또는 활성화 트리거를 수행하여 엔터프라이즈 시스템 전반에서 대기 시간이 최소화됩니다. |
| 솔루션 | 맞춤 | 댓글 |
|---|---|---|
| 기본 클라우드 저장소 커넥터 사용(Amazon S3, Google Cloud Storage, Azure Blob Storage) | 최대 | Data 360\에 대규모 반복 파일 기반 수집을 위한 가장 신뢰할 수 있는 권장 패턴입니다. 기본 커넥터는 Data 360의 데이터 레이크 개체(DLO)로 직접 관리 인증, 스키마 매핑, 안전한 데이터 이동을 제공합니다. 대기 시간이 중요하지 않은 예약된 배치 로드에 적합합니다(예: 시간별 또는 매일 예약). |
| 대규모 데이터 집합 처리(커넥터 제한 초과) | 사전 처리를 사용하는 최고 | 각 커넥터는 수집 제한을 적용합니다(예: S3: 100M 행 또는 개체당 50GB). 더 큰 데이터 집합의 경우 ETL 사전 처리 단계를 구현하여 해당 임계값 아래에 속하는 더 작은 파일/폴더로 데이터를 분할합니다. 그런 다음, 여러 데이터 스트림을 구성하여 각 파티션을 병렬로 수집하고 Data 360 내의 배치 데이터 변환에서 추가 노드를 사용하여 파티션을 통합 데이터 집합으로 다시 결합합니다. |
| 보안 및 거버넌스 | 최대 | 모든 커넥터는 클라우드 네이티브 메서드(IAM 역할, 서비스 계정 또는 액세스 키)를 통한 보안 인증을 지원합니다. 추가 제어를 위해 클라우드 공급자의 허용 목록을 통해 Data 360 IP 범위에 대한 액세스를 제한합니다. 데이터는 암호화된 채널을 통해 전송되며, 수집하는 동안 파일이 임시로 보안된 스테이징 계층에 저장됩니다. |
| 사용하지 않을 경우 | 최적화되지 않음 | 이 패턴은 다음에 적합하지 않습니다.
|
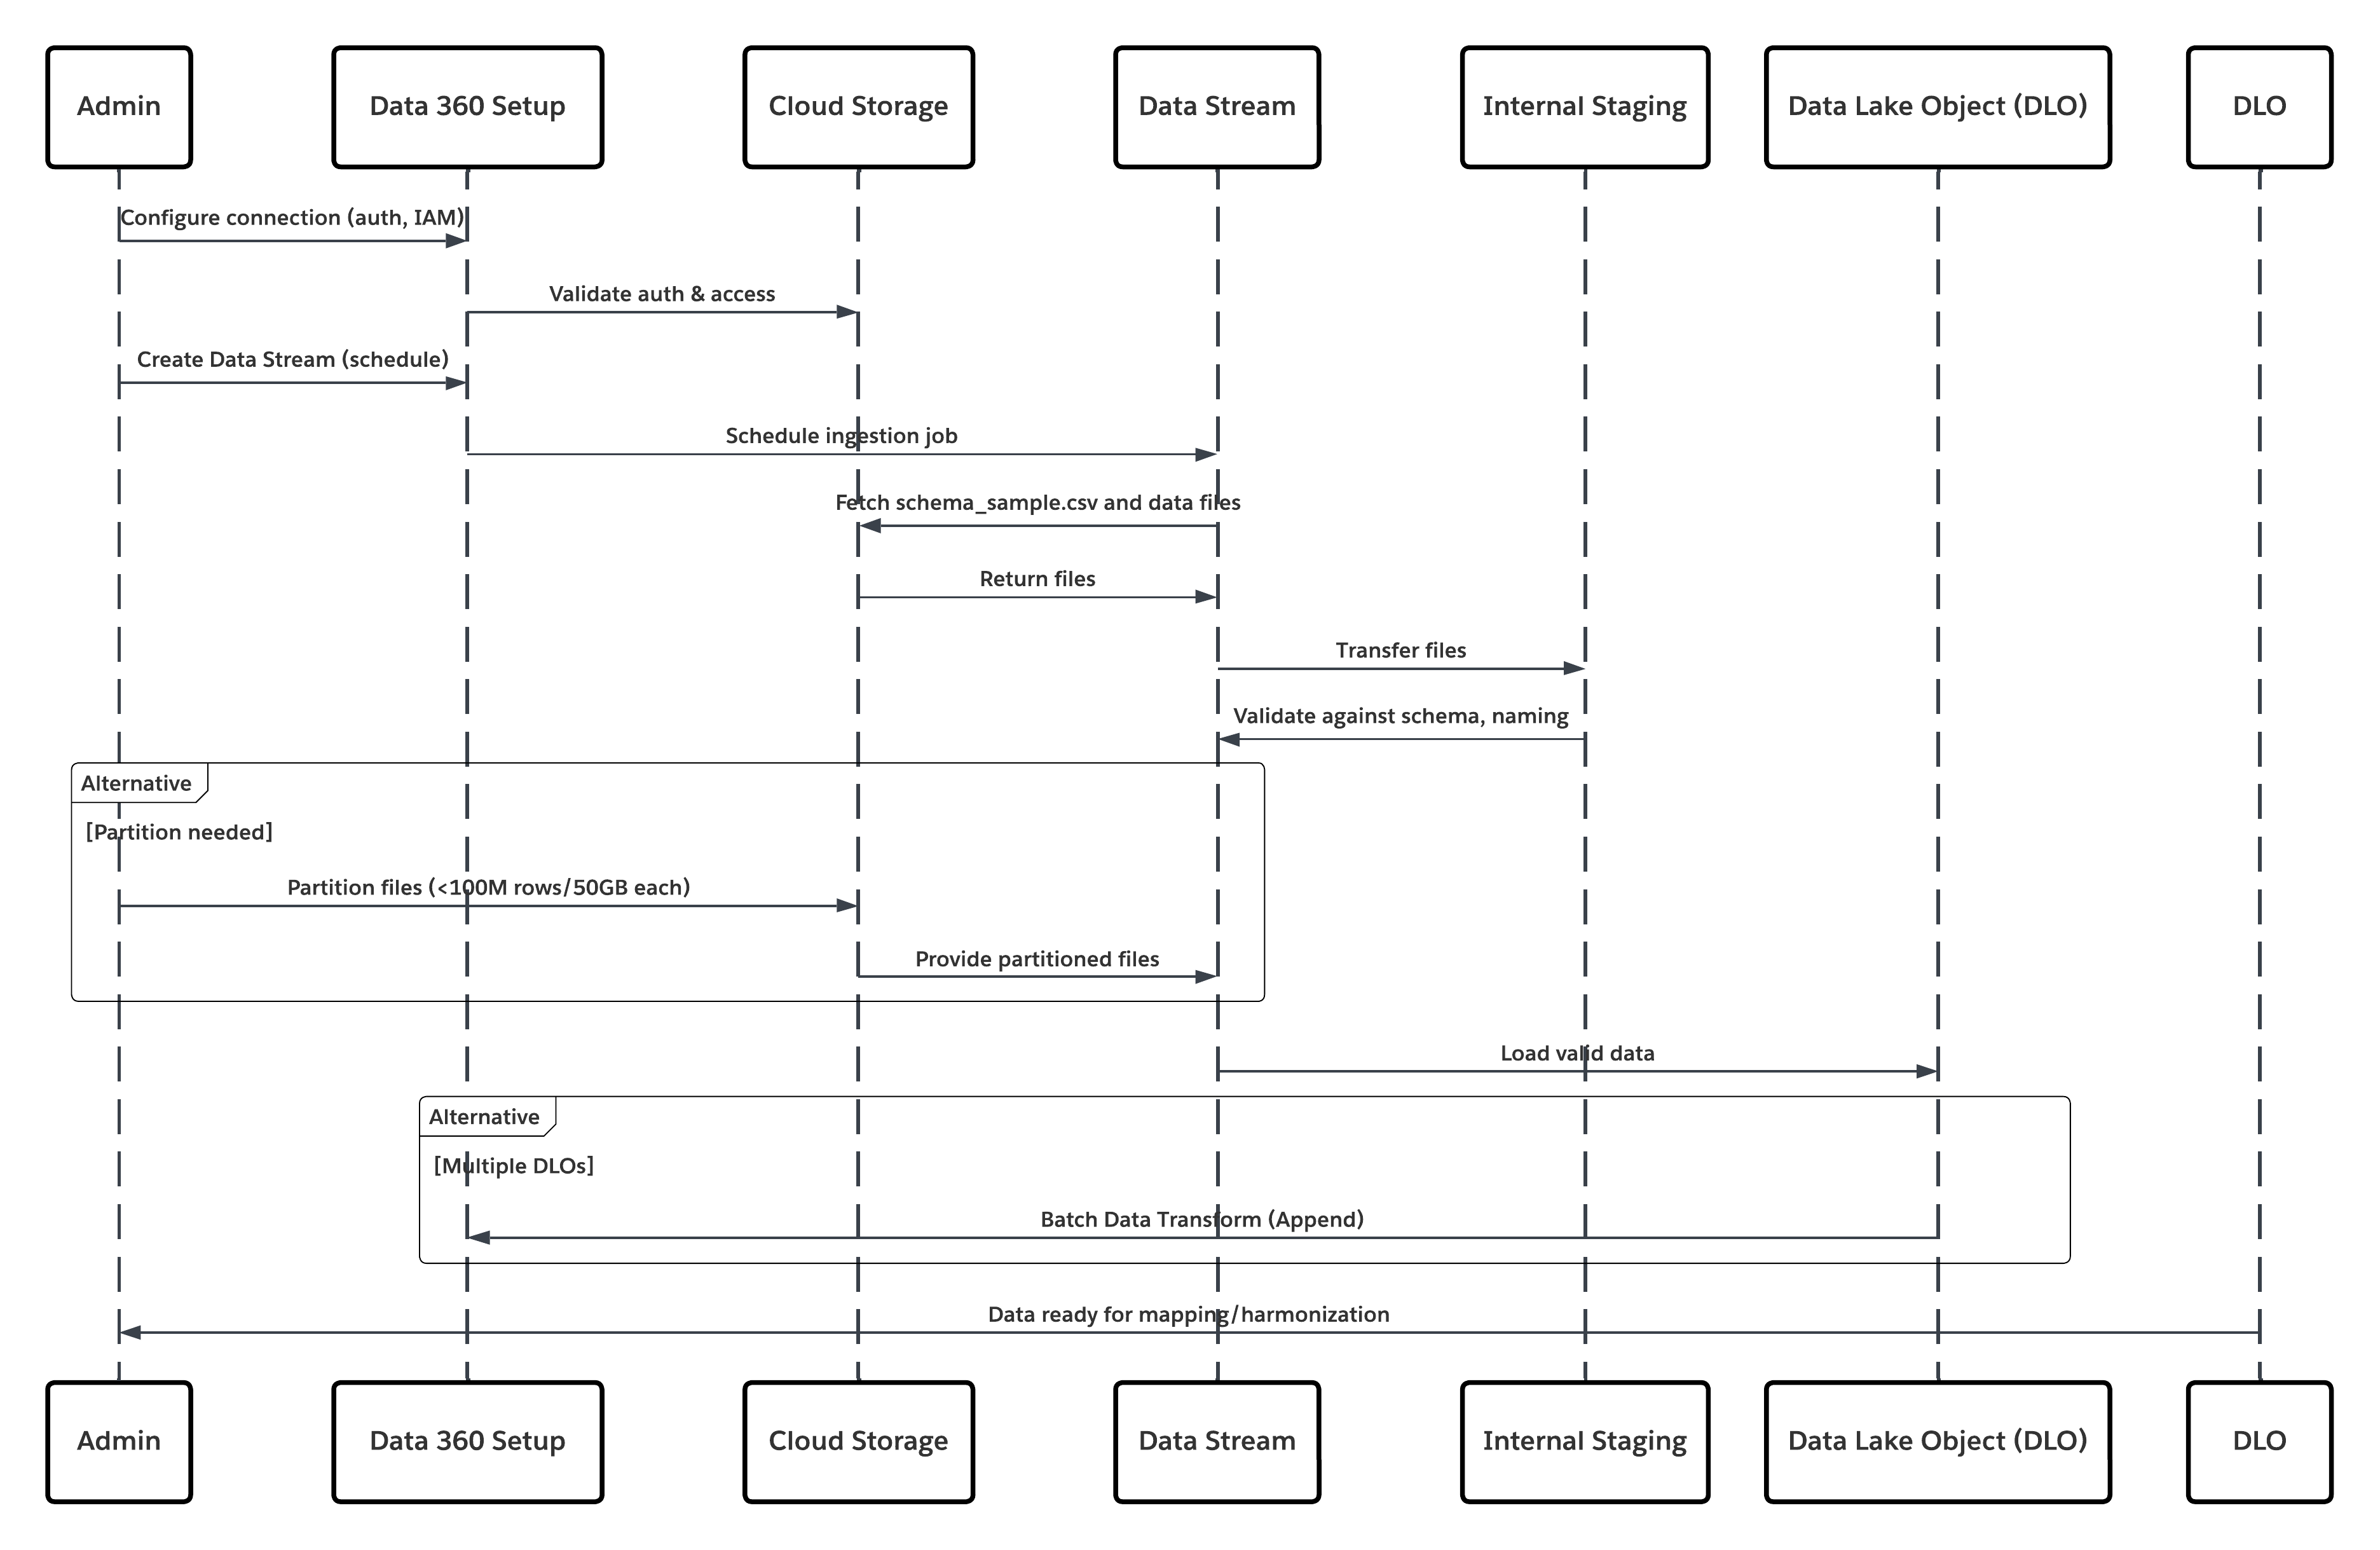 이 시나리오의 경우:
- 관리자는 Data 360 설정 인터페이스(인증, 버킷 세부 사항, IAM 역할, 화이트리스트 지정)를 통해 클라우드 저장소에 대한 연결을 구성합니다.
- Data Cloud 설정 인터페이스는 클라우드 저장소 플랫폼을 사용하여 인증하여 자격 증명 및 액세스를 확인합니다.
- 관리자가 Data 360에서 데이터 스트림을 만들고 데이터 스트림을 클라우드 저장소의 개체/폴더에 연결하고 수집 일정을 정의합니다.
- 일정 트리거에서 데이터 스트림은 클라우드 저장소 플랫폼에서 소스 파일(예: CSV, Parquet)을 요청합니다.
- Cloud Storage Platform은 필수 유효한 schema_sample.csv 및 명명 규칙을 준수하는 기타 데이터 파일을 비롯한 파일을 전달합니다.
- 데이터 스트림은 Data 360 내 내부 내부 스테이징 환경에 파일을 전송합니다.
- Data 360 파이프라인은 파일을 처리합니다. schema_sample.csv의 스키마 정의를 사용하여 구조, 필드 이름을 확인하고 수집 임계값(파일당 100만 개의 행/50GB)을 초과하는 경우 로드를 나누며, 대용량 파일이 감지된 경우 사전 처리 파티션 분할 단계(다음 실행 시 관리자에게 알림)가 외부에서 수행됩니다.
- 레코드는 스테이징에서 데이터 레이크 개체(DLO)로 가져옵니다.
- 필요한 경우 데이터가 분할된 경우 배치 데이터 변환 추가 노드를 사용하여 여러 DLO를 결합합니다.
- Data 360은 성공/실패를 기록하고 모니터링을 위해 상태를 업데이트하며 데이터를 매핑, 조합 및 통합할 준비가 되었음을 나타냅니다.
##### 결과
이 패턴을 적용하면 엔터프라이즈 클라우드 저장소 플랫폼에서 Data 360으로 구조화되거나 구조화되지 않은 파일을 안전하게, 예약적으로, 대규모로 수집할 수 있습니다. 이 프로세스는 자동화되고 확장 가능하며 복원성이 뛰어납니다. 즉, 원시 데이터를 데이터 레이크 객체(DLO)로 전달하여 Customer 360 데이터 모델의 조합 및 매핑을 위한 기초가 됩니다.
###### 수집 메커니즘
수집 메커니즘은 Data 360 내에 정의된 커넥터 및 예약 전략에 따라 다릅니다.
| 수집 메커니즘 | 설명 |
|---|---|
| 기본 클라우드 저장소 커넥터(Amazon S3, GCS, Azure) | 엔터프라이즈의 클라우드 데이터 레이크에서 CSV 또는 Parquet 형식의 파일을 직접 수집하는 것이 좋습니다. 이러한 커넥터는 증분 및 전체 새로 고침 일정을 지원합니다. 예를 들어, 은행은 S3 버킷에서 DLO로의 고객 트랜잭션 파일의 일일 동기화를 구성할 수 있습니다. |
| 분할된 파일 전략 | 매우 큰 데이터 집합(개체당 1억 개 이상의 행 또는 50GB 이상)의 경우 데이터가 더 작은 논리 집합(예: 월 또는 지역별)으로 분할됩니다. 각 파티션은 별도의 데이터 스트림으로 관리되고 나중에 추가 노드와 배치 데이터 변환 사용하여 다시 결합됩니다. |
| 자동화된 예약 동기화 | Data 360은 수집 작업을 자동으로 트리거하는 선언적 스케줄러(시간별, 일별 또는 사용자 정의 케이던스)를 제공하여 수동 중재 없이 데이터를 새로 고칩니다. |
| 커넥터 유형 | 끝점 요구 사항 |
|---|---|
| Amazon S3 커넥터 | 적절한 IAM 정책과 스키마를 정의하는 schema\_sample.csv 파일이 있는 S3 버킷 |
| Google Cloud 스토리지 커넥터 | 일관된 명명 규칙을 사용하여 서비스 계정 자격 증명 및 버킷 액세스 |
| Azure Storage 커넥터 | 키 또는 SAS 토큰 기반 인증에 액세스합니다. Blob 또는 폴더 구조는 Data 360 규칙을 따라야 합니다. |
| 솔루션 영역 | 맞춤 | 댓글/구현 세부 사항 |
|---|---|---|
| 솔루션 맞춤 | 최대 | Data 360\에서 기본 Salesforce CRM 커넥터 및 Marketing Cloud 참여 커넥터를 사용합니다. 표준 사용 사례의 경우 스타터 데이터 번들로 시작하고 온보딩을 가속화합니다. 사용자 정의 또는 도메인별 데이터 모델에 수동 스트림 사용자 정의를 사용합니다. |
| 고도로 사용자 정의된 CRM 인스턴스 처리 | 매핑 워크숍의 최고 기능 | 스타터 번들을 기준으로 처리하고 매핑 워크숍을 실시하여 다음을 식별합니다. 사용자 정의 개체 및 관계. 수식 또는 계산된 필드입니다. 관리 패키지 확장. 대용량 수식 필드의 경우 사전 스테이지 ETL 또는 Data 360 변환 내에서 값을 계산하여 소스 조직에 대한 API 로드를 최소화합니다. |
| 사용하지 않을 경우 | 최적화되지 않은 시나리오 | 다음과 같은 경우 이 패턴을 피하십시오. 대신 스트리밍 커넥터, 플랫폼 이벤트 또는 제로 카피 연합을 사용하여 빈도가 높은 이벤트 또는 실시간 이벤트 수집이 필요합니다. 소스 조직에 API 용량이 제한되어 있으며 조절 또는 대기열 지연 없이 예약된 추출을 유지할 수 없습니다. |
| 보안 및 거버넌스 | 필수 제어 | 최소 권한 원칙 - 최소 읽기 액세스 권한이 있는 전용 통합 사용자를 사용합니다. 조직 전체 관리자를 사용하지 마십시오. 인증 — OAuth 2.0 및 연결된 앱을 사용하고 클라이언트 암호를 정기적으로 순환하고 새로 고침 토큰 사용을 모니터링합니다. 감사 및 추적 가능성 — 모든 수집 실행, 스키마 변경 및 커넥터 이벤트 기록 감사 준비를 위해 SIEM 또는 규정 준수 시스템에 로그를 전달합니다. 데이터 분류 — 수집 후 즉시 CEDAR 정책을 사용하여 PII/PHI 태그 지정 및 특성 기반 액세스 제어(ABAC)를 적용하여 마스킹, 동의, 다운스트림 규정 준수를 적용합니다. |
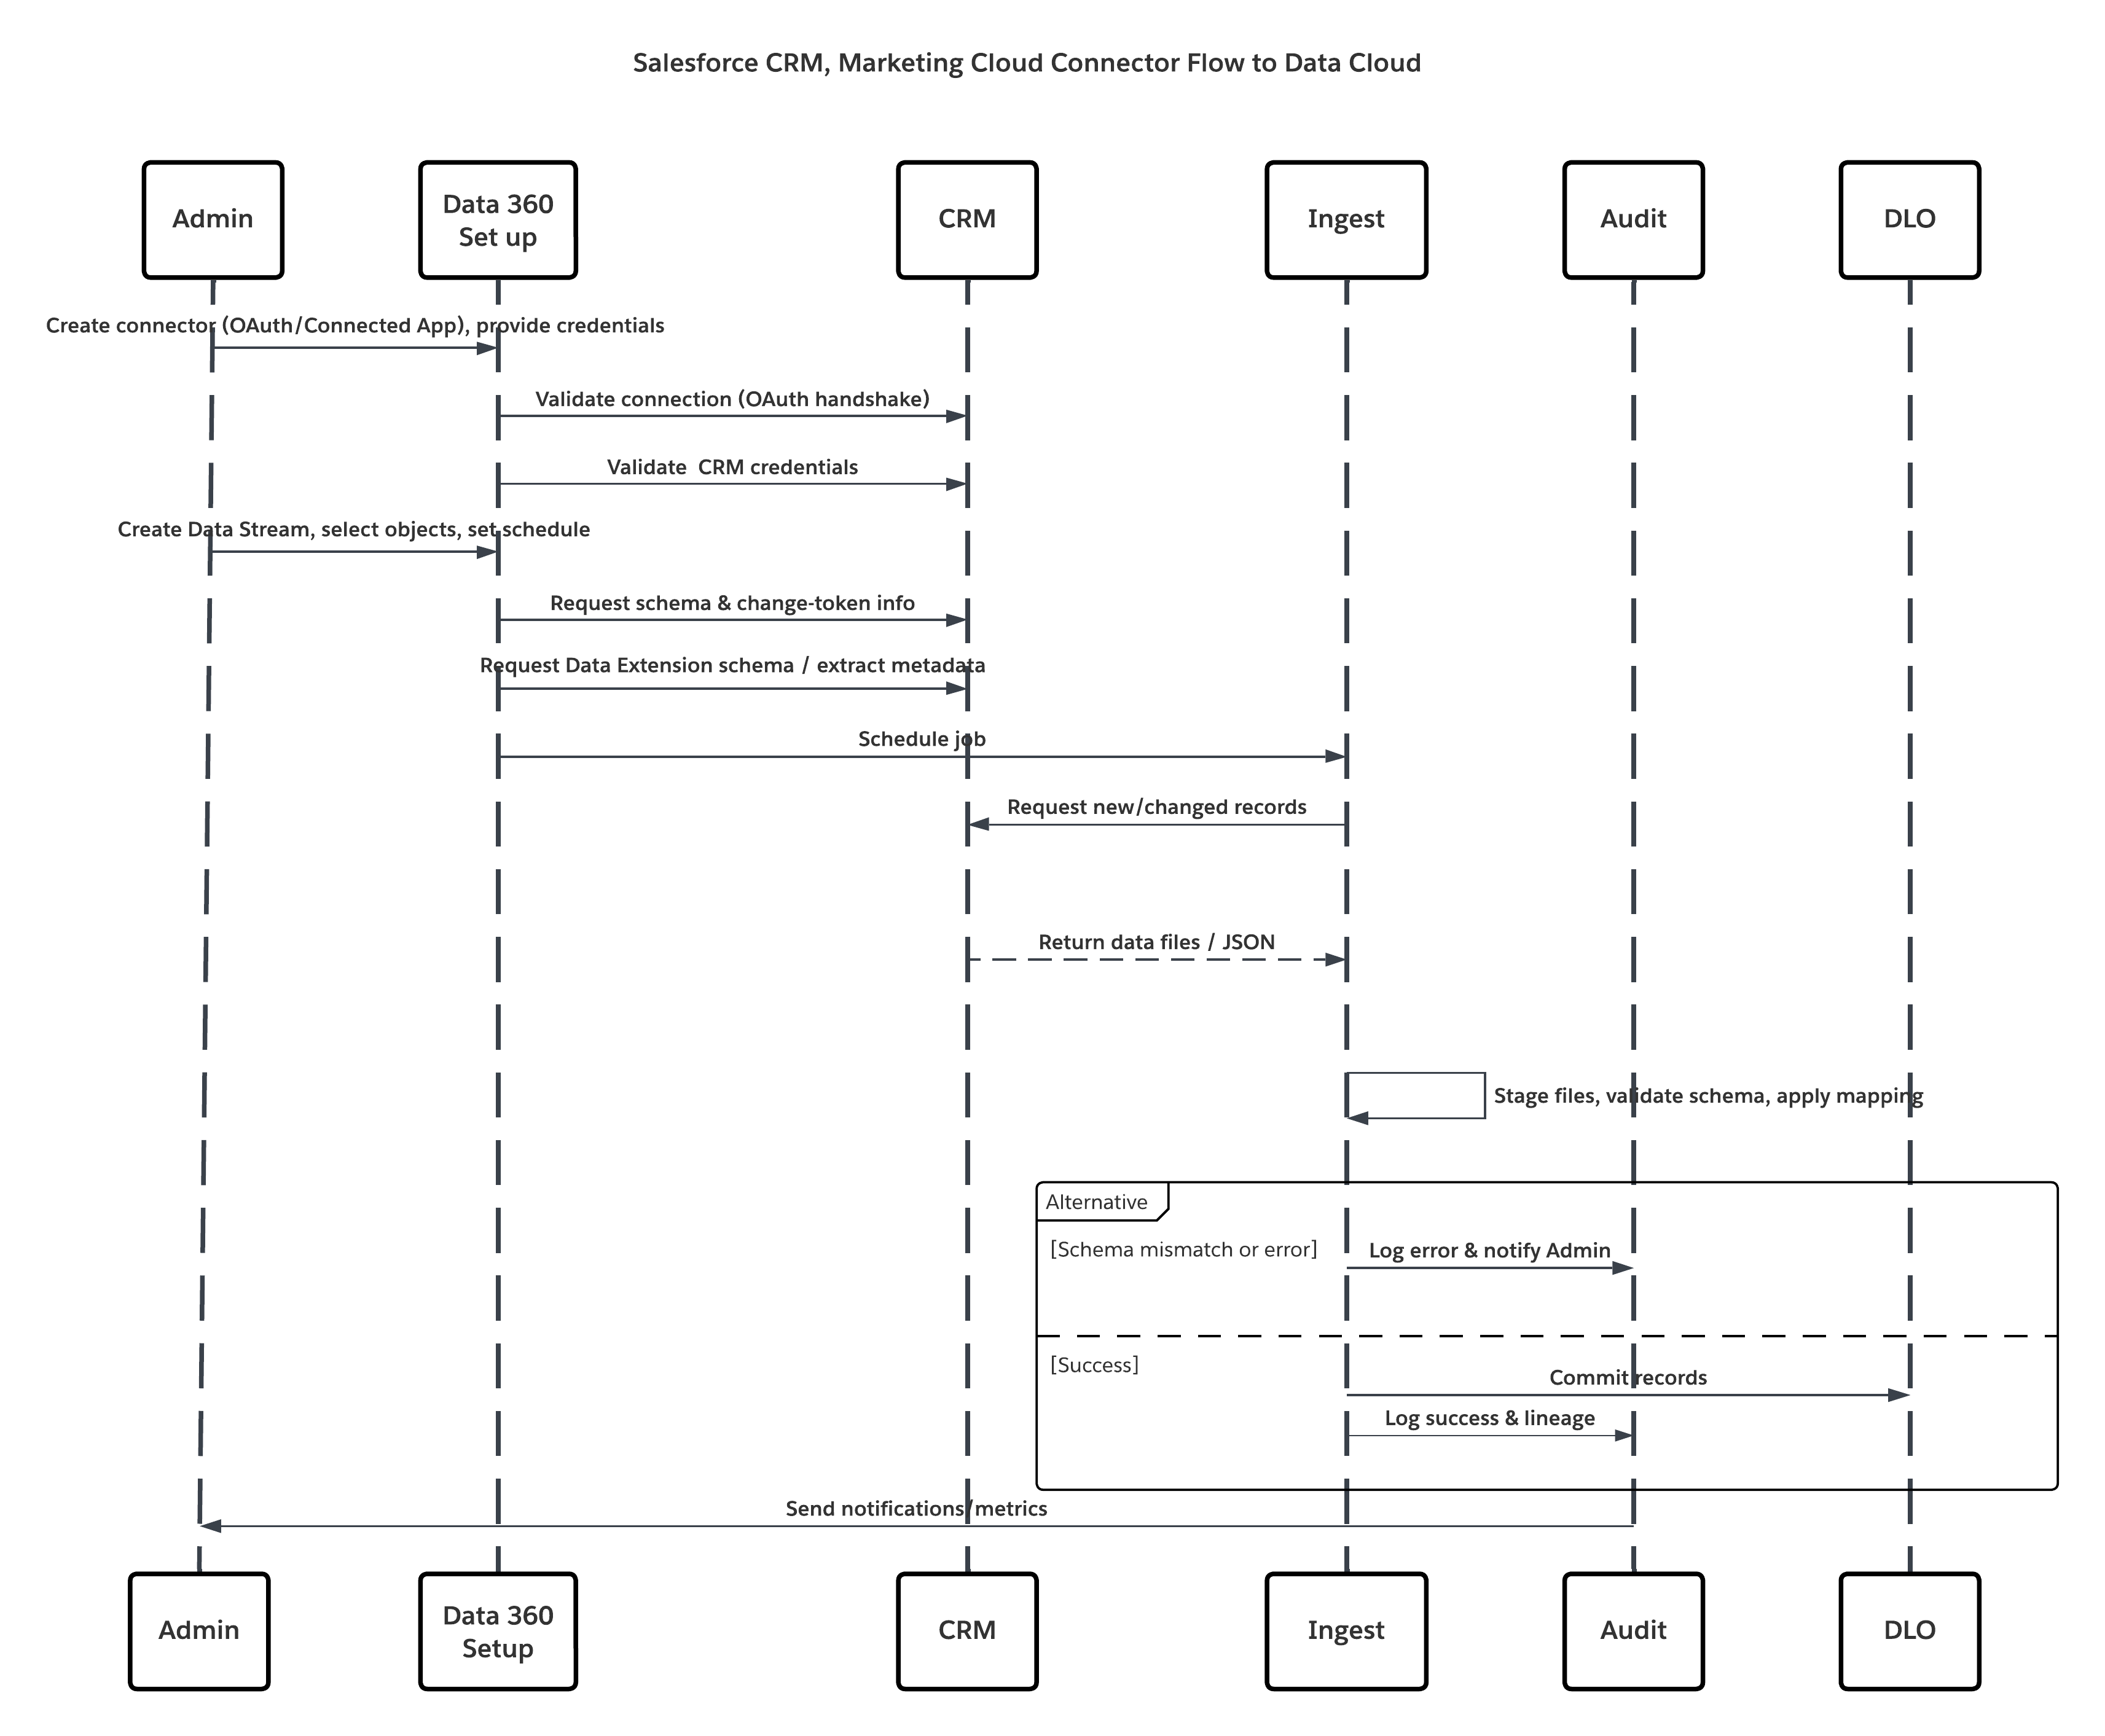 이 시나리오의 경우:
- **관리자가 소스 조직에서 통합 사용자를 프로비저닝**하고 커넥터 권한 집합을 할당합니다.
- 관리자는 Data 360 설정에서 **커넥터를 구성합니다**(OAuth/연결된 앱을 통해 Salesforce CRM 및 Marketing Cloud에 연결).
- **관리자는 개체 및 데이터 확장을 선택하는 데이터 스트림**을 만들고 전체 또는 델타 새로 고침을 선택하고 일정을 설정합니다.
- **예약 실행 시** Data 360은 소스에서 스키마 및 델타 토큰을 요청합니다.
- **소스 시스템은 레코드를 반환**합니다(델타 또는 전체 페이로드). Marketing Cloud에서 추출을 제공하고 CRM에서 JSON/쿼리 결과를 반환할 수 있습니다.
- **Data 360은 내부 보안 스테이징 영역에서 파일**을 스테이징하고 매핑된 스키마에 대해 검증합니다.
- **확인에 실패하면** 수집 로그에서 오류를 기록하고 관리자에게 경고를 보내고 커밋을 중지합니다. 확인에 성공하면 Data 360이 대상 DLO에 레코드를 원자식으로 커밋합니다.
- **모니터링 및 감사 로그**는 계보, 실행 기간, 행 수 및 자격 증명 사용량에 따라 업데이트됩니다. 임계값 또는 오류가 트리거되면 관리자에게 경고가 발송됩니다.
##### 결과
핵심 고객 관계 및 마케팅 참여 데이터는 Data 360에 DLO(데이터 레이크 개체)로 수집됩니다. 결과:
- 프로필, 사례, 기회, 이메일/참여 메트릭을 포함하는 **통합 데이터 집합**
- **ID 확인 기초** 및 통합 개인 프로필 구축
- 관리 및 감사 가능성을 유지하면서 다운스트림 조합, 보강, AI 모델링 및 활성화에 대한 **운영 준비 상태**
###### 수집 메커니즘
수집 메커니즘은 Data 360 내에 정의된 커넥터 및 예약 전략에 따라 다릅니다.
| 메커니즘 | 사용하는 경우 |
|---|---|
| Salesforce CRM 커넥터(네이티브) | 표준/사용자 정의 CRM 개체에 가장 적합하며, 전체 및 델타 새로 고침을 지원합니다. |
| Marketing Cloud 참여 커넥터(네이티브) | 데이터 확장, 보내기, 추적 추출에 가장 적합하며, 전체/델타 모드를 지원합니다. |
| 스타터 데이터 번들 | 일반적인 세일즈/서비스/마케팅 개체에 대한 온보딩을 가속화합니다. |
| 사용자 정의 스트림 + 사전 처리 | 복잡한 변환 또는 심각한 스키마 정규화가 필요한 경우 사용합니다. |
| 커넥터 | 끝점 요구 사항 |
|---|---|
| Salesforce CRM 커넥터 | 소스 조직은 연결된 앱, OAuth 토큰 및 읽기 권한이 있는 전용 통합 사용자를 허용해야 합니다. |
| Marketing Cloud 커넥터 | Marketing Cloud API 자격 증명 또는 설치된 패키지. 데이터 확장은 추출/API를 통해 데이터를 노출해야 합니다. |
| 솔루션 영역 | 맞춤 | 댓글/구현 세부 사항 |
|---|---|---|
| 솔루션 맞춤형 | 저지연 이벤트 캡처를 위해 최적 | Data 360 수집 API(스트리밍 JSON)를 사용하여 단일 이벤트 또는 마이크로 배치를 푸시합니다. 엄격한 OAS 3.0 스키마(.yaml)를 사용하여 수집 API 커넥터를 구성합니다. 대량 CSV 수집을 사용하여 더 큰 동기화 빈도를 줄입니다. |
| 스키마 변경 사항 처리 | 엄격 / 관리형 | 스키마가 크게 변경되었습니다. OAS .yaml 업데이트, 커넥터 버전 업데이트, 계약 테스트 수행 프로듀서가 동시에 변경할 수 없는 경우 롤링 스키마 마이그레이션을 구현합니다. |
| 사용하지 않을 때 | 비최적 | 사전 처리가 필요한 경우(예: 중복 제거, 보증 주문 등) 또는 매우 큰 대량 로드(네이티브 대량 커넥터 또는 배치 ETL 사용)에 적합하지 않습니다. 소스가 스키마 유효한 페이로드를 생성할 수 없거나 안전하게 인증할 수 없는 경우 대체 수집 방법을 사용합니다. |
| 보안 및 거버넌스 | 필수 | 최소 권한 범위의 OAuth 2.0 사용, 키 회전, 토큰 사용 로그 TLS 1.2+를 적용하고 필요한 경우 클라이언트 IP를 확인하고 페이로드 PII 태그 지정을 보장합니다. 모든 이벤트에 출처 메타데이터(소스, 타임스탬프, 스키마 버전, 균일성 키)가 포함되어야 합니다. |
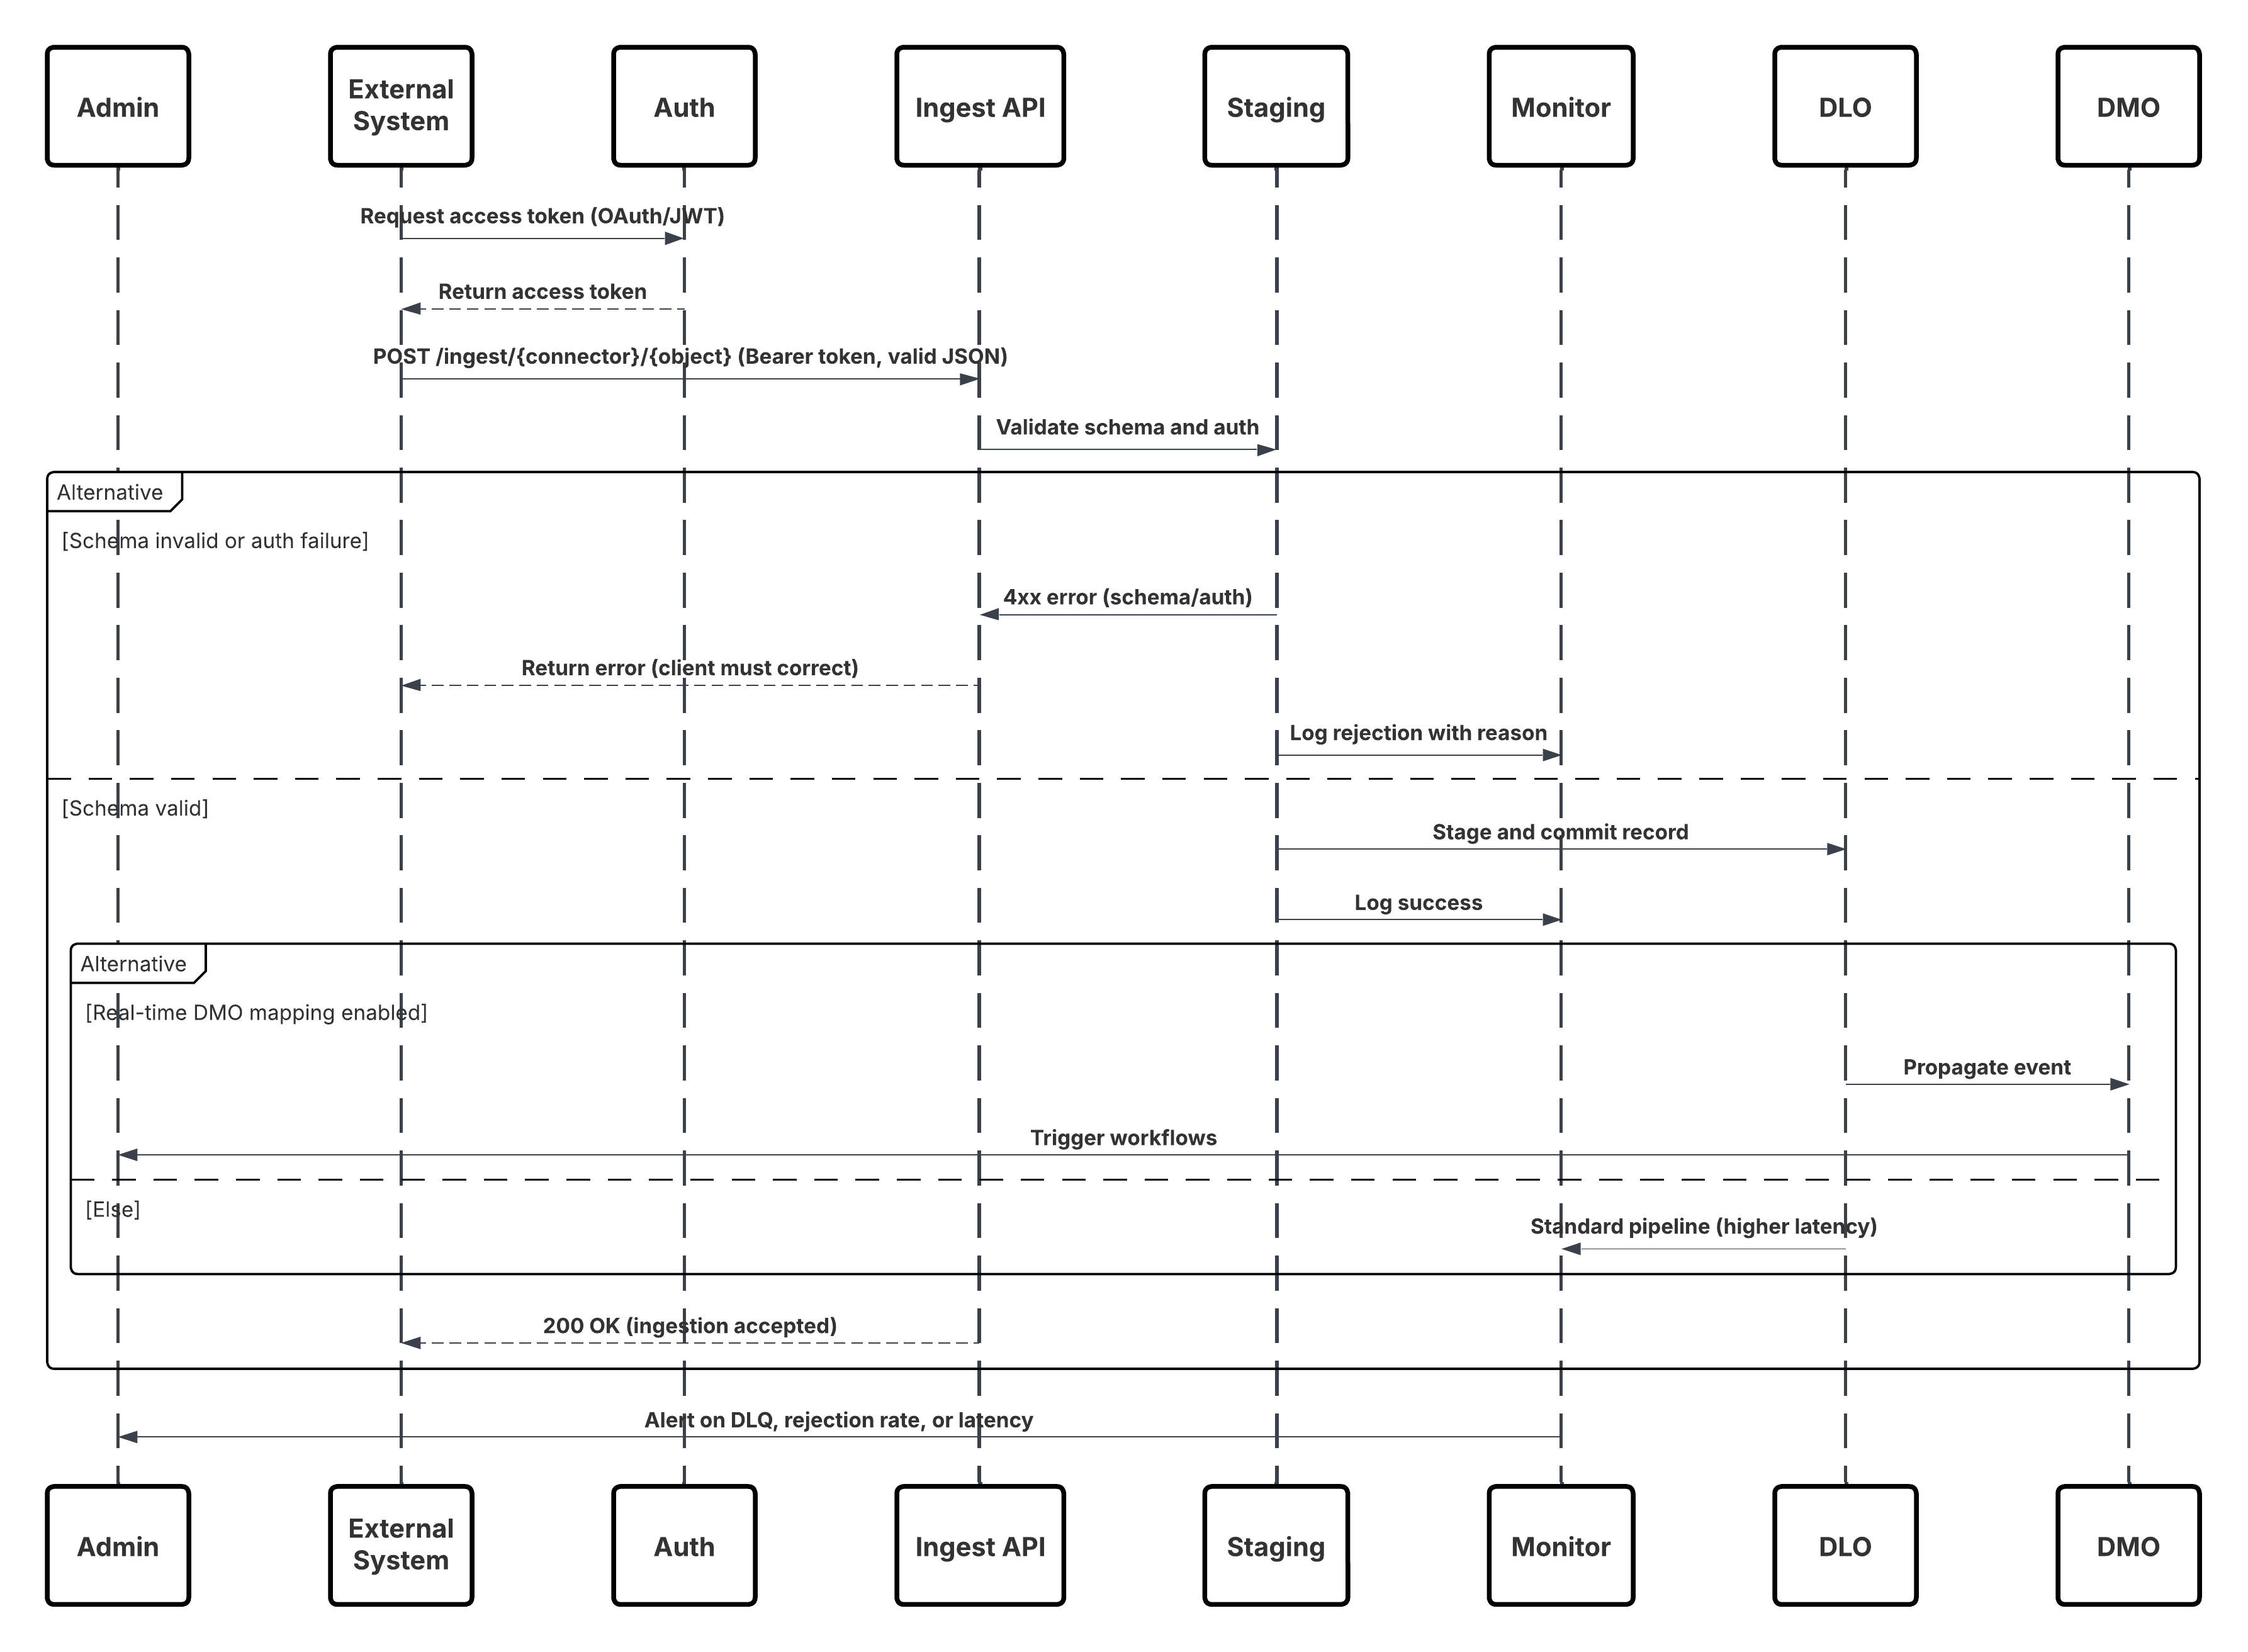 **이 경우:**
- 외부 시스템은 인증 서버에서 OAuth/JWT를 통한 인증을 요청합니다.
- 인증 서버가 외부 시스템에 액세스 토큰을 반환합니다.
- 외부 시스템은 인가 및 JSON 페이로드가 있는 Data 360 수집 API에 데이터 수집 POST 요청을 보냅니다.
- 수집 API는 스테이징 및 유효성 검사 모듈을 통해 요청 스키마 및 인증을 확인합니다.
- 스키마/인증 실패:
- 외부 시스템에 오류가 반환되었습니다.
- 모니터링 및 경고를 위해 로그된 거부
- 확인 성공 시:
- 데이터 레이크 개체(DLO)에 스테이징 및 커밋된 레코드입니다.
- 모니터링에 대한 성공이 기록되었습니다.
- 활성화된 경우 데이터가 실시간 데이터 그래프(DMO)로 전파되어 다운스트림 워크플로를 트리거합니다.
- 그렇지 않으면 표준 배치 또는 더 높은 대기 시간 파이프라인을 통해 데이터가 처리됩니다.
- 수집 API는 외부 시스템에 성공을 확인합니다.
- 모니터링 구성 요소는 대기열, 거부율 또는 대기 시간 문제에 대해 관리자에게 경고합니다.
##### 결과
외부 이벤트 데이터는 대기 시간이 낮은 Data 360 DLO에 수집됩니다. 대상 DMO가 실시간 그래프의 일부인 경우 인스턴트 세분화, 에이전트 워크플로, AI 모델, 운영 활성화에 데이터를 사용할 수 있습니다. 이렇게 하면 연결된 시스템에서 시작된 이벤트에 대한 신속한 비즈니스 응답을 할 수 있습니다.
###### 수집 메커니즘
수집 메커니즘은 Data 360 내에 정의된 커넥터 및 예약 전략에 따라 다릅니다.
| 메커니즘 | 사용하는 경우 |
|---|---|
| 스트리밍 JSON( 수집 API) | 단일 이벤트, 마이크로 배치, 동작 이벤트, 클릭 스트림, IoT Telemetry - 대기 시간이 적으면 |
| Bulk CSV( 수집 API 대량 모드) | 대기 시간 요구 사항이 완화된 대규모 정기 업로드 |
| Edge / 미들웨어 | 수집 API로 푸시하기 전에 확인, 변환, 보강 또는 속도 제한이 필요한 경우 사용합니다. |
| 솔루션 영역 | 맞춤 | 댓글/구현 세부 사항 |
|---|---|---|
| SDK 기반 이벤트 캡처 | 최고 | Salesforce Interactions SDK(웹) 또는 네이티브 SDK(모바일)를 배포합니다. 이러한 경량 라이브러리는 메타데이터(세션 ID, 타임스탬프, 컨텍스트)를 첨부하여 실시간으로 사용자 상호 작용을 수집하고 직렬화합니다. |
| Event 스트리밍 파이프라인 | 최고 | 이벤트는 보안 HTTPS를 통해 Marketing Cloud Personalization의 이벤트 스트리밍 서비스로 전송됩니다. 이 레이어는 가로로 확장 가능하며 저 대기 시간 전송(<2s)에 최적화되어 있습니다. |
| Data 360 통합 | 최고 | Data 360의 개인 설정 커넥터는 스트리밍 피드를 구독하여 각 이벤트를 데이터 레이크 개체(DLO)에 거의 실시간으로 수집합니다. |
| 데이터 모델 매핑 | 모범 사례 | 수집된 DLO가 Customer 360 데이터 모델 개체(DMO)에 매핑됩니다. 이렇게 하면 ID 확인을 통해 익명 및 알려진 사용자를 연결할 수 있습니다. |
| 실시간 그래프 활성화 | 옵션 / 권장 | 실시간 그래프에 매핑된 DMO를 포함하여 즉시 세분화를 수행하고 Einstein 또는 Agentforce 워크플로를 통해 맞춤형 작업을 트리거합니다. |
| 사용하지 않을 때 | 비최적 | 이 패턴은 다음과 같은 경우에 적합하지 않습니다. 소스 데이터는 웹 클라이언트 및 이벤트입니다(대신 수집 API 사용). 조직은 웹/모바일 클라이언트를 제어하지 않습니다. 실시간 동작 추적은 필요하지 않습니다(배치 수집 사용). |
| 스키마 변경 사항 처리 | 관리형 진화 | 새 상호 작용이 추가되면 이벤트 스키마가 발전합니다. SDK는 버전 이벤트 정의여야 합니다. 이전 버전과 호환되는 변경 사항(옵션 필드 추가)은 안전합니다. 변경 사항을 중단하려면 커넥터 재구성 및 계약 테스트가 필요합니다. |
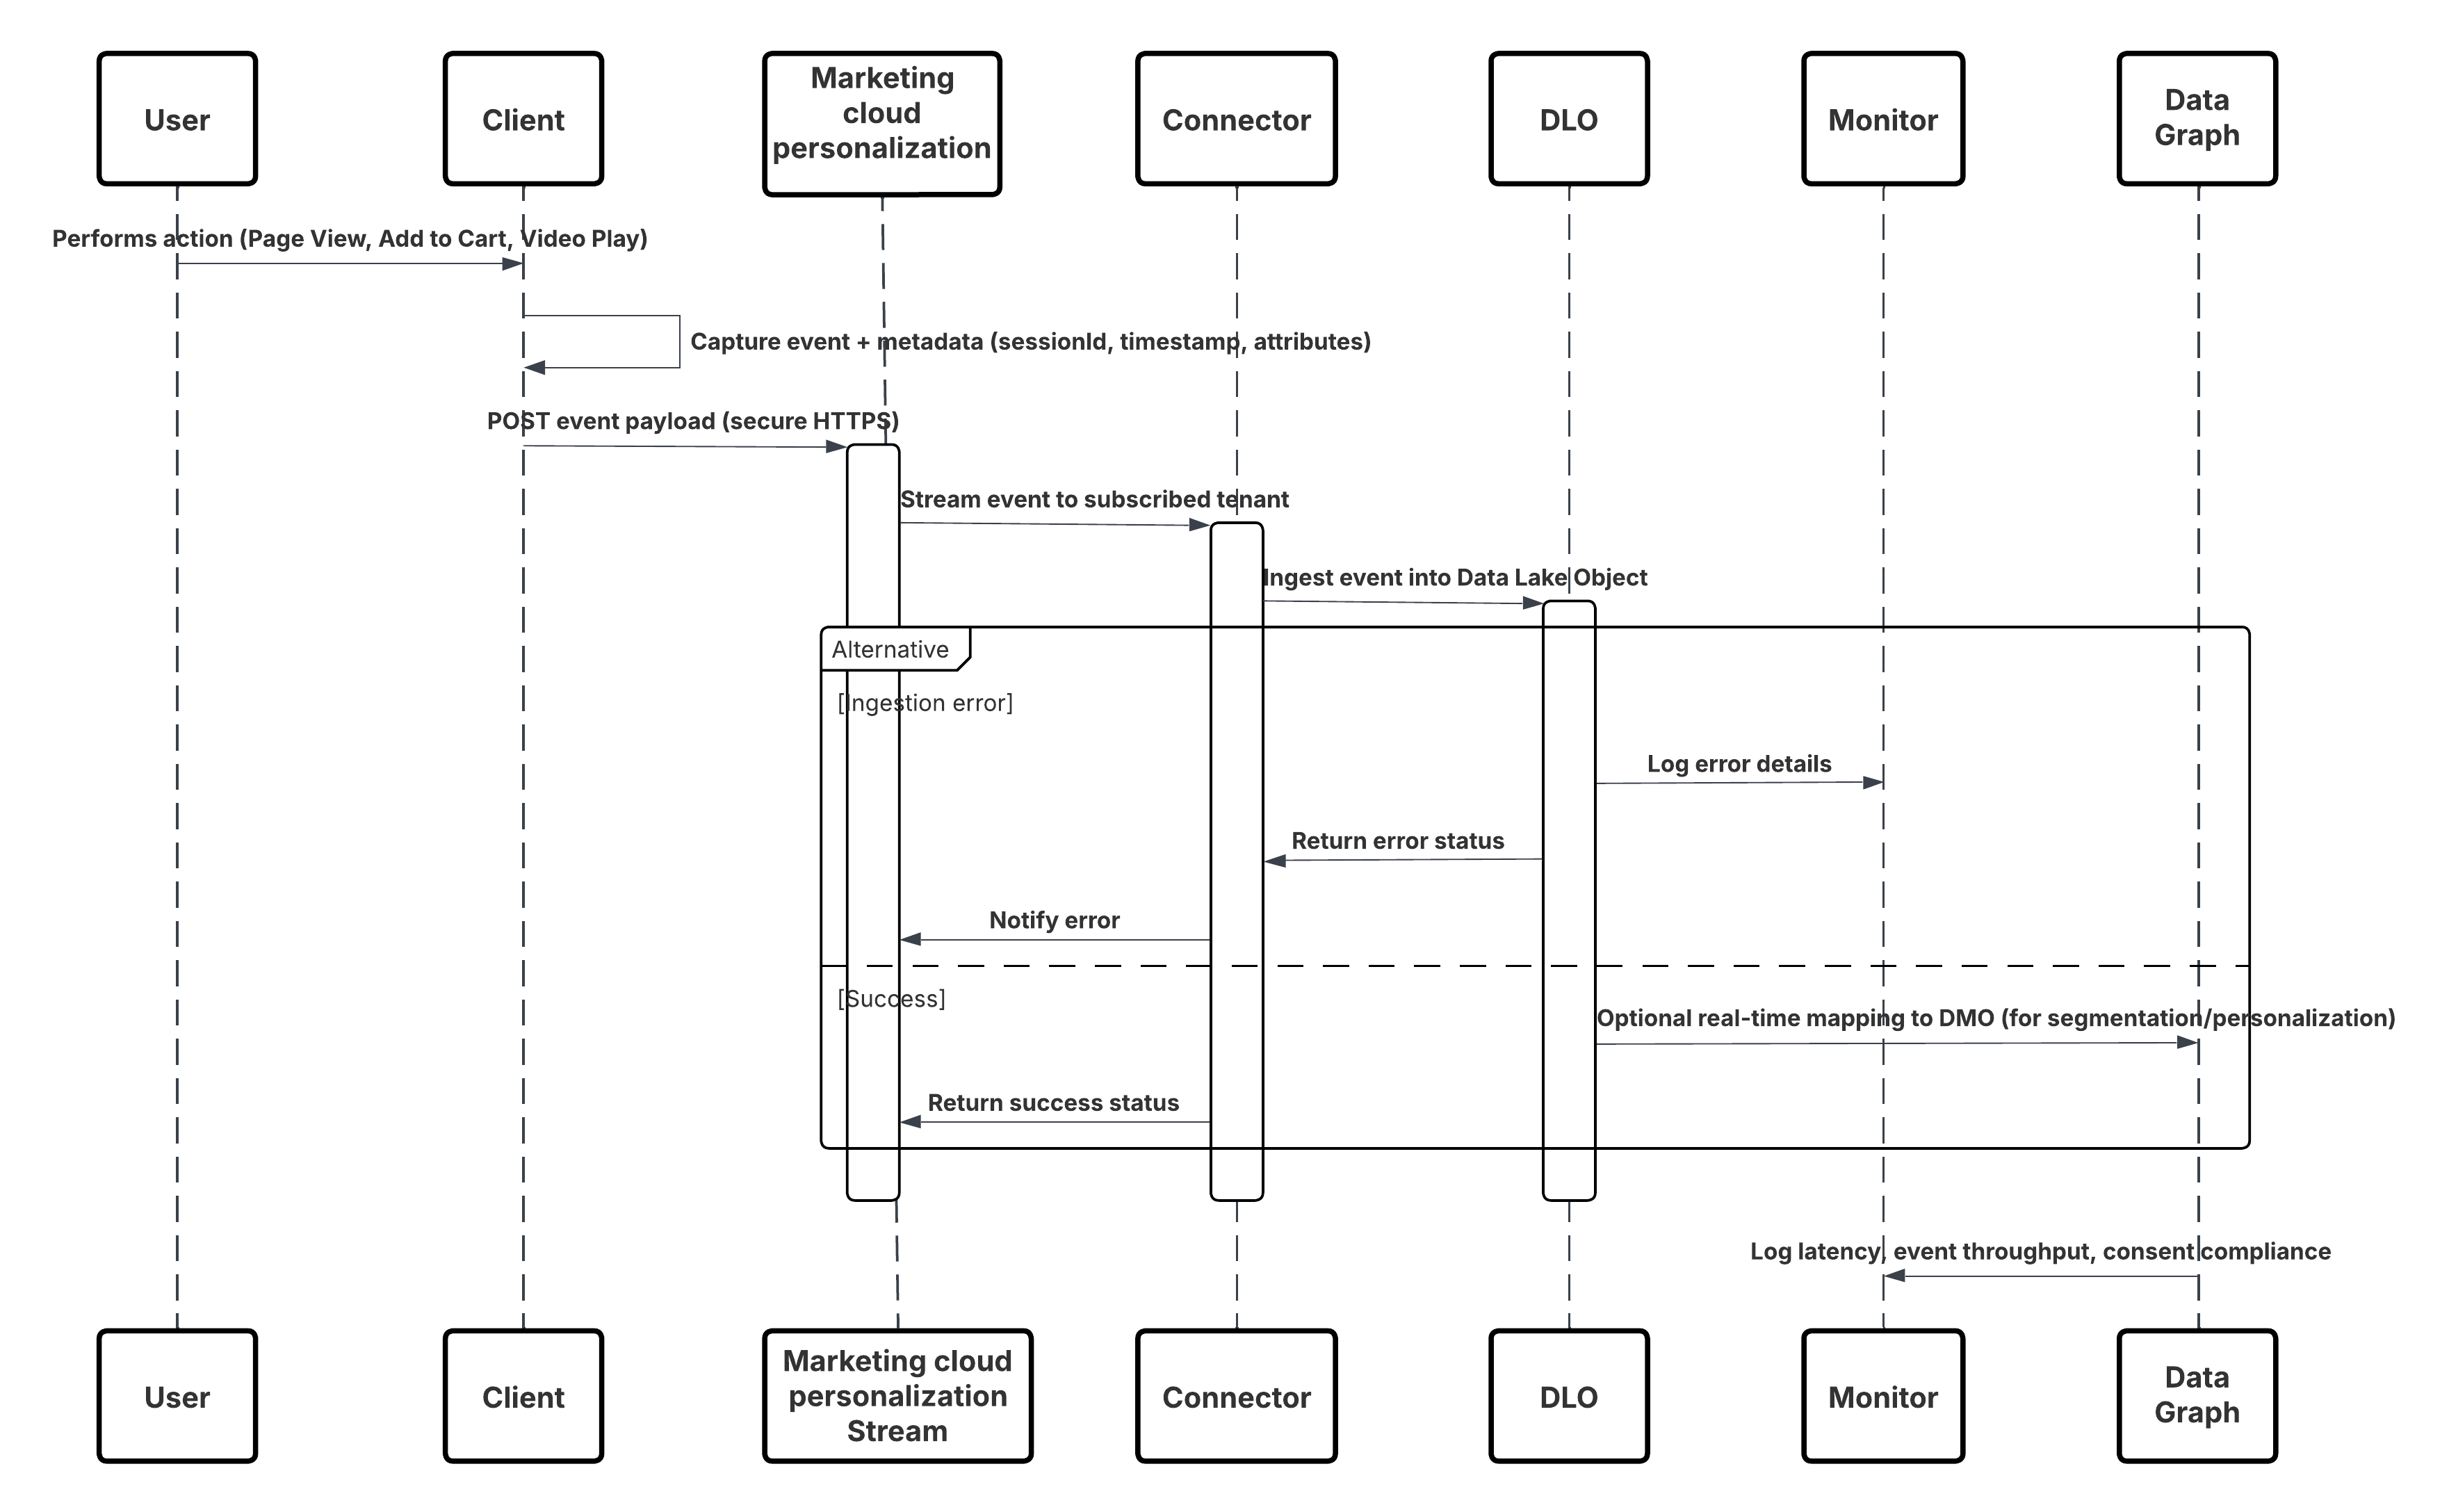 **이 경우:**
- 웹 또는 모바일 채널에서 SDK를 배포합니다(사용자-상호 작용 수집).
- 테넌트 ID, 환경, 동의 제어를 사용하여 SDK를 구성합니다.
- 수집된 JSON 이벤트(메타데이터 + 특성)를 Marketing Cloud 스트리밍 끝점에 스트리밍합니다.
- Data 360 설정에서 테넌트에 대한 개인 설정 커넥터를 만들고 구성합니다.
- 이벤트를 DLO에 수집하고 Data 360 내부에 DLO → DMO를 매핑합니다.
- 즉시 활성화를 위해 실시간 그래프에서 DMO를 활성화합니다.
- 대기 시간, 스키마 규정 준수, 동의 플래그, 처리량, 오류 비율을 모니터링합니다.
- 프로덕션에 배포하고 지속적으로 모니터링합니다.
##### 결과
지속적인 지연이 낮은 동작 이벤트 스트림은 디지털 채널에서 Data 360으로 흐릅니다. 몇 초 이내에 각 사용자 작업을 실시간 세분화, 예측 모델링 또는 트리거된 개인 설정에 사용할 수 있으므로 실제로 적응 가능한 고객 환경이 가능합니다.
###### 수집 메커니즘
수집 메커니즘은 Data 360 내에 정의된 커넥터 및 예약 전략에 따라 다릅니다.
| 메커니즘 | 사용하는 경우 |
|---|---|
| Interactions SDK(웹) | 웹 브라우저 및 SPA에서 실시간으로 수집합니다. |
| Mobile SDK | 기본 모바일 응용 프로그램에서 실시간 수집 |
| 개인화 커넥터 | Marketing Cloud 및 Data 360\ 간의 관리형 구독입니다. |
| 실시간 그래프 매핑 | Segmentation, Einstein 및 Journeys에서 즉시 활성화합니다. |
| 솔루션 영역 | 맞춤 | 댓글/구현 세부 사항 |
|---|---|---|
| CDC 기반 스트리밍 커넥터 | 최대 | 기본 Salesforce 메커니즘, 플랫폼 이벤트 인프라와 완전히 관리 및 통합 |
| 이벤트 가입 및 배송 | 최대 | 커넥터는 지속적인 재생 ID를 통해 ChangeEvent 채널(예: /data/ContactChangeEvent)을 구독합니다. |
| 데이터 매핑 및 스키마 진화 | 모범 사례 | 스트리밍된 페이로드를 해당 DLO에 매핑하고, 수집 중단을 방지하기 위해 메타데이터에서 스키마 버전 관리를 처리합니다. |
| 재생 및 오류 복구 | 권장 | 중복을 방지하고 일시적인 오류로부터 복구하려면 재생 ID 및 역량 키를 활용합니다. |
| 하이브리드 모드(스트리밍 + 배치) | 옵션 | 지원되지 않는 개체 또는 초기 대량 로드의 경우 CDC 스트리밍과 함께 배치 수집을 사용합니다. |
| 사용하지 않을 때 | 최적화되지 않음 | 이 패턴은 다음과 같은 경우에 비최적일 수 있습니다. 소스 개체는 CDC가 활성화되어 있지 않습니다. 사용 사례는 실시간 업데이트가 필요하지 않습니다(배치가 충분). 소스 조직의 네트워크 출력이 제한되거나 이벤트 제한이 초과됩니다. |
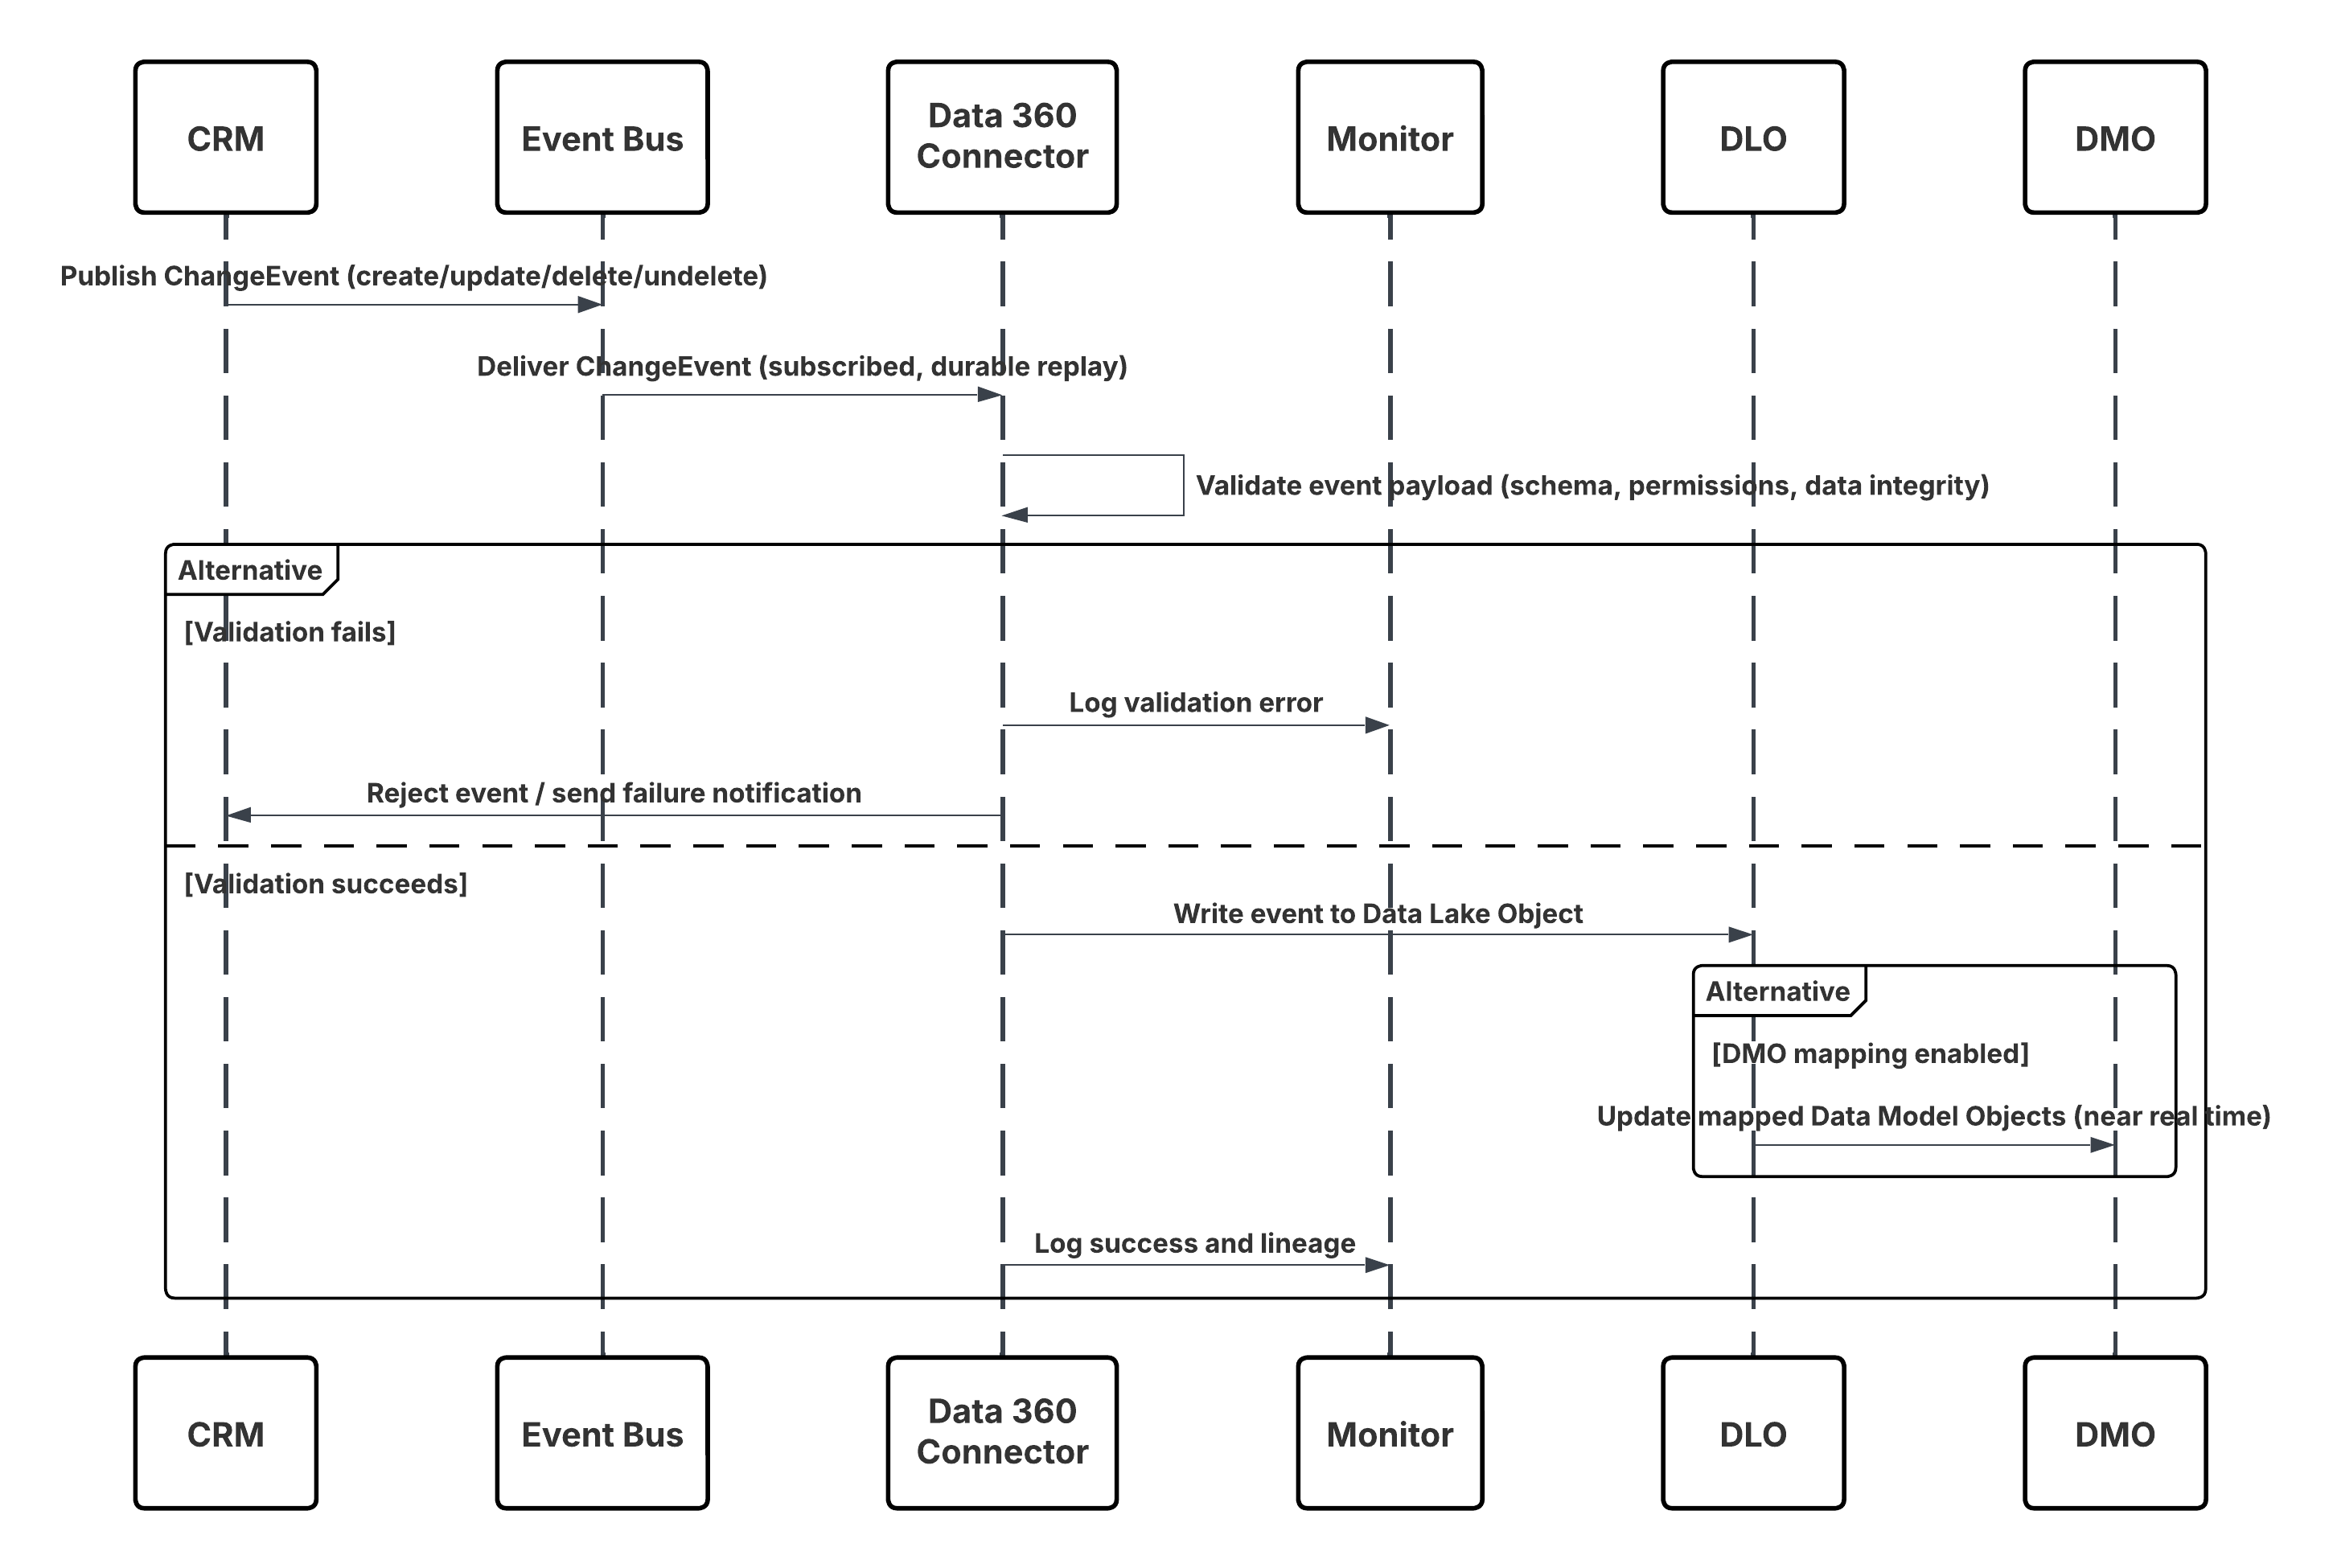 **이 경우:**
- 변경 사항은 Salesforce CRM(만들기/업데이트/삭제/삭제)에서 발생합니다.
- CDC가 내부 Salesforce 이벤트 버스에 ChangeEvent를 게시합니다.
- Data 360 CRM 커넥터는 지속적인 재생 커서를 사용하여 이벤트 버스를 구독합니다.
- 이벤트 페이로드가 스키마, 권한 및 데이터 무결성에 대한 유효성을 검사합니다.
- Data 360은 확인된 이벤트를 매핑된 **Data Lake Object(DLO)**에 기록합니다.
- 활성화한 경우 매핑된 **데이터 모델 개체(DMO)**가 nearReal-Time으로 업데이트되어 세분화 및 활성화를 촉진합니다.
##### 결과
Data 360은 핵심 CRM 데이터의 지속적으로 동기화된 미러를 유지합니다.
이를 통해 다음을 수행할 수 있습니다.
- 실시간 트리거(예: 사례가 생성되면 여정이 시작됨)
- 최신 세분화(예: 계정 상태 변경 시 고객을 "골드" 세그먼트로 이동)
- 실시간 CRM 컨텍스트를 기반으로 더 정확한 분석 및 개인 설정
###### 수집 메커니즘
이 패턴의 수집 메커니즘은 변경 데이터 수집(CDC)이 활성화된 Salesforce CRM 커넥터를 통해 기본적으로 관리됩니다. Data 360은 CDC 이벤트 스트림 구독자 역할을 하므로 소스 CRM 조직과 Data 360 간의 신뢰할 수 있고 대기 시간이 낮은 동기화를 보장합니다.
| 메커니즘 | 사용하는 경우 |
|---|---|
| CDC를 통한 스트리밍(권장) | 거의 실시간 동기화가 필요한 지원되는 모든 Salesforce 표준 및 사용자 정의 개체. |
| 하이브리드 모드(CDC + 배치) | 아직 CDC가 활성화되지 않은 개체 또는 초기 내역 로드가 필요한 경우 |
| 재생 가입 모드 | 가동 중지 시간 또는 배포 후 재동기화 |
| 오류 격리 모드 | 테스트 및 유효성 검사 환경의 경우 |
| 솔루션 영역 | 맞춤 | 댓글/구현 세부 사항 |
|---|---|---|
| Kinesis 네이티브 커넥터 | 최대 | AWS Kinesis와 자사 통합, 지속적인 고처리량 수집 지원 |
| MSK 기본 커넥터 | 최대 | OIDC 및 키 기반 인증 지원을 통한 관리 Kafka 수집 |
| 스키마 매핑 및 검증 | 모범 사례 | 이벤트 구조를 정의하는 스키마 업로드(.json/.avro), 수집 중 일관성을 적용합니다. |
| IAM 구성 | 권장 | 대상 Kinesis 스트림 또는 MSK 주제에 읽기 전용 액세스 권한이 있는 최소 권한의 IAM 역할을 할당합니다. |
| 개인 네트워크 라우팅 | 옵션 | 안전한 내부 라우팅을 위해 PrivateLink/VPC 끝점을 구성합니다. |
| 하이브리드 패턴(스트리밍 + 배치) | 옵션 | 델타에 스트리밍을 사용하고 백필 또는 내역 로드에 배치 수집을 사용합니다. |
| 오류 격리 모드 | 권장 | 재생을 위해 스키마 거부 및 임시 오류를 DLQ로 라우팅 |
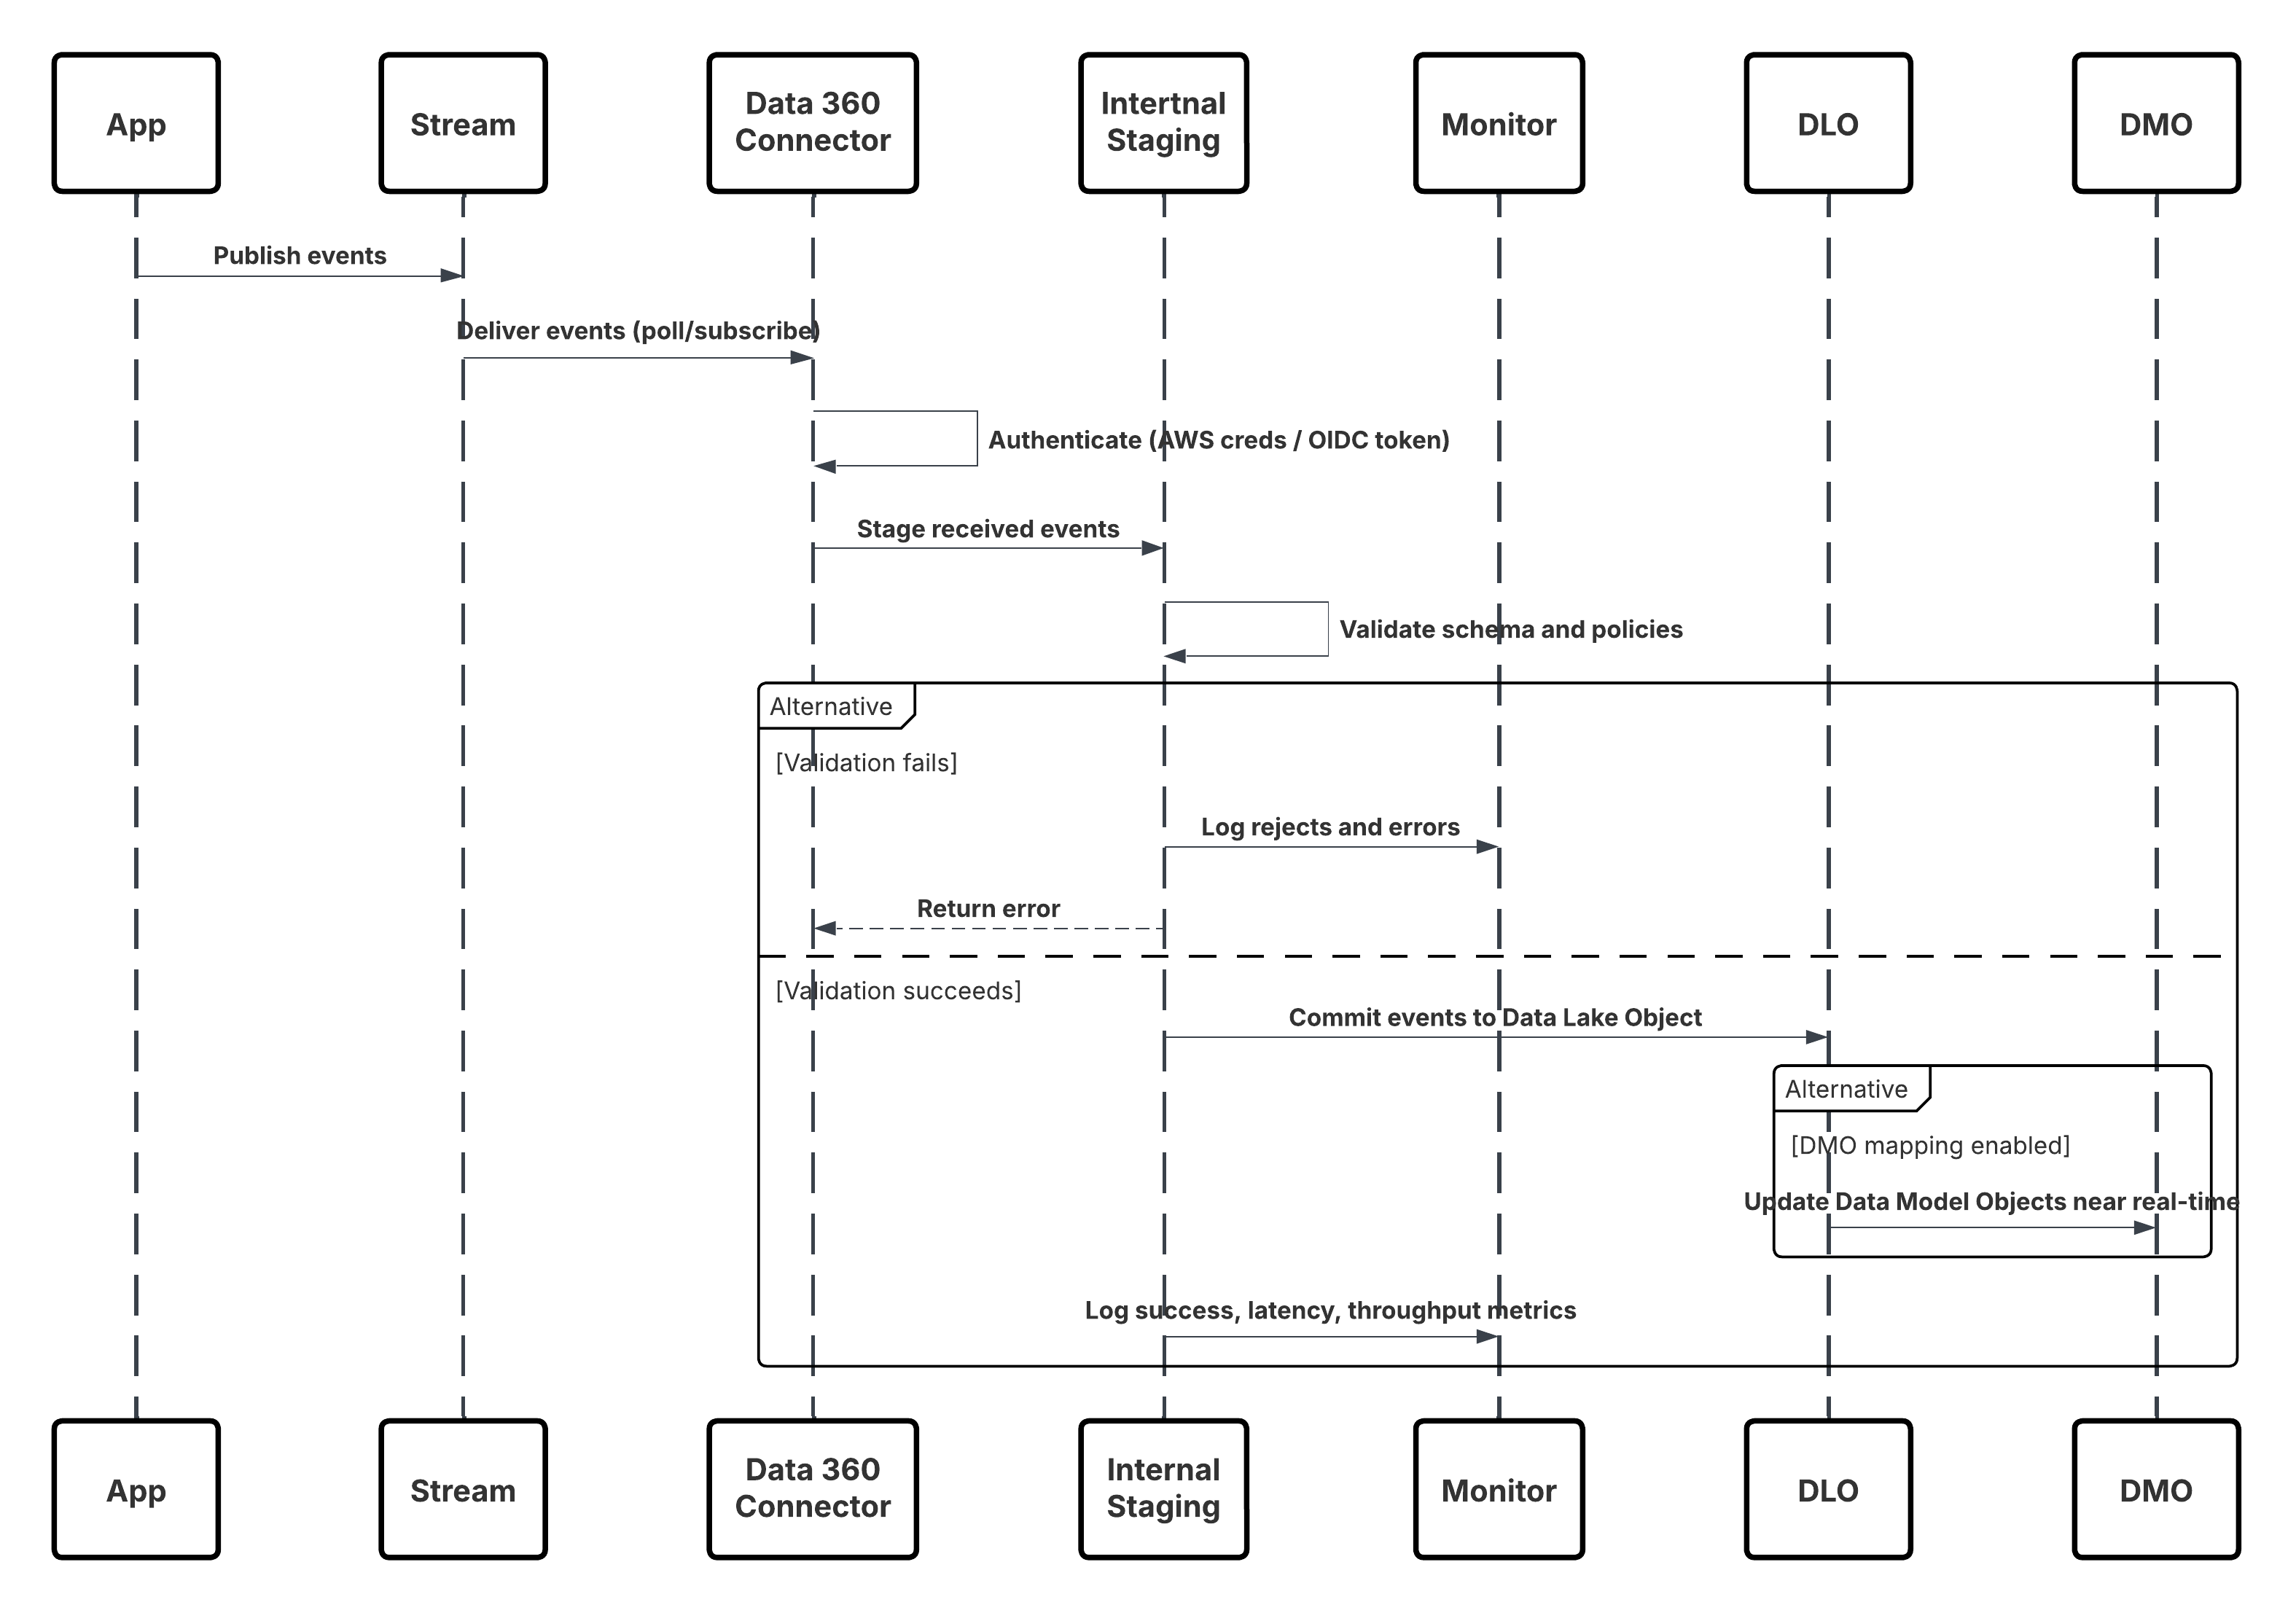 **이 경우:**
- 응용 프로그램 또는 장치가 Kinesis 스트림 또는 MSK 주제에 이벤트를 게시합니다.
- Data 360 커넥터는 AWS 자격 증명 또는 OIDC 토큰을 사용하여 인증합니다.
- 커넥터가 계속해서 스트림을 폴링하거나 구독합니다.
- 이벤트가 단계화되고 스키마 및 정책에 대한 유효성을 검사한 후 DLO(데이터 레이크 개체)로 커밋됩니다.
- 매핑된 경우 활성화를 위해 데이터 모델 개체(DMO)가 거의 실시간으로 업데이트됩니다.
- 모니터링 레이어는 메트릭, 스키마 거부, 대기 시간을 추적합니다.
##### 결과
AWS Kinesis 또는 MSK에서 Data 360으로 직접 구조화된 데이터를 연속적으로 저지연하게 수집합니다. 데이터를 즉시 사용할 수 있습니다.
- ID 확인
- 실시간 세분화
- Einstein AI 활성화
- Agentforce 구동 트리거
배치 ETL에 대한 종속성을 없애 엔터프라이즈 이벤트 중심 설계에 부합하는 스트림 기반 아키텍처를 활성화합니다.
###### 수집 메커니즘
| 메커니즘 | 사용하는 경우 |
|---|---|
| Kinesis 커넥터(권장) | 대용량의 구조화된 데이터를 지속적으로 수집해야 하는 AWS 기본 스트리밍 소스의 경우 |
| MSK 커넥터 | Kafka 호환 플랫폼에서 이벤트 파이프라인을 실행하는 조직 |
| Hybrid(스트리밍 + 배치) | 정기적인 대량 로드와 결합된 증분 이벤트 수집의 경우 |
| 솔루션 영역 | 맞춤 | 댓글/구현 세부 사항 |
|---|---|---|
| Snowflake Zero Copy Connector | 최고 | 자사 네이티브 통합, Snowflake의 데이터 공유 또는 외부 테이블 API를 통해 실시간 쿼리 연합을 설정합니다. |
| Databricks Zero Copy 커넥터 | 최고 | 델타 레이크의 테이블/뷰에 대한 직접 실시간 액세스를 지원하며, 푸시다운 쿼리는 Databricks 런타임에서 실행됩니다. |
| 파일 통합 (아파치 아이스베르그 / 델타 / 파켓) | 새로운 Best Practice | Data 360은 외부 계산 종속성 없이 개체 저장소에서 열려 있는 테이블 형식을 직접 판독합니다. 대량 데이터 집합에 적합합니다. |
| 개인 네트워크 구성 | 권장 | 보안 네트워크 수준 연합을 위해 Salesforce 비공개 연결 또는 VPC 피어링을 사용합니다. |
| 인증 및 키 관리 | 모범 사례 | 정기적인 순환 및 볼트 관리를 통해 안전한 키 기반 또는 OAuth 기반 인증을 구현합니다. |
| 스키마 등록 | 필수 | Data 360이 외부 스키마를 검색하고 외부 데이터 레이크 개체(외부 DLO)에 매핑합니다. |
| 관리 메타데이터 | 권장 | 모든 외부 DLO는 규정 준수 가시성을 위해 분류, 동의, 계보 메타데이터를 상속합니다. |
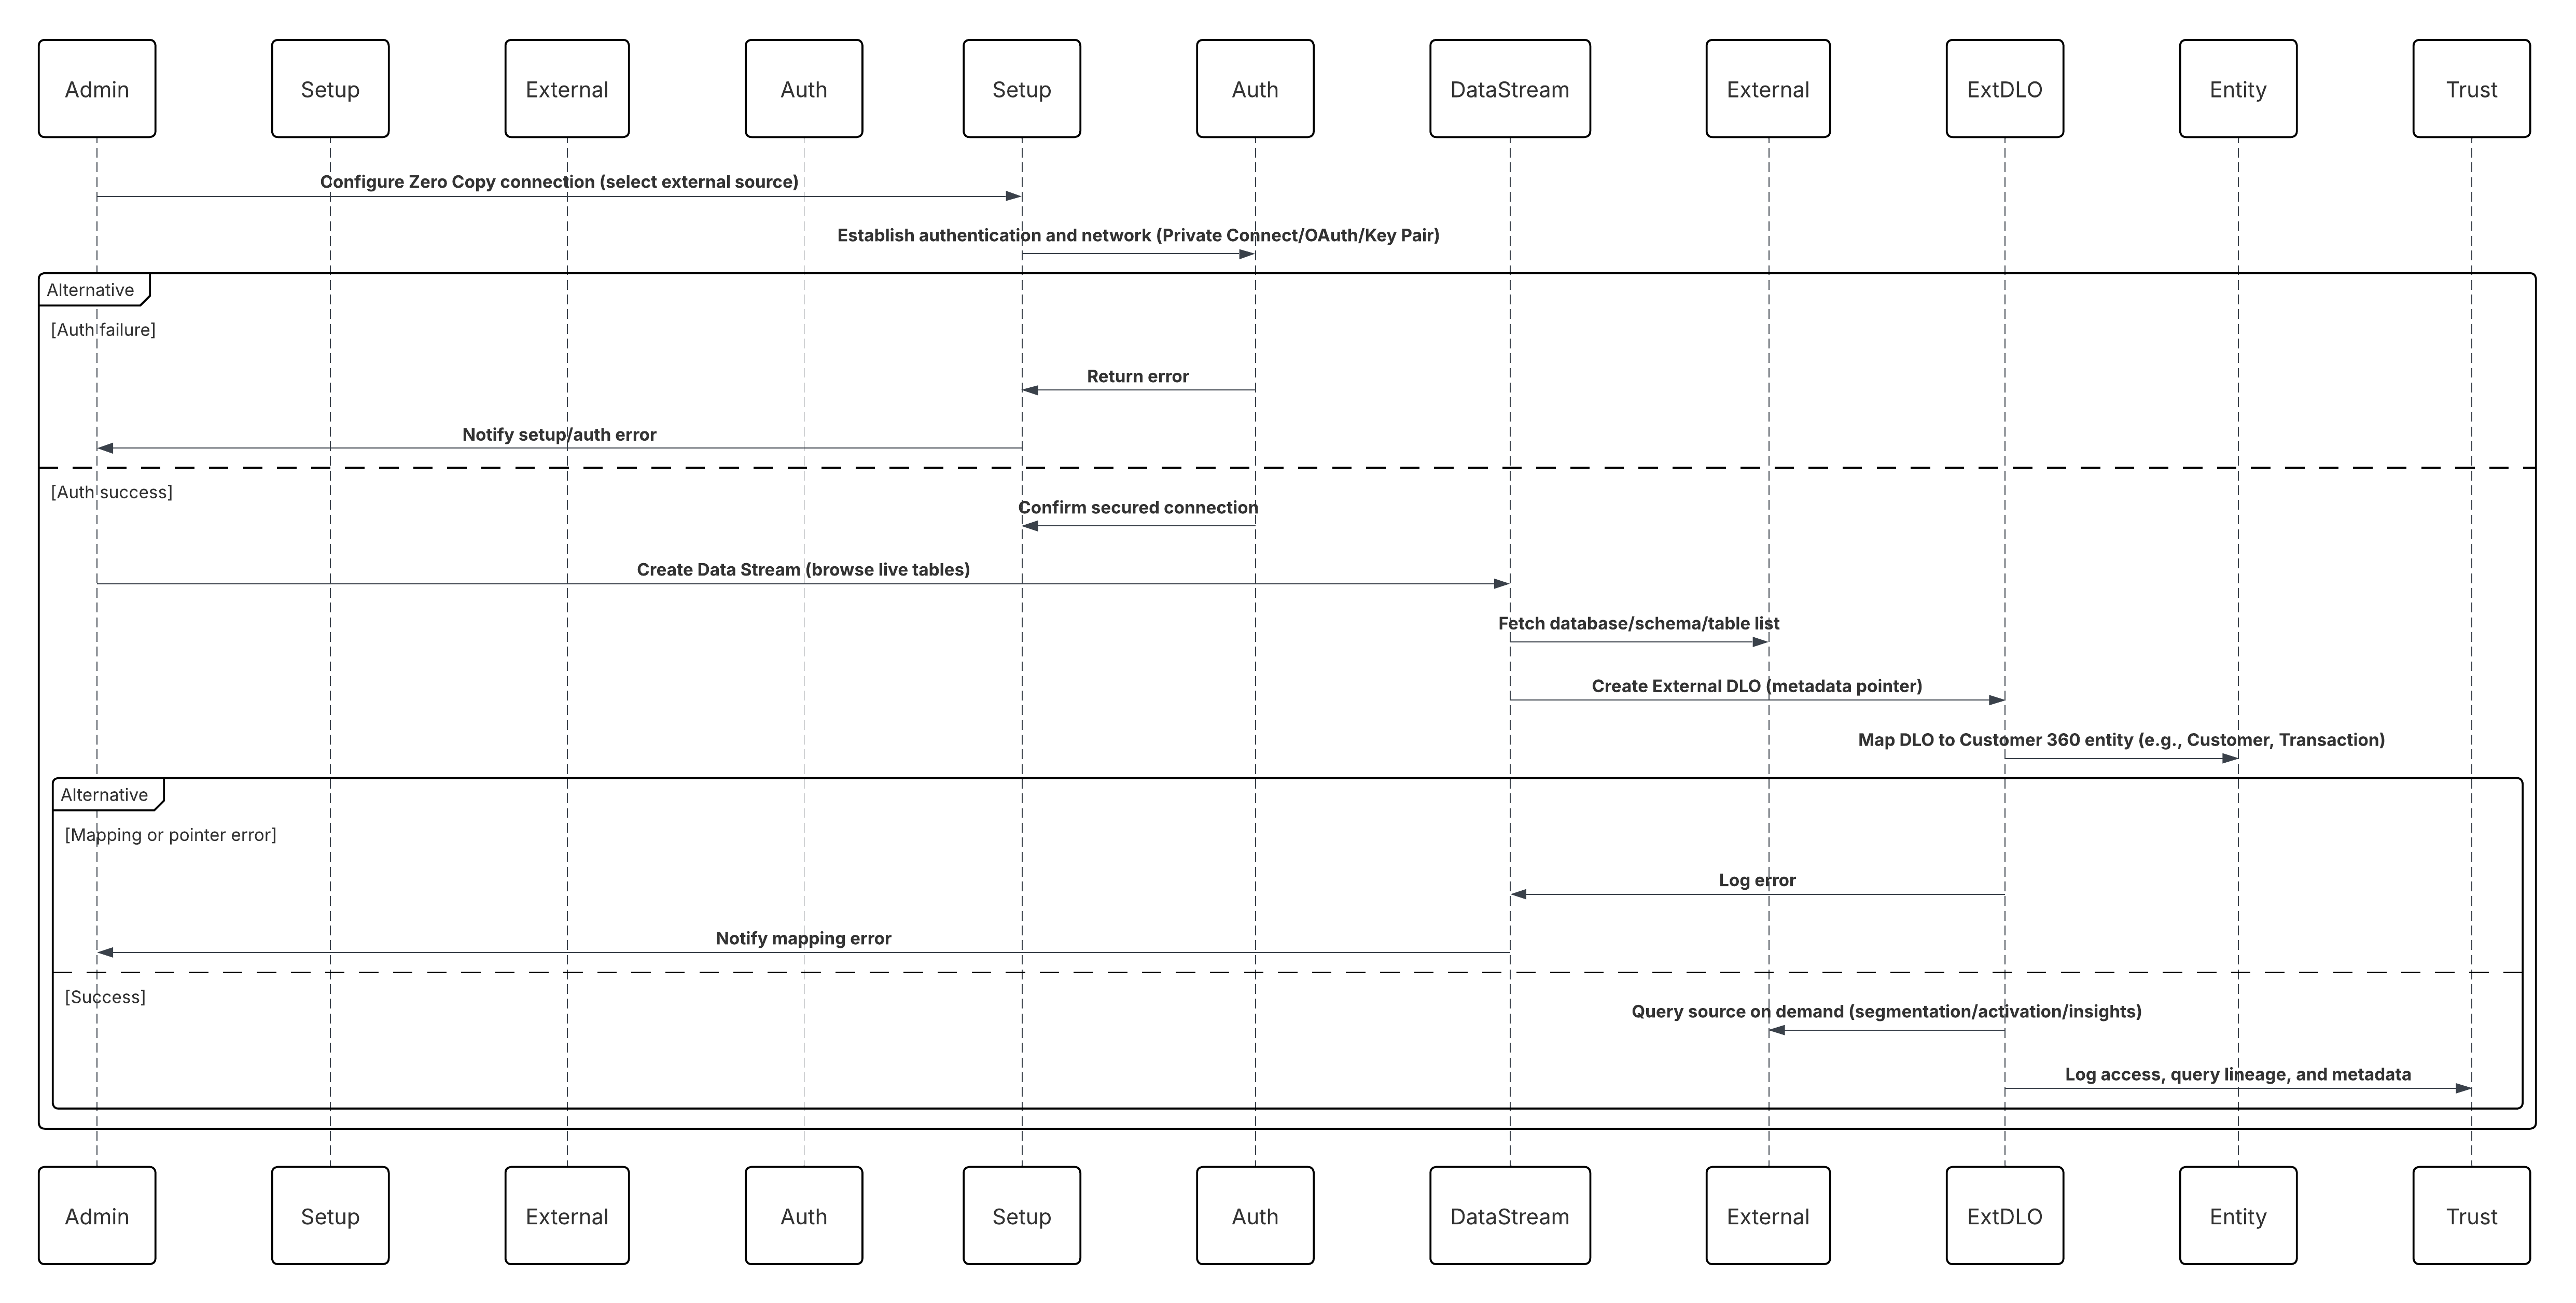 이 시나리오의 경우:
- 관리자는 Data 360 설정에서 Zero Copy 연결(Snowflake, Databricks 또는 파일 통합)을 구성합니다.
- 안전한 인증 및 네트워크 라우팅이 설정됩니다(비공개 연결/OAuth/키 쌍).
- 관리자가 실시간 데이터베이스, 스키마, 테이블을 찾아 외부 소스를 선택하는 데이터 스트림을 만듭니다.
- 데이터를 복사하는 대신 Data 360은 실시간 테이블 또는 아이스버그 파일을 참조하는 메타데이터 포인터인 외부 DLO(데이터 레이크 개체)를 만듭니다.
- 외부 DLO는 Customer 360 엔티티(예: 고객, 트랜잭션, 제품)에 매핑됩니다.
- Data 360은 세분화, 활성화 또는 인사이트 계산 중에 위치한 소스를 쿼리합니다.
- 모든 액세스, 쿼리 계보, 메타데이터는 Data 360 Trust 계층 내에서 감사됩니다.
##### 결과
- 외부 데이터는 Snowflake, Databricks 또는 S3에 남아 있습니다(ETL, 중복, 추가 저장소 없음).
- Data 360은 ID 확인, 계산된 인사이트, 활성화를 위해 엔터프라이즈 규모의 데이터에 대한 실시간 읽기 시간 액세스를 확보합니다.
- 조직은 기존의 거버넌스, 암호화, 규정 준수 프레임워크에서 완벽한 제어를 유지합니다.
- 이 패턴은 로컬 액세스의 성능과 연합 스토리지의 관리 기능을 결합하는 진정한 Zero Copy 아키텍처를 활성화합니다.
###### 메커니즘 호출
호출 메커니즘은 이 패턴을 구현하기 위해 선택한 솔루션에 따라 다릅니다.
| 메커니즘 | 사용하는 경우 |
|---|---|
| Snowflake 연합(권장) | 관리되는 엔터프라이즈 데이터 웨어하우스를 사용하는 실시간 고성능 쿼리 연합. |
| Databricks 연합 | 델타 또는 Parquet 지원 데이터 집합이 있는 통합 분석 및 레이크하우스 환경 |
| 파일 통합 (아파치 아이스베르그 / 델타 레이크) | 계산 분리 및 비용 최적화가 핵심인 개체 저장소의 대규모 데이터 집합 |
| 하이브리드 모드(영제 복사 + 수집) | 내역 데이터는 일회성 수집이 필요하지만 실시간 데이터는 Zero Copy를 통해 액세스됩니다. |
| 솔루션 영역 | 맞춤 | 댓글/구현 세부 사항 |
|---|---|---|
| 데이터 공유 생성 | 최고 | 관리자가 Data 360 내에서 데이터 공유를 만들어 선택한 DMO 및 CIO(예: 통합 개인, 고객 건강 점수)를 추가합니다. |
| 목표 구성 | 최고 | Snowflake 또는 Databricks 계정 식별자 및 인증 매개 변수를 지정하는 데이터 공유 대상을 만듭니다. |
| 공유 게시 | 모범 사례 | 데이터 공유를 데이터 공유 대상에 연결하여 안전하게 게시합니다. |
| 스토리지 수용 | 필수 | 외부 관리자가 공유를 수락하여 공유 개체를 창고의 읽기 전용 보기/테이블로 구체화합니다. |
| Granular Access Control | 권장 | Data 360 내에서 개체 및 역할 기반 권한을 적용하고 웨어하우스 수준 역할 기반 액세스 제어에 부합합니다. |
| 연합 쿼리 액세스 | 최고 | 분석가는 표준 SQL을 통해 실시간 공유 데이터를 쿼리하며 다운스트림 분석 및 ML을 위해 기본 웨어하우스 데이터와 조인합니다. |
| 파일 통합 옵션 | 옵션 | 대용량 데이터 집합의 경우 계산 종속성이 없는 직접 S3 또는 델타 레이크 판독을 위해 Apache Iceberg 기반 연합을 활용합니다. |
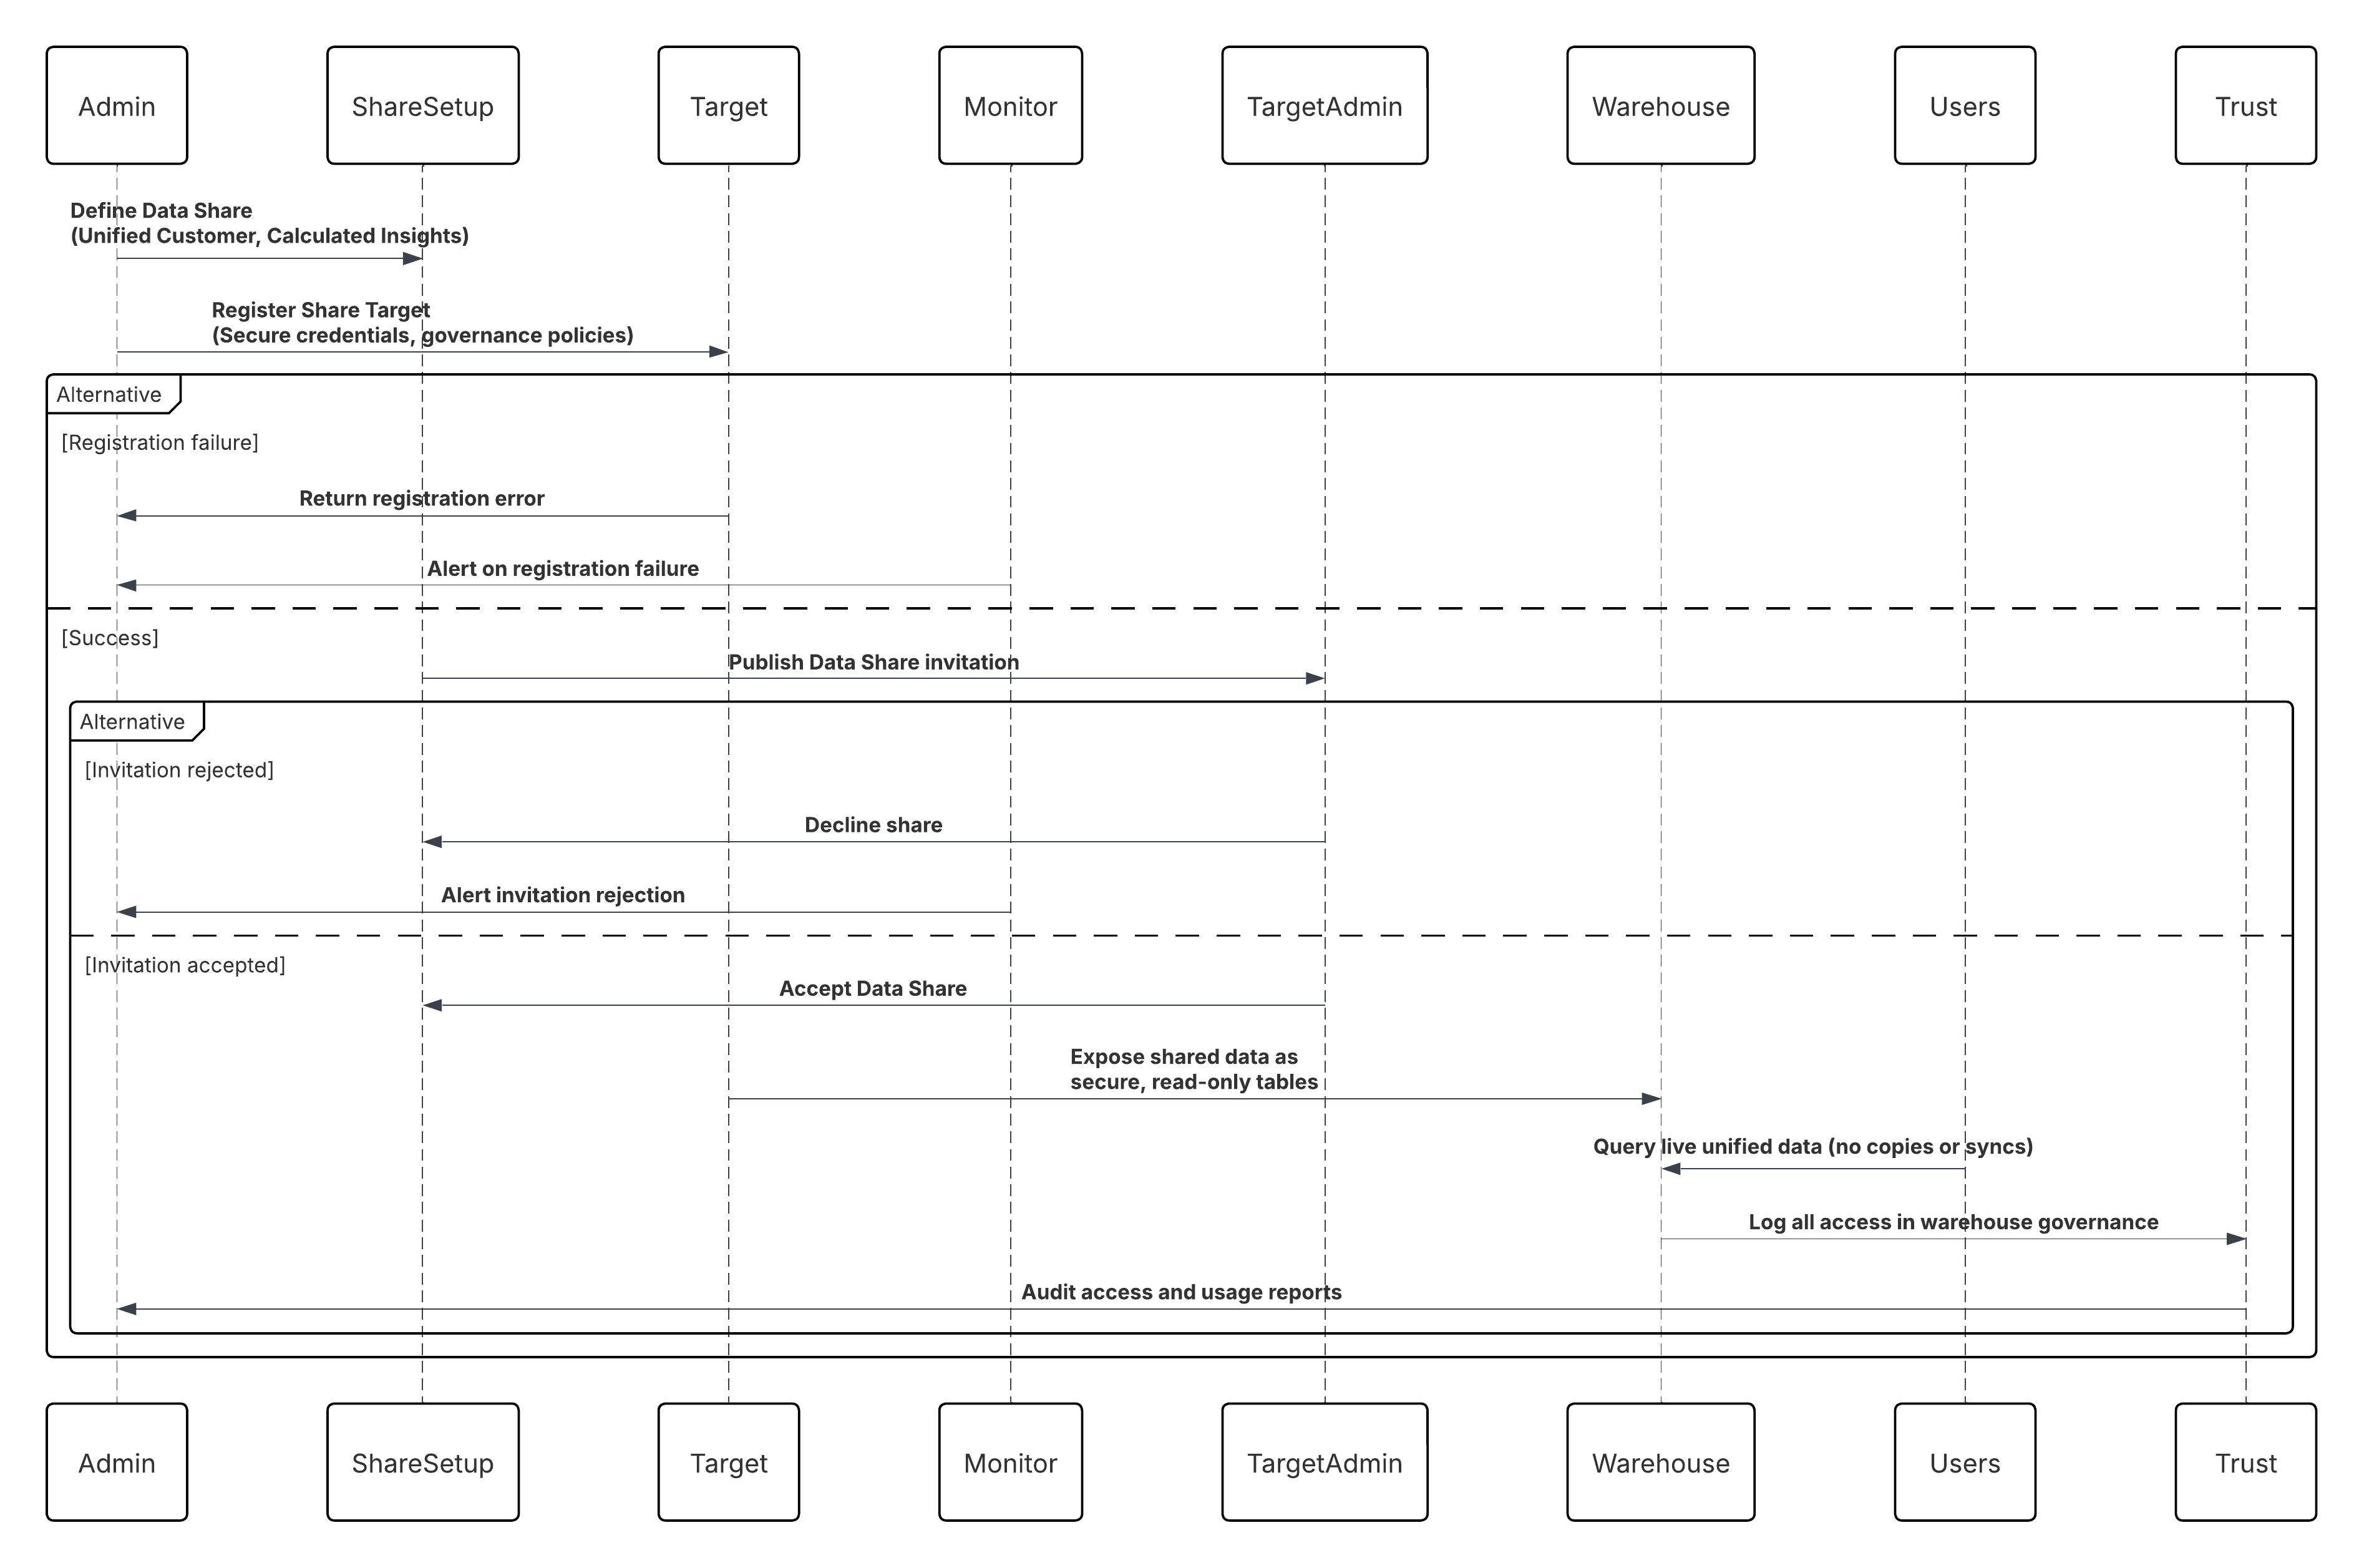 **이 경우:**
- Data 360 관리자는 통합 고객 및 계산된 인사이트 개체를 포함하는 데이터 공유를 정의합니다.
- 데이터 공유 대상(Snowflake 또는 Databricks 계정)이 보안 자격 증명 및 거버넌스 정책으로 등록됩니다.
- Data 360에서 공유를 게시하며 Snowflake/Databricks 관리자가 수락합니다.
- 공유된 데이터는 창고 내에서 안전한 읽기 전용 테이블로 표시됩니다.
- 분석가, BI 도구 또는 ML 파이프라인은 복사하거나 동기화하지 않고 실시간 통합 고객 데이터를 쿼리합니다.
- 모든 액세스는 Data 360 Trust Layer 및 창고 거버넌스 로그 내에서 감사됩니다.
##### 결과
- 외부 웨어하우스는 조화된 Data 360 데이터에 실시간으로 쿼리 가능한 액세스할 수 있습니다.
- 역 ETL 파이프라인을 제거하여 운영 부담 및 대기 시간을 줄입니다.
- 통합 데이터에서 직접 AI/ML 교육, 예측 모델링, 고급 BI를 활성화합니다.
- 중복 제한, 강력한 거버넌스, 안전한 설계별 액세스 제어를 유지합니다.
- 단일 거버넌스 모델 아래 인바운드 연합과 아웃바운드 공유가 공존하는 양방향 0 Copy 루프를 완료합니다.
###### 메커니즘 호출
호출 메커니즘은 이 패턴을 구현하기 위해 선택한 솔루션에 따라 다릅니다.
| 메커니즘 | 사용하는 경우 |
|---|---|
| Snowflake 보안 데이터 공유(권장) | 엔터프라이즈 웨어하우스가 Snowflake이고 데이터 이동 또는 중복 없이 조화된 Data 360 데이터 집합에 대한 실시간 관리 액세스 권한이 필요한 경우 사용합니다. 제로 대기 공유 및 네이티브 계보 집행이 필요한 분석, AI, 규정 준수 중심 워크로드에 적합합니다. |
| Databricks 델타 점유율 | 다운스트림 소비자가 Databricks 또는 Delta Lake 환경에서 운영하고 열려 있는 델타 공유 프로토콜을 통해 통합 또는 활성화된 데이터 집합에 대한 실시간 읽기 전용 액세스 권한이 필요한 경우 사용합니다. |
| 외부 테이블 공유 (아파치 아이스베르크 / 파켓) | 개체 저장소(S3, ADLS 또는 GCS)에서 오픈 형식 아키텍처를 유지하고 Athena, BigQuery 또는 Snowflake-on-Iceberg와 같은 분석 엔진 간의 상호 운용 가능한 저렴한 비용 공유가 필요한 경우 사용합니다. |
| 데이터 공유 API(프로그래밍 액세스) | 사용자 정의 앱 또는 미들웨어(예: MuleSoft)가 이벤트 기반 새로 고침 알림 및 세분화된 액세스 제어를 통해 API를 통해 공유 데이터 집합을 안전하게 검색, 구독 또는 사용해야 하는 경우 사용합니다. |
| 하이브리드 공유(제로 복제 + 아웃바운드 공유) | 양방향 교환 패턴을 구현할 때 사용합니다. 인바운드 데이터의 경우 Zero Copy를 활용하고 인사이트를 게시하는 경우 아웃바운드 데이터 공유를 활용하여 엔터프라이즈 데이터 플레인 전반에서 시맨틱 및 거버넌스 일관성을 보장합니다. |
| 솔루션 영역 | 맞춤 | 댓글/구현 세부 사항 |
|---|---|---|
| 홈 조직 프로비저닝 | 최고 | 하나의 Salesforce 조직을 Data 360이 프로비저닝되는 홈 조직으로 지정합니다. 이는 중앙 데이터 리포지토리 및 거버넌스 허브가 됩니다. |
| Companion Org 연결 | 최고 | Data Cloud One 앱을 통해 홈 조직에서 하나 이상의 동료 조직에 대한 동료 연결을 구성합니다. 사용자 정의 코드가 필요하지 않습니다. |
| 데이터 공간 정의 | 모범 사례 | 홈 조직 내의 데이터 공간을 정의하여 데이터(예: 리테일, 서비스, 마케팅)를 논리적으로 분할하고 액세스 경계를 격리합니다. |
| 데이터 공간 공유 | 최고 | 홈 조직에서 동료 조직으로 선택한 데이터 공간을 명시적으로 공유하여 통합 데이터의 관리 기반 역할 기반 가시성을 보장합니다. |
| 액세스 구성 | 필수 | 동료 조직에서 Data Cloud One 앱을 활성화하고 프로필, 인사이트, 세그먼트 액세스에 대한 사용자 권한을 할당합니다. |
| 거버넌스 및 정책 관리 | 권장 | 홈 조직에서 모든 수집, ID 확인 및 Trust 구성을 중앙 집중화하고 종단간 관리를 유지합니다. |
| 다중 조직 동기화 | 최고 | 홈 조직의 데이터 변경 사항 및 계산된 인사이트는 관리 동기화 파이프라인을 통해 동료 조직 전체에서 실시간으로 반영됩니다. |
| 하이브리드 배포 옵션 | 옵션 | 대기업의 경우 여러 동료 조직이 로컬 컨텍스트 및 규정 준수 경계를 유지하면서 단일 홈 조직에 연결할 수 있습니다. |
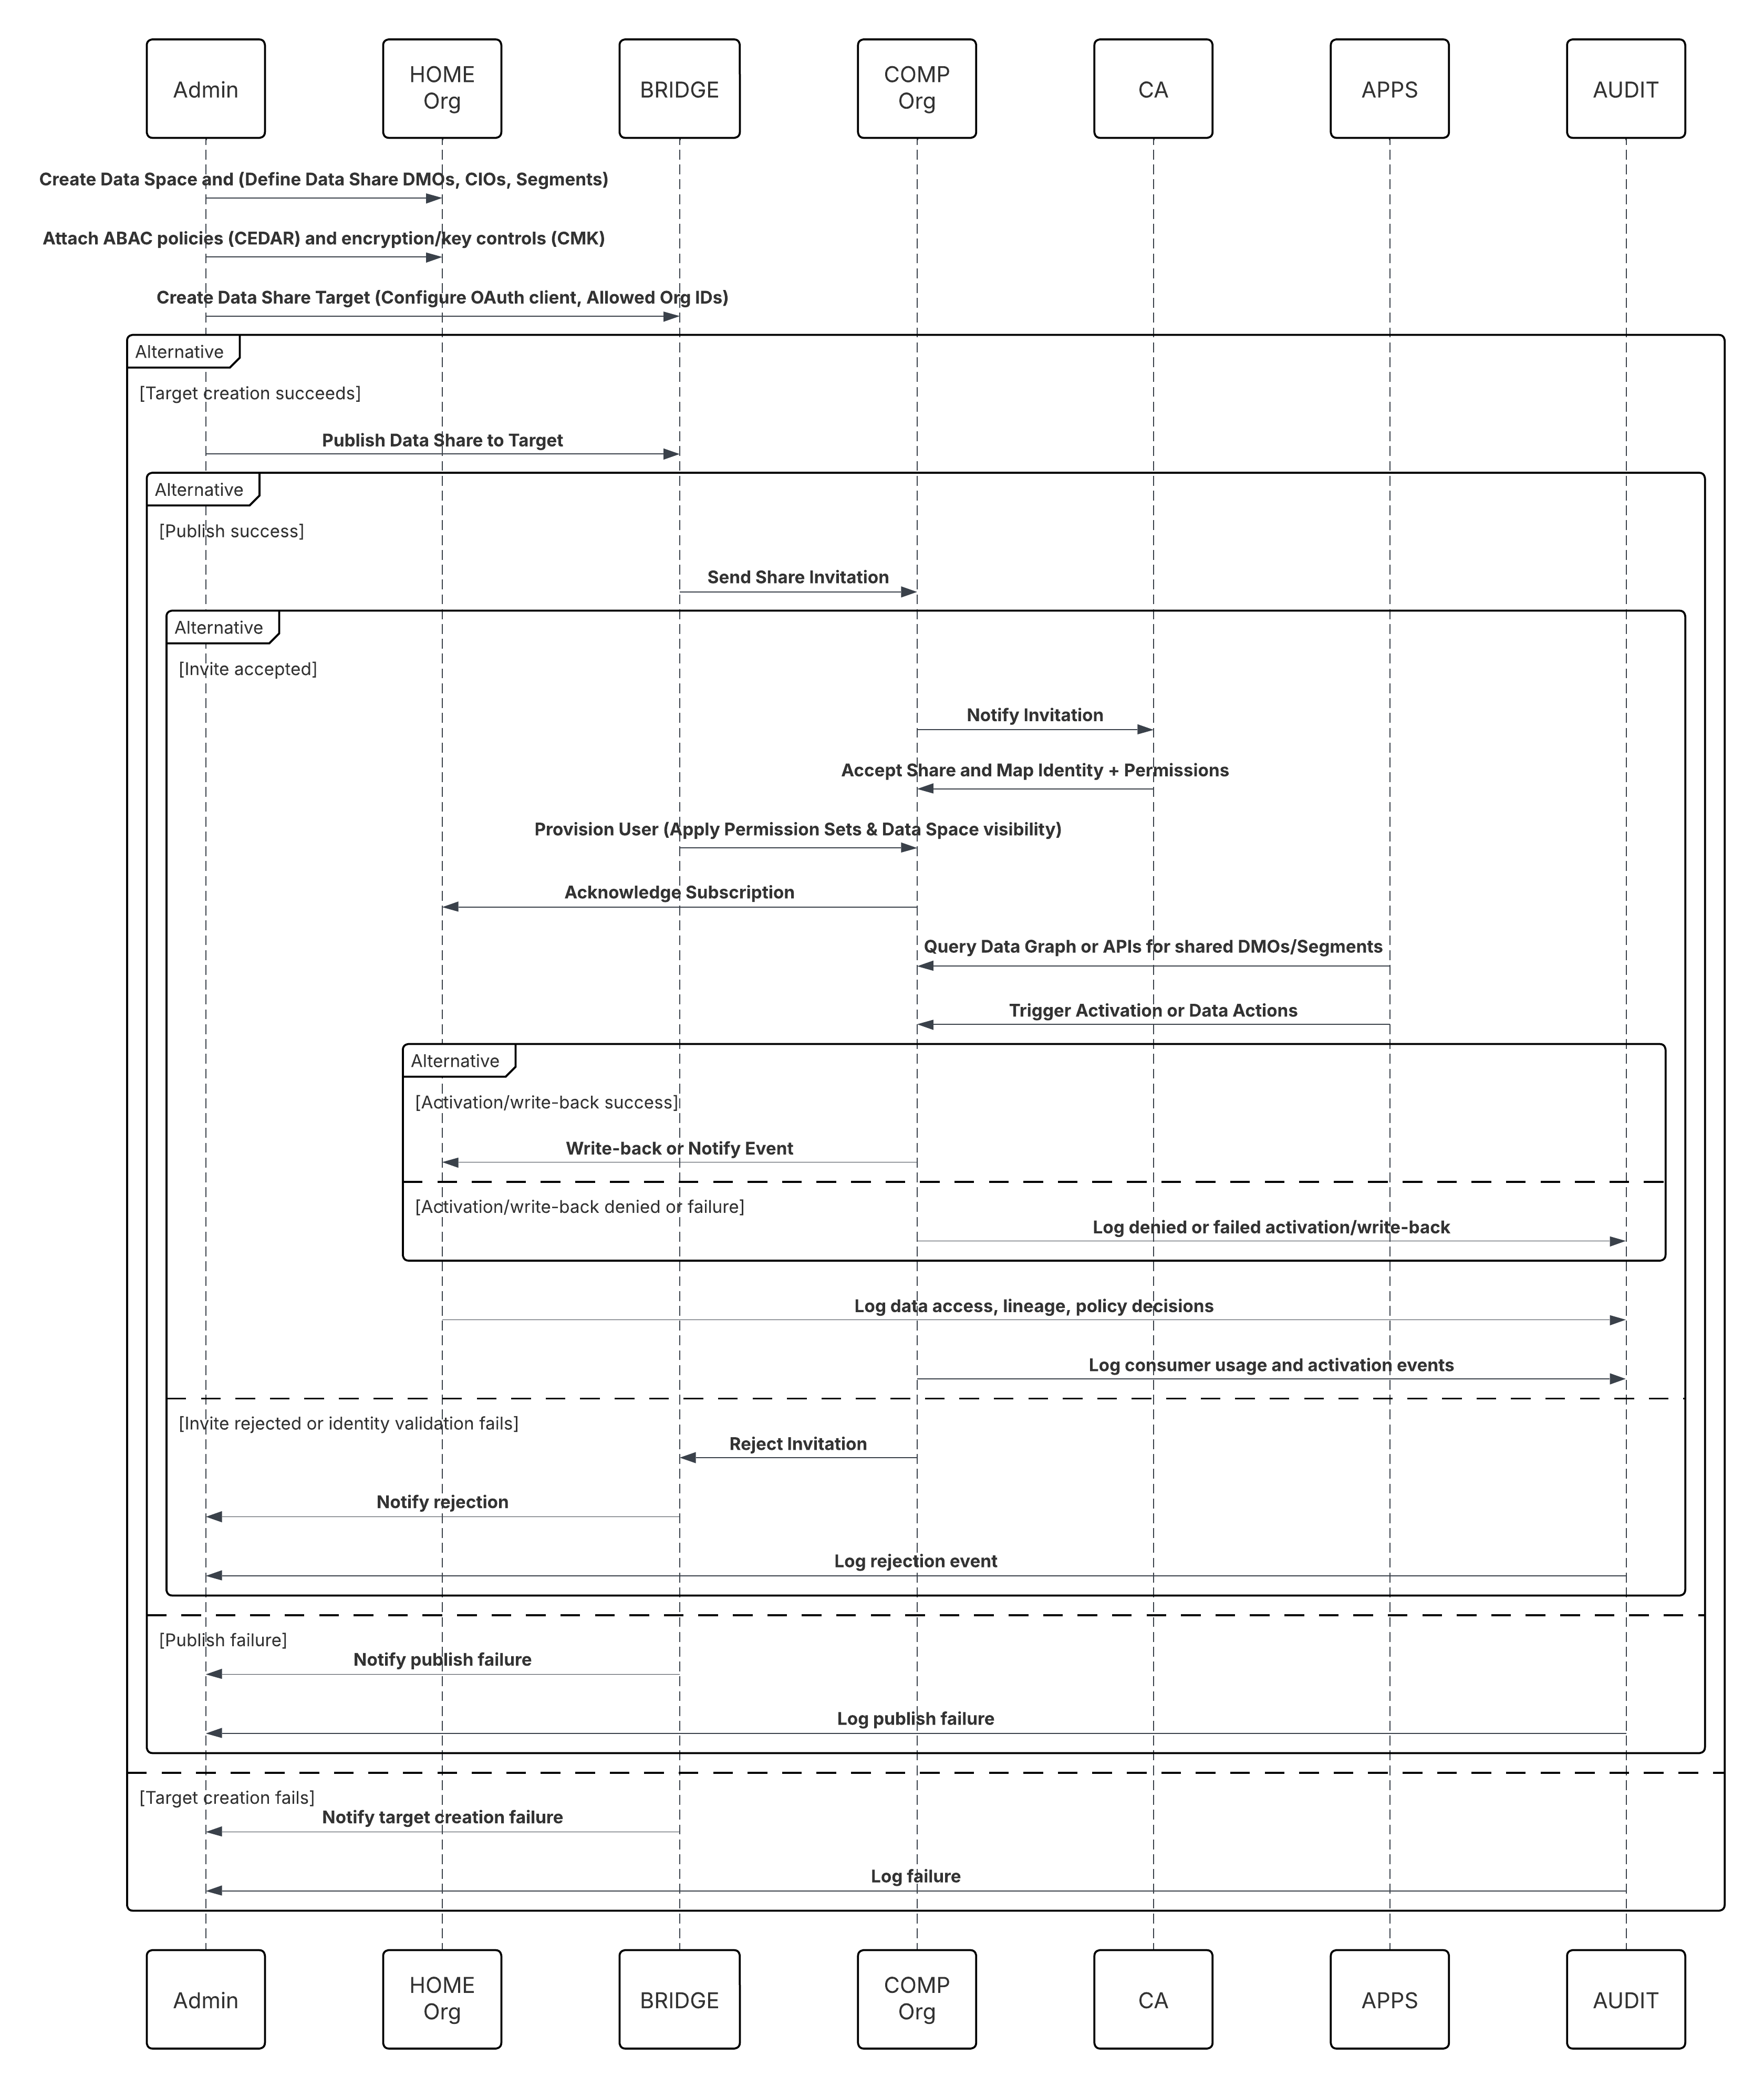 **이 경우:**
- **홈 관리자**: 데이터 공간을 만들고 데이터 공유를 정의합니다(선택한 DMO/CIO, 세그먼트).
- **홈 관리자**: 동료 조직에 대한 데이터 공유 대상을 만들고 Trust(OAuth 클라이언트, 허용된 조직 ID)를 구성합니다.
- **홈 관리자**: 대상에 데이터 공유를 게시하고 ABAC 정책(CEDAR) 및 암호화/키 제어(필요한 경우 CMK)를 첨부합니다.
- **공동 조직 관리자**: 초대를 수신하고, ID 매핑을 확인하고, 공유를 수락합니다.
- **Companion Org**: Data Cloud One Bridge는 Data Cloud One 사용자를 프로비저닝하고 권한 집합 및 데이터 공간 가시성을 적용합니다.
- **Companion Org 앱(플로스 / Einstein / Apex)**: 데이터 그래프를 쿼리하거나 Data Cloud One API를 호출하여 공유 DMO 또는 세그먼트를 읽습니다.
- **활성화**: 동료 조직이 활성화를 트리거하거나 데이터 작업을 통해 다시 쓸 수 있습니다(허용되는 경우).
##### 결과
- 연결된 모든 조직에서 고객 데이터(Customer 360)에 대한 **단일 진실 소스** \- 중복 Data 360 인스턴스가 없습니다.
- **가치 실현 시간을 단축합니다. 동료 조직은 몇 주간의 사용자 정의 코딩이 아닌 몇 분 만에 통합 데이터 및 Data 360 지원 기능에 액세스할 수 있습니다**.
- **제어된 데이터 공유.** 승인된 데이터 공간만 공유되므로 보안 및 거버넌스를 유지하고 비즈니스 유연성을 활성화합니다.
- 비즈니스 기능(세일즈, 서비스, 마케팅)은 동일한 통합 데이터 파운데이션에서 작동하여 엔터프라이즈 전반에서 일관된 메트릭, 활성화, 인사이트를 제공합니다.
###### 메커니즘 호출
호출 메커니즘은 이 패턴을 구현하기 위해 선택한 솔루션에 따라 다릅니다.
| 메커니즘 | 사용하는 경우 |
|---|---|
| Data Cloud One 네이티브 공유(권장) | 여러 Salesforce 조직(Sales, Service 또는 Industry Cloud)이 Data 360\에서 직접 통합 고객 데이터에 실시간으로 액세스해야 하는 경우 사용합니다. 이렇게 하면 복제가 해제되고 골든 레코드, 세그먼트, 계산된 인사이트에 대한 제로 대기 시간 액세스가 활성화됩니다. |
| Data Cloud One Bridge를 통한 조직 간 공유 | 여러 사업부 또는 자회사가 별도의 Salesforce 조직에서 운영되지만 중앙 Data 360 인스턴스에서 공통 고객 데이터 및 세그먼트에 대한 공유 액세스 권한이 필요한 경우 사용합니다. 독립 운영 체제를 유지하는 다중 조직 엔터프라이즈에 적합합니다. |
| Einstein 1 플랫폼 쿼리 API | Salesforce 앱, 플로 또는 Einstein Copilot Data 360 데이터를 프로그래밍 방식으로 쿼리하거나 활성화해야 하는 경우 사용합니다. 배치 내보내기를 사용하지 않고 다른 Salesforce 응용 프로그램에 통합 프로필, 메트릭 또는 활성화 결과를 실시간으로 검색할 수 있습니다. |
| Salesforce 채널 활성화 | 개인 설정, 캠페인 실행 또는 에이전트 지원 환경을 위해 Marketing Cloud, Service Cloud 또는 Commerce Cloud에 Data 360 데이터(세그먼트, 인사이트 또는 특성)를 활성화해야 하는 경우 사용합니다. |
| 데이터 그래프 액세스(시맨틱 쿼리 레이어) | 수동 조인 또는 변환 없이 Copilot, AI 워크플로, 실시간 클라우드 간 분석을 지원하는 Salesforce 데이터 그래프를 통해 통합 데이터 모델에 시맨틱 수준으로 액세스해야 하는 경우 사용합니다. |
| 솔루션 영역 | 맞춤 | 댓글/구현 세부 사항 |
|---|---|---|
| 세그먼트 생성 | 최고 | 마케터 또는 분석가가 데이터 모델 개체(DMO) 또는 계산된 인사이트 개체(CIO)에서 필터를 적용하여 시각적 세분화 캔버스에서 세그먼트를 구축합니다. 이렇게 하면 활성화 대상 그룹이 정의됩니다. |
| 활성화 설정 | 최고 | 사용자가 활성화를 만들고 소스로 방금 구축한 세그먼트를 선택합니다. 이를 통해 다운스트림 시스템으로 Data 360을 내보낼 대상 그룹이 정의됩니다. |
| 활성화 대상 선택 | 모범 사례 | 마케터가 사전 구성된 활성화 대상을 선택합니다(예: Marketing Cloud, Google Ads, LinkedIn Ads). 각 대상은 인증 자격 증명 및 필드 매핑을 사용하여 Data 360에 등록됩니다. |
| Payload 정의 | 필수 | 마케터는 연락처 식별자(예: 이메일, 모바일, 해시 ID)를 선택하고 대상 시스템에서 보강할 추가 프로필 특성(예: 이름(성 없이), 충성도 계층 또는 CLV)을 선택하여 페이로드를 정의합니다. |
| 예약 및 빈도 | 권장 | 활성화를 한 번 또는 반복적으로 실행하도록 예약할 수 있습니다(예: 매일 또는 매주). 예약을 통해 다운스트림 대상 그룹이 동기화되고 최신 상태로 유지됩니다. |
| 실행 및 내보내기 | 최고 | 활성화 작업이 실행되면 Data 360이 세그먼트를 쿼리하고, 선택한 특성을 수집하고, 동의 필터를 적용하고, 데이터를 대상 플랫폼으로 내보냅니다. Marketing Cloud의 경우 일반적으로 공유 데이터 확장이 생성되거나 업데이트됩니다. |
| 거버넌스 및 규정 준수 | 필수 | Trust 계층은 데이터 보호 및 마케팅 규정(예: GDPR, CCPA)을 준수하기 위해 스키마 검증, 동의 메타데이터 및 정책 제어를 적용합니다. |
| 모니터링 및 감사 기능 | 모범 사례 | 모든 활성화 실행은 성공/실패 메트릭, 실행 로그 및 계보 가시성을 통해 Trust 계층 모니터링 대시보드에서 추적되므로 운영 투명성과 SLA 보증이 가능합니다. |
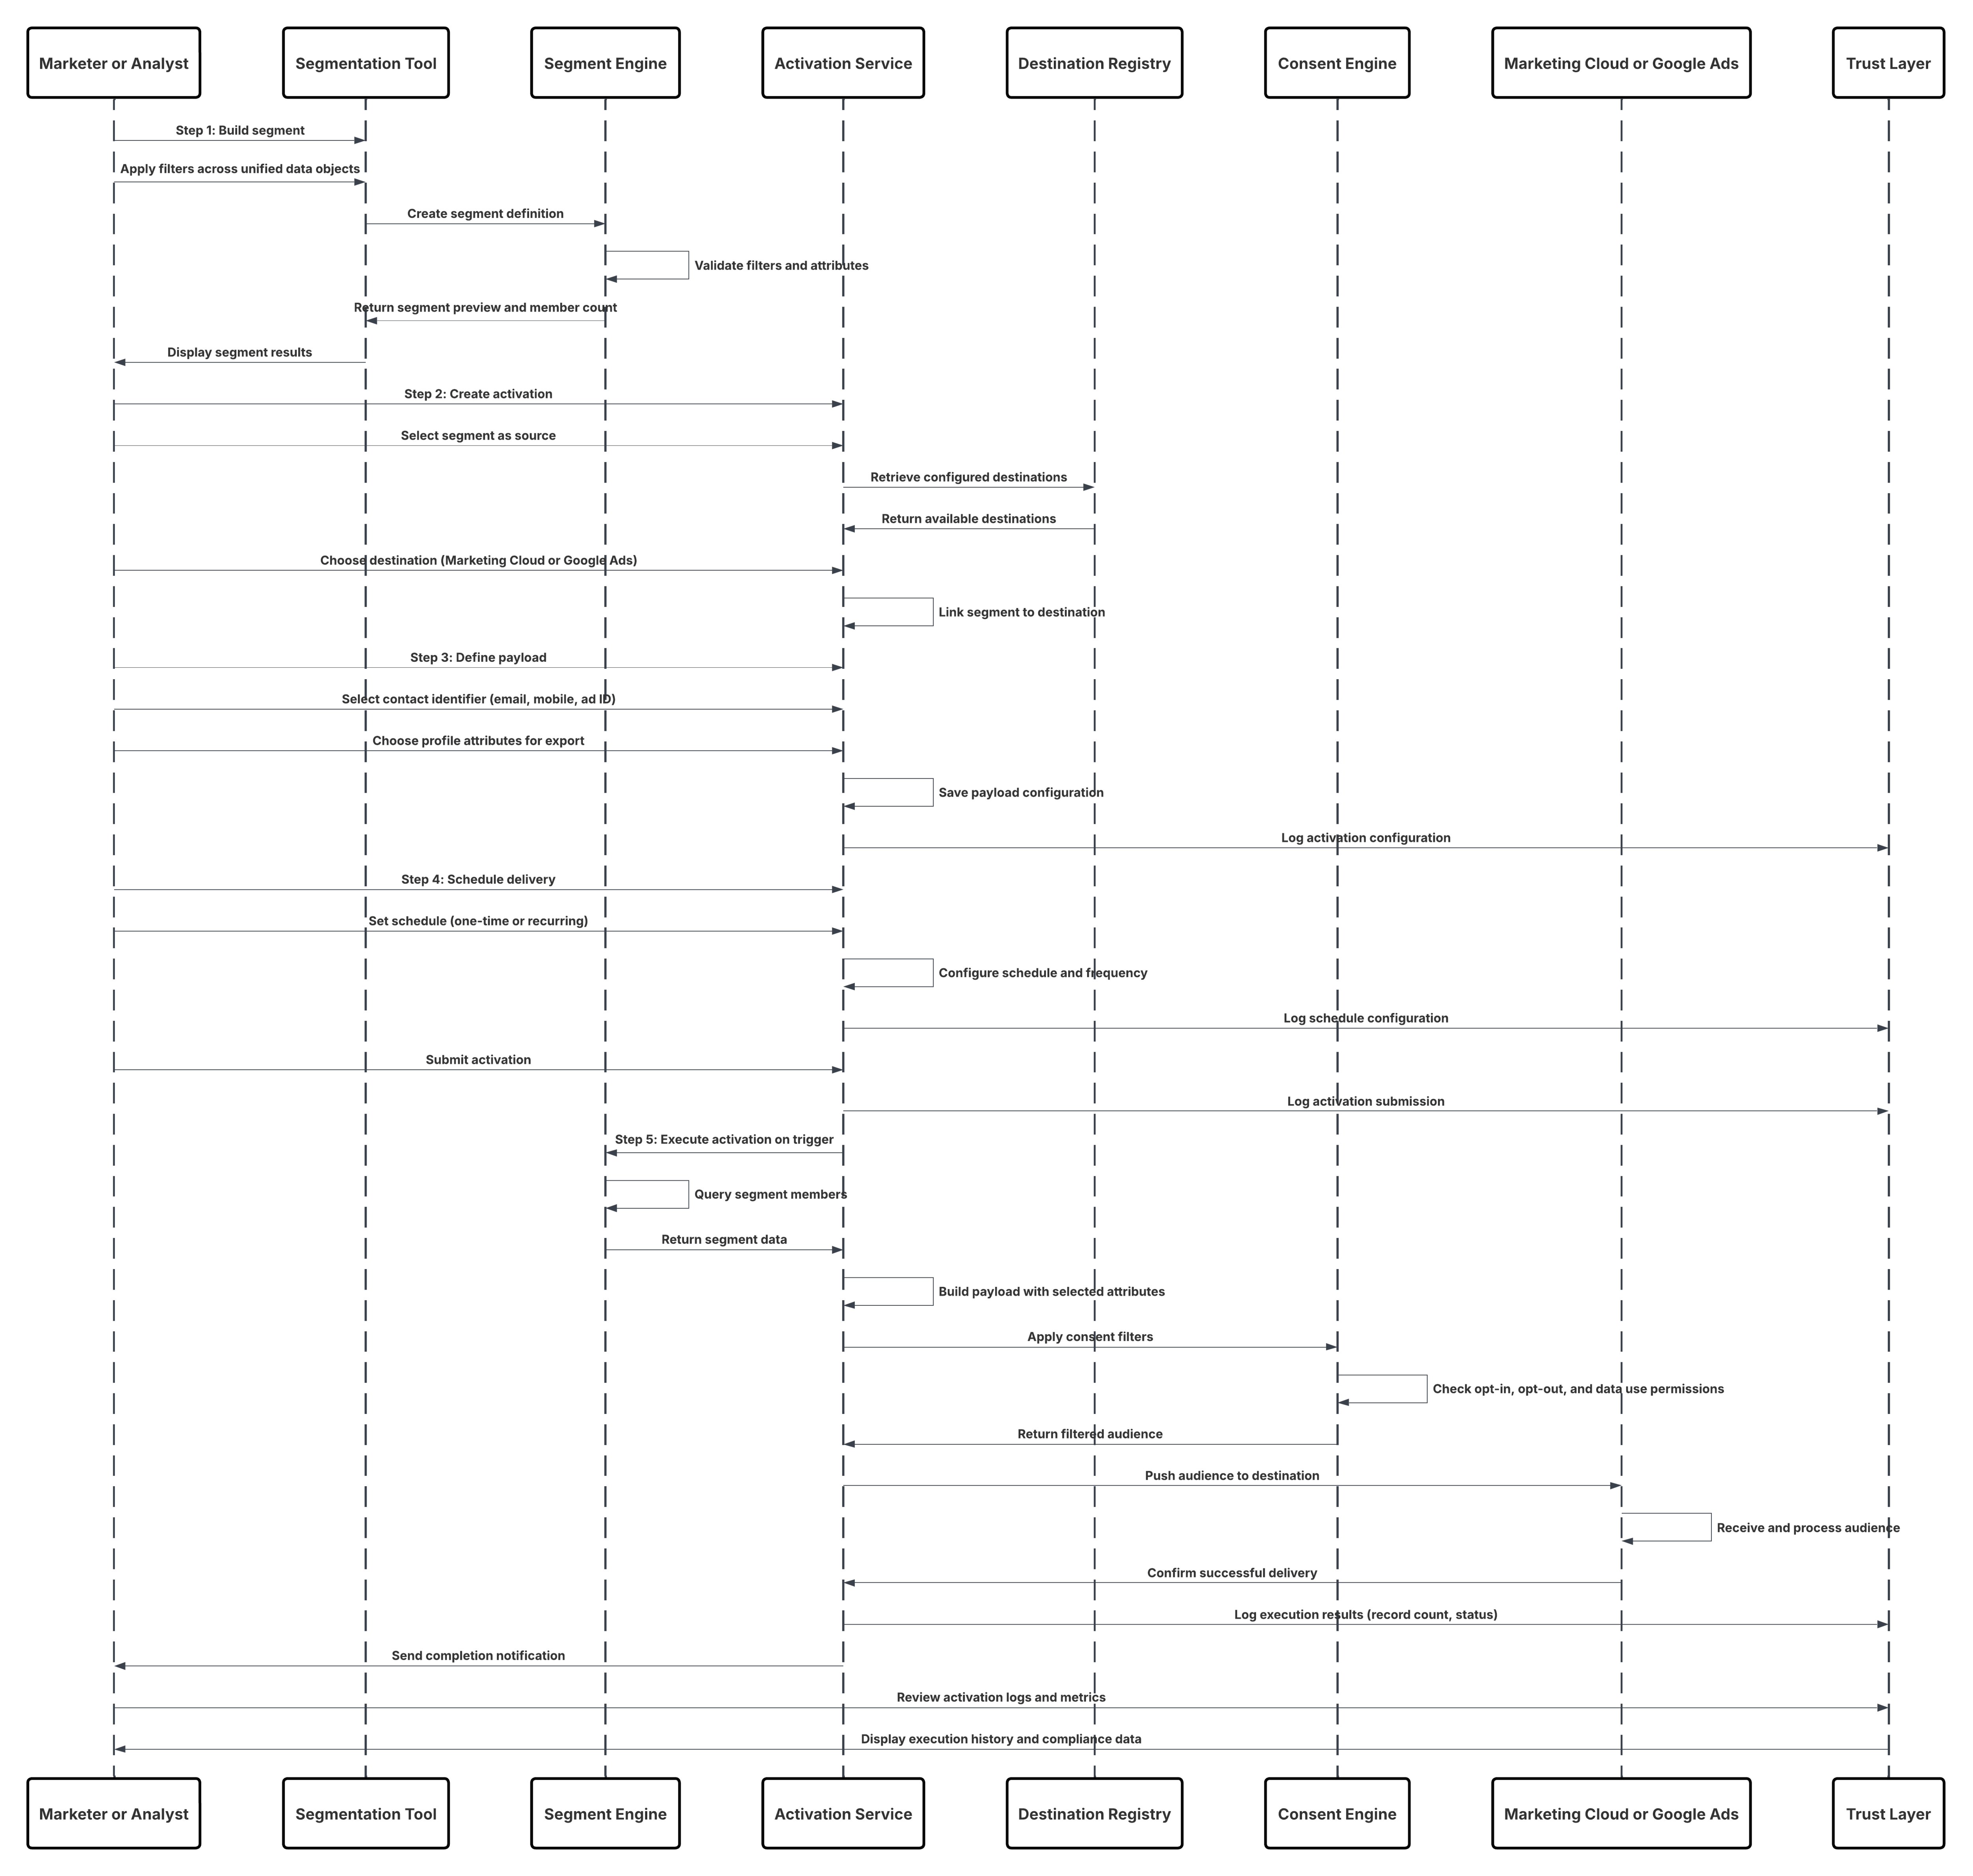 ##### 결과
- Data 360의 대상 그룹 세그먼트를 다운스트림 마케팅 및 광고 플랫폼에서 바로 사용할 수 있습니다.
- 대상 그룹이 자동으로 새로 고쳐 최신 통합 고객 데이터와 동기화되어 실시간 캠페인 관련성을 유지합니다.
- 마케터는 활성화된 대상 그룹을 Google Ads, Meta 또는 LinkedIn Ads와 같은 디지털 광고 플랫폼에서 Marketing Cloud Journeys, 이메일 캠페인 또는 사용자 정의 대상 그룹의 입력 소스로 사용할 수 있습니다.
- 모든 활성화 실행은 종단간 계보를 유지하여 Data 360과 외부 시스템 간의 규정 준수, 추적 가능성, 일관성을 보장합니다.
- 비즈니스 사용자는 완벽하고 신뢰할 수 있는 Customer 360 뷰를 통해 고도로 맞춤화된 데이터 중심 환경을 제공할 수 있습니다.
###### 메커니즘 호출
호출 메커니즘은 대상 플랫폼 및 활성화 대상 구성에 따라 다릅니다.
| 메커니즘 | 사용하는 경우 |
|---|---|
| Marketing Cloud 참여 활성화(권장) | Marketing Cloud에서 동적 세그먼트, 맞춤형 특성, 실시간 업데이트가 필요한 이메일 또는 교차 채널 여정을 실행할 때 사용합니다. Data 360은 캠페인 활성화를 위해 공유 데이터 확장으로 직접 내보냅니다. |
| Ad Platform 활성화(Google Ads, LinkedIn Ads, Meta Ads) | 재타겟팅 또는 유사 모델링을 위해 Data 360 세그먼트를 광고 플랫폼의 사용자 정의 대상 그룹으로 활성화할 때 사용합니다. 해시 식별자 및 동의 인식 전달을 지원합니다. |
| CRM 활성화(Sales 또는 Service Cloud) | 맞춤형 세일즈 참여 또는 서비스 상호 작용을 위해 CRM 사용자와 보강된 고객 데이터, 인사이트 또는 성향 점수를 공유할 때 사용합니다. 데이터는 데이터 작업 또는 통합 프로필 구성 요소를 통해 보강된 레코드 또는 인사이트로 사용할 수 있습니다. |
| MuleSoft 또는 API를 통한 외부 활성화 | 충성도, 전자상거래 또는 타사 데이터 웨어하우스와 같은 비Salesforce 시스템에 활성화해야 하는 경우 사용합니다. MuleSoft 또는 Data 360 활성화 API는 이벤트 기반 새로 고침 옵션과 함께 안전한 정책 관리 전달을 보장합니다. |
| 하이브리드 활성화(배치 + 이벤트 트리거형) | 예약된 배치 활성화를 이벤트 기반 트리거와 결합하는 경우 사용합니다. 중단된 장바구니 또는 이탈 위험 경고와 같은 시간이 중요한 캠페인에 대해 "항상" 개인 설정을 활성화합니다. |
| 솔루션 영역 | 맞춤 | 댓글/구현 세부 사항 |
|---|---|---|
| 세그먼트 선택 | 최고 | 분석가가 Data 360\ 내에서 기존 세그먼트 또는 쿼리 정의를 선택합니다. 세그먼트에 따라 내보낼 레코드 및 특성이 결정됩니다. |
| 활성화 설정 | 최고 | 사용자가 세그먼트를 소스로 선택하고 클라우드 저장소 대상을 대상으로 선택하는 새 활성화를 만듭니다(예: S3). |
| 활성화 대상 구성 | 필수 | 관리자가 자격 증명, IAM 역할 및 출력 경로를 사용하여 대상을 미리 구성합니다. 지원되는 형식에는 CSV, Parquet, JSON이 포함됩니다. |
| Payload 정의 | 모범 사례 | 필수 특성(예: ID, 이름, 이메일, 지역, 동의 플래그)을 선택하여 내보내기 스키마를 정의합니다. 시스템에서 특성 수준 관리를 적용합니다. |
| 예약 및 빈도 | 권장 | 정의된 케이던스(매일, 매주, 매달)에서 실행되도록 내보내기를 예약하거나 필요에 따라 수동으로 트리거할 수 있습니다. |
| 실행 및 배달 | 최고 | 실행 시 Data 360은 세그먼트를 쿼리하고 내보내기 파일을 컴파일하고 암호화한 후 클라우드 공급자의 API를 사용하여 구성된 버킷/폴더에 작성합니다. |
| 거버넌스 및 규정 준수 | 필수 | Data 360의 Trust 레이어는 모든 내보내기가 동의 정책, 스키마 검증 및 규정 준수 필터를 준수하도록 합니다. |
| 모니터링 및 감사 기능 | 모범 사례 | 각 내보내기는 Trust 계층 모니터링 대시보드에서 상태, 실행 로그 및 계보 메타데이터와 함께 추적됩니다. |
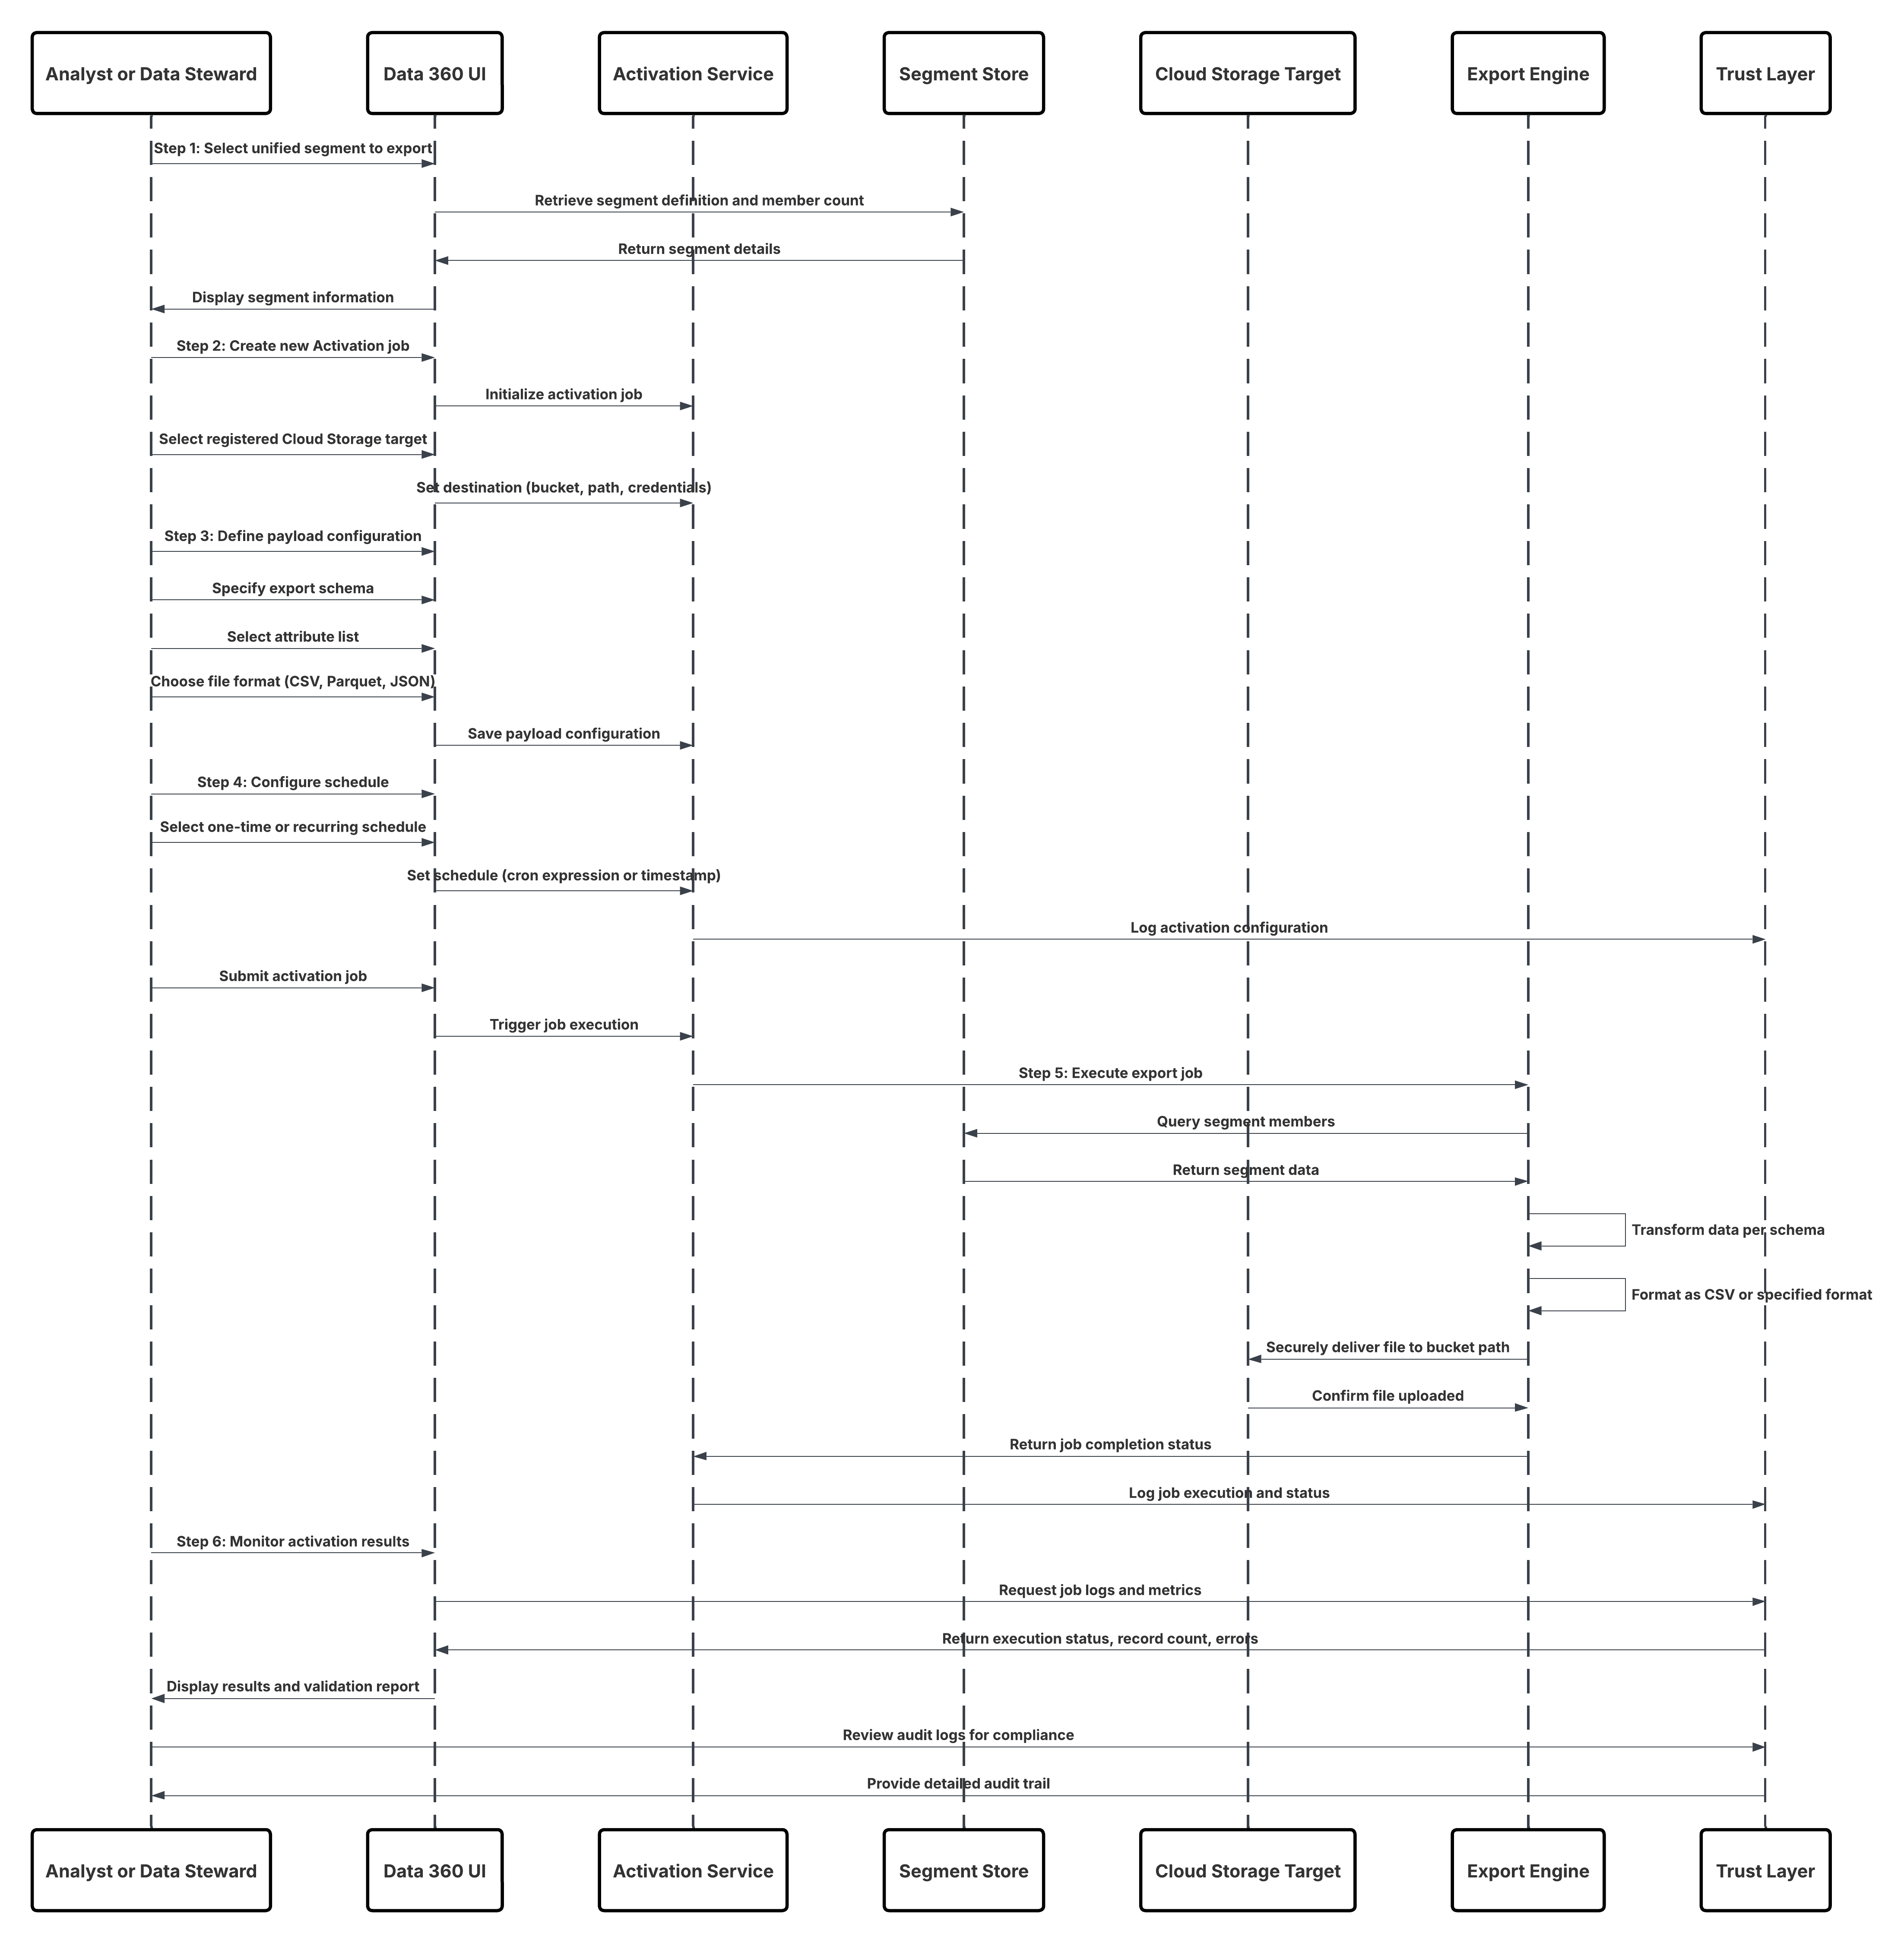 ##### 결과
- Data 360의 대상 그룹 세그먼트를 다운스트림 마케팅 및 광고 플랫폼에서 바로 사용할 수 있습니다.
- 대상 그룹이 자동으로 새로 고쳐 최신 통합 고객 데이터와 동기화되어 실시간 캠페인 관련성을 유지합니다.
- 마케터는 활성화된 대상 그룹을 Google Ads, Meta 또는 LinkedIn Ads와 같은 디지털 광고 플랫폼에서 Marketing Cloud Journeys, 이메일 캠페인 또는 사용자 정의 대상 그룹의 입력 소스로 사용할 수 있습니다.
- 모든 활성화 실행은 종단간 계보를 유지하여 Data 360과 외부 시스템 간의 규정 준수, 추적 가능성, 일관성을 보장합니다.
- 비즈니스 사용자는 완벽하고 신뢰할 수 있는 Customer 360 뷰를 통해 고도로 맞춤화된 데이터 중심 환경을 제공할 수 있습니다.
###### 메커니즘 호출
호출 메커니즘은 target Cloud 스토리지 플랫폼 및 활성화 구성에 따라 다릅니다.
| 메커니즘 | 사용하는 경우 |
|---|---|
| Amazon S3 활성화 | 엔터프라이즈 데이터 레이크가 AWS에서 호스팅되는 경우 사용합니다. Data 360은 IAM 역할 또는 임시 자격 증명을 사용하여 S3 버킷에 직접 작성하여 안전하고 확장 가능한 내보내기를 보장합니다. |
| Azure Blob 스토리지 활성화 | 조직이 Microsoft Azure에서 운영하는 경우 사용합니다. Data 360은 SAS 토큰 또는 서비스 주체를 사용하여 Blob 컨테이너에 암호화된 파일을 작성합니다. |
| Google Cloud Storage(GCS) 활성화 | 데이터 과학 또는 분석 워크로드가 GCP에서 실행되는 경우 사용합니다. Data 360은 OAuth 자격 증명을 사용하여 CSV 또는 Parquet 형식의 GCS 버킷으로 파일을 내보냅니다. |
| SFTP 또는 외부 파일 게이트웨이 | 규제 또는 레거시 시스템에서 SFTP 끝점 또는 엔터프라이즈 관리 파일 전송 플랫폼을 통해 안전한 파일 전달이 필요한 경우 사용합니다. |
| 하이브리드 내보내기(파일 + API) | 다운스트림 응용 프로그램에 분석을 위한 파일 기반 내보내기와 워크플로 오케스트레이션을 위한 API 트리거(예: MuleSoft 플로)가 모두 필요한 경우 사용합니다. |
| 솔루션 영역 | 맞춤 | 댓글/구현 세부 사항 |
|---|---|---|
| 인증 및 앱 등록 | 필수 | Salesforce에서 OAuth 2.0 기반 인증을 위한 연결된 앱을 만듭니다. Data 360 API 액세스에 대한 범위를 구성합니다. |
| 데이터 액세스(프로필, 세그먼트, 인사이트) | 최대 | Connect API 끝점(/services/data/vXX.X/connect)을 사용하여 조화된 Data 360 데이터, 통합 프로필, 계산된 인사이트를 쿼리합니다. |
| UI 통합 | 최대 | 프런트엔드 앱(반응형, 각도, iOS, Android)은 Connect API를 호출하여 대시보드, 포털 또는 모바일 인터페이스에서 Data 360 데이터를 렌더링합니다. |
| 데이터 그래프 쿼리 | 권장 | 복잡한 조인 및 관계를 간소화하는 시맨틱 수준 쿼리에 대해 Connect API와 데이터 그래프 API를 결합합니다. |
| 실시간 새로 고침 | 옵션 | 라이브 데이터 업데이트를 위해 Connect API와 WebSocket 또는 스트리밍 확장을 사용합니다. |
| 보안 및 거버넌스 | 필수 | OAuth 범위, Data 360 정책 및 Trust 계층 감사 프레임워크를 사용하여 데이터 가시성을 적용합니다. |
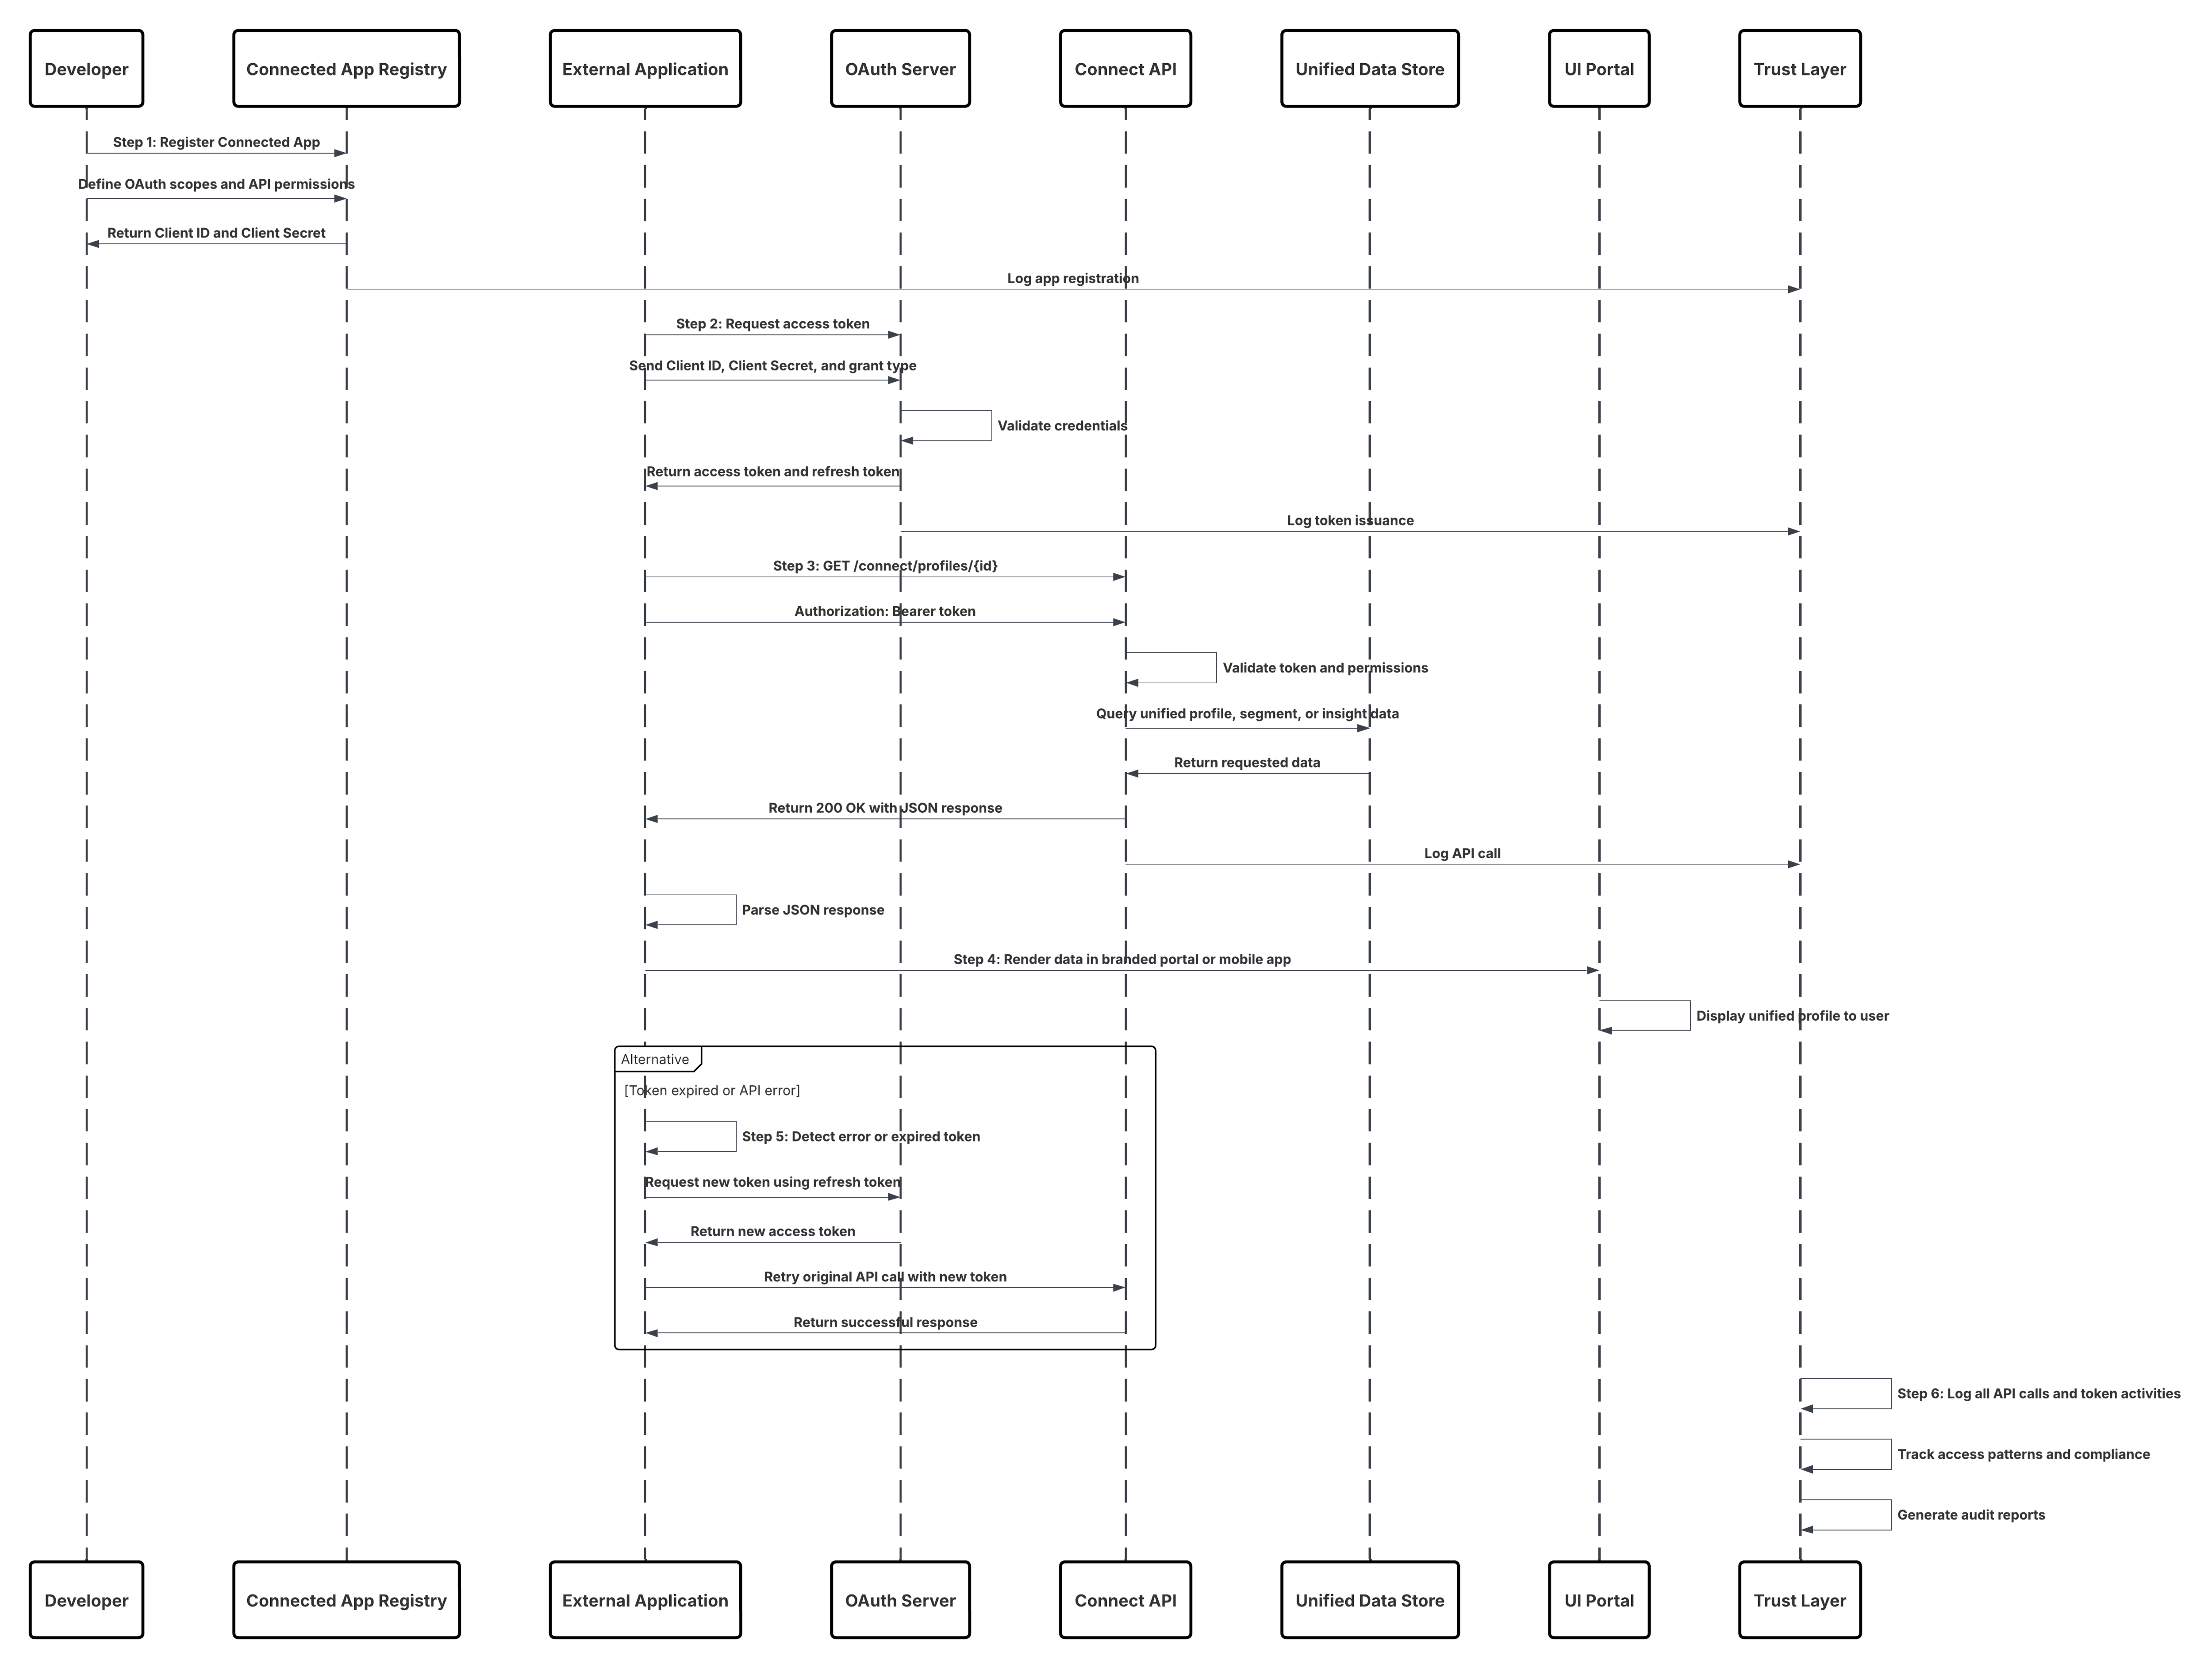 ##### 결과
개발자는 Data 360과 긴밀하게 통합되는 안전한 사용자 정의 브랜딩 응용 프로그램을 만들 수 있습니다. 이러한 앱은 다음을 수행할 수 있습니다.
- 실시간으로 조화된 고객 프로필 및 인사이트를 표시합니다.
- 통합 API를 통해 CRM 또는 사용자 정의 개체와 함께 Data 360 데이터를 표시합니다.
- Trust 계층을 통해 일관된 인증, 인가, 감사 제어를 활용합니다.
- 비즈니스 사용자 또는 파트너에게 환경 전반에서 신뢰할 수 있는 고객 인텔리전스 대한 원활하고 관리되는 액세스 권한을 제공합니다.
##### 메커니즘 호출
호출 메커니즘은 target Cloud 스토리지 플랫폼 및 활성화 구성에 따라 다릅니다.
| 메커니즘 | 사용하는 경우 |
|---|---|
| Connect REST API(권장) | UI 친화적인 JSON 형식으로 Data 360 데이터에 실시간 액세스해야 하는 웹, 모바일 또는 타사 앱을 구축할 때 사용합니다. |
| 데이터 그래프 API | 앱이 여러 개체(예: 고객 → 트랜잭션 → 캠페인)에서 시맨틱 수준 쿼리를 수행해야 하는 경우 사용합니다. |
| 쿼리 API | SOQL과 유사한 쿼리를 실행할 때 사용하여 전체적으로 조화된 데이터 집합을 검색합니다. |
| Einstein 1 플랫폼 API | 사용자 정의 UI 내에서 AI 기반 인사이트 또는 Copilot 생성 권장 사항을 통합하는 경우 사용합니다. |
| MuleSoft 또는 Apex 게이트웨이 래퍼 | 앱과 Connect API 간에 추가 오케스트레이션, 캐싱 또는 정책 적용이 필요한 경우 사용합니다. |
| 솔루션 영역 | 맞춤 | 댓글/구현 세부 사항 |
|---|---|---|
| 데이터 그래프 정의 | 필수 | 설계자는 여러 DMO를 하나의 시맨틱 엔티티(예: UnifiedCustomerProfile)로 결합하는 데이터 그래프를 정의합니다. |
| 프로필 검색 검색 | 최대 | 애플리케이션은 GET /api/v1/dataGraph/{entity}/{id}를 호출하여 고유한 ID 또는 키로 전체 비정규화 프로필을 검색합니다. |
| 실시간 매개 변수 사용 | 옵션 | ?live=true를 추가하여 캐시된 검색이 아닌 새 계산을 강제 적용합니다. 중요한 결정에 적합합니다. |
| 인증 | 필수 | 연결된 앱을 통해 OAuth 2.0을 사용하여 API 호출을 안전하게 인증합니다. |
| 응답 구문 분석 | 모범 사례 | 응용 프로그램이 JSON 응답을 UI 또는 결정 엔진에 직접 구문 분석하며 추가 조인이 필요하지 않습니다. |
| 캐싱 전략 | 권장 | 반복 프로필 조회를 위해 단기 로컬 캐싱(예: 메모리 내 또는 CDN)을 구현합니다. |
| 모니터링 및 관찰 가능성 | 필수 | Trust 계층 대시보드를 사용하여 쿼리 성능, 응답 시간 및 정책 준수를 모니터링합니다. |
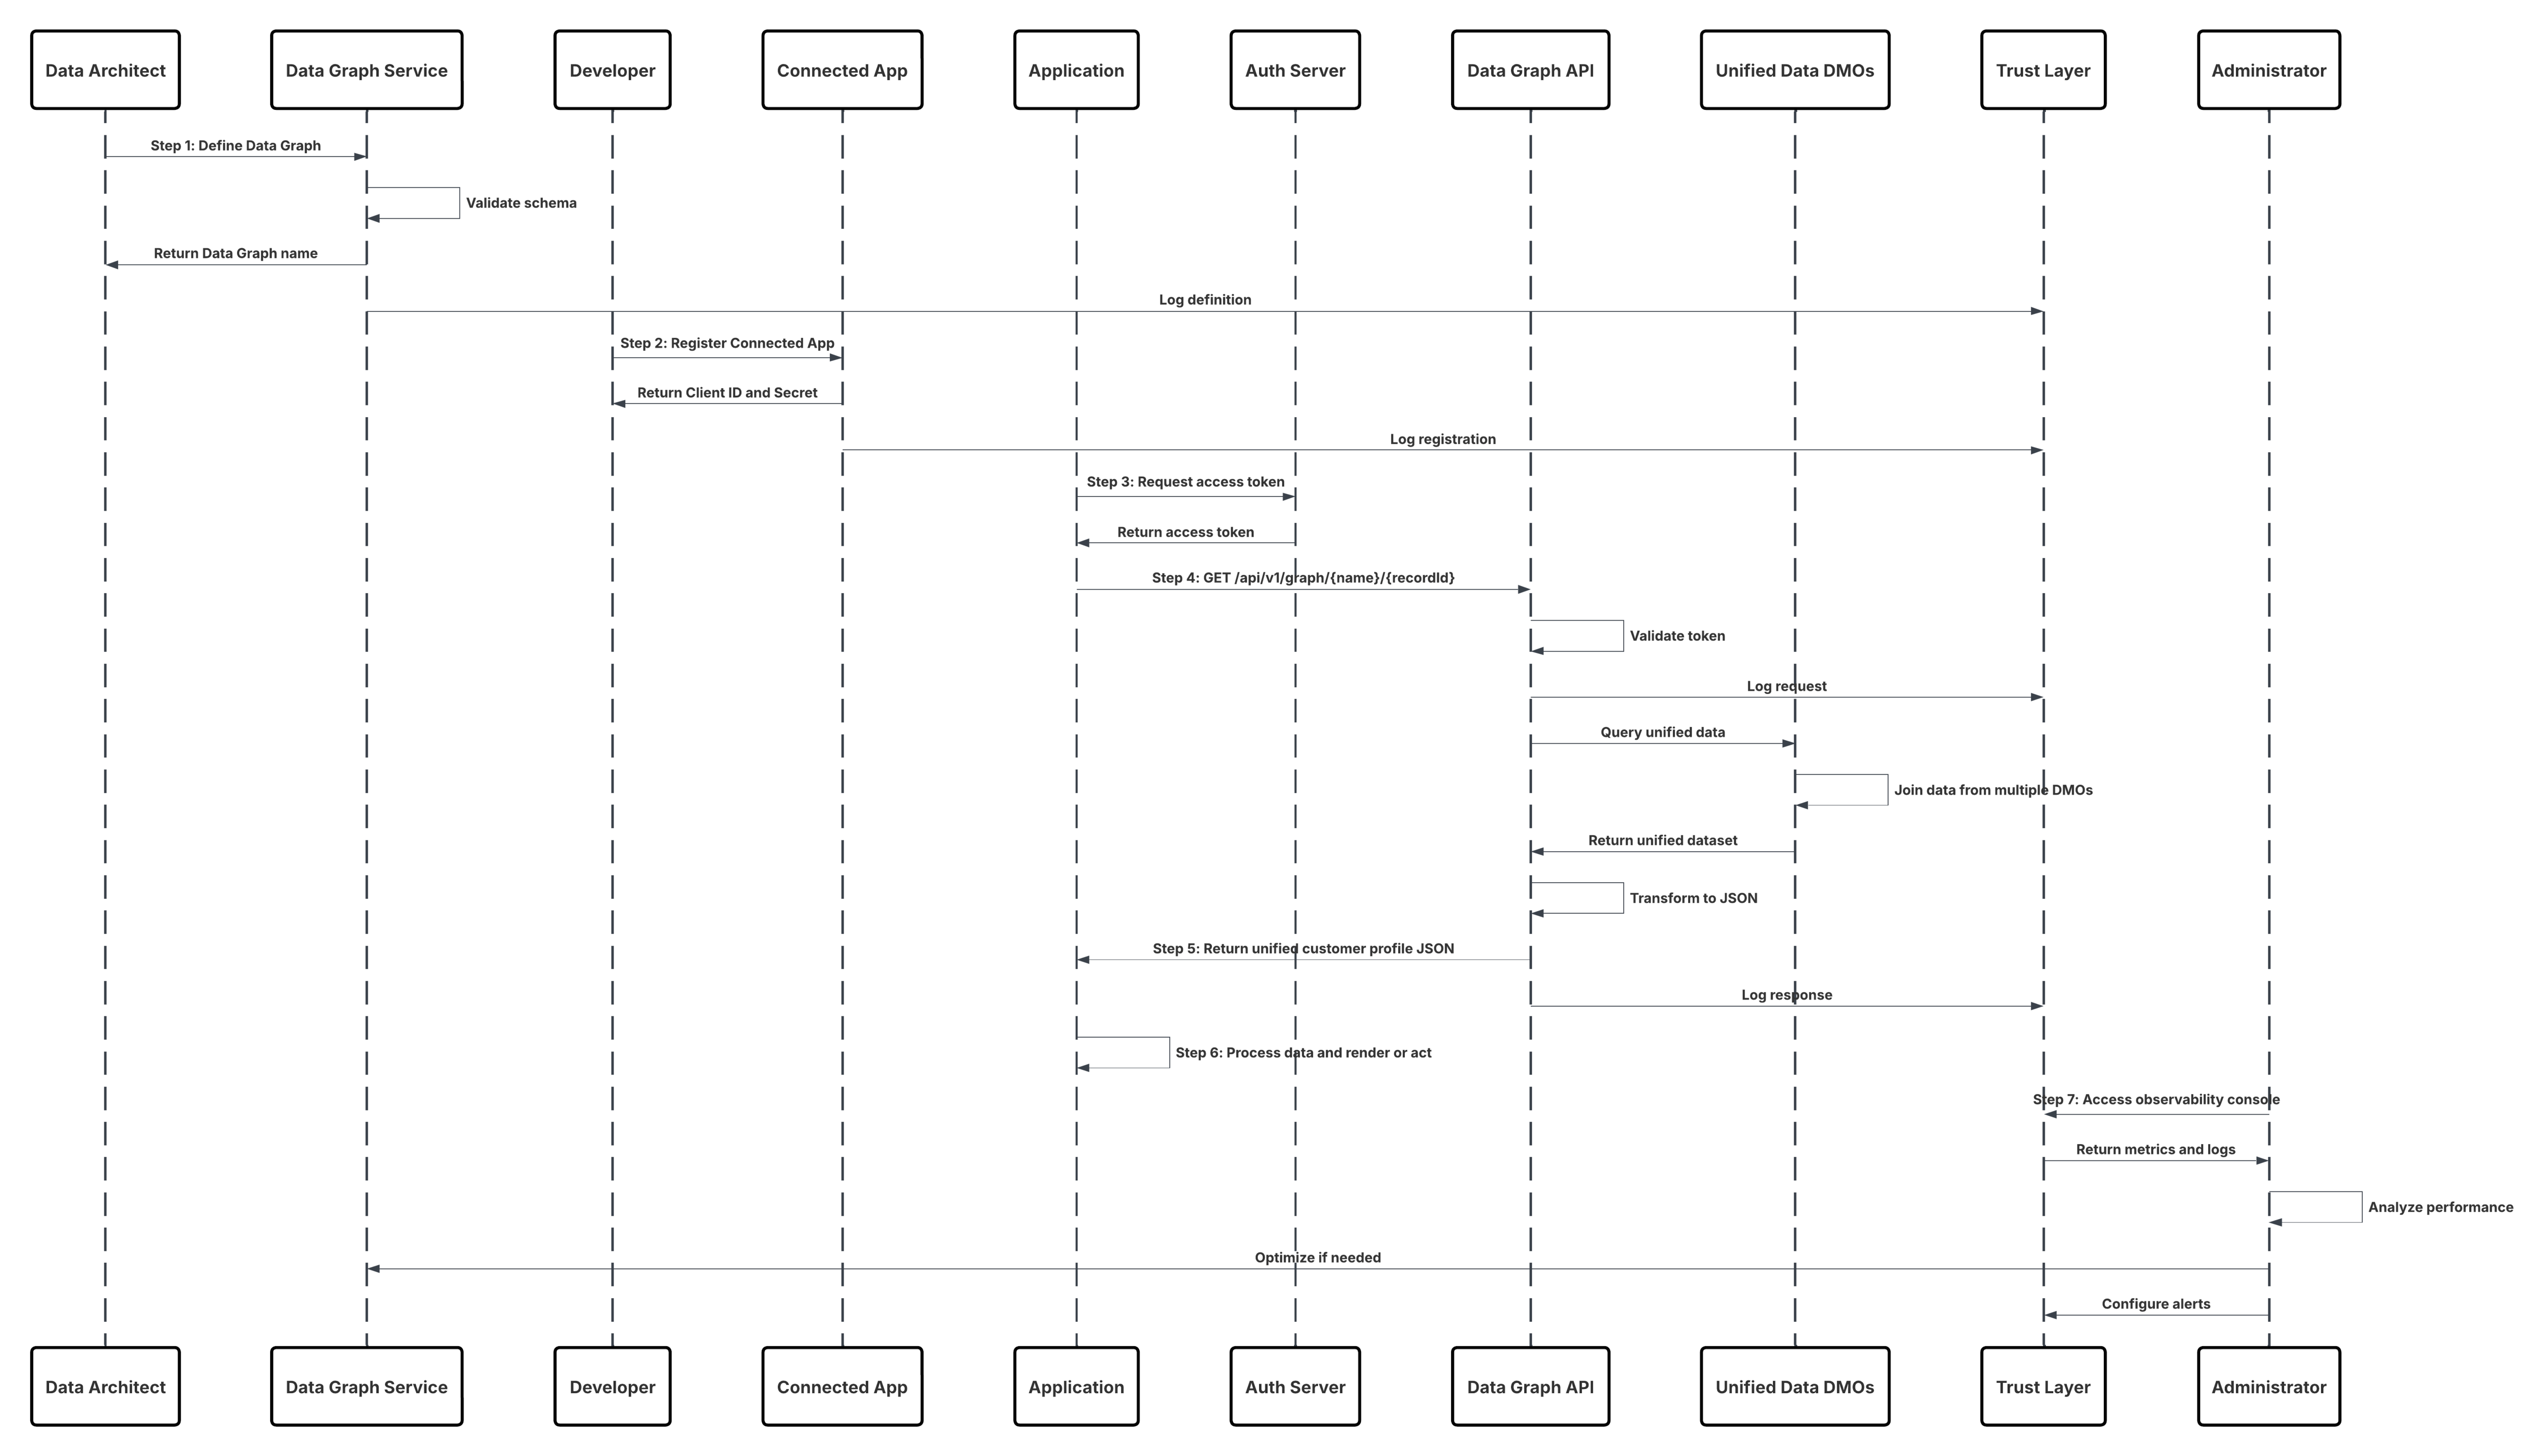 ##### 결과
이제 응용 프로그램이 사전 결합된 전체 고객 프로필을 즉시 검색하여 개인 설정, 서비스, 의사 결정 자동화와 같은 실시간 상호 작용을 제공할 수 있습니다.
이 패턴은 다음을 보장합니다.
- 즉시 결정에 대한 초과 응답 시간입니다.
- Data 360 시맨틱 모델에 맞춰 일관되고 관리되는 데이터 검색
- 간소화된 응용 프로그램 논리 - 조인, 스키마 조정 없음
- 감사 및 관찰성을 위해 Trust 계층을 통해 추적 가능한 규정 준수 액세스
###### 메커니즘 호출
호출 메커니즘은 target Cloud 스토리지 플랫폼 및 활성화 구성에 따라 다릅니다.
| 메커니즘 | 사용하는 경우 |
|---|---|
| 데이터 그래프 API(권장) | ID 또는 키로 사전 구체화된 전체 프로필을 즉시 검색하는 데 사용합니다. |
| live=true를 사용하는 데이터 그래프 API | 최신 데이터가 필요한 가치가 높은 사용 사례(예: 사기 감지, 실시간 제안)에서 약간 더 높은 대기 시간을 허용합니다. |
| Connect API(폴백) | 데이터 그래프 검색을 다른 Salesforce 데이터와 결합하는 복합 앱 시나리오에 사용합니다. |
| 쿼리 API | 즉각적인 프로필 검색 대신 임시 쿼리 또는 분석 판독을 구성할 때 사용합니다. |
| MuleSoft API Proxy | 엔터프라이즈 게이트웨이를 통해 데이터 그래프 호출을 라우팅하거나 추가 오케스트레이션/정책을 적용해야 하는 경우 사용합니다. |
| 솔루션 영역 | 맞춤 | 댓글/구현 세부 사항 |
|---|---|---|
| 실시간 데이터 액션 | 최고 | 단일 레코드 읽기/쓰기 및 작업 트리거에 대한 끝점을 표시합니다. OAuth/JWT를 통해 인증합니다. |
| ID 확인 | 필수 | 수신 식별자(email, externalId, 쿠키)를 통합 개인 ID 인라인으로 확인합니다. 캐시와 함께 결정적 확인자를 사용합니다. |
| 정책 집행(CEDAR) | 모범 사례 | 요청 시 동의, ABAC, 마스킹 정책을 평가하고 정책 결정당 필드를 거부하거나 마스킹합니다. |
| Edge/Cache 레이어 | 권장 | 프로필 조각 및 계산된 인사이트에 짧은 TTL 캐시를 사용하여 대기 시간을 줄이고 변경 이벤트에 대해 무효화합니다. |
| 경량 변형 | 권장 | 작업 경로에 간단한 보강 또는 계산된 필드를 적용합니다. 대량 변환은 사전 계산해야 합니다. |
| 작업 오케스트레이션 | 최고 | 복잡한 플로에 대해 동기식 단일 단계 작업(예: 반품 제공 토큰) 및 비동기식 오케스트레이션(대기열 \+ 웹후크)을 지원합니다. |
| 관찰성 & 추적 | 필수 | 감사 및 디버깅을 위해 요청/응답, 정책 결정 및 계보를 Trust Layer/SIEM에 기록합니다. |
| 레이트 제한 & Throttling | 필수 | 트래픽이 많은 순간에 클라이언트 할당량 및 정상적인 저하 전략을 적용합니다. |
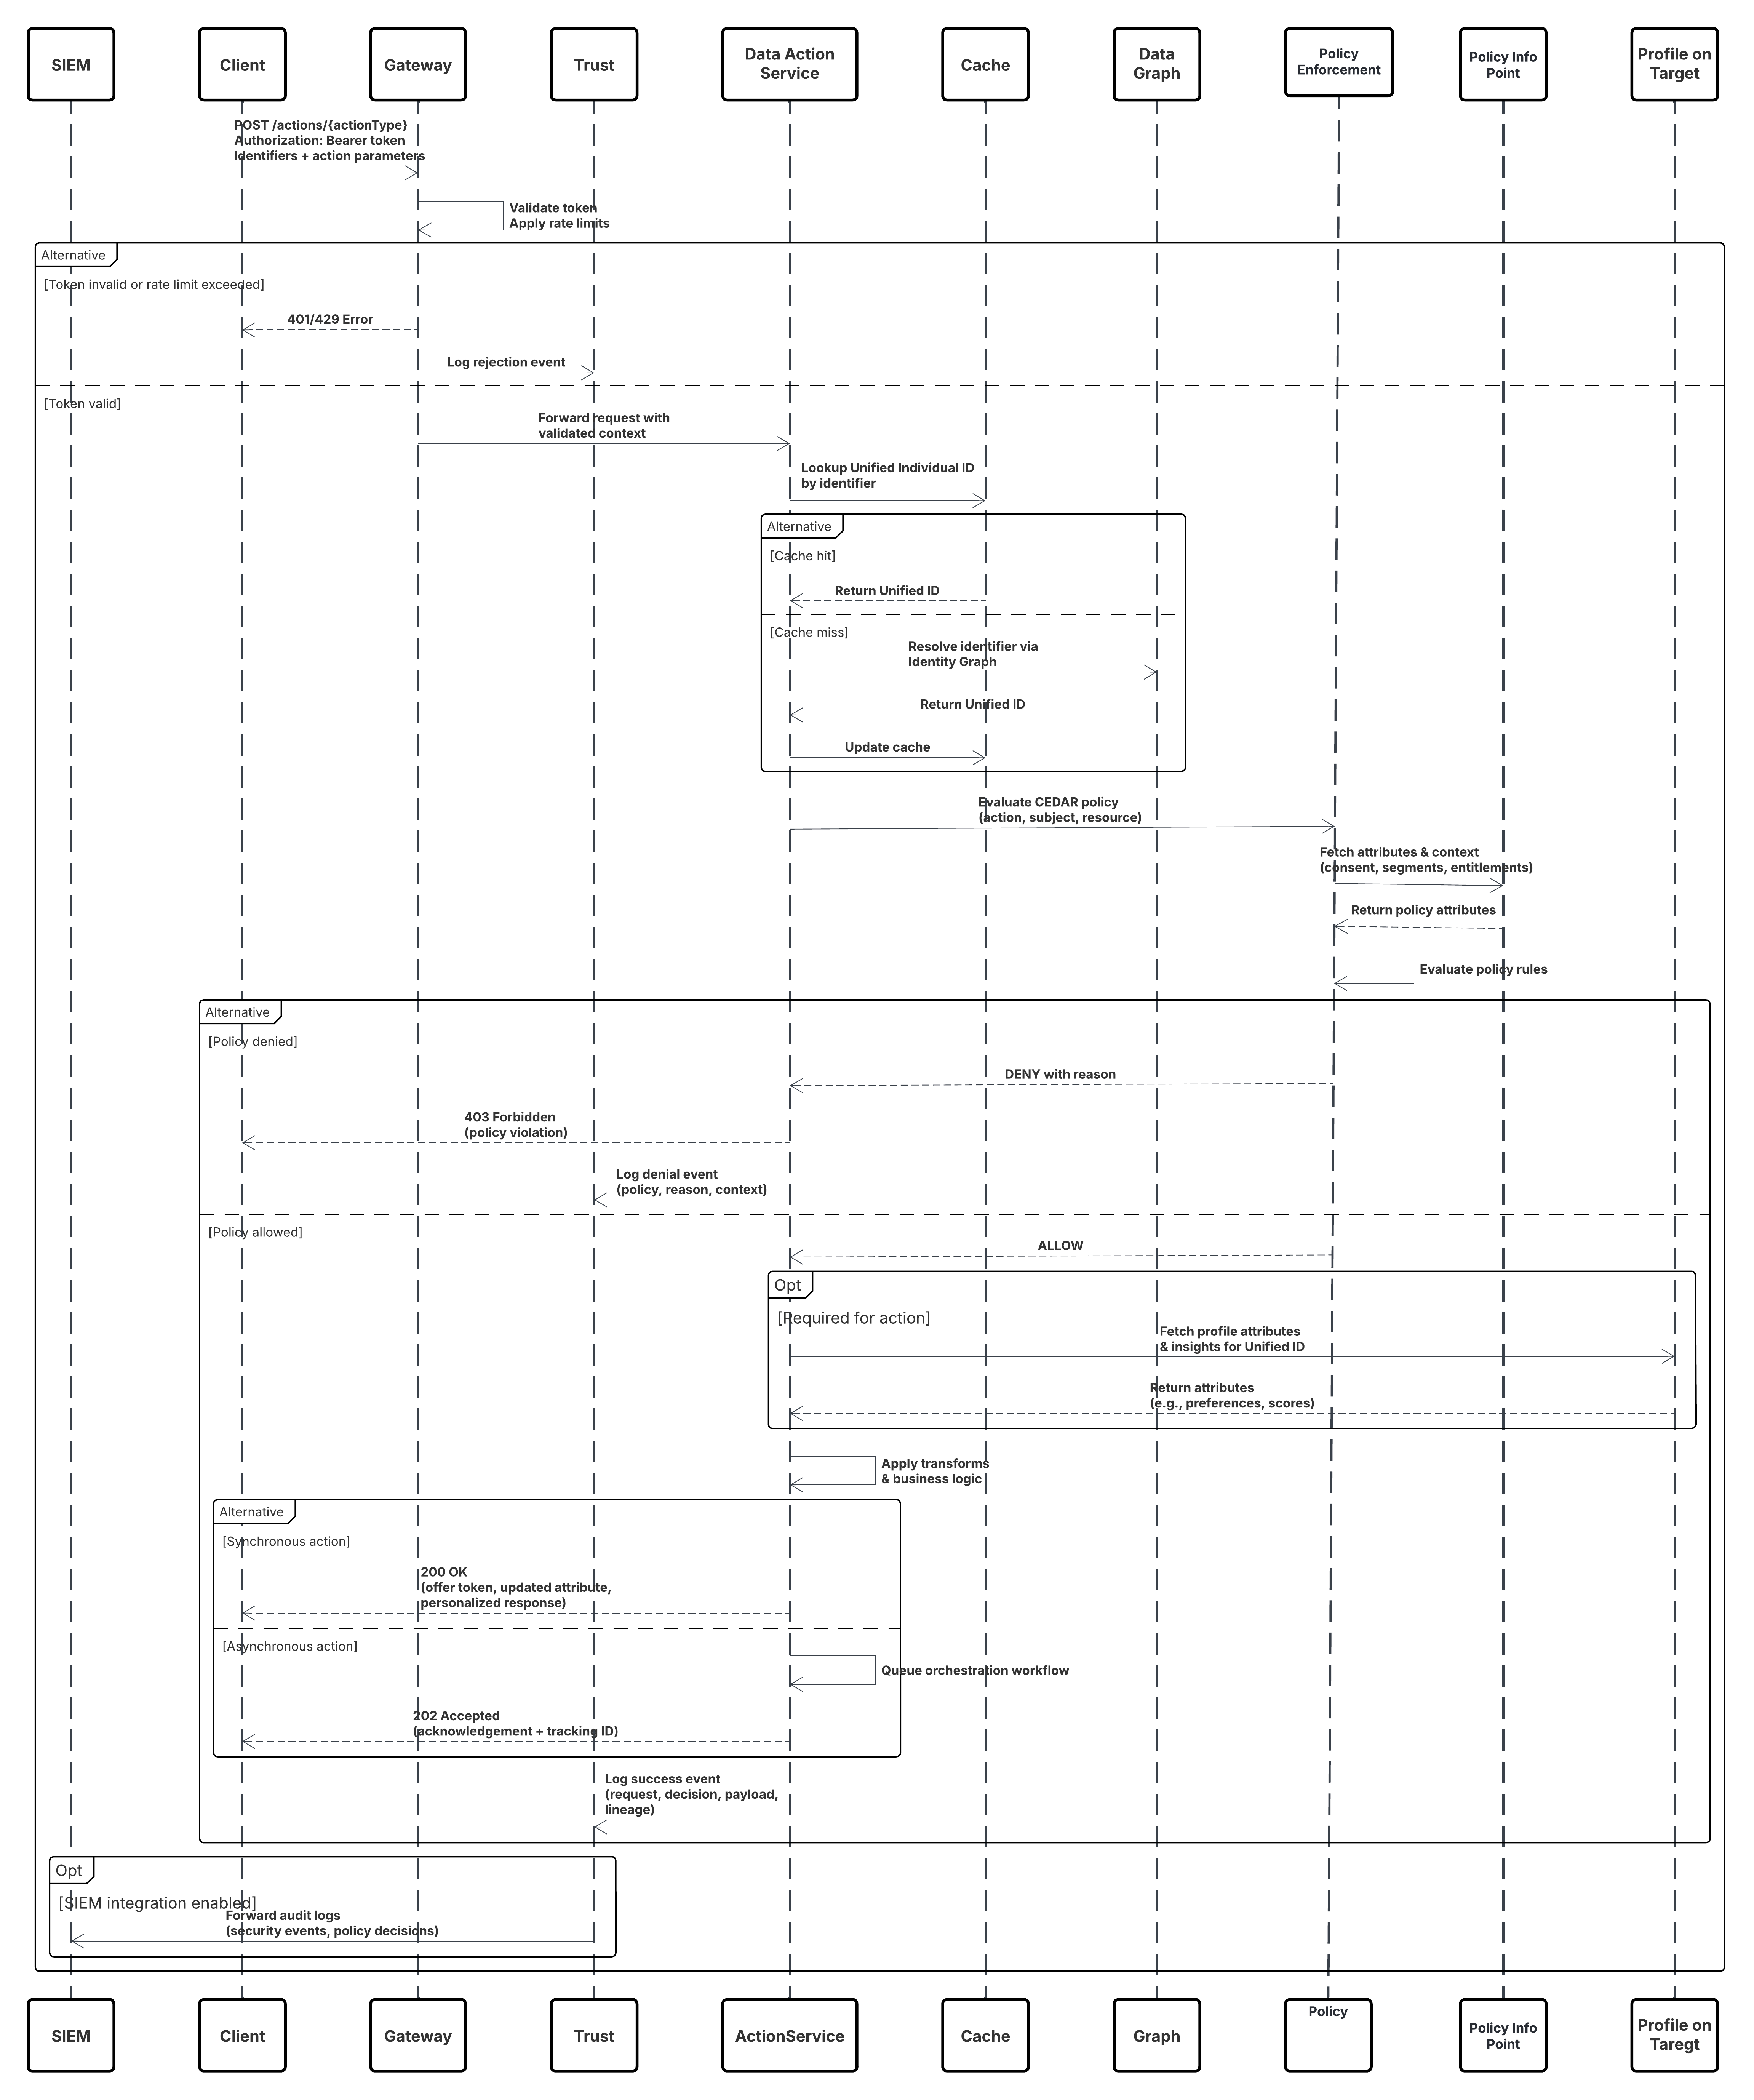 ##### 결과
- 응용 프로그램은 하위 초~초 대기 시간으로 통합 프로필 읽기/쓰기 및 작업 트리거에 즉시 정책 관리 액세스할 수 있습니다.
- 배치 지연 없이 실시간 개인 설정, 결정, 운영 워크플로(예: 제안, 에이전트 지원, 재고 업데이트)가 활성화됩니다.
- 모든 작업은 감사 가능하고 동의에 근거하며 개인 정보 보호 및 규정 준수를 유지하기 위해 특성 수준 마스킹을 적용합니다.
###### 메커니즘 호출
호출 메커니즘은 대상 플랫폼 및 활성화 대상 구성에 따라 다릅니다.
| 메커니즘 | 사용하는 경우 |
|---|---|
| RESTful 데이터 작업 API | 동기 프로필 읽기 또는 작업 응답이 필요한 웹/모바일 앱 및 미들웨어에 기본 설정됩니다. |
| gRPC / Binary RPC | 대기 시간이 매우 낮은 엔터프라이즈 서비스 또는 지속적인 연결이 있는 내부 마이크로 서비스에 사용합니다. |
| GraphQL 단일 레코드 쿼리 | 클라이언트에게 유연한 필드 선택이 필요하고 페이로드를 최소화하려는 경우 사용합니다. |
| 이벤트 트리거형 웹후크 | 작업이 다운스트림 프로세스를 트리거하는 비동기 워크플로에 사용합니다(예: 여정 시작). |
| 플랫폼 이벤트 / PubSub | 여러 시스템이 단일 작업 이벤트에 반응해야 하는 팬 아웃 시나리오에 사용합니다. |
| Edge SDK(클라이언트 라이브) | 프로필 조각을 캐시하고 필요한 경우에만 데이터 작업 API를 호출하는 대기 시간이 낮은 클라이언트에 사용합니다. |
 |
Salesforce Lightning Platform은 직원, 자율 AI 에이전트, 회사 데이터 및 애플리케이션을 신뢰할 수 있는 단일 시스템으로 통합하여 생산성과 고객 경험을 향상시킬 수 있는 종합적인 AI 기반 플랫폼입니다. 이를 통해 Customer 360 앱, Data Cloud, Slack을 연결하여 엔드 투 엔드 자동화를 수행할 수 있게 되었습니다. |
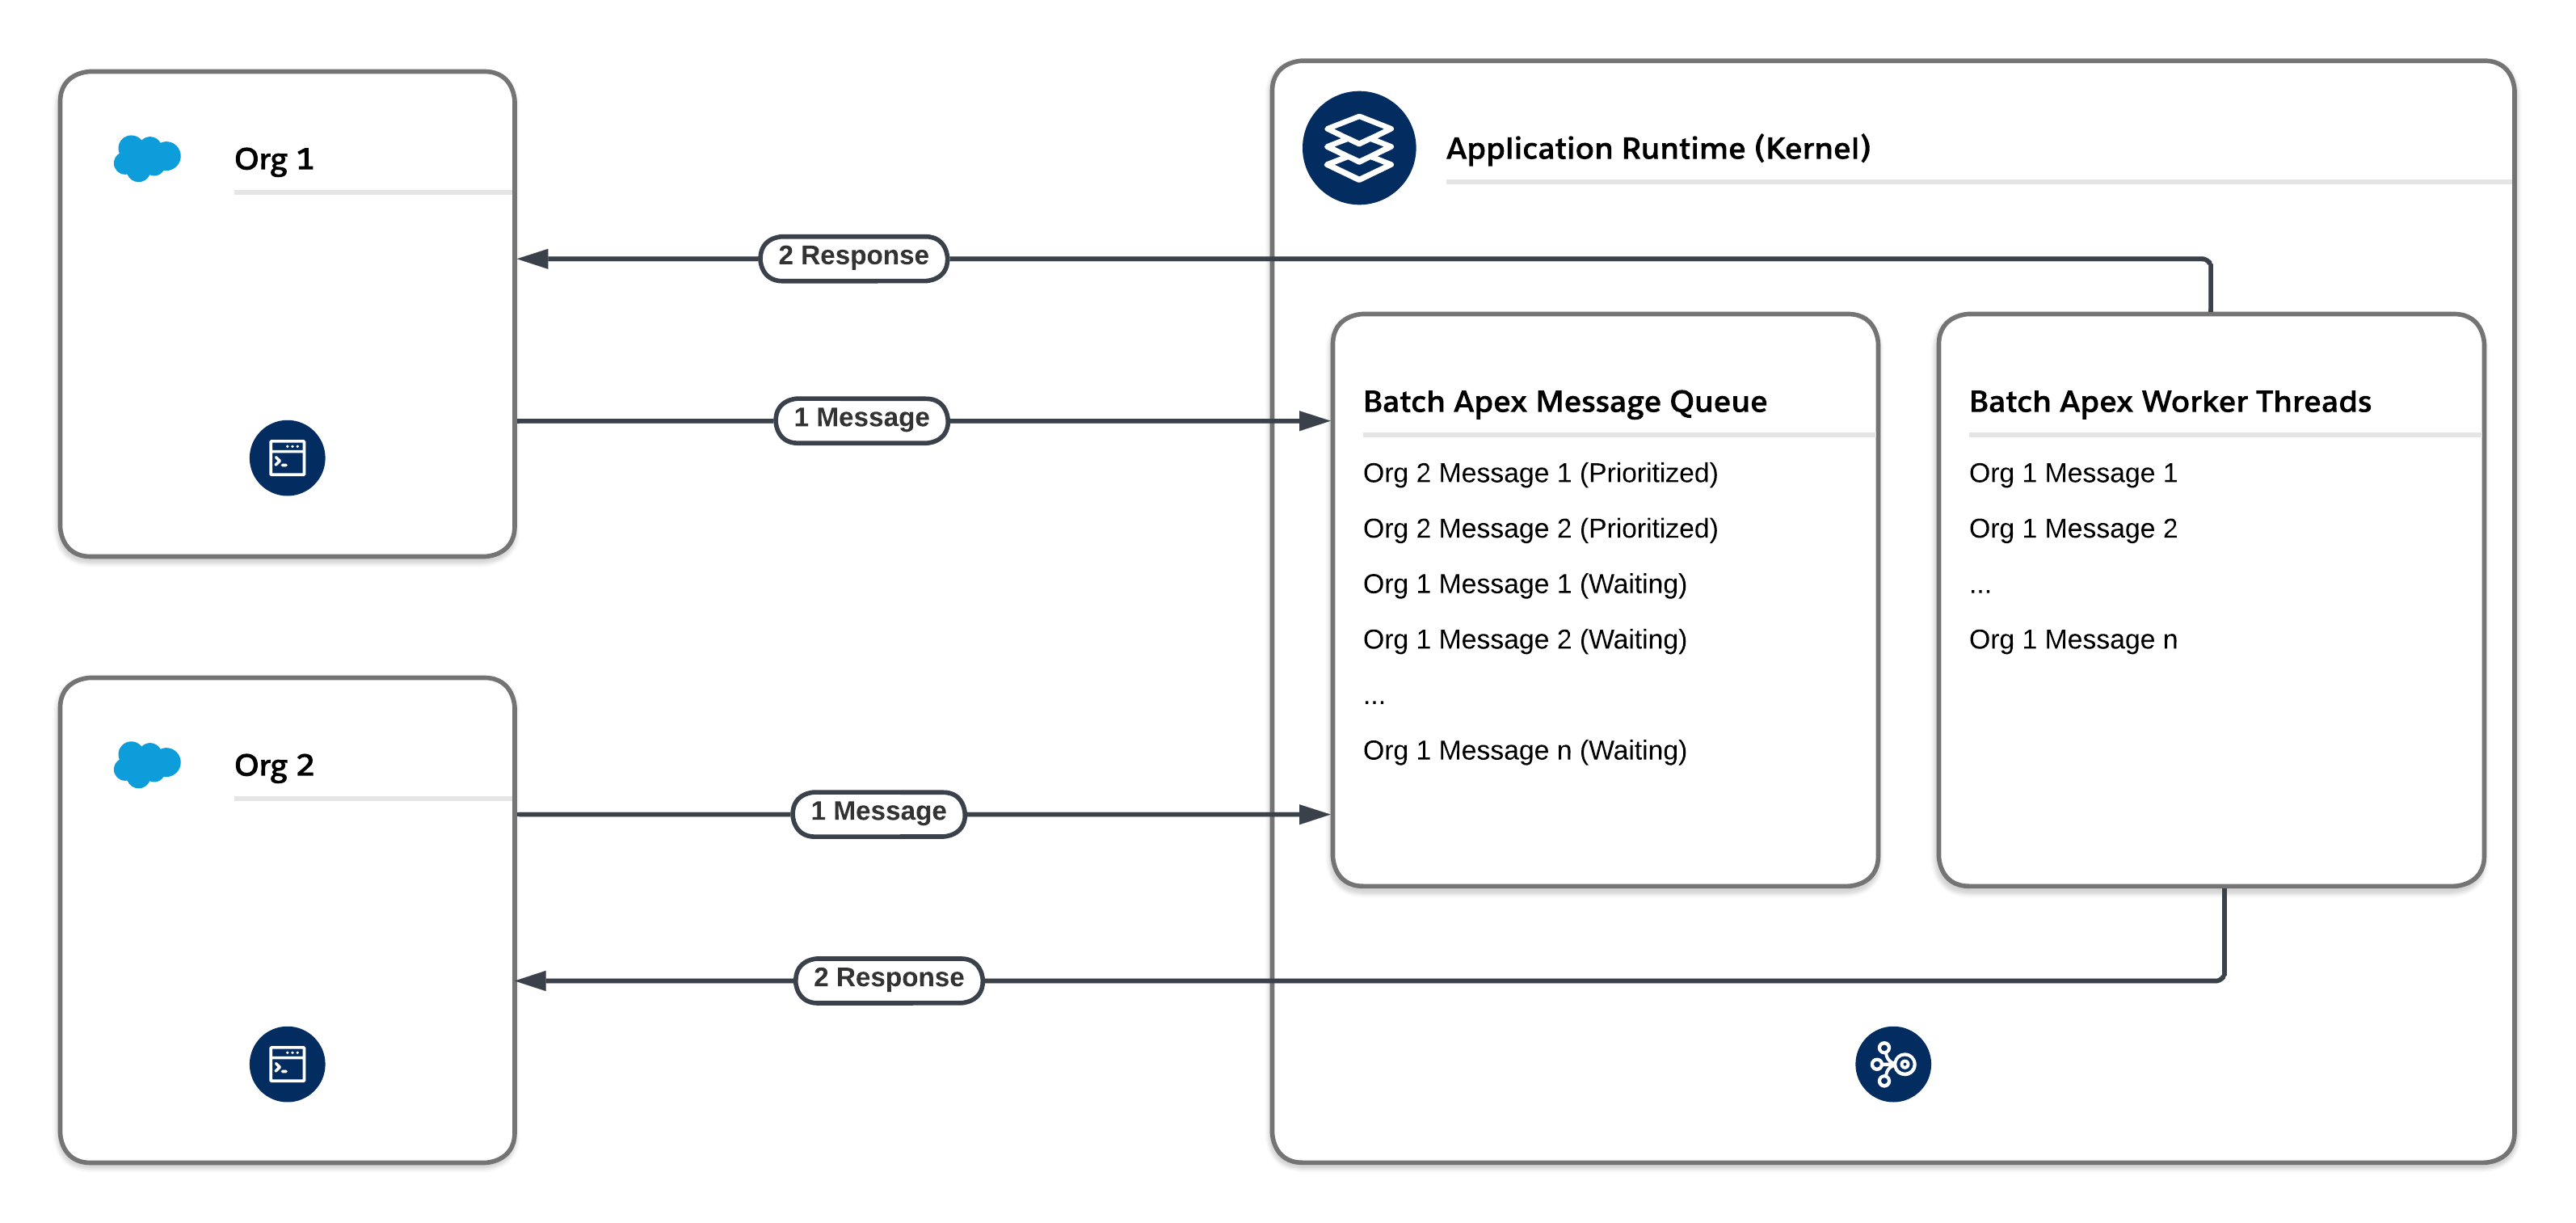 #### 공정한 사용
플랫폼의 공정 사용 메커니즘은 계층 기반 시스템을 구현합니다. 시스템을 사용하면 Salesforce Platform의 각 조직이 향후, 대기 가능, 배치 메시지 유형을 포함하여 지정된 메시지 유형에 대한 처리 시간을 공정하게 할당할 수 있습니다. 한 조직이 동일한 메시지 유형에 대한 작업을 수행하기 위해 다른 조직이 대기하는 동일한 시간 동안 지정된 메시지 유형을 지배하는 경우 공정 사용 알고리즘은 조직에서 해당 메시지 유형에 사용할 수 있는 스레드 수를 줄입니다.
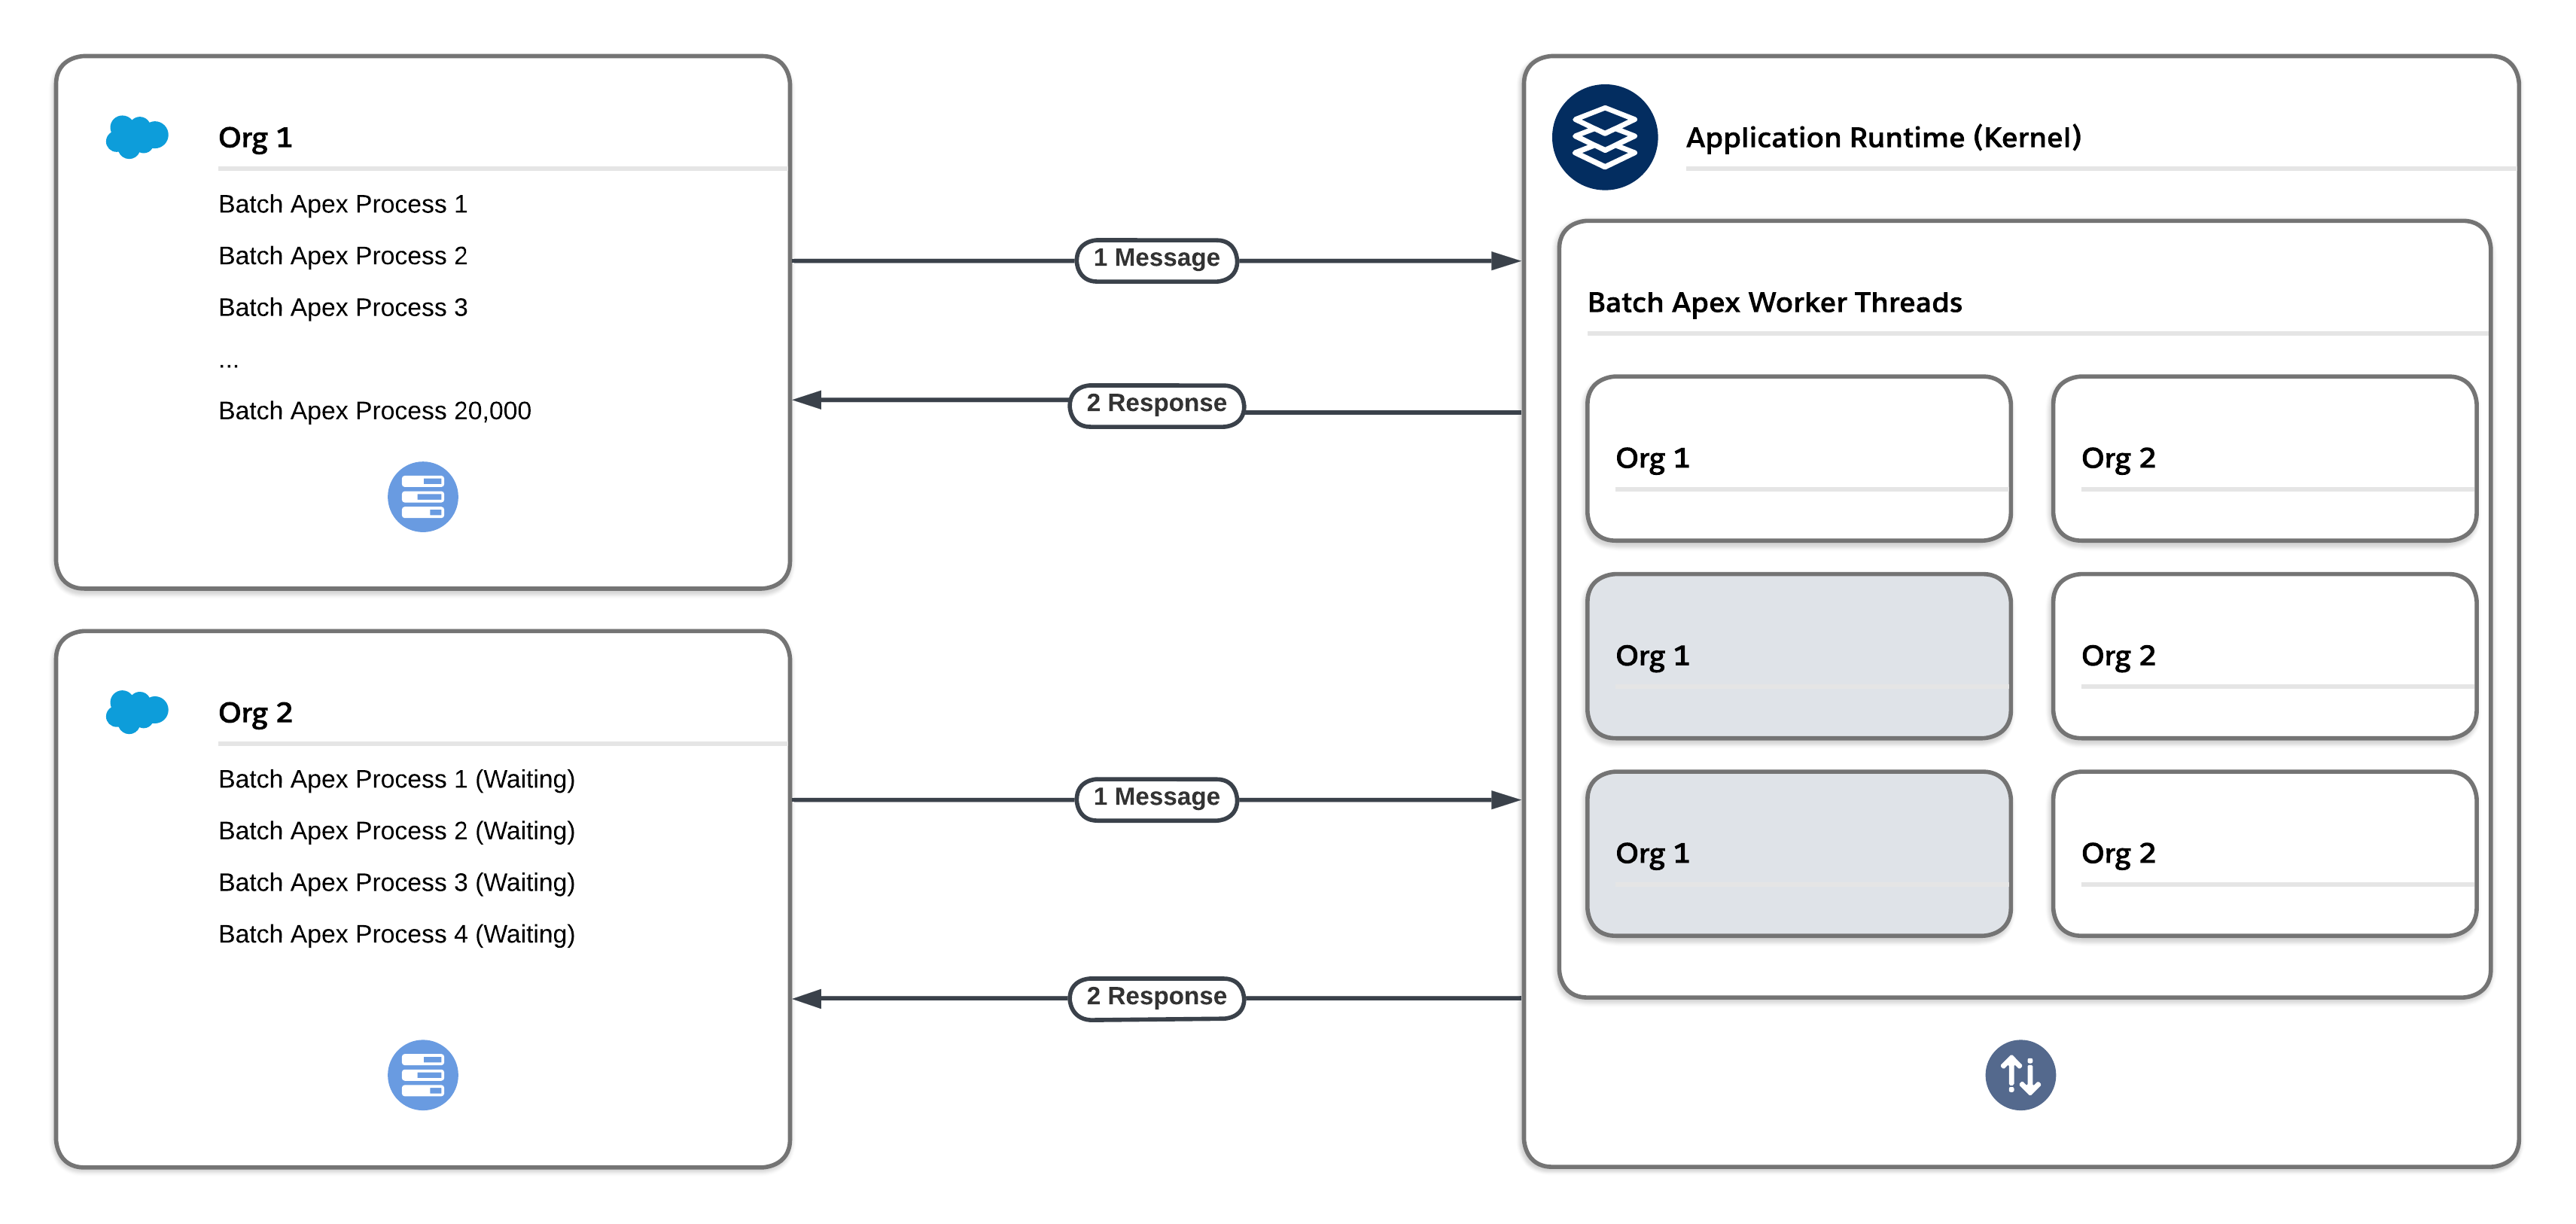 비동기식 Apex 메서드를 사용하는 장점은 SOQL 쿼리 제한 및 힙 크기 제한과 같은 일부 총괄자 제한이 더 높다는 것입니다. 그러나 이러한 방법에 지나치게 의존하지 마십시오. 비동기 인프라에 할당되는 유한한 자원으로 인해 Future, Queueable, Batch Apex 사용하는 것이 많으면 공정한 사용 및 플로 제어를 기반으로 한 제한으로 인한 처리 지연이 발생할 수 있습니다.
#### 비동기 Apex 통한 아웃바운드 콜아웃에 대한 특별 고려 사항
비동기 Apex 사용하는 아웃바운드 콜아웃은 비동기 Apex 제한에 포함됩니다. 일일 제한은 현재 적용 가능한 사용자 라이센스의 250,000개 또는 200배입니다. 더 큰 값입니다. 이 제한은 대량 사용 사례에 문제가 될 수 있습니다. 제한을 초과하면 비동기식 Apex 작업과 연결된 아웃바운드 콜아웃이 실패합니다.
또한 플랫폼에 사용 가능한 비동기 스레드 수가 제한되므로 비동기 Apex 통한 아웃바운드 통합의 확장성이 제한됩니다. 사용 가능한 스레드를 초과하는 대용량 아웃바운드 통합은 처리 시간이 길어지며 지연이 발생할 수 있습니다.
대량 사용 사례의 경우 다음과 같은 대체 접근 방식을 고려하십시오. 이러한 접근 방식의 API 호출은 일일 API 요청 제한에 포함됩니다. 이는 일일 비동기식 Apex 제한보다 상당히 높습니다. 따라서 이러한 접근 방식은 더욱 확장 가능합니다. 그러나 CPU에서 처리할 수 있는 동시 요청 수에 여전히 물리적 제한이 있습니다.
- **중간웨어 예약 가져오기.** 비동기식 Apex 통해 데이터를 푸시하는 대신 미들웨어를 사용하여 예약에 따라 데이터를 가져오는 방식으로 대용량 아웃바운드 통합 작업과 관련된 지연을 방지합니다. MuleSoft Anypoint Platform과 같은 중간웨어는 기본 SOAP API 또는 REST API를 동기식으로 사용할 수 있으므로 지연이 거의 발생하지 않습니다(있는 경우). 중간웨어는 대용량 데이터에 기본 대량 API를 사용할 수도 있습니다.
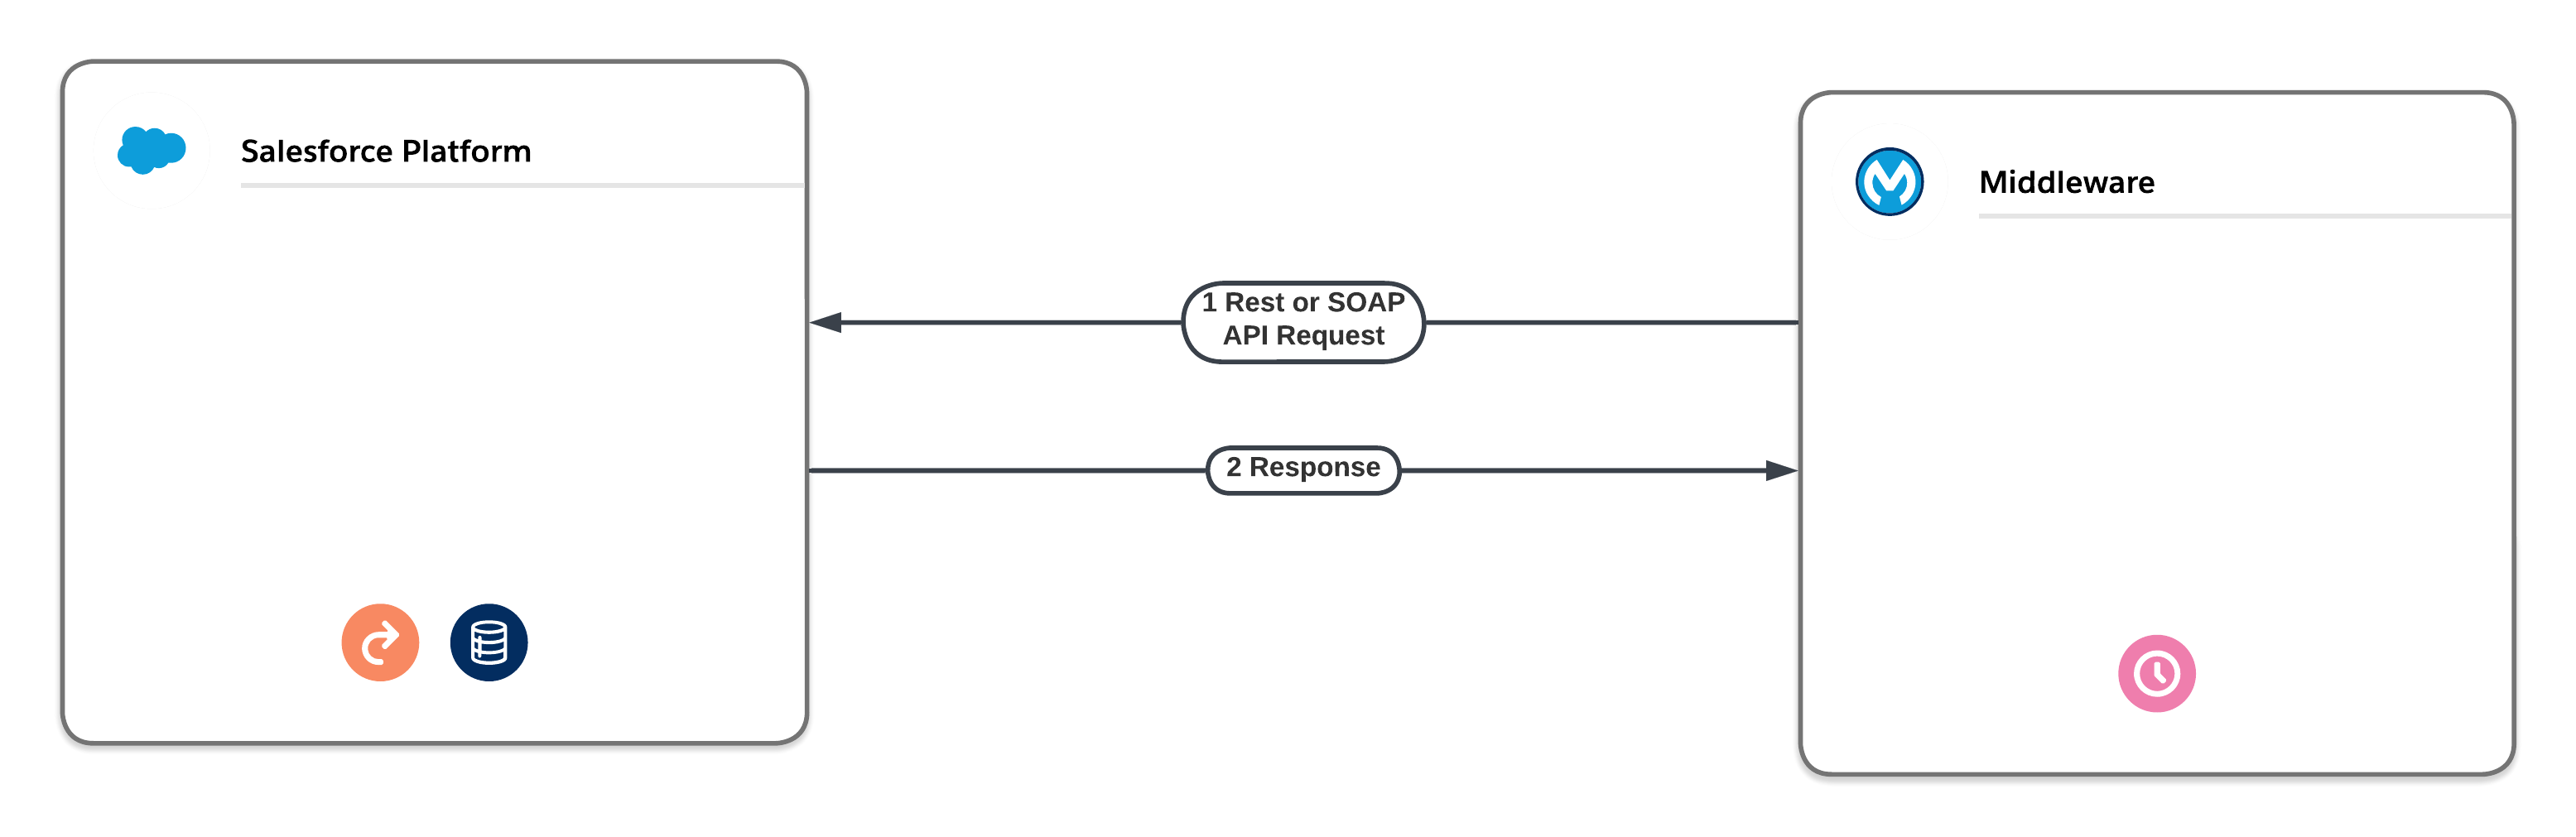 - **플랫폼 이벤트 알림을 통해 중간 장치 가져오기.** 아웃바운드 통합을 수행하기 위해 Future, Queueable 또는 Batch 비동기 Apex 대기열에 지정하는 대신 플랫폼 이벤트를 사용할 수 있습니다. 플랫폼 이벤트는 아웃바운드 정보를 직접 전달하거나 미들웨어 도구에 네이티브 API를 통해 필수 정보를 가져와 최종 대상으로 전달하도록 지시할 수 있습니다. 이러한 접근 방식에는 비동기 Apex 적용되는 지연이 적용되지 않습니다. 그러나 [플랫폼 이벤트 제한](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_events_limits_default.htm)은 여전히 적용됩니다.
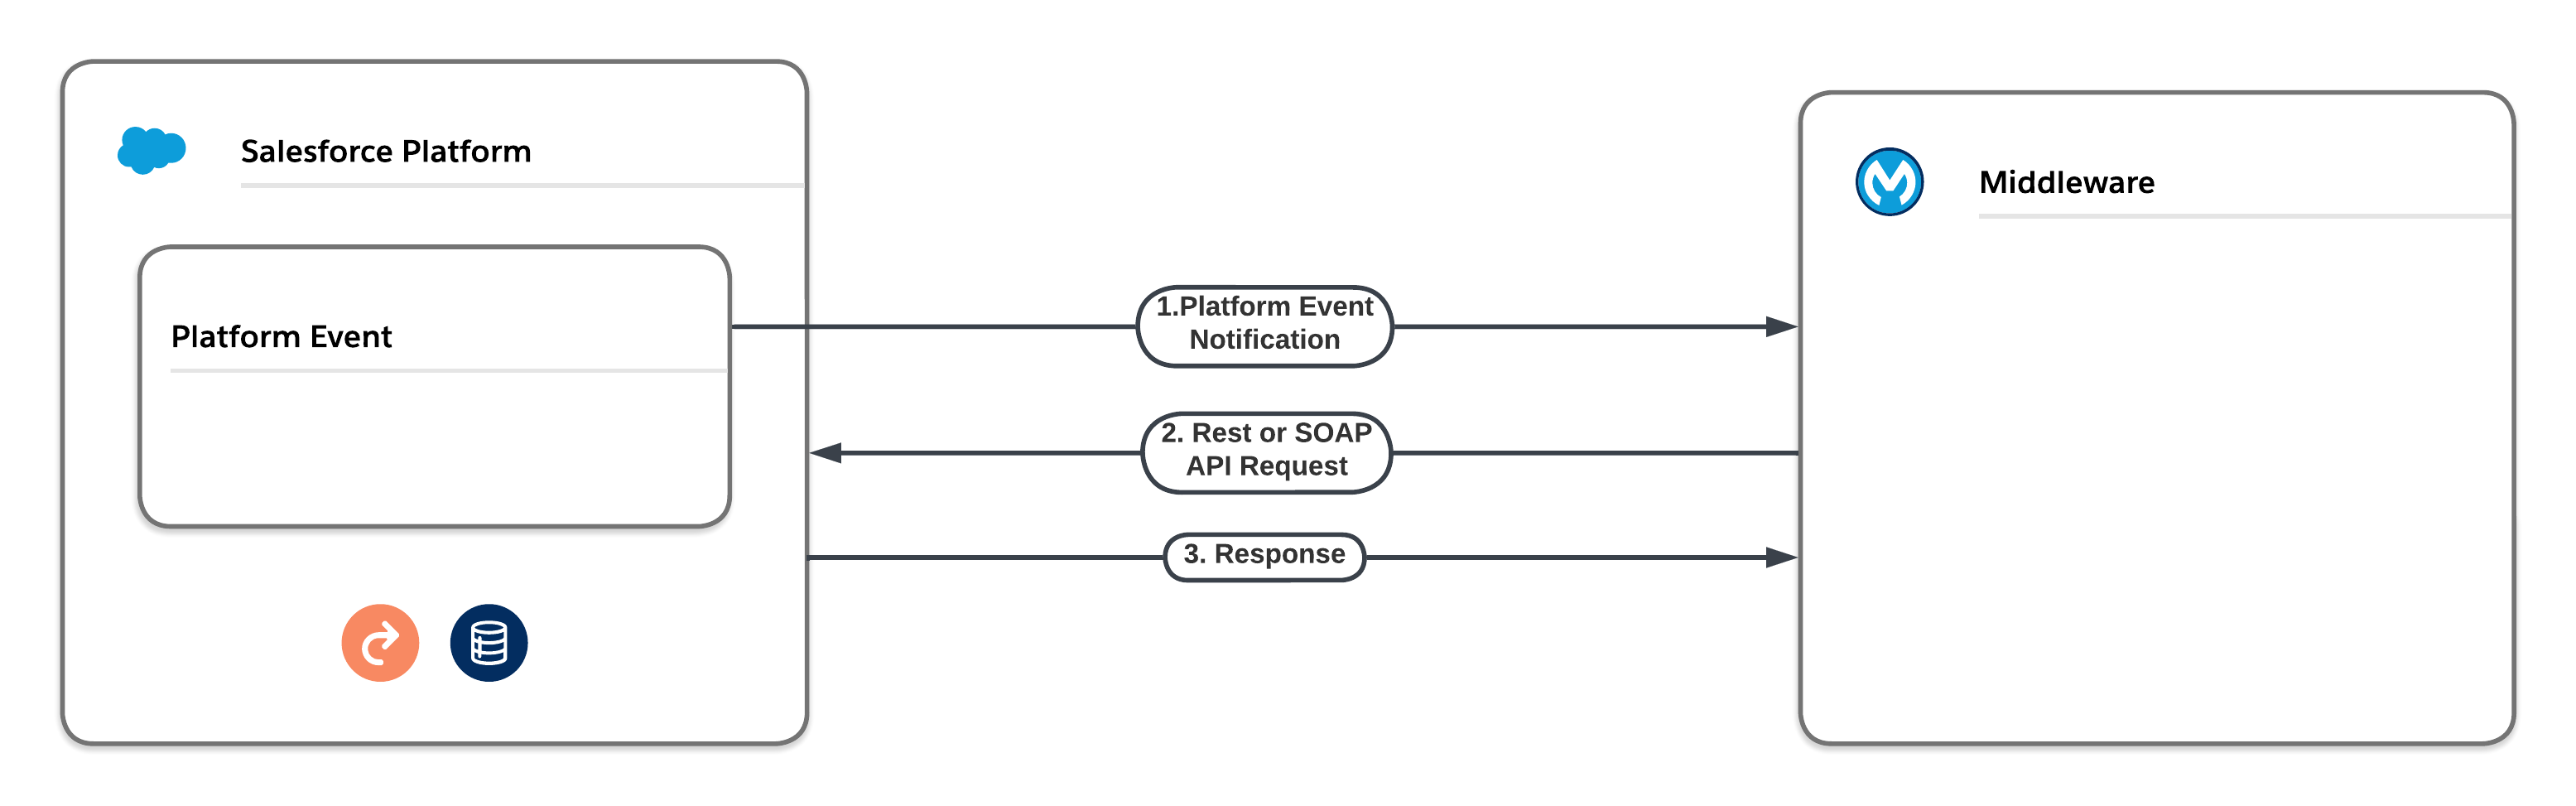 #### 비동기식 Apex 트레이드오프
| 제품/방식 | 사용 사례 | 필요한 기술 | 클라이언트와 관련하여 비동기식 | 서버와 관련하여 비동기식 | 적용되는 플랫폼 제한 유형 |
|---|---|---|---|---|---|
| Apex Future Methods | Apex future 메서드 대신 대기 가능한 Apex 사용하는 것이 좋습니다. 대기 가능에는 future 메서드와 동일한 사용 사례가 있지만 추가 혜택을 제공합니다. | 프로 코드 | 예 | 예 | 비동기식 |
| Queueable Apex | 향후 방법 대신 이 접근 방식을 선호합니다. 장기 실행 데이터베이스 작업 또는 외부 웹 서비스 콜아웃과 관련된 프로세스에 사용합니다. 대기 가능한 Apex 작업 ID, 비기본 유형 지원, 작업 체인화 등 향후 메서드보다 추가적인 혜택을 제공합니다. | 프로 코드 | 예 | 예 | 비동기식 |
| 예약된 Apex | Cron 식으로 정의된 예약된 시간에 Apex 실행합니다. Cron 식을 통해 Apex 예약하는 작업은 비동기식 프로세스이지만, 작업이 시작되면 기본 코드가 동기식으로 실행됩니다. | 프로 코드 | 예 | 예 | 동기식 |
| Apex 계속 콜아웃 | 동기 트랜잭션 컨텍스트에서 실행되는 Apex 메서드의 콜아웃입니다. | 프로 코드 | 예 | 예 | 동기식 |
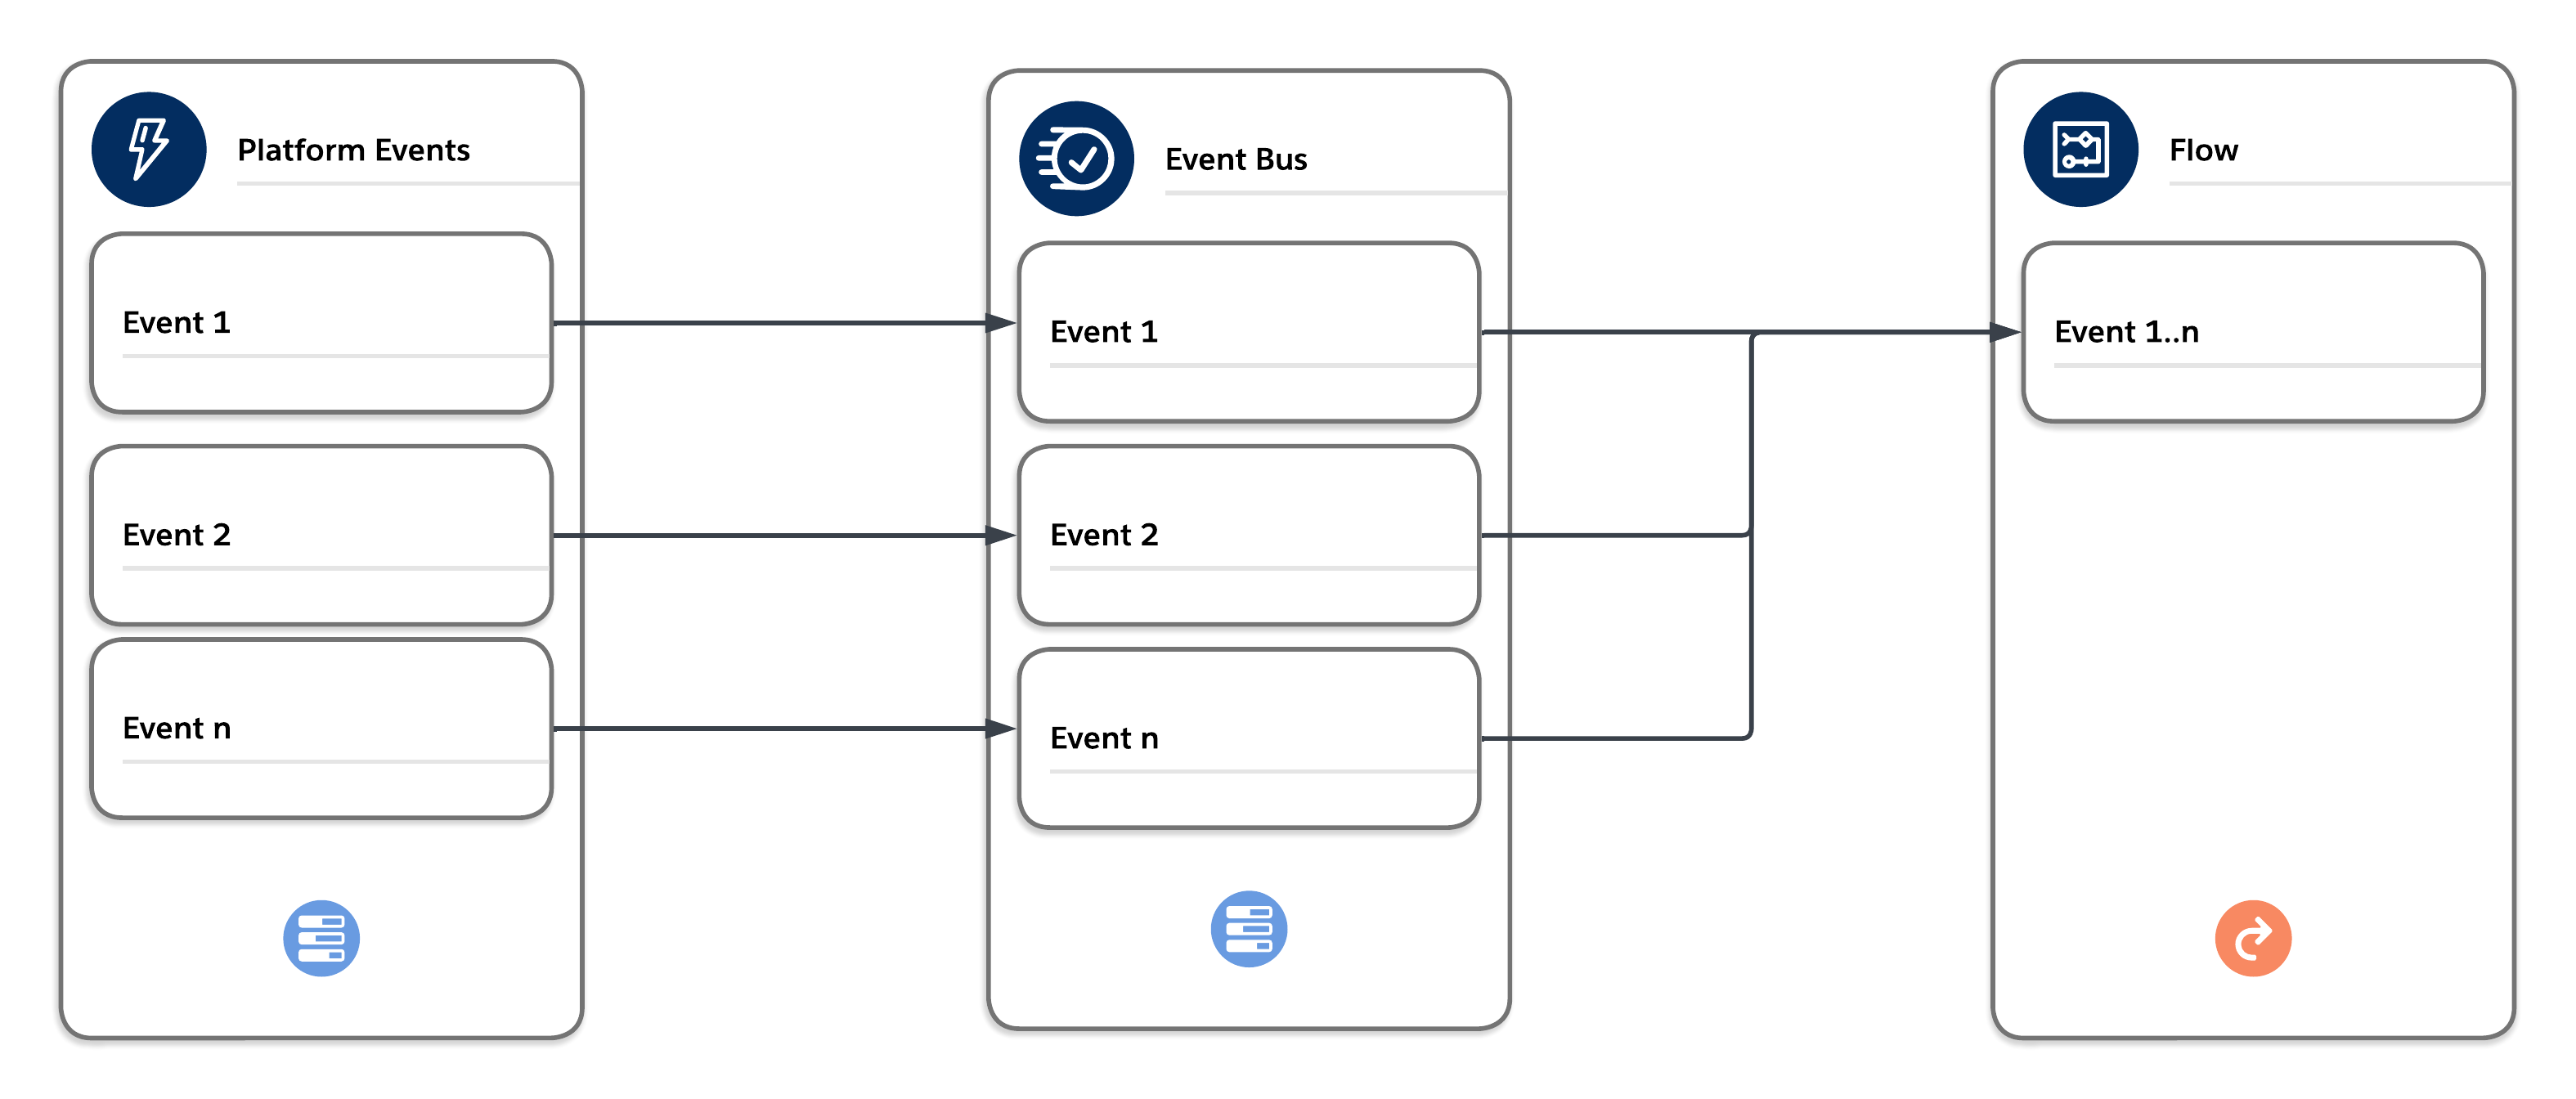 [공개 후 커밋](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_events_intro.htm)을 통해 버스에 게시된 이벤트는 순서대로 전달되며 트리거 또는 플로에서 별도의 동기식 컨텍스트에서 대량 처리할 수 있습니다. 컨텍스트는 동기식이며 모든 동기식 총괄자 제한이 적용됩니다. 플랫폼 이벤트 트리거/플로 배치 크기를 신중하게 선택하여 제한에 도달하지 않도록 합니다.
| 제품/방식 | 사용 사례 | 필요한 기술 | 클라이언트와 관련하여 비동기식 | 서버와 관련하여 비동기식 | 적용되는 플랫폼 제한 유형 |
|---|---|---|---|---|---|
| 플랫폼 이벤트 트리거 | Salesforce를 외부 시스템과 쉽게 연결하고 비동기 플랫폼 구성 요소 간에 통신합니다. | 하위 코드 + Pro 코드 | 예 | 예 | 동기식 |
| 제품/방식 | 사용 사례 | 필요한 기술 | 클라이언트와 관련하여 비동기식 | 서버와 관련하여 비동기식 | 적용되는 플랫폼 제한 유형 |
|---|---|---|---|---|---|
| 예약 경로(커밋 플로 후) | 이벤트 트리거 후 동적으로 예약된 시간에 실행합니다. | 낮은 코드 | 예 | 예 | 비동기식 |
| 비동기 경로(레코드 트리거 플로) | 자체 시간에 실행할 작업을 실행하여 혼합 DML 오류를 방지합니다. | 낮은 코드 | 예 | 예 | 비동기식 |
| 제품/방식 | 사용 사례 | 필요한 기술 | 클라이언트와 관련하여 비동기식 | 서버와 관련하여 비동기식 | 적용되는 플랫폼 제한 유형 |
|---|---|---|---|---|---|
| 아웃바운드 메시지 | SOAP 프로토콜을 통해 타사 시스템과 거의 실시간으로 데이터 공유 | 낮은 코드 | N/A | 예 | N/A |
| 제품/방식 | 사용 사례 | 필요한 기술 | 클라이언트와 관련하여 비동기식 | 서버와 관련하여 비동기식 | 적용되는 플랫폼 제한 유형 |
|---|---|---|---|---|---|
| Email-to-Case | 수신 이메일의 값을 기반으로 사례를 자동으로 만들고 사례 필드를 채웁니다. | 낮은 코드 | 예 | 예* | 동기식 |
| * Email-to-Case는 동기화 및 비동기식으로 처리되지만 동기식 Apex 제한이 적용됩니다. | |||||
| 제품/방식 | 사용 사례 | 필요한 기술 | 클라이언트와 관련하여 비동기식 | 서버와 관련하여 비동기식 | 적용되는 플랫폼 제한 유형 |
|---|---|---|---|---|---|
| 배치 Apex | 수천 개의 레코드를 포함하는 복잡한 장기 실행 프로세스 | 프로 코드 | 예 | 예 | 비동기식 |
| 예약 트리거 플로 | 플로를 통해 지정된 시간 및 반복 빈도로 백그라운드의 레코드 배치에서 작업을 수행합니다. | 낮은 코드 | 예 | 예 | 동기식 |
| Bulk API | 많은 레코드를 비동기식으로 삽입, 업데이트, 업서트, 쿼리 또는 삭제합니다. | 프로 코드 | 예 | 예 | 비동기식 |
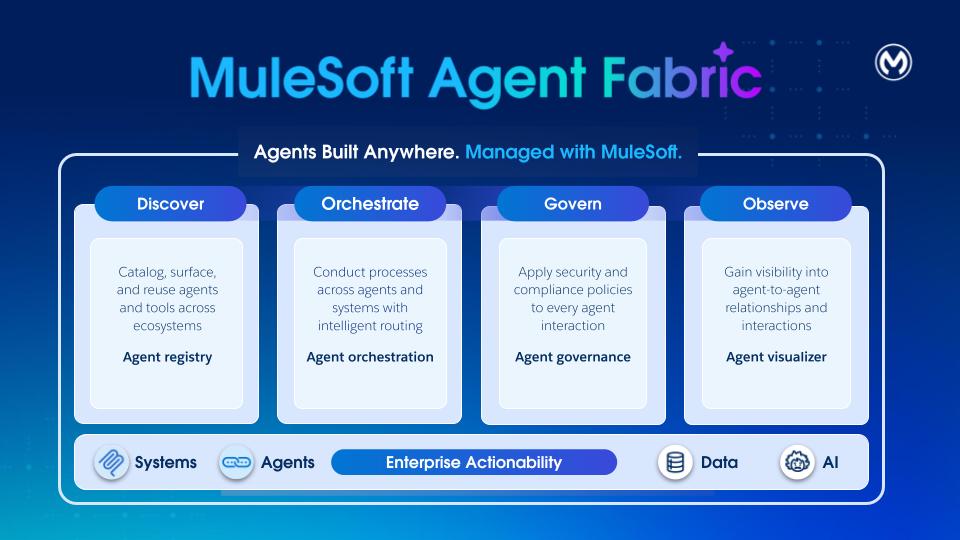 **검색:** 에이전트 레지스트리는 조직 전반의 모든 AI 에이전트 및 도구의 중앙 집중화된 카탈로그를 제공합니다. 내부 구축, SaaS 내장형, 외부 자산을 검색하고 재사용할 수 있습니다. 에이전트 레지스트리는 모든 에이전트 자산에 대한 신뢰할 수 있는 단일 소스를 제공하여 중복을 없애고 개발자가 대규모로 기존 기능을 활용할 수 있도록 합니다.
**오케스트레이트:** MuleSoft 에이전트 브로커는 가장 적합한 에이전트 또는 도구에 과업을 동적으로 일치시키는 지능형 라우팅 솔루션입니다. 선택한 LLM을 기반으로 복잡한 다단계 요청 및 비즈니스 프로세스가 높은 신뢰성과 추적 가능한 결과로 실행되도록 에이전트 및 도구 간에 조율됩니다.
**구버:** [MuleSoft Agent Governance는](https://www.mulesoft.com/platform/ai/ai-agent-governance) Flex Gateway를 활용하고 [모델 컨텍스트 프로토콜(MCP)](https://www.mulesoft.com/platform/ai/model-context-protocol) 및 [Agent2Agent(A2A) 프로토콜](https://www.mulesoft.com/platform/ai/a2a-support)을 지원합니다. Flex 게이트웨이를 사용하면 엔터프라이즈에서 모든 에이전트-에이전트 및 에이전트-도구 상호 작용에 보안 및 규정 준수 정책을 적용할 수 있습니다.
**참고:** 에이전트 시각화 프로그램은 동적 대화형 에이전트 상호 작용 맵을 통해 실시간 관찰 가능성을 제공합니다. 결정을 추적하고 시스템 상태를 모니터링하여 전체 에이전트 에코시스템을 지속적으로 최적화하고 신뢰할 수 있는 감독할 수 있습니다.
에이전트 패브릭은 사용자가 메타데이터 설명자("YAML 파일")를 통해 에이전트 네트워크를 정의하는 사양 우선(YAML) 접근 방식을 옹호합니다. 이 YAML 파일은 MuleSoft에 무시적이며, 실행에서 에이전트 네트워크의 정의를 분리합니다.
## 에이전트 네트워크 사양(메타데이터 설명자)
각 에이전트 네트워크(YAML)는 운영 규칙 및 정책을 포함하여 에이전트 자산을 사용하여 특정 기능 영역을 정의합니다. YAML은 다음의 4가지 에이전트 패브릭 기둥을 활성화하는 데 사용됩니다.
1. 검색: 에이전트 레지스트리를 다음과 같은 기존 에이전트 자산으로 채웁니다.
1. 다양한 플랫폼에 배포된 에이전트(MuleSoft 또는 기타)
2. MCP 서버
3. LLM 공급자
2. 오케스트레이트: 오케스트레이션을 위한 에이전트 브로커 만들기
3. 관리: 보안 및 거버넌스를 위한 자산에 정책 적용
4. 관찰: 정의된 자산에 대한 연결을 정의하고 재사용합니다. 또한 에이전트 네트워크에 관찰 가능성 및 모니터링 기능을 사용할 수 있습니다.
### 작성
사용자 여정은 Anypoint 코드 빌더에서 시작됩니다. "MuleSoft: 명령 팔레트를 통해 사용할 수 있는 새 명령을 사용합니다. 에이전트 네트워크 프로젝트 만들기"를 사용하여 새 프로젝트를 만듭니다. 이 명령은 두 개의 파일이 포함된 새 프로젝트("에이전트 네트워크")를 만듭니다.
- **agent-network.yaml:** 이 파일은 외부 도구(MCP를 통해) 및 에이전트(A2A 프로토콜을 통해)를 사용하여 AI 에이전트를 오케스트레이션할 수 있도록 다중 에이전트 시스템에 대한 구성을 정의합니다. 이 형식은 에이전트 기능, 종속성, 통합을 정의하는 선언적 방법을 제공합니다.
- **exchange.json:** 모든 에이전트 네트워크 프로젝트에는 exchange.json 파일도 있습니다. 이 파일에는 에이전트 네트워크 자산이 게시된 후 Anypoint Exchange에서 사용할 수 있는 자산 메타데이터가 포함되어 있습니다.
에이전트 네트워크 개발은 다음의 네 가지 주요 단계를 포함하는 표준 소프트웨어 개발 수명 주기(SDLC)를 따릅니다.
1. **환경 설정:** 런타임 환경 및 게이트웨이 설정
2. **프로젝트 작성 및 설계**: 에이전트 네트워크 프로젝트 사양 만들기
3. **건축 및 출판:** 에이전트 레지스트리에 자산 구축 및 게시
4. **배포:** 지정된 환경에 에이전트 네트워크 배포 또는 승격
프로젝트를 구축하고 필요한 MuleSoft 응용 프로그램 및 자산을 생성한 후 Exchange에서 사용할 수 있도록 지정합니다. Anypoint Code Builder 내에서 **_"MuleSoft: 명령 팔레트를 통해 Agent Broker Project to Exchange”_** 명령을 게시합니다.
게시 단계는 YAML 파일의 각 에이전트 자산을 A2A, MCP 또는 LLM 사양으로 변환하고 Exchange에 게시합니다.
또한 새 Agent-Network 자산 유형을 사용하여 Exchange에 YAML을 **게시합니다**. 이 자산은 에이전트 등록 UI에서 **보기**하고 Exchange API를 통해 해당 자산을 **검색할 수 있습니다**.
### 예제
엔터프라이즈에 대한 에이전트 네트워크를 정의하는 [에이전트 네트워크 파일](https://docs.mulesoft.com/anypoint-code-builder/af-project-files)을 참조하십시오. 이 에이전트 네트워크는 단일 정책 관리 환경을 통해 Salesforce, Stripe, 다른 주문 처리 에이전트, 재고 MCP 서버 전반에 걸쳐 주문 처리를 위한 네트워크를 활성화합니다.
- **검색**
재사용할 수 있도록 기존 에이전트 및 도구(Salesforce, Stripe, 주문 처리, 재고 등)를 Exchange 자산으로 게시합니다. 또한 버전이 지정되고 공유 가능하여 플로를 다시 구축하지 않고 역할, 지역 또는 자회사에 대한 빠른 조정이 가능합니다.
- **오케스트레이트**
에이전트 중개인이 LLM을 사용하여 주문 처리 프로세스를 고객 세부 사항 확인, 재고 할당, 배송 비용 계산과 같은 일련의 과업으로 세분화합니다. 그런 다음 MCP 및 A2A 에이전트를 호출하여 이 워크플로를 실행하여 필요할 때마다 즉시 승인을 요청합니다.
- **관리**
Anypoint Flex 게이트웨이는 인증, 최소 권한 액세스, 가드 레일을 적용합니다. API 관리자 정책은 모든 통화 및 데이터 교환 전반에서 일관된 제어를 보장합니다.
- **관찰**
모니터링 및 추적을 통해 진행 상황, 실패, 대기 시간을 전체적으로 파악할 수 있습니다. 시각화는 상호 작용한 에이전트와 지체 지점을 보여줍니다.
- **신뢰 및 규정** 준수
중앙 집중식 자격 증명, 감사 추적, 정책 상속은 보안, 개인정보보호, 규제 요구 사항(PII 처리, 승인, 업무 분리)을 지원합니다.
이 다이어그램은 YAML에 정의된 에이전트 네트워크(메타데이터)의 다양한 노드를 보여줍니다.
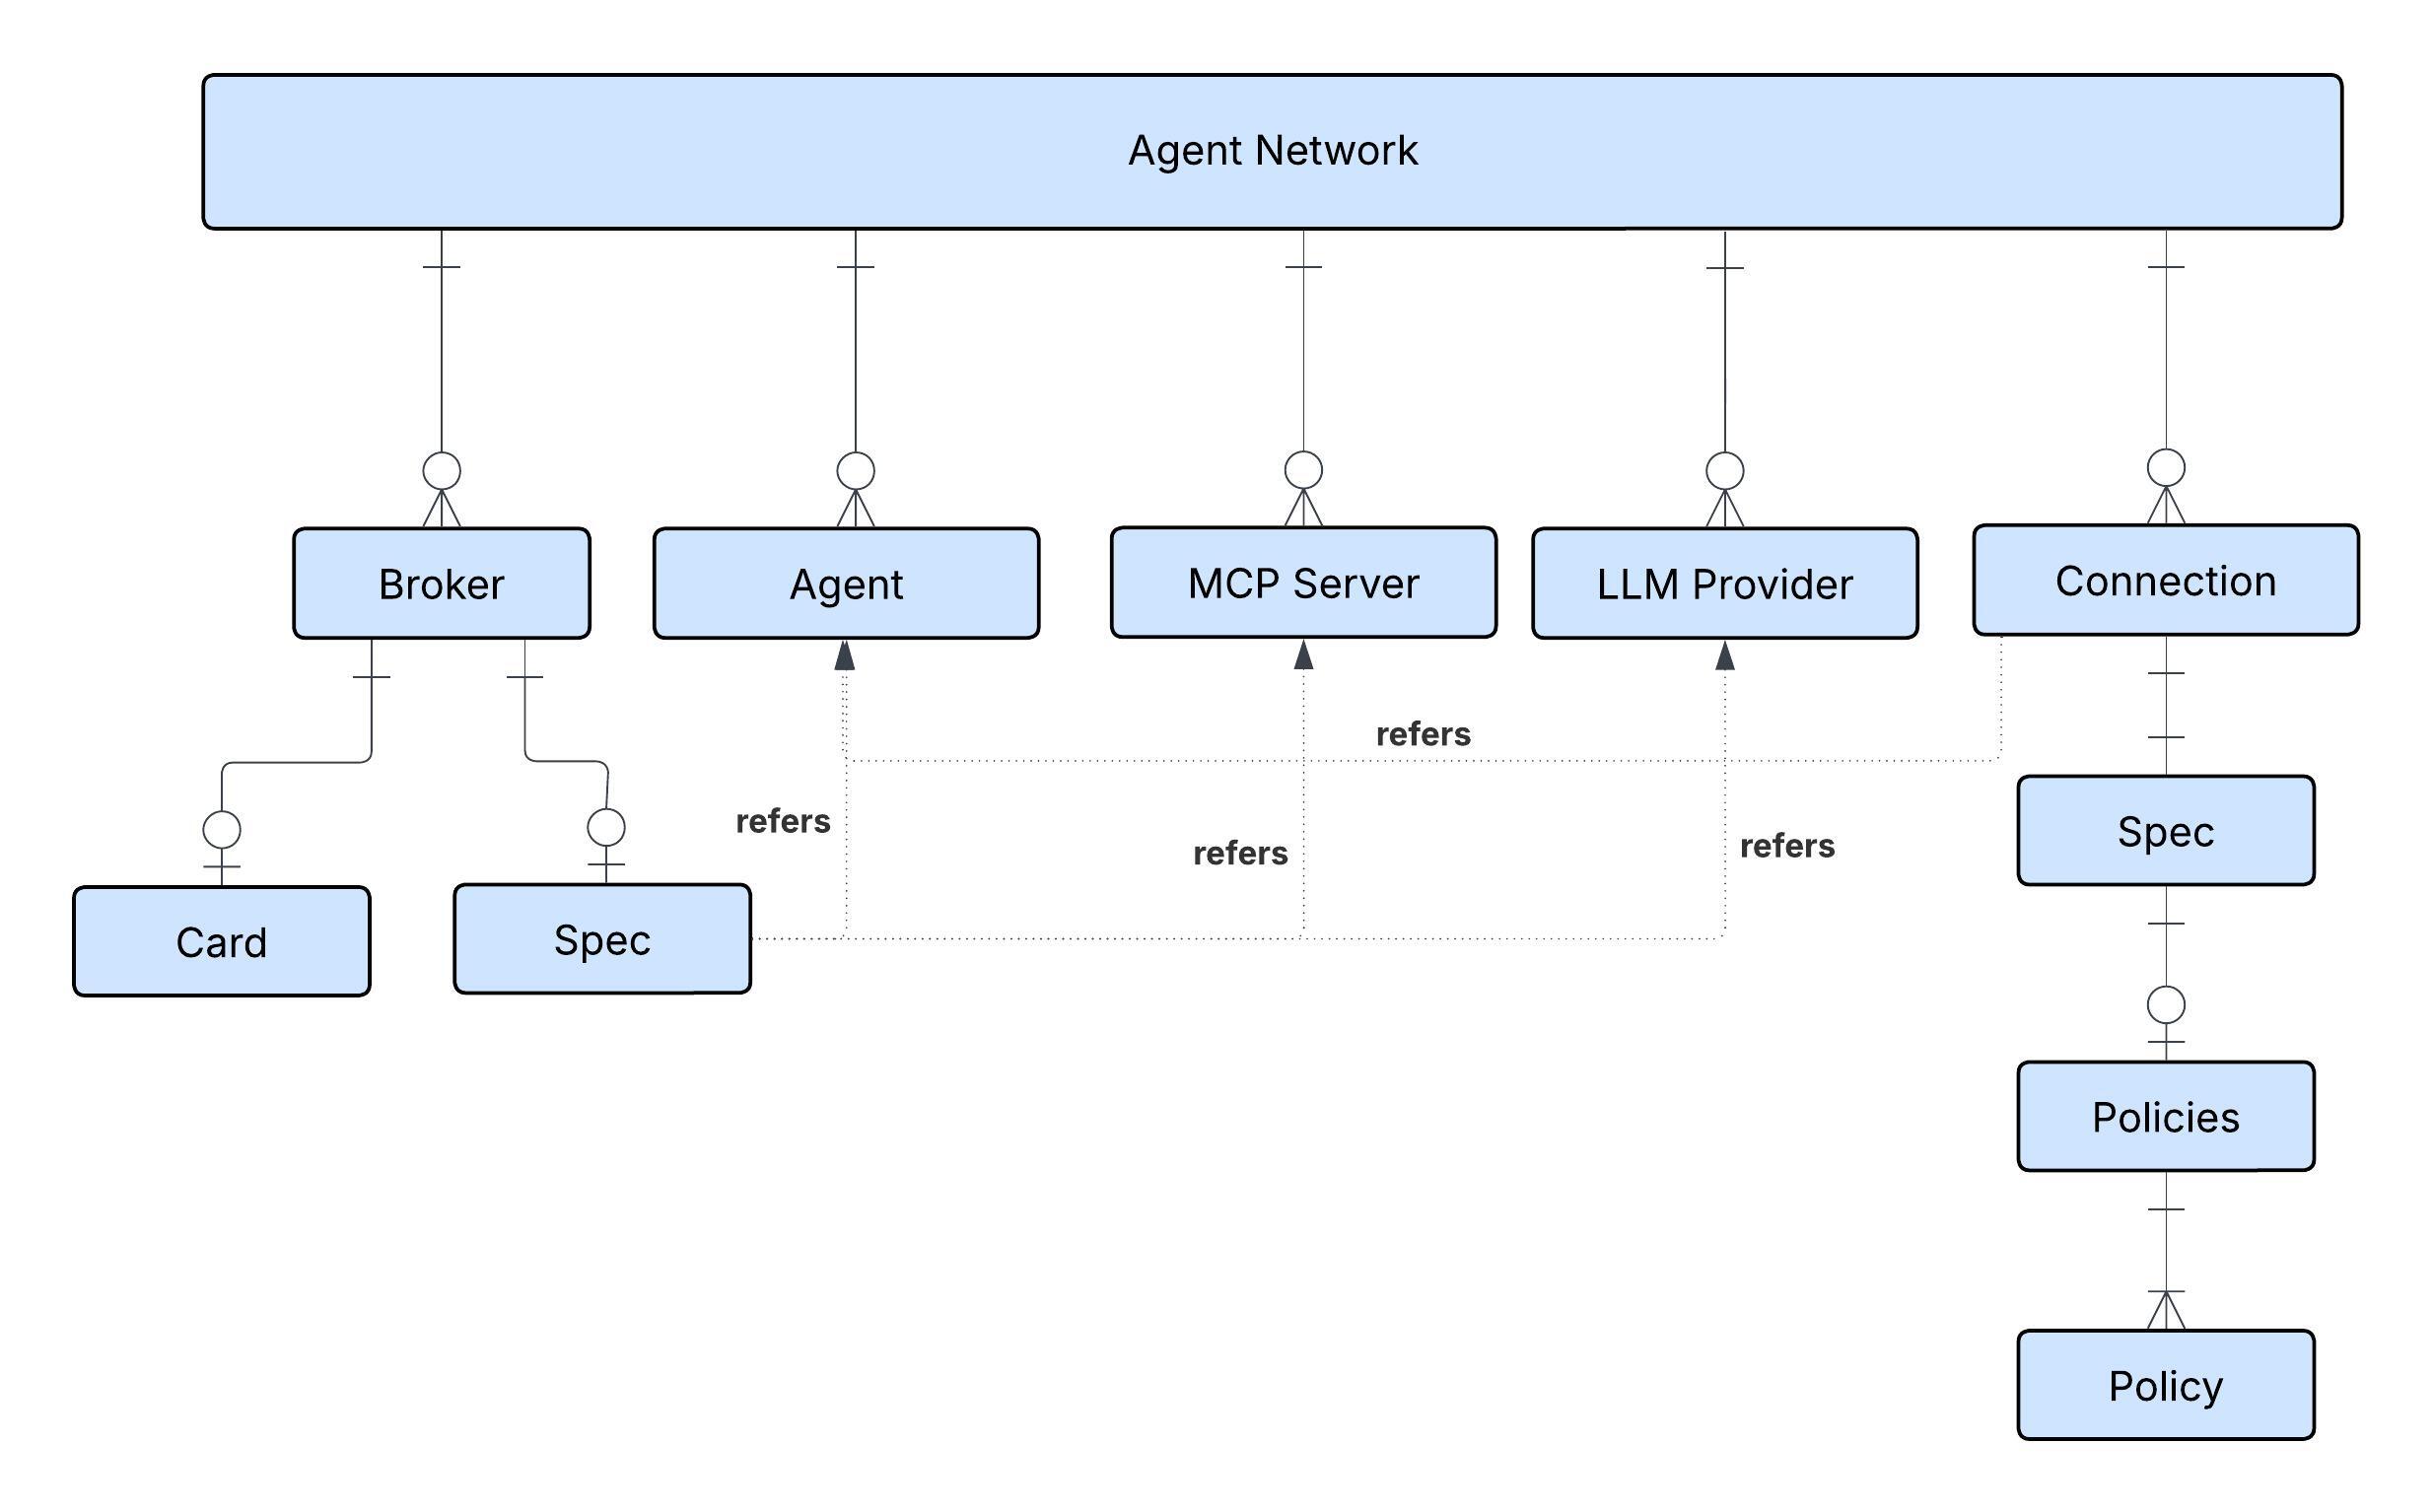 ## 에이전트 레지스트리(검색)
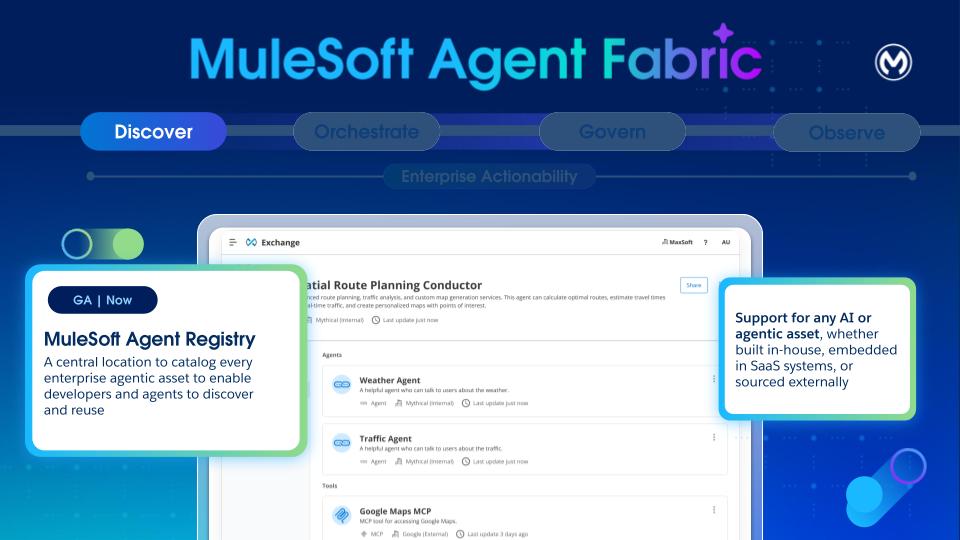 - **목적**: Exchange는 에이전트, 도구 및 기타 자산의 카탈로그입니다. 기본 목표는 이기종 에이전트의 검색, 큐레이팅, 수명 주기 관리를 위한 단일 관리 카탈로그를 제공하여 "에이전트 확산"을 해결하는 것입니다. 이를 통해 개발자가 에이전트, 플랫폼 소유자가 가시성을 유지하고 오케스트레이터가 기능을 검색할 수 있습니다.
- **설계에 따른 이기종**: 이제 Anypoint Exchange에서 에이전트, MCP, LLM의 세 가지 새 자산을 지원합니다. Exchange는 모든 유형의 에이전트를 등록하고 관리할 수 있는 범용 카탈로그로 설계되었습니다. 타사, Agentforce 및 맞춤형 MuleSoft 에이전트를 비롯한 모든 소스의 A2A 호환 에이전트, MCP 서버 및 LLM 공급자를 지원합니다.
- **핵심 메타데이터**: 등록된 모든 자산에는 고유 이름 및 버전, 소유권 및 게시자 등 변경할 수 없는 메타데이터의 기준 집합이 있습니다. 수명 주기 상태(개발, 스테이징, 프로덕션, 폐기)도 추적됩니다.
- **검색**:
- **설계-시간**: 개발자는 기존 Exchange UI를 통해 또는 Anypoint Code Builder 내에서 Vibes를 사용하여 자연어 검색을 통해 등록된 에이전트를 검색할 수 있습니다.
- **태그 지정 및 분류**: 기본 키 값 태그 지정 시스템을 사용하여 자산을 유형(에이전트, MCP, LLM, 중개인) 및 도메인(예: HR, 날씨)별로 분류하고 동적 연결, 검색, 선택 정책을 활성화할 수 있습니다.
- **카탈로그**: 리포지토리는 조직 내에서 에이전트를 공유하기 위한 비공개 및 내부 카탈로그 모델을 모두 지원합니다.
- **시각화**: 네트워크 보기를 지원하는 시각적 도구를 제공하며 단일 자산 또는 조직 전체의 노드 및 링크 맵에 대한 연결을 표시하고 필터링 기능을 제공합니다.
에이전트 네트워크 내의 중개인은 Anypoint Exchange에 저장된 등록된 에이전트, MCP 서버, LLM 공급자를 참조할 수 있습니다. 그러나 아직 등록되지 않은 경우 에이전트 네트워크(YAML)의 메타데이터에서 선언할 수 있으며 자동으로 등록됩니다. 이 예에서는 여러 에이전트, MCP 서버, LLM 공급자가 Anypoint Exchange에 선언 및 등록됩니다.
```
agents:
orders-agent:
label: Order Fulfilment Agent
metadata:
protocol: a2a
platform: OpenAI
salesforce-agent:
label: Salesforce Agent
metadata:
protocol: a2a
platform: OpenAI
stripe-agent:
label: Stripe Payment Agent
metadata:
protocol: a2a
platform: OpenAI
mcpServers:
inventory:
label: Inventory MCP
metadata:
transport:
kind: streamableHttp
path: /mcp
llmProviders:
open-ai:
label: OpenAI
description: OpenAI LLM Provider
metadata:
platform: OpenAI
```
## 에이전트 중개인(Orchestrate)
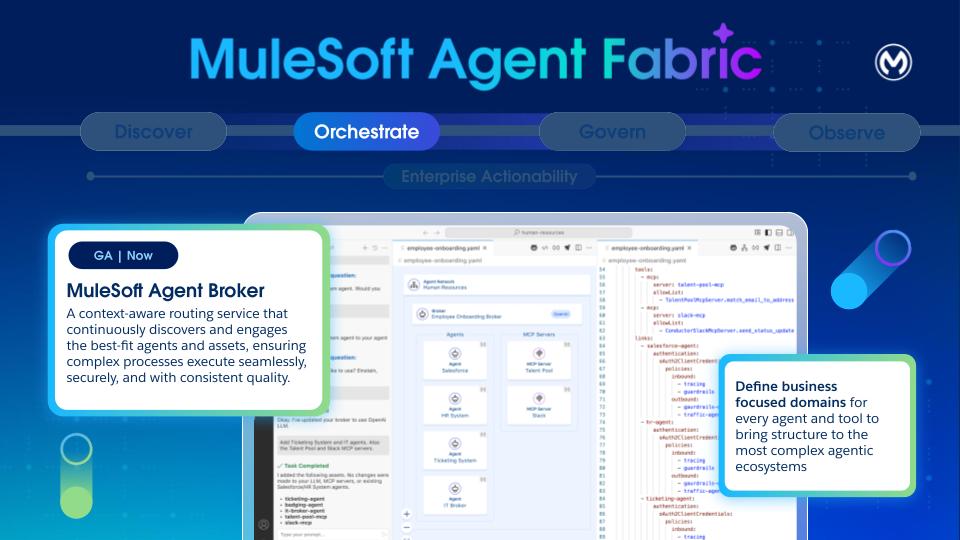 에이전트 중개인은 엔터프라이즈의 전문 에이전트 전체에서 과업 위임을 조율하는 지능형 라우팅 에이전트입니다. 과업을 수행하는 데 사용하는 에이전트 및 MCP 서버에 의해 정의됩니다.
중개인은 에이전트 네트워크 자산을 게시하고 다른 중개인이 재사용한 후 Anypoint Exchange에 나타나는 전문 에이전트입니다.
브로커는 YAML의 _브로커_ 섹션에서 정의됩니다. 정의된 중개인은 Mule에 대한 사전 Knowledge 필요하지 않아도 응용 프로그램에 투명하게 "구성"됩니다. 생성된 응용 프로그램이 CloudHub 2.0(CH2)에 배포되고 강력한 CH2 인프라를 활용합니다.
즉, 에이전트 중개인이 로깅 및 메트릭 기능 등 CloudHub 2.0의 설정된 성능 특성에서 혜택을 누릴 수 있습니다. "운영 비용" 및 "모니터링/경고/도구"와 같은 운영 측면은 다른 모든 작업 부하와 동일합니다.
사람이 개입해야 하는 시나리오(Human-in-the-Loop)의 경우 MuleSoft Object Store를 사용하여 각 상호 작용의 상태를 유지합니다. 이는 고동시 환경에서 효과적인 상태 관리를 위해 고안된 분산 솔루션입니다.
중개인 정의는 카드 및 사양과 같은 두 섹션으로 구성됩니다.
### 카드
카드 섹션은 [에이전트-에이전트(A2A) 사양](https://a2a-protocol.org/v0.2.5/specification/)을 따릅니다. 중개인 에이전트의 계약, 기술 및 기능을 설명합니다. 카드 URL에 ${ingressgw.url}/broker-name 값이 자동으로 채워집니다. 배포 시 ${ingressgw.url} 자리 표시자가 에이전트 진입 요청을 전면 처리하는 Anypoint Flex 게이트웨이의 URL로 자동으로 대체됩니다.
### 사양
사양 섹션은 중개인의 "소스 코드"를 구성합니다. 여기에서 개발자는 사용할 LLM, 지침, 사용 가능한 도구, 오류 처리, 그리고 가장 중요한 것은 이 중개인이 사용할 수 있는 다양한 에이전트 및 MCP 도구를 지정할 수 있습니다.
**LLM 공급자**
이 섹션은 각 중개인의 사양에 포함됩니다. 이는 서비스 섹션에 정의된 LLM 중 하나에 대한 참조입니다. 모든 중개인 간에 하나의 LLM을 공유할 것인지 또는 필요한 경우 여러 중개인이 과업에 더 적합한 LLM을 사용할 것인지 선택할 수 있습니다.
중개인은 LLM 공급자를 가리킬 수 있습니다. 필요에 따라 해당 공급자의 모델을 선택할 수 있습니다.
```
llmProviders:
open-ai:
label: OpenAI
description: OpenAI LLM Provider
metadata:
platform: OpenAI
```
** 지침**
이 섹션은 선택 사항이며 이 섹션을 사용하여 이 중개인 에이전트와 관련된 지침을 지정할 수 있습니다. 해당 지침은 특정 비즈니스 지향 우려 사항에 중점을 둡니다. 예를 들어 고객 보고 사고에 대한 관리를 조정하는 고객 서비스 에이전트 가정합니다.
```
instructions:
- |
You are an Incident Management Orchestrator Agent. Your primary responsibility is to coordinate the resolution of incidents reported by customers.
The process for incident management is:
1. Fetch Salesforce Case Details: Retrieve the latest critical case details for the given customer.
2. Fetch Entitlement Details: Obtain the customer's entitlement information.
3. Fetch On-Call Engineer: Identify the current on-call engineer for the incident.
4. Create Slack War Room and invite on-call engineer: Set up a Slack war room channel and invite the on-call engineer.
5. Summarize Actions: Provide a clear, human-readable summary of the steps performed, including information about the created slack channel and the on-call engineer assigned
```
브로커가 직접 처리할 수 있으므로 명시적 지침(예: **"업무 분할" 또는 "최상의 도구 선택"**)을 제공할 필요가 없습니다. 해당 지침은 특정 비즈니스 프로세스를 설명하는 경우에만 필요합니다.
**도구 구성**
도구는 에이전트에게 외부 기능을 제공합니다. 중개인이 외부 시스템(기존 API 또는 SaaS 서비스 등 다른 에이전트가 아닌)에 액세스해야 할 때마다 MCP(모델 컨텍스트 프로토콜) 서버에 연락합니다.
```
tools:
- mcp:
server: collaboration-mcp # MCP server reference
allowed: # Allowlist specific tools
- create_channel
- invite_user
```
MCP 서버는 교환 자산의 이름으로 참조됩니다. 서비스 섹션에 연결 세부 사항이 지정되어 있습니다.
기본적으로 중개인은 MCP 서버에서 사용할 수 있는 모든 도구에 액세스할 수 있습니다. 관찰 결과에 따르면 대부분의 최신 LLM은 컨텍스트당 약 20~25개의 도구만 처리할 수 있으므로 부정확성이 생성되거나 컨텍스트가 손실됩니다. 따라서 일반적으로 필요한 최소한으로 사용 가능한 도구를 제한하는 것이 좋습니다. 허용 목록을 통해 해당 필터링을 적용할 수 있습니다.
**에이전트 링크**
이 섹션은 전체 정의의 가장 중요한 부분입니다. 링크 섹션은 에이전트 간 커뮤니케이션 및 오케스트레이션을 지원합니다. 즉, 이 중개인은 여기에 연결된 에이전트에 의존하여 사용자의 목표를 완료하기 위한 적절한 작업을 실행합니다.
```
links:
- agent:
ref:
name: orders-agent
- agent:
ref:
name: salesforce-agent
- agent:
ref:
name: stripe-agent
```
실제로 이 섹션은 공동 작업을 위한 에이전트-네트워크를 정의합니다.
## Flex 게이트웨이(관리)
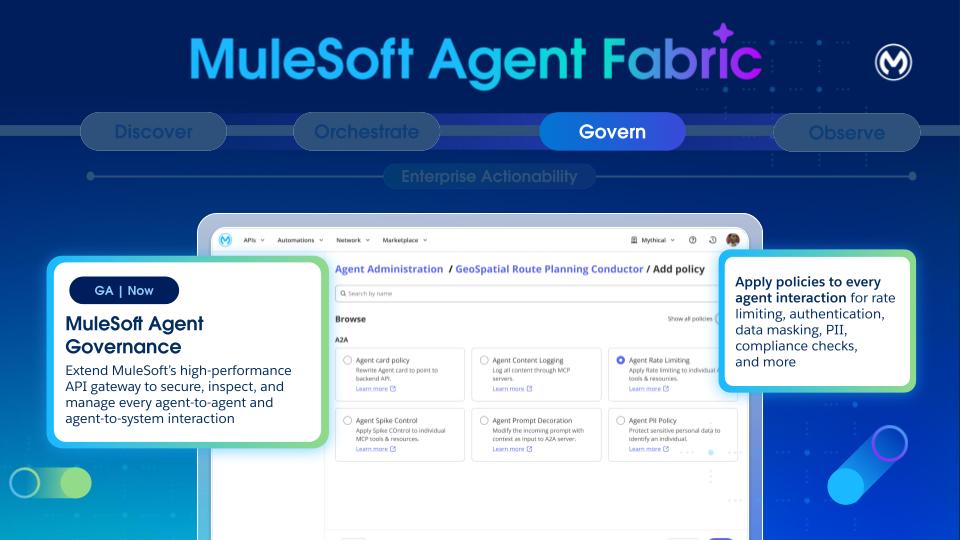 에이전트 거버넌스는 신뢰할 수 있는 에이전트 네트워크를 구축하고 보안 및 규정 준수를 보장하는 데 중요한 에이전트 패브릭의 중요한 기둥입니다.
거버넌스의 경우 비공개 공간 내에 총 2개의 Flex 게이트웨이(1개 입력 및 1개 출력)가 필요합니다.
거버넌스는 전체 ADLC(에이전트 개발 수명 주기)를 안전하게 확장하기 위해 필요한 구조, 제어, 증거를 설정합니다. 특히, 거버넌스는 에이전트 인증, 카탈로그, 수명 주기 결정, 런타임 정책 시행과 같은 주요 프로세스를 구현합니다.
- **카탈로그:**
- 교환: 에이전트 목적, 소유자, 환경, 데이터 및 분류 경계의 녹음을 지원합니다. 또한 기능, 도구, 리소스, 프롬프트 및 외부 종속성을 버전과 함께 등록합니다.
- **버전 관리 및 수명 주기:**
- 전체 에이전트 개발 수명 주기 동안 에이전트, 도구, 자산의 시맨틱 버전 관리를 문서화하고 관리합니다.
- 버전 관리는 에이전트 사용 중지 시간 표시 막대를 관리하는 데 도움이 되며, 가능한 경우 이중 실행을 지원하여 원활한 마이그레이션을 보장합니다.
- **정책 집행**:
- 에이전트 AI 아키텍처는 공격 표면(대화 인터페이스, 프롬프트 및 MCP와 같은 새로운 프로토콜)을 확장합니다. 구성 요소가 저하되면 프로토콜, 프롬프트, API 또는 도구와 같은 구성 요소를 제공하는 여러 시스템에 계단식 효과가 발생할 수 있습니다.
- 엔터프라이즈 에이전트 AI 배포를 보호하려면 이러한 자율적이고 예측할 수 없는 환경이 기본적으로 에이전트 간 상호 작용을 통해 공격 영역을 넓히기 때문에 전문적인 접근 방식을 필요로 합니다. 정적 시스템에 대한 기존 보안 도구는 필수이지만 더 이상 자체적으로 충분하지 않습니다. 기업은 사전에 에이전트 AI와 관련된 심각한 비즈니스 위험을 직접 해결하는 네 가지 특정 보안 솔루션을 계획하고 구현해야 합니다.
- Flex 게이트웨이: 대상 시스템이 안전하지 않은 경우에도 모든 A2A 및 MCP 트래픽이 Flex 게이트웨이를 통해 라우팅되어 모든 끝점에 정책이 적용되도록 합니다. 이 라우팅은 에이전트 통신을 보호하고 인가 서버와 통합하는 데 매우 중요합니다.
- 정책 번들: 사용자는 실행 전에 워크플로에 미리 정의된 정책의 번들을 정의하고 적용하여 일관된 보안 및 운영 정책 집합을 적용할 수 있습니다.
- 정책 유형: 플랫폼은 다음을 포함하여 다양한 인바운드 및 아웃바운드 정책을 지원합니다.
- A2A 정책: 에이전트 카드, PII 감지기, 프롬프트 데코레이터, 스키마 유효성 검사.
- MCP 정책: 특성 기반 액세스 제어, 스키마 유효성 검사, MCP 지원.
- LLM/AI 정책: AI 프롬프트 데코레이터, AI 프롬프트 가드(해로운 콘텐츠 필터링), AI 프롬프트 템플릿(사전 정의된 템플릿 적용), AI 기본 토큰 속도 제한.
- Telemetry 정책: A2A 및 MCP Telemetry - 로그 데이터 수집 및 내보내기를 위한 오픈 Telemetry 솔루션을 확장합니다.
- :로깅**** 자동 추적 덕분에 에이전트 네트워크 전반에서 로그를 사용하여 모든 에이전트의 상호 작용을 추적하고, 행동을 설명하고 Trust 구축할 수 있습니다.
이 예는 에이전트 네트워크 메타데이터를 사용하여 구성된 메시지 로깅에 대한 정책을 설명합니다. Orderfullfillment 브로커는 Salesforce 에이전트라는 기존 에이전트를 참조하며 메타데이터를 사용하여 메시지에 대한 정책이 구성됩니다. 에이전트 패브릭은 Flex Gateway의 "사양" 섹션 아래 언급된 모든 정책을 자동으로 구성합니다. 추가 단계는 필요하지 않습니다.
```
salesforce-agent-connection:
kind: agent
ref:
name: salesforce-agent
spec:
url: ${salesforce-agent.cardUrl}
policies:
- ref:
name: message-logging
namespace: 68ef9520-24e9-4cf2-b2f5-620025690913
configuration:
loggingConfiguration:
- itemName: "Payload"
itemData:
message: "#[payload]"
firstSection: true
secondSection: true
level: "INFO"
- itemName: "Headers"
itemData:
message: "#[attributes.headers]"
firstSection: true
secondSection: true
level: "INFO"
```
## 에이전트 시각화 프로그램(관찰)
 LLM 에이전트 및 다중 에이전트 배포의 결정적이고 복잡하지 않은 특성으로 인해 관찰 가능성 및 모니터링이 중요합니다.
- **기본 로그 및 추적**: 로그를 통해 사유 및 도구 실행 추적이 제공됩니다. 워크플로 실행의 로그 및 추적은 런타임 관리자에서 실행 후에 볼 수 있습니다.
- **메트릭**: 초기 단계에서 플랫폼은 a2a_total_calls 및 mcp_total_calls를 레이블(경로, 상태, 메서드, 도구 등)이 있는 카운터로 게시하여 총 통화, 성공 통화, 실패 통화를 결정합니다. 해당 메트릭은 기본적으로 mcp_support_policy 및 a2a_agent_card_policy와 같은 기존 정책을 통해 Envoy(Flex Gateway)의 기본 통계 인터페이스를 사용하여 정책 코드에서 게시됩니다.
- **개시성 향상(미래)**: 계획에는 향후 버전에서 배포된 추적에 대한 Open Telemetry 사용이 포함됩니다. 고급 관찰 기능에는 다음이 포함됩니다.
- **세부 요청 추적**: 요청에 대한 전체 가시성을 확보하고 프롬프트, 플래너 프로세스, 호출된 작업, 하위 에이전트와의 상호 작용을 포괄합니다.
- **에이전트 상태 모니터링**: 에이전트 가동 시간, 응답 대기 시간, 처리량, 오류 비율, 기본 자원 사용량(CPU, 메모리, 네트워크, GPU)을 모니터링합니다.
- **다중 에이전트 조정 모니터링**: 에이전트 간 상호 작용의 성공률 및 실패율을 수집하고, 순환 호출 패턴(루프)을 감지하고, 과업 완료 및 호출 수와 같은 에이전트별 메트릭을 추적합니다.
- **비용 추적**: 대시보드 및 경고를 사용하여 각 LLM 호출에 대한 토큰 사용 및 관련 비용을 추적합니다(에이전트당 이상).
- **지능 추적**: 내부 생각 프로세스 및 모든 도구 호출 등 에이전트의 세션에 대한 자세한 추적을 수집하고 표시하며, 변경할 수 없는 감사 추적 역할을 합니다.
- **에이전트 세션 재생**: 딥 디버깅을 위해 에이전트의 인지 추적을 단계별로 시각적으로 "재생"할 수 있는 UI입니다.
- **DAG 시각화**: 복잡한 다중 에이전트 상호 작용에 대한 에이전트 워크플로 실행의 DAG(Directed Acyclic Graph) 시각화를 제공합니다.
에이전트 시각화 도우미는 에이전트 네트워크의 일부를 식별하고 함께 작동하는 방식을 확인하는 데 사용됩니다.
- 노드 유형(에이전트 및 MCP 서버)을 구분합니다.
- 선언된 상호 작용 및 런타임 상호 작용을 보려면 가장을 봅니다.
- 레이어를 사용하여 특정 환경에 대한 보기 집중
- 노드의 메타데이터 및 메트릭을 검사하고 로그 및 추적에 액세스하는 세부 사항 카드 열기
- Flex 게이트웨이 보호 및 적용된 정책과 같은 거버넌스 지표를 검토합니다.
Agent Visualizer의 구성 요소에 대한 자세한 내용은 [여기에](https://docs.mulesoft.com/agent-visualizer/agent-visualizer-components) 있습니다.
## 에이전트 패브릭: 4가지 기둥 모두
MuleSoft Agent Fabric은 이러한 네 가지 기초를 함께 사용하여 내장된 거버넌스가 있는 모든 에이전트에게 보안 및 제어를 확장합니다. 에이전트는 A2A(에이전트-에이전트) 및 MCP(모델 컨텍스트 프로토콜)와 같은 새로운 프로토콜을 활용하여 비즈니스 프로세스를 구축하고 확장하여 어디서나 작업할 수 있습니다. 애플리케이션, 데이터, 시스템 등 모든 항목을 연결하여 전체 비즈니스에서 작업할 때 에이전트의 권한을 부여하고 관리합니다. 인텔리전트 도구는 AI를 기본적으로 사용하거나 타사 AI 도구를 가져와 비즈니스 프로세스 또는 API 생성 및 확장을 지원합니다.
4개의 기둥을 모두 함께 사용하는 것은 필수 항목이 아니지만 권장됩니다. 필요에 따라 독립적으로 기둥을 선택할 수 있습니다. 예를 들어 오케스트레이션 레이어를 사용하지 않고도 등록 및 거버넌스에 에이전트 패브릭을 활용할 수 있습니다. 마찬가지로 중개인을 사용하여 다른 플랫폼을 통해 관리되는 에이전트를 오케스트레이션할 수 있습니다.
다음 다이어그램은 네 가지 구성 요소가 모두 상호 작용하는 방식을 보여줍니다.
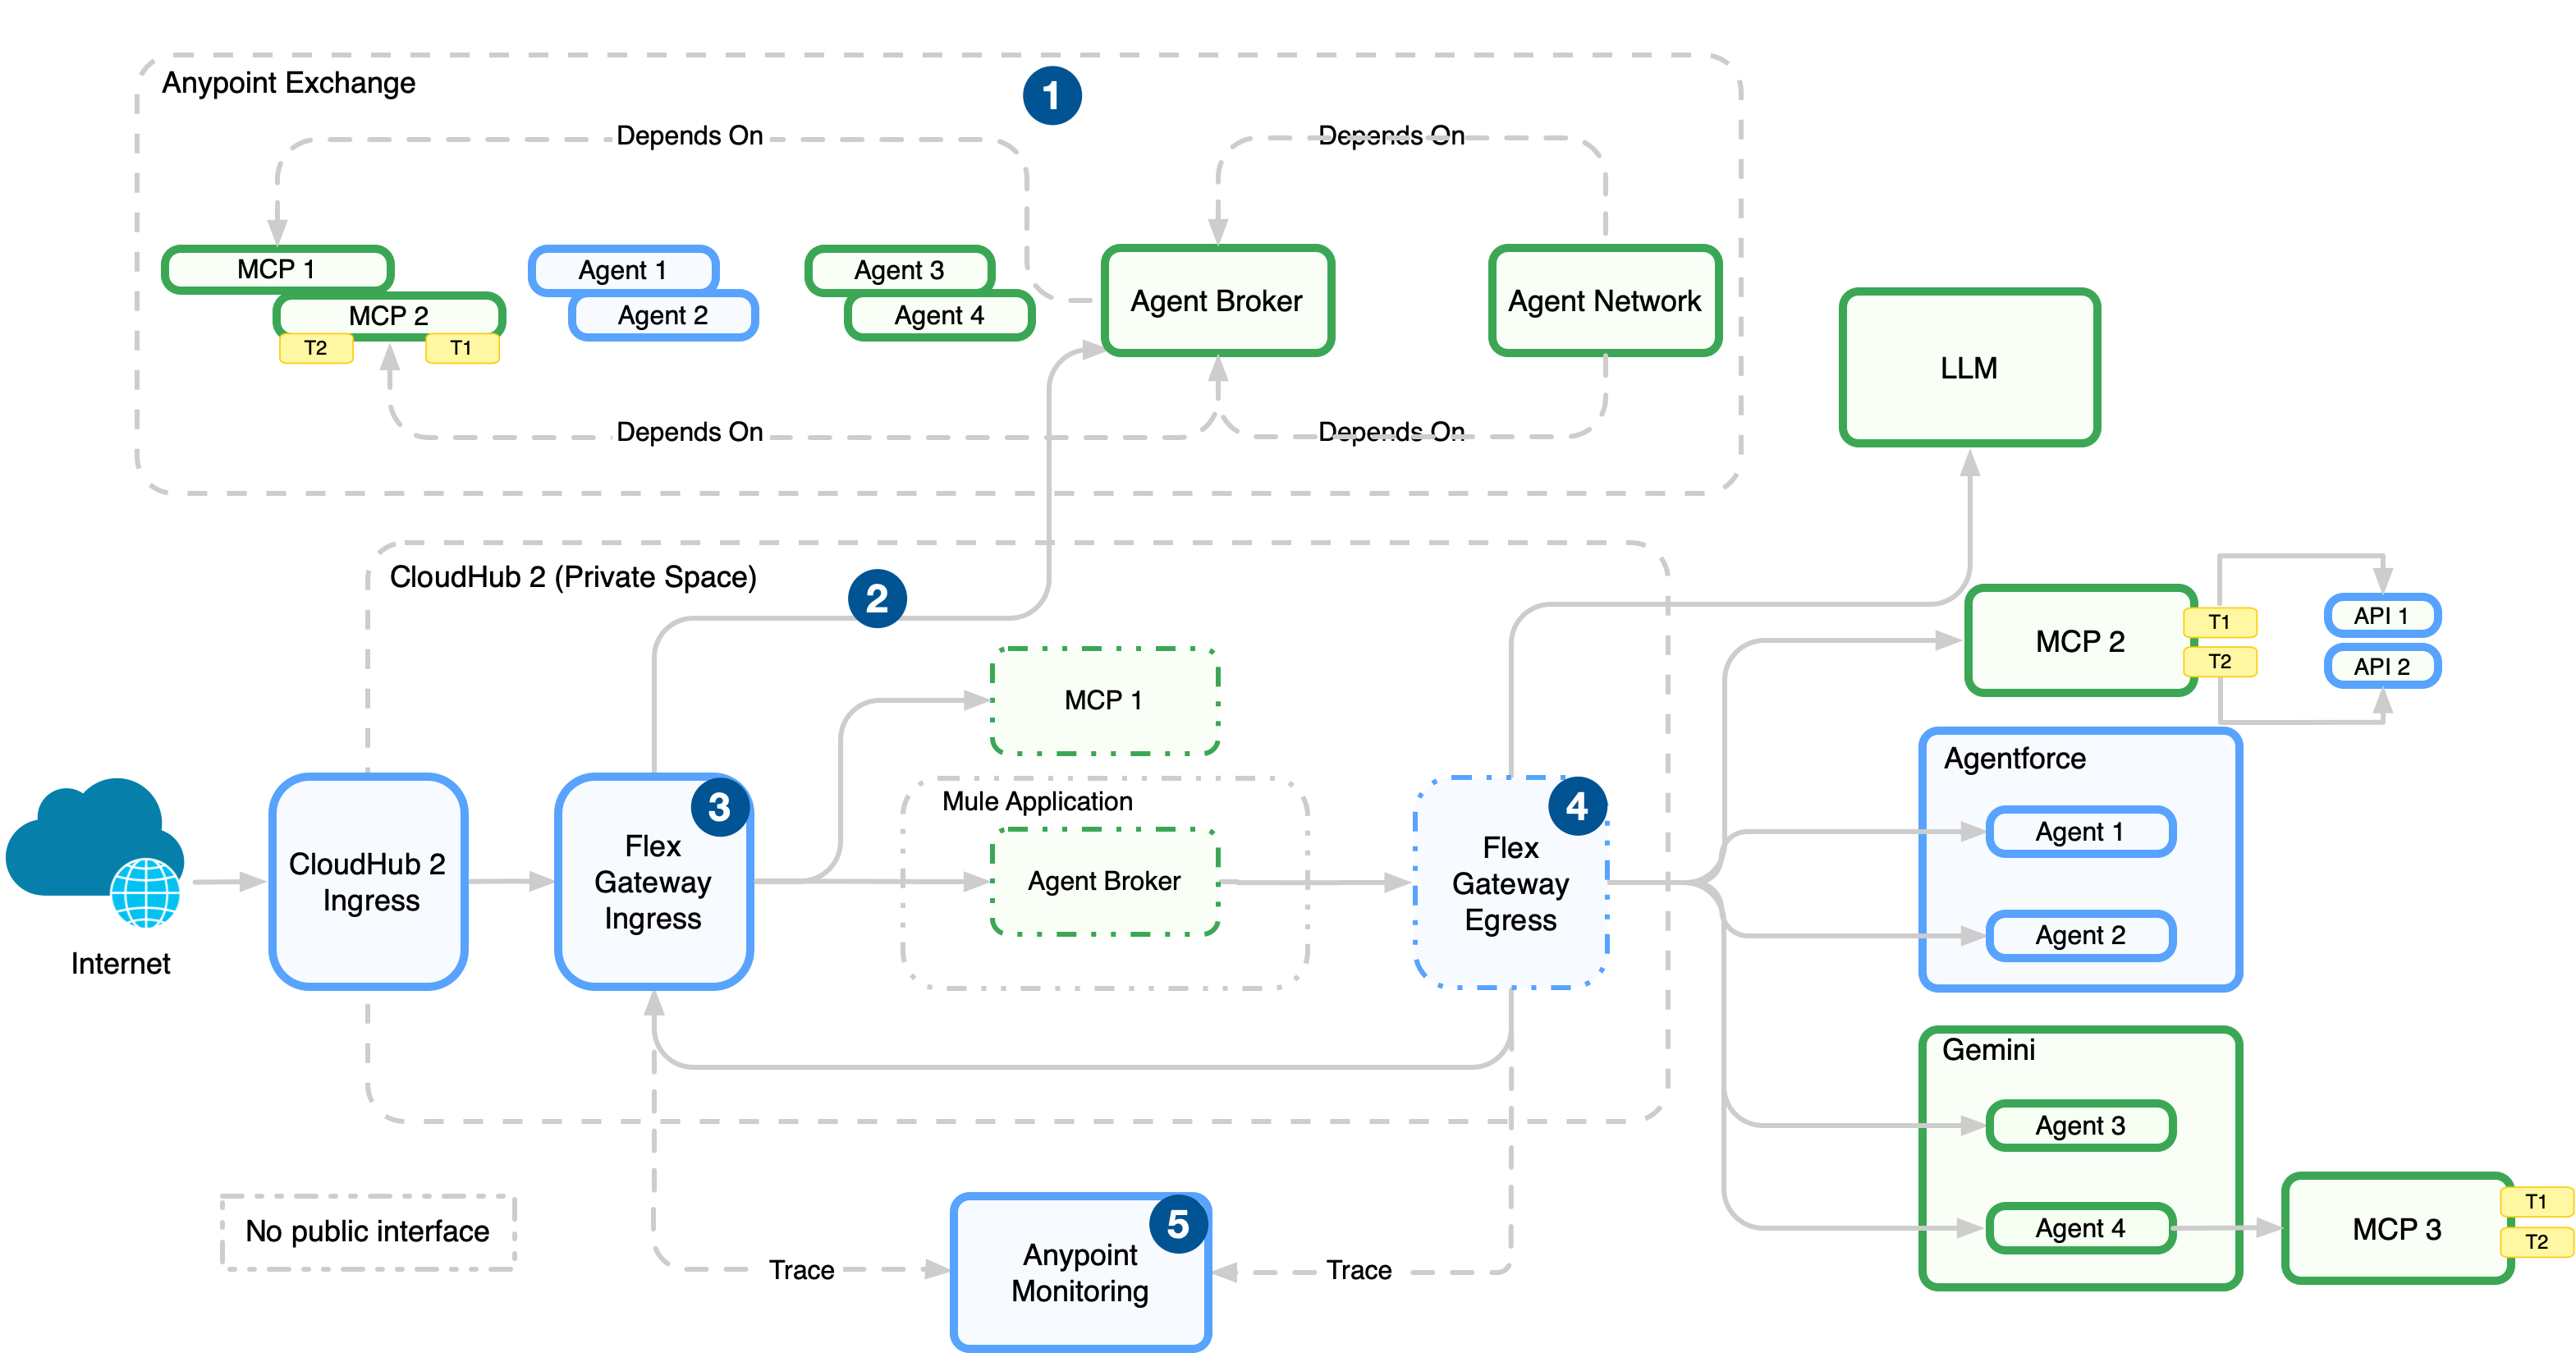 1. Anypoint 코드 빌더의 에이전트 네트워크 YAML에서 에이전트 네트워크(중개인, 에이전트, MCP 서버)를 정의한 후 검색 및 재사용을 위해 Anypoint Exchange에 에이전트 자산을 게시합니다.
2. 에이전트 자산을 CloudHub 2.0(런타임 관리자에서 관리)에 배포합니다.
3. 중개인 및 API 끝점 앞에 있는 접속 Flex 게이트웨이를 사용하여 네트워크에 수신되는 트래픽에 정책을 적용합니다.
4. 탈출 Flex 게이트웨이를 사용하여 정책을 적용하고, 연결을 관리하고, Telemetry 데이터를 발송합니다. 이 게이트웨이는 중개인 및 에이전트에서 외부 서비스로의 아웃바운드 경로에 위치합니다.
5. Anypoint Monitoring에서 Flex 게이트웨이 및 런타임에서 로그, 메트릭, 추적을 수집합니다.
## 에이전트 오케스트레이션 설계 패턴
사용 가능한 모든 AI 자산에 액세스하여 모든 과업을 처리할 수 있는 단일 오케스트레이터를 사용하여 평면하고 제한되지 않은 아키텍처에서 모든 전문 에이전트에게 즉시 액세스할 수 있도록 만드는 것은 유용합니다. 그러나 이 접근 방식은 전체 시스템의 효율성과 신뢰성을 손상시킬 수 있습니다. 초과 개별 툴에 적용되는 원칙과 마찬가지로, 많은 에이전트 옵션은 중앙 **브로커 에이전트**(또는 오케스트레이터)에게 상당한 소음과 복잡성을 제공합니다. 이러한 복잡성 증가로 인해 중개인의 의사 결정 정확도(작업에 적합한 에이전트 선택)와 시스템의 응답 결정성(비슷한 쿼리에 대해 예측 가능한 일관된 결과)이 크게 떨어집니다. 중개인 에이전트는 효과적으로 옵션 마비로 인해 라우팅이 느리고 신뢰도가 떨어집니다.
평면 구조 대신 에이전트 네트워크 구조화에 대한 **다단계 계층 접근법**을 강력히 옹호합니다. 이 조직 원칙은 여러 가지 중요한 이점을 제공합니다. 첫째, 그것은 본질적으로 **추적 가능성 및 관리**를 선호한다. 계층 구조는 설정된 조직 모범 사례를 미러링하여 요청 플로를 더욱 쉽게 감사하고, 실패 레이어를 파악하여 문제를 디버그하고, 특정 에이전트 또는 하위 네트워크의 배포 및 사용 중지를 관리할 수 있습니다.
두 번째로, 이 에이전트를 강화하는 대규모 언어 모델(LLM)의 맥락에서 계층 구조는 **컨텍스트 크기를 확인하는 데** 크게 도움이 됩니다. 에이전트 환경을 세분화하면 지정된 계층의 중개인 에이전트가 바로 아래에 있는 제한된 에이전트 집합 또는 하위 중개인만 고려합니다. 이 구조는 기본 오케스트레이터가 _모든 에이전트의_ 설명, 기능, 내역 컨텍스트를 작업 메모리에 로드하지 않도록 방지하여 LLM의 컨텍스트 기간 제한을 빠르게 **초과하고** 비용 및 대기 시간이 오래 **걸릴** 위험을 **방지합니다**.
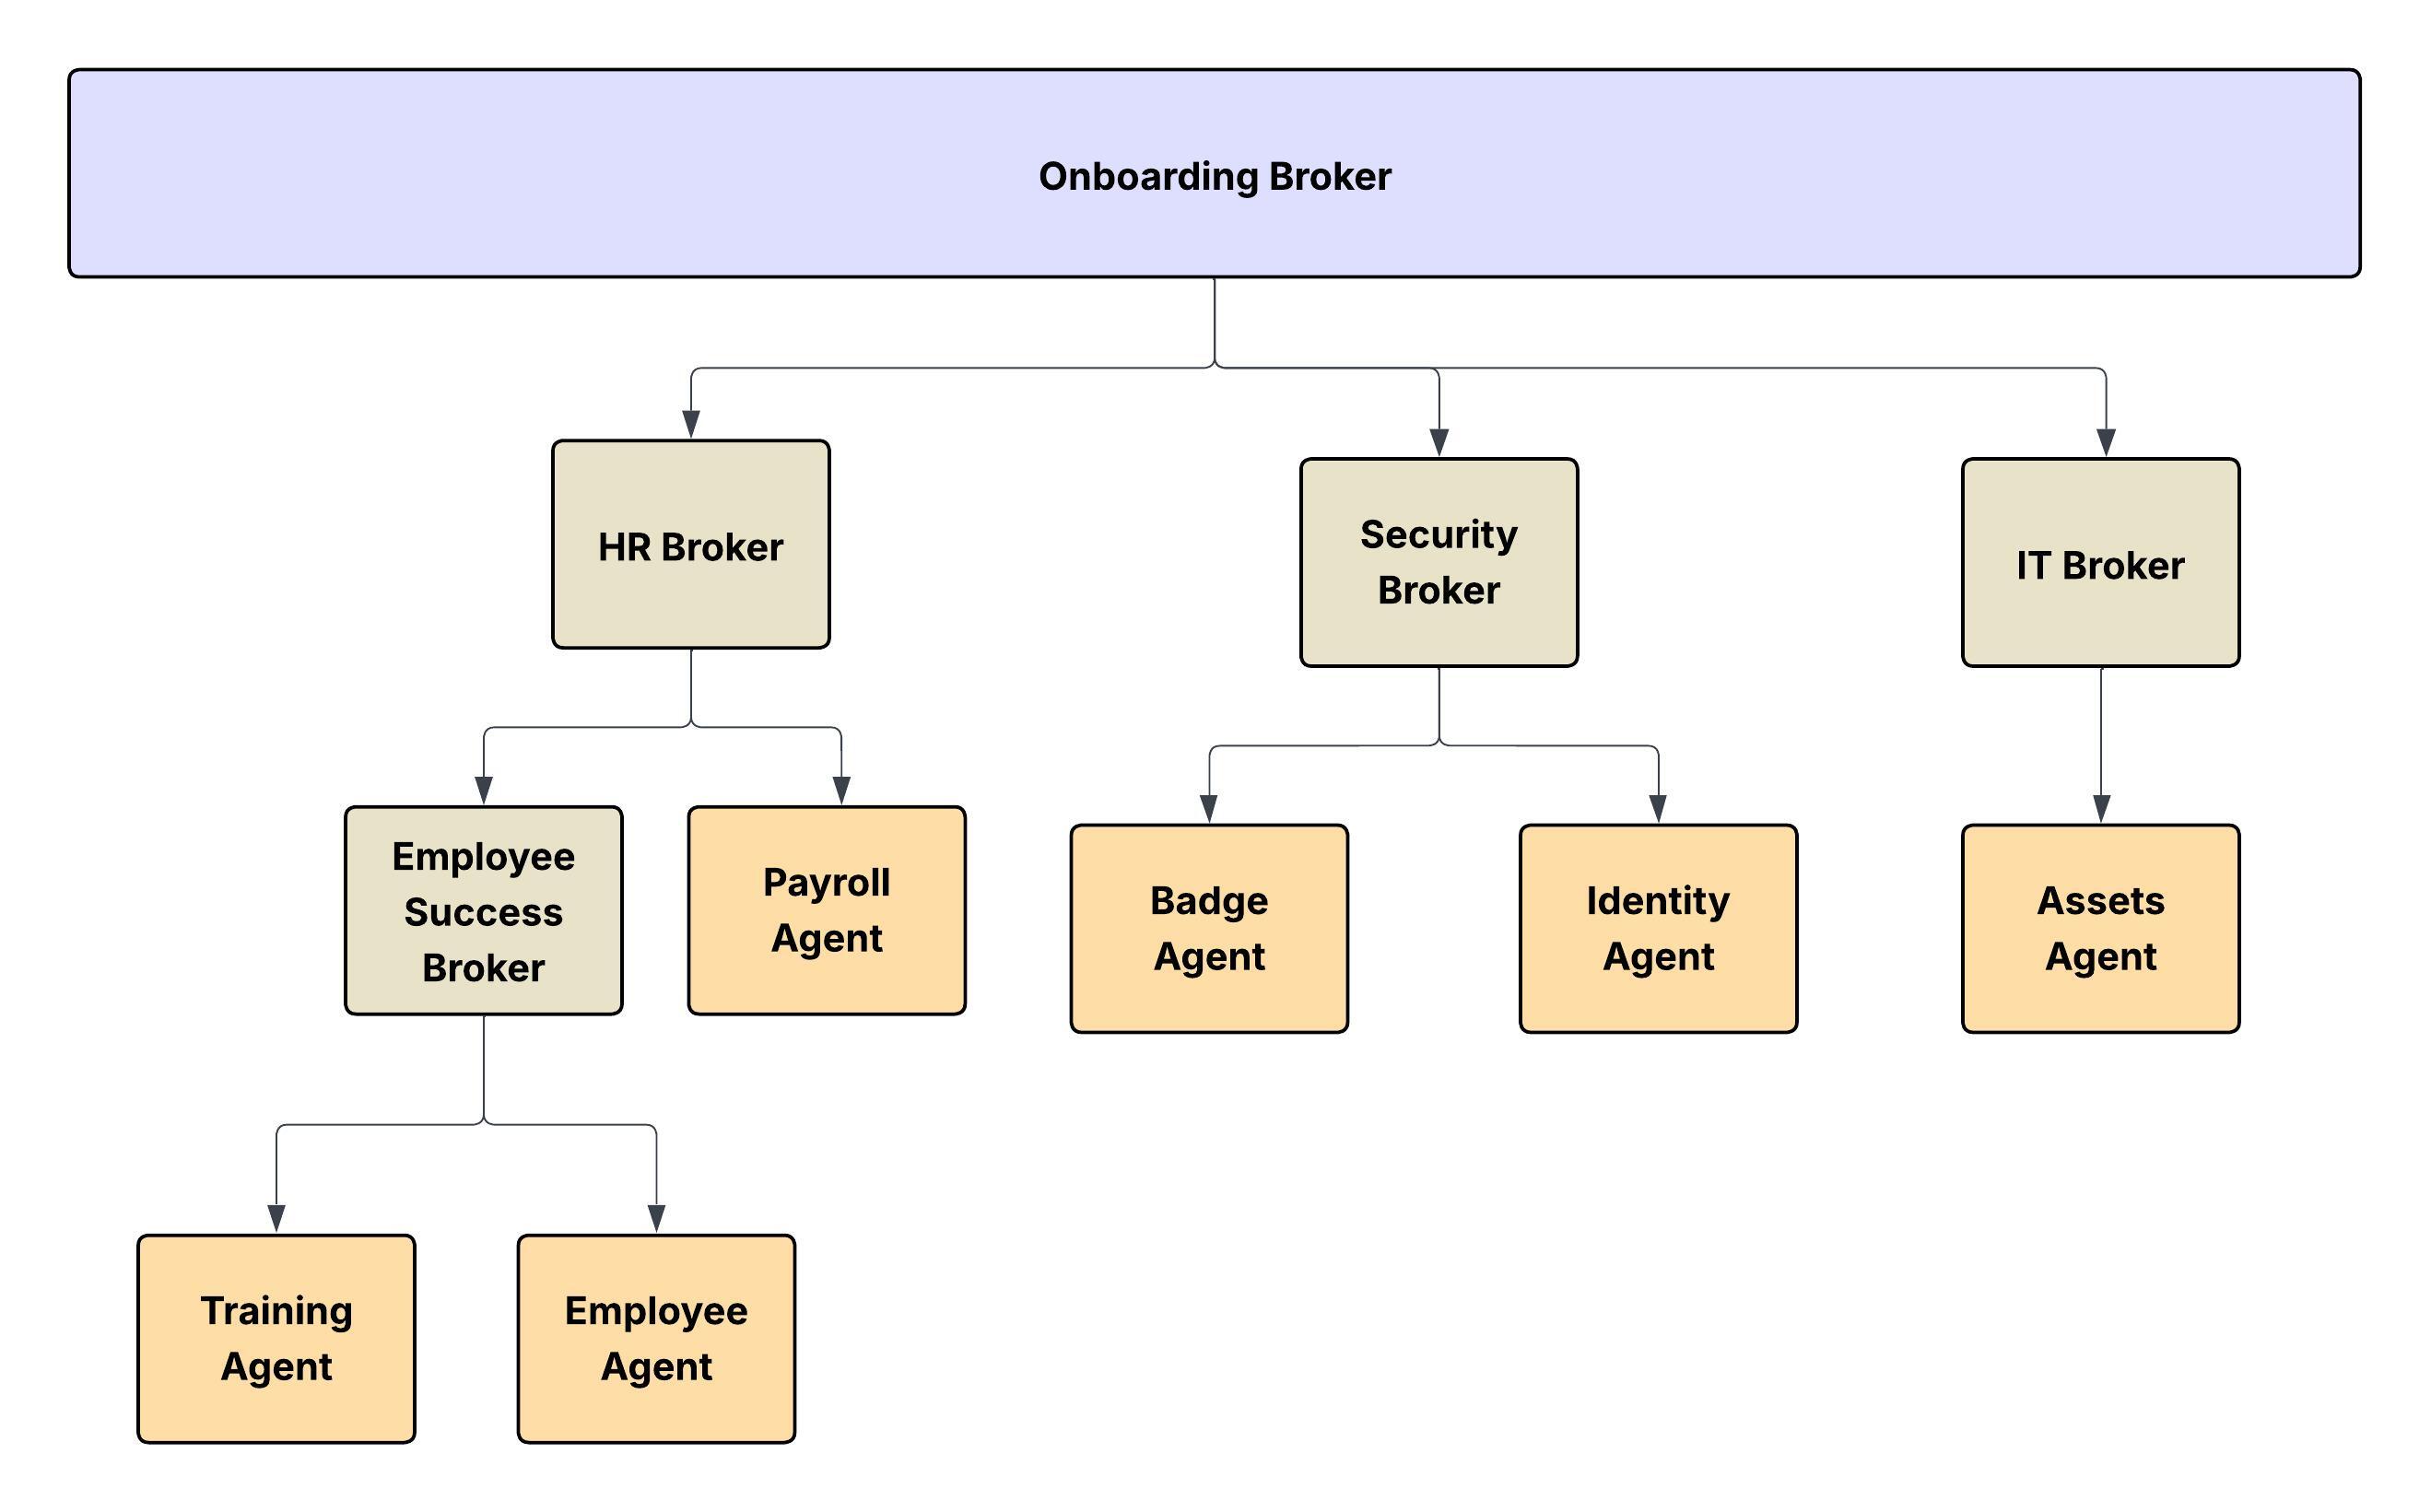 여러 방법으로 에이전트 네트워크를 구현할 수 있습니다. 두 가지 방법은 다음과 같습니다.
1. Conway의 법칙 - 직관적으로 실제 계층 구조에 매핑할 수 있습니다.
2. 도메인 중심 설계 - 비즈니스 도메인에 더 집중
# 옵션 1: 실제 계층 구조를 사용한 매핑
계층 조직에서 커뮤니케이션은 관리자에서 하위 역할에 이르기까지 세로로 흐르며 결정은 주로 중앙 집중화됩니다. Conway의 법에 따라:
- 해당 조직에서 구축한 시스템 또는 소프트웨어 아키텍처는 계층화되고 계층화되는 경향이 있습니다.
- 각 팀은 자체 경계 및 권한을 반영하는 하위 시스템을 설계하는 경향이 있습니다.
- 시스템 간의 인터페이스는 부서 간의 통신 채널을 반영합니다.
에이전트 네트워크는 또한 Conway의 법칙에 따라 대기업의 **실제 계층 구조**에 직관적으로 매핑할 수 있습니다.
- **개념 모델:** 기업에 고유한 디비전, 부서 및 관리 계층(예: C-suite, VP, 디렉터, 관리자)이 있는 것처럼 특정 도메인 내에서 운영되는 에이전트 네트워크도 병렬 조직 차트로 모델링할 수 있습니다.
- **노드와 잎:** 이 계층에서:
- 나무 구조의 **잎**은 **특수 대리인** 또는 **MCP**입니다. 이는 실제 작업을 수행하는 기능 단위입니다(예: "데이터베이스 쿼리 에이전트", "고객 인증 에이전트", "분위기 분석 에이전트"). 조직의 개별 공동작업자 또는 작업 단위를 나타냅니다.
- 루트 및 중간 계층을 포함하여 계층의 **기타 노드**는 **메로커 에이전트**(또는 하위 오케스트레이터)입니다. 해당 에이전트는 최종 과업을 수행하지 않지만 특정 도메인 또는 계층 내에서 라우팅, 위임, 집계, 충돌 해결에 대한 책임이 있습니다. 상위 수준 중개인은 "세일즈 도메인 중개인"에 과업을 위임하며, 그러면 "기회 관리 중개인"에 위임하여 "기회 상태 업데이트 에이전트"(리프)를 통해 과업을 수행합니다.
이 구조를 통해 복잡성이 로컬로 관리되고, 컨텍스트가 포함되며, 시스템이 예측 가능하고 신뢰할 수 있도록 확장됩니다. 새 전문가 에이전트를 조직 트리의 특정한 적절한 분기에 도입할 수 있습니다.
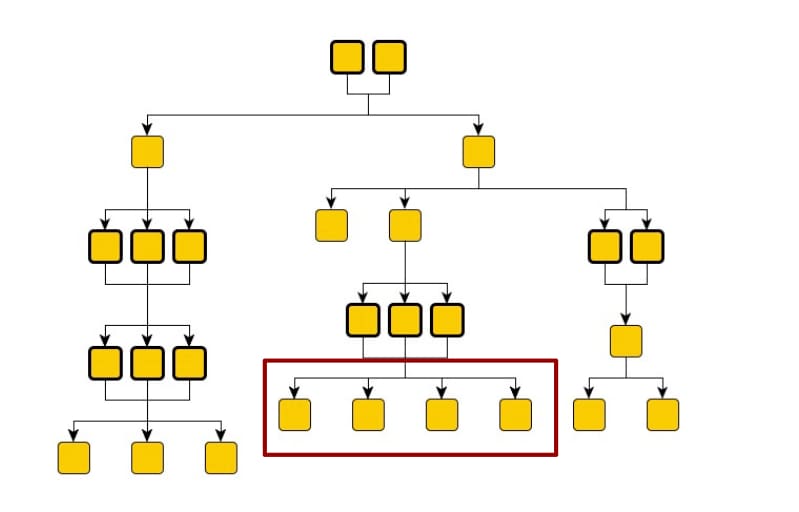 디지털 공임에 대한 조직 차트의 아날로그를 고려하십시오. 각 YAML 파일은 각 내부 조직(직원 성공, 보안, 재무 등)을 나타냅니다. 각 조직(에이전트-네트워크) 내에서 작업자가 공동 작업을 수행하고 작업을 과업으로 분할하고 할당하는 계층 구조가 있을 수 있습니다. 위 다이어그램에서 커뮤니케이션은 상단에서 하단으로 흐릅니다. 또한 리드는 중개인 에이전트 집합에 의한 소비만으로 제한되지 않습니다.
## 옵션 2: 도메인 중심 설계 및 에이전트 AI 구현
인적 조직 차트를 기반으로 에이전트 네트워크를 모델링하면 특히 자주 재구성을 수행하는 회사에서 자주 재구성해야 할 위험이 있습니다. 다른 방법은 기능적 도메인별로 에이전트를 구성하는 것입니다. 이 그룹화는 기존의 인적 조직 경계를 넘어야 할 수 있습니다. 예를 들어, 새 직원 온보딩은 하드웨어 및 사용자 프로비저닝에 대한 IT 작업을 포함하며, 세일즈 작업에는 운영 및 마케팅이 모두 필요합니다.
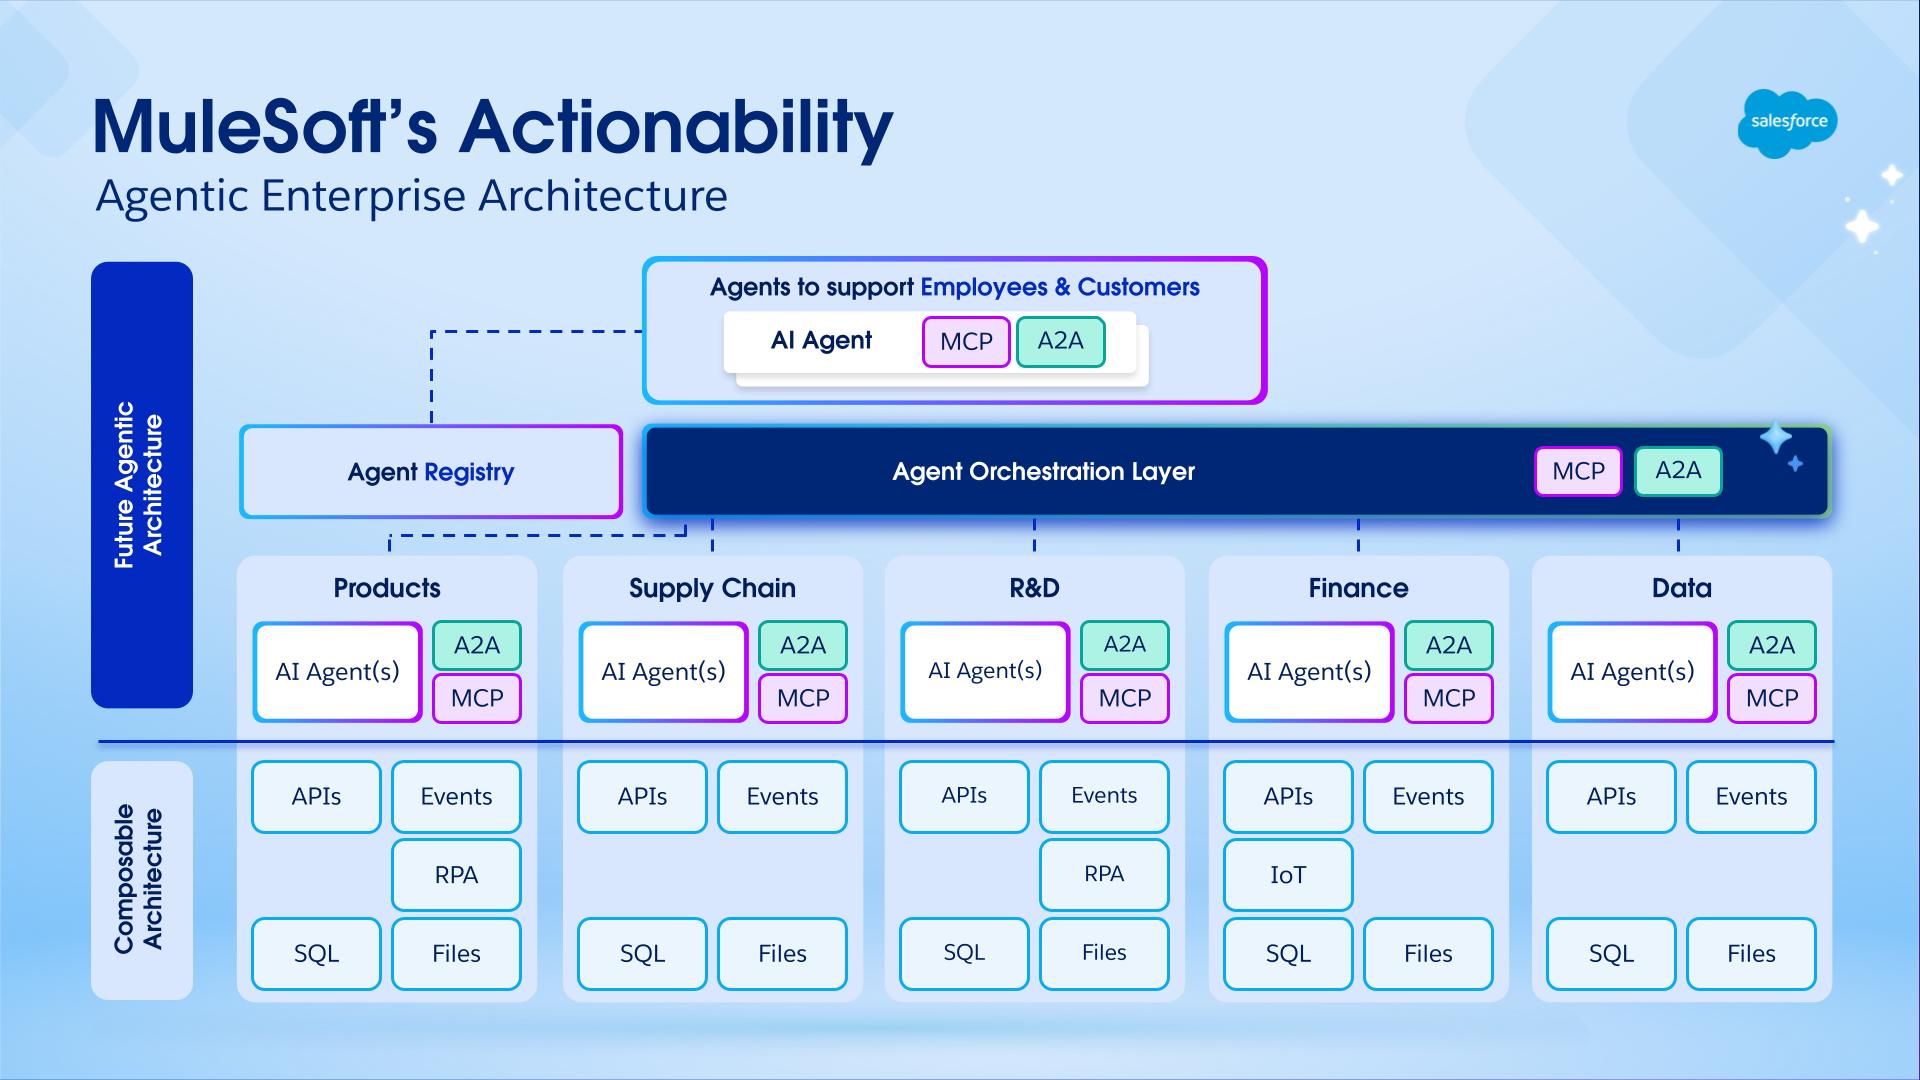 ## 작성자 정보
Nikhil Aggarwal은 MuleSoft 및 Salesforce Automation Cloud의 아키텍처를 이끄는 Salesforce의 주 아키텍처입니다. Nikhil은 대규모 제품을 제공하는 데 18년 이상의 경험을 보유하고 있으며 확장 가능한 아키텍처, 직관적인 개발자 경험, 고성능 팀 구축에 열정적입니다. Salesforce 이전에는 Microsoft Power Platform, Dataverse, Office 365의 여러 이니셔티브를 개념부터 출시까지 이끌었습니다. 그는 계속해서 AI 우선 시대의 현대 기업이 시스템을 연결하고, 워크플로를 자동화하고, 비즈니스 가치를 확보하는 방식을 구축합니다.
Mariano Gonzalez는 2011년 MuleSoft에 입사하여 미션 크리티컬 분산 시스템, 통합, PaaS, 클라우드 컴퓨팅을 전문으로 했습니다. 현재 Mariano는 특히 거버넌스, 오케스트레이션, 검색, 관찰 가능성에 중점을 두고 AI 플랫폼을 발전시키는 데 중점을 두고 있습니다. IT 업계에서 20년 이상 근무한 Mariano는 소프트웨어 아키텍처 및 팀 리더로서 농업, 에너지, 정부, IT, 통신, 콘텐츠 관리 분야에서 BPM, ERP, 통합 솔루션을 설계 및 제공했습니다.
Pedro Colunga는 Salesforce의 API 및 메타데이터 아키텍처 전문 소프트웨어 엔지니어 아키텍처입니다. Pedro는 전체 플랫폼 수명 주기에 중점을 두고 조직이 시스템 인텔리전스, 의미론, 메타데이터 중심 솔루션과 상호 작용하는 방식을 구성하는 데 중요한 역할을 합니다. 기업가 경험을 포함한 Pedro의 20년 경력은 후고, BEA Systems, Oracle, 나중에 MuleSoft에 인수된 TekGenesis와 같은 회사에 걸쳐 있으며, 그곳에서 지속적으로 플랫폼 방식 아키텍처를 구동하여 BPM, RAD, 통합과 같은 영역에서 심층적인 전문 지식을 제공했습니다.
Gulal Kumar는 데이터 및 통합 아키텍처에 중점을 둔 Salesforce의 소프트웨어 엔지니어링 아키텍처입니다. 통합 및 API, 현대화 프로그램, 보안, AIML 이니셔티브 분야에서 20년 이상의 경험을 보유한 그는 풍부한 전문 지식을 제공합니다. Gulal은 비즈니스 전환 이니셔티브를 발전시키고, 보안 및 복원 능력을 향상하고, 아키텍처 우수성을 촉진하고, 다양한 도메인 전반에 걸쳐 AIML 이니셔티브를 선도하기 위해 노력하고 있습니다.
## 구성 가능한 통합에서 관리되는 에이전트 엔터프라이즈로 이동
에이전트 엔터프라이즈로의 전환은 클라우드 시작 이후에 가장 중요한 아키텍처 변화입니다. 이는 전례 없는 수준의 생산성과 자동화를 약속하지만, 거버넌스, 보안, 운영 복잡성과 관련된 심각한 문제도 제시합니다. 통합 전략 없이 조각식으로 에이전트를 배포하는 방법을 사용하면 기술 부채와 조직 혼란으로 바로 이동할 수 있습니다.
중앙 관리 플레인을 사용하지 않고 에이전트를 배포하면 직접 시스템 액세스의 보안 취약점, 에이전트 상호 작용 및 작업에 대한 관찰 가능성 부족, 중복된 지점 간 통합으로 인한 높은 비용 등 상당한 운영 위험이 발생합니다. 이 사일로형 배포 전략으로 인해 대규모로 관리하기 어려운 취약한 환경이 생깁니다. 지속 가능 모델은 에이전트 통합 및 거버넌스를 위한 통합 플랫폼이 필요합니다.
_MuleSoft는_ 포괄적이고 통합된 개방형 플랫폼을 제공하여 기업의 여정 전체를 안전하게 안내합니다. 에이전트 작업을 위한 기초로 기업의 기존 API 환경을 활용하고 신뢰할 수 있는 AI 기반 개발 수명 주기를 통해 새로운 에이전트 지원 자산을 신속하게 생성합니다. MCP(모델 컨텍스트 프로토콜) 및 Agent2Agent(A2A) 프로토콜과 같은 개방형 표준에 대한 엔터프라이즈급 지원을 통해 AI 환경의 발전과 상관없이 간단한 명령과 복잡한 다중 에이전트 공동 작업 모두에서 이러한 자산을 실행할 수 있습니다. [_MuleSoft Agent Fabric은_](https://docs.mulesoft.com/agent-fabric/) 전체 에이전트 생태계를 검색, 오케스트레이션, 관리 및 관찰할 수 있는 솔루션을 제공합니다. 이 통합 접근 방식을 통해, _MuleSoft Agent Fabric은_ 신뢰할 수 있는 AI 에이전트의 네트워크 확장에 대한 입증된 기반을 제공합니다. 이 네트워크는 AI의 약속을 실질적이고 자동화된 비즈니스 결과로 전환하고 지능형 엔터프라이즈의 모든 잠재력을 실현합니다.
## **실행 가능한 AI를 위한 컴포지블 기반**
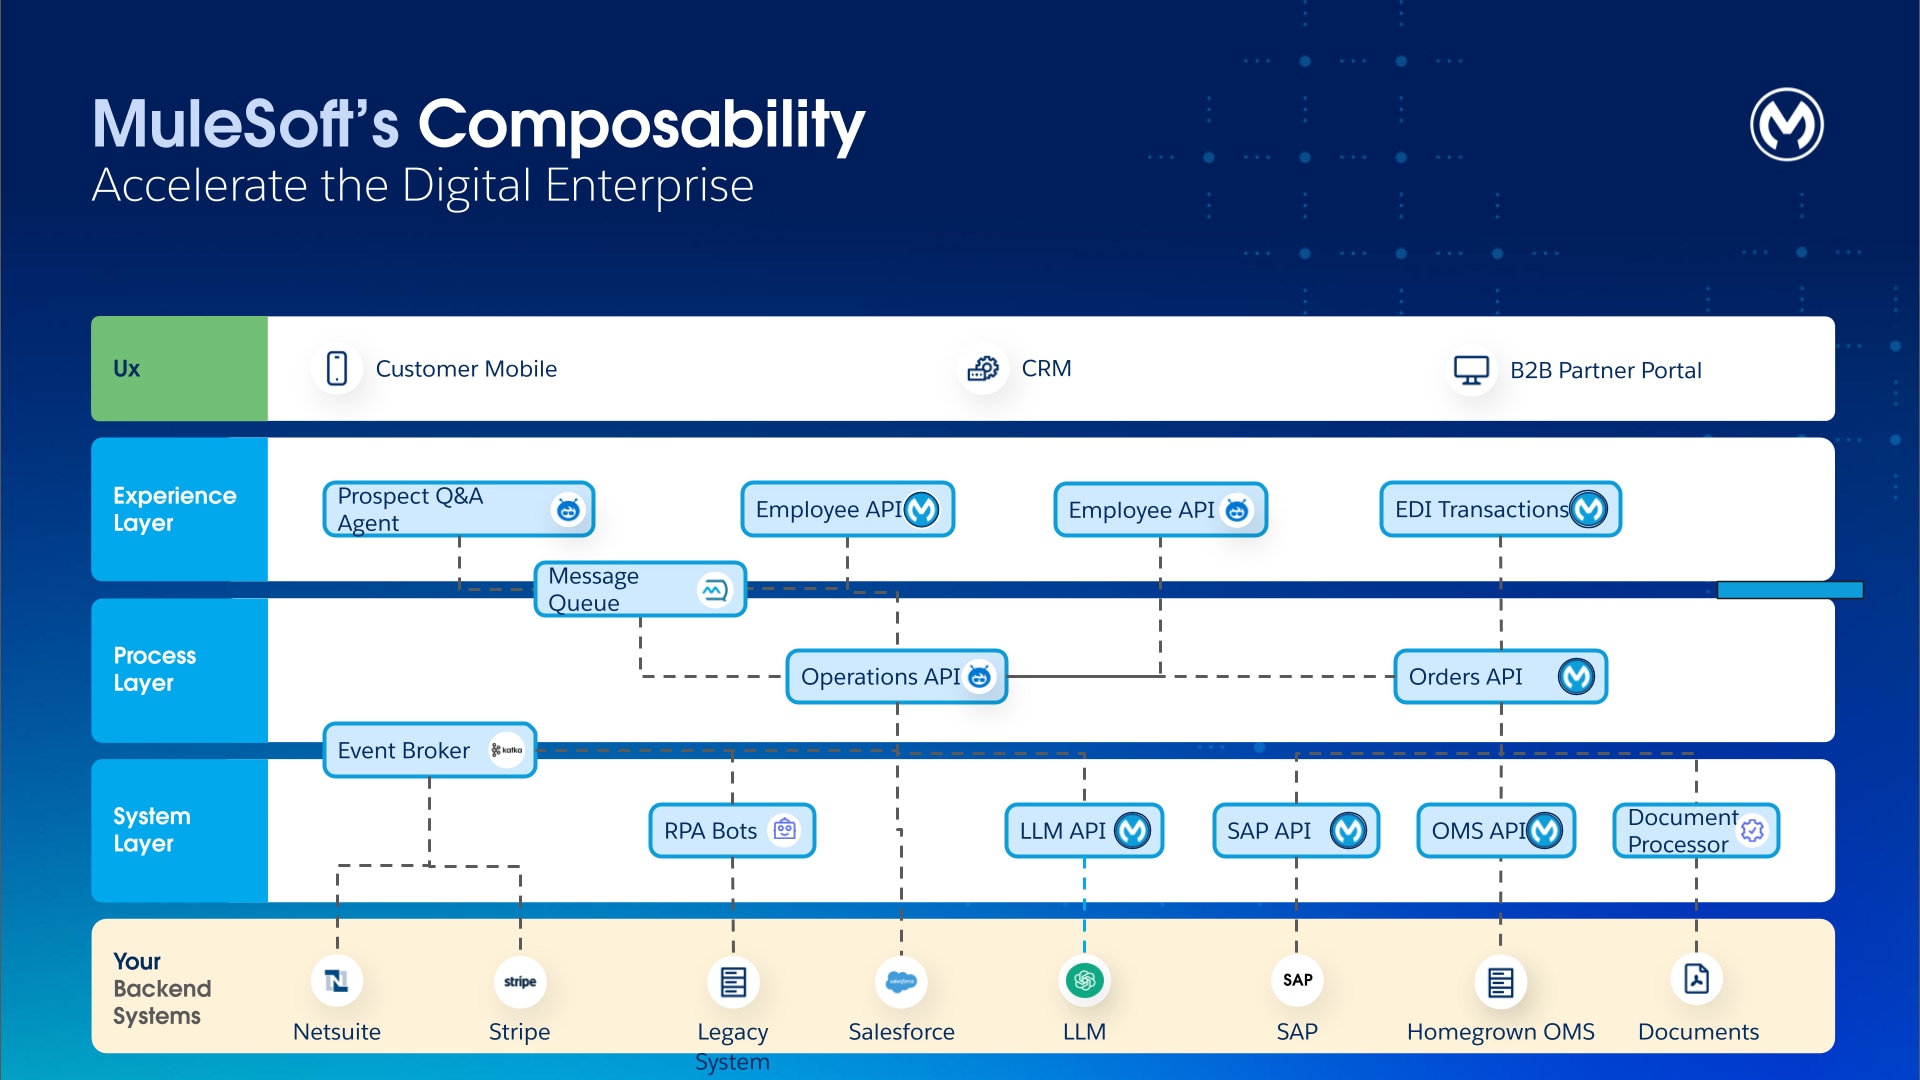 구축된 API 기반 연결의 3계층 접근 방식(시스템, 프로세스, 익스피리언스 API)은 에이전트의 실행성을 구성하는 강력한 프레임워크를 제공합니다.
- **시스템 API는** 기본 레코드 시스템에 일관되고 안전하며 추상화된 인터페이스를 제공합니다. 백엔드 프로토콜 및 데이터 모델의 복잡성에서 에이전트를 분리하여 모든 에이전트 작업이 관리되고 신뢰할 수 있는 끝점에서 수행되도록 합니다.
- 복잡한 다단계 비즈니스 논리를 캡슐화하는 **프로세스 API** 에이전트는 세일즈 주문 생성, 재고 점검 또는 배송 시작의 복잡한 오케스트레이션을 이해할 필요가 없습니다. 기본 복잡성을 처리하지 않아도 프로세스 API(예: "프로세스 주문")를 사용할 수 있습니다. 프로세스 API는 에이전트가 비즈니스 프로세스를 실행할 수 있는 안전하고 트랜잭션적이며 감사 가능한 메커니즘을 제공하므로 에이전트의 필요한 추론을 크게 줄이고 비즈니스 규칙이 일관되게 적용되도록 합니다.
- **Experience API는** 전통적으로 특정 UI 애플리케이션(예: 주문 관리 앱)을 제공하도록 설계되었지만, 에이전트의 컨텍스트가 풍부한 작업으로도 변경할 수 있습니다. 이렇게 하면 에이전트가 다운스트림 시스템에 여러 번 호출하지 않고 주어진 과업을 수행할 수 있는 필수 정보를 확보할 수 있습니다.
## **1\. 생성 생성: 에이전트 지원 자산 개발 가속화**
에이전트가 사용할 수 있는 도구 및 기능에 대한 증가하는 수요를 충족하기 위해서는 기업이 구성 가능한 파운데이션을 구성하는 API 및 통합 개발을 가속화해야 합니다. _MuleSoft는_ 생성형 AI를 개발 수명 주기에 직접 포함하여 이 과제를 해결합니다. 이 과정은 AI를 사용하여 다른 에이전트가 소비하는 고품질 자산을 구축하는 유익한 주기를 만듭니다.
### **1.1 MuleSoft Vibes**
개발자의 경우, [MuleSoft Vibes는](https://www.mulesoft.com/platform/api/anypoint-code-builder/announcing-mulesoft-vibes) 통합 개발의 가장 반복적인 측면을 자동화하고 전체 소프트웨어 개발 수명 주기 동안 통합된 에이전트 인터페이스를 제공함으로써 지능적인 파트너 역할을 합니다. [Anypoint Code Builder](https://docs.mulesoft.com/anypoint-code-builder/)의 MuleSoft Vibes를 통해 개발자는 [신뢰할 수 있는 _Einstein AI 파이프라인_](https://blogs.mulesoft.com/automation/how-mulesoft-turns-generative-output-into-value/)에서 제공되는 생성 기능과 상호 작용하여 AI 지원 개발 프로세스를 원활하고 효율적으로 만듭니다. 이 파이프라인 - _인벤션 그래프 실행 서비스(IGES)_ \- 고품질의 결과를 달성하기 위해 사용되는 다단계 프로세스입니다. 이는 기초 교육, 유효성 검사, 오류 정정, 엄격한 평가로 구성됩니다.
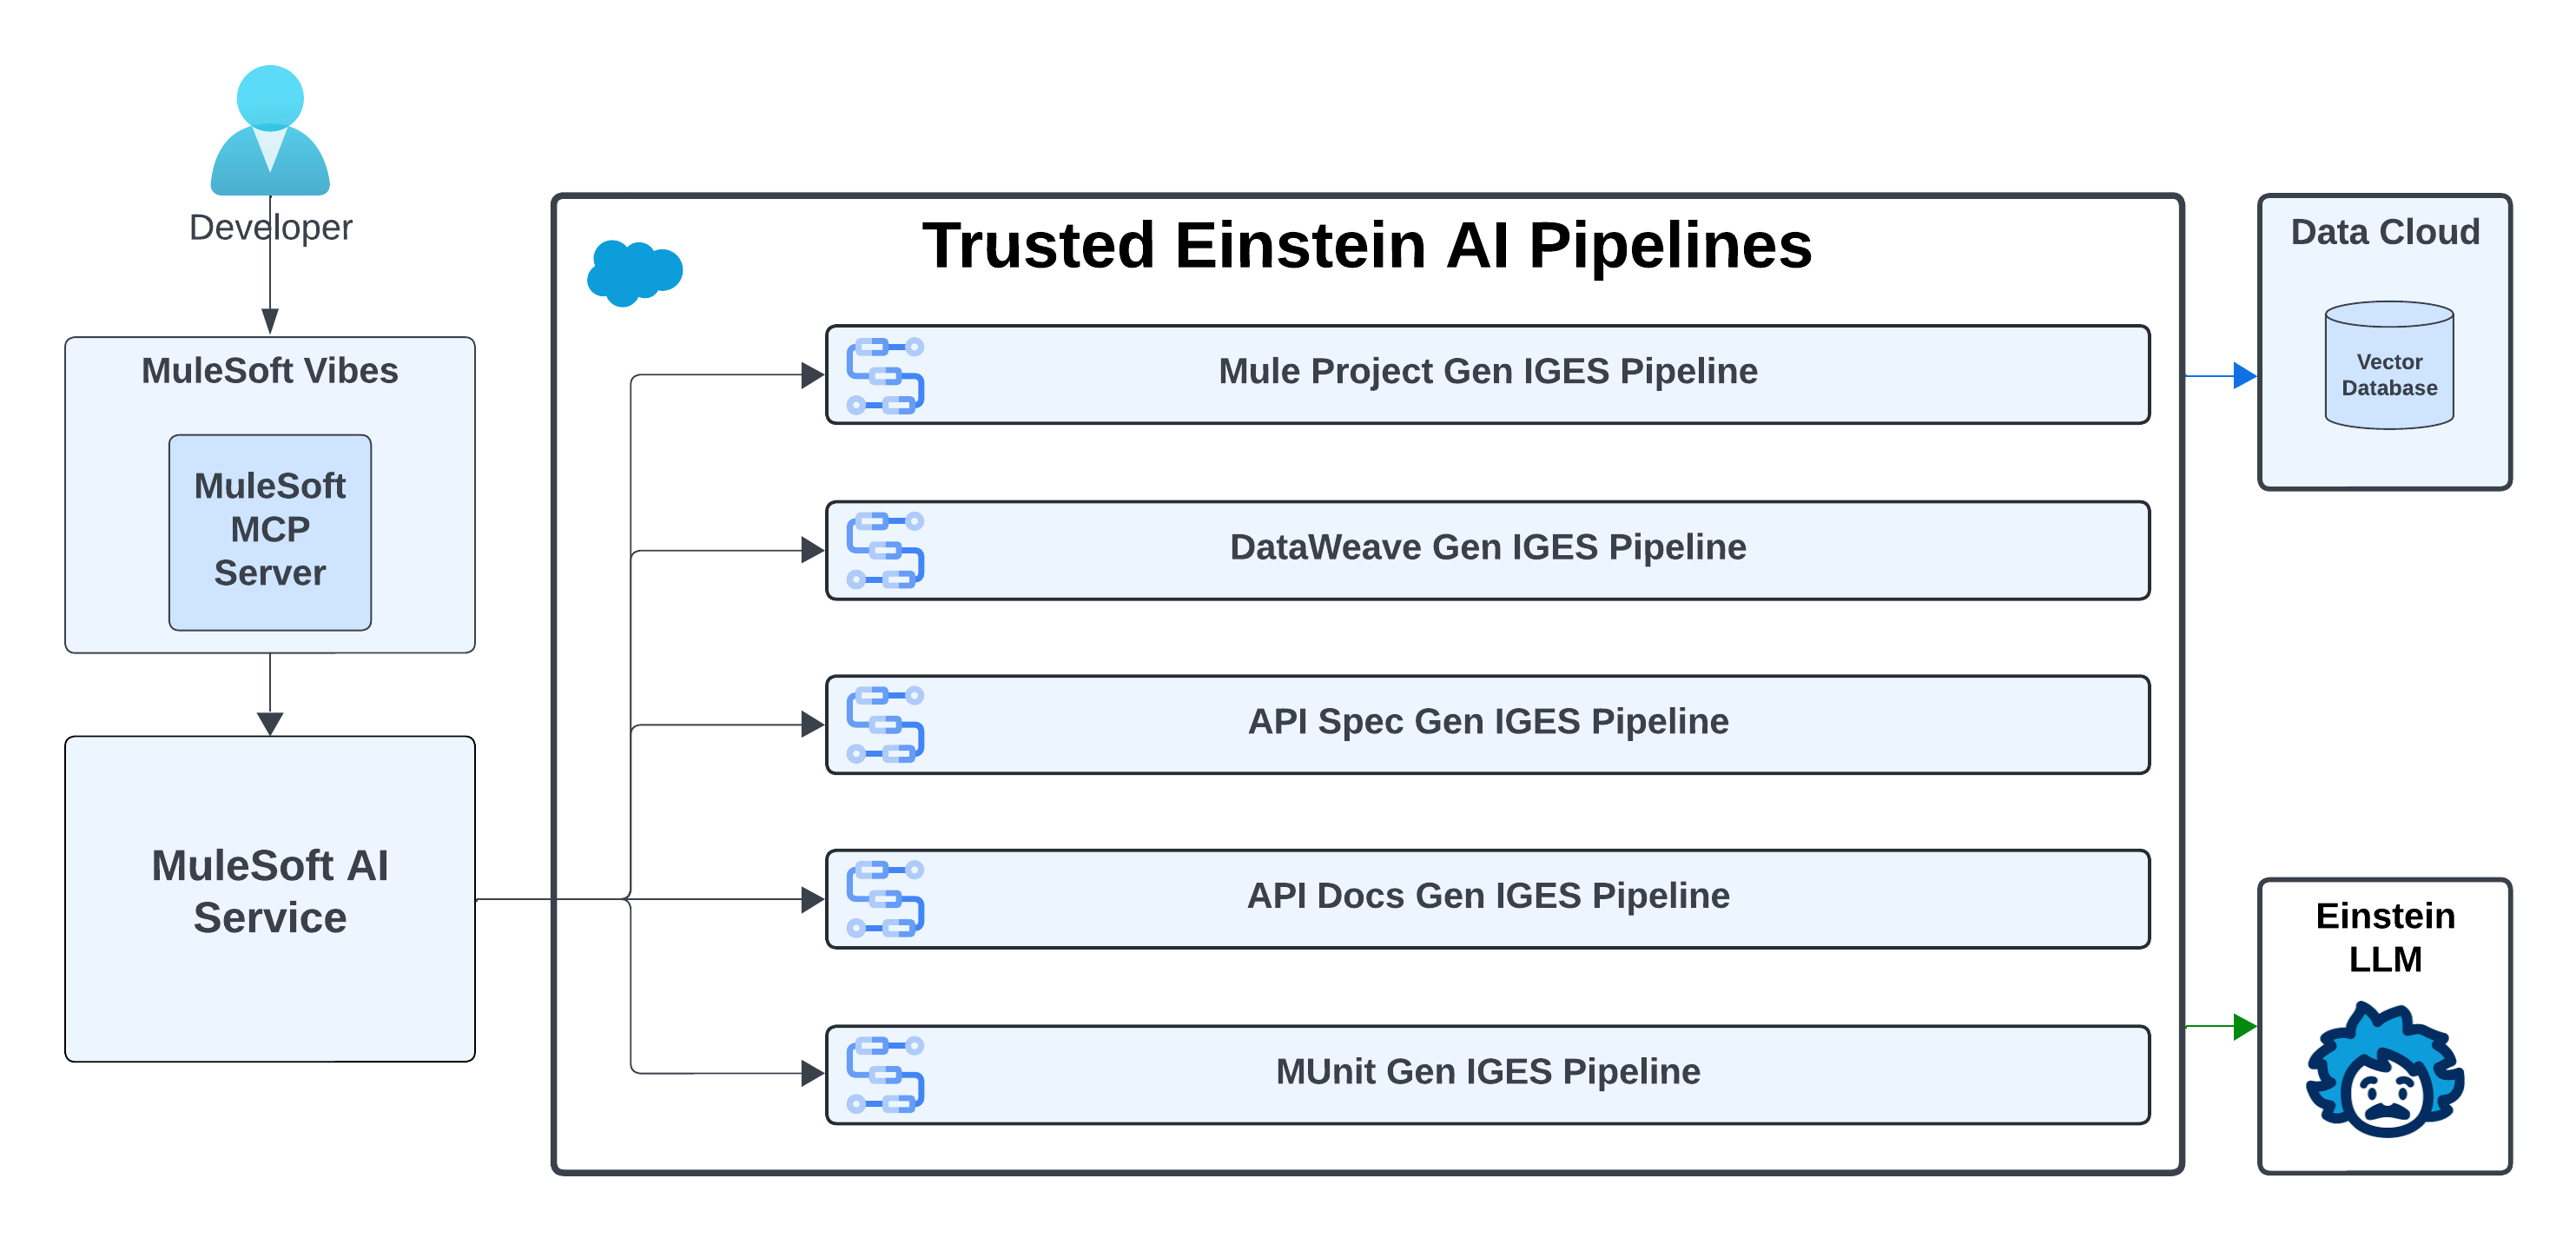 - *MuleSoft Vibes*의 [**Generative Flows**](https://blogs.mulesoft.com/dev-guides/einstein-for-acb/) 기능은 _Agentforce AI_ 프레임워크를 기반으로 구축됩니다. 자연어 비즈니스 논리(사용자 프롬프트)를 기능적인 Mule 응용 프로그램으로 변환합니다. *IGES 파이프라인*은 다음 단계로 구성됩니다.
- **대화 내역 요약:** LLM은 현재 프롬프트 및 사용자의 이전 메시지를 분석하여 사용자 의도 및 대화 내역을 수집하는 요약 프롬프트를 만듭니다. 이 통합 프롬프트는 후속 데이터 검색 및 생성 단계의 정확성을 향상합니다.
- **벡터 데이터베이스에서 플로 시맨틱 검색:** 시스템은 이전 단계에서 요약된 프롬프트를 가져와 200개 이상의 커넥터, 7,000개 이상의 커넥터 작업, 7,000개 이상의 샘플 코드 조각이 포함된 벡터 데이터베이스에 대한 시맨틱 검색을 수행합니다. 정확한 데이터를 사용하여 생성 프로세스를 기반으로 가장 관련성이 높은 커넥터, 작업, 코드 예를 검색하고 출력이 MuleSoft의 광범위한 커넥터 에코시스템에 부합하는지 확인합니다. MuleSoft는 커넥터 및 운영에 대한 업계 표준이므로 이 기초 교육을 통해 일반 LLM이 부족한 풍부한 컨텍스트 및 도메인 정확성을 모델에 제공합니다.
- **추가:** 검색된 콘텐츠 및 대화 내역 메시지가 요약된 프롬프트와 결합됩니다. 이 증가 프롬프트는 LLM에서 환각을 줄이도록 안내합니다. 또한 독성 콘텐츠가 생성되지 않도록 방지하는 지침도 포함되어 있습니다.
- **플로 생성:** 이 단계에서는 _Einstein AI LLM_ 모델을 활용하여 제공된 컨텍스트와 예를 기반으로 원시 XML 코드를 생성합니다. 이는 생성 파이프라인의 핵심 단계입니다.
- **후 처리 및 검증:** 사후 처리 및 유효성 검사기는 코드를 검사하여 올바른 구문 및 유효한 커넥터 작업 사용을 확인하고 별도의 독성 검사를 통해 유해한 콘텐츠에 플래그를 지정합니다.
- **다단계 오류 수정:** 모든 초기 생성이 유효하지 않은 경우 자동 오류 정정 메커니즘이 오류 메시지를 분석하여 패턴을 감지합니다. 그런 다음, 보강된 오류 메시지 및 수정 메타데이터와 함께 LLM에 프롬프트를 다시 제출합니다.
- **파일 생성 구성:** 이 단계는 관련 커넥터 메타데이터를 추출하고 프롬프트를 증가시키고 LLM에 전송하여 정확한 커넥터 구성을 생성합니다. 마지막으로 모든 POM 및 XML 네임스페이스는 최신 버전의 각 종속성을 사용하여 결정적으로 생성되므로 환각을 없애고 일관성을 보장합니다.
- [**DataWeave Transformation Generation**](https://blogs.mulesoft.com/dev-guides/dataweave-generative-transformation/)**:** 데이터 변환은 통합 개발에서 가장 시간이 많이 소요되는 부분입니다. *MuleSoft Vibes*는 _Mule Flow XML_ 생성과 유사한 다단계 접근 방식을 사용하여 이 프로세스를 해결합니다.
- **의도 이유:** LLM은 사용자 입력 및 출력 데이터 샘플을 분석하여 자연어로 높은 수준의 변환 논리를 추론하고 명확하게 설명합니다. 이 단계는 프롬프트에서 제공된 리터럴 데이터 값과 사용자의 목표를 구분합니다.
- **DataWeave 시맨틱 검색:** 가장 시맨틱하게 관련성이 높은 DataWeave 함수 문서와 완전한 변환 예제를 찾기 위해 이전 단계에서 생성된 프롬프트를 쿼리로 벡터 데이터베이스에 사용합니다. 이를 통해 고품질의 확인된 정보로 생성 프로세스를 기반으로 합니다.
- **추가:** 검색된 함수 및 예제가 원래 사용자 프롬프트와 결합되어 후속 LLM 호출에 대한 컨텍스트 인식 지침 집합을 만들어 LLM의 행동에 영향을 미치고 환각을 줄입니다.
- **DataWeave 생성:** 이 단계는 LLM 모델을 활용하여 제공된 컨텍스트 및 예제를 기반으로 하는 DataWeave 변환 스크립트와 첨부 설명을 생성합니다. 이는 생성 파이프라인의 핵심 단계입니다.
- **후 처리 및 검증** 생성된 스크립트는 두 가지 특정 메트릭(유효성 및 정확성)을 기준으로 평가됩니다. 스크립트는 구문 오류(유효성) 없이 컴파일하고 샘플 입력을 사용하여 실행할 때 예상 출력을 생성해야 합니다(정확성).
- **다단계 오류 수정:** 초기 확인에 실패할 경우 이 플러그인은 오류 범주를 식별하고 생성된 스크립트의 문제를 수정합니다. 이 구체화는 전반적인 시스템 성공률 및 정확도를 향상하는 데 도움이 됩니다.
- **마지막 후처리 및 검증** 오류 수정 모듈의 수정된 스크립트는 구문적으로 유효하고 기능적으로 올바른지 확인하기 위해 재검증 프로세스를 거칩니다. 이 최종 품질 게이트는 사용자에게 다시 보내기 전에 출력이 정확하고 신뢰할 수 있도록 합니다.
- [**API 사양**](https://docs.mulesoft.com/anypoint-code-builder/api-ai-create-spec) **및 [문서 생성](https://docs.mulesoft.com/exchange/generating-documentation-with-ai):** 개발자는 원하는 API를 자연어로 설명하여 완전히 검증된 _OpenAPI(OAS)_ 또는 _RAML_ 사양을 생성할 수 있습니다. _MuleSoft Vibes는_ 프롬프트(자원, 메서드, 보안 스키마 및 매개 변수에 대한 세부 사항 포함)를 수집하고 유효하고 구문적으로 올바른 API 정의를 생성합니다. 생성 후 *Anypoint Exchange*에서 API에 대한 문서를 생성할 수 있습니다. 이 문서는 인증부터 엔드포인트 세부 사항 및 오류 처리에 이르기까지 모든 것을 다룹니다. 그러면 개발자는 이러한 종류의 지루한 작업에서 벗어날 수 있습니다.
- **AI 지원 MUnit 생성:** 자율 에이전트가 소비하는 자산의 경우 품질 보증이 중요합니다. _MuleSoft Vibes는_ Mule 플로 코드에서 직접 MUnit 테스트 사례를 생성하는 데 도움이 됩니다. 이를 통해 외부 종속성 및 어설션을 모의하고 일반적인 테스트 공백을 식별할 수 있습니다. 따라서 높은 테스트 범위를 달성하고 통합 논리의 신뢰성을 보장하는 데 필요한 수작업 노력이 크게 줄어듭니다.
### **1.2 MuleSoft Your Way**
개발자는 선호하는 환경에서 번영합니다. 따라서 _MuleSoft는_ 개발자를 어디서나 만날 수 있으므로 선택한 AI IDE에 통합을 구축할 수 있습니다. [MuleSoft의 MCP(모델 컨텍스트 프로토콜) 서버](https://www.npmjs.com/package/@mulesoft/mcp-server)는 모든 VS 코드 기반 AI 기본 IDE(예: Cursor, Windsurf 또는 Trae)가 자연어를 사용하여 *Anypoint Platform*과 상호 작용하기 위해 사용할 수 있는 MCP 도구로 개발, 배포 및 관리 기능을 공개합니다.
핵심 IDE 기능을 [표준 VS 코드 확장 프로그램](https://marketplace.visualstudio.com/items?itemName=salesforce.mule-dx-extension-pack)에 패키지화함으로써, _MuleSoft는_ 브랜드 IDE 셸에서 도구를 분리하여 개발 도구가 IDE를 무시할 수 있게 합니다. 이 아키텍처를 선택하면 빠르게 발전하는 아이디어와 경쟁하는 대신 MuleSoft의 개발 도구가 현대 AI 기반 아이디어의 성장하는 에코시스템 전체에서 호환되고 액세스할 수 있습니다.
## **2\. 실천 가능성 활성화: API를 에이전트를 위한 도구로 전환**
에이전트 엔터프라이즈에서는 구성 가능한 API의 강력한 기반이 필요하지만 충분하지 않습니다. 다음 중요한 단계는 해당 자산을 AI 에이전트가 검색하고 이해하고 호출할 수 있는지 확인하는 것입니다. 이를 위해 특별히 에이전트 커뮤니케이션을 위해 설계된 개방형 표준에 구축된 "실행 가능성 계층"이 필요합니다. _MuleSoft는_ 두 가지 주요 신규 프로토콜에 대한 엔터프라이즈급 툴링을 제공합니다.
- 에이전트-시스템 상호 작용을 위한 **MCP**
- 에이전트 간 상호 작용을 위한 **A2A**
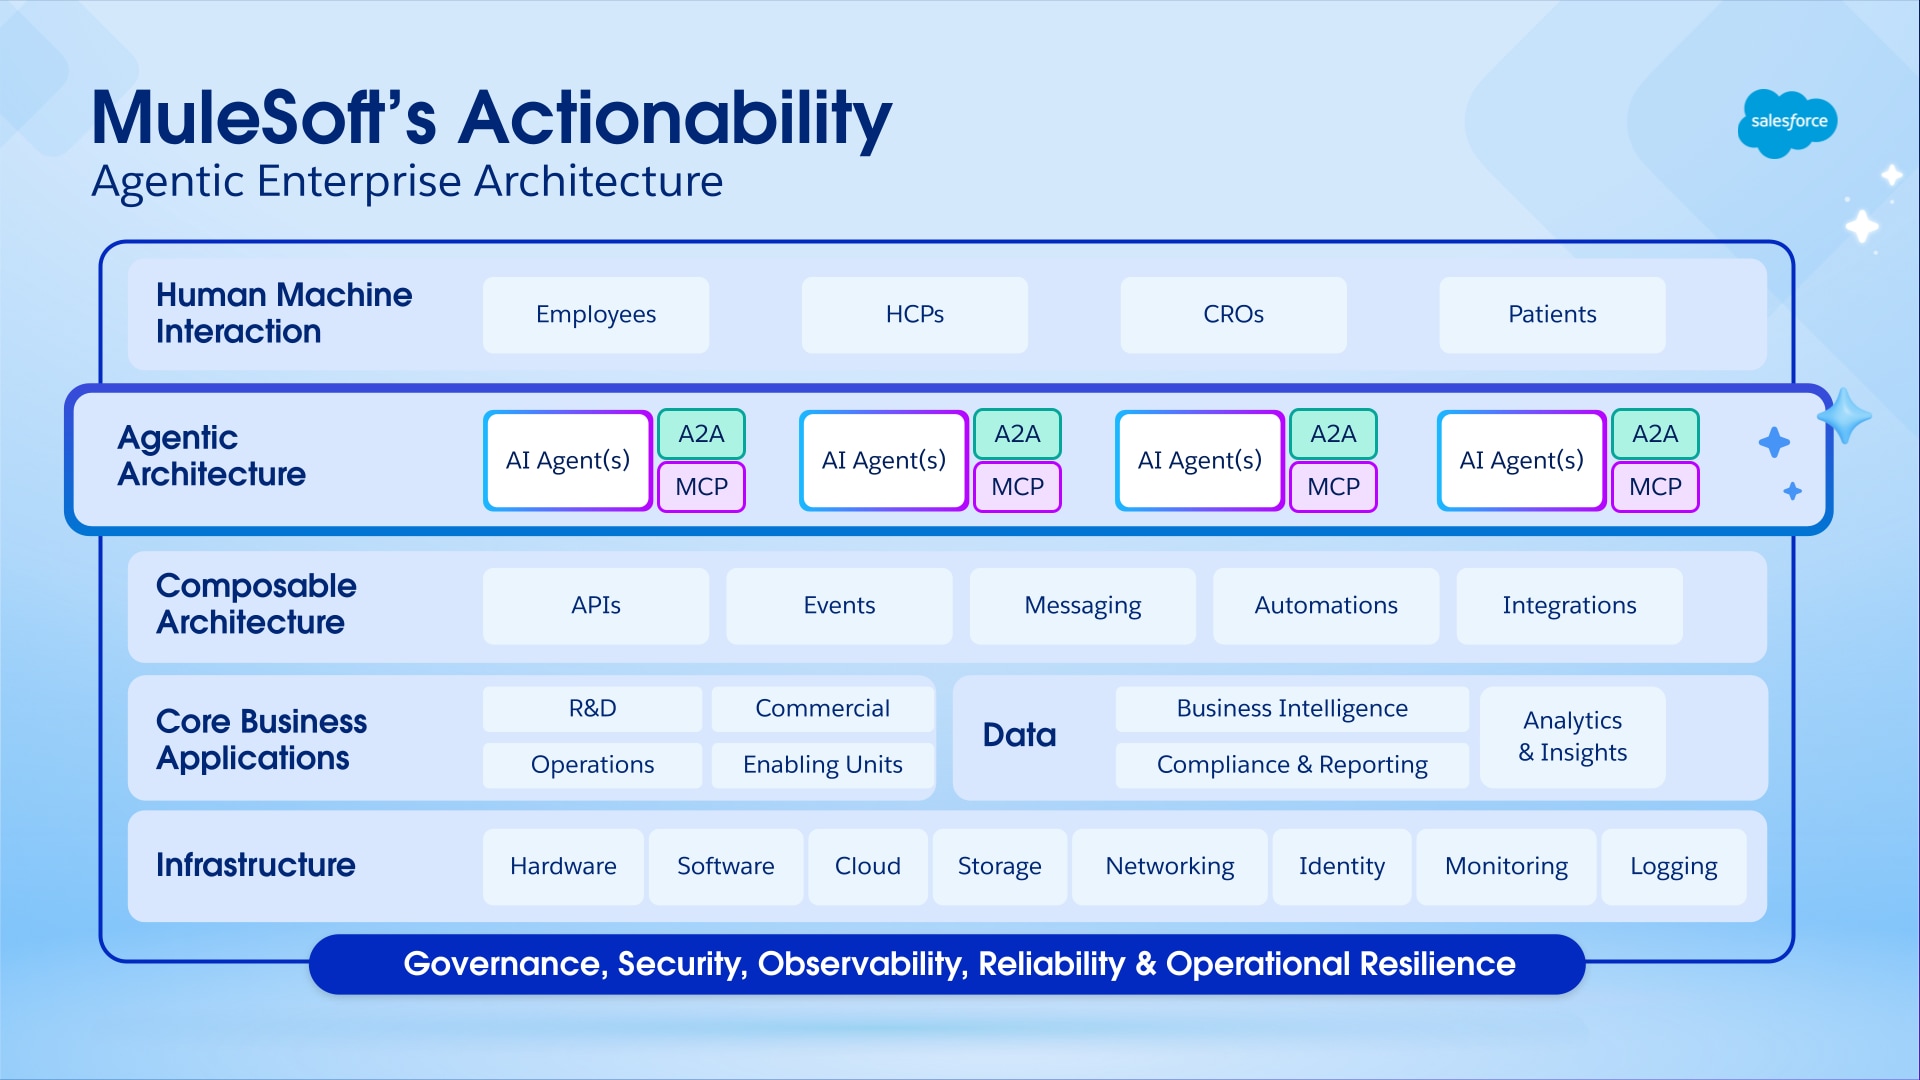 ### **2.1 모델 컨텍스트 프로토콜(MCP)**
_MCP_ 는 에이전트-도구 간 통신을 위한 업계 표준으로 빠르게 진화하였으며, 이는 _REST_ 가 웹 서비스에 적용된 것과 유사합니다. _MCP를 사용하면_ AI 에이전트가 사전 프로그래밍되거나 하드 코딩된 논리 없이 시스템의 기능을 동적으로 발견하고, 입력 및 출력을 이해하고, 작업을 수행하기 위해 호출할 수 있습니다.
[MuleSoft MCP 커넥터를 사용하면](https://docs.mulesoft.com/mcp-connector/latest/) Mule 애플리케이션으로 구현된 모든 API를 MCP 서버로 게시할 수 있습니다. _MuleSoft는_ 거의 모든 주요 엔터프라이즈 시스템(예: SaaS, 레거시 및 데이터베이스)에 수백 개의 사전 구축 커넥터를 제공하므로 즉시 조직의 API 및 애플리케이션을 에이전트가 사용할 수 있는 도구로 전환합니다. SAP에서 재고를 확인하기 위해 설계된 API, Salesforce에서 새 리드를 처리하는 플로 또는 _MuleSoft를 통해_ 연결된 사용자 정의 응용 프로그램은 모두 _MCP 커넥터를_ 사용하여 AI 에이전트에게 원자식 관리 도구로 제공될 수 있습니다.
### **2.2 에이전트 간 프로토콜(A2A)**
_MCP는_ 계층적, 에이전트 호출 도구 상호 작용에서 우수하지만, 복잡한 비즈니스 프로세스에서는 종종 여러 전문 에이전트 간의 협업이 필요합니다. _A2A(Agent-to-Agent)_ 프로토콜은 정교한 다중 에이전트 워크플로를 가능하게 하는 피어 투 피어 통신을 촉진하도록 설계된 새로운 개방형 표준입니다.
MuleSoft의 A2A 지원을 통해 엔터프라이즈는 API에 대해 기대하는 것과 동일한 수준의 관리 및 신뢰성을 갖춘 고급 시스템을 설계 및 구축할 수 있습니다. [MuleSoft A2A 커넥터를 사용하면](https://docs.mulesoft.com/a2a-connector/latest/) 개발자가 에이전트를 A2A 서버로 쉽게 노출하거나 Mule 애플리케이션에서 A2A 호환 에이전트를 호출할 수 있습니다. 예를 들어, 주택 담보 대출 신청 프로세스는 "신용 확인 에이전트", "문서 서명 에이전트" 및 "규제 준수 에이전트" 간에 오케스트레이션될 수 있으며, 각 에이전트가 다른 에이전트의 기능을 찾아 필요에 따라 호출하여 응용 프로그램을 진행합니다.
MCP 및 A2A에 강력한 엔터프라이즈급 도구를 제공함으로써 MuleSoft는 직접 에이전트-시스템 상호 작용(MCP 도구를 통해) 및 에이전트-에이전트(A2A) 상호 작용으로 구성된 유연한 에코시스템 구축을 지원합니다. AI 환경이 어떻게 진화하든 상관없이 이 접근 방식은 모든 형태의 에이전트 커뮤니케이션을 연결하는 기본 기반으로 _MuleSoft를_ 배치합니다.
## **3\. MuleSoft Agent Fabric: 에이전트 엔터프라이즈의 중앙 신경계**
엔터프라이즈가 에이전트 AI를 도입함에 따라 에이전트 확산의 과제가 반드시 발생합니다. 이 상황이 혼란스러워지는 것을 방지하려면 전용 오케스트레이션 레이어가 필요합니다. [MuleSoft Agent Fabric](https://docs.mulesoft.com/agent-fabric/)([데모](https://www.youtube.com/watch?v=GAqwPie16ic))은 이 문제를 직접 해결하도록 설계된 포괄적인 아키텍처 솔루션입니다. AI 에이전트가 구축된 위치 또는 운영 방식과 상관없이 전체 네트워크를 검색, 관리, 오케스트레이션, 관찰할 수 있는 중앙 관리 플레인을 제공합니다. _MuleSoft Agent Fabric은_ 엔터프라이즈의 디지털 인력에 대한 "항공 이동 통제자" 역할을 하여 분할된 단독 에이전트 컬렉션을 일관되고 안전하며 고성능 인텔리전스 네트워크로 전환합니다.
*MuleSoft Agent Fabric*은 최상위 엔터프라이즈 자산으로 에이전트의 전체 수명 주기 관리를 다루는 네 가지 통합 기둥에 기반합니다.
### **3.1 에이전트 등록(검색)**
관리되는 모든 생태계의 기반은 발견 가능성입니다. _에이전트 레지스트리는_ 기업 내의 모든 에이전트 자산에 대한 보편적이고 중앙 집중식 카탈로그 역할을 합니다. 여기에는 사용자 정의 빌드 에이전트, SaaS 응용 프로그램에 포함된 에이전트, 레거시 시스템을 노출하는 MCP 서버, 에이전트 간 공동 작업을 위한 A2A 끝점이 포함됩니다. 단일한 진실 소스를 제공함으로써, _에이전트 레지스트리는_ 팀이 과도한 기능을 구축하는 것을 방지하고 인간 개발자 및 기타 AI 에이전트가 대규모로 기존 자산을 동적으로 찾고 재사용할 수 있도록 지원함으로써 중요한 검색 문제를 해결합니다.
 *에이전트 레지스트리*는 _Anypoint Exchange를 기반으로_ 하며 다음 세 가지 새로운 자산 유형을 추가합니다. 에이전트, MCP 서버 및 LLM 에이전트와 사용하는 MCP 서버 및 도구 간의 종속성뿐만 아니라 MCP 도구, 전송 프로토콜, 에이전트 카드 등 해당 자산에 대한 정보를 수집합니다. 개발자는 레지스트리 내에서 직접 자산을 만들고 관리할 수 있습니다. 또한 새 오케스트레이션을 생성할 때 MuleSoft Vibes 내의 기존 자산을 프로그래밍 방식으로 검색하고 재사용할 수 있습니다(_MuleSoft MCP Server의_ search_asset 도구를 통해). 이렇게 하면 개발자가 해당 자산을 이해하고 사용하는 데 필요한 모든 정보를 확보할 수 있습니다.
### **3.2 에이전트 브로커 (오케스트레이트)**
자산을 검색할 수 있게 되면 유용한 작업을 수행하기 위해 오케스트레이션해야 합니다. *에이전트 브로커*는 다단계 비즈니스 프로세스를 실행하는 오케스트레이션 서비스입니다. 구성 가능한 LLM을 사용하여 상위 수준 과업을 해석하고 해당 워크플로를 생성합니다. _에이전트 브로커는_ 이러한 프로세스를 완료하기 위해 필요한 에이전트와 도구를 동적으로 검색하고 순서대로 호출합니다.
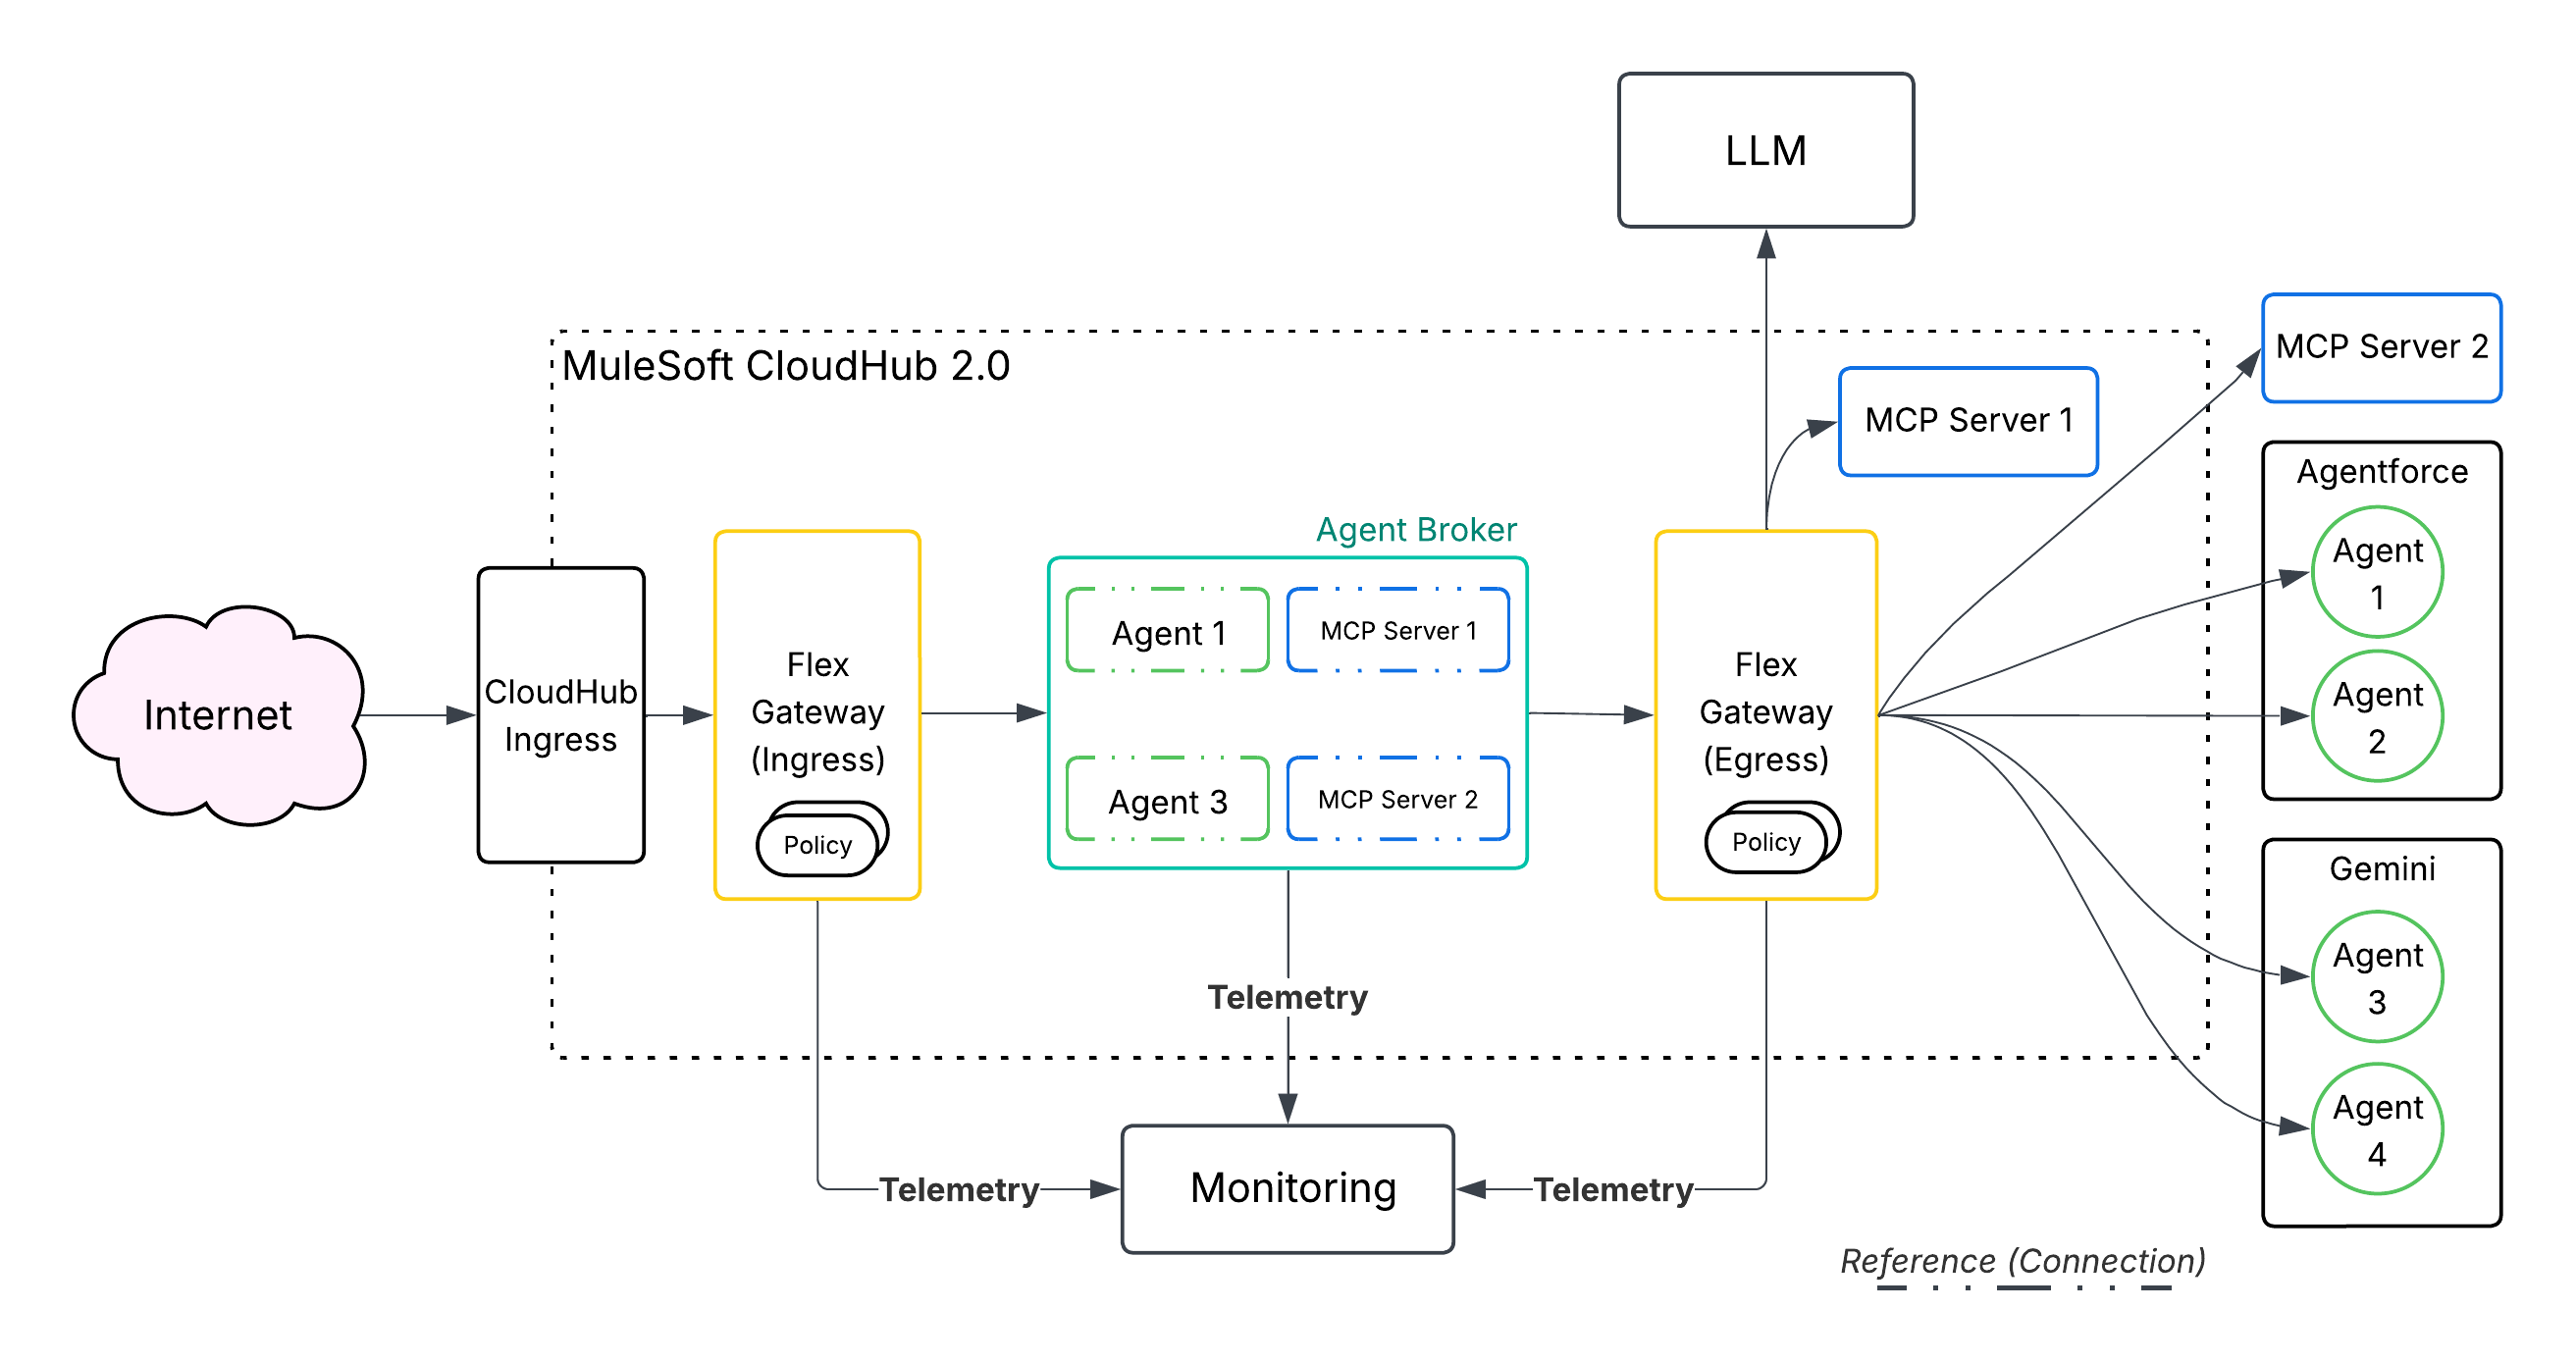 연결은 도구를 위한 _MCP_ 및 에이전트를 위한 _A2A_ 프로토콜을 통해 관리됩니다. 이렇게 하면 시스템에서 에이전트를 비즈니스별 도메인(예: 공급망 또는 금융)으로 구성하고 모든 도메인에 과업을 라우팅할 수 있습니다. 단일 자연어 프롬프트(예: "직원 온보딩")는 여러 백엔드 시스템에서 서로 다른 에이전트 또는 도구가 실행하는 추가 작업 순서로 분해됩니다. 에이전트 중개인 오케스트레이션에는 다음이 포함됩니다.
- **동적 오케스트레이션 패턴:** 이는 전체 목표를 달성하기 위해 하위 과업을 결정하고 가장 적합한 에이전트 및 도구에서 오케스트레이션하는 에이전트 루프 패턴입니다. 이 패턴을 활용하면 복잡한 사용 사례(예: [복잡한 서비스 에스컬레이션 처리](/docs/architect/ko-kr/fundamentals/guide/agentic-patterns#35-공동-작업-에이전트-사용-사례-복잡한-서비스-에스컬레이션))를 해결하기 위해 [공동 에이전트를](/docs/architect/ko-kr/fundamentals/guide/agentic-patterns#15-공동-작업-에이전트에이전트-스워밍) 구축할 수 있습니다.
- **LLM 지원 이유:** LLM을 사용하여 자연어 목표를 해석하고 실행 계획을 생성하므로 하드 코딩된 강력한 워크플로 논리가 필요하지 않습니다.
- **구성 가능한 LLM 모델:** 개발자가 사용할 LLM 모델을 지정할 수 있으므로 비용, 성능, 기능을 제어할 수 있습니다.
- **자연 언어 개발:** _에이전트 브로커_ 논리는 *MuleSoft Vibes*를 통해 자연어를 사용하여 정의할 수 있습니다.
- **관찰 가능:** *Anypoint Monitoring*은 배포 시 로깅 및 추적을 제공하여 사용자가 Agent Broker의 추론과 _MCP_ 도구 및 _A2A_ 에이전트와의 상호 작용을 이해하고 디버그할 수 있도록 지원합니다.
- **관리형 배포:** *Agent Broker*은 배포의 가용성 및 확장성을 관리하는 *Mule Runtime*을 지원하는 컨테이너화된 응용 프로그램입니다.
### **3.3 MCP 및 A2A용 Flex 게이트웨이(Govern)**
_Anypoint Flex Gateway_ 는 특정 정책이 기술적으로 시행되는 메커니즘입니다. _MuleSoft Agent Fabric은_ _Anypoint Flex 게이트웨이를_ 활용하여 _MCP_ 및 _A2A_ 프로토콜을 통해 발생하는 [모든 에이전트 상호 작용을 보호, 검사, 관리합니다](https://docs.mulesoft.com/gateway/latest/flex-agent-secure). 이를 통해 조직은 모든 에이전트 트래픽에 다양한 [엔터프라이즈급 정책 집합](https://docs.mulesoft.com/gateway/latest/flex-agent-policies)을 적용하여 실행하기 전에 모든 작업이 안전하고 규정 준수하며 감사할 수 있도록 할 수 있습니다. 안전하고 책임 있게 AI 채택을 확장하기 위해서는 이러한 가드 레일이 중요합니다.
| 정책 이름 | 프로토콜(s) | 설명 |
| :---------------------------------------- | :---------- | :-------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **JWT 검증 정책/클라이언트 ID 적용 정책** | A2A, MCP | **JWT 확인 정책/클라이언트 ID 적용 정책**은 인증된 호출자에 대한 액세스만 제한하여 _A2A_ 에이전트 및 _MCP_ 서버를 보호합니다. |
| **스키마 검증** | A2A, MCP | **스키마 검증**은 수신 에이전트 요청이 _A2A_ 또는 _MCP_ 사양을 준수하므로 잘못된 트래픽을 방지합니다. |
| **A2A PII 탐지기** | A2A | **A2A PII Detector는** 요청 및 응답에서 *개인 식별 정보(PII)*를 식별하고 규정 준수 요건을 충족하기 위해 로깅 또는 차단을 지원합니다. |
| **A2A 프롬프트 디코레이터** | A2A | **A2A 프롬프트 디코레이터는** 에이전트에게 보내지는 프롬프트에 사용자 정의 컨텍스트 또는 지침을 삽입하여 그들의 행동을 안내하고 가드 레일을 적용합니다. |
| **MCP 속성 기반 액세스 제어** | MCP | **MCP Attribute-Based Access Control**은 사용자 특성(예: 계층, IP 또는 JWT 클레임)을 기반으로 _MCP_ 서버에서 노출하는 특정 도구 및 리소스에 대한 액세스를 규제합니다. |
| **SSE 로깅** | A2A, MCP | 에이전트 프로토콜에서 포괄적인 감사 및 추적성을 위해 사용되는 _서버 전송 이벤트(SSE)_ 스트림의 내용을 기록하는 **SSE 로깅** |
| **율 제한 및 스파이크 제어** | A2A, MCP | **레이트 제한 및 스파이크 컨트롤**은 요청 제한을 적용하여 백엔드 에이전트 및 시스템을 트래픽 증가 및 서비스 거부 공격으로부터 보호합니다. |
| **A2A 에이전트 카드** | A2A | **A2A Agent Card는** 관리되는 Flex Gateway 인스턴스를 통해 모든 트래픽이 올바르게 프록시되도록 Agent Card URL을 다시 작성합니다. |
**에이전트 프로토콜을 위한 엔터프라이즈 거버넌스 정책**
인바운드 요청을 관리하는 것 외에도 _Anypoint Flex 게이트웨이는_ 외부 서비스(예: _MCP_ 서버 및 도구 또는 기타 에이전트)에 대한 에이전트의 모든 발신 연결 및 요청을 관리합니다. 여기에는 다음이 포함됩니다.
- **로그:** 감사 및 문제 해결을 위해 모든 아웃바운드 에이전트 요청을 모니터링하고 기록할 수 있는 중앙 집중화된 관찰 가능 지점을 제공합니다.
- **보안:** 아웃바운드 트래픽을 검사하여 중요한 데이터 누출을 방지합니다.
- **인증:** 단일 지점에서 API 키, OAuth, ClientId/ClientSecret을 비롯한 아웃바운드 인증 메커니즘을 적용하여 외부 시스템에 대한 자격 증명을 관리합니다.
사용자는 _Anypoint Flex Gateway_ [**Policy Development Kit(PDK**)](https://docs.mulesoft.com/pdk/latest/policies-pdk-overview)을 사용하여 기본 정책이 특정 요구 사항을 충족하지 않는 경우 사용자 정의 정책을 만들 수 있습니다. _PDK를_ 사용하여 개발자는 _Rust_ 프로그래밍 언어로 정책 논리를 작성하고 _WebAssembly(WASM)_ 모듈에 컴파일할 수 있습니다. 그런 다음, 독립형 모듈이 *Anypoint Flex Gateway*에 로드되어 API 가장자리에 고유한 보안 규칙, 사용자 정의 데이터 변환 또는 전문 통합 논리를 적용합니다. 이를 통해 고유하거나 복잡한 사용 사례에 대한 게이트웨이 기능을 확장할 수 있는 강력하고 고성능의 방법을 제공합니다.
다음은 _PDK_:의 네 가지 핵심 구성 요소입니다.
- **Anypoint CLI PDK 플러그인:** 이 플러그인은 _PDK_ 프로젝트를 만들고 컴파일된 정책을 *Exchange*에 업로드합니다. 또한 명확한 명령 집합을 제공하여 정책을 구축하고 관리하는 개발 프로세스를 간소화하는 *메이크파일*을 생성합니다.
- **정책 템플릿:** 새 프로젝트가 생성되면 _PDK가_ 기본 스태플로드를 생성합니다. 이 구조에는 정책을 성공적으로 컴파일하는 데 필요한 모든 필수 파일과 구성이 포함되어 있어 개발자에게 사용자 정의 논리의 시작 지점을 제공합니다.
- **SDK 빌딩 도구:** 이러한 도구는 기본 _Envoy_ 프록시의 복잡한 이벤트 기반 아키텍처를 요약합니다. _SDK는_ 반응기와 실행기 패턴을 사용하여 간단하고 선형 코딩 방법을 제공합니다. 이를 통해 복잡성을 줄이고 디버깅을 개선하며 개발자의 학습 곡선을 낮춥니다.
- **정책 관리:** [MuleSoft MCP 서버](https://docs.mulesoft.com/mulesoft-mcp-server/reference-mcp-tools)는 사용자가 사용자 정의 정책 수명 주기를 관리할 수 있도록 _MCP_ 도구를 제공합니다. 이러한 도구의 예는 다음과 같습니다.
- get_flex_gateway_policy_example
- manage_api_instance_policy
- manage_flex_gateway_policy_project
### **3.4 Agent Visualizer(관찰)**
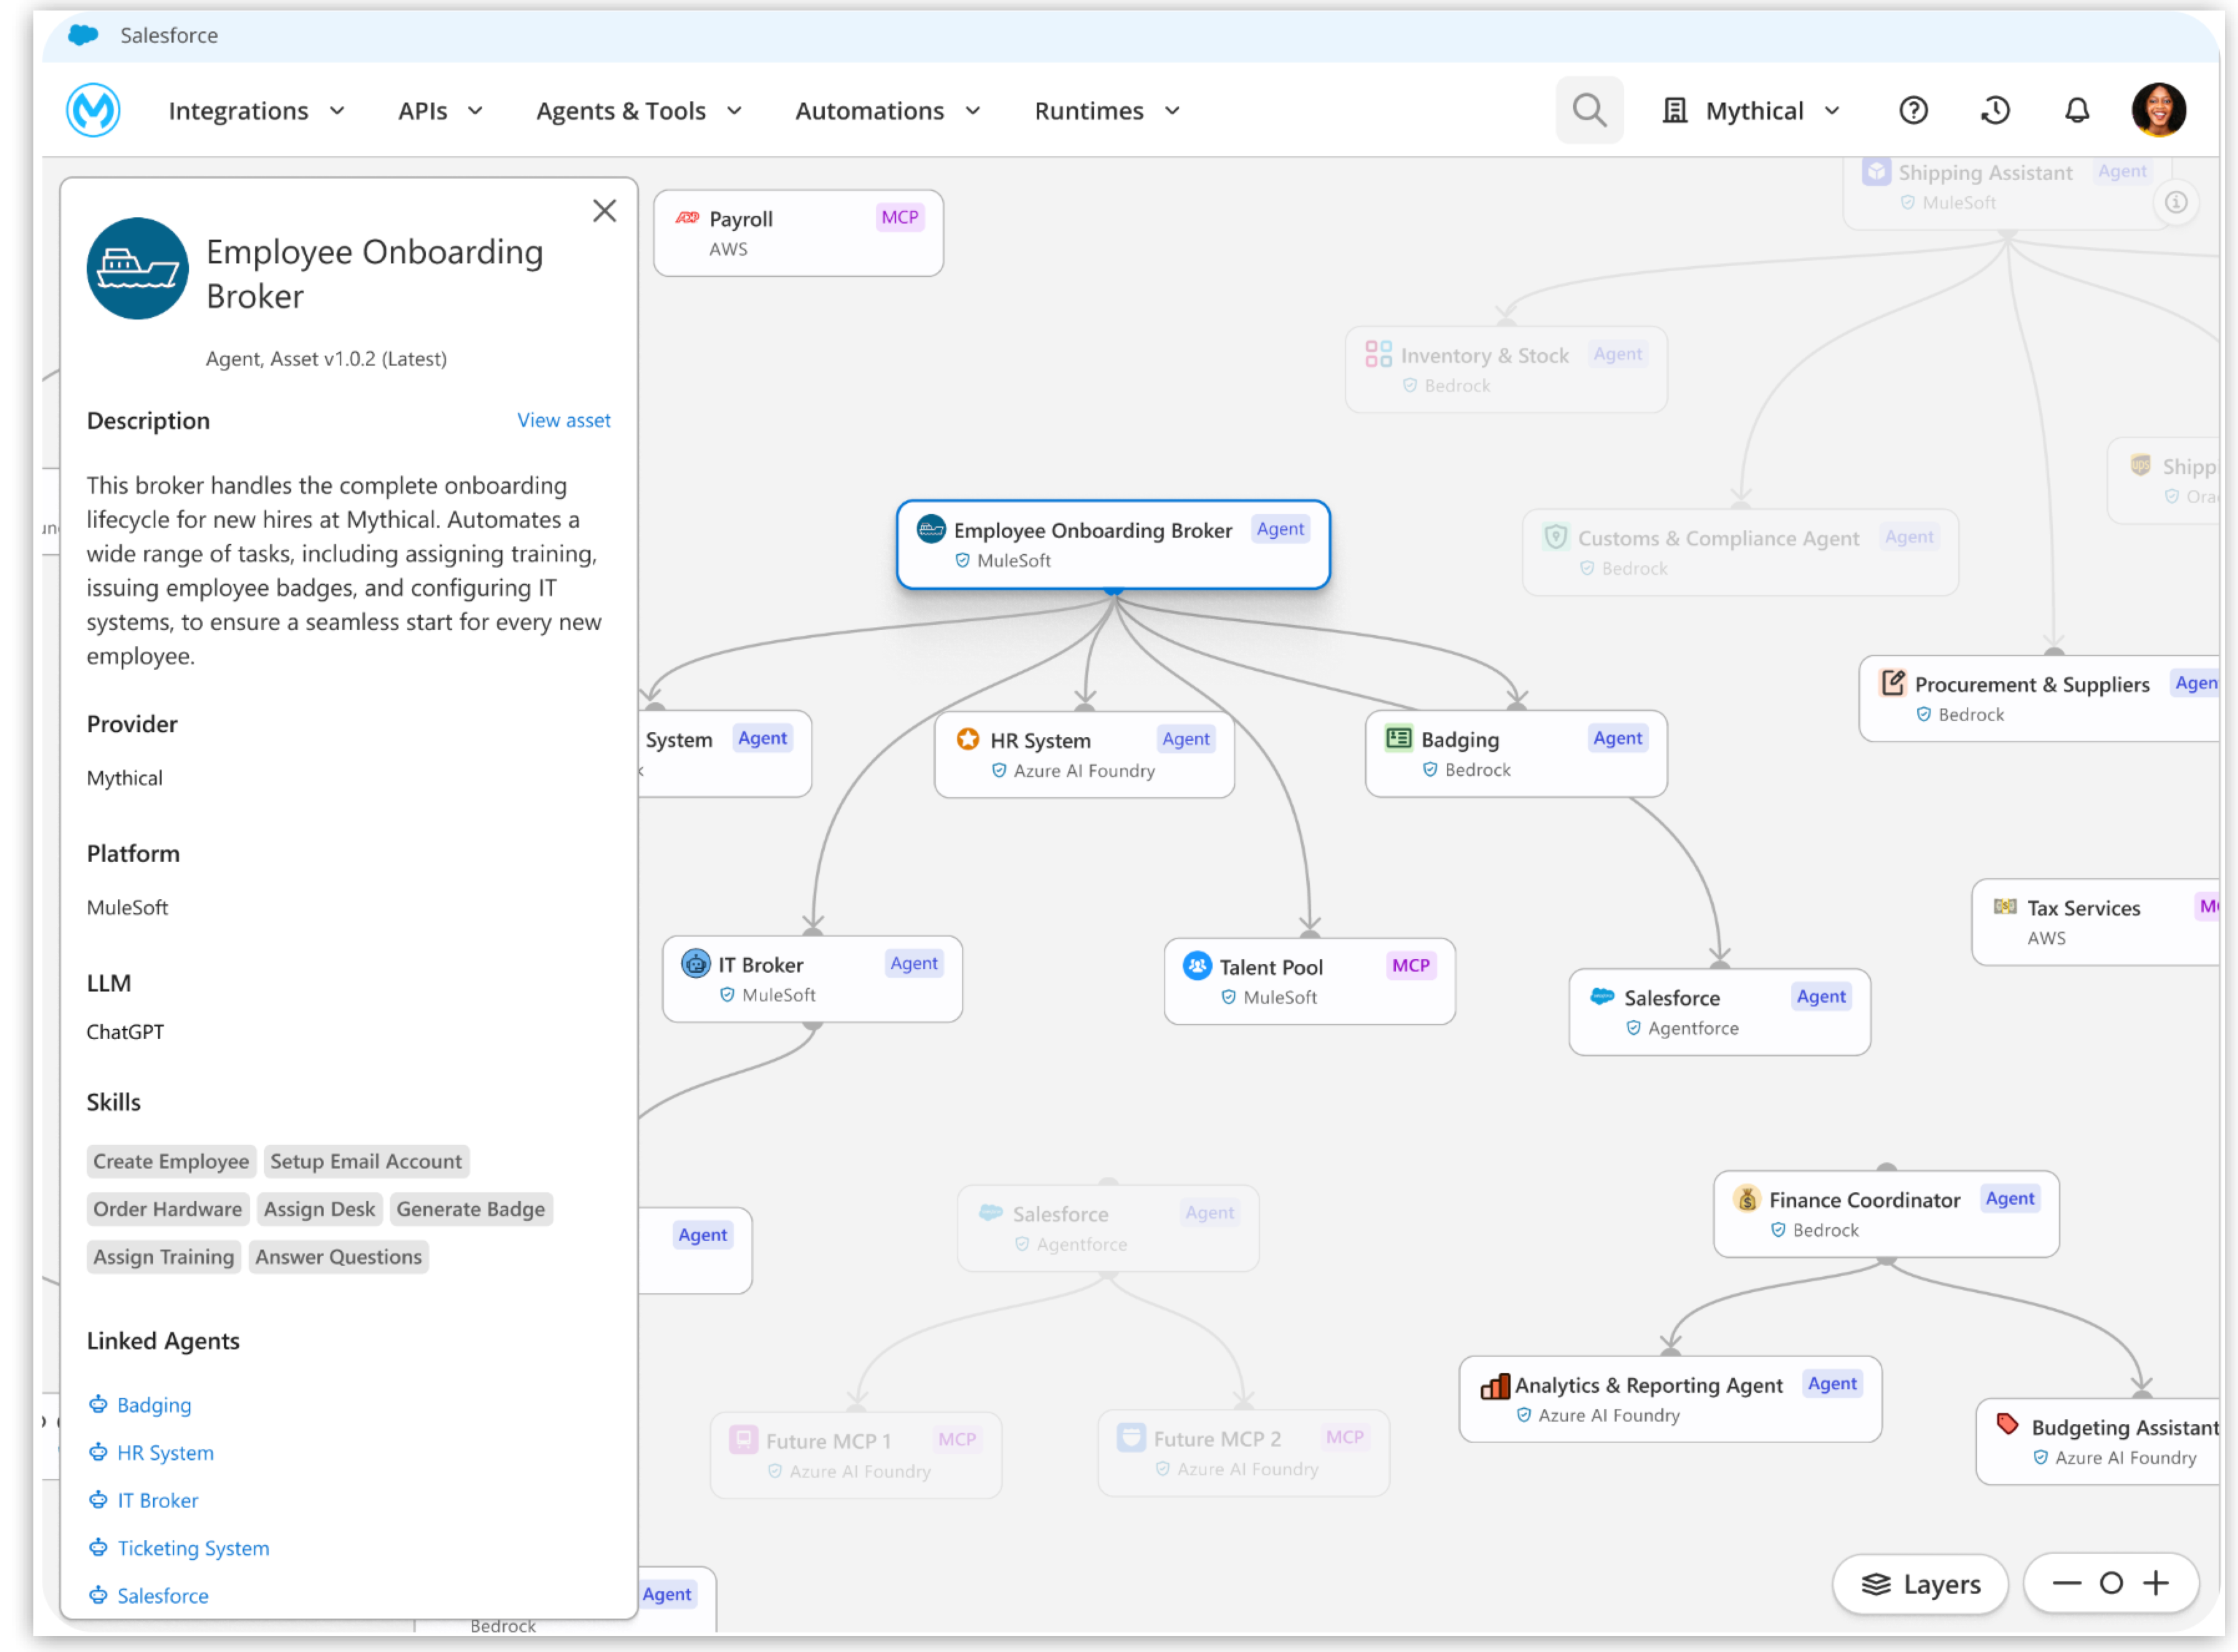 *에이전트 시각화 프로그램*은 전체 에이전트 네트워크의 실시간 동적 지도를 제공하여 AI 상호 작용의 "블랙박스"를 완전히 관찰 가능한 시스템으로 전환합니다. 아키텍처 및 운영 팀은 *에이전트 시각화 프로그램*을 사용하여 에이전트가 연결되는 방식을 검토하고, 의사 결정 흐름을 추적하고, 상태 및 성과를 모니터링하고, 종속성을 식별할 수 있습니다. 이 수준의 가시성은 성능을 최적화하고, 실패를 효율적으로 해결하고, 지체 지점을 감지하고, 배포된 에이전트에 대한 신뢰를 구축하는 데 매우 중요합니다.
## **4\. Salesforce Platform 통합**
### **4.1 API 카탈로그 및 주제 센터**
_MuleSoft API 카탈로그_ 및 *주제 센터*는 특히 _Agentforce와_ 협력하여 API 검색, 사용 및 관리 방식을 개선하도록 설계되었습니다.
설계 및 게시된 모든 _MuleSoft_ API는 *Salesforce Platform*의 [API 카탈로그](https://help.salesforce.com/s/articleView?id=platform.api_catalog.htm&type=5)를 통해 검색 및 사용 가능하게 만들 수 있습니다. *API 카탈로그*는 중앙 집중식 저장소 역할을 하며, _MuleSoft_, _Salesforce_, _Heroku_ 및 기타 클라우드에서 조직의 모든 API를 하나의 보기로 통합합니다. 이렇게 하면 개발자와 관리자가 기존 API를 자동화(예: _Agentforce_, _Flow_ 및 _Apex_)에서 쉽게 찾고 이해하고 재사용할 수 있습니다.
Agentforce용 [MuleSoft: 주제 센터를 사용하면](https://blogs.mulesoft.com/news/mulesoft-for-agentforce-topic-center/) 개발자가 설계 시기에 Agentforce **주제** 및 **작업** 메타데이터를 정의하여 특정 비즈니스 사용 사례를 기반으로 API를 구성할 수 있습니다. 여기에는 다음이 포함됩니다.
- 에이전트가 수행할 수 있는 작업인 **작업**
- 특정 작업을 적용하는 방법을 에이전트에게 안내하는 **지침**
이 시맨틱 레이어를 [추가하면](https://docs.mulesoft.com/anypoint-code-builder/ai-enabling-api-project-topic-center) _토픽 센터에서_ API를 이해하고 *Agentforce*에서 사용 가능하게 만들 수 있으므로 엔터프라이즈 시스템과 효과적으로 상호 작용할 수 있습니다.
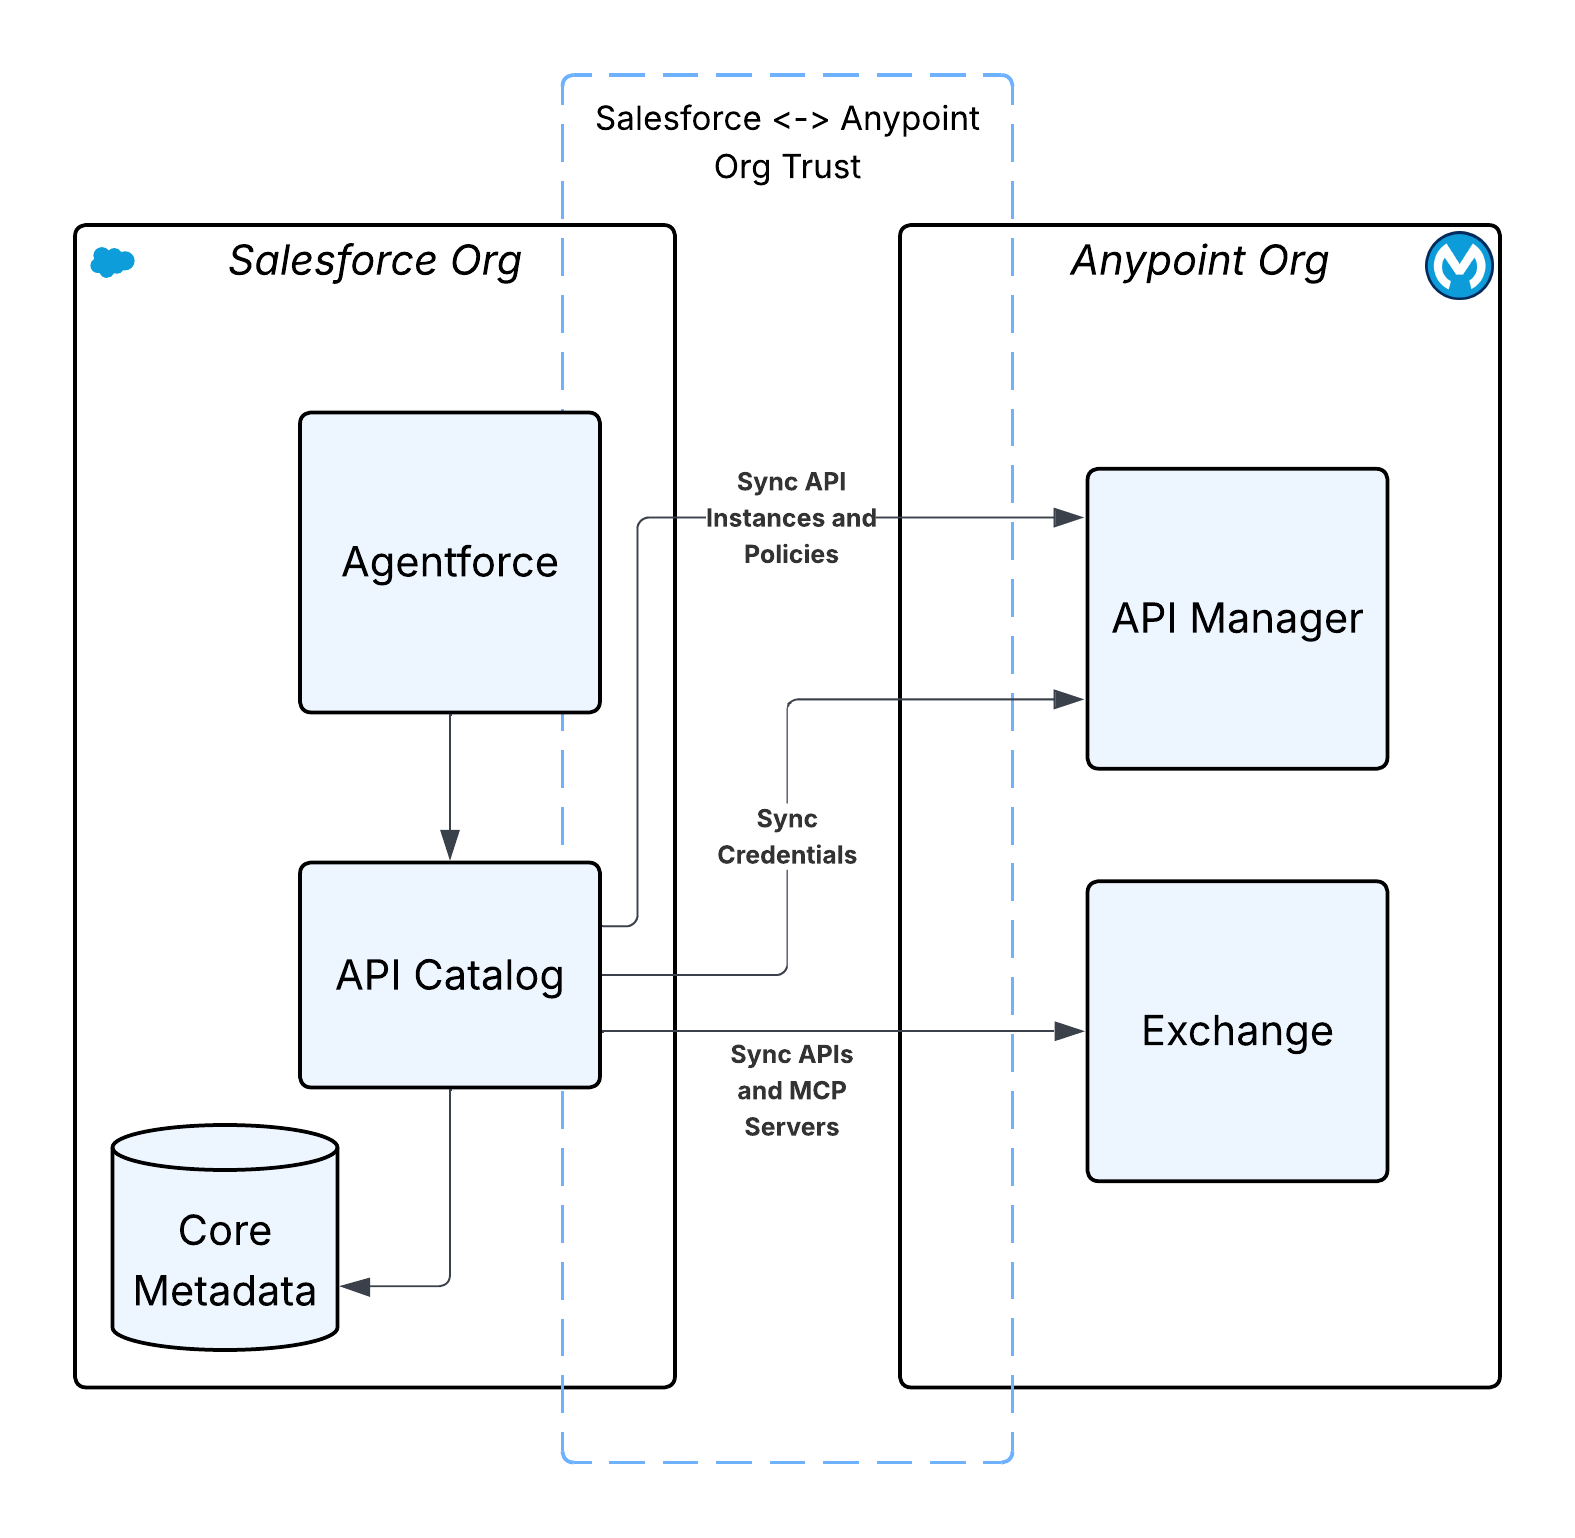 ### **4.2 Agentforce 게이트웨이**
_Agentforce 게이트웨이는_ 확장하는 _Agentforce_ 에코시스템 내에서 상호 작용을 관리하고 보호하도록 설계된 중앙 관리 계층입니다. *Agentforce*는 *MCP*와 같은 프로토콜을 통해 추가 타사 API 및 도구와 통합되므로 *Agentforce 게이트웨이*의 주요 기능은 *Agentforce*가 시작하는 모든 아웃바운드 트래픽에 정책(예: 요금 제한 및 도구 제한)을 적용하고 모든 발신 요청을 감사하는 것입니다.
_Agentforce 게이트웨이는_ 기존의 _MuleSoft_ API 거버넌스 정책 엔진을 활용하며, 이 엔진은 기본적으로 *Salesforce Platform*에 내장되어 있습니다. 이 _Envoy_ 기반 정책 엔진은 고객이 추가 게이트웨이 인프라를 설치할 필요 없이 에이전트 트래픽을 가로채고 구성된 정책(예: 특성 기반 액세스 제어 및 할당량 제한)을 적용하고 인증 및 권한 부여를 관리합니다.
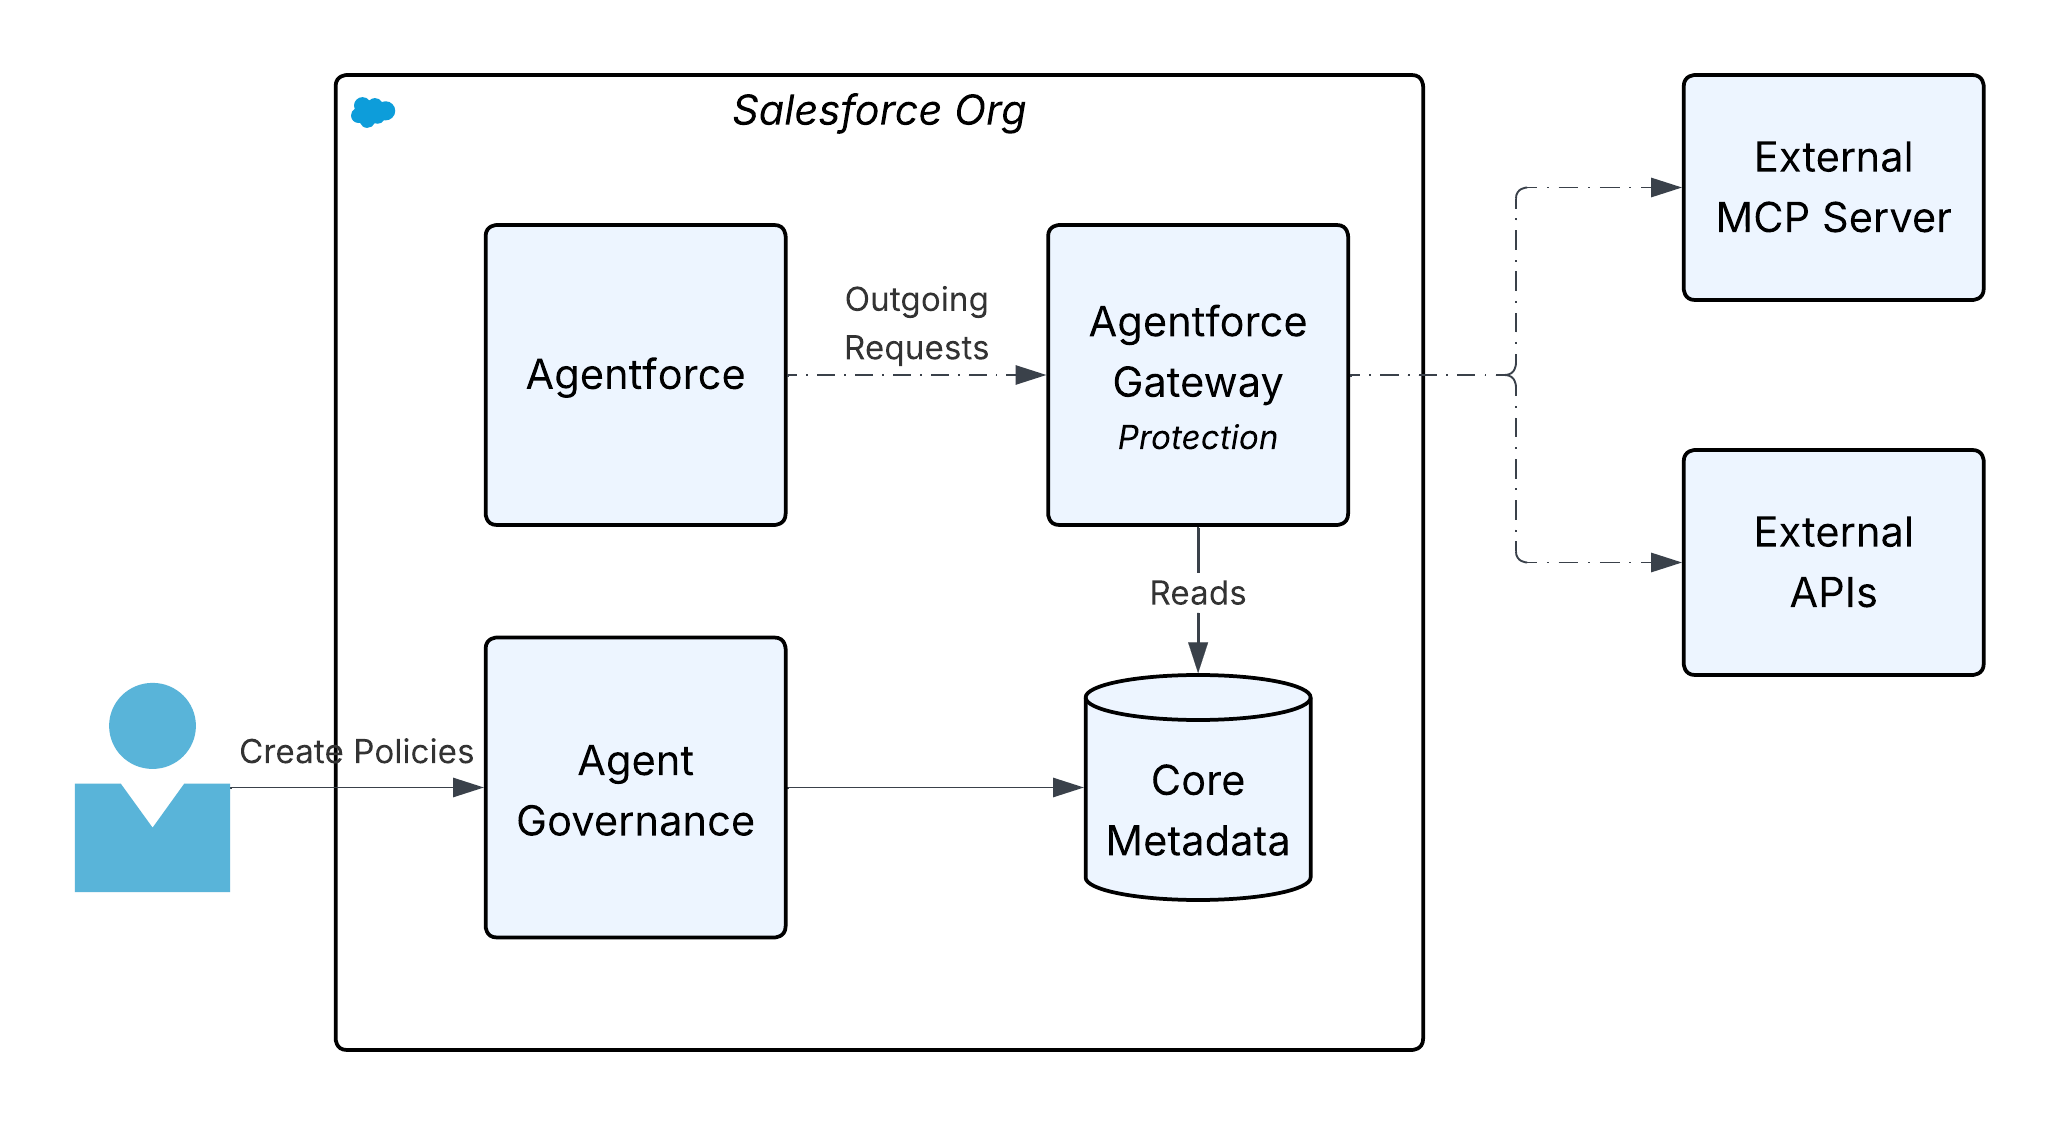 ### **4.3 통합 인텔리전스**
관리되는 에이전트 네트워크를 배포하는 것은 중대 사건입니다. 그러나 새로운 "2일" 운영 문제를 제시합니다. 동적, 분산된 자동 작업자 시스템을 모니터링, 측정, 문제 해결하려면 고급 수준의 운영 인텔리전스가 필요합니다. 최종 아키텍처 비전은 AI가 비즈니스 프로세스를 실행하는 데뿐만 아니라 실행되는 인프라를 모니터링, 관리, 치료하는 데도 사용되는 시스템입니다.
통합 인텔리전스에 대한 _MuleSoft의_ 비전은 광범위한 _Salesforce_ 에코시스템의 힘을 활용하여 통합 패브릭과 에이전트 네트워크의 성능에 대한 심층적이고 맞춤형 인사이트를 제공합니다. **Salesforce Data 360**에서 [OpenTelemetry(OTEL) 준수](https://opentelemetry.io/) 데이터를 캡처하고 저장함으로써 조직은 전체 환경에서 로그, 메트릭, 추적을 위한 통합 저장소를 만들 수 있습니다. 이 데이터는 사전 구축된 대시보드 및 사용자 정의 시각화를 통해 **Tableau에서** 볼 수 있으므로 API 성능, 에이전트 상호 작용 패턴, 전체 시스템 상태에 대한 자세한 정보를 얻을 수 있습니다.
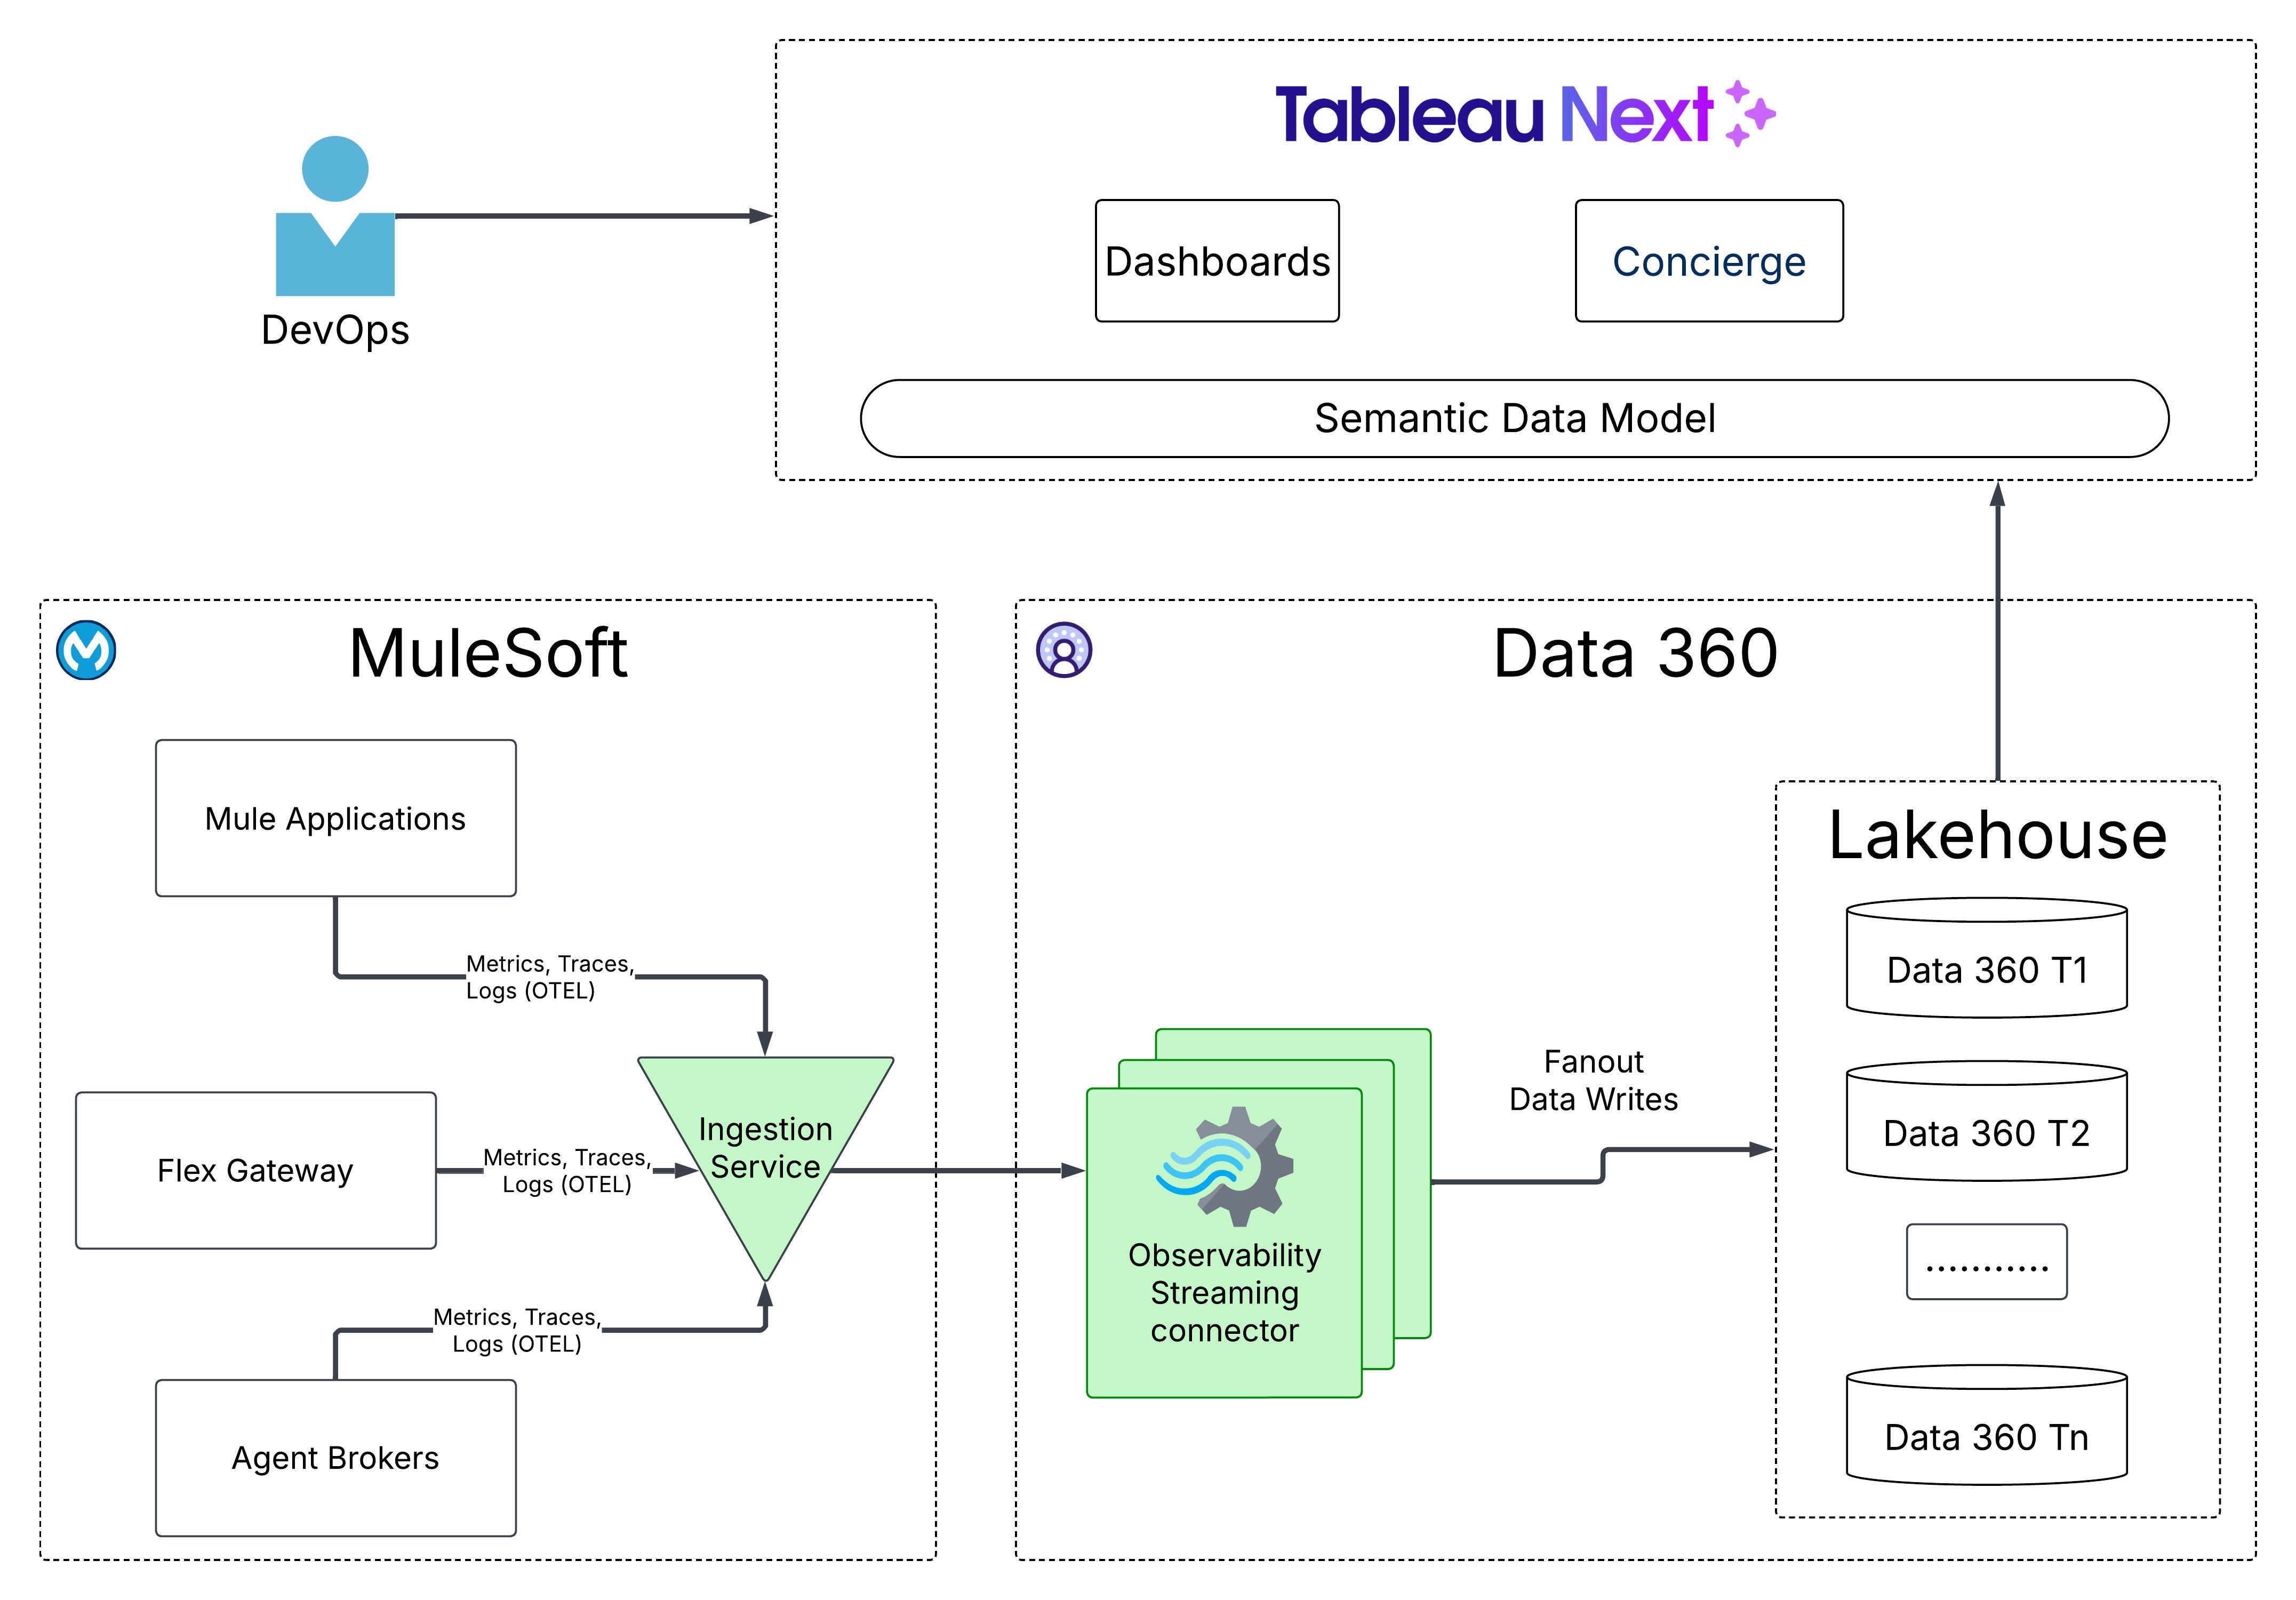 이 시스템에는 세 가지 핵심 구성 요소가 있습니다.
1. **수입:** 수집 서비스는 다양한 _Mule_ 애플리케이션, _Agent Brokers_ 및 *Flex Gateways*에서 텔레메트리 데이터를 수집하고 처리하는 중앙 집중식 입력 지점입니다. 다양한 응용 프로그램에서 데이터 품질과 일관성을 유지하기 위해 스키마 유효성 검사, 데이터 정규화, 필터링을 수행합니다. 또한 수집 파이프라인에서 제어(예: 인증, 암호화, 테넌트 공정성, 속도 제한)를 적용합니다.
2. **스토리지:** 멀티테넌트 _Kafka_ 주제의 데이터를 읽고 _OTEL_ 형식으로 변환하는 고처리 용량 스트리밍 작업이 *Data 360*에서 실행됩니다. 그런 다음, OTEL 데이터는 *레이크하우스*의 _TelemetryTraceSpan_, _TelemetryLogs_ 및 *TelemetryMetrics DMO*에서 테넌트의 *Data 360*에 연결됩니다.
3. **시각화 / 소비량:** 고객은 *Data 360*에서 사용할 수 있는 텔레메트리 데이터를 사용하여 시스템 상태를 검토하고 _Tableau Next를 통해_ 사전 구축되거나 사용자 정의된 대시보드를 사용하여 인사이트를 얻을 수 있습니다. 고객은 *Tableau Next*에서 미리 구축된 에이전트 분석 기술인 [Tableau Concierge를](https://help.salesforce.com/s/articleView?id=analytics.tua_metric_questions.htm&type=5) 활용할 수도 있습니다. 이 기술을 통해 사용자가 원래 언어로 텔레메트리 데이터에 대한 질문을 하고 시각화를 통해 신뢰할 수 있는 실행 가능한 답변을 받을 수 있습니다. 고객은 기존의 _APM(Application Performance Management)_ 시스템(예: _DynaTrace_, _Datadog_, _Splunk_ 등)으로 데이터를 내보낼 수도 있습니다.
## **결과**
에이전트 엔터프라이즈로의 전환은 단순히 IT 업그레이드가 아니라 기본적인 아키텍처 변환 지점입니다. 분할된 사일로형 AI 에이전트 배포는 운영 혼란, 섀도우 IT, 관리 불가능한 기술 부채로 이어지는 직접적인 경로입니다. 지속 가능한 유일한 경로는 통합된 구성 가능한 아키텍처를 통해서입니다. API 기반 연결의 입증된 기반을 바탕으로 _MuleSoft Agent Fabric은_ 이 새로운 디지털 직원을 관리하는 데 필요한 '중앙 신경계'를 제공합니다. 검색, 오케스트레이션, 엔터프라이즈급 거버넌스, 종단간 관찰 기능에 중요한 기능을 제공합니다. 이렇게 하면 AI 실험을 벗어나 진정한 지능형, 자동화되고 안전한 엔터프라이즈를 설계하여 자율적인 잠재력을 실질적이고 관리되는 비즈니스 결과로 전환할 수 있습니다.
## **기술 가이드 및 참조**
- [Anypoint Code Builder 시작하기](https://docs.mulesoft.com/anypoint-code-builder/start-acb)
- Anypoint 코드 빌더용 Einstein의 [기술 가이드: 생성 흐름](https://blogs.mulesoft.com/dev-guides/einstein-for-acb/)
- [DataWeave Generative Transformation Deep Dive: 신속한 데이터 변환을 위한 AI 혁신](https://blogs.mulesoft.com/dev-guides/dataweave-generative-transformation/)
- [MuleSoft Dev Agent로 API 사양 만들기](https://docs.mulesoft.com/anypoint-code-builder/api-ai-create-spec)
- [Einstein 생성형 AI로 API 문서 생성](https://docs.mulesoft.com/exchange/generating-documentation-with-ai)
- [MuleSoft MCP 서버 개요](https://docs.mulesoft.com/mulesoft-mcp-server/)
- [MuleSoft MCP Server Tools](https://docs.mulesoft.com/mulesoft-mcp-server/reference-mcp-tools)
- [MCP 커넥터](https://docs.mulesoft.com/mcp-connector/latest/)
- [A2A 커넥터](https://docs.mulesoft.com/a2a-connector/latest/)
- [Agent Fabric 시작하기](https://docs.mulesoft.com/agent-fabric/learning-map-agent-fabric)
- [Flex 게이트웨이로 에이전트 상호 작용 보호](https://docs.mulesoft.com/gateway/latest/flex-agent-secure)
- [Flex 게이트웨이 에이전트 정책](https://docs.mulesoft.com/gateway/latest/flex-agent-policies)
- [유연한 게이트웨이 정책 개발 키트(PDK) 개요](https://docs.mulesoft.com/pdk/latest/policies-pdk-overview)
- [Salesforce용 MuleSoft API 카탈로그](https://help.salesforce.com/s/articleView?id=platform.api_catalog.htm&type=5)
- [주제 및 에이전트 작업에 대한 API 프로젝트 활성화](https://docs.mulesoft.com/anypoint-code-builder/ai-enabling-api-project-topic-center)
- [Tableau 다음 작업](https://help.salesforce.com/s/articleView?id=analytics.tua_consume.htm&type=5)
- [OpenTelemetry](https://opentelemetry.io/)
- [모델 컨텍스트 프로토콜](https://modelcontextprotocol.io/docs/getting-started/intro)
- [Agent2Agent(A2A) 프로토콜](https://a2a-protocol.org/latest/)
## 작성자 정보
Nikhil Aggarwal은 MuleSoft 및 Salesforce Automation Cloud의 아키텍처를 이끄는 Salesforce의 주 아키텍처입니다. Nikhil은 대규모 제품을 제공하는 데 18년 이상의 경험을 보유하고 있으며 확장 가능한 아키텍처, 직관적인 개발자 경험, 고성능 팀 구축에 열정적입니다. Salesforce 이전에는 Microsoft Power Platform, Dataverse 및 Office 365의 여러 이니셔티브를 개념부터 출시까지 이끌었습니다. 그는 계속해서 AI 우선 시대의 현대 기업이 시스템을 연결하고, 워크플로를 자동화하고, 비즈니스 가치를 확보하는 방식을 구축합니다.
## 1\. 소개
20여 년 전에 Salesforce는 최초의 멀티테넌트 클라우드 플랫폼을 선도하여 업계의 선례를 세웠습니다. 그 이후 Salesforce는 비즈니스의 주요 측면을 캡슐화 및 자동화할 수 있는 포괄적인 엔터프라이즈 플랫폼으로 진화하여 다양한 산업 및 지역의 수천 개의 비즈니스 및 수백만 명의 사용자에게 서비스를 제공합니다. Salesforce는 전략적 인수를 통해 Customer360 제품군도 향상했습니다.
지난 몇 년 동안 시장, 업계, 기술 환경의 변화로 인해 기본 Salesforce Platform에서 일련의 심층적인 변환이 이루어졌습니다. 다음은 포함됩니다.
- 인프라에 크게 투자하는 공개 클라우드 공급자의 출현
- 기계 학습, 생성형 AI, 에이전트 환경 등 AI의 빠른 발전
- 산업 및 국가 전반에서 데이터 보존 및 규제 요구 사항이 증가했습니다.
- 빠르게 증가하는 규모로 실시간 데이터 및 트랜잭션을 처리해야 합니다.
- 사이버 보안, 시스템 가용성, 성능, 복원에 대한 요구 사항에 중점을 두었습니다.
- 복원성이 뛰어난 해부적이고 일관성이 높은 아키텍처를 제공하는 통합 제품군에 대한 고객의 요구입니다.
특히 AI의 지진 변화와 비즈니스에 미치는 영향에 대한 대응으로 Salesforce는 플랫폼을 처음부터 완전히 전환하여 Trust 목표를 유지하면서 차세대 애플리케이션 및 고객 사용 사례의 기반을 마련했습니다.
Dreamforce 2024에서 Agentforce 출시했으며 아래 다이어그램은 수천 명의 Salesforce 기술 및 제품 조직 팀 구성원을 참여시키는 광범위한 노력의 끝을 나타냅니다. 현재 95% 이상의 고객이 이 새로운 플랫폼으로 전환했습니다. 가장 까다로운 작업 부하를 가진 고객을 비롯한 대부분의 고객이 성공적으로 마이그레이션함으로써 엔지니어들의 영리함을 강조하고 Salesforce의 Trust, 고객 성공, 혁신이라는 핵심 가치를 재확인합니다.
Agentforce 출시된 이후 Salesforce는 계속해서 엔터프라이즈 응용 프로그램에서 AI 사용을 선도하고 있으며 기존 및 신규 비즈니스 기능에 대한 실시간 대화형 환경을 제공하는 에이전트 환경 개발 분야에서 선도적입니다.
상위 엔지니어와 공동 작업을 마친 이 백서에서는 주요 기술 변환의 복잡성을 이해하는 빌더를 위해 자세한 탐색을 제공합니다. 이 문서는 플랫폼을 확장 가능하고 안전하며 고객의 변화하는 요구를 충족하면서 향후 응용 프로그램을 처리할 수 있도록 지원하는 필수 아키텍처 고급 기능에 대해 자세히 살펴봅니다. 전체 상황을 이해하려면 아키텍처 개요 장에서 시작하는 것이 좋습니다. 여기에서 독자는 순서대로 계속하거나 가장 관심 있는 장을 탐색할 수 있습니다.
_Emin Gerba_
_Salesforce CEO_
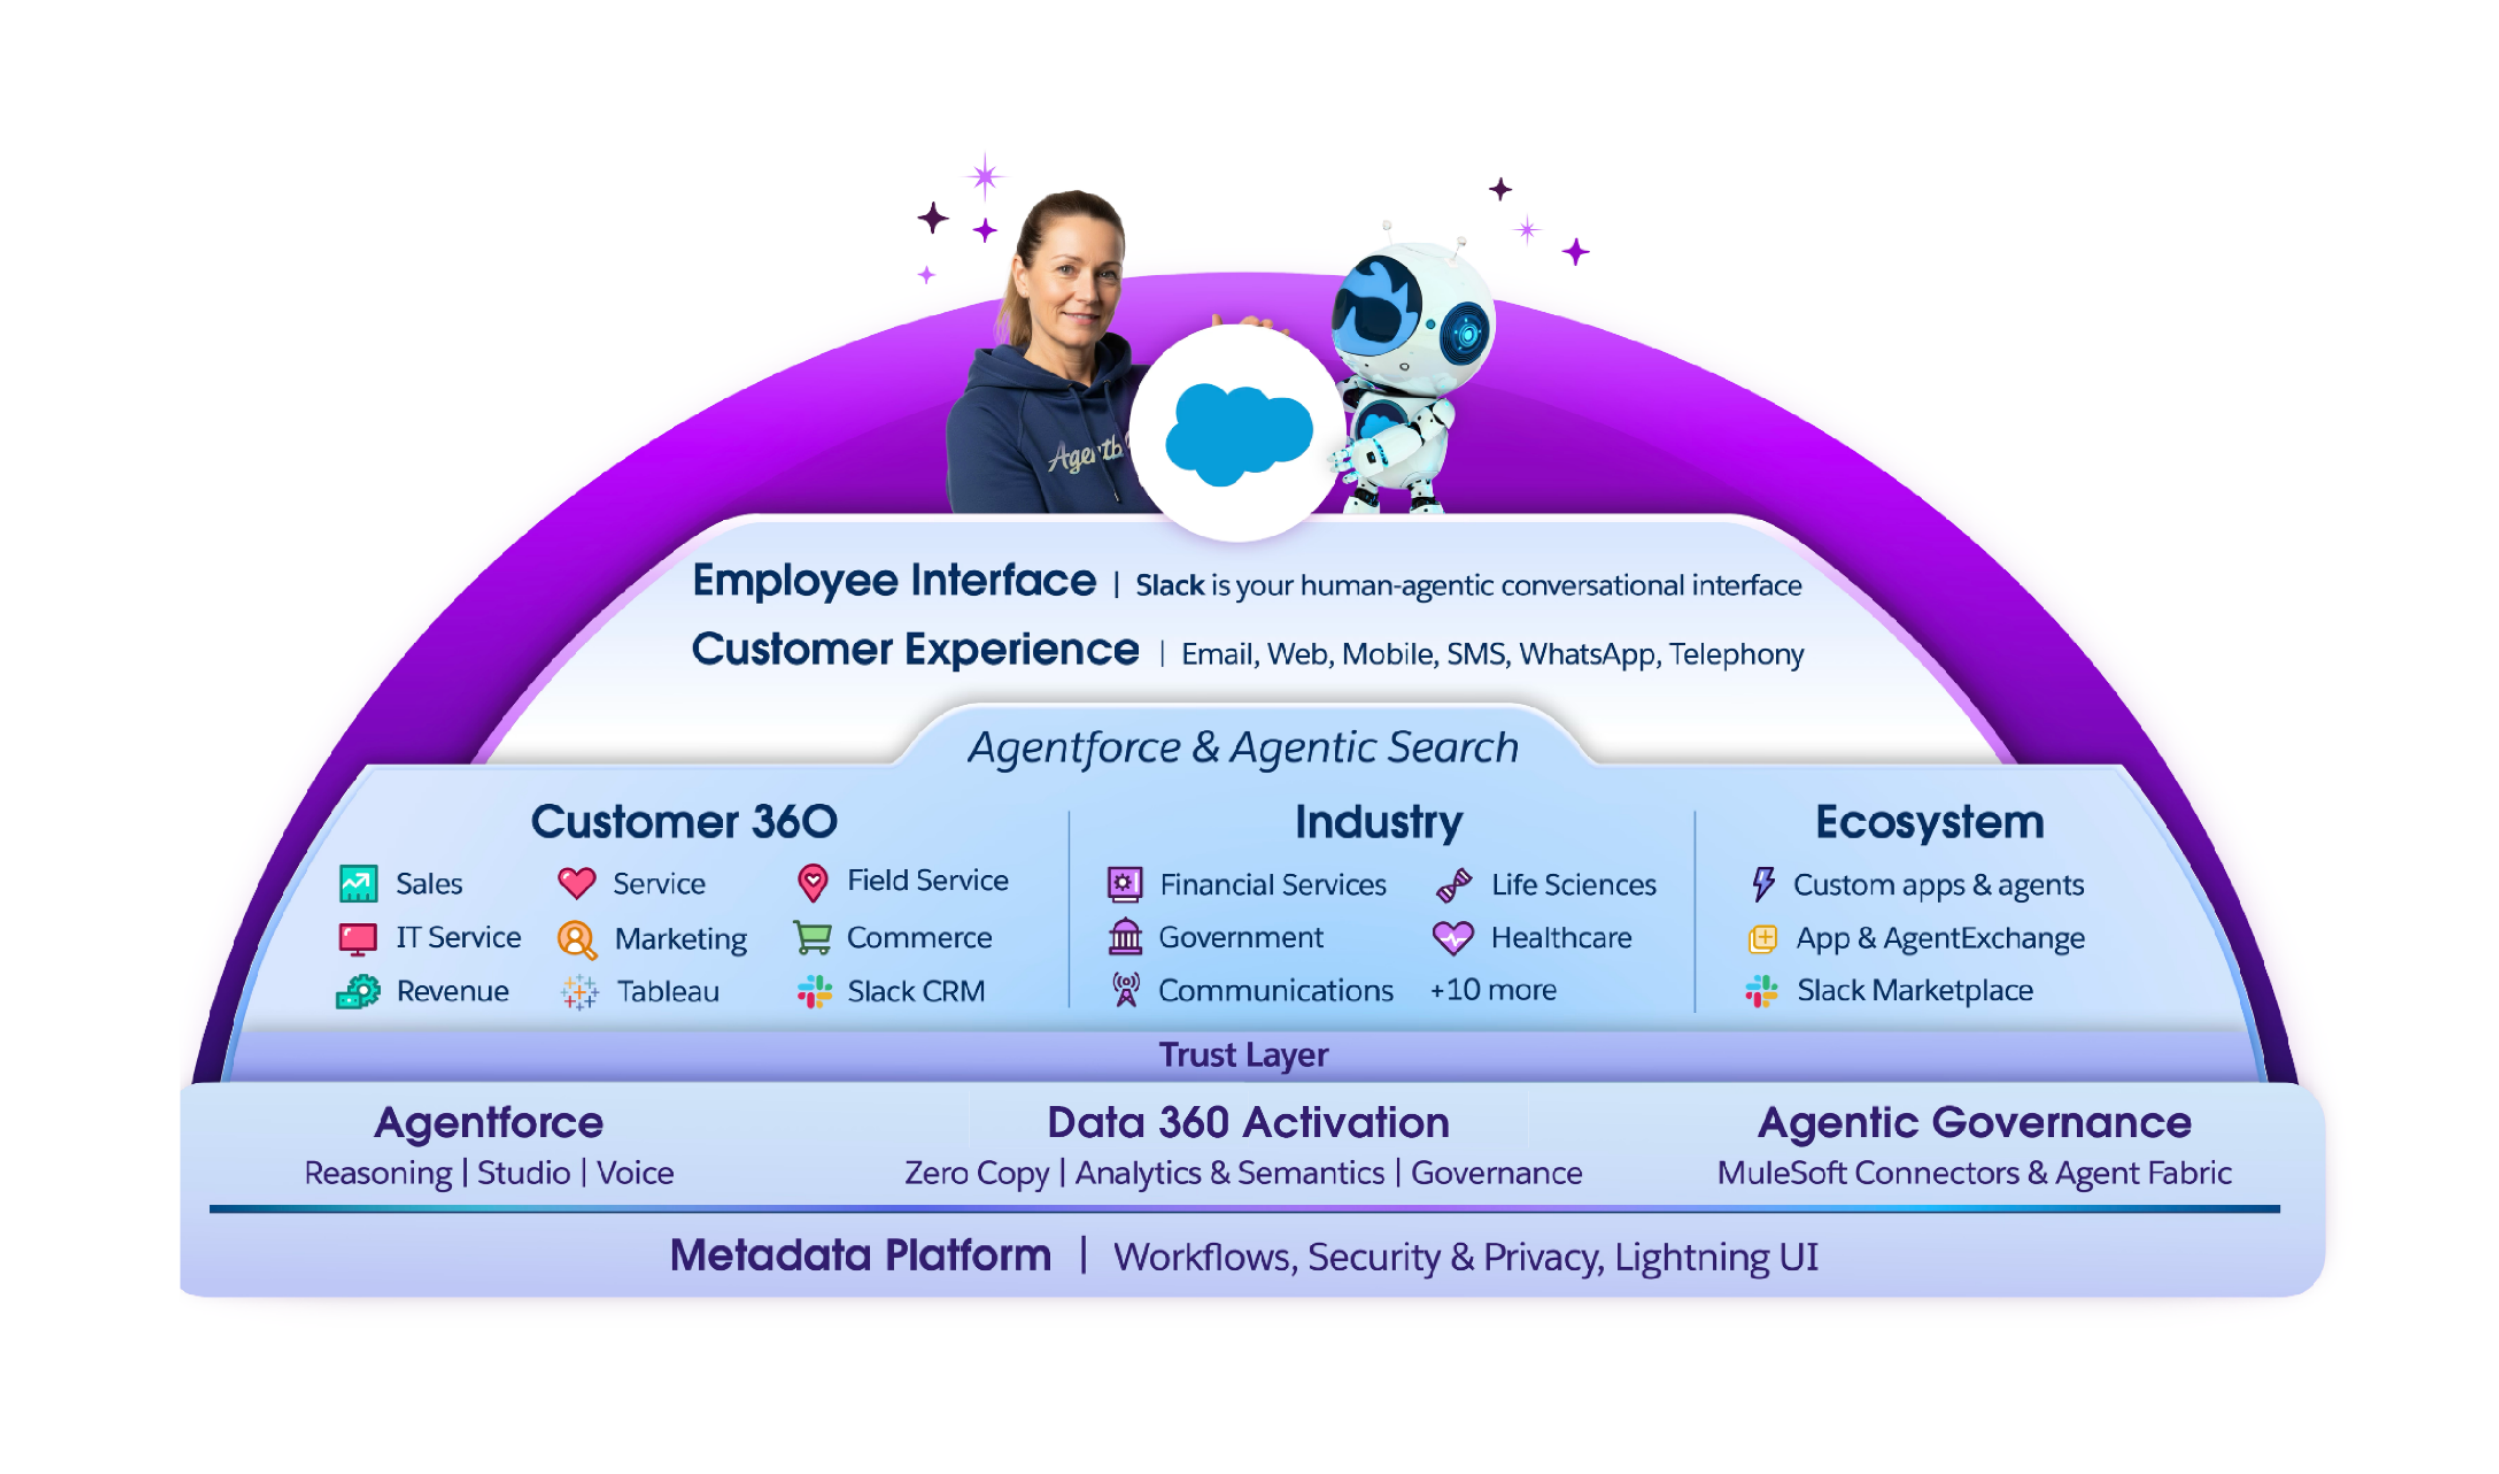 ## 2\. 아키텍처 개요
아래의 Salesforce Platform 아키텍처 원리는 기능 및 성능을 엔지니어링하는 방법에 대한 근거와 차별화를 포착합니다.
- **Enterprise-Grade Trust**: Trust Salesforce의 가장 중요한 가치이며, 서비스의 가용성 및 보안에 우선 순위를 두는 것뿐만 아니라 고객이 Salesforce Platform에서 규정 준수 및 보안 표준을 충족할 수 있도록 액세스 제어, 규정 준수 및 보안 기능을 구축합니다.
- **Multitenant**: 모든 서비스 및 인프라는 여러 고객을 호스팅하도록 구축되어 있습니다. 이를 통해 사용과 함께 확장할 수 있는 전략적 패턴을 제공하고 고객의 규모에 상관없이 공통의 가용성 및 보안 높은 막대에 표준화할 수 있습니다.
- **메타데이터 구동**: 메타데이터는 멀티테넌트 서비스를 사용자 정의할 수 있는 방식의 핵심입니다. 메타데이터는 확장 가능하므로 관리자 및 개발자가 기존 작업을 기반으로 구축하고 Salesforce 및 에코시스템 파트너의 향후 제품 업데이트를 활용할 수 있습니다.
- **API 우선:** Salesforce Platform은 Salesforce 기본 사용자 인터페이스를 통해 수행할 수 있는 모든 작업을 다루는 풍부하고 일관된 API 포트폴리오의 우선 순위를 지정합니다. 이를 통해 개발자 및 파트너가 시스템 통합 또는 새 사용자 환경 구축을 위해 플랫폼 기능을 활용하고 재구성할 수 있습니다.
- **개방 및 상호 운용성**: Salesforce Platform은 고객의 엔터프라이즈 아키텍처에 통합할 수 있습니다. Salesforce Platform은 다른 클라우드 기반 및 온 프레미스 시스템과 함께 작동할 수 있도록 설계되었으며 외부 시스템에 Salesforce Platform과 통합할 수 있도록 API, 도구, 통합 표준을 제공했습니다.
- **에이전트:** Salesforce Platform은 전체 애플리케이션 도구 모음에서 에이전트 우선 순위로 빠르게 발전하고 있습니다. 사용자가 작업을 완료하고 점점 더 자연스러운 방식으로 데이터와 상호 작용할 수 있는 심층적인 에이전트 대화 환경을 통해 Salesforce와 소통할 수 있도록 하려고 합니다.
현재의 Salesforce Platform은 2008년 Force.com 플랫폼의 데뷔 이후 Salesforce의 기능 진화의 최신 단계입니다. 최근 주요 변환에는 다음이 포함됩니다.
- Hyperforce 채택 및 클라우드 기반 아키텍처로의 전환.
- 독립적인 서비스가 있는 구조로의 변화를 의미합니다.
- 기존 관계형 데이터 저장소와 함께 Data 360 및 Lakehouse 기술의 도입
- AI 기술, 생성형 및 기계 학습을 심층적으로 통합하고 플랫폼 전반에서 에이전트 환경으로 발전합니다.
이러한 변경 사항은 Salesforce 엔지니어가 고객 중단을 최소화하면서 기술을 원활하게 발전시킬 수 있는 강력한 추상화 덕분에 중단 없이 플랫폼의 기능을 확장하고 세분화했습니다. 또한 강력한 추상화는 보안, 가용성, 기술 규칙과 같은 엔터프라이즈급 소프트웨어의 기술적 복잡성을 단순화하는 Salesforce Platform의 가치의 핵심이므로 앱 개발자가 고유한 문제 해결에 집중할 수 있습니다. Salesforce Platform의 기능은 다음과 같이 강조 표시됩니다.
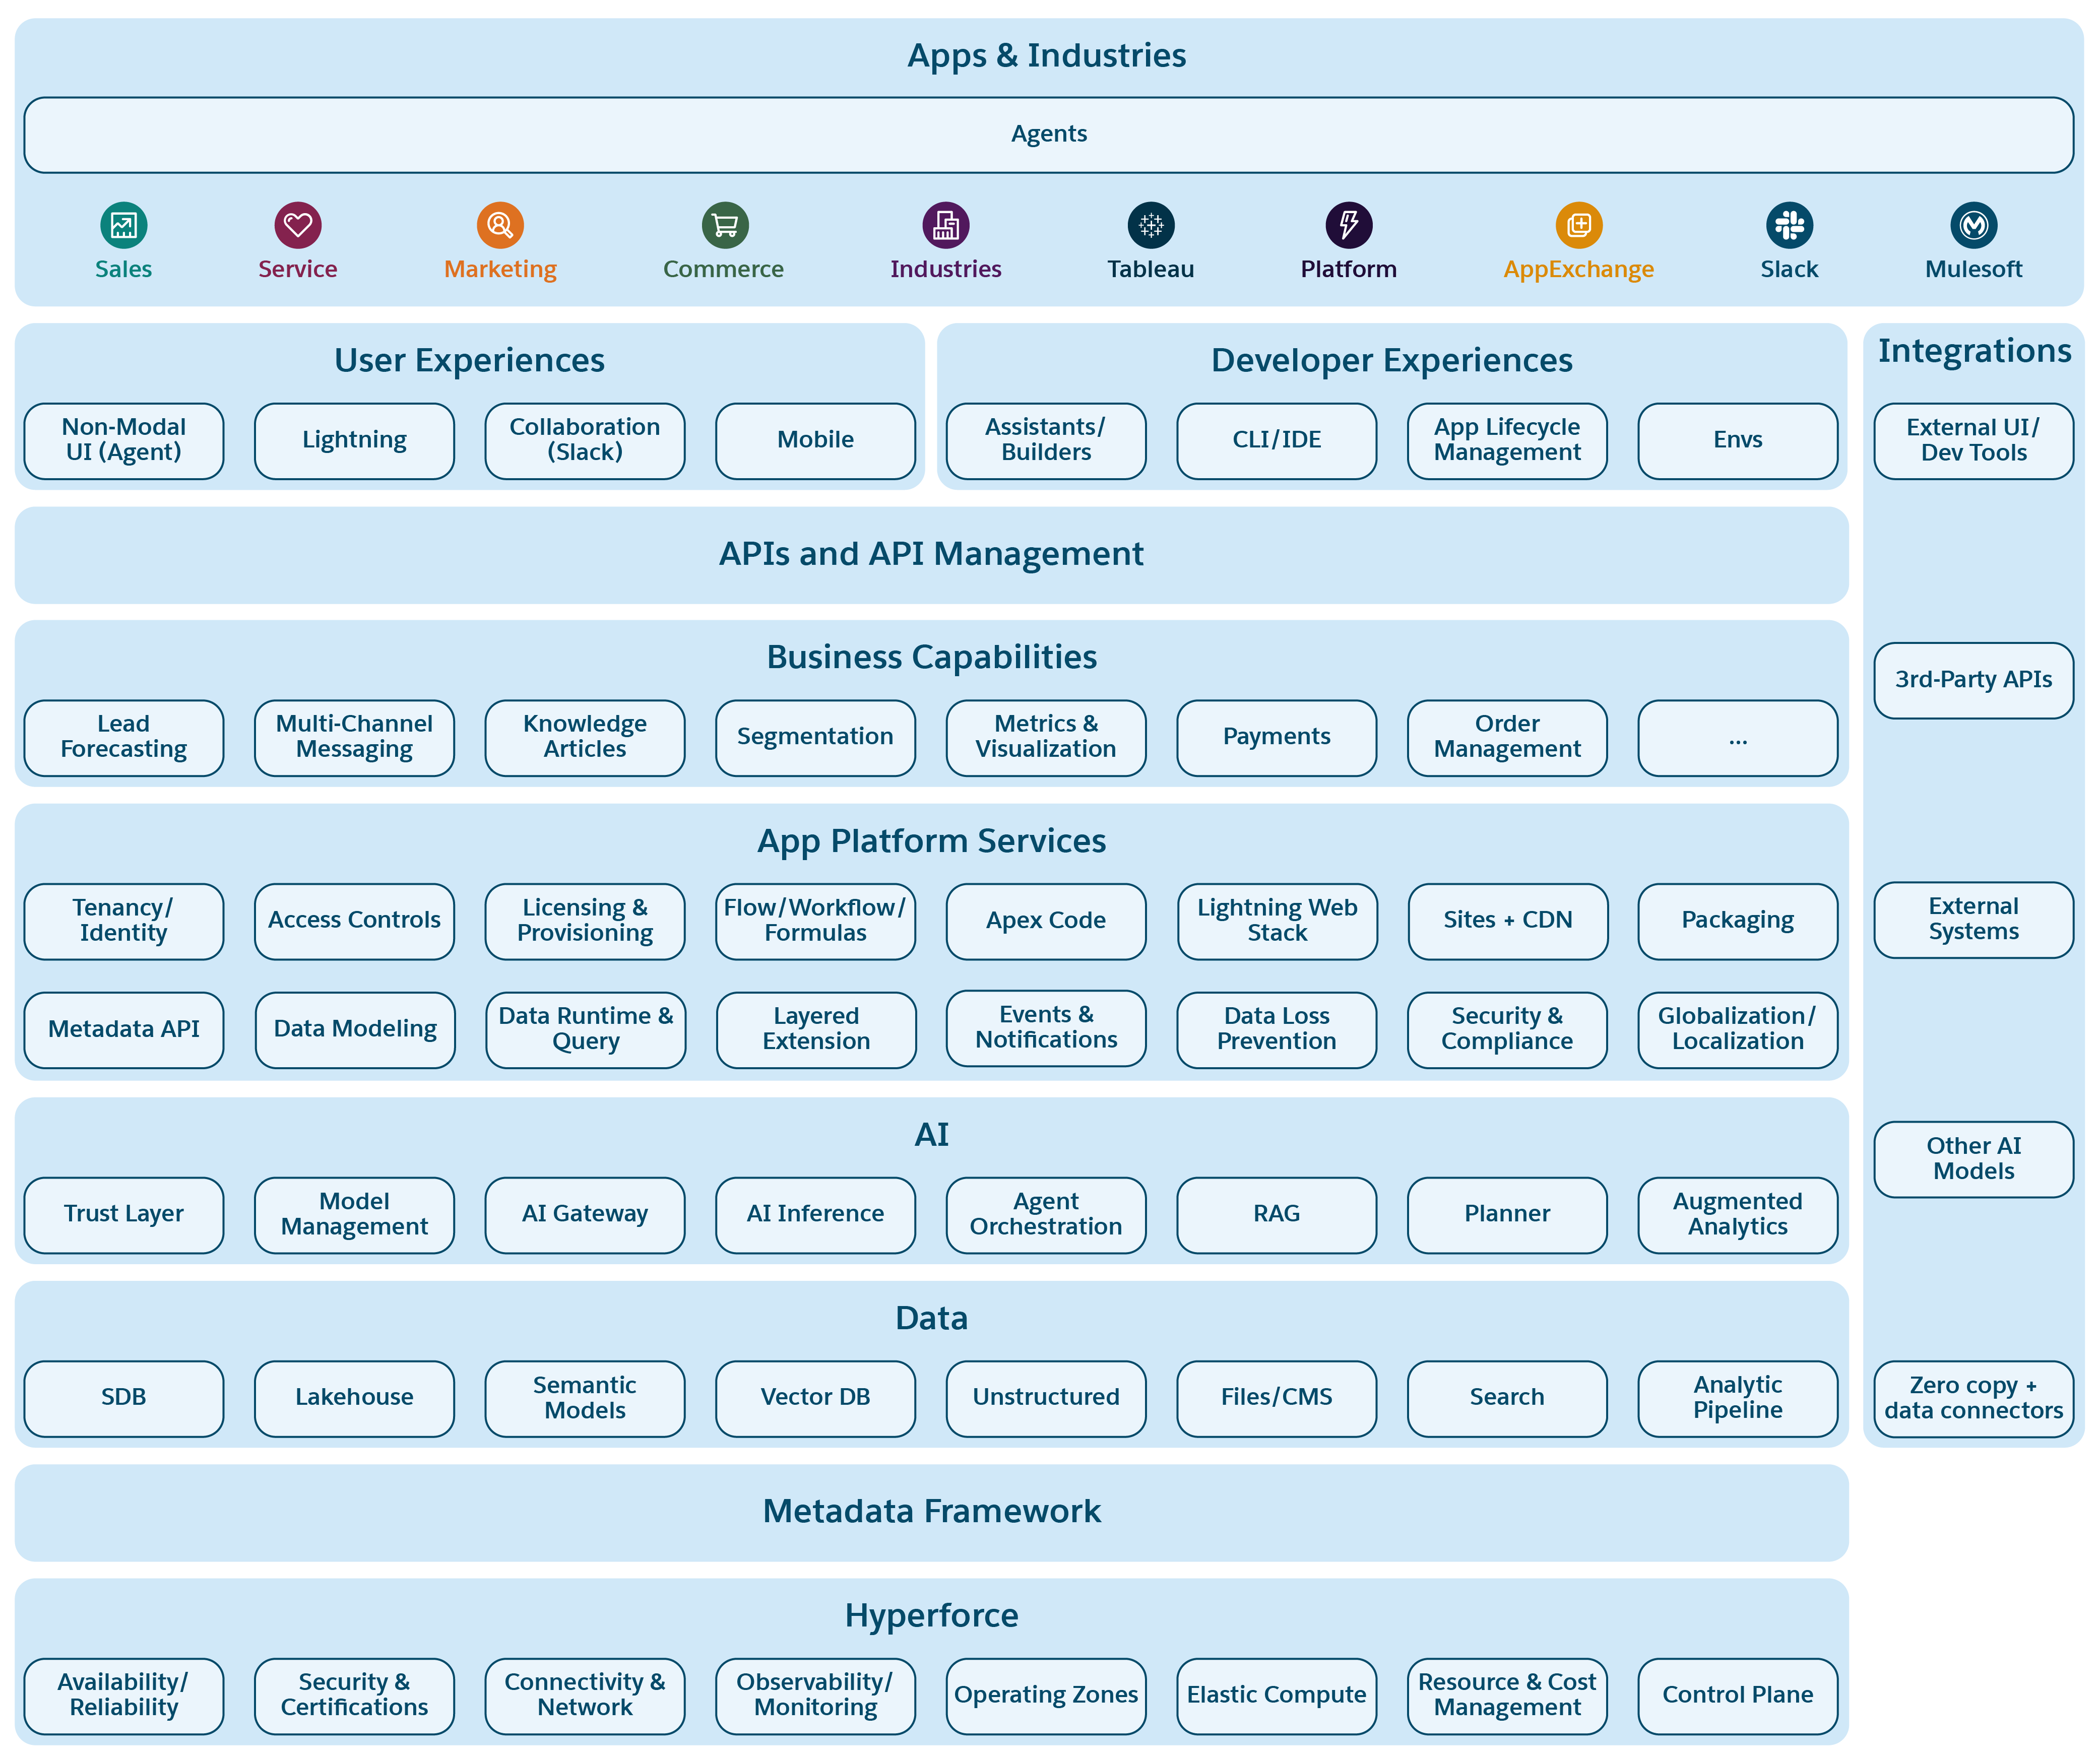 Salesforce Platform은 시스템을 구성하는 계층 집합으로 표시됩니다. 각 레이어는 플랫폼에 구축된 응용 프로그램에 중요한 관련 기능의 그룹을 나타냅니다. 각 레이어 내의 하위 상자는 이러한 기능의 예를 보여줍니다. 각 하위 계층의 기능이 위의 모든 계층에 통합되어 전체 Salesforce 응용 프로그램 제품군에서 일관되고 일관된 환경을 제공합니다.
Salesforce Platform은 지난 20년 동안 개발된 성숙한 기술 플랫폼의 모든 계층에서 광범위한 엔지니어링 변환을 구현합니다. 변화하는 고객의 요구와 새로운 기술에 기반하여 새 앱 유형 및 솔루션을 지원할 수 있습니다. 하위 레이어의 변경 사항이 위의 모든 후속 레이어의 진화에 영향을 미치므로 변환이 상호 연결됩니다.
Salesforce Platform은 각각 포괄적인 기능에 기여하는 여러 계층으로 구조화되어 있습니다.
- **Hyperforce**: 기본 인프라는 자사 데이터 센터에서 퍼블릭 클라우드 공급자로 발전했으며 Salesforce 기술을 통해 보안, 규정 준수, 고가용성, 비용 효율적인 호스팅을 제공합니다.
- **메타데이터 프레임워크**: 사용하고 사용하는 기술이 발전함에 따라 구축할 앱을 안정적으로 추상화할 수 있습니다. 개체 관계 매퍼, 규정 실행 순서, 메타데이터 정의를 메타데이터 구동 런타임과 연결하는 "핵심" 런타임을 포함합니다.
- **데이터**: 비정형 데이터 및 콘텐츠 관리, 고급 검색, 거버넌스, 분석 처리 기능을 지원하는 Salesforce 및 비Salesforce 데이터를 관리하기 위한 페타바이트 규모의 레이크하우스와 멀티테넌트 관계 데이터베이스를 포함합니다.
- **AI**: 예측 및 생성형 AI를 활용하여 에이전트 환경을 강화하는 기본적인 신뢰할 수 있는 AI 기술을 사용하여 데이터 레이어를 기반으로 합니다.
- **앱 플랫폼 서비스:** IT 관리자, 개발자, 공급업체가 응용 프로그램을 구축하고 사용자 정의할 수 있는 도구를 제공하여 일반적인 과업과 복잡한 과업을 간소화하기 위한 추상화를 제공합니다.
- **비즈니스 역량**: 다양한 비즈니스 요구를 충족할 수 있는 다양한 기능을 제공하므로 개발자가 필요에 따라 응용 프로그램을 맞춤 설정할 수 있습니다.
- **API 및 API 관리**: 올바르게 구성된 API를 통해 모든 플랫폼 기능에 액세스할 수 있어 서비스 및 계층 상호 종속성을 촉진합니다.
- **사용자 및 개발자 경험**: 최종 사용자를 위한 사용자에게 친숙한 인터페이스와 응용 프로그램 개발 및 사용자 정의용 하위 코드에서 프로 코드에 이르는 다양한 개발 도구를 제공하며, 현대 AI 기반 개발을 지원합니다.
- **통합**: 데이터 커넥터, 제로 카피 데이터 통합 및 기타 도구를 통해 Salesforce 및 비Salesforce 시스템과 호환되도록 모든 엔터프라이즈 아키텍처와 통합합니다.
- **앱 및 산업**: 플랫폼의 통합 기능을 기반으로 구축된 사용자 정의 가능한 앱 및 산업별 솔루션을 제공하며, 하위 계층 기능의 전체 범위를 활용하고, 심층적으로 통합된 AI 에이전트를 사용합니다.
## 3\. Hyperforce
Salesforce는 현재 많은 하이퍼스케일러 및 IaaS 공급업체보다 앞서 25년 가까이 글로벌 데이터 센터 인프라를 개발해왔습니다. Salesforce의 인프라가 발전한 현재 세대인 Hyperforce 전 세계 여러 공개 클라우드 공급업체에서 작동하도록 설계되었습니다.
유연한 B2C 규모, 글로벌 데이터 보존, 고급 가용성, 최상위 보안, 규정 준수에 대한 고객 요구에 맞게 조정되었습니다. Hyperforce 모든 Salesforce 제품 전반에서 인프라를 표준화하여 신규 인수의 신속한 통합을 촉진합니다.
Hyperforce Salesforce Platform을 제공하므로 신속하게 새로운 기능 및 응용 프로그램을 배포하고 전 세계 20개 이상의 지역에서 데이터 보존 및 규제 준수 요구 사항을 충족할 수 있습니다.
### 3.1 아키텍처 원리
Salesforce가 Hyperforce 전환하는 동안 하이퍼스케일러 간 서비스, 인터페이스, 규정 준수 수준의 상당한 차이가 식별되었습니다. Salesforce Platform에 견고하고 휴대성이 뛰어난 기반을 구축하기 위해 다음 아키텍처 원칙이 도입되었습니다.
- **코드로: 인프라** 도메인 구동 아키텍처를 활용하는 이 원칙은 인프라에 대한 선언적 코딩, 변경할 수 없는 아티팩트 생성, Kubernetes 및 서비스 메쉬와 같은 표준을 사용하여 요청 시 인프라를 자동화하는 작업을 포함합니다.
- **Zero-Trust Security**: 신원 관리, 인증, 인증, 네트워크 격리, 최소 권한 보안 정책, 전송 및 휴무 중 데이터 암호화 등 포괄적인 방어 전략을 갖춘 Zero Trust 보안 모델을 구현합니다.
- **관리 서비스**: 이 원칙은 멀티테넌트 및 멀티 클라우드 서비스 사용을 강조하여 상업, 정부, 공기 간격 시스템과 같은 다양한 인프라 및 환경 전반에서 이동성을 향상합니다.
- **내장형 복원 능력**: 미션 크리티컬 서비스는 고가용성을 보장하기 위해 여러 가용성 영역에 분산되어 있습니다. 데이터는 가용성 영역 전반에서 복제됩니다. 서비스 수준 목표 및 복원 계획을 관리하는 가용성 계층과 함께 레이블이 지정됩니다.
- **완전히 관찰 가능**: 로그 수집, 메트릭 수집, 경고, 분산 추적, 트래픽량, 오류 비율, 자원 활용도와 같은 서비스 작업 추적을 포함하는 효율적인 모니터링을 위해 모든 서비스를 표준 관찰 가능성 플랫폼에 통합합니다.
- **자동화된 작업**: 서비스 품질을 유지, 서비스 저하 감지 및 해결, 장애 감지를 위한 인프라 수명 주기 및 예측 AIOps(운영용 AI) 자동화 관리가 포함됩니다.
- **자동 스케일**: 확장성 및 비용 효율에 중점을 둔 이 원칙은 클라우드 공급자와 관련된 특정 계정 제한을 추상하여 운영 위험을 증가시키지 않고 다양한 규모의 운영 유연성을 제공합니다.
- **FinOps Aware**: 공용 클라우드는 인프라 유연성을 제공하지만 비용이 증가할 위험이 있습니다. 가용성, 보안 및 고객 Trust 저하하지 않고 서비스 수명 주기 전반에 걸쳐 효율성 중심의 엔지니어링 문화를 채택합니다.
이러한 원리는 Salesforce의 Hyperforce 플랫폼 개발 및 운영을 안내하며, 다양한 환경에서 적응성, 보안 및 효율성을 유지합니다.
### 3.2 인프라 컨셉
Salesforce Platform 및 지원 서비스는 여러 Hyperforce 인스턴스로 구성된 Hyperforce Foundation에서 실행됩니다. 이러한 인스턴스는 지역 및 가용성에 대한 고객 기본 설정에 맞춰 다양한 국가에 전략적으로 배포됩니다. 엄격한 데이터 보존 및 운영 요구 사항을 충족하기 위해 하나 이상의 Hyperforce 인스턴스를 선택적으로 그룹화하고 운영 영역으로 지정할 수 있습니다. 각 인스턴스는 안전, 확장성, 현지 및 법적 표준 준수를 위해 정기적으로 업데이트됩니다.
Hyperforce 인스턴스는 특정 기능을 제공하는 서비스 클러스터인 여러 Hyperforce Functional Domain 인스턴스로 구성됩니다. 기본 기능 도메인은 보안, 인증, 로깅 및 모니터링과 같은 중요한 서비스를 제공하며, 이 모든 서비스는 다른 Hyperforce 서비스에 필수적입니다. 비즈니스 기능 도메인은 Sales Cloud, Service Cloud 등 다양한 Salesforce 제품을 지원하므로 제품 기능을 쉽게 사용할 수 있습니다.
기능 도메인 내의 서비스는 확장 가능하고 반복 가능한 서비스 전달 단위인 셀로 구성될 수 있습니다. Hyperforce 셀은 하나 이상의 Salesforce 조직(org)이 거주하는 "Salesforce 인스턴스"라고 알려진 것에 해당합니다. 셀은 강한 폭발 반경 경계뿐만 아니라 배율 단위입니다. 슈퍼셀은 여러 셀의 논리 그룹화를 제공하여 셀 전반의 공유 서비스로 인해 더 큰 폭발 반경을 구분합니다. 기능적 도메인에 여러 개의 슈퍼셀이 존재할 수 있습니다. 셀 및 슈퍼셀을 사용하면 Hyperforce 폭발 반경의 크기를 강력하게 제어하면서 기능 도메인 내에서 수평으로 확장할 수 있습니다.
각 Hyperforce 인스턴스는 하나의 가용성 영역에 매핑되며, 이 개념은 모든 공용 클라우드 인프라에 적용되며 다른 모든 Hyperforce 인스턴스와 독립적으로 작동할 수 있습니다. Hyperforce 인스턴스의 모든 미션 크리티컬 서비스 및 데이터가 최소 3개의 가용성 영역에 분산되고 복제되어 오류 허용 및 안정성을 달성합니다. 또한 비즈니스 연속성 및 규정 준수를 위해 데이터 백업이 다른 적절한 Hyperforce 인스턴스로 복사됩니다.
Hyperforce 인프라스트럭처는 새로운 Hyperforce 인스턴스와 셀이 생성되거나 새로 고쳐지면서 지속적으로 발전하고 있습니다. 고객은 Hyperforce 물리적 세부 사항이 변경되지 않도록 방어됩니다. 트래픽을 현재 데이터 및 서비스 위치로 안전하게 라우팅하는 안정적이고 안전한 Salesforce 내 도메인(예: acme.my.salesforce.com)을 통해 외부에 표시되는 모든 고객 끝점에 액세스할 수 있습니다. 아웃바운드 트래픽(예: 메일, 웹 콜아웃)은 도메인 키 식별 메일(DKIM) 및 mTLS와 같은 보안 메커니즘을 사용하여 고객의 온 프레미스 인프라가 시간에 따라 변경될 수 있는 IP 주소와 같은 Salesforce 인프라의 물리적 세부 사항을 하드 코딩하지 않도록 하는 것이 가장 좋습니다.
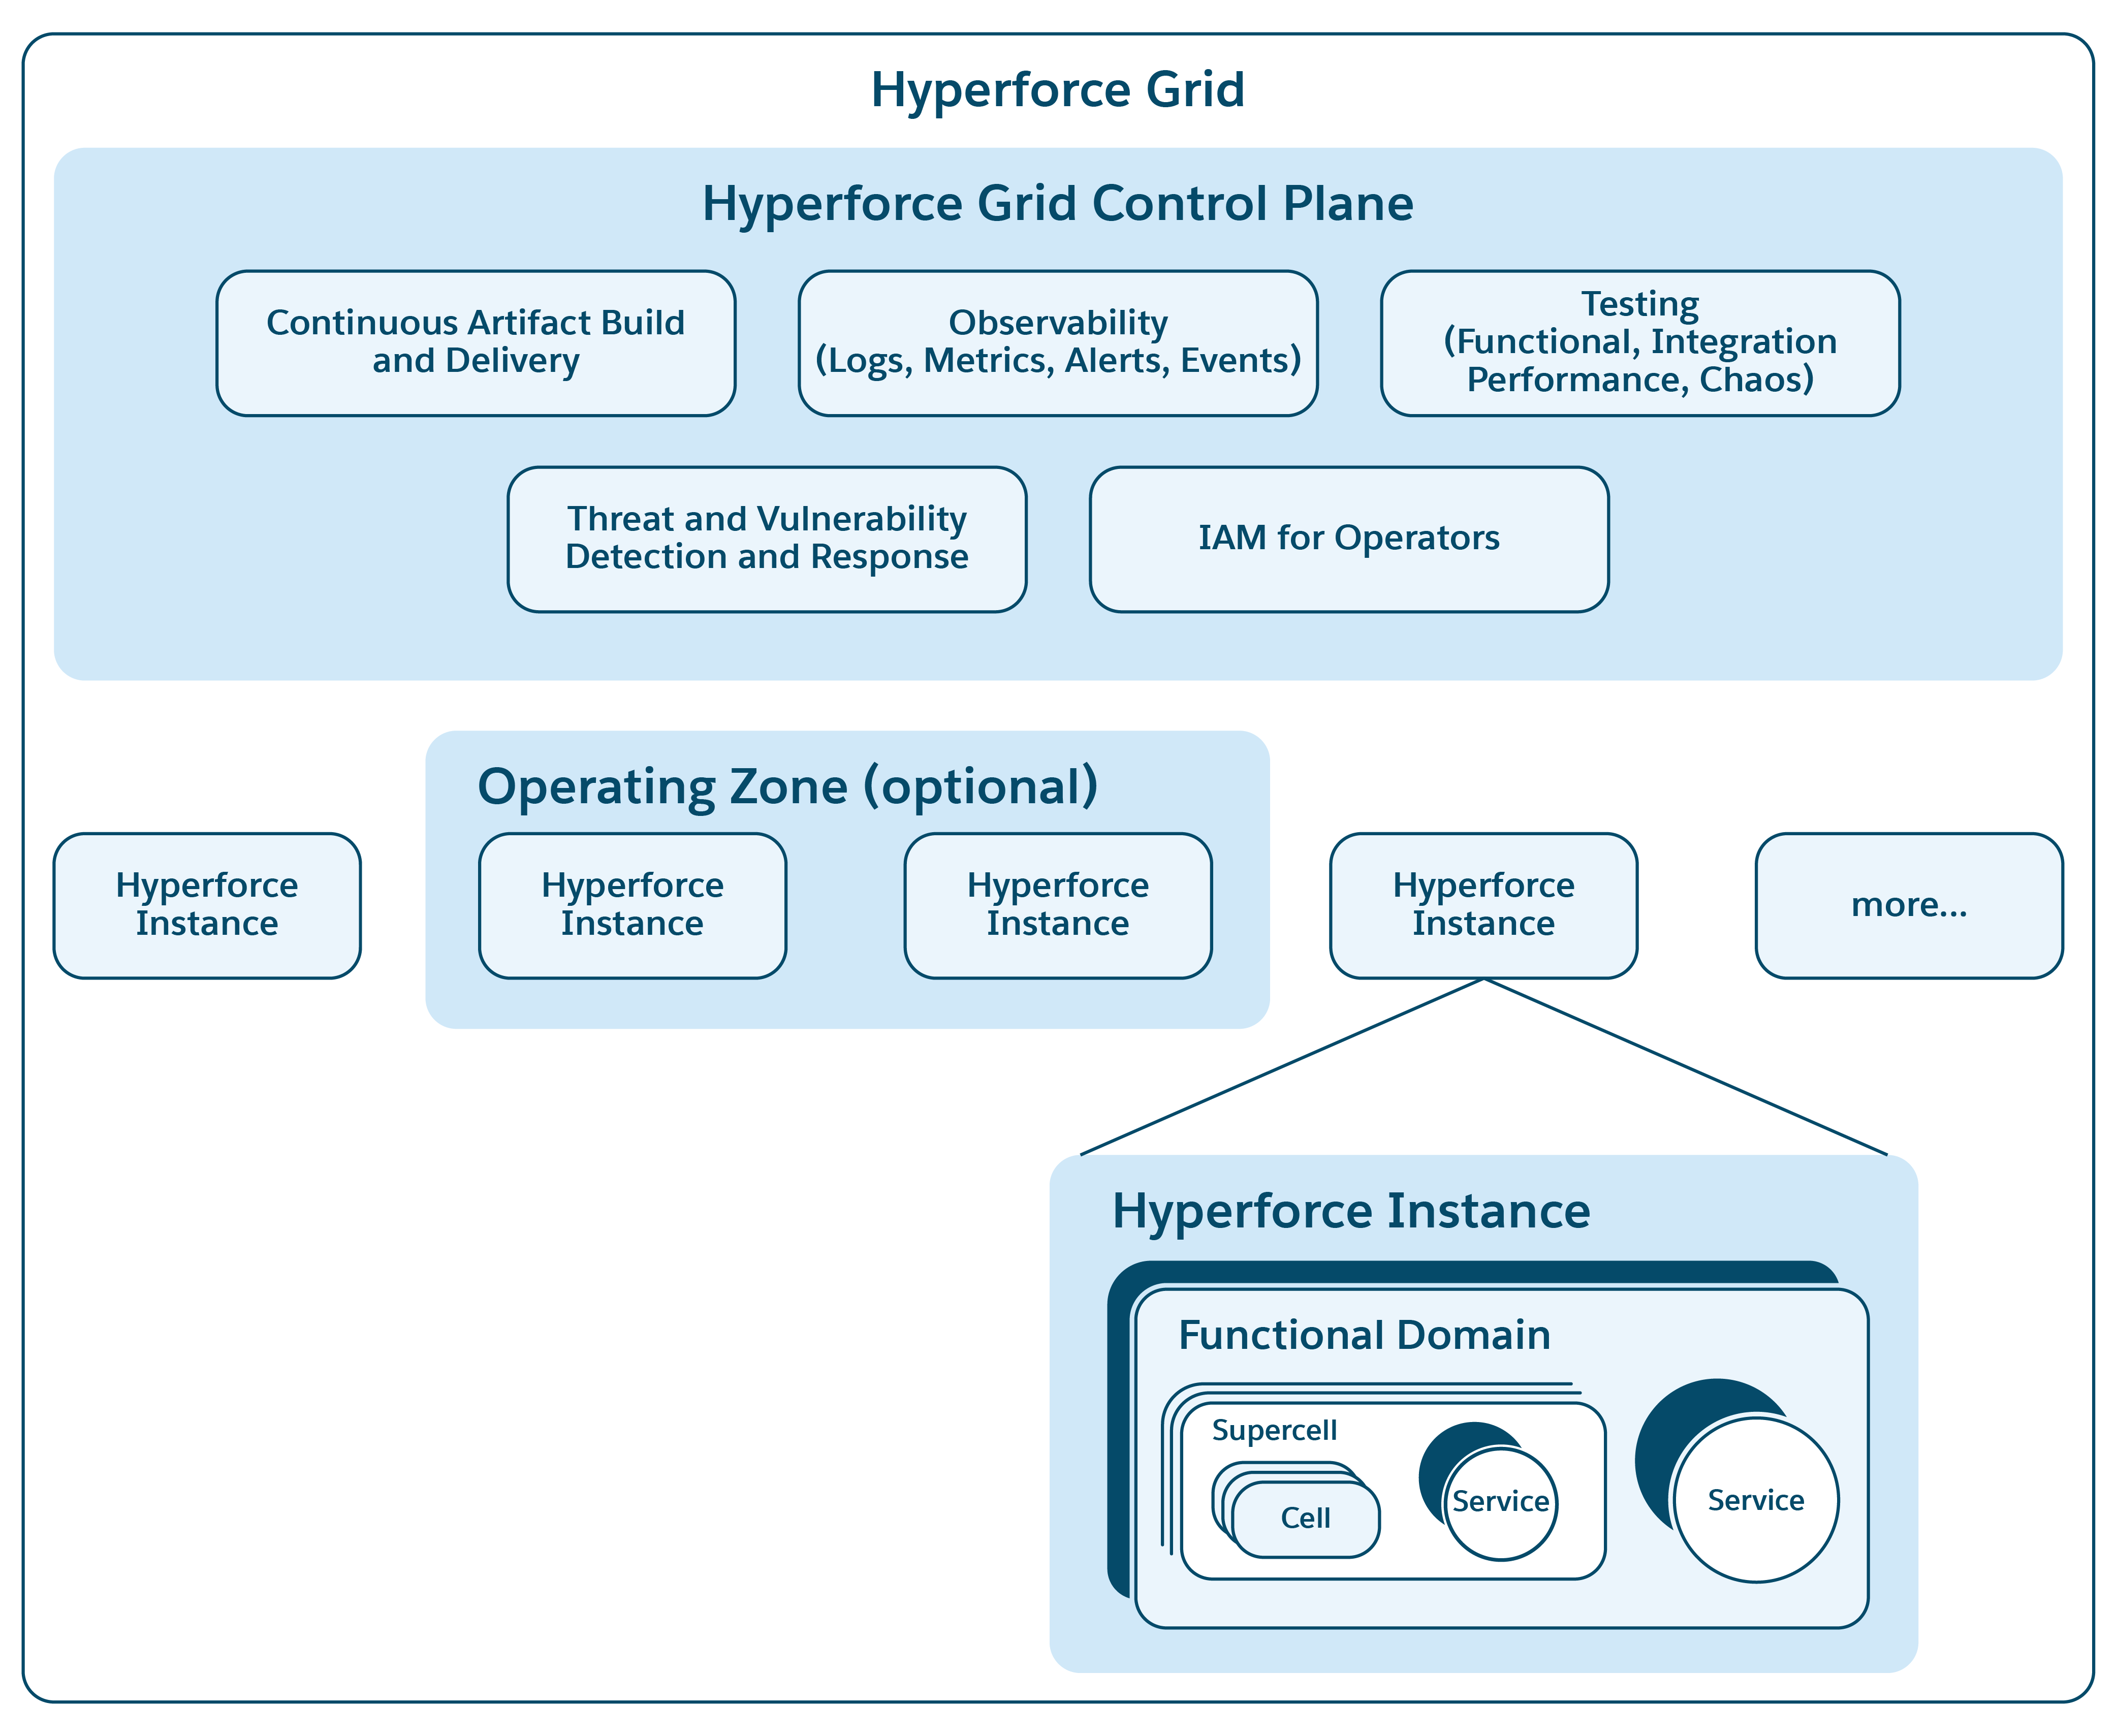 ### 3.3 네트워크 보안
Hyperforce Functional 도메인은 강력한 보안 조치로 설계되었습니다. 각 도메인은 주변에서 보호되고 분리되며, 보안을 강화하기 위해 도메인 내 서비스가 전용 계정으로 분리됩니다. 서비스 간의 통신은 서비스 메쉬 또는 유사한 프로토콜을 통해 안전하게 진행됩니다. 트래픽 관리는 모든 수신 및 발신 트래픽에 회로 차단기 또는 속도 제한과 같은 필수 제어를 검사, 라우팅, 적용하는 입력 및 발신 게이트웨이로 처리됩니다.
Hyperforce Functional Domain 내의 서비스는 보안 그룹으로 그룹화되며, 가장자리의 서비스만 공개 인터넷에 노출됩니다. 런타임 보안 정책은 서비스에 필요한 액세스 권한만 부여하도록 최소 권한 원칙을 준수하여 다양한 보안 그룹 간에 커뮤니케이션 규칙을 적용합니다.
각 지리적 영역에는 전송 계층 보안을 종료하고 프로그래밍 가능한 웹 응용 프로그램 방화벽 정책을 사용하여 위협을 예방적으로 해결하는 Hyperforce Edge 기능 도메인이 있습니다. 이를 통해 합법적인 트래픽만 Hyperforce 엔드포인트에 도달하고 안전하고 효율적인 고객 환경을 유지할 수 있습니다. 또한 Hyperforce 인스턴스 간의 내부 네트워크 연결은 엄격하게 제어되며, 개인 식별 정보를 포함하는 모든 로그 데이터는 GDPR 표준을 준수하기 위해 익명화됩니다.
### 3.4 Hyperforce 그리드 제어판
Hyperforce 그리드는 동일한 컨트롤 플레인을 공유하는 여러 Hyperforce 인스턴스를 구성하며, 이 컨트롤 플레인은 적절한 경우 민감한 워크로드를 분리하도록 설계되어 있습니다. 그러면 고객 또는 시스템 데이터, 플랫폼 메타데이터 또는 그리드 전반의 모니터링 데이터가 누출되지 않습니다. 제어 플레인은 고객 대면 Hyperforce 인스턴스를 생성, 관리 및 모니터링하기 위한 필수 서비스를 호스팅하는 예비 Hyperforce 인스턴스로 구성됩니다.
모든 Hyperforce 서비스에 대한 서비스 및 인프라 코드는 소스 코드 관리, 지속적인 통합, 테스트 및 아티팩트 빌드 서비스를 활용하여 전용 컨트롤 플레인 기능 도메인 내에서 안전하게 개발됩니다. 생성된 코드는 위협 및 취약점을 스캔한 후 표준화된 디지털 서명 컨테이너에 패키지되고 이미지 레지스트리에 저장됩니다. 코드 배포는 Hyperforce 연속 배달 시스템의 승인된 파이프라인에서 처리하며 배포 권한은 승인된 팀 및 운영자에게 제한됩니다. 간격 제어 플레인은 해당 환경에 필요한 추가 보안 조치를 처리합니다.
ID 및 액세스 관리(IAM) 서비스는 적시 승인을 적용하여 액세스 기간 및 작업을 제한하며, 감사 추적은 모든 활동을 모니터링하고 실시간 감지 시스템에 피드를 제공하여 의심스러운 활동을 식별하고 경고합니다.
### 3.5 Hyperforce 비용 관리
Salesforce가 자사 데이터 센터에서 공개 클라우드의 Hyperforce 서비스를 전환할 때 예산 생성, 비용 시각화, 자원 최적화 전략을 개정하는 것이 중요합니다.
비용 관리 접근 방식은 단순히 비용 절감이 아니라 성장을 목표로 하는 제품과 안정적인 제품을 구분하는 전략적 프로세스입니다. 제품 가용성을 유지하는 소비 기반 가격 책정 및 마진을 계획하며, Trust 핵심 가치에 부합합니다. 공개 클라우드 계정은 계층적으로 구성되고 특정 제품 및 경영진과 연결됩니다. 조직 메타데이터로 보강된 자세한 서비스 수준 자원 태그를 사용하면 개별 마이크로서비스에 대한 비용을 파악할 수 있습니다. Tableau 및 Slack과 같은 도구와 고급 예측 도구를 사용하여 경영진 및 팀에 비용, 예측, 예산 분석에 대한 실시간 데이터를 제공하여 향후 재무 계획에 대한 자신감을 부여합니다.
최적의 비용 관리를 위해 Salesforce는 절감 계획, 스팟 용량, 주문형 수용력 예약(ODCR)을 혼합하여 필요한 수용력을 보장합니다. 해당 예약은 고급 시계열 예측 및 사용자 정의 대시보드를 통해 관리되므로 인력이 감독하고 의사 결정을 내릴 수 있습니다. 단위 트랜잭션 비용 절감(정의된 비즈니스 트랜잭션 양을 처리하는 비용)에 대한 달성 가능한 목표를 설정하는 것은 개선 사항을 촉진하는 효과적인 전략입니다. Hyperforce 단위 비용 탐색기 도구를 사용하면 팀이 단위 비용 추세를 분석하고 관리하고, 특정 서비스에 비용을 할당하고, 새로운 개선 기회를 파악할 수 있습니다. Salesforce Cloud 최적화 지표 또는 “COIN” 점수는 절약 기회의 동적 목록을 기준으로 서비스를 평가하여 서비스 팀이 최적의 자원 효율을 유지하도록 동기를 부여합니다.
지속 가능성에 대한 견고한 노력으로 탄소이력 감축을 적극적으로 추구하고 수행된 작업과 관련된 배출 측정값인 탄소 대비 단위를 줄이는 특정 목표를 설정합니다.
## 4\. Enterprise-Grade Trust
보안 및 가용성은 엔터프라이즈급 플랫폼의 핵심적인 요소이며 고객의 Trust 유지에 필수적입니다. Salesforce에서는 해당 컨트롤이 Salesforce Platform에 통합되며 공유 서비스 및 소프트웨어 프레임워크를 통해 자동으로 적용됩니다. 이 내장형 접근 방식을 사용하면 개별 시스템이 추가 작업 없이 혜택을 누릴 수 있습니다.
수천 개의 서비스 및 수백 개의 팀에서 이 광범위한 보안 및 가용성 컨트롤을 관리하고 지속적으로 개선하는 것은 상당한 과제입니다. 그러나 작은 세부 사항을 무시해도 보안 위반 또는 시스템 중단이 발생할 수 있으므로 매우 중요합니다.
### 4.1 보안
Hyperforce 고급 보안 기능이 포함된 서비스의 개발 및 배포를 지원하는 안전하고 규정 준수적인 인프라 플랫폼입니다. 강력한 액세스 제어, 데이터 암호화, 보안 표준 준수를 제공합니다. Salesforce는 PCI/DSS, GDPR, HIPAA, FedRamp 등 40개가 넘는 보안 및 규정 준수 표준을 준수합니다.
핵심 보안 원칙에는 Zero Trust 아키텍처(ZTA)와 엔드 투 엔드 암호화가 포함되어 있으며, 모든 처리 단계에서 고객 데이터를 보호합니다. Salesforce는 보안 소프트웨어 개발 수명 주기에서 프로덕션 운영에 이르기까지 보안 표준 및 모범 사례뿐 아니라 잠재적인 위협을 완화하기 위한 강력한 응용 프로그램 수준 보안 관행을 준수합니다.
#### Zero Trust 아키텍처 (ZTA)
ZTA 사이버 보안 패러다임은 모든 사용자, 장치 및 서비스 연결이 위치에 관계없이 인증, 권한 부여, 연속 유효성 검사를 수행하도록 합니다. ZTA 및 공개 키 인프라 (PKI)는 현대 사이버 보안에 필수적이며, 경계 보안에 의존하지 않고 Trust 경계와 안전한 통신을 설정합니다.
그러나 PKI 배포에서는 루트 인증 기관보다 인증서 해지 및 거버넌스의 중요성을 무시하는 경우가 많습니다. Salesforce의 인증서 취소 구현은 강력하고 확장 가능하며, 종단간 PKI 보안을 지원합니다.
또한 Hyperforce 서비스 간 상호 전송 계층 보안을 통해 ZTA를 적용하며, 역할 기반 액세스 제어를 사용하는 사용자에 대해 단기 비공개 키 및 적시 액세스를 사용합니다.
#### 종단간 암호화
Salesforce Platform은 완벽한 전달 암호화 도구 모음과 함께 TLS를 사용하여 전송 중인 데이터를 보호하므로 사용자 장치와 Salesforce 서비스 간 및 Salesforce 인프라 도메인 내에서 네트워크를 이동할 때 데이터를 보호합니다.
데이터를 유지하는 경우 Salesforce Platform은 하드웨어 보안 모듈에서 지원하는 키 관리 시스템을 사용합니다. 멀티테넌트 플랫폼에서 각 테넌트에게 고유한 암호화 키가 할당되어 테넌트 간의 키 크로스오버를 방지합니다.
커뮤니케이션 및 암호화 보안은 키 또는 무작위 데이터를 생성하기 위해 엔트로피에 크게 의존합니다. 예측 가능한 키 생성으로 인한 암호화 프로토콜의 공격에 대한 취약성을 인식하는 Salesforce Platform은 모든 키 생성 프로세스에 대해 여러 출처에서 엔트로피를 소싱하여 이러한 위험을 완화합니다. 클라우드 서비스 공급자가 활성화하는 다양한 프로세서에서 사용할 수 있는 메모리 암호화 기능을 활용하여 콜드 부트 공격으로부터 보호를 강화합니다.
#### 보안 소프트웨어 개발 수명 주기
Salesforce는 FIPS(연방 정보 처리 표준)와 같은 여러 규정 준수 표준을 충족하도록 사용자 정의된 JDK를 보유하고 있어 개발자 및 운영자가 직접 규정 준수 작업을 수행할 필요가 없어 프로세스를 간소화합니다. 이 사용자 정의는 XML 외부 엔티티 삽입(XXE)과 같은 위험을 방지할 뿐만 아니라 필요에 따라 암호화 전략을 교환할 수 있는 Salesforce의 암호화 민첩성과 능력을 향상합니다. 이를 통해 내부적으로 개발되었거나 오픈 리포지토리에서 소싱되었는지 여부와 상관없이 비준수 코드를 완전한 재작업 없이 FIPS 호환 코드로 변환할 수 있으므로 개발 팀의 작업량을 줄이고 기본 설계 원칙에 따라 보안을 유지할 수 있습니다.
또한 Salesforce는 보호 조치를 SSL(Secure Software Development Lifecycle)에 통합하여 크로스 사이트 스크립팅(XSS), 요청 위조(CSRF), SQL 삽입과 같은 취약성을 해결하기 위한 프레임워크를 통합했습니다.
역할 기반 액세스 제어(RBAC)로 강화된 중앙 집중식 암호 관리 시스템이 구현되어 서비스 및 사용자 액세스를 모두 보호합니다. 또한 코드 스캔 도구는 소스 코드 관리 시스템을 통해 프로덕션 환경에서 실수로 암호가 노출되는 것을 방지하기 위해 사용됩니다.
#### Hyperforce 운영 보안 기능
피싱은 여전히 조직에 대한 상당한 위협이며, Salesforce는 여러 업계의 Best Practice(CISA(Cyber Security and Infrastructure Security Agency) Zero Trust 원칙 등)에 따라 피싱 방지 다단계 인증(MFA)을 구현합니다. 프로덕션 액세스 권한이 있는 직원을 위한 하드웨어 지원 키와 클라우드 서비스 공급자 계정에 대한 액세스를 제어할 수 있는 보안 커널이 포함됩니다.
Salesforce는 강력한 보안 상태를 유지하기 위해 표준화된 보안 제어 기능과 Hyperforce 클라우드 네이티브 보안 서비스를 통합하여 향상된 가시성, 위협 감지, 정책 시행을 제공합니다. 실시간 모니터링, 경고, 보고를 위한 포괄적인 보안 정보 및 이벤트 관리 시스템이 구축되며, 이 시스템은 지속적으로 취약점을 식별, 평가, 수정할 수 있는 종합적인 취약성 관리 프로그램 및 클라우드 보안 조치 관리 도구를 통해 지원됩니다.
또한 웹 응용 프로그램 방화벽은 다양한 공격으로부터 HTTP 트래픽을 필터링하고 모니터링하며, 방화벽, 침입 감지 및 방지 시스템, 가상 비공개 네트워크, 끝점 감지 및 응답 에이전트 등 다양한 네트워크 보안 도구를 활용하여 지속적인 모니터링 및 위협 감지를 제공합니다. 네트워크 세분화 및 마이크로 세분화가 구현되어 공격 표면을 최소화하고 잠재적인 위반을 포함합니다.
또한 Salesforce는 Hyperforce의 고유한 과제에 맞춰 강력한 사고 대응 계획을 개발 및 구현하였으며, 보안 사고를 식별, 차단 및 완화하기 위한 사전 정의된 절차를 포함하여 잠재적인 보안 위협에 대한 신속하고 효과적인 대응을 보장했습니다.
### 4.2 가용성
Salesforce는 고가용성이 필요한 미션에 중요한 고객 워크로드를 관리합니다. 고가용성 전략에는 서비스 소유권 모델, 사고 관리, 운영 검토와 같은 다양한 조직 패싯이 포함되어 있습니다. 전략의 핵심 기술 요소에는 모니터링 아키텍처, AI 기반 운영 자동화, 프로덕션 변경을 위한 자동화된 안전 메커니즘이 포함됩니다.
#### 가용성 아키텍처 표준
수천 개의 서비스에서 고가용성을 지속적으로 달성하기 위해 3단계 접근 방식을 통해 기술 위험을 대규모로 관리합니다.
먼저 다음과 같은 모범 사례를 정의하는 가용성 아키텍처 표준이 설정됩니다.
- 자동 페일오버를 사용하는 **예비 기능** 대규모 클라우드 기반 시스템에서 발생하는 지속적인 오류를 처리하기 위해 Salesforce는 높은 수준의 중복성, 완전 자동화된 오류 감지, 전체 및 부분 오류 모두에 대한 원활한 자동 복구를 사용하여 서비스를 구축합니다.
- **폭발 반경 제한** 장애가 발생할 _것이_ 있으므로 팀은 장애의 영향을 막기 위해 의도적인 폭발 반경 최대값으로 모든 서비스를 설계합니다. 가장 고전적이고 눈에 띄는 예는 Hyperforce Cell(fka Pod)입니다.
- **실패 분할화** 오류가 시스템의 독립 단위 전체에서 확산되고 복합되는 것을 방지합니다. 서비스 간에 방지되는 오류가 발생하는 API 호출은 분산 시스템 전반에서 실패를 계단식으로 방지하는 핵심 패턴입니다. 이 과정에서 팀은 이중화와 분할의 균형을 주의 깊게 조정합니다.
- **자동 확장** 성능 저하 없이 예측할 수 없는 부하를 제공하려면 CPU, 메모리 또는 대기열 깊이와 같은 자원의 채우기 지점에 의해 트리거되는 느린 실패 인적 연산자에 의존하지 않고 빠르게 확장하고 느리게 다운합니다.
- **빠른 롤백** 모든 서비스에 대해 롤백 대상을 분 단위로 설정하고, 롤아웃 앞으로, 뒤로, 앞으로를 다시 기본 작업으로 지정하여 사전 프로덕션 환경에서 롤백을 자동으로 테스트합니다. 팀은 기능 플래그를 광범위하게 사용하여 더욱 빠르고 세부적인 긴급 스위치 및 롤아웃을 수행합니다.
- API 호출을 수신하는 모든 서비스를 **보호합니다**. 로드 분산, 테넌트 공정 한도, 웹 응용 프로그램 방화벽, 정교한 레이어 7 보호 기능은 인터넷에 직접 노출된 가장 외부 주변 서비스에서부터 상위 수준의 통화 서비스에서 실수로 버그에 의해 공격될 수 있는 팀의 가장 깊은 내부 서비스까지 시스템의 모든 수준에 배포됩니다.
- **약한 종속성** 서비스 간의 종속성은 가능할 때마다 소프트로 설계되어 서비스가 실패하거나 독립적으로 성공할 수 있도록 합니다. 캐싱은 여기서 가장 일반적인 패턴 중 하나입니다. 다운스트림 종속성의 오래된 결과가 지속적인 기능에 적합한 경우가 많습니다.
- **비동기식 통신**을 선호합니다. 서비스 간의 비동기식 중개 커뮤니케이션은 해당 서비스를 서로 분리하고 서비스 간의 부하 증가를 완화합니다.
- **API 호출을 오류 허용**으로 만듭니다. 일부 장애 및 일시적 네트워크 문제를 허용하기 위해 타임아웃 및 마감일, 회로 중단, 백오프가 있는 재시도와 같은 몇 가지 패턴을 사용합니다. 가능한 경우 자원 소비 및 차단을 제한하기 위해 통화를 차단하지 않는 것이 좋습니다. 구축 시간 및 통합 테스트 시 스키마 수준 린팅과 함께 이전 및 이전과 호환성이 적용됩니다.
- **서비스 할당량 및 제약 사항 관리** 팀은 IP 주소, 디스크 IOps 또는 지정된 Kubernetes 클러스터의 용량과 같은 서비스 플리트 전반에 걸쳐 할당량 및 제약을 설정합니다. 팀은 근접한 제한이 런타임 시 시스템에 영향을 미치지 않도록 해당 할당량 및 제약 사용에 대해 중앙 집계, 모니터링, 경고합니다.
두 번째로, 다중 계층형 검사 모델은 서비스가 다음 표준을 충족하는지 확인합니다. 여기에는 자동화된 혼란 테스트, 안티 패턴에 대한 스캔, 린팅, 고위 설계자와의 아키텍처 검토가 포함되어 자동화에서 해결되지 않는 문제를 파악합니다.
세 번째로, 솔루션이 Hyperforce 통합되어 해당 표준을 쉽게 준수할 수 있습니다. 여기에는 자동 텔레메트리 수집, 기본 예비 기능, 페일오버 메커니즘, 로드 분실 및 DDoS 방어와 같은 내장형 보호 기능이 포함되며, 개별 서비스에 대해 모두 기본적으로 활성화됩니다.
#### 모니터링 및 관찰 가능
Salesforce는 메트릭, 로그, 이벤트 및 추적을 비롯한 대용량의 원격 데이터를 처리하며, 기존 모니터링 솔루션은 항상 효율적으로 관리할 수 없습니다.
이를 해결하기 위해 Salesforce는 소프트웨어 개발 수명 주기, 운영, 지원 기능과 통합되는 포괄적인 관찰 가능성 시스템을 개발했습니다. 이 시스템은 엔지니어링 및 고객 지원 팀을 위한 통합 환경을 제공하며, 규모 요구를 충족하고 타사 소프트웨어의 라이센스 비용을 절감합니다.
OpenTSDB 및 HBase에 구축된 Salesforce의 메트릭 인프라는 시계열 데이터의 대규모 수집, 저장, 실시간 쿼리를 지원합니다. 비실시간 사용 사례는 Trino 및 Iceberg를 활용하여 분당 20억 개가 넘는 메트릭을 처리하여 CPU 활용도, 메모리 사용량, 요청 비율에 대한 인사이트를 제공합니다. 로그 관리를 위해 Salesforce는 강력한 색인화 및 검색 기능에 Splunk을 사용합니다. Apache Druid는 사용자 상호 작용 및 시스템 이벤트를 이해하는 데 중요한 대규모 이벤트 데이터의 실시간 수집 및 분석을 지원합니다. 마이크로서비스 전반에서 배포된 추적은 OpenTelemetry 및 ElasticSearch를 사용하여 관리되므로 특정 대기 시간 및 오류 지점을 식별하는 데 도움이 됩니다.
또한 Salesforce는 데이터 수집 및 텔레메트리 매장을 위한 기술 스택과 통합되는 응용 프로그램 성능 모니터링(APM) 인프라를 구현했습니다. 이 응용 프로그램 자동 계측은 데이터 수집을 간소화하고 서비스 전반에서 일관된 텔레미터리를 보장합니다. APM의 통합 대시보드는 다양한 데이터 유형을 연관시켜 엔지니어가 성능을 모니터링하고, 문제를 진단하고, 통합형 인터페이스를 통해 시스템을 최적화할 수 있는 능력을 강화합니다.
관찰 가능성 도구를 표준화함으로써 Salesforce는 배포된 추적을 사용하여 서비스 전반에서 서로 다른 텔레메트리 유형을 연결합니다. 이를 통해 전체 서비스 에코시스템을 시각화하고 요청을 세분화하여 추적하는 포괄적인 서비스 종속성 그래프가 생성됩니다. 이 기능은 문제를 파악하고, 지체 지점을 식별하고, 변칙 감지, 예측 분석, 자동 수정과 같은 AI 중심 기능을 지원하는 데 매우 중요합니다.
#### AIOps 에이전트
사고 해결 시간을 늘리기 위해 AI 운영(AIOps) 에이전트를 개발하여 소수의 사례에만 중재하여 사람을 대신하여 사고를 자동으로 감지, 분류, 수정합니다. AIOps 에이전트는 복잡한 반응형 에이전트 기반 시스템을 쉽게 개발하도록 설계된 확장 가능한 다중 에이전트 반응형 툴킷입니다. 이는 매우 모듈식이며 다양한 도구를 사용하여 기능을 확장할 수 있습니다. 에이전트 수가 증가하면서 효율적으로 확장하도록 설계되었습니다. 주요 기능에는 에이전트가 환경의 변화에 동적으로 반응할 수 있는 반응형 아키텍처, 에이전트 기능을 확장하기 위한 도구를 쉽게 통합할 수 있는 도구 향상, 다양한 계획 모듈을 연결하여 에이전트의 계획 전략을 사용자 정의할 수 있는 플러그블 계획 모듈이 포함됩니다.
작성 시점의 핵심 CRM 제품 사고 중 91%에 대해 Merlion 라이브러리의 고급 기계 학습 모델을 사용하여 사전 예방적 인 감지가 수행되었습니다. 이는 AI 연구 팀이 개발한 공개 소스 라이브러리입니다. Merlion은 격리 포레스트, 통계, 랜덤 포레스트, 장기간 단기 메모리(LSTM) 신경 네트워크와 같은 기계 학습 모델의 집합으로, 시스템에서 생성된 광범위한 텔레메트리 데이터를 거의 실시간으로 처리합니다.
작성 시 사고의 79%가 에이전트의 작업에 의해 자동으로 해결됩니다. AIOps 에이전트는 로그, 프로필, 진단, 시계열, 서비스별 아티팩트와 같은 데이터 벡터를 처리하고 정렬하여 수정 조치를 권장할 수 있습니다. AIOps 에이전트 컨트롤러 및 플래너가 프로덕션에서 작업을 수행할 특정 기술을 가진 에이전트를 선택합니다.
인적 참여가 필요한 나머지 사고의 경우 AIOps 에이전트가 해결되지 않은 문제를 적절한 서비스 팀으로 효율적으로 분류합니다. 문제 레코드, 사고, JFR, 로그와 같은 운영 데이터 집합에 대해 교육을 받고 필요한 전문 지식을 보유한 팀에게 전달되는 사내 정밀 조정 모델인 XGenOps를 사용하여 각 사고의 특성과 컨텍스트를 지능적으로 이해하여 이를 수행합니다. 이렇게 하면 일주일에 2,800시간이 넘는 엔지니어링 시간이 절약되어 엔지니어가 해결되지 않은 문제를 분류할 필요가 줄어듭니다.
#### 연속 배포
매주 수행되는 250,000건의 프로덕션 변경으로 인해 중단될 위험을 관리하기 위해 완전 자동화된 배포 시스템을 사용하여 안전한 변경 관행을 적용하여 인적 오류를 방지합니다. 기본 제공 시스템은 확장하거나 사용자 정의할 수 없었으므로 보다 맞춤형 솔루션을 개발할 수 있었습니다.
사용자 정의 연속 배포 시스템은 업계 표준 파란색/녹색 배포 전략에 따라 여러 계층을 통해 안전을 보장합니다.
- 각 변경 사항에 대한 필수 테스트 증거입니다.
- 변경 사항의 초기 Canary 테스트입니다.
- 폭발 반경이 제어된 단계별 배포.
- 배포 단계 간 배치 및 상태 확인
- 기존 중재 및 사고와의 충돌 완화
또한 연속 통합 시스템은 AI가 선택한 수백만 개의 테스트를 실행하도록 최적화되어 회귀 위험을 최소화하면서 신속하게 릴리스할 수 있습니다.
## 5\. 메타데이터 프레임워크
Salesforce Platform의 핵심 아키텍처 원리는 메타데이터 기반 디자인입니다. Salesforce 엔지니어는 멀티테넌트 서비스 및 데이터 저장소를 만듭니다. 플랫폼의 각 응용 프로그램은 기본적으로 개별 고객이 이러한 멀티테넌트 서비스를 활용하는 방법을 맞춤 설정하는 메타데이터 컬렉션입니다. 따라서 Salesforce Platform에 대한 일반적인 마케팅 구문은 "메타데이터를 통해 모든 항목에 액세스할 수 있음"입니다.
플랫폼은 구조화되고 강력하게 유형이 지정된 메타데이터를 강조합니다. 이 메타데이터는 고객 환경과 기본 Salesforce 인프라 및 구현 간의 추상 계층 역할을 합니다. 이 접근 방식은 응용 프로그램의 유용성과 품질을 모두 향상합니다. 예를 들어, 고객은 SQL 스키마 정의 및 쿼리를 사용하는 대신 Salesforce 개체(sObject) API를 통해 엔티티, 필드, 레코드와 같은 구조화된 메타데이터와 상호 작용합니다. 이 설계를 통해 플랫폼은 애플리케이션을 다시 작성할 필요 없이 새 데이터 저장소 기술을 통합하거나 기존 데이터 저장소 기술을 수정할 수 있으므로 지속적인 개발 모범 사례를 지원할 수 있습니다.
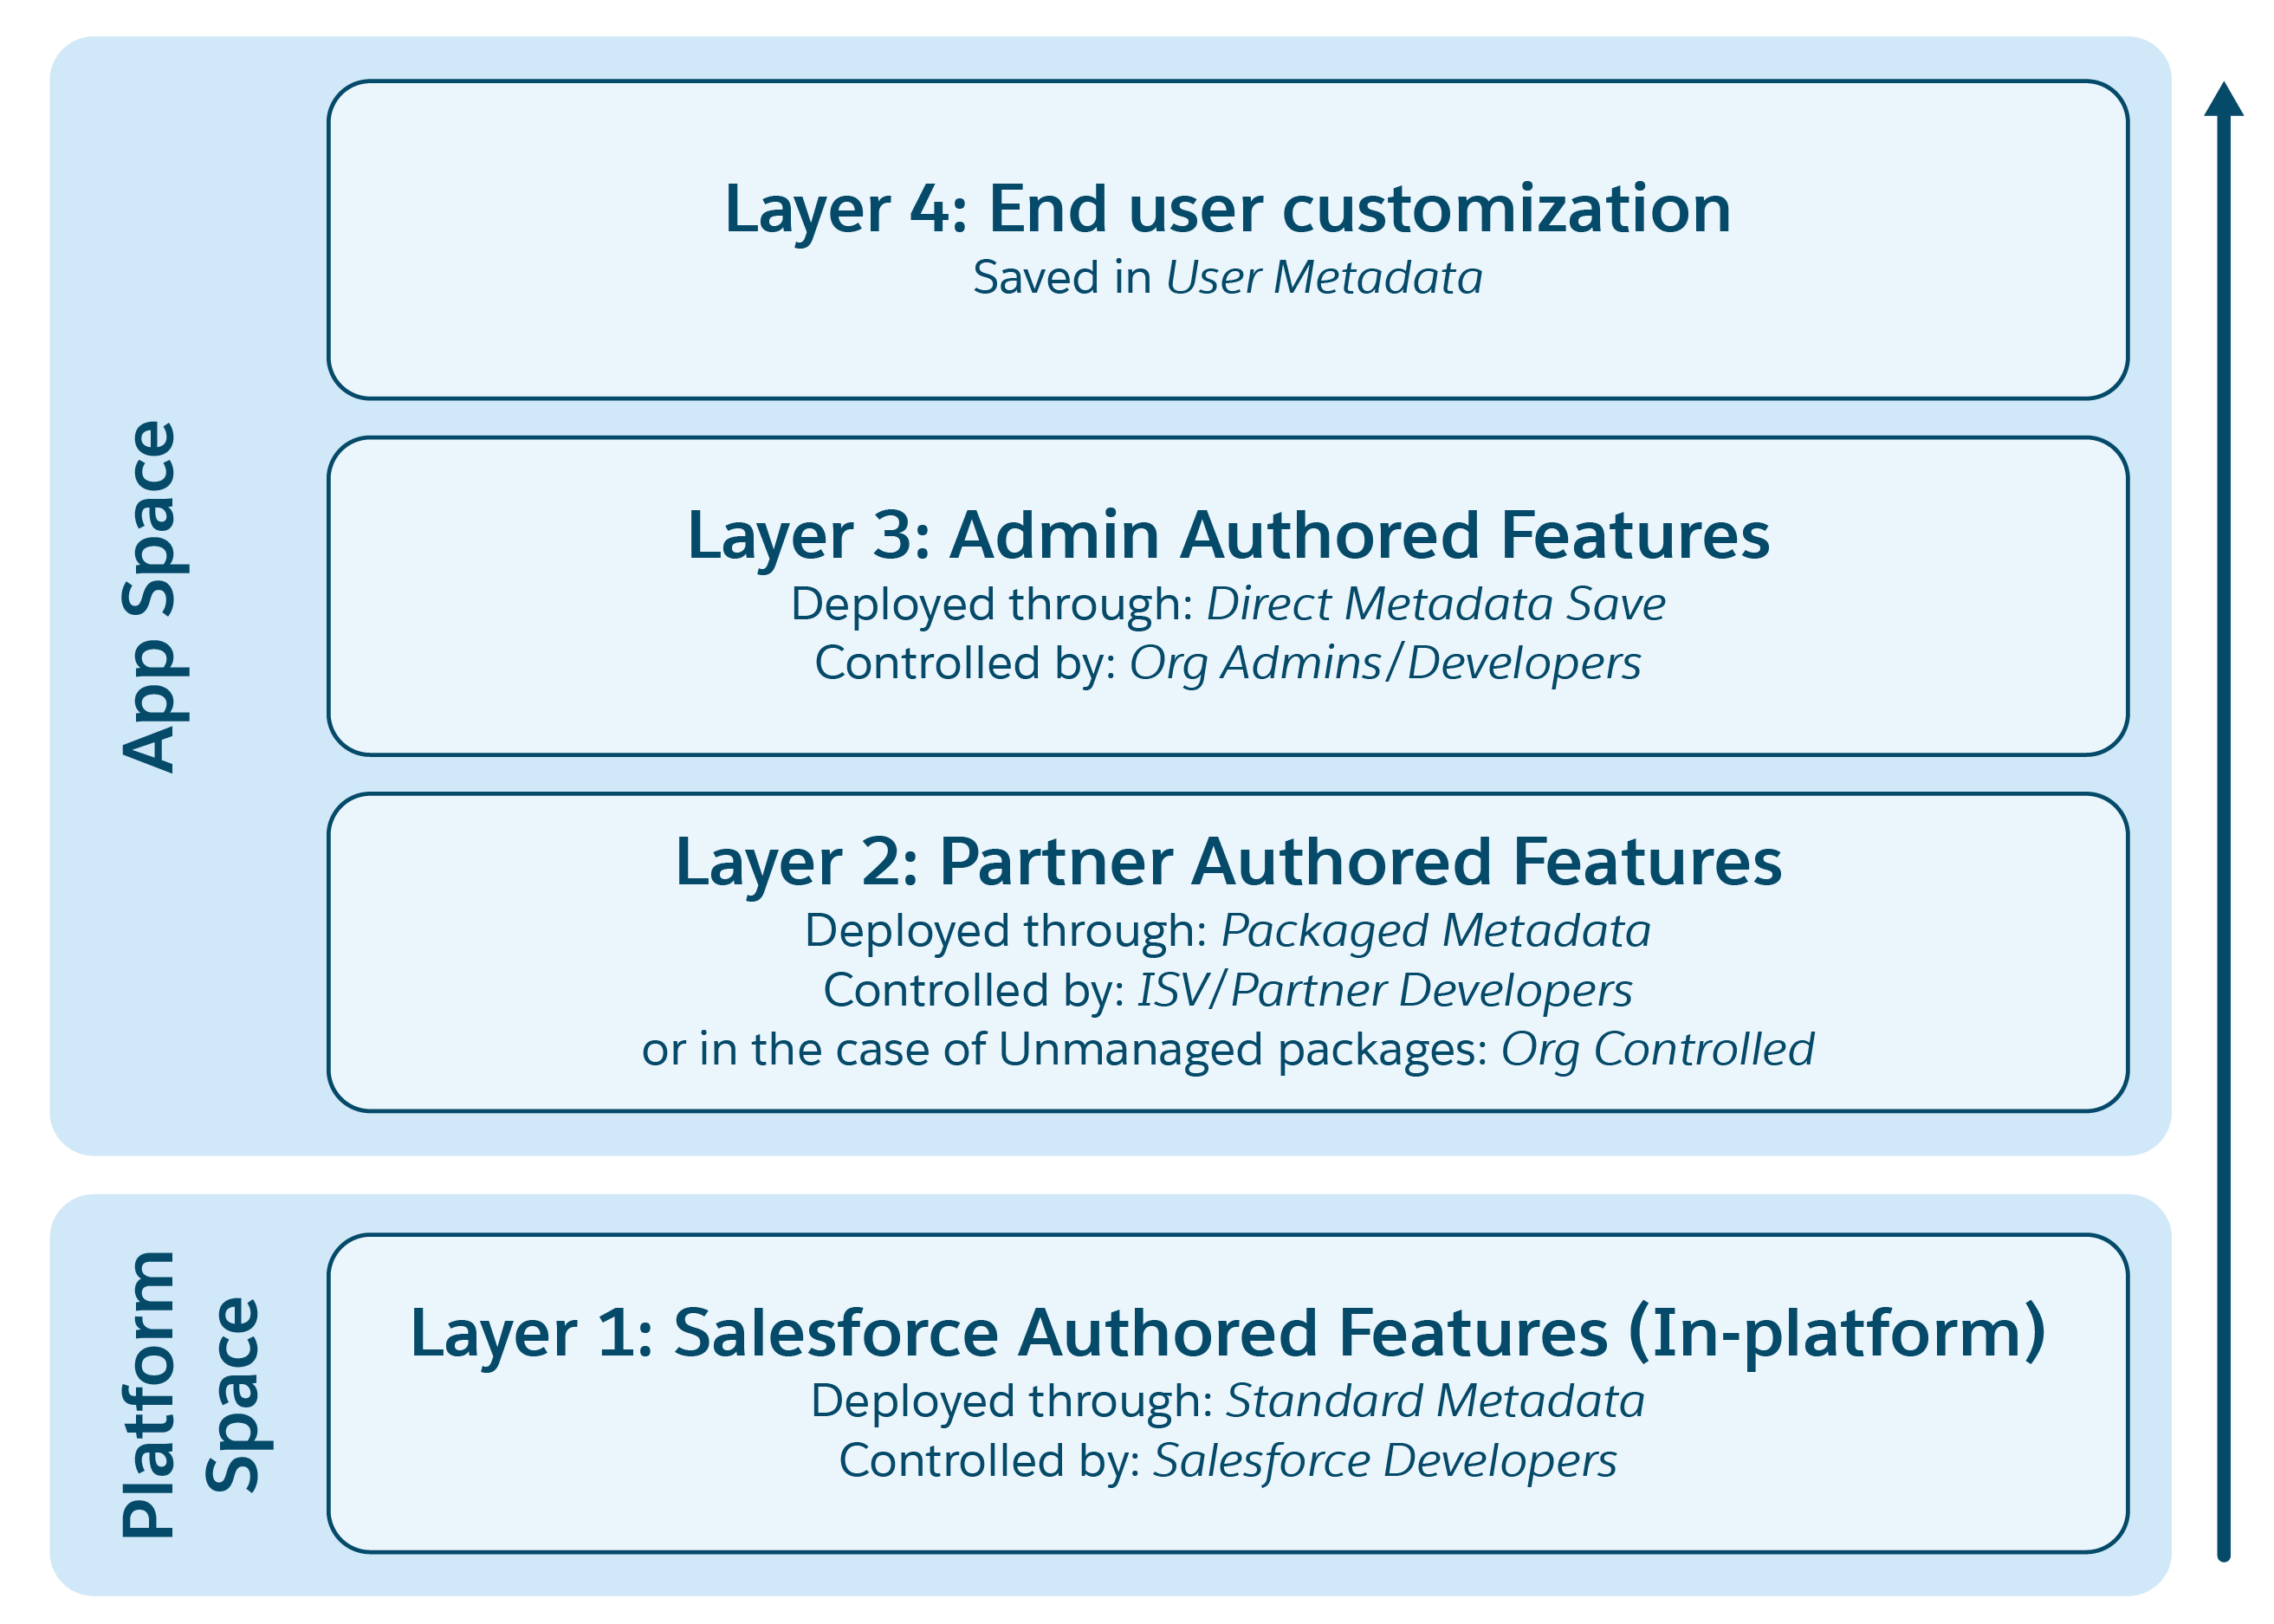 Salesforce Platform 아키텍처는 앱 구축 및 확장에서 4개의 핵심 페르소나를 지원하는 "계층화된 확장" 접근 방식을 제공합니다.
- **Salesforce 엔지니어링:** 팀은 광범위한 릴리스 프로세스를 통해 모든 서비스 및 런타임에 배포되는 Sales Cloud 및 Service Cloud와 같은 기본 앱을 개발합니다. 이러한 앱은 라이센스 및 프로비저닝 메커니즘을 통해 모든 테넌트에서 사용할 수 있습니다.
- **외부 파트너**: 독립 소프트웨어 공급업체(ISV) 및 기타 파트너는 Salesforce에서 만든 메타데이터를 확장하여 Sales Cloud 데이터 모델에 대한 스키마 확장 또는 Service Cloud 사례 레코드에 대한 추가 확인 규칙과 같은 추가 가치 솔루션을 구축할 수 있습니다. 여러 고객에게 배포할 수 있도록 이러한 솔루션을 패키징할 수 있습니다.
- **조직별 IT 관리자 및 개발자**: ISV가 제공하는 것 이상의 응용 프로그램을 사용자 정의하여 독점 프로세스 또는 지역별 프로세스와 같은 고유한 비즈니스 문제를 해결할 수 있는 솔루션을 조정할 수 있습니다.
- **개별 최종 사용자**: 최종 사용자는 목록 보기에서 열 순서 변경 또는 기본 탭 설정 등 앱 환경을 개인 설정할 수 있습니다.
각 페르소나는 하위 레이어가 상위 레이어의 페르소나 변경 사항에 의존하지 않도록 하거나 강력한 버전 관리 및 이전 버전 호환성 계약을 유지하여 동일한 응용 프로그램에서 독립적으로 반복할 수 있습니다.
"계층형 확장" 개념을 강조하는 기능 중 하나는 네 가지 계층 모두의 비즈니스 논리가 예측 가능한 순서대로 적용되도록 하는 실행 레코드 저장 순서입니다. 이렇게 하면 조직 관리자 또는 IT 개발자가 결정한 보다 구체적인 상위 계층 비즈니스 논리가 Salesforce 또는 외부 파트너가 제공할 수 있는 레코드 저장 시 하위 계층 논리를 적절하게 재정의할 수 있습니다.
또한 플랫폼의 메타데이터 프레임워크는 “핵심” 런타임과 관계형 데이터베이스에 연결된 마티테넌스가 내장된 독점 개체 관계 매퍼(ORM)를 활용합니다. 이 핵심 런타임은 공유 메모리 상태, 참조 무결성 검증, 트랜잭션 커밋을 활성화하므로 앱 안정성에 우선 순위를 지정하고 앱 배포의 신뢰성을 향상합니다. 애플리케이션 복잡성의 증가하는 규모를 지원하기 위해 아키텍처가 지속적으로 발전하고 있습니다. 예를 들어 2025년 10월부터 Salesforce에서 정의한 엔티티가 85,000개가 넘고 고객이 정의한 사용자 정의 엔티티가 300만 개가 넘습니다.
기존에는 Core 런타임에서 대부분의 플랫폼 및 앱 기능을 호스팅했습니다. 이제 Salesforce Platform의 현재 아키텍처에 수백 개의 독립 메타데이터 기반 서비스가 포함됩니다. 핵심 런타임은 응용 프로그램 메타데이터의 단일 레코드 시스템으로 유지되며, 메타데이터 관리를 위한 단일 아키텍처의 고유한 이점을 활용합니다. 관련 메타데이터가 독립 서비스의 로컬 캐시에 동기화되어 응용 프로그램 런타임을 위한 다양한 확장 가능한 서비스 배열을 제공합니다.
## 6\. 데이터
데이터는 조직의 필수 자산이며, Hyperforce Salesforce의 저장소에 대한 신뢰할 수 있는 기반을 제공합니다. 주요 과제는 응용 프로그램에 대한 유틸리티를 최적화하는 방식으로 데이터를 저장하는 것입니다. Salesforce Platform은 다양한 저장소 및 액세스 요구 사항을 수용하여 데이터 레이어를 변환했습니다. 다양한 요구를 충족하기 위해 비용, 읽기/쓰기 속도, 저장소 용량, 데이터 유형의 균형을 효과적으로 조정할 수 있습니다.
AI 및 분석이 점점 더 많은 엔터프라이즈 응용 프로그램을 형성함에 따라 데이터가 피벗 요소로 등장했습니다. 중요한 점은 AI와 분석을 사용하여 프로세스를 학습, 분석, 결정, 자동화할 수 있다는 것입니다.
데이터는 SOR(System of Record) 데이터베이스에서 생성되므로 비즈니스의 운영 요구 사항을 충족합니다. 그런 다음, AI 및 분석 기반 응용 프로그램을 구동하는 데 필요한 다양한 변환을 빅 데이터 플랫폼으로 전환합니다.
트랜잭션 정보에서 분석 인사이트까지 데이터를 효과적으로 관리하는 것은 가치를 추출하고 정교한 응용 프로그램을 지원하는 데 매우 중요합니다. Salesforce 데이터베이스(SalesforceDB)는 SOR 데이터를 관리하기 위한 주요 트랜잭션 데이터베이스로서 눈에 띄지만 Data 360은 AI 및 분석 기능을 향상하는 강력한 빅 데이터 플랫폼으로 사용됩니다.
### 6.1 트랜잭션 데이터베이스
트랜잭션 데이터 및 메타데이터는 Salesforce Platform에 필요합니다. SalesforceDB는 주요 공급자의 다른 클라우드 데이터베이스와 유사하지만 Salesforce 아키텍처에 대한 사용자 정의 기능을 제공하는 Salesforce 멀티테넌트 워크로드를 위해 특별히 설계된 최신 클라우드 네이티브 관계형 데이터베이스입니다. PostgreSQL을 확장하고, 계산 및 저장소를 분리하며, Kubernetes 및 클라우드 저장소를 활용하여 암호화 및 Sandbox와 같은 테넌트별 기능으로 작업을 향상합니다.
SalesforceDB는 모든 트랜잭션 CRM 데이터(월별 트랜잭션 수가 1.1조 개 이상)와 Data 360 및 관련 서비스의 메타데이터를 처리합니다. 주요 목표는 내구성, 가용성, 성능 및 보안을 통해 Trust 확보하고, 대규모 고객을 위해 확장하고, 간소화되고 신뢰할 수 있는 클라우드 작업을 수행하는 것입니다. 계산 및 저장소 계층을 구분하는 디자인, 변경할 수 없는 분산형 스토리지 시스템, 로그 구조 병합 트리 데이터 액세스를 통해 이러한 목표를 달성할 수 있습니다. 이렇게 하면 저장소의 데이터를 테넌트별로 암호화하고 효율적인 Sandbox 및 마이그레이션과 같은 고급 기능을 사용할 수 있습니다.
#### 아키텍처 개요
SalesforceDB 서비스 아키텍처는 세 가지 가용성 영역에서 실행되며, 노드 또는 전체 영역이 손실된 경우에도 시스템을 계속 사용할 수 있도록 이러한 영역에서 컴퓨팅 및 저장소가 복제됩니다. 모든 서비스가 Kubernetes에서 실행되어 자동화된 오류 복구 및 서비스 배포를 활성화합니다.
높은 수준의 내구성 및 가용성을 제공하기 위해 SalesforceDB의 최종 레코드 시스템은 AWS의 S3와 같은 클라우드 스토리지입니다. 보관 및 지역 간 복제와 같은 작업은 이 클라우드 저장소 수준에서 관리됩니다. 저장소 개체는 변경할 수 없으므로 고가용성을 위해 데이터 배포 및 복제를 향상합니다.
SalesforceDB는 클라우드 저장소의 대기 시간이 많으므로 저장소 캐시를 사용하여 데이터에 액세스합니다. 캐시는 노드 클러스터에 저장소 개체의 임시 사본을 유지하는 배포된 저장소 시스템으로, 데이터베이스에 필요한 대로 복제 및 지속성을 보장합니다. 별도의 캐시는 트랜잭션 로그 저장소 및 데이터 파일 저장소에 사용됩니다.
SQL 계산 계층은 기본 데이터베이스 클러스터와 3개의 다른 가용성 영역에 있는 2개의 대기 클러스터로 구성됩니다. 기본 클러스터는 모든 데이터베이스 수정 사항을 처리하고, 대기 클러스터는 쿼리 작업만 처리합니다.
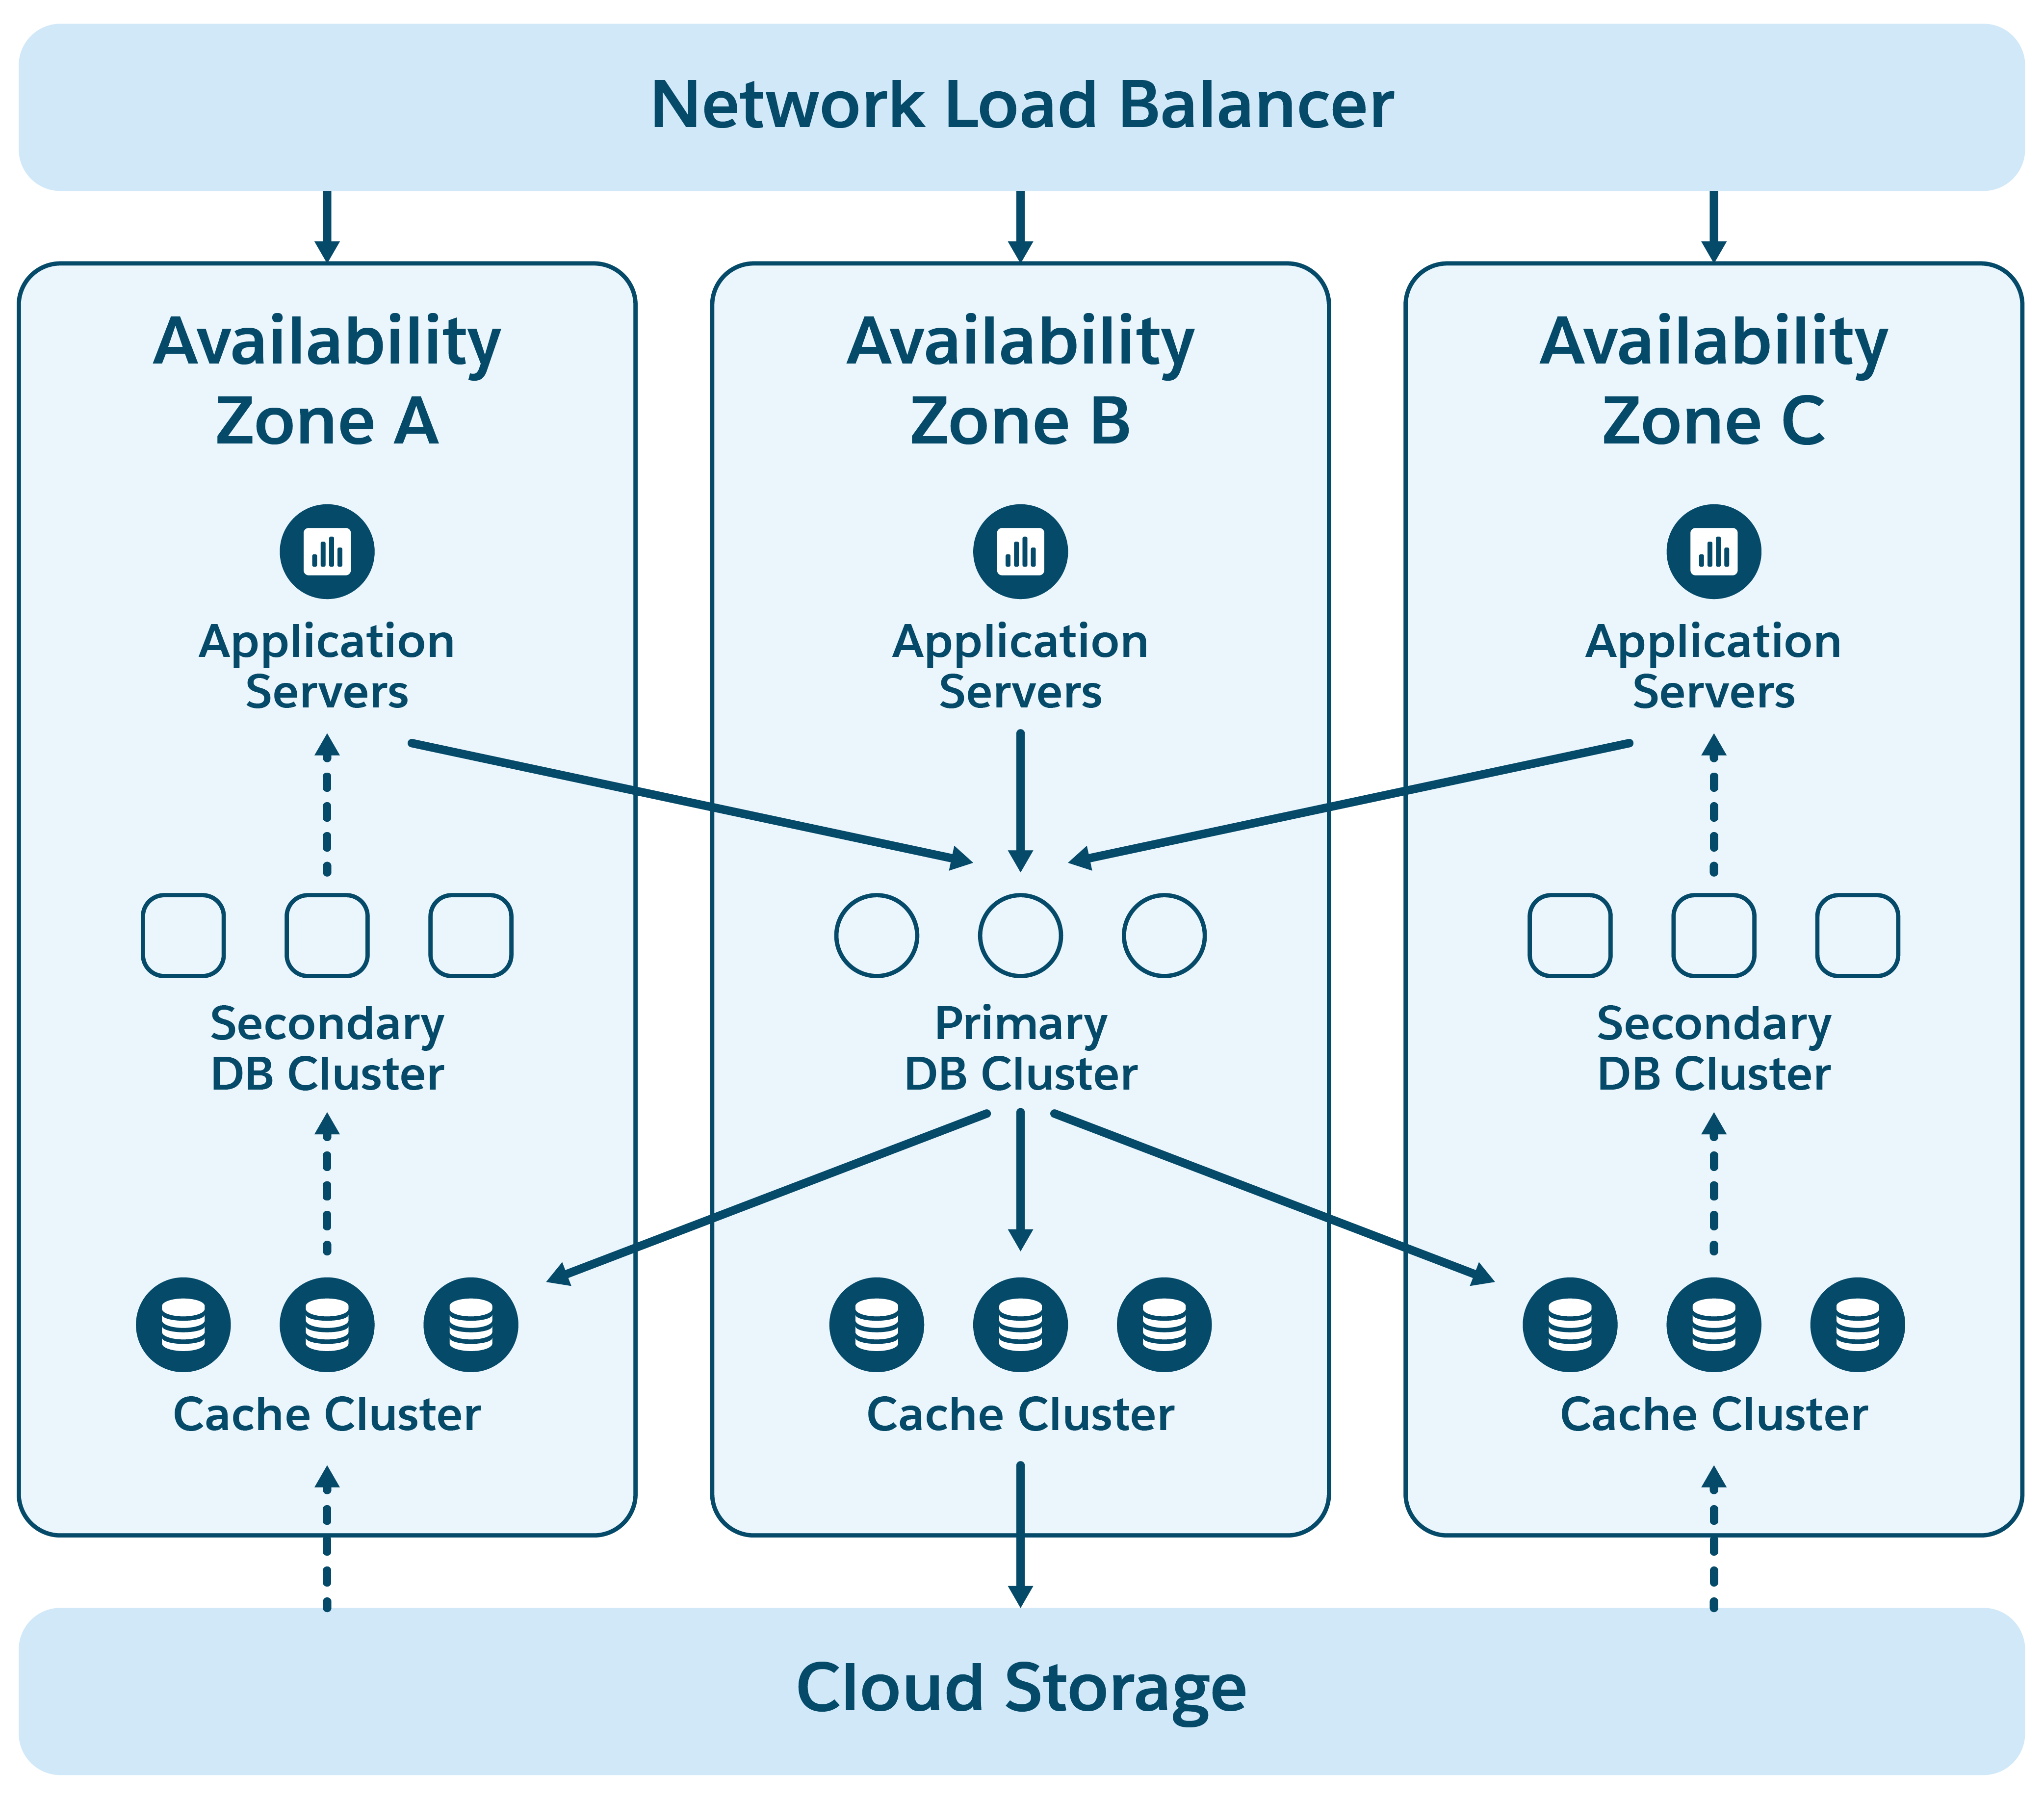 #### LSM 저장소 및 액세스
SalesforceDB는 변경 사항이 처음에 트랜잭션 로그에 기록되고 메모리에 누적되는 로그 구조화된 병합 트리(LSM) 데이터 구조를 활용합니다. 커밋된 변경 사항은 정기적으로 병합 및 축소되어 저장소 효율성을 최적화하는 키 정렬 데이터 파일에 집계적으로 작성됩니다.
이 구조는 저장소를 직접 업데이트하는 데이터베이스에서 일반적인 동시 업데이트 문제를 효과적으로 해결합니다. SalesforceDB는 LSM 접근 방식을 사용하여 변경할 수 없는 저장소와 같은 중요한 기능을 지원하므로 Salesforce 워크로드를 관리하기 위한 강력한 솔루션입니다.
#### 변경할 수 없는 저장소
저장소의 데이터는 변경할 수 없으며 데이터 파일이 작성되고 표시되면 변경되지 않습니다. 트랜잭션 로그는 추가 전용으로 데이터 액세스 패턴을 간소화하고 신뢰성을 향상합니다. 이 구조는 비협정 판독을 지원하고 백업을 간소화하며 확장성을 향상하며 스토리지 가상화를 쉽게 수행하므로 클라우드 환경에 적합합니다.
#### 가용성 및 내구성
SalesforceDB의 트랜잭션은 여러 가용성 영역에서 커밋되므로 노드 또는 영역이 실패해도 데이터가 손실되지 않습니다. 실패가 발생하면 비행 중 트랜잭션이 중단되고 커밋된 트랜잭션이 성공적으로 복구됩니다. 실패로 인해 커밋된 데이터가 손실되지 않으므로 새 노드로 페일오버가 자동화됩니다.
클러스터 관리 소프트웨어는 쿼럼을 모니터링하고 소유권 이전을 관리하여 페일오버를 자동으로 처리합니다. 이 프로세스는 비상 상황에서뿐만 아니라 정기적인 패치를 수행하는 동안 정기적으로 사용되므로 지속적인 사용을 통해 시스템의 신뢰성을 향상합니다. 짧은 데이터베이스 재시작은 일반적으로 최종 사용자에게 인식되지 않으므로 원활한 사용자 환경을 유지합니다.
Salesforce는 매년 세 가지 주요 스키마 업데이트를 수행하며, 매주 더 작은 스키마가 업데이트됩니다. SalesforceDB는 고객에게 영향을 미치지 않고 이러한 업데이트를 수행할 수 있는 중단 시간 스키마 작업을 제공합니다.
#### 레코드 시스템
트랜잭션 데이터베이스는 여러 가용성 영역에서 캐시되고 클라우드에 저장되는 고객 데이터의 기본 리포지토리로 사용됩니다. 각 데이터 블록은 저장소 계층 및 데이터베이스 엔진 모두에서 확인되는 변경할 수 없는 체크섬으로 보호됩니다. 데이터베이스는 계보 추적을 수행하여 주문 외 변경 사항 또는 누락된 버전을 감지하고 색인과 기본 테이블 간 지속적인 일관성 검사를 실행합니다.
랜섬웨어 방지를 위해 데이터베이스는 전체 및 증분 트랜잭션 로그 백업을 모두 포함하여 다른 계정 아래에 있는 별도의 저장소에 보관됩니다. 이러한 백업은 복원 테스트 프로세스를 통해 정기적으로 확인됩니다. 또한 클라우드 인프라는 사전 구성되었지만 활성화되지 않았으므로 필요에 따라 데이터 복원 요청을 관리할 수 있습니다.
#### 배율
각 Salesforce 조직은 SalesforceDB 서비스를 포함하는 Hyperforce 셀에 포함되어 있습니다. 이 설정은 Hyperforce 아키텍처를 통해 새로운 셀을 생성하여 빠른 글로벌 확장을 허용하며, 트래픽을 셀 간에 쉽게 이동하여 로드를 관리할 수 있습니다. 그러나 고객의 작업 부하와 비즈니스 요구가 증가함에 따라 단일 데이터베이스 인스턴스의 용량이 부족할 수 있습니다.
이를 해결하기 위해 SalesforceDB는 저장소와 계산 계층 모두에 가로 크기 조정 아키텍처를 적용합니다. 클라우드 저장소는 가상적으로 무제한이며, 캐시 레이어는 수요에 맞춰 자동으로 확장됩니다. 또한 데이터베이스 컴퓨팅 노드를 추가하여 계산 계층을 확장할 수 있으며, 이는 조정하지 않고도 공유 비변경 가능한 저장소에서 효율적으로 읽을 수 있습니다. 이 접근 방식을 사용하면 SalesforceDB가 특수 네트워킹 또는 하드웨어 없이 상위 상용 클러스터 데이터베이스 아키텍처와 일치하거나 초과하는 확장성을 달성할 수 있습니다.
#### 다중 테넌시
Salesforce는 단일 데이터베이스에서 여러 테넌트를 호스팅하는 멀티테넌트 응용 프로그램입니다. 각 테이블 레코드에는 소유권을 구별하기 위한 테넌트 ID가 포함되며, Salesforce의 응용 프로그램 계층에 추가된 자동 쿼리 조건자를 통해 테넌트 격리가 유지됩니다.
SalesforceDB는 이 모델에 맞게 조정되어 테넌트별 DDL, 메타데이터, 런타임 프로세스를 지원하여 신뢰성, 성능, 보안을 향상합니다. 행별 테넌트 모델의 낮은 오버헤드를 데이터베이스별 테넌트-스키마의 효율성과 결합합니다.
SalesforceDB에서 테넌트 ID는 LSM 데이터 구조에서 테넌트별로 데이터를 클러스터링하여 액세스 효율성을 향상하는 다중 테넌트 테이블의 기본 키의 일부입니다. 이 설정은 효율적인 데이터 액세스 및 테넌트별 암호화뿐만 아니라 테넌트 데이터 관리를 간소화합니다. 축소 메타데이터 구조로 인해 메타데이터 조정이 최소화되어 테넌트를 쉽게 복사하거나 이동할 수 있습니다.
### 6.2 Data 360 및 Data Lake
AI, 분석, 데이터 기능은 현대 기업에서 매우 중요합니다. 엔터프라이즈는 이미 Snowflake, Databricks, BigQuery, Redshift와 같은 성숙한 빅 데이터 플랫폼에 투자하고 있습니다. 그러나 많은
고객은 데이터 중단, AI 처리 부족, 오래된 데이터 또는 기존 비즈니스 프로세스 내의 비활성으로 인해 데이터에서 비즈니스 가치를 도출하지 못하고 있습니다. 고객 참여를 한눈에 파악하여 고객 데이터를 하나의 신뢰할 수 있는 단일 소스로 중앙 집중화하는 것은 비즈니스에 매우 중요하며 데이터 조각화와 시스템 관리의 복잡성으로 인해 어려운 작업입니다. Salesforce는 생성형 AI 및 기계 학습 인사이트를 기반으로 데이터를 기반으로 데이터, AI, CRM을 가상 원에 통합하여 고객을 포괄적으로 파악할 수 있도록 돕고 있습니다.
SalesforceDB는 구조화된 데이터의 고성능 트랜잭션 워크로드에 최적화되어 있으며, AI 및 분석 워크로드는 다양한 소스에서 대량의 비정형 데이터를 처리하고 복잡한 쿼리 및 배치 처리를 수행해야 합니다. 이러한 요구 사항을 해결하기 위해 Salesforce는 Data 360을 개발하였으며, 데이터를 안전하고 효율적으로 통합, 저장, 처리하고 AI 및 분석 요구를 지원하며 실시간 엔터프라이즈 운영을 지원하도록 설계된 플랫폼입니다.
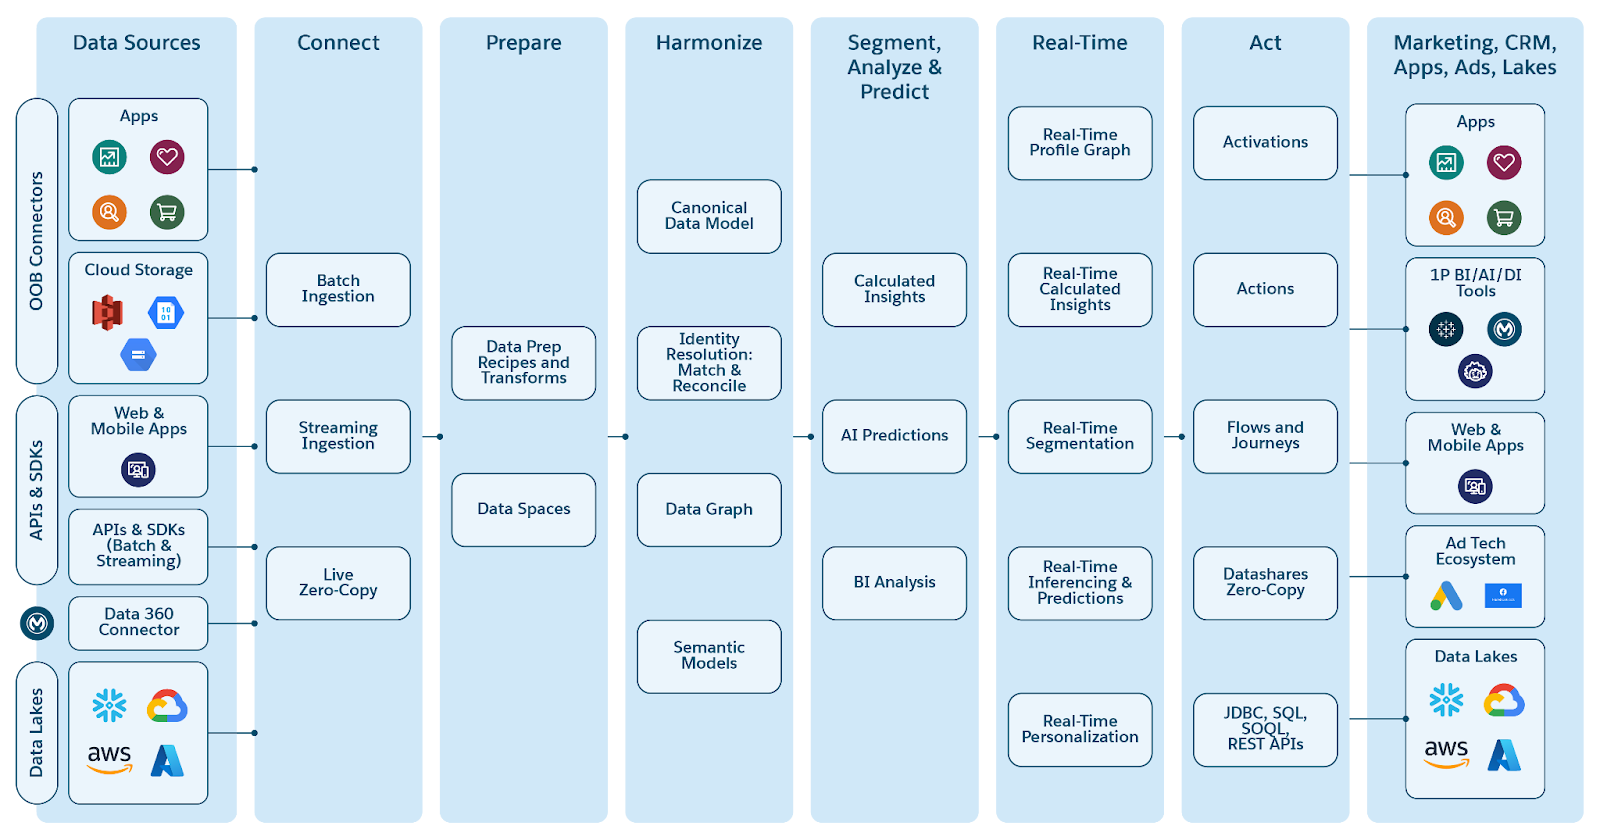 Hyperforce 구축된 Data 360은 AI 및 Analytics를 위한 기본 플랫폼으로 제공하며, 다음을 제공합니다.
- 연결을 통해 데이터 사일로를 통합하는 통합 인프라 및 코드 없는 플랫폼
- 실시간 및 거의 실시간 데이터 수집
- 제로 카피 연합
- 처리할 데이터 정리, 준비, 형성
- 구조화된 데이터 및 비정형 데이터에 대한 통합 쿼리 서비스
- 인사이트 생성을 위한 분석 및 AI/ML 모델 개발
- 데이터 트리거 작업 및 활성화
- 생성형 AI 검색 증강 생성(RAG) 지원
- 포괄적인 정책 기반 거버넌스
Data 360 아키텍처는 아래에 요약된 여러 구성 요소 및 기능을 지원합니다.
#### 연결, 변환 및 조합
Data 360은 배치, 거의 실시간, 실시간 데이터 처리를 위해 다양한 구조화된 비정형 데이터 소스에서 효율적인 수집 파이프라인을 지원합니다. Data 360의 수집 서비스는 대기 시간이 낮고 B2C 규모에 적합한 ELT(Extract-Load-Transform) 패턴에 따라 작동합니다. 실시간 수집에는 API 및 대화형 스트림이 포함되며, 거의 실시간 소스에는 자세한 제품 사용량이 포함됩니다. 수집되면 데이터가 광범위하게 변환되어 준비, 조화(예: 다양한 연락처 유형 통합)하고 효과적인 쿼리, 분석, AI 응용 프로그램을 위해 모델링됩니다. 플랫폼에는 즉시 사용할 수 있는 광범위한 조화 데이터 모델도 포함되어 있습니다.
Data 360은 Sales Cloud, Service Cloud, Marketing Cloud, Commerce Cloud와 같은 Salesforce 응용 프로그램과 원활하게 통합됩니다. 또한 외부 데이터 소스에 대한 수백 개의 커넥터를 제공하여 원활한 데이터 통합을 보장합니다.
#### 빅 데이터용 레이크하우스
Data 360은 배치, 스트리밍, 실시간 시나리오에 대한 대규모 데이터 관리 및 처리를 처리하도록 설계된 Iceberg/Parquet 기반의 네이티브 레이크하우스 아키텍처를 제공합니다. 이 아키텍처는 AI 및 분석 응용 프로그램에 매우 중요한 구조화된 데이터와 비정형 데이터를 모두 지원합니다.
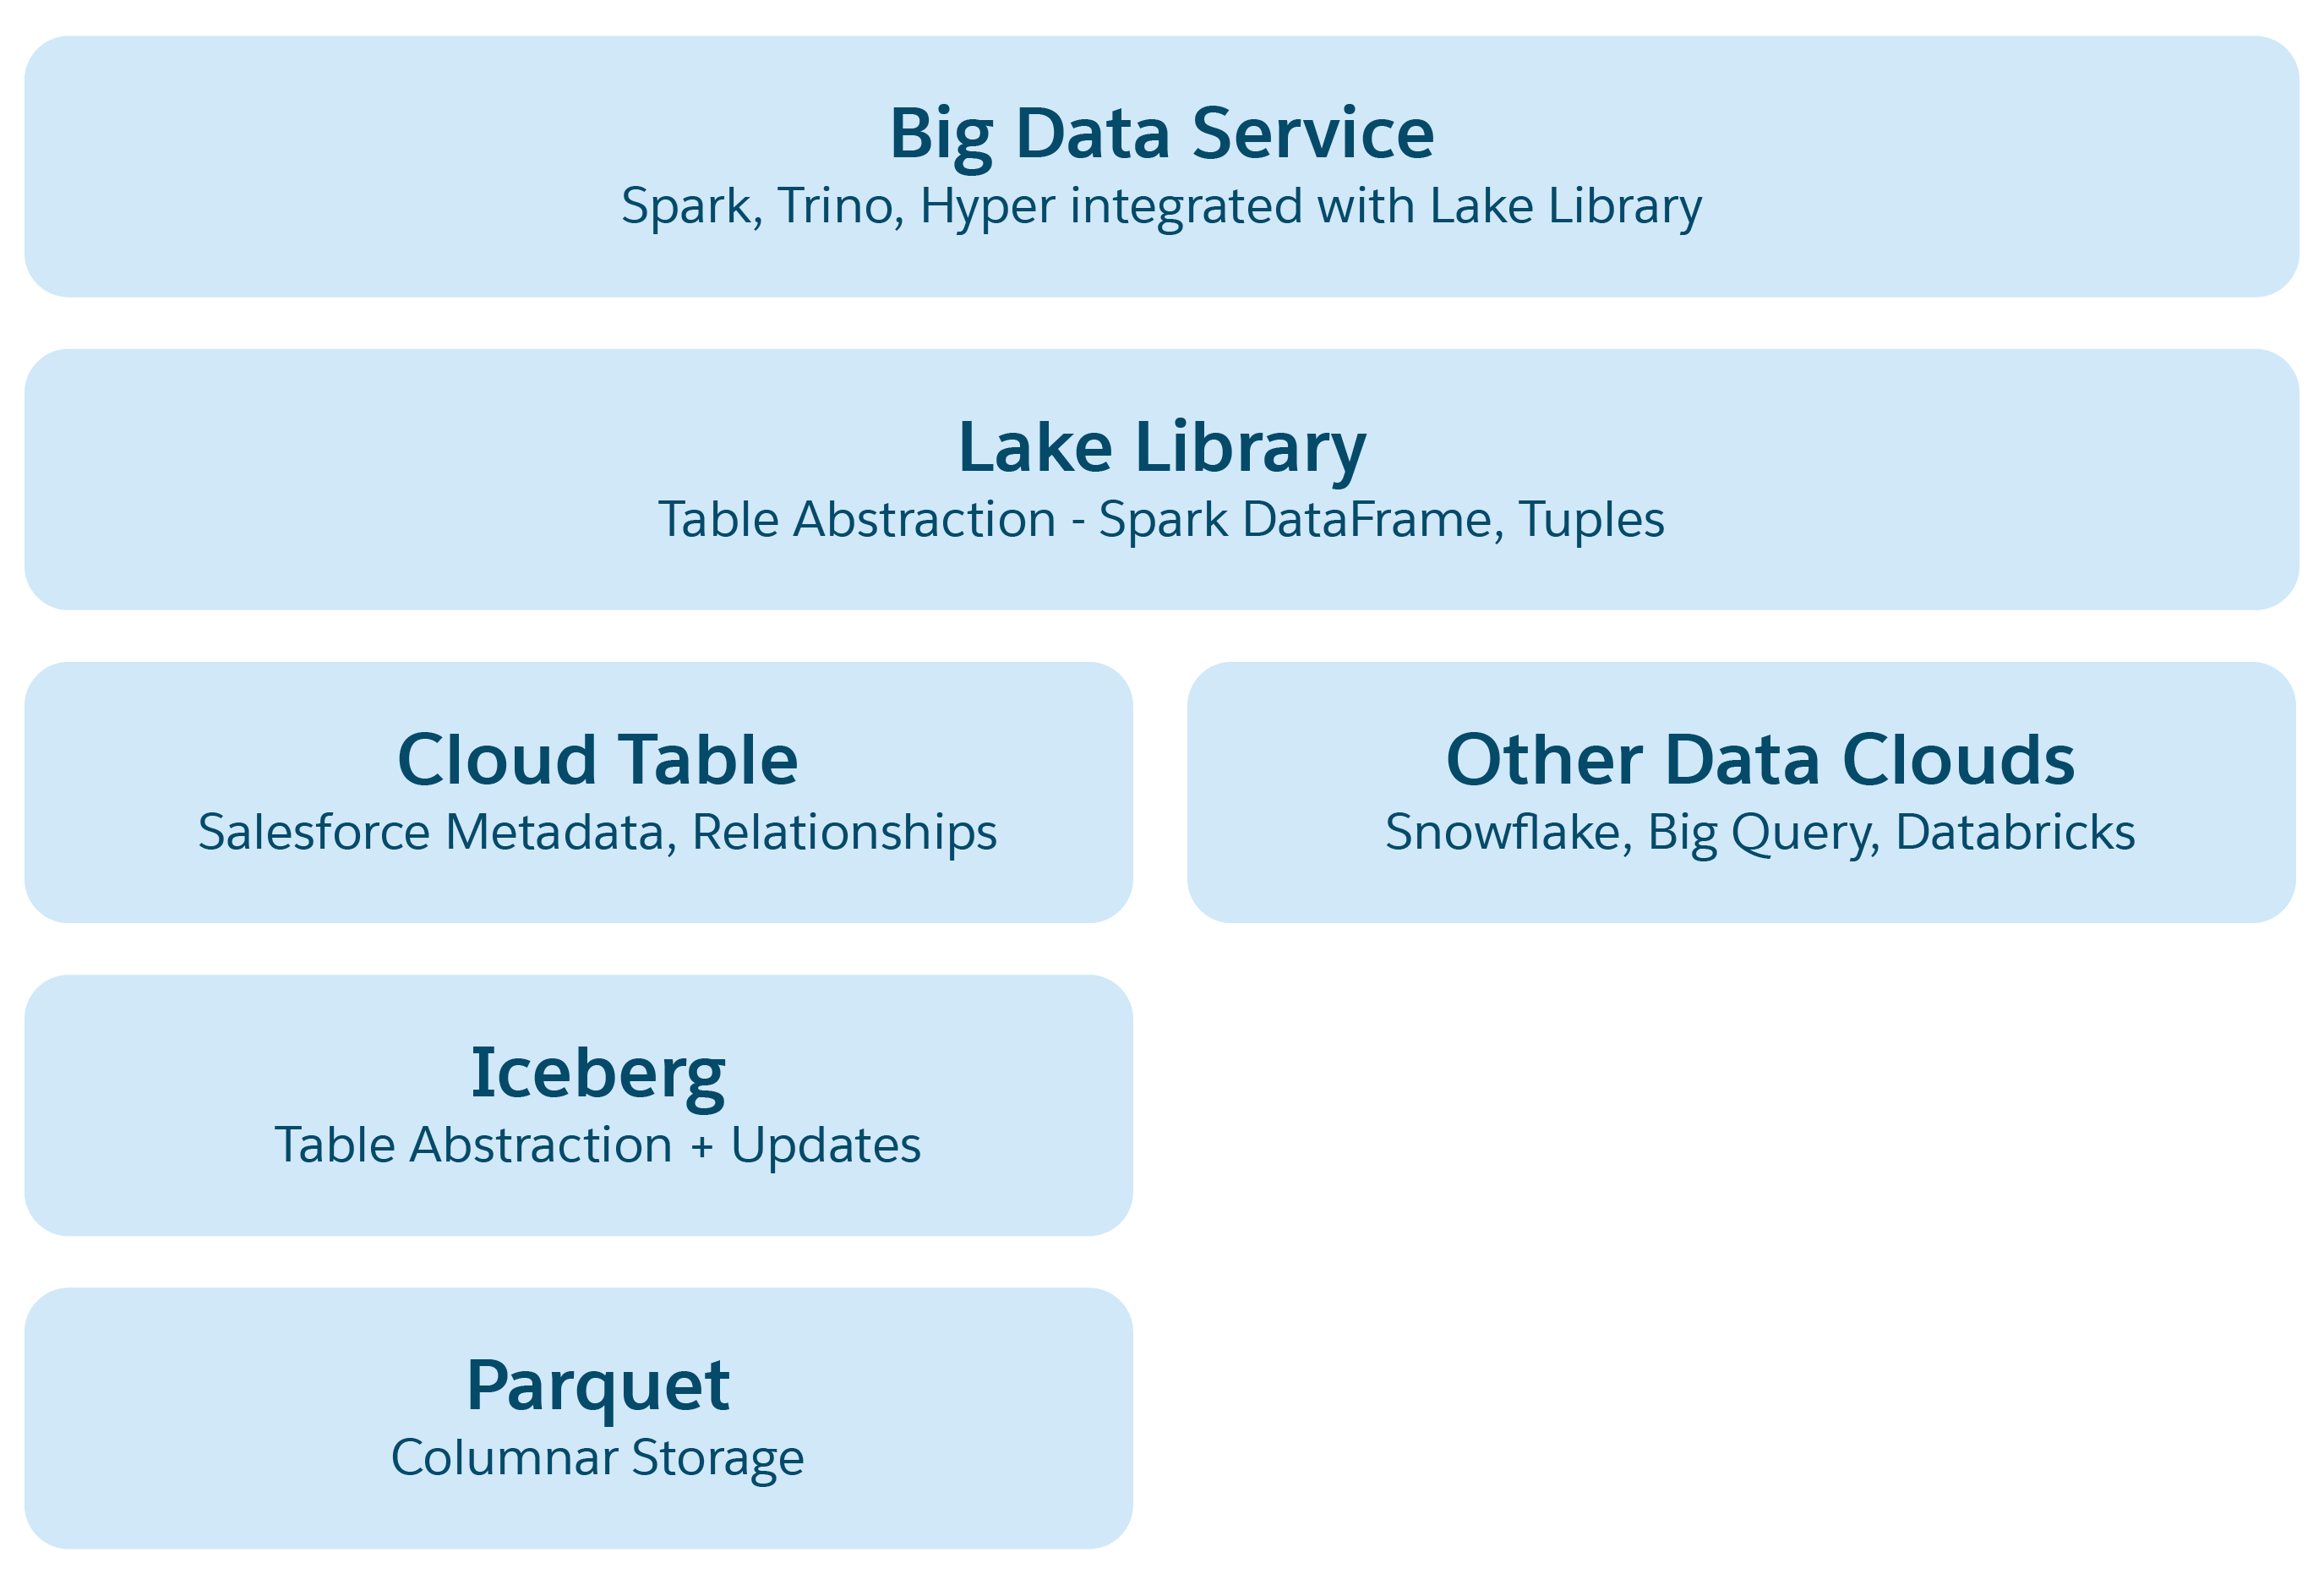 Azure, AWS 또는 GCP와 같은 클라우드 기반 데이터 레이크에서 기본 저장소는 일반적으로 폴더 및 계층으로 구성된 파일입니다. 이 호수는 쿼리 및 AI/ML 처리와 같은 작업을 쉽게 수행할 수 있도록 더 높은 수준의 구조적 및 의미적 추상화를 도입하여 이 구조를 강화합니다. 기본 추상은 구조 및 의미론을 정의하는 메타데이터가 포함된 테이블이며, Data 360에서 추가 의미론 레이어를 추가하여 아이세버그 또는 델타 레이크와 같은 오픈 소스 프로젝트의 요소를 통합합니다.
레이크하우스의 추상 레이어:
- **Parquet 파일 요약**: 기본적으로 저장소는 Parquet 형식의 데이터 레이크 파일(예: AWS의 S3 또는 Azure의 Blob)으로 구성됩니다. 소스 테이블의 데이터는 여러 파티션에서 Parquet 파일로 저장되며, 각 테이블은 해당 파일의 모음입니다.
- **Iceberg Table Abstraction**: 테이블은 폴더로 구성되며, 데이터 파티션은 해당 폴더 내에 Parquet 파일로 저장됩니다. 파티션을 수정하면 새 Parquet 파일이 스냅샷으로 표시됩니다. Iceberg는 스키마, 파티션 사양, 스냅샷을 자세히 설명하는 각 테이블의 메타데이터 파일을 관리합니다.
- **Salesforce Cloud 테이블 요약**: 이 레이어는 아이스버그에서 구축되며, 대상 파일 크기 및 압축과 같은 구성과 함께 열 이름 및 관계와 같은 의미 있는 메타데이터를 추가합니다. Snowflake 및 Databricks와 같은 다양한 플랫폼에서 테이블을 추상화하여 기본 스토리지 플랫폼 세부 사항으로부터 Data 360 응용 프로그램을 보호합니다.
- **레이크 액세스 도서관**: 이 라이브러리는 Salesforce Cloud 테이블에 대한 액세스 권한을 제공하며, 데이터와 메타데이터를 모두 처리하고 응용 프로그램 개발자의 기본 저장 메커니즘을 추상합니다.
- **Big Data Service Abstraction**: 여기에는 쿼리용 Trino 및 Hyper와 같은 처리 프레임워크와 클라우드 테이블 플랫폼 전반에서 처리하는 Spark가 포함됩니다.
Data 360 레이크하우스는 B2C 규모, 실시간 수집, 처리, 스키마 적용 및 진화, 스냅샷을 지원하며 개방형 저장소 형식을 사용합니다.
#### 실시간 저장소
실시간 분석 및 에이전트 애플리케이션을 지원하기 위해 Data 360은 추가적인 낮은 대기 시간 저장소(LLS)를 사용하여 레이크하우스의 주요 데이터 저장소를 늘립니다. Data 360의 실시간 처리 계층은 메모리의 실시간 신호 및 참여 데이터를 분석합니다. 메모리 기반 저장 용량이 제한되므로 모든 데이터를 한 번에 처리할 수 없습니다. Data 360은 이러한 제한 사항을 제거하기 위해 이 LLS를 추가하여 확장 가능한 실시간 처리를 활성화합니다.
Low Latency Store는 레이크하우스의 페타바이트 규모 NVMe(SSD) 저장소 계층입니다. 이는 견고한 캐시이며 대부분의 데이터는 결국 레이크하우스로 이동하여 장기간 유지됩니다. 실시간 레이어의 세션 내 데이터는 후속 빠른 액세스를 위해 저 대기 시간 저장소로 플러시할 수 있습니다. 예를 들어 에이전트 대화에서 메모리에서 최근 메시지를 처리하고 이전 메시지를 LLS에 플러시할 수 있습니다. 이전 대화가 필요한 경우 LLS에서 몇 밀리초 이내에 액세스할 수 있습니다. NVMe 기반 저장소를 사용하면 대량의 데이터를 밀리초 대기 시간으로 저장하고 액세스할 수 있습니다. 데이터는 오래 지속되도록 레이크하우스로 이동할 수 있습니다.
또한 실시간 처리 또는 실시간 경험 증강에 필요한 레이크하우스의 데이터가 검색되어 LLS에 유지됩니다. 예를 들어 고객 프로필 컨텍스트가 미리 가져오거나 레이크하우스에서 가져와 LLS에 캐시됩니다. 또한 세션 내 처리의 실시간 처리에 필요한 레이크하우스 개체 및 기타 개체도 LLS에 캐시할 수 있습니다. LLS는 메모리, SSD, 레이크하우스 스토리지 레이어를 사용하여 실제 저장소 계층에 실시간 레이어를 활성화하며, 각 계층 간에 데이터가 원활하게 마이그레이션됩니다.
또한 Data 360은 고객이 관리하는 키를 사용하는 테넌트 수준 암호화(TLE)를 비롯한 보안에 대한 강력한 지원을 제공하며, 거버넌스 기술을 통해 개인정보 보호 및 규정 준수를 지원합니다. 핵심은 엔티티, 운영, 환경 요소와 관련된 특성을 기반으로 액세스를 동적으로 평가하는 특성 기반 액세스 제어(ABAC) 지원입니다. 이 시스템은 임의 및 필수 액세스 제어를 모두 지원합니다.
ABAC를 보완하는 자세한 데이터 분류 시스템은 민감도 및 목적별로 데이터를 분류하여 규정 준수, 위험 관리, 사고 대응을 향상합니다. ABAC와 이 분류 시스템은 함께 포괄적인 데이터 관리를 제공하므로 Data 360 내의 데이터가 안전하고 효율적으로 관리됩니다.
#### 메타데이터 중심
Data 360은 AppExchange 통해 메타데이터, 패키징, 확장성, 사용자 환경, 응용 프로그램 배포를 위해 Salesforce Platform과 긴밀하게 통합됩니다. 고객은 다른 Salesforce 메타데이터와 마찬가지로 레이크하우스 스트림 및 테이블의 메타데이터를 정의하고 관리할 수 있습니다. 모든 데이터 개체(연합 또는 외부 테이블 포함)는 Salesforce 개체로 표시되고 Data 360의 데이터 저장소에서 지원되는 가상 엔티티로 모델링됩니다. 개발자가 Salesforce Platform에서 응용 프로그램을 구축하는 데 사용할 수 있습니다.
#### 제로 카피 연합 및 확장성
Data 360은 제로 카피 연합에 대한 광범위한 지원을 제공하므로 사용자는 Snowflake 및 Redshift와 같은 외부 데이터 웨어하우스, Google BigQuery, Databricks, Azure Fabric과 같은 레이크하우스, SQL 데이터베이스 및 Excel을 비롯한 다양한 파일 유형과 통합할 수 있습니다. Data 360은 이미지에 표시된 대로 실시간 쿼리 및 액세스 가속화를 사용하여 파일 및 쿼리 기반 연합을 지원합니다. 레이블(1) 및(2)은 외부 데이터 레이크/웨어하우스/데이터 소스의 데이터에 액세스하기 위한 Data 360의 쿼리(실시간 쿼리 푸시다운 포함) 및 파일 기반 연합을 보여주며, 레이블(3)은 외부 데이터 레이크/데이터 소스의 연합 액세스 가속화를 강조합니다. 레이블(4) 및(5)은 외부 데이터 레이크/웨어하우스와 Data 360의 쿼리 및 파일 기반 데이터 공유를 보여줍니다. 기능은 Slack 및 Google Drive와 같은 비정형 데이터 소스에도 확장되며, Data 360의 비정형 처리 파이프라인에서 액세스할 수 있습니다. 또한 Data 360은 외부 소스에서 연합된 데이터에 대한 Salesforce 개체 추상 및 데이터 액세스를 쉽게 지원하므로 Salesforce Platform 및 응용 프로그램 전반에서 해당 데이터에 액세스할 수 있습니다.
#### Customer Data Platform(CDP)
Data 360은 고급 ID 확인 기능을 갖춘 CDP를 통합하여 포괄적인 참여 내역과 함께 통합 개인 식별자 및 프로필을 만듭니다. 이 플랫폼은 정확한 일치 규칙과 퍼지 일치 규칙을 모두 활용하는 ID 그래프를 지원하여 B2B(B2B) 및 B2C(B2C) 프레임워크를 모두 처리하는 데 숙련되어 있습니다. 이러한 ID 그래프는 다양한 채널의 참여 데이터로 보강되므로 중요한 분석 인사이트 및 세그먼트가 포함된 자세한 프로필 그래프를 작성하는 데 도움이 됩니다.
또한 CDP를 사용하면 Salesforce의 Marketing Cloud, Facebook, Google 등 다양한 플랫폼에서 효과적으로 세분화 및 활성화할 수 있습니다. 즉시 의사 결정을 내리고 개인 설정을 할 수 있도록 배치, 거의 실시간, 실시간으로 고객 프로필을 처리합니다. 이 기능은 B2C 및 B2B 시나리오 모두에서 상호 작용을 강화하여 비즈니스가 고객의 요구와 행동에 빠르고 정확하게 대응할 수 있도록 합니다.
#### 데이터 그래프
Data 360은 다양한 레이크하우스 테이블 및 상호 관계에서 파생된 비정규화 개체인 JSON 형식의 엔터프라이즈 데이터 그래프를 제공합니다. 여기에는 개인의 구매 및 탐색 내역, 사례 내역, 제품 사용, 기타 계산된 인사이트를 포괄하는 CDP에서 만든 "프로필" 데이터 그래프가 포함되며 고객 및 파트너가 확장할 수 있습니다. 해당 데이터 그래프 특정 응용 프로그램에 맞게 조정되며 관련 고객 또는 사용자 컨텍스트를 제공하여 생성형 AI 프롬프트 정확성을 향상합니다.
또한 추출된 엔티티 및 비정형 데이터에서 관계와 같이 파생된 Knowledge 수집하고 모델링하는 Knowledge 그래프를 포함하도록 이러한 데이터 그래프 확장할 계획이 있습니다. Data 360의 실시간 레이어는 프로필 그래프를 활용하여 실시간 개인 설정 및 세분화를 수행합니다.
#### 실시간 레이어
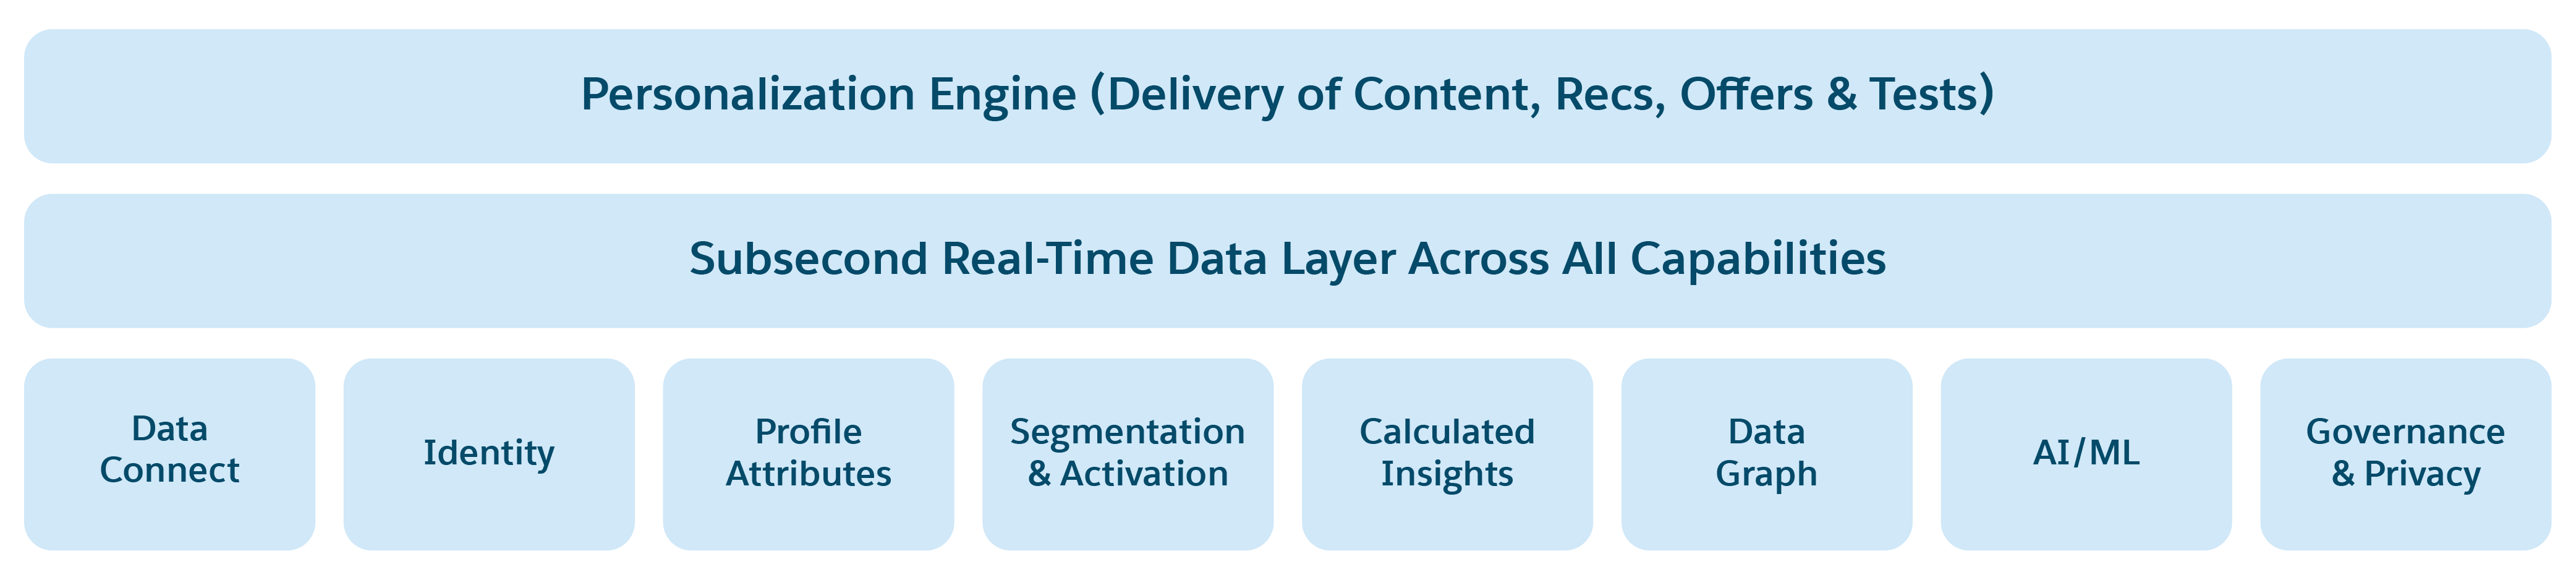 Data 360의 실시간 레이어는 웹 및 모바일 클릭 스트림, 방문, 장바구니 데이터, 결제와 같은 이벤트를 밀리초 대기 시간으로 처리하도록 설계되어 고객 경험 개인 설정을 향상합니다. 즉시 개인 설정을 위해 실시간 참여 데이터, 세그먼트, 계산을 사용하여 CDP의 고객 참여를 지속적으로 모니터링하고 고객 프로필을 업데이트합니다.
예를 들어 소비자가 쇼핑 웹 사이트에서 항목을 구매하면 실시간 레이어가 이 이벤트를 빠르게 감지 및 수집하고, 소비자를 식별하고, 업데이트된 평생 지출 정보로 프로필을 보강합니다. 이를 통해 사이트에서 몇 초 이내에 환경을 개인 설정할 수 있습니다. 또한 이 계층에는 실시간 트리거 및 응답 기능이 포함되어 있어 고객 상호 작용을 기반으로 즉각적인 조치를 취할 수 있습니다.
#### 개인 설정
개인 설정은 대상이 될 페르소나, 관련 콘텐츠 및 권장 사항을 전달할 시기 및 위치, 말할 내용 및 빈도를 파악하는 것입니다. Data 360의 개인 설정 서비스 플랫폼 기능은 맞춤형 환경을 통해 목표 달성을 최적화하기 위해 결정되는 오케스트레이터입니다. 이 플랫폼은 다음 기능을 제공합니다.
- Data 360에서 프로필, 활동, 자산 데이터를 해석하는 일관된 모델 집합 및 방법
- 플랫폼 통합 실험(예: A/B/n 또는 다중 암 범죄자 결정).
- 구성, ML 교육 시간, 런타임(ML 추론)을 통해 설계 시 목표 통합
- B2C 규모, 실시간 및 배치 상호 작용 지원(익명 사용자, 대용량 실시간/대화형 외부, 대용량 내부 배치).
- Data 360을 통해 분석을 구동합니다.
- 다른 당사자(내부 및 외부 모두)의 AI 모델과 서비스를 통합하는 패턴입니다.
- OOTB 구현 가치가 높은 AI 중심 사용 사례(프로모션/콘텐츠 선택, 제품 권장 사항, 가격 책정 결정에 대한 컨텍스트 범주 등 다양한 ML 알고리즘을 사용하는 권장 사항 및 결정).
#### 데이터 작업
Data 360은 데이터 이벤트에 대한 파이프라인 활성화를 지원하는 활성 플랫폼입니다. 예를 들어, 고객의 계정 잔고가 떨어지는 등 중요한 이벤트가 Salesforce 플로를 트리거하여 해당 작업을 오케스트레이션할 수 있습니다. 마찬가지로 평생 소비와 같은 주요 메트릭에 대한 업데이트가 관련 응용 프로그램에 자동으로 전파될 수 있습니다.
#### 데이터 계산 패브릭
Data 360은 처리 과업을 효율적으로 처리하는 탄력적인 확장 계산 클러스터를 제공합니다. 멀티테넌트 및 전용 컴퓨팅 환경 모두에 강력한 관리를 제공합니다. 또한 Spark 및 SQL에 대한 관리 지원도 제공합니다. BYOC(Bring Your Own Compute/Code) 기능은 Java, Python, Spark 등 여러 프로그래밍 언어를 지원하므로 사용자 정의 변환, 모델(LLM 포함) 및 함수를 통합하여 확장성을 향상할 수 있습니다.
Data 360 계산 패브릭은 모든 주요 데이터 작업 부하를 관리하고 실행할 수 있는 데이터 처리 컨트롤러(DPC)라는 통합 계층을 제공합니다. DPC는 다양한 클라우드 컴퓨팅 환경에서 Job-as-a-Service(JaS) 기능을 제공하는 포괄적인 다중 작업 부하 데이터 처리 오케스트레이션 서비스입니다. 이는 인프라 복잡성을 추상하고 Spark(EC2의 EMR 및 EKS의 EMR) 및 Kubernetes 리소스 컨트롤러(KRC) 워크로드와 같은 프레임워크에 대한 작업 실행을 통합합니다. 중앙 집중식 제어 플레인 게이트웨이로 사용되므로 DPC는 여러 데이터 플레인에서 작업을 오케스트레이션, 예약 및 모니터링하여 신뢰성, 확장성, 비용 효율성, 일관된 개발자 환경을 보장합니다.
#### 통합 쿼리
Data 360의 쿼리 서비스는 Trino 및 Hyper를 통해 구조화된 데이터와 비정형 데이터 모두에 대한 광범위한 SQL 지원을 제공하는 고급 쿼리 기능을 제공합니다. 테이블 함수를 통해 연산자 확장성을 통해 기능을 강화하여 텍스트, 이미지, 공간 및 기타 비정형 데이터 유형 전반에서 다양한 검색 작업을 수행할 수 있습니다. 해당 기능은 고객 레코드 선택과 같은 관계 작업과 원활하게 통합됩니다. 이 통합 접근 방식을 사용하면 대상이 지정된 맞춤형 결과를 생성하여 RAG를 사용하여 보다 정밀한 LLM 응답을 수행할 수 있습니다.
#### 비정형 데이터 처리
Data 360은 데이터 수집, 처리, 색인화, 쿼리 메커니즘 전반에서 원활하게 구조화(테이블), 세미 구조화(JSON), 비정형 데이터의 저장 및 관리를 지원합니다. Data 360은 오디오, 비디오, 이미지 등 텍스트 외에도 다양한 비정형 데이터 유형을 지원하여 데이터 처리 및 분석 범위를 넓힙니다. 아래 그림은 기초 교육의 양면( 수집 및 검색)을 보여줍니다.
Data 360은 열에 텍스트로 저장하거나 더 큰 데이터 집합의 파일에 저장하여 비정형 데이터를 관리합니다. 구조화되지 않은 콘텐츠에 대한 데이터 연합을 지원하므로 여러 소스의 데이터를 통합하고 관리할 수 있습니다.
Data 360의 비정형 데이터 색인화 파이프라인은 5가지 핵심 단계인 모듈식 확장 가능한 아키텍처로 설계되었습니다. 구문 분석, 사전 처리, 청크, 사후 처리, 임베딩 다음 단계에 키워드 및 벡터 색인화가 따릅니다. 사전 처리에는 소음 제거, 언어 정규화, 이미지 이해(광학 문자 인식)와 같은 작업이 포함되며, 사후 처리 단계에는 메타데이터 보강, 시맨틱 그룹화 또는 청크와 같은 고급 기술이 포함될 수 있습니다.
Data 360은 청크 및 임베딩 생성을 위한 여러 개의 기본 및 플러그 가능한 모델을 제공합니다. Data 360의 데이터 파이프라인은 코드 확장을 완전히 지원하므로 고객 및 내부 팀이 모든 단계에서 사용자 정의 논리를 연결할 수 있습니다. 해당 단계에서는 LLM 기반 처리를 지원하므로 고객이 필요에 따라 자체 프롬프트를 정의할 수 있습니다.
색인화의 경우 Data 360은 검색 서비스를 사용하는 키워드 색인화를 지원하고, 오픈 소스 네이티브 벡터 색인인 Milvus를 사용하는 벡터 색인화를 지원합니다. 비정형 처리를 사용하여 RAG를 설정할 경우 Data 360은 컨텍스트 색인화를 활용하여 샘플 테스트 쿼리를 사용하여 빠른 반복 및 빠른 유효성 검사를 활성화하며, 사용하는 페르소나 또는 사용자에 맞게 구성된 페르소나별 콘텐츠를 사용합니다.
Data 360의 문서 AI 기능은 인보이스, 이력서, 실습 보고서, 구매 주문과 같은 문서에서 비정형 또는 반정형 데이터를 읽고 가져올 수 있습니다. 이 기능은 특별 대화형 처리와 대량 배치 처리를 지원합니다. 이는 고객의 비즈니스 프로세스 자동화를 지원하는 핵심 기능입니다.
#### 시맨틱 레이어
Data 360은 Tableau Next와 유사하게 비즈니스 시맨틱 및 AI/ML 기반 분석을 향상하도록 설계된 API가 포함된 헤드리스 시맨틱 레이어를 제공합니다. 이 계층에는 측정값 및 메트릭과 같은 비즈니스 분류로 기존 분석 모델을 보강하는 시맨틱 데이터 모델링 서비스가 포함되어 있습니다.
시맨틱 쿼리 서비스는 선언적 언어를 사용하여 해당 모델과 상호 작용하여 Data 360 내의 네이티브 및 연합 데이터 소스 모두에서 데이터에 액세스할 수 있도록 쿼리를 SQL로 번역합니다.
이 통합은 타사 시각화 도구와 호환되는 확장 가능한 대화형 분석 탐색, 보고서 및 대시보드를 지원합니다.
#### 데이터 거버넌스
Data 360은 중앙 집중화된 거버넌스 허브 역할을 하므로 원시 수집에서 활성화된 인사이트까지 모든 데이터가 무결하고 제어적으로 관리됩니다. Data 360은 핵심 권한 부여 모델로 특성 기반 액세스 제어를 채택했습니다. ABAC를 사용하면 미리 정의된 역할이 아닌 사용자의 특성(부서, 역할, 위치), 데이터(개인 정보, 민감도, 데이터 공간), 환경(예: 시간)을 기반으로 액세스 결정을 내릴 수 있습니다. 이를 통해 데이터 및 사용자 특성 변경에 따라 적응하는 매우 세분화되고 상황에 맞는 액세스 정책을 사용할 수 있습니다. Data 360의 ABAC 구현의 핵심은 CEDAR 정책 언어 사용입니다. 목적에 따라 구축된 오픈 소스 형식 정책 언어는 복잡한 권한 부여 규칙을 정의하는 정확하고 확인 가능한 방법을 제공하므로 정책이 명확하고 규모에 따라 일관되게 평가할 수 있습니다.
거버넌스 수명 주기에는 정책 정보, 적용, 결정 지점과 관련된 주요 기능이 포함됩니다.
- **태그 지정 및 분류(정책 정보 지점):** 데이터가 식별되고 중요 특성으로 보강됩니다. Data 360은 검색, LLM, 기계 학습을 활용하여 구조화된 데이터와 비정형 데이터 모두에서 중요한 데이터 범주(예: 이메일, 전화, 이름 등 개인 식별 정보)를 식별하는 자동화된 태그 지정 및 분류 메커니즘을 제공합니다.
- **승인 서비스(정책 집행 지점):** 이 서비스는 다양한 소비 계층(하이브리드 구조화/구조화되지 않은 쿼리, RAG 검색기 및 프롬프트, CRM 보강)의 모든 데이터 액세스 요청을 가로채고 정책 결정 지점과 상담하여 액세스 허용 여부를 결정합니다.
- **정책 평가 엔진(정책 결정 지점):** 이 엔진은 정책 적용 지점의 액세스 요청 컨텍스트와 정책 정의(CEDAR) 및 정책 정보 지점의 특성을 가져와 권한 있는 액세스 결정을 내립니다.
CEDAR 정책이 포함된 ABAC 프레임워크는 제어 및 유연성을 제공하여 고객 데이터를 실행할 수 있을 뿐만 아니라 엔터프라이즈 전체에서 안전하고 규정 준수하며 신뢰할 수 있도록 합니다.
### 6.3 데이터 캐싱
캐시는 자주 사용하는 데이터에 빠르게 액세스하는 데 필요합니다. Salesforce는 핵심 응용 프로그램 서버, SalesforceDB 및 Edge 등 Salesforce Platform 전체에서 많은 캐시를 사용합니다. Salesforce Platform 및 응용 프로그램에는 대기 시간이 낮고 처리량이 높은 확장 가능한 테넌트 인식 캐싱 솔루션이 필요합니다. 이 솔루션을 사용하면 Salesforce 엔지니어가 캐시되는 항목 및 기간을 제어하여 시스템 소음 또는 다른 고객의 데이터로 인해 데이터가 제거되지 않도록 해야 합니다. Redis를 기반으로 하는 Salesforce 관리 캐싱 서비스인 Vegacache는 다중 언어, 멀티테넌트, 퍼블릭 클라우드 환경에 맞게 제작되었습니다. Salesforce 서비스에서 널리 사용되며 Apex 프로그래밍 언어 API를 통해 플랫폼 개발자가 액세스할 수 있습니다. Hyperforce 대규모로 작동하는 Vegacache는 작성 시점부터 일일 2조 건이 넘는 요청을 처리하며 응답 시간이 백밀리초 미만입니다.
서비스 메쉬를 통해 액세스된 Kubernetes 컨테이너에서 실행되는 Vegacache 인스턴스는 데이터 가용성과 대기 시간의 균형을 유지하기 위해 여러 가용성 영역에 배포됩니다. 시스템 로드에 따라 자동으로 확장되어 데이터 가용성 및 슬롯 순서 보존을 보장합니다. Vegacache는 고객당 보증된 캐시 크기를 제공하고, 복제된 데이터 저장소를 통해 인프라 장애에 대처할 수 있는 방어를 제공합니다.
Salesforce Platform 개발자의 경우 Vegacache를 사용하면 개발자가 Apex 개체 및 SOQL 데이터베이스 쿼리 결과를 캐시할 수 있으므로 SalesforceDB에서 불필요한 데이터 가져오기를 제거하여 CPU 사용량과 지연 시간을 줄일 수 있습니다. Put(), Get(), Delete() 작업을 지원하므로 자주 사용하는 개체에 쉽게 액세스할 수 있습니다.
### 6.4 비동기 데이터 처리
Salesforce는 워크플로 유연성, 복원성, 확장성을 향상하기 위해 기본적으로 비동기 데이터 프로세스 및 아키텍처를 지원합니다.
Salesforce 엔지니어는 먼저 메시지 대기열을 활용하여 대량 및 대규모 데이터 프로세스를 분리하고 독립 시스템 간 프로세스를 조정합니다. 이러한 메시지 대기열은 대량 API 쿼리 또는 비동기 Apex 같은 플랫폼 기능을 통해 외부 개발자로부터 추출되었습니다. Salesforce Platform은 내부적으로 관리되는 Apache Kafka 클러스터의 강력한 Messaging 인프라에 구축된 로그 조직 이벤트 스트림을 도입했습니다. 이렇게 하면 게시/구독 상호 작용 모델을 사용하는 이벤트 기반 아키텍처가 활성화되고 외부 개발자에게 플랫폼 이벤트로 생성되었습니다.
메시지 대기열과 이벤트 스트림은 계속해서 플랫폼에 구축된 앱 및 솔루션의 활용도가 높은 기술이며, 특히 더 많은 기능, 클라우드, 독립 실행 시간에 호스팅되는 외부 시스템을 활용합니다. 버전이 지정된 이벤트 스키마를 통해 커뮤니케이션하면 다양한 런타임에 대한 독립 소프트웨어 개발 수명 주기가 활성화됩니다. 이벤트를 통해 시스템을 분리하면 로드 급증 및 개별 런타임의 탄력성/규모도 관리하여 앱의 전반적인 복원 및 가용성을 높이는 데 도움이 됩니다.
### 6.5 엔터프라이즈 검색
글로벌 검색에서 생성형 AI에 이르는 응용 프로그램에 매우 중요한 Salesforce의 검색 기능은 아키텍처 접근 방식을 형성하는 고유한 문제에 직면합니다.
- **배율**: 수천 명의 고객과 수백만 개의 테넌트를 지원하는 클라우드 네이티브 검색 솔루션은 비용 효율성을 유지하면서 대규모로 설계되었습니다.
- **고객 다양성**: 다양한 산업에 걸쳐 Salesforce의 다양한 고객 기반은 다양한 개체 유형 및 필드를 포함하는 광범위한 플랫폼 사용자 정의로 인해 고유하고 복잡한 검색 요구 사항을 갖고 있습니다.
- **운영성**: 검색 솔루션은 복원 가능하고 가용성이 높아야 하며, 지역 마이그레이션, Sandbox와 같은 데이터 보존, 테넌트 수명 주기 작업을 지원하고, 테넌트 간의 공정성과 함께 낮은 색인화 대기 시간을 유지해야 합니다.
- **규모 관련성**: 특히 다양한 테넌트, 데이터 유형, 검색 시나리오를 수용하기 위해 관련성 알고리즘을 확장할 때 다양한 사용자 쿼리를 충족하기 위해 검색 결과의 관련성을 높이는 것이 중요합니다.
- **AI 및 시맨틱 기능**: 검색은 기계 학습 및 생성형 AI(특히 RAG(검색 증가 생성) 및 에이전트 검색)를 지원합니다.
- **완벽한 통합**: 일관된 사용자 경험을 위해 Salesforce의 검색 기술은 메타데이터 모델 및 AI/데이터 서비스를 비롯한 광범위한 Salesforce Platform과 긴밀하게 통합됩니다.
Salesforce의 클라우드 네이티브 솔루션인 SeaS(서비스로 검색)는 오픈 소스 배포된 검색 엔진인 Solr을 기반으로 구축됩니다. Salesforce는 고유한 문제를 충족하기 위해 Solr을 크게 확장 및 최적화했으며, 시맨틱 기술을 통합하여 AI 응용 프로그램 및 검색 관련성을 향상하기 위해 Salesforce 응용 프로그램 및 플랫폼과 심층적으로 통합했습니다.
SeaS는 계산/저장소 분리 아키텍처를 사용하므로 노드 전체에서 색인을 확장 가능한 방식으로 배포하고 장애 발생 시 로드와 가용성의 균형을 조정할 수 있습니다. 자동으로 섀드 분할 및 크기 조정, 가동 중지 시간 제로 업그레이드, 복제본 게으른 로드 및 보관과 같은 최적화 기능을 사용하여 드물게 사용되는 색인을 충족합니다.
아키텍처에는 대량 필드에 최적화된 하위 수준 색인 구현, 자동 완성, 맞춤법 정정, 자체 키 가져오기 암호화도 포함되어 있습니다. 전 세계적으로 약 6,000개의 Solr 노드를 관리하는 Hyperforce 검색 인프라스트럭처는 각 지역의 여러 개의 독립 클러스터(Hyperforce 셀)를 사용하여 비용과 제어를 균형 잡고 로드, 도메인 및 유형을 기반으로 자동으로 클라이언트 인덱스를 배치합니다.
Salesforce의 검색 관련성 파이프라인은 순위 학습 기법을 사용하여 고객의 다양한 요구에 적응하고 결과 순위와 같은 기능을 지원합니다. 사용자 쿼리 및 지난 상호 작용의 엔티티 예측도 포함됩니다. 관련성 모델은 사용자 상호 작용으로부터 학습하여 지속적으로 개선되고 A/B 테스트를 통해 평가되어 검색 결과의 정확성을 향상합니다. 이 프로세스는 Knowledge 전송을 통해 AI 애플리케이션의 부트스트레이핑 모델도 지원합니다.
스택은 생성형 AI 기능을 위해 Data 360과 통합된 시맨틱 검색 및 AI 응용 프로그램용 벡터 검색 엔진을 통합합니다. 데이터 변환을 위한 포괄적인 파이프라인, 하이브리드 검색 지원, 연관성이 낮은 검색 결과를 필터링하는 딥 퓨전 랜커 및 자동 끌기와 같은 구성 가능한 순위의 카탈로그가 포함됩니다.
생성형 AI가 검색 서비스의 기본 소비자를 인간 사용자에서 LLM을 사용하도록 전환함에 따라 Salesforce 검색 스택이 이 프로그램 방식의 소비에 최적화된 결과를 찾고 반환하도록 조정하고, 더 길고 복잡한 쿼리를 처리하고 청크와 같은 더 자세한 결과를 반환합니다. 이를 통해 Agentforce 에이전트가 복잡한 작업을 수행하기 위해 추론 루프를 사용하여 검색을 활용하는 새로운 Agenttic Search 기능을 지원합니다.
Salesforce의 검색 기능은 글로벌 검색, 조회, 답변 검색, 커뮤니티 검색, 관련 목록, 설정, 모바일 및 생성형 AI 응용 프로그램 등 다양한 컨텍스트를 다룹니다. 이 광범위한 기능은 검색 스택과 Salesforce의 메타데이터 시스템 및 UI 에코시스템을 긴밀하게 통합하여 표준 및 사용자 정의 개체 모두를 원활하게 지원할 수 있도록 해줍니다.
또한 Data 360과 통합하면 코드 없는 구성을 통해 데이터 개체에 대한 검색 기능이 향상되고 SQL 쿼리에 검색 문을 포함하는 등 데이터 파이프라인 내에서 검색 함수를 구성할 수 있습니다. 검색 스택은 Google Drive 권한 인식 커넥터와 같은 Data 360 풍부한 커넥터 에코시스템을 활용하여 완벽한 엔터프라이즈 검색 기능을 제공합니다. 통합은 AI 플랫폼으로 확장되므로 검색 쿼리를 기초 교육용 프롬프트 빌더 및 에이전트 검색에서 검색 쿼리로 사용할 수 있습니다.
## 7\. AI 및 Agentforce
AI는 기술 환경을 재구성했으며, 통합된 풍부한 데이터 레이어를 갖춘 Salesforce Platform은 Salesforce에 영향력 있는 AI 환경을 고객에게 제공할 수 있도록 지원합니다. Salesforce는 거의 10년 전에 AI 전환을 시작했으며 2013년부터 연구, 윤리, 제품 개발에 중점을 두고 복잡한 문제를 해결하고 성장을 촉진할 수 있도록 지원합니다.
Salesforce는 혁신의 핵심 가치를 활용하여 Einstein 예측 AI를 도입하여 Einstein 예측 빌더 및 AI 봇과 같은 종합적인 AI 기반 도구 제품군을 사용하여 데이터를 분석하고 프로세스를 자동화하고 고객을 이해하고 운영을 최적화할 수 있습니다. 생성형 AI의 증가와 함께 Salesforce는 예측 및 생성형 모델을 병합하여 데이터 프라이버시 우선 순위를 지정하면서 고급 AI 기능을 제공하는 플랫폼인 Agentforce 출시했습니다.
이벤트 기반 프레임워크를 사용하는 파이썬에 구축된 Agentforce 3.0의 최근 출시를 통해 Salesforce는 내장형 대화 내역, 엔드 투 엔드 세션 추적, 음성 지원 및 사용자 정의 추론 엔진(Bring Your Own Planner) 기능과 같은 기능을 통해 향상된 유연성을 도입하여 더욱 확장 가능하고 사용자 정의 가능한 지능형 멀티 에이전트 시스템을 제공합니다.
### 7.1 핵심 AI 원칙
Agentforce 다음 핵심 원칙을 따릅니다.
- **데이터 보안 및 윤리**: 데이터 보호, 규정 준수, 윤리적 AI 원칙의 우선 순위를 지정합니다.
- **투명성 및 설명 가능성**: AI 생성 출력을 명확하게 이해하고 확인합니다.
- **유연성 및 맞춤형 구성**: 특정 요구 사항 및 산업에 맞게 AI 응용 프로그램을 조정합니다.
- **완벽한 통합**: Salesforce CRM 및 기타 시스템과 통합됩니다.
- **확장성**: 대규모 배포를 처리하고 실시간 AI 환경을 제공합니다.
- **지능적이고 일관된 경험**: 연결된 데이터 및 컨텍스트에 대한 이해를 통해 개인 설정, 증가, 자동화된 환경을 제공합니다.
- **전체적인 관찰 가능:** AI 에이전트 상호 작용에 대한 심층 가시성 및 모니터링을 제공하여 Agentforce Interaction Explorer를 사용하여 에이전트를 사전 예방적으로 최적화하고 미세 조정할 수 있습니다.
### 7.2 아키텍처 개요
 AI 스택은 다음과 같은 몇 가지 핵심 구성 요소로 구성됩니다.
- **AI 플랫폼**: 이 플랫폼 계층은 예측 및 생성 응용 프로그램 모두에서 사용되는 AI 모델을 관리, 교육, 미세 조정할 책임이 있습니다. OOTB(Out-of-the-box) 서비스, Trust 서비스 및 모델 교육, 테스트 및 추론 수행을 위한 기본 모델을 제공합니다. 또한 자체 예측 및 생성 모델의 통합을 지원하므로 플랫폼 내에 사용자 정의 모델을 가져올 수 있습니다.
- **AI 기본 서비스**: 여기에는 비즈니스 응용 프로그램과 AI 스택을 쉽게 통합할 수 있는 AI 게이트웨이, 사용자 의견 프레임워크, RAG, 에이전트 오케스트레이션, 에이전트 평가, 이유 분석 서비스가 포함됩니다.
- **AI 기반 사용자 및 에이전트 환경**: Salesforce는 클라우드 서비스를 통해 전문화된 AI 지원 응용 프로그램을 제공합니다. 고객은 플랫폼의 모든 구성 요소(예: Flow, Apex 또는 Lightning Web Components(LWC)))를 활용하여 AI 기반 환경을 생성하여 워크플로 및 비즈니스 프로세스에 원활하게 통합할 수 있습니다.
- **Agentforce Studio**: 이 구성 요소에는 Agent Builder, 프롬프트 빌더, 테스트 센터 및 모델 빌더와 같은 도구가 포함되어 있어 생성형 및 예측형 AI 환경을 모두 만들 수 있습니다. AI 모델 개발/교육, 테스트, 조정에 대한 종단간 지원을 제공합니다. 차세대 작성은 향상된 UX 및 SFDX와의 호환성을 통해 AI 에이전트 구축을 간소화하고 가속화하도록 설계된 이러한 기능을 강화합니다.
### 7.3 기본 구성 요소
#### Agentforce Trust 계층
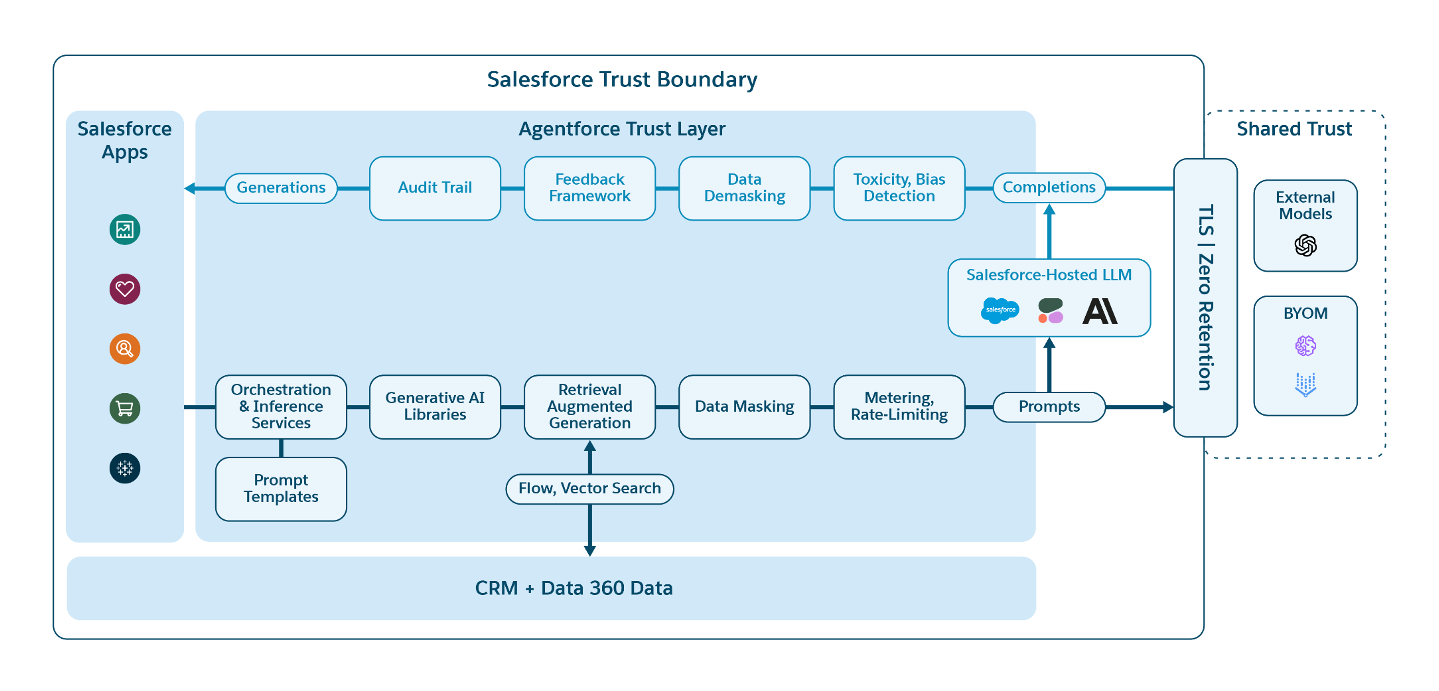 Agentforce Trust Layer는 다음과 같은 강력한 기능을 제공하여 생성형 AI 애플리케이션에서 고객 데이터를 보호하는 데 도움이 되는 특정 사용 사례에서 사용할 수 있습니다.
- **데이터 개인 정보 보호**: 강력한 마스킹 및 개인 정보 보호 제어는 외부 AI 모델에서 민감한 정보에 액세스하지 못하도록 보호합니다.
- **보안**: 안전한 데이터 처리 환경을 보장하고 무단 액세스를 방지합니다.
- **신뢰**: 타사 AI 저장소 또는 사용 없이 데이터에 대한 고객의 제어를 유지합니다.
- **가드레일:** 에이전트가 사전 정의된 지침 및 워크플로를 일관되게 따르는지 확인하여 에이전트의 행동 표준을 적용하고 LLM의 내재적인 불결정을 완화합니다.
- **정밀도**: 관련 Salesforce 데이터를 사용하여 AI 출력을 향상하고 프롬프트를 기반으로 합니다.
- **콘텐츠 조정**: 콘텐츠 전후 중재, 민감한 정보에 대한 사용자 정의 가능한 데이터 마스킹(PII/PCI/PHI), 대규모 언어 모델(LLM) 응답에 대한 독성 분류를 모두 제공합니다.
#### Agentforce AI 게이트웨이
AI 게이트웨이는 다양한 LLM 및 예측 모델에 액세스하고 관리할 수 있는 통합 인터페이스를 제공합니다. Salesforce와 LLM 세계 간의 교량 역할을 하며, 다양한 LLM 공급자와 고객의 자체 예측 AI 모델의 복잡성을 추상화하여 일관된 방식으로 상호 작용할 수 있습니다. Agentforce AI 게이트웨이는 여러 LLM 공급자와 통합되므로 고객이 요구에 맞는 최적의 모델을 선택할 수 있으며, 다양한 LLM 사용과 관련된 비용을 관리하는 데 도움이 되는 강력한 데이터 보안 조치를 통합합니다.
사용자 의견 서비스는 사용자 의견을 수집, 분석, 측정, 활용하여 AI 모델을 재교육하고 구체화하는 구성 요소입니다. Salesforce Platform 내에서 AI 중심 기능 및 기능을 지속적으로 개선하는 데 중요한 역할을 합니다.
#### 검색 증강 생성(RAG)
RAG는 생성형 AI로 검색 성능을 향상시키는 중요한 기법으로 보다 정보가 풍부하고 정확한 응답을 제공합니다. 광범위한 Salesforce Data 360 및 통합형 벡터 데이터베이스를 활용하여 Agentforce 플랫폼은 사용자의 쿼리에 대한 관련 데이터를 빠르게 검색합니다. 이 데이터는 최적의 응답을 생성하기 위해 LLM의 기초 교육으로 사용됩니다.
또한 이 방법은 응답에 소스 데이터를 포함하여 응답 속도와 사용자 Trust 향상합니다. RAG는 Agentforce Platform에서 특히 Agentforce for Service 및 세일즈용 Agentforce 같은 응용 프로그램에서 광범위하게 사용되며, 이러한 사용 사례에 대한 관련 정보를 표시하는 방법을 강조합니다.
### 7.4 Agentforce 플랫폼
AI 모델이 발전함에 따라 다음 단계는 추론이 필요한 과업을 자동화하는 에이전트를 개발하는 것입니다. 이러한 에이전트는 자연어로 쿼리를 이해하고 응답할 수 있는 지능형 도우미 역할을 하므로 사용자가 다양한 과업에 대해 쿼리를 설계, 테스트, 배포할 수 있습니다. 이 시스템의 중요한 구성 요소는 다음과 같이 작동하는 플래너 서비스입니다.
- **사용자 요청 해석**: 사용자의 입력을 분석하여 의도를 결정합니다.
- **계획 구축**: 사용자의 요구를 충족하기 위한 구조화된 계획을 수립합니다.
- **작업 실행**: 직접 또는 다른 서비스를 통해 작업을 시작하여 계획을 실행합니다.
플래너 서비스가 프로세스를 오케스트레이션하여 에이전트가 필요한 단계를 관리하고 실행하여 사용자 요청을 효율적으로 이행할 수 있도록 합니다.
#### Agentforce
Agentforce 에이전트를 구축할 수 있는 플랫폼을 나타내며, 고객 및 ISV가 서비스 에이전트 및 세일즈 에이전트와 같은 응용 프로그램에 자동화된 AI 에이전트를 만들 수 있습니다. 해당 에이전트는 자연스럽고 인간적인 방식으로 고객 문의를 처리하고 응답하고 광범위한 비즈니스 과업을 처리하며 비즈니스 및 고객 모두에게 상당한 혜택을 제공할 수 있습니다.
에이전트의 워크플로에는 다음이 포함됩니다.
- **활성화**: 에이전트는 다양한 채널 전반에서 고객의 요청과 같은 사전 정의된 기준에 의해 트리거됩니다.
- ** 이해 및 응답**: 자연어 처리(NLP)를 사용하여 고객의 문의, 의도 및 분위기를 파악한 다음, Salesforce의 Knowledge 자료 또는 기타 데이터 소스를 참조하여 적절한 응답을 작성합니다.
- **복잡성 처리**: 복잡한 문제에 직면하거나 인적 감독이 필요한 경우 에이전트가 상호 작용을 원활하게 인적 에이전트에게 전달할 수 있습니다.
- **연속 학습**: 에이전트는 각 상호 작용에서 학습하여 지속적으로 응답 및 전반적인 성과를 향상합니다.
#### Agentforce Studio
Agentforce Studio는 고객이 Salesforce 응용 프로그램 및 워크플로에 AI를 통합할 수 있는 로우 코드 플랫폼을 제공하므로 데이터 과학자 외에도 AI 기술을 액세스할 수 있습니다.
스튜디오의 주요 기능은 다음과 같습니다.
- **모델 빌더**: 특정 비즈니스 요구에 맞게 AI 모델을 구축하거나 가져올 수 있습니다.
- **프롬프트 빌더**: 생성형 AI 프롬프트를 만들고 관리할 수 있는 코드 없음/하위 코드 도구로서 프롬프트 구축, 테스트, 배포를 위한 간단한 인터페이스로 사용자 환경을 향상합니다.
- **에이전트 빌더**: 고객 및 ISV가 사용자 정의된 대화형 및 자율 에이전트를 개발할 수 있습니다.
- **테스트 센터**: 모델, 프롬프트, 에이전트의 테스트를 지원하며, 이는 고품질 AI 응용 프로그램을 보장하고 성능 및 비용 효율성을 최적화하는 데 있어 결정적 응답과 사용자 환경의 품질을 향상하는 동시에 중요합니다.
Agentforce 예측 및 생성형 AI를 결합하여 Salesforce Platform 및 Data 360의 통합 메타데이터 프레임워크를 활용하여 지능형, 맞춤형, 효과적인 비즈니스 솔루션을 제공합니다.
### 7.5 Next Evolution: Agentforce 3.0
신속한 논리 발전, 확장 가능한 멀티 에이전트 시스템의 필요성, 멀티 모달 인터페이스로의 전환 등 생성형 AI 시장의 증가하는 요구 사항을 충족하기 위해 Salesforce는 Agentforce 3.0을 통해 아키텍처를 발전시킵니다. 이 차세대 플랫폼은 다음과 같은 몇 가지 주요 고급 기능을 기반으로 구축됩니다.
- **비동기식 이벤트 기반 아키텍처:** Agentforce 3.0은 향상된 이벤트 기반 프레임워크와 함께 파이썬 기반에 구축됩니다. 이렇게 하면 에이전트가 이벤트를 통해 커뮤니케이션할 수 있는 복잡한 다중 에이전트 사용 사례에 대한 기초를 마련하고 성능을 향상시키고 비동기적이고 확장성이 뛰어난 에이전트 구현이 가능합니다.
- **다중 모달 음성 기능:** 텍스트 기반 상호 작용을 넘어서 Agentforce 3.0은 음성 지원을 기본 모달로 도입합니다. 아키텍처는 전화 통신 공급자 및 WebRTC 게이트웨이와 통합되어 실시간 오디오 스트리밍을 처리합니다. 새 서비스는 오디오를 텍스트로 변환(ASR)하고 텍스트를 오디오로 변환(TTS)을 관리하므로 자동화된 상담 센터와 같은 사용 사례에 자연스러운 대화형 음성 환경을 제공합니다.
- **Agentforce 스크립트 및 결정론:** 명시적으로 정의된 구조 내에서 에이전트의 동작을 제한하는 시/도 기계 기반 가로채기 메커니즘으로 실행 경로가 일관되게 유지됩니다. 이를 통해 결정적 그래프를 활성화하고, 메모리 손실을 방지하는 강력한 상태 관리를 제공하며, 조건부 및 LLM 결정된 핸드오프를 쉽게 수행할 수 있으므로 중요한 비즈니스 프로세스에 대해 예측 가능한 일관된 에이전트 작업을 보장할 수 있습니다.
## 8\. 응용 프로그램 플랫폼 서비스
Salesforce Platform의 앱 생태계는 App Platform 서비스, API, 사용자 환경, 개발자 환경 계층 전반의 기능 통합으로 구별됩니다. 앱 플랫폼 서비스는 Salesforce Platform에서 대부분의 앱을 구축하고 사용자 정의하는 데 사용되는 일반적인 기능이며 비즈니스 기능은 일반적으로 솔루션에 따라 다릅니다.
### 8.1 주요 기능
앱 생태계는 앱 개발 프로세스를 안내하는 5가지 핵심 기능을 기반으로 구축됩니다.
- **테넌시**: 이는 다중 테넌트 서비스 내에서 데이터와 메타데이터를 논리적으로 분리하여 인증된 사용자가 특정 데이터 및 기능에 액세스할 수 있도록 합니다. 이는 등록 시 고객이 Salesforce 조직을 받으면 가장 잘 볼 수 있습니다.
- **단체**: 데이터베이스 테이블을 나타내는 엔티티는 테이블 열과 유사한 필드로 구성됩니다. 엔티티 및 필드 메타데이터에는 데이터 유형 및 API 이름과 같은 데이터 모델링용 특성과 엔티티가 쿼리 가능 또는 쓰기 가능인 경우와 같은 기능 특성이 포함됩니다. 이 추상화는 데이터 저장소 자체를 직접 조작하는 대신 IT 개발자에게 업데이트를 요구하지 않고도 Salesforce에서 스토리지 기술을 원활하게 도입하고 전환할 수 있으므로 앱 기능을 지속적으로 유지할 수 있습니다.
- **액세스 제어**: 이러한 제어는 주로 사용자 ID 및 특정 정책을 기반으로 데이터 및 기능에 대한 사용자 액세스를 규제합니다. 정책은 규칙 및 기능 토글으로 구성되며 액세스할 수 있는 엔티티, 필드 및 기능을 관리합니다. 정책 및 권한은 "권한 집합"에 수집되며, 사용자 ID에 권한 집합을 할당하여 액세스 권한이 부여됩니다.
- **계층 확장**: 앞서 설명한 바와 같이 구조화된 저장 주문 및 메타데이터 네임스페이스를 통해 Salesforce 엔지니어, 외부 파트너, IT 관리자, 최종 사용자를 비롯한 다양한 역할에 의한 메타데이터 및 앱의 독립적인 개발을 지원합니다.
- **포장**: 이 기능을 사용하면 Salesforce 테넌트에서 메타데이터를 번들링 및 배포할 수 있으므로 다시 구축할 필요 없이 앱 업데이트 및 배포 프로세스를 간소화할 수 있습니다.
이러한 핵심 기능 외에도 앱 플랫폼 서비스에는 다음이 포함됩니다.
- **데이터 런타임 및 쿼리**: 여러 전문 데이터 저장소에서 데이터 생성, 업데이트, 삭제, 쿼리와 같은 작업을 지원합니다. 데이터 규모 및 성능의 스펙트럼은 데이터 저장소에서 직접, Salesforce 엔지니어가 사용할 내부 추상화를 통해 또는 고객 대면 "Salesforce 개체" 또는 sObject 규칙을 통해 데이터 작업을 실행할 수 있는 아키텍처에 의해 지원됩니다.
- **플로 / 워크플로 / 수식**: 하위 코드 도구를 사용하여 비즈니스 논리 및 확인 규칙을 정의하고 실행합니다.
- **Apex 코드**: 플랫폼 데이터 런타임 및 API와 기본적으로 통합된 앱 논리의 프로 코드 언어입니다.
- **Cloud-Native Infrastructure Services:** Heroku는 산업 프로그래밍 언어 및 프레임워크를 사용하여 플랫폼 데이터 및 이벤트와 통합되는 응용 프로그램을 구축, 배포, 관리하는 개발자를 위한 강력한 환경을 제공합니다.
- **이벤트 및 알림**: 트리거 및 이벤트 기반 오케스트레이션을 관리합니다.
- **세계화**: 다국어 및 다국어 앱에 대한 지원을 제공합니다.
- **라이센싱 및 프로비저닝**: 플랫폼 기능 및 앱에 대한 액세스의 구매 및 관리를 처리합니다.
- **Lightning 웹 스택**: 레이아웃과 같은 구조화된 메타데이터 및 표준 웹 기술을 사용하여 시각적 인터페이스를 사용자 정의할 수 있습니다.
- **Sites + CDN**: 인증되지 않은 사용자를 포함하여 대기 시간이 낮고 트래픽이 많은 웹 환경을 보장합니다.
- **보안 및 규정 준수**: 특정 조직 보안 및 규정 준수 요구 사항을 충족하기 위한 도구 및 제어를 제공합니다.
- **데이터 손실 방지**: 데이터 백업, 복원, 보관 기능이 포함되어 있습니다.
### 8.2 클라우드 응용 프로그램 플랫폼
Salesforce Platform은 Heroku를 통해 개발자가 선택한 프로그래밍 언어 및 프레임워크를 사용하여 클라우드에서 응용 프로그램을 구축, 실행, 관리할 수 있는 도구 및 기능을 제공합니다. Heroku의 관리 클라우드 응용 프로그램 플랫폼은 응용 프로그램 런타임, 데이터 저장소, Messaging 대기열, 확장 가능한 서비스로 시스템을 제공하여 Salesforce 응용 프로그램에 대한 확장을 구축합니다.
Heroku에서 실행되는 응용 프로그램은 전체 Salesforce 기능, 고객 데이터, 비즈니스 논리에 액세스하고 타사 시스템 및 서비스와 연결할 수 있습니다. Heroku를 사용하면 개발자가 기본 인프라 문제로 인해 부담을 받지 않고 가치 제공에 집중할 수 있습니다.
## 9\. 자동화
자동화는 앱을 동적으로 만들고 필수 비즈니스 프로세스의 디지털 변환에 매우 중요합니다.
Salesforce 프로세스 자동화는 조직의 규모가 증가함에 따라 간소화되고 효율적인 비즈니스 프로세스의 필요성을 비롯해 고객이 직면하는 주요 문제를 해결하기 위해 만들어졌습니다. 이러한 문제는 과도한 수작업 노력이 필요한 워크플로와 관련된 경우가 많아 비효율성과 운영 비용이 증가합니다. 고객은 해당 프로세스를 자동화하고 수동 작업을 최소화하거나 일관성과 정확성을 유지할 수 있는 솔루션을 찾고 있습니다.
중요한 문제는 비기술 사용자가 광범위한 코딩 기술 없이 비즈니스 프로세스를 설계 및 구현할 수 있는 사용자 친화적인 도구가 없다는 점입니다. 또한 데이터 입력, 승인, 알림, 복잡한 다단계 프로세스와 같은 기존 자동화된 Salesforce 과업과 안전하고 확장 가능하며 원활하게 통합할 수 있는 솔루션이 필요했습니다.
Salesforce 프로세스 자동화는 자동화된 워크플로를 만들 수 있는 강력하지만 직관적인 플랫폼을 제공하여 이러한 요구를 충족합니다. 이를 통해 기술 및 비기술 사용자가 액세스할 수 있는 시각적 인터페이스를 통해 사용자가 플로를 구축하고 사용자 정의할 수 있으므로 반복 과업을 자동화하고 비즈니스 규칙을 적용하고 Salesforce 에코시스템 내에서 프로세스를 간소화할 수 있습니다.
트랜잭션 데이터와 상호 작용하는 복잡한 오케스트레이션이 필요한 자동화의 경우 Salesforce는 비즈니스 논리를 작성하기 위한 프로 코드 언어로 Apex 제공합니다.
### 9.1 프로세스 자동화 아키텍처 및 기능
**Visual Logic Builder**: 고객 및 ISV는 끌어서 놓기 인터페이스인 Flow Builder를 사용하여 코딩 없이 프로세스 자동화 플로를 만듭니다. 이 시각적 도구는 모든 기술 수준에서 사용자에게 친숙하므로 비즈니스 분석가 및 관리자가 복잡한 자동화를 쉽게 설계할 수 있습니다.
Flow Builder를 사용하면 고객이 핵심 플로 엔진에서 지원되는 다양한 컨텍스트에서 작동하는 다양한 플로를 만들 수 있습니다.
- **레코드 트리거**: 플로는 레코드 업데이트 또는 양식 제출 시 활성화되어 고객 작업을 기반으로 데이터 수정, 확인, 워크플로 시작을 활성화합니다.
- **예약 또는 이벤트 기반 플로**: 해당 플로는 사전 결정된 일정 또는 특정 이벤트 후 트리거에 따라 작동하고 외부 서비스에 대한 콜아웃을 만들 수 있습니다.
- **스크린 플로**: 데이터 입력, 문제 해결 또는 온보딩과 같은 과업에 유용한 양식, 화면 및 기타 대화형 요소가 포함된 단계별 안내 프로세스에 대한 사용자 인터페이스를 제공합니다.
- **Orchestrator Flows**: 여러 단계 프로세스를 관리하고 통합하여 복잡한 작업을 쉽게 처리할 수 있습니다.
오프라인 플로 엔진은 Salesforce 앱 서버에 연결하지 않고 실행할 수 있습니다. 오프라인 플로는 Field Service 모바일 사용 사례에 대한 자동화를 지원합니다. 대규모 플로 엔진은 마케팅 플로를 구동합니다. 고용량 장기 실행 플로를 동시에 처리할 수 있도록 B2C 규모를 제공합니다.
모든 사용 사례 및 환경은 Flow Builder의 통합 메타데이터 모델에 의해 향상되며, 이는 모든 프로세스 자동화 플로에서 적용되는 다양한 강력한 논리 요소를 지원합니다.
- **고급 논리 및 조건**: 사용자는 결정 요소, 루프, 대기 조건과 같은 복잡한 논리를 워크플로에 통합하여 복잡한 비즈니스 시나리오를 처리할 수 있습니다.
- **데이터 관리 및 변환**: Flow Builder를 사용하면 웹 서비스, Salesforce 조직, Data 360을 비롯한 다양한 소스에서 데이터를 수집, 변환, 관리할 수 있습니다. 레코드 생성, 업데이트, 삭제 및 쿼리와 같은 포괄적인 데이터 작업을 지원합니다.
### 9.2 Salesforce Platform 전반의 자동화
Salesforce 프로세스 자동화는 다른 Salesforce 제품 및 타사 시스템과 원활하게 통합되므로 응용 프로그램 간에 원활한 데이터 흐름을 보장하고 비즈니스 프로세스 및 고객 상호 작용을 통합합니다. API, 웹 콜아웃, MuleSoft 커넥터와 같은 다양한 통합 방법을 지원합니다.
Salesforce 내의 외부 서비스 및 MuleSoft 연결을 사용하면 외부 API에 연결하고 Salesforce 프로세스 자동화 내에서 데이터를 활용할 수 있습니다. API 스키마를 등록하면 플로에 원활하게 통합되는 호출 가능한 작업을 만들 수 있으므로 외부 데이터 소스로 프로세스를 쉽게 자동화할 수 있습니다. MuleSoft의 강력한 통합 기능은 Salesforce와 다른 응용 프로그램 간의 원활한 데이터 흐름을 보장하므로 데이터 중단을 없애고 비즈니스 프로세스에 대한 통합 보기를 제공합니다.
**Agentforce 통합**: Salesforce 프로세스 자동화는 Agentforce 활용하여 지능형 의사 결정을 통해 워크플로를 향상합니다. AI 인사이트를 사용하여 리드를 적절한 판매 담당자에게 자동으로 전달하거나 고객 동작을 기반으로 맞춤형 마케팅 캠페인을 시작하여 인텔리전스를 추가하여 자동화의 효율성을 높입니다.
**Platform Synergy**: Salesforce 프로세스 자동화는 Sales Cloud, Service Cloud, Commerce Cloud, Marketing Cloud와 같은 다른 Salesforce 제품과 원활하게 통합됩니다. 이 통합을 통해 조직은 다양한 부서에서 프로세스를 자동화하여 운영 효율성을 향상할 수 있습니다. 예를 들어, 워크플로는 Marketing Cloud 양식을 통해 고객 컴플레인이 제출될 때 Service Cloud에서 지원 사례를 자동으로 생성할 수 있습니다.
### 9.3 Apex 통한 Pro-Code 자동화
Apex 개발자가 사용자 정의 비즈니스 논리를 작성하고 Salesforce Platform에서 복잡한 작업을 수행할 수 있는 강력하고 개체 지향적인 프로그래밍 언어입니다. 이 플랫폼은 플랫폼의 핵심 요소였으며 현재 플랫폼은 매월 350억 개 이상의 Apex 트랜잭션을 처리합니다(2025년 10월 기준).
Apex 다음을 포함하여 Salesforce Platform에 광범위한 사용자 정의 기능 및 심층 통합을 개발하는 데 사용됩니다.
- **트리거 기반 자동화**: 레코드가 삽입, 업데이트 또는 삭제되기 전이나 후에 실행되는 복잡한 자동화를 구현합니다. 이렇게 하면 복잡한 데이터 유효성 검사, 관련 레코드 업데이트, 특정 데이터 변경 사항을 기반으로 다른 프로세스를 호출할 수 있습니다.
- **웹 서비스:** 외부 시스템과 사용자 정의 통합을 만들고 Apex REST 또는 SOAP API를 호출합니다.
- **사용자 지정 사용자 인터페이스**: Apex 데이터 조작 및 비즈니스 논리를 처리하는 백엔드 컨트롤러 역할을 하는 Visualforce 및 Lightning 웹 구성 요소(LWC)를 사용하여 고도로 사용자 정의된 사용자 인터페이스 및 환경을 구축합니다.
- **사용자 정의 API:** 개발자는 Apex REST 및 Apex SOAP를 사용하여 API로 사용자 정의 논리를 노출할 수 있으므로 외부 시스템이 Salesforce 데이터 및 프로세스와 프로그래밍 방식으로 상호 작용할 수 있습니다.
- **비동기 처리**: 향후 메서드, 대기 가능한 Apex, 예약된 Apex 통해 장기 실행 또는 자원 집약적인 과업을 비동기식으로 실행합니다. 이를 통해 장기 실행 작업을 백그라운드에서 오프로드하고 처리하여 사용자 경험과 시스템 성능을 개선할 수 있습니다.
- **예약된 Apex:** 개발자는 Apex Scheduler를 사용하여 특정 시간에 Apex 클래스를 실행하도록 예약하여 일별 데이터 동기화, 보고서 생성 및 유지 관리 작업과 같은 정기적인 작업을 수행할 수 있습니다.
## 10\. 사용자 환경
Salesforce Platform의 사용자 환경 기능을 사용하면 최종 사용자가 브라우저 기반 Lightning 응용 프로그램, 익스피리언스 사이트, 모바일 네이티브, AI 지향, 공동 작업 UX 또는 Lightning Out을 사용하여 다양한 배포 옵션을 통해 응용 프로그램과 상호 작용할 수 있습니다.
### 10.1 Lightning 설계 시스템
Salesforce Lightning 설계 시스템(SLDS)은 모든 제품에 걸쳐 일관된 사용자 경험을 제공하기 위해 Salesforce의 설계 원칙에 따라 일관되고 액세스 가능한 사용자 인터페이스를 만드는 포괄적인 설계 프레임워크입니다. 이를 통해 Salesforce 엔지니어, 고객, 파트너가 Salesforce 에코시스템 전반에서 기본적인 응용 프로그램을 구축할 수 있습니다.
설계 시스템의 주요 기능은 다음과 같습니다.
- **설계 패턴**: 일반적인 설계 문제에 대한 입증된 솔루션으로 레이아웃, 데이터 프레젠테이션, 사용자 상호 작용에 대한 지침을 제공하여 일관적인 사용자 환경을 보장합니다.
- **스타일링 후크**: 색상, 타이포그래픽, 간격, 크기와 같은 설계 결정을 나타내는 CSS 변수로 응용 프로그램 전반에서 일관성을 보장합니다.
- **Lightning Base 구성 요소 라이브러리**: 빠르고 효율적으로 개발할 수 있도록 Salesforce의 설계 원칙을 준수하는 버튼, 양식 요소, 탐색 요소와 같은 재사용 가능한 UI 구성 요소 컬렉션입니다.
- **가용성**: 장애인이 모든 구성 요소를 사용할 수 있도록 하며 웹 콘텐츠 접근성 지침(WCAG)과 같은 표준을 준수하는 내장된 액세스 가능성 기능 및 지침.
- **응답 레이아웃**: 응용 프로그램이 다양한 장치 및 화면 크기에서 원활하게 조정할 수 있는 유연한 그리드 시스템 및 레이아웃 지침입니다.
- **툴링**: 구성 요소 위생, 안티 패턴 감소, 설계 시스템 거버넌스를 지원하는 도구, 자원, 기술 컬렉션입니다.
SLDS 프레임워크는 더 풍부한 스타일링 후크와 더 깊은 사용자 정의 기능을 지원하도록 계속해서 진화하여 구성 요소를 재사용할 수 있지만, 독특한 브랜드 및 테마 요구 사항을 충족하도록 사용자 정의할 수 있습니다. Salesforce의 설계 시스템 목표는 Salesforce를 빠르고 간편하며 AI와 함께 사용할 수 있게 하는 것입니다.
### 10.2 Lightning 웹 스택
Salesforce의 브라우저 기반 인터페이스(Lightning)는 일관된 UI 컨테이너와 메타데이터 기반 UI 프레임워크를 제공하며, Salesforce 엔지니어, IT 관리자, 개발자 및 파트너가 일관된 Salesforce 미학을 바탕으로 UI를 신속하게 개발할 수 있는 기술을 제공하며, 스타일을 변경하고 브랜드를 다시 지정할 수 있는 완벽한 제어 기능을 제공합니다. Lightning Web Stack에는 다음과 같은 몇 가지 기술이 포함되어 있습니다.
- **Lightning 웹 구성 요소**: HTML 및 JavaScript로 작성된 사용자 정의 웹 구성 요소로서 W3C 웹 표준을 준수합니다.
- **Lightning 웹 보안**: 브라우저에서 JavaScript 코드를 관리하여 타사 코드에 대한 Salesforce의 보안 표준을 준수하는 가상화 엔진입니다.
- **Lightning 데이터 서비스**: 서버측 데이터와 효율적으로 상호 작용하도록 설계된 프레임워크입니다.
- **Lightning Web Runtime**: 다양한 클라이언트에서 성능이 뛰어난 일관된 UI 렌더링을 보장합니다.
Salesforce 엔지니어링은 이전 UI 기술의 교훈을 통합하고 웹 표준 본문에 기여하여 표준 기반 구성 요소 구현의 개발에 영향을 미쳤습니다. 예를 들어 Salesforce는 계속해서 약 20개의 W3C 작업 그룹의 구성원입니다. Lightning Web Components 및 Lightning Web Stack은 이러한 업계 표준에 부합하여 개발자에게 복잡성을 줄입니다.
### 10.3 모바일
모바일은 계속해서 사용자가 Salesforce 앱과 상호 작용할 수 있는 확장되고 중요한 인터페이스입니다.
Salesforce는 네이티브 모바일 앱을 제공하므로 모든 브라우저 기반 Lightning 앱이 새 코드를 작성할 필요 없이 모바일 앱이 됩니다. Salesforce는 장치에 최적화된 완전 사용자 정의 기본 앱을 만들 수 있는 다양한 도구, SDK, 기능도 제공합니다. 다음은 포함됩니다.
- **모바일 SDK**: 인증, 세션/토큰 관리, Salesforce API 등과 통합을 간소화하는 모바일 운영 체제 전반의 개발자를 위한 프로 코드 인터페이스입니다.
- **모바일 기본 런타임**: 개발자는 장치 기능을 활용하는 iOS 및 Android 기술을 사용하여 런타임 시 동적으로 렌더링되는 메타데이터 기반 기본 환경을 만들 수 있습니다.
- **브랜딩**: Mobile Publisher 파이프라인을 통해 모바일 앱 미학을 사용자 정의하여 Salesforce 모바일 앱을 고객 브랜드 앱으로 변환할 수 있습니다.
- **오프라인 기능**: 일관되지 않거나 인터넷 연결이 없는 앱 기능을 원활하게 제공합니다.
MCF(모바일 사용자 정의 프레임워크)는 사용 편의성과 광범위한 사용자 정의 옵션을 제공하여 기본 Salesforce 모바일 응용 프로그램 개발을 크게 향상합니다. 주요 장점은 다음과 같습니다.
- **메타데이터 기반 접근 방식**: MCF는 시각적 빌더, 공통 리포지토리, Salesforce 호스팅 리소스에서 가져올 수 있는 메타데이터를 활용하여 특정 요구에 맞춰 동적이고 적응 가능한 사용자 환경을 만듭니다.
- **실험 및 최적화**: 프레임워크는 다양한 레이아웃의 런타임 실험을 지원하므로 지속적인 참여 최적화 및 사용자 환경 구체화가 가능합니다.
- **확장성**: 유연성을 위해 설계된 MCF를 사용하면 사용자 정의 구성 요소를 핵심 메타데이터 프레임워크에 통합하여 기능과 다양성을 향상할 수 있습니다.
- **구성 가능한 사용자 환경**: 최신 iOS 및 Android 기술을 활용하여 MCF는 버튼, 목록, 카드와 같은 재사용 가능한 구성 요소의 어셈블리를 지원하여 정교한 사용자 인터페이스를 만듭니다.
- **런타임 사용자 정의**: MCF는 실시간 UI 사용자 정의 및 실험을 활성화하여 더욱 맞춤화되고 매력적인 사용자 환경을 조성합니다.
오프라인 및 연결 상태가 낮은 시나리오는 모바일 장치에서 앱을 사용할 때 점점 더 걱정되는 문제입니다. 모바일 기술 스택은 오프라인 우선으로 사용할 수 있는 앱 구축의 우선 순위를 지정합니다. 주요 기능은 다음과 같습니다.
- **캐시 첫 경험**: 오프라인 사용을 위해 캐싱 데이터에 중점을 두고 고성능 및 보안을 보장합니다. 또한 사용자 상호 작용은 오프라인 렌더링 원칙을 염두에 두고 설계되었습니다.
- **캐시 관리**: 오프라인 상태에서도 캐시의 관련성 및 업데이트 상태를 유지합니다.
- **공유 캐시**: 네이티브 화면과 하이브리드 화면 모두에 단일 캐시를 활용하여 원활한 오프라인 환경을 제공합니다.
Nimbus는 플랫폼의 프로덕션 지원 솔루션으로 하이브리드 앱 개발자의 장치 기능에 액세스하는 프로세스를 간소화합니다. 기존에는 JavaScript와 모바일 네이티브 코드 간의 격차를 막는 작업이 복잡했습니다. 그러나 Nimbus를 사용하면 개발자가 낮은 수준의 코딩을 탐색하지 않고도 모바일 장치의 전체 잠재력을 활용할 수 있습니다. 주요 기능은 다음과 같습니다.
- **넓은 접근**: 카메라, 마이크, 지리적 위치, LiDAR과 같은 다양한 장치 기능과 원활하게 통합할 수 있습니다.
- **표준화된 인터페이스**: 장치 기능에 액세스하기 위한 일관된 방법을 제공합니다.
- **하이브리드 앱 통합**: 하이브리드 앱을 활성화하여 장치 기능을 완전히 활용합니다.
- **효율적인 개발**: 앱 개발 프로세스를 간소화하여 복잡성을 줄입니다.
AI는 계속해서 Salesforce 앱으로 가능한 것을 전환하면서 Salesforce는 클라우드 기반 솔루션과 함께 장치의 과업별 AI 모델을 활용하여 차별화된 사용자 환경을 제공합니다.
- **소규모 언어 모델(SLM):** 모바일 장치에서 효율적으로 저렴한 비용으로 실행할 수 있습니다.
- **개인 정보 보호 및 보안:** 사용자의 개인 정보를 보호하고 서버 기반 모델과 비슷한 수준의 Trust 및 보안을 유지합니다.
- **오프라인 기능:** 연결이 적은 환경에서 효과적으로 작동하여 오프라인 사용 사례를 활성화합니다.
- **음성:** 이제 최첨단 Speech-to-Text, Natural Text-to-Speech, 스피커 다이러레이션 모델이 장치에서 기본적으로 실행되므로 전체 프라이버시 및 0 대기 시간이 포함된 높은 신뢰도 음성 상호 작용을 제공합니다.
### 10.4 AI 및 공동 작업
자연어 및 앱과의 다중 전환 상호 작용을 위한 비모델 UI는 계속해서 증가합니다. 향후 개발은 모델, 장치 기능, 응용 프로그램 간 통합을 향상하고 보다 직관적인 음성 및 텍스트 인터페이스를 통해 사용자 상호 작용을 개선할 것으로 예상됩니다. 장치의 메트릭 컬렉션은 사용자 기본 설정을 기반으로 개인 설정된 조정을 허용합니다.
자동화와 인적 감독의 결합된 강점을 활용하려면 사람과 에이전트를 모두 포함한 모든 사용자 간 공동 작업이 필수적입니다. 이러한 공동 작업은 조직의 직원 및 고객과 관련된 복잡한 비즈니스 상호 작용에 특히 중요합니다. Slack은 Salesforce Platform 내의 기본 도구로 사용되며, 특정 토론 주제에 적합한 다이렉트 메시지 및 다중 사용자 채널을 통해 상호 작용을 촉진합니다. 이러한 토론은 사용자 생성의 자발적인 대화에서 상당한 고객 문제를 해결하는 자세한 Slack 메시지 스레드 등 사용자의 워크플로 내에서 특정 데이터를 중심으로 하는 더 구조화된 대화에 이르기까지 다양합니다.
Salesforce Platform은 향후 현재 Slack에서 제공하는 공동 작업 환경을 향상할 계획입니다. 이 확장은 플랫폼의 광범위한 기능을 최대한 활용하여 사용자가 디지털 작업 영역 내에서 상호 작용하고 공동 작업하는 방식을 강화합니다.
## 11\. 개발자 환경
플랫폼의 개발자 경험 기능은 앱을 구축, 사용자 정의, 테스트, 배포할 수 있는 도구를 제공하며, 프로 코드 접근 방식을 통해 하위 코드의 스펙트럼에 초점을 맞추어 모든 기술 수준의 개발자에게 동등한 기회를 제공합니다.
- **로우 코드 도구**: 데이터 모델용 스키마 빌더, 비즈니스 규칙용 플로, UI용 AppBuilder 사용자 정의가 모두 구조화된 메타데이터를 조작하고 기술적 개념 및 용어 대신 비즈니스 솔루션 언어로 작업하여 개발 프로세스를 간소화하도록 설계되었습니다.
- **Pro-Code 도구**: 다양한 복잡한 사용자 정의가 필요한 개발자를 위해 플랫폼은 고급 코딩 및 구성 요소 생성을 위한 CLI(명령줄 인터페이스) 및 API와 함께 클라우드 기반 IDE인 Salesforce Code Builder와 같은 도구를 제공합니다. 개발자는 Heroku를 사용하여 앱을 배포, 관리, 최적화하기 위한 솔루션을 활용하여 원하는 언어로 코딩할 수 있습니다.
- **통합 개발 환경**: Salesforce 에코시스템은 하위 코드 및 프로 코드 도구 간의 원활한 통합과 산업 표준 도구를 사용하여 클라우드 내 및 로컬에서 일관된 개발을 지원합니다.
- **어플리케이션 수명 주기 관리(ALM)**: 초기 개발을 위한 스크래치 조직 및 프로덕션과 유사한 데이터 및 규모에 대한 테스트를 위한 전체 Sandbox 조직을 비롯하여 운영 환경과 별도로 개발할 수 있는 다양한 Sandbox 조직을 제공합니다.
### 개발자용 11.1 AI
AI 및 "개발자 도우미"는 효율적이고 고품질 응용 프로그램 생성을 간소화하고 가속화하여 개발자 환경을 혁신하고 있습니다. Salesforce의 AI 연구 및 개발자 경험 팀은 지속적으로 예측 및 생성형 AI를 에이전트적인 이유로 강력한 개발자 에이전트로 전환하는 방법을 반복하고 탐색합니다. 이러한 개발자 에이전트는 VS Code, Code Builder, 명령줄, DevOps Center 및 Code Analyzer와 같은 개발자가 이미 사용하고 있는 도구와 기본적으로 통합되어 관련성과 영향력을 높입니다.
우리는 Apex 코드의 안티 패턴 및 핫스팟을 식별하기 위해 코드 분석에서 상당한 발전을 거쳤으며, 그 구현을 개선하기 위한 중요한 권장 사항을 제공했습니다. 식별된 문제는 일반적으로 컴퓨팅 자원을 낭비하며 대규모 사고로 이어집니다. 이 기능은 2024년 1월에 ApexGuru 인사이트로 출시되었습니다.
출시 후 첫 해에 2,800개가 넘는 Salesforce 조직이 ApexGuru를 사용하여 Salesforce 구현을 분석하고 개선했습니다. 22,000개가 넘는 권장 사항이 성공적으로 구현되었으므로 매주 28,000시간의 CPU 시간을 절약할 수 있습니다. 이 개선 사항은 성능을 높일 뿐만 아니라 지속 가능성 및 탄소 배출 절감에 대한 서약의 핵심 가치와 일치함으로써 매주 135kg의 CO2 배출을 줄여 환경 지속 가능성에도 기여합니다.
또한 AI를 프로 코드 개발자 도구 및 기능에 통합하여 Developer Productivity 향상합니다. 2024년에 "개발자용 Agentforce"로 생성된 개발자는 Visual Studio 코드 및 코드 빌더의 Salesforce Extension 팩 내에서 이러한 새로운 기능에 액세스할 수 있습니다. 다음 확장 프로그램을 사용할 수 있습니다.
- 개발자가 작성하고 Apex 및 Lightning 웹 구성 요소(JavaScript, CSS, HTML)에 대한 코드를 생성하는 동안 인라인 코드 제안
- Apex 및 Lightning 웹 구성 요소에 대한 코드 설명 및 문서 생성
- Apex 단위 테스트 코드 생성.
- 코드 생성, 설명, 문서를 위해 여러 응답에서 작업할 수 있는 IDE의 고유한 다중 전환 채팅 환경입니다.
- Lighting 웹 구성 요소 최적화.
- 에이전트 테스트 및 디버깅 기능을 포함하여 사람이 읽을 수 있는 YAML 메타데이터가 포함된 에이전트 생성
2025년 10월부터 42,000명 이상의 개발자가 매월 이 기술을 활발하게 사용하고 있으며, 1760만 개의 코드 행이 수락됩니다. 이 포괄적인 제품군은 유연하고 통합적이며 효율적인 개발 환경을 제공하므로 Salesforce Platform 내의 광범위한 개발 요구 사항을 충족할 수 있습니다. 또한 AI 개발자 도구는 여러 외부 및 Salesforce 구축 모델에서 작동하는 아키텍처로 향상되어 주어진 사용 사례에 가장 효과적이고 효율적인 모델을 선택합니다.
### 11.2 MCP 지원 및 AI 지원 코딩
모델 컨텍스트 프로토콜(MCP)은 AI 에이전트가 도구 또는 데이터 소스와 안전하고 일관적으로 상호 작용할 수 있도록 설계된 새롭게 나타나는 개방형 표준입니다. Salesforce는 기본적으로 MCP 지원을 Salesforce 개발자 툴킷에 통합하여 엔터프라이즈 전반의 기능 및 도구에 액세스할 수 있는 개발자 에이전트를 지원합니다. 여기에는 다음이 포함됩니다.
- **로컬 MCP 서버:** 로컬 MCP 서버를 사용하면 개발자가 프로덕션에 배포하기 전에 로컬 IDE 내에서 에이전트 통합을 쉽게 구축, 테스트, 디버그할 수 있으므로 생산성이 크게 향상됩니다. 로컬 MCP 서버는 모바일 개발, 액세스 가능성 테스트, Aura-to-LWC 마이그레이션, 에이전트 DevOps 등 조직 상호 작용 및 개발 워크플로를 위한 특수 도구를 제공합니다. 로컬 MCP 서버에는 에이전트 사유 및 LLM과의 통합도 포함되어 있어 개발자가 앱을 반복적으로 자연어로 "비브 코드"할 수 있는 권한을 강화할 수 있습니다.
- **Salesforce API를 위한 사용자 정의 MCP 서버:** 이제 개발자는 Salesforce API, Data 360 개체, 자동화 플로를 MCP "도구"로 안전하게 노출할 수 있습니다. 이렇게 하면 전체 Salesforce Platform이 모든 외부 AI 에이전트 또는 응용 프로그램에 대해 풍부하고 신뢰할 수 있고 검색 가능한 기능 집합으로 전환되며 세분화된 액세스 제어와 새로운 소비 기반 수익화 모델의 잠재력이 포함됩니다.
- **네이티브 외부 MCP 연결:** 개발자는 MCP 표준을 준수하는 외부 서버에 대한 연결을 안전하게 관리할 수도 있습니다. 이를 통해 개발자는 엔터프라이즈 전반에서 작업할 수 있는 에이전트를 구축할 수 있습니다.
## 12\. 응용 프로그램 제품군
Sales Cloud, Service Cloud, Marketing Cloud, Revenue Cloud 및 Commerce Cloud를 비롯한 애플리케이션 클라우드는 Salesforce Platform에 구축되어 선도적인 비즈니스 기능을 제공하며 고객 성공을 촉진하는 애플리케이션 제품군을 구성합니다. 주요 기능은 다음과 같습니다.
- **완벽한 통합**: 고객 여정 전반에서 일관되게 작업하고 고객 접점 전반에서 원활한 데이터 및 프로세스 흐름을 보장하도록 설계되어 고객 경험을 향상합니다.
- **엔드 투 엔드 사용자 정의 기능**: 플랫폼에 구축된 응용 프로그램은 코드 없음에서 프로 코드까지 광범위한 사용자 정의 옵션을 제공하므로 고객 요구에 맞게 정밀하게 조정할 수 있습니다.
- **고급 AI 기능**: Agentforce 에이전트를 사용하여 에이전트 지원 및 에이전트 독립형 대화형 채널 기반 워크플로를 제공합니다. 예측 및 생성형 AI를 통합하여 자동화, 예측 분석, 맞춤형 사용자 환경을 통해 효율성을 높이고 실행 가능한 인사이트와 권장 사항을 제공합니다.
- **실시간 데이터 처리**: Data 360을 활용하여 실시간 데이터 액세스 및 분석을 통해 최신 정보를 기반으로 적시에 정보에 근거한 의사 결정을 내릴 수 있습니다. 이렇게 하면 빠른 속도 환경에서 반응성과 민첩성이 향상됩니다.
- **통합 데이터 및 Analytics**: 일관되고 포괄적인 데이터 보기를 위해 다양한 데이터 소스를 중앙화된 플랫폼에 통합하여 정확한 분석을 제공하고 의사 결정을 개선합니다.
- **고급 보안 및 규정 준수**: 강력한 보안 및 규정 준수 도구를 사용하여 민감한 데이터를 보호하고 규제 표준을 충족합니다.
- **소비자급 사용자 경험**: 장치, 채널 및 모달 전반에서 응용 프로그램에 액세스하고 효과적으로 사용할 수 있는 직관적이고 사용자에게 친숙한 인터페이스를 제공합니다.
- **신뢰성**: 가동 중지 시간 및 확장성을 최소화하여 긴급 서비스 및 중요 운송 시스템 등 임무 및 생명 크리티컬 작업을 지원합니다.
- **엘라스틱 확장성**: 성능이나 서비스 비용을 절감하지 않고 데이터 및 사용자 상호 작용 볼륨을 늘릴 수 있도록 지원하는 Hyperforce 구축됩니다.
- **계속적인 개선**: 기존 작업을 중단하지 않고도 혁신을 정기적으로 통합하여 기능을 향상합니다.
Salesforce는 이 백서에 설명된 기본 기술을 기반으로 플랫폼 전체에서 기능을 통합하여 응용 프로그램을 발전시키는 데 전념합니다. 이 변환은 Salesforce 응용 프로그램 도구 모음의 설계 및 개발을 구성하는 주요 우선 순위 집합에 따라 결정됩니다.
### 12.1 규모 및 성능
애플리케이션 팀은 성능 및 확장성을 전문으로 고급 성능 실습을 활용하여 합성 데이터를 사용하여 프로덕션 환경의 정확한 복제본을 만듭니다. 이 설정을 통해 각각의 새 기능이 성능을 철저하게 테스트하고 영향을 평가할 수 있도록 병렬 사용자 여정을 광범위하게 시뮬레이션할 수 있습니다. 런타임 지체 지점을 식별하면 속도 제한 및 기타 조치를 동적으로 조정하여 시스템 상태를 보호하고 데이터를 수집하여 해결을 촉진합니다.
Dell 시스템은 공개 클라우드의 유연성을 효과적으로 활용할 수 있도록 가로 확장용으로 설계되었습니다. 자동 확인을 통해 업데이트 또는 개선 사항이 성능에 부정적인 영향을 미치지 않습니다. 증가하는 수요에 반응하는 것뿐만 아니라 미리 예측하고 조정하는 시스템 로드를 사전에 관리하는 예측 자동 스케일러를 사용합니다.
자동 확장은 미사용 용량을 줄여 서비스 비용을 최소화하는 데 매우 중요합니다. 시스템 실행 비용을 면밀하게 모니터링하여 자동 확장 또는 자원 사용의 비효율성을 식별하고 해결합니다. 비용 효율성이 중요하지만 신뢰할 수 있는 애플리케이션 전달은 우선 순위가 주어지며, 비용이 더 많은 경우에도 빠르게 확장하고 느리게 축소하여 고객 Trust 유지하는 자동 스케일러를 선택합니다.
### 12.2 원활한 통합
#### 일반 데이터 모델
데이터 모델은 Salesforce의 모든 비즈니스 운영에 기본적이며, 비즈니스 기능, API, 탐색, UI 디스플레이, 생성할 수 있는 보고서에 영향을 미칩니다. 이 기능은 플랫폼의 기능에 고유합니다.
Sales Cloud, Service Cloud, Revenue Cloud, Commerce Cloud, Marketing Cloud, Industries Cloud에서 공통 데이터 모델을 공유합니다. 이는 통합된 제품군에 기여하여 일관된 동작과 상호 운용성을 제공하고 업그레이드 및 확장을 위한 명확한 경로를 제공합니다.
예를 들어 모든 클라우드에서 계정 및 제품 엔티티를 공유하면 Marketing Cloud 및 Sales Cloud의 사용자가 데이터, 메타데이터, UI 구성 요소, 비즈니스 논리를 교환할 수 있습니다. 이 통합은 사일로를 풀고 기능 간 공동 작업을 촉진하는 데 도움이 됩니다.
#### 가상 데이터 플랫폼
모든 Salesforce Cloud에서 공통 데이터 모델을 사용하면 통합이 크게 향상되지만, 모든 복잡한 파트너 통합 요구 사항을 충족하지 못할 수 있습니다. Data 360 일반 데이터 모델은 공유 데이터 모델 이점을 Salesforce의 일반적인 데이터 경계 이상으로 확장하여 더 광범위한 통합 시나리오를 수용합니다.
#### 계층형 확장성
Salesforce의 메타데이터 프레임워크를 사용하면 엔지니어링 팀, ISV, 파트너, 관리자, 최종 사용자와 같은 다양한 그룹이 서로 간섭하지 않고 고유한 확장성 계층 내에서 응용 프로그램을 사용자 정의하고 확장할 수 있습니다. 이 구조는 한 그룹의 수정이 다른 그룹을 중단하지 않고 시스템 무결성을 유지하는 확장 가능한 환경을 지원합니다.
실행 중인 프레임워크의 주요 예는 통합 지식 제품으로서 모든 Knowledge 소스를 데이터 호수로 통합합니다. 이 설정에는 시맨틱 레이어와 검색기가 포함되어 있으며, Sales Cloud, Service Cloud, Revenue Cloud, Marketing Cloud, Commerce Cloud 전반에서 예측 및 생성형 AI 기능을 강화합니다. 기존의 구조화된 Knowledge 모델에 연결된 비정형 및 세미정형 Knowledge 데이터 모델을 통합합니다.
또한 프레임워크는 메타데이터를 사용하여 데이터 유형 간의 사용자 정의 관계를 정의하여 고급 쿼리 생성을 촉진합니다. 이를 통해 애플리케이션 팀은 이 포괄적인 Knowledge 기반을 활용하는 사용자 정의 가능한 애플리케이션을 만들 수 있으며, ISV, 파트너 및 고객은 메타데이터 관계를 수정하거나 특정 비즈니스 사용 사례에 맞게 사용자 정의 검색기를 개발하여 애플리케이션 기능을 더욱 향상할 수 있습니다.
#### 공통 데이터 플랫폼 향상
고객 데이터는 SalesforceDB 및 Data 360과 같은 다양한 플랫폼에서 안전하게 저장되며, 구조화된 형식 또는 비정형 형식에 관계없이 표준화되고 정규화됩니다. 이렇게 하면 모든 고객 데이터 전반에서 통합 데이터 플랫폼을 지원하는 sObject라는 통합 형식을 통해 일관된 데이터를 처리할 수 있습니다.
이 표준화를 통해 모든 데이터 작업에 단일 API, Apex 트리거를 위한 통합 인터페이스, 플로를 사용하여 사용자 정의 워크플로 만들기를 지원합니다. 또한 Tableau Next를 지원하므로 고객 데이터를 기반으로 지능형 응답 생성을 위해 프롬프트 빌더 같은 생성형 AI 도구와 사용자 정의된 데이터 보기를 만들고 통합할 수 있습니다.
또한 Salesforce 응용 프로그램은 다양한 데이터 저장소와 통합되어 제품 내의 비즈니스 프로세스 유연성을 향상합니다. 예를 들어 Marketing Cloud에서 플로는 미리 설계된 템플릿을 사용하거나 기본 고객 데이터를 기반으로 다른 비즈니스 프로세스와 마케팅을 통합하는 사용자 정의 플로를 구축하는 옵션과 함께 멀티 터치 고객 환경을 관리하는 데 사용됩니다.
### 12.3 공유 비즈니스 기능
응용 프로그램은 ID 확인, 콘텐츠 오케스트레이션, 개인 설정, 분석, LLM 게이트웨이, 이유 제공 서비스와 같은 공유 서비스를 활용하고 향상하여 신속한 혁신과 배달을 지원합니다. 해당 서비스는 실시간 데이터 처리, AI 기반 인사이트, 풍부한 사용자 환경을 지원하므로 포괄적인 포괄적인 고객 보기를 제공합니다.
지능형 자동화 및 예측 분석을 통한 효율성 향상, 데이터 및 사용자 상호 작용을 향상하기 위한 확장성, 강력한 보안 및 규정 준수 등이 있습니다. 플랫폼의 사용자 정의 기능을 사용하면 조직이 변화하는 요구에 빠르게 적응하여 성장 및 운영 우수성을 촉진할 수 있습니다.
응용 프로그램 계층의 혁신은 Salesforce Platform 및 개별 응용 프로그램을 기반으로 Salesforce 에코시스템을 강화하고 응용 프로그램을 업계 리더로 설정합니다.
### 12.4 다중 채널 및 채널 최적화
Salesforce 응용 프로그램은 웹, 모바일, 이메일, SMS, WhatsApp, 기타 채널 등 다양한 플랫폼에서 사용자를 만날 수 있도록 설계되었습니다. 각 채널의 기본 기능을 최적화하여 사용자 환경 및 효율성을 향상합니다.
기능에는 Salesforce Field Service 사용자를 위한 월간 오프라인 기능, 브라우저 푸시 알림, Lightning Service Console의 서비스 에이전트를 위한 와이드스크린 레이아웃, Commerce 구매자를 위한 고성능 상점 및 공동 파일럿이 포함됩니다.
메타데이터 플랫폼을 사용하면 Salesforce, 파트너 및 고객이 즉시 이러한 기능을 즉시 활용할 수 있습니다.
### 12.5 신속한 혁신 전달
Salesforce의 기본 서비스, 플랫폼, 공유 비즈니스 기능을 사용하면 응용 프로그램이 빠르게 시장 변화 및 기술 추세에 적응하여 빠른 혁신을 제공할 수 있습니다. 예를 들어, 생성형 AI의 출현으로 Salesforce는 NLP Trust Layer 및 Intent Detection과 같은 기존 AI 서비스를 신속하게 활용하여 프롬프트 템플릿을 Universal Communications Platform에 통합했습니다. 이 통합은 제품 전반에서 Messaging 및 전화 기능을 향상하여 더 많은 개인 클라이언트 연결을 촉진합니다.
독립형 AI로의 추세에 따라 Salesforce는 기존 투자를 활용하여 처음부터 구축할 필요 없이 에이전트와 함께 비즈니스 사용 사례를 효율적으로 자동화하는 Agentforce 출시했습니다.
### 12.6 응용 프로그램 도구 모음 경로
Salesforce Platform에 Marketing Cloud, Revenue Cloud, Commerce Cloud를 재구축하여 이러한 클라우드를 사용하여 동일한 인프라, 플랫폼, 메타데이터, 데이터, AI, UI 구성 요소, 비즈니스 논리를 공유하고 Salesforce Platform의 모든 기능을 활용할 수 있습니다. 예를 들어, Revenue Cloud 기능을 가져오고 제약 기반 구성기, 가격 책정 엔진, 카탈로그 관리를 비롯한 기본 기능을 내장하여 제품군 전체에서 사용할 수 있는 기본 서비스를 제공합니다. 이를 통해 모든 클라우드에서 원활하게 통합할 수 있으며 Commerce Cloud 및 Marketing Cloud에서 제공하는 기능이 다른 응용 프로그램에서 활용할 수 있는 공유 비즈니스 기능의 일부가 됩니다. 이는 통합 애플리케이션 제품군의 비전입니다.
Salesforce Platform의 여정은 Sales Cloud, Service Cloud, Marketing Cloud, Revenue Cloud, Commerce Cloud를 통합 솔루션으로 결합하는 통합 애플리케이션 제품군을 개발했습니다. Salesforce Starter Edition부터 사용할 수 있는 이 제품군은 하나의 통합 패키지에서 다중 채널 지원, 고객 관계 관리, 비즈니스 인사이트를 제공합니다. 선택한 Edition에 관계없이 사용자는 Sales Cloud, Service Cloud, Marketing Cloud, Commerce Cloud의 핵심 기능에 액세스하여 모든 수준에서 일관된 환경을 보장할 수 있습니다.
## 13\. 산업별 솔루션
금융 서비스, 건강, 생명 과학, 미디어, 에너지 및 유틸리티, 제조, 자동차, 소비재, 리테일, 탄소 중립, 공공 부문, 교육, 비영리 분야의 Salesforce Industries 제품은 응용 프로그램 제품 및 플랫폼을 확장하여 산업의 고유한 문제를 해결하는 맞춤형 솔루션을 제공합니다. 산업별 워크플로, 규정 준수 조치, 데이터 모델을 통합하여 운영을 간소화하고 생산성을 향상합니다.
산업 포트폴리오가 Salesforce Platform에 재구축되어 세로 간에 구성 가능성을 활성화했습니다. 이제 고객은 하나 이상의 산업 기능을 맞춤형 솔루션으로 조합하여 공유 메타데이터, API, 비즈니스 서비스를 활용할 수 있습니다. 이 접근 방식은 세로 차별화와 플랫폼 일관성의 균형을 맞추어 다양한 규제 및 비즈니스 컨텍스트에서 적응성과 규모를 보장합니다.
### 13.1 계층형 아키텍처 접근 방식
Dell 제품은 계층형 아키텍처를 사용합니다. 기본적으로 Sales Cloud 및 Service Cloud와 같은 Salesforce Platform 및 가로 응용 프로그램이 모든 산업 솔루션의 기반 역할을 합니다. 또한 Salesforce는 대부분의 산업에 내장된 재사용 가능한 구성 요소를 향상하는 공통 서비스를 추가했습니다. 이러한 예에는 디지털 자동화, 타임라인, 작업 계획 등에 대한 기능이 포함됩니다. 이 레이어 위에는 사용자 의견 관리, CPQ(구성, 가격, 견적) 및 서비스 관리와 같은 가로 기능을 캡슐화하는 재사용 가능한 비즈니스 논리 레이어가 있습니다.
상위 레이어는 특정 산업 요구 사항에 맞게 조정된 도메인별 사용자 정의를 제공하며, 기본 플랫폼을 활용하여 확장성과 효율성을 향상합니다. 예를 들어 제조 세로에서 이 설정은 정확한 예측을 통해 프로덕션 계획을 최적화합니다. 생명 과학 분야에서 제약품 세일즈 팀에 다양한 지리적 규제 요구 사항을 준수하면서 워크플로 및 샘플 처리를 효율적으로 관리하는 모바일 오프라인 솔루션을 제공합니다.
### 13.2 산업별 기능
**신뢰할 수 있는 AI 우수성**: 신뢰할 수 있는 생성형 AI 솔루션은 산업별 AI 기능을 제공합니다. 여기에는 에이전트 및 프롬프트 엔지니어링이 포함되며, 헬스케어, 생명과학, 금융 서비스와 같은 섹터에서 하위 코드/무코드 자동화 및 디지털화를 지원합니다. 또한 문서/텍스트 마이닝 및 요약과 같은 기능은 대용량 데이터를 처리하는 산업에 적합하여 정보 추출 및 인사이트 수집에 도움이 됩니다.
사용자 정의된 에이전트는 에이전트와 고객 간의 3방향 커뮤니케이션을 강화하여 더 빠르게 해결할 수 있습니다. Salesforce Platform의 Trust 계층은 모든 업계의 규정 준수 및 규제 표준을 준수할 수 있도록 지원합니다.
**규제 준수 및 보안을 통한 데이터, 통찰력 및 인텔리전스**: Salesforce Industries는 GDPR, HIPAA, FedRamp 등 특정 산업 규정에 적합한 엄격한 데이터 프라이버시, 공유, 보안 조치와 함께 포괄적인 360o 보기를 제공합니다. Salesforce는 다양한 소스의 데이터를 통합하여 규정 준수 및 보안을 지원하며 테넌트 데이터 암호화용 Shield Encryption BYOK(Bring Your Own Keys)와 같은 추가 기능으로 해당 솔루션을 강화합니다.
**고급 사용자 경험**: Salesforce Industries는 산업별 요구에 맞게 조정된 원활한 사용자 환경을 강조하여 사용자 여정을 향상합니다. 여기에는 실천 가능한 리소스 센터, Experience Cloud 템플릿, OmniStudio 기반 솔루션과 같은 도구가 포함됩니다.
**디지털화, 통합 및 온보딩**: Salesforce Industries는 하위 코드에서 비코드 솔루션을 통해 디지털화, 통합, 온보딩을 제공하며, 신규 고객을 위해 플로 및 Omnistudio와 같은 도구를 활용하고 기존 CRM 시스템에 마이그레이션 솔루션을 제공합니다. 외부 시스템 및 데이터와의 통합은 MuleSoft에서 제공하는 커넥터를 통해 간소화됩니다. Salesforce에는 Retail Banking 분쟁 관리와 같은 산업별 서비스 프로세스도 포함되어 있습니다.
**모바일 및 오프라인**: Salesforce Industries는 Salesforce 모바일 앱 및 Field Service 모바일 앱에 강력한 도메인별 지원을 제공합니다. 고도의 오프라인 지원이 필요한 고도로 전문화된 도메인의 경우 Industries는 Salesforce Mobile SDK에 구축된 맞춤형 모바일 앱을 제공합니다.
**공통 비즈니스 역량**: Salesforce Industries는 일반적인 비즈니스 기능의 기반에 구축되어 일관성과 생산성을 제공하는 동시에 은행 및 병원의 다양한 약속 예약 시스템과 같은 고유한 산업 요구에 맞춰 솔루션을 조정합니다. Salesforce는 광범위한 Salesforce 에코시스템과 통합되어 전체적인 Customer 360 뷰를 제공하므로 Salesforce 제품군의 중요한 부분입니다.
## 14\. Analytics
수년간 Analytics 및 BI(비즈니스 인텔리전스) 플랫폼 시장에서 최종 사용자가 더 빠르고 데이터 중심의 결정을 내릴 수 있도록 시각적 셀프 서비스 및 AI 중심 자동 인사이트를 홍보해 왔습니다. 그러나 다음과 같은 몇 가지 문제로 인해 모든 사람이 이 작업을 수행한 적은 없습니다.
- **연결 해제된 인사이트**: 인사이트는 사용자의 워크플로에 통합되지 않으므로 의사 결정에 정보를 제공하는 잠재력이 있더라도 인사이트에 대한 조치를 취하기가 어렵습니다.
- **데이터 과부하 및 사일로**: 데이터는 계속해서 빠르게 증가하고 분할화된 상태로 유지되므로 조직화 및 보안 위험이 발생합니다. 조직은 혼란스러운 셀프 서비스 데이터 환경과 잘 관리되는 제한적인 데이터 환경 간의 딜레마에 직면합니다.
- **데이터에 대한 신뢰**: 데이터가 확장되고 조각화되어 회사 데이터에서 파생된 인사이트에 대한 사용자의 Trust 손상되었습니다.
- **구성 불가능성**: 작업 프로세스에서 구성 가능성 및 재사용이 크게 부족하므로 사용자가 과업을 반복하도록 강제 적용되며, 분명한 수단으로 수익을 창출할 수 없습니다.
Tableau Next는 비즈니스 사용자와 데이터 전문가를 새로운 공동 작업 방식으로 모아 시각적 분석 순환을 확대하도록 설계되었으며, 모두 AI로 향상되었습니다. Salesforce Platform을 통해 신뢰할 수 있는 시기적절한 메트릭 및 인사이트를 제공하므로 실천 가능한 인사이트에 모든 곳에서 쉽게 액세스할 수 있습니다.
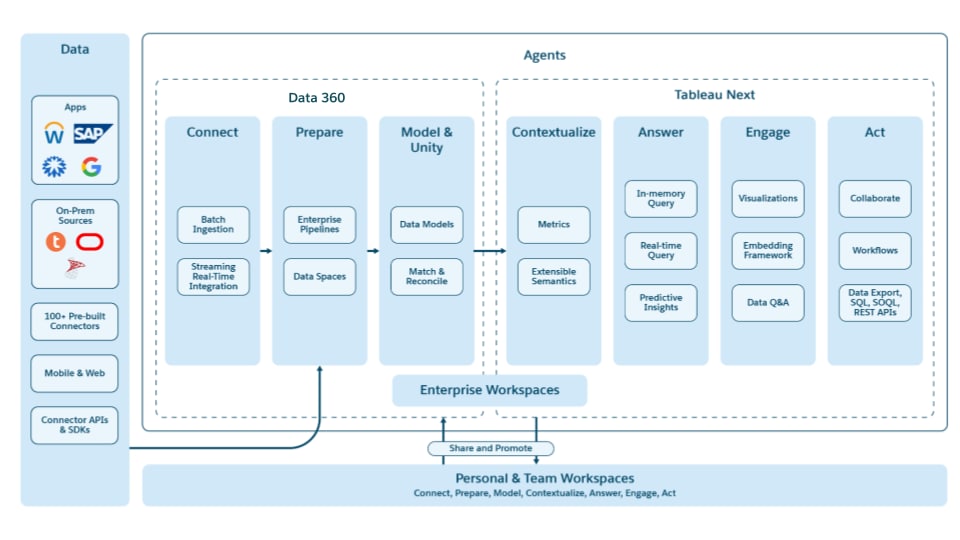 Tableau Next는 다음과 같은 과제를 해결합니다.
- 데이터 연결에서 작업으로 연결된 환경을 위한 개방적이고 구성 가능한 API 우선 플랫폼을 만듭니다. 개발 도구, 서식 있는 분석 응용 프로그램용 구성 요소, 패키징 및 배포를 관리할 수 있는 기능을 제공합니다.
- 핵심에 AI를 사용하여 구축하고 데이터 전문가가 Trust 보장하기 위해 효율적으로 검토하고 유효성을 검사할 수 있는 도구를 사용하여 상황별 및 관련 인사이트를 제공할 수 있습니다.
- 제어 가능하고 유연한 에코시스템 내에서 빠른 셀프 서비스, 관리 데이터 분석을 위한 범용 시맨틱 계층으로 Tableau 시맨틱을 구축합니다.
- 신뢰할 수 있고 확장 가능하며 관리되는 데이터 액세스를 위해 Data 360을 통해 실시간 클라우드 규모의 데이터 기능을 제공합니다.
- 개발자가 응용 프로그램을 구축하고 수익을 창출할 수 있는 풍부한 환경과 마켓플레이스를 제공합니다.
- 인텔리전스를 핵심으로 통합하여 권한을 부여하는 에이전트에게 조직의 의미와 Knowledge 제공합니다.
- Trust 우선 순위를 지정하여 데이터, 분석, 에이전트 워크로드 및 배포에 대한 신뢰를 확보할 수 있으며, 데이터의 활동과 효율성을 직접 제어하고 볼 수 있습니다.
- Slack 및 조직의 다른 공동 작업 도구와의 심층적이고 풍부한 통합을 통해 일급의 설계 원칙으로 공동 작업을 활용합니다.
### 14.1 최상위 Analytics 환경
Tableau Next는 성능을 향상하고 경험을 통합하는 개방형 플랫폼을 제공하여 Tableau의 데이터 분석 도구 리더십을 기반으로 합니다. 주요 기능은 다음과 같습니다.
- ** 풍부한 데이터 시각화**: Tableau의 VizQL 기술을 활용하여 광범위한 시각적 분석을 수행합니다.
- **공동 운영 작업 공간**: 분석 과업을 위한 통합 인터페이스를 제공하며 실시간 공동 작업을 위해 Slack과 통합합니다.
- **신뢰할 수 있는 관리 데이터**: 안전한 환경에서 글로벌 관리를 위한 구조화된 프로모션 경로로 셀프 서비스 분석을 지원합니다.
- **고급 메트릭 작성**: 분석가가 조직 전체에서 효율적으로 KPI를 만들고 재사용할 수 있어 일관성과 신뢰성을 높일 수 있습니다.
### 14.2 Agentic Analytics
Tableau Next는 기본 아키텍처 구조로 Agentforce 사용하여 기본적으로 구축되었으므로 Tableau Next가 고도로 연결되고 신뢰할 수 있으며 공동 작업하는 AI 기반 데이터 도구를 제공하는 기능을 강화합니다.
- **BI 도구**: 데이터 준비, 시각적 및 시맨틱 메타데이터 큐레이팅에 중점을 두고 데이터 작업자의 셀프 서비스 분석 효율성을 향상합니다.
- **상관적 경험**: 대부분의 조직이 작업하는 컨텍스트(예: Slack)에 데이터 인사이트, 경험, 투명한 AI를 가져옵니다.
- **Agentforce 아키텍처**: Agentforce 스택에 구축되어 고급 에이전트 아키텍처를 기반으로 Tableau Next에 풍부한 컨텍스트를 제공합니다.
- **세맨틱 카탈로그**: 메타데이터, 계보, 검색을 관리할 수 있는 중앙 집중식 시스템을 제공하여 Tableau Next 사용자 전체에서 공유된 환경을 활성화합니다.
- **공유 및 생성 메타데이터**: 포괄적인 에코시스템 내에서 셀프 서비스 분석 및 관리 콘텐츠 간의 원활한 워크플로를 지원합니다.
- **작업 프레임워크**: 사전 패키지, 사람이 선별하거나 생성한 워크플로를 통해 인사이트를 활용하여 작업을 수행합니다.
- **개인화된 통찰력**. 데이터 기본 설정, 역할 등을 자세히 학습하여 맥락에 맞는 맞춤형 데이터 인사이트를 즉시 얻을 수 있습니다.
- **Proactive Insights**. 데이터 에코시스템을 지능적으로 탐색하고 통계적으로 관심이 있는 장소를 찾는 동시에 변경의 동인을 사전에 이해하고 조치를 취할 수 있는 방법을 제시하고 다음 단계로 취할 조치를 권장합니다.
- **신뢰할 수 있는 데이터 에이전트** 데이터 에이전트의 운전자로서 통합된 환경을 통해 응용 프로그램을 구축하고 조정할 수 있는 권한을 다시 부여합니다. 또한 데이터 변경 사항 및 에이전트의 정확성 및 효율성에 미치는 영향을 미리 평가할 수 있는 테스트 도구를 제공합니다.
### 14.3 통합 솔루션 기반 비즈니스 사용자 환경
Tableau Next는 Slack 및 Salesforce와 같은 다양한 플랫폼에서 비즈니스 사용자 환경을 향상하고 Tableau Pulse와 같은 새로운 분석 기능을 통해 에이전트 환경을 통해 액세스하여 분석 참여를 간소화합니다. 주요 측면은 다음과 같습니다.
- **협력**: 신뢰할 수 있는 분석에 중점을 두고 다양한 분석 구성 요소 간 상호 작용을 촉진하고 사용자의 워크플로 내에서 유효성 검사 도구를 통합합니다.
- **펄스 메트릭**: 일반 분석가가 만든 대시보드보다 선별된 인사이트와 자동화된 인사이트를 더 효율적으로 제공합니다.
- **AI 기반 환경**: AI를 활용하여 고급 분석 기술 전문 지식의 필요성을 줄여 결정적 메타데이터 및 관리 데이터의 신뢰성을 보장합니다.
- **다중 플레이어 인사이트 제공**: 비즈니스 사용자가 분석가와 공동 작업하여 시스템에서 제공하는 인사이트에 대한 Knowledge Trust 얻을 수 있도록 합니다.
- **딥 통합**: 공유 메타데이터 및 데이터 플랫폼에 구축되어 다양한 시스템 및 환경에서 구성 가능성을 제공하여 프로모션, 데이터 플로, 서로 작업을 검토하고 완료할 수 있는 다양한 페르소나의 구성 가능성을 제공합니다.
### 14.4 Tableau 시맨틱스
Tableau 시맨틱 레이어는 원시 데이터와 사용자 해석 간의 중요한 교차로 작동하여 데이터 분석, 의사 결정, 응용 프로그램 개발을 간소화하고 AI 중심 컨텍스트 및 검색을 향상합니다. 주요 기능은 다음과 같습니다.
- **통합 메타데이터 관리**: 셀프 서비스 및 관리 메타데이터를 모두 지원하므로 조직의 신뢰할 수 있는 단일 소스가 되기 위한 구조화된 경로를 통해 특별 분석을 수행할 수 있습니다.
- **Tableau의 최고의 성능**: 다중 논리적 개체 지원, 모델 구성 가능성, 공유 치수, 복잡한 지리 공간 계층, 시간 모델링을 포함합니다.
- **다양한 데이터 및 분석**: 이미지 기반 제품 범주와 구조화된 세일즈 데이터의 상관 관계, 세미 구조화된 제품 리뷰의 분위기 분석 통합 등 구조화되지 않은 데이터와 구조화된 데이터를 연결하는 데 도움이 됩니다.
- **Salesforce Platform 통합**: 일관된 비즈니스 시맨틱스와 응용 프로그램 전반의 원활한 통합 및 다양한 사용자 환경 및 사용 사례를 지원하는 통합 메타데이터 모델을 지원하는 신뢰할 수 있는 통합 소스를 구축합니다.
- **Agent Intelligence**: 시맨틱 레이어는 비즈니스를 구동하는 데이터 및 메타데이터뿐만 아니라 조직에 맞는 자세한 설명 및 기본 설정을 포함하여 시맨틱을 정의하는 시맨틱도 이해하여 에이전트가 인텔리전스를 얻을 수 있는 핵심 영역 중 하나입니다.
### 14.5 통합 워크플로 및 실천 가능한 인사이트
Tableau Next는 간단한 작업, 사전 정의된 플로, 예약, API 통합을 포함하여 데이터 중심 의사 결정 및 신뢰할 수 있는 자동화를 향상하는 통합 솔루션을 제공합니다. 주요 구성 요소에는 다음이 포함됩니다.
- **표준화된 지능형 비즈니스 작업**: 비즈니스 내에서 긴급하고 상황별 커뮤니케이션을 수행할 수 있습니다. 이는 필수이지만 복잡합니다.
- **사전 정의 및 생성된 흐름 일정**: 신뢰할 수 있지만 확인할 수 있는 정적 및 동적으로 생성된 플로를 통해 임시 및 예약된 작업을 모두 활성화합니다.
- **Agentforce**: AI 기반 데이터 대화 및 상호 작용을 지원하므로 사용자가 비즈니스 응용 프로그램 내부 및 외부에서 기존 UI의 인사이트와 유사한 작업을 수행하고 대화를 통해 간소화할 수 있습니다.
### 14.6 구성 가능한 개발자 플랫폼
Tableau Next는 Data 360의 Tableau 시맨틱을 활용하여 응용 프로그램 개발을 위한 코드 없음, 하위 코드, 프로 코드 옵션이 포함된 구성 가능한 개발자 플랫폼을 제공합니다. 주요 제안 사항:
- **프리패키지형 산업/인텔리전트 애플리케이션**: 특정 산업 요구에 맞게 템플릿 기반 및 사용자 정의 가능한 분석 응용 프로그램을 제공합니다.
- **제3자 및 ISV 신청**: 분석, 산업별, 사용자 정의 목적으로 동적 및 대화형 응용 프로그램 생성을 지원합니다.
- **시장 및 교환**: ISV 및 개발자가 가장 크고 신뢰할 수 있는 비즈니스 응용 프로그램 개발 에코시스템 내에서 응용 프로그램을 패키지하고 배포할 수 있습니다.
### 14.7 공동 작업
Tableau Next는 비즈니스 사용자와 데이터 전문가 모두를 위해 설계되어 데이터 이해에 대한 공동 작업 접근 방식을 촉진합니다. 기술적 또는 비기술적 관계에서 비즈니스 사용자에서 데이터 전문가에 이르는 모든 팀 구성원이 서로의 데이터 인사이트를 검토할 수 있습니다. 또한 해당 인사이트는 BI 플랫폼 내의 브라우저 탭으로 제한되지 않습니다.
BI 플랫폼인 Tableau Next는 다음과 같습니다.
- **플랫폼 간 복합 가능**. 인사이트를 보는 플랫폼과 상관없이 인사이트가 동일한 방식으로 렌더링됩니다. 이 일관성은 데이터를 시각적으로 작업할 때 중요한 설계 원칙입니다.
- **Slack과 깊이 통합** Slack을 통한 통합 개발은 현재 시장에서 가장 직관적이고 몰입성이 뛰어난 공동 작업 데이터 환경을 제공합니다.
- **모든 도구를 사용할 수 있음** API 우선 순위 원칙을 심층적으로 통합된 플랫폼에 적용하면 통합이 다른 공동 작업 및 타사 도구로 확장되므로 다양한 기능을 유지할 수 있습니다.
## 15\. 통합
Salesforce Platform은 광범위한 디지털 문제를 해결할 수 있는 포괄적인 통합 기능을 제공하지만, 많은 고객이 다양한 공급업체 및 기술을 사용하여 시간이 지남에 따라 개발된 엔터프라이즈 아키텍처 내에서 운영합니다.
현대 엔터프라이즈는 시스템 통합 및 비즈니스 프로세스 자동화와 관련된 문제에 직면해 있으므로 데이터가 중단되고 효율성이 떨어집니다. MuleSoft의 기능을 활용하는 Salesforce 통합 플랫폼은 자동 프로세스의 빠른 개발 및 향상을 촉진하여 이러한 문제를 해결합니다. 다양한 플랫폼에서 원활한 시스템 연결을 보장하고 정보 흐름을 향상하며 의사 결정을 지원하므로 인건비 및 자동화 비용을 절감할 수 있습니다. 이 계층은 Salesforce 서비스와 기타 사용자 정의 또는 타사 서비스 간의 통합을 생성, 관리, 관리 및 모니터링하는 데 매우 중요합니다.
다음을 수행하는 API를 통해 시스템이 정의됩니다.
- ERP, 고객 및 청구 시스템, 독점 데이터베이스와 같은 필수 시스템에서 데이터에 액세스합니다.
- 데이터 상호 작용 및 통합을 촉진하여 데이터 중단을 방지합니다.
- 시스템 및 프로세스 API에서 관리하는 데이터 및 프로세스에 비즈니스 컨텍스트를 추가합니다.
효과적인 커뮤니케이션을 위해 다음을 사용하여 API를 설명합니다.
- 즉시 동기식 교환을 위한 OpenAPI 사양(OAS)
- 비동기식 이벤트 중심 커뮤니케이션을 위한 AsyncAPI
- 구조화된 모델 컨텍스트 상호 작용을 위한 모델 컨텍스트 프로토콜(MCP)
- 직접 에이전트 간 통합을 위한 에이전트 간 통합(A2A) 프로토콜입니다.
Salesforce 통합 계층은 시스템을 통합하고 관리할 수 있는 강력한 기능을 제공하여 Salesforce의 데이터, AI, 앱 기능에 대한 연결을 향상합니다. 시스템이 Salesforce 또는 다른 공급자의 기본 시스템인지 여부와 상관없이.
복잡한 통합에는 고급 변환이 필요하며 범용 연결, API 관리 및 거버넌스, 통합 워크로드를 구축하기 위한 통합 개발 환경(IDE), 통합을 배포, 관리, 감독하기 위한 런타임 플랫폼, 통합에 대한 전체 가시성을 제공하는 관찰 가능성 플랫폼 등 강력한 도구가 필요합니다.
통합 프로세스를 더욱 가속화하기 위해 일반적인 통합 패턴 및 요구를 인코딩하는 업계별 템플릿과 액셀러를 제공합니다.
### Salesforce와의 15.1 통합 패턴
Salesforce와 광범위한 에코시스템 간의 데이터 및 프로세스 흐름을 다루는 두 가지 기본 통합 패턴은 아웃바운드 통합 및 인바운드 통합입니다.
**외부 시스템에 Salesforce 연결(아웃바운드):** 이 패턴에는 데이터에 액세스하거나 외부 시스템에서 작업을 트리거하는 Salesforce 내에서 생성되는 프로세스가 포함됩니다.
- **보안 엔드포인트 관리(명명된 자격 증명):** 명명된 자격 증명은 끝점 및 인증 세부 사항을 저장할 수 있는 안전하고 중앙 집중화된 위치를 제공합니다. 응용 프로그램 및 자동화는 논리 이름을 참조하고 플랫폼은 인증 수명 주기의 복잡성을 처리합니다.
- **선언적 통합(외부 서비스):** 표준 OpenAPI 사양을 제공하는 외부 시스템의 경우 관리자가 외부 서비스를 사용하여 API를 선언적으로 등록할 수 있습니다. 플랫폼이 사양을 처리하여 플로와 같은 도구에서 서비스 작업을 기본 작업으로 또는 Apex 기본 개체로 자동으로 사용할 수 있도록 합니다.
- **복잡한 시스템 통합(MuleSoft)**: 최신 인터페이스가 없는 시스템의 경우 MuleSoft는 재사용 가능한 표준 API 레이어를 만듭니다. 이렇게 하면 레거시 복잡성이 추상화되고 Salesforce 에코시스템에 온 프레미스 데이터 및 프로세스를 가져옵니다.
- **실시간 데이터 액세스(외부 개체):** 외부 시스템의 테이블을 Salesforce 데이터 모델 내의 가상 개체로 표시하여 복제 없이 표준 쿼리 및 UI 구성 요소를 통해 외부 데이터에 액세스할 수 있도록 합니다.
- **중앙 기능 관리(통합 API 카탈로그):** 통합 API 카탈로그는 중앙 집중식 리포지토리이며 모든 API 사양 및 위치 및 보안 프로토콜과 같은 연결된 메타데이터에 대한 신뢰할 수 있는 단일 소스입니다. 따라서 데이터 또는 비즈니스 논리가 있는 위치와 상관없이 Salesforce 에코시스템 전반에서 검색하고 안전하게 연결하고 강력한 새 애플리케이션 및 자동화로 구성할 수 있습니다.
- **사용자 정의 프로 코드 논리(Apex REST):** 개발자는 Apex 작성된 사용자 정의 비즈니스 논리를 REST API 및 작업으로 노출할 수 있습니다. 그러면 플로의 단계 또는 AI 에이전트의 도구로 작업을 사용할 수 있습니다.
**Salesforce에 외부 시스템 연결(인바운드):** 이 패턴을 사용하면 외부 시스템 및 응용 프로그램이 Salesforce Platform에 연결하여 데이터에 액세스하고 비즈니스 논리를 트리거하고 프로세스를 오케스트레이션할 수 있습니다. 이 기능은 대규모로 작동하는 검증된 엔터프라이즈급 API의 기반에 구축되어 있습니다. 2025년 10월부터:
- 쿼리 API(SOQL)는 매일 50억 개가 넘는 요청을 처리합니다.
- REST API는 외부 시스템에서 하루에 약 50억 건의 통화를 제공하며, 사용량은 매년 30% 증가합니다.
- 대량 API는 대규모 데이터 작업을 위해 매일 수십억 개의 레코드를 처리합니다.
검증된 신뢰성 및 규모는 다음 기능을 기반으로 합니다.
- **통합 API 환경:** 모든 Salesforce 기능에 대한 액세스는 일관된 끝점 구조(api.salesforce.com)를 통해 통합되므로 개발자가 각 제품에 대해 서로 다른 패턴 또는 인증 플로를 학습할 필요가 없습니다.
- **전체적인 용도에 맞게 구축된 API 포트폴리오:** 이 플랫폼은 트랜잭션 운영을 위한 REST 및 SOAP API, 대용량 데이터 처리를 위한 대량 API, 이벤트 기반 응용 프로그램을 위한 Pub/Sub API, 특수 제품 또는 사용자 지정 Apex API를 비롯하여 특정 요구에 맞게 조정된 다양한 API 모음을 제공합니다.
- **Agenttic 통합의 미래 준비:** MCP와 같은 표준을 통해 고객은 Salesforce 데이터 및 작업을 외부 AI 에이전트에 대한 "도구"로 안전하게 노출하여 Salesforce 인스턴스를 디지털 직원의 확장 가능한 기술 집합으로 전환할 수 있습니다.
### 15.2 에이전트와 MCP의 통합
데이터 및 프로세스 통합에 대해 설정된 인바운드 및 아웃바운드 패턴 외에도 에이전트 시대에 대한 새로운 패턴이 등장하고 있습니다. Salesforce Platform은 포괄적인 MCP 전략을 구현하여 AI 기반 서비스의 소비자 및 공급자로 포지셔닝합니다. 이 양방향 접근 방식은 에이전트 상호 운용성을 활성화하므로 엔터프라이즈급 보안 및 거버넌스를 유지하면서 Salesforce 데이터 및 기능을 AI 에이전트 및 도구의 진화하는 에코시스템과 원활하게 통합할 수 있습니다.
**MCP 클라이언트로서의 Salesforce:** 에이전트는 외부 시스템 및 API를 현명하고 동적으로 활용하여 MCP 클라이언트 역할을 수행할 수 있습니다. 이 기능을 사용하면 조직이 최신 API가 있거나 MuleSoft를 통해 기존 시스템 또는 RPA Bot에 연결해야 하는지 여부와 상관없이 Salesforce 경계를 넘어 Agentforce 도달 범위를 확장하여 모든 시스템에서 작업을 오케스트레이션할 수 있습니다. 구성은 익숙한 선언적 주제 기반 설정 환경을 통해 처리되므로 사용자 정의 개발 없이 신속하게 통합할 수 있습니다. 파트너 제공 MCP 서버에 대한 검색 메커니즘이 간소화되어 외부 기능 통합이 더욱 간소화됩니다. 대규모 스택을 통해 외부 연결의 복잡성을 추상화하여 엔터프라이즈는 Agentforce 광범위한 기술 환경과 신속하게 통합할 수 있습니다.
**MCP 서버로서의 Salesforce:** MCP 서버로서 플랫폼은 표준 REST API, 사용자 정의 끝점, 호출 가능한 작업, 플로를 비롯한 논리와 자산을 외부 에이전트를 위한 검색 가능한 "도구"로 노출합니다. 선언적 인터페이스를 통해 고객 및 ISV는 고유한 비즈니스 프로세스에 적합한 도구 컬렉션에 기능을 큐레이팅하여 자체 사용자 정의 MCP 서버를 만들고 구성할 수 있습니다. 이는 MCP 프롬프트로 확장되므로 플랫폼의 프롬프트 템플릿 기능과 자연스러운 동기화를 생성하고 조직이 프롬프트 엔지니어링에 대한 투자를 외부 AI 시스템에 액세스할 수 있도록 합니다.
이 기능은 다중 계층 보안 모델에 따라 관리됩니다.
- **응용 프로그램 제어:** 외부 클라이언트 앱 구조는 관리자에게 Salesforce 조직에 액세스할 수 있는 외부 에이전트 응용 프로그램을 강력하게 제어할 수 있는 권한을 제공합니다.
- **범위 지정 권한:** 인증은 세분화된 OAuth 범위를 통해 증강되므로 인증된 에이전트가 수행할 수 있는 작업을 정확하게 추적하고 적용할 수 있습니다.
- **코어 플랫폼 인증:** 이러한 새 제어는 레코드 액세스 제어, 엔티티 및 필드 수준 권한, 프로필 및 권한 집합에 정의된 기타 권한을 포함하여 Salesforce의 강력한 권한 부여 모델을 기반으로 구축됩니다.
ISV 및 파트너는 MCP 서버 구성을 패키지하고 배포할 수도 있으므로 Salesforce 에코시스템 전체에서 AI 지원 통합을 빠르게 배포할 수 있습니다.
### 15.3 범용 연결
Salesforce의 현대적인 접근 방식은 모든 플랫폼(MuleSoft, Flow 또는 Data 360)에서 프로그래밍 없이 모든 사용 사례에 대해 실행할 수 있는 커넥터를 개발하는 메타데이터 중심의 접근 방식인 _interpreted connectivity_입니다. 메타데이터 모델은 원격 서비스에 연결하여 요청을 인증하고, 반환된 데이터를 모델링하고, 쿼리를 만들고, 결과를 페이지로 매기며, 프로세스를 자동화하기 위해 이벤트(트리거)를 수신하는 방법을 이해합니다.
HTTP 기반 API를 사용하지 않는 시스템의 경우 Salesforce는 사용자 정의 커넥터를 구축하기 위한 수백 개의 사전 구축 커넥터와 완전한 SDK를 제공합니다. API 액세스 권한이 없는 시스템의 경우 Salesforce는 에이전트를 사용하여 일반적으로 사람이 수행하는 반복적인 규칙 기반 과업을 자동화하는 로봇 프로세스 자동화(RPA)를 제공합니다. 이러한 과업에는 데이터 입력, 트랜잭션 처리, 간단한 고객 서비스 쿼리에 응답이 포함될 수 있습니다. 문서에서 정보를 추출하기 위해 Salesforce는 인보이스, 계약, 양식과 같은 다양한 유형의 문서에서 데이터를 자동으로 추출, 분류, 처리하는 AI를 활용하는 인텔리전트 문서 처리(IDP)를 제공합니다. 정보가 있지만 Salesforce는 자동화된 방법을 제공하여 정보를 검색하고 조작합니다.
Salesforce는 AI의 최근 개선 사항을 바탕으로 조직에서 에이전트 기능을 빠르게 활성화할 수 있는 빌딩 블록을 제공합니다.
- **모델 컨텍스트 프로토콜(MCP) 커넥터를 사용하면** 조직에서 API를 MCP 도구로 빠르게 노출하고 에이전트가 쉽게 API 및 자원을 찾을 수 있습니다.
- **A2A(에이전트 간 커넥터)**를 사용하면 에이전트에 대한 A2A 프로토콜 지원을 제공하여 조직에서 에이전트 간 커뮤니케이션을 표준화할 수 있습니다. 각 에이전트(도메인의 기능 전문가)는 고객의 쿼리를 찾아 도메인에 가장 적합한 에이전트에게 위임할 수 있습니다.
- **Inference Connector는** LLM 호출, 벡터 내장 및 검색, RAG 검색, MCP 도구 지원을 통해 처음부터 에이전트를 구축할 수 있는 빌딩 블록을 제공합니다.
### 15.4 API 관리
Anypoint API 관리자를 통해 제공되는 MuleSoft의 API 관리는 모든 배포 환경에서 API 및 마이크로서비스를 설계, 보호, 관리, 모니터링, 확장할 수 있는 포괄적인 플랫폼을 제공합니다. 조직은 플랫폼과 상관없이 단일 창에서 일관된 엔터프라이즈급 제어 및 인사이트를 사용하여 API 및 마이크로 서비스를 관리할 수 있으며, 배포에서 버전 관리까지 중앙 집중식으로 관리할 수 있습니다. 주요 기능은 다음과 같습니다.
- **Anypoint Flex 게이트웨이는** API를 관리하고 보호하는 애플리케이션 계층 API 게이트웨이로서 HTTP/S 수준에서 속도 제한, 캐싱, 인증, 권한 부여, 위협 보호, 모니터링 및 로깅 정책을 적용합니다. 마이크로서비스 기반 분산 환경을 위해 설계된 경량의 고성능 Envoy 기반 게이트웨이로서 DevOps 및 CI/CD 워크플로와 원활하게 통합되도록 구축되었으며, 인바운드 및 아웃바운드 정책을 모두 지원하면서 모든 환경에서 엔터프라이즈 보안 및 관리 기능을 제공합니다.
- **API 경고를 사용하면** 조직이 비정상적 또는 원치 않는 동작을 감지하기 위해 API에 대한 특정 임계값 또는 조건을 정의하고 모니터링할 수 있습니다. 예를 들어 응답 시간이 제한을 초과하는 경우(예: 60초), 시간 기간의 요청 수가 너무 많은 경우, 특정 HTTP 응답 코드가 반환되는 경우 또는 정책 위반이 발생하는 경우 경고가 표시됩니다.
- **API Analytics**는 API가 사용되는 방식 및 성능에 대한 가시성을 제공합니다. Analytics 대시보드를 사용하면 조직에서 상위 수준 메트릭을 추적 및 확인하고 차트를 자세히 살펴보고 대시보드 및 보고서를 만들고 사용자 정의하여 사용 추세, 정책 위반, 응답 시간, 요청/응답 코드 등을 이해할 수 있습니다.
### 15.5 차세대 통합 개발 환경
MuleSoft Anypoint Code Builder(ACB)는 API 및 통합 개발을 위해 설계된 차세대 IDE로서 백엔드로 VS Code를 사용하는 최신 통합 환경을 제공합니다.
- **통합 개발 환경:** 전체 API 및 통합 개발 프로세스를 AsyncAPI, OAS, RAML API, 거버넌스 규칙 집합, 하위 코드 플로 캔버스, 사전 구축 커넥터, 통합 테스트 및 배포 옵션을 지원하는 하나의 도구로 통합합니다. 또한 ACB는 지능형 컨텍스트에 맞는 제안 사항을 사용하여 디버깅, 문제 해결, 지속적인 서비스 점검을 지원합니다.
- **Agtic 개발 경험:** 전체 응용 프로그램 개발 수명 주기 전반에 걸쳐 에이전트 환경을 제공합니다. 핵심은 에이전트 통합 개발을 지원하는 MuleSoft MCP 서버입니다. MuleSoft MCP Server는 자연어에서 API 사양 및 통합을 생성하고, 데이터 변환을 생성하고, MuleSoft Exchange에서 자산을 관리하고, 응용 프로그램 및 API 정책을 관리할 수 있는 강력한 도구를 제공합니다. MuleSoft MCP Server 도구는 커서, 윈드서프 등을 비롯한 VS 코드 기반 AI 코드 편집기에서 사용자의 API 사양 및 통합 개발을 탑재합니다.
- **AI 통합:** MuleSoft는 엔터프라이즈 시스템 액세스를 위해 API 호출을 Agentforce 작업으로 변환하는 MuleSoft Topic Center를 활용하여 에이전트 기능으로 통합 개발을 강화합니다. Agentforce 커넥터는 자연어 자동화를 통합에 포함합니다. 유추 커넥터는 외부 LLM 공급자를 안전하게 통합하여 MuleSoft 응용 프로그램에서 AI 기반 논리를 활성화합니다. 조직은 이러한 결합된 기능을 사용하여 지능형 적응형 통합을 구축할 수 있습니다.
### 15.6 런타임 플랫폼
MuleSoft의 런타임 플랫폼은 환경 전반에서 MuleSoft 응용 프로그램, API, 통합을 실행할 수 있는 유연한 배포 옵션을 제공합니다. 조직은 Anypoint Platform을 통해 일관된 관리 및 거버넌스를 유지하면서 운영, 규정 준수, 확장성 요구에 가장 적합한 런타임 모델을 선택할 수 있습니다. 이 유연성을 통해 애플리케이션이 데이터 소스와 가까운 곳에서 실행되고, 지역 규정을 준수하며, 수요에 따라 원활하게 확장할 수 있습니다.
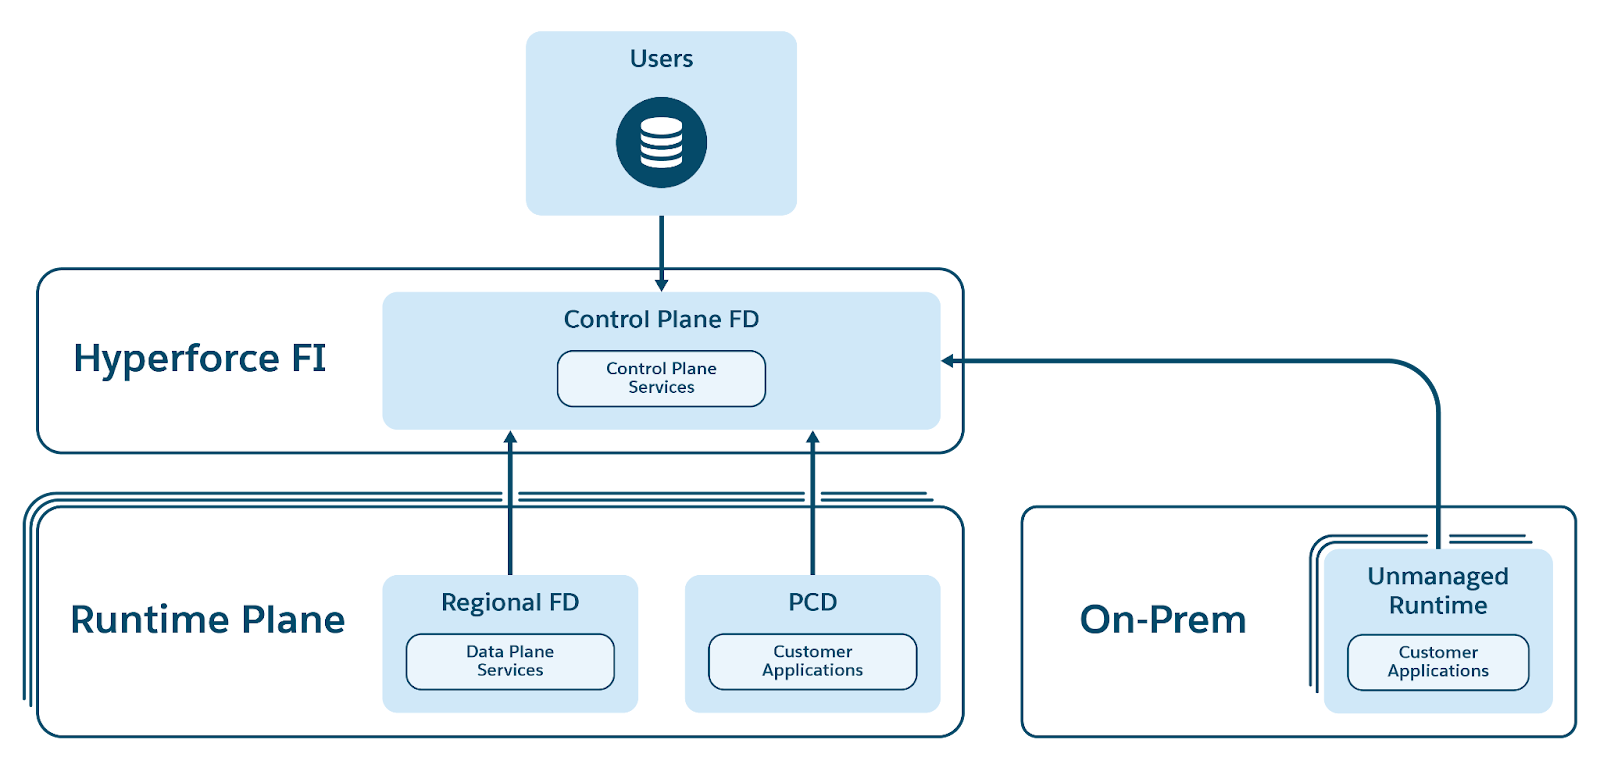 주요 호스팅 옵션은 다음과 같습니다.
- **Cloud:** 인프라 관리 오버헤드를 없애는 MuleSoft의 완전 관리형 멀티테넌트 통합 플랫폼(iPaaS)입니다. CloudHub 2.0은 탄력적인 확장, 고가용성, 가동 중지 시간 제로 배포/업그레이드를 제공하며 내장된 관찰 가능성 요구 사항 및 규정 준수 인증을 제공합니다. 개발자는 MuleSoft가 런타임 인프라를 관리하는 동안 API 및 통합 구축에 집중하여 엔터프라이즈급 보안, 신뢰성, 고가용성을 보장할 수 있습니다.
- **하이브리드:** 더 많은 제어를 위해 응용 프로그램을 자체 호스팅해야 하는 조직을 위해 MuleSoft는 Kubernetes 또는 가상 시스템 전체에서 MuleSoft 런타임 배포 및 오케스트레이션을 자동화하는 컨테이너 서비스인 런타임 패브릭을 제공합니다. 가로 확장, 중단 시간 제로 배포, 내장된 보안 제어, 간소화된 클러스터 관리를 지원합니다.
- **Private Cloud Edition(PCE):** MuleSoft의 Private Cloud Edition은 조직이 엄격한 규제, 데이터 보존 및 보안 요구 사항을 충족할 수 있도록 완전히 자체 관리되는 온 프레미스 버전의 Anypoint Platform(제어 및 런타임 플레인 포함)을 제공합니다. 이를 통해 대기업이 Anypoint Platform의 통합 통합 및 API 관리 기능을 활용하면서 인프라를 완벽하게 제어할 수 있습니다.
### 15.7 관찰 가능
MuleSoft는 모든 배포 모델 전반에서 API, 통합, 응용 프로그램에 대한 종단간 가시성을 제공하는 포괄적인 관찰 가능성 솔루션을 제공합니다. 관찰 기능은 워크로드가 실행되는 위치와 상관없이 일관되므로 환경을 통합적으로 볼 수 있습니다. MuleSoft는 실시간 및 내역 Telemetry 데이터를 모두 수집하여 조직이 전체 응용 프로그램 네트워크에서 프로덕션 문제를 더 빠르게 감지, 분석, 해결할 수 있도록 지원합니다. 관찰 가능성 데이터는 Anypoint Platform 내에서 기본적으로 보거나 OpenTelemetry를 통해 고객이 선호하는 APM으로 내보낼 수 있으므로 기존 모니터링 에코시스템과 원활하게 통합할 수 있습니다. 이를 통해 조직은 사전에 인프라 복원 능력을 강화하고 미션 크리티컬 어플리케이션의 신뢰성을 향상할 수 있습니다.
MuleSoft는 두 가지 기본 제공을 통해 관찰 가능성을 제공합니다.
- **Anypoint Monitoring**은 Anypoint Platform에 내장된 시장 내 관찰 가능성 솔루션입니다. 응용 프로그램 상태 모니터링, 로그 관리를 위한 고급 로그 검색, 정의된 임계값 또는 변칙이 발생할 경우 팀에 알리는 경고 기능을 위한 기본 제공 및 사용자 정의 가능한 대시보드를 제공합니다.
- **통합 인텔리전스**는 MuleSoft용 차세대 AI 최초의 관찰 가능 플랫폼으로 Salesforce Platform을 기반으로 재설계되고 구축되었습니다. 이 혜택은 Data 360을 Telemetry 데이터의 통합 데이터 레이어로 사용하고, Tableau 시맨틱을 신뢰할 수 있는 시맨틱 계층으로 사용하여 지능형 실행 가능한 인사이트를 제공하며, Tableau Concierge를 사용하여 AI 지원 문제 해결, Tableau Next 대시보드를 사용하여 여러 서식 있는 데이터 시각화를 하나의 통합된 보기로 결합하는 대화형 시각적 인터페이스를 제공합니다. Tableau Next를 사용하면 관찰 가능성 기능과 함께 시맨틱 데이터 모델 위에 사용자 정의 대시보드를 구축할 수도 있습니다.
또한 이 스택은 고객에게 결정적이지 않은 엔드 투엔드 에이전트 호출 경로에 대한 완전한 투명성을 제공하는 에이전트 중심 추적 기능을 제공하므로 각 중간 단계에서 작업하는 에이전트를 관찰할 수 있으므로 사용자가 실패의 근본 원인을 빠르게 파악하고 성능 병목을 식별할 수 있습니다.
## 16\. 생태계 및 AppExchange
Salesforce 에코시스템은 플랫폼의 강력한 기능을 보여줍니다. 시스템 통합자(SI) 및 컨설팅 파트너는 복잡한 Salesforce 솔루션을 개발, 구성, 최적화하여 고객을 지원합니다. 독립 소프트웨어 공급업체(ISV)는 플랫폼에 혁신적인 응용 프로그램 및 솔루션을 구축하고 고객이 Salesforce 조직에 설치할 수 있습니다. 해당 ISV 앱은 Salesforce의 응용 프로그램 스토어인 AppExchange 사용할 수 있으며, 이 스토어는 2025년 10월 현재 10,000개 이상의 응용 프로그램과 1430만 건 이상의 설치를 제공합니다.
고객이 광범위한 시장을 탐색하고 관련 애플리케이션을 검색할 수 있도록 AppExchange 검색 환경은 2025년에 Data 360을 활용하도록 재구성되었습니다. Salesforce Data 360의 벡터 검색 기능은 기존의 키워드 일치와 함께 작동하여 자연어를 통해 사용자의 의도를 이해하여 의미적으로 관련성이 높은 결과를 제공합니다. 궁극적인 비전은 이 기반을 Agentforce 플랫폼과 통합하여 발전시키는 것입니다. 고객이 비즈니스 과제를 대화 방식으로 설명하고 개인 맞춤형 솔루션 추천을 받을 수 있는 완벽한 에이전트형 인터페이스를 제공합니다.
AppExchange Salesforce와 긴밀하게 협력하여 코드 분석기, 보안 스캐너, 참조 구현 가이드를 포함하는 엄격한 검토 프로세스를 통해 고품질의 솔루션을 보장합니다. 이 플랫폼은 ISV에 응용 프로그램 라이센스 및 수익을 조정할 수 있는 라이센스 관리 도구를 제공하며, 사용자 기반 및 소비 기반 옵션을 비롯한 다양한 가격 책정 모델을 지원합니다.
"메타데이터 구동 플랫폼" 원칙을 사용하면 ISV가 Salesforce의 기본 앱 및 메타데이터를 확장하여 데이터 모델, 비즈니스 논리, 사용자 인터페이스를 쉽게 개발할 수 있습니다. Salesforce Platform은 업계별 애플리케이션에서부터 UI용 Lightning 웹 구성 요소 및 비즈니스 논리용 Apex Code와 같은 기술을 활용하는 맞춤형 브랜드 앱에 이르기까지 다양한 솔루션을 지원합니다.
"패키징" 개념은 다양한 Salesforce 조직에서 이러한 앱을 배포하는 데 매우 중요합니다. 패키징은 다양한 환경에서 메타데이터 관리를 위해 설계된 기본 기술을 사용하여 Salesforce 고객이 설치할 수 있는 아티팩트로 메타데이터를 직렬화하는 작업을 수행합니다. 패키징의 고유한 측면은 개발자가 알지 못하는 환경에 설치할 수 있다는 점입니다.
패키징 내의 "관리 가능성" 기능을 사용하면 다른 사용자가 해당 부품에 의존할 수 없기 때문에 ISV가 응용 프로그램의 부품을 안전하게 업그레이드할 수 있지만 고객이 다른 부품을 소유하고 관리할 수 있습니다. 예를 들어 ISV는 사용자 정의 설정과 같은 특정 메타데이터를 "관리"으로 설정하여 고객에게 표시되지 않고 편집할 수 없도록 만들어 고객 환경의 중단을 방지할 수 있습니다. 관리 패키지에는 이러한 관리 기능 제어가 포함되어 있지만 비관리 패키지는 배포된 메타데이터를 고객이 만든 것으로 처리하며 배포 후에는 업그레이드할 수 없습니다.
AppExchange 및 Salesforce Platform이 시작된 이후에 생성 및 설치되는 패키지의 수와 복잡성이 크게 증가했습니다. 이러한 요구 사항에 대응하여 플랫폼은 2020년에 2세대 패키징 아키텍처를 도입했습니다. 이 새로운 아키텍처는 관리 패키지의 모듈성을 향상하고 버전 관리 유연성을 향상하며 네임스페이스 공유를 허용하며 소프트웨어 개발 수명 주기의 다른 고급 기능을 포함하여 선언적 종속성을 지원합니다. 또한 패키지 배포 아키텍처에는 변경된 메타데이터 결정 및 델타 배포만 등 효율성과 규모 향상을 위한 몇 가지 중요한 개선 사항이 포함되어 있습니다.
새 제품 및 기능 개발에 중요한 측정값은 패키지와의 호환성 및 ISV 사용 준비입니다. 이 플랫폼은 파트너가 기능을 빠르게 사용할 수 있도록 강조하여 Salesforce 에코시스템이 Salesforce Platform의 혁신적 잠재력을 효과적으로 활용하고 Salesforce의 즉시 제공되는 기능을 벗어날 수 있도록 합니다. 그러나 Salesforce 내부 개발자가 사용할 수 있는 이 문서에 설명된 모든 기능을 ISV 개발자에서도 사용할 수 있도록 지속적으로 투자해야 하는 영역입니다.
또한 Heroku Marketplace 및 Slack Marketplace는 Salesforce 응용 프로그램의 기능을 향상할 수 있는 광범위한 타사 통합 및 추가 기능을 제공합니다. Heroku Marketplace는 추가 앱 기능을 위한 도구 및 서비스를 제공하고 개발자가 응용 프로그램을 구축, 배포, 관리하는 방법을 개선합니다. Slack Marketplace는 워크플로를 간소화하고 Salesforce 환경 내에서 공동 작업을 향상할 수 있는 통합을 제공합니다.
## 17\. Salesforce의 Salesforce
Salesforce는 핵심 가치인 고객 성공의 정신에 따라 Salesforce Platform의 모든 응용 프로그램 및 서비스에 대해 "고객 중립" 역할을 하며 가능한 경우 내부적으로 고객 대면 제품을 활용합니다. 이는 다음과 같은 중요한 이점을 제공합니다.
- **범위한 제품 테스트**: Salesforce 직원은 제품군을 매일 사용하여 실제 문제에 플랫폼을 노출하고 제품 품질을 향상하고 개선 영역을 식별합니다.
- **정제품**: 내부 사용의 즉각적인 사용자 의견을 통해 기능 및 유용성을 신속하게 세분화하고 버그를 신속하게 식별하고 해결할 수 있으므로 릴리스 시 고객 요구를 더 잘 충족하는 제품이 생성됩니다.
- ** Deep Industry Expertise**: 다양한 기능 전반에서 내부적으로 사용하면 특히 하이테크 섹터에서 특정 제품 및 산업 문제에 대한 유용한 인사이트를 얻을 수 있습니다.
- **고객 동정심 향상**: 직원이 플랫폼을 직접 사용하여 고객의 불만 사항을 더 잘 이해하고 해결할 수 있습니다.
- **마케팅 및 영업 인사이트**: 일일 제품 사용은 세일즈 및 마케팅 전략에 정보를 제공하므로 고객 요구에 맞게 플랫폼을 조정할 수 있습니다.
- **강력한 시장 진입 전략**: 내부에서 성공적으로 구현하면 Salesforce가 확신을 가지고 검증된 솔루션으로 제품군을 마케팅할 수 있습니다.
또한 모든 운영용 소프트웨어 업데이트는 단계별 배포 프로세스의 일환으로 전용 "Salesforce on Salesforce" Hyperforce 인스턴스에 처음 배포됩니다. 2020년 8월 이후 이 인스턴스는 엔지니어링 팀을 위한 Salesforce 조직인 GUS와 Salesforce CRM 운영을 성공적으로 호스팅하여 모든 고객을 위해 Hyperforce 강력한 기능과 준비 상태를 보여줍니다. 이 전략을 통해 내부 팀은 외부 고객에게 프로덕션을 배포하기 전에 모든 문제를 테스트하고 표시할 수 있습니다.
Salesforce 기술 조직은 SDLC 전반에서 생산성과 품질을 향상하기 위한 내부 플랫폼으로 Agentforce 완전히 채택했습니다. 이를 통해 빠르게 버그를 감지하고 완화하여 고객에게 전송하는 코드의 품질을 향상할 수 있을 뿐만 아니라 본인 내부 피드백을 기반으로 에이전트 환경을 신속하게 반복할 수 있습니다.
## 18\. 대규모 변환 제공
1999년 설립 이후 Salesforce는 여러 기술 변화를 경험했습니다. 그러나 Salesforce Platform과 관련된 변환은 규모와 변경이 구현된 빠른 속도 때문에 특히 중요했습니다. 통합 플랫폼을 구현하려면 모든 주요 아키텍처 구성 요소의 동시 진화가 필요했습니다. 이 변환이 반복적이고 이해당사자 및 내역자들에게 최소한의 중단을 야기하도록 Salesforce 기술 조직은 엔지니어링 및 제품 배달 관행도 발전해야 했습니다.
Salesforce 기술 조직은 14개 국가에서 20개가 넘는 사이트에 위치한 2,500개가 넘는 팀으로 구성된 대규모하고 다양한 팀입니다. 이 그룹은 대규모로 운영되며, 매주 200개가 넘는 제품 릴리스를 제공하고 250,000건의 시스템 변경 사항을 구현합니다. 광범위한 회사 윤리에 따라 기술 그룹은 다음의 5가지 핵심 가치에 따릅니다. Trust, 고객 성공, 혁신, 평등 및 지속 가능성 이러한 값은 그룹의 전략을 형성하고 실행을 안내하며 일상적인 결정을 결정하는 데 중요한 요소입니다.
핵심 가치에 따라 Salesforce Engineering 360 프레임워크는 엔지니어링 팀에 작업 지향 대시보드와 운영에 대한 포괄적인 인사이트를 제공하여 조직 내 표준 및 모범 사례에 대한 명확한 기대치를 설정합니다. 이 전체적인 뷰는 가용성, 보안, 규정 준수, 품질, 접근성, Developer Productivity, 민첩한 제품 개발, 비용 효율성을 비롯한 다양한 중요한 영역을 다룹니다. 이러한 인사이트를 제공하기 위해 프레임워크는 보안 시스템, 운영 상태 로그, 코드 저장소, 개발 환경, CI/CD, 릴리스/작업 계획 및 추적 시스템과 같은 수백 개의 내부 엔지니어링 시스템에서 수십억 개의 레코드를 처리합니다. 이 모든 레코드는 Agentforce, Data 360, Tableau 및 Slack의 최신 혁신을 활용하여 Salesforce Platform을 기반으로 합니다.
이 데이터 및 기타 데이터에 기반한 Salesforce 기술 조직은 AI 및 에이전트 기술을 활용하여 생산성을 가속화합니다. 내부 AI 도구의 일일 활성 사용자가 10,000명 이상이며 내부 AgentExchange 프로그램의 일부인 100명 이상의 AI 에이전트를 구축하여 조직 전체에서 생산성을 향상시켰습니다.
최고 Trust 가치 덕분에 서비스 소유권은 엔지니어링 문화에 깊이 빠져 있습니다. 각 서비스 및 제품은 TTD(Time To Detect) 및 TTR(Time To Restore)와 같은 가용성 및 사고 관리 메트릭과 관련된 서비스 수준 목표(SLO)를 충족하고 초과하도록 설계되었습니다. 변경 관리, 릴리스 준비, 문제 관리에 대한 접근 방식은 높은 표준을 준수합니다. 보안은 기본 원칙에 따라 보안 개발 수명 주기의 모든 단계에 통합되어 있습니다. CI/CD 파이프라인 내에서 단위, 기능, 통합, 로드/스케일 테스트 전반에 걸쳐 수백만 개의 자동 테스트가 포함된 Agile Testing Methodology를 통해 품질 및 성능이 우선적으로 지정됩니다.
아키텍처적으로 공유 기능을 개발하여 성능을 높이고 효율성을 높이는 방식으로 품질을 향상시키는 데 중점을 두고 있습니다. 예를 들어, Hyperforce 내에서 관리형 서비스를 개발하여 컴퓨팅 및 데이터 관리와 같은 다양한 요구 사항을 충족하므로 제품 팀이 제품 혁신에 집중할 수 있으며, 중앙 팀은 보안, 가용성 및 비용 효율성 측면에서 이러한 서비스를 강화할 수 있습니다.
Dell의 운영은 민첩하며 고객에게 혁신을 전달합니다. 3,000개가 넘는 각 팀은 스크럼 또는 칸반을 사용하여 민첩한 프레임워크를 구현하는 방법에 대한 자율성을 갖습니다. 조직 전반의 제품 개발 계획은 전략적 방향에 대한 3년 장거리 계획, 연간 실행 계획, 2주간 스프린트 계획을 알려주는 4개월 제품 릴리스 계획 등 다양한 타임라인으로 구조화됩니다. 제품, 기능, 버그 수정은 3개의 주요 연간 릴리스, 주간 릴리스, 일일 릴리스 등 다양한 고객 요구를 충족하기 위해 여러 릴리스 차량을 통해 배포됩니다.
생산성은 규모에 따라 매우 중요합니다. Engineering 360 시스템에서 제공하는 포괄적인 메트릭 집합을 통해 생산성을 효과적으로 측정하기 위해 SPACE 프레임워크를 활용합니다. 또한 에이전트 환경 및 AI, 워크플로, 빌드 도구, 개발 설정, 안전한 릴리스, 보안 서비스에 대한 투자로 개발 수명 주기를 간소화하기 위해 내부 개발자를 위한 도구 및 환경을 개선하는 데 중점을 두고 있습니다.
## 19\. 결론
결론적으로, Salesforce Platform은 지난 5년 동안 탁월한 변화를 거쳤으며, 획기적인 멀티테넌트 클라우드 플랫폼에서 선택한 지역의 애플리케이션 및 서비스 제품군을 구동하는 신뢰할 수 있고 통합되고 에이전트적인 데이터 지원 플랫폼으로 발전했습니다. 이러한 발전은 공개 클라우드 공급자의 증가, 증가하는 규제 요구 사항, 생성형 AI 및 기계 학습의 발전과 같은 새롭게 발생하는 문제를 해결해야 하는 필요성에 따라 달라졌습니다.
Hyperforce, Data 360, Agentforce 도입되었으므로 플랫폼의 성능이 크게 향상되어 Trust 신뢰성을 유지하면서 혁신의 최전선을 유지합니다. 대부분의 고객이 이 새로운 플랫폼으로 성공적으로 마이그레이션되었으므로 엔지니어들의 창의성과 헌신이 강조됩니다.
Salesforce Platform은 계속해서 혁신하고 변화하는 시장 수요에 맞게 조정할 수 있으므로 차세대 애플리케이션 및 고객 사용 사례를 지원할 수 있는 좋은 위치에 있어 고객 성공 및 기술 우수성에 대한 약속을 재확인합니다.
# 기본 사항 시작하기
이 섹션에서는 Salesforce Platform이 핵심에서 작동하는 방식을 이해하기 위한 필수 Knowledge 제공합니다. Salesforce 아키텍처를 처음 사용하거나 이해를 강화하려는 경우 이러한 기본 기사는 견고한 아키텍처 기반을 구축하는 데 도움이 됩니다.
## Salesforce Platform 아키텍처
[아키텍처 기본 사항](/docs/architect/ko-kr/fundamentals/guide/architecture-basics)은 Salesforce Platform에서 솔루션을 구성하는 방법을 이해할 수 있는 시작 지점입니다. 이 기사는 모든 설계자가 마스터해야 하는 세 가지 필수 영역에 대해 다룹니다.
- **거래**: Salesforce가 총괄자 제한 및 실행 컨텍스트를 통해 트랜잭션을 정의하고 제어하는 방법에 대해 알아봅니다. 플랫폼의 실행 순서와 모든 데이터베이스 작업 전반에서 데이터 무결성을 보장하는 방법을 이해합니다.
- **메타데이터 vs. 데이터**: 메타데이터와 데이터 간의 중요한 차이점과 Sandbox 개발에서 프로덕션 배포 및 패키지 관리에 이르기까지 응용 프로그램 수명 주기에 미치는 영향을 알아봅니다.
- **플랫폼 API**: 사용 가능한 다양한 Salesforce Platform API를 살펴보고, 각 API를 사용하는 시기를 이해하고, API 버전 관리 및 서비스 점검 계획을 수립하는 방법을 알아봅니다.
이 기사를 시작하여 플랫폼이 자원을 관리하고 제한을 적용하고 응용 프로그램 개발을 위한 API를 제공하는 방법에 대한 기본적인 이해를 구축합니다.
## Salesforce Platform - 내일을 위해 전환됨
[Salesforce Platform - Transformed for Tomorrow는](/docs/architect/ko-kr/fundamentals/guide/platform-transformation) Salesforce의 플랫폼 아키텍처를 재구성한 포괄적인 변형을 설명합니다. 이 자세한 백서에서는 다음을 살펴봅니다.
- **현대 플랫폼 아키텍처**: Salesforce가 일종의 아키텍처에서 AI 기반 응용 프로그램 및 에이전트 환경을 지원하는 독립 서비스가 있는 구조로 발전한 방법을 알아봅니다.
- **Hyperforce 인프라스트럭처**: 여러 공개 클라우드 공급자에서 작동하는 Salesforce 차세대 인프라에 대해 알아보고 향상된 확장성, 규정 준수, 데이터 보존 기능을 제공합니다.
- **건축 원칙**: 플랫폼 개발을 안내하는 6가지 핵심 원칙을 이해합니다. 엔터프라이즈급 Trust, 멀티테넌트 설계, 메타데이터 기반 아키텍처, API First 접근 방식, 개방형 및 상호 운용 가능한 시스템, Agentic 기능
- **플랫폼 레이어**: 인프라에서 사용자 환경까지 현대 Salesforce Platform을 구성하는 상호 연결된 계층과 포괄적인 비즈니스 기능을 제공하기 위해 함께 작동하는 방법을 살펴봅니다.
이 기사는 특히 AI 및 클라우드 네이티브 아키텍처의 시대에서 Salesforce가 엔터프라이즈 응용 프로그램의 미래에 대해 자신을 어떻게 포지셔닝했는지 이해하기 위해 읽어야 합니다.
## 플랫폼 다중 테넌트 아키텍처
[플랫폼 멀티테넌트 아키텍처](/docs/architect/ko-kr/fundamentals/guide/platform-multitenant-architecture)에서는 Salesforce Platform이 신뢰할 수 있고 확장 가능하며 사용자 정의할 수 있는 환경을 제공하는 방법에 대해 자세히 알아봅니다. 이 기사는 다음을 설명합니다.
- **Multitenant Design**: 단일 공유 데이터베이스 및 스키마가 수백만 조직의 테넌트별 데이터, 메타데이터, 비즈니스 논리를 안전하게 격리하는 방법을 이해합니다.
- **플랫폼 데이터 레이어**: 범용 데이터 사전(UDD), 유연한 열, 색인화 시스템, 플랫폼이 메타데이터와 데이터를 모두 효율적으로 저장하는 방법을 살펴봅니다.
- **응용 프로그램 개발**: 플랫폼에서 브라우저 기반 도구, API, 쿼리 언어, Apex 비롯한 코드 없음, 하위 코드, 프로 코드 개발 접근 방식을 지원하는 방법에 대해 알아봅니다.
- **내부 처리**: 플랫폼이 쿼리, 검색, 대량 작업, 스키마 수정, 멀티테넌트 격리를 처리하여 최적의 성능 및 보안을 보장하는 방법을 알아봅니다.
이 기술 요약은 Salesforce Platform을 확장 가능하고 안전하며 사용자 정의할 수 있는 기본 메커니즘을 이해해야 하는 아키텍처에게 매우 유용합니다.
## 플랫폼 공유 아키텍처
[플랫폼 공유 아키텍처](/docs/architect/ko-kr/fundamentals/guide/platform-sharing-architecture)는 보안 데이터 액세스 모델을 구성하는 포괄적인 가이드입니다. 이 문서는 다음을 다룹니다.
- **공유 구성 요소**: 프로필, 권한 집합, 역할 계층, 조직 전체 기본값, 공유 규칙, 팀, 영역 등을 포함하여 공유 모델을 구성하는 모든 구성 요소에 대해 알아봅니다.
- **구현 시나리오**: 실제 고객 시나리오와 다양한 공유 구성 요소가 함께 작동하여 복잡한 데이터 액세스 요구 사항을 충족하는 방법을 살펴봅니다.
- **모범 사례**: 대용량 데이터, 소유권 왜곡, 영역 관리, 조직 변경 계획에 대한 고려 사항을 이해합니다.
- **문제 해결**: 체계적인 접근 방식을 통해 사용자가 레코드에 액세스하거나 액세스할 수 없는 이유를 진단하고 일반적인 공유 모델 문제를 해결하는 방법을 알아봅니다.
새 공유 모델을 설계하거나 기존 공유 모델을 최적화하는지 여부와 상관없이 이 가이드는 안전하고 유연하며 유지 관리 가능한 데이터 액세스 아키텍처를 만드는 데 필요한 Knowledge 제공합니다.
---
다음 네 가지 기사는 Salesforce Platform 아키텍처 Knowledge 기반입니다. 아키텍처 기본 사항부터 시작하여 기본 개념에서 고급 아키텍처 패턴으로의 이해를 점진적으로 구축하려면 순서대로 해당 개체를 읽는 것이 좋습니다.
## 소개
Salesforce Customer 360 플랫폼은 각각의 Salesforce 테넌트 인스턴스("org")에 강력한 [다중 테넌트 메타데이터 기반 아키텍처를](/docs/architect/ko-kr/fundamentals/guide/platform-multitenant-architecture) 제공합니다. 이 아키텍처 기본 사항 문서는 Salesforce Platform의 기본 아키텍처가 플랫폼에 구축된 솔루션 아키텍처에 대한 주요 고려 사항을 만드는 영역에 대한 개요를 제공합니다.
Salesforce Platform에서 아키텍처를 설계할 때 이해해야 할 세 가지 필수 영역이 있습니다.
- [거래](/docs/architect/ko-kr/fundamentals/guide/architecture-basics#트랜잭션)
- [메타데이터 vs. 데이터](/docs/architect/ko-kr/fundamentals/guide/architecture-basics#메타데이터와-데이터-비교)
- [플랫폼 API](/docs/architect/ko-kr/fundamentals/guide/architecture-basics#플랫폼-api)
## 트랜잭션
Salesforce Platform에서 코드 실행 및/또는 데이터베이스 작업을 통해 트랜잭션을 인스턴스화할 수 있습니다. Salesforce의 아키텍처를 위한 기본적인 역량은 플랫폼이 테넌트에 대한 트랜잭션을 정의하고 제어하는 방식을 이해하는 것입니다. 모든 테넌트에 대한 리소스를 유지하기 위해 Salesforce는 모든 테넌트에 트랜잭션별 및 조직별로 계산되는 제한을 적용합니다.
트랜잭션 수준에서 Salesforce는 코드 실행의 개별 인스턴스와 데이터베이스 트랜잭션이 공유 컴퓨팅 리소스를 독점하지 않도록 [관리자 및 실행 제한](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_gov_limits.htm)을 설정합니다. 조직 전체 수준에서 Salesforce는 [판매 및 기능 유형](https://help.salesforce.com/s/articleView?id=sf.overview_limits_general.htm&type=5)을 기반으로 제한을 설정합니다. 조직 전체 제한에는 [API 제한이 적용되는](https://developer.salesforce.com/docs/atlas.en-us.salesforce_app_limits_cheatsheet.meta/salesforce_app_limits_cheatsheet/salesforce_app_limits_platform_api.htm) 조직의 모든 트랜잭션에서 API 사용량이 순차적으로 계산됩니다.
Salesforce Platform에서 트랜잭션의 두 가지 핵심 부분인 실행 컨텍스트 및 데이터베이스 조작을 자세히 살펴보겠습니다.
### 실행 컨텍스트
Salesforce는 [실행 컨텍스트](https://trailhead.salesforce.com/content/learn/modules/apex_basics_dotnet/execution_context)의 개념을 기반으로 트랜잭션 제한을 계산합니다. Salesforce 응용 프로그램의 경우 단일 Salesforce 조직 내에서 사용자 정의 코드 실행에만 해당하는 것은 아닙니다. 실행 컨텍스트는 플랫폼 런타임 엔진을 기반으로 하며 특정 테넌트의 런타임 엔진에서 사용할 수 있는 모든 코드를 기반으로 합니다. 즉, 테넌트 조직 내에 정의된 사용자 정의 코드, 해당 조직과 함께 설치된 패키지의 코드, Salesforce Platform 서비스 내에 포함된 코드 모두 트랜잭션을 인스턴스화할 수 있습니다. 플랫폼은 다양한 종류의 Apex 코드를 구분하고 이러한 구분을 기반으로 총괄자 제한을 계산합니다.
[Apex 트랜잭션 제한](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_gov_limits.htm)에 대한 자세한 내용은 Apex 개발자 가이드를 참조하십시오.
### 데이터베이스 조작
트랜잭션에 데이터베이스 조작이 포함된 경우 내장된 [실행 순서](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_triggers_order_of_execution.htm)에 따라 조직 구성 및 코드의 다른 부분이 어떻게 작동하는지 명시됩니다. Salesforce 응용 프로그램에서 실행 순서를 올바르게 사용하는 방법을 이해하는 핵심은 이 동작이 Salesforce 응용 프로그램에 제공하는 강력한 데이터 무결성을 이해하는 것입니다.
| 동작 | 데이터 | 메타데이터 |
|---|---|---|
| 프로덕션에서 Sandbox 환경으로 복사됨 | 아니요* | 예 |
| 메타데이터 API로 마이그레이션 | 아니요 | 예** |
| 데이터 로드별 마이그레이션 | 예 | 아니요 |
| 패키지에 포함할 수 있음 | 아니요 | 예** |
| 데이터 저장소 제한에 포함됩니다. | 예 | 아니요 |
| *전체 사본 및 부분 사본 Sandbox는 프로덕션에서 데이터를 복제할 수 있습니다. ** 일부 메타데이터 유형은 메타데이터 API 및/또는 패키지와 함께 사용할 수 없습니다. 예외는 메타데이터 적용 범위 보고서에서 확인할 수 있습니다. |
||
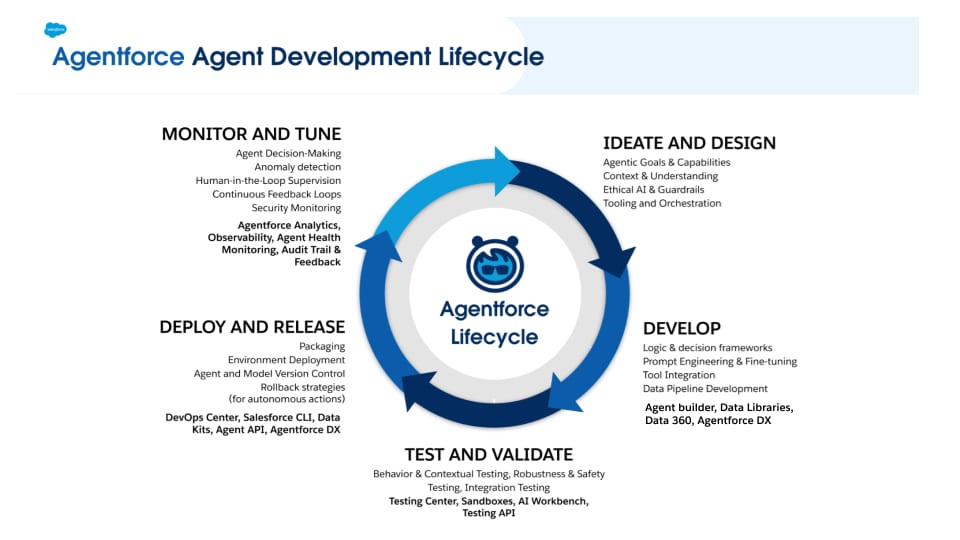 이 장에서는 Agentforce가 **단일 통합 플랫폼 내에서 모든 단계의 ADLC를 지원하는 방법을 설명합니다.**
#### 1단계: 아이디어 및 설계
##### 아이디어
아이디어 단계는 에이전트에 대한 초기 비전 및 요구 사항이 수립되는 ADLC의 기본 단계입니다. 이를 통해 문제를 이해하고 잠재적인 솔루션을 식별하고 에이전트의 핵심 기능을 간략하게 설명합니다.
핵심 특성을 정의하여 에이전트의 아이디어 프로세스를 시작합니다.
1. **목표/목표**: 에이전트의 기본 목표를 명확하게 정의합니다. 해결할 특정 문제 또는 수행할 과업은 무엇입니까? 에이전트가 담당해야 하는 사람은 누구입니까? 이는 전체 개발 프로세스를 안내하는 간결하고 측정 가능한 설명이어야 합니다.
2. **Persona**: 에이전트에 대한 자세한 개인 정보를 개발합니다. 여기에는 ID, 커뮤니케이션 스타일, 사용자 또는 다른 시스템과의 상호 작용에서 수행할 역할 정의가 포함됩니다. 톤, 형식성 수준, 의도한 컨텍스트에서 효과적으로 사용할 수 있는 특정 특성을 고려하십시오.
3. **패턴**: 관련 에이전트 패턴 및 구현 전략을 식별하고 연결합니다. 여기에는 에이전트의 구조와 행동에 정보를 제공할 수 있는 아키텍처 설계 또는 모범 사례가 포함됩니다. "Salesforce Agentforce의 [에이전트 패턴 및 구현: A Technical Whitepaper(기술 백서](/docs/architect/ko-kr/fundamentals/guide/agentic-patterns)))는 이 단계에서 중요한 자료로서 Salesforce 플랫폼 및 Agentforce에서 효과적인 에이전트 설계에 대한 인사이트를 제공합니다.
##### 설계
설계 단계는 아이디어의 개념을 에이전트의 구축을 위한 자세한 청사진으로 변환합니다. 여기에는 에이전트의 아키텍처, 사용자 플로, 상호 작용 모델, 주제, 도구, 가드 레일과 같은 기술 사양 정의가 포함됩니다.
설계 단계 동안 다음을 포함하는 에이전트의 구축에 대한 세부 청사진 만들기를 만듭니다.
- **에이전트 디자인**: 구성 요소, 모듈, 상호 작용 방식 등 에이전트의 내부 구조를 간략하게 설명합니다. 이는 에이전트 동작, 자연어 처리(NLP) 구성 요소 및 다른 시스템과의 통합 지점을 제어하는 Knowledge 기반, 구성 및 논리를 정의해야 할 수 있습니다.
- **사용자 플로/상호 작용 설계**: 전체 사용자 여정 및 에이전트의 상호 작용을 매핑합니다. 대화 플로, 결정 트리, 오류 처리, 사용자 의견 메커니즘을 정의하여 직관적이고 효과적인 환경을 만듭니다.
- **기술 사양**: 성능 메트릭, 확장성 고려 사항, 보안 프로토콜, 통합 사양 등 에이전트에 대한 기능이 아닌 기술 요구 사항을 문서화합니다.
- **프로토타이핑 & 모형 제작**: 에이전트의 인터페이스 및 상호 작용에 대한 시각적 표현 또는 대화형 프로토타입을 만듭니다. 이를 통해 조기에 테스트 및 사용자 의견을 제공하여 전체 규모 개발을 시작하기 전에 설계를 구체화할 수 있습니다.
- **데이터**: 에이전트에게 필요한 데이터 유형 및 소스를 결정할 때 에이전트가 액세스해야 하는 데이터 집합, API, 데이터베이스, 리포지토리를 식별합니다. Agentforce 경우 컨텍스트로 제공되는 데이터, 구조화 또는 비정형인지, 실시간 또는 배치인지에 초점을 맞춥니다. Agentforce 플랫폼은 Data 360과 깊이 통합되므로 Salesforce CRM 및 기타 소스의 구조화된 데이터와 비정형 데이터를 모두 사용할 수 있습니다. 구조화되지 않은 콘텐츠는 RAG에 대해 기본적으로 청크 및 색인화할 수 있습니다. MuleSoft를 사용하면 외부 시스템에 연결할 수 있습니다.
- **도구**: 에이전트가 수행해야 하는 작업을 식별합니다. Agentforce 작업을 사용하여 비즈니스 목표를 달성하는 도구를 표시합니다. 이러한 작업은 기존 Salesforce 자산(예: 프롬프트 빌더, MuleSoft, Apex, 플로 및 OpenAPI 사양을 사용하는 API를 통해 프롬프트)을 활용합니다. 호출 가능한 작업을 Agentforce 통합하고 에이전트가 사용할 수 있으므로 모든 익숙한 Salesforce 개발 도구를 Agentforce 작업으로 쉽게 사용할 수 있습니다.
- **에이전트의 입력 데이터**: 기존 SDLC에서는 입력이 정확하게 지정됩니다. ADLC에서 입력은 자연스럽고 결정적이지 않은 자유 형식의 발화인 경우가 많습니다. 적절한 응답을 생성할 것으로 예상되는 발화의 대표 코퍼스를 수집합니다.
#### 2단계: 개발
개발 단계에서는 아이디어 및 설계 단계에서 결정한 정의된 에이전트의 목적, 기능 및 운영 범위를 새로운 Agentforce 에이전트로 전환하는 데 중점을 둡니다.
개발자가 에이전트를 만들 수 있도록 Agentforce는 **에이전트 빌더** 및 **Aventforce Developer Experience(AFDX)를 모두 제공합니다.** 이러한 기본 도구는 에이전트를 구성하고 구성하기 위한 기본 환경으로 사용됩니다.
- **에이전트 빌더**는 에이전트의 핵심 기능을 정의할 수 있는 UI 환경을 제공합니다.
- **AFDX는** 맞춤화 및 다른 시스템과의 통합을 위한 프로그래밍 인터페이스를 제공합니다.
에이전트 개발 및 구축에는 에이전트 빌더 또는 AFDX를 사용하여 수행할 수 있는 다음 단계가 포함됩니다.
1. **Persona 정의**: 에이전트 설계의 중요한 측면은 고유한 개인 정보를 설정하는 것입니다. 다음 구성이 포함됩니다.
- **에이전트 설명**: 처리하도록 설계된 에이전트의 역할, 목표, 특정 고객 서비스 과업에 대한 자세한 설명입니다.
- **어조**: 에이전트의 커뮤니케이션 스타일, 공감 수준 및 준수해야 하는 특정 브랜드 지침입니다.
2. **에이전트 주제 및 작업 정의**: 에이전트가 정교하고 다양한 과업을 처리할 수 있도록 하려면 해당 작업을 통해 해당 기능을 고유한 주제로 분류해야 합니다.
- **주제**: 각 주제를 고유한 지침 및 도구 집합을 통해 자체 전문 에이전트로 개념화할 수 있습니다.
- **모듈식 아키텍처.** 주제에 대한 모듈식 접근 방식을 통해 더 나은 구성 및 확장성을 제공할 수 있습니다. 에이전트는 여러 주제를 정의하여 더 광범위한 복잡한 시나리오를 처리할 수 있습니다. 예를 들어, 에이전트에게 "주문 관리", "자주 묻는 질문(FAQ),"기술 지원", "청구"에 대한 별도의 주제가 있을 수 있습니다.
- **주제 지침(가드레일)**: 각 주제에는 에이전트가 해당 주제 내에서 논의하거나 수행할 수 있는 작업 범위를 정의하는 가드 레일 역할을 하는 특정 지침이 포함되어 있습니다. 해당 지침은 에이전트가 주제 외에 이동하거나 관련이 없는 정보를 제공하지 못하도록 방지합니다. 또한 응답의 일관성과 정확성을 유지하는 데 도움이 됩니다.
- **작업**: 주제에는 에이전트가 수행할 수 있는 작업을 나타내는 "도구"도 있습니다. 다음 도구가 될 수 있습니다.
- **정보 활동**: Knowledge 데이터베이스 또는 외부 시스템에서 데이터를 검색하여 질의에 응답합니다.
- **거래 조치**: 주문하기, 고객 레코드 업데이트 또는 환불 프로세스 시작과 같은 사용자를 대신하여 작업 수행 이러한 작업은 다른 시스템(예: CRM, ERP)과 통합되는 경우가 많습니다.
#### 3단계: 테스트 및 유효성 검사
테스터는 AI 에이전트의 성능 및 신뢰도를 평가할 때 사용자 환경이 저하될 수 있는 다양한 문제에 직면하게 됩니다. 이러한 문제는 사용자 의도 잘못 해석에서 과업을 올바르게 실행하지 못할 때까지 다양합니다.
##### 일반적인 에이전트 실패 시나리오
강력한 에이전트를 구축하려면 실패할 수 있는 방법과 위치를 이해해야 합니다. 다음 표는 에이전트 수명 주기 동안 발생하는 일반적인 문제를 범주화합니다. 결함이 있는 추론에서 나쁜 Knowledge 검색에 이르기까지. 이를 개발 도중 전략 가이드 및 테스트 도중 체크리스트로 사용하여 에이전트가 기능뿐만 아니라 최종 사용자에 대해 신뢰할 수 있고 직관적인지 확인합니다. 다음 실패 시나리오는 테스트 사례를 정의하는 데 도움이 됩니다.
| 범주 | 설명 | 실패 예제 |
|---|---|---|
| 주제 분류 | 에이전트가 사용자의 의도 또는 목표를 올바르게 식별하지 못합니다. |
|
| 응답 품질 | 에이전트의 회신 내용, 정확성 및 형식에 실패했습니다. |
|
| 작업 실행 | 특정 기능 또는 과업을 수행하려고 할 때 에이전트가 실패합니다. |
|
| 가드 레일 및 지침 | 에이전트가 사전 정의된 규칙, 제약 또는 대화 경계를 위반합니다. |
|
| Knowledge 검색 | 에이전트는 Knowledge 자료에서 정보를 가져오고 표시하는 데 문제가 있습니다. |
|
| 구조화된 지침 | 에이전트는 다단계 프로세스를 통해 사용자를 안내하는 데 어려움을 겪고 있습니다. |
|
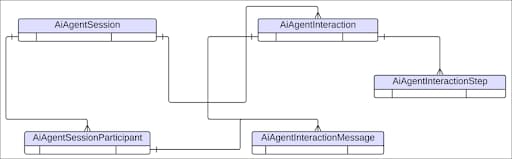
| 데이터 레이크 개체/데이터 모델 개체 | 설명 |
|---|---|
| AIAgentSession | 하나 이상의 AI 에이전트와 연속 상호 작용을 수집하는 전체 컨테이너입니다. |
| AIAgentSessionParticipant | AIAgentSession에 참여하는 엔티티(사람 또는 AI). |
| AIAgentInteraction | 세션 내의 세그먼트입니다. 일반적으로 사용자의 요청으로 시작하고 AI 에이전트가 해당 요청에 대한 응답을 제공하면 끝납니다. |
| AIAgentInteractionStep | 상호 작용 중에 사용자의 요청을 이행하기 위해 수행되는 개별 작업 또는 작업입니다. |
| AIAgentInteractionMessage | 세션 중에 사용자가 제공하거나 AI 에이전트가 생성한 단일 커뮤니케이션입니다. |
 ##### 발화 분석
발화 분석은 Agentforce(기본) 사용자가 에이전트를 사용하는 방식, 요청한 내용 및 에이전트가 이러한 요청을 처리할 수 있는지 여부를 보여줍니다. 이러한 사용자 정의 가능한 보고서는 에이전트가 보다 효과적이고 정확하게 응답할 수 있도록 주제 및 작업을 구체화하는 데 도움이 됩니다.
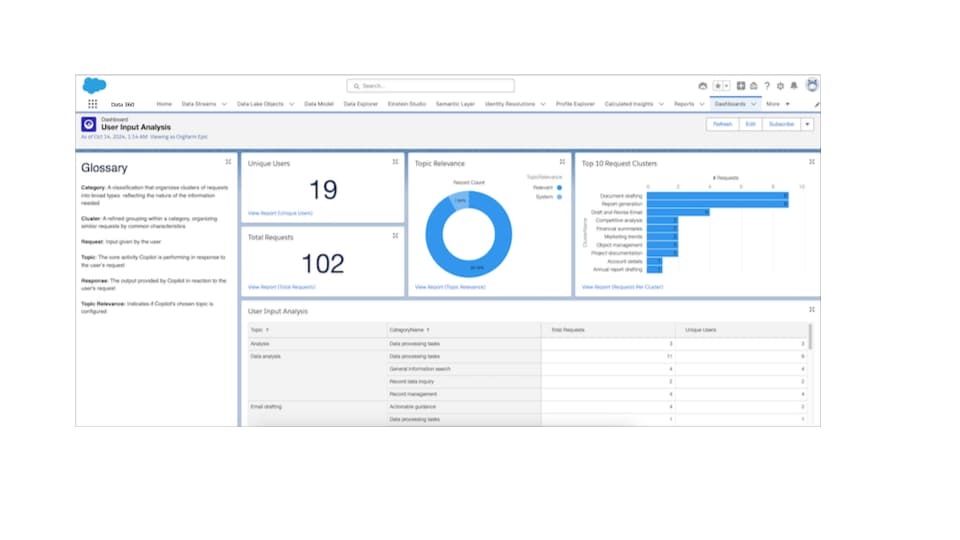 ##### Agentforce Python SDK: Data 360 통합을 통한 모니터링
에이전트 SDK 구현은 Data 360 Python 커넥터와 함께 고급 모니터링 및 분석을 사용하여 Salesforce Data 360에 연결하고, 에이전트 성과 메트릭을 쿼리하고, 포괄적인 모니터링 대시보드를 만듭니다.
시스템은 응답 시간, 성공률, 사용자 만족도, 비용 메트릭을 추적하여 에이전트 최적화를 위한 실천 가능한 인사이트를 제공합니다.
```py
# Data 360 Python Connector Integration
from salesforce_cdp_connector import SalesforceCDPConnector
# Initialize Data 360 Connector
cdp_connector = SalesforceCDPConnector(
client_id='your_client_id',
client_secret='your_client_secret',
username='your_username@example.com',
password='your_password'
)
# Query agent performance data
performance_data = cdp_connector.query("""
SELECT timestamp, response_time_ms, success_rate, user_satisfaction
FROM AgentPerformanceMetrics
WHERE agent_id = 'Coral_Cloud_Resorts_Resort_Manager'
""")
# Create monitoring dashboard
def create_monitoring_dashboard(performance_data):
fig = go.Figure()
fig.add_trace(go.Scatter(
x=performance_data['timestamp'],
y=performance_data['response_time_ms'],
mode='lines+markers'
))
return fig
```
##### Agentforce DX: 에이전트 모니터링
구현은 CLI 기반 에이전트 관리와 함께 표준 AFDX 명령을 사용하여 에이전트가 플랫폼 변경 사항에 대해 최신 상태를 유지하고 사용자 피드백을 통합하여 지속적으로 개선합니다.
```zsh
# List all agents and their status
sf agent list --target-org "production-org"
# Get detailed agent information
sf agent get \
--api-name "Resort_Manager" --target-org "production-org"
# Activate agent if needed
sf agent activate --api-name "Resort_Manager" --target-org "production-org"
# Query agent performance data
sf data query \
--query "SELECT Id, Name, Status, LastModifiedDate FROM BotDefinition WHERE DeveloperName = 'Resort_Manager'" \
--target-org "production-org"
```
```python
# AgentforceDX Dashboard Creation (Similar to Agent SDK)
import pandas as pd
import plotly.graph_objects as go
from salesforce_cdp_connector import SalesforceCDPConnector
# Initialize Data 360 Connector for AgentforceDX
cdp_connector = SalesforceCDPConnector(
client_id='your_client_id',
client_secret='your_client_secret',
username='your_username@example.com',
password='your_password'
)
# Query agent performance data from Data 360
performance_data = cdp_connector.query("""
SELECT timestamp, agent_id, response_time_ms, success_rate, user_satisfaction
FROM AgentPerformanceMetrics
WHERE agent_id = 'Resort_Manager'
AND timestamp >= CURRENT_DATE - 30
ORDER BY timestamp DESC
""")
```
Agent SDK 및 AFDX를 사용하여 ADLC 구현을 위해 [여기에](https://github.com/akshatasawant9699/ADLC_Whitepaper) GitHub 저장소를 참조하십시오.
## 모범 사례
에이전트 개발 수명 주기를 관리하려면 효율성, 신뢰성, 전략적 조율을 보장하는 핵심 원칙 집합을 준수해야 합니다. 다음 지침은 각 ADLC 단계의 핵심 과정을 설계자 및 개발자를 위한 전략적 프레임워크로 통합합니다.
**1\. 계획 및 아이디어 작성**
이 초기 단계는 에이전트의 목적을 비즈니스 목표에 맞추고 견고한 기반에 구축하는 데 중점을 둡니다.
- **비즈니스 영향 우선 순위 지정**: 먼저 잠재적인 사용 사례를 전략적 비즈니스 목표에 직접 매핑합니다. 우선 순위 매트릭스를 사용하여 잠재적인 영향에 대한 점수를 매기고 명확한 KPI를 사용하여 집중적인 단일 사용 사례로 시작합니다.
- ** 이해당사자를 조기에 참여시키기**: 고장점에 대한 인사이트를 수집하고 정렬합니다.
- **기타 데이터 인사이트**: 에이전트는 데이터만큼만 유용합니다. Data 360을 사용하여 사용 가능한 구조화된 데이터와 구조화되지 않은 데이터를 탐색하여 에이전트의 컨텍스트 및 기능에 정보를 제공합니다. 기존 보고서 및 대시보드를 검토하여 사용 사례 선택 항목에 정보를 제공할 수 있는 현재 추세를 식별합니다.
- **Ideation Framework 사용**: 구조화된 아이디어 메서드를 적용하여 설계 사고 또는 SWOT 분석과 같은 잠재적인 애플리케이션을 브레인스토밍하고 구체화합니다.
**2\. 빌딩 에이전트**
이 단계에서는 성과가 높은 효율적인 에이전트를 구성하기 위한 모범 사례를 다룹니다.
- **Too Many Topics 피하기**: 주제 수를 제한하여 에이전트를 혼동시킬 수 있는 유사하거나 중첩되는 주제를 만드는 위험을 줄입니다.
- **명령 및 프롬프트를 간결하게 유지**: 직접적이고 간단한 언어를 사용하고 예제 발화를 제공하여 에이전트를 효과적으로 안내합니다.
- **기타 변수 및 결정적 동작**: 이러한 도구를 사용하여 에이전트의 동작을 안내하고 예측 가능한 결과를 위해 성능을 최적화합니다.
- **작고 간결한 작업 출력 유지**: 에이전트의 응답이 간단하고 정확한지 확인합니다. 더 긴 출력은 더 많은 컨텍스트를 사용하며 생성 속도가 느려집니다.
- **속도에 대한 작업 최적화**: 필요한 최소한의 데이터를 반환하도록 플로 및 Apex 클래스를 설계합니다. 가능한 경우 사전 처리를 통해 응답을 생성하는 데 필요한 작업을 줄이십시오.
- **확인 범위 정의**: 적절한 작업 설명, 지침 및 범위를 작성하여 에이전트가 범위 외 질문에 대해 RAG(검색 증가 생성)을 호출하지 못하도록 합니다.
- **해결한 하이브리드 검색 사용**: 대기 시간에 부정적인 영향을 미칠 수 있으므로 절대적으로 필요한 경우에만 하이브리드 검색을 사용하십시오.
**3\. 테스트, 모니터링 및 튜닝**
이 반복 단계는 에이전트의 정확성과 성능을 세분화하는 데 매우 중요합니다.
- **테스트 흐름 설정**: 일관된 테스트 주기를 따르십시오.
1. **실행 배치 테스트**: 포괄적인 테스트 집합을 실행합니다.
2. **점수/오류 보기**: 성능 메트릭을 분석하고 실패를 식별합니다.
3. **검사 실패**: 각 실패 행을 검사하여 불일치를 이해합니다.
4. **Agent 업데이트**: 에이전트 또는 평가 데이터를 필요한 조정합니다.
- **세션 추적 정보 검토**: 세션 추적 데이터 모델 및 Agentforce Interaction Explorer를 사용하여 문제 또는 예기치 않은 동작이 식별되면 근본 원인을 분석합니다. 정보를 기반으로 에이전트를 조정하고 계속해서 에이전트를 반복합니다.
## 결론
*에이전트 개발 수명 주기*는 지능형 자율 시스템의 시대를 위해 설계된 기존 소프트웨어 개발 원칙의 중요한 진화입니다.
- **진화, 대체가 아니라**: 에이전트 개발 수명 주기는 대체하지 않고 기존 응용 프로그램 수명 주기 관리를 확장하고 향상합니다.
- **1등급 시민으로서의 데이터**: 데이터는 에이전트 개발에서 훨씬 더 동적이고 중앙적인 역할을 합니다.
- **특수 도구 및 기술**: 데이터 과학, ML 엔지니어링, 에이전트 개발 전반에 걸친 새로운 도구와 광범위한 전문 기술이 필요합니다.
- **연속 학습**: 에이전트 개발은 시스템 자체의 지속적인 *학습*과 *조정*을 추가합니다.
- **미래 영향**: 에이전트 AI는 복잡한 IT 운영 및 소프트웨어 개발 워크플로를 추가로 자동화하고 최적화할 수 있습니다.
## 소개
이 문서에서는 에이전트 직원의 가치를 완전히 포착하기 위해 앞으로 3~5년 동안 엔터프라이즈가 필요로 하는 IT 아키텍처를 설명하는 관점을 제공하며, AI 에이전트의 대규모 배포를 지원하는 데 필요한 IT 전환을 간략하게 설명합니다. 목표는 CIO, CDO, IT 리더가 에이전트 엔터프라이즈로의 여정을 계획할 수 있도록 전략 가이드 및 참조 아키텍처를 제공하는 것입니다.
강력한 AI 모델을 사용하면 환경을 감지하고, 데이터에 대해 추론하고, 자율적인 결정을 내리고, 과업을 수행하고, 인적 작업자와 효과적으로 공동 작업할 수 있는 에이전트 직원을 만들 수 있습니다. 이 새로운 직원은 혁신, 생산성, 민첩성의 단계별 변화로 주주 및 고객을 위한 가치를 창출합니다. 이 비전을 실현하려면 조직이 비즈니스 및 IT 변환을 거쳐 에이전트 엔터프라이즈가 되어야 합니다.
## 에이전트 엔터프라이즈의 비즈니스 기능
오늘날 기존 엔터프라이즈는 정보 사일로, 수동 작업에 묻혀 있는 직원, 조직 구조의 잘못 조정된 인센티브, 전략 및 결과 간의 분리된 사용자 의견 루프로 인한 운영 효율성 부족에 직면하고 있습니다. 이러한 문제로 인해 최적화되지 않은 고객 경험, 비효율적인 프로세스, 성장에 대한 누락된 기회가 발생합니다.
에이전트 엔터프라이즈는 인텔리전트 AI 에이전트의 디지털 직원과 인적 작업자를 통합하여 이러한 제한을 극복합니다. 이 새로운 AI 증가 인력으로 조직은 성장을 위한 혁신을 촉진하고, 운영 우수성을 촉진하고, 여러 유형의 새로운 비즈니스 기능으로 엔터프라이즈 복원 능력을 구축할 수 있습니다.
**혁신을 촉진하는 새로운 비즈니스 역량:**
- 인적 생산성 향상: AI 에이전트의 속도, 규모, 항상 활성화된 특성을 통해 기업은 반복적인 작업을 자동화하고 인적 작업자가 더 중요한 창의적인 과업에 집중할 수 있습니다.
- 적응성 향상: AI 에이전트의 이유를 관찰할 수 있으므로 새 기술을 동적으로 학습하고 배포할 수 있으므로 엔터프라이즈가 비즈니스 목표를 달성하기 위해 성과를 지속적으로 향상하고 신속하게 새로운 시장 기회에 적응할 수 있습니다.
_작업의 예 — 금융 서비스의 고객 경험 혁신:_ 자산 관리 회사는 AI 에이전트를 사용하여 클라이언트 참여 모델을 재개발할 수 있습니다. 에이전트는 자율적으로 포트폴리오를 모니터링하고, 클라이언트 검토를 위한 주요 순간을 식별하고, 상담원에 대한 사전 통화 계획을 준비하며, 뉴스가 나타날 때 계획을 조정합니다. 이렇게 하면 담당자가 대규모로 사전 예방적이고 맞춤형 고객 경험을 제공하고 관계를 강화하고 새로운 기회를 발견할 수 있습니다.
**조직의 복원 능력을 보호하고 보장하기 위한 새로운 비즈니스 역량:**
- 탄력적인 직원 수용력: 엔터프라이즈는 완전히 인적 인 직원 증가로 인한 비용과 지연 없이 변화하는 비즈니스 환경으로 인한 작업량의 급증을 충족하는 능력을 빠르게 확장할 수 있습니다.
- 예측 운영 복원: 24시간 연중무휴 AI 에이전트의 특성은 운영, 규정 준수, 보안 위험을 실시간으로 자동으로 예측, 모델링, 완화하여 기업이 고객 및 이해당사자의 Trust 유지할 수 있도록 지원합니다.
_작업의 예 — 고객 데이터 보호:_ 대기업은 AI 데이터 거버넌스 에이전트를 배포하여 데이터 프라이버시 법의 변경 사항에 대한 규제 환경을 스캔하고, 엔터프라이즈 데이터 집합에서 중요한 정보를 검색 및 분류한 다음, 적절한 거버넌스 정책을 적용할 수 있습니다. 에이전트는 데이터 액세스 요청을 검토하고 검토를 위해 예외를 분석가에게 라우팅하여 데이터를 신뢰할 수 있는 방식으로 사용할 수 있는 동시에 규정 준수 위험을 줄일 수 있습니다.
**운영 우수성을 최적화하는 새로운 비즈니스 기능:**
- 자율 프로세스 실행: 디지털 직원은 기계 속도와 함께 복잡한 다단계 과업을 연중무휴 연중무휴로 실행하여 비용을 절감하고 효율적으로 프로세스를 확장할 수 있습니다.
- 교차 경계 오케스트레이션: AI 에이전트는 일반적으로 인공 작업자를 제약하는 정보 및 인센티브 사일로에서 작업하여 교차 기능 프로세스에 대한 민첩성을 조성할 수 있습니다.
_작업의 예 — 소매 분야의 마케팅 퓨널 최적화:_ 리테일 마케팅 팀은 AI 에이전트를 배포하여 새로운 소비자 추세에 대응하여 캠페인 프로세스를 가속화할 수 있습니다. 에이전트는 마케팅 계획을 생성하고, 검토를 위해 마케팅, 제품, 세일즈 팀과 공동 작업을 수행한 다음, 디지털 자산을 자동 생성하고 여러 채널에서 실시간 피드백을 기반으로 캠페인을 동적으로 조정할 수 있습니다.
## 에이전트 엔터프라이즈의 IT 아키텍처
### 기존 IT 아키텍처의 한계
레이어 구조를 사용하여 엔터프라이즈의 IT 아키텍처를 설명할 수 있습니다. 레이어는 논리적으로 관련 기술 기능을 그룹화하고 구조화된 추론을 용이하게 하지만 특정 구현이나 레이어가 단독으로 또는 더 이기종 방식으로 설계되어야 하는 정도를 의미하지는 않습니다. 이 레이어 보기(그림 1)에서 기존의 IT 아키텍처는 5가지 주요 레이어로 구성됩니다. 인프라, 데이터, 통합, 응용 프로그램, 환경 두 가지 교차 계층인 보안 및 IT 운영은 이러한 계층에 걸쳐 관리, 모니터링, 보호를 보장합니다.
기존의 IT 아키텍처는 데이터에 액세스하고 비즈니스 논리를 적용하고 공동 작업을 촉진하며 워크플로를 실행하기 위해 응용 프로그램에서 조치를 취하는 인텔리전스가 인간 작업자와 상주하는 패러다임을 위해 고안되었습니다. AI 에이전트가 AI 에이전트를 감독하고 더 창의적이고 모호한 과업에 집중하는 동안 이전에 사람이 수행했거나 전혀 수행하지 않은 특정 사용 사례에 대해 고려하고 조치를 취할 수 있는 패러다임을 위해 고안되지는 않았습니다.
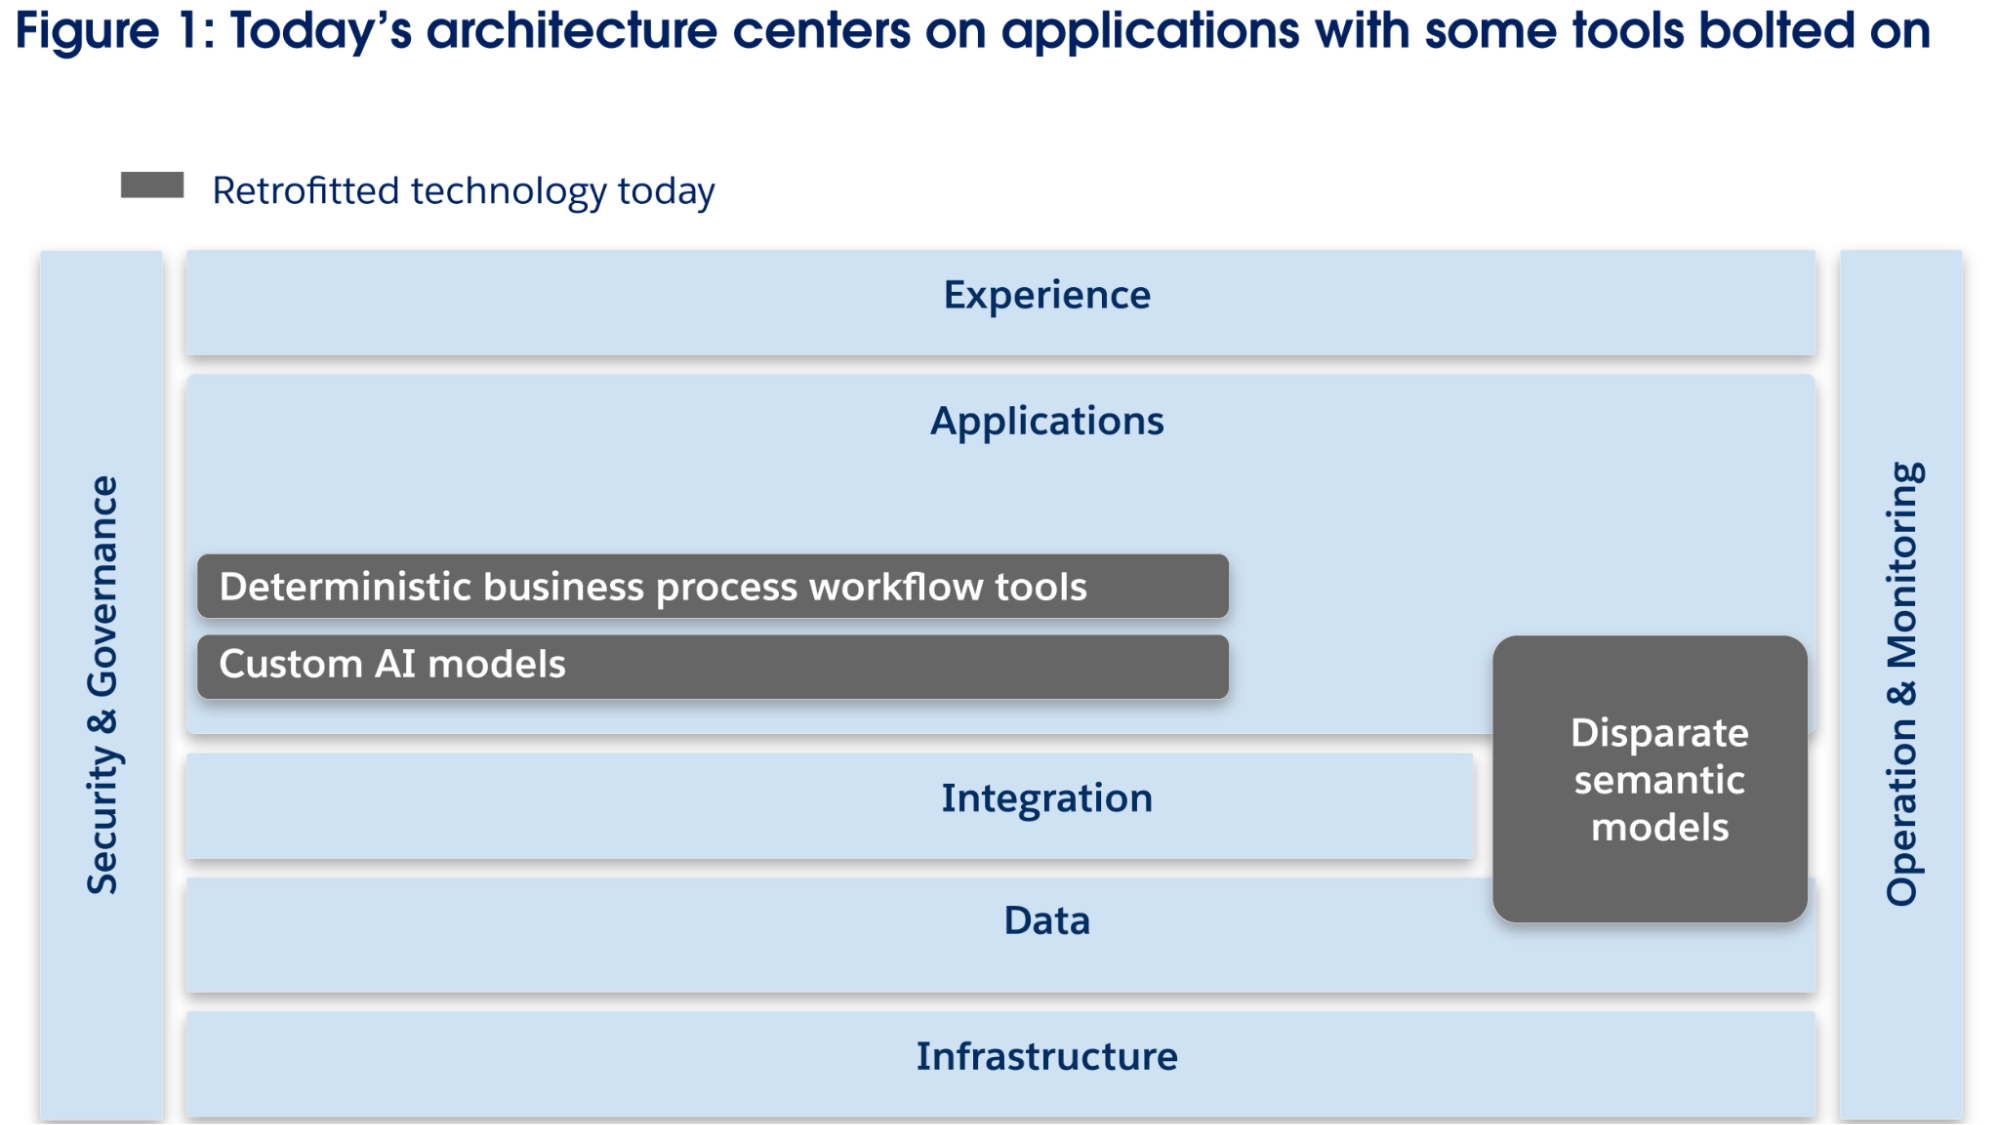 기존 아키텍처는 현재 AI 에이전트의 하위 규모 배포를 지원하지만 위에 설명된 에이전트 엔터프라이즈의 비즈니스 성능을 완전히 제공할 수 없습니다. 이러한 기능을 구현하려면 좁은 사용 사례를 대상으로 하는 제한된 배포로 제한되지 않고 광범위한 사용 사례를 해결할 수 있는 강력한 AI 에이전트의 광범위한 배포를 위해 고안된 IT 아키텍처가 필요합니다.
AI 에이전트는 향후 5년 동안 계속해서 개선될 예정이며, 향후의 검증을 위해 더 강력하고 지능적인 AI 에이전트의 가치를 실현하기 위해 IT 아키텍처가 발전해야 합니다. 먼저 기본 AI 모델(예: 다중 모달 LLM) 및 에이전트의 인지 아키텍처(예: 다단계 계획, 과업 세분화 등)가 발전함에 따라 에이전트가 더 지능적이 됩니다. 두 번째로, AI 에이전트는 메모리 향상, 자가 반영 기능, 사용자 의견에서 학습 능력을 통해 학습 및 적응 능력을 향상할 것입니다. 세 번째로, AI 에이전트는 개방형 기술 표준의 빠르게 발전하는 생태계(예: 모델 컨텍스트 프로토콜, Agent2Agent 등)에 의해 증명된 바와 같이 다른 에이전트, 도구, 데이터와 상호 작용할 수 있는 능력이 향상됩니다. 이러한 세 가지 기술 추세는 AI 에이전트가 더 추상적이고 복잡한 과업을 실행할 때 더욱 강력한 기능을 제공하지만 오늘날의 IT 아키텍처에도 많은 문제를 야기합니다.
먼저 AI 에이전트는 내부적으로 개발되고 외부에서 소싱되는 AI 모델에 근본적으로 의존하며, 이는 빠르게 발전하고 정교하고 공유되고 표준화된 AI/ML 모델 관리를 요구합니다. 오늘날 AI 모델은 교육, 배포, 거버넌스, 위험 관리에 대한 공통 도구와 함께 재사용할 수 있는 공유 기능이 아닌 응용 프로그램의 특정 사용 사례에 적용됩니다. 앞으로에는 에이전트가 비즈니스 컨텍스트를 기반으로 기본 모델(예: 기본 모델 및 도메인별 작은 모델)을 교체할 수 있는 도구가 필요한 다양한 에이전트 사용 사례에 다양한 AI 모델을 사용할 수 있어야 합니다. 따라서 일관성, 재사용 가능성, 확장성, 효율성을 보장하기 위해 내부적으로 개발되거나 호스팅되는 AI 모델을 통합 수명 주기 도구로 관리해야 합니다. 마찬가지로 외부에서 호스팅되는 AI 모델에 액세스하려면 최적의 성능, 보안, 규정 준수, 가용성, 신뢰성을 보장하기 위한 엔터프라이즈 전체 제어 프레임워크가 필요합니다.
두 번째로, AI 에이전트에는 호스팅, 개발, 추론, 학습, 메모리 관리, 운영과 같은 고유한 확장 패턴 및 운영 요구 사항이 있으므로 에이전트에게 별도의 전용 아키텍처 경계가 필요합니다. 이 기능을 오늘날의 정적 및 결정적 애플리케이션 아키텍처에 직접 포함하면 불필요한 아키텍처 복잡성과 위험이 발생합니다. 또한 AI 에이전트는 실시간 상호 작용을 위해 표준화된 인터페이스 또는 Messaging 시스템을 통해 기존 응용 프로그램과 상호 작용해야 합니다.
세 번째로, AI 에이전트는 서로 다른 데이터 집합을 고려하고 서로 공동 작업할 수 있어야 하며, 종종 사일로 애플리케이션 스택을 통해 작업할 수 있지만, 오늘날의 아키텍처에서는 이러한 에이전트가 서로 다른 데이터 집합을 고려할 수 있도록 공유 이해를 제공하는 공통 시맨틱 기능이 없습니다. 따라서 단일 용도 에이전트를 성공적으로 배포할 수 있지만 복잡한 교차 실로 과업에 대해 대량으로 작업하도록 확장하는 것은 어렵고 위험합니다.
마지막으로, 현재의 엔터프라이즈 IT 아키텍처는 더 강력한 에이전트가 수행하는 동적 워크플로를 포함하는 종단간 비즈니스 프로세스를 오케스트레이션, 최적화, 관리할 수 있는 효과적인 방법이 부족하며, 경우에 따라 해당 프로세스에서 인적 작업자가 수행하는 역할을 대체합니다. 현재 자동화 도구는 일반적으로 사전 정의된 순서에 따라, 프로세스별 언어로 문서화되고, 거의 변경되지 않는 정적 논리에 의존하는 선형 결정적 워크플로를 관리하기 위해 활용됩니다. AI 기술은 이러한 선형 프로세스 중 일부를 향상할 수 있습니다(예: 하드 코딩된 비즈니스 규칙 대신 ML 모델을 사용하여 대출 승인 임계값을 계산하는 등). 그러나 대부분의 중요한 비즈니스 프로세스의 전략 및 실행 측면은 본질적으로 동적이고 유연하게 유지됩니다. 마케팅 전략 개발, 복잡한 고객 문제 해결 또는 클라이언트 예상과 같은 과업에는 명확한 목표(고객 만족도, 사례 해결 속도 등)가 있지만, 사전 정의된 고정 실행 순서에 따르지 않습니다.
현재 기존 엔터프라이즈는 복잡한 비즈니스 프로세스(예: 전략 설정 및 복잡한 프로그램 관리)를 조정하고 수행하기 위해 주로 사람을 사용합니다. 향후 3~5년 동안 AI 에이전트가 계속해서 발전할수록(인텔리전스, 학습, 상호 작용 역량 향상) 이러한 동적 프로세스를 자동으로 실행할 수 있는 능력이 크게 확대되어 기존 통합 및 자동화 도구의 성능을 훨씬 뛰어넘는 복잡성과 통합 문제를 도입할 수 있습니다. AI 에이전트의 적응적이고 동적 특성은 특히 AI 에이전트, 인사, 자동화 도구 및 기타 결정적 시스템을 포함하는 복잡하고 길고 여러 단계의 워크플로를 관리하는 경우 엔터프라이즈 수준의 제어, 포괄적인 가시성, 엔터프라이즈 전체 전략 목표에 일관된 조율을 보장하기 위해 신규 오케스트레이션 기능을 필요로 합니다.
에이전트 엔터프라이즈의 IT 아키텍처는 인공 작업자, AI 에이전트, 결정적 시스템을 원활하게 통합하여 지능형 작업을 위한 플랫폼을 구축합니다. 이 아키텍처를 사용하면 인적 및 AI 에이전트가 다양한 데이터 소스에서 통합 엔터프라이즈 Knowledge 동적으로 액세스하고 활용할 수 있으며, 시맨틱 컨텍스트로 보강되어 복잡한 워크플로와 프로세스를 전략적 비즈니스 목표에 맞춰 효율적으로 실행할 수 있습니다. 사일로 플랫폼 및 포인트 솔루션 집합의 기존 IT 아키텍처는 새로운 지능형 비즈니스 프로세스 오케스트레이션 도구로 감독 및 관리되는 AI 에이전트의 구성 가능한 응용 프로그램 서비스, 시맨틱 및 데이터 도구, 네트워크 집합으로 발전합니다.
이 아키텍처를 사용하면 에이전트가 각 범위 내에서 이해, 이유, 조치를 취하고 비즈니스 도메인 내부 및 전반에서 작업하고 지속적으로 학습, 개선, 조정할 수 있습니다. 따라서 데이터 및 Knowledge 액세스하기 위한 강력한 메커니즘(시맨틱한 이해), 유연하고 표준화된 커뮤니케이션 프로토콜 및 인터페이스(예: 에이전트 간 커뮤니케이션, 결정적 시스템에 대한 에이전트, 사람에 대한 에이전트)에 초점을 맞춘 설계와 에이전트, 사람, 자동화 도구 및 결정적 시스템 간의 워크플로 및 프로세스를 중요한 방식으로 오케스트레이션해야 합니다.
### 아키텍처 원리
지능형 작업을 위한 플랫폼의 아키텍처 비전을 실현하기 위해 다음 설계 원칙을 모범 사례로 사용하는 것이 좋습니다.
- **구성 및 모듈화:** 표준화된 인터페이스를 사용하여 아키텍처 요소를 모듈식 구성 요소로 설계하여 에이전트 성능, 워크플로, 사람 접면 표면을 빠르고 동적으로 조립할 수 있습니다. 명확한 인터페이스 계약 및 추상화의 우선 순위를 지정하여 AI 에이전트가 워크플로를 가장 유연하게 작성할 수 있도록 합니다.
- **Data and semantic first:** 에이전트가 사일로 시스템 전반에서 효과적으로 설명할 수 있는 공유 시맨틱 이해를 통해 데이터에 포괄적이고 정확하고 빠르고 안전하며 비용 효율적으로 액세스할 수 있습니다. 이를 위해 데이터(및 메타데이터)를 제품으로 처리해야 하며, 품질, 계보, 거버넌스, 액세스를 보장하는 도구와 에이전트와 사람 간에 공유되는 의미 있는 이해를 제공하는 방법을 사용해야 합니다.
- **IT 및 비즈니스 관찰성 내장:** 전체 아키텍처 내에 종단간 모니터링, 추적, 평가, 설명 가능성 기능을 포함하여 에이전트의 사유, 동작, 시스템 상호 작용, 비즈니스 KPI에 미치는 영향에 대한 인사이트를 확보하여 에이전트의 성과를 지속적으로 최적화할 수 있습니다. 여기에는 비용 최적화(FinOps), 지속 가능성 메트릭 및 운영 텔레메트리가 포함되며 Trust, 규정 준수 및 책임 있는 리소스 소비를 유지합니다. AI 에이전트는 본질적으로 결정적이지 않으므로 관찰성이 AI 에이전트가 인적 감독을 통해 신뢰할 수 있고 규정을 준수하며 감사할 수 있는 방식으로 작업할 수 있도록 하는 것이 중요합니다.
- **Trust 전체:** 에이전트의 과업 의도(데이터 액세스, 작업 등)를 기반으로 동적이고 세분화된 권한을 적용하고 빨간색 팀 구성, 자동화된 CVE 스캔, 취약성 감지, 위험 기반 확인 제어 등 포괄적인 보안 관행을 구현합니다. 기계 속도에서 작업할 수 있는 능력으로 인해 에이전트가 계단식으로 위험을 야기할 수 있으므로 더욱 세부적이고 동적 조치가 필요합니다. 사용 또는 배달 전에 모든 AI 생성 출력(에이전트 또는 모델에서)이 정의된 규정 준수, 안전, 독성, 편향에 대해 엄격하게 검증되었는지 확인하십시오. 따라서 AI 결정, 작업, 콘텐츠, 예측에 대해 확인 가능한 감사 추적과 함께 로깅 및 설명 가능성 메커니즘이 필요합니다.
- **인간 감독이 있는 에이전트 우선:** AI 에이전트가 비즈니스 사용 사례를 해결하는 기본 도구가 되도록 하려면 비용, 기술적 적합성 등 기타 고려 사항을 제외하고 에이전트 워크플로에 액세스할 수 있도록 IT 시스템을 설계합니다. 여기에는 에이전트 프로세스의 모든 단계를 모니터링, 중재, 재정의할 수 있는 사람의 기능이 포함됩니다. 의사 결정에 대한 자신감이 사전 프로그래밍된 임계값 미만이면 에이전트에게 사전에 인적 지침을 요청하는 자체 반영 기능이 필요합니다.
- **대응형 및 멀티모델 상호 작용:** 에이전트 간 프로토콜, 사람 다중 모달 입력(음성, 텍스트, 시각), 비즈니스 이벤트, 시스템 신호, 스트리밍 데이터 등 모든 상호 작용 유형에 걸쳐 포괄적인 에이전트 호출 및 응답 메커니즘을 지원하도록 아키텍처를 활성화합니다. 이벤트 중심 및 실시간 처리 기능을 모두 활성화하여 에이전트가 모든 소스 또는 형식의 시기 적절한 신호에 반응할 수 있도록 합니다.
- **AI 지원 인프라:** 인프라는 변동하는 AI 워크로드를 처리하기 위해 내장된 중복성을 사용하여 유연하게 확장할 수 있으며, 데이터 보존 요구 사항을 준수하면서 ML/LLM 파이프라인을 데이터 및 응용 프로그램 아키텍처에 통합합니다.
- **개방된 생태계:** 개방형 표준, 프로토콜 및 잘 정의된 인터페이스(API, 이벤트)를 선호하여 상호 운용성에 우선 순위를 두고 기술 잠금을 피합니다.
## 아키텍처 레이어
에이전트 변환을 성공적으로 활성화하고 확장하려면 엔터프라이즈는 단순히 현재 레이어를 향상하는 것 이상을 거쳐야 하며, 특히 AI 에이전트의 요구를 충족하도록 설계된 4개의 추가 아키텍처 레이어(그림 2)를 명시적으로 도입하는 것을 고려해야 합니다.
**에이전트 계층**은 계획, 추론, 메모리, 도구 활용, 상태 관리 및 수명 주기 제어와 같은 인지 기능을 포함하는 AI 에이전트의 개발 및 관리에 전념합니다. 이 계층은 AI 에이전트의 고유한 기술 및 운영 요구 사항을 해결하고 표준화된 프로토콜을 통해 응용 프로그램 및 데이터 저장소 간 상호 운용성을 보장하며 에이전트 간 공동 작업을 촉진합니다. 기존 응용 프로그램 계층은 에이전트 워크플로에 대해 동적으로 구성할 응용 프로그램 서비스로 발전합니다.
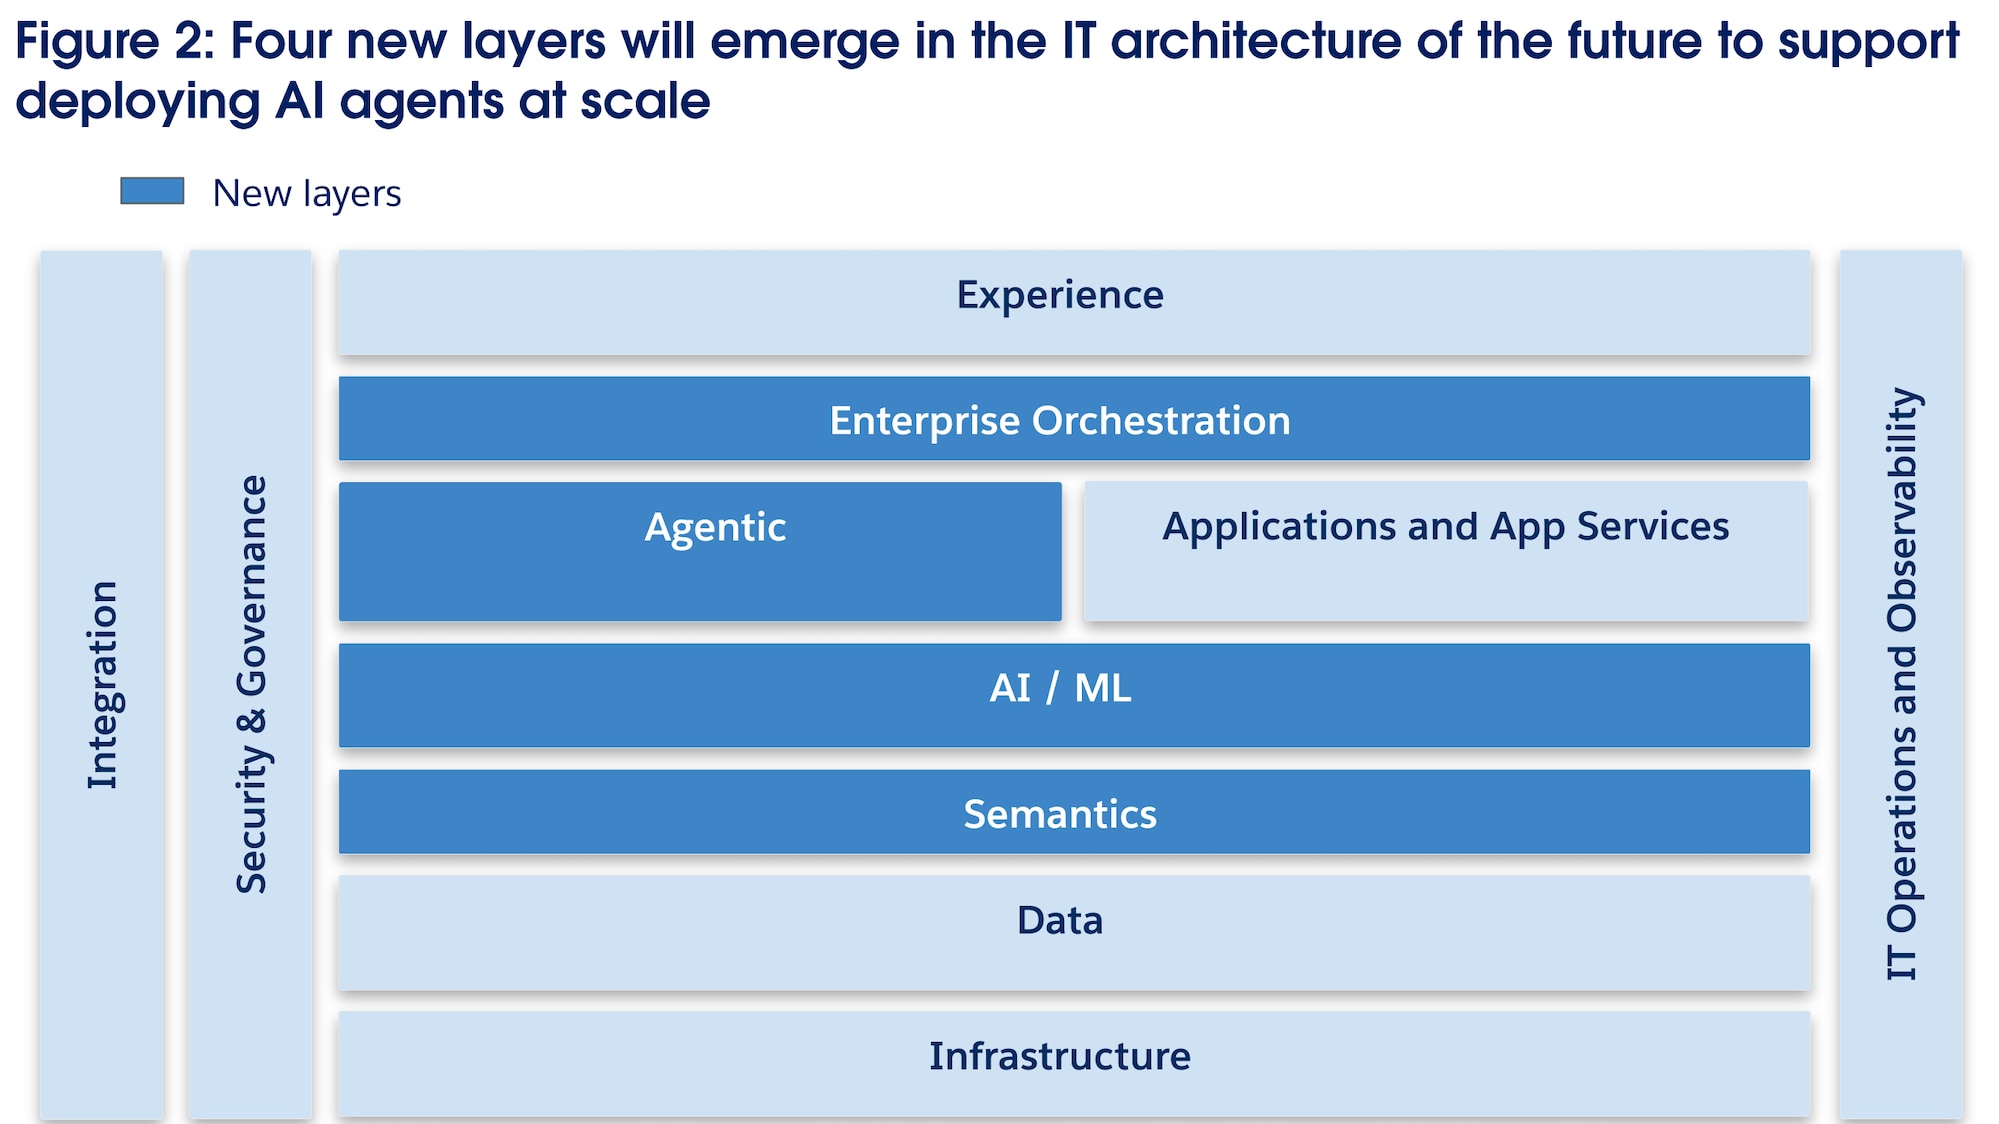 원시 엔터프라이즈 데이터와 AI 에이전트가 필요로 하는 시맨틱 이해 간의 연결 끊김을 해결하기 위해 **세맨틱 레이어**가 도입되었습니다. 비즈니스 엔티티, 개념, 정의, 상호 관계를 명시적으로 인코딩하고 관리하여 엔터프라이즈 엔터프라이즈 엔터프라이즈 엔터프라이즈 및 비즈니스 Knowledge 표현을 만들어 보다 복잡한 다중 에이전트 워크플로를 강화하는 공유 시맨틱 이해를 활성화합니다. 데이터 카탈로그 외에도 시맨틱 레이어는 자연어 쿼리를 특정 데이터 저장소에 대한 정밀한 쿼리로 변환하고 결과를 조화롭게 조정하고 에이전트에게 상황에 맞는 더 풍부한 답변을 반환합니다. 기존 데이터 레이어는 중앙 집중식 레이크하우스 채택을 통해 통합되고 AI 지원 데이터 패브릭을 통해 데이터 액세스를 확장하여 데이터 메쉬 운영 모델 원칙을 지원합니다.
**AI/ML 계층**은 대규모 언어 모델, 대규모 작업 모델 및 도메인별 ML 모델을 비롯한 엔터프라이즈 AI 기능의 관리를 중앙 집중화하여 수명 주기 동안 내부적으로 개발된 AI 모델과 외부 AI 서비스에 대한 제어된 액세스/사용을 모두 처리합니다. 응용 프로그램 내에 AI 모델이 포함된 기존 아키텍처와 달리 이 레이어는 AI 모델을 엔터프라이즈의 최상위 구성 요소 및 공유 서비스로 설정합니다. 외부 공급업체에서 제공하는 AI 기능이 아닌 엔터프라이즈 제어형 AI 기능에 초점을 맞춥니다. 이 계층은 Trust, 안전, 규정 준수 및 배포를 위한 표준화된 메커니즘을 통해 기업의 다양한 에이전트 및 기타 AI 워크로드에 대한 인텔리전스를 제공합니다.
**엔터프라이즈 오케스트레이션 계층**은 AI 에이전트, 사람, 자동화 도구, 결정적 시스템을 포함하는 복잡한 다단계 워크플로 및 비즈니스 프로세스를 조정, 관리 및 최적화하기 위한 기능적 추상화입니다. 이 계층은 MCP 및 A2A와 같은 개방형 프로토콜을 사용하여 개별 에이전트와 시스템이 전체 프로세스의 중앙 집중식 감독 및 조율을 제공하는 동시에 로컬로 구성된 과업을 자동으로 처리할 수 있는 블렌딩된 오케스트레이션 모델을 활용합니다. 블렌딩된 오케스트레이션 모델을 구현하기 위해 이 계층은 비즈니스 프로세스의 결정적 단계(설계 시간 동안 모델링)와 동적 단계(런타임 동안 에이전트가 결정)를 모두 정의하는 기계에서 읽을 수 있는 풍부한 의미 형식으로 중요한 비즈니스 프로세스를 나타내며, 이를 통해 관리 및 최적화를 위한 프로세스 모델 기반을 만듭니다.
일반적으로 사람 중심 비즈니스 프로세스의 상당 부분은 문서화되지 않거나 기계에서 읽을 수 있는 형태로 액세스할 수 없습니다. 그러나 과업 및 작업에 대한 풍부한 데이터 및 메타데이터를 포함하여 AI 에이전트의 활동을 자세히 관찰할 수 있으므로 동적, 이전에 구조화되지 않은 작업을 결정적 선형 워크플로와 수집, 문서화, 통합하여 포괄적인 프로세스 모델을 만들 수 있습니다. 자세한 프로세스 문서는 이전에 보이지 못했던 과업 상호 종속성 및 실행 경로를 포착하여 엔터프라이즈에서 운영 효율성을 지속적으로 최적화하고, 병목 지체를 효과적으로 해결하고, 에이전트가 식별한 모범 사례를 재사용 가능한 엔터프라이즈 전체 플레이북으로 체계적으로 코딩할 수 있습니다. 이렇게 하면 개별 프로세스 및 확장 시 전체 엔터프라이즈의 전체 디지털 쌍둥이가 생성됩니다.
예를 들어, 포괄적인 세일즈 전략 실행 또는 새 직원 온보딩과 같은 복잡한 프로세스에는 오케스트레이션 계층이 적절한 수준의 인적 참여(예: 예외 처리), AI 에이전트의 제한된 자율성, 규정 준수 적용을 보장할 수 있는 여러 상호 의존적인 단계가 포함됩니다. 해당 프로세스 전반에서 맨 아래 오케스트레이션 계층은 예측 가능성 및 거버넌스를 추가하고, 핵심 성과 지표(KPI)를 지속적으로 추적 및 평가하며, 워크플로 및 롤백 논리의 트랜잭션 무결성을 보장하고, 워크플로의 모든 스테이지에 대한 가시성을 유지하여 전체 비즈니스 목표에 부합합니다. 이 기능을 구현하기 위해 이 계층은 시맨틱 계층에 저장된 보안 및 거버넌스 계층( 정책-as-코드를 통해)의 정책, 규칙, 가드 레일과 비즈니스 목표, KPI를 사용합니다. AI 중심 상호 작용의 자율적이고 빠른 특성에 따라 분산된 연도에만 의존하면 특히 장기 실행 중인 다단계 워크플로에서 전략적 잘못 정렬 또는 규정 준수 위반이 발생할 수 있습니다. 블렌딩된 오케스트레이션 접근 방식은 복잡한 워크플로에 엔터프라이즈 전체 비즈니스 규칙, 규정 준수 확인, 정책 집행을 직접 포함하여 이러한 위험을 완화하고 중요한 상황에서 인적 감독을 통합합니다.
이러한 11개 레이어를 각각 사용하면 안전하고 신뢰할 수 있고 효과적인 방식으로 대규모로 AI 에이전트를 배포하는 데 특정 기능을 제공하여 에이전트 AI의 전체 잠재력을 확보하여 엔터프라이즈에서 작업을 수행하는 방식을 전환할 수 있습니다. 아래 섹션에서는 레이어의 기능, AI 에이전트 증가로 인한 새로운 변경 사항, 주요 기술 기능을 간략하게 설명합니다.
### 환경 계층
**기능:** 익스피리언스 레이어는 사용자의 기본 인터페이스로 사용되며, 입력(텍스트, 음성, 시각)을 수집하고 여러 장치에서 상황에 맞는 응답을 전달하여 다중 모달 상호 작용을 지원합니다. 작업을 위해 에이전트 계층에 사용자 의도를 원활하게 전달하고 에이전트 워크플로 내에서 에이전트 에스컬레이션 및 승인을 수행하는 동적 UI 및 시각화를 제공합니다.
**오늘과 다른 점:** AI는 자연어 처리, 상황에 대한 인지도, 사전 예방적 의사 결정 지원을 통해 기존 GUI 기반 인터페이스를 강화합니다. AI 에이전트는 사전에 상호 작용을 시작하여 모든 채널 및 모달에서 맞춤형 실시간 권장 사항을 전달할 수 있습니다.
**핵심 기술 기능:**
- **대화형 AI 및 디지털 도우미:** 기본적으로 UX를 활성화하여 AI 지원을 사용하여 사용자를 지원합니다.
- **속성 및 투명도 UI:** 따옴표 표시, 파일/시스템의 소스, 결정에 대한 접근 방식/논리와 같은 사용자 인터페이스에서 답변을 설명 가능한 상태로 만듭니다.
- **Proactive & Ambient 알림 서비스:** 에이전트가 사용자의 현재 컨텍스트를 기반으로 가장 적절한 채널 및 양식 요소에서 사용자에게 인사이트 또는 경고를 사전에 푸시할 수 있습니다.
- **옴니채널 환경:** 여정 연속성을 통해 모든 채널에서 원활하고 일관되고 통합된 환경을 제공합니다. 여기서 대화 및 과업은 앱이 아닌 사람을 따릅니다.
- **다중 모달 기능:** 에이전트가 가장 효율적인 모달로 정보를 이해하고 제시할 수 있도록 텍스트, 음성, 이미지, 터치, 비디오, AR/VR을 통해 에이전트 및 응용 프로그램과 상호 작용할 수 있습니다.
- **컨텍스트 인식 개인 설정 및 동적 UI:** 상황에 따라 인식되는 실시간(시간, 위치, 사용자 작업) 사용자 환경을 활성화하여 즉시 UI 생성을 비롯한 개인 설정을 활성화합니다.
### 에이전트 계층
**기능:** 에이전트 계층은 AI 에이전트가 익스피리언스 계층에서 과업을 분해하고 응용 프로그램 및 앱 서비스 계층 및 데이터 계층의 도구를 사용하여 워크플로를 동적으로 어셈블하여 과업을 실행하는 엔터프라이즈에서 작업을 수행하는 기본 런타임 환경 역할을 합니다. AI 에이전트의 구성 상태는 이 레이어에 저장 및 관리됩니다. 특정 과업에 대한 에이전트가 인스턴스화되고 나중에 특정 에이전트 인스턴스가 폐기됩니다. 이 구현을 통해 에이전트는 항상 오프라인 최적화(AI/ML의 기능, 관찰 가능성 및 오케스트레이션 계층 사용)를 기반으로 최신 구성 상태에서 호출할 수 있습니다. 이 계층은 AI 에이전트의 포괄적인 수명 주기 관리, 조정, 거버넌스를 책임집니다.
**오늘과 다른 점:** 이 계층은 현재의 편파된 파일럿 및 제한된 에이전트 배포 집합으로 나타납니다. 규칙 기반 Bot이 있지만 대규모로 배포된 적응형, 결정적이지 않은, 목표 지향 소프트웨어 프로그램은 거의 없습니다.
**핵심 기술 기능:**
- **에이전트 런타임 환경:** AI 에이전트의 수명 주기, 실행, 자원 할당을 관리합니다.
- **에이전트 수명 주기 관리 제품군:** 에이전트 활동 및 버전 관리에 대한 개발 프레임워크, 개발 및 테스트 도구, 관리 시스템이 포함됩니다.
- **에이전트 논리 엔진:** 에이전트가 복잡한 문제를 해결하기 위해 사용할 도구를 세분화하고 계획하고 결정할 수 있는 인지 프레임워크입니다.
- **에이전트 메모리 및 컨텍스트 저장소:** 에이전트 인스턴스가 이전 상호 작용에 대한 컨텍스트를 회수하고 유지하여 일관성과 개인 설정을 보장할 수 있습니다.
- **에이전트 상호 운용성 프로토콜:** 에이전트 간 커뮤니케이션(A2A) 및 외부 시스템과 인터페이스를 수행하는 에이전트(예: 모델 컨텍스트 프로토콜을 통해)를 위한 표준화된 인터페이스입니다.
- **도구 등록:** 특정 과업을 수행하기 위해 에이전트가 호출할 수 있는 선별된 내부 및 외부 지원 도구 집합입니다.
- **에이전트 등록:** 검색 및 성능 일치를 지원하는 사전 구축된 AI 솔루션 및 에이전트의 선별된 에코시스템입니다.
- **분산된 에이전트 정책 적용:** 에이전트가 조치를 취하기 전에 규정 준수를 직접 확인할 수 있도록 허용하여 엔터프라이즈 전체의 거버넌스를 활성화합니다.
- **에이전트 자기 반영 및 적응 프레임워크:** 에이전트가 자체 성과를 분석하고 사람의 승인을 받아 개선 사항을 트리거하거나 수정 사항을 제안할 수 있는 메커니즘을 제공합니다.
### AI/ML 레이어
**기능:** 이 계층은 중앙 집중식 인텔리전스 허브 역할을 하며, 에이전트 계층(및 응용 프로그램)에서 소비할 공유 서비스 집합으로 AI 모델을 제공하여 안전 프레임워크 및 모니터링 내장형으로 사유 및 의사 결정 기능을 강화합니다.
**오늘과 다른 점:** 기존에는 특정 응용 프로그램 내에 AI 모델이 포함되었습니다. 에이전트 엔터프라이즈의 IT 아키텍처에서 AI/ML 계층은 1차급 중앙 집중식 서비스 집합으로서, 개발에서 대규모 실시간 서비스에 이르는 전체 모델 수명 주기를 지원합니다.
**핵심 기술 기능:**
- **사전 구축된 기본 모델:** 광범위한 데이터 스펙트럼에 대해 교육된 대규모 ML 모델은 다양한 일반 과업을 수행할 수 있습니다.
- **Retryval-Augmented Generation(RAG):** 정확성을 향상하고 환각을 줄이기 위해 엔터프라이즈별 데이터에서 기본 모델을 기반으로 하는 AI 중심 파이프라인입니다.
- **AI Trust, Safety, & Governance Hub:** 편향 감지, 설명 가능성, 안전 모니터링과 같은 책임 있는 AI 원칙을 적용하기 위해 모델 수명 주기에 통합된 도구 제품군입니다.
- **모델 게이트웨이:** 모든 모델 추론 요청에 대한 단일 진입점 역할을 하는 라우팅 엔진으로, 다양한 내부 및 외부 모델에 대한 호출을 관리하여 비용, 성능, 규정 준수에 최적화합니다.
- **모델 개발 워크벤치:** 데이터 사전 처리, 모델 교육, 실험을 위한 도구가 포함된 데이터 과학자를 위한 통합 개발 환경입니다.
- **MLOps 및 Lifecycle Automation 파이프라인:** 기계 학습용 CI/CD 엔진으로, 교육에서 배포 및 사용 중지까지 모델의 수명 주기 전체를 자동화합니다.
- **모델 서비스 및 추론 런타임:** 실시간 사용을 위해 교육된 모델을 보안 API 끝점으로 배포하기 위한 확장 가능한 저지연 환경입니다.
- **모델 & 자산 등록:** 모델, 데이터 집합, 소스 코드를 포함하여 모든 AI/ML 자산에 대한 중앙 집중식 버전 관리 리포지토리로서 재현 가능성 및 감사 가능성을 보장합니다.
- **합성 데이터 생성 및 관리:** 중요한 정보를 노출하지 않고 실제 데이터의 통계 속성을 유지하는 합성 데이터를 생성 및 관리하는 도구입니다.
### 엔터프라이즈 오케스트레이션 계층
**기능:** 엔터프라이즈 오케스트레이션 계층은 에이전트 엔터프라이즈에서 종단간 작업을 위한 제어 플레인입니다. 에이전트 워크플로 및 상호 작용이 엔터프라이즈 목표 및 거버넌스 정책을 준수하도록 합니다. 다른 계층의 관찰 가능성 텔레매터리를 사용하여 포괄적인 비즈니스 프로세스 모델을 구축하여 시맨틱 계층에서 가져온 KPI에 대해 최적화할 수 있습니다. 이 레이어는 중요 워크플로를 위해 AI 에이전트의 각 새 인스턴스에 공유 컨텍스트 및 장기 실행 메모리를 제공합니다.
**오늘과 다른 점:** 이 레이어는 구조화된 결정적 단계와 사람과 에이전트가 수행하는 비정형 동적 작업을 모두 캡처하는 기계에서 읽을 수 있는 모델을 만들어 비즈니스 프로세스에 대한 통합 가시성을 제공합니다. 비즈니스 목표 및 규정 준수 규칙을 에이전트 직원을 관리하기 위한 에이전트 워크플로의 제약으로 프로그래밍 방식으로 인코딩하여 오늘날의 사람 중심 공동 작업 및 거버넌스 모델을 넘어갑니다.
**핵심 기술 기능:**
- **하이브리드 워크플로 실행 엔진:** "블렌딩된 오케스트레이션 모델"을 실행하는 핵심 런타임으로 로컬 에이전트 연계를 허용하면서 중앙 집중식 감독을 제공합니다.
- **프로세스 거버넌스 및 제약 엔진:** 선언적 비즈니스 규칙, 정책 및 제약을 사용하여 모든 비행 중 프로세스에 적용하는 실시간 거버넌스 서비스입니다.
- **공유 메모리 및 컨텍스트 관리:** 여러 단계에서 연속성과 일관성을 유지하기 위해 워크플로의 모든 작업자가 액세스할 수 있는 공유 메모리 레이어입니다.
- **프로세스 모델링 스튜디오:** 결정적 단계와 동적 목표 지향 단계를 모두 정의하는 기계에서 읽을 수 있는 시맨틱한 프로세스 모델을 만들고 관리하는 설계 시간 환경입니다.
- **프로세스 최적화 및 시뮬레이션:** 고급 분석, What-if 시뮬레이션, 예측 최적화를 위한 비즈니스 프로세스의 디지털 시뮬레이션을 구성하는 기능입니다.
- **프로세스 검색 및 상태 모니터링:** 프로세스 모델 및 실시간 데이터를 수집하여 프로세스 건전성의 비즈니스 메트릭에 대해 보고합니다.
- **디지털 트윈 프로세스 모델링:** 프로덕션에 영향을 미치지 않고 테스트, 변경 시뮬레이션, 최적화를 위한 실시간 실시간 워크플로의 미러입니다.
### 응용 프로그램 및 앱 서비스 계층
**기능:** 이 레이어는 에이전트가 사용할 수 있는 구성 가능한 모듈식 도구 및 서비스로 기존 비즈니스 응용 프로그램 기능을 노출합니다. 또한 사용자 환경에 에이전트 기능을 포함하기 위한 프레젠테이션 런타임 역할을 합니다. 응용 프로그램은 계속해서 레코드 시스템이지만 에이전트의 "헤드리스" 기능으로 재설계됩니다.
**오늘과 다른 점:** 응용 프로그램은 모노리틱 UI에서 에이전트가 API 및 이벤트를 통해 동적으로 호출할 수 있는 "백엔드 서비스"로 발전합니다. 이 계층은 AI 에이전트 및 모델과 기본적으로 통합되며, 코드 생성 LLM의 확산으로 인해 에이전트가 구축한 사용자 정의 마이크로 응용 프로그램 수가 증가합니다.
**핵심 기술 기능:**
- **모듈식 애플리케이션 서비스:** 통화할 에이전트에 대해 기계 읽기 작업으로 게시된 기존 응용 프로그램에서 분해된 비즈니스 논리입니다.
- **에이전트 내장 SDK:** 개발자가 에이전트를 응용 프로그램 UI에 직접 안전하게 포함할 수 있는 툴킷 및 라이브러리입니다.
- **동적 UI 생성 서비스:** AI 에이전트가 사용자 컨텍스트를 기반으로 UI 구성 요소를 실시간으로 생성 또는 수정할 수 있는 서비스입니다.
- **AI 기본 UI 프레임워크:** 확률적 데이터 관리 및 스트리밍 텍스트 응답 등 AI 기반 UI를 처리하기 위한 내장 지원을 통해 설계된 프런트 엔드 프레임워크입니다.
- **Agent-Infused Systems of Engagement:** 시각적 구성 요소를 통해 AI 에이전트 기능을 통합하는 엔터프라이즈 생산성 및 공동 작업 응용 프로그램입니다.
- **AI 향상된 로우 코드/노코드 애플리케이션 개발:** 사용자 및 에이전트가 자연어 및 프롬프트를 사용하여 사용자 정의 앱 및 서비스를 만들 수 있는 도구입니다.
- **에이전트용 앱 가드 레일 사용:** 속도 제한, 범위 지정 권한, 텔레메트리 등 에이전트 사용에 대한 응용 프로그램 측 제어
### 시맨틱 레이어
**기능:** 시맨틱 레이어는 엔터프라이즈 전반에 걸쳐 데이터 및 Knowledge 대한 통합적인 이해를 제공하므로 사람과 AI 에이전트가 정보를 일관되게 해석하고 조치를 취할 수 있습니다. 그것은 본문학 및 Knowledge 그래프와 같은 Knowledge 표현 도구를 사용하여 자연어 쿼리를 정확하고 컨텍스트 인식 데이터 쿼리로 번역합니다.
**오늘과 다른 점:** 오늘날의 기업에는 서로 다른 메타데이터 저장소가 있지만, 에이전트 엔터프라이즈의 IT 아키텍처는 명시적으로 정의된 시맨틱 관계로 도메인 간 데이터를 연결하는 중앙 집중식 엔터프라이즈 Knowledge 그래프(EKG)를 필요로 합니다. 이는 AI 에이전트가 복잡한 추론을 수행할 수 있는 풍부한 컨텍스트를 제공하며, 여러 기능 영역에 걸쳐 Knowledge 그래프를 강화할 수 있는 기술 기능의 집합에 대한 요구 사항을 만듭니다.
**핵심 기술 기능:**
- **메타데이터 서비스:** 데이터 계보, 소유권, 분류를 비롯한 설명 메타데이터를 제공합니다.
- **비즈니스 용어집 및 분류 관리:** 비즈니스 사용자가 표준 비즈니스 용어를 정의하고 동의할 수 있는 도구입니다.
- **세맨틱 모델 관리:** Knowledge 엔지니어가 시맨틱한 모델과 본문을 만들고 관리하고 관리할 수 있는 워크벤치입니다.
- **Enterprise Knowledge 그래프(EKG):** 비즈니스 엔티티 간 관계를 저장하고 매핑하는 엔터프라이즈 본문학의 런타임 인스턴스입니다.
- **메타데이터 수집 및 조합 엔진:** 다양한 소스 시스템에서 엔터프라이즈 Knowledge 그래프를 채우고 유지 관리하는 자동 파이프라인입니다.
- **시맨틱 쿼리 엔진**: 자연어 쿼리를 해석하고 다양한 소스에서 데이터를 검색하기 위해 EKG를 기반으로 구조화된 쿼리를 구성합니다.
- **Semantic Reasoning Engine:** ECG에서 암시적 Knowledge 및 숨겨진 관계를 분석하고 파생합니다.
### 데이터 레이어
**기능:** 데이터 레이어는 시맨틱 레이어가 해석할 수 있는 모든 엔터프라이즈 데이터, 교육에 사용할 수 있는 AI/ML 레이어, 트랜잭션에 사용할 수 있는 응용 프로그램, 추론을 위한 에이전트에 대해 안전하고 관리되는 액세스를 관리하고 제공하는 신뢰할 수 있는 기본 소스입니다.
**오늘과 다른 점:** 데이터 레이어는 더욱 통합적이고 실시간이며 거버넌스에 초점을 맞추며 클라우드 규모 데이터 레이크하우스에 중심을 두는 경우가 많습니다. 반응형 에이전트를 지원하기 위해 더 많은 용량과 다양한 데이터를 처리하고 배치 지향 처리를 실시간 스트리밍으로 전환해야 합니다. 데이터 거버넌스 및 품질은 결함이 있는 데이터가 결함이 있는 AI 출력을 생성하지 못하도록 방지하기 위해 더욱 중요합니다.
**핵심 기술 기능:**
- **VectorDB:** RAG에 매우 중요한 고차원 벡터 임베딩을 저장하고 쿼리하기 위해 최적화된 전문 데이터베이스입니다.
- **인텔리전트 분석 데이터 파이프라인:** 데이터 계층에 데이터 수집, 변환, 로드(ETL/ELT)를 위한 자동화된 메타데이터 중심 서비스입니다.
- **Enterprise Data Lakehouse:** 분석 및 AI 워크로드 모두에 최적화된 구조화된, 반정형, 비정형 데이터의 중앙 리포지토리입니다.
- **제로 카피 데이터 연합 및 검색:** 물리적 데이터 이동 없이 여러 매장의 데이터에 액세스, 쿼리, 검색을 위한 기술입니다.
- **Natural Language to SQL:** 자연어 쿼리를 SQL로 변환하는 기법입니다.
- **엔터프라이즈 데이터 카탈로그 및 검색 서비스:** 엔터프라이즈 전반에 걸친 모든 데이터 자산의 중앙 집중식 검색 가능 재고입니다.
- **마스터 & 참조 데이터 관리 (MDM):** 고객 및 제품과 같은 중요 비즈니스 엔티티에 대한 "골든 레코드"를 관리합니다.
- **적응형 데이터 품질 서비스:** AI를 사용하여 실시간으로 데이터 품질 문제 자동으로 감지하고 수정하는 연속 모니터링 서비스입니다.
- **데이터 계약:** 데이터 교환의 스키마, 의미론, SLA를 지정하는 데이터 프로듀서와 소비자 간의 기계 판독 가능한 협약입니다.
- **AI 전문 데이터 저장소:** 시계열 또는 그래프 데이터베이스와 같은 특정 AI 사용 사례에 맞게 설계된 데이터베이스입니다.
- **AI-Ready Data Fabric:** 서로 다른 물리적 시스템 전반에서 데이터의 통합 가상화를 제공하는 논리적 데이터 추상 레이어입니다.
- **실시간 데이터 처리:** 시스템 속도에서 지속적으로 다중 모달 데이터 스트림을 처리하고 분석하는 기능입니다.
### 인프라 계층
**기능:** 인프라 계층은 다른 모든 계층을 기반으로 하며, 복원 가능하고 비용 효율적인 방식으로 AI 및 에이전트 워크로드를 대규모로 실행하는 데 필요한 계산, 저장소, 네트워크, 클라우드 기능을 제공합니다.
**오늘과 다른 점:** AI 워크로드는 에이전트 시스템의 확률적 특성을 처리하기 위해 더 높은 확장성과 탄력을 필요로 합니다. 인프라스트럭처는 신속한 프로비저닝, GPU와 같은 특수 하드웨어, 대기 시간이 낮은 고처리량 네트워크 트래픽을 지원하여 에이전트 간 통신을 수행해야 합니다.
**핵심 기술 기능:**
- **Code인 인프라:** CI/CD 배포 파이프라인을 사용하여 인프라를 자동으로 프로비저닝하고 관리합니다.
- **하이브리드 및 멀티 클라우드 AI 인프라:** 생성형 AI 워크로드를 위한 퍼블릭 클라우드 탄력성 및 전문 인프라를 활용합니다.
- **AI 최적화 컴퓨팅, 스토리지 및 네트워크:** AI 워크로드의 변수 수요를 기반으로 인프라 자원을 동적으로 할당하고 규모를 조정합니다.
- **Edge AI 인프라:** 고유한 대기 시간 또는 개인 정보 보호 요구 사항이 있는 사용 사례에 대해 네트워크 가장자리에 AI 모델 및 에이전트를 배포할 수 있습니다.
- **자기 치료 인프라:** AI를 사용하여 수동 입력 없이 시스템 복구를 관리하여 고가용성을 보장합니다.
- **지속적인 AI 컴퓨팅:** 에너지 효율적인 접근 방식으로 AI 워크로드의 환경 영향을 완화합니다.
- **비용 및 탄소 인식 자동 확장:** FinOps 및 지속 가능성 신호를 사용하여 수용력 확장 및 배치를 촉진합니다.
### 통합 레이어
**기능:** 통합 계층은 API, 이벤트, 프로토콜, 미들웨어를 통해 모든 시스템(레거시 및 신규)의 범용 커뮤니케이션 패브릭 역할을 하여 에이전트가 서비스, 데이터, 도구를 원활하게 검색하고 상호 작용할 수 있도록 합니다.
**오늘과 다른 점:** AI 에이전트의 동적 다대다 커뮤니케이션 패턴을 지원하도록 통합을 발전시켜야 하며, 몇몇 알려진 시스템 간의 사전 결정된 정적 상호 작용을 처리하지 않아야 합니다. 실시간 데이터 처리가 필요하며 에이전트 간의 특별 검색 및 공동 작업을 수용해야 합니다.
**핵심 기술 기능:**
- **운영 데이터 연결 파이프라인:** API 기반, 이벤트 기반, 역 ETL 기능을 비롯한 자동 스키마 매핑, 데이터 변환, 워크플로 생성을 위한 AI 지원 도구입니다.
- **Adaptive API Management 및 Service Mesh:** 에이전트에 대한 적응형 정책을 적용하여 서비스를 동적으로 등록, 검색, 관리할 수 있는 API 게이트웨이 및 서비스 메쉬 기술입니다.
- **Semantic Knowledge 어댑터:** 일관된 데이터 해석을 위해 에이전트 및 응용 프로그램 전체에서 공유된 용어와 데이터 모델을 제공하는 통합 구성 요소입니다.
- **이벤트 구동 통합 패브릭:** 분리된 비동기식 커뮤니케이션을 지원하는 대기 시간이 낮은 고처리용 Messaging 및 스트리밍 백본입니다.
- **에이전트 프로토콜 게이트웨이:** 에이전트가 도구를 안전하게 검색하고 작업을 트리거하여 MCP를 내부 API 및 이벤트에 연결할 수 있는 MCP 서비스의 게이트웨이입니다.
- **Composable Capability 카탈로그 및 마켓플레이스:** API, 서비스, 에이전트 기술, 모델, 데이터 집합 등 모든 엔터프라이즈 기능에 대한 중앙 집중식 관리 카탈로그, 주문형 구성용 시맨틱 메타데이터에 주석이 지정되어 있습니다.
### IT 운영 및 관찰 가능성 계층
**기능:** 이 계층은 에이전트 및 전체 시스템의 상태 및 운영 성과(관찰 가능 내장형 원칙)를 모니터링 및 관리하며, 인사이트를 생성하여 엔터프라이즈의 에이전트 직원에 대한 감사, 디버깅, 설명 가능성, 비용, 자원 최적화를 활성화하여 투명성과 제어를 제공합니다.
**오늘과 다른 점**: AI 에이전트가 기계 속도에서 오류를 일으킬 위험에 따라 이 계층이 더욱 중요해집니다. 자율 에이전트의 예측할 수 없는 동작을 포함하도록 인프라 모니터링을 넘어 확장해야 하며, 이는 새로운 유형의 텔레메트리와 기술 성능뿐만 아니라 시맨틱 정확성을 이해할 수 있는 기능을 요구합니다.
**핵심 기술 기능:**
- **실시간 모니터링 및 관찰 플랫폼:** ML 메트릭 및 에이전트 동작에 대한 확장과 함께 전체 IT 환경 전반에서 로그, 메트릭, 추적을 지속적으로 수집합니다.
- **FinOps 및 클라우드 비용 관리:** AI 및 에이전트 작업 부하와 관련된 인프라 비용을 모니터링, 분석, 최적화할 책임이 있습니다.
- **에이전트 및 ML별 모니터링:** 변경할 수 없는 감사 추적에 에이전트 실행의 각 단계를 기록하고 에이전트 동작을 지속적으로 프로파일링하여 설정된 표준과의 편차를 감지합니다.
- **AIOps, 사고 및 변경 관리:** AI/ML을 사용하여 잠재적인 IT 문제를 예측하고, 근본 원인을 식별하고, 수정 워크플로를 만듭니다.
- **마감된 학습 피드백 루프:** 에이전트의 관찰 가능성 Telemetry를 MLOps 파이프라인으로 다시 통합하여 자동 모델 재교육 또는 프롬프트 조정을 활성화합니다.
- **Semantic Observability Engine:** 관찰 가능성을 컨텍스트화용 시맨틱 레이어와 통합하여 에이전트 동작에서 시맨틱 변칙을 감지할 수 있습니다.
### 보안 및 거버넌스 계층
**목적:** 이 계층은 위협으로부터 엔터프라이즈 자산을 보호하고 위험을 관리하며 규제 요구 사항을 준수하여 아키텍처 전반에 걸쳐 Trust 안전을 포함합니다. ID 관리, 위협 감지, GRC, AI별 보안 조치가 포함됩니다.
**오늘과 다른 점:** 보안 계층은 신속한 주사 및 모델 중독과 같이 AI 모델 및 에이전트가 제공하는 새로운 공격 영역을 해결하려면 발전해야 합니다. ID 및 액세스 관리는 정적 역할 기반 컨트롤에서 적시에 부여되고 사용 후 즉시 해지되는 동적 의도 기반 권한으로 전환해야 합니다.
**핵심 기술 기능:**
- **LLM 입력/출력 보안 및 가드레일:** 안전하지 않은 콘텐츠, PII 누출, 실수 방지를 차단하기 위해 프롬프트 및 응답 시간에 엔터프라이즈 가드 레일이 적용됩니다.
- **AI 검증을 통한 Zero Trust 아키텍처:** AI 기반 동작 분석으로 향상된 연속 인증으로 특정 과업을 기반으로 에이전트에게 세분화된 적시 액세스 권한을 제공합니다.
- **에이전트 보안 프레임워크:** 에이전트 활동을 안전하게 중단할 수 있는 정밀 세분화된 권한 모델, 유해한 동작 모니터링, 제어 메커니즘
- **AI 모델 보안:** 모델 수명 주기의 각 스테이지에 대한 제어 기능이 포함된 심층적인 방어 전략으로, 독성, 추출, 대립 공격으로부터 보호합니다.
- **개인 정보 보호 AI:** 민감한 데이터를 보호하기 위해 연합 학습 및 차별 개인 정보 보호와 같은 기술을 사용합니다.
- **AI 향상 GRC:** AI 에이전트를 사용하여 IT 아키텍처의 컨트롤 준수를 지속적으로 모니터링합니다.
- **Policy-as-Code Engine:** 에이전트 행동에 대한 가드 레일을 설정하기 위해 선언적이고 기계에서 읽을 수 있는 형식으로 비즈니스 규칙 및 규정 준수 제약을 정의하기 위한 신뢰할 수 있는 단일 소스입니다.
- **Continuous Red-Teaming:** AI 모델 및 에이전트의 자동화된 지속적인 대립 테스트를 통해 공격자가 취약점을 활용하기 전에 취약점을 식별합니다.
## 에이전트 엔터프라이즈에 대한 참조 아키텍처 로드맵
에이전트 엔터프라이즈로 전환하려면 기술 기반을 설정하고 실질적인 비즈니스 가치를 만드는 여러 단계의 여정을 수행해야 합니다(아래 그림 3 참조). 정확한 로드맵은 엔터프라이즈의 전략, 문화, AI 거버넌스 모델 및 IT 아키텍처 시작 지점에 따라 다르지만 대부분의 조직은 지속적인 IT 투자로 범위, 복잡성, 가치 창출이 증가함에 따라 단계별 접근 방식을 채택해야 합니다. Salesforce의 [에이전트 성숙도 모델](https://www.salesforce.com/news/stories/agentic-maturity-model/)은 기업이 변환을 전략화할 수 있는 성숙도 수준의 유용한 프레임워크를 제공하며, 에이전트 기능이 기본 정보 검색(레벨 1)에서 더욱 복잡한 다중 도메인(레벨 2 및 3) 및 다중 에이전트 워크플로(레벨 4)에 이르기까지 어떻게 증가할 수 있는지 간략하게 설명합니다. 이러한 단계를 성공적으로 진행하려면 AI 에이전트의 보다 복잡하고 가치가 높은 배포의 요구를 충족하기 위해 각 단계에서 서로 다른 계층의 아키텍처에 대한 대상 투자와 함께 IT 아키텍처가 조율된 방식으로 발전해야 합니다. 각 성숙도 수준에 대해 11개의 아키텍처 계층에서 필요한 특정 기술 기능이 투자 이유와 함께 식별됩니다.
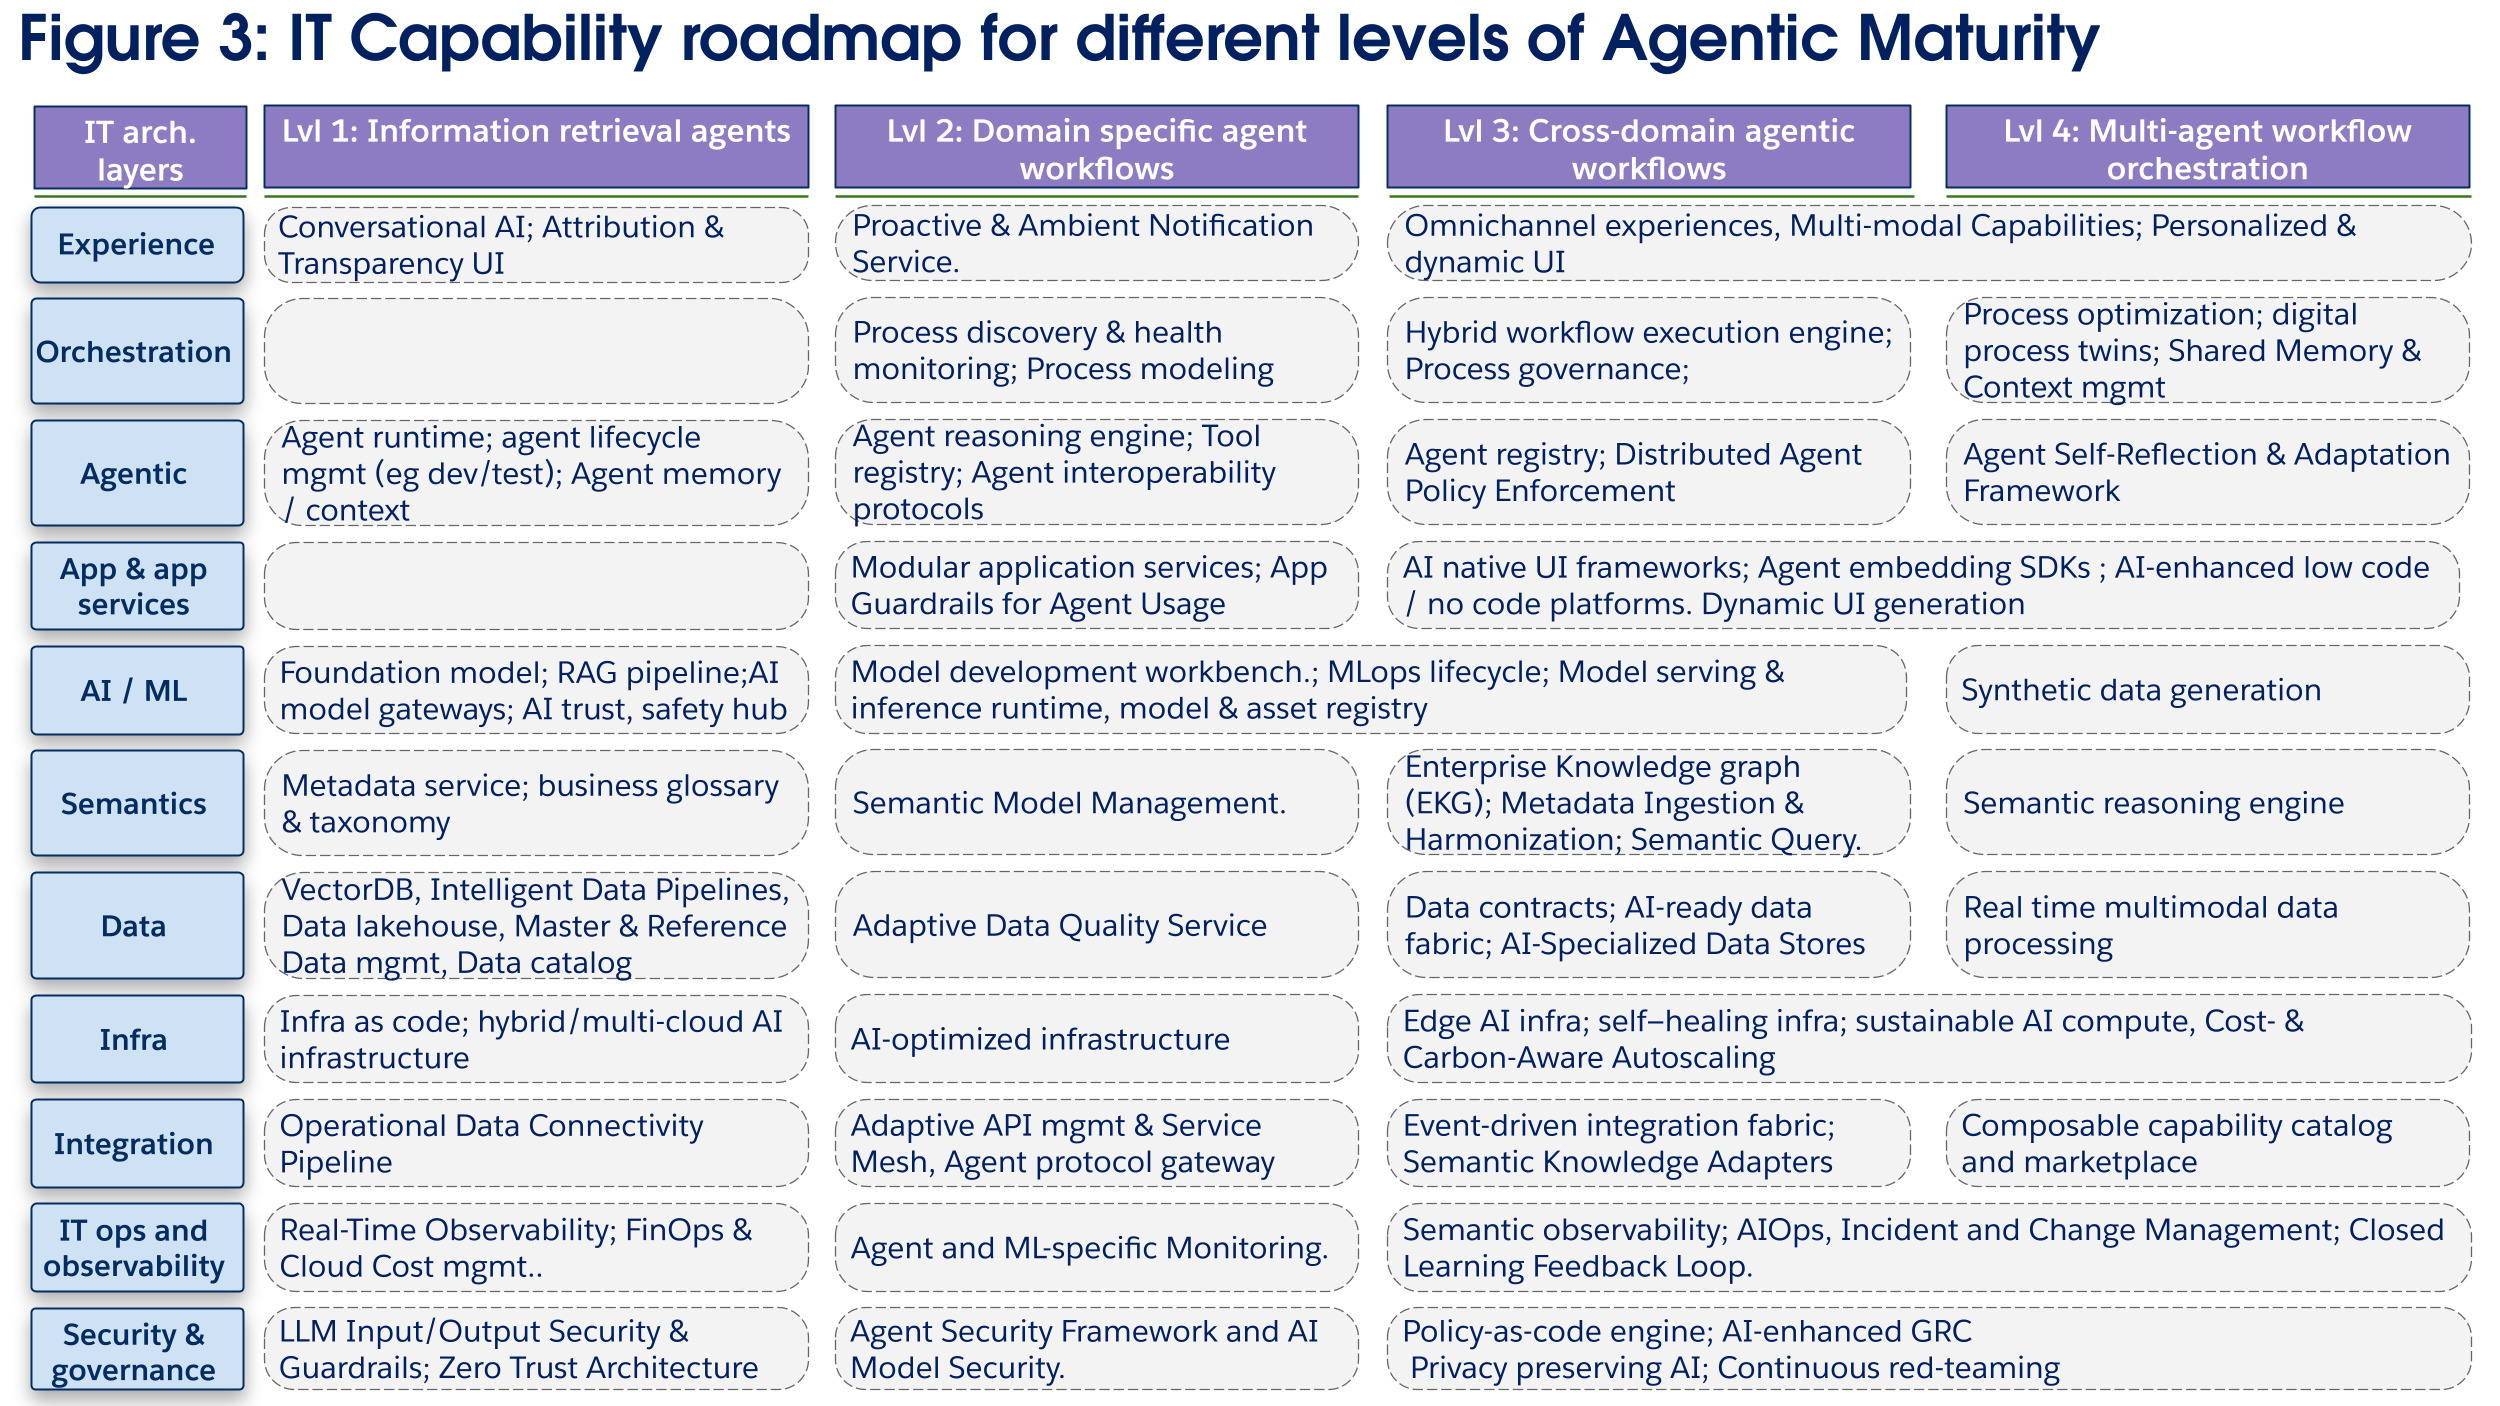 **성숙도 레벨 1: 정보 검색 에이전트**
**비즈니스 목표 및 가치: 기업 Knowledge를 쿼리할 수 있는 신뢰할 수 있는 대화형 인터페이스를 제공하여 인적 작업자의 생산성을 높입니다.** 기본값은 사람의 성능을 대체하는 것이 아니라 향상시키는 것입니다. 해당 에이전트는 정보를 검색하고 조치를 권장하여 사람을 지원합니다.
**아키텍처 초점:** 안전하고 신뢰할 수 있는 데이터 파운데이션과 정보 검색에 필요한 기본 AI 구성 요소를 구축하는 데 중점을 두고 있습니다. 사용자 Trust 구축하고 비용을 관리하기 위해서는 처음부터 거버넌스 및 관찰 가능성이 중요합니다.
**핵심 기술 투자(그림 4):**
이 단계에서 IT 부서는 신뢰할 수 있는 데이터-에이전트 파이프라인 및 기타 기초 기능을 만드는 데 집중해야 합니다. **벡터DB**와 같은 **데이터 레이어**의 기술은 정보 검색 에이전트를 구동하는 검색 증강 생성(RAG) 기술을 활성화하는 데 필수적입니다. 이 기능은 기본 모델에 대한 보안 및 비용 관리 액세스를 위한 **모델 게이트웨이**와 안전하지 않은 출력을 모니터링하고 규정 준수를 보장하는 **AI Trust, Safety & Governance Hub**를 포함하는 중앙 집중식 **AI/ML 레이어**와 함께 제공됩니다. **Semantic** **Layer**의 **마스터 데이터 관리** 및 **비즈니스 용어집**은 에이전트가 정확한 정보를 가져오는 데 매우 중요합니다. 이 단계에서 구축된 에이전트를 향후 사용 사례에 맞게 수정하고 확장할 수 있도록 에이전트 런타임 및 수명 주기 기능이 필요합니다. 가치를 제공하고 사용자의 신뢰를 구축하려면 **익스피리언스 레이어에** **속성 및 투명성 UI**가 포함되어 있어야 하며, 에이전트의 응답은 인용과 해당 정보의 출처를 표시하여 설명할 수 있습니다. 기본 관찰 가능성 및 보안 투자(예: **제로** **트러스트**)는 미래의 에이전트 배포를 위한 기초를 마련하기 위해 구현을 시작해야 합니다.
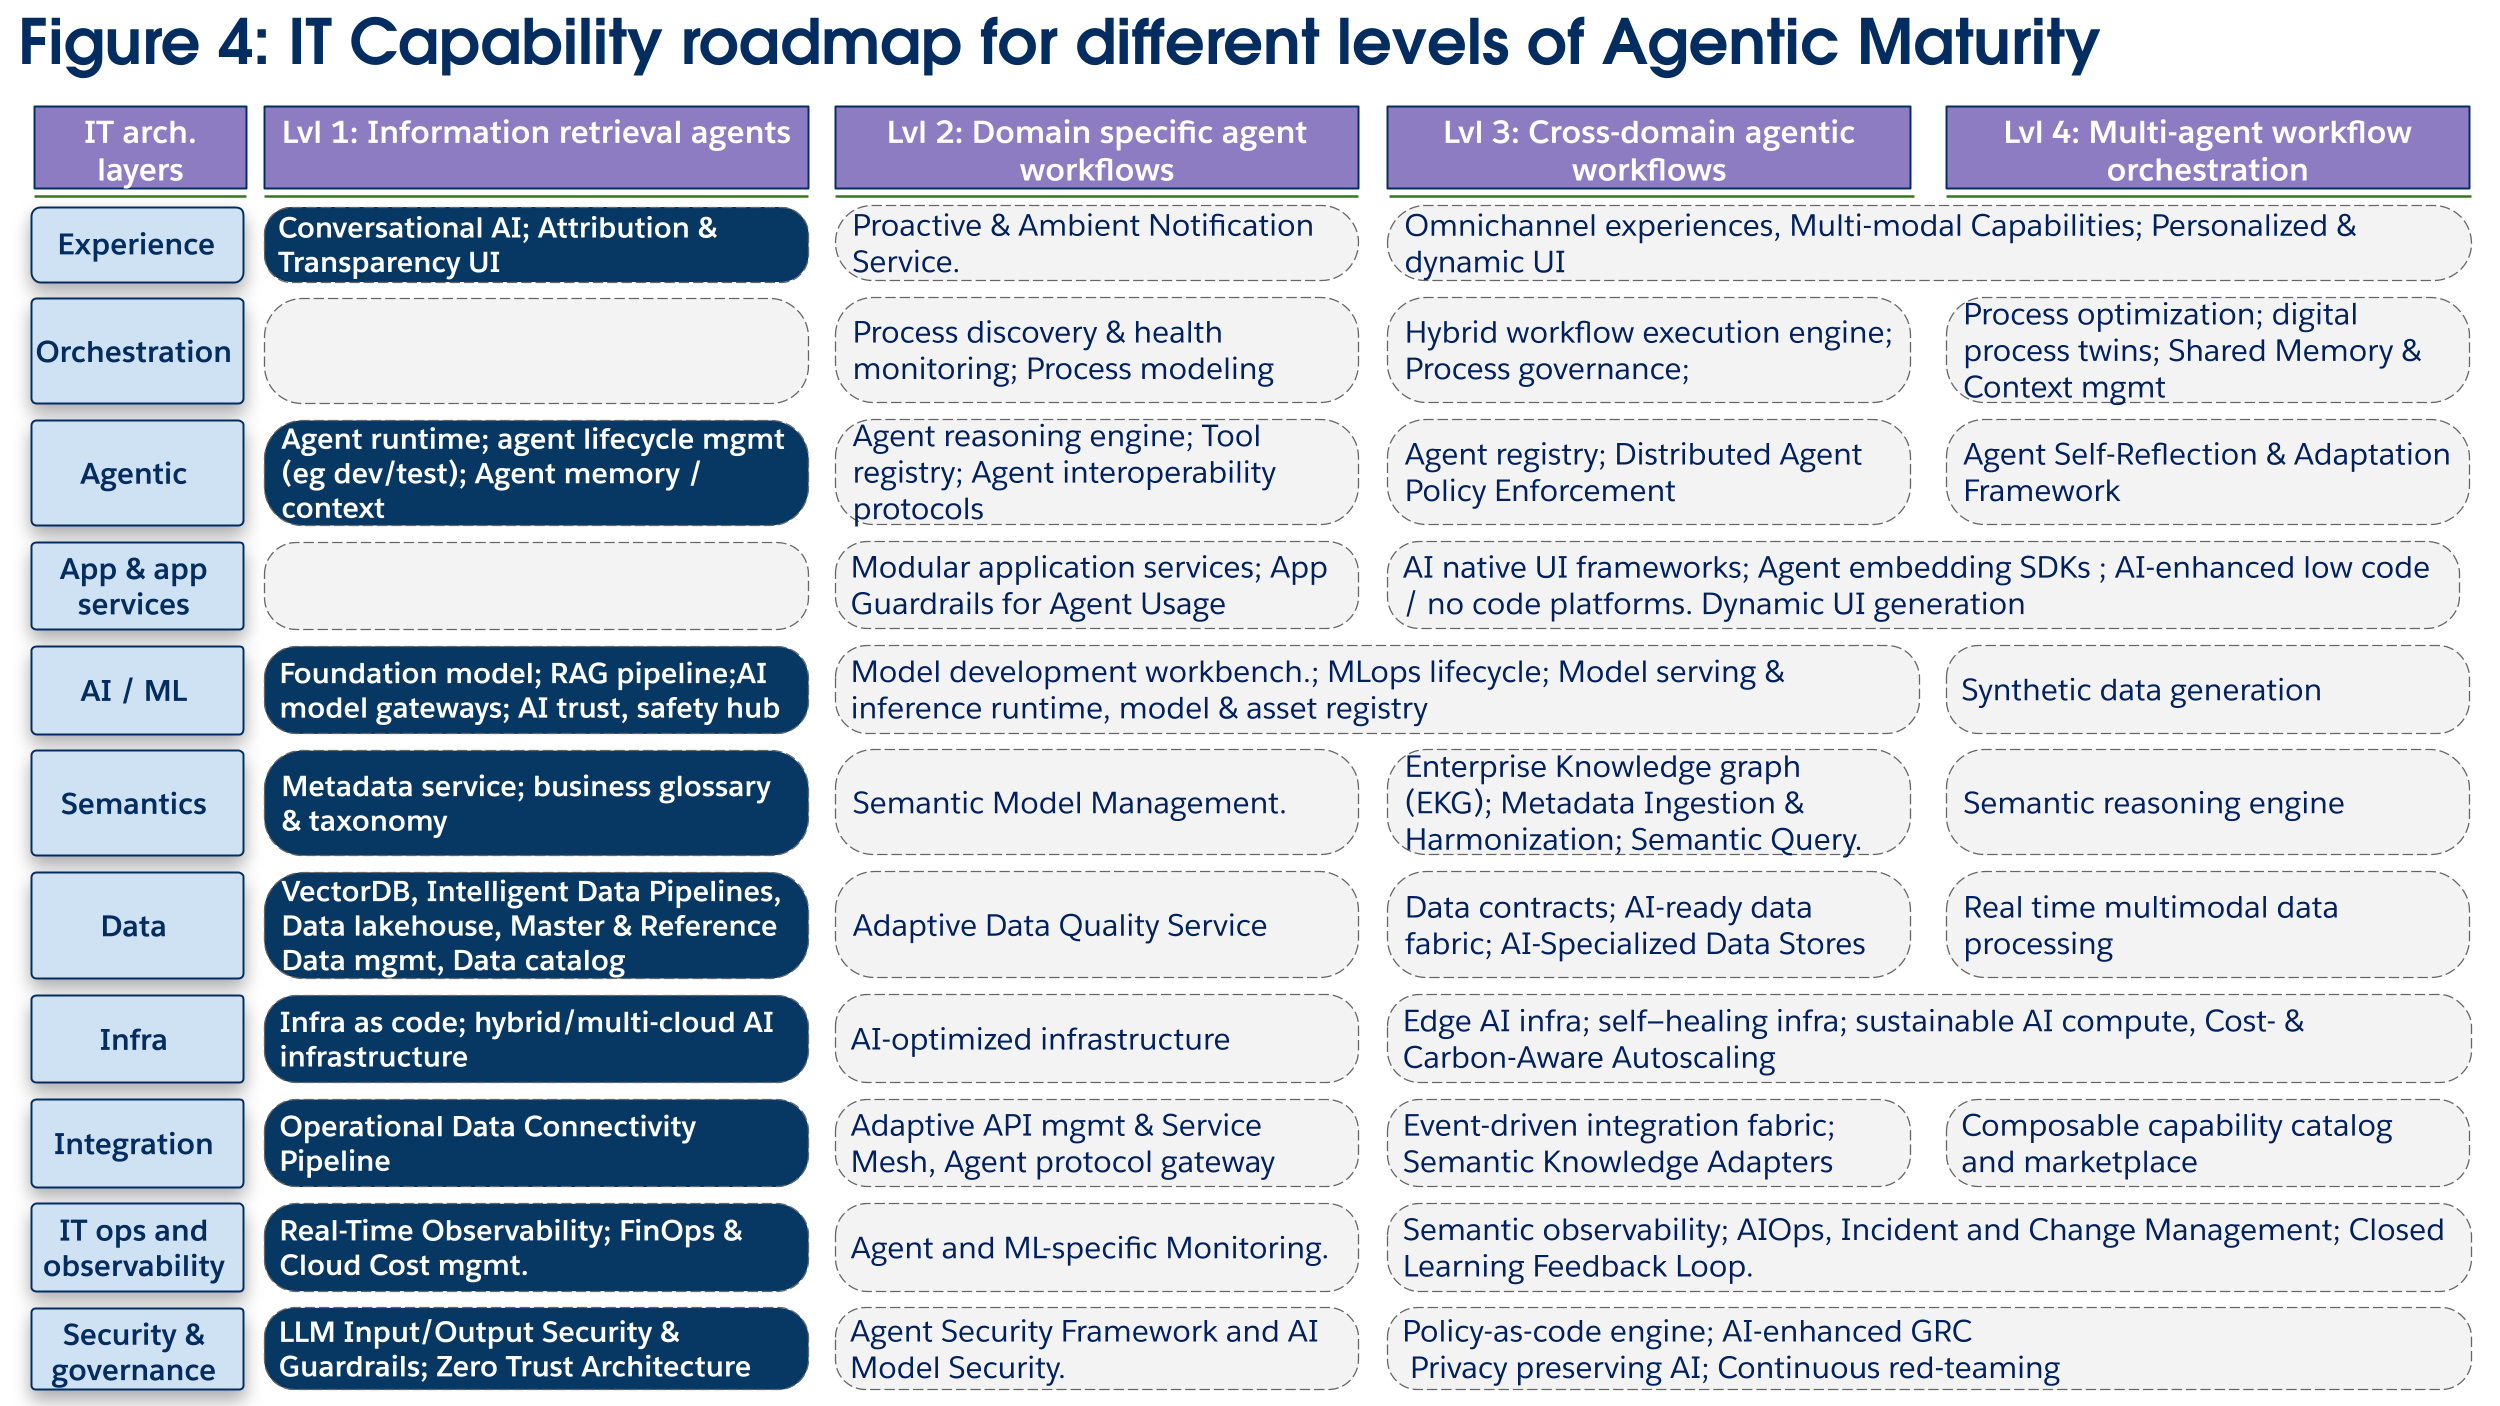 **성숙도 레벨 2: 단순 오케스트레이션, 단일 도메인 에이전트**
**비즈니스 목표 및 가치: 일상적인 작업을 자동화하고 단일 비즈니스 도메인 내에서 복잡도가 낮은 워크플로를 오케스트레이션합니다.** 이렇게 하면 운영 효율성이 향상되고 수동 작업이 줄어들어 더 중요한 활동에 집중할 수 있습니다.
**아키텍처 초점:** 주요 아키텍처 변화는 읽기 전용 데이터 검색에서 작업 실행으로 이동합니다. 이를 위해 에이전트가 액세스할 수 있도록 응용 프로그램 기능(주로 API로 노출됨)을 모듈화하고, 에이전트 작업에 강력한 보안을 구현하고, 시맨틱 및 AI 개발 기능을 구축하여 AI 에이전트의 인텔리전스를 향상해야 합니다.
**핵심 기술 투자(그림 5):**
투자는 주제적으로 AI 에이전트가 적절한 거버넌스를 통해 조치를 취할 수 있도록 합니다. **응용 프로그램 및 앱 서비스 계층**은 단일 비즈니스 논리가 에이전트가 호출할 수 있는 **모듈식 응용 프로그램 서비스**(API)로 분해되므로 중요한 변화를 겪고 있습니다. 이들은 관찰 가능성 도구에 통합되어 에이전트가 시스템을 압도하는 것을 방지하기 위해 **App Guardrails**로 보호됩니다. 이러한 에이전트를 강화하려면 에이전트 논리, 도구 프로토콜(MCP 등) 및 **등록**에 투자해야 합니다. 따라서 새로운 위험이 발생하므로 전용 **에이전트 보안 프레임워크 및 AI 모델과 에이전트 모니터링 기능**이 관리 및 보안에 필수적입니다. 마지막으로, 엔터프라이즈는 사용자 정의 모델에 대한 AI/ML 기능을 확장하여 해당 에이전트가 도메인별 과업을 처리할 수 있도록 지원할 수 있습니다.
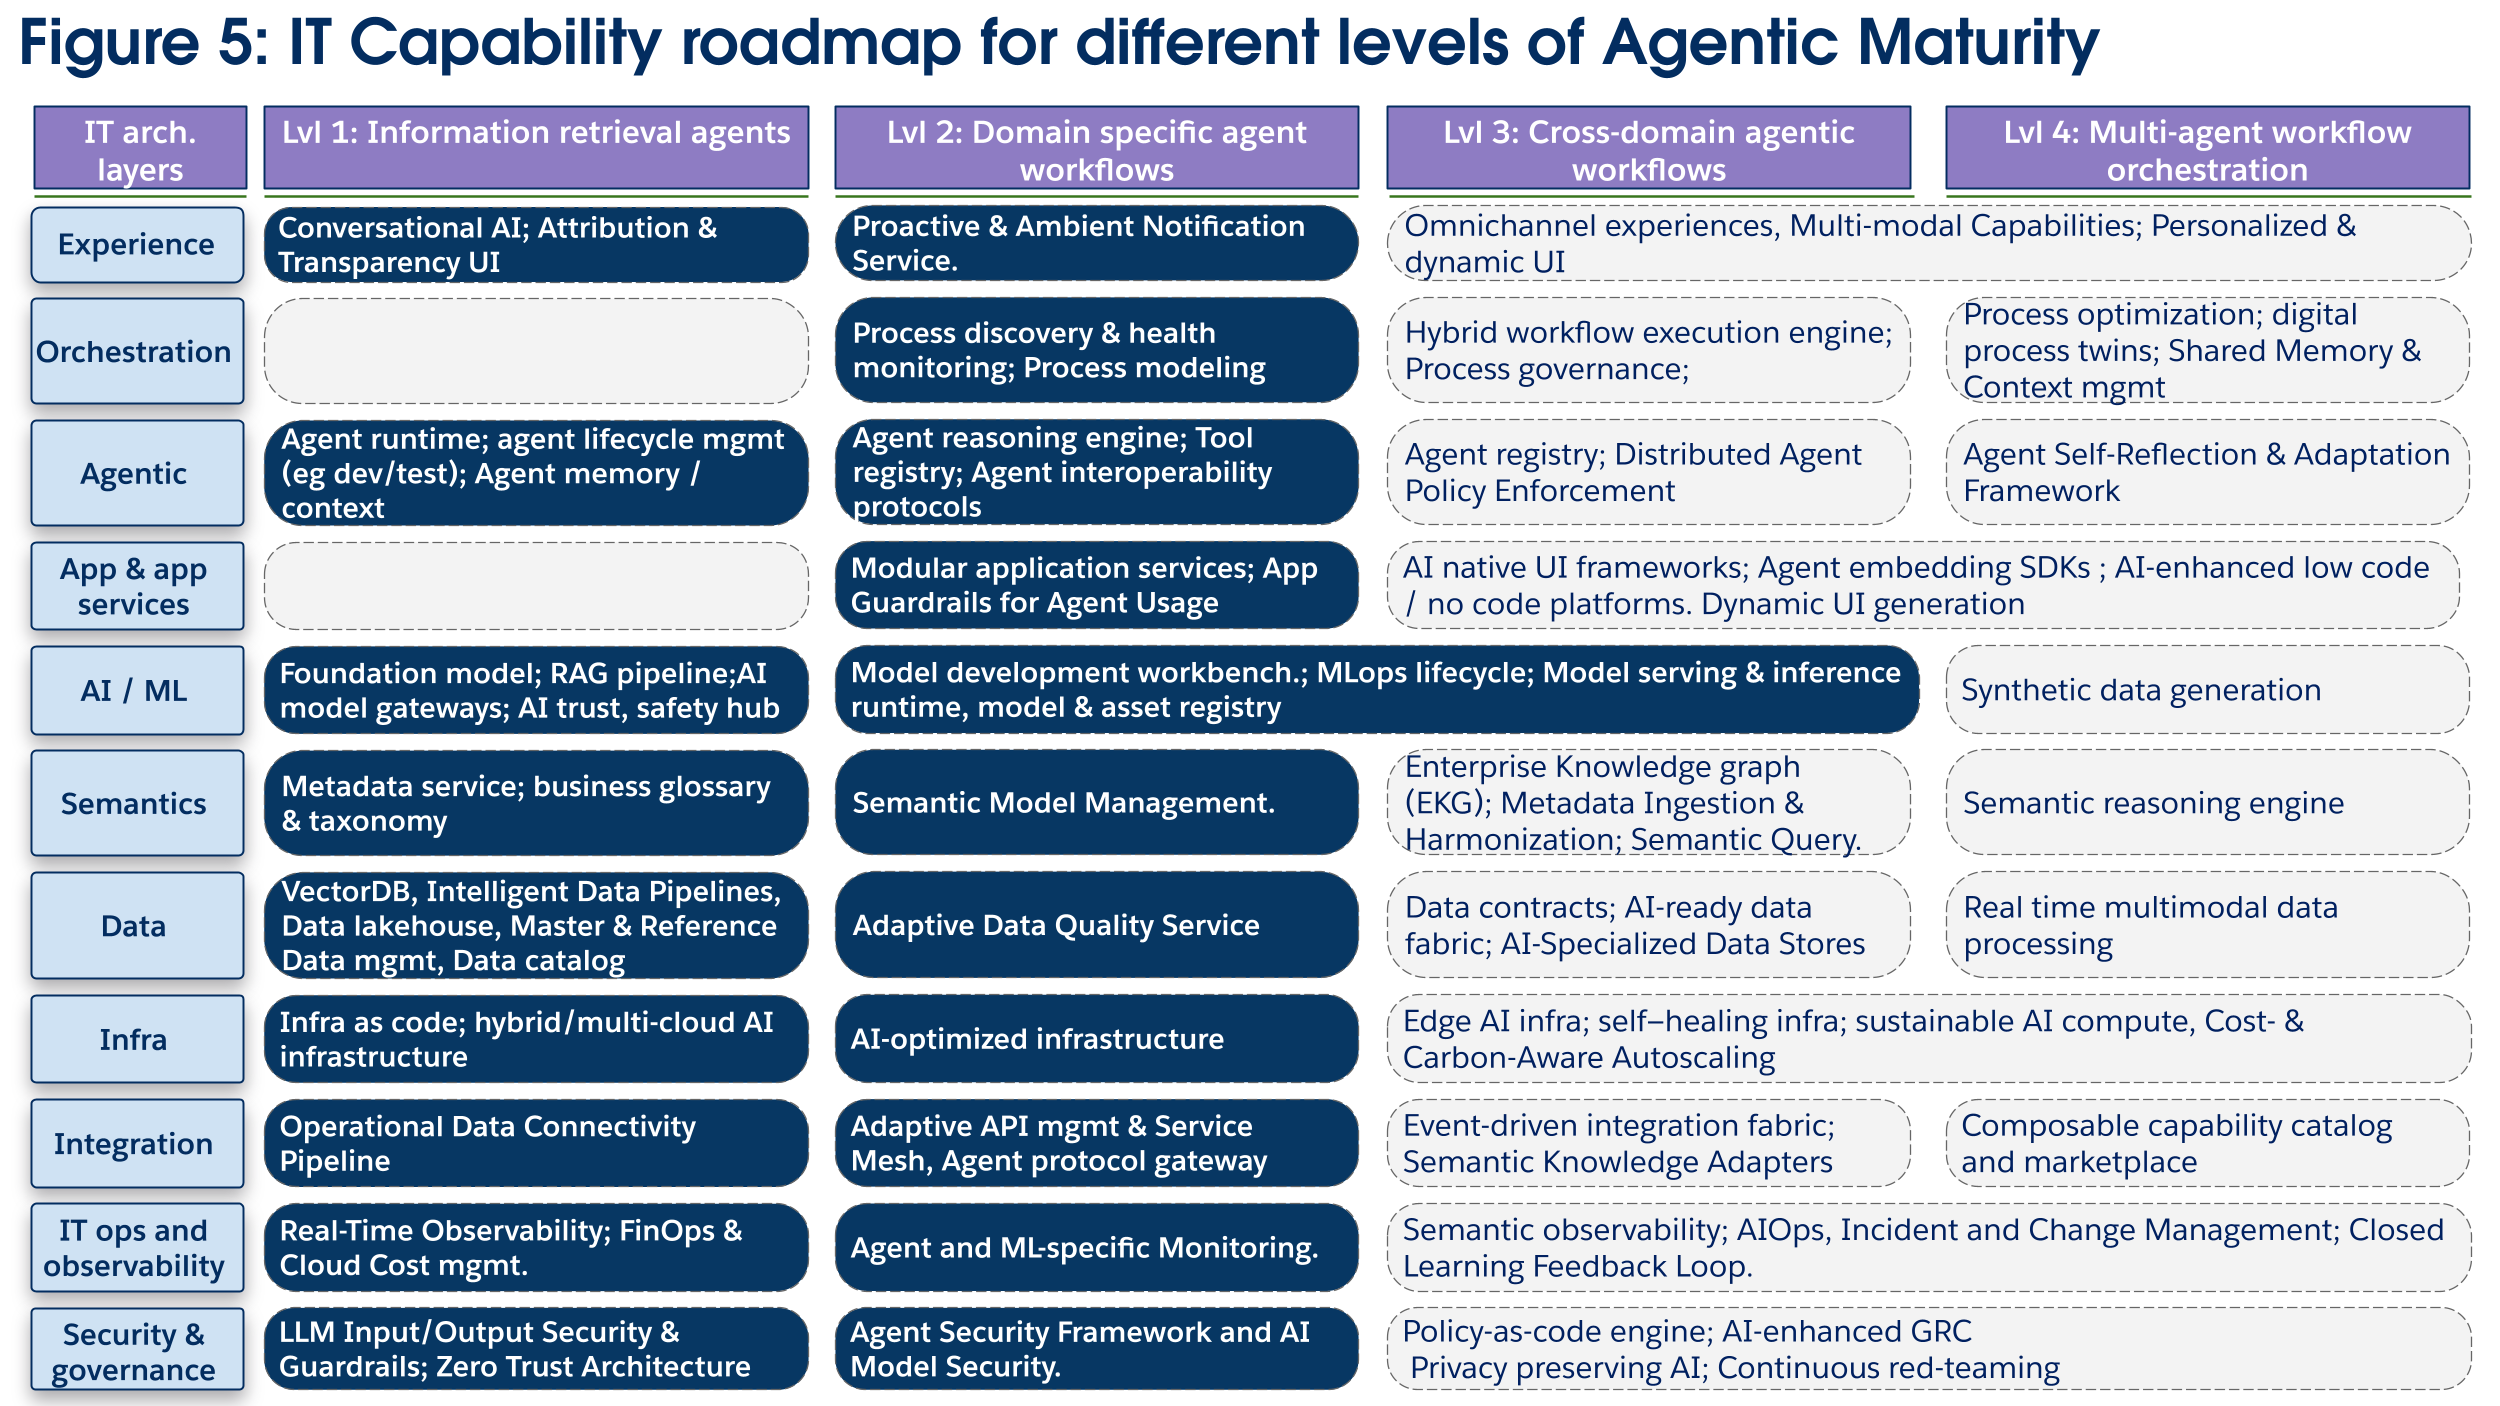 **성숙도 레벨 3: 다중 도메인 오케스트레이션 에이전트**
**비즈니스 목표 및 가치:** 조직적 및 기능적 경계를 넘는 복잡한 엔드 투 엔드 비즈니스 프로세스를 **자동화합니다**(예: "금액 견적서", "주문 견적서"). 중요한 것은 사일로를 파악하고 프로세스 주기 시간을 가속화하거나 비즈니스 내 전체 가치 사슬을 최적화하는 것입니다. 조직의 장벽이 끊어지기 시작하고 인력이 AI 에이전트 감독에 더 집중하기 시작하면 인적 작업자 생산성에 더 많은 단계의 변화가 발생할 수 있습니다.
**아키텍처 초점:** 이제 아키텍처가 교차 분야 기술 문제를 지원해야 합니다. 엔터프라이즈 전반의 공유 시맨틱 이해, 관리용 중앙 집중식 오케스트레이션 엔진, 분리된 이벤트 중심 통합 패브릭이 중요한 활성화 요소가 됩니다.
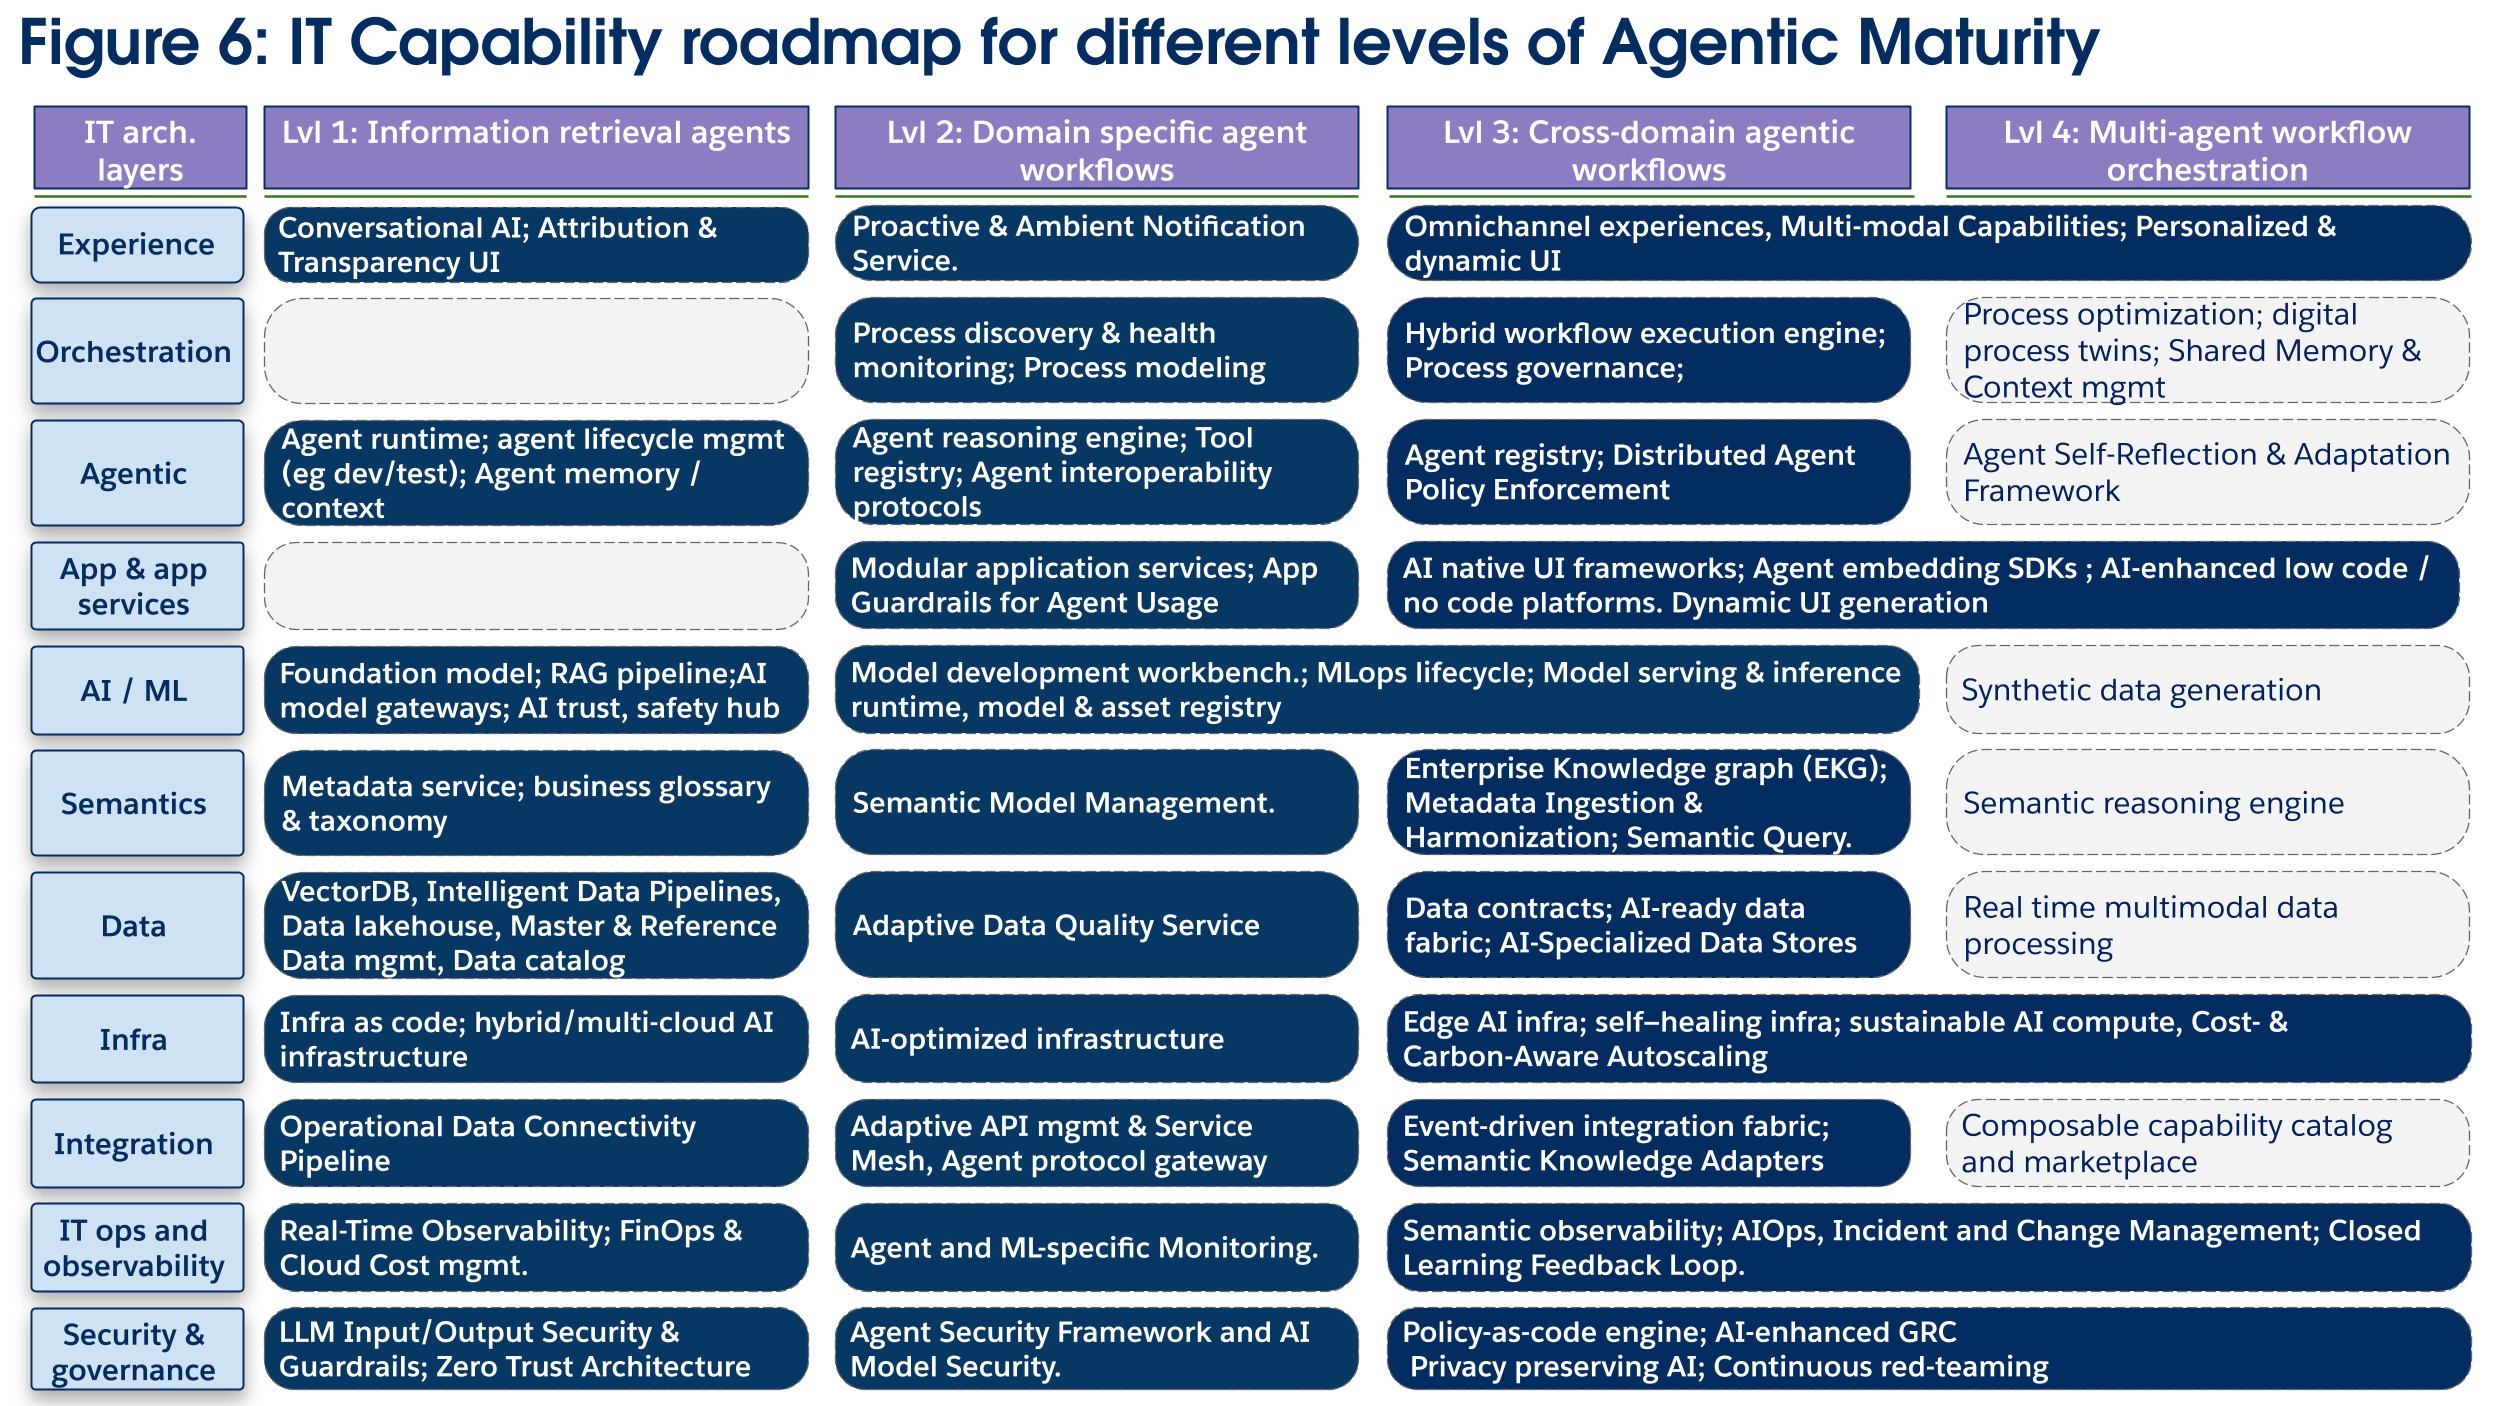 **핵심 기술 투자(그림 6):**
기술 투자는 사람, 에이전트, 결정적 시스템 전반에서 엔터프라이즈 규모의 프로세스를 오케스트레이션하는 데 테마적으로 초점을 맞춥니다. **엔터프라이즈 오케스트레이션 계층**은 투자의 초점이 되고, 작업을 조정할 수 있는 **하이브리드 워크플로 실행 엔진**과 비즈니스 규칙 및 규정 준수 정책을 실행할 수 있는 **프로세스 거버넌스 및 제약 엔진**이 필요합니다. 에이전트가 도메인 간에 작업하기 때문에 비즈니스 규칙과 규정 준수 정책이 적용됩니다. 이 도메인 간 조정은 **엔터프라이즈 Knowledge 그래프(EKG)**가 포함된 성숙한 **세맨틱 레이어를 통해서**만 가능하며, 이는 비즈니스 엔티티가 도메인 간에 어떻게 관계를 맺는지에 대한 공유적인 이해를 창출합니다. **통합 계층**은 스트리밍 척추를 사용하여 시스템을 분리하고 장기 실행 엔터프라이즈 프로세스의 일반적인 탄력적이고 비동기식 통신을 가능하게 하는 **이벤트 기반 통합 패브릭**을 포함하도록 진화해야 합니다. 이러한 워크플로의 가치와 관련된 위험을 고려하여 보안 및 모니터링에 대한 추가 투자가 중요합니다(예: **AIOps, policy-as-code**). 마지막으로 애플리케이션 및 서비스 계층(예: **AI 지원 LCNC, 더 역동적이고 다중 모달** 사용자 환경)에 대한 추가 투자는 인간 사용자가 더 능숙한 AI 에이전트와 모니터링하고 협력하기 시작함에 따라 이루어져야 합니다.
**성숙도 레벨 4: 멀티 에이전트, 멀티 도메인 오케스트레이션**
**비즈니스 목표 및 가치: 도메인 간의 비즈니스 운영을 재설계하고 최적화하여 생산성과 효율성의 단계별 변화를 유도합니다.** 이 단계에서는 주요 비즈니스 프로세스 및 워크플로 전반에서 지속적인 개선과 전략 계획을 수립하기 위해 엔터프라이즈에 대한 전체적인 디지털 시뮬레이션(디지털 쌍둥이)을 만듭니다.
**아키텍처 초점:** 최종 스테이지는 에이전트 간의 동적 및 비상 공동 작업 활성화에 중점을 둡니다. 이를 위해서는 고급 에이전트 간 커뮤니케이션 프로토콜(A2A), 에이전트 자가 학습 기능, 오케스트레이션, 데이터, 시맨틱 계층의 성숙에 대한 추가 투자, 엔터프라이즈 전반에 걸쳐 확장되는 동적 AI 워크로드의 증가하는 요구를 지원하는 완전 동적 및 자가 치료 인프라가 필요합니다.
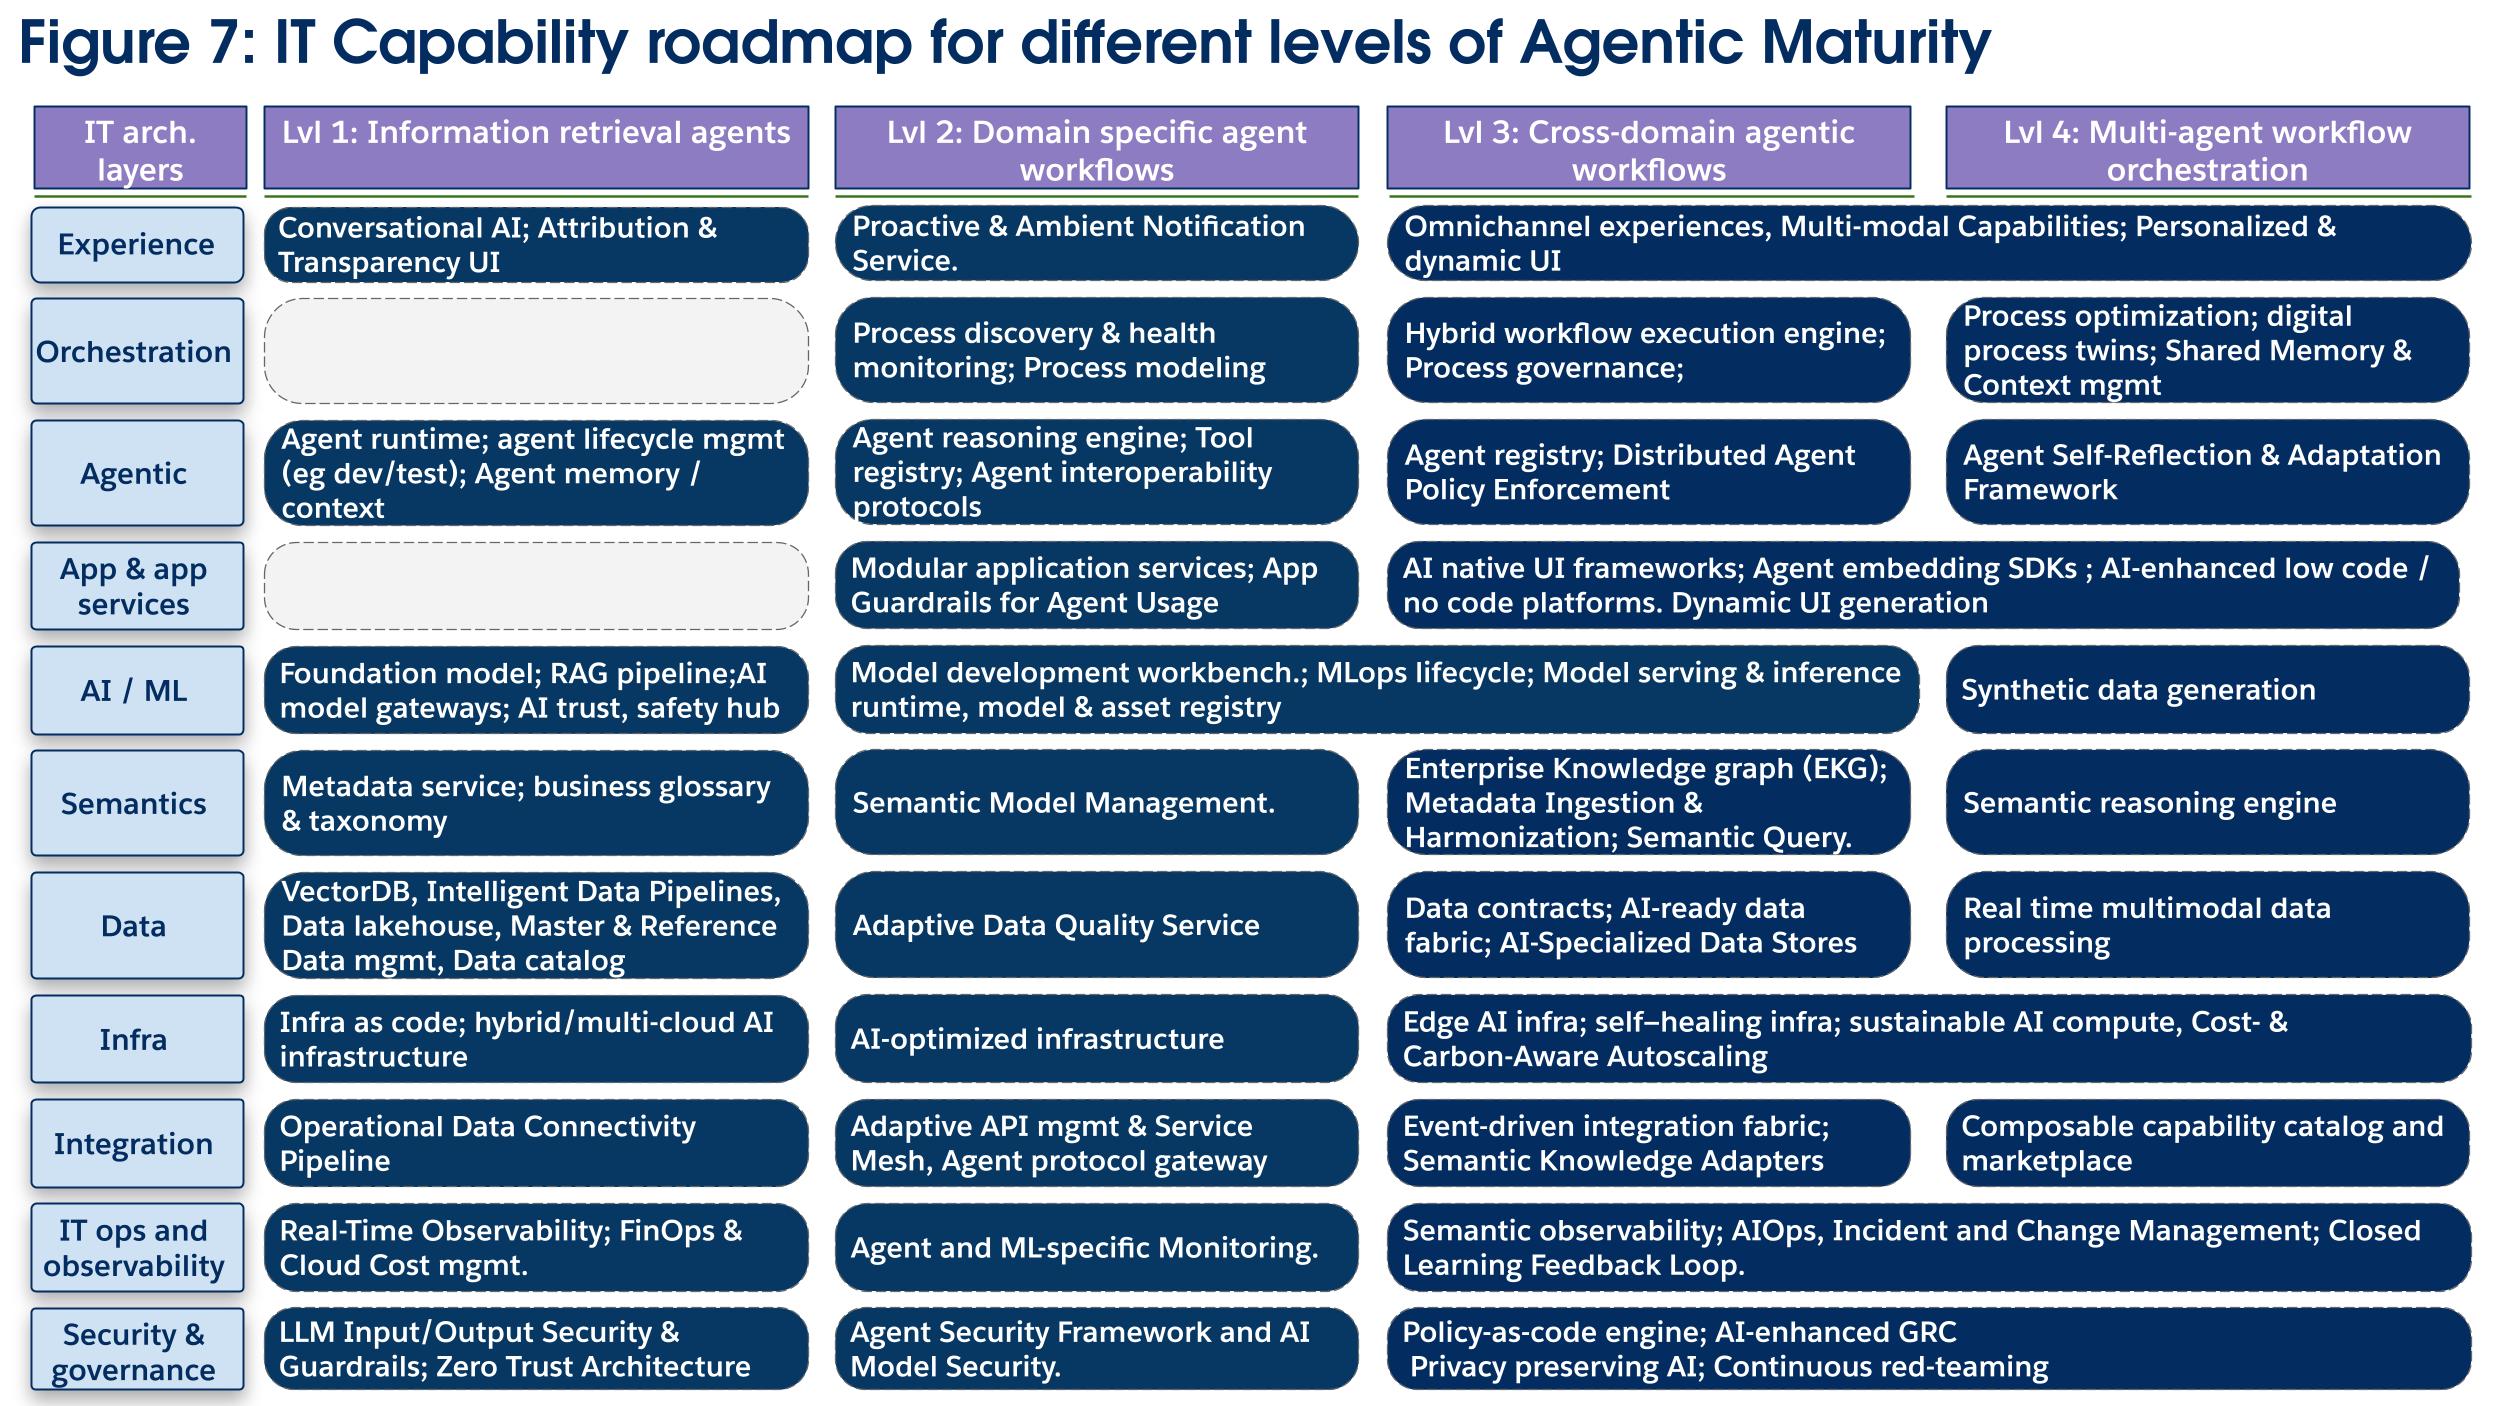 **핵심 기술 투자(그림 7):**
테마 투자는 자체 개선을 위한 자율 시스템을 만드는 데 중점을 둡니다. **에이전트 계층**에서 **에이전트 자가 반영 및 조정 프레임워크**는 에이전트가 자체 성능 로그를 분석하고 개선 사항을 트리거할 수 있는 메커니즘을 제공합니다. 이 학습은 **IT 운영 및 관찰 가능성 계층**을 통해 지원되며, 이 계층은 **Closed Learning Feedback Loop**을 구현하여 모델 재교육을 위해 관찰 가능성 데이터를 MLOps 파이프라인으로 자동으로 다시 공급합니다. 이 계층은 또한 합성 데이터 생성을 활용하여 모델 성능을 더욱 최적화할 수 있습니다. 부서 간 에이전트 네트워크가 구축되고 애플리케이션 모듈화 작업이 진행되고 있으므로 에이전트가 역동적으로 기능을 구성하여 더 추상적이고 가치가 높은 작업을 해결할 수 있도록 보안 및 특히 **구성 가능한 기능 카탈로그**에 대한 추가 투자가 필요합니다. 이러한 프로세스는 모두 새로운 **디지털 트윈 프로세스 모델링 기능을** 통해 오케스트레이션 및 최적화되며, 이 기능은 실시간 데이터를 사용하여 "what-if" 분석 및 예측 최적화를 위한 시뮬레이션을 생성하므로 엔터프라이즈에서 새로운 에이전트 배포를 안전하게 테스트하고 배포할 수 있습니다.
**결과**
에이전트 엔터프라이즈에 대한 로드맵은 IT 아키텍처의 발전을 통해 실행됩니다. 엔터프라이즈 아키텍처는 이 변환의 핵심 동인이며, 조직이 에이전트 엔터프라이즈의 새로운 비즈니스 기능에서 가치를 실현하는 데 필요한 비즈니스 및 IT의 다른 파트너와 함께 중요한 투자 결정을 이끌어낼 것입니다.
## 이 백서 소개
**엔터프라이즈 에이전트 아키텍처 및 디자인 패턴**은 멀티 에이전트 아키텍처의 가능성을 구조화하여 AI 에이전트에 새로운 기능을 결합하여 신뢰할 수 있고 반복 가능하며 확장 가능하며 관리 가능한 에이전트 솔루션을 제공하는 방법을 파악하고 강조합니다. 개체 지향 프로그래밍에 대한 "설계 패턴"에서 영감을 얻은 패턴을 결합하고 확장하여 에이전트 기술 이전에 기존 결정적 기술을 기반으로 구축된 비즈니스 시스템 범위를 벗어난 많은 흥미로운 문제를 해결할 수 있습니다.
다중 에이전트 아키텍처의 근거에 대한 논의 후 자연어 처리를 활용하여 사용자 의도를 결정하는 간단한 패턴에서 에이전트 간의 우려 사항을 분리하는 다중 에이전트 패턴, 시스템, 정보, 콘텐츠와의 프레젠테이션 및 상호 작용에 에이전트의 근거를 가져오는 UX 에이전트 패턴에 이르기까지 다양한 에이전트 패턴이 소개됩니다.
## 이 문서에서 얻을 수 있는 내용은 무엇입니까?
먼저 에이전트를 구성 요소로 생각하고, 에이전트를 작성자로, 에이전트를 작업자로, 에이전트를 공동 작업자로 생각하며, 특히 더 큰 아키텍처 내에서 의도적으로 행동하고 개별 관심 범위 내에서 행동하는 에이전트를 새로운 방식으로 생각합니다.
사용자 여정을 펼치고 이전에 가능하지 않은 중요한 에이전트 경험을 알리는 풍부한 에이전트 솔루션을 구상하는 데 필요한 포인터를 확보할 수 있습니다.
이 문서의 초기 섹션은 muti-agent 아키텍처에 대한 근거를 제공합니다. 다중 에이전트 아키텍처가 제공하는 문제 및 기회를 더 잘 이해하려면 다음을 읽으십시오.
다음은 상호 작용을 지원하는 패턴, 전문 에이전트의 패턴, 백그라운드 작업의 패턴, 장기 실행 패턴을 포함하는 간단에서 복잡한 간단한 에이전트 패턴에 대한 정의 및 설명입니다. 각 패턴에는 패턴을 실현하는 주요 구성 요소의 다이어그램과 사용량 및 대표적인 사용 사례에 대한 권장 사항이 포함되어 있습니다.
마지막으로 부록에 이러한 패턴이 고객 서비스 또는 중개 판매를 지원하는 등 더 큰 에이전트 환경을 지원하는 포괄적인 에이전트 솔루션으로 결합되는 방법에 대한 예가 포함되어 있습니다. 이 섹션을 참조하여 풍부한 에이전트 환경이 에이전트 및 작업 수준에서 우려 사항의 세분화 및 분리 기능을 활용하여 보조 및 자율 모드에서 내부 및 외부 구성원을 모두 지원하는 공유 에이전트를 통해 상호 작용 수준에서 재사용을 유도하는 방법을 알아보십시오.
## 1\. 다중 에이전트 시스템 아키텍처
엔터프라이즈 설계자가 생성형 AI를 에코시스템에 통합할 때 일반적인 설계 질문 집합을 해결해야 합니다.
- 필요한 에이전트는 몇 명입니까?
- 에이전트가 상호 운용하는 방식
- 에이전트와 사람 간의 공임 분할은 어떻습니까?
- 이러한 구성 요소를 일관된 시스템에 어떻게 어셈블합니까?
이 문서는 에이전트 솔루션 설계 및 구축을 위한 패턴 기반 방법론을 제공합니다.
_모놀리틱_ 에이전트는 대부분의 에이전트 솔루션의 출발점입니다. 에이전트(특히 Agentforce 에이전트)는 다양한 주제에서 능숙한 수행자입니다. 일반적인 사용 사례의 경우 단일 에이전트로 시작합니다.
조직이 성장함에 따라 다중 에이전트 아키텍처가 선호되는 접근 방식입니다. _다중 에이전트 아키텍처는_ 단일 에이전트 시스템에 비해 더 큰 규모, 제어 및 유연성을 제공합니다.
다중 에이전트 아키텍처는 다음의 주요 혜택을 제공합니다.
- **성능 및 복잡성 개선**: 여러 전문 에이전트가 있는 시스템은 향상된 기능을 제공하고 지침 준수를 간소화합니다.
- **모듈화 및 확장성**: 개별 에이전트를 더 쉽게 추가, 교체, 수정 및 테스트하여 민첩성을 촉진할 수 있습니다.
- **기존성 및 고장 내성**: 단일 구성 요소가 실패하면 전체 시스템이 손상되지 않으므로 전반적인 복원 능력이 향상됩니다.
- **분산된 거버넌스**: 문제 해결 및 관리를 특정 에이전트 및 해당 응용 프로그램으로 분리하여 서비스 점검 및 감독을 간소화할 수 있습니다.
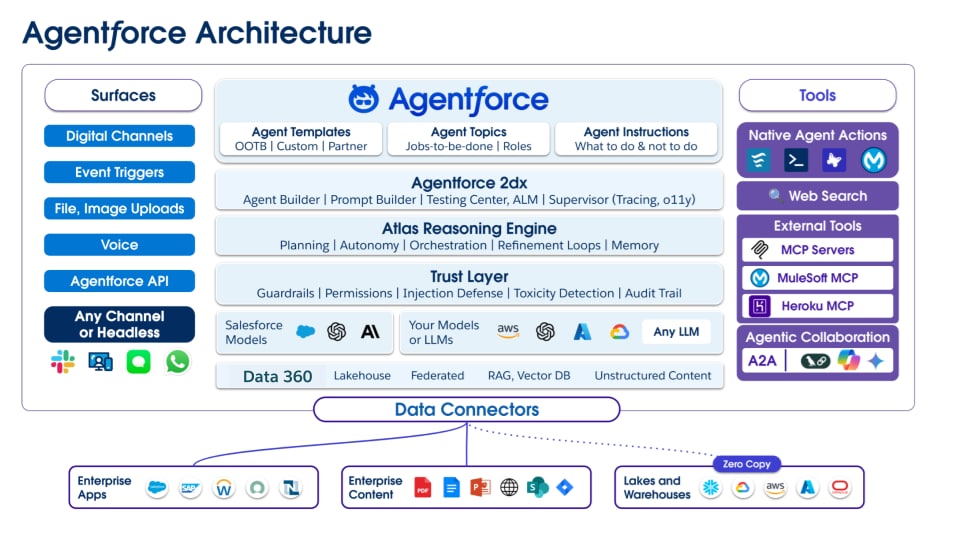 ## 2\. 핵심 아키텍처 원리
다중 에이전트 아키텍처를 합리화하는 것은 에이전트의 기능 및 구조에 핵심 아키텍처 원칙을 표시하는 것부터 시작합니다. 그러면 결과의 다중 에이전트 아키텍처는 AI 기술의 고유한 "분자"에 부합하는 핵심 시스템 설계 및 시스템 아키텍처 원칙의 표현입니다.
이 아키텍처를 구동하는 핵심 원칙은 다음과 같습니다.
- 세분화를 통한 복잡성 관리
- 분리하여 복원 능력 향상 및 취약성 줄이기
- 코드를 재사용하여 신뢰성 및 효율성 향상
- 에이전트 한 명의 우려 범위를 제한하여 에이전트 신뢰도 향상
- 모듈화 및 확장성을 통해 시스템 유지 관리 및 진화 개선
- 전문 분야를 통해 에이전트 관리 및 책임 간소화
더 원시적인 에이전트 아키텍처(예를 들어, LLM을 핵심 아키텍처 구조로 사용하는 아키텍처)와 달리, _Agentforce는 초기부터_ 멀티 에이전트 오케스트레이션을 위해 설계되었습니다. 다중 에이전트 오케스트레이션은 Atlas Reasoning 엔진 및 에이전트 사유를 기반으로 에이전트 응답 내에서 동적이고 효과적인 프로그래밍 경로를 만들어 사용자 환경(UX)에 광범위하고 심층적인 에이전트 증강을 제공하는 기능을 대폭 확장합니다.
Agentforce 내에서 이러한 키가 열려 있고 상호 운용 가능한 프로토콜 및 Salesforce 제품에 의해 이러한 유형의 조정이 활성화됩니다.
- **Agentforce는 Agent** 하위 시스템을 제공하여 에이전트의 모든 주요 요소를 캡슐화합니다. 주제, 지침, 작업, 가드레일, 컨텍스트, 호출, 출력, 실행 세부 사항, 로그 등.
- **작업**: 데이터 액세스, 호출 플로, 외부 시스템 호출 및 다른 에이전트 호출을 위한 후크를 제공합니다.
- **Data 360**: 데이터 가상화 계층을 제공하여 에이전트에게 특정하고 개별화된 컨텍스트를 제공합니다(Data 360의 통합 프로파일 및 키 체인을 활용하여 엔터프라이즈 전반에서 특정 정보를 가져옵니다).
엔터프라이즈 전반의 에이전트 또는 에이전트 또는 리소스에 액세스하려면 다음을 지원합니다.
- **모델 컨텍스트 프로토콜(MCP)**: 컨텍스트 정확성을 보장하기 위해 에이전트를 엔터프라이즈 도구, 데이터 및 Knowledge에 연결하는 안전한 통신 계층입니다.
- **에이전트 간(A2A) 프로토콜**: 시스템, 조직 및 공급업체 간의 안전하고 규제된 조정이 가능하도록 하는 에이전트 간 위임을 위한 표준화된 손잡이입니다.
이러한 원칙은 확장 가능하고 관리 가능한 오케스트레이션 인텔리전스 시스템을 구축하는 기반을 제공합니다.
### 추가 고려 사항
강력한 에이전트 솔루션은 효과적인 기술 전달을 기반으로 하는 비기능 요구 사항에 대한 명확한 접근 방식을 필요로 합니다.
- 보안 및 거버넌스(ID 및 액세스 관리, 데이터 프라이버시, 데이터 보안, 위협 모델링).
- 관찰 가능성 및 모니터링(배포 추적, 중앙 집중식 로깅, 메트릭, 대시보드)
- 운영 및 수명 주기 관리(사양, 테스트 사례 생성, 테스트, 사용자 의견, 연속 학습, 폐기)
다음은 이 백서에 포함되지 않은 엔터프라이즈 에이전트 솔루션 구축을 위한 주요 아키텍처 고려 사항입니다. 그러나 향후 게시물에서 다룰 것입니다.
## 3\. 엔터프라이즈 에이전트 분류
엔터프라이즈 전체 에이전트 환경을 관리하려면 설계자가 기술 기능 및 비즈니스 영향의 두 가지 보완 렌즈를 통해 에이전트를 분류해야 합니다.
### 3.1 기능적 역할 분류
이 분류는 에이전트가 아키텍처 내에서 가정할 수 있는 기능적 역할을 범주화합니다.
- **채널/UX 역할**: 상호 작용 모달을 정의합니다(예: 헤드리스, 프롬프트, 채팅 및 메시지 또는 AI 관리 작업 영역).
- **전문가 역할**: Deep-domain Knowledge(예: Domain Expert, Knowledge Minion, Assistant 또는 Planner)를 캡슐화합니다.
- **유틸리티 서비스 역할**: 개별 트랜잭션 과업(예: 생성, 요약, 변환 또는 구성)을 수행합니다.
- **서비스 점검 및 사전 예방적 서비스 역할**: 데이터 상태 및 품질에 중점을 두십시오(예: 큐레이션, 조정, 데이터 품질 또는 데이터 보강).
- **장기 실행 역할**: 오랜 기간 동안 프로세스를 관리합니다(예: Concierge, 프로젝트 관리자, Nurturer 또는 Watcher/Alerter).
## 4\. 에이전트 매핑 템플릿
명확한 설계와 통신을 촉진하기 위해 **에이전트 지도**는 에이전트 솔루션을 설명하는 표준 템플릿입니다. 특정 설계 패턴 내에서 주요 엔티티, 시스템, 상호 작용을 정의합니다.
다음은 에이전트 매핑 템플릿 구성 요소입니다.
- **사용자 계층**은 시스템의 인적 작업자를 정의합니다(예: 고객, 인증된 직원(SF-Users), 인증되지 않은 직원).
- **에이전트 계층**은 필수 에이전트, 표시된 패턴, 서로의 관계, 특정 패턴을 실현하는 데 사용되는 지침을 설명합니다.
- **컨텍스트/작업**은 에이전트가 관리하거나 액세스하는 리소스, 기능 또는 작업입니다.
- **소스**는 에이전트가 연결하는 기본 데이터, 응용 프로그램, Knowledge 자료 및 기타 시스템입니다.
부록 A 및 B는 에이전트 맵 템플릿 수영기 내에서 구성 요소를 설명하여 시스템 수준 에이전트 패턴을 설명합니다.
## 5\. 에이전트 패턴 프레임워크
Salesforce에서는 에이전트 패턴 라이브러리를 사용하여 신뢰할 수 있고 예측 가능한 에이전트 솔루션을 구성하고 제공합니다. 이러한 패턴은 일반적인 아키텍처 문제를 해결하기 위한 청사진입니다.
이는 네 가지 기본 범주로 그룹화됩니다.
- **상호 작용 패턴**: 에이전트 참여 및 사용자 환경(UX)에 중점을 둡니다.
- **전문가/작업자 패턴**: 특정 영역 내에서 깊은 Knowledge 또는 특정 기술을 캡슐화합니다.
- **유틸리티 및 데이터 관리 패턴**: 다른 에이전트 또는 프로세스를 지원하는 특정한 반복 가능한 과업을 수행합니다.
- **장기 실행 패턴**: 여러 단계를 포함하여 장기간 발생하는 프로세스 및 워크플로를 관리합니다.
다음 섹션은 각 범주의 주요 패턴을 자세히 설명합니다. 각 패턴 설명은 **개요**, **출력 유형**, ** 패턴 사용 지침**, **전체적인 사용 사례** 및 **솔루션 다이어그램**을 제공하며, **Salesforce Agentic 성숙도 범주**에 대한 매핑을 제공합니다.
## 6\. 상호 작용 패턴
*상호 작용 패턴*은 에이전트 참여 및 사용자 경험에 초점을 맞춘 기본 설계입니다.
### 고객을 맞이하는 사람 패턴
- **개요**: *그레터 패턴*은 사용자 의도를 결정하기 위해 자연어를 사용하는 간단하고 구현하기 쉬운 패턴입니다. 그런 다음, 사용자를 적절한 에이전트에게 라우팅합니다.
- **출력 유형**: 다음 자원에 허용/에스컬레이션합니다.
- **비즈니스 가치**: 서비스 공급자의 의도 해결 및 컨텍스트 수집을 극대화하면서 고객에게 원활하고 효율적인 첫 연락을 제공합니다.
- **패턴 사용 지침**: 에이전트를 브랜드 채널의 기본 참여 자원으로 구성합니다. 사용자 의도를 기반으로 라우팅 지침과 연결된 브랜드, 제품, 서비스에 대한 지침을 제공합니다. 에이전트가 핫핸드오프를 전달하기 위해 의도를 수집하고 요약합니다.
- **전체적인 사용 사례**: 채팅 Bot을 사용하여 사용자가 모든 옵션을 클릭해야만 사람에게 라우팅되는 옵션 메뉴를 표시하는 웹 페이지를 가정해 보겠습니다. 백오피스 생산성과 효율성을 향상하기 위해 Chatbot은 종종 복잡하고 복잡한 작업 경로와 상호 작용을 사용합니다. 이를 통해 고객에게 "필기, 선택, 클릭" 피로 시나리오가 발생하며, 사용 가능한 메뉴 옵션 외에 컨텍스트가 있을 경우 불만이 발생합니다. 전통적인 채팅봇을 자연어 상호 작용을 사용하는 *에이전트 프런트 도어*로 대체함으로써 부담을 완화하고 인간과 유사한 상호 작용을 제공합니다.
- **Agentforce 레시피**:
- Agentforce 서비스 에이전트: [Service 에이전트 구축](https://trailhead.salesforce.com/content/learn/projects/quick-start-build-your-first-agent-with-agentforce)
- 패키지된 서비스 에이전트 다음 전송을 지원하는 구성 가능한 전송 기능이 있습니다.
- 에이전트 대상
- AI 에이전트
- 외부 에이전트
- 코드 예가 포함된 산업별 패턴
- **도표**:
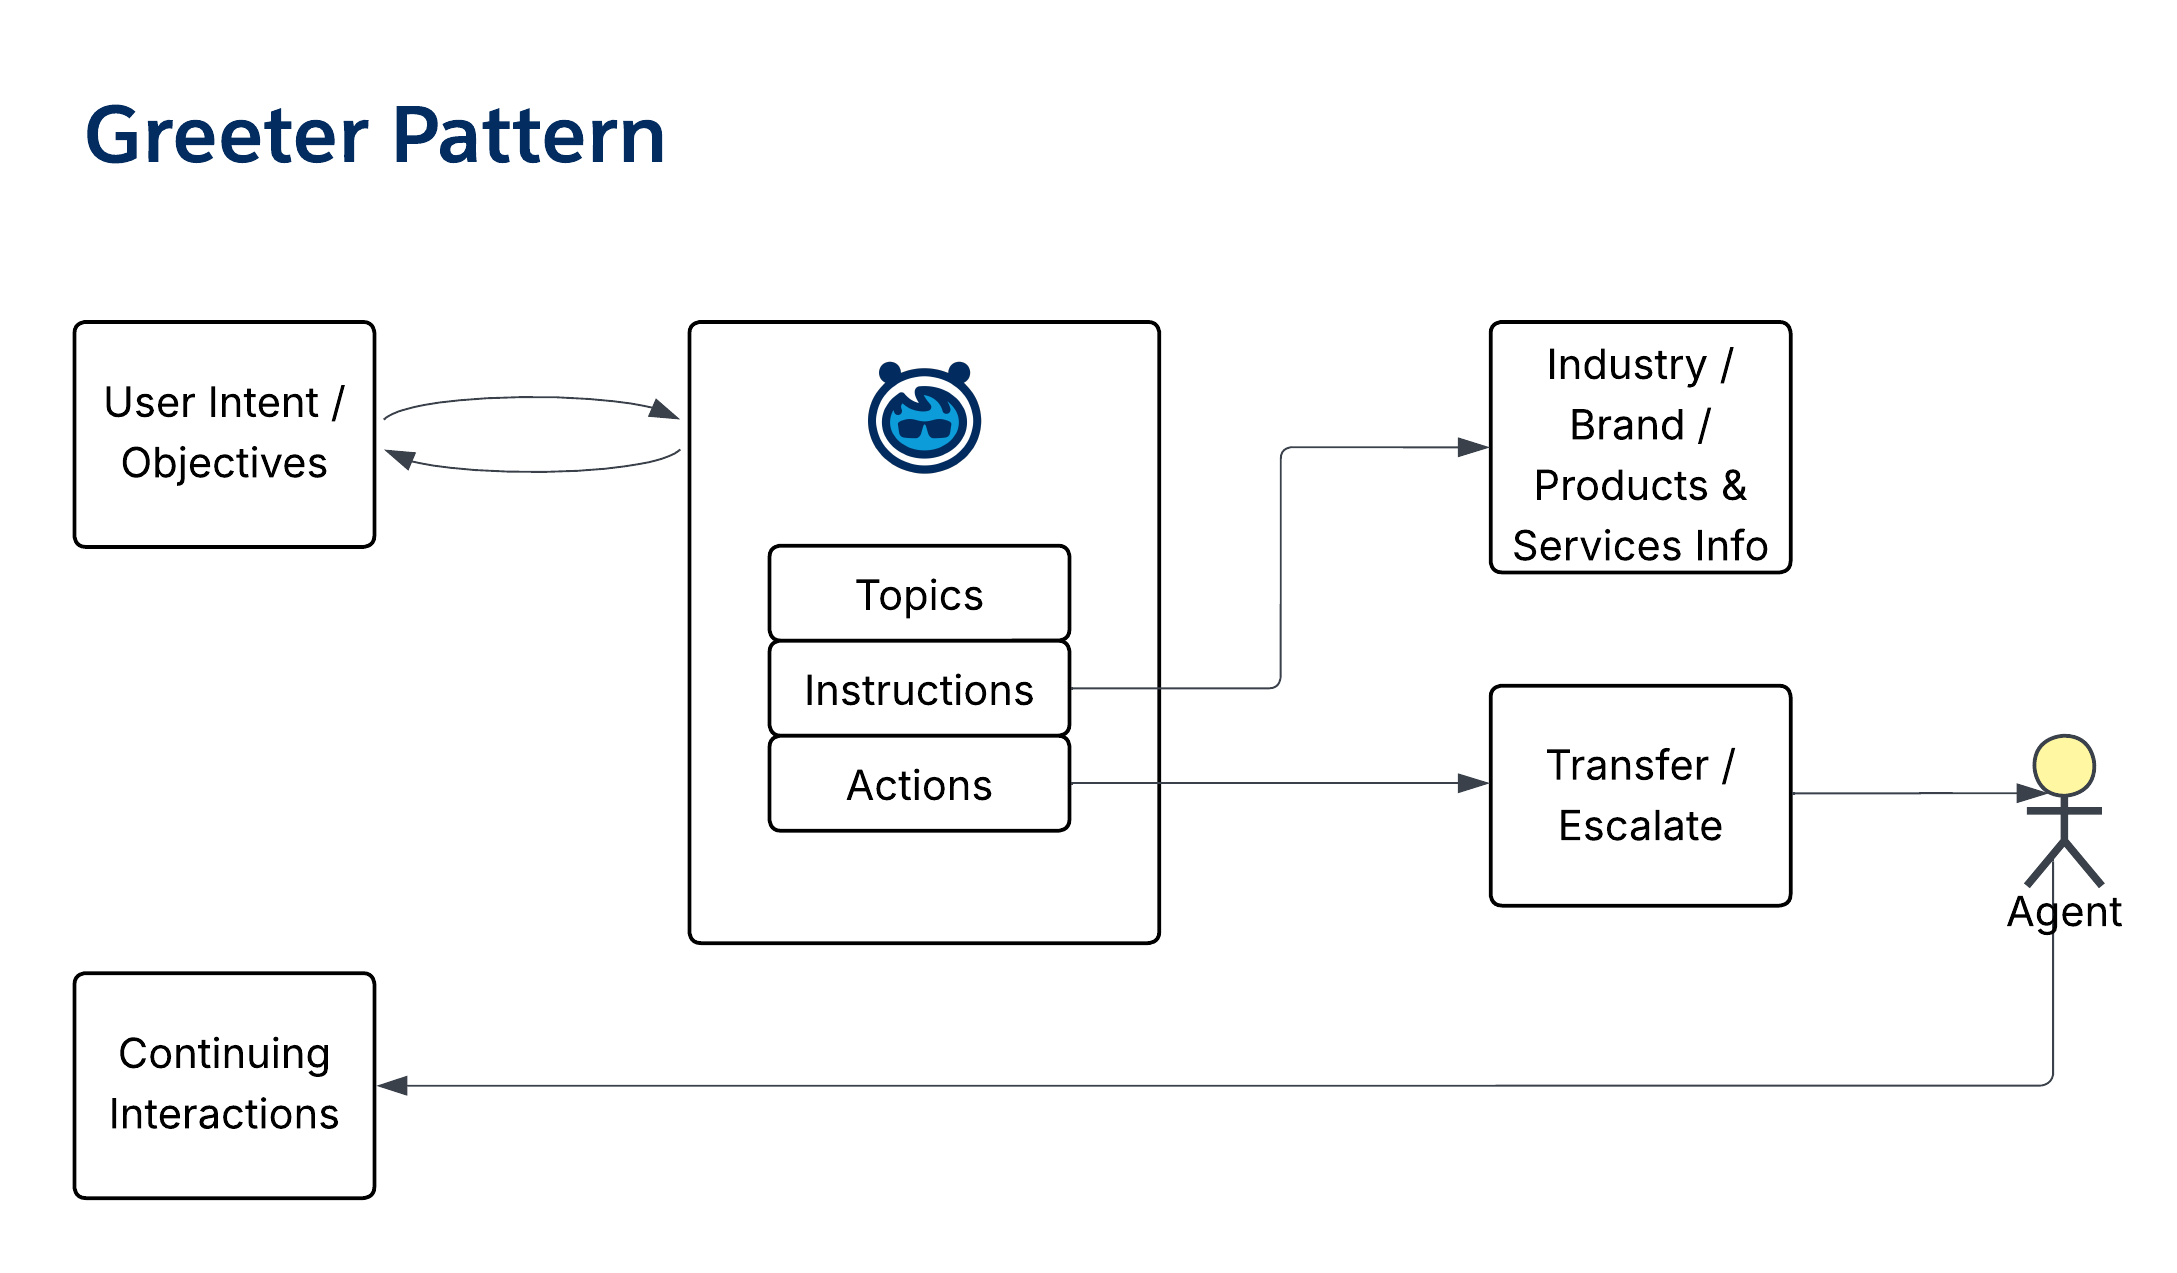 - **Salesforce 에이전트 성숙도**: 레벨 1(또는 전송 및 에스컬레이션이 내장된 기본 서비스 에이전트 사용하는 경우 레벨 0)
### 연산자 패턴
- **개요**: *Operator 패턴*은 요청을 적절한 전문 에이전트 또는 인간 및 협상 의도(필요한 경우)로 라우팅하여 *Greeter 패턴*을 기반으로 합니다.
- **출력 유형**: 핸드오프/다음 자원으로 전송
- **패턴 사용 지침**: 브랜드 및 서비스별 지침을 의도에 따라 사용자를 보낼 위치에 대한 지침과 연결합니다. 에스컬레이션 리소스를 정의합니다. 이는 사람이거나 다른 에이전트일 수 있습니다.
- **전체적인 사용 사례**: 인간 또는 AI 담당자가 높은 수준의 전문성이 있는 시나리오에 _에이전트 프런트 도어를_ 사용합니다.
- **도표**:
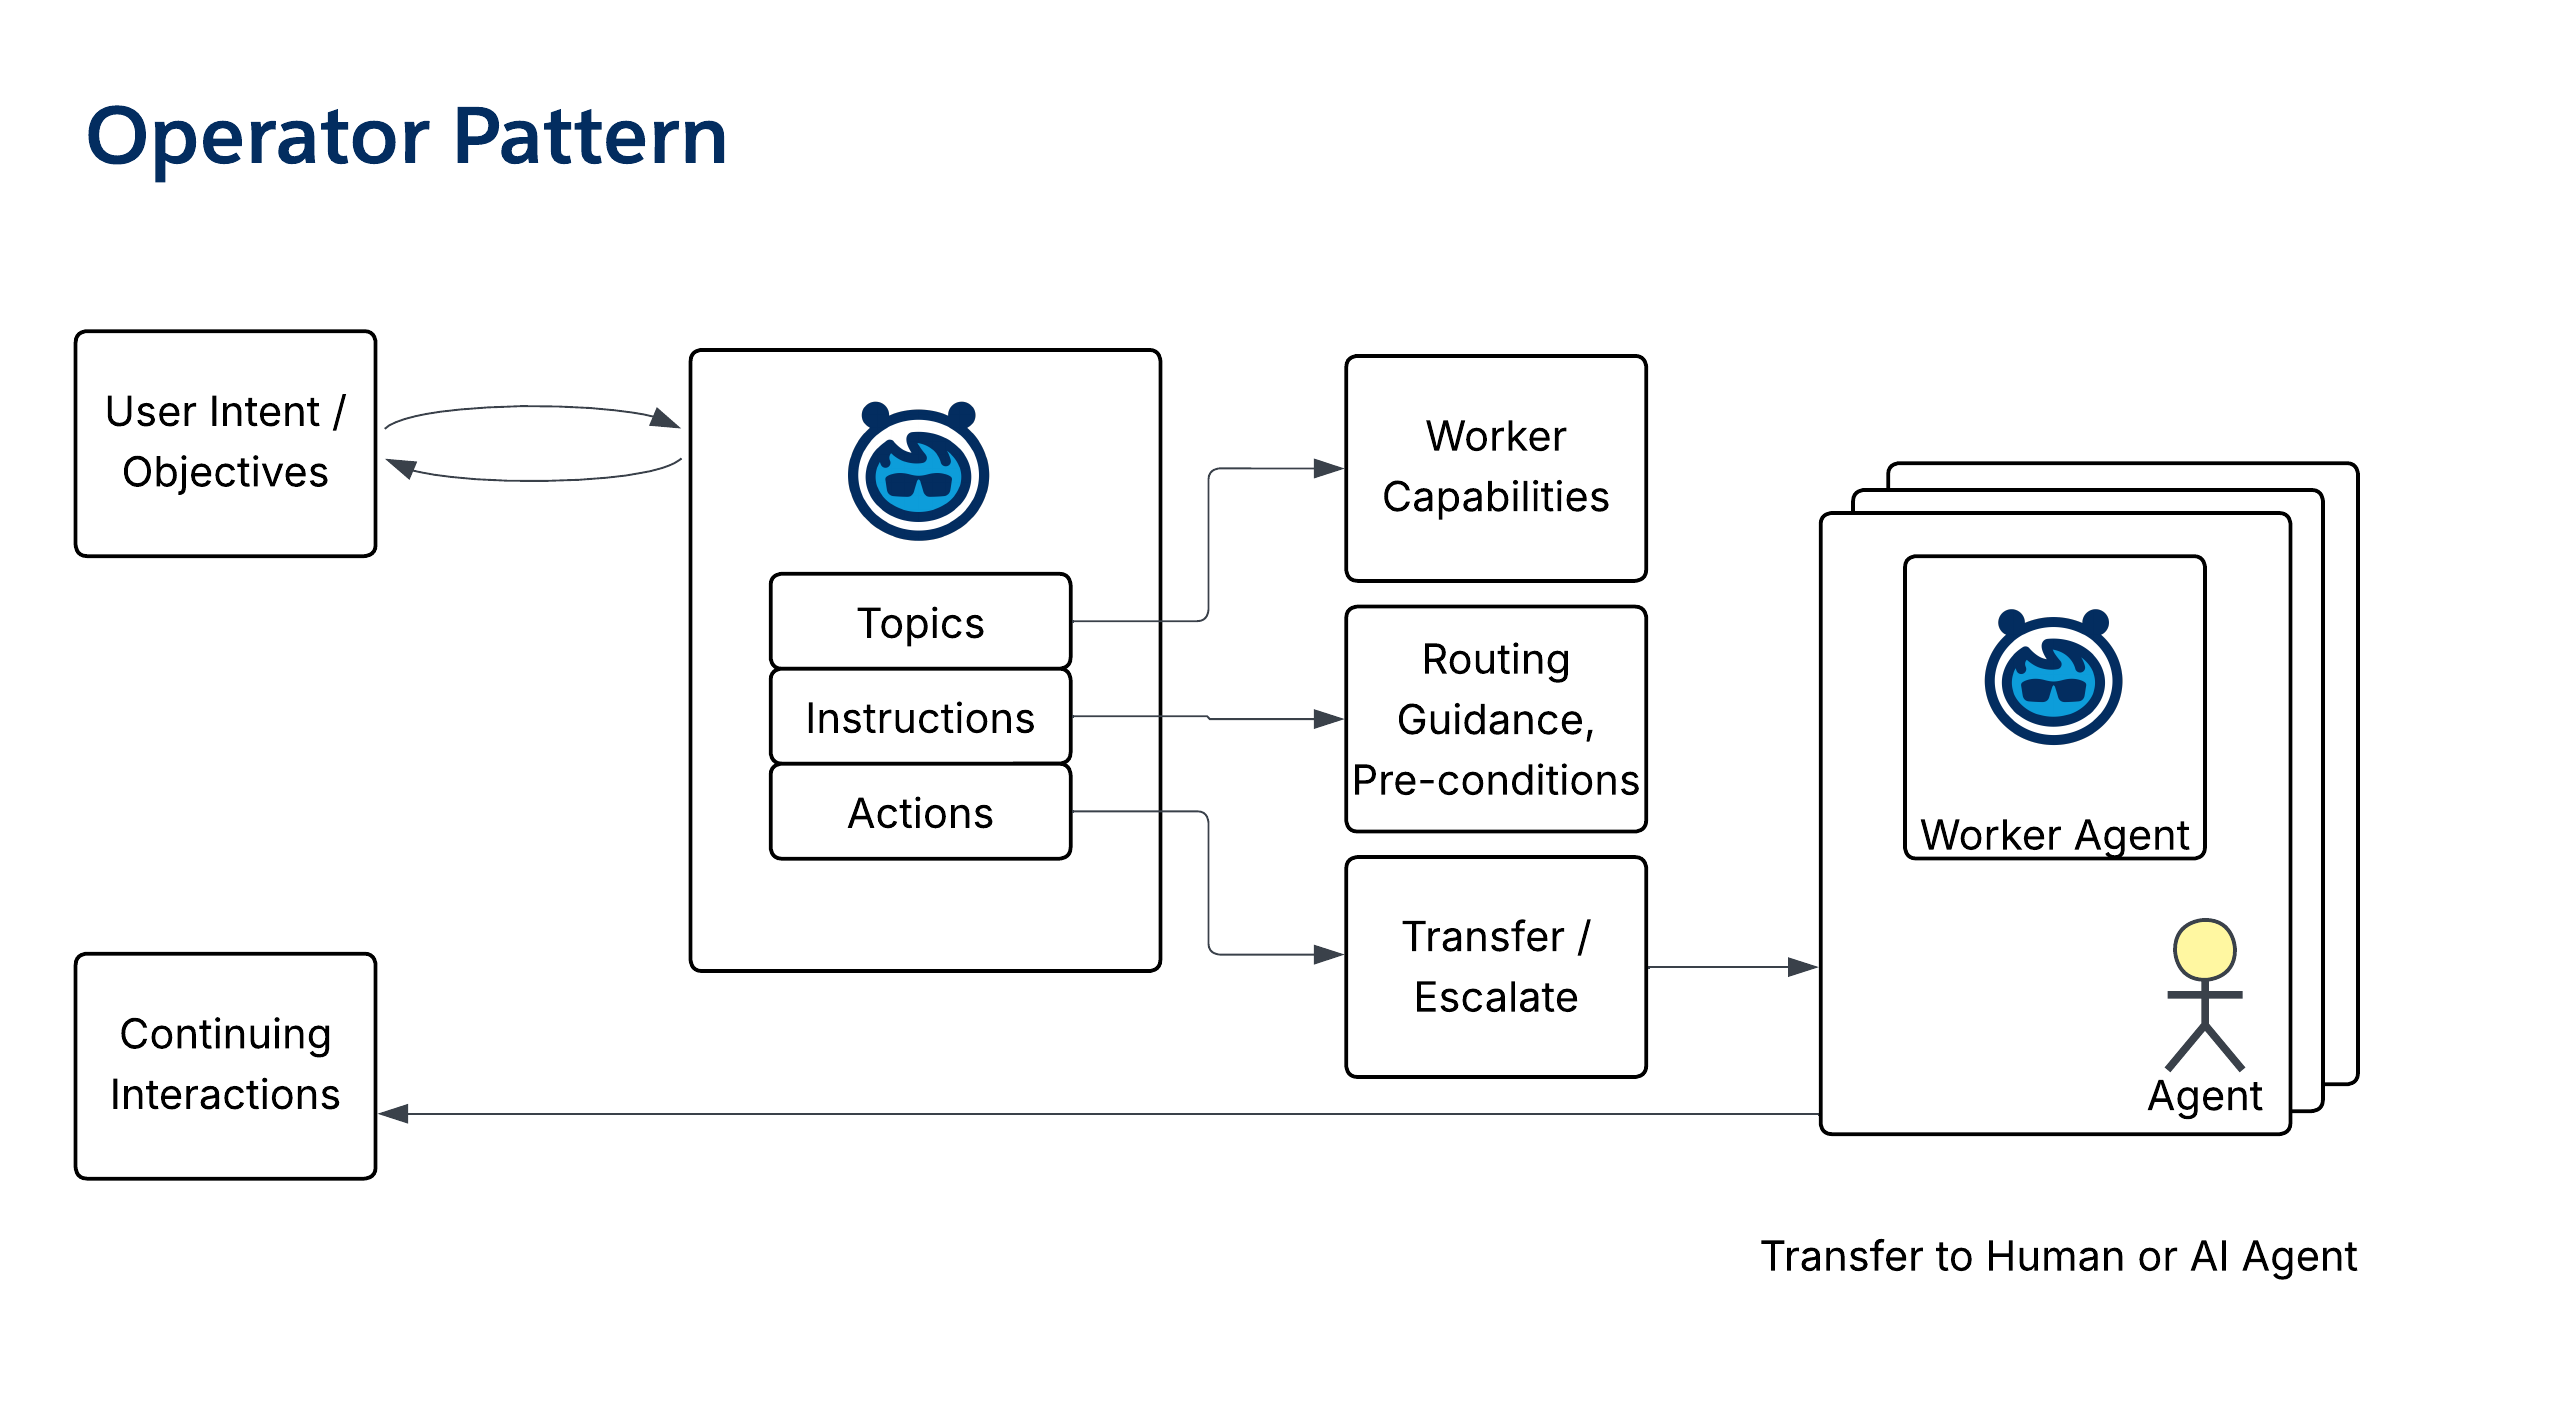 - **Salesforce 에이전트 성숙도**: 레벨 2
### 오케스트레이터 패턴
- **개요**: *Orchestrator 패턴*은 AI Agent "Swarm"을 관리합니다. 사용자 요청을 수신하면 하나 이상의 전문 에이전트에게 발화를 전달한 다음, 사용자에 대한 응답을 집계합니다. _운영자 패턴과_ 달리, 첫 번째 접촉점(POC)이 됩니다.
- **출력 유형**: 작업자 에이전트의 응답을 수집하고 준비합니다.
- **패턴 사용 지침**: 기본 참여자로 구성됩니다. 오케스트레이터가 각 지원 작업자 에이전트(예: Prioritizer 또는 도메인 SME)에게 발화를 릴레이할 수 있는 지침을 제공합니다.
- **전체적인 사용 사례**: *Orchestrator Pattern*을 에이전트 전면 문으로 사용하여 대화당 여러 주제를 논의해야 하는 고객을 지원합니다. 이는 멀티 에이전트 솔루션과 일관된 상호 작용이 필요합니다. 다중 시스템 아키텍처에서 *Orchestrator 패턴*을 고려하여 외부 에이전트의 협력과 함께 시스템 간에 응답을 조정합니다.
- **도표**:
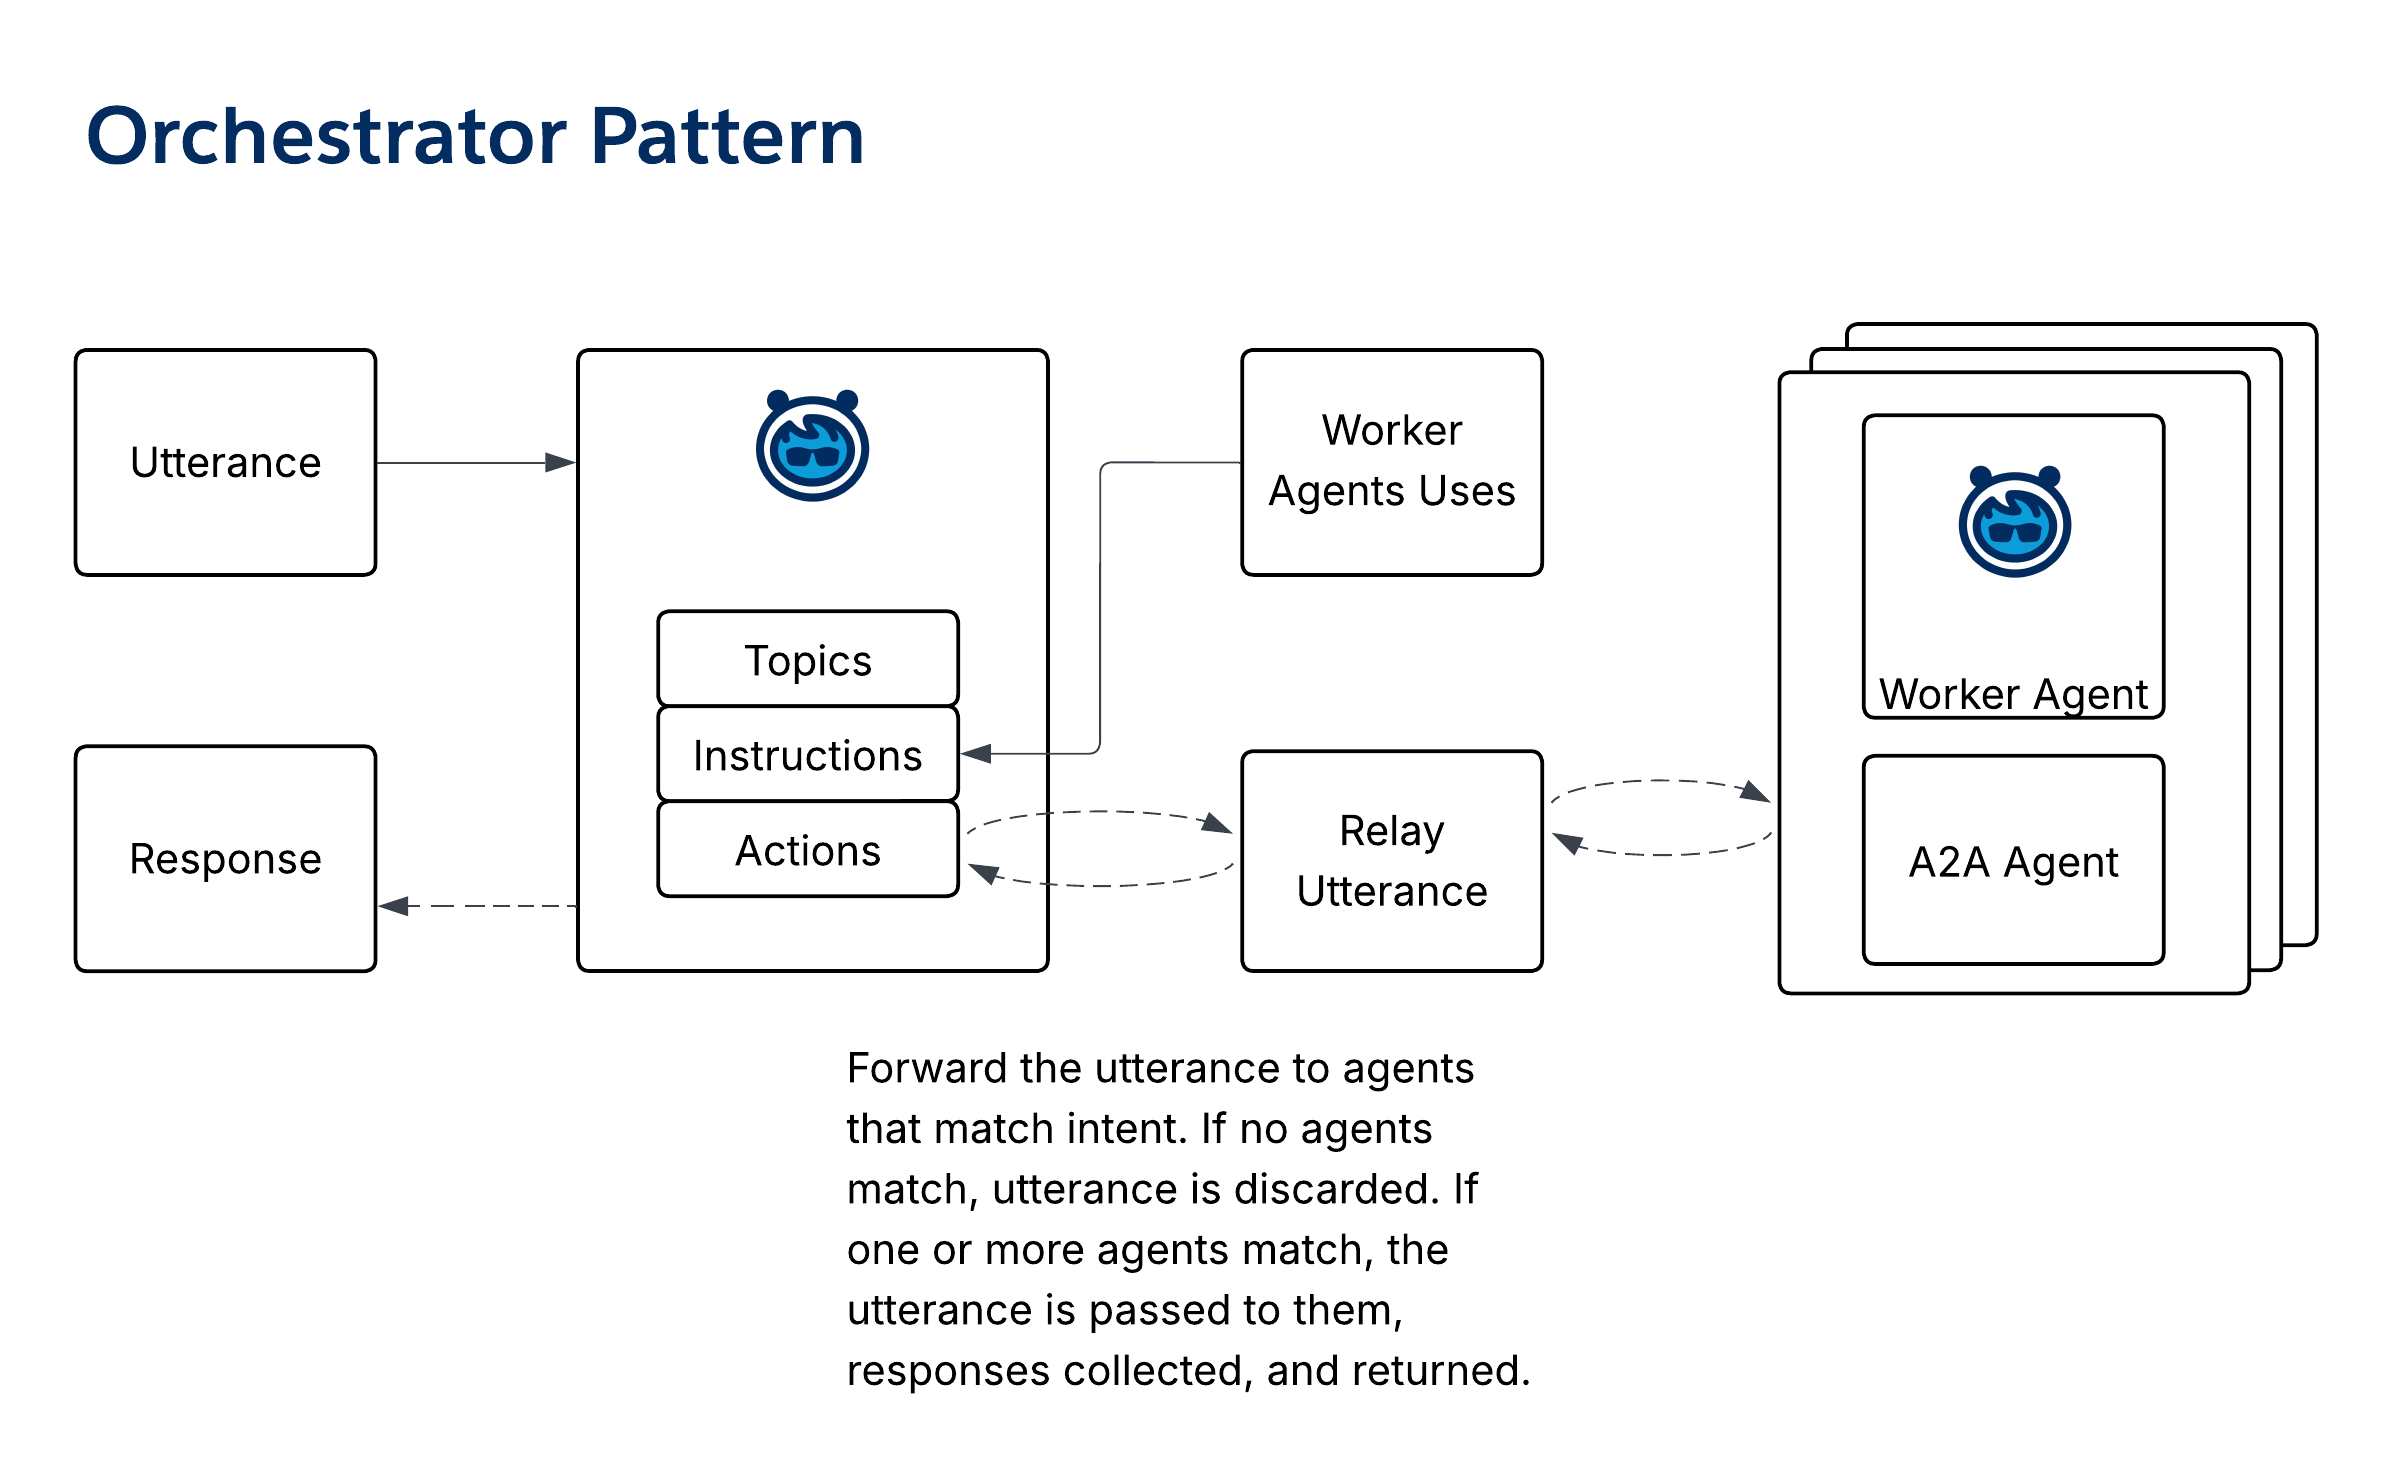 - **Salesforce 에이전트 성숙도**: 레벨 3
### 수신기/피드 패턴
- **개요**: *Listener/Feed 패턴*은 대화의 흐름 중에 컨텍스트와 인사이트를 표시합니다. *Listener*은 각 대화 순간에 트리거되어 직원의 관련 정보를 찾고 표시합니다.
- **출력 유형**: 대화를 기반으로 관련 컨텍스트를 제공합니다. 이 컨텍스트는 효과(예: 비교 또는 핵심 지점 강조)를 위해 서식 지정할 수 있습니다.
- **패턴 사용 지침**: 수신기를 회전 기반 채널(예: 채팅, 음성 또는 SMS)에 첨부합니다. 각 주제 영역에 대한 주제를 정의합니다. 에이전트가 기록을 사용하고, 주제를 식별하고, 작업을 호출하여 직원에 대한 실행 중인 피드에 관련 콘텐츠를 검색하고 게시합니다.
- **전체적인 사용 사례**: _Universal Assistant를_ 사용하여 고객 서비스 또는 세일즈 담당자를 지원합니다.
- **도표**:
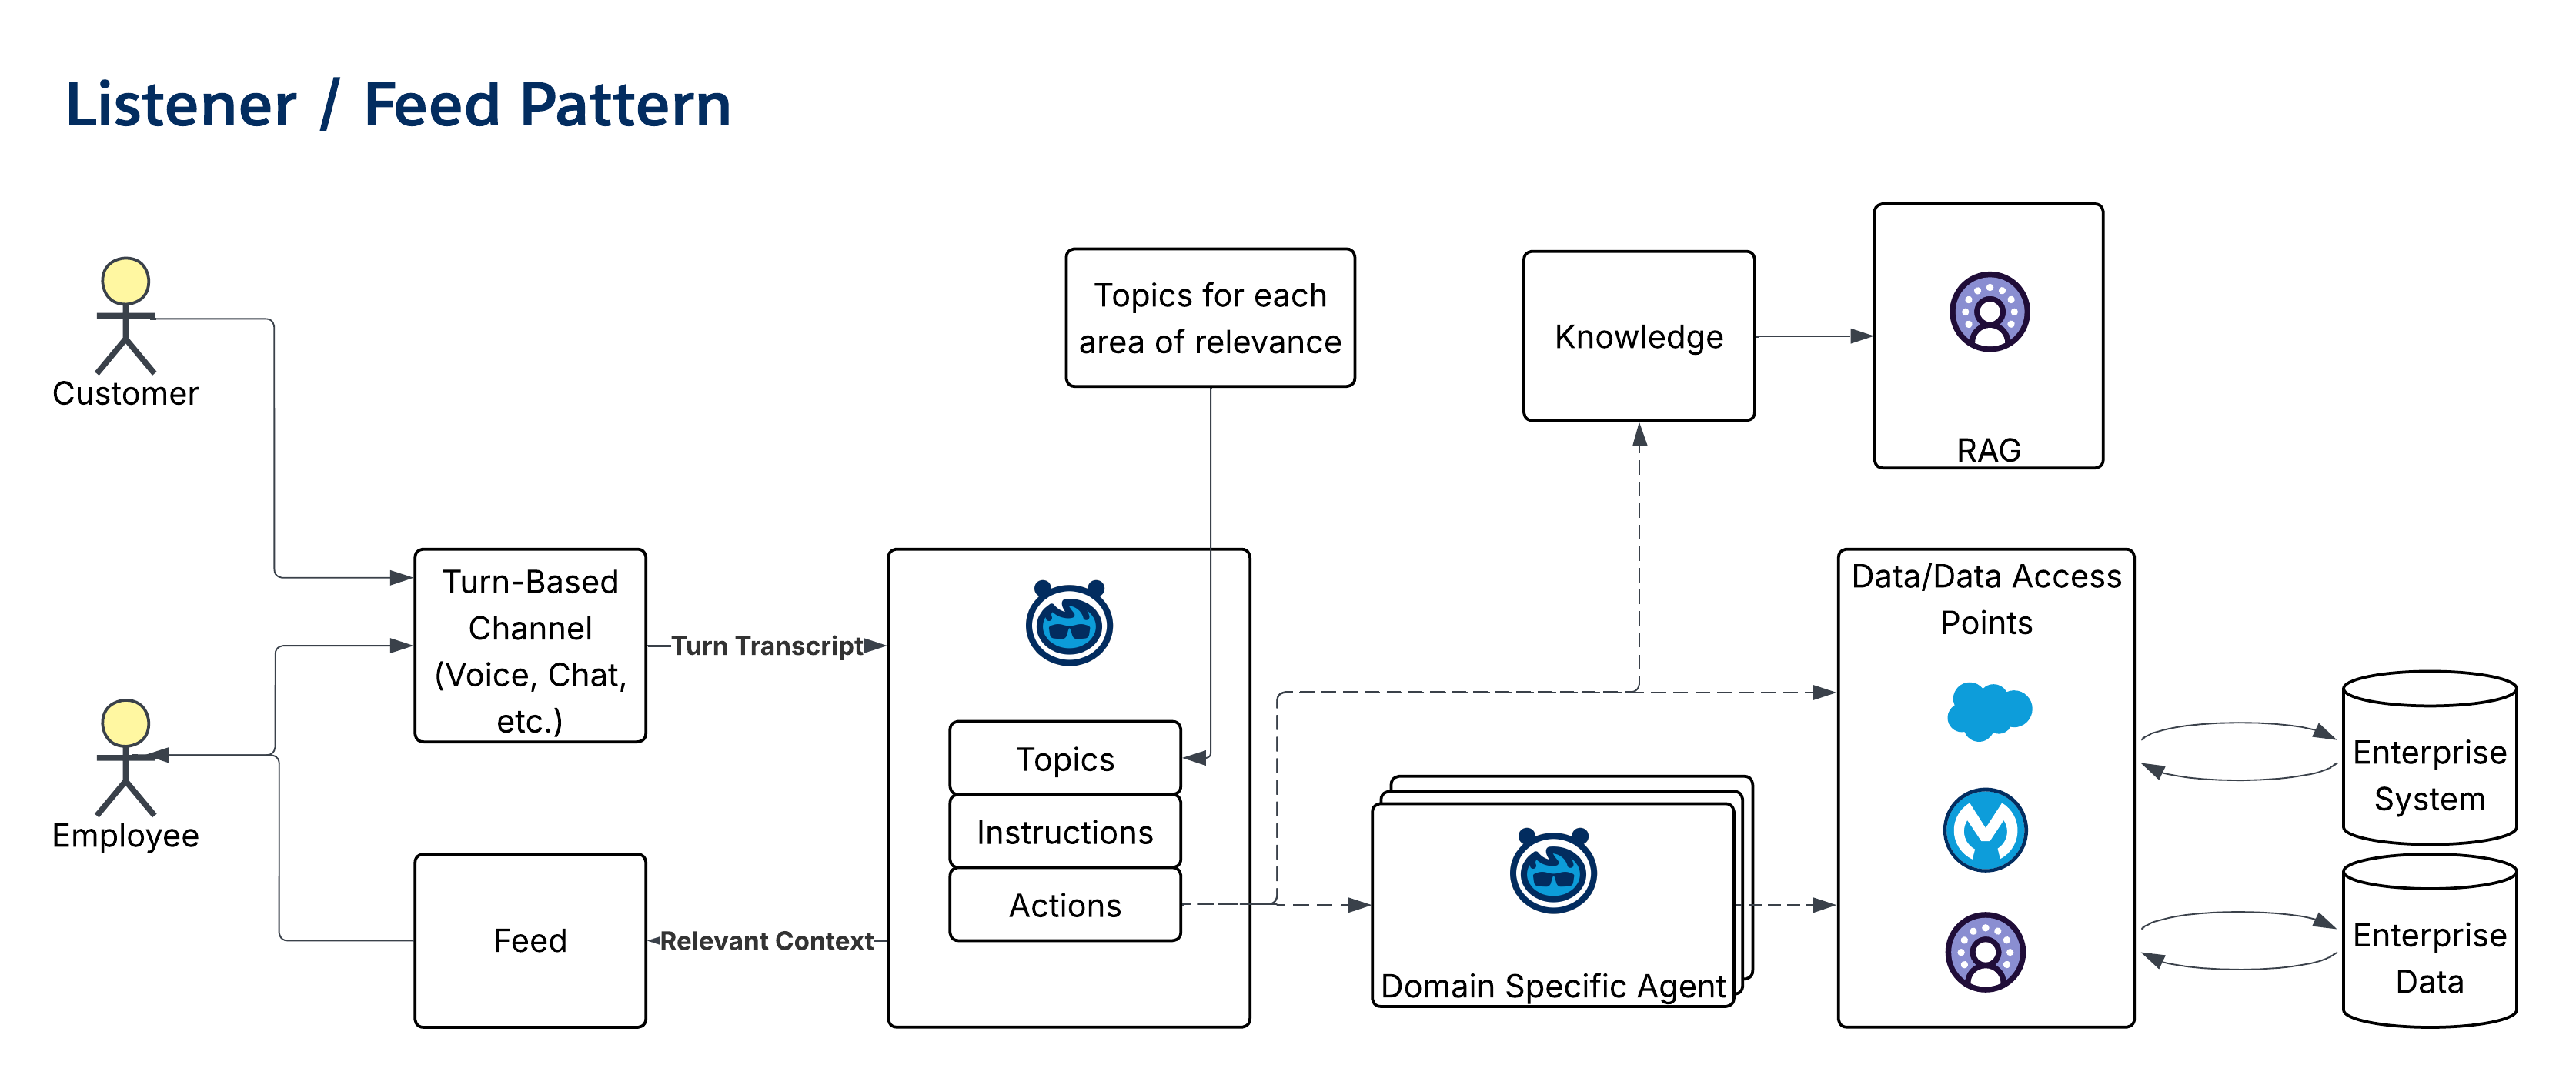 - **Salesforce 에이전트 성숙도**: 레벨 3
### 작업 영역(Radar O'Reilly) 패턴
- **개요**: *Workspace(Radar O’Reilly) 패턴*은 대화의 흐름에서 반응형 단일 창 UX를 관리합니다. 각 발화를 처리하여 관련 콘텐츠를 사용하여 UX의 일부를 업데이트합니다.
- **출력 유형**: 더 큰 단일 창 보기 내에서 포틀릿에 있는 관련 컨텍스트를 제공합니다.
- **패턴 사용 지침**: _Orchestrator_ 에이전트가 발화를 _주제_ 에이전트 모음에 전달합니다. 각 주제 에이전트가 UX 업데이트가 필요한지 여부를 판단하기 위해 문을 평가합니다. 이러한 경우 해당 LWC에 동적 업데이트를 푸시합니다.
- **전체적인 사용 사례**: 이는 고급 에이전트 프런트 도어와 같은 기능을 제공합니다.
- **도표**:
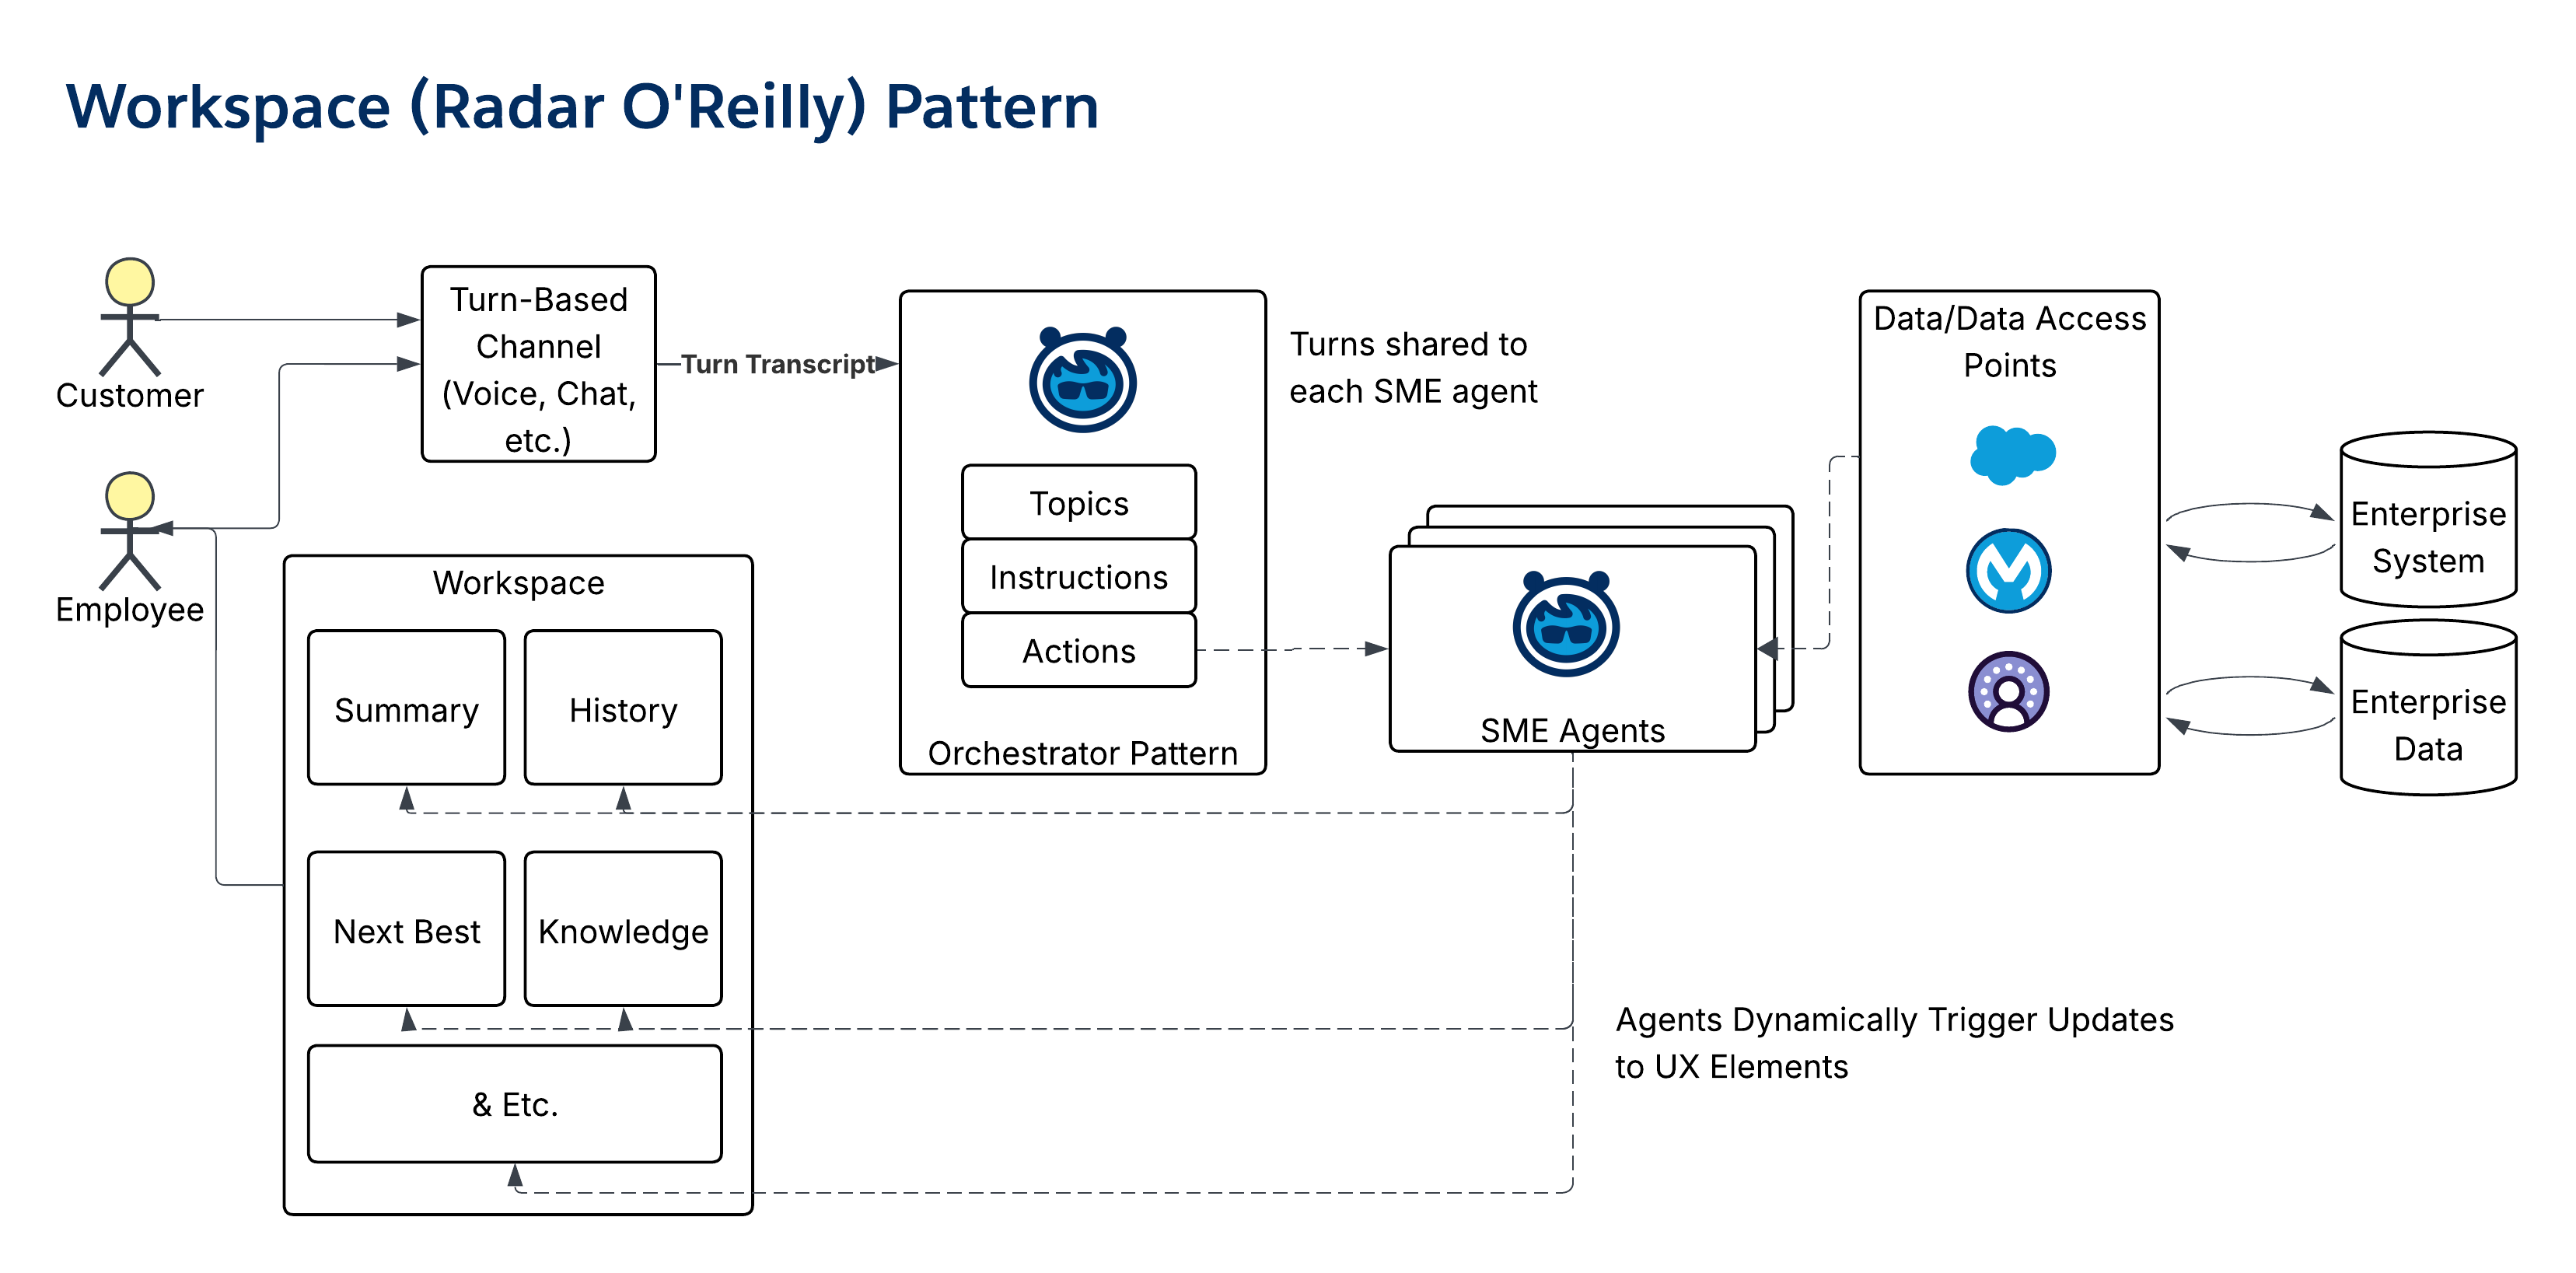 - **Salesforce 에이전트 성숙도**: 레벨 3
## 7\. 전문가 패턴
*전문가 패턴*은 특정 영역에 대한 깊은 Knowledge 또는 기술을 캡슐화하며, 일반적으로 *상호 작용 패턴*으로 오케스트레이션됩니다.
### Answerbot 패턴
- **개요**: *Answerbot 패턴*은 셀프 서비스에 대한 효과적인 패턴으로, 키워드가 아닌 Knowledge 검색을 위한 자연어를 결정하기 위해 GenAI를 사용합니다.
- **출력 유형**: 요약된 Knowledge 및 지원 자료에 대한 참조/따옴표.
- **패턴 사용 지침**: 에이전트를 구성하기 위해 신뢰할 수 있는 소스 자료(예: Knowledge Stores 또는 FAQ)를 구성하고 수집합니다. 회사 웹 사이트 또는 내부 포털 내에서 에이전트를 배치합니다. Knowledge 공백을 식별하고 해결하기 위해 질문을 모니터링합니다.
- **전체적인 사용 사례**: 기업 웹 사이트에서 자연어 검색을 수행하고, HR Benefits Bot과 상호 작용하고, 모든 구성원에게 셀프 서비스 구성 요소를 제공합니다.
- **도표**:
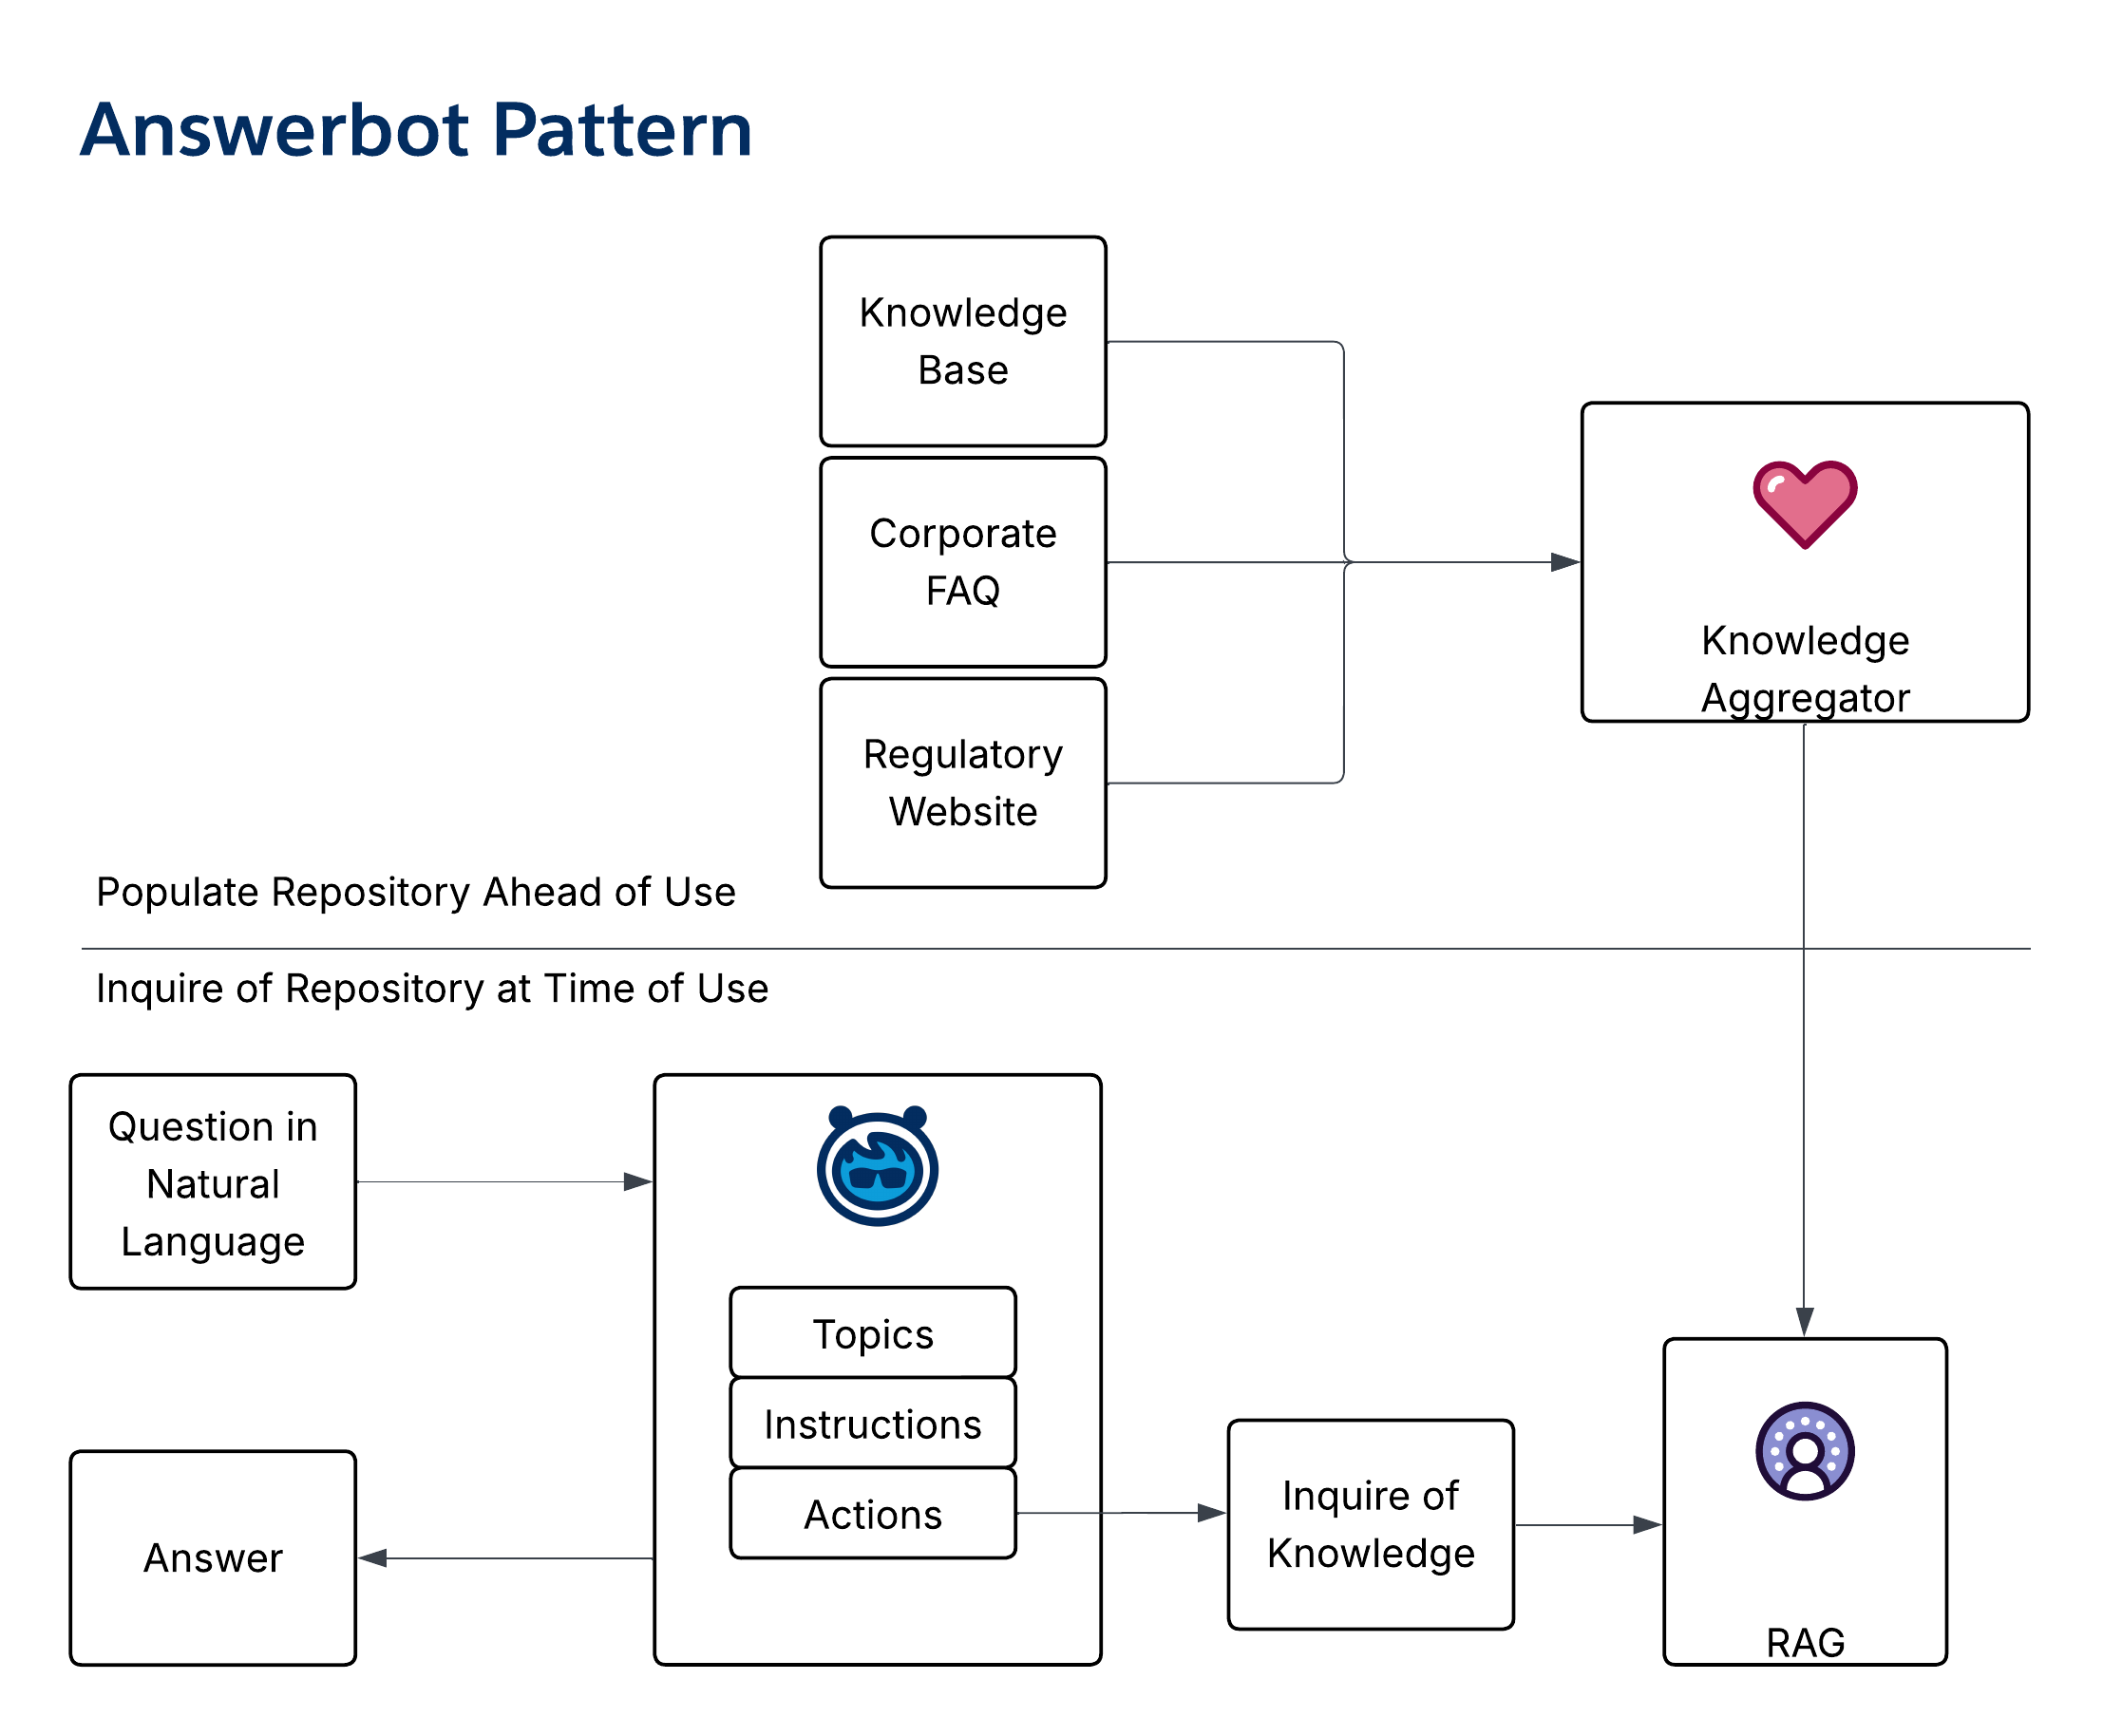 - **Salesforce 에이전트 성숙도**: 레벨 1
### 도메인 SME 패턴
- **개요**: *도메인 SME 패턴*은 비즈니스 도메인(예: 주문 또는 청구)에 대한 자연스러운 언어 프런트엔드를 제공하는 기본 패턴입니다.
- **출력 유형**: 도메인에 대한 관련 콘텐츠, 주제, 데이터, 서식이 지정된 정보를 제공합니다.
- **패턴 사용 지침**: 이 패턴을 사용하여 주체 또는 비즈니스 도메인을 캡슐화합니다. 적절한 CRUD 작업을 수행할 수 있는 능력을 가진 에이전트를 구성합니다. 이러한 에이전트를 [_상호 작용 패턴_](/docs/architect/ko-kr/fundamentals/guide/enterprise-agentic-architecture#6-상호-작용-패턴)(예: - 오케스트레이터 또는 수신기)을 통해 사용할 수 있도록 지정합니다.
- **전체적인 사용 사례**: 비즈니스 데이터 도메인을 관리하고, "주문 에이전트" 또는 "재고 에이전트"를 제공하고, 비즈니스 도메인에 대한 에이전트 인터페이스를 제공합니다.
- **도표**:
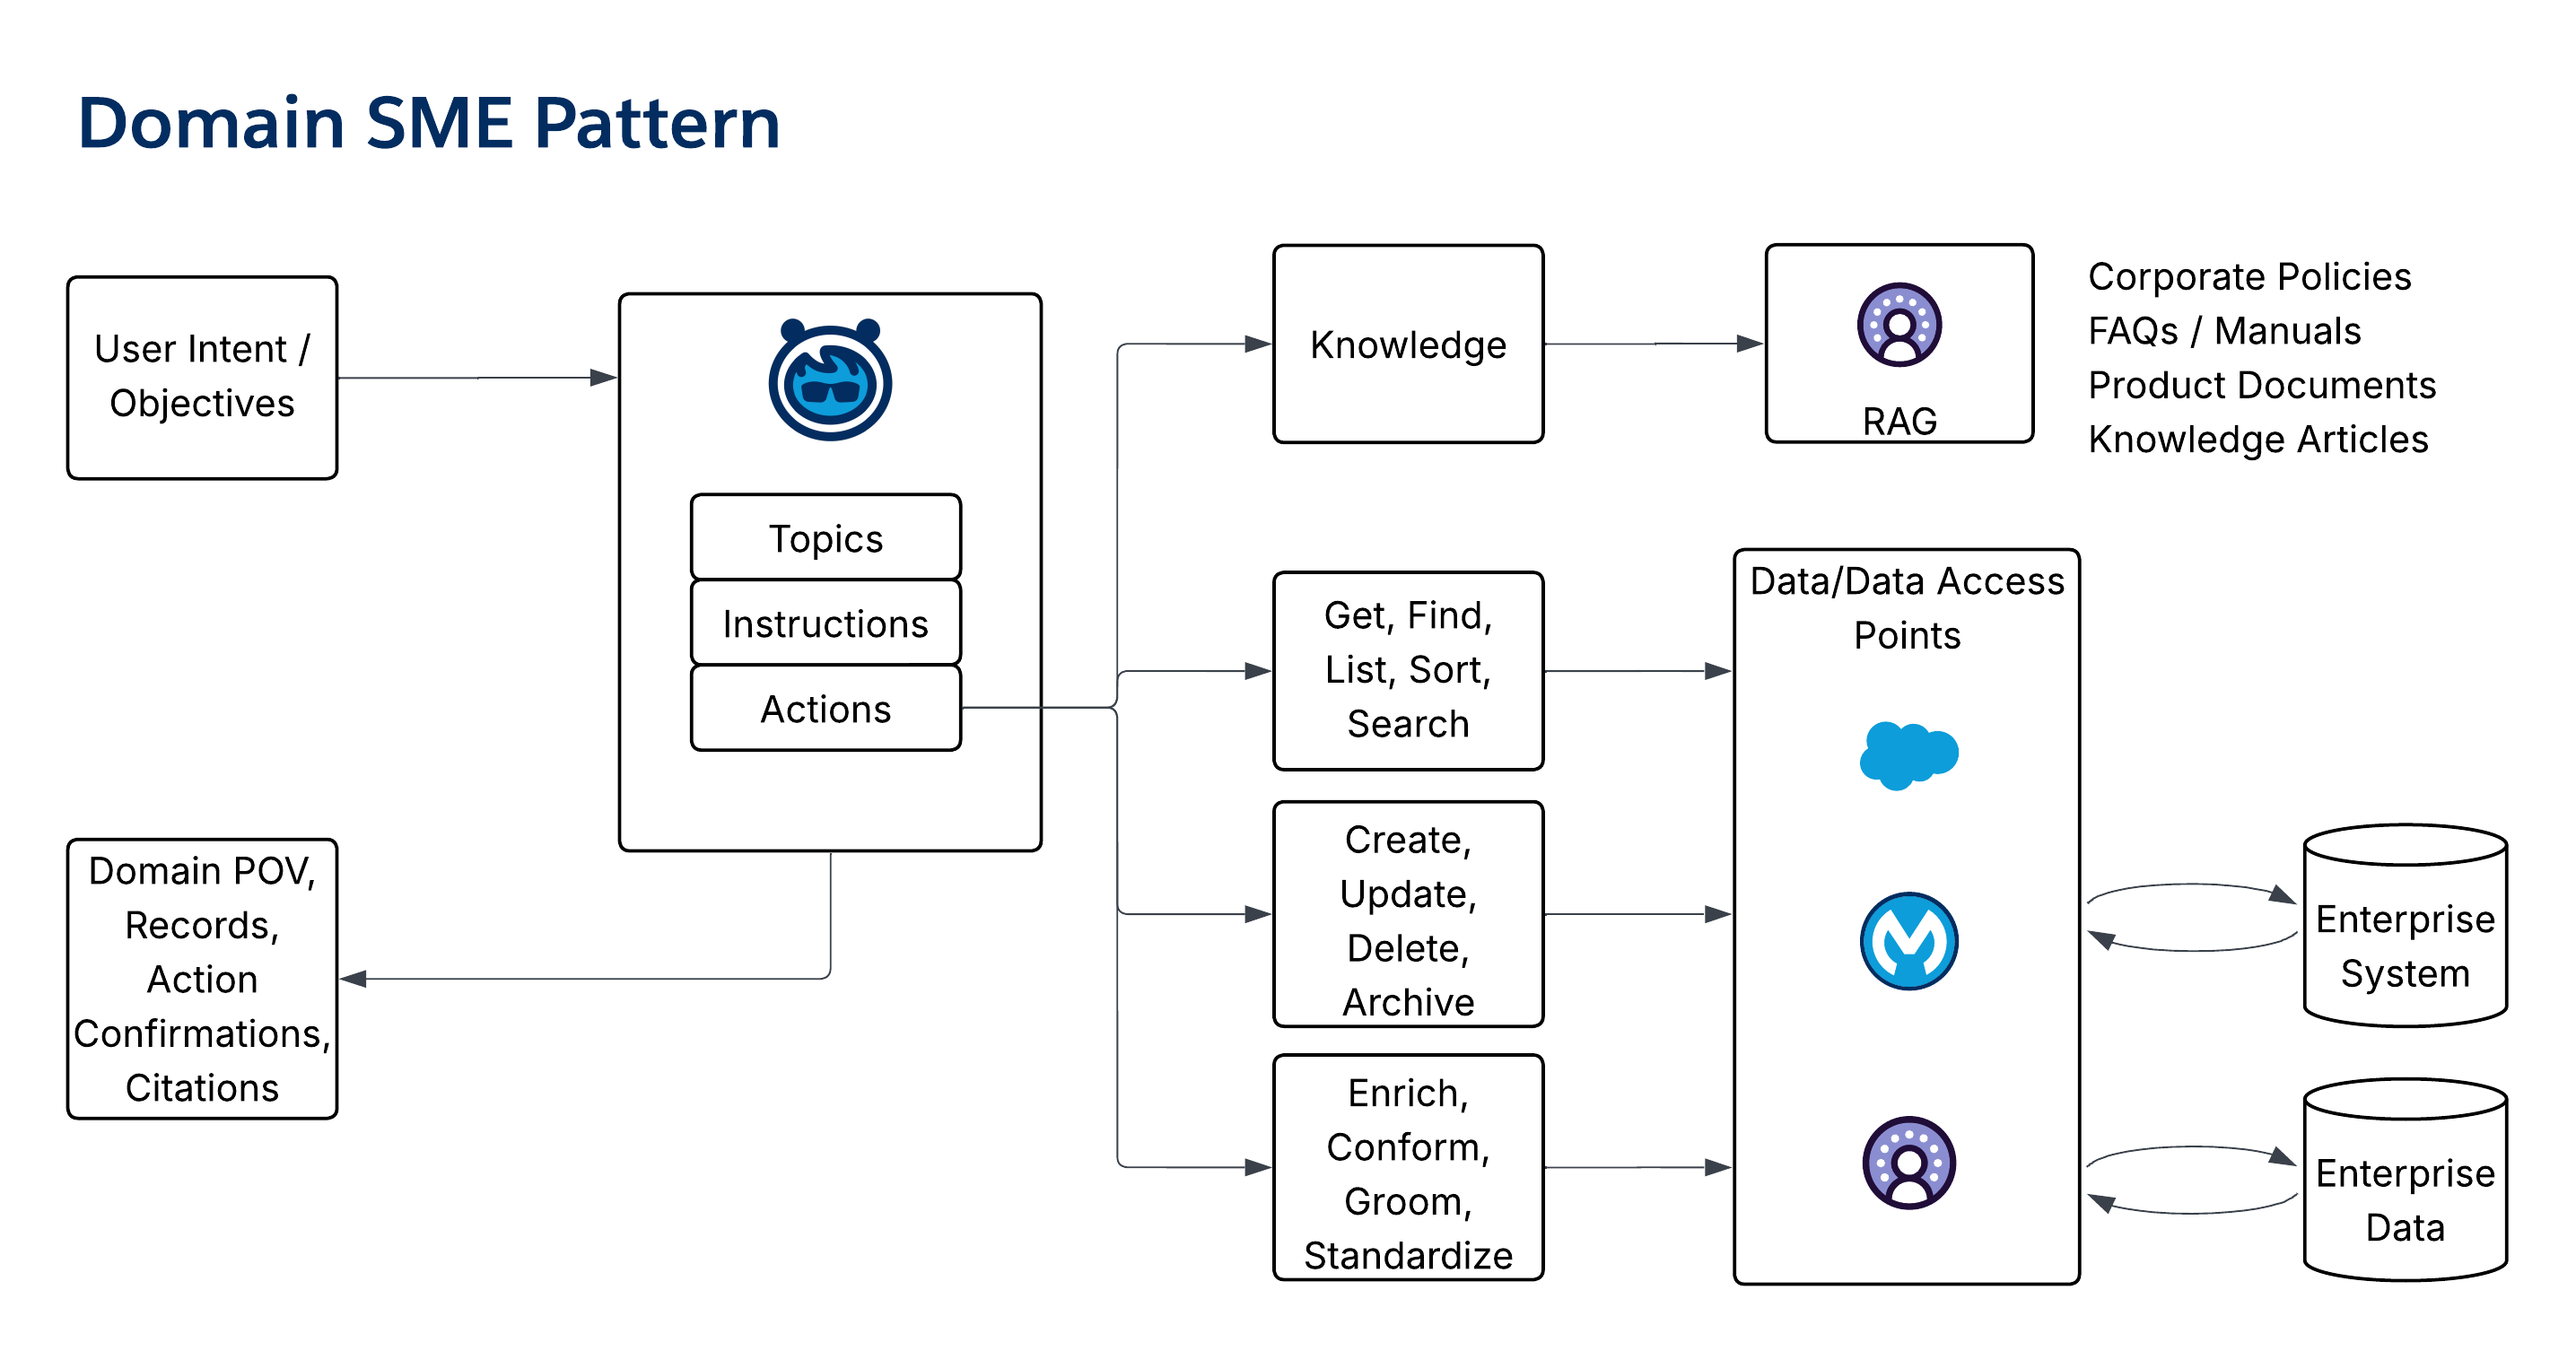 - **Salesforce 에이전트 성숙도**: 레벨 2
### 문의자 패턴
- **개요**: *검색자 패턴*은 주제에 대해 조회할 수 있는 중소기업 에이전트로서 여러 소스의 컨텍스트를 조합하여 질문에 답할 수 있습니다. 사용되는 핵심 에이전트 기능은 콘텐츠를 읽고 내부화한 후 인간이 원하는 방식으로 컨텍스트를 가져오고 컨텍스트를 콘텐츠 본문에 연결하는 기능입니다. 이 패턴을 사용하면 "스빌 카드 통합"이 필요하지 않습니다.
- **출력 유형**: 질문에 대한 답변을 제공합니다.
- **패턴 사용 지침**: 대개 사용자가 직접 질문할 수 있도록 사용자의 현재 컨텍스트에 연결된 콘솔 위젯으로 구성됩니다. 또한 FAQ, 정책 및 제품 카탈로그와 같은 Knowledge 리소스와 함께 사용됩니다. *Interrogator 패턴*을 표준 프롬프트와 연결하여 일반 질문에 대한 일반적인 답변을 확장합니다.
- **전체적인 사용 사례**: 계약 도우미 에이전트, 보상 문의 도우미 또는 다중 에이전트 패턴(예: 수신기 또는 작업 영역)의 전문 작업자 에이전트로 사용합니다.
- **도표**:
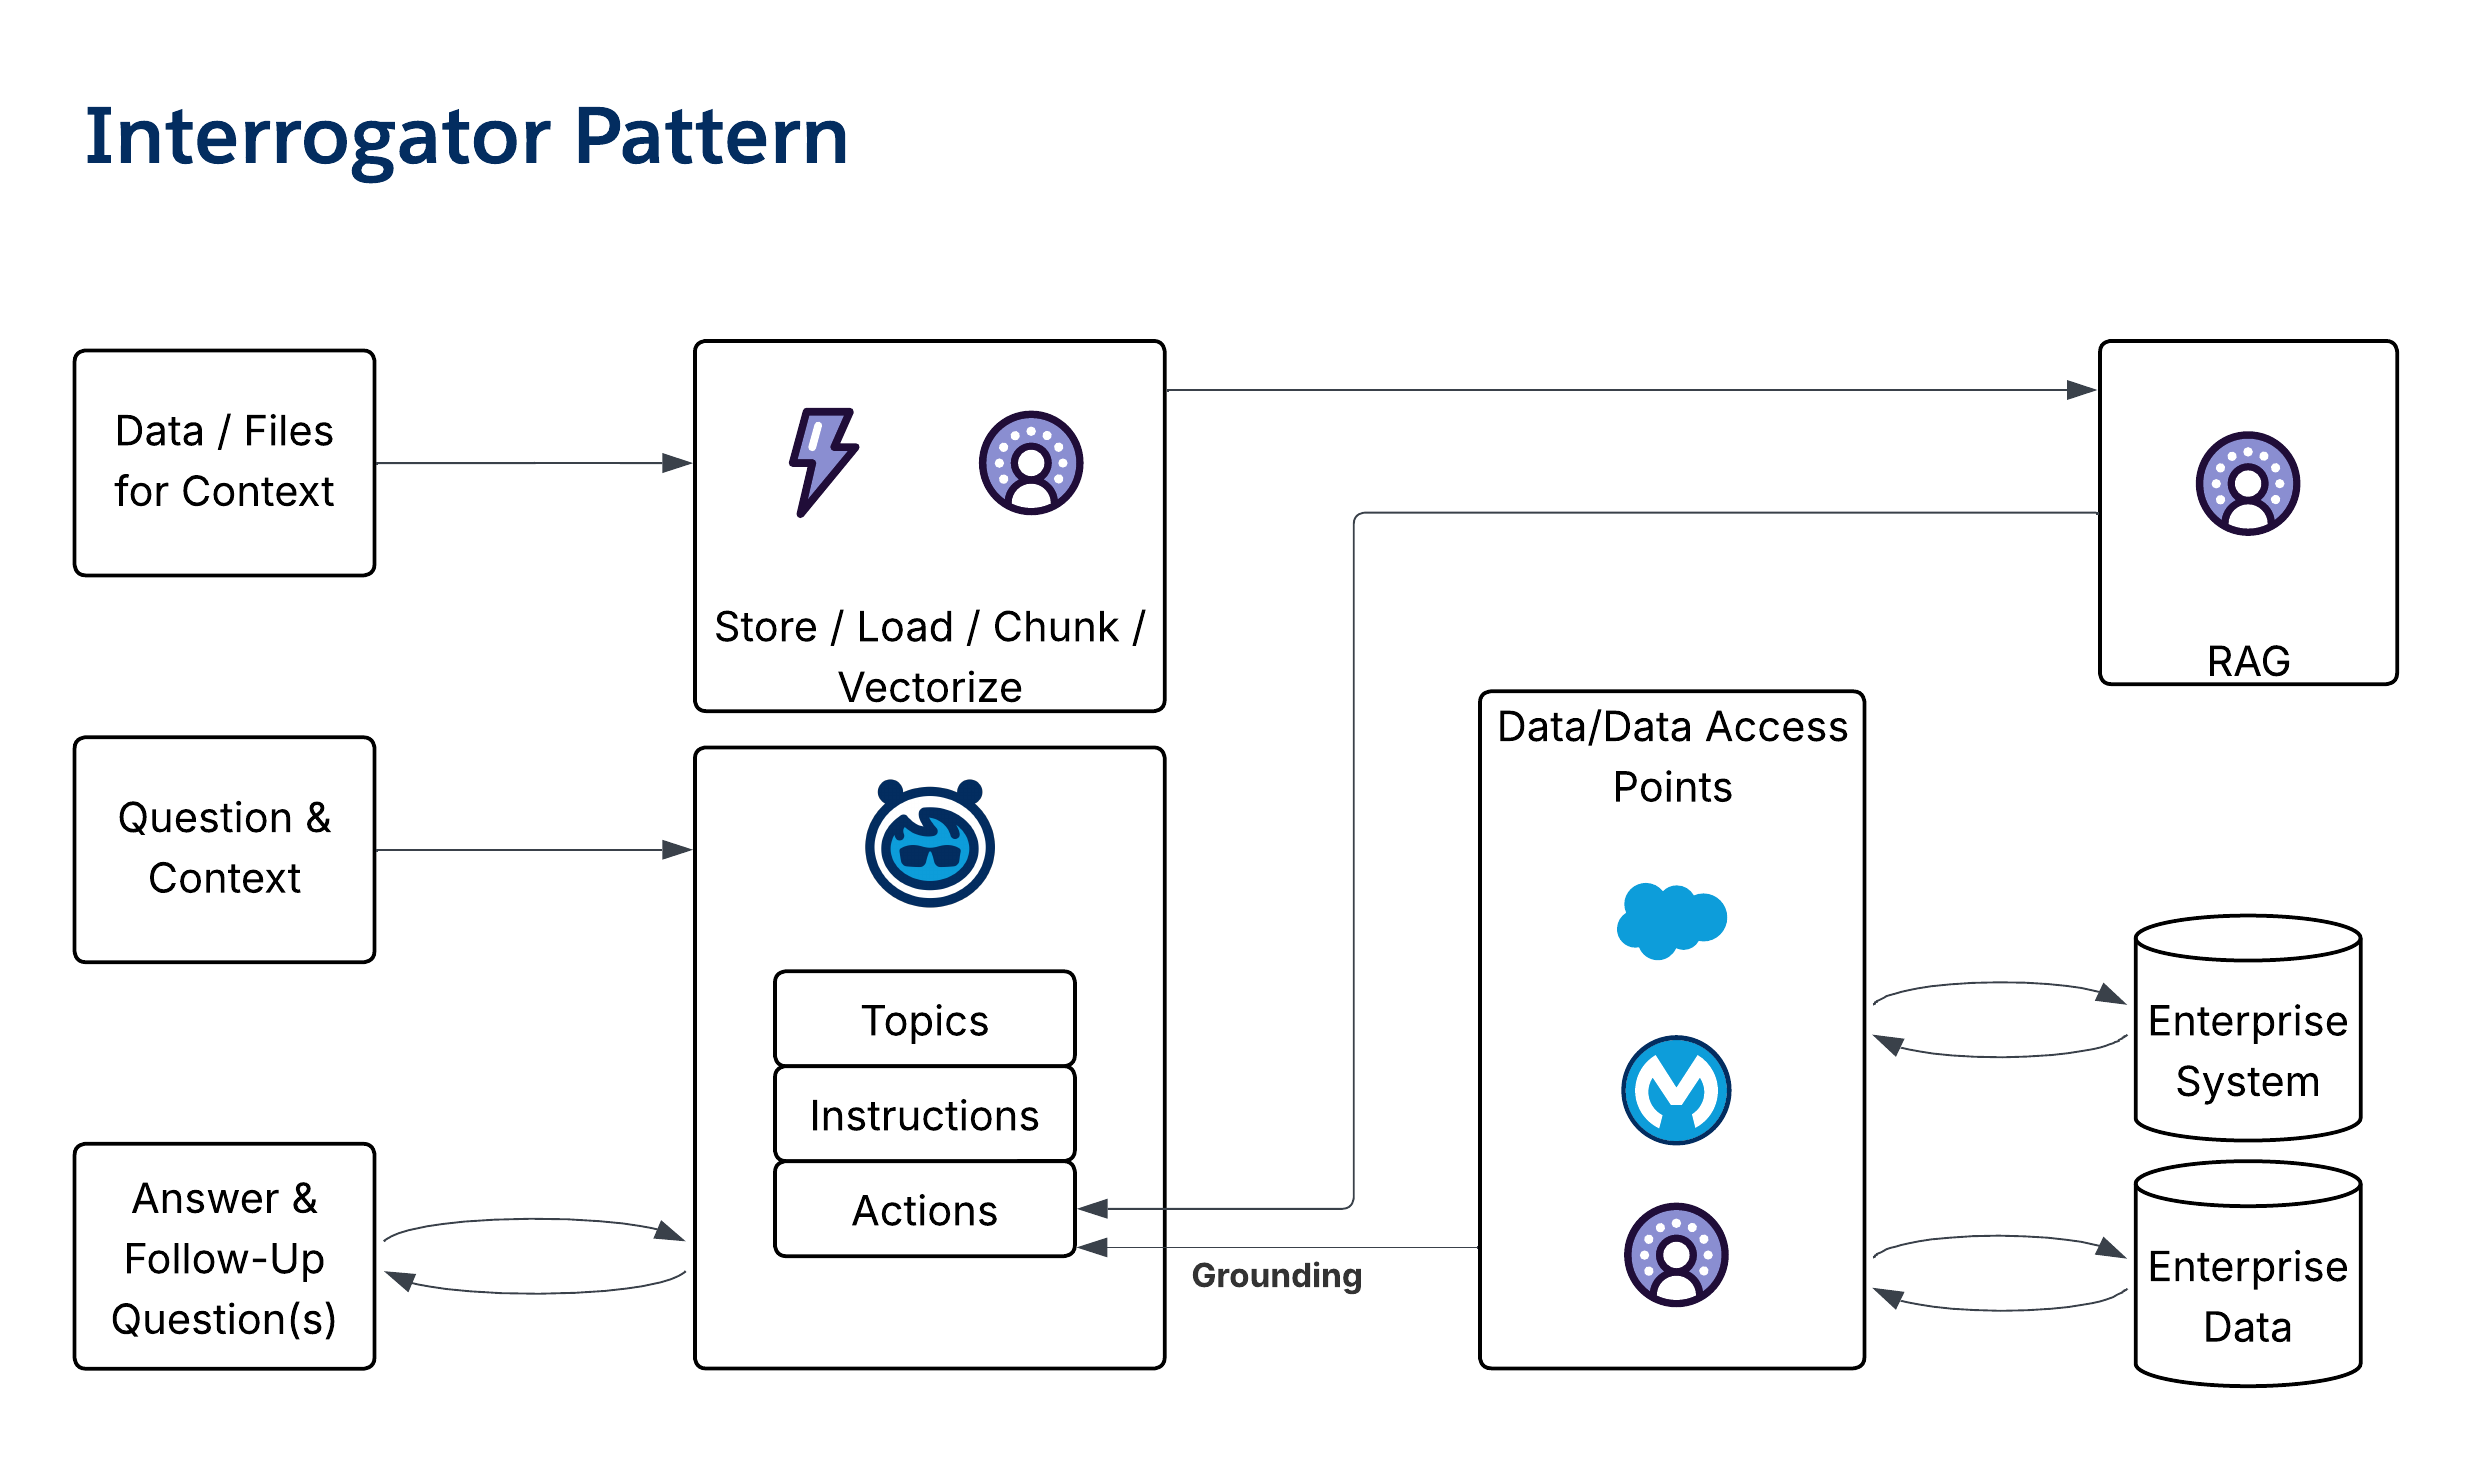 - **Salesforce 에이전트 성숙도**: 레벨 2
### 우선 순위 지정자 패턴
- **개요**: *Prioritizer 패턴*은 정의된 목표를 기반으로 작업 집합 또는 작업 개체를 정렬하는 데 사용됩니다. 여러 데이터 도메인의 정성 분석, 비정형 데이터 분석 또는 통합 분석에 GenAI를 활용합니다.
- **출력 유형**: 생성 인사이트를 제공합니다.
- **패턴 사용 지침**: 자연어를 사용하여 우선 순위 지정에 필요한 특성을 설명합니다. 선택 가능한 옵션 집합을 사용하여 에이전트를 기초 교육합니다. 수신기 패턴과 결합하여 작업 플로에서 반응형 "Next Best Action"을 만듭니다.
- **전체적인 사용 사례**: 장기 실행 또는 멀티 에이전트 패턴에서 _Next Best Action_ 발생기 또는 전문 작업자 에이전트로 사용합니다.
- **도표**:
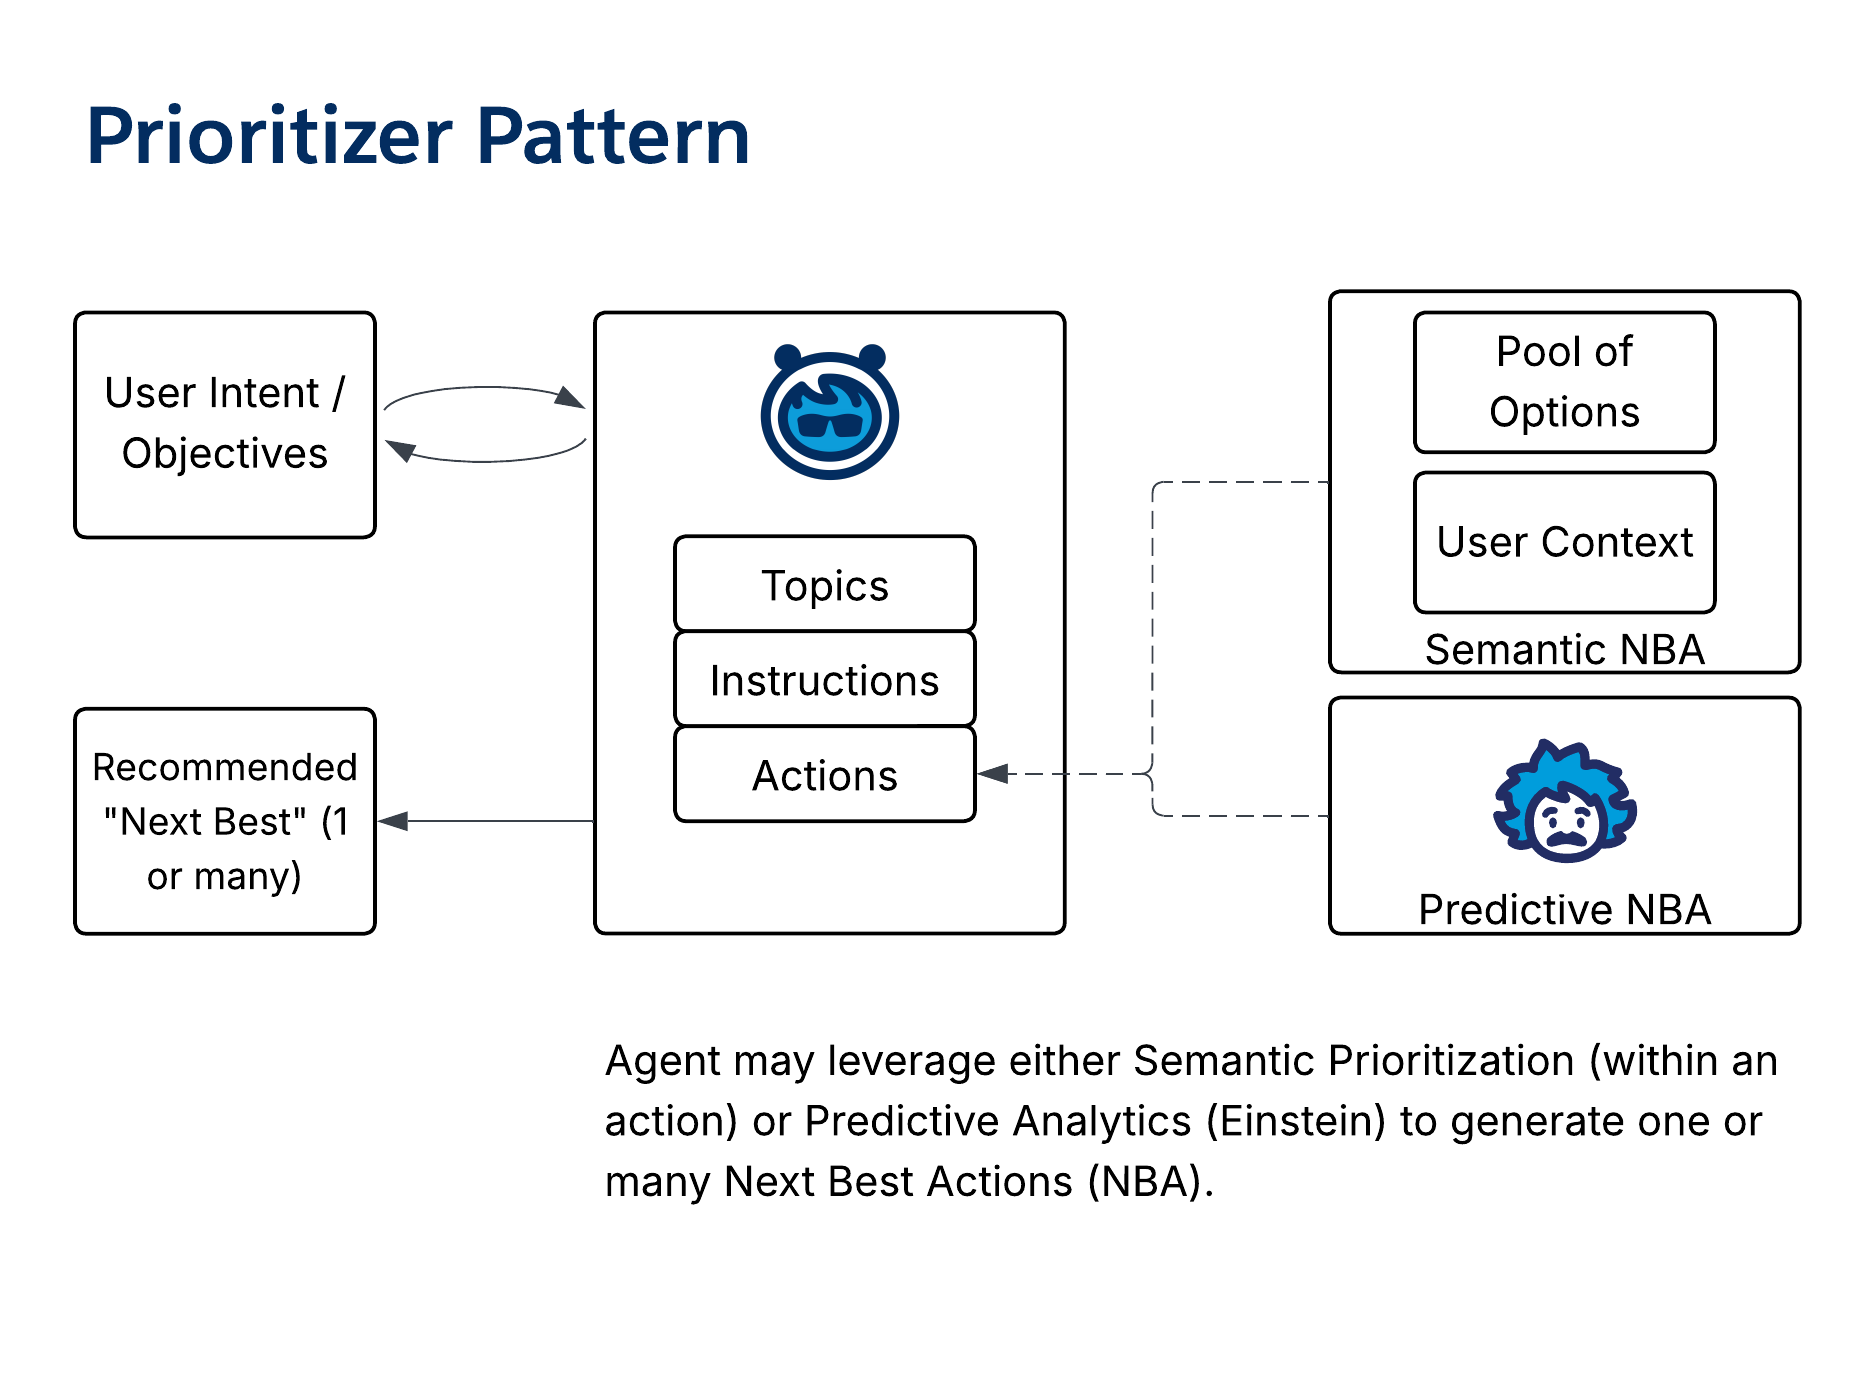 - **Salesforce 에이전트 성숙도**: 레벨 2
## 8\. 유틸리티 및 데이터 패턴
*유틸리티 패턴*은 다른 에이전트 또는 프로세스를 지원하는 특정하고 반복 가능한 작업을 수행합니다.
### 발전기 패턴
- **개요**: *생성기 패턴*은 기존 입력 및 표준에서 새로운 콘텐츠(예: 사례 요약 또는 이메일 초안)를 만드는 기본 패턴입니다. 이는 주로 프롬프트로 구현되며 다른 에이전트 내에 포함될 수 있습니다.
- **출력 유형**: 요청된 형식 및 의도를 준수하는 생성된 콘텐츠를 제공합니다.
- **패턴 사용 지침**: *발전기 패턴*은 대부분의 다른 패턴 내에서 또는 독립형으로 사용할 수 있습니다. 컨텍스트는 요청, 실행 중의 채우기 또는 추가 보강 단계를 통해 제공될 수 있습니다.
- **전체적인 사용 사례**: 사례 요약, 이메일 초안, Knowledge 기사 또는 QBR에 대한 제안/응답을 제공합니다.
- **도표**:
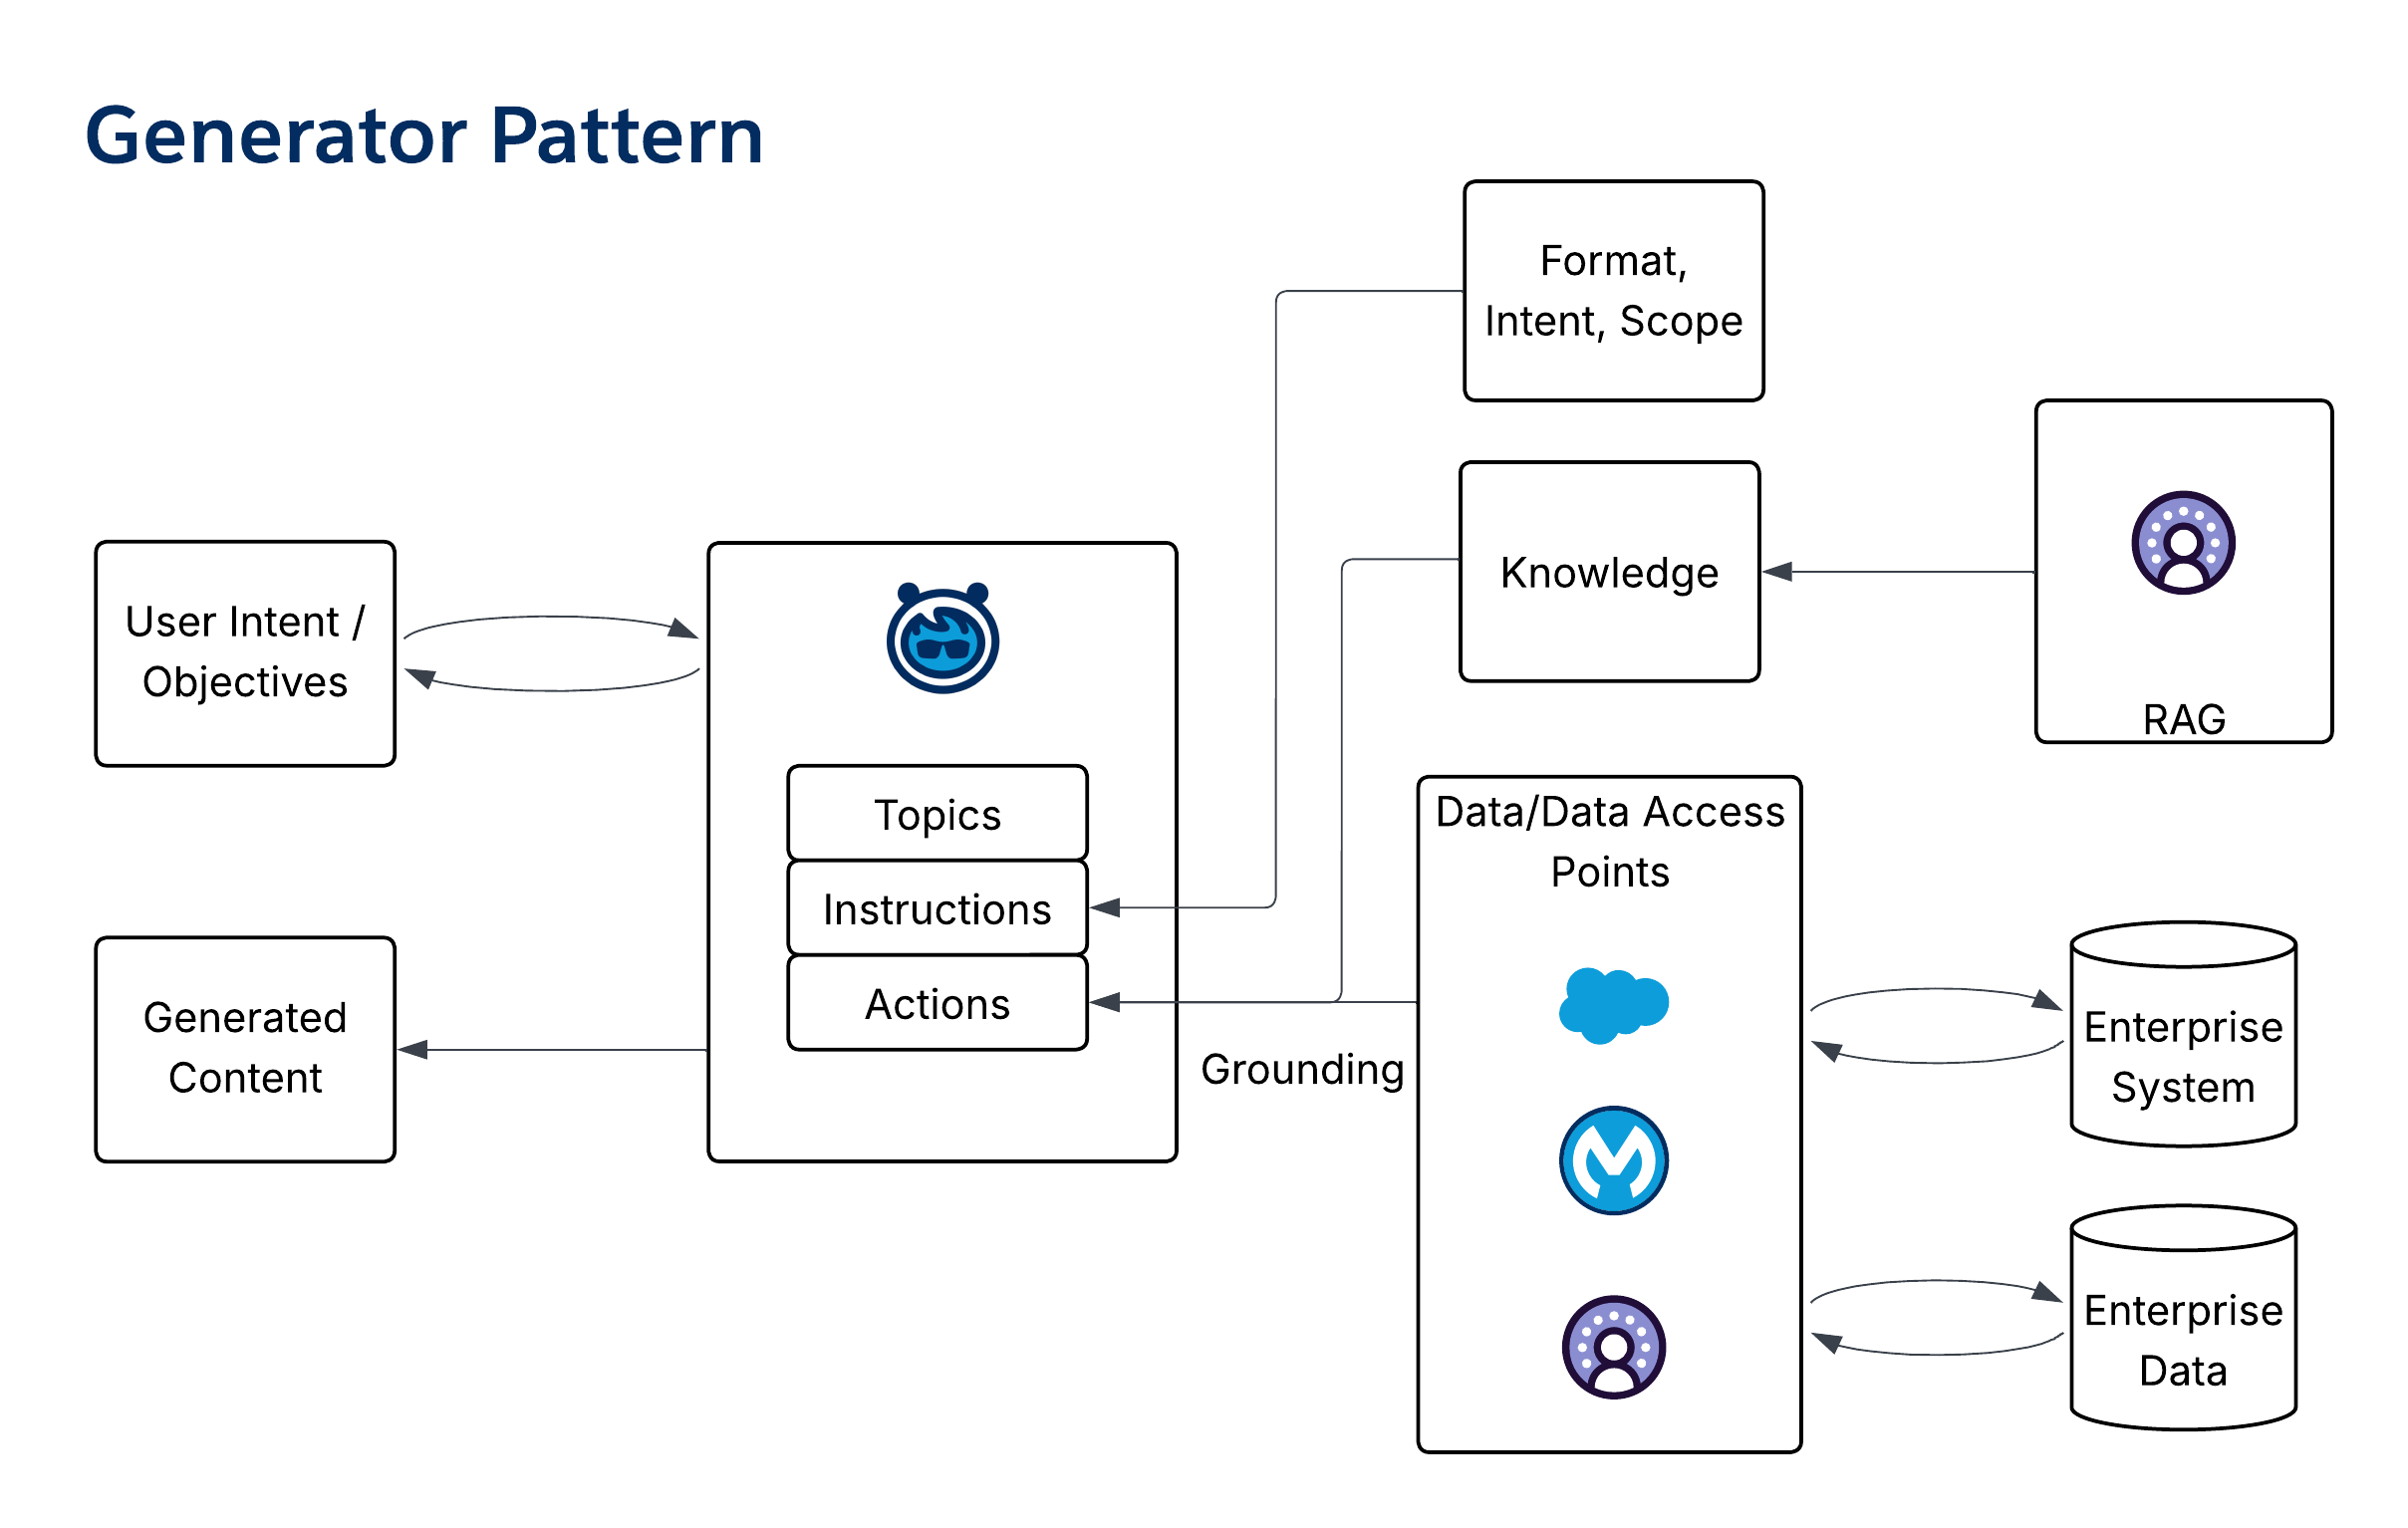 - **Salesforce 에이전트 성숙도**: 레벨 1
### 데이터 스튜어드 패턴
- **개요**: *Data Steward 패턴*은 일관된 데이터 품질, 규정 준수 및 보강을 보장하기 위해 데이터 작업에 에이전트적 단계를 도입하는 자율적인 백그라운드 패턴입니다.
- **출력 유형**: 저장하기 전에 업데이트된 레코드 및 데이터 필드를 제공합니다.
- **패턴 사용 지침**: 데이터 저장 전에 플로를 기록 트리거하는 데이터 관리자를 추가하여 데이터 생성 시점의 데이터 품질을 포함합니다. 분류, 요약, 상태 데이터를 일관되게 적용할 수 있습니다.
- **전체적인 사용 사례**: 일관된 "피자 추적기" 스타일 업데이트를 보장하고 계정 데이터를 보강하거나 일치하지 않는 우편 번호와 주소를 제거합니다.
- **도표**:
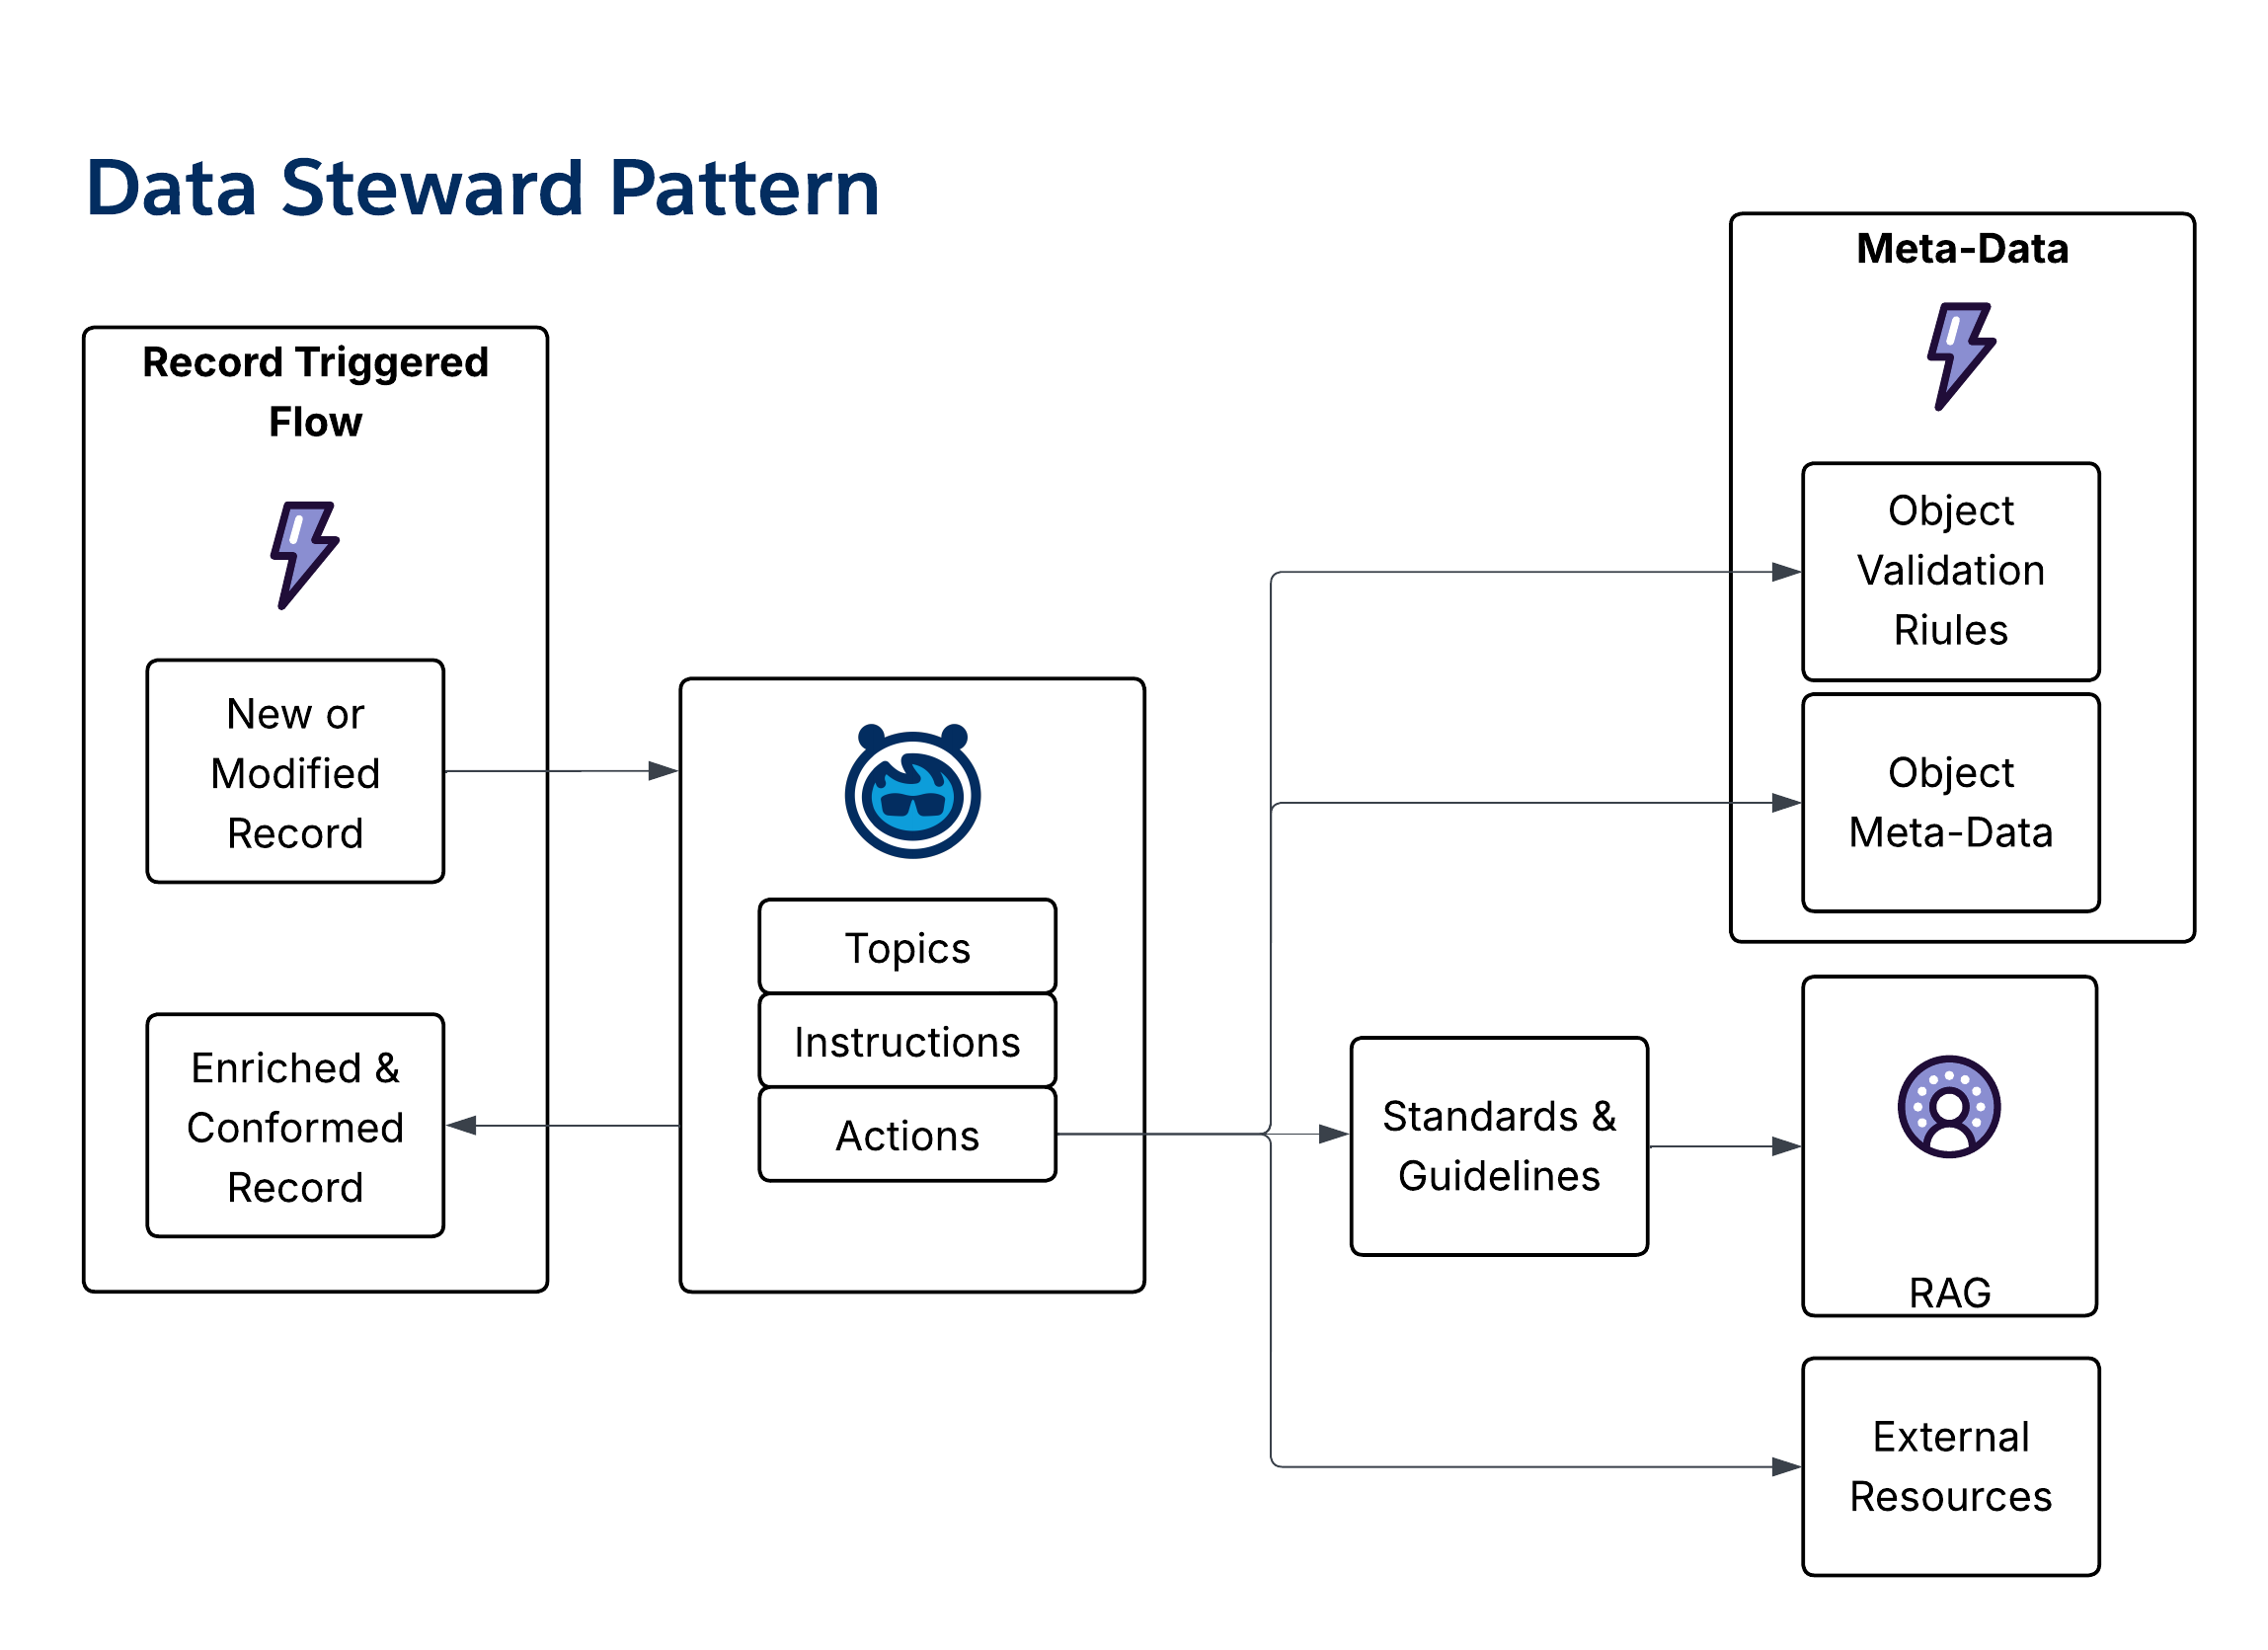 - **Salesforce 에이전트 성숙도**: 레벨 2
### Zen 데이터 가든러 패턴
- **개요**: *젠 데이터 가든러 패턴*은 데이터를 정리하고 표준화하는 데 사용되는 예약된 백그라운드 패턴으로, 저렴한 비용의 추론을 활용하여 연결되지 않은 데이터 도메인 전반에 걸쳐 데이터를 검증, 보강 및 조정합니다.
- **출력 유형**: 업데이트된 레코드 및/또는 데이터 관리 과업을 제공합니다.
- **패턴 사용 지침**: 패턴을 사용하여 정기적인 데이터 검토 및 유효성 검사를 활성화합니다. 느리게 변경되는 데이터의 경우 느린 케이던스(예: 매월)에 에이전트를 예약합니다. [데이터 스튜어드 패턴](/docs/architect/ko-kr/fundamentals/guide/enterprise-agentic-architecture#데이터-스튜어드-패턴)과 결합하여 예상 및 소급 데이터 품질 작업을 제공합니다.
- **전체적인 사용 사례**: 판매된 혜택과 청구 시스템을 정렬하고 국가 레지스트리에 대한 중개인 라이센스를 정기적으로 확인합니다.
- **도표**:
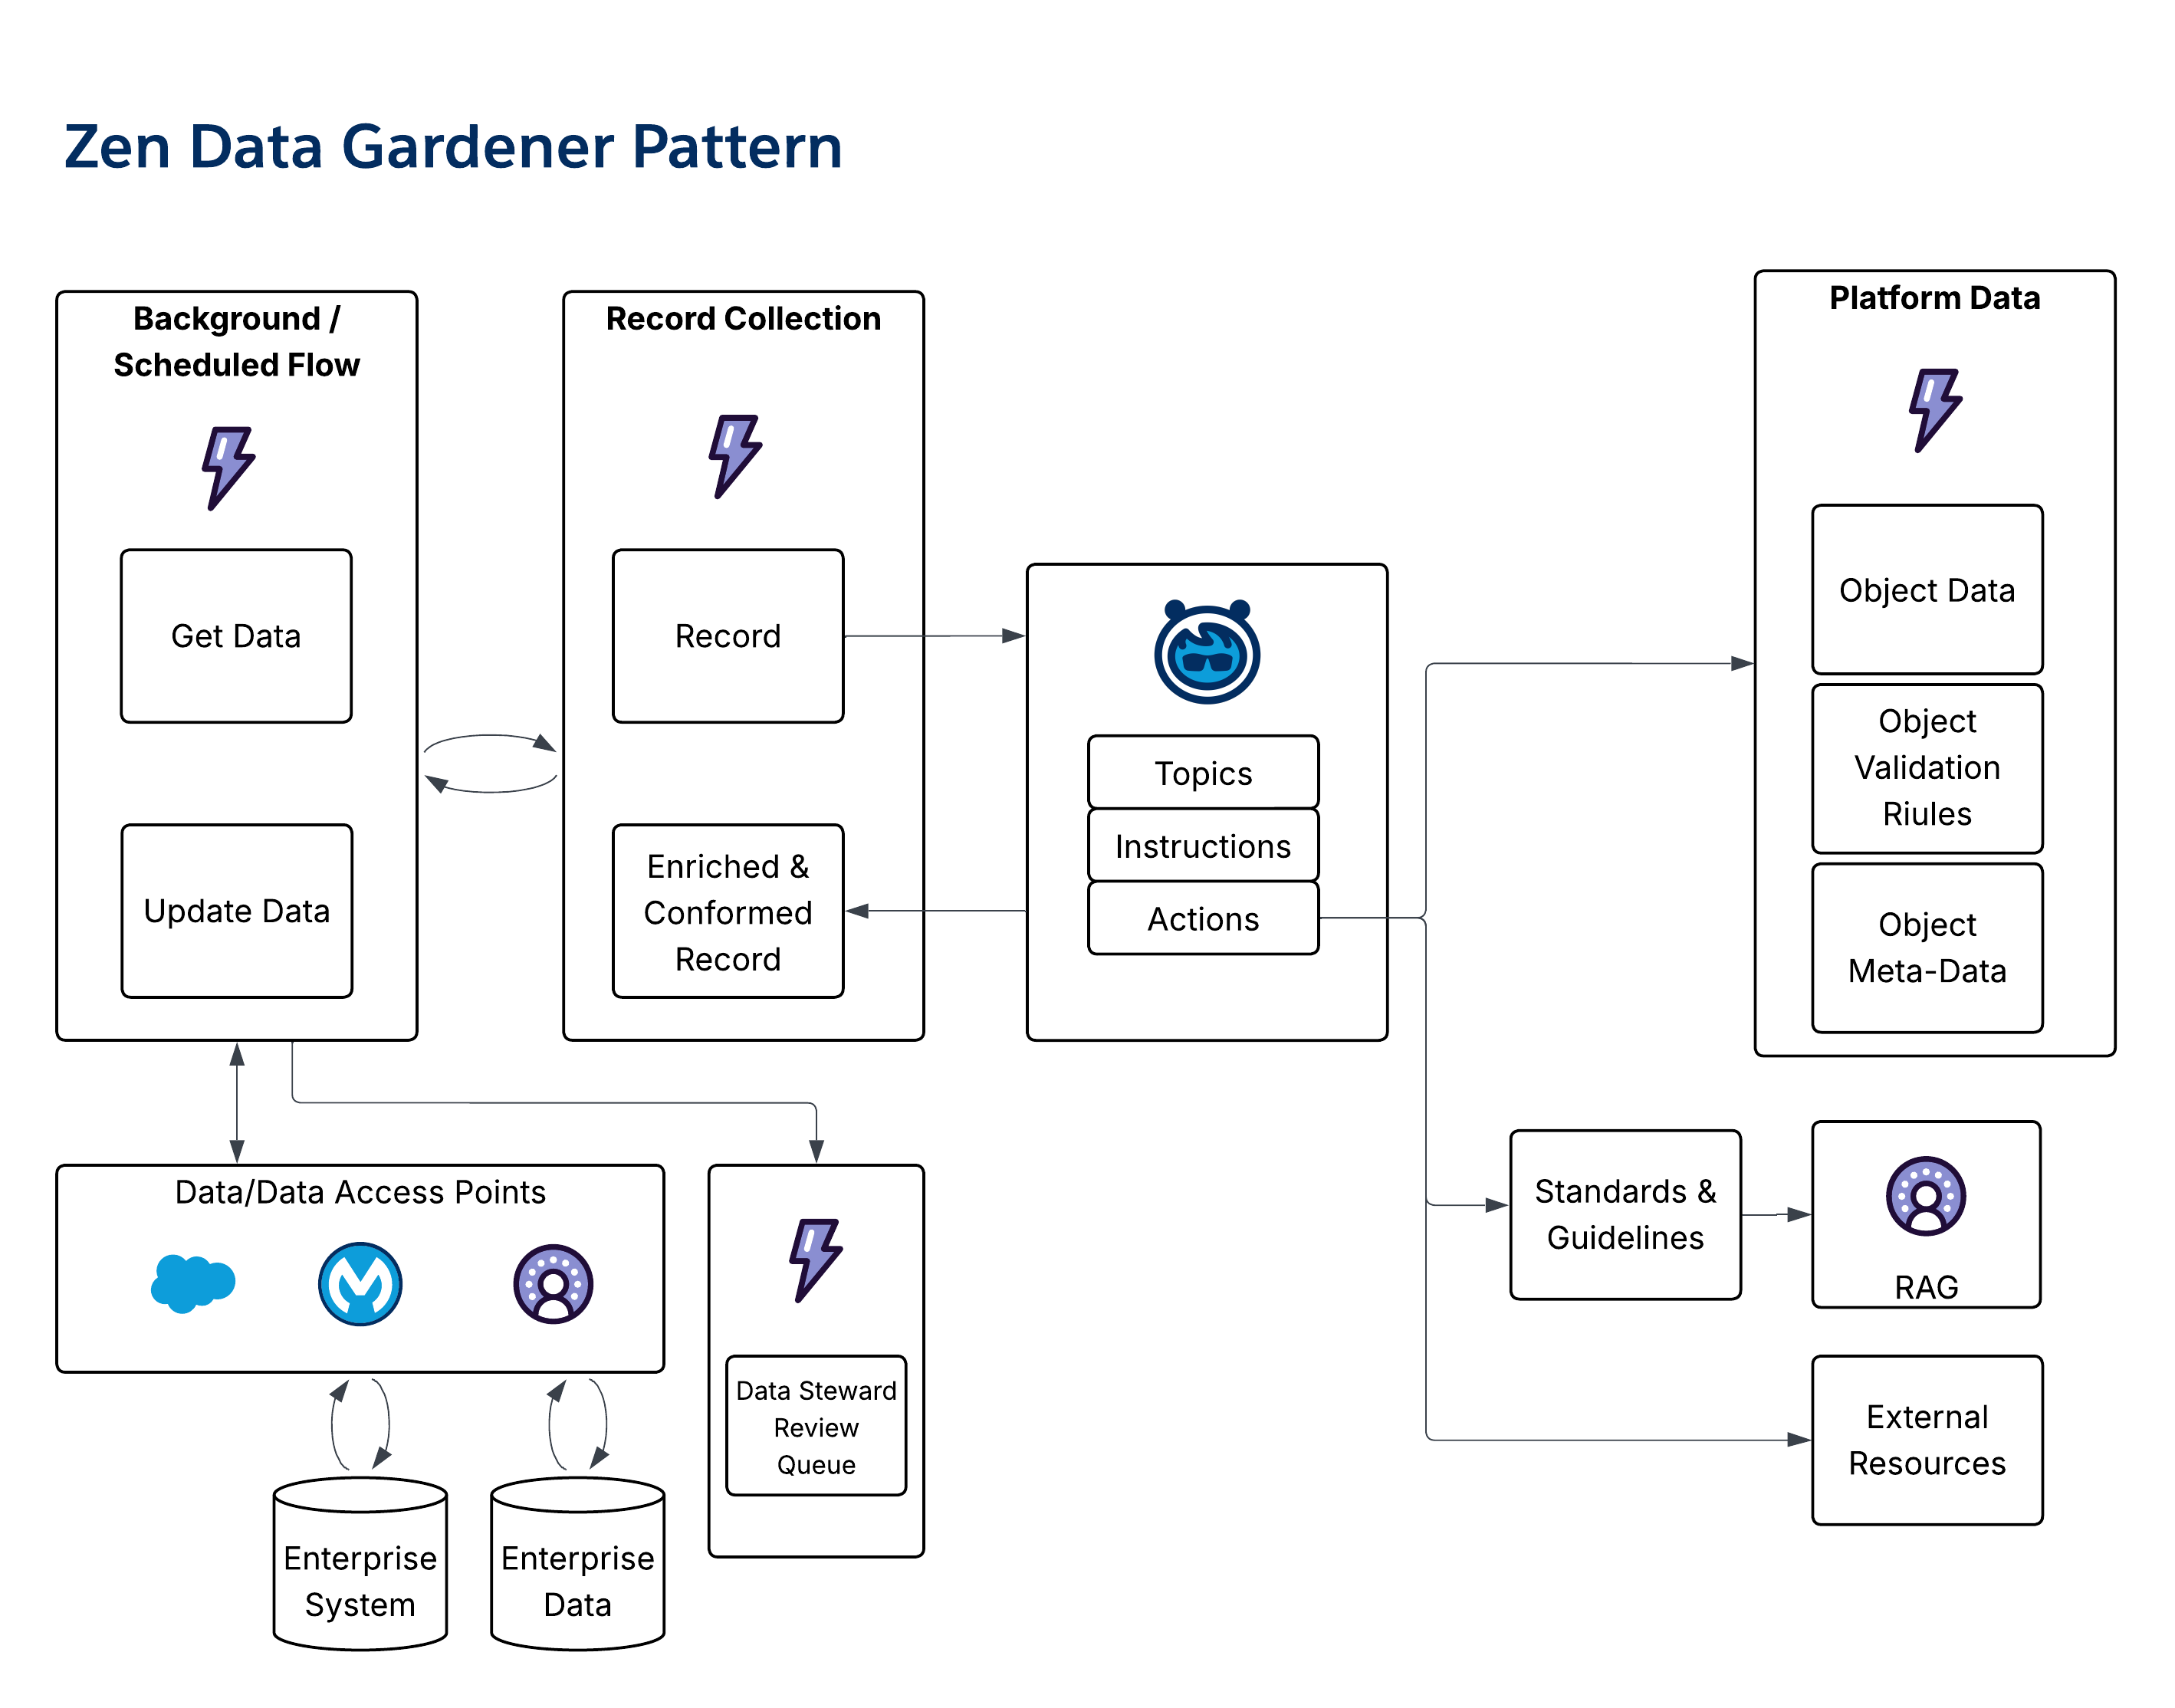 - **Salesforce 에이전트 성숙도**: 레벨 4
### Configurer 패턴
- **개요**: *Configurer 패턴*은 자연어 요구 사항에서 구성 아티팩트(예: SQL/SOQL, JSON 및 CSV)를 생성합니다. 반대로 실행하여 요구 사항에 대한 기존 구성을 확인할 수도 있습니다.
- **출력 유형**: 업데이트된 레코드, 데이터 관리 과업을 제공하거나 문제/오류를 구축하여 수정합니다.
- **패턴 사용 지침**: 특정 표준, 지침 또는 예를 사용하여 에이전트를 기초 교육합니다. 계약 또는 제품 사양과 같은 소스를 사용하여 빌드 요구 사항을 구성합니다. *Configurer 패턴*을 대상 시스템에 연결하여 생성된 구성을 푸시합니다.
- **전체적인 사용 사례**: 의료 보험 제품에 대한 제품 구성 레코드를 생성하고 의료 제공자의 계약/결제 조건을 확인합니다.
- **도표**:
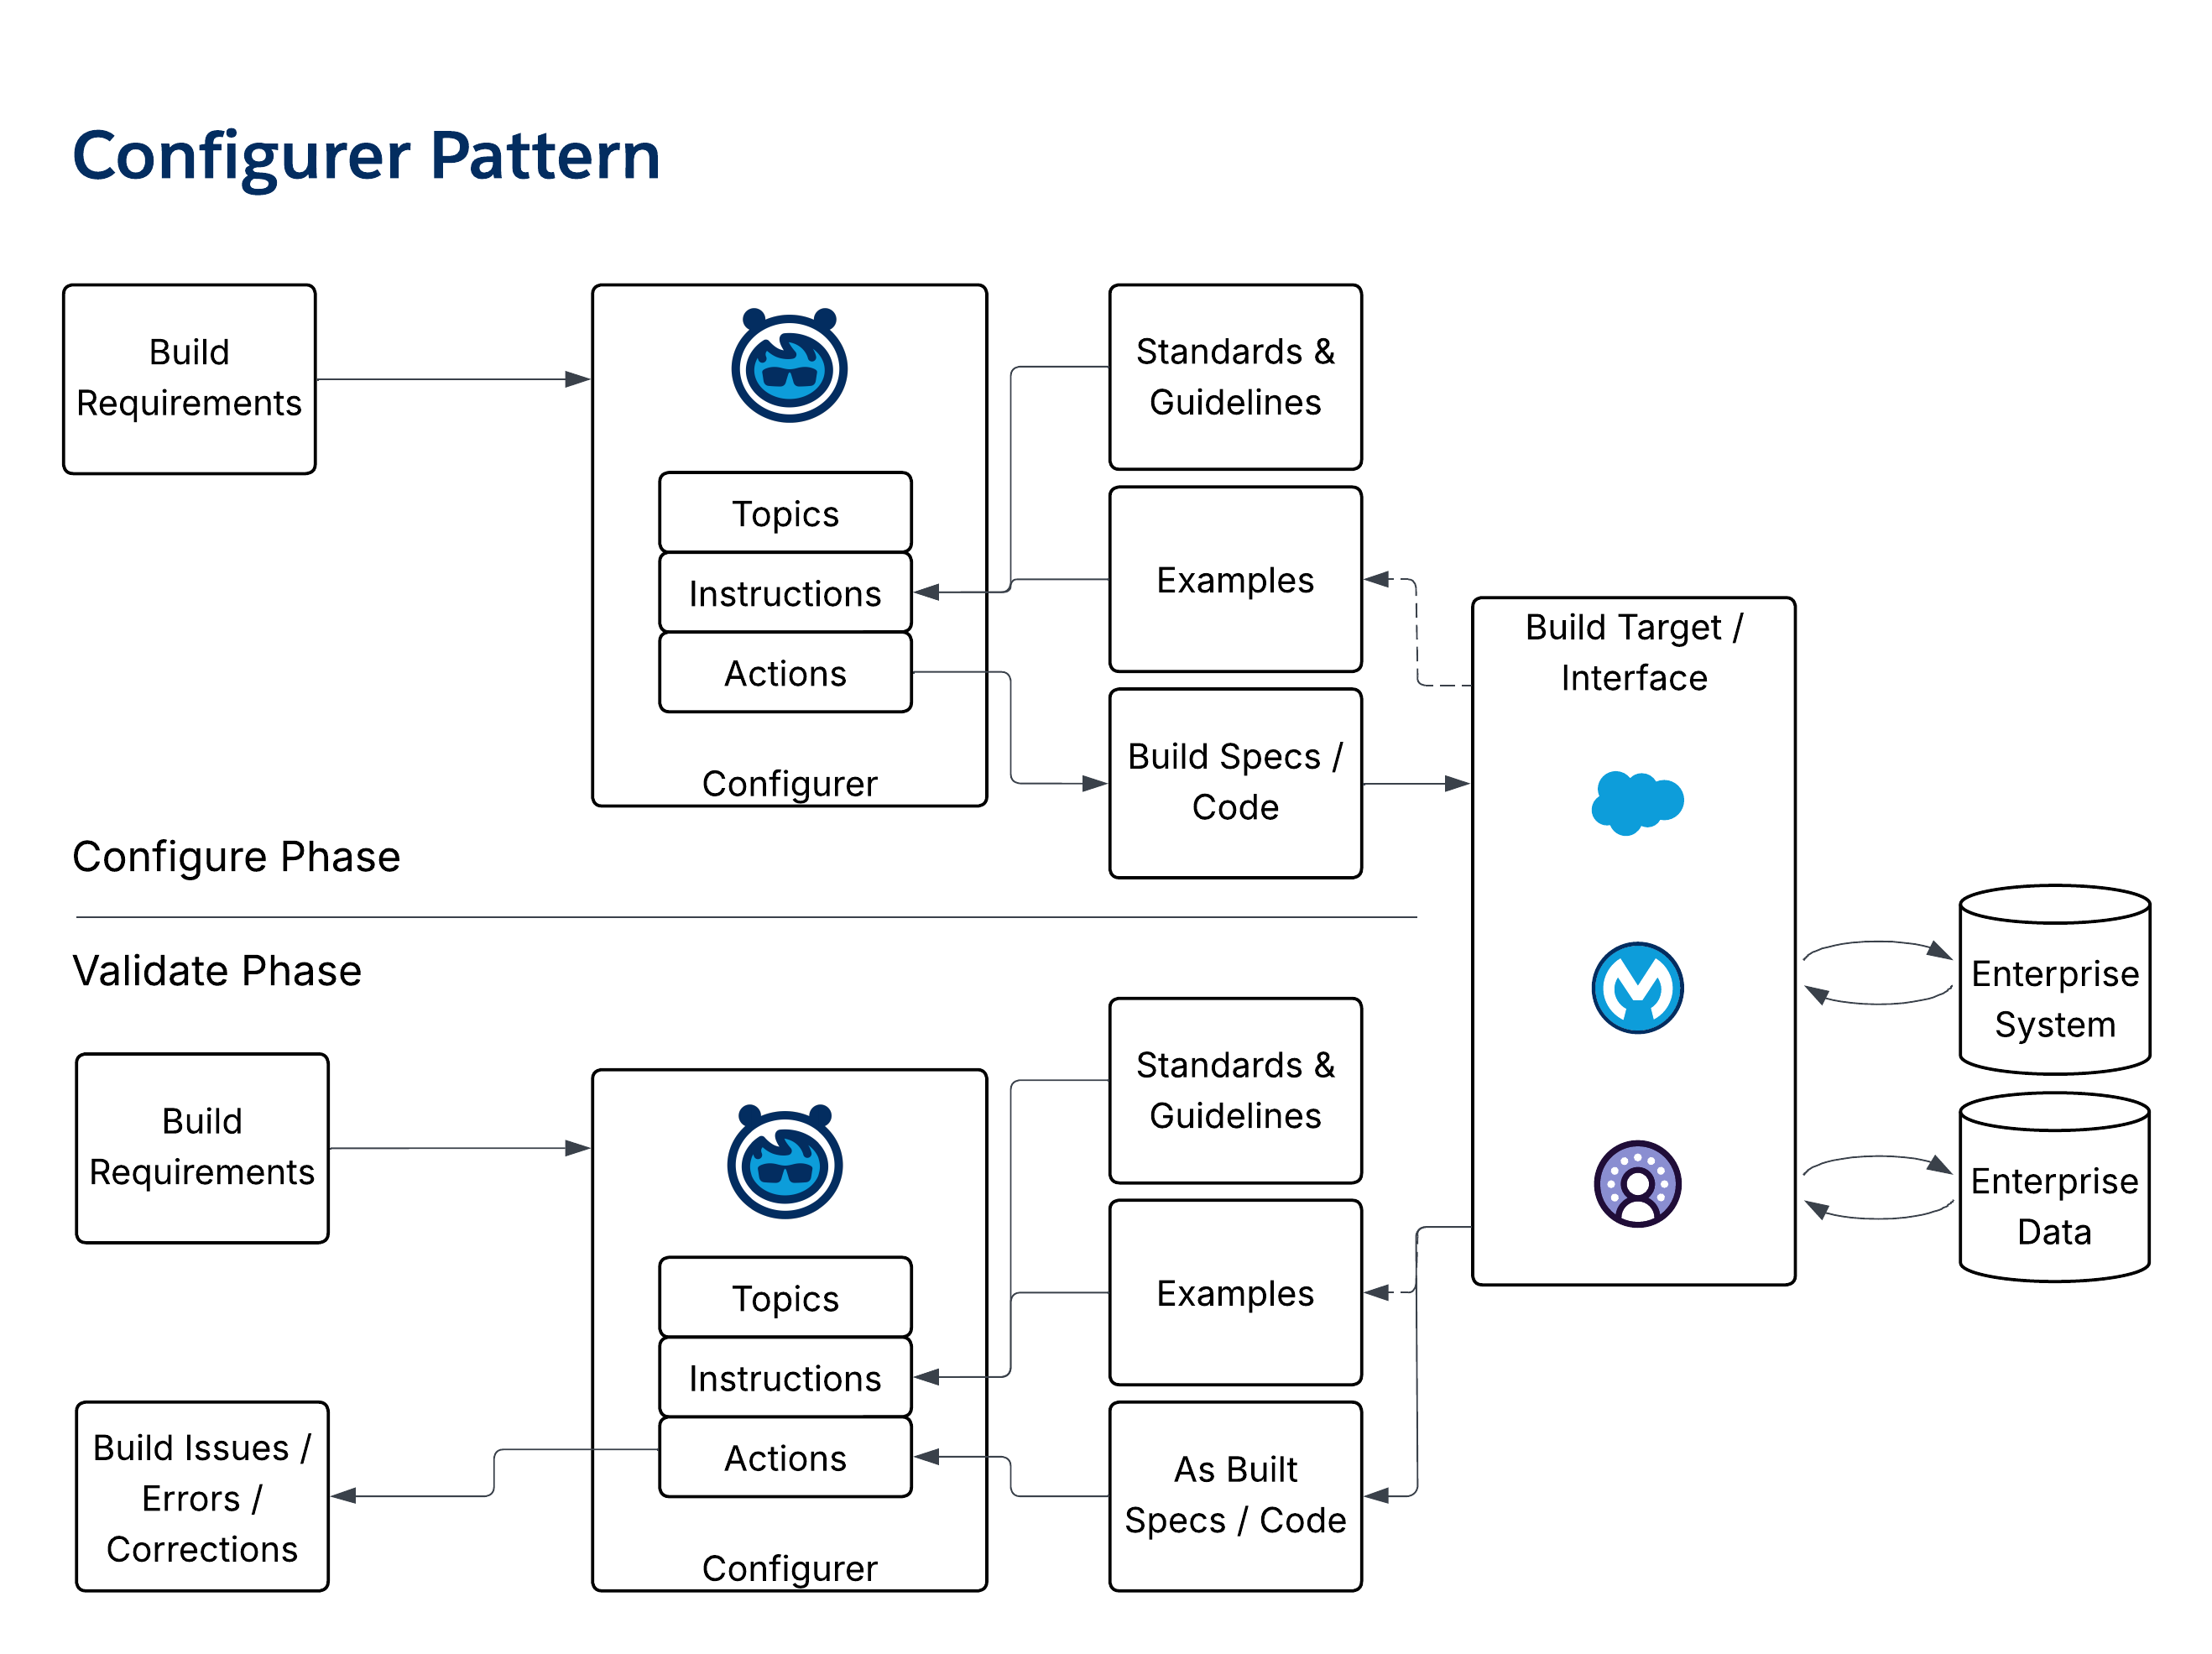 - **Salesforce 에이전트 성숙도**: 레벨 4
### 판사 및 심사 패턴
- **개요**: *Judge & Jury 패턴*은 "jury" 에이전트와 "judge" 에이전트를 사용하여 환각을 최소화하도록 설계되었으며, 응답의 일관성을 평가하여 응답이 실질적으로 일관되고 근거가 되는지 확인합니다.
- *Ensemble Approach*은 Agentforce 및 Atlas Reasoning 엔진에 내장되어 응답의 정확성과 관련성을 해결합니다. 높은 수준의 정확성이 필수인 경우 이 기능을 기반으로 하는 *판사 및 심사 패턴*입니다.
- _데이터 기초 교육_(예: “이 레코드/문서에서 답변을 찾으세요”) 및 _프롬프트 엔지니어링_(예: “이 레코드에서 찾을 경우에만 답변을 반환” 또는 “이 외부 소스에 대한 답변을 확인”)의 조합은 환각을 최소화하는 효과적인 방법입니다.
- **출력 유형**: 생성 인사이트를 제공합니다.
- **패턴 사용 지침**: 일관되고 기초 교육된 생성 출력이 필요한 경우 사용합니다. *판사 담당자*는 기초 지정된 메시지를 작성하고 두 명 이상의 *Juror 담당자*에게 전달한 다음, 판사는 응답을 평가합니다. 최상의 결과를 얻으려면 각 Jury 에이전트에 대해 서로 다른 모델(예: OpenAI의 모델 및 Anthropic의 모델)을 사용하십시오.
- **전체적인 사용 사례**: 충성도가 높은 사실 기반 응답을 제공하여 환각을 최소화합니다.
- **도표**:
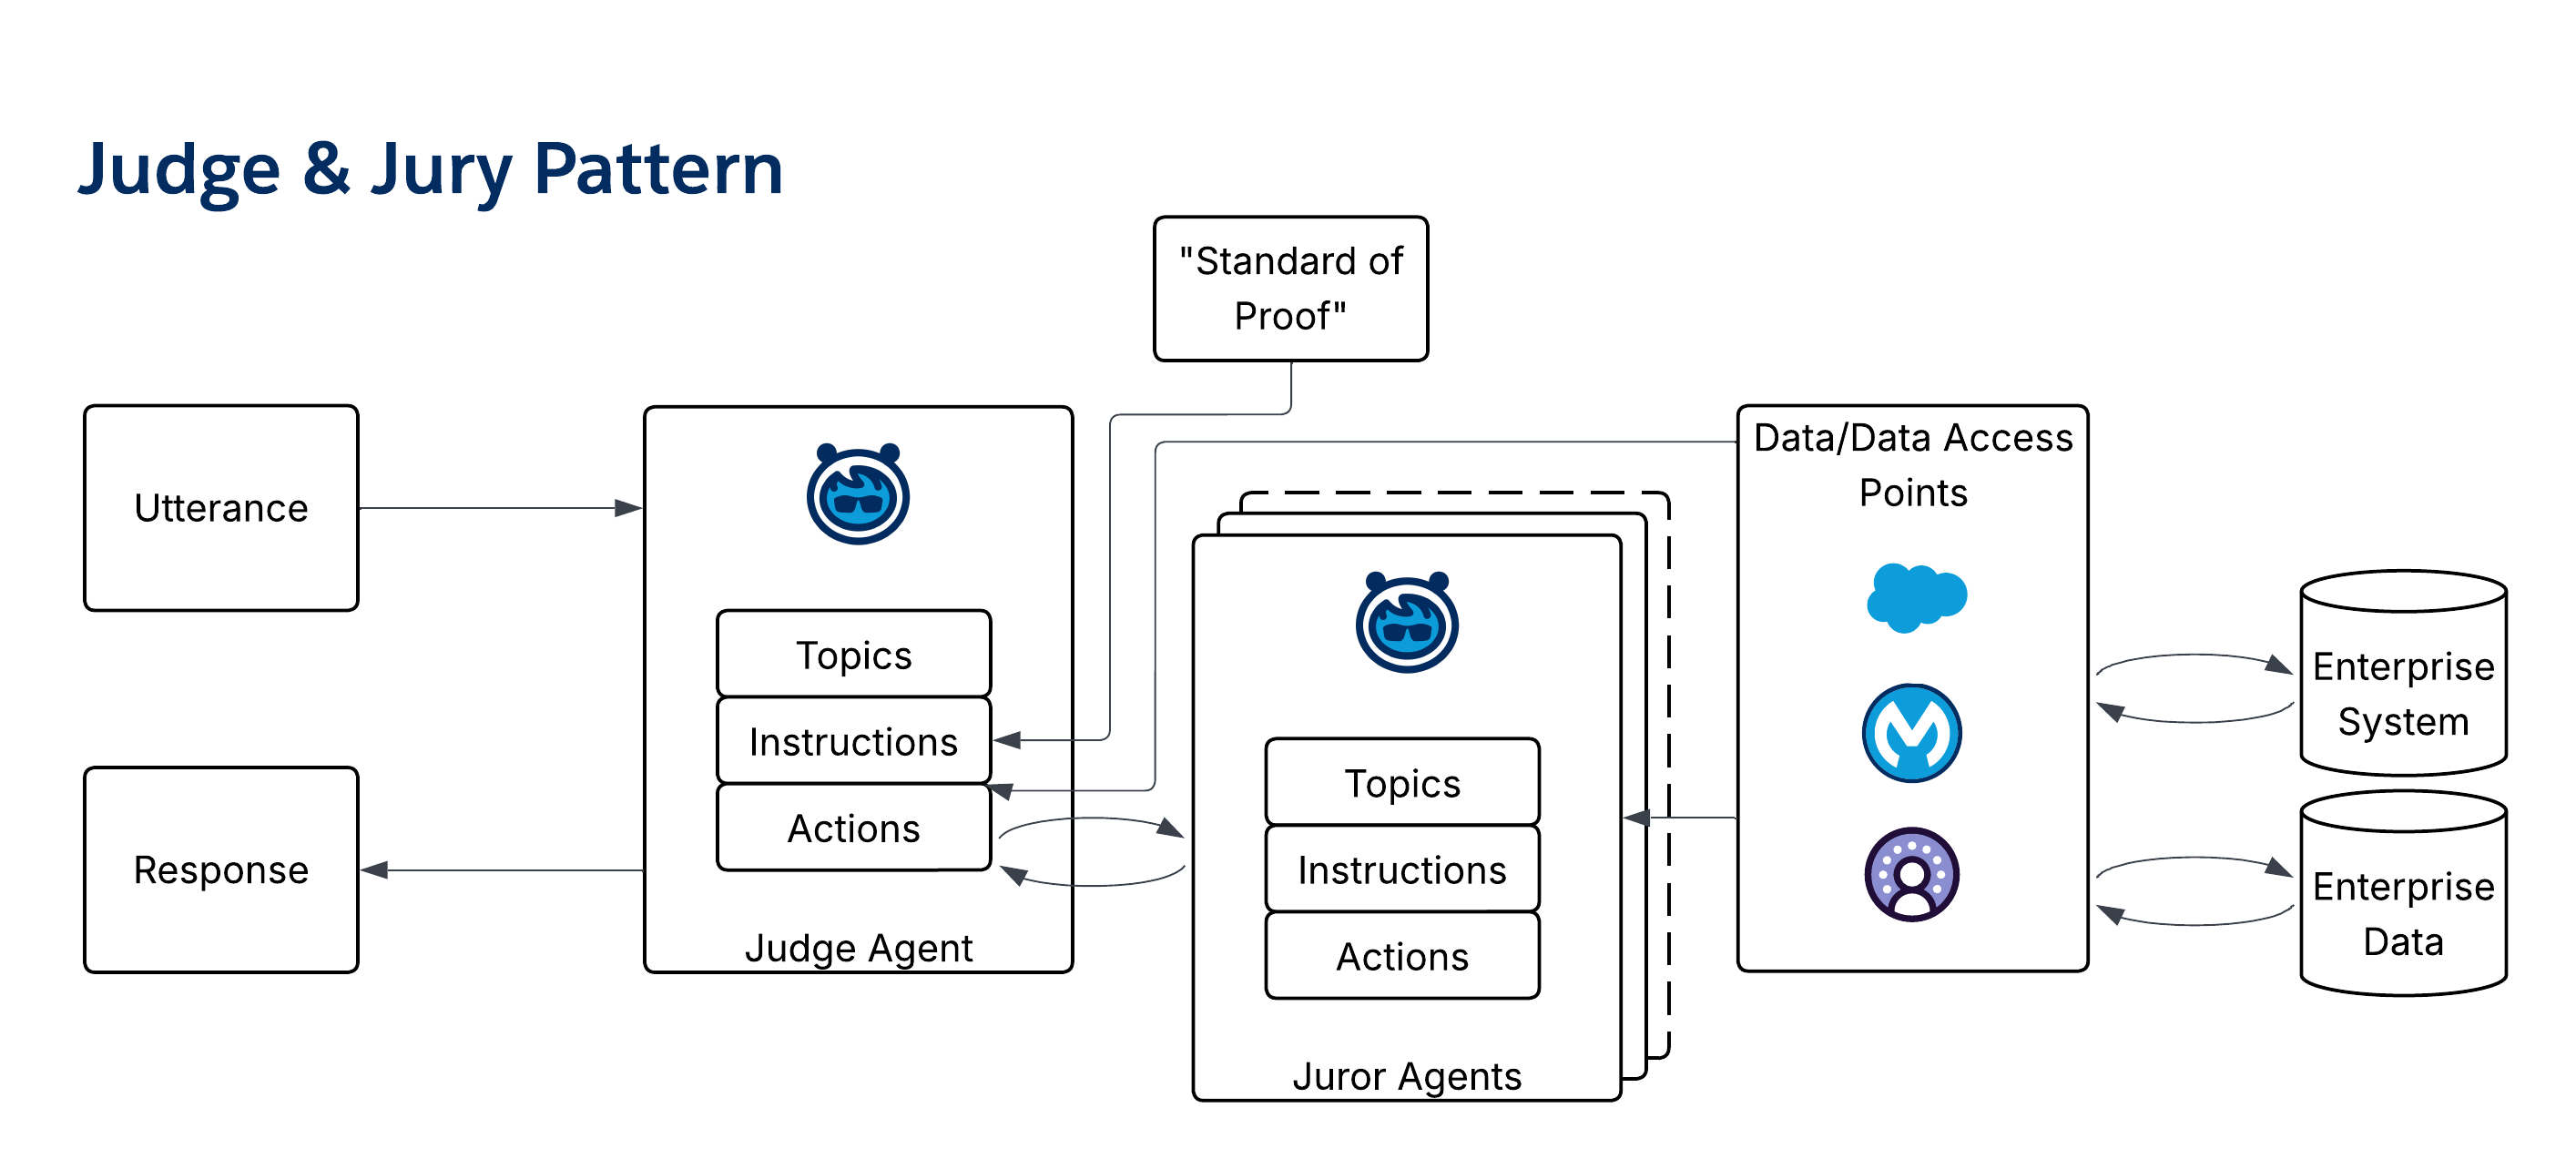 - **Salesforce 에이전트 성숙도**: 레벨 2
### 모델 패턴의 모델
- **개요**: *모델 패턴*은 여러 전문가 에이전트를 활용하여 광범위한 관점을 생성한 다음, 합의를 추출합니다. 이 패턴은 [Judge & Jury 패턴과](/docs/architect/ko-kr/fundamentals/guide/enterprise-agentic-architecture#판사-및-심사-패턴) 달리 다양한 관점을 포용하여 풍요를 높입니다.
- 이 패턴은 탭에 유용할 수 있는 다른 POV(View Points)가 있는 전문가 모델이 있는 경우 전문가 패턴이라고도 불릴 수 있습니다.
- 판사와 심사 기관의 패턴과 달리, 그 목적은 일반적으로 액세스할 수 있는 "진실"에 대한 에이전트 응답을 확보하는 것입니다. *모델 패턴*은 에이전트 환경의 다양성을 활용하여 응답 범위를 확장합니다.
- 이 패턴은 고유한 POV가 있는 추가 에이전트가 있다고 가정합니다. 예를 들어, 멀티 조직, 멀티 에이전트 환경 또는 기술 스택에 걸쳐 여러 공급업체가 공급하는 에이전트가 있는 환경에서 *모델 패턴*은 여러 POV를 통합하는 구조를 제공합니다.
- 이 패턴을 고려할 때 가벼운 다른 방법도 고려하십시오.
- 여러 전문가 에이전트를 정의하는 대신 여러 프롬프트를 지정하고 시스템이 프롬프트의 집합으로 작동하도록 합니다.
- 상황에 맞는 데이터에 액세스하는 작업을 통해 "그라운딩"을 활용합니다.
- **출력 유형**: 생성 인사이트를 제공합니다.
- **패턴 사용 지침**: _집계기_ 에이전트의 역할은 모델 에이전트가 반환한 주요 개념을 기반으로 풍부한 POV를 형성하고 반환하는 것입니다. 모델 에이전트는 고유한 POV를 기반으로 응답을 결정합니다.
- **전체적인 사용 사례**: 서로 다른 관점을 결합하여 응답 품질을 향상할 수 있는 상황에서 사용합니다.
예를 들어, 권한이 있는 에이전트(예: _ERP 에이전트_)가 가치 있고 그렇지 않으면 액세스할 수 없는 POV를 가질 수 있는 멀티 시스템 에이전트 환경입니다.
- **도표**:
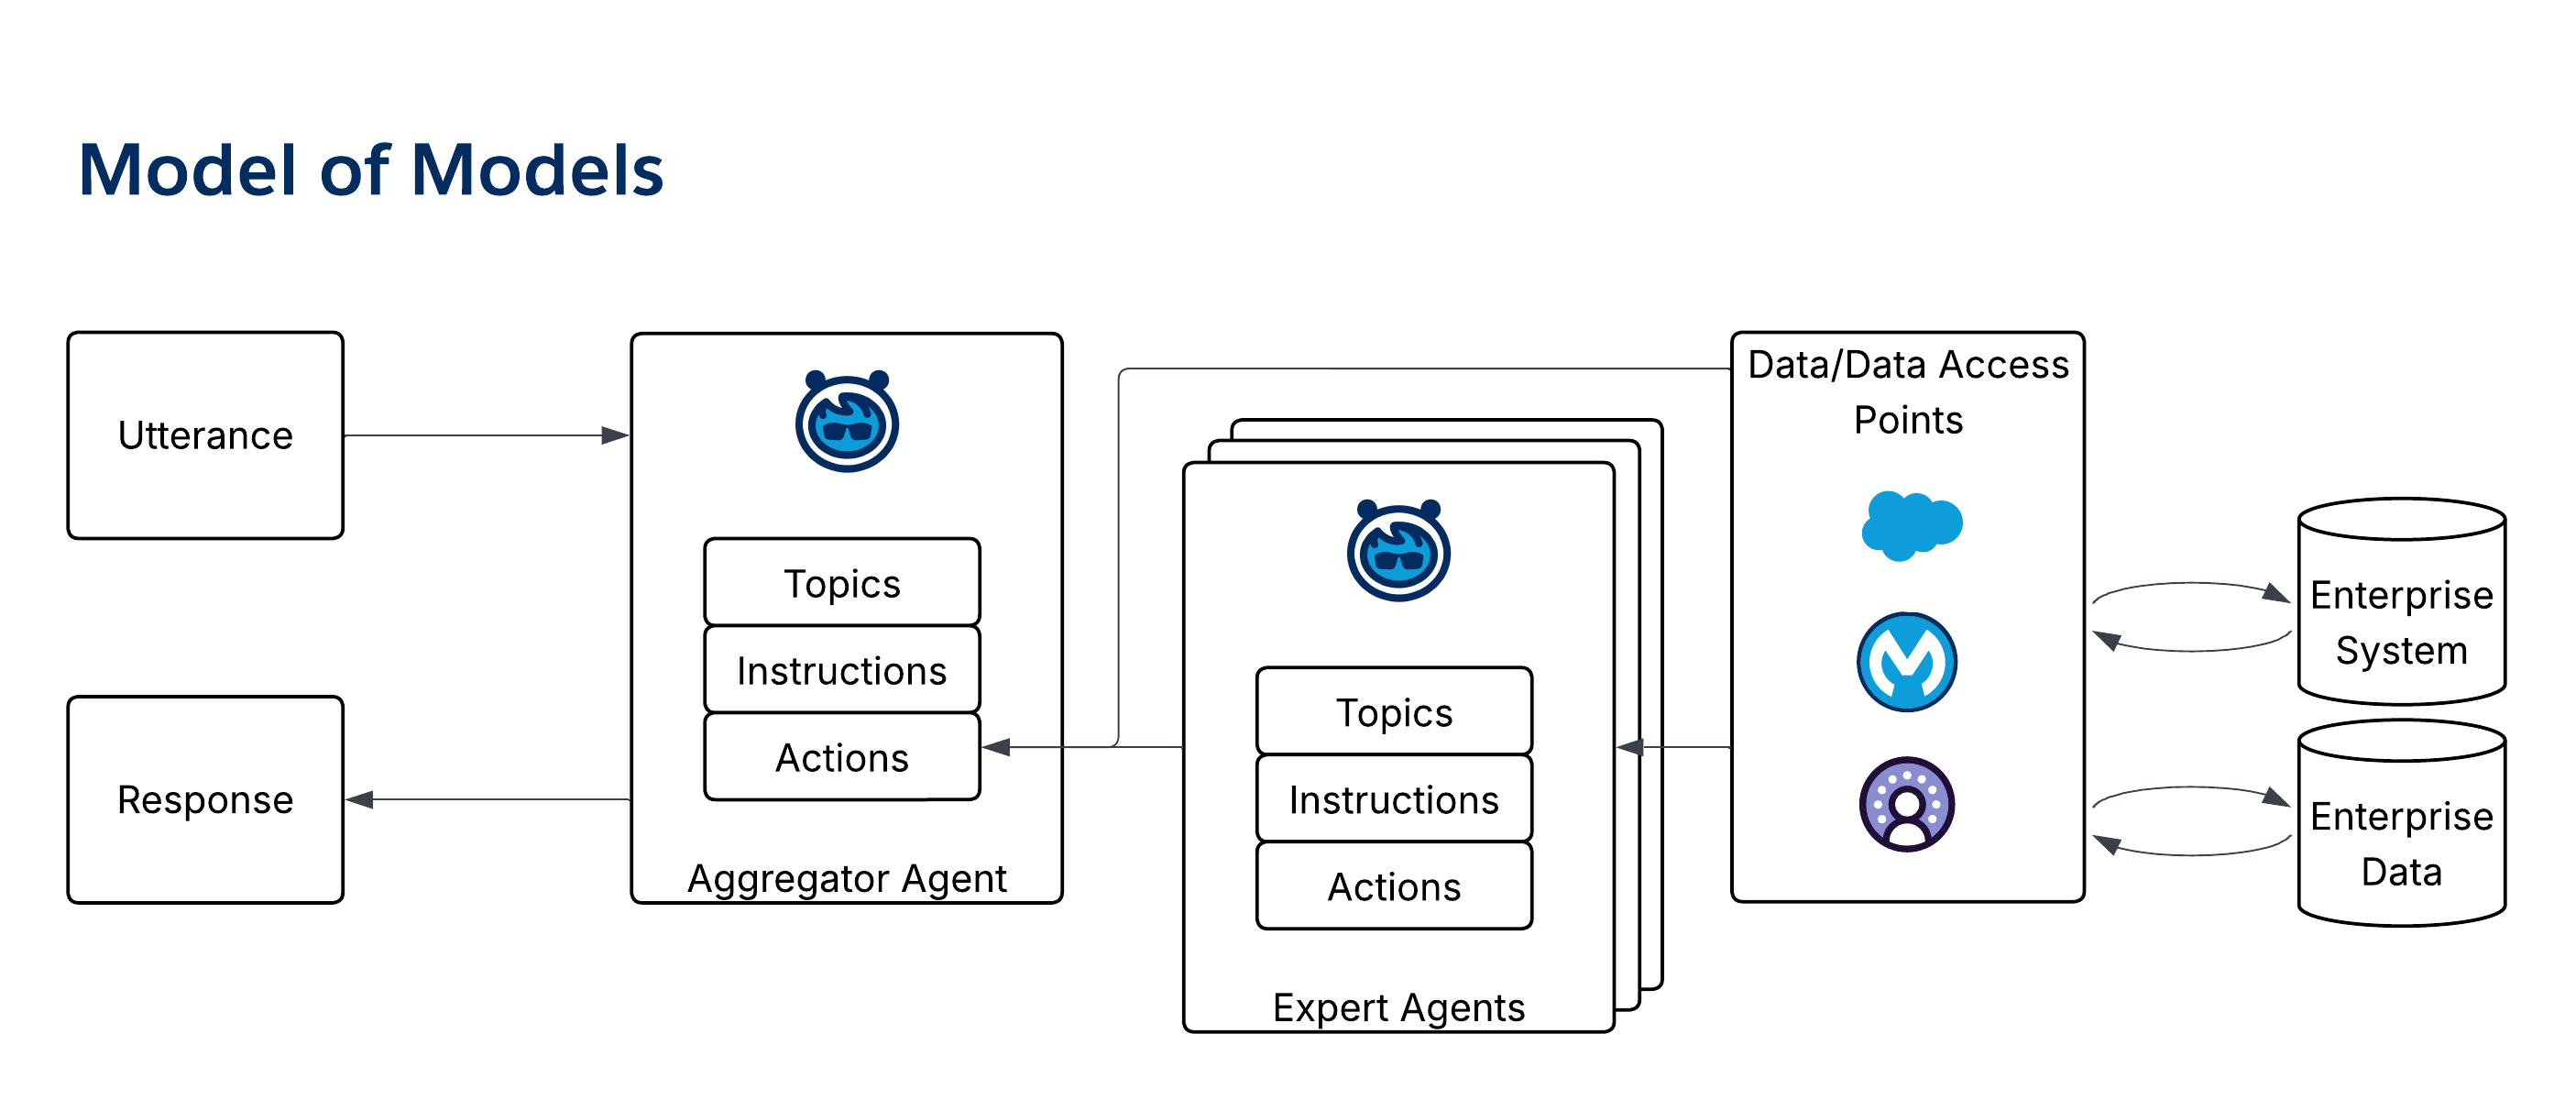 - **Salesforce 에이전트 성숙도**: 레벨 2
## 9\. 장기 실행 프로세스 패턴
*장기 실행 프로세스 패턴*은 긴 기간 동안 발생하는 프로세스를 관리하며 여러 단계와 작업자를 포함합니다.
### 프로젝트 관리자 패턴
- **개요**: *프로젝트 관리자 패턴*은 장기 실행 프로젝트를 감독하는 복잡한 패턴입니다. 활동을 조율하고 완료를 추적하고 사용자에게 알리고 이해당사자에게 프로젝트 상태를 나타냅니다.
- **출력 유형**: 출력이 여러 개 있습니다(예: 사례, 과업, 상태 업데이트 및 알림).
- **패턴 사용 지침**: 정기적이고 반복적인 다단계 활동을 지원하려면 대시보드 패턴으로 사용합니다. *프로젝트 관리자 패턴*은 프로젝트의 입력 템플릿/개요(과업, 역할 및 종속성 포함)을 가져온 다음, 사례와 활동을 인스턴스화하고 사용자에게 할당합니다.
- **전체적인 사용 사례**: 계정 설치 관리 및 엔터프라이즈 세일즈 참여에 사용합니다.
- **도표**:
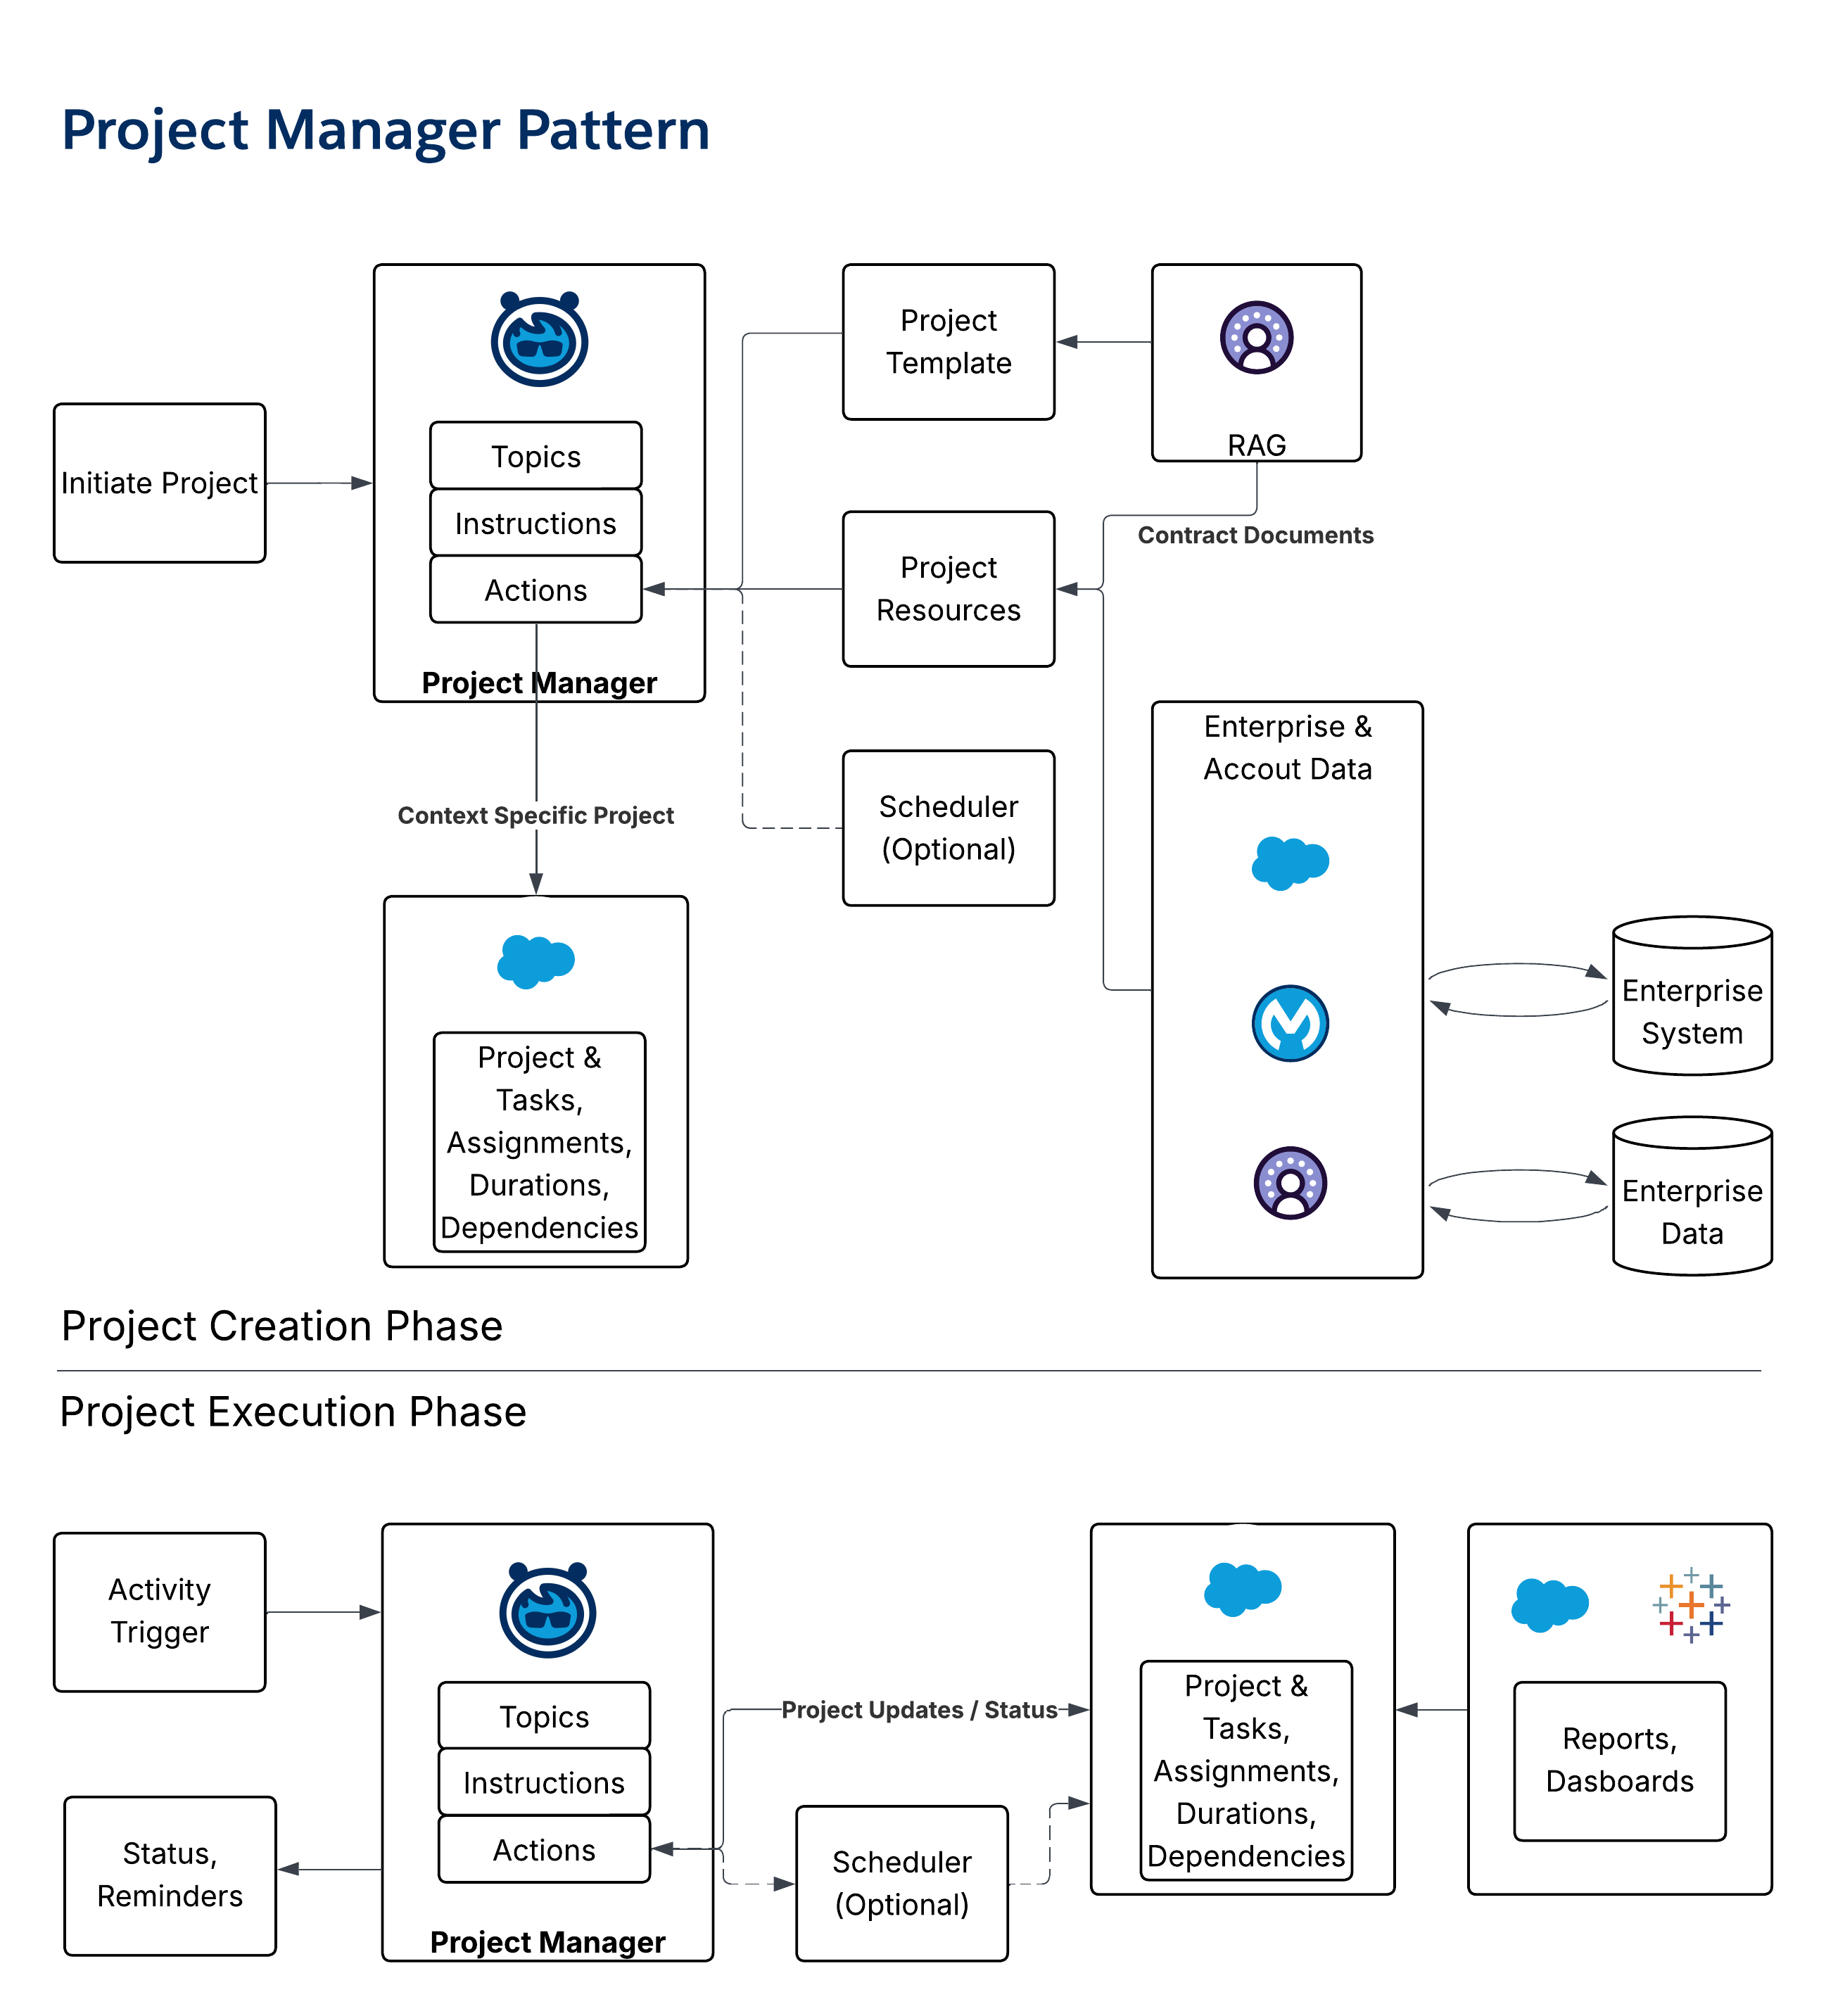 - **Salesforce 에이전트 성숙도**: 레벨 4
## 10\. 엔터프라이즈 오케스트레이션 아키테피
패턴은 에이전트 역할을 설명하지만, *오케스트레이션 원형*은 에이전트의 플리트가 공동 작업하는 방법에 대한 시스템 수준의 청사진을 정의합니다. 이러한 원형은 오케스트레이션 뇌로서의 _Agentforce_ 및 범용 커넥터 및 어댑터로서의 _MuleSoft_ 역할을 명확히 합니다.
**기형 1: SOMA(단일 조직, 여러 에이전트)**
- **정의**: 여러 에이전트가 공유 관리 및 데이터를 사용하는 하나의 Salesforce 조직 내에서 공동 작업을 수행합니다.
- **아키텍처 흐름**: Agentforce에서 _Supervisor 에이전트는_ 단일 프런트 도어 역할을 하며 조직 내의 *전문가 에이전트*에게 요청을 라우팅합니다. 외부 기능을 위해 에이전트는 _Agentforce MCP Client를_ 사용하며 MuleSoft는 비MCP 지원 API의 MCP-wrapper 역할을 합니다.
- **기본 고려 사항**: 이 패턴은 CRM 컨텍스트 및 Data 360과 유사한 Salesforce에서 오케스트레이션 논리를 중앙 집중화하여 통합 관리, ID, 권한, 관찰 가능성을 유지합니다.
**기형 2: MOMA(다중 조직, 여러 에이전트)**
- **정의**: 에이전트는 여러 Salesforce 조직에서 공동 작업을 수행하므로 데이터 및 권한 경계에서 안전하게 조율해야 합니다.
- **아키텍처 흐름**: 한 조직의 *감독자 에이전트*는 표준화된 _에이전트 간(A2A)_ 프로토콜을 통해 다른 조직의 에이전트에게 과업을 위임합니다. 이 핸드샷은 조직 수준의 Trust, 사용자 ID 플로 및 공유 대화 컨텍스트를 보장합니다.
- **기본 고려 사항**: 이 패턴은 복잡한 다중 조직 속성에서 일관된 에이전트 작업을 위한 기초를 제공하는 엔터프라이즈 전체 워크플로를 활성화하면서 조직의 자율성을 유지합니다.
**기형 3: 멀티 공급업체 A2A(Salesforce 주도 오케스트레이션)**
- **정의**: Salesforce의 _감독자 에이전트는_ A2A 프로토콜을 통해 Salesforce 네이티브 에이전트와 다른 공급업체(예: Google/Vertex 또는 LangGraph)의 에이전트의 혼합 작업을 조정합니다.
- **아키텍처 흐름**: *감독 담당자*는 요청을 처리하고 계획을 조정하며 A2A 프로토콜을 통해 내부 및 외부 공급업체 담당자를 호출합니다. A2A를 지원하지 않는 외부 시스템의 경우, _MuleSoft는_ 기존 도구를 래핑하고 A2A와 통신하는 "경량 에이전트 패싯"을 노출할 수 있습니다.
- **기본 고려 사항**: A2A를 사용하여 별도의 오케스트레이션 계층 없이 깨끗하고 관리 가능한 구성을 생성하여 오케스트레이션 뇌를 CRM 및 Data 360과 가까이 유지합니다.
**기형 4: 멀티 벤더 A2A(MuleSoft 주도 오케스트레이션)**
- **정의**: 오케스트레이션은 비Salesforce 입력 지점에서 시작되며, 중립적인 외부 오케스트레이터가 추론 및 라우팅을 수행해야 합니다.
- **아키텍처 흐름**: 외부 시스템의 _UI 에이전트가_ 요청을 오케스트레이션 서비스(*MuleSoft Conductor*로 개념화)에 전달하여 의도를 해석하고 작업을 계획합니다. 그런 다음 A2A를 사용하여 CRM 또는 서비스 작업을 위해 Agentforce 에이전트를 비롯한 공급업체 에이전트에게 통화를 라우팅합니다.
- **기본 고려 사항**: 이 패턴은 중립 오케스트레이터가 아키텍처적으로 선호되는 비Salesforce 입력 지점에 적용됩니다. 이는 MuleSoft에서 추론, 거버넌스, 정책, 관찰 가능성을 중앙 집중화하면서 도메인 시스템에서 UX를 유지합니다.
## 11\. 솔루션 어셈블리: 패턴 작성
이러한 개별 패턴 및 오케스트레이션 아키텍처는 종단간 솔루션으로 구성되도록 설계된 아키텍처 빌딩 블록입니다. 에이전트적 솔루션 맵은 해당 구성 요소가 함께 연결되는 방식을 시각화하는 데 사용됩니다.
- 의료 서비스 제공자를 위한 *멤버 서비스 솔루션*은 SOMA 아케타입의 표준 구현입니다. 익명 사용자를 위한 Answerbot, 인증된 구성원을 위한 _Orchestrator_ 및 여러 _도메인 SME 에이전트_(예: 사례, 청구서 및 보상)를 사용하여 특정 요청을 처리합니다.
- *B2C 브로커 포털*은 포털 _오케스트레이터_ 에이전트를 사용하여 RFP 프로세스에 대해 오랫동안 실행 중인 _프로젝트 관리자 에이전트를_ 호출하는 복잡한 구성입니다. 이 에이전트는 _Headless_, _Data Steward_ 및 _Interrogator 에이전트를_ 백오피스 데이터 작업에 사용합니다.
## 12\. 결론
에이전트적인 디자인 패턴 방법론은 강력하고 확장 가능하며 유지 관리 가능한 엔터프라이즈 AI 시스템을 구축하는 데 필요한 아키텍처 분야를 제공합니다. 이러한 패턴은 복잡성을 파악하고 모듈성을 촉진하여 설계자가 신뢰할 수 있고 예측 가능한 에이전트 솔루션을 제공할 수 있도록 지원합니다.
오케스트레이션 아세타입 선택은 사용자가 작업하는 위치, 컨텍스트가 있는 위치, 엔터프라이즈가 사람, 에이전트, 시스템 간의 상호 작용을 관리하는 방식을 기반으로 하는 전략적 결정입니다. 빌드 에이전트와 오케스트레이션 간의 차이점을 이해하고 _MCP_ 및 *A2A*와 같은 개방형 프로토콜을 활용함으로써 건축가들은 고립된 봇을 만드는 것 이상으로 일관되고 규제되고 분산된 엔터프라이즈 인식 시스템을 설계할 수 있습니다. 이 접근 방식은 공유 언어와 재사용 가능한 청사진 집합을 제공하여 지속 가능 에이전트 아키텍처를 구축합니다.
## 부록: 솔루션 맵 및 시스템 아키텍처
이 부록은 에이전트 패턴이 시스템 수준 솔루션으로 구성되는 방법에 대한 구체적인 예를 제공합니다.
### 부록 A: 기본 패턴 구성 예제
이 다이어그램은 5가지 기본 패턴을 함께 연결하여 공통 고객 서비스 워크플로를 만드는 방법을 보여줍니다.
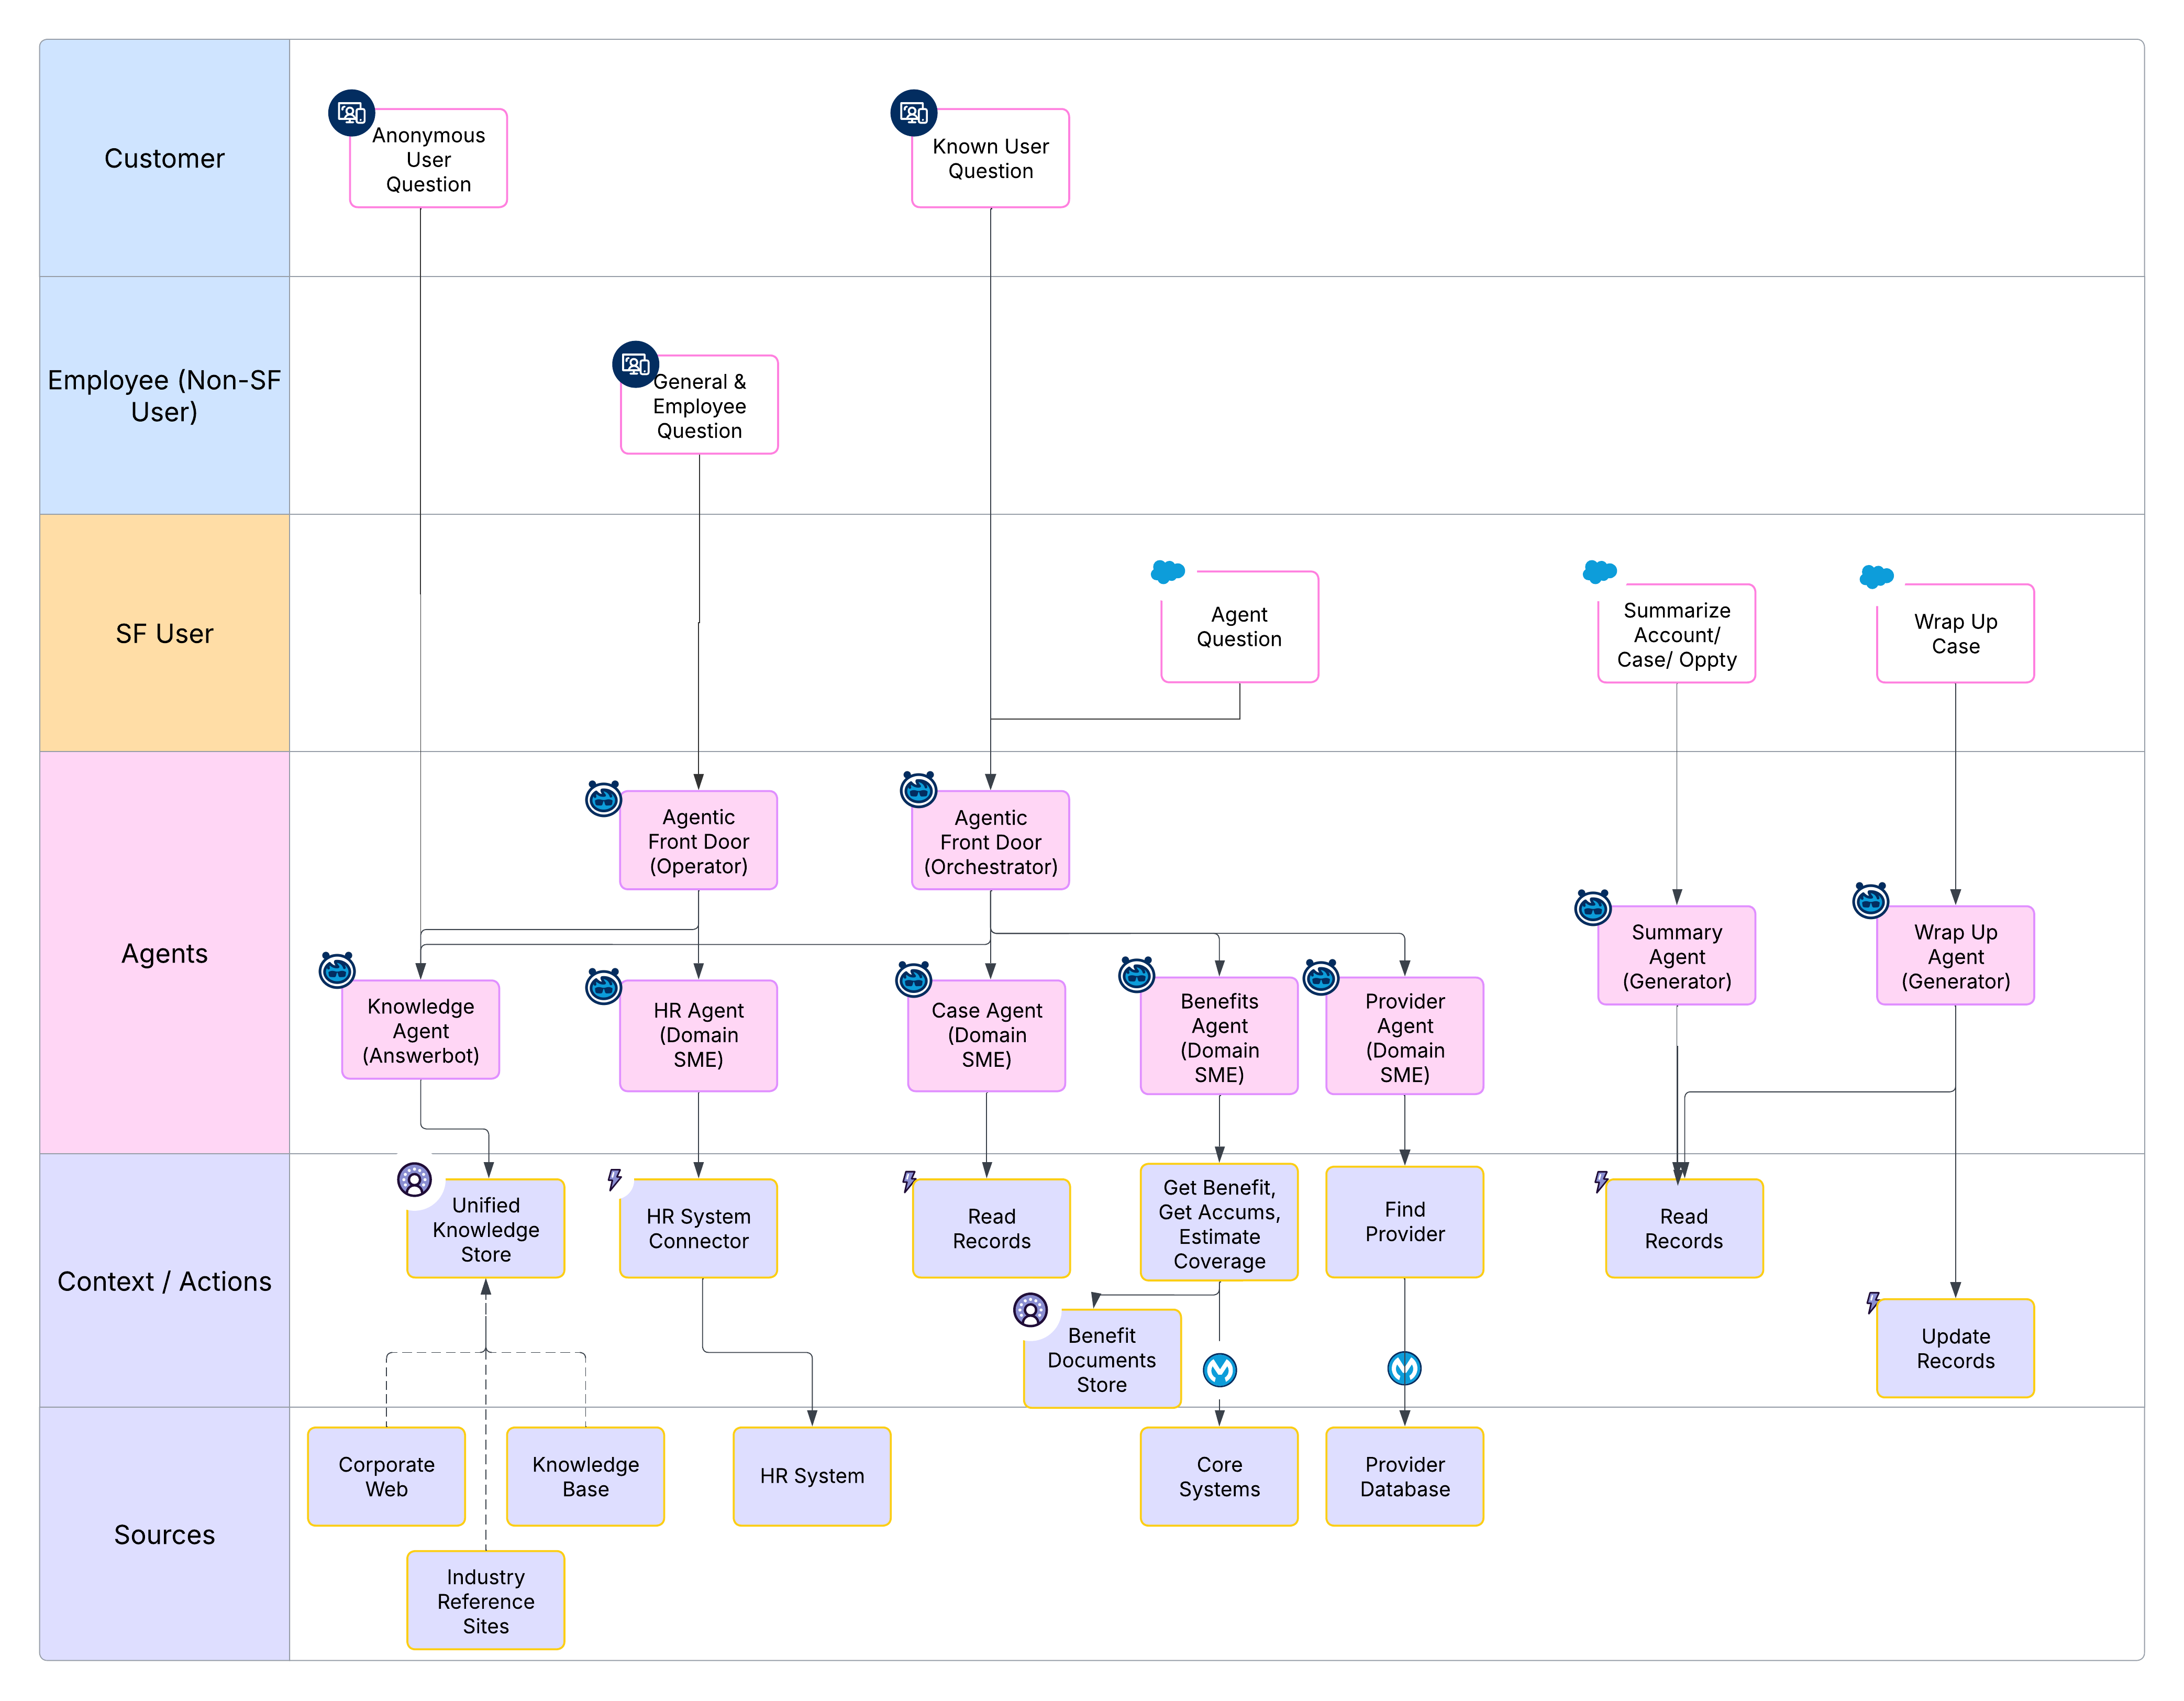 1. **Answerbot**: 익명 사용자가 Knowledge 기반 에이전트가 처리하는 질문을 합니다.
2. **운영자**: 작업자가 직원의 질문을 정렬하여 대화를 필드화하고 더 전문적인 에이전트에게 전달합니다.
3. **Orchestrator**: 인증된 사용자(SF 사용자)가 여러 에이전트를 조율하여 잠재적으로 다각적인 문의를 처리하는 오케스트레이터와 소통합니다.
4. **Domain SME**: 전문가 에이전트(예: HR 에이전트 또는 혜택 에이전트)가 오케스트레이터에 의해 호출되어 주제 업데이트를 수행하고 특정 데이터를 검색합니다.
5. **제너레이터**: 유틸리티 에이전트는 상호 작용이 완료된 후 계정 세부 사항을 요약하거나 사례를 마무리하는 데 사용됩니다.
### 부록 B: 에이전트 솔루션 맵 - 구성원 서비스
이 솔루션 맵은 여러 패턴의 구성을 보여주는 구성원 서비스 사용 사례의 에이전트적 아키텍처를 자세히 설명합니다.
- **사용자 프로필**: 솔루션은 다음과 같은 세 가지 고유한 사용자 유형을 제공합니다. 익명 사용자, 인증된 구성원, SF 사용자(예: 인간 CSR)
- **상호 작용 패턴**: *Answerbot*은 익명 "Find-A-Doc" 쿼리를 처리하고 오케스트레이터(Agent Front Door)는 인증된 사용자 문의를 관리합니다. *Listener/Feed 패턴*이 SF 사용자를 지원합니다.
- **Domain Agent 재사용**: 전문화된 _Domain SME 에이전트_(예: 사례 에이전트, 청구 에이전트 또는 보상 에이전트)는 다양한 상호 작용 플로에서 재사용됩니다.
- **자율 및 보조**: 이 시스템은 _자율적인 에이전트_(사용자 상호 작용을 직접 지정하기 위해)와 _자동 에이전트_(사람 CSR을 강화하기 위해)를 결합합니다.
- **데이터 소스**: 아키텍처는 공용 및 엔터프라이즈 데이터 소스의 혼합을 통합하며, 연결을 위해 _Data 360_ 및 *MuleSoft*을 광범위하게 사용합니다.
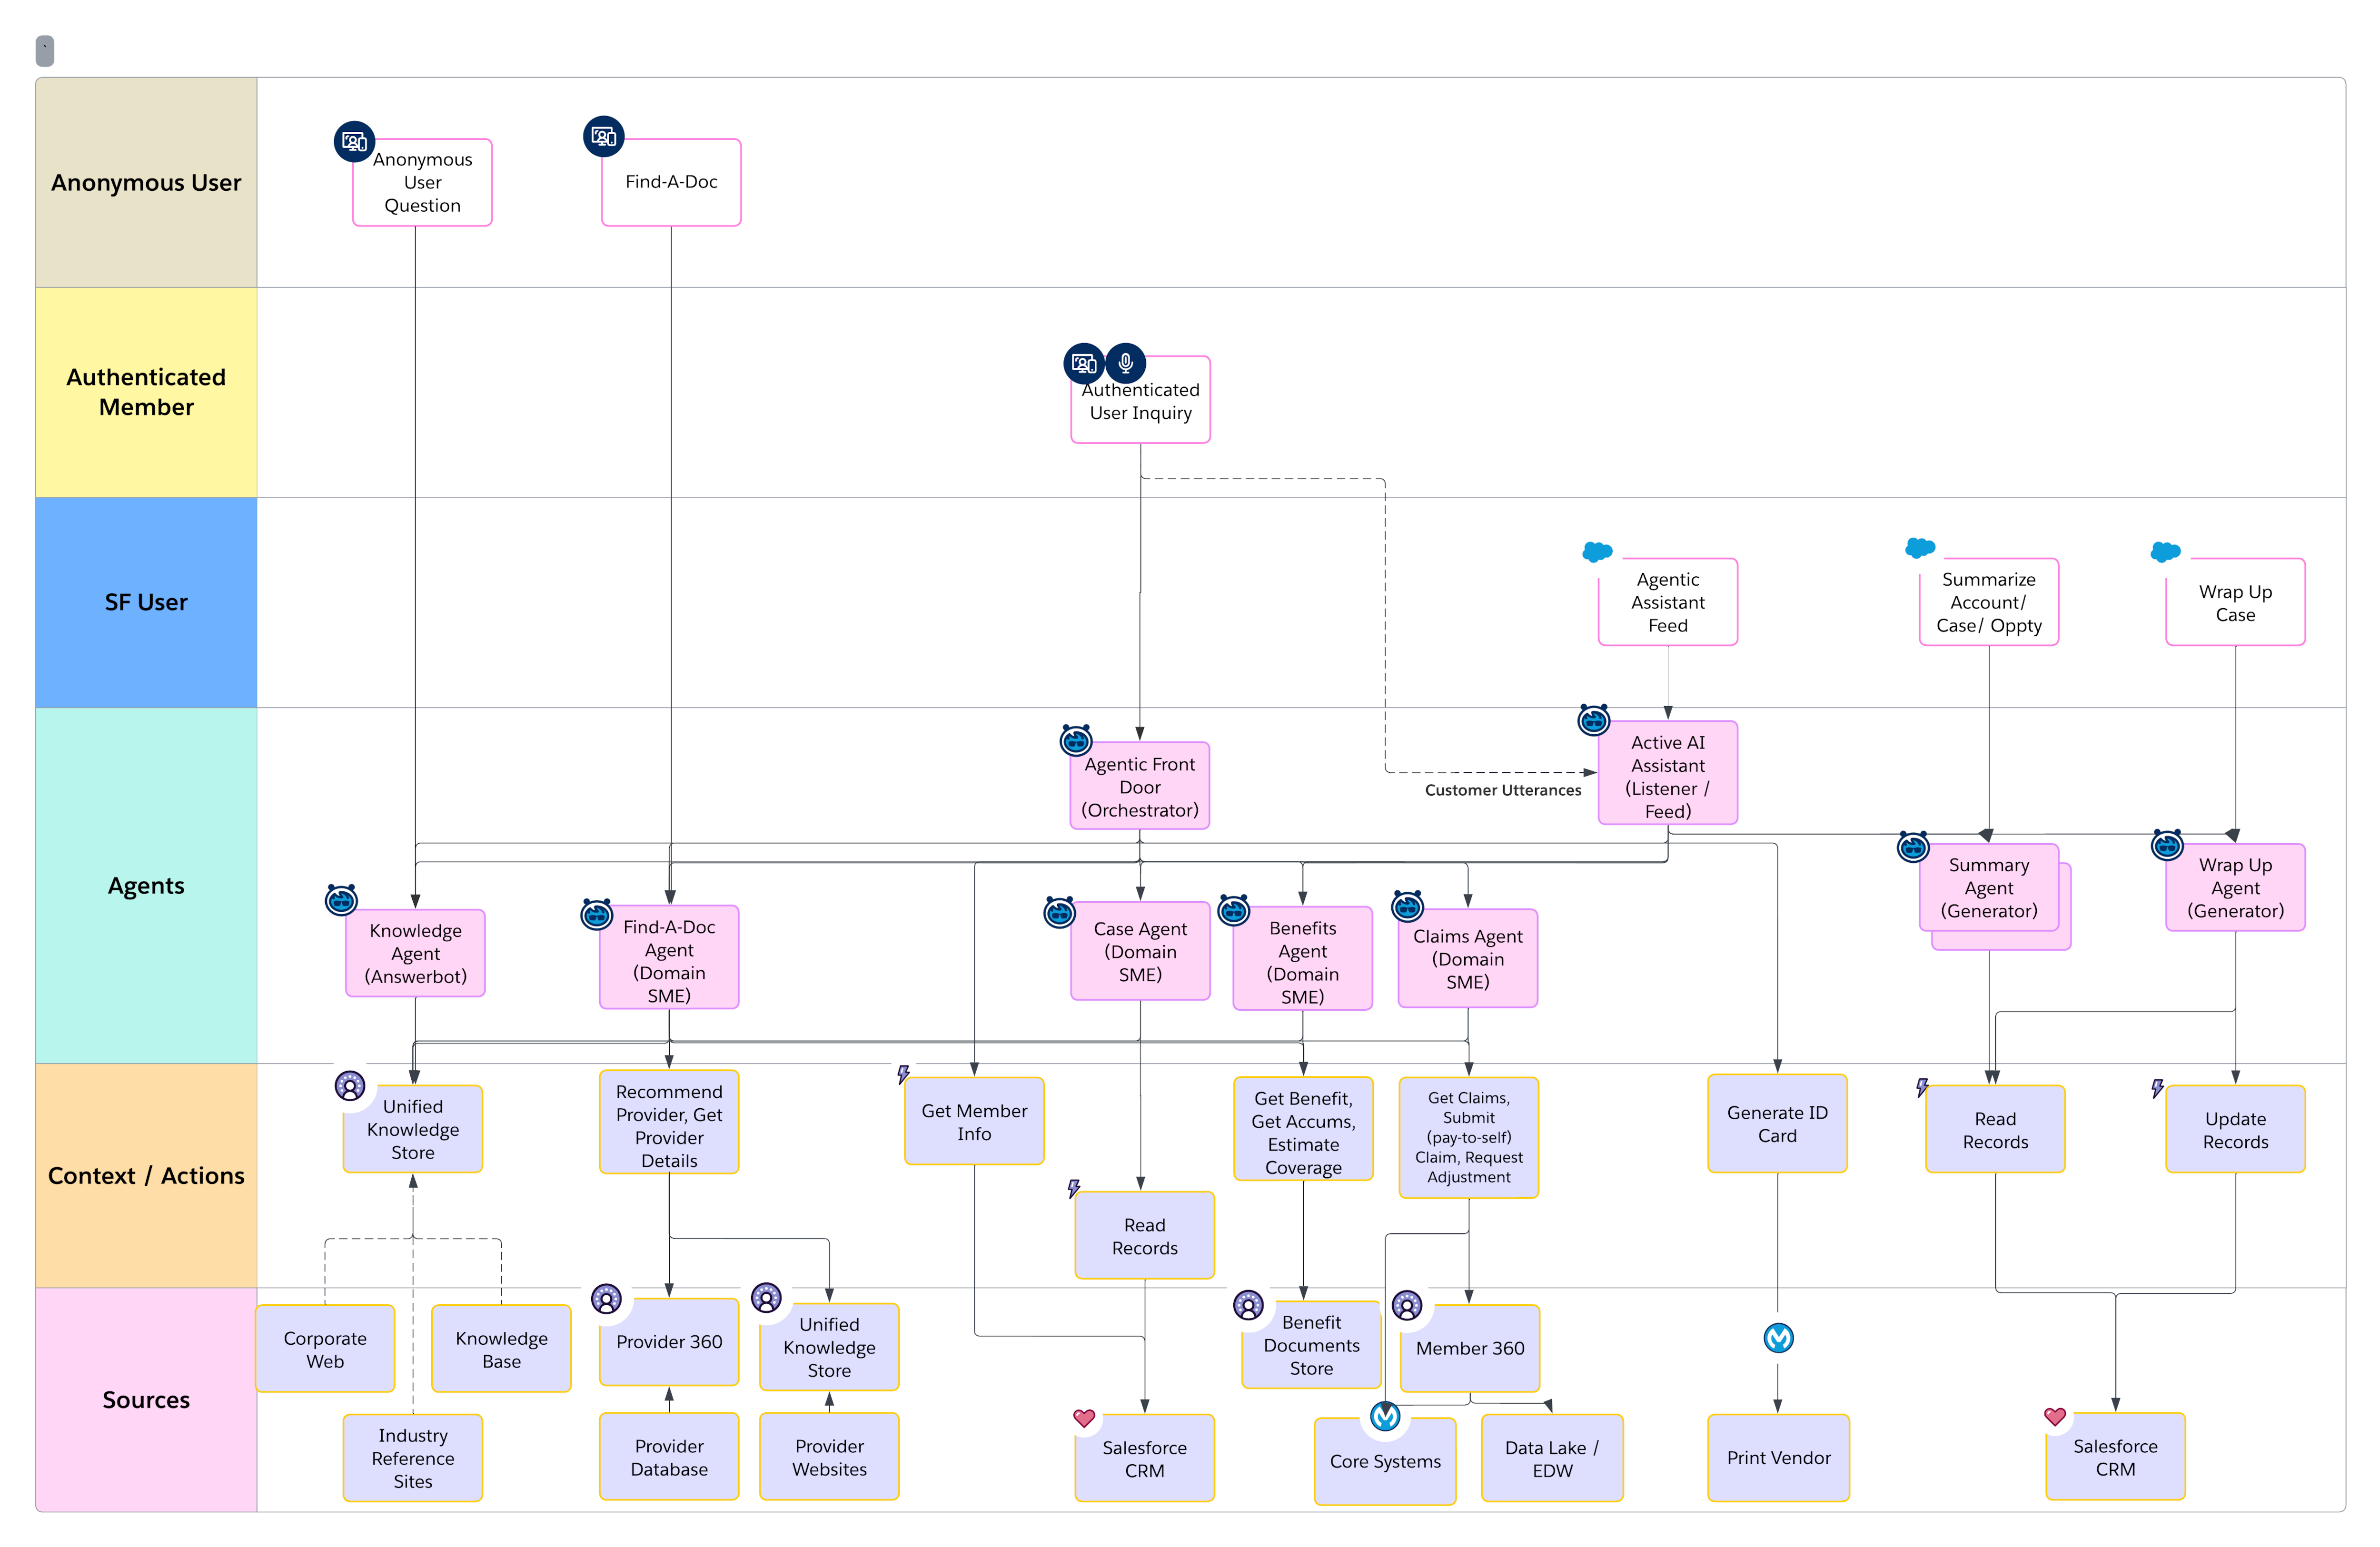 ### 부록 C: 시스템 아키텍처 - 상담 센터
이 다이어그램은 기능 계층으로 구성된 상담 센터의 보조 AI 솔루션에 대한 논리 아키텍처를 보여줍니다.
- **오케스트레이터 에이전트**: 다양한 개인 정보(예: 익명, 외부 구성원 또는 CSR)에 대한 사용자 환경을 관리하고 전체 상호 작용 플로를 오케스트레이션합니다.
- **노동자 대리인**: *다중 중소기업 대리인*은 Knowledge, 사례/청구/보상, 제공자 디렉토리와 같은 핵심 비즈니스 영역에 초점을 맞춥니다. _Next Best Action_ 에이전트도 포함되어 있습니다.
- **유틸리티 에이전트**: 번역, 사례 마무리, 통화 요약과 같은 재사용 가능한 특정 과업을 수행합니다.
통합 및 핵심 시스템: 전체 에이전트 시스템은 플랫폼 간 통합 계층을 통해 구조화되지 않은 데이터 자원, 구조화된 데이터 자원, 핵심 엔터프라이즈 시스템에 연결됩니다.
- **거버넌스**: 거버넌스 계층은 에이전트가 사용하는 LLM/SLM에 대한 관찰 가능성, 평가, 관리를 제공합니다.
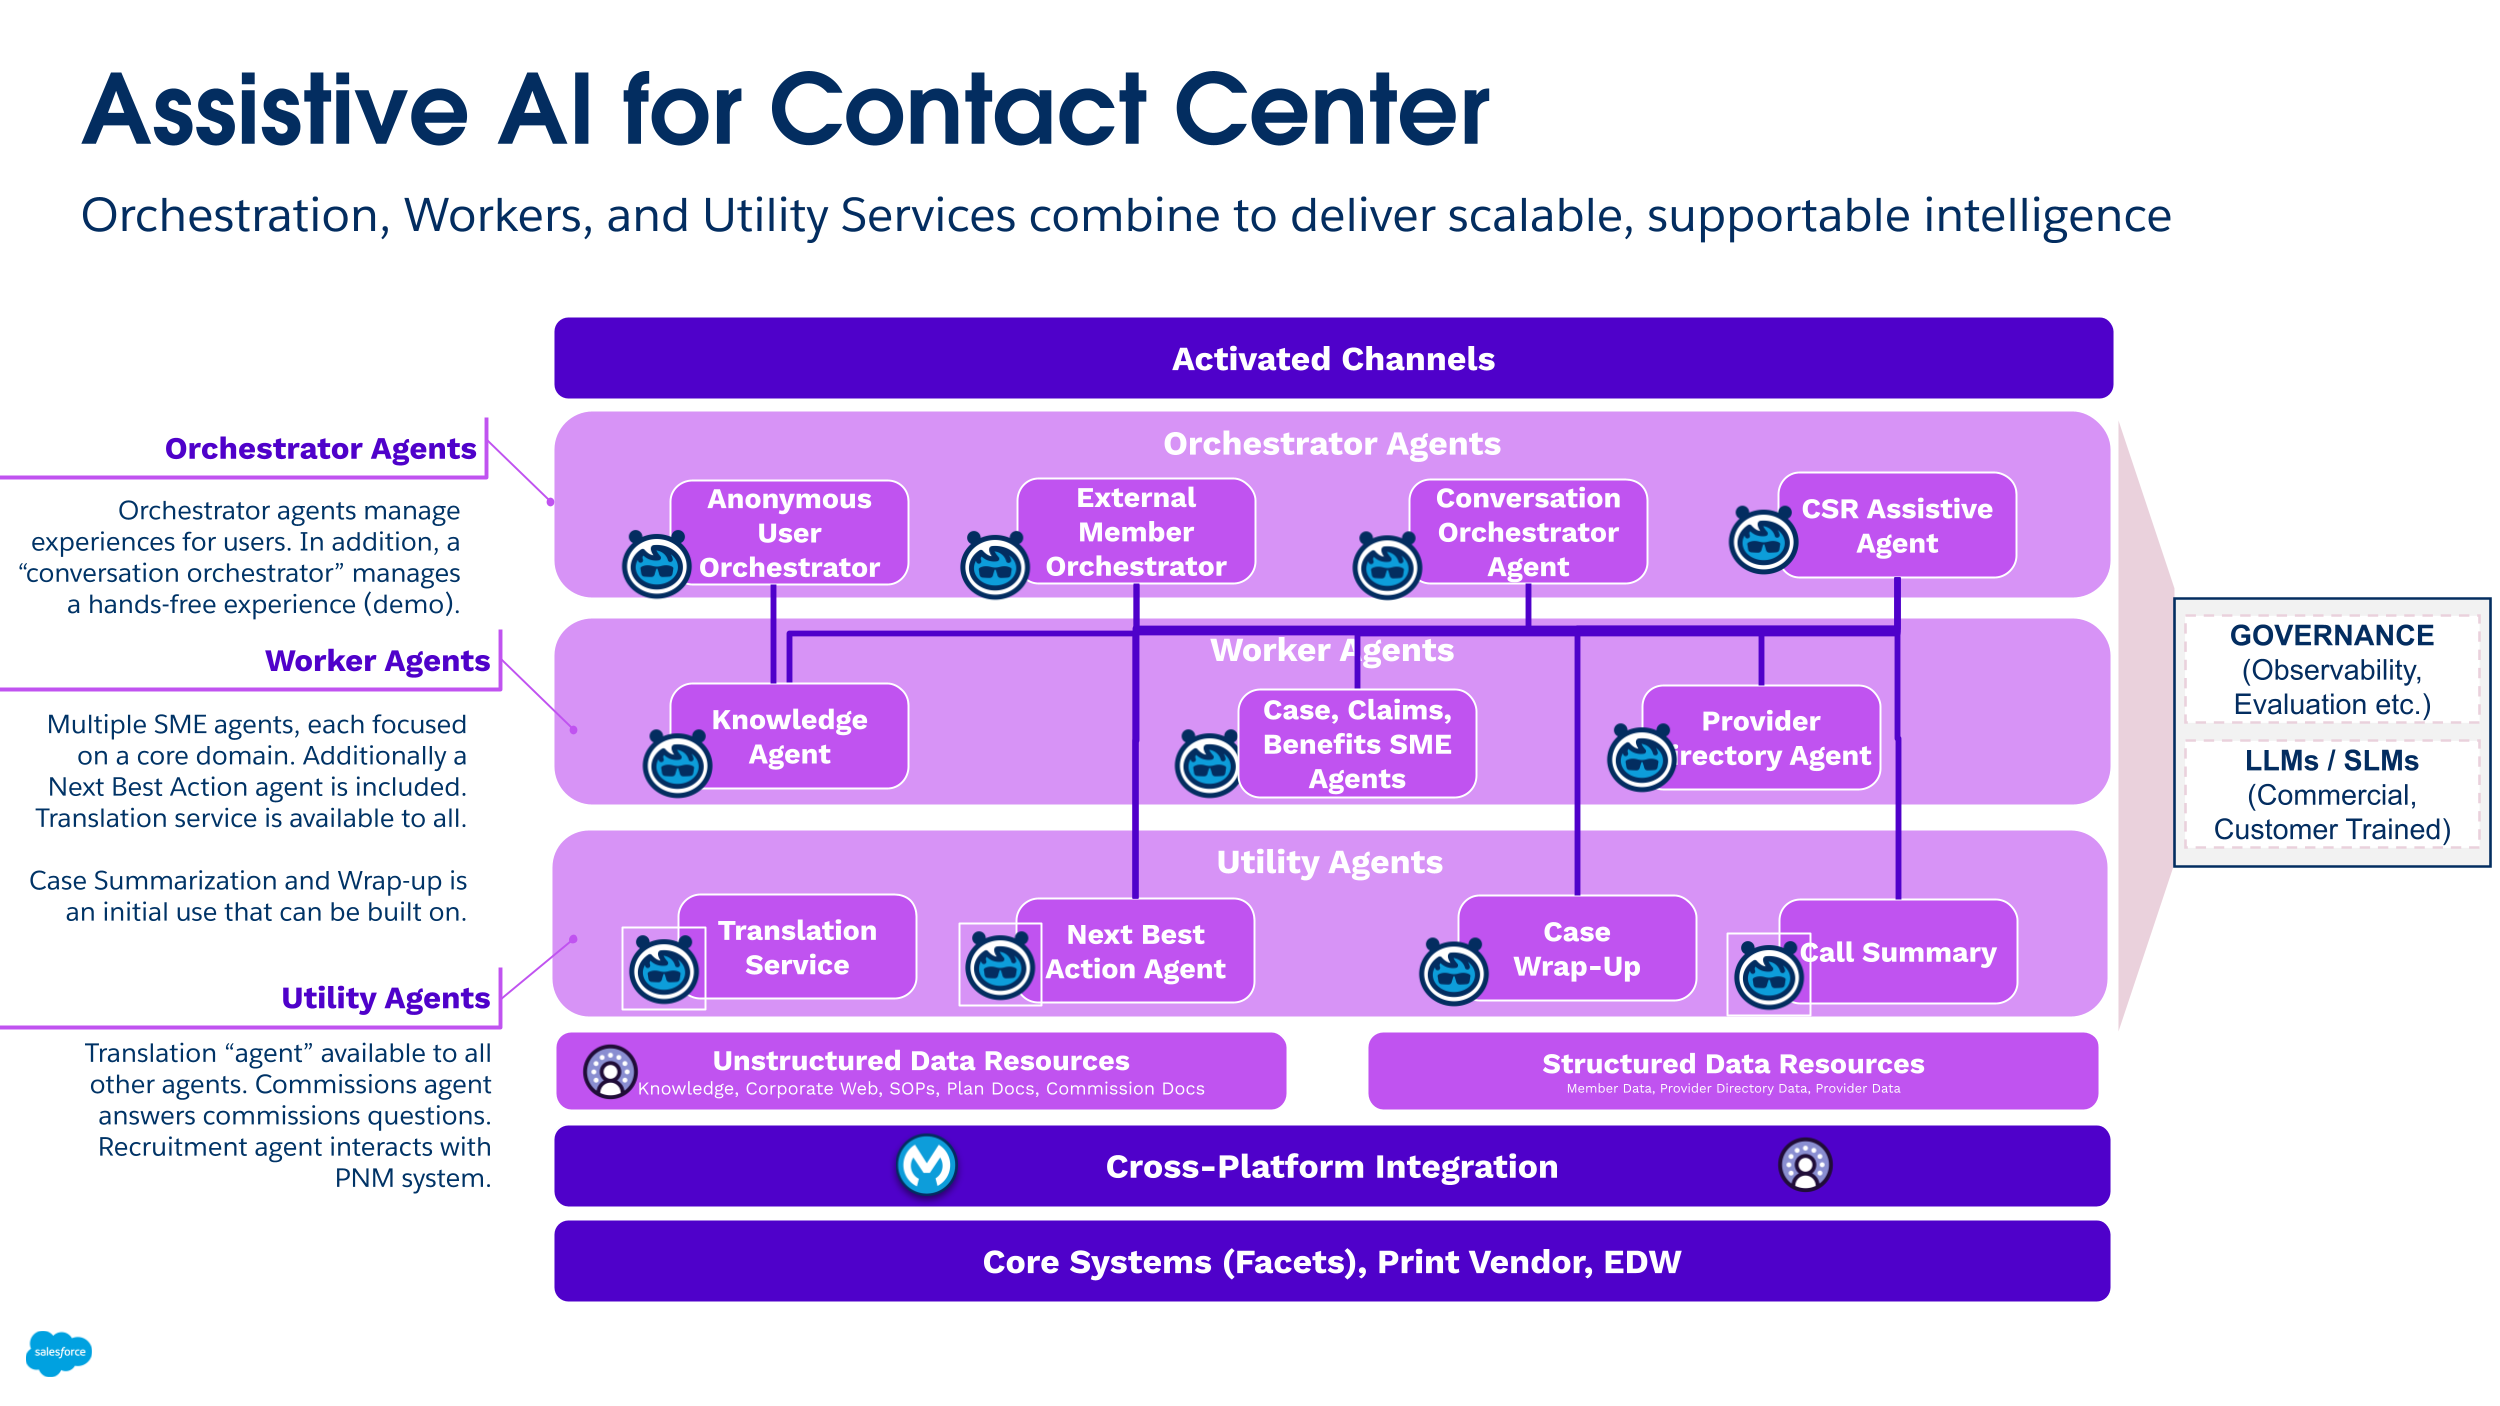 ### 부록 D: 에이전트 솔루션 맵 - 중개인 포털
이 솔루션 맵은 B2B 건강 보험 중개인 포털에 대한 복잡한 장기 실행 에이전트 상호 작용을 자세히 설명합니다. 이 모델에는 _포털 에이전트_(_Orchestrator_)가 포함되어 있으며, 이는 브로커의 여러 단계(예: RFP 제출 및 제안 수신)를 통해 이동할 수 있습니다. 이 오케스트레이터는 _프로젝트 관리자_ 에이전트를 호출하여 RFP 추출기, 인구 조사 변환, 데이터 스튜어드와 같은 백오피스 데이터 품질 및 변환을 위해 여러 헤드리스 에이전트를 조정합니다.
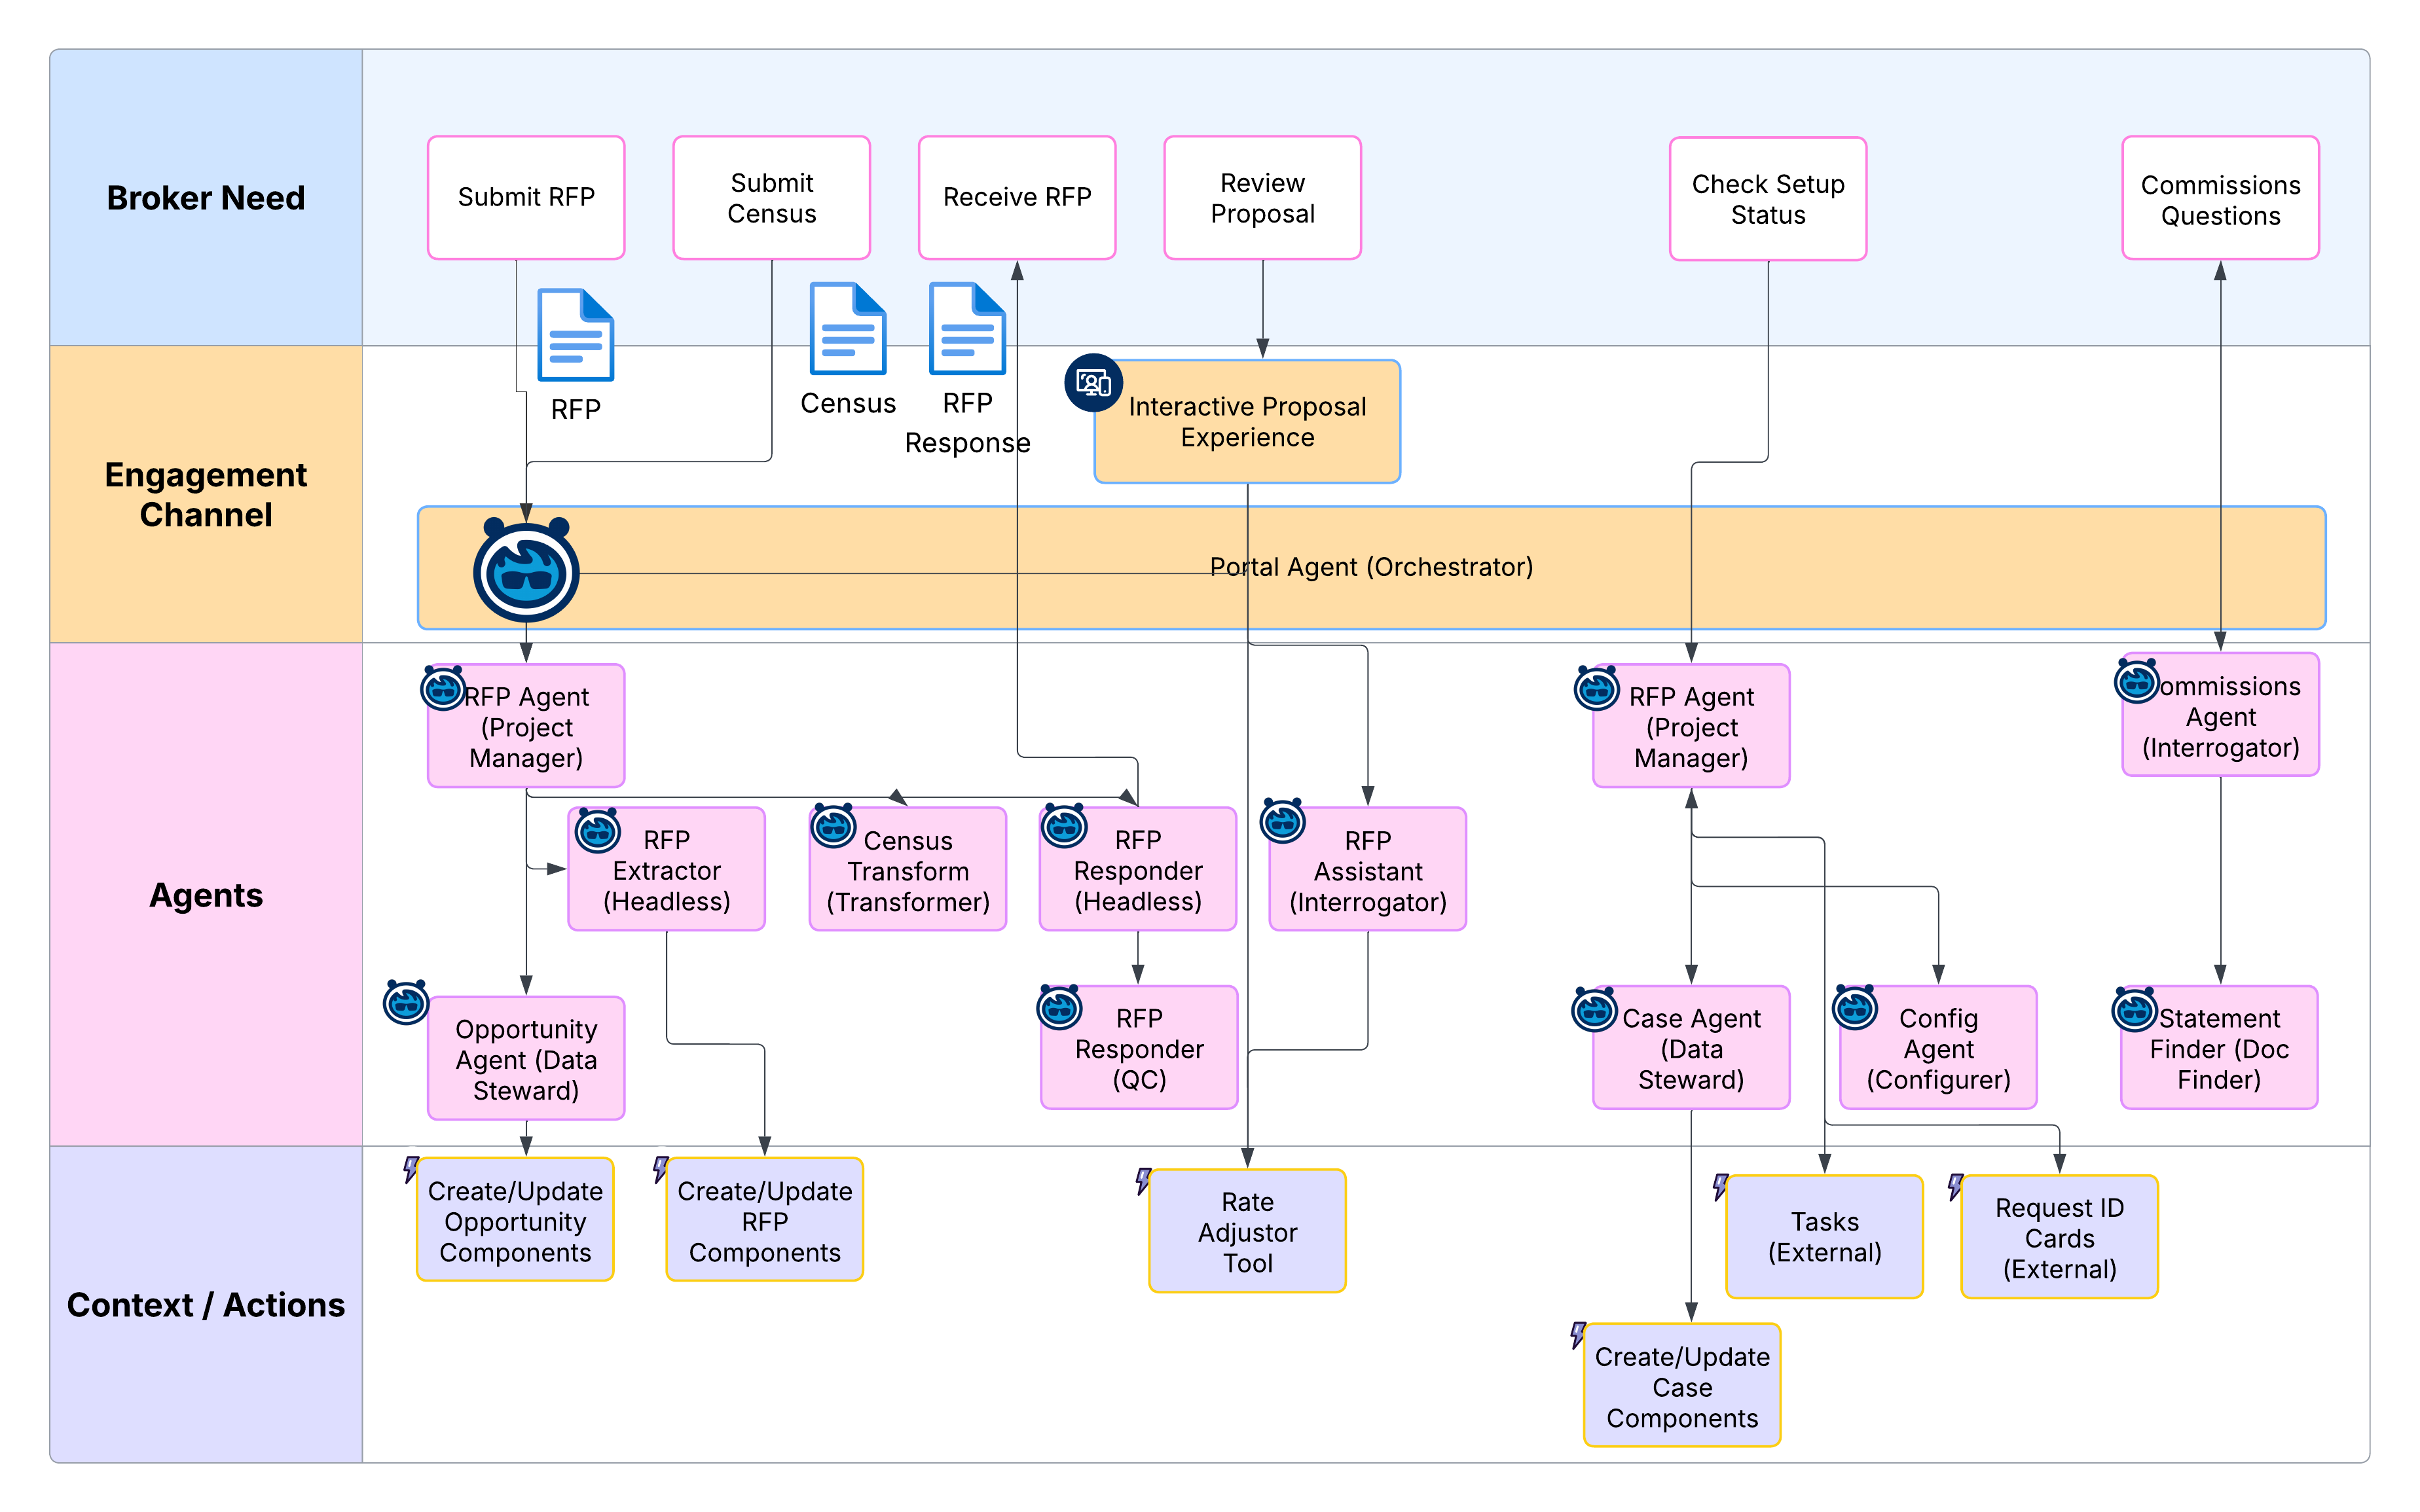 ### 부록 E: 시스템 아키텍처 - B2C 중개인 에이전트
이 다이어그램은 상담 센터와 유사한 계층형 접근 방식을 보여주는 B2C Broker 솔루션의 논리 아키텍처를 보여줍니다. 다른 사용자 개인 정보에 대한 _오케스트레이터 에이전트_, 주요 도메인(예: Knowledge, 회원 서비스 또는 커미션)에 대한 재사용 가능한 _노동 에이전트_, 번역 및 요약과 같은 특정 기능을 위한 *유틸리티 에이전트*가 포함됩니다.
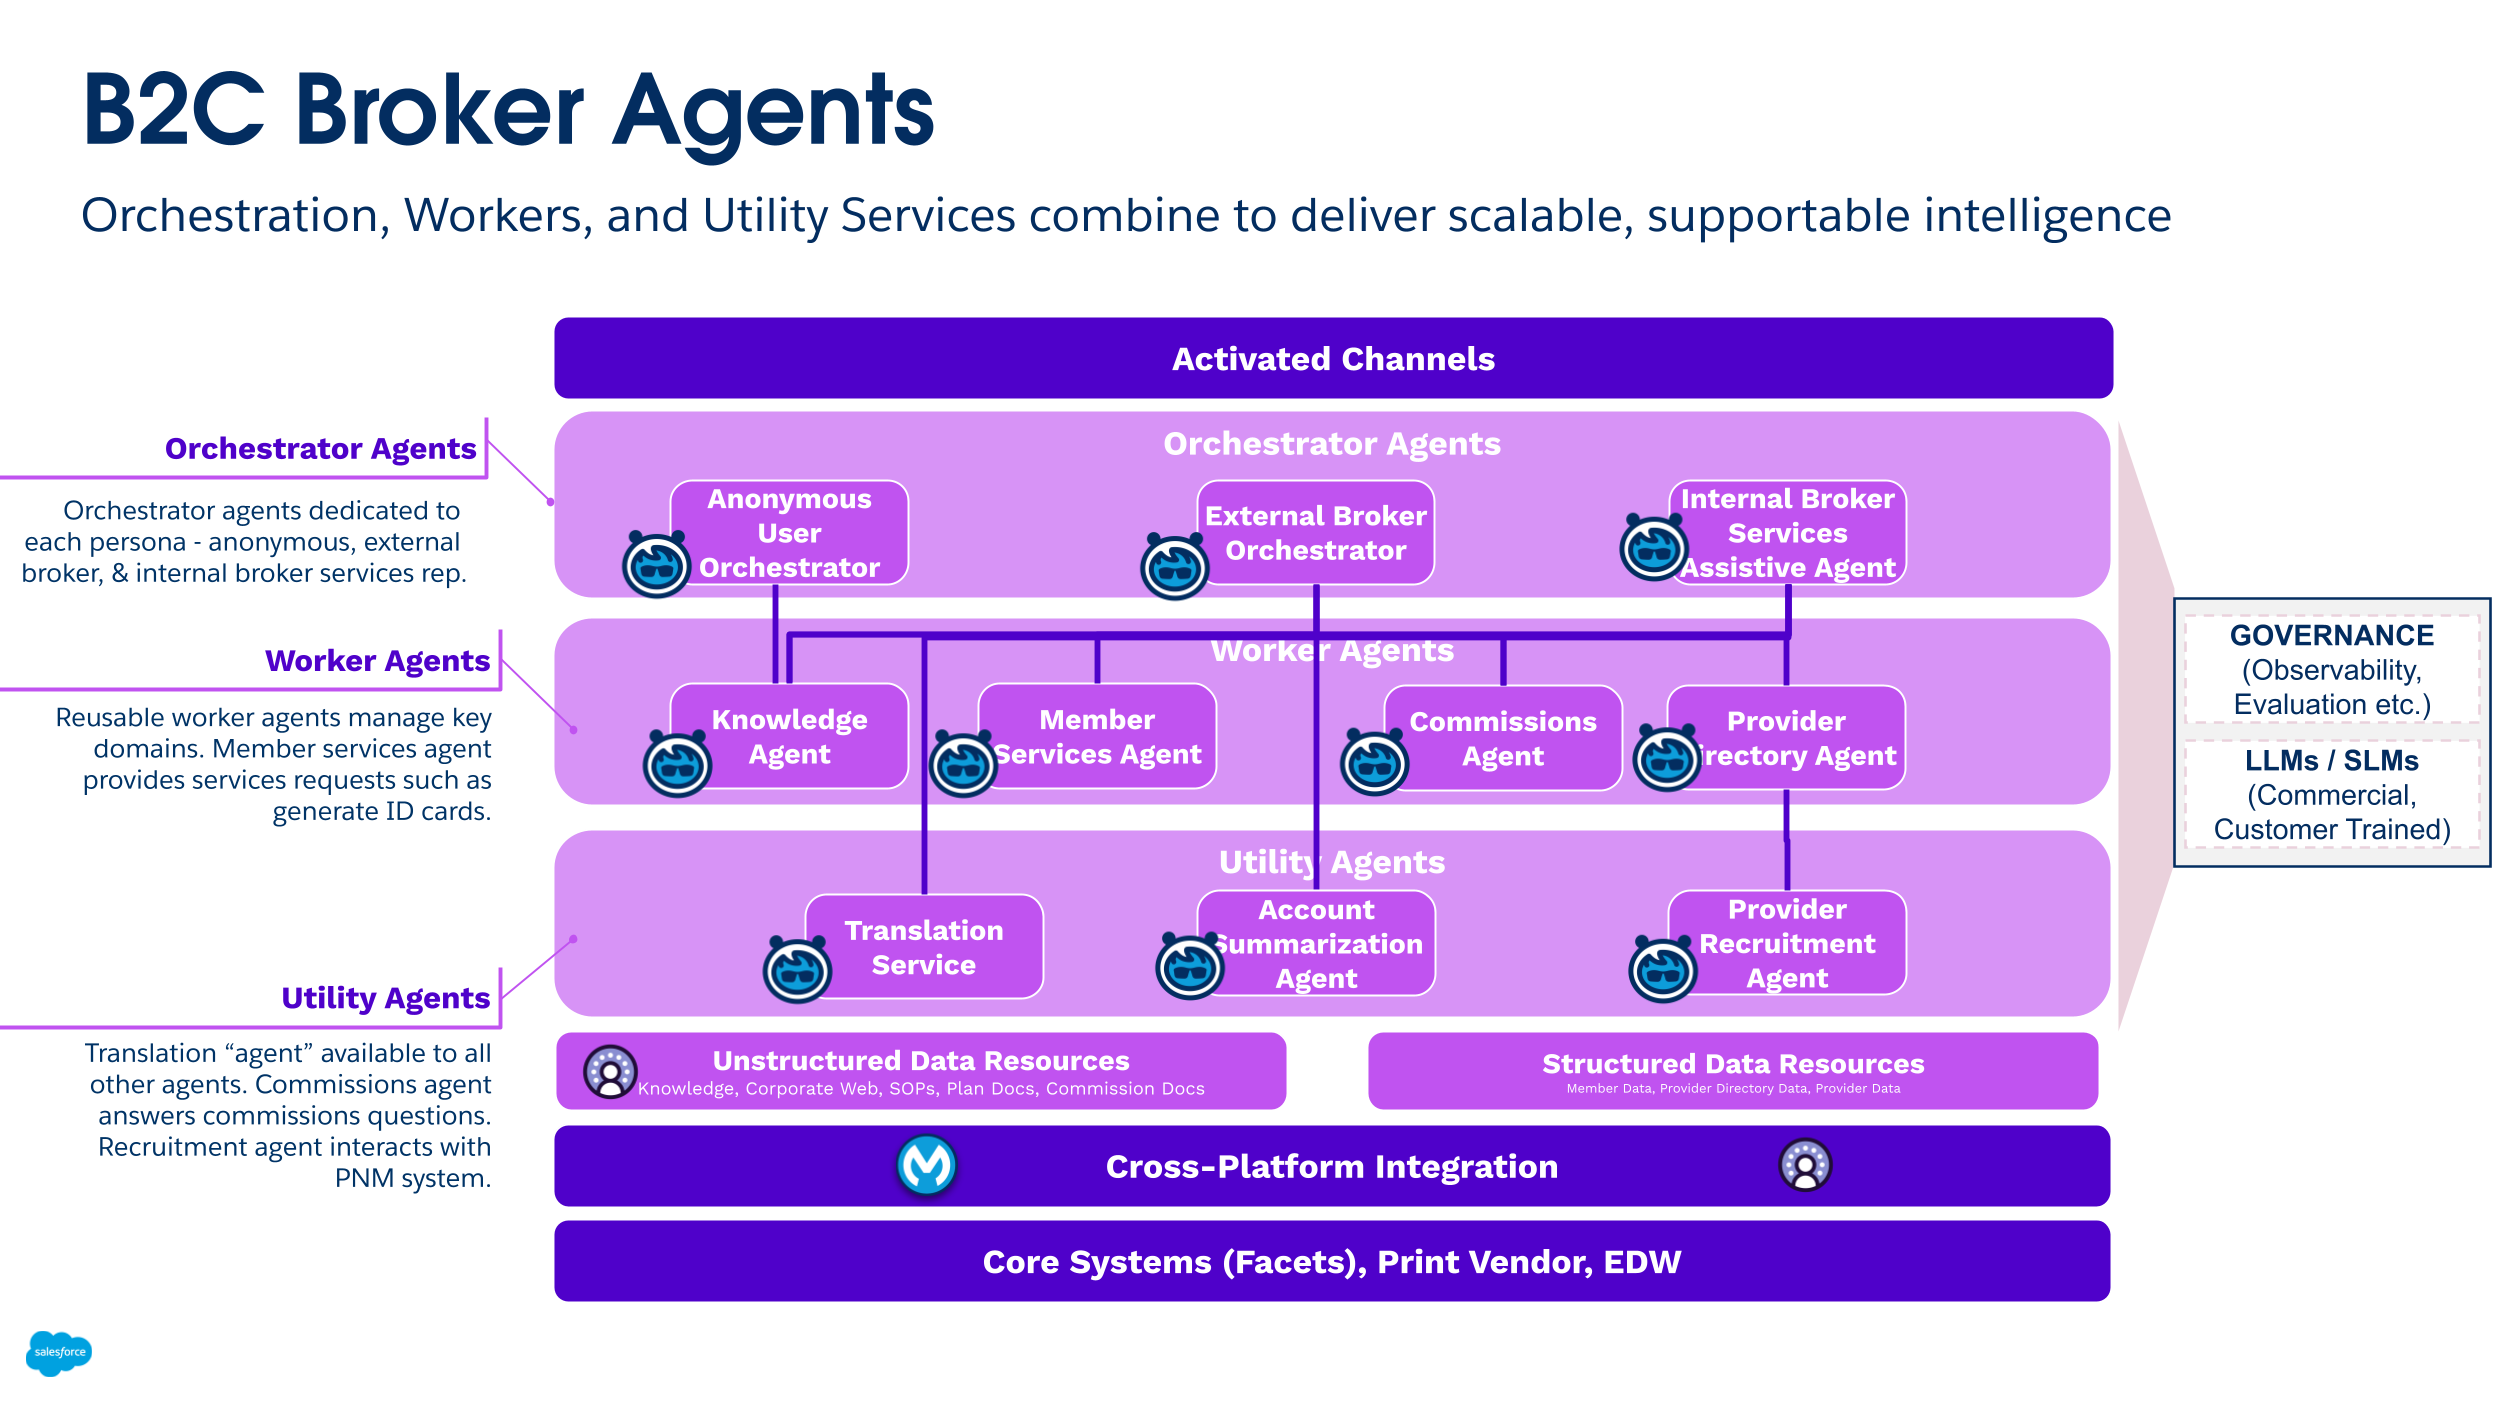 ### 부록 F: 시스템 아키텍처 - 공급자 계약
다음 다이어그램은 제공자 계약 솔루션의 논리 아키텍처를 보여줍니다. _오케스트레이터_ 에이전트는 전체 상호 작용을 관리하고, _작업 에이전트는_ 도메인 내의 특정 의도를 관리합니다(예: 계약 중소기업 에이전트), _유틸리티_ 에이전트는 계약 비교 또는 인사이트 생성과 같은 별도의 작업을 수행합니다.
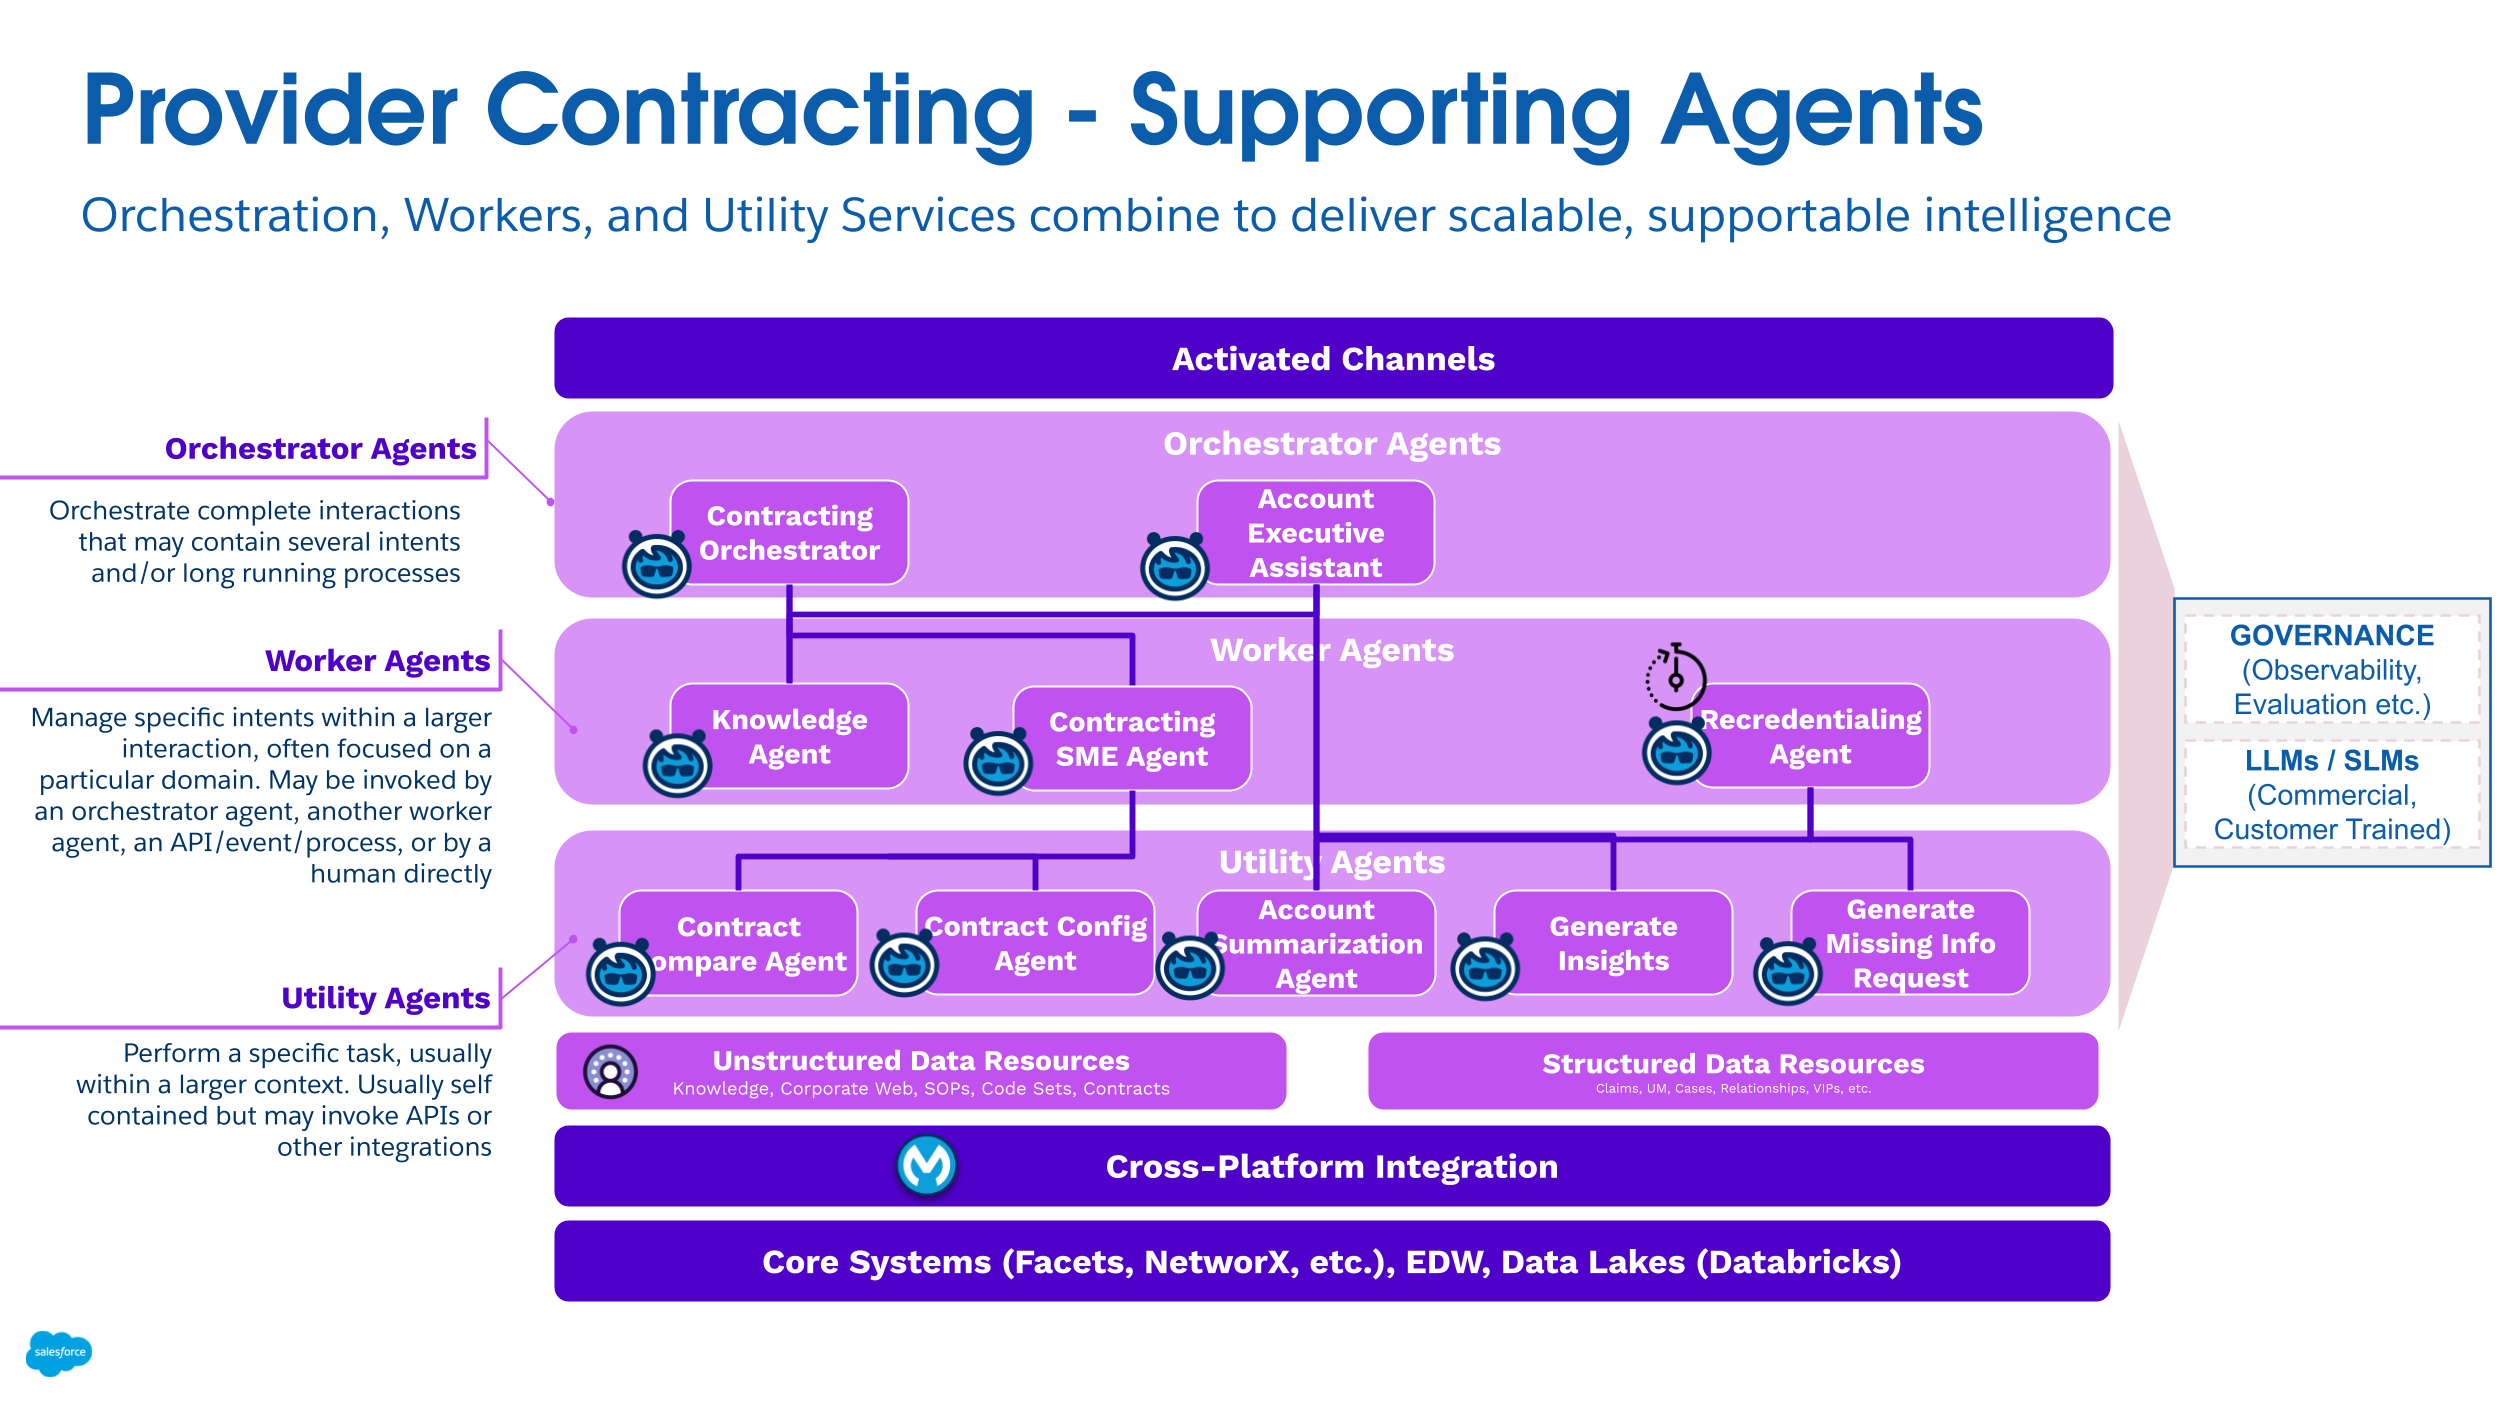 ### 부록 G: 상호 작용 패턴 요약 테이블
다음 표에는 몇 가지 핵심 상호 작용 패턴, 일반적인 사용자 환경, 기본 아키텍처 목적이 요약되어 있습니다.
| 패턴 | 사용자 환경(UX) | 목적 |
|---|---|---|
| 고객을 맞이하는 사람 | 사람에게 상호 작용을 전송하는 응답자로 끝나는 전환(채팅, 음성, SMS 등) 텍스트 | 이는 사용자 의도를 결정하는 데 사용되는 간단한 패턴이며 사용자를 적절한 에이전트에게 라우팅합니다. |
| 연산자 | 사람 또는 전문가 에이전트에 상호 작용을 전송하는 응답자로 끝나는 전환(Chat, Voice, SMS 등) 텍스트 | 이는 적절한 하이브리드 에이전트에 요청을 라우팅하는 데 사용됩니다. 고객을 맞이하는 사람을 기반으로 하는 간단한 패턴으로 의도를 협상한 다음, 전문화된 사람 또는 AI 에이전트에게 상호 작용을 전달합니다. |
| 오케스트레이터 | 응답자가 전문가 에이전트 응답을 수집 및 집계하고 UX에 전달하는 전환 순서대로 텍스트(Chat, Voice, SMS 등) | 이는 대화가 진행될 때 대화에 응답하는 관리형 AI-에이전트 "스워밍"을 조정하는 데 사용됩니다. 오케스트레이터 에이전트가 각 턴의 텍스트를 하나 이상의 전문 에이전트에게 전달한 다음, 각 에이전트의 응답을 집계합니다. |
| Answerbot | 프롬프트 및 응답 | 이것은 Knowledge 자원, FAQ, 정책 등을 사용하여 응답을 형성하는 자연어 인터페이스입니다. |
| 인터로그레이터 | 프롬프트 및 응답 | 이는 특정 도메인 또는 영역에서 질문하는 데 사용되는 자연어 인터페이스입니다. |
| 수신기/피드 | 선형 피드를 피드하는 오케스트레이터 패턴으로 끝나는 전환 순환 텍스트(Chat, Voice, SMS 등) | 이는 대화 플로에서 컨텍스트 및 인사이트를 표시하는 데 사용됩니다. |
| 작업 영역(Radar O'Reilly) | 적응형 단일 창 헤드업 표시로 끝나는 전환형 텍스트(Chat, Voice, SMS 등) | 대화 플로에서 반응형 단일 창 UX를 관리하는 데 사용됩니다. |
| 패턴 | 시나리오 |
|---|---|
| 원격 프로세스 호출—요청 및 회신 | Salesforce는 원격 시스템에서 프로세스를 호출하고 해당 프로세스가 완료될 때까지 기다린 다음, 원격 시스템의 응답을 기반으로 상태를 추적합니다. |
| 원격 프로세스 호출 - Fire and Forget | Salesforce는 원격 시스템에서 프로세스를 호출하지만 프로세스가 완료될 때까지 기다리지 않습니다. 대신 원격 프로세스가 요청을 수신 및 승인한 다음, Salesforce에 다시 제어를 전달합니다. |
| 배치 데이터 동기화 | Lightning Platform에 저장된 데이터는 외부 시스템의 업데이트 및 Lightning Platform의 변경 사항이 외부 시스템으로 전송될 때 생성되거나 새로 고쳐집니다. 두 방향의 업데이트는 배치 방식으로 수행됩니다. |
| 원격 통화 | Salesforce Platform에 저장된 데이터는 원격 시스템에서 생성, 검색, 업데이트 또는 삭제됩니다. |
| 데이터 변경을 기반으로 하는 UI 업데이트 | Salesforce 데이터 변경으로 인해 Salesforce 사용자 인터페이스가 자동으로 업데이트되어야 합니다. |
| 데이터 가상화 | Salesforce가 외부 데이터에 실시간으로 액세스합니다. 이렇게 하면 Salesforce에서 데이터를 유지한 다음, Salesforce와 외부 시스템 간에 데이터를 조정할 필요가 없습니다. |
| 모양 | 설명 |
|---|---|
| 유형 | 통합 스타일을 지정합니다. 프로세스, 데이터 또는 가상.
|
| 시기 | 통합 스타일을 지정합니다. 프로세스, 데이터 또는 가상.
|
| 유형 | 시기 | 고려할 핵심 패턴 |
|---|---|---|
| 프로세스 통합 | 동기식 | 원격 프로세스 호출—요청 및 회신 |
| 프로세스 통합 | 비동기식 | 원격 프로세스 호출 - Fire and Forget |
| 데이터 통합 | 동기식 | 원격 프로세스 호출—요청 및 회신 |
| 데이터 통합 | 비동기식 | 데이터 변경을 기반으로 하는 UI 업데이트 |
| 가상 통합 | 동기식 | 데이터 가상화 |
| 유형 | 시기 | 고려할 핵심 패턴 |
|---|---|---|
| 프로세스 통합 | 동기식 | 원격 통화 |
| 프로세스 통합 | 비동기식 | 원격 통화 |
| 데이터 통합 | 동기식 | 원격 통화 |
| 데이터 통합 | 비동기식 | 배치 데이터 동기화 |
| 기간 | 정의 |
|---|---|
| 이벤트 처리 | 이벤트 처리는 지정된 수신자("처리기")에서 식별 가능한 발생의 영수증입니다. 이벤트 처리와 관련된 핵심 프로세스에는 다음이 포함됩니다.
이벤트 처리기가 최종적으로 이벤트를 이벤트 소비자에게 전달할 수 있다는 점에 유의하십시오. 미들웨어와 함께 이 기능의 일반적인 사용은 인기 있는 "게시/구독" 또는 "pub/sub" 기능을 포함하도록 확장할 수 있습니다. 게시/구독 시나리오에서 미들웨어는 활성 데이터 이벤트 게시자의 활성 데이터 이벤트 구독자에게 요청 또는 메시지를 라우팅합니다. 그러면 활성 수신자가 있는 해당 소비자가 게시된 이벤트를 검색할 수 있습니다. 미들웨어를 사용하는 Salesforce 통합에서 미들웨어 계층은 이벤트 처리를 제어한다고 가정합니다. 동기식 또는 비동기식인 모든 관련 이벤트를 수집하고 Salesforce를 포함한 모든 끝점에 대한 배포를 관리합니다. 또는 이 기능은 플랫폼 이벤트가 있는 이벤트 버스를 사용하여 Salesforce 엔터프라이즈 Messaging 플랫폼을 사용하여 달성할 수 있습니다. |
| 프로토콜 변환 | 프로토콜 변환은 일반적으로 상호 운용성을 위해 한 장치의 표준 또는 독점 프로토콜을 다른 장치에 적합한 프로토콜로 변환하는 소프트웨어 응용 프로그램입니다. 미들웨어 컨텍스트에서 특정 대상 시스템에 대한 연결은 프로토콜에 의해 제약될 수 있습니다. 이러한 경우 메시지 형식을 대상 시스템 형식으로 변환하거나 페이로드를 추출할 수 있는 대상 시스템 형식 내에 캡슐화해야 합니다. 이를 터널링이라고도 합니다. Salesforce는 네이티브 프로토콜 변환을 지원하지 않으므로 미들웨어 계층 또는 끝점에서 이러한 요구 사항을 충족한다고 가정합니다. |
| 번역 및 변환 | 변환은 통합되는 다양한 시스템 간의 상호 운용성을 보장하기 위해 한 데이터 형식을 다른 데이터 형식으로 매핑하는 기능입니다. 일반적으로 이 프로세스는 발신자 또는 수신자의 요구 사항에 맞게 이동 중인 메시지의 형식을 다시 지정합니다. 더 복잡한 경우 하나의 응용 프로그램이 자체 네이티브 형식으로 메시지를 보내고 다른 두 개 이상의 응용 프로그램이 각각 자체 네이티브 형식으로 메시지 사본을 수신할 수 있습니다. 중간웨어 번역 및 변환 도구에는 레거시 또는 기타 비표준 끝점에 대한 서비스 패싯을 만드는 기능이 포함되는 경우가 많습니다. 해당 서비스 패싯을 사용하면 해당 끝점이 서비스 주소 지정 가능으로 표시됩니다. Salesforce 통합을 사용하면 미들웨어 계층 또는 끝점이 이러한 요구 사항을 충족한다고 가정합니다. 데이터 변환은 Apex 코딩할 수 있지만 서비스 점검 및 성능 고려 사항으로 인해 코딩하지 않는 것이 좋습니다. |
| 대기열 및 완충 | 대기열 및 완충은 일반적으로 요청 응답 아키텍처와 달리 비동기식 메시지 전달에 의존합니다. 비동기식 시스템에서는 대상 프로그램이 사용 중이거나 연결이 손상된 경우 메시지 대기열에서 임시 저장소를 제공합니다. 또한 대부분의 비동기 미들웨어 시스템은 메시지 대기열을 백업할 수 있는 영구 저장소를 제공합니다. 비동기 메시지 프로세스의 주요 장점은 어떤 이유로 인해 수신자 응용 프로그램이 실패할 경우 발신자가 영향을 받지 않고 계속 진행될 수 있다는 것입니다. 수신기가 다시 시작되면 나중에 처리하기 위해 보낸 메시지가 메시지 대기열에 누적됩니다. Salesforce는 워크플로 기반 아웃바운드 메시지 형식의 명시적 대기열 기능만 제공합니다. 오케스트레이션, 프로세스 연습, 서비스 품질 등 기타 통합 시나리오에 대한 실제 메시지 대기열을 제공하려면 미들웨어 솔루션이 필요합니다. |
| 동기식 전송 프로토콜 | 동기식 전송 프로토콜은 활동을 지원하는 프로토콜을 말합니다. "발신자의 단일 스레드가 요청 메시지를 보내고 회신 메시지를 대기한 다음 회신을 처리합니다.... 응답을 대기하는 요청 스레드는 미해결 요청이 하나만 있거나 이 요청에 대한 회신 채널이 이 스레드에 대해 비공개임을 의미합니다." |
| 비동기식 전송 프로토콜 | 비동기식 전송 프로토콜은 활동을 지원하는 프로토콜을 말합니다. "발신자의 스레드 하나가 요청 메시지를 보내고 회신에 대한 콜백을 설정합니다. 별도의 스레드는 회신 메시지를 수신합니다. 회신 메시지가 도착하면 회신 스레드가 적절한 콜백을 호출하여 발신자의 컨텍스트를 재설정하고 회신을 처리합니다. 이 접근 방식을 사용하면 여러 개의 미해결 요청이 단일 회신 스레드를 공유할 수 있습니다." |
| 중재 라우팅 | 중재 라우팅은 구성 요소에서 구성 요소로 메시지의 복잡한 "플로"를 지정합니다. 예를 들어, 많은 미들웨어 기반 솔루션이 메시지 대기열 시스템에 종속됩니다. 일부 구현에서는 Messaging 레이어 자체에서 라우팅 논리를 제공할 수 있지만, 다른 구현에서는 클라이언트 응용 프로그램에 따라 라우팅 정보를 제공하거나 두 패러다임을 혼합할 수 있습니다. 이러한 복잡한 사례에서 미들웨어의 중재는 개발, 통합, 유효성 검사를 간소화합니다. computerator [Mediator]는 올바른 메시지가 올바른 소비자에게 전달되도록 할 수 있습니다." |
| 프로세스 통합 및 서비스 오케스트레이션 | 프로세스 코레이오그래픽 및 서비스 오케스트레이션은 각각 여러 개의 끝점 및 성능이 조정되는 "서비스 구성"의 형태입니다.
choreography 및 service orchestration 간의 차이점은 다음과 같습니다.
Salesforce 워크플로에서 또는 Apex 사용하여 비즈니스 프로세스 통합 부분을 작성할 수 있습니다. Salesforce 시간 초과 값 및 총괄자 제한으로 인해 특히 실제 트랜잭션 처리가 필요한 솔루션에서 모든 복잡한 오케스트레이션을 미들웨어 계층에서 구현하는 것이 좋습니다. |
| 트랜잭션성(암호화, 서명, 신뢰할 수 있는 배달, 트랜잭션 관리) | 트랜잭션성은 각 필수 자원에 대한 모든 필수 작업을 포함하는 전역 트랜잭션을 지원하는 기능으로 정의할 수 있습니다. 트랜잭션성은 atomicity, consistency, isolation, durability, where atomicity guarantees all-or-nothing outcomes for the unit of work(트랜잭션)의 4가지 ACID 속성 모두를 지원한다는 의미입니다.
Salesforce는 자체적으로 트랜잭션이지만 Salesforce 외부에서 시작된 배포된 트랜잭션 또는 트랜잭션에 참여할 수 없습니다. 따라서 복잡한 다중 시스템 트랜잭션이 필요한 솔루션의 경우 트랜잭션성 및 관련 롤백/상환 메커니즘이 미들웨어 계층에서 구현된다고 가정합니다. |
| 라우팅 | 라우팅은 구성 요소에서 구성 요소로의 복잡한 메시지 플로를 지정하도록 정의할 수 있습니다. 현대 서비스 기반 솔루션에서는 해당 메시지 플로가 머리글, 콘텐츠 유형, 규칙, 우선 순위를 포함한 여러 기준을 기반으로 할 수 있습니다.
Salesforce 통합을 사용하면 미들웨어 계층 또는 끝점이 이러한 요구 사항을 충족한다고 가정합니다. 메시지 라우팅은 Apex 코딩할 수 있지만 서비스 점검 및 성능 고려 사항으로 인해 코딩하지 않는 것이 좋습니다. |
| 추출, 변환, 로드 | ETL(추출, 변환, 로드)은 다음과 같은 프로세스를 말합니다.
Salesforce는 이제 Salesforce 레코드에 대한 변경 사항을 나타내는 변경 이벤트 게시인 변경 데이터 수집 지원합니다. 변경 데이터 수집 사용하면 클라이언트 또는 외부 시스템이 Salesforce 레코드의 변경 사항을 거의 실시간으로 수신합니다. 이 정보를 사용하면 클라이언트 또는 외부 시스템에서 외부 데이터 저장소의 해당 레코드를 동기화할 수 있습니다. |
| 긴 폴링 | Comet 프로그래밍이라고도 하는 긴 폴링은 서버에서 클라이언트로의 정보 푸시를 에뮬레이트합니다. 클라이언트는 일반 폴링과 마찬가지로 서버에서 정보를 연결하고 요청합니다. 그러나 정보를 사용할 수 없는 경우 빈 응답을 보내는 대신 서버가 요청을 유지하고 정보를 사용할 수 있을 때까지 기다립니다(이벤트가 발생). 그러면 서버가 클라이언트에게 전체 응답을 보냅니다. 그러면 클라이언트가 정보를 즉시 다시 요청합니다. 클라이언트는 서버에 대한 연결을 지속적으로 유지하므로 항상 응답을 받을 때까지 기다립니다. 서버 시간이 초과되면 클라이언트가 다시 연결하고 다시 시작합니다. Salesforce 스트리밍 API는 Bayeux 프로토콜 및 CometD를 사용하여 장기간 폴링합니다.
|
| 솔루션 | 맞춤 | 댓글 |
|---|---|---|
| 외부 서비스에서 REST API 호출 호출 | 최대 | 외부 서비스를 사용하면 선언적 방식으로 외부에서 호스팅되는 서비스를 호출할 수 있습니다(코드가 필요하지 않음). 이 기능은 다음 조건이 충족된 경우에 가장 적합합니다.
|
| Salesforce Lightning - Lightning 구성 요소 또는 페이지가 동기식 Apex REST 또는 SOAP 콜아웃을 시작합니다.</ 원격 엔드포인트가 높은 지연 응답 위험을 야기하는 경우(해당되는 제한에 대한 최신 제한 문서 참조) 동기식 Apex 트랜잭션 총괄자 제한에 도달하지 않도록 비동기식 콜아웃(계속)을 권장합니다. |
최대 | Salesforce를 사용하면 WSDL을 사용하고 결과 프록시 Apex 클래스를 생성할 수 있습니다. 이 클래스는 원격 서비스를 호출하는 데 필요한 논리를 제공합니다. 또한 Salesforce에서는 표준 GET, POST, PUT, DELETE 메서드를 사용하여 HTTP(REST) 서비스를 호출할 수 있습니다. Lightning 페이지에서 사용자가 시작하는 작업이 Apex 컨트롤러 작업을 호출한 다음, 이 프록시 Apex 클래스를 실행하여 원격 호출을 수행합니다. Lightning 페이지는 Salesforce 응용 프로그램을 사용자 정의해야 합니다. |
| Salesforce 데이터 변경 사항에서 호출되는 동기 트리거는 비동기 Apex SOAP 또는 HTTP 콜아웃을 수행합니다. | 최적화되지 않음 | Apex 트리거를 사용하여 레코드 데이터 변경 사항을 기반으로 자동화를 수행할 수 있습니다. Apex 프록시 클래스는 Apex 트리거를 사용하여 DML 작업의 결과로 실행될 수 있습니다. 그러나 트리거 컨텍스트 내에서 이루어진 모든 호출은 시작 이벤트에서 비동기식으로 실행되어야 합니다. 따라서 이 통합 문제에서는 이 솔루션을 사용하지 않는 것이 좋습니다. 이 솔루션은 원격 프로세스 호출 - 불 및 잊음 패턴에 더 적합합니다. |
| 배치 Apex 작업은 동기식 Apex SOAP 또는 HTTP 콜아웃을 수행합니다. | 최적화되지 않음 | 배치 작업에서 원격 시스템에 전화를 걸 수 있습니다. 이 솔루션을 사용하면 Salesforce의 원격 시스템에서 배치 원격 프로세스를 실행하고 응답을 처리할 수 있습니다. 그러나 지정된 배치에는 통화 수에 대한 제한이 있습니다. 자세한 내용은 Governor Limits를 참조하십시오. 지정된 배치 실행은 여러 트랜잭션 컨텍스트(일반적으로 200개의 레코드 간격)를 실행할 수 있습니다. 거래 컨텍스트별로 총괄자 제한이 재설정됩니다. |
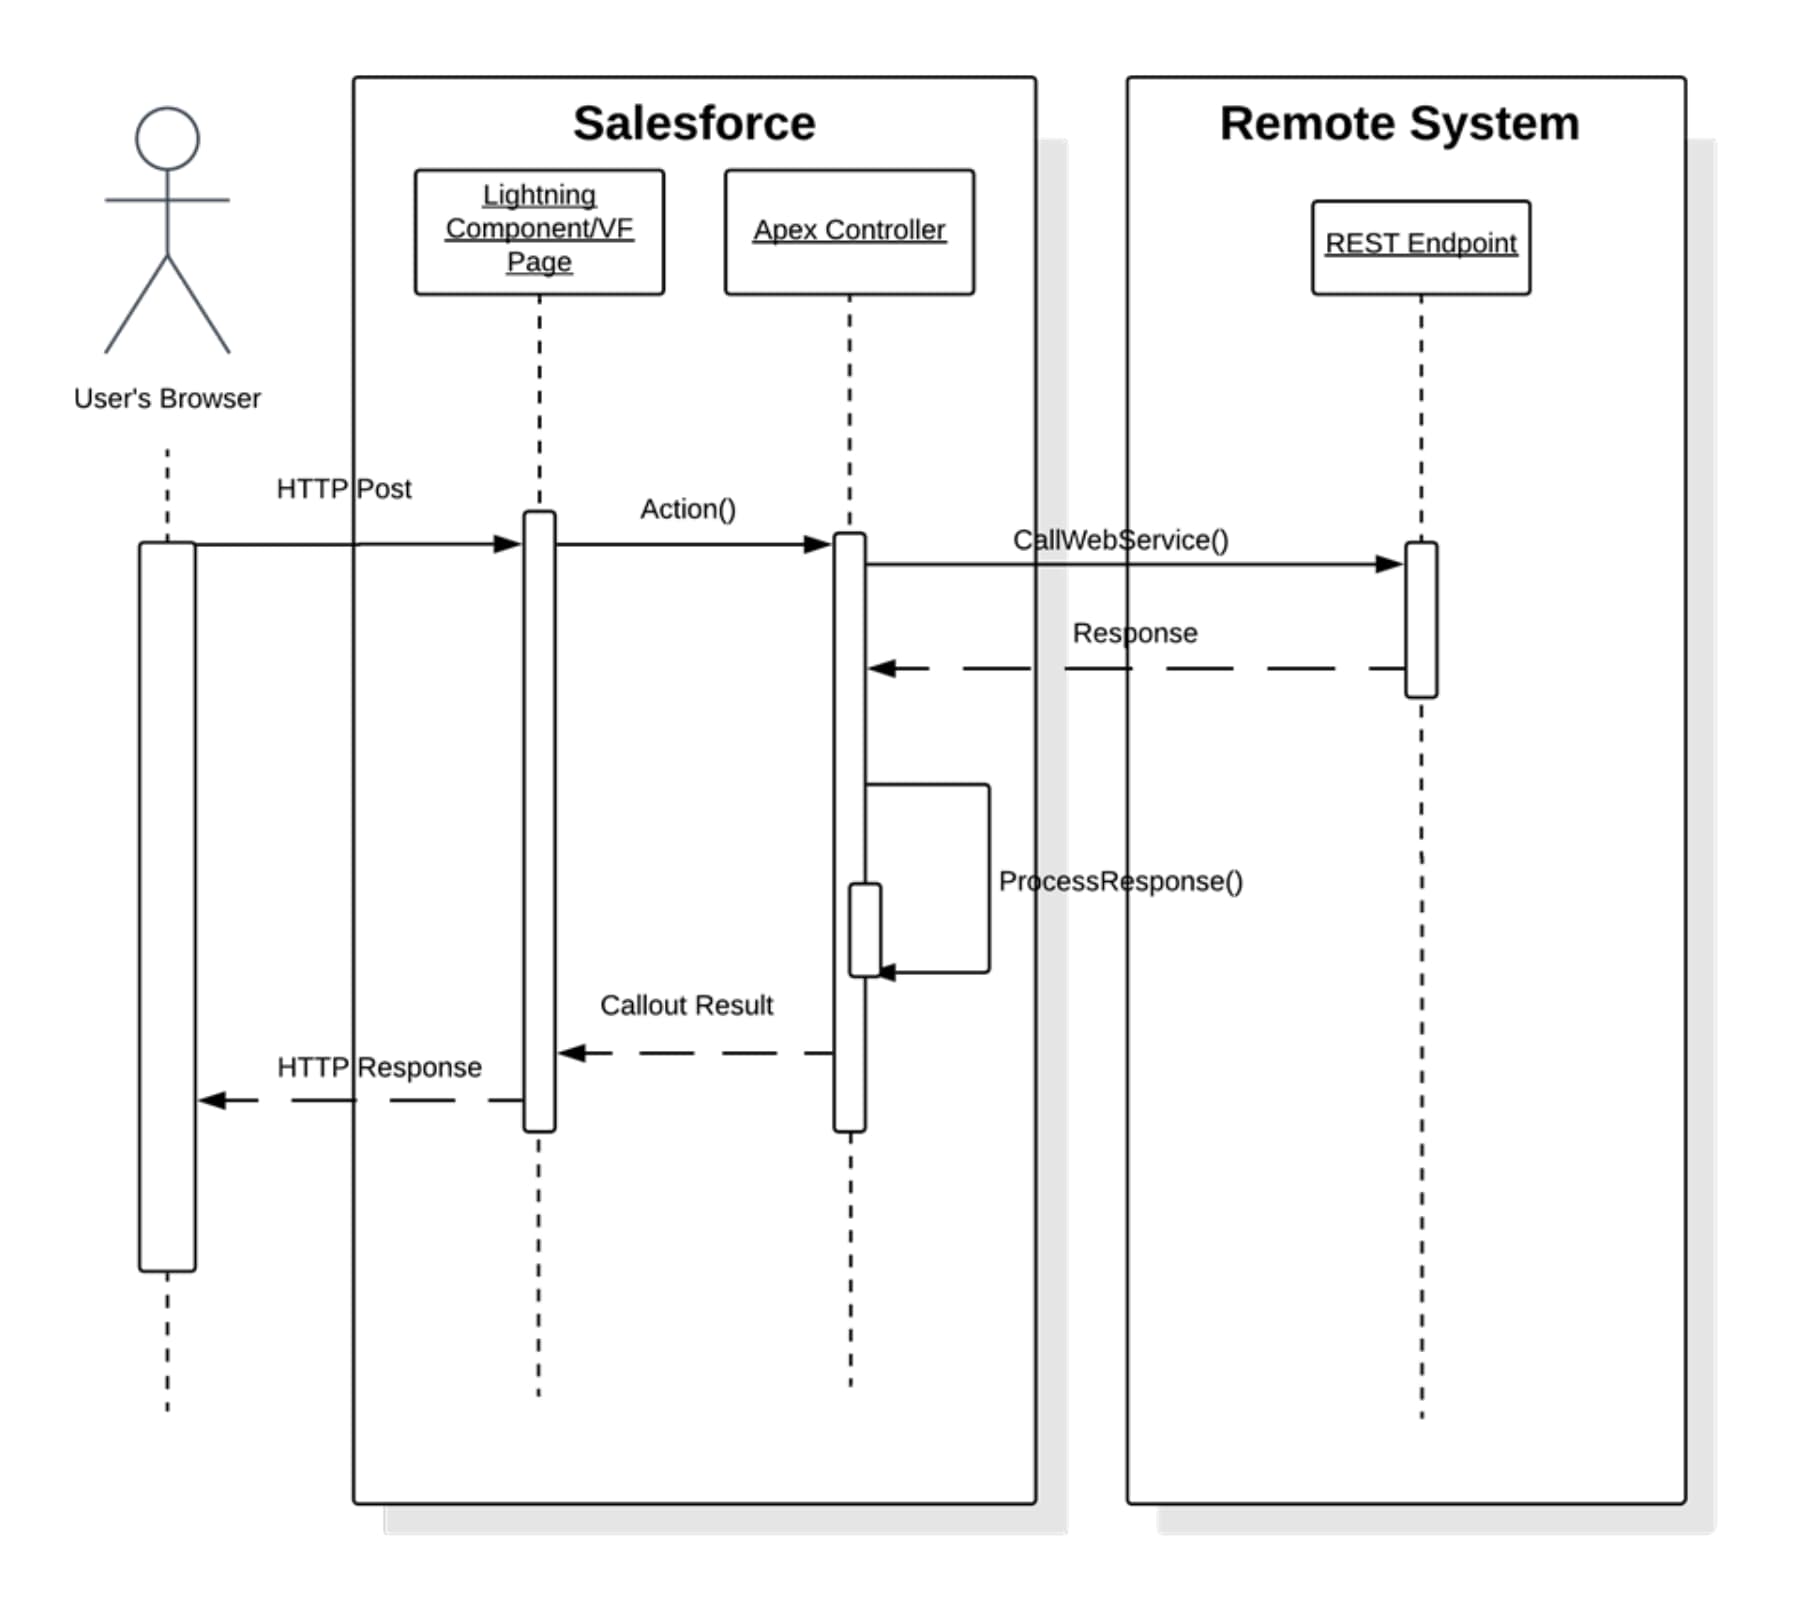 다운로드 다이어그램
이 시나리오의 경우: - Lightning 페이지에서 작업이 시작됩니다(예: 버튼 클릭). - 브라우저(Lightning 구성 요소의 경우 클라이언트측 컨트롤러를 통해)는 HTTP POST를 수행하여 해당 Apex 컨트롤러에서 작업을 수행합니다. - 컨트롤러가 원격 웹 서비스에 대한 실제 호출을 호출합니다. - 원격 시스템의 응답이 Apex 컨트롤러로 반환됩니다. 컨트롤러가 응답을 처리하고 필요에 따라 Salesforce의 데이터를 업데이트한 후 페이지를 다시 렌더링합니다. 후속 상태를 추적해야 하는 경우 원격 시스템에서 Salesforce 레코드에 저장된 고유 식별자를 반환합니다. **결과** 이 패턴과 관련된 솔루션을 적용하면 Salesforce가 처리를 처리하는 이벤트 시작 원격 프로세스 호출을 사용할 수 있습니다. **통화 기법** 호출 메커니즘은 이 패턴을 구현하기 위해 선택한 솔루션에 따라 다릅니다.
| 메커니즘 호출 | 설명 |
|---|---|
| 플로에 포함된 고급 외부 서비스 또는 Lightning 구성 요소 또는 Apex 컨트롤러 |
사용자 인터페이스와 관련된 전체 프로세스의 일부로 원격 프로세스가 트리거되고 결과가 Salesforce 레코드에 표시되거나 업데이트되어야 하는 경우 사용됩니다. 예를 들어, 외부 결제 게이트웨이에 신용 카드 결제를 제출하고 결제 결과가 즉시 반환되어 사용자에게 표시됩니다. |
| Apex 트리거 | 주로 DML 시작 이벤트의 Apex 콜아웃을 사용하여 원격 프로세스를 호출하는 데 사용됩니다. 이 호출 메커니즘에 대한 자세한 내용은 패턴 원격 프로세스 호출 - 화재 및 잊기 를 참조하십시오. |
| Apex 배치 클래스 | 배치로 원격 프로세스를 호출하는 데 사용됩니다. 이 호출 메커니즘에 대한 자세한 내용은 패턴 원격 프로세스 호출 - 화재 및 잊기 를 참조하십시오. |
| 솔루션 | 끝점 고려 사항 |
|---|---|
| Apex HTTP 콜아웃 | 끝점에서 HTTP 호출을 수신할 수 있어야 합니다. Salesforce는 공개 인터넷을 통해 끝점에 액세스할 수 있어야 합니다. 비공개 및 보안 커뮤니케이션의 경우 Salesforce는 이제 Hyperforce 플랫폼을 통해 Salesforce 비공개 연결을 안전하게 지원하기 시작했습니다. 자세한 내용은 Salesforce 사설 연결을 참조하십시오.
Apex HTTP 콜아웃을 사용하여 표준 GET, POST, PUT, DELETE 및 PATCH 메서드를 사용하여 REST 서비스를 호출할 수 있습니다. |
| Apex SOAP 콜아웃 | 끝점에서 HTTP 호출을 수신할 수 있어야 합니다. Salesforce는 공개 인터넷을 통해 끝점에 액세스할 수 있어야 합니다. 비공개 및 보안 커뮤니케이션의 경우 Salesforce는 이제 Hyperforce 플랫폼을 통해 Salesforce 비공개 연결을 안전하게 지원하기 시작했습니다. 자세한 내용은 Salesforce 사설 연결을 참조하십시오.
이 솔루션을 사용하려면 원격 시스템이 Salesforce에서 지원하는 표준과 호환되어야 합니다. 작성 시 Salesforce에서 Apex SOAP 콜아웃에 대해 지원하는 웹 서비스 표준은 다음과 같습니다.
|
- Salesforce는 원격 레코드에 대한 원격 시스템의 기본 또는 고유 대리 키를 저장합니다.
- 원격 시스템에 Salesforce 고유 레코드 ID 또는 기타 고유한 대리 키가 저장됩니다.
| 마스터 | 시스템 설명 |
|---|---|
| Salesforce | 원격 시스템은 Salesforce RecordId 또는 레코드에서 고유한 일부 대리 키를 저장합니다. |
| 원격 시스템 | 원격 프로세스에 대한 호출은 응용 프로그램에서 고유한 키를 반환하며 Salesforce는 고유한 레코드 필드에 해당 키 값을 저장합니다. |
- 복잡한 플로 논리와 관련된 비즈니스 프로세스 및 규칙 오케스트레이션
- 다중 시스템 통화 전반의 통화 및 통화 결과 집계
- 인바운드 및 아웃바운드 메시지 모두 변환
- 다중 시스템에 대한 통화 전반의 트랜잭션 무결성 유지
| 부부동산 | 필수 | 원하는 항목 | 필수 아님 |
|---|---|---|---|
| 이벤트 처리 | X | ||
| 프로토콜 변환 | X | ||
| 번역 및 변환 | X | ||
| 대기열 및 완충 | X | ||
| 동기식 전송 프로토콜 | X | ||
| 비동기식 전송 프로토콜 | X | ||
| 중재 라우팅 | X | ||
| 프로세스 통합 및 서비스 오케스트레이션 | X | ||
| 트랜잭션성(암호화, 서명, 신뢰할 수 있는 배달, 트랜잭션 관리) | X | ||
| 라우팅 | X | ||
| 추출, 변환, 로드 | X | ||
| 긴 폴링 | X |
- Salesforce는 Apex 프록시 클래스에서 청구 계정 서비스 WSDL을 사용합니다.
- 사용자 정의 Apex 컨트롤러 또는 외부 서비스에서 외부 웹 서비스에 전달된 고객 정보를 사용하여 Apex 프록시 클래스를 실행합니다.
- 그런 다음, 사용자 정의 컨트롤러는 Apex 콜아웃에서 반환 값을 구문 분석하고 해당 정보를 salesforce 개체에 저장합니다.
- 고객의 상태는 Salesforce 계정 개체에 저장된 계정 번호로 추적됩니다.
- 발신자의 후속 회신 메시지 처리
- 원격 시스템 호출 시 Salesforce가 계속 처리하기 전에 응답을 기다려야 합니까? 원격 시스템에 대한 호출이 동기식이거나 비동기식입니까?
- 원격 시스템에 대한 호출이 동기식일 경우 통화와 동일한 트랜잭션의 일부로 Salesforce에서 응답을 처리해야 합니까?
- 메시지 크기가 작습니까?
- 통합은 Salesforce 사용자 인터페이스에서 버튼 클릭과 같은 특정 이벤트 발생 또는 DML 기반 이벤트를 기반으로 합니까?
- Salesforce에서 원격 시스템으로의 보증된 메시지 전달이 요구 사항입니까?
- 원격 시스템이 Salesforce에서 계약을 지정하는 계약 우선 통합에 참여할 수 있습니까? 일부 솔루션 변형(예: 아웃바운드 메시징)에서 Salesforce는 원격 시스템 끝점에서 구현하는 계약을 지정합니다.
- 끝점 또는 엔터프라이즈 서비스 버스(ESB)가 장기간 폴링을 지원합니까?
- 선언적 구성 방법은 사용자 정의 Apex 개발보다 선호합니까? 이 경우 플랫폼 이벤트와 같은 솔루션이 Apex 콜아웃보다 선호됩니다.
| 솔루션 | 맞춤 | 댓글 |
|---|---|---|
| 플로 중심 플랫폼 이벤트 | 최대 | 플로를 선언적으로 만들어 플랫폼 이벤트를 구현합니다. 권장되는 솔루션은 삽입 또는 업데이트 이벤트에서 원격 프로세스가 호출되는 경우입니다. 플랫폼 이벤트는 앱이 추가 조치를 취하기 위해 보내고 받는 이벤트 메시지 또는 알림입니다. 플랫폼 이벤트는 복잡한 논리를 작성하지 않고도 변경 사항을 전달하고 변경 사항에 대응하는 프로세스를 간소화합니다. 한 명 이상의 구독자가 같은 이벤트를 듣고 작업을 수행할 수 있습니다. 예를 들어 소프트웨어 시스템에서 프린터 잉크 카트리지를 포함하는 이벤트를 보낼 수 있습니다. 구독자는 이벤트를 구독하여 프린터 잉크 수준을 모니터링하고 잉크 수준이 낮은 카트리지를 교체하도록 주문할 수 있습니다. 외부 앱은 CometD를 통해 채널을 구독하여 이벤트 메시지를 들을 수 있습니다. Lightning 구성 요소와 같은 플랫폼 앱은 CometD로 이벤트 메시지를 구독할 수도 있습니다. gRPC 및 HTTP/2를 기반으로 하는 Salesforce PubSub API도 여기에 사용할 수 있습니다. Salesforce는 플랫폼 이벤트 트리거형 플로도 지원하므로 Flow Builder 인터페이스를 사용하여 수신기를 효율적으로 만들 수 있습니다. 이 유형의 플로는 Salesforce 이벤트 버스에 특정 플랫폼 이벤트 메시지가 게시되면 자동으로 시작됩니다. |
| Pub/Sub API | 최대 | Pub/Sub API는 외부 소비자가 이벤트 버스에서 이벤트를 사용하는 것이 좋습니다. gRPC 기반 Pub/Sub API:
Salesforce에 플랫폼 이벤트가 정의되면 내부 및 외부 소비자가 모두 사용할 수 있습니다. |
| 변경 데이터 수집 | 최대 | 변경 데이터 수집(CDC)은 Salesforce 레코드에서 만들기, 업데이트, 삭제 및 삭제 취소 작업에 해당하는 변경 사항에 대한 이벤트를 게시합니다. Salesforce에서 변경 데이터 수집(CDC)을 활성화하는 것은 단순히 선언적 프로세스이며 Apex 코드가 필요하지 않습니다. Pub/Sub API 또는 Apex 트리거를 사용하여 고객이 구독할 수 있는 이벤트 버스에 알림 메시지가 전송됩니다. 이벤트 중심 시스템은 배포된 엔터프라이즈 시스템 간의 통신을 간소화하고 확장성을 향상하며 실시간 데이터를 전달합니다. 예를 들어, 주문 정보가 ERP 시스템과 Salesforce 모두에 있는 경우 Salesforce에서 통합 앱으로 주문 변경 이벤트를 스트리밍할 수 있습니다. 그러면 앱이 ERP 시스템의 변경 사항을 동기화합니다. |
| Omnistudio 통합 절차 | Good | Omnistudio 통합 절차를 사용하여 Salesforce 및 외부 타사 응용 프로그램 간 데이터 상호 작용을 선언적으로 자동화합니다. 통합 절차는 복잡한 데이터 변환, API 호출, 이벤트 중심 자동화를 처리하며 단일 서버 호출에서 여러 작업을 실행할 수 있습니다. 실행 중 사용자 상호 작용이 필요하지 않으며 다음을 수행하려는 경우 통합 절차를 사용합니다.
통합 절차에 대한 자세한 내용을 확인하십시오. |
| 사용자 정의 중심 플랫폼 이벤트 | Good | 플로 구동 플랫폼 이벤트와 유사하지만 이벤트는 Apex 트리거 또는 클래스에 의해 생성됩니다. Apex 또는 API를 사용하여 플랫폼 이벤트를 게시하고 사용할 수 있습니다. 플랫폼 이벤트는 Apex 트리거를 통해 Salesforce 플랫폼과 통합됩니다. 트리거는 이벤트 메시지를 듣는 Salesforce Platform의 이벤트 소비자입니다. 외부 앱이 API를 사용하거나 기본 Salesforce 앱이 Apex 사용하여 이벤트 메시지를 게시하면 해당 이벤트에 대한 트리거가 실행됩니다. 트리거는 이벤트 알림에 대한 응답으로 작업을 실행합니다. |
| 플로 중심 아웃바운드 Messaging | 맞춤 | 이 유형의 통합에 대한 권장 솔루션은 삽입 또는 업데이트 이벤트에서 원격 프로세스가 호출되는 경우입니다. Salesforce는 Salesforce의 삽입 또는 업데이트 작업으로 트리거된 SOAP 메시지를 원격 시스템으로 보낼 수 있는 플로 기반 아웃바운드 메시징 기능을 제공합니다. 해당 메시지는 비동기식으로 전송되며 Salesforce 사용자 인터페이스와 무관합니다. 아웃바운드 메시지가 특정 원격 끝점으로 전송됩니다. 원격 서비스는 Salesforce가 계약을 제공하는 계약 우선 통합에 참여할 수 있어야 합니다. 메시지가 수신되면 원격 서비스가 긍정적인 확인을 통해 응답하지 않을 경우 Salesforce에서 메시지를 다시 보내고 보증된 배달 형태를 제공합니다. |
| Apex SOAP 또는 HTTP 비동기식 콜아웃을 시작하는 사용자 정의 Lightning 구성 요소 | 최적화되지 않음 | 이 솔루션은 일반적으로 사용자 인터페이스 기반 시나리오에서 사용되지만 사용자 정의가 필요합니다. 또한 솔루션은 코드에서 메시지의 보증 전달을 처리해야 합니다. Lightning 구성 요소와 함께 Apex 콜아웃을 사용하여 지정하는 원격 프로세스 호출 - 요청 및 회신 패턴 솔루션과 유사합니다. 이 패턴에서 Salesforce는 요청이 완료될 때까지 기다리지 않고 사용자에게 제어 권한을 부여합니다. 메시지를 수신하면 원격 시스템이 응답하고 메시지 수신을 나타낸 다음, 비동기식으로 메시지를 처리합니다. 메시지를 처리하기 전에 원격 시스템이 Salesforce에 다시 제어합니다. 따라서 Salesforce는 처리가 완료될 때까지 기다릴 필요가 없습니다. |
| Apex 트리거를 사용하여 Apex SOAP 또는 HTTP 비동기식 콜아웃 만들기 | 최적화되지 않음 | Apex 트리거를 사용하여 레코드 데이터 변경 사항을 기반으로 자동화를 수행할 수 있습니다. Apex 프록시 클래스는 Apex 트리거를 사용하여 DML 작업의 결과로 실행될 수 있습니다. 그러나 트리거 컨텍스트 내에서 이루어진 모든 호출은 비동기식으로 실행되어야 합니다. |
| Apex 트리거를 사용하여 Apex SOAP 또는 HTTP 비동기식 콜아웃 만들기 | 최적화되지 않음 | 배치 작업에서 원격 시스템에 대한 호출을 수행할 수 있습니다. 이 솔루션을 사용하면 배치 원격 프로세스를 실행하고 Salesforce의 원격 시스템에서 응답을 처리할 수 있습니다. 그러나 지정된 배치 컨텍스트에 대한 호출 수는 제한됩니다. 자세한 내용은 Salesforce 개발자 제한 및 할당 빠른 참조를 참조하십시오.
|
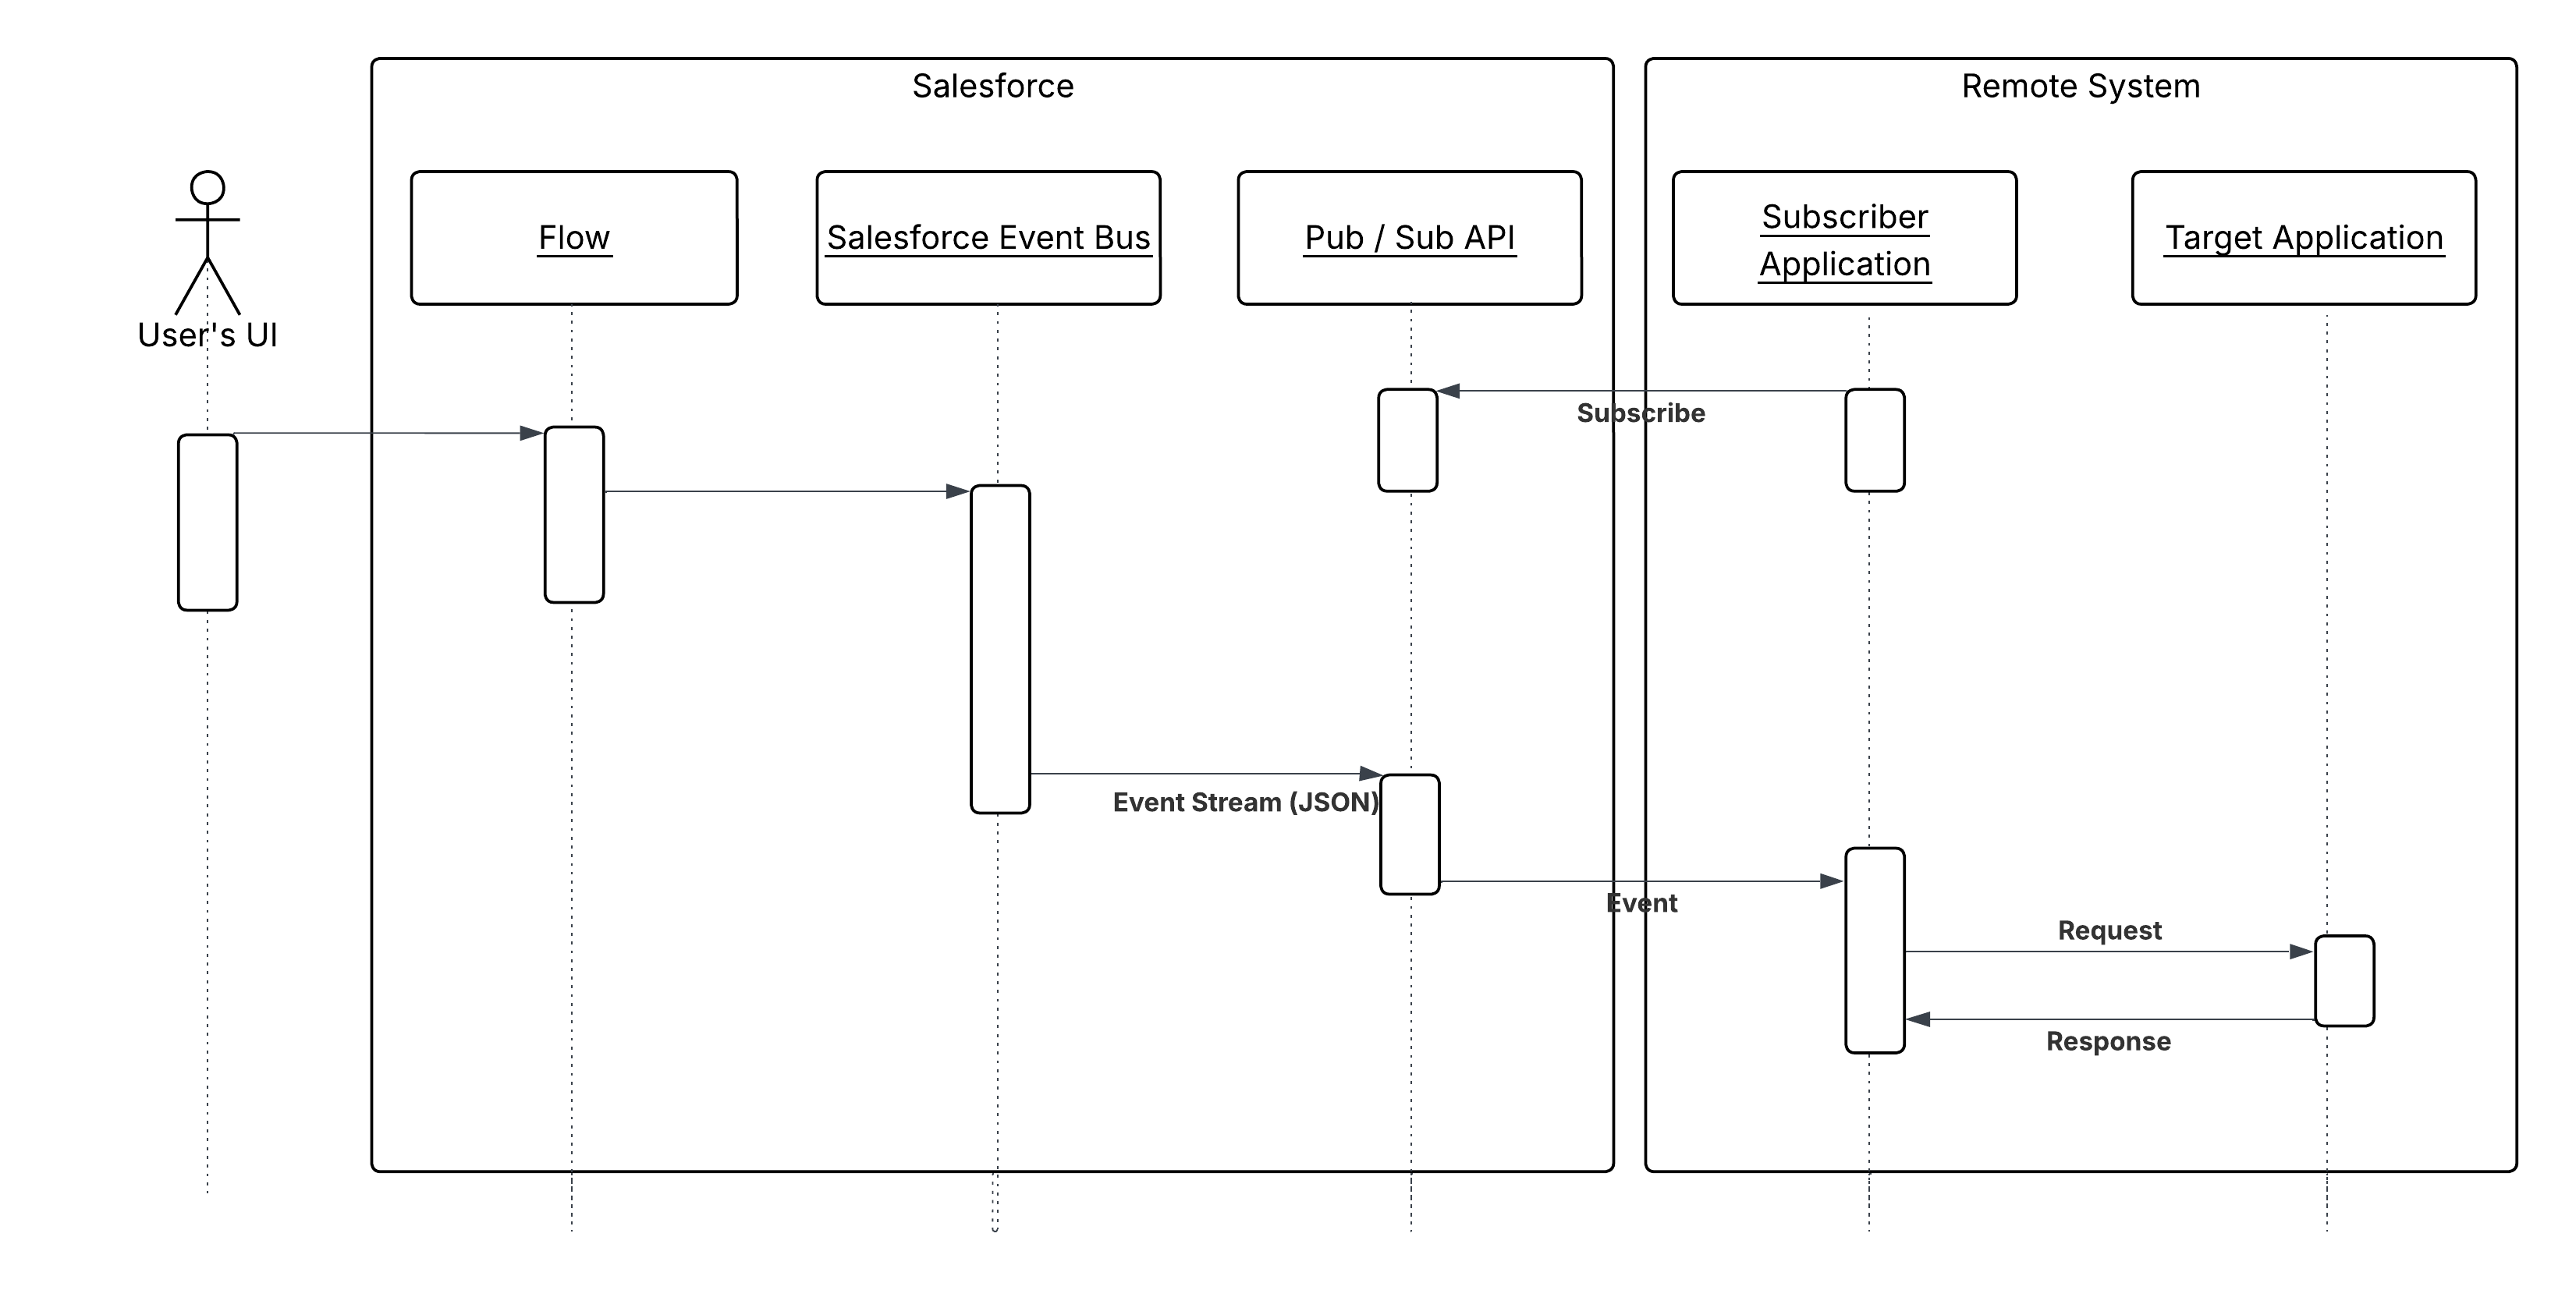 다운로드 다이어그램
이 시나리오의 경우:
- 원격 시스템에서 플랫폼 이벤트를 구독합니다.
- Salesforce의 지정된 레코드 집합에 업데이트 또는 삽입이 발생합니다.
- 조건 집합이 충족되면 Salesforce 플로가 트리거됩니다.
- 이 플로는 플랫폼 이벤트를 만듭니다.
- 원격 수신기가 이벤트 메시지를 수신하고 메시지를 로컬 대기열에 배치합니다.
- 대기열 응용 프로그램이 처리를 위해 원격 응용 프로그램에 메시지를 전달합니다.
- 최종 사용자에게 트랜잭션 결과를 표시할 수 있는 사용자 인터페이스 시작 원격 프로세스 호출
- 통화 프로세스에서 트랜잭션 결과를 처리할 수 있는 DML 이벤트 시작 원격 프로세스 호출
| 메커니즘 호출 | 설명 |
|---|---|
| 플로 | 프로세스 중심 및 사용자 정의 중심 솔루션 모두에서 사용됩니다. 이벤트가 Salesforce 프로세스를 트리거하면 원격 시스템에서 구독할 수 있도록 플랫폼 이벤트를 게시할 수 있습니다. |
| Pub/Sub API | Pub/Sub API는 실시간 이벤트 모니터링 이벤트 및 변경 데이터 수집 이벤트를 비롯한 플랫폼 이벤트 게시 및 구독을 위한 단일 인터페이스를 제공합니다. gRPC 및 HTTP/2를 기반으로 Pub/Sub API는 Apache Avro 형식으로 이진 이벤트 메시지를 효율적으로 게시하고 전달합니다. |
| 변경 데이터 수집 | Salesforce 변경 데이터 수집 Salesforce 레코드에 대한 변경 사항을 나타내는 변경 이벤트를 게시합니다. 변경 사항에는 새 레코드 만들기, 기존 레코드 업데이트, 레코드 삭제, 레코드 삭제 취소가 포함됩니다. |
| Lightning 구성 요소 및 Apex 컨트롤러 | Apex 콜아웃을 사용하여 원격 프로세스를 비동기식으로 호출하는 데 사용됩니다. |
| 플로 중심 아웃바운드 메시징 | 아웃바운드 Messaging 솔루션에만 사용됩니다. DML 이벤트를 만들고 업데이트하면 Salesforce 워크플로 규칙이 트리거되어 원격 시스템에 메시지를 보낼 수 있습니다. |
| Apex 트리거 | DML 시작 이벤트의 Apex 콜아웃을 사용하여 트리거 구동 플랫폼 이벤트 및 원격 프로세스 호출에 사용됩니다. |
| Apex 배치 클래스 | 배치 모드에서 원격 프로세스를 호출하는 데 사용됩니다. |
| 솔루션 | 오류 처리 및 복구 전략 |
|---|---|
| 플로 |
|
| Apex 콜아웃 |
|
| 변경 데이터 수집(CDC) / 플랫폼 이벤트 |
|
| 솔루션 | 보안 고려 사항 |
|---|---|
| Apex 콜아웃 | 원격 시스템에 대한 호출은 요청의 기밀성, 무결성, 가용성을 유지해야 합니다. 다음은 이 패턴에서 Apex SOAP 및 HTTP 호출을 사용하는 특정 보안 고려 사항입니다.
|
| 변경 데이터 수집(CDC) / 플랫폼 이벤트 | 플랫폼 이벤트의 경우 구독하는 외부 시스템이 Salesforce 스트리밍 API에 인증할 수 있어야 합니다. 플랫폼 이벤트는 Salesforce 조직에 구성된 기존 보안 모델을 준수합니다. 이벤트를 구독하려면 사용자에게 이벤트 엔티티에 대한 읽기 액세스 권한이 있어야 합니다. 이벤트를 게시하려면 사용자에게 이벤트 엔티티에 대한 "만들기" 권한이 필요합니다. |
| 솔루션 | 끝점 고려 사항 |
|---|---|
| Apex SOAP 콜아웃 | 끝점은 HTTP를 통해 웹 서비스 호출을 처리할 수 있어야 합니다. Salesforce는 공개 인터넷을 통해 끝점에 액세스할 수 있어야 합니다. 이 솔루션을 사용하려면 원격 시스템이 Salesforce에서 지원하는 표준과 호환되어야 합니다. 작성 시 Salesforce에서 Apex SOAP 콜아웃에 대해 지원하는 웹 서비스 표준은 다음과 같습니다.
|
| Apex HTTP 콜아웃 | 끝점은 HTTP 호출을 수신하고 Salesforce에서 공개 인터넷을 통해 액세스할 수 있어야 합니다. Apex HTTP 콜아웃을 사용하여 표준 GET, POST, PUT 및 DELETE 메서드를 사용하여 RESTful 서비스를 호출할 수 있습니다. |
| 변경 데이터 수집(CDC) / 플랫폼 이벤트 |
|
- Salesforce는 원격 레코드에 대한 원격 시스템의 기본 또는 고유 대리 키를 저장합니다.
- 원격 시스템에 Salesforce 고유 레코드 ID 또는 기타 고유한 대리 키가 저장됩니다.
| 마스터 | 시스템 설명 |
|---|---|
| Salesforce | 원격 시스템은 Salesforce 레코드에 Salesforce RecordId 또는 기타 고유한 대리 키를 저장해야 합니다. |
| 원격 시스템 | Salesforce는 원격 시스템에 고유 식별자에 대한 참조를 저장해야 합니다. 프로세스가 비동기식이므로 이 고유 식별자를 저장해도 원래 트랜잭션의 일부가 될 수 없습니다. Salesforce는 원격 프로세스 호출에 고유 ID를 제공해야 합니다. 그런 다음, 원격 시스템이 Salesforce에 다시 전화를 걸어 Salesforce 고유 ID를 사용하여 원격 시스템의 고유 식별자를 사용하여 Salesforce의 레코드를 업데이트해야 합니다. 콜백은 처리가 완료되거나 Salesforce 고유 식별자가 원격 시스템의 레코드에 저장될 때 콜백에 사용할 트랜잭션에 대한 Salesforce 고유 식별자를 저장하는 원격 응용 프로그램의 특정 상태 처리를 의미합니다. |
| 솔루션 | 고려 사항 |
|---|---|
| Apex 콜아웃 | 특정 사례에서 이 패턴에 따라 규정된 솔루션은 미들웨어를 사용하거나 Salesforce에서 복합 서비스를 호출하는 것이 가장 적합한 여러 복잡한 통합 시나리오를 구현해야 합니다. 다음 시나리오는 다음과 같습니다.
|
| 변경 데이터 수집(CDC) / 플랫폼 이벤트 | 이벤트의 정적 선언적 특성에 따라 집계, 오케스트레이션 또는 변환과 같은 복잡한 통합 시나리오는 Salesforce에서 수행할 수 없습니다. 원격 시스템 또는 미들웨어에서 다음 유형의 작업을 처리해야 합니다. |
| OmniStudio 통합 절차 | 통합 절차(OmniStudio)는 서버측의 상태가 없는 오케스트레이션을 제공하여 복잡한 선언적 데이터 변환을 수행하면서 여러 백엔드 서비스를 조율합니다. 통합 절차는 HTTP 작업, DataRaptor 추출/변환/로드, 값 설정, 루프/인, 매트릭스 조회와 같은 단계를 체인하여 UI 계약 및 편파 API 간 페이로드를 정규화, 보강, 집계, 매핑합니다. 이는 조건부 분기, 페이지 매김, 시간 초과, 재시도, 부분 실패 처리, 계속 실패와 같은 강력한 런타임 제어뿐만 아니라 서버측 캐싱 및 응답 형성과 같은 성능 최적화를 지원합니다. IP는 OmniScript에서 동기식으로 호출하거나 REST를 통해 헤드리스 방식으로 호출할 수 있으므로 채널에서 백엔드 복잡성을 숨기는 버전이 지정된 재사용 가능한 "통합 패싯"이 활성화됩니다. |
| 솔루션 | 신뢰할 수 있는 Messaging 고려 사항 |
|---|---|
| Apex 콜아웃 | Salesforce는 신뢰할 수 있는 Messaging 프로토콜(예: WS-ReliableMessaging)에 대한 명시적 지원을 제공하지 않습니다. Salesforce 메시지를 수신하는 원격 끝점에서 JMS 또는 MQ와 같은 신뢰할 수 있는 Messaging 시스템을 구현하는 것이 좋습니다. 이 시스템은 최종적으로 메시지를 처리하는 원격 시스템에 포괄적인 전달을 보장합니다. 그러나 이 시스템은 Salesforce에서 호출하는 원격 끝점으로 전달되는 것을 보장하지 않습니다. 보증 배달은 Salesforce에 대한 사용자 정의를 통해 처리해야 합니다. 사용자 정의 재시도 논리 외에 원격 끝점에서 긍정적인 승인 처리와 같은 특정 기법을 구현해야 합니다. |
| 변경 데이터 수집(CDC) / 플랫폼 이벤트 | 플랫폼 이벤트는 이벤트 버스에 이벤트 메시지를 일시적으로 유지하여 신뢰할 수 있는 메시지를 제공하려고 시도합니다. 구독자는 이벤트 메시지 재생 ID를 사용하여 이벤트 버스에서 메시지를 재생하여 누락된 이벤트 메시지를 파악할 수 있습니다. 이벤트 버스는 배포 시스템이며 트랜잭션 데이터베이스와 동일한 보증이 적용되지 않습니다. 따라서 Salesforce는 이벤트 게시 요청에 대해 동기식 응답을 제공할 수 없습니다. 이벤트가 대기열에 지정되고 완충되며 Salesforce는 이벤트를 비동기식으로 게시하려고 시도합니다. 드문 경우이지만 초기 또는 후속 시도를 수행하는 동안 이벤트 메시지가 배포된 시스템에 유지되지 않을 수 있습니다. 즉, 이벤트가 구독자에게 전달되지 않으며 복구할 수 없습니다. |
| 부부동산 | 필수 | 원하는 항목 | 필수 아님 |
|---|---|---|---|
| 이벤트 처리 | X | ||
| 프로토콜 변환 | X | ||
| 번역 및 변환 | X | ||
| 대기열 및 완충 | X | ||
| 동기식 전송 프로토콜 | X | ||
| 비동기식 전송 프로토콜 | X | ||
| 중재 라우팅 | X | ||
| 프로세스 통합 및 서비스 오케스트레이션 | X | ||
| 트랜잭션성(암호화, 서명, 신뢰할 수 있는 배달, 트랜잭션 관리) | X | ||
| 라우팅 | X | ||
| 추출, 변환, 로드 | X | ||
| 긴 폴링 | X(플랫폼 이벤트 필수) |
- 커밋 후 게시 - 트랜잭션이 성공적으로 커밋된 후에만 이벤트 메시지가 게시됩니다. 구독자가 게시 트랜잭션이 커밋하는 데이터에 의존하는 경우 이 옵션을 선택합니다. 예를 들어 프로세스에서 이벤트 메시지를 게시하고 과업 레코드를 만듭니다. 이벤트를 구독하는 두 번째 프로세스가 실행되고 과업 레코드를 찾을 것으로 예상됩니다. 이 동작을 선택하는 또 다른 이유는 트랜잭션이 실패할 경우 이벤트 메시지를 게시하지 않으려는 경우입니다.
- 즉시 게시 - 게시 호출이 실행되면 이벤트 메시지가 게시됩니다. 트랜잭션 성공 여부에 관계없이 이벤트 메시지를 게시하려는 경우 이 옵션을 선택합니다. 또한 게시자와 구독자가 독립적이고 구독자가 게시자가 커밋한 데이터에 의존하지 않는 경우 이 옵션을 선택합니다. 예를 들어 즉시 게시 동작은 로깅 목적으로 사용되는 이벤트에 적합합니다. 이 옵션을 사용하면 구독자가 게시자 트랜잭션에서 데이터를 커밋하기 전에 이벤트 메시지를 수신할 수 있습니다.
- 선언적 개발만 구현할 수 있습니다.
- 기회가 주문으로 변환된 후에는 주문 번호에 대한 즉시 알림이 필요하지 않습니다.
- 조직에 CometD 프로토콜을 지원하고 플랫폼 이벤트를 구독할 수 있는 ESB가 있습니다.
- 플로를 만들어 플랫폼 이벤트를 시작합니다(예: 기회 상태가 마감-수주로 변경되는 경우).
- 기회 세부 사항을 게시하는 새 플랫폼 이벤트를 만듭니다.
- ESB가 CometD 프로토콜을 사용하여 Salesforce Platform 이벤트를 구독합니다.
- ESB는 주문으로 기회를 변환하라는 알림을 하나 이상 받습니다.
- ESB가 주문을 만들 수 있도록 백엔드 ERP 시스템에 메시지를 전달합니다.
- ERP 시스템에서 주문이 생성되면 별도의 스레드가 SessionId를 인증 토큰으로 사용하여 Salesforce로 다시 호출합니다. 콜백은 주문 번호 및 상태를 사용하여 기회를 업데이트합니다. Salesforce 플랫폼 이벤트, Salesforce SOAP API, REST API 또는 Apex 웹 서비스와 같은 문서화된 패턴 솔루션을 사용하여 이 콜백을 수행할 수 있습니다.
- 비동기식으로 호출된 원격 프로세스 구현
- 종단간 보증 배달
- 레코드 상태를 업데이트하기 위해 Salesforce에 후속 콜백
- 현재 CRM 시스템에서 계정, 연락처, 기회를 추출 및 변환하고 데이터를 Salesforce에 로드합니다(초기 데이터 가져오기).
- 원격 시스템에서 매주 고객 청구 데이터를 추출, 변환, Salesforce에 로드합니다(진행).
- Salesforce에서 고객 활동 정보를 추출하고 매주(진행 중) 온 프레미스 데이터 웨어하우스로 가져옵니다.
- Salesforce에 데이터를 저장해야 합니까? 그렇지 않은 경우 설계자가 고려할 수 있고 고려해야 하는 기타 통합 옵션이 있습니다(예: 매시업).
- 데이터가 Salesforce에 저장되어야 하는 경우 원격 시스템의 이벤트에 대한 응답으로 데이터를 새로 고쳐야 합니까?
- 데이터를 예약된 대로 새로 고쳐야 합니까?
- 데이터가 기본 비즈니스 프로세스를 지원합니까?
- Salesforce에서 이 데이터의 가용성에 영향을 미치는 분석(보고) 요구 사항이 있습니까?
| 솔루션 | 맞춤 | 데이터 마스터 | 댓글 |
|---|---|---|---|
| 타사 ETL 도구를 통한 복제 | 최대 | 원격 시스템 | 외부 시스템에서 대량의 데이터를 Salesforce로 보내야 하는 경우 소스 데이터에 대한 변경 데이터 수집 실행할 수 있는 타사 ETL 도구를 활용합니다. 도구는 소스 데이터 집합의 변경 사항에 반응하고 데이터를 변환한 다음, Salesforce 대량 API를 호출하여 DML 문을 발행합니다. 레코드 수가 적을 경우 Salesforce REST API를 사용하여 구현할 수도 있습니다. |
| 타사 ETL 도구를 통한 복제 | Good | Salesforce | 타사 ETL 도구를 활용하여 ERP 및 Salesforce 데이터 집합에 대한 변경 데이터 수집 실행할 수 있습니다. 이 솔루션에서 Salesforce는 데이터 소스이며, 개별 행의 시간/상태 정보를 사용하여 데이터를 쿼리하고 대상 결과 집합을 필터링할 수 있습니다. 이는 대량 API 2.0 또는 표준 REST API를 사용하여 구현할 수 있습니다(레코드 수가 적을 경우). |
| 데이터 가져오기 마법사 및 Data Loader | 맞춤 | Salesforce/외부 시스템 | 데이터 가져오기 마법사 및 Data Loader를 사용하여 데이터를 가져오고 내보내거나 마이그레이션할 수 있습니다. Data Loader 명령을 스크립팅하여 데이터 가져오기 및 내보내기를 자동화할 수도 있지만 명령줄 인터페이스는 Windows 전용입니다. 이러한 도구는 데이터 통합 전략의 권장 기준이 아닙니다. 대신 데이터 관리 및 서비스 점검 전략을 보완해야 합니다. Data Loader에 대한 자세한 내용은 여기를 참조하십시오. |
| 원격 콜인 | 최적화되지 않음 | 원격 시스템 | 원격 시스템에서 API 중 하나를 사용하여 Salesforce에 호출하고 데이터 업데이트를 수행할 수 있습니다. 그러나 두 시스템 간에 상당한 지속적인 트래픽이 발생합니다. 오류 처리 및 잠금에 더 중점을 두어야 합니다. 이 패턴은 지속적인 업데이트를 유발할 수 있으므로 최종 사용자의 성능에 영향을 미칠 수 있습니다. |
| 원격 프로세스 호출 | 최적화되지 않음 | Salesforce | Salesforce에서 원격 시스템을 호출하고 데이터 업데이트를 수행할 수 있습니다. 그러나 두 시스템 간에 상당한 지속적인 트래픽이 발생합니다. 오류 처리 및 잠금에 더 중점을 두어야 합니다. 이 패턴은 지속적인 업데이트를 유발할 수 있으므로 최종 사용자의 성능에 영향을 미칠 수 있습니다. |
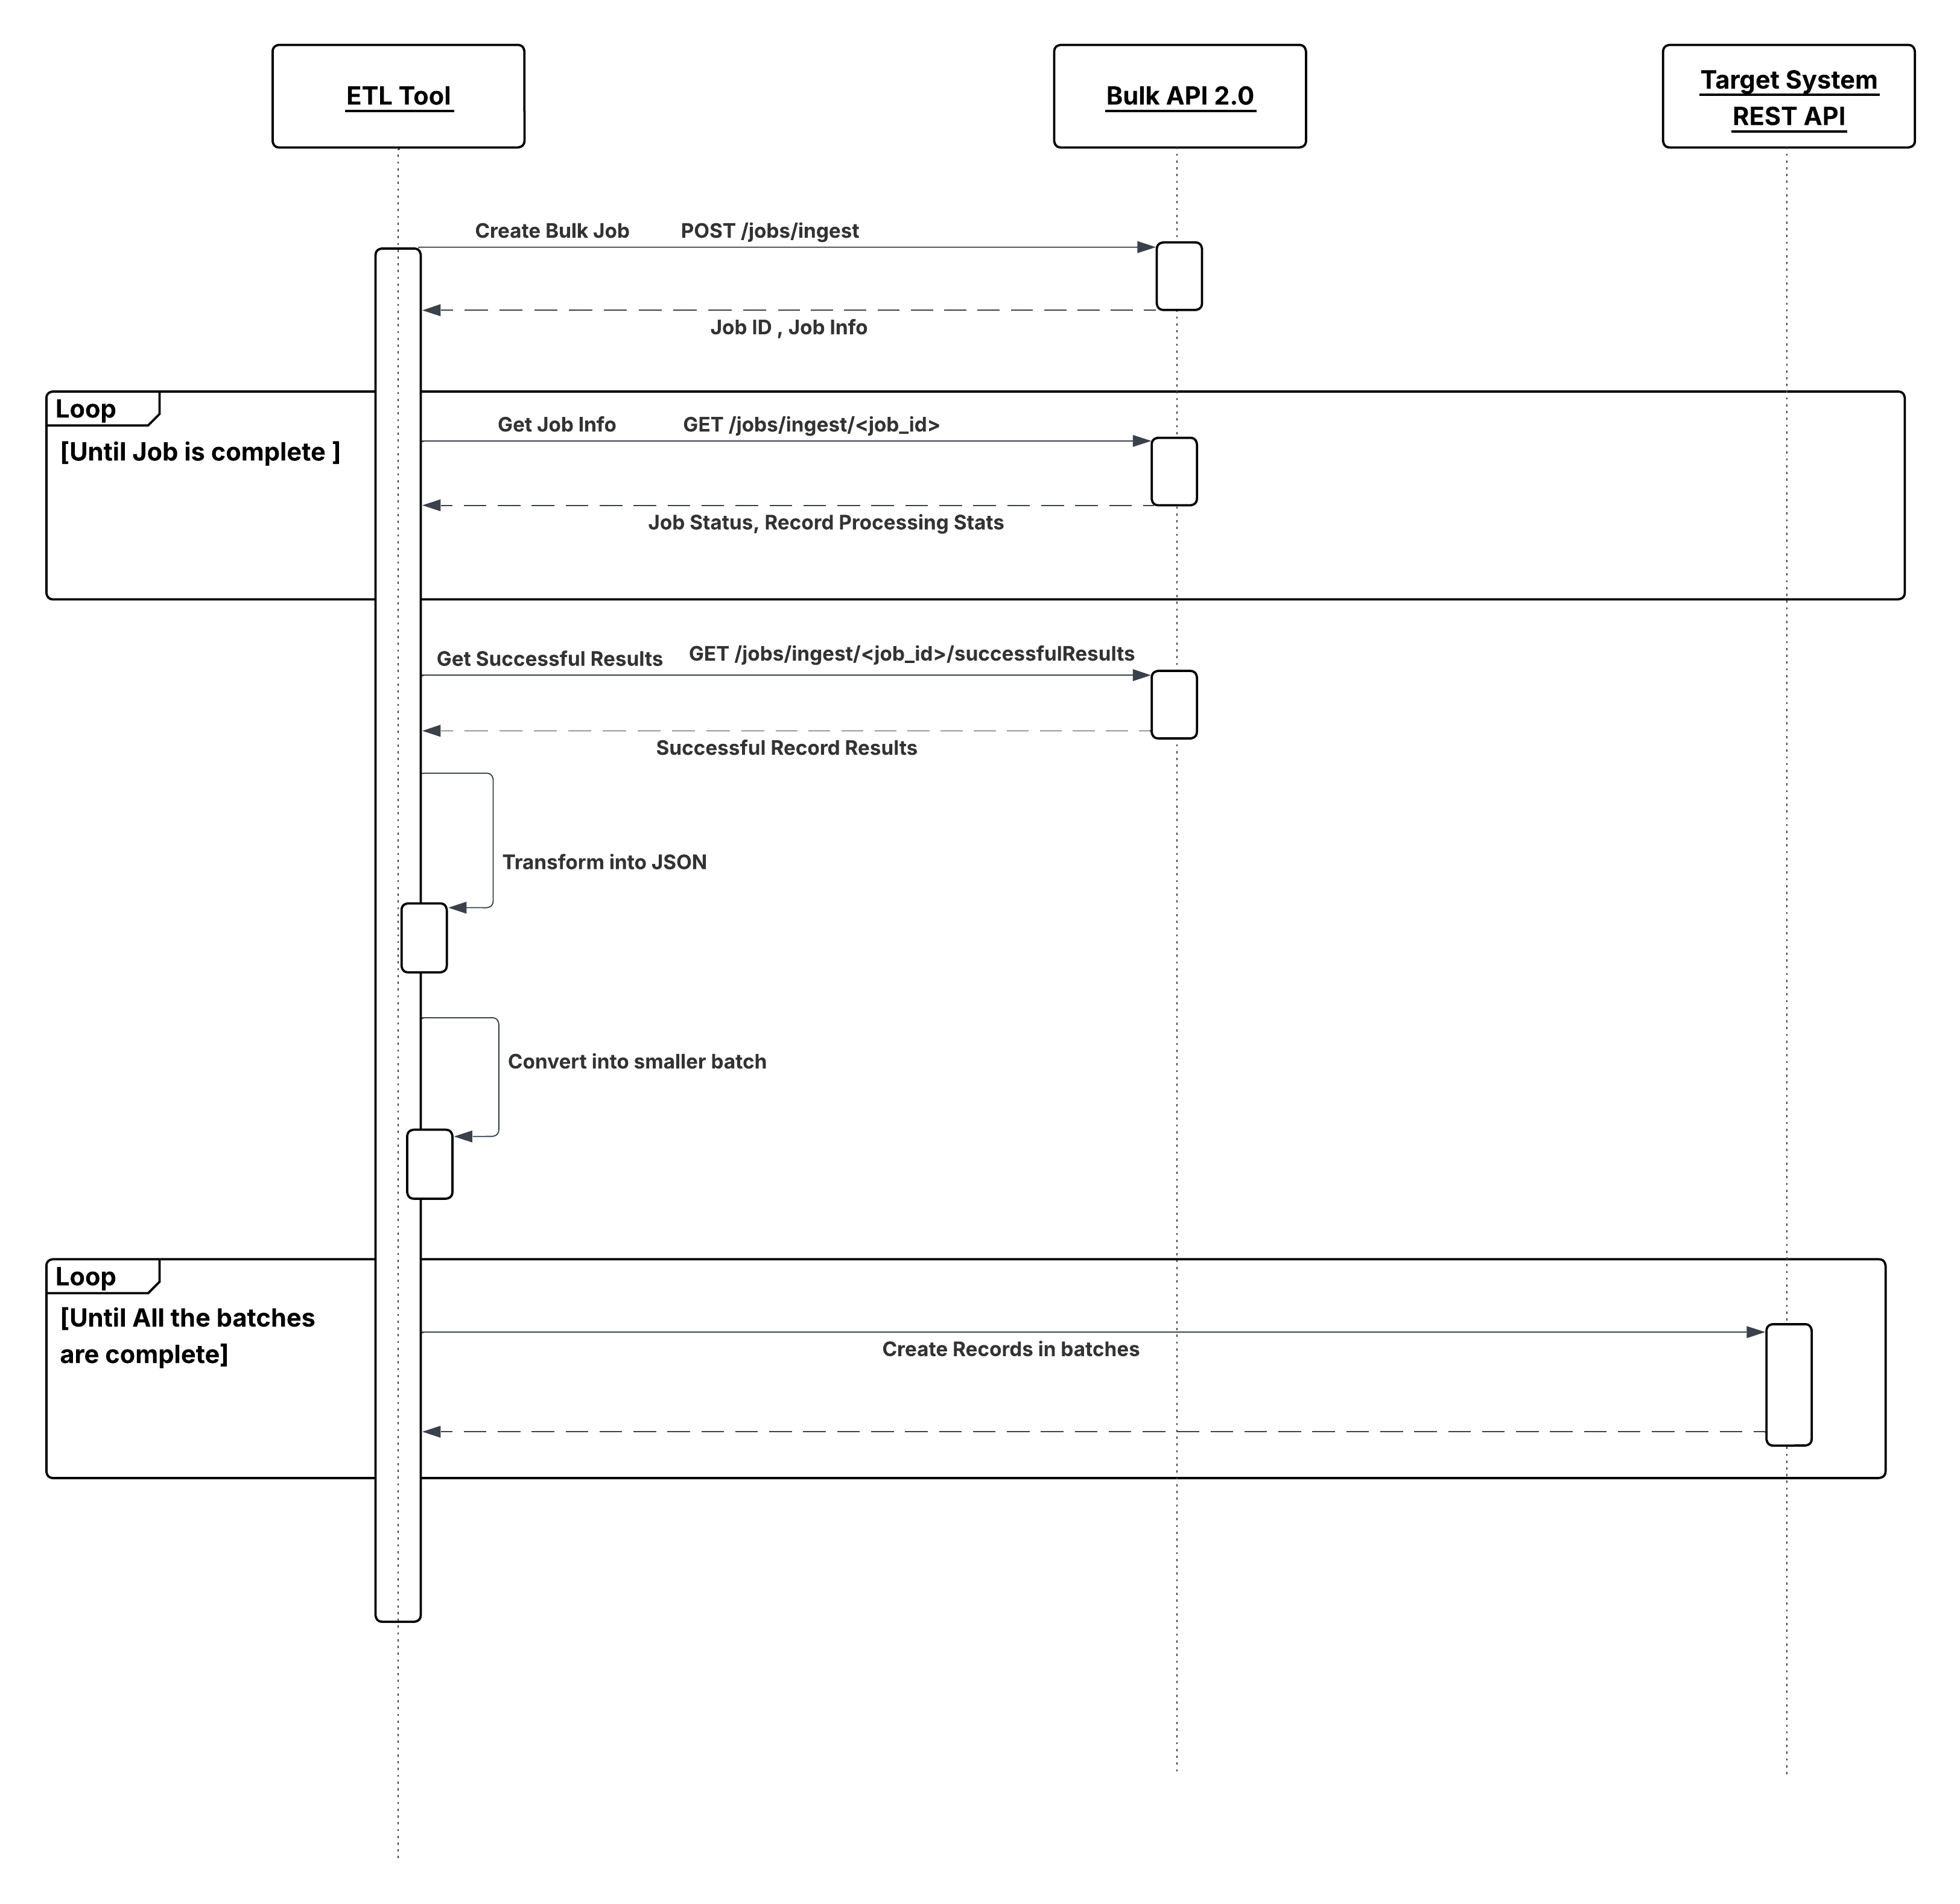 다운로드 다이어그램
다음 다이어그램은 Salesforce가 데이터 마스터인 이후 이벤트의 거의 실시간 동기화를 보여줍니다.
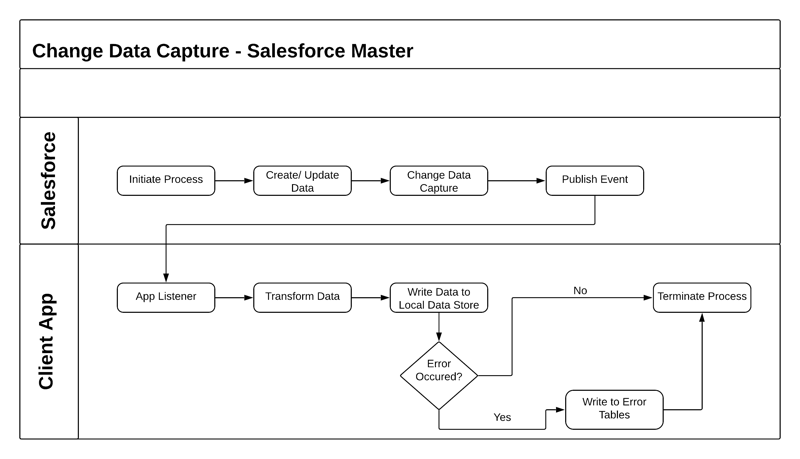 **결과**
다음 시나리오에서 외부에서 소싱된 데이터를 Salesforce와 통합할 수 있습니다.
- 외부 시스템은 데이터 마스터 - Salesforce는 단일 소스 시스템 또는 여러 시스템에서 제공하는 데이터의 소비자입니다. 이 시나리오에서는 데이터를 Salesforce로 가져오기 전에 데이터를 집계하는 데이터 웨어하우스 또는 데이터 마트를 보유하는 것이 일반적입니다.
- Salesforce는 데이터 마스터입니다. Salesforce는 특정 엔티티의 레코드 시스템이며 Salesforce 변경 데이터 수집 클라이언트 응용 프로그램은 Salesforce 데이터의 변경 사항을 알 수 있습니다.
- 소스 데이터 집합에서 변경 데이터 수집 구현합니다.
- 임시 온 프레미스 데이터베이스에서 제어 테이블이라고 하는 지원 데이터베이스 구조 집합을 구현합니다.
- 제어 테이블을 읽어 작업의 마지막 실행 시간을 결정하고 필요한 기타 제어 값을 추출합니다.
- 위의 제어 값을 필터로 사용하고 소스 데이터 집합을 쿼리합니다.
- 확인, 보강 등 사전 정의된 처리 규칙을 적용합니다.
- ETL 도구의 사용 가능한 커넥터/변환 기능을 사용하여 대상 데이터 집합을 만듭니다.
- Salesforce 개체에 데이터 집합을 작성합니다.
- 처리에 성공하면 제어 테이블의 제어 값을 업데이트합니다.
- 처리에 실패할 경우 재시작 및 종료를 활성화하는 값을 사용하여 제어 테이블을 업데이트합니다.
- ETL 작업을 연결하고 순서대로 만들어 조화로운 프로세스를 제공합니다.
- 두 시스템의 기본 키를 사용하여 수신 데이터를 일치시킵니다.
- 특정 API 메서드를 사용하여 업데이트된 데이터만 추출합니다.
- 마스터-세부 사항 또는 조회 관계에서 하위 레코드를 가져오는 경우 잠금을 피하기 위해 소스에서 상위 키를 사용하여 가져온 데이터를 그룹화합니다. 예를 들어, 연락처 데이터를 가져오는 경우 하나의 API 호출에서 단일 계정에 대한 최대 연락처 수를 로드할 수 있도록 상위 계정 키별로 연락처 데이터를 그룹화해야 합니다. 가져온 데이터를 그룹화하지 못하면 일반적으로 첫 번째 연락처 레코드가 로드되고 해당 계정에 대한 후속 연락처 레코드가 API 호출 컨텍스트에서 실패합니다.
- 트리거와 같은 가져오기 후 처리는 데이터만 선택적으로 처리해야 합니다.
- 시나리오에 대용량 데이터가 포함된 경우 이 Trailhead 모듈의 모범 사례를 따르십시오. 대용량 데이터의 배포 모범 사례 .
| 오류 위치 | 오류 처리 및 복구 전략 |
|---|---|
| 변경 데이터 수집 사용하여 Salesforce에서 읽기 |
|
| 타사 ETL 시스템을 사용하여 Salesforce에서 읽기 |
|
| Salesforce에 쓰기 |
|
| 외부 마스터 시스템 | 오류는 마스터 시스템의 모범 사례에 따라 처리해야 합니다. |
- Salesforce API에 대한 인증된 API 액세스를 허용하려면 최소한 “API 전용” 사용자 권한이 있는 Lightning Platform 라이센스가 필요합니다.
- 암호 액세스를 안전하게 유지하기 위해 표준 암호화를 사용하는 것이 좋습니다.
- Salesforce API를 호출할 때 HTTPS 프로토콜을 사용합니다. 필요한 경우 온 프레미스 보안 솔루션을 통해 Salesforce API에 트래픽을 프록시할 수도 있습니다.
- Salesforce는 특정 사용자가 편집하는 레코드의 상태를 유지하지 않습니다.
- 읽을 때 데이터가 추출된 시간을 기록합니다.
- 사용자가 레코드를 업데이트하고 저장하면 Salesforce에서 다른 사용자가 중간에 레코드를 업데이트했는지 확인합니다.
- 레코드가 업데이트된 경우 사용자에게 업데이트가 이루어졌음을 알리고 사용자는 업데이트를 진행하기 전에 최신 버전의 레코드를 검색해야 합니다.
| 부부동산 | 필수 | 원하는 항목 | 필수 아님 |
|---|---|---|---|
| 이벤트 처리 | X | ||
| 프로토콜 변환 | X | ||
| 번역 및 변환 | X | ||
| 대기열 및 완충 | X | ||
| 동기식 전송 프로토콜 | X | ||
| 비동기식 전송 프로토콜 | X | ||
| 중재 라우팅 | X | ||
| 프로세스 통합 및 서비스 오케스트레이션 | X | ||
| 트랜잭션성(암호화, 서명, 신뢰할 수 있는 배달, 트랜잭션 관리) | X | ||
| 라우팅 | X | ||
| 추출, 변환, 로드 | X | ||
| 긴 폴링 | X(Salesforce 변경 데이터 수집 필요) |
- Cron 유형 스케줄러는 사용자 및 팀에 잠재 고객을 할당하는 배치 작업을 실행합니다.
- 배치 작업이 실행되고 데이터가 업데이트되면 ETL 도구가 변경 데이터 수집 사용하여 이러한 변경 사항을 인식합니다. ETL 도구는 데이터 저장소의 변경 사항을 합산합니다.
- ETL 커넥터는 Salesforce REST API를 사용하여 Salesforce에 변경 사항을 로드합니다.
- Salesforce에 대한 원격 호출의 목적은 이벤트 중심 아키텍처를 사용하여 외부에서 발생한 이벤트를 Salesforce에 알리는 것입니까? 또는 특정 레코드에서 CRUD 작업을 수행하는 목적이 있습니까? 이벤트 중심 아키텍처를 사용하는 경우 이벤트 프로듀서(원격 프로세스)가 Salesforce 이벤트 소비자와 분리됩니다.
- Salesforce에 통화하려면 계속 처리하기 전에 응답을 기다리는 원격 프로세스가 필요합니까? Salesforce에 대한 원격 통화는 항상 동기식 요청-응답이지만 비동기식 통화를 시뮬레이션하는 데 필요하지 않은 경우 원격 프로세스에서 응답을 삭제할 수 있습니다.
- 각 트랜잭션이 단일 Salesforce 개체 또는 여러 관련 개체에 대해 작동합니까?
- 메시지 형식은 무엇입니까(예: SOAP 또는 REST 또는 HTTP를 통해 모두)?
- 메시지 크기가 상대적으로 작거나 크습니까?
- 원격 시스템이 SOAP 지원인 경우 Salesforce가 계약을 지정하는 계약 우선 접근 방식을 사용할 수 있습니까? 이는 사전 정의된 WSDL이 제공되는 SOAP API를 사용하는 경우 필요합니다.
- 트랜잭션 처리가 필요합니까?
- Salesforce에서 사용자 정의를 얼마나 허용합니까?
| 솔루션 | 맞춤 | 댓글 |
|---|---|---|
| 복합 API | 최대 | Salesforce는 기본적으로 REST API이며 복합 요청을 지원하는 복합 API를 제공합니다. 원격 시스템에서 다음 작업에 사용할 수 있습니다.
동기식 API - API 호출이 수행되면 원격 클라이언트 응용 프로그램이 서비스로부터 응답을 받을 때까지 기다립니다. 트랜잭션/커밋 동작 - 일부 레코드에 오류가 표시될 경우 기본적으로 복합 API에서 부분적인 성공을 허용하지 않습니다. "모두 또는 아무것도" 플래그를 false로 표시하여 부분적으로 성공할 수 있도록 변경할 수 있습니다. 오류 처리: 올바른 오류 처리는 HTTP 상태 코드뿐만 아니라 응답 본문을 검사해야 합니다. 응답 본문 내부에 하위 요청 중 하나가 실패했으며 트랜잭션이 롤백되어야 했음을 보여주는 경우에도 복합 끝점이 200 HTTP 상태 코드로 응답합니다. |
| REST API | 최대 | 액세스 가능성 - Salesforce는 원격 시스템에서 사용할 수 있는 REST API를 제공합니다.
동기식 API - API 호출이 수행되면 원격 클라이언트 응용 프로그램이 서비스로부터 응답을 받을 때까지 기다립니다. REST API는 로그인한 사용자의 프로필을 기반으로 Salesforce에 구성된 개체 수준 및 필드 수준 보안을 준수합니다. REST는 리소스(엔티티/개체)를 URI로 노출하고 HTTP 동사를 사용하여 해당 리소스에 대한 CRUD 작업을 정의합니다. SOAP와 달리, REST API는 미리 정의된 계약이 필요하지 않으며, 응답에 XML 및 JSON을 사용하며, 실시간으로 입력합니다. REST API는 가볍고 Salesforce와 상호 작용하는 간단한 방법을 제공합니다. 간편한 통합 및 개발이 포함된 이점은 모바일 앱 및 웹 앱과 함께 사용할 수 있는 훌륭한 선택입니다. 트랜잭션/커밋 동작 - 기본적으로 각 레코드는 별도의 트랜잭션으로 처리되고 별도로 커밋됩니다. 하나의 레코드 변경에 실패해도 다른 레코드 변경 사항은 롤백되지 않습니다. 이 동작은 "모두 또는 아무것도" 동작으로 변경할 수 있습니다. REST API 복합 자원을 사용하여 하나의 API 호출에서 일련의 업데이트를 수행합니다. 대량 데이터 - 2,000개가 넘는 레코드를 포함하는 모든 데이터 작업은 대량 프레임워크를 사용하는 비동기식 워크플로를 성공적으로 준비, 실행, 관리할 수 있는 대량 API 2.0에 적합한 후보입니다. |
| Bulk API 2.0 | 대량 작업에 가장 적합 | 대량 API 2.0은 대규모 데이터 작업을 처리하기 위한 Salesforce의 현대적이고 간소화된 API입니다. REST 기반 대량 API 2.0은 Salesforce 조직에서 대규모 데이터 집합을 비동기식으로 삽입, 업서트, 쿼리 또는 삭제할 수 있는 프로그래밍 방식 옵션을 제공합니다. Salesforce에 대량의 데이터를 로드하거나 조직의 데이터에 대한 대량 쿼리를 수행해야 하는 경우 효율성을 위해 고안되었습니다. 대량 API 1.0과 달리 대량 API 2.0은 항상 일괄 처리 작업을 병렬로 처리하며 직렬 모드를 지원하지 않습니다. 이는 다음을 의미합니다.
대량 API 2.0의 각 배치는 자체 트랜잭션으로 처리됩니다. 다음을 의미합니다.
SOAP API는 대량의 레코드를 처리하는 데도 사용할 수 있지만 데이터 집합에 수백만에서 수백만 개의 레코드가 포함되어 있으면 최적화되지 않습니다. 이는 상대적으로 높은 오버헤드와 낮은 성능 특성 때문입니다.
|
| Pub/Sub API | 최대 |
Pub/Sub API는 외부 게시자가 이벤트 버스에 이벤트를 게시하는 권장 방법입니다. Pub/Sub API는 외부 시스템에서 플랫폼 이벤트를 게시할 수 있는 gRPC 기반 API입니다. Pub/Sub API:
Salesforce에 플랫폼 이벤트가 정의되면 내부 및 외부 소비자가 모두 사용할 수 있습니다. |
| 플랫폼 이벤트 | 최대 |
플랫폼 이벤트는 Salesforce 개체를 정의하는 방식과 동일하게 정의됩니다. 플랫폼 이벤트는 REST API, 대량 API, SOAP API와 같은 다양한 메커니즘을 사용하여 게시할 수 있습니다.
REST API를 통해 이벤트를 게시하는 것은 Salesforce 레코드 만들기와 동일합니다. 끝점 형식: POST /services/data/vXX.X/sobjects/EventName__e/
대량 API를 사용하면 만들기 및 삽입 작업만 지원됩니다. 배치 작업이 처리될 때 배치 내 이벤트가 Salesforce 이벤트 버스에 비동기식으로 게시됩니다. 플랫폼 이벤트가 SObject이므로 표준 SOAP API 작업이 지원됩니다. |
| SOAP API | 맞춤 |
액세스 가능성 - Salesforce는 원격 시스템에서 사용할 수 있는 SOAP API를 제공합니다.
동기식 API - API 호출이 수행되면 원격 클라이언트 응용 프로그램이 서비스로부터 응답을 받을 때까지 기다립니다. Salesforce에 대한 비동기식 호출은 지원되지 않습니다. 생성된 WSDL - Salesforce는 두 가지 원격 시스템용 WSDL을 제공합니다.
보안 - SOAP API를 실행하는 클라이언트에 유효한 로그인이 있고 API 호출을 수행하려면 세션을 가져와야 합니다. API는 로그인한 사용자의 프로필을 기반으로 Salesforce에 구성된 개체 수준 및 필드 수준 보안을 준수합니다. 트랜잭션/커밋 동작 - 일부 레코드에 오류가 표시될 경우 기본적으로 각 API 호출이 일부 성공을 허용합니다. 오류가 발생할 경우 모든 결과가 롤백되는 "모두 또는 아무것도" 동작으로 변경할 수 있습니다. 여러 API 호출에서 트랜잭션을 적용할 수 없습니다. 이 제한을 극복하기 위해 단일 API 호출이 여러 개체에 영향을 미칠 수 있습니다. |
| Apex 웹 서비스 | 최적화되지 않음 |
Apex 클래스 방법은 웹 서비스 방법으로 외부 응용 프로그램에 노출될 수 있습니다. 이 메서드는 SOAP API의 대안이며 일반적으로 다음의 추가 요구 사항을 충족해야 하는 경우에만 사용됩니다.
Apex 웹 서비스 사용의 이점은 Salesforce에서 유지 관리해야 하는 추가 코드와 비교해야 합니다. 소비자의 트랜잭션 사전 삽입 논리가 적용되지 않으므로 플랫폼 이벤트에 적용할 수 없습니다. 이벤트 중심 아키텍처. 이벤트가 발생했음을 Salesforce 조직에 알리려면 SOAP API, REST API 또는 대량 API 2.0을 사용합니다. |
| Apex REST 서비스 | 최적화되지 않음 |
Apex 클래스는 정의된 HTTP 동사(예: POST 또는 GET)를 사용하여 특정 URI에 매핑된 REST 리소스로 노출될 수 있습니다.
REST API 복합 자원을 사용하여 단일 트랜잭션에서 여러 업데이트를 수행할 수 있습니다. SOAP와 달리 클라이언트는 서비스 정의/계약(WSDL)을 사용하고 클라이언트 스풀을 생성할 필요가 없습니다. 원격 시스템에는 HTTP 요청을 생성하고 반환된 결과(XML 또는 JSON)를 처리하는 기능만 필요합니다. 소비자의 트랜잭션 사전 삽입 논리가 적용되지 않으므로 플랫폼 이벤트에 적용할 수 없습니다. 이벤트 중심 아키텍처. 이벤트가 발생했음을 Salesforce 조직에 알리려면 SOAP API, REST API 또는 대량 API 2.0을 사용합니다. |
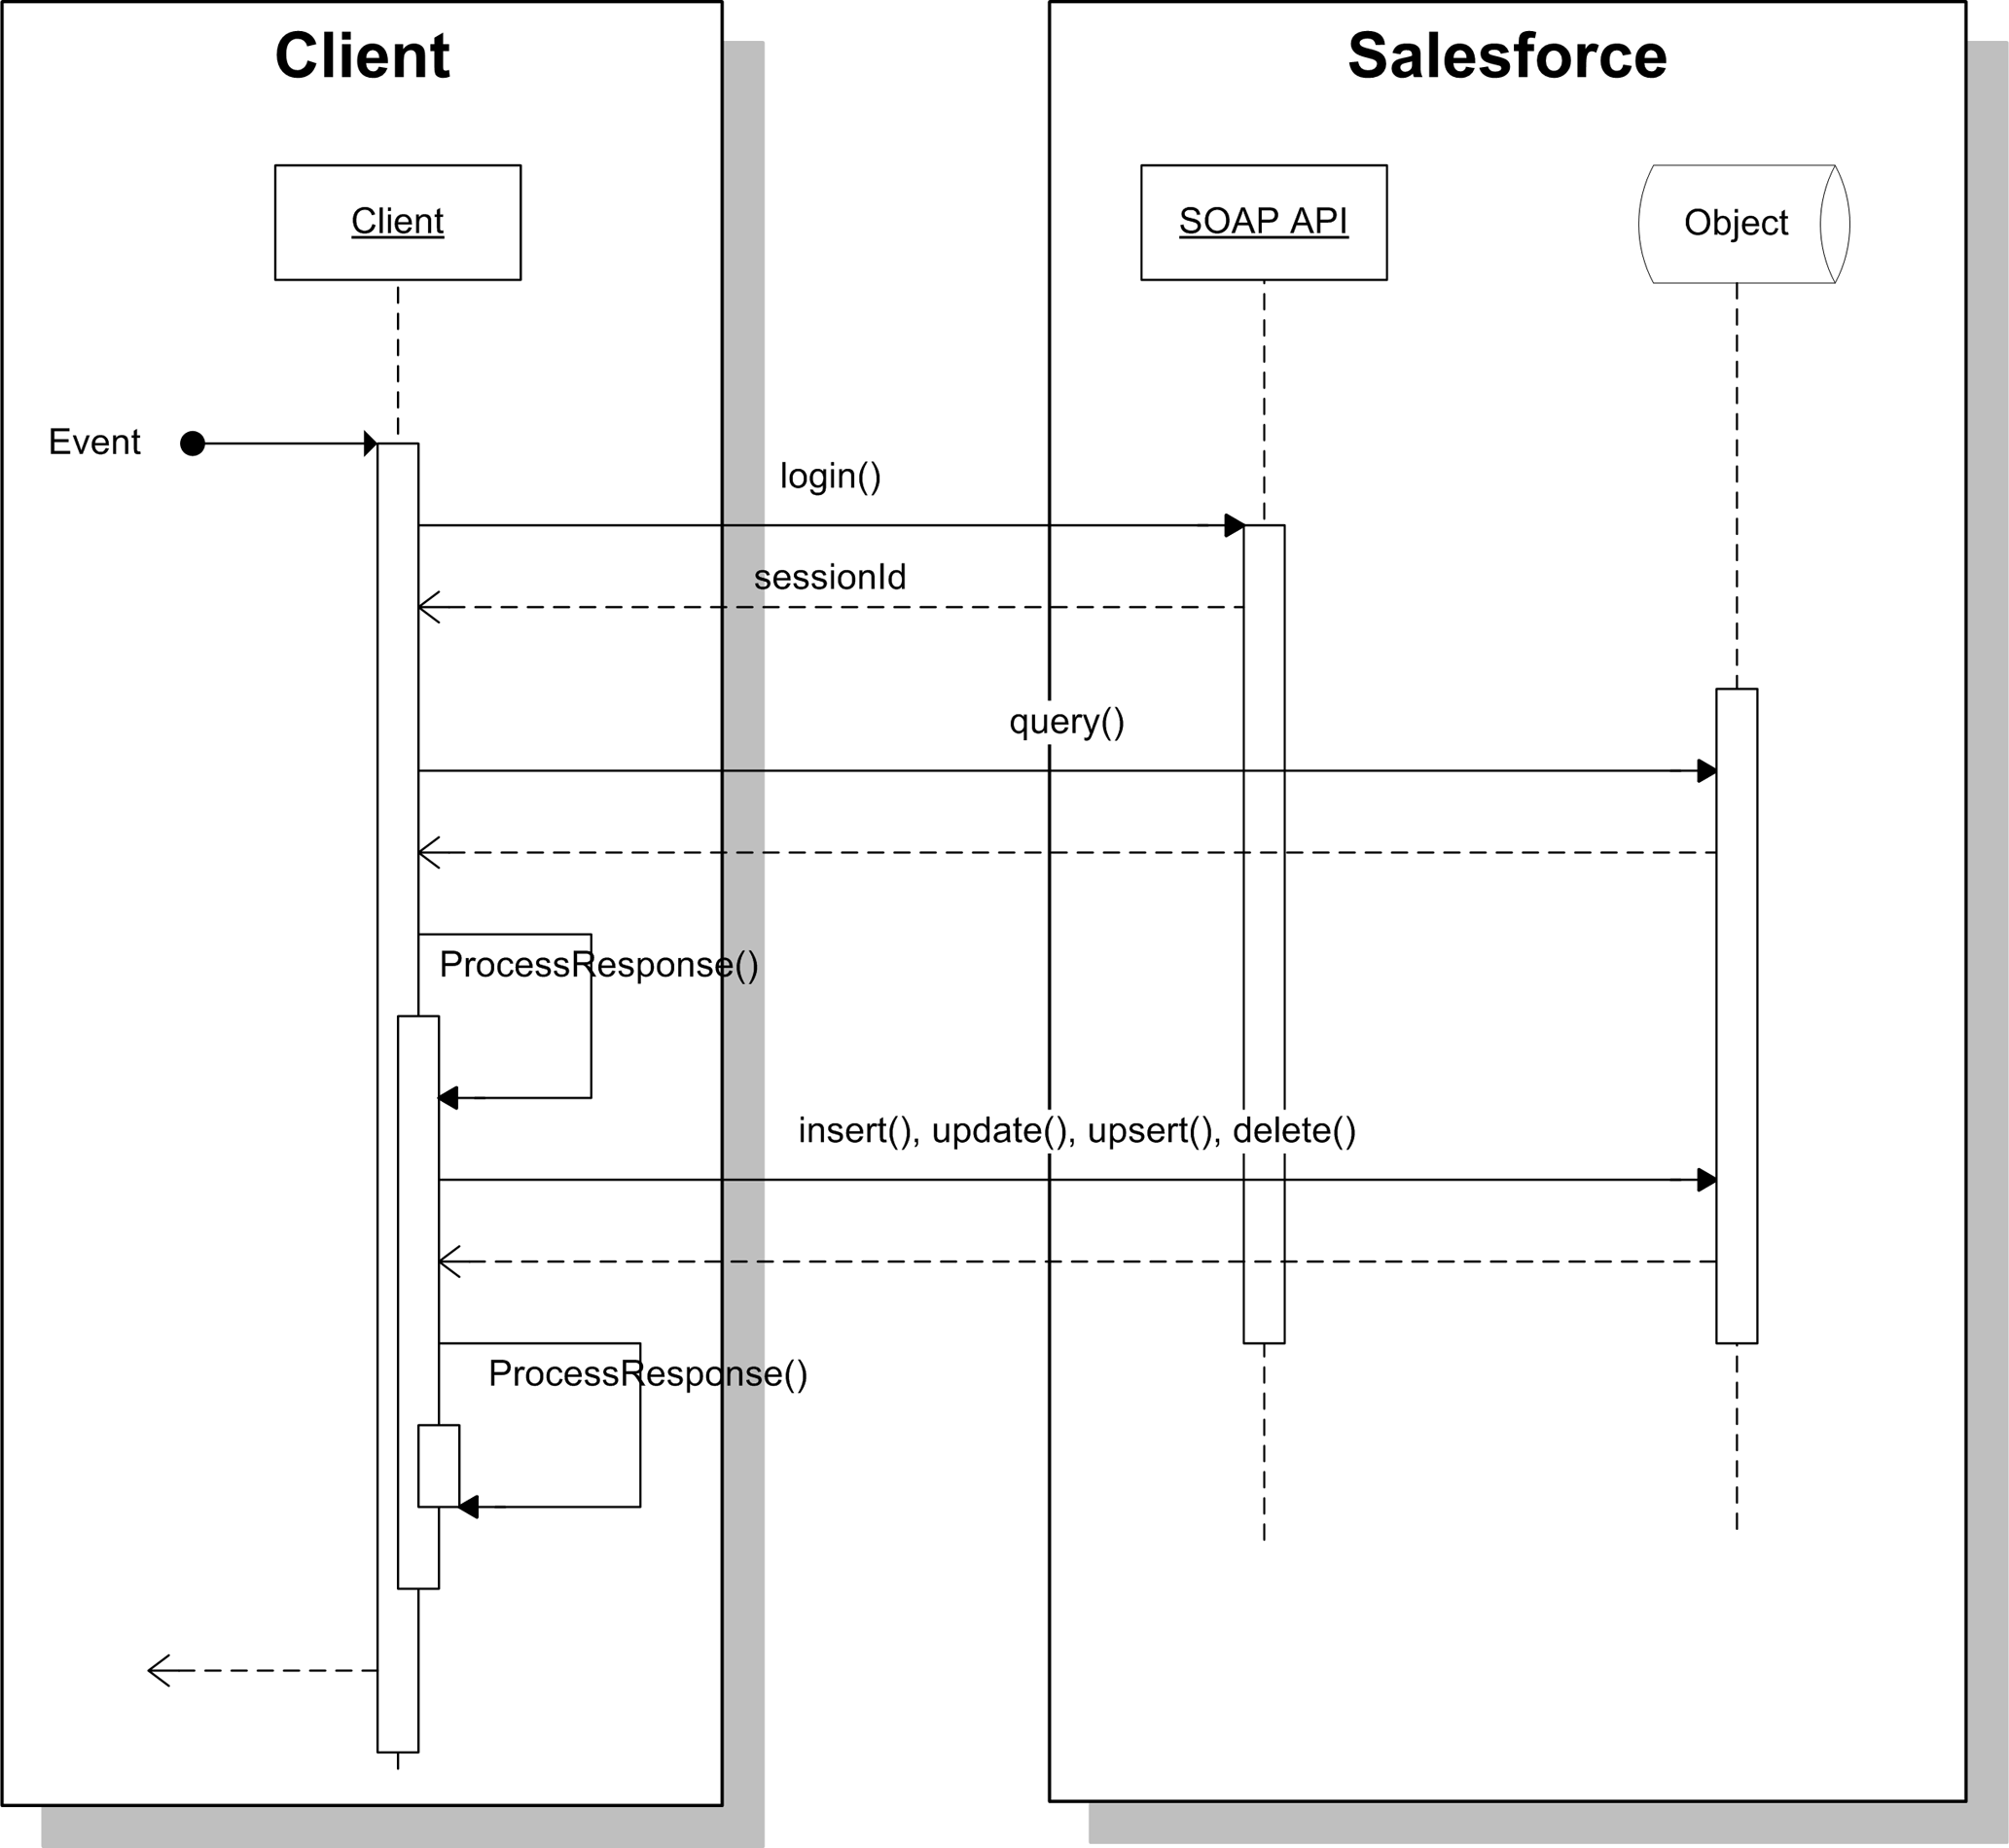 _REST API를 통해 Salesforce에 이벤트를 알리는 원격 시스템_
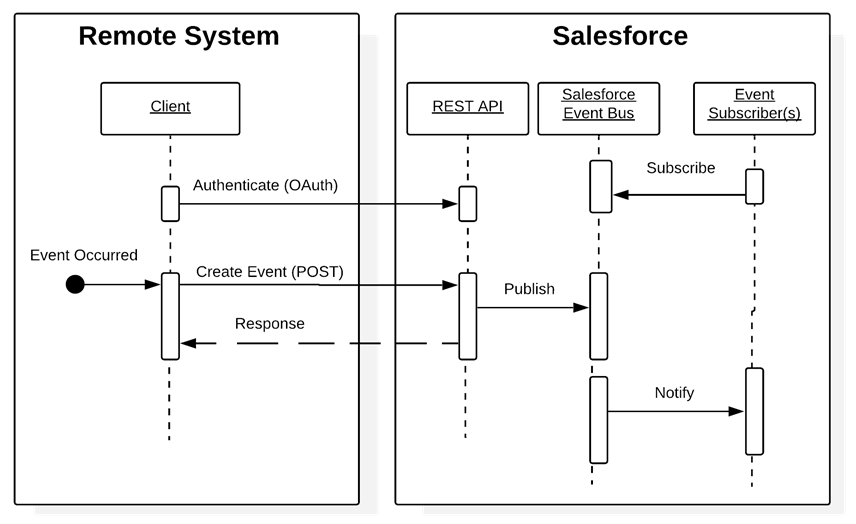 **결과**
이벤트 중심 아키텍처에서 원격 시스템은 SOAP API, REST API 또는 대량 API 2.0을 사용하여 Salesforce 이벤트 버스에 이벤트를 게시하기 위해 Salesforce에 호출합니다. 이벤트를 게시하면 모든 구독자에게 알림이 전송됩니다. 이벤트 구독자는 플로 또는 Lightning 구성 요소, Apex 트리거와 같은 Salesforce Platform에 있을 수 있습니다. 이벤트 구독자는 CometD 구독자와 같은 Salesforce Platform 외부일 수도 있습니다.
Salesforce 개체를 직접 사용하여 작업할 경우 이 패턴과 관련된 솔루션을 통해 다음을 수행할 수 있습니다.
- 원격 시스템에서 Salesforce API를 호출하여 데이터베이스를 쿼리하고 단일 개체 작업(만들기, 업데이트, 삭제 등)을 실행합니다.
- 일련의 개체 작업을 수행하기 위해 Salesforce REST API 복합 리소스를 호출하는 원격 시스템입니다.
- 다중 개체 트랜잭션 작업 및 사용자 정의 사전/후 처리 논리를 지원할 수 있는 사용자 정의 빌드 Salesforce API(서비스)를 호출하는 원격 시스템
| 호출 메커니즘 | 설명 |
|---|---|
| SOAP API | 원격 시스템은 Salesforce Enterprise 또는 Partner WSDL을 사용하여 표준 SOAP API를 호출하는 데 사용되는 클라이언트 스풀을 생성합니다. |
| REST API | 원격 시스템은 Apex REST 서비스에 액세스하기 전에 인증해야 합니다. 원격 시스템에서 OAuth 2.0 또는 사용자 이름 및 암호 인증을 사용할 수 있습니다. 두 경우 모두 클라이언트가 권한 부여 HTTP 머리글을 적절한 값으로 설정해야 합니다(SOAP API에 대한 로그인 호출을 통해 OAuth 액세스 토큰 또는 세션 ID를 획득할 수 있음). 그런 다음 원격 시스템에서 적절한 동사와 함께 REST 호출(HTTP 요청)을 생성하고 반환된 결과를 처리합니다(JSON 및 XML 데이터 형식 지원). |
| Apex 웹 서비스 | 원격 시스템은 사용자 정의 Apex 웹 서비스 WSDL을 사용하여 클라이언트 스풀을 생성하여 사용자 정의 Apex 웹 서비스를 호출하는 데 사용합니다. |
| Apex REST 서비스 | REST API에 따라 리소스 URI 및 해당 동사는 @RestResource, @HttpGet, @HttpPost 주석을 사용하여 정의됩니다. |
| Bulk API 2.0 | 대량 API 2.0은 REST 기반 API이므로 REST API와 동일한 호출 메커니즘이 적용됩니다. |
| 플로를 호출하는 REST API | REST API를 사용하여 사용자 정의 호출 가능한 작업 끝점을 호출하여 자동 실행 플로를 호출합니다. |
- 오류 처리 - 표준 또는 사용자 정의 API와 같은 모든 원격 콜인 메서드에는 타임아웃 및 재시도 관리와 같은 후속 오류를 처리할 원격 시스템이 필요합니다. 중간웨어를 사용하여 오류 처리 및 복구를 위한 논리를 제공할 수 있습니다.
- 복구 - 서비스 품질 요구 사항에 따라 사용자 정의 재시도 메커니즘을 만들어야 합니다. 이 경우 동일한 디자인 특성을 유지해야 합니다. 플랫폼 이벤트를 사용하면 구독자가 재생 ID를 사용하여 해당 메시지가 게시된 후 특정 기간 내에 메시지를 가져올 수 있습니다.
| 솔루션 | 보안 고려 사항 |
|---|---|
| SOAP API | alesforce는 SSL(Secure Socket Layer v3) 및 TLS(Transport Layer Security) 프로토콜을 지원합니다. 암호는 최소 128비트의 키 길이여야 합니다. 세션 ID를 가져오려면 원격 시스템에서 유효한 자격 증명을 사용하여 로그인해야 합니다. 원격 시스템에 이미 유효한 세션 ID가 있는 경우 명시적 로그인 없이 API를 호출할 수 있습니다. 이는 이전 Salesforce 아웃바운드 메시지에 후속 사용을 위해 세션 ID 및 레코드 ID가 포함된 이 문서의 앞서 다루는 콜백 패턴에 사용됩니다. SOAP API 캐시를 호출하고 세션 ID를 재사용하는 클라이언트는 각 호출에 대해 새 세션 ID를 가져오지 않고 성능을 극대화하는 것이 좋습니다. |
| REST API | 원격 시스템에서 인증을 위한 OAuth Trust 관계를 설정하는 것이 좋습니다. 그러면 HTTP 동사를 사용하여 특정 자원에 대해 REST 호출을 수행할 수 있습니다. 또한 다른 방법으로 얻은 유효한 세션 ID(예: SOAP API 호출을 통해 검색 또는 아웃바운드 메시지를 통해 제공)를 사용하여 REST 호출을 만들 수 있습니다. REST API 캐시를 호출하고 세션 ID를 재사용하는 클라이언트는 각 호출에 대해 새 세션 ID를 가져오지 않고 성능을 극대화하는 것이 좋습니다. |
| Apex 웹 서비스 | 원격 시스템에서 인증을 위한 OAuth Trust 관계를 설정하는 것이 좋습니다. |
| Apex REST 서비스 | 원격 시스템에서 인증을 위한 OAuth Trust 관계를 설정하는 것이 좋습니다. |
| Bulk API 2.0 | 원격 시스템에서 인증을 위한 OAuth Trust 관계를 설정하는 것이 좋습니다. |
- 세션 시간 초과 - Salesforce 조직의 세션 시간 초과 설정을 기반으로 하는 활동이 없는 경우 세션 시간이 초과됩니다.
- 쿼리 시간 초과 - 각 SOQL 쿼리의 개별 시간 초과 제한은 120초입니다.
| 솔루션 | 커뮤니케이션 유형 | 제한 |
|---|---|---|
| SOAP API 또는 REST API | 동기식 |
|
| Bulk API 2.0 | 비동기식 | 대량 API 2.0은 대규모 데이터 집합을 비동기식으로 가져오고 내보내기 위해 최적화되어 있습니다. 2,000개가 넘는 레코드를 포함하는 데이터 작업은 대량 프레임워크를 사용하는 비동기식 워크플로를 성공적으로 준비, 실행, 관리하는 대량 API 2.0에 적합한 후보입니다. 레코드가 2,000개 미만인 작업에는 REST(예: 복합) 또는 SOAP의 "불량화된" 동기식 호출이 포함되어야 합니다. 대량 API 2.0은 배치 요청 및 관련 데이터를 제출할 때 동기식입니다. 데이터의 실제 처리는 비동기식으로 수행됩니다. API 및 배치 처리 제한에 대한 자세한 내용은 제한을 참조하십시오. |
| 솔루션 | 끝점 고려 사항 |
|---|---|
| SOAP API | 원격 시스템은 Salesforce에서 미리 정의한 메시지 형식을 기반으로 Salesforce SOAP API를 호출할 수 있는 클라이언트를 구현할 수 있어야 합니다. 원격 시스템(클라이언트)은 Salesforce에서 계약을 제공하는 계약 우선 구현에 참여해야 합니다(예: Enterprise 또는 Partner WSDL). |
| REST API | 원격 시스템은 Salesforce 정의 REST 서비스를 호출하고 XML 또는 JSON 결과를 처리하는 REST 클라이언트를 구현할 수 있어야 합니다. |
| Apex 웹 서비스 | 원격 시스템은 Salesforce에서 정의한 대로 사전 정의된 형식의 SOAP 메시지를 호출할 수 있는 클라이언트를 구현할 수 있어야 합니다. 원격 시스템은 Apex 웹 서비스가 구현된 후 Salesforce에서 계약을 제공하는 코드 우선 구현에 참여해야 합니다. 각 Apex 웹 서비스에는 자체 WSDL이 있습니다. |
| Apex REST 서비스 | REST API와 동일한 끝점 고려 사항이 적용됩니다. |
- Salesforce는 원격 레코드에 대한 원격 시스템의 기본 또는 고유 대리 키를 저장합니다.
- 원격 시스템에 Salesforce 고유 레코드 ID 또는 기타 고유한 대리 키가 저장됩니다. 이 동기 패턴에서 통합 키를 처리하는 데 특정 고려 사항이 있습니다.
| 마스터 | 시스템 설명 |
|---|---|
| Salesforce | 이 시나리오에서 원격 시스템은 Salesforce RecordId 또는 레코드에서 고유한 일부 대리 키를 저장합니다. |
| 원격 시스템 | 이 시나리오에서 Salesforce는 원격 시스템에 고유 식별자에 대한 참조를 저장합니다. 프로세스가 동기식이므로 외부 ID 필드를 사용하여 같은 트랜잭션의 일부로 키를 제공할 수 있습니다. |
| 솔루션 | 고려 사항 |
|---|---|
| SOAP API 또는 REST API | SOAP API 및 REST API는 개체에 대한 간단한 트랜잭션을 제공합니다. 집계, 오케스트레이션, 변환과 같은 복잡한 통합 시나리오는 Salesforce에서 수행할 수 없습니다. 이러한 시나리오는 원격 시스템 또는 미들웨어에서 처리해야 하며, 미들웨어는 기본 방법으로 처리해야 합니다. |
| Apex 웹 서비스 또는 Apex REST 서비스 | 사용자 정의 웹 서비스는 교차 개체 기능, 사용자 정의 논리, 보다 복잡한 트랜잭션 지원을 제공할 수 있습니다. 이 솔루션은 주의를 기울여 사용해야 하며 항상 변환, 오케스트레이션, 오류 처리 논리에 대한 미들웨어의 적합성을 고려해야 합니다. |
| 솔루션 | 제한 |
|---|---|
| SOAP API, REST API 및 사용자 정의 Apex API |
|
| Bulk API 2.0 | 자세한 내용은 데이터 볼륨 링크 모음을 참조하십시오. |
| 플랫폼 이벤트 |
|
| 부부동산 | 필수 | 원하는 항목 | 필수 아님 |
|---|---|---|---|
| 이벤트 처리 | X | ||
| 프로토콜 변환 | X | ||
| 번역 및 변환 | X | ||
| 대기열 및 완충 | X | ||
| 동기식 전송 프로토콜 | X | ||
| 비동기식 전송 프로토콜 | X | ||
| 중재 라우팅 | X | ||
| 프로세스 통합 및 서비스 오케스트레이션 | X | ||
| 트랜잭션성(암호화, 서명, 신뢰할 수 있는 배달, 트랜잭션 관리) | X | ||
| 라우팅 | X | ||
| 추출, 변환, 로드 | X(대량/배치) |
- PMS는 Salesforce가 계약을 제공하고 PMS가 Salesforce 서비스(엔터프라이즈 또는 파트너 WSDL을 통해 정의됨)의 클라이언트(소비자) 역할을 하는 계약 우선 통합에 참여할 수 있습니다.
- Salesforce에는 사용자 정의 개발이 없어야 합니다.
- Salesforce에서 플랫폼 이벤트를 정의하여 PMS에서 가져오는 알림 데이터를 포함합니다.
- 프린터 이벤트 알림에 의해 트리거되는 플로를 만듭니다. 프로세스에서 프린터 자산을 업데이트하고 자동 실행 플로를 사용하여 주문을 만듭니다.
- Enterprise 또는 Partner WSDL을 다운로드하고 원격 시스템에 제공합니다.
- Enterprise 또는 Partner WSDL에서 클라이언트 스풀을 만듭니다.
- 통합 사용자의 자격 증명을 사용하여 Salesforce(OAuth 웹 서버 또는 전달자 토큰 플로를 통해)에 인증합니다.
- 프린터 상태 이벤트 시 PMS가 API를 호출하여 프린터 상태 플랫폼 이벤트(프린터 사용 통계 포함)를 만듭니다. Salesforce 이벤트 버스는 플로 구독자 및 기타 모든 구독자에게 알립니다.
- Salesforce 동기식 API 클라이언트 구현(소비자).
- Salesforce에 대한 콜백으로 플랫폼 이벤트를 게시합니다(이전에 적용된 요청/응답 플랫폼 이벤트 패턴과 일치).
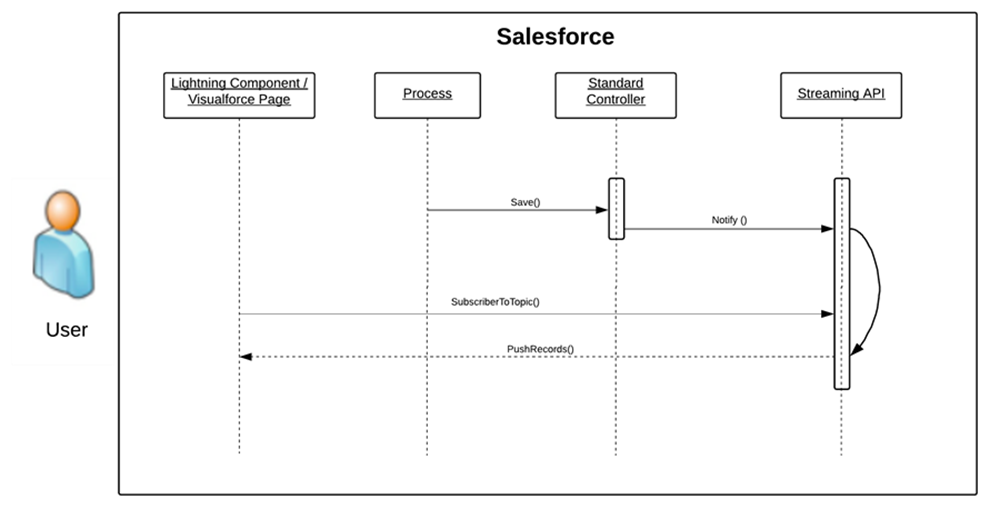 **결과**
**혜택**
이 패턴과 관련된 솔루션을 적용하면 다음과 같은 이점이 있습니다.
- 사용자 정의 폴링 메커니즘 작성 필요 없음
- 사용자가 시작하는 사용자 의견 루프 필요 없음
- 알림 전달은 보장되지 않습니다.
- 알림 순서는 보장되지 않습니다.
- 대량 API에서 변경한 레코드에서는 알림이 생성되지 않습니다.
- Apex 트리거 PushTopic을 생성하여 사례가 “마감됨” 상태와 “성공함” 상태로 저장되면 플랫폼 이벤트를 보냅니다.
- 고객 서비스 관리자가 사용할 수 있는 사용자 정의 사용자 인터페이스를 만듭니다. 이 사용자 인터페이스는 이벤트 버스를 구독하여 플랫폼 이벤트를 사용합니다.
- 관리자의 고객 서비스 담당자가 생성한 경고를 표시하는 사용자 정의 사용자 인터페이스에 논리를 구현합니다.
- Salesforce에서 선언적/포인트 앤 클릭 아웃바운드 통합 또는 UI 매시업을 구축하려고 합니까?
- Salesforce 조직에 복사하지 않으려는 대용량 데이터가 있습니까?
- 언제든지 소량의 원격 시스템 데이터에 액세스해야 합니까?
- 최신 데이터에 실시간으로 액세스해야 합니까?
- 클라우드 또는 백오피스 시스템에 데이터를 저장하지만 Salesforce 조직에 해당 데이터를 표시하거나 처리하려고 합니까?
- Salesforce에 특정 유형의 데이터를 저장할 때 데이터 보존에 대한 우려 사항이 있습니까?
| 솔루션 | 맞춤 | 댓글 |
|---|---|---|
| Salesforce Connect | 최대 | Salesforce Connect 사용하여 Salesforce 데이터와 함께 외부 소스의 데이터에 액세스합니다. Salesforce에서 데이터 사본을 만들지 않고 실시간으로 SAP, Microsoft, Oracle, Snowflake와 같은 기타 클라우드 기반 시스템에서 데이터를 가져옵니다. Salesforce Connect 외부 시스템의 데이터 테이블을 조직의 외부 개체에 매핑합니다. 외부 개체는 Salesforce 조직 외부에 있는 데이터에 매핑하는 것을 제외하고 사용자 정의 개체와 유사합니다. Salesforce Connect 외부 데이터에 대한 실시간 연결을 사용하여 항상 외부 개체를 최신 상태로 유지합니다. 외부 개체에 액세스하면 외부 시스템에서 데이터를 실시간으로 가져옵니다. Salesforce Connect 사용하면 다음을 수행할 수 있습니다.
|
| 요청 및 회신 | 최적화되지 않음 |
Salesforce 웹 서비스 API를 사용하여 외부 시스템 데이터에 액세스하고 업데이트할 수 있는 특별 데이터 요청을 만듭니다. 이 솔루션에는 다음 접근 방식이 포함됩니다.
Salesforce SOAP API를 사용합니다. 사용자 정의 페이지 또는 버튼은 Apex REST/SOAP 콜아웃을 동기식으로 시작합니다. Salesforce에서 WSDL을 사용하고 결과 프록시 Apex 클래스를 생성할 수 있습니다. 이 클래스는 원격 서비스를 호출하는 데 필요한 논리를 제공합니다. 페이지에서 사용자가 시작하는 작업은 이 프록시 Apex 클래스를 실행하여 원격 호출을 수행하는 Apex 컨트롤러 작업을 호출합니다. 페이지는 Salesforce 앱을 사용자 정의해야 합니다. Salesforce REST API를 사용합니다. 사용자 정의 페이지 또는 버튼은 동기식으로 Apex HTTP 콜아웃(REST 서비스)을 시작합니다. Salesforce에서 표준 GET, POST, PUT, DELETE 메서드를 사용하여 HTTP 서비스를 호출할 수 있습니다. 이 솔루션에 대한 자세한 내용은 원격 프로세스 호출 - 요청 및 회신을 참조하십시오. |
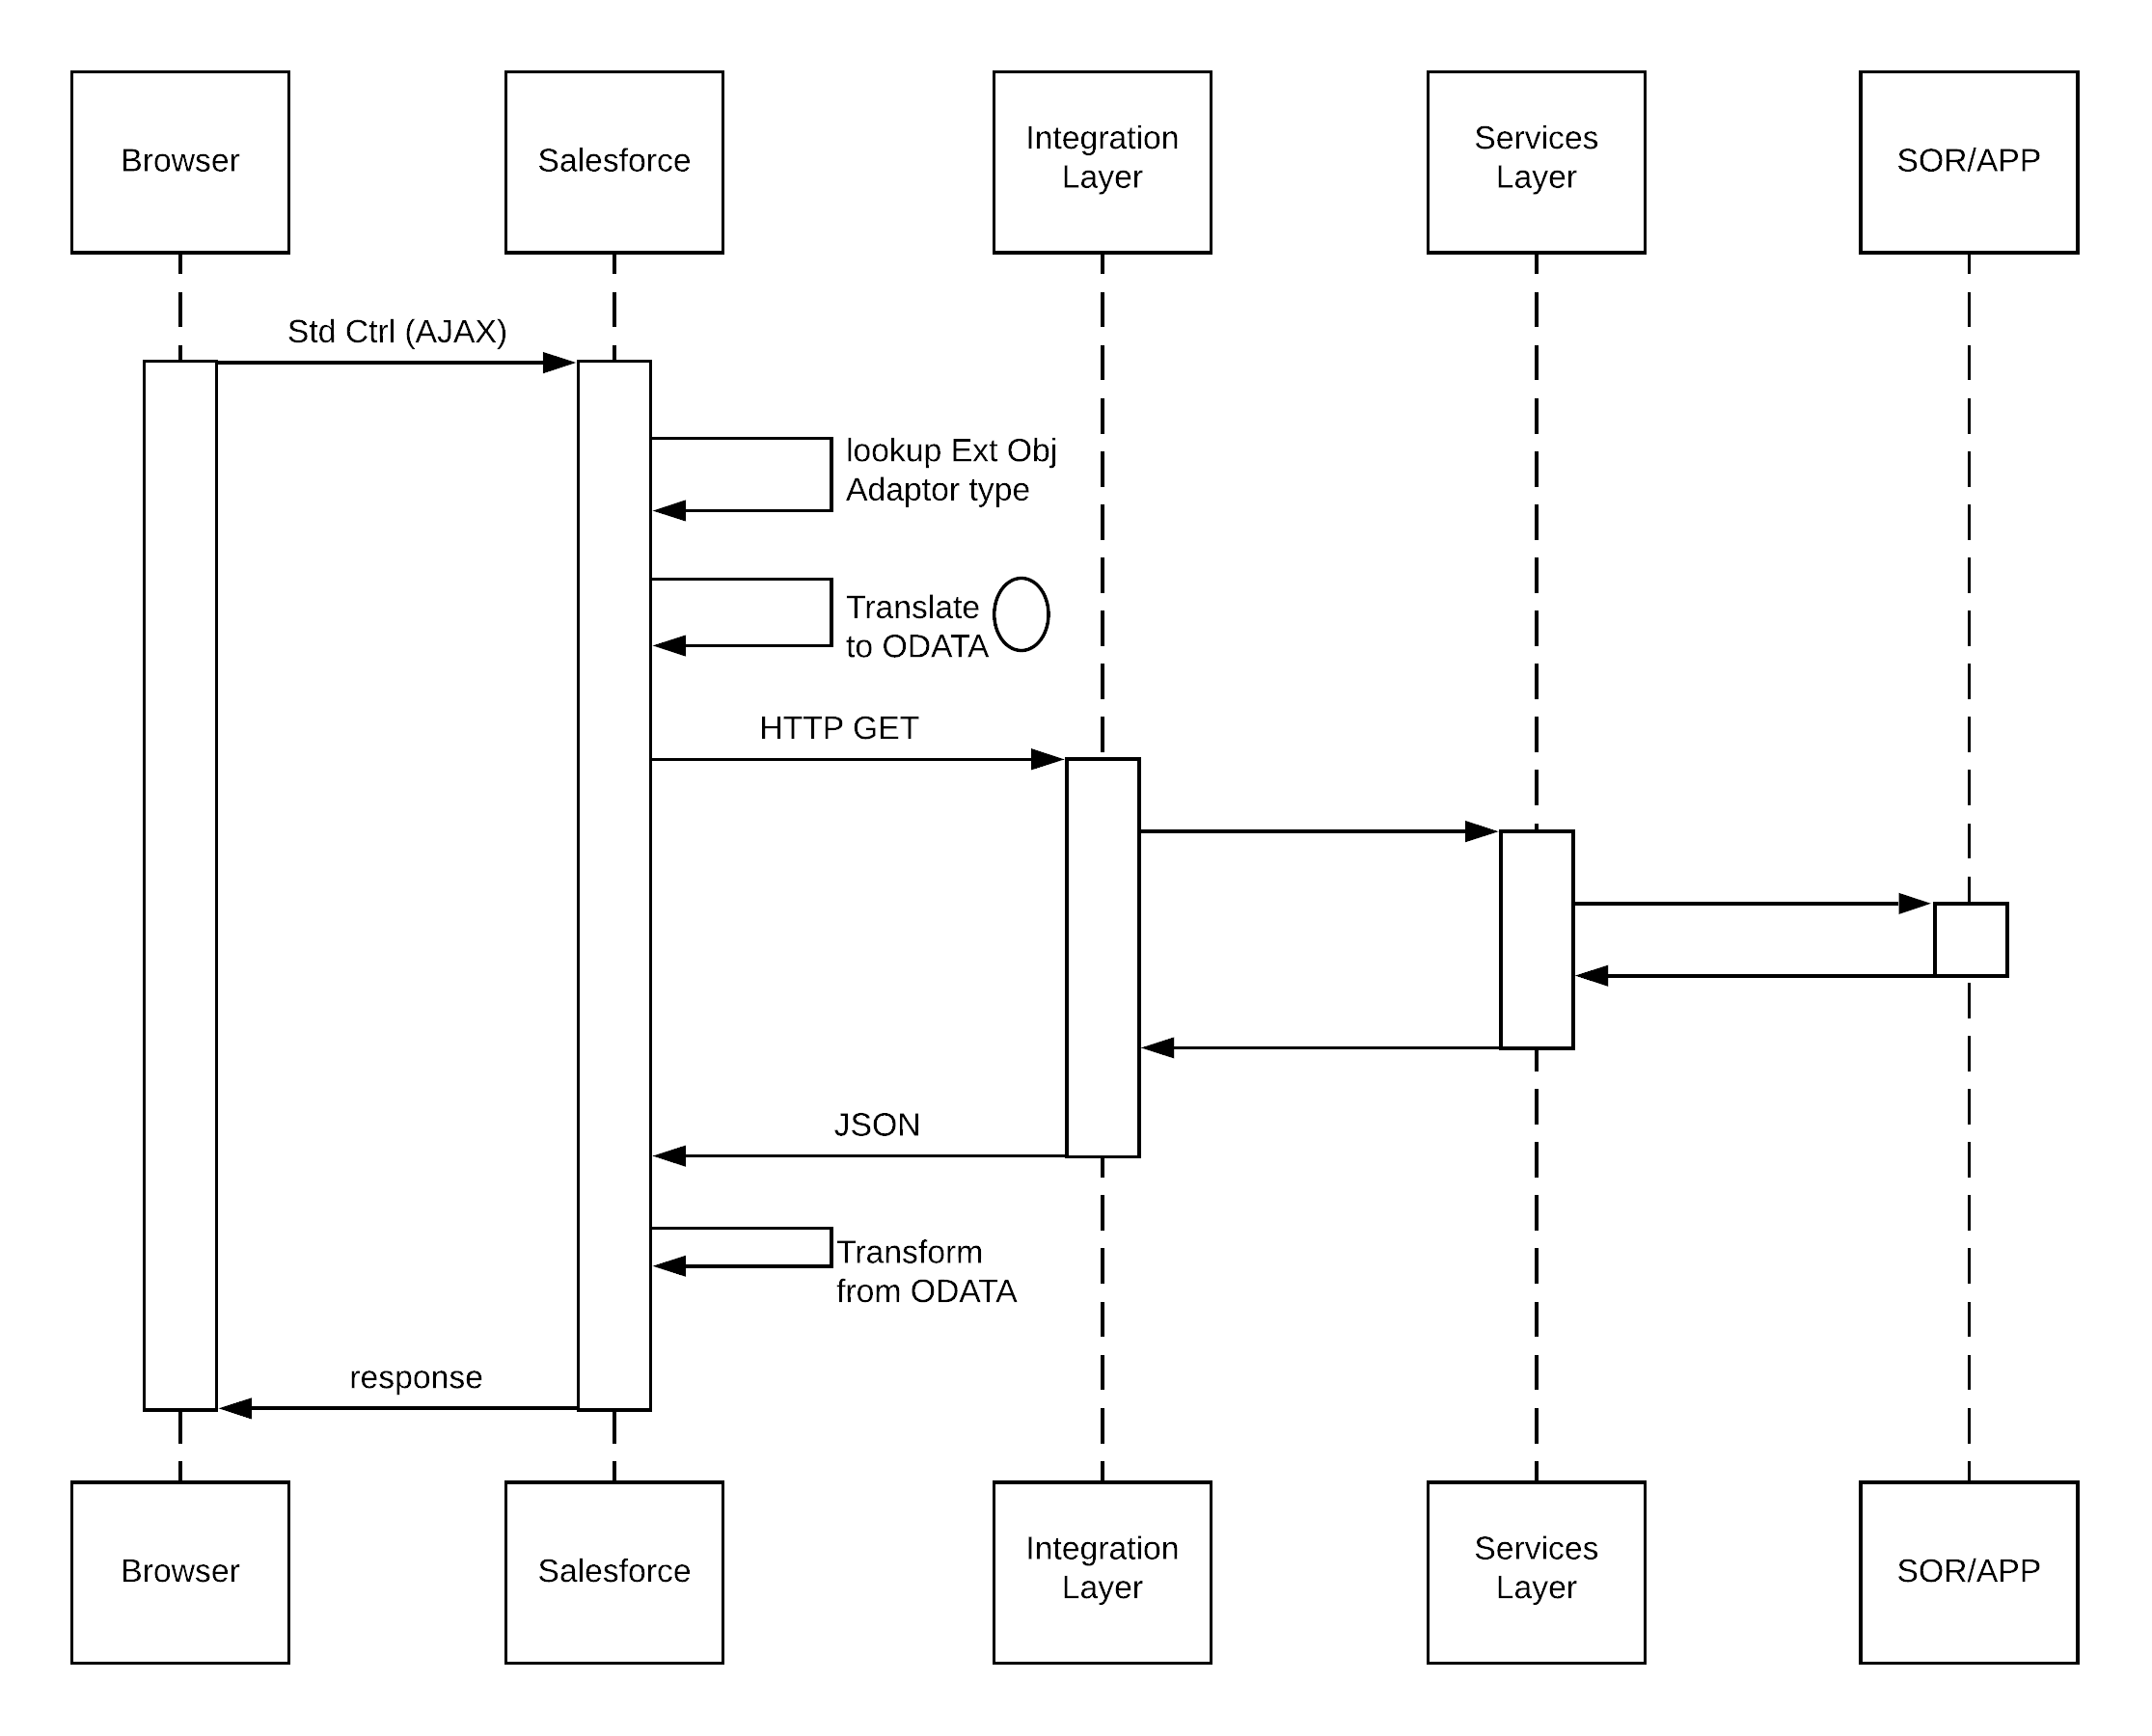 이 시나리오의 경우:
- 브라우저가 AJAX 호출을 수행하여 해당 외부 개체 어댑터에서 작업을 수행합니다.
- 어댑터는 작업을 OData 요청으로 변환하고 통합 및 서비스 계층을 통해 원격 시스템에 HTTP GET 요청을 수행합니다.
- 원격 시스템은 통합 및 서비스 계층을 통해 Salesforce에 JSON 응답을 반환합니다.
- 응답이 Odata 외부 개체로 번역되고 브라우저에 다시 표시됩니다.
| 메커니즘 호출 | 설명 |
|---|---|
| 외부 개체 | Salesforce Connect 외부 시스템의 데이터 테이블에 Salesforce 외부 개체를 매핑합니다. Salesforce Connect 조직에 데이터를 복사하는 대신 요청 시 실시간으로 데이터에 액세스합니다. 데이터가 조직 외부에 저장되더라도 Salesforce Connect Lightning 플랫폼과의 원활한 통합을 제공합니다. 외부 개체는 전역 검색, 조회 관계, 레코드 피드, Salesforce 모바일 앱과 같은 Salesforce 도구에서 사용할 수 있습니다. 외부 개체는 Apex, SOSL, SOQL 쿼리, Salesforce API 및 메타데이터 API, 변경 집합 및 패키지를 통해 배포할 수도 있습니다. |
| 조명 구성 요소 | 사용자 인터페이스와 관련된 전체 프로세스의 일부로 원격 프로세스가 트리거되고 결과가 Salesforce 레코드에 표시되거나 업데이트되어야 하는 경우 사용됩니다. 예를 들어, 외부 결제 게이트웨이에 신용 카드 결제를 제출하고 사용자에게 표시되는 결제 결과를 즉시 반환하는 프로세스입니다. 사용자 인터페이스 이벤트에서 트리거된 통합은 일반적으로 사용자 정의 Lightning 구성 요소를 생성해야 합니다. |
- 이 솔루션은 Salesforce의 데이터 저장소를 사용하지 않습니다.
- 사용자는 외부 시스템과 Salesforce 간에 데이터를 정기적으로 동기화할 필요가 없습니다.
- OData 또는 cross-org 어댑터를 사용하거나 사용자 지정 Apex 어댑터를 사용하여 최소한의 코드를 사용하여 빠르게 수행할 수 있는 선언적 설정입니다.
- 사용자는 외부 개체 형태의 사용자 정의 개체와 동일한 기능을 사용하여 외부 데이터에 액세스할 수 있습니다.
- 전역 검색을 사용하여 연결된 외부 시스템에서 연합 검색을 수행할 수 있는 기능
- 클라우드 및 온 프레미스 소스에서 외부 데이터에 액세스하는 보고서를 실행할 수 있는 기능 아래의 보고 고려 사항을 참조하십시오.
- 외부 개체는 사용자 정의 개체처럼 동작하지만 일부 기능은 외부 개체에 사용할 수 없습니다. 자세한 내용은 Salesforce Connect의 Salesforce 호환성 고려 사항을 참조하십시오.
- 외부 개체가 보고서 성능에 영향을 미칠 수 있습니다. 자세한 내용은 Salesforce Connect의 보고서 고려 사항을 참조하십시오.
- Salesforce Connect 어댑터 사용에 대한 추가 고려 사항은 Salesforce Connect - 모든 어댑터 고려 사항을 참조하십시오.
- cross-org 어댑터를 사용할 계획인 경우 Salesforce Connect—Cross-Org 어댑터의 고려 사항을 참조하십시오.
- OData 어댑터를 사용하려는 경우 Salesforce Connect - OData 2.0 및 4.0 어댑터의 고려 사항을 참조하십시오.
- 사용자 정의 Apex 어댑터를 사용하려는 경우 Salesforce Connect - 사용자 정의 어댑터의 고려 사항을 참조하십시오.
- 일반적으로 요청은 사용자 인터페이스에서 호출되므로 프로세스에서 사용자가 대기하지 않아야 합니다.
- 외부 시스템의 가용성 및 연결에 따라 외부 데이터를 검색하는 데 시간이 오래 걸릴 수 있습니다. Salesforce에는 구성 가능한 외부 시스템의 응답을 대기할 수 있는 최대 120초 시간 초과 값이 있습니다.
- 원격 프로세스 완료는 적시에 실행되고 Salesforce 시간 초과 제한 내 및 사용자 기대 내에서 완료되어야 합니다.
| 솔루션 | 끝점 고려 사항 |
|---|---|
| Salesforce Connect | OData API — Open Data Protocol을 사용하여 Salesforce 외부에 저장된 데이터에 액세스합니다. 외부 데이터는 OData 생산자를 통해 노출되어야 합니다. 기타 API — 다른 사용 가능한 어댑터가 필요에 맞지 않을 경우 Apex 커넥터 프레임워크를 사용하여 자체 사용자 정의 어댑터를 개발할 수 있습니다. 사용자 정의 어댑터는 모든 소스에서 데이터를 가져올 수 있습니다. 예를 들어, 일부 데이터는 콜아웃을 통해 인터넷에서 검색할 수 있으며, 다른 데이터는 조작하거나 프로그래밍 방식으로 생성할 수 있습니다. Salesforce에 연결 - Lightning Platform REST API를 사용하여 다른 Salesforce 조직에 저장된 데이터에 액세스합니다. 중간웨어를 통한 연결 중간웨어를 통해 연결 — Salesforce Connect 파트너 에코시스템은 Salesforce와 긴밀하게 협력하여 중간웨어 게이트웨이에서 서비스에서 OData 엔드포인트를 노출하므로 Salesforce가 추가 코드를 작성하지 않고 연결할 수 있습니다. |
| 요청 및 회신 | Apex SOAP 콜아웃 - 끝점은 HTTP를 통해 웹 서비스 호출을 받을 수 있어야 합니다. Apex HTTP 콜아웃 - 끝점에서 HTTP 호출을 수신할 수 있어야 합니다. Apex HTTP 콜아웃을 사용하여 표준 GET, POST, PUT 및 DELETE 메서드를 사용하여 RESTful 서비스를 호출할 수 있습니다. |
- Salesforce는 원격 레코드에 대한 기본 또는 고유 대리 키를 저장합니다.
- 원격 시스템에 Salesforce 고유 레코드 ID 또는 기타 고유한 대리 키가 저장됩니다. 이 동기 패턴에서 통합 키를 처리하는 데 특정 고려 사항이 있습니다.
| 마스터 시스템 | 설명 |
|---|---|
| Salesforce | 원격 시스템은 Salesforce 레코드 ID 또는 레코드에서 고유한 일부 대리 키를 저장합니다. |
| 원격 시스템 | 원격 프로세스에 대한 호출은 응용 프로그램에서 고유한 키를 반환하며 Salesforce는 고유한 레코드 필드에 해당 키 값을 저장합니다. |
- 다중 시스템 통화 전반의 통화 및 통화 결과 집계
- 인바운드 및 아웃바운드 메시지 모두 변환
- 다중 시스템에 대한 통화 전반의 트랜잭션 무결성 유지
- Salesforce와 외부 시스템 간의 기타 프로세스 오케스트레이션 활동
| 부부동산 | 필수 | 원하는 항목 | 필수 아님 |
|---|---|---|---|
| 이벤트 처리 | X | ||
| 프로토콜 변환 | X | ||
| 번역 및 변환 | X | ||
| 대기열 및 완충 | X | ||
| 동기식 전송 프로토콜 | X | ||
| 비동기식 전송 프로토콜 | X | ||
| 중재 라우팅 | X | ||
| 프로세스 통합 및 서비스 오케스트레이션 | X | ||
| 트랜잭션성(암호화, 서명, 신뢰할 수 있는 배달, 트랜잭션 관리) | X | ||
| 라우팅 | X | ||
| 추출, 변환, 로드 | X | ||
| 긴 폴링 | X |
| 관계 | 허용된 하위 개체 | 허용된 상위 개체 | 일치하는 레코드의 상위 필드 |
|---|---|---|---|
| 조회 | 표준, 사용자 정의, 외부 | 표준, 사용자 정의 | 18자 Salesforce 레코드 ID |
| 외부 검색 | 표준, 사용자 정의, 외부 | 외부 | 외부 ID 표준 필드 |
| 간접 검색 | 외부 | 표준, 사용자 정의 | External ID 및 Unique 특성이 있는 사용자 정의 필드 선택 |
- OData 끝점을 사용하여 외부 데이터 소스를 구성합니다. 원격 응용 프로그램에 Odata 대한 기본 지원이 포함될 수 있습니다. 기타 응용 프로그램의 경우 Dell Boomi, Informatica, Jitterbit, MuleSoft, Progress Software와 같은 주요 통합 공급업체가 Salesforce Connect 협력하여 어댑터를 구축했습니다.
- 직접 또는 미들웨어 솔루션을 통해 Odata 끝점에서 Salesforce Connect 가리킵니다.
- 외부 데이터베이스 테이블을 Salesforce의 외부 개체와 동기화합니다. 사용자가 해당 외부 개체의 데이터가 포함된 페이지에 액세스하면 Salesforce Connect 백엔드 응용 프로그램에 대한 실시간 콜아웃을 만듭니다.
| 쿼리 전 선택도 측정 | 마지막 데이터베이스 액세스 쿼리 쓰기, 강제... | |
| 사용자 | 필터 | |
| 낮음 | 낮음 | ... 중첩 루프 조인, 사용자가 볼 수 있는 행 보기를 사용하여 드라이브 |
| 낮음 | 높음 | 필터와 관련된 색인 사용 |
| 높음 | 낮음 | ... 순서가 지정된 해시 조인, MT_DATA를 사용하는 드라이브 |
| 높음 | 높음 | ... 색인 관련 필터 사용 |