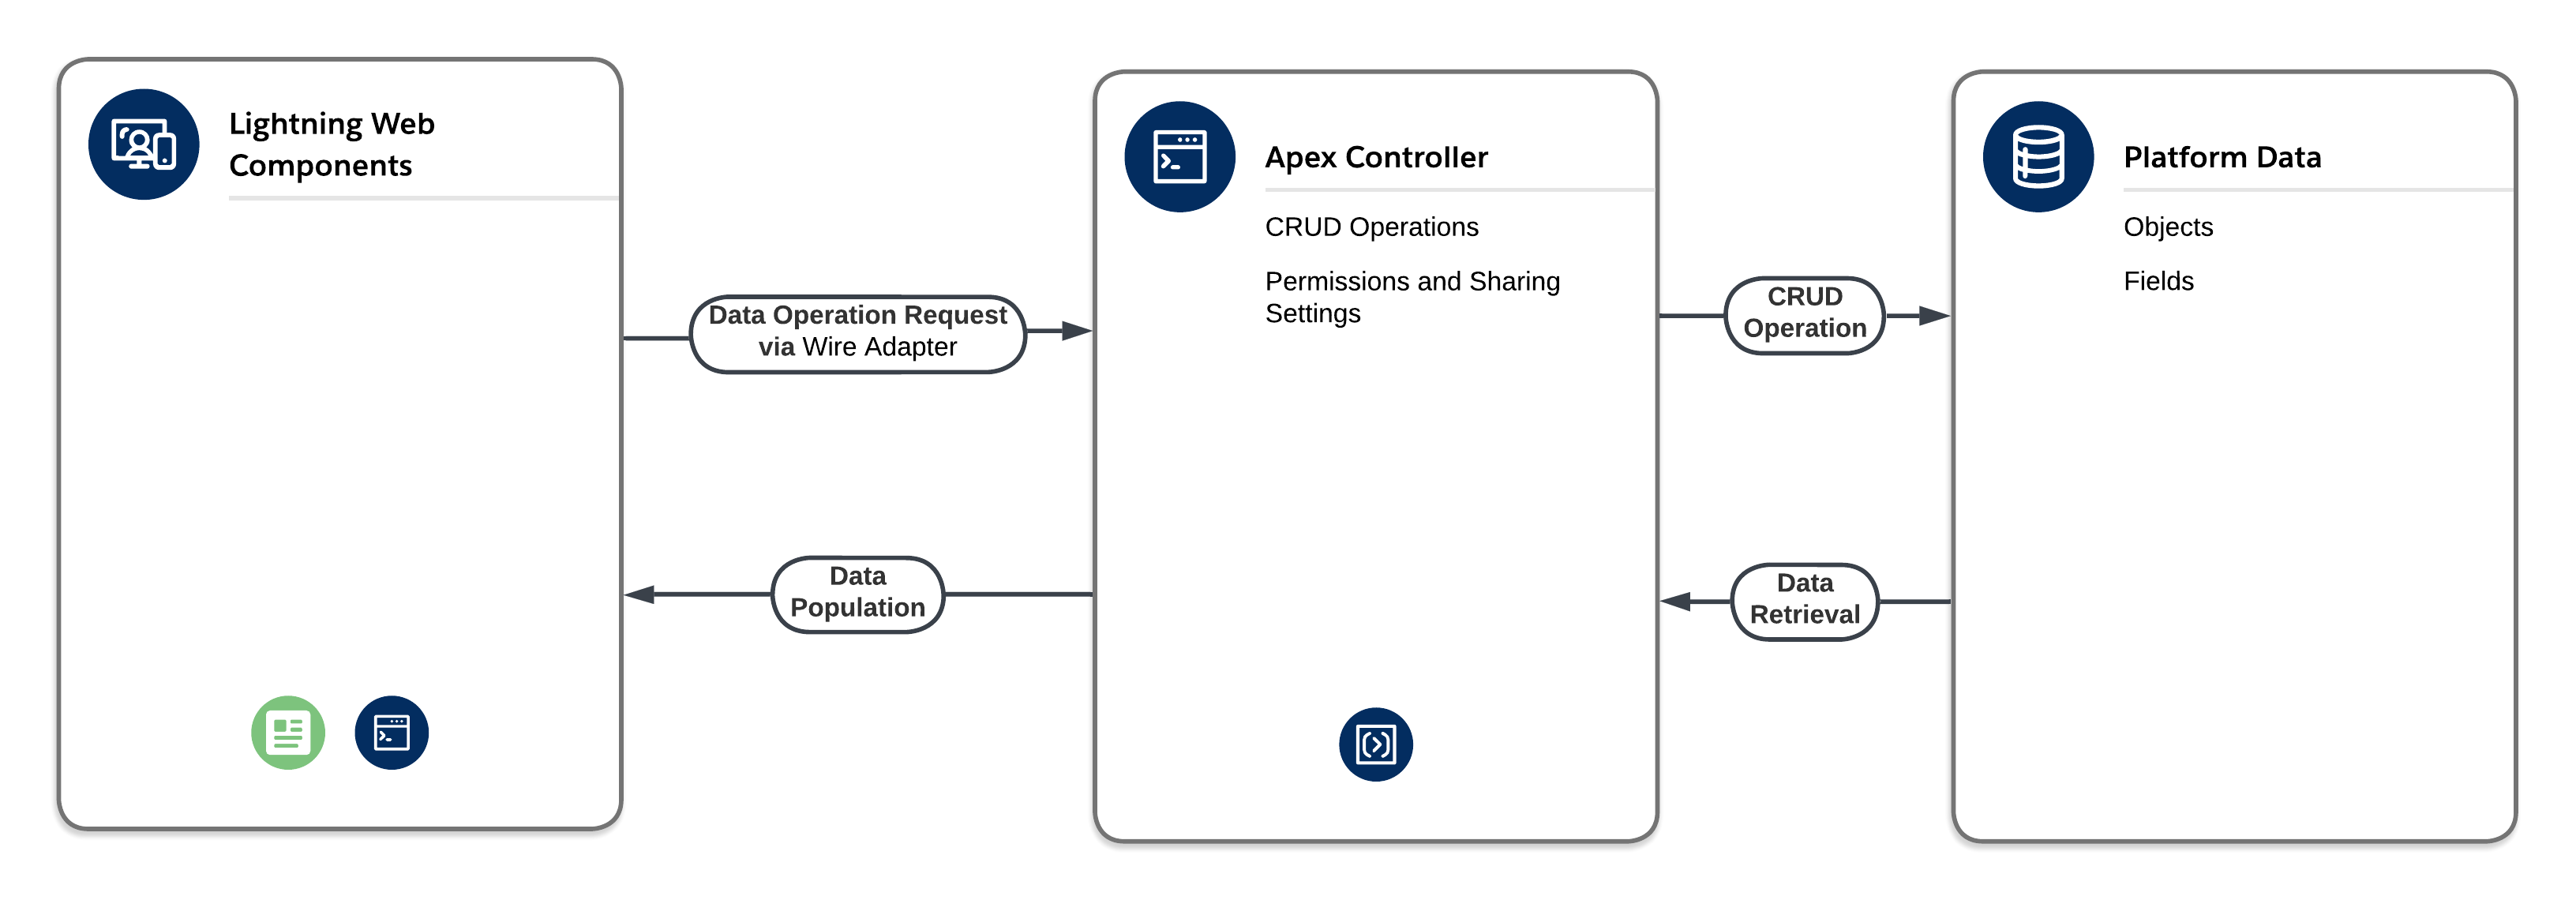
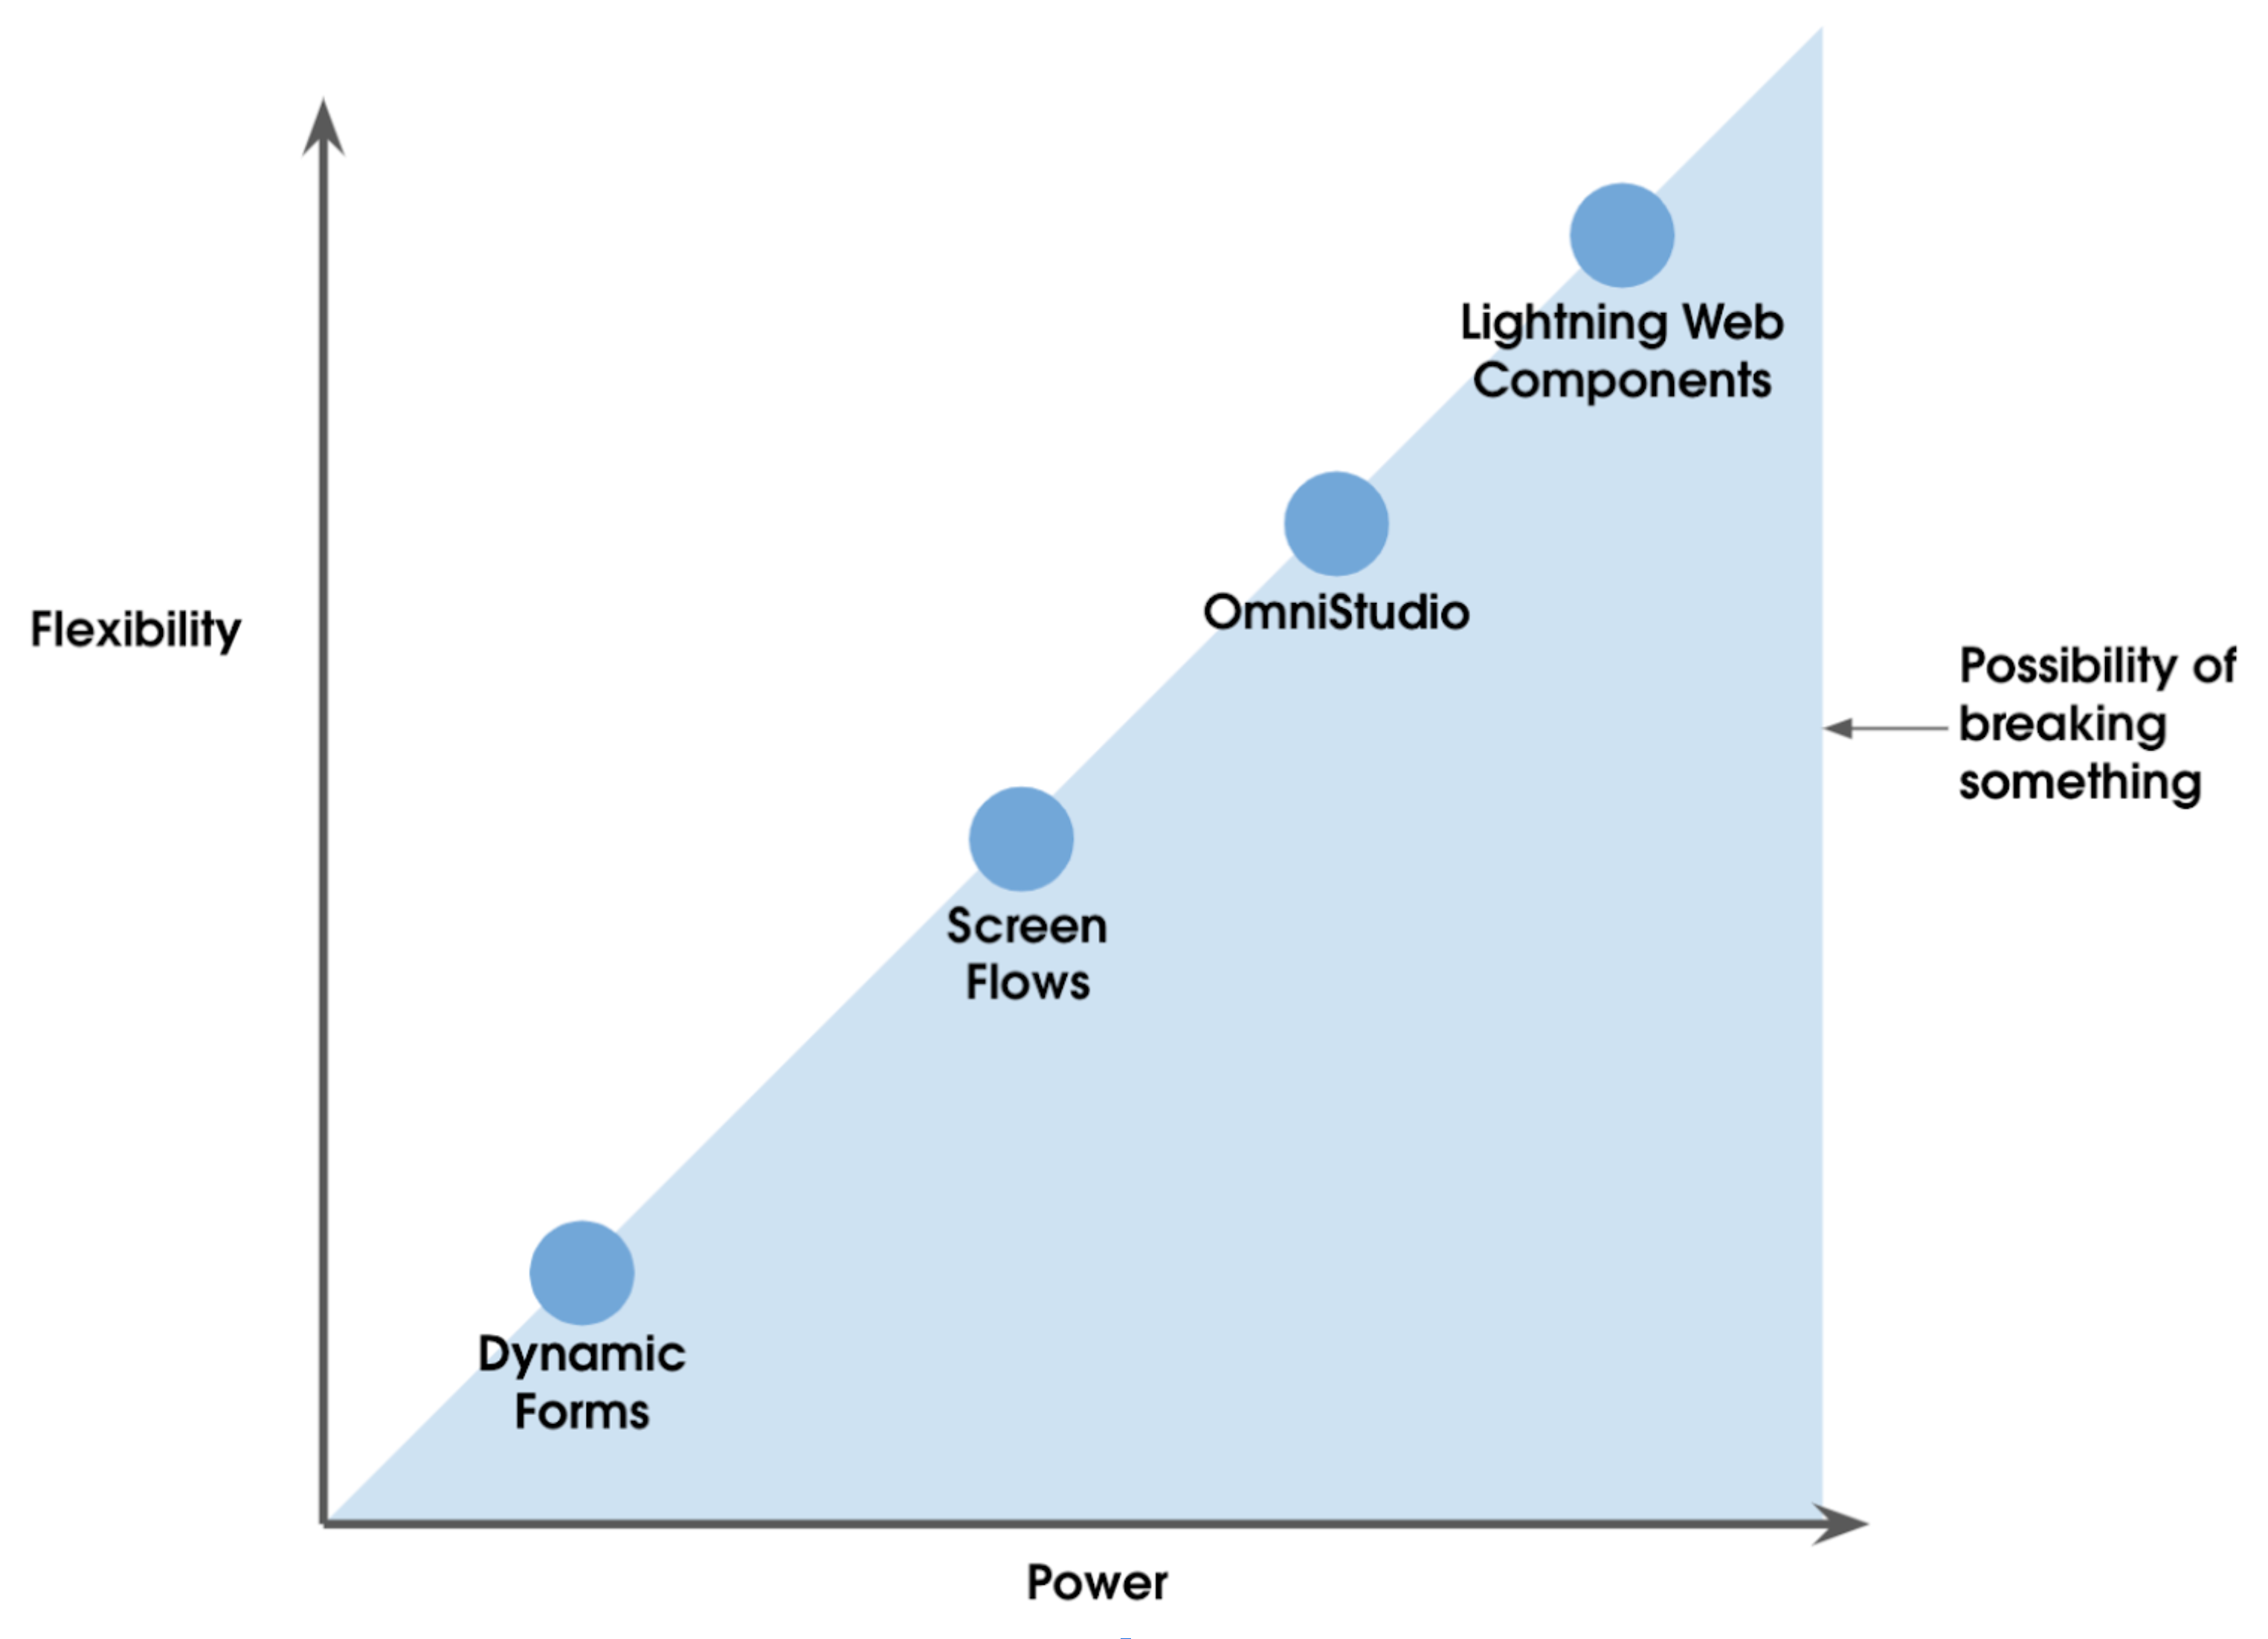
# architect 결정 가이드 (decision-guides) - Full Documentation # Data 360 결정 가이드 시작하기 이 섹션에서는 프로비저닝 전략, 다중 조직 연결, 통합 패턴 등 Salesforce Data 360에 대한 중요한 아키텍처 결정을 내릴 수 있는 실용적인 지침을 제공합니다. 해당 가이드를 사용하여 고객 데이터를 통합하고 AI 지원 기능을 활성화하는 효과적인 데이터 아키텍처를 설계 및 구현합니다. --- ## Data 360 프로비저닝 [Data 360 프로비저닝은](/docs/architect/ko-kr/decision-guides/guide/data-360-provisioning) Salesforce Data 360 프로비저닝 시 기본적인 결정을 다룹니다. - **홈 조직 선택**: 기존 프로덕션 조직에서 Data 360을 프로비저닝할지 아니면 전용 조직을 만들지 결정합니다. 거버넌스, 규정 준수, 가치 확보 시간을 고려하십시오. - **다중 조직 전략**: 여러 개의 독립 Data 360 인스턴스 중에서 선택하거나 Data Cloud One을 사용하여 여러 Salesforce 조직을 통합하여 자율성, 규정 준수, 비용의 균형을 맞춥니다. - **Data Cloud One 아키텍처**: 여러 동료 조직을 활성화하여 조직 전체에서 중앙 집중식 관리, 메타데이터 공유, 기능 패리티를 통해 단일 Data 360 인스턴스를 공유합니다. - **Data 360 조직 간 데이터 공유**: 지역 규정 준수, 사업부 공동 작업 또는 연합 실행 대시보드에 대해 독립 인스턴스 간의 제로 카피 데이터 공유를 사용합니다. - **프로비저닝 고려**: 사항 데이터 보존, 거버넌스 모델, 대기 시간, 통합 복잡성, 비용, 엔터프라이즈 전체 배포에 대한 AI 준비의 요소입니다. 설계자가 Customer 360, AI, 크로스 플랫폼 혁신을 위한 단순성, 엔터프라이즈 일관성, 규정 준수 및 확장성을 보장하는 프로비저닝 전략을 설계하는 데 도움을 줍니다. --- ## Data 360 상호 운용성 [Data 360 Interoperability는](/docs/architect/ko-kr/decision-guides/guide/data-360-interoperability) Data 360을 외부 플랫폼 및 데이터 레이크와 통합하는 프레임워크를 제공합니다. - **데이터 수집 패턴**: 실시간 스트리밍 및 배치 수집을 통해 Customer 360, 규정 준수 및 중앙 집중식 관리에 이상적인 규제 정규 데이터 집합을 만들 수 있습니다. - **Zero-Copy Data Federation**: 실시간 쿼리, 가속 쿼리(캐싱) 및 파일 통합 방법으로 중복 없이 실시간으로 외부 시스템에 액세스하여 개인 설정, 대시보드 및 AI/ML 워크로드를 지원합니다. - **하이브리드 접근 방식**: 핵심 데이터 집합에 대한 관리 수집과 제로 카피 연합을 결합하여 신선하고 확장성을 제공하며, 옴니채널 참여, Agentforce 구동 작업, 엔터프라이즈 분석을 지원합니다. - **결정 프레임워크**: 대기 시간, 비용, 확장성, 거버넌스, 복잡성 측면에서 제약을 평가하여 데이터 소스당 올바른 통합 패턴을 선택합니다. - **아키텍트 플레이북**: 금융, 헬스케어, 소매, 통신 시나리오에 대한 산업별 지침, 설계 관행, 비용 고려 사항 아키텍처가 운영 및 분석 워크로드를 모두 지원하는 확장 가능하고 상호 운용 가능한 AI 지원 데이터 아키텍처를 구축하기 위해 데이터 새로 고침, 거버넌스, 파이프라인 효율성의 균형을 맞추는 과정을 안내합니다. ## 개요 엔터프라이즈는 Salesforce 및 기타 외부 데이터 레이크(예: Snowflake, Google BigQuery, Databricks, Redshift 또는 Amazon S3)에 모두 데이터를 저장합니다. 다른 소스 시스템에서 데이터를 사일로 지정하는 것은 데이터의 전체 기능을 활용하려는 기업에게 어려움을 야기합니다. 여러 데이터 레이크 전반에 걸쳐 데이터를 결합하기 위해 작업하는 설계자는 해당 데이터를 가장 효과적으로 통합하는 방법에 대한 주요 아키텍처 결정에 직면하게 됩니다. Data 360은 각각 다른 장단점과 장단점을 제공하는 여러 가지 데이터 통합 옵션을 제공합니다. 이 가이드는 데이터를 통합할 때 대기 시간, 비용, 확장성, 거버넌스, 복잡성에 대한 요구 사항에 가장 적합한 패턴을 평가하는 프레임워크를 제공하므로 데이터 수집, Zero Copy 데이터 연합 또는 하이브리드 접근 방식을 사용할 시기를 선택할 수 있습니다. 가이드는 각각 다른 요구를 충족하는 다양한 데이터 수집 및 데이터 연합 방법 중에서 선택하는 데도 도움이 됩니다. 외부 데이터 레이크하우스를 Data 360과 통합하려면 데이터 새로 고침, 거버넌스, 파이프라인 효율성 간의 제약을 주의 깊게 고려해야 합니다. 예를 들어, Zero Copy 데이터 연합 실시간 쿼리를 사용하면 데이터의 새로 고침이 극대화되지만 네트워크를 통해 더 많은 데이터를 이동할 때 파이프라인 효율성이 저하될 수 있습니다. 따라서 대부분의 실제 구현에서 다중 클라우드 레이크하우스 생태계 내의 수집 및 연합 조합이 최적의 경로입니다. 이 하이브리드 접근 방식은 실시간 개인 설정 및 사기 감지와 같은 낮은 대기 시간 운영 워크로드와 규제 보고 및 내역 추세 분석과 같은 분석 워크로드를 모두 원활하게 지원하는 확장 가능, 관리 가능, 상호 운용 가능한 아키텍처를 보장합니다. 이 결정 가이드는 이러한 제약을 탐색하고 올바른 전략을 선택하는 방법을 이해하는 데 도움이 됩니다. ## 서비스 - **데이터 수집:** 데이터를 Salesforce Data 360에 복사하여 관리되는 정규 데이터 모델을 만듭니다. 다음을 수행해야 하는 경우에 적합합니다. - **전체적인 Customer 360 구축:** 편파 소스를 통합하고 신뢰할 수 있는 단일 프로필로 변환합니다. - ** 엄격한 규정 준수:** 데이터 액세스 및 계보를 엄격하게 제어할 수 있는 중앙 집중식으로 감사 가능한 사본을 만듭니다. - **Zero Copy Federation:** 중복 없이 외부 소스를 실시간으로 쿼리하여 실시간 개인 설정, 실시간 대시보드, 빠른 소스 온보딩을 활성화합니다. 균형을 맞추어야 하는 제약이 있는 두 가지 기본 옵션: - **라이브 및 캐싱(가속 쿼리):** Snowflake, Google BigQuery, Redshift 또는 Databricks와 같은 외부 데이터 플랫폼에 존재하는 데이터에 대한 대화형 분석 및 실시간 대시보드에 가장 적합합니다. 소스 시스템으로 프로세싱을 푸시하여 비용이 많이 드는 느린 데이터 중복을 방지합니다. - **파일 통합:** 클라우드 데이터 레이크(S3, ADLS)의 데이터에 대한 대규모 배치 처리 및 AI 모델 교육에 가장 적합합니다. 열려 있는 테이블 형식으로 파일을 직접 쿼리하여 ETL 및 데이터 과학 워크로드에 대한 대용량 데이터 집합을 잠금 해제하여 비용이 많이 들고 느린 수집을 방지합니다. - **하이브리드 모델:** 통합 프로필에 대한 수집을 연합하여 신선함, 옴니채널 참여, Agentforce 기반 작업, AI/ML 교육을 지원합니다. ### 중요 고려 사항 - **하이브리드 아키텍처:** 데이터 수집 및 데이터 연합을 혼합해야 하는 경우가 많습니다. - 정규 데이터 모델 및 핵심 관리를 위해 중요한 데이터에 대한 데이터 수집을 사용합니다. - Zero Copy를 통해 다른 모든 데이터를 통합하여 수집 데이터 파이프라인을 구축하고 유지 관리하는 운영 오버헤드를 최소화합니다. - **데이터 수집 주기 문제:** 비즈니스 가치, 대기 시간 요구, 운영 복잡성을 기반으로 주기를 선택합니다. - 시간에 민감한 워크플로를 실시간으로 사용합니다(개인화, 실시간 대시보드, Agentforce 작업). - 약간 긴급한 프로세스(캠페인, 운영 보고서)의 경우 거의 실시간입니다. - 내역 또는 저속 데이터 집합의 경우 배치 - **연합 패턴을 지연 및 성능에 맞춥니다.** 액세스 패턴 및 신선도, 성능, 비용에 대한 요구 사항에 가장 적합한 항목을 선택합니다. - 실시간 쿼리를 사용하여 운영 대시보드 및 실시간 개인 설정을 수행할 수 있으며, 대기 시간이 매우 적습니다. - 쿼리가 자주 쿼리되었지만 약간 오래된 결과가 허용되므로 성능과 비용의 균형을 유지할 수 있는 경우 캐싱(가속 쿼리)을 사용합니다. - 처리량이 많은 대규모 분석 또는 배치 워크로드에 파일 통합 사용하십시오. 이는 내역 데이터 집합이나 시간이 중요한 데이터 집합에 적합합니다. - **거버넌스를 데이터 보존 요구 사항에 맞게 조정:** - 중앙 집중화된 거버넌스가 중요할 때 수집을 사용합니다. - 외부 소스에 엄격한 관리를 적용하면서 분산된 관리를 허용하는 경우 연합을 사용합니다. Zero Copy는 행 수준 보안(RLS) 및 데이터 마스킹과 같은 소스 수준 정책을 준수합니다. - **고가치 워크플로를 위한 수집 우선 순위 지정:** ID 확인, 규제 보고, 운영 활성화와 같은 중요한 프로세스에 선택적으로 수집을 적용합니다. - **비용 및 복잡성은 결정을 주도합니다.** 실시간 수집은 비싸고 복잡할 수 있습니다. 설계자는 데이터 온보딩, 저장, 변환 비용을 Zero Copy를 통해 직접 쿼리하는 비용과 비교해야 합니다. 올바른 통합 패턴(데이터 수집, 제로 복사 또는 하이브리드 접근 방식)을 선택하면 다중 클라우드 플랫폼에서 대기 시간, 거버넌스, 운영 효율성, 비용에 직접적인 영향을 미칩니다. 이 결정은 실시간 인사이트, AI 기반 활성화, 맞춤형 참여를 신뢰할 수 있고 대규모로 전달하는 방법을 결정합니다. ## 제품 비교 이 표에서는 엔터프라이즈 사용 사례 및 결과와 함께 기능, 제약, 이점에 초점을 맞춘 Salesforce Data 360의 데이터 수집 및 제로 복사 패턴을 기술적으로 비교합니다. 설계자는 성능, 비용, 규정 준수에 균형을 맞추는 하이브리드 멀티 클라우드 데이터 플랫폼을 설계하기 위한 참조로 사용할 수 있습니다.
패턴 유형 모드/도구 혜택 고려 사항 결과
데이터 수집 실시간: CDC 지원을 통해 수집 API를 통한 2초 미만의 지연 수집 연속 스트리밍 파이프라인. - 즉각적 인사이트
- 대기 시간이 낮은 운영 및 개인 설정 사용 사례에 적합
- 이벤트 중심 워크플로 지원
- 높은 비용
- 복잡한 아키텍처
- 저 대기 시간 소스 시스템 필요
- 대용량 소스는 과도한 스트리밍으로 인해 파이프라인이 채워질 수 있습니다.
- 입출력 집약
- 선택적 필드 및 필터링을 고려하여 오버헤드 줄이기
Agentforce:
- 실시간 사기 경고, 리테일 개인 설정, 운영 경고
Analytics:
- 초과 대시보드, KPI 모니터링
규정 준수:
- 규제된 워크플로에 대한 지속적인 고객 레코드 업데이트
스트리밍: 네이티브 커넥터를 통해 1~3분마다 마이크로 배치 수집 - 균형 잡힌 비용 및 새로 고침 비교
- 실시간 대비 더 간단한 아키텍처
- 증분 업데이트 지원
- 약간의 대기 시간
- 중요한 하위 초 결정에 적합하지 않을 수 있습니다.
- 배치 크기가 메모리/계산에 영향을 미칩니다.
- I/O가 보통
- 예측 가능한 반복 업데이트 패턴에 가장 적합
- 프로세싱 부하를 줄이기 위해 윈도우가 포함된 집계를 고려합니다.
Agentforce:
- 적시에 캠페인 트리거, 근시 참여
Analytics:
- 권장 사항 엔진, 근접 대시보드
규정 준수:
- 감사 기능이 있는 자주 업데이트
배치: 커다란 볼륨 로드를 커넥터 또는 API를 통해 예약합니다. 개체 저장소 및 ETL/ELT 파이프라인을 지원합니다. - 대량 데이터 집합의 비용 효율성
- 쉽게 구현
- 내역 분석을 신뢰할 수 있음
- 데이터 대기 시간
- 시간이 많은 작업에 적합하지 않음
- 로드 기간 동안 I/O 집약성
- 네트워크 처리량이 대용량 파일의 지체 지점이 될 수 있습니다.
- 내역 집계 또는 규제된 보고 워크플로에 가장 적합
Agentforce:
- IT 지원 티켓(Jira/ServiceNow), 집계된 워크플로
Analytics:
- 내역 분석, 추세 평가
규제 준수:
- 규제 보고, 환자/ 청구 데이터 집계
영제 복제본 Live Query: 외부 시스템에서 직접 쿼리, 스키마 읽기, 데이터 중복 없음 - 최대 새로 고침
- 최소 저장소 오버헤드, 실시간 운영 인사이트 지원
- 소스 성능에 종속
- 쿼리 용량이 많은 경우 대기 시간에 영향을 미칠 수 있습니다.
- 입출력 최소화를 위한 조건자 푸시다운 및 집계가 있는 쿼리에 적합합니다.
- 대량 데이터 집합에서 필터링되지 않은 쿼리 방지
Agentforce:
- 실시간 활동에 적응하는 동적 워크플로
Analytics:
- 운영 대시보드, 실시간 보고
규정 준수:
- 소스에서 행 수준 보안 및 마스킹 준수
고속 쿼리(캐싱): 연합 쿼리에 대해 캐시된 로컬 복제본. 15분~7일 사이에 구성할 수 있습니다. 최적화된 쿼리 실행 - 대기 시간 줄이기
- 반복 실시간 쿼리보다 비용이 낮음
- 자주 액세스하는 패턴의 성능 향상
- 캐시 관리 필요
- 중단은 캐시 간격에 따라 다릅니다.
- 빈도가 높은 쿼리에 가장 적합
- 초과 결정에 적합하지 않음
Agentforce:
- 빠른 결정을 위한 사전 집계된 참여 메트릭
Analytics:
- BI 대시보드, 세분화, 분석 보고
규정 준수:
- 감사 로그가 있는 일관된 규제 대시보드
파일 통합: 객체 저장소 또는 호수(S3, Iceberg, Google BigQuery, Redshift)의 대규모 기록 데이터 집합에 직접 액세스합니다. - 대규모 데이터 집합 처리
- Data 360의 최소 저장소
- AI/ML 워크로드 지원
- 읽기 전용
- 쿼리 성능은 외부 시스템 처리량에 따라 다릅니다.
- 처리량이 많은 배치 작업에 최적화됨
- 실시간 대시보드에 적합하지 않음
Agentforce:
- (일반적이지 않음 - 일괄 처리 중)
Analytics:
- ML/AI 교육, 내역 분석, 페타바이트 규모 보고
규정 준수:
- 중복 없이 외부 데이터 집합에 대한 관리 액세스
## Data 360 통합 패턴 ### 데이터 수집 데이터 수집을 사용하면 데이터가 소스에 남아 있는 Zero Copy와 달리 데이터가 Data 360에 물리적으로 복사되고 완전히 관리됩니다. 중앙 집중식 관리 및 감사를 허용하는 Data 360 내에서 변환을 계산합니다. #### 데이터 수집 사용 사례 데이터 수집을 사용하여 규정 준수 및 운영 관리를 위해 Salesforce Data 360에 정규 관리 데이터 집합을 저장합니다. 전체 제어, 감사, 추적 가능성이 필요한 경우 수집을 사용합니다. 중앙 집중식 계산 및 거버넌스가 중요한 규제 또는 가치가 높은 워크플로에 적합합니다. 수집은 ID 확인, 규제 보고, 미션 크리티컬 AI 중심 워크플로 및 고객 참여를 위한 신뢰할 수 있는 기반을 구축하는 데 가장 적합합니다. 데이터 수집 개요 #### 데이터 수집 방법 데이터 수집 방법은 데이터 수집에 사용하는 커넥터에 따라 다릅니다. 일부 커넥터는 다양한 수집 방법을 제공하며, 다른 커넥터는 배치 또는 스트리밍 모드에서만 작동합니다. [Data 360을 참조하십시오. Data 360 커넥터 및 사용 가능한 방법의 전체 목록에 대한 통합 및 커넥터](https://help.salesforce.com/s/articleView?id=data.c360_a_sources_targets.htm&type=5)입니다. - **실시간** - 스트리밍 파이프라인 또는 변경 데이터 수집(CDC)을 사용하여 초과 수집 - 시간이 중요한 워크플로(사기 감지, 개인 설정, 운영 대시보드)에 가장 적합합니다. - Data 360 내에서 변환 및 집계를 푸시하여 다운스트림 I/O를 줄이고 계산 사용량을 최적화합니다. 증분 CDC를 사용하여 데이터 섞기를 최소화합니다. - **스트리밍** - 1~3분마다 소규모 증분으로 수집합니다. - 캠페인 오케스트레이션, 거의 실시간 참여, 운영 보고에 적합한 신선함과 비용의 균형을 맞춥니다. - 마이크로 배치를 사용하여 입출력 급증을 제어합니다. 가능한 경우 소스에서 데이터를 집계하여 전송량을 줄이고 저장소를 최적화합니다. - **배치(예약 로드)** - 대규모 데이터 집합을 정기적으로 수집합니다(시간별, 매일, 매주). - 내역 데이터 집합, 규제 보고, 규정 준수 사용 사례에 비용 효율적이고 신뢰할 수 있습니다. - 성능 및 비용을 최적화하기 위해 소스 저장소와 동일한 지역의 지역성을 계산하십시오. #### 설계자 플레이북 - **데이터 수집을 위한 사용 사례** - **Customer 360 통합 프로필 생성:** 고객 ID 및 특성에 대한 신뢰할 수 있는 단일 소스를 구축합니다. - **규제 준수 데이터 집합 유지:** 중요한 데이터에 대한 거버넌스, 계보, 감사 가능성을 적용합니다. - **캠페인 오케스트레이션 중앙 집중화:** 마케팅, 세일즈, 서비스가 모두 일관되고 신뢰할 수 있는 데이터 집합에서 작동하도록 합니다. - **설계 관행** - 보관 보고 또는 정기 스냅샷 등 과거 또는 저 대기 허용 요구 사항에 대한 배치 수집을 추천합니다. - CDC 또는 스트리밍 API를 사용하여 운영 및 개인 설정 워크플로를 최신 상태로 유지하여 실시간에 가까운 업데이트를 보장합니다. - 비용 및 효율성을 최적화하기 위해 전체 데이터 집합을 다시 로드하는 대신 증분 로드를 적용하여 저장소 및 계산 성장을 제어합니다. - 수집 파이프라인을 계산 로캘 및 증분 처리에 맞춰 네트워크 I/O를 줄입니다. Data 360 내에서 변환을 적용하여 불필요하게 원시 데이터를 이동하지 않도록 합니다. - **비용 고려 사항** - **실시간 수집:** 가장 높은 컴퓨팅 및 파이프라인 비용; 개인 설정, 운영 대시보드 또는 Agentforce 구동 작업과 같은 시간에 민감한 가치가 높은 워크플로에 적합합니다. - **스트리밍 수집:** 캠페인 오케스트레이션 또는 운영 보고와 같은 약간의 지연을 허용할 수 있는 자주 업데이트에 적합한 계산 및 저장 비용을 중재합니다. - **배치 수집:** 계산 비용 및 예측 가능한 저장소 절감 - 내역 데이터 집합 또는 저주량 업데이트에 가장 적합합니다. 특정 커넥터를 사용하여 Salesforce 조직에서 배치 데이터를 수집하는 것은 무료입니다. - **새로 고침 모드:** 증분 새로 고침 모드를 선택하면 총 수집 및 계산 비용이 절감됩니다. 가능한 경우 증분 새로 고침을 사용하여 모든 수집 유형 전반에서 효율성을 최적화하는 것이 좋습니다. - 비용은 소스에서 Data 360으로의 I/O 용량에도 영향을 받습니다. 배치 크기, 파티션, 지역 정렬을 최적화하면 전송 비용이 절감되고 성능이 향상됩니다. - **산업 시나리오** - **금융:** 감사 가능성 및 규정 준수는 협상할 수 없는 고객 파악(KYC), AML(Anti Money Laundering) 및 사기 감지에 필요한 데이터 집합을 수집합니다. - **헬스케어:** 환자 ID 확인 및 HIPAA 준수 레코드에 수집을 사용하여 안전하고 통합된 보기를 활성화합니다. - **소매:** 세일즈 지점(POS), 전자상거래, 충성도 프로그램 데이터를 통합 프로필로 통합하여 세분화 및 개인 설정 - **Telecom:** 정규 관리형 구독자 데이터로 이탈 방지 및 사용량 분석을 지원합니다. #### 데이터 수집 방법 결정 기준
기능 실시간 수집 스트리밍 수집 배치 수집
지연성과 신선함 변경 데이터 수집(CDC)을 지원하는 수집 API를 통해 초과 대기 시간 수집 연속 스트리밍 파이프라인을 제공합니다. 대기 시간이 낮은 운영 사용 사례에 가장 적합합니다. 네이티브 커넥터를 통해 1~3분마다 마이크로 배치 수집 증분 업데이트를 지원합니다. 약간의 대기 시간이 예상됩니다. 데이터 대기 시간이 예상됩니다. 예약된 대용량 로드. 정기 수집(시간별, 매일, 매주). 시간이 많은 작업에 적합하지 않습니다.
기본 사용 사례 대기 시간이 낮은 운영 및 개인 설정 사용 사례에 적합합니다. 시간이 중요한 워크플로에 사용됩니다. 이벤트 중심 워크플로를 지원합니다. 실시간 사기 경고 및 운영 경고에 사용됩니다. 매우 긴급한 프로세스에 적합합니다. 캠페인 오케스트레이션, 실시간 참여, 운영 보고에 사용됩니다. 적시에 캠페인 트리거에 사용됩니다. 대량 데이터 집합의 경우 비용 효율적입니다. 내역 분석을 신뢰할 수 있습니다. 내역 집계 또는 규제된 보고 워크플로에 사용됩니다. 내역 또는 저속 데이터 집합에 가장 적합합니다.
아키텍처 복잡성 및 I/O 비용이 많이 들고 복잡한 아키텍처입니다. 저 대기 시간 소스 시스템이 필요합니다. 입출력 집약적입니다. 대용량 소스는 포화 파이프라인을 야기할 수 있습니다. 실시간보다 더 간단한 아키텍처입니다. 입출력은 보통입니다. 예측 가능한 반복 업데이트 패턴에 가장 적합합니다. 배치 크기는 메모리/계산에 영향을 미칩니다. 구현하기 쉽습니다. 로드 기간 동안 I/O 집약성 네트워크 처리량은 대량 배치의 지체 지점이 될 수 있습니다.
비용 고려 사항 가장 높은 계산 및 파이프라인 비용. 중요한 시간에 중요한 가치가 높은 워크플로에 대해서만 유효합니다. 계산 및 저장소 비용을 중재합니다. 균형 잡힌 비용 및 새로 고침 대비 접근 방식을 제공합니다. 약간의 지연을 허용할 수 있는 자주 업데이트에 적합합니다. 계산 비용 및 예측 가능한 저장소를 절감합니다. 내역 데이터 집합 또는 낮은 빈도 업데이트에 권장됩니다. Salesforce 내부 파이프라인을 통한 수집은 무료입니다.
설계 관행 증분 CDC를 사용하여 데이터 섞기를 최소화합니다. 선택적 필드를 필터링하고 사용하여 오버헤드를 줄입니다. 마이크로 배치를 사용하여 입출력 급증을 제어합니다. 프로세싱 부하를 줄이려면 윈도우가 포함된 집계를 고려하십시오. 보관 보고 또는 정기 스냅샷의 경우 이 옵션을 사용하십시오. 비용을 최적화하기 위해 소스 저장소와 동일한 지역의 지역성을 계산하십시오.
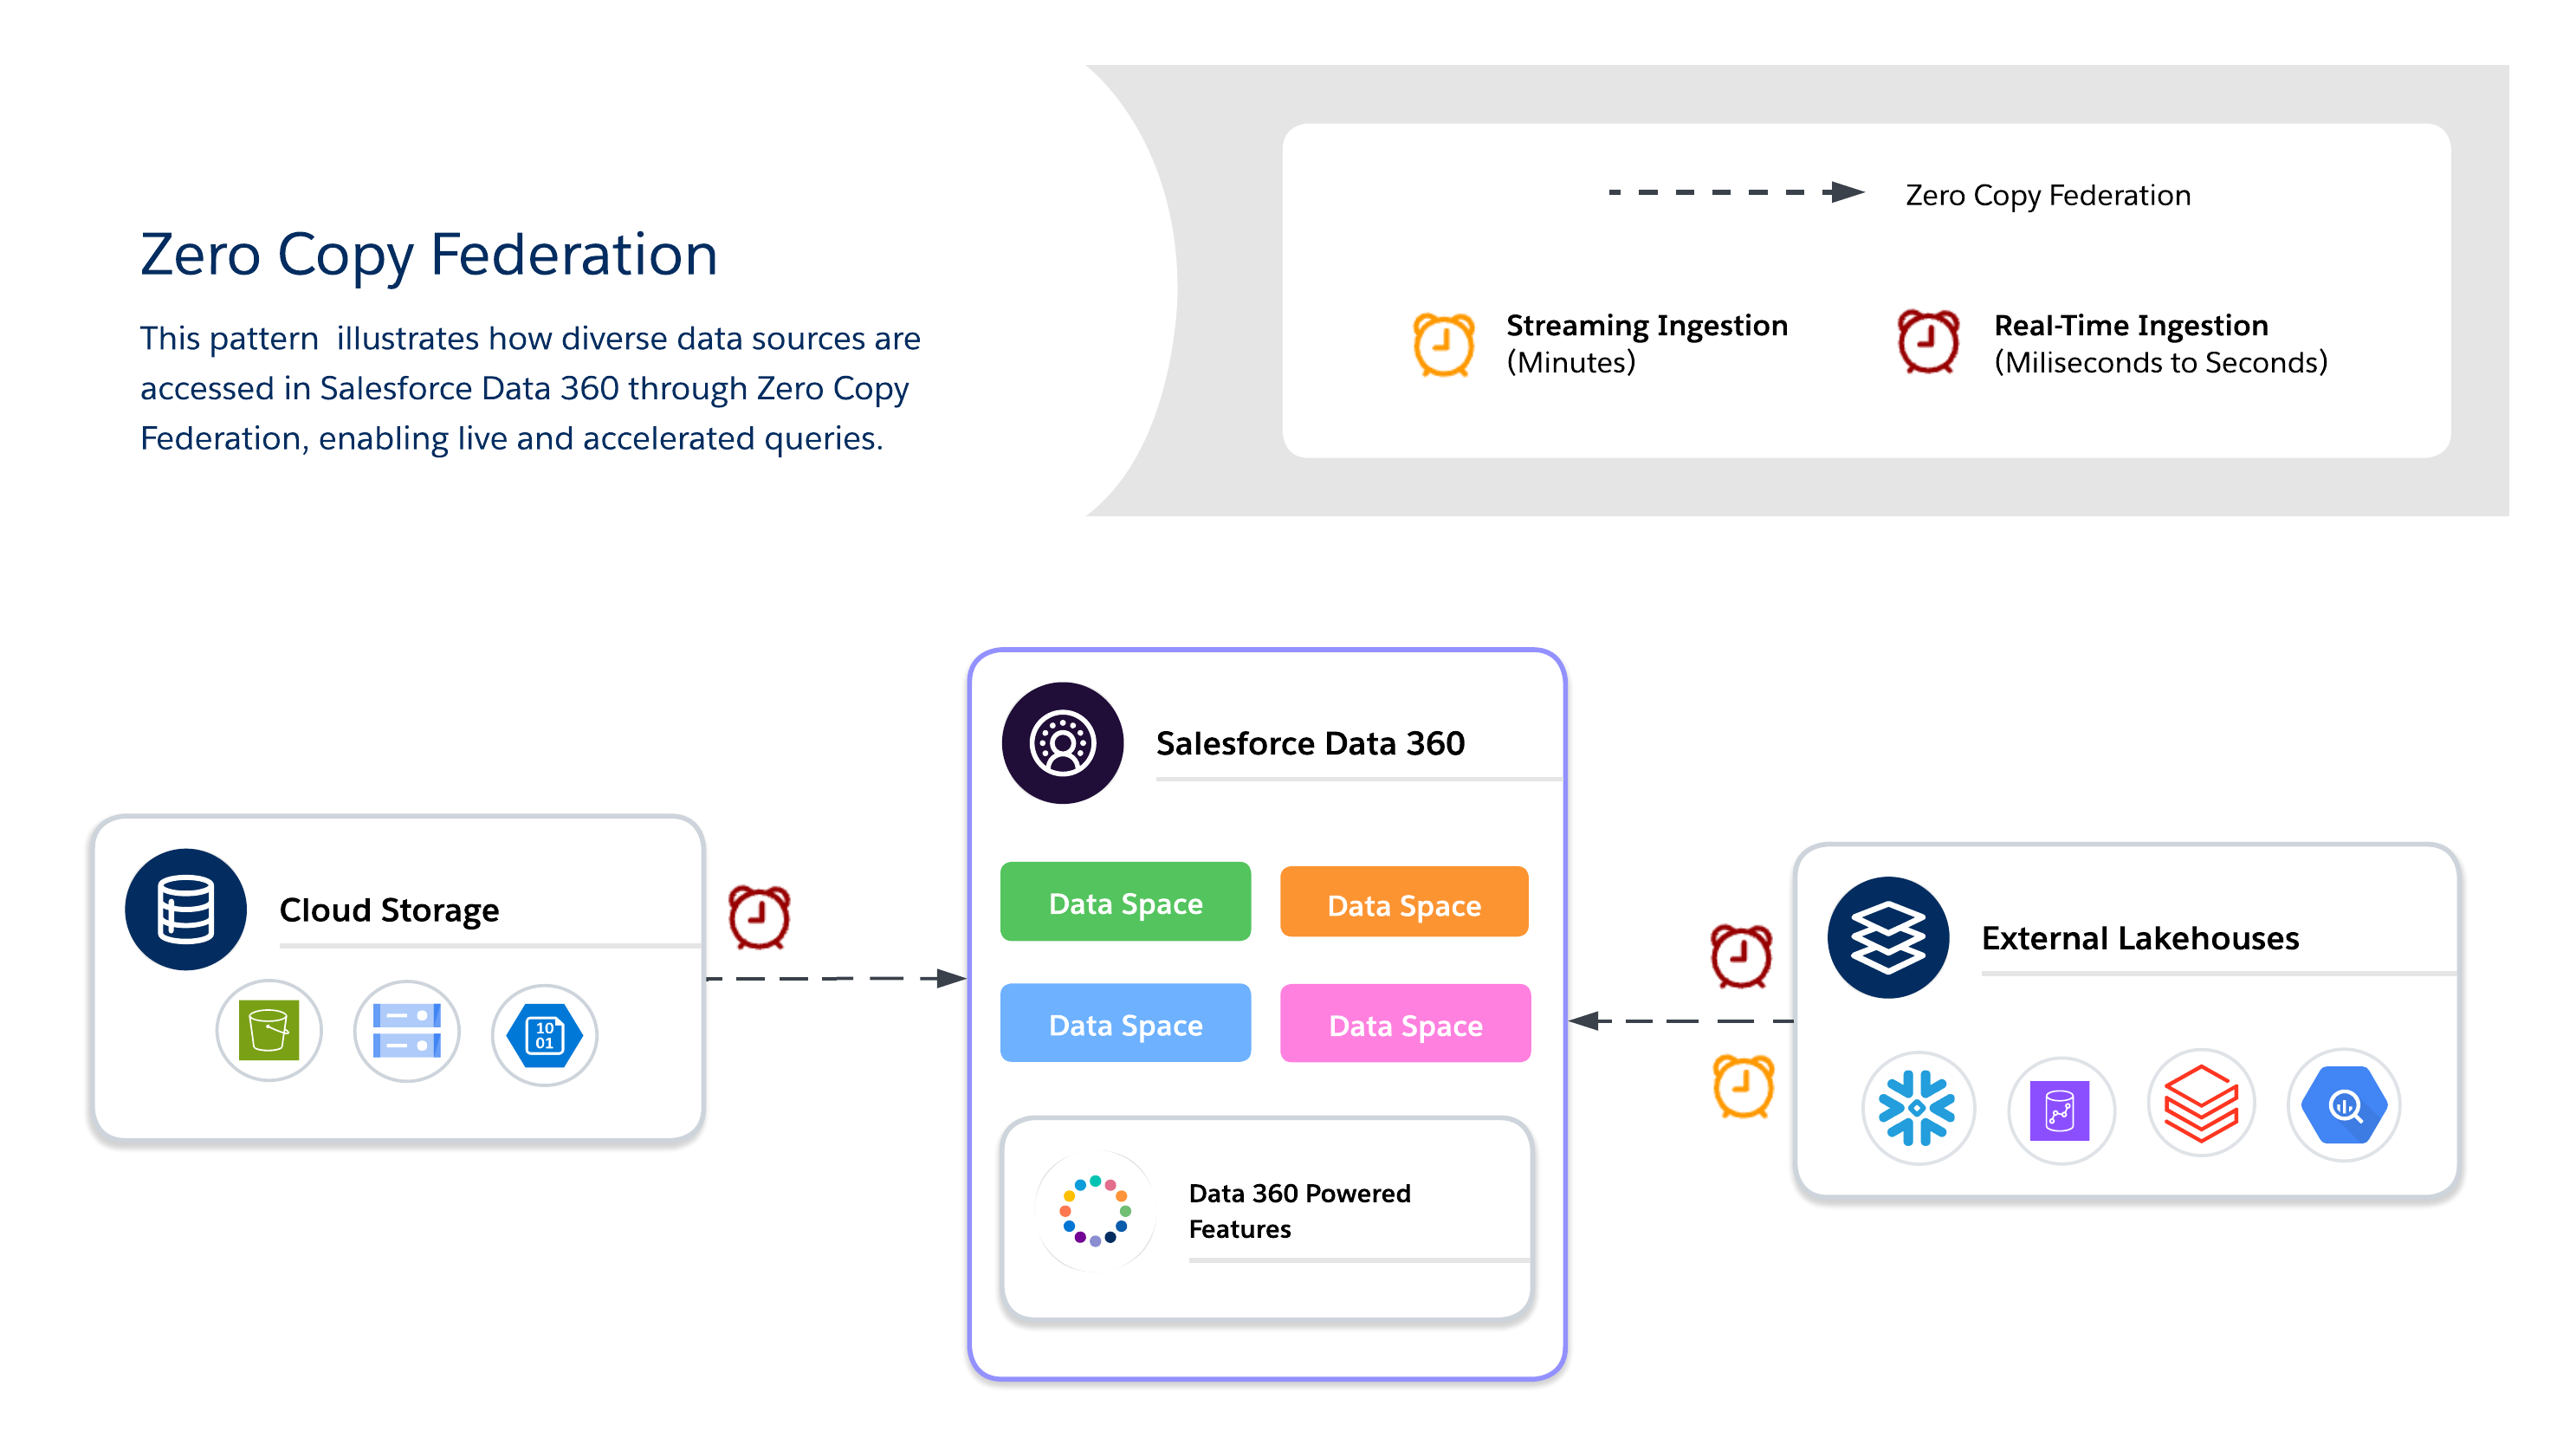
### 제로 카피 데이터 연합 #### 제로 카피 사용 사례 데이터 중복 없이 외부 시스템을 실시간으로 쿼리하려면 Zero Copy를 사용하여 대규모 또는 임시 데이터 집합에 대한 유연성, 새로 고침, 확장 가능한 액세스를 활성화합니다. 라이브 대시보드, 탐색 분석, AI/ML 모델 교육, Salesforce Data 360을 통해 직접 실시간 고객 참여에 가장 적합합니다. Zero Copy Data Federation 개요 #### 제로 카피 메서드 Zero Copy를 사용할 경우 아키텍처는 사용 가능한 세 가지 데이터 연합 메서드를 추가로 결정해야 하며, 각각은 신선도, 성능, 비용 사이에 고유한 제약을 제공합니다. - **Live Query** - 데이터 중복 없이 외부 시스템(Snowflake, Google BigQuery, Redshift, Databricks 등)에 대해 직접 쿼리를 실행합니다. - 조건자 및 집계를 푸시하여 네트워크를 통한 데이터 이동을 최소화하고 Salesforce Data 360 계산의 I/O를 줄일 때 최적화됩니다. - 실시간 인사이트 및 대기 시간이 낮은 운영 대시보드에 가장 적합합니다. 외부 시스템의 성능에 따라 다릅니다. - **캐싱(고속 쿼리)** - Salesforce Data 360에 연합 데이터의 캐시된 사본을 임시로 저장합니다. - 구성 가능한 기간(분~일)으로 자주 액세스하는 데이터 집합에 대한 반복 쿼리 비용 및 대기 시간을 줄입니다. - 데이터는 영구적으로 복사되거나 완전히 관리되지 않으며, 소스에서 예약된 새로 고침을 통해 최신 상태를 관리합니다. - **파일 통합** - 개체 저장소의 대규모 데이터 집합에 대한 직접적인 읽기 전용 액세스 권한을 제공합니다(예: S3, GCS with Iceberg). - 데이터를 이동하지 않고 AI/ML 워크로드, 내역 분석, 페타바이트 규모 보고에 가장 적합합니다. - 쿼리 성능은 개체 형식, 분할, 네트워크 I/O에 크게 의존합니다. 최적화되지 않은 경우 대규모 스캔에서 상당한 I/O를 생성할 수 있습니다. #### 설계자 플레이북 - **사용 사례** - **실시간 맞춤화 및 적응형 워크플로우:** 고객 동작이 변화함에 따라 동적 제안, 권장 사항, 차선 조치를 제공합니다. - **실시간 대시보드 및 운영 분석:** 외부 웨어하우스에서 직접 비즈니스에 중요한 대시보드 및 KPI를 강화합니다. - **대형 외부 데이터 세트를 사용하는 AI/ML 모델 교육:** 파일 통합 이동하지 않고 데이터 레이크 및 창고에서 페타바이트 규모의 데이터를 활용합니다. - **산업 시나리오** - **소매/미디어:** 클릭스트림 또는 콘텐츠 상호 작용 데이터를 연합하여 맞춤형 권장 사항 및 실시간 고객 참여를 활성화합니다. - **금융:** 중요한 데이터를 복제하지 않고 외부 창고를 쿼리하여 사기 감지 및 위험 점수 매기기를 거의 실시간으로 실행합니다. - **Tech/Enterprise:** 데이터 집합이 여러 시스템에 있는 클라우드 간 보고, IT 서비스 대시보드, 운영 분석을 지원합니다. - **설계 관행** - **Live Query** - 신선도가 중요할 경우 높은 QPS 및 낮은 대기 시간 쿼리에 사용합니다. - 외부 시스템에 조건자 및 집계를 푸시하여 네트워크를 통한 데이터 교체를 줄입니다. - 불필요하게 대용량 데이터를 스캔하는 쿼리를 피하십시오. 파티션 자르기 및 필터링을 고려하십시오. - **파일 통합** - 수집하지 않고 개체 저장소에서 페타바이트 규모의 데이터 집합에 액세스합니다. - Salesforce 계산과 동일한 클라우드 지역에 개체 저장소를 유지하여 대기 시간 및 탈퇴 비용을 최소화합니다. - 분할된 열 형식(Parquet/ORC) 및 푸시다운 필터를 사용하여 입출력 및 네트워크 전송을 줄입니다. - 쿼리 및 조건자 푸시다운을 활용하여 소스에서 데이터를 필터링하고 집계하여 데이터 이동을 줄입니다. - 필요한 경우를 제외하고 I/O, 대기 시간, 비용이 증가하므로 지역 간 데이터 액세스를 방지하십시오. - **캐싱(고속 쿼리)** - 자주 액세스하는 데이터 집합을 캐시하여 비용과 성능의 균형을 맞춥니다. - 새로 고침 간격을 구성하여 새로 고침과 쿼리 비용의 균형을 맞춥니다. - **규정 준수:** 연합 시스템 내에서 직접 행 수준 보안(RLS) 및 마스킹 정책을 활용하여 소스에 관리를 적용합니다. 다음은 플랫폼 전반에서 균일한 RLS 및 마스킹에 대한 모범 사례입니다. - **중앙 집중식 엔터프라이즈 ID 사용:** Salesforce Data 360의 사용자 및 엔티티를 외부 시스템의 ID에 해당하는 고유한 중앙 집중식 엔터프라이즈 식별자에 매핑합니다. - **보안 정책 조정:** 매핑된 ID를 기반으로 연합 시스템의 행 수준 보안 및 마스킹 정책이 적용되는지 확인합니다. 이렇게 하면 외부 데이터를 쿼리할 때 규정 준수를 유지할 수 있습니다. - **ID 스키마 표준화:** 모든 데이터 소스에서 일관된 ID 특성(이메일, 사용자 ID, 고객 ID 등)을 유지하여 불일치 및 액세스 위반을 방지합니다. - **비용 고려 사항** - **Live Query:** Pay-per-query 모델 - 외부 레이크하우스 계산에 비용이 발생하고 QPS가 높은 경우 급증할 수 있습니다. 가치가 비용 변수보다 큰 신선도에 중요한 사용 사례에 가장 적합합니다. - **고속 쿼리(캐싱):** 소스 시스템에 대한 호출을 줄여 라이브 쿼리와 비교하여 쿼리 비용을 절감하지만 캐시 채우기 및 새로 고침에 대한 배치 데이터 수집 비용을 늘립니다. 자주 액세스하는 데이터 집합에 가장 적합합니다. - **파일 통합:** 개체 저장소에서 데이터로 저장하는 가장 저렴한 저장소 옵션이지만 쿼리 비용은 파일 크기, 분할, 축소에 따라 다릅니다. 페타바이트 규모의 내역 또는 대량 데이터에 가장 적합합니다. #### 제로 복사 방법 결정 기준
결정 지점 라이브 쿼리 캐싱(가속 쿼리) 파일 통합
데이터 소스 위치 외부 데이터 레이크하우스(Snowflake, Google BigQuery, Redshift, Databricks). 외부 데이터 레이크하우스(Snowflake, Google BigQuery, Redshift, Databricks) 개체 저장소 또는 클라우드 데이터 레이크(S3, ADLS, GCS)에서 Iceberg와 같은 열려 있는 테이블 형식을 사용하는 경우가 많습니다.
용도/사용 사례 대화형 분석 및 실시간 대시보드에 이상적입니다. 실시간 개인 설정 및 동적 워크플로에 가장 적합합니다. 쿼리가 자주 이루어지지만 결과가 약간 오래된 경우에 적합합니다. BI 대시보드 및 세분화에 적합합니다. 대규모 배치 처리 및 AI/ML 모델 교육에 가장 적합합니다. 내역 분석 및 페타바이트 규모 보고에 적합합니다.
신선도/대기 시간 최대한의 새로 고침, 쿼리가 실시간으로 직접 실행됩니다. 초과 결정을 지원합니다. 약간 오래된 결과는 허용됩니다. 새로 고침은 캐시 간격에 따라 다르며 15분에서 7일 사이에 구성할 수 있습니다. 처리량이 많은 배치 작업에 최적화됩니다. 실시간 대시보딩에 적합하지 않습니다.
액세스 패턴 드물거나 특정 쿼리에 가장 적합합니다. QPS가 높은(초당 쿼리), 대기 시간이 낮은 쿼리에 대해 사용합니다. 빈도가 높은 읽기 시나리오에 가장 적합합니다. 자주 사용하는 액세스 패턴에 대한 성능을 개선합니다. 읽기 전용 액세스. 수집하지 않는 페타바이트 규모의 데이터 집합에 적합합니다.
성능 드라이버 외부 소스 시스템의 성능에 크게 의존합니다. 조건자 및 집계를 소스로 푸시할 수 있는 경우 최적화됩니다. 반복 실시간 쿼리와 비교하여 대기 시간을 줄입니다. 성능은 캐시 관리 및 간격에 따라 다릅니다. 성능은 개체 형식, 파티션 분할 및 외부 시스템 처리량에 크게 의존합니다. 분할된 열 형식(Parquet/ORC)을 사용합니다.
비용 영향 쿼리별 결제 모델. 외부 레이크하우스 계산에 따른 비용입니다. 자주 사용하지 않는 쿼리에 비용 효율적이지만, 초당 QPS(쿼리) 용량이 많은 경우 비용이 급증할 수 있습니다. 반복 실시간 쿼리보다 비용이 낮습니다. 외부 소스를 반복적으로 쿼리할 필요가 줄어듭니다. 캐시 저장소 및 새로 고침 오버헤드를 추가합니다. 가장 저렴한 저장소 옵션입니다. 쿼리 비용은 파일 크기 및 분할에 따라 다릅니다.
핵심 고려 사항 불필요하게 대량의 데이터를 스캔하는 필터링되지 않은 쿼리를 피하십시오. 캐시 관리가 필요합니다. 초과 결정에는 적합하지 않습니다. 쿼리 성능은 분할 및 조건자 푸시다운을 통한 최적화에 크게 의존합니다.
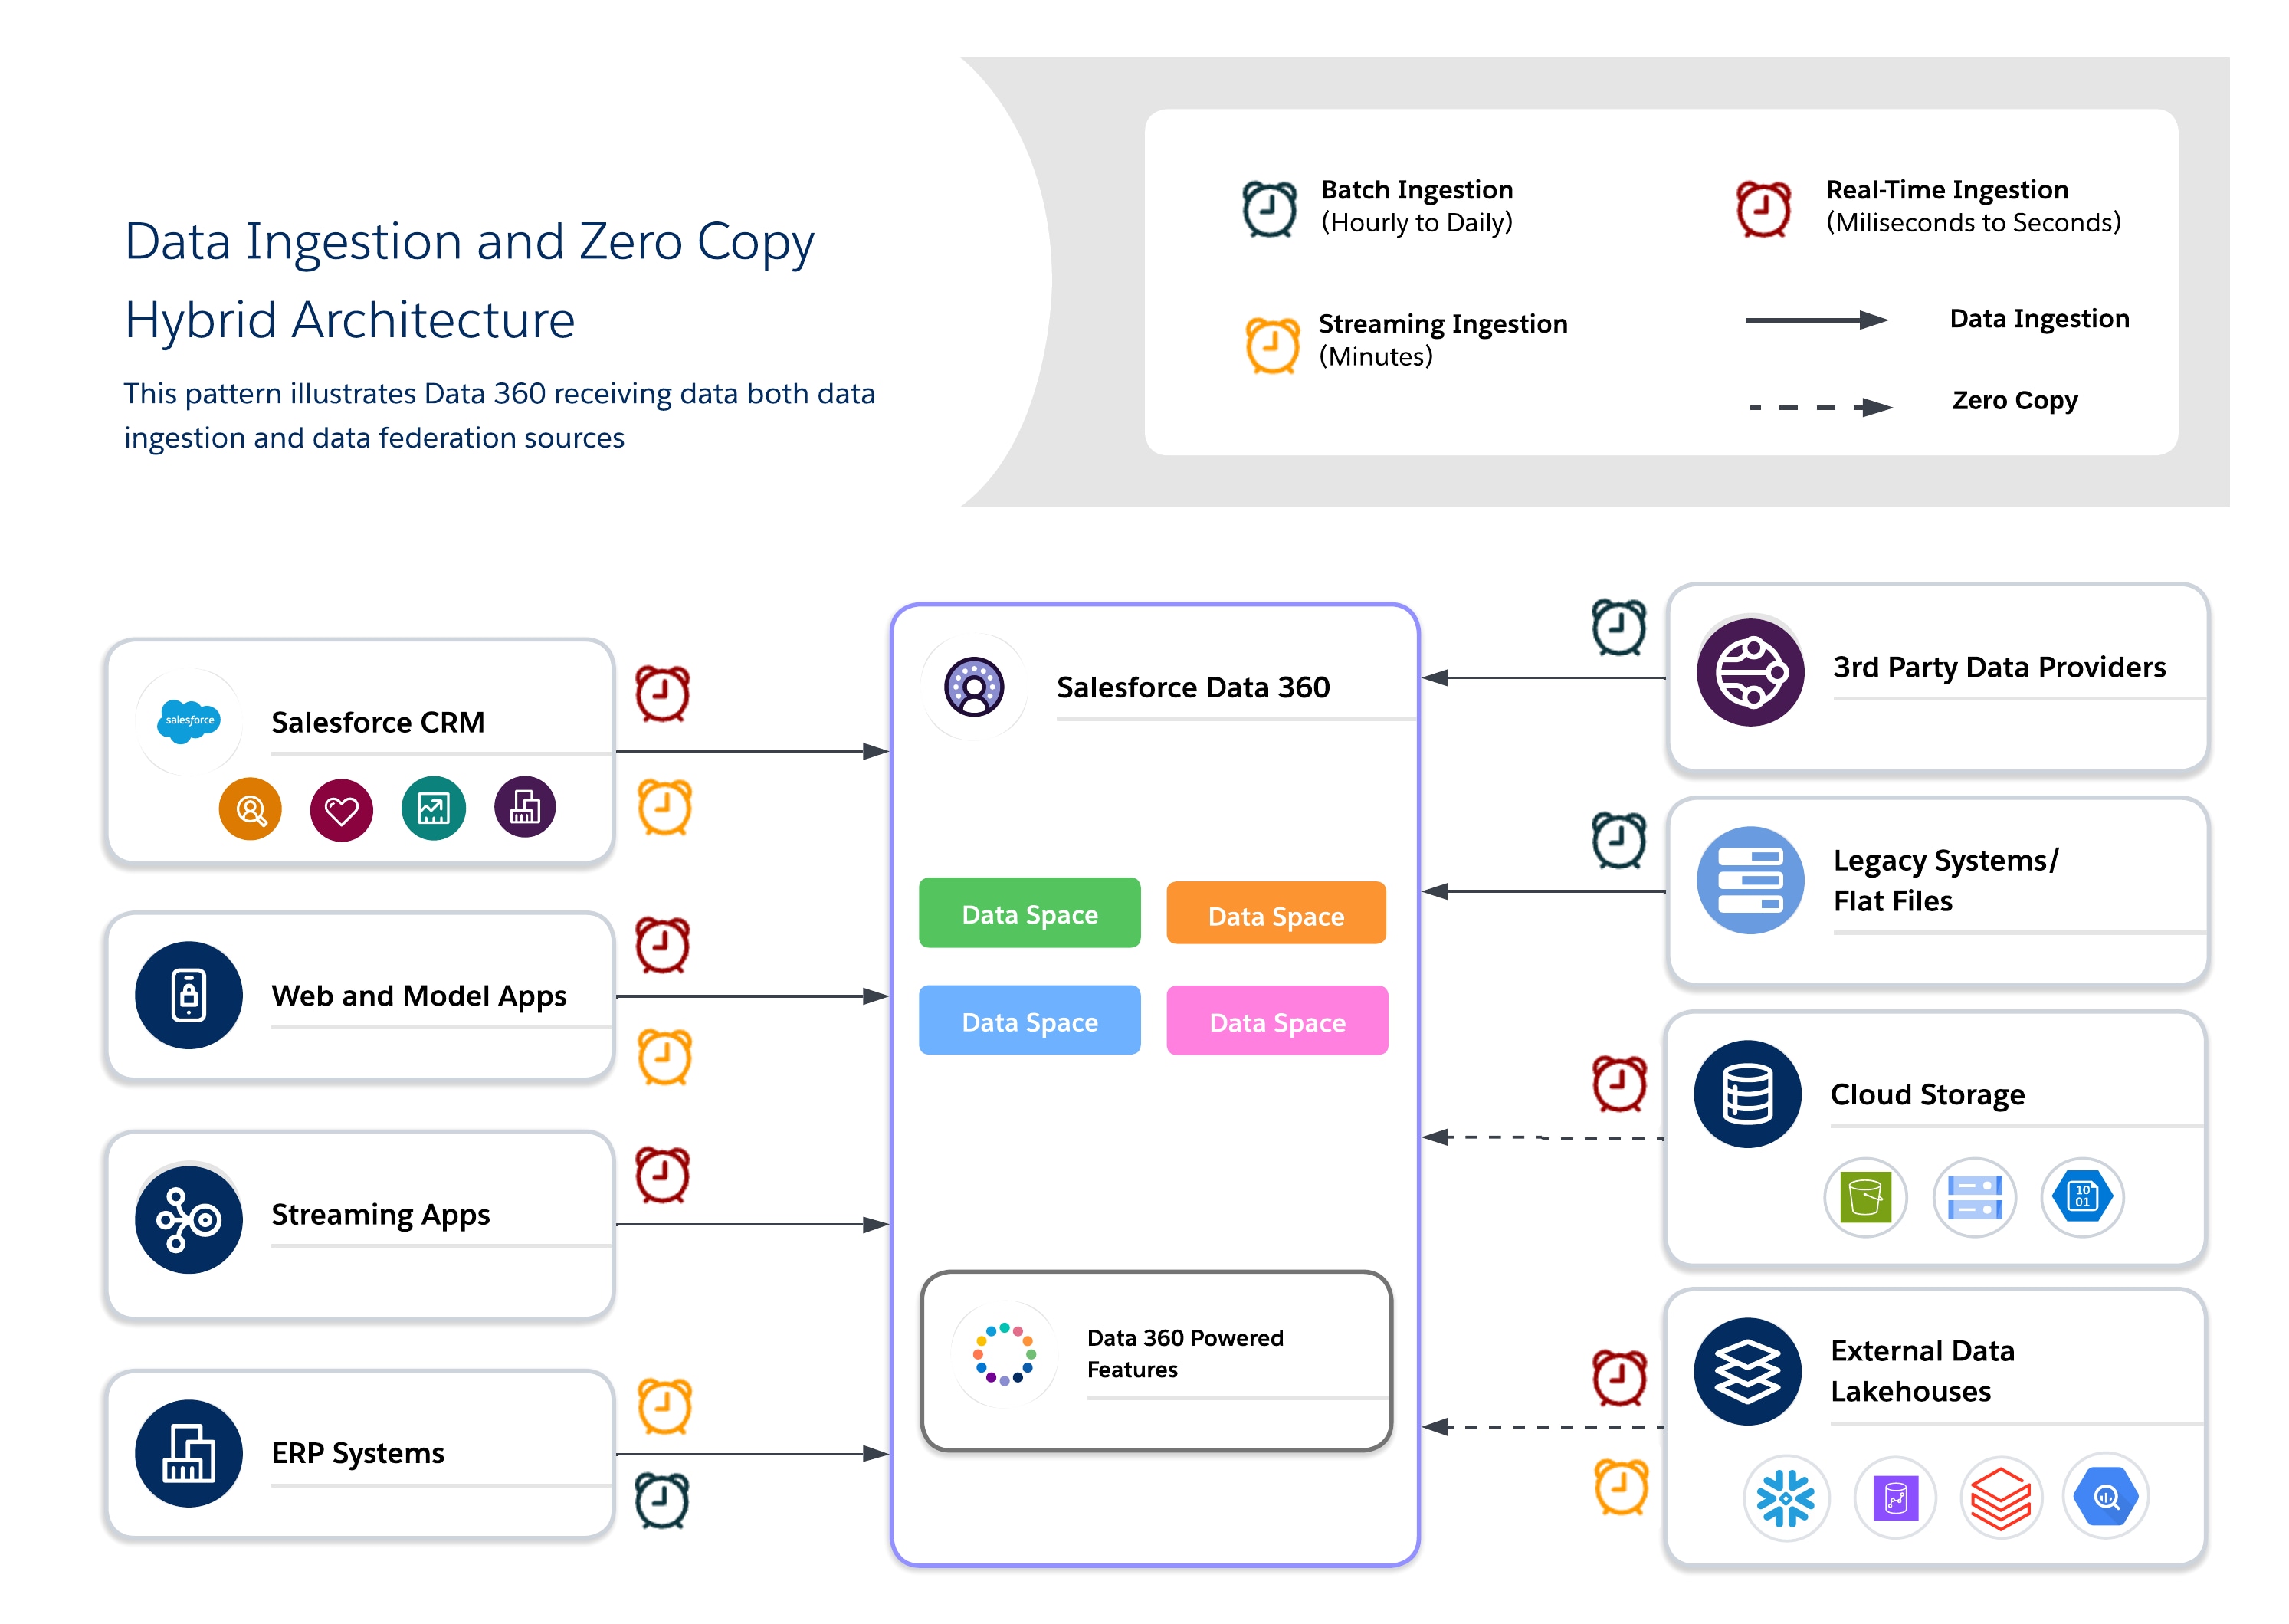
### 하이브리드 접근 방식 하이브리드 아키텍처를 사용하면 아키텍처가 Data 360에서 중요 데이터 집합을 앵커링하여 중앙 집중식 관리를 수행하고 연합 쿼리를 활용하여 대규모 외부 데이터 집합에 대한 신선함, 중복을 줄이고 확장 가능한 액세스를 할 수 있습니다. 이 접근 방식은 입출력, 현지, 비용, 규정 준수 요구 사항의 균형을 맞춥니다. #### 하이브리드 사용 사례 데이터 수집 및 복제 제로를 결합하여 실시간 실행 가능한 인사이트를 제공하여 균형 잡힌 거버넌스, 신선함, 운영 효율성을 위해 하이브리드 접근 방식을 사용합니다. 추적 가능성, RLS, 마스킹이 필요한 규제된 가치가 높은 데이터 집합에 대한 수집을 사용하고, 신속성 및 성능이 중요한 임시 또는 대용량 데이터 집합에 대한 연합을 사용합니다. 하이브리드 접근 방식 개요 #### 설계자 플레이북 - **사용 사례** - **옴니채널 참여:** 내역 고객 데이터를 실시간 동작과 결합하여 상황에 맞는 일관된 환경을 제공합니다. - **AI/ML 파이프라인:** 선별된 정규 데이터 집합에서 모델을 교육하고 외부 소스의 원시 또는 실시간 신호로 보강합니다. - **조합 규정 준수 및 민첩성 요구 사항:** 중요한 데이터에 엄격한 관리를 적용하지만 운영 유연성을 위해 연합을 적용합니다. - **산업 시나리오** - **소매:** ID 확인 및 프로필 통합에 수집을 사용하고 실시간 제안 및 개인 설정을 위해 연합합니다. - **헬스케어:** 수집을 통해 금형 환자 레코드를 유지하면서 즉각적인 컨텍스트를 위해 IoT 장치 스트림 및 센서 데이터를 연합합니다. - **재무 서비스:** 규제된 데이터를 규정 준수 관리 레이크에 수집하고 사기 감지 및 위험 모니터링을 위해 외부 쿼리를 연합합니다. - **설계 관행** - ** 수집을 통한 앵커 거버넌스:** 높은 가치 또는 규제된 데이터를 정규 모델로 수집하여 Trust 및 규정 준수를 보장합니다. - **신선을 위한 연합 사용:** 외부 레이크하우스에서 중복 없이 실시간 또는 대규모 데이터 액세스를 제공할 수 있습니다. - **잔액 비용 vs. 성능:** 프로필 워크로드를 통해 수집할 항목과 연합을 결정하여 불필요한 저장소 또는 쿼리 비용을 최소화합니다. - **계층형 거버넌스 적용:** 연합 시스템의 자체 보안 제어(예: RLS, 마스킹)를 활용하면서 수집된 데이터에 중앙 집중식 관리를 적용합니다. - 하이브리드 파이프라인을 설계할 때 내역 데이터 집합을 증분적으로 수집하고 연합 소스에 집계 또는 필터를 푸시하여 입출력 및 계산 사용을 최적화합니다. - **비용 고려 사항** - 새로운 기능이 필요한 경우 규정 준수 또는 중요 데이터 수집과 연합을 결합하여 총 비용 대비 성능을 최적화합니다. - 수집 및 연합을 혼합할 때 입출력 및 계산 분포를 고려합니다. 반복 쿼리의 소스 시스템에서 계산 비용을 줄이려면 자주 액세스하는 읽기가 많은 연합 데이터 집합에 캐싱(가속 쿼리)을 사용합니다. ## 사례 결정 가이드 사용 다음은 이 논리를 적용하는 방법을 보여주는 일반적인 원형입니다. 1. **"단일 진리의 근원" 아치타입: 중앙 집중화 및 거버넌스** - **시나리오:** 전체 글로벌 엔터프라이즈에 대해 규정 준수 및 통합 Customer 360 프로필을 작성해야 합니다. 데이터는 다양한 시스템에서 가져오며 엄격한 GDPR 및 CCPA 규정을 준수해야 하며 모든 마케팅 및 서비스 상호 작용을 위한 신뢰할 수 있는 소스로 제공됩니다. - **권장 패턴:** **데이터 수집.** 우선 순위는 지배, Trust 및 통제입니다. 데이터를 Data 360에 수집하면 소스 시스템에서 격리되는 완전히 감사 가능한 정규 프로필을 만들 수 있습니다. 2. **"실시간 인사이트" 아키타입: 이동하지 않고 분석** - **시나리오:** 데이터 과학 팀은 Snowflake의 대규모 지속적으로 업데이트되는 트랜잭션 테이블에서 탐색 쿼리를 실행해야 합니다. 동시에 경영진은 동일한 데이터를 기반으로 하는 실시간 BI 대시보드를 원합니다. 페타바이트의 데이터를 매일 이동하는 작업은 너무 느리고 비싸습니다. - **권장 패턴:** **Zero Copy Federation.** 우선 순위는 속도, 민첩성, 대규모 비용 효율성입니다. Zero Copy를 사용하면 데이터 중복의 오버헤드 및 대기 시간 없이 기존 데이터 웨어하우스의 엄청난 기능을 실시간 쿼리할 수 있습니다. 3. **"하이브리드 인텔리전스" 아키타입: 핵심 관리, 극단화** - **시나리오:** 데이터 레이크의 실시간 동작 신호(예: 웹 사이트 클릭)를 사용하여 관리되고 수집된 고객 프로필을 보강하려는 경우 핵심 프로필의 안정성이 필요하지만 실시간 데이터의 즉각성이 필요하면 즉각적인 개인 설정이 가능합니다. - **권장 패턴:** **하이브리드 접근법.** 데이터 수집을 사용하여 고객 데이터의 안정적이고 관리되는 핵심을 만듭니다. 그런 다음, Zero Copy를 사용하여 변동성이 높은 실시간 "Edge" 데이터를 연합하고 쿼리 시간에 조인하여 완전한 즉시 보기를 제공합니다. ## 앞으로의 경로 엔터프라이즈 데이터 전략은 단일 통합 패턴을 선택하는 것이 아니라 상호 운용 가능한 데이터 에코시스템 내에서 유연성을 제어하는 아키텍처를 구성하는 것입니다. 비즈니스 요구를 기반으로 각 소스 데이터 시스템에 적합한 데이터 통합 방법을 선택하면 데이터 수집 및 데이터 연합의 강점 모두를 결합하는 하이브리드 접근 방식으로 이어집니다. - 규정 준수, ID 확인, 운영 워크플로를 위해 임무에 중요한 관리 데이터 집합을 Salesforce Data 360에 수집합니다. - 스토리지를 복제하지 않고 실시간, 탐색, AI 기반 분석을 위해 Zero Copy를 통해 데이터를 통합합니다. Hyperforce Salesforce Data 360은 다중 지역의 복원성과 확장성을 제공합니다. 아이스베거 테이블이 있는 개방형 레이크하우스를 사용하면 Snowflake, Databricks, S3 아이스베거와 같은 플랫폼과의 계산 분리 및 상호 운용성이 가능해 진정으로 상호 운용 가능한 멀티 클라우드 데이터 에코시스템의 기반을 형성할 수 있습니다. 데이터 에코시스템이 발전함에 따라 신선성, 비용, 성능, 규정 준수의 균형을 지속적으로 유지하여 아키텍처 유연성을 유지합니다. 통합 액세스 권한을 사용하여 수집된 관리 데이터를 통합하여 플랫폼을 향상시킵니다. 이를 통해 클라우드, 지역, 비즈니스 도메인 전반에서 실시간 인텔리전스, AI 활성화, 엔터프라이즈 규모 개인 설정이 가능합니다. 모든 규모를 충족하는 솔루션은 대부분의 비즈니스에 적합하지 않습니다. 최적의 전략은 올바른 패턴을 올바른 비즈니스 동인에게 매핑합니다. ## 작성자 정보 Yugandhar Bora는 데이터 및 인텔리전스 응용 프로그램 플랫폼 내 데이터 아키텍처를 전문으로 하는 Salesforce의 소프트웨어 엔지니어링 아키텍처입니다. 그는 데이터 거버넌스 및 통합 데이터 모델에 초점을 맞춘 EARB(Enterprise Architecture Review Board) 이니셔티브를 이끌고 자동화된 플랫폼 프로비저닝 솔루션에 기여합니다. Jan Fernando는 Salesforce의 치프 아키텍처 사무실의 주 아키텍처입니다. 그는 2012년에 Salesforce에 합류하여 스타트업 생태계에서의 풍부한 경험을 얻었습니다. CFO 사무실에 합류하기 전에 플랫폼 조직에서 10년 이상 근무하여 몇 가지 핵심 기술 전환을 이끌었습니다. ## 개요 Salesforce Data 360은 Hyperforce에 구축된 데이터 플랫폼으로 모든 고객이나 계정에 대한 명확하고 완전하며 신뢰할 수 있는 360도 보기로 Salesforce 및 외부 데이터를 통합합니다. 기업은 병합 및 인수, 지역 운영, 기능적 분리 또는 과거 이유로 여러 Salesforce 조직을 운영하는 경우가 많습니다. 설계자는 단일 홈 조직과 다중 조직 구성 간에만 결정해야 하며, 여러 독립 Data 360 인스턴스를 프로비저닝할지, Data Cloud One을 사용하여 단일 인스턴스 아래에서 조직을 통합할지 또는 Data 360 간 데이터 공유(Data 360-to-Data 360 데이터 공유)를 사용하여 독립 Data 360 인스턴스 간에 공동 작업을 수행할지 여부도 결정해야 합니다. 이러한 선택 항목은 거버넌스, 규정 준수, 비용, 대기 시간, 조직의 AI 및 교차 조직 플랫폼 기능 확장 능력에 영향을 미칩니다. Data 360은 Data 360 라이센스를 수신하는 프로덕션 조직에서 자동으로 프로비저닝됩니다. Data Cloud One은 단일 홈 조직에서 Data 360 인스턴스를 호스팅할 수 있는 Salesforce의 다중 조직 연결 아키텍처이며, 다른 Salesforce 조직은 동료 조직으로 연결됩니다. Data 360 라이센스를 보유하고 따라서 Data 360 홈 조직이 되는 조직 선택은 장기적인 영향을 미치는 중요한 아키텍처 결정입니다. Salesforce Data 360의 프로비저닝 방식은 엔터프라이즈에서 고객 데이터를 통합하고, 거버넌스를 적용하고, 조직 전체에서 중요한 플랫폼 기능, 특히 AI, Agentforce 및 분석을 활성화하는 방법을 결정하기 때문에 기본적인 아키텍처 결정입니다. 조직의 클러스터를 단일 Data 360에 고정하면 통합 데이터 모델, 중앙 집중식 거버넌스, 엔터프라이즈 전체 AI 준비가 제공되며 동료 조직은 데이터가 로컬인 것처럼 공유 메타데이터 및 기능에 액세스할 수 있습니다. 이와 달리 여러 개의 독립 Data 360 인스턴스는 규제, 규정 준수 또는 자율성 요구 사항이 중앙 집중화를 방지하는 경우 적합하며, Data 360 조직 간 데이터 공유는 해당 인스턴스 간의 선택적, 제로 카피 공동 작업을 지원합니다. 설계자의 경우 이 결정이 매우 중요합니다. 이는 데이터 거버넌스를 제어하는 사람, 데이터가 있는 위치, 플랫폼 기능이 활성화되는 방법, 향후 통합 및 AI 이니셔티브의 원활한 확장 방식을 정의합니다. 현재 Data 360이 없는 조직의 경우에도 향후 Data 360 액세스를 추가하기 위한 전략을 개발하여 아키텍처를 향상시키는 것이 중요할 수 있습니다. 세일즈, 서비스, 마케팅, 상거래, 산업, Agentforce 전반의 Salesforce 기능이 점점 Data 360에 구축되고 있습니다. 이러한 플랫폼 기능을 사용하려는 조직은 자체 Data 360을 프로비저닝하거나 공유 Data 360에 동료 조직으로 연결해야 합니다. 이 가이드는 설계자가 단순성, 엔터프라이즈 전체 일관성, 규정 준수 및 확장성의 균형을 맞추는 프로비저닝 전략을 설계하는 데 도움이 되므로 조직이 Data 360을 확실하게 Customer 360, AI, 크로스 플랫폼의 혁신을 위해 활용할 수 있습니다. 이를 통해 Data 360을 프로비저닝할 조직을 선택하는 방법과 Data Cloud One 및 Data 360 조직 간 데이터 공유를 선택하는 방법을 결정할 수 있어 비즈니스를 Data 360 중심의 미래로 발전시키는 견고한 기반을 마련할 수 있습니다. --- ## 프로비저닝 고려 사항 Data Cloud One 및 Data 360 조직 간 데이터 공유 또는 홈 조직으로 지정할 조직 중 선택 여부와 같은 모든 프로비저닝 선택 항목은 다음과 같은 교차 범위 고려 사항에 대해 평가해야 합니다.
고려 사항 중요한 이유 예제 시나리오
데이터 보존 및 규정 준수 데이터가 저장 및 처리되는 위치를 결정합니다. 규제 규칙에는 특정 지역 또는 여러 인스턴스가 필요할 수 있습니다. 글로벌 은행은 GDPR 규정을 준수하기 위해 프랑크푸르트에 지리적으로 위치한 Salesforce 조직에 Data 360 테넌트를 프로비저닝하고 미국 부서에 버지니아에 있는 조직에 다른 테넌트를 프로비저닝합니다.
거버넌스 및 보안 Data 360을 소유하고 관리하는 사람은 누구입니까? 정책을 중앙에서 관리하거나 사업부별로 위임해야 합니까? 중앙 IT가 강력한 다국적 기업은 탁월한 센터에서 관리하는 전용 홈 조직을 만듭니다.
자율성 vs. 중앙 집중화 다양한 리더가 데이터의 별도의 소유권을 원할 수 있습니다. 자동화는 여러 Data 360을 선호하며 중앙 집중화는 Data Cloud One을 선호합니다. 독립 자회사가 있는 증권 회사는 각 BU가 자체 Data 360을 실행할 수 있도록 허용합니다.
대기 시간 및 성능 쿼리 속도 및 환경에 영향을 미치며, 특히 지역 전반에서 Data 360 테넌트에 연결된 동료 조직에 영향을 미칩니다. 미국의 Data 360 테넌트에서 데이터를 쿼리하는 런던의 세일즈 팀은 대기 시간이 더 길어질 수 있습니다.
통합 복잡성 더 많은 Data 360 테넌트 = 더 많은 파이프라인, API, 미들웨어. 통합을 통해 통합이 간소화됩니다. 소매업체는 Data Cloud One 구성으로 통합하여 10개의 ETL 파이프라인을 구축하지 않도록 합니다.
Zero Copy 데이터 소스 지역 Zero Copy 커넥터에는 Data 360이 위치할 수 있는 지역을 제한하는 지역 간 액세스 요구 사항이 있을 수 있습니다. 회사에 AWS eu-west-1 지역에 Snowflake 인스턴스가 있는 경우 Zero Copy를 사용하여 해당 지역의 Data 360에 데이터를 연합할 수 있지만, Zero Copy를 사용하여 미국 지역의 Data 360에 연합할 수는 없습니다.
Private Connect 지역 간 호환성 경우에 따라 비공개 연결 지원은 데이터 소스가 Data 360 테넌트와 동일한 영역에 있는지 여부에 따라 다릅니다. 회사에 제로 사본을 통해 연결하려는 aws-east-1 지역의 Snowflake 인스턴스가 있습니다. Data 360 홈 조직이 동일한 지역에 있는 경우에만 비공개 연결 네트워크 연결을 설정할 수 있습니다.
비용 & 라이센스 각 Data 360 테넌트는 비용을 추가합니다. 더 적은 인스턴스로 통합하면 지출이 최적화됩니다. 헬스케어 공급자는 여러 개의 독립적인 Data 360 인스턴스 대신 Data Cloud One을 채택하여 라이센스 비용을 절감합니다.
미래 확장성 오늘의 프로비저닝 선택 항목은 성장의 기반을 설정합니다. SaaS 회사는 단일 Data 360 인스턴스로 시작하지만 Salesforce 조직의 자회사를 확보할 때 Data Cloud One으로 확장할 계획입니다.
엔터프라이즈급 AI 준비 AI 기능 및 Agentforce 모든 조직에 연결된 Data 360 테넌트가 필요합니다. 프로비저닝 결정은 AI 모델이 엔터프라이즈 전반에서 교육 및 활성화하는 방식에 영향을 미칩니다. 금융 서비스 회사는 Data Cloud One에서 데이터를 통합하여 Einstein AI 모델이 엔터프라이즈 전체 고객 데이터에 액세스할 수 있도록 합니다.
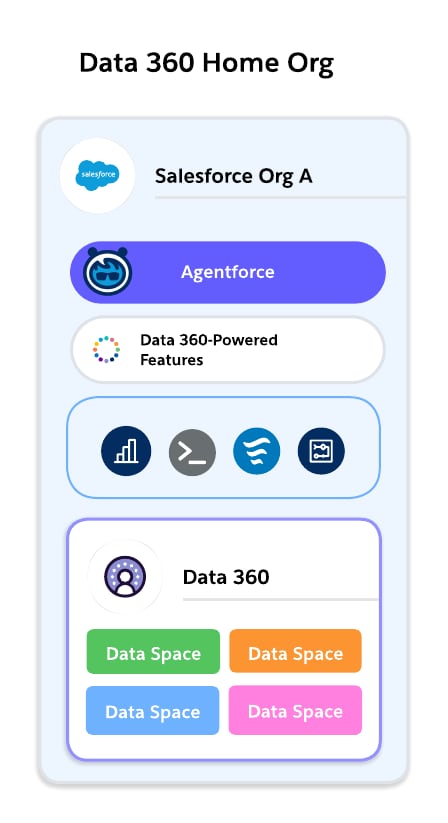
### 중요 고려 사항 --- ## 섹션 1: Data 360 프로비저닝 – 홈 조직 선택 ### 1.1 Data 360 홈 조직이란 무엇입니까? Data 360 라이센스를 구매하면 해당 라이센스와 연결된 Salesforce 조직에서 Data 360 인스턴스가 프로비저닝됩니다. 이 조직을 Data 360 홈 조직이라고 합니다. Data 360 홈 조직을 보여주는 결정 다이어그램 홈 조직은 Data 360 인스턴스의 앵커입니다. 다음 위치: - Data 360 저장소 및 컴퓨팅이 관리됩니다(프로비저닝 시 선택된 영역). - 관리, 거버넌스, 보안 정책이 적용됩니다. - 데이터 수집, 조합, ID 확인, 세분화 및 활성화가 수행됩니다. 다중 조직 시나리오에서 홈 조직은 다른 Salesforce "공동" 조직의 중앙 Data 360 인스턴스를 관리합니다. 홈 조직이 중요한 이유: - Data 360 인스턴스의 지리적 위치를 결정합니다. - Data 360 인스턴스를 소유하고 관리하는 사람을 결정합니다. Data 360 홈 조직의 관리자는 Data 360에 수집된 모든 데이터에 액세스할 수 있습니다. - Data Cloud One 구성에서 동료 조직 연결을 제어합니다. - 이를 통해 엔터프라이즈 데이터 전략의 기반을 마련할 수 있습니다. 나중에 변경하기가 어렵고 중단될 수 있습니다. ### 1.2 결정: 기존 조직 또는 새 조직이 홈 조직인 경우 첫 번째 주요 결정은 기존 프로덕션 조직에서 Data 360을 프로비저닝할지 아니면 홈 조직 역할을 할 새 전용 조직을 만드는지 여부입니다. 기존 조직과 새 조직을 홈 조직으로 표시하는 결정 다이어그램 #### 옵션 A: 기존 조직에서 Data 360 프로비저닝 **작업 최고:** 단일 Salesforce 조직이 있는 고객 또는 대부분의 비즈니스를 실행하는 중앙 집중식 주요 조직이 이미 있는 다중 조직 고객 기존 조직에서 Data 360 프로비저닝을 보여주는 다이어그램 - **성과**: - 가장 간단한 경로: Data 360은 이미 CRM 데이터가 있는 위치에서 프로비저닝됩니다. - 로컬 세일즈, 서비스, 마케팅 데이터에 즉시 액세스합니다. - 추가 통합이 필요하지 않습니다. - 관리할 라이센스 및 환경이 더 적습니다. - 조기에 채택, 파일럿, 프로덕션 사용 사례를 가속화합니다. - **단점**: - 기존 조직의 거버넌스 또는 기술 부채를 승계할 수 있습니다. - 단일 "기본 조직"이 없는 경우 하나를 선택하면 소유권 논쟁이 발생할 수 있습니다. - 조직의 위치와 연결된 성능이며, 엔터프라이즈 전체 레지던스 요구에 부합하지 않을 수 있습니다. - 여러 사업부에서 서로 다른 조직을 사용하는 경우 Data Cloud One과 페어링되지 않으면 로컬 프로비저닝이 조각화될 수 있습니다. **예:** Salesforce 조직이 하나인 SaaS 회사는 해당 조직에서 Data 360을 프로비저닝하여 고객 구독 및 지원 데이터를 통합합니다. #### 옵션 B: 새 전용 조직에서 Data 360 프로비저닝 **작업 최고:** 단일 주요 조직에 맞출 수 없는 여러 Salesforce 조직이 있는 고객 또는 강력한 CoE(Center of Excellence) 모델이 있는 기업 새 전용 조직에서 Data 360 프로비저닝을 보여주는 다이어그램 - **성과**: - 상속된 조직 복잡성 없이 거버넌스를 위한 정리 슬레이트 - 여러 비즈니스 부분에서 중앙 집중식으로 제어합니다. - 규정 준수 요구에 따라 지역을 유연하게 선택할 수 있습니다. - 단일 사업부에 연결되지 않은 중립 "공유 서비스" 조직 역할을 합니다. - 향후 Data Cloud One 아키텍처(여러 개의 동료 조직이 있는 홈 조직)를 설정합니다. - **단점**: - 고객은 Data 360을 프로비저닝할 새 Salesforce 조직을 라이센스가 있어야 합니다. - Data Cloud One 동료 연결을 통해 Data 360에 조직을 연결하는 데 필요한 추가 통합입니다. - 관리 오버헤드(사용자 관리, 보안, ID)를 추가할 수 있습니다. - 기존 프로덕션 조직의 프로비저닝 대비 가치 실현 시간이 느려집니다. **예:** 다국적 금융 서비스 회사는 Data 360을 프로비저닝하기 위한 전용 홈 조직을 만듭니다. 모든 사업부 조직(Retail, Wealth, Commercial Banking)은 Data Cloud One을 통해 동료 조직으로 연결됩니다. #### 결정 기준
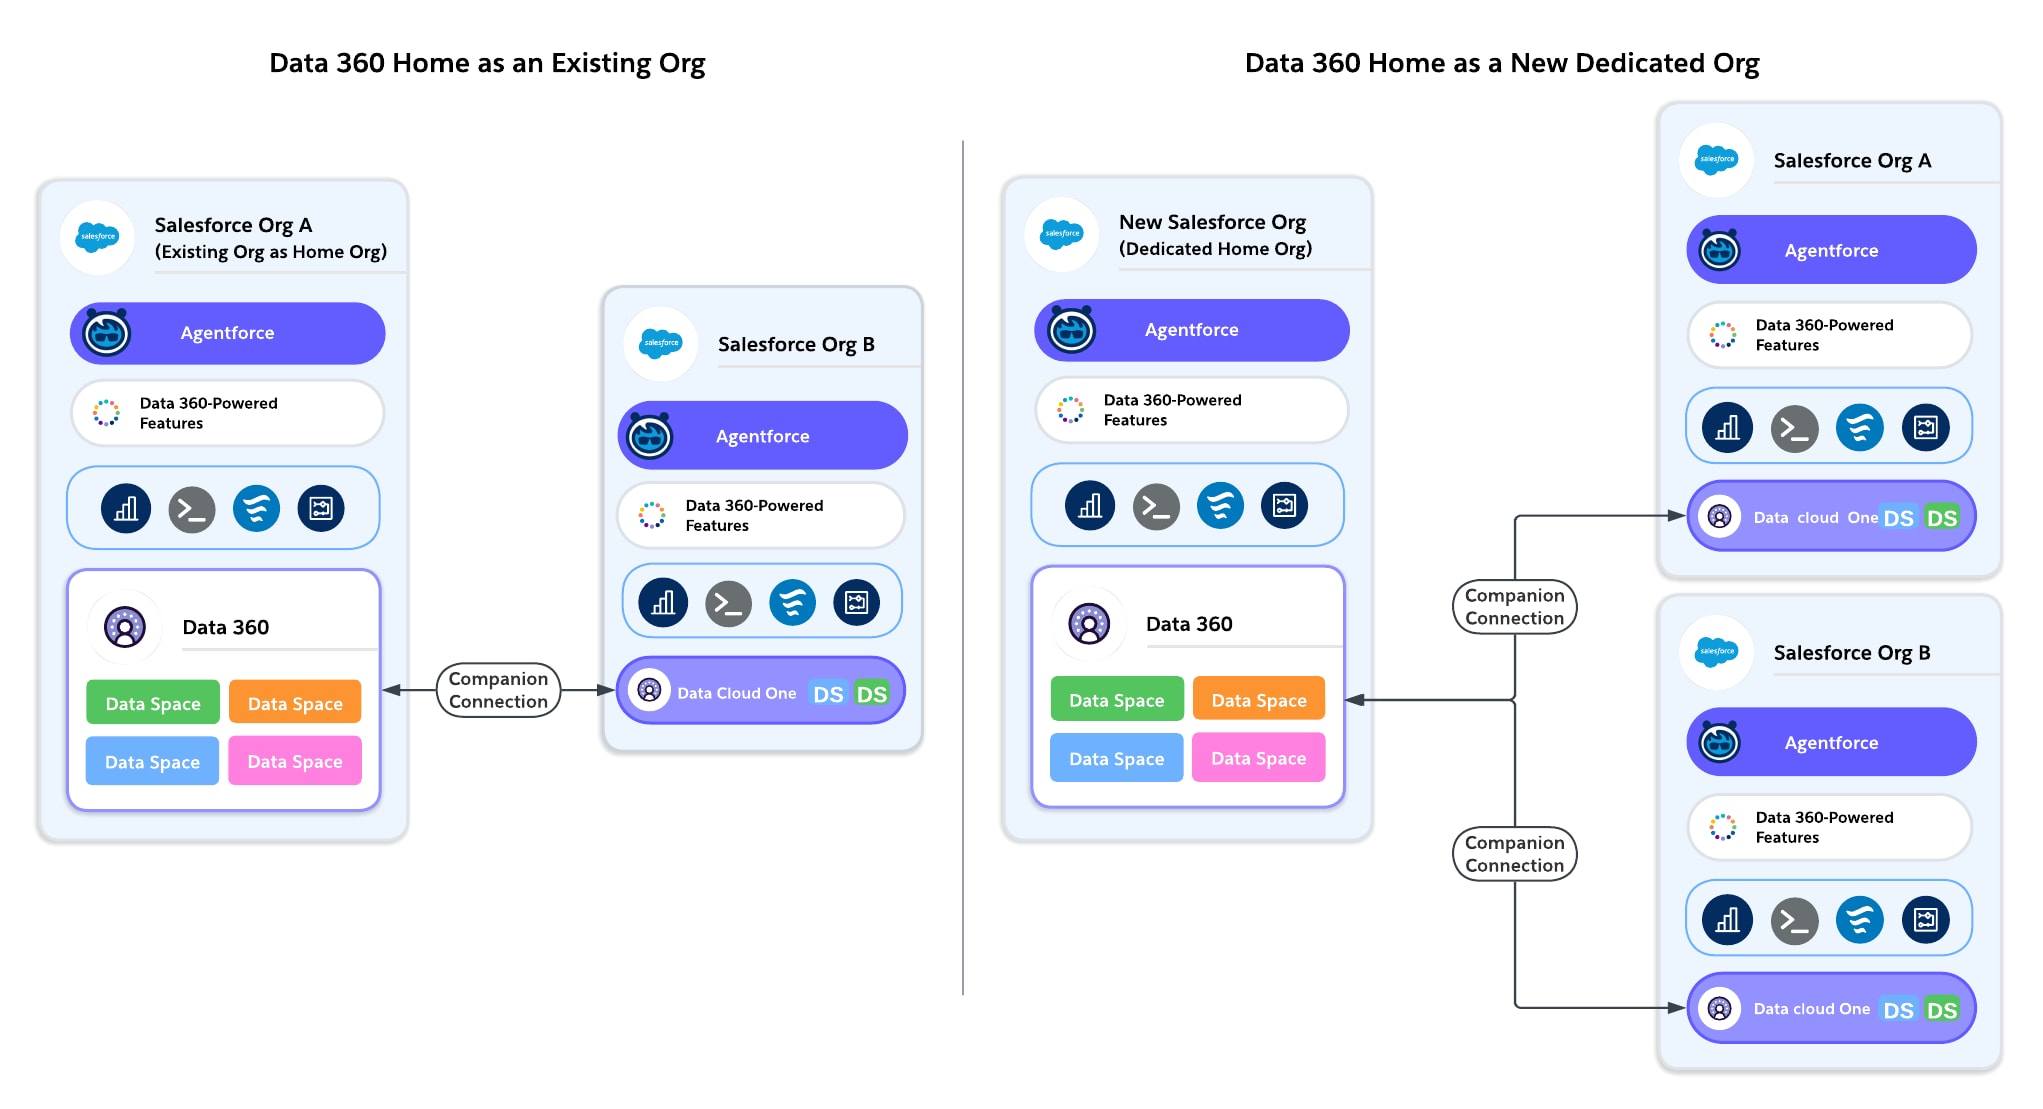
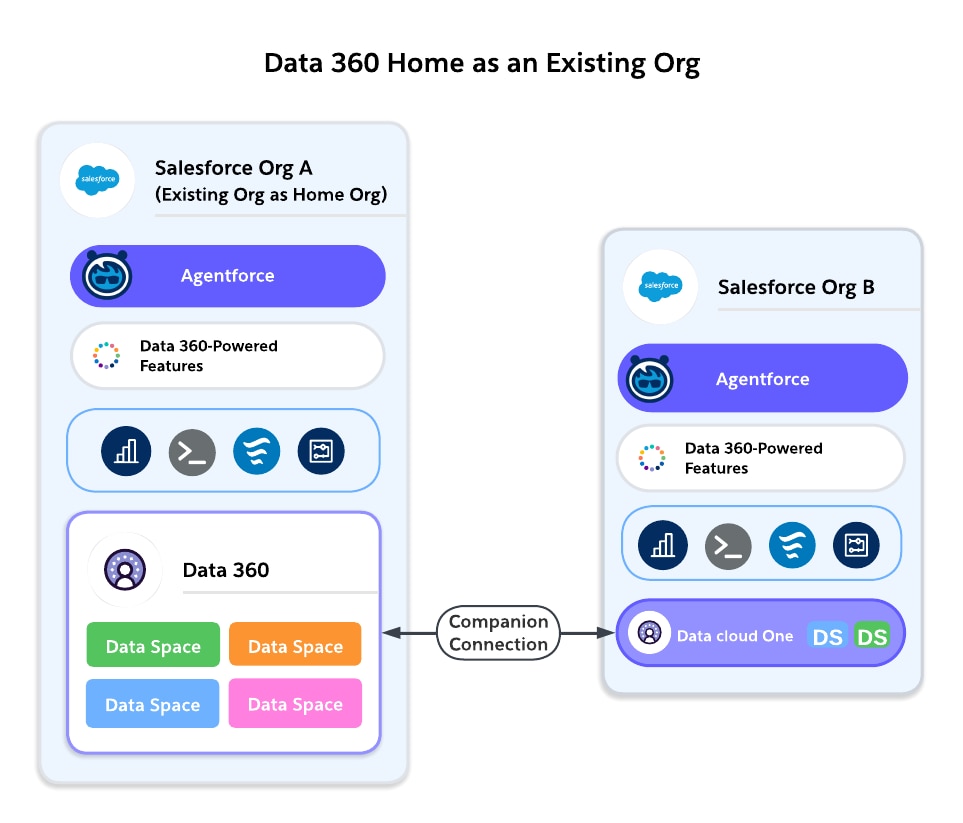
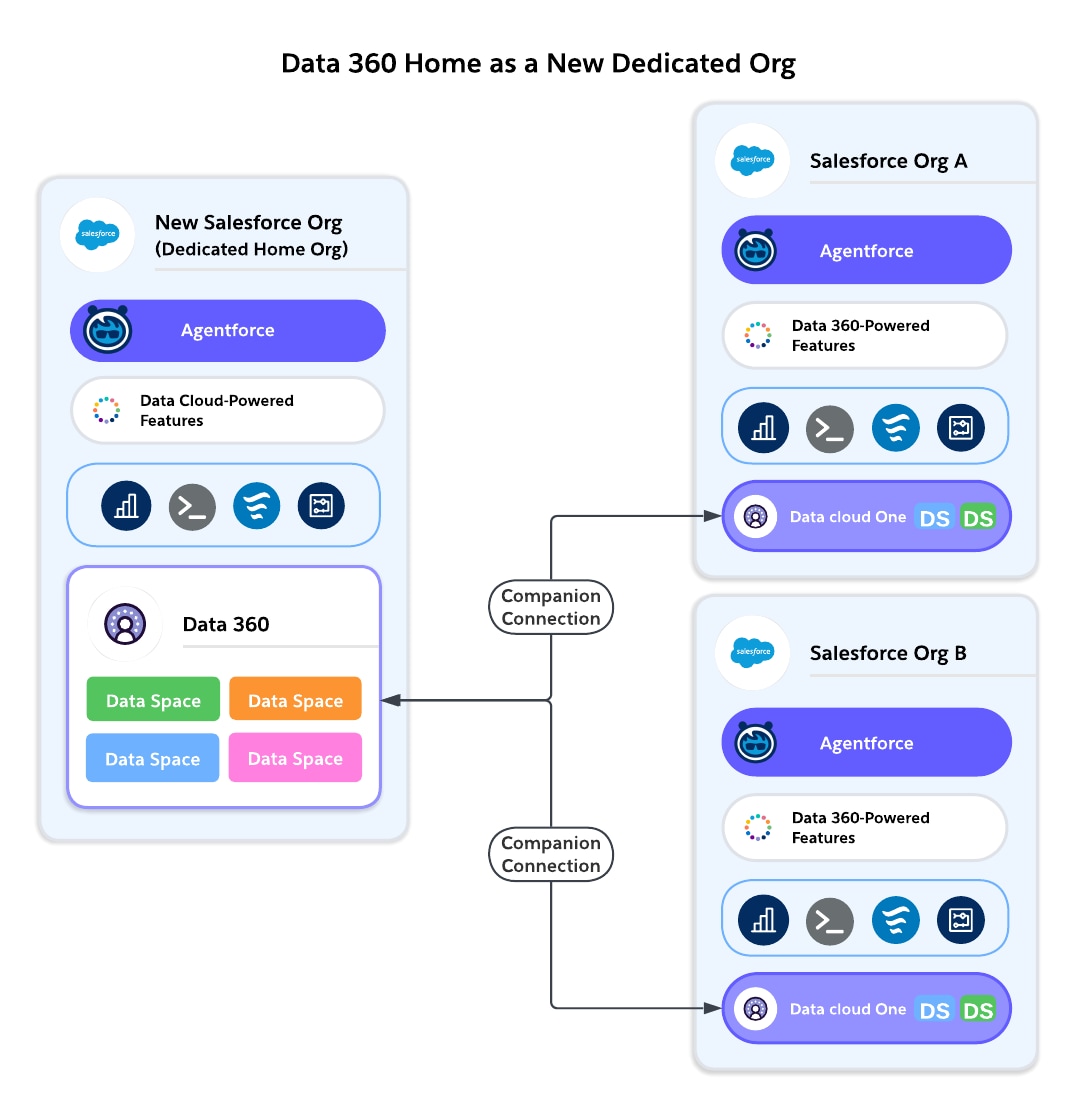
고려 사항 홈 조직인 기존 조직(원하는 기본값) 홈 조직으로 새 조직(대안)
단순성 신속한 설정을 위해 기존 사용자 및 데이터 구조를 기반으로 구축합니다. Data 360은 기본적으로 홈 조직과 통합됩니다. 새 Salesforce 조직의 라이센스 및 설정과 추가 관리 오버헤드가 있어야만 관리할 수 있습니다.
Time-to-Value 로컬 CRM 데이터를 즉시 사용합니다. 속도가 느려짐, 통합 필요.
거버넌스 기존 조직의 기본 거버넌스 모델(기존 사용자 및 권한 집합)을 상속합니다. 조직이 이미 중앙에 있는 경우 괜찮을 수 있습니다. CoE 주도 모델에 적합한 거버넌스를 위한 정리 슬레이트입니다.
규정 준수 기존 조직의 지역에 연결된 주거입니다. 기존 조직과 독립된 지역을 유연하게 선택할 수 있습니다.
성능 로컬 CRM 쿼리에 대한 최상의 성능 동료 조직의 연결에 따라 달라지며, 다른 조직에 대한 동일한 지역 또는 지역 간 연결 여부
미래 확장성 Data Cloud One과 페어링된 경우 적절하게 작동하며 잘못된 조직을 선택한 경우 나중에 전환하기가 어렵습니다. 중립성을 위해 설계된 Data Cloud One으로 쉽게 확장할 수 있습니다.
비용 증분 비용을 낮춥니다. 추가 환경에서 더 높은 오버헤드.
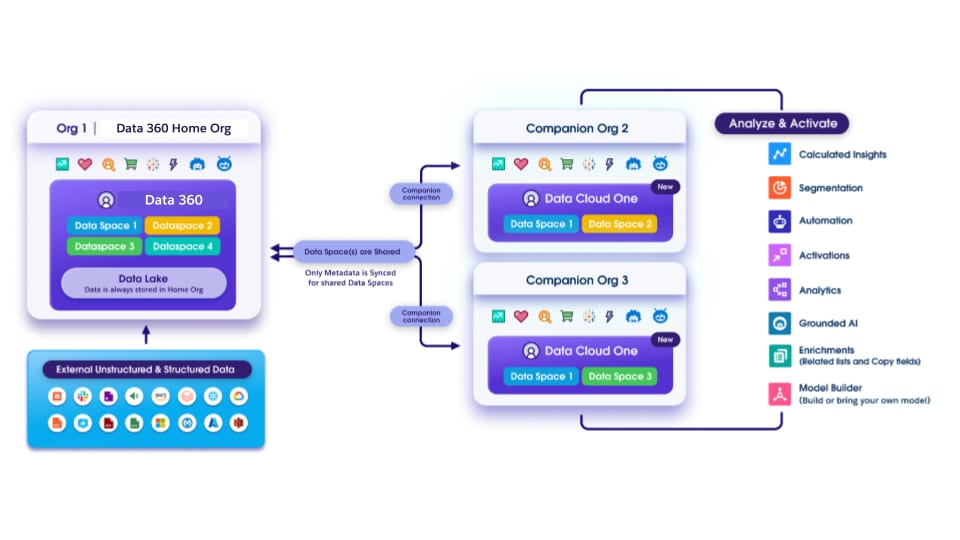
### 1.3 권장 사항 일반적인 원칙으로 기존 주요 조직을 홈 조직으로 사용하여 초기 노력을 최소화하고 채택을 가속화합니다. 장기 거버넌스 또는 규정 준수 전략에 필요한 경우에만 새 전용 홈 조직을 만듭니다. 새로운 전용 홈 조직을 만드는 것은 COE(Center of Excellence)를 보유한 대기업의 일반적인 선택입니다. **단일 조직 환경** 기존 프로덕션 조직에서 Data 360을 프로비저닝합니다. 이렇게 하면 단순성과 즉각적인 가치를 극대화할 수 있습니다. 불필요한 통합 오버헤드를 방지합니다. **다중 조직 환경** 일반적으로 대부분의 비즈니스를 실행하는 주요 조직 중 하나 또는 이미 중앙 집중식 CRM으로 작동하는 조직 중 하나를 선택하여 홈 조직 역할을 수행합니다. 이를 통해 복잡성을 줄이고 설정 작업을 최소화하며 Data 360의 가치를 빠르게 실현할 수 있습니다. 기존 주요 조직을 사용하면 새 환경을 관리하는 데 드는 비용과 통합 노력을 피할 수도 있습니다. **새로운 전용 홈 조직 고려 시기** 조직에 강력한 CoE(Center of Excellence)가 있고 사업부 조직과 별도의 거버넌스를 원하는 경우 규정 준수 또는 조직 제약으로 인해 단일 기존 조직이 적합하지 않은 경우 이러한 경우 새 홈 조직을 만들면 유연성과 중립성이 제공되지만 가치 창출 시간이 느려집니다. --- ## 섹션 2: 다중 조직 전략 및 Data Cloud One ### 2.1 다중 조직 챌린지 엔터프라이즈는 여러 Salesforce 조직을 운영하는 경우가 많으며, 이는 최종 사례가 아니라 표준입니다. 2024년 2월 현재 약 19,000명의 Salesforce 고객이 둘 이상의 Salesforce 조직을 운영하고 있습니다. 발생하는 이유는 무엇입니까? - **인수 및 합병:** 새로 인수한 회사는 자체 Salesforce 인스턴스를 가져옵니다. - **지역 운영:** 데이터 보존 법을 충족하기 위해 EU, 북미, 아시아 태평양 등에 대한 조직을 구분합니다. - **기능적 분리:** 다양한 사업부(예: Retail Banking, Wealth Management, Insurance)는 자율성을 위해 자체 조직을 유지합니다. - **규제 또는 보안 차단:** 특정 산업에서는 규정 준수 이유로 논리적으로 고유한 조직을 요구합니다. - **기존적/기술적 이유:** 시간이 지남에 따라 고객은 여러 조직을 조직적으로 누적합니다. 각 이유는 개별적으로 이해되지만 함께 데이터를 조각화합니다. 통합 레이어가 없으면 각 조직에 고객에 대한 부분 보기만 제공됩니다. 아키텍처 문제: 규정 준수, 거버넌스, 자율성 요구 사항을 존중하면서 조직 전반의 데이터를 신뢰할 수 있는 단일 소스로 통합하는 방법은 무엇입니까? --- ### 2.2 Data Cloud One이란 무엇입니까? Data Cloud One은 여러 Salesforce 조직이 단일 Data 360 인스턴스를 공유할 수 있는 Salesforce의 다중 조직 연결 아키텍처입니다. Salesforce 조직이 여러 개 있는 기업에 권장되는 패턴입니다. Data Cloud One 클러스터에서 하나의 Salesforce 조직이 Data 360 인스턴스를 호스팅하는 홈 조직으로 지정됩니다. 다른 Salesforce 조직은 동료 조직으로 연결되어 홈 조직의 Data 360에서 통합된 데이터 및 메타데이터를 사용합니다. Data Cloud One 아키텍처를 보여주는 다이어그램 #### Data Cloud One 작동 방식
  1. 데이터 수집 및 통합(홈 조직)
  2. 데이터 공간 아키텍처
  3. 메타데이터 공유
    동료 조직은 데이터 모델 개체(DMO), 통합 프로필 스키마, 계산된 인사이트, 세그먼트 및 기타를 포함하여 홈 조직에서 메타데이터 정의를 받습니다. 이는 로컬 자산인 것처럼 동료 조직 내에 기본적으로 표시되지만 실제로 홈 조직에 연결되어 있습니다.
  4. 홈 조직에서 수행할 작업 vs. 동료 조직
  5. 기능 액세스는 홈 및 동료 조직 간에 다릅니다. 동료 조직은 데이터를 수집하거나 통합할 수 없으며, 수집, 모델링, 통합을 위해 홈 조직에 의존합니다. 동료 조직은 Data 360 데이터에 액세스하여 Data 360 지원 플랫폼 기능을 강화할 수 있으며, 공유되고 신뢰할 수 있는 데이터 위에 로컬 인사이트, 세그먼트, 플로를 만들 수 있습니다. 향후 비전에서 활성화 기능에 액세스할 수도 있습니다.
    기능 홈 조직 동료 조직
    연결 커넥터 구성, 데이터 스트림 생성, 데이터 수집 또는 통합 ✅ ❌
    데이터 변환 및 ID 확인 구축 및 실행 통합 및 통합 ✅ ❌
    데이터 공간 및 권한이 있는 보안 데이터 관리 ✅ ✅
    세그먼트 및 예측 세그먼트, 인사이트 및 Einstein Studio 모델 구축 ✅ ✅
    Everywhere 활성화 활성화, 데이터 작업 ✅ ✅
    프롬프트 빌더, 플로, 보고서, 보강 및 기타 플랫폼 기능 ✅ ✅
    Prospecting Center, Sales 및 Service Cloud 기능, Agentforce 등의 Data 360 지원 기능 ✅ ✅
  6. 플랫폼 기능 패리티
    사용자 및 빌더의 관점에서 메타데이터가 공유되면 Salesforce 플랫폼 기능 사용과 관련하여 홈 및 동료 조직 간에 몇 가지 기능 차이가 있습니다. 지원되는 기능 목록은 Companion 조직의 Data 360 기능에서 확인할 수 있습니다.
  7. 소비 모델
    모든 동료 조직 활동(쿼리, 세그먼트 실행, Data 360 트리거 플로, AI 사용, Einstein Trust Layer 로깅 등)은 홈 조직의 Data 360 크레딧을 사용합니다. 소비는 한 가지 방법으로 진행됩니다. 크레딧은 집 조직의 크레딧 할당 대비 중앙 집중화, 청구, 추적됩니다. 그러나 Digital Wallet 사용된 각 개별 조직의 크레딧 수를 자세히 살펴볼 수 있습니다.
  8. 설계 원리: 수평 구조
    Data Cloud One은 Sandbox와 유사하게 Salesforce Platform의 가로 구조로 설계되었습니다. 목표는 Salesforce 릴리스의 모든 새로운 기능이 추가 설정 없이 홈 및 동료 조직 모두에서 작동하는 것입니다. 이렇게 하면 Data Cloud One이 단순한 데이터 아키텍처 선택이 아닌 Salesforce 플랫폼의 기본 요소가 됩니다.
--- ### 2.3 결정: 여러 독립 데이터 360과 비교. 하나의 공유 데이터 360(Data Cloud One) 조직이 여러 개인 기업은 생태계 내에서 Data 360을 찾을 방법과 위치를 선택해야 합니다. 각 조직에서 독립 Data 360을 프로비저닝하거나 Data Cloud One을 사용하여 단일 홈 조직 아래에서 조직을 통합하려고 합니까? #### 옵션 A: 여러 독립 Data 360 각 Salesforce 조직은 자체 Data 360 인스턴스를 프로비저닝합니다. **성과**: - **자동**: 각 사업부 또는 지역은 자체 Data 360을 제어합니다. - 각 조직 내의 **간편성**: 거버넌스, 보안, 사용자 정의가 현지화됩니다. - **규제 준수**: 엄격한 규제 구분이 필요한 경우 유용합니다(예: 데이터는 경계를 넘지 않아야 함). **단점**: - **데이터 실패:** 조직 전체에서 Customer 360 사용할 수 없습니다. - **높은 비용**: 각 인스턴스에는 라이센스, 관리, 통합이 필요합니다. 고객은 여러 조직에서 전체 C360 보기를 얻기 위해 동일한 소스 데이터를 여러 번 수집합니다. - **중복 작업:** ID 확인, 세분화, 보강은 각 Data 360에서 반복해야 합니다. #### 옵션 B: 하나의 공유 데이터 360(Data Cloud One 클러스터) 단일 Data 360은 홈 조직에서 프로비저닝되며 다른 Salesforce 조직은 동료 조직으로 연결됩니다. **성과**: - **단일 진리의 근원(SSOT):** 모든 조직은 같은 통합 데이터 모델을 공유합니다. - **비용 효율:** 관리할 Data 360 라이센스 및 인프라 하나만 있습니다. - **통합 관리:** 정책, 보안, 규정 준수 제어가 중앙 집중식으로 적용됩니다. - **Cross-org 보강:** 동료 조직은 조화된 프로필, 인사이트, 세그먼트에 액세스할 수 있습니다. - **AI 준비도:** 엔터프라이즈 전체 데이터 집합을 사용하면 AI 모델의 교육 및 활성화를 향상할 수 있습니다. - **미래 증거:** 새 동료 조직을 추가하는 것은 간단합니다. 새 Data 360은 필요하지 않습니다. **단점**: - **추가 준비:** 조직 간 조직 연결을 계획해야 합니다. - **지연 시 고려 사항:** 다른 지역의 동료 조직은 더 느린 쿼리를 볼 수 있습니다. - **복잡한 거버넌스:** 각 조직에 매우 다른 사용자 정의 요구 사항이 있는 경우 세분화된 관리는 복잡할 수 있습니다. #### 옵션 C: 여러 Data Cloud One 클러스터 경우에 따라 모든 조직을 함께 클러스터링하는 것이 실용적이지 않을 수도 있습니다. 따라서 각각 동료 조직의 다른 클러스터에 대한 홈 조직인 여러 Data 360을 운영하는 하이브리드 솔루션을 구현해야 할 수 있습니다. #### 예: 다국적 기업은 유럽, 미국, 아시아 등 다양한 지역에 Salesforce 조직을 보유하고 있습니다. 지역 데이터 보존 규정을 준수하기 위해 각각의 별도의 지역에 대해 하나의 Data 360을 프로비저닝합니다. #### 결정 기준
고려 사항 여러 독립 Data 360 하나의 공유 데이터 360(Data Cloud One )
자율성 각 조직 또는 사업부에 대한 높은 자율성입니다. 중앙 집중화된 거버넌스, 조직당 더 적은 자율성
규정 준수 엄격한 구분이 필요한 경우(예: 지역 법률) 유용합니다. 중앙 집중화를 허용하는 경우 가장 적합합니다.
비용 라이센스 및 관리 비용이 더 높습니다. 더욱 비용 효율적이며 여러 조직에 대해 하나의 라이센스가 제공됩니다.
거버넌스 조각화됨, 정책은 조직마다 다릅니다. 조직 전체에서 중앙 집중화된 일관된 정책
데이터 중단 각 조직에는 자체 보기가 있으며, Enterprise 360은 없습니다. 통합 데이터 집합, 중복 안 함
AI/Analytics 각 조직의 데이터로 제한됩니다. 정확도가 향상된 엔터프라이즈 전체 모델
복잡성 관리할 인스턴스가 많고 통합이 많습니다. 더 간단한 아키텍처, 더 적은 이동 부품 수.
성능 조직 내 사용 사례에 가장 적합합니다. 동료 조직 액세스에 지연 시간이 발생할 수 있습니다.
--- ### 2.4 권장 사항 **원하는 패턴:** **Data Cloud One** 기본적으로 다중 조직 엔터프라이즈의 연결된 동료 조직이 있는 단일 홈 조직으로 설정됩니다. 이를 통해 엔터프라이즈 전체 Customer 360 만들고, 거버넌스를 간소화하며, 비용을 최적화할 수 있습니다. **다중 Data 360을 사용하는 경우:** 규정 준수, 보존 또는 조직적 자율성이 엄격하게 요구하는 경우에만 예를 들어 규정으로 인해 유럽의 운영이 미국의 운영과 완전히 구분되어야 하는 경우 **Data Cloud One에서 홈 조직을 선택하는 방법:** 먼저 대부분의 비즈니스가 실행되는 주요 조직 중 하나를 고려합니다. Data 360을 프로비저닝하면 복잡성을 최소화하고 조기에 가치를 극대화할 수 있습니다. 적합한 기존 조직이 없는 경우에만 탁월한 센터 팀이 관리하는 전용 홈 조직을 만드는 것이 좋습니다. **일반 원칙:** 다중 조직 환경에서는 Data 360 수를 최소화합니다. Data Cloud One을 기본 패턴으로 추천하여 중복을 줄이고, AI 준비를 활성화하고, 거버넌스를 간소화합니다. --- ## 섹션 3: Data 360 조직 간의 여러 Data 360 및 데이터 공유 ### 3.1 Data 360 조직 간 데이터 공유란 무엇입니까? Data Cloud One은 대부분의 엔터프라이즈에 권장되는 접근 방식이지만, 고객이 여러 Data 360 인스턴스를 프로비저닝해야 하는 시나리오가 있습니다. 여러 Data 360이 존재하면 통합이 자동으로 이루어지지 않습니다. Data 360에서 Data 360 데이터 공유를 사용하면 고객이 중복 또는 사용자 정의 파이프라인 없이 Data 360 인스턴스 간에 특정 개체를 공유할 수 있습니다. Data 360 전반의 공동 작업을 위해 고안된 제로 카피 메타데이터 공유 메커니즘입니다. #### 작동 방식 - 각 Data 360은 자체 홈 조직에서 프로비저닝됩니다. - 관리자는 공유할 특정 개체의 그룹인 데이터 공유를 만들 수 있습니다. - 선택한 데이터에 대한 액세스는 대상 조직의 Data 360과 공유되며, 여기에서 개체가 로컬로 정의된 것처럼 표시됩니다. 기본 데이터는 소스 Data 360에 남아 있으며 액세스 권한만 공유됩니다. - 태그는 공유되지 않습니다. 원시 개체만 사용할 수 있으며, 대상 조직은 필요에 따라 관리, 운영 또는 AI 태그를 다시 적용해야 합니다. #### Data Cloud One의 주요 차이점 - Data Cloud One에서는 여러 동료 조직이 단일 Data 360 인스턴스를 공유합니다. 플랫폼 기능(Agentforce, Prospecting Center, Tableau Next 등)은 모두 동일한 기본 데이터에서 실행되므로 일관성을 보장합니다. - Data 360 조직 간에 데이터 공유를 사용할 경우 각 조직에 자체 Data 360이 있습니다. 조직 A 및 조직 B의 Agentforce 같은 기능은 각각 로컬 인스턴스에서 독립적으로 작동합니다. 공유는 자동으로 발생하지 않으며 특정 개체에 대해서만 공동 작업하기 위해 의도한 데이터 공유를 만들어야 합니다. --- ### 3.2 Data 360 조직 간 데이터 공유를 위한 사용 사례 **지역 규정 준수:** 다국적 소매업체는 EU 및 미국에서 Data 360을 하나씩 프로비저닝합니다. Data 360-to-Data 360 데이터 공유를 사용하면 회사에서 원시 데이터가 로컬로 유지되는 동안 미국 본사와 공유할 수 있도록 충성도 KPI 등 인사이트를 집계할 수 있습니다. **비즈니스 단위 협업:** 한 기업은 Retail 및 Insurance용 Data 360을 별도로 실행합니다. Data 360 간 데이터 공유를 사용하면 사용자가 이동하거나 복사하지 않고 단일 권한이 있는 데이터 소스에 액세스할 수 있습니다. Data 360 조직 간 데이터 공유를 사용하면 보험 조직이 표적 교차 판매 캠페인에 대해 리테일의 "고가치 고객" 세그먼트를 수신합니다. **병합 및 인수:** 모회사가 자체 Data 360을 사용하여 자회사를 인수합니다. 관리할 인스턴스 두 개를 사용하면 단기 데이터 사일로를 유지하면 데이터 보안 및 SSOT 무결성이 유지됩니다. 동시에 두 Data 360 인스턴스 간에 데이터를 공유하면 전환 시 필요한 공동 작업을 수행할 수 있습니다. **연합 경영진 대시보드:** 대륙 전반에 걸쳐 분산된 다국적 기업은 지역당 개별 Data 360을 프로비저닝합니다. 경영진은 연합 분기별 성과 보기를 원합니다. 각 지역의 Data 360은 "실행 조직"과 집계된 계산된 인사이트를 공유하여 엔터프라이즈 전체 보고를 지원합니다. #### Data 360 조직 간 데이터 공유의 장단점
요소 성과 단점
데이터 레지던스 공동 작업을 활성화하면서 지역 분리를 지원합니다. 여러 Data 360을 관리하지 않아도 됩니다.
데이터 중복 제로 카피, 개체 중복 없음 각 데이터 공유에 포함할 개체를 의도적으로 선택해야 합니다.
거버넌스 공유는 명시적이고 의도적입니다(개체 수준). 태그 또는 정책 플로가 없으며, 대상 조직은 관리를 다시 적용해야 합니다.
복잡성 중앙 집중화 없이 선택적 공동 작업을 활성화합니다. 여러 Data 360 및 데이터 공유를 관리해야 합니다.
AI/Analytics 지역별 AI/Analytics가 가능하며, 조직 간에 인사이트를 공유할 수 있습니다. 데이터가 의도적으로 공유되지 않는 한 엔터프라이즈 전체 AI가 없습니다.
플랫폼 기능 각 조직의 Data 360 지원 기능은 독립적으로 실행됩니다. 자동 공유 없음 - 주의를 기울이지 않으면 중복 위험이 있습니다.
비용 ETL 파이프라인의 필요성을 줄일 수 있습니다. 여전히 여러 Data 360의 비용이 발생합니다. 데이터 쿼리 및 데이터 공유에 대한 크레딧을 사용합니다.
#### 결정 기준
고려 사항 Data Cloud One(다중 조직의 기본 설정) Data 360 조직 간 데이터 공유
단일 진리의 근원 ✅ 예 - 모든 조직이 동일한 DC를 공유합니다. ⚡ 아니요 - 각 Data 360에는 자체 데이터 모델이 있습니다.
규정 준수 중앙 집중화를 허용하는 경우에만 작동합니다. 주거 법에서 중앙 집중화를 방지하는 경우 필요합니다.
거버넌스 중앙 집중식, 일관적입니다. 연합, 의도적인 개체 수준 공유.
복잡성 이동하는 부품이 줄어들고 간단해집니다. ore complex - 구성 데이터 공유 및 여러 Data 360이 필요합니다.
AI/Analytics 엔터프라이즈 전체 AI 모델. 지역별 AI, 인사이트를 선택적으로 공유할 수 있습니다.
플랫폼 기능 공유된 Data 360은 모든 기능이 홈 + 동료에서 일관적으로 작동함을 의미합니다. 기능은 각 Data 360에서 독립적으로 실행되며, 공유는 명시적이어야 합니다.
### 3.3 모범 사례 **기업에 여러 Data 360이 있는 경우:** - 사용자 정의 파이프라인을 구축하거나 데이터를 복제하는 대신 Data 360 조직 간 데이터 공유를 사용하여 공동 작업을 수행합니다. - 데이터 공유를 만들고 대상 조직에 부여하여 특정 개체(DMO, 계산된 인사이트, 세그먼트)를 공유합니다. - 태그는 공유되지 않으며 수신 조직은 태그(예: 거버넌스, 분류, AI 보강)를 다시 적용해야 합니다. **Data 360 조직 간 데이터 공유를 사용하는 경우:** - 중앙 집중화를 방지하는 규제 요구 사항을 충족합니다. - 선택적 공동 작업을 활성화하면서 사업부 독립성을 유지합니다. - 여러 지역에 걸쳐 연합 실행 대시보드를 제공합니다. - 즉시 통합이 불가능한 M&A 시나리오를 연결합니다. **조심스럽게 설계** 공유는 의도적이고 개체별이어야 합니다. "오버 공유"를 피하십시오. 데이터 공유를 비즈니스 및 규정 준수 요구에 맞춥니다. Data 360-to-Data 360 데이터 공유를 Data Cloud One 을 대체하는 대신 연합 전략으로 취급하십시오. --- ## 요약
  1. 모든 조직은 Data 360에 대한 액세스를 계획해야 합니다.
  2. Organ-by-org가 아닌 엔터프라이즈 전체를 생각하십시오.
  3. 데이터 사일로 최소화
  4. 다중 Data 360을 실행해야 하는 경우 의도적으로 설계
  5. 예전에 거버넌스 및 소유권 계획 수립
  6. 단기 바로 가기 피하기
이러한 프로비저닝 선택 항목은 Salesforce Platform이 Data 360 우선 모델로 진화하므로 고객 세분화에서 AI 에이전트 기초 교육에 이르기까지 모든 기능이 해당 모델에 의존하기 때문에 중요합니다. 오늘의 결정은 엔터프라이즈에서 고객 데이터를 얼마나 효과적으로 통합하는지, 신속하게 새 Salesforce 기능을 도입할 수 있는지, 비즈니스 전반에서 AI를 확장할 수 있는지에 대한 기초를 마련합니다. 성공하려면 주의를 기울이고, 중복을 최소화하고, 규정 준수 요구 사항에 부합하고, 의도적으로 관리하고, 장기적으로 생각해야 합니다. 궁극적으로 Data 360 프로비저닝은 데이터, AI, CRM을 하나의 통합 플랫폼으로 함께 작동시키는 첫 번째 단계입니다. # ## 작성자 정보 Kunal Goyal은 Data 360 내에서 멀티 조직 아키텍처 및 확장성 향상에 중점을 둔 Salesforce의 제품 관리 책임자입니다. 2017년부터 교차 조직 공동 작업 및 멀티 테넌트 시스템 설계에 중점을 둔 여러 이니셔티브 및 제품을 이끌어 왔습니다. Kunal은 Data 360 모범 사례 아키텍처 리드 중 하나이며 Data Cloud One, 설정, 프로비저닝, 관리자 환경에 대한 제품 소유자입니다. Erin Wagner Tidwell은 Data 360의 주요 기술 작성자 및 콘텐츠 디자이너입니다. 2013년부터 Salesforce에 근무하고 있습니다. 그녀는 명확하고 일관되고 정확한 기술 문서와 앱 내 커뮤니케이션을 통해 Data 360을 더 쉽게 이해하고 사용할 수 있도록 합니다. Yugandhar Bora는 데이터 및 인텔리전스 응용 프로그램 플랫폼 내 데이터 아키텍처를 전문으로 하는 Salesforce의 소프트웨어 엔지니어링 아키텍처입니다. 그는 데이터 거버넌스 및 통합 데이터 모델에 초점을 맞춘 EARB(Enterprise Architecture Review Board) 이니셔티브를 이끌고 자동화된 플랫폼 프로비저닝 솔루션에 기여합니다. Samarpan Jain은 Commerce Cloud, 플랫폼 통합, 교차 조직 아키텍처를 전문으로 하는 Salesforce의 주 아키텍처입니다. Salesforce에서 가장 오랫동안 근무한 직원은 정부 고객의 데이터 보존 규정 준수 및 Data 360 사용량 귀속 시스템 등 주요 이니셔티브를 이끌고 있습니다. ## 가이드 개요 이 가이드는 Salesforce Platform에서 비동기 처리 요구 사항에 대한 올바른 접근 방식을 평가하는 데 도움이 됩니다. 각 접근 방식을 설명하여 각각의 강점과 제한 사항을 자세히 설명합니다. 대부분의 접근 방식은 제품 기능과 일치하지만 일부 접근 방식은 여러 기능을 조정합니다. 가이드에는 각 접근 방식을 사용할 시점을 강조하는 사용 사례가 포함되어 있습니다. 비동기 처리는 아키텍처에 두 가지 주요 혜택을 제공합니다. 먼저 비동기 프로세스에 더 높은 총괄자 제한이 있으므로 확장성이 향상됩니다. 두 번째로 비동기식 요청은 자체 스레드에서 실행되므로 사용자가 비동기식 과업이 백그라운드에서 실행되는 동안 다른 작업을 수행할 수 있습니다. 이 가이드는 Salesforce Platform 내에서 비동기 처리 기술 선택에만 중점을 두고 있습니다. 결정 프로세스를 돕는 다른 리소스는 [리소스 섹션](#자원)에 나와 있습니다. ## 이 가이드의 범위에 속하는 제품
Salesforce Platform Salesforce Lightning Platform은 직원, 자율 AI 에이전트, 회사 데이터 및 애플리케이션을 신뢰할 수 있는 단일 시스템으로 통합하여 생산성과 고객 경험을 향상시킬 수 있는 종합적인 AI 기반 플랫폼입니다. 이를 통해 Customer 360 앱, Data Cloud, Slack을 연결하여 엔드 투 엔드 자동화를 수행할 수 있게 되었습니다.
이 문서에서는 MuleSoft, Informatica, Commerce Cloud, Tableau, Marketing Cloud와 같은 다른 에코시스템의 기술을 다루지 않습니다. ## 서비스 - **비동기식 처리를 사용하기 전에 사용 사례가 패턴에 맞는지 확인하십시오.** 비동기 패턴에는 SLA가 없으며, 다중 총괄자 메커니즘이 적용되며, 라이센스를 기반으로 정의된 수용력 제한이 있을 수 있으며, Salesforce Platform 내 비동기 인프라에 할당된 리소스의 유한적인 특성으로 인해 처리 지연이 발생할 수 있습니다. 사용자가 작업을 계속하기 전에 시스템에서 응답해야 하는 시나리오에서 비동기 처리를 사용할 때 다음 제한 사항을 고려하십시오. - **Salesforce를 통한 비동기식 처리는 경계 없는 확장 요구에 맞는 솔루션이 아닙니다.** Salesforce Platform은 무제한으로 확장되지 않으며 비동기 패턴에는 제한이 적용됩니다. 비동기 처리는 스레드를 사용하며, 이는 CPU가 명령 스트림을 실행하기 위해 필요한 컨텍스트 정보를 포함합니다. 스레드는 병렬로 실행할 수 있습니다. CPU의 사용 가능한 스레드는 제한되므로 플랫폼에 사용 가능한 스레드를 최대한 효율적으로 사용할 수 있는 메커니즘이 마련되어 있습니다. 플랫폼의 [흐름 제어 메커니즘](/docs/architect/ko-kr/fundamentals/guide/async-fundamentals#플로-제어)은 조직이 너무 많은 스레드를 소비하고 다른 조직에 부정적인 영향을 미치지 않도록 방지합니다. 플랫폼의 [공정 사용 알고리즘](/docs/architect/ko-kr/fundamentals/guide/async-fundamentals#공정한-사용)은 또한 조직이 각 메시지 유형에 사용할 수 있는 스레드 수를 제어합니다. - **극적인 부하를 유발할 수 있는 이벤트를 고려하십시오.** 비동기 프로세스를 설계할 때 작업 부하 급증 및 Lull을 예측 가능한 방식으로 관리할 수 있는지 확인하십시오. 구현에서 전력 중단과 같은 예기치 않은 이벤트를 처리하는 방법을 고려하고 데이터 손실 또는 기능 손실을 완화하는 보안 조치를 설계합니다. ## 제품 비교 이 표는 Salesforce와 함께 비동기식 처리에 사용할 수 있는 도구를 간략하게 보여줍니다. 의사 결정 프로세스 동안 각 도구의 주요 특성을 검토하려면 이 표를 참조하십시오. 아키텍처에 적합한 도구를 선택하는 데 도움이 되는 [사용 사례](#사용-사례) 및 [결정 지점](#결정-지점)을 참조하십시오.
접근 방식 설명 필요한 기술 라이센스 및 제한
Queueable Apex 장기 실행 데이터베이스 작업 또는 외부 웹 서비스 콜아웃과 관련된 프로세스에 사용합니다. 대기 가능한 Apex 작업 ID, 비기본 유형 지원, 작업 체인화와 같은 기능을 제공합니다. 프로 코드 라이센스 수는 제한을 늘릴 수 있습니다.
배치 Apex 레코드 집합을 분할하고 관리 가능한 청크로 처리하여 수백만 개의 레코드를 포함하는 복잡한 장기 실행 프로세스를 구축합니다. 프로 코드 라이센스 수는 제한을 늘릴 수 있습니다.
예약된 Apex Cron 식으로 정의된 예약된 시간에 Apex 실행합니다. Cron 식을 통해 Apex 예약하는 작업은 비동기식 프로세스이지만, 작업이 시작되면 기본 코드가 동기식으로 실행됩니다. 프로 코드 라이센스 수는 제한을 늘릴 수 있습니다.
Apex 계속 콜아웃 동기 트랜잭션 컨텍스트에서 실행되는 Apex 메서드의 콜아웃을 실행합니다. 프로 코드 아니요
비동기 경로(레코드 트리거 플로) 자체 시간에 실행할 작업을 실행합니다. 플로를 트리거한 레코드의 일부가 아닌 관련 레코드의 값을 업데이트할 때 발생하는 혼합 DML 오류를 방지합니다. 낮은 코드 라이센스 수와 유형에 따라 제한이 증가할 수 있습니다.
예약 경로(커밋 플로 후) 트리거 이벤트 후 동적으로 예약된 시간(예: 레코드가 생성, 업데이트 또는 삭제된 경우)에 실행합니다. 낮은 코드 라이센스 수와 유형에 따라 제한이 증가할 수 있습니다.
예약된 흐름 지정된 시간 및 반복 빈도(매일, 매주 또는 한 번)에 백그라운드에서 플로를 실행하여 레코드 배치에 대한 작업을 수행합니다. 낮은 코드 라이센스 수와 유형에 따라 제한이 증가할 수 있습니다.
플랫폼 이벤트 트리거 Salesforce를 외부 시스템과 쉽게 연결하고 Salesforce Platform 내 비동기 구성 요소 간에 통신합니다. 하위 코드 + Pro 코드 대용량 플랫폼 이벤트 사용 사례에 추가 기능 라이센스가 필요합니다.
변경 데이터 수집 데이터베이스 트랜잭션이 커밋된 후 비동기식으로 변경 이벤트를 수집하고 처리합니다. 프로 코드 기본 할당을 넘어 확장하려면 추가 기능 라이센스가 필요합니다.
Bulk API 많은 레코드를 비동기식으로 삽입, 업데이트, 업서트, 쿼리 또는 삭제하고 나중에 결과를 처리합니다. 프로 코드 제한이 있습니다.
Lightning 작업 사용자가 페이지를 완전히 새로 고칠 필요 없이 Lightning 페이지가 서버와 상호 작용하도록 허용합니다. 낮은 코드 아니요
## 결정 지점 이 표에는 사용할 비동기식 도구를 결정할 때 고려해야 할 사항의 개요가 포함되어 있습니다.
필수 기술 이 가이드에 설명된 일부 도구에는 코드가 필요하며, 다른 도구는 선언적으로 구성할 수 있습니다. 옵션을 고려할 때 팀 구성원이 보유한 기술 집합을 생각해 보십시오. 초기 구현을 위해 개발자를 사용할 수 있는 경우(예: 구현 파트너를 통해) 나중에 솔루션을 수정해야 할 수도 있다는 점에 유의하십시오. 서비스 점검 팀에 개발자가 부족할 경우 하위 코드 옵션이 더 적합할 수 있습니다.
적용되는 플랫폼 제한 유형 실행에 적용되는 제한의 유형을 결정합니다. 솔루션을 설계할 때 매일 선택한 접근 방식의 총괄자 제한에 트랜잭션의 양과 빈도가 어떻게 계산되는지 주의 깊게 생각합니다. 매일 발생할 실행 횟수를 계산합니다. 계산된 값이 선택한 도구와 연결된 제한에 속하는지 확인합니다.
대기 시간 플랫폼에서 처리 결과를 얼마나 빠르게 사용할 수 있는지 결정합니다. 일부 접근 방식에서는 변경 사항이 거의 즉시 적용되지만, 다른 접근 방식에서는 분 또는 시간으로 변경될 수 있습니다.
## 사용 사례 비동기식 처리를 위한 도구를 선택할 때 먼저 조직의 요구 사항 및 사용 가능한 자원을 평가합니다. 목표는 구현 및 유지 보수 비용을 최소화하지만 확장성을 유지하고 제한 위반 가능성을 최소화하는 도구를 선택하는 것입니다. 이 목표는 앞서 요약된 기술적 고려 사항 및 팀 구성에 따라 다릅니다. Salesforce에서 비동기 주문 프로세스를 고려하십시오. 주문이 저장되면 항목을 패킹하고 배송하는 방법에 대한 특별 지침이 포함된 외부 창고 관리 시스템에 메시지를 트리거합니다. 주문하는 사용자는 창고 관리 시스템의 즉각적인 응답이 필요하지 않으므로 비동기식으로 요청을 보낼 수 있습니다. 비동기 처리를 사용하면 사용자가 응답을 기다리지 않고 작업을 계속할 수 있습니다. 이 사용 사례의 경우 Apex 사용하여 구현할 수 있습니다. 이 접근 방식은 팀에 프로 코드 솔루션을 유지 관리할 수 있는 Apex 개발자가 있는 경우에만 작동합니다. 그렇지 않으면 선언적 접근 방식이 더 적합합니다. 또한 다른 도구에 다른 집합의 [제한](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_gov_limits.htm)이 적용된다는 점에 유의하십시오. 다음 표에서 왼쪽 끝의 열에 일반적인 사용 사례를 나열하고 설명을 확인할 수 있습니다. _첫 번째 선택_ 열은 이러한 사용 사례를 충족하기 위해 사용되는 가장 일반적인 접근 방식을 제공하고 첫 번째 선택 접근 방식을 설명합니다. 이를 분석의 시작점으로 사용하십시오. 첫 번째 선택 접근 방식에는 사용 사례에서 작동하지 않는 제한 사항이 있을 수 있습니다.
사용 사례 설명 첫 번째 선택 접근 방식 근거
고성능 배치 가공 수천 또는 수백만 개의 레코드를 효율적으로 처리해야 하는 자동화 배치 Apex 배치 Apex 플랫폼과 인터페이스하고 원시 속도를 위해 서식 있는 API를 제공합니다.
데이터 정리 작업 정리하는 데이터를 정기적으로 실행하거나 요청 시 실행하는 작업입니다. 중복 제거, 주소 확인 또는 데이터 통합을 예로 들 수 있습니다. 배치 Apex 배치 Apex 플랫폼과 인터페이스하고 원시 속도를 위해 서식 있는 API를 제공합니다.
야간 롤업 작업 영업일이 끝날 때 롤업 데이터를 계산하는 작업입니다. 배치 Apex 배치 Apex 플랫폼과 인터페이스하고 원시 속도를 위해 서식 있는 API를 제공합니다.
레코드 트리거형 논리 레코드 업데이트에 대한 응답으로 논리를 실행합니다. 다른 동료 결정 가이드, 레코드 트리거 이벤트 자동화를 참조하십시오. 대기 가능한 Apex, 배치 Apex, 예약된 Apex, 예약된 플로, 비동기 경로 플로, 변경 데이터 수집 등 비동기 사용 사례에 대한 결정 트리가 포함되어 있습니다.
개체 그래프를 통해 업데이트 캐스팅 사용자의 저장 작업을 빠르게 완료할 수 있으므로 다른 개체에 대한 계단식 업데이트가 비동기식으로 실행되도록 지연됩니다. 대기 가능한 Apex 대기 가능한 Apex 논리를 사용하여 업데이트 체인을 일련의 비동기 트랜잭션으로 나눌 수 있는 강력한 체인화 기능이 있습니다.
레코드별 예약된 처리 레코드에 고유한 향후 동적 날짜(예: 마감 날짜 3일 전)의 자동화 예약 경로가 있는 플로 예약 경로는 플로에 고유한 강점이므로 플랫폼이 레코드의 데이터가 변경될 경우 해당 경로의 예약, 취소, 재예약을 자동으로 처리합니다.
다중 느린 외부 서비스 병렬 호출 동기 실행 중에는 전체 실행 시간을 최적화하기 위해 여러 외부 서비스를 병렬로 호출합니다. Apex 계속 콜아웃 느리게 실행되는 여러 콜아웃을 병렬로 실행하도록 허용하면 작업을 완료하는 전체 시간이 최소화됩니다.
외부 시스템에서 레코드의 데이터 마이그레이션 대량의 레코드를 외부 시스템에서 Salesforce Platform으로 이동합니다. 일회성 또는 정기적으로 예약된 프로세스입니다. 대량 API 이는 데이터 마이그레이션을 위한 가장 효율적이고 제한적인 접근 방식입니다.
외부 시스템에서 추가 논리 실행 플랫폼에서 외부 시스템에 이벤트를 알린 후 해당 시스템이 비동기식으로 이벤트를 처리할 수 있도록 합니다. 플랫폼 이벤트 또는 변경 데이터 수집 pub-sub 모델은 여기에서 가장 적합하며, 준비가 되면 외부 시스템에서 이벤트를 처리할 수 있습니다. 이 패턴에 대한 자세한 내용은 이벤트 구동 아키텍처를 참조하십시오.
사용 사례 테이블은 각 사용 사례에 가장 적합한 접근 방식을 안내합니다. 그러나 First Choice 기술이 사용 사례의 특정 요구 사항에 얼마나 적합한지 확인해야 합니다. 특히 선택한 접근 방식을 조직의 총괄자 제한을 준수할 수 있는지 확인합니다. 사용 사례에 대한 후보 접근 방식을 식별하면 [비동기 처리 기본 사항 가이드](/docs/architect/ko-kr/fundamentals/guide/async-fundamentals)가 솔루션을 완벽하게 검사하는 데 도움이 됩니다. ## 자원 결정 프로세스에 도움이 되는 추가 자원은 다음과 같습니다. - 플랫폼 비동기 기술 각각을 자세히 살펴봅니다. [비동기식 처리 기본 사항](/docs/architect/ko-kr/fundamentals/guide/async-fundamentals) - 레코드 트리거에 대한 Apex 및 플로 선택: [레코드 트리거 이벤트 자동화](/docs/architect/ko-kr/decision-guides/guide/record-triggered) - 비동기 통합 패턴에 대한 정보: [이벤트 중심 아키텍처](/docs/architect/ko-kr/decision-guides/guide/event-driven) ## 가이드 개요 Salesforce와 외부 시스템 간에 데이터에 액세스, 동기화, 공유할 수 있는 다양한 방법이 있습니다. 그러나 일부 도구가 특정 프로젝트에 적합하지는 않습니다. 이 가이드에서는 Salesforce에서 사용할 수 있는 데이터 통합 도구의 환경을 살펴봅니다. 또한 특정 사용 사례에 가장 적합한 도구(또는 도구의 조합)에 대한 권장 사항과 특정 시나리오에서 피할 수 있는 도구에 대한 지침을 제공합니다. 이 결정 가이드는 Salesforce와 관련된 데이터 수준 통합에 중점을 둡니다. 특히 다음 데이터 통합 사용 사례를 다룹니다. - Salesforce -> 외부 시스템 - Salesforce에 외부 시스템 연결 - Salesforce 조직 -> Salesforce 조직 이는 Salesforce 아키텍처가 직면하는 통합 문제의 하위 집합일 뿐이므로 이벤트 중심 통합, 프로세스 통합을 사용하여 효과적인 고객 또는 직원 대면 워크플로 구축에 초점을 맞춘 더 많은 의사 결정 가이드를 추가할 계획입니다. 마지막으로 여기에 설명된 많은 도구와 접근 방식을 사용하여 더 광범위한 엔터프라이즈 전반에서 통합 문제를 해결할 수 있지만 이러한 용도는 이 가이드의 범위를 벗어난다는 점에 유의해야 합니다. ### 서비스 - **필요하지 않은 데이터 복제를 피하십시오.** 데이터가 Salesforce에 있어야 하는 경우를 제외하고 Salesforce Connect 사용하여 데이터를 가상화하는 것이 좋습니다. 조직의 데이터가 많을수록 데이터 볼륨이 늘어날 수 있으며, 이는 [성능](/docs/architect/ko-kr/well-architected/guide/reliable#성능)에 부정적인 영향을 미치고 기술 부채를 늘릴 수 있습니다. 데이터가 Salesforce에 이미 있고 외부 시스템에 필요한 경우 절대적으로 필요한 경우를 제외하고 외부 시스템에 복사하지 마십시오. 대신 외부 시스템이 Salesforce API를 통해 데이터에 액세스하도록 합니다. - **사용 가능한 경우 MuleSoft 또는 기타 엔터프라이즈 서비스 버스(ESB) 또는 ETL(Extract-Transform-Load) 솔루션을 사용하십시오.** 이러한 도구는 데이터 마이그레이션 및 변환을 지원하기 위해 구축되었으므로 기업 전체에서 통합을 재사용하고, 더 강력한 관리를 유지하고, 통합 관리를 중앙 집중화할 수 있는 강력한 기능을 자주 갖추고 있습니다. 이 가이드에서 MuleSoft Anypoint가 권장되는 모든 위치에서 기존 ESB/ETL 솔루션이 충분한지 여부를 고려합니다. - **Data 360 및 Data Cloud One을 사용하여 다양한 소스의 데이터를 조화시킵니다.** Customer 360 데이터 모델, ID 확인, 데이터 통합 및 기타 기능을 통해 Data 360은 Salesforce 및 기타 외부 시스템의 데이터를 고객에 대한 통합 보기로 통합합니다. 또한 [Data Cloud One을 사용하면](/docs/architect/ko-kr/fundamentals/guide/data360_integration_patterns_and_practices.html#unified-multi-org-data-platform-with-data-cloud-one) 다른 Salesforce 조직의 사용자가 데이터 공간을 통해 Data 360에서 가상으로 공유된 데이터에 안전하게 액세스할 수 있습니다. - **Data 360 작업 및 활성화를 사용하여 조직 간에 데이터를 이동합니다.** 데이터가 다른 조직에서 Data 360으로 수집되면 데이터 [작업 및 활성화](/docs/architect/ko-kr/fundamentals/guide/data360_integration_patterns_and_practices.html#data-activation-patterns--data-outbound)로 데이터를 다른 조직에 동기화할 수 있습니다. 이 접근 방식은 Marketing Cloud 조직과의 통합에 매우 유용합니다. - **MuleSoft Anypoint를 사용하여 데이터를 추출하고 이동합니다.** MuleSoft Anypoint를 사용하여 Connect API 및 데이터 그래프 API를 사용하여 Data 360에서 데이터를 추출하고 다른 Salesforce 조직으로 이동할 수 있습니다. Data 360이 없으면 Data 360에서 복제하지 않고 조직 간에 데이터를 이동해야 하는 경우에도 MuleSoft Anypoint를 사용할 수 있습니다. - **아웃바운드 메시징을 사용하여 구축하려는 경우 주의하십시오.** Salesforce는 현재 기능 용량 내에서 계속해서 아웃바운드 메시징을 지원하지만 이 기술에 대한 추가 투자를 계획하지는 않습니다. - **모든 통합에 대해 "API 전용" 프로필이 있는 통합 사용자 라이센스를 항상 권장합니다.** 또한 Salesforce는 모든 통합에 대해 적절하게 허용된 AuthN 및 AuthZ 패턴으로 외부 클라이언트 응용 프로그램(연결된 앱 또는 SOAP 로그인 지원)을 사용하는 것이 좋습니다. ## 데이터 통합 도구를 선택하기 위한 일반적인 고려 사항 사용 가능한 데이터 통합 도구를 자세히 살펴보려면 도구를 선택할 때 몇 가지 일반적인 고려 사항에 유의하십시오. 아키텍처와 마찬가지로 모든 비즈니스 문제에 대한 처방적 답변이 없습니다. 통합을 선택할 때 "대상에 따라 다름"이라는 단어를 사용했을 경우 적절한 위치를 찾았습니다.
고려할 영역 일반적인 질문
기존 도구 및 환경 기존 ESB 또는 ETL 솔루션이 있습니까? 관련 데이터에 규제 또는 규정 준수 요구 사항이 있습니까? 통합하려는 시스템은 클라우드 또는 온 프레미스에서 어디에 있습니까?
데이터 플로(타이밍, 예상 사용자 환경, 방향) 데이터를 동기식으로 비동기식으로 이동해야 하는지 아니면 배치/예약할 수 있습니까? 데이터 복제가 필요합니까? 신뢰할 수 있는 소스가 되는 시스템은 무엇입니까? 데이터 소스는 무엇입니까? 대상 대상은 무엇입니까? 사용자 상호 작용이 필요합니까? 사용자가 통합 결과를 확인해야 합니까? 예외 처리에 대한 요구 사항은 무엇입니까(재시도, 알림, 실패)? 시스템이 얼마나 긴밀하게 연결되어야 합니까?
구현 비Salesforce 시스템의 수고 수준은 얼마입니까? 통합을 전달할 책임이 있는 팀은 누구입니까? 사용자가 선호하는 도구는 무엇입니까?
기존성 통합을 유지할 것으로 예상되는 팀은 누구입니까? 현재 보유한 기술은 무엇입니까? 향후 어떤 기술이 필요합니까? 시간에 따른 총 소유 비용은 얼마입니까? 하위 코드 또는 프로 코드 도구를 사용하여 테스트, 디버그, 문제 해결 기능이 얼마나 중요합니까?
데이터 볼륨 통합에 포함된 데이터는 몇 개입니까? 대용량 데이터(LDV)를 사용할 수 있습니까? 변경 사항은 얼마나 자주 대량으로 발생합니까? Singleton 업데이트는 어떤 영향을 미칩니까? 얼마나 자주 발생합니까?
제한 데이터가 복잡한 변환을 수행해야 합니까? 여러 소스 시스템에서 데이터를 결합해야 합니까? 사용자 단위를 기준으로 통합이 얼마나 자주 이루어집니까? 총 사용자 수는 몇 명입니까? 미리 대량 데이터 로드를 계획했습니까(예: 새 인스턴스의 초기 데이터 로드)?
## 제품 비교 다음은 데이터 통합에 사용할 수 있는 도구의 상위 수준 개요와 각 옵션 평가를 시작하기 위한 몇 가지 고려 사항입니다. 다음 섹션에는 자세한 사용 사례와 해당 도구의 기능에 대한 세부 사항이 포함되어 있습니다.
Salesforce에서 외부 시스템으로 이동 외부 시스템에서 Salesforce로 이동 실행 추가 라이센스 필수
Apex 작업 사용 가능 사용 가능 서버측 아니요
변경 데이터 수집 사용 가능 사용할 수 없음 서버측 아니요*
사용자 정의 Apex(REST 및 SOAP 웹 서비스) 사용 가능 사용 가능 서버측 아니요
외부 서비스 사용 가능 사용할 수 없음 서버측 아니요
Heroku Connect 사용 가능 사용 가능 서버측 예
Data 360 사용 가능 사용 가능 서버측 예
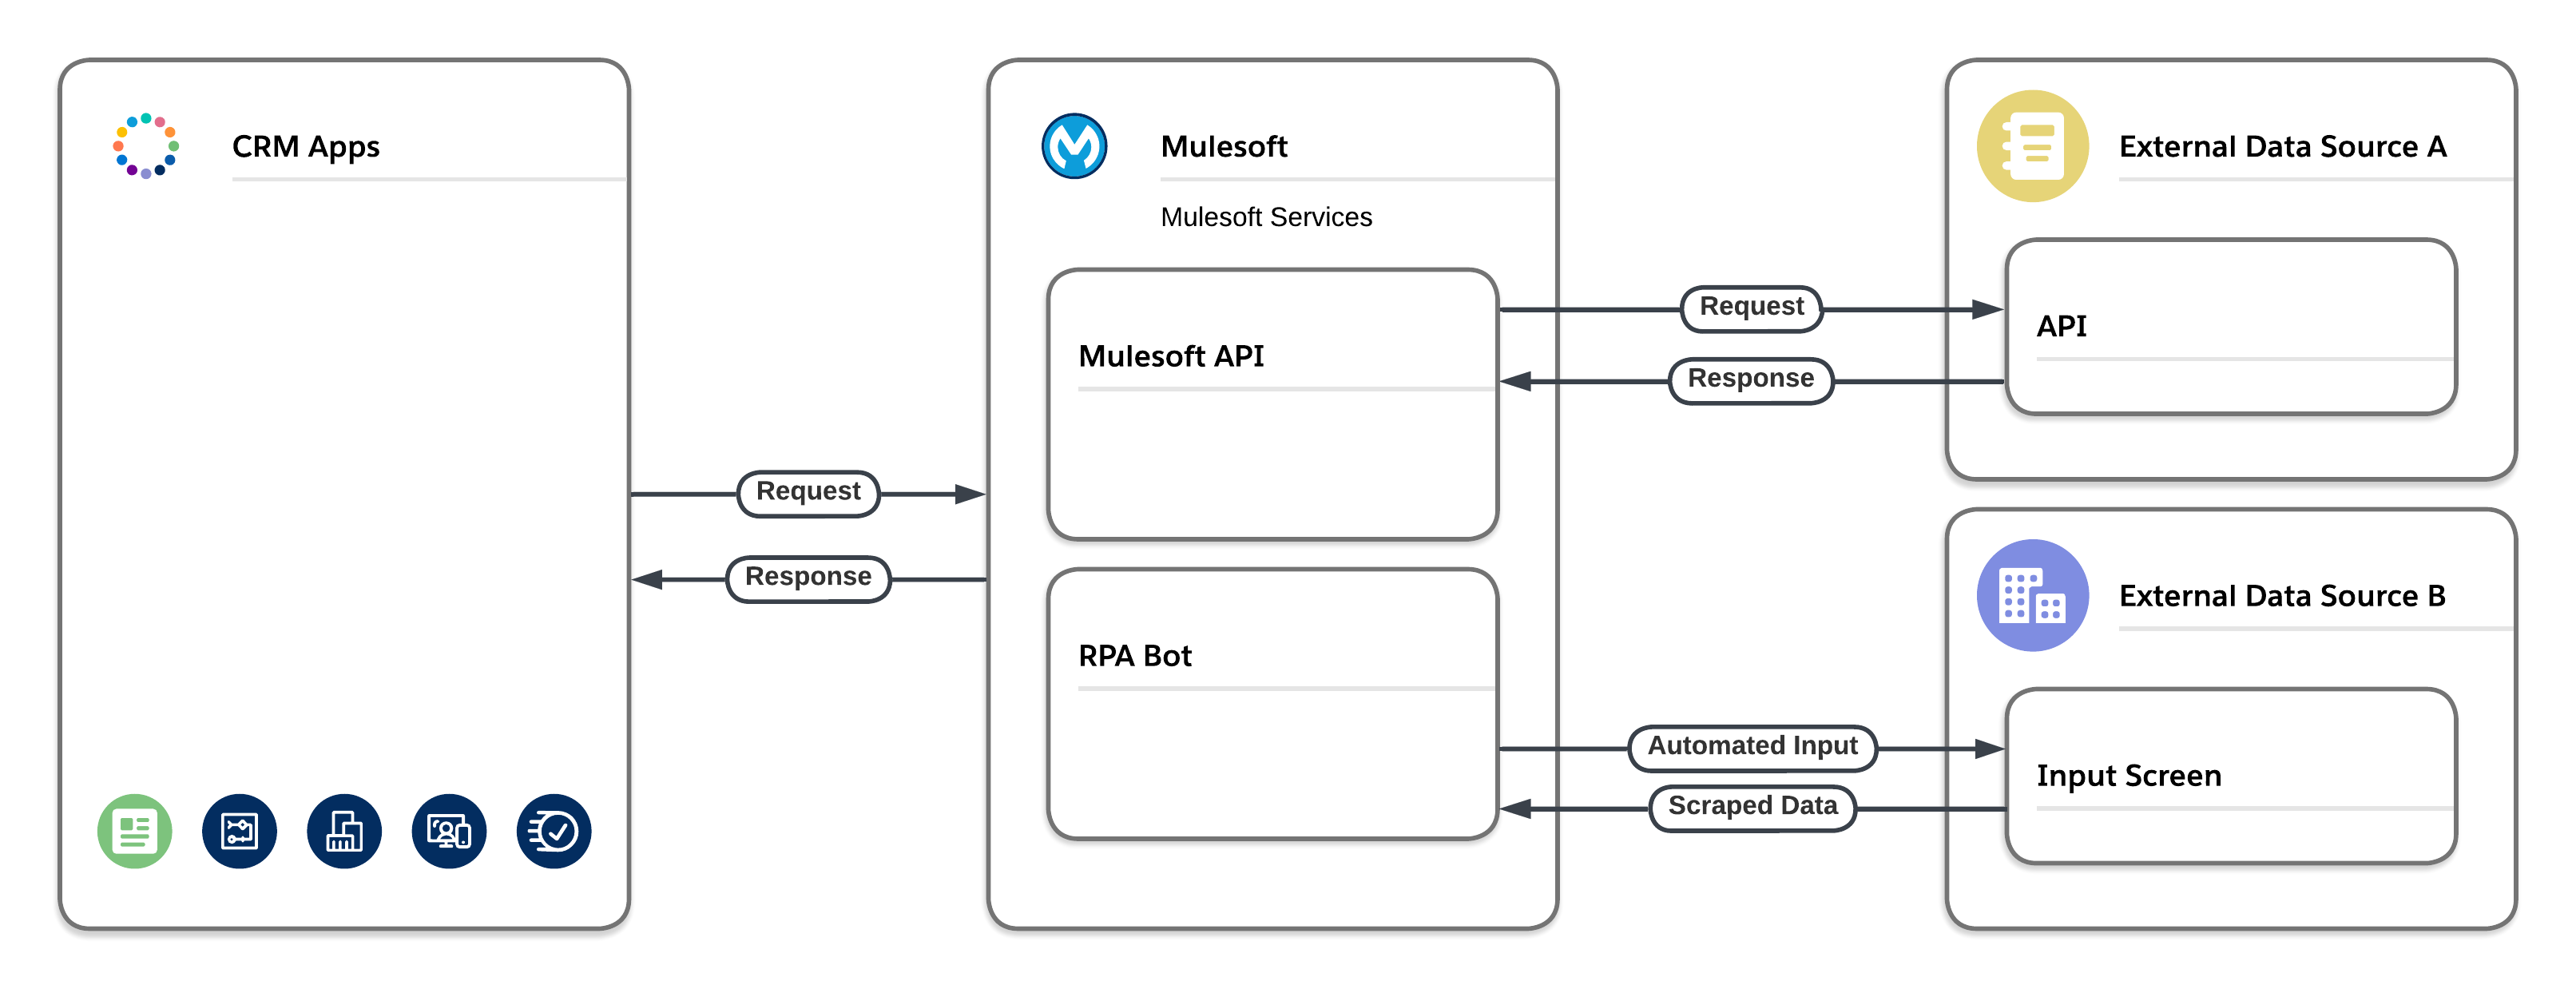
MuleSoft Anypoint 사용 가능 사용 가능 서버측 예
Native Salesforce API 사용할 수 없음 사용 가능 서버측 아니요
Omniscript 사용 가능 사용 가능 클라이언트측*** 예
OmniStudio 통합 절차 사용 가능 사용 가능 서버측 예
아웃바운드 메시징 이상적이지 않음 사용할 수 없음 서버측 아니요
플랫폼 이벤트 사용 가능 사용 가능 서버측 아니요**
Salesforce Connect/외부 개체 사용 가능 사용 가능 서버측 예
[\*대용량 변경 데이터 수집 이벤트 사용 사례에 필요한 추가 기능](https://developer.salesforce.com/docs/atlas.en-us.change_data_capture.meta/change_data_capture/cdc_allocations.htm) [\*\*대용량 플랫폼 이벤트 사용 사례에 필요한 추가 기능](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_event_limits.htm) \*\*\*웹 브라우저 내에서 비즈니스 논리를 실행하는 것이 좋을 경우 적합합니다. 열 범례: - **사용 가능**: 대부분의 사용 사례에 잘 작동 - **이 이상적이지 않음**: 가능하지만 대체 도구를 고려하십시오. - **사용 불가**: 향후 12개월 동안 지원할 계획 없음 ### 데이터를 Salesforce에서 또는 Salesforce에서 이동하는 과정과 관련이 있을 수 있는 기타 도구: 데이터 레이어 통합의 일부 측면을 지원할 수 있는 다른 도구가 있지만 통합 문제를 해결하는 기본 수단으로 간주해서는 안 됩니다. 이제 이러한 도구를 빠르게 살펴보겠습니다. **Lightning 웹 구성 요소**는 일반적으로 프로세스 통합에 사용되지만, JavaScript 기능을 사용하여 콜아웃을 만들 수 있으므로 해당 트랜잭션에 데이터가 포함될 수 있습니다. 외부 서비스 또는 Apex 작업을 사용하여 외부 콜아웃을 오케스트레이션하는 데 **Salesforce 플로**를 사용할 수 있습니다. Salesforce 플로 자체는 독립 실행형 데이터 통합 도구로 간주되지 않습니다. **데이터 가져오기 마법사 및 Data Loader를** 사용하여 데이터를 동기화, 가져오기 및 마이그레이션할 수 있습니다. Data Loader 명령은 데이터 가져오기 및 내보내기를 자동화하기 위해 스크립트를 지정할 수도 있지만, [명령줄 인터페이스](https://developer.salesforce.com/docs/atlas.en-us.dataLoader.meta/dataLoader/command_line_intro.htm)는 Windows에만 적용되며, 이러한 도구 중 어느 것도 데이터 통합 전략을 위한 권장 기초가 아닙니다. 대신 이를 사용하여 데이터 관리 및 서비스 점검 전략을 보완합니다. [**Salesforce CLI**](https://developer.salesforce.com/docs/atlas.en-us.sfdx_cli_reference.meta/sfdx_cli_reference/cli_reference_force_data.htm) 데이터 명령을 사용하여 조직의 레코드를 조작할 수 있습니다. 대량 API 및 SObject 트리 저장 API를 사용하여 데이터를 가져오거나 내보내는 데 도움이 되는 명령을 사용할 수 있으며, REST API를 사용하여 개별 레코드에서 간단한 CRUD 작업을 수행할 수 있습니다. Salesforce CLI 자체는 독립형 데이터 통합 도구로 간주되지 않습니다. **OmniStudio Data Mapper** 은 선언적 ETL 도구로 사용하여 Salesforce 개체와 JSON 데이터 구조 간에 데이터를 이동할 수 있습니다. REST 인터페이스는 각 데이터 매퍼 인터페이스에 대해 자동으로 생성되며, 외부 시스템에서 Salesforce 개체로 데이터를 이동하는 선언적 방법을 제공하지만 데이터 매퍼 독립형은 데이터 통합 전략의 기준이 아닙니다. 데이터 매퍼 작업은 OmniStudio 통합 절차에서 사용할 수 있습니다. [**Dataloader.io**](http://dataloader.io/)는 MuleSoft의 Anypoint 플랫폼을 통해 제공되는 Salesforce의 또 다른 데이터 로더 도구로서 기업의 데이터 양을 빠르고 안전하게 가져오고 내보내거나 삭제할 수 있습니다. Dataloader.io는 데이터 통합 전략의 기준이 아닙니다. ## 외부 시스템에 Salesforce(아웃바운드 통합) Salesforce의 아웃바운드 통합의 경우 하위 코드, 프로 코드 또는 하이브리드와 같은 다양한 유형의 도구를 고려할 수 있습니다. 다음 섹션에서는 이러한 각 도구 유형에 대한 지침을 제공하고 샘플 솔루션을 제공합니다. - [아웃바운드 통합을 위한 로우 코드 도구](#salesforce의-아웃바운드-통합을-위한-하위-코드-도구) - [아웃바운드 통합을 위한 하이브리드 도구](#salesforce의-아웃바운드-통합을-위한-하이브리드-도구) - [아웃바운드 통합을 위한 Pro-Code 도구](#salesforce의-아웃바운드-통합을-위한-pro-code-도구) ### Salesforce의 아웃바운드 통합을 위한 하위 코드 도구
지침 라이센스 시기 볼륨 및 규모 배달 및 서비스 점검 개인 정보 보호 및 보안
때 사용하기 추가 라이센스 동기화(요청/응답) 또는 비동기화(발전/잊기) 다중 개체 지원 LDV/Bulk 테스트 및 구축** 디버깅 내장 오류 처리 / 재시도 동작 나머지 암호화된 데이터와 함께 사용할 수 있음 인증 프로토콜
변경 데이터 수집 Salesforce의 레코드 수준 변경 사항을 외부 시스템에 게시해야 하며 사용자 정의 페이로드가 필요하지 않은 경우 필수 비동기 아니요 아니요 예 프로 코드 도구 사용 예 예 OAuth
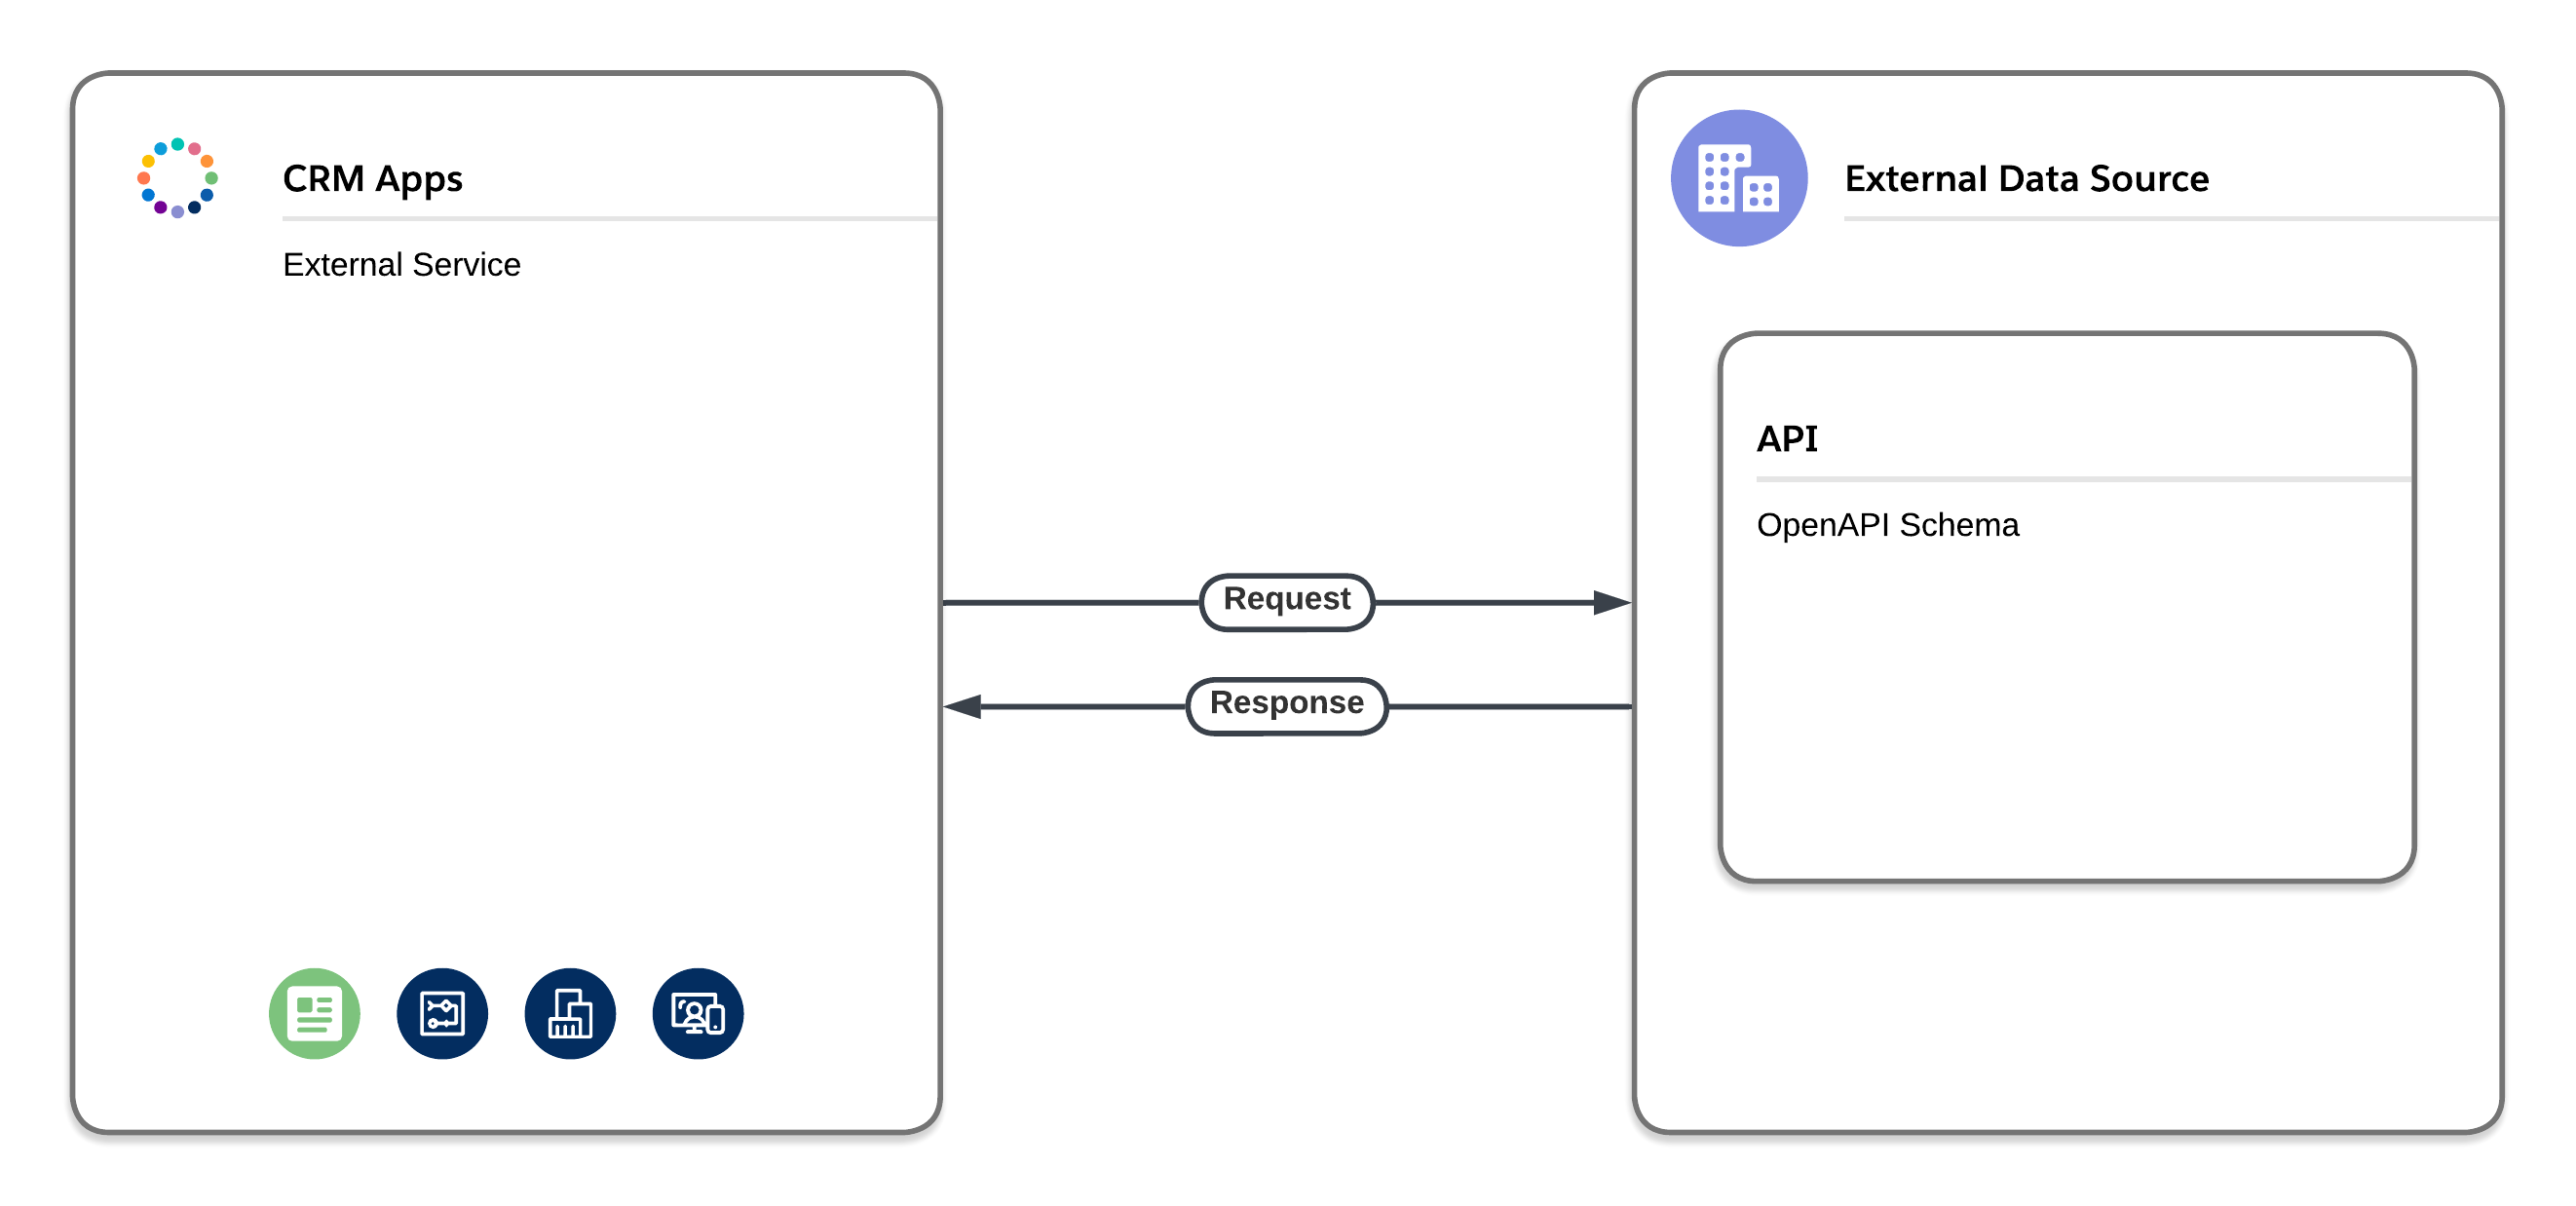
외부 서비스 Flow, Apex, Einstein Bots 또는 OmniStudio를 사용하여 프로세스를 오케스트레이션하는 경우 외부 시스템 API가 OpenAPI 사양을 사용하여 설명됩니다. 필수 아님 동기화 예 아니요 예 프로 코드 도구 사용 아니요 N/A 명명된 자격 증명
Heroku Connect 양방향 동기화를 사용하여 데이터를 확장하여 Heroku에서 모바일 및 기타 앱을 활성화하고 데이터를 Salesforce에도 복제하려는 경우 필수 비동기 예 예 아니요 프로 코드 도구 사용 예 예, Shield Connect를 통해 OAuth
OmniStudio 통합 절차 사용자 상호 작용 없이 데이터를 변환하고 브라우저 대신 서버에서 처리하여 성능을 향상해야 하는 경우 필수 모두 예 예 예 선언적 지원 예 예 명명된 자격 증명
Salesforce Connect/외부 개체 Salesforce UI에 데이터를 표시하되 외부 시스템에 데이터를 저장하려는 경우 데이터는 Salesforce에 복제되지 않습니다. 필수 동기화 아니요 예* 예 프로 코드 도구 및 선언적 트래커 사용 아니요 N/A 명명된 자격 증명
*버전 4.01보다 오래된 OData 어댑터는 콜아웃 제한이 적용됩니다. 자세한 내용은 OData 콜아웃 요금 제한 고려 사항을 참조하십시오. ** 테스트 및 배포는 낮은 환경에서 구축하고 메타데이터 API, 패키지 또는 변경 집합을 통해 프로덕션에 배포할 수 있는 기능을 말합니다.
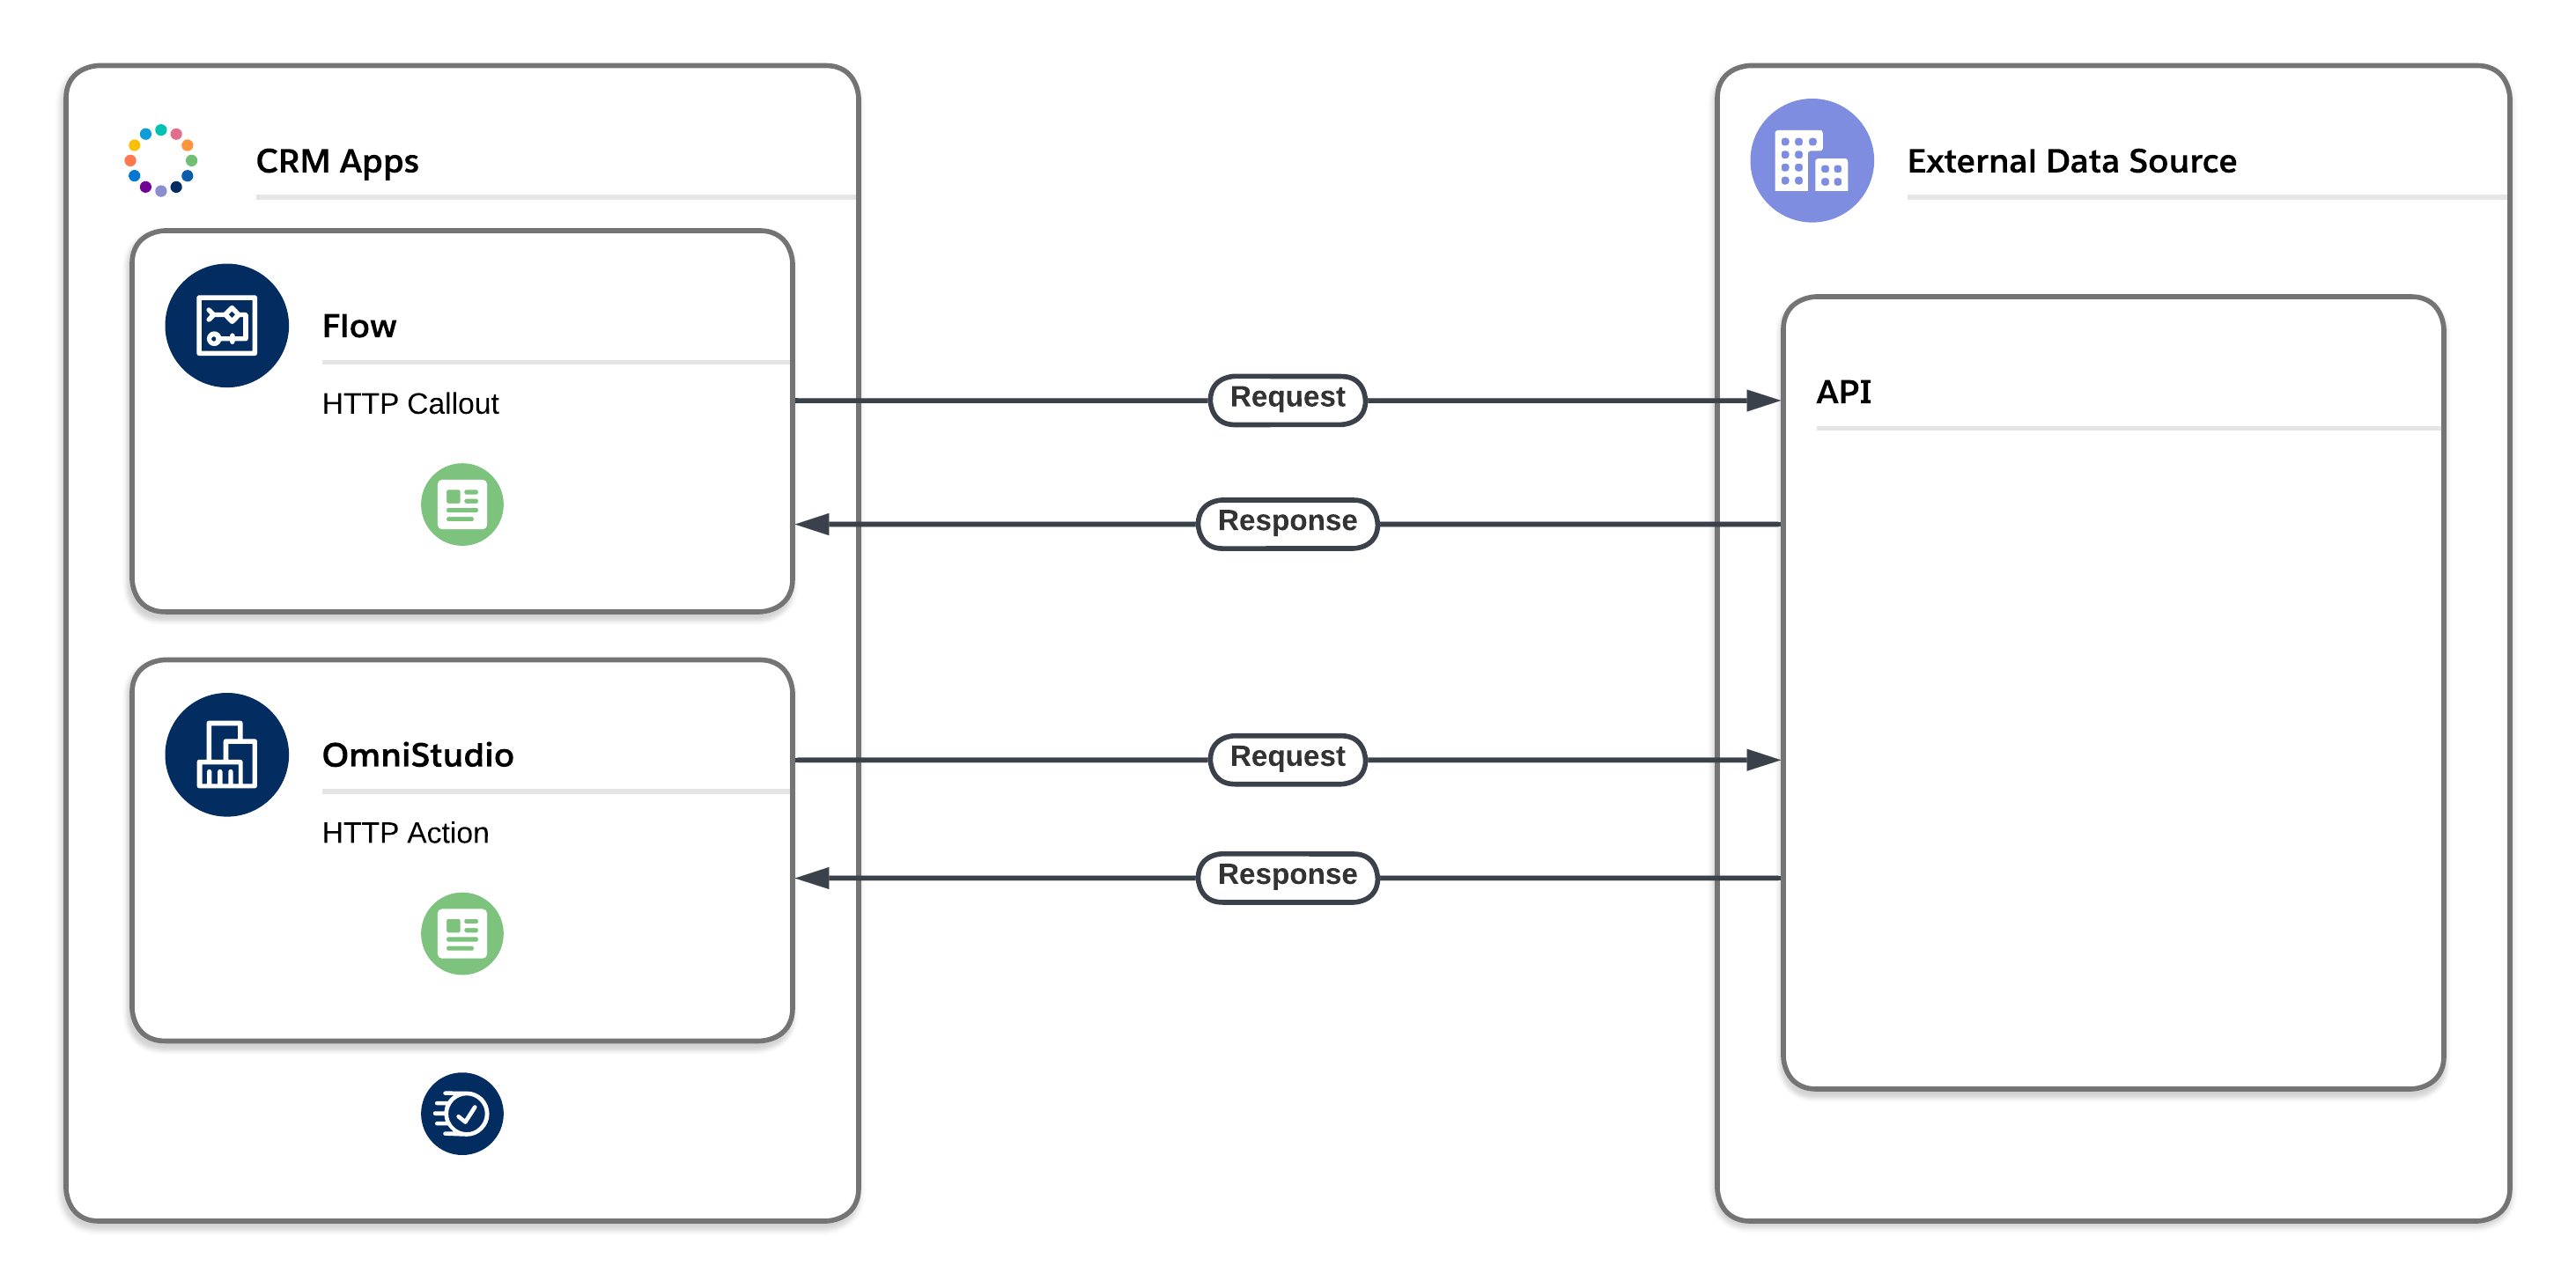
### 사용 사례: 하위 코드 도구를 사용한 아웃바운드 통합 > 기회가 수주되면 회사의 ERP 시스템 또는 주문 관리 시스템에서 관련 제품에 대한 주문을 만들어야 합니다. **변경 데이터 캡처** 기회 레코드가 업데이트되면 변경 데이터 캡처가 개체에 대한 업데이트가 포함된 변경 이벤트를 게시합니다. 변경 이벤트는 CometD 연결(또는 MuleSoft 커넥터를 통해)을 통해 고객이 소비하고 고객의 ERP 또는 주문 관리 시스템을 업데이트하는 데 사용됩니다. 변경 이벤트를 보강하여 항상 통합에 필요한 개체의 외부 레코드 ID 또는 기타 데이터(예: 지역)를 포함할 수 있습니다. 여러 개체에 대한 변경 이벤트 스트림을 단순화된 구독 및 스트림 처리를 위해 *채널*으로 결합할 수 있습니다(다중 스트림 대신 하나의 스트림을 구독하고 처리할 수 있음). **외부 서비스** OpenAPI 2.0 또는 3.0 사양을 지원하는 웹 서비스가 있는 경우 Salesforce 내에서 운영 및 서비스를 외부 서비스로 표시할 수 있습니다. 기회의 단계가 "수주"로 변경되면 API 작업(예: 주문 만들기)을 Flow Builder로 구축된 플로에서 호출 가능한 작업으로 호출할 수 있습니다. **Heroku Connect** Heroku Connect는 일반적으로 Heroku Postgres 데이터베이스와 Salesforce를 동기화하는 데 사용됩니다. 고객이 Heroku Postgres를 신뢰할 수 있는 트랜잭션 매장으로 사용하는 경우 Heroku Connect를 사용하여 Salesforce의 레코드 및 변경 사항을 Heroku Postgres에 동기화할 수 있습니다. 여기에서 Heroku 스트리밍 커넥터를 사용하여 변경 사항을 Apache Kafka에 게시하고 ERP 또는 주문 관리 시스템 등 다운스트림 응용 프로그램에 이벤트로 보낼 수 있습니다. **OmniStudio 통합 절차** 주문이 제출되면 프로세스를 오케스트레이션하는 Omniscript가 주문 세부 사항을 ERP 또는 MuleSoft 커넥터에 게시할 수 있습니다. 게시물을 Omniscript(클라이언트측)에서 직접 실행하거나 통합 절차(서버측)를 통해 간접적으로 실행할 수 있습니다. ERP 시스템에서 유효성 검사 오류가 발생하는 경우 Omniscript UI가 사용자에게 알리고 필요한 경우 사용자에 대한 오류를 번역하고 맥락화해야 합니다. **Salesforce Connect/External Objects** 기회의 단계가 "수주"로 변경되면 관련 외부 개체에 레코드를 삽입하는 Salesforce에서 레코드 트리거 플로를 만들 수 있습니다. 이는 [교체 트랜잭션](https://help.salesforce.com/articleView?id=000328873&type=1&mode=1)이므로 오류를 방지하기 위해 Opportunity 업데이트와 관련 외부 개체 삽입 사이에 0초 동안 일시 중지 요소를 추가하여 새로운 트랜잭션을 시작하기 전에 하나의 트랜잭션 컨텍스트를 닫습니다. ### Salesforce의 아웃바운드 통합을 위한 하이브리드 도구
지침 라이센스 시기 볼륨 및 규모 배달 및 서비스 점검 개인 정보 보호 및 보안
때 사용하기 추가 라이센스 동기화(요청/응답) 또는 비동기화(발전/잊기) 다중 개체 지원 LDV/Bulk 테스트 및 구축** 디버깅 내장 오류 처리 / 재시도 동작 나머지 암호화된 데이터와 함께 사용할 수 있음 인증 프로토콜
Apex 작업 Salesforce 플로를 통해 다른 시스템에 대한 콜아웃을 자동화하려는 경우 개발자는 플로에서 호출할 수 있는 Apex 클래스를 작성하거나 AppExchange 사전 빌드된 솔루션을 다운로드할 수 있습니다. 필수 아님 모두 예 아니요 예 프로 코드 도구 사용 아니요 예 다중
이벤트 릴레이 Salesforce에서 플랫폼 이벤트를 보내고 데이터 수집 이벤트를 Amazon EventBridge로 변경해야 하는 경우 이벤트 릴레이는 AWS Eventbridge에만 연결됩니다. 아니요 비동기 예 아니요 예 예 예 예 TLS를 사용하는 HTTP/1.1
아웃바운드 메시징 워크플로 규칙에 의해 트리거될 때 수신이 보장된 지정된 끝점에 HTTP(S)를 통해 SOAP 메시지를 보내야 하는 경우 필수 아님 비동기 아니요 아니요 예 선언적 지원 예 예 양방향 TLS
플랫폼 이벤트 Salesforce 또는 외부 시스템에서 거의 실시간 변경을 위해 사용자 정의 정의된 구조화된 페이로드가 필요한 경우 필수 아님* 비동기 예 아니요 예 프로 코드 도구 사용 예 예 OAuth
Salesforce Connect/외부 개체(사용자 정의 Apex 어댑터 포함) 데이터가 Salesforce UI에 표시되지만, OData 또는 GraphQL과 같은 표준 프로토콜을 사용할 수 없는 외부 시스템에 저장되도록 하려는 경우 필수 모두 예 예 예 프로 코드 도구 사용 아니요 N/A 다중
Data 360 단일 데이터 저장소의 여러 소스에서 조화된 데이터를 원하거나 다른 Salesforce 조직 또는 다른 외부 시스템에 데이터를 복제하려는 경우 필수 모두 예 예 예 예 예 예 다중
대용량 사용 사례에 필요한 [\*추가 기능](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_event_limits.htm) \*\*테스트 및 배포는 낮은 환경에서 구축하고 [메타데이터 API](https://developer.salesforce.com/docs/metadata-coverage/), 패키지 또는 변경 집합을 통해 프로덕션에 배포할 수 있는 기능을 말합니다. ### 사용 사례: 하이브리드 도구를 사용한 아웃바운드 통합 > 기회가 수주되면 회사의 ERP 또는 주문 관리 시스템에서 관련 제품에 대한 주문을 만들어야 합니다. **Apex 작업** 기회가 수주되면 기회 상태를 기반으로 레코드 트리거 플로가 자동으로 트리거될 수 있습니다. 플로는 외부 콜아웃을 사용하여 주문을 주문 관리 시스템 또는 ERP 솔루션에 제출하는 호출 가능한 작업을 실행합니다. 대용량 제출 및 다중 사이트 주문은 Apex 배치 및 대기열 메커니즘으로 처리됩니다. **아웃바운드 메시징** [아웃바운드 메시징을 설정한](https://developer.salesforce.com/docs/atlas.en-us.api.meta/api/sforce_api_om_outboundmessaging_setting_up.htm) 후 기회 업데이트로 트리거된 워크플로 규칙을 정의하여 수신기를 호스팅하는 지정된 끝점 URL에 HTTP(S)를 통해 SOAP 메시지를 보낼 수 있습니다. 메시지에 아웃바운드 메시지가 생성될 때 지정된 필드가 포함됩니다. 알림이 대기열에 지정된 후이지만 전송되기 전에 개체의 정보가 변경되는 경우 업데이트된 정보만 전달되고 메시지가 성공적으로 전송될 때까지 또는 24시간이 지난 후까지 대기열에 남아 있게 됩니다. 24시간 후에는 메시지가 대기열에서 삭제됩니다. ERP 시스템에 추가 데이터가 필요한 경우 외부 시스템에서 콜백 요청을 만들 수 있도록 아웃바운드 메시지에서 sessionId를 전달할 수 있습니다. 외부 시스템에서 레코드를 생성하는 데 필요한 데이터와 함께 사용자 정의 페이로드를 포함하는 플랫폼 이벤트를 정의할 수 있습니다**. 플랫폼 이벤트** 플랫폼 이벤트는 레코드 변경 시 자동 게시되지 않으므로 기회의 단계가 "수주"로 변경되면 Apex, Salesforce 플로 또는 프로세스 빌더를 통해 이벤트를 게시해야 합니다. 외부 서비스는 CometD(또는 MuleSoft 커넥터)를 사용하여 플랫폼 이벤트 채널을 수신하고 외부 시스템에서 적절한 레코드를 만듭니다. **Salesforce Connect/External Objects(사용자 지정 Apex 어댑터 포함)** Salesforce Connect/External Objects를 기반으로 하는 솔루션은 단순히 데이터 동기화를 요구하는 사용 사례에 적합하지 않습니다. 그러나 이 솔루션은 Salesforce 내 사용자가 확인해야 하며 잠재적으로 외부 시스템의 데이터와 상호 작용하고 Salesforce에서 데이터를 복제할 수 없는 사례에 적용할 수 있습니다. ERP 또는 주문 관리 시스템에서 OData 또는 GraphQL 프로토콜을 지원하지 않는 경우 개발 팀은 [Apex Connector Framework를](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_connector_start.htm) 사용하여 지원되는 프로토콜을 통해 외부 시스템과 통신을 처리하는 Apex 클래스를 작성할 수 있습니다. **Data 360** Data 360을 기반으로 한 솔루션은 하나의 데이터 저장소에서 서로 다른 소스의 데이터를 조화롭게 처리해야 하는 사용 사례에 완벽하게 적합합니다. 또한 Data 360을 데이터 허브로 사용하여 하나의 Salesforce 조직에서 여러 Salesforce 조직 또는 다른 외부 시스템으로 데이터를 복제해야 하는 경우에도 사용할 수 있습니다. 기회가 수주되고 소스 조직에서 업데이트되면 기회 데이터가 Data 360에 동기화되어 작업, 활성화, API와 같은 다양한 메커니즘을 사용하여 Salesforce 조직을 비롯한 다른 시스템에서 복제할 수 있습니다. 마찬가지로 Data Cloud One을 사용하여 다른 Salesforce 조직에서 데이터를 복제하지 않고 기회를 참조할 수 있습니다. 그러나 Data Cloud One은 비Salesforce Platform을 지원하지 않습니다. ### Salesforce의 아웃바운드 통합을 위한 Pro-Code 도구
지침 라이센스 시기 볼륨 및 규모 배달 및 서비스 점검 개인 정보 보호 및 보안
때 사용하기 추가 라이센스 동기화(요청/응답) 또는 비동기화(발전/잊기) 다중 개체 지원 LDV/Bulk 테스트 및 구축** 디버깅 내장 오류 처리 / 재시도 동작 나머지 암호화된 데이터와 함께 사용할 수 있음 인증 프로토콜
사용자 정의 Apex 하위 코드 도구에서 사용할 수 있는 것보다 더 많은 기능이 필요한 경우 필수 아님 모두 예 예 예 프로 코드 도구 사용 아니요 예* 다중
외부 서비스 OpenAPI 사양을 사용하여 코드와 외부 시스템 API의 통합을 설명합니다. 필수 아님 동기화 예 아니요 예 프로 코드 도구 사용 아니요 N/A 다중
MuleSoft Anypoint 통합을 구축, 오케스트레이션, 관리하기 위해 단일 엔터프라이즈급 통합 솔루션이 필요한 경우, 레거시 지점 간 아키텍처를 교체해야 하는 경우 또는 API 관리 지원이 필요한 경우 필수 모두 예 예 예 프로 코드 도구 사용 아니요 예* 다중
\*Shield Platform Encryption을 활성화하면 특정 동작이 변경됩니다. 자세한 내용은 [General Shield Platform Encryption Considerations](https://help.salesforce.com/articleView?id=sf.security_pe_considerations_general.htm&type=5)를 참조하십시오. \*\*테스트 및 배포는 낮은 환경에서 구축하고 [메타데이터 API](https://developer.salesforce.com/docs/metadata-coverage/), 패키지 또는 변경 집합을 통해 프로덕션에 배포할 수 있는 기능을 말합니다. ### 사용 사례: Pro-Code 도구를 사용한 아웃바운드 통합 > 기회가 수주되면 회사의 ERP 또는 주문 관리 시스템에서 관련 제품에 대한 주문을 만들어야 합니다. **사용자 정의 Apex** 기회의 단계가 "수주"로 변경되면 ERP 또는 주문 관리 시스템에 콜아웃을 수행하는 Opportunity에서 Apex 트리거 및 트리거 처리기를 만들 수 있습니다. 트리거에서 또는 DML 작업을 수행한 후 콜아웃을 만드는 경우 향후 또는 대기 가능으로 주석이 지정된 메서드를 사용해야 합니다. 트리거의 콜아웃은 콜아웃의 생애 동안 데이터베이스 연결을 열어 둡니다. 모든 Apex 코드는 지속적으로 수정되는 [Apex 총괄자 및 API 제한](https://developer.salesforce.com/docs/atlas.en-us.salesforce_app_limits_cheatsheet.meta/salesforce_app_limits_cheatsheet/salesforce_app_limits_overview.htm)에 따라 바인딩됩니다. **외부 서비스** 회사의 외부 ERP 또는 주문 관리 시스템이 OpenAPI 사양을 통해 정의되면 향후 방법 또는 대기 가능한 작업에서 수행되는 서비스에 대한 콜아웃이 단순화될 수 있습니다. 보일러플릿 코드를 작성하지 않아도 Apex 직접 등록된 외부 서비스를 호출할 수 있습니다. 이 예에서는 주문을 만드는 콜아웃을 외부 서비스에서 처리할 수 있습니다. **MuleSoft Anypoint** MuleSoft Anypoint는 엔터프라이즈급 API 관리를 제공합니다. MuleSoft Anypoint는 Salesforce 및 기타 여러 엔터프라이즈 시스템에 대한 데이터에 대한 읽기/쓰기 액세스를 활성화하는 API를 만들 수 있습니다. 구축을 단순화하기 위해 [많은 사전 구축된 커넥터가](https://www.mulesoft.com/platform/cloud-connectors) 있으며, 회사는 자체 커넥터를 만들고 게시할 수도 있습니다. 이러한 API는 중앙 집중식 관리 및 거버넌스를 지원하는 유연한 보안 정책을 사용하여 Anypoint에 배포할 수 있습니다. API가 최대 사용량(vCores에서 측정)에 맞게 적절하게 크기가 조정된 경우 트랜잭션 용량에 대한 제한은 없습니다. ## Salesforce에 외부 시스템 데이터 전송(인바운드 통합) Salesforce에 대한 인바운드 통합의 경우 하위 코드, 프로 코드 또는 하이브리드와 같은 다양한 유형의 도구를 고려할 수 있습니다. 다음 섹션에서는 이러한 각 도구 유형에 대한 지침을 제공하고 샘플 솔루션을 제공합니다. - [인바운드 통합을 위한 로우 코드 도구](#salesforce에-대한-인바운드-통합을-위한-하위-코드-도구) - [인바운드 통합을 위한 하이브리드 도구](#salesforce에-대한-인바운드-통합을-위한-하이브리드-도구) - [인바운드 통합을 위한 Pro-Code 도구](#salesforce에-대한-인바운드-통합을-위한-pro-code-도구) ### Salesforce에 대한 인바운드 통합을 위한 하위 코드 도구
지침 라이센스 시기 볼륨 및 규모 배달 및 서비스 점검 개인 정보 보호 및 보안
사용하는 경우 추가 라이센스 동기화(요청/응답) 또는 비동기화(발행/실패) 다중 개체 지원 LDV/Bulk 테스트 및 배포* 디버깅 내장 오류 처리/재시도 동작 암호화된 데이터와 함께 사용 가능 인증 프로토콜
Heroku Connect 양방향 동기화를 사용하여 데이터를 확장하여 Heroku에서 모바일 및 기타 앱을 활성화하고 데이터를 Salesforce에도 복제하려는 경우 필수 비동기 예 예 아니요 프로 코드 도구 사용 예 예, Shield Connect를 통해 OAuth
OmniStudio 통합 절차 사용자 상호 작용 없이 타사 소스에서 데이터를 가져오고 변환해야 하는 경우 필수 모두 예 예 예 선언적 지원 아니요 예 명명된 자격 증명
Salesforce Connect/외부 개체 데이터가 Salesforce UI에 표시되지만, OData 또는 GraphQL과 같은 표준 프로토콜을 사용할 수 있는 외부 시스템에 저장되도록 하려는 경우 필수 동기화 예 예 예 프로 코드 도구 사용 아니요 N/A 다중
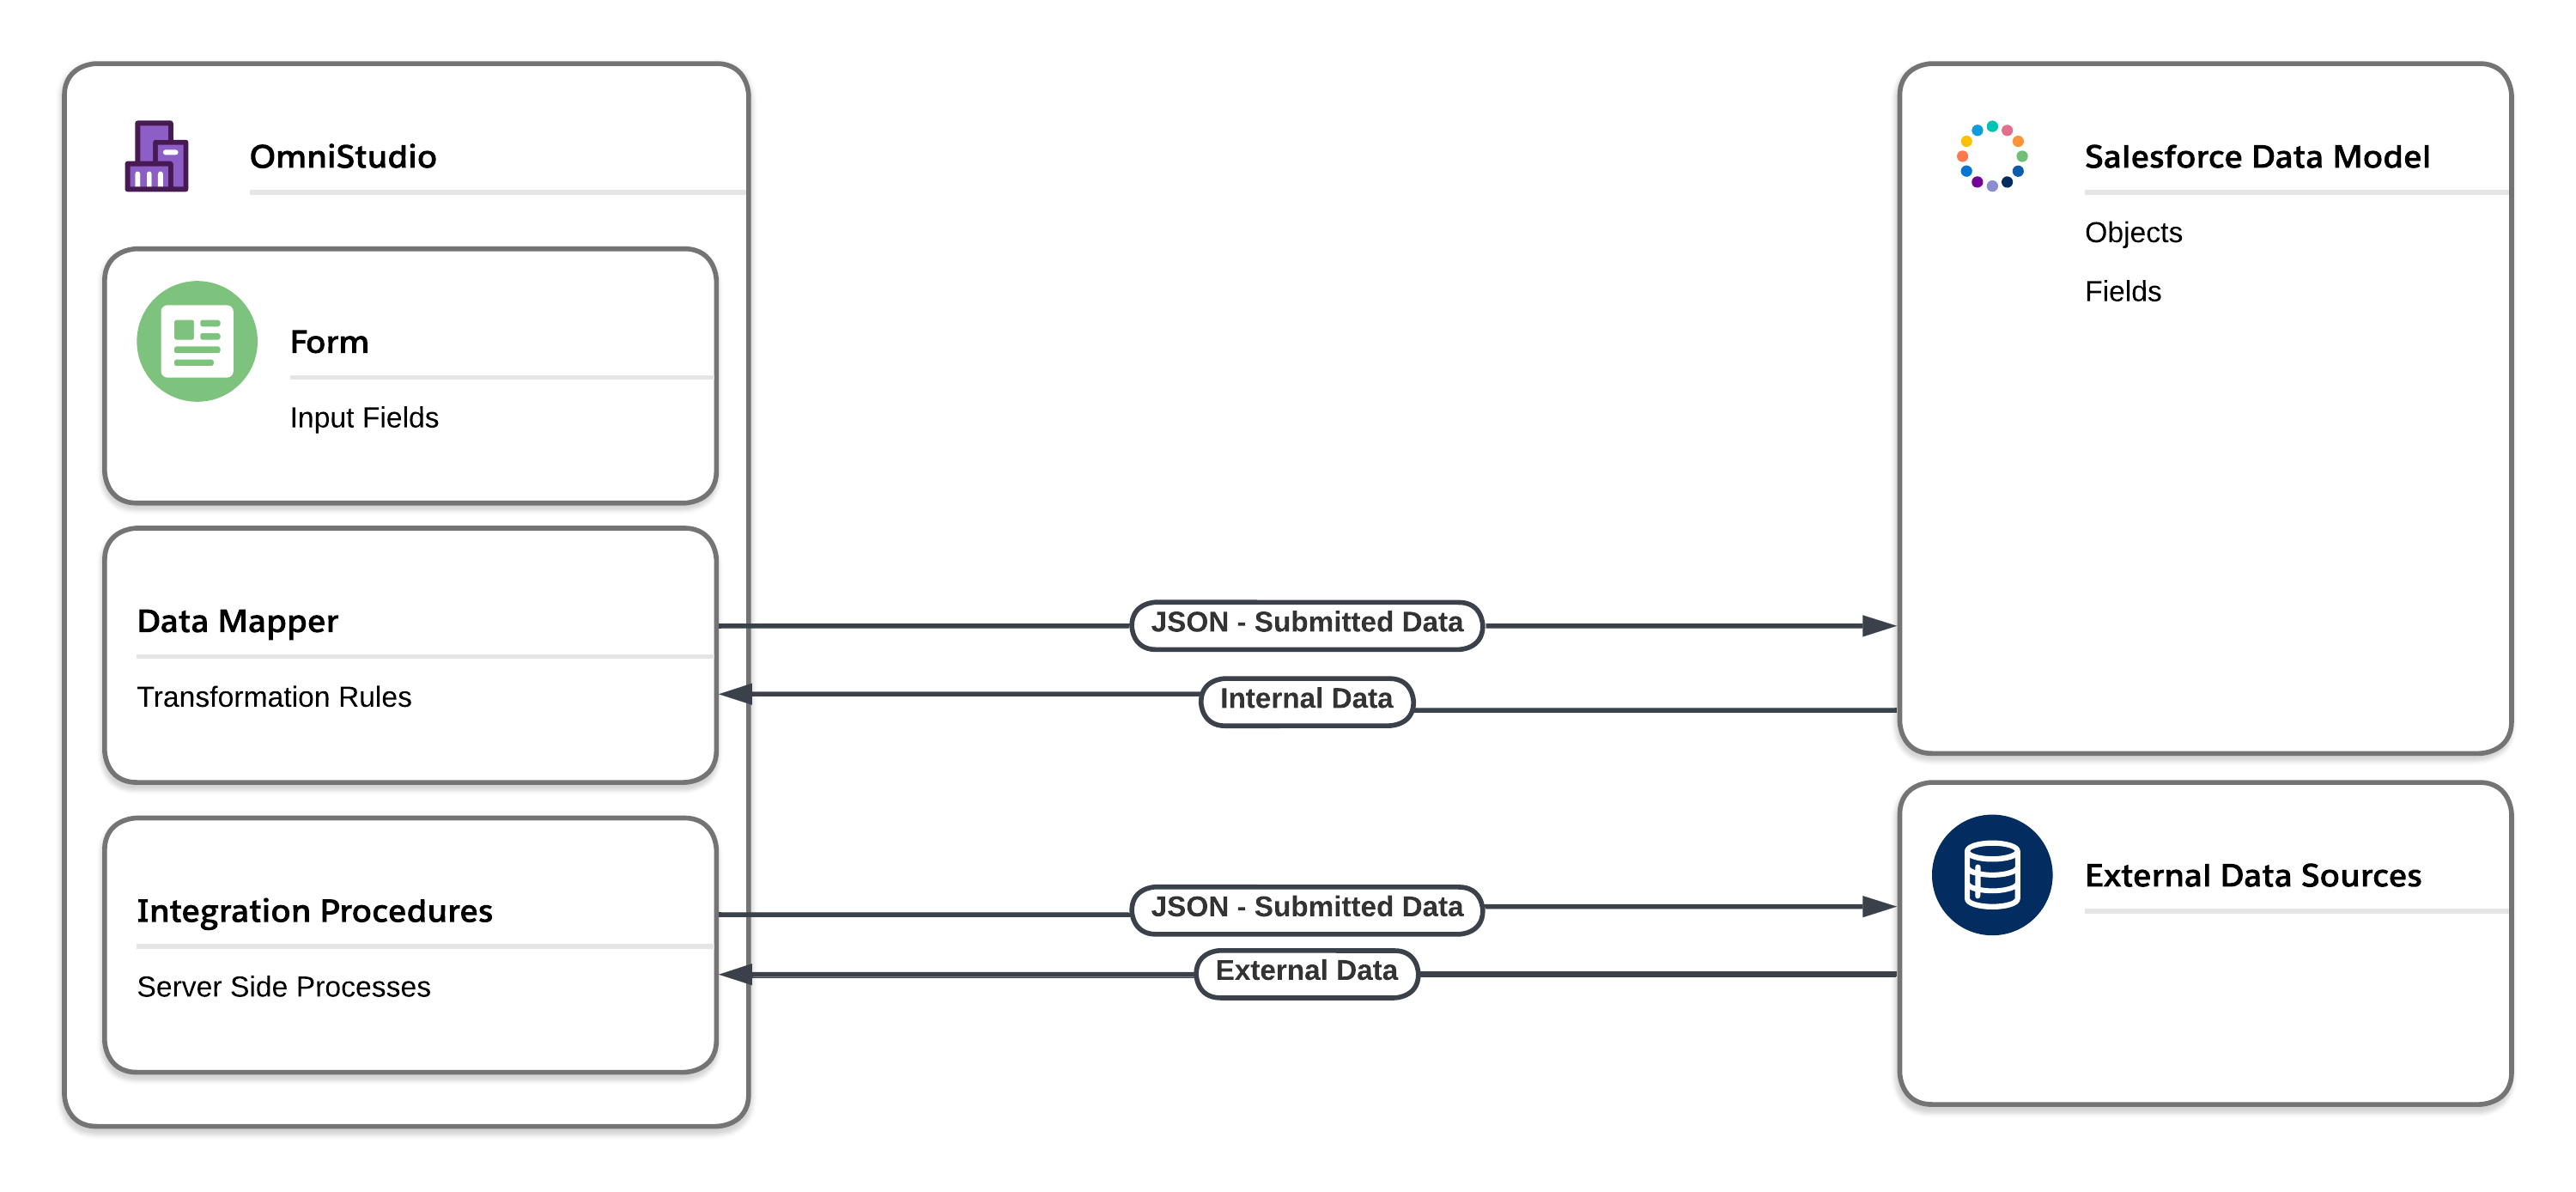
\*테스트 및 배포는 낮은 환경에서 구축하고 [메타데이터 API](https://developer.salesforce.com/docs/metadata-coverage/), 패키지 또는 변경 집합을 통해 프로덕션에 배포할 수 있는 기능을 말합니다. ### 사용 사례: 하위 코드 도구를 사용한 인바운드 통합 > 조직의 ERP 시스템에서 연락처가 업데이트됩니다. 이 연락처 정보를 Salesforce에서 업데이트해야 합니다. **Heroku Connect** Heroku Connect는 일반적으로 Heroku Postgres 데이터베이스와 Salesforce를 동기화하는 데 사용됩니다. ERP 시스템에서 Heroku Postgres를 트랜잭션 저장소로 사용하지 않는 한 이 사용 사례는 불가능합니다. Heroku Postgres를 사용하는 경우 Heroku Connect를 사용하여 Postgres 테이블의 변경 사항을 Salesforce의 개체에 동기화할 수 있습니다. **OmniStudio 통합 절차** ERP 시스템이 연락처 레코드를 업데이트한 후 Data Mapper에서 생성한 REST API를 통해 Data Mapper 로드 작업 및 응답 작업이 포함된 OmniStudio 통합 절차를 호출할 수 있습니다. 먼저 데이터 매퍼 로드 작업은 JSON 또는 XML 페이로드를 보내며, 이는 외부 ID 필드 또는 [업서트 키를 통해](https://trailhead.salesforce.com/content/learn/modules/omnistudio-data-tools-and-internal-data/build-an-integration-procedure-with-conditional-dataraptor-loads?trail_id=build-guided-experiences-with-omnistudio) 연락처 레코드를 업서트하는 데 사용됩니다. JSON의 간단한 응답만 예상되는 경우 응답 작업에서 이전 작업의 관련 정보를 다시 보내 성공 또는 실패를 나타낼 수 있습니다. ERP 시스템에서 특정 응답을 예상하는 경우 데이터 매퍼 변환 또는 추출 작업을 사용하여 연락처 레코드 업데이트에서 트리거에 생성된 데이터를 선언적으로 포함하는 추가 기능이 포함된 JSON 또는 XML 응답을 생성할 수 있습니다. 이 시나리오의 주요 과제는 동시성입니다. 동일한 연락처 레코드를 동시에 업데이트하기 위해 여러 번 호출하면 API가 Salesforce에 직접 존재하므로 문제가 발생합니다. **Salesforce Connect / 외부 개체** Salesforce Connect 및 외부 개체는 Salesforce에서 데이터 복제를 특별히 필요로 하므로 이 사용 사례에 사용하지 않는 것이 좋습니다. ERP에 구축된 기존 Salesforce Connect 통합이 있는 경우 ERP에서 변경 데이터 데이터 수집 데이터 수집 지원하도록 Odata 데이터 수집 커넥터를 구성할 수 있습니다. 또한 Salesforce에서 Pub/Sub API를 사용하여 ERP에서 변경 스트림을 구독하도록 구성해야 합니다. ### Salesforce에 대한 인바운드 통합을 위한 하이브리드 도구
지침 라이센스 시기 볼륨 및 규모 배달 및 서비스 점검 개인 정보 보호 및 보안
사용하는 경우 추가 라이센스 동기화(요청/응답) 또는 비동기화(발행/실패) 다중 개체 지원 LDV/Bulk 테스트 및 배포** 디버깅 내장 오류 처리/재시도 동작 암호화된 데이터와 함께 사용 가능 인증 프로토콜
플랫폼 이벤트 Salesforce 또는 외부 시스템에서 거의 실시간 변경을 위해 사용자 정의 정의된 구조화된 페이로드가 필요한 경우 필수 아님* 비동기 예 아니요 예 프로 코드 도구 사용 예 예 OAuth
Salesforce Connect/외부 개체(사용자 정의 Apex 어댑터 포함) 데이터가 Salesforce UI에 표시되지만 OData 2.0/4.0 프로토콜을 사용할 수 없는 외부 시스템에 저장되도록 하려는 경우 필수 모두 예 예 예 프로 코드 도구 사용 아니요 N/A 다중
Data 360 단일 데이터 저장소의 다양한 소스에서 조화된 데이터를 원하거나 다른 Salesforce 조직 또는 다른 외부 시스템으로 데이터를 복제하려는 경우 Data 360은 일부 플랫폼에서도 가상화를 지원합니다. 필수 모두 예 예 예 아니요 예 예 다중
\* 대용량 사용 사례에 필요한 [추가 기능](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_event_limits.htm)입니다. \*\*테스트 및 배포는 낮은 환경에서 구축하고 [메타데이터 API](https://developer.salesforce.com/docs/metadata-coverage/), 패키지 또는 변경 집합을 통해 프로덕션에 배포할 수 있는 기능을 말합니다. ### 사용 사례: 하이브리드 도구를 사용한 인바운드 통합 > 조직의 ERP 시스템에서 연락처가 업데이트됩니다. 이 연락처 정보를 Salesforce에서 업데이트해야 합니다. **ERP에서 연락처 레코드가 업데이트되면 외부 시스템의 플랫폼 이벤트** 사용자 정의 코드가 플랫폼 이벤트를 게시합니다. Salesforce의 트리거, 프로세스 또는 플로에서 플랫폼 이벤트를 구독하고 이벤트가 처리될 때 해당 Salesforce 개체를 업데이트할 수 있습니다. 플랫폼 이벤트는 데이터를 포함하지 않고 고객의 ERP 시스템에서 변경 사항이 발생했다는 신호로만 작동하거나 Salesforce 개체 업데이트에 필요한 실제 데이터를 포함할 수 있습니다. **Salesforce Connect/External Objects(사용자 정의 Apex 어댑터 포함)** 이 솔루션은 데이터 복제가 필요한 사용 사례에 적용되지 않습니다. 이 솔루션은 Salesforce의 사용자가 Salesforce에서 복제할 수 없거나 복제할 수 없는 외부 시스템의 정보를 볼 필요가 있고 외부 시스템에서 OData 또는 GraphQL과 같은 표준 프로토콜을 지원할 수 없는 경우에 적용됩니다. [사용 사례: Apex 사용자 정의 어댑터의 예제 사용 사례에 대해 하이브리드 도구를 사용하는 아웃바운드 통합](#사용-사례-하이브리드-도구를-사용한-아웃바운드-통합) **Data 360** ERP와 같은 외부 시스템에서 연락처를 업데이트하면 상자 외부 커넥터를 사용하거나 MuleSoft와 같은 API 및 프로 코드 도구를 사용하여 연락처 업데이트를 Data 360에 동기화할 수 있습니다. 연락처는 제로 복사 메커니즘을 사용하여 Data 360에서 참조할 수도 있습니다(일부 플랫폼에서 사용 가능). Data 360에서 데이터를 사용할 수 있으면 다른 통합 메커니즘을 사용하여 다른 Salesforce 조직에 데이터를 동기화할 수 있습니다. Data Cloud One을 사용하여 참조하여 데이터에 액세스할 수 있습니다. 활성화 및 기본 커넥터를 사용하는 기타 API를 사용하거나 MuleSoft Anypoint 플랫폼과 같은 프로 코드 도구를 사용하여 데이터를 복제할 수도 있습니다. ### Salesforce에 대한 인바운드 통합을 위한 Pro-Code 도구
지침 라이센스 시기 볼륨 및 규모 배달 및 서비스 점검 개인 정보 보호 및 보안
사용하는 경우 추가 라이센스 동기화(요청/응답) 또는 비동기화(발행/실패) 다중 개체 지원 LDV/Bulk 테스트 및 배포**** 디버깅 내장 오류 처리/재시도 동작 암호화된 데이터와 함께 사용 가능 인증 프로토콜
사용자 정의 Apex REST 및 SOAP 웹 서비스 교차 개체 처리 또는 기타 복잡한 논리와 같은 기본 API 끝점에서 제공하는 것보다 더 많은 기능이 필요한 경우 필수 아님 모두 예 예 예 프로 코드 도구 사용 아니요 예*** 다중
MuleSoft Anypoint 통합을 구축, 오케스트레이션, 관리하기 위해 단일 엔터프라이즈급 통합 솔루션이 필요한 경우, 레거시 지점 간 아키텍처를 교체해야 하는 경우 또는 API 관리 지원이 필요한 경우 필수 모두 예 예 예 프로 코드 도구 사용 아니요 예*** 다중
Native Salesforce API 추가 제어가 필요하거나 REST API, SOAP API, 대량 API 또는 GraphQL API 또는 gRPC를 통해 통합을 구축하기 위한 프로 코드 기술 집합이 있는 경우 필수 아님* 모두 예***** 예 예 프로 코드 도구 사용 예** 예*** 다중
\*[API 요청 제한 및 할당](https://developer.salesforce.com/docs/atlas.en-us.salesforce_app_limits_cheatsheet.meta/salesforce_app_limits_cheatsheet/salesforce_app_limits_platform_api.htm)이 적용됩니다. \*\*Bulk API에는 재시도 동작의 측면이 있으며, 여러 API는 allOrNone 설정을 통해 _롤백_ 보호를 제공합니다(예: 복합 및 컬렉션 요청의 [allOrNone 매개 변수](https://developer.salesforce.com/docs/atlas.en-us.api_rest.meta/api_rest/resources_composite_allornone.htm) 참조). \*\*\*Shield Platform Encryption을 활성화하면 특정 동작이 변경됩니다. 자세한 내용은 [General Shield Platform Encryption Considerations](https://help.salesforce.com/articleView?id=sf.security_pe_considerations_general.htm&type=5)를 참조하십시오. \*\*\*\*테스트 및 배포는 낮은 환경에서 구축하고 [메타데이터 API](https://developer.salesforce.com/docs/metadata-coverage/), 패키지 또는 변경 집합을 통해 프로덕션에 배포할 수 있는 기능을 말합니다. \*\*\*\*\*복합 API는 다중 개체를 지원합니다. ### 사용 사례: Pro-Code 도구를 사용한 인바운드 통합 > 조직의 ERP 시스템에서 연락처가 업데이트됩니다. 이 연락처 정보를 Salesforce에서 업데이트해야 합니다. **사용자 정의 Apex REST 및 SOAP 웹 서비스** 연락처 개체에서 CRUD(만들기, 읽기, 업데이트, 삭제) 작업을 수행할 수 있는 Apex 코드를 사용하여 웹 서비스를 만들 수 있습니다. 이 서비스는 외부 시스템(ERP)에서 SOAP 또는 REST를 통해 호출됩니다. **MuleSoft Anypoint** MuleSoft Anypoint의 의도는 엔터프라이즈급 API 관리를 제공하는 것입니다. MuleSoft Anypoint는 SAP, Oracle EBS, Oracle ERP 및 NetSuite를 비롯한 많은 ERP 시스템과 통합하는 데 사용할 수 있는 [대형 사전 구축 커넥터 세트를](https://www.mulesoft.com/platform/cloud-connectors) 제공합니다. 이러한 ERP 시스템에서 이벤트를 들을 수 있는 플로를 만들 수 있습니다(이 경우에는 새 연락처가 생성되는 경우). 플로가 시작되면 Salesforce 커넥터를 사용하여 새 연락처 레코드를 만들거나 연락처가 이미 있는 경우 업데이트합니다. 또한 복제 트랜잭션에 연락처를 다른 시스템으로 신디케이션하는 작업이 포함된 경우 다른 시스템과 통합할 수 있습니다. 필요한 경우 매핑 및 변환 언어(DataWeave)를 사용하여 복잡한 논리와 계산을 수행할 수 있습니다. 정보가 여러 서로 다른 시스템에서 흐르는 동안. 이러한 시스템에 대한 인증은 기본 인증 및 OAuth 등 다양한 인증 메커니즘을 통해 수행할 수 있습니다. 최대 사용량(vCore로 측정)에 맞게 플로의 크기가 적절한 경우 트랜잭션 용량에 대한 제한은 없습니다. **기본 Salesforce API** ERP 시스템의 업데이트 트랜잭션이 완료되면 SOAP API를 통해 연락처 개체에 대한 업서트 작업을 수행하거나 Salesforce 조직에서 Contact sObjects REST API에 대한 [PATCH를](https://developer.salesforce.com/docs/atlas.en-us.api_rest.meta/api_rest/dome_update_fields.htm) 수행할 수 있습니다. ## Salesforce에서 Salesforce 통합 Salesforce to Salesforce 제품의 수명이 끝났습니다. Salesforce to Salesforce를 사용하면 파트너가 공동 작업을 통해 공동 고객에게 판매 및 지원을 쉽게 할 수 있지만 Salesforce는 다른 도구에 더 많은 혁신을 가져오는 데 투자합니다. 앞으로 Salesforce 조직 간 데이터 공유에 다음 접근 방식을 사용하는 것이 좋습니다. ### Salesforce 조직 전반의 데이터 통합을 위한 도구
지침 비용 시기 볼륨 및 규모 배달 및 서비스 점검 개인 정보 보호 및 보안 구현할 도구
때 사용하기 추가 라이센스 동기화(요청/응답) 또는 비동기화(발전/잊기) 다중 개체 지원 LDV/Bulk 테스트 및 구축* 디버깅 내장 오류 처리 / 재시도 동작 나머지 암호화된 데이터와 함께 사용할 수 있음 인증 프로토콜 로우 코드 → 프로 코드
Heroku Connect Salesforce 조직 전체에서 양방향 동기화를 통해 데이터를 확장하고 Heroku에서 실행되는 모바일 및 기타 앱의 데이터에 대한 액세스 권한도 활성화하려는 경우 필수 비동기 예 예 아니요 프로 코드 도구 사용 예 예, Shield Connect를 통해 OAuth 낮은 코드
MuleSoft Anypoint 통합을 구축, 오케스트레이션, 관리하기 위해 단일 엔터프라이즈급 통합 솔루션이 필요한 경우, 레거시 지점 간 아키텍처를 교체해야 하는 경우 또는 API 관리 지원이 필요한 경우 필수 모두 예 예 예 프로 코드 도구 사용 아니요 예** 다중 Pro 코드
Native Salesforce API Salesforce 또는 Heroku Connect가 옵션이 아니거나 더 복잡한 처리가 필요한 경우 필수 아님 모두 아니요 예 예 프로 코드 도구 사용 아니요 예** 다중 Pro 코드
변경 데이터 수집 Salesforce의 레코드 수준 변경 사항을 외부 시스템에 게시해야 하며 사용자 정의 페이로드가 필요하지 않은 경우 필수 비동기 아니요 아니요 예 프로 코드 도구 사용 예 예 OAuth
Cross-Org 어댑터를 사용하는 Salesforce Connect 한 조직의 사용자가 데이터 복제 없이 다른 조직의 레코드를 보거나 편집하도록 하려는 경우 필수 비동기 예 예 예 프로 코드 도구 사용 N/A N/A 다중 낮은 코드
Data 360 한 조직의 사용자가 Data 360에서 복제된 데이터를 사용하여 다른 조직의 레코드를 보거나 편집하도록 하려는 경우 필수 모두 예 예 예 프로 코드 도구 사용 예 예 다중 하이브리드
\*테스트 및 배포는 낮은 환경에서 구축하고 [메타데이터 API](https://developer.salesforce.com/docs/metadata-coverage/), 패키지 또는 변경 집합을 통해 프로덕션에 배포할 수 있는 기능을 말합니다. \*\*Shield Platform Encryption을 활성화하면 특정 동작이 변경됩니다. 자세한 내용은 [General Shield Platform Encryption Considerations](https://help.salesforce.com/articleView?id=sf.security_pe_considerations_general.htm&type=5)를 참조하십시오. 하나의 Salesforce 조직에서 다른 조직으로 데이터를 통합하는 데 최적의 _플랫폼 이벤트는 동일한 이벤트에 대해 조직 간에 "청취"할 수 없기 때문입니다. 사용자 지정 Apex도 이 유형의 통합에 적합하지 않습니다._ ### 사용 사례: 여러 Salesforce 조직 연결 > 대기업은 여러 사업부(BU)에서 운영됩니다. 각 BU에는 자체 Salesforce 조직이 있습니다. 단일 고객이 여러 사업부를 다루므로 여러 조직에 계정 및 기회 데이터를 보유합니다. 엔터프라이즈는 단일 조직의 모든 BU 전반에서 모든 계정 및 기회 데이터의 집계 보기에 액세스해야 합니다. _참고: 아래의 모든 솔루션은 [Takeaway #1](#서비스)에 따라 최소한의 데이터 복제를 위해 설계되었습니다._ **Data 360** 계정 및 다양한 Salesforce 조직의 기회 데이터는 Salesforce 커넥터를 사용하여 Data 360에 수집할 수 있습니다. 필요한 경우 집계 및 조화할 수도 있습니다. 데이터가 Data 360에 집계되면 데이터 복제 없이 Data Cloud One을 사용하여 다른 Salesforce 조직에서 액세스할 수 있습니다. **Heroku Connect** 각 BU의 개별 조직의 경우 Heroku Connect를 사용하여 Salesforce의 변경 사항을 단일 Heroku Postgres 데이터베이스에 동기화할 수 있습니다. 이 시나리오에서는 양방향 동기화가 활성화되지 않으며 Salesforce에서 Postgres로만 동기화됩니다. 그런 다음 Heroku Connect에서 OData 공급자를 활성화하고 집계 보기를 원하는 Salesforce 조직에서 외부 개체로 표시할 테이블을 선택할 수 있습니다. Salesforce 내에서 Heroku에서 OData 공급자를 가리키는 외부 데이터 소스를 정의합니다. **MuleSoft Anypoint** MuleSoft Anypoint는 엔터프라이즈급 API 관리를 제공합니다. 조직에 대한 여러 연결이 있는 Salesforce 커넥터를 사용하여 여러 관련 Salesforce 조직의 정보를 읽도록 MuleSoft Anypoint API를 구성할 수 있습니다. MuleSoft 플로는 다양한 Salesforce 조직을 쿼리하고 필요한 경우 다른 타사 정보로 향상되거나 보강된 특정 구조를 반환할 수 있습니다. API가 호출되면 모든 적절한 Salesforce 조직 콜아웃(이 예에서는 계정 및 기회 정보 쿼리)을 만들어 소비자(가장 가능성이 높은 UI)가 데이터를 처리할 수 있도록 합니다. 이러한 시스템에 대한 인증은 기본 인증 및 OAuth를 비롯한 다양한 인증 메커니즘을 통해 수행할 수 있습니다. 최대 사용량(vCores 또는 Cores로 측정)에 맞게 플로의 크기가 적절하게 조정된 경우 트랜잭션 용량에 대한 제한은 없습니다. **Native Salesforce API** 쿼리 작업은 수천 개의 레코드를 효율적으로 추출하는 데 적합한 Salesforce 대량 API 2.0을 통해 관심 있는 각 조직에 발행할 수 있습니다. 각 조직에서 쿼리 결과를 개별적으로 검색하고 고객 요구 사항에 따라 사용자 정의 응용 프로그램 또는 미들웨어를 사용하여 집계할 수 있습니다. **Salesforce Connect with Cross-Org 어댑터** Salesforce Connect Cross-Org 어댑터는 원격 조직의 계정 또는 기회가 모두 중앙 조직에 _다른_ 개체로 표시되므로 이 시나리오에 적합하지 않습니다. 예를 들어 모든 조직 전반에서 모든 기회의 총합계를 합산할 수 있는 방법은 없습니다. **선택적 업데이트 Cross-Org 시나리오:** Salesforce 조직 A를 사용하는 판매 담당자는 조직 A에서 작업하는 동안 Salesforce 조직 B의 사례 데이터를 보고 업데이트하고 Salesforce 조직 B의 상위 사례에 사례 댓글을 추가해야 합니다. 데이터를 조직 A에 복제해서는 안 됩니다. **Heroku Connect** 위의 *데이터 집계 시나리오*에서 설명한 것과 동일한 접근 방식을 사용할 수 있습니다. 그러나 OData 커넥터를 통해 외부 객체에서 CRUD를 활성화하고 변경 사항을 Heroku Postgres에 다시 작성해야 합니다. **MuleSoft Anypoint** MuleSoft Anypoint는 엔터프라이즈급 API 관리를 제공합니다. 위의 *데이터 집계 시나리오*에 설명된 것과 동일한 접근 방식을 사용할 수 있습니다. **Native Salesforce API는** 명명된 자격 증명을 사용하고 네이티브 Salesforce API를 호출하여 관련 Salesforce 조직의 데이터를 읽고 업데이트합니다. 구성 요소는 데이터를 표시하도록 설계되어 있어야 합니다. **Salesforce Connect with Cross-Org Adapter** 외부 개체에서 데이터를 볼 수 있는 기능(외부 개체에서 CRUD가 활성화된 경우 데이터를 편집하는 기능)은 [Salesforce cross-org 어댑터를 통해](https://help.salesforce.com/articleView?id=sf.xorg_adapter_about.htm&type=5) 지원됩니다. 외부 개체 간 관계도 지원되므로 외부 개체의 상위 사례에 연결할 수 있습니다. 그러나 관계 만들기는 기존 데이터 유형을 관계 데이터 유형으로 변환하는 수동 프로세스입니다. 또한 사례를 보다 효과적으로 사용할 수 있도록 Service Cloud 내에서 수행한 최적화는 원격 조직으로 계단식으로 전달되지 않습니다. Salesforce는 Cross-Org 어댑터를 테스트하고 사용 사례에 대해 외부 개체와 표준 개체를 사용할 때의 제약점을 평가하는 것이 좋습니다. **데이터 동기화 Cross-Org**: 조직의 사업부 Salesforce 조직 중 하나에서 고객에 대한 계정이 업데이트되면 다른 Salesforce 조직 계정 개체를 업데이트해야만 일관된 계정 정보를 유지할 수 있습니다. **Data 360** Data 360은 한 조직에서 다른 Salesforce 조직으로 데이터 복제에 사용할 수 있습니다. 단일 Salesforce 조직의 계정 데이터는 기본 Salesforce 커넥터를 사용하여 Data 360에 수집할 수 있습니다. 배치 활성화, 거의 실시간 데이터 작업 또는 API 기반 활성화와 같은 데이터 활성화 메커니즘을 사용하여 Data 360에서 Salesforce 조직으로 데이터를 이동할 수도 있습니다. **Heroku Connect** 위의 *데이터 집계 시나리오*에서 설명한 것과 동일한 접근 방식을 사용할 수 있습니다. 그러나 양방향 동기화를 활성화해야 하며, 양방향 동기화는 Postgres 테이블을 변경할 때 모든 조직을 최신 상태로 유지하므로 더 이상 Salesforce Connect 활성화할 필요가 없습니다. **MuleSoft Anypoint** MuleSoft Anypoint는 엔터프라이즈급 API 관리를 제공합니다. MuleSoft Anypoint에서 Flow Designer를 사용하여 표준 및 사용자 정의 개체 이벤트를 듣고 Salesforce에서 자동 실행 플로를 시작하도록 Mule 응용 프로그램을 [구성할 수 있습니다](https://docs.mulesoft.com/design-center/about-designing-a-mule-application). Mule 응용 프로그램이 트리거되면 Salesforce용 Anypoint 커넥터를 호출하여 여러 Salesforce 조직과 통신할 수 있습니다. 이 사용 사례에서 하나의 Salesforce 조직에서 계정 레코드가 업데이트되면 Mule 앱이 관련 Salesforce 조직의 계정 레코드를 업데이트할 수 있습니다. 각 관련 Salesforce 조직에는 MuleSoft의 전체 응용 프로그램 플로에 내장된 고유한 업데이트 단계가 있습니다. 이러한 시스템에 대한 인증은 기본 인증 및 OAuth를 비롯한 다양한 인증 메커니즘을 통해 수행할 수 있습니다. 최대 사용량(vCores 또는 Cores로 측정)에 맞게 플로 크기가 적절하게 조정된 경우 트랜잭션 용량에 대한 제한은 없습니다. **Native Salesforce API** [복제 API](https://developer.salesforce.com/docs/atlas.en-us.api.meta/api/sforce_api_guidelines_datareplication.htm)(getUpdated, getDeleted 작업)를 사용하여 조직 간 데이터를 동기화할 수 있지만 이 접근 방식은 권장되지 않습니다. **Salesforce Connect with Cross-Org Adapter** 레코드 트리거 플로 및 외부 개체를 사용하여 Salesforce 조직 간에 일부 데이터를 동기화 상태로 유지할 수 있습니다. 예를 들어, 조직 A의 계정 레코드를 업데이트하면 계정 외부 개체의 일치하는 레코드를 업데이트하는 플로가 트리거되며, 이는 이러한 업데이트를 조직 B의 계정 레코드에 씁니다. 이렇게 하면 [ 혼합 DML 트랜잭션](https://help.salesforce.com/articleView?id=000328873&type=1&mode=1)을 피하기 위해 플로 시맨틱을 적절하게 사용해야 합니다. 또한 조직 B의 확인 규칙 및 플로는 REST/SOAP API에서 변경한 경우와 동일한 방식으로 트리거됩니다. ## 마감 주석 Salesforce와 관련된 새 데이터 통합을 계획할 때 이 가이드에 유의하십시오. 사용 가능한 옵션의 전체 범위와 특정 사용 사례에 맞는 방법을 이해하는 것이 좋습니다. ### 의견을 알려주십시오. 가장 관련성이 높은 내용을 게시할 수 있도록 지원합니다. 이 콘텐츠에 대한 피드백을 제공하고 다음에 원하는 내용을 알려주려면 [원하는 설문 조사를 수행하십시오](https://sfdc.co/J0cWb). ## 가이드 개요 Salesforce Platform에서 양식을 작성하려는 경우 전체 하위 코드에서 프로 코드 연속성까지 다양한 옵션을 사용할 수 있습니다. Low-code는 Lightning 앱 빌더의 동적 양식과 Flow Builder의 화면 플로를 나타냅니다. LWC를 사용하여 화면 플로를 확장하고 OmniStudio를 사용하여 고객 대면 양식을 작성하는 기능은 연속 중간에 있습니다. 프로 코드는 LWC 프레임워크와 계속해서 성장하는 기본 구성 요소 라이브러리를 나타냅니다. 옵션은 훌륭하지만 올바른 옵션 또는 조합을 어떻게 결정합니까? 여기에서 이 가이드가 들어갑니다. ## 주요 인테이크 - **테이크아웃 #1: Lightning 페이지의 만들기/편집/보기 레이아웃을 작성할 때 동적 양식을 사용하십시오.** 이 가이드의 비교 테이블에서 페이지 레이아웃이 누락되었는지 확인할 수 있습니다. 앞으로 레코드 세부 사항 페이지를 구성하는 것이 좋습니다. Lightning 앱 빌더에서 동적 양식을 사용하는 것이 좋습니다. [페이지 레이아웃](#페이지-레이아웃) 섹션을 참조하여 더 이상 개선하지 않을 이유에 대한 자세한 내용을 확인하십시오. - **테이크아웃 #2: 정확히 하나의 개체에 대한 만들기 또는 편집 양식을 작성해야 하는 경우 Lightning 페이지 및 동적 양식으로 시작합니다.** Salesforce Platform에서 양식을 작성하는 가장 간단한 방법입니다. 또한 필드 가시성을 제어하는 기능과 같은 몇 가지 추가 기능도 제공합니다. 요구 사항이 더 고급 경우 계속 읽으십시오. 화면 플로, OmniStudio 또는 Lightning 웹 구성 요소(LWC)가 더 적합할 수 있습니다. - **테이크아웃 #3: 다중 페이지 양식 또는 마법사를 작성하고 있으며 엄격한 UX 또는 브랜딩 요구 사항이 없는 경우 화면 플로로 시작하십시오.** 화면 플로는 여러 양식을 함께 오케스트레이션할 수 있는 선형 탐색 프레임워크를 제공합니다. LWC를 사용하여 양식 간에 탐색할 수 있는 자체 프레임워크를 구축할 수 있지만, [형식 상태](/docs/architect/ko-kr/well-architected/guide/engaging#양식)에 대해 걱정하지 않고 양식 자체에 집중할 수 있도록 Flow가 당신을 위해 힘든 작업을 수행하는 것이 좋습니다. - **테이크아웃 #4: 추가 논리 또는 작업이 필요한 경우 화면 플로, OmniStudio 또는 LWC를 사용하십시오*.*** 세 가지 도구 모두 솔루션이 단일 레코드를 만들거나 편집하는 것 이상의 작업을 수행할 수 있는 방법을 제공합니다. 해당 "더"는 분기 또는 반복과 같은 더 고급 논리일 수 있으며, 외부 시스템과 통합, 이메일 보내기 또는 사용자의 모바일 앱에 알림 푸시와 같은 더 많은 작업일 수 있습니다. - **테이크아웃 #5: 정교한 UX 요구 사항이 있습니까? 가시성 이상을 동적으로 처리해야 합니까? LWC 또는 Omniscript를 사용합니다.** 간단한 테마 및 열 기반 레이아웃으로 요구 사항을 충족할 수 있는 경우 하위 코드 빌더에서 직접 양식을 작성할 수 있습니다. 양식의 스타일을 더욱 세분화적으로 제어하려면 LWC의 최상의 유연성이 필요합니다. 산업 고객이며 픽셀 퍼펙트 브랜딩이 필요하거나 복잡한 계층 데이터가 있는 경우 OmniStudio를 사용하여 복잡한 비즈니스 논리 및 데이터 변환을 처리할 수 있는 소비자 등급 양식을 구축할 수 있습니다. - **테이크아웃 #6: 테스트 자동화가 필요한 경우 Lightning 웹 구성 요소로 시작하십시오.** 포함할 위치와 상관없이 LWC에 대한 단위 테스트를 작성할 수 있습니다. 이를 통해 여러 레코드가 있는 대량 테스트 및 음수 테스트를 포함할 수 있는 더 강력한 테스트 전략을 만들 수 있습니다. 양식이 기능 및 비 기능 요구 사항에 얼마나 잘 부합하는지 확인할 수 있는 테스트를 만드는 방법에 대한 자세한 내용은 [Salesforce Well-Architected - Testing Strategy를 참조하십시오](/docs/architect/ko-kr/well-architected/guide/resilient#테스트-전략). 선택 항목 중 하나가 될 필요가 없으므로 여러 옵션을 결합할 수 있습니다. 예를 들어, 플로의 내장형 탐색 시스템과 LWC가 제공하는 전체 스타일 지정 유연성이 모두 필요한 경우 함께 사용하십시오. ## Salesforce로 양식 작성 도구 아래 표는 Salesforce로 양식을 작성하는 데 사용할 수 있는 도구와 필수 기술 및 라이센스 고려 사항을 간략하게 보여줍니다. 나중에 각 도구에 대해 지원되는 특정 기능과 클릭 기반 도구와 코드 기반 도구 간에 선택하는 방법(및 결합 시점)을 자세히 살펴보겠습니다.
필요한 기술 추가 라이센스 요구 사항
동적 형태 낮은 코드 아니요
스크린 플로 낮은 코드 아니요
OmniStudio 낮은 코드 + Pro 코드 산업 패키지 필요
스크린 플로 + Lightning 웹 구성 요소 낮은 코드 + Pro 코드 아니요
Lightning 웹 구성 요소 Pro 코드 아니요
## 한눈에 결정 사항 아래 표에는 제품을 선택할 때 고려해야 할 결정 지점의 개요와 각각에 대해 자신에게 질문해야 하는 질문이 포함되어 있습니다. 이 가이드의 나머지 부분에서 각 주제를 자세히 살펴볼 것입니다.
개체 영향 양식이 단일 개체에 대해 작동할지 아니면 여러 개체에 대해 작동해야 하는지를 결정합니다.
형식 범위 및 탐색 양식의 모든 필드가 하나의 화면에 논리적으로 맞추거나 사용자가 여러 화면 사이를 탐색할 수 있는지 확인합니다.
위치 Salesforce 앱 내에서 모바일 앱 또는 외부 웹 사이트까지 범위가 될 수 있는 양식을 포함할 위치를 식별합니다.
컨트롤러 데이터 변환 및 외부 시스템과의 통합 등 사용자가 양식과 상호 작용하는 동안 백그라운드에서 수행해야 하는 작업 또는 논리를 식별합니다.
확인 Salesforce에서 제공하는 표준 시스템 수준 확인을 넘어 추가 입력 확인 요구 사항이 있는지 여부를 결정합니다.
보안 특정 작업을 수행하기 전에 양식에서 사용자의 액세스를 확인해야 하는지, 양식에 액세스할 수 있는 사람을 제어할 것인지, 양식이 포함될 수 있는 위치를 제어할 것인지 여부를 결정합니다.
상호 작용 설계 양식 내에서 동적 응답을 트리거해야 하는 상호 작용 또는 조건 유형을 식별합니다.
스타일링 원하는 스타일 및 CSS에 대한 정교도 수준을 결정합니다.
레이아웃 필수 열, 탭, 아코디언 수 및 반복 데이터 블록을 표시할 수 있는 기능 측면에서 양식의 레이아웃 요구 사항을 식별합니다.
번역 양식을 다른 언어로 현지화해야 하는지 여부를 결정합니다.
UI 테스트 자동화 DevOps 프로세스에서 양식이 자동 단위 테스트 또는 자동 종단간 테스트를 수행해야 하는지 여부 결정
Metrics 페이지 보기, 양식에 소요된 시간, 완료율 및 성공률 등 양식 사용을 추적할 방법을 식별합니다.
포장 및 배포 양식을 작성한 후 배포하거나 배포할 방법을 결정합니다.
다음은 비교 테이블에서 정의와 함께 사용하는 용어입니다. - **사용 가능:** 기본 고려 사항과 함께 작동합니다. - ** 이상적이지 않음:** 작동할 수 있지만 최적의 도구는 아닙니다. - **로드맵:** 향후 12개월(2025년 6월) 이내에 지원 예상 - **미래**: 향후 12개월 이후 지원 예상 - **사용 불가:** 향후 12개월 이내에 이 기능을 지원할 계획이 없습니다. ## 결정 지점 연습 약속대로 동적 양식, 화면 플로, OmniStudio, 내장형 LWC가 있는 화면 플로, LWC 프레임워크 자체 간의 다양한 비교 지점과 기능적 차이점을 자세히 살펴보겠습니다. ### 개체 영향 양식이 단일 Salesforce 개체에 대해 작동하는 경우 비교하는 도구가 작동합니다. 교차 개체 또는 개체가 없는 형태로 인해 상황이 조금 더 복잡해집니다. 개체 비정의는 Salesforce 개체에 매핑되지 않는 입력을 의미합니다. 양식은 Stripe 또는 DocuSign과 같은 외부 서비스에 보낼 데이터 구조를 나타낼 수 있습니다. 또는 양식에서 여러 입력을 사용하여 값을 계산한 다음, 데이터베이스에 해당 값을 커밋합니다. #### 질문: - 양식이 작동하는 개체는 무엇입니까? - 개체가 하나일까요? 개체가 여러 개입니까? - 특정 개체(예: 계정, 연락처, 기회, 리드 및 사례)로 작업하거나 양식이 다른 개체에서도 작동해야 합니까?
단일 개체 교차 개체 개체 무시성
동적 양식 사용 가능 사용 가능 사용할 수 없음
화면 플로 사용 가능 사용 가능 사용 가능
OmniStudio 사용 가능 사용 가능 사용 가능
화면 플로 + LWC 사용 가능 사용 가능 사용 가능
LWC 사용 가능 사용 가능 사용 가능
교차 개체 및 개체 비호 양식의 경우 Flow 및 OmniStudio는 모두 솔리드 옵션입니다. 플로 화면에서 사용할 수 있는 구성 요소는 본질적으로 무시적이므로 해당 데이터를 사용하여 수행할 작업을 선택할 수 있습니다. 예를 들어, 하나의 양식에 입력한 데이터를 사용하여 여러 레코드를 만듭니다. 또는 Chatter 게시물 생성, Slack 메시지 보내기, 이메일 보내기 또는 외부 서비스에 연결하는 등 다른 작업을 수행합니다. 간단한 경우 Lightning 같은 기존 LWC 구성 요소를 사용하면 강력한 솔루션을 제공하기 위해 필요한 코드를 낮출 수 있습니다. 그러나 여러 개체가 포함된 시나리오의 경우 플로에서 모든 개체를 포괄적으로 제어하고 개발자가 복잡한 관계 및 종속성을 살펴볼 필요가 없습니다. OmniStudio는 한 단계 더 나아가 완전히 개체 무시적이며 사용자에게 표시되는 양식을 기본 데이터 모델과 구분합니다. 대신 OmniStudio는 [데이터 매퍼](https://help.salesforce.com/s/articleView?id=sf.os_dataraptors.htm&type=5) 및 [통합 절차](https://help.salesforce.com/s/articleView?id=sf.os_omnistudio_integration_procedures_48334.htm&type=5)와 같은 도구를 사용하여 Salesforce 개체(또는 외부 데이터)에 매핑되는 기본 JSON을 조작합니다. 데이터 매퍼 및 통합 절차는 OmniStudio 양식을 Salesforce 내부 및 외부 데이터와 연결하는 두 가지 핵심 구성 요소입니다. 끌어서 놓기 요소를 사용하면 외부 시스템에서 복잡한 계층 데이터로 작업한 다음, 데이터가 이동해야 하는 위치에 따라 필요에 맞게 데이터를 변환할 수 있습니다. 또한 수식을 사용하여 배열 또는 Apex 같은 데이터 목록에서 수학 및 논리를 수행할 수도 있습니다. [OmniStudio 통합_OmniStudio 통합_](/docs/architect/ko-kr/reference-diagrams/guide/omnistudio-integrations) ### 양식 범위 및 탐색 단일 화면 양식에서 모든 사용자 입력을 가져올 수 있는 경우 동적 양식부터 시작합니다. 그러나 레코드 페이지의 동적 양식은 경로 기능을 사용하여 비즈니스 프로세스의 다양한 단계를 느슨하게 나타낼 수 있지만, 대부분의 사용 사례에 적합하지 않을 수 있습니다. #### 질문: - 단일 화면이 필요합니까? 과업을 완료하려면 사용자가 여러 화면 사이를 탐색해야 합니까? - 사용자가 양식을 작성하는 과정에서 얼마나 진행되었는지 시각적으로 설명하도록 하시겠습니까? - 사용자가 각 화면의 정보를 특정 순서로 작성해야 하거나 필요에 따라 화면 간에 앞뒤로 이동할 수 있어야 합니까?
단일 화면 다중 화면 양식 진행률 지표 단계 간에 이동 탐색/화면
동적 양식 사용 가능 사용할 수 없음 사용 가능 사용할 수 없음
화면 플로 사용 가능 사용 가능 사용 가능 사용할 수 없음
OmniStudio 사용 가능 사용 가능 사용 가능 사용 가능
화면 플로 + LWC 사용 가능 사용 가능 사용 가능 사용 가능
LWC 사용 가능 이상적이지 않음 이상적이지 않음 이상적이지 않음
동적 양식에서 제공하는 것보다 더 많은 기능이 필요한 경우 플로, OmniStudio, LWC 간 선택 항목은 몇 가지 다른 질문에 따라 다릅니다. - 팀은 어떤 기술을 보유하고 있습니까? 관리자가 많은 조직의 경우 플로로 시작하는 것이 좋습니다. 산업 솔루션이 있는 경우 팀에서 이미 OmniStudio에 익숙하며 프로젝트에 엄격한 UX 요구 사항이 있는 경우 OmniStudio부터 시작합니다. - 양식 하단에 탐색 모음을 표시할 수 있습니까? 화면 플로 및 Omniscript 탐색 환경이 바람직하지 않은 UX인 경우 LWC로 이동합니다. - 양식 뒤에 수행해야 하는 작업은 무엇입니까? 관리자가 동작을 구성할 수 있어야 하는 경우 플로를 구축하거나 필드 레이블 변경과 같은 기본 변경의 경우 Omniscript를 구축합니다. 그렇지 않으면 복잡한 다중 개체 관계의 경우 Omniscript 또는 LWC를 구축합니다. - 플로 또는 OmniStudio를 선택하는 경우 적절한 UX를 위해 LWC를 구축해야 할 수 있습니다. 이미 양식의 스타일을 올바르게 지정하기 위해 LWC를 구축 중인 경우 [플로에 해당 구성 요소를 포함하는](https://developer.salesforce.com/docs/platform/lwc/guide/use-flow-embed-component.html) 작업이 과도한 것인지 고려하십시오. 반면, 솔루션이 마법사처럼 보일 경우 사용자가 여러 화면 사이를 탐색하는 경우 플로 또는 OmniStudio를 고려하십시오. 플로 및 OmniStudio는 내장 탐색 모델과 함께 제공되므로 함께 연결된 LWC를 구축하고 유지할 필요가 없습니다. 탐색은 선형이며 앞으로 이동하는 작업, 뒤로 이동하는 작업 및 나중에 양식을 저장할 수 있는 메커니즘이 있습니다. 목적에 맞는 경우 비선형 탐색을 사용하여 양식을 작성할 수도 있습니다. 화면 플로를 사용하는 좋은 예는 Salesforce Labs의 [디지털 매장 감사](https://appexchange.salesforce.com/appxListingDetail?listingId=a0N3A00000FMkOtUAL) 패키지를 참조하십시오. OmniStudio는 양식에 '단계'를 표시하는 표준 탐색의 진행률 표시기를 제공하여 주요 탐색 이점을 제공합니다. 이 단계 보기는 사용자가 지정된 다단계 양식에 있는 위치를 자동으로 표시합니다. 플로와 달리 사용자는 양식의 다양한 단계를 클릭하여 화면 간에 '건너뛰기'할 수 있습니다. 단일 화면 또는 다중 화면 양식을 만드는지 여부와 상관없이 양식이 사용자가 쉽게 탐색할 수 있도록 [간소화되어 있는지 확인하십시오](/docs/architect/ko-kr/well-architected/guide/engaging#양식). ### 위치 표준 Lightning 레코드 페이지에 양식을 포함하는 경우 비교하는 모든 도구가 작동합니다. 동적 양식은 현재 데스크톱에서만 사용할 수 있다는 점에 유의하십시오. 그러나 사용자가 다른 위치에서 양식에 액세스할 수 있는 환경을 제공하려는 경우 대체 옵션을 고려해야 할 수 있습니다. #### 질문: - 사용자가 데스크톱, 모바일 또는 둘 모두를 통해 양식에 액세스해야 합니까? - 사용자가 유틸리티 막대를 통해 앱의 모든 위치에서 양식에 액세스할 수 있어야 합니까? - 사용자가 현재 있는 페이지에서 이동하지 않고도 양식을 작성할 수 있도록 빠른 작업을 사용하려고 합니까? - 외부 웹 사이트에서 양식을 사용할 수 있어야 합니까?
Lightning 레코드 페이지 Lightning 홈페이지 또는 앱 페이지 Aura Experience Cloud 사이트 LWR Experience Cloud 사이트 내장형 Snap-Ins 유틸리티 막대 개체별 작업 글로벌 작업 Salesforce 모바일 앱** Field Service 모바일 모바일 SDK 외부 사이트 및 앱 사용자 정의 LWC
동적 양식 사용 가능 사용할 수 없음 사용할 수 없음 사용할 수 없음 사용할 수 없음 사용할 수 없음 사용할 수 없음 사용할 수 없음 사용 가능 사용할 수 없음 사용할 수 없음 사용할 수 없음 사용할 수 없음
화면 플로 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능 로드맵 사용 가능 사용 가능*** 사용할 수 없음 로드맵 사용 가능
OmniStudio 사용 가능 사용 가능 사용 가능 사용할 수 없음 사용할 수 없음 사용 가능 사용할 수 없음 사용할 수 없음 사용 가능 사용할 수 없음 사용할 수 없음 사용 가능 사용 가능
화면 플로 + LWC 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능 로드맵 사용 가능 사용할 수 없음 사용할 수 없음 이상적이지 않음 사용 가능
LWC 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능 로드맵 로드맵 사용 가능 로드맵 로드맵 사용 가능 사용 가능
*플로는 LWR Experience Cloud 사이트에 포함할 수 있지만 유의해야 할 고려 사항이 있습니다.
**플로 및 LWC는 Salesforce 모바일 앱에서 지원되지만 Salesforce 모바일 앱은 플로 및 LWC를 포함할 수 있는 모든 방법을 지원하지 않습니다. 예를 들어, 개체별 작업은 모바일에서 지원되지만 유틸리티 막대 항목은 지원되지 않습니다.
***Field Service 모바일 앱은 이전 플로 엔진 및 화면 플로 런타임에서 설계되었으므로 대부분의 최신 플로 기능을 지원하지 않습니다. 오프라인에서 작동하도록 특별히 수정되었습니다.
동적 양식은 Lightning 레코드 페이지에서만 지원되므로 레코드 컨텍스트가 필요합니다. 그러나 Experience Cloud 페이지에서는 동적 양식이 지원되지 않습니다. Experience Cloud는 동적 양식이 종속되는 기본 프레임워크를 사용하지 않으므로 이 제한 사항이 적용됩니다. Lightning 페이지. Experience Cloud의 동적 양식 요청을 기반으로 이를 평가하고 있습니다. 레코드 컨텍스트가 필요한 플로 또는 전역적으로 작동하는 플로를 구축할 수 있습니다. 따라서 다양한 위치에 플로를 포함할 수 있습니다. 레코드 컨텍스트 플로의 경우 Lightning 레코드 페이지, Experience Cloud 레코드 페이지, 개체별 작업 또는 작업 및 권장 사항 배포일 수 있습니다. 전역 플로의 경우 유틸리티 막대, 기타 Lightning 또는 익스피리언스 빌더 페이지, Snap 또는 외부 응용 프로그램일 수 있습니다. 플로는 현재 전역 작업으로 지원되지 않지만 해결 방법으로 Aura 구성 요소에 플로를 래핑할 수 있습니다. OmniStudio를 사용하면 플로를 배치할 수 있는 거의 모든 위치에 배치할 수 있는 구성 가능한 FlexCard 및 Omniscript를 구축할 수 있습니다. 그러나 구성할 수는 있지만 패키징할 수는 없습니다. LWC는 Salesforce, 커뮤니티 전체, 오픈 소스 프로젝트에서도 메타데이터를 통해 대상과 연결할 수 있는 구성 요소를 만들기 때문에 높은 수준의 재사용성을 지원합니다. LWC 구성 요소는 [Lightning Out](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lightning_out)을 통해 자체 웹사이트 내부에 포함할 수도 있습니다. [External Sites에서 Lightning Out _External Sites에서 Lightning Out_](/docs/architect/ko-kr/reference-diagrams/guide/lightning-out-on-external-sites) Lightning 웹 구성 요소는 현재 빠른 작업(개체별 또는 전역)으로 지원되지 않지만, 해결 방법으로 LWC를 Aura 구성 요소에 래핑할 수 있습니다(플로와 마찬가지로). LWC 구성 요소는 또한 [Lightning-flow](https://developer.salesforce.com/docs/component-library/bundle/lightning-flow/documentation) 구성 요소로 흐름을 시작할 수 있습니다. OmniStudio는 OmniOut 기능을 통해 외부 사이트에 콘텐츠를 노출하는 데 우수합니다. OmniStudio 및 OmniOut을 사용하면 OmniScript 양식 및 FlexCard 구성 요소를 표준 구성 요소로 컴파일하고 타사 사이트 또는 앱에서 플랫폼 외부에서 실행할 수 있습니다. 이 가이드에 포함된 양식 기술은 현재 Mobile SDK 템플릿에서 공식적으로 지원되지 않습니다. Mobile SDK가 사용 사례에 필수적이라면 Salesforce Well-Architected [form factor](/docs/architect/ko-kr/well-architected/guide/engaging#양식-요소) 지침을 염두에 두고 모바일 응용 프로그램에서 기본적으로 양식을 작성하거나 Visualforce 페이지를 작성하는 것이 좋습니다. **로드맵 참고:** Mobile SDK 팀은 Visualforce 페이지 내에서 LWC를 지원하는 데 적극적으로 노력하고 있습니다. ### 컨트롤러 동적 양식은 양식에서 값을 사용하여 레코드를 만들거나 업데이트해야 하는 경우에 적합합니다. 이외의 기능을 사용하려면 플로, OmniStudio 또는 LWC를 활용해야 합니다. 이러한 기능에는 결정 또는 반복 계층 또는 양식의 입력을 사용하여 Slack 게시물 또는 이메일 생성이 포함될 수 있습니다. #### 질문: - 백그라운드에서 수행하려는 작업 또는 논리는 무엇입니까? - 데이터 모델에 계층적 데이터가 포함되어 있습니까? - 단일 트랜잭션 또는 여러 트랜잭션에서 양식의 작업을 완료해야 합니까? - 외부 시스템과 통합해야 합니까? - 재사용 가능성 및 모듈성에 대한 요구 사항은 무엇입니까?
로그 및 작업 계층적 데이터 관리 단일 트랜잭션 내 작업 여러 거래에서 작업 수행 통합 모듈식 설계 및 재사용 패키징
동적 양식 사용할 수 없음 사용할 수 없음 사용할 수 없음 사용할 수 없음 사용할 수 없음 사용할 수 없음 사용 가능
화면 플로 사용 가능 로드맵 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능
OmniStudio 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능 사용할 수 없음
화면 플로 + LWC 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능
LWC 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능
Flow는 Slack에 게시, 이메일 보내기 및 Quip 문서와 상호 작용을 위한 표준 작업을 제공하므로 이러한 작업에 코드를 작성할 필요가 없습니다. LWC는 [사용자 인터페이스 API](https://developer.salesforce.com/docs/atlas.en-us.uiapi.meta/uiapi/ui_api_get_started.htm)와 상호 작용하는 유선 어댑터를 사용하여 단일 레코드 및 관련 객체와 풍부한 상호 작용을 제공합니다. 또한 LWC는 [getListInfoByName](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/reference_get_list_info_by_name.html)의 유선을 사용할 때 여러 레코드와 상호 작용할 수 있습니다. [유선 어댑터를 통한 LWC 상호 작용_Lightning 웹 구성 요소 유선 어댑터를 통한 상호 작용_](/docs/architect/ko-kr/reference-diagrams/guide/lightning-web-components-interaction-via-wire-adapters) 위에서 언급한 것처럼 OmniStudio는 통합 절차 및 데이터 매퍼를 사용하여 외부 및 내부 데이터를 쉽게 캡처하고 Salesforce로 변환합니다. 사용 가능한 수많은 코드가 없는 기능 덕분에 다양한 수준의 관계를 갖춘 데이터 집합을 평면화하고 확장할 수 있습니다. **로드맵 참고:** 플로는 곧 레코드 컬렉션을 업서트하고 계층적 데이터를 관리하는 기능을 지원합니다. Flow, OmniStudio, LWC는 모두 Apex 통합되므로 선택한 솔루션에서 간편하게 격차를 해소할 수 있습니다. 예를 들어, LWC에서 레코드를 필터링해야 하는 경우 항상 Apex 유선 어댑터를 사용하여 복잡한 SOQL 쿼리를 만들 수 있습니다. 클릭 기반 스토리로 인해 영향을 받는 경우 서버 측의 요구에 맞게 Apex 컨트롤러의 실용적인 대안으로 Flow 또는 OmniStudio를 고려하십시오. 여기서 두 번째 질문은 작업을 즉시 커밋할 것인지 또는 작업을 양식의 특정 부분으로 연기할 것인지 여부입니다. 이는 다중 페이지 양식인 경우 특히 유용합니다. 플로를 사용하면 여러 양식(플로 화면)의 입력을 쉽게 결합하고 마법사(플로)에서 훨씬 나중에 사용하여 일부 작업을 수행할 수 있습니다. 실제로 사용자가 화면 간에 앞뒤로 반전하여 답변을 변경할 경우 플로를 이 방식으로 설계하는 것이 좋습니다. #### 작업 제어 트랜잭션 및 [관리 제한](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_gov_limits.htm)은 Salesforce Platform에서 생활 방식입니다. 사용 사례가 상당히 간단한 경우 특정 작업이 발생하는 트랜잭션을 제어하는 것이 중요하지 않을 수 있습니다. 그러나 여러 작업을 여러 트랜잭션에 걸쳐 수행하는 대신 여러 작업을 하나의 [트랜잭션](/docs/architect/ko-kr/fundamentals/guide/architecture-basics#트랜잭션)에 결합할 수 있는 몇 가지 사용 사례가 있습니다. 몇 가지 예: - **Rollback 또는 Not to Rollback**: 바로 질문입니다. 양식이 백그라운드에서 여러 레코드를 생성한다고 가정합니다. 세 번째 레코드를 만들지 못할 경우 처음 두 개의 레코드를 롤백해야 합니까? 각 작업이 서로 독립적인 경우 별도의 트랜잭션에서 실행할 수 있습니다. 그러나 종속적이고 하나의 실패로 인해 다른 항목도 롤백되도록 하려는 경우 단일 트랜잭션에서 구현합니다. 양식이 플로에 있는 경우 오류 경로의 롤백 요소를 사용하여 트랜잭션을 롤백하고 데이터 무결성을 보장할 수 있습니다. - **Governor Limits에 대한 다운스트림 영향**: 특히 양식에서 레코드를 만들거나 업데이트하는 경우 해당 작업의 다운스트림 영향을 고려하십시오. 이 레코드 변경에 따라 어떤 프로세스, 워크플로 규칙, 플로 트리거, Apex 트리거 또는 저장 순서의 다른 항목이 실행될 것입니까? 이러한 집합 변경 사항은 해당 트랜잭션에서 사용되는 총괄자 제한에 어떤 영향을 미칩니까? 특정 레코드 변경으로 인해 제한에 영향을 미치는 많은 다운스트림 변경 사항이 발생할 경우 해당 레코드 변경 사항을 자체 트랜잭션으로 분리하는 것이 좋습니다. - **배치 처리**: UI 컨텍스트에서도 여러 업데이트를 함께 배치해야 할 수 있습니다. 다중 화면 양식이 대규모 레코드 그룹에서 반복되는 경우 각 화면 이후에 레코드 업데이트를 커밋하는 대신 모든 레코드에 대한 업데이트를 수집할 때까지 기다린 다음, 모든 레코드를 업데이트하기 위한 한 번의 요청을 제출합니다. 동적 양식을 사용하여 레코드를 만들거나 편집하는 경우 한 번만 작업을 수행하고 해당 작업은 항상 순 새 트랜잭션의 시작입니다. 화면 플로를 구축할 때 지정된 트랜잭션에서 수행되는 작업을 크게 제어할 수 있습니다. 화면 및 로컬 작업은 트랜잭션 간 경계 역할을 합니다. 다음은 화면 플로 아키텍처에서 트랜잭션이 관리되는 방법에 대한 상위 수준 요약입니다. 1. 최종 사용자가 화면과 상호 작용한 다음, **다음**을 클릭합니다. 2. 클라이언트가 입력과 함께 API에 요청을 게시합니다. 3. API가 요청을 수신하고 트랜잭션 및 데이터베이스 연결이 열립니다. 그런 다음, API가 플로 엔진을 호출하여 요청을 호출합니다. 4. 플로 엔진이 화면 또는 로컬 작업 노드에 도달할 때까지 플로 정의의 적절한 경로를 차지하고 따릅니다. 엔진이 해당 노드에 대한 정보를 API에 반환합니다. 5. API가 렌더링할 다음 화면의 세부 사항을 포함하는 응답 개체를 만들고 클라이언트에게 해당 개체를 반환합니다. 이 시점에서 데이터베이스 변경 사항이 커밋되고([주문 저장 실행](/docs/architect/ko-kr/fundamentals/guide/architecture-basics#데이터베이스-조작)) 데이터베이스 연결 및 트랜잭션이 종료됩니다. 6. 클라이언트가 API 응답을 사용하여 사용자가 상호 작용할 다음 화면을 렌더링합니다. 7. 1단계에서 반복합니다. 다시 말해, "중단" 트랜잭션을 표시합니다. 이러한 경우 보류 중인 작업 또는 DML이 커밋되고 이전 트랜잭션이 마감되고 새 트랜잭션이 시작됩니다.
다중 화면 흐름 지정된 트랜잭션에 그룹화하는 작업에 대한 올바른 설계는 호출입니다. 몇 가지 예를 살펴보겠습니다.
별 거래가 있는 화면 흐름
왼쪽에서 여러 화면에서 입력을 수집한 다음, 하나의 트랜잭션에서 여러 작업을 수행하는 플로를 볼 수 있습니다.
오른쪽의 플로는 별도의 트랜잭션에서 각 작업을 수행합니다.
플로 팀은 최근에 새로운 요소를 도입했습니다. 레코드 롤백 요소를 사용하면 일련의 데이터베이스 작업에서 단일 작업이 실패할 경우 전체 트랜잭션을 롤백할 수 있습니다.
다중 만들기 레코드가 있는 화면 플로

오른쪽의 다음 플로에 표시된 것처럼 레코드를 생성하고, 레코드를 업데이트한 다음, 더 많은 레코드를 생성하는 플로가 있다고 가정합니다.
이 시나리오에서 처음 두 개의 요소가 성공하고 마지막 두 개의 요소가 실패하면 처음 두 개의 DML 작업이 해당 레코드를 만들고 업데이트하지만 세 번째 작업은 실패합니다.
Rollback 스크린 플로우
레코드 롤백 요소를 사용하면 왼쪽의 최종 플로에 표시된 것처럼 세 가지 작업을 모두 동시에 수행해야 하는 경우 전체 트랜잭션이 롤백되는지 확인할 수 있습니다. 자세한 내용은 [트랜잭션 플로](https://help.salesforce.com/articleView?id=flow_concepts_transaction.htm) 및 [트랜잭션 플로 대량 처리](https://help.salesforce.com/articleView?id=flow_concepts_bulkification.htm)을 참조하십시오. Salesforce Well-Architected의 Automated 섹션은 또한 [데이터 처리](/docs/architect/ko-kr/well-architected/guide/automated#데이터-처리)에 대해 자세히 설명합니다. LWC에서 트랜잭션을 제어하는 기능은 LWC가 작업을 수행하는 데 사용하는 기본 서비스에 속합니다. Lightning 기본 구성 요소를 사용하는 경우 양식이 제출된 즉시 독립형 트랜잭션에서 기본 작업(레코드 만들기 또는 업데이트)이 수행됩니다. 일반적으로 다음 규칙이 적용됩니다. - 각 UI API 호출은 자체 트랜잭션으로 분리됩니다. - 단일 트랜잭션 내에서 여러 작업을 수행해야 하는 경우 입력 내용을 Apex 컨트롤러 또는 플로와 같은 서버측 기술로 보냅니다. 해당 기술에 대한 일반 트랜잭션 규칙이 적용됩니다. #### 외부 통합 Flow, OmniStudio 및 LWC는 모두 플랫폼 이벤트([이벤트 기반 아키텍처](/docs/architect/ko-kr/decision-guides/guide/event-driven)) 및 API 통합을 지원합니다. 사용자 정의 Apex 코드 외에도 Flow 및 OmniStudio는 API를 통합하기 위한 선언적 메커니즘을 모두 지원합니다. MuleSoft API 또는 RPA Bot에 연결해야 하는 경우 MuleSoft 서비스를 사용하십시오. 이렇게 하면 외부 서비스가 생성됩니다. [MuleSoft를 통한 외부 통합 _MuleSoft API 및 RPA Bots를 통한 외부 통합_](/docs/architect/ko-kr/reference-diagrams/guide/external-integrations-via-mulesoft-apis-and-rpa-bots) API에 OpenAPI 스키마가 있는 경우 외부 서비스를 만듭니다. [OpenAPI를 통한 외부 통합 _OpenAPI 스키마를 사용하는 API에 대한 외부 통합_](/docs/architect/ko-kr/reference-diagrams/guide/external-integrations-to-apis-with-openapi-schemas) 그렇지 않으면 플로의 HTTP 콜아웃 기능 또는 OmniStudio의 HTTP 작업을 사용합니다. 플로의 HTTP 콜아웃은 외부 서비스에서 제공됩니다. [HTTP를 통한 외부 통합 _HTTP를 통한 외부 통합_](/docs/architect/ko-kr/reference-diagrams/guide/external-integrations-via-http) OmniStudio는 통합 절차를 통해 외부 시스템에 콜아웃하고 데이터 매퍼를 사용하여 데이터를 변환할 수 있는 다양한 통합 기능을 제공합니다. (자세한 내용은 [개체 영향을](#개체-영향) 참조하십시오.) 사용자 정의 Apex 또는 외부 서비스로 구현하든 상관없이 콜아웃은 콜아웃입니다. 다음은 알아야 할 사항입니다. 1. 콜아웃에는 시간이 오래 걸릴 수 있습니다. 2. 콜아웃이 동기식으로 실행되면 데이터베이스 트랜잭션이 열려 있는 동안 수행됩니다. 3. 보류 중인 데이터베이스 작업이 있는 경우 Salesforce에서 데이터베이스 트랜잭션을 열어 둘 수 없습니다. 주된 제한 사항은 소위 **_나쁜 거래_**의 위험입니다. 여기서 생성, 업데이트 또는 삭제 작업을 수행한 다음, 동일한 거래에서 콜아웃을 실행합니다. 위의 고려 사항 #3이므로 이 패턴은 허용되지 않습니다. 이는 고려 사항 #1 및 #2 때문에 물론 존재합니다. 플로에서 트랜잭션을 중단하여 이 제한을 해결할 수 있습니다. 화면 및 로컬 작업이 모두 브라우저 컨텍스트를 다시 도입하여 트랜잭션을 중단한다는 점에 유의하십시오. 외부 콜아웃으로 작업할 때 화면 및 로컬 작업을 사용할 수 있지만 호출 가능한 고급 설정에서 트랜잭션 제어를 활성화하는 것이 좋습니다. 트랜잭션 제어는 콜아웃을 만들기 전에 트랜잭션을 자동으로 종료할 수 있는 호출 가능한 작업의 기능입니다. 호출된 작업의 고급 섹션에서 항상 새 트랜잭션 시작을 선택하여 트랜잭션 관리를 활성화할 수 있습니다. 콜아웃을 통한 외부 통합 LWC에서는 트랜잭션에 대한 콜아웃이 미치는 영향이 복잡해집니다. 일반적으로 Lightning 데이터 서비스(LDS)를 사용하여 데이터 작업을 수행한 다음, Apex 컨트롤러를 사용하여 외부 콜아웃을 수행합니다. 이 설계는 LDS 호출이 Apex 콜아웃과 별도의 자체 트랜잭션에서 분리되므로 더러운 트랜잭션으로부터 보호합니다. _Apex 콜아웃, 외부 서비스 및 일반 데이터 통합 기능에 대한 자세한 지침은 [Salesforce와 데이터 통합을 위한 아키텍트 가이드](/docs/architect/ko-kr/decision-guides/guide/data-integration)를 참조하십시오._ #### 재사용 가능성 및 모듈화 동적 양식은 재사용을 지원하지 않습니다. 각 동적 양식은 특정 개체에 대한 특정 Lightning 레코드 페이지에 연결됩니다(여러 앱, 프로필 등에 해당 Lightning 레코드 페이지를 할당할 수 있음). 여러 다른 구성 요소에서 사용할 라이브러리, 유틸리티 및 구성 요소를 작성할 수 있는 것과 마찬가지로 **_하위 플로_**의 기능을 사용하여 플로를 만들 때 비슷한 디자인 패턴을 적용할 수 있습니다. 더 작은 모듈식 버킷에 플로를 저장한 다음, 서브플로 요소를 사용하여 다른 플로에서 플로를 호출합니다. 설계에 필요할 경우 자체적으로 지원되고 다른 플로의 하위 플로로 유용한 플로를 구축할 수 있습니다. OmniStudio는 기본적으로 모듈성을 위해 구축되었습니다. 데이터 매퍼, OmniScript, FlexCard 및 통합 절차는 모두 독립적으로 구축되며 상호 교환적으로 작동할 수 있습니다. 또한 FlexCard는 다른 LWC, Omniscript, 레코드 페이지, Experience Cloud 사이트에 포함할 수 있는 LWC 구성 요소로 구축할 수 있습니다. 화면 플로, Omniscript 및 LWC는 모두 재사용할 수 있으며 외부 사이트 및 Lightning Out 애플리케이션을 비롯한 다양한 위치에 내장할 수 있습니다. 솔루션을 [조립 가능하게](/docs/architect/ko-kr/well-architected/guide/composable) 설계하면 적응성 및 안정성과 같은 추가적인 이점을 얻을 수 있습니다. ### 확인 레코드를 만들거나 업데이트하는 데 사용되는 모든 기술은 기존의 검증 규칙이든 Apex 트리거에 내장된 사용자 정의 검증이든 시스템 수준의 검증을 준수합니다. 레코드 변경을 수행하는 데 사용하는 기술과 상관없이 모든 변경 사항은 저장 주문을 통해 전달됩니다. 즉, 확인 규칙 외에도 레코드 변경 사항은 트리거 전후, 에스컬레이션 규칙, 할당 규칙 등과 같은 여러 저장 전후 플로에서 처리됩니다. 아직 작성하지 않은 경우 북마크를 지정하고 Apex [실행 순서](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_triggers_order_of_execution.htm)에 익숙해지십시오. #### 질문: - 시스템 수준 확인 외에도 양식에 추가 요구 사항이 있습니까? - 양식 내에서 필드를 필수 또는 읽기 전용으로 동적으로 설정해야 합니까?
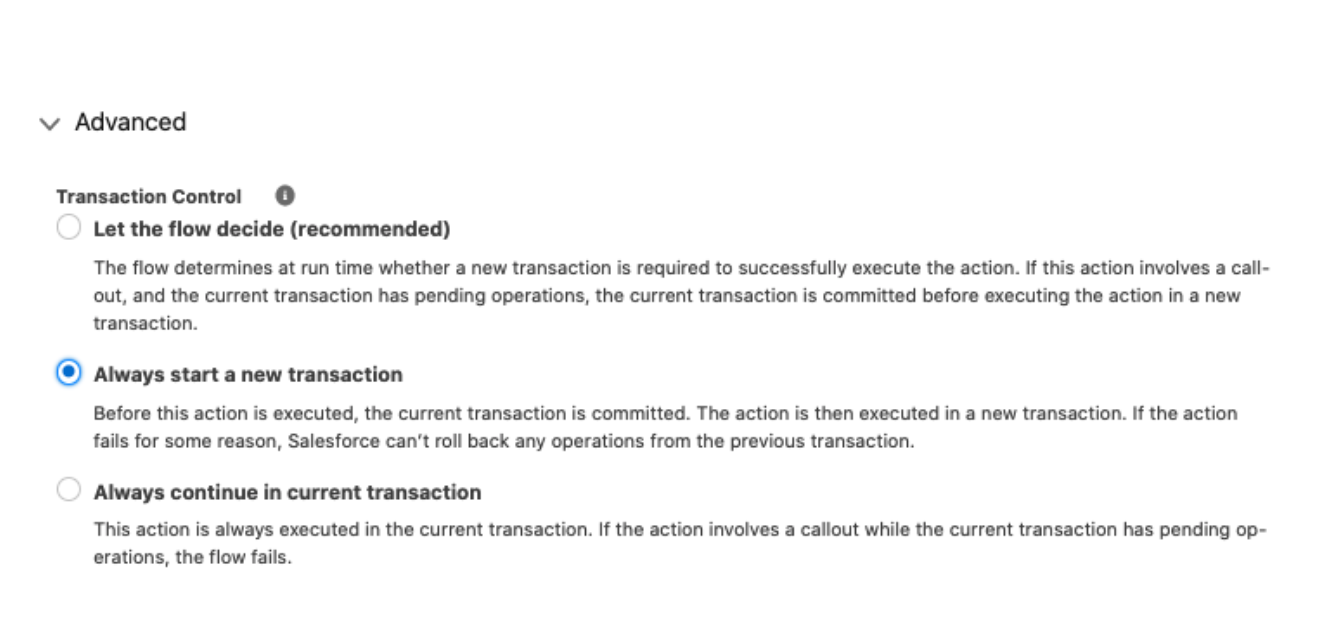
시스템 수준 확인 준수 이 양식에 고유한 사용자 정의 필드 수준 확인 사용자 정의 필드 수준 확인
동적 양식 사용 가능 사용할 수 없음 사용할 수 없음
화면 플로 사용 가능 사용할 수 없음 로드맵
OmniStudio 사용 가능 사용 가능 사용 가능
화면 플로 + LWC 사용 가능 사용 가능 사용 가능
LWC 사용 가능 사용 가능 사용 가능
플로 화면 또는 Omniscript 단계의 입력은 본질적으로 제한되지 않으므로 양식 자체가 특정 개체와 관련된 시스템 수준 확인을 기본적으로 준수하지 않습니다. 그러나 레코드를 만들거나 업데이트하는 데 사용하는 값은 저장 순서에 의해 처리되므로 개체의 시스템 수준 확인을 통과합니다. 그러나 일부 화면 플로 구성 요소는 입력 유효성 검사를 지원하지 않는다는 점에 유의하십시오. Summer '24부터 입력 유효성 검사를 지원하지 않는 나머지 화면 구성 요소는 라디오 버튼, 선택 목록, 다중 선택 선택 목록, 확인란 그룹, 선택 항목 조회입니다. 페이지 레이아웃과 마찬가지로 동적 양식을 사용하면 페이지 수준에서 필수성 및 읽기 전용 상태를 설정할 수 있습니다. 그러나 시스템 수준 설정을 재정의할 수 없습니다. 플로는 양식의 입력에 대한 유효성 검사를 유연하게 사용자 정의할 수 있습니다. 클라이언트에서 일부 확인을 수행하는 경우(예: 누락된 필수 필드 또는 호환되지 않는 값에 플래그 지정) 클라이언트측 확인은 사용자의 탐색을 차단하지 않습니다. 실제 유효성 검사는 서버에서 수행됩니다. 사용자가 **다음**을 클릭하면 Flow가 확인을 위해 서버에 입력을 보냅니다. 입력이 잘못된 것으로 반환되는 경우 탐색이 차단되고 적절한 오류가 표시됩니다. 서버가 다음을 확인하여 입력을 확인합니다. 1. 입력의 필수성 설정 또는 입력한 값이 기본 데이터 유형과 호환되는지 여부입니다. 2. 해당 입력에 대한 사용자 정의 유효성 검사: 여러 표준 구성 요소(확인란, 통화, 날짜, 날짜/시간, 긴 텍스트 영역, 숫자, 암호, 텍스트)는 화면별로 사용자 정의 유효성 검사를 지원합니다. 수식이 충족되지 않을 경우 표시할 부울 수식 및 오류 메시지를 제공합니다. 3. 기본 구성 요소에 대한 사용자 정의 확인: 플로에 대한 사용자 정의 LWC를 구축하는 경우 validate() 메서드에 자체 확인 코드를 추가합니다. OmniStudio는 [조건부 보기](https://help.salesforce.com/s/articleView?id=sf.os_conditionally_display_elements_using_the_conditional_view_property.htm&type=5) 및 [메시징](https://help.salesforce.com/s/articleView?id=sf.os_display_messages_in_omniscripts_19551.htm&type=5) 구성 요소와 함께 [오류 설정](https://help.salesforce.com/s/articleView?id=sf.os_set_errors_in_an_omniscript.htm&type=5) 작업을 통해 풍부한 오류 및 검증 처리를 제공합니다. LWC 측에서는 대부분의 기본 구성 요소가 자체 클라이언트측 유효성 검사를 수행합니다. 예를 들어 Lightning 페이지 수준 필수 항목이 아닌 시스템 수준 필수 항목을 준수합니다. 사용자 정의 구성 요소에 대해 Build Your Own 검증 메커니즘을 만들 수 있습니다. 사용자가 데이터를 입력해야 하는 필드는 양식에 조기에 표시되어야 합니다. 가능한 경우 양식을 제출하기 전에 클라이언트 측에서 사용자 입력을 확인합니다. 양식 간소화에 대한 추가 모범 사례는 Salesforce Well-Architected - Engaging의 [ 양식](/docs/architect/ko-kr/well-architected/guide/engaging#양식) 지침을 참조하십시오. ### 보안 보안은 일반적으로 복잡한 주제이며 양식 구축과 관련하여 고려하지 않은 여러 가지 고려 사항이 있습니다. 기본 수준에서 양식이 올바른 컨텍스트에서 실행되고 사용자에게 기본 데이터에 대해 작업하는 데 필요한 권한이 있는지 확인하려고 합니다. 그러나 추가 조치를 취하여 서식 있는 텍스트 필드에서 잠재적으로 악성 코드 또는 URL을 제거하고 특정 사용자가 양식에 액세스할 수 없게 하거나 관리자가 향후 양식을 포함할 수 있는 위치 유형에 제한을 적용할 수도 있습니다. 도구를 선택하기 전에 보안 요구 사항을 철저하게 문서화해야 합니다. Salesforce 잘 구축된 [보안 정책 템플릿](/docs/architect/ko-kr/resources/guide/security-policy-template)에는 이 유형의 문서에 대한 지침이 포함되어 있습니다. #### 질문: - 특정 작업을 수행하기 전에 양식에서 사용자의 액세스를 확인해야 합니까? - 사용자 입력을 비활성화해야 합니까? - 양식에 액세스할 수 있는 사람을 제어하려는 경우 - 양식을 포함할 수 있는 위치를 제어하려는 경우
사용자 권한 높이기 액세스 권한이 있는 사용자 제어 허용 위치 제한
동적 양식 사용할 수 없음 사용 가능 사용할 수 없음
화면 플로 사용 가능 사용 가능 사용할 수 없음
OmniStudio 사용할 수 없음 사용 가능 사용할 수 없음**
화면 플로 + LWC 사용 가능 사용 가능 사용할 수 없음
LWC 사용 가능* 사용 가능 사용 가능
*Apex 필요
** OmniScript는 지정된 대상 위치 집합을 가질 수 없지만 FlexCard는 사용할 수 있습니다.
#### 사용자 권한 높이기 **_사용자 컨텍스트_**에서 실행되는 경우 Salesforce는 조직의 공유 규칙을 기반으로 필드 수준 보안, CRUD 권한 및 레코드 액세스를 확인하는 등 일련의 액세스 검사를 적용합니다. 예를 들어 사용자는 사례를 업데이트할 수 있는 기능, 적절한 필드 수준 보안, 관련 레코드에 대한 액세스 권한이 있는 경우에만 사례 업데이트 양식을 실행할 수 있습니다. 그러나 사용자가 다른 양식이나 상호 작용을 통해서가 아닌 _당사_ 양식을 사용할 때 특정 작업을 수행할 수 있도록 하려면 어떻게 해야 합니까? 여기서 **_시스템 컨텍스트_**가 들어옵니다. 시스템 컨텍스트는 사용자가 사례 업데이트 양식을 성공적으로 완료하기 위해 사례 개체에 대한 액세스 업데이트와 같이 필요하지 않도록 세션 기간 동안 실행 중인 사용자의 권한을 높이는 방법입니다. 이는 특히 인증되지 않은 커뮤니티에 유용합니다. 게스트 사용자에게 잠재적으로 위험한 기능을 부여하는 대신 시스템 컨텍스트에서 실행되도록 양식을 설정합니다. 물론 시스템 컨텍스트는 양쪽 가장자리 검이며 필요한 경우에만 사용해야 합니다. 시스템 컨텍스트에서 양식이 실행되면 모든 단일 CRUD 작업이 관심 있는 특정 작업뿐만 아니라 개체 및 필드 수준 보안 및 공유를 우회합니다. 또한 시스템 컨텍스트는 Salesforce에서 작업자로 간주하는 사람(마지막 수정자 필드에 표시되는 이름)에 영향을 미치지 않습니다. 사례 업데이트와 같이 양식이 수행하는 각 작업에 대해 작업자는 양식이 다른 컨텍스트에서 실행되는 경우에도 실제 사용자입니다. 동적 양식, OmniScript 및 LWC는 항상 사용자 컨텍스트에서 실행되며 이 동작을 재정의할 수 있는 방법은 없습니다. 화면 플로는 기본적으로 사용자 컨텍스트에서 실행되지만 시스템 컨텍스트에서 실행되도록 설정할 수 있습니다. 플로에서 모든 데이터에 대한 액세스 권한을 부여해야 하는지 아니면 공유와 같은 레코드 수준 액세스를 계속 적용해야 하는지 여부를 선택할 수 있습니다. - 시스템 컨텍스트에서 실행되는 플로에 Lightning 구성 요소를 포함하는 경우 플로가 구성 요소의 컨텍스트를 재정의하지 않습니다. 사용자 액세스 검사를 우회해야 하는 경우 플로를 사용하여 해당 작업을 수행하고 Lightning 구성 요소에 적절한 데이터를 전달하거나 전달하는 것이 좋습니다. 일부 기본 구성 요소(예: 조회)는 시스템 컨텍스트에서 작동할 수 없습니다. - 플로에서 Apex 작업을 호출하는 경우 이해해야 할 몇 가지 요소가 있습니다. Apex 클래스가 상속된 공유로 설정된 경우 플로가 설정된 내용과 상관없이 공유와 함께 시스템 컨텍스트에서 실행됩니다. 클래스에 명시적 공유 선언이 없는 경우 플로 설정에 관계없이 공유 없이 시스템 컨텍스트에서 실행됩니다. 클래스가 공유 또는 비공유로 설정된 경우 해당 클래스가 설정되고 플로의 컨텍스트를 재정의합니다. **Experience Cloud 사이트를 사용하여 시스템 컨텍스트의 레코드 쿼리:** Experience Cloud 사이트에서 시스템 컨텍스트에서 플로를 실행하는 경우(**특히 인증되지 않은** 경우) 레코드 가져오기 요소에 특정 필드만 저장하는 것이 좋습니다. Flow로 작업하고 레코드 가져오기 요소의 결과를 하위 플로, 호출 가능한 작업 또는 Lightning 구성 요소로 전달하면 해당 개체의 모든 필드를 브라우저의 개발자 도구를 통해 검사할 수 있습니다. 그러면 의도하지 않은 Experience Cloud 사이트 사용자가 필드를 사용할 수 있습니다. 레코드 가져오기 요소에서 특정 필드를 지정하면 시스템 컨텍스트가 활성화된 경우에도 올바른 필드만 노출되도록 할 수 있습니다. Omniscript 논리는 클라이언트 측에서 실행되므로 공격자는 Omniscript의 예상 실행을 수정할 수 있습니다 _또는_ 브라우저의 개발자 도구를 사용하여 통합 절차, 데이터 매퍼 및 Apex 메서드 호출에 대한 응답을 볼 수 있습니다. Omniscript를 사용할 경우 가능한 경우 서버 측에서 비즈니스 논리를 실행하고 [@InvocableMethod 주석](https://help.salesforce.com/s/articleView?id=sf.os_integration_procedure_invocation_55721.htm&type=5)을 통해 노출되는 모든 Apex 메서드에 입력 검증 규칙을 구현하는 것이 좋습니다. **세분화 입력:** 악의적인 요인으로부터 조직을 보호하려면 입력 세분화를 고려하십시오. 조직의 서식 있는 텍스트 필드에 매핑할 수 있는 공개적으로 액세스할 수 있는 양식에 입력이 있다고 가정합니다. 악의적인 URL을 숨길 수 있는 HTML을 제외하는 자동화를 고려할 수 있습니다. 일반적으로 이러한 필드를 작성할 수 있는 소스 수가 많을 수 있으므로 양식 수준에서 이 제거를 구현하는 것이 좋지 않습니다. 빠른 필드 업데이트 플로(저장 전)를 만들거나 개체에 기존 Apex 트리거를 사용하여 양식에 입력할 수 있는 잠재적인 HTML을 제거하거나 수정하는 것이 좋습니다. **_모범 사례:_** - _지정된 작업에 대해 실제 사용자의 액세스 권한을 늘려야 하는 경우를 제외하고 기본 컨텍스트에서 플로를 실행하도록 합니다._ - _보안상의 이유로 게스트 사용자를 위해 시스템 컨텍스트에서 플로를 실행하지 마십시오. Experience Cloud 사이트의 게스트 사용자 프로필에 할당된 제한된 필드 액세스 권한이 있는 권한 집합을 만듭니다._ - _Experience Cloud 사이트의 시스템 컨텍스트 실행 플로에서 레코드를 쿼리할 때 레코드 가져오기 요소 또는 호출 가능한 작업에 필요한 필드만 저장하십시오._ - _플로에서 다양한 작업을 수행하고 모든 작업에 상위 액세스 권한이 필요하지 않은 경우 하위 플로를 사용하여 시스템 컨텍스트에서 실행해야 하는 작업을 분리합니다._ - _외부 웹 페이지에 양식을 포함하려는 경우 서식 있는 텍스트 필드에 매핑될 경우 빠른 필드 업데이트 플로 또는 Apex 트리거를 사용하여 HTML을 제거하기 위해 사용자 입력 내용을 제거하여 악의적인 행위자의 잠재적인 피싱 공격을 방지하십시오._ #### 추가 참고 사항: - OmniScript, FlexCard, LWC는 기본적으로 사용자 컨텍스트에서 실행됩니다. - LWC는 기본적으로 사용자 컨텍스트에서 실행되고 플로는 사용자 컨텍스트에서 실행되지만 Apex 컨트롤러에서 이를 재정의할 수 있습니다. - UI API를 통해 수행되는 작업은 사용자 컨텍스트에서 실행됩니다. - Apex 컨트롤러를 통해 수행되는 작업은 해당 클래스에 따라 다릅니다. 이러한 작업을 시스템 모드에서 수행하려면 Apex 클래스를 공유 또는 공유 없이로 설정합니다. #### 액세스 제어 양식에 액세스할 수 있는 사람을 제어해야 하는 경우 양식이 포함된 컨테이너를 찾을 수 있습니다. 예를 들어 특정 앱, 레코드 유형 또는 프로필에 사용할 수 있도록 Lightning 페이지를 할당할 수 있습니다. 양식의 특정 입력이 민감한 경우 가시성 규칙을 사용하여 표시할 사람에게 표시되는 내용을 세부적으로 제어합니다. 이 기능은 동적 양식과 화면 플로 모두에 적용됩니다. Apex 클래스 또는 Visualforce 페이지처럼 특정 프로필 또는 권한 집합으로 [플로를 제한할 수 있습니다](https://help.salesforce.com/articleView?id=flow_distribute_security.htm). 기본적으로 플로는 제한되지 않으며, 즉 플로 실행 사용자 권한이 있는 모든 사용자가 플로를 실행할 수 있습니다. OmniStudio를 사용하는 경우 사용자에게 Omniscript, Flexcard, Classic 카드 또는 REST API에서 호출된 원격 작업을 관리하는 Apex 클래스에 대한 명시적 액세스 권한이 필요하도록 [Apex 클래스 권한 검사기](https://help.salesforce.com/s/articleView?id=sf.os_add_an_apex_class_permissions_checker_1.htm&type=5)를 구성할 수 있습니다. - 참고 새로 만든 스크립트에 대해 Apex 클래스 권한 확인이 기본적으로 활성화되어 있습니다. 그러나 기존 스크립트에 대해 수동으로 활성화해야 합니다. - 또한 Apex 클래스 권한 확인은 Apex 클래스에만 적용됩니다. [통합 절차 및 데이터 매퍼](https://help.salesforce.com/s/articleView?id=sf.os_security_for_dataraptors_and_integration_procedures_48147.htm&type=5)에 대해서도 프로필 수준 권한을 설정하는 것이 좋습니다. 게스트 사용자 권한에 대한 자세한 내용 및 모범 사례는 다음을 참조하십시오. - [게스트 사용자 레코드 액세스 모범 사례](https://www.learnexperiencecloud.com/s/article/Guest-User-Record-Access-Development-Best-Practices#Pattern6) - 보안 사이트 [개발: 인증된 사용자 및 게스트 사용자](https://developer.salesforce.com/docs/atlas.en-us.communities_dev.meta/communities_dev/communities_dev_security_authenticated_and_guest_users.htm) **_모범 사례:_** - _게스트 사용자에게 플로를 노출할 경우 게스트 사용자 프로필에 필요한 플로에 대한 액세스 권한만 부여합니다. 게스트 사용자 프로필에 실행 플로를 추가할 수 있지만 위험한 행동이라고 생각합니다._ - 시스템 컨텍스트에서 작동하는 플로에 _특히 주의하십시오. 이러한 플로를 특정 사용자 집합으로 제한하는 것이 좋습니다. 이들은 데이터를 보호하기 위해 적은 검사 및 균형을 사용합니다._ - _게스트 사용자 커뮤니티에서 Apex를 실행하는 모든 Omniscript에 Apex 클래스 정의에 "공유"가 있는지 확인하십시오._ - _게스트 사용자 프로필에서 게스트 사용자가 호출할 수 있도록 하려는 Apex 클래스만 할당하거나 의도치 않게 게스트 사용자에게 추가 비즈니스 논리를 노출할 위험이 있습니다._ LWC의 경우 실제 사용자의 권한 할당을 확인하여 특정 표준 또는 사용자 정의 권한이 있는지 확인할 수 있습니다. JavaScript에서 직접 @salesforce/userPermission 및 @salesforce/customPermission 범위 모듈에서 Salesforce 권한을 가져올 수 있습니다. 또는 Apex 사용하여 같은 항목을 확인할 수 있습니다. #### 포함 제어 Lightning 웹 구성 요소는 지정된 위치에서 유효한 [목표](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.reference_configuration_tags)로 추가된 경우에만 사용할 수 있습니다. 예를 들어, 레코드 페이지에서 구성 요소를 사용 가능하고 유틸리티 막대 항목으로 사용할 수 없도록 지정할 수 있습니다. 화면 플로가 활성화되면 모든 위치에서 화면 플로를 사용할 수 있는지 여부와 상관없이 화면 플로가 지원되는 모든 위치에서 사용할 수 있습니다. 그러나 Flow Builder는 화면이 있는 여러 유형의 플로를 지원합니다. 브레드 앤 버터 유형은 화면 플로이지만 특정 위치로 제한되는 몇 가지 다른 전문 유형이 있습니다. 예를 들어, Field Service 모바일 앱은 Field Service Mobile 플로만 지원합니다(정의한 경우). Experience Cloud에서만 지원되는 연락 요청 플로에도 동일하게 적용됩니다. 플로 유형에 관계없이 플로를 만드는 개인은 플로를 포함할 수 있는 위치를 제어할 수 없습니다. 플로는 해당 플로 유형에 대해 지원되는 모든 위치에서 사용할 수 있습니다. Salesforce Industries를 사용하는 경우 Omniscript와 관련하여 약간의 주의 사항이 있습니다. Omniscript 자체에 대한 대상을 지정할 수는 없지만 FlexCard에 포함할 수 있는 대상을 지정할 수 있습니다. ### 상호 작용 설계 정적 양식은 과거의 형태입니다. 오늘날에는 이 사용자, 이 장소에 대해 적절한 속성 및 값을 사용하여 양식을 동적으로 업데이트해야 합니다. Salesforce의 양식 작성 도구에 대해 이 방법에서 가능한 사항에 대해 살펴보겠습니다. #### 질문: - 양식 내에서 동적 응답을 트리거해야 하는 상호 작용 또는 조건 유형은 무엇입니까? - 양식을 작성하는 동안 백그라운드에서 화면 외로 작업을 실행해야 합니까? - 필드를 표시, 필수, 읽기 전용 또는 비활성화로 설정하거나 양식 입력을 기반으로 서식을 변경해야 합니까?
오프스크린 데이터 작업 실행 조건부 값 및 계산 조건부 표시 조건부 요구 사항 조건부 서식 조건부 읽기 전용 상태 조건부 비활성화 상태
동적 양식 사용할 수 없음 사용할 수 없음 사용 가능 사용할 수 없음 로드맵 사용할 수 없음 사용할 수 없음
화면 플로 사용 가능 사용 가능** 사용 가능 사용 가능* 사용할 수 없음 사용 가능** 사용 가능**
OmniStudio 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능
화면 플로 + LWC 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능
LWC 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능
*정적 확인란이 아닌 자원 선택기를 사용하는 구성 요소로 제한됩니다.
**베타 제한
반응형 화면을 통해 화면 플로 상호 작용이 현실화되었습니다. 반응성을 사용하면 플로 화면의 개별 구성 요소가 서로 통신하므로 화면 플로가 무한히 강력해집니다. **스크린 외부 데이터 작업 실행:** 화면 플로는 화면 작업을 통해 동일한 화면에서 데이터를 가져오는 선언적 접근 방식을 제공합니다. 화면 작업을 사용하면 화면의 변경 사항 또는 사용자가 작업 버튼 구성 요소를 클릭할 때 자동 실행 플로를 트리거할 수 있습니다. 그러면 자동 실행 플로의 결과를 동일한 화면에 매핑하여 사용자가 다른 화면으로 이동할 필요가 없습니다. LWC는 Salesforce 데이터에 액세스하여 양식 구성 요소의 데이터를 동적으로 채울 수 있는 전체 배열의 유선 어댑터를 제공하며, 개발자는 Apex 컨트롤러를 통해 레코드를 업데이트, 삭제 및 생성할 수 있습니다. [Lightning 웹 구성 요소 화면 외 데이터 작업_Lightning 웹 구성 요소 화면 외 데이터 작업_](/docs/architect/ko-kr/reference-diagrams/guide/lightning-web-components-off-screen-data-operations) **가시성:** 모든 양식 구축 도구에서 가시성을 동적으로 제어할 수 있습니다. 동적 양식, Flow Builder, OmniStudio는 구성 요소 가시성 기능을 사용하여 이를 해결합니다. 이를 사용하면 양식의 다른 값 또는 사용자가 모바일 장치에 있는지 여부를 기반으로 필드를 선언적으로 표시하거나 숨길 수 있습니다. - 동적 양식을 사용하면 레코드 필드 값, 조회 필드를 통한 관련 레코드, 양식 요소를 기반으로 가시성을 제어할 수 있습니다. - 플로를 사용하면 가시성 규칙을 화면의 다른 입력과 다른 레코드의 수식 또는 값과 같은 플로에서 이전에 채워진 다른 자원의 기준으로 지정할 수 있습니다. - **장치 기반 규칙:** 처음부터 명확하지는 않지만, 사용자가 모바일 장치에 있을 때 수식을 사용하여 특정 필드를 표시하거나 숨길 수 있습니다. \$User.UIThemeDisplayed 전역 변수의 값을 확인하는 플로 수식을 작성합니다. 값이 Theme4t인 경우 사용자가 Salesforce 모바일 앱에 있습니다. - **다른 자원 평가:** 수동 변수 및 수식 참조는 서버에서만 평가됩니다. 따라서 자원이 화면을 처음 렌더링할 때 보유한 값은 다른 화면으로 이동할 때까지 보유할 값입니다. 탐색 시 플로 런타임이 플로 엔진(서버)에 요청을 제출하고 수동 변수 및 수식의 최신 값을 가져옵니다. 사용자가 단일 화면을 통과할 때 가시성 규칙이 업데이트될 것으로 예상되는 경우(예: onblur) 화면의 다른 구성 요소의 값만 참조하십시오. - OmniStudio를 사용하면 조건부 보기 속성을 설정하여 구성 요소를 조건부로 표시하거나 숨길 수 있습니다. 그러나 입력에 대해 둘 이상의 조건부 보기 속성을 추가할 수 없습니다. **조건부 입력 상태:** 필드가 필수인지, 비활성화인지 또는 읽기 전용인지와 같은 기타 속성을 동적으로 제어해야 하는 경우 몇 가지 옵션을 사용할 수 있습니다. 예상대로 LWC는 입력 상태를 완벽하게 반응형으로 제어합니다. 반응형 화면 플로 구성 요소를 사용하면 해당 구성 요소를 지원하는 표준 구성 요소에 대해 읽기 전용, 비활성화됨, 필수와 같은 구성 요소 특성을 동적으로 제어할 수 있으며, OmniStudio는 전체 구성 요소별 특성을 지원합니다. 요구 사항에 따라 플로가 필요하고 구성 요소가 특정 특성 상태를 지원하지 않는 경우 내장형 LWC를 만들어 동적 입력 상태를 달성할 수 있습니다. 필드가 필수인지 읽기 전용인지와 같은 다른 속성을 동적으로 제어해야 하는 경우 단기적으로 완벽하게 제어할 수 있는 LWC가 가장 좋습니다. 이는 특히 onblur 또는 onclick을 처리하는 방법에 대한 맞춤형 요구 사항이 있는 경우에 적용됩니다. 화면 플로의 반응형 LWC: 화면 흐름의 다른 구성 요소에 반응하거나 변경할 수 있는 LWC를 구축할 때, 이 [LWC 화면 흐름용 Best Practice](https://developer.salesforce.com/blogs/2023/02/lwc-best-practices-for-screen-flows) 가이드를 참조하여 구성 요소가 흐름 런타임 엔진 내에 잘 통합되고 향후 예상대로 작동하는지 확인하십시오.
표준 이벤트 처리(blur, onfocus) 사용자 정의 이벤트 처리
동적 양식 사용할 수 없음 사용할 수 없음
화면 플로 사용할 수 없음 사용할 수 없음
OmniStudio 사용할 수 없음 사용 가능*
화면 플로 + LWC 사용 가능 사용 가능
LWC 사용 가능 사용 가능
*OmniStudio 표준 런타임은 Pub/Sub를 지원하지 않지만 Windows postMessage를 지원합니다.
이제 사용자 정의 이벤트입니다. 일부 입력 또는 전체 양식이 페이지의 다른 항목과 통신해야 하는 경우 LWC는 유일한 옵션입니다. - 동일한 DOM 트리 내에서 통신하려면 [**CustomEvent 인터페이스를**](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.events) 사용합니다. - DOM 간에 통신하려면 [**Lightning Messaging 서비스**](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.use_message_channel)를 사용합니다. - 대상 컨테이너에서 Lightning Messaging 서비스가 [지원되지 않으면](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.use_message_channel_considerations) **파브/하위 모듈을** 사용합니다. #### 추가 자원 - 자세한 내용은 *Lightning 웹 구성 요소 개발 가이드*에서 [이벤트와 통신](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/events) 및 DOM 간 [통신](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.events_pubsub)을 참조하십시오. - OmniStudio의 경우 Lightning 웹 구성 요소에서 [Omniscript와 통신을 참조하십시오.](https://help.salesforce.com/s/articleView?id=sf.os_communicate_with_omniscript_from_a_lightning_web_component_18222.htm&type=5) ### 스타일링 최상의 사용자 환경을 제공하려면 양식의 스타일이 내장된 나머지 앱 또는 사이트와 일치하는지 확인해야 합니다. 이를 수행하려면 Salesforce에서 제공하는 표준 템플릿을 활용하는 것부터 디자인의 모든 픽셀을 완전히 활용하여 더 선명한 모양과 느낌을 제공하는 사용자 정의 CSS를 만드는 것까지 다를 수 있습니다. #### 질문: - 원하는 스타일 및 CSS는 얼마나 정교합니까? - 사용자 정의된 픽셀 완벽한 스타일링이 필요합니까? 표준 테마를 사용할 수 있습니까?
직접 스타일링 조직 및 익스피리언스 빌더 테마 픽셀 완벽한 스타일링
동적 양식 사용할 수 없음 사용 가능 사용할 수 없음
화면 플로 사용할 수 없음 사용 가능 로드맵
OmniStudio 사용 가능* 사용할 수 없음 사용 가능
화면 플로 + LWC 사용할 수 없음 사용 가능 사용 가능
LWC 사용할 수 없음 사용 가능 사용 가능
*Flex 카드만 해당
FlexCard는 이 가이드에 포함된 유일한 제품으로, 여부와 상관없이 여백 및 패딩, 타이포그래픽, 색상 등 도구에서 구축하는 UI의 스타일 및 레이아웃을 선언적으로 직접 제어할 수 있습니다. 동적 양식과 플로 모두 선언적 테마 기능을 준수합니다. [Salesforce 테마](https://help.salesforce.com/articleView?id=brand_your_org_in_lightning_experience.htm&mode=1), [익스피리언스 빌더 브랜딩 집합](https://help.salesforce.com/articleView?id=community_designer_brandsets.htm) 또는 [LWR Experience Cloud 사이트](https://developer.salesforce.com/docs/atlas.en-us.exp_cloud_lwr.meta/exp_cloud_lwr/brand_overview.htm) 지원을 제어할 필요가 있는 경우 프로그래밍 솔루션을 고려하십시오. CSS로 편하게 작업하는 팀의 경우 다음과 같은 몇 가지 옵션을 사용할 수 있습니다. - 플로 및 LWC는 [표준 설계 토큰](https://developer.salesforce.com/docs/atlas.en-us.lightning.meta/lightning/tokens_standard.htm)을 상속합니다. - OmniScript 및 FlexCard에는 사용자 정의 가능한 디자인 시스템 지원이 포함되어 있습니다. [뉴포트](https://help.salesforce.com/s/articleView?id=sf.os_customize_omniscripts_and_flexcards_with_the_newport_design_system.htm&type=5) - LWC를 사용하면 자체 구성 요소를 작성하고 HTML 및 CSS를 완전히 제어할 수 있습니다. 가능한 경우 모든 콘텐츠에서 모양과 느낌이 일관되게 적용되도록 테마 및 디자인 시스템을 사용하는 것이 좋습니다. 미리 알림: Lightning 구성 요소를 플로에 포함할 수 있습니다. 따라서 양식의 모양과 느낌을 픽셀 완벽하게 제어해야 하지만 탐색 모델과 같은 플로의 다른 혜택을 사용하려는 경우 두 가지 모두를 최대한 활용할 수 있습니다. Omniscript 및 FlexCard에도 동일한 원칙이 적용됩니다. ### 레이아웃 적절한 레이아웃을 선택하는 것은 빠르고 효율적인 데이터 입력을 활성화하고 데이터 무결성을 향상하는 간소화된 양식을 설계하는 데 매우 중요합니다. 이 주제에 대한 자세한 내용은 [Salesforce Well-Architected - 양식](/docs/architect/ko-kr/well-architected/guide/engaging#양식)을 참조하십시오. #### 질문: - 양식의 레이아웃을 활용하여 사용자 환경을 최적화하는 방법은 무엇입니까? - 사용자가 쉽게 양식에 새 데이터를 입력할 수 있도록 기존 데이터를 사용자에게 표시할 수 있는 방법은 무엇입니까?
열 2개 4열 4열 초과 반복 데이터 블록 탭 컨테이너 아코디언 컨테이너
동적 양식 사용 가능 사용할 수 없음 사용할 수 없음 사용할 수 없음 사용 가능 사용 가능
화면 플로 사용 가능 사용 가능 사용할 수 없음 사용 가능 사용할 수 없음 사용 가능
OmniStudio 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능* 사용 가능
화면 플로 + LWC 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능
LWC 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능
*Omniscript의 FlexCard에 데이터를 포함하는 경우 탭을 사용할 수 있습니다.
동적 양식은 2열 레이아웃을 지원하며 필드가 있는 개별 섹션으로 나눌 수 있습니다. 이러한 섹션은 탭 및 아코디언과 같은 구성 요소에 배치하여 쉽게 사용할 수 있는 정리된 레이아웃을 만들 수 있습니다. 경우에 따라 섹션 구성 요소를 사용하여 플로를 렌더링할 수 있습니다. 섹션을 사용하면 플로 화면에서 원하는 수만큼 최대 4개의 열과 섹션을 추가할 수 있습니다. 구성 요소는 화면 너비에도 반응하므로 더 작은 화면에서 작동할 수 있습니다. 마지막으로 전체 섹션에 조건부 가시성을 적용하여 섹션 내의 여러 필드에 더 쉽게 가시성을 대량으로 적용할 수 있습니다. 플로 섹션은 열 머리글도 지원하며 사용자가 레이블을 클릭하여 전체 섹션을 축소할 수 있는 아코디언과 유사한 환경을 제공합니다. OmniScript는 필드 및 데이터를 표시하기 위한 다양한 레이아웃 옵션을 제공합니다. 조건부로 축소 가능한 아코디언을 포함하여 최대 12개의 열로 데이터 섹션을 만들 수 있습니다. LWC를 사용하면 Lightningedit|view] 형식 및 지원되는 Lightning] 필드를 사용하여 레이아웃을 제어할 수 있습니다. 레이아웃 제한은 HTML/CSS에서만 적용됩니다. Lightning 연결된 페이지 레이아웃의 섹션 구성을 준수합니다. 예를 들어, 섹션이 페이지 레이아웃에서 2열인 경우 이 구성 요소의 2열입니다. ### 번역 다른 지역의 사용자 또는 다른 언어를 사용하는 사용자가 양식에 액세스할 수 있는 경우 구축하는 데 사용하는 도구가 현지화 요구 사항을 충족하는지 확인해야 합니다. 추가 지침 및 권장 사항은 [Salesforce Well-Architected - Localization](/docs/architect/ko-kr/well-architected/guide/compliant#현지화)을 참조하십시오. 특히 양식의 경우 현지화 요구 사항은 일반적으로 텍스트 요소를 다른 언어로 번역하는 작업을 수행합니다. #### 질문: - 양식을 두 개 이상의 국가 또는 지역에서 사용합니까? - 양식의 텍스트를 다른 언어로 현지화해야 합니까?
빌더에 입력된 레이블 코드의 레이블
동적 양식 사용 가능* 사용할 수 없음
화면 플로 사용 가능 사용 가능
OmniStudio 사용 가능 사용 가능
화면 플로 + LWC 사용 가능 사용 가능
LWC 사용할 수 없음 사용 가능
*필드 섹션 머리글만 해당
사용자 정의 필드를 현지화한 경우 동적 양식에서 번역된 레이블이 적용됩니다. 동적 양식은 Lightning 앱 빌더에서 [구성 요소 레이블 및 특성에 할당한 사용자 정의 레이블도](https://help.salesforce.com/s/articleView?id=platform.lightning_page_components_use_expressions_for_labels.htm&type=5) 반영합니다. 플로는 번역 워크벤치의 기능을 통해 모든 표준 및 사용자 정의 화면 구성 요소에 대한 사용자 대면 레이블 번역을 지원합니다. 다음 화면 구성 요소의 레이블, 도움말 텍스트, 오류 메시지를 현지화할 수 있습니다. 텍스트, 긴 텍스트 영역, 숫자, 통화, 확인란, 라디오 버튼, 선택 목록, 다중 선택 선택 목록, 확인란 그룹, 암호, 날짜, 날짜/시간. 이메일 보내기 또는 Chatter 게시와 같은 기본 작업에 대한 번역 지원이 내장되어 있지 않습니다. 그러나 해결 방법이 있습니다. 번역된 레이블을 [사용자 정의 레이블](https://help.salesforce.com/articleView?id=cl_about.htm)으로 정의하는 경우 Flow Builder에서 해당 레이블을 구성할 때 작업 또는 구성 요소에서 해당 사용자 정의 레이블을 참조할 수 있습니다. 사용자 정의 레이블을 참조하는 플로 수식을 만들고 플로의 적절한 위치에서 해당 수식을 참조합니다. OmniScript는 번역에 사용자 정의 레이블을 사용합니다. Omniscripts 다국어를 준비하려면 [이 도움말 문서](https://help.salesforce.com/s/articleView?id=sf.os_create_multi_language_omniscripts.htm)을 참조하십시오. 이제 LWC입니다. 특정 기본 구성 요소는 번역 워크벤치(예: Lightning 구성된 경우 관련 개체의 필드, 도움말 텍스트, 확인 메시지 번역을 자동으로 상속합니다. 코드에 새 번역 가능한 레이블을 도입해야 할 경우 사용자 정의 레이블은 계속해서 히어로입니다. 필요한 사용자 정의 레이블을 선언한 다음 @salesforce/label 범위 모듈에서 구성 요소로 가져옵니다. ### UI 테스트 자동화 사용 가능한 몇 가지 종단간 테스트 자동화 도구(예: Selenium)를 사용하여 사용자가 양식과 상호 작용하는 방식을 시뮬레이션할 수 있습니다. Lightning 페이지 및 화면 플로를 포함하여 표준 또는 사용자 정의 UI에 대해 이러한 테스트를 작성할 수 있습니다. 그러나 이러한 유형의 테스트는 수행 중인 각 메서드의 출력을 확인할 수 없습니다. UI 테스트 자동화 요구 사항을 고려할 때 이 사항을 고려하십시오. #### 질문: - 양식에 대한 자동 테스트가 필요합니까? - 수행해야 하는 테스트 유형은 무엇입니까? - 테스트 자동화에 필요한 세분화 수준은 어느 정도입니까?
단위 테스트 전체 자동화
동적 양식 사용할 수 없음 사용 가능*
화면 플로 사용할 수 없음 사용 가능*
OmniStudio 사용 가능* 사용 가능*
화면 플로 + LWC 사용 가능* 사용 가능*
LWC 사용 가능 사용 가능
*코드 필요
UI 테스트 자동화 요구 사항을 고려하십시오. 업계 표준 CI/CD 시스템 및 도구와 함께 작동하는 보다 세분화된 자동화 및 검증을 가능하게 하는 **유닛 테스트**는 구성 요소 비즈니스 논리, JavaScript 컨트롤러 및 출력을 테스트할 수 있습니다. 하위 코드만 사용하면 테스트를 자체 작성할 수 없지만 Salesforce는 포괄적인 솔루션을 엄격하게 테스트합니다. 구성 요소의 메서드가 충분히 복잡하여 개별적으로 테스트하려는 경우 메서드를 전용 JavaScript 파일에 넣습니다. 그런 식으로, 당신은 그들을 LWC로 가져올 수 있습니다 그리고 `import { sort } from 'c/utils';`와 같은 Jest 테스트. Salesforce에서 엔드 투 엔드 자동화를 구축하는 다양한 옵션을 비교하려면 [UI 테스트 자동화](https://developer.salesforce.com/blogs/2020/01/ui-test-automation-on-salesforce.html)를 참조하십시오. ISV의 코드 없는 솔루션을 사용하거나, Build Your Own 맞춤형 테스트 자동화 솔루션을 사용하거나, Selenium WebDriver 또는 WebdriverIO와 같은 오픈 소스 테스트 프레임워크를 사용하는 경우에 대한 고려 사항이 포함됩니다. 이러한 솔루션은 Lightning 페이지의 동적 양식, 유틸리티 막대의 화면 플로 또는 빠른 작업 플로의 LWC 등 Salesforce의 모든 UI 상호 작용에 유효합니다. ### 메트릭 프로덕션 환경에 양식을 배포한 후에는 양식이 효과적으로 사용되고 있는지 확인하려고 합니다. 사용 사례에 따라 정보가 작성된 횟수를 추적하는 것에서 정보를 제출하기 전에 사용자가 입력하는 데 소요되는 시간까지 모든 것을 의미할 수 있습니다. 도구를 선택하기 전에 추적할 KPI를 식별해야 합니다. #### 질문: - 양식 사용을 추적해야 합니까? - 양식이 효과적으로 사용되고 있는지 여부를 결정하는 KPI는 무엇입니까?
페이지 보기 양식에 소요된 시간 양식 완성 추적 성공률 추적
동적 양식 사용 가능** 사용할 수 없음 사용할 수 없음 사용할 수 없음
화면 플로 사용 가능 사용 가능* 사용 가능 사용 가능
OmniStudio 사용 가능 사용 가능* 사용 가능 사용 가능
화면 플로 + LWC 사용 가능 사용 가능* 사용 가능 사용 가능
LWC 사용 가능** 사용 가능* 사용 가능 사용 가능
*패키지 기반 OmniStudio 런타임이 활성화된 경우 사용 가능
** 상위 Lightning 페이지 사용량 추적을 통해 사용 가능
양식의 전반적인 사용 및 채택을 추적해야 하는 경우 하위 코드 도구로 시작합니다. 동적 양식과 화면 플로는 모두 즉시 사용 가능한 사용자 정의 보고서 유형을 사용하여 추적할 수 있지만 화면 플로 추적 보고서에서 더 세분화할 수 있습니다. LWC 사용을 추적해야 하는 경우 해당 LWC를 사용하는 위치에 따라 기본 가용성이 결정됩니다. Lightning 페이지에 있는 경우 Lightning 페이지 사용량을 추적할 수 있는 항목이 LWC에 적용됩니다. 플로에 포함된 LWC에도 동일한 사례가 적용됩니다. 동적 양식 자체는 기본으로 추적할 수 없지만, [Lightning 사용 개체](https://help.salesforce.com/articleView?id=lex_usage_reports.htm)를 통해 상위 Lightning 페이지의 사용을 추적할 수 있습니다. 표준 Lightning 페이지를 추적하려면 페이지 메트릭별 _Lightning 사용자_ 사용자 정의 보고서 유형을 사용합니다. 사용자 정의 Lightning 페이지에서 동일한 경우 _FlexiPage 메트릭별 Lightning 사용이 있는 사용자_ 사용자 사용자 정의 보고서 유형을 사용합니다. 플로에서 특정 양식의 채택을 추적할 수 있습니다(그것이 있는 페이지뿐만 아니라). "샘플 플로 보고서: 화면 플로" - 다음과 같은 질문에 답변합니다. - 이 양식의 완료율은 얼마입니까? 제대로 채택되었습니까? - 사용자가 이 양식을 작성하는 데 시간이 얼마나 걸립니까? - 사용자가 가장 많은 시간을 사용하는 화면은 무엇입니까? - 사용자는 얼마나 자주 뒤로 이동합니까? - 오류는 얼마나 자주 발생합니까? 표준 보고서가 요구 사항을 충족하지 않는 경우 해당 보고서를 복제하여 자체적으로 변경하거나 _스크린 플로_ 보고서 유형을 사용하여 처음부터 Build Your Own을 만듭니다. 패키지 기반 Omniscript 런타임을 사용하는 경우 [Vlocity용 OmniStudio 추적 서비스](https://help.salesforce.com/s/articleView?id=sf.os_vlocity_tracking_service.htm&type=5)를 사용할 수 있습니다. 이 서비스는 모든 유형의 이벤트를 추적합니다. 예를 들어 Omniscript에서 단계를 완료하는 데 소요되는 시간을 추적하여 프로세스 개선 사항을 식별할 수 있습니다. 표준 OmniStudio에서 이 서비스를 지원하는 OmniStudio 팀의 로드맵에 명시되어 있습니다. 화면 플로, Omniscript 또는 Lightning 페이지에 포함되지 않은 LWC에 대해 동일한 내용을 추적하려면 기본 제공 옵션이 없습니다. Apex 사용하여 사용자 정의 솔루션을 구축할 수 있습니다. ### 패키징 및 배포 솔루션을 테스트 또는 프로덕션에 배포하기 위해 상위 환경에 배포해야 하는 경우 변경 집합 또는 DevOps Center 사용하여 배포할 수 있습니다. 동적 양식, 플로, LWC는 해당 배포 옵션에서 완전히 지원됩니다. OmniStudio에는 별도의 도구가 필요합니다. [IDX 워크벤치](https://help.salesforce.com/s/articleView?language=en_US&id=sf.os_idx_workbench_desktop_application.htm&type=5). #### 질문: - 양식을 배포할 계획은 무엇입니까? - 양식을 둘 이상의 Salesforce 조직에 배포합니까?
1세대 관리 패키지(1GP) 2세대 관리형 패키지(2GP) 잠금 해제된 패키지 변경 집합 DevOps Center
동적 양식 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능
화면 플로 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능
OmniStudio 사용할 수 없음 사용할 수 없음 사용할 수 없음 사용할 수 없음* 사용할 수 없음*
화면 플로 + LWC 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능
LWC 사용 가능 사용 가능 사용 가능 사용 가능 사용 가능
*IDX 워크벤치를 사용하여 다른 조직에 OmniStudio 솔루션을 배포합니다.
ISV 또는 AppExchange 배포를 위해 솔루션을 패키징하려는 파트너인 경우 먼저 동적 양식, 플로, LWC를 살펴보는 것이 좋습니다. OmniStudio는 패키징을 지원하지 않습니다. ## 추가 주제 ### 하위 코드를 Pro-Code Continuum으로 이동 이 가이드는 동적 양식, 화면 플로, OmniStudio, LWC를 통해 가능한 기능 및 사용자 정의 수준을 이해하는 데 도움이 되는 것입니다. 상위 수준: Low-Code to Pro-Code Continuum
- LWC는 양식을 만드는 데 가장 사용자 정의 가능하고 강력한 옵션이지만, 가드 레일이 가장 적습니다. [보안](/docs/architect/ko-kr/well-architected/guide/secure) 및 [확장성을](/docs/architect/ko-kr/well-architected/guide/reliable#확장성) 보장하는 방식으로 구성 요소를 구축하는 것은 귀하에게 달려 있습니다. - 동적 양식은 가장 유연하지 않지만, 오류가 발생할 가능성이 훨씬 적습니다. - 플로 및 OmniStudio는 동적 양식보다 강력하지만 LWC 수준에서는 강력하지 않습니다. 동일한 토큰으로 동적 양식보다 가드 레일이 더 적지만 사용자 정의 코드보다 깨지기가 더 어렵습니다. 여러 도구가 요금에 맞는 경우 팀에 적합한 도구를 결정합니다. 다른 [아키텍트 의사 결정 가이드](/decision-guides)에서는 해당 결정을 내릴 때 고려해야 할 추가적인 측면을 소개합니다. 여기에서는 각각의 측면에 대한 세부 사항을 살펴보지 않지만 이 문서에서 평가하는 특정 도구에 대해 해당 측면을 해석해야 합니다. **특수 기술**: 비교 중인 도구에 대한 팀의 전문 지식은 어느 정도입니까? LWC 또는 JavaScript에 익숙하고 숙지된 작성자는 몇 명입니까? Flow Builder 전문가이거나 손가락 세로 탐색에 관심을 보인 작성자는 어떨까요? 일반적으로 동적 양식 및 플로 기술은 양식을 작성하는 사람들의 더 많은 집단에 대해 더 잘 사용할 수 있습니다. 동적 양식은 가장 선언적 양식 작성 도구이며 플로보다 항상 쉽게 학습할 수 있습니다. 그러나 플로 팀은 이 막대를 최대한 낮춰야 합니다. 복잡성 측면에서 OmniStudio는 플로와 LWC 사이에 위치하며 상당한 양식 구축 능력을 제공합니다. **제공 위임**: 일부 요구 사항이 LWC를 호출하더라도 전체 솔루션을 LWC로 구축해야 하는 것은 아닙니다. LWC가 필요한 부품과 하위 코드 솔루션에 구축되지 않은 부품이 코딩되도록 솔루션을 모듈 방식으로 구축하는 방법을 고려합니다. 이를 수행하면 다양한 팀의 효율성을 극대화하고 각 개인이 전문 분야에 적합한 문제를 해결할 수 있습니다. 이제 플로 및 LWC에 대해 살펴보겠습니다. 반응형 화면 구성 요소를 사용하면 화면 플로 구성 요소가 동일한 화면에서 서로 대화하여 설계자, 관리자, 개발자를 위한 완전히 새로운 도구 상자를 확보할 수 있습니다. 개발자는 이제 조직 전체에서 재사용할 수 있는 용도에 맞는 모듈식 구성 요소를 만들 수 있으므로 팀원 모두의 생산성을 높일 수 있습니다. 개발자는 표준 및 사용자 정의 플로 구성 요소의 혼합을 사용하여 새로운 문제 해결에 집중하고 시간을 절약하여 양식의 역동성을 달성할 수 있습니다. 플로의 반응형 구성 요소를 사용하면 양식을 작성할 때 플로와 LWC를 혼합하는 것이 가장 적합한 시기가 되었습니다. **기존성 및 장기 소유권**: 다단계 양식이 있는 경우 플로 또는 플로와 LWC의 혼합으로 시작하는 것이 좋습니다. 솔루션을 유지 관리하는 하위 코드 팀이 있는 경우 해당 대상 그룹에 대해 가능한 한 솔루션을 구성하고 확장할 수 있는 방법을 생각해 보십시오. 선택한 도구에 상관없이 솔루션을 [복합 가능한](/docs/architect/ko-kr/well-architected/guide/composable) 단위로 구성하여 유지 보수 및 안정성을 향상합니다. ### 페이지 레이아웃 앞으로 레코드 세부 사항 페이지를 구성하는 것이 좋습니다. Lightning 앱 빌더에서 Lightning 페이지를 사용하는 동적 양식입니다. 고급 페이지 레이아웃이 출시된 지 오래되었으며 해당 추세는 계속됩니다. 다음은 이유입니다. - 동적 양식은 보다 유연합니다. Lightning 앱 빌더에서 원하는 곳에 필드와 섹션을 배치하여 섹션, 탭 및 아코디언을 활용할 수 있습니다. Lightning 페이지의 구성 요소와 마찬가지로 여러 페이지 레이아웃이나 레코드 유형을 정의하지 않고도 필드 및 섹션의 가시성을 제어할 수 있습니다. - 아코디언 및 탭 구성 요소를 사용하면 처음에 표시되는 필드의 양을 제한할 수 있습니다. 무슨 뜻인지 예측해 보세요? 페이지 로드 시간을 단축합니다. - Lightning 페이지의 레이아웃 관리는 Lightning 앱 빌더에서 페이지에 대한 모든 내용을 관리할 수 있으므로 페이지의 내용이나 페이지에 액세스할 수 있는 사용자에 상관없이 간단합니다. 더 이상 Lightning 페이지를 변경하기 위해 페이지 레이아웃을 업데이트할 필요가 없습니다. 가시성 규칙의 강력한 기능을 사용하면 더 이상 여러 페이지(또는 페이지 레이아웃)를 만들어 언제 어떤 필드를 볼 수 있는 사람을 제어할 필요가 없습니다. 또한 사용자에게 Lightning 페이지와 페이지 레이아웃을 모두 할당하는 대신 Lightning 페이지만 할당해야 합니다. 가능한 경우 동적 양식을 사용하고 필요한 경우에만 페이지 레이아웃으로 돌아가는 것이 좋습니다. [Idea Exchange](https://ideas.salesforce.com/s/)에서는 항상 귀사에 가장 큰 영향을 미치는 개선 사항에 대한 피드백을 환영합니다. ### 성능 동적 양식, 화면 플로, OmniStudio, LWC와 관련된 모든 성능 고려 사항은 해당 기술 자체의 프레임워크에 중점을 둡니다. LWC에 기반하는 항목(LWC 외에도 물론)은 Aura에 기반하는 항목보다 성능이 뛰어납니다. LWC 프레임워크는 프레임워크 추상화를 통해 JavaScript가 아닌 웹 엔진에서 기본적으로 핵심 기능이 구현되므로 더 나은 성능을 제공합니다. 익숙하지 않은 경우, [이 블로그 게시물](https://developer.salesforce.com/blogs/2018/12/introducing-lightning-web-components.html)을 읽어 주십시오. 2019년에는 Aura와 LWC의 동일한 기능의 성능을 비교하는 [사례 연구를](https://developer.salesforce.com/blogs/2019/06/case-study-dreamhouse-gains-speed-by-switching-to-lwc.html) 실시했습니다. DreamHouse를 Aura에서 LWC로 변환한 결과 개발 환경이 현재의 웹 프런트엔드 개발 표준 및 패턴에 훨씬 더 부합했을 뿐만 아니라 성능 향상도 크게 향상되었습니다. 실험실 측정은 콜드 캐시의 경우 **2.4%~24.7%,** 핫 캐시의 경우 같은 두 페이지의 경우 **31.83%~\*\***63.32%\*\*의 이점을 보여주었습니다. 이제 양식 기술이 사용하는 프레임워크는 무엇입니까? 다시 말해, 이러한 우수한 성능으로 인한 혜택은 무엇입니까? - Lightning 페이지 메타데이터에 통합된 동적 양식은 LWC 스택을 사용하는 기초에 구축되므로 오랫동안 요청한 기능을 구현할 수 있습니다. 동적 양식은 성능 보너스로 프로그레시브 렌더링을 사용하므로 필드 수가 많은 페이지의 페이지 로드 시간이 향상됩니다. - 화면 플로는 대부분의 기본 개별 구성 요소가 이제 LWC로 변환되어 LWC에 구축되며, 다음 두 가지 기본 구성 요소는 제외됩니다. 파일 업로드 및 이미지 플로 팀이 플로 런타임 클라이언트를 LWC 및 대부분의 구성 요소로 변환했지만, 고객은 Aura 화면 구성 요소를 LWC로 변환해야 합니다. 뿐만 아니라 Salesforce는 화면 플로의 새로운 반응형 구성 요소 프레임워크에서 LWC 구성 요소만 지원합니다. 이 작업을 수행하는 방법을 설명하는 훌륭한 Trailhead 모듈이 있습니다. [Aura 개발자를 위한 Lightning 웹 구성 요소](https://trailhead.salesforce.com/en/content/learn/modules/lightning-web-components-for-aura-developers). 즉, 화면 플로 또는 기타 컨테이너에 대한 사용자 정의 구성 요소를 구축하려는 경우 항상 LWC로 이동하십시오. - 몇 가지 버전의 OmniStudio를 사용할 수 있습니다. 장기 고객인 경우 Angular를 사용하고 있을 수 있습니다. 모든 신규 고객은 LWC 기반 Omniscript 및 FlexCard를 사용하여 시작하고 기존 고객은 Angular에서 마이그레이션하는 것이 좋습니다. - LWC는 ...에 구축되었습니다. 물론 LWC입니다. 프리베이입니다. ## 마감 주석 설계자는 사용 가능한 모든 옵션 및 특정 사용 사례에 적용할 수 있는 방법을 철저하게 이해해야 합니다. Salesforce에서 양식을 작성하려면 하위 코드(Lightning 앱 빌더에서 동적 양식 사용, Flow Builder에서 화면 플로, Omniscripts에서 OmniStudio)에서 프로 코드(LWC 프레임워크 사용)에 이르기까지 다양한 옵션을 사용할 수 있으며, 중간에 화면 플로 또는 Omniscripts 및 LWC가 조합되어 있습니다. 이 가이드에 유의하고 Salesforce에서 양식을 작성하거나 재설계할 계획인 경우 참조로 사용하십시오. 간소화되고 유용한 양식을 설계하는 방법에 대한 지침을 찾고 있다면 [Salesforce Well-Architected: 참여하고 있어요](/docs/architect/ko-kr/well-architected/guide/engaging). ### 의견을 알려주십시오. 귀하에게 가장 적합한 내용을 게시하도록 도와주십시오. 이 콘텐츠에 대한 피드백을 [받으려면 설문 조사](https://forms.gle/FCFCES6vsRbKv4E29)를 진행하고 다음에 원하는 내용을 알려주십시오. ## 개요 현대 Salesforce 아키텍처는 비동기 처리에 점점 더 많은 영향을 받습니다. 편리함이 아니라 규모에 대한 전략적 요구 사항입니다. 최근 몇 년 동안 증가하는 데이터 용량, 다중 접점과 관련된 복잡한 통합, 연중무휴 연중무휴 연중무휴를 실행하는 자율 시스템의 증가와 관련된 문제를 점점 더 많은 기업이 다루고 있습니다. 이러한 모든 요소는 아키텍처가 비동기식 우선 시스템을 설계하도록 촉진합니다. Salesforce에서 비동기 처리를 수행하는 것은 종종 총괄자 제한 및 복잡성에 맞춰 설계하는 것을 의미합니다. 이러한 제한은 대량 안전하고 확장 가능한 시스템을 생성하는 데 도움이 되는 가드 레일 및 아키텍처 제약으로 작동합니다. 플랫폼 제한은 복잡성을 직접 관리하는 데 도움이 되지 않지만, [설계 패턴](https://refactoring.guru/design-patterns)은 해당 측면에서 위험을 완화하는 데 도움이 됩니다. 내부적으로 Salesforce는 종종 플랫폼의 경계를 푸시하여 새로운 기능을 사전 테스트하고 복잡한 비즈니스 프로세스를 자동화합니다. 임의의 수의 단계를 사용하여 비동기 작업을 실행하기 위한 단계 기반 비동기 처리 프레임워크를 구축했습니다. 각 단계는 중앙 집중식 로깅을 통해 공유 관리 제어 및 전체 운영 가시성을 사용하여 독립적으로 실행, 재시도, 재시작할 수 있습니다. 이 문서에서는 주요 아키텍처 구성 요소를 간략하게 설명합니다. 대기 가능한 Apex 및 파이널라이저, 예약된 플로, Apex 커서, 호출 가능한 작업 및 Slack과의 통합 이러한 구성 요소는 함께 진행 중인 엔터프라이즈 요구에 적합한 모듈식, 확장 가능, 관찰 가능한 아키텍처를 제공합니다. ## 주요 인테이크 - 현대 Salesforce 아키텍처는 비동기식 우선 접근 방식을 채택하여 규모, 복원력, 운영 투명성을 달성해야 합니다. - 복잡한 작업을 독립적으로 실행 가능한 단계로 나누면 핵심 워크플로를 재설계하지 않고 예측 가능한 성능, 안전한 재시도, 점검 포인트, 롤백, 모듈식 진화가 가능합니다. - 프레임워크는 단일 및 오래된 배치 작업, 체인화된 비동기 호출, 심층적으로 중첩된 플로에 확장 가능한 대안을 제공하며 플랫폼 외부 오케스트레이션 없이 Salesforce 내에서 가로로 확장해야 하는 대용량 워크로드에 대해 구축되어 있습니다. - 결정적이고 관찰 가능한 실행은 중앙 집중식 로깅 및 거버넌스를 통해 진행률 추적, SLA 모니터링, 오류 진단, 감사 수준 투명성을 보장합니다. - 장기 실행 비즈니스 프로세스 전반에서 통합 관리, 규정 준수, 분산된 시/도 제어 등 엔터프라이즈급 엄격성을 위해 설계되었습니다. ## 플랫폼 모범 사례 요구 사항을 검토하기 전에 다음과 같은 프레임워크를 사용하는 시기에 대한 몇 가지 필요 사항 및 필요 사항이 있습니다. 무엇보다 신뢰할 수 있는 단일 소스인 시스템을 고려하십시오. Salesforce 조직이 외부 데이터에 최소한 의존하지만 레코드를 수백 개에서 수백 개까지 확장해야 하는 경우 단계 기반 비동기 프레임워크를 고려하십시오. 다음과 같은 경우 이 프레임워크를 사용하십시오**.** - 작업할 정보의 대부분 또는 전부가 이미 CRM에 있습니다. - 외부 데이터를 조화하기 위해 ETL(Extract Transform Load) 작업을 유지 관리하는 초기 또는 진행 중인 비용이 너무 높습니다. - 설정된 일정에 따라 대량의 Salesforce 레코드 처리를 지연해야 합니다. - 처리를 개별 단계로 세분화할 수 있습니다. 예를 들어, 특히 데이터 용량의 팬이 계층 또는 트리 아래에 있는 경우 계층 또는 트리 기반 레코드 집합을 만들 수 있습니다. 다음과 같은 경우 이 프레임워크를 사용하지 마십시오**.** - 레코드를 만들거나 업데이트하려면 즉시 재계산해야 합니다. - 외부 시스템에서 레코드 업데이트를 위한 기본 데이터를 호스팅하므로 통합이 어려울 수 있습니다. (대량 API를 사용하여 업데이트된 데이터를 Salesforce로 푸시하는 것이 좋습니다.) 이러한 관행을 염두에 두고 요구 사항을 검토하고 구축을 시작해 보겠습니다. ## 요구 사항 세분화 문제 설명: > 매일 실행해야 하는 작업에 따라 특정 레코드가 사전 설정된 추가 처리를 위한 기준을 충족하는지 확인합니다. 그러면 해당 처리 작업을 시작합니다. 레코드를 처리하면 여러 외부 시스템에서 데이터를 가져와 계산을 수행할 수 있습니다. 작업의 단계는 Slack을 통해 처리된 레코드를 검토할 준비가 되었음을 사람들에게 알립니다. 또한 단계는 첫 번째 알림 라운드 후 구성 가능한 지연을 기반으로 역할 계층의 관리자 및 상위에 알림을 에스컬레이션해야 합니다. 이 문제는 몇 가지 다른 단계에 포함되며 일부 단계는 서로 독립적으로 수행될 수 있습니다. 여러 가지 방법으로 작업을 분할할 수 있습니다. 다음은 하나의 그룹화입니다. - 스케줄러. - 처리 유형에 관계없이 레코드를 처리하는 단계 인터페이스 및 구체적인 구현입니다. - 단계를 구성하는 프로세서입니다. - 스케줄러에서 호출한 Apex 호출 가능. - 알림 항목입니다. 우리는 [Apex Slack SDK를](https://developer.salesforce.com/docs/platform/salesforce-slack-sdk/guide/overview.html) 사용합니다. - "구성 가능한 지연"이라는 구문에는 몇 가지 복잡성이 숨겨져 있습니다. 이 문서에서는 나중에 이 복잡성을 검토하겠습니다. 다음은 내장형 프레임워크에 대한 의견 다이어그램입니다. 플로 스케줄러, Apex 비동기 처리, 다양한 단계 구현을 보여주는 아키텍처 다이어그램 이제 해당 다이어그램을 구분하고 조각을 구축합니다. ## 예약된 플로를 사용한 예약 예약 플로는 예약 메커니즘으로서 다음과 같은 몇 가지 장점을 제공합니다. - 예약된 플로는 패키지화하고 메타데이터로 배포할 수 있습니다. 이는 Apex(또는 예약된 작업 페이지)를 통해 예약된 작업에 적용되지 않습니다. - 대기 요소는 콜아웃이 필요한 프레임워크에 중요합니다. 플로에서 이를 사용하면 프레임워크의 호출 가능 부분에서 콜아웃이 필요하지 않습니다. - 예약 세분화는 요건을 충족합니다. 예약된 플로의 최소 간격은 매일입니다. 빈도가 더 높아야 하는 경우(예: 시간별) 이 요구 사항에 대해 예약된 플로를 다시 고려하십시오. 예약된 플로를 구성할 때 고려해야 할 또 다른 사항은 환경 게이팅입니다. Apex 작업을 호출하기 전에 `{!$Api.Enterprise_Server_URL_100}` 변수를 평가하는 Decision 요소를 추가합니다. 이렇게 하면 작업이 UAT 및 프로덕션과 같은 의도한 환경에서만 실행됩니다. 이 패턴은 Sandbox가 SDLC 동안 자주 새로 고치거나 새로 생성되므로 중요하며 명시적인 환경 확인이 없으면 프레임워크가 실행되지 않은 환경에서 예약된 플로가 의도치 않게 실행될 수 있습니다. 결정 요소에서 `contains` 연산자를 사용하면 설정이 향후 sandbox 생성 또는 URL 변경에 대응할 수 있습니다. 마지막으로 프레임워크에서 실패를 수집하는 방법을 고려합니다. 항상 플로에서 작업을 호출할 때 오류 경로를 추가합니다. 예를 들어, 오류를 [Nebula 로거의](https://www.nebulalogger.com/) "로그 항목 추가" 작업에 연결할 수 있습니다. Nebula Logger는 로그를 사용자 정의 개체에 작성하므로 고객은 로그 데이터가 조직 저장소를 사용한다는 사실을 알고 있어야 합니다. 기본적으로 로그는 조직 내에 14일 동안 저장된 후 정리됩니다. 이 보존 기간은 구성할 수 있습니다. Nebula Logger는 플랫폼 이벤트를 사용하여 로그를 게시하므로 로그 항목이 기본 데이터 처리 트랜잭션과 독립적으로 저장되므로 기본 플로 또는 Apex 작업이 롤백되는 경우에도 장애가 캡처됩니다. 고객은 로깅 프레임워크 추가를 고려할 때 예상되는 로그 용량 및 보존 요구 사항을 평가해야 합니다. 다음은 플로의 형태입니다. 실행 여부를 위한 결정 요소, 콜아웃을 허용하는 일시 중지 요소, Nebula Logger 오류 경로와 함께 호출되는 Apex 호출 가능 작업이 포함된 예약 플로 이제 예약 요구 사항이 충족된 첫 번째 Apex 코드 조각으로 이동합니다. ## 단계 인터페이스 만들기 `Step` 인터페이스 정의: ```java public interface Step { void execute(); void finalize(); String getName(); Boolean shouldRestart(); } ``` 이 문서의 경우 명확성을 위해 `step` 인터페이스가 외부 클래스로 표시됩니다. 프레임워크 자체는 유연합니다. 팀은 모든 단계 클래스가 동일한 인터페이스를 참조하는 한 원하는 Apex 패키징 패턴을 사용하여 인터페이스 및 구현을 구성할 수 있습니다. 인터페이스 내에 정의된 메서드에 대해 참고해야 할 몇 가지 사항이 있습니다. - `execute`는 현재 논리 없이도, 주문이 중요한 경우 단계 간에 데이터를 오케스트레이션하기 위해 `State` 클래스(또는 인터페이스)를 전달하면 개선됩니다. - `getName`은 `String` 대신 `System.Type` 값을 반환할 수 있습니다. 목표는 오케스트레이션 레이어에 다른 속성을 노출하지 않고 단계 이름을 기록하는 방법을 제공하는 것입니다. 다음은 이러한 조각이 함께 어울리는 방식을 보여주는 첫 번째 구체적인 구현입니다. 나중에 하나의 예외를 제외하고, Apex 내에서 비동기식 처리를 구현하기 위해 Queueable Apex를 사용하는 것이 좋습니다. 배치 Apex는 일반적으로 필요하지 않습니다(그리고 `@future` 방법은 권장되지 않습니다). 대기 가능한 Apex 빠르게 시작되며 Apex 커서를 사용하면 배치 Apex 비해 많은 장점이 있습니다. ### Apex 커서와 유사한 구현 [Apex Cursor는](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_cursors.htm) 기존 배치 Apex 모델의 현대적인 대안을 제공합니다. 배치 처리에 유사한 커서 구현은 청크로 레코드를 가져올 수 있습니다(배치당 최대 2,000개). 그러나 커서는 단일 트랜잭션 내에서 여러 개의 가져오기를 허용하므로 대용량 작업의 처리량이 현저하게 높아집니다. 이 프레임워크의 일부로 커서를 도입할 때 팀은 현재의 테스트 및 조용성 제한 사항을 알고 있어야 합니다. 테스트의 커서 동작은 프로덕션 동작과 다를 수 있으므로 커서 내부에 의존하지 않고 경계에서 오케스트레이션 논리를 확인하는 테스트 전략을 설계하는 것이 중요합니다. 플랫폼이 발전함에 따라 이러한 영역은 계속해서 개선되지만 핵심 지침은 다음과 같습니다. 커서는 여러 사용 사례의 배치 Apex 비교하여 더 높은 성능과 감소된 오케스트레이션 오버헤드를 제공합니다. 시스템에서 제공하는 커서와 자체 코드 간의 명확한 경계를 정의하려면 `Step` 인터페이스를 구현할 때 커서와 유사한 표현을 만드는 것이 좋습니다. 다음 코드를 고려하십시오. ```java public inherited sharing abstract class CursorStep implements Step { private static final Integer MAX_CHUNK_SIZE = 2000; protected Cursor cursor; private Integer chunkSize = System.Limits.getLimitDMLRows(); private Integer position = 0; protected abstract Cursor getCursor(); protected abstract void innerExecute(List records); public abstract String getName(); public virtual CursorStep withChunkSize(Integer chunkSize) { this.chunkSize = chunkSize; return this; } public void execute() { this.cursor = this.cursor ?? this.getCursor(); this.cursor.setFetchesPerTransaction(this.getFetchesPerTransaction()); List records = new List(); if (this.shouldAdvance()) { records = this.cursor.fetch(this.position, this.chunkSize); this.position += this.chunkSize; } this.innerExecute(records); } public virtual void finalize() { Logger.info('finished cursor step for ' + this.getName()); } public virtual Boolean shouldRestart() { return this.position < this.cursor.getNumRecords(); } protected virtual Integer getFetchesPerTransaction() { Integer maxRecordsPerFetchCall = 2000; if (this.chunkSize < maxRecordsPerFetchCall) { return this.chunkSize; } // Integer division rounds down // which is perfect for our use-case return this.chunkSize / maxRecordsPerFetchCall; } protected virtual Boolean shouldAdvance() { return true; } } ``` `Cursor` 수업에 주목하십시오. Apex 커서는 `Database.Cursor`의 인스턴스이지만, `Cursor` 구현은 Cursors의 단점에 대해 유연성을 제공합니다. 다음은 구현 방법입니다. ```java public virtual without sharing class Cursor { private static final Integer MAX_FETCHES_PER_TRANSACTION = Limits.getLimitFetchCallsOnApexCursor(); @TestVisible private static Integer maxRecordsPerFetchCall = 2000; private Integer cursorNumRecords; private Integer fetchesPerTransaction = MAX_FETCHES_PER_TRANSACTION; private final Database.Cursor cursor; public Cursor( String finalQuery, Map bindVars, System.AccessLevel accessLevel ) { try { this.cursor = Database.getCursorWithBinds(finalQuery, bindVars, accessLevel); } catch (FatalCursorException e) { Logger.newEntry( System.LoggingLevel.WARN, 'Error creating cursor. This can happen if there' + ' are no records returned by the query: ' + e.getMessage() ); } } public Cursor setFetchesPerTransaction(Integer possibleFetchesPerTransaction) { // Handle accidental round downs from Integer division if (possibleFetchesPerTransaction == 0) { return this; } if (possibleFetchesPerTransaction > MAX_FETCHES_PER_TRANSACTION) { Logger.newEntry( System.LoggingLevel.DEBUG, 'Fetches per transaction: ' + possibleFetchesPerTransaction + ' exceeded platform max fetches per transaction: ' + MAX_FETCHES_PER_TRANSACTION + ', defaulting to platform max' ); possibleFetchesPerTransaction = MAX_FETCHES_PER_TRANSACTION; } this.fetchesPerTransaction = possibleFetchesPerTransaction; return this; } @SuppressWarnings('PMD.EmptyStatementBlock') protected Cursor() { } public virtual List fetch(Integer start, Integer advanceBy) { if (this.getNumRecords() == 0) { Logger.newEntry( System.LoggingLevel.DEBUG, 'Bypassing fetch call, no records to fetch' ); return new List(); } Integer localStart = start; List results = new List(); while ( Limits.getFetchCallsOnApexCursor() < this.fetchesPerTransaction && results.size() < this.getNumRecords() && localStart < start + advanceBy ) { Integer actualAdvanceBy = this.getAdvanceBy(localStart, advanceBy); results.addAll(this.cursor?.fetch(localStart, actualAdvanceBy) ?? new List()); localStart += actualAdvanceBy; } return results; } public virtual Integer getNumRecords() { this.cursorNumRecords = this.cursorNumRecords ?? this.cursor?.getNumRecords() ?? 0; return this.cursorNumRecords; } protected Integer getAdvanceBy(Integer start, Integer advanceBy) { Integer possibleFetchSize = Math.min(advanceBy, this.getNumRecords() - start); if (possibleFetchSize > maxRecordsPerFetchCall) { Logger.newEntry( System.LoggingLevel.DEBUG, 'Fetch size: ' + possibleFetchSize + ' exceeded platform max fetch size of ' + maxRecordsPerFetchCall + ', defaulting to max fetch size' ); possibleFetchSize = maxRecordsPerFetchCall; } else if (possibleFetchSize < 0) { possibleFetchSize = 0; } return possibleFetchSize; } } ``` 이 문서의 나머지 부분에서는 Apex 클래스를 참조할 때 `sharing` 선언을 생략합니다. 실제로 최상위 클래스를 공유와 관계없이 명시적으로 사용하여 개체 모델 및 권한을 준수해야 합니다. 또한 저희의 `Cursor` 구현은 플랫폼 `Database.Cursor`에 위임되며, 추가적인 이점은 다음과 같이 논의됩니다. 먼저 해당 테스트는 다음과 같습니다. ```java @IsTest private class CursorTest { @IsTest static void itCapsAdvanceByArgument() { String accountName = 'helloWorld!'; insert new Account(Name = accountName); String query = 'SELECT Name FROM Account WHERE Name = :bindVar0'; Map bindVars = new Map{ 'bindVar0' => accountName }; Cursor instance = new Cursor(query, bindVars, System.AccessLevel.SYSTEM_MODE); Assert.areEqual(1, instance.getNumRecords()); Assert.areEqual(accountName, instance.fetch(0, 1000).get(0).get('Name')); Assert.areEqual(1, System.Limits.getApexCursorRows()); } @IsTest static void itCapsMaxRecordsPerFetchCall() { Cursor.maxRecordsPerFetchCall = 20; Integer oneMoreThanMaxFetch = Cursor.maxRecordsPerFetchCall + 1; List accounts = new List(); for (Integer i = 0; i < oneMoreThanMaxFetch; i++) { accounts.add(new Account(Name = 'Fetch ' + i)); } insert accounts; Exception ex; List results; Cursor instance = new Cursor( 'SELECT Id FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ); try { results = instance.fetch(0, oneMoreThanMaxFetch); } catch (System.InvalidParameterValueException e) { ex = e; } Assert.areEqual(null, ex?.getMessage()); Assert.areEqual(2, Limits.getFetchCallsOnApexCursor()); Assert.areEqual(oneMoreThanMaxFetch, results.size()); } @IsTest static void itFetchesMultipleTimesPerTransactionWhenMoreThanMaxFetch() { Cursor.maxRecordsPerFetchCall = 20; List accounts = new List(); Set expectedFetchNames = new Set(); for (Integer i = 0; i < Cursor.maxRecordsPerFetchCall + 1; i++) { String accountName = 'Fetch' + i; expectedFetchNames.add(accountName); accounts.add(new Account(Name = accountName)); } insert accounts; Integer oneMoreThanMaxFetch = Cursor.maxRecordsPerFetchCall + 1; Cursor instance = new Cursor( 'SELECT Name FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ); List results = instance.setFetchesPerTransaction(2).fetch(0, oneMoreThanMaxFetch); Assert.areEqual(Cursor.maxRecordsPerFetchCall + 1, results.size()); Assert.areEqual(2, Limits.getFetchCallsOnApexCursor()); Set actuallyFetchedNames = new Set(); for (Account account : (List) results) { actuallyFetchedNames.add(account.Name); } Assert.areEqual(expectedFetchNames, actuallyFetchedNames); } @IsTest static void itFetchesMultipleTimesPerTransaction() { Cursor.maxRecordsPerFetchCall = 1; insert new List{ new Account(Name = 'One'), new Account(Name = 'Two') }; Cursor instance = new Cursor( 'SELECT Id FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ) .setFetchesPerTransaction(2); List results = instance.fetch(0, 2); Assert.areEqual(2, instance.getNumRecords()); Assert.areEqual(2, results.size()); results = instance.fetch(2, 1); Assert.areEqual(0, results.size()); } @IsTest static void fetchesCorrectAmountOfRecords() { List accounts = new List(); for (Integer i = 0; i < 10; i++) { accounts.add(new Account(Name = 'Fetch ' + i)); } insert accounts; Cursor instance = new Cursor( 'SELECT Id FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ) .setFetchesPerTransaction(10); List results = instance.fetch(0, 2); Assert.areEqual(2, results.size(), '' + results); Assert.areEqual(1, Limits.getFetchCallsOnApexCursor()); } @IsTest static void doesNotExceedPlatformMaxFetch() { List accounts = new List(); for (Integer i = 0; i < 101; i++) { accounts.add(new Account(Name = 'Fetch ' + i)); } insert accounts; Test.startTest(); Cursor instance = new Cursor( 'SELECT Id FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ) .setFetchesPerTransaction(100); Integer counter = 0; List results; while (counter <= 100) { results = instance.fetch(counter, counter + 1); counter++; } Test.stopTest(); Assert.areEqual(101, counter); Assert.areEqual(0, results.size()); } } ``` `Cursor`를 가상화함으로써 구체적인 `CursorStep` 구현은 배치 Apex에서 `Database.QueryLocator` 대신 `System.Iterable`를 반환하는 것과 비슷하게 대규모 레코드 집합을 반복할 필요가 없는 경우 `Database.Cursor` 없이 작동할 수 있습니다. 다음은 예제입니다. ```java public abstract class CursorLikeImplementation extends CursorStep { private final Cursor cursorLike; public CursorLikeImplementation(List previouslyRetrievedRecords) { this.cursorLike = new CursorLike(previouslyRetrievedRecords); } public override String getName() { return CursorLikeImplementation.class.getName(); } public override Cursor getCursor() { return this.cursorLike; } private class CursorLike extends Cursor { private final List records; public CursorLike(List records) { super(); this.records = records; } public override List fetch(Integer position, Integer chunkSize) { // clone, to keep the underlying list type List clonedRecords = this.records.clone(); clonedRecords.clear(); for (Integer i = position; i < this.getAdvanceBy(position, chunkSize); i++) { clonedRecords.add(this.records[i]); } return clonedRecords; } public override Integer getNumRecords() { return this.records.size(); } } } ``` 이 클래스도 추상적이므로, `innerExecute`의 구체적인 구현은 하위 클래스에 남겨 둡니다. `CursorLike` 내부 하위 클래스에도 대안이 있습니다. 이와 같은 단계의 구체적인 버전이 다른 총괄자 제한을 통과하지 않을 경우 `CursorLike.fetch`에서 `this.records`을 반환하고 상위 `CursorStep.shouldRestart()`을 false로 재정의할 수 있습니다. 이렇게 하면 비동기 트랜잭션당 12MB의 Apex 힙 제한에 의한 목록을 반복할 수 있습니다. ### 기타 가능한 단계 기반 구현 커서 기반 구현을 사용하면 대량의 데이터에 대한 페이지를 매길 때 유연하게 사용할 수 있습니다. 한편, `Step` 인터페이스는 다양한 단계를 설명하고 캡슐화할 수 있는 유연성을 제공합니다. 플로 기반 단계: ```java public virtual class FlowStep implements Step { private final Invocable.Action specificFlow; private Boolean shouldRestart = false; public FlowStep(String specificFlowName, Map inputs) { this.specificFlow = Invocable.Action.createCustomAction('flow', specificFlowName); this.specificFlow.setInvocations(new List>{ inputs }); } public void execute() { List results = this.specificFlow.invoke(); for (Invocable.Action.Result result : results) { if (result.isSuccess()) { Map outputParams = result.getOutputParameters(); Object potentialShouldRestartValue = outputParams.get('shouldRestart'); // Flow does not enforce Booleans being initialized // so a null check is sadly necessary here if (potentialShouldRestartValue != null) { this.shouldRestart = this.shouldRestart || Boolean.valueOf(potentialShouldRestartValue); } } else { List errorMessages = new List(); for (Invocable.Action.Error error : result.getErrors()) { errorMessages.add( 'Error code: ' + error.getCode() + ', error message: ' + error.getMessage() ); } Logger.error( 'An error occurred within your auto-launched flow:\n' + String.join(errorMessages, '\n\t') ); } } } public virtual void finalize() { Logger.info(this.getName() + ' finished processing'); } public String getName() { return FlowStep.class.getName() + ':' + this.specificFlow.getName(); } public Boolean shouldRestart() { return this.shouldRestart; } } ``` Flows는 Apex 정의 유형에 부합하는 출력 매개 변수를 반환할 수 없으므로 사용하기 전에 `shouldRestart` 출력 매개 변수를 확인합니다. 일부 단계는 기능 플래그를 지정할 수 있습니다. 논리를 구현하여 포함할 단계를 결정하거나 비활성화된 기능에 대한 비활성화 단계를 사용할 수 있습니다. [Null 객체 패턴](https://refactoring.guru/introduce-null-object)은 오케스트레이션 계층 내에서 복잡성을 줄이는 일반적인 방법입니다. ```java @SuppressWarnings('PMD.EmptyStatementBlock') public class NoOpStep implements Step { // The null object pattern is commonly implemented // as a singleton to reduce memory consumption public static final NoOpStep SELF { get { SELF = SELF ?? new NoOpStep(); } private set; } public void execute() { } public void finalize() { } String getName() { return NoOpStep.class.getName(); } Boolean shouldRestart() { return false; } } ``` 이제 작업할 몇 가지 빌딩 블록이 있습니다. 단계별 반복에 대한 책임이 있는 오케스트레이션 레이어를 살펴보겠습니다. ## 단계 프로세서 만들기 프로세서는 아키텍처의 변화 지점입니다. 초기화되는 단계 및 위치를 정의하는 사람을 결정해야 합니다. 옵션은 다음과 같습니다. - 프로세서가 비즈니스 논리에 매핑되는 단계를 정의하도록 합니다. 이 옵션은 간단하지만 가독성을 위해 크기가 떨어집니다. - 사용자 정의 메타데이터(CMDT)를 사용하여 매핑을 정의합니다. 메타데이터 관계 필드는 `ApexClass`를 지원하지 않으며, 이를 통해 클래스 이름 맞춤법을 비즈니스 프로세스 설정에 쉽게 연결할 수 있습니다. 필드를 선택 목록으로 만들고 유형이 있는지 확인(`Type.forName()` 또는 `ApexClass` 쿼리)하여 관리자 위험을 줄일 수 있지만 CMDT 레코드에서 트리거를 지원하지 않으므로 런타임 시 확인이 수행됩니다. 이 경로는 테스트할 수 있지만 관리자는 프로덕션에서만 CMDT 레코드를 만들 수 있습니다. 주의를 기울여 진행하십시오. - 레코드와 매핑을 정의합니다. 관리자가 아닌 사람은 단계를 구성할 수 있지만 배포가 어려워지고 환경이 드리프트될 수 있습니다. 주의를 기울여 진행하십시오. [Clean Code](https://www.oreilly.com/library/view/clean-code-a/9780136083238/)의 유명한 인용은 이 특정한 복잡성을 처리하는 방법에 관한 것입니다. > 이 문제의 해결책은 \[개체를 만드는 것]의 `switch` 문구를 추상 공장의 지하실에 묻는 것입니다, 그리고 아무도 그것을 볼 수 없습니다. 이를 염두에 두고 현재 단계 수가 잘 정의되어 너무 커질 가능성이 없으므로 단계 프로세서도 단계의 공장이 될 수 있습니다. 다음과 같이 열거형을 사용하여 switch 문을 구동할 수 있습니다. ```java public enum StepType { TYPE_ONE, TYPE_TWO, TYPE_THREE, TYPE_FOUR // etc ... } ``` 그리고`StepProcessor`: ```java public StepProcessor implements System.Queueable, System.Finalizer, Database.AllowsCallouts { private final List steps = new List(); private Step currentStep; public StepProcessor setSteps(List stepTypes) { for (StepType type : stepTypes) { switch on type { WHEN TYPE_ONE { this.addTypeOneSteps(); } WHEN TYPE_TWO { this.addTypeTwoSteps(); } // ... etc } } this.cleanSteps(); return this; } public void execute(System.QueueableContext context) { this.currentStep = this.currentStep ?? this.steps.remove(0); if (context != null) { System.attachFinalizer(this); Logger.setAsyncContext(context); } Logger.info('Executing step ' + this.currentStep.getName()); try { this.currentStep.execute(); } catch (Exception e) { Logger.exception('Unexpected exception', e); } Logger.info('Finished executing step ' + this.currentStep.getName()); Logger.saveLog(); } public void execute(System.FinalizerContext context) { Logger.info('Executing finalizer for step ' + this.currentStep.getName()); Logger.setAsyncContext(context); switch on context?.getResult() { when UNHANDLED_EXCEPTION { // see the note below about this logging paradigm Logger.warn( 'Failed to run on step' + this.currentStep, context?.getException() ); } when else { this.currentStep.finalize(); if (this.currentStep.shouldRestart()) { this.kickoff(); } else if (this.steps.isEmpty() == false) { this.currentStep = this.steps.remove(0); this.kickoff(); } else { Logger.info('Finished executing steps'); } } } Logger.info( 'Finished executing finalizer for step ' + this.currentStep.getName() ); Logger.saveLog(); } public String kickoff() { return this.steps.isEmpty() ? null : System.enqueueJob(this); } private void cleanSteps() { for (Integer reverseIndex = this.steps.size() - 1; reverseIndex >= 0; reverseIndex--) { if (this.steps[reverseIndex] instanceof NoOpStep) { this.steps.remove(reverseIndex); } } } private void addTypeOneSteps() { this.steps.addAll( new List { new ExampleCursorStepOne(), new ExampleCursorStepTwo() } ); } private void addTypeTwoSteps() { this.steps.addAll( new List { new FlowStep(' ExampleInvocableName', new Map( 'exampleParameter' => true) ), new ExampleCursorStepThree() } ); } } ``` `addTypeOneSteps()`와 같이 표시된 공장 방법은 기능 플래그 지정과 같은 우려 사항을 위임할 수 있습니다. `cleanSteps()`는 수집된 단계를 한 번 확인하여 진정한 비동기화 이전에 "비어 있는" 단계가 없는지 확인합니다. 다음과 같이 표시될 수 있습니다. ```java private Step getStepOrDefault(String customPermissionName, Step defaultStep) { if (System.FeatureManagement.checkPermission(customPermissionName)) { return defaultStep; } return NoOpStep.SELF; } ``` 예약된 플로 섹션에서 Nebula Logger를 언급한 이후 오류 처리에 대해 논의하지 않았습니다. `System.Finalizer`를 사용하면 각 단계에서 특정 오류 처리를 추가하지 않고도 모든 오류 조건에 대한 덮개 로깅을 수행할 수 있습니다. 각 `Step`는 달리기에 초점을 맞추고, 불행한 경로를 기록하고 재배치하여 단위 테스트에 나타납니다. 이는 안전한 반복 및 프로덕션 수준 경고(모든 WARN 및 ERROR 로그에 대해 [Nebula용 Slack Logger 플러그인](https://github.com/jongpie/NebulaLogger/tree/main/nebula-logger/plugins/slack) 사용)를 지원합니다. 오류 로깅에 대한 한 가지 참고 사항: 단계 인스턴스를 로그 메시지에 전달하면 로그에 표시되는 것에 대한 Trust 수준을 가정합니다. Apex 클래스의 기본 `toString()`에는 메시지의 모든 정적 및 인스턴스 수준 속성이 포함됩니다. 이는 바람직하거나 민감한 정보가 누출될 수 있습니다. 로깅 및 보안이 여기서 초점이 아니지만, 일부 시스템의 경우 `Step`와 같은 인터페이스를 준수하면 `toString()`에 대한 강제 재정의도 포함될 수 있습니다. ```java public interface Step { void execute(); void finalize(); String getName(); Boolean shouldRestart(); String toString(); } ``` 이러한 방법은 각 개체 작성자에게 원하는 인쇄 허용 항목을 결정할 책임을 부여합니다. 나무 처리 수준: `StepProcessor` 수준에서 가장 높은 오류가 없는 수준인 `INFO`을 사용합니다. 응용 프로그램 내에서 세분화되면 로그 수준이 그에 따라 감소해야 합니다. 개별 단계에서는 높은 수준의 정보에 대한 `DEBUG`를 사용할 수 있으며, `FINE`, `FINER` 및 `FINEST`는 점점 더 자세한 결과를 위해 예약됩니다. 로깅은 과학만큼이나 예술이지만 다음 원칙에 따라 로그의 일관성과 유용성을 유지할 수 있습니다. ### 단계 프로세서 내의 추가 복잡성 처리 진행하기 전에 단계 프로세서에서 사용되는 단계 논리를 호스팅하도록 결정하는 것에 대해 간략하게 생각해 보겠습니다. 대규모 코드베이스에서 `StepProcessor`를 가상 또는 추상으로 만들고 하위 클래스에서 우려 사항을 제대로 구분하기 위한 특정 단계를 식별하도록 합니다. ## Apex 호출 가능한 레이어 스케줄러가 결국 Apex 호출합니다. 나머지 설정이 완료되면 호출 가능한 Apex 섹션에서 실행할 단계를 결정하고 프로세서에 `List`를 전달할 수 있습니다. ```java public class DailyJobExecutor { @InvocableMethod(label='Execute Daily Job') public static void executeJob() { Logger.info('Executing daily Job'); List correspondingTypes = new List(); // based on [business logic], determine which step types // should be included for any daily invocation if (correspondingTypes.isEmpty() == false) { try { new StepProcessor().setSteps(correspondingTypes).kickoff(); } catch (Exception ex) { Logger.exception('Error starting job', ex); } } } Logger.saveLog(); } ``` 이는 레코드, 데이터 또는 논리를 사용하여 실행할 단계 유형을 결정하는 방정식의 간단한 부분입니다. 호출 가능한 작업은 복잡성을 다른 곳으로 캡슐화하므로 간단합니다. 또한 예기치 않은 예외를 방지하고 각 항목을 격리적으로 쉽게 테스트할 수 있습니다. ## Slack 호출 전 지연 처리 [Apex Slack SDK](https://developer.salesforce.com/docs/platform/salesforce-slack-sdk/guide/overview.html)는 이 문서의 범위를 벗어나지만, 요구 사항 중 하나의 잠재적인 장애물은 구성 가능한 지연을 기반으로 역할 계층에서 상향으로 사람을 알리는 것입니다. 종이에, 이것은 간단하고, 당신은 (정확하게) `StepProcessor`에서 `System.enqueueJob(this)`를 고려할 수 있습니다. [System.AsyncOptions를](https://developer.salesforce.com/docs/atlas.en-us.apexref.meta/apexref/apex_class_System_AsyncOptions.htm) 사용하는 경우, 당사의 초기 성향은 이 요구 사항을 충족하기 위해 `enqueueJob` 과부하를 사용하는 것이었습니다. 그러나 `System.AsyncOptions.MinimumQueueableDelayInMinutes`를 통한 최대 지연 시간은 10분입니다. 요구 사항은 120분이므로 몇 가지 옵션이 남아 있습니다. 순진한 접근 방식은 다음과 같습니다. ```java public class ExampleDelayedNotifier implements Step { private final List notifications = new List(); private final Slack.BotClient botClient = Slack.App .getAppByKey('some-slack-app-key') .getBotClientForTeam('slack team id'); // account for the initial delay, // so 120 - 10 = 110 private Integer delayMinutes = 110; public void execute() { if ( this.delayInMinutes > 0) { return; } Integer maximumAllowedCallouts = 100; while (this.notifications.isEmpty() == false && maximumAllowedCallouts > 0) { this.botClient.chatPostMessage(this.notifications.remove(0)); maximumAllowedCallouts--; } } public void finalize() { this.delayInMinutes -= 10; } public String getName() { return ExampleDelayedNotifier.class.getName(); } public Boolean shouldRestart() { return this.delayInMinutes > 0 || this.notifications.isEmpty() == false; } } ``` 실제로는 지연이 구성 중심이므로 지연이 이 클래스에 전달됩니다. 지연된 알림 유형이 한 개만 있는지 확신하지 않는 한 이 접근 방식을 사용하지 않는 것이 좋습니다. 지연이 증가하는 경우 시작하기 전에 추가 비동기 작업 11개를 굽힙니다. 해당 비용은 한 작업에 적합할 수 있으며, 여러 작업에 적합하지 않습니다. 또한 `Step` 인터페이스에 메서드를 추가해야 각 단계가 프로세서에 재시작하기 전에 얼마나 오래 기다려야 하는지 알려주므로 소음이 추가됩니다. 두 가지 흥미로운 가능성이 있습니다. - 이미 적절한 간격에 폴링 작업이 예약된 경우 지연된 단계를 기존 작업 프레임워크에 슬롯할 수 있습니다. 지정된 지연이 최대 15분 후에 발생하는 경우에도 확인해야 합니다(15분은 Apex 예약 CRON 식의 최소 새로 고침 간격입니다). 이는 대략적으로 호출 가능한 Apex 예와 일치하며, 대신 Apex 통해 예약이 수행됩니다. 즉, 동일한 `Step` 기반 아키텍처를 재사용하여 "시작 후" 타임스탬프를 기반으로 레코드를 처리하고 이전에 표시된 `StepType` 열거형 값으로 선택 목록 또는 다중 선택 선택 목록 매핑을 기반으로 사용할 단계를 결정할 수 있습니다. - 또는 추가 외부 Apex 클래스를 정의하는 데 편한 경우 `System.scheduleBatch()`를 사용하여 배치 Apex로 돌아갑니다(내부 클래스를 지원하는 Queueable Apex와 달리 배치 Apex 클래스는 외부 클래스여야 합니다). 배치 Apex 예제를 고려하십시오. 유연성과 제어를 위해 대기 가능한 Apex 일반적으로 권장하지만 배치 Apex 여전히 최상위인 사례는 다음과 같습니다. ```java public class DelayedNotifier implements Database.Batchable { private final StepProcessor processor = new StepProcessor(); public Iterable start(Database.BatchableContext bc) { return new List(); } @SuppressWarnings('PMD.EmptyStatementBlock') public void execute(Database.BatchableContext bc, Object scope) { // we don't need to actually do anything in execute, // we just need to start up the processor in finish } public void finish(Database.BatchableContext bc) { try { // you can imagine Notifier as an elided, // simpler version of the naive implementation // we showed above, now only focused on sending messages this.processor.setSteps(new List{ new Notifier() }).kickoff(); } catch (Exception ex) { Logger.exception('Unexpected error', ex); } finally { Logger.saveLog(); } } } ``` 그리고 `StepProcessor`에서 이전에 표시된 `addTypeOneSteps()` 메서드가 다음 지연 단계로 업데이트된다고 가정합니다. ```java public StepProcessor implements System.Queueable, System.Finalizer, Database.AllowsCallouts { // .... unchanged top of class elided private void addTypeOneSteps() { this.steps.addAll( new List { new ExampleCursorStepOne(), new ExampleCursorStepTwo(), new DelayedNotifierStep() } ); } // ... private class DelayedNotifierStep implements Step { private final DelayedNotifier delayedNotifier = new DelayedNotifier(); // again — in practice this value would also be passed in private final Integer delayInMinutes = 120; public void execute() { System.scheduleBatch( this.delayedNotifier, 'Delayed notifier: ' + System.now().getTime(), this.delayInMinutes ); } public void finalize() { Logger.debug('Nothing to finalize, batch scheduled'); } public String getName() { return DelayedNotifierStep.class.getName(); } public Boolean shouldRestart() { return false; } } } ``` 일반적으로 이렇게 많은 점프는 권장하지 않지만 이 단계 지연은 다시 사용할 수 있는 또 다른 빌딩 블록이 됩니다. 대기 가능 Apex 더 긴 지연이 허용될 때까지 폴링 메커니즘 없이도 이 효과를 생성하는 가장 쉬운 방법이기도 합니다. ## 결론 개체 중심 설계를 사용하여 요구 사항을 충족하고 건물 및 유지 관리 비용의 장기적인 균형을 유지하면서 확장할 수 있는 시스템을 만들었습니다. 단계 선언 및 인스턴스화는 결국 `StepProcessor`에서 그 자리를 뛰어넘을 수 있지만 여기에 추가적인 기술 부채가 거의 없습니다. `FlowStep`를 통해 관리자와 개발자는 코드 없음 또는 프로코드 솔루션이 가장 적합한 시점을 함께 결정할 수 있습니다. Apex의 Queueable 프레임워크 내의 `System.Finalizer` 인터페이스를 사용하여 Nebula Logger와 함께 강력하고 테스트 가능한 시스템을 구축하여 향후 단계에 명시적인 로깅이 없더라도 예기치 않은 실패를 경고합니다. 이 시스템은 숫자를 축소하고 비용과 복잡성을 줄여줍니다. 또한 실제 작업 부하에서 Apex Cursors의 동작에 대한 귀중한 인사이트를 제공하여 접근 방식을 개선하면서 기능 자체를 개선할 수 있습니다. 복잡한 대용량 작업 부하를 모듈식 실행 단계로 분해함으로써 단계 기반 비동기 처리 프레임워크 프레임워크는 플랫폼 제약을 엔지니어링된 장점으로 전환하여 예측 가능한 성능, 관찰 가능성, 기업 규모의 거버넌스를 지원합니다. 관리자와 개발자가 모두 단계를 설정할 수 있으며, 두 경우 모두 단계 작성자는 각 단계의 크기 조정 방법에 대해 걱정하지 않고도 기본 플랫폼 총괄자 제한(예: DML 행 및 검색된 쿼리 행)을 준수하는 데 안전하게 집중할 수 있습니다. ## 앞으로의 경로 엔터프라이즈 구현에서 이 패턴을 운영하고 채택하려면 설계자가 다음을 수행해야 합니다. - 비동기 오케스트레이션이 성능을 향상하고 관찰성을 향상할 수 있는 영역을 식별하기 위해 **기존 자동화**을 평가합니다. - 명확한 처리 목표와 분리된 작성 지점(예: Flow 또는 Apex)을 사용하여 개별적으로 실행할 수 있는 단계로 대규모 프로세스를 **분할합니다**. - 사업부 간의 단계 재사용 및 표준화를 가속화하기 위해 단계 유형을 **정의하고 그룹화**합니다. - 새로운 프로세스 또는 기존 자동화를 사용하여 **방식을 시승**합니다. 내장형 로깅 및 관찰성을 관리하는 단계 내에서 무료로 찾을 수 있는 여러 가지 가장자리 사례를 발견하면 놀랄 수 있습니다. ## 작성자 정보 James Simone은 Salesforce의 주 소프트웨어 엔지니어이며 플랫폼에서 10년 이상 작업한 경험을 보유하고 있습니다. 그는 개발을 시작하기 전에 Salesforce 고객이자 제품 소유자였으며, 2019년부터 [The Joys Of Apex](https://www.joysofapex.com/)에서 Salesforce에 대한 기술적 심층 분석을 작성하고 있습니다. 이전에는 [Salesforce 개발자 블로그](https://developer.salesforce.com/content-archive?authors=James%20Simone&content-type=Blogs&language=English) 및 [Salesforce 엔지니어링 블로그](https://engineering.salesforce.com/author/james-simone/)에도 기사를 게시했습니다. ## 개요 Salesforce Platform은 복잡한 비즈니스 프로세스의 요구를 충족하기 위해 자동화 아키텍처를 지속적으로 향상했습니다. 이전 세대(워크플로 규칙 및 프로세스 빌더)는 이벤트 중심 논리의 초기 단계를 제공하여 이벤트 중심 논리의 자동화 기능을 확장하고 더 광범위한 빌더에게 도달 범위를 확대했습니다. 이러한 발전은 다음의 두 가지 보완적인 기둥에 중점을 둔 고성능 통합 아키텍처로 끝났습니다. 레코드 트리거 플로 및 Apex 트리거. 이 문서에서는 트리거 자동화를 설계할 때 정보에 근거한 결정을 내릴 수 있는 프레임워크 및 지침을 제공합니다. ## 범위의 제품
플로 Salesforce Flow는 강력한 포인트 앤 클릭 자동화 도구로 사용자가 코드를 작성하지 않고 Flow Builder를 사용하여 복잡한 비즈니스 프로세스, 화면 및 논리를 시각적으로 구축할 수 있습니다. 데이터 업데이트, 이메일 보내기, 사용자 안내와 같은 과업을 자동화하여 화면 플로(사용자 상호 작용) 및 트리거 플로(레코드/예약 이벤트)와 같은 유연성을 제공합니다.
Apex Salesforce Apex는 Java와 유사한 Salesforce 플랫폼의 독점적이고 개체 지향 프로그래밍 언어로, 사용자 지정 비즈니스 논리를 구축하고 프로세스를 자동화하며 선언적 도구를 넘어 핵심 CRM 기능을 확장합니다.
## 서비스 Salesforce Platform에서 확장 가능, 유지 가능, 성능이 뛰어난 레코드 트리거형 자동화를 구축하려면 아키텍처를 기반으로 한 규제에 따른 접근 방식이 필요합니다. Flow와 Apex 사이의 선택과 각각의 구현은 명확한 원칙 집합에 따라 결정됩니다. 이러한 사항은 이러한 원칙을 요약하고 현대 자동화 설계의 기본 규칙 역할을 합니다. - **Salesforce 개체 자동화 밀도에 따라 작업에 적합한 도구를 선택합니다.** - Salesforce 개체에 대한 레코드 트리거형 플로를 사용하여 **저밀도** 자동화를 수행합니다. - 호출 가능한 Apex를 사용하여 레코드 트리거형 플로 논리를 증가하여 **중간 밀도** 자동화 - Salesforce 개체에 대한 Apex 트리거를 사용하여 **고밀도** 자동화를 수행합니다. - **비동기 프로세스를 트리거할 때 주의하십시오.** 이 규칙은 레코드 트리거 플로에서 비동기 프로세스를 호출하거나 Apex 대기 가능한 작업을 대기열에 지정하는 경우에 적용됩니다. 이 패턴은 작업을 오프로드하는 데 유혹할 수 있지만 복잡한 오류 처리 시나리오를 도입하고 총괄자 제한에 도달할 위험을 높일 수 있습니다. - **Salesforce 개체당 하나의 입력 지점을 사용합니다.** 지정된 Salesforce 개체의 경우 한 메커니즘을 자동화의 진입점으로 사용합니다. 동일한 개체에 대한 입력 지점으로 Flow 및 Apex 트리거를 혼합하지 마십시오. ## 결정 지점 ### 선언적 및 프로그래밍 방식 구현 비교 플로와 Apex 일반적인 기본 기능 집합을 공유합니다. 각 도구는 레코드를 쿼리하고, 조건부 논리를 실행하고, 변수를 할당하고, 지정된 순서대로 실행되도록 순서가 지정된 레코드 만들기, 업데이트, 삭제와 같은 DML 작업을 수행할 수 있습니다. 그러나 이 기능적 겹침은 도구를 상호 교환할 수 있다는 의미는 아닙니다. 아키텍처 선택은 과업을 수행할 수 _있는지_ 여부가 아니라 과업을 수행하는 _방법_ 및 성능, 확장성, 유지 관리에 미치는 장기적인 영향에 관한 것입니다. 플로는 선언적 명확성과 간단한 프로세스를 구현하는 속도에서 우수하며, Apex 복잡한 솔루션에 필요한 세부적인 제어 및 원시 기능을 제공합니다. ### 자동화 밀도 **자동화 밀도**은 특정 Salesforce 개체에 배치되는 로드입니다. 이는 개체의 최적 구현을 결정하기 위한 heuristic 역할을 합니다. 자동화 밀도가 증가함에 따라 트랜잭션 제한을 위반할 가능성이 증가합니다. 볼륨 및 복잡성의 세 가지 특정 치수를 검사하여 자동화 밀도를 계산합니다. - **자동화 수량:** 단일 DML(데이터 조작 언어) 이벤트 동안 실행되는 고유한 자동화 메타데이터 항목(플로, 트리거 작업 등)의 원시 수입니다. - **레코드 볼륨:** API 로드 또는 대량 배치 처리를 통해 처리되는 트랜잭션당 레코드이며, 이는 성능이 매우 중요합니다. - **독립성 확산:** 초기 CRUD 작업으로 트리거된 다운스트림 DML 작업의 측정값입니다. 관련 개체에 대한 하나의 업데이트가 계단식으로 업데이트되는 그래프의 깊이를 수량화합니다(예: 사례 → 계정 → 연락처 → 사용자 정의 롤업). 자동화 밀도 치수 Salesforce 응용 프로그램의 범위와 복잡성이 증가함에 따라 레코드 트리거형 플로 또는 Apex 트리거와 같은 단일 기본 엔트리포인트를 사용하십시오. 단일 Salesforce 개체에서 여러 메커니즘 전반에 걸쳐 자동화를 분할하지 마십시오. 이는 서비스 점검이 불가능하고 관리가 분할되지 않게 만듭니다. ### 밀도 선택 매트릭스 이 매트릭스를 사용하여 Salesforce 개체에 대한 필수 아키텍처 표준을 결정합니다. - **레코드 트리거 플로**는 낮은 자동화 밀도에 대한 선호 솔루션입니다. 간단하고 서로 독립적인 자동화에 이상적인 기능과 접근성의 균형을 제공합니다. - **하이브리드 패턴(Record-Triggered Flow with Invocable Apex)**은 복잡성이 증가하는 중간 집적도 자동화에 강력하고 유지 보수 가능한 선택입니다. 이 패턴을 사용하면 팀이 계산량 작업을 Apex 위임하면서 선언적 플로에서 순서가 지정된 큐레이그래픽을 유지할 수 있어 액세스 가능성과 성능의 균형을 유지할 수 있습니다. - **Apex 트리거는** 고집적 자동화를 지원하는 견고한 아키텍처 기반을 위한 필수 빌딩 블록을 제공합니다. Apex 성능, 세분화된 제어, 개체 지향적 추상화 및 다형성은 이러한 시나리오의 복잡성과 규모를 관리하는 데 더 적합합니다.
밀도 수준 자동화 수량 데이터 용량(배치 크기) 종속성 스크롤 아키텍처 표준
낮음 < 15
자동화
표준
사용자 중심 UI 상호 작용 또는 소규모 API 로드(1~200개 레코드)
기타
자체 로직. 동일한 개체 또는 관련 개체에 대한 다운스트림 DML 작업 0~1개
레코드 트리거 플로
중간 15–30
자동화
조정
표준 배치 처리(주의 깊게 대량 처리해야 하는 논리 사용)
커플링됨
상위/하위가 다운스트림 DML 작업 2~4개를 업데이트합니다. 반복 위험
하이브리드 패턴
플로 + 호출 가능한 Apex
높음 > 30
자동화
높음
대량 API 로드가 있는 대용량 데이터(2,000 – 10,000개 이상의 레코드)
복잡하고 반복적
딥 종속성 그래프(다운스트림 DML 작업 5개 이상). 삼각형 반복 루프의 위험
Apex 트리거 메타데이터 프레임워크
실제 아키텍처를 결정하려면 자동화 밀도의 모든 차원을 집계적으로 가중해야 합니다. 주어진 Salesforce 개체에 대한 자동화 메커니즘을 선택할 때 잠재적인 미래 범위를 고려하십시오. 또한 Salesforce는 멀티테넌트 환경에서 공유 자원 관리 및 [관리자 제한](https://developer.salesforce.com/docs/atlas.en-us.salesforce_app_limits_cheatsheet.meta/salesforce_app_limits_cheatsheet/salesforce_app_limits_platform_apexgov.htm)을 적용하여 런웨이 자동화가 공유 자원을 독점하지 않도록 하기 때문에 일일 총 DML 작업 수를 고려하십시오. 일일 DML 용량이 많은 Salesforce 개체는 주의를 기울여 자동화를 선택해야 합니다. 예를 들어, CPU 시간(60,000ms) 및 힙 크기(12MB)에 대한 비동기 제한은 동기 제한보다 높습니다. 또한 비동기 실행에 대한 조직 전체 24시간 제한(사용자 라이센스의 250,000배 또는 200배)은 런타임 예외를 피하기 위해 아키텍처 설계에 일일 총 DML을 고려해야 합니다. ## 제품 비교 레코드 트리거형 플로는 레코드 트리거형 자동화를 위한 플랫폼의 주요 선언적 도구입니다. 플로의 사용 편의성과 내장된 플랫폼 보안을 통해 팀은 확장 가능하고 신뢰할 수 있는 솔루션을 쉽게 구축할 수 있습니다. Salesforce Platform에 솔루션을 구축하는 대부분의 팀에게 이상적인 선택입니다. Apex 플랫폼의 독점적이고 강력하게 입력된 개체 지향 프로그래밍 언어입니다. 자동화 밀도가 높은 Salesforce 개체 및 고성능, 정교한 논리 또는 트랜잭션을 세부적으로 제어해야 하는 사용 사례에 Apex 사용합니다. 결정 프로세스를 지원하기 위해 이 매트릭스는 핵심 아키텍처 기능 전반에서 플로 및 Apex 직접 비교합니다.
기능 레코드 트리거 플로 Apex 트리거
제공 및 유지 보수 속도 권장
Flow Builder의 시각적 사용자 인터페이스를 사용하면 관리자 및 기타 선언적 빌더가 Apex 코드를 작성, 테스트 및 배포하는 것보다 빠르게 자동화를 만들고 수정할 수 있습니다. 이 인터페이스를 사용하면 광범위한 팀 구성원이 비즈니스 가치를 전달하고 간단한 과업을 위한 전문 개발자 자원에 대한 의존성을 줄일 수 있습니다.
전문 지식 필요
Apex 코드를 구현, 테스트, 유지 관리하려면 적절한 기술을 갖춘 소프트웨어 개발자가 필요합니다.
모듈러성 가용
레코드 트리거 플로는 기본적으로 모듈식입니다. 팀은 모노리틱 논리가 아닌 특정 요구 사항에 대한 개별 플로를 구축하고 플로 트리거 탐색기를 사용하여 함께 통합합니다. 이 모듈을 사용하면 분리된 수정 및 간단한 확장을 수행하여 장기적인 소유 비용을 크게 줄일 수 있습니다.
가용
Apex 설계에 따라 기능 모듈로 구분됩니다. 각 Apex 클래스는 단일 기능 모듈을 구현하도록 고안되었습니다.
가시성 및 거버넌스 권장
플로의 시각적 특성은 비즈니스 논리를 직관적으로 표현합니다. 플로 트리거 탐색기는 개체에 대한 모든 플로의 통합 보기를 제공하므로 설계자 및 관리자가 코드를 읽지 않고 쉽게 이해하고 관리하고 문제를 해결할 수 있습니다.
전문 지식 필요
메타데이터 프레임워크를 사용하여 트리거를 구성하는 것은 유용하지만, 코드를 체계적으로 유지하고 유지할 수 있도록 Apex 조율된 개발 팀이 필요합니다.
고성능 대량 데이터 처리 권장 안 함
복잡한 논리 또는 대용량 데이터를 처리할 때 총괄자 제한에 도달할 위험이 증가합니다.
권장
Apex 코드는 플랫폼의 핵심 서비스와 더 가까이 실행되며 개발자에게 쿼리 최적화, 데이터 처리, 알고리즘 효율성에 대한 향상된 제어 기능을 제공합니다. 따라서 특히 대용량 데이터와 관련된 복잡한 시나리오에서 성능과 규모가 향상됩니다.
강력한 논리 및 데이터 구조 가용
플로 변환 요소는 몇 가지 복잡한 처리 작업에 도움이 될 수 있습니다. 그러나 플로에는 기본 지도 및 설정 데이터 구조가 없으므로 복잡한 데이터 처리가 번거롭고 계산상 효율적이지 않습니다.
권장
Apex 매핑, 설정, 프로그래밍 루프에 대한 전체 액세스를 제공하여 매우 효율적이고 안전한 대량 데이터 조작을 수행합니다. 전체 기능을 갖춘 프로그래밍 언어로서 Apex 유지 관리 가능한 효율적인 방식으로 복잡한 비즈니스 문제를 해결하는 데 도움이 되는 복잡한 논리 구조, 데이터 구조, 설계 패턴에 대한 액세스 권한도 제공합니다. Apex 선언적 도구에서 현재 사용할 수 없는 고급 함수(예: BusinessHours, Crypto)의 서식 있는 표준 라이브러리가 포함되어 있습니다.
트랜잭션 관리 사용 불가
플로는 부분 트랜잭션 커밋 또는 롤백에 대해 `Database.savepoint`, `Database.rollback` 또는 부분적으로 성공한 DML 작업에 대한 액세스 권한을 제공하지 않습니다.
가용
Apex 트랜잭션 무결성 및 복잡한 오류 복구 시나리오를 완벽하고 세부적으로 제어합니다.
이메일 배포 권장
레코드 트리거 플로에서 미리 구성된 이메일 경고를 쉽게 확장할 수 있습니다. 런타임 시 사용자 정의 이메일 경고를 작성하고 배포할 수 있습니다. 사용자 지정 이메일에는 일일 이메일 보내기 제한이 적용됩니다.
가용
Apex 사용자 정의 이메일 메시지를 생성하고 보낼 수 있습니다. Apex에서 보낸 모든 이메일은 일일 이메일 보내기 제한이 적용됩니다.
플랫폼 보호 적용 권장
플로에는 자동 대량 처리 및 자동 재시도와 같은 기본 보호 기능이 포함되어 있습니다. 이러한 보안 조치는 가치 가져오기 속도를 높이고, 그렇지 않으면 복잡한 수동 코딩이 필요한 성능 함정을 방지합니다.
수동 구현 필요
대량 처리와 같은 보안은 명시적으로 코딩되어야 합니다(예: 컬렉션 관리 및 루프 내 SOQL 방지). 자동 재시도는 트리거에 기본적으로 적용되지 않으며 구현하려면 복잡한 사용자 정의 논리가 필요합니다.
비동기식 처리 가용
플로는 비동기 경로에서 별도의 트랜잭션이 필요한 자동화를 위한 간편한 메커니즘을 제공합니다. 이러한 자동화에는 일일 제한이 적용됩니다.
가용
Apex 데이터 수집 변경 및 분리된 트리거 구독자가 처리하는 대기 가능한 이벤트를 통해 전체 제어를 활성화합니다.
예약된 처리 권장
플로의 예약 경로는 고유하고 강력한 예약 기능을 제공합니다(예: "마감 날짜 3일 전 시작"). 이 기능에는 레코드의 데이터가 변경될 경우 자동 취소 및 재예약이 포함됩니다. 이러한 자동화에는 일일 제한이 적용됩니다.
사용 불가
Apex 트리거는 자동 취소를 통해 시간별 레코드별 이벤트를 기본적으로 예약할 수 없습니다. 예약된 Apex 존재하지만, 이는 특정 시간에 실행되고 트리거의 일부로 개별 레코드를 처리하는 동안 예약되지 않는 근본적으로 다른 메커니즘입니다.
주문 및 작곡 가용
플로 트리거 탐색기를 사용하면 관리자가 동일한 개체의 여러 플로에 대한 상대 실행 순서를 정의할 수 있습니다.
가용
트리거 프레임워크는 자동화의 정확한 순서를 세부적으로 제어합니다.
같은 레코드 필드 업데이트 사용 가능 (저장 전)
레코드 트리거 플로는 초기 DML 커밋 전에 트리거 레코드를 업데이트하는 데 가장 효과적인 선언적 옵션입니다.
사용 가능 (저장 전)
Apex 최소한의 오버헤드와 함께 최고 수준의 성능을 제공합니다.
교차 개체 CRUD 사용 가능 (저장 후)
플로는 복잡성이 낮고 간단한 교차 개체 DML 작업에 적합합니다.
사용 가능 (저장 후)
Apex 교차 개체 DML 작업에 대한 중복 제거, 오류 처리, 성능을 탁월하게 제어합니다.
비용이 많이 드는 컴퓨팅 중복 제거 가용
플로는 자동 대량 처리를 통해 중복 쿼리 및 DML 문을 제거하는 데 뛰어납니다. 그러나 각기 다른 플로 트리거 또는 단일 트랜잭션 내에서 동일한 플로의 여러 호출에서 상태를 캐시하거나 공유할 수 없습니다. 이 제한 사항은 극한의 성능 시나리오에서 중요해질 수 있습니다.
권장
Apex 비용이 많이 드는 작업의 중복 제거를 위한 메커니즘을 제공합니다. 개발자는 정적 속성 및 변수를 사용하는 트랜잭션 캐싱과 플랫폼 캐시를 사용하는 플랫폼 수준 캐싱을 활용하여 데이터를 저장하고 재사용할 수 있습니다. 해당 기술은 SOQL 쿼리와 같은 트랜잭션 총괄자 제한 소비를 줄이고 고성능 및 확장성을 보장하는 데 중요합니다.
사용자 정의 오류 처리 가용
CustomError 요소는 저장 작업을 차단하고 사용자에게 메시지를 표시할 수 있습니다.
권장
addError() 메서드는 유연한 필드 수준 및 조건부 오류 메시지를 제공합니다.
## 사용 사례 ### 가장 적합한 권장 사항 이 표는 제시된 기능을 기반으로 일반적인 사용 사례에 대한 일반적인 "최적화" 권장 사항을 제공합니다. 궁극적으로 이 문서의 _관련 모범 사례_ 섹션에 포함된 경우와 같이 특정 시나리오에 가장 적합한 시나리오를 찾으려면 추가 고려 사항을 고려해야 합니다. 여기에서 플로 및 Apex 특정 조합이 가장 적합한 접근 방식을 제공하는 경우에 대해 자세히 알아볼 수 있습니다.
사용 사례 설명 베스트 맞춤 근거
고성능 배치 가공 수천 개의 레코드를 효율적으로 처리해야 하는 모든 자동화 Apex Apex 플랫폼과 인터페이스하고 원시 속도를 위해 서식 있는 API를 제공합니다.
복잡한 데이터 처리 고급 데이터 조작이 필요한 시나리오 Apex Apex 플로에서 기본적으로 사용할 수 없는 지도 및 설정과 같은 데이터 구조를 제공하며, 성능이 뛰어난 대량 안전한 코드를 작성하는 데 중요할 수 있습니다.
트랜잭션 제어 세이브포인트, 롤백, 부분 커밋과 같은 제어 메커니즘 Apex Apex Database.savepoint 및 Database.rollback과 같은 메커니즘에 대한 액세스 권한을 제공하며 부분적으로 성공적인 DML 작업을 처리할 수 있습니다.
고급 맞춤형 검증 레코드의 여러 필드에서 데이터 유효성 검사 Apex 플로는 `CustomError` 요소로 저장을 방지할 수 있지만, 하위 플로를 포함한 모든 플로 유형에서는 사용할 수 없습니다. Apex addError() 메서드는 트리거 처리를 수행하는 동안 언제든지 레코드에 추가할 수 있는 여러 필드별 오류 메시지를 제공합니다.
간단한 프로세스 내에서 약간 복잡한 논리 복잡하지 않은 프로세스의 일부로 발생하는 고급 기능의 표준 라이브러리로 간소화된 복잡한 논리 및 데이터 조작 플로 + Apex 레코드 트리거형 플로는 오케스트레이션 계층으로 작동하며, 고복잡성 작업은 Invocable Apex 내에 캡슐화됩니다.
단순 ~ 상당히 복잡한 논리 복잡성이 낮거나 보통인 데이터 조작, 기본 및 관련 데이터 개체 모두에 대한 트리거 업데이트 플로 플로는 관리자와 개발자가 모두 액세스할 수 있는 선언적 모델을 기반으로 하므로 일반적으로 사용 가능 옵션입니다.
고지 및 아웃바운드 메시지 아웃바운드 이메일 및 메시지 보내기 플로 플로를 사용하면 레코드 변경 사항에 대한 이메일 경고 및 아웃바운드 메시지를 쉽게 확장할 수 있습니다.
예약된 처리 향후 동적 날짜의 자동화(예: 마감 날짜 3일 전) 플로 예약 경로는 플로에 고유한 강점이므로 플랫폼이 레코드의 데이터가 변경될 경우 해당 경로의 예약, 취소, 재예약을 자동으로 처리합니다.
### 확장 가능한 처리: 자세한 비동기식 사용 사례 확장성은 구현을 설계할 때 중요한 고려 사항입니다. 레코드 트리거형 자동화의 비즈니스 논리가 복잡하거나 장기적으로 실행되거나 데이터 용량이 많은 경우 Salesforce Platform의 핵심 총괄자 제한이 아키텍처 제약이 됩니다. 대량 데이터 업데이트, 복잡한 API 콜아웃 또는 대량 계산과 같은 작업은 단일 데이터베이스 트랜잭션 내의 총 CPU 시간 또는 DML 문 수와 같은 제한을 위반할 위험을 높입니다. 제한 예외로 인해 동기 트리거에 실패하면 사용자의 전체 저장 트랜잭션이 롤백되므로 사용자 환경이 좋지 않고 잠재적인 데이터 손실이 발생합니다. 이 기본적인 위험은 복잡한 작업을 오프로드하기 위한 아키텍처 패턴을 요구합니다. 이 경우 비동기 자동화가 필수 항목이 됩니다. 아키텍처는 비동기 메커니즘을 사용하여 장기 실행 또는 대용량 작업을 기본 동기식 레코드 저장 트랜잭션에서 효과적으로 분리할 수 있습니다. 많은 처리가 나중에 실행되는 별도의 플랫폼 관리 트랜잭션에 위임되는 동안 신속하고 신뢰할 수 있게 완료합니다. 분리하면 안정성이 향상되고 트랜잭션 실패를 방지하며 확장 가능한 엔터프라이즈 응용 프로그램을 구축하는 데 매우 중요합니다. 플랫폼은 신뢰성, 볼륨, 복잡성과 관련하여 각각 고유한 혜택과 제약을 제공하는 몇 가지 특수한 도구를 제공합니다. ### 플로의 비동기 경로 레코드 트리거형 플로에서 비동기식으로 실행 경로는 비동기식 논리에 대한 가장 간단한 메커니즘을 제공합니다. 이 경로는 원래 레코드 저장 트랜잭션이 데이터베이스에 성공적으로 커밋된 후 별도의 트랜잭션으로 실행됩니다. - ** 이상적인 사용 사례**: 즉시 실행하거나 사용자 정의 오류 처리가 필요하지 않은 과업에 적합합니다. 예를 들어 이메일 알림 보내기, 팔로우업 과업 만들기 또는 외부 시스템에 대한 간단한 콜아웃을 수행할 수 있습니다. - **제한 사항**: 이 메커니즘은 다른 비동기 플로 인터뷰와 동일한 일일 총괄자 제한을 공유합니다. 매우 대용량 처리에 고안되지 않았습니다. ### 변경 데이터 수집(CDC) 변경 데이터 수집(CDC)은 대용량 시나리오에서 레코드 변경으로 인해 트리거되는 비동기 논리를 처리할 수 있는 대용량, 확장 가능 및 복원형 패턴입니다. 이 모델에서 트리거의 유일한 책임은 레코드를 동기식으로 저장하는 것입니다. 그러면 플랫폼이 대용량 이벤트 버스에 레코드의 변경 사항을 포함하는 자세한 이벤트 메시지를 게시합니다. 별도의 전용 Apex 트리거가 이 변경 이벤트를 구독합니다. 복잡한 장기 실행 또는 비동기 작업을 수행합니다. - **혜택**: 이 패턴은 초기 사용자 트랜잭션에서 비동기 프로세스를 분리합니다. 비동기식 처리에 실패하면 사용자의 레코드 저장이 롤백되지 않습니다. 또한 패턴은 여러 내부 구독자 또는 외부 시스템에서 사용할 수 있는 지속적인 이벤트 스트림을 제공하며 최대 72시간 동안 이벤트를 재생할 수 있어 강력한 복원 능력을 제공합니다. - **제한 사항**: CDC 이벤트 메시지에는 Apex `Trigger.oldMap`에 상응하는 레코드의 이전 상태가 포함되어 있지 않습니다. 이벤트 페이로드에는 변경된 값이 아닌 새 필드 값이 포함됩니다. 따라서 특정 상태 전환을 기반으로 논리를 구현하는 것이 어려워집니다(예: `Status__c`가 "보류 중"에서 "승인됨"으로 변경된 경우에만 실행). 이벤트 구독자에서 개체의 필드 내역을 쿼리하여 이를 완화할 수 있지만, 이를 통해 프로세스에 복잡성이 추가되고 특정 관심 필드에 필드 내역 추적을 사용할 수 없습니다. 따라서 CDC에 오프로드할 수 있는 자동화 유형을 제한할 수 있습니다. 기본적으로 최대 5개의 Salesforce 개체에 대해 CDC를 활성화할 수 있습니다. 필요한 조직은 이 제한을 제거하고 이벤트 배달 할당을 늘리는 추가 기능 라이센스를 구매할 수 있습니다. ### 트리거에서 대기 가능한 Apex 트리거에서 직접 대기 가능한 Apex 작업을 대기열에 지정하는 것은 위험한 패턴으로 간주되어야 하며, Apex 제공 제어가 필요한 경우에만 사용됩니다(예: 복잡한 논리 또는 사용자 정의 재시도 메커니즘). CDC는 실행 가능한 옵션이 아닙니다. 대기 가능한 Apex 필요한 경우 구현에 적절한 보안 조치가 포함되어야 합니다. - **제한 점검**: 다른 작업을 추가하려면 먼저 코드가 트랜잭션에 이미 대기열에 있는 작업 수를 확인해야 합니다. ``` if (Limits.getQueueableJobs() < Limits.getLimitQueueableJobs()) { ... } ``` - **컨텍스트 인식**: 코드는 일괄 처리 작업(`System.isBatch()`)과 같은 비동기 컨텍스트 내에서 실행되는지 여부를 감지하고 해당 컨텍스트에서 더 엄격한 일괄 처리/트랜잭션 한도에 따라 동작을 수정해야 합니다. ### 트리거된 Apex 대한 고려 사항 제한 동기식 트리거에서 비동기식 Apex 호출하면 안정성 위험이 발생합니다. 조직 수준 영향(예: 제한 초과)을 방지하려면 이 패턴을 엄격하게 설계하고 테스트해야 합니다. - 비동기식 Apex 실행(`Batch`, `Queueable`, `@Future`)의 일일 제한은 조직 전체에서 공유됩니다(일반적으로 250,000개 또는 사용자 라이센스를 기반으로 계산). 레코드의 대량 데이터 로드가 20,000개인 경우 트리거가 200개의 청크로 실행되므로 대량 배치 크기가 200개 미만인 경우 100개의 별도의 트리거 호출이 발생합니다. 각 호출이 비동기 작업을 대기열에 지정하는 경우 단일 데이터 로드에서 일일 제한의 상당 부분이 사용될 수 있습니다. 이러한 소비는 비동기 자원의 기타 중요한 비즈니스 프로세스를 잠재적으로 해체할 수 있습니다. - 대기열 작업에 대한 총괄자 제한은 컨텍스트에 따라 크게 다릅니다. UI에서 사용자 작업에 의해 실행되는 트리거(_동기식_ 트랜잭션)에서 최대 50개의 대기 가능한 작업을 대기열에 지정할 수 있습니다. 그러나 배치 Apex 클래스의 `execute` 방법(_비동기_ 트랜잭션) 내에서 시작된 트리거에서 하나의 대기 가능 작업만 대기열에 지정할 수 있습니다. 이 차이를 고려하지 못하는 것은 일반적이고 중요한 오류 지점이며, 대용량 데이터 작업 중에 `LimitException` 오류가 발생합니다. - 트리거 컨텍스트에서 직접 Schedulable Apex(`System.schedule`) 또는 Batch Apex(`Database.executeBatch`)를 호출하는 것은 안티 패턴입니다. 이러한 메서드는 트리거 컨텍스트에서 호출되도록 설계되지 않았습니다. 이렇게 하면 비동기식 Apex 할당이 신속하게 소비되므로 한도 예외가 발생합니다. ### 올바른 비동기 패턴 선택 각 비동기 메커니즘에는 성능, 총괄자 제한, 신뢰성과 관련된 특정 제약이 있습니다. 이 결정 트리를 가이드로 사용하여 이러한 옵션을 탐색하고 사용 사례에 적합한 메커니즘을 선택할 수 있습니다. 비동기 패턴 결정 트리 ### 예약된 작업 대안 플로 차트에 표시된 바와 같이 대용량 DML 작업이 있지만 변경 데이터 수집 사용할 수 없는 경우(개체 제한으로 인해 발생할 수 있음) 트리거 호출 프로세스를 완전히 피하는 것이 아키텍처에 가장 적합한 선택입니다. 대신 예약된 프로세스를 사용하는 것이 좋습니다. 이는 예약 플로 또는 예약된 Apex 수 있습니다. 필수 단계는 다음과 같습니다. 1. 동기식 트리거에서 간단하고 비용이 적은 간단한 업데이트를 수행합니다. 예를 들어, `Status__c` 필드를 "처리 대기 중"으로 설정하거나 Chatter 게시와 같은 저가 관련 레코드를 삽입하여 레코드가 처리되어야 함을 나타냅니다. 2. 15분 또는 매시간과 같이 정기적으로 실행되는 예약된 작업(예: 예약된 플로 또는 예약된 Apex)을 만듭니다. 3. 보류 중 상태인 모든 레코드에 대해 예약된 작업 쿼리를 만들어 제어되는 대용량 컨텍스트에서 복잡한 논리를 실행한 다음, 처리된 레코드를 업데이트합니다. 이 패턴은 사용자의 동기 저장에서 대량 처리를 완전히 분리하고 트리거 시작 배치의 트랜잭션당 하나의 작업 제한에 적용되지 않으며 비실시간 요구 사항에 대해 확장 가능하고 관리 가능한 솔루션을 제공합니다. 예약된 작업의 대기 시간이 비즈니스 요구 사항에 허용되지 않으며 계속해서 CDC 또는 트리거 실행 대기 가능한 대기열을 사용하지 않아도 되는 경우 이는 중대한 아키텍처 불일치가 있음을 나타냅니다. 이때 다른 메커니즘을 고려해야 합니다. 핵심 응용 프로그램 설계를 다시 평가하면 다음과 같은 특정 결론을 내릴 수 있습니다. - 추가 기능을 구매하여 CDC 개체 제한을 제거합니다. - 근 실시간 처리가 실제로 "필수"인지 아니면 예약된 작업의 대기 시간이 플랫폼 안정성에 허용되는 제약인지를 결정하기 위한 비즈니스 요구 사항을 근본적으로 도전합니다. ## 기능이 아닌 고려 사항 ### 복잡성 구현의 복잡성 수준은 솔루션의 총 소유 비용과 변화하는 비즈니스 요구 사항에 적응할 수 있는 기능의 일부입니다. 모범 사례를 따르지 않으면 복잡성이 구현에 영향을 미칠 수 있습니다. 이 문서의 _관련 모범 사례_ 섹션에는 다음 패턴을 포함하여 솔루션의 복잡성을 줄이기 위한 권장 사항이 있습니다. - 하이브리드 패턴: 플로의 복잡한 논리를 위한 호출 가능한 Apex - Apex 트리거에 대한 메타데이터 프레임워크 사용 - 메가 플로와 비교. 다중 플로 ### 프로세스 및 표준 문서는 자동화 자체만큼이나 중요합니다. 유지 관리 기능을 제공할 뿐만 아니라 AI 및 에이전트 기반 도구에도 중요합니다. 문서는 비즈니스 프로세스를 이해하고 관리하는 데 도움이 됩니다. **In Flow** - 모든 요소 및 변수에 일관된 명명 규칙을 설정합니다. - 플로에 대한 설명 필드를 사용하여 전체적인 목적, 트리거 기준, 의도한 결과를 설명합니다. - 각 개별 요소에 대한 설명 필드를 사용합니다(예: `Get Records`, `Action`, `Transform`). 이 방법은 의도를 전달하는 가장 좋은 방법입니다. 특히 설명이 작업에서 수행하는 복잡한 논리를 설명하는 기본 위치인 호출 가능한 작업 및 하위 플로에 중요합니다. **In Apex** - 코드를 명확하게 코멘트하여 논리의 _왜_, _어떤 것_뿐 아니라 설명합니다. - 메타데이터 구동 프레임워크를 사용하는 경우 메타데이터 레코드에 사람이 읽을 수 있는 설명 필드가 포함되어 있어 각 처리기 클래스가 수행하는 작업과 실행 시점을 설명합니다. DevOps 및 소스 제어는 성숙한 개발 수명 주기의 일부입니다. 항상 Salesforce 프로젝트용 Git와 같은 소스 제어 도구를 사용하십시오. Apex 클래스와 Salesforce 플로는 모두 비즈니스 논리를 정의하는 메타데이터이며 버전을 지정하고 관리해야 합니다. 레코드 트리거형 자동화 관리의 컨텍스트 내에서 최신 DevOps 파이프라인은 필수적인 이점을 제공합니다. - **자동 품질 점검:** [Salesforce Code Analyzer](https://developer.salesforce.com/docs/platform/salesforce-code-analyzer/overview)과 같은 도구를 파이프라인에서 자동으로 실행하도록 구성할 수 있습니다. 정적 분석은 두 자동화 도구에서 문제가 발생하기 전에 문제 패턴을 감지할 수 있으며, 이는 성능 저하의 일반적인 원인인인 Flow 루프 내의 비효율적인 `Get Records` 요소 또는 Apex for 루프 내의 `SOQL` 쿼리와 같은 문제를 표시합니다. - **복귀 예방:** 자동화 밀도가 증가함에 따라 하나의 Flow 또는 Apex 클래스로 변경하면 동일한 객체의 다른 자동화에 의도하지 않은 결과가 발생할 수 있습니다. 제안된 변경 사항에 대해 자동화된 Apex 테스트를 실행하는 강력한 DevOps 테스트 전략은 새로운 Flow 버전이 기존 Apex 논리를 중단하지 않도록 보장하는 가장 신뢰할 수 있는 방법입니다(그 반대로). - **공동 작업 및 가시성:** 소스 제어는 "단일 신뢰할 수 있는 소스"입니다. 관리자와 개발자가 동일한 개체에 대한 자동화 작업을 병렬로 수행할 수 있습니다. 또한 프로덕션 프로세스가 중단되면 자동화를 변경한 _사람_, 변경한 _시기_, 커밋 메시지를 통해 변경한 _이유를_ 즉시 확인할 수 있습니다. 관리자와 개발자가 혼합된 팀의 경우, [DevOps Center는](https://help.salesforce.com/s/articleView?id=platform.devops_center_overview.htm&type=5) 통합 인터페이스를 제공하여 이러한 모든 단계를 구성할 수 있도록 도와주므로 팀의 모든 구성원이 확장 가능한 소스 제어 기반 개발 프로세스를 이용할 수 있습니다. 문서 및 DevOps를 결합한 이 분야는 조직의 장기적인 상태 및 유지 관리 기능을 보장하므로 사용자를 팔로우하는 모든 설계자와 관리자에게 도움이 됩니다. ## 관련 모범 사례 위의 결정 가이드는 구현을 계획하기 전에 가장 적합합니다. 사용 사례에 가장 적합한 제품을 선택할 수 있도록 지원합니다. 제품을 선택한 후 구현을 위한 기존 모범 사례를 이해하는 것이 중요합니다. ### 하이브리드 패턴 활용: 플로의 복잡한 논리를 위한 호출 가능한 Apex _One Tool Per Object_ 원칙은 고밀도 자동화 관리에 매우 중요하지만, 단순히 선언적 또는 단순히 프로그래밍 방식의 스택 사이의 이진 선택으로 해석하지 마십시오. 보다 효과적이고 유지 보수 가능한 아키텍처 패턴은 하이브리드 모델을 활용합니다. Record-Triggered Flow 를 오케스트레이션 계층으로 배치하고 고복잡성 작업을 Invocable Apex 내에 캡슐화합니다. 하이브리드 패턴 다이어그램 #### 오케스트레이션 레이어: 플로 레코드 트리거 플로는 비즈니스 프로세스의 오케스트레이션 계층 역할을 합니다. 그것은 입장 기준과 실행 컨텍스트 (_무슨_과 _언제_)를 소유합니다. 결정 논리와 라우팅을 이 계층 내에 유지함으로써 플로 트리거 탐색기를 통해 아키텍처의 프로세스 토폴로지를 투명하고 관리할 수 있어 중요 비즈니스 논리가 코드 내에서 숨겨지지 않도록 방지합니다. #### 복합 구성 요소: 호출 가능한 Apex 복잡한 구성 요소의 일반적인 예는 사례 레코드에 대한 서비스 수준 계약(SLA) 계산 구현입니다. 비업무 시간 및 휴일을 제외한 정확한 계산에 중요한 BusinessHours 개체와 관련 논리가 Flow에서 기본적으로 액세스할 수 없으므로 전용 Apex 클래스가 사용됩니다. 이 클래스는 종종 `ServiceLevelAgreementCalculator`과 같은 이름을 지정하며, `@InvocableMethod`로 주석이 지정된 단일 정적 방법으로 설계되어 경과된 업무 시간을 계산하고 SLA가 "목표 범위 내" 또는 "실패"인지 확인하고 구조화된 출력을 반환합니다. 이 접근 방식은 복잡한 고성능 논리를 Apex 캡슐화하면서 레코드 트리거 플로의 선언적 오케스트레이션 계층에 원활하게 실행하고 통합할 수 있도록 합니다. Apex `ServiceLevelAgreementCalculator` 클래스가 정의되면 레코드 트리거 플로 내에서 사용할 수 있습니다. 이 패턴은 우려 사항을 엄격하게 구분하는 것을 보여줍니다. 선언적 레이어는 트랜잭션 수명 주기 및 오케스트레이션을 관리하는 데 사용되며 코드는 복잡한 실행에 사용됩니다. 코드를 기초가 아닌 기능 유틸리티로 취급하여 성능과 서비스 점검의 균형을 맞춥니다. #### 하이브리드 패턴으로 주요 성과 **모듈러성**: 이 결정은 전체 프로세스에 Apex 또는 Flow를 사용하는 독특성에서 벗어납니다. 대신 아키텍처는 복잡한 논리를 추가된 대량 안전한 독립적으로 테스트 가능한 단위로 캡슐화합니다. 이러한 단위는 선언적 레이어에서 사용되는 재사용 가능한 구성 요소로 작동하므로 아키텍처 설계가 복잡하지 않고 자동화의 규모를 확장할 수 있습니다. **재사용 가능**: 논리가 트리거 이벤트에서 분리됩니다. 잘 설계된 코드 유닛(예: `InvocableMethod`)은 한 번 작성되지만 여러 입력 지점에서 활용됩니다. 레코드 트리거 플로, 화면 플로 또는 외부 통합 이 코드를 재사용하면 중복 개발이 제거됩니다. **기존성**: 프로세스 플로 논리는 선언적 플로 내에서 계속 표시되고 관리할 수 있습니다. 이 중앙 집중화를 통해 디버깅 오버헤드가 크게 줄어들고 시스템의 실행 순서가 결정적이고 투명해집니다. #### 하이브리드 패턴의 제한 사항 및 제약 사항 플로에서 호출 가능한 Apex 사용하는 하이브리드 모델은 강력하지만, 일대일 접근 방식은 아닙니다. 설계자는 하이브리드 솔루션을 적용하기 전에 특정 제한 사항 및 제약 사항을 알고 있어야 합니다. - **저장 전 지원 안 함**: 이는 가장 중요한 제한입니다. 호출 가능한 작업은 저장 후 컨텍스트(작업 및 관련 레코드의 플로)에서만 사용할 수 있습니다. 고성능 저장 전 컨텍스트(빠른 필드 업데이트를 위한 플로)에서는 사용할 수 없습니다. 따라서 이 패턴을 사용하여 동일한 레코드 필드 업데이트를 위임할 수 없습니다. 저장 전 플로 또는 컨텍스트 전 Apex 트리거 내에서 기본 Flow 요소를 사용하여 고성능 작업을 수행합니다. - **삭제 취소 후 지원 없음:** 레코드 트리거형 플로는 현재 삭제 취소 후 컨텍스트를 지원하지 않습니다. Salesforce 개체에 휴지통에서 레코드를 복원할 때 자동화를 실행하는 비즈니스 요구 사항이 있는 경우 Apex 트리거가 유일한 해결 방법입니다. - **고용량 시나리오의 성능 오버헤드:** 플로 런타임에서 Apex 런타임으로의 전환은 비용이 없는 작업이 아닙니다. 일반적으로 빠르지만, Flow 런타임에서 호출 가능한 작업으로 끌어오는 작업은 Apex 트리거 내에 있는 네이티브 실행만큼 빠르지 않습니다. 대부분의 중간 밀도 자동화의 경우 이 마이크로 오버헤드는 액세스 가능성 향상을 위해 소소하고 가치 있는 제약입니다. 그러나 극도로 고성능, 대용량 시나리오의 경우 순수한 Apex 전용 프레임워크는 원시 컴퓨팅 속도 이점이 있습니다. ### 레거시 자동화 전략 자동화 밀도 heuristics는 최신 그린필드 아키텍처에 대한 확실한 지침을 제공하지만, 엔터프라이즈 Salesforce 환경의 현실은 종종 더 구체적입니다. 성숙한 조직에서는 동일한 Salesforce 개체에서 작동하는 레코드 트리거 플로 및 Apex 트리거를 찾는 것이 일반적입니다. 이 시나리오는 앞서 설명한 하이브리드 패턴과는 다릅니다. 여기서, 플로와 Apex 트리거는 결합되거나 함께 작동하도록 설계되지 않습니다. 이러한 공존은 플랫폼 기능이 발전하거나 기존 기술 부채로 인해 발생하는 경우가 많습니다. 이 상태는 허용되는 운영 상태이지만, 설계자는 최종 상태가 아닌 계산된 제약으로 취급해야 합니다. 조각화된 오케스트레이션은 상당한 거버넌스 및 유지 보수 오버헤드를 야기하므로 개발, 테스트, 사고 처리 활동이 분리되고 번거롭습니다. 이를 통해 해결 시간(TTR) 및 운영 복잡성이 증가됩니다. - 새 Salesforce 개체의 경우 자동화 밀도 원칙을 기본 가이드로 준수하십시오. - 하이브리드 이력과 이중 Apex 트리거와 레코드 트리거형 플로 입력 지점이 있는 기존 Salesforce 개체의 경우 밀도를 평가한 다음, 재구성기를 유지 관리 가능한 하이브리드 상태로 구성합니다. - 밀도가 낮으면 리팩터 Apex 레코드 트리거 플로를 트리거하고 실행 순서를 지정하여 단일 자동화 입력 지점으로 이동합니다. - 중간 밀도의 경우 리팩터 복합이 올바른 실행 순서로 플로의 하위 집합으로 메가 플로를 수행합니다. 절대적으로 필요한 경우에만 Apex 트리거를 도입합니다(예: 컨텍스트 삭제 취소 후 지원). - 높은 밀도의 경우 Apex 트리거를 구현하는 것이 좋습니다. ### Apex 트리거에 대한 메타데이터 프레임워크 사용 Salesforce Platform에서 조직의 비즈니스 프로세스가 성숙해지면 레코드 트리거형 자동화의 용량과 복잡성이 불가피하게 증가합니다. 기본적인 모범 사례는 Salesforce 개체당 _한 개의 Apex 트리거_를 유지하는 것입니다. 플랫폼이 동일한 이벤트에 대해 동일한 개체에서 여러 트리거의 실행 순서를 보장하지 않으므로 이 규칙이 중요합니다. 이 제한은 결정적이지 않은 동작, 인종 조건 및 디버그하기 어려운 문제로 이어질 수 있습니다. 그러나 _단일 트리거_ 원칙을 준수하면 관리 가능하고 확장 가능한 방식으로 단일 엔트리포인트에서 호출되는 모든 비즈니스 논리를 관리하고 오케스트레이션하는 아키텍처적인 도전이 발생합니다. #### Classic 트리거 처리기의 제한 사항 이 아키텍처의 첫 번째 진화는 Classic 트리거 처리기 패턴이었습니다. 이 접근 방식에서는 단일 Apex 트리거가 모든 논리를 해당 처리기 클래스(예: `OpportunityTriggerHandler`)에 위임합니다. 이 방법은 트리거 파일에서 논리를 분리하고 개발자가 처리기 클래스의 방법(예: `afterInsert()`) 내에서 실행 순서를 결정적으로 제어할 수 있도록 합니다. 이 패턴은 개선되었지만 종종 모노리틱 처리기 클래스로 이어집니다. 시간이 지남에 따라 더 많은 비즈니스 요구 사항이 추가되면 클래스가 크고 관리하기 어렵고 격리적으로 테스트하기 어렵게 됩니다. 모든 개별 프로세스의 실행 순서는 단일 메서드 내에서 하드 코딩되므로 클래스가 충돌을 병합할 가능성이 있으므로 대규모 엔터프라이즈 환경에서 거버넌스 및 서비스 점검 오버헤드가 크게 증가합니다. #### 솔루션: 메타데이터 중심 트리거 프레임워크 모듈화 및 오케스트레이션의 핵심 문제를 해결하기 위해 아키텍처는 **메타데이터 중심 트리거 프레임워크**로 전환합니다. 이는 실행 _방법_ 및 _시기에_ 대한 구성에서 자동화 논리 자체를 분리하는 중요한 아키텍처 단계입니다. 이 프레임워크는 다음 세 가지 주요 이점을 기반으로 구축됩니다. - **파티셔닝:** 단일 처리기 클래스 대신 핵심 비즈니스 논리는 작은 원자식 Apex 클래스(예: `RecalculateAccountValues` 클래스 또는 `NotifySalesLeads` 클래스)로 분할되며, 각 클래스는 _단일 책임 원칙_을 준수합니다. 이 모듈성을 통해 논리를 쉽게 테스트, 디버그, 이해할 수 있습니다. - **주문 및 조작:** 실행 순서는 더 이상 Apex 하드 코딩되지 않습니다. 대신 구성 레코드에 의해 선언적으로 정의되며, 일반적으로 사용자 정의 메타데이터 유형(예: `TriggerAction__mdt`)에 저장됩니다. 이렇게 하면 관리자가 배포 또는 코드 변경이 필요하지 않은 메타데이터 레코드를 수정하여 자동화 작업을 다시 정렬, 추가 또는 제거할 수 있습니다. - **Bypass 기능:** 프레임워크는 표준화된 세분화된 우회 기능을 제공합니다. 각 자동화 작업은 메타데이터 레코드를 통해 전역적으로 해제되도록 구성하거나 사용자 정의 권한을 참조하여 특정 관리 사용자에 대해 무시할 수 있습니다. 그런 다음, 개체에 대한 단일 Apex 트리거는 동적 발송자로만 작동합니다. 비즈니스 논리를 포함하지 않지만 중앙 `MetadataTriggerHandler` 클래스를 인스턴스화합니다. 이 처리기는 사용자 지정 메타데이터 레코드를 쿼리하여 실행 순서를 동적으로 결정하고 지정된 순서대로 올바른 원자 Apex 클래스를 호출합니다. 자동화는 투명하고 관리 가능한 단일 계층 아래 통합됩니다. ### 트랜잭션에서 비용이 많이 드는 작업 중복 제거 강력한 프레임워크에서 Apex 사용하면 중복 작업을 제거하여 트랜잭션 상태를 관리하고 성능을 최적화할 수 있는 기능을 활용할 수 있습니다. 논리가 누적되면 저장 주문 내의 다양한 자동화가 동일한 비용이 많이 드는 작업을 독립적으로 실행하여 유용한 총괄자 제한을 소비하고 DML 작업 시간을 늘리는 것이 일반적입니다. 프레임워크는 두 가지 기본 전략인 - **공유 상태 관리:** 단일 Apex 트랜잭션 범위 내에서 정적 속성 및 변수가 캐시 데이터에 활용됩니다. 이렇게 하면 트리거의 다른 레코드 또는 단계에서 자동화 논리를 여러 번 호출하는 경우에도 구성 설정에 대한 `SOQL` 쿼리와 같은 비용이 많이 드는 작업이 한 번만 실행됩니다. 트랜잭션 제한 소비량이 현저하게 감소합니다. - **플랫폼 캐시 활용도:** 단순한 트랜잭션 내 캐싱을 벗어나려면 플랫폼 캐시를 사용하여 특정 데이터에 대한 전체 데이터베이스를 쿼리하지 않도록 합니다. 이 관리형 메모리 내 캐시는 기본이 아닌 데이터를 검색하고, 코드베이스에서 자주 읽고, 트랜잭션 과정에서 변경할 수 없는 데이터(예: 프로필, 역할, 업무 시간)를 검색하는 데 적합합니다. `Cache.CacheBuilder` 인터페이스를 사용하면 시스템이 캐시를 먼저 확인하고 데이터가 없는 경우에만 데이터베이스 쿼리를 수행하여 성능과 확장성을 극대화합니다. ### 동일한 레코드 업데이트에 저장 전 사용 자동화가 트랜잭션을 시작하는 레코드의 필드 값만 변경해야 하는 경우 항상 저장 전 업데이트를 사용하십시오. 이는 플로의 빠른 필드 업데이트(저장 전에 실행)와 Apex 트리거의 컨텍스트 전 논리에 모두 적용됩니다(삽입 전, 업데이트 전). 이 패턴은 두 번째 DML 작업 및 반복 저장 주기를 방지하므로 사용되는 도구와 상관없이 성능이 향상됩니다. 변경 사항은 레코드가 데이터베이스에 커밋되기 _전에_ 메모리에 적용되며 원래 트랜잭션의 일부로 저장됩니다. 그렇지 않으면 전체 저장 주문을 다시 실행하고 모든 자동화를 다시 실행하는 두 번째 저장에 대한 오버헤드가 제거됩니다. ### 제어되지 않는 반복 방지 제어되지 않는 반복은 트리거의 논리가 DML 업데이트를 수행하여 동일한 트리거가 다시 실행되는 후 업데이트 트리거의 일반적인 함정입니다. 이렇게 하면 결국 총괄자 제한 예외로 종료되는 무한 루프가 생성됩니다. 정적 부울 플래그 또는 처리된 레코드 ID의 컬렉션은 과거에 해당 반복을 방지하기 위해 사용되었지만, 보다 정밀하고 강력한 패턴은 레코드 자체의 새 버전과 이전 버전 간 필드 값을 비교하여 논리를 게이트하는 것입니다. 특정 관심 필드가 실제로 변경된 경우에만 논리를 실행합니다. 이렇게 하면 트리거가 중요 데이터가 변경되지 않은 동일한 트랜잭션 내의 후속 DML 작업에서 논리를 실행하지 못할 수 있습니다. #### 레코드 트리거형 플로에서 반복 제어 레코드 트리거 플로에서 레코드가 조건 요구 사항을 충족하도록 업데이트되는 경우에만 플로가 실행되도록 설정하여 제어되지 않는 반복을 방지합니다. 레코드 트리거 플로의 반복 제어 플로에 입력 기준 수식을 사용하도록 선택하는 경우 `$Record` 전역 변수(새 값을 나타내는)와 `$RecordPrior` 전역 변수(저장 전의 원래 값을 나타내는)를 비교하여 실행 중 반복을 방지할 수 있습니다. 예를 들어 기회의 금액 필드가 변경된 경우에만 플로가 실행되도록 하려면 항목 기준에서 다음을 사용합니다. ``` $Record.Amount != $Record__Prior.Amount ``` #### Apex 반복 제어 레코드의 새 버전인 `Trigger.new`의 필드 값을 레코드의 이전 버전인 `Trigger.oldMap`의 필드 값과 비교하여 원하는 변경 사항이 발생했는지 확인합니다. 이 접근 방식을 통해 자동화가 동일하게 작동하고 필요한 경우에만 실행되므로 시스템의 효율성을 높이고 재해가 발생하는 반복 루프를 방지할 수 있습니다. ### 자동화 무시 올바르게 설계된 Salesforce 조직은 자동화를 우회하기 위해 일관되고 신뢰할 수 있는 메커니즘이 필요합니다. 이는 옵션 기능이 아니라 데이터 무결성을 유지하고 관리 과업을 활성화하기 위한 핵심 운영 요구 사항입니다. 다음과 같은 일부 시나리오에서는 무시 프레임워크가 필요합니다. - 대용량 데이터를 로드할 때 모든 레코드에 대한 트리거를 실행하면 프로세스가 급격하게 느려지며 제한 예외가 발생하고 잘못된 관련 레코드 및 알림이 생성될 수 있습니다. 무시하면 데이터를 원활하고 효율적으로 삽입할 수 있습니다. - 통합 사용자는 레코드의 외부 시스템에서 데이터를 동기화해야 할 수 있습니다. 일반적으로 사용자 시작 변경(예: 이메일 보내기, 과업 만들기)에 대해 실행되는 자동화는 변경이 다른 시스템에서 시작되었을 때 바람직하지 않거나 중복될 수 있습니다. - 관리자 또는 지원 담당자가 레코드에 대한 수정 업데이트를 수행해야 할 수 있습니다. 무시 메커니즘을 사용하면 표준 비즈니스 자동화를 트리거하지 않고 이러한 사항을 변경할 수 있으므로 의도하지 않은 결과가 발생할 수 있습니다. **사용자 정의 권한**: 무시 논리를 구현하기 위한 최신 확장 가능한 표준은 사용자 정의 권한입니다. 다음은 다음과 같은 몇 가지 이유로 이전 메서드보다 우수합니다. - **유연성:** 권한 집합을 통해 사용자에게 사용자 정의 권한을 할당할 수 있습니다. 이 방법은 최신 Salesforce 보안 및 액세스 모델과 일치하므로 세분화되고 유연한 할당을 수행할 수 있습니다. 특정 사용자에게 무시 또는 특정 만료 일자/시간이 있는 경우 일시적으로 허용할 수 있습니다. - **기존성:** 사용자 정의 권한을 사용하면 프로필 또는 사용자가 자동화 논리에 하드 코딩되지 않습니다. 사용자의 역할이 변경되거나 새 프로필에 액세스 권한을 무시해야 하는 경우 변경 사항은 배포가 필요한 코드 또는 플로 수정이 아닌 간단한 권한 집합 할당입니다. - **확장성:** 사용자 정의 권한은 복잡한 사용자 기반에서 예외를 관리할 수 있는 확장 가능한 프레임워크를 제공합니다. 권한 집합, 권한 집합 그룹 또는 프로필을 통해 사용자에게 할당할 수 있습니다. 권한 집합 또는 프로필에 대한 연결은 소스 메타데이터에서도 표시됩니다. **구현 패턴**: 조직의 모든 레코드 트리거형 자동화에 일관된 우회 패턴을 적용합니다. **레코드 트리거 플로 우회**: 플로가 실행되지 않도록 차단하는 것이 가장 효과적인 방법입니다. 플로의 항목 기준에 조건을 추가하면 이 작업을 수행할 수 있습니다. - 레코드 트리거 플로의 시작 요소에서 조건 요구 사항을 수식이 True로 평가됨으로 설정합니다. - 수식 빌더에서 `$Permission` 전역 변수를 사용하여 사용자 정의 권한에 대한 확인을 통합합니다. 기존 항목 기준과 확인을 결합합니다. - 수식 패턴: ``` ( ) && NOT($Permission.Bypass_This_Flow) ``` - 이 패턴을 사용하면 사용자에게 지정된 사용자 정의 권한이 할당되지 _않은_ 경우에만 플로가 실행됩니다. 이 확인은 플로 인터뷰가 생성되기 전에 수행되므로 가장 성능이 뛰어난 접근 방식입니다. **Apex 트리거 프레임워크 우회**: Apex 메타데이터 구동 트리거 프레임워크에 바로 우회 논리를 통합하여 세부적으로 제어할 수 있습니다. - `TriggerAction__mdt` 사용자 정의 메타데이터 유형에는 텍스트 필드(예: `BypassPermission__c`)가 포함되어야 합니다. - `MetadataTriggerHandler` 클래스에서 동적으로 작업을 실행하기 전에 코드는 이 필드의 값을 읽어야 합니다. - 필드가 채워지면 처리기가 `FeatureManagement.checkPermission()` 메서드를 사용하여 현재 실행 중인 사용자에게 지정된 사용자 정의 권한이 있는지 확인합니다. - `checkPermission()`이 true를 반환하면 처리기가 해당 특정 작업을 건너뛰고 순서대로 다음 작업으로 진행합니다. - 이 패턴은 전역 우회전(모든 `TriggerAction__mdt` 레코드가 동일한 권한을 참조하는 경우)과 세분화된 작업 우회전(다른 레코드가 다른 권한을 참조하는 경우 또는 일부 레코드에 우회전 권한이 전혀 없는 경우)을 모두 허용하기 때문에 강력합니다. ### 메가 플로와 비교. 다중 플로 이는 모든 개체 자동화를 하나의 대규모 메가 플로로 통합하는 안티 패턴입니다. 하나의 플로에 통합하고 여러 조건이 적절한 플로로 논리를 분할해도 성능에 큰 영향을 미치지 않습니다. 가장 중요한 성과는 다음과 같습니다. - 동일한 레코드 필드 업데이트에 저장 전 플로 사용 - 정확한 입력 조건을 작성하여 특정 사용 사례에 영향을 미치지 않는 변경 사항에 대해 플로가 실행되지 않도록 합니다. [플로 트리거 탐색기](https://trailhead.salesforce.com/content/learn/modules/record-triggered-flows/meet-flow-trigger-explorer)를 사용하면 개체의 각 플로에 순서 값을 할당하여 순차 실행 순서를 보장할 수 있습니다. 플로 트리거 탐색기 ## 자원
Apex 플로 작업
# 이벤트 중심 아키텍처에 적합한 도구 및 패턴 사용 ## 개요 이벤트 중심 아키텍처는 시스템 또는 응용 프로그램 상태 변경을 전달하는 이벤트의 효율적인 생산 및 소비를 지원합니다. 이러한 아키텍처는 시스템 간에 유연한 연결을 활성화하고 시스템 전체에서 작동하는 프로세스 및 실시간 업데이트를 지원합니다. 이벤트 기반 아키텍처의 장점은 쉽게 확인할 수 있지만 구현 세부 사항은 항상 명확하지 않습니다. 이벤트 중심 아키텍처 패턴에서 고려해야 할 기능은 무엇입니까? 이러한 패턴이 해결하는 특정 문제는 무엇입니까? 솔루션에 적용되는 특별 고려 사항은 무엇입니까? 솔루션을 해결하기 위한 최적의 패턴은 무엇입니까? 이 가이드는 Salesforce 기술을 사용하여 작업할 때 최적의 이벤트 중심 아키텍처를 구축하는 데 사용되는 패턴을 제공합니다. 또한 Salesforce에서 사용할 수 있는 예비 도구를 설명하고 사용 사례의 선택에 대한 도구 권장 사항을 제공합니다. Salesforce와 관련된 데이터 수준 통합에 대한 자세한 내용은 [데이터 통합 결정 가이드](/docs/architect/ko-kr/decision-guides/guide/data-integration)를 참조하십시오. ## 서비스 - **요청에 대한 동기식 응답이 필요하지 않은 프로세스에 이벤트 기반 아키텍처를 사용합니다.** 이 가이드에 설명된 패턴은 데이터 일관성, 확장성, 재사용을 위해 고안되었으므로 조직의 응용 프로그램 환경이 발전함에 따라 기술 부채를 최소화할 수 있습니다. (자세한 내용은 [Well-Architected - Throughput](/docs/architect/ko-kr/well-architected/guide/reliable#처리량)을 참조하십시오.) - **MuleSoft 또는 다른 Enterprise Service Bus(ESB) 솔루션이 기존 환경의 일부인 경우 가능한 경우 이를 사용하십시오.** 해당 솔루션은 이벤트 중심 아키텍처 패턴을 지원하도록 고안되었으며, 엔터프라이즈 전체에서 통합을 재사용할 수 있는 강력한 기능을 갖추고 있습니다. - **스트리밍 API를 비롯한 다른 API를 사용하여 자체 이벤트 처리기를 구축하는 대신 향후 게시/구독 패턴에 Pub/Sub API를 사용하십시오.** 이제 Pub/Sub API가 정식 출시되었으므로 새 게시/구독 패턴에 사용하십시오. 가능한 경우 스트리밍 API 또는 사용자 정의 Apex 서비스와 같은 다른 플랫폼 API를 사용하여 기존 이벤트 통신을 Pub/Sub API로 마이그레이션할 계획입니다. - **플랫폼 이벤트 및 변경 데이터 수집(CDC)은 다른 시스템에서 사용해야 하는 레코드 및 필드 변경 사항을 게시하는 데 가장 적합한 메커니즘입니다.** 새 구현에 PushTopic 및 일반 이벤트를 사용하지 않는 것이 좋습니다. Salesforce는 현재 기능 기능 내에서 계속해서 PushTopic 및 일반 이벤트를 지원하지만 이 기술에 추가 투자를 계획하지는 않습니다. ## 범위의 제품
Salesforce Platform Salesforce Platform은 직원, 자율 AI 에이전트, 회사 데이터 및 애플리케이션을 신뢰할 수 있는 단일 시스템으로 통합하여 생산성과 고객 경험을 향상시키는 종합적인 AI 기반 플랫폼입니다. 이를 통해 Customer 360 앱, Data Cloud, Slack을 연결하여 엔드 투 엔드 자동화를 수행할 수 있게 되었습니다.
MuleSoft MuleSoft는 조직이 온 프레미스 및 클라우드 환경 전반에서 애플리케이션, 데이터, 장치를 연결할 수 있는 Salesforce의 선도적인 통합 플랫폼입니다. MuleSoft는 시스템 전반에서 데이터를 잠금 해제하고, 확장 가능한 통합 및 자동화 프레임워크를 개발하고, 차별화되고 연결된 환경을 빠르게 만들 수 있는 플랫폼을 제공하는 플랫폼입니다.
## 결정 지점 이벤트 중심 아키텍처(EDA)는 거의 실시간 알림이 필요하며, 대용량 또는 복잡한 메시지에 대한 처리 부하를 배포하고, 대기열을 통해 연결 복원을 필요로 하는 IoT 및 모바일 장치와 같은 시스템을 통합하는 시나리오에 권장됩니다. 그러나 비동기 실행을 위해 설계되었으므로 즉각적이고 동기식 인적 응답이 필요한 프로세스에는 EDA를 구현해서는 안 됩니다. 또한 소스 데이터가 너무 자주 변경될 경우 배치 처리와 같은 간단한 패턴이 충분하지 않을 경우 적합하지 않습니다. ### 이벤트 중심 아키텍처를 사용하는 경우 다음은 이벤트 중심 아키텍처에 적합한 몇 가지 일반적인 시나리오입니다.
결정 지점지침
직접 실시간 알림게시/구독, 폴아웃, 스트리밍과 같은 이벤트 중심 아키텍처 패턴은 여러 응용 프로그램이 상태 변경 또는 레코드 업데이트를 거의 실시간으로 통지해야 하는 시나리오에서 효과적으로 작동하는 경향이 있습니다.
동시 처리게시/구독과 같은 패턴은 대용량 데이터 또는 매우 복잡한 메시지가 여러 시스템 간에 처리 부하를 배포해야 하는 시나리오에서 잘 작동하는 경향이 있습니다.
고용량 읽기전달된 메시지 및 대기열 패턴은 조직이 증가하고 생성되는 메시지의 양이 구독자가 즉시 처리할 수 있는 능력을 초과할 수 있는 시나리오에서 일반적으로 사용됩니다.
고용량 쓰기스트리밍 및 대기열 패턴은 조직에서 생성되는 메시지 수가 급증하는 여러 시나리오에서 적절하게 작동합니다.
다른 시스템에 동일한 데이터 보내기게시/구독은 여러 시스템에 동일한 데이터를 보내야 하는 조직에서 꽤 일반적인 솔루션이지만 여기에서 다루는 대부분의 패턴으로 해결할 수 있습니다. 가장 적합한 항목을 찾으려면 자세히 검토하십시오.
새 시스템 또는 장치의 자주 도입게시/구독, 스트리밍, 대기열 패턴은 전체 환경이 변동하는 경향이 있으며 새 시스템 및 장치가 정기적으로 추가되는 시나리오에서 적절하게 작동하는 경향이 있습니다. 이 시나리오에서 새 시스템 또는 장치는 단순히 이벤트 버스 구독자이거나 대기열과 연결되어 있어야만 사용자 정의 지점 간 통합이 필요하지 않고 메시지 수신을 시작할 수 있습니다.
IoT 장치IoT 장치는 일반적으로 자주 업데이트를 제공하고 일부 시나리오에서 메시지의 급증을 생성할 수도 있으므로 스트리밍 및 대기열 패턴은 IT 환경에 통합할 때 제대로 작동하는 경향이 있습니다.
오프라인 모바일 장치 및 시스템품질이 낮거나 인터넷 액세스가 없거나 메시지가 전달될 때 오프라인 상태일 수 있는 시스템에서 작업해야 하는 모바일 장치는 대기열에 연결하고 다시 온라인 상태가 되면 관련 메시지를 검색할 수 있는 대기열 패턴을 활용할 수 있습니다.
대부분의 대규모 조직에는 다양한 기능을 갖춘 시스템 조합이 포함된 복잡한 IT 환경이 있습니다. 조직에 이벤트 중심 통합을 지원하지 않는 레거시 시스템이 있을 수 있거나 특히 가능성이 높습니다. 또한 시스템에서 지원하는 경우에도 이벤트 중심 통합이 적합하지 않은 사용 사례가 있을 수 있습니다(예: 타사에서 SFTP 파일 전송). 이전 단계로 돌아가 조직의 전체 IT 환경을 살펴보면 다른 아키텍처 솔루션과 마찬가지로 다양한 시나리오를 지원하는 패턴의 혼합을 적용할 수 있습니다. 이벤트 중심의 기본 통합 접근 방식을 만들기로 결정할 경우 도구 상자의 다른 도구로 생각하십시오. 올바른 시나리오에서 사용할 수 있고 사용해야 하지만 모든 시스템에 적용되는 접근 방식은 아닙니다. 포괄적인 통합 전략을 개발하면 이 가이드에 설명된 패턴이 적절하거나 적절하지 않을 때를 판단하는 데 도움이 됩니다. ### 이벤트 중심 아키텍처를 사용하지 않는 경우 많은 시나리오에서 이벤트 기반 아키텍처가 필요하며, 일부 시나리오에서는 가장 적합하지 않은 경우에도 이벤트 기반 아키텍처가 작동합니다. 그러나 일부 시나리오에서는 이벤트 중심 아키텍처를 사용해서는 안 됩니다. 다음은 다음 시나리오를 식별하는 데 도움이 되는 몇 가지 결정 지점 질문입니다.
결정 지점질문할 지침/질문
비즈니스 요구 사항[이벤트 중심 아키텍처 사용 시기](#이벤트-중심-아키텍처를-사용하는-경우) 섹션에 설명된 기능에 대한 실제 비즈니스 요구 사항이 있습니까?
기술 요구 사항데이터 가상화, 배치 또는 요청/응답과 같은 다른 패턴에 맞는 통합을 설계하고 있습니까? 다시 말해, 둥근 구멍에 제곱 구멍을 넣으려고 합니까?
사람들이 응답을 기다리는 과정대상 시스템에서 응답을 대기하는 사람이 포함된 통합은 비동기 실행을 위해 설계되었으므로 응답 시간을 보장할 수 없으므로 이벤트 중심 아키텍처에 적합하지 않습니다. 기술 솔루션을 구현하기 전에 이와 같은 프로세스가 조직에 최적인지 고려하십시오. 자세한 내용은 [Well-Architected - 프로세스 설계](/docs/architect/ko-kr/well-architected/guide/automated#프로세스-설계)를 참조하십시오.
소스 데이터 변경 빈도소스 시스템의 데이터가 자주 변경되지 않아 정기적인 업데이트가 충분할 경우 이벤트 기반 패턴 대신 [배치 패턴](https://developer.salesforce.com/docs/atlas.en-us.integration_patterns_and_practices.meta/integration_patterns_and_practices/integ_pat_batch_data_sync.htm)를 사용하여 아키텍처를 간소화할 수 있습니다.
실행 요구 사항솔루션과 관련된 대부분의 시스템에서 이벤트 중심 아키텍처를 지원합니까? 업그레이드, 사용자 정의 또는 미들웨어 등 지원되지 않는 시스템에서 이벤트 기반 아키텍처를 사용하려면 어떻게 해야 합니까? 이러한 요구 사항을 충족하기 위해 얼마나 많은 노력이 필요합니까?
메시지 구조 안정성메시지 구조를 얼마나 자주 변경해야 합니까? 이러한 변경 사항이 영향을 받는 시스템 및 수정 프로세스는 무엇입니까?
조직 거버넌스모든 이해당사자가 메시지 구조, 트리거, 기타 아키텍처 및 프로세스 관련 결정에 대한 변경 사항을 파악하고 고려할 수 있도록 관리 구조가 마련되어 있습니까?
필수 기술 집합직원은 이벤트 중심 아키텍처에 대한 경험이 있고 이를 지원하는 방법을 알고 있습니까?
## 사용 사례 다양한 이벤트 중심 아키텍처 패턴이 있습니다. 일부는 이벤트 기반 이외의 특별한 요구 사항이 없는 사용 사례에 적용할 수 있는 일반 용도 패턴입니다(예: [Well-Architected - Interoperability](/docs/architect/ko-kr/well-architected/guide/composable#상호-운용성) 참조). 다른 패턴은 여기에 설명된 특정 사용 사례에 적용할 수 있습니다(예: 대용량 데이터를 포함하는 통합 또는 메시지를 더 오래 보관해야 하는 시나리오). ### 패턴 한눈에 보기 아래 표는 이 문서에 요약된 패턴의 특성을 비교합니다. 지정된 사용 사례에 대한 잠재적인 패턴을 식별해야 하는 경우 빠른 참조로 사용합니다.
패턴거의 실시간고유 메시지 복사본보증 배달메시지 크기 줄이기데이터 변환
게시/구독✓✓✓
Fanout✓✓✓
전달된 메시지✓✓✓✓
스트리밍✓✓✓
대기열✓✓✓
### 이벤트 중심 아키텍처용 도구 Salesforce는 이벤트 중심 사용 사례를 해결하는 데 도움이 되는 여러 가지 도구를 제공합니다. 이 표에는 사용 가능한 도구의 상위 수준 개요가 포함되어 있습니다.
도구설명필요한 기술
MuleSoftAnypoint PlatformAPI 계층을 사용하여 데이터 통합을 활성화하는 플랫폼입니다.프로 코드
Salesforce Pub/Sub 커넥터Pub/Sub API용 커넥터 - 플랫폼 이벤트 게시 및 구독, 실시간 이벤트 모니터링, 변경 데이터 수집 이벤트를 위한 단일 인터페이스를 제공합니다.프로 코드
MuleSoft Anypoint JMS ConnectorJMS(Java Message Service) 사양을 구현하는 메시지 서비스의 대기열 및 주제에 메시지를 보내고 받을 수 있는 커넥터입니다.프로 코드
MuleSoft Anypoint Apache Kafka 커넥터Apache Kafka와 엔터프라이즈 응용 프로그램 및 서비스 간 데이터를 이동하는 커넥터프로 코드
MuleSoft Anypoint Solace 커넥터JCSMP Java SDK를 사용하는 네이티브 API 통합을 사용하는 Solace PubSub+ 이벤트 브로커용 커넥터프로 코드
MuleSoft Anypoint MQ Connector고객이 응용 프로그램 간에 고급 비동기식 메시지를 수행할 수 있는 멀티 테넌트 클라우드 메시지 서비스입니다.프로 코드
MuleSoft Anypoint MQTT 커넥터MQTT(Message Queuing Telemetry Transport) v3.x 프로토콜 준수 MuleSoft 확장자입니다.프로 코드
MuleSoft Anypoint AMQP 커넥터응용 프로그램에서 AMQP 0.9.1 준수 브로커를 사용하여 메시지를 게시하고 사용하는 커넥터입니다.프로 코드
MuleSoft Anypoint 이벤트 구동(Async) API이벤트, 채널, 전송 계층으로 구분하여 이벤트 중심 API의 게시를 지원하는 산업별 언어입니다.프로 코드
MuleSoft Anypoint MQ고객이 응용 프로그램 간에 고급 비동기식 메시지를 수행할 수 있는 멀티테넌트 클라우드 메시지 서비스입니다.프로 코드
MuleSoft Anypoint Data Streams스트리밍 데이터를 게시하고 구독하는 MuleSoft Anypoint 내에서 사용할 수 있는 프레임워크입니다.프로 코드
Salesforce PlatformHerooku에서 아파치 카프카Heroku 플랫폼에 전체 플랫폼 통합이 포함된 서비스로 Apache Kafka를 제공하는 Heroku 추가 기능입니다.프로 코드
변경 데이터 수집변경 이벤트 로그 - Salesforce 레코드에 변경 사항을 게시합니다. 변경 사항에는 새 레코드 만들기, 기존 레코드 업데이트, 레코드 삭제, 레코드 삭제 취소가 포함됩니다.하위 코드 -> 프로 코드
아웃바운드 메시지Salesforce 내에서 필드 값이 업데이트될 때 외부 끝점에 XML 메시지를 보내는 작업입니다.낮은 코드
플랫폼 이벤트사용자 정의 이벤트 데이터가 포함된 안전하고 확장 가능한 메시지입니다.하위 코드 -> 프로 코드
Pub/Sub API플랫폼 이벤트, 변경 데이터 수집 이벤트 및/또는 실시간 이벤트 모니터링 이벤트에 대한 구독을 지원하는 API입니다.프로 코드
이벤트 릴레이Salesforce에서 Amazon EventBridge로 전송할 플랫폼 이벤트 및 변경 데이터 수집 이벤트를 활성화합니다. 이벤트 릴레이는 AWS Eventbridge에만 연결됩니다.낮은 코드
### 게시/구독 핵심 응용 프로그램 내에서 중요한 레코드가 상태를 변경하는 경우(예: 주문 상태가 "처리 중"에서 "배송됨"으로 변경됨) 여러 다른 시스템에서 각 과업을 수행하기 위해 거의 실시간으로 알림을 요구할 수 있습니다. 이러한 변경 사항의 용량이 많고 메시지가 복잡한 경우 특정 비즈니스 요구 사항이 발생하므로 기존 지점 간 통합이 부담스럽고 유지 관리하기 어려울 수 있습니다. 모든 종속 응용 프로그램에 대해 취약한 사용자 정의 연결을 설정하면 기술 부채가 발생하고 조직의 신속한 확장 능력이 저하됩니다. 소스 시스템을 모든 소비 시스템에 직접 연결하지 않고 이러한 자주 발생하는 데이터 동기화를 관리하려면 강력한 통합 접근 방식이 필요합니다. #### 게시/구독 패턴 아래 다이어그램은 이벤트 버스를 통해 데이터를 공유하는 여러 게시자 및 구독자가 있는 일반적인 게시/구독 패턴을 보여줍니다. 이 기본 패턴은 이 가이드의 나머지 부분에서 찾을 수 있는 더 구체적인 패턴의 기반이 됩니다. 이 패턴의 일부 주요 특성은 다음과 같습니다. - 게시자와 구독자 간에 직접적인 연결이 없습니다. 게시자는 이벤트 버스에 메시지를 보내기만 하면 해당 메시지를 수신하려는 다른 시스템으로 브로드캐스트합니다. - 동일한 시스템은 게시자 및 구독자일 수 있습니다. - 시스템에서 여러 유형의 이벤트를 게시하거나 구독할 수 있습니다. - 이 가이드의 모든 패턴과 마찬가지로 게시/구독 패턴은 원격 절차 호출(RPI) 또는 단순히 ["화면 및 잊기"로 알려진 일반적인 통합 패턴 범주에 속합니다.](/docs/architect/ko-kr/fundamentals/guide/integration-patterns#원격-프로세스-호출---fire-and-forget) 이 레벨 2 다이어그램은 여러 게시자, 여러 구독자, 이벤트 버스의 채널을 통해 전달되는 여러 이벤트를 포함하는 게시/구독 패턴의 예를 보여줍니다. 이 패턴에서는 동일한 시스템이 모두 게시자와 구독자이고 시스템이 여러 이벤트를 구독할 수 있습니다. #### 게시/구독 패턴과 관련된 도구
이벤트 플로 및 동작페이로드 고려 사항
사용 가능한 도구필요한 기술게시 via구독을 통해재생 기간페이로드 구조페이로드 제한
MuleSoftAnypoint Platform프로 코드APIAPI구성됨사용자 정의됨없음
Salesforce Pub/Sub 커넥터프로 코드APIAPI구성됨사용자 정의됨없음
MuleSoft Anypoint JMS Connector프로 코드APIAPI구성됨사용자 정의됨없음
MuleSoft Anypoint Apache Kafka 커넥터프로 코드APIAPI구성됨사용자 정의됨없음
MuleSoft Anypoint Solace 커넥터프로 코드APIAPI구성됨사용자 정의됨없음
MuleSoft Anypoint MQ Connector프로 코드APIAPI구성됨사용자 정의됨없음
MuleSoft Anypoint MQTT 커넥터프로 코드APIAPI구성됨사용자 정의됨없음
MuleSoft Anypoint AMQP 커넥터프로 코드APIAPI구성됨사용자 정의됨없음
MuleSoft Anypoint 이벤트 구동(Async) API프로 코드APIAPI구성됨사용자 정의됨없음
MuleSoft Anypoint MQ프로 코드APIAPI구성됨사용자 정의됨없음
Salesforce PlatformHerooku에서 아파치 카프카프로 코드API, Heroku Postgres의 레코드 변경 사항N/A1~6주사용자 정의됨사용자 정의됨
변경 데이터 수집하위 코드 -> 프로 코드레코드 변경 사항Apex, API, Lightning 웹 구성 요소(LWC)3일사전 정의됨1MB
아웃바운드 메시지*낮은 코드플로 및 워크플로 규칙N/A24시간사용자 정의됨메시지당 100개의 알림
플랫폼 이벤트하위 코드 -> 프로 코드API, Apex, 플로Apex, API, 플로, LWC3일사용자 정의됨1MB
Pub/Sub API프로 코드Pub/Sub API 또는 API, Apex, 플로Pub/Sub API3일사용자 정의됨1MB
이벤트 릴레이**낮은 코드플랫폼 이벤트, 변경 데이터 수집API3일사용자 정의됨1MB
*Salesforce는 현재 기능 기능 내에서 아웃바운드 메시지를 계속 지원하지만 이 기술에 대한 추가 투자를 계획하지 않습니다. **이벤트 릴레이는 AWS Eventbridge에만 연결됩니다.
### Fanout 조직이 모바일 장치에 푸시 알림 또는 SMS 메시지와 같은 대규모 클라이언트 응용 프로그램에 즉각적인 업데이트를 보내야 하는 경우 모든 단일 수신자에 대해 고유한 전송을 만드는 기존 프로세스가 빠르게 확장성 지체가 됩니다. 이 경우 핵심 비즈니스 요구 사항은 계정 경고 또는 중요한 서비스 변경 알림과 같은 단일 정보의 빠르고 고성능한 배포를 여러 엔드포인트 응용 프로그램에 동시에 수행하는 것입니다. 이 요구 사항을 충족하기 위한 간소화된 접근 방식은 모든 메시지를 단일 대기열을 통해 라우팅하는 것을 포함하며, 이는 모든 소비 시스템에 대한 이벤트 정보의 중앙 지점 역할을 합니다. 이 접근 방식은 여러 개의 별도의 메시지 사본을 관리할 필요가 없어 성능을 향상합니다. #### Fanout 패턴 fanout 패턴을 사용하면 단일 메시지 대기열을 통해 하나 이상의 대상(즉, 클라이언트 또는 구독자 수신)에 메시지가 전달됩니다. 구독자는 고유한 사본이 아닌 대기열에서 동일한 메시지를 검색합니다. 성능이 향상되지만 특정 구독자가 메시지를 수신했는지 여부를 확인하기가 더 어려울 수 있습니다. 이 레벨 3 문서 및 구현 다이어그램은 응용 프로그램 패턴의 예를 보여줍니다. 레코드가 사용자 상호 작용, 플로 또는 배치 작업을 통해 수정될 때 하나의 대기열에 게시되고 작성되는 이벤트를 보여줍니다. 구독자 시스템에는 메시지 대기열에서 동일한 이벤트를 수신하는 여러 서비스가 있습니다. #### Fanout 패턴과 관련된 도구
이벤트 플로 및 동작페이로드 고려 사항
사용 가능한 도구필요한 기술게시 via구독을 통해재생 기간페이로드 구조페이로드 제한
MuleSoftMuleSoft Anypoint JMS Connector프로 코드APIAPI구성됨사용자 정의됨없음
Salesforce Pub/Sub 커넥터프로 코드APIAPI구성됨사용자 정의됨없음
MuleSoft Anypoint Apache Kafka 커넥터프로 코드APIAPI구성됨사용자 정의됨없음
MuleSoft Anypoint Solace 커넥터프로 코드APIAPI구성됨사용자 정의됨없음
MuleSoft Anypoint MQ Connector프로 코드APIAPI구성됨사용자 정의됨없음
MuleSoft Anypoint MQTT 커넥터프로 코드APIAPI구성됨사용자 정의됨없음
MuleSoft Anypoint AMQP 커넥터프로 코드APIAPI구성됨사용자 정의됨없음
MuleSoft Anypoint MQ프로 코드APIAPI구성됨사용자 정의됨없음
Salesforce PlatformHerooku에서 아파치 카프카프로 코드API, Heroku Postgres의 레코드 변경 사항N/A1~6주사용자 정의됨사용자 정의됨
변경 데이터 수집하위 코드 -> 프로 코드레코드 변경 사항Apex, API, Lightning 웹 구성 요소(LWC)3일사전 정의됨1MB
플랫폼 이벤트하위 코드 -> 프로 코드API, Apex, 플로Apex, API, 플로, LWC3일사용자 정의됨1MB
Pub/Sub API프로 코드Pub/Sub API 또는 Apex, API, 플로Pub/Sub API3일사용자 정의됨1MB
이벤트 릴레이*낮은 코드플랫폼 이벤트, 변경 데이터 수집API3일사용자 정의됨1MB
*이벤트 릴레이는 AWS Eventbridge로만 데이터를 전송합니다.
### 전달된 메시지 일부 이벤트 시나리오는 동기화 및 변환 프로세스의 용량을 압도할 위험이 있는 메시지 볼륨의 상당한 유입 또는 이벤트 데이터를 처리하고 변환하는 데 필요한 복잡한 다단계 논리로 특징화됩니다. 일부 예는 다음과 같습니다. - **계절 볼륨 급증:** 선택 제품이 "계절에 있음"일 때 온라인 소매업체가 경험하는 볼륨이 급증할 수 있습니다. 많은 고객이 동시에 구매하는 경우 생성된 이벤트 수가 일시적으로 동기화 및 변환 프로세스의 용량을 초과할 수 있습니다. 자세한 내용은 [Well-Architected - Data Handling](/docs/architect/ko-kr/well-architected/guide/automated#데이터-처리)을 참조하십시오. - **사례 또는 청구 관리:** 서비스 기반 회사는 중단 시 사례 또는 청구 수가 급증할 수 있습니다. - **복잡한 데이터 변환:** 메시지를 변환하기 위해 복잡한 논리가 필요한 조직은 변환할 수 없는 속도로 생성되는 이벤트가 걱정되는 경우가 많습니다. #### 전달된 메시지 패턴 이 패턴은 변환할 수 없는 속도로 메시지가 생성되는 문제를 해결합니다. 스트리밍 메시지 플랫폼을 통합하고 메시지 처리 논리를 전용 구성 요소에 세분화하여 대용량 메시지 및 필수 데이터 조작을 신뢰할 수 있도록 합니다. 전달된 메시지 패턴은 메시지 처리 논리를 여러 구성 요소로 세분화하여 작동합니다. - 한 구성 요소가 메시지 라우팅을 처리하여 필수 변환 및 최종 대상을 결정합니다. - 별도의 구성 요소 집합은 다양한 메시지 변환 계층(예: 필드 매핑, 개체 관계 등)을 처리합니다. - 마지막 구성 요소는 최종 수정된 메시지를 작성합니다. 이 레벨 3 문서 및 구현 다이어그램은 게시자, 구독자 및 메시지를 포함하는 전달된 메시지 패턴에 대한 프로세스 흐름의 예를 보여줍니다. 메시지는 여러 부분으로 분할되어 개별적으로 변환되고 구독자에게 전송되기 전에 다시 조립됩니다. #### 전달된 메시지 패턴과 관련된 도구
이벤트 플로 및 동작페이로드 고려 사항
사용 가능한 도구필요한 기술게시 via구독을 통해재생 기간페이로드 구조페이로드 제한
MuleSoftMuleSoft Anypoint Apache Kafka 커넥터프로 코드APIAPI구성됨사용자 정의됨없음
Salesforce Pub/Sub 커넥터프로 코드APIAPI구성됨사용자 정의됨없음
Salesforce PlatformHerooku에서 아파치 카프카프로 코드API, Heroku Postgres의 레코드 변경 사항N/A1~6주사용자 정의됨사용자 정의됨
변경 데이터 수집하위 코드 -> 프로 코드레코드 변경 사항Apex, API, Lightning 웹 구성 요소(LWC)3일사전 정의됨1MB
플랫폼 이벤트하위 코드 -> 프로 코드API, Apex, 플로Apex, API, 플로, LWC3일사용자 정의됨1MB
Pub/Sub API프로 코드Pub/Sub API 또는 API, Apex 플로Pub/Sub API3일사용자 정의됨1MB
이벤트 릴레이*낮은 코드플랫폼 이벤트, 변경 데이터 수집API3일사용자 정의됨1MB
*이벤트 릴레이는 AWS Eventbridge로만 데이터를 전송합니다.
### 스트리밍 일부 프로듀서는 이벤트의 연속 스트림을 생성합니다. 일반적인 예로는 미디어 스트리밍으로서 자연스럽게 개별 이벤트로 발생하는 사용자 상호 작용이 수반됩니다. 핵심 스트리밍 환경을 차단하지 않고 여러 시스템이 동일한 사용자 동작에 동시에 반응해야 합니다. 음악 스트리밍 플랫폼에 대한 이벤트를 고려하십시오. 다음이 포함될 수 있습니다. - 시작/일시 중지됨/ 건너뛰기 이벤트 추적 - 타임스탬프를 사용하여 세션 이벤트 듣기 - 재생 목록 만들기/수정 이벤트 - 소셜 공유 이벤트 - 오프라인 수신용 다운로드 #### 스트리밍 패턴 스트리밍 패턴에서 구독자는 각 이벤트 스트림에 액세스하고 수신된 정확한 순서대로 이벤트를 처리합니다. 각 구독자에게 각 메시지 스트림의 고유 사본이 전송되므로 구독자별 콘텐츠를 전달하고 어떤 구독자가 어떤 스트림을 수신하는지 식별할 수 있습니다. 이 레벨 3 문서 및 구현 다이어그램은 게시되는 이벤트 스트림을 보여주는 스트리밍 패턴의 예를 보여줍니다. 스트림을 듣는 구독자는 스트림을 수신하고 그에 따라 처리합니다. #### 스트리밍 패턴과 관련된 도구
이벤트 플로 및 동작페이로드 고려 사항
사용 가능한 도구필요한 기술게시 via구독을 통해재생 기간페이로드 구조페이로드 제한
MuleSoftMuleSoft Anypoint Data Streams프로 코드APIAPI구성됨사용자 정의됨없음
Salesforce Pub/Sub 커넥터프로 코드APIAPI구성됨사용자 정의됨없음
MuleSoft Anypoint Apache Kafka 커넥터프로 코드APIAPI구성됨사용자 정의됨없음
Salesforce PlatformHerooku에서 아파치 카프카프로 코드API, Heroku Postgres의 레코드 변경 사항N/A1~6주사용자 정의됨사용자 정의됨
Pub/Sub API프로 코드Pub/Sub API 또는 API, Apex 플로Pub/Sub API3일사용자 정의됨1MB
#### 스트리밍된 이벤트 주문 관리 스트림을 이해하려면 모든 이벤트와 관련 메시지가 올바른 순서로 표시되어야 합니다. 다른 시스템에서 스트림의 데이터를 소싱하는 경우 추가 주문 논리를 설계 프로세스의 일부로 통합해야 합니다. ### 대기열 대기열 사용 사례는 모든 곳에 존재합니다. 예: - **저품질 인터넷 연결:** 해당 장치의 응용 프로그램이 대기열에 연결하고 연결이 복원되면 관련 메시지를 검색할 수 있으므로 Field Service 조직 또는 모바일 장치가 있는 팀이 품질이 낮거나 간헐적으로 인터넷에 액세스하는 영역에서 작업해야 하는 기타 조직은 대기열에서 혜택을 누릴 수 있습니다. - **메시지 버퍼링:** 메시지 용량이 구독자의 처리 용량을 가끔 초과하고 대기 시간이 증가하면 추가적인 문제가 발생하지 않으면 대기열이 초과 메시지를 저장하고 데이터 손실을 방지하는 버퍼가 될 수 있습니다. - **교통 관리:** 플리트를 모니터링해야 하는 물류 조직은 이 패턴을 사용하여 각 차량이 사용 중인 경로를 거의 실시간으로 보고 운전자가 가능한 한 효율적으로 작업하는지 확인할 수 있습니다. - **IoT 장치:** 제조업체는 빠른 데이터 스트림을 생성하는 시스템을 자주 사용하며, 해당 스트림은 추가 시스템에 다운스트림 영향을 미칠 수 있습니다. 이 패턴은 여러 시스템에 걸친 재해적 오류가 발생하기 전에 사람이 개입해야 하는 이벤트의 시퀀스를 식별하는 데 사용할 수 있습니다. #### 대기열 패턴 대기열 패턴에서 프로듀서는 대기열에 메시지를 보내고, 구독자가 메시지를 검색할 때까지 메시지를 보관합니다. 대부분의 메시지 대기열은 FIFO(Primer In, First Out) 순서를 따르며 검색 후 모든 메시지를 삭제합니다. 각 구독자에게는 고유한 대기열이 있으므로 추가 설정 단계가 필요하지만, 배달을 보장하고 어떤 구독자가 어떤 메시지를 수신했는지 식별할 수 있습니다. 이 레코드가 수정될 때 이벤트가 게시되고 대기열에 기록되는 대기열 패턴의 예를 보여주는 레벨 3 문서 및 구현 다이어그램입니다. 가입자는 연결된 대기열에서 이벤트 사본을 수신하고 자신의 레코드에 적절한 업데이트를 수행합니다. #### 대기열 패턴과 관련된 도구
이벤트 플로 및 동작페이로드 고려 사항
사용 가능한 도구필요한 기술게시 via구독을 통해재생 기간페이로드 구조페이로드 제한
MuleSoftMuleSoft Anypoint MQ프로 코드APIAPI구성됨사용자 정의됨없음
Salesforce Pub/Sub 커넥터프로 코드APIAPI구성됨사용자 정의됨없음
MuleSoft Anypoint Apache Kafka 커넥터프로 코드APIAPI구성됨사용자 정의됨없음
MuleSoft Anypoint MQ Connector프로 코드APIAPI구성됨사용자 정의됨없음
MuleSoft Anypoint MQTT 커넥터프로 코드APIAPI구성됨사용자 정의됨없음
MuleSoft Anypoint AMQP 커넥터프로 코드APIAPI구성됨사용자 정의됨없음
Salesforce PlatformHerooku에서 아파치 카프카프로 코드API, Heroku Postgres의 레코드 변경 사항N/A1~6주사용자 정의됨사용자 정의됨
변경 데이터 수집하위 코드 -> 프로 코드레코드 변경 사항Apex, API, Lightning 웹 구성 요소(LWC)3일사전 정의됨1MB
플랫폼 이벤트하위 코드 -> 프로 코드API, Apex, 플로Apex, API, 플로, LWC3일사용자 정의됨1MB
Pub/Sub API프로 코드Pub/Sub API 또는 API, Apex, 플로Pub/Sub API3일사용자 정의됨1MB
이벤트 릴레이*낮은 코드플랫폼 이벤트, 변경 데이터 수집API3일사용자 정의됨1MB
*이벤트 릴레이는 AWS Eventbridge로만 데이터를 전송합니다.
#### 메모리 및 저장소 관리 대기열 패턴의 비동기적 특성으로 인해 대기열에 추가되는 메시지와 검색되는 메시지 사이에 긴 지연이 있을 수 있습니다. 대기열에는 메시지를 보관하는 메모리 또는 저장소 공간이 필요하므로 무기한으로 증가할 수 없습니다. 즉, 대기열에 메시지가 충분히 구축되면 무기한으로 오프라인 상태인 구독자가 실패할 수 있습니다. 구독자 처리 시간이 너무 길면 메시지 버퍼링이 동일한 영향을 미칠 수 있으므로 대기열에 많은 양의 메시지가 구축됩니다. 이러한 위험을 완화하려면 모든 메시지 대기열에 대한 철저한 저장소 요구 사항 분석을 수행하고 필요한 경우 메시지가 설정된 시간 내에 검색되지 않거나 사전 결정된 볼륨에 도달하면 대기열을 제거하고 비활성화하는 프로세스를 설계합니다. ## 기능이 아닌 고려 사항 ### 지점 간 통합에서 마이그레이션 이벤트 기반 아키텍처가 조직에 적합하다고 확신하는 경우에도 이미 많은 지점 간 통합이 있는 환경에서 시작할 수 있습니다. 모든 통합을 한 번에 대체하기 위해 프로젝트에 대한 자금을 확보하는 것은 어려울 수 있으며 일부 레거시 시스템에서 이벤트 중심 아키텍처를 직접 사용할 수도 없습니다. 이러한 시나리오에서 가장 비즈니스에 중요한 응용 프로그램을 먼저 변환한 다음, 향후 프로젝트에서 업데이트되거나 교체될 때 다른 시스템을 변환하여 더 느슨하게 연결된 아키텍처로 마이그레이션하는 증분 접근 방식을 취할 수 있습니다. 이 접근 방식을 통해 이벤트 버스에 새 응용 프로그램을 쉽게 추가할 수 있으며, 시간이 지남에 따라 시스템이 계속해서 추가되면서 전반적인 IT 환경이 확장 가능하고 복원 가능해집니다. ### 느슨하게 연결된 시스템 내 제약 설계자는 모든 아키텍처에 제약이 있다는 사실을 알고 있습니다. 이벤트 중심 아키텍처는 예외가 아닙니다. 매끄럽게 연결된 시스템으로 가득한 환경은 확장성이 높고 복원성이 뛰어나지만 고려해야 할 몇 가지 제약 사항도 있습니다. - **전체적 통합 전략:** 사용하기로 결정한 도구 및 패턴과 상관없이 조직의 다양한 시스템에서 데이터를 공유하는 방법에 대한 전략을 시작하는 것이 중요합니다. 이 전략에는 조직의 데이터 목표, 데이터를 공유할 수 있는 방법, 사용되는 패턴, 데이터 소스, 목표, 구조, 소유권 및 액세스 요구 사항이 포함되어야 합니다. - **레거시 시스템 지원:** 조직에 단순히 이벤트 중심 아키텍처 패턴을 지원하지 않는 기존 시스템이 있을 수 있습니다. 해결 방법을 구축할 수 있지만(예: 이벤트를 구독한 후 다른 데이터 전송 수단을 통해 대상 시스템에 출력을 보내는 방식으로 진행 방법으로 작동하는 프로세스) 이 경우 다른 통합 방법을 고려할 수 있습니다. - **메시지의 구조적 변경:** 게시자와 구독자 간에 초기 메시지 구조가 정의되고 동의되면 특히 구독자가 외부인 경우 변경하기 어려울 수 있습니다. 이 문제를 해결할 수 있는 몇 가지 방법이 있습니다. 버전이 지정된 끝점을 사용할 수 있지만 개발자가 너무 많은 버전을 동시에 유지할 필요가 없도록 각 버전에 대해 명확한 수명 주기를 정의하고 전달해야 합니다. Heroku의 아파치 카프카가 가로에 속하는 경우 스키마 레지스트리 또는 유사한 도구도 고려할 수 있지만 가로에 있는 다른 시스템에서도 지원하고 사용해야 합니다. - **발행자와 가입자 간의 가시성 부족:** 대부분의 이벤트 중심 아키텍처 패턴에서 게시자는 구독자의 상태를 인식하지 못합니다. 따라서 모든 구독자가 오프라인 상태인 동안 게시자가 중요 메시지를 보내는 경우 메시지가 전달되지 않을 수 있습니다. 재생 기능을 사용하거나 모든 중요 메시지에 대해 별도의 서버에서 실행되는 중복 구독자를 추가하여 이 문제를 해결할 수 있습니다. - **성능 병목:** 이벤트 중심 아키텍처가 확장되면 너무 많은 게시자가 동시에 너무 많은 구독자에게 메시지를 보내려고 하면 이벤트 버스가 메시지 전달의 지체가 될 수 있습니다. 이벤트 버스에 할당된 메모리 및 처리 자원을 늘리거나 여러 이벤트 버스를 사용하여 다양한 유형의 메시지를 병렬로 처리하여 문제를 해결할 수 있습니다. ## 관련 모범 사례 ### 이벤트 중심 아키텍처 구현 이벤트 기반 아키텍처를 구현하기 전에 먼저 실제로 사용해야 하는지 고려하십시오. 이전 섹션에서는 각 이벤트 중심 아키텍처 패턴에 적합한 일반적인 비즈니스 시나리오를 설명합니다. [Well-Architected - Interoperability](/docs/architect/ko-kr/well-architected/guide/composable#상호-운용성) 에서 자세히 읽을 수 있습니다. 이벤트 기반 아키텍처를 구현할 때 고려해야 할 챌린지를 검토하여 고려하는 패턴이 특정 사용 사례에 가장 적합한지 판단합니다. 이 가이드에 포함된 대부분의 시나리오에는 통합이 포함되어 있지만 이벤트 중심 아키텍처를 사용하여 예를 들어 플랫폼 이벤트를 사용하여 단일 Salesforce 조직 내에서 메시지를 보낼 수도 있습니다. 플랫폼 이벤트를 내부 메시징 시스템으로 사용하는 프로세스를 설계할 때 해당하는 [이벤트 할당 제한](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_event_limits.htm)을 고려하십시오. ### 안티 패턴 방지 이벤트 중심 아키텍처에 대한 안티 패턴은 Salesforce 조직 내에서 내부 커뮤니케이션에 대한 해결 방법으로 이벤트를 사용하여 발생하는 경우가 많습니다. 일반적인 안티 패턴은 다음과 같습니다. - **동일한 이벤트 개체와 연결된 Apex 트리거에서 이벤트 게시:** 이렇게 하면 무한 트리거 루프가 생깁니다. - **DML 트랜잭션이 완료되기 전에 Apex에서 이벤트 게시:** 트랜잭션이 실패하고 롤백되는 경우 즉시 게시 동작이 있는 게시된 이벤트는 롤백 동작에 포함되지 않습니다. - **다음 자동화를 오케스트레이션하기 위해 Flow에서 이벤트 게시:** 여러 자동화 간에 논리를 조정하는 가장 좋은 방법은 [하위 플로](https://developer.salesforce.com/docs/atlas.en-us.salesforce_vpm_implementation_guide.meta/salesforce_vpm_implementation_guide/vpm_designer_elements_subflow.htm) 또는 [플로 오케스트레이터](https://help.salesforce.com/s/articleView?id=sf.orchestrator_flow_orchestrator.htm)를 사용하는 것입니다. - **런타임 종속성 만들기:** 런타임 종속성을 제거하기 위해 적절한 [단계를](https://medium.com/salesforce-architects/5-anti-patterns-in-package-dependency-design-and-how-to-avoid-them-87bb50331cb8) 취하지 않고도 패키지 간의 통신을 촉진하기 위해 이벤트를 게시하지 마십시오. - **불필요하게 큰 페이로드:** 요청할 때 페이로드에서 가능한 한 적은 양의 데이터를 보내서 받는 것이 가장 좋습니다. 사용자의 모든 작업이 잠재적으로 여러 요청을 생성할 수 있으며, 해당 요청을 효율적으로 처리하는 것이 중요합니다. 필요보다 많은 데이터를 보내도 전송 속도가 느려지고 처리 시간이 늘어날 수 있습니다. - **응용 이벤트의 무선 처리:** 응용 프로그램 이벤트를 수신하는 구성 요소가 여러 개인 경우 개발자는 이벤트 처리기가 실제로 원하고 유용한 경우에만 실행되는지 확인해야 합니다. 예를 들어 Lightning 콘솔에서 포커스가 맞지 않은 탭에 포함된 구성 요소는 보이지 않더라도 여전히 청취할 수 있습니다. 개발자는 백그라운드 유틸리티 항목을 유일한 수신자로 사용하거나 getEnclosingTabId() 호출과 같은 다양한 기법을 사용하여 이 구성 요소의 인스턴스가 초점이 맞춰진 탭 내에 묶여 있는지 여부를 판단하여 각 이벤트가 의도한 경우에만 처리되도록 할 수 있습니다. - **플랫폼 이벤트를 사용하여 잘못된 게시 동작:** 플랫폼 이벤트에는 즉시 게시 및 커밋 후 게시의 두 가지 게시 동작이 있습니다. 트랜잭션 성공 및 커밋 여부와 상관없이 로깅 이벤트를 게시하려는 사용 사례에 실시간 플랫폼 이벤트를 사용할 수 있습니다. 그러나 실시간 플랫폼 이벤트에 Publish Immediately를 매우 주의 깊게 사용하십시오. 이벤트는 같은 트랜잭션 내에서 구독자가 소비할 수 있으며 행 잠금 또는 기타 경쟁 조건을 야기할 수 있습니다. ### 효과적인 이벤트 설계 이벤트 중심 아키텍처를 구현할 때 성공의 핵심 중 하나는 이벤트 자체가 설계되는 방법에 대한 표준을 설정하는 것입니다. 세부 사항은 조직의 사용 사례에 따라 다르지만 다음은 몇 가지 일반 지침입니다. - **이벤트 페이로드에 최적의 구조를 결정합니다.** 메시지 크기가 작을수록 처리 시간이 줄어들지만, 메시지 볼륨이 대량인 구독자를 폭격하면 성능 지체가 발생할 수 있습니다. 적절한 균형을 찾으려면 페이로드 크기 및 구조를 반복해야 할 수 있습니다. MuleSoft 및 유사한 ESB 도구는 이벤트와 관련된 메시지에서 사용자 정의 페이로드를 설계할 수 있는 기능을 제공하며, 이를 통해 데이터 구조를 시각화하여 구독자 측의 성능을 개선할 수 있습니다. (자세한 내용은 [Well-Architected - API Management](/docs/architect/ko-kr/well-architected/guide/composable#api-관리)를 참조하십시오.) - **단계별로 프로세스를 생각해 보십시오.** 통합이 롤아웃되면 추적하기 어려울 수 있는 "무종일 루프" 시나리오를 만들지 마십시오. 이러한 예는 레코드가 업데이트될 때 이벤트를 게시하는 두 시스템이며, 레코드가 처리될 때 추가 게시된 이벤트를 트리거하는 서로의 이벤트를 듣는 동시에 있습니다. 소비되는 이벤트로 인해 변경된 논리를 통해 새 이벤트가 게시되지 않도록 두 시스템 모두에 추가하여 이 유형의 안티 패턴을 수정할 수 있습니다. 모든 이벤트, 관련 트리거, 영향을 받을 수 있는 다운스트림 시스템도 문서화해야 합니다. 설계 세션 중에 이 문서를 참조로 사용하여 가능한 한 빨리 무한 루프 및 유사한 시나리오를 파악할 수 있습니다. (자세한 내용은 [Well-Architected - Process Design](/docs/architect/ko-kr/well-architected/guide/automated#프로세스-설계)을 참조하십시오.) - **시스템 간 공통 명명 규칙 사용하기.** 일관된 명명 규칙은 이벤트 중심 아키텍처를 포함하여 모든 소프트웨어 개발에 대한 모범 사례입니다. 이벤트 이름, 구조, 관련 개체, 오류 처리 프로세스에 대한 일관성을 보장하기 위해 시간을 내어 일련의 표준을 문서화합니다. (자세한 내용은 [Well-Architected - Design Standards](/docs/architect/ko-kr/well-architected/guide/intentional#설계-표준)를 참조하십시오.) ## 자원
패턴자원
게시/구독Salesforce 솔루션 - 처리량
Salesforce - 데이터 처리
Salesforce의 올바른 설계 - 상호 운용성
블로그 게시물: 이벤트 릴레이로 아키텍처 효율성 달성
블로그 게시물: Pub/Sub API 정식 출시 발표
블로그 게시물: RESTful에서 Eventful으로 이동
블로그 게시물: 이벤트 기반 아키텍처 및 AsyncAPI 사양
비디오: 게시 / 구독 패턴 연습
Fanout블로그 게시물: 플랫폼 이벤트 배달 제한 내에서 작업하는 방법
비디오: Fanout 패턴 연습
전달된 메시지비디오: 전달된 메시지 패턴 연습
스트리밍블로그 게시물: Salesforce에서 대용량 쓰기를 위한 설계
비디오: 스트리밍 패턴 연습
문서: Mule 앱에서 스트리밍
대기열블로그 게시물: Salesforce에서 대용량 쓰기를 위한 설계
블로그 게시물: Evented API를 사용하여 결제 아키텍처를 설계하는 방법
비디오: 대기열 패턴 연습
# 통합 결정 가이드 시작하기 이 섹션에서는 Salesforce에 적합한 데이터 통합 도구 및 접근 방식을 선택하기 위한 실용적인 지침을 제공합니다. 아웃바운드 통합, 인바운드 통합, 교차 조직 시나리오에 대해 다루며, 설계자가 성능, 유지 관리 기능, 비용의 균형을 맞추는 데이터 계층 통합을 설계 및 구현할 수 있도록 지원합니다. --- ## Salesforce와 데이터 통합 [Salesforce 데이터 통합](/docs/architect/ko-kr/decision-guides/guide/data-integration)은 Salesforce 데이터 통합 도구 및 모범 사례에 대한 포괄적인 개요를 제공합니다. - **통합 도구 환경**: 특정 사용 사례에 적합한 도구를 선택하는 방법에 대한 지침과 함께 하위 코드, 하이브리드, 프로 코드 옵션 등 Salesforce 데이터 통합 도구의 개요입니다. - **아웃바운드 통합**: 변경 데이터 수집, 외부 서비스, Heroku Connect, OmniStudio 통합 절차, Salesforce Connect, MuleSoft Anypoint 및 사용자 정의 Apex 솔루션을 비롯한 Salesforce에서 외부 시스템으로 데이터를 보내는 방법입니다. - **인바운드 통합**: 데이터 복제 및 가상화와 각 도구를 사용하는 시기에 대한 지침과 함께 외부 데이터를 Salesforce로 가져오는 방법입니다. - **교차 조직 통합**: MuleSoft Anypoint, Heroku Connect, 네이티브 Salesforce API, 변경 데이터 수집, Salesforce Salesforce Connect 및 Cross-Org 어댑터를 사용하여 레거시 Salesforce-to-Salesforce 구현을 교체하는 지침을 포함하여 Salesforce 조직 간 데이터 공유를 위한 권장 방법입니다. - **결정 프레임워크**: 기존 도구 및 환경, 데이터 플로 요구 사항(타이밍, 방향, 예상 사용자 환경), 구현 복잡성, 유지 관리 가능성, 데이터 용량, 플랫폼 제한 등 통합 도구를 선택하기 위한 주요 고려 사항 설계자가 각 시나리오에 적합한 통합 도구 및 패턴을 선택하여 불필요한 데이터 복제를 최소화하고 기존 ESB/ETL 솔루션을 활용하며 엔터프라이즈 아키텍처 원칙에 부합하는 확장 가능한 유지 관리 가능한 통합을 보장할 수 있습니다. # 플랫폼 결정 가이드 시작하기 이 섹션에서는 Salesforce Platform 기능에 대한 중요 아키텍처 결정을 내릴 수 있는 실용적인 지침을 제공합니다. 여기에는 비동기 처리, 레코드 트리거 이벤트, 양식 구축, 이벤트 중심 아키텍처, 단계 기반 비동기 프레임워크가 포함되어 있어 설계자가 확장 가능, 유지 가능, 고성능 플랫폼 솔루션을 설계할 수 있습니다. --- ## 비동기식 처리 [비동기 처리](/docs/architect/ko-kr/decision-guides/guide/async-processing)은 Salesforce에서 비동기 작업을 위한 도구 및 접근 방식에 대한 지침을 제공합니다. - **비동기식 처리 도구**: 대기 가능한 Apex, 예약된 Apex, 플랫폼 이벤트 트리거, 변경 데이터 수집, 예약 경로(커밋 플로 후) 및 비동기 경로(레코드 트리거 플로)의 비교 및 적절한 사용 사례에 대한 지침. - **서버측 비동기식 처리**: 장기 실행 데이터베이스 작업, 외부 콜아웃, 대용량 레코드 처리를 위한 패턴입니다. - **클라이언트측 비동기식 처리**: 브라우저 또는 모바일 앱에서 실행될 수 있는 Apex 계속 콜아웃 및 클라이언트측 비동기 처리와 같은 기술 - **결정 프레임워크**: 사용 사례 유효성 검사, 확장성, 트랜잭션이 실제로 비동기식일 때의 이해, 대량 로드 이벤트 모니터링, 처리를 고려하십시오. - **모범 사례 및 방지 패턴**: 아웃바운드 통합, 모니터링, 일반적인 함정을 피하는 등 적절한 사용 지침 설계자가 확장 가능하고 신뢰할 수 있으며 유지 관리 가능한 비동기 패턴을 구현하여 성능을 저하하는 함정을 피할 수 있습니다. --- ## 건물 양식 [만들기 양식](/docs/architect/ko-kr/decision-guides/guide/build-forms)은 Salesforce 양식 작성 옵션에 대해 아키텍트에게 안내합니다. - **폼 작성 도구**: 동적 양식, 화면 플로, OmniStudio, Lightning 웹 구성 요소(LWC) 및 LWC의 화면 플로와 기술 및 라이센스 고려 사항을 비교합니다. - **결정 프레임워크**: 개체 영향, 양식 범위, 탐색, 위치(앱, 모바일, 웹), UX, 테스트 자동화를 고려합니다. - **도구 선택 지침**: 간단한 레코드 레이아웃에서 다중 페이지 마법사 및 브랜드화된 고객 대면 양식에 이르는 권장 사항입니다. - **조합 패턴**: 도구를 결합하는 지침입니다(예: LWC 스타일링과 화면 플로 탐색). - **고급 기능**: 기능 및 제한 사항을 자세히 살펴보고 도구 선택을 알립니다. 설계자는 특정 UX, 기능, 통합 요구 사항에 맞는 양식 작성 접근 방식을 선택할 수 있습니다. --- ## 이벤트 중심 아키텍처 [이벤트 기반 아키텍처](/docs/architect/ko-kr/decision-guides/guide/event-driven)는 Salesforce 이벤트 도구 및 패턴에 대한 포괄적인 가이드를 제공합니다. - **Eventing Tools**: 플랫폼 이벤트, 변경 데이터 수집, Pub/Sub API, MuleSoft Anypoint, 스트리밍 API 및 통합 고려 사항의 개요. - **이벤트 중심 패턴**: 다양한 이벤트 중심 사용 사례에 대한 게시/구독, 폴아웃, 전달된 메시지, 스트리밍, 대기열 지정 패턴을 포함합니다. - **MuleSoft와의 통합**: 엔터프라이즈 아키텍처에 Anypoint 커넥터(Pub/Sub, JMS, Kafka, Solace, MQ, MQTT, AMQP) 사용 - **플랫폼 이벤트 및 변경 데이터 수집**: PushTopic/Generic 이벤트에서 마이그레이션을 사용하여 레코드 및 필드 변경 사항을 게시하기 위한 기본 메커니즘에 대한 지침입니다. - **구현 패턴**: 확장성, 일관성, 오류 처리, 모니터링에 대한 모범 사례입니다. 설계자가 여러 시스템을 효율적으로 연결하는 확장 가능한 거의 실시간 이벤트 중심 시스템을 설계할 수 있습니다. --- ## 단계 기반 비동기 프레임워크 [단계형 비동기식 프레임워크](/docs/architect/ko-kr/decision-guides/guide/step-based-async-framework)는 모듈식으로 확장 가능한 비동기식 작업 처리를 위한 프레임워크를 제공합니다. - **프레임워크 아키텍처**: 구성 요소에는 Queueable Apex, Finalizers, Scheduled Flow, Apex 커서, 호출 가능한 작업 및 Slack 통합이 포함됩니다. - **단계별 처리**: 공유된 거버넌스 및 운영 가시성을 사용하여 실행, 재시도, 다시 시작할 수 있는 독립 단계로 작업을 중단합니다. - **실행 지침**: 단계 인터페이스, 단계 처리기, Apex 호출 가능 레이어, 지연 처리 및 알림에 대한 패턴 - **모범 사례**: 대용량 작업 로드 및 계층 또는 트리 기반 레코드 처리의 경우 CRM에 대부분의 정보가 있는 경우 권장됩니다. 사용하지 않는 경우에 대한 지침입니다. - **엔터프라이즈급 기능**: 거버넌스, 규정 준수, 분산된 상태, 진행률 추적, SLA 모니터링, 오류 진단, 감사 수준 로깅 설계자에게 모노리틱 배치 작업 및 체인식 비동기 호출에 대한 확장 가능한 대안을 제공하여 대용량 Salesforce 워크로드를 완벽한 운영 투명도로 지원합니다. --- ## 레코드 트리거형 자동화 [레코드 트리거형 자동화](/docs/architect/ko-kr/decision-guides/guide/record-triggered)는 Salesforce Platform에서 레코드 트리거형 자동화를 설계하는 프레임워크를 제공합니다. - **도구 선택**: 자동화 밀도(낮음, 중간, 높음) 및 밀도 선택 매트릭스에 따라 레코드 트리거형 플로와 Apex 트리거를 사용해야 하는 시기 - **자동화 밀도**: 자동화 수량, 레코드 용량 및 종속성 확산을 평가하는 방법 플로, 하이브리드(Invocable Apex 포함 플로) 또는 Apex 트리거를 선택합니다. - **진입점 및 거버넌스**: Salesforce 개체당 하나의 진입점, 항목 조건, 반복 제어, 순서가 지정된 실행에 대한 지침 - **비동기식 호출**: 오류 처리 및 총괄자 제한에 주의하여 레코드 트리거 플로 또는 Apex 비동기 프로세스를 호출하는 시기 및 방법 - **모범 사례**: 대량 처리, 하이브리드 Flow–Apex 설계 및 트리거 자동화의 일반적인 함정을 피하는 패턴 설계자가 플랫폼 표준에 맞춰 확장 가능, 유지 가능, 성능이 뛰어난 레코드 트리거형 자동화를 설계할 수 있습니다.