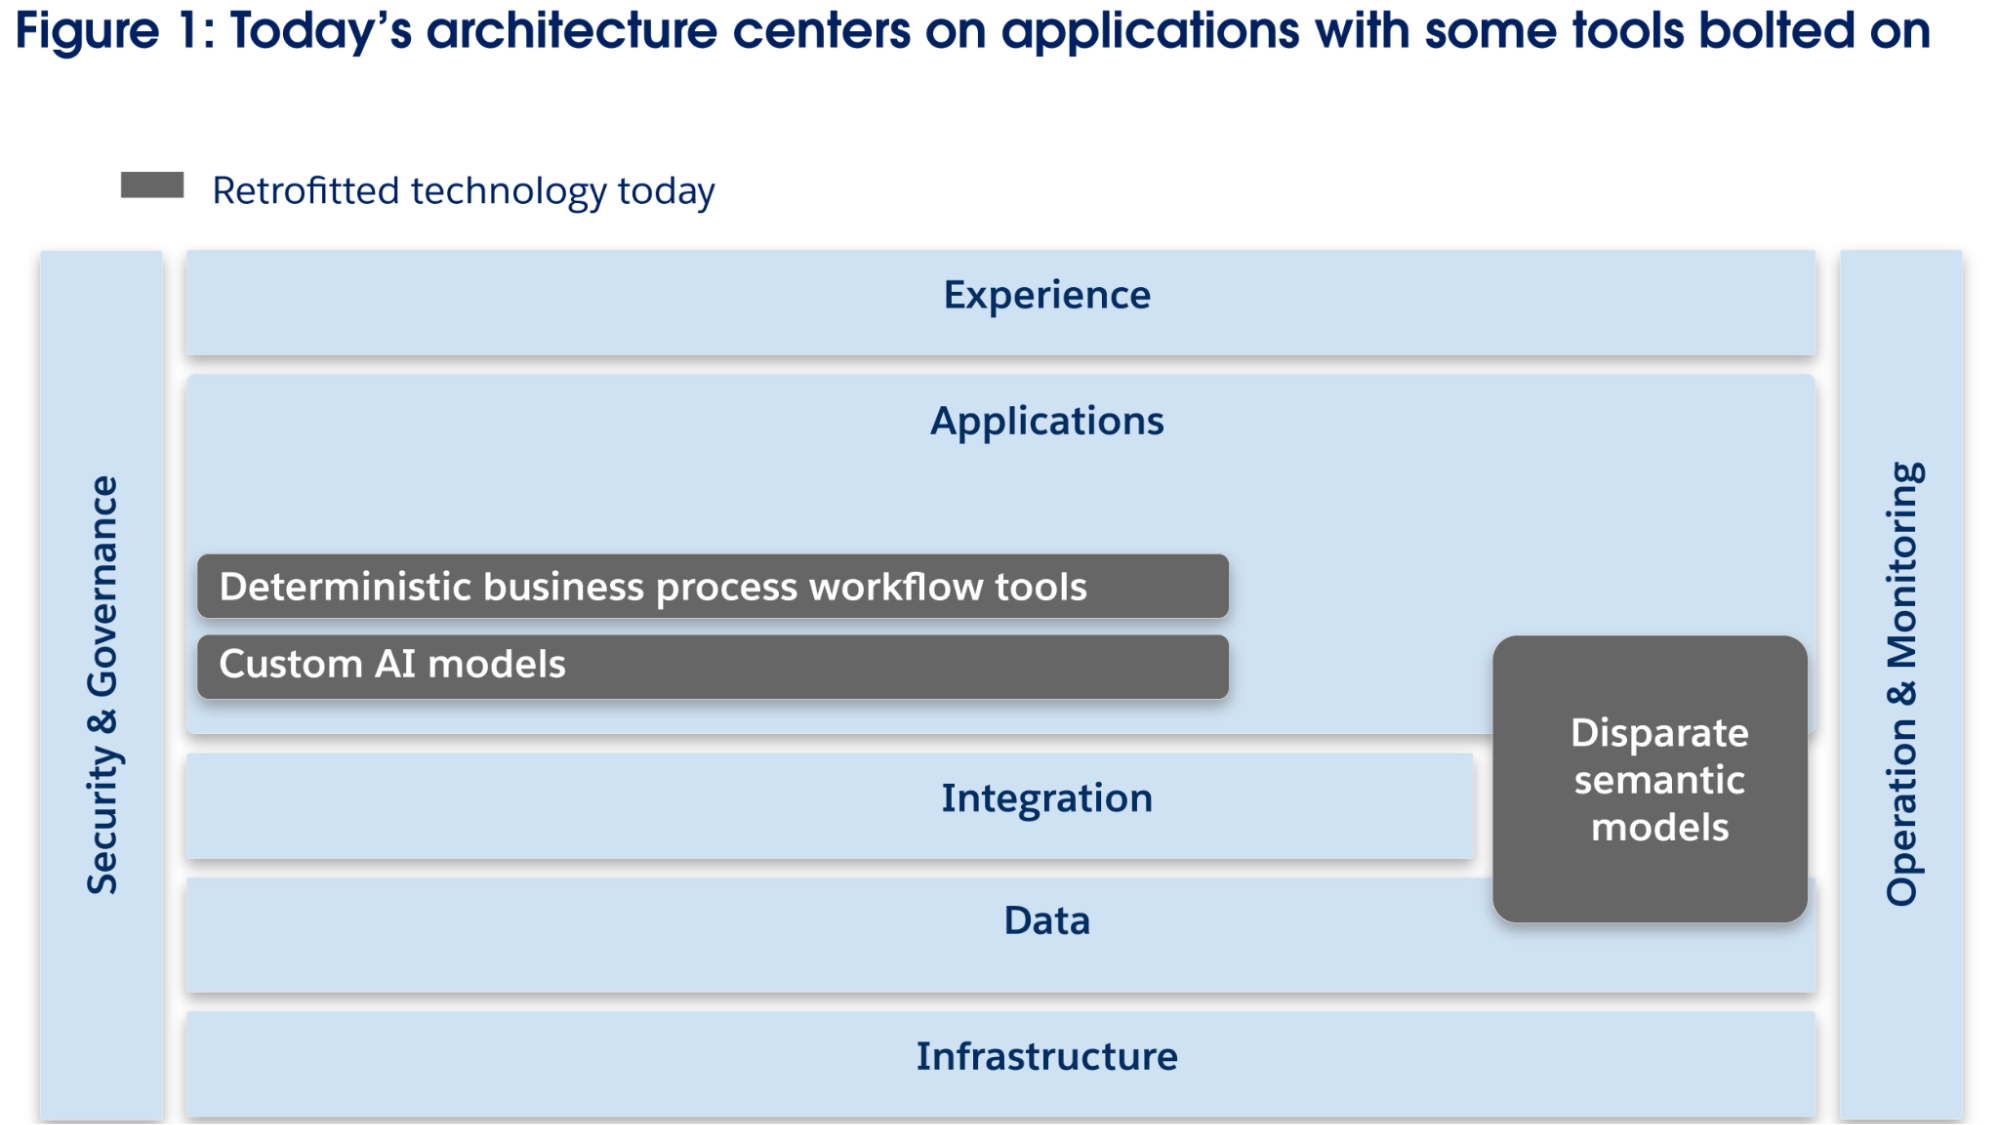
 従来のアーキテクチャでは、今日の AI エージェントのサブスケールのリリースをサポートできますが、上記のエージェント型エンタープライズのビジネス機能を完全に提供することはできません。これらの機能を実現するには、狭い使用事例を対象とする限定的な導入に制限されるのではなく、広範な使用事例に対応できる強力な AI エージェントを幅広く導入できるように設計された IT アーキテクチャが必要です。
AI エージェントは今後 5 年間で継続的に改善され、より強力でインテリジェントな AI エージェントの価値を実現して将来のニーズに対応するために、IT アーキテクチャを進化させる必要があります。まず、基盤となる AI モデル (マルチモーダル LLM など) とエージェントの認知アーキテクチャ (複数ステップの計画、ToDo の分解など) の進化に伴い、エージェントのインテリジェンスが向上します。第 2 に、AI エージェントは、記憶の改善、自己省察機能、フィードバックから学習する機能により、学習および適応能力が向上します。第 3 に、AI エージェントは、急速に進化するオープンテクノロジー標準 (モデルコンテキストプロトコル、Agent2Agent など) のエコシステムが示すように、他のエージェント、ツール、およびデータを操作する能力が向上します。これら 3 つのテクノロジートレンドにより、AI エージェントはより抽象的で複雑なタスクを実行できるため、より強力になりますが、今日の IT アーキテクチャには多くの課題も発生します。
まず、AI エージェントは基本的に、急速に進化し、高度で共有化された AI/ML モデル管理を必要とする、内部開発と外部ソースの両方の AI モデルに依存します。現在、AI モデルは、トレーニング、リリース、ガバナンス、リスク管理のための一般的なツールと再利用するための共有機能ではなく、アプリケーションの特定の使用事例に合わせてボルトオンされています。今後、企業はエージェントのさまざまな使用事例に異なる AI モデルを使用できるようにする必要があります。これには、エージェントがビジネスコンテキストに基づいて基盤となるモデル (基盤モデルとドメイン固有の小規模なモデルなど) を切り替えるためのツールが必要です。これには、一貫性、再利用性、拡張性、効率性を確保するために、統合ライフサイクルツールで社内で開発またはホストされる AI モデルを管理する必要があります。同様に、外部でホストされる AI モデルにアクセスするには、最適なパフォーマンス、セキュリティ、コンプライアンス、可用性、信頼性を確保するために、企業全体の制御フレームワークが必要です。
次に、AI エージェントには、ホスティング、開発、推論、学習、メモリ管理、操作などの個別の拡張パターンと運用要件があり、エージェント用に個別の専用のアーキテクチャ境界が必要です。この機能を現在の静的で確定的なアプリケーションアーキテクチャに直接組み込むと、アーキテクチャの不要な複雑さとリスクが生じます。さらに、AI エージェントは、標準化されたインターフェースまたはメッセージングシステムを介して既存のアプリケーションと相互運用し、リアルタイムでやりとりする必要があります。
第三に、AI エージェントは、多くの場合サイロ化されたアプリケーションスタック間で、異種データセットを推論し、相互にコラボレーションできる必要がありますが、今日のアーキテクチャでは、これらのエージェントが異なるデータセットを推論するための共通のセマンティック機能がありません。そのため、単一目的のエージェントは正常にリリースできますが、複雑でサイロ間のタスクで多数動作するように拡張することは困難でリスクの高いままです。
最後に、現在のエンタープライズ IT アーキテクチャには、より強力なエージェントが実行する動的なワークフローを含むエンドツーエンドのビジネスプロセスを調整、最適化、管理するための効果的な方法がありません。このワークフローは、場合によっては、そのプロセスで人間の作業員が行う役割を増強し、置き換えます。現在、自動化ツールは、プロセス固有の言語で文書化され、通常は定義済みの順序に従い、ほとんど変更されない静的ロジックに依存する線形の確定的ワークフローを管理するために利用されています。AI テクノロジーは、これらの線形プロセスの一部を強化できますが (ハードコードされたビジネスルールの代わりに ML モデルを使用してローン承認しきい値を計算するなど)、最も重要なビジネスプロセスの戦略的側面と実行側面は本質的に動的で柔軟性に富んでいます。マーケティング戦略の作成、複雑な顧客の問題の解決、見込み客の探索などのタスクには明確な目的 (顧客満足度、ケースの解決速度など) がありますが、事前に定義された実行順序には従いません。
現在、従来の企業では、このような複雑なビジネスプロセスの調整と実行 (戦略の設定や複雑なプログラムの管理など) は主に人に依存しています。今後 3 ~ 5 年で AI エージェントが進化 (インテリジェンス、学習、インタラクション機能の向上) を続けるにつれて、このような動的なプロセスを自律的に実行する能力が大幅に拡大し、既存のインテグレーションおよび自動化ツールの機能を大幅に上回る複雑さと統合の課題が生じます。AI エージェントの適応的で動的な性質により、特に AI エージェント、人間、自動化ツール、その他の確定的システムを網羅する複雑で時間のかかる複数ステップのワークフローの管理において、エンタープライズレベルの制御、包括的な可視性、および全社的な戦略目標との一貫した整合性を確保するために、新しいオーケストレーション機能が強く求められています。
Agentic Enterprise の IT アーキテクチャでは、人間の作業員、AI エージェント、確定的システムをシームレスに統合することで、インテリジェントなアクションのプラットフォームが確立されます。このアーキテクチャにより、人とAIの両方のエージェントが、さまざまなデータ ソースの統合エンタープライズKnowledgeに動的にアクセスして活用できるようになります。また、セマンティック コンテキストが強化され、戦略的なビジネス目標に沿った複雑なワークフローとプロセスを効率的に実行できます。一連のサイロ化されたプラットフォームとポイントソリューションの既存のITアーキテクチャは、新しいインテリジェントなビジネスプロセスオーケストレーションツールによって監督および管理される一連の構成可能なアプリケーションサービス、セマンティックツール、データツール、AIエージェントのネットワークへと進化していきます。
このアーキテクチャにより、エージェントはそれぞれの範囲で感知、推論、行動し、ビジネスドメイン内およびビジネスドメイン間で作業し、継続的に学習、改善、適応できます。そのためには、データとKnowledgeにアクセスするための堅牢なメカニズム(意味的理解)、柔軟で標準化されたコミュニケーション プロトコルとインターフェース(エージェント間、エージェントと確定的システム間、エージェントと人間間など)に重点を置いた設計が必要です。また、エージェント、人間、自動化ツール、確定的システム間でワークフローとプロセスを批判的に調整します。
### アーキテクチャの原則
インテリジェントなアクションのプラットフォームのアーキテクチャビジョンを実現するために、ベストプラクティスとして次の設計原則をお勧めします。
- **コンポーザビリティとモジュール性:**標準化されたインターフェースを使用して、アーキテクチャ要素をモジュールコンポーネントとして設計し、エージェント機能、ワークフロー、および人間面をすばやく動的に組み立てることができます。明確なインターフェース契約と抽象化を優先し、AI エージェントがワークフローを柔軟に構成できるようにします。
- **データおよびセマンティック優先:**エージェントがサイロ化されたシステム間で効率的に推論できるようにセマンティックを共通理解することで、包括的で正確、高速、安全、かつコスト効率に優れたデータアクセスを実現します。これには、品質、系統、ガバナンス、アクセスを保証するツール、およびエージェントと人間間で共有されるセマンティック理解を提供する方法を使用して、データ (およびメタデータ) を商品として取り扱う必要があります。
- **ITとビジネスの監視機能の組み込み:**エージェントの推論、動作、システムインタラクション、ビジネス KPI への影響に関するインサイトを得るために、アーキテクチャ全体にエンドツーエンドの監視、追跡、評価、説明可能性の機能を組み込み、エージェントのパフォーマンスを継続的に最適化できるようにします。これには、Trust、コンプライアンス、責任あるリソース消費を維持しながら、FinOps(コスト最適化)、Sustainability評価指標、運用テレメトリが含まれます。AI エージェントは本質的に非確定的であるため、AI エージェントが人の監視の下で信頼され、コンプライアンスに準拠し、監査可能な方法で業務を行うことができるようにするには、観察可能性が最も重要です。
- **Trust-throughout:**エージェントの ToDo (データアクセス、アクションなど) のインテントに基づいて動的で詳細な権限を適用し、レッドチーミング、自動 CVE スキャン、脆弱性検出、リスクベースの検証制御などの包括的なセキュリティプラクティスを実装します。エージェントがマシン速度で操作できるためにリスクが連鎖するリスクを考えると、より詳細で動的な制御が必要です。AI が生成したすべての出力 (エージェントまたはモデルから) を使用または提供する前に、コンプライアンス、安全性、有害性、バイアスに関する定義済みのポリシーに対して厳密に検証します。これには、AI の意思決定、アクション、コンテンツ、予測の検証可能な監査履歴を含むロギングと説明可能性メカニズムが必要です。
- **人の監視によるエージェント優先:**AI エージェントをビジネスの使用事例を解決するためのデフォルトツールにすることで、他の考慮事項 (コスト、技術的適合性など) を排除し、エージェントのワークフローでアクセスできる IT システムを設計します。これには、エージェントのプロセスのすべてのステップを人間が監視、介入、上書きする機能が含まれます。エージェントは、意思決定に対する信頼性が事前にプログラムされたしきい値を下回った場合に、人間の指針を積極的に求めるための自己省察機能を必要とします。
- **反応型およびマルチモーダルのインタラクション:**エージェント間プロトコル、人間のマルチモーダル入力 (音声、テキスト、視覚)、ビジネスイベント、システムシグナル、ストリーミングデータなど、すべてのインタラクション種別で包括的なエージェント呼び出しおよび応答メカニズムをサポートするアーキテクチャを有効にします。イベント駆動型とリアルタイムの両方の処理機能を有効にして、エージェントが任意のソースまたは形式からのタイムリーなシグナルに確実に反応できるようにします。
- **AI対応インフラストラクチャ:**変動する AI ワークロードを処理するために組み込まれている冗長性によってインフラストラクチャを柔軟に拡張し、ML/LLM パイプラインをデータとアプリケーションアーキテクチャに統合しながら、データレジデンシー要件へのコンプライアンスを維持できるようにします。
- **オープンなエコシステム:**オープンスタンダード、プロトコル、明確に定義されたインターフェース (API、イベント) を採用してテクノロジーエコシステムのメリットを享受することで、相互運用性を優先し、テクノロジーロックインを回避します。
## アーキテクチャレイヤー
エージェント型トランスフォーメーションを有効にして拡張するには、企業は単に現在のレイヤーを強化するだけでなく、AIエージェントのニーズを満たすために特別に設計された4つの追加アーキテクチャ レイヤー(図2)を明示的に導入することを検討する必要があります。
**エージェント レイヤー**は、AIエージェントの開発と管理専用であり、計画、推論、メモリ、ツール使用率、状態管理、ライフサイクル制御などの認知機能が含まれます。このレイヤーは、AI エージェント固有の技術要件と運用要件に対応し、標準化されたプロトコルを使用してアプリケーションとデータストア間の相互運用性を確保し、エージェント間のコラボレーションを促進します。既存のアプリケーションレイヤーは、エージェントワークフロー用に動的に構成されるアプリケーションサービスに進化します。
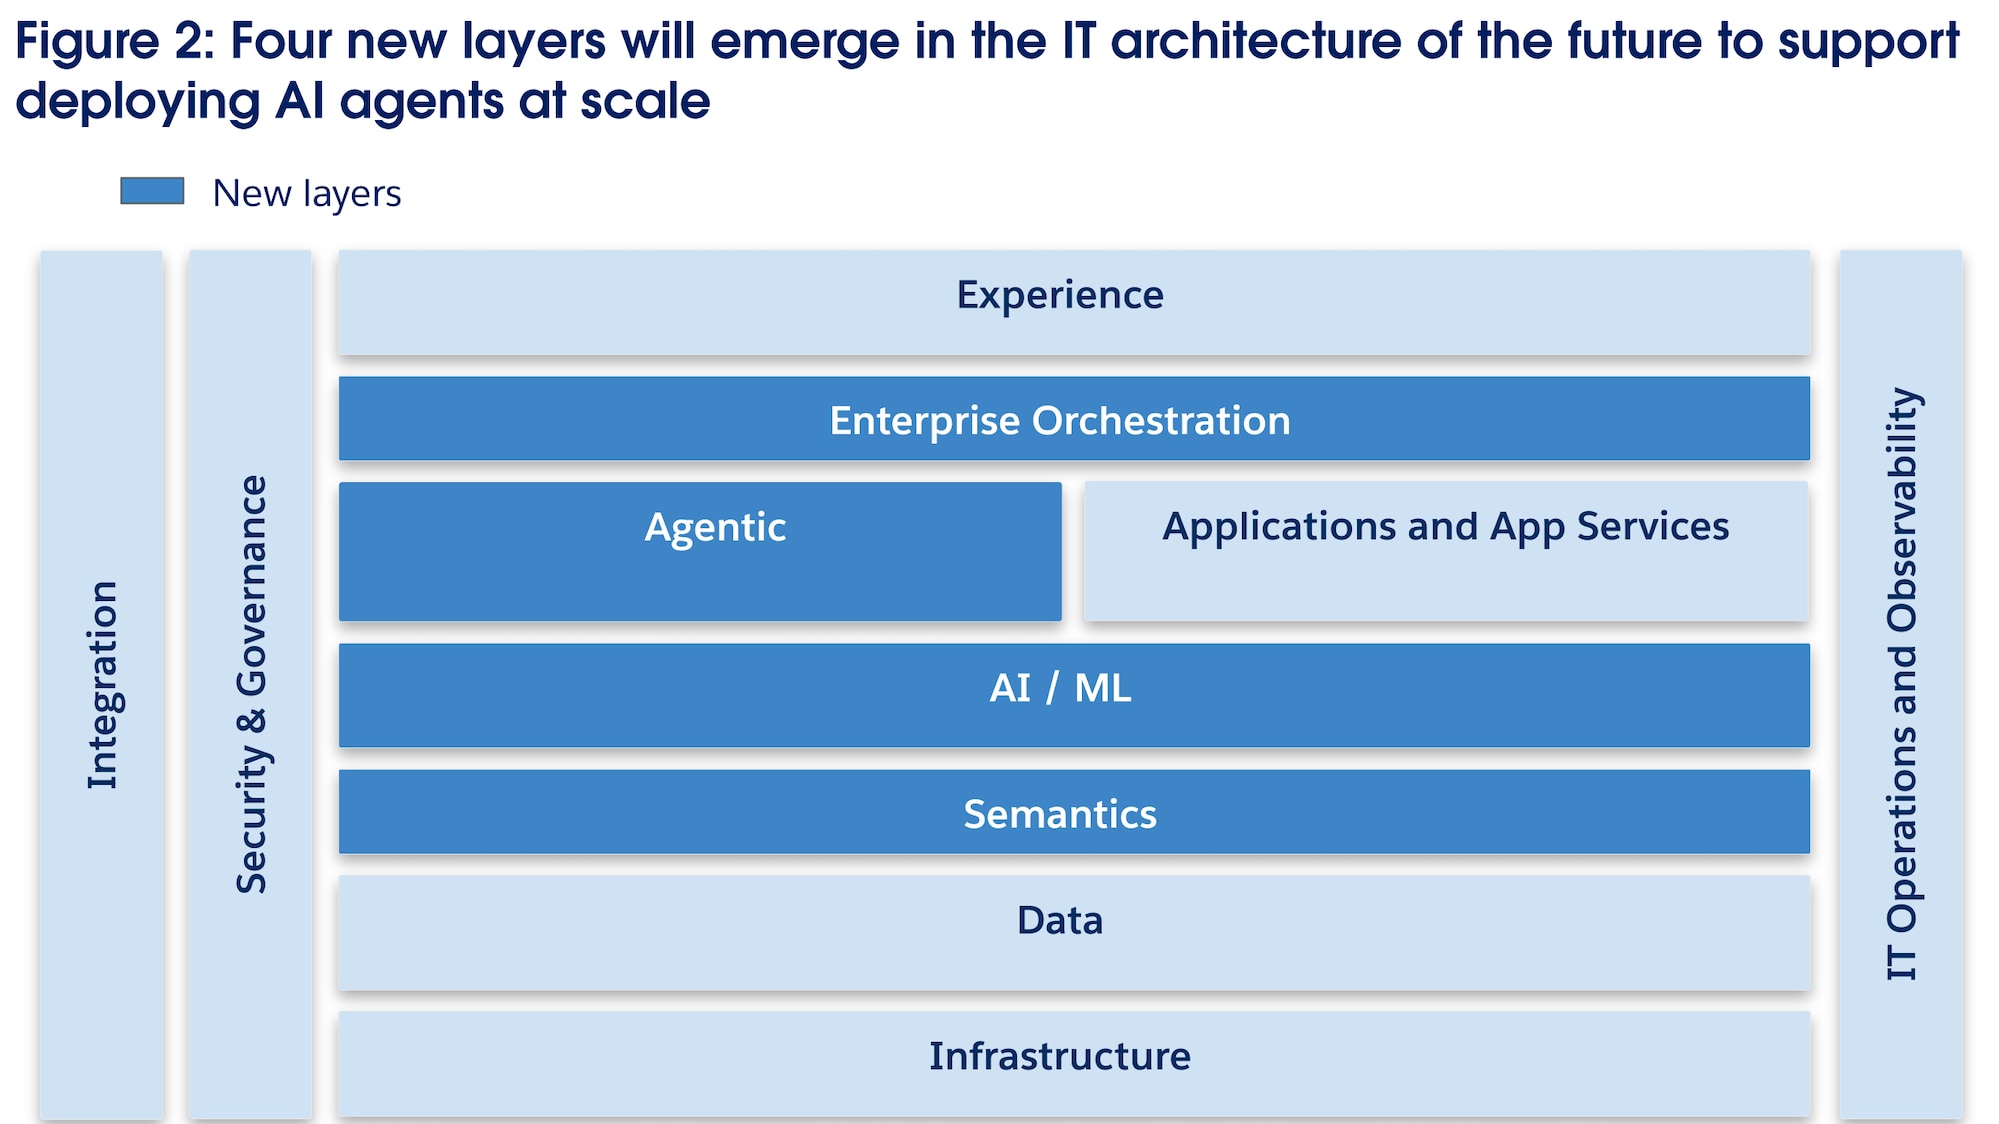 **セマンティック レイヤー**は、未加工のエンタープライズ データとAIエージェントに必要なセマンティック理解との間の切断を解決するために導入されました。ビジネス・エンティティ、概念、定義、相互リレーションを明示的にエンコードして管理し、エンタープライズ・オントロジーとBusiness Knowledgeの表現を作成して、より高度なタスクを実行する複雑なマルチエージェント・ワークフローを強化する共有セマンティック理解を可能にします。セマンティックレイヤーは、データカタログだけでなく、自然言語クエリを特定のデータストアに対する正確なクエリに変換し、結果をハーモナイズして、エージェントに状況に応じたより充実した回答を返します。一方、既存のデータレイヤーは一元化されたレイクハウスの採用によって統合され、AI 対応データファブリックを介してデータアクセスを拡大してデータメッシュ運用モデルの原則をサポートします。
**AI/MLレイヤー**は、大規模言語モデル、大規模アクション モデル、ドメイン固有のMLモデルなど、エンタープライズAI機能の管理を一元化し、ライフサイクル全体にわたって内部で開発されたAIモデルと、外部AIサービスへのアクセス/使用の制御の両方を処理します。AI モデルがアプリケーション内に埋め込まれる従来のアーキテクチャとは異なり、このレイヤーでは AI モデルがエンタープライズのファーストクラスのコンポーネントおよび共有サービスとして確立されます。エンタープライズで制御される AI 機能に焦点を当てています (外部ベンダーが提供する AI 機能ではありません)。このレイヤーは、Trust、安全性、コンプライアンス、導入のための標準化されたメカニズムを使用して、エンタープライズのさまざまなエージェントやその他のAIワークロードにインテリジェンスを提供します。
**エンタープライズ オーケストレーション レイヤー**は、AIエージェント、人、自動化ツール、確定的システムにまたがる複雑な複数ステップのワークフローとビジネス プロセスを調整、管理、最適化するための機能の抽象化です。このレイヤーでは、ブレンドされたオーケストレーションモデルを活用して、個々のエージェントとシステムが MCP や A2A などのオープンプロトコルを使用してローカルで振付された ToDo を自律的に処理しながら、プロセス全体を一元的に監視および調整できます。ブレンドされたオーケストレーションモデルを実装するために、このレイヤーは、ビジネスプロセスの確定的ステップ (設計時にモデル化) と動的ステップ (実行時にエージェントが決定) の両方を定義する、マシンが読みやすいセマンティックリッチな形式で重要なビジネスプロセスを表し、ガバナンスと最適化のプロセスモデルの基盤を作成します。
従来、人間が主導するビジネスプロセスの大部分が、機械で判読可能な形式で文書化されていないか、アクセスできないままでした。ただし、AI エージェントの ToDo やアクションに関する豊富なデータとメタデータを含む活動の詳細な観察可能性により、動的で以前は構造化されていなかった作業を取得、文書化し、確定的線形ワークフローと統合して、包括的なプロセスモデルを作成できます。詳細なプロセスドキュメントには、以前は見えなかった ToDo の相互依存関係と実行パスが取り込まれており、企業は継続的に業務効率を最適化し、ボトルネックに効果的に対処し、エージェントが特定したベストプラクティスを体系的に体系化して、再利用可能な企業全体のプレイブックにまとめることができます。これにより、個々のプロセスと、拡張すれば企業全体の総合的なデジタルツインが実現します。
たとえば、包括的な営業戦略の実行や新規従業員のオンボーディングなどの複雑なプロセスには、オーケストレーションレイヤーで適切なレベルの人間の関与 (例外処理など)、AI エージェントの限定された自律性、コンプライアンスの実施を確保できる相互依存する多数のステップが含まれます。これらのプロセス全体にわたって、トップダウンオーケストレーションレイヤーは予測可能性とガバナンスを追加し、重要業績評価指標 (KPI) を継続的に追跡して評価し、ワークフローとロールバックロジックのトランザクションの整合性を確保し、ワークフローのすべてのフェーズに対する可視性を維持して、全体的なビジネス目標との整合性を確保します。この機能を実装するために、このレイヤーではセキュリティおよびガバナンスレイヤーのポリシー、ルール、ガードレール (コードとしてのポリシーを使用) と、セマンティックレイヤーに保存されているビジネス目標と KPI を使用します。AI 主導のインタラクションの自律的で迅速な特性を踏まえると、特に実行時間が長い複数ステップのワークフローでは、分散型の振付のみに頼ると戦略的に不一致やコンプライアンス違反が生じるリスクがあります。ブレンドオーケストレーションアプローチでは、企業全体のビジネスルール、コンプライアンスチェック、ポリシー適用を複雑なワークフローに直接組み込んで、重要な連結点における人の監視を統合することで、これらのリスクを軽減します。
これら 11 個の各レイヤーは、安全で信頼できる効果的な方法で AI エージェントを大規模にリリースするための特定の機能を提供し、エージェント型 AI の可能性を最大限に引き出して、企業における作業の方法を変革します。以下のセクションでは、レイヤーの機能、AI エージェントの台頭による新しい変化、主要なテクノロジー機能の概要を説明します。
### エクスペリエンスレイヤー
**機能:**エクスペリエンスレイヤーは、人間のユーザーにとって主要なインターフェースとして機能し、入力 (テキスト、音声、ビジュアル) を取得してコンテキストに関連する応答を複数のデバイスに配信することで、マルチモーダルインタラクションを可能にします。ユーザーの意図をアクションのためにエージェントレイヤーにシームレスに渡すと同時に、エージェントのワークフロー内で人のエスカレーションと承認を容易にする動的な UI と視覚化も提供します。
**現在の製品との違い:**AI は、自然言語処理、コンテキスト認識、プロアクティブな意思決定支援で従来の GUI ベースのインターフェースを強化します。AI エージェントはインタラクションを積極的に開始し、すべてのチャネルとモダリティでパーソナライズされたリアルタイムのおすすめを提供できます。
**主要なテクノロジー機能:**
- **対話型AIおよびデジタル アシスタント:**人間のユーザーをサポートする AI アシスタンスを機能させるには、デフォルトで UX を有効にします。
- **属性と透明性のUI:**ユーザーインターフェースで回答を説明可能にします (引用、ファイル/システムのソース、決定に対するアプローチ/合理性の表示など)。
- **プロアクティブおよび環境通知サービス:**ユーザーの現在のコンテキストに基づいて、エージェントが最適なチャネルとフォーム要素でユーザーにインサイトやアラートを積極的に転送できるようにします。
- **オムニチャネル環境:**会話や ToDo がアプリケーションではなくユーザーをフォローするジャーニー継続性により、すべてのチャネルでシームレスで一貫性のある統合環境が提供されます。
- **マルチモーダル機能:**テキスト、音声、画像、タッチ、動画、AR/VR を使用してエージェントやアプリケーションを操作できるため、エージェントは最も効率的な方法で情報を理解して表示できます。
- **コンテキスト対応パーソナライズと動的UI:**状況に応じたリアルタイム (時間、場所、ユーザーアクション) のユーザーエクスペリエンスを有効にして、その場での UI 生成などのパーソナライズを可能にします。
### エージェントレイヤー
**機能:**エージェントレイヤーは、エンタープライズで作業を行うためのデフォルトのランタイム環境として機能します。AI エージェントは、アプリケーションおよびアプリケーションサービスレイヤーとデータレイヤーのツールを使用してワークフローを動的に組み立てることで、エクスペリエンスレイヤーから ToDo を分解し、タスクを実行します。AI エージェントの設定状態はこのレイヤーに保存および管理されます。エージェントは特定の ToDo に対してインスタンス化され、特定のエージェントインスタンスはその後に廃止されます。この実装により、エージェントは (AI/ML、オブザーバビリティ、オーケストレーションレイヤーの機能を使用して) オフライン最適化に基づいて常に最新の設定状態から呼び出すことができます。このレイヤーは、AI エージェントの包括的なライフサイクル管理、調整、ガバナンスを担当します。
**現在の製品との違い:**このレイヤーは、現在のさまざまなパイロットと限られたエージェントによる導入で出現します。ルールベースのボットは存在しますが、大規模にリリースされた適応型、非確定的、目標指向のソフトウェアプログラムはほとんどありません。
**主要なテクノロジー機能:**
- **エージェントランタイム環境:**AI エージェントのライフサイクル、実行、リソース割り当てを管理します。
- **Agent Lifecycle Management Suite:**開発フレームワーク、開発およびテストツール、エージェント活動とバージョン管理のための管理システムが含まれます。
- **エージェント推論エンジン:**エージェントが目標を分解し、計画して、複雑な問題を解決するためにどのツールを使用するかを決定するための認知フレームワーク。
- **エージェントメモリおよびコンテキストストア:**エージェントインスタンスが以前のやりとりに関するコンテキストを呼び出して管理できるため、一貫性とパーソナライズが確保されます。
- **エージェント相互運用性プロトコル:**エージェント間通信 (A2A) およびエージェントが外部システム (モデルコンテキストプロトコルなど) とやりとりするための標準化されたインターフェース。
- **ツールレジストリ:**エージェントが特定の ToDo を達成するために呼び出すことができる、内部および外部でサポートされる選定されたツールセット。
- **エージェントレジストリ:**検出と機能の照合をサポートする、事前作成済み AI ソリューションとエージェントの選定されたエコシステム。
- **分散エージェントポリシーの適用:**エージェントがアクションを実行する前にコンプライアンスをセルフチェックできるようにすることで、企業全体のガバナンスを実現します。
- **エージェントの自己反映および適応フレームワーク:**エージェントが自身のパフォーマンスを分析し、人間の承認を得て改善をトリガーしたり、エージェント自身に変更を提案したりするためのメカニズムを提供します。
### AI/ML レイヤー
**機能:**このレイヤーは一元化されたインテリジェンスハブとして機能し、AI モデルをエージェント層 (およびアプリケーション) が使用する共有サービスのセットとして提供し、安全フレームワークと監視が組み込まれていて、推論と意思決定の機能を強化します。
**現在の製品との違い:**従来、AI モデルは特定のアプリケーション内に埋め込まれていました。Agentic Enterprise の IT アーキテクチャでは、AI/ML レイヤーは、多くのアプリケーションとエージェントを強化する、一元的なファーストクラスのサービスセットとなり、開発から大規模なリアルタイムサービスまでのモデルライフサイクル全体をサポートします。
**主要なテクノロジー機能:**
- **事前作成済み基盤モデル:**広範なデータに基づいてトレーニングされ、さまざまな一般的なタスクを実行できる大規模な ML モデル。
- **取得拡張生成 (RAG):**基盤モデルを企業固有のデータにグラウンディングして精度を高め、幻覚を軽減する AI 中心のパイプライン。
- **AI Trust、安全性、ガバナンス ハブ:**バイアス検出、説明可能性、安全監視などの責任ある AI 原則を適用するためにモデルライフサイクルに統合された一連のツール。
- **モデルゲートウェイ:**すべてのモデル推測要求の 1 つのエントリポイントとして機能するルーティングエンジン。さまざまな内部モデルと外部モデルへのコールを管理して、コスト、パフォーマンス、コンプライアンスを最適化します。
- **モデル開発ワークベンチ:**データの前処理、モデルのトレーニング、実験のためのツールを備えたデータサイエンティスト向けの統合開発環境。
- **MLOps & Lifecycle Automation Pipeline:**トレーニングからリリース、廃止までのモデルのエンドツーエンドのライフサイクルを自動化する機械学習用の CI/CD エンジン。
- **モデル提供および推測ランタイム:**トレーニング済みモデルをリアルタイム消費用の安全な API エンドポイントとしてリリースするための、拡張性が高く低レイテンシの環境。
- **モデルおよび納入商品レジストリ:**モデル、データセット、ソースコードを含むすべての AI/ML アセットのバージョン管理された一元化されたリポジトリにより、再現性と監査可能性が確保されます。
- **合成データの生成と管理:**機密情報を公開することなく、実際のデータの統計的なプロパティを維持する合成データを生成および管理するツール。
### エンタープライズオーケストレーションレイヤー
**機能:**エンタープライズオーケストレーションレイヤーは、エージェント企業におけるエンドツーエンドの作業のコントロールプレーンです。これにより、エージェントのワークフローとインタラクションがエンタープライズの目的とガバナンスポリシーに準拠するようになります。他のレイヤーの可観測性テレメトリを使用して包括的なビジネスプロセスモデルを構築し、セマンティックレイヤーから取得した KPI に対する最適化を可能にします。このレイヤーは、重要なワークフローで AI エージェントの新しい各インスタンスに共有コンテキストと実行時間の長いメモリを提供します。
**現在の製品との違い:**このレイヤーでは、構造化された確定的ステップと、人間やエージェントが実行する非構造化で動的な作業の両方を取得する機械可読性の高いモデルを作成することで、ビジネスプロセスを統合的に可視化できます。制約としてビジネス目標とコンプライアンスルールをプログラムでエージェントワークフローにエンコードしてエージェントのワークフォースを管理することで、今日の人間中心のコラボレーションおよびガバナンスモデルを超えます。
**主要なテクノロジー機能:**
- **ハイブリッド ワークフロー実行エンジン:**「ブレンドされたオーケストレーションモデル」を実行するコアランタイム。ローカルエージェントの振付を許可しながら、一元的な監視を行います。
- **プロセスガバナンスおよび制約エンジン:**宣言型のビジネスルール、ポリシー、制約を消費してすべての未処理プロセスに適用するリアルタイムガバナンスサービス。
- **共有メモリおよびコンテキスト管理:**複数のステップで継続性と一貫性を維持するために、ワークフローのすべてのアクターがアクセスできる共有メモリレイヤー。
- **Process Modeling Studio:**確定的ステップと動的な目標指向ステップの両方を定義する、機械で読みやすく、セマンティックに豊富なプロセスモデルを作成および管理するための設計時環境。
- **プロセスの最適化とシミュレーション:**高度な分析、What-if シミュレーション、予測最適化のためのビジネスプロセスのデジタルシミュレーションを構築する機能。
- **プロセスの検出と稼働状態の監視:**プロセスモデルとリアルタイムデータを取り込み、プロセスの健全性に関するビジネス評価指標に関するレポートを作成します。
- **デジタルツインプロセスモデリング:**本番に影響を与えることなく、ライブワークフローをテスト、変更をシミュレーション、最適化するためのリアルタイムミラー。
### アプリケーションおよびアプリケーションサービスレイヤー
**機能:**このレイヤーは、既存のビジネスアプリケーション機能をエージェントが使用できるコンポーザー可能なモジュール化されたツールおよびサービスとして公開します。また、エージェント機能をユーザーエクスペリエンスに組み込むためのプレゼンテーションランタイムとしても機能します。アプリケーションは引き続き記録システムですが、エージェント向けの「ヘッドレス」機能として再設計されています。
**現在の製品との違い:**アプリケーションはモノリシック UI から、エージェントが API やイベントを介して動的にコールできる「バックエンドサービス」に進化します。このレイヤーは AI エージェントやモデルとネイティブに統合され、コード生成 LLM の急増により、エージェントが作成するカスタムマイクロアプリケーションが増加するでしょう。
**主要なテクノロジー機能:**
- **モジュラー型アプリケーションサービス:**従来のアプリケーションから分解されたビジネスロジック。エージェントがコールできるように機械で読み取り可能なアクションとして公開されます。
- **エージェント埋め込みSDK:**開発者がエージェントをアプリケーション UI に直接安全に組み込むことができるツールキットとライブラリ。
- **動的UI生成サービス:**AI エージェントがユーザーコンテキストに基づいてリアルタイムで UI コンポーネントを生成または変更できるサービス。
- **AIネイティブUIフレームワーク:**確率データの管理やテキスト応答のストリーミングなど、AI 駆動の UI の処理のサポートが組み込まれて設計されたフロントエンドフレームワーク。
- **エージェントが導入したエンゲージメントのシステム:**ビジュアルコンポーネントを介して AI エージェント機能を組み込むエンタープライズ生産性およびコラボレーションアプリケーション。
- **AIで強化されたローコード/ノーコード アプリケーション開発:**ユーザーとエージェントが自然言語とプロンプトを使用してカスタムアプリケーションとサービスを作成できるツール。
- **エージェントの利用状況に関するアプリケーション ガードレール:**レート制限、範囲設定済み権限、テレメトリなど、エージェントの使用に関するアプリケーション側の制御。
### セマンティックレイヤー
**機能:**セマンティック レイヤーは、企業全体のデータとKnowledgeの統合的な理解を提供し、人とAIエージェントの両方が一貫した方法で情報を解釈して処理できるようにします。オントロジーやKnowledgeグラフなどのKnowledge表現ツールを使用して、自然言語クエリをコンテキスト対応の正確なデータ クエリに変換します。
**現在の製品との違い:**今日の企業にはさまざまなメタデータ ストアがありますが、Agentic Enterprise の IT アーキテクチャでは、明示的に定義されたセマンティック関係を持つドメイン間でデータをリンクする一元化された Enterprise Knowledge Graph(EKG)が必要です。これにより、AIエージェントが複雑な推論を実行するためにトラバースできる豊富なコンテキストが提供され、複数の機能ドメインにまたがるKnowledgeグラフを強化する一連の技術的機能の要件が作成されます。
**主要なテクノロジー機能:**
- **メタデータサービス:**データの系統、所有権、分類などの説明メタデータを提供します。
- **ビジネス用語集および分類管理:**ビジネスユーザーが標準ビジネス用語を定義して合意するためのツール。
- **セマンティック・モデル管理:**Knowledgeエンジニアがセマンティック モデルとオントロジーを作成、管理、統制するためのワークベンチ。
- **Enterprise Knowledgeグラフ(EKG):**ビジネスエンティティ間のリレーションを保存およびマッピングするエンタープライズオントロジーの実行時インスタンス。
- **メタデータ取り込みおよびハーモナイゼーションエンジン:**さまざまなソース システムから Enterprise Knowledge グラフに入力して管理する自動パイプライン。
- **セマンティッククエリエンジン**:自然言語クエリを解釈し、ECG に基づいて構造化されたクエリを作成して、さまざまなソースからデータを取得します。
- **セマンティック推論エンジン:**暗黙的なKnowledgeと非表示のリレーションを分析して、ECGから取得します。
### データレイヤー
**機能:**データレイヤーは、セマンティックレイヤーで解釈するすべてのエンタープライズデータ、トレーニングで使用する AI/ML レイヤー、トランザクションで使用するアプリケーション、推論に使用するエージェントへの安全な管理アクセスを管理して提供する、基本的な情報源です。
**現在の製品との違い:**データレイヤーは、多くの場合クラウドスケールのデータレイクハウスを中心に、より統合され、リアルタイムかつガバナンス重視に進化しています。大量のさまざまなデータを処理し、反応型エージェントをサポートするためにバッチ指向の処理からリアルタイムストリーミングに移行する必要があります。データガバナンスと品質は、貧弱なデータによって欠陥のある AI 出力が生成されないようにするためにさらに重要になります。
**主要なテクノロジー機能:**
- **VectorDB:**RAG に不可欠な高ディメンションのベクトル埋め込みを保存および照会するために最適化された特殊なデータベース。
- **インテリジェントな分析データ・パイプライン:**データの取り込み、変換、データレイヤーへの読み込み (ETL/ELT) のための自動化されたメタデータ駆動型サービスです。
- **Enterprise Data Lakehouse:**分析と AI の両方のワークロード向けに最適化された、構造化データ、半構造化データ、非構造化データの中央リポジトリ。
- **ゼロコピー データの統合と検索:**物理的なデータを移動することなく、複数のストアのデータへのアクセス、クエリ、検索を行う手法。
- **自然言語から SQL:**自然言語クエリを SQL に変換する手法。
- **エンタープライズデータカタログおよび検出サービス:**企業全体のすべてのデータアセットの一元化された検索可能なインベントリ。
- **マスターおよび参照データ管理 (MDM):**Customer や Product などの重要なビジネスエンティティの「ゴールデンレコード」を管理します。
- **Adaptive Data Quality Service:**AIを使用してデータ品質の問題をリアルタイムで自動的に検出して修正する継続的な監視サービス。
- **データ契約:**データ交換のスキーマ、セマンティクス、SLA を指定する、データプロデューサーとコンシューマー間の機械で読み取り可能な契約。
- **AIに特化したデータ ストア:**時系列データベースやグラフデータベースなど、特定の AI 使用事例向けに設計されたデータベース。
- **AI対応データ ファブリック:**さまざまな物理システム間でデータを統合および仮想化して表示する論理データ抽象化レイヤー。
- **リアルタイムのデータ処理:**マシン速度でマルチモーダルデータストリームを継続的に処理および分析する機能。
### インフラストラクチャレイヤー
**機能:**インフラストラクチャ レイヤーは、他のすべてのレイヤーの基盤となるもので、AIとエージェントのワークロードを大規模に耐障害性とコスト パフォーマンスに優れた方法で実行するために必要なコンピューティング、ストレージ、ネットワーク、クラウドの機能を提供します。
**現在の製品との違い:**AI ワークロードには、エージェントシステムの確率的性質を処理するための拡張性と柔軟性の向上が必要です。インフラストラクチャでは、迅速なプロビジョニング、GPU などの特殊なハードウェア、およびエージェント間通信用の低レイテンシで高スループットのネットワークトラフィックをサポートする必要があります。
**主要なテクノロジー機能:**
- **コードとしてのインフラストラクチャ:**CI/CDリリースパイプラインを使用したインフラストラクチャの自動プロビジョニングと管理。
- **ハイブリッドおよびマルチクラウドAIインフラストラクチャ:**パブリック クラウドの融通性と生成 AI ワークロード専用のインフラストラクチャを活用します。
- **AIで最適化されたコンピューティング、ストレージ、ネットワーク:**AI ワークロードからの変動需要に基づいて、インフラストラクチャリソースを動的に割り当てて拡張します。
- **エッジAIインフラストラクチャ:**AI モデルとエージェントをネットワークのエッジにリリースして、固有のレイテンシやプライバシーの要件がある使用事例に対応できるようにします。
- **自己修復インフラストラクチャ:**AI を使用して、手入力なしでシステムリカバリを管理し、高可用性を確保します。
- **持続可能なAIコンピューティング:**AI ワークロードの環境への影響を軽減するエネルギー効率の高いアプローチ。
- **コストとカーボンアウェアの自動拡張:**FinOps と Sustainability シグナルを使用して、容量の拡張と配置を促進します。
### インテグレーションレイヤー
**機能:**インテグレーションレイヤーは、API、イベント、プロトコル、ミドルウェアを通じてすべてのシステム (従来および新規) のユニバーサルコミュニケーションファブリックとして機能し、エージェントがサービス、データ、ツールをシームレスに検出して操作できるようにします。
**現在の製品との違い:**インテグレーションは、いくつかの既知のシステム間の事前定義された静的なやりとりを処理するだけでなく、AI エージェントの動的な多対多のコミュニケーションパターンをサポートするように進化する必要があります。リアルタイムのデータ処理が必要であり、エージェント間のアドホック検出とコラボレーションに対応する必要があります。
**主要なテクノロジー機能:**
- **Operational Data Connectivity Pipeline:**API 主導、イベント駆動、リバース ETL 機能を含む、スキーマの自動マッピング、データ変換、ワークフロー生成のための AI 支援ツール。
- **適応型API管理とサービス メッシュ:**エージェントの適応型ポリシー適用を使用してサービスを動的に登録、検出、管理できる API ゲートウェイおよびサービスメッシュテクノロジー。
- **Semantic Knowledge Adapters:**一貫したデータ解釈のためにエージェントとアプリケーションで共有される語彙とデータモデルを提供するインテグレーションコンポーネント。
- **イベント駆動型インテグレーションファブリック:**分離された非同期通信を可能にする高スループット、低レイテンシのメッセージングおよびストリーミングバックボーン。
- **エージェントプロトコルゲートウェイ:**MCP サービスと内部 API およびイベントとの橋渡しとしてエージェントがツールを安全に検出してアクションをトリガーできるようにする MCP サービスのゲートウェイ。
- **構成可能な機能カタログとマーケットプレイス:**すべてのエンタープライズ機能 (API、サービス、エージェントのスキル、モデル、データセット) の一元管理されたカタログ。オンデマンドで構成できるようにセマンティックメタデータでアノテーションが付けられています。
### IT運用およびオブザーバビリティレイヤー
**機能:**このレイヤーは、エージェントとシステム全体の健全性と業務パフォーマンス (オブザーバビリティ組み込み原則) を監視して管理し、インサイトを生成して透明性と制御性を提供し、企業のエージェントの従業員の監査、デバッグ、説明可能性、コスト、リソースの最適化を可能にします。
**現在の製品との違い**:AI エージェントがマシン速度でエラーを作成するリスクを考えると、このレイヤーはさらに重要になります。インフラストラクチャ監視の範囲を超えて自律エージェントの予測不能な動作まで拡張する必要があり、技術的なパフォーマンスだけでなく、新しい種類のテレメトリとセマンティックの正しさを理解する機能が必要になります。
**主要なテクノロジー機能:**
- **Real-Time Monitoring & Observability Platform:**ML 評価指標とエージェントの動作の拡張機能を使用して、IT 環境全体のログ、評価指標、トレースを継続的に収集します。
- **FinOps & Cloud Cost Management:**AI およびエージェントのワークロードに関連するインフラストラクチャコストの監視、分析、最適化を行います。
- **エージェントおよびML固有の監視:**エージェントの実行の各ステップを変更不可能な監査履歴に記録し、エージェントの行動を継続的にプロファイルして、確立された規範からの逸脱を検出します。
- **AIOps、インシデント、変更管理:**AI/ML を使用して、潜在的な IT 問題を予測し、根本原因を特定して、修復ワークフローを作成します。
- **Closed Learning Feedback Loop:**エージェントからの観測可能性テレメトリを MLOps パイプラインに統合し、モデルの再トレーニングや迅速な調整を自動化します。
- **Semantic Observability Engine:**コンテキスト化のために可観測性をセマンティックレイヤーと統合し、エージェントの行動のセマンティック異常を検出できるようにします。
### セキュリティおよびガバナンスレイヤー
**目的:**このレイヤーは、企業の資産を脅威から保護し、リスク管理を行い、規制要件へのコンプライアンスを確保することで、アーキテクチャ全体にTrustと安全性を組み込みます。ID 管理、脅威検知、GRC、AI 固有のセキュリティ対策が含まれます。
**現在の製品との違い:**セキュリティレイヤーは、プロンプトインジェクションやモデルポイズニングなど、AI モデルやエージェントによって提供される新しい攻撃対象領域に対応するために進化する必要があります。ID およびアクセス管理は、静的なロールベースの制御から、ジャストインタイムで付与され、使用直後に取り消される動的なインテントベースの権限に移行する必要があります。
**主要なテクノロジー機能:**
- **LLM 入出力セキュリティおよびガードレール:**プロンプト時と応答時に適用されるエンタープライズガードレールにより、安全でないコンテンツ、PII 漏洩、脱獄をブロックします。
- **AI検証を使用したZero Trustアーキテクチャ:**AI ベースの行動分析によって強化された継続的な認証。エージェントは特定のタスクに基づいてきめ細かくジャストインタイムにアクセスできます。
- **エージェントセキュリティフレームワーク:**エージェントの活動を安全に中断するためのきめ細かな権限モデル、有害な動作の監視、および封じ込めメカニズム。
- **AIモデル セキュリティ:**モデルライフサイクルの各フェーズで制御を行い、中毒、抽出、攻撃者の攻撃から保護する多層防御戦略。
- **プライバシー保護AI:**機密データを保護するための統合学習や差分プライバシーなどの技術。
- **AIで強化されたGRC:**AI エージェントを使用して、IT アーキテクチャの統制へのコンプライアンスを継続的に監視します。
- **コードとしてのポリシーエンジン:**宣言型の機械で判読可能な形式でビジネスルールとコンプライアンス制約を定義するための一元化された情報源で、エージェントの行動のガードレールを設定します。
- **継続的なレッド・チーミング:**AI モデルとエージェントの自動的かつ継続的な敵対的テストにより、攻撃者が脆弱性を悪用する前に特定します。
## エージェント型企業への参照アーキテクチャロードマップ
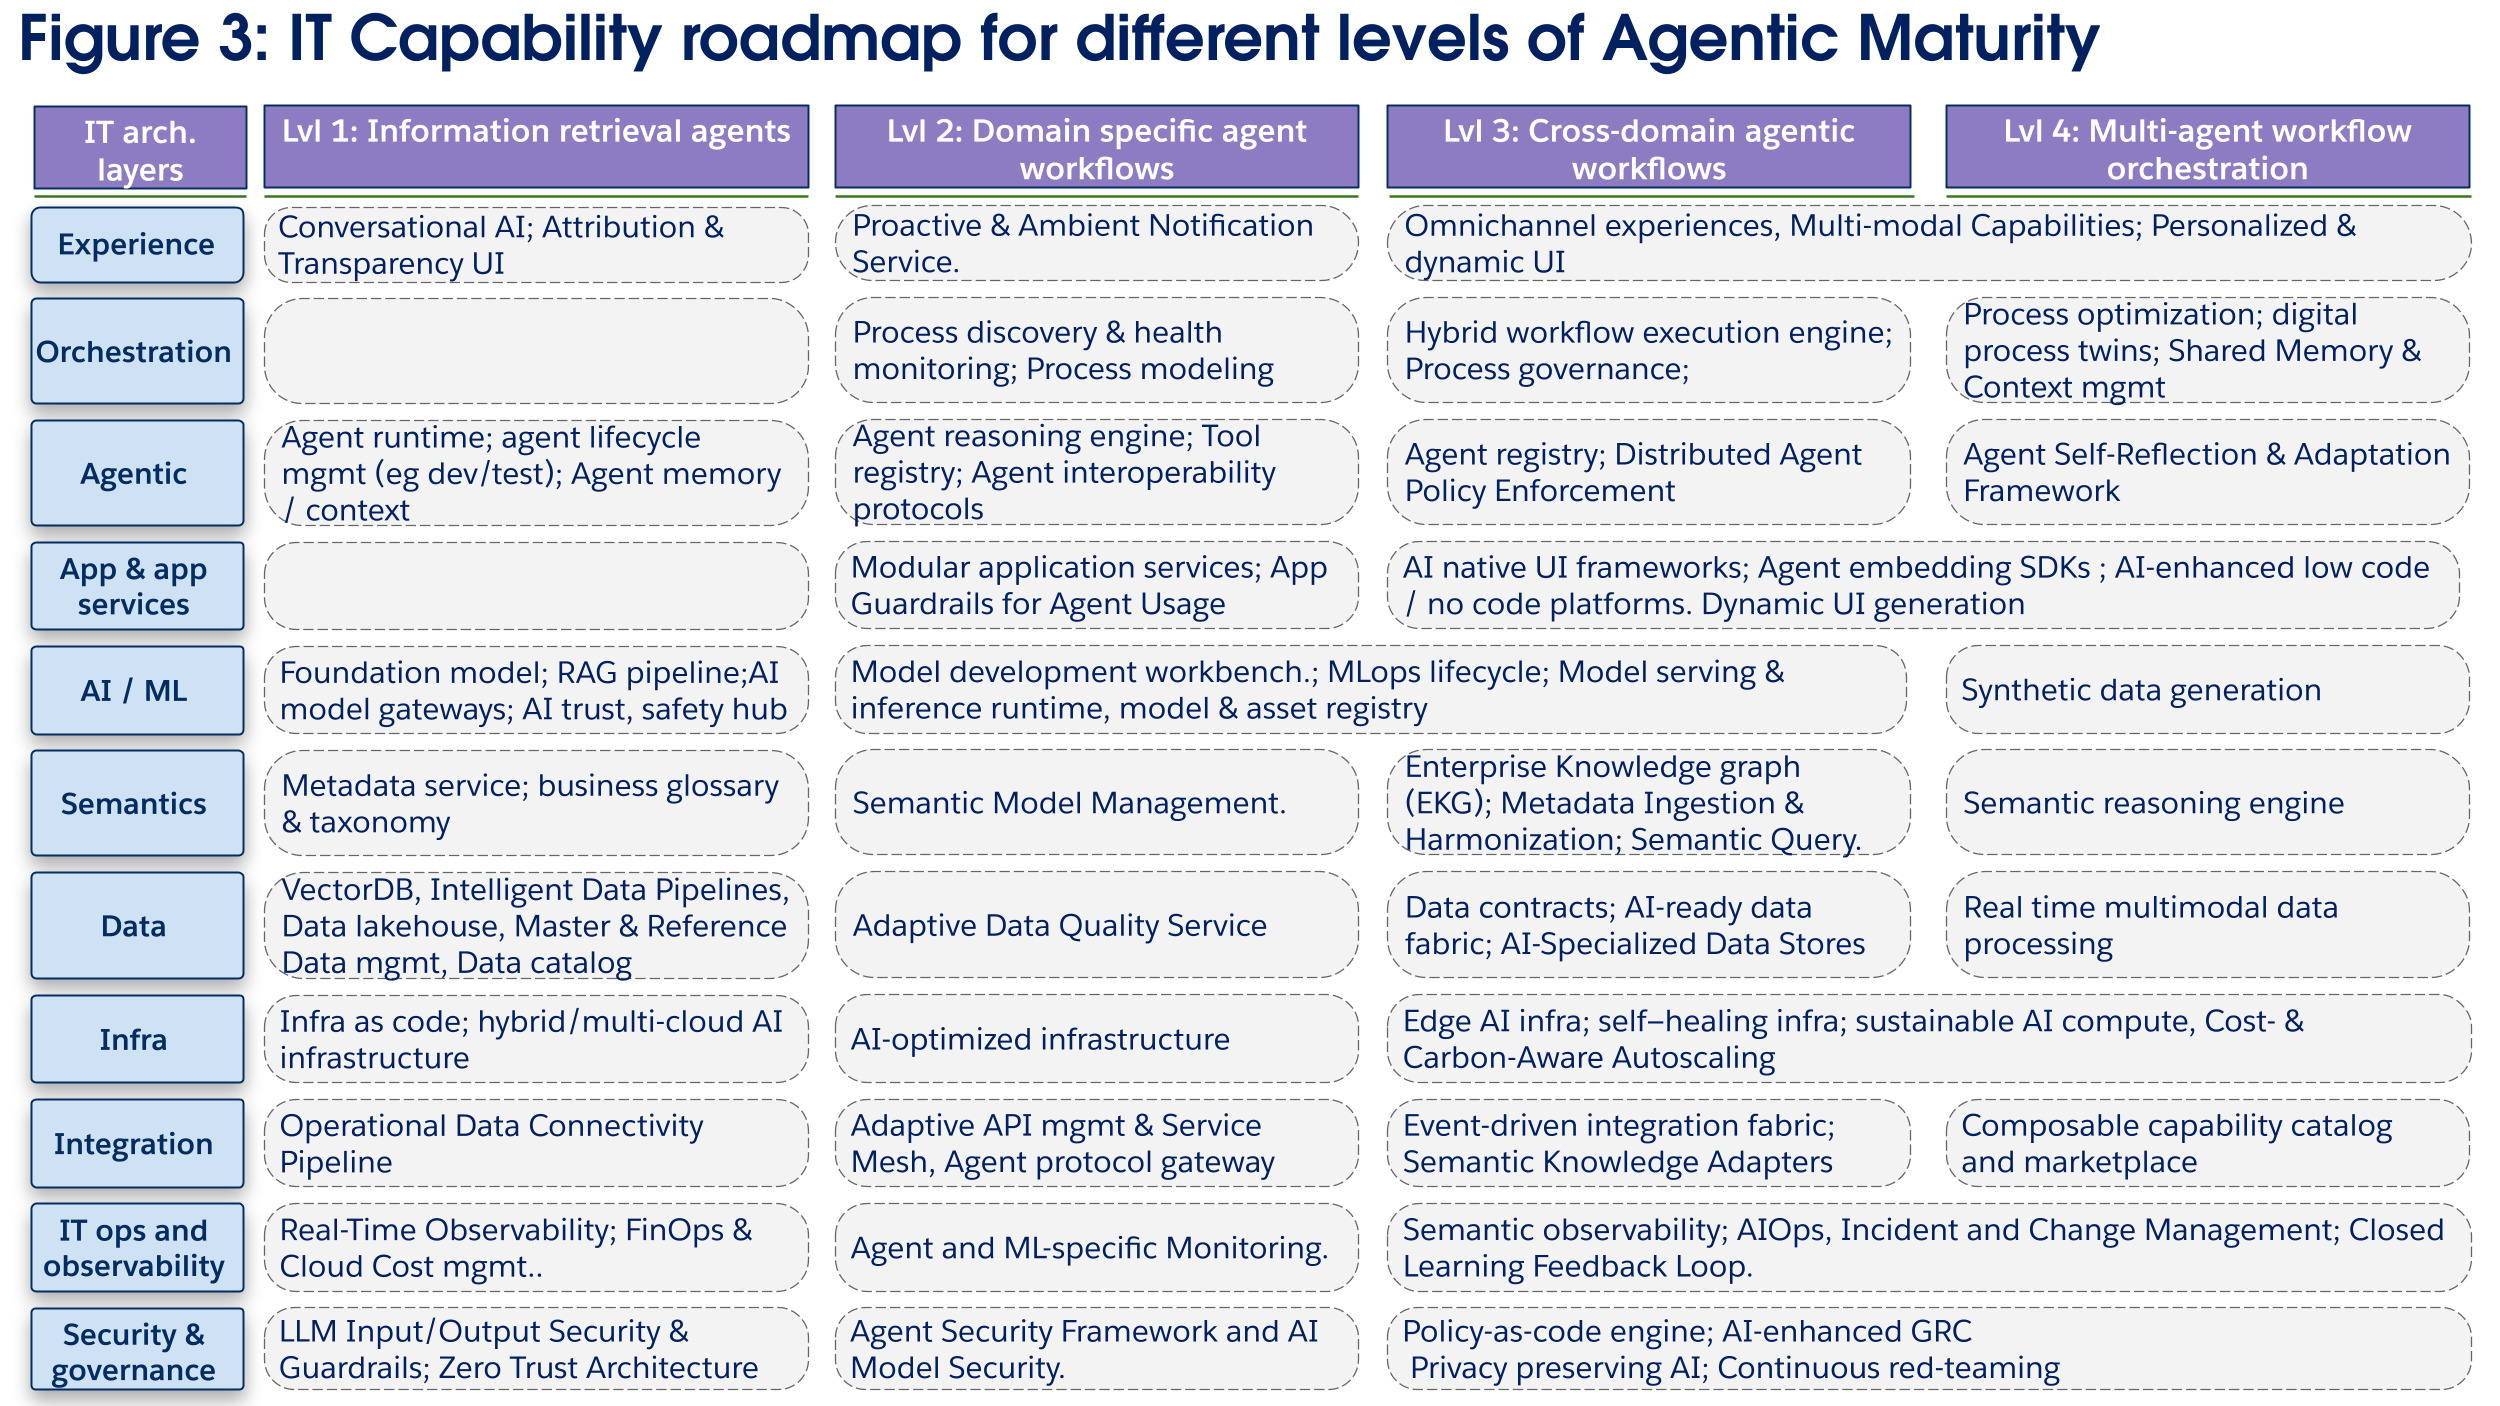
Agentic Enterprise に移行するには、具体的なビジネス価値を創出しながら、テクノロジー基盤を設定して複数フェーズのジャーニーに従う必要があります (次の図 3 を参照)。正確なロードマップは、企業の戦略、文化、AI ガバナンスモデル、IT アーキテクチャの開始点によって異なりますが、継続的な IT 投資は、範囲の拡大、複雑さの増大、価値の創出を伴うエージェントを強化するため、ほとんどの組織は段階的なアプローチを採用する必要があります。Salesforce の[エージェント成熟度モデル](https://www.salesforce.com/news/stories/agentic-maturity-model/)は、企業がトランスフォーメーションを戦略化するための有用な成熟度のフレームワークを提供します。このフレームワークでは、基本的な情報取得 (レベル 1) から、より複雑なマルチドメイン (レベル 2) およびマルチエージェントワークフロー (レベル 4) のオーケストレーションまで、エージェント機能をどのように拡張できるかを概説します。これらのフェーズを順調に進めるには、AIエージェントのより複雑で価値の高い導入のニーズを満たすために、各フェーズのアーキテクチャのさまざまなレイヤーに対象を絞った投資を行い、ITアーキテクチャを協力して進化させる必要があります。成熟度レベルごとに、11のアーキテクチャ レイヤーで必要とされる特定のテクノロジー機能が投資の根拠と共に特定されます。
 **成熟度レベル 1:情報取得エージェント**
**ビジネス目標と価値:Enterprise Knowledgeを照会するための信頼性の高い対話型のインターフェースを提供することで、人間の作業員の生産性を向上させます。**最も重要なのは、人間の能力を増強することであり、置き換えることではありません。これらのエージェントは、情報を取得してアクションを推奨することで人間をサポートします。
**アーキテクチャの焦点:**焦点は、安全で信頼性の高いデータ基盤と、情報検索に必要な基本的な AI コンポーネントを確立することです。ガバナンスとオブザーバビリティは、ユーザーのTrustを構築し、コストを管理するために初日から不可欠です。
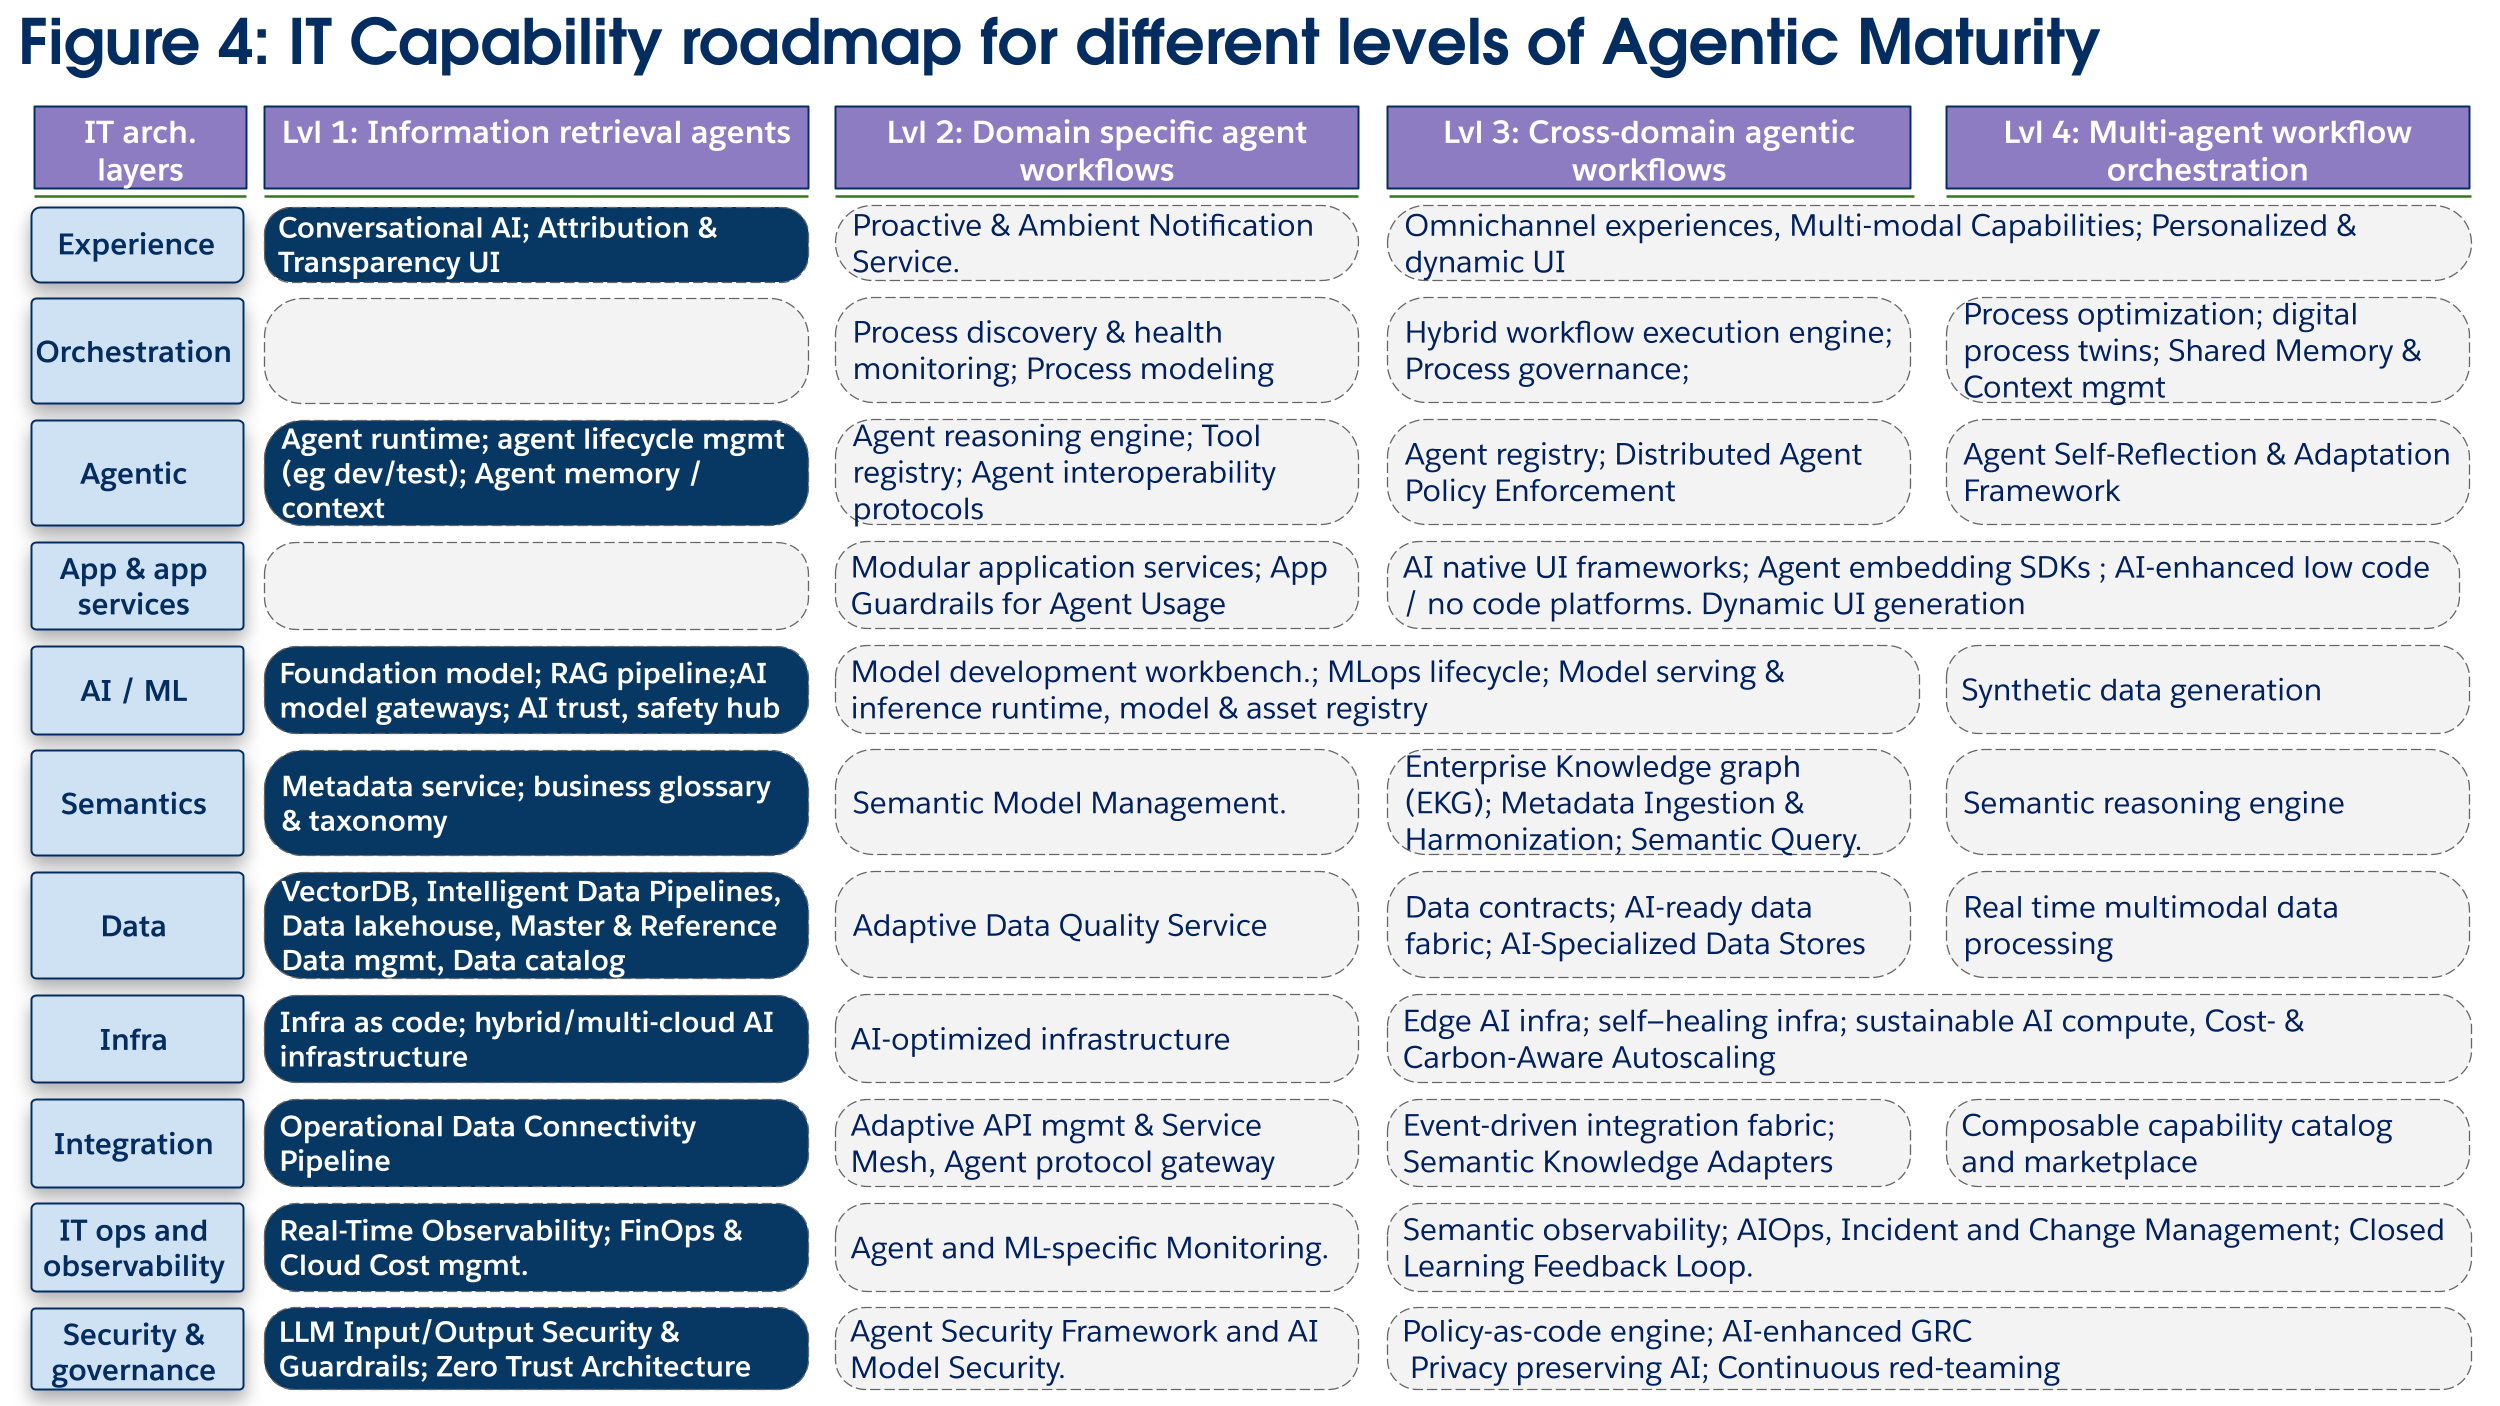
**主要なテクノロジー投資(図4):**
このフェーズでは、信頼できるデータからエージェントへのパイプラインやその他の基盤機能の作成に焦点を絞る必要があります。**VectorDB**などの**データ レイヤー**のテクノロジーは、情報取得エージェントを強化するRAG(取得拡張生成)技術を実現するために不可欠です。これに、基盤モデルへの安全でコスト コントロールされたアクセスのための**モデル ゲートウェイ**と、安全でない出力を監視してコンプライアンスを確保するための**AI Trust、Safety**、Governanceハブが含まれる一元化された**AI/MLレイヤー**を組み合わせます。**セマンティック****層**の**マスターデータ管理**と**ビジネス用語集**は、エージェントが正確な情報を取得するための基礎となります。このフェーズで作成されたエージェントを将来の使用事例に合わせて変更および拡張できるようにするには、エージェントのランタイム機能とライフサイクル機能が必要です。価値を提供し、ユーザーの信頼性を高めるには、**エクスペリエンスレイヤー**に属性と透明性の **UI** を組み込む必要があります。この UI では、引用とその情報源を表示することでエージェントの回答を説明可能にします。基本的な可観測性とセキュリティへの投資(**Trust****ゼロ**など)は、実装を開始して、将来のエージェントによる導入に備える必要があります。
 **成熟度レベル 2:シンプルなオーケストレーション、単一ドメインエージェント**
**ビジネス目標と価値:1つのビジネスドメイン内で日常的なタスクを自動化し、複雑さの低いワークフローを調整します。**これにより、業務効率が向上し、手作業が減るため、作業員はより価値の高い活動に集中できます。
**アーキテクチャの焦点:**アーキテクチャの主要なシフトは、参照のみのデータ取得からアクションの実行です。これには、エージェントがアクセスするためのアプリケーション機能 (多くの場合 API として公開) のモジュール化、エージェントアクションの堅牢なセキュリティの実装、AI エージェントのインテリジェンスを促進するためのセマンティックおよび AI 開発機能の構築など、より長いジャーニーを開始する必要があります。
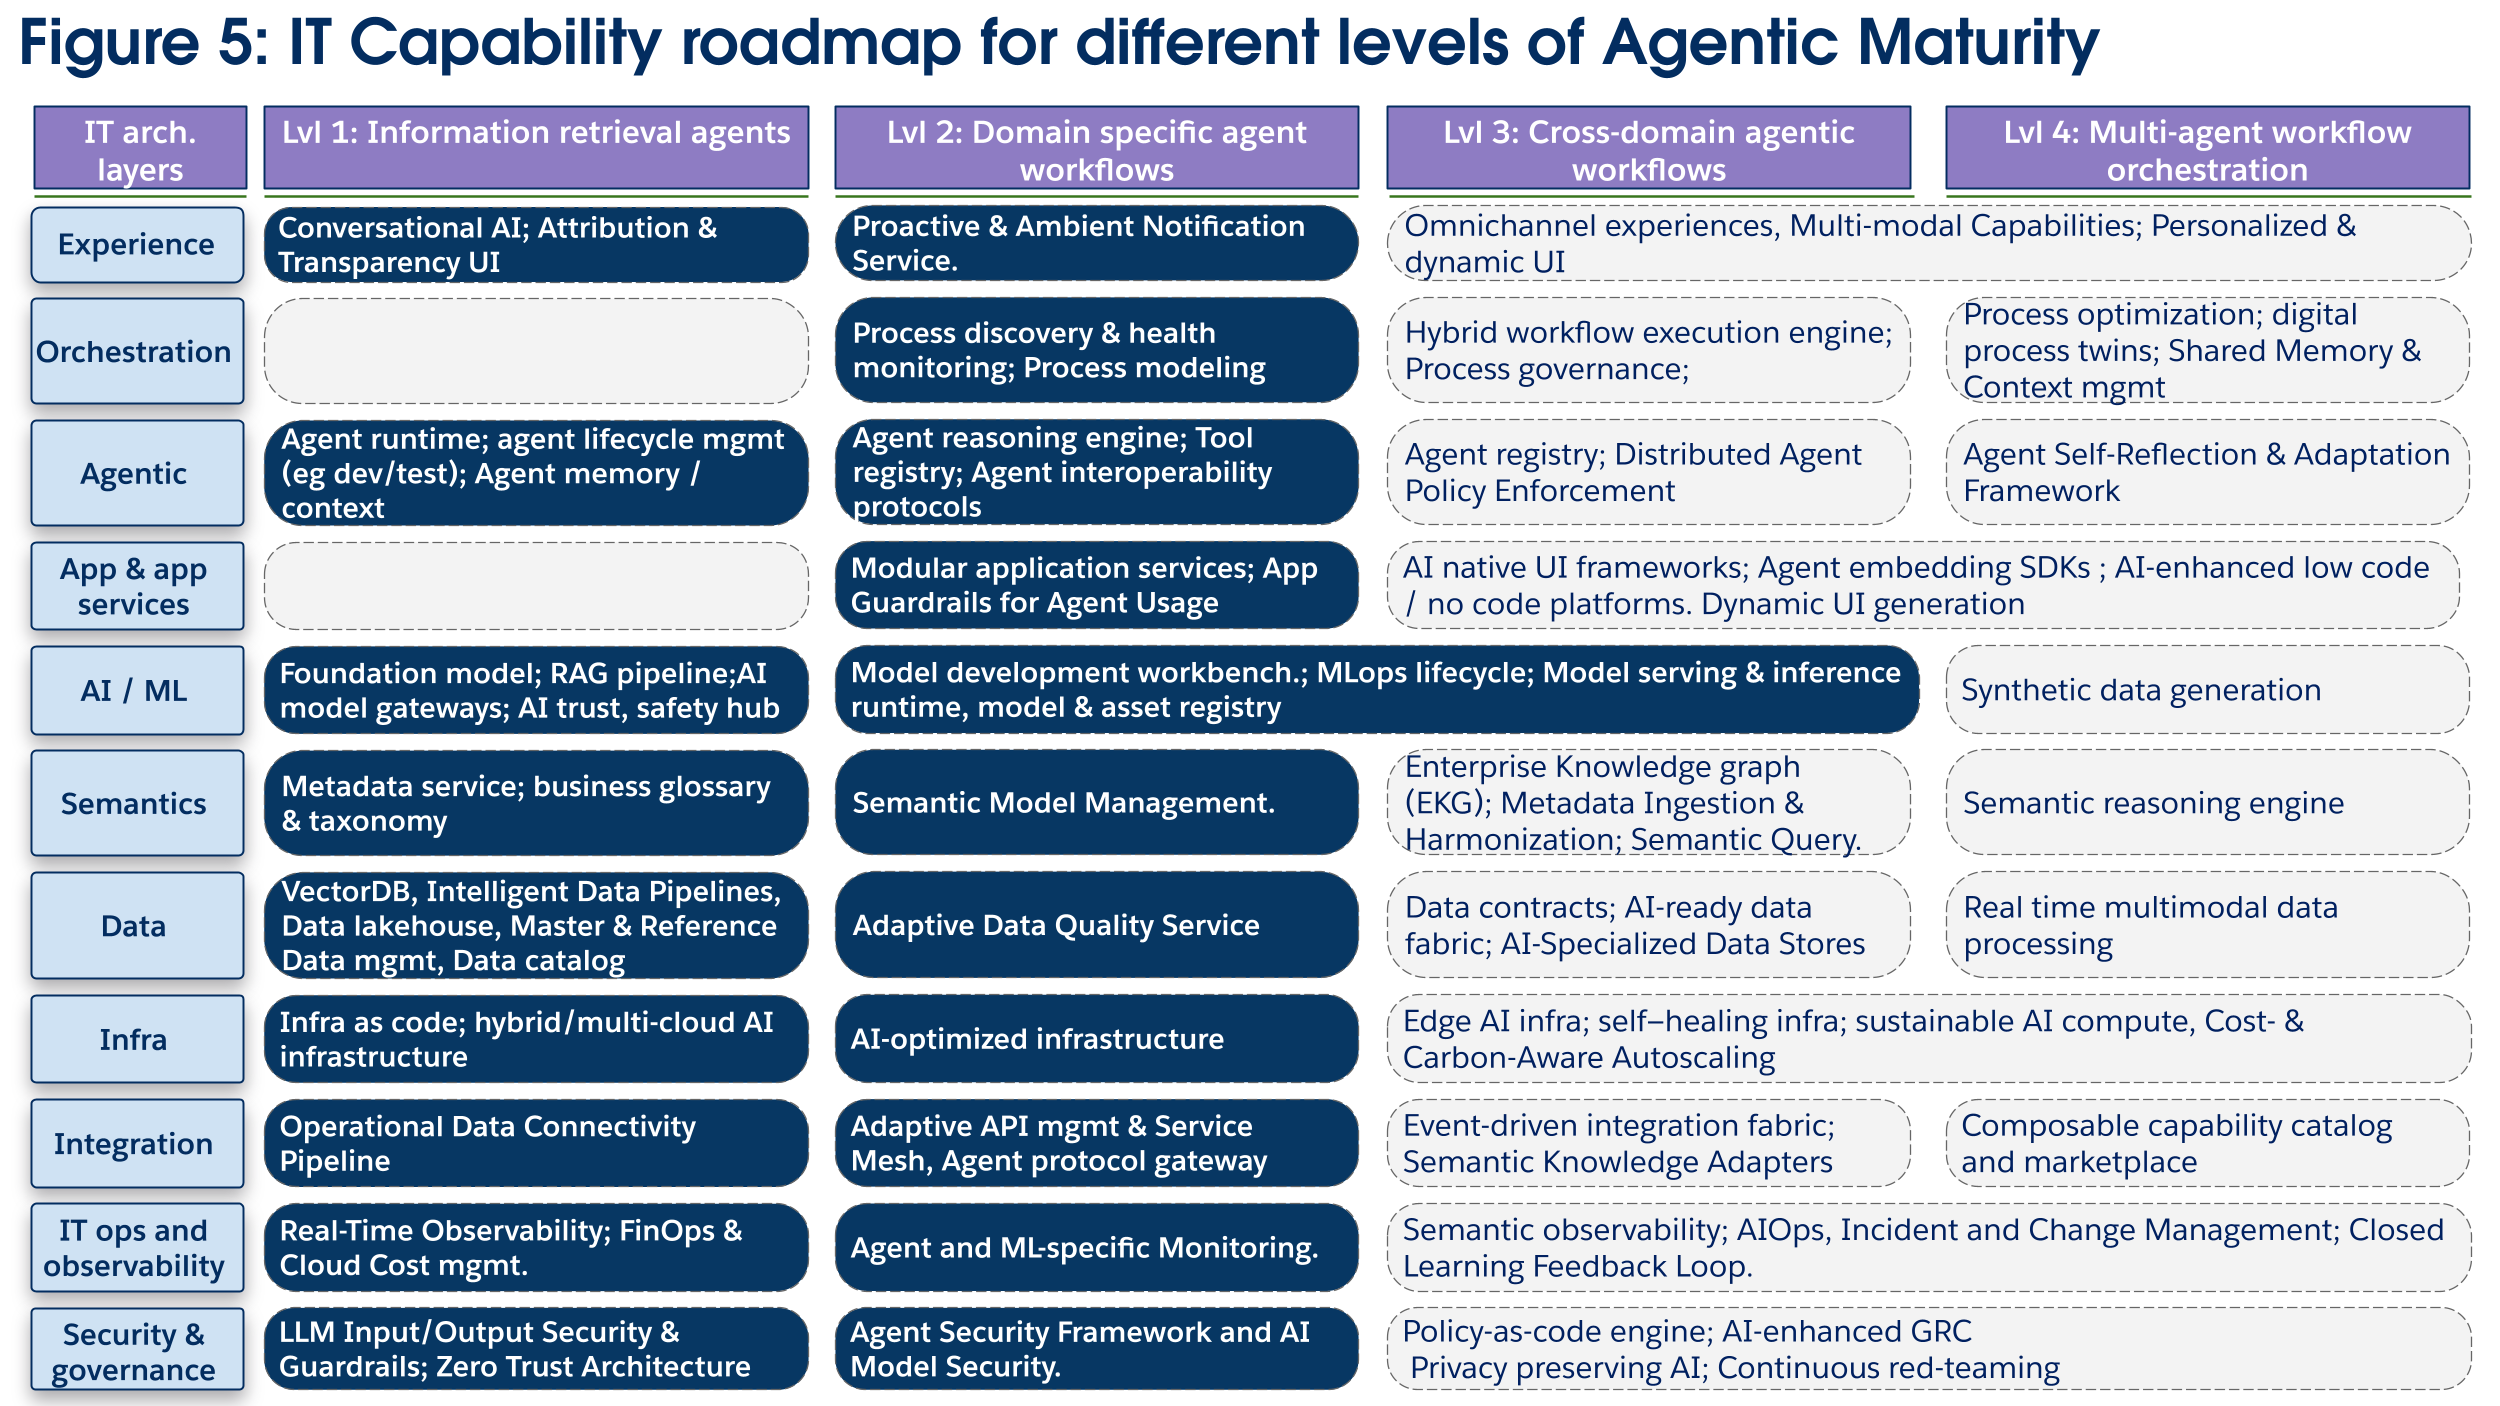
**主要なテクノロジー投資(図5):**
投資は、AI エージェントが適切なガバナンスの下でアクションを実行できるようにすることをテーマにしています。**アプリケーションおよびアプリケーションサービスレイヤー**は、モノリシックなビジネスロジックがエージェントがコールできる**モジュラーアプリケーションサービス**(API)に分解されるため、重要な変更を受けます。これらは**App Guardrails**によって保護され、エージェントがシステムを圧倒することを防ぎます。また、オブザーバビリティ ツールに統合されています。これらのエージェントを強化するには、エージェントの推論、ツールプロトコル (MCP など)、および**レジストリ**に投資する必要があります。これにより、新しいリスクが発生し、専用の**エージェント セキュリティ フレームワーク**とAIモデル、エージェント監視機能がガバナンスとセキュリティに不可欠になります。最後に、企業はカスタムモデルの AI/ML 機能を拡張して、ドメイン固有のタスクに取り組むエージェントを強化できます。
 **成熟度レベル 3:マルチドメインオーケストレーションエージェント**
**ビジネス目標と価値:**組織と機能の境界にまたがる複雑なエンド・ツー・エンドのビジネス・プロセス(「見積-to-キャッシュ」、「リード-to-注文」など)を**自動化**します。価値は、サイロの解消、プロセスのサイクル時間の短縮、ビジネス内のバリューチェーン全体の最適化にあります。組織の障壁が取り払われ始め、人間が AI エージェントの監視により集中し始めると、人間の作業員の生産性のより高いステップの変化が可能になります。
**アーキテクチャの焦点:**アーキテクチャは、横断的な技術的な問題をサポートする必要があります。企業全体で共有されているセマンティック理解、ガバナンスのための一元化されたオーケストレーションエンジン、分離されたイベント駆動型インテグレーションファブリックが重要なイネーブラーになります。
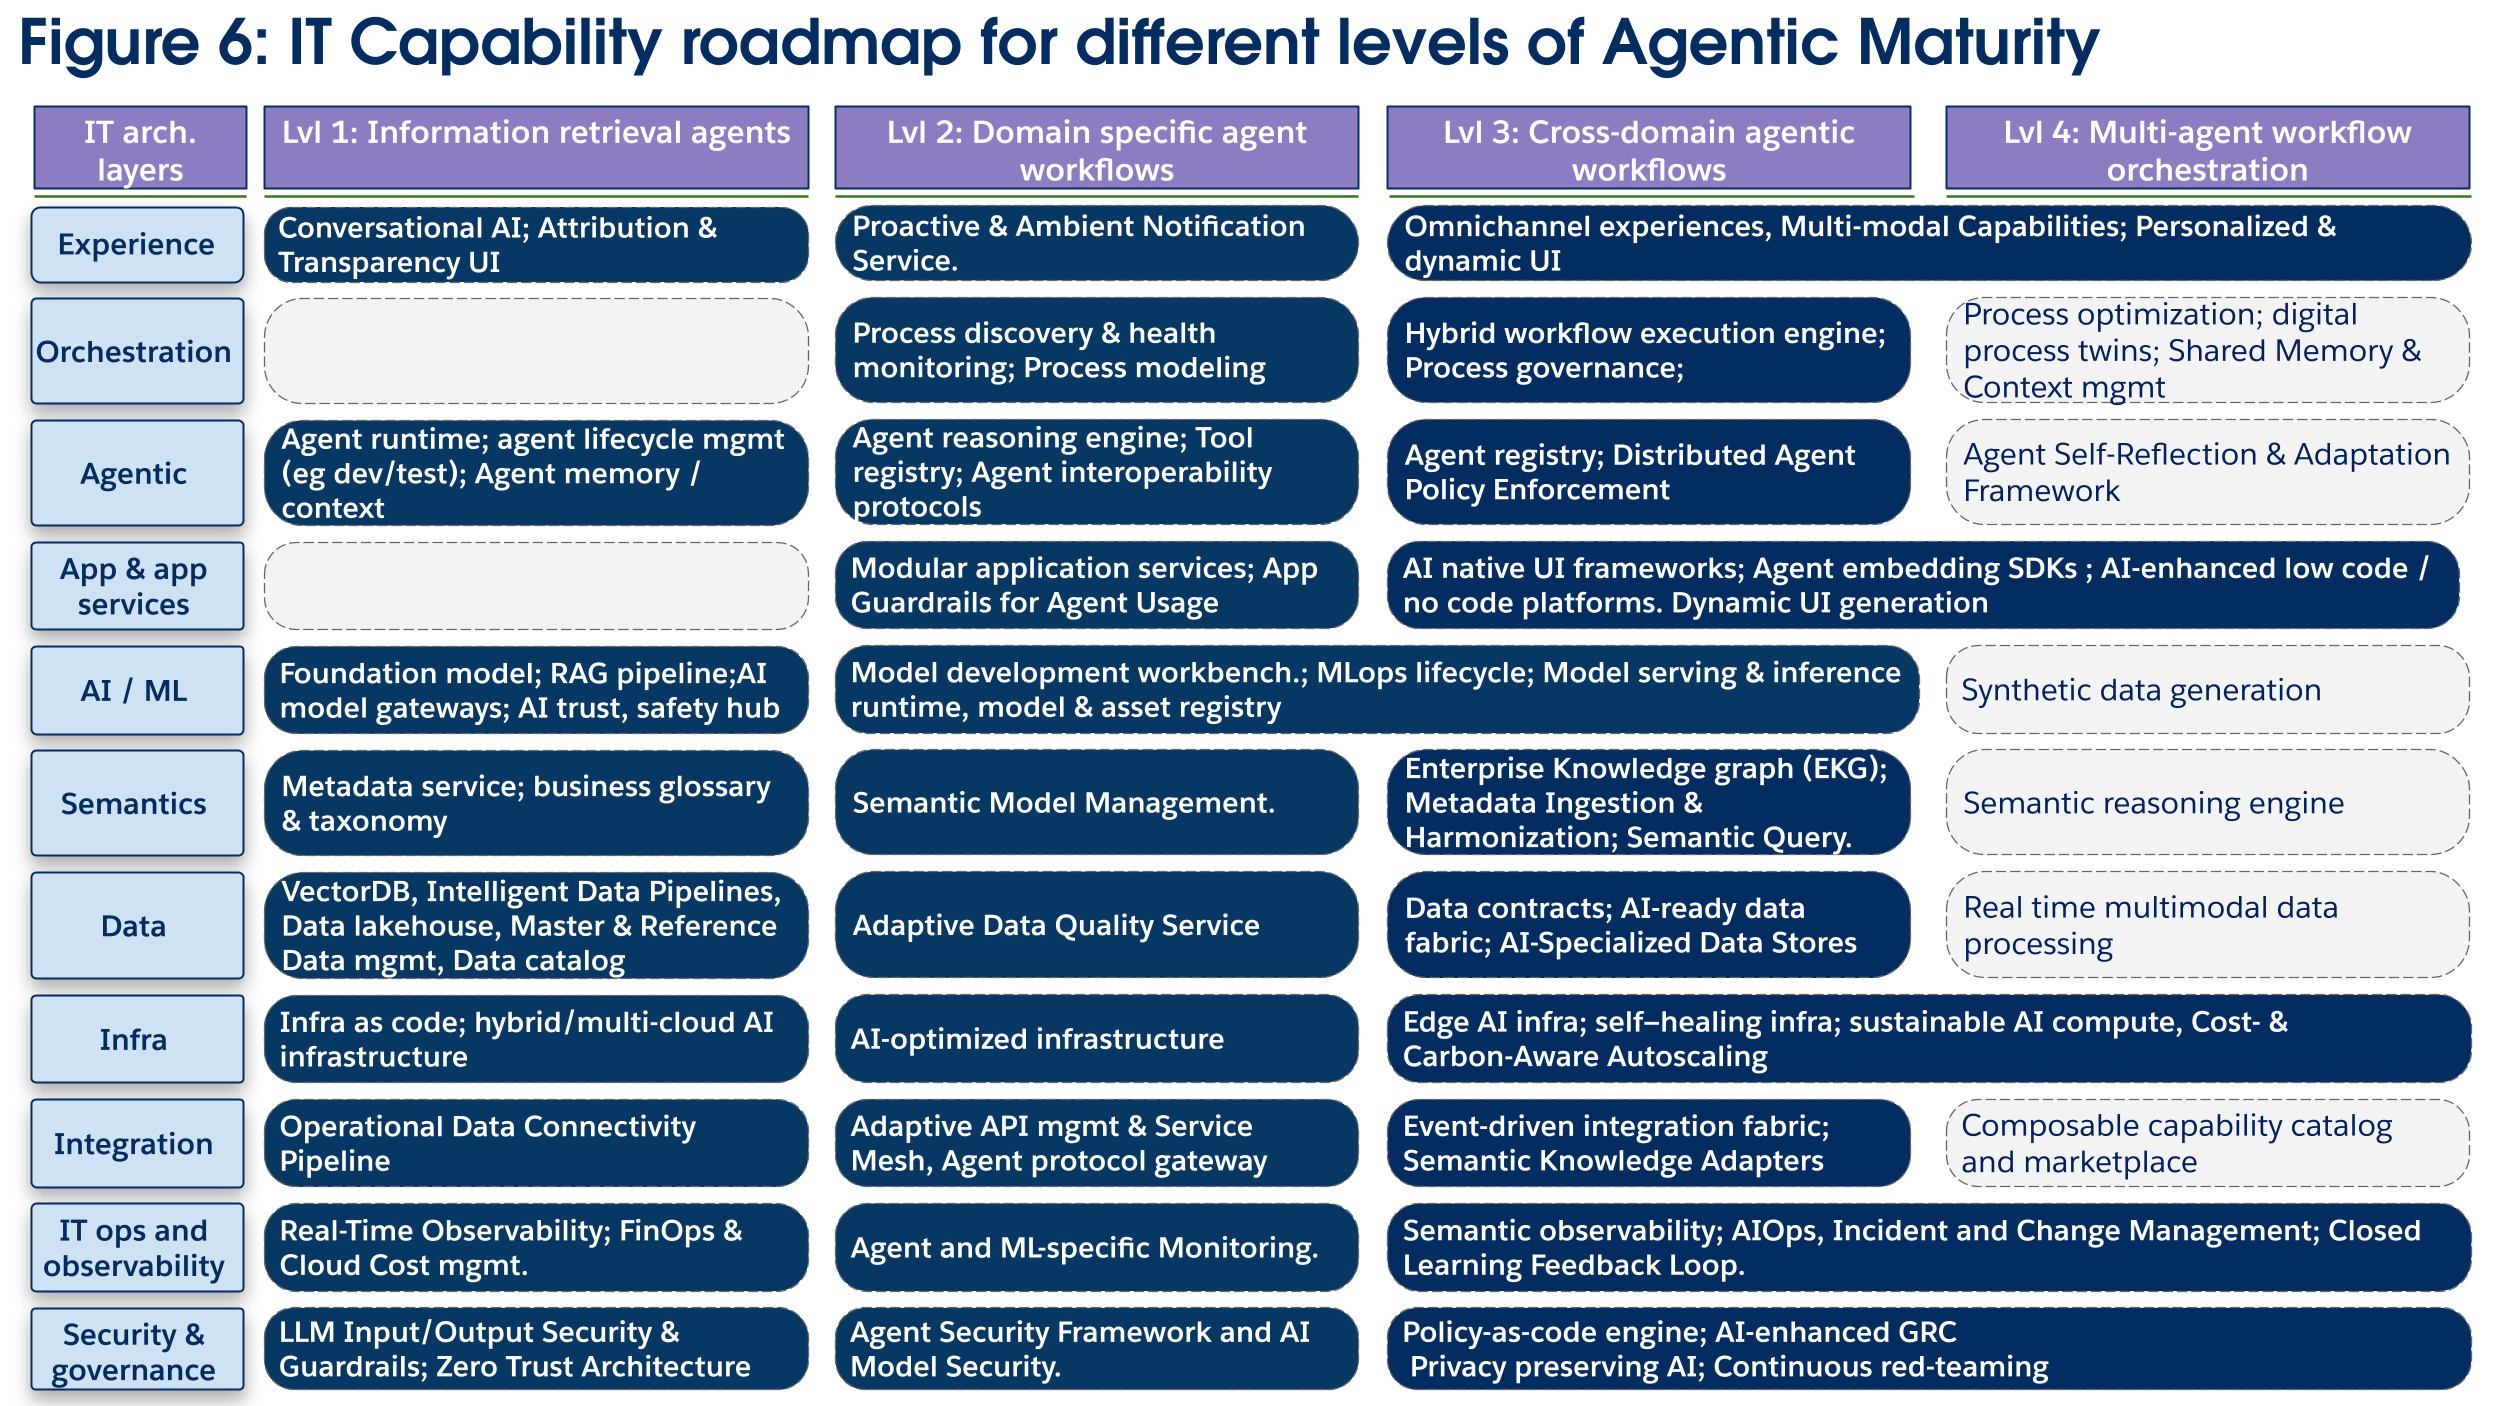 **主要なテクノロジー投資(図6):**
テクノロジーへの投資は、人、エージェント、確定的システムにまたがるエンタープライズ規模のプロセスの調整にテーマ別に重点を置いています。**エンタープライズ・オーケストレーション**・レイヤーは投資の焦点となり、アクティビティを調整するための**ハイブリッド・ワークフロー実行エンジン**と、処理中のプロセスにビジネス・ルールとコンプライアンス・ポリシーを適用するための**プロセス・ガバナンス**/制約エンジンが必要になります。これは、多くの場合、エージェントがドメイン間で作業し、ポリシーやセマンティック定義が異なるためです。このクロス・ドメイン調整は、ドメイン間でのビジネス・エンティティの関連性について共通の理解を作成する**EKG(Enterprise Knowledge Graph)**を備えた成熟した**セマンティック・レイヤー**でのみ可能です。**インテグレーションレイヤー**は、ストリーミングバックボーンを使用してシステムを分離し、長時間実行されるエンタープライズプロセスに典型的な耐障害性の高い非同期通信を可能にする**イベント駆動型インテグレーションファブリック**を含めるように進化する必要があります。これらのワークフローの価値が高く、関連するリスクを考えると、セキュリティとモニタリングへの追加投資が最も重要になります(**AIOps、コード**としてのポリシーなど)。最後に、アプリケーションおよびサービス レイヤー(**AI対応LCNC、より動的でマルチモーダル**なユーザー エクスペリエンスなど)では、人間のユーザーがより能力の高いAIエージェントの監視やコラボレーションを開始するため、さらなる投資を行う必要があります。
**成熟度レベル 4:マルチエージェント、マルチドメインオーケストレーション**
**ビジネス目標と価値:ドメイン全体のビジネス運用を再設計して最適化し、生産性と効率性の段階的な変更を促進します。**このフェーズでは、主要なビジネスプロセスとワークフロー全体で継続的な改善と戦略的計画を行うための、企業の総合的なデジタルシミュレーション (デジタルツイン) を作成します。
**アーキテクチャの焦点:**最終フェーズでは、エージェント間の動的で創発的なコラボレーションの実現に焦点を当てます。これには、高度なエージェント間通信プロトコル (A2A)、エージェントの自己学習機能、オーケストレーションレイヤー、データレイヤー、セマンティックレイヤーの成熟に向けたさらなる投資、およびエージェントが企業全体でスケールアウトされるにつれて増大する動的 AI ワークロードのニーズをサポートするための完全動的および自己修復インフラストラクチャが必要です。
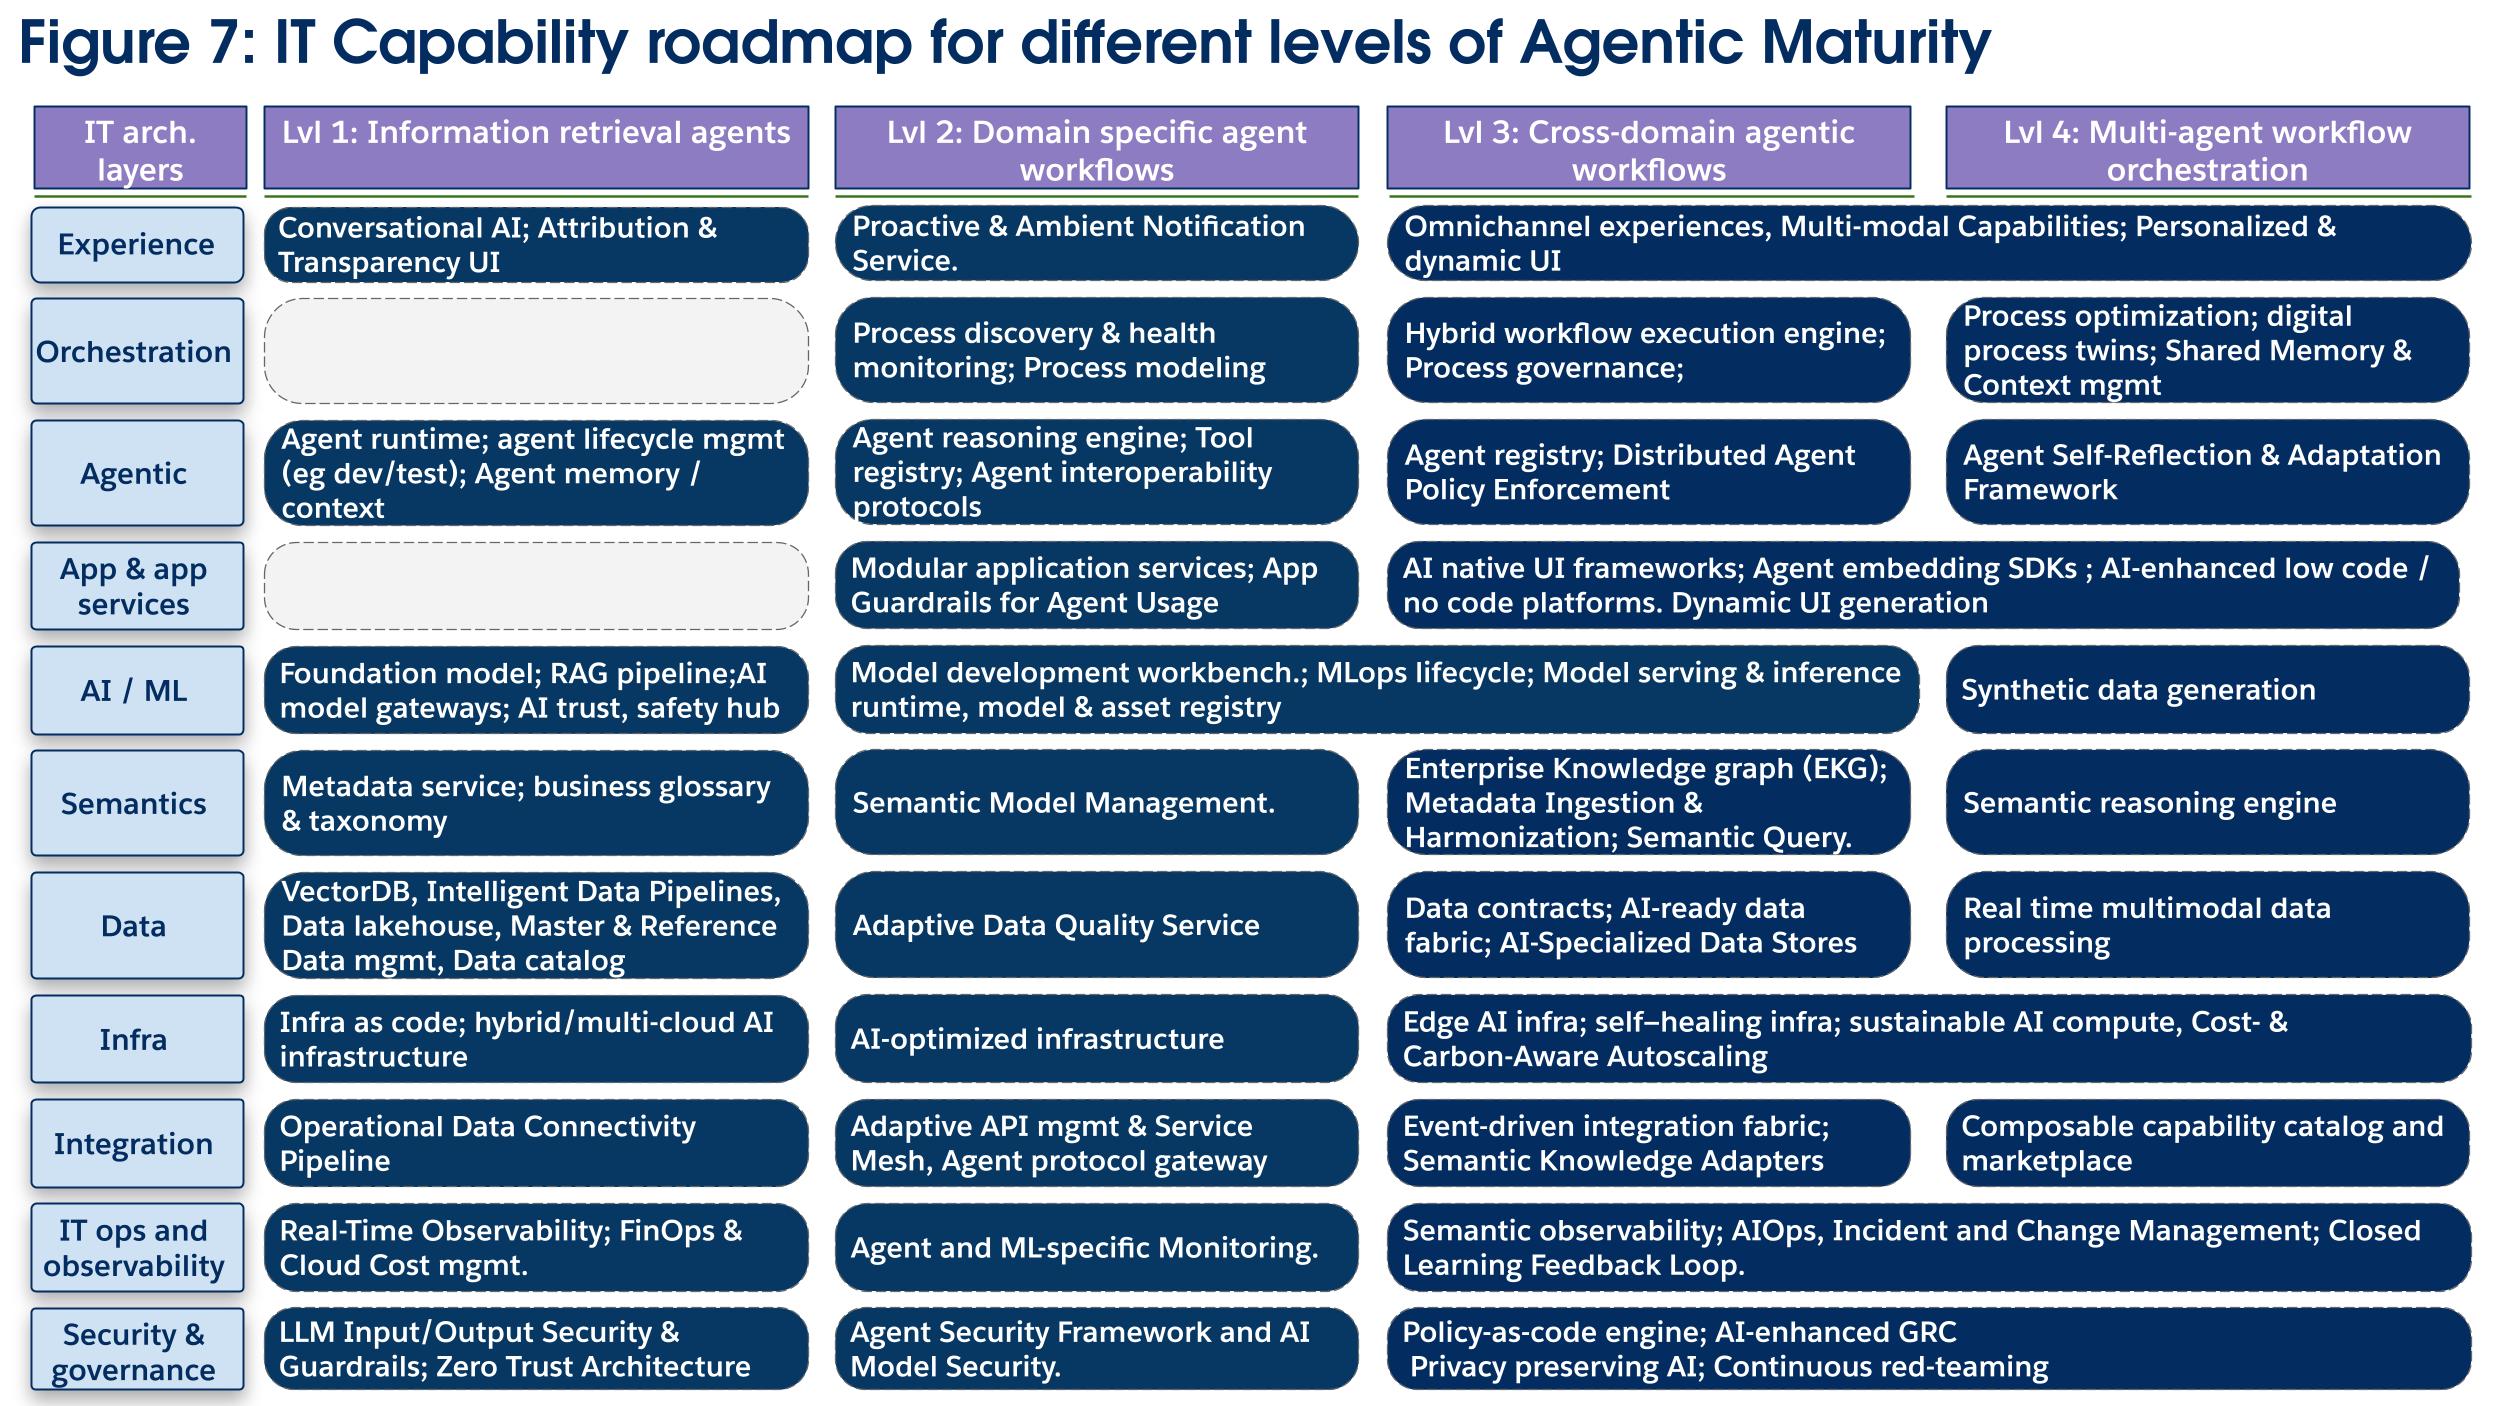 **主要なテクノロジー投資(図7):**
テーマ別投資では、自己改善型の自律システムの作成に焦点が当てられます。**エージェント層**では、**Agent Self-Reflection & Adaptation Framework** によって、エージェントが自身のパフォーマンスログを分析し、改善をトリガーするメカニズムが提供されます。この学習は、**IT Operations and Observability Layer**によってサポートされます。**Closed Learning Feedback Loop**を実装し、モデルの再トレーニングのためにオブザーバビリティ データを自動的にMLOpsパイプラインにフィードバックします。また、合成データ生成を活用してモデルのパフォーマンスをさらに最適化することもできます。エージェントのネットワークが部門全体に展開され、アプリケーションのモジュール化の取り組みも進行中であるため、セキュリティへのさらなる投資と、エージェントがより抽象的で価値の高いタスクを解決するための機能を動的に構成するための**構成可能機能カタログ**が不可欠になります。これらのプロセスはすべて、新しい**デジタル ツイン プロセス モデリング機能**によって調整および最適化されます。この機能により、リアルタイムのデータを使用して What-If 分析と予測最適化のシミュレーションが作成され、企業は新しいエージェント導入を安全にテストおよび導入できます。
**結論**
エージェント型企業へのロードマップは、IT アーキテクチャの進化に沿って実行されます。エンタープライズアーキテクトは、この変革の重要なドライバーであり、組織がエージェント型エンタープライズの新しいビジネス機能から価値を実現するために必要な、ビジネスおよび IT の他のパートナーと共に重要な投資意思決定を促進します。
## アブストラクト
ソフトウェアのパラダイムは、直接操作からゴール指向の委任に移行しつつあります。この変革の最前線にあるのは、AI エージェントです。AI エージェントは、ユーザーに代わって理解、推論、アクションを行うことができる自律的なインテリジェントなエンティティです。このホワイトペーパーでは、主要な種別の AI エージェントの技術的な探索について説明します。対話型、プロアクティブ、アンビエント、自律、コラボレーション。各タイプを定義し、CRM(顧客リレーション管理)の具体的な使用事例を示し、Salesforce _Agentforce_ Platform でこれらのエージェントを構築するためのアーキテクチャのブループリントを提供します。また、フロー、Apex、Data 360、Agent2Agent(A2A)通信、MCP(モデルコンテキストプロトコル)の相互運用性を活用する技術例も紹介します。
## Chapter 1:AI エージェントの分類
AI エージェントは、環境を認識し、特定の目標を達成するためにアクションを実行するシステムです。この概念は新しいものではありませんが、強力な大規模言語モデル (LLM) の登場により、その機能が強化されました。エージェントは、その主な操作モードとインタラクションに基づいて分類できます。
### 1.1 会話型エージェント
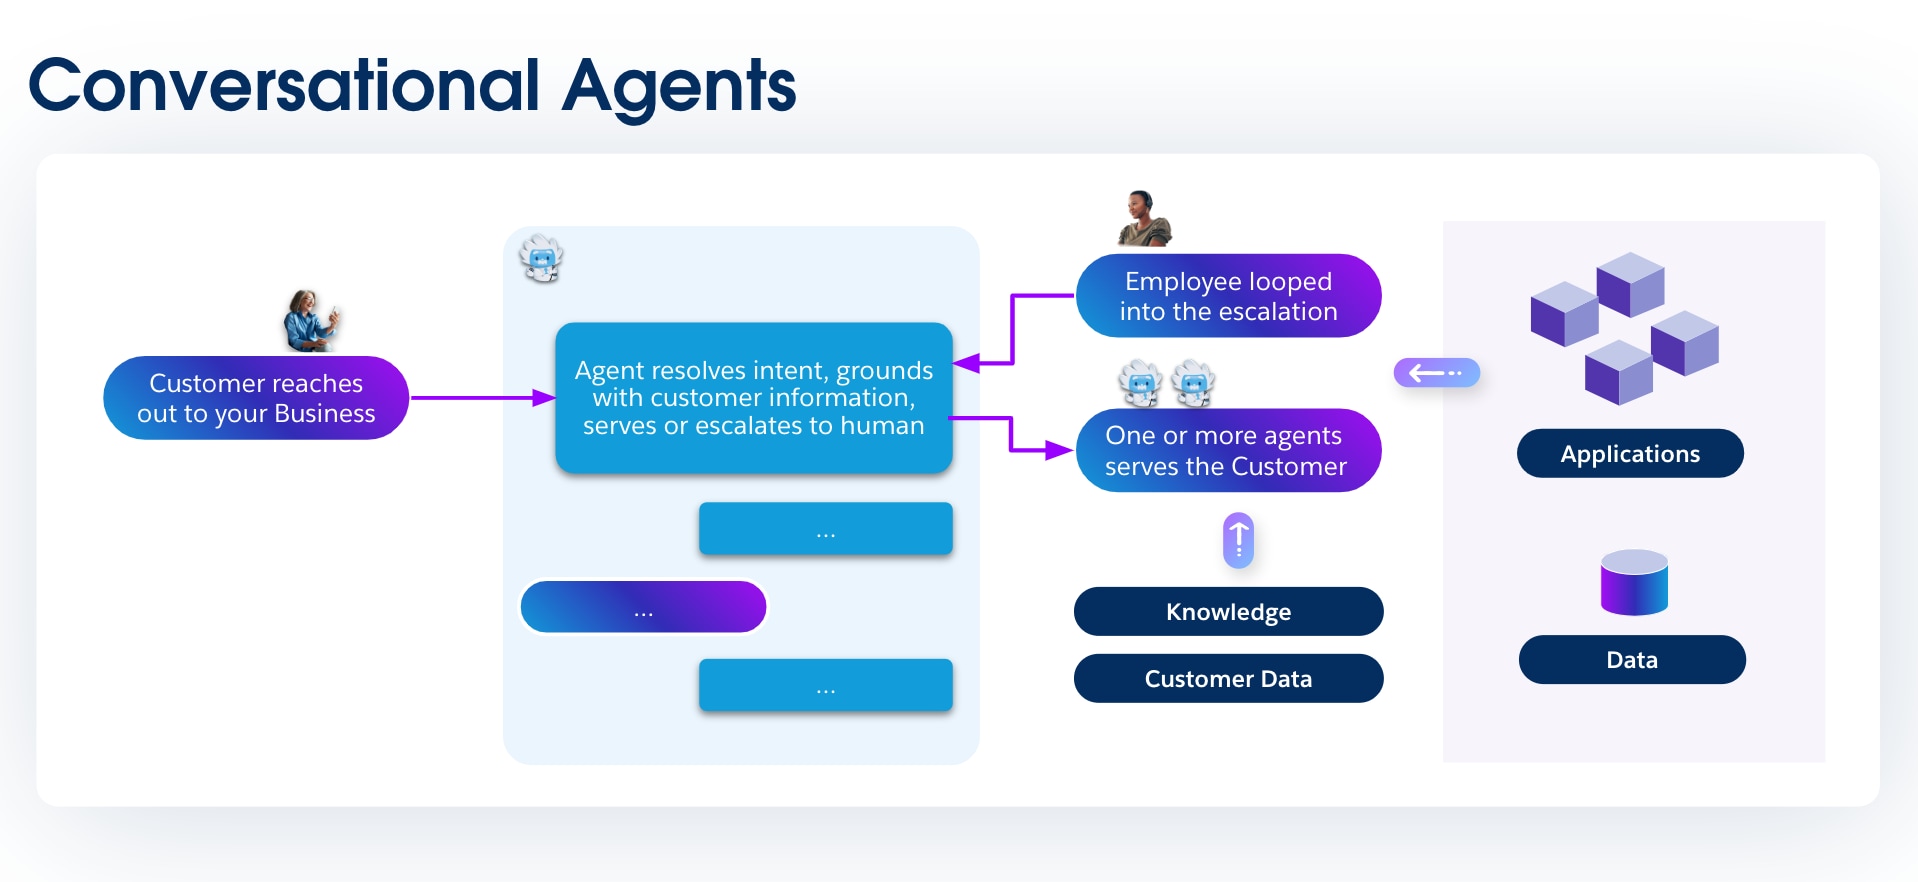
**定義:**会話型のエージェントは、最も馴染みのあるエージェントです。主に自然言語インターフェース (テキストまたは音声) を介して、反応型の要求-応答方式で動作します。コア機能は、質問への回答、情報の取得、簡単なコマンドの実行など、ユーザーのインテントを理解して関連する応答を提供することです。
**重要度:**会話型エージェントは、組織のデジタルフロントドアです。明確に定義された反復作業の処理に優れているため、人的リソースを解放できます。有効性は、ユーザーのインテントをすばやく正確に解決し、ユーザーに代わってアクションを実行する能力によって測定されます。
 ### 1.2 プロアクティブエージェント
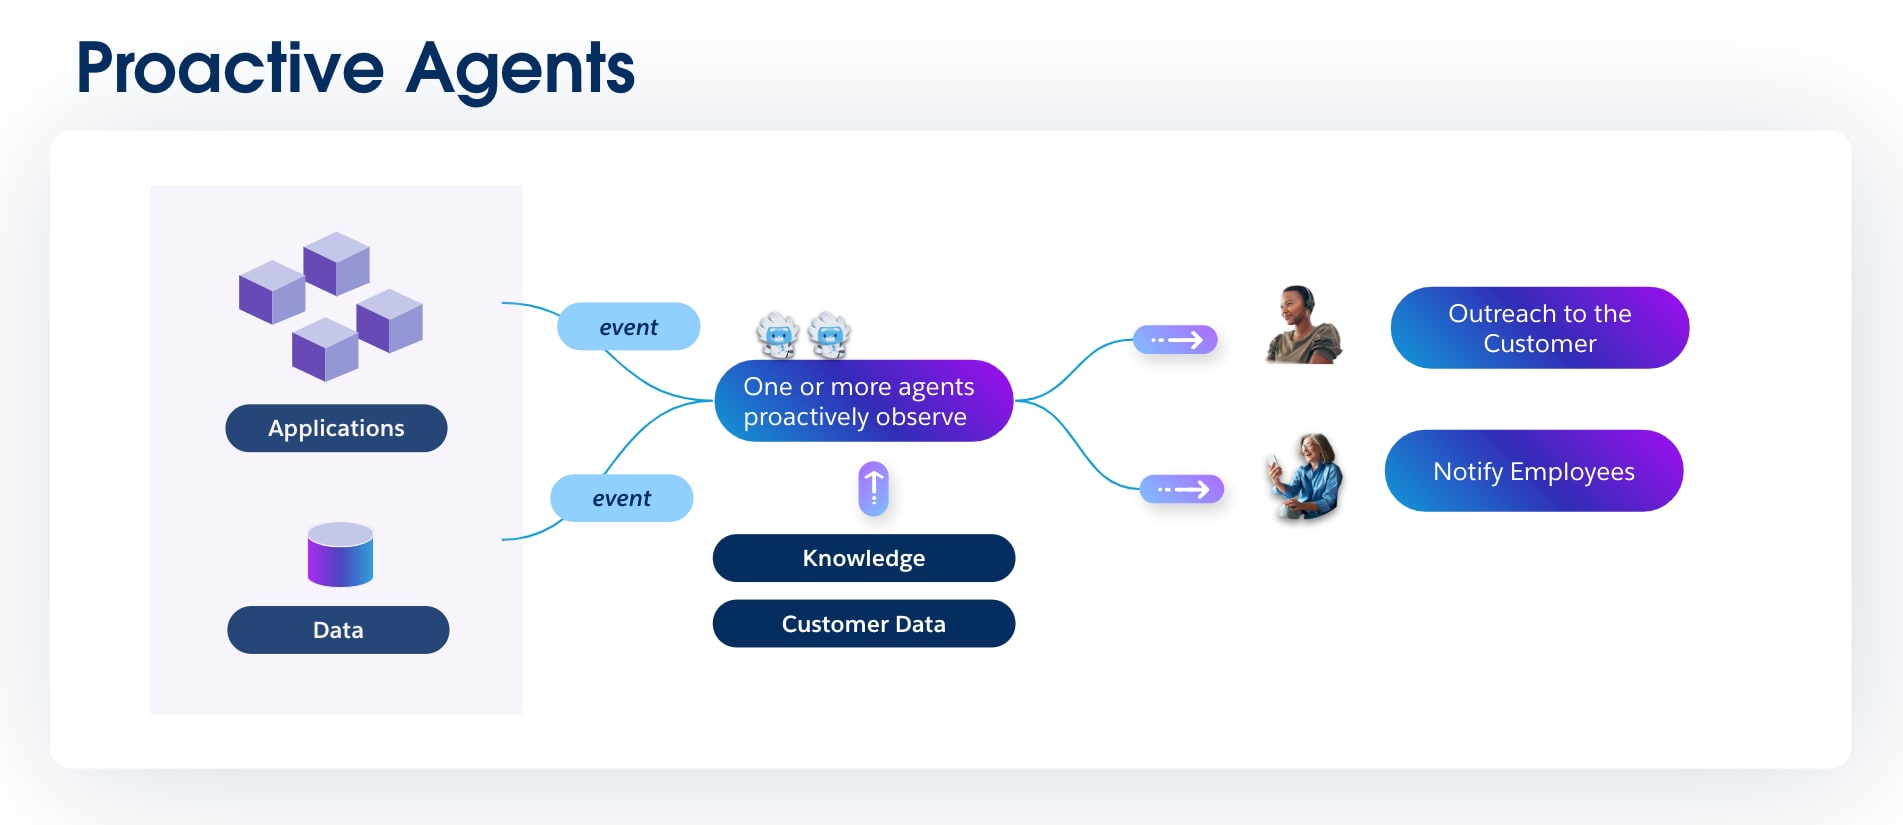
**定義:**プロンプトを待機する会話型エージェントとは異なり、プロアクティブなエージェントは用心深いオブザーバーとして機能します。これらは、特定のイベント、データの変更、またはシステム内の定義済みの条件によってトリガーされます。トリガーされると、ユーザーは直接操作することなく ToDo を実行するか、ワークフローを開始します。
**重要度:**プロアクティブなエージェントは、システムをデータのパッシブなリポジトリからビジネスプロセスのアクティブな関係者に変換します。商談やリスクが発生したときに特定できるため、企業は重要なシグナルにリアルタイムで対応できます。
 ### 1.3 アンビエントエージェント
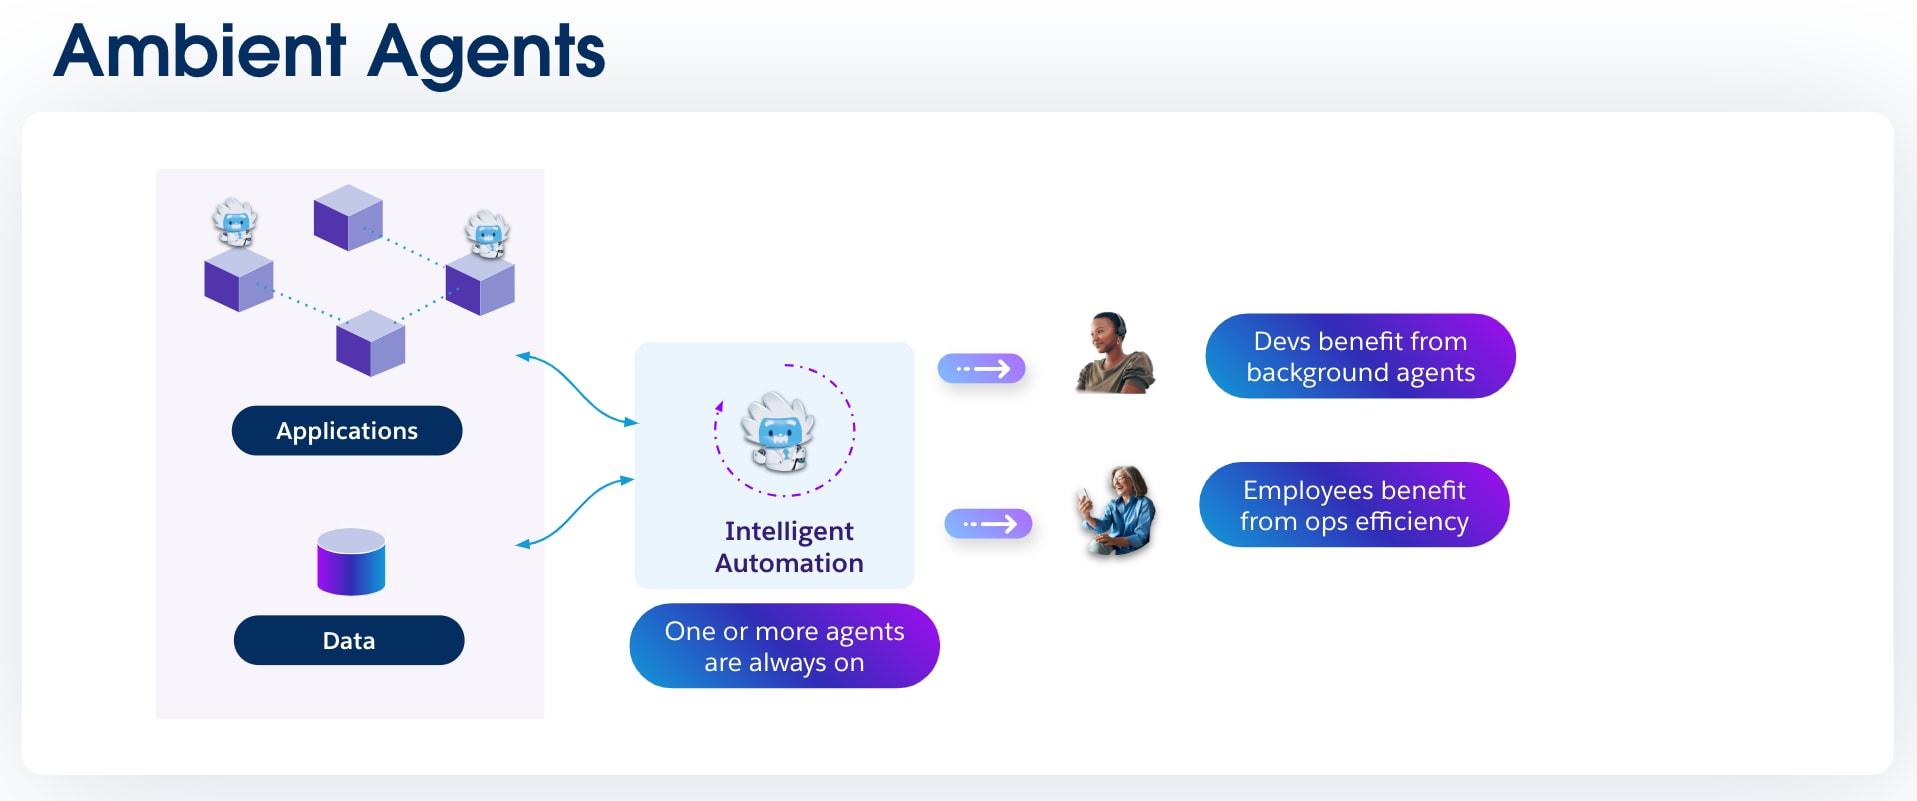
**定義:**アンビエントエージェントは、明示的なコマンドを必要とせずにユーザーのワークフローのバックグラウンドで継続的に動作する特定のタイプのプロアクティブエージェントです。多くの場合、ユーザーは操作を意識することなくアクションを利用できます。これは、これらのアクションは、ロープロファイルを維持しながら人間の能力を強化するように設計されているためです。
**重要度:**アンビエントエージェントの目標は、ありふれた「仕事に関する作業」を自動化することでユーザーの認知負荷を軽減することです。従業員が毎日使用するツールにシームレスに統合し、情報を自動的に取得して構造化することで、プロセスを効率化します。
 ### 1.4 自律エージェント
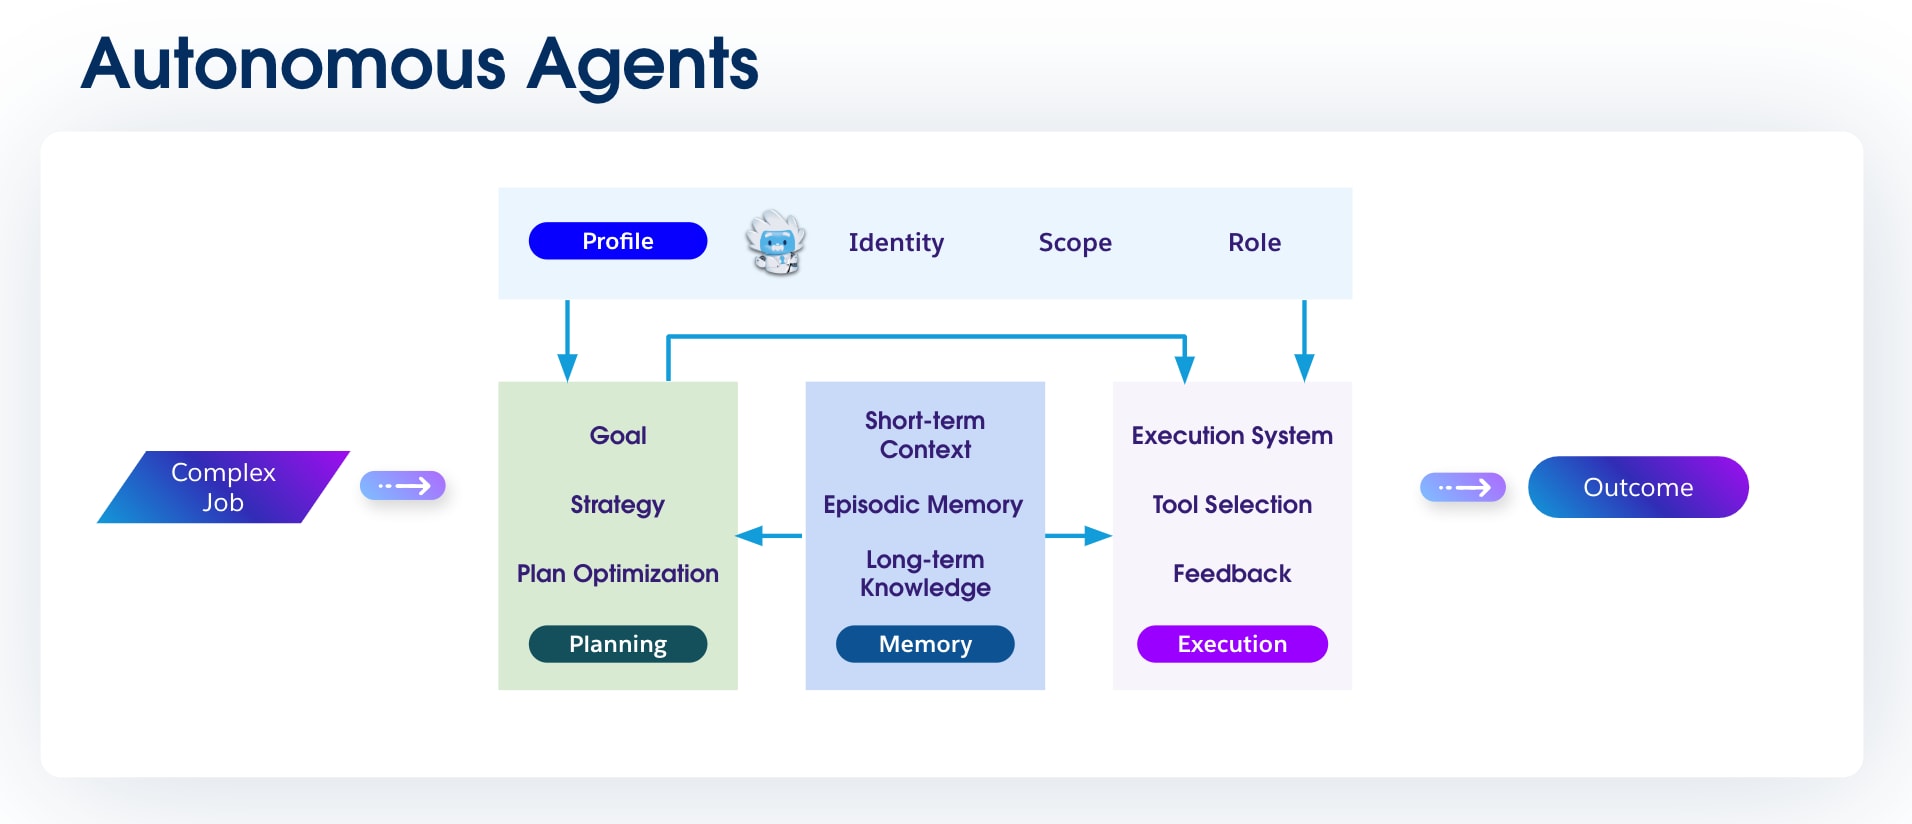
**定義:**自律エージェントは、複雑さを大幅に飛躍させます。高レベルの目標が与えられ、その目標を達成するための一連のステップを独立して計画および実行できます。ユーザーは、経時的なパフォーマンスを改善するために、推論や意思決定を行ったり、アクションから学習したりできます。
**重要度:**これは、真のデジタル従業員に最も近いものです。自律エージェントは、「この四半期に製造セクターで 50 件の新規適格リードを生成」などの複雑な複数ステップの目的を委任され、その達成に向けた計画を策定して実行できます。
 ### 1.5 コラボレーションエージェント (エージェントスウォーム)
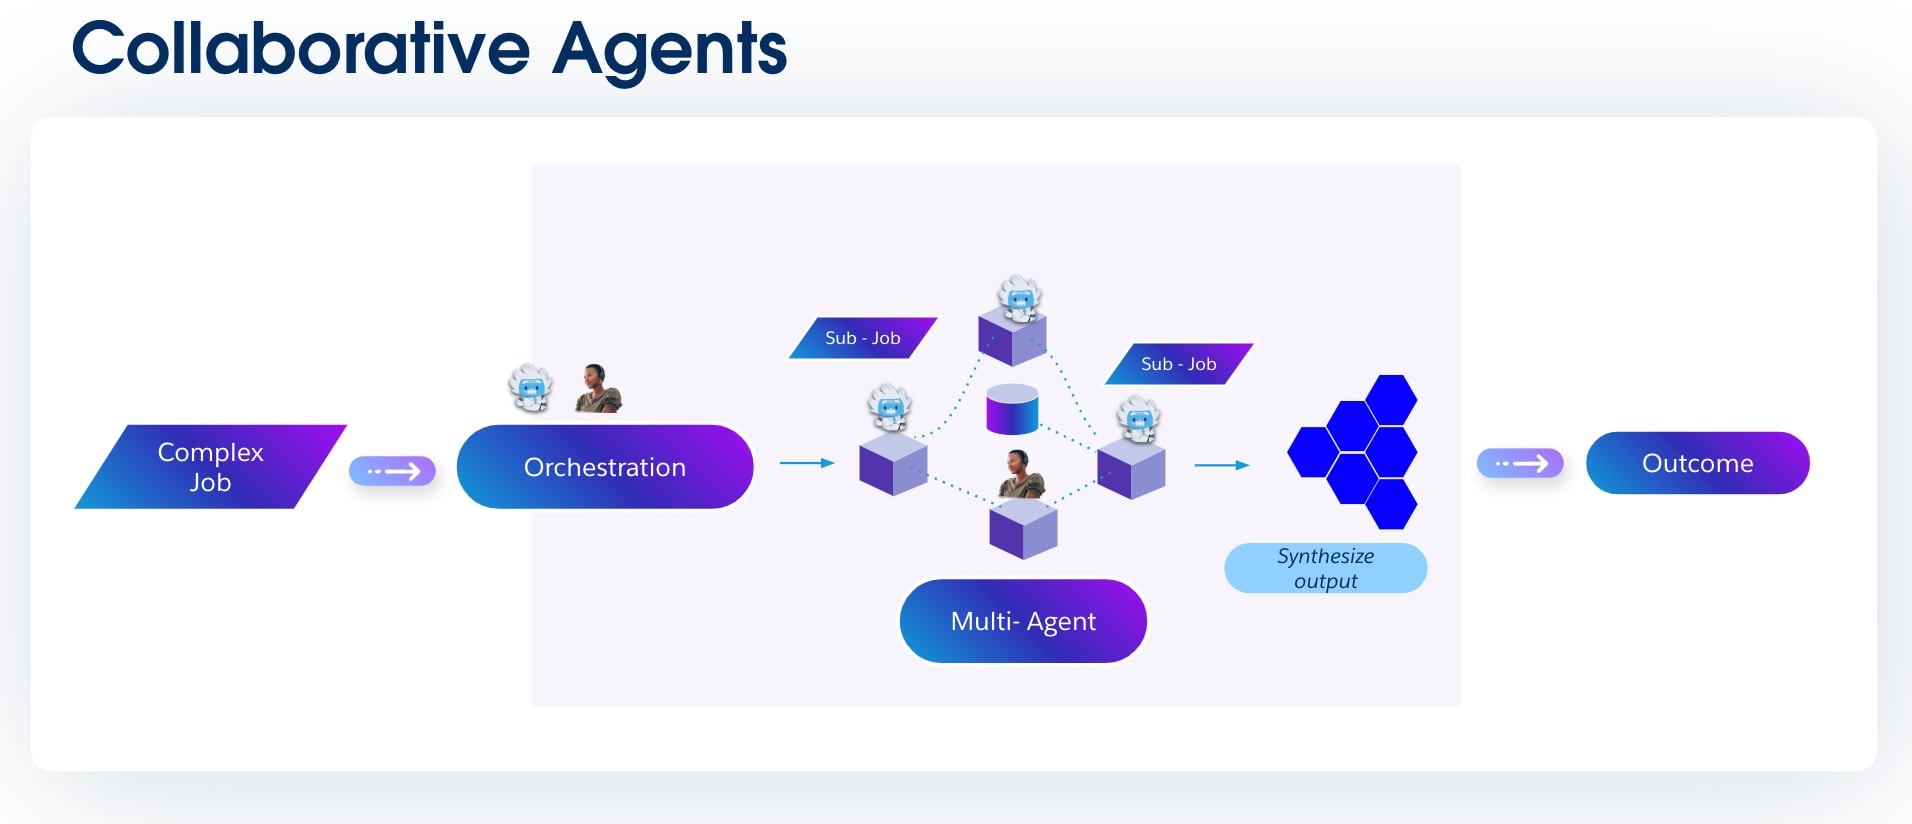
**定義:**コラボレーションエージェントは「エージェントスウォーム」と呼ばれることが多く、1 人のエージェントでは処理できない複雑な問題を協力して解決するための特殊なエージェントのコレクションです。多くの場合、「オーケストレーター」または「マスター」エージェントは、大きな ToDo を分解し、サブ ToDo を適切な専門エージェントに委任して、その出力を合成します。堅牢な Agent2Agent (A2A) 通信プロトコルでは、これを実現します。
**重要度:**このアプローチは、人間のチームを反映しています。複雑な問題を分解することで、各専門エージェントは独自のスキルを持つことができます。1 つはデータ分析、もう 1 つは顧客とのコミュニケーション、もう 1 つはシステムインテグレーションを専門とし、より堅牢で包括的なソリューションを実現します。
 ## Chapter 2:Agentforce アーキテクチャパターン
AI エージェントの分類を探索しましたが、これらの要素をどのように組み合わせて、実際のビジネスの問題を効率的かつ確実に解決するか? という重要な疑問が残ります。この章では、一般的なエージェント設計パターンのリポジトリを提供することで、この質問に答えます。各パターンは繰り返し発生する課題に対する実証済みのソリューションであり、単純な単一目的のエージェントから複雑なコラボレーションエージェントスウォームまで、あらゆるもののブループリントを提供します。
### 2.1 会話型エージェントパターン
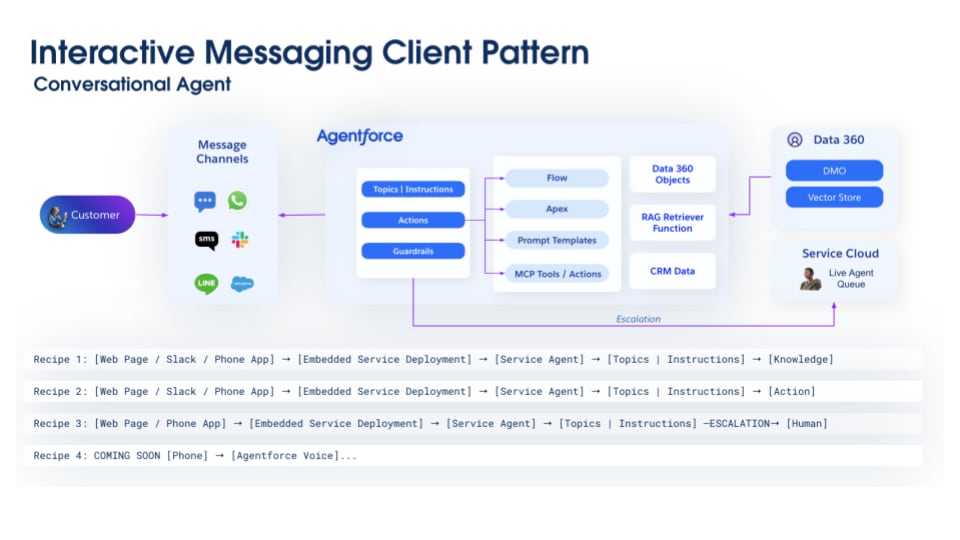
会話型エージェントは、多くの場合、組織の AI 機能のフロントドアです。これらは、ユーザーが自然言語を使用して ToDo を実行し、情報を取得するための主要なインターフェースとして機能する、ステートフルな複数ターンのダイアログに関与する機能によって定義されます。このセクションでは、会話型エージェントを構築するための 2 つの基本的なレシピを紹介します。1 つはメッセージングクライアントの迅速な対話型交換用、もう 1 つはメールの構造化された非同期用です。
会話型エージェントのインテリジェンスは、適切なデータに適切なタイミングでアクセスし、推論できることから生まれます。このパターンは、顧客レコード、Knowledge Article、ビジネス分析に接続する高度なデータ基盤に依存します。これらのインテグレーションの完全な再利用可能なレシピは、[第 4 章を参照してください。Integration Patterns (インテグレーションパターン](#chapter-4エージェントのインテグレーションパターン))。
#### 2.1.a 会話型エージェント:インタラクティブメッセージングクライアントパターン
**問題**
お客様は多くのデジタル チャネルでエンゲージし、**即時、コンテキスト**に基づくインテリジェントな応答を期待しています従来のチャットボットは**スクリプト**形式か**データ ブラインドです。**そのため、パーソナライズが不十分で、早期に人間にエスカレーションされ、サービス コストが高くなる可能性があります。
**コンテキスト**
- 組織にマルチチャネルデジタルエンゲージメント (WhatsApp、SMS、Slack、Salesforce Experience Cloud) がある。
- 組織の顧客は、[複数の言語](https://help.salesforce.com/s/articleView?id=ai.service_agent_considerations.htm&type=5)で組織とやりとりします。
- 組織では、次のようなエージェントを使用してサービスおよびセールスワークフローを強化する必要があります。
- 信頼できるリアルタイムの顧客データから取得
- ガードレールとコンプライアンス要件の遵守
- 必要な場合にのみ人間のエージェントにエスカレーションする
 **主要コンポーネント**
- **チャネルの抽象化:**Service Cloud 拡張チャット (旧称: アプリ内および Web のメッセージング) を使用すると、エージェントは 1 つの環境を介して複数のチャネルでコミュニケーションできます。
- **Agentforce サービスエージェント:**エージェントの動作と目的は、次のコンポーネントで定義されます。
- **トピックと手順:**ユーザーと直接やりとりするためのエージェントの人格と会話の目的を定義します。これには、そのコアミッション (「あなたはカスタマーサポートの問題を解決するエキスパートです」など)、共感的でプロフェッショナルな口調を保つための手順、処理が許可されている問い合わせの範囲に関する明確なガードレールが含まれます。
- **アクション:**エージェントが顧客の問題をリアルタイムに診断および解決するために使用するサービス指向のアクション。これらのツールは、注文の状況の確認、ソリューションの Knowledge ベースの検索、新しいサポートケースの作成などのタスクを対話型インターフェースから直接実行するように設計されています。
- **ガードレール:**ガードレールは、エージェントの動作を制約する設定可能なルールとランタイムチェックのセットとして機能します。プロンプトを傍受し、エージェントの提案されたアクションを検証し、最終応答を絞り込んで有害なコンテンツを防止し、ビジネスルールを適用し、エージェントが指定された範囲内で業務を行うことができる安全レイヤーとして機能します。
- **プロンプトテンプレート:**差し込み項目または Data 360 RAG Retrievers のセマンティックデータを介してライブ CRM データが動的に入力される再利用可能なテンプレート。これらのテンプレートにより、エージェントはブランド情報に基づいたコンテキストのコンテンツを生成できます。一方、Einstein Trust Layer では、指示が LLM に送信される前に機密情報を安全にマスキングできます。
- **Data 360**
- Data 360 コンポーネント(DLO、DMO、ベクトル ストア、RAG 取得など)により、構造化された顧客レコードから非構造化 Knowledge 記事まで、関連するすべてのエンタープライズ データをエージェントに一元化されたビューで表示し、正確でコンテキストに基づいた応答を実現します。
- **Service Cloud**
- **CRM データ:**エージェントを完全なケース履歴に接続し、取引先の詳細、取引先責任者レコード、エンタイトルメントに関する重要なコンテキストを提供する
- **Live Agent キュー:**完全な会話コンテキストが差し込まれた人間のサービス担当者へのエスカレーションとルーティングのサポート
**接触**
1. 組織の顧客がチャネルを介して会話を開始する。
2. メッセージは **Agentforce** に転送され、Agentforce によって範囲(トピック)が決まり、ガードレールが適用されます。
3. AI は**プロンプト テンプレートを**使用して応答を作成しますが、フローまたは Apex はバックエンド ロジックをトリガーする可能性があります。
4. コンテキストは、**Data 360 オブジェクト、**ベクトル ストア、CRM から RAG retriever を使用して取得されます。
5. AI がコンテキストに応じた回答を返します。
6. AI で解決できない場合、会話は **Service Cloud Live Agent** にエスカレーションされます
**Trade-Offs**
 **主要コンポーネント**
- **メールチャネル:**受信メッセージの取得、コンテンツと添付ファイルの解析、スレッドの継続性の維持を行い、非同期の会話を可能にします。
- **Agentforce SDR エージェント:**エージェントの動作と目的は、次のコンポーネントで定義されます。
- **トピックと手順:**会話を通じて受信リードを引き付け、評価するためのエージェントの使命を定義します。これには、見込み客のニーズを理解し、主要な評価データ (予算、権限、スケジュールなど) を収集し、取引先責任者とのミーティングのスケジュールなど、明確な次のステップに向けて会話を導く手順が含まれます。
- **アクション:**エージェントがリードライフサイクルを管理できるようにする特殊なセールスアクション。これらのツールは、リードデータの強化、テンプレート化されたフォローアップメールの送信、カレンダーシステムとの統合によるディスカバリーコールの予約など、SDR のコアタスクを実行するように設計されています。
- **ガードレール:**ガードレールは、エージェントの動作を制約する設定可能なルールとランタイムチェックのセットとして機能します。プロンプトを傍受し、エージェントの提案されたアクションを検証し、最終応答を絞り込んで有害なコンテンツを防止し、ビジネスルールを適用し、エージェントが指定された範囲内で業務を行うことができる安全レイヤーとして機能します。
- **プロンプトテンプレート:**差し込み項目または Data 360 RAG Retrievers のセマンティックデータを介してライブ CRM データが動的に入力される再利用可能なテンプレート。これらのテンプレートにより、エージェントはブランド情報に基づいたコンテキストのコンテンツを生成できます。一方、Einstein Trust Layer では、指示が LLM に送信される前に機密情報を安全にマスキングできます。
- **Data 360**
- Data 360 コンポーネント(DLO、DMO、ベクトル ストア、RAG 取得など)により、構造化された顧客レコードから非構造化 Knowledge 記事まで、関連するすべてのエンタープライズ データをエージェントに一元化されたビューで表示し、正確でコンテキストに基づいた応答を実現します。
- **Sales Cloud**
- **CRM データ:**エージェントを完全なケース履歴に接続し、取引先の詳細、取引先責任者レコード、エンタイトルメントに関する重要なコンテキストを提供する
- **顧客と SDR 間のミーティングをスケジュールします。**SDR Live Agent ハンドオフは、ToDo とミーティングのスケジュール (次のアクション) を使用してライブミーティングを設定するように設定できます。
- **アクティビティ・ログ:**行動、ToDo、メール活動を取得し、SDR エージェントのやりとりの結果としてリード、取引先、商談に関連付けます。
**接触**
1. 顧客はチャネルを介してメールを送受信し、チャネルは Agentforce に転送します。
2. Agentforce は、トピック、アクション、ガードレールを適用してインテントを解析します。
3. Agentforce は、CRM および Data 360 コンテキストで強化されたプロンプトテンプレートを使用して、コンテキスト応答のドラフトを作成します。
4. 複数ターンのメールの会話は、解決またはポリシーガイドラインまで続行されます。
5. 評価済みのリードの場合、Agentforce はミーティングをスケジュールし、CRM を更新します。
6. インテントが AI の範囲を超える場合、Agentforce は人間のサービス担当者による対応を求めて Sales Cloud SDR にエスカレーションします。
**Trade-Offs**
 **主要コンポーネント**
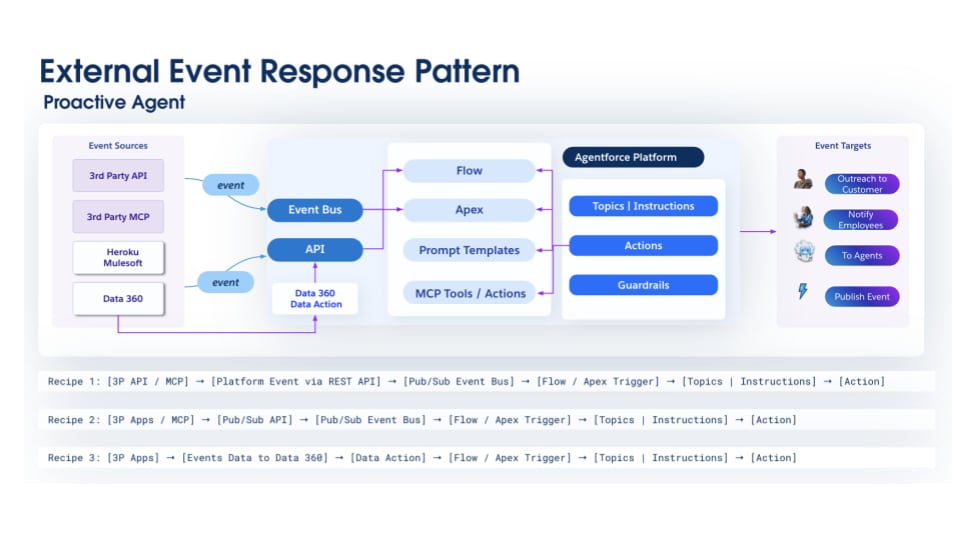
- **イベントソース**
- 外部データが Data 360 に取り込まれた後にトリガーされるデータアクションイベント
- Salesforce Pub/Sub API を使用してイベントを Salesforce に送信できるサードパーティまたは Salesforce Heroku MCP サーバー
- Salesforce Pub/Sub API を介してイベント通知を送信できる外部アプリケーション
- **オプションのミドルウェア:**変換用の MuleSoft または Data 360
- **Agentforce Agent:**エージェントの動作と目的は、次のコンポーネントで定義されます。
- **トピックと手順:**エージェントのコアミッションとそのトリガー (主目的の定義など) を指定します (「すべての優先度の高いケースを監視し、SLA 違反を防止する」など)。エージェントが ToDo を開始するためにリスンする必要がある特定のイベントまたはデータ条件が含まれる
- **アクション:**外部イベントに対応するように設計されたイベントトリガーおよびスケジュール済みアクション。これらのアクションは日常業務では自律的に動作しますが、多くの場合、人の介入を伴うワークフローを調整し、レビュー、承認、または人の判断が必要なシナリオの処理のためにユーザーにエスカレーションする機能が含まれます。
- **ガードレール:**ガードレールは、エージェントの動作を制約する設定可能なルールとランタイムチェックのセットとして機能します。プロンプトを傍受し、エージェントの提案されたアクションを検証し、最終応答を絞り込んで有害なコンテンツを防止し、ビジネスルールを適用し、エージェントが指定された範囲内で業務を行うことができる安全レイヤーとして機能します。
- **プロンプトテンプレート:**差し込み項目または Data 360 RAG Retrievers のセマンティックデータを介してライブ CRM データが動的に入力される再利用可能なテンプレート。これらのテンプレートにより、エージェントはブランド情報に基づいたコンテキストのコンテンツを生成できます。一方、Einstein Trust Layer では、指示が LLM に送信される前に機密情報を安全にマスキングできます。
- **Data 360**
- [外部システムで生成](https://developer.salesforce.com/docs/data/data-cloud-int/guide/c360-a-create-eventbusconnector-data-stream.html)され、営業担当に送信されるイベントデータを保存し、ストリーミングまたはリアルタイムのインサイトを変換および構築する **DLO や DMO** などの Data 360 コンポーネント
- **計算済みインサイト、ストリーミングインサイト**、リアルタイムインサイトは、顧客に関する即時の関連データをエージェントに提供します。これにより、エスカレーションを軽減して、プリエンプティブな問題解決が可能になります。**データグラフ**により、さまざまなデータソースからのリレーションとインサイトがプロアクティブに表示され、顧客のエンゲージメント、活動、プロファイルに関連するパターンや異常を早期に検出できます。
- **Data 360 ベクトル ストアと RAG**取得機能によって、関連するすべてのエンタープライズ データと非構造化 Knowledge 記事の統合ビューがエージェントに提供され、応答が正確でコンテキストに基づいてグラウンディングされます。
- **イベント対象**
- 従業員への積極的な通知または顧客への連絡
- エージェントに拡張可能 (「[アンビエントエージェント](#23-アンビエントエージェントパターン)」および「[自律エージェント](#25-自律エージェントパターン)」パターンを参照)
**接触**
1. 外部システムで重大な変更が発生します。
2. 外部システムがイベントを生成し、API (プラットフォームイベントを作成) または Pub/Sub API を介して Salesforce イベントバスに公開するか、イベントデータが Data 360 にストリーミングされます。
3. イベントの登録者がトリガーされます。フローがトリガーされた。
4. フローはイベントデータを使用して[エージェントアクションを](https://help.salesforce.com/s/articleView?id=platform.automate_flow_ref_elements_actions_generate_ai_agent_response.htm&type=5)コールします。エージェントは適切なアクション方針を決定し、実行します。
5. 結果は通知またはワークフローがトリガーされます。通知はコラボレーションツール (Slack など) でユーザーに配信されます。ToDo または行動も生成されます。さらに、アクションで外部システムをコールできます。そのため、イベントは失われるのではなく、プロアクティブに実行、シグナル、アクションが実行されるため、検出するための人的オーバーヘッドや複雑な自動化が排除されます。
**Trade-Offs**
 **主要コンポーネント**
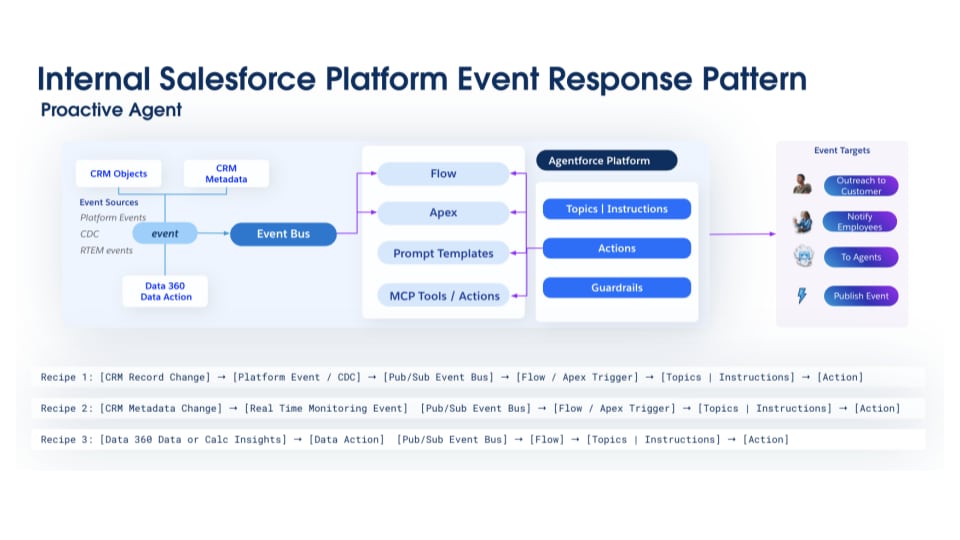
- **イベントソースレイヤー**
- 低レベルのプラットフォーム活動からの CRM データ、プラットフォームイベント、変更データキャプチャ (CDC) データ、リアルタイムイベント監視 (RTEM) データ
- **Data 360**
- [CRM イベントまた](https://developer.salesforce.com/docs/data/data-cloud-int/guide/c360-a-create-eventbusconnector-data-stream.html)はプラットフォームイベントによって生成されたイベントデータを保存する **DLO や DMO** などの Data 360 コンポーネント。ストリーミングインサイトやリアルタイムインサイトを変換および構築します。
- **計算済みインサイト、ストリーミングインサイト、リアルタイムインサイト** は、顧客、従業員の活動、またはシステムのメタデータの変更に関する即時の関連データをエージェントに提供します。これにより、エスカレーションを軽減して、プリエンプティブな問題解決が可能になります。このリアルタイムの状況把握により、エージェントはガバナンスとコンプライアンスの運用スループットのためにタイムリーな介入を提供できます。
- **データグラフ**により、さまざまなデータソースからのリレーションとインサイトがプロアクティブに表示され、顧客のエンゲージメント、活動、プロファイルに関連するパターンや異常を早期に検出できます。
- **Data 360 ベクトル ストアと RAG**取得機能によって、関連するすべてのエンタープライズ データと非構造化 Knowledge 記事の統合ビューがエージェントに提供され、応答が正確でコンテキストに基づいてグラウンディングされます。
- **Agentforce Agent:**エージェントの動作と目的は、次のコンポーネントで定義されます。
- **トピックと手順:**Salesforce 内のデータの変更に基づいてビジネスルールを適用し、プロセスを自動化するエージェントのミッションを指定します。エージェントの目的 (「交渉フェーズに達する前に主取引先責任者とすべての商談を更新する」など) と、エージェントをトリガーする特定のレコード作成、項目自動更新などが定義されます。
- **アクション:**内部 Salesforce イベントに応答するように設計されたイベントトリガーおよびスケジュール済みアクション。これらのアクションは日常業務では自律的に動作しますが、多くの場合、人の介入を伴うワークフローを調整し、レビュー、承認、または人の判断が必要なシナリオの処理のためにユーザーにエスカレーションする機能が含まれます。
- **ガードレール:**ガードレールは、エージェントの動作を制約する設定可能なルールとランタイムチェックのセットとして機能します。プロンプトを傍受し、エージェントの提案されたアクションを検証し、最終応答を絞り込んで有害なコンテンツを防止し、ビジネスルールを適用し、エージェントが指定された範囲内で業務を行うことができる安全レイヤーとして機能します。
- **プロンプトテンプレート:**差し込み項目または Data 360 RAG Retrievers のセマンティックデータを介してライブ CRM データが動的に入力される再利用可能なテンプレート。これらのテンプレートにより、エージェントはブランド情報に基づいたコンテキストのコンテンツを生成できます。一方、Einstein Trust Layer では、指示が LLM に送信される前に機密情報を安全にマスキングできます。
- **イベント対象**
- 従業員に積極的に通知したり、顧客に問い合わせたりします。
- 他のエージェントをコールできる拡張性([環境 AI](#23-アンビエントエージェントパターン)および[自律 AI](#25-自律エージェントパターン)パターンを参照)
**接触**
1. CRM レコードの更新、メタデータの変更、Data 360 からトリガーされたデータアクションなど、内部システム内で顕著な変更が発生します。
2. 内部システムがイベントを発行し、API (プラットフォームイベントを作成) または Pub/Sub API を介して Salesforce イベントバスに公開するか、イベントデータが Data 360 にストリーミングされます。
3. イベントのサブスクライバがトリガーされ、フローまたは Apex がアクティブ化されます。
4. 有効化されたフローまたは Apex が[エージェントアクションを](https://help.salesforce.com/s/articleView?id=platform.automate_flow_ref_elements_actions_generate_ai_agent_response.htm&type=5)コールします。
5. 結果は通知またはワークフローがトリガーされます。通知はコラボレーションツール (Slack など) でユーザーに配信されます。ToDo または行動も生成されます。さらに、アクションで外部システムをコールできます。
6. そのため、イベントは失われるのではなく、プロアクティブに実行、シグナル、アクションが実行されるため、検出するための人的オーバーヘッドや複雑な自動化が排除されます。
**Trade-Offs**
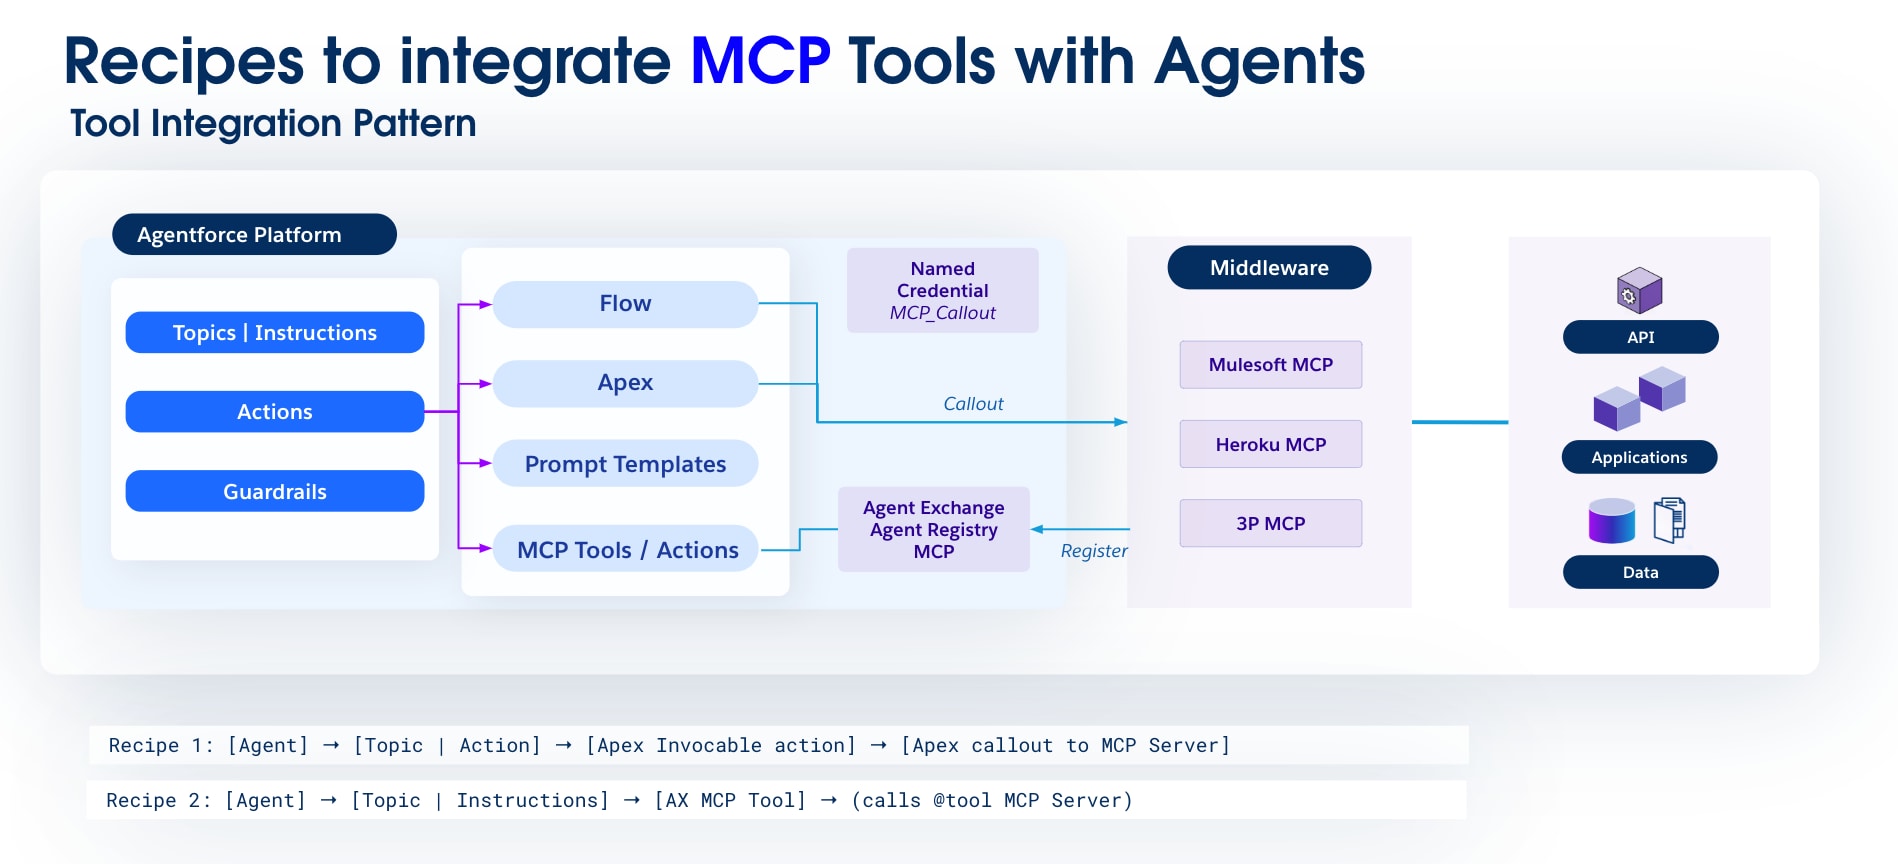 **レシピ 1:\*\***MCP を使用した外部ツールの有効化\*\*
**問題**
組織は従来の ERP と最新の SaaS を組み合わせて運用していますが、共通のプロトコルがないためエージェントとの統合は困難です。各ツールには独自の API、認証、データモデルがあります。開発者は、ツールごとにカスタムのポイントツーポイントコネクタを作成して管理することになるため、脆弱で拡張性がなく、コストのかかるインテグレーションが生成されます。
**パターン**
エージェントは構造化されたアクションを介して (MCP を介して) 外部ツールを呼び出すため、Salesforce Platform 以外の特殊なツールを使用できます。
**コンテキスト**
- エージェントは、Salesforce Platform の外部に存在するツールセットのプロキシとして機能します。
- これらの外部ツールには、さまざまな API、認証メカニズム、データ形式がある場合があります。
- エージェントとこれらの外部ツールとのシームレスなやりとりを可能にするには、標準化された通信プロトコルが必要です。
- 同じ外部ツールを複数のエージェントがさまざまな目的で使用する可能性があるため、再利用性は重要な懸念事項です。
**接触**
1. **トリガー:**Agentforce 内のユーザ要求または内部イベントでは、外部ツールを使用する必要があります。
2. **行動の意図:**Agentforce Agent はインテントを識別し、外部 MCP ベースのツールが必要であると判断します。
3. **プランナー (内部):**Agentforce Agent のプランナーは、設定された手順と使用可能なツールに基づいて適切な MCP ツールまたはアクションを選択します。
4. **実行:**Agentforce エージェントが MCP 準拠要求を外部 MCP サーバに送信します(たとえば、MuleSoft エンドポイントへの Apex コールアウトを介して、MuleSoft エンドポイントが外部 MCP サーバに転送します)。
5. **外部処理:**外部 MCP サーバーは要求を処理し、基盤となる外部アプリケーションを操作し、MCP 準拠の応答を準備します。
6. **結果**:外部 MCP サーバは応答を Agentforce Agent に返します。
7. **フォローアップ:**Agentforce エージェントは応答を処理し、内部状態を更新して、タスクを続行するか、ユーザにフィードバックします。
**Trade-Offs**
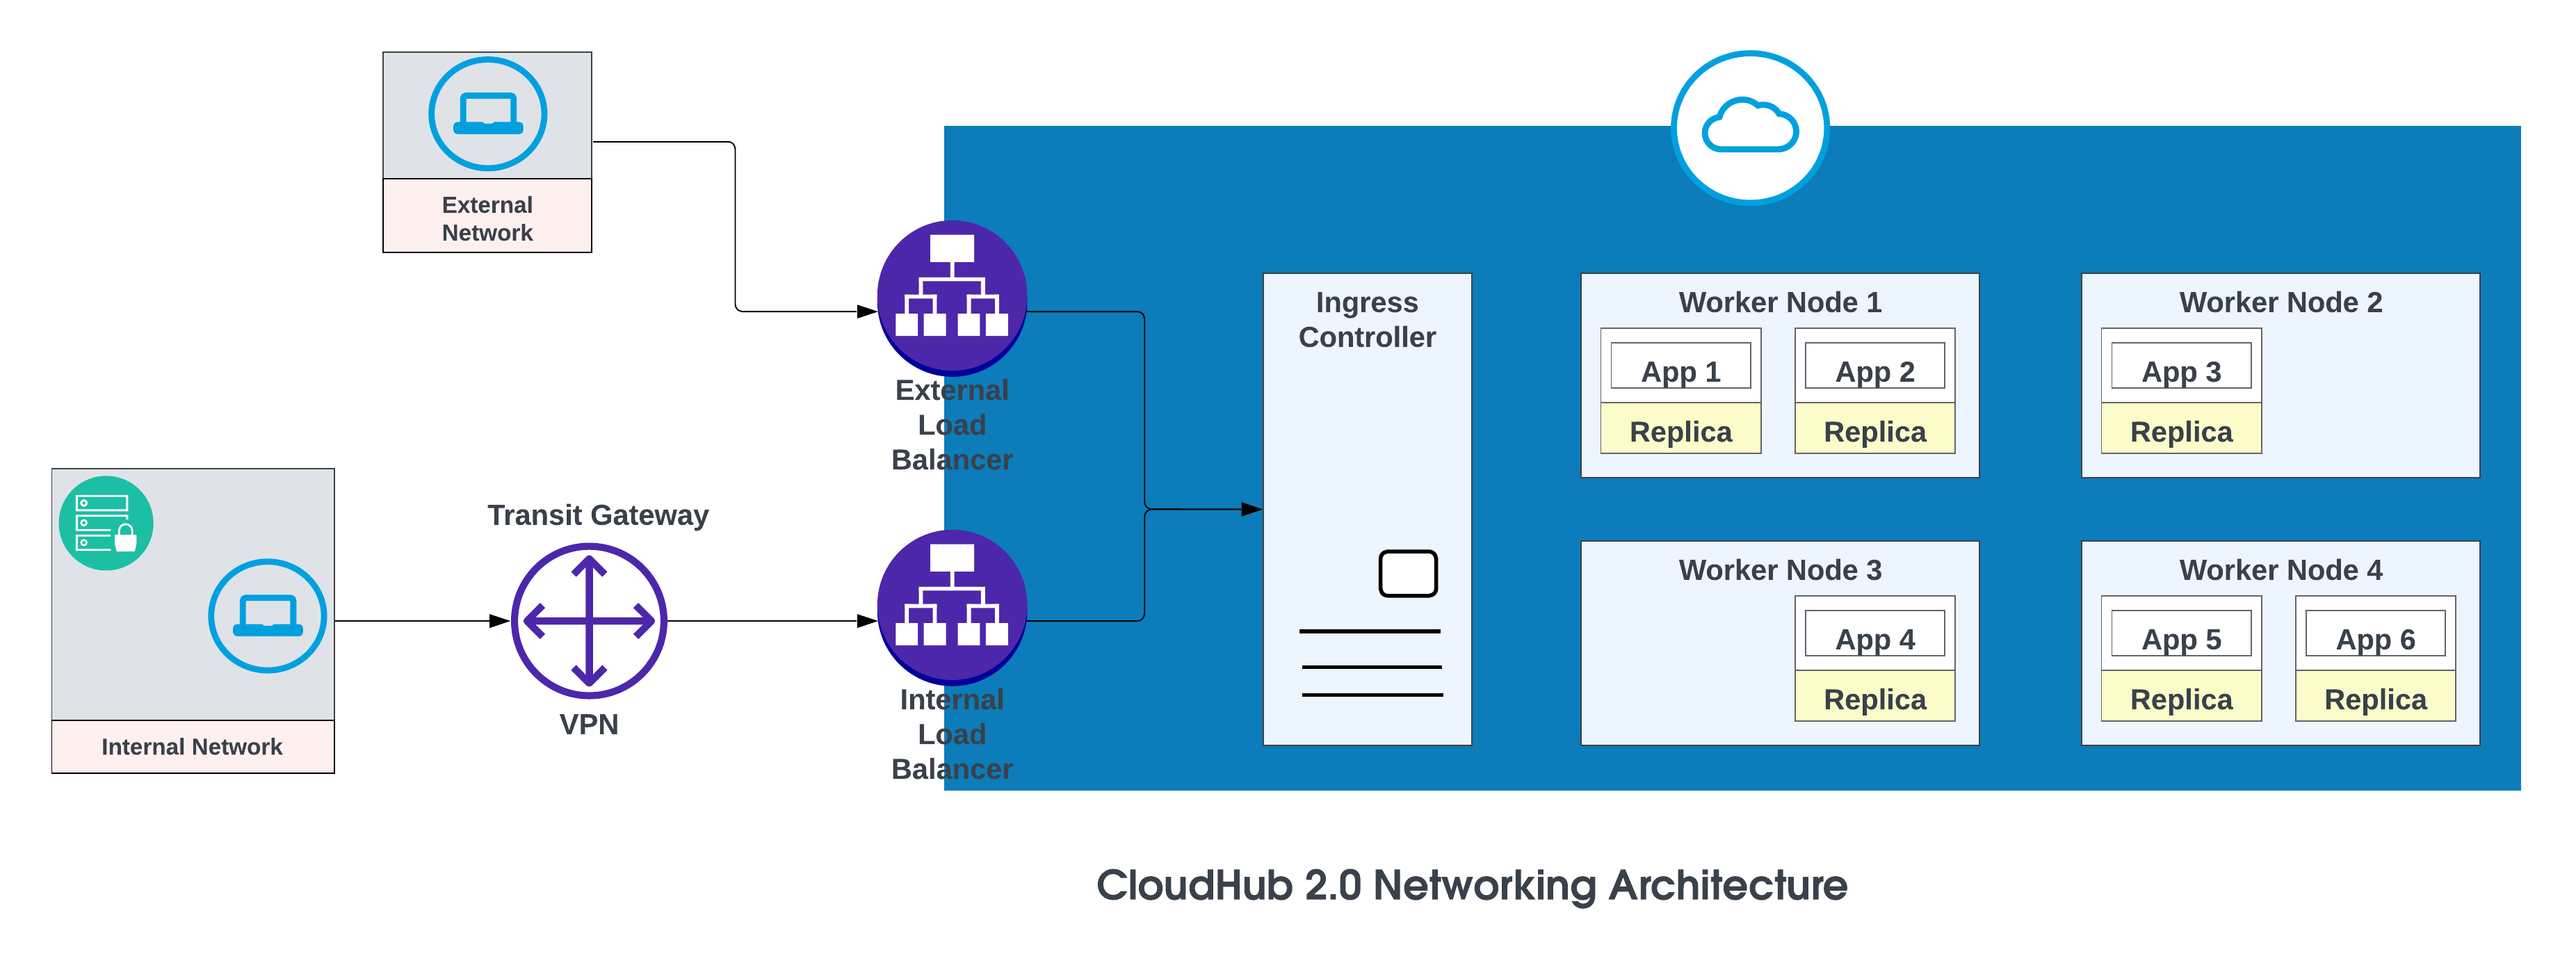 CloudHub 2.0 ネットワークアーキテクチャの基本コンポーネントは次のとおりです。
- HTTP ロードバランサー
- Mule レプリカ DNS レコード
- 非公開スペース
- 地域サービス
詳細については、「[CloudHub 2.0 Networking Architecture](https://docs.mulesoft.com/cloudhub-2/ch2-networking-guide)」を参照してください。
**Vanity Domains**
非公開スペースが作成されると、\
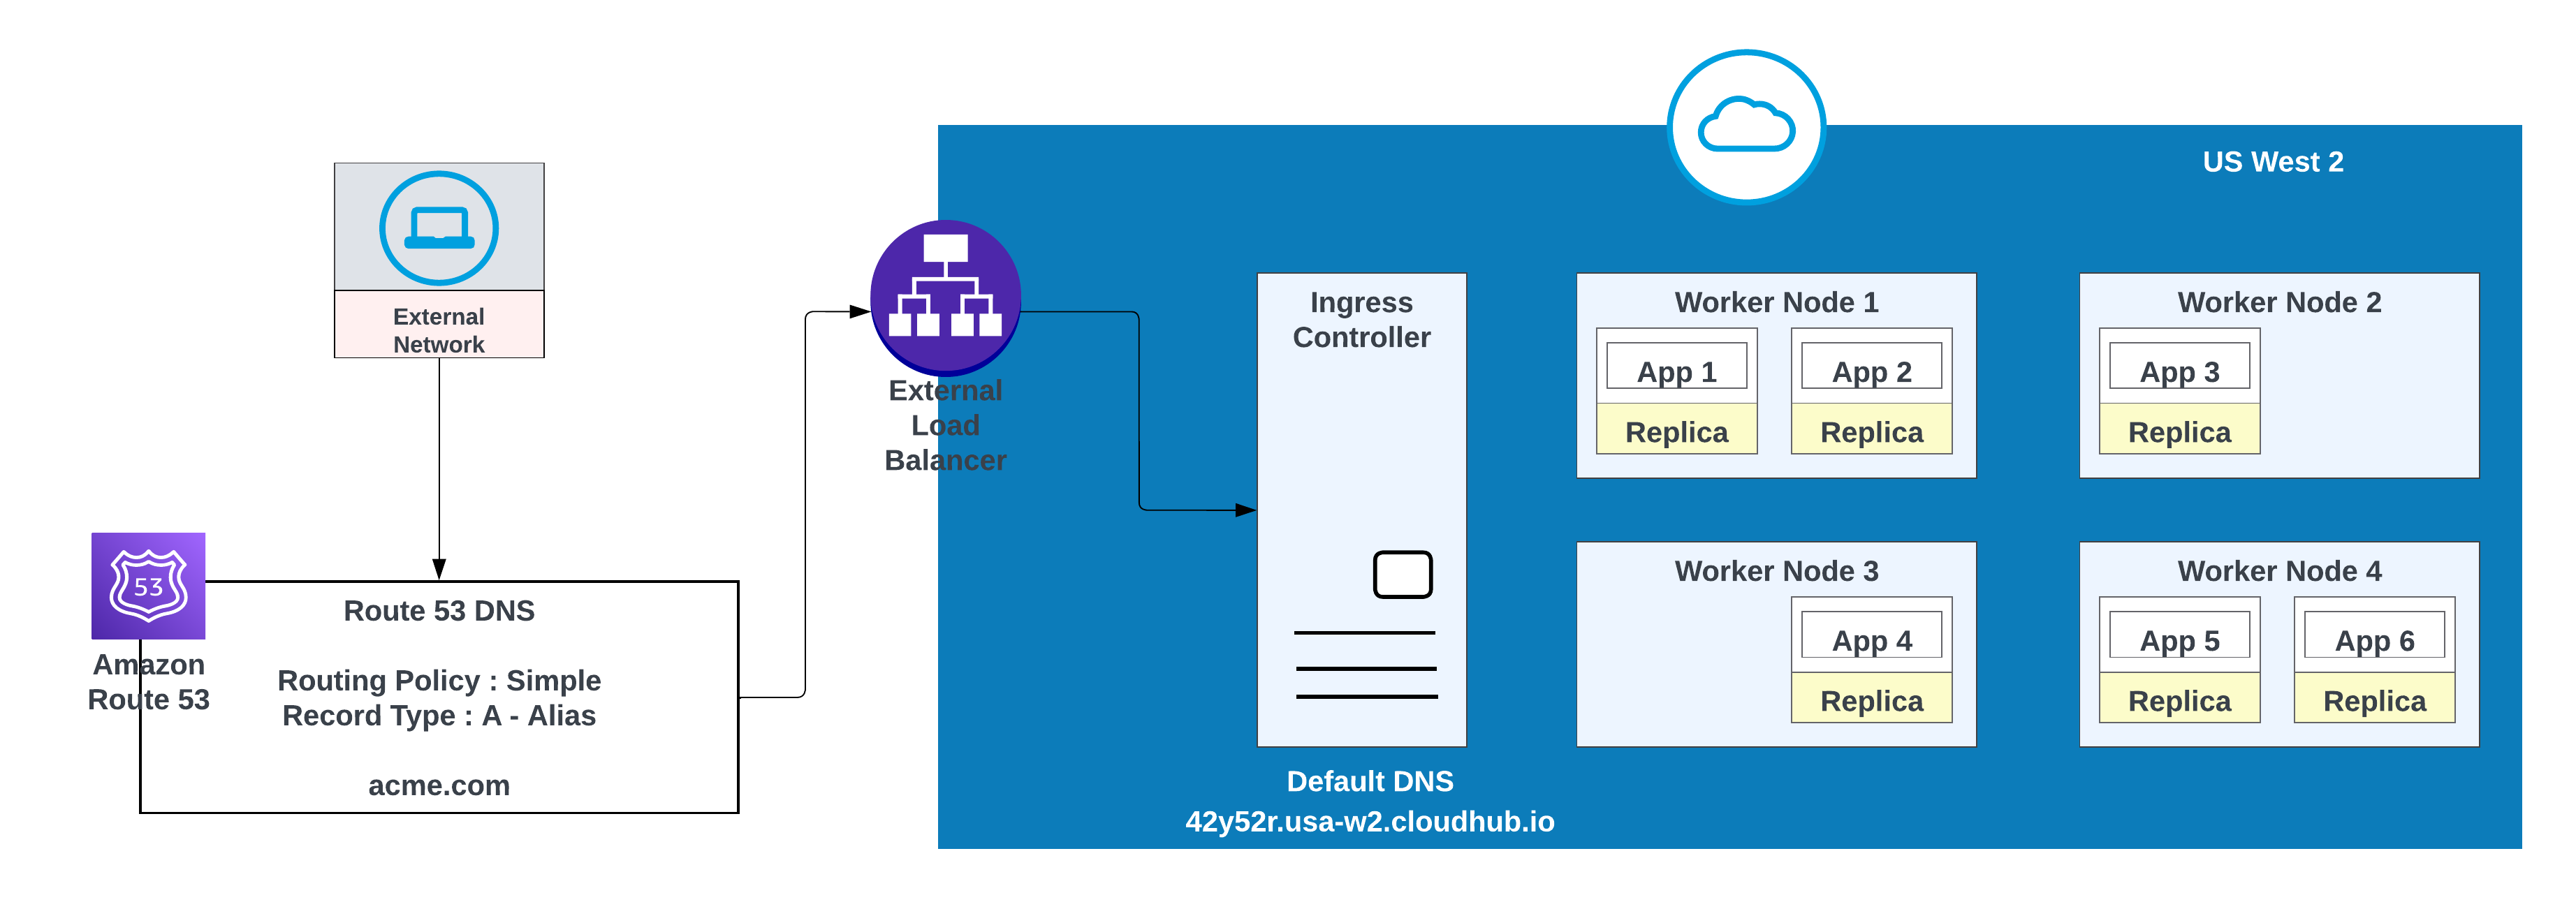
 CloudHub 2.0 では、TLS コンテキストと DNS レコードを使用して非公開スペース内で設定することで、カスタムドメイン (虚栄心) もサポートされます。非公開スペースのランタイムマネージャーで TLS コンテキストを作成するには、公開証明書と非公開鍵をアップロードし、そのドメインを使用するようにアプリケーションの設定にカスタムエンドポイントを追加します。バニティドメインが非公開スペースのデフォルトホスト名を参照する DNS レコード (CNAME など) を作成します。
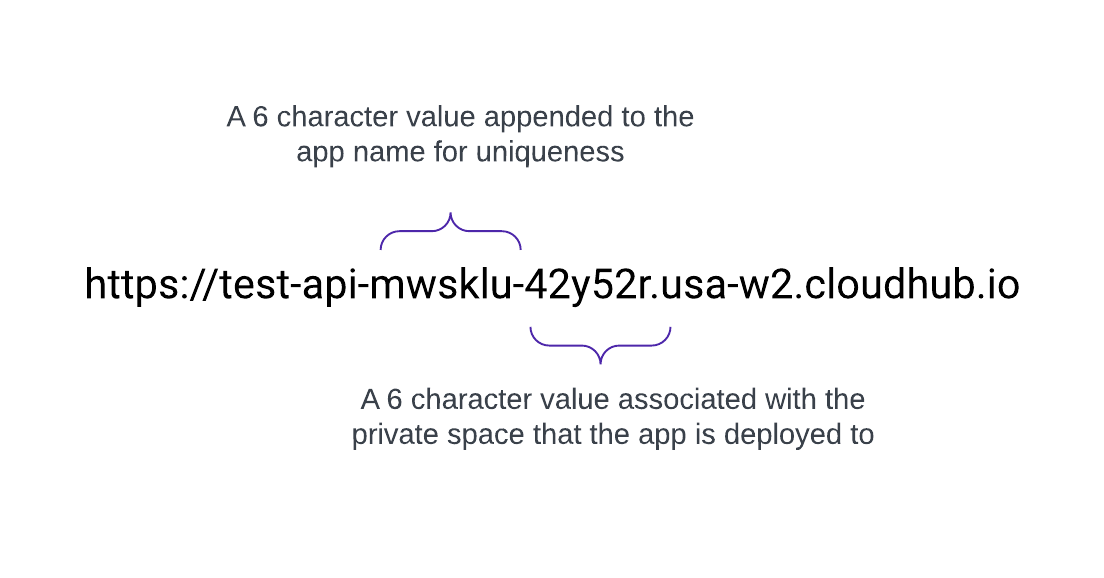
たとえば、デフォルトの DNS が 42y52r.usa-w2.cloudhub.io で us-west-2 にリリースされた test-api という名前のアプリケーションの API エンドポイントは次のようになります。
https://test-api-mwsklu-42y52r.usa-w2.cloudhub.io
この URL では、バニティまたはカスタムドメインは使用されません。API URL が [https://test-api.acme.com](https://test-api.acme.com) として表示されるように [acme.com](https://acme.com) を使用するには、次の手順に従います。
1. Runtime Manager で公開鍵と非公開鍵を使用して TLS コンテキストを作成します。
2. アプリケーションの設定でバニティドメインを追加して、そのドメインを使用します。
3. AWS ルート 53 で DNS レコードを作成し、バニティドメインがプライベートスペースのデフォルトホスト名に解決されるように簡単なルーティングポリシー (CNAME など) を設定します。
カスタムドメインの場合、AWS ルート 53 またはルーティングポリシーを使用するその他のグローバル CDN サービスを使用できます。次の図では、AWS ルート 53 が「シンプル」なルーティングポリシーで使用されています。パブリック (外部) ネットワークのコンシューマーが acme.com を要求すると、AWS ルート 53 はその要求を MuleSoft 非公開スペース入力コントローラーに転送します。
 ## フェールオーバー戦略
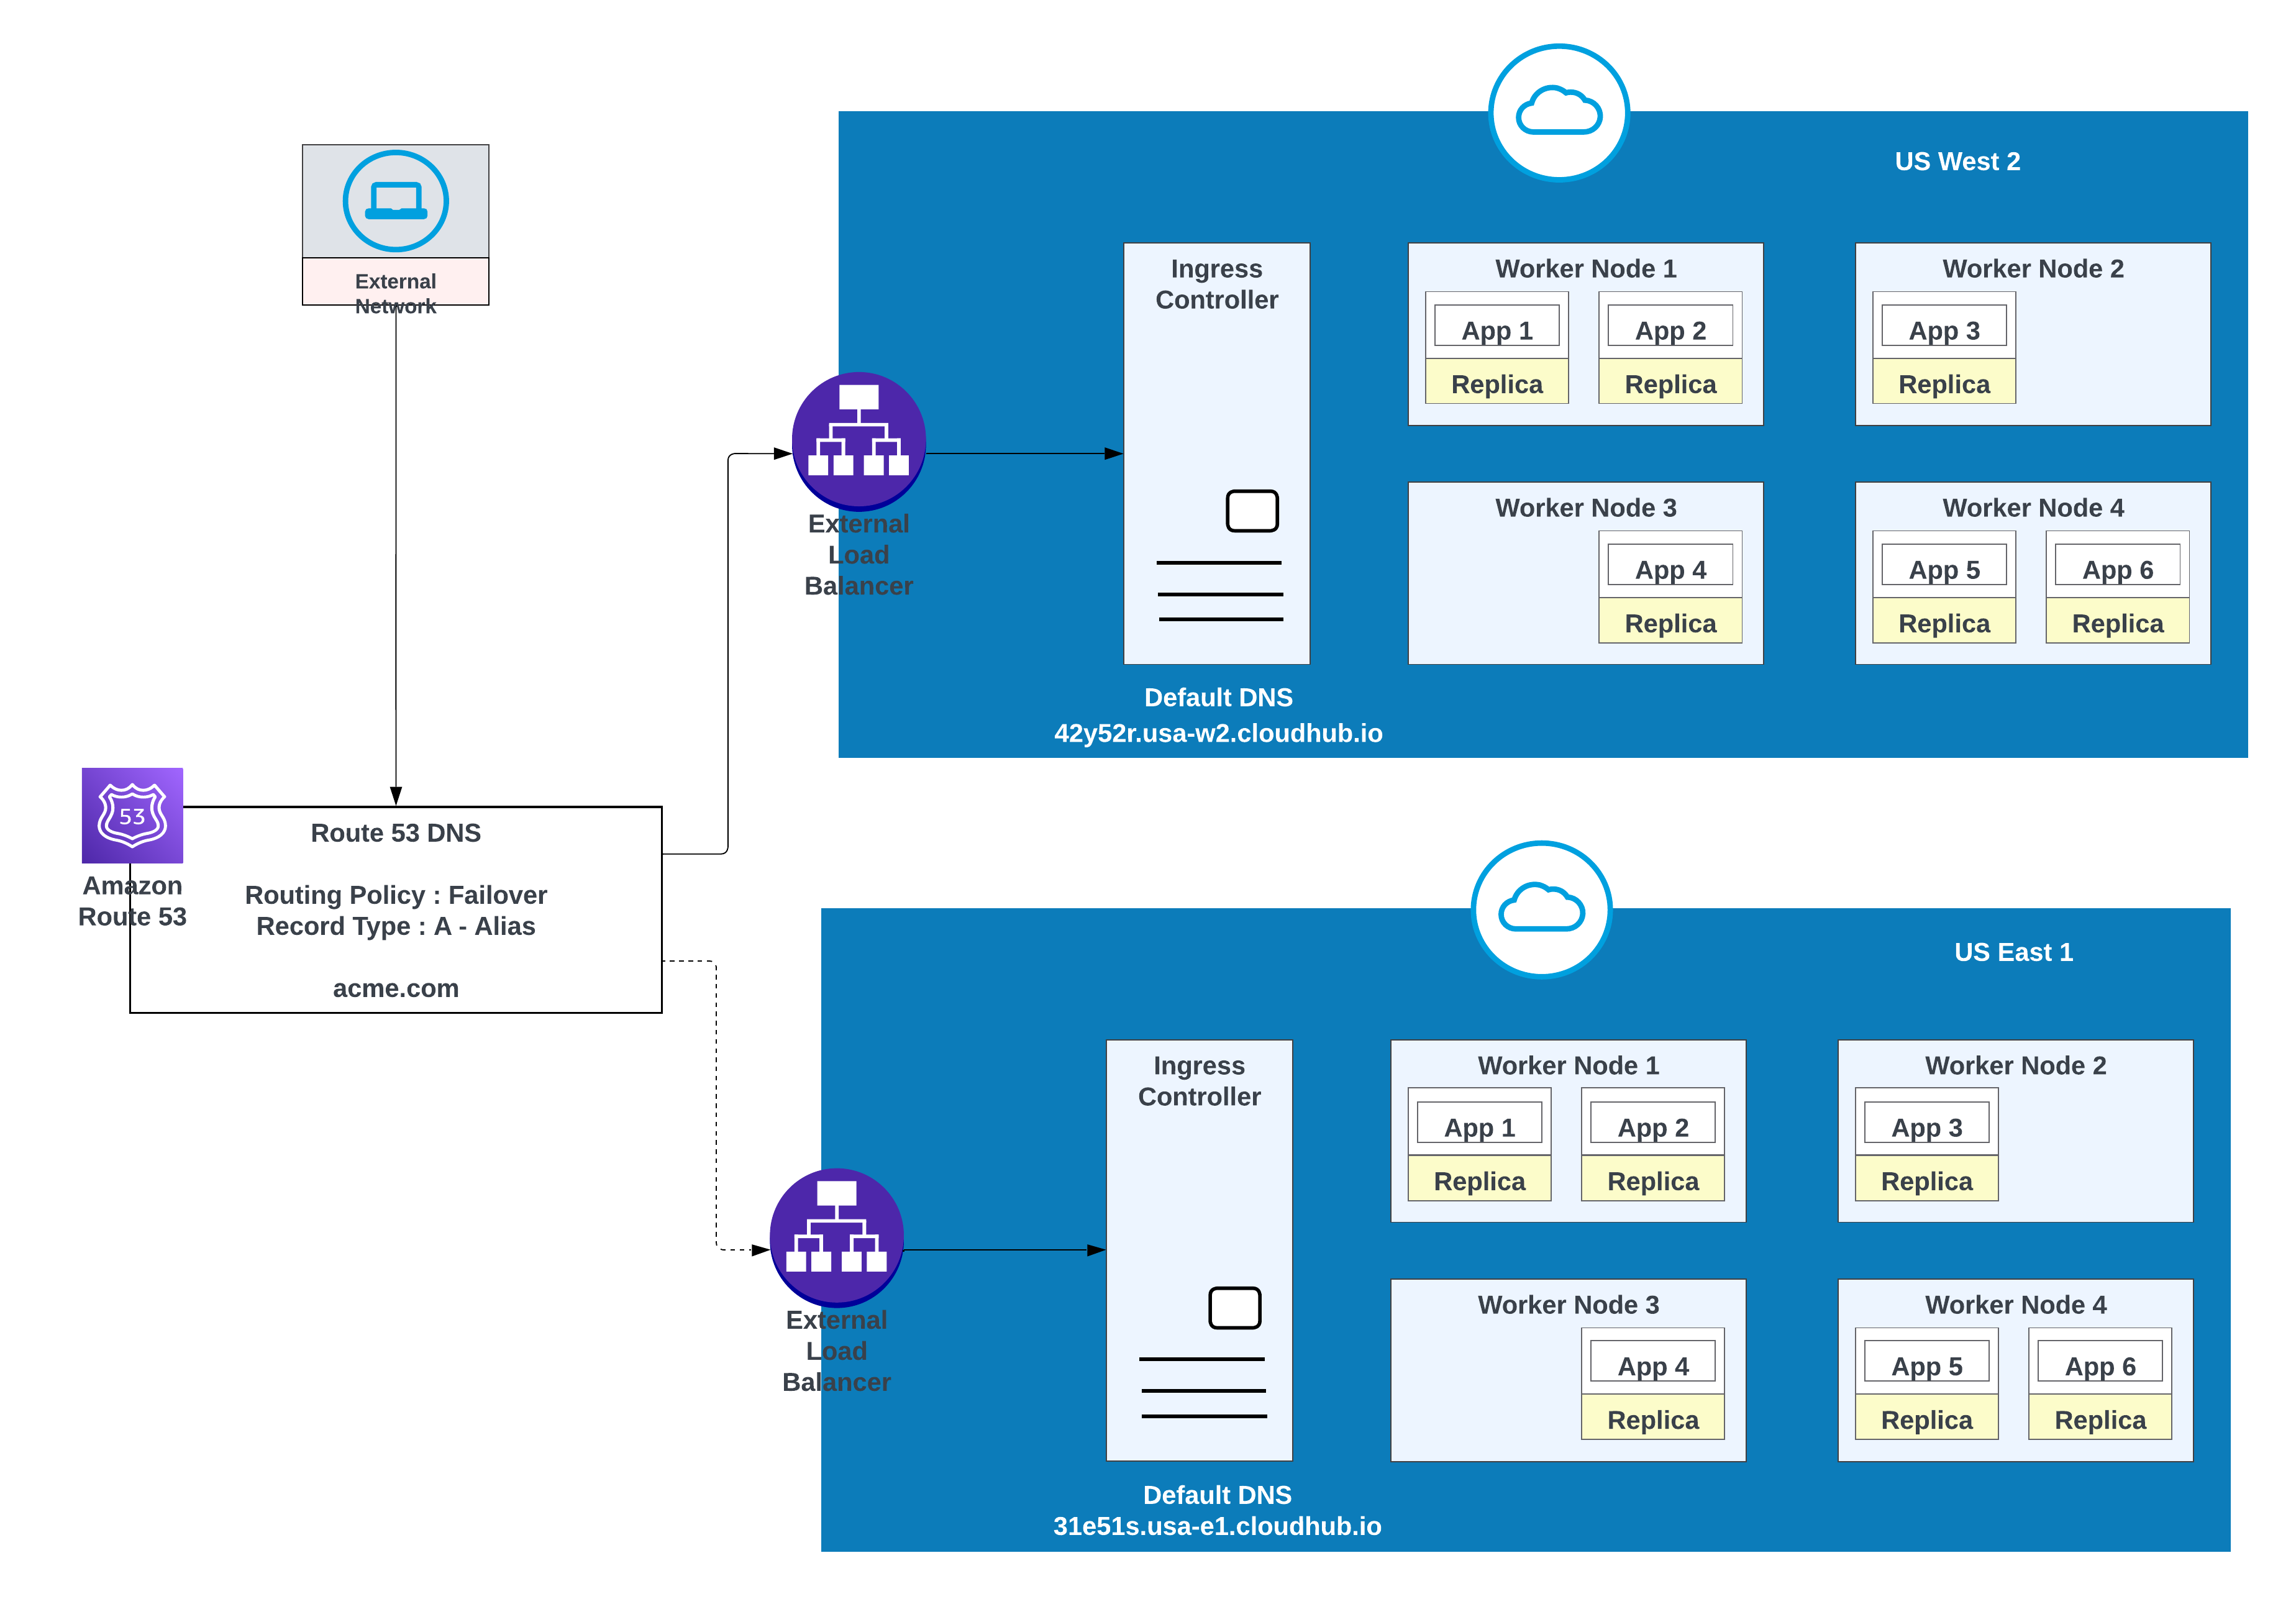
このオプションは、アプリケーションでフェイルオーバーが必要な場合に使用します。1 つのインスタンスをプライマリ領域 (us-west-2 など) にリリースし、別のインスタンスをセカンダリ領域 (us-east-1 など) にリリースします。
可能な場合はセカンダリリージョンで既存の環境を使用します。新しい環境を作成するには、追加の作業が必要です。
**1 つのリージョンに導入されるアプリケーションの例(米国西部 2)と別のリージョンへのフェイルオーバーの例(米国東部 1)**
 | レコード名 | Value/Route Traffic To (値/トラフィックの転送先) | ルーティングポリシー | 状態チェック ID |
| :--------: | :----------------------------------------------: | :------------------: | :-------------: |
| acme.com | 42y52r.usa-w2.cloudhub.io | フェールオーバー | 31s3wseq121 |
| acme.com | 31e51s.usa-e1.cloudhub.io | フェールオーバー | 43e131s131sq |
この設定では、AWS ルート 53 がトラフィックを米国西部 2 と米国東部 1 のプライベートスペースの入力コントローラーにルーティングします。フェールオーバールーティングポリシーが状態チェックで設定されている。
## 高可用性と低遅延
高可用性と共に低遅延を実現するには、図で説明されているリリース戦略を使用します。この戦略では、アプリケーションを 2 つのリージョン (この例では us-west-2 と us-east-1) にリリースできます。
AWS ルート 53 の遅延ルーティングポリシーを使用して、高可用性を維持しながら、遅延が最も少ないリージョンに要求を転送します。 AWS ルート 53 の「遅延」ルーティングポリシーを使用して、高可用性を維持しながら、遅延が最も少ないリージョンに要求を転送します。
**アプリケーション レイテンシと高可用性を実現するため、両方の地域(米国西部 2 と米国東部 1)に導入**
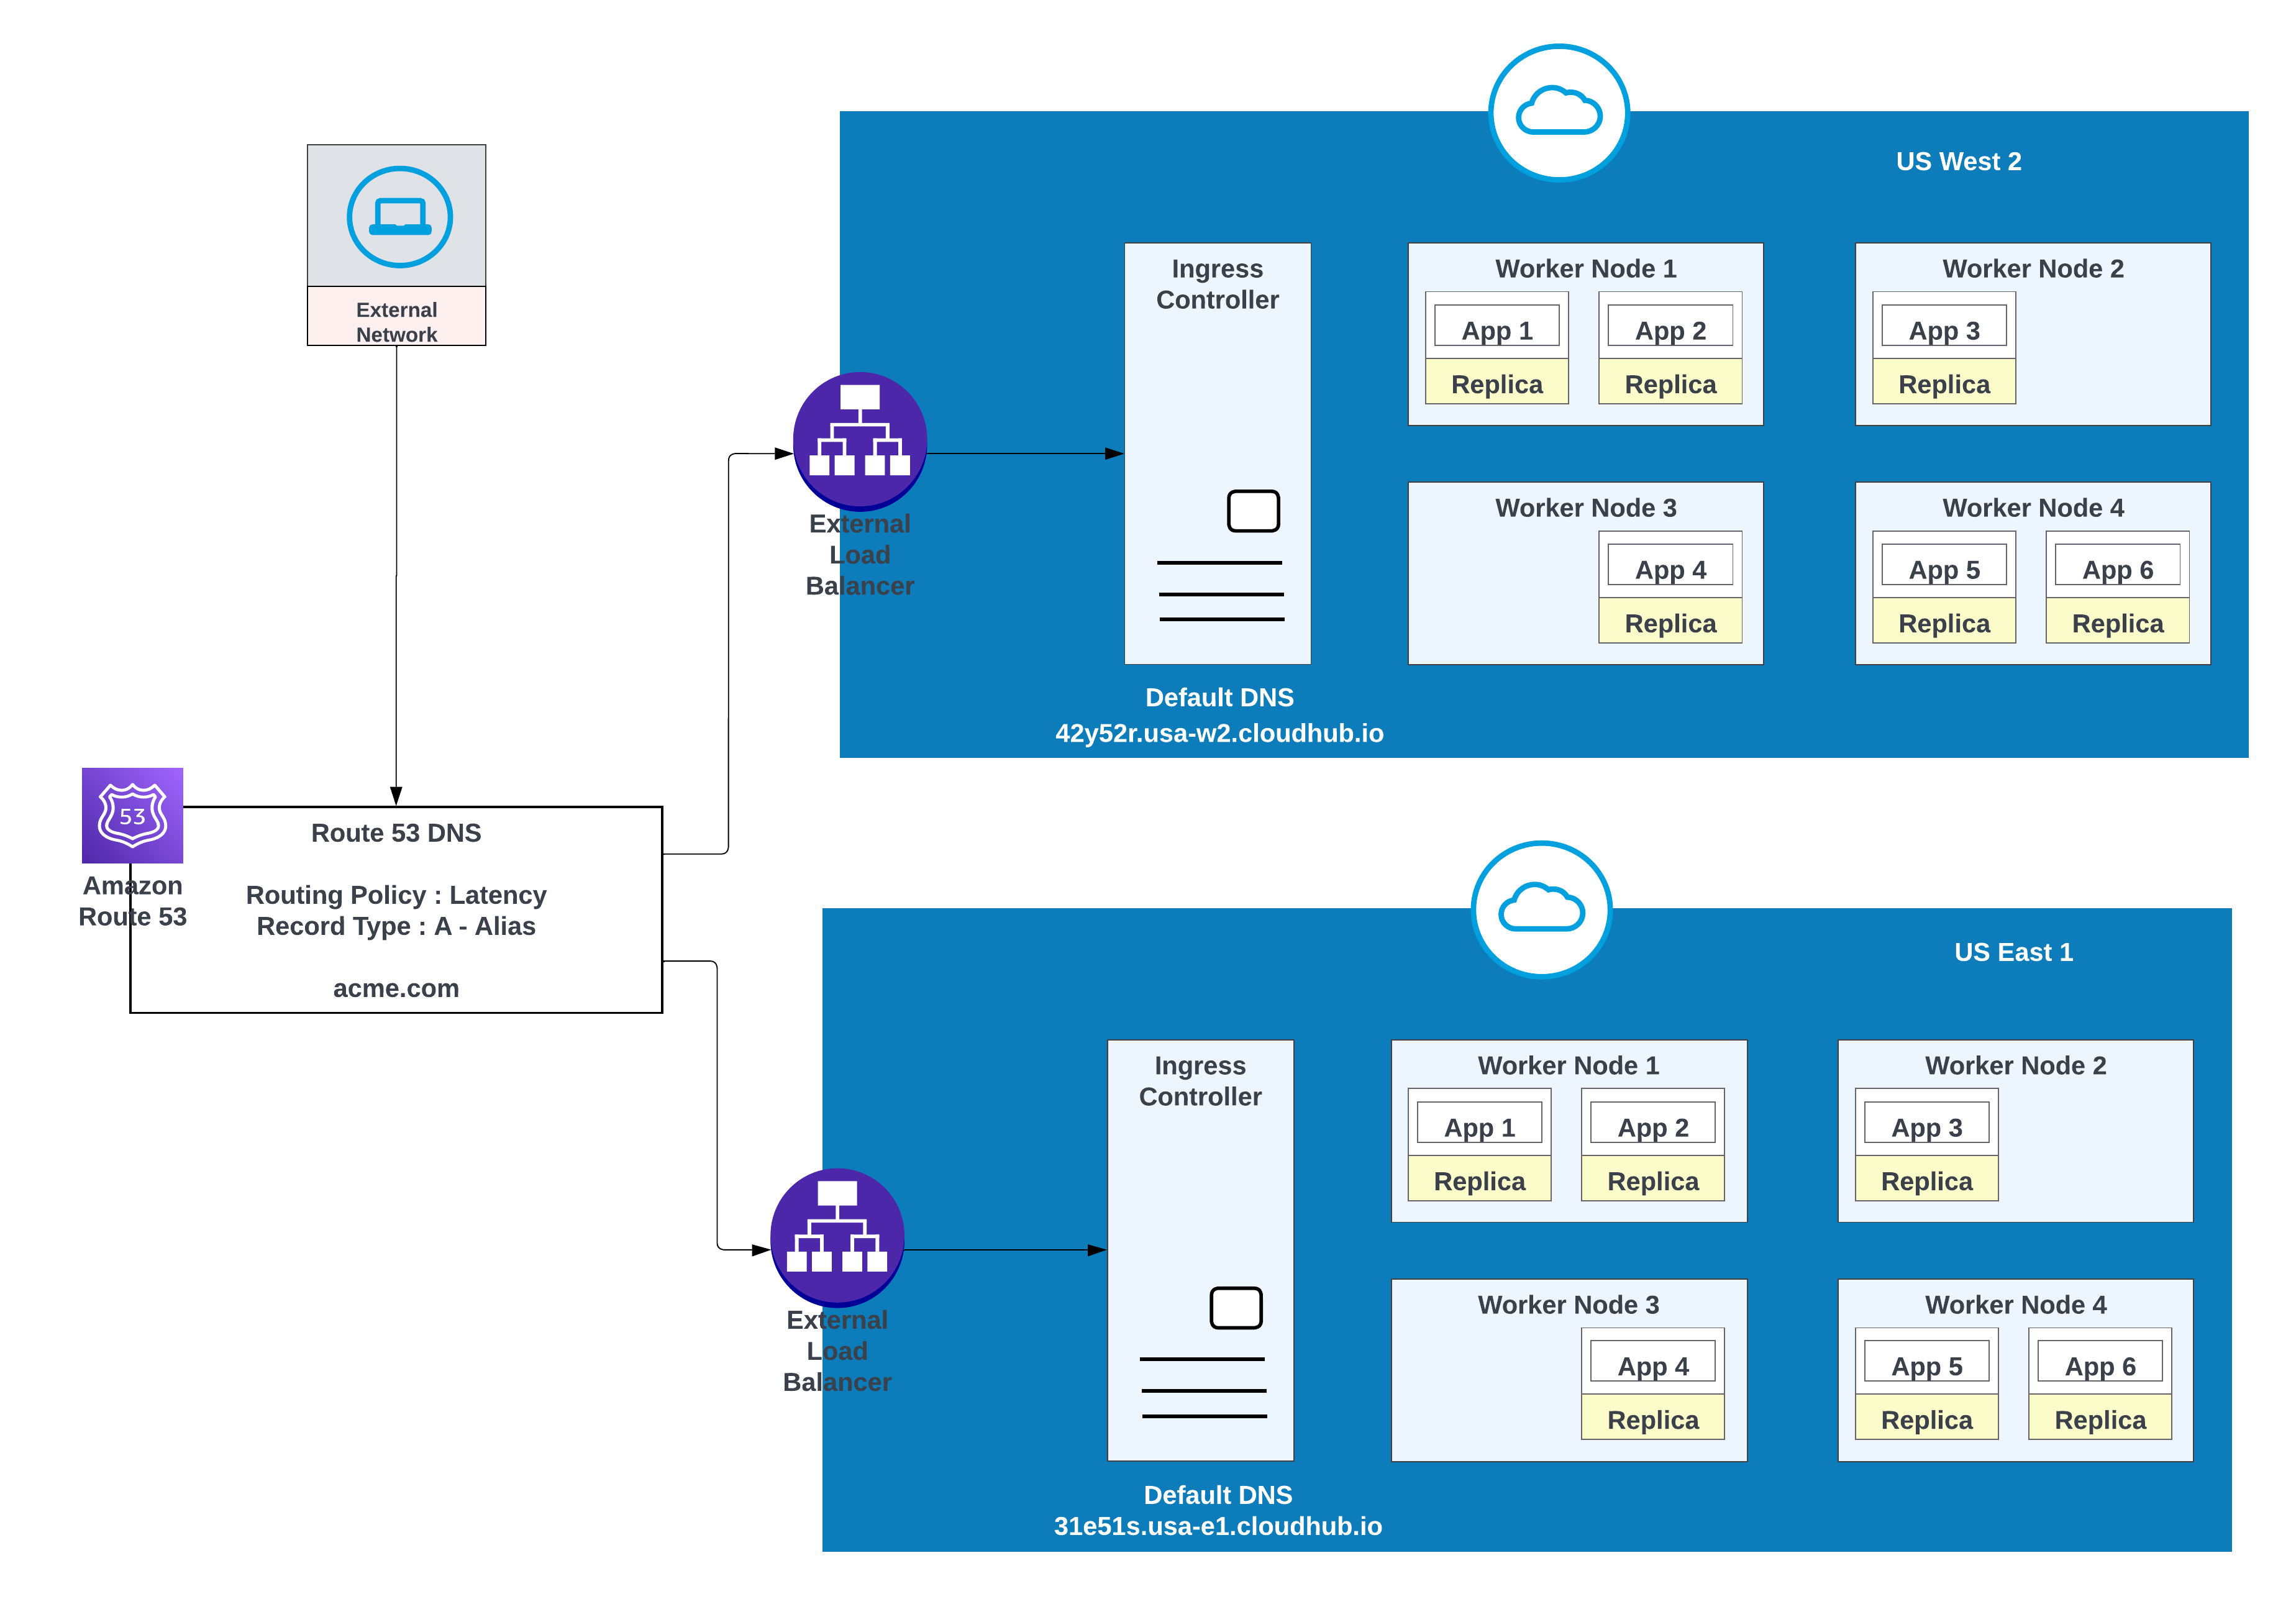 | レコード名 | 値/トラフィックの転送先 | ルーティングポリシー | 状態チェック ID |
| :--------: | :-----------------------: | :------------------: | :-------------: |
| acme.com | 42y52r.usa-w2.cloudhub.io | 遅延 | 31s3wseq121 |
| acme.com | 31e51s.usa-e1.cloudhub.io | 遅延 | 43e131s131sq |
## 結論
MuleSoft CloudHub 2.0 は、主に自動レプリカ冗長性とインテリジェントなロードバランシングを活用して、リージョン内レジリエンスの堅牢な基盤を提供します。1 つのクラウド領域内で複数のレプリカを使用するアプリケーションを導入することで、1 つのインスタンスに障害が発生しても、他のユーザーがすぐにワークロードを引き継ぐことができます。統合されたロードバランサーにより、受信トラフィックがこれらの正常なレプリカに効率的に分散されるため、ダウンタイムが最小限に抑えられ、通常の運用条件での継続的なサービス可用性が確保されます。
ただし、この単一リージョンアーキテクチャのみに依存すると、冗長性が高くても、広範囲にわたる壊滅的な地域停止が発生する重大なリスクがあります。歴史が示すとおり、最も信頼性が高く、技術的に高度なクラウド プロバイダーであっても、地理的な地域全体に影響する可能性のある破壊的なインシデントが発生しやすくなります。これらの単一障害点は、まれではありますが、次のようなさまざまなイベントによって発生する可能性があります。
- 大規模なインフラストラクチャインシデント
- 重大な停電
- 広範囲のネットワーク中断
したがって、真の高可用性 (HA) とディザスターリカバリー (DR) を実現するには、単一リージョンモデルの制限を超えるアーキテクチャを設計する必要があります。推奨される戦略は、地理的に異なる複数の地域にリリースすることです。このリージョン間の復元性により、予期しない災害によってクラウドリージョン全体が使用できなくなった場合でも、影響を受けない別のリージョンで実行されているアプリケーションインスタンスにトラフィックをシームレスにフェールオーバーできるため、サービスの中断を最小限に抑え、アップタイムの目標を達成できます。
## 参照
[CloudHub 2.0 Networking Architecture](https://docs.mulesoft.com/cloudhub-2/ch2-networking-guide)
[標準キューのクロスリージョンフェイルオーバの設定](https://docs.mulesoft.com/mq/mq-failover)
[オブジェクトストア V2 リリース地域](https://docs.mulesoft.com/object-store/osv2-faq#osv2-regions)
[オブジェクトストアリリース地域](https://docs.mulesoft.com/object-store/osv2-faq#is-object-store-v2-persistent-in-the-same-region-as-the-worker)
## 著者について
Gulal Kumar は、Salesforce のソフトウェアエンジニアリングアーキテクトで、データおよびインテグレーションアーキテクチャに重点を置いています。インテグレーションと API、モダナイゼーションプログラム、セキュリティ、AIML イニシアチブで 20 年以上の経験があり、豊富な専門知識を備えています。Gulal は、ビジネス変革イニシアチブを推進し、セキュリティと耐障害性を強化し、アーキテクチャの卓越性を促進し、さまざまなドメインで AIML イニシアチブをリードしてきました。
Ajay Nagaraju は、MuleSoft のエンタープライズアーキテクト兼シニアディレクターで、エンタープライズアーキテクチャ、システムインテグレーション、大規模なデジタルトランスフォーメーションの分野で 28 年以上の経験があります。また、API 主導の接続、SOA、クラウドテクノロジー、エンタープライズインテグレーションパターンに関する深い専門知識を持ち、Fortune 100 および Fortune 500 の組織で数百万ドルの複雑なプログラムのアーキテクチャと提供を主導してきました。Ajay は、ビジネスプロセス、データプラットフォーム、インテグレーションエコシステムを最新化するために経営陣と密接に連携し、拡張性の高いアーキテクチャの構築、チームの指導、テクノロジーによる測定可能なビジネス成果の促進に取り組んでいます。
## コンテキスト
データプラットフォームは 30 年以上進化し続けています。当初は、この業界はオンプレミスの一元化された構造化された (主にリレーショナルの) 運用/OLTP データベースが主流でした。これは、主に分析処理に使用され、リレーショナルで一元化されたデータウェアハウス OLAP/Big Data プラットフォームを含むように拡張されました。クラウド ストレージは、データ ウェアハウス、レイクハウス、分離ストレージなどの分散アーキテクチャを推進しました。ただし、業務プラットフォームと分析プラットフォームは別々でした。今日、クラウド コンピューティングとAI革命によって、データ プラットフォーム アーキテクチャが根本的に変化しています。
企業は、Snowflake、Databricks、BigQuery、Redshift などの成熟したビッグデータプラットフォームにすでに投資しています。ただし、これらのプラットフォームはデータサイロとして機能します。データはビジネスフローやアプリケーション内で直接操作できないため、お客様はデータからビジネス価値を引き出すことはできません。これらのソリューションは生成エージェント型 AI 処理がなく、データアクセスをリアルタイムで提供できないため、顧客エンゲージメントの瞬間に AI 主導のパーソナライズや他の業界をリードする機能を提供できません。
データプラットフォームの未来は、統合され、柔軟で、アクセス可能で、オープンなデータインフラストラクチャによって特徴付けられます。この新しいアーキテクチャは、最新のコンピューティングとストレージのトレンド (GPU、大容量メモリ、NVMe SSD、クラウド ストレージ) に基づいて構築されており、クラウドコンピューティングと AI と統合します。リアルタイムのインサイトを提供し、自律的な意思決定を強化し、リアルタイムアプリケーションを促進できます。これには、エージェント型 AI、予測 AI、分析、リアルタイムの大規模 OLTP データベース、データレイク、レイクハウスの台頭が含まれます。これらの最新のデータプラットフォームは、シンプルさ、拡張性、俊敏性、パフォーマンス、セキュリティ、可用性、コスト効率を考慮して設計されています。
### 次世代データプラットフォームアーキテクチャの主要なトレンド
次のデータトレンドは、次世代データプラットフォームアーキテクチャを推進します。
- **コアとなるAI、機械学習、分析**:エージェント型 AI の台頭により、データプラットフォームの開発、リリース、利用状況/アクセスが根本的に変わります。エージェント型 AI が会話/クエリのインテントを理解し、計画し、ワークフローを生成し、意思決定を自動化します。エージェント的 (短期および長期) 記憶は会話履歴から構築され、エージェントの計画と意思決定、リアルタイムの会話モデリング、データプラットフォームで重要なパーソナライズサポートをパーソナライズします。エージェントは、データ ガバナンス(セキュリティ、コンプライアンス、Trust)、パフォーマンス(同時実行、スループット、レイテンシの自動拡張)、フェールオーバー、可用性、オブザーバビリティ、メンテナンスなどの運用上の「機能」の自動化を支援します。AI を駆使した分析、売上予測、分析 Q/A の自然言語処理 (NLP)、非構造化データ (PDF、画像、音声、動画などのテキスト) の分析が標準となり、企業はさまざまなデータソースからより深いインサイトを取得できます。
- **データの分散と統合データアクセス**:エージェントがインサイトを取得して意思決定を行い、ビジネス活動を自動化するには、エンタープライズデータが必要です。データは本質的に、企業内のさまざまなアプリケーションやデータプラットフォームで分散化されています。ただし、社内のさまざまなビジネスユニット間や社外のパートナーとシームレスにサイロを統合するのは容易ではありません。データの統合には、ソースからの取り込みまたはデータ ソースとの連携によるデータ共有、分析およびAI処理のためのデータプレップ、ハーモナイゼーション、モデリングからの未加工データ、低CTSで効率的なアクセスを実現する大規模なデータの保存と管理、基盤となるストレージおよびデータ アクセス プラットフォームと密接に統合されたさまざまなクエリおよび分析メカニズムとツールによるデータ アクセスが含まれます。
- **クラウド ベースのオープン レイクハウス**:クラウドベースのビッグデータ (OLAP) プラットフォームは、データの統合 (データイン) と共有 (データアウト) を可能にするオープンファイル形式 (Parquet) とテーブル形式 (Iceberg) の採用に集約されています。
- **非構造化データ処理**:生成 AI の出現、進歩、採用に伴い、企業は大量のテキストドキュメント、音声トランスクリプト、動画記録などのメディアで構成されるエンタープライズコーパスから貴重なインサイトとビジネス価値を引き出し始めています。チャンク、ベクトル化、セマンティック検索、Knowledgeグラフなどの非構造化データ処理により、これらのインサイトが可能になります。RAG (取得増強生成) や CAG (キャッシュ増強生成) などの手法は、データコーパス全体の高速かつエージェント的な検索の主流となっています。
- **Knowledge Management**:Knowledgeは、未加工のコンテンツ自体(ドキュメント、記事、動画)にとどまりません。意味を導き出し、メタデータを選定し、コンテキストに配置して、組織や企業全体でコンテンツについて共通の理解を育むことで、そのコンテンツの強化を表します。Knowledge自体は一般的に構造化されています。Knowledge Managementには、コンテンツ管理、Knowledge抽出、グラフなどのモデルを使用した表示、ナビゲーションが含まれます。
- **豊富なデータアクセス**:豊富なデータアクセスとは、エンドユーザー、ビジネスユーザー、システム管理者、アナリストなど、さまざまな人格がデータ、分析、AI ツールにアクセスできる必要があることを意味します。アクセシビリティは、アンサンブルクエリ (リレーショナルクエリ、キーワードクエリ、セマンティッククエリを使用)、自然言語から SQL (NL2SQL) へのクエリ、リアルタイムアクセスなどのメカニズムによって実現されます。
- **リアルタイム処理**:エージェントアプリケーションは、現在の状態と新しいイベントに基づいてリアルタイムの意思決定を行い、応答とアクションをパーソナライズします。アクションには、リアルタイムデータへのアクセス、処理、およびアクションが必要です。リアルタイム処理には、最新のデータ (データ遅延) と対話型アクセス (アクセス遅延) が必要です。このようなデータとアクセス遅延には、業務ストアや分析ストアからの最新データアクセス、低遅延アクセス (ポイントルックアップとクエリ) 処理、高いデータスケール、高いスループットをサポートするための基盤となるデータプラットフォームが必要です。
- **データ セキュリティ、ガバナンス、レジデンシー**:エージェント型 AI と会話型 AI により、アプリケーション UI が簡素化され、消費者から従業員、他の AI エージェントまで、誰もが話し言葉や記述された自然言語を使用して対話形式でアプリケーションを操作できます。Agentic アプリケーション用に保存およびモデル化する必要がある貴重な顧客および個人データは、明確に定義されたアクセスおよび共有ポリシーで保護および管理する必要があります。ますます多くの顧客が、自国の国または地域でデータレジデンシーを必要とする規制に準拠する必要があります。特に、政府関係者や政府関係者です。
Salesforce Data 360 は、これらのデータトレンドに対応する将来に向けて設計されています。Data 360 は、企業全体のサイロ化されたデータを統合するクラウドネイティブのメタデータ駆動型データプラットフォームです。これにより、組織はデータを保存、モデル化、処理して、分析、AI、機械学習、エージェントアプリケーションを有効にできます。
このドキュメントは、エンタープライズアーキテクトと CTO にとって不可欠なガイドです。Data 360 のアーキテクチャ、機能、設計原則、使用事例について詳しく説明します。Data 360 アーキテクチャの基本を入門編として紹介し、続いて、マルチ組織戦略、セキュリティ、ガバナンスとプライバシー、リアルタイム有効化、データクリーンルームなど、既存のデータプラットフォームとの相互運用性など、Data 360 アーキテクチャの主な差別化要因について詳しく説明します。
## 設計原則
Salesforce Data 360 は、エンタープライズデータを運用、信頼、およびリアルタイムで利用できるようにするためのコア原則セットに基づいて設計されています。
- **オープン性と相互運用性**:マルチクラウドエコシステム向けに構築されています。Snowflake、Databricks、BigQuery、Redshiftなどのデータ プラットフォームを重複なしで統合し、既存の投資を維持しながらCustomer 360を拡張します。
- **ストレージとコンピューティングの分離**:ストレージと処理 (バッチ、ストリーミング、インタラクティブ) を個別に拡張します。大規模でハイ パフォーマンスのワークロードに弾力性と効率性を提供します。
- **マルチモデルのストレージと処理**:テキスト、画像オーディオ、動画などの構造化されたさまざまな非構造化データ型をサポートします。効率的なストレージ、リアルタイムおよびバッチ処理、拡張可能なインデックス付け、統合検索、クエリ、分析を提供します。
- **メタデータ駆動設計**:アプリケーションは、コードではなくメタデータで定義されます。メタデータは第一級のアセットとして扱われ、統合ガバナンス、柔軟性、Salesforce Platform への緊密な統合を実現します。
- **リアルタイムハイブリッド処理**:バッチ処理および分析ワークロードと共に、低レイテンシのクエリとインスタント意思決定をサポートします。
- **インテリジェントでアクティブなデータ**:インサイトを継続的に取り込み、分析し、ビジネスワークフローに直接転送します。最新のコンテキストを使用して、ノーコード、ローコード、プロコード、AI 駆動の自動化を強化します。
- **設計によるガバナンスとプライバシー**:系統、アクセス制御、レジデンシー、データ暗号化、コンプライアンスが組み込まれています。Trustと規制の信頼性がすべてのレイヤーで強化されます。
- **1対多のテナント**:一元化されたData 360組織は、Customer 360の単一の情報源として機能し、Salesforceのお客様に広く使用されている複数組織のセールスフォース環境をシームレスにサポートします。
これらの原則により、Data 360 はリアルタイムでデータをオープン、インテリジェント、アクション可能にします。
### 原則から機能へ
Salesforce Data 360 は、現在のデータトレンドに対応する設計原則に基づいて構築された最新のデータプラットフォームです。そのアーキテクチャ機能により、エンタープライズデータは、その指針に従ってリアルタイムで信頼性と統合され、アクションを実行できます。
- **クラウド ネイティブ基盤**:不変のマイクロサービス ベースのインフラストラクチャを使用して、Hyperscaler(AWSなど)に導入されるHyperforceで実行されます。柔軟な拡張、ゼロトラスト セキュリティ、継続的なデリバリ、グローバル コンプライアンスを実現します。
- **Salesforce (コア) メタデータ駆動型**:メタデータは、Salesforce メタデータとして設計、モデル化、保存され、すべての Salesforce アプリケーションですぐに使用できます。このようなメタデータは、完全に ACID 準拠の RDBMS に保存されます。ガバナンス、ライフサイクルの一貫性、Salesforce Lightning Platformとの緊密な統合を実現します。
- **Lakehouse Storage**:Apache Iceberg と Parquet を基盤に構築され、スキーマの進化、タイムトラベル、大量の更新をサポートするデータレイクスケールとウェアハウスガバナンスを組み合わせています。Data 360 は、最新のオープンスタンダードを備えた大規模なストレージと、バッチおよびイベント駆動型ワークロード向けの豊富な変換およびデータ処理能力を使用して、構造化データと非構造化データを保存、モデル化、処理します。
- **柔軟な取り込みによるエンド ツー エンドのデータ パイプライン**:ライフサイクル全体 (取り込み、準備、モデル化、統合、分析、有効化) をカバーし、断片的なポイントソリューションへの依存を軽減します。270 以上のコネクタと MuleSoft でバッチ、ほぼリアルタイム、ストリーミングをサポートします。ELT ファーストのアプローチにより、ダウンストリーム変換の柔軟性を維持しながらデータの迅速な可用性を実現できます。
- **オープン フレームワークおよび統合とのエンタープライズ データの相互運用性**:Snowflake、Databricks、BigQuery、Redshift との双方向の Zero Copy 統合により、データの移行や重複を回避し、企業全体のサイロ化されたデータを統合します。
- **データ分類、モデリング、および整理**:Data 360 では、取り込まれた未加工データ、クリーンアップおよび保存されたデータ、SSOT (Single Source of Truth) と呼ばれる一般的な情報スキーマに従ってモデル化されているデータとしてデータが整理されます。このような SSOT オブジェクトは、セマンティックデータモデル (SDM) や他の選定されたアプリケーション固有のモデルを定義するための基礎となります。
- オープン セマンティック クエリAPIを使用した拡張可能な分析のための組み込み**セマンティック データ モデリング**により、Tableau Nextを推進し、アプリケーション固有の分析を可能にします。
- 構造化データ、非構造化データ、グラフデータの統合Data 360 SQLクエリをサポートする**ハイパフォーマンスSQLクエリエンジン**。
- **低レイテンシのデータストア**:ミリ秒のレスポンス タイムのホット データ用のキー バリュー ストレージ。パーソナライズとイベント駆動型シナリオをリアルタイムで有効にします。顧客エンゲージメントデータをリアルタイムで収集して処理します。ID、インタラクション、会話を1つの信頼できるCustomer 360プロファイルおよびコンテキストグラフに統合します。
- **非構造化データ**処理パイプラインにより、非構造化データ・ストレージ、チャンク、埋め込み生成(ベクトル化)、メタデータ抽出(拡張)、要約、インデックス付け、Knowledge抽出、インテリジェントなドキュメント処理、短期/長期(会話)メモリ作成などに対する柔軟で拡張可能なサポートが提供されます。
- **ネイティブのキーワード**、ベクトル、ハイブリッド インデックスにより、高速およびエージェント検索、RAG、Knowledge抽出、エージェントによるメモリ派生などの非構造化データに正確かつ効率的にアクセスできます。
- AI/MLおよびエージェント アプリケーションを有効にするための**プロファイル、パーソナライズ**、コンテキスト サービス。
- すべてのレイヤーに**ガバナンスとセキュリティ**が組み込まれており、系統追跡、データ マスキング、データ レジデンシー、ゼロトラスト セキュリティにより、コンプライアンスと信頼性が確保されます。
- **Elastic Compute Fabric**:Kubernetes ネイティブのマルチテナントコンピューティングファブリック。分散処理の場合は Spark、SQL ワークロードの場合は Hyper を実行します。さまざまなジョブで柔軟に拡張でき、信頼できないコードの実行の分離をサポートします。
これらはすべて、Salesforceのクラウド基盤であるHyperforceで実行されます。Hyperforce は次の機能を提供します。
- 暗号化ポリシー、分離ポリシー、最小権限ポリシーによる**Zero-Trustセキュリティ**。
- 複数リージョンの導入による**耐障害性**。Salesforce Data 360はHyperforceの複数リージョンの耐障害性とプラットフォーム レベルのフォールト トレランスからメリットを得ていますが、真のエンタープライズ クラスのDR(ディザスタリカバリ)では、すべての連動エコシステムで再生可能な取り込みパイプライン、レプリケーション、メタデータ主導のリハイドレーションなどの主要機能を備えた、あらゆるデータ プラットフォームに似たより広範なアーキテクチャが必要です。
- 監視、評価指標、追跡が組み込まれ**た可観測性**。
- コスト オーバーフローのない効率性を実現する**自動拡張とFinOps**認識。
Data 360 は、既存のエンタープライズ投資に代わるものではありません。代わりに、Data 360 では、すでに信頼、管理、およびアクション可能なデータを使用して、最も重要な部分に AI 主導のリアルタイムエンゲージメントを提供します。つまり、Salesforce は外部データを含むすべてのエンタープライズデータを (Salesforce) メタデータ駆動型オブジェクトに変換し、エージェントアプリケーションが検出、意思決定、アクションを実行できるようにします。
次の図は、Data 360 リファレンスアーキテクチャを示しています。
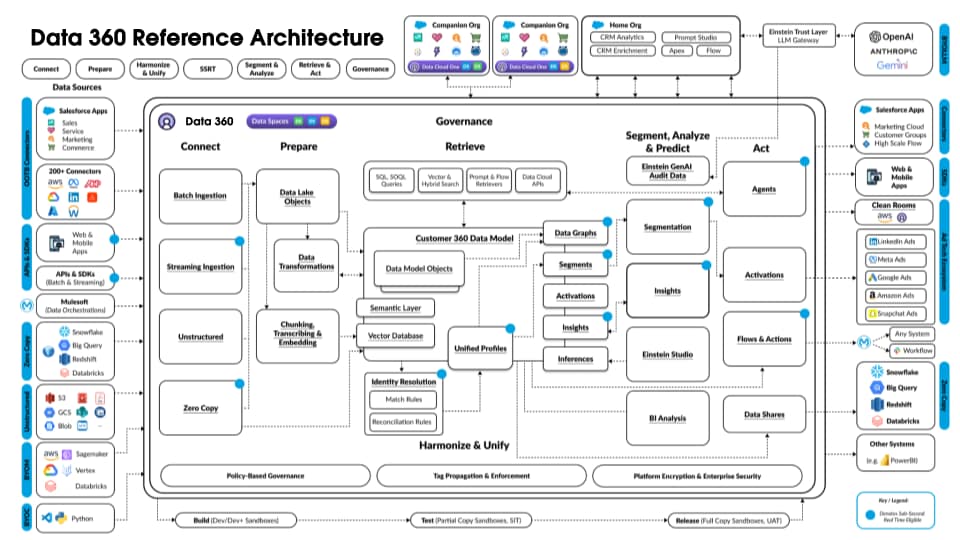 Data 360 上に階層化された仮想の Agentforce Loan Agent で、アーキテクチャフローの例を説明するとします。たとえば、ローンエージェントは、顧客 (消費者) がローンを申請し、すぐにローンの承認を受ける顧客対応エージェントです。
Data 360 はスケジュールどおりにこれらの手順を実行し、ローンエージェントが使用するデータを準備します。
- Data 360 は構造化されたカスタマー取引先データを CRM から取り込み、データレイクに保存します。
- Data 360 は、会社のローンおよび財務契約に関する非構造化データを処理します。
- Data 360 は、Snowflake などの外部データソースから個人データを統合します。
- Data 360 は、取り込まれたデータと統合データを変換およびモデル化します。
- Data 360 は、プロファイルデータグラフを作成して管理します。
顧客がローンを申請するたびに、次のアクションが実行されます。
- 顧客がローンエージェントにサインインすると、リアルタイムレイヤーで顧客セッションが開始されます。顧客の統合プロファイルがリアルタイムレイヤーに取り込まれます。
- 顧客が必要な情報を入力してローン申込を完了します。
- 顧客が非構造化データ処理のために財務ドキュメント (確定申告、投資、銀行取引明細書など) を Data 360 にアップロードします。
- アップロードされたデータはチャンク化およびベクトル化 (埋め込み生成) され、インデックス (キーワードとベクトル) が作成されます。
- 次に、顧客はローン申込ドキュメントに入力してアップロードします。Data 360 は、ローン金額と期間をリアルタイムで抽出します。
- ローンエージェントは、Data 360 クエリとプロファイルおよび他の事前作成済みインデックスを使用したハイブリッド検索を使用して、関連する財務データを取得します。
- ローンエージェントは、ローンデータとその他の財務プロファイルデータを使用して承認エージェントを有効化し、ローンの承認を決定します。
- ローンエージェントが顧客に決定で応答します。
- 顧客とローンエージェント間のこのやりとりもすべて取得され、Data 360 に保存されます。
上記の例では、ローンエージェントなどのエージェントアプリケーションを構築するために使用される Data 360 アーキテクチャコンポーネントの概要を示しています。次のセクションでは、Data 360 アーキテクチャのレイヤーとコンポーネントについて説明します。
## Data 360 アーキテクチャ
このセクションでは、Salesforce Data 360 の基盤となるビルディングブロックについて、堅牢なストレージモデルから始めて、データの接続、取り込み、準備のメカニズムまでを掘り下げます。次に、構造化データと非構造化データの保存、モデル化、処理方法を検討し、ハーモナイゼーション、統合、取得、インテリジェントな有効化の機能を理解します。
### Data 360 ストレージ
Salesforce Data 360 は、レイクハウスの強みとリアルタイムストレージを組み合わせた階層型の統合ストレージモデルに基づいて構築されています。Lakehouse レイヤーは、大量の履歴データとバッチデータに対応する拡張性とコスト効率に優れたストレージを提供し、高度な分析と機械学習の使用事例を可能にします。一方、リアルタイムストレージは、低レイテンシのアクセスと頻繁な更新を実現するように最適化されており、顧客とのやりとり、プロファイル、エンゲージメントシグナルが常に最新の状態に保たれます。これらの階層がシームレスに連携することで、履歴コンテキストとリアルタイムコンテキスト間でデータを柔軟に移動でき、パーソナライズ、AI、有効化のための統合されたデータ基盤で深さと即時性の両方が提供されます。
#### レイクハウス
Data 360 は、Iceberg/Parquet に基づくネイティブの Lakehouse アーキテクチャを特徴としており、AI および分析アプリケーションに不可欠な構造化データと非構造化データの両方をサポートするバッチ、ストリーミング、リアルタイムシナリオの大規模なデータ管理と処理を処理するように設計されています。
Azure、AWS、GCP などのクラウドベースのデータレイクでは、基本的なストレージユニットはファイルであり、通常はフォルダーと階層に整理されます。Lakehouse は、クエリや AI/ML 処理などの操作を容易にするために、より高いレベルの構造と意味の抽象化を導入することで、この構造を強化しています。プライマリ抽象化は、その構造とセマンティックを定義するメタデータを含むテーブルで、Iceberg や Delta Lake などのオープンソースプロジェクトの要素と、Data 360 によって追加されたセマンティックレイヤーが組み込まれています。
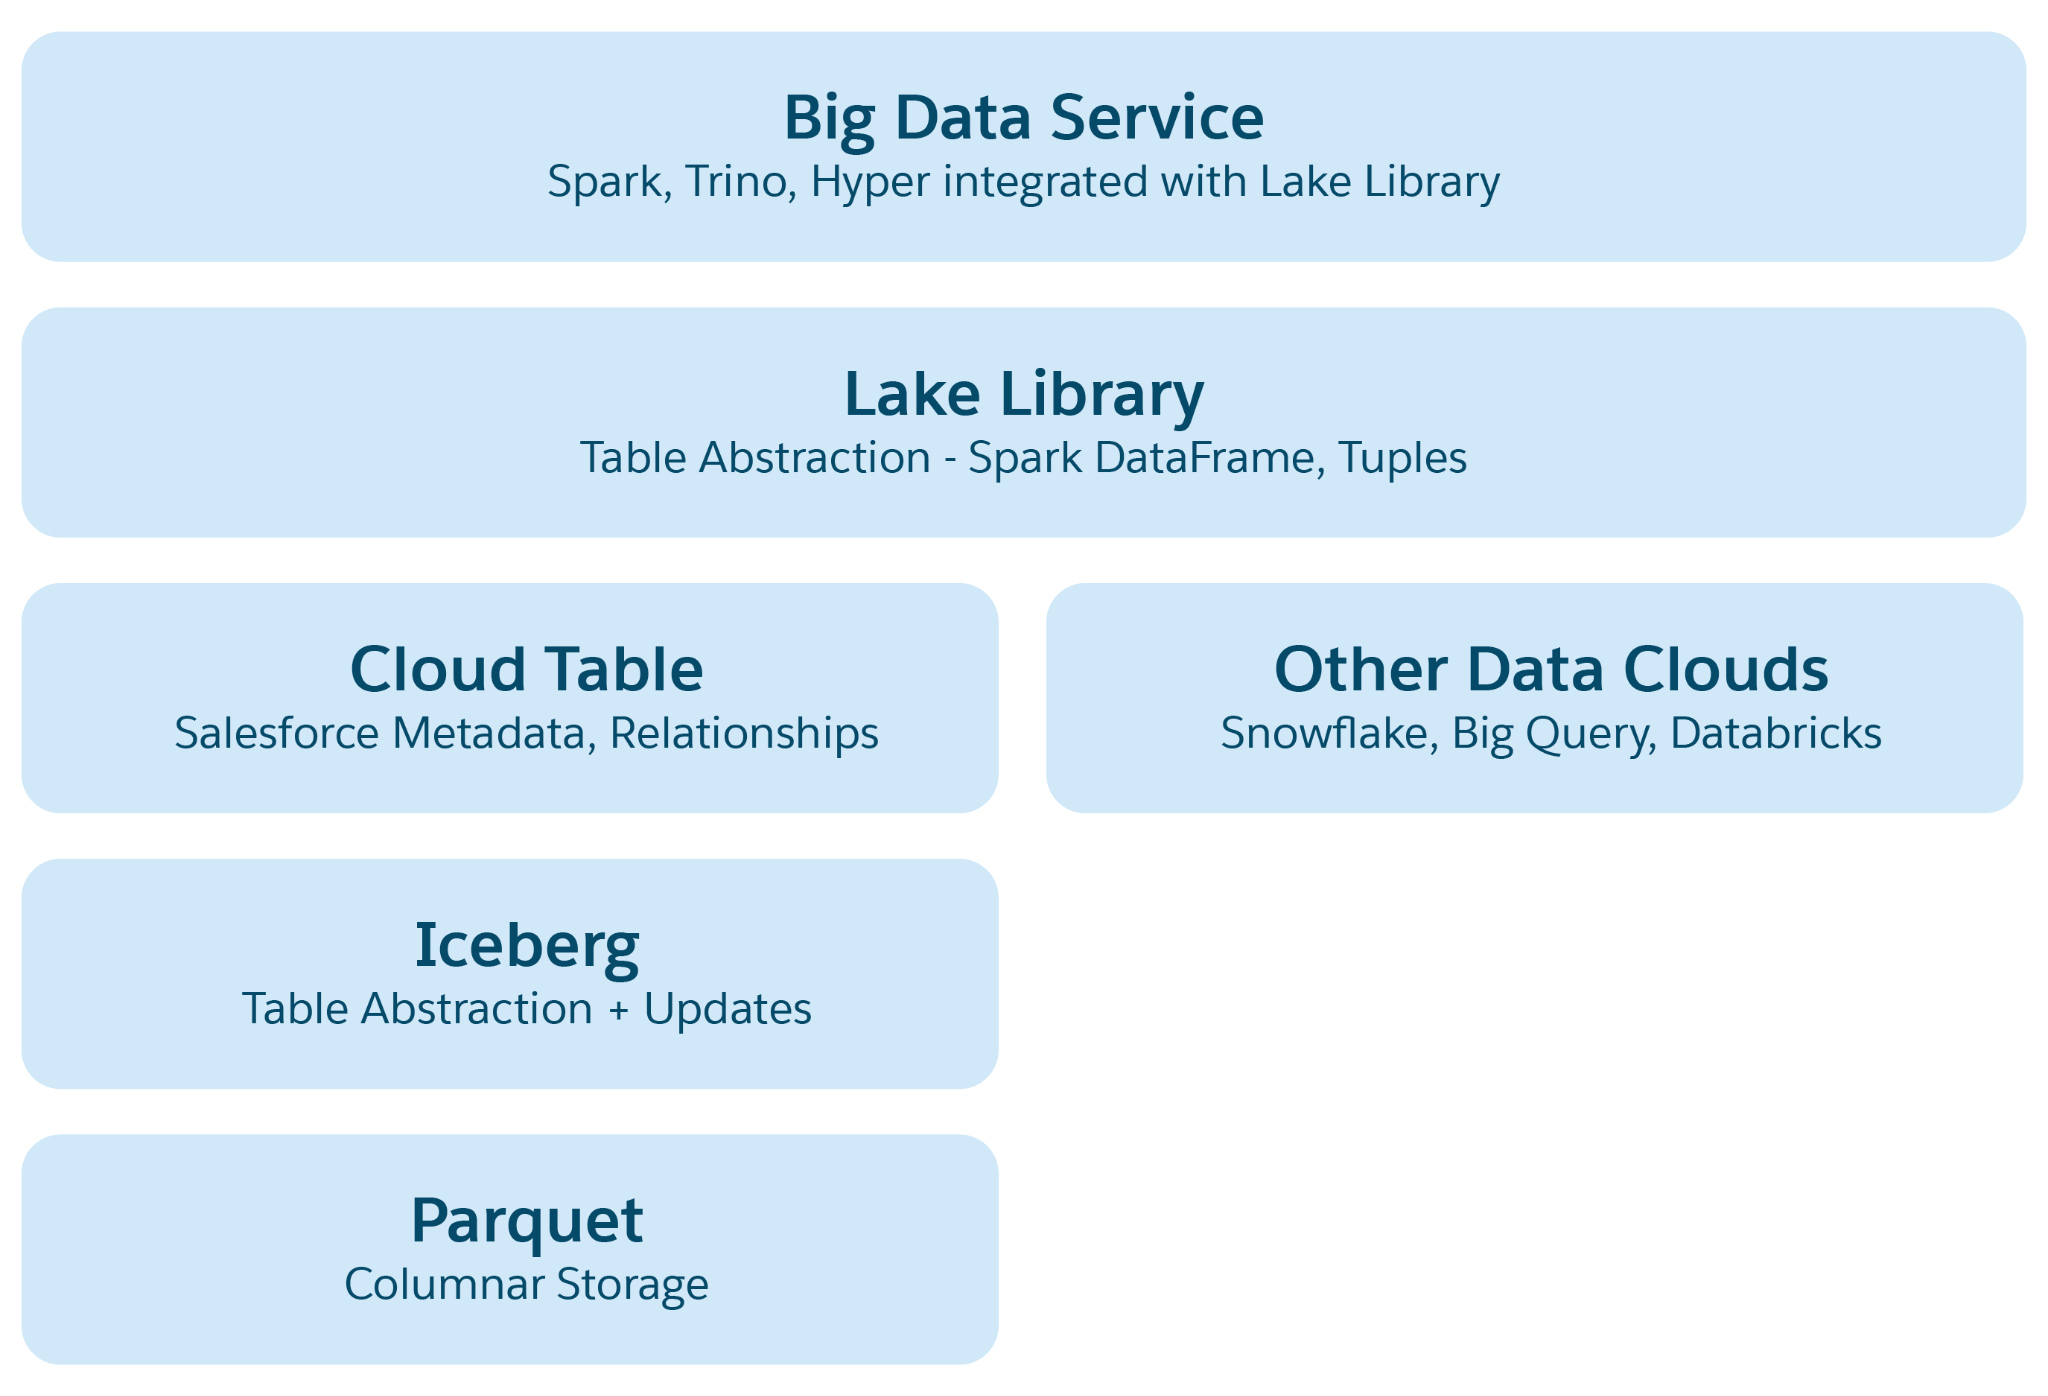 Lakehouse の抽象レイヤー:
1. **Parquet File Abstraction**:基本のストレージは Parquet 形式のデータレイクファイル (AWS の S3 や Azure の Blob など) で構成されます。ソーステーブルのデータは Parquet ファイルとして複数のパーティションに保存され、各テーブルはこれらのファイルのコレクションになります。
2. **Iceberg Table Abstraction**:テーブルはフォルダーとして整理され、データパーティションはこれらのフォルダー内に Parquet ファイルとして保存されます。パーティションを変更すると、新しい Parquet ファイルがスナップショットとして作成されます。Iceberg は、スキーマ、パーティション仕様、スナップショットの詳細を含む各テーブルのメタデータファイルを管理します。
3. **Salesforce Cloud Table Abstraction**:Iceberg を基盤とするこのレイヤーでは、列名やリレーションなどのセマンティックメタデータと、対象ファイルサイズや圧縮などの設定が追加されます。Snowflake や Databricks などのさまざまなプラットフォームのテーブルを抽象化し、Data 360 アプリケーションを基盤となるストレージプラットフォーム固有のものから保護します。
4. **Lake Access Library**:このライブラリは、Salesforce Cloud テーブルへのアクセスを提供し、データとメタデータの両方を処理し、アプリケーション開発者の基盤となるストレージメカニズムを抽象化します。
5. **Big Dataサービスの抽象化**:これには、クエリ用の Hyper や、あらゆるクラウドテーブルプラットフォームで処理するための Spark などの処理フレームワークが含まれます。
#### リアルタイムストレージ
リアルタイム分析とエージェントアプリケーションをサポートするために、Data 360 は Lakehouse Big Data ストレージを低レイテンシストアで強化します。Data 360 Real-Time Layer は、メモリ内のリアルタイムシグナルとエンゲージメントデータを処理します。ただし、メモリベースのストレージ容量は限られているため、すべてのデータが収まることはなく、処理がリアルタイムで行われない可能性があります。Data 360 では、このような制限を排除するために低遅延ストア (LLS) が追加され、拡張性の高いリアルタイム処理が可能になります。
低レイテンシ ストアは、Lakehouse 上のペタバイト規模の NVMe (SSD) ストレージ レイヤーです。すべてのデータを低遅延ストアに保存する必要はありません。これは耐久性のあるキャッシュです。ほとんどのデータは、最終的に長期間保持するためにレイクハウスに保存されます。リアルタイムレイヤーのセッション中データは、後続の高速アクセスのために低レイテンシストアにフラッシュできます。たとえば、Agentic 会話では、最近のメッセージはメモリで処理でき、古いメッセージは低遅延ストアにフラッシュできます。以前の会話が必要な場合、低遅延ストアから数ミリ秒以内にアクセスできます。NVMeベースのストレージでは、大量のデータをミリ秒のレイテンシーで保存およびアクセスできます。データは、長期間保持するために Lakehouse クラウドストレージに転送される場合があります。さらに、リアルタイム処理やリアルタイムエクスペリエンスの追加に必要な Lakehouse のデータが取得され、低レイテンシストアに保持されます。たとえば、顧客のプロファイルコンテキストが Lakehouse から事前取得または取得され、低遅延ストアにキャッシュされます。また、セッション中処理中のリアルタイム処理に必要なレイクハウスオブジェクトやその他のオブジェクトも低レイテンシストアにキャッシュできます。
Data 360 低レイテンシストアでは、メモリ (SSD) Lakehouse ストレージレイヤーを使用して、真のストレージ階層のリアルタイムレイヤーを有効にし、これらのレイヤー間でデータをシームレスに移行できます。Data 360 Real Time レイヤーについては、このドキュメントの後半で説明します。
### データ整理
Salesforce Data 360 は、未加工の入力を統合された最新のデータモデルに変換する厳格なライフサイクルに従って、構造化および非構造化のすべての顧客データを標準化、ハーモナイズ、有効化するように設計されています。
#### データライフサイクルとオブジェクト種別
ライフサイクルでは、さまざまな外部データ入力を取得し、永続的なモデル化されたオブジェクトに構造化することに重点を置いています。モデル化されたデータは Customer 360 統合プロファイルにハーモナイズできます。
**未加工の取り込みデータと初期変換**
このプロセスは、ソースシステム (CRM、マーケティング、ファイルなど) からそのまま取り込まれた未加工データから始まります。これには、現在の状態を維持するために管理され、永続的なデータにマージされるフルデータ読み込みと連続変更イベント (デルタ) が含まれます。
**インライン変換**(トリミング、正規化、連結など)は、暫定的なデータ品質とクリーンアップを確保するために取り込み時にすぐに適用されます。
##### データレークオブジェクト (DLO):永続的レイヤー
**DLO**(データ レイク オブジェクト)は、Data 360内のコア永続ストレージ レイヤーを形成します。クリーンな変換済みデータを保存し、すべての顧客情報の整理された長期的なリポジトリとして機能します。
**高度なデータ変換**(結合、集計、計算済みインサイトなど)がソースDLOに適用され、厳選された新しい派生DLOが生成されます。
Zero Copy Data Federation を介して使用可能になるデータは、DLO として直接表されます。
**非構造化データとメタデータの整理**
非構造化コンテンツ (テキスト、メディア、ドキュメントなど) の場合、Data 360 では、非構造化データレイクオブジェクト (UDLO) と呼ばれる特定の DLO 内で構造化メタデータを抽出して保持することでデータが取り込まれます。
これらの特殊な DLO はディレクトリテーブルとして機能し、非構造化アセットの物理的な場所とコンテキストへのマップを提供します。この機能により、アーキテクトは非構造化データのメタデータを残りの構造化された顧客データとシームレスに関連づけることができ、統合されたクエリとハーモナイゼーションが可能になります。
##### データモデルオブジェクト (DMO):ハーモナイズレイヤー
**DMO** (データモデルオブジェクト) は、最終的なハーモナイズされた構造化されたデータレイヤーを表します。
これらは、(ソース、派生、および非構造化メタデータの)DLOフィールドを標準のCustomer 360データ モデルにマッピングすることで作成されます。
DMO レイヤーは、すべての顧客データの一元化された情報源として機能し、広範なエコシステム全体で統合されたプロファイルの作成、セグメンテーション、有効化を可能にします。
#### データスペース:論理コンテナ
データスペースは、すべての DLO (構造化および非構造化) と DMO を含む、Data 360 内のすべてのデータとメタデータを整理するための基本的な論理コンテナです。データスペースは、データ処理とモデリングのための安全で隔離された環境を提供します。
データスペースは論理境界とガバナンス境界として機能し、ビジネスユニット、地域、ブランドなどの個別のエンティティのデータを分離することで内部のマルチテナンシーを実現すると同時に、企業全体の表示、系統、コンプライアンスを維持し、きめ細かなアクセス制御を定義するための基礎となります。
データスペース内の分離は、プラットフォームの複数のレイヤーで適用されます。
- **データレベルの分離**:各 DLO/DMO は 1 つのデータスペースに属するため、明示的に承認されていない限り、クエリ、変換、オブジェクトマッピングがデータスペースの境界を超えることはありません。
- **アクセス制御の統合**:権限セットはデータスペースにネイティブに関連付けられ、参照、更新、および管理操作を制御できます。これにより、承認されたユーザーとサービスのみがデータスペース内のオブジェクト、インサイト、有効化にアクセスできます。
- **ガバナンスと監査**:データスペース内のすべての操作がエンタープライズクラスの監査履歴で記録されるため、コンプライアンス、スチュワードシップ、規制レポートのトレーサビリティを実現できます。
アクセス権と権限は権限セットで管理されるため、詳細な表示、更新の制御、クロスドメインデータ漏洩の防止が保証されます。データスペース境界を Data 360 のセキュリティおよびガバナンスアーキテクチャと統合することで、アーキテクトは複数のクラウドおよびビジネスドメインで一貫性を維持しながら、一元化されたガバナンス戦略と分散化されたガバナンス戦略の両方を確実に実装できます。
#### コンピューティングファブリック
Data 360 コンピューティングファブリックは、すべてのビッグデータワークロードを管理および実行する統合レイヤーを提供し、基盤となるインフラストラクチャの複雑さを簡素化します。そのコアコンポーネントはデータ処理コントローラー (DPC) です。
DPC は、さまざまなクラウドコンピューティング環境にサービスとしてのジョブ (JaaS) 機能を提供する包括的なマルチワークロードデータ処理オーケストレーションサービスです。インフラストラクチャの複雑さを抽象化し、Spark (EC2 上の EMR と EKS 上の EMR) や Kubernetes リソースコントローラー (KRC) ワークロードなどのフレームワークのジョブの実行を統合します。DPC は一元化されたコントロールプレーンゲートウェイとして機能することで、複数のデータプレーン間でジョブを調整、スケジュール、監視し、信頼性、拡張性、コスト効率、一貫した開発者エクスペリエンスを確保します。
DPC のニーズは、EMR などのネイティブのクラスター管理システムを直接操作するという制限に起因します。
##### インフラストラクチャとクラウドの抽象化
EMR では、クラスター、ToDo、ステップの API が提供されますが、プロビジョニング、拡張、パフォーマンスチューニング、コストの最適化など、重要なインフラストラクチャ管理タスクがクライアントチームに課せられます。DPC は、ジョブ登録用の簡略化されたプラットフォームレベルの API を提供することで、これに対応します。自動障害処理、再試行、動的負荷バランシングがサポートされています。ビンパッキング、スポットおよび重力ベースのノードにより、コスト効率が向上します。TLS、PKI、IAM の分離、自動パッチで強力なセキュリティを提供します。Spark および EMR ランタイムのバージョンアップグレードを管理して、パフォーマンスの向上、セキュリティパッチ、機能強化を実現します。
さらに、DPC は、データジョブを送信および管理するためのクラウドに依存しない統合インターフェースを提供し、基盤となるクラウド基盤 (AWS、将来のプロバイダー) の複雑さと独自の API を抽象化します。これにより、クライアントチームは、Kubernetes や YARN などの基盤となるリソースマネージャーの複雑さを抽象化した、Data 360 API ベースの一般的なジョブ登録インターフェースのみを操作することができます。これにより、クライアントチームはポッド、ノードプール、Spark クラスター設定を直接管理することなく、シンプルな統合 API を使用して Spark ジョブを送信できます。
Spark パラメーターを手動で調整するには特殊なスキルが必要であり、誤った設定を行うとジョブの実行が遅くなる可能性があります。DPCチームはこの専門知識を一元化し、一般的なパフォーマンスの問題を回避するために最適化された設定を提供します。この専門チームは、オープン ソース コミュニティのKnowledgeを継続的に統合し、コントローラーで管理されるすべてのワークロードで最適なパフォーマンスを確保します。
DPC は Spark に限定されず、さまざまなワークロードをサポートします。これには以下が含まれます。
- リアルタイム処理ワークロード
- データアクション機能のイベント配信
- Milvus (非構造化データインデックス付け用のベクトルデータベース) の管理
- 低レイテンシのストレージインフラストラクチャ
また、DPCは、クエリ用のTrino、データアクション用のイベント配信、コネクタ用のデータ抽出ジョブ、リアルタイム処理などのワークロードをサポートする**Kubernetesリソースコントローラ(KRC)**フレームワークも活用します。すべてのKRCワークロードに対して、DPCは一元化されたサービスとしてのジョブ機能を提供し、コンピューティングのプロビジョニング、導入、管理を高レベルのジョブ抽象化で処理します。
##### JaaS の利点とアーキテクチャ
DPC が提供する Job-as-a-Service モデルにより、コスト効率と復元性の高いジョブ処理パイプラインが確保されます。
ユーザーは、必要な CPU、メモリ、ストレージ、インスタンス数、最小/最大クラスター数、クラスター一致のタグに焦点を絞ったシンプルなクラスター仕様を提供します。その後、DPCは最適なVM SKUの選択、インスタンス フリートの管理、コアと仮想インフラストラクチャの比率の決定など、抽象インフラストラクチャの詳細を自動的に管理します。ToDo ノード、およびオンデマンドと入力に基づいてインスタンスを見つけます。また、EMR およびコンポーネントのバージョン管理とアップグレードもダウンタイムなしで処理します。
重要な点として、DPC は本質的にマルチテナントをサポートしており、Data 360 のテナント境界とリソースの分離を理解して適用するように設計されています。また、Salesforce 認定のマシンイメージを適用し、サービス固有の IAM ロールを管理し、転送中と保存中の両方で暗号化を保証することで、セキュリティとコンプライアンスを確保します。ルーティングと業務量制御では、ジョブとクラスターの一致はクラスタータグを使用して管理され、業務量ベースのルーティングでは最大ジョブ同時実行設定を使用してリソース使用率を効果的に制御します。
クラウドに依存しないクライアント環境は、基盤となるクラウド環境の複雑さをクライアントサービスに隠蔽し、ビジネスロジックのみに集中できるため、中核的なメリットとなります。これにより、クラウドプロバイダーの抽象化の目標が達成されます。最後に、DPC により、使用量とコストの追跡が容易になり、クラスターの稼働率とコストをサービス別にセグメント化して正確な会計を行うことができます。全体的に、DPC はプラグイン可能なアーキテクチャに従っており、基盤となるインフラストラクチャの詳細をユーザーに公開することなく、新しい実行エンジン (Flink、Ray など) とクラウド基盤 (GKE/Dataproc) をシームレスに統合できます。この設計により、コントロールプレーンが実行レイヤーから分離され、バックエンドに関係なく一貫した API と操作環境が保証されます。
### Data 360 でのデータ処理:未加工からアクション可能へ
Data 360 は未加工データを調整して強化し、未加工情報とアクション可能なビジネス消費のギャップを埋めます。高度な有効化と分析のために複雑なデータを準備することで、データオブジェクトのライフサイクルを補完します。Data 360 では、バッチおよびストリーミングデータ変換、バッチおよびストリーミング計算済みインサイト、非構造化データ処理、ID 解決など、さまざまな処理種別がサポートされます。特にほぼリアルタイムかつ膨大なデータセット全体でこれらの多様な操作を効率的に実行するには、データの変更を効果的に処理するための高度なメカニズムが必要です。
#### 増分処理の強化
Data 360 は、特にテラバイト規模のテーブルと数百万の更新の可能性の高いデータで、ほぼリアルタイムの効率的なデータ処理を実現するために、画期的な方法を必要としていました。データが変更されたときに正確にシステムに通知し、どのデータが変更されたかを効率的に特定して、関連する更新のみが処理され、その更新のみが更新されるようにする必要がありました。この課題は、次の 2 つの補完的なイノベーションにつながりました。何かが変更されたら通知するストレージネイティブ変更イベント (SNCE) と、何が変更されたかを識別する変更データフィード (CDF)。
##### ストレージネイティブ変更イベント (SNCE)
SNCE は、Data 360 を反応型の増分データプラットフォームに根本的に変えました。この移行には、標準化されたイベント形式と高スループットのメッセージ配信システムを使用して、データレイクを積極的にポーリングする作業から、アトミック確定イベントを受動的に監視する作業への移行が含まれます。
Iceberg テーブルへの書き込み操作 (INSERT、UPDATE、DELETE) が成功すると、カタログ内のテーブルの現在のメタデータファイルポインターがアトミックに切り替わります。基盤となるオブジェクトストレージレイヤー (S3 など) は、新しいメタデータスナップショットがテーブルのディレクトリに書き込まれるたびにネイティブの通知イベント (S3 イベントなど) を送信するように構成されています。
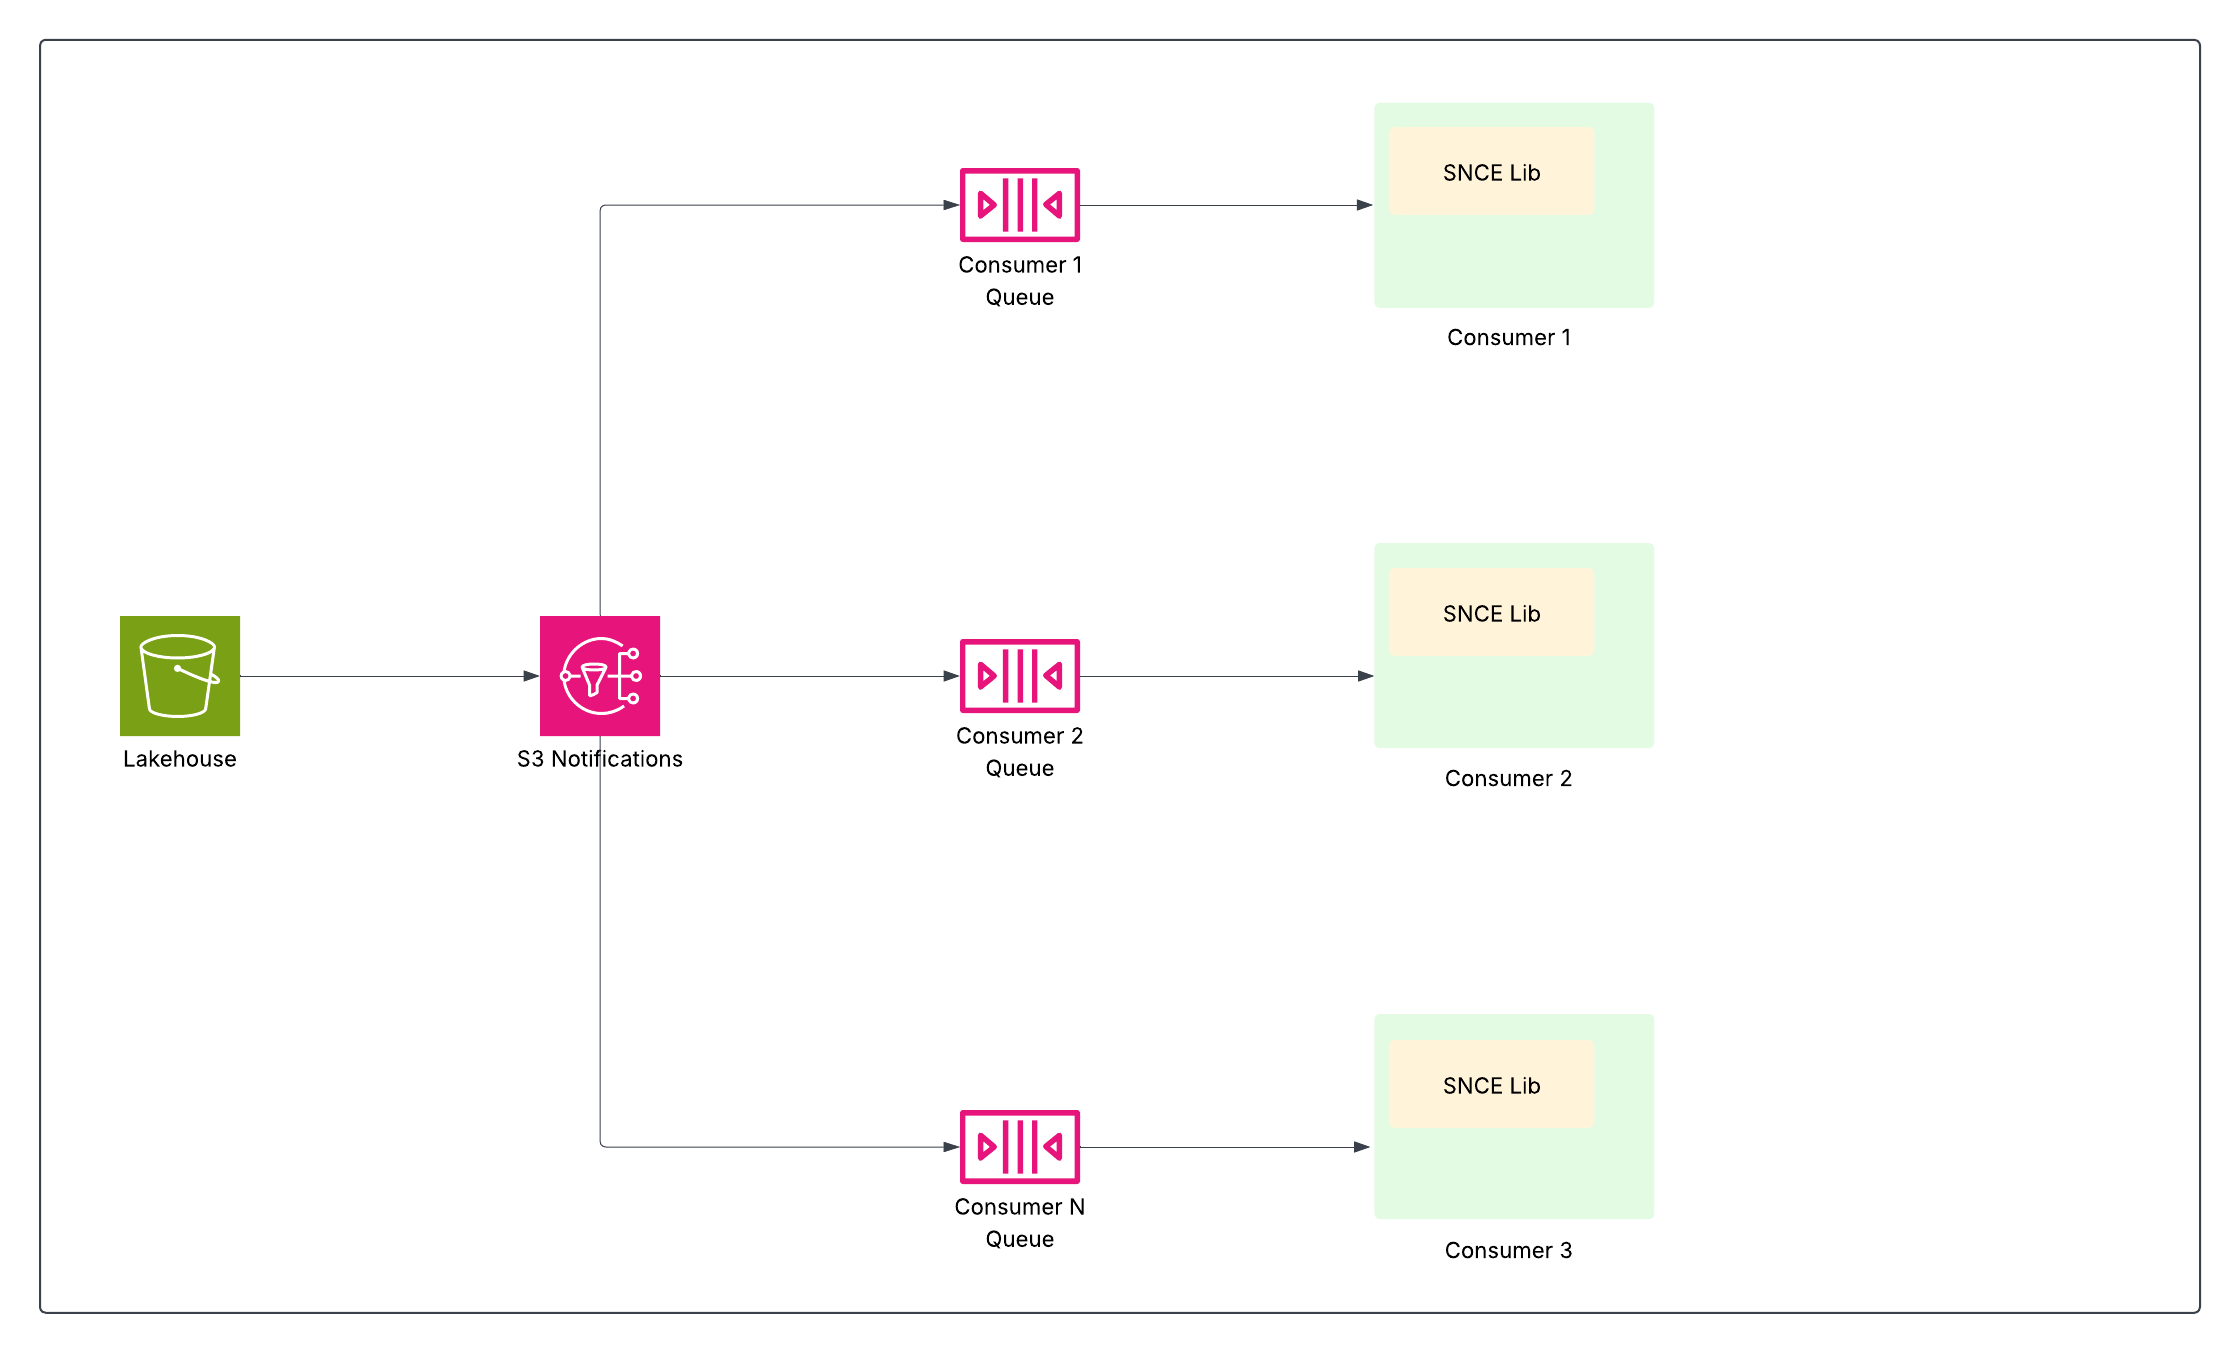 SNCE ライブラリでは、これらのイベントを使用するための標準化された方法が提供され、要求に応じてスナップショットメタデータで強化することもできます。
これにより、計算済みインサイトのストリーミング、ID 解決、セグメンテーションなどのダウンストリームデータパイプラインは、データが変更された場合にのみ登録してアクションを実行でき、コストのかかるテーブル全体のスキャンを回避して効率を大幅に向上できます。
##### 変更データフィード (CDF)
SNCE を基盤とする変更データフィード (CDF) では、変更を消費して増分処理するための合理化されたメカニズムが提供されます。
CDF は Iceberg スナップショットを使用して、変更のストリームを効率的に生成します。Data 360 の最適化された Iceberg ライターは、書き込み操作自体の一環として変更を計算して保持するため、CDF 生成の効率が高く、追加のオーバーヘッドを最小限に抑えることができます。これにより、処理ジョブ (ストリーミング変換やストリーミング計算済みインサイトなど) は、高価なスナップショットの差分計算を回避して、変更されたレコードのみを選択的に処理できます。
この増分戦略は、大規模なデータセットにコスト削減、遅延の短縮、効率の向上など、いくつかのメリットをもたらします。これにより、ストリーミング変換や増分 ID 解決などの機能が有効になり、インサイトの迅速化、システムの読み込みの予測可能性の向上、パフォーマンスの向上、運用コストの削減につながります。
### 接続、取り込み、準備
Data 360 は、Salesforce 製品のネイティブサポートにより、堅牢な取り込み機能を提供し、シームレスなデータフローを実現します。外部ソースの場合、270 を超えるコネクタ、API、SDK、MuleSoft を介して広範な接続を提供します。さらに、Data 360 にはゼロコピー統合機能があり、データの重複のない BI および分析が可能です。
#### Data 360 コネクタフレームワーク
Data 360 コネクタフレームワーク (DCF) は、ほとんどの Data 360 接続の基盤です。統合されたアーキテクチャを使用して、取り込み、統合、出力が可能になります。DCF では、設定と管理のための UI から、メタデータの保持、データの抽出、Lakehouse への配信、外部ソースに対するライブクエリまで、コネクタの作成と管理に関する標準が定義されています。また、プライベート接続オプション (プライベートリンク、VPN、セキュアトンネルなど) もサポートし、顧客またはパートナー環境に接続するときにエンタープライズクラスのデータセキュリティとコンプライアンスを確保します。すべてのコネクタで一貫したアプローチを提供することで、DCF は拡張性、信頼性、安全なインテグレーションを確保し、Data 360 をより広範なエコシステムにシームレスに接続します。
#### Data 360 コネクタ
Data 360 は、ネイティブの Salesforce 製品と多数の外部システムの両方をサポートする、膨大なデータソースエコシステムへの堅牢な接続を提供します。この広範な接続性は、サイロ化されたエンタープライズデータを統合し、AI/ML およびエージェントアプリケーションを有効にするために不可欠です。
Data 360 は、バッチ、ストリーミング、またはリアルタイム取り込みによるエンドツーエンドのデータパイプライン機能をサポートするために、ネイティブまたは MuleSoft、API、SDK を介して 270 を超えるコネクタを提供します。これらのコネクタは、統合するソースシステムの種別によって大きく分類できます。
**Salesforce ネイティブコネクタ**
これらのコネクタにより、Salesforce 製品からのシームレスでネイティブなデータフローが確保されます。
たとえば、Salesforce CRM、Data Cloud One、Marketing Cloud Engagement、Marketing Cloud Account Engagement、B2C Commerce のコネクタがあります。
**外部アプリケーションとSaaS**
さまざまなビジネスアプリケーションとクラウドサービスのコネクタでは、外部ソフトウェアプラットフォームからデータを取得できます。
たとえば、Adobe Marketo Engage、Microsoft Dynamics 365、Mailchimp、Airtable などがあります。
**データベースとデータウェアハウス**
Data 360 は、さまざまなリレーショナルおよびクラウドベースのデータストレージプラットフォームに接続します。
たとえば、Amazon Redshift、Amazon DynamoDB、Amazon RDS (MySQL、PostgreSQL、Oracle)、Google BigQuery、Microsoft SQL Server などがあります。
**クラウド オブジェクト ストレージとファイル システム**
これらのコネクタは、構造化データと非構造化データの両方のハイパースケーラー ストレージ ソリューションと統合されます。
たとえば、Amazon S3、Google Cloud Storage (GCS)、Azure Blob Storage などがあります。
**ストリーミングおよびメッセージングサービス**
継続的なリアルタイムデータストリームを処理するコネクタは、イベント駆動型のシナリオとリアルタイム処理に不可欠です。
たとえば、Amazon Kinesis コネクタです。
**インテグレーションプラットフォーム**
MuleSoft Anypoint Connector は、Anypoint Exchange を介して幅広いアプリケーションやデータベースと統合することで、Data 360 の範囲を拡大します。
**非構造化データおよびクラウド オブジェクト ストレージ コネクタ**
これらのコネクタは、非構造化データ (定義済みモデルがないデータ) を取り込んで参照し、生成 AI 機能を強化するために不可欠です。
これらのコネクタはすべて、Data 360 コネクタフレームワーク上に構築されており、一貫した環境が提供されます。
#### データ変換
データ変換は、Data 360の基本的なアーキテクチャ コンポーネントであり、取り込まれた未加工データをクリーンアップ、強化し、Customer 360データ モデルに合わせて正規化されたアクション可能なデータ資産に形成するように設計されています。このプロセスは、データのハーモナイゼーション、品質の向上、およびプロファイルの統合、セグメンテーション、有効化などのダウンストリームの使用事例に向けたデータの準備に不可欠です。変換では、入力としてソースデータレイクオブジェクト (DLO) とデータモデルオブジェクト (DMO) の両方を活用し、それぞれ新しい DLO または DMO に結果を生成します。
Data 360 では、さまざまなデータ速度要件に対応するために、一括処理データ変換とストリーミングデータ変換の 2 つの主要な変換パラダイムが提供されます。
##### 一括処理データ変換
一括処理データ変換は、定義されたスケジュールまたはオンデマンドトリガーに基づいて大量の処理を実行するように設計されています。このエンジンは、リソースを大量に消費する複雑な再構築操作を処理するように最適化されています。
一括変換プロセスは、ユーザーが複数フェーズの変換ロジックを定義できる、視覚的なローコードパイプラインキャンバスを使用して設定されます。このエンジンは、正規データモデルのアライメントに不可欠な複雑な再構築操作 (データの構造化と正規化) を独自にサポートします。これには、ピボット (非正規化されたレコードを複数の正規化されたレコードに分解) やフラット化 (JSON などの階層データを構造化テーブルに再構築) が含まれます。システムの実行モードでは、完全同期 (すべてのレコードの処理) と効率の高い増分処理モードの両方がサポートされます。増分モードでは、前回成功した実行以降に変更されたレコードのみが処理されるため、処理時間とリソースの消費が大幅に削減されます。一括変換は、定期的な集計や複雑なデータの再構築など、リアルタイムの更新が不可欠なタスクに最適です。
##### ストリーミングデータ変換
ストリーミングデータ変換では、データがシステムに取り込まれるとほぼリアルタイムでデータが継続的かつ段階的に処理されるため、低レイテンシの使用事例には不可欠です。
プライマリインターフェースは SQL ファーストアプローチで、変換は、レコード変更の受信ストリームに対して継続的に実行される SQL SELECT クエリとして定義されます。このエンジンでは、データクレンジングや標準化 (PII の検証やデータ形式の標準化など)、データ強化やマージ (結合や結合を使用) などのコア変換機能がサポートされます。重要な点は、ストリーミングルックアップ結合がサポートされているため、リアルタイムのデータ強化と静的または変化の遅い参照データに対するルックアップが可能になり、プロファイルの即時更新が保証されます。提供コストを最適化するために、このアーキテクチャでは高密度 (HD) ジョブ設計を採用しています。この設計では、1 つのテナントの複数のストリーミング変換定義を 1 つの基盤となるコンピューティングジョブにまとめ、リソースの使用率を最大化します。ストリーミング変換は、イベント監視、即時パーソナライズ、リアルタイムプロファイル更新などの使用事例に不可欠です。
### Zero Copy データの統合とデータ共有
Data 360 では、ゼロコピー統合とデータ共有がサポートされるため、データの移動や重複が不要になり、データ管理が変革されます。この機能により、ユーザーはさまざまな外部ソースのデータにシームレスかつ直接アクセスし、外部環境とデータを共有できるため、複雑さが大幅に軽減され、ストレージコストが削減され、すべての意思決定が信頼性の高い最新の情報に基づいて行われます。
 #### データ統合
Data 360 では、外部データウェアハウス (Snowflake、Redshift)、レイクハウス (Google BigQuery、Databricks、Azure Fabric)、SQL データベース、その他の多くのソースとのゼロコピー統合がサポートされます。抽象化レイヤーにより、重複のない外部データの直接クエリが可能になり、取り込み時間、ストレージコストを削減し、最新情報を確保できます。
Data 360 は、Salesforce オブジェクトと外部オブジェクトの両方を抽象化する統合メタデータレイヤーを提供することで、外部および統合データへのアクセスを簡素化します。これにより、Salesforce Platform とそのアプリケーション全体でこのデータをシームレスに使用できます。
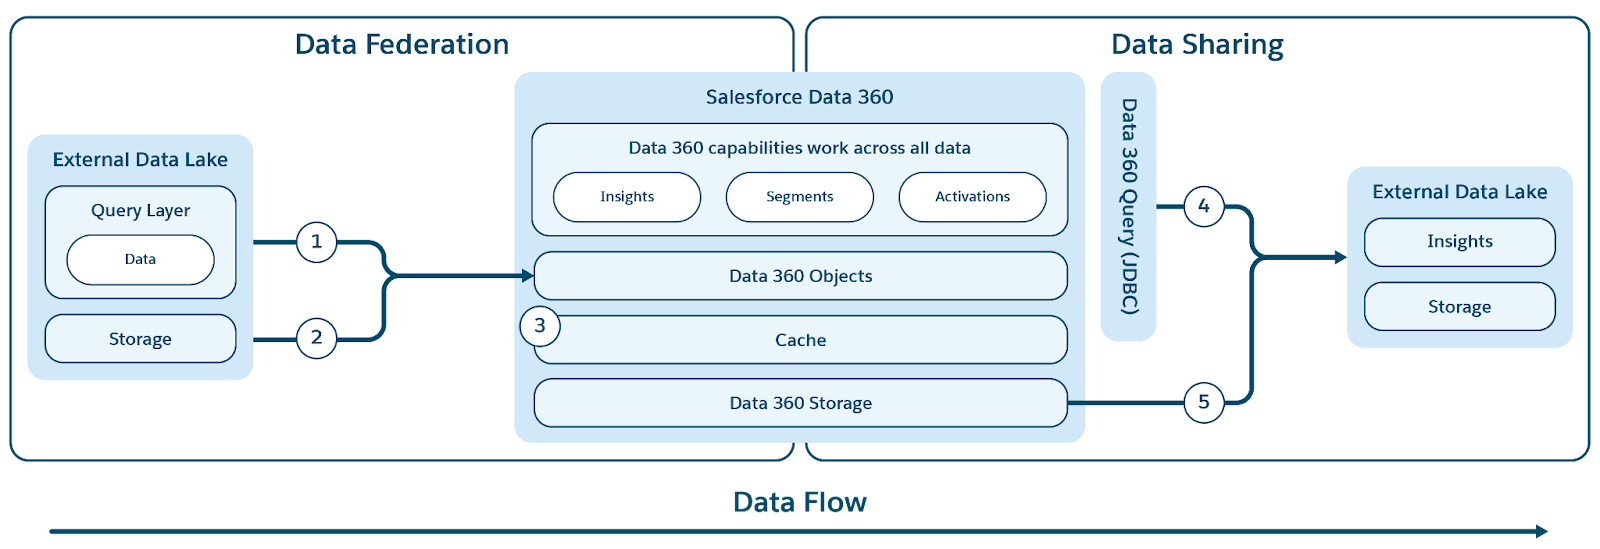
Data 360 では、ファイルベースとクエリベースの両方の統合がサポートされ、図に示すようにライブクエリとアクセスアクセラレーションが提供されます。
表示ラベル (1) と (2) は、外部データレイク/ウェアハウス/データソースからデータにアクセスするための Data 360 のクエリ (ライブクエリプッシュダウンを含む) とファイルベースの統合を示し、表示ラベル (3) は、外部データレイク/データソースからの統合アクセスの高速化を示します。
##### クエリ統合
Data 360 の統合機能の中核は、外部データにアクセスしてインテリジェントなクエリプッシュダウンを実行する複雑なプロセスを管理するクエリ統合レイヤーにあります (表示ラベル 1 を参照)。Data 360 は、JDBC プロトコルを使用してソースに接続し、ソースからデータを取得します。このプロトコルは、効率を向上させるためにロジックが追加されています。クエリ統合レイヤーは、さまざまな SQL 方言を理解して翻訳し、効率的な処理のために外部システムに転送されるクエリの最適な部分を特定し、結果を取得して、最終的なインサイトを導き出すために必要な追加処理を実行します。
###### キャッシュ (クエリアクセラレーション)
拡張ユーティリティの場合、Data 360 では統合機能に省略可能な高速化機能が提供されます。
アクセラレーションが有効になっている場合、Data 360 は統合データをキャッシュして、外部ソースへの繰り返しの直接アクセスを回避し、アクセスの高速化とコスト削減を実現します。このキャッシュはアクセラレーションレイヤーとして扱われ、外部ソースデータの変更をすばやく反映するように増分更新され、アクセラレーションビューがほぼリアルタイムになります。
##### ファイルフェデレーション
Data 360 では、外部データレイクおよびソースからデータにアクセスするためのファイルベースの統合 (表示ラベル 2 で示されています) がサポートされています。このゼロコピー機能の技術的な基盤は標準化に依存しています。基盤となるデータは Apache Parquet ファイル形式であり、Apache Iceberg 表形式を使用する必要があります。Data 360 は、Iceberg REST Catalog (IRC) を公開する任意のソースに統合してメタデータとストレージにアクセスできるため、プラットフォーム外にあるファイルへのシームレスな管理されたアクセスが保証されます。
ファイルベースの統合では、Data 360 コンピューティングは基盤となるストレージに直接アクセスするため、すべてのデータ処理を処理します。これにより、クエリベースの統合でよく必要となるクエリプッシュダウンやさまざまな SQL 方言の管理が不要になります。
これに加えて、ゼロコピー機能は、Data 360 の非構造化処理パイプラインからアクセスできるハイパースケーラーストレージソリューション (S3/GCS/Azure ストレージ)、Slack、Google ドライブなどの非構造化データソースにも拡張されます。
#### データ共有
Data 360 では、外部データレークやウェアハウスで管理するデータのクエリベースとファイルベースの共有が促進されます (元の Figure コンテキストでは表示ラベル 4 と 5 で示されています)。
##### クエリベースの共有
クエリベースのデータ共有の場合、Data 360 は JDBC ドライバーを公開します。このドライバーを使用して、外部エンジンとアプリケーションはデータに安全にアクセスできます。このメカニズムにより、外部システムは Data 360 内のデータに対してライブクエリを直接接続、認証、実行できます。
##### ファイルベースの共有 (データ共有および DaaS)
ファイルベースの共有の主なメカニズムには、DaaS (サービスとしてのデータ) API を活用するデータ共有とデータ共有対象という 2 つの概念が含まれます。
- 詳細な制御:データ共有の概念により、外部で共有するオブジェクト (DLO、DMO、CIO など) を正確に定義できるため、意図しないデータ漏洩を防止できます。
- 安全なターゲティング:また、データ共有対象も制御し、明示的に承認された外部環境、取引先、またはパートナー組織のみがデータを使用できるようにします (特定の Redshift または Databricks インスタンスとの共有など)。
DaaS API は、外部エンジンがデータを消費するための安全で管理されたインターフェースを提供します。Data 360 のすべてのセマンティクスを保持しながら、重要なメタデータと基盤となるテーブルストレージの両方にアクセスできます。これにより、外部エンジンは一貫性のある有意義なコンテキストで安全にデータにアクセスできます。
### プライベート接続
セキュリティに敏感な顧客 (特に大企業、規制対象の業界、公共セクターの組織) の多くは、セキュリティ体制の一環として、データレイクへのすべてのインターネットアクセスを制限しています。このポリシーは、コンプライアンスとリスク軽減には不可欠ですが、Salesforce Data 360 と Agentforce がパブリックインターネットを介してこれらの環境に接続することも防止します。
これらのデータレイクのほとんどは、AWS、Azure、Google Cloud などのハイパースケーラー環境にリリースされます。Data 360 自体は AWS で実行されるため、別のクラウドプロバイダーでホストされている顧客データレイクにアクセスするには、クロスクラウドネットワーク接続が必要です。パブリック インターネットを迂回する安全なプライベート接続オプションがない場合、お客様は多くの場合、これらのデータ レイクに依存するユースケースにData 360やAgentforceを採用できないか、採用を拒否します。
#### 非公開リンク
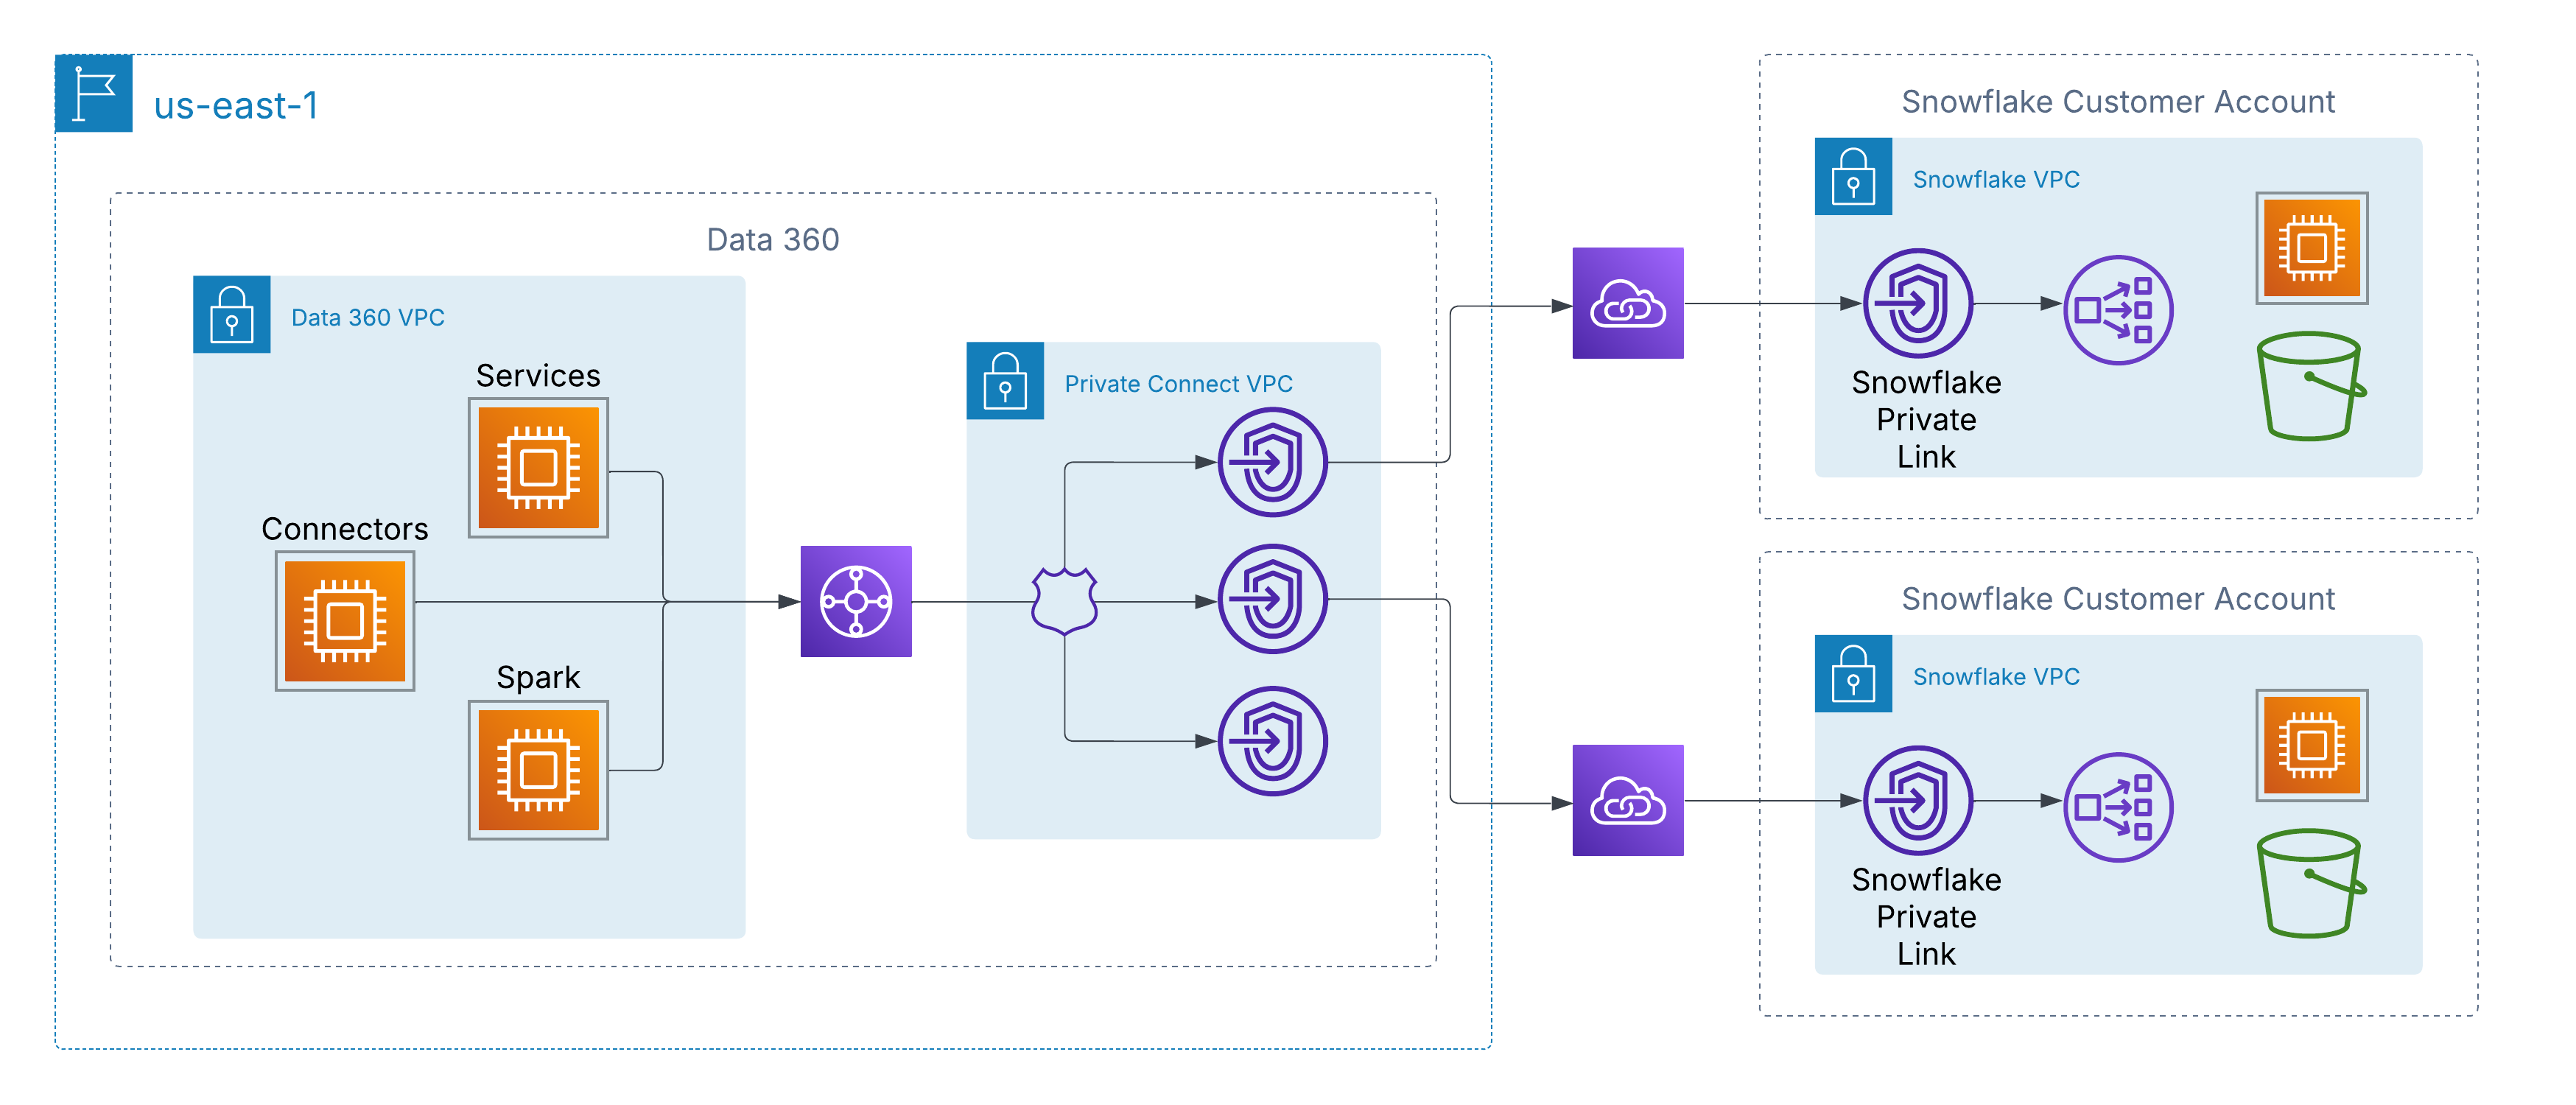 これに対応するために、Data 360 では、クラウド間で顧客が管理するデータソースへの非公開のネットワークレベルの接続がサポートされています。AWS では、これは AWS PrivateLink を介して有効になります。これにより、Data 360 は、パブリックインターネットを経由することなく、独自のアカウント内またはサードパーティのデータレイク環境 (Snowflake など) 内で、顧客がプロビジョニングしたエンドポイントに直接接続できます。
このアーキテクチャにより、プライベート IP アドレスとルーティング不可能なネットワークパスを使用して、すべてのトラフィックが AWS バックボーンに完全に保持されるため、厳格なセキュリティとコンプライアンスの要件を満たしながら、顧客データへのシームレスなアクセスが可能になります。
#### プライベート相互接続
マルチクラウドアーキテクチャを使用するお客様のために、Data 360 ではクロスクラウド相互接続のサポートを通じてプライベート接続を AWS 以外にも拡張しています。これにより、Data 360 から Azure または Google Cloud でホストされているデータレイクやサービスへの安全なバックボーン専用ネットワークパスが可能になり、AWS PrivateLink と同じ原則 (プライベート IP アドレス、非公開ルーティング、インターネット公開ゼロ) が維持されます。
顧客は 2 つのリリースモデルのいずれかを選択できます。
- **顧客が管理する相互接続**:Azure ExpressRoute、Google Cloud Interconnect、Equinix Fabric などの既存のプライベート回線を Data 360 の VPC に直接統合します。
- **Salesforce 管理インターコネクト**:Salesforce がクロスクラウドリンクをプロビジョニングして操作し、対象クラウドで非公開エンドポイントを公開できる、完全に管理されたターンキー接続を使用します。
どちらのモデルでも、操作性は一貫しています。Data 360 サービスは、ハイパースケーラーを介して外部データソースにローカルであるかのように接続し、公衆インターネットを経由することなく安全に取り込み、有効化、照会できるようにします。
### Data 360 のデータガバナンス:Trustと管理の基盤
エンタープライズ アーキテクトにとって、堅牢なデータ ガバナンスは単なるコンプライアンス チェックボックスではなく、信頼性、拡張性、アクション可能な顧客インテリジェンスを構築するための基本的な柱です。Salesforce Data 360 は、データ品質、セキュリティ、およびデータライフサイクル全体の規制要件への遵守を保証する包括的なガバナンスフレームワークを使用して設計されています。
Data 360 は一元化されたガバナンスハブとして機能し、未加工の取り込みから有効化されたインサイトまで、すべてのデータが整合性と制御をもって管理されるようにします。
 #### 高度なアクセス制御:属性ベースのアクセス制御 (ABAC) を使用する理由
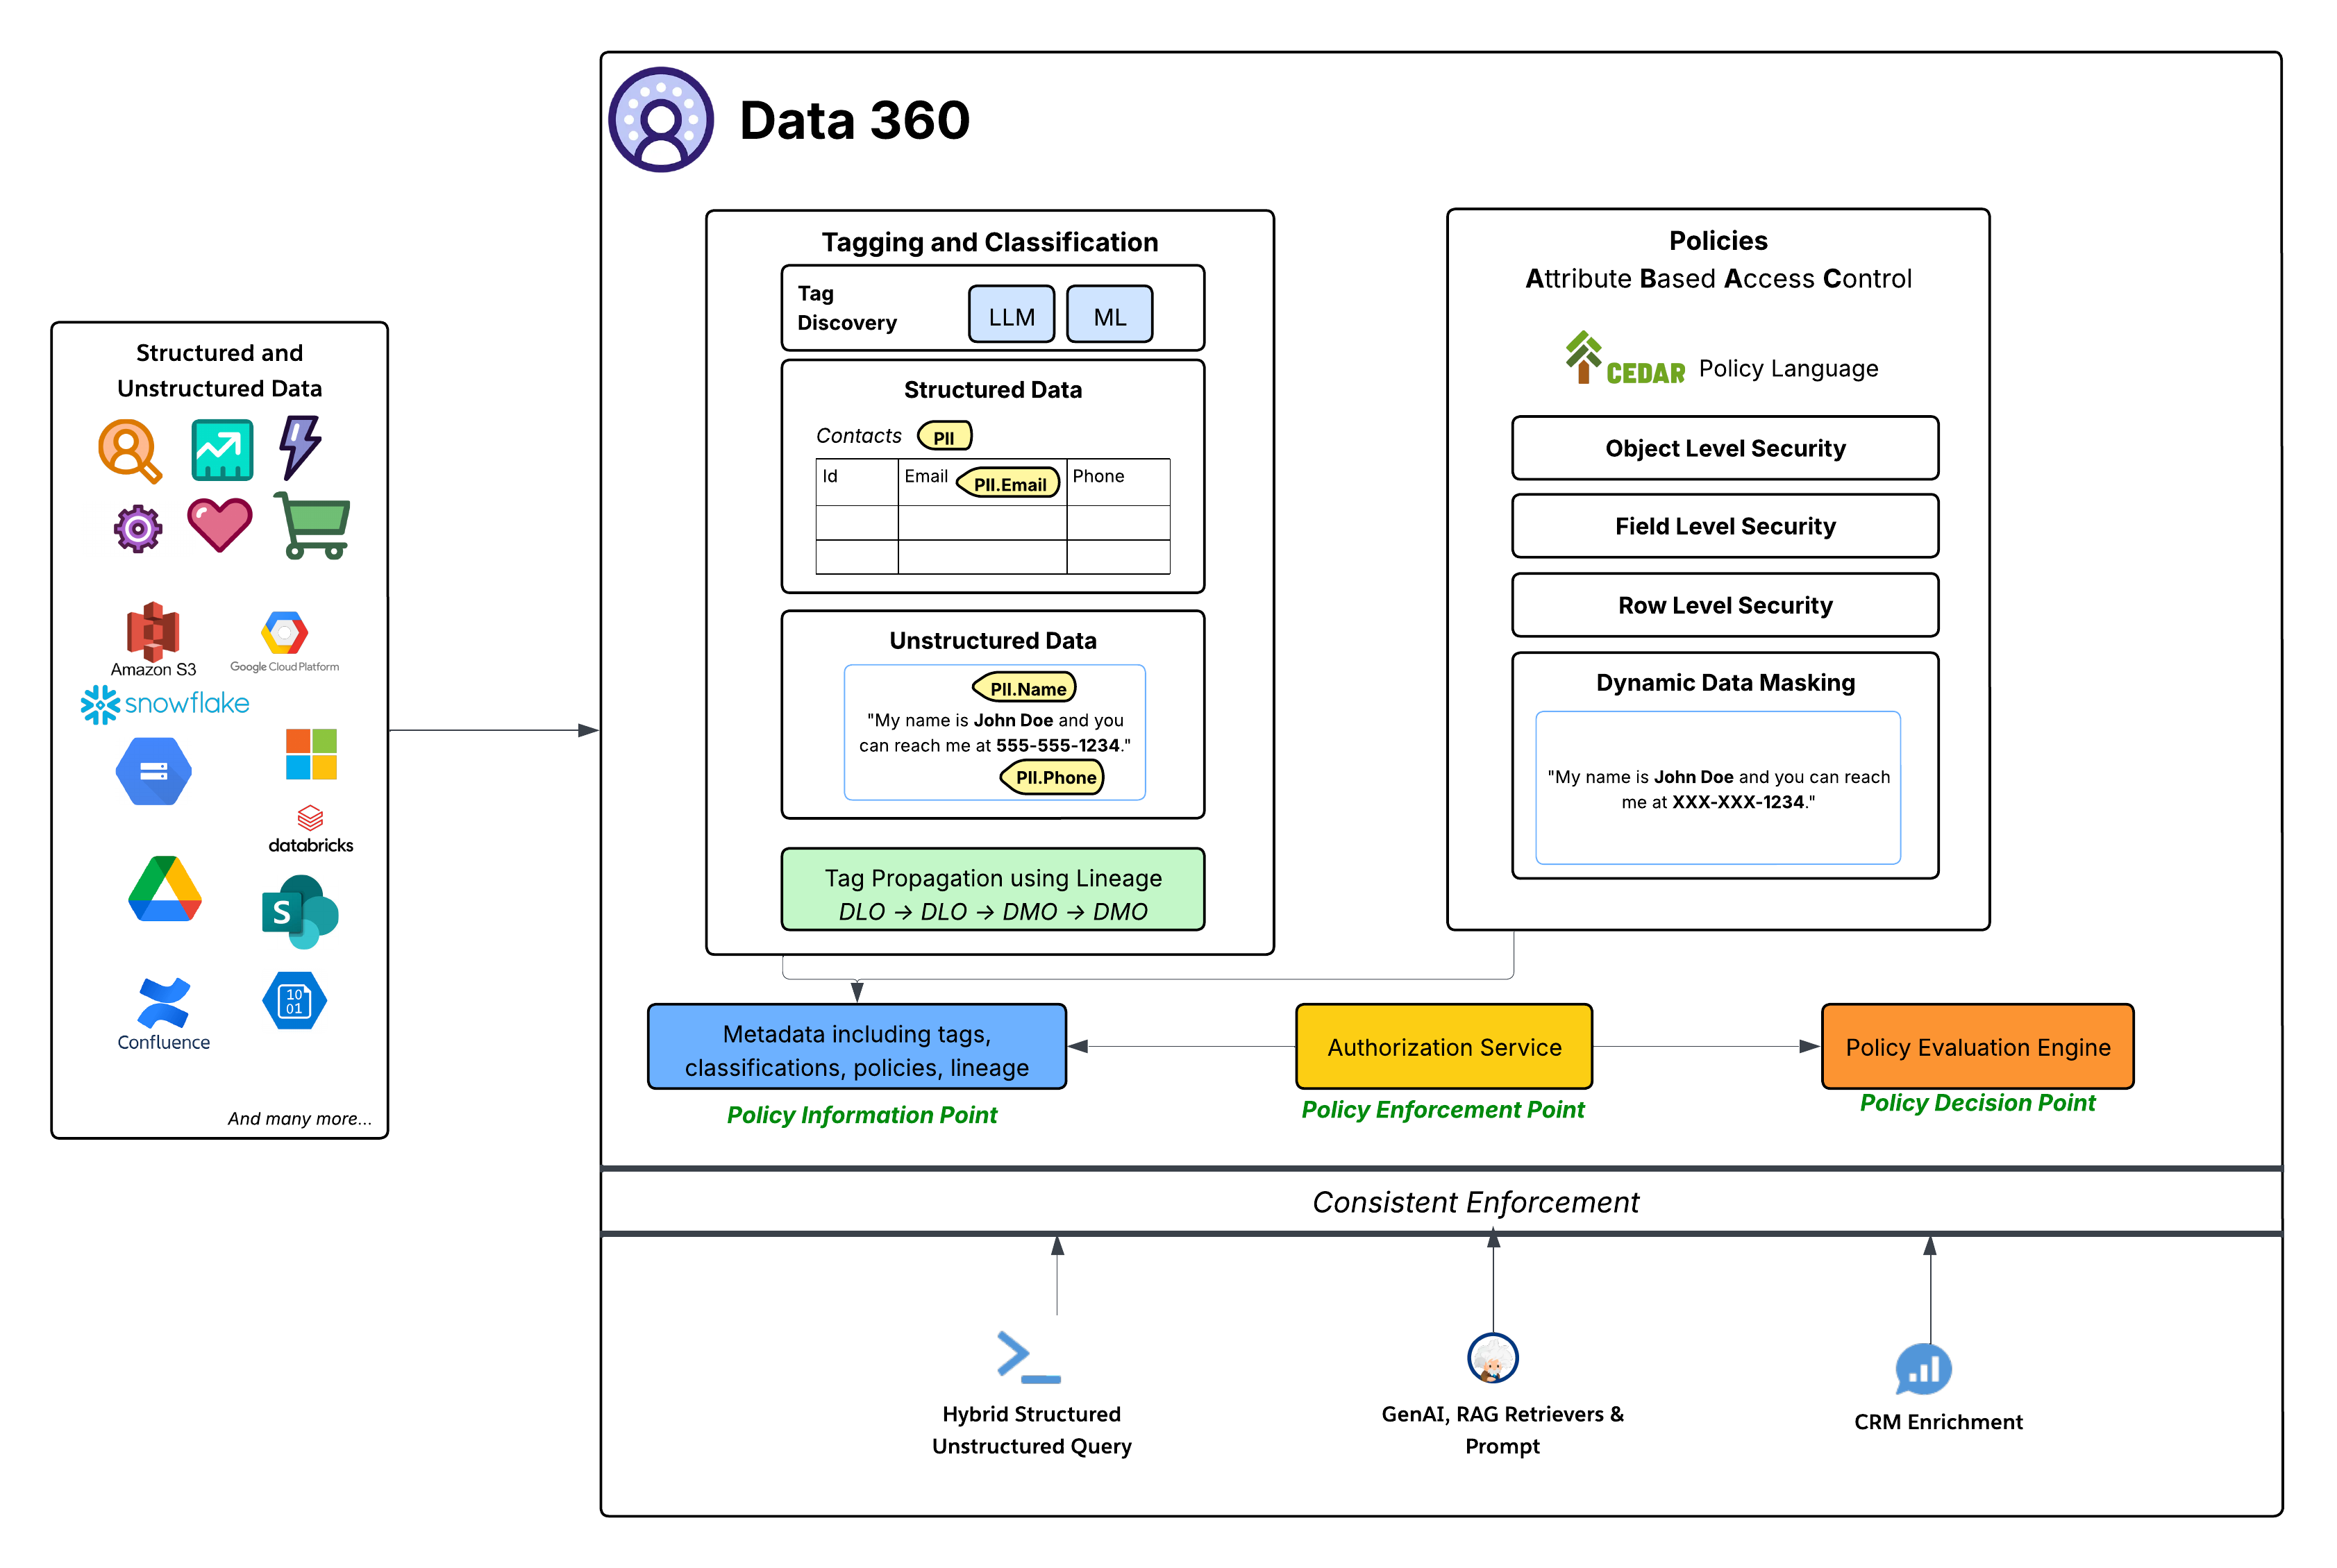
データスペースでは、データスペース内のすべてのオブジェクトへのアクセス権を決定するための粗いきめ細かいアクセス制御が提供されますが、ABAC ベースのポリシーでは、データスペース内の個々のオブジェクト、項目、行へのきめ細かなアクセス制御が提供されます。Data 360 では、きめ細かなアクセス制御を実現するため、属性ベースのアクセス制御 (ABAC) をコア認証モデルとして採用しています。この戦略的な選択により、従来のロールベースのアクセス制御 (RBAC) よりも優れた柔軟性と拡張性が提供されます。これは、大量のデータとさまざまなアクセスニーズがある動的で複雑なエンタープライズ環境で特に重要です。ABAC では、事前定義されたロールだけでなく、ユーザーの属性 (部署、ロール、場所など)、データ (PII、機密性、データスペースなど)、環境 (時間帯など) に基づいてアクセスを決定できます。これにより、データとユーザー属性の変化に応じて適応する、きめ細かいコンテキストに基づいたアクセスポリシーが可能になります。
- **CEDAR ポリシー言語**:Data 360 の ABAC 実装の中心となるのは、CEDAR ポリシー言語を使用することです。この専用の正式なポリシー言語により、複雑な認証ルールを正確かつ検証可能な方法で定義できるため、ポリシーが明確になり、大規模で一貫した評価が可能になります。
#### ガバナンス アーキテクチャ:保険契約情報、適用、決定ポイント
Data 360 内のガバナンスシステムは、標準の堅牢な ABAC アーキテクチャに準拠しています。
- **タギング、分類、ポリシーの作成 (Policy Information Point (PIP))**:
- Data 360 では、LLM (Large Language Model) と ML (機械学習) を活用して、構造化データ (取引先責任者テーブルなど) と非構造化データ (Google ドライブなど) の両方で機密データカテゴリ (PII.Email、PII.Phone、PII.Name など) やその他の専用の分類 (PHI、FinancialData) を識別する自動タギングおよび分類メカニズムが提供されます。
- 重要な点として、タグの伝達はデータ系統に沿って行われ (DLO → DLO → DMO)、未加工の取り込まれたデータからハーモナイズ DMO レイヤー、プロセス定義から作成された派生データに至るまで、データ変換と派生に従って分類が自動的に行われます。
- 最後に、ポリシー作成ペインでは、データとユーザー属性を活用して組織の動的アクセスルールを定義するためのシンプルな環境が提供されます。
- この強化されたメタデータ (タグ、分類、ポリシー、系統など) は、ポリシー情報ポイント (PIP) に入力されます。
- **承認サービス (Policy Enforcement Point (ポリシー適用ポイント) - PEP)**:
- 認証サービスはポリシー適用ポイント (PEP) として機能します。さまざまな消費レイヤー (ハイブリッド構造化/非構造化クエリ、GenAI RAG Retrievers & Prompt、CRM Enrichment) からのすべてのデータアクセス要求をインターセプトし、ポリシー決定ポイントを参照してアクセスが許可されているかどうかを判断します。
- **Policy Evaluation Engine(Policy Decision Point(PDP; ポリシー決定ポイント))**:
- このエンジンは Policy Decision Point(PDP; ポリシー決定ポイント)として機能します。PEP のアクセス要求コンテキスト、ポリシー定義 (CEDAR 内)、および PIP の属性を取得して、権限のあるアクセスを決定します。
#### 主要なポリシーの適用と統合
- **詳細なセキュリティポリシー**:CEDAR で定義されたポリシーは、次のようなさまざまなセキュリティレベルを適用します。
- **オブジェクトレベルセキュリティ**:これらのオブジェクトに関連付けられたタグに基づいて DLO 全体または DMO へのアクセスを制御する。
- **項目レベルセキュリティ**:タグに基づいてオブジェクト内の特定の機密項目へのアクセスを制限する。
- **行レベルセキュリティ**:特定のオブジェクトのデータを絞り込んで、ユーザー属性に基づいて関連する行のみを表示する。
- **動的データマスキング**:基盤となるデータを変更せずに、アクセス ポイントで特定のデータを(タグに基づいて)動的にマスキングします。これにより、機密情報を保護しながら、広範なユーティリティを確保できます。これは、構造化データのマスキング項目と非構造化データのコンテンツに適用されます。
- **一貫した適用**:ABAC フレームワーク全体では、データの直接クエリ、生成 AI アプリケーション (RAG) の取得、関連リストを使用した Salesforce CRM 環境の強化など、Data 360 のすべての消費パターンでポリシーの一貫した適用が保証されます。
- **Salesforce Platformとの緊密な統合**:Data 360 のガバナンス機能は、Salesforce コアプラットフォーム内で直接定義および管理されます。このインテグレーションにより、管理者は使い慣れた Salesforce ツールを使用してアクセスポリシー、ユーザー ID、属性管理を管理できるため、Salesforce エコシステム全体で統一された一貫したガバナンスレイヤーが保証されます。
CEDAR ポリシーを使用してこの高度な ABAC フレームワークを構築することで、Data 360 はアーキテクトに比類のないレベルの制御と柔軟性を提供し、顧客データがアクション可能だけでなく、企業全体でセキュリティ、コンプライアンス、信頼性を確保できるようにします。
### Data 360 Encryption:Bring Your Own Key
業界では、データ漏洩、不正アクセス、改ざん、破壊から確実に保護するために、エンドツーエンドのデータセキュリティが重要視されています。現在の Data 360 を含むほとんどのデータプラットフォームでは、ベンダーが管理する暗号化鍵を使用して保存時の暗号化が提供されます。ただし、企業 (特に規制対象セクター) は、保存データと転送データの両方について、顧客による暗号化機能の管理を義務付ける傾向が強まっています。
このモデルでは、企業は独自の暗号化鍵を制御できるため、プラットフォームレベルの侵害や不正アクセスの可能性が極めて低い場合でも、データは暗号化されて保護されます。顧客の独自の鍵がない場合、どのエンティティ (プラットフォームプロバイダーを含む) もデータを復号化または再構築できないため、完全な機密性と制御が維持されます。
### 非構造化データの保存と処理
Data 360 では、データの取り込み、処理、インデックス付け、クエリメカニズム全体で、構造化データ (テーブル)、半構造化データ (JSON)、非構造化データの保存と管理がシームレスにサポートされます。Data 360 では、テキスト以外のさまざまな非構造化データ型 (音声、動画、画像など) がサポートされ、データ処理と分析の範囲が広がります。次の図は、グラウンディングの両側 (取り込みと取得) を示しています。
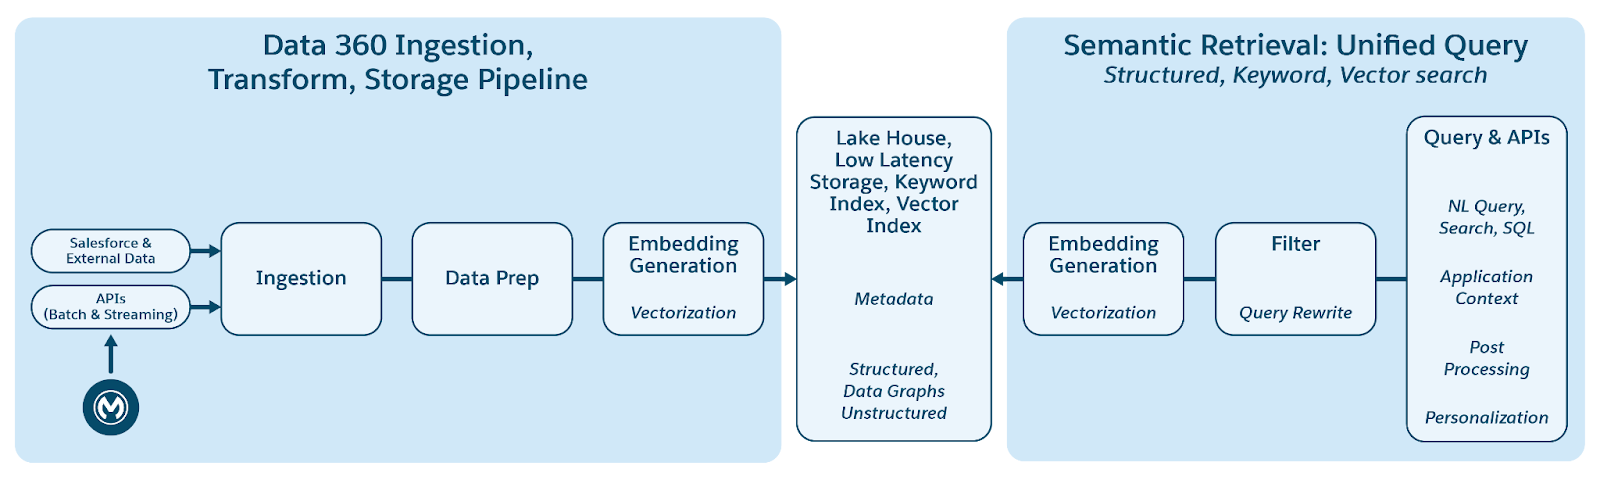 Data 360 では、非構造化データをテキストとして列に保存するか、より大きなデータセットの場合はファイルに保存して管理します。非構造化コンテンツのデータ統合をサポートしているため、複数のソースからのデータを統合および管理することができます。
その後、データが準備されてチャンクされ、埋め込みが生成され、キーワードインデックス付けとベクトルインデックス付けのために処理されます。Data 360 では、チャンク生成と埋め込み生成用の標準で接続可能な複数のモデルがホストされます。Data 360 では、後続の処理とインデックス付けのために、音声および動画コンテンツの自動的な設定可能な文字起こしがサポートされます。検索サービスはキーワードインデックス付けに使用されます。ベクトルインデックス付けの場合、Data 360 はネイティブインデックス付け (Hyper を使用) の両方をサポートし、オープンソースの Milvus などのベクトルデータベースも活用します。Data 360 は Salesforce 検索プラットフォームとも統合され、非構造化データのキーワードインデックス付けをサポートします。このような Data 360 の統合マルチモーダルインデックスにより、ドキュメントの後半の「エージェント型エンタープライズ検索」セクションで説明されているように、非構造化データの検索が強化されます。
取得のために、Data 360 には検索用の API が用意されています。ハイパーベースの統合クエリにより、構造化インデックス、キーワードインデックス、ベクトルインデックス間のアンサンブルクエリが容易になり、厳格な表示と権限が維持されるため、RAG と検索が強化されます。
#### 拡張可能なパイプライン
Data 360 の非構造化データのインデックス付けパイプラインは、次の 5 つのコアフェーズで構成されるモジュラー型の拡張可能なアーキテクチャとして設計されています。
1. 解析
2. 前処理
3. チャンキング
4. 後処理
5. 埋め込み
すべてのフェーズで LLM ベースの処理もサポートされ、顧客はカスタムプロンプトを作成できます。前処理フェーズと後処理フェーズの両方に複数の連続したステップを含めることができるため、複雑な変換を柔軟に構成できます。各フェーズは完全にメタデータ駆動型であるため、コードを変更することなくシームレスな設定と拡張が可能です。
前処理の例としては、ノイズ除去、言語の正規化、画像理解 (光学式文字認識やキャプション) などの操作があり、後処理フェーズにはメタデータ強化、セマンティックグルーピング、Raptor チャンクなどの高度な技術が含まれる場合があります。
このパイプラインでは Data 360 Code Extension が完全にサポートされているため、顧客と内部チームはどのフェーズでもカスタムロジックを組み込むことができます。コード拡張コンポーネントは軽量な Python 関数であり、そのライフサイクル (実行、スケール、障害処理) は Data 360 によって完全に管理されます。このアプローチにより、プラットフォーム全体の運用の一貫性とガバナンスを維持しながら、イノベーションとドメイン固有の処理を迅速に導入できます。
##### コンテキストインデックス
非構造化処理を使用して RAG を設定する場合、次の 2 つの要素が重要です。
1. **迅速な反復**:サンプルテストクエリを使用してすばやく検証する機能。
2. **人格固有のコンテンツ**:消費人格に合わせてコンテンツを設定する容量。
コンテキストインデックスは、これらの両方の側面に対処するように設計された使いやすいツールです。この対話型 UI は、以前に概説した 5 つのフェーズすべてを実行するリアルタイム (RT) パイプラインによって機能します。パイプラインでは、埋め込み生成や光学式文字認識 (OCR) などのタスクで必要な場合に GPU が使用されます。さらに、包括的なコンテンツ処理の設定をリリースする前に、エージェントを使用して RAG パイプラインをすばやくテストできます。
##### ドキュメント AI
Data 360 Document AI では、請求書、履歴書、ラボレポート、購入注文などのドキュメントから非構造化データまたは半構造化データを参照およびインポートできます。この機能は、一括処理だけでなく、アドホックな対話型処理もサポートします。これは、お客様のビジネスプロセスの自動化を可能にする主要な機能です。これは、LLM や ML モデルなどの人工知能によって強化されています。
### エンタープライズKnowledge
企業は、Wiki、ファイル共有、コンテンツ管理システム、内部データベースなど、さまざまなシステムに分散した大量のKnowledgeを所有しています。このフラグメンテーションにより、従業員 (特にサービスエージェントと営業担当) と顧客が関連情報をすばやく効率的に見つけることが難しくなります。主な問題は次のとおりです。すべてのKnowledgeソースにわたる単一の統合された検索環境の欠如、さまざまなソースのコンテンツの表示と表示の一貫性の欠如、システムに分散している機密情報へのアクセス・ガバナンスの欠如、コア・ビジネス・ワークフロー内での信頼できるKnowledgeソースの活用の難しさ(関連記事のケースへの添付など)。
Enterprise Knowledgeは、より広範なエンタープライズ・データ・プールから手動または自動で選定されたコンテンツを表します。手動キュレーションには、Salesforce Knowledge Article の作成や外部システム内での Knowledge の開発などの慎重なアクションが含まれ、これらは取り込まれます。Salesforce エージェントや変換などのプロセスを使用して、取り込まれたデータに基づいて調整された選定されたレイヤーを生成し、構造化コンテンツと非構造化コンテンツを混在させる自動キュレーションを想定しています。手動で選定するか自動的に選定するか、Salesforce 内で選定するか、取り込み前に外部で選定するかに関係なく、結果は未加工データとは異なる付加価値コンテンツになります。
Enterprise Knowledge Hubソリューションは、Data 360の機能を活用して次のことを実現します。
- **取り込みと保存**:CRM ConnectorはSalesforce Knowledge Articleを取り込み、DCF(データコネクタフレームワーク)非構造化コネクタは未加工のコンテンツとメタデータを外部ソースから取り込みます。コンテンツは、SFDrive (ゼロコピーの場合はソース) のコンテンツへのソース固有の非構造化データレイクオブジェクト (UDLO) の対応付けに取り込まれます。
- **ハーモナイゼーション & 構造化**:ハーモナイゼーション パイプラインでは、UDLOとファイル データが処理され、クリーニング、正規化、強化(NLPなど)、PIIマスキング、ハーモナイゼーション中間形式への変換が実行され、SFドライブとそれにマッピングされるHUDLO(ハーモナイゼーションUDLO)に保存されます。
- **インデックス付け**:ハーモナイズされたコンテンツに対して非構造化パイプライン (UDS) がトリガーされ、各 HUDMO に対して検索インデックスが設定されます。
- **消費**:使用するアプリケーションには、検索、取得、表示、ケースなどのビジネスオブジェクトへのリンクなどがあります。アプリケーションを使用したエンゲージメントが収集され、利用状況の分析 (クリック、レビューなど) が提供されます。
### 計算済みインサイト
Data 360 の計算済みインサイト (CI) を使用すると、顧客はデータから集計された総計値を定義および生成できます。これらの総計値は、タイムリーな顧客エンゲージメント、分析、セグメンテーション、有効化に使用されます。CI によって計算された集計データは Lakehouse に書き込まれ、計算済みインサイトオブジェクト (CIO) として表されます。
計算済みインサイトには、主に次の 2 種類があります。
- **一括計算済みインサイト**:総計値を定期的 (毎日、毎週など) に計算できる複雑で大量のデータの集計用に設計されています。
- **ストリーミングインサイト**:リアルタイムイベントデータから評価指標とアクションを生成する機能を提供することで、即座に低遅延の顧客エンゲージメントを実現します。
計算済みインサイトはデータモデルオブジェクト (DMO) で定義され、他の計算済みインサイトオブジェクトでも定義できます。計算済みインサイトサービスは、一括処理ジョブとストリーミングジョブの両方のオーケストレーションを管理します。
バッチインサイトとストリーミングインサイトの両方の計算で Spark が使用されます。主な違いは、ストリーミングインサイトは Spark 構造化ストリーミングを使用するのに対し、バッチ CI は定期的なスケジュール済み一括処理 Spark ジョブを使用して実行されることです。コスト効率を高めるために、計算済みインサイトサービスでは、ソースデータオブジェクトの連動関係や重複などの要素に基づいて、同じ一括処理 CI ジョブまたはストリーミング CI ジョブで CI がグループ化されます。
SNCE と CDF は、ストリーミングインサイトの計算で重要な役割を果たします。
### ID 解決
ID 解決は、複数のソースからのさまざまなデータを 1 つの包括的な統合プロファイルに変換する役割を果たします。
統合プロファイルは「ゴールデンレコード」ではなく、ID 解決によってプロファイルの統合中に当選値が選択されたり、既存のデータが上書きされたりすることはありません。統合プロファイルは、1 つのデータソース内または複数のソースで同じエンティティに関連するすべての一致レコードを識別することで、ソースデータのロックを解除する一連のキーとして機能します。この情報を使用して、特定のビジネス使用事例で使用する適切なソースシステムデータを選択できます。
ID 解決では、個人、取引先、世帯など、さまざまなレコードタイプを統合できます。また、リードを既存の取引先と照合するためにも使用できます。統合プロセスは、完全なCustomer 360ビューを実現し、B2CとB2Bの両方のシナリオでパーソナライズされたリアルタイム エンゲージメントを促進するために不可欠です。
ID 解決パイプラインは、大量のデータを継続的に処理するように設計された、拡張性の高いクラウドネイティブフレームワーク上に構築されています。このプロセスには 3 つの主要なフェーズがあり、強力な検索インデックスを使用して一致プロセスを管理します。
- **一致 (候補の選択)**:一致プロセスの目標は、同じエンティティに属するレコードを検索することです。レコードは、カスタマイズ可能なルールセットに対して分析されます。各ルールセットには、どのデータをどのレベルの厳格さで照合するかを定義する一連の条件が含まれます。データストアから一致の可能性があるレコードを効率的に取得するために、次の 2 つの方法を使用して、一致する可能性が高いレコードを見つけるインデックスが生成されます。
- **ブロックキー**:ブロックキーとは、レコードのデータから生成される値であり、類似する可能性のあるレコードをグループ化するための一致ルール (名前の最初の数文字、標準化された電話番号など) です。各レコードには複数のブロックキーがあり、インデックス付けされて転置インデックスとして保存されるため、データセット全体ではなく、小さなレコードグループでのみ詳細な比較が実行されます。
- **Locality Sensitive Hashing (LSH)**:あいまい一致を使用する一致ルールの場合、ハッシュはトレーニング済みモデルからの埋め込みに基づいて生成されます。
- **ディープマッチング**:候補選択ステップで一致する可能性のある小さなグループが作成されると、より詳細な比較が開始されます。このフェーズでは、AI モデルと高度なアルゴリズムが各レコードのペアを分析して、確率的一致スコアを計算します。このスコアは、スペルミス、バリエーション、書式設定の違いが頻繁に発生する項目をインテリジェントに比較することで、2 つのレコードが同じエンティティを参照している可能性を定量化します。
- **クラスタリングと統合**:候補から一致するレコードが識別されると、それらはクラスターにグループ化されます。このプロセスには、推移的な一致の解決が不可欠です。たとえば、レコード A がレコード B に一致し、レコード B がレコード C に一致する場合、A と C が直接比較されなくても、3 つはすべて同じクラスタにリンクされます。これらの完全なクラスターは、統合プロファイルの基本構造を形成します。このクラスター化プロセスにより、すべての関連ソースレコードが 1 つの永続的な識別子で正しくリンクされます。
- **調整**:クラスター化されたすべてのソース レコードのデータ値は、プロファイル データの抜粋を結果の統合プロファイルに入力する定義済みの調整ルール(\[_Most Frequent (最も頻繁_)]、\[_Most Recent (最新_)]、\[_Source Priority (_ソース優先度)] など)を使用して評価されます。統合プロファイルにリンクされたキーを使用してすべてのソースデータを使用できるため、調整によって既存のデータが上書きされることはありません。
#### ID 解決種別
このアーキテクチャでは、さまざまな使用事例を満たすために複数のエンティティ種別の解決がサポートされます。
- **個人照合**:すべての既知の個人識別子 (メール、電話番号、ロイヤルティ ID、Cookie) を 1 人の個人にリンクする統合個人プロファイルの作成に焦点を絞ります。
- **取引先照合**:取引先に関するデータをリンクする統合取引先プロファイルの作成に焦点を絞ります。会社名を照合する場合、あいまい一致ではエンジンで微調整されたモデルが使用されます。
- **世帯照合**:一致ロジックを拡張して、統合個人レコードを関連する個人のグループに集計します。
- **Cross Entity Matching**:ID 解決では、統合とは別に、同じ一致ルールを使用してプロファイルオブジェクト間のリンクも作成されます。たとえば、取引先名のあいまい一致を使用してリードを取引先にリンクできます。
#### ほぼリアルタイムの処理
統合プロファイルが常に最新になるように、ID 解決エンジンはほぼリアルタイムのアーキテクチャで動作します。このクラウドに最適化されたアーキテクチャは継続的な処理を目的として設計されており、処理時間が短縮されます。処理速度はソースデータの受信方法によって異なりますが、小さな変更のバッチは 15 分ごとに ID 解決で処理できます。
#### ソースプロファイルのリンク
すべてのソースレコード ID を対応する統合プロファイル ID に対応付ける ID リンクオブジェクトが保持されます。この基本的なデータ構造により、エンジンでリレーションを効率的に追跡し、変更や更新を統合プロファイルにすばやく反映できるため、カスタマーエクスペリエンス (Web サイトのパーソナライズ、Next Best-Action のおすすめ、セグメンテーションなど) で常に最新の顧客データを活用できます。
### セグメンテーション
セグメンテーションは、統合顧客プロファイルをアクション可能な利用者に変換するためのコアプロセスです。この機能は、マーケティング、コマース、サービスチャネル全体でパーソナライズされたエクスペリエンスを強化するために不可欠です。Salesforce Data 360 セグメンテーションプラットフォームは、大規模な運用向けに設計されています。何千ものオブジェクトとリレーションで構成されるデータモデルを使用して、複雑なメタデータを管理します。このプラットフォームでは、複雑なルール、集計ベースの検索条件、ウィンドウベースのランキングをすべてサポートしながら、ペタバイト規模の高速で信頼性の高い計算を実現します。
#### セグメンテーション種別とケイデンス
Data 360 は、速度、複雑さ、階層に関する個別のビジネス要件を満たすために、さまざまなセグメント種別をサポートしています。
1. **標準セグメント**:バッチ処理されたプライマリセグメント種別。標準公開のケイデンスは最小で 12 時間から最大 24 時間、高速公開のケイデンスは 1 ~ 4 時間で、カスタマイズ可能なスケジュールで公開されます。これは最近のエンゲージメントデータ用に最適化されています。
2. **リアルタイムセグメント**:このセグメントは、最近のイベントとプロファイルデータに基づいてすぐにアクションを実行するためにミリ秒でオンデマンドで完了します。インスタントパーソナライズ用に高度に最適化されていますが、除外条件やネストされたセグメントは使用できません。
3. **滝の区分**:複数の条件に該当する場合に、顧客を 1 つの最も価値のあるセグメントに優先順位付けするために使用するサブセグメントの階層構造。
4. **ネストされたセグメント**:これにより、親セグメントのスケジュールを継承して、既存のセグメントをより具体的な新しいセグメント (ベースセグメントの絞り込み) の検索条件として再利用できます。
#### セグメンテーションエンジン:アーキテクチャの基礎
セグメンテーションエンジンは、スピード、拡張性、復元性を保証する堅牢なクラウドネイティブアーキテクチャで動作します。
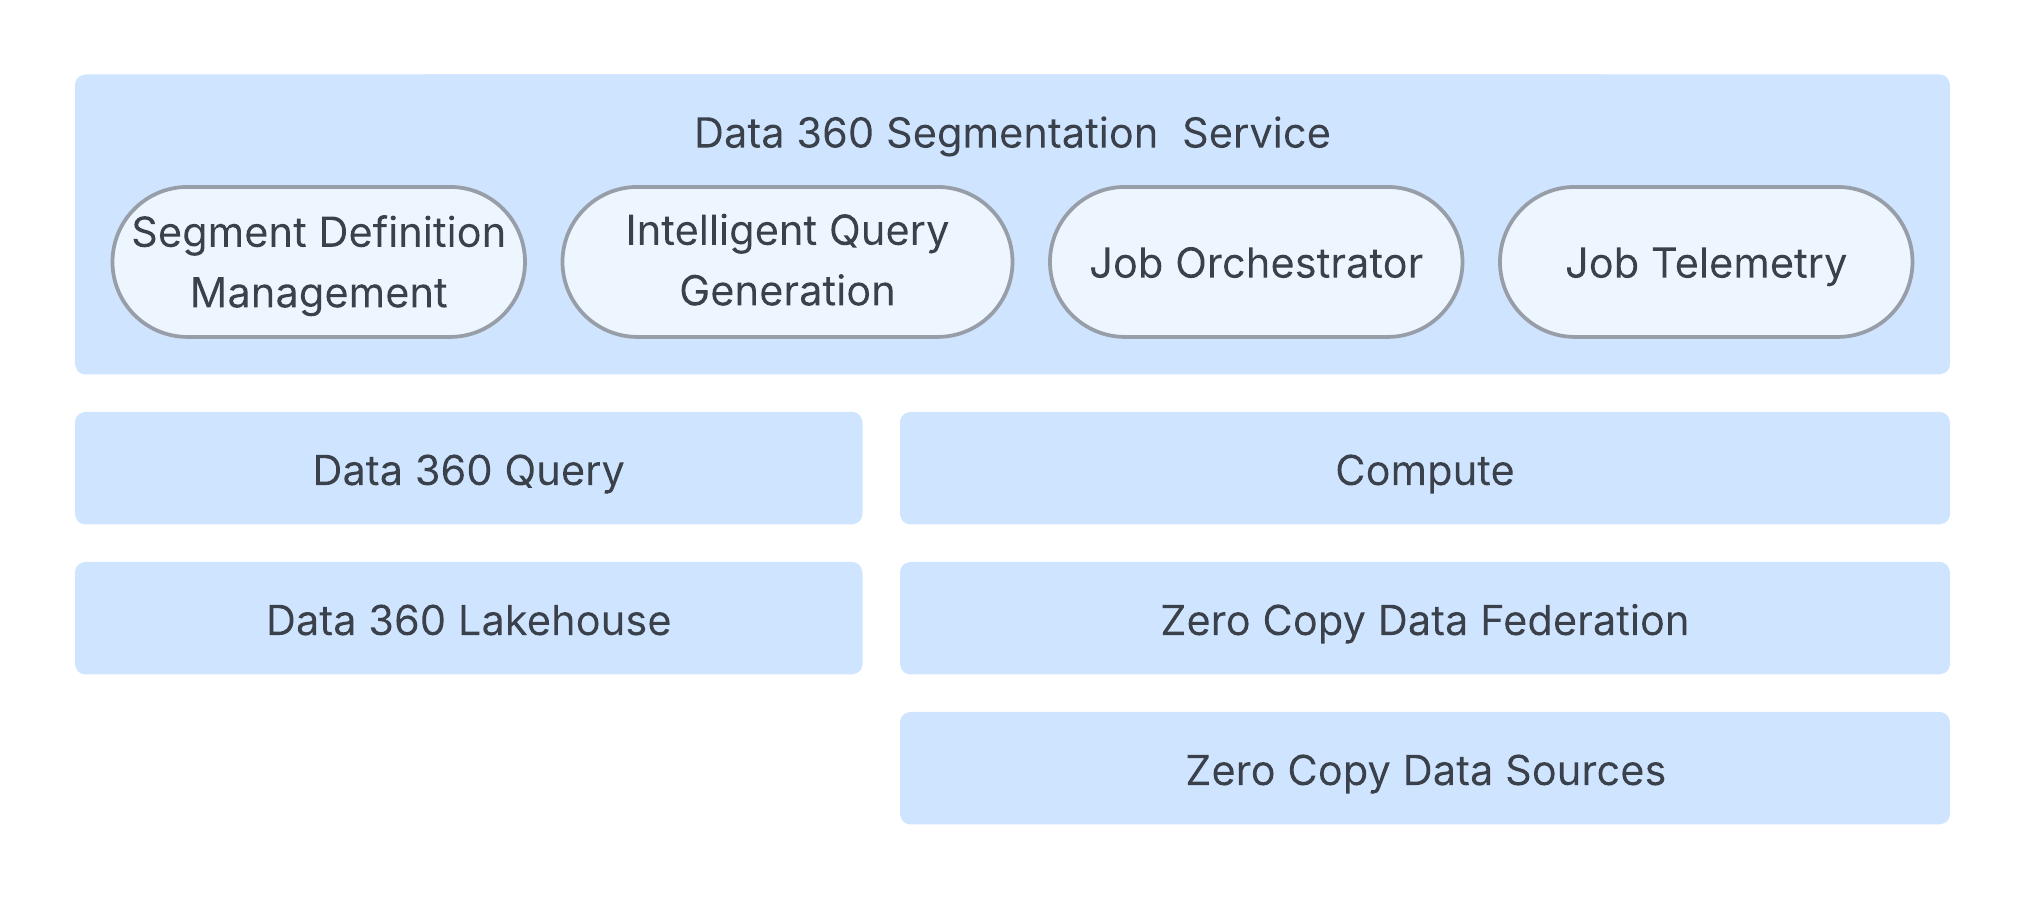 コアプロセスは、セグメントのライフサイクルを制御するジョブオーケストレーションサービスによって管理され、必要なジョブ設定が生成されて実行がトリガーされます。このオーケストレーションレイヤーでは、拡張性のために状態とメタデータがシャーディングされたデータベースに保持されます。
Data 360 クエリではセグメンテーション数の計算が処理されますが、実際のセグメントメンバーシップの計算は Spark 計算レイヤーが行います。Spark アプリケーションは、広範な顧客データに対して Spark SQL クエリを実行します。このデータは、Data 360 Lakehouse、または Zero Copy データフェデレーションを介した外部システム、あるいはその両方の組み合わせに存在できます。
システムは、基盤となる Spark SQL クエリを調整するインテリジェントなクエリ生成によって高度に最適化されています。これには、データスキャンを最小限に抑え、冗長なサブ式を排除するインテリジェントなパーティションプルーニングなどの技術が含まれます。サービスの信頼性を確保するために、このアーキテクチャにはワークロードのサイズと複雑さに基づいてコンピューティングリソースを動的に調整する適応型リソース管理が備わっています。さらに、SLO 遵守は適応期間と再試行ロジックでプロアクティブに管理されます。高速ユーザーエクスペリエンスを実現するために、セグメント数の高速化では、サンプリングベースのアプローチを使用してセグメントの作成時にサイズを迅速に推定し、クエリの実行全体を回避します。
最後に、包括的な Spark 実行評価指標とエラー (顧客側またはシステムの問題など) の自動分類により、観察可能性と根本原因の属性に深い焦点が当てられ、診断時間が大幅に短縮され、復元性の高いデータプラットフォームが確保されます。
### 有効化
有効化は、Data 360 ライフサイクルの重要な最終ステップです。そのコア機能は、静的でセグメント化された統合顧客プロファイルをアクション可能で強化されたデータに変換し、そのデータを内部および外部のエンドポイント (Marketing Cloud、Commerce Cloud、Adtech プラットフォームなど) に提供することです。このプロセスは、パーソナライズされたカスタマージャーニーとほぼリアルタイムのインタラクションをトリガーするように設計されています。関連属性、有効化メンバーシップの絞り込み、同意の絞り込み、制限、ランキングなどの高度な機能がサポートされます。
有効化では、外部配信とチャネルコンプライアンスの 3 つの異なる方法が提供されます。
- **バッチの有効化**:大規模なメールキャンペーンや広告オーディエンスの更新など、大規模でスケジュールされた業務向けに設計されています。データは、セキュアな内部バケット (クラウドオブジェクトストレージ) にステージングするか、セキュアなファイル転送を介して配信され、その後、ターゲットシステムによって API 取り込みプロセスが開始します。一括有効化では、特殊な更新モード (増分) を使用して、Salesforce パートナーに送信および処理される量を削減できます。
- **ストリーミングの有効化**:イベント駆動型の自動化を必要とするほぼリアルタイムの使用事例向けに最適化されています。配信は、送信先エンドポイントに送信される直接 API コールを介して実現されます。
- **アクティベーショントリガーフロー**:この高度にプラットフォーム化されたチャネルでは、オーディエンスデータを数百もの顧客 API 対応エンゲージメントプラットフォームと統合するためのノーコード/ローコードアプローチが提供されます。有効化が完了すると、Data 360 によってオーディエンス DMO が入力され、高スケールフローがトリガーされます。その後、フローエンジンは利用者データを使用し、外部サービスや Mule Outbound 送信先などのプラットフォーム機能を使用して、最終的な API ベースの送信先へのコールを実行します。この方法では、新しい有効化対象のオンボーディングに必要な時間が大幅に短縮されます。
有効化では、ジョブ管理、分散実行、監視でセグメンテーションと同じパターンが使用されます。これには、ライフサイクル管理用のジョブオーケストレーションサービスの原則と処理用のコンピューティングレイヤー (Spark) が含まれ、パフォーマンスの可観測性とサービスレベル目標 (SLO) の遵守のためにジョブテレメトリが利用されます。
これに加えて、有効化には - があります。
**有効化対象管理**は、すべての宛先エンドポイントの安全な接続、ログイン情報、設定を監視します。これにより、データ形式とセキュリティプロトコルが標準化され、Marketing Cloud、Adtech パートナー、その他の外部アプリケーションなど、さまざまなプラットフォームへの信頼性の高いアウトバウンド配信が保証されます。
有効化では、ペイロードが特定の対象に合わせて調整されます。Salesforce Marketing Cloud の場合、これにはビジネスユニット (BU) 対応絞り込み、マルチ EID サポート、受粉制御が含まれます。
**コミュニケーション ガバナンス**はゲートキーパーとして機能し、データ使用量とコミュニケーションが顧客の設定と法的要件に準拠するようにします。一元化された同意モデルでは、グローバルオプトアウトからチャネルおよび目的固有の同意まで、すべての顧客設定が統合され、統合個人プロファイルに保存されます。実行時に、プラットフォームは除外フィルターを使用して同意していない個人を最終ペイロードから自動的に削除することで、これらのポリシーを厳格に適用します。さらに、データが送信される前に、目的のチャネルで 1 つの最も準拠性の高い優先連絡先が使用されるように連絡先選択ルールが適用されます。この適用メカニズムは、有効化プロセス全体で機密データ項目を保護するための動的データマスキングやアクセス制御などの保護手段を使用する、基盤となるガバナンスフレームワークによって保護されます。
### 統合クエリ:すべての顧客データへのシームレスなアクセス
統合データプラットフォームの真の価値は、その発生源や構造に関係なく、すべてのデータアセットに容易で一貫したアクセスを提供できることです。Salesforce Data 360 の統合クエリ機能は、これを実現するために厳密に設計されており、さまざまなデータストアの基盤となる複雑さを抽象化して、1 つの強力なクエリインターフェースを提供します。
統合クエリレイヤーでは、さまざまな消費パターンに対して高度なアクセスが提供されます。
- **ハイブリッド構造化および非構造化クエリ**:構造化データと非構造化データの構造化メタデータの両方をシームレスに照会するための広範な SQL サポートが提供されます。これは、テーブル関数による演算子の拡張性によって強化され、テキスト、画像、空間種別を横断する特殊な検索が可能になります。
- **Hyper によるパフォーマンスの向上**:Data 360 は、ハイパフォーマンスのインメモリエンジンである Hyper を活用して複雑な分析クエリと対話型ダッシュボードを高速化し、大規模なデータセットに対してほぼ瞬時に応答します。
- **AIとパーソナライズの統合アプローチ**:この統合アクセスは、対象を絞ったパーソナライズされた結果を生成するために不可欠であり、リッチなエンタープライズデータで AI モデルをグラウンディングすることで、取得拡張生成 (RAG) を使用してより正確な LLM 応答を直接促進します。
- **ダウンストリーム消費との統合**:UI 駆動型エクスペリエンス、堅牢な API、生成 AI ワークフロー、CRM 強化の基盤データアクセスレイヤーとして機能し、データを有効化にシームレスに接続します。
Data 360 の統合クエリでは、単一のインテリジェントでパフォーマンスの高いクエリインターフェースが提供されるため、アーキテクトはあらゆる顧客情報を最大限に活用する俊敏なデータ駆動型アプリケーションを構築できます。
### データアクション
Data 360 は、データイベントに応じてパイプラインを有効化できる有効なプラットフォームです。たとえば、顧客の口座残高の減少などの重要なイベントが発生すると、Salesforce フローがトリガーされ、対応するアクションが調整されます。同様に、生涯費用などの主要な評価指標の更新は、関連するアプリケーションに自動的に反映できます。
データアクションでは、ストレージネイティブ変更イベント (SNCE) と変更データフィード (CDF) を使用して、増分データの変更を継続的に監視します。このデータは、しきい値の監視や状態の変更など、顧客が設定したアクションルールに対して評価されます。これらのルールが満たされると、データアクションイベントが生成されます。このイベントは追加情報 (顧客ロイヤルティ状況など) で強化され、設定された宛先 (Salesforce フローや外部アプリケーションなど) にすぐに送信され、ビジネスオーケストレーションがトリガーされます。
#### Customer Data Platform (顧客データプラットフォーム)
Data 360 では、高度な ID 解決機能、包括的なエンゲージメント履歴と共に統合個人 ID とプロファイルの作成など、ネイティブの CDP (Customer Data Platform) 機能がサポートされます。このプラットフォームは、前述のように完全一致ルールとあいまい一致ルールの両方を使用する ID 解決と ID グラフをサポートすることで、企業間 (B2B) および企業間 (B2C) の両方のフレームワークの処理に適しています。これらの ID グラフは、さまざまなチャネルからのエンゲージメントデータで強化されており、貴重な分析インサイトとセグメントを含む詳細なプロファイルグラフを作成するのに役立ちます。
顧客プロファイルをサポートする主要な概念はデータグラフです。Data 360 では、さまざまな Lakehouse テーブルとその相互関係から派生した非正規化オブジェクトである JSON 形式のエンタープライズデータグラフが提供されます。これには、CDP によって作成された、個人の購入および閲覧履歴、ケース履歴、商品の使用状況、その他の計算済みインサイトを含む「プロファイル」データグラフが含まれ、顧客やパートナーが拡張できます。これらのデータグラフは特定のアプリケーションに合わせて調整されており、関連する顧客またはユーザー コンテキストを提供することで生成AIプロンプトの精度を高めます。Data 360 のリアルタイムレイヤーでは、プロファイルグラフを使用してリアルタイムのパーソナライズとセグメンテーションを行います。会話、セッション、およびエージェント記憶をデータグラフとして含む Agentforce コンテキストのモデル化を想定しています。
さらに、CDP により、Salesforce の Marketing Cloud、Facebook、Google など、さまざまなプラットフォームで効果的なセグメンテーションと有効化が可能になります。顧客プロファイルはバッチ、ほぼリアルタイム、リアルタイムで処理されるため、即時の意思決定とパーソナライズが可能です。この機能により、B2C と B2B の両方のシナリオでインタラクションが強化され、企業が顧客のニーズや行動に迅速かつ正確に対応できるようになります。
### リアルタイムレイヤー
Data 360 のリアルタイムレイヤーは、Data 360 CDP によってサポートされ、リアルタイムの使用事例に合わせてその概念を拡張しています。Data 360 のリアルタイムレイヤーは、Web およびモバイルのクリックストリーム、訪問、カートデータ、チェックアウトなどのイベントをミリ秒の遅延で処理するように設計されており、カスタマーエクスペリエンスのパーソナライズを強化します。顧客エンゲージメントを継続的に監視し、リアルタイムのエンゲージメントデータ、セグメント、計算で Customer 360 から顧客プロファイルを更新して、すぐにパーソナライズします。
たとえば、消費者がショッピング Web サイトで商品を購入すると、リアルタイムレイヤーはこのイベントをすばやく検出して取り込み、消費者を識別して、更新された生涯支出情報でプロファイルを強化します。これにより、サイトでのエクスペリエンスを数秒でパーソナライズできます。さらに、このレイヤーにはリアルタイムのトリガーと応答の機能が含まれており、顧客とのやりとりに基づいてすぐにアクションを実行できます。
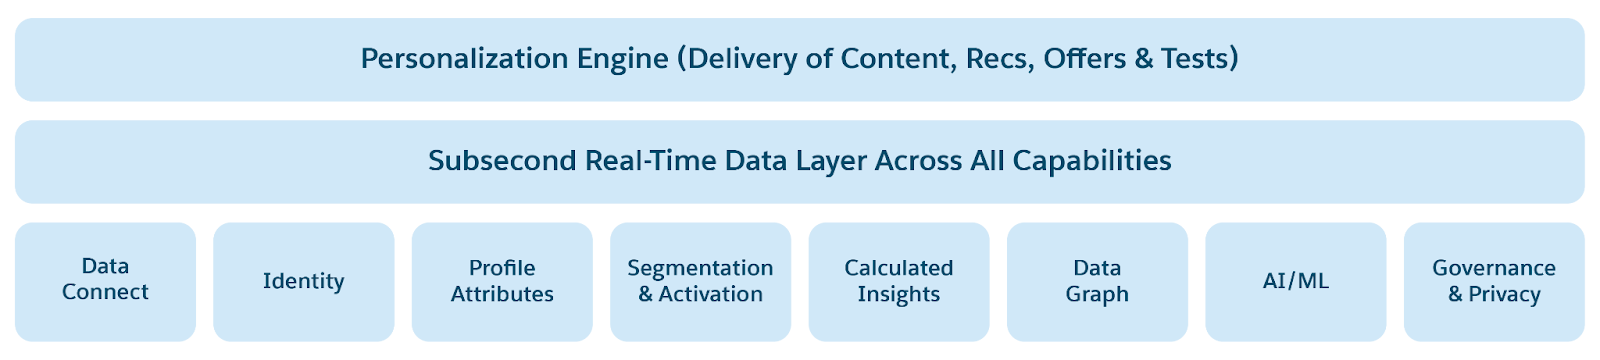 Sub-Second Real-Time Platform は、次の主要な機能によってこの変換を強化します。
1. **リアルタイムデータグラフ**:Customer 360プロファイルは、ブランドに最も関連する主要なオブジェクトと項目を含む非正規化されたグラフを使用して作成されます。これらのデータグラフにより、リアルタイムのデータ処理が可能になり、アクション可能なコンテンツとインサイトをミリ秒以内に提供できます。
2. **リアルタイム取り込みおよび変換**:Web およびモバイルソースからユーザーイベントとプロファイルをミリ秒単位で取り込みます。
3. **リアルタイム ID 解決**:デバイス間で顧客プロファイルをマージし、不明なユーザーと既知のユーザーをすぐに統合します。
4. **リアルタイムの計算済みインサイト**:生涯価値(LTV)やユーザー訪問履歴などの評価指標をミリ秒単位で計算して、Web、チャットボット、サービスエージェントのパーソナライズまたは提案を有効にします。
5. **リアルタイムセグメンテーション**:オーディエンスをその場でセグメント化し、メッセージとインタラクションをリアルタイムでパーソナライズします。
6. **リアルタイムアクション**:Salesforce フローまたはその他の関連するコミュニケーションチャネルを使用して、ブランドがすべてのユーザーエンゲージメントを評価し、アクションを実行できるようにします。
Data 360 では、リアルタイムパイプライン、低レイテンシストレージ、1 秒未満のデータ処理レイヤーを備えた新しいリアルタイムプラットフォームを構築しました。Web およびモバイルチャネルから高速インタラクティブデータが取り込まれると、一連の高速プロセスが実行されます。
Web およびモバイル SDK とリアルタイム API は、Web/モバイルアプリケーション (今後の Agentic インタラクション) からデータを収集し、ビーコンサーバーに送信します。その後、このデータはミリ秒処理のためにリアルタイムレイヤーに転送され、バッチ/ストリーミングデータと統合するために Lakehouse レイヤーに転送されます。リアルタイムレイヤーは、ユーザープロファイル (匿名またはログイン済み) のコンテキストで受信リアルタイムデータを処理し、セッション中のリアルタイムパーソナライズのためにユーザーの総支出や生涯価値などを更新します。リアルタイムレイヤーは、メインメモリと NVme (SSD) ストレージによってサポートされ、リアルタイムデータと顧客プロファイルを保存します。データがリアルタイムレイヤーに取り込まれると、リアルタイムデータグラフに更新される前に次のプロセスが実行されます。
- **単純な取り込みと変換**:データが取り込まれ、さらに処理できるように変換されます。
- **ID 解決**:完全一致ルールは、プロファイルを既存のすべての一致ルールセットと統合するために適用されるため、データアウェアスペシャリストはリアルタイム専用の新しい ID 解決ルールセットを作成する必要はありません。
- **計算済みインサイト**:すべてのエンゲージメントが評価され、sum や count in milliseconds などの簡単な計算が実行され、リアルタイムデータグラフのデータが更新されます。
- **リアルタイムセグメント**:すべてのエンゲージメントデータは、定義されたリアルタイムセグメントの条件を満たすかどうかを判断するために評価され、ユーザーはミリ秒単位で対象セグメントに追加されます。
- **リアルタイムアクションおよびトリガー**:すべてのエンゲージメントは定義済みのルールに対して評価され、ルールがミリ秒単位で満たされたときにリアルタイムでアクションがトリガーされます。
- **リアルタイムデータグラフおよび API**:リアルタイムデータグラフにはリアルタイム API も含まれており、ブランドは各ユーザーの更新された JSON 形式のデータを取得できます。これにより、すべての顧客とのやりとりに最新のデータが提供されます。
#### Personalization
パーソナライズは、誰を対象にするか、関連するコンテンツとおすすめをいつどこで提供するか、何を話すか、どの頻度を使用するかを理解することがすべてです。Personalization Services Platform は、パーソナライズされた環境を通じて目標達成を最適化するためにどのような意思決定を行うかを調整するオーケストレーターです。
**Personalization Services**には次の機能があります。
- Data 360 のプロファイル、活動、アセットデータを解釈するための一貫したモデルと方法のセット
- プラットフォーム統合実験 (A/B/n、マルチアームバンディット)
- 設計時 (設定)、ML トレーニング時、実行時 (ML 推測) の目標の統合
- B2C スケールのリアルタイムおよびバッチインタラクションのサポート (匿名ユーザー、大量のリアルタイム/インタラクティブ外部、大量の内部バッチ)
- Data 360 で実行される分析
- AI モデルと他の関係者 (内部と外部) のサービスを統合するパターン
- コアメタデータエコシステムへの統合 (PLATE の特性)
- 価値の高い AI 駆動型使用事例の OOTB 実装 (プロモーション/コンテンツ選択のためのコンテキスト盗賊、商品のおすすめ、価格設定の決定など、さまざまな ML アルゴリズムを使用したおすすめ/決定)
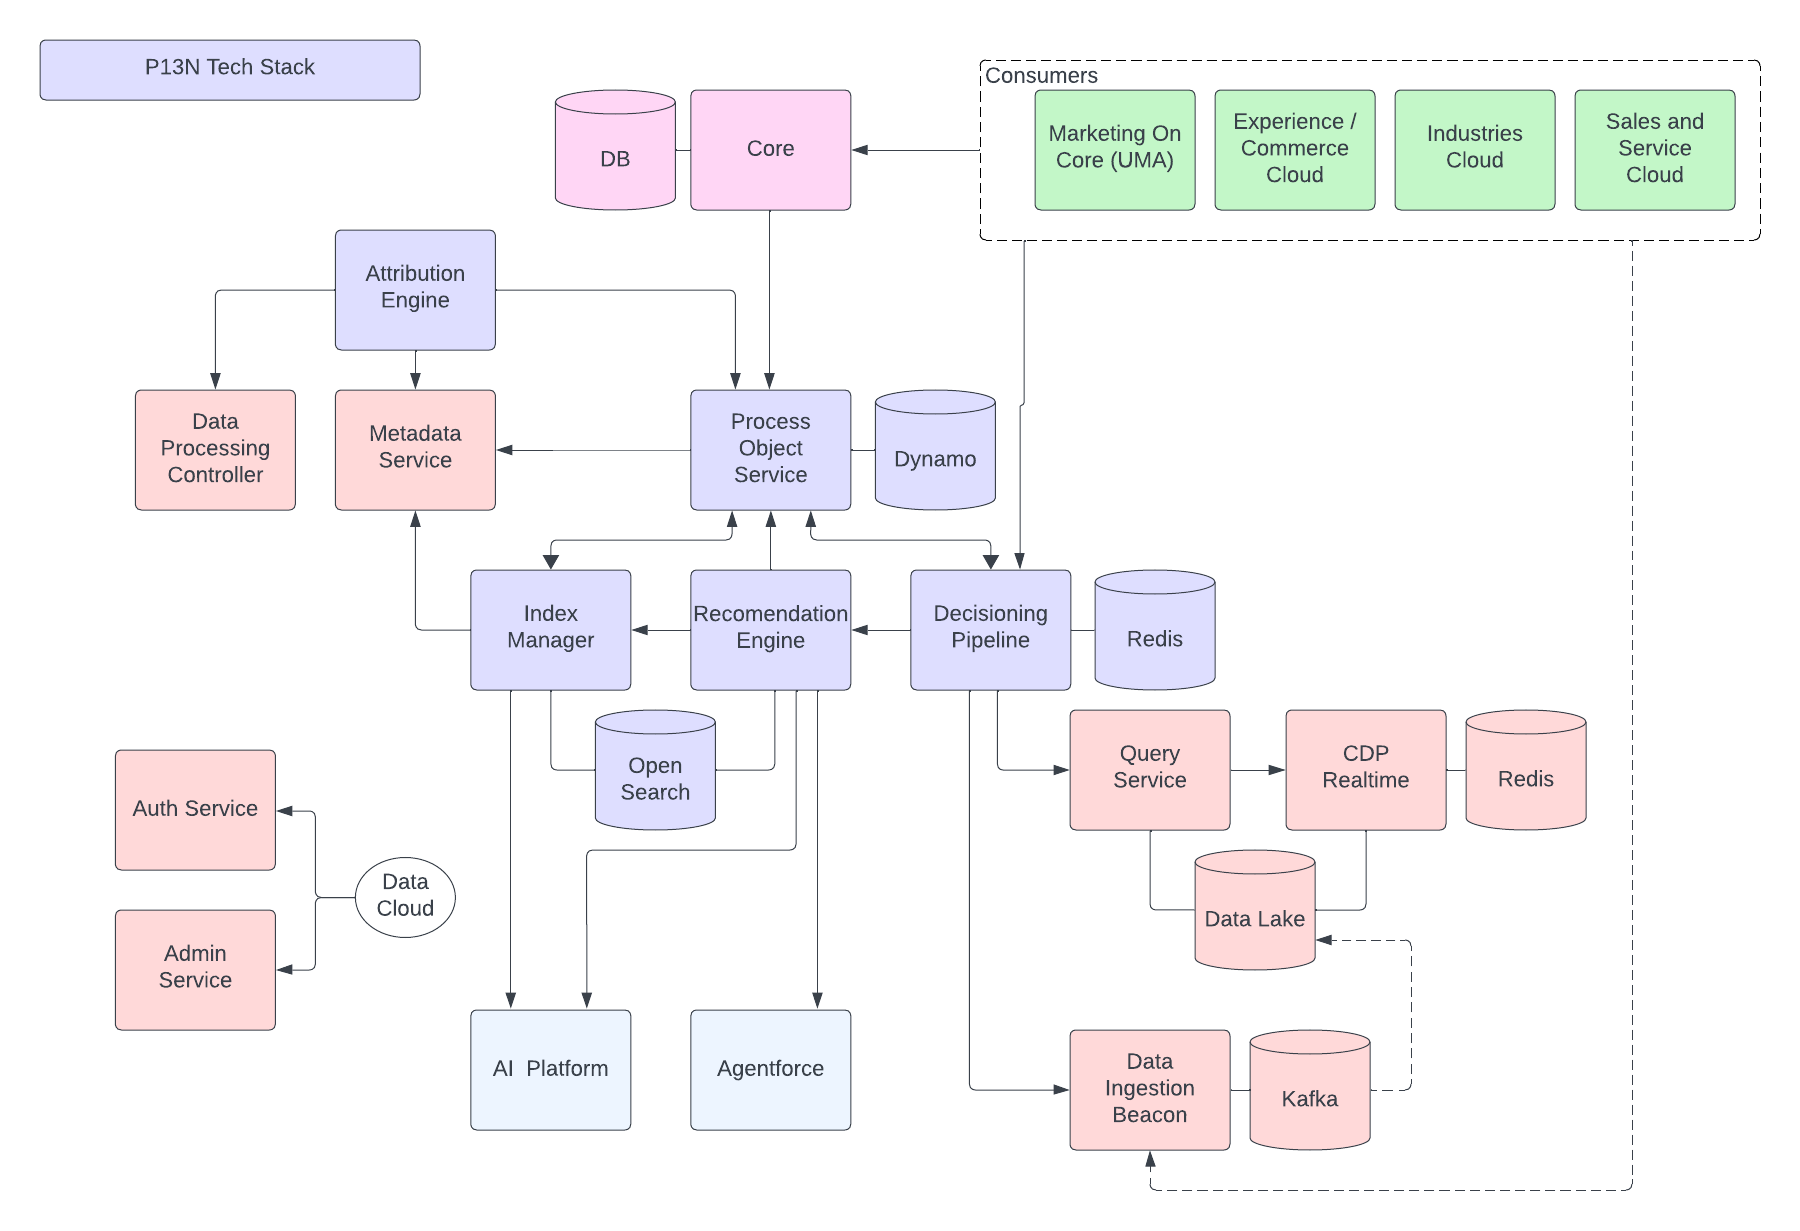 - **Decisioning Pipeline**
- プロファイルの追加、実験、おすすめなど、パーソナライズの決定に関する外部要求に対応する。
- **おすすめエンジン**
- ルールまたは ML ベースのおすすめの実行時サービス。
- **Index Manager**
- おすすめモデルの ML トレーニングを含む非同期プロセスのワークフローを管理/オーケストレーションする
- **プロセスオブジェクトサービス**
- コアとオフコア間でパーソナライズメタデータを同期する
- **属性エンジンと実験**
- Analytics の属性設定とパーソナライズレコメンデーションの実験
### エージェント型エンタープライズ検索
Data 360 は、新しいエージェント環境をサポートするための堅牢で豊富なプラットフォームとして設計されています。これらの機能は、さまざまな既存のData 360サービスを基盤とし、Agentforceとの緊密な統合によって実現しています。
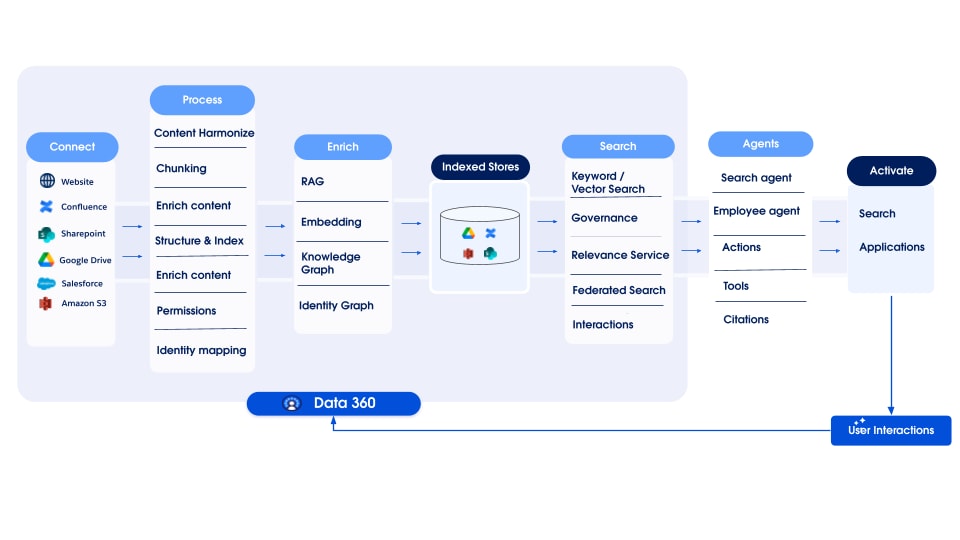 #### Data 360 のコアな強みの活用
エージェント型エンタープライズ検索へのアプローチは、次の原則に基づいています。
- エンタープライズデータはサイロ化されたサービスまたはストアに保存され、アクセスに必要な安全な権限が付与されます。Trustを確保するためには、ソース権限を維持しながらこのデータにアクセスして処理する機能が不可欠です。
- データの完全なコーパス全体でのクロスランキングと関連性により、より適切な結果を得られ、エージェントエクスペリエンスのコンテキストも改善されます。
これらの環境を提供するために、エージェント型エンタープライズ検索は次の主要なアーキテクチャコンポーネント上に構築されています。
- **コネクタ**:Data 360 で使用できる幅広いコネクタセットにより、さまざまなソースからデータにアクセスして取り込むことができます。
- **非構造化データ処理**:これは、表形式以外のコンテンツを処理するための基礎であり、システムが多様なデータから意味とコンテキストを抽出できるようにします。
- **ガバナンス**:検索で消費されるすべてのデータのエンタープライズクラスのセキュリティ、コンプライアンス、アクセス制御を確保します。ソース表示権限がサポートされているため、簡単な検索とエージェント操作の両方で、承認されたユーザーのみがデータにアクセスできます。迅速に取得できるように、セキュリティ権限はデータアクセスの最も早い段階で検索バックエンドによってネイティブに評価され、適用されます。
- **統合取得レイヤー**:サイロ化されたデータの課題に対応するために、コネクタは包括的な統合取得レイヤーにフィードされます。このレイヤーは、統合検索でアクセスする外部システムにデータを保持する場合でも、ゼロコピーおよび取り込まれたデータの高度なインデックスでネイティブに管理される場合でも、すべてのデータへの単一のアクセスポイントを提供します。
- **インテリジェントなクエリの理解**:取得前に、システムは AI を駆使したメカニズムを使用してユーザーのインテントを解釈します。セマンティックベクトル照合用のクエリの表現を埋め込むことができるだけでなく、キーワードベースの検索を書き換えて拡張し、精度を向上させることができます。
- **ハイブリッド検索と高度なクエリ**:最も関連性の高い情報を見つけるために、プラットフォームでは複数の戦略が並行して使用されます。ハイブリッド検索では、最適化されたデータチャンクのセマンティックベクトル検索でキーワードの正確な一致が提供されますが、フルレコード検索ではドキュメント全体が同時に取得されます。両方を組み合わせて、セマンティックな関連性とコンテンツの完全なカバー率を確保します。
- **階層ランキング**:データが取得されると、複数フェーズの階層ランキングアーキテクチャによって、すべてのソースおよびメソッドの結果のスコアリング、マージ、再ランク付けが行われます。このプロセスでは、ユーザーまたはエージェントにとって最も関連性の高い情報が表示される 1 つの統合リストが作成されます。
#### エージェント検索アプリケーション
生成 AI は、エンタープライズ検索の主要な消費者を人間のユーザーから大規模言語モデル (LLM) に移行しています。Data 360 Search は、その両方に対応するようにゼロから設計されています。エージェントからのより長く複雑なクエリを処理し、プログラムでの消費および推論ループに必要な豊富なコンテキスト結果を返すように最適化されています。同時に、このシステムは人間のユーザーにありがちな短くあいまいなクエリを処理でき、スニペットや強調表示などの機能を提供して UI ですばやく評価できます。
エージェントによる検索エクスペリエンスの究極の提供では、次の両方のアプローチを組み合わせます。
1. **直接検索結果**: アプリケーションは、Data 360 統合検索基盤上に構築されたメタデータ駆動型 API を使用して、ランク付けされた従来の結果のリストを表示できます。
2. **エージェントによる**複数ターンの対話形式の回答: エージェントによる回答は、Agentforce とのネイティブ統合によって実装されます。この会話環境は、アクションとクエリを調整し、すべての情報取得タスクを専門の社内検索エージェントに委任する主エージェントによって促進されます。
この特殊な検索エージェントは、エンタープライズ情報の取得用に最適化されています。推論ループを使用して並列検索を策定して実行し、ユーザーの要求のさまざまな側面を探索します。すべてのデータ型に対応する Data 360 統合検索や、テーブルやエンティティから正確なデータを取得する構造化されたクエリ言語などの強力なツールセットを使用します。
このアーキテクチャの統合により、Data 360 は高度にインテリジェントでコンテキストを認識し、アクション可能なエージェント型のエンタープライズ検索環境の作成を強化します。
### カスタムコードを使用した Data 360 の拡張
拡張性は、Salesforce Platform の主要な機能です。Code Extension は Data 360 の拡張性を提供し、プロコードユーザーは Data 360 環境内でカスタム Python ロジックを直接実行でき、その豊富な宣言型機能とローコード機能を補完します。コードエクステンションを使用すると、ユーザーは変換や非構造化データパイプライン (カスタムチャンク) などの Data 360 コア機能を安全に拡張できます。
コードエクステンションの設計では、柔軟性、セキュリティ、効率性、合理化された開発者エクスペリエンスが優先されます。それぞれ特定のアーキテクチャニーズに合わせて調整された 2 つの主実行モデルがサポートされます。
- **スクリプトモデル**:
- **目的**:Data 360 Lakehouse を直接操作する必要がある包括的なカスタムロジックの場合。
- **機能**:顧客は Code Extension SDK を使用して完全な Python スクリプトを作成し、SDK API を介して Lakehouse への参照および更新アクセス権を有効にします。カスタム/複雑なデータプレップや、特注のデータ操作に最適です。
- **分離とセキュリティ**:スクリプトが Lakehouse にアクセスする間、スクリプトの実行は Data 360 ランタイム内の安全で隔離された環境に制限されるため、他のプロセスへの干渉や不正なシステムアクセスが防止されます。
- **機能モデル**:
- **目的**:既存の Data 360 パイプライン (非構造化パイプラインのカスタムチャンクなど) から呼び出されるモジュール型のステートレス計算の場合、サーバーレス関数に似ています。
- **機能**:顧客が指定した関数は、入力、計算、出力を返します。
- **分離とセキュリティ**:これらの関数は厳密に分離するように設計されており、Lakehouse に直接アクセスすることはできません。実行は Sandbox でステートレスであり、リソースが制限されているため、集中したステートレスな処理ステップに適しており、セキュリティ、予測可能な実行、ブラスト半径の最小化を実現します。
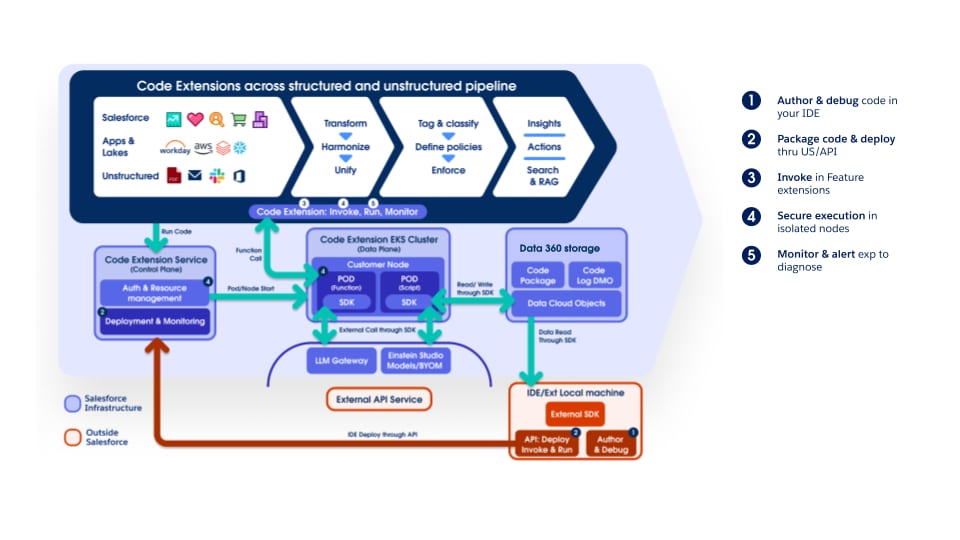 スクリプトモデルと関数モデルのどちらも、顧客のコードを安全に実行し、あるテナントのコードが他のテナントに影響を与えたり、他のテナントのデータ、Salesforce リソース、外部リソースに不正にアクセスしたりすることを防止することを目的としています。このセキュリティは、階層型 (多層防御) アーキテクチャによって実現されます。このアーキテクチャでは、さまざまなガードレールが組み込まれ、各テナントのカスタムコードに対して分離された実行環境が提供されます。これには、Kubernetes (K8) レベルでの論理的な分離、ネットワークの分離、実行時の Sandbox、最小限の権限などが含まれ、さらに、運用監視とインシデント対応の準備状況によって検出と対応が補完されます。
#### 開発者エクスペリエンスと操作の可視性
堅牢な開発ライフサイクルをサポートするために、Code Extension には次の機能があります。
- **外部作成およびデバッグ**:開発者は、VSCode などの使い慣れた環境で SDK を使用して Python コードを作成してデバッグできます。
- **柔軟な導入**:SDK ユーティリティ、Data 360 UI、または API を使用してカスタムコードをパッケージ化してリリースできるため、CI/CD に統合できます。
**操作ログ**:詳細な実行ログにアクセスできるため、透明性が高く、本番でのトラブルシューティングに役立ちます。
Data 360 は、これらの安全で柔軟なコード拡張機能を提供することで、アーキテクトが最もユニークで複雑なデータ処理要件に合わせてプラットフォームを調整し、拡張可能なエンタープライズデータファブリックとしての役割を真に強固なものにします。
### 独自の AI モデルを使用した Data 360 の拡張
企業が AI の採用を加速するにつれ、そのほとんどは Amazon SageMaker、Google Vertex AI、カスタム Python ベースの環境など、信用リスクスコアリング、離脱傾向、商品のおすすめ、Next Best Action の決定など、ミッションクリティカルな予測を促進するモデルをホストする異種混在 ML エコシステムを維持しています。
これまで、これらの外部モデルを Salesforce に統合するには、専用の API レイヤー、ETL パイプライン、ミドルウェアオーケストレーションが必要でした。そのため、データの重複、ガバナンスオーバーヘッド、レイテンシ、運用の複雑さが発生し、統合的でコンプライアンスに準拠したリアルタイムの Customer Data Platform (CDP) ビジョンと相反する課題が生じていました。
**Bring Your Own Model (BYOM)**:Data 360のEinstein Studioを介して提供されるため、データを移動したりレプリケートしたりすることなく、Salesforceワークフロー、Apexロジック、自動化ツール内で外部トレーニングを受けたモデルを直接呼び出すことができるため、これらの課題に対処できます。ゼロ コピー統合により、Data 360は管理された単一の情報源として機能し、ハーモナイズされたCustomer 360データを外部エンドポイントで推測できるようにします。予測出力はリアルタイムで戻されるため、拡張性の高いインテリジェンスでビジネスプロセスを強化できます。
BYOM は、モデル開発、管理データ、消費レイヤーを分離することで、データサイエンスと業務実行の間のギャップを効果的に埋めます。プラットフォームの独立性が維持され、インテグレーションの複雑さが軽減され、AI の導入が迅速化され、機密データのガバナンスが維持されます。
このアーキテクチャは次のように動作します。Data 360は統合されたCustomer 360データ基盤を提供し、Einstein Studioは外部MLプラットフォーム(SageMaker、Vertex AI、カスタム エンドポイント)への接続を調整します。外部モデルは、リアルタイム、バッチ、またはストリーミングモードで推測を実行します。Salesforceレイヤー(フロー、Apex、クエリAPI)では、出力を使用して、Sales Cloud、Service Cloud、Marketing Cloud、Industry Cloudでパーソナライズされた自動分析インサイトを提供します。
エンタープライズの観点から見ると、BYOM には次の利点があります。
- **データの整合性とガバナンス**:制御されていないデータコピーを排除し、ポリシーコンプライアンスを適用します。
- **AIの民主化**:技術者以外のユーザーが Salesforce ツールを使用して複雑なモデルにアクセスできるようにします。
- **タイム トゥ バリューの短縮**:外部モデルは、Salesforce プロセス内ですぐに有効化されます。
- **拡張性とハイブリッド アーキテクチャのサポート**:AI ワークロードのマルチクラウドリリースを有効にします。
- **未来志向のAIアーキテクチャ**:構成可能な AI 戦略をサポートし、データ、モデル、消費レイヤーを分離することで、運用の俊敏性を実現します。
**Bring Your Own LLM (BYO-LLM)**:生成モデルに同じ拡張性メカニズムを提供します。外部 LLM の直接呼び出しを有効にすることで、顧客は Salesforce が提供するモデルの代わりに Agentforce Platform で外部 LLM を使用できます。エンタープライズの場合、BYO-LLM では次のことができます。
- 微調整されたモデルへのアクセス
- 現在 Salesforce で提供されていないモデルのインテグレーション
- 顧客が指定した取引先でのモデルの使用
### データコラボレーション
モダン エンタープライズは、2 つの主要なアーキテクチャ上の課題によって特徴付けられる複雑なデータ ランドスケープ内で運用されます。
1. **企業内フラグメンテーション**:大規模な組織では、複数の Salesforce 組織 (多くの場合、地域、ビジネスユニット、または過去の買収履歴でセグメント化) やその他の多数のデータシステムが頻繁に使用されます。このフラグメンテーションにより、内部データサイロが作成されるため、ビジネス全体でリアルタイムのエンゲージメントを行うための顧客の 1 つの信頼できる統合ビューを確立できなくなります。課題は、すべてのシステムでデータを物理的に統合または複製せずにこのデータを統合し、ガバナンスを確実に維持することです。
2. **企業間コラボレーション**:多くの場合、企業は共同マーケティング、メジャメント、ビジネスインテリジェンスのためにパートナーやサプライヤーとデータを共有する必要があります。課題は、機密性の高い独自データを保護し、GDPR や CCPA などのプライバシー規制や競争障壁を遵守しながら、このコラボレーションを実現することです。
Salesforce Data 360は、データの移動や複製ではなく、アクセスとインサイトの共有の原則に基づいて構築されたゼロ コピーのTrust-by-Designフレームワークでこれらの課題に対処します。
#### Data 360 コラボレーションメカニズム
Salesforce Data 360 は、Data Cloud One、Data 360 間のデータ共有、プライバシー優先のデータクリーンルームを使用して、データの断片化とコラボレーションの課題に対処します。これらのソリューションは、顧客データを統合し、安全なデータ交換を可能にし、プライバシー保護に関するインサイトを提供します。ゼロ コピーのTrust by Designアプローチにより、組織はリアルタイムのエンゲージメント、強化されたパートナーシップ、インテリジェントな意思決定のためにデータの可能性を引き出すことができます。これらのデータコラボレーションオプションの目的はそれぞれ異なります。
##### Data Cloud One を使用した内部エンタープライズイネーブルメント
Data Cloud One は、複数の Salesforce 組織を運用しているエンタープライズ向けの基本的なアーキテクチャソリューションです。その目的は単なるデータ共有にとどまらず、単一の信頼できる顧客ビューを確立し、組織全体で Data 360 プラットフォームのすべての機能を実現するように設計されています。
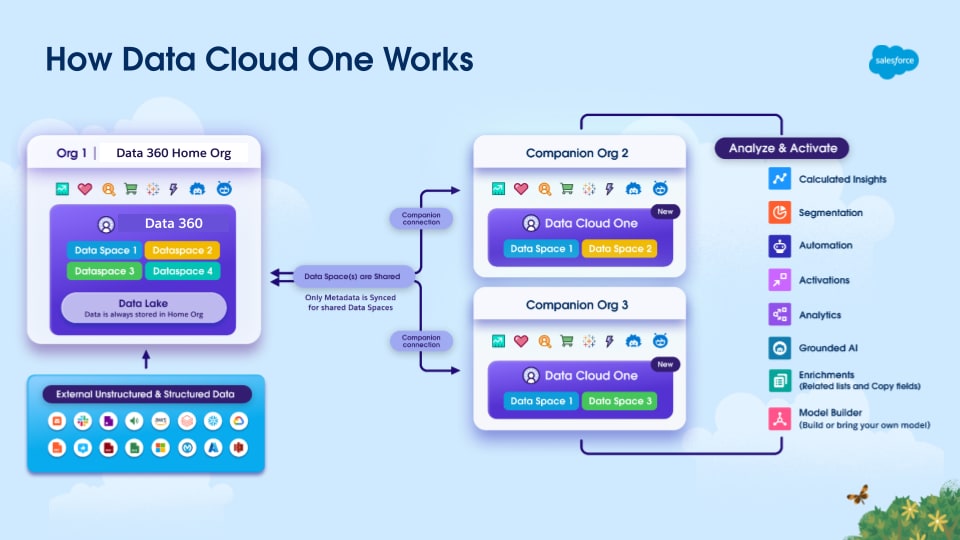 このメカニズムは、指定された Home Org Data 360 インスタンスを中心に機能します。このインスタンスは、データ管理と統合顧客プロファイルの作成の中心機関として機能します。ホーム組織は、Data 360 がプロビジョニングされている組織です。Data 360 と他の Salesforce 組織 (コンパニオン組織) の間に Data Cloud One 接続が確立されます。Data Cloud One 接続の一環として、Data 360 は各コンパニオン組織と 1 つ以上のデータスペースを共有し、各共有データスペースのデータとメタデータの両方へのアクセスを提供します。これは、ゼロコピー統合モデルと組織間メタデータ同期によって実現されます。
Data Cloud One では、コンパニオン組織で自宅の組織の Data 360 インスタンスを活用して、独自の有効化、パーソナライズ、インテリジェンスのニーズにも対応できます。この戦略は、内部データの断片化を排除し、すべてのビジネスユニットが同じ管理対象の統合顧客プロファイルに対して有効化され、コア Data 360 実装の ROI を最大化するために不可欠です。
##### Data 360 組織間でのデータ共有
Data 360-to-Data 360 データ共有では、分散内部環境 (完全な一元化が不可能) や信頼できる外部パートナーとのコラボレーションのために、独立した Data 360 インスタンスが接続されます。
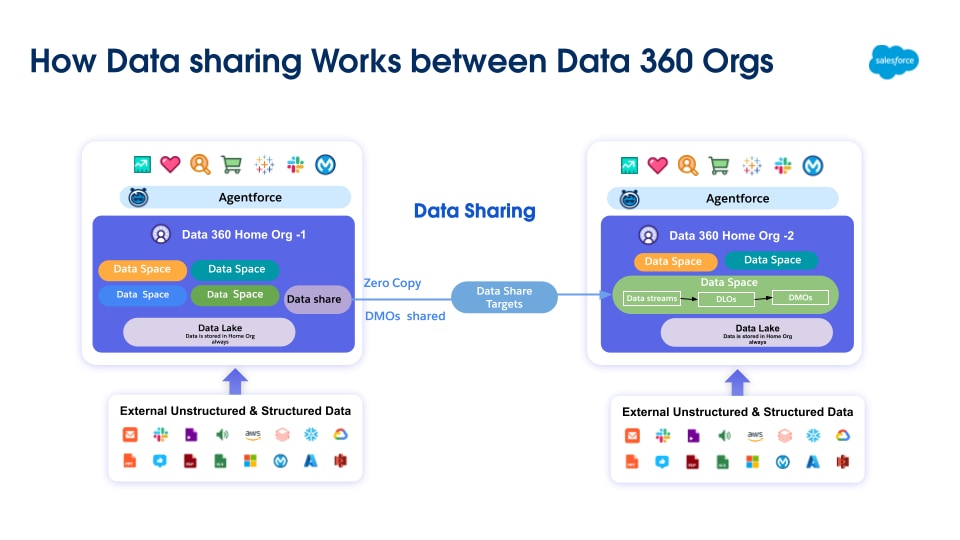 このゼロコピー共有モデルでは、データオブジェクト (DLO、DMO、CIO) の安全な交換を目的として、異なる Salesforce 組織にプロビジョニングされた別々の Data 360 テナント間の接続が確立されます。接続すると、受信者の Data 360 でデータオブジェクト全体にアクセスできるようになります。受信者 Data 360 の管理者は、このデータへのユーザーアクセスを管理するガバナンスルールを設定できます。
##### Data 360 Clean Room Collaboration を使用したプライバシー優先のコラボレーション
コラボレーションで最高レベルのプライバシーとコンプライアンスが必要な場合や、競合上の懸念から未加工データの共有が禁止されている場合は、Data 360 Clean Rooms のアーキテクチャが義務付けられています。
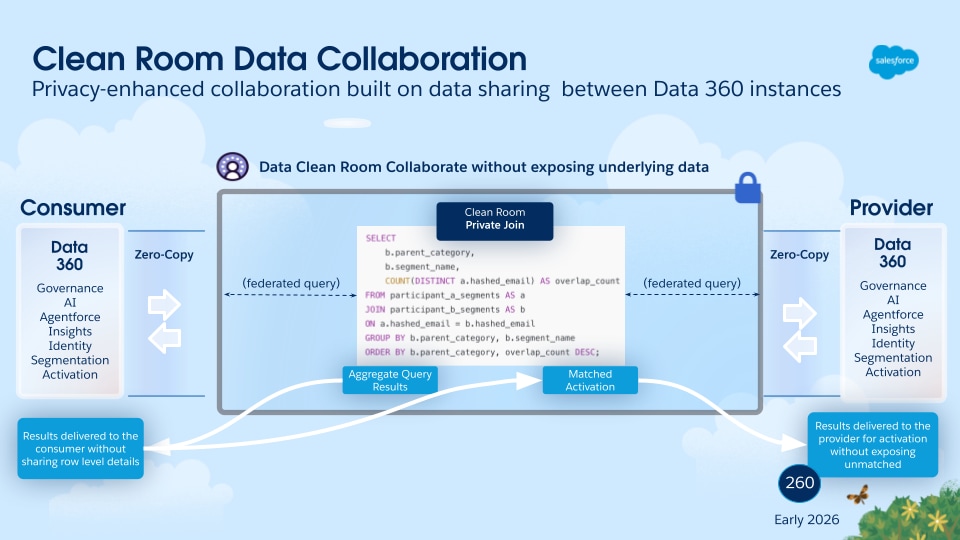 アーキテクチャ的には、Data 360 クリーンルームコラボレーションは、Data 360-to-Data 360 データ共有で使用されるゼロコピー共有フレームワーク上に構築されていますが、ガバナンスと計算上の制約が一層追加されています。Data 360 クリーンルームは、関係者が匿名化された鍵に基づいてデータセットを結合できる安全で制御されたコンピューティング環境を提供します。その主な目的は、基盤となる独自データを公開することなく、共同分析とインサイト生成を可能にすることです。環境では、最小集計しきい値やエクスポートできない識別子などの厳格でプログラム可能なルールが適用されます。これらのルールにより、承認されたインサイト、プライバシーを強化するインサイト、集計されたインサイトのみが取得および共有されます。これにより、クロスプラットフォームキャンペーンメジャメントや機密性の高いオーディエンスの重複分析などの使用事例でクリーンルームが不可欠になります。
## 結論:Salesforce Data 360:Agentic Enterprise に不可欠なデータバックボーン
Data 360 は、次世代の AI を強化するために必要な、インテリジェントで拡張可能な信頼できるデータファブリックとして設計されています。そのアーキテクチャ設計により、断片化されたデータの問題に対処し、組織は Zero Copy Data Federation を使用して、すべての顧客データを大規模に統合、処理、有効化して効率を確保できます。
その堅牢なデータ整理により、パーティション分割されたデータスペース内で保護されている DLO (非構造化データを含む) から DMO までのハーモナイズビューが確立されます。Data 360 の汎用性の高いデータ処理能力 (バッチ変換、ストリーミング変換、計算済みインサイト、非構造化データ処理、ID 解決など) は、増分 SNCE および CDF アーキテクチャによって強化され、効率的でほぼリアルタイムの処理と大幅なコスト削減を実現します。
拡張性は、コードエクステンションアーキテクチャによって提供され、スクリプトまたは独立した関数を使用して、固有の要件に合わせてカスタム Python ロジックを安全に有効化します。さらに、CEDAR ポリシーを使用した属性ベースのアクセス制御 (ABAC) を基盤とする包括的なデータガバナンスフレームワークにより、詳細なセキュリティ、動的データマスキング、およびすべてのデータ消費の一貫した適用が保証されます。これにより、高度なセグメンテーションと有効化機能が実現し、統合された顧客プロファイルがリアルタイムの応答性を備えた動的なマルチチャネルエンゲージメント戦略に変換されます。
重要な点として、インテリジェント AI エージェントを強化するには、Data 360 の膨大で多様なデータの統合、統合クエリによるリアルタイムのコンテキストの提供 (ハイブリッド構造化/非構造化検索、ハイパーアクセラレーションなど)、厳格なガバナンスの適用が不可欠です。RAG(生成AIワークフロー)をグラウンディングし、Agentforceを利用するエージェントの複数ターンのアクション指向の機能を強化するために必要な、信頼性の高い最新の関連データが提供され、エージェントが正確かつ正確に操作できるようにします。
Data 360 は、ソースデータをアクション可能なインサイトに変換する将来を見据えたプラットフォームを提供することで、エージェント型のカスタマーエクスペリエンスを構築する組織に不可欠なアーキテクチャ基盤として機能します。顧客データを、今日の組織の成功を促進する洗練されたパーソナライズされたカスタマーエクスペリエンスに変換する重要なバックボーンです。
## 概要
最新の Salesforce インテグレーションでは、単純なデータ交換以上のサポートが必要です。リアルタイムのカスタマーエクスペリエンスの強化、複数のシステム間のアクションの調整、エンタープライズ規模の信頼性の高い運用を実現すると同時に、厳格なセキュリティとコンプライアンスの要件も満たすことが求められます。したがって、適切なインテグレーションアプローチを選択することは、実装の詳細ではなく、アーキテクチャ上の重要な決定事項です。
一般的なエンタープライズシナリオについて考えてみます。顧客がモバイルアプリケーションで購入を完了すると、パーソナライズされたオファーのリアルタイムの対象資格チェックがトリガーされます。同時に、トランザクションデータを ERP システムに記録し、Salesforce で顧客属性を更新し、分析をデータレイクにストリーミングする必要があります。これにより、遅延、データの重複、コンプライアンスのリスクを回避できます。このようなシナリオは、現在の Salesforce 環境では一般的です。Salesforce は、単独で運用されることがほとんどなく、アプリケーションやデータプラットフォームの広範なエコシステムとシームレスに統合する必要があります。
このガイドは、アーキテクトと開発者がこれらのインテグレーションを明確に自信を持って設計できるようにするために用意されています。ポイント・ツー・ポイントの実装に焦点を当てるのではなく、プロセスの調整、データ同期、リアルタイムのデータ・アクセスなど、繰り返し発生するエンタープライズ・シナリオに対応する一連の実証済みの**統合パターン**を提示します。各パターンでは、アーキテクチャの意図、トレードオフ、実行モデルが強調されるため、チームは拡張性と耐久性を備えた十分な情報に基づいた設計上の意思決定を行うことができます。
このドキュメントには、次の情報が含まれています。
- プロセス、データ、仮想アクセスのシナリオで一般的なエンタープライズの「原型」を表すインテグレーションパターン
- インテグレーションインテントと実行タイミングに基づいて適切なアプローチを識別するためのパターン選択フレームワーク
- 拡張性、耐障害性、ガバナンス、セキュリティに関する考慮事項に関する実践的なガイダンス
- Salesforce および Data 360 の実際の実装から得られたベストプラクティス
このドキュメントの目標は、統合のための共通のアーキテクチャ言語を提供し、チームがエンタープライズ データおよびガバナンス戦略に合わせてパフォーマンス、柔軟性、Trust のバランスを取るソリューションを設計できるようにすることです。
### 目的と範囲
このドキュメントは、社内の他のアプリケーションのデータを Salesforce Data 360 (旧 Data Cloud) と統合する必要があるデザイナーやアーキテクトを対象としています。このコンテンツは、Salesforce アーキテクトとパートナーによる多くの成功した実装を絞り込んだものです。
Data 360 の大規模な採用に使用できるインテグレーション機能とオプションについての詳細は、以下の「パターンの概要」および「パターン選択ガイド」セクションを参照してください。アーキテクトと開発者は、Data 360 へのデータインタラクションプロジェクトの設計および実装フェーズで、次のパターンの詳細とベストプラクティスを考慮する必要があります。
これらのパターンを適切に実装すれば、本番環境にできるだけ早く移行でき、可能な限り安定性と拡張性が高く、メンテナンスフリーな一連のアプリケーションを使用できます。Salesforce 独自のコンサルティングアーキテクトは、アーキテクチャレビュー時にこれらのパターンを参照点として使用し、積極的に維持および改善します。
すべてのパターンと同様に、このコンテンツではほとんどのインテグレーションシナリオがカバーされますが、すべてはカバーされません。たとえば、Salesforce ではユーザーインターフェース (UI) インテグレーションやマッシュアップが可能ですが、そのようなインテグレーションはこのドキュメントの範囲外です。
### パターンテンプレート
各インテグレーションパターンは一貫した構造に従います。これにより、各パターンで提供される情報の一貫性が確保され、パターンの比較も容易になります。
- **名前**:パターンに含まれるインテグレーションの種別も示すパターン識別子。
- **コンテキスト:**パターンで対応する全体的なインテグレーションシナリオ。コンテキストは、ユーザーが何を達成しようとしているか、および要件をサポートするためにアプリケーションがどのように動作するかに関する情報を提供します。
- **問題:**質問として表現され、パターンで解決するように設計されたシナリオです。このセクションを読んで、パターンがインテグレーションシナリオに適しているかどうかを確認してください。
- **強制:**示されたシナリオを解決するのを困難にする制約と状況。
- **ソリューション:**インテグレーションシナリオを解決するための推奨方法。
- **スケッチ:**ソリューションがシナリオにどのように対処するかを示す UML シーケンス図。
- **結果:**ソリューションをインテグレーションシナリオに適用する方法の詳細と、そのシナリオに関連する勢力を解決する方法について説明します。このセクションでは、パターンの適用によって発生する可能性のある新しい課題についても説明します。
- **サイドバー:**主要な技術的な問題、パターンのバリエーション、パターン固有の懸念などが含まれる、パターンに関連する追加のセクション。
- **例:**実際の Salesforce シナリオでデザインパターンがどのように使用されるかを説明する実際のシナリオ。この例では、インテグレーションの目標とその目標を達成するためにパターンを実装する方法について説明します。
## パターン概要
次の表は、このドキュメントに記載されているインテグレーションパターンの目次として使用します。
### パターンのリスト
| パターンレベル1 | パターンレベル2 | パターン | シナリオ |
|---|---|---|---|
| データ取り込みパターン--データ受信 | バッチ取り込みパターン | クラウドストレージからの一括データ取り込み | データは、Amazon S3、Azure Blob、Google Cloud Storage などのエンタープライズクラウドストレージソースから、大量の未加工データ (トランザクションや商品ログなど) の形式で Data 360 に取り込まれます。 |
| Salesforce クラウドからの一括データ取り込み | Data 360 は、複数の Salesforce 組織 (Sales Cloud、Service Cloud など) から CRM データを一括で受信し、統合顧客プロファイルを作成します。 | ||
| ストリーミングおよびリアルタイム取り込みパターン | 取り込みAPIを使用したイベント駆動型取り込み--ストリーミング | Data 360 は、リアルタイムのプロファイル更新のためにエンタープライズシステムから継続的なイベントペイロード (購入イベント、IoT テレメトリーなど) を受信するストリーミング取り込みエンドポイントを登録します。 | |
| リアルタイムの Web およびモバイル動作の取り込み | Data 360 は、SDK を介してリアルタイムの Web サイトおよびモバイルアプリケーションの行動データを収集して処理し、エンゲージメント評価指標とパーソナライズモデルを強化します。 | ||
| ストリーミングによるほぼリアルタイムの CRM 同期 | Data 360は、イベントストリームを介してCRMデータの更新(取引先責任者、ケース、商談の変更など)をほぼリアルタイムで受信し、継続的に同期されたCustomer 360ビューを維持します。 | ||
| クラウドメッセージングプラットフォームからのイベントストリームの取り込み--キネシスと MSK | Data 360 では、AWS Kinesis や Kafka (MSK) などのクラウドイベントプラットフォームから直接ストリーミングデータを使用して、頻度の高い運用イベントや IoT イベントを処理します。 | ||
| ゼロコピーパターン--受信と送信 | 受信ゼロコピー--Data 360への外部プラットフォーム | Data 360 は、データを物理的に Salesforce に移動することなく、ゼロコピー取り込みを使用して外部データセット (Snowflake、BigQuery など) をオンデマンドで照会します。 | |
| 送信ゼロコピー--外部プラットフォームへのData 360 | Databricks や Tableau などの外部システムは、データレプリケーションなしで Zero Copy Outbound 接続を介して Data 360 の拡張セグメントとインサイトにアクセスします。 | ||
| Data Cloud Oneを使用した統合マルチ組織データ プラットフォーム | Data Cloud Oneは、複数のSalesforce組織と外部データソースを共有メタデータおよびセマンティック モデルの下で統合し、データの重複のない一貫したCustomer 360を提供します。 | ||
| データ有効化パターン--データ送信 | バッチ有効化パターン | マーケティングおよび広告プラットフォームへのセグメントの有効化 | Data 360 は、選定された顧客セグメントを Marketing Cloud、Meta、Google 広告、またはその他の広告プラットフォームに直接有効化して、パーソナライズされたキャンペーン配信を実現します。 |
| クラウドストレージへのデータのエクスポート | Data 360 は、統合データセットまたは絞り込まれたデータセット (同意済みの顧客レコードなど) を CSV または Parquet ファイルとして Enterprise Cloud Storage にエクスポートし、分析またはコンプライアンスアーカイブを行います。 | ||
| オンデマンド API ベースの有効化 | Connect API を使用したカスタムアプリケーションインテグレーション | 外部アプリケーションは、Data 360 Connect API をリアルタイムで呼び出して、現在の顧客データに基づいてパーソナライズされたアクション (ロイヤルティ残高チェックや AI オファーの生成など) を取得またはトリガーします。カスタム作成の Web またはモバイルアプリケーションは、Connect REST API を使用してハーモナイズされた Data 360 インサイトを安全に取得し、エンタープライズまたはパートナーの UI 内に表示します。 | |
| データグラフ API を使用した顧客プロファイルの取得の完了 | システムはデータグラフ API を使用して顧客の統合プロファイルを取得し、意思決定やパーソナライズのために 360° ビュー全体の事前結合されたリアルタイムの JSON 表現を返します。 | ||
| リアルタイムデータアクション | リアルタイムデータアクションによる顧客のシグナルのインスタントアクションへの変換 | Data 360 は、ライブイベント (同意の更新、購入トリガーなど) を検出して処理し、接続済みシステムまたは Salesforce フローをすぐに呼び出してダウンストリームアクションを実行します。Data 360 の顧客活動のシグナル (離脱リスクの検出など) によって、CRM の更新、Einstein スコアリングの呼び出し、保持ジャーニーの開始などのリアルタイムアクションがすぐにトリガーされます。 |
| タイプ | タイミング | 送信に関する考慮事項 |
|---|---|---|
| データインテグレーション | 非同期 | マーケティングおよび広告プラットフォームへのセグメントの有効化 |
| プロセス/データインテグレーション | 同期 | Connect API を使用したカスタムアプリケーションインテグレーション データグラフ API を使用した顧客プロファイルの取得の完了 |
| データインテグレーション | 同期 | リアルタイムデータアクションによる顧客のシグナルのインスタントアクションへの変換 |
| 仮想インテグレーション (ゼロコピーを使用) | 非同期 | 送信ゼロコピー--外部プラットフォームへのData 360 |
| 仮想インテグレーション | 非同期 | Data Cloud Oneを使用した統合マルチ組織データ プラットフォーム |
| タイプ | タイミング | 受信に関する考慮事項 |
|---|---|---|
| データインテグレーション | 非同期 | クラウドストレージからの一括データ取り込み Salesforce クラウドからの一括データ取り込み |
| データインテグレーション | 非同期 | クラウドメッセージングプラットフォームからのイベントストリームの取り込み--キネシスと MSK ストリーミングによるほぼリアルタイムの CRM 同期 |
| プロセスインテグレーション | 同期 | 取り込みAPIを使用したイベント駆動型取り込み--ストリーミング リアルタイムの Web およびモバイル動作の取り込み |
| 仮想インテグレーション | 非同期 | 受信ゼロコピー--Data 360への外部プラットフォーム |
| 用語 | 定義 |
|---|---|
| イベント処理 | イベント処理とは、ソースシステムまたはアプリケーションからの識別可能な発生の受信、ルーティング、応答を指します。ミドルウェアは、対象エンドポイントを特定し、イベントを転送して、必要なビジネスアクション (ログの記録、再試行、ダウンストリームサービスの有効化など) をトリガーすることでイベントを処理します。Data 360 アーキテクチャでは、イベントの処理はリアルタイムのデータ取り込み、有効化トリガー、公開/登録パターンにとって重要です。イベントは外部システム (Kafka、AWS Kinesis) または Salesforce Platform イベントから発生する可能性があり、ミドルウェアまたは Data 360 イベントバスによってルーティングされ、すぐに処理されます。 |
| プロトコル変換 | プロトコル変換により、異なるデータ転送標準を使用するシステム間の通信が可能になります。ミドルウェアは、独自のプロトコルや従来のプロトコル (AMQP、MQTT、FTP など) を、サポートされている Data 360 プロトコル (REST、gRPC、HTTPS) に変換します。これにより、異種システム間の相互運用性が確保されます。Data 360 はプロトコルの変換をネイティブに処理しないため、ミドルウェアは適応レイヤーを提供し、メッセージを Data 360 API とコネクタが解釈できる形式にカプセル化または変換します。 |
| 翻訳と変換 | 翻訳と変換では、あるデータ形式またはスキーマを別のデータ形式またはスキーマに対応付けることで相互運用性を確保します。ミドルウェアは、さまざまなデータペイロード (CSV、XML、JSON) を Data 360 データモデルオブジェクト (DMO) と統合データレイヤーオブジェクト (UDLO) に合わせるために、これらの変換を実行します。これには、取り込み前のセマンティックまたはオントロジーベースの対応付けのクリーンアップ、強化、適用が含まれます。Salesforceはデータプレップレシピなどの変換ツールを提供していますが、複雑な変換(特にセマンティックハーモナイゼーション)はミドルウェアで処理するのが最適です。 |
| キューイングとバッファリング | キューイングとバッファリングは、復元性のある分離された通信を確保するために非同期メッセージパッシングに依存します。ミドルウェアプラットフォーム (MuleSoft、Kafka、Azure Event Hub など) には、Data 360 やダウンストリームシステムがビジー状態やアクセス不能な場合にデータを一時的に保存する永続的なキューが用意されています。これにより、データの損失を防止し、ほぼリアルタイムの取り込みまたは有効化の再試行をサポートします。Data 360 ではストリーミング取り込みとフローベースのアウトバウンドメッセージングがサポートされますが、耐久性のあるキューと保証された配信は通常ミドルウェアで処理されます。 |
| 同期転送プロトコル | 同期転送プロトコルには、ブロックされたリアルタイムの要求/応答操作が含まれます。送信者は返信を待ってから続行します。Data 360 では、これらはオンデマンド API ベースの有効化、リアルタイム強化、またはすぐに応答が必要なプロファイル検索に使用されます。ミドルウェアは、接続の信頼性を確保し、同期 Data 360 API コールの再試行またはフォールバック処理を管理します。 |
| 非同期転送プロトコル | 非同期転送プロトコルでは、送信者が応答を待たずに処理を続行するノンブロッキングの分離通信がサポートされます。ミドルウェアは、一括有効化、ストリーミング取り込み、イベント駆動型有効化の非同期フローを処理します。これにより、イベントストリーミングや Data 360 のほぼリアルタイムのデータ取り込みパターンに重要な高いスループットと復元性を実現できます。 |
| 仲介ルーティング | 仲介ルーティングでは、システム間の複雑なメッセージフローを定義して、適切なデータまたはイベントが適切なコンシューマーに到達するようにします。ミドルウェアはメディエーターとして機能し、ルール、ヘッダー、コンテンツ、またはイベント種別に基づいてルーティングロジックを処理します。Data 360 インテグレーションでは、メディエーションにより、複数のシステムからのイベントとプロファイルの更新がデータ取り込み API、有効化エンドポイント、または外部コンシューマーに適切に転送されます。これによりオーケストレーションが簡素化され、マルチシステムデータ同期がサポートされます。 |
| プロセス振付とサービスオーケストレーション | プロセス振付とオーケストレーションでマルチシステムプロセスを調整します。振付では、中央コントローラーを使用せずにシステムが共有ルールに基づいて動作する自律的な非同期イベント駆動型フローがサポートされます。オーケストレーションは、サービスの実行を指示する一元管理されたフローです。Data 360 アーキテクチャでは、ミドルウェアでシステム全体の取り込みと有効化のオーケストレーションを管理し、Salesforce ワークフローまたはフローでプラットフォーム内の軽量な振付を処理します。ミドルウェアレイヤーでは、トランザクションの調整や状態管理を必要とする複雑なオーケストレーションをお勧めします。 |
| トランザクション性 (暗号化、署名、信頼性の高い配信、トランザクション管理) | トランザクション性により、システム全体でアトミック、一貫性、分離、耐久性 (ACID) のある操作が保証されます。Salesforce と Data 360 は境界内でトランザクションを行いますが、外部システム間の分散トランザクションはサポートされません。ミドルウェアは、暗号化、メッセージ署名、ロールバック、補償、信頼性の高い配信など、グローバルなトランザクション制御を処理します。ミッションクリティカルなデータフロー (財務や同意の更新など) の場合、ミドルウェアにより、Data 360 と外部システム全体でエンドツーエンドの整合性とリカバリが確保されます。 |
| ルーティング | ルーティングでは、コンポーネント間のメッセージまたはデータの制御フローを指定します。ヘッダー、コンテンツタイプ、優先度、ルールに基づく場合があります。ミドルウェアは、Data 360 に関連するイベントや有効化のルーティングロジックを処理します。たとえば、強化されたオーディエンスセグメントをさまざまな下流システム (広告プラットフォーム、倉庫、CRM アプリケーション) に転送します。ルーティングはSalesforce内に実装できますが(Apex、フロー)、拡張性、柔軟性、ガバナンスの観点からミドルウェア ルーティングが推奨されます。 |
| ETL (抽出、変換、読み込み) | ETL には、ソースシステムからデータを抽出し、一貫性のあるスキーマに変換して、対象 (Data 360 など) に読み込む作業が含まれます。ミドルウェアまたは ETL ツールでは、データを取り込む前にこれらの操作が処理されます。Data 360 は API、コネクタ、または一括取り込みパイプラインを介して ETL 出力を受信でき、ほぼリアルタイムの同期を実現する変更データキャプチャ (CDC) もサポートしています。ミドルウェア ETL プロセスは、Data 360 で統合する前にレガシーシステムを統合し、データ品質を確保するために不可欠です。 |
| Long Polling | ロングポーリング (コメットプログラミング) は、リアルタイム更新のためにシステム間のオープンな通信を維持する方法です。クライアントは要求を送信し、サーバーはイベントが発生するまで要求を保持し、イベントが発生すると応答して新しい接続を再オープンします。Salesforce は、イベント駆動型データ同期のために、これをストリーミング API および CometD/Bayeux プロトコルで使用します。ミドルウェアは、これらのイベントを登録して Data 360 に転送し、リアルタイムの取り込みまたは有効化トリガーを実行できるため、エンタープライズシステム全体の遅延を最小限に抑えることができます。 |
| ソリューション | 適合 | コメント |
|---|---|---|
| ネイティブクラウドストレージコネクタの使用 (Amazon S3、Google Cloud Storage、Azure Blob Storage) | 最善 | これは、Data 360\ への大規模で定期的なファイルベースの取り込みに推奨される最も信頼性の高いパターンです。ネイティブコネクタは、管理された認証、スキーママッピング、Data 360 のデータレークオブジェクト (DLO) への安全なデータ移動を直接提供します。遅延が重要ではないスケジュール済みバッチ読み込み (1 時間ごとや 1 日ごとなど) に最適です。 |
| 大きなデータセットの処理 (コネクタの制限を超える) | 前処理に最適 | 各コネクタで取り込み制限が適用されます (S3 など)。オブジェクトあたり 1 億行または 50 GB)。データセットが大きい場合は、ETL 前処理ステップを実装して、これらのしきい値に該当する小さなファイル/フォルダーにデータを分割します。次に、Data 360 内で複数のデータストリームを設定して各パーティションを並列で取り込み、一括処理データ変換で追加ノードを使用してパーティションを統合データセットに再結合します。 |
| セキュリティとガバナンス | 最善 | すべてのコネクタで、クラウドネイティブの方法 (IAM ロール、サービスアカウント、またはアクセスキー) による安全な認証がサポートされます。制御を強化するには、クラウドプロバイダーの許可リストを使用して Data 360 IP 範囲へのアクセスを制限します。データ転送は暗号化されたチャネルを介して行われ、取り込み時にファイルは一時的な安全なステージングレイヤーに保存されます。 |
| 使用しないケース | 最適ではない | このパターンは、次の場合に最適ではありません。
|
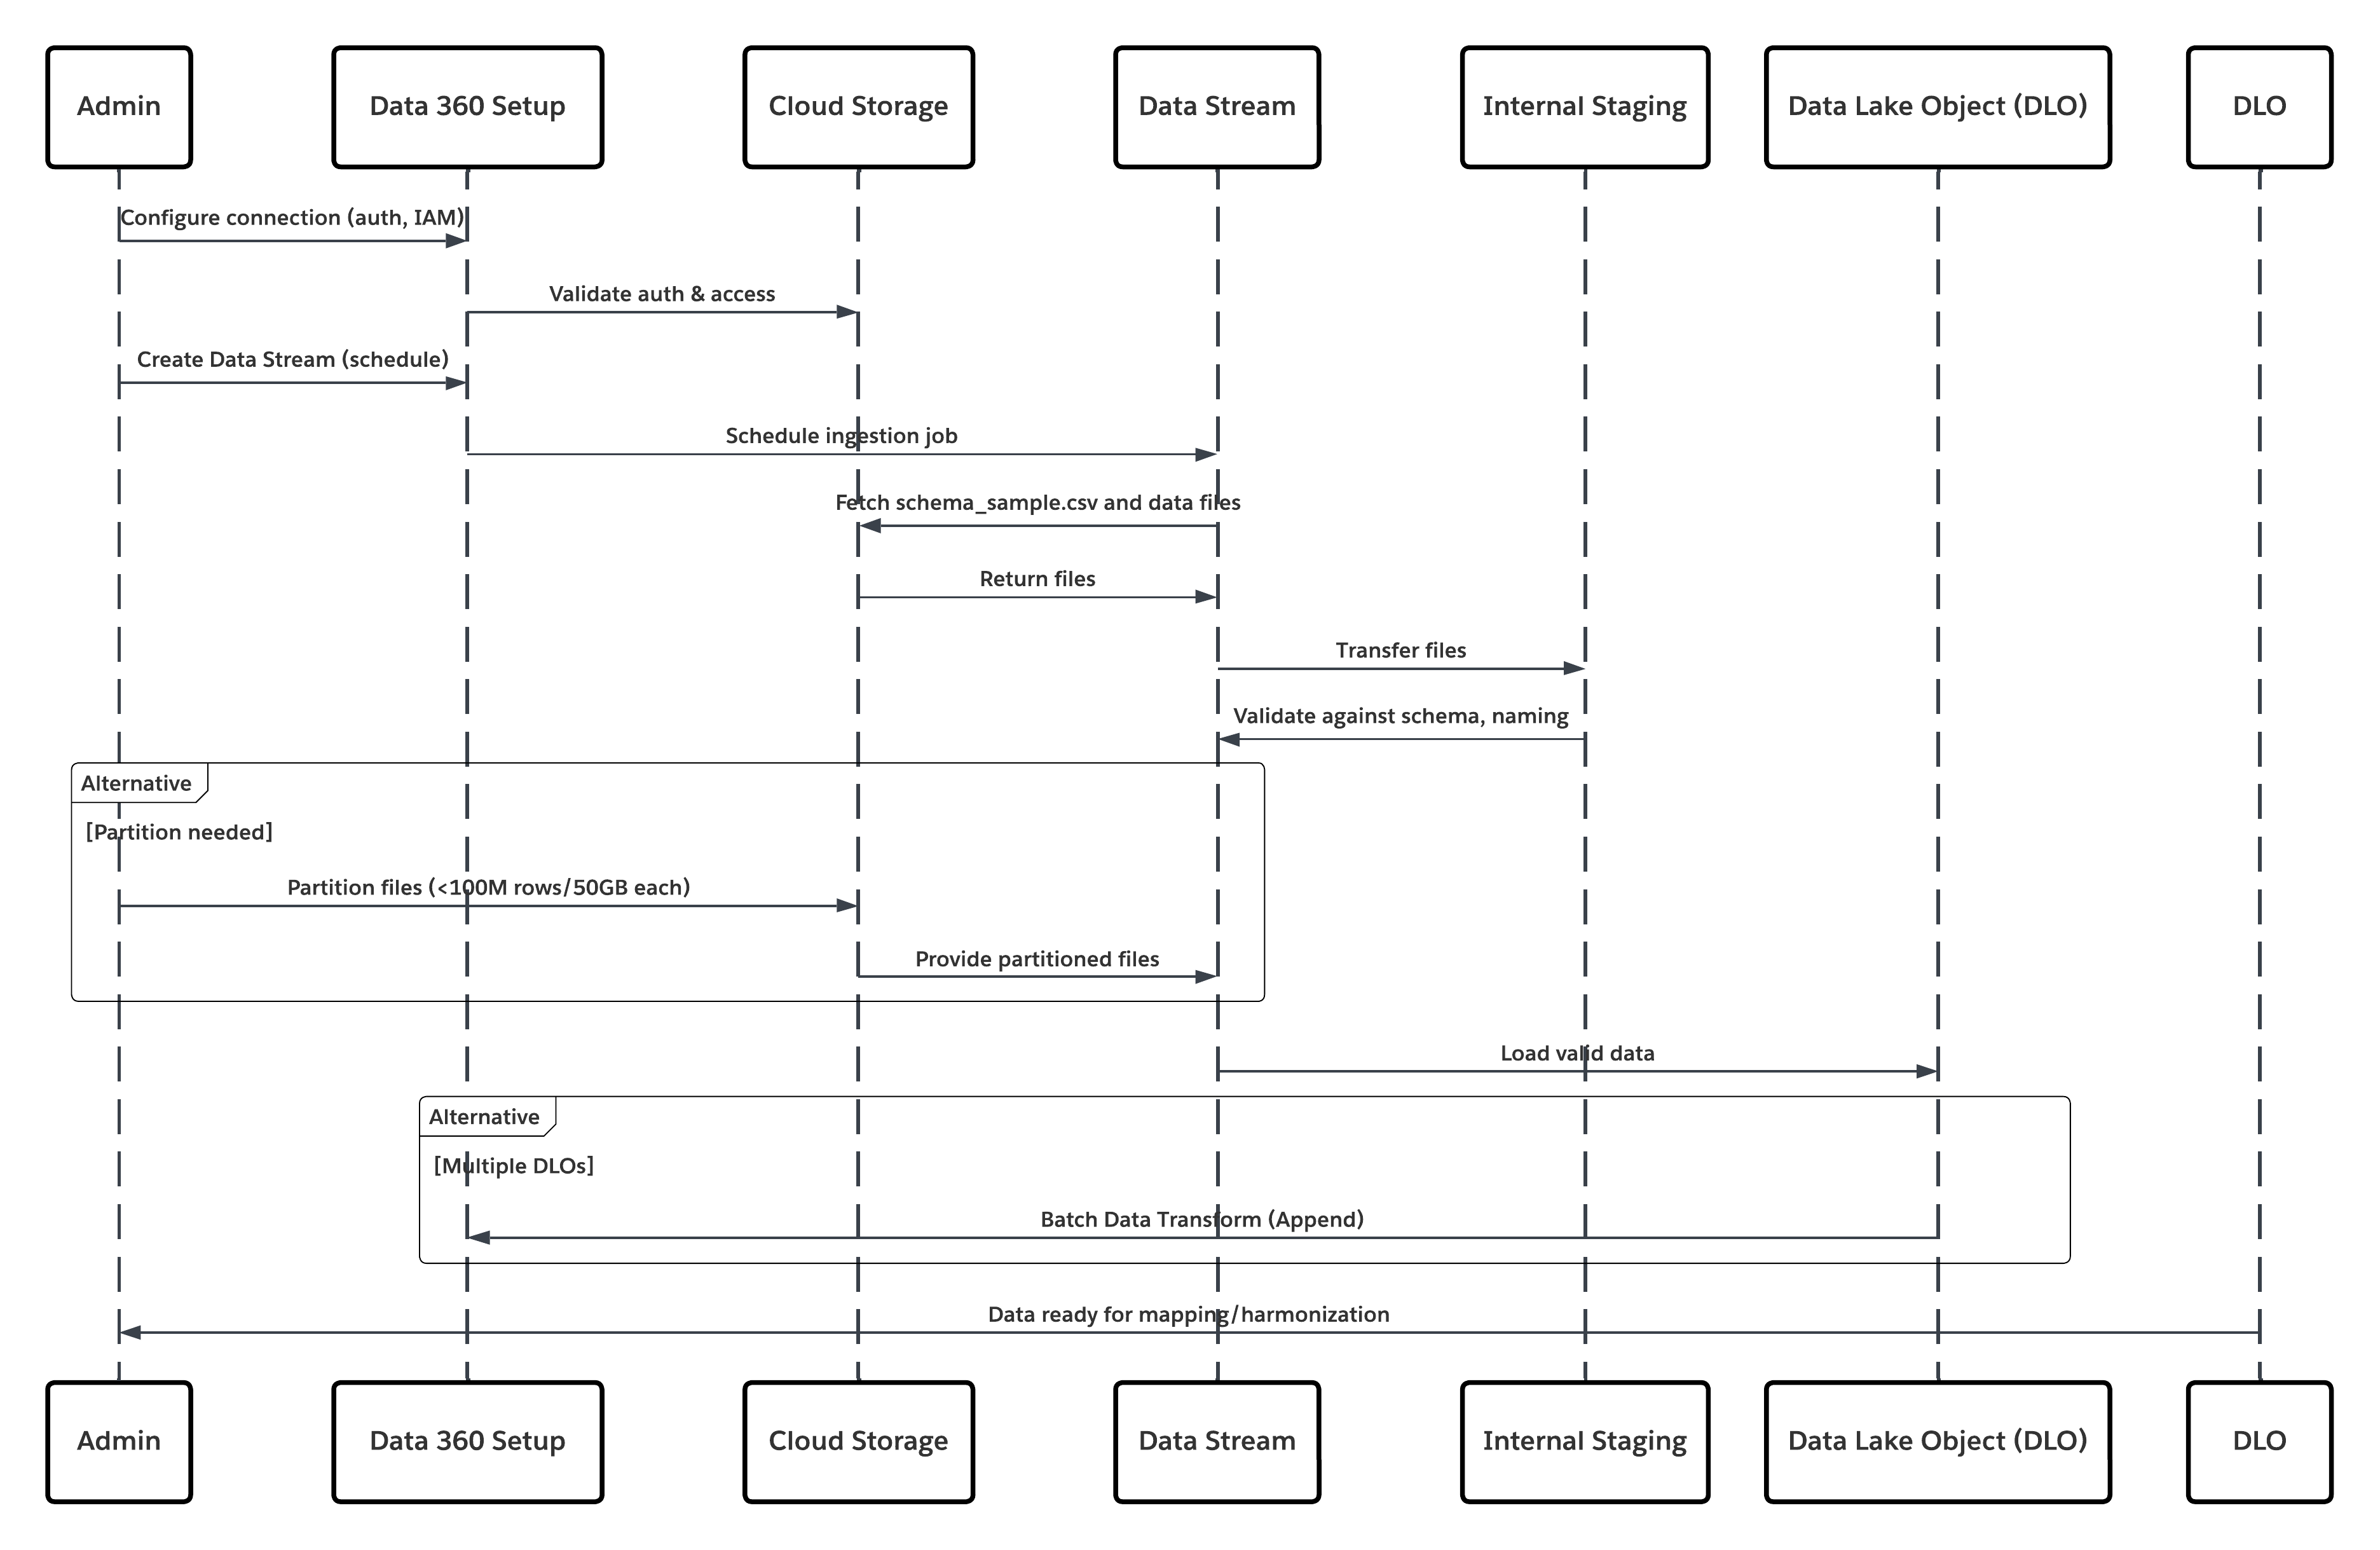 このシナリオの内容は次のとおりです。
- システム管理者は、Data 360 設定インターフェースを使用してクラウドストレージへの接続を設定します (認証、バケットの詳細、IAM ロール、ホワイトリストの指定)。
- Data Cloud 設定インターフェースは、Cloud Storage Platform で認証し、ログイン情報とアクセス権を検証します。
- システム管理者が Data 360 でデータストリームを作成し、データストリームを Cloud Storage のオブジェクト/フォルダーにリンクして取り込みスケジュールを定義します。
- スケジュールトリガー時に、データストリームは Cloud Storage Platform からソースファイル (CSV、Parquet など) を要求します。
- Cloud Storage Platform では、必要な有効な schema_sample.csv や、命名規則に準拠するその他のデータファイルなどのファイルが提供されます。
- データストリームは、Data 360 内の内部ステージング環境にファイルを転送します。
- Data 360 Pipeline でファイルが処理されます。schema_sample.csv のスキーマ定義を使用して、構造と項目名を検証し、取り込みしきい値 (1 ファイルあたり 1 億行/50 GB) を超える場合は負荷を除算します。大きなファイルが検出された場合、前処理パーティショニングステップ (次の実行のためにシステム管理者に通知) が外部で実行されます。
- レコードはステージングからデータレイクオブジェクト (DLO) にインポートされます。
- 必要に応じてデータがパーティション分割されている場合は、一括処理データ変換で追加ノードを使用して複数の DLO を結合します。
- Data 360 は成功/失敗を記録し、監視のステータスを更新して、データのマッピング、ハーモナイゼーション、統合の準備が整ったことを通知します。
##### 結果
このパターンを適用すると、Enterprise Cloud Storage プラットフォームから Data 360 に構造化ファイルまたは非構造化ファイルを安全かつスケジュール済みで大規模に取り込むことができます。このプロセスは自動化され、拡張性と復元力を備えています。ハーモナイゼーションと Customer 360 データ モデルへのマッピングの基盤となる DLO(データ レイク オブジェクト)に未加工データを配信します。
###### 取り込みメカニズム
取り込みメカニズムは、Data 360 内で定義されたコネクタとスケジュール戦略によって異なります。
| 取り込みメカニズム | 説明 |
|---|---|
| ネイティブクラウドストレージコネクタ (Amazon S3、GCS、Azure) | CSV 形式または Parquet 形式のファイルを企業のクラウドデータレイクから直接取り込むことをお勧めします。これらのコネクタでは、増分更新スケジュールとフル更新スケジュールがサポートされます。たとえば、銀行は S3 バケットから DLO への顧客トランザクションファイルの日次同期を設定できます。 |
| パーティション分割ファイル戦略 | データセットが非常に大きい場合 (1 億行またはオブジェクトあたり 50 GB を超える場合)、データは月別や地域別など、小さな論理セットに分割されます。各パーティションは個別のデータストリームとして管理され、後で追加ノードとの一括処理データ変換を使用して再結合されます。 |
| 自動スケジュール同期 | Data 360 には、取り込みジョブを自動的にトリガーする宣言型スケジューラー (1 時間ごと、1 日ごと、またはカスタムケイデンス) があり、手動操作なしでデータの新鮮度を確保できます。 |
| コネクタ種別 | エンドポイント要件 |
|---|---|
| Amazon S3 コネクタ | 適切な IAM ポリシーとスキーマを定義する schema\_sample.csv ファイルを含む S3 バケット。 |
| Google Cloud Storage コネクタ | 統一した命名規則を使用したサービスアカウントのログイン情報とバケットアクセス。 |
| Azure Storage コネクタ | アクセスキーまたは SAS トークンベースの認証。blob またはフォルダー構造は Data 360 の規則に従う必要があります。 |
| ソリューション領域 | 適合 | コメント/実装の詳細 |
|---|---|---|
| ソリューション適合 | 最善 | Data 360\ でネイティブの Salesforce CRM コネクタと Marketing Cloud Engagement コネクタを使用します。標準使用事例のスターターデータバンドルから開始して、オンボーディングを加速します。特注またはドメイン固有のデータモデルでは、手動のストリームカスタマイズを使用します。 |
| 高度にカスタマイズされた CRM インスタンスの処理 | Best with Mapping Workshop (マッピングワークショップに最適) | スターターバンドルをベースラインとして扱い、マッピングワークショップを実施して以下を特定します。カスタムオブジェクトとリレーション。数式項目または計算項目。管理パッケージ拡張。数式項目が多い場合、ソース組織の API 負荷を最小限に抑えるために、事前フェーズの ETL または Data 360 変換内で値を計算します。 |
| 使用しないケース | 最適でないシナリオ | 次の場合、このパターンは避けてください。高頻度またはリアルタイムのイベントの取り込みが必要です (代わりに、ストリーミングコネクタ、プラットフォームイベント、または Zero-Copy 統合を使用します)。ソース組織の API 容量は制限されており、調整やキューの遅延なしでスケジュール済み抽出を維持することはできません。 |
| セキュリティとガバナンス | 必須コントロール | 最小権限の原則 - 参照アクセス権が最小限の専用のインテグレーションユーザーを使用します。組織の共有管理者は絶対に使用しないでください。 認証 — OAuth 2.0 と接続アプリケーションを使用します。クライアントの秘密を定期的に循環し、更新トークンの使用状況を監視します。 監査とトレーサビリティ — すべての取り込みの実行、スキーマの変更、コネクタイベントを記録します。監査準備のためにログを SIEM またはコンプライアンスシステムに転送します。 データ分類 — CEDARポリシーを使用してPII/PHIタギングとABAC(属性ベースのアクセス制御)を取り込み後すぐに適用し、マスキング、同意、ダウンストリームコンプライアンスを適用します。 |
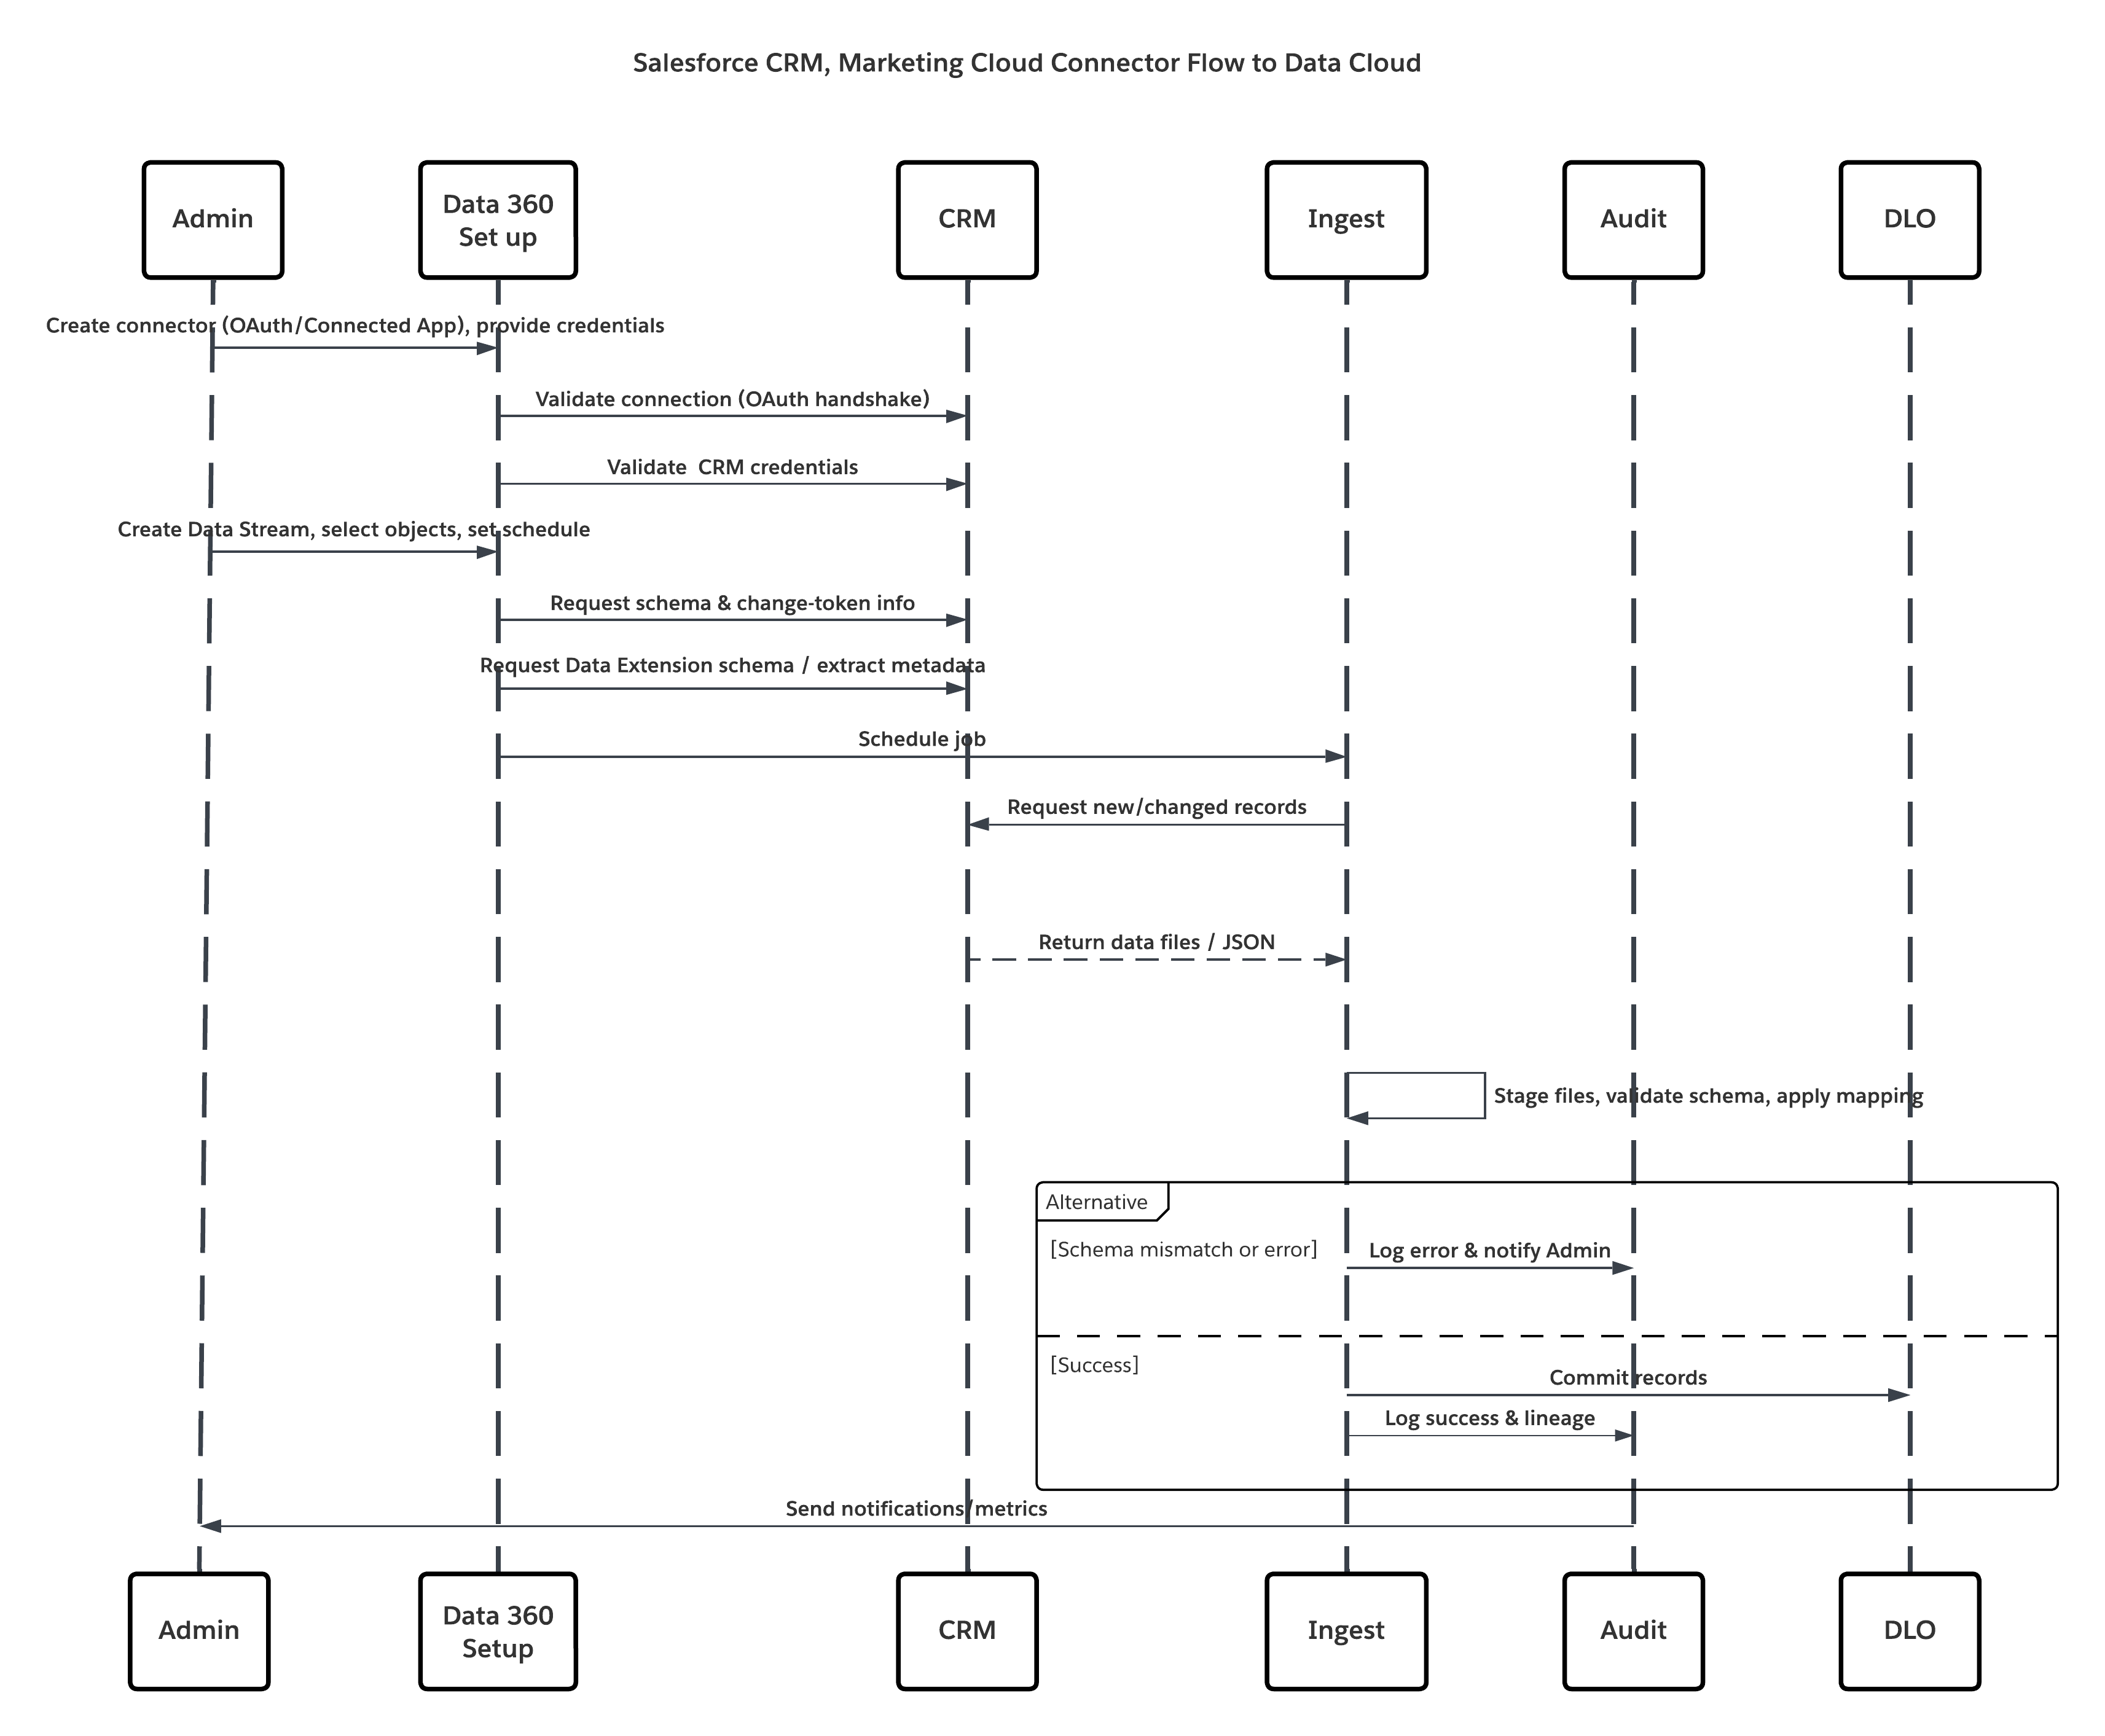 このシナリオの内容は次のとおりです。
- **システム管理者**がインテグレーションユーザーのプロビジョニングを行い、ソース組織でコネクタ権限セットを割り当てます。
- **システム管理者**は、Data 360 の \[設定] でコネクタを設定します (OAuth/接続アプリケーションを介して Salesforce CRM および Marketing Cloud に接続します)。
- **システム管理者**は、オブジェクトとデータエクステンションを選択してデータストリームを作成し、フル更新またはデルタ更新を選択して、スケジュールを設定します。
- **スケジュール済み実行**時、Data 360 はソースからスキーマとデルタ トークンを要求します。
- **ソースシステムはレコード** (デルタまたはフルペイロード) を返します。Marketing Cloud で抽出が提供される場合もあれば、CRM で JSON/クエリ結果が返される場合もあります。
- **Data 360 はファイル**を内部の安全なステージング領域にステージングし、マッピングされたスキーマに対して検証します。
- **検証に失敗**すると、取り込みログにエラーが記録され、管理者にアラートが送信され、コミットが停止します。検証に成功すると、Data 360 はレコードを対象 DLO にアトミックにコミットします。
- **監視および監査ログ**は、系統、実行期間、行数、ログイン情報の使用状況で更新されます。しきい値またはエラーがトリガーされた場合にシステム管理者に発行されるアラート。
##### 結果
コア顧客リレーションとマーケティングエンゲージメントデータは、データレイクオブジェクト (DLO) として Data 360 に取り込まれます。これにより、次の結果が得られます。
- プロファイル、ケース、商談、メール/エンゲージメント評価指標を含む**統合データセット**。
- 統合個人プロファイルの **ID 解決**および構築の基盤。
- ガバナンスと監査性を維持しながら、ダウンストリームのハーモナイゼーション、強化、AI モデリング、有効化のための**運用準備**を行います。
###### 取り込みメカニズム
取り込みメカニズムは、Data 360 内で定義されたコネクタとスケジュール戦略によって異なります。
| メカニズム | 使用するケース |
|---|---|
| Salesforce CRM コネクタ (ネイティブ) | 標準/カスタム CRM オブジェクトに最適。フル更新と差分更新をサポートします。 |
| Marketing Cloud Engagement コネクタ (ネイティブ) | データエクステンション、送信、抽出の追跡に最適。フル/デルタモードをサポート。 |
| スターターデータバンドル | 一般的なセールス/サービス/マーケティングオブジェクトのオンボーディングを加速します。 |
| カスタムストリーム + 前処理 | 複雑な変換や重いスキーマの正規化が必要な場合に使用します。 |
| コネクタ | エンドポイント要件 |
|---|---|
| Salesforce CRM コネクタ | ソース組織は、接続アプリケーション、OAuth トークン、および参照権限を持つ専用のインテグレーションユーザーを許可する必要があります。 |
| Marketing Cloud Connector | Marketing Cloud API ログイン情報またはインストール済みパッケージ。データエクステンションは抽出/API を使用してデータを公開する必要があります。 |
| ソリューション領域 | 適合 | コメント/実装の詳細 |
|---|---|---|
| ソリューション適合 | 低レイテンシのイベントキャプチャに最適 | Data 360 取り込み API (ストリーミング JSON) を使用して、単一イベントまたはマイクロバッチをプッシュします。厳格な OAS 3.0 スキーマ (.yaml) を使用して取り込み API コネクタを設定します。より頻繁ではない大きな同期には、一括 CSV 取り込みを使用します。 |
| スキーマ変更の処理 | 厳格/管理 | スキーマの変更は、OAS .yaml の更新、コネクタのバージョン管理、契約テストの実行など、破壊的です。プロデューサーを同時に変更できない場合は、ローリングスキーマ移行を実装します。 |
| 使用しないケース | 準最適 | 前処理が必要な場合 (重複排除、注文の保証など) や、非常に大きなバルク積荷の場合 (ネイティブのバルクコネクタまたはバッチ ETL を使用) は理想的ではありません。ソースでスキーマが有効なペイロードを生成できない場合、または安全に認証できない場合は、別の取り込み方法を使用します。 |
| セキュリティとガバナンス | 必須 | 最小権限範囲で OAuth 2.0 を使用し、鍵を循環し、トークンの使用状況を記録します。TLS 1.2+ を適用し、必要に応じてクライアント IP を検証し、ペイロードの PII タギングを確認します。すべてのイベントでは、provinance メタデータ (ソース、タイムスタンプ、スキーマバージョン、緊急キー) を伝達する必要があります。 |
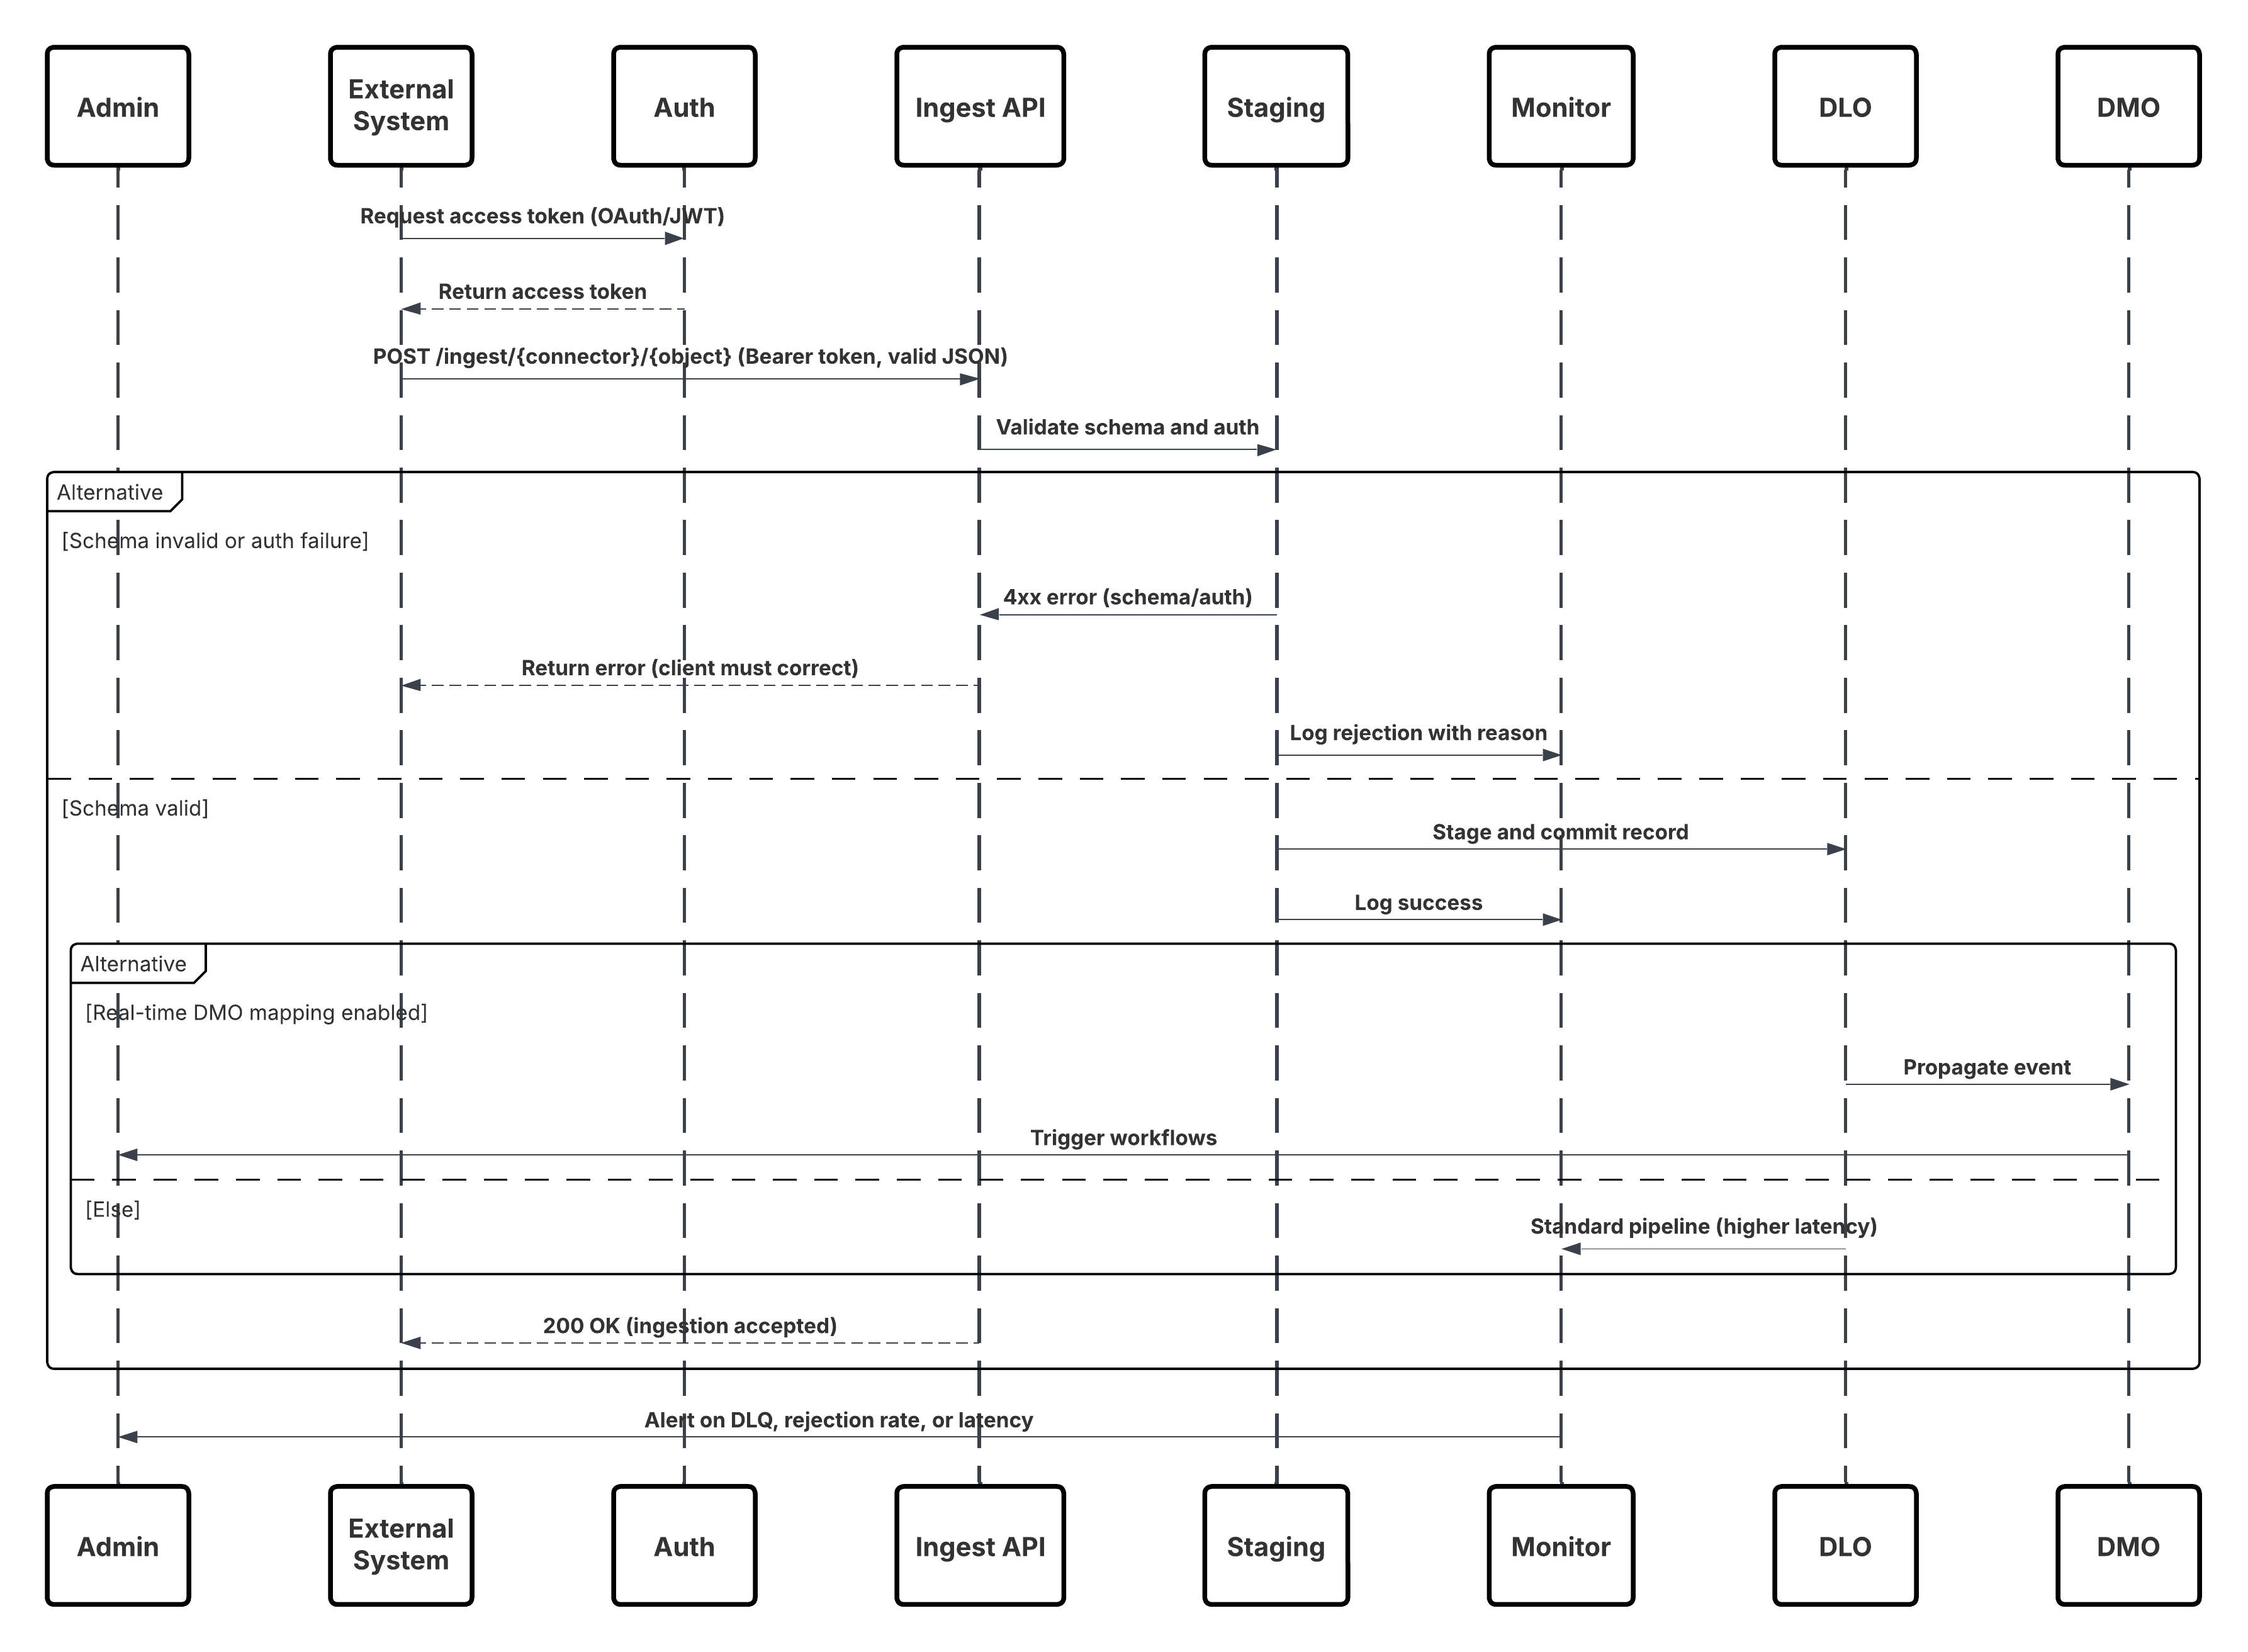 **このシナリオの内容は次のとおりです。**
- 外部システムは、認証サーバーから OAuth/JWT を介して認証を要求します。
- 認証サーバーがアクセストークンを外部システムに返します。
- 外部システムは、認証と JSON ペイロードを使用してデータ取り込み POST 要求を Data 360 取り込み API に送信します。
- 取り込み API は、「ステージング & 検証」モジュールを使用して要求スキーマと認証を検証します。
- スキーマ/認証に失敗した場合:
- エラーが外部システムに返されました。
- 監視とアラートのために記録された却下。
- 検証が成功した場合:
- ステージングされてデータレークオブジェクト (DLO) にコミットされたレコード。
- 監視のために記録された成功。
- 有効になっている場合、データはリアルタイムデータグラフ (DMO) に伝搬され、下流のワークフローがトリガーされます。
- それ以外の場合は、標準バッチまたは高遅延パイプラインで処理されるデータ。
- 取り込み API で外部システムへの成功が確認されます。
- 監視コンポーネントは、デッドレターキュー、却下率、または遅延の問題についてシステム管理者に警告します。
##### 結果
外部イベントデータは、低遅延で Data 360 DLO に取り込まれます。対象 DMO がリアルタイムグラフの一部である場合、そのデータをインスタントセグメンテーション、エージェントワークフロー、AI モデル、運用の有効化で使用できます。これにより、接続システムから発生したイベントに迅速にビジネスで対応できます。
###### 取り込みメカニズム
取り込みメカニズムは、Data 360 内で定義されたコネクタとスケジュール戦略によって異なります。
| メカニズム | 使用するケース |
|---|---|
| ストリーミング JSON (取り込み API) | 単一イベント、マイクロバッチ、行動イベント、クリックストリーム、IoT テレメトリ (低遅延が必要な場合)。 |
| Bulk CSV (取り込み API 一括モード) | 遅延要件が緩和された、より大規模な定期的なアップロード。 |
| Edge / Middleware | 取り込み API に転送する前に検証、変換、強化、またはレート制限が必要な場合に使用します。 |
| ソリューション領域 | 適合 | コメント/実装の詳細 |
|---|---|---|
| SDK ベースのイベントキャプチャ | 最善 | Salesforce Interactions SDK (Web) またはネイティブ SDK (モバイル) をリリースします。これらの軽量ライブラリは、ユーザー操作をリアルタイムで取得して逐次化し、メタデータ (セッション ID、タイムスタンプ、コンテキスト) を添付します。 |
| Event Streaming Pipeline | 最善 | イベントは、セキュアな HTTPS を介して Marketing Cloud Personalization のイベントストリーミングサービスに送信されます。このレイヤーは水平方向に拡張可能で、低遅延の送信用に最適化されています (<2s)。 |
| Data 360 インテグレーション | 最善 | Data 360 の Personalization Connector はストリーミングフィードを登録し、各イベントをほぼリアルタイムでデータレイクオブジェクト (DLO) に取り込みます。 |
| データモデルマッピング | ベストプラクティス | 取り込まれた DLO は Customer 360 DMO (データモデルオブジェクト) にマッピングされます。これにより、ID 解決を使用して匿名ユーザーと既知ユーザーをリンクできます。 |
| リアルタイムグラフの有効化 | 省略可能/推奨 | マッピングされた DMO をリアルタイムのグラフに含め、Einstein または Agentforce ワークフローを介してパーソナライズされたアクションをすぐにセグメンテーションできます。 |
| 使用しないケース | 準最適 | このパターンは、次の場合には理想的ではありません。ソースデータは Web クライアントとイベントです (代わりに取り込み API を使用します)。組織は Web / モバイルクライアントを制御できない。リアルタイムの行動追跡は必要ありません (一括取り込みを使用します)。 |
| スキーマの変更の処理 | Managed Evolution | イベントスキーマは、新しいインタラクションが追加されると進化します。SDK はイベント定義のバージョンを設定する必要があります。下位互換性のある変更 (省略可能な項目の追加) は安全です。変更を破棄するには、コネクタの再設定と契約テストが必要です。 |
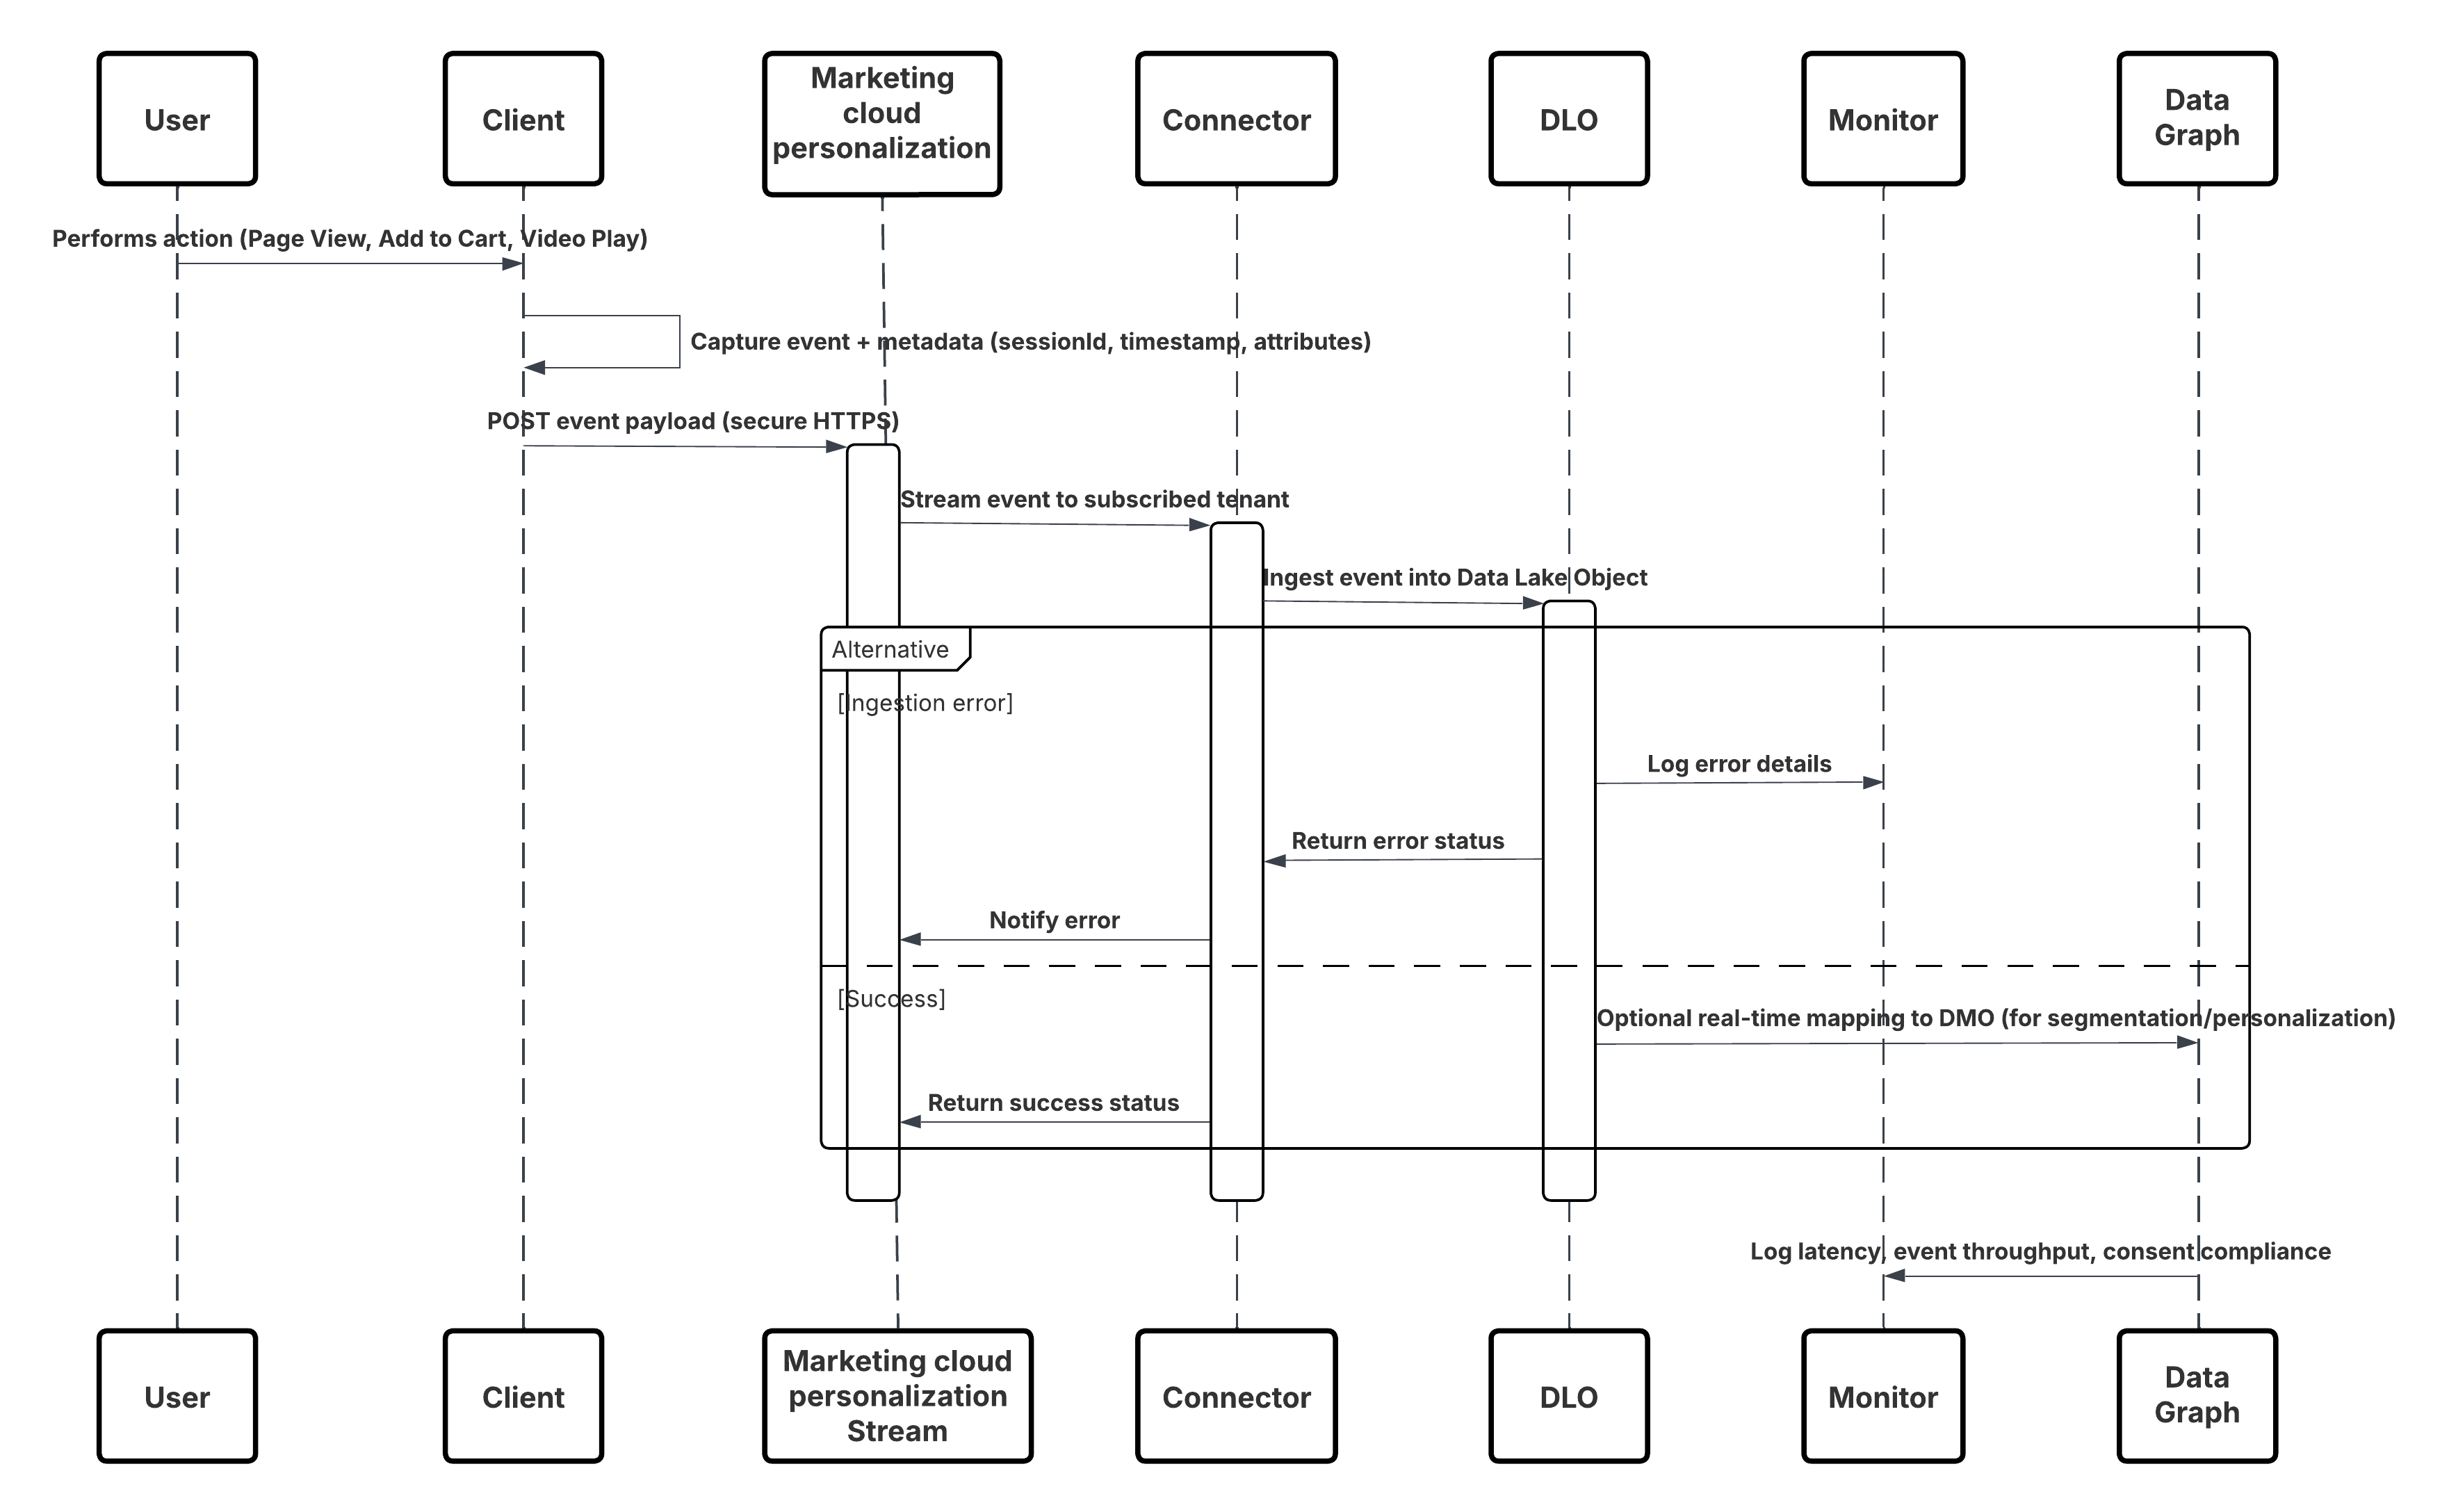 **このシナリオの内容は次のとおりです。**
- Web またはモバイルチャネルで SDK をリリースします (ユーザーインタラクションキャプチャ)。
- テナント ID、環境、同意コントロールを使用して SDK を設定します。
- 取得した JSON イベント (メタデータ + 属性) を Marketing Cloud ストリーミングエンドポイントにストリーミングします。
- Data 360 の \[設定] で、テナントのパーソナライズコネクタを作成および設定します。
- イベントを DLO に取り込み、Data 360 内で DLO → DMO をマッピングします。
- リアルタイムグラフで DMO を有効にして、すぐに有効化します。
- 遅延、スキーマの適合性、同意フラグ、スループット、エラー率を監視します。
- 本番にリリースし、継続的に監視します。
##### 結果
行動イベントの継続的な低遅延ストリームがデジタルチャネルから Data 360 に流れます。数秒で、各ユーザーアクションをリアルタイムセグメンテーション、予測モデリング、トリガーされたパーソナライズで使用できるようになり、真に適応したカスタマーエクスペリエンスが可能になります。
###### 取り込みメカニズム
取り込みメカニズムは、Data 360 内で定義されたコネクタとスケジュール戦略によって異なります。
| メカニズム | 使用するケース |
|---|---|
| Interactions SDK (Web) | Web ブラウザーおよび SPA からのリアルタイムキャプチャ。 |
| Mobile SDK | ネイティブモバイルアプリケーションからのリアルタイムキャプチャ。 |
| Personalization コネクタ | Marketing Cloud と Data 360\ 間の管理サブスクリプション。 |
| リアルタイムグラフの対応付け | セグメンテーション、Einstein、ジャーニーで即時有効化を有効にします。 |
| ソリューション領域 | 適合 | コメント/実装の詳細 |
|---|---|---|
| CDC ベースのストリーミングコネクタ | 最善 | ネイティブの Salesforce メカニズム。完全に管理され、プラットフォームイベントインフラストラクチャと統合されています。 |
| イベント登録および配信 | 最善 | コネクタは、耐久性のある再生 ID を使用して ChangeEvent チャネル (/data/ContactChangeEvent など) を登録します。 |
| データマッピングとスキーマの進化 | ベストプラクティス | ストリーミングされたペイロードを対応する DLO に対応付けます。取り込みが中断されないようにメタデータでスキーマバージョンを管理します。 |
| リプレイと障害復旧 | 推奨 | リプレイ ID と緊急キーを使用して重複を回避し、一時的なエラーから回復します。 |
| ハイブリッドモード (ストリーミング + バッチ) | 省略可能 | サポートされないオブジェクトまたは最初の一括読み込みの場合、一括取り込みを CDC ストリーミングと組み合わせて使用します。 |
| 使用しないケース | 最適ではない | このパターンは、次の場合に最適ではない場合があります。ソースオブジェクトが CDC 対応ではありません。この使用事例では、リアルタイムの更新は必要ありません (バッチで十分)。ソース組織からのネットワーク出力が制限されているか、イベント制限を超えている。 |
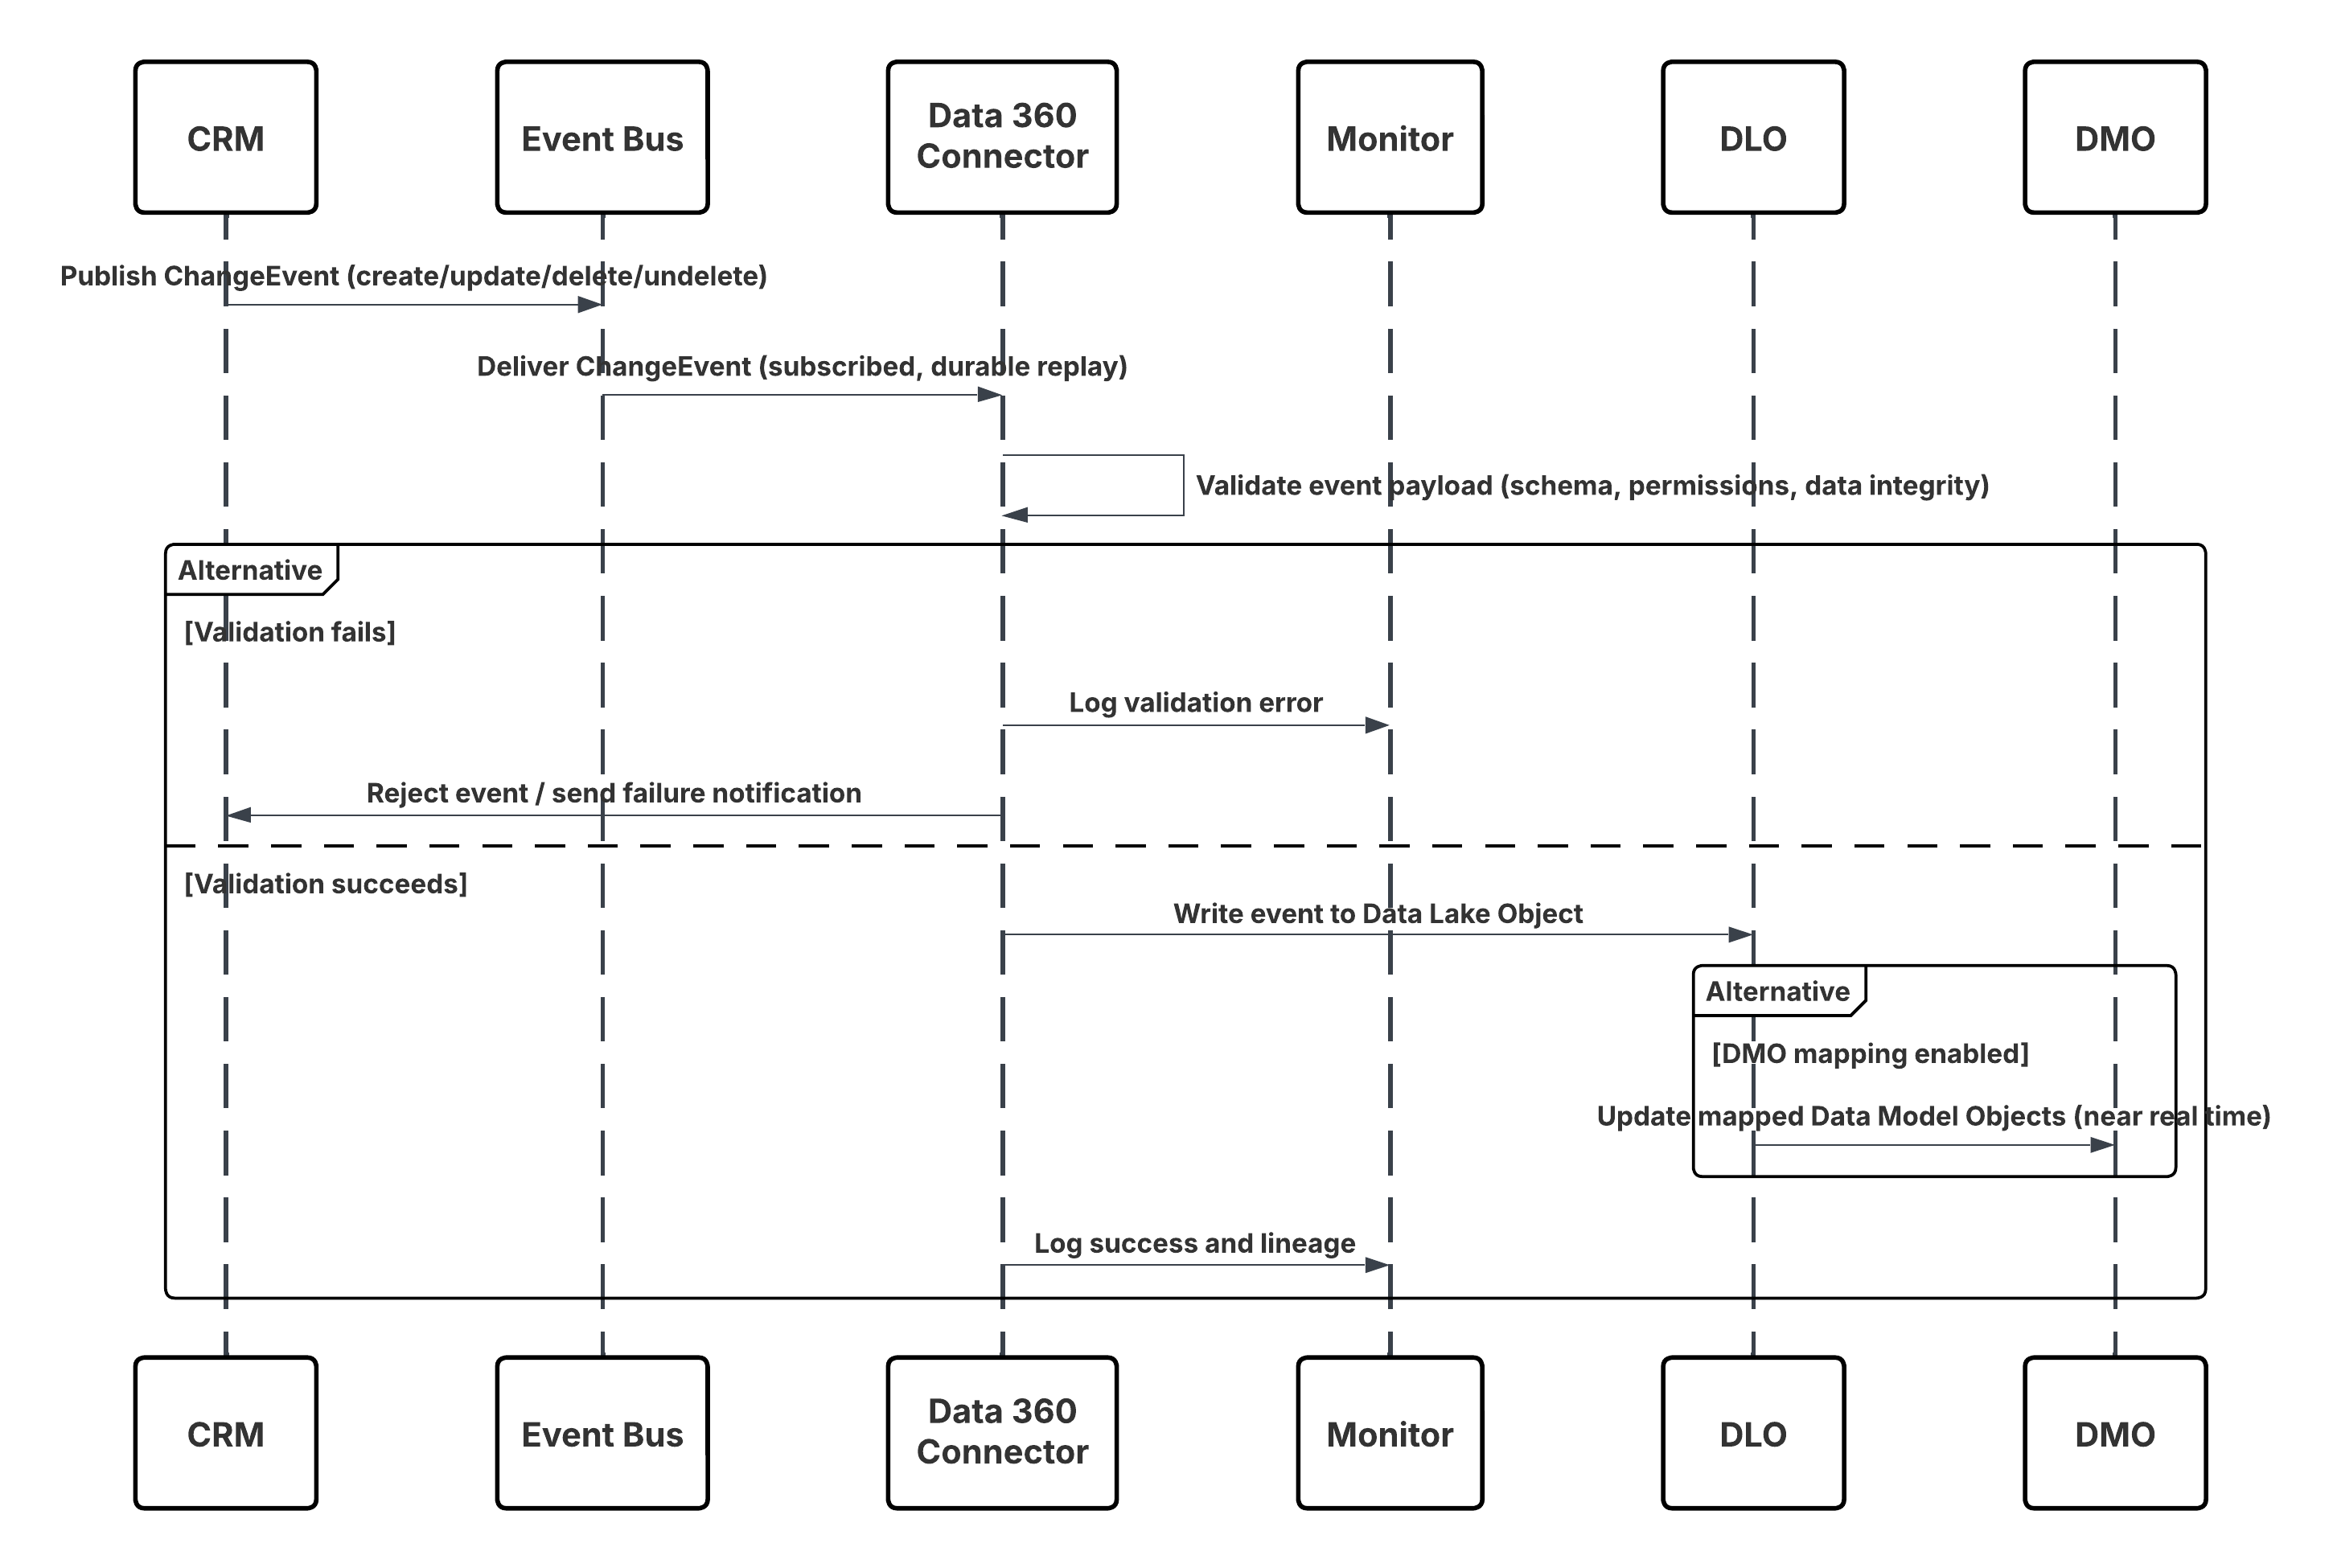 **このシナリオの内容は次のとおりです。**
- Salesforce CRM で変更が行われる (作成/更新/削除/復元)。
- CDC が ChangeEvent を内部 Salesforce イベントバスに公開します。
- Data 360 CRM コネクタは、耐久性のあるリプレイカーソルを使用してイベントバスを登録します。
- イベントペイロードは、スキーマ、権限、およびデータの整合性が検証されます。
- Data 360 は、検証済みイベントをマッピングされた**データレークオブジェクト (DLO)** に書き込みます。
- 有効にすると、マッピングされた**データモデルオブジェクト (DMO)** がほぼリアルタイムで更新され、セグメンテーションと有効化が強化されます。
##### 結果
Data 360 では、主要な CRM データの継続的な同期ミラーが維持されます。
これにより、次のことが可能になります。
- リアルタイムトリガー (ケースが作成されたときに Journey が起動するなど)。
- 最新のセグメンテーション (取引先状況の変更時に顧客を「ゴールド」セグメントに移動するなど)。
- ライブ CRM コンテキストに基づくより正確な分析とパーソナライズ。
###### 取り込みメカニズム
このパターンの取り込みメカニズムは、変更データキャプチャ (CDC) が有効になっている Salesforce CRM コネクタでネイティブに管理されます。Data 360 は CDC イベントストリームの登録者として機能し、ソース CRM 組織と Data 360 間の信頼性の高い低遅延の同期を保証します。
| メカニズム | 使用するケース |
|---|---|
| CDC を介したストリーミング (優先) | ほぼリアルタイムの同期が必要な、サポートされているすべての Salesforce 標準オブジェクトおよびカスタムオブジェクト。 |
| ハイブリッドモード (CDC + バッチ) | まだ CDC 対応ではないオブジェクト、または初期履歴読み込みが必要なオブジェクト。 |
| 登録モードをリプレイ | ダウンタイムまたはリリース後の再同期用。 |
| エラー分離モード | テストおよび検証環境用。 |
| ソリューション領域 | 適合 | コメント/実装の詳細 |
|---|---|---|
| Kinesis ネイティブコネクタ | 最善 | AWS Kinesis とのファーストパーティインテグレーション。継続的な高スループット取り込みをサポートします。 |
| MSK ネイティブコネクタ | 最善 | OIDC と鍵ベースの認証のサポートによる Kafka の管理取り込み。 |
| スキーマの対応付けと検証 | ベストプラクティス | イベント構造を定義するスキーマ (.json/.avro) をアップロードし、取り込み時に一貫性を適用します。 |
| IAM 設定 | 推奨 | 対象 Kinesis ストリームまたは MSK トピックへの参照のみのアクセス権を持つ最小権限の IAM ロールを割り当てます。 |
| プライベートネットワークルーティング | 省略可能 | セキュアな内部ルーティングのために PrivateLink/VPC エンドポイントを設定します。 |
| ハイブリッドパターン (ストリーミング + バッチ) | 省略可能 | 差分にはストリーミングを使用し、バックフィルや履歴読み込みには一括取り込みを使用します。 |
| エラー分離モード | 推奨 | リプレイのためにスキーマ却下と一時的なエラーを DLQ に転送 |
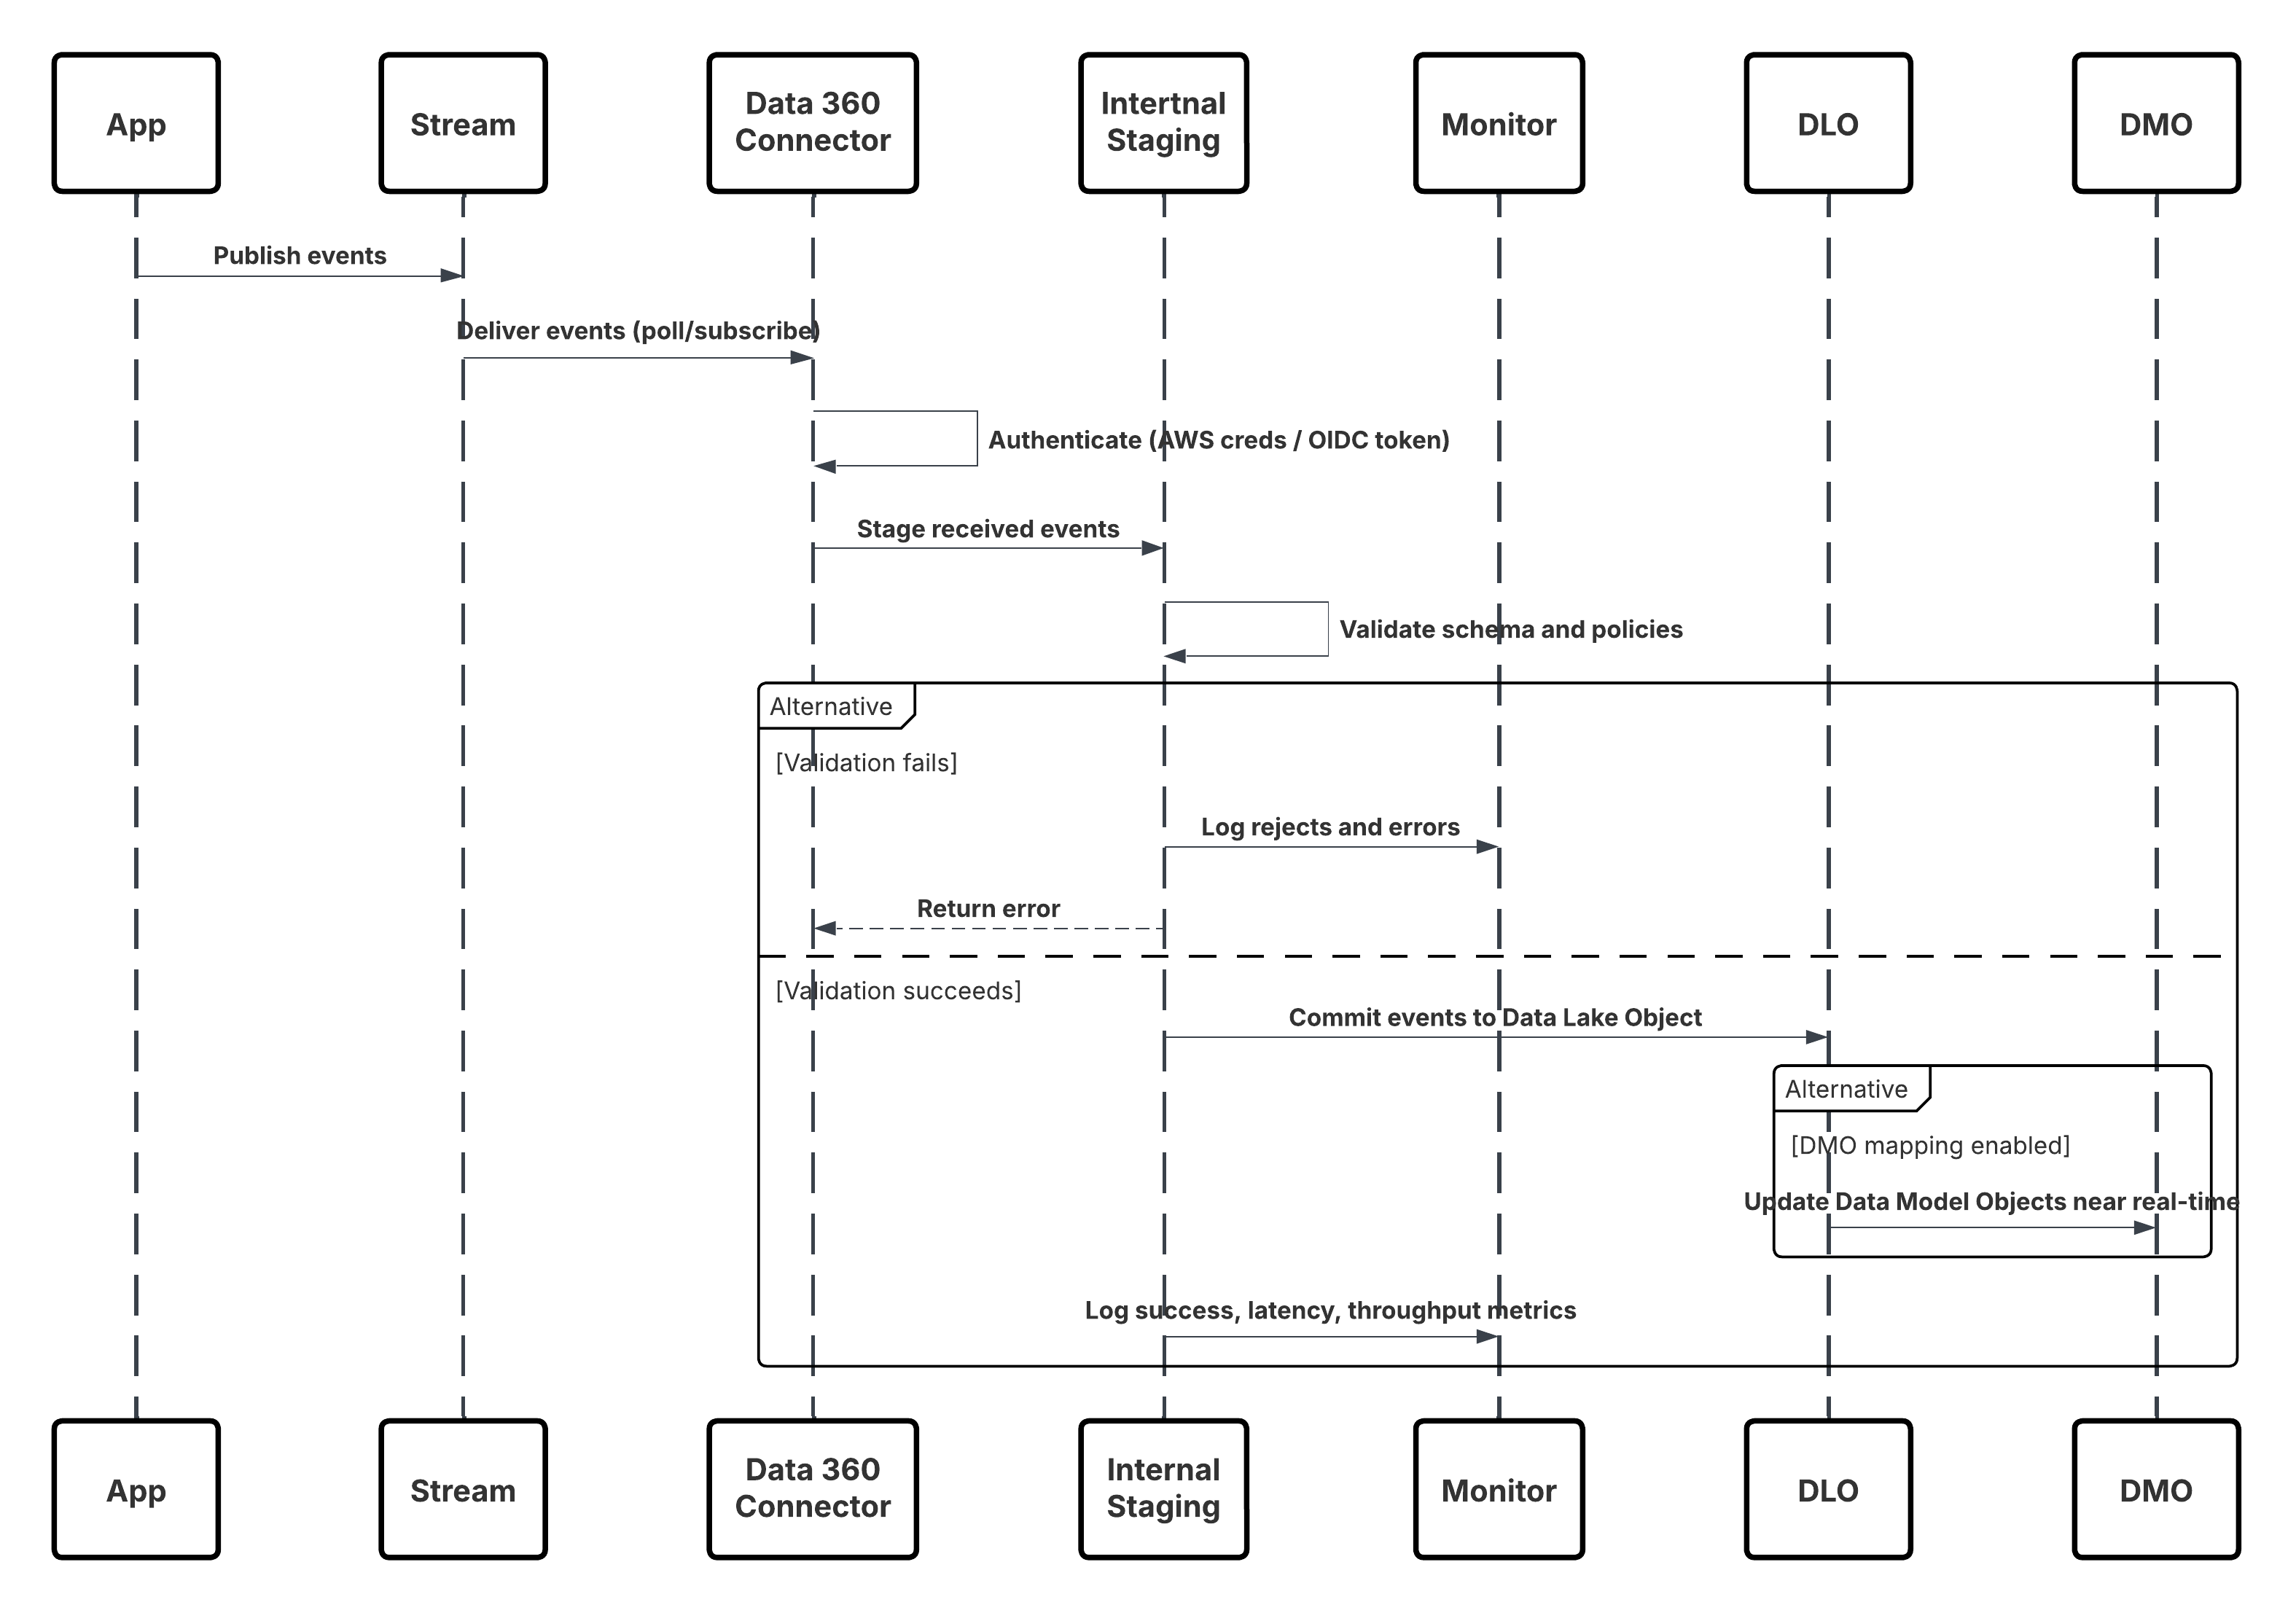 **このシナリオの内容は次のとおりです。**
- アプリケーションまたはデバイスは、イベントを Kinesis ストリームまたは MSK トピックに公開します。
- Data 360 コネクタは、AWS ログイン情報または OIDC トークンを使用して認証します。
- コネクタがストリームを継続的にポーリングまたは登録する。
- イベントがステージングされ、スキーマとポリシーが検証され、データレークオブジェクト (DLO) にコミットされます。
- マッピングされている場合、データモデルオブジェクト (DMO) は有効化のためにほぼリアルタイムで更新されます。
- 監視レイヤーは、総計値、スキーマ却下、遅延を追跡します。
##### 結果
AWS Kinesis または MSK から Data 360 への構造化データの継続的な低遅延取り込み。データは、次の場合にすぐに使用できます。
- ID 解決
- リアルタイムセグメンテーション
- Einstein AI 有効化
- Agentforce 駆動型トリガー
バッチ ETL への依存を排除し、エンタープライズイベント駆動型設計に準拠したストリームベースのアーキテクチャを実現します。
###### 取り込みメカニズム
| メカニズム | 使用するケース |
|---|---|
| Kinesis コネクタ (優先) | 大量の構造化データの継続的な取り込みが必要な AWS ネイティブストリーミングソース用。 |
| MSK Connector | Kafka 互換プラットフォームでイベントパイプラインを実行している組織向け。 |
| ハイブリッド(ストリーミング + バッチ) | 増分イベントの取り込みと定期的な一括読み込みの組み合わせの場合。 |
| ソリューション領域 | 適合 | コメント/実装の詳細 |
|---|---|---|
| Snowflake Zero Copy Connector | 最善 | ファーストパーティネイティブインテグレーション。Snowflake のデータ共有または外部テーブル API を使用してライブクエリ統合を確立します。 |
| Databricks Zero Copyコネクタ | 最善 | Delta Lake のテーブル/ビューへの直接ライブアクセスがサポートされ、プッシュダウンクエリは Databricks ランタイムで実行されます。 |
| ファイルフェデレーション(Apache Iceberg/Delta/Parquet) | 新しいベストプラクティス | Data 360 は、外部コンピューティングの連動関係なしに、オブジェクトストレージから開いているテーブル形式を直接読み取ります。大量のデータセットに最適です。 |
| プライベートネットワーク設定 | 推奨 | Salesforce プライベートコネクトまたは VPC ピアリングを使用して、安全なネットワークレベルの統合を実現します。 |
| 認証と鍵の管理 | ベストプラクティス | 定期的な循環と保管庫管理を使用して、安全な鍵ベースまたは OAuth ベースの認証を実装します。 |
| スキーマ登録 | 必須 | Data 360 は外部スキーマを取得して、外部データレークオブジェクト (外部 DLO) にマッピングします。 |
| 管理メタデータ | 推奨 | すべての外部 DLO は、コンプライアンス表示のために分類、同意、系統メタデータを継承します。 |
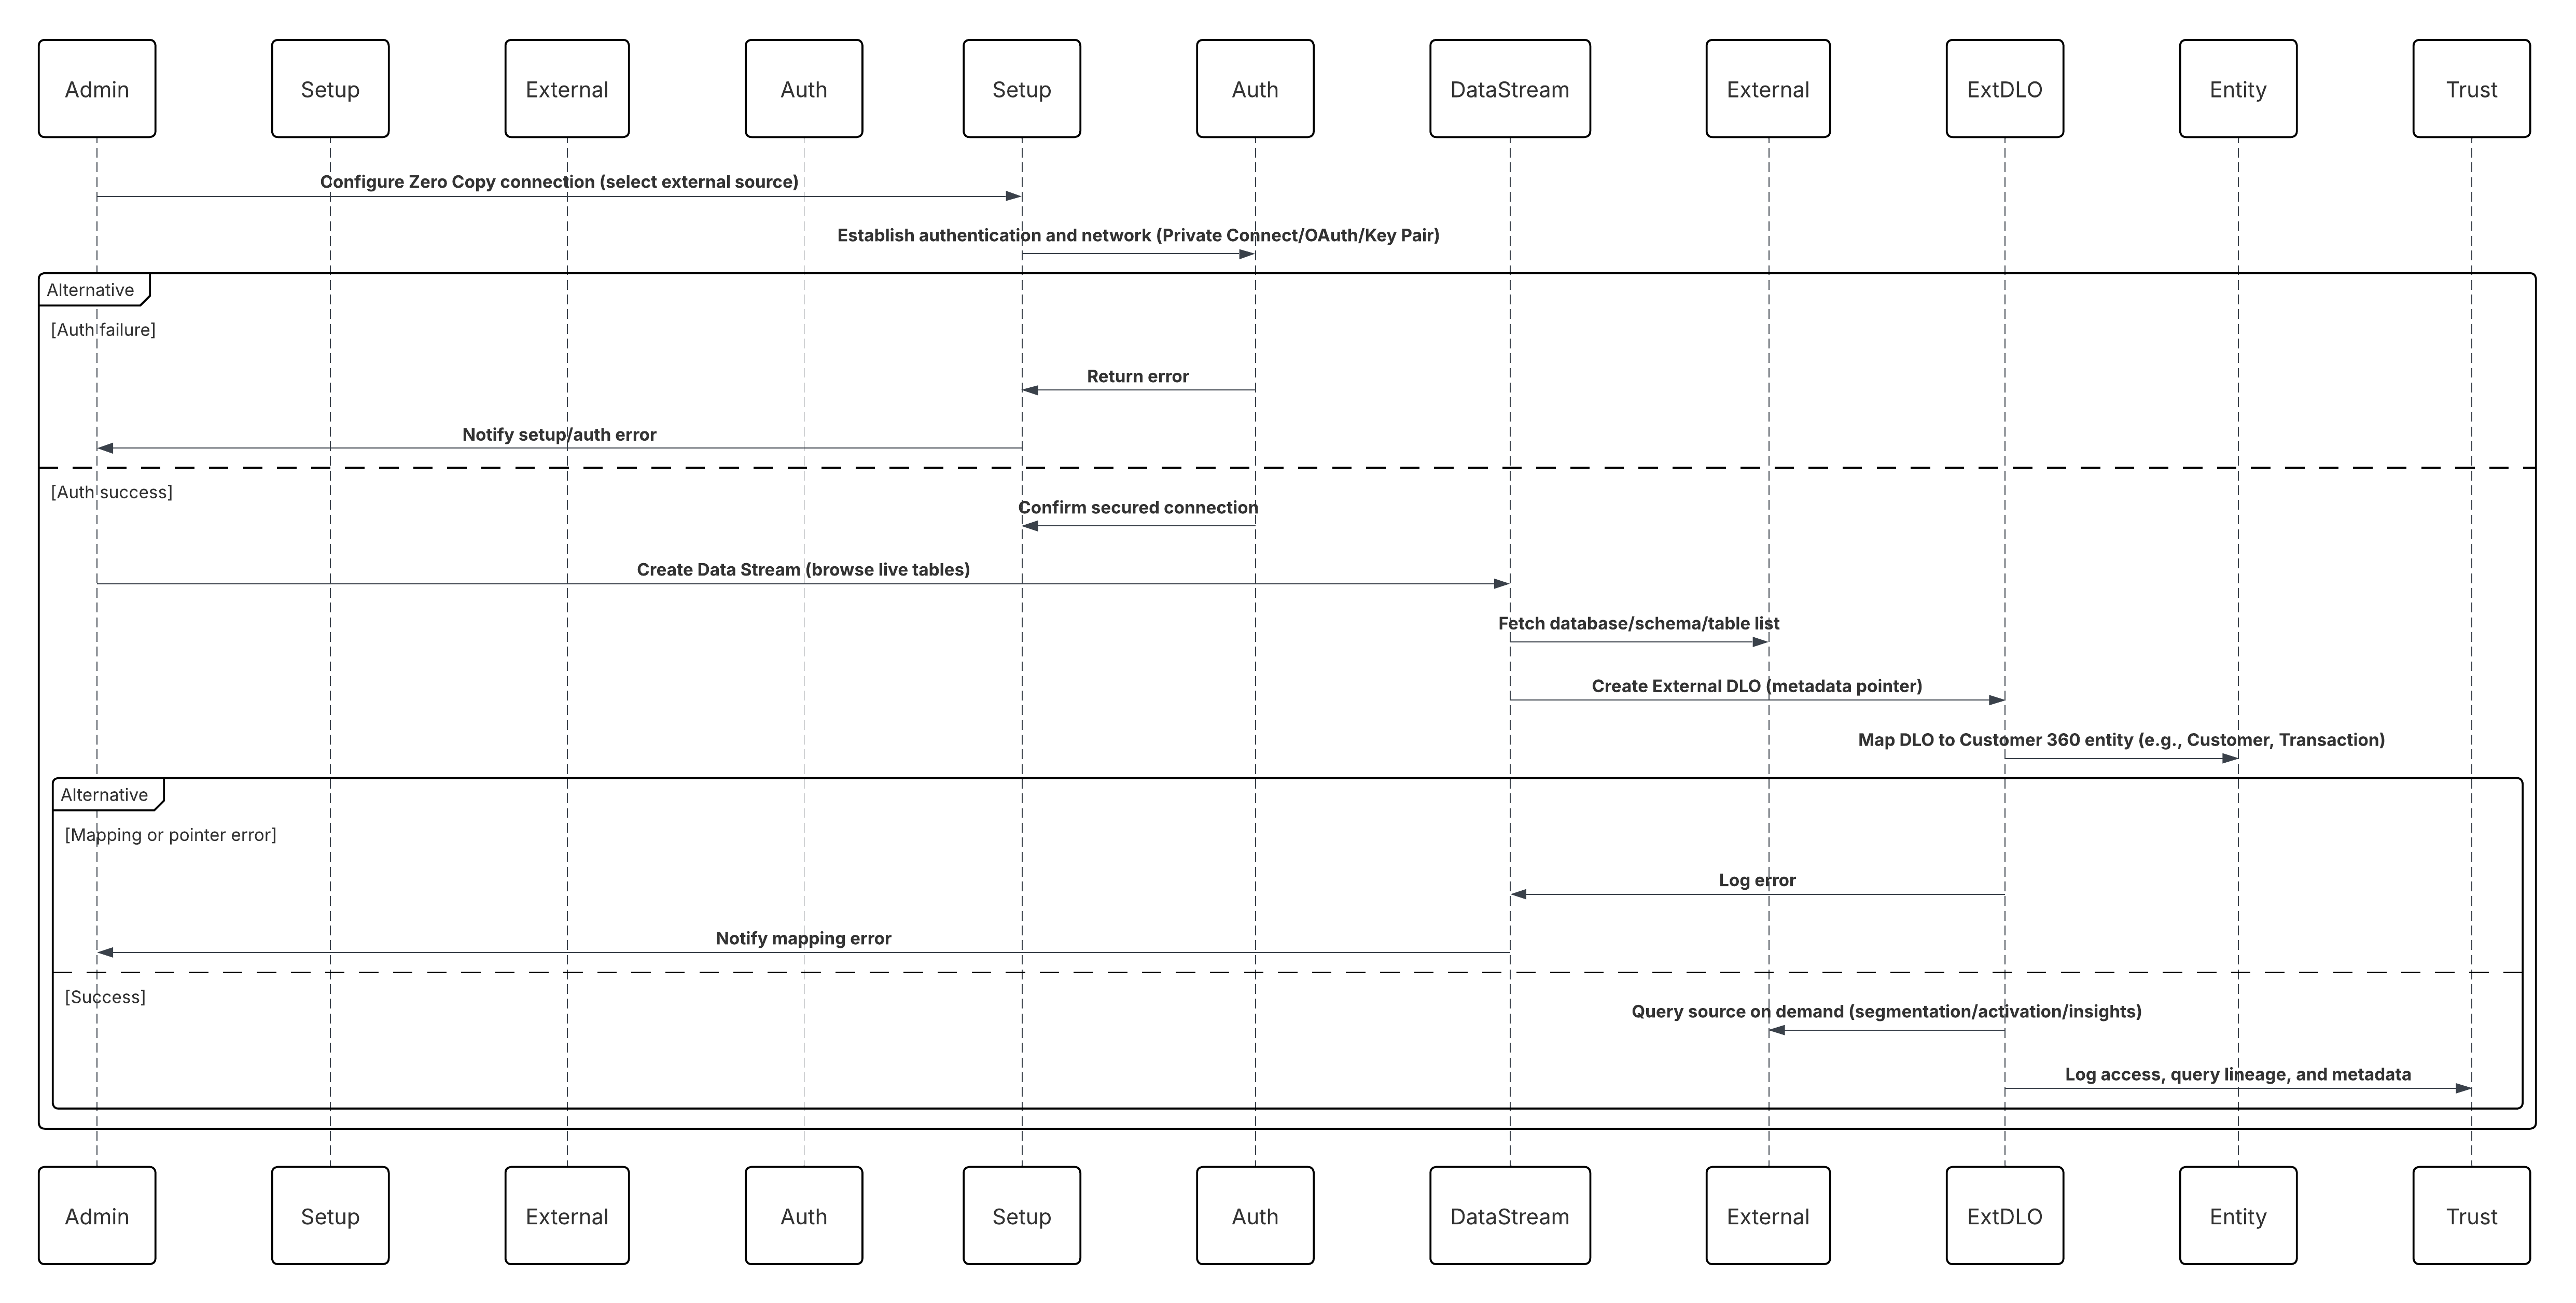 このシナリオの内容は次のとおりです。
- 管理者は、Data 360 の\[設定\](https://staging.architect.salesforce.com/docs/architect/ja-jp/fundamentals/guide/Snowflake%E3%80%81Databricks%E3%80%81%E3%81%BE%E3%81%9F%E3%81%AF%E3%83%95%E3%82%A1%E3%82%A4%E3%83%AB%E3%83%95%E3%82%A7%E3%83%87%E3%83%AC%E3%83%BC%E3%82%B7%E3%83%A7%E3%83%B3)でゼロ コピー接続を設定します。
- セキュアな認証とネットワークルーティングが確立されている (プライベートコネクト/OAuth/鍵のペア)。
- システム管理者は、外部ソース (ライブデータベース、スキーマ、テーブルの参照) を選択してデータストリームを作成します。
- Data 360 では、データをコピーする代わりに、外部 DLO (データレイクオブジェクト) が作成されます。これは、ライブテーブルまたは Iceberg ファイルを参照するメタデータポインタです。
- 外部 DLO は Customer 360 エンティティ(Customer、Transaction、Product など)にマッピングされます。
- Data 360 は、セグメンテーション、有効化、またはインサイト計算中にソースを照会します。
- すべてのアクセス、クエリの系統、メタデータは、Data 360 Trust Layer 内で監査されます。
##### 結果
- 外部データは Snowflake、Databricks、または S3 に残ります。ETL、重複、追加ストレージはありません。
- Data 360 では、ID 解決、計算済みインサイト、有効化のためにエンタープライズ規模のデータにリアルタイムで参照できます。
- 組織は、既存のガバナンス、暗号化、およびコンプライアンスフレームワークの下で完全に制御できます。
- このパターンにより、ローカルアクセスのパフォーマンスと統合ストレージのガバナンスを組み合わせた、真のゼロコピーアーキテクチャが可能になります。
###### コールメカニズム
コールメカニズムは、このパターンを実装するために選択されたソリューションによって異なります。
| メカニズム | 使用するケース |
|---|---|
| Snowflake 統合 (優先) | 管理対象のエンタープライズデータウェアハウスを使用したライブのハイパフォーマンスクエリ統合。 |
| データブリックス連盟 | Delta または Parquet で支援されるデータセットを使用する統合分析および Lakehouse 環境用。 |
| ファイルフェデレーション(Apache Iceberg/Delta Lake) | コンピューティングの分離とコストの最適化が重要なオブジェクトストレージの大規模データセット用。 |
| ハイブリッドモード (ゼロコピー + 取り込み) | 履歴データに 1 回のみ取り込む必要があるが、ライブデータには Zero Copy を使用してアクセスする場合。 |
| ソリューション領域 | 適合 | コメント/実装の詳細 |
|---|---|---|
| データ共有の作成 | 最善 | 管理者は Data 360 内にデータ共有を作成し、選択した DMO と CIO (統合個人、顧客の正常性スコアなど) を追加します。 |
| 対象設定 | 最善 | Snowflake または Databricks のアカウント識別子と認証パラメーターを指定して、データ共有対象を作成します。 |
| 共有公開 | ベストプラクティス | データ共有をデータ共有対象にリンクして安全に公開します。 |
| 倉庫受け入れ | 必須 | 外部管理者は共有を受け入れ、共有オブジェクトを倉庫内の参照のみのビュー/テーブルとして具体化します。 |
| 詳細なアクセス制御 | 推奨 | Data 360 内でオブジェクトおよびロールベースの権限を適用し、倉庫レベルのロールベースのアクセス制御に従います。 |
| 統合クエリアクセス | 最善 | アナリストは標準 SQL を使用してライブ共有データを照会し、ネイティブの倉庫データと結合して下流の分析と ML を実行します。 |
| ファイルフェデレーションオプション | 省略可能 | 大規模なデータセットの場合、Apache Iceberg ベースの統合を使用して、コンピューティングに依存しない S3 または Delta Lake の直接読み取りを行います。 |
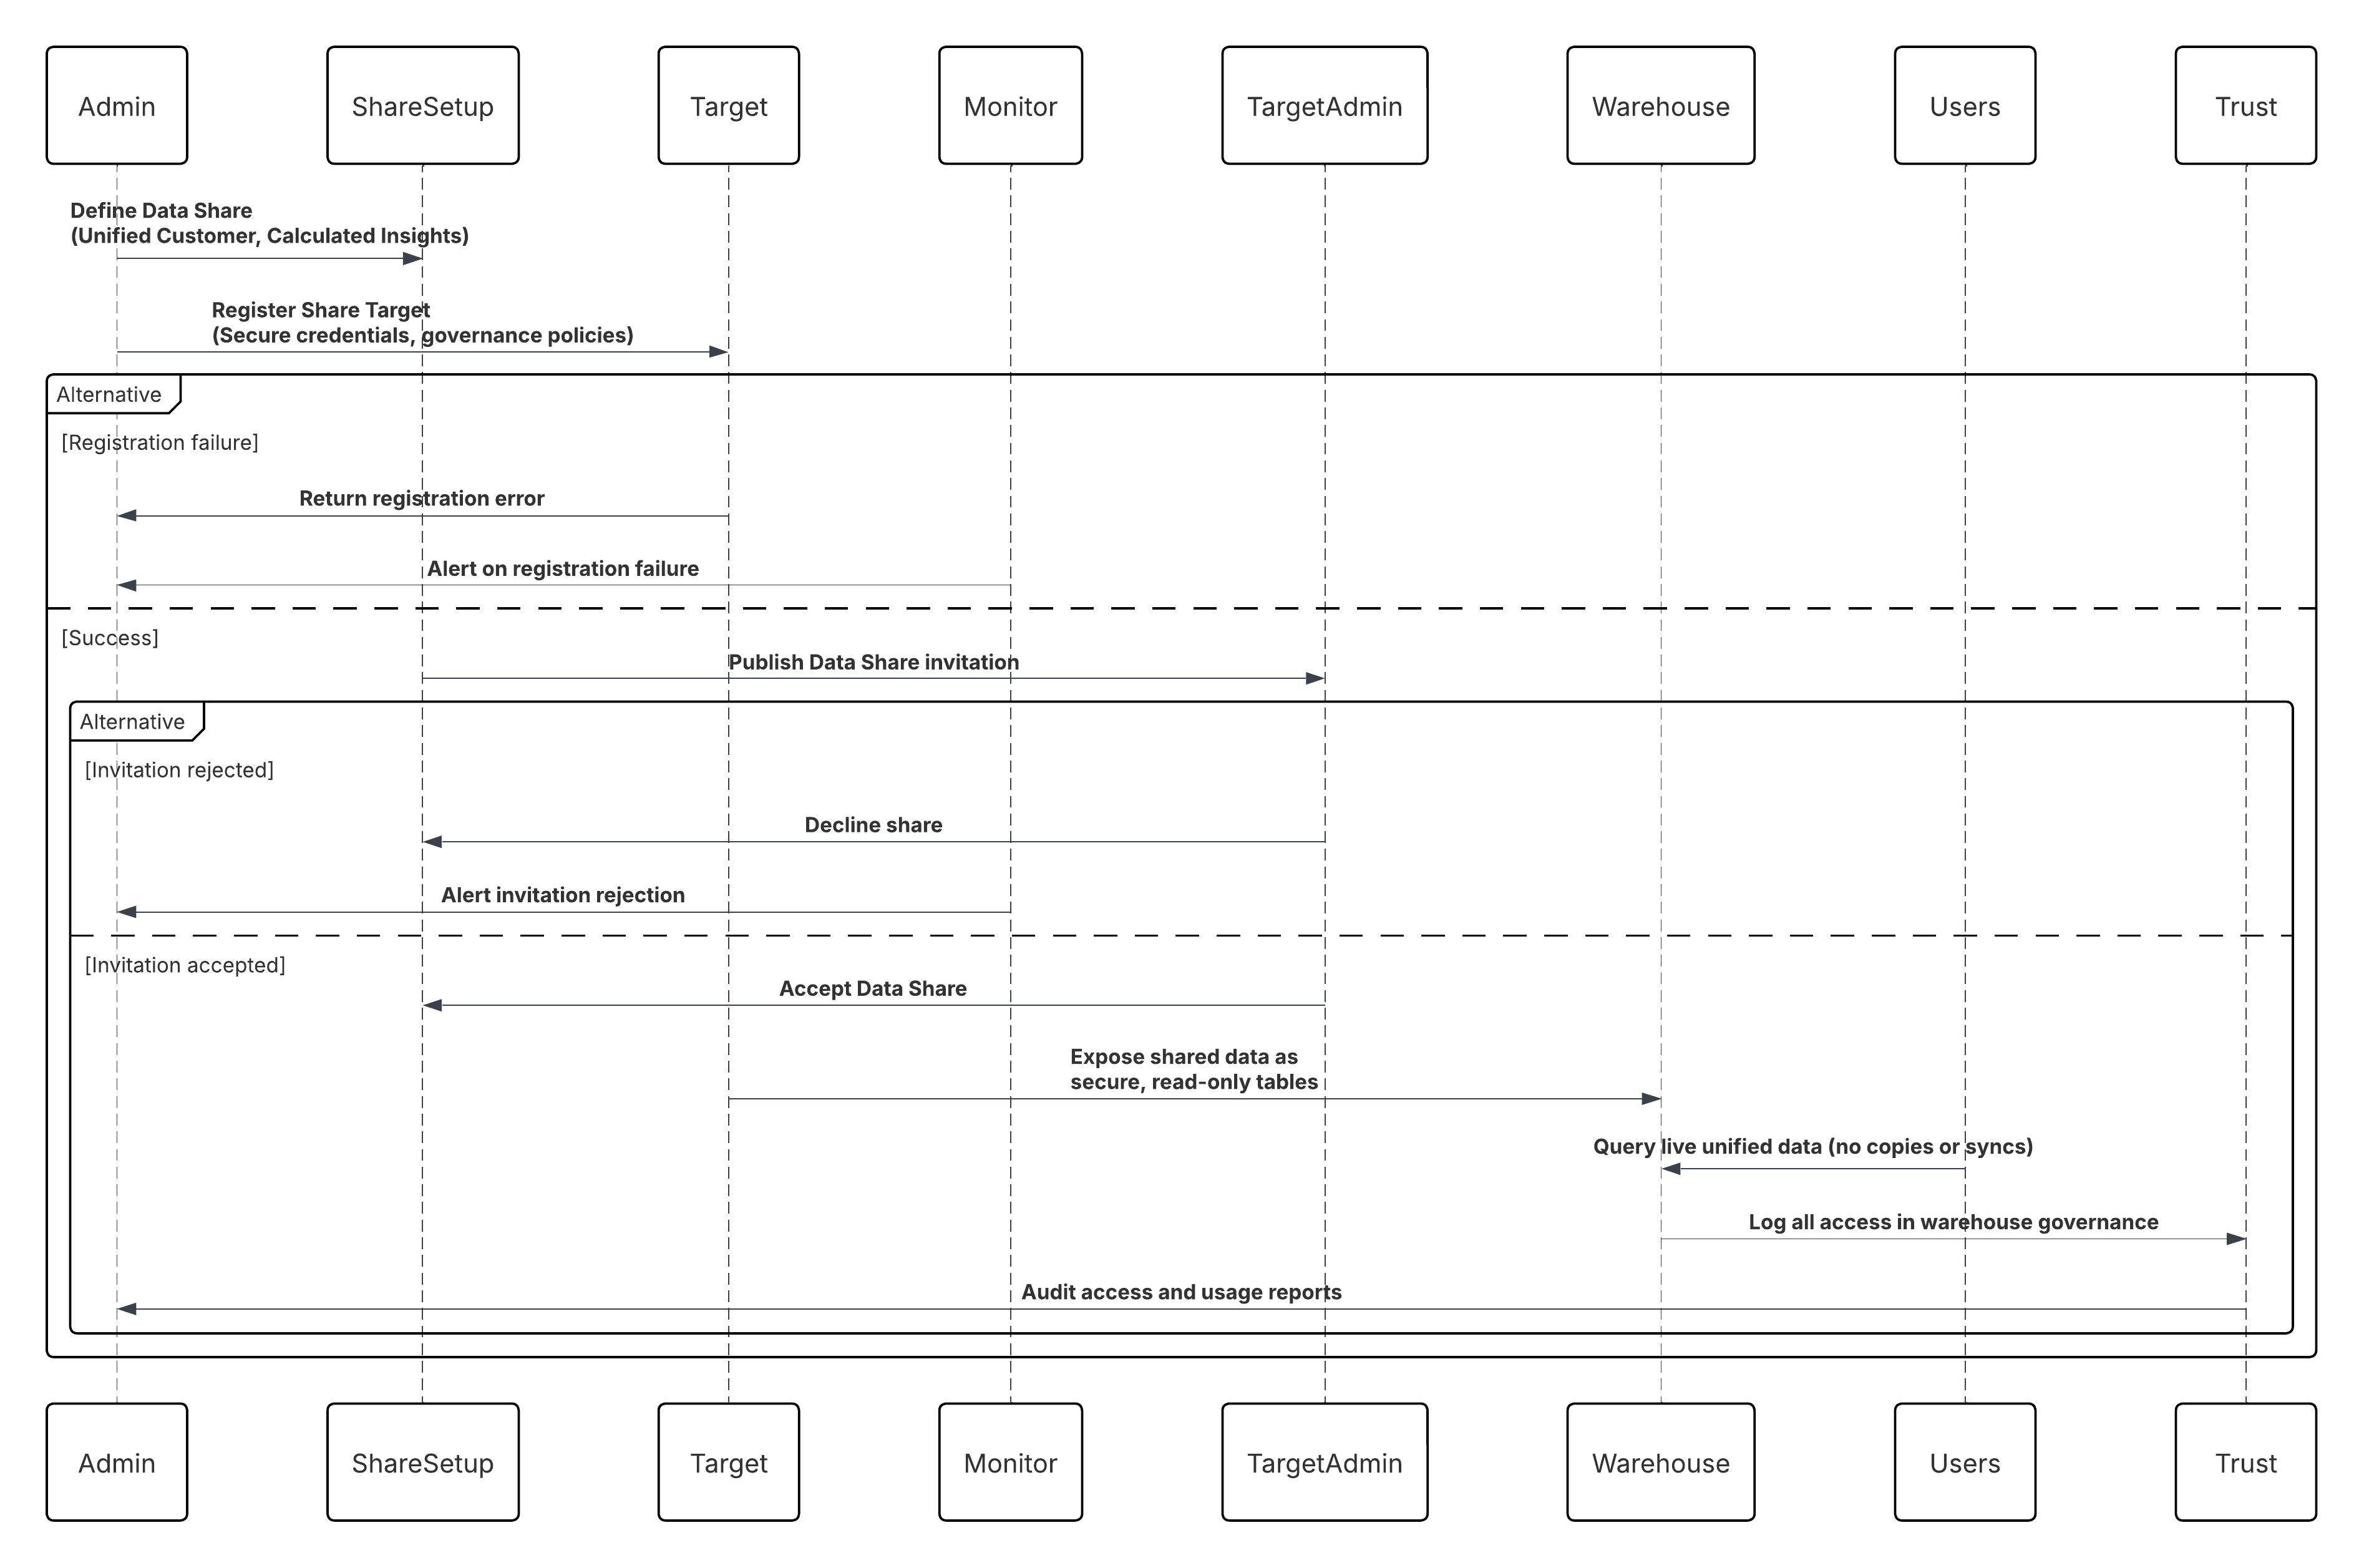 **このシナリオの内容は次のとおりです。**
- Data 360 管理者は、統合顧客オブジェクトと計算済みインサイトオブジェクトを含むデータ共有を定義します。
- データ共有対象 (Snowflake または Databricks アカウント) が安全なログイン情報とガバナンスポリシーで登録されている。
- Data 360 は共有を公開し、Snowflake/Databricks の管理者は共有を受け入れます。
- 共有データは、倉庫内の安全な参照のみのテーブルとして表示されます。
- アナリスト、BI ツール、または ML パイプラインは、コピーや同期を行わずにライブの統合顧客データを照会します。
- すべてのアクセスは、Data 360 Trust Layer およびウェアハウス ガバナンス ログ内で監査されます。
##### 結果
- 外部倉庫は、ハーモナイズされた Data 360 データにリアルタイムでクエリ可能にアクセスできます。
- Reverse ETL パイプラインを排除し、運用負荷と遅延を軽減します。
- 統合データで直接 AI/ML トレーニング、予測モデリング、高度な BI を有効にします。
- 重複ゼロ、強力なガバナンス、安全な設計によるアクセス制御を維持します。
- 1 つのガバナンスモデルで受信統合と共有送信が共存する双方向のゼロコピーループを完了します。
###### コールメカニズム
コールメカニズムは、このパターンを実装するために選択されたソリューションによって異なります。
| メカニズム | 使用するケース |
|---|---|
| Snowflake Secure Data Share (優先) | エンタープライズウェアハウスが Snowflake で、データの移動や重複なしでハーモナイズされた Data 360 データセットへのライブで管理されたアクセスが必要な場合に使用します。ゼロレイテンシーの共有とネイティブの系統適用を必要とする分析、AI、コンプライアンス主導のワークロードに最適です。 |
| Databricks Delta Share | 下流のコンシューマーが Databricks または Delta Lake 環境で操作し、オープンなデルタ共有プロトコルを使用して統合データセットまたは有効化されたデータセットへのリアルタイムの参照のみアクセスを必要とする場合に使用します。 |
| 外部テーブル共有 (Apache Iceberg / Parquet) | オブジェクトストレージ (S3、ADLS、または GCS) でオープン形式のアーキテクチャを維持し、Athena、BigQuery、Snowflake-on-Iceberg などの分析エンジン間で相互運用可能で低コストの共有が必要な場合に使用します。 |
| データ共有 API (プログラムによるアクセス) | カスタムアプリケーションまたはミドルウェア (MuleSoft など) で、API を使用してイベントベースの更新通知と詳細なアクセス制御を使用して、共有データセットを安全に検出、登録、消費する必要がある場合に使用します。 |
| ハイブリッド共有 (ゼロコピー + 送信共有) | 双方向の交換パターンを実装するときに使用します。受信データには Zero Copy、インサイトを公開するには Outbound Data Share を使用し、エンタープライズデータプレーン全体でセマンティックとガバナンスの一貫性を確保します。 |
| ソリューション領域 | 適合 | コメント/実装の詳細 |
|---|---|---|
| ホーム組織のプロビジョニング | 最善 | Data 360 がプロビジョニングされるホーム組織として 1 つの Salesforce 組織を指定します。これが中央データリポジトリおよびガバナンスハブになります。 |
| コンパニオン組織の接続 | 最善 | Data Cloud One アプリケーションを使用して、ホーム組織から 1 つ以上のコンパニオン組織へのコンパニオン接続を設定します。カスタムコードは必要ありません。 |
| データスペース定義 | ベストプラクティス | 自宅組織内でデータスペースを定義して、データ (小売、サービス、マーケティングなど) を論理的に区分し、アクセス境界を分離します。 |
| データスペース共有 | 最善 | 選択したデータスペースをホーム組織からコンパニオン組織まで明示的に共有し、統合データをロールベースで管理します。 |
| アクセス設定 | 必須 | コンパニオン組織で、Data Cloud One アプリケーションを有効にし、プロファイル、インサイト、セグメントアクセスのユーザー権限を割り当てます。 |
| ガバナンスとポリシーの管理 | 推奨 | すべての取り込み、ID解決、Trust設定をホーム組織で一元化し、エンド・ツー・エンドのガバナンスを維持します。 |
| 複数組織同期 | 最善 | ホーム組織のデータ変更と計算済みインサイトは、管理された同期パイプラインを介してコンパニオン組織全体でリアルタイムに反映されます。 |
| ハイブリッド導入オプション | 省略可能 | 大企業の場合、ローカルコンテキストとコンプライアンスの境界を維持しながら、複数のコンパニオン組織を 1 つの自宅組織に接続できます。 |
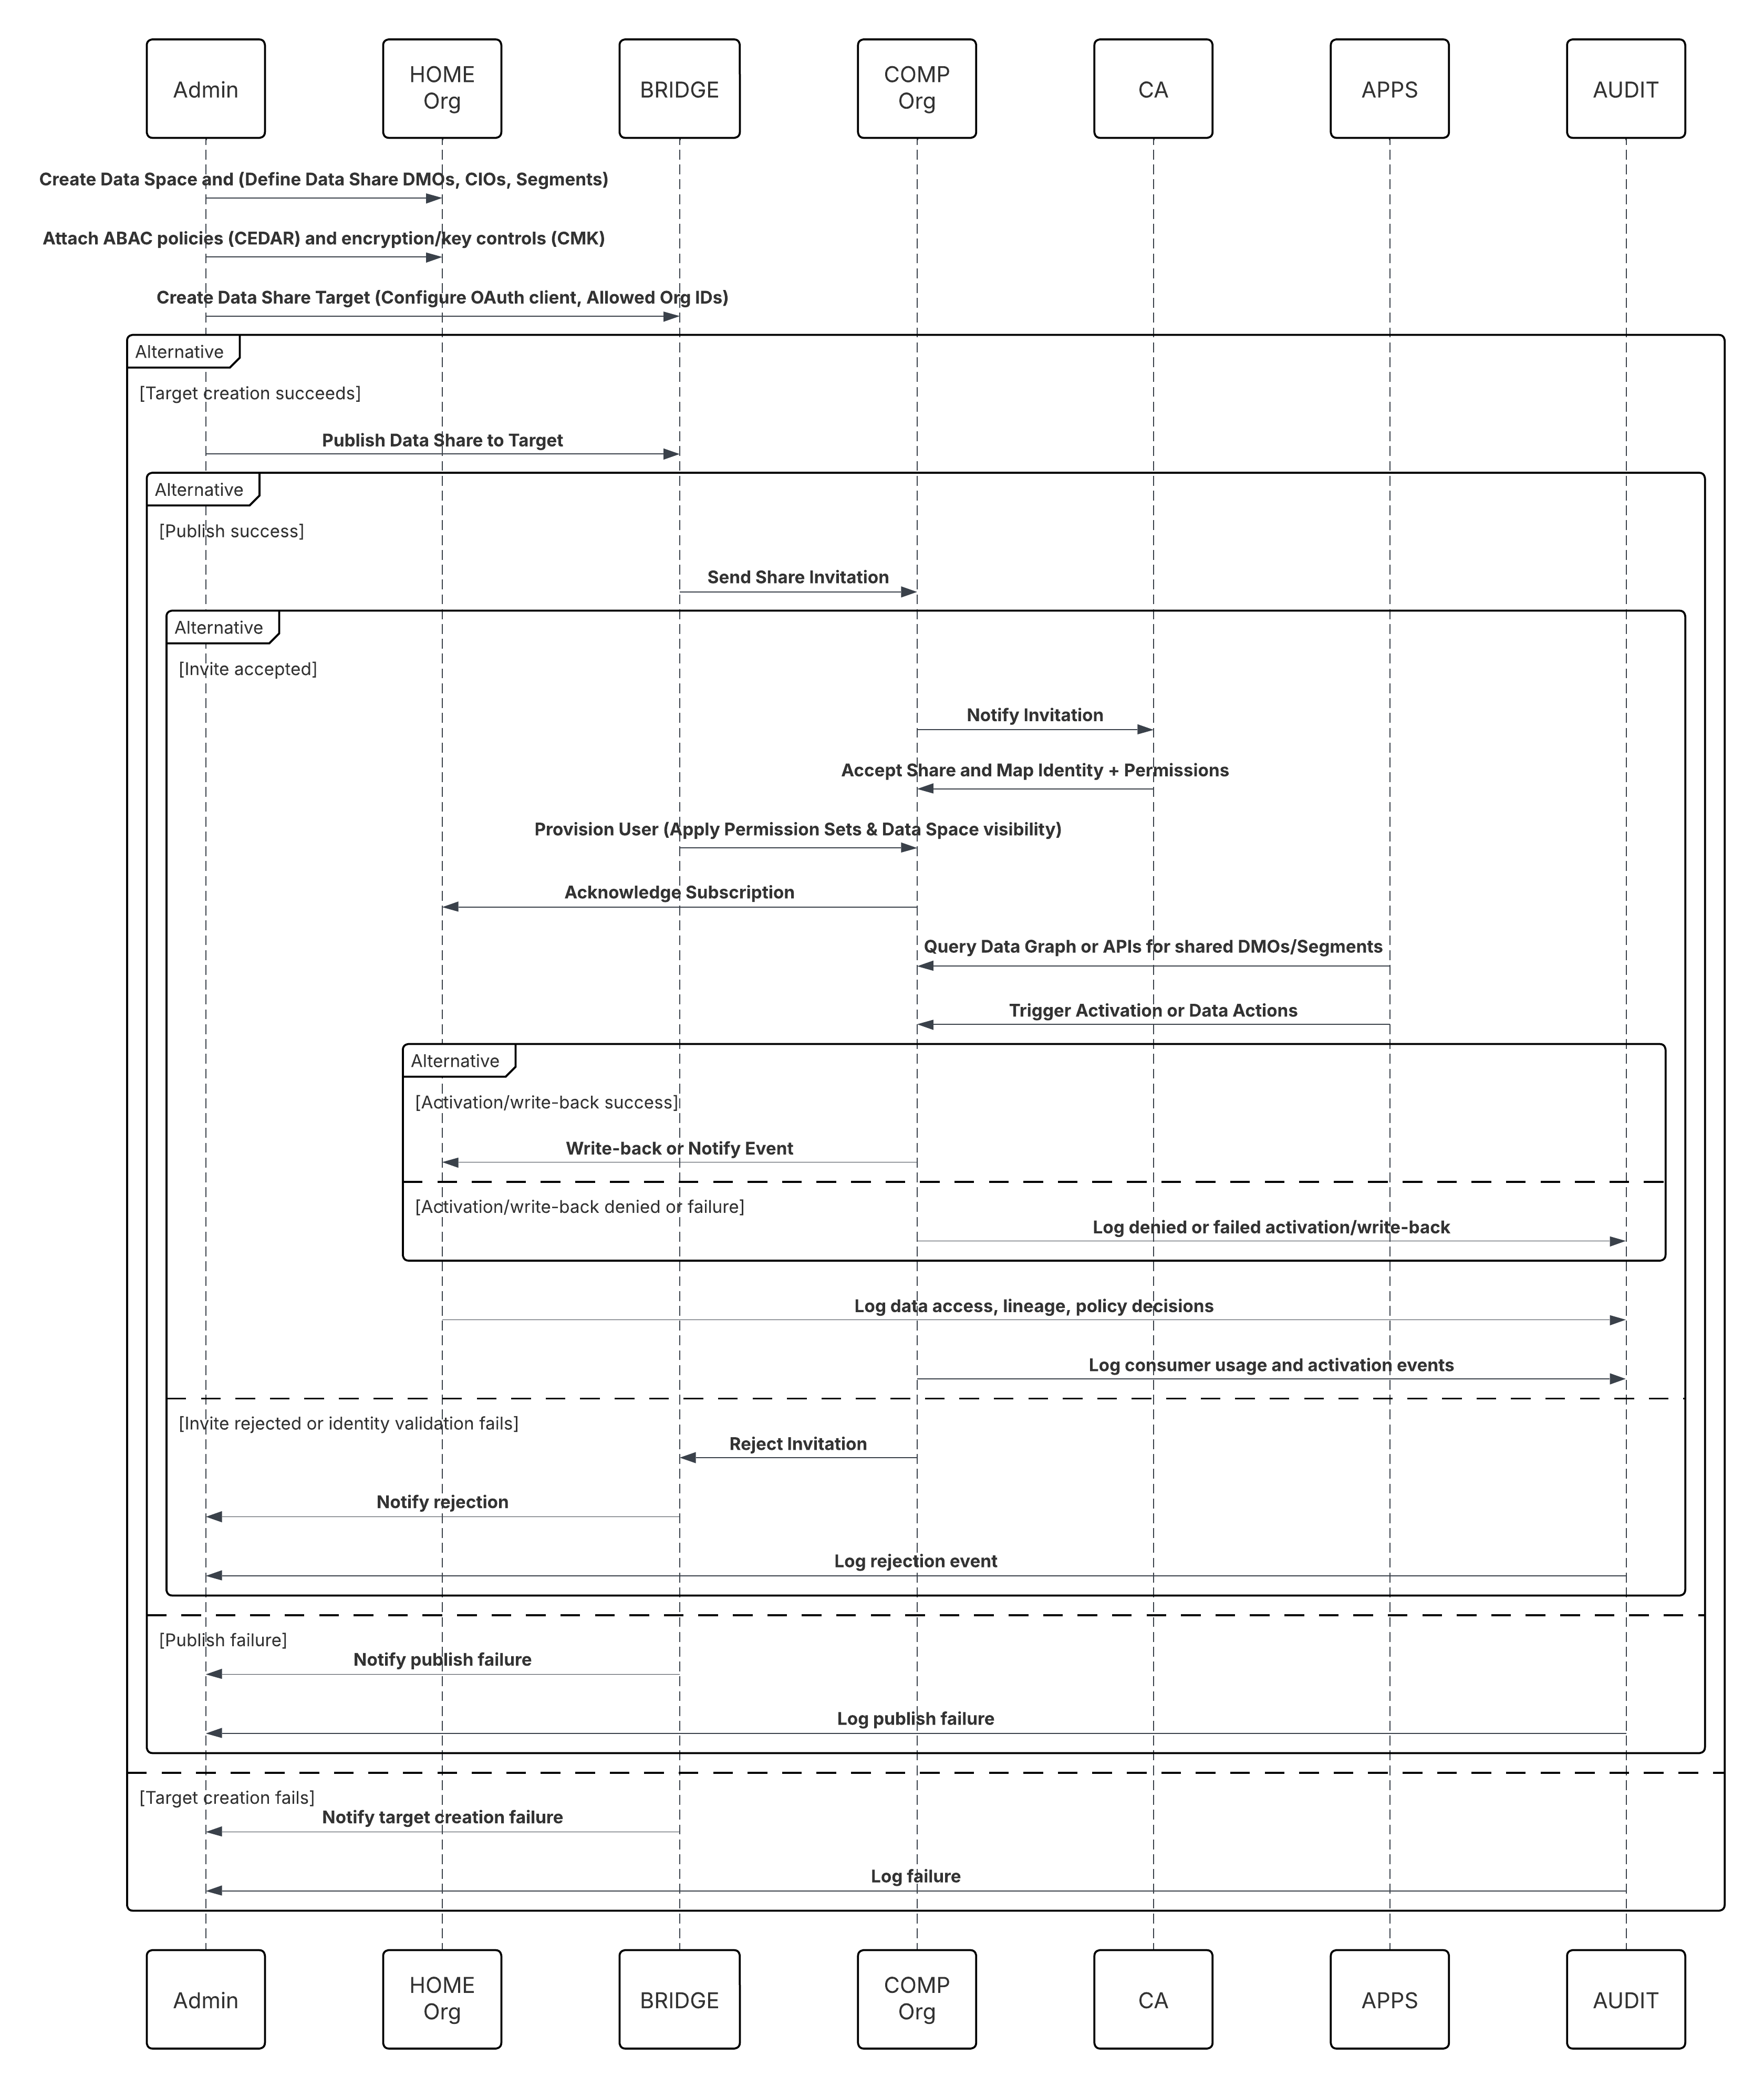 **このシナリオの内容は次のとおりです。**
- **ホーム管理者**: データスペースを作成し、データ共有を定義します (DMO/CIO、セグメントを選択)。
- **ホーム管理者**:コンパニオン組織のデータ共有対象を作成し、Trust(OAuth クライアント、許可された組織 ID)を設定します。
- **ホーム管理者**: データ共有をターゲットに公開し、ABAC ポリシー (CEDAR) と暗号化/鍵制御 (必要に応じて CMK) を添付します。
- **組織管理者**: 招待を受信し、ID の対応付けを検証し、共有を受け入れます。
- **コンパニオン組織**:Data Cloud One Bridge は、Data Cloud One ユーザーをプロビジョニングし、権限セットとデータスペースの表示を適用します。
- **コンパニオン組織アプリケーション(フロー/Einstein/Apex)**:データグラフを照会するか、Data Cloud One API をコールして共有 DMO またはセグメントを参照します。
- **有効化**:コンパニオン組織は、有効化をトリガーするか、データアクションを使用して書き戻します (許可されている場合)。
##### 結果
- すべての接続組織で顧客データ(Customer 360)の**一元管理**が可能:冗長な Data 360 インスタンスはありません。
- タイム トゥ バリュー**を短縮。**コンパニオン組織は、数週間のカスタム コーディングではなく、数分で統合データと Data 360 の機能にアクセスできます。
- **制御されたデータ共有。**承認されたデータスペースのみが共有されるため、セキュリティとガバナンスを維持しながら、ビジネスの機敏性を実現できます。
- ビジネス機能 (セールス、サービス、マーケティング) は同じ統合データ基盤で動作し、企業全体で一貫した評価指標、有効化、インサイトを実現します。
###### コールメカニズム
コールメカニズムは、このパターンを実装するために選択されたソリューションによって異なります。
| メカニズム | 使用するケース |
|---|---|
| Data Cloud One ネイティブ共有 (優先) | 複数の Salesforce 組織 (Sales Cloud、Service Cloud、Industry Cloud) で Data 360\ から直接統合顧客データにリアルタイムにアクセスする必要がある場合に使用します。これにより、複製が不要になり、ゴールデンレコード、セグメント、計算済みインサイトへのゼロレーテンシーアクセスが可能になります。 |
| Data Cloud One Bridge を介した組織間の共有 | 複数のビジネスユニットまたは関連子会社が別々の Salesforce 組織で業務を行っているが、中央の Data 360 インスタンスから共通の顧客データおよびセグメントへの共有アクセスが必要な場合に使用します。独立した運用システムを維持している複数組織の企業に最適です。 |
| Einstein 1プラットフォーム クエリAPI | Salesforce アプリケーション、フロー、または Einstein Copilot がプログラムで Data 360 データを照会または有効化する必要がある場合に使用します。一括エクスポートなしで、統合プロファイル、評価指標、有効化結果を他の Salesforce アプリケーションにリアルタイムで取得できるようにします。 |
| Salesforce チャネルへの有効化 | パーソナライズ、キャンペーンの実行、またはエージェント支援環境のために Marketing Cloud、Service Cloud、または Commerce Cloud に対して Data 360 データ (セグメント、インサイト、属性) を有効化する必要がある場合に使用します。 |
| データグラフアクセス (セマンティッククエリレイヤー) | Salesforce データグラフを使用して統合データモデルにセマンティックレベルでアクセスする必要がある場合に使用します。手動の結合や変換を行うことなく、リアルタイムで Copilot、AI ワークフロー、クロスクラウド分析がサポートされます。 |
| ソリューション領域 | 適合 | コメント/実装の詳細 |
|---|---|---|
| セグメント作成 | 最善 | マーケティング担当者またはアナリストは、データモデルオブジェクト (DMO) または計算済みインサイトオブジェクト (CIO) 全体に検索条件を適用して、ビジュアルセグメンテーションキャンバスでセグメントを作成します。これにより、有効化の対象利用者を定義します。 |
| 有効化の設定 | 最善 | ユーザーは有効化を作成し、作成したばかりのセグメントを取得元として選択します。これにより、Data 360 で下流システムにエクスポートする利用者を定義します。 |
| 有効化対象の選択 | ベストプラクティス | マーケティング担当者は事前設定された有効化対象 (Marketing Cloud、Google 広告、LinkedIn 広告など) を選択します。各対象は、認証ログイン情報と項目の対応付けを使用して Data 360 に登録されます。 |
| ペイロード定義 | 必須 | マーケティング担当者は、取引先責任者識別子 (メール、モバイル、ハッシュ ID など) を選択し、対象システムで強化する追加のプロファイル属性 (名、ロイヤルティランク、CLV など) を選択してペイロードを定義します。 |
| スケジュールと頻度 | 推奨 | 有効化は 1 回のみ実行することも、繰り返し実行 (毎日、毎週など) することもできます。スケジュール設定により、下流の利用者は常に最新の状態に同期されます。 |
| 実行とエクスポート | 最善 | 有効化ジョブが実行されると、Data 360 はセグメントを照会し、選択した属性を収集し、同意検索条件を適用して、対象プラットフォームにデータをエクスポートします。Marketing Cloud では、通常、共有データエクステンションが作成または更新されます。 |
| ガバナンスとコンプライアンス | 必須 | Trust Layerは、スキーマ検証、同意メタデータ、ポリシー制御を適用して、データ保護とマーケティングの規制(GDPR、CCPAなど)へのコンプライアンスを確保します。 |
| 監視と監査機能 | ベストプラクティス | すべての有効化の実行は、Trust Layer Monitoringダッシュボードの成功/失敗評価指標、実行ログ、系統表示を使用して追跡され、運用の透明性とSLA保証を実現します。 |
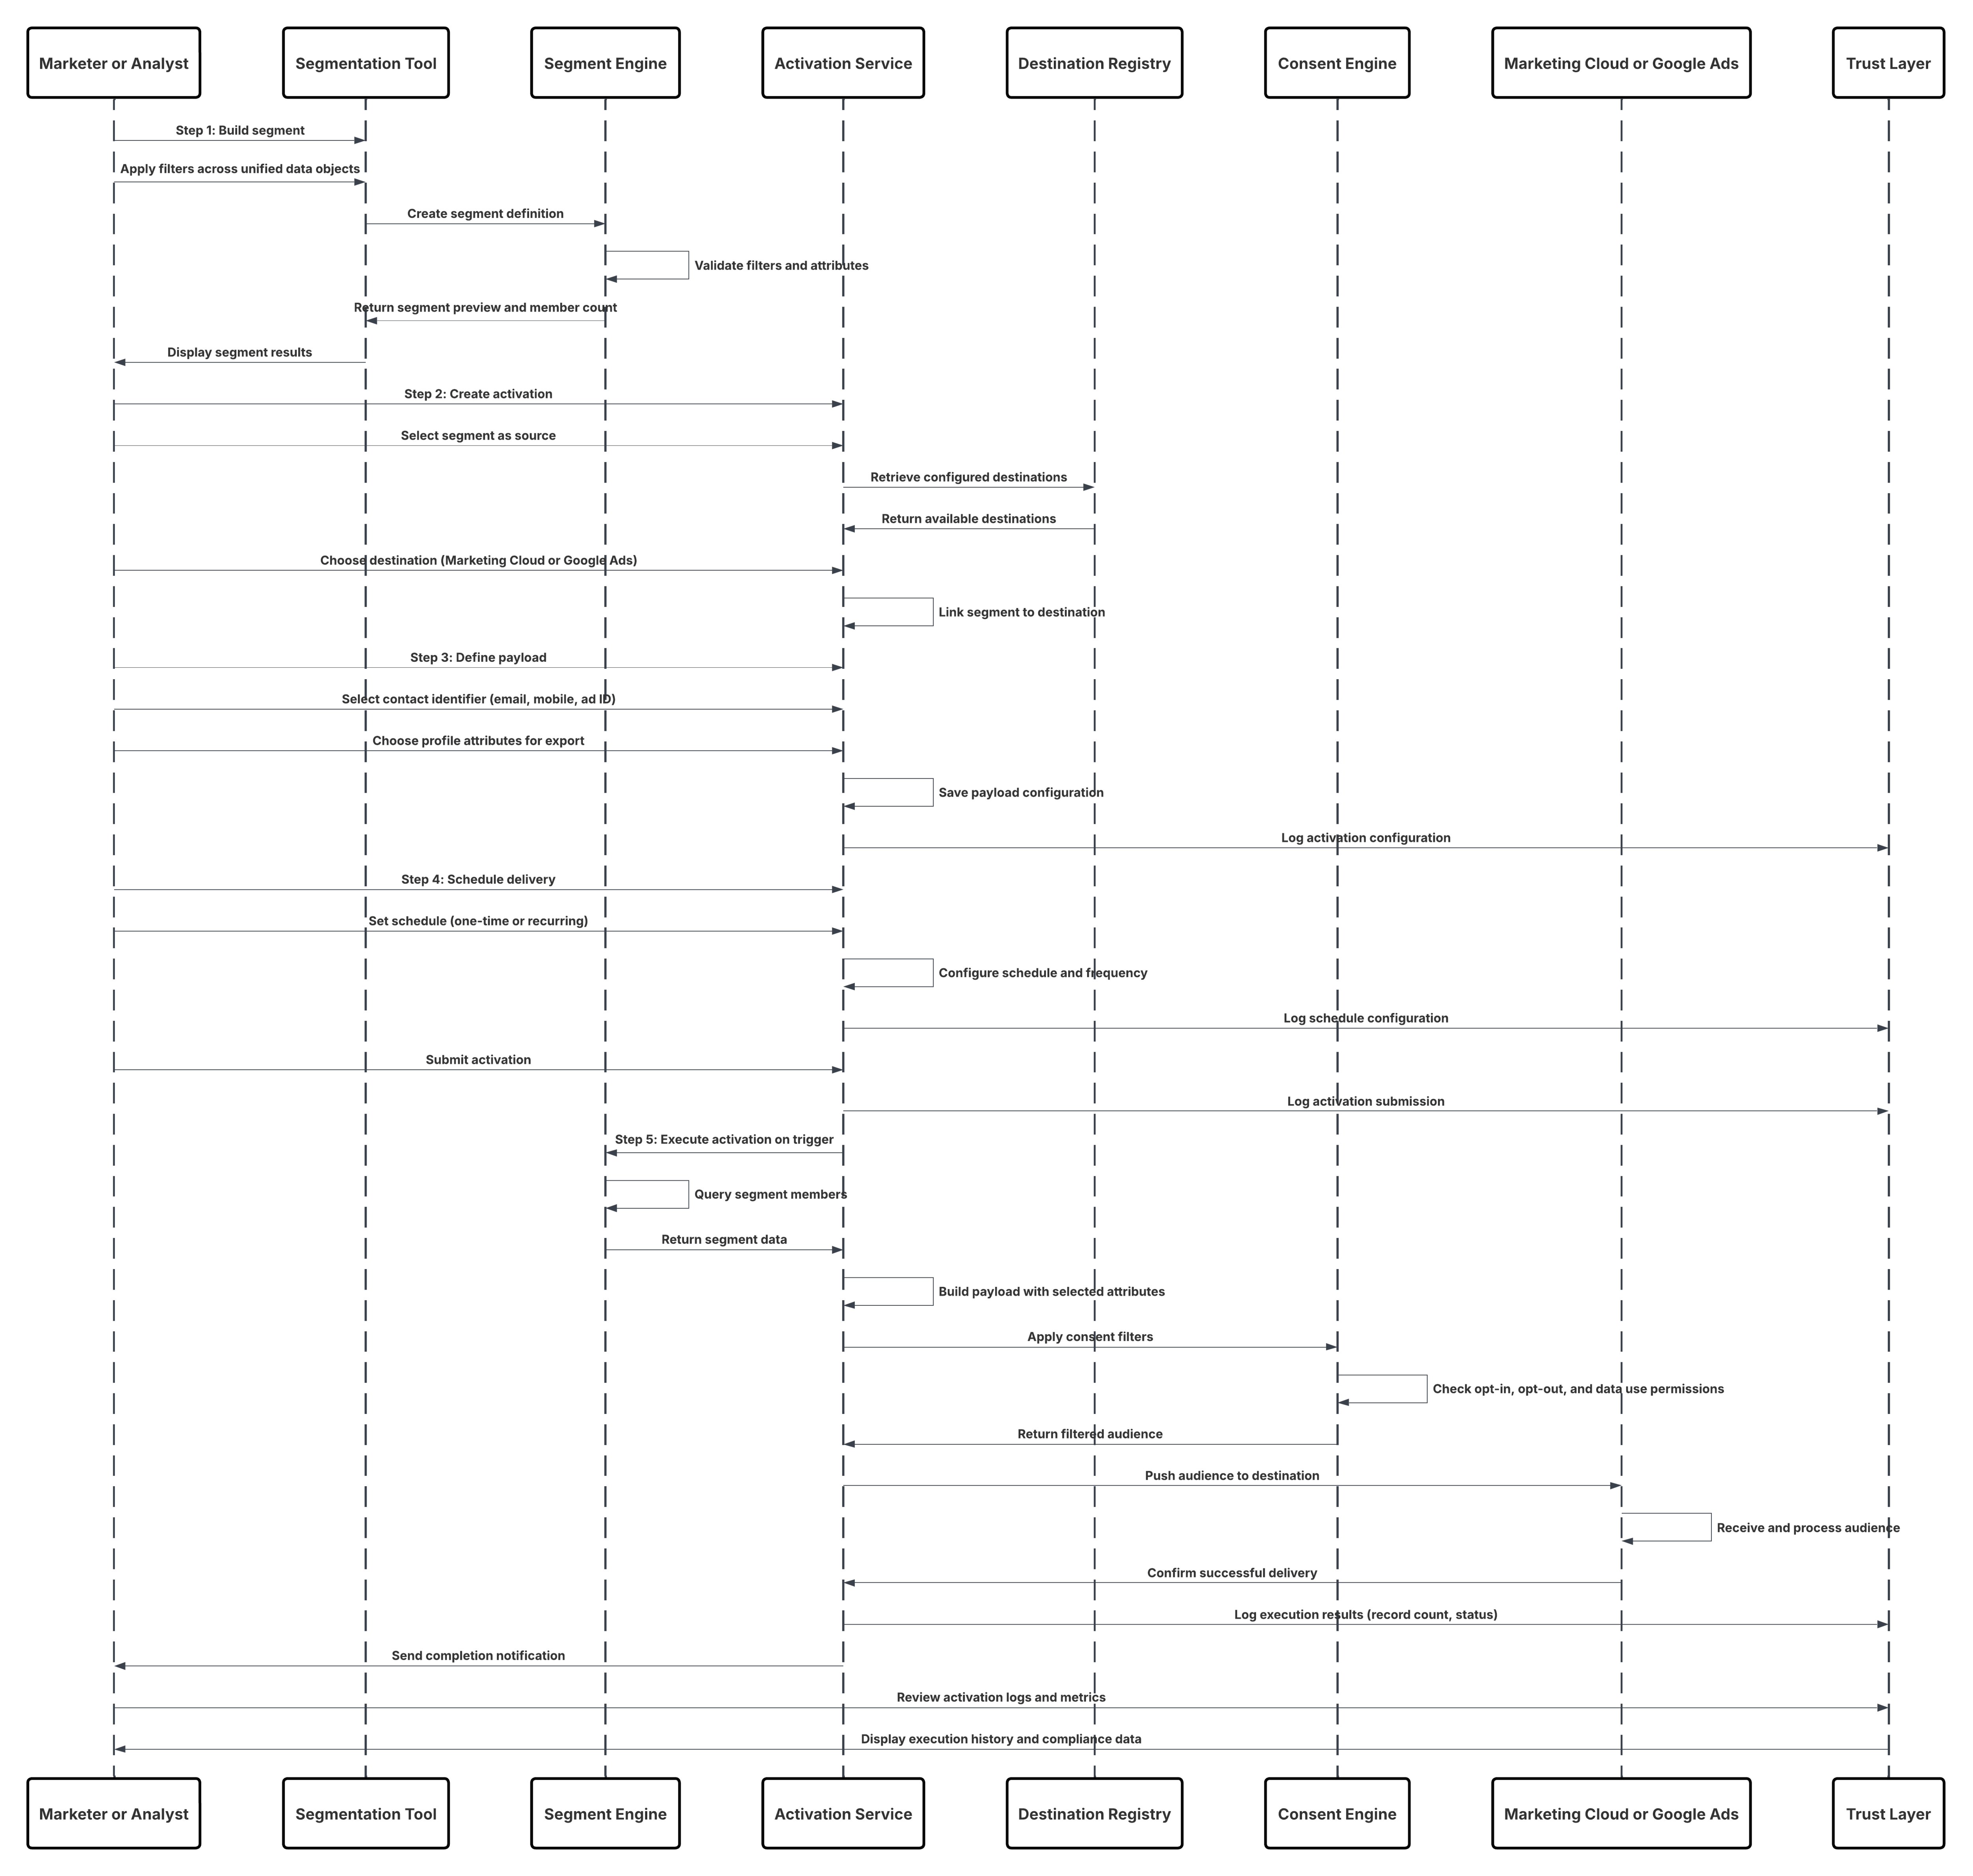 ##### 結果
- Data 360 の対象を絞った強化されたオーディエンスセグメントは、下流のマーケティングおよび広告プラットフォームで直接使用できます。
- オーディエンスは自動的に更新され、最新の統合顧客データと同期されるため、リアルタイムのキャンペーン関連性が維持されます。
- マーケティング担当者は、有効化されたオーディエンスを Marketing Cloud ジャーニー、メールキャンペーン、または Google 広告、Meta、LinkedIn 広告などのデジタル広告プラットフォームのカスタムオーディエンスのエントリソースとして使用できます。
- 有効化の実行ごとにエンドツーエンドの系統が維持され、Data 360 と外部システム間のコンプライアンス、トレーサビリティ、一貫性が確保されます。
- ビジネス ユーザーは、完全で信頼できる Customer 360 ビューにより、高度にパーソナライズされたデータ主導のエクスペリエンスを提供できます。
###### コールメカニズム
コールメカニズムは、対象プラットフォームと有効化対象の設定によって異なります。
| メカニズム | 使用するケース |
|---|---|
| Marketing Cloud Engagement の有効化 (推奨) | Marketing Cloud で動的セグメント、パーソナライズされた属性、リアルタイムの更新が必要なメールジャーニーまたはクロスチャネルジャーニーを実行する場合に使用します。Data 360 は、キャンペーンを有効化するために共有データエクステンションに直接エクスポートします。 |
| 広告プラットフォームの有効化 (Google 広告、LinkedIn 広告、メタ広告) | リターゲティングまたは類似モデリング用の広告プラットフォームで Data 360 セグメントをカスタムオーディエンスとして有効化するときに使用します。ハッシュされた識別子と同意認識配信をサポートします。 |
| CRM の有効化 (Sales Cloud または Service Cloud) | パーソナライズされたセールスエンゲージメントやサービスインタラクションのために、充実した顧客データ、インサイト、傾向スコアを CRM ユーザーと共有するときに使用します。データは、データアクションまたは統合プロファイルコンポーネントを使用して、強化されたレコードまたはインサイトとして使用できます。 |
| MuleSoft または API を使用した外部有効化 | ロイヤルティ、e コマース、サードパーティデータウェアハウスなど、Salesforce 以外のシステムに有効化する必要がある場合に使用します。MuleSoft または Data 360 Activation API により、イベントベースの更新オプションを使用して、ポリシーに基づいた安全な配信が保証されます。 |
| ハイブリッド有効化(バッチ + イベントトリガー) | スケジュール済みバッチ有効化をイベントベースのトリガーと組み合わせる場合に使用します。これにより、放棄カートや離脱リスクアラートなど、時間的制約のあるキャンペーンで「常時」パーソナライズが可能になります。 |
| ソリューション領域 | 適合 | コメント/実装の詳細 |
|---|---|---|
| セグメントの選択 | 最善 | アナリストは Data 360\ 内の既存のセグメントまたはクエリ定義を選択します。セグメントによって、エクスポートするレコードと属性が決まります。 |
| 有効化の設定 | 最善 | ユーザーが新しい有効化を作成し、取得元としてセグメント、取得先としてクラウドストレージ対象 (S3 など) を選択します。 |
| 有効化対象設定 | 必須 | システム管理者は、ログイン情報、IAM ロール、出力パスを使用して対象を事前設定します。サポートされる形式には、CSV、Parquet、JSON などがあります。 |
| ペイロード定義 | ベストプラクティス | 必要な属性 (ID、名前、メール、地域、同意フラグなど) を選択して、エクスポートスキーマを定義します。属性レベルのガバナンスが適用されます。 |
| スケジュールと頻度 | 推奨 | エクスポートは、定義された頻度 (毎日、毎週、毎月) で実行するようにスケジュールするか、必要に応じて手動でトリガーできます。 |
| 実行 & デリバリ | 最善 | 実行時に、Data 360 はセグメントを照会し、エクスポートファイルをコンパイルして暗号化し、クラウドプロバイダーの API を使用して設定されたバケット/フォルダーに書き込みます。 |
| ガバナンスとコンプライアンス | 必須 | Data 360のTrust Layerにより、すべてのエクスポートが同意ポリシー、スキーマ検証、コンプライアンス・フィルタに準拠します。 |
| 監視と監査機能 | ベストプラクティス | 各エクスポートは、状況、実行ログ、系統メタデータと共に Trust Layer Monitoring ダッシュボードで追跡されます。 |
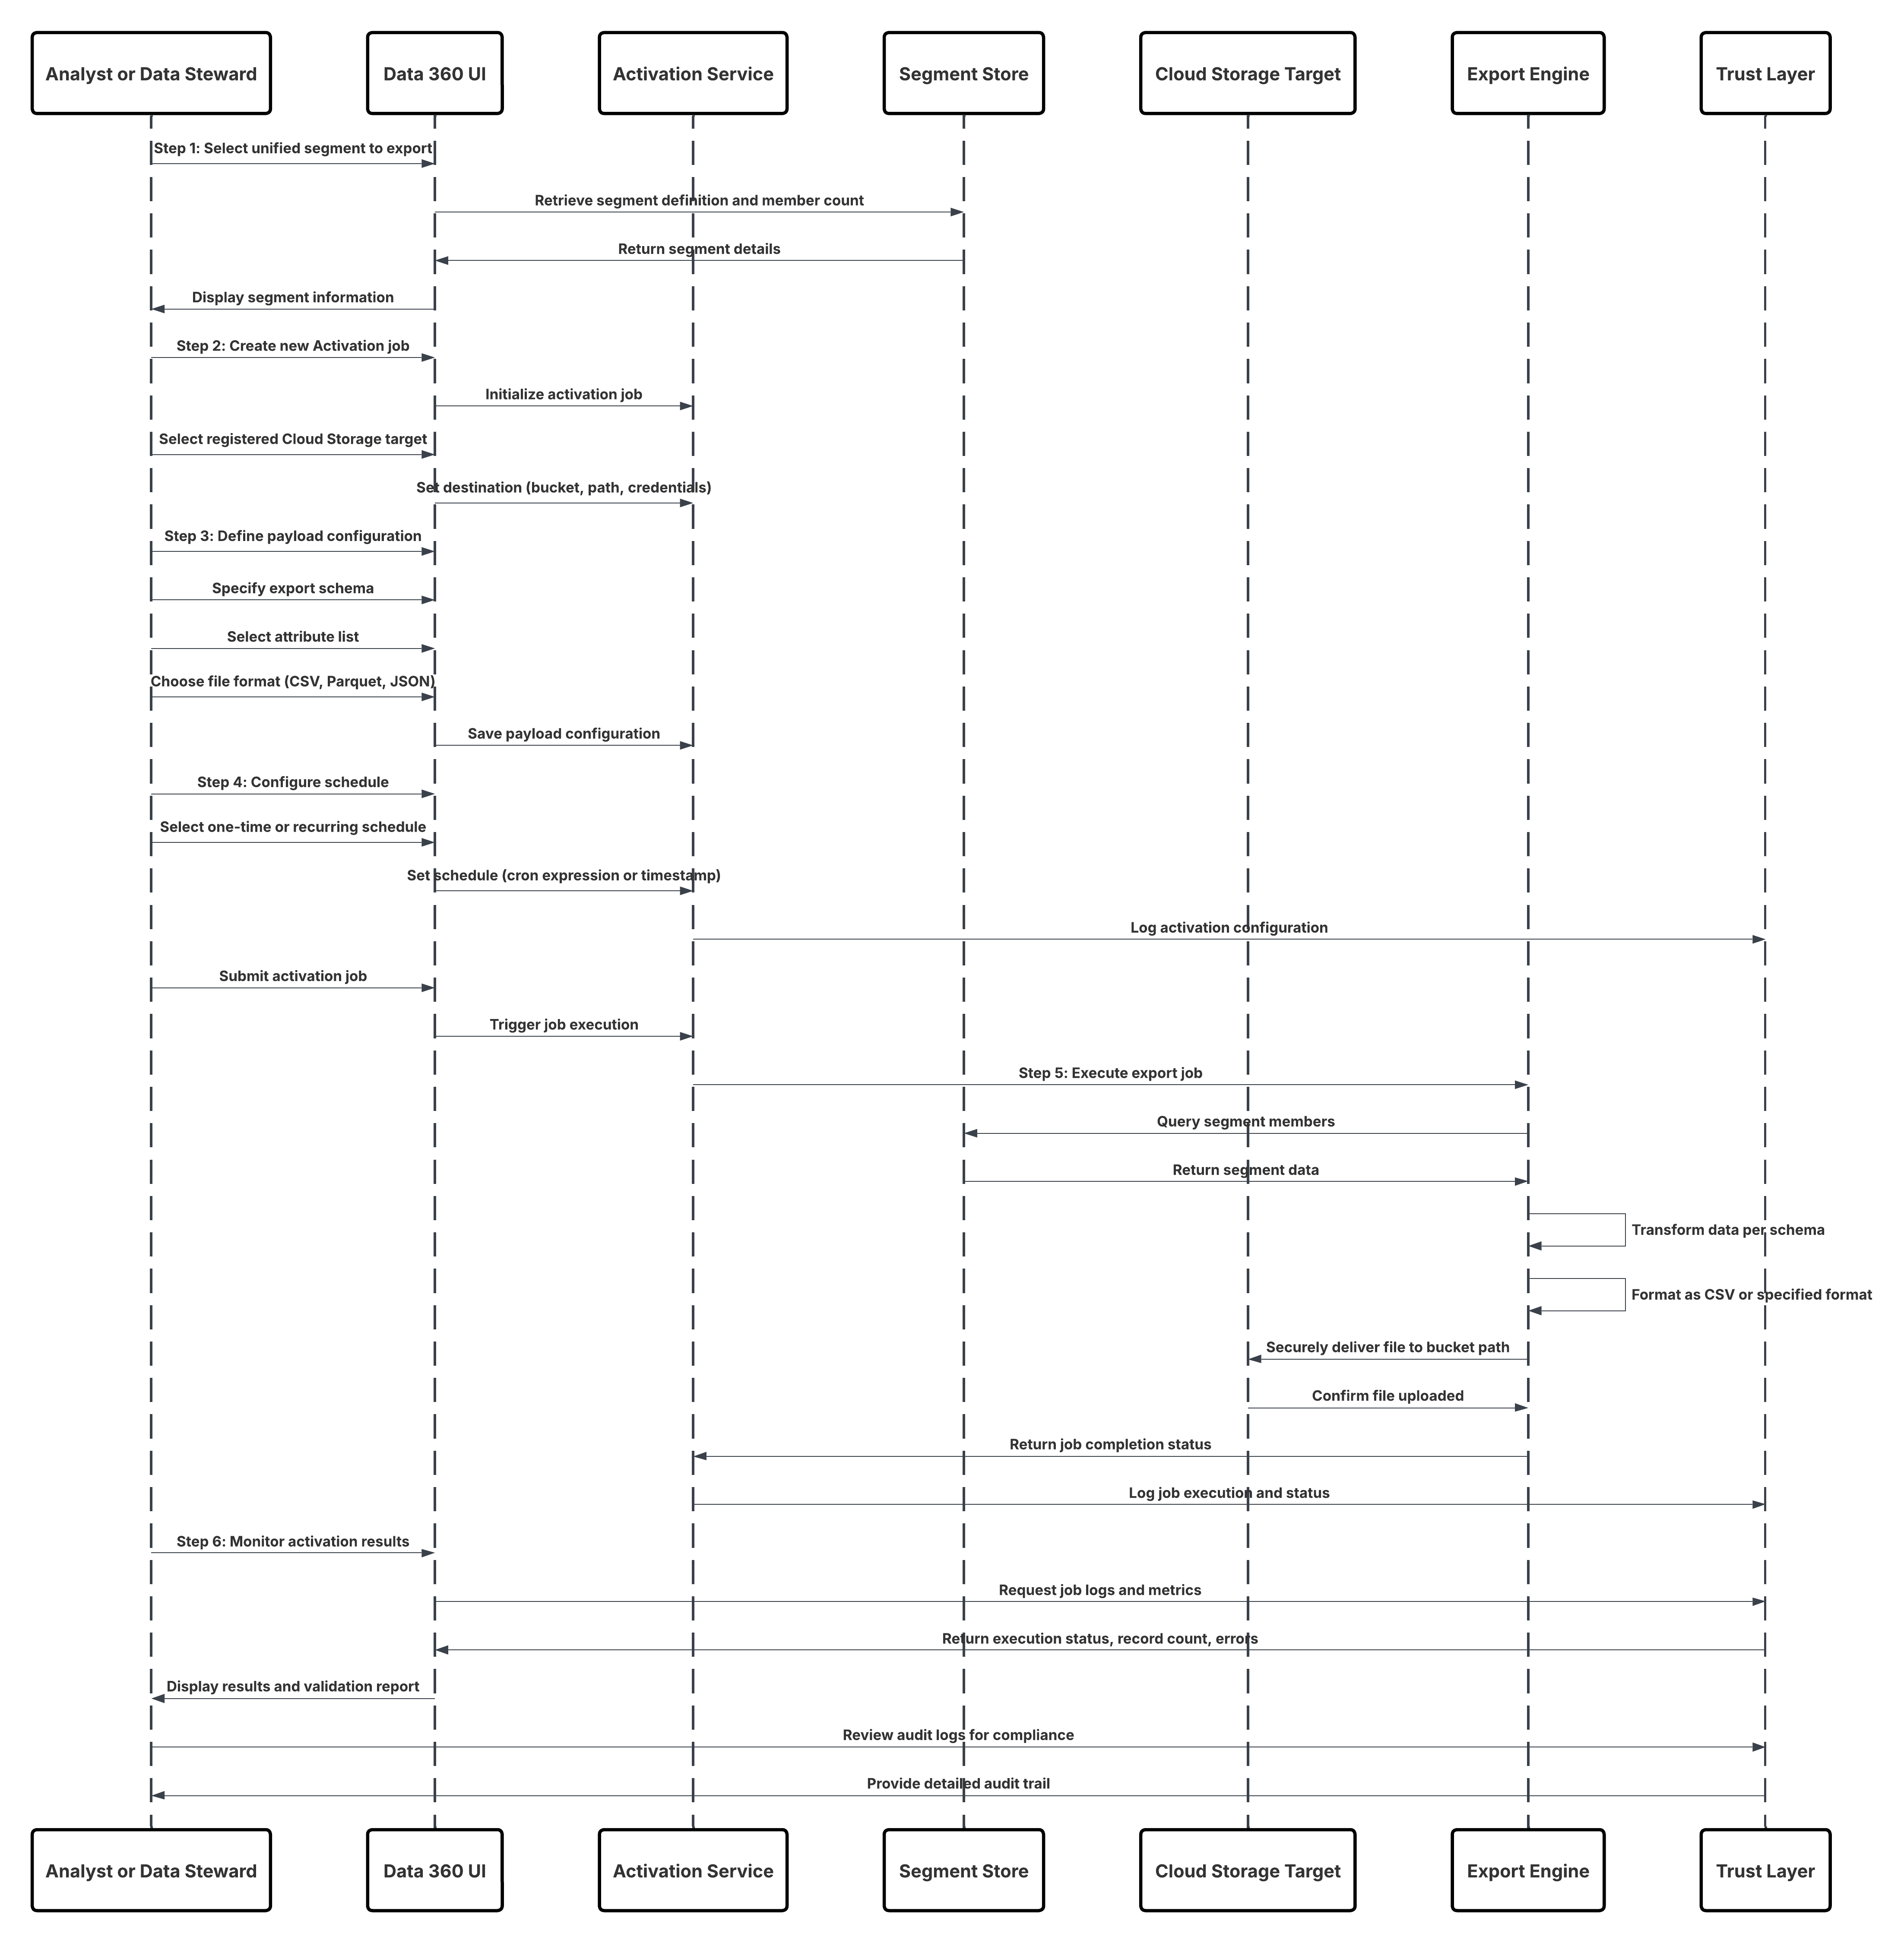 ##### 結果
- Data 360 の対象を絞った強化されたオーディエンスセグメントは、下流のマーケティングおよび広告プラットフォームで直接使用できます。
- オーディエンスは自動的に更新され、最新の統合顧客データと同期されるため、リアルタイムのキャンペーン関連性が維持されます。
- マーケティング担当者は、有効化されたオーディエンスを Marketing Cloud ジャーニー、メールキャンペーン、または Google 広告、Meta、LinkedIn 広告などのデジタル広告プラットフォームのカスタムオーディエンスのエントリソースとして使用できます。
- 有効化の実行ごとにエンドツーエンドの系統が維持され、Data 360 と外部システム間のコンプライアンス、トレーサビリティ、一貫性が確保されます。
- ビジネス ユーザーは、完全で信頼できる Customer 360 ビューにより、高度にパーソナライズされたデータ主導のエクスペリエンスを提供できます。
###### コールメカニズム
コールメカニズムは、対象クラウドストレージプラットフォームと有効化設定によって異なります。
| メカニズム | 使用するケース |
|---|---|
| Amazon S3 の有効化 | エンタープライズデータレイクが AWS でホストされている場合に使用します。Data 360 は、IAM ロールまたは一時的なログイン情報を使用して S3 バケットに直接書き込むため、安全でスケーラブルなエクスポートが保証されます。 |
| Azure Blobストレージの有効化 | 組織が Microsoft Azure で運用している場合に使用します。Data 360 は SAS トークンまたはサービスプリンシパルを使用して、暗号化されたファイルを Blob コンテナに書き込みます。 |
| Google Cloud Storage (GCS) の有効化 | データサイエンスまたは分析ワークロードが GCP で実行される場合に使用します。Data 360 は OAuth ログイン情報を使用して、CSV または Parquet 形式でファイルを GCS バケットにエクスポートします。 |
| SFTP または外部ファイルゲートウェイ | 規制やレガシーシステムで SFTP エンドポイントまたはエンタープライズ管理ファイル転送プラットフォームを介した安全なファイル転送が必要な場合に使用します。 |
| ハイブリッドエクスポート (ファイル + API) | 下流アプリケーションで分析用のファイルベースのエクスポートとワークフローオーケストレーション用の API トリガーの両方が必要な場合に使用します (MuleSoft フローなど)。 |
| ソリューション領域 | 適合 | コメント/実装の詳細 |
|---|---|---|
| 認証とアプリケーションの登録 | 必須 | OAuth 2.0 ベースの認証用の接続アプリケーションを Salesforce で作成します。Data 360 API アクセスの範囲を設定します。 |
| データアクセス (プロファイル、セグメント、インサイト) | 最善 | Connect API エンドポイント (/services/data/vXX.X/connect) を使用して、ハーモナイズされた Data 360 データ、統合プロファイル、計算済みインサイトを照会します。 |
| UI インテグレーション | 最善 | フロントエンドアプリケーション (React、Angular、iOS、Android) は Connect API をコールして、ダッシュボード、ポータル、またはモバイルインターフェースで Data 360 データを表示します。 |
| データグラフの照会 | 推奨 | Connect API をデータグラフ API と組み合わせて、複雑な結合とリレーションを簡略化するセマンティックレベルのクエリを実行します。 |
| リアルタイム更新 | 省略可能 | ライブデータ更新には、WebSocket またはストリーミング拡張機能で Connect API を使用します。 |
| セキュリティとガバナンス | 必須 | OAuth範囲、Data 360ポリシー、Trust Layer監査フレームワークを使用して、データの表示を適用します。 |
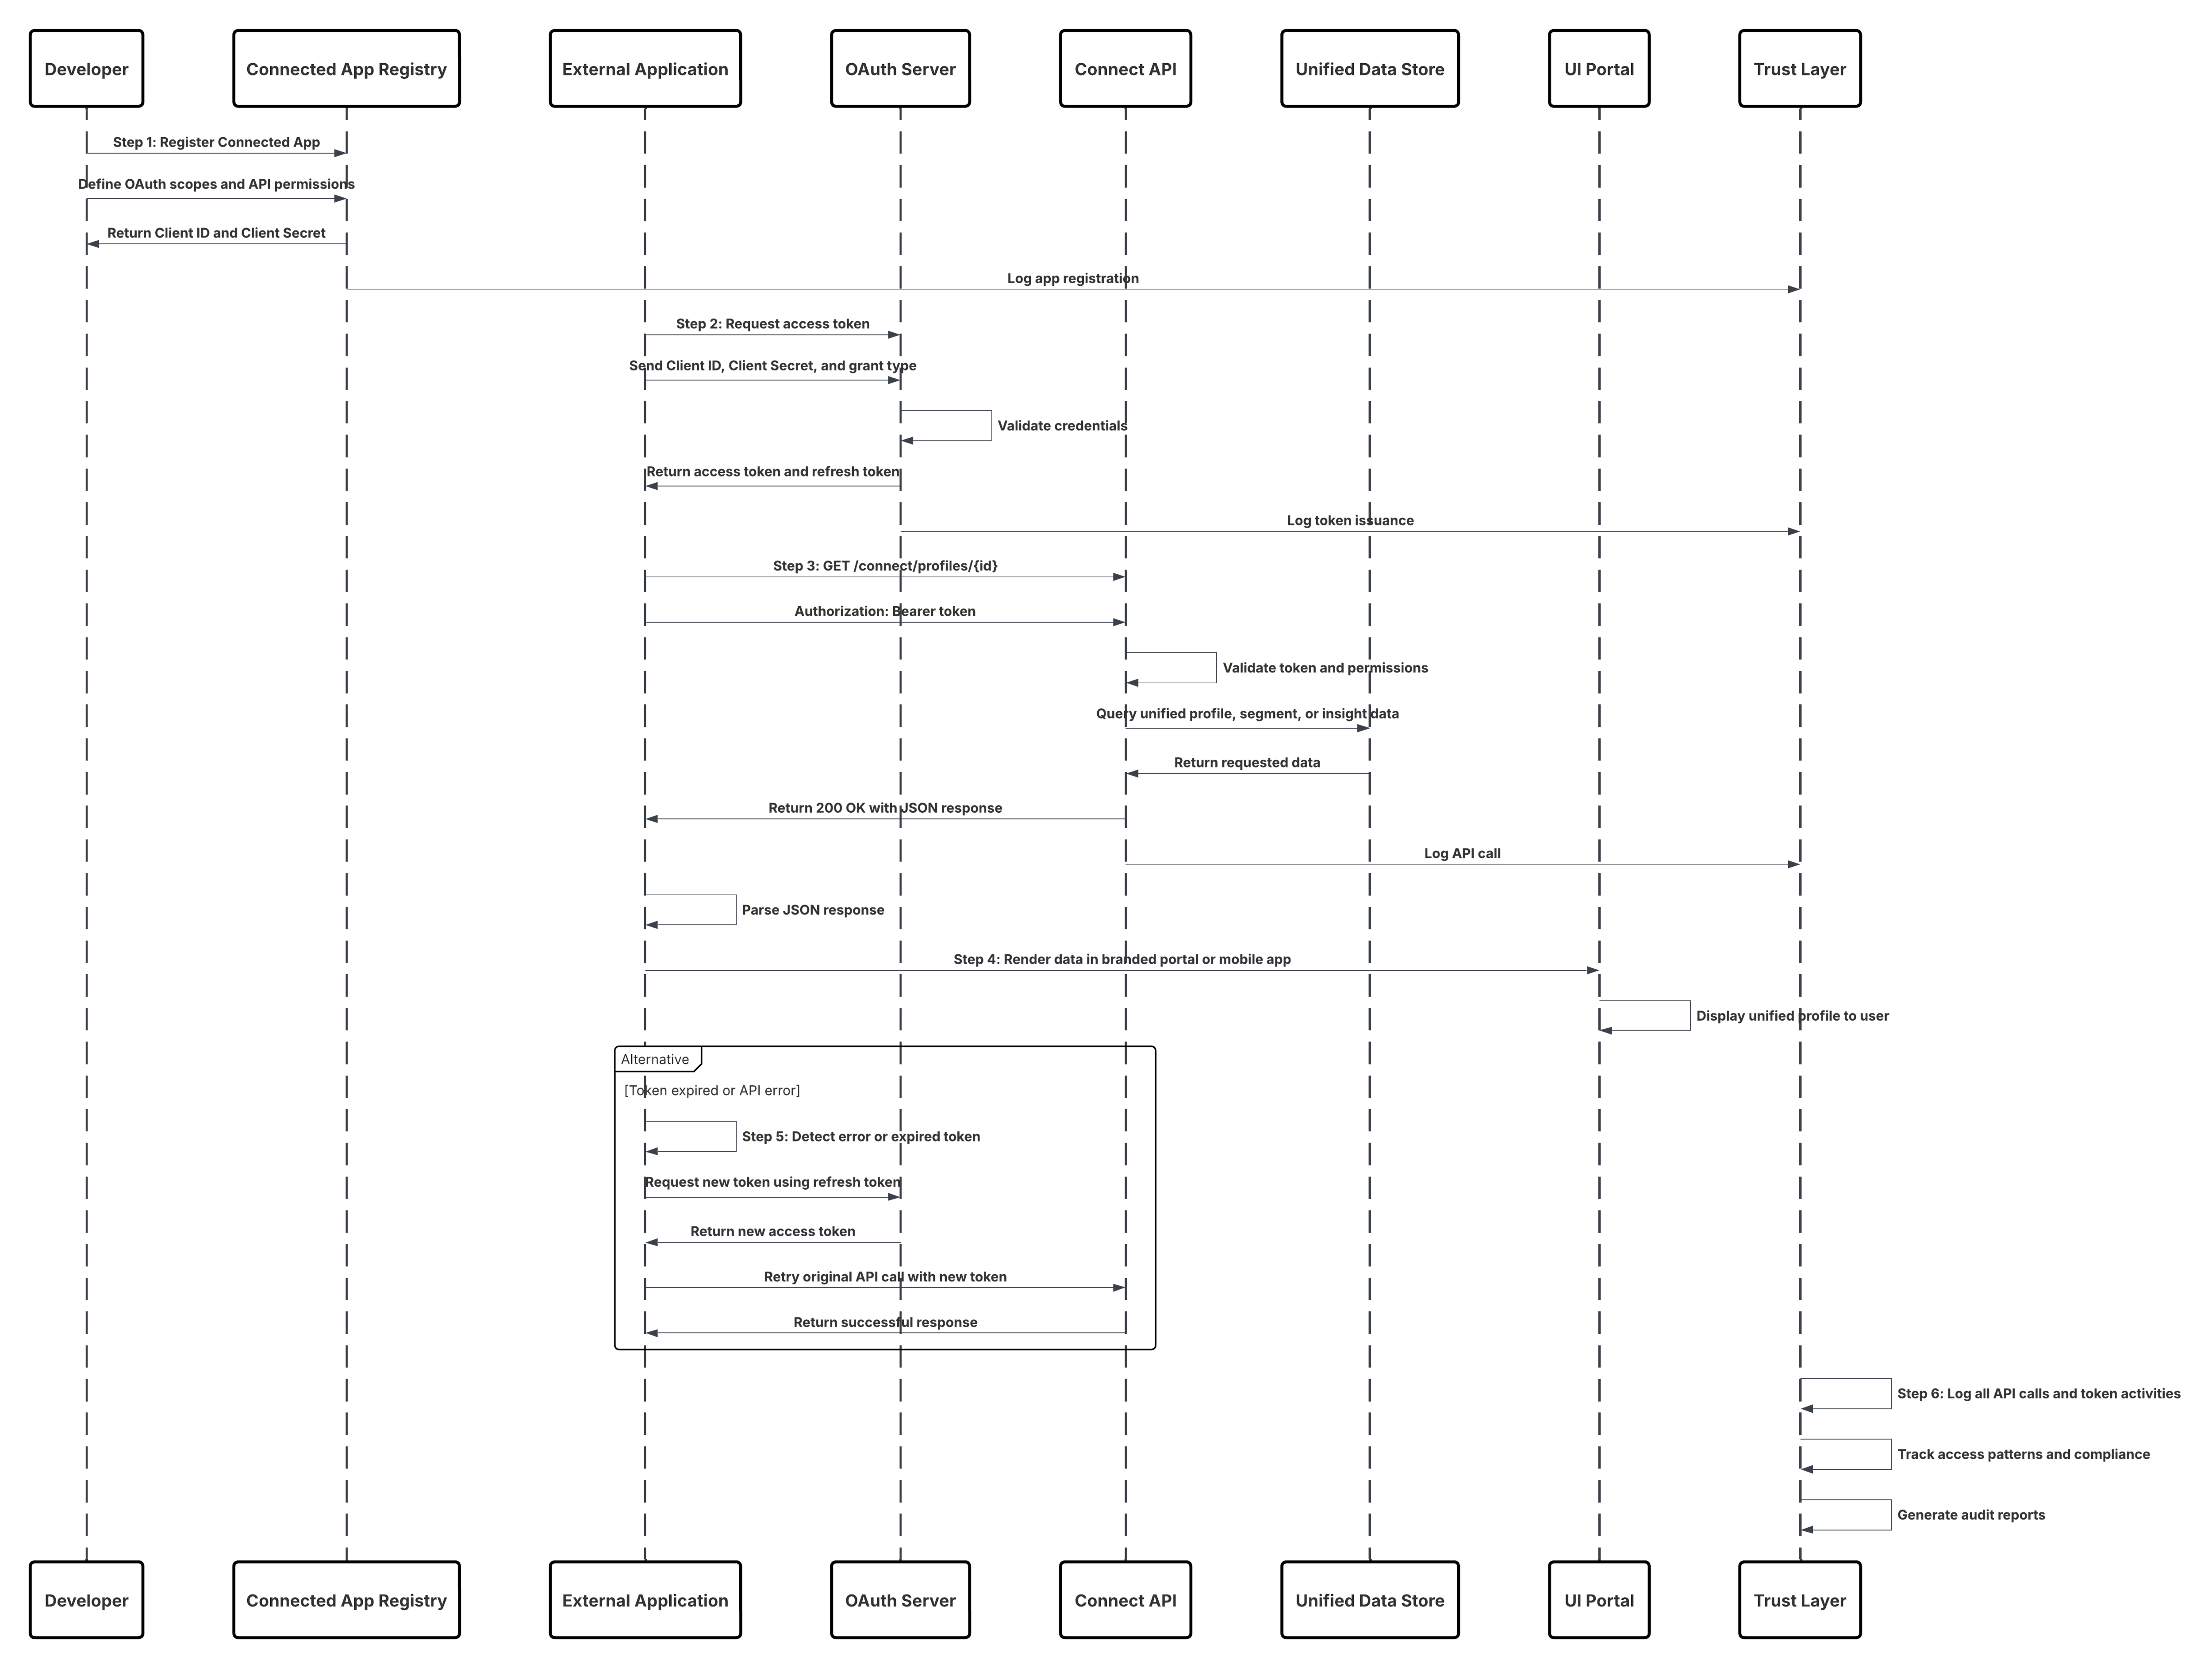 ##### 結果
開発者は、Data 360 と緊密に統合された安全なカスタムブランドアプリケーションを作成できます。次のアプリケーションを実行できます。
- ハーモナイズされた顧客プロファイルとインサイトをリアルタイムに表示します。
- 統合 API を使用して、CRM またはカスタムオブジェクトと共に Data 360 データを表示します。
- Trust Layer を介した一貫した認証、承認、監査コントロールを活用します。
- ビジネス ユーザーまたはパートナーに、エクスペリエンス全体で信頼できる顧客インテリジェンスへのシームレスで管理されたアクセスを提供します。
##### コールメカニズム
コールメカニズムは、対象クラウドストレージプラットフォームと有効化設定によって異なります。
| メカニズム | 使用するケース |
|---|---|
| Connect REST API (優先) | UI に適した JSON 形式で Data 360 データにリアルタイムでアクセスする必要がある Web アプリケーション、モバイルアプリケーション、またはサードパーティアプリケーションを作成する場合に使用します。 |
| データグラフ API | アプリケーションが複数のオブジェクト間でセマンティックレベルのクエリを実行する必要がある場合に使用します (例: 顧客 → トランザクション → キャンペーン)。 |
| Query API | SOQL のようなクエリを実行するときに使用し、ハーモナイズされたデータセットを高い精度で取得します。 |
| Einstein 1プラットフォームAPI | AI 駆動のインサイトまたは Copilot で生成されたおすすめをカスタム UI 内で統合するときに使用します。 |
| MuleSoft または Apex ゲートウェイラッパー | アプリケーションと Connect API 間で追加のオーケストレーション、キャッシュ、またはポリシー適用が必要な場合に使用します。 |
| ソリューション領域 | 適合 | コメント/実装の詳細 |
|---|---|---|
| データグラフ定義 | 必須 | アーキテクトは、複数の DMO を 1 つのセマンティックエンティティ (UnifiedCustomerProfile など) にまとめるデータグラフを定義します。 |
| プロファイルルックアップの取得 | 最善 | アプリケーションは GET /api/v1/dataGraph/{entity}/{id} をコールして、一意の ID またはキーで非正規化された完全なプロファイルを取得します。 |
| ライブパラメーターの利用状況 | 省略可能 | キャッシュされた取得ではなく、新しい計算を強制するには ?live=true を付加します。重要な決定に適しています。 |
| 認証 | 必須 | API コールを安全に認証するには、接続アプリケーションを介して OAuth 2.0 を使用します。 |
| 応答解析 | ベストプラクティス | アプリケーションは JSON 応答を UI または決定エンジンに直接解析します。それ以上の結合は必要ありません。 |
| キャッシュ戦略 | 推奨 | プロファイルの参照を繰り返すために短期ローカルキャッシュ (メモリ内や CDN など) を実装します。 |
| 監視とオブザーバビリティ | 必須 | Trust Layerダッシュボードを使用して、クエリのパフォーマンス、応答時間、ポリシー遵守を監視します。 |
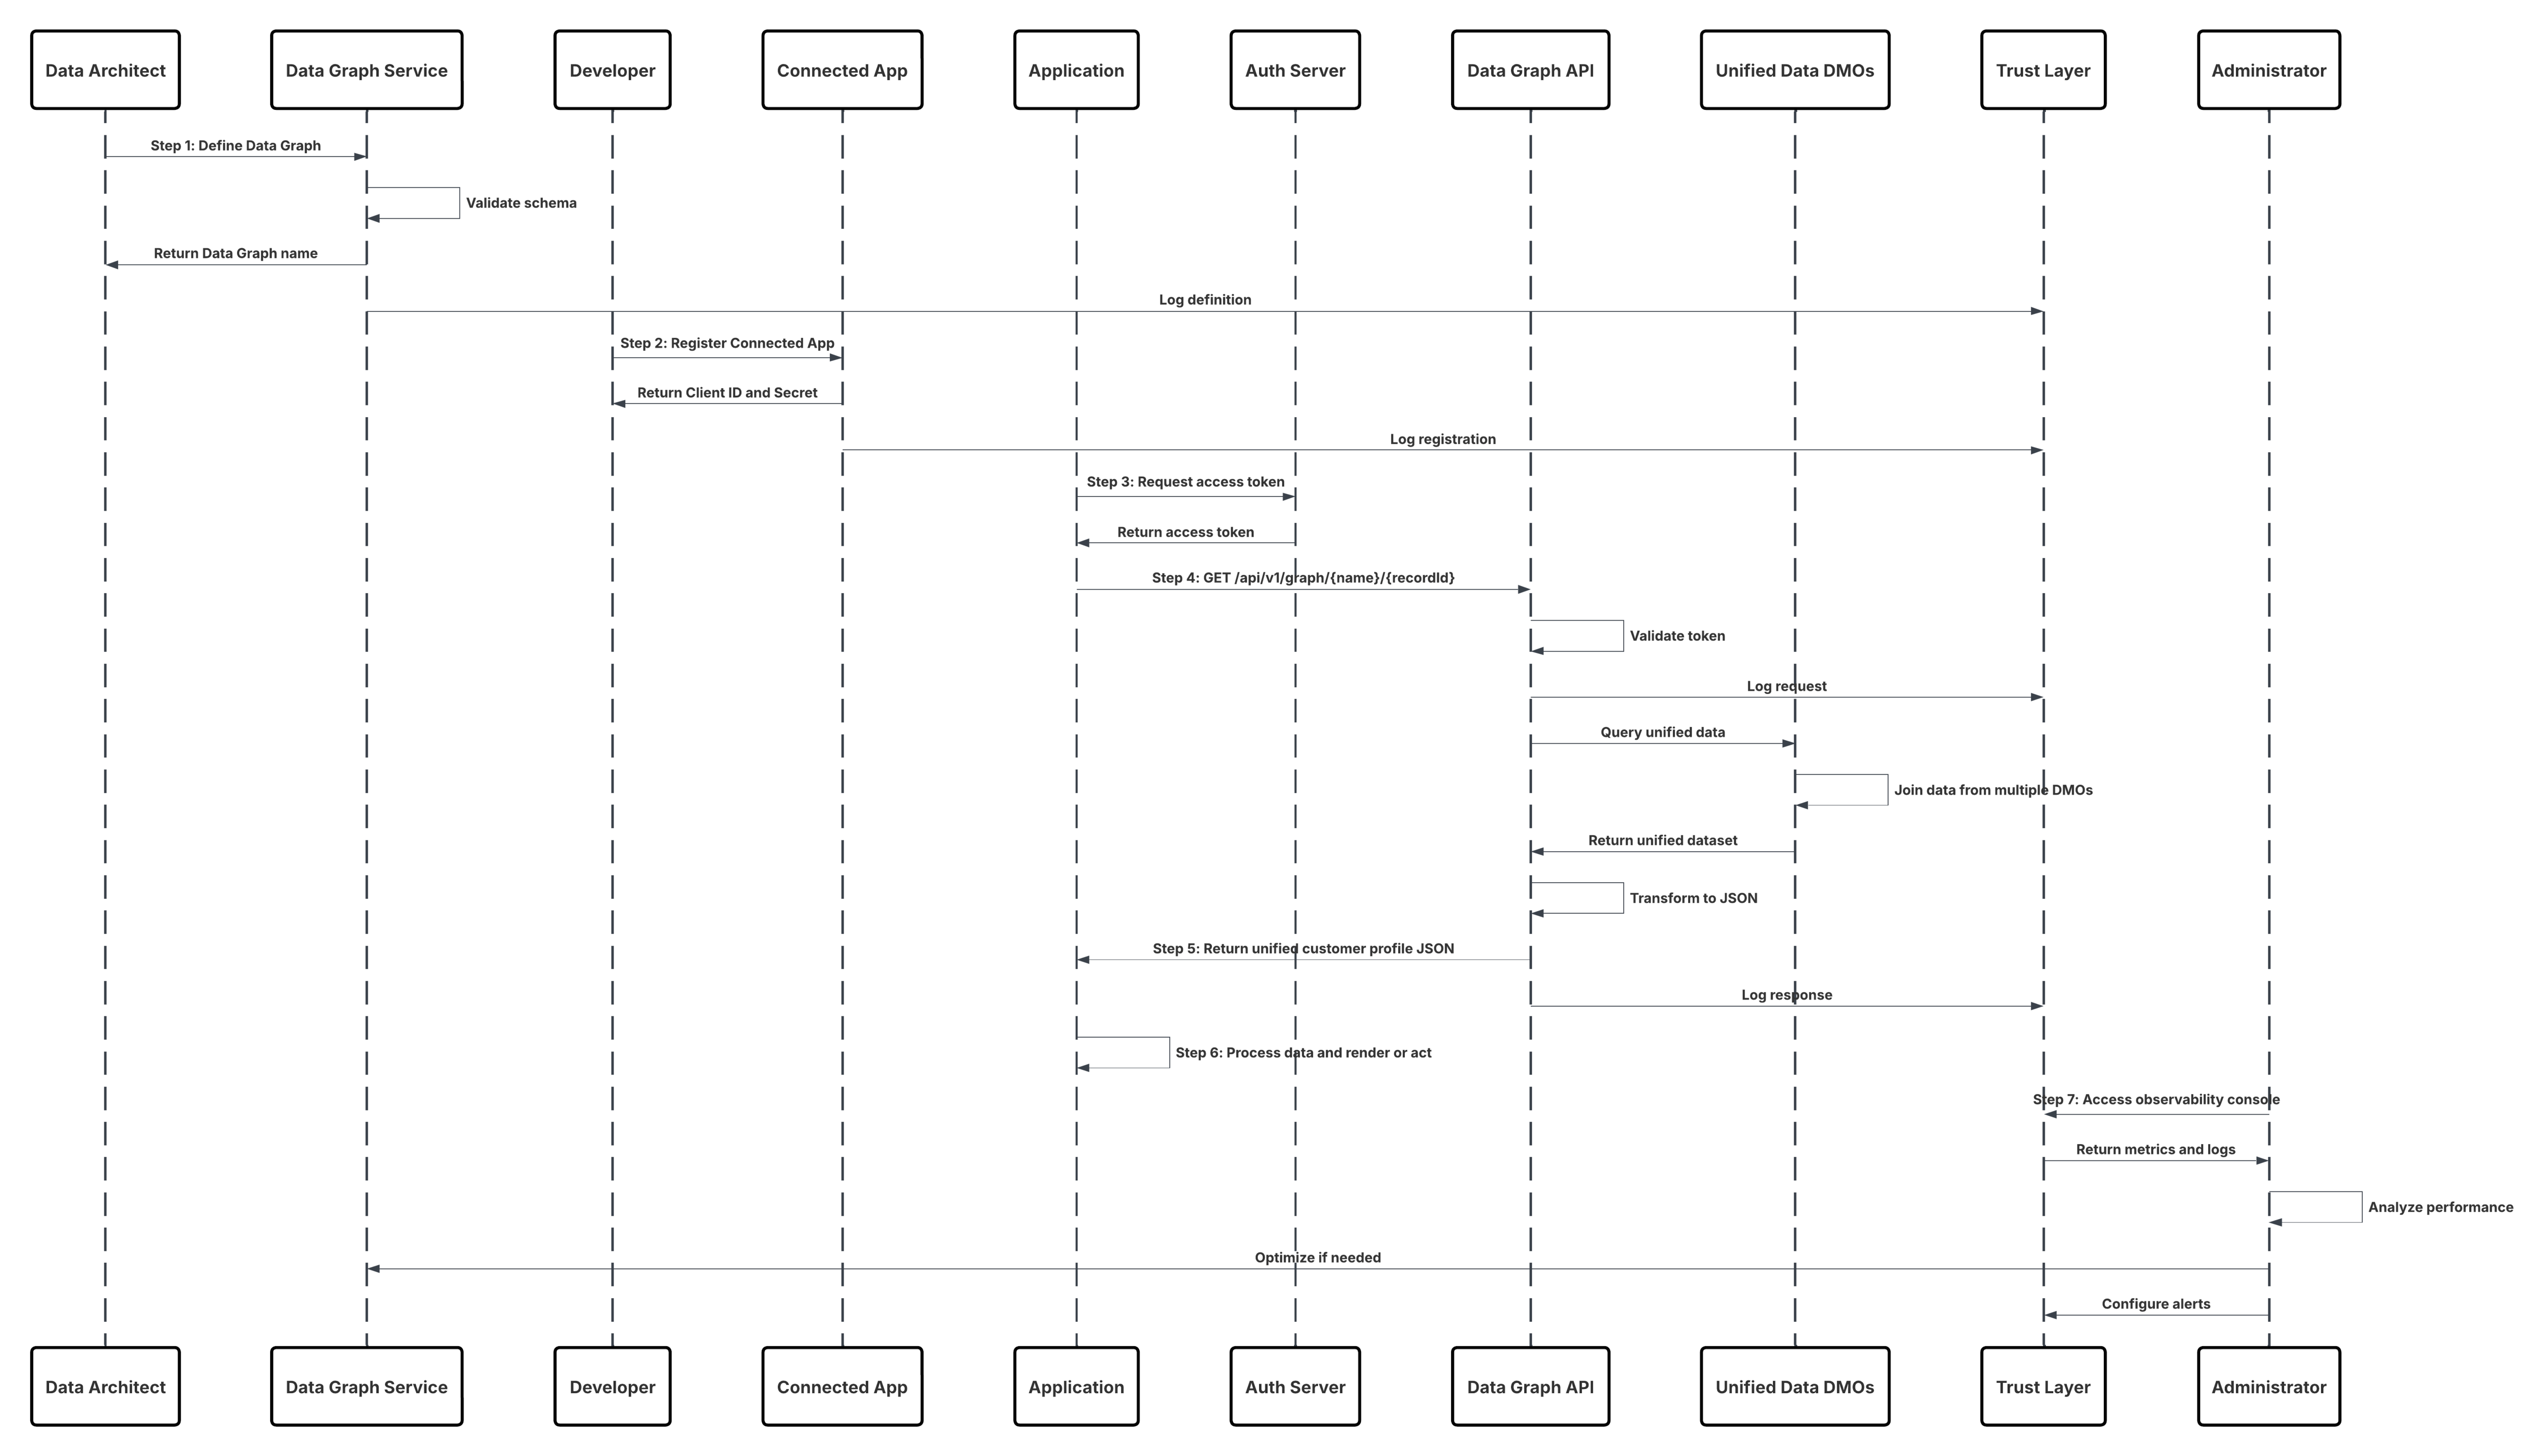 ##### 結果
アプリケーションは、事前参加済みの完全な顧客プロファイルをすぐに取得できるようになり、パーソナライズ、サービス、意思決定の自動化などのリアルタイムインタラクションを強化できます。
このパターンにより、次のことが保証されます。
- 瞬時の意思決定のための 1 秒未満の応答時間。
- Data 360 セマンティックモデルに準拠した一貫性のある管理されたデータ取得。
- アプリケーションロジックの簡略化 — 結合やスキーマの調整が不要。
- Trust Layer を介した追跡可能でコンプライアンスに準拠したアクセスにより、監査と監視が可能になります。
###### コールメカニズム
コールメカニズムは、対象クラウドストレージプラットフォームと有効化設定によって異なります。
| メカニズム | 使用するケース |
|---|---|
| データグラフ API (優先) | ID または鍵で完全な事前具体化されたプロファイルをすぐに取得するために使用します。 |
| live=true のデータグラフ API | 最新のデータが必要で、若干高いレイテンシを受け入れる、価値の高い使用事例 (不正行為の検出、ライブオファーなど) に使用します。 |
| Connect API (フォールバック) | データグラフの取得と他の Salesforce データを組み合わせた複合アプリケーションのシナリオに使用します。 |
| Query API | プロファイルのインスタント取得ではなく、アドホッククエリまたは分析読み取りを作成する場合に使用します。 |
| MuleSoft API Proxy | エンタープライズゲートウェイを介してデータグラフコールを転送する場合や、追加のオーケストレーション/ポリシー適用が必要な場合に使用します。 |
| ソリューション領域 | 適合 | コメント/実装の詳細 |
|---|---|---|
| リアルタイムデータアクション | 最善 | 単一レコードの参照・更新トリガーとアクショントリガーのエンドポイントを公開します。OAuth/JWT を使用して認証します。 |
| ID 解決 | 必須 | 受信識別子 (メール、externalId、Cookie) をインラインで統合個人 ID に解決します。キャッシュで確定的リゾルバーを使用します。 |
| ポリシー適用 (CEDAR) | ベストプラクティス | 要求時に同意、ABAC、マスキングポリシーを評価し、ポリシーの決定ごとに項目を拒否またはマスキングします。 |
| Edge/Cache Layer | 推奨 | プロファイルフラグメントと計算済みインサイトの短い TTL キャッシュを使用して、遅延を減らし、変更イベントで無効化します。 |
| 軽量変換 | 推奨 | アクションパスに単純な強化または計算項目を適用します。重い変換は事前に計算する必要があります。 |
| アクションオーケストレーション | 最善 | 複雑なフローの同期シングルステップアクション (返品提案トークンなど) と非同期オーケストレーション (キュー \+ Web フック) をサポートします。 |
| オブザーバビリティと追跡 | 必須 | 要求/レスポンス、ポリシーの決定、系統を監査とデバッグのためにTrust Layer/SIEMに記録します。 |
| レート制限および調整 | 必須 | トラフィックが多い瞬間にクライアント割り当てとグレースフルデグラデーション戦略を適用します。 |
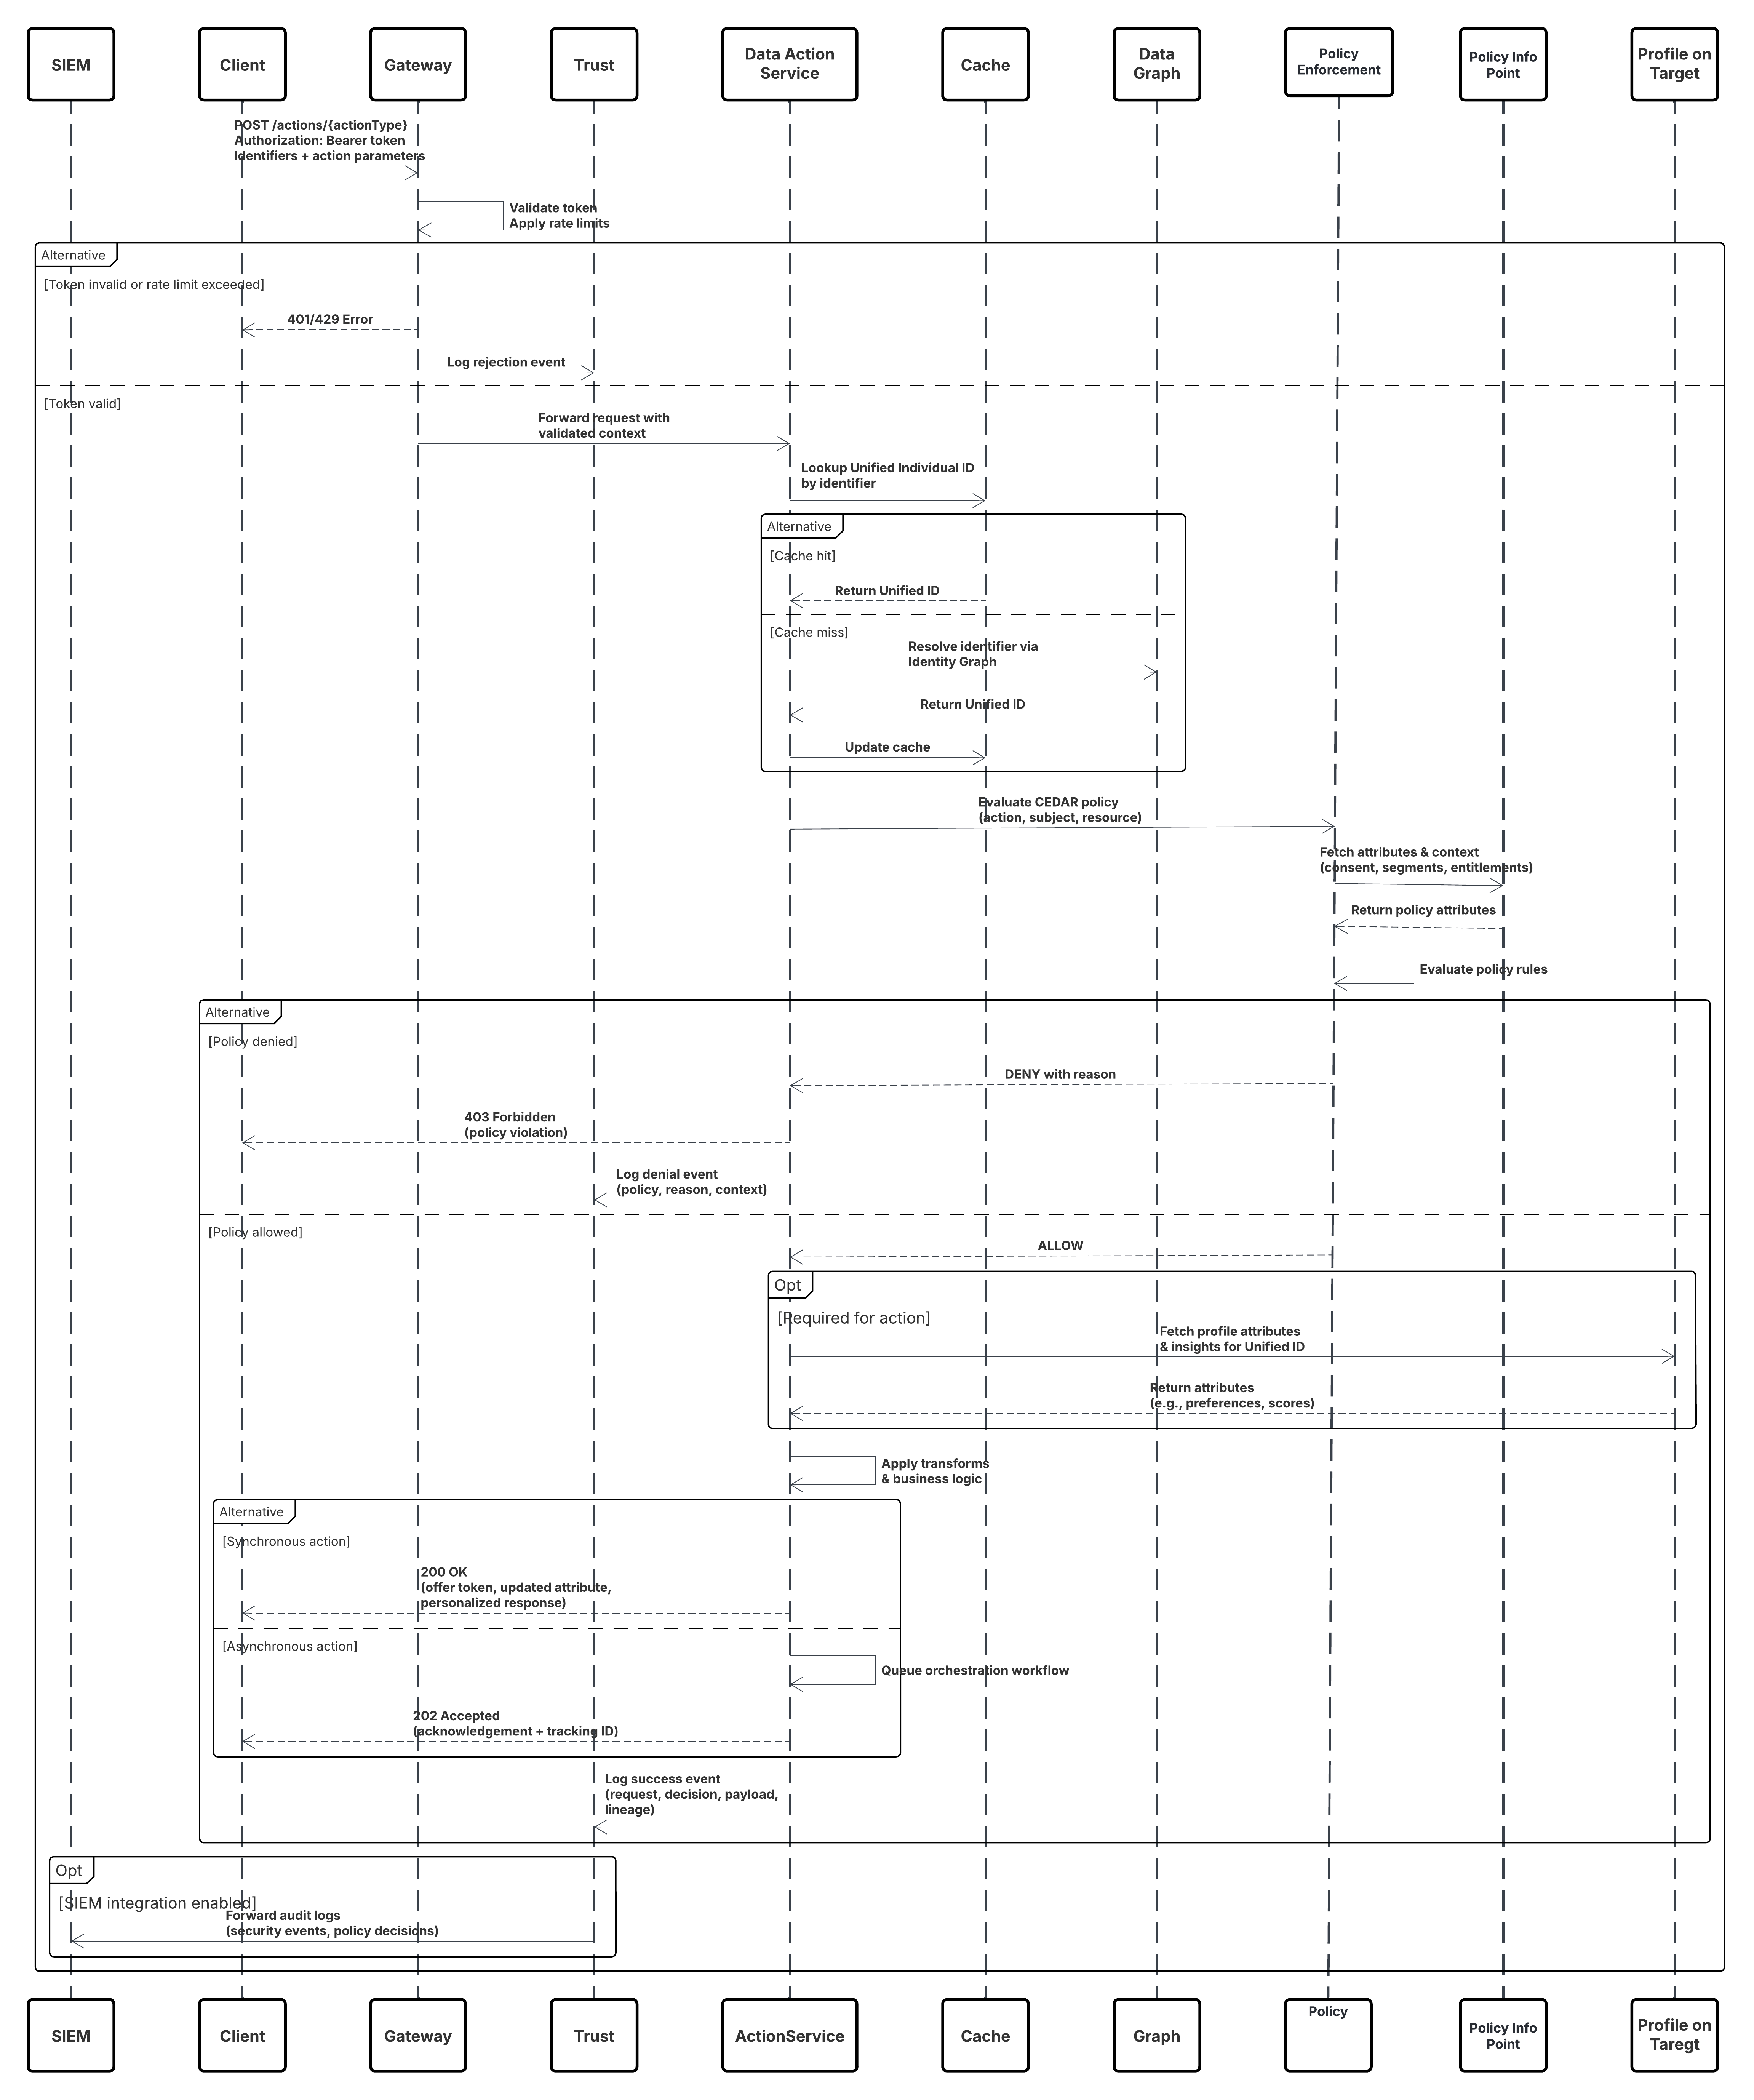 ##### 結果
- アプリケーションは、1 秒から 2 秒未満のレイテンシーで、統合プロファイルの読み取り/書き込みとアクショントリガーへのポリシーで管理されたアクセス権をすぐに取得できます。
- リアルタイムのパーソナライズ、判断、業務ワークフロー (提案、エージェント支援、在庫の更新など) がバッチ遅延なしで有効になります。
- すべてのアクションは監査可能で同意を認識し、プライバシーとコンプライアンスを維持するために属性レベルのマスキングを適用します。
###### コールメカニズム
コールメカニズムは、対象プラットフォームと有効化対象の設定によって異なります。
| メカニズム | 使用するケース |
|---|---|
| RESTful データアクション API | 同期プロファイル読み取りまたはアクション応答が必要な Web/モバイルアプリケーションおよびミドルウェアに適しています。 |
| gRPC/バイナリRPC | 永続的な接続を使用する超低レイテンシのエンタープライズサービスまたは内部マイクロサービスに使用します。 |
| GraphQL 単一レコードクエリ | クライアントが柔軟な項目選択を必要とし、ペイロードを最小限に抑えたい場合に使用します。 |
| イベントトリガー Web フック | アクションによって下流プロセスがトリガーされる非同期ワークフロー (ジャーニーの開始など) に使用します。 |
| プラットフォームイベント/PubSub | 複数のシステムが 1 つのアクションイベントに反応する必要があるファンアウトシナリオに使用します。 |
| Edge SDK (クライアントライブラリ) | プロファイルフラグメントをキャッシュし、必要な場合にのみデータアクション API をコールする低遅延クライアントに使用します。 |
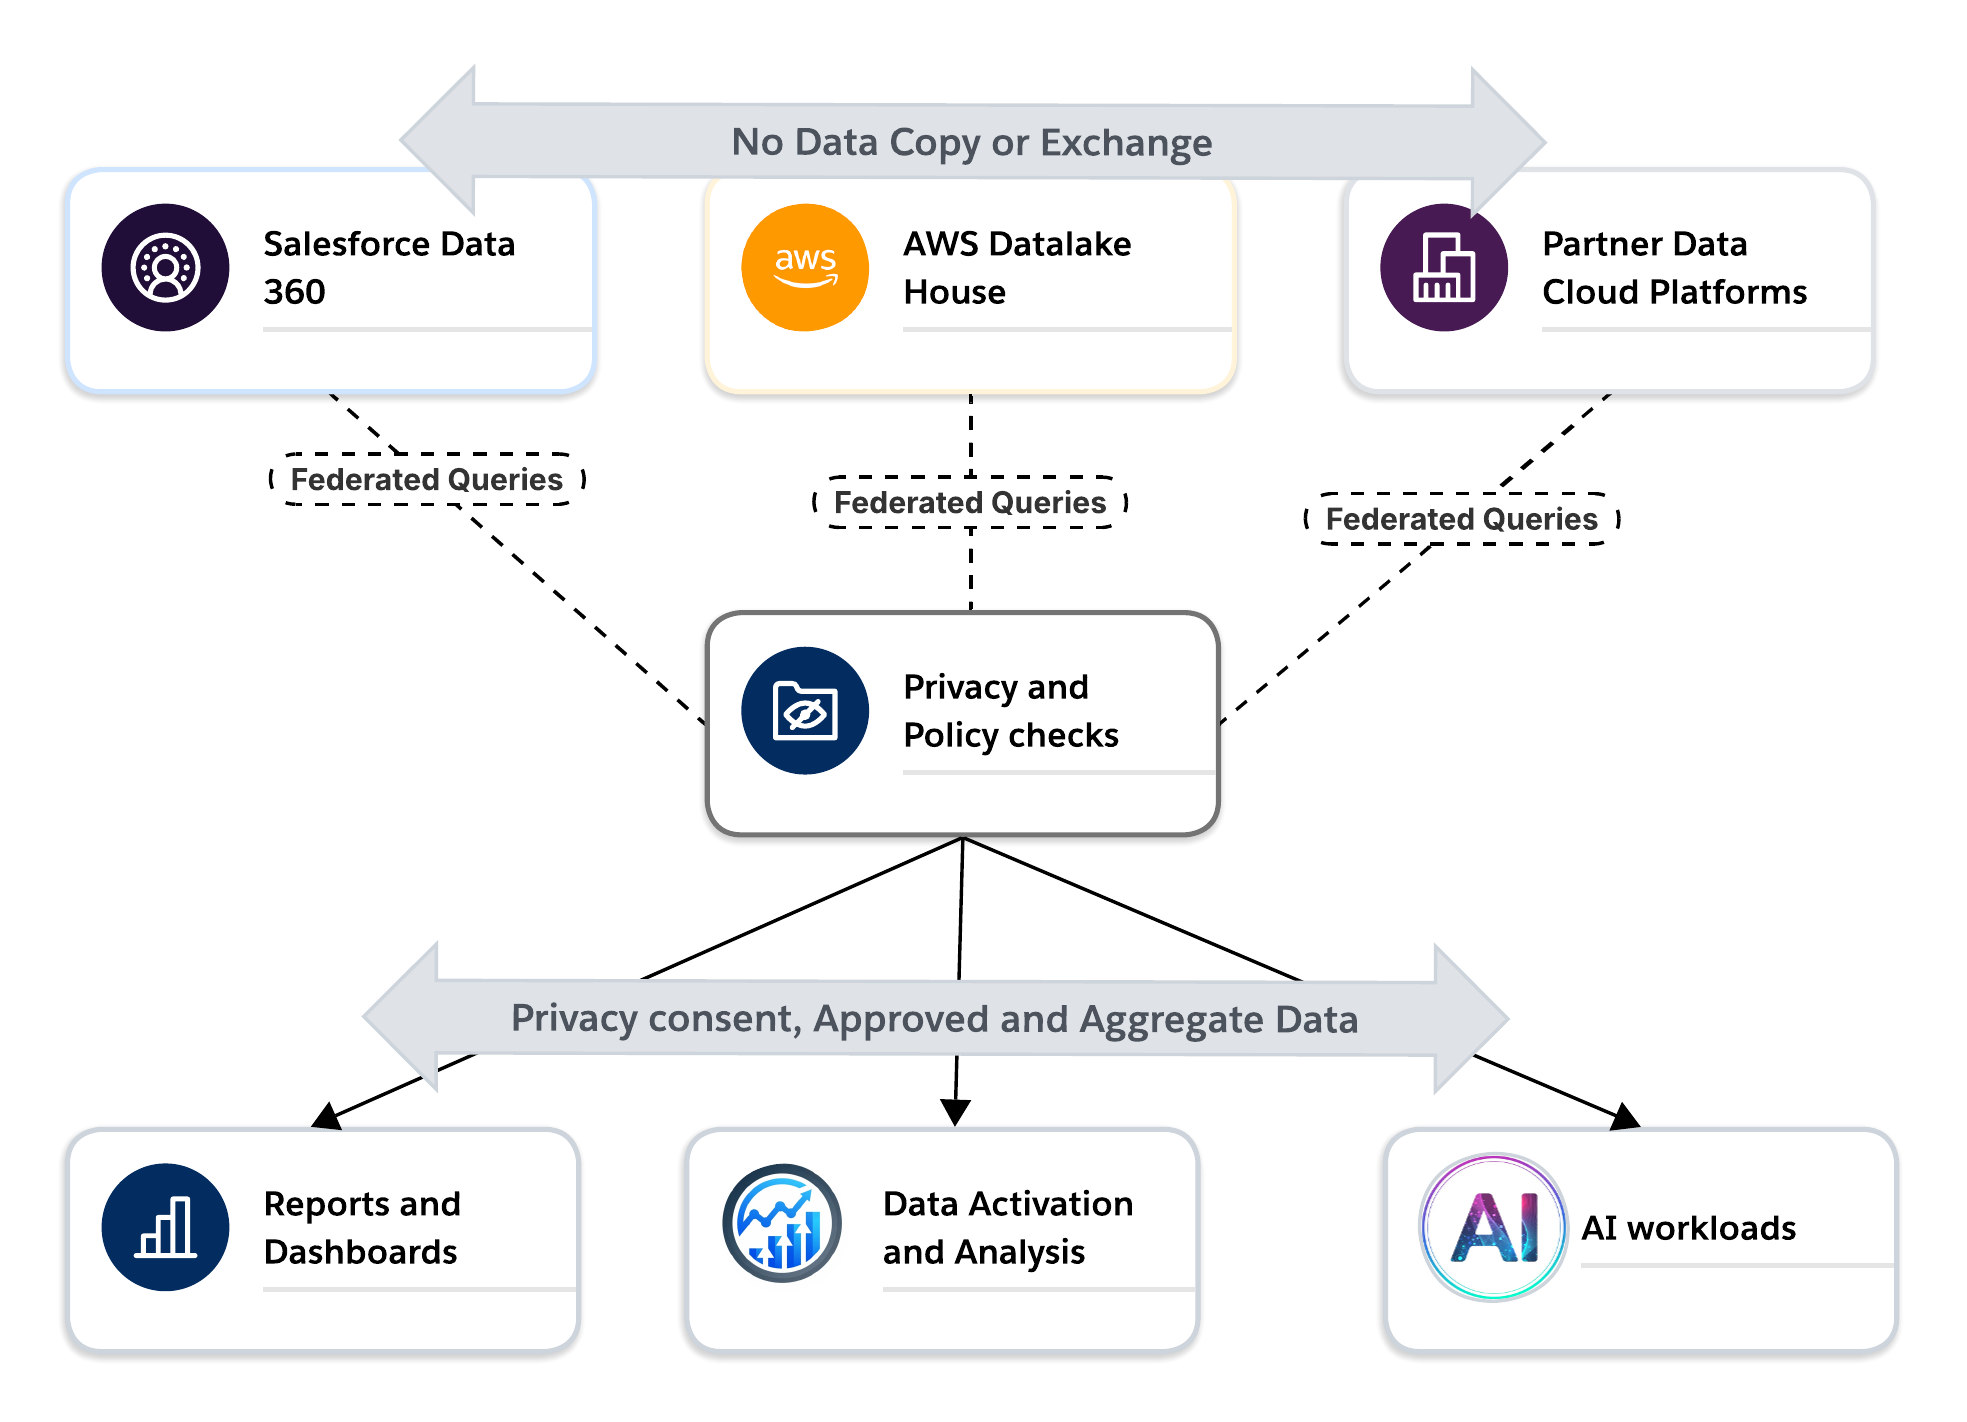 このモデルでは、データ クリーン ルームはモダン データ アーキテクチャのTrust境界として機能します。これにより、組織はデータの制御を失うことなくパートナーや関連子会社と連携し、ポリシーのみではなくシステム制御によってプライバシーと同意を適用し、データのレジデンシーと契約上の制限を尊重しながらクラウド全体で運用できます。
有効化、分析、AI の使用事例の場合、クリーンルームでは機密情報を公開することなく、外部データからインサイトを安全に生成できます。データ共有から信頼できるコラボレーションへの移行が可能になります。有効化の使用事例では、クリーンルームは許可された対象に直接有効化できる利用者を安全に生成する方法を提供します。これらはすべて、個人識別情報 (PII) をいずれの関係者にも公開することなく実現されます。これは、エンタープライズデータアーキテクチャの転換点となります。データクリーンルームはもはやニッチなツールではありません。これらは、プライバシーを保護し、AI に対応した統合データプラットフォームのコアインフラストラクチャになりつつあります。
## 関係者の人格とテクニカル ガードレール
成功するデータクリーンルームアーキテクチャは、データユーティリティ、セキュリティ、スピードの競合するプレッシャーを解決するために設計されたマルチインターフェースシステムです。3 つの主要な人格があり、基盤となる技術設計で個別の摩擦点に対処する必要があります。
### プライバシーおよびコンプライアンス責任者 (リスク軽減担当者)
プライバシーとコンプライアンスの責任者は、ガバナンスツールとしてデータクリーンルームを使用します。主な懸念事項はコンプライアンスのドリフトです。これは、外部コラボレーション環境が内部システムと同じ厳格な基準を適用できないリスクです。
- **摩擦点:**規制違反 (GDPR、CCPA、DMA) や、パートナーが詳細なクエリを繰り返してユーザーの ID を三角測量しようとする「フィッシング」攻撃。
### データサイエンティストおよびアナリスト (ユーティリティオプティマイザー)
データサイエンティストは、データクリーンルームを高度なモデリングの安全な避難所と考えています。プライバシー保護対策によってデータが統計的に無駄にならないよう、ユーティリティの維持が主な関心事です。
- **摩擦点:**機械学習 (ML)、類似モデリング、離脱予測に必要な詳細な属性への高レイテンシーと制限されたアクセス。
### マーケティングおよびビジネスユーザー (価値実現者)
この人格は、タイムトゥバリュー (TTV) のみに焦点を当てています。懸念事項は、データクリーンルームプロジェクトが、数週間のデータエンジニアリングサポートを必要とする技術的なボトルネックになることです。
- **摩擦点:**複雑な設定プロセス、手動のデータクリーンアップ、単純な重複結果を得るためにコードを記述する必要があるという「空白のページ」の問題。
### 「ビジネスファースト」人格モデル
従来のアーキテクチャはユーザーレイヤーよりもデータレイヤーの構築に焦点を絞っていましたが、「ビジネスファースト」手法に沿った戦略的アプローチではこのモデルが逆転しています。コード不要、数回のクリックでインサイトを生成してすぐにアクションを実行できるアプローチが優先されます。
**「Insight-to-Action」ワークフロー:**このアーキテクチャは、パッシブリポジトリではなく、アクティブなワークスペースとして設計されています。使用事例テンプレート (セグメントの重複、有効化、キャンペーンパフォーマンスなど) を提供することで、ビジネスユーザーはインサイトをセルフサービスで提供できます。これにより、最適化された類似セグメントなどのインサイトをマーケティングエコシステム全体ですぐに有効化できます。データエンジニアが手動でファイルを移動する必要はありません。
**戦略的資産としてのゼロコピー統合:**TTV を最大化するために、このアーキテクチャではゼロコピーロジックを採用しています。遅延やセキュリティリスクが発生する従来の ETL プロセスではなく、このアーキテクチャではデータが存在する場所 (Snowflake、BigQuery、Amazon S3 など) へのクエリを直接統合します。これにより、組織の既存のデータ投資が戦略的な資産となり、ビジネスユーザーは最新のデータにリアルタイムで対応しながら、厳格なガバナンスを維持し、データの冗長性のコストを排除できます。
## 主要なデータクリーンルームの使用事例
データクリーンルームは、Cookie の廃止とプライバシー規制に対応するために広告で登場しましたが、測定だけでなく、さまざまな業種の顧客分析、オーディエンスセグメンテーション、有効化の使用事例に発展しました。2025 State of Retail Media (2025 年の小売メディアの状況) レポートによると、測定可能なビジネス成果をもたらすプライバシーで安全なコラボレーションの必要性から、66% の組織がクリーンルームを一定の業務量で使用しています。
パターンはセクター全体で一貫しており、データは所有者に保持され、計算は管理され、プライバシーが保護されたインサイトのみが共有されます。
### マーケティングと広告:サードパーティ Cookie を使用しないメジャメント
**課題:**マーケティング担当者は、キャンペーンの効果を測定し、広告インプレッションの重複を回避し、リーチ/頻度を最適化する必要がありますが、サードパーティの Cookie やデバイス ID に依存することはできなくなりました。
**クリーンルームソリューション:**
- 広告主がハッシュされた顧客またはキャンペーン露出データを寄稿する
- パブリッシャーがインプレッションシグナルとエンゲージメントシグナルを寄稿する
- クリーンルームでリーチ、頻度、属性、リフトを計算
- 未加工データのエクスポートなしで承認済みプラットフォーム経由で有効化
**ビジネス結果:**クリーンルームでは、広告インプレッションを実際の取引にリンクするクローズドループ属性、真のキャンペーンリフトを分離する増分分析、チャネル間の統合メジャメントなど、従来のデジタル広告では提供できなかった機能が提供されます。
**業界の証拠:**メジャメントは、現在最も確立されたクリーンルームの使用事例であり、Pinterest、ディズニー、パラマウントなどの大手メディアネットワークが独自のクリーンルームを作成しています。
### 小売メディアおよび消費者パッケージ商品 (CPG) :ファーストパーティデータを共有せずに収益化
**課題:**CPG ブランドは小売メディアに多額の費用を費やしているが、購入結果を可視化していない。小売業者は豊富な POS データを所有していますが、プライバシーのコミットメントに違反しずに公開することはできません。
**クリーンルームソリューション:**
- 小売業者と CPG 会社は、小売店の POS データとマーケティングデータを組み合わせてプロモーション活動を最適化します。
- ブランドがハッシュされた CRM またはロイヤルティ識別子を貢献する
- 店舗内/オンライン購入へのクリーンルーム広告リンク
- 有効化は小売業者のメディアエコシステム内にとどまる
**ビジネス結果:**
- 小売業者は未加工の顧客情報を販売せずにファーストパーティデータを収益化
- ブランドは、どのキャンペーンが購入を促進したかを示す循環利用属性を取得します。
- プライバシーリスクのないリテールメディアネットワークの拡張
**業界の証拠:**Walmart の Luminate や Kroger Precision Marketing などのリテールメディアネットワークは、CPG ブランドが小売業者データを使用して顧客の行動を分析し、マーケティング戦略を最適化するのに役立つクリーンルームを提供しています。
### 金融サービス:コラボレーション不正検出
**課題:**不正行為ネットワークは複数の機関で運用されていますが、GLBA や新しいプライバシー保護法などの規制により、銀行は顧客データや取引データをオープンに共有できません。
**クリーンルームソリューション:**
- 複数の銀行が匿名データをプールして、異常な銀行間活動などの不正行為を示すパターンを特定
- 共有された不正行為のシグナル全体で実行される統合分析またはモデル
- 別の顧客の顧客レベルのデータはどの機関にも表示されない
**ビジネス結果:**
- 機関間不正行為パターンの早期発見
- 豊富な信号セットによる偽陽性の減少
- 機密データを一元化せずに法規制に準拠
**業界の証拠:**Experian と TransUnion の金融サービスソリューションは、厳格なデータプライバシー管理を維持しながら、銀行と保険会社が不正行為の検出とリスク評価でコラボレーションできるようにするクリーンルームテクノロジーを提供します。
### ヘルスケアおよびライフサイエンス:患者データ漏洩のない研究
**課題:**製薬会社は医薬品開発のために実際の患者転帰を必要としていますが、データは HIPAA および同様の規制で保護された病院の EHR システムにあります。
**クリーンルームソリューション:**
- 医師と製薬研究者がクリーンルーム内でデータを共有することで、患者が治療にどのように反応しているかを把握できます。
- 患者データは提供者環境内に残ります。
- 研究者はクリーンルームを介して承認済みの統計分析を実行します。
- 差分プライバシーにより、再識別を防止できます。
**ビジネス結果:**
- 大規模で統計的に有効な実際の証拠
- 匿名化された患者データを臨床試験条件と照合し、医療プライバシー保護法に違反することなく適格な候補者を見つけることで、臨床試験の患者募集を合理化
- 制限された臨床試験母集団への依存を軽減
**業界の証拠:**Datavant のようなヘルスケアに焦点を絞ったクリーンルームは、研究者やヘルスケア組織が臨床試験や医薬品開発のために患者データを安全に分析するための HIPAA 準拠の環境を提供します。
### 業種間パターン:コラボレーションの必要性
これらの主な使用事例以外にも、クリーンルームには次の利点があります。
- **サプライチェーンの最適化:**メーカーとサプライヤーが協力して在庫の詳細、生産スケジュール、需要予測を共有することで、機密情報を保護しながら連携を強化できます。
- **M&Aデューデリジェンス:**ある企業が別の企業を買収する場合、デューデリジェンスでは機密情報を直接共有せずに財務予測と顧客データベースを調査する必要があります。クリーンルームでは、顧客セグメントのアライメントやコンプライアンスリスクなどのインサイトを明らかにします。
- **メディアおよびエンターテインメント:**パブリッシャーは購読者 ID を保護しながら広告主にオーディエンスの価値を証明し、確率的ターゲティングではなく、信頼できるメジャメントに裏打ちされたプレミアム CPM を実現します。
AdTech、小売、金融サービス、医療、メディア全体で、データ クリーン ルームはTrustインフラストラクチャの基盤となっています。これにより、以前はプライバシー、規制、または競合上の制約によってブロックされていた価値の高いコラボレーションが可能になります。クリーンルームは、安全で管理されたコラボレーションを可能にする**コア アーキテクチャ コンポーネント**であり、データの制御やコンプライアンスを損なうことなく、インサイトと収益化を実現します。
## データクリーンルーム:信頼できるデータコラボレーションの基盤
データクリーンルームは、未加工データを公開または交換することなく、複数の関係者が共同インサイトを生成できる安全な管理環境です。データセットを複製する代わりに、承認済みの分析、AI、有効化ワークロードが実行され、ポリシーに準拠した出力のみが返されます。有効化に個人レベルのレコードが必要な場合、データはコラボレーション関係者に公開されずに目的の宛先に直接配信されます。
アーキテクチャ上、クリーンルームはコラボレーションをデータ共有から制御された計算に移行します。各参加者はデータの管理権を保持し、ランタイム適用によってクエリの動作、出力制約、同意、使用ポリシーが制御されます。
コラボレーションは、プライバシーが保持される識別子アライメントメカニズムによってさらに有効になり、基盤となる識別子を公開することなく、さまざまな関係者のデータセットを相関させることができます。この機能は、このドキュメントの後半で詳しく説明します。
そのため、データクリーンルームは、ゼロコピーの統合データ戦略で業務を行う、プライバシーが規制されたマルチクラウドの AI 駆動型企業の基盤インフラストラクチャとして機能します。
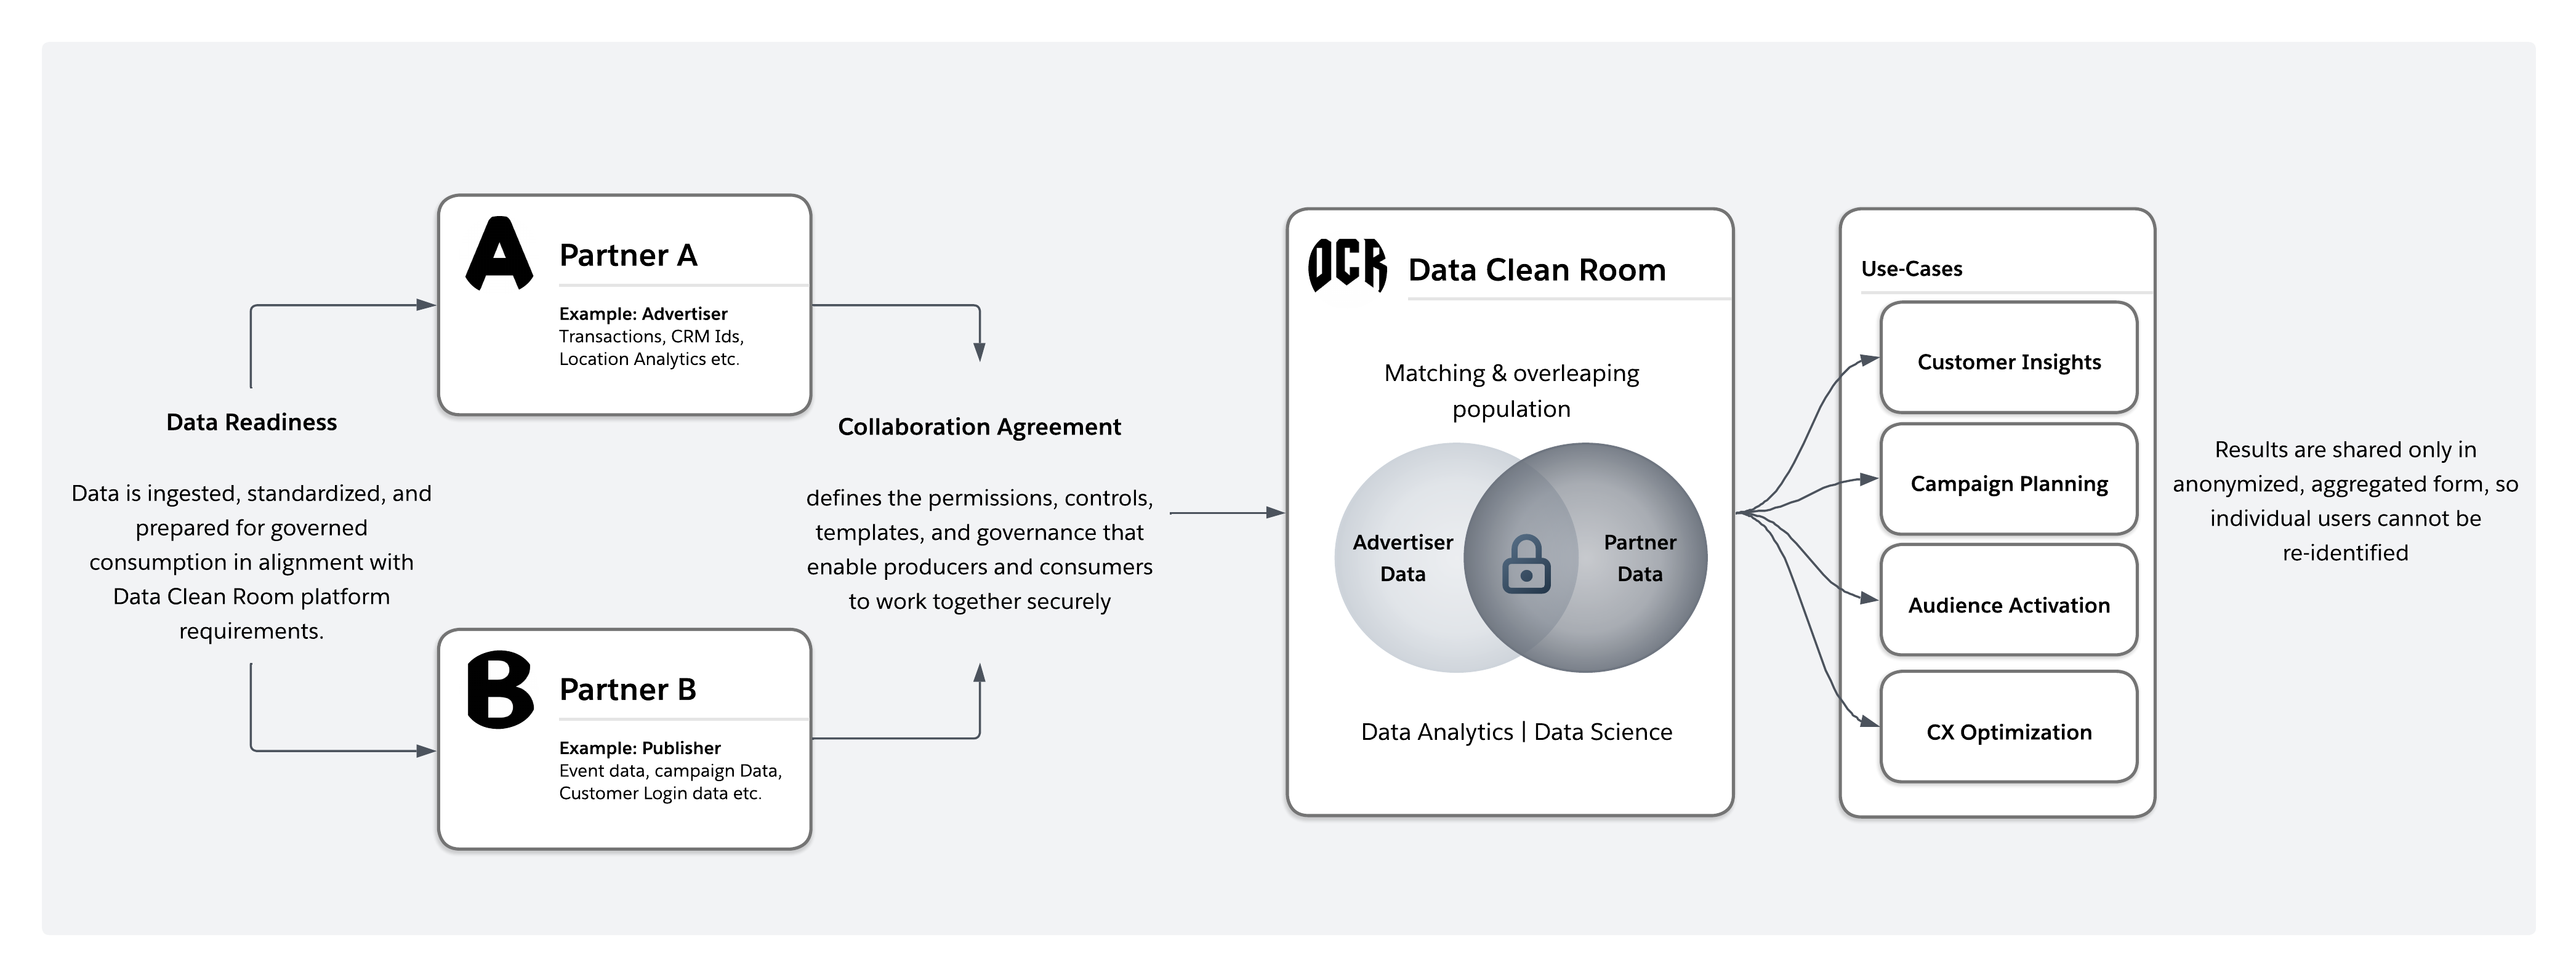 初期のデータクリーンルームは、一元化された「バンカー」モデルに従っていました。すべての参加者は、分析のために中立的なサードパーティ環境にデータをコピーする必要がありました。このアプローチは概念的には単純ですが、大きな摩擦を引き起こしました。データ移動によって遅延とコストが増加し、法規制とコンプライアンスの合意が複雑になり、組織は機密データの直接管理を断念せざるを得なくなりました。規制のある業界では、これらのトレードオフによってコラボレーションが現実的でなくなることがよくありました。
最新のデータクリーンルームは、分散型の統合モデルへと進化しました。データは所有者の環境に残り、統合クエリを使用して分析が実行されます。クリーンルーム自体は、各クエリを代行受信し、実行時にプライバシーとポリシーの制御を適用し、承認された集計出力のみを返すガバナンスレイヤーとして機能します。
| ディメンション | 従来のクリーンルーム (「バンカー」モデル) | 最新のクリーンルーム (分散/統合モデル) |
|---|---|---|
| データの場所 | データは一元化されたサードパーティ環境にコピーされる | データは所有者の環境に残る |
| データ移動 | データセットの物理的な転送と複製が必要 | 未加工データを移動せず、クエリを実行 |
| 制御と保管 | 保管がサードパーティプラットフォームに一部譲渡 | 各当事者が保持する未加工データの所有権と保管 |
| アーキテクチャモデル | 一元化された集計 | 分散統合計算 |
| ガバナンスの実施 | データの移動後に適用されるポリシー | クエリ実行時に適用されるポリシー |
| プライバシーモデル | 契約および手続き上の管理に大きく依存 | ランタイム制御と集計しきい値によって技術的に適用 |
| 遅延 | 取り込みと同期によるレイテンシの増加 | 低レイテンシ、ほぼリアルタイムの統合クエリ |
| コスト構造 | ストレージ、転送、複製のコストの増加 | 重複の削減、データが存在する場所での自動計算 |
| コンプライアンスの複雑さ | 境界を越えたデータの移動による複雑な法的合意 | データがソース境界から離れないため、コンプライアンスが簡略化される |
| 拡張性 | 拡張にはより多くのストレージとデータレプリケーションが必要 | データを重複させることなく分散コンピューティングで拡張 |
| 規制対象の業界適合 | 親権や居住権の懸念から非現実的であることが多い | 主権、同意、規制上の制約へのより適切な対応 |
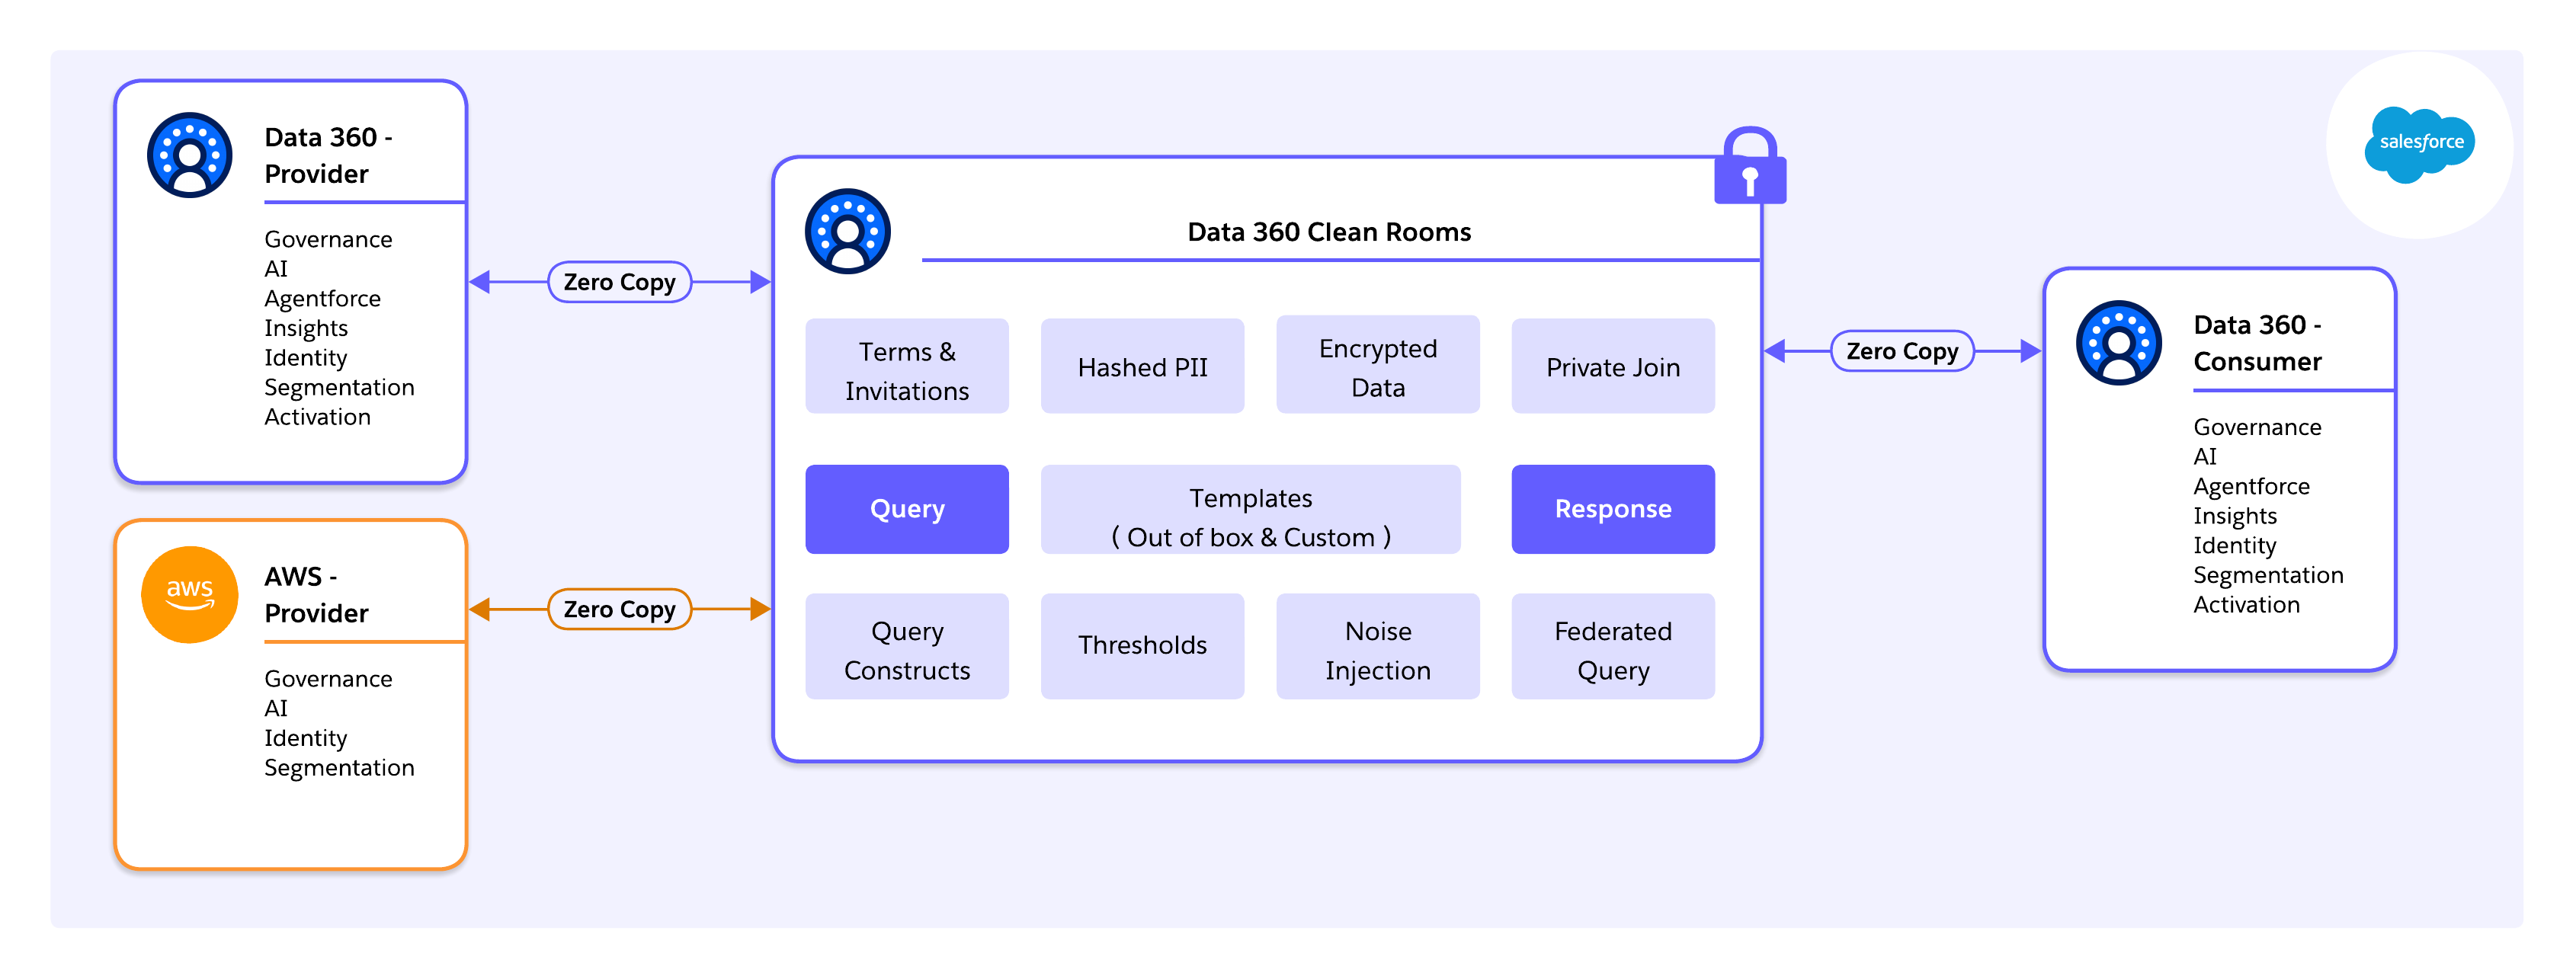 ### スケーラブルなデータクリーンルームのプラットフォーム基盤
インフラストラクチャ レイヤーでは、Salesforce Data 360はHyperforceで実行されます。Hyperforceは、統合されたコントロール プレーンの背後にあるハイパースケーラー リソース(AWS、Azure、GCP)を抽象化するSalesforceのクラウド ネイティブ ランタイムです。このアーキテクチャにより、主権と居住要件を満たすためにデータを地域内に保持しながら、グローバルに管理されたクリーンルーム業務が可能になります。
重要なのは、この基盤により、AWS Clean Rooms とのネイティブの相互運用性を含め、クラウド間のクリーンルームコラボレーションが可能になることです。Data 360 をオーケストレーションおよびガバナンスレイヤーとして使用すると、企業は Salesforce が管理するストレージにデータを強制的に移行することなく、AWS で直接業務を行うパートナーとコラボレーションできます。クエリはソースに転送され、プライバシールールが一貫して適用され、準拠した集計結果のみがプラットフォーム間で交換されます。
コンプライアンスとTrustは、アプリケーション レイヤーで改良するのではなく、インフラストラクチャと実行の境界で適用されます。これにより、マルチクラウド、マルチパーティ コラボレーションの大規模な耐久性のある基盤が提供されます。
### 取り込みから有効化までの Data 360 パイプライン
Data 360 は追跡可能なエンドツーエンドのデータパイプラインを実装し、未加工の抽出データではなく、ハーモナイズされ、管理された ID 認識データでクリーンルームの運用を実行します。
主なフェーズは次のとおりです。
- **接続**:標準のコネクタ、API、SDK、MuleSoft、またはゼロコピーコネクタを使用したデータの取り込みと仮想化
- **持続**:ネイティブ形式 (Parquet/Iceberg) の未加工データの保存
- **Harmonize**:一貫した結合のための正規データモデルオブジェクト (DMO) へのマッピング
- **統合**:ID 解決によってゴールデンレコードが作成される
- **インサイトの取得**:計算済みインサイトは、管理境界内の集計された総計値を計算します。
- **活動**:Salesforce 組織、マーケティングプラットフォーム、広告ネットワーク、外部データプラットフォーム、その**他のクリーンルーム**への出力フローを管理し、インサイトとアクションのループを閉じる
このパイプラインにより、クリーンルームはアドホック抽出ではなくエンタープライズクラスのデータで動作します。
### ネイティブインテグレーションと「コード未クリック」
個別のプロビジョニングと SQL 開発が必要なスタンドアロンのデータクリーンルームプラットフォームとは異なり、Salesforce クリーンルームは Data 360 にネイティブに組み込まれています。これにより、DMO、ID ルール、同意モデル、ガバナンスポリシーの再利用が可能になり、重複するセキュリティレイヤーが排除されます。
Salesforce のテンプレート駆動型クリーンルームモデルは、以下を使用する主要なアクセラレーターです。
- 利用者の重複、抑制、リーチ、リフト測定などの一般的なコラボレーション・パターンをサポートする**標準のテンプレート**。
- **カスタム・テンプレート**により、アーキテクトや上級ユーザーは、未加工データやポリシーの複雑さを公開することなく、業界固有またはパートナー固有のニーズに合わせて調整された再利用可能な分析ロジックを定義できます。
このアプローチでは、コラボレーションを標準化しながら柔軟性を確保できるため、クリーンルームを 1 回限りの分析プロジェクトではなく、反復可能なエンタープライズ機能として拡張できます。
### 「ゴールデンパス」 - インサイト-to-アクションループのクローズ
Data 360 は、従来のクリーンルームの一般的な障害モードである有効化ギャップに対処します。Golden Path フレームワークにより、未加工データをエクスポートすることなく、クリーンルーム内で生成されたインサイトをすぐに処理できます。
- **設定と検出**:パートナーはスキーマメタデータを共有し、テンプレートを活用して、契約が完了する前に実現可能性を評価します。
- **分析**:事前作成済みテンプレートとカスタムテンプレートにより、重複分析、抑制、類似モデリング、リフト測定がすべて管理境界内で実行されます。
- **有効化**:承認されたセグメントは Marketing Cloud、広告プラットフォーム、またはパートナーシステムに直接転送され、集計された準拠の結果のみが共有されます。
テンプレートは、評価済み実行パスになり、コラボレーションが予測どおりに分析から有効化に移行します。
## Salesforce Data 360 クリーンルームのプレイブック
Salesforce Data 360 Clean Room の導入は、単なる設定作業ではなく、データの準備、ガバナンス設計、安全な接続、運用監視にわたる統制の取れたアーキテクチャワークフローです。
### ステップ 1:コラボレーションの使用事例の定義 (インテントから開始)
アーキテクトは、データまたは設定に触れる前に、以下を明確に定義する必要があります。
- どんな質問に答えようとしてるんだ?
- 想定される結果 (重複分析、リフト測定、抑制、不正行為の検出など)
- 必要な集計レベルは?
- 適用される規制または契約上の制約は?
- 結果を使用する有効化パスは?
コラボレーターの目的を理解することで、結合キー、ID ルール、ガバナンスしきい値、コストモデリングなど、後続のすべてが形作られます。クリーンルームは目的に特化した環境であり、汎用的なデータ公開ではなく、定義された分析目標に基づいて設計する必要があります。
### ステップ 2:クリーンルームコラボレーション用のデータの準備
コラボレーションを開始する前に、エンタープライズデータを構造的および意味的に準備する必要があります。クリーンルームは、基礎となるデータの強みと弱みを増幅します。ゴミは入ってゴミは出て行く
**取り込み:**Salesforce CRM、Marketing Cloud、AWS S3、Google Cloud Storage などのソースシステムを Data 360 に接続します。可能な限り、ゼロコピーコネクタ (Snowflake など) を使用して、データの不要な移動や重複を回避します。
**セマンティック マッピング:**データストリームを Customer 360 データモデルにマッピングします。電話番号 (E.164 形式)、国/都道府県コード (ISO 標準)、メールアドレスなどの主要な項目を標準化します。不一致 (たとえば、「CA」と「California」を使用している関係者) があると、通知なしで結合に失敗し、一致率が低下する可能性があります。
**ID 解決:**確定的 (完全一致) ルールと確率的 (あいまい一致) ルールを設定して、統合個人 (ゴールデンレコード) を作成します。この統合エンティティは、クリーンルーム照合の表面です。
ID 解決の品質は、コラボレーションの価値に直接影響します。一致精度を上げると、重複率や分析の信頼性が高まり、偽陰性が減少します。
### ステップ 3:クリーンルームのプロビジョニング
データをハーモナイズしたら、クリーンルーム自体をプロビジョニングしてコラボレーションの境界を定義する必要があります。
**ライセンス検証:**すべての参加組織に必要な Data 360 とクリーンルームエンタイトルメントがあることを確認します。
**データスペースの範囲設定:**クリーンルームオブジェクトの範囲は、特定のデータスペースにする必要があります。そのデータスペースに対応付けられたオブジェクトのみがクリーンルームに表示されます。これにより、クリーンルーム専用の新しいデータスペースを作成することなく、コラボレーションを論理的に分離できます。
**ガバナンスルールの定義:**クエリを実行する前に宣言的にポリシーを設定します。
- **集計しきい値:** 出力あたり最低 100 件のレコードなど
- **結合キー:** Email_Hash_SHA256 など
- **許可されている**操作: COUNT、SUM、AVG などの集計関数のみ
- **明示的な制限:** 行レベルのエクスポートをブロック (SELECT \*)
ガバナンスルールは実行時に適用されるため、手順ガイダンスではなく、プライバシーとコンプライアンスのシステムレベルのプロパティになります。
### ステップ 4:安全なマルチパーティ接続の確立
多くの場合、クリーンルームは組織とプラットフォームの境界にまたがっています。接続は明示的に厳密に制御する必要があります。
**取引先リンク:**
- **Salesforce-to-Salesforce:**Data Cloud One または承認済みの組織間共有メカニズムを使用します。
- **マルチ クラウド シナリオ:**クエリを有効にする前に、地域の調整とレジデンシーを検証します。
**認証と承認:**最小権限の原則を使用して、専用のインテグレーションユーザーの OAuth ベースのアクセスを設定します。つまり、アクセスを必要なデータスペースに厳密に制限し、管理者権限を回避します。
多くの場合、セキュリティの失敗は、暗号化やプラットフォーム制御の脆弱性ではなく、権限が過剰なインテグレーションユーザーに起因します。
### ステップ 5:クリーンルーム作業負荷の実行、監視、制御
稼働開始後は、業務監視、クエリ品質、コスト管理に重点が置かれます。
**クエリ実行:**アナリストまたはワークフローは、計算済みインサイトまたは承認された SQL インターフェースを使用して重複分析と集計を実行します。すべてのクエリで集計しきい値とプライバシー制御が自動的に適用されます。
**監査とトレーサビリティ :**Salesforce Data 360 クリーンルームでは、監査データモデルオブジェクト (DMO) の形式で監査履歴が提供されます。これにより、クエリの実行者、実行日時、適用されたポリシーなど、クエリ活動に関するメタデータが取得されます。監査 DMO により、コンプライアンスレポート、ガバナンス検証、フォレンジック追跡が可能になり、コラボレーションがプライバシー保護され、レビュー可能になります。
**消費の監視:**Data Cloud では、消費ベースのクレジットモデルが使用されます。主な推進要因は次のとおりです。
- 処理行数 (例: 100 万行 = ベースラインクレジット単位)
- クエリの複雑さ
- ID 解決操作 (高い乗数)
- 一括取り込み (低い乗数)
**デジタルウォレットとアラート:**Digital Walletを使用してリアルタイムの消費を追跡し、50%、75%、90%のしきい値でアラートを設定します。急増を特定のワークロードに関連付けて、予期しないコストを回避します。
ゼロコピーでは計算コストが排除されません。物理的な重複が削除されている間は、ソース・システムで実行されます。アーキテクトは、クエリパターン、結合の選択性、実行頻度を管理して、コストとパフォーマンスを制御する必要があります。
## ガバナンス、セキュリティ、コンプライアンス
### Architecting Clean Rooms for Trust at Scale(大規模なクリーン ルームの信頼構築)
モダン エンタープライズでは、Trustはデータ クリーン ルームに固定されません。これは建築的な結果ですSalesforce Data 360 は、ガバナンス、セキュリティ、コンプライアンスを継続的かつ自動的に適用し、クリーンルームをポリシー主導の環境からプラットフォームが管理するシステムに移行します。
実行時の制御 (ロックされた ID、監査履歴、差分プライバシー) は、コラボレーションが Salesforce 内、パートナー間、クラウド間で発生するかどうかに関係なく一貫して適用されます。
### 実行時のTrustとガバナンス
アーキテクトにとって最も重要な変化は、Trustが事前に想定されず、実行時に適用されることです。Salesforce Data 360 は、次のようないくつかのコアプラットフォームコントロールでこれを実現します。
- **ロックされた ID:**パートナーアクセスは、検証済みの Salesforce 組織の ID に暗号で関連付けられているため、なりすましや不正な参加を防止できます。
- **監査履歴:**すべてのクエリ、結合、セグメントの重複、有効化が記録され、完全な監査可能性と規制コンプライアンスが確保されます。
- **差分プライバシー:**行レベルの検査は構造的に不可能です。出力は集計され、統計的に境界があります。コラボレーターには、リーチ総計値やリフト率など、プライバシーに安全な結果のみが表示され、個々の取引や ID は表示されません。
これらの制御により、契約上のTrustが数学的保証とプラットフォーム レベルの適用に置き換えられ、運用リスクと法的リスクが軽減されます。
### Einstein Trustレイヤーを介したAIガバナンス
AIエージェントがクリーン ルーム データを操作することが増えるにつれて、SalesforceはEinstein Trust Layerを導入しました。これは、企業の機密データと外部 LLM 間のアーキテクチャ上のエアロックとして機能します。これにより、クリーンルームのインサイトは、基礎となるデータを公開することなく、AI 主導の意思決定を安全に促進できます。
**主な機能:**
- **データ保存ゼロ:**LLM に送信されるデータは一時的です。モデルプロバイダーは、トレーニング用のプロンプトや応答を保存できません。
- **有害言語検出と PII マスキング:**入力と出力は自動的にスキャンされ、Data 360 で設定されたデータマスキングポリシーに従って PII がマスキングされます。
### データスペースと権限セットを介した論理的な分離
**データスペースは**、組織内で論理的に分離され、次のような規制、地域、パートナーシップの境界に合わせる必要があります。
- EU データスペース
- 北米データスペース
データスペースに割り当てられたデータセットのみがクリーンルーム内に表示されるため、偶発的な越境漏洩を防止できます。
権限セットでは、クリーンルームの作成や管理、クエリの実行、セグメントの有効化ができるユーザーを詳細に制御できます。データアウェア権限では、データモデルオブジェクト内に項目レベルの制限が適用されます。たとえば、マーケティング担当者にはセグメント名とオーディエンスサイズは表示されますが、収入や健康インジケーターは表示されません。
セキュリティはセマンティックレイヤーで適用されるため、IT 部門が常に監視することなく、ビジネスユーザーが安全にセルフサービスを行うことができます。
### 設計によるコンプライアンスと同意
同意シグナルは Data 360 を介してクリーンルームの実行に自動的に伝搬されます。同意を取り消したユーザーは、デフォルトで分析と有効化から除外されます。これにより、コンプライアンスが手動でポリシングされるのではなく、システムによって適用されます。
Salesforce Data 360 では、ガバナンス、セキュリティ、コンプライアンスは、省略可能なアドオンではなく、第一級のアーキテクチャプリミティブとして扱われます。実行時の監査可能性、ロックされたID、差分プライバシー、データ スペース、同意認識ID解決、Einstein Trust Layerを組み合わせることで、企業は、Trust、プライバシー、規制コンプライアンスを損なうことなく、パートナー、マルチクラウド システム、AI主導のワークロード間でクリーン ルーム コラボレーションを拡張できます。
## 結論と進むべき道
### アーキテクトのための実践的なパス
データクリーンルームの価値をすべて把握するには、アーキテクトはデータを分離された分析ツールではなく、コアアーキテクチャインフラストラクチャとして取り扱う必要があります。次の優先度により、実用的で拡張性の高いパスが定義されます。
**コラボレーションを第一級のアーキテクチャ上の懸念事項にする ―**外部データコラボレーションは、内部インテグレーションと同じ厳格さで設計する必要があります。クリーンルームは、データプラットフォーム、インテグレーションレイヤー、AI システムと共にエンタープライズリファレンスアーキテクチャ内に組み込む必要があり、アドホックな拡張機能としてリリースすることはできません。相互運用性の拡大 (Data 360 クリーンルームと AWS クリーンルームの統合や将来のクリーンルーム間の互換性など) に伴い、アーキテクトは単一ベンダーのサイロではなく、マルチプラットフォームエコシステムを見据えたコラボレーションパターンを設計する必要があります。
**デフォルトで取得されるプライバシーの設計**
Data Fluidity**の設計 ―アーキテクトは、デフォルトで重いETLと一元的なレプリケーションを使用する**のではなく、まずフェデレーションとゼロ コピー アクセスを検討する必要があります。必要に応じて計算をデータに移行すると、不要な重複が減り、コストが削減され、情報源の整合性が維持されます。「Connect vs. Copy」は、継承された習慣ではなく、意識的なアーキテクチャ上の決定である必要があります。
**インサイトとアクションのギャップの解消 :**分析で停止したクリーンルームでは、ビジネス価値を提供できません。アーキテクチャでは、クリーンルームの出力を有効化システムと AI ワークフローにネイティブに接続する必要があります。フィードバックループ、パフォーマンス測定、下流の実行は最初から設計する必要があります。
**Agentic Enterprise の準備 ―**AI エージェントによるエンタープライズデータの使用が増加するにつれて、クリーンルームは未加工データを公開せずにエージェントが操作できる制御された実行環境として機能します。クリーン ルーム戦略をAIガバナンスおよびTrustフレームワークと連携させるアーキテクトは、この次のフェーズに最適な位置づけになります。
### 結論
モダンデータクリーンルームは、エンタープライズデータアーキテクチャの根本的な変化を表します。データ漏洩のないコラボレーションを実現することで、データユーティリティとプライバシーの長年の緊張を解決します。
Salesforce Data 360 などのアーキテクチャは、このトレードオフが「どちらか」または「どちらか」の考慮事項ではないことを示しています。ゼロコピーパターンによってデータストレージの有効化を切り離し、プライバシー強化テクノロジーを実行に直接組み込むことで、企業はデータの制御を放棄することなく、価値の高い分析でコラボレーションできます。プライバシーは契約上の義務からアーキテクチャ上の保証に移行します。
最も重要なのは、クリーンルームによってデータが静的でサイロ化されたアセットから、管理されたアクション可能なリソースに変換されることです。有効化レイヤーと AI レイヤーにネイティブに接続されている場合、ダッシュボードでインサイトが停止しなくなります。意思決定、キャンペーン、自律システムに直接取り込まれ、エンタープライズ規模でデータ、アクション、結果間のループを閉じます。
## 著者について
**Yugandhar Bora**は、Salesforceのソフトウェアエンジニアリングアーキテクトで、データおよびインテリジェンスアプリケーションプラットフォーム内のデータアーキテクチャを専門としています。データガバナンスと統合データモデルに焦点を絞ったエンタープライズアーキテクチャレビューボード (EARB) イニシアチブを主導しながら、自動化プラットフォームプロビジョニングソリューションに貢献しています。
**Birendra Kumar Singh**はテクニカル スタッフのプリンシパル メンバーであり、SalesforceのData 360内のプラットフォームとデータ アーキテクチャを専門としています。有効化プラットフォームの中心メンバーであり、Data 360 の顧客へのデータクリーンルームインフラストラクチャの提供に重点を置いたクリーンルームイニシアチブを主導しています。
**Priyanka Kshirsagar**は、Salesforceのシニア プロダクト マネージャーであり、Data 360 Clean Roomsを率いています。Data 360 Clean Roomsは、エンタープライズ環境のお客様がプライバシーを保持しながらファースト パーティ データでコラボレーションできるようにするためにゼロから構築した機能です。クリーンルームでの類似モデリングや ID 強化など、エージェント型 AI と ML を駆使した使用事例のビジョンを推進し、製品の正式リリースと Tier-1 Dreamforce のリリースを実現しました。
## 概要
Salesforce Data 360 は、企業が顧客データを大規模に接続、ハーモナイズ、有効化する方法を変革します。しかし、その真の強みは、データがライフサイクル全体でいかに安全に管理されているかにあります。このセキュリティリファレンスアーキテクチャは、Data 360 環境を保護するための実用的なエンドツーエンドのブループリントを提供します。これは、デフォルトで最小権限、ゼロトラスト設計、ガバナンスという基本原則によって達成されます。
Data 360 のセキュリティは、その基礎において共有責任モデルです。Salesforce は、ISO 27001、SOC 2、一般データ保護規則 (GDPR) などのグローバル標準に従って、インフラストラクチャ、ネットワーク、暗号化サービス、プラットフォーム、コンプライアンス、およびアプリケーション自体を保護します。Salesforce システム管理者は、アクセスの定義、プライバシーの適用、インテグレーションの管理を行って、プラットフォーム内の組織のデータを保護します。これには、必要なアクセス権のみを付与する強力な ID およびアクセス管理 (IAM) の実装、2 要素認証 (2FA) の適用、最小権限の原則の遵守、企業および規制要件の遵守が含まれます。
Data 360 Governance は、これらの責任レイヤーを接続し、セキュリティとコンプライアンスの一貫性を確保します。これにより、ロール、ポリシー、権限、データ処理ルールが定義され、取り込みから有効化までのプロセス全体で継続的に適用されます。データ系統、メタデータ分類、同意認識は、すべてのオブジェクトとプロセスに組み込まれています。これにより、ガバナンスが手動監視機能から運用コントロールプレーンに変換されます。
Salesforce は、企業がデータポスチャ、プライバシー設定、インテグレーション境界に関する完全な権限を保持できる、弾力的でコンプライアンスに準拠した基盤を提供します。これらを組み合わせることで、すべてのデータセット、ポリシー、ユーザー アクションを追跡可能で一貫性があり、Trustで固定できるセキュリティとガバナンスのファブリックが作成されます。
Data 360 のセキュリティは静的制御以外にも拡張されています。これは、データライフサイクルのすべてのフェーズに組み込まれています。データは取り込まれた瞬間から、エンタープライズポリシーに基づいて暗号化、検証、分類されます。統合および強化されると、説明責任を確保するためにメタデータの系統と同意属性が保持されます。ビジネスまたは AI で使用するためにインサイトを有効化すると、暗号化されたチャネル、強力な認証と承認、ポリシー対応ガバナンス、同意適用によって送信フローが保護され、取り込みから有効化までデータの信頼、コンプライアンス、セキュリティが維持されます。
## Data 360 のセキュリティ基盤
### Hyperforceを基盤とする
Salesforce Data 360は、グローバル運用のための安全でコンプライアンスと拡張性に優れた基盤を提供する、SalesforceのHyperforceアーキテクチャに基づいて完全に構築されたクラウド ネイティブのデータ プラットフォームです。
### セキュアバイデザイン基盤
- Hyperforceは、セキュリティとコンプライアンスをアドオンではなく組み込み機能として提供します。Salesforce のプラットフォームとアプリケーション全体で緊密に統合された共通の基盤制御セットが提供され、インフラストラクチャからアプリケーション環境まで、すべてのレイヤーがセキュリティ、プライバシー、コンプライアンスを中核として設計されています。
- Data 360は、堅牢なアクセス制御、暗号化、およびコンプライアンス フレームワークをHyperforceの基盤制御から直接継承します。
- このセキュアなデフォルトモデルは、脆弱性を最小限に抑え、信頼できる準拠データサービスの提供を簡素化します。
### クラウド ネイティブ アーキテクチャ
- Data 360は、分離、パフォーマンス、マルチ テナントのセキュリティを確保する統合クラウド プラットフォームであるHyperforce上でホストされる専用の機能ドメイン内で実行されます。
- Data 360 ではマイクロサービスアーキテクチャが使用され、すべてのサービスが Kubernetes を介してコンテナ化およびオーケストレーションされます。
- Zero Trustの原則を適用して、Istioサービス メッシュは安全なサービス間通信を管理し、トラフィック管理、オブザーバビリティ、ポリシー適用を提供します。
### 拡張性とモジュラー型のリリース
- Data 360 サービスは、Salesforce で管理される仮想プライベートクラウド (VPC) を使用してプロビジョニングおよび運用され、分離、効率的な制御、最適化された内部ネットワーキングを実現します。
- このアーキテクチャは水平スケーラビリティをサポートしているため、Data 360 はペタバイト規模のデータ処理ワークロードを確実に処理できます。
### インテグレーションと拡張性
- Data 360 では、Salesforce CRM アプリケーションや他のデータソースと統合するための明確に定義された API が公開されています。
- ファーストパーティ (1P) 組織と Hyperforce ベースの Salesforce CRM 組織の両方をサポートしているため、環境間の幅広い互換性が確保されています。
- Data Cloud One では、複数の Salesforce CRM 組織を 1 つの Data 360 インスタンスに接続できます。
### 共有責任モデル
Salesforce Data 360内のセキュリティは、[共有責任モデル](https://compliance.salesforce.com/en/documents/a006e000010nW2FAAU)に基づいて動作します。このフレームワークは、Amazon Web Services(AWS)、Microsoft Azure、Google Cloudなどの主要なクラウド プロバイダーでも使用されています。
このモデルは明確な境界を定義します。Salesforceはクラウド**の**セキュリティを担当し、お客様はクラウド**内**のセキュリティを担当します。この違いを理解して運用することは、耐障害性、コンプライアンス、セキュリティに優れたデータエコシステムを維持するために不可欠です。
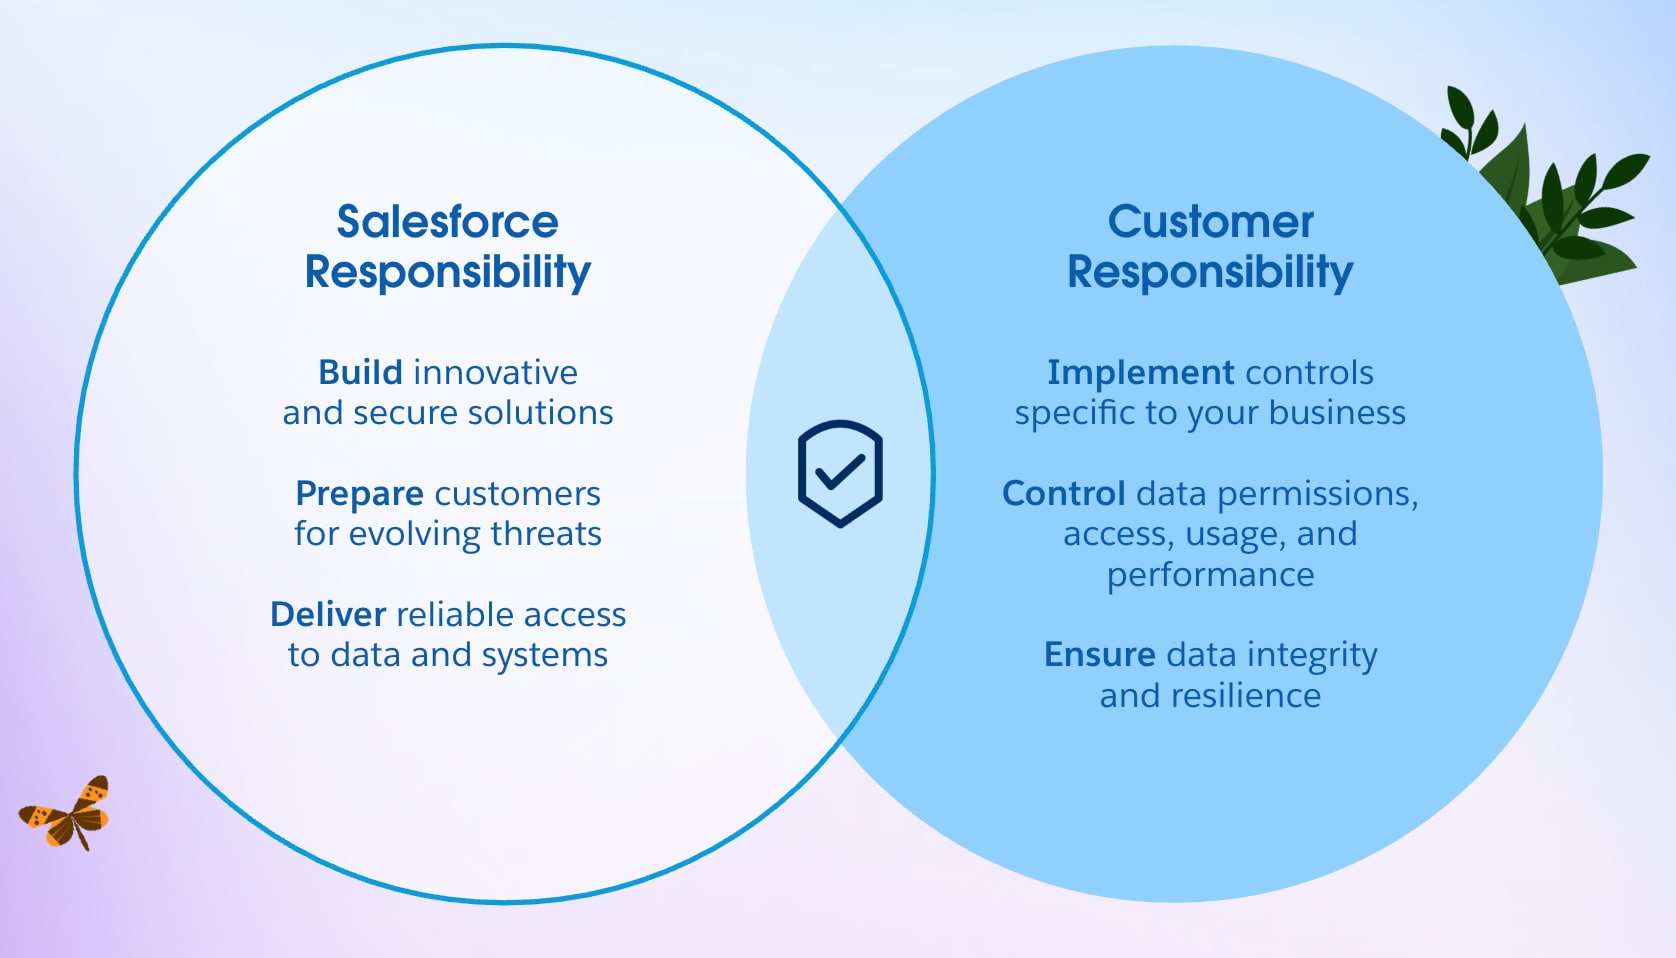 #### Salesforce:クラウドのセキュリティ
Salesforce は、Data 360 プラットフォームとそのグローバルインフラストラクチャの整合性を確保し、維持する責任があります。具体的な動作は次のとおりです。
- **物理的および環境的なセキュリティ:**HyperforceはAWSインフラストラクチャでホストされ、Amazonはアクセス制御、監視、環境保護を通じてグローバル データセンターの保護を委任されています。
- **ネットワークと境界の防御:**転送中 (TLS 1.2 以上) および保存中のすべてのトラフィック (AES-256) の分散サービス拒否 (DDoS) の軽減、侵入検知、暗号化。
- **プラットフォームの強化とパッチ管理:**継続的な脆弱性管理、パッチリリース、OS レベルのセキュリティベースライン。
- **コンプライアンスと認定:**SOC 1/2/3、ISO 27001、ISO 27017、ISO 27018 などの規格、および GDPR などのフレームワークの準備状況に対する継続的な監査。
これらの制御により、Data 360 プラットフォームの安全性、信頼性、コンプライアンスが維持されるため、顧客はインフラストラクチャの防御ではなくビジネスロジックとデータ管理に集中できます。
#### 顧客:クラウドのセキュリティ
お客様は、Salesforce Data 360 組織内のデータ、設定、および運用プロセスを保護する責任があります。説明責任の主要な領域は次のとおりです。
- **IDおよびアクセス管理(IAM):**ロールを定義し、多要素認証 (MFA) とシングルサインオン (SSO) を適用し、最小権限の原則を適用します。
- **データ ガバナンス:**機密データを分類し、必要に応じてマスキングを適用し、オブジェクトレベル、項目レベル、およびレコードレベルのアクセス制御を適用します。
- **インテグレーションセキュリティ:**指定ログイン情報と外部ログイン情報を使用して、OAuth 2.0、JSON Web トークン JWT、およびその他の認証標準を介して API アクセスを管理します。
- **監視と対応:**イベント監視と監査履歴を使用して、ログをセキュリティ情報およびイベント管理 (SIEM) システムに転送し、高度な脅威検知を実現します。
Salesforce は安全な基盤を提供しますが、お客様は設定、制御、警戒を通じて実際のセキュリティ体制を決定します。
#### 人間中心の責任
セキュリティは単なる技術的な構造ではなく、組織の規律です。Salesforce Data 360 のデータ保護は、アーキテクチャチーム、運用チーム、ガバナンスチーム間のコラボレーションによって実現されます。
**企業は次のことを行う必要があります。**
- 使用されていない取引先や権限が過剰な取引先を継続的に確認して廃止します。
- ポリシーをコードおよび CI/CD パイプラインとして使用して適用を自動化します。
- 不正なデータの有効化や持ち出しなどのインシデントをシミュレーションする机上演習を実施し、対応準備を強化します。
Data 360 の有効性は、機能のみではなく、顧客がどの程度責任をもって運用できるかによって拡張されます。
#### デフォルトで保護:プロアクティブなセキュリティ体制
Salesforce Data 360 では、事後対応型の制御から予防設計への移行という、デフォルトでセキュアな考え方を採用しています。後でオープンにして厳格化する代わりに、すべての新しい Data 360 組織は「すべて拒否」状態になり、最初のリリースからTrustの原則が適用されます。
#### 反応型制御から予防設計へ
以前の環境では、オンボーディングを迅速化するために、顧客は「すべて許可」という権限のあるモデルを継承していました。これは便利な反面、偶発的な露出過剰や設定ミスによるリスクを生み出していました。
新しいデフォルトのセキュア アーキテクチャでは、このアプローチが逆になります。
- 暗黙的なアクセス権を持つユーザーまたはシステムはありません。
- すべての権限が明示的に付与されている必要があります。
- データアクセス、インテグレーション、およびガバナンスコントロールは 0 日目から適用されます。
これにより、意図的に最小限の権限が適用されるため、誤って情報が漏洩したり、権限がエスカレーションされたりするリスクが大幅に軽減されます。
#### オペレーショナルおよびガバナンスへの影響
このモデルには、技術的な影響と行動的な影響の両方があります。
- チームはアクセスモデルを意図的に計画し、権限をコンプライアンスとビジネスの境界に合わせる必要があります。
- ガバナンスは、後付けではなく組み込みの設計要件になります。
- データの所有権と説明責任は最初から定義されます。
従来の Data 360 組織が引き続き \[すべて許可] で運用されている場合、システム管理者はセキュリティのモダナイズや Data 360 成熟度プログラムの重要なステップである新しいベースラインに合わせて手動で設定を厳格化する必要があります。
#### Trust by Design (設計による信頼)
デフォルトのアクセスをゼロにして明示的なポリシー定義を要求することで、Salesforce Data 360はエンタープライズ データ セキュリティの基本的な進化であるTrust-by-Designを確立します。
このアプローチにより、次のことが保証されます。
- 不正アクセスやデータ漏洩のリスクを最小限に抑えます。
- ガバナンスフレームワークは、任意ではなく構造的に適用されます。
- 企業は、さまざまな環境でより予測可能、監査可能、かつ復元性の高いセキュリティ体制を実現できます。
本質的に、セキュリティはユーザーが追加する機能ではなくなります。これは、開始する基盤です。
## IDおよびアクセス管理:データへのゲートウェイ
**Salesforce Data 360**のIAM(Identity and Access Management)は、防御の最初で最も重要なレイヤーです。プラットフォームにアクセスできる**ユーザー**と、プラットフォーム内で 1 回実行できるアクション**を**制御します。適切に実装された IAM フレームワークは、企業が顧客データを保護し、業務の整合性を確保するために必要とする唯一の強力な制御です。
### 認証:「自分らしさ」の検証
認証により**、Digital Trust**が確立され、Salesforce Data 360にアクセスするすべてのユーザー、サービス、外部システムが正当なものであるかどうかが確認されます。
### 統合 ID 管理
Data 360 では、 [**SAML 2.0**](https://help.salesforce.com/s/articleView?id=xcloud.sso_saml.htm&type=5)、OpenID Connect ([**OIDC**](https://help.salesforce.com/s/articleView?id=xcloud.sso_provider_openid_connect.htm&type=5))、または System for Cross-domain ID Management ([**SCIM**](https://help.salesforce.com/s/articleView?id=xcloud.identity_scim_overview.htm&type=5)) を使用した [**Microsoft Entra ID (Azure AD)**](https://learn.microsoft.com/en-us/entra/identity/saas-apps/salesforce-tutorial)、 [**Okta**](https://help.okta.com/en-us/content/topics/provisioning/salesforce/sfdc-provision.htm)、 [**Ping Identity**](https://docs.pingidentity.com/configuration_guides/salesforce/config_saml_salesforce_pf.html) などのエンタープライズグレードの ID プロバイダー (IdP) を使用した **統合認証** がサポートされます。
この統合により、企業 ID ライフサイクルが Salesforce に直接拡張されます。従業員が入社、異動、退職すると、アクセス権が自動的に調整され、孤立した取引先が減り、コンプライアンスの準備が向上します。
### シングルサインオン (SSO)
[**シングルサインオン(SSO)**](https://help.salesforce.com/s/articleView?id=xcloud.sso_about.htm&type=5)を使用すると、ユーザーは会社のログイン情報を使用して一度認証すると、個別のパスワードなしでSalesforceアプリケーションへの安全なアクセスが可能になります。これにより、ログイン情報の疲労が軽減され、パスワードの再利用やフィッシングによるリスクが最小限に抑えられます。
### 適応型および条件付きアクセス
ID プロバイダー (IdP) は、多要素認証 (MFA)、条件付きアクセス、リスクベースの制御を適用して、認証に関する意思決定を行う唯一の機関となります。認証は、1つのイベントから、ユーザーの行動やコンテキストに応答する継続的なTrust評価に進化します。
統合認証には次の機能があります。
- **一元的なポリシー適用:**認証標準は、すべての Salesforce 環境で 1 か所で管理されます。
- **エンド・ツー・エンドのトレーサビリティ:**統合監査履歴では、すべてのアクションが検証済み ID にリンクされます。
- **人間中心の環境:**スムーズで安全なログインプロセスにより、チームはログイン情報ではなくインサイトに集中できます。
### 承認:「できること」の定義
ユーザーが検証されると、認証によってユーザーがアクセス、表示、または変更できる内容を定義します。機密データを保護し、最小限の権限を適用する運用境界を設定します。
**PoLP(最小権限の原則):**すべてのユーザーとシステムには、職務に必要な権限のみが付与され、それ以上の権限は付与されません。この原則により、侵害されたログイン情報や設定ミスによる潜在的な損害が大幅に制限されます。
**ロールベースのアクセス制御 (RBAC):**Salesforce Data 360 では、権限セットと権限セットグループを使用して、ビジネスロールに応じたきめ細かな機能を割り当てます。次に例を示します。
- データエンジニアは、「Data 360 Architect」権限セットを使用して取り込みパイプラインと変換を管理できます。
- マーケティングアナリストはハーモナイズデータを照会できますが、「Data 360 有効化マネージャー」権限セットを使用してモデルを変更することはできません。
- 有効化マネージャーは送信キャンペーンを実行できますが、Data 360 有効化マネージャー権限セットを使用してソースデータにアクセスすることはできません。
アクセス権は一元管理され、監査可能であるため、データライフサイクル全体で説明責任を果たすことができます。Entra ID、Okta、Ping Identity などの IdP と統合すると、アクセスポリシーは SCIM プロビジョニングと SAML/SSO 統合を介してシームレスに企業全体に拡張されます。
### Data 360 の標準ロールと権限について
Salesforce には、職務の分離と ISO 27001 などの業界標準への準拠のためのベストプラクティスをカプセル化した定義済みの権限セットが用意されています。
| ロール | 主な責任 | アクセス設計原則 |
|---|---|---|
| システム管理者 | 環境の設定、プロビジョニング、設定 | 基盤となるデータセットへのアクセス権なし — システムとデータ制御の分離を確保 |
| Data 360 Architect | データの取り込み、変換、ID 解決、モデリング | データ公開境界を維持するためにデータの有効化を実行できない |
| Data 360 Activation Manager | セグメントの作成、チャネル管理、有効化 | データモデルへの参照のみアクセス権。変更権限なし |
| Data 360 ユーザー | 分析とインサイトを消費する | 参照のみ、変更権限なし |
| Data 360 One ユーザー | コンパニオン組織を介した組織間アクセス | 共有スペース権限と範囲設定済みアクセスポリシーにより管理 |
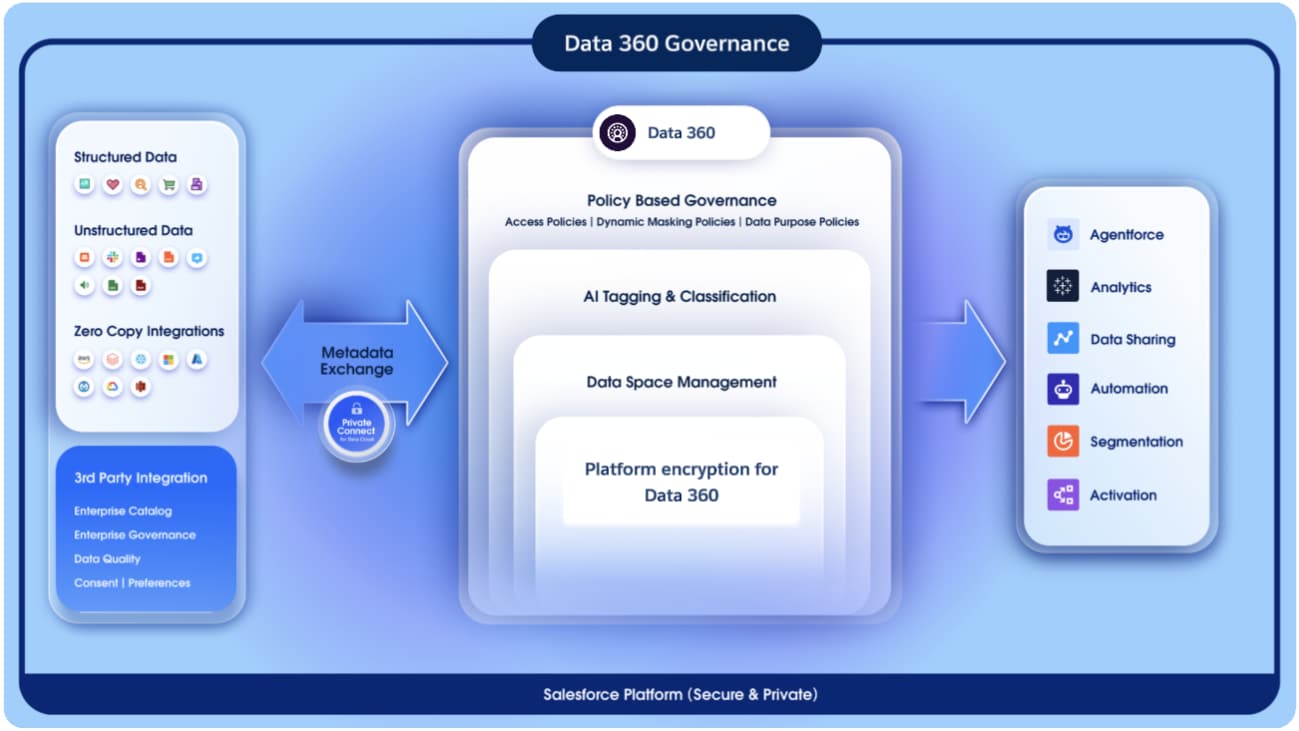 ### コントロールプレーンとしてのガバナンス
Data 360 は、ガバナンスファーストモデルに基づいて設計されており、取り込みからインサイトの有効化まで、すべてのデータインタラクションがポリシー対応で監査可能、かつコンプライアンスを確保します。ガバナンスは中央コントロールプレーンとして機能し、ライフサイクル全体でデータを検出、分類、保護する方法を管理します。
この統合コントロールプレーンにより、次のことが可能になります。
- **データ アクセスはコンテキスト**に応じて許可されます。適切なポリシーに基づいて適切なユーザーのみが適切なデータに対してアクションを実行できます。
- **ガバナンスはセマンティック レイヤー**と運用レイヤーの両方に組み込まれ、データのモデル化方法と保護方法の一貫性が確保されます。
- ** Zero Trust と Least Privilege** の原則が適用されます。つまり、ID、コンテキスト、ポリシーは、アクセス権を付与する前にリアルタイムで評価されます。
このアーキテクチャにより、Salesforce Data 360 はガバナンスを静的な権限管理から動的なポリシー主導のオーケストレーションレイヤーに変換します。コンテキストに継続的に適応し、設計によってコンプライアンスを適用し、エンタープライズ規模でTrustを維持するものです。
### データスペースを使用した論理データの分離
マクロレベルでは、データスペースによってエンタープライズデータドメインが論理的に分離され、マルチブランド、マルチリージョン、またはマルチテナントの運用モデルを持つ組織は、1 つの統合プラットフォーム内でデータを管理できます。データスペースは、ビジネスドメイン (セールス、マーケティング、カスタマーサクセスなど) または規制や地理的境界 (EU、AMER、APAC など) に合わせることができるため、基盤となるデータプラットフォームを断片化することなく、ガバナンスとアクセス制御で組織の業務とコンプライアンスの構造を反映できます。
- 各データスペースは仮想境界として機能し、ユーザーまたはチームが参照または操作できるデータ収集を定義します。
- データスペース内のアクセス権は明示的に付与され、暗黙的な権限やデータ表示の交差汚染がなくなります。
- これにより、所有権の統合が可能になります。各ビジネスユニットは、一元的な監視とコンプライアンスを維持しながら、ドメインを個別に管理できます。
設計上、データスペースはガバナンスの第 1 層を提供し、エンタープライズデータセット全体の構造的な明確さと説明責任を確立します。
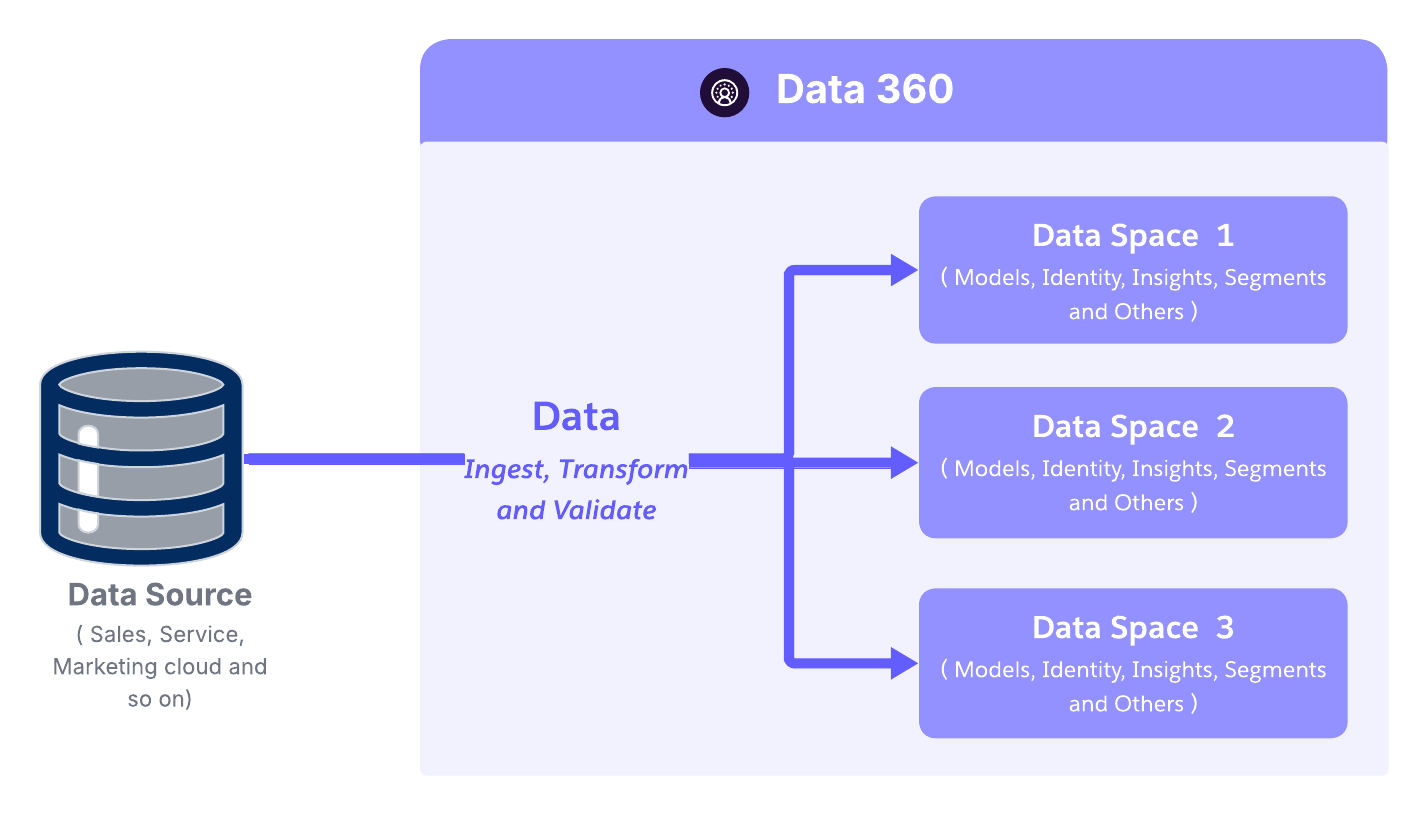 ### RBAC から ABAC へ:コンテキスト認証への移行
Salesforce Data 360 では、RBAC と ABAC は異なる補完的な役割を果たし、プラットフォームの異なるレイヤーで適用されます。
RBAC は主にプラットフォームと機能へのアクセスに使用されます。データスペース、プロセス作成、管理機能、ツールアクセスなど、Data 360 の構造と機能にアクセスできるユーザーを管理します。RBAC は、権限と権限セットを使用して実装されます。たとえば、特定の有効な機能を使用してデータスペースへのユーザーアクセス権を割り当てます。
ABAC はデータアクセスの適用に使用されます。ABAC ポリシーは、オブジェクトレベルセキュリティ (OLS)、項目レベルアクセス、行レベル制約など、誰がどのデータオブジェクトおよび属性にアクセスできるかを決定する責任をすべて負っています。これらの決定は、実行時にアクション、ユーザー属性、リソース属性を評価することで動的に行われます。
ABAC では、権限はモデルの一部のままですが、アクセス権はロールのみではなくポリシー自体によって決定されます。ポリシーでは、ビジネスユニット、地域、データの機密性、使用目的、アクセスを許可または拒否する規制の制約などのコンテキストを評価します。
次に例を示します。
- RBAC を使用すると、ユーザーは Data 360 データスペースと分析機能にアクセスできます。
- ABAC は、同じユーザーが特定の顧客データセットを参照できるかどうか、表示できる行、マスキングまたは制限される属性を決定します。
この明確な分離により、Data 360 は安全に拡張できます。
- RBAC は、プラットフォームの機能とワークフローへのアクセスを制御します。
- ABACは、コンプライアンス、レジデンシー、データ保護の要件に合わせて、きめ細かなポリシー・ベースのデータ・アクセスを実現します。
これらを組み合わせることで、プラットフォーム権限とデータ認証ロジックを混同することなく、管理されたデータの民主化が可能になります。
基本的に、RBAC は権限の割り当てに基づいてアクセス権を適用し、ABAC はコンテキストに基づいて権限を評価します。つまり、アクション、ユーザー、リソース属性を組み合わせて、Salesforce Data 360 全体で適応性のあるきめ細かなアクセス制御を実現します。
### ABAC:多層セキュリティ階層
Salesforce Data 360 のきめ細かなアクセス制御の中心となるのは、属性ベースのアクセス制御 (CEDAR ポリシー言語に基づく ABAC) です。
静的なロール ベースの権限とは異なり、ABACはアクセスを要求している_ユーザー_、アクセスしようとしている_内容_、_条件_を動的に評価し、すべてのデータのやり取りがエンタープライズ ポリシーとTrust Boundaryに準拠するようにします。
#### 動的ポリシー評価
Data 360 の ABAC エンジンは、次の 3 つのコア属性種別の組み合わせに基づいてアクセスの決定を評価します。
- **ユーザー属性:** 部門、場所、クリアランスレベル
- **データ属性:** 分類、機密性 (PII、PHI、財務データ)、データスペース
この柔軟でポリシー主導のモデルにより、ユーザーロール、データ分類、または運用条件の変化に応じて適用を自動的に適応させることができます。これは、大規模で分散した規制対象の企業にとって不可欠です。
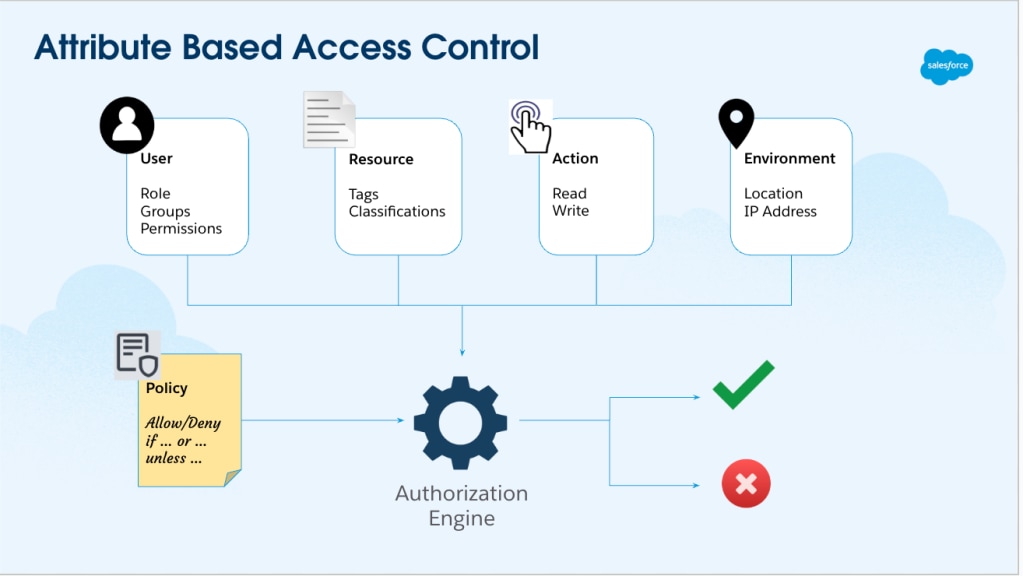 #### Salesforce Data 360 の ABAC アーキテクチャコンポーネント
Salesforce Data 360 は、ポリシー主導のデータガバナンスの業界のベストプラクティスに準拠した標準ベースの属性ベースのアクセス制御 (ABAC) アーキテクチャを実装しています。次の 3 つの主要な機能コンポーネントで構成されます。
- **PIP(ポリシー情報ポイント) - ポリシー、強化されたメタデータ、分類:**
- エンタープライズデータを管理するデータアクセス、分類、マスキング、保持、使用ポリシーなど、ポリシー定義自体を格納します。
- タグ、分類、ビジネスコンテキスト、エンドツーエンドの系統など、強化されたメタデータを維持します。
- LLM および ML 駆動の分類を使用して、機密データ (PII.Email、PII.Phone、PHI など) を自動的にタグ付けします。
- タグの伝搬により、データ系統 (DLO → DLO → DMO) に沿って分類が自動的に流れます。
- 変換全体で機密性とコンプライアンスを維持します。
- **Policy Decision Point (PDP)**:PDP は、CEDAR ポリシーを解釈する決定エンジンです。
- PEP (ユーザー ID、要求メタデータ) からのコンテキスト入力と PIP からの参照属性を取り込みます。
- ポリシーを確定的に評価して、一貫性があり、説明可能で、拡張可能なアクセスの決定を行います。
- リアルタイム評価と一括評価の両方がサポートされ、大規模環境でもパフォーマンスと精度が確保されます。
- **Policy Enforcement Point (PEP)**:PEP は、実行時に承認の決定が適用される場所です。
- API、UI クエリ、CRM 強化、GenAI 取得拡張生成 (RAG) パイプラインなど、すべてのインタラクションチャネルでデータアクセス要求を代行受信します。
- PDP の結果をすぐに適用し、すべてのクエリと取得がエンタープライズアクセスポリシーに準拠するようにします。
PIP と PDP と PEP の 3 つの組み合わせにより、分散ガバナンスファブリックが形成され、すべての Data 360 サービスとアクセスモードに一貫したポリシーベースの制御が適用されます。
重要なのは、Data 360 の [ABAC](https://help.salesforce.com/s/articleView?id=data.c360_a_policy_based_governance_dg.htm&type=5) が設定されており、構築されていないことです。アーキテクトは、カスタムコントロールプレーンや適用ロジックを組み立てません。代わりに、統合ガバナンスファブリックとして連携して動作する 3 つのネイティブアーキテクチャコンポーネントを入力して接続します。
実装は、データを分類し、ポリシーを定義して、プラットフォームで自動的に適用するという単純な手順に従います。一度設定すると、アクセス制御は手動プロセスや手順プロセスではなくシステムの動作になります。
この分散ガバナンス ファブリックにより、すべてのアクセス チャネルで**一貫した**ポリシーを適用し、Data 360全体で統合されたTrust境界を作成できます。
#### 複数レベルのポリシー適用
Data 360 の ABAC フレームワークでは、階層化されたアクセス境界がサポートされているため、オブジェクトレベルだけでなく、特定の項目やレコード内でもデータが保護されます。
- **オブジェクトレベルセキュリティ (OLS)**:アクセス制御の最外境界。
データレークオブジェクト (DLO) やデータモデルオブジェクト (DMO) などのデータ構造全体へのアクセスを管理します。
例:_Customer_ オブジェクトへのアクセス権の付与。ただし、_トランザクション_へのアクセス権の付与は不可。
- **項目レベルセキュリティ (FLS)**:オブジェクト内の特定の項目へのアクセスを制御します。
例:マーケティングユーザーは顧客名を表示できますが、クレジットカード番号や国民 ID の表示は制限されます。
- **レコードレベルセキュリティ (RLS)** ―最も詳細な制御レイヤー。
ユーザーが表示または変更できるデータセット内の個々のレコードを決定します。
例:地域マネージャーは、割り当てられた地域に関連付けられた顧客データにのみアクセスできます。
- **動的データマスキング (DDM) ―**リアルタイムのデータ保護を有効にします。ABAC を補完する DDM は、基盤となるデータセットを変更することなく、機密情報をポリシーに基づいて難読化します。クエリ時に、DDM はユーザーロール、コンテキスト、またはコンプライアンスルールに基づいて PII などの項目や財務データを自動的にマスキングします。
- 機密データは、UI ビュー、API、AI ワークフロー全体で保護されます。
- すべての消費レイヤーで一貫したマスキングを確保することで、データ漏洩のリスクを軽減します。
- 監査可能性を維持します。マスクされたすべてのクエリは、Data 360 のガバナンスフレームワーク内で記録され、追跡できます。
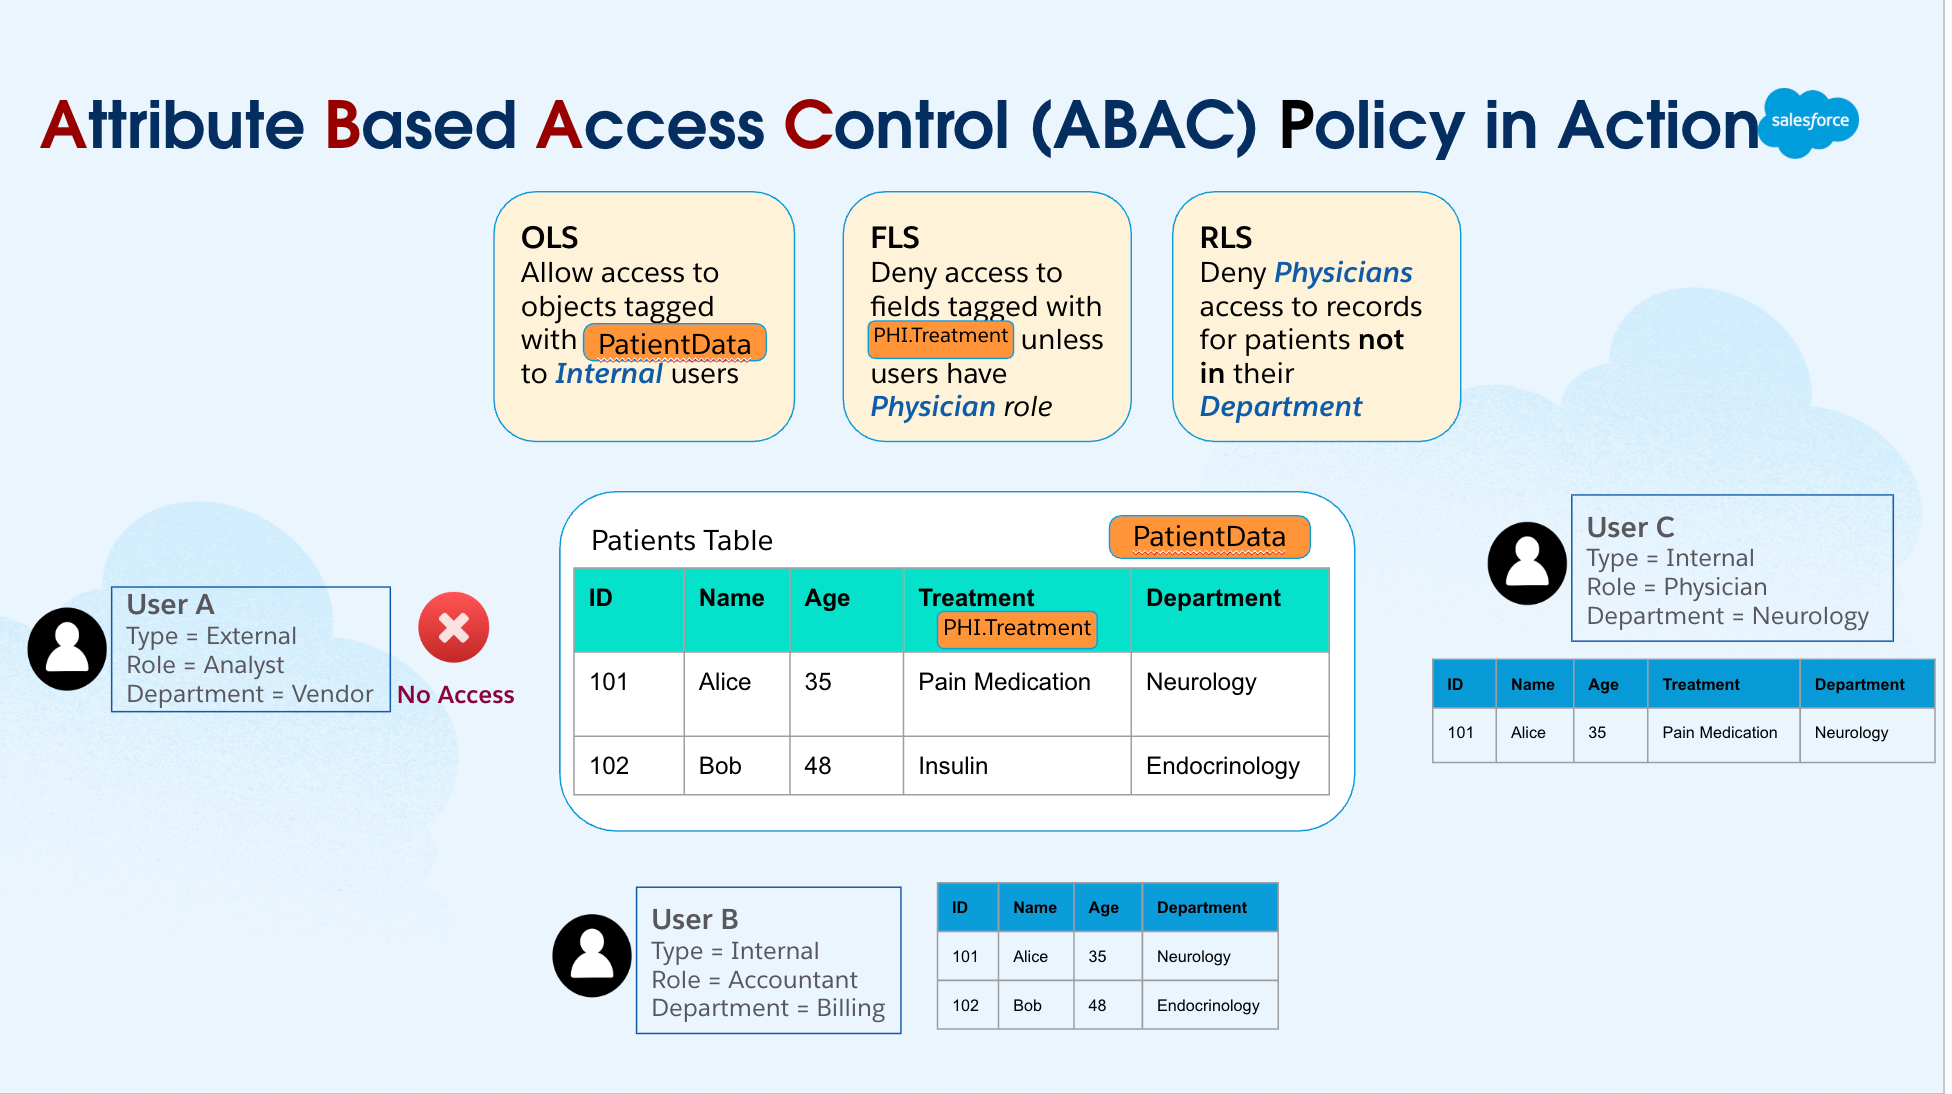 このアーキテクチャにより、アクセス制御が静的権限モデルから動的なコンテキスト対応ポリシーファブリックに変換されます。RBAC の構造的なシンプルさと ABAC のコンテキストの深さを組み合わせることで、Salesforce Data 360 は次のことを実現します。
- 取り込み、ハーモナイゼーション、有効化にわたって一貫したポリシーを適用します。
- データ、ロール、コンプライアンスのニーズに応じて進化する適応型ガバナンス。
- 取り込みからAIの有効化まで、データ ライフサイクル全体にわたる統合されたTrust Border。
#### Salesforce Platform との緊密な統合
Salesforce Data 360 のガバナンスモデルは Salesforce Platform 内にネイティブに組み込まれており、運用データと分析データの両方にわたって統合されたセキュリティ、コンプライアンス、およびアクセス制御を実現します。SalesforceのコアIDおよびアクセス管理機能(IDフェデレーション、権限セット、一元化されたポリシー作成、プラットフォーム暗号化など)を継承することで、Data 360は並列ガバナンス スタックを導入することなく、一貫したTrustポリシーをクラウド全体に適用します。プラットフォームでは、分離、承認、系統を個別の懸念事項として処理するのではなく、データ ライフサイクル全体にわたる単一の実行対応Trustファブリックに統合します。
構造レベルでは、このガバナンス ファブリックは、3 つの補完レイヤーが連携して機能することで形成されます。
- **データスペース**: データの分離と規制区分のための明確な論理境界を確立
- **属性ベースアクセス制御 (ABAC)**。ID、目的、データ属性に基づいて、コンテキストに応じたきめ細かな承認判断が可能
- **セマンティックな系統**: データの取り込みからインサイトおよび有効化への移行時に、ビジネス上の意味、機密性、トレーサビリティを維持します。
これらを組み合わせることで、アクセスの決定が説明可能で、適用が自動的に行われ、コンプライアンスが遡及的ではなく継続的であるガバナンスモデルが作成されます。その結果、ガバナンスが制限要因や後付けではなくなるプラットフォームが実現します。代わりに、有効化レイヤーになり、アーキテクトは、Trust、プライバシー、規制の要件がシステム自体によって確実に適用されるようにデータ製品とAI主導のワークフローを設計できます。
この構成的アプローチにより、透明性、セキュリティ、制御を犠牲にすることなく、大規模でインサイト、有効化、自動化をサポートすることで、エンタープライズデータを使用できるだけでなく、責任をもってアクションを実行できるようになります。
## データライフサイクルの保護:取り込みから有効化まで
AI 主導の企業の時代では、データの保護は 1 回限りのイベントではなく、情報がエコシステムに入った瞬間からビジネスや AI で使用するために有効化されるまで情報を保護する継続的なプロセスです。
Salesforce Data 360は、データ ライフサイクルのすべてのフェーズにセキュリティとガバナンスの制御を組み込み、取り込みからインサイトの有効化までデータの整合性、機密性、Trustが維持されるようにします。
### 保護の基盤:保存中および転送中の暗号化
Salesforce Data 360 の保護モデルの中核となるのは、使いやすさや拡張性を損なうことなく、保存中および転送中のデータを保護できる透過的で高性能な暗号化フレームワークである Platform Encryption for Data 360 です。
#### 保存時の暗号化:ストレージレイヤーセキュリティ
Data 360データレークに保持されるデータはストレージ**階層で自動**的に暗号化されるため、物理的なアクセスや不正アクセスが発生しても、データを読み取ることはできません。主な機能は次のとおりです。
- **透過的なデータレーク暗号化:**データレイクに保持されるすべてのデータは、顧客が管理する鍵 (CMK) を使用してストレージ階層で暗号化されます。これにより、物理ストレージへの不正アクセスが発生しても、データは読み取り不能のままになります。
- **顧客が管理する鍵(CMK):**顧客は暗号化鍵を完全に制御できます。これは、金融サービス、医療、政府など、規制対象の業界にとって重要な機能です。CMK は、GDPR、HIPAA、ISO 27001 などの規制要件に直接準拠し、詳細な監査、制御、データ主権の証明を可能にします。
- **外部鍵管理(EKM) ―**Data 360 のプラットフォーム暗号化の機能である外部鍵管理では、顧客の AWS KMS アカウントに保存されている鍵を使用して Data 360 のデータを暗号化できます。これにより、Data 360 のデータをより安全に保護しながら、柔軟性を高めることができます。
- **Bring your own Key (BYOK):**CMK と EKM を基盤とする Data 360 では、顧客が独自の鍵素材を Salesforce 内に直接アップロードして、保存データと検索インデックスを暗号化できるようになりました。この機能強化により、顧客が AWS KMS で鍵を作成または管理しなくても、PII、機密データ、機密データ、専有データの保護が強化されます。
- **鍵の循環とライフサイクル管理:**キーの循環は適切に処理されます。新しいデータは新しい鍵で暗号化され、古いデータは元の鍵で暗号化されたままであるため、ダウンタイムやパフォーマンスの低下を回避できます。この循環メカニズムにより、業務を中断することなくコンプライアンスを強化できます。
#### 転送中の暗号化:ネットワークレベルセキュリティ
Data 360 サービス、API、コネクタ間で転送されるすべてのデータは、トランスポート層セキュリティ (TLS) 1.2 以上を使用して保護され、移動中のエンドツーエンドの暗号化が提供されます。
これにより、次のことが保証されます。
- 転送中にデータを傍受または変更することはできません。
- Salesforce サービス、信頼済みコネクタ、および顧客エンドポイント間の通信は非公開で検証可能です。
- セキュリティは、取り込みパイプライン、ハーモナイゼーション プロセス、有効化ワークフロー、外部APIインテグレーションにわたって一貫して拡張されます。
Salesforce Data 360 は、顧客が管理する保存時の暗号化と転送中の継続的な暗号化を組み合わせることで、外部攻撃と内部インフラストラクチャの脅威の両方から顧客データを保護する多層防御アーキテクチャを構築します。
### Data 360 でのシステム間インテグレーション (データインテグレーション) の保護
暗号化とアクセス制御により Salesforce Data 360 内のデータは保護されますが、システム全体でのデータ移動の保護も同様に重要です。最新の企業は、Salesforce、分析プラットフォーム、外部 API、データレイク間で機密データが流れるマルチクラウドおよびハイブリッド環境で運用されています。
これに対応するために、SalesforceはNC(指定ログイン情報)とEC(外部ログイン情報)を中心とした安全な統合フレームワークを設計し、安全な接続のためのポリシー ベースのゼロ トラスト連携基盤を提供しています。
#### Salesforce のセキュアなインテグレーションフレームワーク
Salesforceは、NC(指定ログイン情報)とEC(外部ログイン情報)を中心とした堅牢な**[安全な統合](https://developer.salesforce.com/docs/platform/named-credentials/guide/get-started.html)**フレームワークを構築しています。これらを組み合わせることで、コードや設定の秘密を公開することなく、ログイン情報の複雑さを抽象化し、最小限の権限でのアクセスを適用し、すべてのインテグレーションで一貫した認証管理が可能になります。
このフレームワークは、セキュリティの複雑さを抽象化し、ベスト プラクティスを適用して、Salesforceの**Zero Trust**と**設計別セキュリティ**の原則に準拠した、すべての外部接続のポリシー ベースの**コントロール プレーン**を確立します。
##### 指定ログイン情報
指定ログイン情報 (NC) は、Salesforce のセキュアなインテグレーションアーキテクチャの基盤です。外部エンドポイントとその認証パラメーターを定義する宣言型の一元的なメカニズムが提供されるため、Apexコードや構成ファイルでユーザー名、パスワード、トークンなどの機密性の高いログイン情報をハードコードする必要はありません。代わりに、開発者とシステム管理者は指定ログイン情報の別名 (SnowflakeConnector_NC など) を参照するだけで、Salesforce が自動的に基礎となる認証と接続管理を処理します。
**アーキテクチャとセキュリティのメリット:**
- **シンプルなメンテナンス:**NC は、外部エンドポイント URL と認証パラメーターを 1 つの管理レコードに統合します。更新 (エンドポイントの変更やログイン情報の循環など) では、NC レコードの変更のみが必要で、環境間でコードやフローを再リリースする必要はありません。
- **セキュリティの強化:**ログイン情報は Salesforce の暗号化された秘密のストアに安全に保存されるため、コードリポジトリ、設定ファイル、またはログでの漏洩を防止できます。認証プロセス自体は実行時に自動的に管理されるため、人為的ミスや漏洩のリスクが軽減されます。
**コンプライアンス遵守:**認証情報をビジネス ロジックから分離することで、**GDPR、HIPAA、PCI DSS**などのデータ保護規制へのコンプライアンスが簡素化されます。監査人は、外部データアクセスが企業のセキュリティおよびガバナンスポリシーに準拠していることを簡単に検証できます。
- **リモートサイト設定をバイパス**するNC を使用すると、リモートサイト設定の従来の要件がなくなり、特に大規模または複数環境のエンタープライズ実装で設定とリリースが合理化されます。
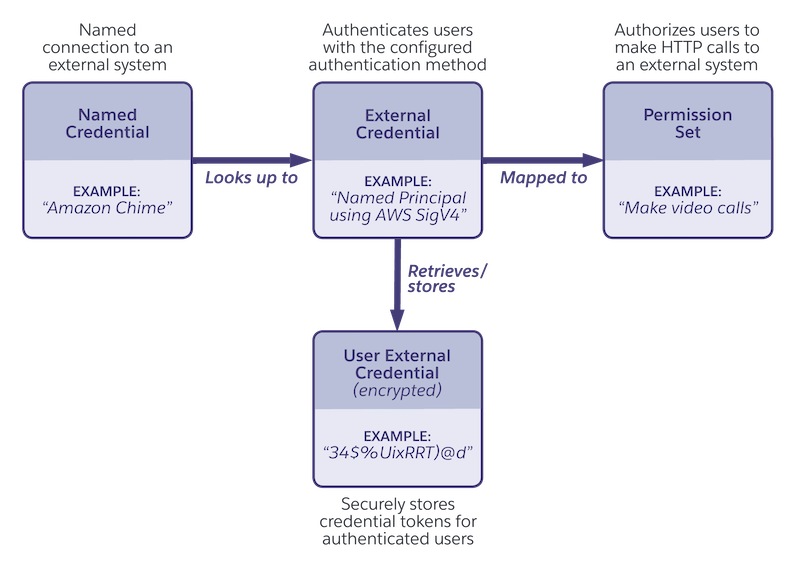 #### 外部ログイン情報
外部ログイン情報 (EC) は、Salesforce が外部サービスに接続するときに使用する認証プロトコルとフローを定義します。つまり、「認証方法」に効果的に回答します。1 つの EC を同じ認証種別を共有する複数の NC で再利用できるため、設定の再利用と一貫したセキュリティ適用を促進できます。
**サポートされる認証プロトコル:**
- OAuth 2.0 (すべてのバリエーションをサポート)
- JWT (JSON Web トークン)
- 基本認証
- AWS 署名 v4
- カスタム認証
- 認証なし (オープン API または公開エンドポイントの場合)
外部ログイン情報と指定ログイン情報は、明確な職務分掌に基づいて設計されています。外部ログイン情報では、認証方法を定義します。つまり、外部システムに接続するための認証プロトコル、トークン種別、更新動作を指定します。一方、指定ログイン情報は、接続する場所 (エンドポイント URL とその接続で使用する外部ログイン情報) を定義します。この設計により、認証ロジックとエンドポイント設定が分離された状態が維持されるため、Salesforce はさまざまなインテグレーションプロトコルを安全にサポートしながら、企業全体で一貫した一元的なログイン情報管理を維持できます。
### Data 360 コネクタでこのフレームワークを活用する方法
Data 360 のユーザーインターフェースは基礎となる設定の多くを抽象化しますが、指定ログイン情報と外部ログイン情報フレームワークは、内部的にはネイティブコネクタとデータストリームによって頻繁に使用されます。つまり、管理者がガイド付き UI を使用して単に「データ接続を追加」している場合でも、Data 360 はバックグラウンドでこの標準化されたセキュリティモデルを適用します。
アーキテクチャ上の影響:
- **統合セキュリティモデル:**外部データベース 、AWS S3、エンタープライズ API のいずれのコネクタでも、指定ログイン情報と外部ログイン情報で適用される同じ暗号化、認証、鍵管理標準を利用できます。
- **開発者の抽象化:**開発者とシステム管理者は、認証フローやログイン情報の循環を手動で処理する必要はありません。Salesforce はトークンのライフサイクル、有効期限、更新を自動的に管理します。
- **一貫したポリシーの適用:**このフレームワークにより、すべてのコネクタで一貫した認証、監査、ログポリシーが遵守されます。これは、規制対象の業界での大規模なマルチソース取り込みに不可欠です。
- **将来を見据えた拡張性:**Salesforce が認証スタックを強化すると (たとえば、新しい OAuth フローや FIDO2 標準をサポートするため)、リファクタリングや再リリースを行うことなく、これらの改善が自動的にすべてのコネクタに反映されます。
### Data 360 コネクタのセキュリティとガバナンス
Salesforce Data 360 には、さまざまなソースからのデータインテグレーションを合理化する、豊富な標準コネクタスイートが用意されています。これにより、企業はデータを効率的に統合して活用できるようになります。Salesforce には、ネイティブ Salesforce コネクタ、クラウドストレージコネクタ、データベースコネクタ、アプリケーションコネクタ、API コネクタなど、複数のコネクタ種別が用意されています。提供されるコネクタに加えて、ゼロ ETL ツールもサポートされています。Salesforce コネクタを使用すると、Sales Cloud、Service Cloud、Marketing Cloud などの Salesforce 製品と Data 360 をシームレスに統合できます。さらに、Amazon S3、Google Cloud Storage、Azure Data Lake などのクラウドストレージプロバイダーへのさまざまなコネクタが提供されています。Snowflake、Redshift、BigQuery などのデータベース用の事前作成済みコネクタにより、企業は既存のデータウェアハウスを Data 360 にリンクできます。さらに、Data 360 には、Google 広告、Facebook 広告、その他のマーケティングプラットフォームなど、さまざまなサードパーティアプリケーションや API 用のコネクタが用意されています。柔軟性を高めるために、Data 360 は MuleSoft や Informatica などの ETL ツールと統合されています。
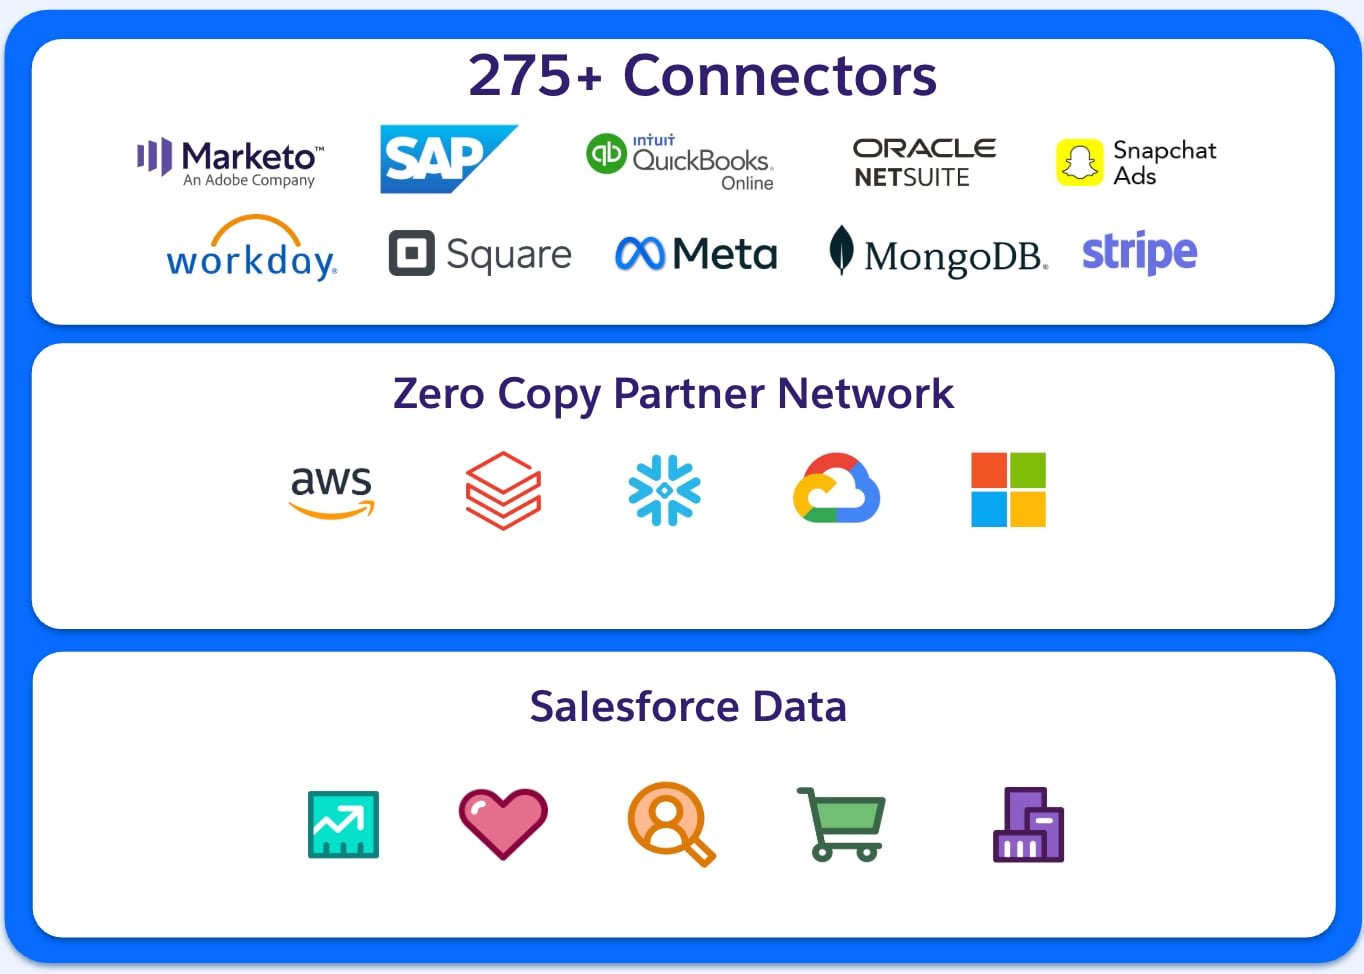 #### データセキュリティおよび Salesforce Data 360 コネクタ
Salesforce Data 360 内に保存されているデータのセキュリティは、Data 360 に関連する多くの会話で重視されています。多層防御セキュリティアプローチに対する Salesforce の取り組みの一環として、Data 360 環境にデータを取り込む方法の保護も同様に重要です。
Salesforce は、企業がさまざまなデータエコシステム (多くの場合、複数のクラウドプラットフォーム、ストレージソリューション、分析ツールにまたがる) で事業を展開していることを認識しています。Data 360 コネクタは、これらの環境間のブリッジとして機能します。このコネクタにより、Salesforce の高いセキュリティ標準を維持しながら、安全で拡張性が高く効率的なデータインテグレーションが可能になります。これらのコネクタにより、整合性やプライバシーを損なうことなくシームレスなデータフローを実現できます。
Data 360 コネクタセキュリティの 3 つの必須コンポーネントは次のとおりです。
- **認証/承認マッピング**:安全なアクセス管理は、データセキュリティの基本です。さまざまなクラウドコネクタでは、さまざまな認証および承認メカニズムを使用して、ユーザーアクセスを検証および制御します。認証ではユーザーまたはシステムが正当なエンティティであることが確認され、承認では付与されるアクセスレベルが定義されます。Salesforce では、可能な限りコネクタに業界標準を使用しています。
- **ゼロコピー (ZETL) 機能の相互運用性**:データの複製には、セキュリティと運用上の課題があります。また、不要なストレージコスト、データの不整合、リスクの増大も伴います。Salesforce のゼロ抽出、変換、読み込み (ZETL) アプローチにより、物理的なデータレプリケーションを必要とせずに、プラットフォーム間でリアルタイムのデータ共有を実現できます。つまり、データは元の環境内に残したまま、処理、レポート、分析のために引き続きアクセスできます。さらに、これにより攻撃対象領域が大幅に減少し、データレジデンシー法への潜在的なコンプライアンスも強化されます。
- **データ統合のサポート**:今日のマルチクラウド環境では、組織は不要なデータを移動することなく包括的なデータ アクセスを必要としています。Data 360 コネクタ統合データモデルでは、ファイルベースとクエリベースの両方のデータ統合がサポートされているため、企業は外部データソースをリアルタイムで活用できます。Salesforce のコネクタは、構造化データベース、半構造化ログ、または非構造化ファイルへのアクセスのいずれであっても、ライフサイクル全体にわたってデータのセキュリティを確保します。
Salesforce は、インテグレーションを使用しても、データセキュリティとコンプライアンスの複雑さに対処するのに必要な透明性を顧客に提供することを目指しています。AWS S3、Google Cloud Storage、Snowflake、その他のプラットフォームと統合する場合でも、Data 360コネクタは重要なビジネス データに対するTrust、透明性、制御を確保するように設計されています。
##### Salesforce Data 360 コネクタのセキュリティと認証の対応付け
| コネクタ種別 | 接続種別のサポート | プライマリ認証種別 | 主要なセキュリティ面とメモ |
|---|---|---|---|
| Salesforce CRM | N/A (内部) | セッションベース (内部) | Salesforce の堅牢な内部 ID およびアクセス管理 (IAM) モデルを使用します。すべてのデータは、Salesforce インフラストラクチャ内で転送中および保存中に暗号化されます。 |
| Marketing Cloud Engagement | 公開インターネットのみ | OAuth 2.0、ユーザー名/パスワード | 安全な認証には、標準 OAuth 2.0 プロトコルが使用されます。データは、公開インターネットを介して転送中 (TLS) に暗号化されます。 |
| B2C Commerce | 公開インターネットのみ | OAuth 2.0 | 標準 OAuth 2.0。データ転送にセキュアなパブリックインターネットプロトコル (TLS) を使用します。 |
| Web & モバイルアプリケーション | 公開インターネットのみ | API キー、OAuth 2.0 | API (取り込み API、ストリーミング API) を介して取り込まれるデータ。API 鍵管理と標準 Web プロトコルで管理されるセキュリティ。 |
| Amazon S3 | プライベートコネクト & 公開 | IAM ロール、外部ログイン情報 | AWS PrivateLink をサポートしてセキュアなプライベート接続を実現します。公開接続では、安全なログイン情報が使用されます。データは転送中および保存時に暗号化されます (S3 では顧客が管理する鍵が省略可能)。 |
| Snowflake | プライベートコネクト & 公開 | OAuth 2.0、非公開鍵認証、ユーザー名/パスワード | VPC プライベート接続 (AWS PrivateLink) をサポートします。安全な認証方法でパブリック接続を使用できます。Snowflake 内で顧客鍵を使用してデータを暗号化できます。 |
| Amazon Redshift | プライベートコネクト & 公開 | ユーザー名/パスワード、IAM 認証 | プライベート接続 (AWS PrivateLink) をサポートします。パブリック接続では、標準のセキュリティのベストプラクティスが使用されます。 |
| Microsoft Azure (ストレージ/SQL) | 公開インターネットのみ | SAS トークン、OAuth 2.0、ユーザー名/パスワード | 接続では、認証にセキュアな SAS トークンまたは OAuth が使用されます。データは暗号化チャネル (TLS) を介してパブリックインターネットを経由します。 |
| Google Cloud Storage (GCS) | 公開インターネットのみ | OAuth 2.0、サービスアカウント | 接続はセキュアな OAuth 2.0 に依存します。データは暗号化チャネル (TLS) を介してパブリックインターネットを経由します。 |
| MuleSoft (API) | 公開インターネットのみ | OAuth 2.0、API キー | API を使用して接続します。セキュリティは、MuleSoft Anypoint Platform を介して実装された標準 API 認証と堅牢なガバナンスポリシーによって管理されます。 |
| フェーズ | メカニズム | セキュリティ/ガバナンス管理 |
|---|---|---|
| アクティベーション設定 | Data 360 有効化設定で定義 | 指定ログイン情報と外部ログイン情報による保護 |
| データの準備 | DMO からの絞り込みと結合 | 適用される同意およびプライバシーメタデータ |
| アウトバウンド転送 | TLS/プライベートコネクトで暗号化 | ポリシーの適用とログイン情報の抽象化 |
| 外部配信 | SFTP / クラウドストレージ / API | アクセス制御された監査可能な配信 |
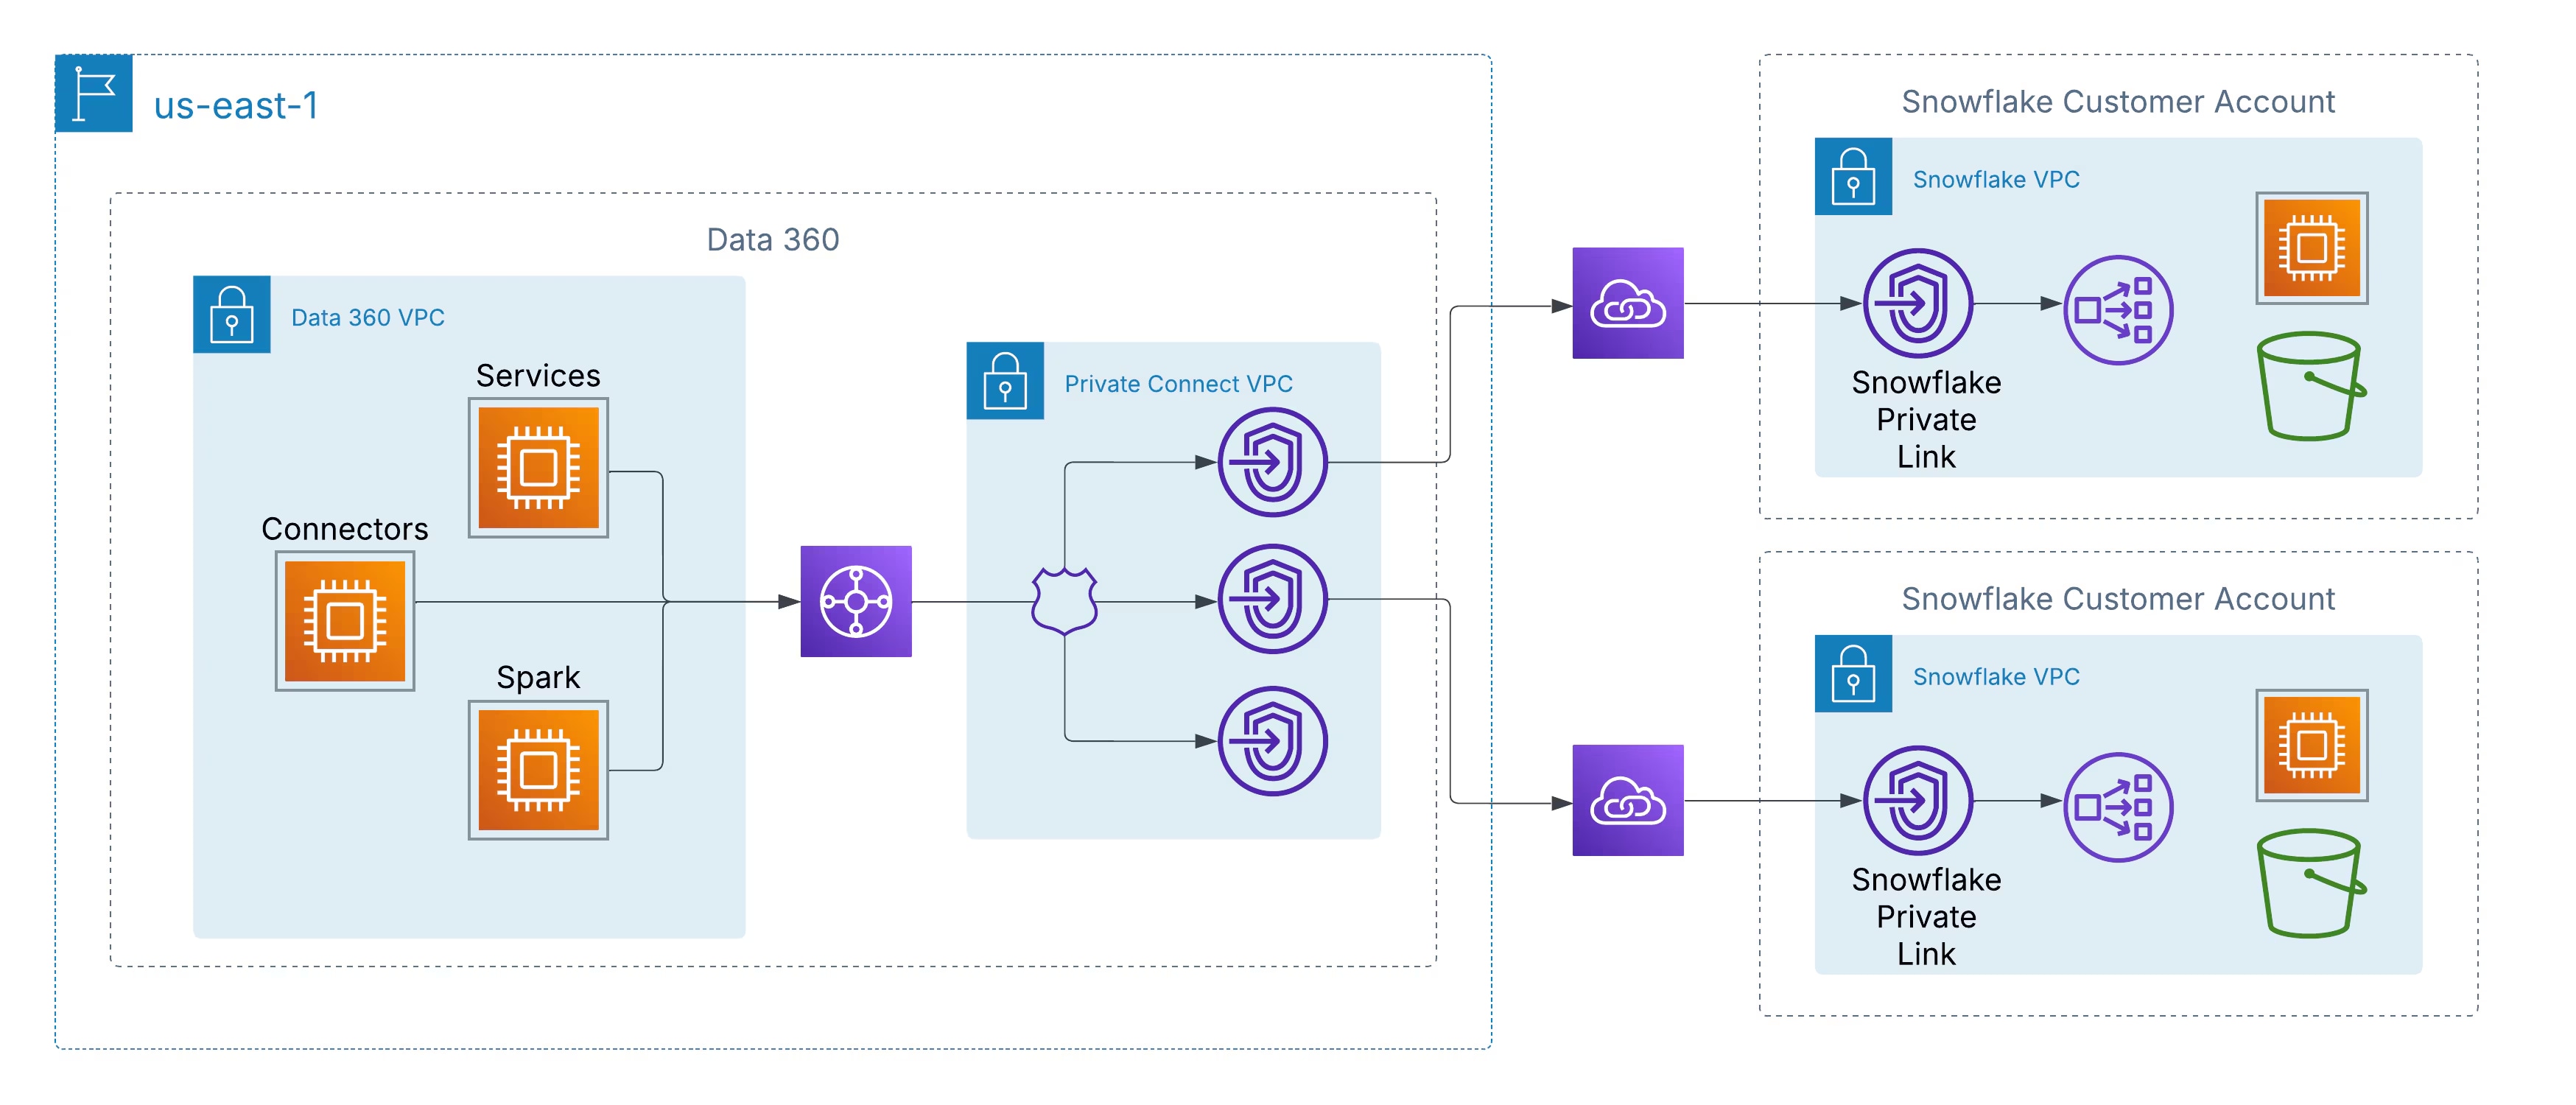 すべての通信は、プライベート IP アドレスとルーティング不可能なネットワークパスを使用して AWS バックボーン内に保持されるため、転送中のデータが傍受されるリスクがなくなり、厳しいエンタープライズおよび規制のセキュリティ要件を満たすことができます。
このアーキテクチャにより、次のことが保証されます。
- **インターネット漏洩ゼロ:**データが AWS プライベートネットワークから出ることはありません。
- **プライベート IP 通信:**トラフィックは外部で分離され、アドレス指定不能のままです。
- **コンプライアンスの調整:**ISO 27001、SOC 2、FedRAMP などのセキュリティ基準を満たしています。
#### プライベート相互接続:クラウド間のセキュリティの拡張
マルチクラウド環境で業務を行う顧客をサポートするために、Salesforce はプライベート相互接続を使用して同じセキュリティ原則を AWS 以外にも拡張しています。この機能により、Data 360 と Azure または Google Cloud でホストされているデータレイク間のクロスクラウドプライベート接続が可能になり、プライベートルーティング、インターネットトラバースゼロ、暗号化されたバックボーンのみのトラフィックが同じ保証で維持されます。
2 つのアーキテクチャリリースモデルを使用できます。
- **お客様が管理する相互接続:**顧客は、Azure ExpressRoute、Google Cloud Interconnect、Equinix Fabric などの既存のプライベートネットワーク回線を Data 360 VPC に直接統合します。
- **Salesforceが管理する相互接続:**Salesforce はクロスクラウドリンクをプロビジョニングして管理し、すぐに設定できるように顧客の対象クラウド環境にプライベートサービスエンドポイントを公開します。
### ゲートの保護:Salesforce Data 360 の API セキュリティ機能
エンタープライズデータを統合する強力なプラットフォームである Salesforce Data 360 は、堅牢な多層セキュリティ制御で構築されています。顧客にとって、API セキュリティの管理は包括的なデータ保護戦略の重要な部分であり、アクセスの制御、インテグレーションの管理、使用状況の監視を効果的に行うことができます。
Salesforce Data 360 内で API セキュリティを設定、制御、管理するためにお客様が使用できる主要な機能を次に示します。
#### 主要な API セキュリティ機能
お客様は、いくつかの組み込み Salesforce 機能を活用して、Data 360 インスタンスへの安全な API アクセスを確保できます。
##### 1\.堅牢な認証と承認 (OAuth 2.0)
Salesforce では、Data 360 API に対して厳格な認証を義務付けており、OAuth 2.0 が標準および推奨プロトコルです。
- **接続アプリケーション**:顧客は外部アプリケーションアクセスを管理する接続アプリケーションを作成および設定します。これは、Data 360 取り込み API とクエリ API へのアクセスを認証および許可するための主要なメカニズムです。
- **OAuth 範囲**:システム管理者は、最小権限の原則に従って、必要な最小限の権限を要求する特定の OAuth 範囲 (cdp_ingest_api、api など) を定義できます。
- **多要素認証 (MFA)**:Salesforce Authenticatorやその他のMFAソリューションを適用して、重要なセキュリティ レイヤーを追加し、検証済みのユーザーのみがAPIログインを使用してシステムにアクセスできるようにします。
##### 2\.詳細なアクセス制御と権限
顧客は、データにアクセスできるユーザーとアプリケーション、および実行できるアクションを詳細に制御できます。
- **API アクセスコントロール (機能)**:Salesforce サポートによって有効化されると、管理者は API へのアクセスに使用できる接続アプリケーションを明示的に承認できます。未承認のアプリケーションはすべて自動的にブロックされるため、不正なデータ抽出のリスクが大幅に軽減されます。
- **権限セットとプロファイル**:システム管理者は、ユーザープロファイルまたは専用の権限セットを使用して「API の有効化」権限を割り当てることで、API アクセスを管理します。これにより、ユーザーは職務に関連するアクセス権のみを持つことができます。
- **ロールベースのアクセス制御 (RBAC)**:Data 360 内で、ユーザーはロールベースのアクセス制御ポリシーを作成して管理し、データアクセスレベル (オブジェクト、項目、レコードレベルセキュリティ) を定義できるため、プラットフォーム全体の一貫性と制御を確保できます。
- **専用のインテグレーションユーザー**:ベストプラクティスとして、インテグレーション用に特定の「API 限定」ユーザーを作成し、システム管理者アカウントを使用するのではなく、API コールに必要な権限のみに制限することをお勧めします。
##### 3\.ネットワークセキュリティコントロール
- **IP ホワイトリスト/ログイン IP 範囲**:顧客は、API アクセスを定義済みの信頼できる IP アドレスの範囲に制限できます。未承認の IP アドレス範囲からのログイン試行は拒否されるか、検証が促される可能性があります。
- **プライベートコネクト**:AWS PrivateLink 上に構築されたこの機能により、管理者はエンドポイントを公開インターネットに公開することなく機密データを管理できるため、公開されているエンドポイントに対する攻撃のリスクを排除できます。
- **転送中および保存中の暗号化**:すべてのデータは転送中および保存中に暗号化され (TLS を使用)、傍受された場合でも機密情報が不正アクセスから保護されます。
##### 4\.監視、監査、ガバナンス
セキュリティにとって可視性は重要です。Salesforce には、API 活動を監視および監査するための広範なツールが用意されています。
- **イベント監視**:API コールやログイン試行など、さまざまなイベントをほぼリアルタイムで追跡します。顧客はこのデータを監査に使用し、トランザクションセキュリティポリシーを作成できます。
- **セキュリティセンター**:この機能により、すべての Salesforce 組織のセキュリティの健全性、コンプライアンス、およびガバナンスの総計値を 1 つの統合されたビューで確認でき、監視と管理が簡素化されます。
- **Field Audit Trail**:顧客がログイン履歴と項目履歴を追跡し、設定変更を監視して、監査とデータ保持のコンプライアンス義務に対処できるようにします。
- **データ ガバナンス機能**:データのタギングと分類、ポリシーの適用、動的データマスキングが含まれ、API を使用してアクセスするものを含め、すべてのデータタッチポイントに一貫したガバナンスポリシーが適用されます。
#### API セキュリティの設定と管理:カスタマージャーニー
1. コアコントロールの有効化:まず、MFA や IP 制限などの組織の共有設定を有効にします。
2. API アクセスコントロールの要求:Salesforce サポートにケースを登録して、組織で「API アクセスコントロール」機能を有効にします。
3. 接続アプリケーションの設定:インテグレーションごとに特定の接続アプリケーションを作成し、必要な OAuth 範囲を定義して、承認されたプロファイル/権限セットに割り当てます。
4. 最小権限の実装:すべてのインテグレーションユーザーに「API 限定」権限があり、データアクセスが最小限であることを確認します。
5. 監視と監査:イベント監視およびセキュリティセンターを定期的に使用して、API の使用状況を確認し、異常を検出して、脆弱性評価を実行します。
6. ベストプラクティスの適用:常に TLS を適用し、更新トークンを安全に保存し、セッション ID を循環し、データ入力を検証します。
これらの堅牢で顧客が設定できる機能を活用することで、企業は Salesforce Data 360 内のすべての API インタラクションで安全でコンプライアンスに準拠した環境を維持できます。
### コンプライアンス、監査、継続的な監視
#### サービスの可用性とデータレジデンシー
Salesforce Data 360 は、地理的に分散されたリリースモデルを使用して、グローバルなデータの居住性と主権の要件を満たすように設計されています。現在、このサービスは、米国、カナダ、ブラジル、ドイツ、インド、オーストラリア、日本など、複数の規制地域で利用できます。
データレジデンシーは、各顧客のコア組織インスタンスを最も近い対応する Data 360 地域インスタンスに対応付けることで決定されます。たとえば、米国またはカナダにあるコア組織は米国リージョン内の Data 360 インスタンスとペアになり、欧州連合内のコア組織はドイツでホストされているインスタンスに対応付けられます。同様に、インド、オーストラリア、ニュージーランド、シンガポールのコア組織は、インドでホストされている Data 360 インスタンスに関連付けられます。
SalesforceのHyperforceインフラストラクチャはこのモデルの基盤であり、地理的データの制御、セキュリティの分離、規制へのコンプライアンスの基盤となります。Hyperforceは、メタデータ、バックアップ、派生データセットなどの顧客データを、定義された地域の境界内に保持します。このアーキテクチャにより、企業は APAC と EMEA の各地域で、GDPR、FFIEC、HIPAA、地域のプライバシー保護法などのデータレジデンシーとコンプライアンス要件を満たすことができます。
Salesforceは、進化するグローバル プライバシー基準、地域のコンプライアンス要件、主権あるデータ管理に対するお客様の期待に合わせて、Data 360の可用性をさらにHyperforceリージョンに拡張し続けています。
#### 法令順守の実現
Salesforce Data 360 は、GDPR や CCPA などの厳しいグローバルプライバシーおよび規制要件を企業が満たすことができるように設計されています。このプラットフォームは、データアクセス、エクスポート、削除 (「忘れられる権利」) などのデータ主体の権利 (DSR) を管理するネイティブ機能を提供し、ライフサイクル全体で個人データのコンプライアンス対応を保証します。
コンプライアンスの最終責任は顧客が負うことになりますが、Salesforce は CCPA などの規制に基づく認定「サービスプロバイダー」として業務を行い、組織がコンプライアンスフレームワークを効率的かつ大規模に実装するためのプラットフォームレベルの管理、セキュリティ保証、契約メカニズムを提供します。
#### Foundational Trust:認定と証明
TrustはSalesforceプラットフォームの基盤であり、そのTrustは独立した検証によって獲得されます。Salesforce は、顧客データの保護と最高水準のクラウドセキュリティの維持に対する継続的な取り組みを示す、グローバルセキュリティ認定および証明の広範なポートフォリオを保持しています。
これらの認定は単なるチェックボックスではなく、Salesforce のセキュリティ制御、プロセス、インフラストラクチャの強度と一貫性を検証する厳格な定期的な監査を表します。これらが組み合わされて、Salesforce の基盤 Trust モデルのバックボーンが形成されます。
**主な認定および証明は次のとおりです。**
- **ISO/IEC 27001:**Salesforce の包括的な情報セキュリティ管理システムを検証します。
- **ISO/IEC 27017:**クラウド固有のセキュリティ制御のベストプラクティスを確立します。
- **ISO/IEC 27018:**クラウドでの個人識別情報 (PII) の保護に焦点を当てています。
- **SOC 1、SOC 2、SOC 3**Salesforce のセキュリティおよびプライバシー管理の設計と運用の有効性を確認する独立したレポート。
- **PCI DSS:**支払カード情報を安全に処理および保存します。
- **FedRAMP High & DoD Impact Level 4:**機密ワークロードを管理する米国連邦政府機関が使用するために Salesforce Government Cloud を認定します。
この包括的な認定セットを維持することで、Salesforce は、データがプラットフォーム内で管理され、グローバルなコンプライアンスとセキュリティの期待に応えている (そして多くの場合、それを上回る) という信頼性を顧客に提供します。
### 表示の最大化:Salesforce Data 360 でのログ記録、監視、オブザーバビリティ
急速に変化する今日のデジタル環境では、顧客データを全方位から把握することも重要ですが、同様に重要なのは、そのデータを管理するプラットフォームを全方位から把握することです。Salesforce Data 360 には、堅牢なロギング、監視、オブザーバビリティ機能が組み込まれており、顧客はデータの品質、セキュリティ、パフォーマンスを確保できます。
これらのツールは、事後対応型の問題解決からプロアクティブな管理への移行を支援し、Data 360 実装をスムーズかつ効率的に実行します。
#### プロアクティブな脅威の検出と対応
セキュリティは予防で終わりではなく、警戒しながら進化します。常に変化する脅威の状況では、Salesforce は高度なプラットフォーム監視機能と顧客が管理するレビュープロセスを組み合わせて、プロアクティブで継続的な保護を確保します。
Salesforce には、可視性と脅威検知のための強力なネイティブツールが用意されています。
- **監査履歴の設定**では、管理上の変更の完全な履歴が取得されるため、チームは設定やポリシーの更新を追跡できます。
- **イベント監視**では、ユーザーの行動、APIアクティビティ、データ アクセス パターンに関する詳細なインサイトが提供されます。このテレメトリは、**SIEM(セキュリティ情報**およびイベント管理)ソリューションとシームレスに統合して、一元的な分析と関連づけを行うことができます。
#### 1\.イベント監視:組織の鼓動
Salesforce Shield製品の一部であるイベント モニタリングは、Data 360固有のアクションなど、Salesforce組織の詳細なユーザー アクティビティとシステム パフォーマンス データを追跡する中央ハブです。分析のために、さまざまな「イベント」をログファイルとオブジェクトに取り込みます。
- **イベントログファイル (ELF):**これらは、ユーザー活動とシステムイベントの詳細な詳細を提供し、少し遅れて (1 時間ごとまたは 1 日ごと) ダウンロードできるようにします。API または \[イベントログファイル] ブラウザーから最大 30 日分のデータにアクセスできます。長期保存用にエクスポートすることもできます。
- **リアルタイムイベント監視:**リアルタイムイベントはプラットフォームイベントとしてストリーミングされるため、ほぼリアルタイムで活動を監視および検出できます。これはセキュリティとパフォーマンスにとって不可欠であり、必要に応じてすぐに対応できます。
- **Data 360 固有のイベント:**イベント モニタリングには、Lightning ページ ビュー、Lightning インタラクション、Data 360 ページおよびデータに関連するレポート イベントなど、Data 360 の使用状況に固有のイベント タイプが含まれます。
- **外部ツールとの統合:**Salesforce は、Splunk、Datadog、New Relic、Sumo Logic などの一般的なサードパーティ監視ソリューションとのシームレスな統合を促進します。イベントモニタリングデータをこれらのプラットフォームにストリーミングまたはエクスポートして、技術スタック全体で監視することができます。
#### 2\.パフォーマンス監視および最適化
Data 360 実装のパフォーマンスを理解することは、優れたユーザーエクスペリエンスの鍵となります。
- **Lightning Usageアプリケーション:**この組み込みアプリケーションでは、Lightning Experience の Data 360 ページのパフォーマンス評価指標 (ページ読み込み時間 (EPT) やブラウザーのパフォーマンスなど) の集計ビューが提供されます。
- **カスタムレポートおよびダッシュボード:**Event Monitoring Plus という無料の CRM Analytics テンプレートアプリケーションの使用を含め、Data 360 オブジェクトとイベント監視データを使用してカスタムレポートとダッシュボードを作成できます。これらの視覚化により、トレンドを特定し、パフォーマンスのボトルネックをすばやく特定できます。
しかし、テクノロジーだけでは不十分です。真のレジリエンスを実現するには、自動検出と人によるレビューの連携が必要です。自動化されたアラートはリアルタイムで異常を示す可能性がありますが、多くの場合、有効なユーザーによる低速で不正なデータの持ち出しなど、微妙な脅威や長期的な脅威は、定期的な監査とトレンド分析によって特定できます。
Salesforce はテレメトリ、監査ログ、インテグレーションフックを提供します。顧客はプロセスの厳格さ、運用のケイデンス、コンテキスト固有のインテリジェンスを提供します。これらを組み合わせることで、**多層防御モデル**が形成されます。自動化、分析、手動監視を組み合わせて、インシデントになる前に脅威を検出、調査、対応します。
### 情報に基づいた意思決定の促進:Salesforce Data 360 のレポート、ダッシュボード、評価指標、通知
Salesforce Data 360 は、顧客データを統合するだけでなく、そのデータをインテリジェントでアクション可能なものにします。この価値提案の中核となるのは、堅牢なレポート、強力なダッシュボード、インサイトに富んだ評価指標、リアルタイム通知機能です。これらのツールを使用すると、使い慣れた Salesforce 環境内で、データの健全性の監視、パフォーマンスの追跡、統合データに基づくアクションの自動化をすべて行うことができます。
#### レポートとダッシュボード:データ視覚化ハブ
Salesforce のネイティブのレポートおよびダッシュボード機能は Data 360 にシームレスに拡張され、プラットフォームを離れることなく統合データを視覚化および分析できます。
#### 統合データに基づくレポートの作成
さまざまなソースからの統合データや計算済みインサイトなど、Data 360 に保存されているデータに関する標準レポートとカスタムレポートを作成できます。
- **標準およびカスタムレポートタイプ:**Data 360 では、データストリーム、セグメント、有効化、ID 解決、計算済みインサイトなど、Data 360 オブジェクト専用の新しいレポートタイプが導入されています。これにより、標準の Salesforce レポートビルダーを使用して統合データを照会できます。
- **詳細分析:**レポートでは、最大 10 行のグルーピングがサポートされるため、顧客の属性とトレンドをより詳細にセグメンテーションして詳細に分析できます。
- **数式と概要:**行レベルの数式と集計項目を活用して、各レコードまたはレコードグループを評価し、1 つのレポート内で詳細な総計値と集計の概要を追跡できます。
#### 総合的なビューの動的ダッシュボード
ダッシュボードでは、Data 360 実装全体の主要な総計値とトレンドが視覚的に表示されます。
- **統合ビュー:**複数の Data 360 レポートのデータを統合したり、Data 360 レポートと標準 CRM レポートを 1 つのダッシュボードで混在させたりして、業務と顧客インサイトの全体像を把握できます。
- **カスタマイズ可能なウィジェット:**さまざまな種類のグラフ (棒グラフ、折れ線グラフ、円グラフ、ゲージグラフなど) とテーブルを使用して、レポートデータを効果的に表示します。
- **リアルタイム・インサイト:**ダッシュボードを更新して最新情報を提供し、データ主導の迅速な意思決定を支援します。
#### 総計値 & KPI:成功の測定
Data 360 では、ビジネス目標に関連する重要業績評価指標 (KPI) を定義して追跡できます。これらは次の方法で生成できます。
- **計算済みインサイト:**大量のバッチで処理されたデータを使用して、強力な評価指標を作成します。たとえば、「Average Customer Lifetime Value (平均顧客生涯価値)」や「Total Active Contract Revenue (有効な契約収益の合計)」などの総計値を計算し、レポートやダッシュボードでディメンションや基準として使用します。
- **ストリーミングインサイト:**ストリーミングソースのデータをほぼリアルタイムで処理し、Web サイトやモバイルエンゲージメントデータなどの時系列集計を作成します。これらの総計値は、すぐにオーケストレーションとデータアクションを促進できます。
#### 通知とアラート:最新情報とプロアクティブな対応
Salesforce には、Data 360 内の重要なイベントやデータの変更を確実に把握するための強力な自動化機能と通知機能があります。
- **フローベースの通知:**データストリーム、セグメント、有効化などの Data 360 オブジェクトのイベントに基づいてアクションをトリガーし、通知を送信するようにプロセスフローを設定できます。
- **カスタムアラート:**メールをトリガーするか、特定の条件を満たしたときに Salesforce 通知ベルに表示されるカスタム通知を作成します。たとえば、データストリームが失敗した場合、ID 解決ルールでエラーが発生した場合、主要な指標が特定のしきい値を超えた場合にアラートを受信できます。
- **イベント通知サービス (ENS):**開発者の場合、API ファーストイベント通知サービスを使用すると、特定のイベントが発生したときに外部システムで通知を受信できるため、技術スタック全体でシームレスなインテグレーションとリアルタイムの反応が可能になります。
- **データアクション:**ストリーミングインサイトに基づいて、データアクションをトリガーできます。データアクションは、アラートの送信、プラットフォームイベントの呼び出し、Web フックを介した他の SaaS アプリケーションとの統合を行うように設定できます。
Salesforce Data 360 のお客様は、これらの包括的な機能を活用して、データエコシステムを効果的に監視し、主要な評価指標を視覚化して、タイムリーなアラートを受信し、プロアクティブなエンゲージメントと優れた運用性を実現できます。
### エンタープライズ導入のための戦略的推奨事項
Salesforce Data 360 をエンタープライズ規模で採用するには、技術的なイネーブルメント以上のものが必要です。慎重なセキュリティ優先のアーキテクチャが必要です。次の戦略的推奨事項は、CTOとエンタープライズ アーキテクトがData 360導入のすべてのレイヤーにTrust、耐障害性、コンプライアンスを構築するためのロードマップを提供します。
- **「設計によるセキュリティ保護」アプローチの実装 :**セキュリティは、後付けではなく、基本にする必要があります。Salesforce のデフォルトの_「すべて拒否」_ポリシーから開始し、必要に応じてアクセス権を明示的に付与します。データを取得または有効化する前に、ガバナンス、ポリシー、アクセスフレームワークを定義します。初日からセキュリティを構築することで、隠れた情報漏洩のリスクを排除し、長期的なコンプライアンスを簡素化します。
- **堅牢なIAM(Identity and Access Management)戦略の適用 ―**統合 SSO で ID を一元化し、多要素認証 (MFA) を適用してログイン情報のセキュリティ侵害を軽減します。ログイン IP アドレスの制限によってアクセスを制限し、Salesforce の ID プロバイダー (IdP) 機能を使用して、ユーザーおよびインテグレーション全体でエンドツーエンドの説明責任を確立します。統合された IAM レイヤーにより、運用の複雑さが軽減され、認証表面が強化されます。
- **最小権限の原則の適用 ―**利便性ではなく精度のためにロールを設計します。Salesforce の標準権限セットを職務分掌の基盤として使用し、ユーザーが必要な情報にのみアクセスできるようにします。権限の過剰なカスタマイズを避ける — 逸脱が発生するたびに、メンテナンスオーバーヘッドが増加し、意図しないアクセスのリスクが高まります。
- **多層データガバナンスフレームワークの確立:**データスペースを使用してビジネスユニットまたはブランド別にデータを分離し、オブジェクトレベル、項目レベル、レコードレベルセキュリティ (OLS、FLS、RLS) を使用して属性ベースのアクセス制御 (ABAC) を適用します。動的データマスキングを使用して、分析や操作性を損なうことなく、機密情報をリアルタイムで保護します。この階層化されたモデルにより、ドメイン間でデータの規模を拡大してもガバナンスの一貫性が維持されます。
- **暗号化と安全なインテグレーションの戦略的な活用 :**機密ワークロードの場合、顧客が管理する鍵を使用したプラットフォームの暗号化 (CMK) をリリースして、暗号化ライフサイクルの主権を維持します。指定ログイン情報とプライベートコネクトを使用して、すべてのシステム間インテグレーションを保護します。これにより、ハードコードされた秘密が排除され、すべてのトラフィックが非公開、コンプライアンス、監査可能のままになります。
- **継続的なセキュリティ・オペレーション・プログラムの構築:**セキュリティは設定だけで終わりではなく、運用の規律によって強化されます。イベントログとアクセス履歴の定期的な監査レビューで自動監視を補完します。異常の特定、脅威の調査、コンプライアンスの検証を行うための専用のセキュリティオペレーション (SecOps) 機能を確立します。目標は、早期発見、迅速な対応、姿勢の継続的な改善です。
### Path Forward:耐障害性と信頼性に優れた Data 360 の構築
安全でインテリジェントなエンタープライズへの移行は、導入で終わりではありません。導入は、規律、設計、Trustによって進化します。Salesforce Data 360 はアーキテクチャの基盤を提供しますが、真の価値は、組織がセキュリティ、ガバナンス、インテリジェンスを 1 つの統合された動きとして運用することで現れます。
企業は、Data 360を別のデータ プラットフォームとしてではなく、単一のガバナンス フレームワークでデータ、AI、カスタマー エンゲージメントを接続する安全で構成可能なTrustレイヤーとしてアプローチする必要があります。_セキュア バイ デザイン_の理念を採用し、すべてのレイヤーに最小限の権限を適用し、すべてのデータ フローにプライベート接続を拡張することで、組織はコンプライアンスをチェックボックスから競争優位性に変換します。
次のステップは、継続的なモダナイゼーションです。監査の自動化、ポリシーの適用、暗号化ライフサイクル管理を日常業務に組み込みます。企業がエージェント型の AI 駆動型アーキテクチャに進化するにつれ、現在のデータを保護する同じ原則が将来の AI ガバナンスのバックボーンを形成することになります。これにより、すべてのモデル、エージェント、意思決定が説明可能で、ポリシーを認識し、設計に従っているようになります。
最終的には、Trustがデジタル トランスフォーメーションの新しい通貨になります。Salesforce Data 360 を使用すると、企業はデータエコシステムを自信を持って拡張できます。すべてのバイト、すべての接続、およびすべてのインサイトが、整合性をもって保護、管理、有効化されます。
## 著者について
**Krishna Chalamasandra**は、情報セキュリティ テクノロジーとコンプライアンスで25年以上の経験を有する経験豊富なサイバーセキュリティ エキスパートです。Salesforceでは、顧客の信頼できるアドバイザーとして、CISO組織内のSecurity and Compliance Customer Trust機能の主要なリーダーを務めています。以前は、Cisco に 10 年間在籍し、IAM、ネットワークセキュリティ、PKI のセキュリティアーキテクチャをリードし、ISO 27001、SOC 1 ~ 3、PCI、FedRAMP、FIPS 140-2 などの主要な認定を推進しました。また、Novell に 8 年以上在籍し、インフラストラクチャレベルの制御を実装し、規制の厳しい世界中の顧客の複雑なセキュリティレビューをサポートしました。
**Yugandhar Bora**は、Salesforceのソフトウェアエンジニアリングアーキテクトで、Data & Intelligence Applicationsプラットフォーム内のデータアーキテクチャを専門としています。データガバナンスと統合データモデルに焦点を絞ったエンタープライズアーキテクチャレビューボード (EARB) イニシアチブを主導しながら、自動化プラットフォームプロビジョニングソリューションに貢献しています。
# Data 360 とインテグレーションの使用開始
このセクションでは、データプラットフォームを設計し、Salesforce をエンタープライズシステムと統合する方法について説明します。これらの記事では、統合データ アーキテクチャを構築し、Salesforce を広範なテクノロジー エコシステムに接続するための不可欠な Knowledge を提供します。
## Data 360 アーキテクチャ
[Data 360 アーキテクチャ](/docs/architect/ja-jp/fundamentals/guide/data-360-architecture)は、AI を駆使した未来に向けて設計された Salesforce の次世代データ プラットフォームを紹介します。この包括的なガイドでは、次の内容について説明します。
- **モダン データ プラットフォーム アーキテクチャ**:Data 360 は、AI/ML、分散データ、クラウド レイクハウス、非構造化データ、Knowledge Management、リアルタイム処理を統合します。
- **設計原則**:オープン性、相互運用性、マルチモデル ストレージ、メタデータ主導の設計、リアルタイムのハイブリッド処理、インテリジェントなデータ、ガバナンス、1 対多のテナント。
- **主な差別化要因**:Snowflake、Databricks、BigQuery、Redshift と統合し、既存の投資を重複させることなく Customer 360 を拡張します。
- **使用事例と機能**:リアルタイムのインサイト、自律的な意思決定、構造化データと非構造化データへの統合アクセスを実現します。
このドキュメントは、エンタープライズアーキテクトと CTO がエージェント型エンタープライズ時代のデータ戦略を計画するうえで不可欠であり、Data 360 のアーキテクチャに関する戦略的な指針と技術的な詳細の両方を提供します。
## インテグレーションパターン
[Integration Patterns](/docs/architect/ja-jp/fundamentals/guide/integration-patterns) では、Salesforce Platform を社内の他のアプリケーションと統合するための包括的なガイドが提供されます。このドキュメントの内容は次のとおりです。
- **パターンベースのアプローチ**:一般的なシナリオのインテグレーションパターン (Salesforce 実装の成功例から抽出)。
- **パターン選択ガイド**:特定のインテグレーションシナリオに適したパターンを選択するマトリックス。
- **インテグレーションのベストプラクティス**:安定性、拡張性、メンテナンス性に優れたインテグレーションをすばやく構築するためのヒント。
- **包括的な補償**:リアルタイム同期、一括処理、データ移行、イベント駆動型アーキテクチャのパターン。
このドキュメントは、Salesforce を他のエンタープライズアプリケーションと統合する必要があるアーキテクトと開発者を対象としています。Salesforce 独自のコンサルティングアーキテクトは、アーキテクチャレビュー時にこれらのパターンを参照ポイントとして使用し、インテグレーションアーキテクチャの権威あるガイドにします。
---
この 2 つの記事は、Data 360 を使用して最新のデータプラットフォームを設計する方法と、Salesforce を既存のエンタープライズシステムと効果的に統合する方法の両方を理解するのに役立ちます。まず Data 360 アーキテクチャから始めてデータプラットフォームの機能を理解し、次にインテグレーションパターンを探索して Salesforce を広範なテクノロジーエコシステムに接続する方法を説明します。
## ガイドの概要
非同期処理では、コンテキストあたりの制限を引き上げることができるため、[スケーラビリティ](/docs/architect/ja-jp/well-architected/guide/reliable#拡張性)が向上します。非同期要求はバックグラウンドで独自のスレッドで実行されるため、ユーザーは非同期 ToDo をバックグラウンドで実行しながらクライアント側で作業を続行できます。
Salesforce Lightning Platform には、特定の使用事例を解決するために使用できるさまざまな非同期テクノロジーが用意されています。各テクノロジーには、使用事例ごとにアプローチを選択するときに考慮する必要がある利点と制限があります。
実装するテクノロジーを選択するときには、次の 3 つの重要な考慮事項に留意してください。
1. 非同期処理は、すべての問題に最適なアプローチではありません。ユーザー操作を直接必要としないプロセスは、非同期処理の優れた候補と考えがちですが、いくつかの欠点があります。まず、非同期プロセスには SLA がありません。つまり、設定された時間内に非同期プロセスを完了できる保証はありません。次に、一貫した応答遅延の保証はありません。非同期プロセスが一定時間内に完了すると、後続のプロセスが完了するまでに異なる時間がかかる可能性があります。そのため、ユーザーが応答を直接待機していなくても、応答に依存する後続のプロセスがある場合や、応答時間が長すぎるとデータが外部システムのデータと同期しなくなる可能性がある場合、非同期処理はシナリオに適さない可能性があります。
2. Salesforce Platform では非同期要求を処理する方法が異なるため、最適な方法を選択してください。Salesforce Platform で非同期処理をサポートする技術は「内部では」動作が異なりますが、非常に具体的な使用事例に合わせて設計されたものもあります。
3. 技術がクライアント側で非同期の場合、すべてのエンドツーエンドの処理が並列で実行されるとは限りません。選択した内容によっては、クライアントのメッセージがサーバー側でシリアライズされることもあります。
ジョブで誤ったテクノロジーや誤ったテクノロジーの組み合わせを使用すると、非同期処理の利点が取り消される意図しない結果が生じる可能性があります。このガイドでは、さまざまな非同期使用事例の説明と推奨事項、潜在的な欠点とアンチパターン、および推奨事項の根拠について説明します。また、Salesforce Platform でさまざまな非同期実装技術がどのように動作し、規制されているかに関するインサイトも提供されます。
使用するテクノロジーについて意思決定を行う場合は、一般的な使用事例を最適なテクノロジーにすばやくマッピングできる、焦点を絞った非[同期処理決定ガイド](/docs/architect/ja-jp/decision-guides/guide/async-processing)が用意されています。
## 範囲内の商品
 |
Salesforce Lightning Platformは、従業員、自律型AIエージェント、会社のデータ、アプリケーションを単一の信頼できるシステムに統合し、生産性とカスタマー エクスペリエンスを向上させる包括的なAI駆動型プラットフォームです。Customer 360アプリケーション、Data Cloud、Slackを接続してエンドツーエンドの自動化を実現することで、「エージェント エンタープライズ」の作成を可能にします。 |
 #### 公正な使用量
プラットフォームの公正な使用メカニズムでは、階層ベースのシステムが実装されています。このシステムにより、Salesforce Platform の各組織は、Future、Queueable、Batch などのメッセージ種別の処理時間を公平に配分できます。特定のメッセージタイプで他の組織が作業の実行を待機している間に、ある組織がそのメッセージタイプを独占している場合、使用量の適正化アルゴリズムによって、その特定のメッセージタイプで使用可能なスレッド数が減少します。
 非同期 Apex メソッドを使用する利点は、SOQL クエリ制限やヒープサイズ制限などの一部のガバナ制限が高くなることです。ただし、これらの方法に過度に依存しないでください。非同期インフラストラクチャに割り当てられるリソースには限りがあるため、Future、Queueable、および Batch Apex を頻繁に使用すると、公正な使用とフロー制御に基づく制限が原因で処理の遅延が発生する可能性があります。
#### 非同期 Apex を介した発信コールアウトに関する特別な考慮事項
非同期 Apex を使用する発信コールアウトは、非同期 Apex 制限に含まれます。現在の 1 日あたりの制限は、適用可能なユーザーライセンス数の 25 万倍または 200 倍のいずれか大きい方です。この制限は、大規模な使用事例で問題になる可能性があります。この制限を超えると、非同期 Apex ジョブおよび関連付けられたアウトバウンドコールアウトは失敗します。
また、プラットフォームで使用できる非同期スレッドの数には限りがあるため、非同期 Apex を介した送信インテグレーションの拡張性も制限されます。使用可能なスレッド数を超える大量の送信インテグレーションでは、処理時間が長くなり、遅延が発生する可能性があります。
大規模な使用事例では、次の代替方法を検討してください。これらのアプローチでの API コールは、1 日の API 要求制限に含まれます。これは、1 日の非同期 Apex 制限よりも大幅に高くなります。したがって、これらのアプローチは拡張性が高くなります。ただし、どの CPU でも処理できる同時要求数には物理的な制限があります。
- **Middleware Scheduled Pull.**大量の送信インテグレーション・ジョブに関連する遅延を回避するには、ミドルウェアを使用して、非同期 Apex を介してデータを転送するのではなく、スケジュールに従ってデータを取得します。MuleSoft Anypoint Platform などのミドルウェアでは、ネイティブの SOAP API または REST API を同期して使用できるため、遅延が発生することはほとんどありません。ミドルウェアでは、大量のデータに対してネイティブの Bulk API を使用することもできます。
 - **プラットフォームイベント通知を介したミドルウェアの取り込み。**Future、Queueable、または Batch 非同期 Apex をキューに追加して送信インテグレーションを実行する代わりに、プラットフォーム イベントを使用できます。プラットフォームイベントは、アウトバウンド情報自体を配信することも、ネイティブ API を介して必要な情報を取得して最終的な目的地に配信するようにミドルウェアツールに指示することもできます。どちらのアプローチも、非同期 Apex で適用される遅延の影響を受けません。ただし、[プラットフォームイベント制限](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_events_limits_default.htm)は引き続き適用されます。
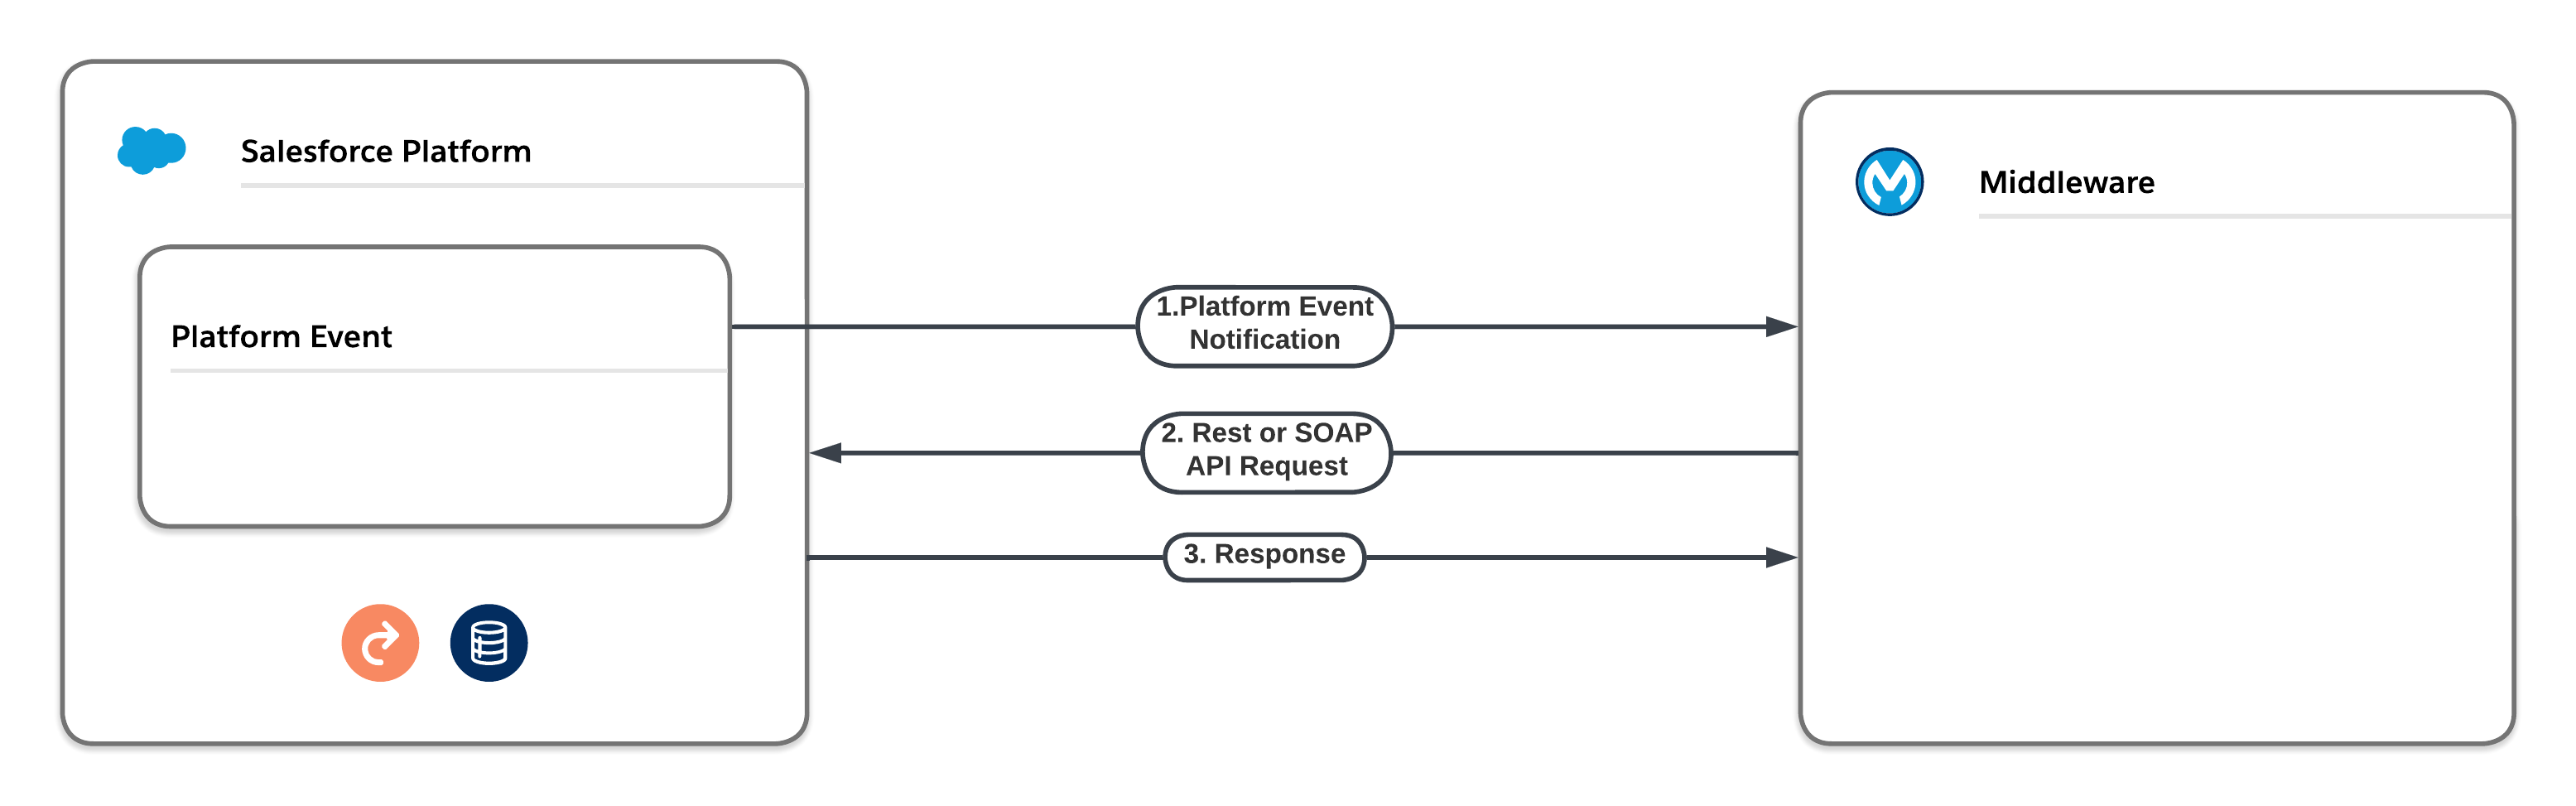 #### 非同期 Apex のトレードオフ
| 商品/アプローチ | 使用事例 | 必要なスキル | クライアントに関する非同期 | サーバに関する非同期 | 適用されるプラットフォーム制限の種別 |
|---|---|---|---|---|---|
| Apex Future メソッド | Apex future メソッドの代わりに Queueable Apex を使用することをお勧めします。キュー可能の使用事例は future メソッドと同じですが、追加の利点もあります。 | プロコード | はい | はい | 非同期 |
| Queueable Apex | future メソッドよりもこのアプローチを推奨します。実行時間の長いデータベース操作や外部 Web サービスのコールアウトが含まれるプロセスに使用します。Queueable Apex には、ジョブ ID、プリミティブ型以外の種別のサポート、ジョブのチェーンなど、将来の方法よりも多くの利点があります。 | プロコード | はい | はい | 非同期 |
| スケジュール済み Apex | cron 式で定義されたスケジュールされた時間に Apex を実行します。cron 式を使用して Apex をスケジュールする動作は非同期プロセスですが、基盤となるコードはジョブの開始時に同期して実行されます。 | プロコード | はい | はい | 同期 |
| Apex 継続コールアウト | 同期トランザクション コンテキストで実行されている Apex メソッドからのコールアウト。 | プロコード | はい | はい | 同期 |
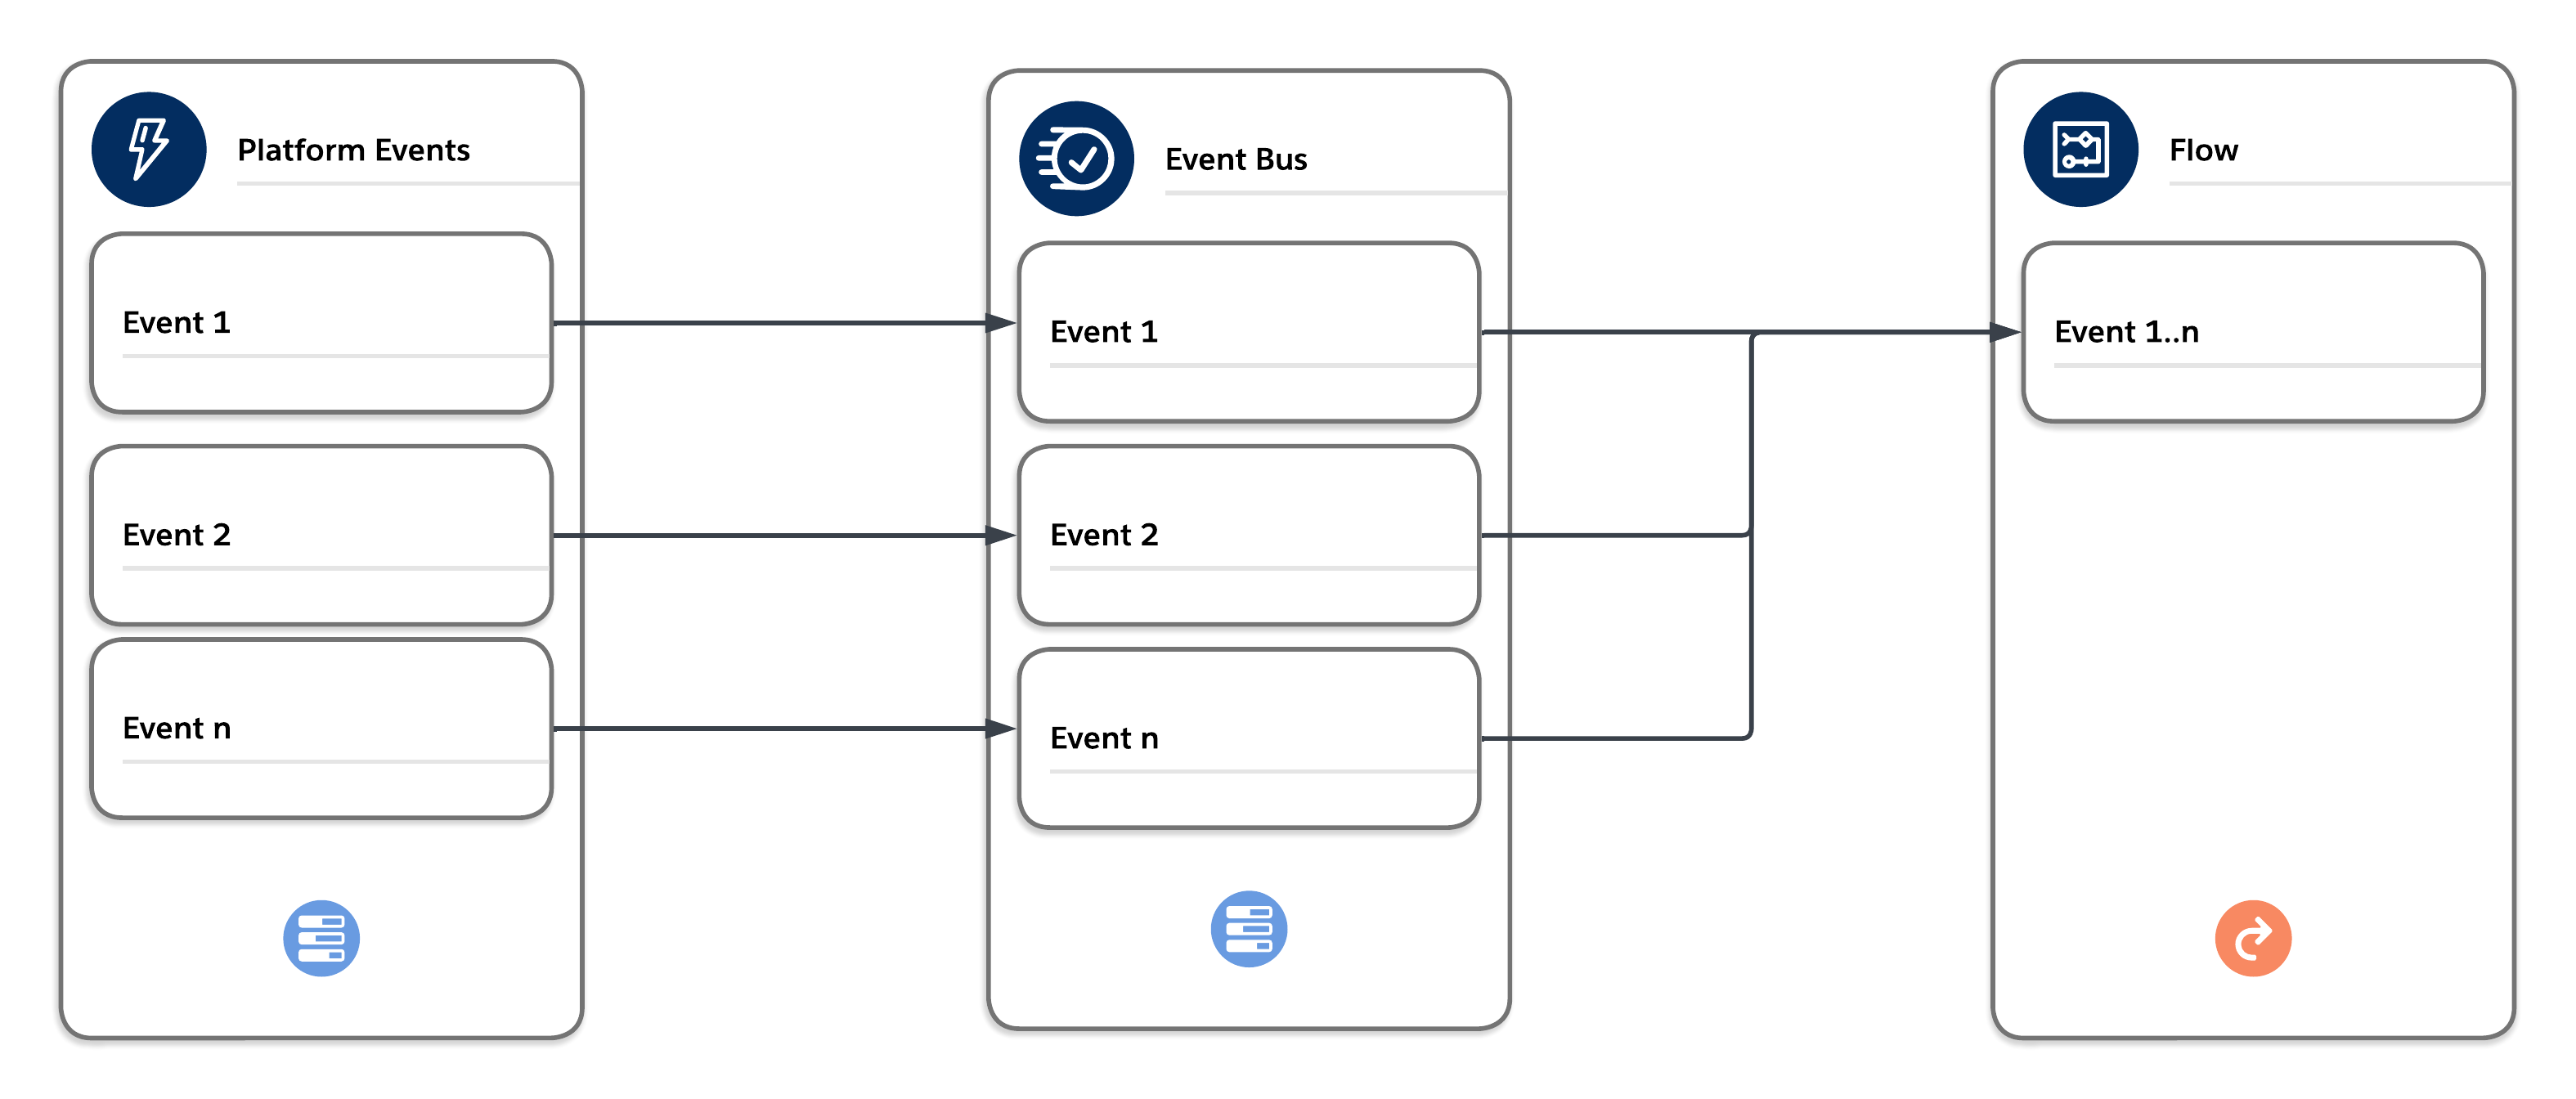 [Publish after commit](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_events_intro.htm) を介してバスに公開されたイベントは順番に配信され、トリガーまたはフローによって個別の同期コンテキストで一括処理できます。コンテキストは同期であり、すべての同期ガバナ制限が適用されます。制限に達しないように、プラットフォームイベントトリガー/フローのバッチサイズを慎重に選択します。
| 商品/アプローチ | 使用事例 | 必要なスキル | クライアントに関する非同期 | サーバに関する非同期 | 適用されるプラットフォーム制限の種別 |
|---|---|---|---|---|---|
| プラットフォームイベントトリガー | Salesforce を外部システムと疎結合し、非同期プラットフォームコンポーネント間で通信します。 | ローコード + プロコード | はい | はい | 同期 |
| 商品/アプローチ | 使用事例 | 必要なスキル | クライアントに関する非同期 | サーバに関する非同期 | 適用されるプラットフォーム制限の種別 |
|---|---|---|---|---|---|
| スケジュール済みパス (確定後フロー) | イベントをトリガーした後、動的にスケジュールされた時間に実行します。 | ローコード | はい | はい | 非同期 |
| 非同期パス (レコードトリガーフロー) | 独自の時間で実行する操作を実行し、混在する DML エラーを回避します。 | ローコード | はい | はい | 非同期 |
| 商品/アプローチ | 使用事例 | 必要なスキル | クライアントに関する非同期 | サーバに関する非同期 | 適用されるプラットフォーム制限の種別 |
|---|---|---|---|---|---|
| 送信メッセージ | SOAP プロトコルを使用して、ほぼリアルタイムでデータをサードパーティシステムと共有 | ローコード | なし | はい | なし |
| 商品/アプローチ | 使用事例 | 必要なスキル | クライアントに関する非同期 | サーバに関する非同期 | 適用されるプラットフォーム制限の種別 |
|---|---|---|---|---|---|
| メール-to-ケース | 受信メールの値に基づいてケースを自動的に作成し、ケース項目に入力します。 | ローコード | はい | はい* | 同期 |
| * メール-to-ケースは同期と非同期の両方で処理されますが、同期 Apex の制限があります。 | |||||
| 商品/アプローチ | 使用事例 | 必要なスキル | クライアントに関する非同期 | サーバに関する非同期 | 適用されるプラットフォーム制限の種別 |
|---|---|---|---|---|---|
| Apex の一括処理 | 何千ものレコードが含まれる複雑で実行時間の長いプロセス | プロコード | はい | はい | 非同期 |
| スケジュールトリガーフロー | フローを使用して、指定された時間および繰り返しの頻度でバックグラウンドでレコードのバッチに対するアクションを実行します。 | ローコード | はい | はい | 同期 |
| Bulk API | 多数のレコードを非同期で挿入、更新、更新/挿入、照会、削除します。 | プロコード | はい | はい | 非同期 |
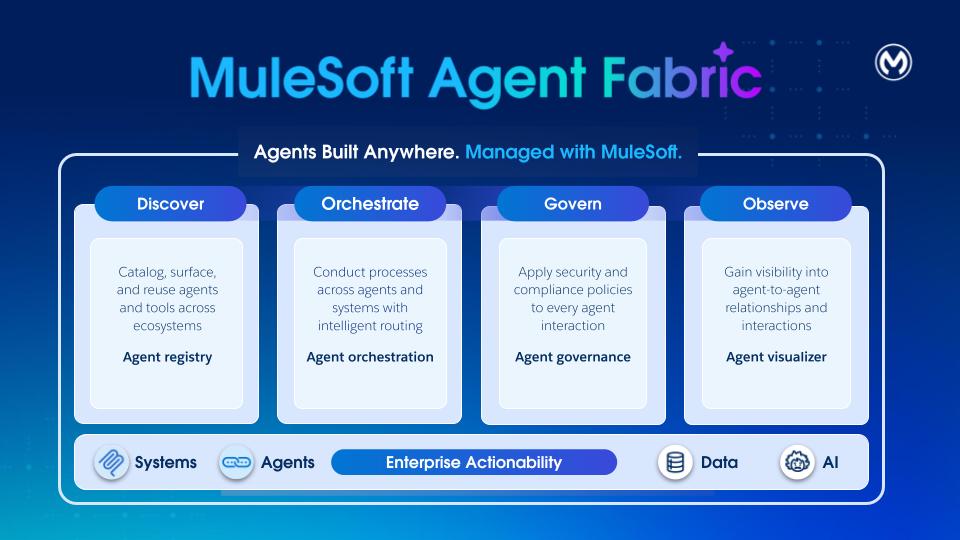 **検出:**エージェント登録では、組織内のすべての AI エージェントとツールの一元化されたカタログが提供されます。これにより、内部で構築されたアセット、SaaS 組み込みアセット、外部アセットの検出と再利用が可能になります。エージェント登録では、すべてのエージェントアセットの情報源を一元化することで、冗長性を排除し、開発者が既存の機能を大規模に活用できます。
**オーケストレーション:**MuleSoft エージェントブローカーは、ToDo を最適なエージェントまたはツールに動的に一致させるインテリジェントなルーティングソリューションです。任意の LLM を搭載しており、エージェントとツール間で連携して、複雑な複数ステップの要求とビジネスプロセスを高い信頼性と追跡可能な結果で実行できます。
**ガバナンス:**[MuleSoft Agent Governance](https://www.mulesoft.com/platform/ai/ai-agent-governance) は、Flex Gateway と、[モデルコンテキストプロトコル (MCP)](https://www.mulesoft.com/platform/ai/model-context-protocol) および [Agent2Agent (A2A)](https://www.mulesoft.com/platform/ai/a2a-support) プロトコルのサポートを使用します。Flex Gateway を使用すると、企業はすべてのエージェント-エージェント間およびエージェント-ツール間のやりとりにセキュリティポリシーとコンプライアンスポリシーを適用できます。
**観察:**エージェントビジュアライザーは、エージェントのインタラクションの動的で対話型の地図を通じてリアルタイムの観察機能を提供します。意思決定を追跡し、システムの健全性を監視することで、継続的な最適化とエージェントエコシステム全体の信頼性の高い監視を実現します。
エージェントファブリックは、ユーザーがメタデータ記述子 (「YAML ファイル」) を使用してエージェントネットワークを定義する仕様優先 (YAML) アプローチを支持します。この YAML ファイルは MuleSoft に依存せず、エージェントネットワークの定義を実行から分離します。
## エージェントネットワーク仕様 (メタデータ記述子)
各エージェントネットワーク (YAML) では、業務ルールやポリシーなど、エージェントアセットを使用して特定の機能領域を定義します。YAML は、4 つのエージェントファブリックの柱を有効にするために使用されます。
1. 検出:エージェントレジストリに次のような既存のエージェントアセットを入力します。
1. さまざまなプラットフォーム (MuleSoft など) にリリースされたエージェント
2. MCP サーバ
3. LLM プロバイダー
2. オーケストレーション:オーケストレーション用のエージェントブローカーの作成
3. ガバナンス:セキュリティとガバナンスのためにアセットにポリシーを適用する
4. 観察:定義されたアセットへの接続を定義して再利用します。また、エージェントネットワークには観測機能と監視機能を使用できます。
### 作成
ユーザージャーニーは Anypoint Code Builder で始まります。「MuleSoft:Create an Agent Network Project (エージェントネットワークプロジェクトを作成)」をクリックして、新しいプロジェクトを作成します。このコマンドは、2 つのファイルを含む新しいプロジェクト (「エージェントネットワーク」) を作成します。
- **agent-network.yaml:**このファイルでは、マルチエージェントシステムの設定を定義し、外部ツール (MCP 経由) とエージェント (A2A プロトコル経由) を使用して AI エージェントをオーケストレーションできるようにします。この形式では、エージェントの機能、連動関係、インテグレーションを宣言的に定義できます。
- **exchange.json:**すべてのエージェントネットワークプロジェクトにも exchange.json ファイルがあります。このファイルには、エージェントのネットワークアセットが公開された後に Anypoint Exchange で使用できるアセットメタデータが含まれます。
エージェントネットワークの開発は、次の 4 つの主要なフェーズを含む標準のソフトウェア開発ライフサイクル (SDLC) に従います。
1. **環境の設定:**ランタイム環境とゲートウェイの設定
2. **プロジェクトの作成と設計**:エージェントネットワークプロジェクト仕様の作成
3. **作成と公開:**アセットを作成してエージェントレジストリに公開する
4. **リリース:**特定の環境にエージェントネットワークをリリースまたは昇格する
プロジェクトを作成し、必要な MuleSoft アプリケーションとアセットを生成したら、Exchange で使用できるようにします。Anypoint Code Builder で、**_「MuleSoft:コマンドパレットから \[Publish Agent Broker Project to Exchange (エージェントブローカープロジェクトを Exchange に公開)]_** コマンドを使用できます。
公開ステップでは、YAML ファイル内の各エージェントアセットを A2A、MCP、または LLM 仕様に変換して Exchange に公開します。
また、新しいエージェントネットワークアセットタイプを使用して、YAML が Exchange に**公開さ**れます。このアセットは、エージェントレジストリ UI で**表示**し、Exchange API を使用して**検索**できます。
### 例
企業のエージェント ネットワークを定義する[エージェント ネットワーク ファイル](https://docs.mulesoft.com/anypoint-code-builder/af-project-files)を参照してください。このエージェントネットワークは、Salesforce、Stripe、別の注文履行エージェント、および 1 つのポリシー管理環境を持つ在庫 MCP サーバー全体で注文履行のネットワークを有効化します。
- **検出**
既存のエージェントとツール (Salesforce、Stripe、Order Fulfillment、Inventory など) を Exchange アセットとして公開して再利用します。また、バージョン管理されて共有可能な注文履行定義 (YAML) により、フローを再構築することなくロール、地域、関連子会社に迅速に適応できます。
- **オーケストレーション**
エージェントブローカーは LLM を使用して、注文履行プロセスを一連のタスク (顧客の詳細の確認、在庫の割り当て、送料の計算など) に分解します。次に、MCP および A2A エージェントをコールしてこのワークフローを実行し、必要に応じて Human-in-the-Loop 承認が申請されるようにします。
- **統治**
Anypoint Flex Gateway は、認証、最小権限アクセス、ガードレールを適用します。API マネージャーポリシーにより、すべてのコールとデータ交換で一貫した制御が保証されます。
- **監視**
監視とトレースにより、進行状況、障害、レイテンシーをエンドツーエンドで可視化できます。視覚化により、操作したエージェントとボトルネックが発生した場所が表示されます。
- **信頼とコンプライアンス**
一元化されたログイン情報、監査履歴、ポリシー継承により、セキュリティ、プライバシー、規制要件 (PII の処理、承認、職務の分離) がサポートされます。
次の図は、YAML で定義されたエージェントネットワーク (メタデータ) のさまざまなノードを示しています。
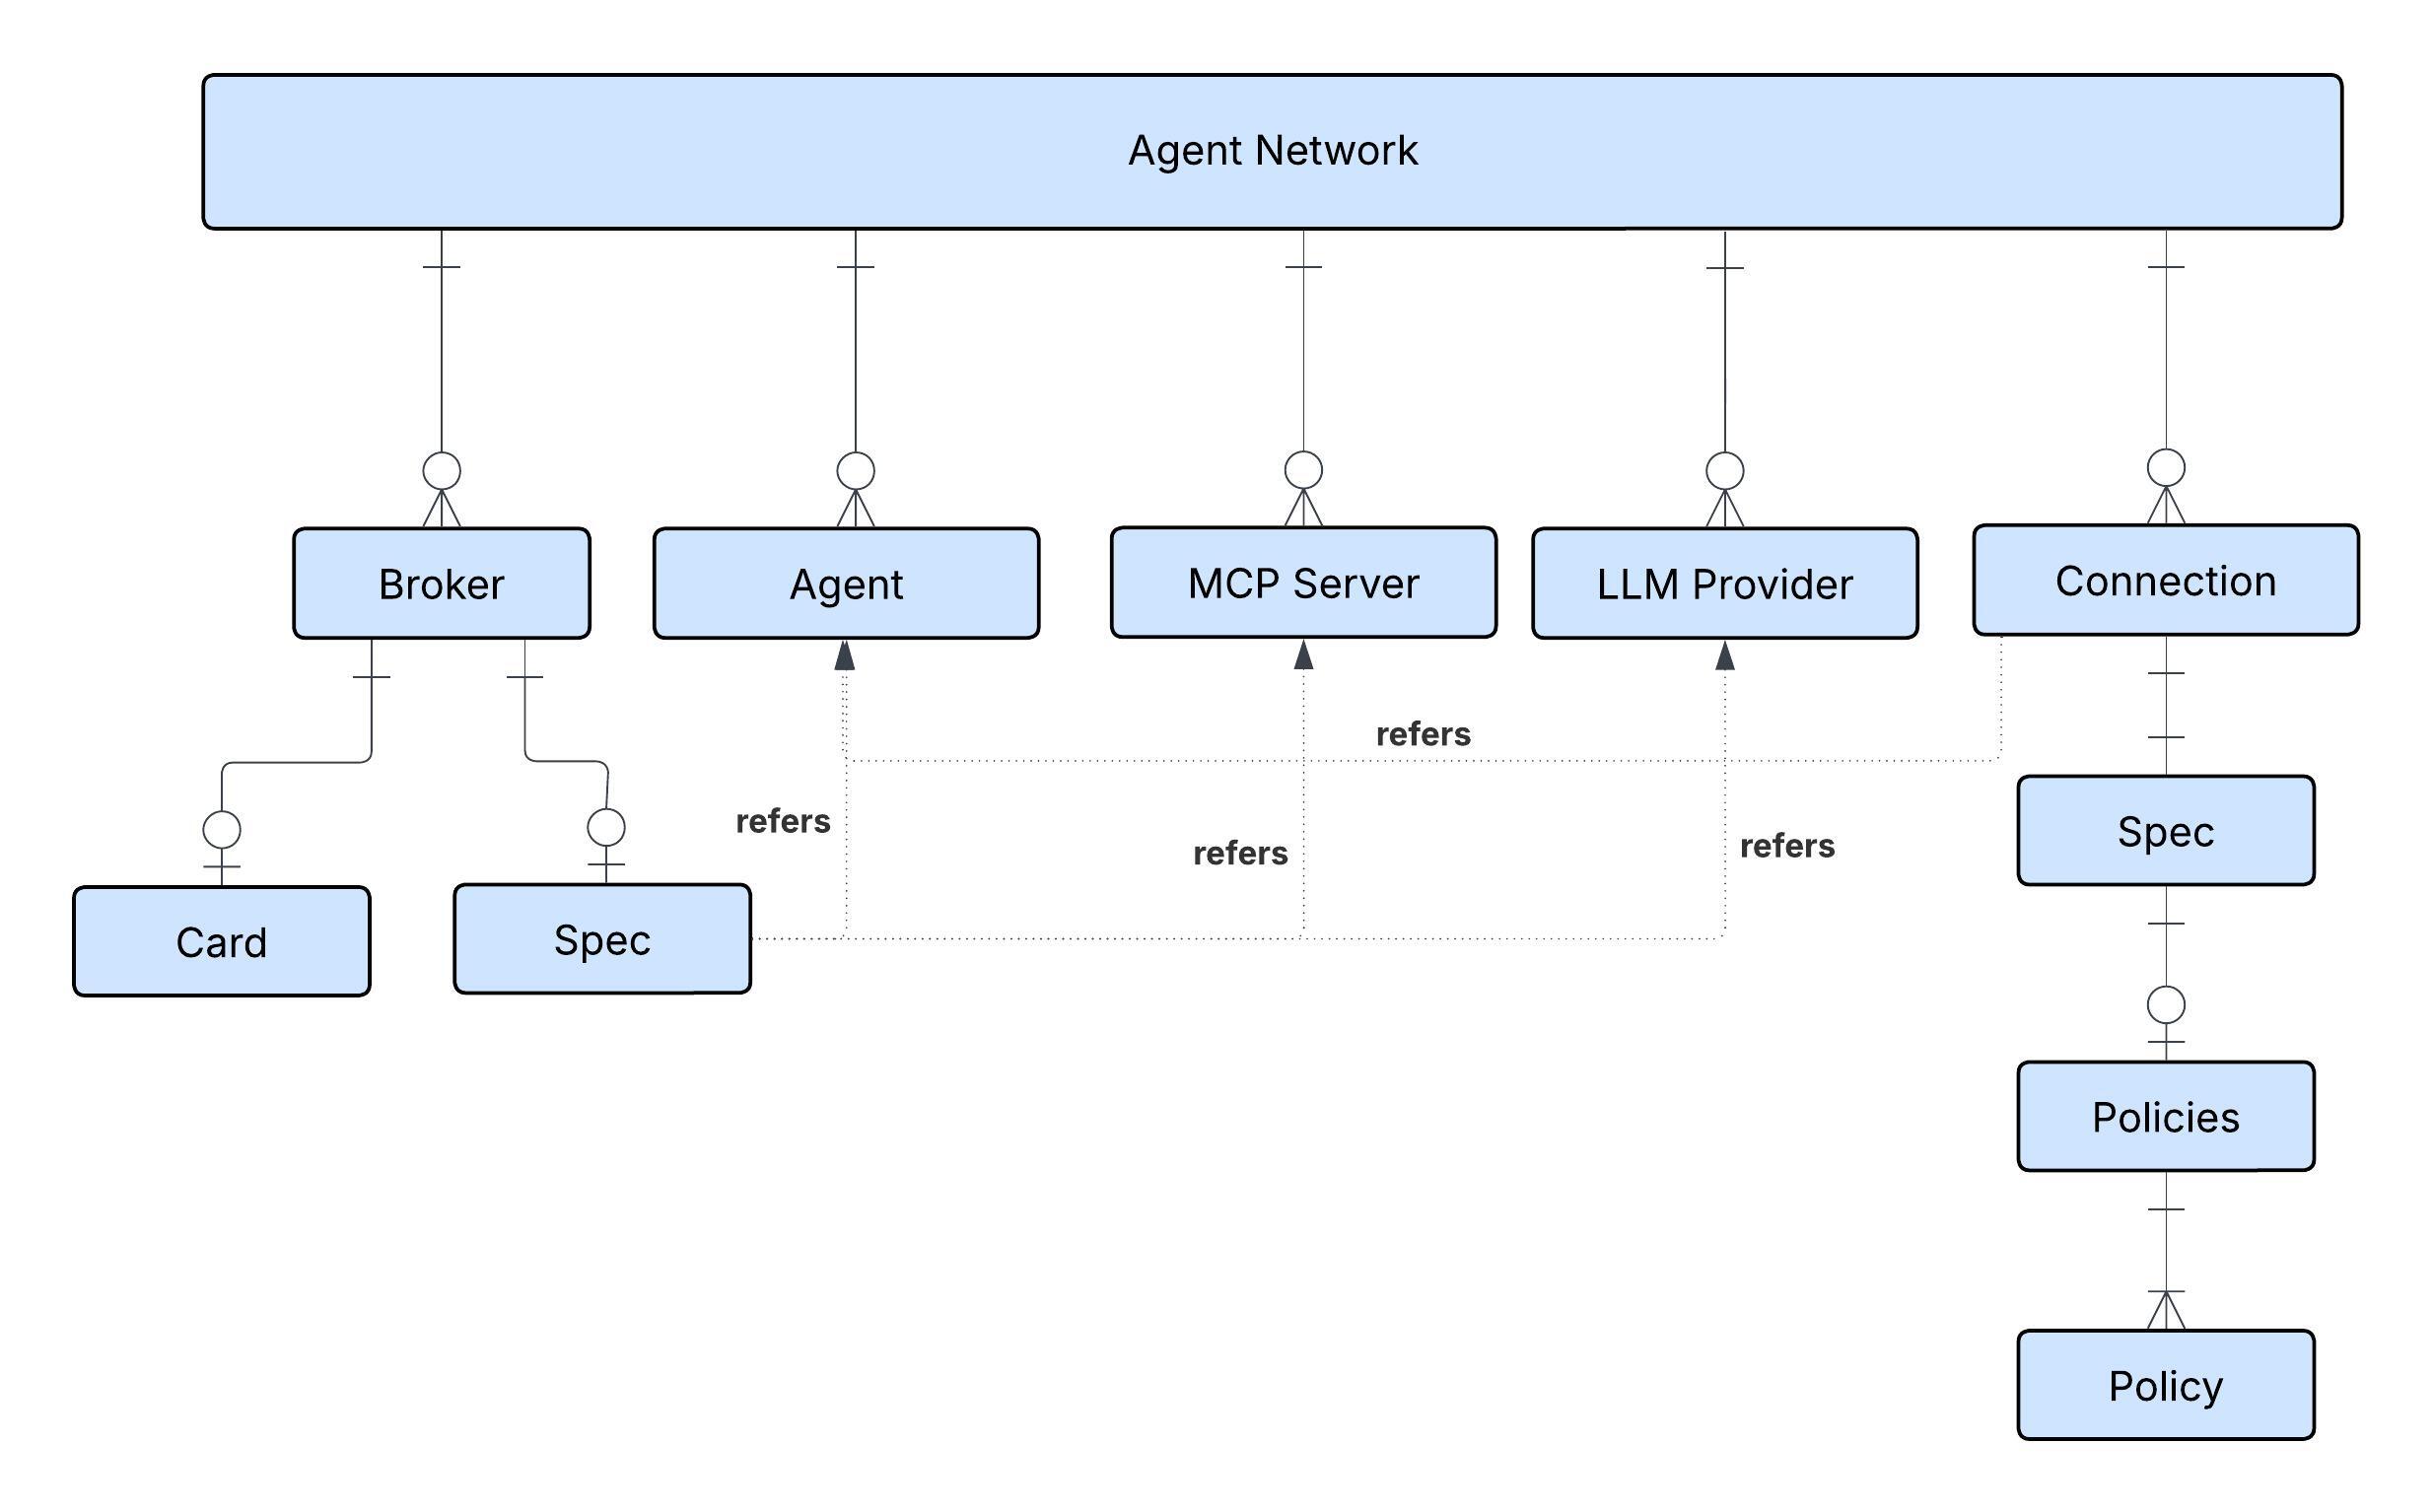 ## エージェントレジストリ (検出)
 - **目的**:Exchange は、エージェント、ツール、その他のアセットのカタログです。その主な目標は、異種エージェントの検出、選定、ライフサイクル管理のための単一の管理カタログを提供することで、「エージェントの無秩序な増加」を解決することです。これにより、開発者はエージェントを見つけて再利用し、プラットフォーム所有者は表示を維持し、オーケストレーターは機能を検出できます。
- **設計による異種混在**:Anypoint Exchange で 3 つの新しいアセット (エージェント、MCP、LLM) がサポートされるようになりました。Exchange は、あらゆる種別のエージェントを登録および管理するためのユニバーサルカタログとして設計されています。サード・パーティ製エージェント、Agentforce製エージェント、カスタムMuleSoftエージェントなど、あらゆるソースのA2A準拠のエージェント、MCPサーバ、LLMプロバイダをサポートします。
- **コアメタデータ**:すべての登録済みアセットには、一意の名前とバージョン、所有権、公開者などの不変メタデータのベースラインセットがあります。ライフサイクル状態 (開発、ステージング、本番、非推奨) も追跡されます。
- **検出**:
- **設計時**:開発者は、既存の Exchange UI を使用するか、Anypoint Code Builder 内の Vibes を使用して自然言語検索で登録済みエージェントを検出できます。
- **タグ付けと分類**:基本的なキー-値タギングシステムを使用して、種別 (エージェント、MCP、LLM、ブローカー) とドメイン (HR、天気など) でアセットを分類し、動的リンク、検索、選択ポリシーを有効にできます。
- **カタログ**:リポジトリでは、組織内でエージェントを共有するための非公開カタログモデルと内部カタログモデルの両方がサポートされています。
- **視覚化**:ネットワークビューをサポートするビジュアルツールを提供し、絞り込み機能を使用して、組織全体の 1 つのアセットまたはノードとリンクのマップ全体の接続を表示します。
エージェントネットワーク内のブローカーは、Anypoint Exchange に保存されている登録済みのエージェント、MCP サーバー、LLM プロバイダーを参照できます。ただし、まだ登録されていない場合は、エージェントネットワーク (YAML) のメタデータで宣言でき、自動的に登録されます。この例では、複数のエージェント、MCP サーバー、LLM プロバイダーが Anypoint Exchange で宣言および登録されています。
```
agents:
orders-agent:
label: Order Fulfilment Agent
metadata:
protocol: a2a
platform: OpenAI
salesforce-agent:
label: Salesforce Agent
metadata:
protocol: a2a
platform: OpenAI
stripe-agent:
label: Stripe Payment Agent
metadata:
protocol: a2a
platform: OpenAI
mcpServers:
inventory:
label: Inventory MCP
metadata:
transport:
kind: streamableHttp
path: /mcp
llmProviders:
open-ai:
label: OpenAI
description: OpenAI LLM Provider
metadata:
platform: OpenAI
```
## エージェントブローカー (オーケストレーション)
 エージェントブローカーは、社内の専門エージェント間で ToDo の委任を調整するインテリジェントなルーティングエージェントです。これは、タスクを完了するために使用するエージェントと MCP サーバーによって定義されます。
ブローカーは、エージェントネットワークアセットを公開し、他のブローカーが再利用した後に Anypoint Exchange に表示される専門エージェントです。
ブローカーは、YAML の「_ブローカー」_セクションで定義します。定義されたブローカーは透過的にアプリケーションに「コンパイル」されます。Mule に関する予備Knowledgeは必要ありません。この生成されたアプリケーションは CloudHub 2.0 (CH2) にリリースされ、堅牢な CH2 インフラストラクチャを活用します。
つまり、エージェントブローカーは、ログ機能や総計値機能など、CloudHub 2.0 の確立されたパフォーマンス特性を活用できます。「運用コスト」や「監視/アラート/ツール」などの運用面は他のワークロードと同じです。
人間の介入が必要なシナリオ (Human-in-the-Loop) では、同時進行の多い環境で効果的な状態管理を行うために設計された分散ソリューションである MuleSoft Object Store を使用して、各インタラクションの状態が維持されます。
ブローカー定義は、カードと仕様の 2 つのセクションで構成されます。
### カード
カードセクションは、[エージェント間 (A2A) 仕様](https://a2a-protocol.org/v0.2.5/specification/)に従います。特に、ブローカーエージェントの契約、スキル、機能について説明します。カード URL には、値 ${ingressgw.url}/broker-name が自動的に入力されます。リリース時に、${ingressgw.url} プレースホルダーはエージェントの入力要求の前にある Anypoint Flex Gateway の URL に自動的に置き換えられます。
### 仕様
仕様セクションでは、ブローカーの「ソースコード」を設定します。ここで、開発者は使用する LLM、手順、使用可能なツール、エラー処理、そして最も重要なのは、このブローカーで使用できるさまざまなエージェントと MCP ツールを指定できます。
**LLM プロバイダー**
このセクションは各ブローカーの仕様の一部です。これは、「サービス」セクションで定義された LLM のいずれかへの参照です。1 つの LLM をすべてのブローカーで共有するか、必要に応じて異なるブローカーにその ToDo により適した LLM を使用させるかを選択できます。
ブローカーは LLM プロバイダーを参照できます。ニーズに応じて、これらのプロバイダーのモデルを選択できます。
```
llmProviders:
open-ai:
label: OpenAI
description: OpenAI LLM Provider
metadata:
platform: OpenAI
```
**説明**
このセクションは省略可能であり、このブローカーエージェントに固有の手順を指定するために使用できます。これらの手順は、多くの場合、特定のビジネス指向の懸念事項に焦点を当てています。たとえば、顧客が報告したインシデントの管理を調整するカスタマーサービスエージェントを想像してください。
```
instructions:
- |
You are an Incident Management Orchestrator Agent. Your primary responsibility is to coordinate the resolution of incidents reported by customers.
The process for incident management is:
1. Fetch Salesforce Case Details: Retrieve the latest critical case details for the given customer.
2. Fetch Entitlement Details: Obtain the customer's entitlement information.
3. Fetch On-Call Engineer: Identify the current on-call engineer for the incident.
4. Create Slack War Room and invite on-call engineer: Set up a Slack war room channel and invite the on-call engineer.
5. Summarize Actions: Provide a clear, human-readable summary of the steps performed, including information about the created slack channel and the on-call engineer assigned
```
ブローカーが独自に処理するため、**「プロンプトを** ToDo に分割」や「最適なツールを選択」などの明示的な指示は必要ありません。これらの手順は、特定のビジネスプロセスを説明する場合にのみ必要です。
**ツールの設定**
ツールはエージェントに外部機能を提供します。ブローカーが外部システム (別のエージェント (既存の API や SaaS サービスなど) にアクセスする必要がある場合は、常に MCP (モデルコンテキストプロトコル) サーバーにアクセスします。
```
tools:
- mcp:
server: collaboration-mcp # MCP server reference
allowed: # Allowlist specific tools
- create_channel
- invite_user
```
MCP サーバーは、取引所アセットの名前で参照されます。接続の詳細は、\[サービス] セクションで指定します。
デフォルトでは、ブローカーは MCP Server で使用できるすべてのツールにアクセスできます。最新の LLM では、コンテキストあたり約 20 ~ 25 個のツールしか処理できないため、不正確なツールが生成され始めます (コンテキストが失われます)。そのため、一般的に、使用可能なツールは必要最小限に制限することをお勧めします。その絞り込みは許可リストで適用できます。
**エージェントリンク**
このセクションは、定義全体で最も重要な部分です。リンクセクションでは、エージェント間のコミュニケーションとオーケストレーションを有効にします。つまり、このブローカーはここにリンクされたエージェントに依存して適切なアクションを実行し、ユーザーのゴールを完了します。
```
links:
- agent:
ref:
name: orders-agent
- agent:
ref:
name: salesforce-agent
- agent:
ref:
name: stripe-agent
```
実際には、このセクションではコラボレーション用のエージェントネットワークを定義します。
## Flex Gateway (ガバナンス)
 エージェントガバナンスは、エージェントファブリックの重要な柱であり、信頼できるエージェントネットワークを構築し、セキュリティとコンプライアンスを確保するために不可欠です。
ガバナンスのために、非公開スペース内に合計 2 つの Flex Gateway (1 つの入力と 1 つの出力) が必要です。
ガバナンスにより、エージェント開発ライフサイクル (ADLC) 全体を安全に拡張するために必要な構造、制御、証拠が確立されます。具体的には、ガバナンスでは、エージェント認定、カタログ化、ライフサイクルの意思決定、ランタイムポリシーの適用などの主要なプロセスを実装します。
- **カタログ:**
- Exchange:エージェントの目的、所有者、環境、データと分類の境界の記録をサポートします。また、機能、ツール、リソース、プロンプト、外部連動関係もバージョンに登録されます。
- **バージョン管理とライフサイクル:**
- エージェント開発ライフサイクル全体で、エージェント、ツール、アセットのセマンティックバージョンを文書化して管理します。
- バージョン管理は、エージェントの非推奨タイムラインの管理に役立ち、デュアルラン (可能な場合) をサポートしているため、移行がスムーズです。
- **ポリシー適用**:
- エージェント型 AI アーキテクチャにより、攻撃対象領域 (会話インターフェース、プロンプト、MCP などの新しいプロトコル) が拡張されます。コンポーネントが侵害されると、プロトコル、プロンプト、API、ツールなどのコンポーネントを提供する複数のシステムに影響が連鎖する可能性があります。
- このような自律的で予測できない環境では、本質的にエージェント間のやりとりによって攻撃対象範囲が広がるため、エンタープライズエージェントの AI リリースを保護するには、特殊なアプローチが必要です。静的システムの既存のセキュリティツールは不可欠ですが、それだけでは不十分です。企業は、エージェント型 AI に関連する重要なビジネスリスクに直接対応する 4 つの特定のセキュリティソリューションを積極的に計画して実装する必要があります。
- Flex Gateway:すべての A2A および MCP トラフィックは、ターゲットシステムが保護されていない場合でも Flex Gateway を介してルーティングされ、すべてのエンドポイントにポリシーが適用されます。このルーティングは、エージェントの通信を保護し、認証サーバーと統合するために不可欠です。
- 保険契約バンドル:ユーザーは、実行前に定義済みポリシーのバンドルを定義してワークフローに適用し、一貫したセキュリティポリシーと運用ポリシーを適用できます。
- 保険契約の種別:このプラットフォームでは、次のようなさまざまな受信および送信ポリシーがサポートされています。
- A2A ポリシー:エージェントカード、PII Detector、Prompt Decorator、スキーマ検証。
- MCP ポリシー:属性ベースのアクセス制御、スキーマ検証、MCP サポート。
- LLM/AI ポリシー:AI プロンプトデコレーター、AI プロンプト保護 (有害なコンテンツのフィルタリング)、AI プロンプトテンプレート (定義済みテンプレートの適用)、AI 基本トークンレート制限。
- テレメトリポリシー:A2A および MCP テレメトリーを使用して、ログデータの収集とエクスポートのためのオープンテレメトリーソリューションを拡張します。
- **ロギング**:自動トレーシングにより、エージェント ネットワーク全体のログを使用して、すべてのエージェント操作を追跡し、動作について説明し、Trust を構築できます。
この例では、エージェントネットワークメタデータを使用して設定されるメッセージロギングのポリシーを示しています。注文履行ブローカーは、Salesforce エージェントと呼ばれる既存のエージェントを参照し、メタデータを使用してメッセージングのポリシーを設定します。エージェントファブリックは、Flex Gateway の「spec」セクションで説明されているすべてのポリシーを自動的に設定します。追加の手順は必要ありません。
```
salesforce-agent-connection:
kind: agent
ref:
name: salesforce-agent
spec:
url: ${salesforce-agent.cardUrl}
policies:
- ref:
name: message-logging
namespace: 68ef9520-24e9-4cf2-b2f5-620025690913
configuration:
loggingConfiguration:
- itemName: "Payload"
itemData:
message: "#[payload]"
firstSection: true
secondSection: true
level: "INFO"
- itemName: "Headers"
itemData:
message: "#[attributes.headers]"
firstSection: true
secondSection: true
level: "INFO"
```
## Agent Visualizer (監視)
 LLM エージェントとマルチエージェントリリースの非確定性および複雑さを考慮すると、可観測性と監視は重要です。
- **基本的なログとトレース**:理由とツール実行追跡はログを介して提供されます。ワークフロー実行のログとトレースは、ランタイムマネージャーで実行後に表示できます。
- **総計値**:初期フェーズでは、a2a_total_calls と mcp_total_calls が表示ラベル (パス、状況、メソッド、ツールなど) 付きのカウンタとして公開され、通話の合計数、成功数、失敗数がわかります。これらの総計値は、Envoy (Flex Gateway) のネイティブ統計インターフェース (mcp_support_policy や a2a_agent_card_policy などの既存のポリシーを使用するのが望ましい) を使用してポリシーコードから公開されます。
- **オブザーバビリティの向上 (将来)**:今後のバージョンでは、Open Telemetry を使用して分散トレースを実行する予定です。より高度なオブザーバビリティには次のものが含まれます。
- **詳細な要求トレーシング**:プロンプト、プランナープロセス、呼び出されたアクション、サブエージェントとのやりとりなど、要求に関するエンドツーエンドの可視性を実現します。
- **エージェント状態監視**:エージェントのアップタイム、応答遅延、スループット、エラー率、基盤となるリソース使用率 (CPU、メモリ、ネットワーク、GPU) を監視します。
- **マルチエージェント協調監視**:エージェント間のやりとりの成功率と失敗率を取得し、循環呼び出しパターン (ループ) を検出して、ToDo の完了や呼び出し数などのエージェントごとの評価指標を追跡します。
- **コスト追跡**:ダッシュボードとアラートを使用して、各 LLM コール (エージェントごとが理想的) のトークンの使用状況と関連コストを追跡する。
- **コグニティブ トレーシング**:内部思考プロセスやすべてのツールコールなど、エージェントのセッションの詳細な追跡を取得して表示し、不変の監査履歴として機能させます。
- **エージェントセッションの再生**:エージェントの認知トレースをステップごとに視覚的に「再生」して詳細なデバッグを行うことができる UI。
- **DAGの視覚化**:複雑なマルチエージェントインタラクションのエージェントワークフロー実行をダイレクトアサイクリックグラフ (DAG) で視覚化します。
エージェントビジュアライザーは、エージェントネットワークの各部分を特定し、それらの連携を確認するために使用されます。
- ノード種別 (エージェントと MCP サーバー) を区別します。
- エッジを表示して、宣言されたインタラクションとランタイムインタラクションを確認します。
- レイヤーを使用して特定の環境にビューを絞り込む
- 詳細カードを開いて、ノードのメタデータと総計値、およびアクセスログとトレースを調べる
- Flex Gateway 保護や適用済みポリシーなどのガバナンスインジケーターを確認します。
Agent Visualizer のコンポーネントについての詳細は、[こちら](https://docs.mulesoft.com/agent-visualizer/agent-visualizer-components)を参照してください。
## エージェントファブリック:4 つの柱
この 4 つの柱を組み合わせることで、MuleSoft エージェントファブリックのセキュリティと制御が、組み込みのガバナンスを使用するすべてのエージェントに拡張されます。A2A (Agent to Agent) や MCP (Model Context Protocol) などの新しいプロトコルを活用してビジネスプロセスを構築および拡張することで、エージェントがあらゆる場所で行動できるようにします。アプリケーション、データ、システムなど、すべてを接続して、エージェントがビジネス全体で行動するときにエージェントを支援し、統制します。インテリジェントなツールは、AI をネイティブで使用するか、サードパーティの AI ツールを使用して、ビジネスプロセスまたは API の作成と拡張をサポートします。
4 つの柱をすべて一緒に使用することは必須ではありませんが、お勧めします。必要に応じて柱を個別に選択できます。たとえば、オーケストレーションレイヤーを使用せずに、レジストリとガバナンスにエージェントファブリックを活用できます。同様に、ブローカーを使用して、別のプラットフォームで管理されるエージェントを調整できます。
次の図は、4 つのすべてのコンポーネントがどのように相互作用するかを示しています。
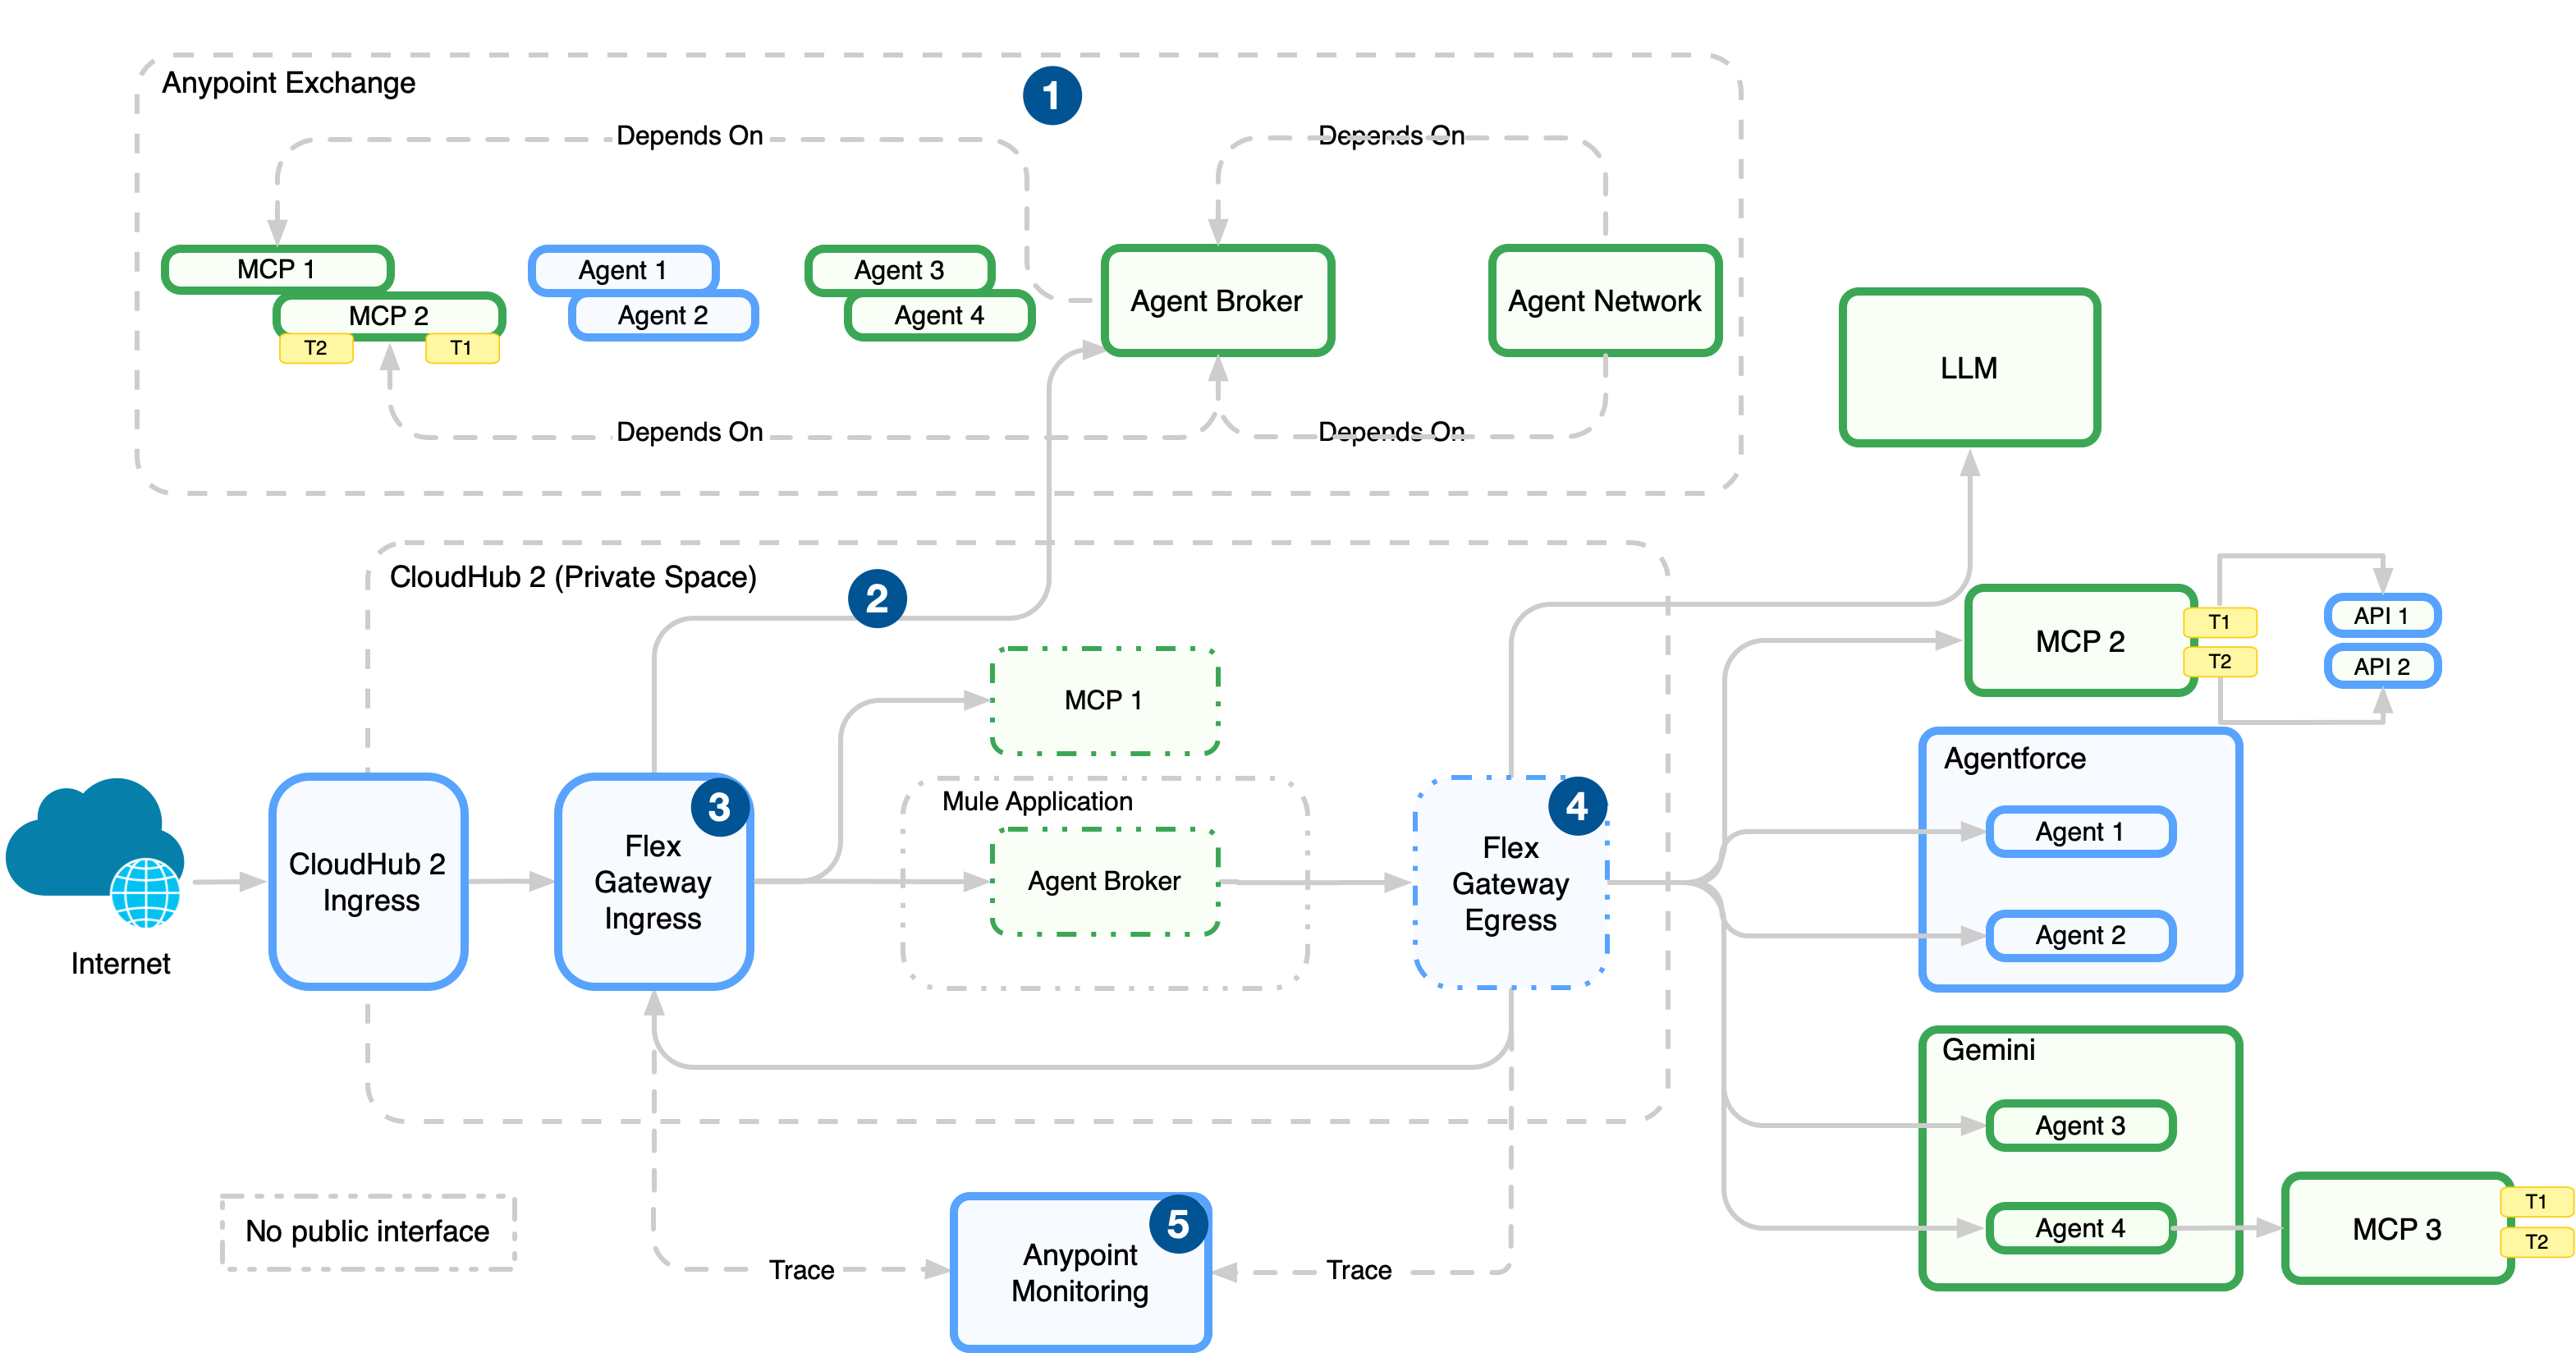 1. Anypoint Code Builder でエージェントネットワーク YAML にエージェントネットワーク (ブローカー、エージェント、MCP サーバー) を定義したら、検出と再利用のためにエージェントアセットを Anypoint Exchange に公開します。
2. エージェントアセットを CloudHub 2.0 (ランタイムマネージャーで管理) にリリースします。
3. ブローカーエンドポイントと API エンドポイントの前にある入力 Flex Gateway を使用して、ネットワークへの着信トラフィックにポリシーを適用します。
4. 出力 Flex Gateway を使用して、ポリシーを適用し、接続を管理し、テレメトリデータを送信します。このゲートウェイは、ブローカーやエージェントから外部サービスへのアウトバウンドパスに配置されます。
5. Anypoint Monitoring で Flex Gateway およびランタイムからログ、評価指標、トレースを収集します。
## エージェントオーケストレーション設計パターン
すべての専門エージェントがフラットで制限のないアーキテクチャですぐにアクセスできるようにし、1 人のオーケストレーターがすべての AI アセットにアクセスできるようにすることで、あらゆる作業に対応できるようにしたいと考えています。ただし、このアプローチでは、システム全体の効率と信頼性がすぐに損なわれます。過剰な個々のツールに適用される原則と同様に、多くのエージェントオプションでは、中央**ブローカーエージェント** (またはオーケストレーター) に大きなノイズと複雑さが生じます。この複雑さの増加は、ブローカーの意思決定 (ジョブに適したエージェントの選択) の精度とシステムの応答の決定性 (類似するクエリの予測可能で一貫した結果) の両方の低下に直接つながります。ブローカーエージェントは実質的にオプションの麻痺に苦しみ、ルーティングが遅くなり、信頼性が低下します。
エージェント ネットワークを構造化するには、フラットな構造ではなく、**複数レベルの**階層アプローチを強く推奨します。この組織原則には、多くの重要な利点があります。まず、本質的に**トレーサビリティと管理**が優先されます。階層構造には、確立された組織のベストプラクティスが反映されているため、要求のフローの監査、障害レイヤーの特定による問題のデバッグ、特定のエージェントまたはサブネットワークの導入と廃止の管理が容易になります。
次に、これらのエージェントを強化する大規模言語モデル (LLM) のコンテキストで重要なのは、階層によって**コンテキストのサイズ**を劇的に抑えることができることです。エージェント状況を区分することで、特定のレイヤーのブローカーエージェントは、その直下の限られたエージェントまたはサブブローカーのセットのみを考慮します。この構造により、プライマリ オーケストレーターが_各エージェント_の説明、機能、履歴コンテキストを作業メモリに読み込むのを防ぎ、LLM のコンテキスト ウィンドウの制限をすぐに**超えて**しまい、莫大なコストと遅延が**発生する**リスクを**回避し**ます。
 エージェントネットワークは複数の方法で実装できます。そのうちの 2 つは次のとおりです。
1. Conway’s Law (コンウェイの法則) - 実際の階層構造に対応付ける直感的な方法。
2. ドメイン駆動型設計 - ビジネスドメインにより重点を置く
# オプション 1実世界階層構造とのマッピング
階層組織では、コミュニケーションはマネージャーから部下まで縦方向に流れ、意思決定は多くの場合一元化されます。コンウェイの法則に従う:
- このような組織が構築するシステムやソフトウェアアーキテクチャも階層化および階層化される傾向にあります。
- 各チームは、独自の境界と権限を反映するサブシステムを設計する傾向にあります。
- システム間のインターフェースは、部門間のコミュニケーションチャネルを反映します。
エージェントネットワークは、Conway の法則に従う**大企業**の実際の階層構造に直感的に対応付けることもできます。
- **概念モデル:**会社に個別のディビジョン、部門、管理レイヤー (経営幹部、統括責任者、取締役、マネージャーなど) があるのと同じように、特定のドメイン内で業務を行うエージェントネットワークを並列組織図としてモデル化できます。
- **ノードと脱退:**次の階層:
- ツリー構造**の葉**は、**スペシャリスト エージェント**または **MCP** です。これらは、実際の作業を実行する機能単位です (「データベースクエリエージェント」、「顧客認証エージェント」、「センチメント分析エージェント」など)。組織の個々の寄稿者または作業単位を表します。
- 階層内のその**他のすべて**のノード (ルートレイヤーと中間レイヤーを含む) は、**ブローカーエージェント** (またはサブオーケストレーター) です。これらのエージェントは最終タスクを実行しませんが、特定のドメインまたはレイヤー内のルーティング、委任、集計、競合の解決を担当します。上位レベルのブローカーは「Sales Domain Broker (営業ドメインブローカー)」に ToDo を委任し、続いて「Opportunity Management Broker (商談管理ブローカー)」が「Opportunity Status Update Agent (商談状況更新エージェント)」 (リーフ) を介して ToDo を実行します。
この構造により、複雑さがローカルで管理され、コンテキストが含まれ、システムが予測可能かつ確実に拡張されます。新しいスペシャリストエージェントを組織ツリーの特定の適切なブランチに導入できます。
 デジタル作業の組織図のたとえを考えてみます。各 YAML ファイルは、各内部組織 (従業員サクセス、セキュリティ、財務など) を表します。各組織 (エージェントネットワーク) には、アクターがコラボレーションしたり、ジョブが ToDo に分割されたり、割り当てられたりするための階層構造があります。上記の図では、コミュニケーションは上から下へ流れます。また、葉は一連のブローカーエージェントによってのみ消費が制限されません。
## オプション 2:ドメイン駆動設計とエージェント型 AI 実装
人間の組織図に基づいてエージェントネットワークをモデル化すると、特に頻繁に組織を再構築する会社では、頻繁に再構築が必要になるリスクがあります。別のアプローチとして、エージェントを機能ドメイン別に整理することもできます。このグルーピングでは、従来の人間の組織の境界を超えることが必要になる場合があります。たとえば、新入社員のオンボーディングでは、ハードウェアとユーザーのプロビジョニングに関する IT 業務を行い、営業活動では業務とマーケティングの両方を行います。
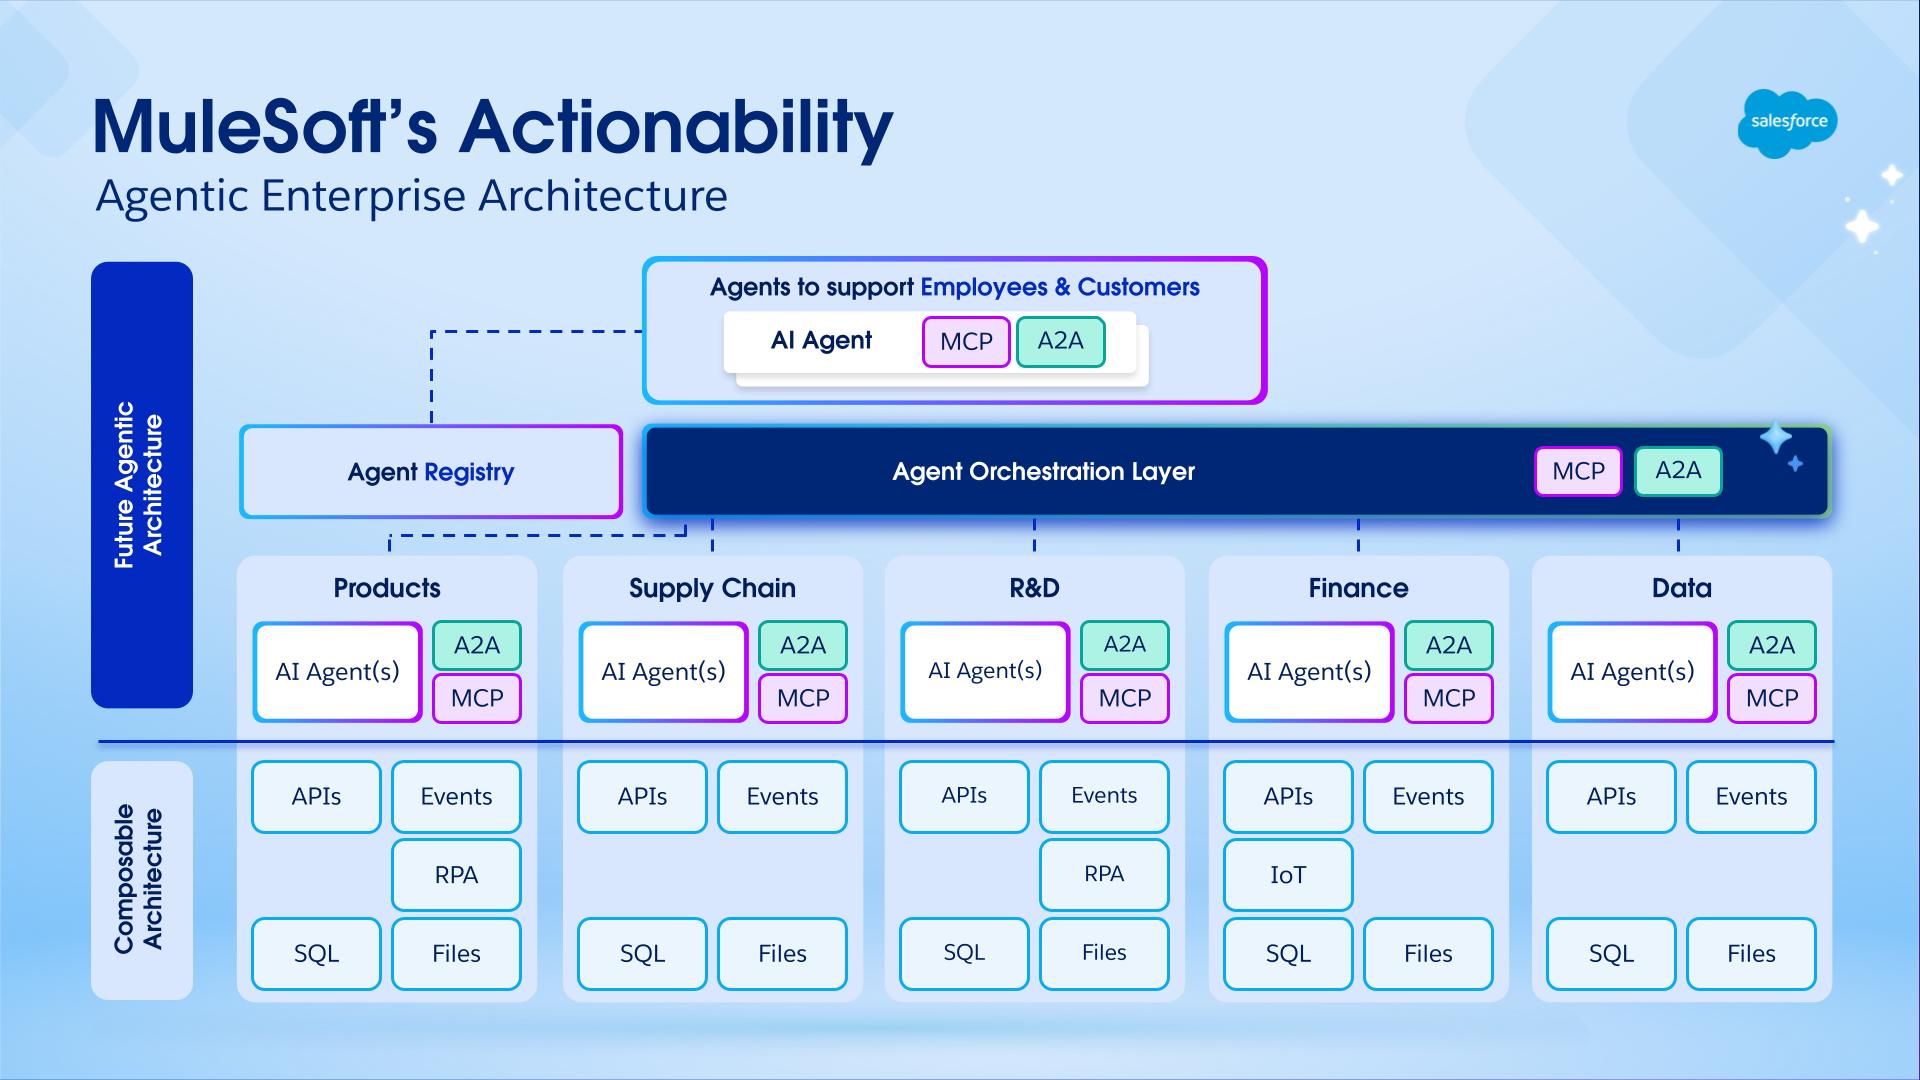 ## 著者について
Nikhil Aggarwal は Salesforce のプリンシパルアーキテクトで、MuleSoft および Salesforce Automation Cloud のアーキテクチャをリードしています。Nikhil は、大規模な製品の提供に 18 年以上の経験を持ち、拡張性の高いアーキテクチャ、直感的な開発者エクスペリエンス、ハイパフォーマンスなチームの構築に情熱を注いでいます。Salesforce 以前は、Microsoft Power Platform、Dataverse、Office 365 の複数のイニシアチブを構想から立ち上げまで主導していました。彼の仕事は、AIファースト時代において、現代の企業がシステムを接続し、ワークフローを自動化し、ビジネス価値を引き出す方法を形成し続けています。
Mariano Gonzalez は 2011 年に MuleSoft に入社し、ミッションクリティカルな分散システム、インテグレーション、PaaS、クラウドコンピューティングを専門としていました。現在、Mariano は、ガバナンス、オーケストレーション、検出、およびオブザーバビリティに特に注意を払い、AI プラットフォームの高度化に重点を置いています。IT 業界に 20 年以上携わってきた Mariano は、農業、エネルギー、政府、IT、通信、コンテンツ管理の各セクターで BPM、ERP、インテグレーションソリューションを設計し、提供しています。
Pedro Colunga は、API とメタデータアーキテクチャを専門とする Salesforce のソフトウェアエンジニアアーキテクトです。Pedro は、プラットフォームのライフサイクル全体に重点を置き、組織によるシステムインテリジェンス、セマンティクス、メタデータ駆動型ソリューションの活用方法の形成に重要な役割を果たしています。Pedro の 20 年間のキャリアには起業家経験が含まれており、Fuego、BEA Systems、Oracle、TekGenesis (後に MuleSoft が買収した会社) などの企業を渡り歩き、一貫してプラットフォームベースのアーキテクチャを推進し、BPM、RAD、インテグレーションなどの分野に深い専門知識を提供しています。
Gulal Kumar は、Salesforce のソフトウェアエンジニアリングアーキテクトで、データおよびインテグレーションアーキテクチャに重点を置いています。インテグレーションと API、モダナイゼーションプログラム、セキュリティ、AIML イニシアチブで 20 年以上の経験があり、豊富な専門知識を備えています。Gulal は、ビジネス変革イニシアチブを推進し、セキュリティと耐障害性を強化し、アーキテクチャの卓越性を促進し、さまざまなドメインで AIML イニシアチブをリードしてきました。
## コンポーザブルインテグレーションから管理されたエージェント型企業へ
Agentic Enterprise への移行は、クラウドの黎明期以降で最も重要なアーキテクチャの移行を表します。これまでにないレベルの生産性と自動化が約束される一方で、ガバナンス、セキュリティ、運用の複雑さに関連する重大な課題も発生します。断片的なアプローチ (統合戦略を使用せずにエージェントをサイロに配置する) を使用すると、技術的負債と組織の混乱に直接つながります。
中央管理プレーンを使用せずにエージェントをリリースすると、システムへの直接アクセスによるセキュリティの脆弱性、エージェントのインタラクションとアクションの監視の欠如、冗長なポイントツーポイントインテグレーションによる高コストなど、重大な運用リスクが生じます。このサイロ化された導入戦略では、大規模な管理が困難な脆弱な環境になります。持続可能なモデルには、エージェントの統合とガバナンスのための統合プラットフォームが必要です。
*MuleSoft*は、包括的で統合されたオープンなプラットフォームを提供し、移行中の企業を確実にガイドします。エージェントアクションの基盤として企業の既存の API ランドスケープを活用し、信頼できる AI を駆使した開発ライフサイクルを通じて新しいエージェント対応アセットの作成を加速します。モデルコンテキストプロトコル (MCP) や Agent2Agent (A2A) プロトコルなどのオープン標準に対するエンタープライズグレードのサポートにより、AI の状況がどのように進化しているかに関係なく、これらのアセットを簡単なコマンドと複雑なマルチエージェントコラボレーションの両方でアクション可能にします。[_MuleSoft Agent Fabric_](https://docs.mulesoft.com/agent-fabric/)は、エージェントエコシステム全体を検出、オーケストレーション、管理、監視するソリューションを提供します。この統合アプローチにより、*MuleSoft エージェント ファブリック*は、信頼できる AI エージェントのネットワークを拡張するための実証済みの基盤を提供します。これにより、AI の約束が具体的で自動化されたビジネス上の成果に変換され、インテリジェントなエンタープライズの可能性を最大限に引き出すことができます。
## **アクション可能 AI のコンポーザブルな基盤**
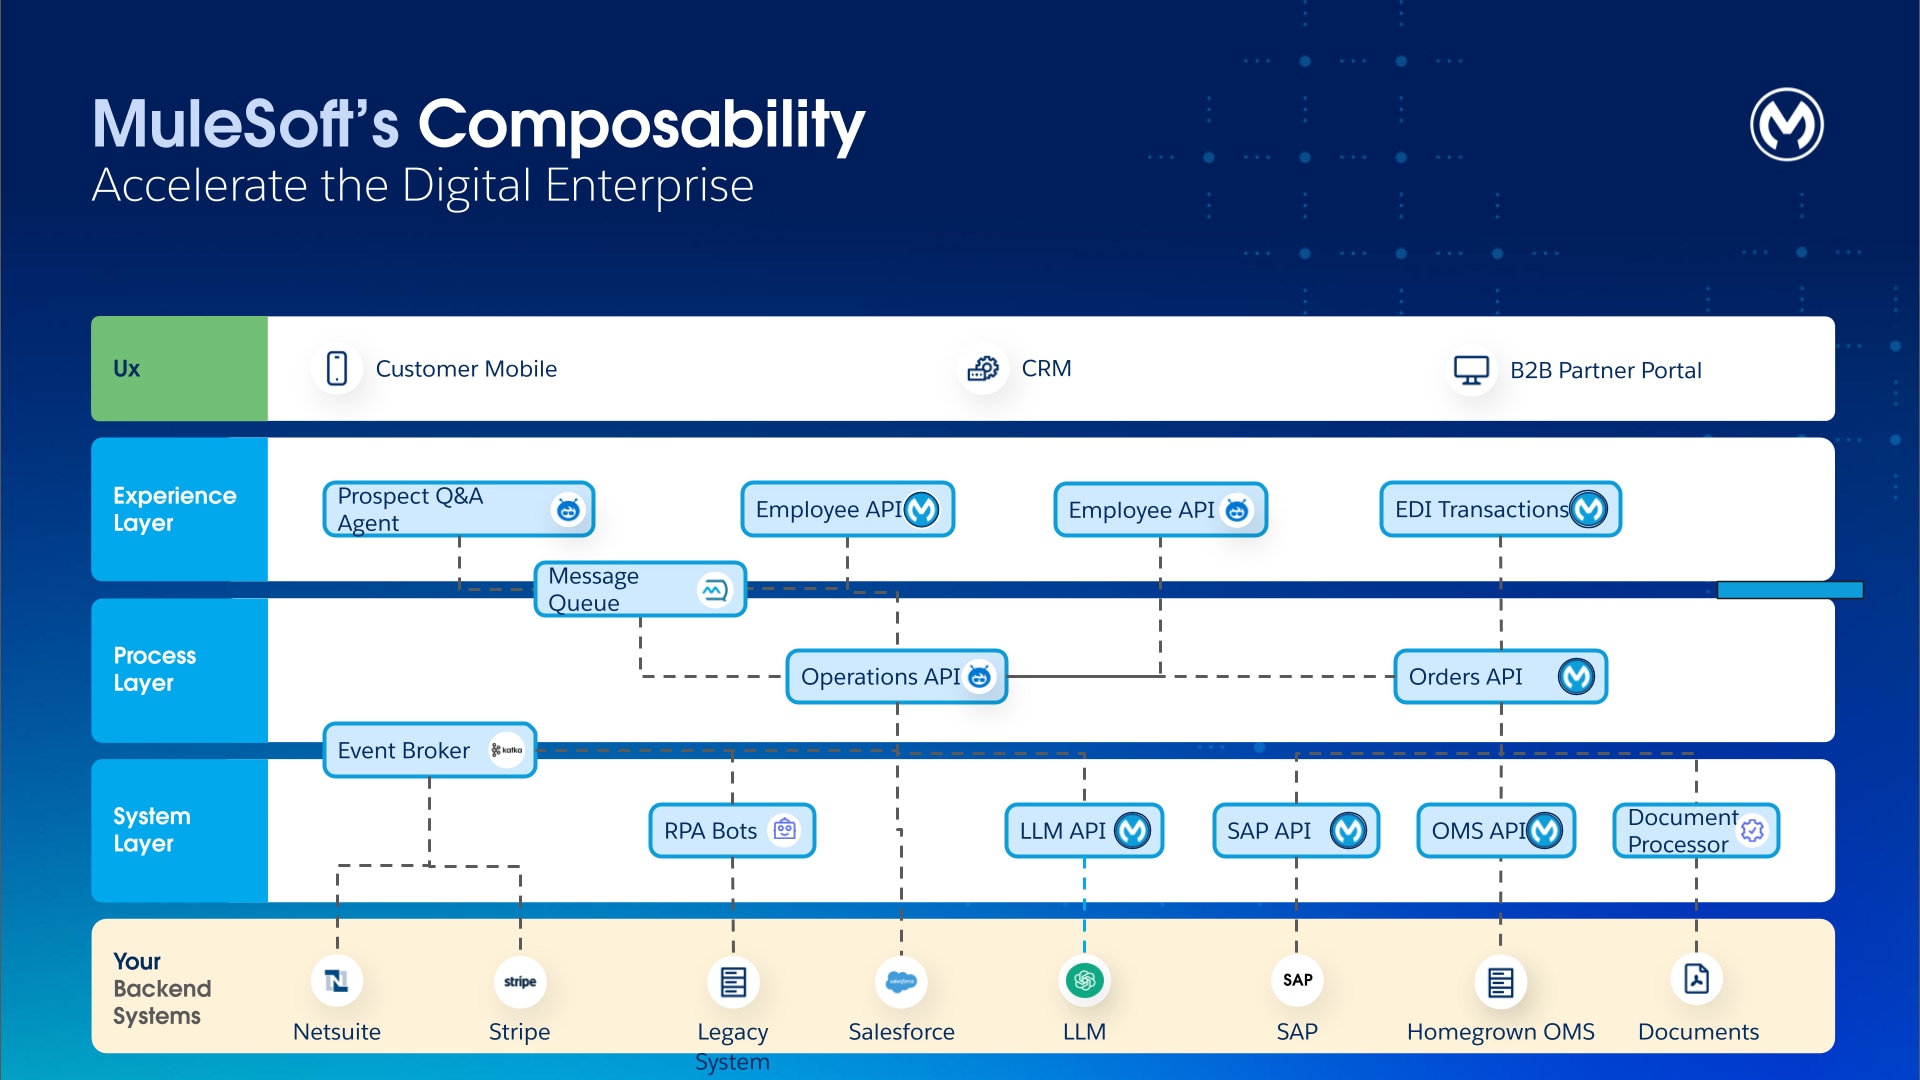 確立された API 主導の接続の 3 階層アプローチ (システム API、プロセス API、エクスペリエンス API) は、エージェントのアクション性を構造化するための強力なフレームワークを提供します。
- **システム API**は、基盤となる記録システムへの一貫性のある安全で抽象化されたインターフェースを提供します。エージェントをバックエンドプロトコルとデータモデルの複雑さから切り離し、すべてのエージェントアクションが管理された信頼性の高いエンドポイントで実行されるようにします。
- **プロセス API は**、複雑な複数ステップのビジネス・ロジックをカプセル化します。エージェントは、販売注文の作成、在庫の確認、出荷の開始の背後にある複雑なオーケストレーションを理解する必要はありません。基盤となる複雑さを処理することなく、プロセス API (「プロセス注文」など) を使用できます。プロセス API は、エージェントがビジネスプロセスを実行するための安全でトランザクション可能なメカニズムを提供します。これにより、必要なエージェントの推論が大幅に削減され、ビジネスルールが一貫して適用されるようになります。
- 従来、**エクスペリエンス API** は特定の UI アプリケーション (Order Management App など) を提供するように設計されていますが、エージェントのコンテキストリッチアクションとして再利用することもできます。これにより、エージェントはダウンストリームシステムに複数回コールすることなく、特定のタスクを実行するための重要な情報を得ることができます。
## **1\.生成:エージェント対応アセット**の開発を加速
エージェント対応のツールと機能に対する需要の増大に対応するため、企業は構成可能な基盤となる API とインテグレーションの開発を加速する必要があります。*MuleSoft*は、生成 AI を開発ライフサイクルに直接組み込むことでこの課題に対処しています。これにより、AI を使用して他のエージェントが利用する高品質のアセットを構築する好循環が生まれます。
### **1.1 MuleSoft Vibes**
開発者にとって、[MuleSoft Vibes](https://www.mulesoft.com/platform/api/anypoint-code-builder/announcing-mulesoft-vibes)は、インテグレーション開発の最も反復的な側面を自動化し、ソフトウェア開発ライフサイクル全体にわたって統合されたエージェント インターフェイスを提供することで、インテリジェントなパートナーとして機能します。開発者は、[Anypoint Code Builder](https://docs.mulesoft.com/anypoint-code-builder/)の MuleSoft Vibes を使用して、[信頼できる*Einstein AI パイプライン*](https://blogs.mulesoft.com/automation/how-mulesoft-turns-generative-output-into-value/)によって提供される生成機能を操作します。これにより、AI 支援の開発プロセスがスムーズかつ効率的になります。このパイプライン(_IGES(推測グラフ実行サービス)_)は、高品質の結果を得るために使用される複数フェーズのプロセスです。グラウンディング、検証、エラー修正、厳格な評価で構成されます。
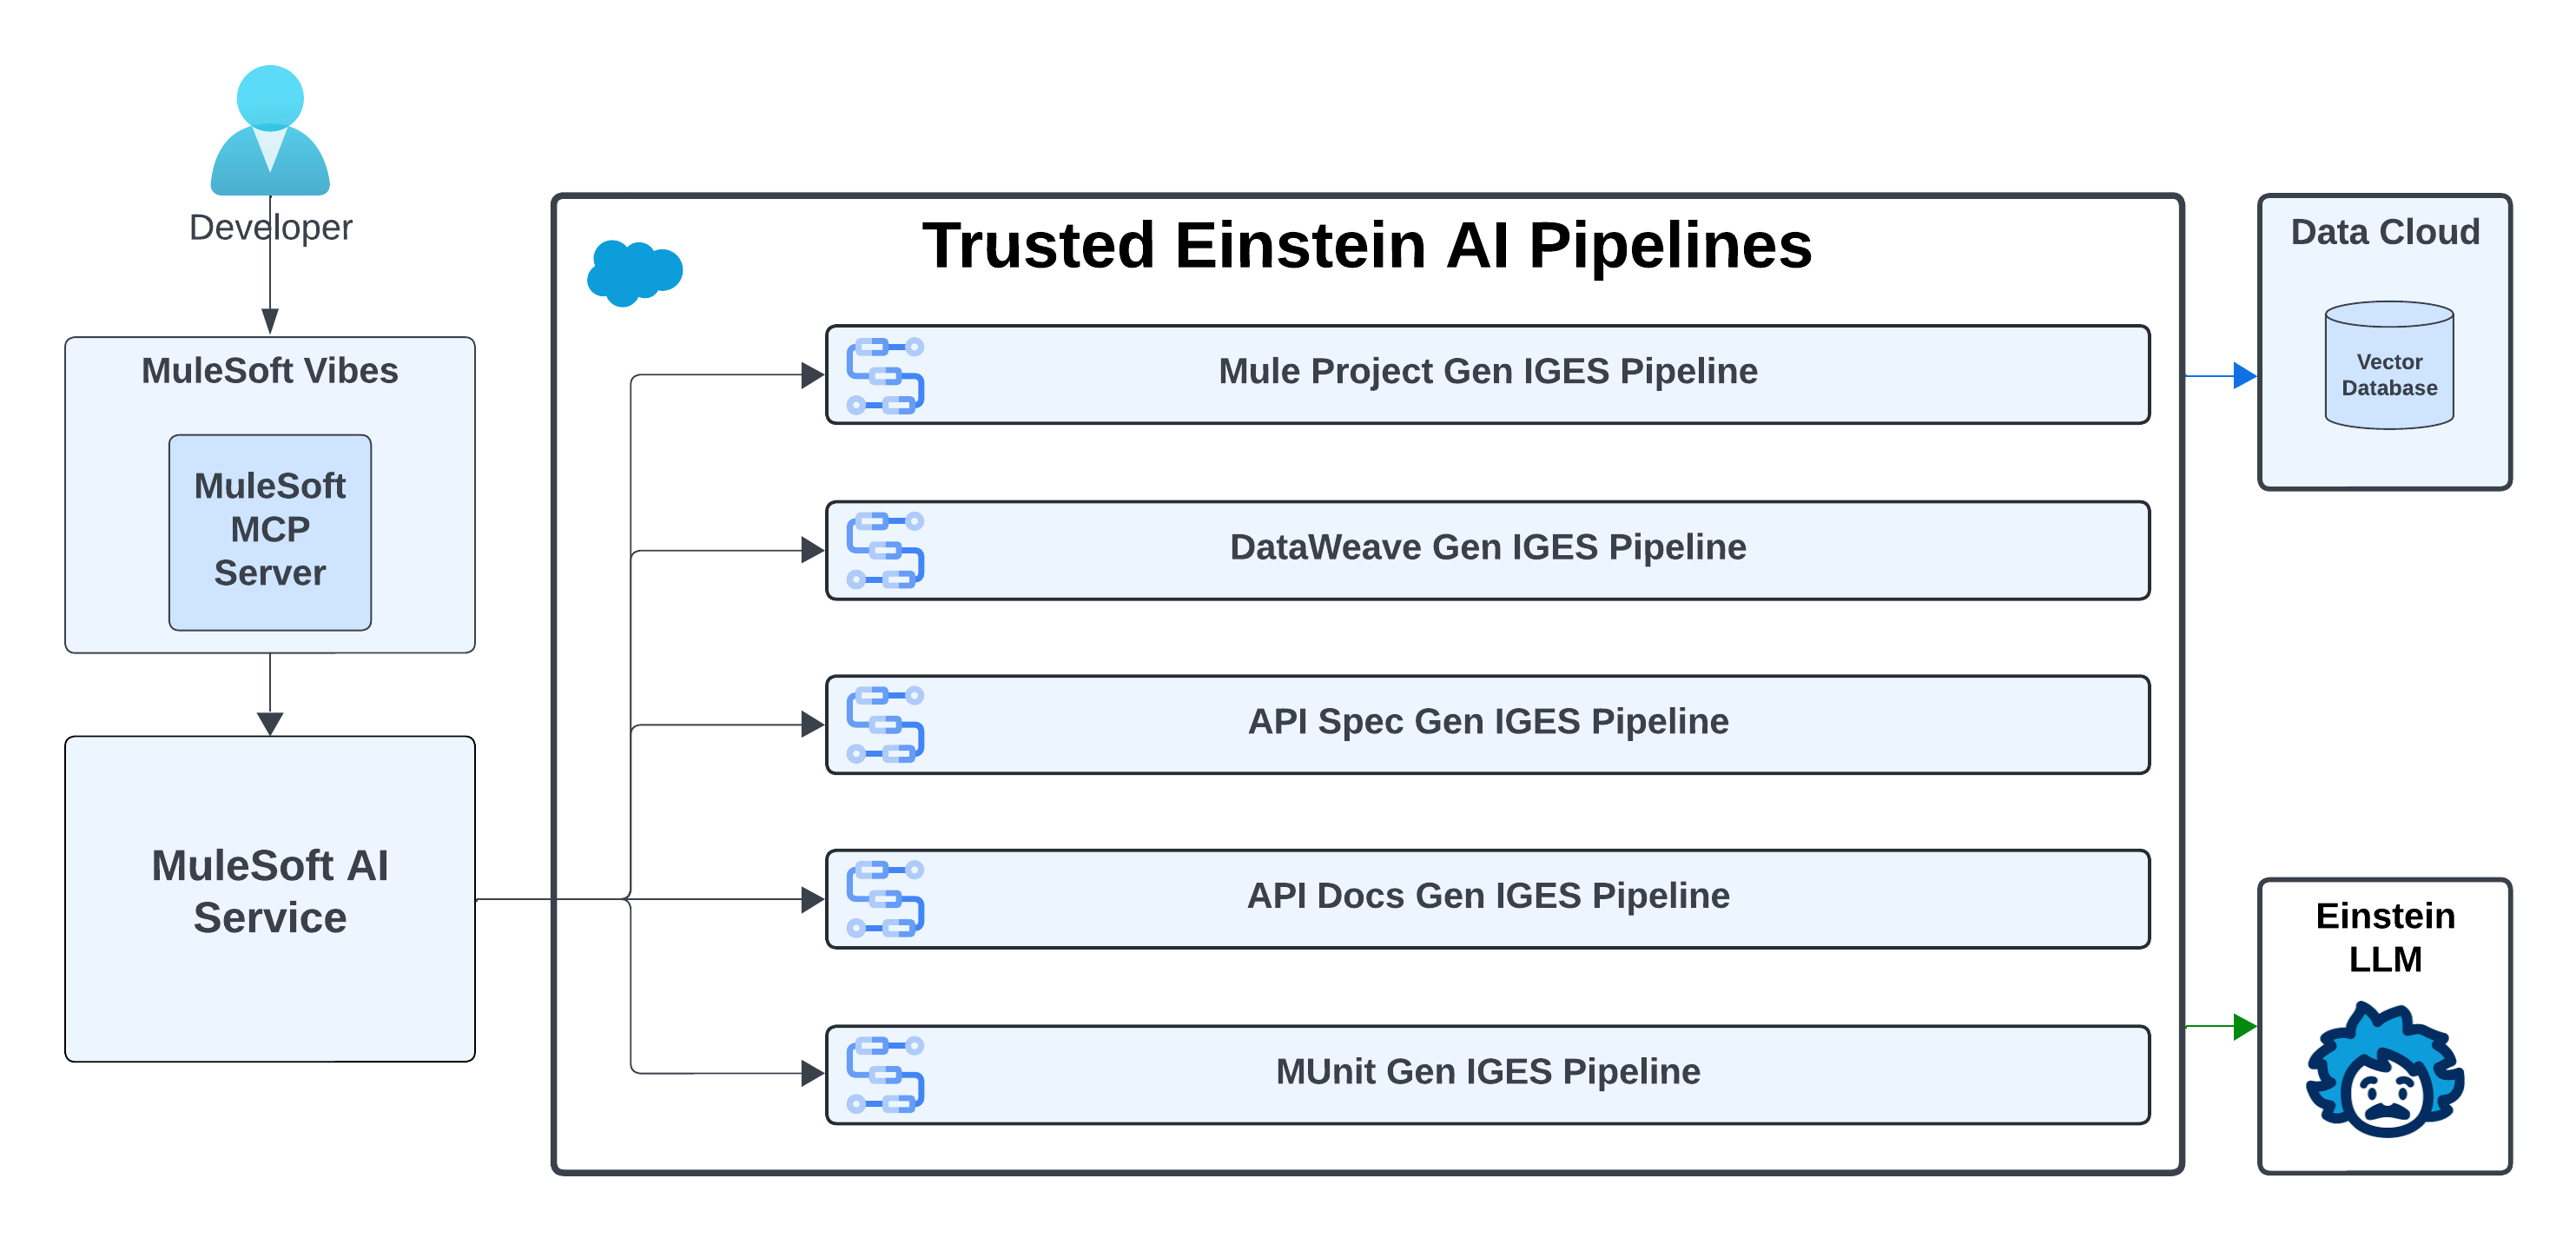 - *MuleSoft Vibes*の[**生成フロー**](https://blogs.mulesoft.com/dev-guides/einstein-for-acb/)機能は、*Agentforce AI*フレームワーク上に構築されています。自然言語ビジネスロジック (ユーザープロンプト) を機能的な Mule アプリケーションに変換します。*IGES パイプライン*は、次のステップで構成されます。
- **会話履歴の概要:**LLM は現在のプロンプトとユーザーの以前のメッセージを分析し、ユーザーのインテントと会話履歴を取得する概要プロンプトを作成します。この統合されたプロンプトにより、後続のデータ取得および生成ステップの精度が向上します。
- **ベクトルデータベースからのフローセマンティック取得:**システムは前のステップの概要プロンプトを取得し、200 以上のコネクタ、7,000 以上のコネクタ操作、7,000 以上のサンプルコードスニペットを含むベクトルデータベースに対してセマンティック検索を実行します。最も関連性の高いコネクタ、操作、コード例を取得して、正確なデータを使用して生成プロセスをグラウンディングし、出力が MuleSoft の広範なコネクタエコシステムと一致するようにします。MuleSoft はコネクタと操作の業界標準であるため、このグラウンディングは汎用 LLM に欠ける豊富なコンテキストとドメイン精度をモデルに提供します。
- **追加:**取得されたコンテンツと会話履歴メッセージは、要約プロンプトと組み合わされます。この拡張プロンプトにより、LLM は幻覚を軽減できます。また、毒性コンテンツの生成を防止する手順も含まれています。
- **フロー生成:**このステップでは、*Einstein AI LLM*モデルを活用して、提供されたコンテキストと例に基づいて未加工の XML コードを生成します。これは生成パイプラインのコアステップです。
- **後処理と検証:**後処理者と検証者はコードをチェックして、構文が正しいことと、有効なコネクタ操作が使用されていることを確認します。また、別の有害性チェックで有害なコンテンツにフラグが付けられます。
- **複数ステップのエラー修正:**すべての初期生成が無効な場合、自動エラー修正メカニズムによってエラーメッセージが分析され、パターンが検出されます。その後、プロンプトは強化されたエラーメッセージと是正メタデータと共に LLM に再送信されます。
- **設定ファイルの生成:**このステップでは、関連するコネクタメタデータを抽出し、プロンプトを追加して LLM に送信し、正確なコネクタ設定を生成します。最後に、すべての POM および XML 名前空間は、各連動関係の最新バージョンを使用して確定的に生成されるため、幻覚がなくなり、一貫性が確保されます。
- [**DataWeave 変換生成**](https://blogs.mulesoft.com/dev-guides/dataweave-generative-transformation/)**:** データ変換は、インテグレーション開発で最も時間のかかる部分です。*MuleSoft Vibes*は、*ミュールフロー XML*の生成に似た複数ステップのアプローチを使用してこのプロセスに取り組みます。
- **意図の理由:**LLM では、ユーザーの入力および出力データサンプルを分析して、自然言語で高レベルの変換ロジックを推測および明示します。このステップでは、プロンプトで指定されているリテラルデータ値からユーザーのゴールを分離します。
- **DataWeave セマンティック取得:**セマンティックに最も関連性の高い DataWeave 関数のドキュメントを見つけて変換例を完了するために、前のステップで生成されたプロンプトがベクトルデータベースへのクエリとして使用されます。これにより、高品質の検証済み情報が生成プロセスの基礎となります。
- **追加:**取得した関数と例は元のユーザープロンプトと組み合わされ、後続の LLM コールに対するコンテキスト対応の指示セットが作成されます。これは、幻覚を軽減するために LLM の動作に影響します。
- **DataWeave の生成:**このステップでは、LLM モデルを活用して、提供されたコンテキストと例に基づいて DataWeave 変換スクリプトと付随する説明を生成します。これは生成パイプラインのコアステップです。
- **後処理と検証** 生成されたスクリプトは、有効性と正確性の 2 つの特定の評価指標に対して評価されます。スクリプトは構文エラーなしでコンパイルされ (妥当性)、サンプル入力を使用して実行されるときに期待される出力が生成されます (正しさ)。
- **複数ステップのエラー修正:**最初の検証に失敗した場合、このプラグインはエラーカテゴリを特定し、生成されたスクリプトの問題を修正します。この調整により、システム全体の成功率と精度が向上します。
- **最終的な後処理**と検証 エラー修正モジュールから修正されたスクリプトは、構文的に有効で機能的に正しいことを確認する再検証プロセスを受けます。この最終品質ゲートにより、出力が正確で信頼性のあるものであることを確認してからユーザーに返送されます。
- [**API 仕様**](https://docs.mulesoft.com/anypoint-code-builder/api-ai-create-spec)**および[ドキュメント生成](https://docs.mulesoft.com/exchange/generating-documentation-with-ai):**開発者は、目的の API を自然言語で記述することで、完全に検証された*OpenAPI(OAS)*または*RAML*仕様を生成できます。*MuleSoft Vibes は*プロンプト(リソース、メソッド、セキュリティスキーム、パラメーターの詳細を含む)を取り込み、構文的に正しい有効な API 定義を生成します。生成後、*Anypoint Exchange*で API のドキュメントを作成できます。このドキュメントには、認証からエンドポイントの詳細、エラー処理まですべてが含まれており、開発者はこのような面倒な作業から解放されます。
- **AI 支援によるユニット生成:**自律エージェントが消費する納入商品では、品質保証が最も重要です。*MuleSoft Vibes*は、Mule フローコードから直接 MUnit テストケースを生成するのに役立ちます。これにより、外部の連動関係やアサーションを疑似的に使用し、一般的なテストのギャップを特定することができるため、高いテストカバー率を達成し、インテグレーションロジックの信頼性を確保するために必要な手作業を大幅に削減できます。
### **1.2 MuleSoft Your Way**
開発者は、各自の希望する環境で力を発揮できます。そのため、*MuleSoft*は開発者と直接会うことができ、開発者は選択した AI IDE でインテグレーションを構築できます。[MuleSoft の Model Context Protocol (MCP) Server](https://www.npmjs.com/package/@mulesoft/mcp-server) では、開発、リリース、管理機能が MCP ツールとして公開されます。VS Code ベースの AI ネイティブ IDE (カーソル、ウィンドサーフィン、Trae など) は、自然言語を使用して _Anypoint Platform_ を操作するために使用できます。
_MuleSoft_ は、そのコア IDE 機能を[標準 VS Code 拡張](https://marketplace.visualstudio.com/items?itemName=salesforce.mule-dx-extension-pack)にパッケージ化することで、ブランド設定された IDE シェルからツールを分離します。これにより、IDE に依存しない開発ツールを使用できます。急速に進化する IDE と競合するのではなく、このアーキテクチャを選択することで、MuleSoft の開発ツールは、AI を駆使した最新の IDE のエコシステム全体で互換性とアクセス性を維持できます。
## **2\.アクション機能を有効化:API のエージェント向けツールへの変換**
Agentic Enterprise では、構成可能な API の堅牢な基盤が必要ですが、不十分です。次の重要なステップは、これらのアセットが AI エージェントによって検出可能、理解可能、呼び出し可能であることを確認することです。これには、エージェントコミュニケーション専用に設計されたオープンスタンダードに基づいて構築された「アクション可能レイヤー」が必要です。*MuleSoft*は、2 つの主要な新興プロトコルに対応するエンタープライズクラスのツールを提供します。
- エージェントとシステム間のやりとりのための **MCP**
- エージェント間のやり取りの **A2A**
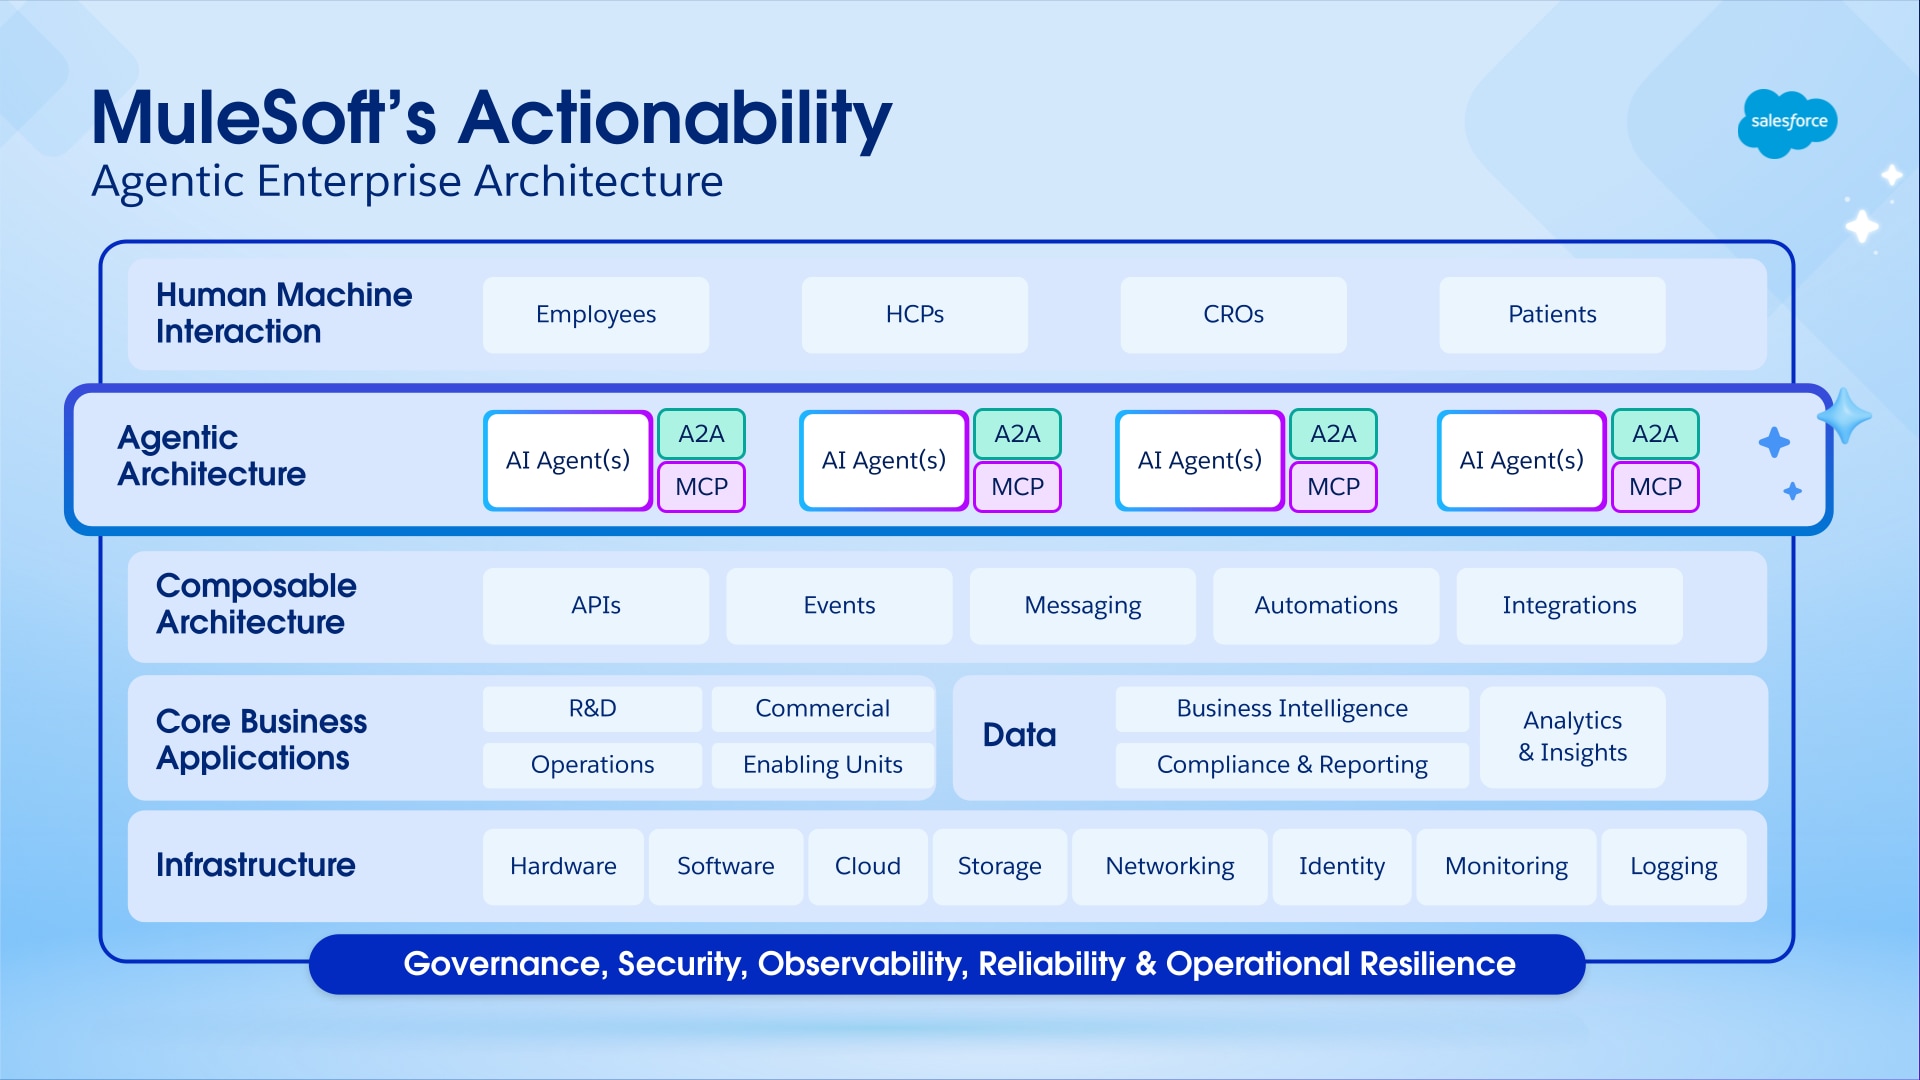 ### **2.1 モデルコンテキストプロトコル (MCP)**
*MCP*は、エージェントとツール間のコミュニケーションの業界標準として急速に普及しています。これは、*REST*が Web サービスに利用されるようになったことに似ています。*MCP を*使用すると、AI エージェントは、事前にプログラムされたロジックやハードコードされたロジックを必要とせずに、システムの機能を動的に検出し、その入力と出力を理解して、アクションを実行するために呼び出すことができます。
[MuleSoft MCP コネクタ](https://docs.mulesoft.com/mcp-connector/latest/)では、Mule アプリケーションとして実装された API を MCP サーバーとして公開できます。_MuleSoft は_、ほぼすべての主要なエンタープライズシステム(SaaS、レガシー、データベースなど)に対して数百もの事前作成済みコネクタを提供するため、組織の API とアプリケーションをエージェント対応のツールセットにすぐに変換できます。SAP で在庫を確認するように設計された API、Salesforce で新規リードを処理するフロー、*MuleSoft*を介して接続されたカスタム アプリケーションはすべて、*MCP コネクタ*を使用して、AI エージェントがアトミックな管理ツールとして使用できます。
### **2.2 エージェント間プロトコル (A2A)**
*MCP*は、エージェントと呼び出しツールの階層的なインタラクションに優れていますが、複雑なビジネスプロセスでは、多くの場合、複数の専門エージェント間のコラボレーションが必要です。_エージェント間 (A2A)_ プロトコルは、高度なマルチエージェントワークフローを可能にするピアツーピア通信を促進するように設計された新しいオープン標準です。
MuleSoft の A2A のサポートにより、企業は API に期待されるのと同じレベルのガバナンスと信頼性を備えた高度なシステムを設計および構築できます。[MuleSoft A2A コネクタ](https://docs.mulesoft.com/a2a-connector/latest/)を使用すると、開発者は任意のエージェントを A2A サーバーとして簡単に公開したり、Mule アプリケーションから A2A 準拠のエージェントを呼び出したりできます。たとえば、住宅ローン申込プロセスは「クレジットチェックエージェント」、「ドキュメント署名エージェント」、および「規制コンプライアンスエージェント」で調整され、各エージェントが (必要に応じて) 申込を進めるために他のエージェントの機能を検出して呼び出すことができます。
MCP と A2A に堅牢なエンタープライズグレードのツールを提供することで、MuleSoft は (MCP ツールを介した) エージェントとシステムの直接インタラクションとエージェント間 (A2A) インタラクションで構成される柔軟なエコシステムの構築をサポートします。AI ランドスケープの進化に関係なく、このアプローチでは*MuleSoft を*あらゆる形式のエージェント コミュニケーションを接続する基盤となる基盤として位置付けます。
## **3\.MuleSoft エージェントファブリック:エージェント企業**の中枢神経系
企業がエージェント型 AI を採用すると、必然的にエージェントの増加という課題に直面します。これが混乱に発展しないように、専用のオーケストレーションレイヤーが必要です。[MuleSoft Agent Fabric](https://docs.mulesoft.com/agent-fabric/)([デモ](https://www.youtube.com/watch?v=GAqwPie16ic))は、この課題に正面から取り組むように設計された包括的なアーキテクチャソリューションです。AI エージェントが構築された場所や運用方法に関係なく、AI エージェントのネットワーク全体を検出、管理、オーケストレーション、監視するための一元管理プレーンが提供されます。*MuleSoft Agent Fabric*は、企業のデジタルワークフォースの「航空管制官」として機能し、断片的でサイロ化されたエージェントのコレクションを、一貫性のある安全でパフォーマンスの高いインテリジェンスネットワークに変換します。
*MuleSoft エージェントファブリック*は、エージェントのライフサイクル管理全体を第一級のエンタープライズ資産としてカバーする 4 つの統合的な柱に基づいて構築されています。
### **3.1 エージェントレジストリ (検出)**
管理エコシステムの基盤は検出可能性です。*エージェントレジストリ*は、企業内のすべてのエージェント資産の一元化されたユニバーサルカタログとして機能します。これには、カスタム作成済みエージェント、SaaS アプリケーションに組み込まれたエージェント、レガシーシステムを公開する MCP サーバー、エージェント間コラボレーション用の A2A エンドポイントが含まれます。*エージェント レジストリ*は、一元化された情報源を提供することで、チームが冗長な機能を構築することを防ぎ、人間の開発者や他の AI エージェントが既存の資産を大規模に動的に検索して再利用できるようにすることで、重要な検出の問題を解決します。
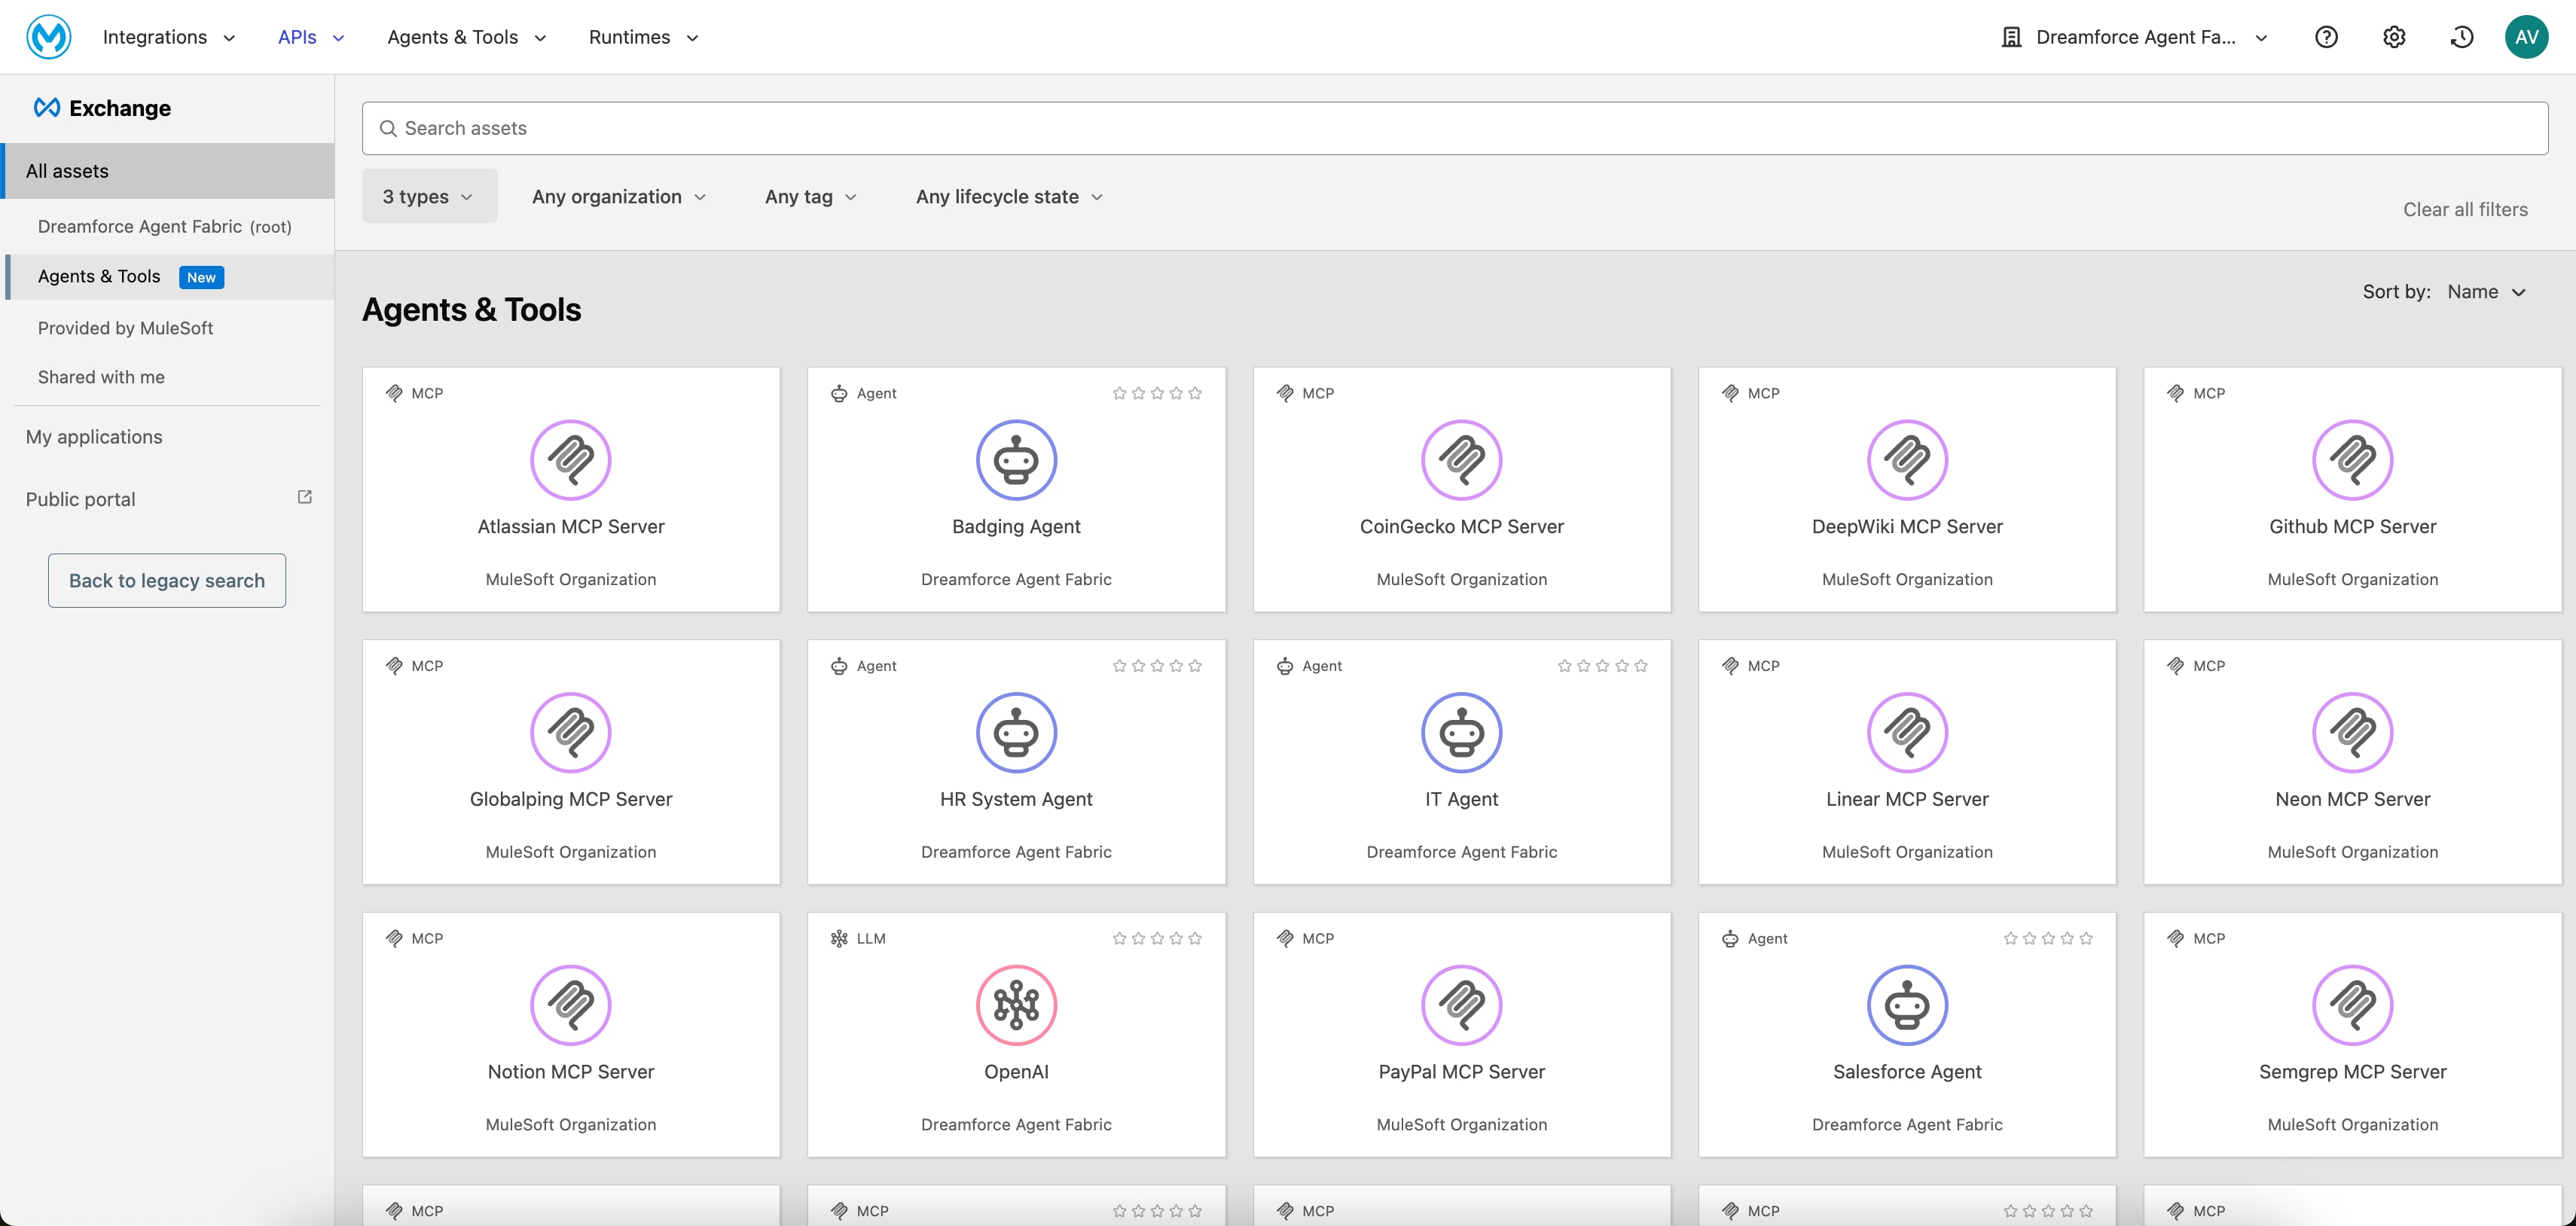 *エージェントレジストリ*は _Anypoint Exchange_ 上に構築され、次の 3 つの新しいアセットタイプが追加されます。エージェント、MCP サーバ、LLM。MCP ツール、転送プロトコル、エージェントカード、およびエージェントと MCP サーバーおよびエージェントが使用するツール間の連動関係など、これらのアセットに関する情報を取得します。開発者は、レジストリ内でアセットを直接作成および管理できます。また、新しいオーケストレーションを作成するときに、(\_MuleSoft MCP Server の\_search_asset ツールを介して)MuleSoft Vibes 内の既存のアセットをプログラムで検出して再利用することもできます。これにより、開発者はこれらのアセットを理解して消費するために必要なすべての情報を得ることができます。
### **3.2 エージェントブローカー (オーケストレーション)**
アセットが検出可能になったら、有用な作業を実行するように調整する必要があります。*エージェント ブローカー*は、複数ステップのビジネスプロセスを実行するオーケストレーション サービスです。設定可能な LLM を使用して、概要レベルの ToDo を解釈し、対応するワークフローを生成します。*エージェントブローカー*は、必要なエージェントとツールを動的に検出、順序付け、呼び出して、これらのプロセスを完了します。
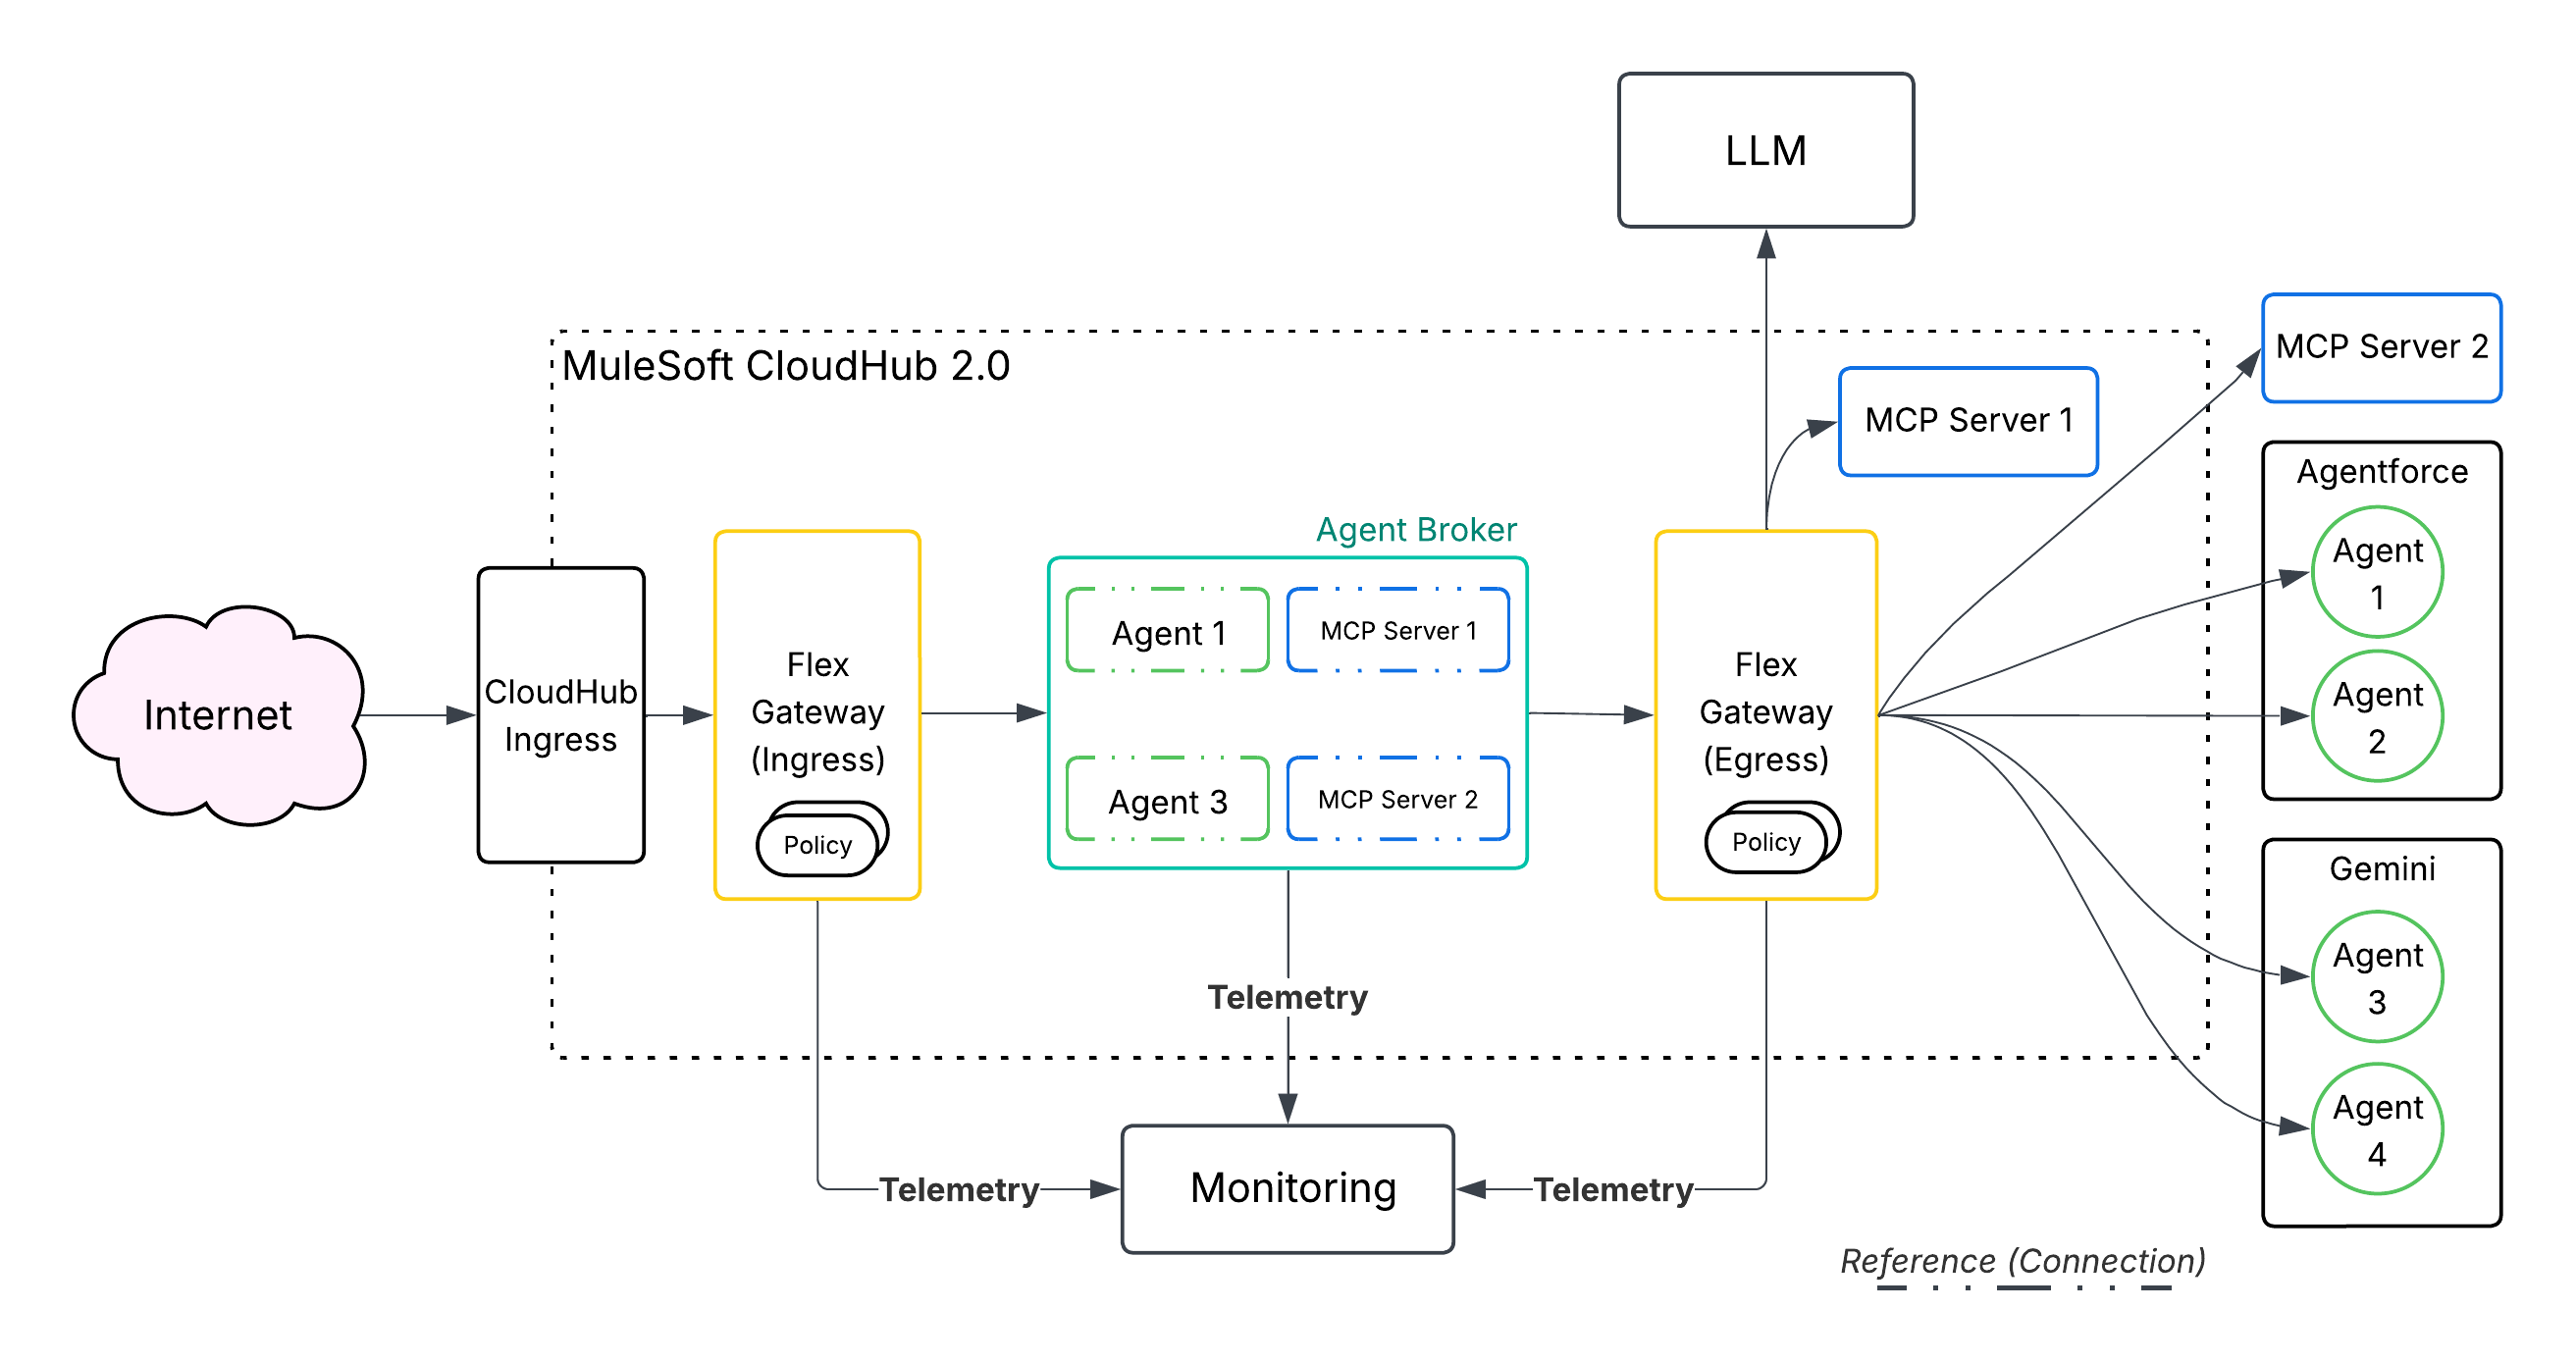 接続は、ツールの場合は _MCP_、エージェントの場合は _A2A_ プロトコルで管理されます。これにより、エージェントをビジネス固有のドメイン (サプライチェーンや財務など) に整理し、すべてのドメインに ToDo を転送できます。1 つの自然言語プロンプト (「Onboard an Employee」 (従業員をオンボーディング) など) は、複数のバックエンドシステムで異なるエージェントまたはツールによって実行される個別のアクションのシーケンスに分解されます。エージェントブローカーオーケストレーションには次のものが含まれます。
- **動的オーケストレーションパターン:**これは、サブ ToDo を決定し、全体的な目標を達成するために最も適したエージェントとツール間で調整するエージェントループパターンです。このパターンを活用することで、複雑な使用事例を解決するために[コラボレーション・エージェント](/docs/architect/ja-jp/fundamentals/guide/agentic-patterns#15-コラボレーションエージェント-エージェントスウォーム)を構築できます(たとえば、[複雑なサービスエスカレーション](/docs/architect/ja-jp/fundamentals/guide/agentic-patterns#35-コラボレーションエージェントの使用事例複雑なサービスのエスカレーション)の処理)。
- **LLM-Powered Reasoning:**LLM を使用して自然言語目標を解釈し、実行計画を生成することで、ハードコードされた厳格なワークフローロジックが不要になります。
- **設定可能な LLM モデル:**開発者が使用する LLM モデルを指定でき、コスト、パフォーマンス、機能を制御できます。
- **自然言語開発:***エージェント ブローカー*のロジックは、*MuleSoft Vibes を*介して自然言語を使用して定義できます。
- **可観測性:**_Anypoint Monitoring_ では、リリース時にログとトレースが提供されるため、ユーザーはエージェントブローカーの理由と _MCP_ ツールおよび _A2A_ エージェントとのやりとりを理解してデバッグできます。
- **導入管理:***エージェントブローカー*は、リリースの可用性と拡張性を管理する*ミュールランタイム*によってサポートされるコンテナ化されたアプリケーションです。
### **3.3 MCP および A2A 向け Flex Gateway (管理)**
_Anypoint Flex Gateway_ は、特定のポリシーを技術的に適用するメカニズムです。_MuleSoft Agent Fabric_ は _Anypoint Flex Gateway_ を使用して、_MCP_ および _A2A_ プロトコルを介して発生するすべてのエージェントとのやりとりを[保護、検査](https://docs.mulesoft.com/gateway/latest/flex-agent-secure)、管理します。これにより、組織は豊富なエンター[プライズ クラスのポリシー](https://docs.mulesoft.com/gateway/latest/flex-agent-policies)をすべてのエージェント トラフィックに適用して、すべてのアクションの実行前にセキュリティ、コンプライアンス、監査を確保できます。AI の採用を安全かつ責任をもって拡張するには、次のガードレールが不可欠です。
| ポリシー名 | Protocol(s) (プロトコル) | 説明 |
| :------------------------------------------------ | :----------------------- | :------------------------------------------------------------------------------------------------------------------------------------------------------------------------ |
| **JWT 検証ポリシー/クライアント ID 適用ポリシー** | A2A、MCP | **JWT Validation Policy/Client ID Enforcement Policy** は、認証された通話者のみへのアクセスを制限することで、_A2A_ エージェントと _MCP_ サーバーを保護します。 |
| **スキーマ検証** | A2A、MCP | **スキーマ検証**により、受信エージェント要求が _A2A_ または _MCP_ 仕様に準拠するため、不正な形式のトラフィックが防止されます。 |
| **A2A PII ディテクタ** | A2A | **A2A PII Detector** は、要求と応答で *PII (個人識別*情報) を識別し、コンプライアンス要件を満たすためにログ記録またはブロックを有効にします。 |
| **A2A Prompt Decorator** | A2A | **A2A プロンプトデコレータ**は、エージェントに送信されるプロンプトにカスタムコンテキストまたは命令を挿入して、エージェントの動作をガイドし、ガードレールを適用します。 |
| **MCP 属性ベースのアクセス制御** | MCP | **MCP 属性ベースアクセス制御**は、ユーザー属性(階層、IP、JWT 要求など)に基づいて、*MCP*サーバーによって公開される特定のツールおよびリソースへのアクセスを規制します。 |
| **SSE ロギング** | A2A、MCP | **SSE ロギング**は、包括的な監査とトレーサビリティのためにエージェントプロトコルで使用される _Server-Sent Events (SSE)_ ストリームのコンテンツを記録します。 |
| **レート制限とスパイク制御** | A2A、MCP | **レート制限およびスパイク**制御は、要求制限を適用することで、トラフィックの急増やサービス拒否攻撃からバックエンドエージェントとシステムを保護します。 |
| **A2A エージェントカード** | A2A | **A2A エージェント カード**はエージェント カードの URL を書き換えて、すべてのトラフィックが管理対象の Flex Gateway インスタンスを介して正しくプロキシされるようにします。 |
**エージェントプロトコルのエンタープライズガバナンスポリシー**
受信要求の管理に加えて、_Anypoint Flex Gateway_ はエージェントから外部サービス(_MCP_ Servers and Tools や他のエージェントなど)へのすべての発信接続と要求も管理します。具体的な動作は次のとおりです。
- **ログ:**監査とトラブルシューティングのためにすべての送信エージェント要求を監視および記録するための一元的な監視ポイントを提供します。
- **セキュリティ:**送信トラフィックを検査して機密データの漏洩を防止します。
- **認証:**API キー、OAuth、ClientId/ClientSecret などの送信認証メカニズムを 1 か所から適用して、外部システムのログイン情報を管理します。
_Anypoint Flex Gateway_ [**Policy Development Kit(PDK**)](https://docs.mulesoft.com/pdk/latest/policies-pdk-overview)を使用すると、標準のポリシーが特定の要件を満たしていない場合にカスタムポリシーを作成できます。開発者は _PDK_ を使用して、_Rust_ プログラミング言語でポリシーロジックを記述し、*WebAssembly(WASM)*モジュールにコンパイルできます。次に、この自己完結型モジュールが _Anypoint Flex Gateway_ に読み込まれ、API エッジで独自のセキュリティルール、カスタムデータ変換、または特殊なインテグレーションロジックを直接適用します。これにより、ユニークまたは複雑な使用事例に合わせてゲートウェイ機能を拡張できる強力でハイパフォーマンスな方法が提供されます。
_PDK_: の 4 つの主要なコンポーネントを次に示します。
- **Anypoint CLI PDK プラグイン:**このプラグインは、_PDK_ プロジェクトを作成し、コンパイル済みポリシーを _Exchange_ にアップロードします。また、ポリシーを作成および管理するための明確なコマンドセットを提供することで、開発プロセスを簡略化する*メイクファイル*も生成されます。
- **ポリシーテンプレート:**新しいプロジェクトが作成されると、_PDK_ によって基本的なスキャフォールドまたはテンプレートが生成されます。この構造には、ポリシーを正常にコンパイルするために必要なすべてのファイルと設定が含まれており、開発者はカスタムロジックを開始できます。
- **SDK 構築ツール:**これらのツールは、基盤となる _Envoy_ プロキシの複雑なイベント駆動型アーキテクチャを抽象化します。_SDK_ では、反応器パターンと実行パターンを使用して、わかりやすい線形コーディング方法を提供します。これにより、開発者の複雑さが軽減され、デバッグが改善され、学習曲線が短縮されます。
- **Policy Management (ポリシー管理):**[MuleSoft MCP Server](https://docs.mulesoft.com/mulesoft-mcp-server/reference-mcp-tools) には、ユーザーがカスタムポリシーライフサイクルを管理するのに役立つ _MCP_ ツールが用意されています。このツールの例を次に示します。
- get_flex_gateway_policy_example
- manage_api_instance_policy
- manage_flex_gateway_policy_project
### **3.4 Agent Visualizer (監視)**
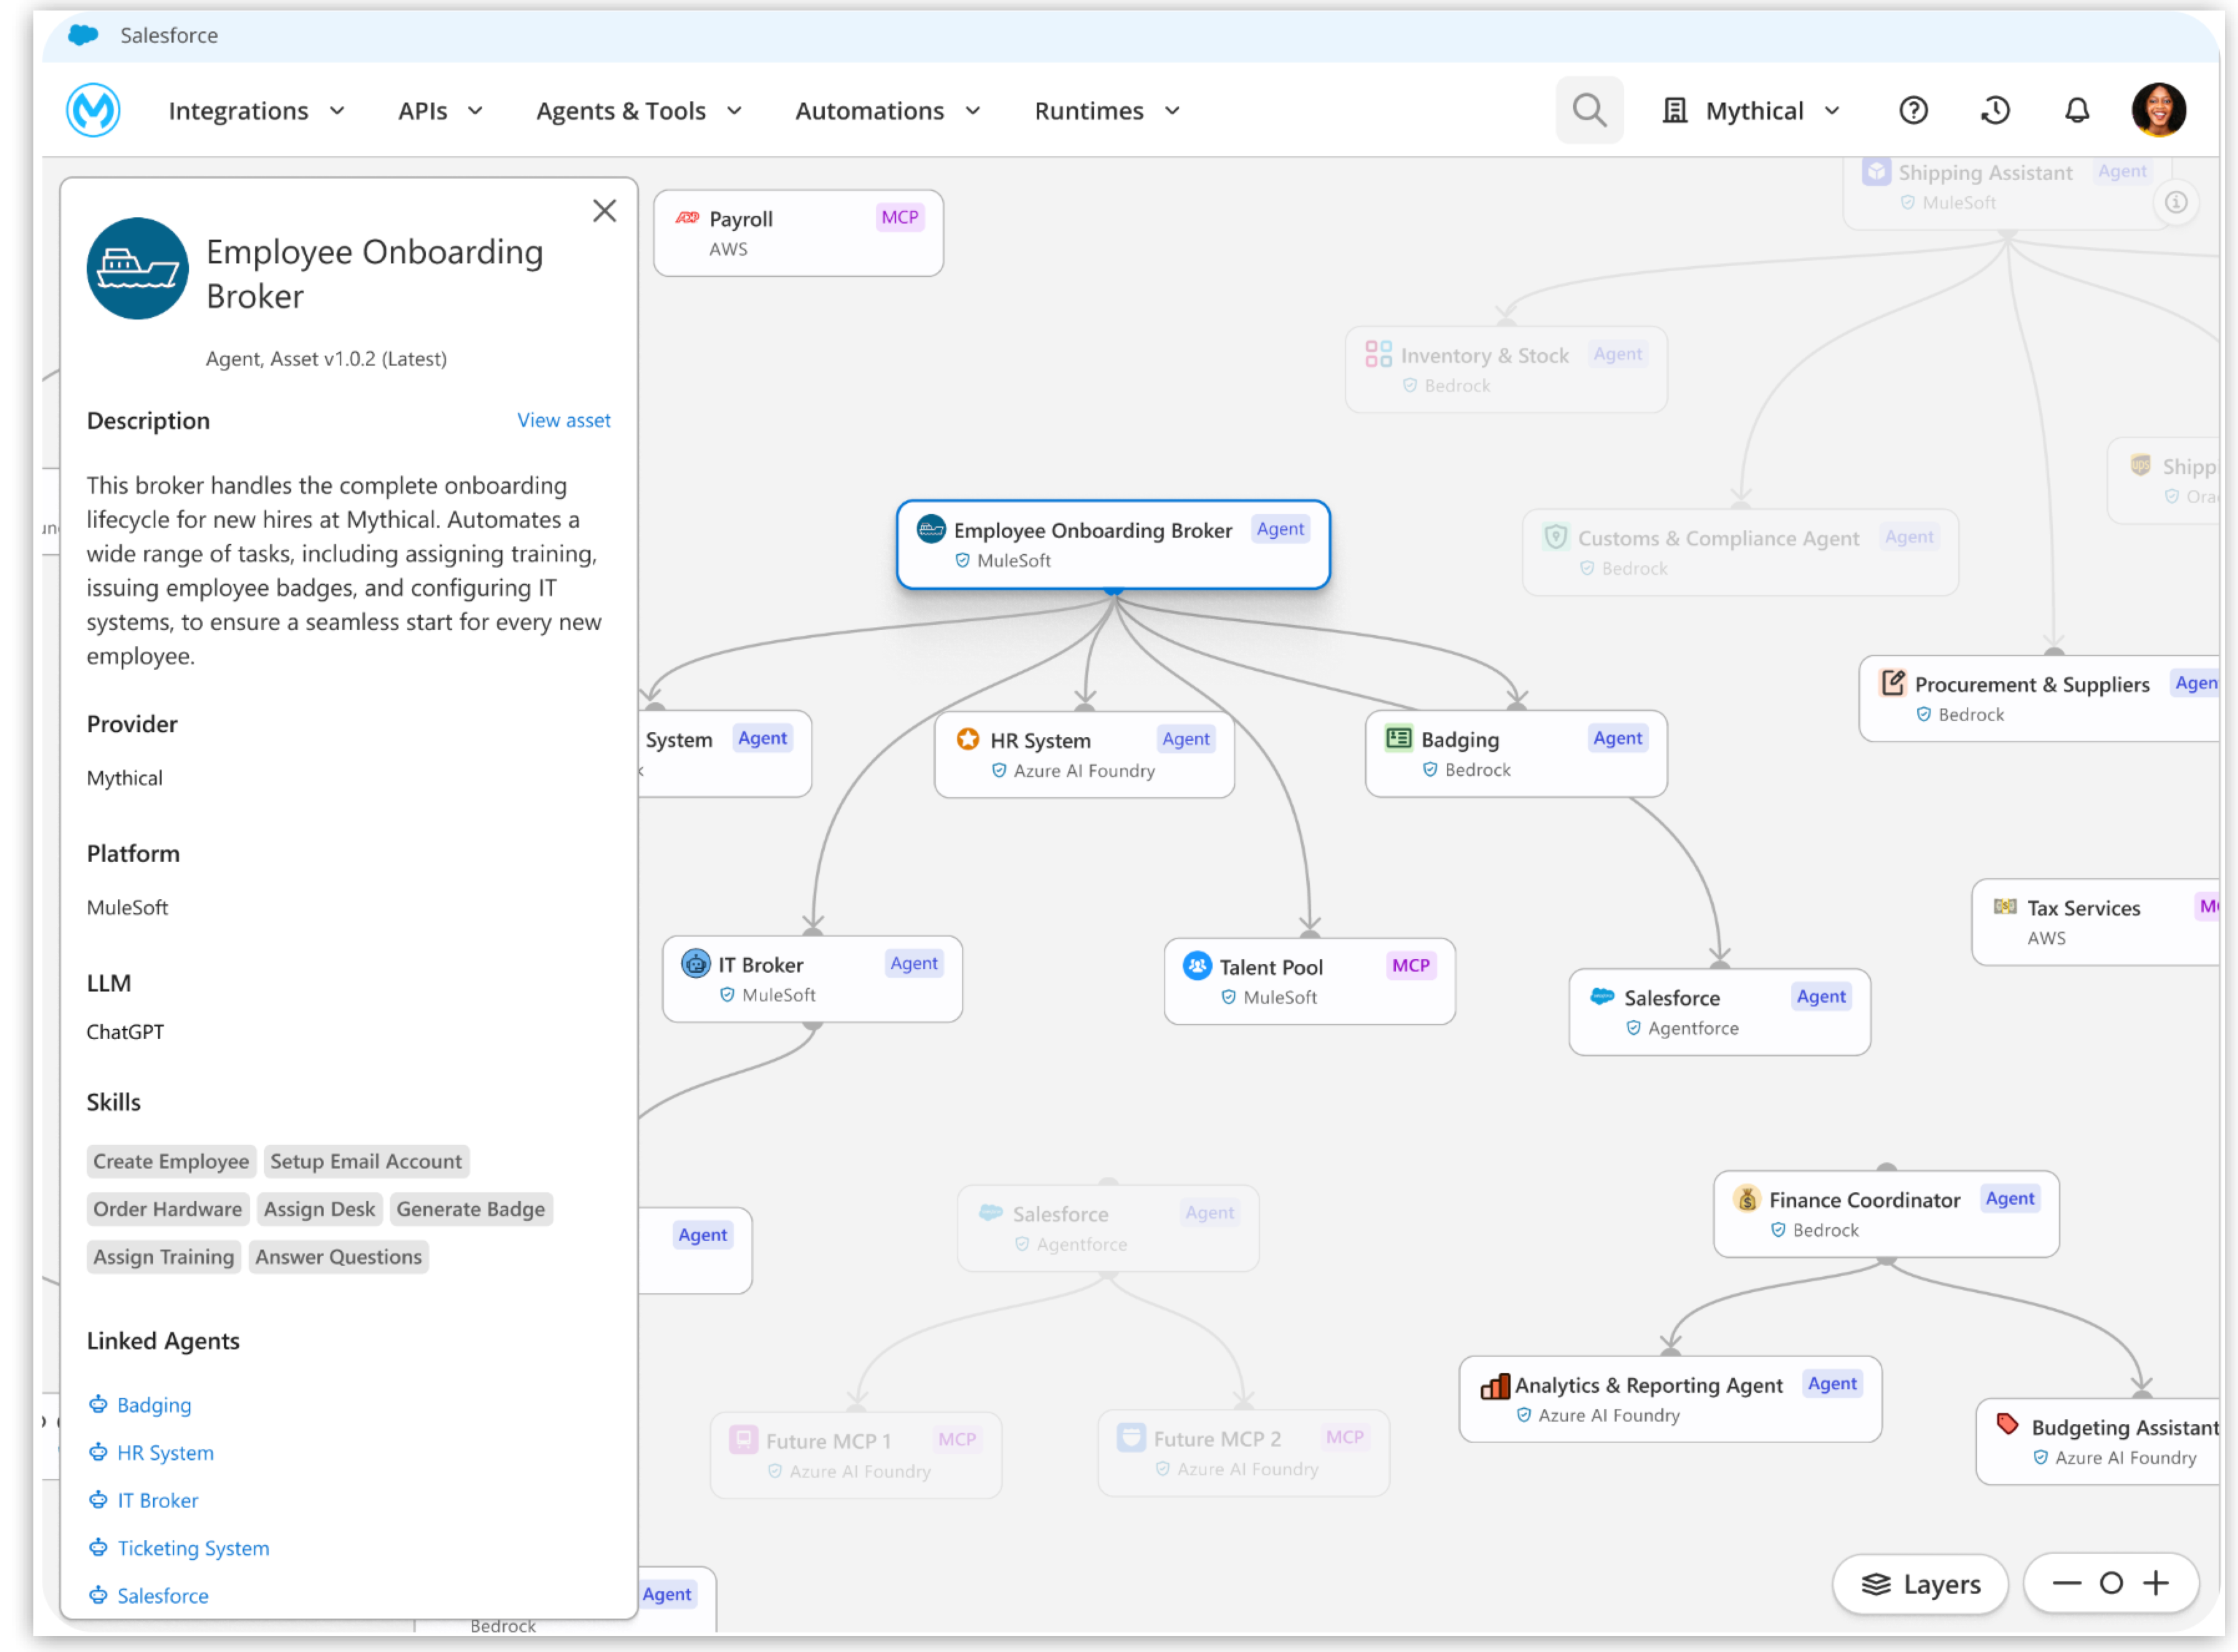 *エージェント ビジュアライザー*は、エージェント ネットワーク全体のリアルタイムの動的マップを提供し、AI インタラクションの「ブラック ボックス」になり得るものを完全に監視可能なシステムに変換します。アーキテクトと運用チームは*エージェントビジュアライザー*を使用して、エージェントの接続方法の確認、意思決定フローの追跡、健全性とパフォーマンスの監視、連動関係の特定を行うことができます。このレベルの表示は、パフォーマンスを最適化し、障害を効率的にトラブルシューティングし、ボトルネックを検出して、リリースされたエージェントの信頼性を高めるために不可欠です。
## **4\.Salesforce Platform の統合**
### **4.1 API カタログとトピックセンター**
*MuleSoft API カタログ*と*トピックセンター*は、特に*Agentforce*と組み合わせて、API の検出、使用、管理方法を改善するように設計されています。
設計および公開されたすべての*MuleSoft* API は、*Salesforce Platform*の[API カタログ](https://help.salesforce.com/s/articleView?id=platform.api_catalog.htm&type=5)を使用して検出および利用できます。*API カタログ*は一元化されたリポジトリとして機能し、_MuleSoft_、_Salesforce_、_Heroku_、その他のクラウドから組織のすべての API を 1 つのビューに統合します。これにより、開発者と管理者は、既存の API を自動化(_Agentforce_、_フロー_、*Apex*など)で使用できるようになるため、既存の API の検出、理解、再利用が容易になります。
[MuleSoft for Agentforce:トピック・センター](https://blogs.mulesoft.com/news/mulesoft-for-agentforce-topic-center/)では、設計時に Agentforce**トピック**および**アクション**のメタデータを定義することで、開発者は特定のビジネス使用事例に基づいて API を構造化できます。具体的な動作は次のとおりです。
- **アクション**: エージェントが実行できる ToDo。
- **手順**: 特定のアクションの適用方法をエージェントに指示します。
[このセマンティック・レイヤー](https://docs.mulesoft.com/anypoint-code-builder/ai-enabling-api-project-topic-center)を追加することで、*トピック・センター*は*Agentforce*によって API を理解および利用できるようにし、効果的にエンタープライズ・システムを操作できるようにします。
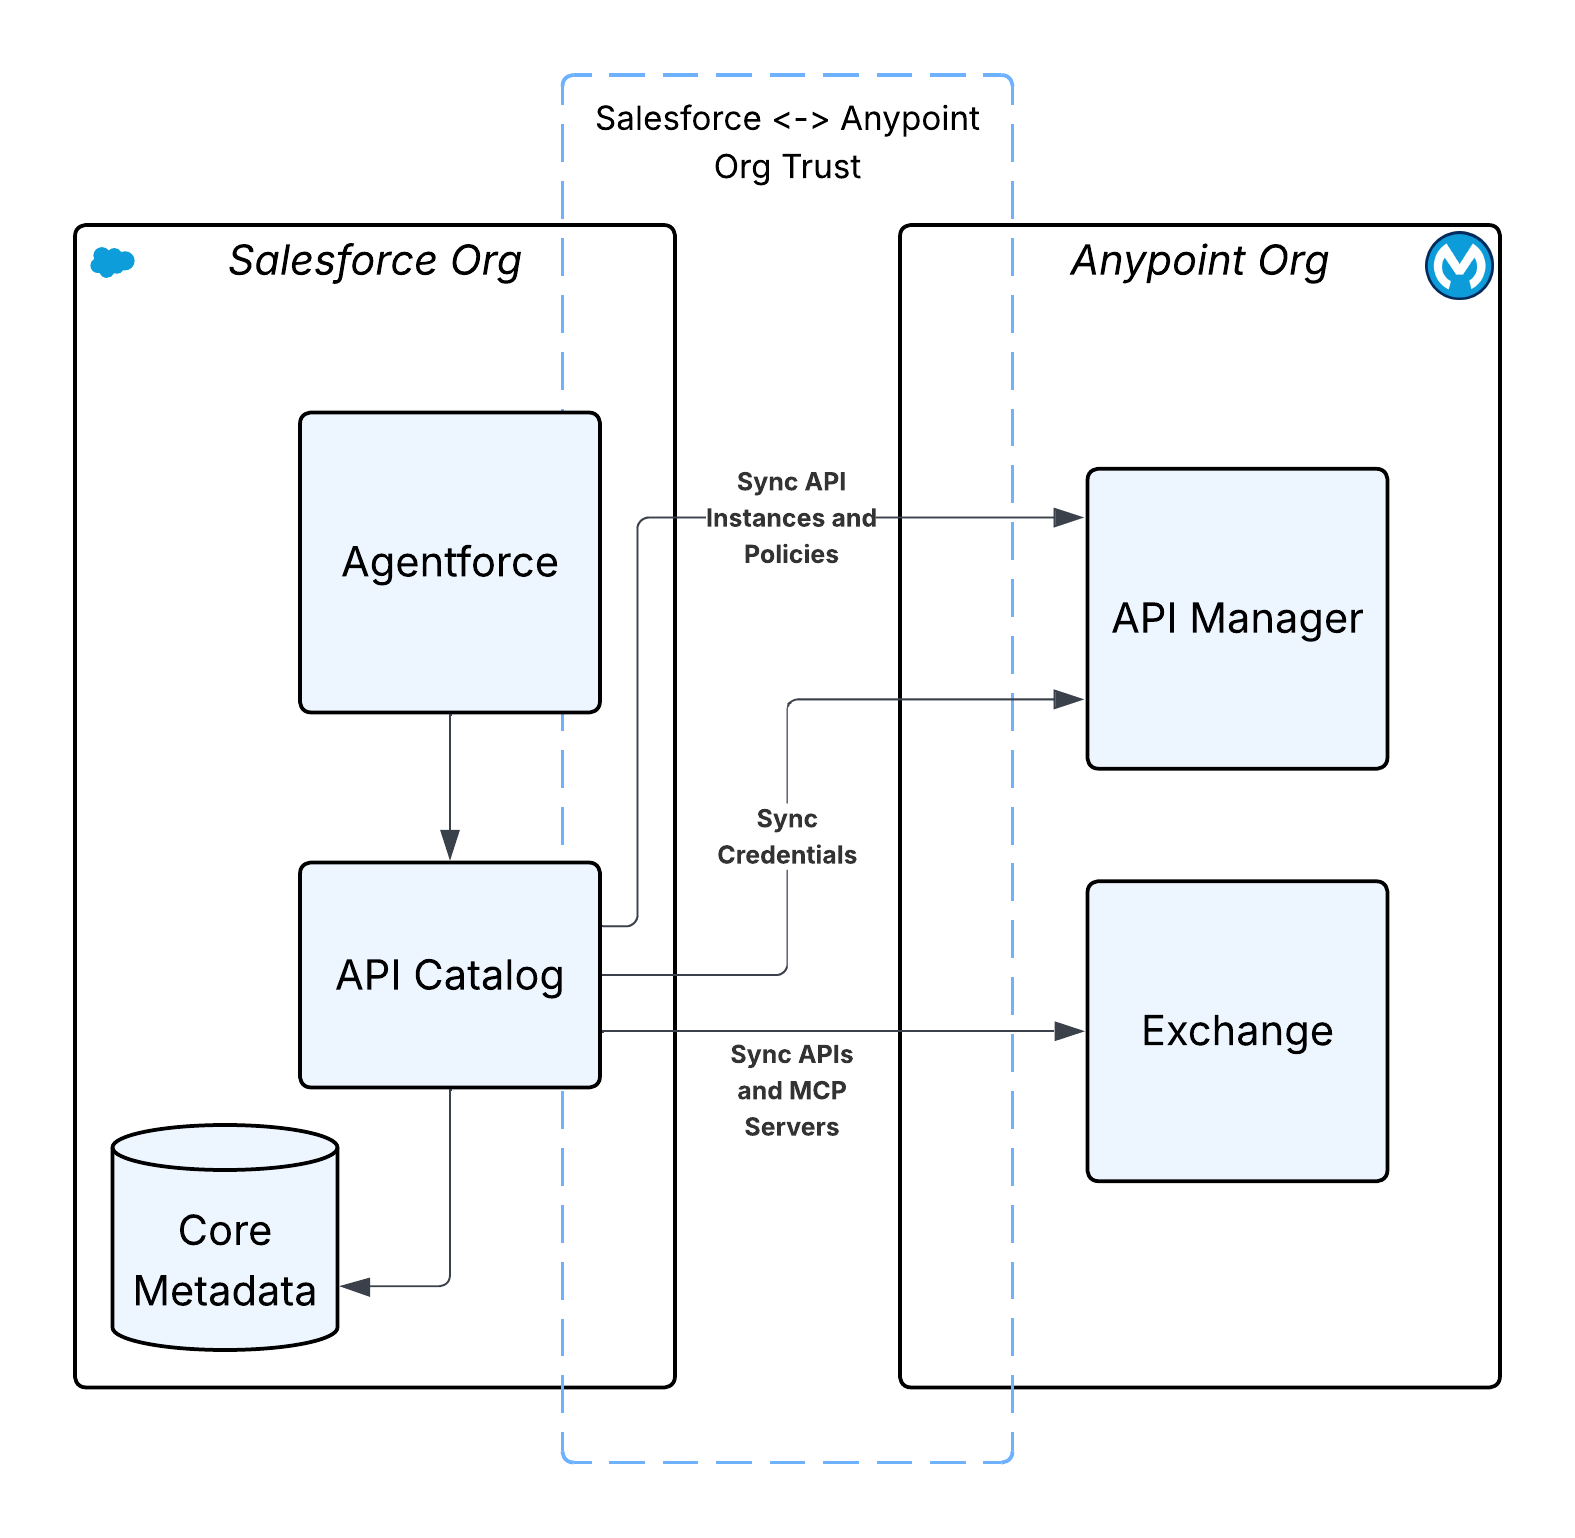 ### **4.2 Agentforce ゲートウェイ**
*Agentforce ゲートウェイ*は、拡大する _Agentforce_ エコシステム内のインタラクションを管理して保護するように設計された一元化されたガバナンス層です。_Agentforce_ は _MCP_ などのプロトコルを介して追加のサードパーティ API およびツールと統合するため、*Agentforce ゲートウェイ*の主な機能は、_Agentforce_ によって開始されたすべての送信トラフィックにポリシー(レート制限やツール制限など)を適用し、すべての送信要求を監査することです。
*Agentforce Gateway*は、*Salesforce Platform*にネイティブに組み込まれている既存の*MuleSoft* API ガバナンスポリシーエンジンを活用します。この _Envoy_ ベースのポリシー エンジンは、エージェント トラフィックの代行受信、設定済みのポリシーの適用 (属性ベースのアクセス制御や目標制限など)、認証と認可の管理をすべて行います。顧客は追加のゲートウェイ インフラストラクチャをインストールする必要はありません。
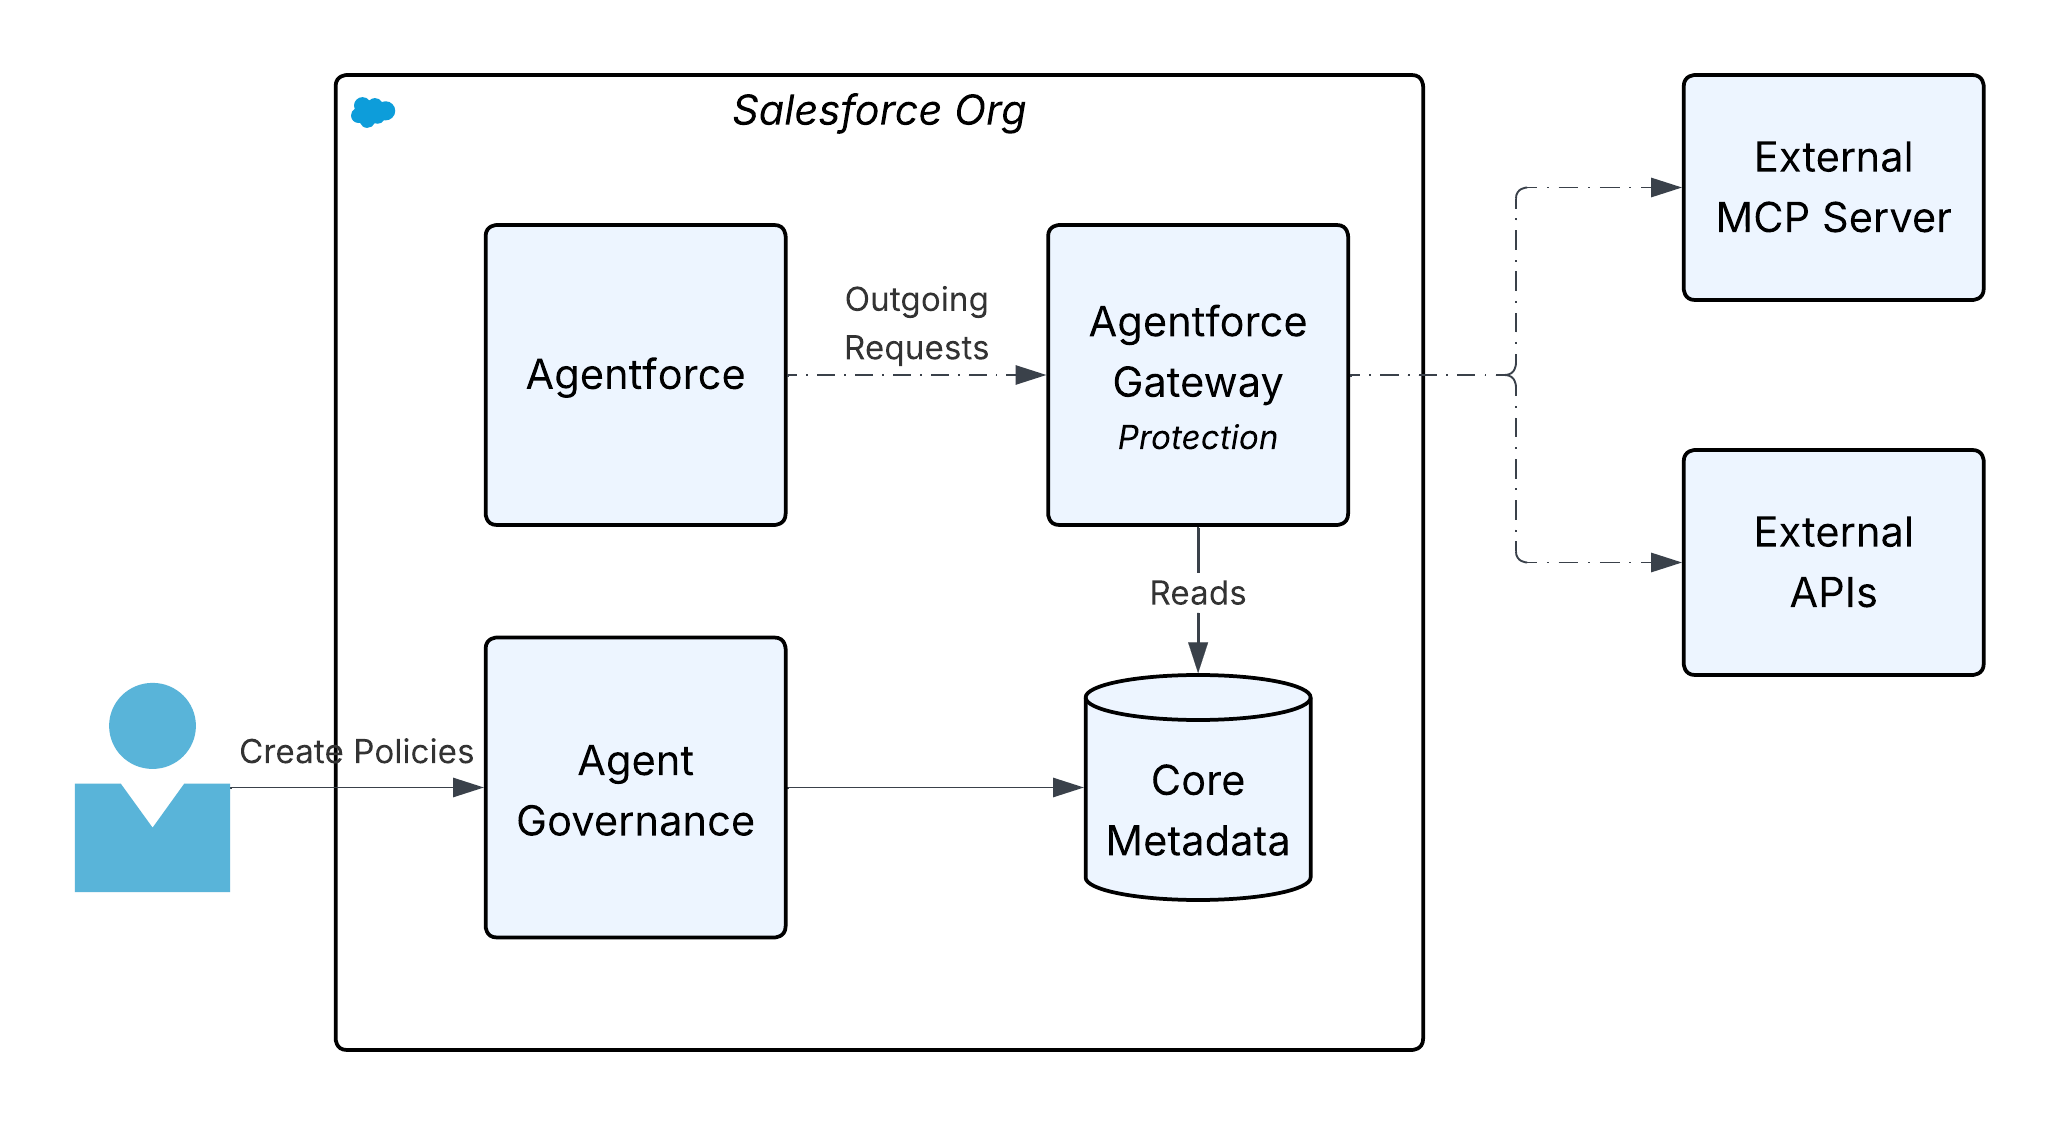 ### **4.3 インテグレーションインテリジェンス**
管理されたエージェントネットワークのリリースは画期的な成果です。ただし、新しい「Day 2」運用上の課題が発生します。自律アクターの動的な分散システムを監視、測定、トラブルシューティングするには、高度な運用インテリジェンスが必要です。最終的なアーキテクチャビジョンは、AI を使用してビジネスプロセスを実行するだけでなく、AI が実行されているインフラストラクチャの監視、管理、修復を行うシステムです。
インテグレーションインテリジェンスに関する*MuleSoft の*ビジョンは、より広範な*Salesforce*エコシステムの機能を活用して、インテグレーションファブリックとエージェントネットワークのパフォーマンスに関する詳細でカスタマイズ可能なインサイトを提供します。オブザーバビリティの新しい標準である[OpenTelemetry(OTEL)](https://opentelemetry.io/)データを**Salesforce Data 360**に取得して保存することで、組織はランドスケープ全体のログ、総計値、トレースの統合リポジトリを作成できます。このデータは、事前作成済みのダッシュボードとカスタムの視覚化を使用し**て Tableau** で表示でき、API パフォーマンス、エージェントの操作パターン、システム全体の健全性に関する詳細なインサイトを得ることができます。
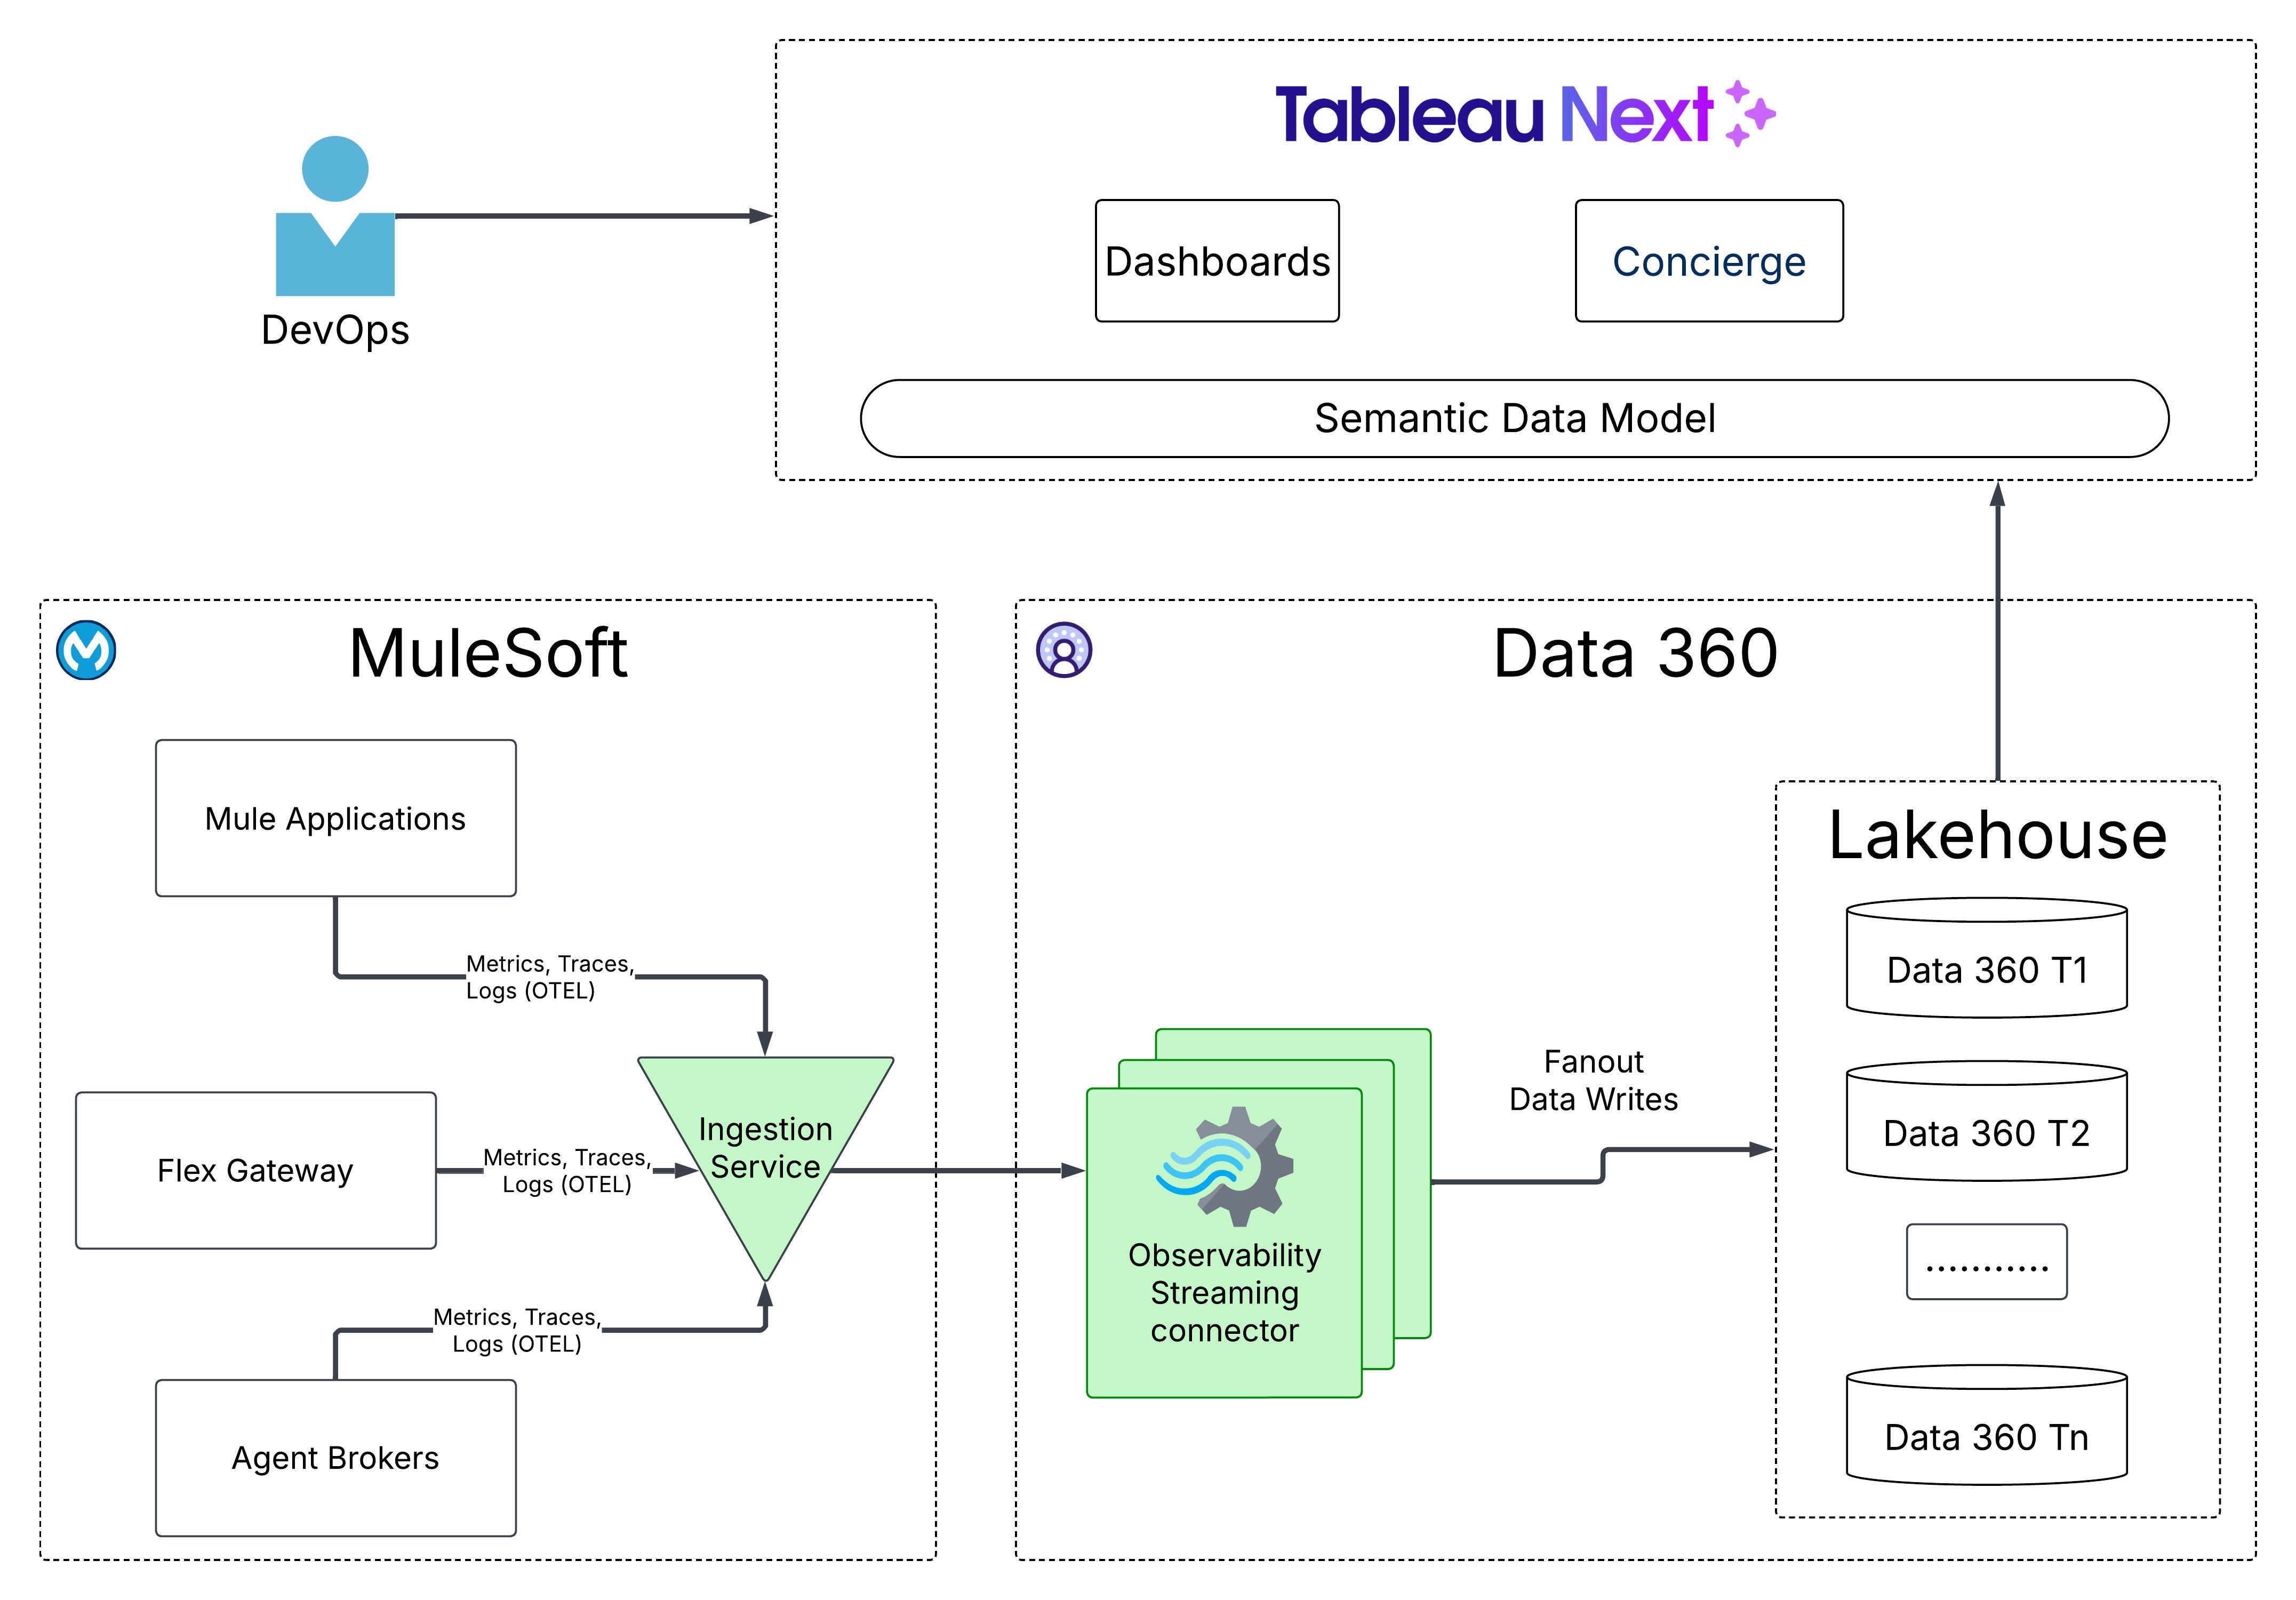 このシステムには 3 つの主要なコンポーネントがあります。
1. **取り込み:**取り込みサービスは、さまざま*な Mule* アプリケーション、_エージェントブローカー_、および _Flex Gateway_ からのテレメトリデータを収集および処理するための一元化されたエントリポイントです。スキーマ検証、データの正規化、絞り込みを実行して、さまざまなアプリケーションでデータの品質と一貫性を維持します。さらに、取り込みパイプラインで制御 (認証、暗号化、テナントの公平性、レート制限など) を適用します。
2. **ストレージ:**高スループットのストリーミングジョブは、マルチテナントの _Kafka_ トピックからデータを読み取り、_OTEL_ 形式に変換する _Data 360_ で実行されます。その後、OTEL データは*、レイクハウス*の _TelemetryTraceSpan_、_TelemetryLogs_、_TelemetryMetrics DMO_ でテナントの _Data 360_ にコミットされます。
3. **視覚化/消費:***Data 360*で使用できるテレメトリ データを使用すると、顧客は*Tableau Next*を使用して事前作成済みダッシュボードまたはカスタム ダッシュボードを使用して、システムの健全性を確認し、インサイトを得ることができます。また、*Tableau Next*内の事前作成済みのエージェント分析スキルで[ある Tableau Concierge](https://help.salesforce.com/s/articleView?id=analytics.tua_metric_questions.htm&type=5)を活用することもできます。Tableau Concierge では、ユーザーはテレメトリ データについて自然言語で質問し、信頼できるアクション可能な回答を視覚化して受け取ることができます。また、既存の*アプリケーションパフォーマンス管理(APM)*システム(_DynaTrace_、_Datadog_、*Splunk*など)にデータをエクスポートすることもできます。
## **結論**
Agentic Enterprise への移行は、単なる IT のアップグレードではなく、アーキテクチャの基本的な転換点となります。AI エージェントの断片的でサイロ化された導入は、業務の混乱、シャドウ IT、管理不能な技術的負債に直接つながります。持続可能な唯一の方法は、統合され、構成可能なアーキテクチャを使用することです。*MuleSoft エージェントファブリック*は、API 主導の接続の実証済みの基盤を基盤に構築されており、この新しいデジタルワークフォースの管理に必要な「中枢神経系」を提供します。検出、オーケストレーション、エンタープライズ・クラスのガバナンス、エンド・ツー・エンドの可観測性に関する重要な機能を提供します。このようにして、AI の実験から一歩先に進み、真にインテリジェントで自動化された安全なエンタープライズの構築を開始し、自律的な可能性を具体的で管理されたビジネス成果に変換します。
## **テクニカルガイドおよびリファレンス**
- [Anypoint Code Builder の使用開始](https://docs.mulesoft.com/anypoint-code-builder/start-acb)
- Anypoint Code Builder 用 Einstein [テクニカル ガイド:生成フロー](https://blogs.mulesoft.com/dev-guides/einstein-for-acb/)
- [DataWeave 生成変換の詳細:迅速なデータ変換のための AI イノベーション](https://blogs.mulesoft.com/dev-guides/dataweave-generative-transformation/)
- [MuleSoft 開発者エージェントを使用した API 仕様の作成](https://docs.mulesoft.com/anypoint-code-builder/api-ai-create-spec)
- [Einstein 生成 AI を使用した API ドキュメントの生成](https://docs.mulesoft.com/exchange/generating-documentation-with-ai)
- [MuleSoft MCP Server Overview](https://docs.mulesoft.com/mulesoft-mcp-server/)
- [MuleSoft MCP Server Tools](https://docs.mulesoft.com/mulesoft-mcp-server/reference-mcp-tools)
- [MCP コネクタ](https://docs.mulesoft.com/mcp-connector/latest/)
- [A2A コネクタ](https://docs.mulesoft.com/a2a-connector/latest/)
- [エージェントファブリックの使用開始](https://docs.mulesoft.com/agent-fabric/learning-map-agent-fabric)
- [Flex Gateway を使用したエージェントインタラクションの保護](https://docs.mulesoft.com/gateway/latest/flex-agent-secure)
- [Flex Gateway エージェントポリシー](https://docs.mulesoft.com/gateway/latest/flex-agent-policies)
- [Flex Gateway Policy Development Kit (PDK) の概要](https://docs.mulesoft.com/pdk/latest/policies-pdk-overview)
- [MuleSoft API Catalog for Salesforce](https://help.salesforce.com/s/articleView?id=platform.api_catalog.htm&type=5)
- [トピックおよびエージェントアクションの API プロジェクトの有効化](https://docs.mulesoft.com/anypoint-code-builder/ai-enabling-api-project-topic-center)
- [Tableau Next の操作](https://help.salesforce.com/s/articleView?id=analytics.tua_consume.htm&type=5)
- [OpenTelemetry](https://opentelemetry.io/)
- [モデルコンテキストプロトコル](https://modelcontextprotocol.io/docs/getting-started/intro)
- [Agent2Agent (A2A) プロトコル](https://a2a-protocol.org/latest/)
## 著者について
Nikhil Aggarwal は Salesforce のプリンシパルアーキテクトで、MuleSoft および Salesforce Automation Cloud のアーキテクチャをリードしています。Nikhil は、大規模な製品の提供に 18 年以上の経験を持ち、拡張性の高いアーキテクチャ、直感的な開発者エクスペリエンス、ハイパフォーマンスなチームの構築に情熱を注いでいます。Salesforce 以前は、Microsoft Power Platform、Dataverse、Office 365 で構想から立ち上げまで複数のイニシアチブを率いていました。彼の仕事は、AI ファースト時代において、現代の企業がシステムを接続し、ワークフローを自動化し、ビジネス価値を引き出す方法を形成し続けています。
## 1\.はじめに
20 年以上前、Salesforce は業界初のマルチテナントクラウドプラットフォームのパイオニアとして業界の先駆者となりました。その後、Salesforce は包括的なエンタープライズプラットフォームに進化し、ビジネスの主要な側面をカプセル化して自動化し、さまざまな業種や地域で数十万の企業と数百万のユーザーにサービスを提供できるようになりました。また、Salesforce は戦略的買収を通じて Customer360 製品スイートを強化しました。
過去数年間、市場、業界、およびテクノロジーの状況の変化により、Salesforce Platform の基盤には数多くの深い変革が生じています。これには以下が含まれます。
- インフラストラクチャに多額の投資を行うパブリック クラウド プロバイダーの出現。
- 機械学習、生成 AI、エージェントエクスペリエンスなど、AI の急速な進歩。
- 業界や国全体のデータレジデンシーと規制要件の増加。
- 急速に拡大するリアルタイムのデータとトランザクションを処理するニーズ。
- サイバーセキュリティ、システムの可用性、パフォーマンス、耐障害性の要件に焦点が絞られています。
- 耐障害性が高く、疎結合で、一貫性の強いアーキテクチャを提供する統合スイートを求める顧客のニーズ。
このような変化、特にAIの急激な変化とそれがビジネスに与える影響に対応するため、Salesforceはプラットフォームを完全に一から変革し、Trust目標を維持しながら、次世代のアプリケーションとお客様の使用事例のための基盤を構築しました。
Dreamforce 2024でのAgentforceのリリースと次の図は、何千人ものSalesforceテクノロジーおよび製品組織のチーム メンバーが参加したこの広範な取り組みの結晶です。現在、95% 以上のお客様がこの新しいプラットフォームに移行しています。最も要求の厳しいワークロードを抱えるお客様を含め、ほとんどのお客様の移行に成功したことは、エンジニアの創意工夫を示し、Trust、Customer Success、InnovationというSalesforceのコア バリューを再確認するものです。
Agentforceの発売以来、Salesforceはエンタープライズ アプリケーションでのAIの使用の先駆者であり続け、既存および新しいビジネス機能にリアルタイムの会話環境を提供するエージェント エクスペリエンスの開発で市場をリードしてきました。
このホワイトペーパーでは、主要な技術変革の背後にある複雑さを理解するビルダー向けに、トップエンジニアと協力して作成されています。このホワイト ペーパーでは、プラットフォームの拡張性、安全性、将来のアプリケーションへの準備を維持しながら、変化するお客様のニーズに対応する重要なアーキテクチャの機能強化について詳しく説明します。全体像を把握するには、「アーキテクチャの概要」の章から開始することをお勧めします。そこから、閲覧者は順序どおりに読み進めるか、最も関心を引く章を探索できます。
_Emin Gerba_
_Salesforce、チーフ アーキテクト_
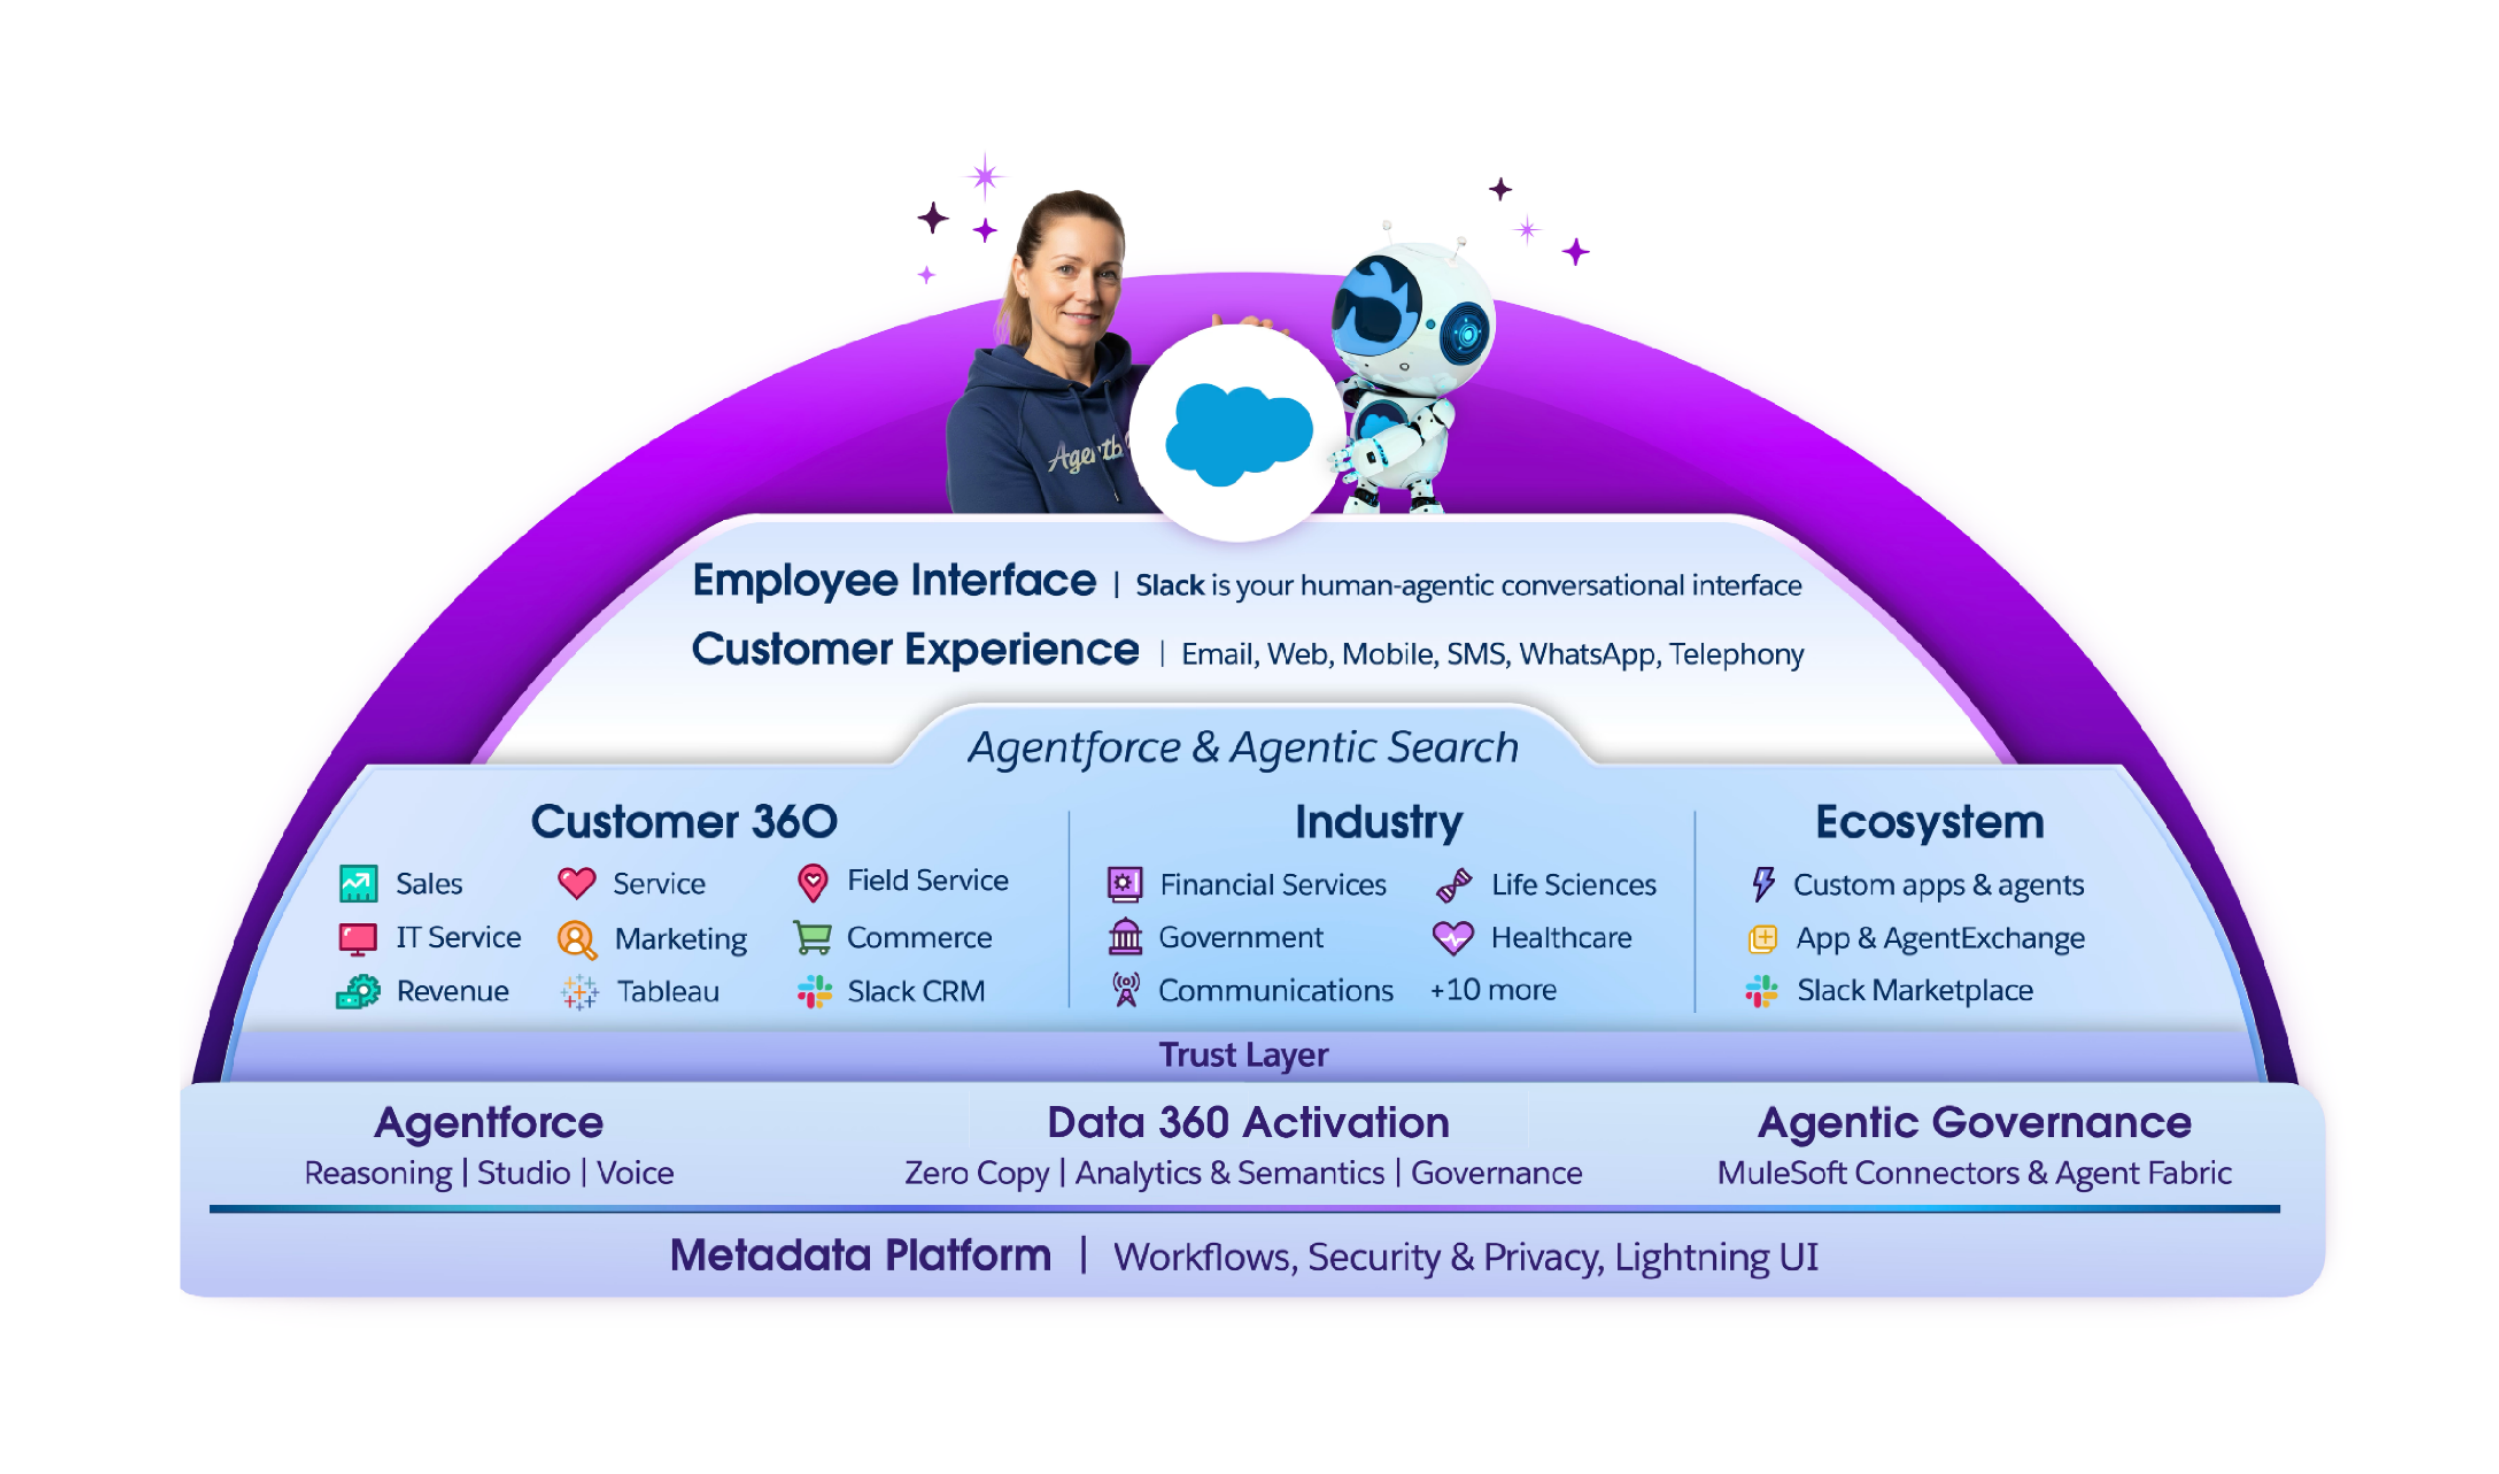 ## 2\.アーキテクチャの概要
次の Salesforce Platform のアーキテクチャ原則は、機能の設計方法の基盤と差別化要因を示しています。
- **Enterprise-Grade Trust**:TrustはSalesforceのNo.1の価値であり、サービスの可用性とセキュリティを優先するだけでなく、アクセス制御、コンプライアンス、セキュリティ機能も構築して、お客様がSalesforce Platformでコンプライアンスとセキュリティの基準を満たすことができるようにします。
- **マルチテナント**:すべてのサービスとインフラストラクチャは、複数の顧客をホストするように構築されています。これにより、用途に合わせて拡張するための戦略的なパターンが提供され、お客様の規模に関係なく、可用性とセキュリティの共通する高い基準で標準化されます。
- **メタデータ駆動型**:メタデータは、マルチテナントサービスのカスタマイズ方法の中心にあります。メタデータは拡張可能であるため、システム管理者と開発者は既存の作業に基づいて構築できるほか、Salesforce やエコシステムパートナーからの今後の製品更新を活用できます。
- **API First:**Salesforce Platform では、Salesforce ネイティブのユーザーインターフェースで実行できるすべての操作をカバーする、豊富で一貫性のある API ポートフォリオが優先されます。これにより、開発者とパートナーはプラットフォームの機能を活用して再構成し、システムの統合や新しいユーザーエクスペリエンスの構築を行うことができます。
- **オープンで相互運用可能**:Salesforce Platform は、お客様の任意のエンタープライズアーキテクチャに統合できます。Salesforce Platform は他のクラウドベースおよびオンプレミスのシステムと連携するように設計されており、外部システムを Salesforce Platform と統合するための API、ツール、インテグレーション標準も提供しています。
- **エージェント:**Salesforce Platform は、アプリケーションスイート全体でエージェントファーストを実現するように急速に進化しています。ユーザーはエージェントの深い会話環境を通じて Salesforce とエンゲージし、より自然な方法で仕事を遂行してデータを操作できます。
現在の Salesforce Platform は、2008 年の Force.com Platform のデビュー以降、Salesforce の機能の進化の最も遅い段階を示しています。最近の鍵の変換は次のとおりです。
- Hyperforceの採用とクラウド ベースのアーキテクチャへの移行。
- モノリス型アーキテクチャから独立したサービスを備えた構造への進化。
- 従来のリレーショナルデータストアと共に Data 360 および Lakehouse テクノロジーを紹介します。
- AI テクノロジー、生成および機械学習の緊密な統合、およびプラットフォーム全体のエージェントエクスペリエンスへの進化。
これらの変更により、Salesforce エンジニアは顧客の中断を最小限に抑えながらシームレスにテクノロジーを進めることができるようになり、プラットフォームの機能が大幅に拡張され、調整されました。また、アプリケーション開発者が固有の課題の解決に集中できるように、セキュリティ、可用性、テクノロジーの規則など、エンタープライズクラスのソフトウェアの技術的な複雑さを簡素化するという Salesforce Platform の価値にとって、堅牢な抽象化は引き続き重要です。Salesforce Platform の機能を次に示します。
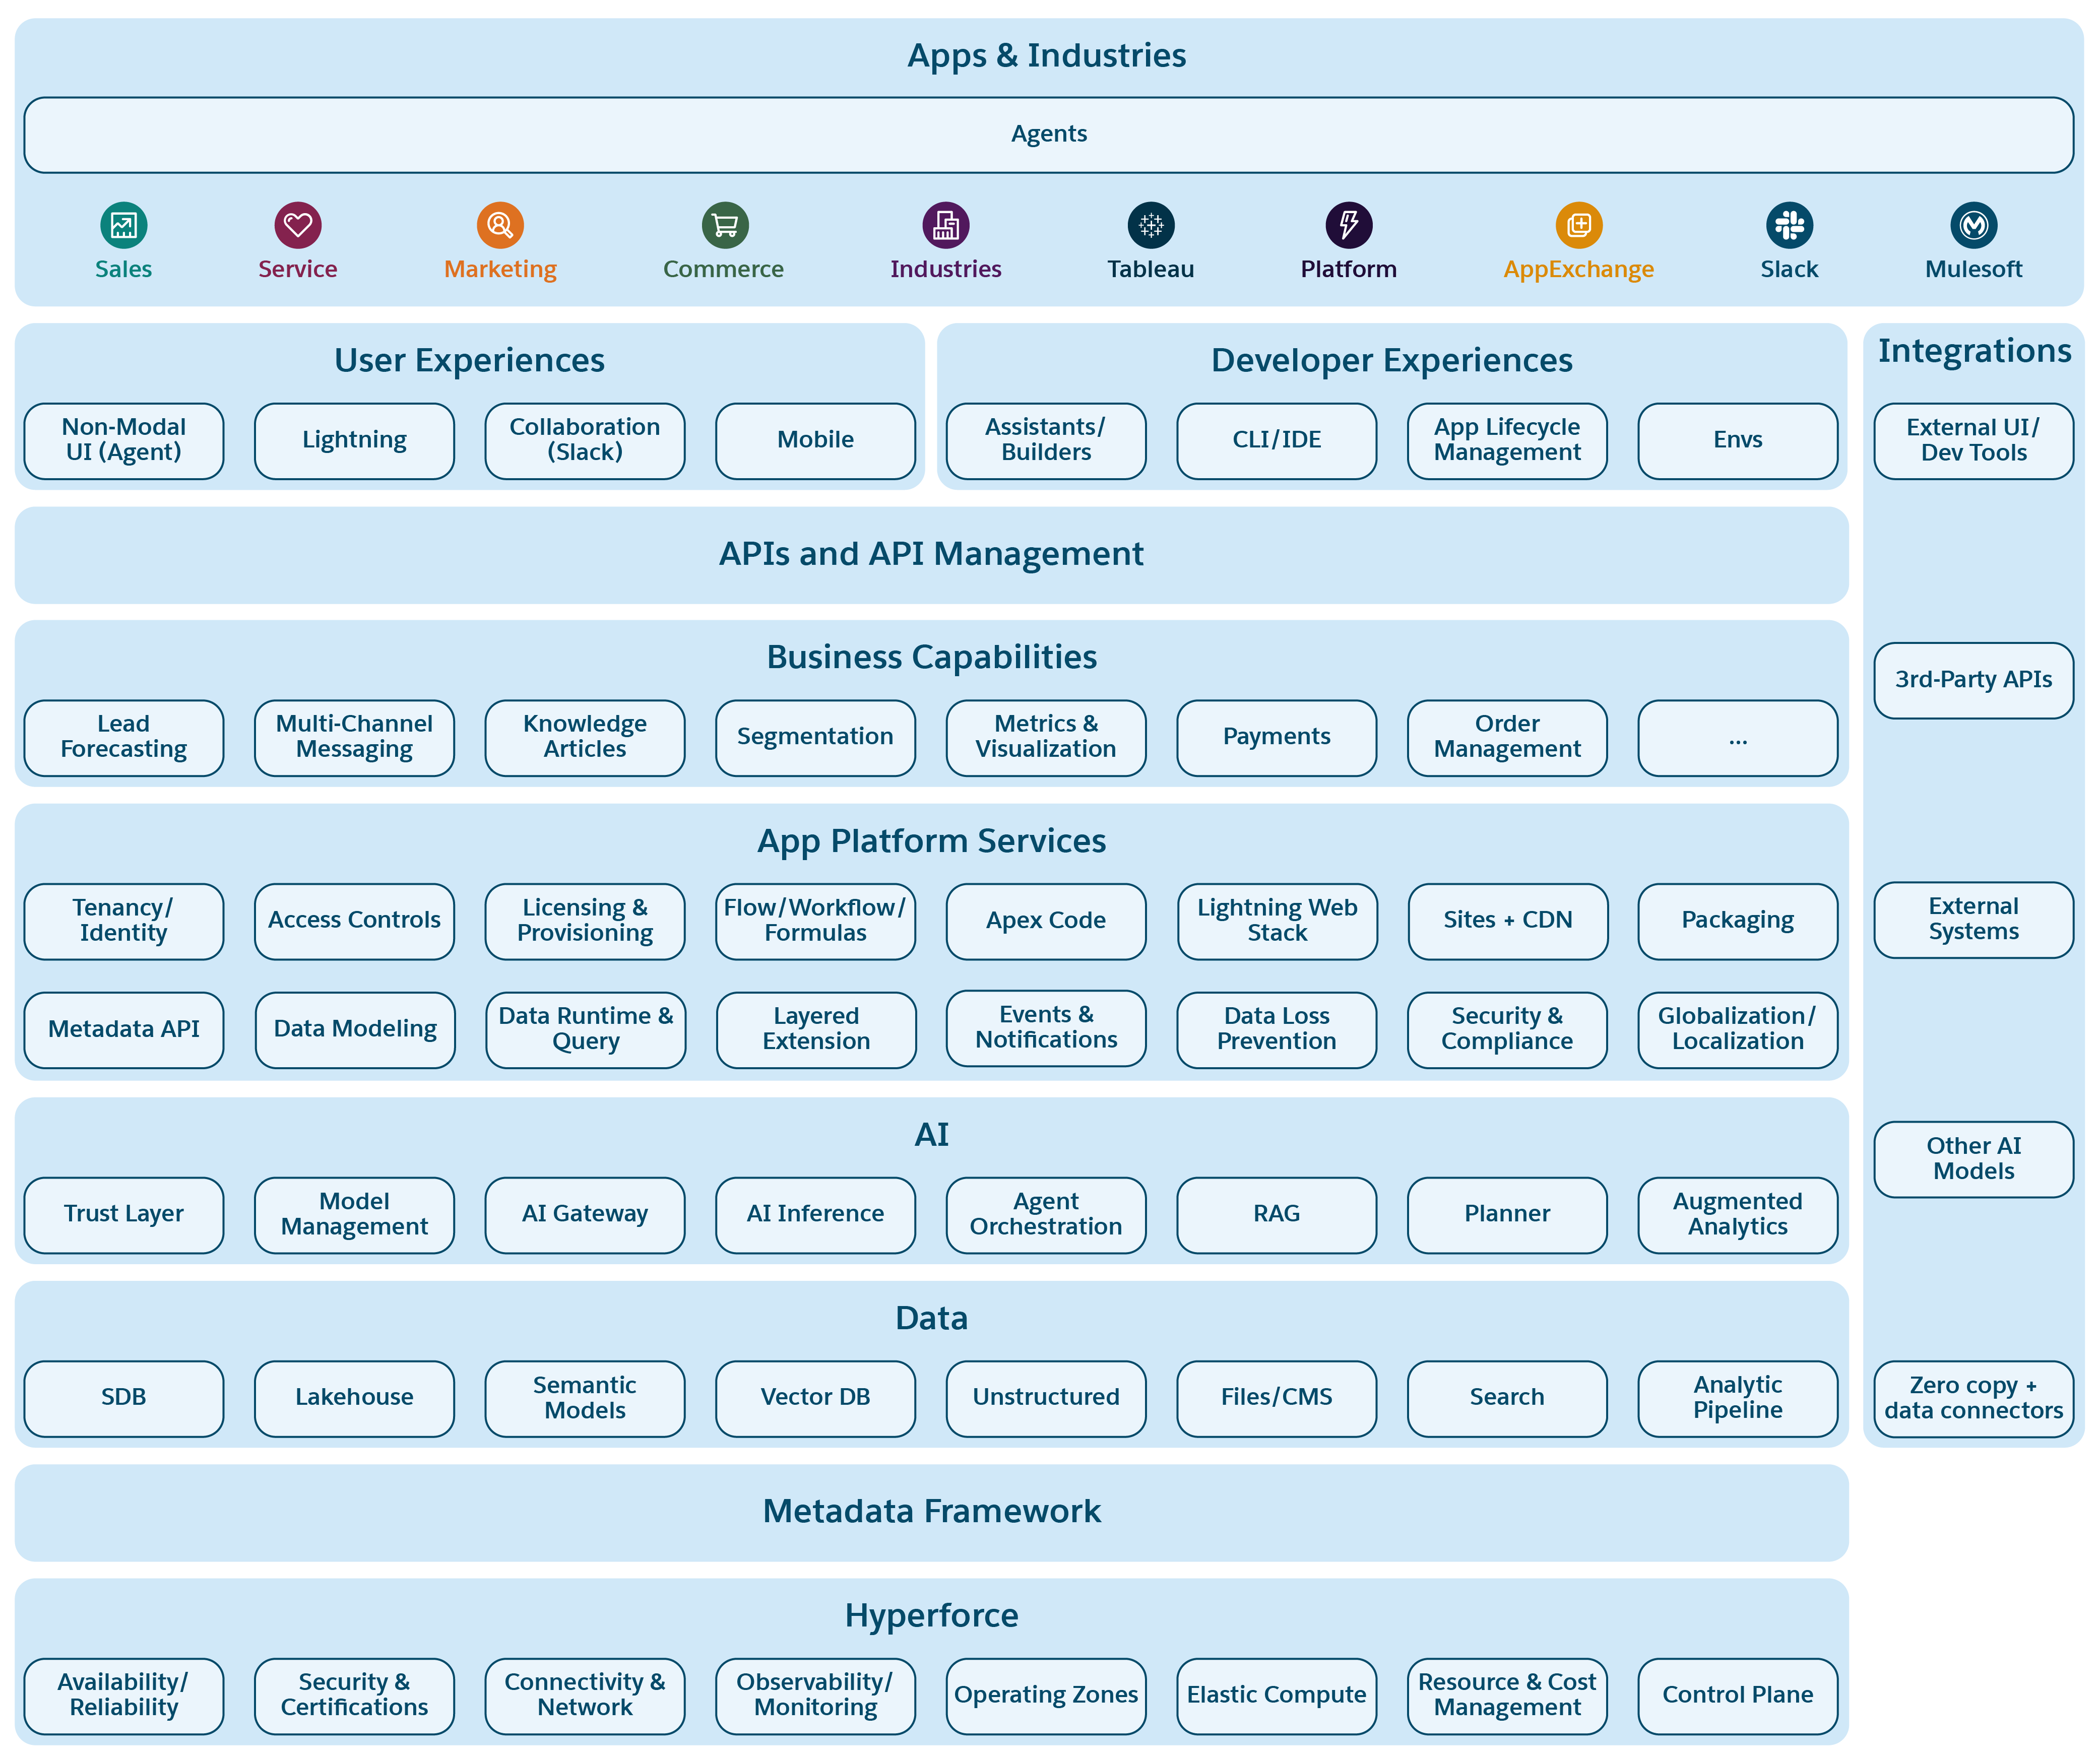 Salesforce Platform は、システムを構成する一連のレイヤーとして表示されます。各レイヤーは、プラットフォーム上に構築されたアプリケーションにとって重要な関連機能のグループを表します。各レイヤー内のサブボックスには、これらの機能の例が説明されています。各下位レイヤーの機能は上記のすべてのレイヤーに統合されているため、Salesforce アプリケーションスイート全体で一貫した一貫した環境が実現します。
Salesforce Platform は、過去 20 年間に開発された成熟したテクノロジープラットフォームのすべてのレイヤーにわたる広範なエンジニアリング変革を実現します。これらの変更は、顧客の需要と新しいテクノロジーの進化によって推進され、新しいアプリケーション種別とソリューションのサポートを可能にします。変換は相互接続されており、下位レイヤーの変更は、上のすべての後続レイヤーの進化に影響します。
Salesforce Platform は複数のレイヤーで構成され、各レイヤーが包括的な機能を果たします。
- **Hyperforce**:基盤インフラストラクチャは、ファーストパーティデータセンターからパブリッククラウドプロバイダーへと進化し、Salesforce テクノロジーによってセキュリティ、コンプライアンス、高可用性、コスト効率に優れたホスティングを実現しています。
- **メタデータフレームワーク**:所有および使用するテクノロジーが進化しても、アプリケーションを構築するための安定した抽象化を提供します。オブジェクトリレーショナルマッパー、実行の順序、およびメタデータ定義をメタデータ駆動型ランタイムと連結する「コア」ランタイムが含まれます。
- **データ**:マルチテナントリレーショナルデータベースと、Salesforce および Salesforce 以外のデータを管理するためのペタバイト規模の Lakehouse が含まれており、非構造化データとコンテンツ管理、高度な検索、ガバナンス、分析処理機能をサポートします。
- **AI**:予測AIと生成AIを活用してエージェント エクスペリエンスを強化する、基盤となる信頼できるAIテクノロジーを使用してデータ レイヤー上に構築されています。
- **アプリケーション・プラットフォーム・サービス:**IT 管理者、開発者、ベンダーがアプリケーションを構築およびカスタマイズするためのツールを提供し、一般的で複雑なタスクを簡略化するための意見に基づいた抽象化を提供します。
- **ビジネス機能**:多様なビジネスニーズに対応する幅広い機能を提供することで、開発者は必要に応じてアプリケーションをカスタマイズできます。
- **API および API 管理**:適切な形式の API を使用してすべてのプラットフォーム機能にアクセスできるようにすることで、サービスとレイヤーの相互依存関係を促進します。
- **ユーザーおよび開発者エクスペリエンス**:エンドユーザー向けの使いやすいインターフェースと、アプリケーション開発とカスタマイズのためのローコードからプロコードまで幅広い開発ツールを備え、最新の AI 駆動型開発をサポートしています。
- **インテグレーション**:あらゆるエンタープライズアーキテクチャと統合し、データコネクタ、ゼロコピーデータインテグレーション、その他のツールを使用して Salesforce および Salesforce 以外のシステムとの互換性を実現します。
- **アプリケーションと業種**:プラットフォームの統合機能に基づいて構築されたカスタマイズ可能なアプリケーションと業種固有のソリューションスイートを提供し、下位レイヤーのすべての機能を活用して、緊密に統合された AI エージェントを使用します。
## 3\.Hyperforce
Salesforce は、現在のハイパースケーラーや IaaS ベンダーが多数存在する前から、約 25 年間グローバルデータセンターインフラストラクチャを開発してきました。Hyperforceは、Salesforceのインフラストラクチャの進化の現世代であり、世界中の複数のパブリック クラウド プロバイダーで運用できるように設計されています。
柔軟な B2C 拡張性、グローバルデータレジデンシー、可用性の向上、トップレベルのセキュリティ、規制へのコンプライアンスに対する顧客のニーズを満たすように調整されています。Hyperforceは、すべてのSalesforce製品でインフラストラクチャを標準化し、新規買収の迅速な統合を促進します。
Hyperforceは、Salesforce Platformを確実に提供し、新しい機能とアプリケーションを迅速に導入して、世界の20を超える地域でのデータレジデンシーと法規制へのコンプライアンスの要件を満たします。
### 3.1 アーキテクチャの原則
SalesforceのHyperforceへの移行中に、ハイパースケーラーによってサービス、インターフェイス、コンプライアンス レベルに大きな違いがあることが確認されました。Salesforce Platform の堅牢で移植性の高い基盤を構築するために、次のアーキテクチャ原則を採用しました。
- **コードとしてのインフラストラクチャ**:この原則では、ドメイン駆動型アーキテクチャを使用して、インフラストラクチャの宣言型コーディング、不変のアーティファクトの作成、Kubernetes や Service Mesh などの標準を使用したオンデマンドでのインフラストラクチャの自動化を行います。
- **Zero-Trust Security**:ID管理、認証、承認、ネットワークの分離、最小権限セキュリティ ポリシー、転送中および保存中データの暗号化などの包括的な防御戦略を使用して、ゼロトラスト セキュリティ モデルを実装します。
- **管理サービス**:この原則では、マルチテナントとマルチクラウド サービスの使用に重点を置き、商業システム、政府機関システム、エアギャップ システムなど、さまざまなインフラストラクチャや環境間での可搬性を高めます。
- **組み込みの復元力**:ミッションクリティカルなサービスは、高可用性を確保するために複数の可用性ゾーンに分散されています。データは対応可能状況リージョン間で複製されます。サービスには、サービスレベル目標と耐障害性計画を管理するための可用性階層のラベルも付けられています。
- **Fully Observable**:ログ収集、評価指標の収集、アラート、分散追跡、トラフィック量、エラー率、リソース使用率などのサービス操作の追跡など、すべてのサービスを標準の可観測性プラットフォームに統合して効率的に監視します。
- **運用の自動化**:これには、サービス品質の維持、サービスの低下の検出と対処、障害検出のためのインフラストラクチャライフサイクルと予測 AIOps (運用の AI) の自動管理が含まれます。
- **自動化された拡張性**:拡張性とコスト効率に重点を置いたこの原則により、運用リスクを増やすことなく、さまざまな規模で柔軟に運用でき、クラウド プロバイダーに関連する特定のアカウント制限を抽象化できます。
- **FinOps対応**:パブリック クラウドはインフラストラクチャの俊敏性をもたらしますが、コストが増加するリスクがあります。デルは、可用性、セキュリティ、および Customer Trust を損なうことなく、サービスライフサイクル全体にわたって効率重視のエンジニアリング文化を採用しています。
これらの原則は、Salesforce Hyperforce Platformの開発と運用の指針となり、さまざまな環境で適応性、安全性、効率性が維持されるようにします。
### 3.2 インフラストラクチャの概念
Salesforce Platformとそのサポート サービスは、複数のHyperforceインスタンスで構成されるHyperforce Foundationで実行されます。これらのインスタンスは、地理的および対応可能状況に関する顧客の希望に合わせて、さまざまな国に戦略的に分散されます。厳格なデータ レジデンシーと運用の要件を満たすために、必要に応じて1つ以上のHyperforceインスタンスをグループ化し、運用ゾーンとして指定できます。各インスタンスは定期的に更新され、安全性、拡張性、および地域や法的基準へのコンプライアンスが確保されます。
Hyperforceインスタンスは、特定の機能を提供するサービスのクラスターである複数のHyperforce機能ドメイン インスタンスで構成されます。基本的な機能ドメインは、セキュリティ、認証、ログ、監視などの重要なサービスを提供します。これらはすべて、他の Hyperforce サービスに不可欠です。ビジネス機能ドメインでは、Sales Cloud、Service Cloud などのさまざまな Salesforce 製品がサポートされ、製品機能が促進されます。
機能ドメイン内のサービスは、拡張可能で反復可能なサービス提供単位であるセルに編成できます。Hyperforce Cell は、1 つ以上の Salesforce 組織 (組織) が存在する従来の「Salesforce インスタンス」に対応します。セルはスケール単位であり、強力なブラスト半径の境界でもあります。スーパーセルでは、複数のセルの論理グルーピングが提供され、セル間でサービスが共有されるため、より大きなブラスト半径が設定されます。機能ドメインには複数の Supercell を含めることができます。セルとSupercellにより、Hyperforceは機能領域内で水平に拡張でき、同時にブラスト半径のサイズも強力に制御できます。
各Hyperforceインスタンスは、すべてのパブリック クラウド インフラストラクチャにある概念である1つの可用性リージョンに対応付けられ、他のすべてのHyperforceインスタンスから独立して動作できます。Hyperforceインスタンスのすべてのミッションクリティカルなサービスとデータは、フォールト トレランスと安定性を実現するために、少なくとも3つの可用性ゾーンに分散およびレプリケートされます。さらに、ビジネス継続性と規制コンプライアンスのために、データバックアップは他の適切な Hyperforce インスタンスにコピーされます。
Hyperforceインフラストラクチャは、新しいHyperforceインスタンスとセルがその場で作成または更新されるため、常に進化しています。お客様は、Hyperforceの物理的な詳細の変更の影響を受けません。外部に表示されるすべての顧客エンドポイントは、現在のデータとサービスロケーションにトラフィックを安全に転送する安定した安全な Salesforce の \[私のドメイン] (acme.my.salesforce.com など) を介してアクセスします。送信トラフィック (メール、Web コールアウトなど) は、ドメイン鍵 ID メール (DKIM) や mTLS などの安全なメカニズムを使用して実装し、顧客のオンプレミスインフラストラクチャが Salesforce インフラストラクチャの物理的な詳細 (経時的に変化する IP アドレスなど) をハードコードしないようにすることをお勧めします。
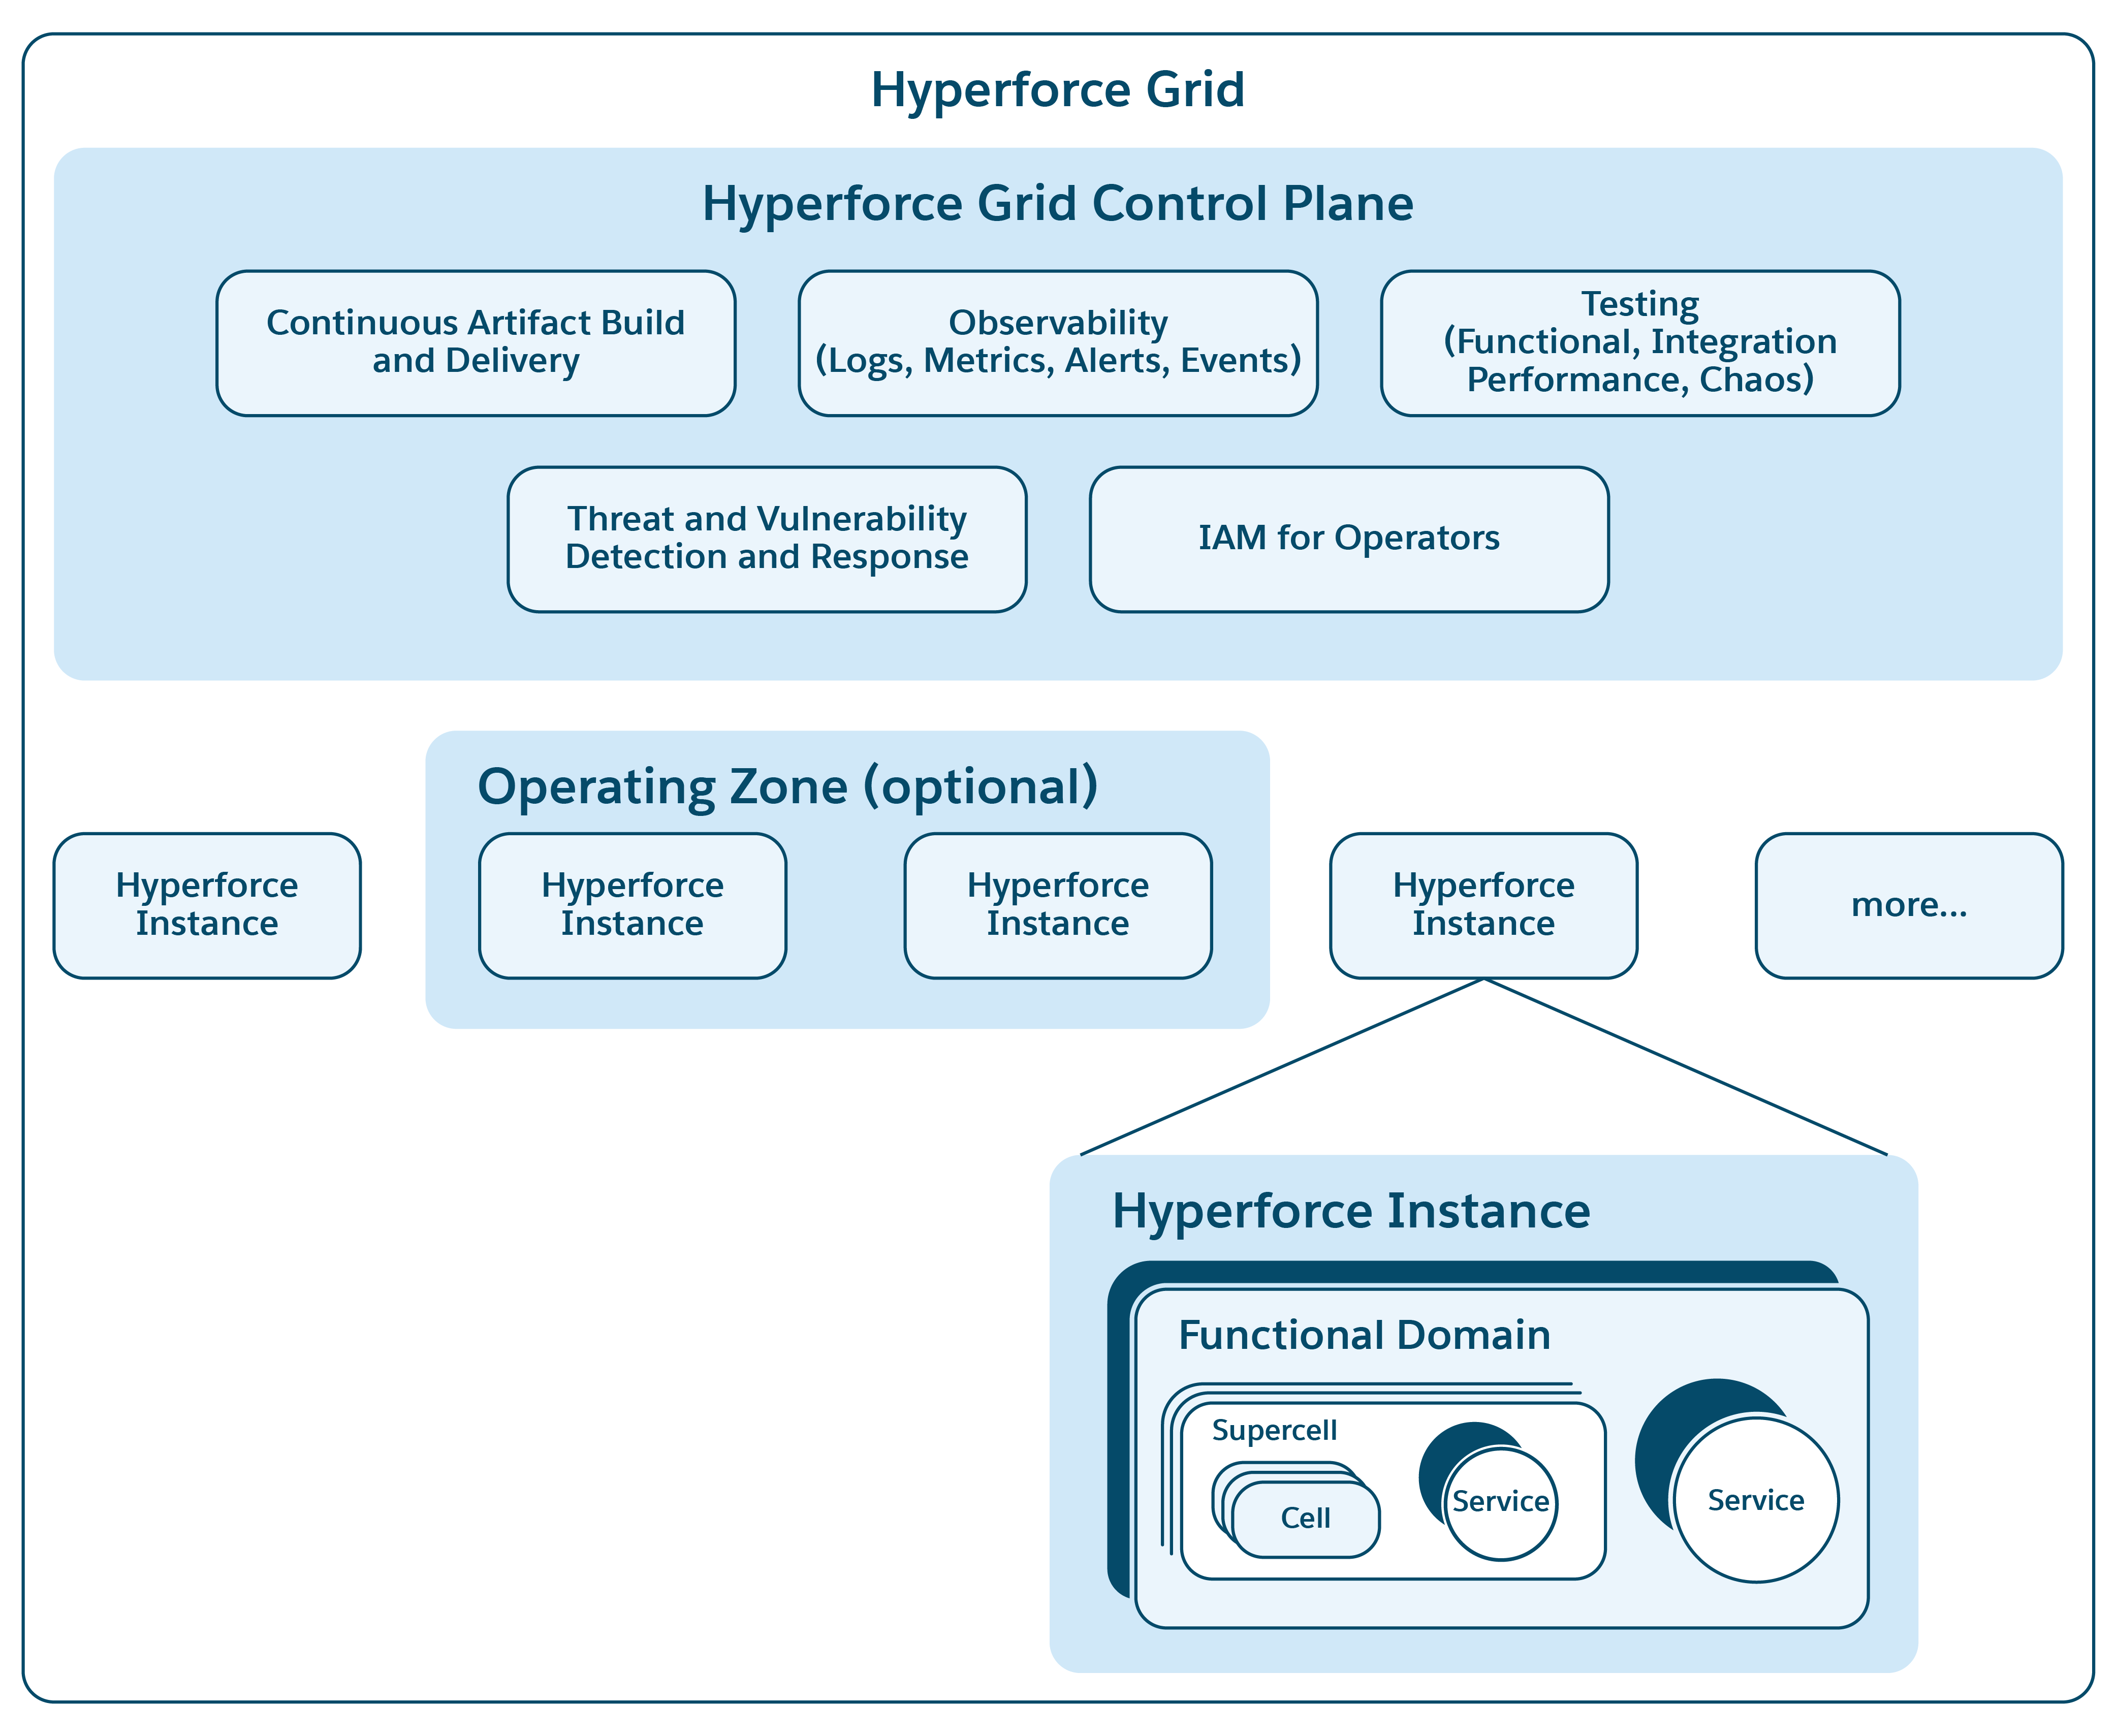 ### 3.3 ネットワークセキュリティ
Hyperforce 機能ドメインは、堅牢なセキュリティ対策を使用して設計されています。各ドメインは境界で保護され、隔離されています。ドメイン内のサービスはセキュリティを強化するために専用アカウントに分割されています。サービス間の通信は、サービスメッシュまたは同様のプロトコルを使用して安全に促進されます。トラフィック管理は、入力ゲートウェイと出力ゲートウェイによって処理され、必要な制御 (サーキットブレーカーやレート制限など) が検査、ルーティングされ、すべての着信トラフィックと発信トラフィックに適用されます。
Hyperforce機能ドメイン内のサービスはセキュリティ グループにグループ化され、エッジ グループのサービスのみがパブリック インターネットに公開されます。ランタイムセキュリティポリシーでは、サービスに必要なアクセス権のみが付与されるように最小権限の原則に従って、さまざまなセキュリティグループ間の通信ルールが適用されます。
各地域には、トランスポート レイヤー セキュリティを終了し、プログラム可能なWebアプリケーション ファイアウォール ポリシーを採用して脅威に事前に対処するHyperforce Edge機能ドメインがあります。これにより、安全で効率的なカスタマー エクスペリエンスを維持しながら、正当なトラフィックのみがHyperforceエンドポイントに到達します。さらに、Hyperforceインスタンス間の内部ネットワーク リンクは厳密に制御され、個人識別情報を含むすべてのログ データはGDPR標準に準拠するように匿名化されます。
### 3.4 Hyperforce グリッドコントロールプレーン
Hyperforceグリッドは、同じコントロール プレーンを共有する複数のHyperforceインスタンスで構成され、機密性の高いワークロードを必要に応じて分離するように設計されています。これにより、グリッド全体で顧客データ、システムデータ、プラットフォームメタデータ、監視データの漏洩がなくなります。コントロール プレーンは、冗長なHyperforceインスタンスで構成されます。このインスタンスは、顧客向けのHyperforceインスタンスを作成、管理、監視するための基本的なサービスをホストします。
すべてのHyperforceサービスのサービスおよびインフラストラクチャ コードは、専用のコントロール プレーン機能ドメイン内で安全に開発され、ソース コード管理、継続的インテグレーション、テスト、アーティファクト作成サービスが使用されます。生成されたコードは、標準化されたデジタル署名コンテナにパッケージ化され、画像レジストリに保存される前に、脅威と脆弱性がないかスキャンされます。コードのリリースは、Hyperforce Continuous Deliveryシステムの承認されたパイプラインによって処理され、リリース権限は承認されたチームとオペレーターに制限されます。Airgapped Control Plane (エアギャップコントロールプレーン) は、そのような環境に必要な追加の保護を処理します。
ID およびアクセス管理 (IAM) サービスでは、ジャストインタイム承認を適用してアクセス期間とアクションを制限します。また、監査履歴ではすべての活動を監視し、疑わしい活動を特定してアラートを出すためにリアルタイム検出システムに入力されます。
### 3.5 Hyperforceコスト管理
Salesforceがファースト パーティ データセンターからパブリック クラウドのHyperforceにサービスを移行する場合、予算の作成、コストの視覚化、リソースの最適化戦略を刷新することが非常に重要です。
当社のコスト管理アプローチは、コスト削減のみを目的とするのではなく、成長に向けた商品と安定した商品を区別する戦略的なプロセスです。Trustのコア バリューに沿って、商品の可用性を維持する消費ベースの価格設定とマージンを計画します。パブリッククラウドアカウントは階層的に整理され、特定の製品とエグゼクティブにリンクされています。組織のメタデータで強化された詳細なサービスレベルのリソースタグ付けにより、個々のマイクロサービスのコストを特定できます。Tableau や Slack などのツールと高度な売上予測ツールを使用して、役員やチームはコスト、売上予測、予算分析に関するリアルタイムデータを取得し、将来の財務計画の信頼性を高めることができます。
コスト管理を最適化するために、Salesforce では \[Compute Savings Plans (節約プランを計算)]、\[Spot Capacity (スポット業務量)]、\[On-Demand CapacityReservations (ODCR)] を組み合わせて、必要な業務量を保証します。これらの予約は、高度な時系列予測とカスタムダッシュボードで管理され、人の監視と意思決定を可能にします。単位トランザクションコストの削減 (定義されたビジネストランザクション量の処理コスト) に関する達成可能な目標を設定することは、改善を促進する効果的な戦略です。Hyperforce Unit Cost Explorerツールを使用すると、チームはユニット コストのトレンドを分析および管理し、コストを特定のサービスに帰属させ、新しい改善の機会を特定できます。Salesforce Cloud 最適化インデックス (「COIN」スコア) は、節約商談の動的なリストに対してサービスを評価し、サービスチームが最適なリソース効率を維持できるようにします。
サステナビリティへの揺るぎないコミットメントでは、カーボンフットプリントの削減を積極的に追求し、遂行する作業に対する排出量の指標である「Carbon to Serve (提供するカーボン)」という単位を削減する具体的な目標を設定します。
## 4\.エンタープライズ クラスのTrust
セキュリティと可用性は、エンタープライズ クラスのプラットフォームの極めて基本的な側面であり、Customer Trustを維持するために不可欠です。Salesforce では、これらの制御は Salesforce Platform に不可欠であり、共有サービスとソフトウェアフレームワークを介して自動的に適用されます。この組み込みのアプローチにより、個々のシステムに追加の手間をかけることなくメリットが得られます。
何千ものサービスと何百ものチームにまたがるこの広範なセキュリティと可用性の制御を管理し、継続的に強化するには、大きな課題があります。ただし、些細なことでも見逃してしまうとセキュリティ侵害やシステム停止につながるため、注意が必要です。
### 4.1 セキュリティ
Hyperforceは、高度なセキュリティ機能を備えたサービスの開発と導入をサポートする、安全でコンプライアンスに準拠したインフラストラクチャ プラットフォームです。強力なアクセス制御、データ暗号化、セキュリティ標準へのコンプライアンスが提供されます。Salesforce は、PCI/DSS、GDPR、HIPAA、FedRamp など、40 を超えるセキュリティおよびコンプライアンス標準に準拠しています。
主要なセキュリティ原則には、ZTA(Zero Trust Architecture)とエンド ツー エンドの暗号化が含まれ、すべての処理フェーズで顧客データを保護します。Salesforce は、セキュアなソフトウェア開発ライフサイクルから本番運用に至るまでのセキュリティ標準とベストプラクティスに準拠し、潜在的な脅威を軽減する堅牢なアプリケーションレベルのセキュリティプラクティスも備えています。
#### ゼロトラストアーキテクチャ (ZTA)
ZTAサイバーセキュリティパラダイムでは、場所に関係なく、すべてのユーザー、デバイス、サービス接続が認証、承認、継続的な検証を受けます。ZTAとPKI(公開鍵インフラストラクチャ)は、境界セキュリティに依存せずにTrust境界を確立し、通信を保護する最新のサイバーセキュリティに不可欠です。
ただし、PKI リリースでは、多くの場合、証明書の取り消しとルート認証機関に対するガバナンスの重要性が見過ごされています。Salesforce の証明書失効の実装は堅牢で拡張性が高く、エンドツーエンドの PKI セキュリティをサポートします。
さらに、Hyperforceは、ロール ベースのアクセス制御を使用するユーザーに対して、有効期間の短い非公開鍵とジャスト イン タイム アクセスを使用して、サービス間の相互トランスポート層セキュリティを通じてZTAを適用します。
#### エンドツーエンドの暗号化
Salesforce Platform では、TLS と完全転送秘密暗号化スイートを使用して転送中のデータを保護します。これにより、データがユーザーデバイスと Salesforce サービス間のネットワーク上および Salesforce インフラストラクチャドメイン内で転送されるときにデータが保護されます。
保存データの場合、Salesforce Platform ではハードウェアセキュリティモジュールでサポートされる鍵管理システムが使用されます。マルチテナントプラットフォームでは、各テナントに一意の暗号化鍵が割り当てられるため、テナント間で鍵がクロスすることはありません。
通信と暗号化のセキュリティは、鍵やランダムなデータを生成するエントロピーに大きく依存します。予測可能な鍵の生成による攻撃に対する暗号プロトコルの脆弱性を認識し、Salesforce Platform はすべての鍵の生成プロセスで複数の発生源からエントロピーを調達することでこのリスクを軽減します。コールド ブート攻撃からの保護を強化するために、クラウド サービス プロバイダーによって有効化されるさまざまなプロセッサーで使用できるメモリー暗号化機能を活用します。
#### セキュアなソフトウェア開発ライフサイクル
Salesforce には、連邦情報処理標準 (FIPS) などの多くのコンプライアンス標準を満たすようにカスタマイズされた JDK があり、開発者とオペレーターがコンプライアンス作業を自分で行う必要がなくなるため、プロセスが簡素化されます。このカスタマイズにより、XML 外部エンティティインジェクション (XXE) などのリスクを回避できるだけでなく、Salesforce の暗号化の俊敏性が向上し、必要に応じて暗号化戦略を交換できます。完全な書き直しを必要とせずに、非準拠コードを (内部で開発されたか、オープンリポジトリから取得されたかに関係なく) FIPS 準拠のコードに変換できるため、開発チームの作業負荷が軽減され、デフォルトでセキュアな設計原則が遵守されます。
さらに、Salesforce では、保護措置をセキュアなソフトウェア開発ライフサイクル (SSDL) に統合することで、クロスサイトスクリプティング (XSS)、リクエストフォージェリ (CSRF)、SQL インジェクションなどの脆弱性に対処するフレームワークを取り入れています。
ロールベースのアクセス制御 (RBAC) で強化された一元化された秘密管理システムが実装され、サービスとユーザーアクセスの両方が保護されます。さらに、コードスキャンツールを使用して、本番環境でソースコード管理システムを介して秘密が誤って公開されるのを防ぎます。
#### Hyperforce 運用セキュリティ機能
フィッシングは依然として組織にとって重大な脅威であり、SalesforceはCISA(サイバーセキュリティおよびインフラストラクチャ セキュリティ機関)のZero Trustの原則など、さまざまな業界のベスト プラクティスに従って、フィッシングに強いMFA(多要素認証)を実装しています。これには、本番アクセス権を持つ従業員のハードウェアベースの鍵と、クラウドサービスプロバイダーアカウントへのアクセスを制御するための安全なカーネルが含まれます。
堅牢なセキュリティ体制を維持するために、Salesforceは標準化されたセキュリティ コントロールとクラウド ネイティブのセキュリティ サービスをHyperforceに統合し、可視性、脅威検出、ポリシー適用を強化しています。リアルタイムの監視、アラート、およびレポートを行うための包括的なセキュリティ情報とイベント管理システムが導入されており、徹底した脆弱性管理プログラムとクラウドセキュリティ体制管理ツールによって、脆弱性を継続的に特定、評価、修正できます。
さらに、Web アプリケーションファイアウォールは HTTP トラフィックをフィルタリングして監視し、さまざまな攻撃から保護します。また、ファイアウォール、侵入検知および防止システム、仮想プライベートネットワーク、エンドポイント検知および応答エージェントなどのさまざまなネットワークセキュリティツールを使用して、継続的な監視と脅威検知が提供されます。ネットワークセグメンテーションとマイクロセグメンテーションは、攻撃対象領域を最小限に抑え、潜在的な侵害を抑制するために実装されます。
また、SalesforceはHyperforce固有の課題に合わせて調整された堅牢なインシデント対応計画を作成して実装し、セキュリティ インシデントを特定、阻止、軽減するための手順を事前定義して、潜在的なセキュリティ脅威に迅速かつ効果的に対応できるようにします。
### 4.2 可用性
Salesforce は、高可用性を必要とするミッションクリティカルな顧客のワークロードを管理します。高可用性の戦略には、サービス所有権モデル、インシデント管理、運用レビューなどのさまざまな組織の側面が含まれます。当社の戦略の主要な技術要素には、監視アーキテクチャ、AI 主導の業務の自動化、生産変更の自動安全メカニズムが含まれます。
#### 可用性アーキテクチャ標準
数千ものサービスで一貫して高可用性を実現するために、3 ステップのアプローチで大規模な技術リスクを管理します。
まず、可用性アーキテクチャ標準が確立され、次のようなベストプラクティスが定義されます。
- 自動フェール**オーバーによる冗長性**。大規模なクラウドベースのシステムで頻繁に発生する障害に対応するために、Salesforce は高度な冗長性、完全に自動化された障害検出、完全な障害と部分的な障害の両方に対するシームレスな自動復旧機能を備えたサービスを構築しています。
- **制限爆風半径**。障害_は_発生するため、チームは意図的な突風半径の最大値を使用してすべてのサービスを設計し、障害の影響に対応します。最も一般的でわかりやすい例は、Hyperforce セル (fka Pod) です。
- **失敗を区分**化する。システムの独立したユニット間での障害の拡散や複合化を防止します。サービス間のフォールトトレラント API コールは、分散システム全体で障害が連鎖しないようにする主要なパターンです。この過程で、チームは冗長性と区画化のバランスを慎重に調整します。
- **自動拡張**。パフォーマンスを低下させることなく予測できない負荷を提供するには、CPU、メモリ、キューの深度などのリソースの飽和ポイントによってトリガーされ、低速で誤動作しやすい人間の演算子に頼らずに、自動的に迅速にスケールアップおよびスケールダウンします。
- **高速ロールバック**。すべてのサービスのロールバック目標が分単位で設定され、ロールバック、戻る、および再び進む操作をデフォルトに設定することで、本番稼働前の環境でロールバックが自動的にテストされます。チームは、より迅速で詳細な緊急切り替えとロールアウトのために機能フラグを幅広く使用しています。
- **API コールを受信**するすべてのサービスを保護します。負荷制限、テナントの公正制限、Web アプリケーションファイアウォール、高度なレイヤー 7 保護は、インターネットに直接公開される境界サービスから、上位レベルの通話サービスのバグによって誤って攻撃される可能性があるチームの最も深い内部サービスまで、システムのすべてのレベルでリリースされます。
- **多くの場合、連動**関係があります。サービス間の連動関係は、単独で失敗または成功できるように、可能な限りソフトに設計されています。キャッシュは、ここで最も一般的なパターンの 1 つです。多くの場合、ダウンストリームの連動関係から生じる古い結果は、機能を継続するために十分です。
- 非**同期通信を推奨**。サービス間の非同期の仲介通信により、それらのサービスが相互に切り離され、サービス間の負荷スパイクがバッファリングされます。
- **API コールを耐障害**性にします。部分的な障害や一時的なネットワークの問題に寛容であるため、タイムアウトと期限、回線切断、バックオフを伴う再試行など、いくつかのパターンを使用します。リソースの消費とブロックを制限するために、可能な場合はノンブロッキングコールをお勧めします。ビルド時およびインテグレーションテスト時にスキーマレベルの下位互換性が適用されます。
- **サービス クォータと制約**を管理します。チームは、IP アドレス、ディスク IOps、特定の Kubernetes クラスターの容量など、サービス車両全体の目標や制約を設定します。チームは、これらの目標や制約の利用状況を一元的に集計、監視、アラートすることで、実行時に制限が近づいてもシステムに影響が及ばないようにします。
2 つ目は、多層検査モデルによってサービスがこれらの標準を満たしていることです。これには、自動化されたカオステスト、アンチパターンのスキャンとライニング、自動化で解決されない問題を把握するためのシニアアーキテクトとのアーキテクチャレビューが含まれます。
第3に、ソリューションはHyperforceに統合されているため、これらの標準への準拠が容易です。これには、自動テレメトリ収集、デフォルトの冗長性、フェールオーバーメカニズム、および負荷制限や DDoS 防御などの組み込み保護が含まれ、これらはすべて個々のサービスでデフォルトで有効化されます。
#### 監視とオブザーバビリティ
Salesforce は、総計値、ログ、イベント、トレースなど、従来の監視ソリューションでは必ずしも効果的に管理できない大量のテレメトリデータを処理します。
これに対応するために、Salesforce はソフトウェア開発ライフサイクル、業務、およびサポート機能と統合された包括的な観測システムを開発しました。このシステムは、エンジニアリングチームとカスタマーサポートチームに統合された環境を提供すると同時に、スケールニーズを満たし、サードパーティソフトウェアのライセンスコストを削減します。
OpenTSDB と HBase 上に構築された Salesforce の指標インフラストラクチャでは、時系列データの大規模な収集、保存、リアルタイムクエリがサポートされます。非リアルタイムの使用事例では、Trino と Iceberg を使用して 1 分あたり 20 億を超える総計値を処理し、CPU 使用率、メモリ使用率、要求レートに関するインサイトを提供します。Salesforce では、ログ管理に Splunk を使用して、強力なインデックス付けと検索機能を実現しています。Apache Druid では、ユーザー操作やシステムイベントを理解するために重要な大規模イベントデータのリアルタイム取り込みと分析がサポートされます。マイクロサービス間の分散トレースは OpenTelemetry と ElasticSearch で管理されるため、特定の遅延や障害ポイントを特定するのに役立ちます。
また、Salesforce はデータ収集およびテレメトリーストアのテクノロジースタックと統合するアプリケーションパフォーマンス監視 (APM) インフラストラクチャを実装しました。このアプリケーションの自動計測により、データ収集が簡素化され、サービス全体で一貫したテレメトリが保証されます。APM の統合ダッシュボードでは、さまざまなデータ型が関連付けられるため、エンジニアは、一貫性のあるインターフェースでパフォーマンスの監視、問題の診断、システムの最適化を行うことができます。
オブザーバビリティツールを標準化することで、Salesforce は分散トレーシングを使用してさまざまなテレメトリ種別をサービス間でリンクします。これにより、包括的なサービス連動関係グラフが作成され、サービスエコシステム全体が視覚化され、要求がきめ細かく追跡されます。この機能は、問題を特定し、ボトルネックを特定し、異常検知、予測分析、自動修復などの AI 主導の機能をサポートするために不可欠です。
#### AIOps エージェント
インシデントの解決時間を短縮するために、AI オペレーション (AIOps) エージェントを開発しました。このエージェントは、人間のオペレーターに代わってインシデントを自動的に検出、トリアージ、修正し、介入するケースはごく少数です。AIOps エージェントは、複雑で反応型のエージェントベースのシステムの開発を促進するように設計された、スケーラブルなマルチエージェント反応型ツールキットです。高度にモジュール化されており、さまざまなツールを使用して機能を拡張できます。エージェント数の増加に合わせて効率的に拡張できるように設計されています。主な機能として、エージェントが環境の変化に動的に対応できる反応型アーキテクチャ、エージェントの機能を拡張するツールを簡単に統合できるツールの機能強化、さまざまな計画モジュールをプラグインしてエージェントの計画戦略をカスタマイズできるプラグイン可能な計画モジュールなどがあります。
AI 研究チームが開発した一般公開されているオープンソースライブラリである Merlion ライブラリの高度な機械学習モデルを使用して、CRM 製品コアインシデントの 91% (執筆時) で迅速なプロアクティブ検出を実現しています。Merlion は、分離フォレスト、統計、ランダムフォレスト、ロング短期記憶 (LSTM) ニューラルネットワークなどの機械学習モデルのアンサンブルであり、システムで生成された広範なテレメトリデータをほぼリアルタイムで処理します。
インシデントの 79% (執筆時) は、エージェントのアクションによって自動的に解決されます。AIOps エージェントは、ログ、プロファイリング、診断、時系列、サービス固有のアーティファクトなどのデータベクトルを処理して優先順位を付け、改善アクションを推奨できます。AIOps エージェントコントローラーとプランナーは、本番でアクションを実行する特定のスキルを持つエージェントを選択します。
人間の関与が必要な残りのインシデントについては、AIOps エージェントが未解決の問題を適切なサービスチームに効率的に優先順位を付けます。これは、問題レコード、インシデント、JFR、ログなどの運用データセットでトレーニングされた社内微調整モデル XGenOps を使用して各インシデントの性質とコンテキストをインテリジェントに理解し、必要な専門知識を持つチームに確実に転送することで実現されます。これにより、エンジニアが未解決の問題に優先順位を付ける必要がなくなり、1 週間あたり 2800 時間以上のエンジニアリング時間が節約されます。
#### 継続的なリリース
毎週行われる約 25 万件の本番変更によるシステム停止のリスクを管理するために、完全に自動化されたリリースシステムを使用して安全な変更方法を適用し、人為的ミスを排除します。既成のシステムでは拡張性やカスタマイズ性に欠けるため、よりカスタマイズされたソリューションを開発する必要がありました。
カスタム連続リリースシステムは、業界標準の青/緑のリリース戦略に従って、複数のレイヤーで安全性を確保します。
- 各変更の必須テスト証拠。
- 変更の初期カナリアテスト。
- ブラスト半径が制御された 段階的配置
- リリースフェーズ間の浸漬と状態チェック。
- 既存のモラトリアムやインシデントとの競合を軽減します。
さらに、継続的インテグレーションシステムは、数百万の AI が選択したテストを実行するように最適化されているため、回帰リスクを最小限に抑えながら迅速なリリースが可能です。
## 5\.メタデータフレームワーク
Salesforce Platform のコアアーキテクチャの原則は、メタデータ駆動設計です。Salesforce エンジニアがマルチテナントサービスとデータストアを作成します。プラットフォーム上の各アプリケーションは、本質的にメタデータのコレクションであり、個々の顧客がこれらのマルチテナントサービスをどのように使用するかを調整します。そのため、Salesforce Platform の一般的なマーケティングフレーズは「すべてメタデータでアクセス」です。
このプラットフォームでは、構造化された強く型指定されたメタデータが強調されます。このメタデータは、カスタマーエクスペリエンスと基盤となる Salesforce インフラストラクチャおよび実装間の抽象レイヤーとして機能します。このアプローチにより、アプリケーションの使いやすさと品質の両方が向上します。たとえば、SQL スキーマ定義とクエリを使用する代わりに、Salesforce オブジェクト (sObject) API を使用してエンティティ、項目、レコードなどの構造化メタデータを操作します。この設計により、アプリケーションを書き直すことなく、プラットフォームで新しいデータストレージテクノロジーを統合したり、既存のテクノロジーを変更したりできるため、継続的な開発のベストプラクティスをサポートできます。
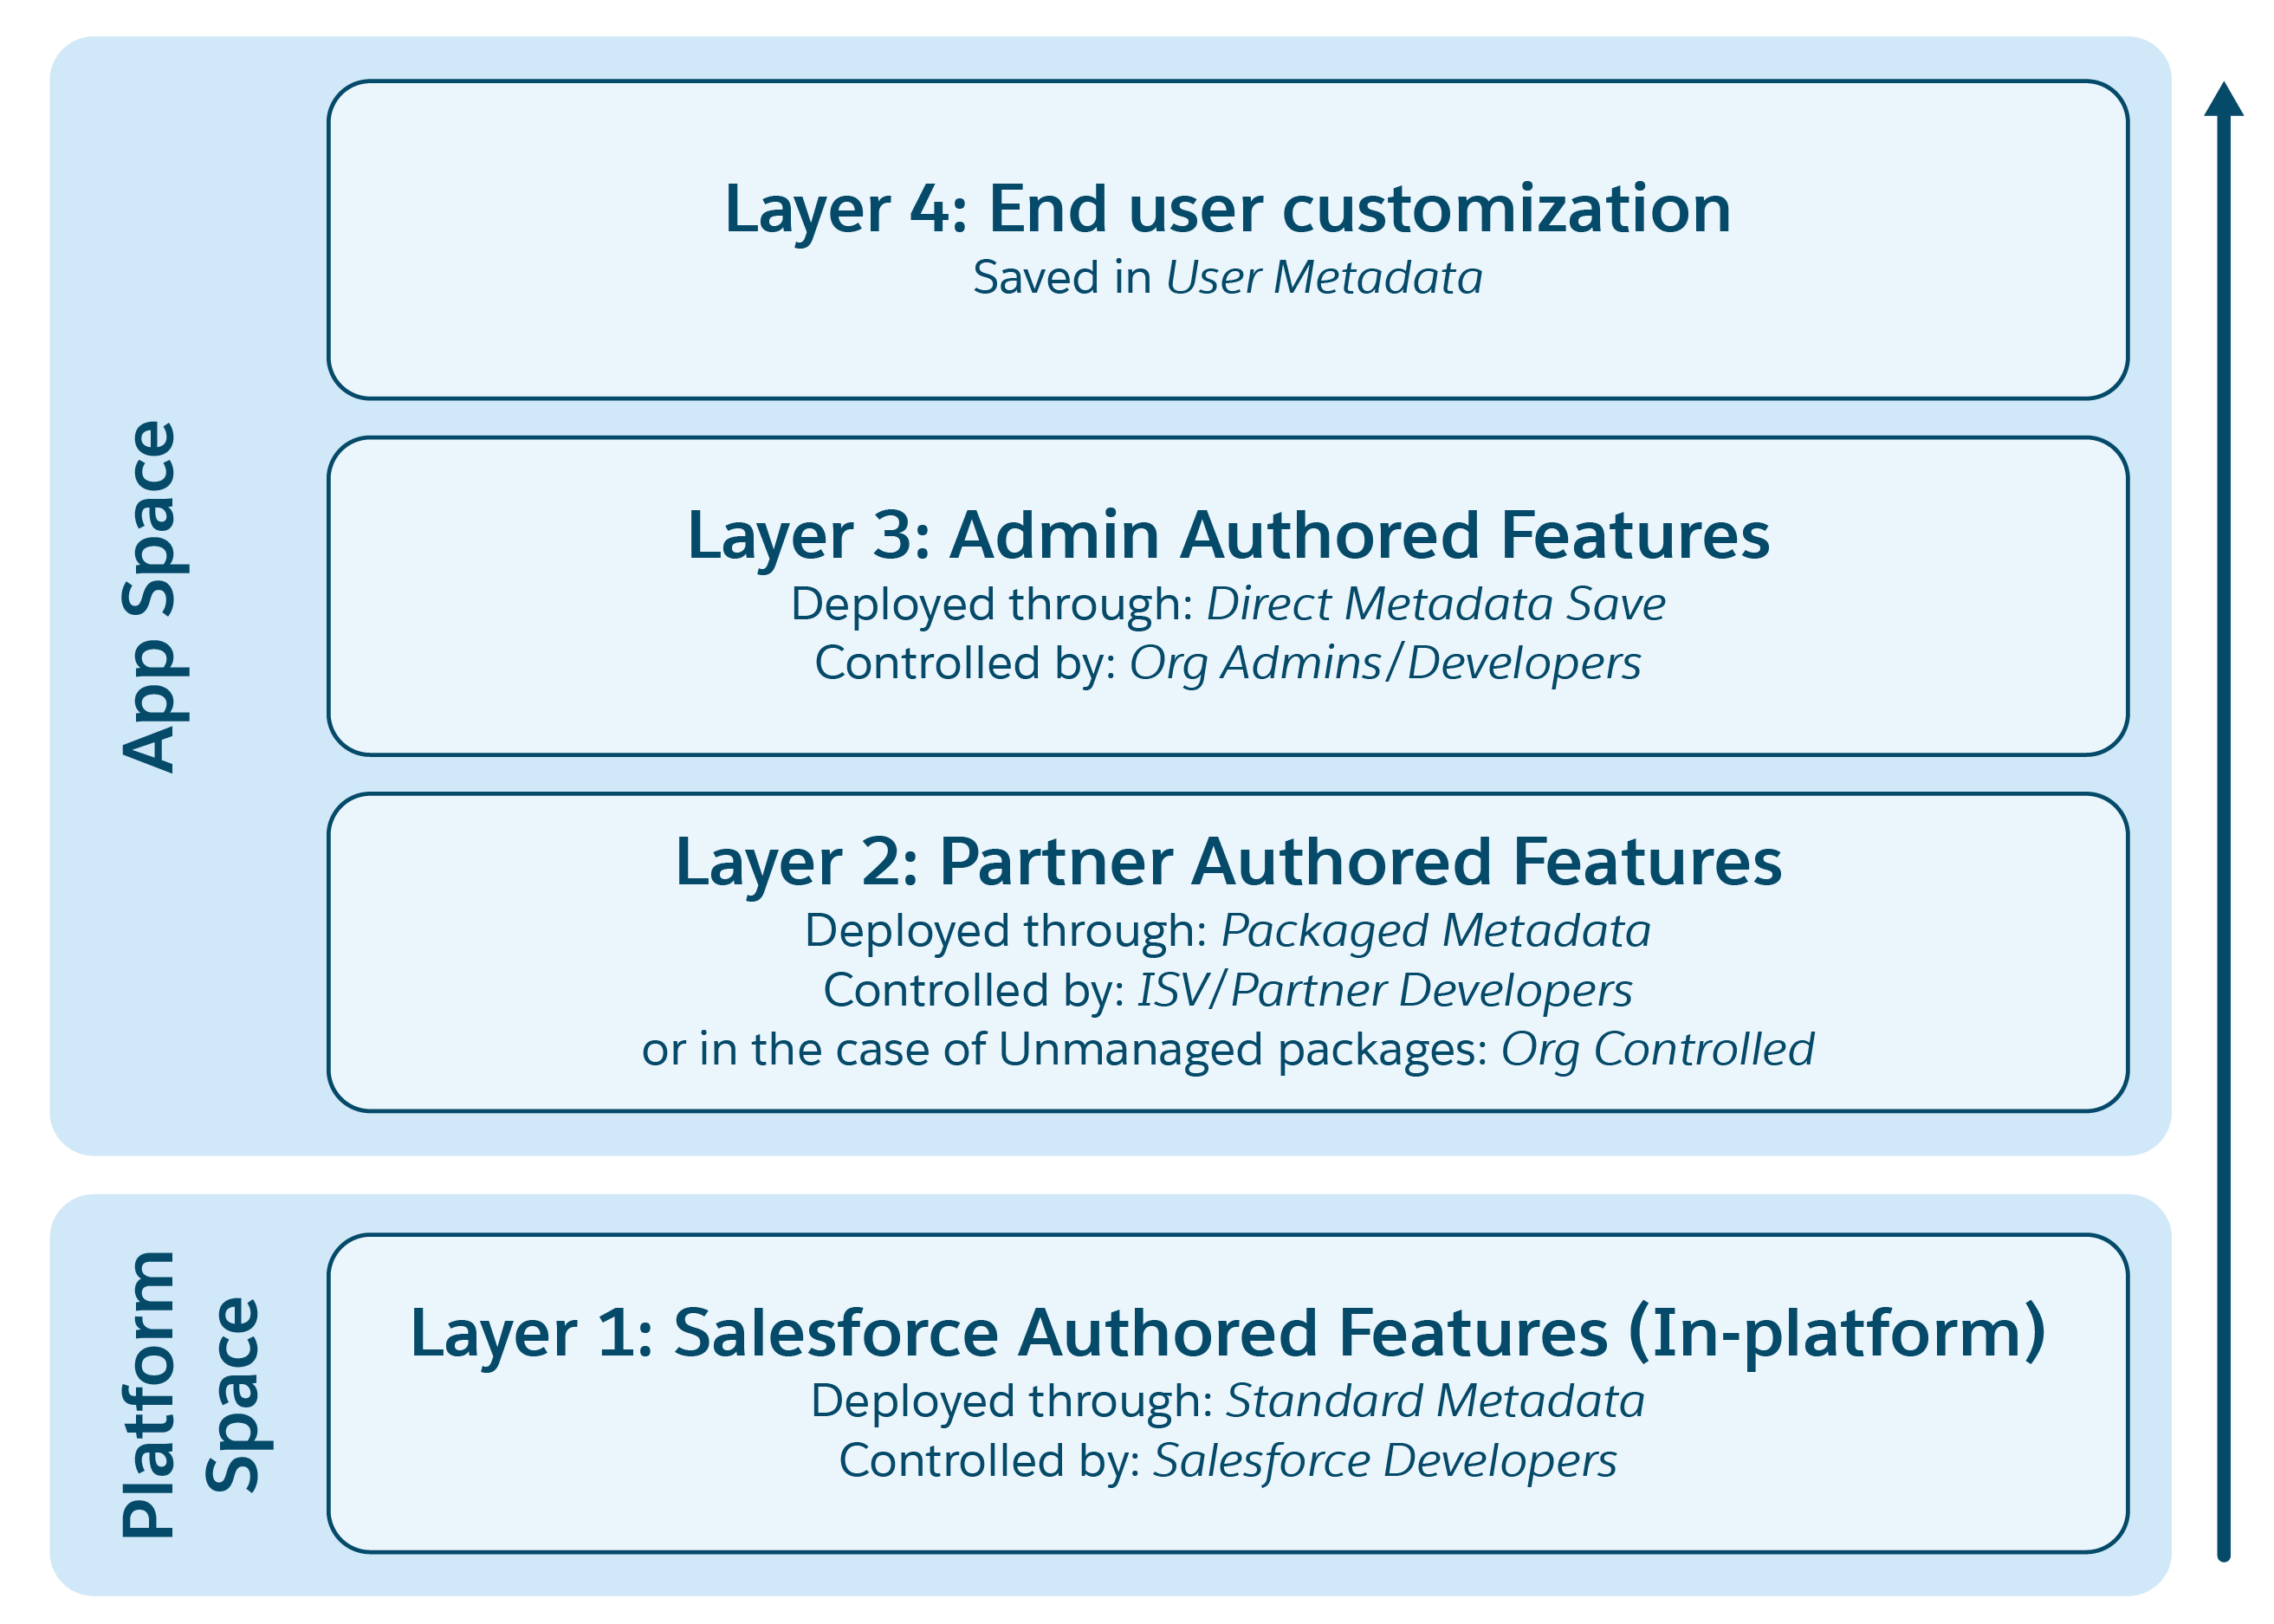 Salesforce Platform アーキテクチャには、アプリケーションの作成と拡張で 4 つの主要な人格をサポートする「階層化された拡張」アプローチがあります。
- **Salesforceエンジニアリング:**チームは Sales Cloud や Service Cloud などのネイティブアプリケーションを開発し、広範なリリースプロセスを通じてすべてのサービスとランタイムにリリースされます。これらのアプリケーションは、ライセンスおよびプロビジョニングメカニズムを介してすべてのテナントが使用できます。
- **外部パートナー**:独立系ソフトウェアベンダー (ISV) や他のパートナーは、Salesforce で作成されたメタデータを拡張して、Sales Cloud データモデルのスキーマ拡張や Service Cloud ケースレコードの追加の入力規則などの付加価値ソリューションを構築できます。これらのソリューションをパッケージ化して、複数の顧客に配布できます。
- **組織固有のIT管理者および開発者**:ISV が提供する以上のアプリケーションをカスタマイズし、独自のプロセスや地域固有のプロセスなど、固有のビジネス課題に合わせてソリューションをカスタマイズできます。
- **個々のエンドユーザー**:エンドユーザーは、リストビューの列の順序の変更やデフォルトタブの設定など、アプリケーション環境をパーソナライズできます。
下位レイヤーが上位レイヤーの人格の変更に依存しないようにし、強力なバージョン管理と下位互換性契約を維持することで、各人格が同じアプリケーションで独立して反復できます。
「階層化された拡張」の概念を強調する機能の 1 つに、4 つのレイヤーすべてのビジネスロジックが予測可能な順序で適用されるようにする実行順序のレコード保存があります。これにより、組織の管理者または IT 開発者が判断したより具体的な上位レイヤーのビジネスロジックを、Salesforce または外部パートナーが提供するレコードの保存時に下位レイヤーのロジックを適切に上書きできます。
さらに、プラットフォームのメタデータフレームワークでは、「コア」ランタイムとマルチテナンシーが組み込まれた独自のオブジェクトリレーショナルマッパー (ORM) が使用され、リレーショナルデータベースに接続されます。このコアランタイムにより、共有メモリ状態、参照整合性の検証、トランザクションコミットが可能になり、アプリケーションの安定性が優先され、アプリケーションリリースの信頼性が向上します。このアーキテクチャは、アプリケーションの複雑さの増大に対応するために進化を続けています。たとえば、2025 年 10 月現在、Salesforce で定義されたエンティティは 85,000 個を超え、カスタムエンティティは 3 億個を超えています。
これまで、コアランタイムはプラットフォームとアプリケーションの機能の大部分をホストしていました。Salesforce Platform の現在のアーキテクチャには、数百もの独立したメタデータ駆動型サービスが含まれるようになりました。コアランタイムは引き続きアプリケーションメタデータの単一レコードシステムであり、モノリシックアーキテクチャの独自のメリットをメタデータ管理に利用します。関連するメタデータは、独立したサービスのローカルキャッシュに同期され、アプリケーションランタイム用のスケーラブルな多様なサービスが強化されます。
## 6\.データ
データは組織にとって不可欠な資産であり、HyperforceはSalesforceのストレージに信頼性の高い基盤を提供します。重要な課題は、アプリケーションのユーティリティを最適化する方法でデータを保存することです。Salesforce Platform は、さまざまなストレージとアクセスの要件に対応することで、データレイヤーを変革しました。コスト、読み取り/書き込み速度、ストレージ容量、およびデータ型を効果的にバランスさせて、さまざまなニーズに対応します。
AI と分析によってエンタープライズアプリケーションが形成されていくにつれて、データが重要な要素として登場しています。その重要性は、AI と分析でプロセスを学習、分析、意思決定、自動化できるようにすることです。
データは記録システム (SOR) データベースから取得され、企業の業務要件を満たします。その後、AI と分析駆動型アプリケーションを強化するために不可欠な Big Data プラットフォームへのさまざまな変換を経て移行します。
価値を引き出し、高度なアプリケーションをサポートするには、トランザクション情報から分析インサイトまで、データを効果的に管理することが不可欠です。Salesforce データベース (SalesforceDB) は SOR データを管理するための高度なトランザクションデータベースであり、Data 360 は AI と分析機能を強化する堅牢なビッグデータプラットフォームとして機能します。
### 6.1 トランザクションデータベース
トランザクションデータとメタデータは、Salesforce Platform に不可欠です。SalesforceDB は、Salesforce のマルチテナントワークロード専用に設計された最新のクラウドネイティブリレーショナルデータベースです。主要プロバイダーの他のクラウドデータベースに似ていますが、Salesforce アーキテクチャのカスタム機能を備えています。PostgreSQL を拡張し、コンピューティングとストレージを分離し、Kubernetes とクラウドストレージを活用して、暗号化や Sandbox などのテナント固有の機能で運用を強化します。
SalesforceDB は、すべてのトランザクション CRM データ、月間 1.1 兆件以上のトランザクション、および Data 360 と関連サービスのメタデータを処理します。その主な目的は、耐久性、可用性、パフォーマンス、セキュリティによるTrustの確保、大規模なお客様向けの拡張性、シンプルで信頼性の高いクラウド運用の促進です。コンピューティングレイヤーとストレージレイヤー、不変の分散ストレージシステム、ログ構造化された差し込みツリーデータアクセスを分離する設計により、これらの目標を達成します。これにより、ストレージ内のデータのテナントごとの暗号化や、効率的な Sandbox および移行などの高度な機能が可能になります。
#### アーキテクチャの概要
SalesforceDB サービスアーキテクチャは 3 つの可用性ゾーンで実行され、コンピューティングとストレージはゾーン間でレプリケートされるため、ノードまたはゾーン全体が消失した場合でもシステムを引き続き使用できます。すべてのサービスは Kubernetes で実行され、自動障害復旧とサービスリリースを実現します。
高レベルの耐久性と可用性を提供するために、SalesforceDB の最終的な記録システムは AWS の S3 のようなクラウドストレージです。アーカイブやリージョン間レプリケーションなどの操作は、このクラウドストレージレベルで管理されます。ストレージオブジェクトは不変であり、データの配布とレプリケーションを強化して高可用性を実現します。
クラウドストレージの遅延が大きいため、SalesforceDB はストレージキャッシュを使用してデータにアクセスします。これらのキャッシュは分散ストレージ システムで、ノードのクラスターでストレージ オブジェクトの一時的なコピーを保持し、データベースで必要とされるレプリケーションと耐久性を確保します。トランザクションログストレージとデータファイルストレージには、別々のキャッシュが使用されます。
SQLコンピューティング階層は、プライマリ データベース クラスターと、3つの異なる可用性ゾーンにある2つのスタンバイ クラスターで構成されます。プライマリクラスタはすべてのデータベースの変更を処理し、スタンバイクラスタはクエリ操作のみを処理します。
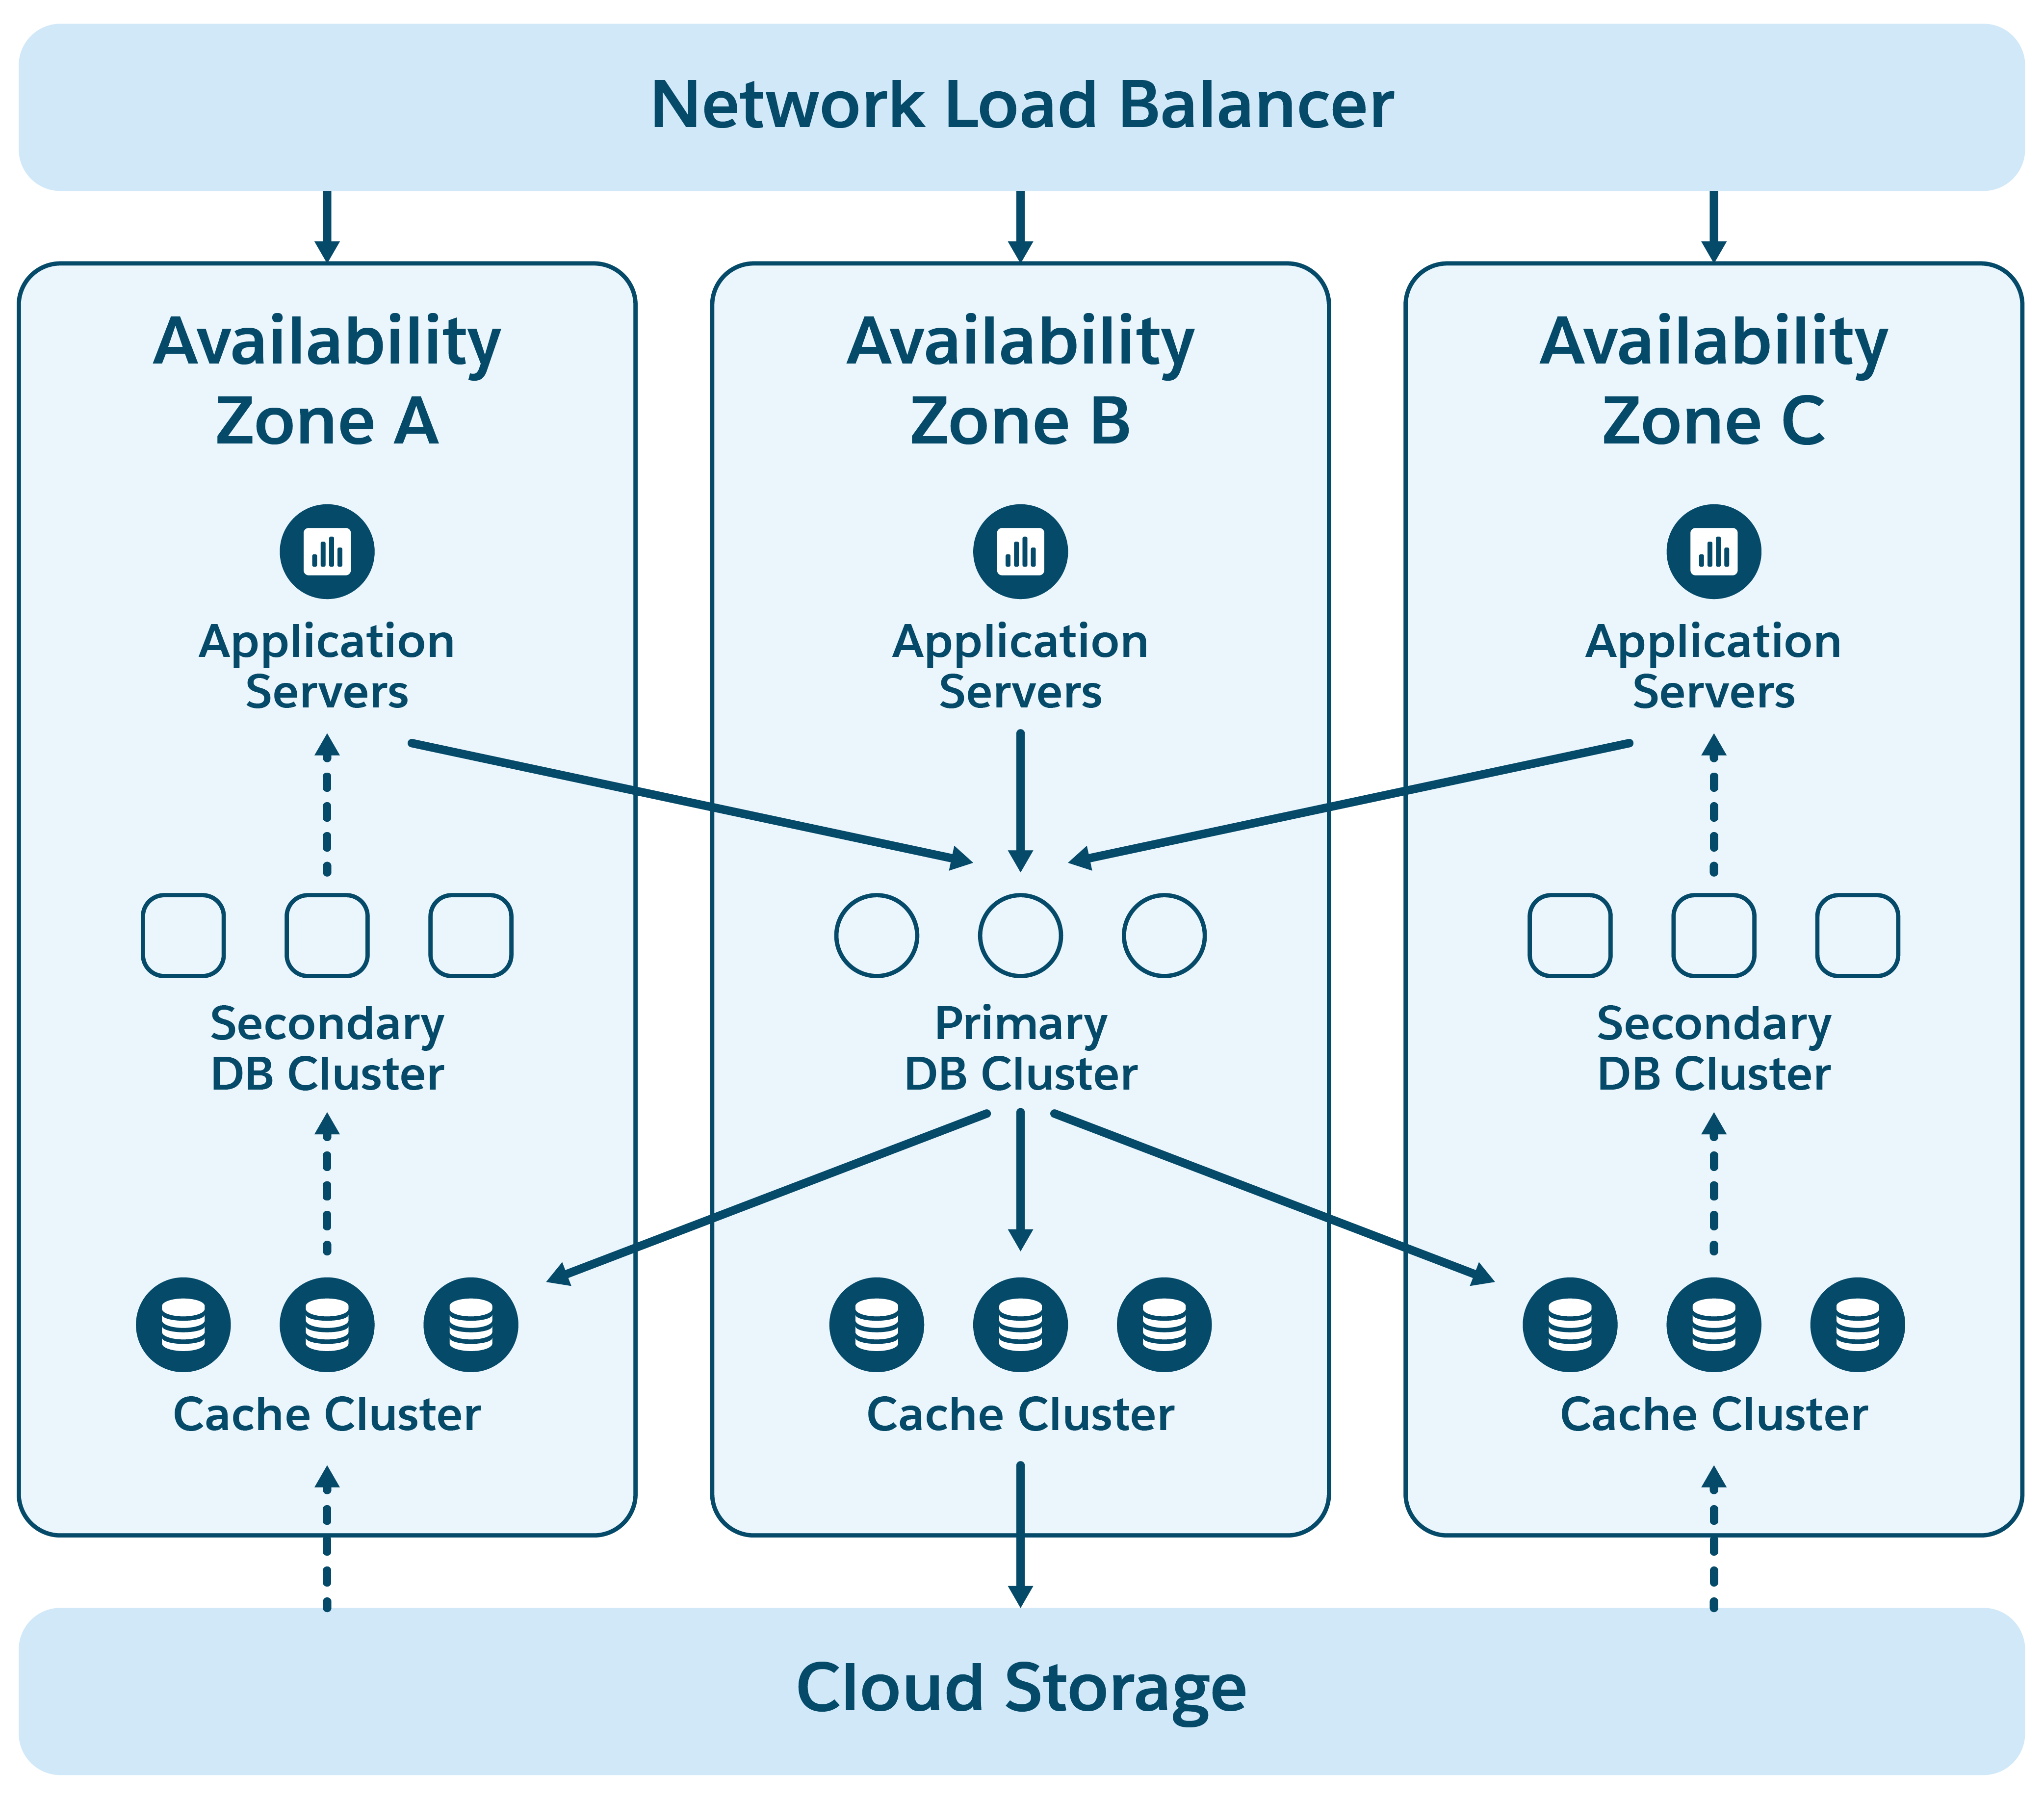 #### LSM の保存とアクセス
SalesforceDB では、ログ構造化マージツリー (LSM) データ構造が使用されます。このデータ構造では、変更が最初にトランザクションログに記録され、メモリに蓄積されます。確定された変更は、キー順序のデータファイルにまとめて書き込まれ、ストレージ効率を最適化するために定期的にマージおよび圧縮されます。
この構造により、ストレージを直接更新するデータベースにありがちな同時更新の問題を効果的に排除できます。LSM アプローチを使用することで、SalesforceDB は不変ストレージなどの重要な機能をサポートし、Salesforce ワークロードを管理するための堅牢なソリューションとなります。
#### 不変ストレージ
ストレージ内のデータは不変です。データファイルが書き込まれて表示されるようになると、変更されません。トランザクションログは追加のみであるため、データアクセスパターンが簡素化され、信頼性が向上します。この構造は、非協調型読み取りをサポートし、バックアップを簡素化し、拡張性を高め、ストレージの仮想化を促進するため、クラウド環境に適しています。
#### 可用性と耐久性
SalesforceDB のトランザクションは複数の可用性ゾーンでコミットされるため、ノードまたはゾーンに障害が発生してもデータが損失することはありません。障害が発生した場合、処理中、トランザクションは中止され、コミットされたトランザクションは正常に回復されます。失敗しても確定されたデータは失われないため、新しいノードへのフェイルオーバーは自動化されます。
クラスター管理ソフトウェアは、クォーラムを監視して所有権の移行を管理することで、フェイルオーバーを自動的に処理します。このプロセスは緊急時だけでなく、定期的なパッチ適用時にも使用され、常時使用することでシステムの信頼性を高めます。通常、短いデータベース再起動はエンドユーザーに気付かれず、シームレスなユーザーエクスペリエンスが維持されます。
Salesforce では、1 年に 3 回の大規模なスキーマ更新を行い、小規模なスキーマ更新を毎週行います。SalesforceDB では、ダウンタイムゼロのスキーマ操作が提供されるため、顧客に影響を与えることなくこれらの更新を行うことができます。
#### 記録システム
トランザクションデータベースは、顧客データのプライマリリポジトリとして機能し、複数の対応可能ゾーンにキャッシュされ、クラウドに保存されます。各データブロックは、ストレージレイヤーとデータベースエンジンの両方で検証された不変のチェックサムで保護されます。データベースは系統追跡を実行して、順序の誤った変更やバージョンの欠如を検出し、インデックスとベーステーブル間で継続的な整合性チェックを実行します。
ランサムウェア保護のため、データベースは、トランザクションログのフルバックアップと増分バックアップの両方を含め、異なるアカウントの個別のストレージにアーカイブされます。これらのバックアップは、復元テストプロセスで定期的に検証されます。さらに、クラウドインフラストラクチャは事前設定されていますが、有効化されていないため、必要に応じてデータ復元要求を管理できます。
#### スケール
各 Salesforce 組織は、SalesforceDB サービスを含む Hyperforce セルに格納されます。この設定では、Hyperforce アーキテクチャを使用して新しいセルを作成することで、グローバルな拡張を迅速に行うことができます。また、セル間でトラフィックを簡単に移行して負荷を管理できます。ただし、顧客のワークロードとビジネスニーズが増加すると、1 つのデータベースインスタンスの容量では不足する可能性があります。
これに対応するために、SalesforceDB ではストレージ階層とコンピューティング階層の両方で水平拡張アーキテクチャを採用しています。クラウドストレージは事実上無制限であり、キャッシュレイヤーは需要に応じて自動的に拡張されます。さらに、データベースコンピューティングノードを追加することで、調整なしで共有不変ストレージから効率的に読み取ることができるため、コンピューティング層を拡張できます。このアプローチにより、SalesforceDB は、特別なネットワーキングやハードウェアを必要とせずに、主要な商用クラスターデータベースアーキテクチャと同等以上の拡張性を実現できます。
#### マルチテナンシー
Salesforce は、1 つのデータベースで複数のテナントをホストするマルチテナントアプリケーションです。各テーブルレコードには、その所有権を区別するテナント ID が含まれ、テナントの分離は Salesforce のアプリケーションレイヤーによって追加された自動クエリ述語によって維持されます。
SalesforceDB はこのモデルに合わせて調整されており、テナント固有の DDL、メタデータ、ランタイムプロセスをサポートし、信頼性、パフォーマンス、セキュリティを強化します。行あたりのテナント数のモデルのオーバーヘッドの低さと、データベースあたりのテナント数のスキーマの効率性を兼ね備えています。
SalesforceDB では、テナント ID はマルチテナントテーブルのプライマリキーの一部であり、LSM データ構造でテナント別にデータをクラスター化することで、アクセス効率を高めます。この設定により、効率的なデータアクセスとテナントごとの暗号化が促進されるだけでなく、テナントデータ管理も簡素化されます。コンパクトなメタデータ構造により、最小限のメタデータ調整でテナントを簡単にコピーまたは移動できます。
### 6.2 Data 360 とデータレイク
AI、分析、データ機能は、現代の企業では不可欠です。企業は、Snowflake、Databricks、BigQuery、Redshift などの成熟したビッグデータプラットフォームにすでに投資しています。ただし、多くの
データサイロ、AI 処理の欠如、古いデータ、既存のビジネスプロセス内の不作為が原因で、顧客がデータからビジネス価値を引き出すことはありません。顧客エンゲージメントを 1 つのビューで把握し、顧客データを 1 つの情報源に一元化することは、ビジネスにとって不可欠であると同時に、データの断片化やシステム管理の複雑さから困難でもあります。Salesforce は、データ、AI、CRM を好循環に統合し、生成 AI と機械学習のインサイトを活用してデータを活用し、顧客の全体像を把握しやすくします。
SalesforceDB は、構造化データの高パフォーマンスのトランザクションワークロード向けに最適化されていますが、AI および分析ワークロードでは、さまざまなソースからの大量の非構造化データを処理し、複雑なクエリとバッチ処理を実行する必要があります。これらのニーズに対応するために、Salesforce はデータサイロの解消、データの統合、保存、処理の安全かつ効率的な実行、AI と分析の要求のサポート、およびリアルタイムのエンタープライズ業務の実現を目的として設計されたプラットフォームである Data 360 を開発しました。
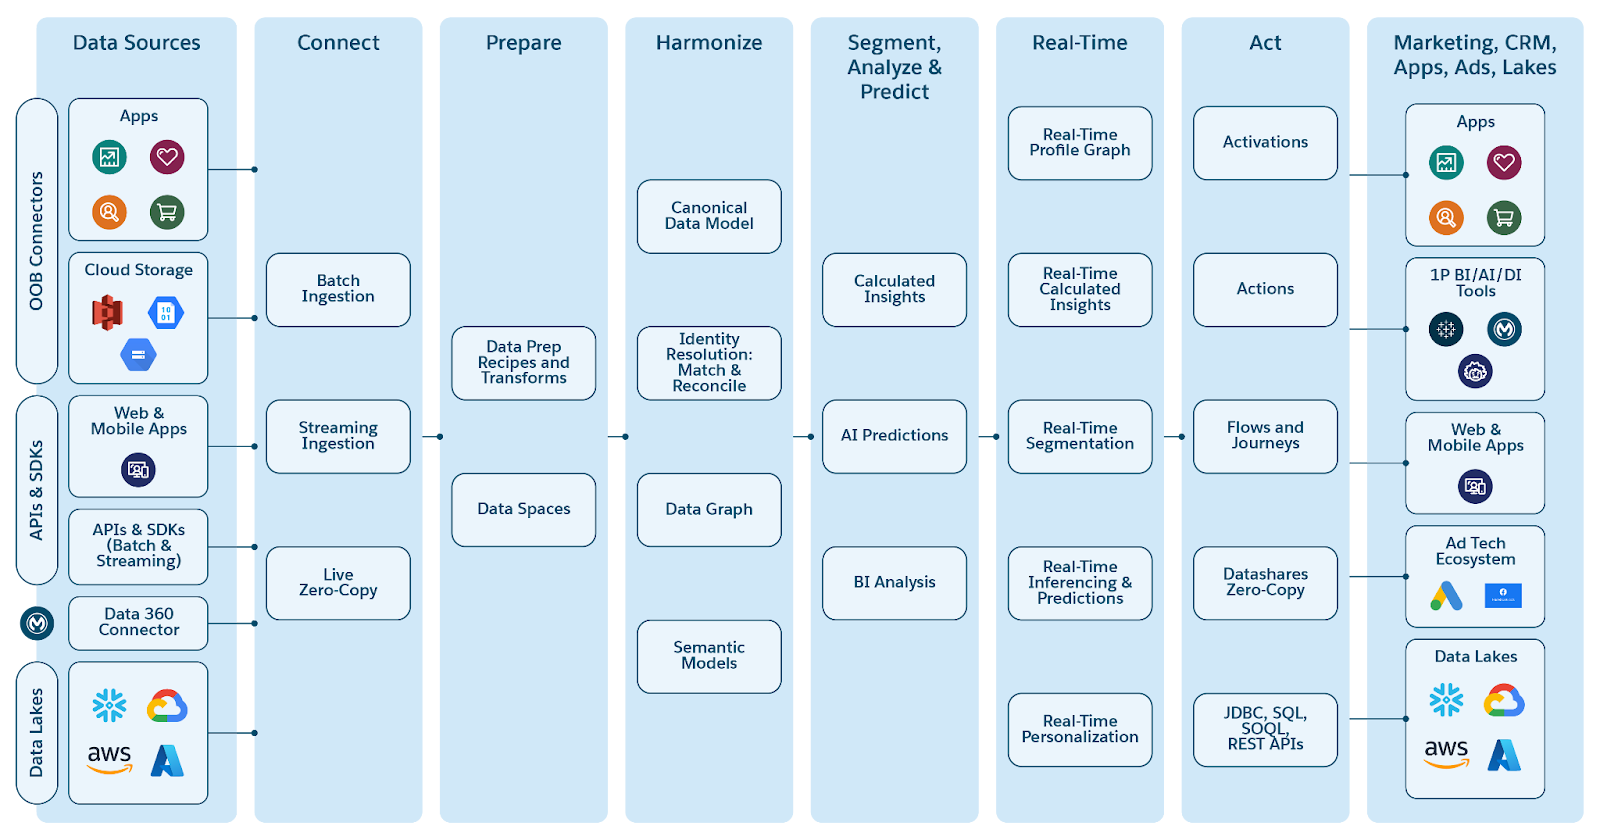 Hyperforce上に構築されたData 360は、AIおよび分析の基盤プラットフォームとして機能し、次の機能を提供します。
- 接続を介してデータサイロを統合する統合インフラストラクチャとノーコードプラットフォーム
- リアルタイムおよびほぼリアルタイムのデータ取り込み
- ゼロコピー統合
- 処理のためのデータクレンジング、準備、シェーピング
- 構造化データと非構造化データの統合クエリサービス
- インサイト生成のための分析モデルと AI/ML モデルの開発
- データトリガーアクションと有効化
- 生成 AI 取得拡張生成 (RAG) のサポート
- 包括的なポリシーベースのガバナンス
Data 360 アーキテクチャでは、次のような多数のコンポーネントと機能がサポートされています。
#### 接続、変換、およびハーモナイゼーション
Data 360 では、さまざまな構造化および非構造化データソースからの効率的な取り込みパイプラインがサポートされ、バッチ、ほぼリアルタイム、リアルタイムのデータ処理が可能です。Data 360 の取り込みサービスは、低遅延で B2C 規模に適した抽出-読み込み-変換 (ELT) パターンで動作します。リアルタイムの取り込みには API とインタラクティブストリームが含まれ、ほぼリアルタイムのソースでは商品の詳細な利用状況がカバーされます。取り込まれると、データは、さまざまな連絡先種別を準備、ハーモナイズ (統合など) し、効果的なクエリ、分析、AI アプリケーションのためにモデル化するために広範囲に変換されます。このプラットフォームには、すぐに使用できる幅広いハーモナイズデータモデルも含まれます。
Data 360 は、Sales Cloud、Service Cloud、Marketing Cloud、Commerce Cloud などの Salesforce アプリケーションとシームレスに統合されます。さらに、外部データソース用に数百のコネクタが用意されているため、スムーズなデータインテグレーションが可能です。
#### Lakehouse for Big Data
Data 360 は、Iceberg/Parquet に基づくネイティブの Lakehouse アーキテクチャを特徴としており、バッチ、ストリーミング、リアルタイムシナリオの大規模なデータ管理と処理を処理するように設計されています。このアーキテクチャでは、AI および分析アプリケーションに不可欠な構造化データと非構造化データの両方がサポートされます。
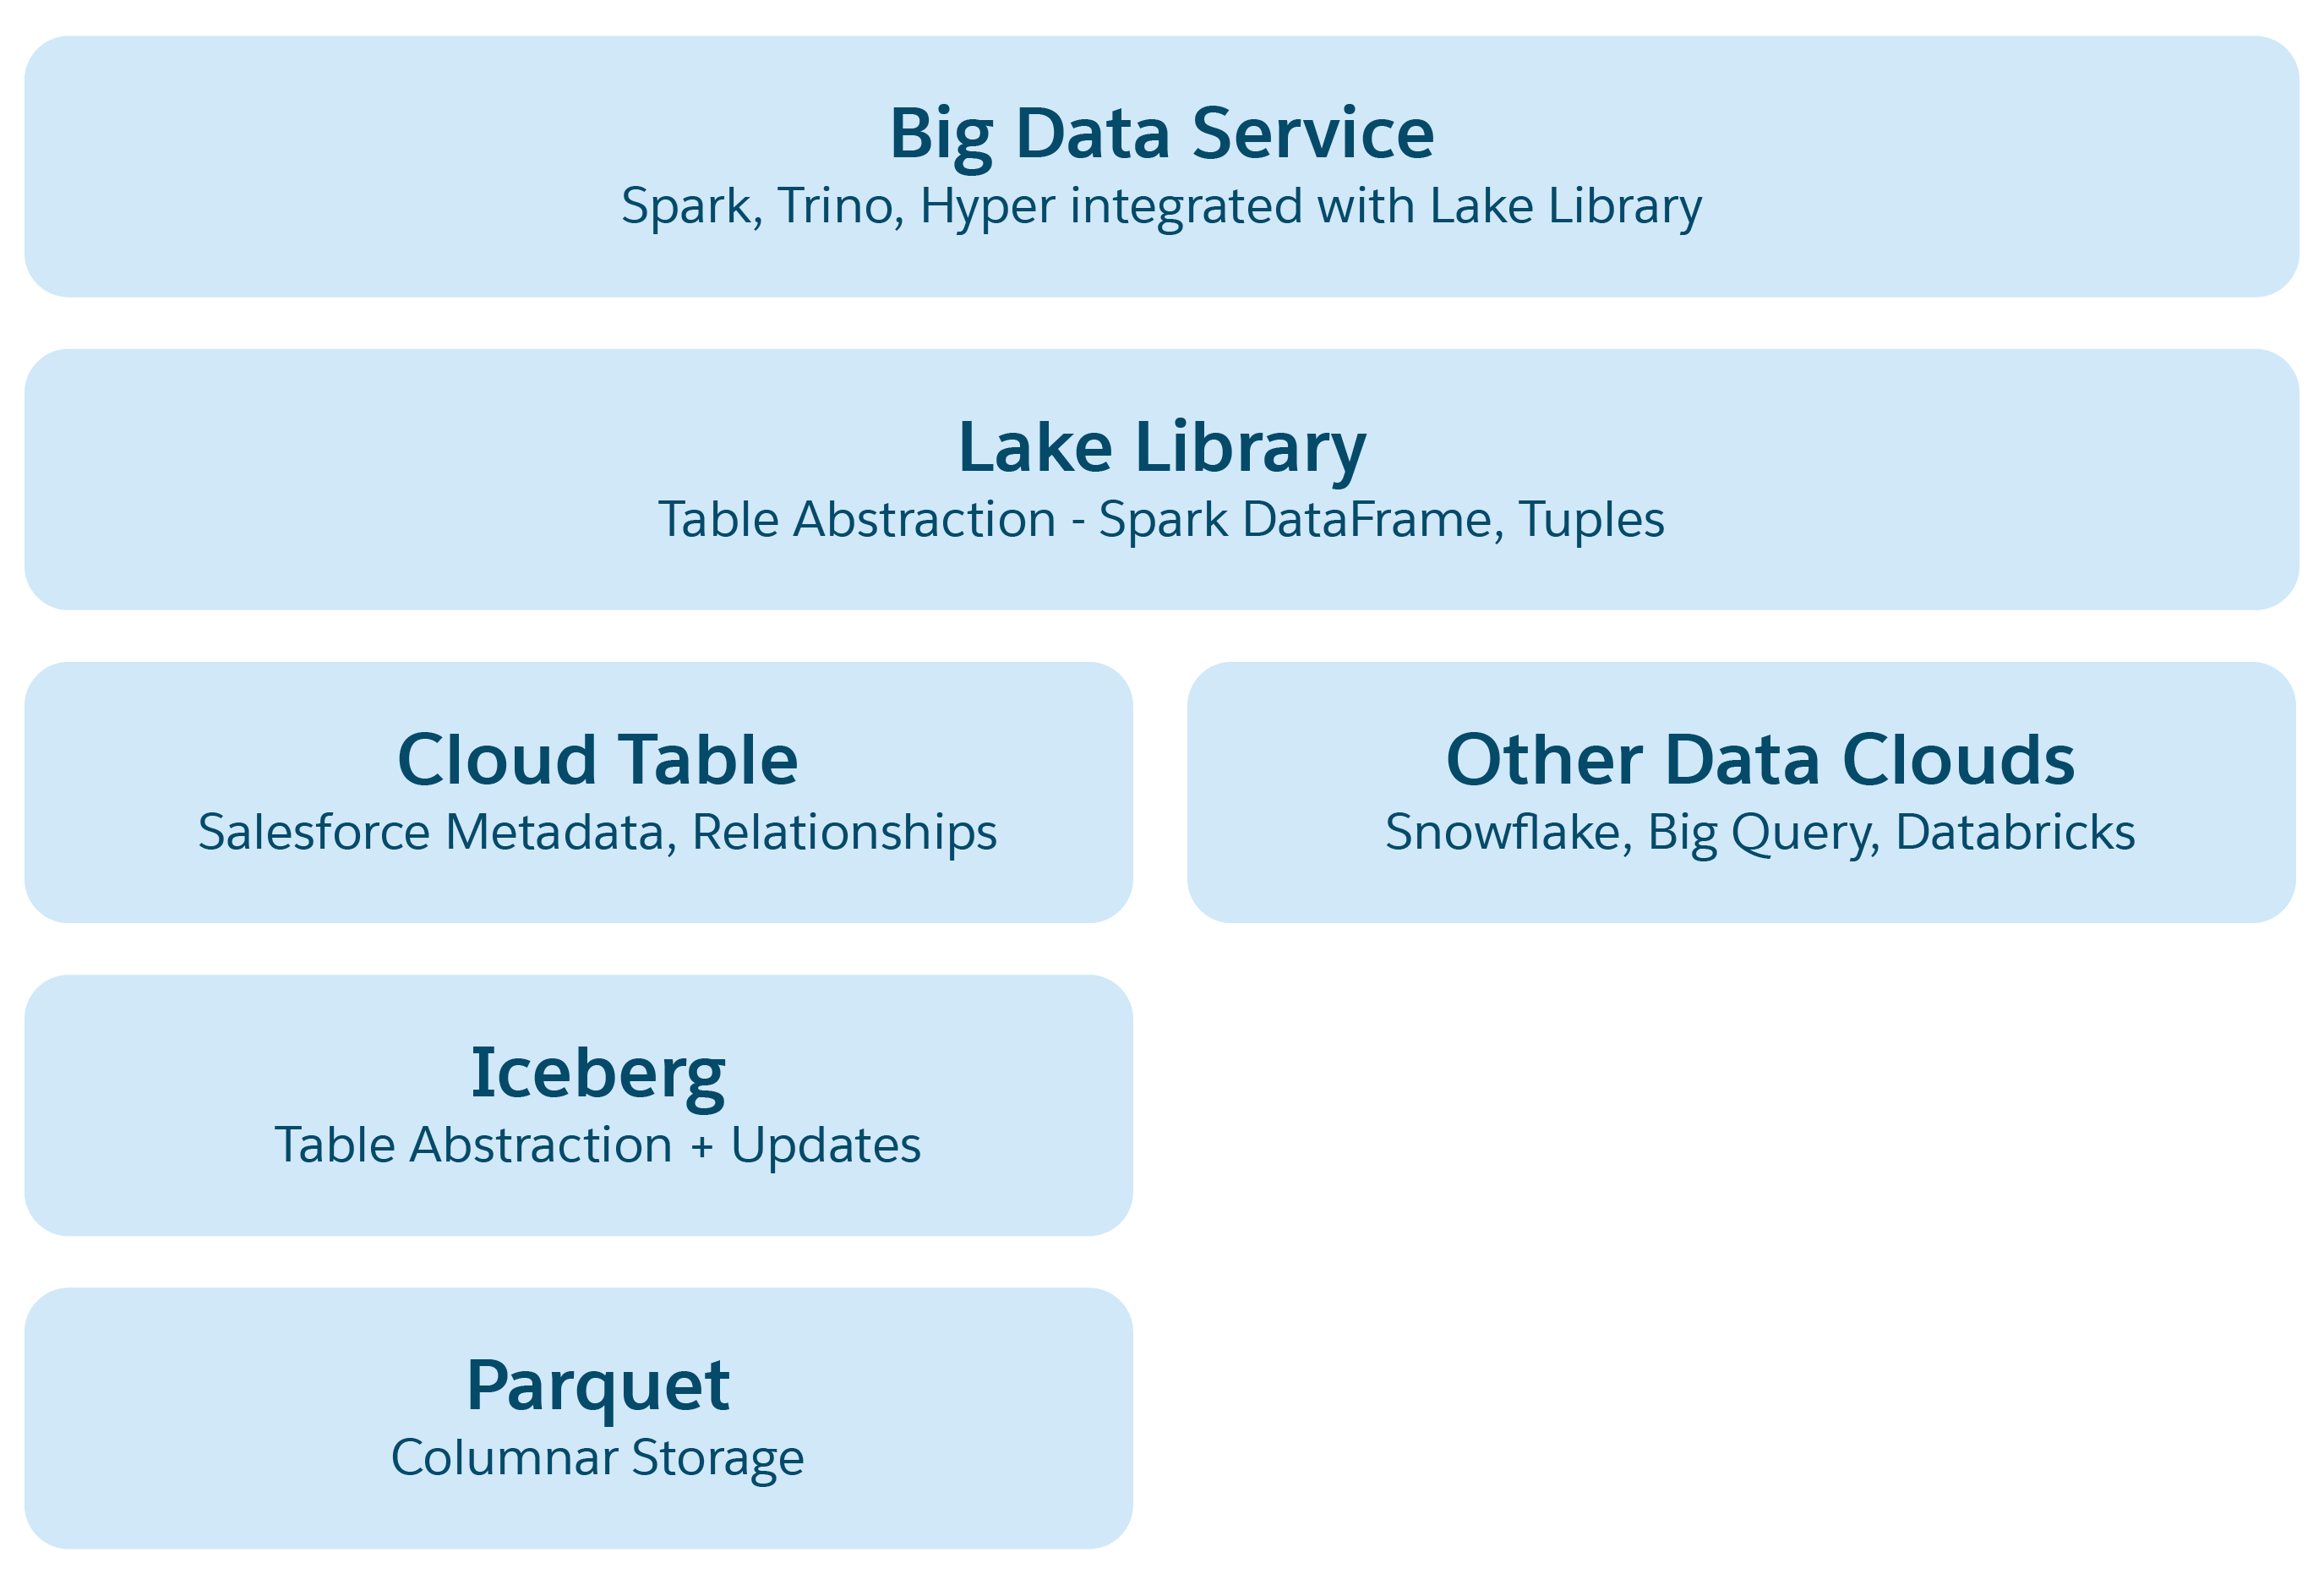 Azure、AWS、GCP などのクラウドベースのデータレイクでは、基本的なストレージユニットはファイルであり、通常はフォルダーと階層に整理されます。この Lakehouse では、クエリや AI/ML 処理などの操作を容易にするために、より高いレベルの構造と意味の抽象化を導入することで、この構造を強化しています。プライマリ抽象化は、その構造とセマンティックを定義するメタデータを含むテーブルで、Iceberg や Delta Lake などのオープンソースプロジェクトの要素と、Data 360 によって追加されたセマンティックレイヤーが組み込まれています。
Lakehouse の抽象レイヤー:
- **Parquet File Abstraction**:基本のストレージは Parquet 形式のデータレイクファイル (AWS の S3 や Azure の Blob など) で構成されます。ソーステーブルのデータは Parquet ファイルとして複数のパーティションに保存され、各テーブルはこれらのファイルのコレクションになります。
- **Iceberg Table Abstraction**:テーブルはフォルダーとして整理され、データパーティションはこれらのフォルダー内に Parquet ファイルとして保存されます。パーティションを変更すると、新しい Parquet ファイルがスナップショットとして作成されます。Iceberg は、スキーマ、パーティション仕様、スナップショットの詳細を含む各テーブルのメタデータファイルを管理します。
- **Salesforce Cloud Table Abstraction**:Iceberg を基盤とするこのレイヤーでは、列名やリレーションなどのセマンティックメタデータと、対象ファイルサイズや圧縮などの設定が追加されます。Snowflake や Databricks などのさまざまなプラットフォームのテーブルを抽象化し、Data 360 アプリケーションを基盤となるストレージプラットフォーム固有のものから保護します。
- **Lake Access Library**:このライブラリは、Salesforce Cloud テーブルへのアクセスを提供し、データとメタデータの両方を処理し、アプリケーション開発者の基盤となるストレージメカニズムを抽象化します。
- **Big Dataサービスの抽象化**:これには、クエリ用の Trino や Hyper、あらゆるクラウドテーブルプラットフォームで処理するための Spark などの処理フレームワークが含まれます。
Data 360 Lakehouse は、B2C スケール、リアルタイム取り込み、処理、スキーマの適用と進化、スナップショットをサポートし、オープンストレージ形式を使用します。
#### リアルタイムストレージ
リアルタイム分析とエージェントアプリケーションをサポートするために、Data 360 は追加の低レイテンシストア (LLS) を使用してレイクハウスのビッグデータストレージを強化します。Data 360 のリアルタイム処理レイヤーでは、メモリ内のリアルタイムシグナルとエンゲージメントデータが分析されます。メモリベースのストレージ容量は限られているため、すべてのデータを一度に処理することはできません。Data 360 では、このような制限を排除するためにこの LLS が追加され、拡張性の高いリアルタイム処理が可能になります。
低レイテンシ ストアは、レイクハウスのペタバイト規模のNVMe(SSD)ストレージ レイヤーです。これは耐久性のあるキャッシュです。ほとんどのデータは、最終的に長期間保持するためにレイクハウスに格納されます。リアルタイムレイヤーのセッション中のデータは、後続の高速アクセスのために低レイテンシストアにフラッシュできます。たとえば、エージェントの会話では、最近のメッセージはメモリで処理でき、古いメッセージは LLS にフラッシュできます。前の会話が必要な場合、LLS から数ミリ秒以内にアクセスできます。NVMeベースのストレージでは、大量のデータをミリ秒のレイテンシーで保存およびアクセスできます。データは、長期保持のためにレイクハウスに送信される可能性があります。
さらに、リアルタイム処理やリアルタイムエクスペリエンスの追加に必要なレイクハウスのデータが取得され、LLS に保持されます。たとえば、顧客プロファイルコンテキストがレイクハウスから事前取得または取得され、LLS にキャッシュされます。また、セッション中の処理中にリアルタイム処理に必要なレイクハウスオブジェクトやその他のオブジェクトも LLS にキャッシュできます。LLSは、メモリ、SSD、レイクハウスストレージレイヤーを使用して、真のストレージ階層のリアルタイムレイヤーを実現し、それぞれ間でデータをシームレスに移行します。
また、Data 360 は、顧客が管理する鍵を使用したテナントレベルの暗号化 (TLE) や、ガバナンス技術によるプライバシーとコンプライアンスなどのセキュリティも堅牢にサポートします。中核となるのは、エンティティ、業務、環境要因に関連する属性に基づいてアクセスを動的に評価する属性ベースのアクセス制御 (ABAC) のサポートです。このシステムでは、自由裁量のアクセス制御と必須のアクセス制御の両方がサポートされます。
ABAC を補完する詳細なデータ分類システムは、機密性と目的別にデータを分類し、コンプライアンス、リスク管理、インシデント対応を強化します。ABAC とこの分類システムを組み合わせることで、包括的なデータガバナンスが提供され、Data 360 内のデータが安全かつ効率的に管理されます。
#### メタデータ駆動型
Data 360 は、メタデータ、パッケージ化、拡張性、ユーザーエクスペリエンス、AppExchange を介したアプリケーションの配布のために Salesforce Platform と緊密に統合されています。顧客は、他の Salesforce メタデータと同様に、レイクハウスストリームとテーブルのメタデータを定義して管理できます。すべてのデータオブジェクト (統合テーブルまたは外部テーブルを含む) は Salesforce オブジェクトとして表され、Data 360 のデータストレージに裏付けられた仮想エンティティとしてモデル化されます。開発者が Salesforce Platform でアプリケーションを作成するために使用できます。
#### ゼロコピー統合と拡張性
Data 360 では、ゼロコピー統合が幅広くサポートされており、ユーザーは Snowflake や Redshift などの外部データウェアハウス、Google BigQuery、Databricks、Azure Fabric などのレイクハウス、SQL データベース、Excel などのさまざまなファイルタイプと統合できます。Data 360 では、次の図に示すように、ライブクエリとアクセスアクセラレーションを使用したファイルとクエリベースの統合がサポートされます。表示ラベル (1) と (2) は、外部データレイク/ウェアハウス/データソースからデータにアクセスするための Data 360 のクエリ (ライブクエリプッシュダウンを含む) とファイルベースの統合を示し、表示ラベル (3) は、外部データレイク/データソースからの統合アクセスの高速化を示します。表示ラベル (4) と (5) は、Data 360 のデータのクエリおよびファイルベースの外部データレイク/ウェアハウスとの共有を示します。この機能は、Data 360 の非構造化処理パイプラインからアクセスできる Slack や Google ドライブなどの非構造化データソースにも拡張されます。さらに、Data 360 では、Salesforce オブジェクトの抽象化と、外部ソースから統合されるデータのデータアクセスが促進され、Salesforce Platform およびアプリケーション全体でそのようなデータにアクセスできるようになります。
#### Customer Data Platform (CDP)
Data 360 は、高度な ID 解決機能を備えた CDP を統合し、包括的なエンゲージメント履歴と共に統合個人 ID とプロファイルを作成します。このプラットフォームは、完全一致ルールとあいまい一致ルールの両方を使用する ID グラフをサポートすることで、企業間 (B2B) および企業対消費者 (B2C) の両方のフレームワークの処理に適しています。これらの ID グラフは、さまざまなチャネルからのエンゲージメントデータで強化されており、貴重な分析インサイトとセグメントを含む詳細なプロファイルグラフを作成するのに役立ちます。
さらに、CDP により、Salesforce の Marketing Cloud、Facebook、Google など、さまざまなプラットフォームで効果的なセグメンテーションと有効化が可能になります。顧客プロファイルはバッチ、ほぼリアルタイム、リアルタイムで処理されるため、即時の意思決定とパーソナライズが可能です。この機能により、B2C と B2B の両方のシナリオでインタラクションが強化され、企業が顧客のニーズや行動に迅速かつ正確に対応できるようになります。
#### データグラフ
Data 360 では、さまざまなレイクハウステーブルとその相互関係から派生した非正規化オブジェクトである JSON 形式のエンタープライズデータグラフが提供されます。これには、CDP によって作成された、個人の購入および閲覧履歴、ケース履歴、商品の使用状況、その他の計算済みインサイトを含む「プロファイル」データグラフが含まれ、顧客やパートナーが拡張できます。これらのデータグラフは特定のアプリケーションに合わせて調整されており、関連する顧客またはユーザー コンテキストを提供することで生成AIプロンプトの精度を高めます。
さらに、これらのデータグラフを拡張して、非構造化データから抽出されたエンティティやリレーションなど、派生Knowledgeを取得してモデル化するKnowledgeグラフを含める計画もあります。Data 360 のリアルタイムレイヤーでは、プロファイルグラフを使用してリアルタイムのパーソナライズとセグメンテーションを行います。
#### リアルタイムレイヤー
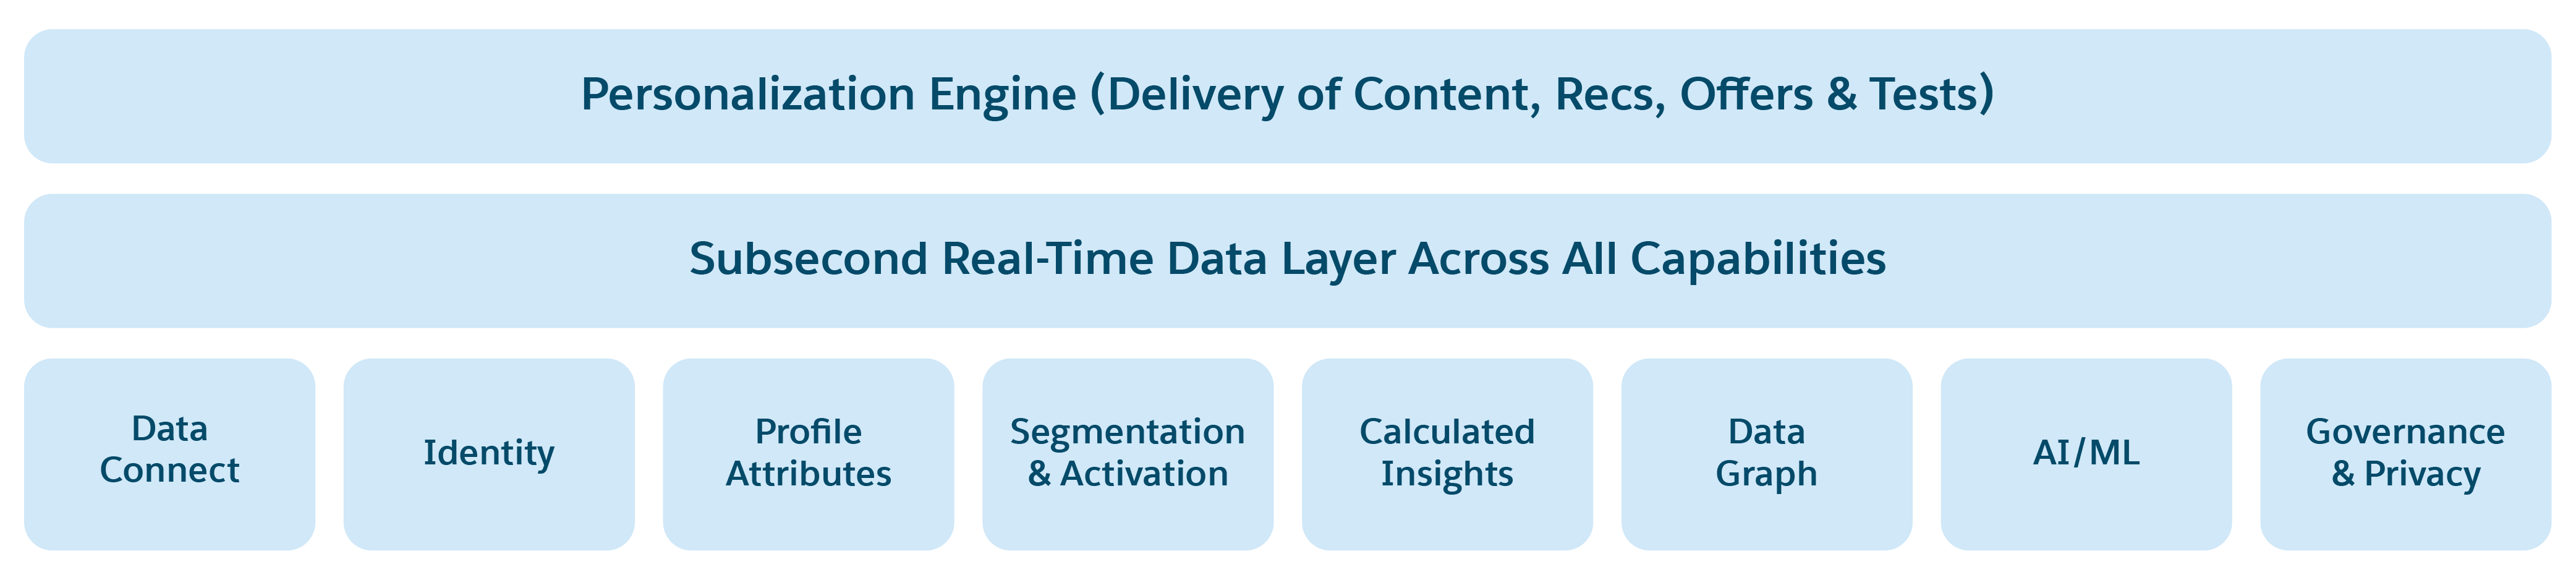 Data 360 のリアルタイムレイヤーは、Web およびモバイルのクリックストリーム、訪問、カートデータ、チェックアウトなどのイベントをミリ秒の遅延で処理するように設計されており、カスタマーエクスペリエンスのパーソナライズを強化します。顧客エンゲージメントを継続的に監視し、リアルタイムのエンゲージメントデータ、セグメント、計算を使用して CDP から顧客プロファイルを更新して、すぐにパーソナライズします。
たとえば、消費者がショッピング Web サイトで商品を購入すると、リアルタイムレイヤーはこのイベントをすばやく検出して取り込み、消費者を識別して、更新された生涯支出情報でプロファイルを強化します。これにより、サイトでのエクスペリエンスを数秒でパーソナライズできます。さらに、このレイヤーにはリアルタイムのトリガーと応答の機能が含まれており、顧客とのやりとりに基づいてすぐにアクションを実行できます。
#### Personalization
パーソナライズとは、対象とする人格、関連するコンテンツとおすすめを提供するタイミングと場所、発言する内容と頻度を知ることです。Data 360 の Personalization Services Platform 機能は、パーソナライズされた環境を通じて目標達成を最適化するための意思決定のオーケストレーターです。このプラットフォームには次の機能があります。
- Data 360 のプロファイル、活動、アセットデータを解釈するためのモデルと方法の一貫したセット。
- プラットフォーム統合実験 (A/B/n やマルチアーム盗賊の意思決定など)。
- 設定、ML トレーニング時間、ランタイム (ML 推測) を使用した設計時の目標の統合。
- B2C スケール、リアルタイムおよびバッチインタラクションのサポート (匿名ユーザー、大規模リアルタイム/インタラクティブ外部、大規模内部バッチ)。
- Data 360 で実行される Analytics。
- 他の関係者 (内部と外部の両方) の AI モデルとサービスを統合するパターン。
- 価値の高い AI 駆動の使用事例の OOTB 実装 (プロモーション/コンテンツ選択のためのコンテキスト盗賊、商品のおすすめ、価格設定の決定など、さまざまな ML アルゴリズムを使用したおすすめと決定)。
#### データアクション
Data 360 は、データイベントに応じてパイプラインを有効化できる有効なプラットフォームです。たとえば、顧客の口座残高の減少などの重要なイベントが発生すると、Salesforce フローがトリガーされ、対応するアクションが調整されます。同様に、生涯費用などの主要な評価指標の更新は、関連するアプリケーションに自動的に反映できます。
#### Data Compute ファブリック
Data 360 には、処理タスクを効率的に処理する柔軟な拡張性を備えたコンピューティングクラスターが備わっています。マルチテナントと専用コンピューティングの両方の環境で堅牢な管理が提供されます。さらに、Spark と SQL の管理サポートも提供されます。BYOC (Bring Your Own Compute/Code) 機能は、Java、Python、Spark などの複数のプログラミング言語をサポートしているため、カスタム変換、モデル (LLM を含む)、関数を統合でき、拡張性が向上します。
Data 360 Compute Fabric は、すべてのビッグデータワークロードを管理および実行するためのデータ処理コントローラー (DPC) と呼ばれる統合レイヤーを提供します。DPC は、さまざまなクラウドコンピューティング環境にサービスとしてのジョブ (JaaS) 機能を提供する包括的なマルチワークロードデータ処理オーケストレーションサービスです。インフラストラクチャの複雑さを抽象化し、Spark (EC2 上の EMR と EKS 上の EMR) や Kubernetes リソースコントローラー (KRC) ワークロードなどのフレームワークのジョブの実行を統合します。DPC は一元化されたコントロールプレーンゲートウェイとして機能することで、複数のデータプレーン間でジョブを調整、スケジュール、監視し、信頼性、拡張性、コスト効率、一貫した開発者エクスペリエンスを確保します。
#### 統合クエリ
Data 360 のクエリサービスは高度なクエリ機能を提供し、Trino と Hyper を使用した構造化データと非構造化データの両方の広範な SQL サポートを特徴としています。テーブル関数を使用した演算子の拡張性により機能が強化され、テキスト、画像、空間、その他の非構造化データ型にわたるさまざまな検索操作が可能になります。これらの機能は、顧客レコードの選択などのリレーショナル操作とシームレスに統合されます。この統合されたアプローチにより、対象を絞ったパーソナライズされた結果の生成が可能になり、RAG を使用したより正確な LLM 応答を促進できます。
#### 非構造化データ処理
Data 360 では、データの取り込み、処理、インデックス付け、クエリメカニズム全体で、構造化データ (テーブル)、半構造化データ (JSON)、非構造化データの保存と管理がシームレスにサポートされます。Data 360 では、テキスト以外のさまざまな非構造化データ型 (音声、動画、画像など) がサポートされ、データ処理と分析の範囲が広がります。次の図は、グラウンディングの両側 (取り込みと取得) を示しています。
Data 360 では、非構造化データをテキストとして列に保存するか、より大きなデータセットの場合はファイルに保存して管理します。非構造化コンテンツのデータ統合をサポートしているため、複数のソースからのデータを統合および管理することができます。
Data 360 の非構造化データのインデックス付けパイプラインは、次の 5 つのコアフェーズで構成されるモジュラー型の拡張可能なアーキテクチャとして設計されています。解析、事前処理、チャンク、後処理、埋め込み。これらのフェーズの後にキーワードとベクトルインデックスが付けられます。前処理の例としては、ノイズ除去、言語の正規化、画像理解 (光学式文字認識) などの操作があり、後処理のフェーズにはメタデータ強化、セマンティックグルーピング、チャンクなどの高度な技術などがあります。
Data 360 には、チャンク生成と埋め込み生成用の複数の標準モデルとプラグイン可能なモデルが用意されています。Data 360 のデータパイプラインはコード拡張を完全にサポートしているため、顧客と内部チームはどのフェーズでもカスタムロジックを組み込むことができます。これらのフェーズでは、必要に応じて独自のプロンプトを定義できる LLM ベースの処理もサポートされます。
インデックス付けでは、Data 360 は検索サービスを使用したキーワードインデックス付けと、オープンソースのネイティブベクトルインデックスである Milvus を使用したベクトルインデックス付けをサポートしています。Data 360 では、非構造化処理を使用して RAG を設定するためにコンテキストインデックスを活用し、サンプルテストクエリを使用して迅速な反復と迅速な検証を可能にします。人格固有のコンテンツは、消費する人格またはユーザーに合わせて設定されます。
Data 360 のドキュメント AI 機能では、請求書、履歴書、ラボレポート、購入注文などのドキュメントから非構造化データまたは半構造化データを参照およびインポートできます。この機能では、一括処理だけでなく、アドホックな対話型処理もサポートされています。これは、お客様のビジネスプロセスの自動化を可能にする主要な機能です。
#### セマンティックレイヤー
Data 360 には、Tableau Next と同様に、ビジネスセマンティクスと AI/ML 駆動型分析を強化する API を備えたヘッドレスセマンティックレイヤーが搭載されています。このレイヤーには、基準や総計値などのビジネス分類を使用して従来の分析モデルを強化するセマンティックデータモデリングサービスが含まれます。
セマンティッククエリサービスでは、宣言型言語を使用してこれらのモデルを操作し、クエリを SQL に変換して、Data 360 内のネイティブデータソースと統合データソースの両方のデータにアクセスします。
このインテグレーションにより、サードパーティの視覚化ツールと互換性のある、拡張性が高く対話型の分析探索、レポート、ダッシュボードが容易になります。
#### データガバナンス
Data 360 は一元化されたガバナンスハブとして機能し、未加工の取り込みから有効化されたインサイトまで、すべてのデータが整合性と制御をもって管理されるようにします。Data 360 では、属性ベースのアクセス制御をコア認証モデルとして採用しています。ABAC では、事前定義されたロールではなく、ユーザーの属性 (部署、ロール、場所)、データ (個人情報、機密度、データスペース)、環境 (時間帯など) に基づいてアクセス権を決定できます。これにより、データとユーザー属性の変化に応じて適応する、きめ細かいコンテキストに基づいたアクセスポリシーが可能になります。Data 360 の ABAC 実装の中心となるのは、CEDAR ポリシー言語を使用することです。この専用のオープンソースの正式なポリシー言語により、複雑な認証ルールを正確かつ検証可能な方法で定義できるため、ポリシーが明確になり、大規模で一貫した評価が可能になります。
ガバナンスライフサイクルには、ポリシー情報、適用、決定ポイントに関する次の主要な機能が含まれます。
- **タグ付けおよび分類 (Policy Information Point):**データは重要な属性で識別され、強化されます。Data 360 は、ディスカバリー、LLM、機械学習を活用して、構造化データと非構造化データの両方で機密データカテゴリ (メール、電話、名前などの個人識別情報) を識別する、自動化されたタギングおよび分類メカニズムを提供します。
- **承認サービス (ポリシー適用ポイント):**このサービスは、さまざまな消費レイヤー (ハイブリッド構造化/非構造化クエリ、RAG 取得およびプロンプト、CRM 強化) からのすべてのデータアクセス要求を代行受信し、ポリシー決定ポイントを参照してアクセスが許可されているかどうかを判断します。
- **Policy Evaluation Engine (Policy Decision Point) (ポリシー評価エンジン (ポリシー決定ポイント):**このエンジンは、ポリシー適用ポイントからのアクセス要求コンテキスト、ポリシー定義 (CEDAR)、ポリシー情報ポイントの属性を取得して、権限のあるアクセスを決定します。
CEDAR ポリシーを使用する ABAC フレームワークは、制御と柔軟性を提供し、顧客データがアクション可能であるだけでなく、企業全体でセキュリティ、コンプライアンス、信頼性を確保できるようにします。
### 6.3 データキャッシュ
キャッシュは、頻繁に使用するデータにすばやくアクセスするために不可欠です。Salesforce は、コアアプリケーションサーバー、SalesforceDB、エッジなど、Salesforce Platform 全体で多くのキャッシュを使用します。Salesforce Platform とアプリケーションには、低レイテンシーと高スループットを備えた拡張性の高いテナント対応キャッシュソリューションが必要です。このソリューションでは、Salesforce エンジニアがキャッシュする内容と時間を制御できるようにし、データがシステムノイズや他の顧客のデータによって立ち退かされないようにする必要があります。Redis に基づく Salesforce で管理されるキャッシュサービスである Vegacache は、ポリグロット、マルチテナント、パブリッククラウド環境に合わせて調整されています。Salesforce サービスで広く使用され、プラットフォーム開発者は Apex プログラミング言語 API を介してアクセスできます。Hyperforceで大規模に運用されているVegacacheは、執筆時点で毎日2兆件を超える要求をサブミリ秒のレスポンス タイムで処理しています。
サービスメッシュを介してアクセスする Kubernetes コンテナで実行される Vegacache インスタンスは、データの可用性とレイテンシのバランスを取るために複数の可用性ゾーンにリリースされます。システム負荷に基づいて自動的に拡張されるため、データの可用性と時間枠の順序が維持されます。Vegacache は、顧客ごとのキャッシュサイズが保証され、ノイジーネイバーに対する保護と、レプリケートされたデータストレージによるインフラストラクチャの障害に対する復元性を提供します。
Salesforce Platform 開発者の場合、Vegacache を使用すると、開発者は Apex オブジェクトと SOQL データベースのクエリ結果をキャッシュでき、SalesforceDB からの不要なデータ取得を排除することで CPU の使用率とレイテンシを削減できます。Put()、Get()、Delete() 操作がサポートされ、頻繁に使用するオブジェクトにいつでもアクセスできます。
### 6.4 非同期データ処理
Salesforce は、ワークフローの柔軟性、耐障害性、拡張性を高めるために、非同期データプロセスとアーキテクチャをネイティブでサポートしています。
Salesforce エンジニアは、まずメッセージキューを活用して、一括処理と大規模処理を切り分け、独立したシステム間でプロセスを調整しました。これらのメッセージキューは、Bulk APIクエリや非同期Apexなどのプラットフォーム機能を使用して、外部開発者から抽象化されました。その後、Salesforce Platform では、内部で管理される Apache Kafka クラスターの堅牢なメッセージングインフラストラクチャ上に構築されたログ整理イベントストリームが導入されました。これにより、公開/登録インタラクションモデルを使用したイベントベースのアーキテクチャが可能になり、プラットフォームイベントとして外部開発者に製品化されました。
メッセージキューとイベントストリームはどちらも、プラットフォーム上に構築されたアプリケーションとソリューションのテクノロジーであり、特に、独立したランタイムでホストされるより多くの機能、クラウド、外部システムを活用するため、引き続き高度に活用されています。バージョン設定されたイベントスキーマを使用してコミュニケーションすることで、さまざまなランタイムで独立したソフトウェア開発ライフサイクルが可能になります。また、イベントを介してシステムを分離することで、負荷の急増や個々のランタイムの弾力性/拡張性を管理し、アプリケーションの全体的な耐障害性と可用性を高めることもできます。
### 6.5 エンタープライズ検索
グローバル検索から生成 AI まで、さまざまなアプリケーションに不可欠な Salesforce の検索機能は、アーキテクチャアプローチを形成する独自の課題に直面しています。
- **拡張性**:数十万の顧客と数百万のテナントをサポートするクラウドネイティブ検索ソリューションは、コスト効率を維持しながら大規模な拡張に対応できるように設計されています。
- **顧客の多様性**:Salesforce のさまざまな業種の多様な顧客ベースには、多数のオブジェクト種別と項目を含むプラットフォームの広範なカスタマイズにより、ユニークで複雑な検索要件があります。
- **操作性**:検索ソリューションは、耐障害性と高可用性を備え、データレジデンシー、テナントライフサイクル業務 (地域移行、Sandbox など) をサポートし、テナント間の公平性を維持しながら、インデックス付けの低遅延を維持する必要があります。
- **大規模な関連性**:特に、さまざまなテナント、データ型、検索シナリオに合わせて関連性アルゴリズムを拡張する場合、多様なユーザークエリに合わせて検索結果の関連性を強化することが不可欠です。
- **AI およびセマンティック機能**:検索では、機械学習と生成 AI (特に取得拡張生成 (RAG) とエージェント検索) がサポートされます。
- **シームレスな統合**:一貫したユーザーエクスペリエンスを確保するために、Salesforce の検索技術はメタデータモデルや AI/データサービスなど、より広範な Salesforce Platform と緊密に統合されています。
Salesforce のクラウドネイティブソリューションである SeaS (Search as a Service) は、オープンソースの分散検索エンジンである Solr 上に構築されています。Salesforce は、独自の課題に対応するために Solr を大幅に拡張および最適化し、Salesforce アプリケーションおよびプラットフォームと緊密に統合して、AI アプリケーションと検索の関連性を強化するセマンティックテクノロジーを取り入れました。
SeaSはコンピューティング/ストレージ分離アーキテクチャを採用しているため、ノード間でインデックスをスケーラブルに分散でき、障害発生時にゾーン間で負荷と可用性を再バランシングできます。シャードの自動シャーディングとサイズ変更、ダウンタイムなしのアップグレード、レプリカの遅延読み込みやアーカイブなどの最適化により、使用頻度の低いインデックスに対応します。
このアーキテクチャには、多数の項目、オートコンプリート、スペル修正、Bring Your Own Key 暗号化用に最適化された低レベルのインデックス実装も含まれます。世界中で約 6,000 の Solr ノードを管理する Hyperforce 検索インフラストラクチャでは、各地域で複数の独立したクラスター (Hyperforce セル) を使用してコストと制御のバランスを取り、負荷、ドメイン、種別に基づいてクライアントインデックスを自動的に配置します。
Salesforce の検索関連性パイプラインでは、学習-to-ランク手法を採用し、顧客の多様なニーズに適応し、結果ランキングなどの機能をサポートしています。ユーザークエリや過去のインタラクションからのエンティティ予測も含まれます。関連性モデルは、ユーザーインタラクションから学習して継続的に絞り込まれ、A/B テストで評価されるため、検索結果の精度が向上します。このプロセスでは、Knowledgeの伝達を介した AI アプリケーションのブートストラップモデルもサポートされます。
このスタックには、セマンティック検索と AI アプリケーション用のベクトル検索エンジンが組み込まれており、生成 AI 機能用の Data 360 と統合されています。これには、データ変換の包括的なパイプライン、ハイブリッド検索のサポート、関連性の低い検索結果を除外するための Deep Fusion Ranker や Autodrop などの設定可能なランカーのカタログが含まれます。
生成 AI によって検索サービスの主な利用者が人間のユーザーから LLM の使用に移行しているため、Salesforce 検索スタックは、このプログラムでの消費に最適化された結果を見つけて返すように適応し、より長く複雑なクエリを処理し、チャンクのようなよりわかりやすい結果を返します。これにより、Agentic Searchの新しい機能がサポートされます。Agentforceエージェントは、推論ループを使用した検索を使用して複雑なタスクを実行します。
Salesforceの検索機能は、グローバル検索、ルックアップ、Search Answer、コミュニティ検索、関連リスト、設定、モバイルおよび生成AIアプリケーションなど、さまざまなコンテキストに対応します。この広範な機能は、検索スタックを Salesforce のメタデータシステムおよび UI エコシステムと緊密に統合することで実現され、標準オブジェクトとカスタムオブジェクトの両方がシームレスにサポートされます。
さらに、Data 360 との統合により、コード不要の設定でデータオブジェクトの検索機能が強化され、SQL クエリに検索ステートメントを含めるなど、データパイプライン内で検索機能を構成できます。検索スタックでは、Google ドライブ権限対応コネクタなどの Data 360 の豊富なコネクタエコシステムを活用して、完全なエンタープライズ検索機能が提供されます。この統合はAIプラットフォームにも拡張され、プロンプトビルダーのグラウンディング用およびエージェント型検索で検索クエリを取得者として使用できます。
## 7\.AIとAgentforce
AI によってテクノロジーの状況が変革され、統合された豊富なデータレイヤーを備えた Salesforce Platform によって、Salesforce はインパクトのある AI エクスペリエンスを顧客に提供できるようになりました。Salesforce は、約 10 年前に AI トランスフォーメーションを開始し、2013 年からこの分野をリードし、研究、倫理、製品開発に重点を置いて、企業が複雑な問題を解決して成長を促進できるように支援しています。
イノベーションのコア バリューを活用するSalesforceは、Einstein予測AIを導入しました。これにより、企業はEinstein予測ビルダーやAIボットなどのAI搭載の包括的なツール スイートを使用して、データ分析、プロセスの自動化、顧客の理解、運用の最適化を行うことができます。生成AIの台頭に伴い、Salesforceは、予測モデルと生成モデルを統合し、データ プライバシーを優先しながら高度なAI機能を提供するプラットフォーム、Agentforceを発売しました。
イベント駆動型フレームワークを使用して Python 上に構築された Agentforce 3.0 の最新のリリースにより、Salesforce では、組み込みの会話履歴、エンドツーエンドのセッション追跡、音声サポート、カスタム推論エンジン (Bring Your Own Planner) 機能などの機能を通じて柔軟性が向上し、拡張性とカスタマイズ性に優れたインテリジェントなマルチエージェントシステムが実現しました。
### 7.1 AI のコア原則
Agentforce は次のコア原則に従います。
- **データセキュリティと倫理**:データ保護、コンプライアンス、倫理的な AI の原則に優先順位を付けます。
- **透明性と説明可能性**:AI が生成した出力を明確に理解して検証できます。
- **柔軟性とカスタマイズ**:AI アプリケーションを特定のニーズと業種に合わせて調整します。
- **シームレスな統合**:Salesforce CRM や他のシステムと統合します。
- **拡張性**:大規模なリリースを処理し、リアルタイムの AI 環境を提供します。
- **インテリジェントで一貫性のある環境**:接続されたデータとコンテキストの理解を通じて、パーソナライズされ、拡張された自動化された環境を提供します。
- **包括的なオブザーバビリティ:**AIエージェントのインタラクションの詳細な可視性と監視を提供し、Agentforce Interaction Explorerを使用してエージェントのプロアクティブな最適化と微調整を可能にします。
### 7.2 アーキテクチャの概要
 AI スタックは、いくつかの主要なコンポーネントで構成されます。
- **AIプラットフォーム**:このプラットフォームレイヤーは、予測アプリケーションと生成アプリケーションの両方で使用される AI モデルの管理、トレーニング、微調整を行います。OOTB(標準)サービス、Trustサービス、モデルに対するトレーニング、テスト、推測の実行のための基盤モデルが提供されます。さらに、独自の予測モデルと生成モデルの統合がサポートされているため、プラットフォーム内にカスタムモデルを取り込むことができます。
- **AI 基盤サービス**:これには、AI ゲートウェイ、フィードバックフレームワーク、RAG、エージェントオーケストレーション、エージェント評価、および推論サービスが含まれ、ビジネスアプリケーションを AI スタックと統合できます。
- **AIを活用したユーザーおよびエージェント エクスペリエンス**:Salesforce は、AI を駆使した特殊なアプリケーションをクラウドサービスで提供します。お客様は、フロー、Apex、さらにはLWC(Lightning Webコンポーネント)など、プラットフォームの任意のコンポーネントを活用してカスタム環境を作成し、ワークフローやビジネス・プロセスにシームレスに統合されたAIを駆使した環境を作成することもできます。
- **Agentforce Studio**:このコンポーネントには、生成AIエクスペリエンスと予測AIエクスペリエンスの両方を作成するように設計されたエージェントビルダー、プロンプトビルダー、テスト センター、モデルビルダーなどのツールが含まれています。AI モデルの開発/トレーニング、テスト、チューニングをエンドツーエンドでサポートします。Next Gen Authoring は、改善された UX と SFDX との互換性により AI エージェントの構築を簡素化および高速化するために設計されたこれらの機能を強化します。
### 7.3 基本コンポーネント
#### Agentforce Trust Layer
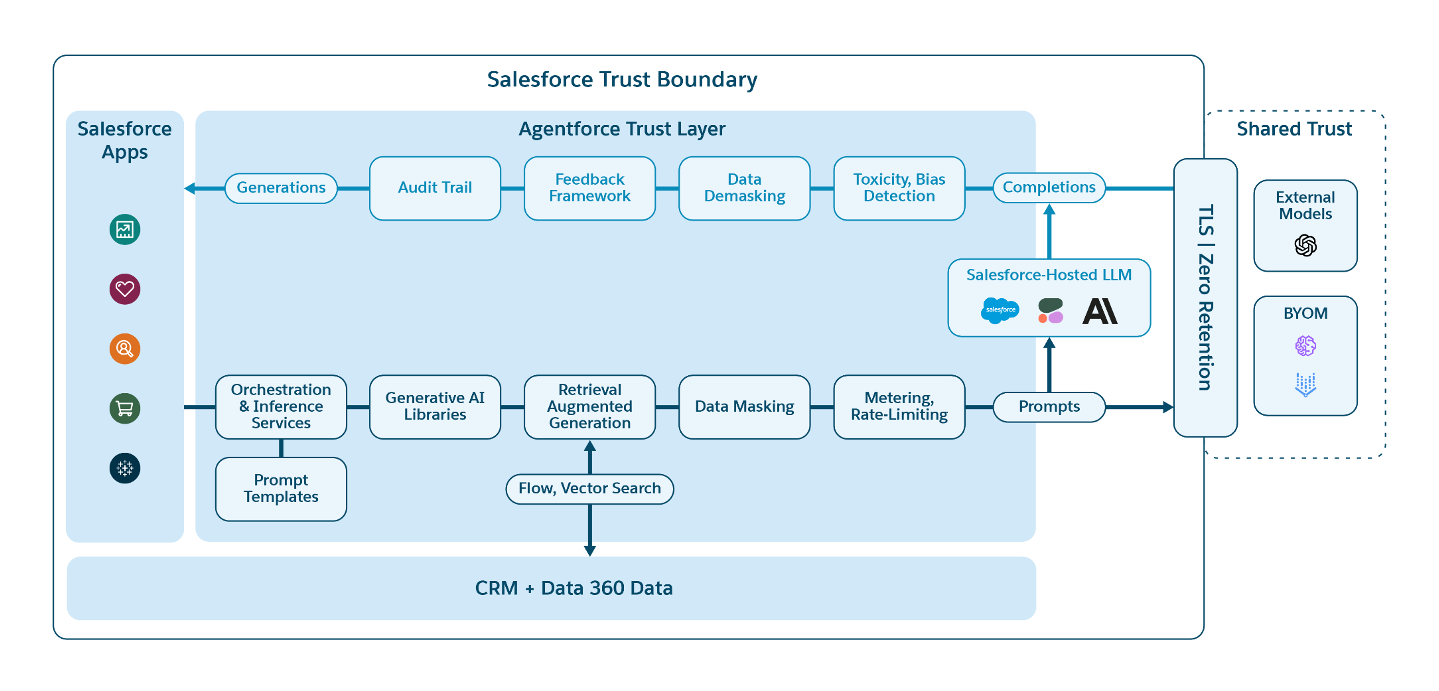 Agentforce Trust Layerは、次のような堅牢な機能を提供することで、生成AIアプリケーションでの顧客データの保護に役立つ特定の使用事例で使用できます。
- **データプライバシー**:強力なマスキングとプライバシー制御により、機密情報が外部 AI モデルからアクセスされないようにします。
- **セキュリティ**:安全なデータ処理環境を確保し、不正アクセスを防止します。
- **信頼**:サードパーティの AI ストレージや利用状況を使用せずに、データを顧客が制御できるようにします。
- **ガードレール:**エージェントの行動基準を適用し、LLM の本質的な非決定性を軽減して、エージェントが定義済みの手順とワークフローに一貫して従っていることを確認します。
- **精度**:関連する Salesforce データを使用して、AI 出力を強化します。
- **コンテンツのモデレーション**:コンテンツ前後のモデレーション、機密情報のカスタマイズ可能なデータマスキング (PII/PCI/PHI)、大規模言語モデル (LLM) 応答の有害性分類を提供します。
#### Agentforce AIゲートウェイ
AI ゲートウェイは、さまざまな LLM と予測モデルにアクセスして管理するための統合インターフェースを提供します。Salesforce と LLM の世界をつなぐ架け橋として機能し、さまざまな LLM プロバイダーの複雑さと顧客独自の予測 AI モデルを抽象化し、一貫した方法で LLM とやりとりします。Agentforce AIゲートウェイは複数のLLMプロバイダーと統合されており、お客様はニーズに最適なモデルを選択でき、さまざまなLLMの使用に関連するコストの管理に役立つ堅牢なデータ セキュリティ対策が組み込まれています。
フィードバックサービスは、ユーザーからのフィードバックを収集、分析、測定し、AI モデルを再トレーニングして調整するために利用するコンポーネントです。これは、Salesforce Platform 内の AI 主導の機能の継続的な改善に重要な役割を果たします。
#### 取得拡張生成 (RAG)
RAG は、生成 AI を使用して検索機能を強化し、より情報が豊富で正確な応答をもたらす重要な手法です。Agentforceプラットフォームでは、広範なSalesforce Data 360と統合ベクトルデータベースを使用して、ユーザーのクエリに関連するデータをすばやく取得します。その後、このデータは LLM のグラウンディングとして使用され、最適な応答が生成されます。
さらに、この方法では、ソース データを応答に含めることで、応答速度と User Trust が向上します。RAGは、Agentforceプラットフォームで幅広く採用されており、特にAgentforce for ServiceやAgentforce for Salesなどのアプリケーションで、これらの使用事例に関連する情報がどのように表示されるかに注目しています。
### 7.4 Agentforce プラットフォーム
AI モデルが進むにつれて、推論が必要なタスクを自動化するエージェントの開発が次のステップになります。これらのエージェントは、自然言語でクエリを理解して応答できるインテリジェントなアシスタントとして機能し、ユーザーはさまざまなタスクに合わせてエージェントを設計、テスト、リリースできます。このシステムの重要なコンポーネントはプランナーサービスで、次のように機能します。
- **ユーザー要求:の解釈**ユーザーの入力を分析してインテントを判断します。
- **計画の作成**:ユーザーのニーズに対処するための構造化された計画を策定します。
- **起動アクション**:アクションを直接または他のサービスから開始して、計画を実行します。
プランナーサービスはプロセスを調整し、必要なステップを管理および実行してエージェントがユーザーの要求を効率的に満たすようにします。
#### Agentforce
Agentforceは、エージェントを構築するためのプラットフォームであり、顧客やISVがサービス エージェントやセールス エージェントなどのアプリケーション用の自動化されたAIエージェントを作成できます。これらのエージェントは、顧客からの問い合わせを人間のような自然な方法で処理および回答し、幅広いビジネスタスクを処理して、企業と顧客の両方に大きなメリットをもたらします。
エージェントのワークフローには次のものが含まれます。
- **有効化**:エージェントは、さまざまなチャネルでの顧客の要求などの定義済みの条件によってトリガーされます。
- **理解と対応**:自然言語処理 (NLP) を使用して顧客のクエリ、インテント、センチメントを把握し、Salesforce のKnowledgeベースまたはその他のデータソースを参照して適切な対応を作成します。
- **複雑な処理**:複雑な問題に直面した場合や、人の監視が必要な場合、エージェントはやりとりを人のエージェントにスムーズに渡すことができます。
- **継続的な学習**:エージェントは各インタラクションから学習し、応答と全体的なパフォーマンスを継続的に向上させます。
#### Agentforce Studio
Agentforce Studioは、お客様がAIをSalesforceアプリケーションとワークフローに統合できるローコード プラットフォームを提供し、データ サイエンティスト以外のユーザーもAIテクノロジーにアクセスできるようにします。
スタジオの主な機能は次のとおりです。
- **モデルビルダー**:特定のビジネスニーズに合わせて調整された AI モデルを構築またはインポートできます。
- **プロンプトビルダー**:生成 AI プロンプトの作成と管理を容易にするノーコード/ローコードツール。プロンプトの作成、テスト、リリースのためのシンプルなインターフェースでユーザーエクスペリエンスを向上させます。
- **エージェントビルダー**:顧客と ISV がカスタマイズされた対話型エージェントと自律型エージェントを開発できるようにします。
- **テストセンター**:モデル、プロンプト、エージェントのテストをサポートします。これは、高品質の AI アプリケーションを確保し、パフォーマンスとコスト効率を最適化すると同時に、確定的応答とユーザーエクスペリエンスの品質を向上させるために不可欠です。
Agentforceは予測AIと生成AIを組み合わせ、Salesforce PlatformとData 360の統合メタデータ フレームワークを活用して、インテリジェントでパーソナライズされた効果的なビジネス ソリューションを提供します。
### 7.5 次の進化:Agentforce 3.0
推論の急速な進歩、拡張性の高いマルチエージェント システムのニーズ、マルチモーダル インターフェイスへの移行など、生成AI市場の加速する需要を満たすために、SalesforceはAgentforce 3.0でアーキテクチャを進化させています。この次世代プラットフォームは、次のようないくつかの重要な進歩に基づいて構築されています。
- **非同期のイベント駆動型アーキテクチャ:**Agentforce 3.0 は、拡張イベント駆動型フレームワークを備えた Python 基盤上に構築されています。これにより、非同期で拡張性の高いエージェントの実装が可能になり、パフォーマンスが向上し、エージェントがイベントを介して通信できる複雑なマルチエージェントの使用事例の基盤が構築されます。
- **マルチモーダル音声機能:**テキストベースのインタラクションを超えた Agentforce 3.0 では、主要なモダリティとして音声がサポートされています。このアーキテクチャはテレフォニープロバイダーや WebRTC ゲートウェイと統合され、リアルタイムのオーディオストリーミングを処理します。新しいサービスでは、音声からテキスト (ASR) への変換とテキストから音声 (TTS) への変換を管理し、自動化されたコンタクトセンターなどの使用事例で自然な会話音声環境を実現します。
- **Agentforceスクリプトと確定性:**明示的に定義された構造内でエージェントの動作を制約し、一貫した実行パスを確保する状態マシンベースの代行受信メカニズム。これにより、確定的グラフが可能になり、堅牢な状態管理を提供してメモリ損失を防止し、条件付きおよび LLM で決定された引き継ぎを容易にして、重要なビジネスプロセスの予測可能で一貫したエージェントアクションを確保できます。
## 8\.アプリケーションプラットフォームサービス
Salesforce Platform のアプリケーションエコシステムは、アプリケーションプラットフォームサービス、API、ユーザーエクスペリエンス、および開発者エクスペリエンスの各レイヤーで機能が統合されている点で際立っています。アプリケーションプラットフォームサービスは、Salesforce Platform でのほとんどのアプリケーションの構築とカスタマイズに使用される一般的な機能ですが、ビジネス機能は一般的にソリューション固有です。
### 8.1 主要な機能
アプリケーションエコシステムは、アプリケーション開発プロセスのガイドとなる 5 つの主要な機能に基づいて構築されています。
- **テナント**:これには、マルチテナントサービス内のデータとメタデータの論理的な分離が含まれ、認証済みユーザーが特定のデータと機能にアクセスできるようにします。これは、登録時に Salesforce 組織を受け取ったときに顧客に最も表示されます。
- **エンティティ**:データベーステーブルを表すエンティティは、テーブル列に似た項目で構成されます。\[エンティティ] および \[項目] メタデータには、データ型や API 参照名などのデータモデリングの属性と、エンティティがクエリ可能か書き込み可能かなどの機能属性が含まれます。データストア自体を直接操作するのではなく、この抽象化により、Salesforce は IT 開発者による更新を必要とせずにストレージテクノロジーをシームレスに導入および切り替えて、継続的なアプリケーション機能を確保できます。
- **アクセス制御**:これらの制御は、主にユーザー ID と特定のポリシーに基づいて、データおよび機能へのユーザーアクセスを制御します。ポリシーはルールと機能の切り替えで構成され、アクセスできるエンティティ、項目、機能を管理します。ポリシーと権限は「権限セット」に取得され、権限セットをユーザー ID に割り当てることでアクセス権が付与されます。
- **Layered Extension**:すでに説明したように、これは構造化された保存順序とメタデータ名前空間によって促進される、Salesforce エンジニア、外部パートナー、IT システム管理者、エンドユーザーなど、さまざまなロールによるメタデータとアプリケーションの独立した開発をサポートします。
- **パッケージ**:この機能により、Salesforce テナント間でメタデータのバンドルと配布が可能になり、再構築することなくアプリケーションの更新と配布プロセスを合理化できます。
これらの主要な機能に加えて、アプリケーションプラットフォームサービスには次の機能も含まれます。
- **データランタイムおよびクエリ**:複数の特殊なデータストアのデータの作成、更新、削除、クエリなどの操作をサポートします。データストアで直接、Salesforce エンジニアが使用できる内部抽象化を介して、または顧客向けの「Salesforce オブジェクト」または sObject 規則を介して、データ操作を実行できるようにするアーキテクチャによって、さまざまなデータスケールとパフォーマンスがサポートされます。
- **フロー/ワークフロー/数式**:ローコードツールを使用したビジネスロジックと入力規則の定義と実行。
- **Apexコード**:プラットフォームデータランタイムおよび API とネイティブに統合されているアプリケーションロジックのプロコード言語。
- **クラウド ネイティブ インフラストラクチャ サービス:**Heroku は、業界のプログラミング言語とフレームワークを使用して、プラットフォームのデータやイベントと統合するアプリケーションを構築、リリース、管理する開発者向けの堅牢な環境を提供します。
- **イベントと通知**:トリガーとイベントベースのオーケストレーションを管理します。
- **グローバリゼーション**:多言語および多国籍アプリケーションのサポートを提供します。
- **ライセンスとプロビジョニング**:プラットフォームの機能とアプリケーションへのアクセス権の購入と管理を処理します。
- **Lightning Web Stack**:レイアウトなどの構造化メタデータと標準 Web 技術を使用してビジュアルインターフェースをカスタマイズできます。
- **サイト + CDN**:認証されていないユーザーを含め、低遅延でトラフィック量の多い Web 環境を実現します。
- **セキュリティとコンプライアンス**:組織の特定のセキュリティおよびコンプライアンス要件を満たすためのツールと制御を提供します。
- **情報漏えい対策**:データのバックアップ、復元、アーカイブの機能が含まれます。
### 8.2 クラウドアプリケーションプラットフォーム
Salesforce Platform には、開発者が任意のプログラミング言語とフレームワークを使用してクラウドでアプリケーションを構築、実行、管理できる Heroku を介した一連のツールと機能が用意されています。Heroku の管理対象クラウドアプリケーションプラットフォームでは、Salesforce アプリケーションの拡張機能を構築するための拡張性の高いサービスとして、アプリケーションランタイム、データストア、メッセージングキュー、イベントシステムが提供されます。
Heroku で実行されるアプリケーションは、Salesforce 機能、顧客データ、ビジネスロジックのフルスイートにアクセスでき、サードパーティのシステムおよびサービスに接続できます。Heroku を使用すると、開発者は基盤となるインフラストラクチャの懸念に煩わされることなく、価値の提供に集中できます。
## 9\.オートメーション
自動化はアプリケーションを動的にするもので、不可欠なビジネスプロセスのデジタルトランスフォーメーションに不可欠です。
Salesforce Process Automation は、組織の規模に応じた合理化された効率的なビジネスプロセスの必要性など、顧客が直面する主要な課題に対応するために作成されました。これらの課題には、多くの場合、過剰な手作業を必要とするワークフローが含まれ、非効率性と運用コストの増加につながります。顧客は、これらのプロセスを自動化し、手作業を最小限に抑え、一貫性と正確性を維持できるソリューションを求めています。
技術者以外のユーザーがコーディングスキルがなくてもビジネスプロセスを設計および実装できる使いやすいツールがないことが大きな課題でした。さらに、データ入力、承認、通知、複雑な複数ステップのプロセスなど、既存の自動化された Salesforce タスクと安全、スケーラブル、シームレスに統合できるソリューションが必要でした。
Salesforce Process Automation は、自動化されたワークフローを作成するための堅牢で直感的なプラットフォームを提供することで、これらのニーズを満たします。ユーザーは視覚的なインターフェースを使用してフローを作成およびカスタマイズできます。このインターフェースは、技術者と技術者以外のユーザーがアクセスでき、反復作業の自動化、ビジネスルールの適用、Salesforce エコシステム内のプロセスの合理化を実現します。
トランザクション データを操作する複雑なオーケストレーションを必要とする自動化のために、Salesforceではビジネス ロジックを記述するためのプロコード言語としてApexを提供しています。
### 9.1 プロセスの自動化のアーキテクチャと機能
**ビジュアルロジックビルダー**:顧客と ISV は、ドラッグアンドドロップインターフェースである Flow Builder を使用して、コーディングなしでプロセス自動化フローを作成します。このビジュアルツールはすべての技術レベルにとって使いやすく、ビジネスアナリストやシステム管理者は複雑な自動化を簡単に設計できます。
Flow Builder では、コアフローエンジンでサポートされているさまざまなコンテキストで動作する汎用性の高いフローを作成できます。
- **レコードトリガー**:フローはレコードの更新またはフォームの送信時に有効化され、顧客のアクションに基づいてデータの変更、検証、ワークフローの開始が可能になります。
- **スケジュール済みフローまたはイベント駆動型フロー**:これらのフローは、事前に決められたスケジュールで操作したり、特定のイベントの後にトリガーしたり、外部サービスにコールアウトしたりできます。
- **画面フロー**:データ入力、トラブルシューティング、オンボーディングなどのタスクに役立つフォーム、画面、その他の対話型要素を使用して、ステップごとのガイド付きプロセスのユーザーインターフェースを提供します。
- **オーケストレーターフロー**:複数のステッププロセスを管理および統合し、複雑な操作の処理を促進します。
オフラインフローエンジンは、Salesforce アプリケーションサーバーに接続せずに実行できます。オフラインフローは、Field Service Mobile の使用事例の自動化を強化します。高スケールフローエンジンは、マーケティングフローを強化します。実行時間の長い大量のフローを同時に処理するための B2C 拡張性が提供されます。
Flow Builder では、すべてのプロセス自動化フローに適用可能なさまざまな強力なロジック要素をサポートする統合メタデータモデルによって、すべての使用事例と環境が強化されます。
- **高度なロジックと条件**:ユーザーは、決定要素、ループ、待機条件などの複雑なロジックをワークフローに統合できるため、複雑なビジネスシナリオを処理できます。
- **データ管理と変換**:Flow Builder では、Web サービス、Salesforce 組織、Data 360 など、さまざまなソースからのデータの取り込み、変換、管理が可能です。レコードの作成、更新、削除、クエリなどの包括的なデータ操作をサポートします。
### 9.2 Salesforce Platform 全体の自動化
Salesforce Process Automation は、他の Salesforce 製品やサードパーティシステムとのシームレスなインテグレーションを提供し、ビジネスプロセスと顧客とのやりとりの統合ビューでアプリケーション間のスムーズなデータフローを実現します。API、Web コールアウト、MuleSoft コネクタなどのさまざまなインテグレーション方法をサポートしています。
Salesforce 内の外部サービスと MuleSoft 接続により、Salesforce Process Automation 内で外部 API への接続とそのデータの使用が可能になります。API スキーマを登録すると、フローにシームレスに統合する呼び出し可能なアクションを作成でき、外部データソースを使用してプロセスを自動化できます。MuleSoft の堅牢なインテグレーション機能により、Salesforce と他のアプリケーション間のシームレスなデータフローが確保され、データサイロが解消され、ビジネスプロセスの統合ビューが提供されます。
**Agentforceインテグレーション**:Salesforce Process AutomationはAgentforceを活用して、インテリジェントな意思決定でワークフローを強化します。AI インサイトを使用して、リードを適切な営業担当者に自動的に転送したり、顧客の行動に基づいてカスタマイズされたマーケティングキャンペーンを開始したりすることで、インテリジェンスを追加して自動化の効果を高めます。
**プラットフォームの相乗効果**:Salesforce Process Automation は、Sales Cloud、Service Cloud、Commerce Cloud、Marketing Cloud などの他の Salesforce 製品とシームレスに統合されます。この統合により、組織はさまざまな部門のプロセスを自動化でき、業務効率が向上します。たとえば、Marketing Cloud フォームから顧客の苦情が送信されると、ワークフローで Service Cloud のサポートケースを自動的に生成できます。
### 9.3 Apexによるプロコードの自動化
Apex は、開発者が Salesforce Platform でカスタム・ビジネス・ロジックを記述し、複雑な操作を実行できるようにする強力なオブジェクト指向プログラミング言語です。当社のプラットフォームの主力であり、現在、このプラットフォームは月間3,500億を超えるApexトランザクションを処理しています(2025年10月現在)。
Apex は、次のような幅広いカスタム機能と Salesforce Platform への緊密な統合を開発するために使用されます。
- **トリガーベースの自動化**:レコードの挿入、更新、削除の前後に実行される複雑な自動化を実装します。これにより、複雑なデータ検証、関連レコードの更新、特定のデータ変更に基づく他のプロセスの呼び出しが可能になります。
- **Web サービス:**外部システムとのカスタムインテグレーションを作成し、Apex から REST または SOAP API をコールします。
- **カスタムユーザーインターフェース**:VisualforceとLWC(Lightning Webコンポーネント)を使用して、高度にカスタマイズされたユーザー インターフェイスと環境を構築します。LWCでは、Apexがデータ操作とビジネス ロジックを処理するバックエンド コントローラーとして機能します。
- **カスタムAPI:**開発者は、Apex RESTとApex SOAPを使用してカスタム・ロジックをAPIとして公開し、外部システムがSalesforceのデータやプロセスをプログラムで操作できるようにします。
- **非同期処理**:Futureメソッド、Queueable Apex、スケジュール済みApexを使用して、実行時間が長いタスクやリソースを消費するタスクを非同期で実行します。これにより、実行時間の長い操作をバックグラウンドでオフロードして処理できるため、ユーザーエクスペリエンスとシステムパフォーマンスが向上します。
- **スケジュール済み Apex:**開発者は、Apex Schedulerを使用して、夜間のデータ同期、レポート生成、メンテナンス・アクティビティなどの定期的なタスクについて、特定の時間にApexクラスを実行するようにスケジュールできます。
## 10\.ユーザーエクスペリエンス
Salesforce Platformのユーザー エクスペリエンス機能を使用すると、エンド ユーザーは、Lightning Outを使用して、ブラウザー ベースのLightningアプリケーション、エクスペリエンス サイト、モバイル ネイティブ、AI指向、コラボレーションUX、組み込みコンポーネントにわたるさまざまな導入オプションを通じてアプリケーションを操作できます。
### 10.1 Lightning Design System
Salesforce Lightning Design System (SLDS) は、Salesforce の設計原則に従って一貫性のあるアクセシビリティの高いユーザーインターフェースの作成を促進する包括的な設計フレームワークであり、すべての製品で一貫したユーザーエクスペリエンスを実現します。Salesforce エンジニア、顧客、パートナーは、Salesforce エコシステム全体でネイティブなアプリケーションを構築できます。
設計システムの主な機能は次のとおりです。
- **デザインパターン**:一貫したユーザーエクスペリエンスを確保するためにレイアウト、データプレゼンテーション、ユーザー操作のガイドラインを提供する、一般的な設計上の課題に対する実証済みのソリューション。
- **スタイルフック**:色、タイポグラフィ、間隔、サイズなど、デザインの決定を表す CSS 変数。アプリケーション全体で一貫性が確保されます。
- **Lightning ベースコンポーネントライブラリ**:Salesforce の設計原則に準拠するボタン、フォーム要素、ナビゲーション要素などの再利用可能な UI コンポーネントのコレクション。迅速かつ効率的な開発を促進します。
- **アクセシビリティ**:Web Content Accessibility Guidelines (WCAG) などの標準に準拠して、すべてのコンポーネントを障害者が使用できるようにするための組み込みのアクセシビリティ機能とガイドライン。
- **応答型レイアウト**:アプリケーションがさまざまなデバイスや画面サイズにシームレスに適応できるようにする柔軟なグリッドシステムとレイアウトのガイドライン。
- **Tooling**:コンポーネントの健全性、パターン対策の削減、設計システムガバナンスをサポートするツール、リソース、テクノロジーのコレクション。
SLDSフレームワークは、より豊富なスタイル設定フックと詳細なカスタマイズ機能をサポートするように進化を続けています。これにより、コンポーネントを再利用しながら、固有のブランド設定およびテーマ設定の要件に合わせてカスタマイズすることができます。Salesforce の設計システムの目標は、Salesforce を AI ですばやく簡単に、そして魅力的に使用することです。
### 10.2 Lightning Web Stack
Lightningと呼ばれるSalesforceのブラウザー ベースのインターフェイスは、一貫したUIコンテナとメタデータ主導のUIフレームワーク、一連のテクノロジーを提供し、Salesforceエンジニア、IT管理者、開発者、パートナーが一貫したSalesforceの美学でUIをすばやく開発できるようにします。また、スタイルの変更やブランド変更を完全に制御するための拡張ポイントも提供します。Lightning Web Stackには、次のテクノロジーが含まれます。
- **Lightning Web コンポーネント**:W3C Web 標準に準拠して HTML および JavaScript で構築されたカスタム Web コンポーネント。
- **Lightning Webセキュリティ**:ブラウザーで JavaScript コードを管理する仮想化エンジンで、サードパーティコードに関する Salesforce のセキュリティ標準に準拠します。
- **Lightning Data Services**:サーバー側データを効率的に操作するために設計されたフレームワーク。
- **Lightning Web Runtime**:さまざまなクライアントでパフォーマンスが高く一貫性のある UI 表示を実現します。
Salesforce エンジニアリングは、以前の UI テクノロジーからの教訓を取り入れ、Web 標準化団体に貢献しており、標準ベースのコンポーネント実装の開発に影響しています。たとえば、Salesforce は引き続き約 20 の W3C 作業グループのメンバーです。Lightning WebコンポーネントとLightning Web Stackはこれらの業界標準に準拠しているため、開発者の複雑さが軽減されます。
### 10.3 モバイル
モバイルは、ユーザーが Salesforce アプリケーションを操作するためにますます重要になっているインターフェースです。
Salesforce はネイティブのモバイルアプリケーションを提供するため、新しいコードを記述することなく、すべてのブラウザーベースの Lightning アプリケーションをモバイルアプリケーションにできます。Salesforce には、デバイス向けに最適化された完全カスタムのネイティブアプリケーションを作成するためのさまざまなツール、SDK、機能も用意されています。これには以下が含まれます。
- **Mobile SDK**:認証、セッション/トークン管理、Salesforce API などとの統合を簡略化する、モバイルオペレーティングシステム全体の開発者向けのプロコードインターフェース。
- **モバイルネイティブランタイム**:開発者は、デバイス上の機能も活用する iOS および Android テクノロジーを使用して、実行時に動的に表示されるメタデータ駆動のネイティブエクスペリエンスを作成できます。
- **ブランド**:Mobile Publisherパイプラインを使用して、Salesforceモバイル・アプリケーションを顧客ブランド・アプリケーションに変換するためのモバイル・アプリケーションの外観をカスタマイズできます。
- **オフライン機能**:一貫性がない、またはインターネット接続がない状態で、シームレスなアプリケーション機能を実現します。
Mobile Customization Framework (MCF) は、使いやすさと広範なカスタマイズオプションを提供することで、ネイティブ Salesforce モバイルアプリケーションの開発を大幅に強化します。主な利点は次のとおりです。
- **メタデータ主導のアプローチ**:MCF は、ビジュアルビルダー、共通リポジトリ、Salesforce でホストされるリソースから取得可能なメタデータを使用して、特定のニーズに合わせて調整された動的で適応可能なユーザーエクスペリエンスを作成します。
- **実験と最適化**:このフレームワークでは、さまざまなレイアウトのランタイム実験がサポートされ、継続的なエンゲージメントの最適化とユーザーエクスペリエンスの改善が促進されます。
- **拡張性**:柔軟性を考慮して設計された MCF では、カスタムコンポーネントをコアメタデータフレームワークに統合できるため、機能と汎用性が向上します。
- **構成可能なユーザー環境**:MCF では、最新の iOS および Android テクノロジーを活用して、ボタン、リスト、カードなどの再利用可能なコンポーネントの組み立てをサポートし、高度なユーザーインターフェースを作成します。
- **ランタイムのカスタマイズ**:MCF により、リアルタイムの UI カスタマイズと実験が可能になり、よりパーソナライズされた魅力的なユーザーエクスペリエンスが促進されます。
モバイルデバイスでアプリケーションを使用する場合、オフラインや接続性の低いシナリオの懸念が高まります。モバイルテクノロジースタックでは、オフラインファーストが可能なアプリケーションの構築が優先されます。主な機能は次のとおりです。
- **Cache First Experience**:オフラインで使用するためにデータをキャッシュすることに重点を置き、高いパフォーマンスとセキュリティを確保します。ユーザー操作も、オフライン表示の原則を念頭に置いて設計されています。
- **キャッシュ管理**:オフラインでもキャッシュの関連性と更新を維持します。
- **共有キャッシュ**:ネイティブ画面とハイブリッド画面の両方で 1 つのキャッシュを利用するため、シームレスなオフライン環境が促進されます。
Nimbus は、ハイブリッドアプリケーション開発者がデバイス機能にアクセスするプロセスを簡略化するプラットフォームの本番対応のソリューションです。これまで、JavaScript とモバイルネイティブコードのギャップを埋めるのは複雑な作業でした。しかし Nimbus を使用すると、開発者は低レベルのコーディングに慎重になることなくモバイルデバイスの可能性を最大限に活用できるようになりました。主な機能は次のとおりです。
- **広範なアクセス**:カメラ、マイク、地理位置情報、LiDAR など、さまざまなデバイス機能とのシームレスな統合を実現します。
- **標準化されたインターフェイス**:デバイスの機能にアクセスするための一貫した方法を提供します。
- **ハイブリッド アプリケーション統合**:ハイブリッドアプリケーションでデバイスの機能を最大限に活用できるようにします。
- **効率的な開発**:アプリケーション開発プロセスを合理化し、複雑さを軽減します。
AI は Salesforce アプリケーションで可能なことを変革し続けていますが、Salesforce では、デバイス上の ToDo 固有の AI モデルをクラウドベースのソリューションと共に活用することで、差別化されたユーザーエクスペリエンスも提供します。
- **小言語モデル (SLM):**これらはモバイルデバイスで効率的かつ低コストで実行できます。
- **プライバシーとセキュリティ:**ユーザーのプライバシーを確保し、サーバー ベースのモデルと同等のレベルでTrustとセキュリティを維持します。
- **オフライン機能:**接続性の低い環境で効果的に動作し、オフラインの使用事例を可能にします。
- **音声:**最先端の音声合成モデル、自然テキスト読み上げモデル、話者ダイアライゼーションモデルがデバイスでネイティブに実行されるようになり、完全なプライバシーとゼロレイテンシーで忠実な音声インタラクションが実現します。
### 10.4 AIとコラボレーション
自然言語と複数ターンのアプリケーションインタラクションの非モデル UI の普及率は今後も高まるでしょう。今後の開発により、モデル、デバイス機能、アプリケーション間のインテグレーションが強化され、より直感的な音声およびテキストインターフェースによるユーザーインタラクションが改善されることが期待されます。デバイス上の評価指標収集では、ユーザー設定に基づいてパーソナライズされた調整も可能です。
自動化と人間による監視の両方の強みを活用するには、人間とエージェントの両方を含むすべてのユーザーのコラボレーションが不可欠です。このコラボレーションは、組織の従業員とその顧客が関与する複雑なビジネスインタラクションでは特に重要です。Slack は Salesforce Platform 内の主ツールとして機能し、特定のディスカッショントピックに合わせて調整されたダイレクトメッセージングとマルチユーザーチャネルを介してこのやりとりを促進します。これらのディスカッションは、ユーザーが自発的に作成した会話から、顧客の重大な問題に対処する詳細な Slack メッセージスレッドなど、ユーザーのワークフロー内の特定のデータを中心としたより構造化された会話まで、多岐にわたります。
今後、Salesforce Platform では、Slack で現在提供されているコラボレーション環境を強化する予定です。この拡張により、プラットフォームの広範な機能を最大限に活用し、デジタルワークスペース内でのユーザーの操作とコラボレーションの方法を強化します。
## 11\.開発者エクスペリエンス
プラットフォームの Developer Experience 機能は、ローコードからプロコードまでのアプローチに焦点を絞ったアプリケーションを構築、カスタマイズ、テスト、リリースするためのツールを提供し、あらゆるスキルレベルの開発者に平等な機会を提供します。
- **ローコードツール**:これには、データモデルのスキーマビルダー、ビジネスルールのフロー、UI カスタマイズの AppBuilder が含まれます。これらはすべて、構造化メタデータを操作して開発プロセスを簡素化し、技術的な概念や専門用語の代わりにビジネスソリューションの言語で作業するように設計されています。
- **プロコードツール**:よりリッチで複雑なカスタマイズを必要とする開発者向けに、このプラットフォームには、Salesforce Code Builder、クラウドベースの IDE、コマンドラインインターフェース (CLI)、高度なコーディングとコンポーネント作成のための API などのツールが用意されています。開発者は、Heroku を使用してアプリケーションをリリース、管理、最適化するソリューションを活用して、選択した言語でコーディングできます。
- **統合開発環境**:Salesforce エコシステムでは、ローコードツールとプロコードツールのシームレスな統合がサポートされ、業界標準のツールを使用してクラウド内およびローカルで一貫した開発を行うことができます。
- **アプリケーションライフサイクル管理 (ALM)**:初期開発用のスクラッチ組織や、本番同様のデータと拡張性に対するテスト用のFull Sandbox組織など、本番環境とは別に開発用のさまざまなSandbox組織を備えています。
### 11.1 開発者向けの AI
AI と「開発者アシスタント」は、効率的で高品質なアプリケーションの作成を簡素化および加速することで、開発者エクスペリエンスに革命をもたらしています。Salesforce の AI 研究および開発者エクスペリエンスチームは、エージェント的推論を備えた予測 AI と生成 AI を強力な開発者エージェントに変換する方法を継続的に反復および探索しています。これらの開発者エージェントは、VS Code、コード ビルダー、コマンド ライン、DevOpsセンター、Code Analyzerなど、開発者がすでに使用しているツールとネイティブに統合されているため、関連性とインパクトが高まります。
Apexコードのアンチパターンとホットスポットを特定し、実装を改善するための重要な推奨事項を提供するように、コード分析が大幅に進化しました。特定された問題は通常、コンピューティングリソースを浪費し、大規模なインシデントにつながることがよくあります。これは、2024 年 1 月に ApexGuru Insights として開始されました。
稼働開始後の最初の 1 年間で、2,800 を超える Salesforce 組織が ApexGuru を使用して Salesforce 実装を分析し、改善しました。22,000 件を超えるおすすめの実装に成功し、毎週 28,000 時間の CPU 時間が節約されました。この強化により、パフォーマンスが向上するだけでなく、CO2 排出量を週あたり 135 kg 削減することで、環境の持続可能性にも貢献します。
また、Developer Productivityを向上させるために、AIをプロコード開発者ツールと機能に統合しています。2024年に「開発者向けAgentforce」として製品化され、開発者はVisual StudioのコードとCode BuilderのSalesforce Extension Pack内でこれらの新機能にアクセスできます。これらの拡張機能により、次のことが可能になります。
- Apex および Lightning Web コンポーネント (JavaScript、CSS、HTML) の開発者としての記述およびコード生成時のインラインコードの提案。
- Apex および Lightning Web コンポーネントのコードの説明とドキュメントの生成。
- Apex 単体テストコードの生成。
- コード生成、説明、およびドキュメントに関する複数の応答を操作できる、IDE の個別の複数ターンチャット環境。
- Lighting Web コンポーネントの最適化。
- エージェントテストおよびデバッグ機能を含む、人間が判読可能な YAML メタデータを含むエージェント生成。
2025 年 10 月現在、42,000 人以上の開発者が毎月この技術を積極的に使用しており、1,760 万行のコードが受け入れられています。この包括的なスイートにより、Salesforce Platform 内の幅広い開発ニーズに対応する柔軟で統合された効率的な開発環境が実現します。AI 開発者ツールも、複数の外部モデルと Salesforce で構築されたモデルで動作するアーキテクチャで強化され、特定の使用事例で最も効果的で効率的なモデルを選択できます。
### 11.2 MCP サポートと AI 支援コーディング
モデルコンテキストプロトコル (MCP) は、AI エージェントが任意のツールやデータソースを安全かつ一貫して操作できるように設計された新しいオープン標準です。Salesforce は、MCP サポートを Salesforce 開発者ツールキットにネイティブに統合し、企業全体で機能やツールにアクセスできる開発者エージェントを支援します。具体的な動作は次のとおりです。
- **ローカル MCP サーバ:**ローカル MCP サーバーを使用すると、開発者は本番にリリースする前にローカル IDE 内でエージェントインテグレーションを簡単に構築、テスト、デバッグできるため、生産性が大幅に向上します。ローカル MCP サーバーには、モバイル開発、アクセシビリティテスト、Aura から LWC への移行、エージェントによる DevOps など、組織のインタラクションと開発ワークフローに特化したツールが用意されています。ローカル MCP サーバーには、エージェント的推論および LLM とのインテグレーションも含まれており、開発者は自然言語でアプリケーションを反復的に「コーディング」できます。
- **Salesforce API用のカスタムMCP Server:**開発者は、Salesforce API、Data 360 オブジェクト、オートメーションフローを MCP の「ツール」として安全に公開できるようになりました。これにより、Salesforce Platform 全体が、外部 AI エージェントまたはアプリケーション向けの豊富で信頼性が高く、発見可能な機能セットになり、詳細なアクセス制御と新しい消費ベースの収益化モデルの可能性が提供されます。
- **ネイティブの外部 MCP 接続:**開発者は、MCP 標準に準拠する外部サーバーへの接続を安全に管理することもできます。これにより、開発者は会社全体で作業できるエージェントを作成できます。
## 12\.アプリケーションスイート
Sales Cloud、Service Cloud、Marketing Cloud、Revenue Cloud、Commerce Cloudなどのアプリケーション クラウドは、Salesforce Platform上に構築されており、業界をリードするビジネス機能を提供し、お客様の成功を促進するアプリケーション スイートを構成します。主な機能は次のとおりです。
- **シームレスな統合**:緊密に統合されており、カスタマージャーニー全体で一貫して機能し、顧客タッチポイント全体でデータとプロセスのフローを円滑にして、カスタマーエクスペリエンスを強化するように設計されています。
- **エンドツーエンドのカスタマイズ性**:当社のプラットフォーム上に構築されたアプリケーションは、ノーコードからプロコードまで幅広いカスタマイズオプションを提供し、お客様のニーズに的確に合わせることができます。
- **高度なAI機能**:Agentforce Agentsを使用して、エージェント支援型およびエージェント自律型の対話型チャネル ベースのワークフローを提供します。予測 AI と生成 AI を組み込み、自動化、予測分析、パーソナライズされたユーザーエクスペリエンスによって効率を高め、アクション可能なインサイトとおすすめを提供します。
- **リアルタイムデータ処理**:Data 360 を使用してリアルタイムのデータアクセスと分析を行い、最新情報に基づいたタイムリーな意思決定をサポートします。これにより、ペースの速い環境での応答性と機敏性が向上します。
- **統合データおよび分析**:さまざまなデータソースを一元化されたプラットフォームに統合して一貫性のある包括的なデータビューを提供し、正確な分析と意思決定の向上を実現します。
- **セキュリティとコンプライアンスの強化**:機密データを保護し、規制基準を満たすための堅牢なセキュリティおよびコンプライアンス ツールを備えています。
- **コンシューマー グレードのユーザー エクスペリエンス**:デバイス、チャネル、モダリティ全体でアプリケーションにアクセスし、効果的に使用できる直観的でユーザーフレンドリーなインターフェースを提供します。
- **信頼性**:緊急サービスや重要な輸送システムなど、ミッションクリティカルな業務をサポートするために最小限のダウンタイムと拡張性を確保します。
- **柔軟な拡張性**:Hyperforce上に構築されており、パフォーマンスや提供コストを犠牲にすることなく、データとユーザー操作量の増加をサポートします。
- **継続的な改善**:既存の業務を中断することなく、イノベーションを定期的に統合して機能を強化します。
Salesforce は、このホワイトペーパーで説明されている基盤技術を基盤として、プラットフォーム全体の機能を統合することで、アプリケーションの強化に取り組んでいます。この変換は、Salesforce のアプリケーションスイートの設計と開発を形作る一連の重要な優先事項に従って行われます。
### 12.1 拡張性とパフォーマンス
当社のアプリケーションチームはパフォーマンスと拡張性に特化しており、高度なパフォーマンスラボを使用して、合成データを使用して本番環境の正確なレプリカを作成します。この設定により、並列ユーザージャーニーの広範なシミュレーションが可能になり、各新機能のパフォーマンステストと影響の評価が徹底されます。実行時のボトルネックが特定されると、処理数制限やその他の基準を動的に調整してシステムの健全性を保護しながら、解決を促進するためのデータを収集します。
Dell EMCのシステムは、パブリック クラウドの柔軟性を効果的に活用するために水平拡張できるように設計されています。自動チェックにより、更新や機能強化がパフォーマンスに悪影響を及ぼさないようにします。需要の増加に対応するだけでなく、事前に予測して調整することで、システム負荷を積極的に管理する予測オートスケーラーを採用しています。
未使用の容量を削減して提供コストを最小限に抑えるには、自動拡張が不可欠です。システム運用コストを詳細に監視し、自動拡張やリソース使用の非効率性を特定して対処します。コスト パフォーマンスは重要ですが、信頼性の高いアプリケーション デリバリを優先し、コストが高くなってもお客様のTrustを維持するために、迅速にスケールアップしてゆっくりとスケールダウンするAutoscalerを選択します。
### 12.2 シームレスなインテグレーション
#### 共通データモデル
データモデルは、Salesforce のすべての業務の基本であり、ビジネス機能、API、ナビゲーション、UI 表示、作成可能なレポートに影響します。これらはプラットフォームの機能に不可欠です。
このアプリケーション スイートは、Sales Cloud、Service Cloud、Revenue Cloud、Commerce Cloud、Marketing Cloud、Industries Cloudで共通のデータ モデルを共有します。これにより、統合スイートの一貫した動作と相互運用性が提供され、アップグレードと拡張の明確なパスが提供されます。
たとえば、取引先エンティティと商品エンティティをすべてのクラウドで共有することで、Marketing Cloud と Sales Cloud の両方のユーザーがデータ、メタデータ、UI コンポーネント、ビジネスロジックを交換できます。この統合により、サイロが解消され、部門間のコラボレーションが促進されます。
#### 仮想データプラットフォーム
すべての Salesforce Cloud で共通のデータモデルを使用すると、インテグレーションが大幅に強化されますが、すべての複雑なパートナーインテグレーションのニーズを満たすとは限りません。Data 360 共通データモデルでは、Salesforce の一般的なデータ境界を超えて共有データモデルの利点を拡張し、より広範なインテグレーションシナリオに対応することで、この点を拡張します。
#### 階層化された拡張性
Salesforce のメタデータフレームワークを使用すると、エンジニアリングチーム、ISV、パートナー、システム管理者、エンドユーザーなどのさまざまなグループが、互いに干渉することなく、独自の拡張性レイヤー内でアプリケーションをカスタマイズおよび拡張できます。この構造により、1 つのグループによる変更で他のグループが中断されることがなく、システムの整合性が維持されるスケーラブルな環境がサポートされます。
フレームワークの実際の代表的な例は、すべてのKnowledgeソースをデータ レイクに統合する統合ナレッジ製品です。この設定にはセマンティック レイヤーと取得機能が含まれており、Sales Cloud、Service Cloud、Revenue Cloud、Marketing Cloud、Commerce Cloudで予測および生成AI機能が強化されています。既存の構造化Knowledgeモデルにリンクされている非構造化および半構造化Knowledgeのデータ モデルが組み込まれています。
さらに、フレームワークではメタデータを使用してデータ型間のカスタムリレーションを定義し、高度なクエリ生成を容易にします。これにより、アプリケーションチームはこの包括的なKnowledgeベースを活用するカスタマイズ可能なアプリケーションを作成でき、ISV、パートナー、および顧客は、特定のビジネス使用事例に合わせてメタデータリレーションを変更したり、カスタム取得ツールを開発したりすることで、アプリケーション機能をさらに強化できます。
#### 共通データプラットフォームの強化
顧客データは SalesforceDB や Data 360 などのさまざまなプラットフォームで安全に保存され、構造化形式や非構造化形式に関係なく標準化および正規化されます。これにより、sObject と呼ばれる統合形式で一貫したデータ処理が可能になります。この形式は、すべての顧客データにわたって一貫性のあるデータプラットフォームをサポートします。
この標準化により、すべてのデータ操作の単一のAPI、Apexのトリガーの統合インターフェース、フローを使用したカスタム ワークフローの作成が可能になります。Tableau Nextもサポートしているため、カスタマイズされたデータ ビューと、顧客データに基づいてインテリジェントな応答を生成するプロンプトビルダーなどの生成AIツールとの統合が可能です。
さらに、Salesforce アプリケーションはさまざまなデータストアと統合され、商品内のビジネスプロセスの柔軟性が向上します。たとえば、Marketing Cloud では、フローを使用してマルチタッチカスタマーエクスペリエンスを管理します。フローには、基盤となる顧客データに基づいて、あらかじめ設計されたテンプレートを使用するか、マーケティングを他のビジネスプロセスと統合するカスタムフローを作成するオプションがあります。
### 12.3 共有ビジネス機能
アプリケーションは、ID 解決、コンテンツオーケストレーション、パーソナライズ、分析、LLM ゲートウェイ、Reasoning Services などの共有サービスを活用して強化し、迅速なイノベーションと提供を可能にします。これらのサービスは、リアルタイムのデータ処理、AI 主導のインサイト、充実したユーザーエクスペリエンスをサポートし、包括的な顧客ビューを提供します。
メリットとして、インテリジェントな自動化と予測分析による効率の向上、データとユーザーのインタラクションを増やすための拡張性、堅牢なセキュリティとコンプライアンスなどがあります。プラットフォームのカスタマイズ機能により、組織はニーズの変化にすばやく適応し、成長と優れた運用性を促進できます。
アプリケーション層のイノベーションは、Salesforce Platform と個々のアプリケーションによって推進され、Salesforce エコシステムを強化し、アプリケーションを業界のリーダーとして確立します。
### 12.4 マルチチャネルおよびチャネル最適化
Salesforce アプリケーションは、Web、モバイル、メール、SMS、WhatsApp、その他のチャネルなど、さまざまなプラットフォームのユーザーと会うように設計されています。各チャネルのネイティブ機能を最適化して、ユーザーエクスペリエンスと効率を向上させます。
Salesforce Field Serviceユーザー向けの複数か月のオフライン機能、ブラウザーのプッシュ通知、Lightningサービスコンソールのサービスエージェント向けのワイド画面レイアウト、コマース買い物客向けの高パフォーマンスのストアフロントおよびCo-pilotなどの機能があります。
メタデータプラットフォームにより、Salesforce、パートナー、および顧客はこれらの機能をすぐに利用できます。
### 12.5 イノベーションの迅速な提供
Salesforce の基盤サービス、プラットフォーム、共有ビジネス機能により、アプリケーションは市場の変化や技術トレンドにすばやく適応し、イノベーションを迅速に提供できます。たとえば、生成AIの出現により、SalesforceはNLP Trust LayerやIntent Detectionなどの既存のAIサービスを迅速に活用して、ユニバーサル コミュニケーション プラットフォームにプロンプト テンプレートを組み込みました。このインテグレーションにより、製品全体でメッセージングと電話の機能が強化され、より個人的なクライアント接続が促進されます。
自律型AIへのトレンドを受けて、Salesforceは、これらの既存の投資を活用して、ゼロから構築することなくエージェントとのビジネス使用事例を効率的に自動化するソリューション、Agentforceを発売しました。
### 12.6 Application Suite へのパス
Marketing Cloud、Revenue Cloud、Commerce CloudをSalesforce Platform上に再構築し、これらのクラウドで同じインフラストラクチャ、プラットフォーム、メタデータ、データ、AI、UIコンポーネント、ビジネス ロジックを共有しながら、Salesforce Platformのフル機能を活用できるようになりました。たとえば、Revenue Cloudの機能と、制約ベースのコンフィグレーター、価格設定エンジン、カタログ管理などのコア機能が組み込まれており、スイート全体で使用可能な基本的なサービスとなっています。これにより、すべてのクラウドでシームレスなインテグレーションが可能になり、Commerce Cloud と Marketing Cloud が提供する機能は、他のアプリケーションで活用できる共有ビジネス機能の一部になります。これは、統合されたアプリケーションスイートのビジョンです。
Salesforce Platformの取り組みにより、Sales Cloud、Service Cloud、Marketing Cloud、Revenue Cloud、Commerce Cloudを統合した統合アプリケーション スイートが開発されました。Salesforce Starter Edition 以降で使用可能なこのスイートでは、マルチチャネルアウトリーチ、カスタマーリレーション管理、ビジネスインサイトが 1 つのまとまったパッケージで提供されます。選択したエディションに関係なく、ユーザーは Sales Cloud、Service Cloud、Marketing Cloud、Commerce Cloud のコア機能にアクセスできるため、すべてのレベルで一貫した環境が提供されます。
## 13\.業種固有のソリューション
金融サービス、健康、ライフサイエンス、メディア、エネルギーおよび公益事業、製造、自動車、消費財、小売、ネットゼロ、公共セクター、教育、非営利団体向けの Salesforce Industries 製品は、アプリケーション製品とプラットフォームを拡張し、業界固有の課題に対応するカスタマイズされたソリューションを提供します。業種固有のワークフロー、コンプライアンス基準、データモデルを組み込むことで、業務を合理化し、生産性を向上させます。
Industries ポートフォリオが Salesforce Platform で再構築され、さまざまな業種でコンポーザブルになりました。顧客は 1 つ以上の業界機能をカスタマイズされたソリューションに組み上げ、共有メタデータ、API、ビジネスサービスを活用できるようになりました。このアプローチでは、垂直方向の差別化とプラットフォームの一貫性のバランスを取り、さまざまな規制やビジネスコンテキストへの適応性と拡張性を確保します。
### 13.1 階層型アーキテクチャアプローチ
デルの製品は階層型アーキテクチャを採用しています。基本となるのは、Salesforce Platform と Sales Cloud や Service Cloud などの水平アプリケーションであり、すべての業種ソリューションの基盤として機能します。これに、Salesforce はほとんどの業種で組み込まれている再利用可能なコンポーネントを強化する付加価値の高い共通サービスを追加しました。たとえば、デジタルオートメーション、タイムライン、アクションプランなどの機能があります。このレイヤーの上には、フィードバック管理、CPQ (設定、価格、見積)、サービス管理などの水平機能をカプセル化する再利用可能なビジネスロジックレイヤーがあります。
最上位レイヤーには、特定の業界要件に合わせて調整されたドメイン固有のカスタマイズ機能があり、基盤となるプラットフォームを活用して拡張性と効率を高めます。たとえば、製造業の垂直市場の場合、この設定により、正確な予測を通じて生産計画が最適化されます。ライフサイエンス分野では、さまざまな地理的規制要件に準拠しながらワークフローとサンプル処理を効率的に管理するモバイルオフラインソリューションを製薬会社の営業チームに提供しています。
### 13.2 業種固有の機能
**信頼できるAI Excellence**:信頼できる生成 AI ソリューションは、業界固有の AI 機能を提供します。これには、ヘルスケア、ライフサイエンス、金融サービスなどのセクターでローコード/ノーコードの自動化とデジタル化を促進するエージェントとプロンプトエンジニアリングが含まれます。さらに、ドキュメント/テキストマイニングや集計などの機能は、大量のデータを処理する業界に対応し、情報の抽出やインサイトの収集に役立ちます。
カスタマイズされたエージェントは、エージェントと顧客の三者間のコミュニケーションを強化し、迅速な解決につながります。Salesforce PlatformのTrustレイヤーにより、業界全体のすべてのコンプライアンスと規制基準への準拠が容易になります。
**データ、インサイト、インテリジェンスと規制コンプライアンスおよびセキュリティ**:Salesforce Industries は、GDPR、HIPAA、FedRamp などの特定の業界規制に合わせて調整された厳格なデータプライバシー、共有、セキュリティ対策により、包括的な 360 度ビューを提供します。Salesforce は、さまざまなソースからのデータを統合してコンプライアンスとセキュリティを実現し、テナントデータ暗号化用の Shield Encryption BYOK (Bring Your Own Keys) などの追加機能でこれらのソリューションを強化します。
**ユーザーエクスペリエンスの向上**:Salesforce Industries は、ユーザージャーニーを強化するために業界固有のニーズに合わせて調整されたシームレスなユーザーエクスペリエンスを重視しています。これには、アクション可能リソースセンター、Experience Cloud テンプレート、OmniStudio ベースのソリューションなどのツールが含まれます。
**デジタル化、統合、オンボーディング**:Salesforce Industries は、ローコードからノーコードまでのソリューションでデジタル化、インテグレーション、オンボーディングを提供し、新規顧客向けにフローや OmniStudio などのツールを活用して、既存の CRM システムの移行ソリューションを提供します。MuleSoft が提供するコネクタにより、外部システムやデータとの連携が合理化されます。Salesforce には、Retail Banking の紛争管理など、業界固有のサービスプロセスも含まれます。
**モバイルおよびオフライン**:Salesforce Industries は、Salesforce Mobile アプリケーションと Field Service Mobile アプリケーションに対して堅牢なドメイン固有のサポートを提供します。Industries は、高度なオフラインサポートを必要とする高度に専門化されたドメイン向けに、Salesforce Mobile SDK 上に構築されたカスタムモバイルアプリケーションを提供しています。
**一般的なビジネス機能**:Salesforce Industries は、一般的なビジネス機能を基盤として構築されており、一貫性と生産性を維持しながら、銀行や病院向けのさまざまな予定予約システムなど、業界固有のニーズに合わせてソリューションをカスタマイズできます。広範なSalesforceエコシステムと統合されているため、Salesforceは総合的なCustomer 360ビューを提供し、Salesforce製品スイートの重要な一部となっています。
## 14\.分析
Analytics and Business Intelligence (BI) プラットフォーム市場では、エンドユーザーがより迅速かつデータ主導の意思決定を行えるように、ビジュアルセルフサービスと AI 主導の自動化されたインサイトが長年宣伝されてきました。ただし、次のようないくつかの課題があるため、すべてのユーザーがこの成果を実感しているわけではありません。
- **切断済みインサイト**:インサイトはユーザーのワークフローに統合されていないため、意思決定に役立つ可能性があるにもかかわらず、インサイトに対してアクションを実行することが困難です。
- **データオーバーロードとサイロ**:データは急速に増加し、区分されたままであるため、無秩序でセキュリティ上のリスクがあります。組織は、無秩序なセルフサービスデータ環境と、制限の厳しい適切に管理されたデータ環境との間でジレンマに直面しています。
- **データに対する信頼**:データの膨張と断片化により、企業データから派生したインサイトに対するユーザーのTrustが損なわれています。
- **コンポーザビリティの欠如**:作業プロセスにコンポーザビリティと再利用性が大幅に欠落しているため、ユーザーは作業の繰り返しを余儀なくされ、収益化の明確な方法がありません。
Tableau Next は、ビジネスユーザーとデータプロフェッショナルを新しいコラボレーション方法で結び付け、すべて AI で強化することで、ビジュアル分析のサイクルを広げるように設計されています。Salesforce Platform を介して信頼性の高い評価指標とインサイトをタイムリーに提供し、アクション可能なインサイトにユビキタスにアクセスできるようにします。
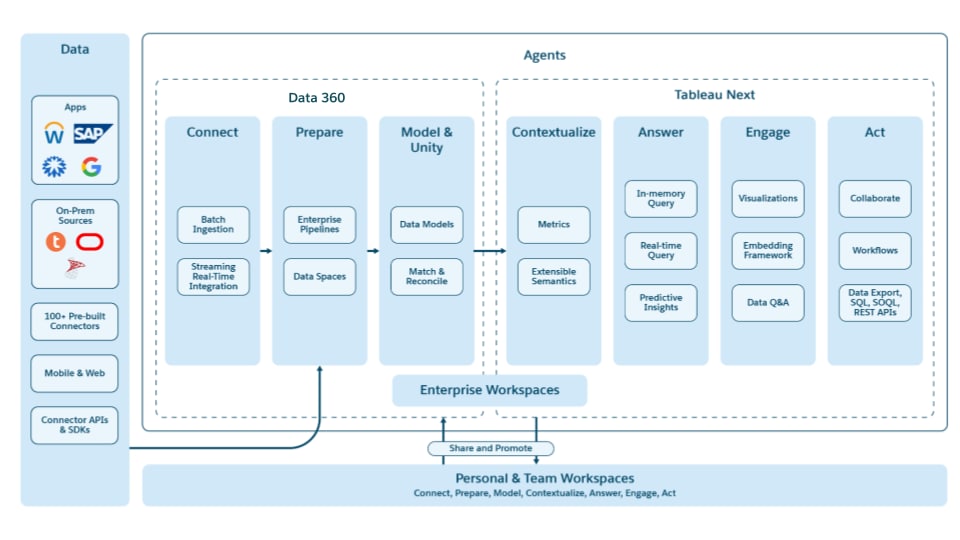 Tableau Next は、次の課題に対処します。
- データ接続からアクションまで、接続された環境のためのオープンでコンポーザー可能な API ファーストプラットフォームを作成します。開発用のツール、豊富な分析アプリケーション用の構成可能なコンポーネント、およびパッケージ化と配布を管理する機能の提供。
- AIをコアとして構築され、データ プロフェッショナルが効率的にレビューおよび検証してTrustを確保するためのツールを使用して、コンテキストと関連性のあるインサイトを提供できます。
- Tableau Semantics をユニバーサルセマンティックレイヤーとして構築し、制御されながらも柔軟なエコシステム内で迅速でセルフサービス、管理されたデータ分析を実現します。
- Data 360 を通じてリアルタイムのクラウドスケールデータ機能を提供し、信頼性と拡張性を備えた管理されたデータアクセスを実現します。
- 開発者がアプリケーションを構築して収益化するための充実した環境とマーケットプレイスを提供する。
- インテリジェンスをコアに統合し、組織のセマンティクスとKnowledgeのパワーをエージェントに提供し、ユーザーを支援します。
- Trustを優先し、データ、分析、エージェントのワークロードと導入のアクティビティと有効性を直接制御して可視化することで、信頼性を確保します。
- Slack や他の組織のコラボレーションツールとの密接で豊富なインテグレーションにより、コラボレーションを第一級の設計理念として活用できます。
### 14.1 クラス最高の Analytics 環境
Tableau Next は、機能を強化してエクスペリエンスを統合するオープンプラットフォームを提供することで、データ分析ツールにおける Tableau のリーダーシップを基盤としています。主な機能は次のとおりです。
- **豊富なデータの視覚化**:Tableau の VizQL テクノロジーを使用して、広範な視覚分析を行います。
- **管理されたコラボレーションワークスペース**:分析タスクの統合インターフェースを提供し、リアルタイムのコラボレーションのために Slack と統合します。
- **信頼できる管理データ**:セキュアな環境でグローバル管理を行うための構造化されたプロモーションパスを使用して、セルフサービス分析をサポートします。
- **高度な評価指標の作成**:アナリストが組織全体で効率的に KPI を作成して再利用できるため、一貫性と信頼性が向上します。
### 14.2 Agentic Analytics
Tableau Nextは、基本的なアーキテクチャ構造としてAgentforceを使用して構築されており、高度な接続性、信頼性、コラボレーション機能を備えたAI搭載データ ツールを提供するTableau Nextの機能を強化します。
- **BI ツール**:データの準備と視覚的および意味的なメタデータの選定に重点を置き、データワーカーのセルフサービス分析の効率を高めます。
- **コンテキスト エクスペリエンス**:データインサイト、エクスペリエンス、透過的な AI を、組織の大部分が作業する場所 (Slack など) のコンテキストに取り込みます。
- **Agentforceアーキテクチャ**:Agentforce スタック上に構築され、高度なエージェントアーキテクチャに関する豊富なコンテキストを Tableau Next に提供します。
- **セマンティックカタログ**:メタデータ、系統、検索を一元管理するシステムを提供し、Tableau Next ユーザー全体で共有環境を実現します。
- **共有および生成されたメタデータ**:包括的なエコシステム内でセルフサービス分析と管理コンテンツ間のシームレスなワークフローを促進します。
- **アクションフレームワーク**:事前にパッケージ化されたワークフロー、人間が選定したワークフロー、または生成されたワークフローを使用して、アクションへのインサイトを取得します。
- **パーソナライズ済みインサイト**。データ設定やロールなどを (許可されている範囲で) 学習し、高度にコンテキスト化されたパーソナライズされたデータインサイトをすぐに取得します。
- **プロアクティブなインサイト**。データエコシステムをインテリジェントに探索し、統計的に関心のある場所を探し、変化のドライバーと対応策を積極的に理解して、次のステップとして実行するアクションを推奨します。
- **信頼できるデータエージェント**。データエージェントのドライバーとして、統合された環境を通じてアプリケーションを構築および調整できます。また、データの変更と、それがエージェントの精度と有効性に及ぼす影響を事前に評価するテストツールも提供されます。
### 14.3 統合されたソリューション主導のビジネスユーザーエクスペリエンス
Tableau Next は、Slack や Salesforce などのさまざまなプラットフォームや、Tableau Pulse などの新しい分析機能を通じてビジネスユーザーエクスペリエンスを強化します。これらはすべて、分析エンゲージメントを簡素化するためにエージェントエクスペリエンスからアクセスできます。主要な側面は次のとおりです。
- **コラボレーション**:信頼できる分析の中心となるこの機能により、さまざまな分析コンポーネント間のやりとりが促進され、ユーザーのワークフロー内で検証ツールが統合されます。
- **Pulse Metrics**:選定されたインサイトと自動化されたインサイトの両方を、従来のアナリストが作成したダッシュボードよりも効率的に提供します。
- **AI主導のエクスペリエンス**:AI を採用して高度な分析の技術的な専門知識の必要性を減らし、確定的メタデータと管理データの信頼性を確保します。
- **Multi-Player Insight Delvery**:ビジネスユーザーがアナリストと協力して、システムが提供するインサイトに関するKnowledgeとTrustを得ることができます。
- **深いインテグレーション**:共有メタデータとデータプラットフォーム上に構築され、さまざまなシステムとエクスペリエンスでコンポーザビリティが提供されるため、プロモーション、データフロー、および異なる人格が相互に作業を確認して完了できるようにコンポーザビリティが確保されます。
### 14.4 Tableau の意味
Tableau セマンティックレイヤーは、未加工データとユーザー解釈の重要な橋渡しとして機能し、データ分析、意思決定、アプリケーション開発を簡素化し、AI 駆動のコンテキストと取得を強化します。主な機能は次のとおりです。
- **統合メタデータ管理**:セルフサービスメタデータと管理メタデータの両方がサポートされ、組織の一元化された情報源になるための構造化されたパスを使用してアドホック分析を促進します。
- **Tableau の最適な組み合わせの機能**:複数論理オブジェクトのサポート、モデルのコンポーザビリティ、共有ディメンション、複雑な地理空間階層、時間モデリングが含まれます。
- **多様なデータと分析**:画像ベースの商品カテゴリを構造化された販売データと関連付けたり、半構造化された商品レビューのセンチメント分析を組み込んだりするなど、非構造化データと構造化データをリンクするのに役立ちます。
- **Salesforce Platform インテグレーション**:統合された情報源を確立し、アプリケーション全体で一貫したビジネスセマンティクスとシームレスな統合を促進し、さまざまなユーザーエクスペリエンスと使用事例をサポートする一貫性のあるメタデータモデルを提供します。
- **エージェントインテリジェンス**:セマンティックレイヤーは、エージェントがビジネスを強化するデータとメタデータだけでなく、それを定義するセマンティクス (組織に合わせたより深い説明や設定など) を理解することでインテリジェンスを得られる重要な領域の 1 つです。
### 14.5 統合されたワークフローとアクション可能インサイト
Tableau Next は、シンプルなアクション、定義済みのフロー、スケジュール、API インテグレーションを特徴とした、データ主導の意思決定と信頼性の高い自動化を強化する統合ソリューションを提供します。主要なコンポーネントは次のとおりです。
- **標準化されたインテリジェントなビジネスアクション**:不可欠でありながら複雑な、ビジネス内の緊急のコンテキスト固有のコミュニケーションを促進します。
- **定義済みおよび生成されたフロースケジュール**:信頼できるが検証可能な静的および動的に生成されるフローを使用して、アドホックアクションとスケジュール済みアクションの両方を有効にします。
- **Agentforce**:AI 駆動のデータ会話とインタラクションがサポートされるため、ユーザーはインサイトとエンゲージし、従来の UI と同様のアクションをビジネスアプリケーション内とビジネスアプリケーション外の両方で実行でき、会話によって簡素化されます。
### 14.6 構成可能な開発者プラットフォーム
Tableau Next では、アプリケーション開発用にノーコード、ローコード、プロコードのオプションを備えた構成可能な開発者プラットフォームが提供されます。これらはすべて Data 360 の Tableau セマンティックを使用します。主なサービス:
- **パッケージ化された業種/インテリジェントアプリケーション**:特定の業界ニーズに合わせて調整されたテンプレート化されたカスタマイズ可能な分析アプリケーションを提供します。
- **サードパーティおよび ISV アプリケーション**:分析、業種固有、カスタムの目的で動的および対話型のアプリケーションの作成をサポートします。
- **市場と交換**:ISV と開発者は、最大かつ最も信頼性の高いビジネスアプリケーション開発エコシステム内でアプリケーションをパッケージ化して配布できます。
### 14.7 緊密なコラボレーション
Tableau Next は、ビジネスユーザーとデータプロフェッショナルの両方を対象に設計されており、データ理解のためのコラボレーションアプローチを促進します。技術系か非技術系かに関係なく、ビジネスユーザーからデータエキスパートまで、すべてのチームメンバーが互いのデータインサイトを確認できます。さらに、これらのインサイトは BI プラットフォーム内のブラウザータブに限定されません。
BI プラットフォームとしての Tableau Next は、次のとおりです。
- **プラットフォーム間**で構成可能。インサイトは、参照するプラットフォームに関係なく同じように表示されます。この一貫性は、データを視覚的に操作するときの柱となる設計原則です。
- **Slack と深く統合**されています。Slack とのインテグレーション開発により、今日の市場で最も直感的で没入型のコラボレーションデータエクスペリエンスの 1 つになりました。
- **任意のツール**で開きます。緊密に統合されたプラットフォームで API ファーストの原則を適用することで、インテグレーションを他のコラボレーションツールやサードパーティツールにも拡張でき、全体にわたってリッチさを維持できます。
## 15\.Integration の制限と考慮事項」
Salesforce Platform は、幅広いデジタル課題に対応するための包括的なインテグレーション機能スイートを提供しますが、多くのお客様は、さまざまなベンダーやテクノロジーを使用して時間をかけて開発されたエンタープライズアーキテクチャ内で業務を行っています。
現代の企業は、システム統合とビジネスプロセスの自動化に伴う課題に直面しており、その結果、多くの場合、データがサイロ化して非効率になっています。MuleSoft の機能を活用した Salesforce Integration Platform は、自動化プロセスの迅速な開発と機能強化を促進することで、これらの問題に対処します。シームレスなシステム接続を確保し、情報フローを強化して、さまざまなプラットフォームの意思決定をサポートすることで、人件費と自動化コストを削減します。このレイヤーは、Salesforce サービスと他のカスタムまたはサードパーティサービス間のインテグレーションを作成、管理、管理、監視するために不可欠です。
システムは API で定義され、次の役割を果たします。
- ERP、顧客および請求システム、独自のデータベースなどの重要なシステムからデータにアクセスします。
- データのやりとりと統合を促進し、データサイロを排除します。
- システムおよびプロセス API で管理されるデータとプロセスにビジネスコンテキストを追加します。
効果的なコミュニケーションのために、API は次を使用して記述されます。
- 即時同期交換のための OpenAPI 仕様 (OAS)
- 非同期のイベント駆動型コミュニケーションのための AsyncAPI
- 構造化されたモデルコンテキストインタラクションのためのモデルコンテキストプロトコル (MCP)
- エージェント間を直接インテグレーションするためのエージェント間 (A2A) プロトコル。
Salesforce Integration Layer は、任意のシステムを統合して管理する堅牢な機能を提供し、システムが Salesforce ネイティブであるか他のプロバイダーであるかに関係なく、Salesforce のデータ、AI、およびアプリケーション機能との接続を強化します。
複雑なインテグレーションには高度な変換が必要であり、ユニバーサル接続、API 管理とガバナンス、インテグレーションワークロードを構築するための統合開発環境 (IDE)、これらのインテグレーションを導入、管理、監視するためのランタイムプラットフォーム、これらのインテグレーションをエンドツーエンドで可視化するためのオブザーバビリティプラットフォームなどの堅牢なツールが必要です。
インテグレーションプロセスをさらに迅速化するために、一般的なインテグレーションパターンとニーズをエンコードするアクセラレーターと業種固有のテンプレートが用意されています。
### 15.1 Salesforce とのインテグレーションパターン
2 つの主要なインテグレーションパターン (アウトバウンドインテグレーションとインバウンドインテグレーション) で、Salesforce と広範なエコシステム間のデータとプロセスのフローに対応します。
**外部システムへの Salesforce の接続 (送信):**このパターンには、Salesforce 内から外部システムのデータにアクセスしたり、アクションをトリガーしたりするプロセスが含まれます。
- **Secure Endpoint Management (指定ログイン情報):**指定ログイン情報では、エンドポイントと認証の詳細を保存する安全な一元的な場所が提供されます。アプリケーションとオートメーションは論理名を参照し、プラットフォームは認証ライフサイクルの複雑さを処理します。
- **宣言型インテグレーション (外部サービス):**標準 OpenAPI 仕様を提供する外部システムの場合、管理者は外部サービスを使用して API を宣言的に登録できます。次に、プラットフォームが仕様を処理し、サービスの操作をフローなどのツールのネイティブ・アクションまたはApexのネイティブ・オブジェクトとして自動的に使用できるようにします。
- **複雑なシステムインテグレーション (MuleSoft)**:最新のインターフェースがないシステムの場合、MuleSoft は標準の再利用可能な API レイヤーを作成します。これにより、従来の複雑さが解消され、オンプレミスのデータとプロセスが Salesforce エコシステムに取り込まれます。
- **リアルタイムデータアクセス (外部オブジェクト):**外部システムのテーブルを Salesforce データモデル内の仮想オブジェクトとして表し、レプリケーションなしで標準クエリおよび UI コンポーネントを介して外部データにアクセスできるようにします。
- **一元化された機能管理 (統合 API カタログ):**統合 API カタログは一元化されたリポジトリであり、すべての API 仕様とそれに関連付けられたメタデータ (場所やセキュリティプロトコルなど) の一元的な情報源です。これにより、データまたはビジネスロジックがどこにあっても、Salesforce エコシステム全体でそのデータを検出し、安全に接続して、強力な新しいアプリケーションや自動化に構成できます。
- **カスタムPro-Codeロジック(Apex REST):**開発者は、Apexで記述されたカスタム・ビジネス・ロジックをREST APIおよびアクションとして公開できます。その後、アクションをフローのステップまたは AI エージェントのツールとして使用できます。
**外部システムと Salesforce の接続 (受信):**このパターンにより、外部システムとアプリケーションが Salesforce Platform に接続してデータにアクセスし、ビジネスロジックをトリガーし、プロセスをオーケストレーションできます。この機能は、大規模に動作する実証済みのエンタープライズクラスの API を基盤としています。2025 年 10 月現在:
- クエリ API (SOQL) は、毎日 500 億件以上の要求を処理します。
- REST API は、外部システムからの 1 日あたり約 50 億件のコールに対応し、使用量は前年比で 30% 増加しています。
- Bulk API では、大規模データ操作用に毎日数千億件のレコードが処理されます。
この実証済みの信頼性と拡張性は、次の機能の基盤となっています。
- **統合されたAPI環境:**すべての Salesforce 機能へのアクセスが一貫したエンドポイント構造 (api.salesforce.com) で統合され、開発者が製品ごとに異なるパターンや認証フローを習得する必要がなくなります。
- **包括的な専用APIポートフォリオ:**このプラットフォームには、トランザクション操作用のREST APIとSOAP API、大規模データ処理用のBulk API、イベント駆動型アプリケーション用のPub/Sub API、特殊な製品またはカスタムApex APIなど、特定のニーズに合わせて調整された多様なAPIコレクションが用意されています。
- **エージェントによる統合の将来への対応:**MCP などの標準を使用して、顧客は Salesforce データとアクションを外部 AI エージェントの「ツール」として安全に公開し、Salesforce インスタンスをデジタルワークフォースの拡張可能なスキルセットに変換できます。
### 15.2 MCP とのエージェントインテグレーション
データおよびプロセスの統合で確立された受信パターンと送信パターンに加えて、エージェント時代の新しいパターンが登場しています。Salesforce Platform は包括的な MCP 戦略を実装しており、コンシューマーとしても AI を駆使したサービスプロバイダーとしても位置付けています。この双方向アプローチにより、エージェントの相互運用性が実現され、エンタープライズクラスのセキュリティとガバナンスを維持しながら、進化する AI エージェントおよびツールのエコシステムと Salesforce のデータおよび機能をシームレスに統合できます。
**MCPクライアントとしてのSalesforce:**エージェントは、外部システムと API をインテリジェントかつ動的に活用することで、MCP クライアントとして機能できます。この機能により、組織はSalesforceの境界を超えてAgentforceの範囲を拡大し、最新のAPIを使用している場合でも、MuleSoftを介してレガシー システムやRPAボットに接続する必要がある場合でも、あらゆるシステムにわたってアクションを調整できます。設定は、使い慣れた宣言型のトピックベースの設定環境で処理されるため、カスタム開発なしですばやく統合できます。パートナーが提供する MCP サーバーの検出メカニズムが簡略化され、外部機能の統合がさらに合理化されます。大規模なスタックを通じて外部接続の複雑さを抽象化することで、企業は Agentforce をより広範なテクノロジー環境と迅速に統合できます。
**MCP ServerとしてのSalesforce:**MCP Server として、プラットフォームはロジックとアセット (標準 REST API、カスタムエンドポイント、呼び出し可能なアクション、フローなど) を外部エージェント向けの検出可能な「ツール」として公開します。宣言型インターフェースを使用して、顧客と ISV は独自のカスタム MCP サーバーを作成して設定し、機能を選定して独自のビジネスプロセスに合わせて調整されたツールのコレクションを作成できます。これは MCP プロンプトにも及び、プラットフォームのプロンプトテンプレート機能との自然な相乗効果を生み出し、組織はプロンプトエンジニアリングへの投資を外部 AI システムから利用できるようになります。
この機能は、多層セキュリティモデルによって管理されます。
- **アプリケーション制御:**外部クライアントアプリケーション構造により、管理者は Salesforce 組織にアクセスできる外部エージェントアプリケーションを堅牢に制御できます。
- **範囲設定済み権限:**認証は、詳細な OAuth 範囲設定によって強化され、認証済みエージェントが実行できるアクションの正確な追跡と適用が可能になります。
- **コアプラットフォーム認証:**これらの新しいコントロールは、レコードアクセス制御、エンティティおよび項目レベルの権限、プロファイルおよび権限セットで定義されたその他の権限など、Salesforce の堅牢な認証モデルに基づいて構築されています。
ISV とパートナーは MCP サーバー設定をパッケージ化して配布できるため、Salesforce エコシステム全体で AI 対応インテグレーションを迅速にリリースできます。
### 15.3 ユニバーサル接続
ユニバーサル接続に対するSalesforceの最新のアプローチは、_解釈接続_です。解釈接続は、プログラミングなしであらゆる使用事例のあらゆるプラットフォーム(MuleSoft、Flow、Data 360)で実行できるコネクタを開発するためのメタデータ中心のアプローチです。メタデータモデルには、要求を認証するためのリモートサービスへの接続方法、返されるデータのモデル化方法、クエリの作成方法、結果のページ処理方法、プロセスを自動化するためのイベント (トリガー) の受信方法が含まれます。
HTTP ベースの API を使用していないシステムの場合、Salesforce では数百の事前作成済みコネクタとカスタムコネクタを作成するための完全な SDK が提供されています。API アクセス権のないシステムの場合、Salesforce では、エージェントを使用して、通常は人間が実行する反復的なルールベースのタスクを自動化するロボットプロセス自動化 (RPA) を提供しています。これらのタスクには、データ入力、トランザクション処理、簡単なカスタマーサービスクエリへの応答などがあります。Salesforce では、ドキュメントから情報を抽出するために、AI を活用して請求書、契約、フォームなどの各種ドキュメントからデータを自動的に抽出、分類、処理するインテリジェントドキュメント処理 (IDP) を提供しています。情報が存在していても、Salesforce では自動的に情報を取得および操作できます。
AI の最近の進歩により、Salesforce は組織でエージェント機能をすばやく有効にするためのビルディングブロックを提供します。
- **モデルコンテキストプロトコル (MCP)** コネクタを使用すると、組織は API を MCP ツールとして迅速に公開し、エージェントが API とリソースを容易に検出して利用できます。
- **エージェント間コネクタ**を使用すると、組織はエージェントに A2A プロトコルのサポートを提供することでエージェント間の通信を標準化できます。各エージェント (ドメインの機能エキスパート) は、顧客のクエリを検出して、ドメインに最も適したエージェントに委任できます。
- **推測コネクタ**では、LLMコール、ベクトル埋め込みと検索、RAG 取得、MCP ツールのサポートにより、エージェントをゼロから構築するためのビルディングブロックが提供されます。
### 15.4 API 管理
Anypoint API Manager を介して提供される MuleSoft の API 管理は、リリース環境全体で API とマイクロサービスを設計、保護、管理、監視、拡張するための包括的なプラットフォームを提供します。組織は、プラットフォームに関係なく、一貫したエンタープライズクラスの制御とインサイトを 1 か所から管理でき、リリースからバージョン管理まで一元管理できます。主な機能は次のとおりです。
- **Anypoint Flex Gateway** は、API を管理および保護するアプリケーション層 API ゲートウェイで、レート制限、キャッシュ、認証、認可、脅威保護、監視、ロギングのポリシーを HTTP/S レベルで適用します。マイクロサービスベースの分散環境向けに設計された軽量でハイパフォーマンスな Envoy ベースのゲートウェイで、DevOps および CI/CD ワークフローとシームレスに統合できるように構築され、受信ポリシーと送信ポリシーの両方をサポートしながら、あらゆる環境でエンタープライズクラスのセキュリティと管理性を提供します。
- **APIアラートを**使用すると、組織はAPIの特定のしきい値や条件を定義および監視して、異常な動作や望ましくない動作を検出できます。たとえば、応答時間が制限を超えた場合 (60 秒など)、時間枠内の要求数が多すぎた場合、特定の HTTP 応答コードが返された場合、ポリシー違反が発生した場合などにアラートが表示されます。
- **API Analytics**では、APIの使用方法とパフォーマンスを可視化できます。Analytics ダッシュボードを使用すると、組織は概要レベルの総計値の追跡と表示、グラフへのドリルダウン、ダッシュボードとレポートの作成とカスタマイズを行い、利用状況のトレンド、ポリシー違反、応答時間、要求/応答コードなどを把握できます。
### 15.5 次世代インテグレーション開発環境
MuleSoft Anypoint Code Builder (ACB) は API およびインテグレーション開発用に設計された次世代 IDE で、VS Code をバックエンドとする最新の統合環境を特徴としています。
- **統合開発環境:**API およびインテグレーション開発プロセス全体を 1 つのツールに統合し、AsyncAPI、OAS、RAML API、ガバナンスルールセット、ローコードフローキャンバス、事前作成済みコネクタ、統合されたテストおよびリリースオプションをサポートします。さらに、ACB では、インテリジェントなコンテキストの提案により、デバッグ、トラブルシューティング、継続的なメンテナンスがサポートされます。
- **エージェント開発経験:**アプリケーション開発ライフサイクル全体でエージェント環境を提供します。コアとなるのは、エージェントによるインテグレーション開発を可能にする MuleSoft MCP Server です。MuleSoft MCP Server には、自然言語からの API 仕様とインテグレーションの生成、データ変換の作成、MuleSoft Exchange でのアセットの管理、アプリケーションと API ポリシーの管理を行うための強力なツールが用意されています。MuleSoft MCP Server ツールは、カーソルや Windsurf など、VS Code ベースの AI コードエディターでのユーザーの API 仕様とインテグレーション開発を促進します。
- **AIインテグレーション:**MuleSoft は、MuleSoft Topic Center を利用したエージェント機能によってインテグレーション開発を強化しています。MuleSoft Topic Center は、エンタープライズシステムアクセスのために API コールを Agentforce アクションに変換します。Agentforce コネクタは、自然言語の自動化をインテグレーションに組み込みます。推測コネクタは外部 LLM プロバイダーを安全に統合し、MuleSoft アプリケーションで AI 駆動のロジックを可能にします。組織はこれらの機能を組み合わせて、インテリジェントな適応型インテグレーションを構築できます。
### 15.6 ランタイムプラットフォーム
MuleSoft のランタイムプラットフォームには、MuleSoft アプリケーション、API、インテグレーションをさまざまな環境で実行するための柔軟なリリースオプションが用意されています。Anypoint Platform を使用して一貫した管理とガバナンスを維持しながら、運用、コンプライアンス、拡張性のニーズに最適なランタイムモデルを選択できます。この柔軟性により、アプリケーションはデータソースの近くで実行でき、地域の規制に準拠し、需要に基づいてシームレスに拡張できます。
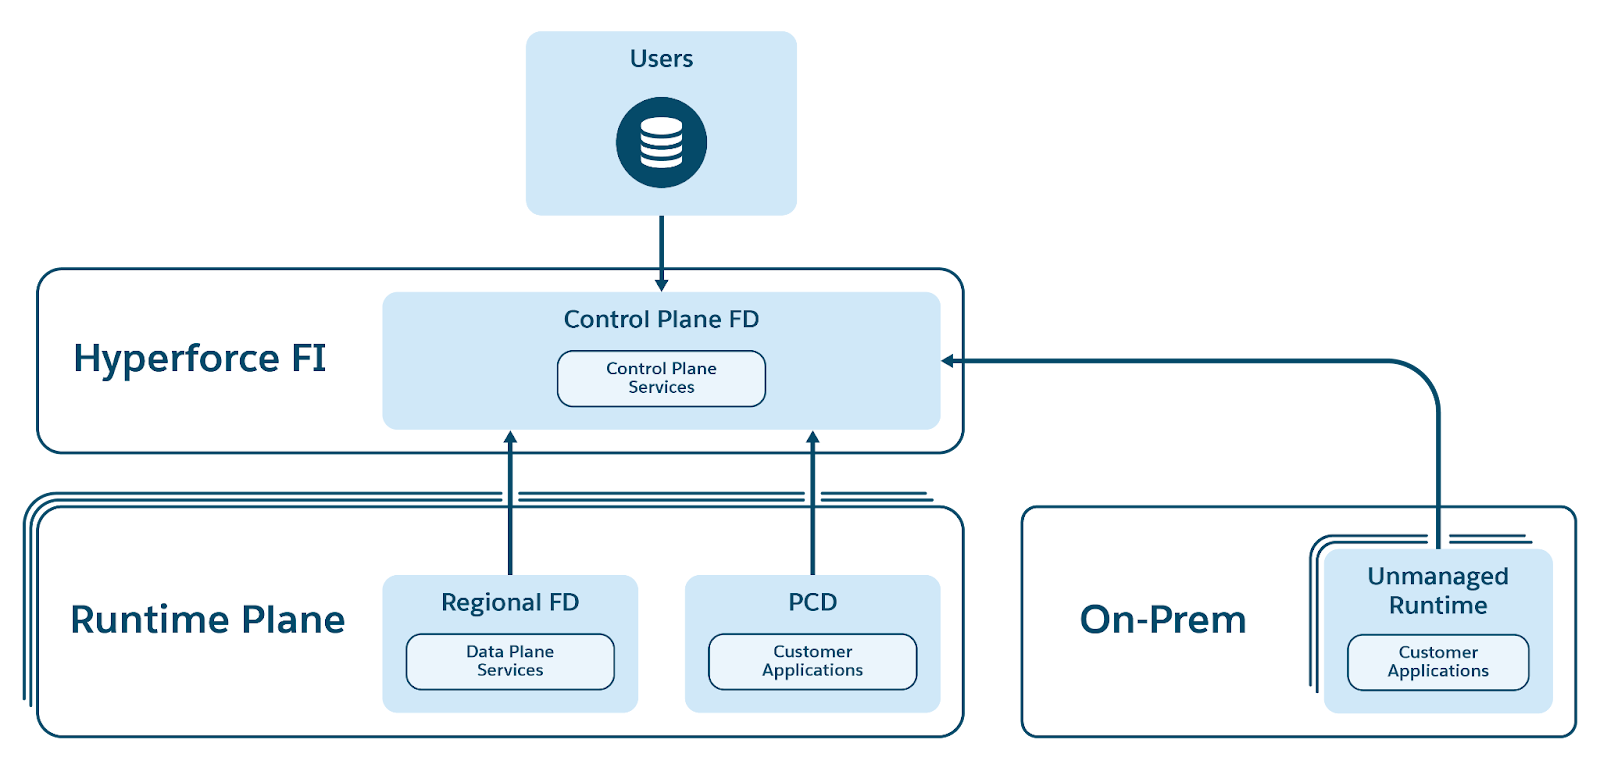 主なホスティングオプションは次のとおりです。
- **クラウド:**インフラストラクチャ管理のオーバーヘッドを排除する MuleSoft の完全に管理されたマルチテナントインテグレーション Platform-as-a-Service (iPaaS)。CloudHub 2.0 は、柔軟な拡張性、高可用性、ダウンタイムゼロの導入/アップグレードを提供し、オブザーバビリティのニーズとコンプライアンス認定が組み込まれています。MuleSoft がランタイムインフラストラクチャを管理している間、開発者は API とインテグレーションの構築に集中でき、エンタープライズクラスのセキュリティ、信頼性、高可用性が確保されます。
- **ハイブリッド:**より詳細に制御するためにアプリケーションをセルフホストする必要がある組織向けに、MuleSoft は Runtime Fabric を提供しています。これは、Kubernetes または仮想マシン全体で MuleSoft ランタイムのリリースとオーケストレーションを自動化するコンテナサービスです。水平拡張、ダウンタイムゼロの導入、組み込みのセキュリティ制御、シンプルなクラスター管理がサポートされています。
- **Private Cloud Edition(PCE):**MuleSoft の Private Cloud Edition では、Anypoint Platform (コントロールプレーンとランタイムプレーンを含む) の完全に自己管理されたオンプレミスバージョンが提供されるため、組織は厳しい規制、データレジデンシー、セキュリティ要件を満たすことができます。大企業は Anypoint Platform の統合インテグレーションと API 管理機能を活用しながら、インフラストラクチャを完全に制御できます。
### 15.7 可観測性
MuleSoft は、あらゆるリリースモデルの API、インテグレーション、アプリケーションをエンドツーエンドで可視化する包括的なオブザーバビリティソリューションを提供します。オブザーバビリティ機能は、ワークロードの実行場所に関係なく一貫しており、環境の統合ビューが提供されます。MuleSoft では、リアルタイムのテレメトリデータと履歴テレメトリデータの両方を取得することで、アプリケーションネットワーク全体で本番の問題をより迅速に検出、分析、解決できます。オブザーバビリティデータは Anypoint Platform 内でネイティブに表示したり、OpenTelemetry を介して顧客が希望する APM にエクスポートしたりできるため、既存の監視エコシステムとシームレスに統合できます。これにより、組織はインフラストラクチャの耐障害性を積極的に強化し、ミッションクリティカルなアプリケーションの信頼性を向上させることができます。
MuleSoft は、2 つの主要なサービスを通じてオブザーバビリティを提供します。
- **Anypoint Monitoring** は、Anypoint Platform に組み込まれた現在の市場内監視ソリューションです。アプリケーションの健全性を監視するための標準でカスタマイズ可能なダッシュボード、ログ管理の高度なログ検索、定義済みのしきい値や異常が発生したときにチームに通知するアラート機能が提供されます。
- **Integration Intelligence**は、MuleSoft向けの次世代のAIファーストのオブザーバビリティ プラットフォームであり、Salesforce Platformでネイティブに再構築および構築されています。この製品では、テレメトリデータの統合データレイヤーとして Data 360、インテリジェントでアクション可能なインサイトを実現する信頼済みセマンティックレイヤーとして Tableau Semantics、AI 支援のトラブルシューティングを実現する Tableau Concierge、複数の豊富なデータを 1 つの一貫性のあるビューにまとめる対話型のビジュアルインターフェースを提供する Tableau Next ダッシュボードを使用します。Tableau Next では、オブザーバビリティ機能が付属するセマンティックデータモデル上にカスタムダッシュボードを作成することもできます。
また、このスタックにより、エージェント中心の追跡が強化され、顧客は非確定的なエンドツーエンドのエージェント呼び出しパスを完全に透過的に操作できます。これにより、エージェントが各中間ステップで作業している様子を観察できるため、ユーザーは障害の根本原因をすばやく特定し、パフォーマンスのボトルネックを特定できます。
## 16\.エコシステムと AppExchange
Salesforce エコシステムは、このプラットフォームの機能を示しています。システムインテグレーター (SI) とコンサルティングパートナーは、複雑な Salesforce ソリューションを開発、設定、最適化することで顧客をサポートします。独立系ソフトウェアベンダー (ISV) は、革新的なアプリケーションとソリューションをプラットフォーム上に構築し、それを顧客が Salesforce 組織にインストールできるようにします。これらの ISV アプリケーションは AppExchange で入手できます。AppExchange は 2006 年にリリースされた Salesforce のアプリケーションストアで、2025 年 10 月現在で 10,000 を超えるアプリケーションがインストールされています。
顧客が広大なマーケットプレイスをナビゲートし、関連するアプリケーションを発見できるように、2025 年に Data 360 を活用するために AppExchange 検索環境が再構築されました。Salesforce Data 360 のベクトル検索機能は、従来のキーワードマッチングと連携して機能し、自然言語を介してユーザーのインテントを理解することで、よりセマンティックに関連性の高い結果を提供します。最終的なビジョンは、この基盤をAgentforceプラットフォームと統合して進化させることです。これにより、完全にエージェント型の「何でも尋ねられる」インターフェイスが可能になり、顧客はビジネスの課題について対話形式で説明して、高度にパーソナライズされたソリューションの推奨事項を受け取ることができます。
AppExchange は、コードアナライザ、セキュリティスキャナー、リファレンス実装ガイドを含む厳格なレビュープロセスを通じて、Salesforce との緊密な連携により高品質のソリューションを実現します。また、このプラットフォームは、ISV にアプリケーションライセンスと収益化をカスタマイズするためのライセンス管理ツールを提供し、ユーザーベースや使用量ベースのオプションを含むさまざまな価格設定モデルをサポートします。
「メタデータ駆動型プラットフォーム」の原則により、ISV は Salesforce のネイティブアプリケーションとメタデータを拡張し、データモデル、ビジネスロジック、ユーザーインターフェースの開発を容易にすることができます。Salesforce Platformは、業界固有のアプリケーションから、Lightning Web Components for UIやApex Code for Business Logicなどのテクノロジーを利用する高度にカスタマイズされたブランド設定されたアプリケーションまで、幅広いソリューションをサポートしています。
これらのアプリケーションをさまざまな Salesforce 組織に配布するには、「パッケージ化」の概念が不可欠です。パッケージ化では、さまざまな環境でメタデータ管理を行うために設計された基盤技術を使用して、Salesforce のユーザーがインストールできるアーティファクトにメタデータをシリアライズします。パッケージ化のユニークな点は、開発者が知らない環境にインストールできることです。
制御と安全性を強化するために、パッケージ内の「管理性」機能を使用すると、ISV はアプリケーションの一部を安全にアップグレードできます。これは、他の部品を他の部品に依存できないためです。また、顧客が他の部品を所有および管理できるようにするためです。たとえば、ISV はカスタム設定などの特定のメタデータを「管理」に設定して、顧客が非表示および編集できないようにできるため、顧客の環境の中断を回避できます。管理パッケージには次の管理制御が含まれますが、未管理パッケージではリリース済みメタデータは顧客が作成したものとして処理され、リリース後にアップグレードすることはできません。
AppExchangeとSalesforce Platformの導入以来、作成およびインストールされるパッケージの数と複雑さは顕著に増加しています。こうした要求に対応するため、2020 年に第二世代パッケージアーキテクチャが導入されました。この新しいアーキテクチャにより、管理パッケージのモジュール性が向上し、バージョン管理の柔軟性が向上し、名前空間の共有が可能になり、宣言型の連動関係がサポートされます。特に、ソフトウェア開発ライフサイクルが向上しています。また、パッケージリリースアーキテクチャには、変更されたメタデータの判断や差分のみのリリースなど、効率性と拡張性を高めるためにいくつかの重要な機能強化も行われました。
新しい製品と機能を開発する上で重要な基準は、パッケージとの互換性と ISV の使用準備です。このプラットフォームでは、パートナーが機能を迅速に利用できることが強調されており、Salesforce エコシステムは Salesforce Platform の革新的な可能性を、Salesforce の標準製品を超えて効果的に活用できます。ただし、これは、Salesforce 内部開発者が使用できるこのドキュメントに記載されているすべての機能を ISV 開発者も利用できるようにするための継続的な投資の領域です。
さらに、Heroku マーケットプレイスと Slack マーケットプレイスでは、Salesforce アプリケーションの機能を強化できる幅広いサードパーティインテグレーションとアドオンが提供されています。Heroku Marketplace では、アプリケーション機能の追加や、開発者によるアプリケーションの構築、リリース、管理方法の改善を行うためのツールとサービスが提供されます。Slack Marketplace には、ワークフローを合理化し、Salesforce 環境内のコラボレーションを改善できるインテグレーションが用意されています。
## 17\.Salesforce on Salesforce
Salesforce のコアバリューである Customer Success の精神に基づき、Salesforce Platform のすべてのアプリケーションとサービスで「Customer Zero」として機能し、可能な限り顧客向け製品を社内で活用します。これには大きな利点があります。
- **厳格な製品テスト**:Salesforce の従業員は、毎日この製品スイートを使用することで、プラットフォームを実際の課題にさらし、製品品質を向上させ、改善すべき領域を特定します。
- **調整済み製品**:社内使用からのフィードバックをすぐに受け取ることで、機能や使いやすさを迅速に改善し、バグをすばやく特定して解決できます。その結果、リリース時に顧客のニーズにより適した製品が提供されます。
- **業界に関する深い専門知識**:さまざまな機能の内部使用により、Salesforce は、特にハイテクセクターの特定の製品や業界の課題に関する貴重なインサイトを得ることができます。
- **顧客の共感の向上**:プラットフォームを直接操作することで、従業員は顧客の課題をより深く理解して解決できます。
- **マーケティングおよびセールスインサイト**:毎日の商品使用状況により、営業戦略やマーケティング戦略が把握され、顧客のニーズに合わせてプラットフォームをカスタマイズできます。
- **より強力なゴー トゥ マーケット戦略**:内部実装が成功すると、Salesforce はこのスイートを実証済みソリューションとして自信を持ってマーケティングできます。
さらに、本番向けのすべてのソフトウェア更新は、段階的リリースプロセスの一環として、最初に専用の「Salesforce on Salesforce」Hyperforce インスタンスにリリースされます。2020年8月以降、このインスタンスはエンジニアリング チーム向けのSalesforceの組織であるGUSと、SalesforceのCRM運用を正常にホストしており、Hyperforceの堅牢性とあらゆる顧客への対応力を実証しています。この戦略により、内部チームは本番を外部顧客にリリースする前に問題をテストして明らかにできます。
Salesforce Technology組織は、SDLC全体の生産性と品質を向上させるため、内部プラットフォームとしてAgentforceを完全に採用しました。これにより、バグを早期に検出して軽減することで、顧客に提供するコードの品質を向上させるだけでなく、社内から直接フィードバックを受けてエージェントエクスペリエンスをすばやく反復できるようになりました。
## 18\.大規模なトランスフォーメーションの実現
1999 年の創業以来、Salesforce は複数のテクノロジー変革を経験してきました。ただし、Salesforce Platform を使用した変革は、その規模と変更の実装ペースの早さから特に重要でした。この変革では、統合プラットフォームを実現するために、すべての主要なアーキテクチャコンポーネントを同時に進化させる必要がありました。この変革を反復的に行い、関係者や関係者への影響を最小限に抑えるために、Salesforce Technology 組織もエンジニアリングと商品配送の方法を進化させる必要がありました。
Salesforce Technology の組織は、14 か国の 20 か所以上の拠点に 2500 を超えるチームで構成される大規模で多様なチームです。このグループは大規模に活動し、毎週 200 件以上の製品リリースと 25 万件のシステム変更を実施しています。テクノロジーグループは次の 5 つのコアバリューに基づいて、より広範な企業精神に従って活動しています。Trust、顧客の成功、イノベーション、平等、持続可能性。これらの値は、グループの戦略を形成し、実行を導き、日々の意思決定に影響を与えるために不可欠なものです。
Salesforce Engineering 360 フレームワークは、当社のコアバリューに従って、エンジニアリングチームがアクション指向のダッシュボードと業務に関する包括的なインサイトを提供し、組織内の標準とベストプラクティスに対する明確な期待を設定します。この総合的なビューには、可用性、セキュリティ、コンプライアンス、品質、アクセシビリティ、Developer Productivity、俊敏な製品開発、コスト パフォーマンスなど、さまざまな重要な領域が含まれます。これらのインサイトを提供するために、このフレームワークでは、セキュリティシステム、本番稼働状態ログ、コードリポジトリ、開発環境、CI/CD、リリース/作業計画および追跡システムなど、数百の内部エンジニアリングシステムからの数十億件のレコードが処理されます。これらはすべて、Agentforce、Data 360、Tableau、Slack の最新イノベーションを利用して Salesforce Platform 上に構築されています。
このデータとその他のデータに基づいて、Salesforce Technology 組織は AI とエージェントテクノロジーを活用して生産性を高めています。社内の AI ツールの 1 日あたりの有効ユーザー数は 10,000 人を超え、社内の AgentExchange プログラムの一環として 100 人を超える AI エージェントを構築して、組織全体の生産性向上を促進しています。
Trustという最上位の価値のおかげで、サービスの所有権はエンジニアリング文化に深く根付いています。各サービスおよび製品は、対応可能状況に関連するサービスレベル目標 (SLO) を満たすだけでなく、インシデント管理総計値 (TTD) や復元時間 (TTR) を超えるように設計されています。変更管理、リリース準備、問題管理へのアプローチは、高い標準に準拠しています。セキュリティは、セキュアな開発ライフサイクルのすべてのフェーズに統合されており、デフォルトでセキュアな原則に準拠しています。品質とパフォーマンスは、CI/CD パイプライン内の単体テスト、機能テスト、インテグレーションテスト、負荷/スケールテストなど、数百万の自動化テストを含むアジャイルテスト手法によって優先されます。
アーキテクチャ的には、活用と効率を高めて品質を向上させるための共有機能の開発に焦点を当てています。たとえば、Hyperforce内でコンピューティングやデータ管理などの多様なニーズを満たすマネージド サービスを開発することで、製品チームは製品のイノベーションに集中できるようになり、中央チームはセキュリティ、可用性、コスト パフォーマンスの点でこれらのサービスを強化できます。
当社の業務は俊敏であり、顧客へのイノベーションの提供を促進します。3000 を超える各チームは、Scrum または Kanban を使用してアジャイルフレームワークを実装する方法を自律的に決定できます。組織全体の製品開発計画は、戦略的な方向性を示す 3 年間の長期計画、その後の年間実行計画、さらに 4 か月の製品リリース計画に分割された隔週のスプリント計画など、さまざまなタイムラインで構成されています。製品、機能、バグ修正は、年 3 回のメジャーリリース、隔週リリース、日次リリースなど、複数のリリース車両でリリースされ、さまざまなお客様のニーズに対応します。
生産性は、規模を考えると非常に重要です。SPACE フレームワークを使用して、Engineering 360 システムによって提供される包括的な総計値セットによってサポートされる効率的な生産性を測定します。また、エージェントエクスペリエンスと AI、ワークフロー、ビルドツール、開発設定、安全なリリース、セキュリティサービスへの投資により、開発ライフサイクルを合理化するために、内部開発者向けのツールとエクスペリエンスの改善にも注力しています。
## 19\.結論
結論として、Salesforce Platform は過去 5 年間で驚くべき変革を遂げ、先駆的なマルチテナントクラウドプラットフォームから、選択した地域の一連のアプリケーションとサービスを強化する、信頼できる統合エージェント型データ活用型プラットフォームへと進化しました。この進化は、パブリッククラウドプロバイダーの台頭、規制要件の増加、生成 AI と機械学習の進歩などの新たな課題に対処する必要性によって促進されました。
Hyperforce、Data 360、Agentforceの導入により、プラットフォームの機能が大幅に強化され、Trustと信頼性を維持しながら、イノベーションの最前線を維持し続けています。お客様の大多数がこの新しいプラットフォームに移行できたことは、エンジニアの創意工夫と献身の表れです。
市場の需要の変化に合わせて革新を続ける Salesforce Platform は、次世代のアプリケーションと顧客の使用事例をサポートする体制が整っており、顧客の成功と優れた技術へのコミットメントを再確認しています。
## はじめに
Salesforce Customer 360 Platform は、すべての個々の Salesforce テナント インスタンス(「組織」とも呼ばれる)に強力な[マルチテナント メタデータ駆動アーキテクチャ](/docs/architect/ja-jp/fundamentals/guide/platform-multitenant-architecture)を提供します。このアーキテクチャの基本ドキュメントでは、Salesforce Platform の基盤となるアーキテクチャで、プラットフォーム上に構築されたソリューションのアーキテクチャに関する主要な考慮事項を作成する領域の概要を説明します。
Salesforce Platform でアーキテクチャを設計するときに理解すべき重要な領域が 3 つあります。
- [トランザクション](/docs/architect/ja-jp/fundamentals/guide/architecture-basics#トランザクション)
- [Metadata Versus Data](/docs/architect/ja-jp/fundamentals/guide/architecture-basics#メタデータとデータ)
- [プラットフォーム API](/docs/architect/ja-jp/fundamentals/guide/architecture-basics#プラットフォーム-api)
## トランザクション
Salesforce Platform では、コード実行やデータベース操作によってトランザクションをインスタンス化できます。Salesforce で設計するための基本的な能力は、プラットフォームでテナントの取引をどのように定義して制御するかを理解することです。すべてのテナントのリソースを維持するために、Salesforce では、トランザクションごと、および組織ごとに計算されるすべてのテナントに制限を設けています。
Salesforce はトランザクション レベルで、コード実行とデータベース トランザクションの個々のインスタンスが共有コンピューティング リソースを独占しないように、[PfR と実行制限](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_gov_limits.htm)を設定します。Salesforce は、組織全体で、[エディションと機能種別](https://help.salesforce.com/s/articleView?id=sf.overview_limits_general.htm&type=5)に基づいて制限を設定します。組織の共有制限には、組織内のすべてのトランザクションの API 使用量のローリング計算も含まれます。これには [API 制限](https://developer.salesforce.com/docs/atlas.en-us.salesforce_app_limits_cheatsheet.meta/salesforce_app_limits_cheatsheet/salesforce_app_limits_platform_api.htm)が適用されます。
Salesforce Platform でのトランザクションの 2 つの主要な部分 (実行コンテキストとデータベース操作) についてもう少し詳しく見てみましょう。
### Execution Context (実行コンテキスト)
Salesforce は、[実行コンテキスト](https://trailhead.salesforce.com/content/learn/modules/apex_basics_dotnet/execution_context)の概念に基づいてトランザクション制限を計算します。Salesforce アプリケーションの場合、これは 1 つの Salesforce 組織内でのカスタムコードの実行に限定されないことを理解しておくことが重要です。実行コンテキストは、プラットフォームランタイムエンジンと、特定のテナントのランタイムエンジンで使用できるすべてのコードに基づいています。つまり、テナントの組織内で定義されたカスタムコード、その組織でインストールされたパッケージのコード、Salesforce Platform サービスに含まれるコードのすべてがトランザクションをインスタンス化できます。プラットフォームは、さまざまな種類の Apex コードを区別し、それらの区別に基づいてガバナ制限を計算します。
[Apex トランザクション制限](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_gov_limits.htm)の詳細については、『 Apex 開発者ガイド 』を参照してください。
### データベース操作
トランザクションにデータベース操作が含まれる場合、組み込み[の実行順序](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_triggers_order_of_execution.htm)によって、組織の設定とコードのさまざまな部分の動作が決まります。Salesforce アプリケーションで実行順序を正しく使用する方法を理解する鍵は、この動作によって Salesforce アプリケーションに提供される堅牢なデータの整合性を理解することです。
| 動作 | データ | メタデータ |
|---|---|---|
| 本番環境から Sandbox 環境にコピー | いいえ* | あり |
| メタデータ API による移行 | 不可 | はい** |
| データ読み込みによる移行 | あり | 不可 |
| パッケージに含めることができる | 不可 | はい** |
| データストレージ制限の対象 | あり | 不可 |
| *Full Copy Sandbox と Partial Copy Sandbox では、本番からのデータレプリケーションが可能です。 * * 一部のメタデータ型は、メタデータ API やパッケージでは使用できません。例外は、メタデータカバー率レポートで確認できます。 |
||
| パターン | シナリオ |
|---|---|
| リモートプロセス呼び出し — 要求と応答 | Salesforce は、リモートシステムでプロセスを呼び出してそのプロセスの完了を待ち、リモートシステムからの応答に基づいて状態を追跡します。 |
| リモートプロセス呼び出し — Fire and Forget | Salesforce はリモートシステムでプロセスを呼び出しますが、プロセスの完了は待機しません。代わりに、リモートプロセスは要求を受信して確認応答し、制御を Salesforce に渡します。 |
| 一括処理データ同期 | Lightning Platform に保存されているデータは、外部システムからの更新を反映して作成または更新されます。また、Lightning Platform からの変更が外部システムに送信されたときにも更新されます。どちらの方向の更新もバッチ方式で行われます。 |
| Remote Call-In | Salesforce Platform に保存されているデータは、リモートシステムによって作成、取得、更新、または削除されます。 |
| データの変更に基づく UI の更新 | Salesforce ユーザーインターフェースは、Salesforce データの変更の結果として自動的に更新する必要があります。 |
| データ仮想化 | Salesforce は外部データにリアルタイムでアクセスします。これにより、Salesforce でデータを保持し、Salesforce と外部システム間でデータを調整する必要がなくなります。 |
| アスペクト | 説明 |
|---|---|
| Type | インテグレーションのスタイルを指定します。プロセス、データ、または仮想。
|
| タイミング | インテグレーションのスタイルを指定します。プロセス、データ、または仮想。
|
| タイプ | タイミング | 考慮すべき主要なパターン |
|---|---|---|
| プロセスインテグレーション | 同期 | リモートプロセス呼び出し — 要求と応答 |
| プロセスインテグレーション | 非同期 | リモートプロセス呼び出し — Fire and Forget |
| データインテグレーション | 同期 | リモートプロセス呼び出し — 要求と応答 |
| データインテグレーション | 非同期 | データの変更に基づく UI の更新 |
| 仮想インテグレーション | 同期 | データ仮想化 |
| タイプ | タイミング | 考慮すべき主要なパターン |
|---|---|---|
| プロセスインテグレーション | 同期 | Remote Call-In |
| プロセスインテグレーション | 非同期 | Remote Call-In |
| データインテグレーション | 同期 | Remote Call-In |
| データインテグレーション | 非同期 | 一括処理データ同期 |
| 用語 | 定義 |
|---|---|
| イベント処理 | イベント処理とは、指定された受信者 (「ハンドラー」) で識別可能な発生を受信することです。イベント処理に関連する主要なプロセスは次のとおりです。
イベントハンドラーは最終的にイベントをイベントコンシューマーに転送できます。 ミドルウェアでのこの機能の一般的な用途は、一般的な「Publish/Subscribe (公開/登録)」または「pub/sub (公開/サブ)」機能に拡張できます。公開/登録シナリオでは、ミドルウェアは有効なデータイベントパブリッシャーからの有効なデータイベント登録者に要求またはメッセージを転送します。有効なリスナーを持つこれらのコンシューマーは、公開時にイベントを取得できます。 ミドルウェアを使用する Salesforce インテグレーションでは、ミドルウェアレイヤーがイベント処理の制御を引き受けます。同期または非同期のすべての関連イベントを収集し、Salesforce を含むすべてのエンドポイントへの配信を管理します。 または、Salesforce Enterprise Messaging Platform では、プラットフォームイベントでイベントバスを使用してこの機能を実現できます。 |
| プロトコル変換 | 通常、プロトコル変換は、あるデバイスの標準プロトコルまたは独自プロトコルを、相互運用性を実現するために別のデバイスに適したプロトコルに変換するソフトウェアアプリケーションです。 ミドルウェアのコンテキストでは、特定の対象システムへの接続がプロトコルによって制限される場合があります。このような場合は、ペイロードを抽出できる対象システムの形式にメッセージ形式を変換するか、その形式内にカプセル化する必要があります。これはトンネリングとも呼ばれます。 Salesforce ではネイティブプロトコルの変換はサポートされていないため、ミドルウェアレイヤーまたはエンドポイントによってそのような要件が満たされていることが前提となります。 |
| 翻訳と変換 | 変換とは、統合するさまざまなシステム間の相互運用性を確保するために、あるデータ形式を別のデータ形式にマッピングする機能のことです。通常、このプロセスでは、送信者または受信者の要件に合わせてメッセージを再フォーマットする必要があります。より複雑なケースでは、1 つのアプリケーションが独自のネイティブ形式でメッセージを送信し、他の 2 つ以上のアプリケーションがそれぞれのネイティブ形式でメッセージのコピーを受信できます。 多くの場合、ミドルウェアの翻訳および変換ツールには、従来のエンドポイントやその他の非標準エンドポイントのサービスの外観を作成する機能が含まれています。これらのサービス正面により、これらのエンドポイントはサービス対応可能であるように表示されます。 Salesforce インテグレーションでは、ミドルウェアレイヤーまたはエンドポイントによってそのような要件が満たされていることが前提となります。 データの変換は Apex でコーディングできますが、メンテナンスとパフォーマンスの考慮事項からお勧めしません。 |
| キューイングとバッファリング | 一般に、キューイングとバッファリングは、要求-応答アーキテクチャとは異なり、非同期メッセージパッシングに依存します。非同期システムでは、対象プログラムがビジー状態の場合や接続性が低下している場合に、メッセージキューによって一時的なストレージが提供されます。また、ほとんどの非同期ミドルウェアシステムは、メッセージキューをバックアップする永続的なストレージを提供します。 非同期メッセージプロセスの主な利点は、何らかの理由で受信者アプリケーションが失敗した場合でも、送信者が影響を受けずに続行できることです。送信されたメッセージは、受信者が再起動したときに後で処理できるようにメッセージキューに蓄積されます。 Salesforce では、ワークフローベースのアウトバウンドメッセージングの形式で明示的なキューイング機能のみを提供しています。オーケストレーション、プロセス振付、サービス品質など、他のインテグレーションシナリオで真のメッセージキューを提供するには、ミドルウェアソリューションが必要です。 |
| 同期転送プロトコル | 同期転送プロトコルとは、「通話者の 1 つのスレッドが要求メッセージを送信し、応答メッセージを待機してブロックし、応答を処理する」活動をサポートするプロトコルです。応答を待機している要求スレッドは、1 つの未処理の要求のみが存在するか、この要求の応答チャネルがこのスレッドで非公開であることを意味します。 |
| 非同期転送プロトコル | 非同期転送プロトコルとは、「通話者の 1 つのスレッドが要求メッセージを送信し、返信のコールバックを設定する」活動をサポートするプロトコルです。別のスレッドが返信メッセージをリスンします。返信メッセージが届くと、返信スレッドは適切なコールバックを呼び出して、通話者のコンテキストを再確立し、返信を処理します。この方法では、複数の未処理の要求で 1 つの返信スレッドを共有できます」 |
| 仲介ルーティング | 仲介ルーティングは、コンポーネント間のメッセージの複雑な「フロー」の仕様です。たとえば、ミドルウェアベースのソリューションの多くはメッセージキューシステムに依存しています。実装によっては、メッセージングレイヤー自体でルーティングロジックを提供できますが、クライアントアプリケーションに依存してルーティング情報を提供したり、両方のパラダイムを混在させたりすることもできます。このような複雑なケースでは、ミドルウェア側で仲介することで、開発、インテグレーション、検証が簡素化されます。 ordinator (仲介者) は、適切なメッセージを適切な消費者に確実に届けることができます」 |
| プロセス振付とサービスオーケストレーション | プロセス振付とサービスオーケストレーションは、任意の数のエンドポイントと機能が調整される「サービス構成」の各形式です。
振付とサービスオーケストレーションの違いは次のとおりです。
ビジネスプロセスの振付の一部は、Salesforce ワークフローで作成することも、Apex を使用して作成することもできます。Salesforce タイムアウト値とガバナ制限のため、特に真のトランザクション処理が必要なソリューションでは、すべての複雑なオーケストレーションをミドルウェアレイヤーに実装することをお勧めします。 |
| トランザクション性 (暗号化、署名、信頼性の高い配信、トランザクション管理) | トランザクション性は、必要な各リソースに対する必要なすべての操作を含むグローバルトランザクションをサポートする機能として定義できます。トランザクション性は、4 つの ACID プロパティ (原子性、一貫性、分離性、耐久性) すべてをサポートすることを意味します。原子性は、作業単位 (トランザクション) の結果がすべて揃うか、まったく揃わないかを保証するものです。
Salesforce 自体はトランザクションですが、分散トランザクションや Salesforce の外部で開始されたトランザクションには参加できません。そのため、複雑なマルチシステムトランザクションを必要とするソリューションの場合、トランザクション性および関連付けられたロールバック/補償メカニズムがミドルウェアレイヤーで実装されることが想定されます。 |
| ルーティング | ルーティングは、コンポーネントからコンポーネントへのメッセージの複雑なフローを指定するものとして定義できます。最新のサービスベースのソリューションでは、このようなメッセージフローは、ヘッダー、コンテンツタイプ、ルール、優先度など、多くの条件に基づくことができます。
Salesforce インテグレーションでは、ミドルウェアレイヤーまたはエンドポイントによってそのような要件が満たされていることが前提となります。メッセージ ルーティングは Apex でコーディングできますが、メンテナンスとパフォーマンスの考慮事項からお勧めしません。 |
| 抽出、変換、読み込み | 抽出、変換、読み込み (ETL) とは、次のプロセスを指します。
Salesforce では、変更データキャプチャもサポートされるようになりました。これは、Salesforce レコードへの変更を表す変更イベントのパブリッシュです。変更データキャプチャを使用すると、クライアントまたは外部システムは Salesforce レコードの変更をほぼリアルタイムで受信できます。この情報を使用して、クライアントまたは外部システムは外部データストアの対応するレコードを同期できます。 |
| ロングポーリング | ロングポーリングは、コメットプログラミングとも呼ばれ、サーバーからクライアントへの情報の転送をエミュレートします。通常のポーリングと同様に、クライアントは接続してサーバーに情報を要求します。ただし、情報が使用できない場合は空の応答を送信する代わりに、サーバーは要求を保持し、情報が使用可能になるまで待機します (イベントが発生する)。その後、サーバーは完全な応答をクライアントに送信します。その後、クライアントは情報をすぐに再要求します。クライアントはサーバーへの接続を継続的に維持するため、常に応答の受信を待機します。サーバーがタイムアウトすると、クライアントは再度接続して最初からやり直します。 Salesforce ストリーミング API では、長時間のポーリングに Bayeux プロトコルと CometD が使用されます。
|
| ソリューション | 適合 | コメント |
|---|---|---|
| 外部サービスが REST API コールを呼び出す | 最善 | 外部サービスでは、外部でホストされるサービスを宣言型で呼び出すことができます (コードは必要ありません)。この機能は、次の条件を満たす場合に最適です。
|
| Salesforce Lightning:Lightning コンポーネントまたはページが同期 Apex REST または SOAP コールアウトを開始します。</ リモート エンドポイントが高レイテンシ応答のリスクになる場合(適用される制限については、最新の制限に関するドキュメントを参照してください)、同期Apexトランザクション ガバナ制限に達しないように、継続とも呼ばれる非同期コールアウトをお勧めします。 |
最善 | Salesforce では、WSDL を使用して、結果のプロキシ Apex クラスを生成できます。このクラスは、リモートサービスをコールするために必要なロジックを提供します。 Salesforce では、標準の GET、POST、PUT、DELETE メソッドを使用して HTTP (REST) サービスを呼び出すこともできます。 Lightning ページでユーザーが開始するアクションは、このプロキシ Apex クラスを実行してリモート コールを実行する Apex コントローラ アクションをコールします。Lightning ページには、Salesforce アプリケーションのカスタマイズが必要です。 |
| Salesforceデータの変更から呼び出される同期トリガーは、非同期Apex SOAPまたはHTTPコールアウトを実行します。 | 最適ではない | Apexトリガーを使用して、レコード データの変更に基づいて自動化を実行できます。 Apex プロキシ クラスは、Apex トリガーを使用して、DML 操作の結果として実行できます。ただし、トリガーコンテキスト内から実行されたすべてのコールは、開始イベントから非同期で実行する必要があります。そのため、このインテグレーションの問題にはこのソリューションはお勧めしません。このソリューションは、Remote Process Invocation — Fire and Forget パターンに適しています。 |
| Apex一括処理ジョブは、同期Apex SOAPまたはHTTPコールアウトを実行します。 | 最適ではない | 一括処理ジョブからリモートシステムへのコールを実行できます。このソリューションでは、Salesforce のリモートシステムから一括リモートプロセス実行と応答処理を実行できます。ただし、特定のバッチにはコール数の制限があります。詳細は、「ガバナ制限」を参照してください 1 つのバッチ実行で複数のトランザクションコンテキストを実行できます (通常は 200 レコード間隔)。ガバナ制限はトランザクションコンテキストごとにリセットされます。 |
 図のダウンロード
このシナリオの内容は次のとおりです。 - Lightning ページでアクションが開始されます(ボタンのクリックなど)。 - ブラウザ(Lightning コンポーネントの場合はクライアント側コントローラ経由)は HTTP POST を実行し、続いて対応する Apex コントローラでアクションを実行します。 - コントローラーがリモート Web サービスへの実際のコールを呼び出します。 - リモート・システムからの応答が Apex コントローラに返されます。コントローラーは応答を処理し、必要に応じて Salesforce のデータを更新して、ページを再表示します。 後続の状態を追跡する必要がある場合、リモートシステムは Salesforce レコードに保存されている一意の識別子を返します。 **結果** このパターンに関連するソリューションの適用により、Salesforce が処理するイベント開始リモートプロセスの呼び出しが可能になります。 **コールメカニズム** コールメカニズムは、このパターンを実装するために選択されたソリューションによって異なります。
| コールメカニズム | 説明 |
|---|---|
| フローに埋め込まれた拡張外部サービスまたは Lightning コンポーネントまたは Apex コントローラ |
リモートプロセスがユーザーインターフェースを含むエンドツーエンドのプロセスの一部としてトリガーされ、その結果を Salesforce レコードに表示または更新する必要がある場合に使用されます。たとえば、クレジットカード支払を外部支払ゲートウェイに送信すると、支払結果がすぐに返され、ユーザーに表示されます。 |
| Apex トリガー | 主に、DML が開始するイベントからの Apex コールアウトを使用したリモートプロセスの呼び出しに使用されます。この呼び出しメカニズムについての詳細は、「Remote Process Invocation — Fire and Forget」パターンを参照してください |
| Apex 一括処理クラス | バッチでのリモートプロセスの呼び出しに使用されます。この呼び出しメカニズムについての詳細は、「Remote Process Invocation — Fire and Forget」パターンを参照してください |
| ソリューション | エンドポイントに関する考慮事項 |
|---|---|
| Apex HTTP コールアウト | エンドポイントは HTTP コールを受信できる必要があります。Salesforce が公開インターネット経由でエンドポイントにアクセスできる必要があります。プライベートで安全な通信のために、Salesforceは、Hyperforceプラットフォームを介した安全なSalesforce Private Connectのサポートも開始しました。詳細は、「Salesforce Private Connect」を参照してください。
Apex HTTP コールアウトを使用して、標準の GET、POST、PUT、DELETE、および PATCH メソッドを使用して REST サービスをコールできます。 |
| Apex SOAP コールアウト | エンドポイントは HTTP コールを受信できる必要があります。Salesforce が公開インターネット経由でエンドポイントにアクセスできる必要があります。プライベートで安全な通信のために、Salesforceは、Hyperforceプラットフォームを介した安全なSalesforce Private Connectのサポートも開始しました。詳細は、「Salesforce Private Connect」を参照してください。
このソリューションでは、リモートシステムが Salesforce でサポートされる標準と互換性がある必要があります。この記事の執筆時点で、Salesforce で Apex SOAP コールアウト用にサポートされている Web サービス標準は次のとおりです。
|
- Salesforce は、リモートレコードのリモートシステムのプライマリまたは一意の代理キーを保存します。
- リモートシステムには、Salesforce の一意のレコード ID またはその他の一意の代理キーが保存されます。
| マスター | システム 説明 |
|---|---|
| Salesforce | リモートシステムには、Salesforce RecordId またはレコードの他の一意の代理キーが保存されます。 |
| リモートシステム | リモートプロセスへのコールでアプリケーションから一意のキーが返され、Salesforce はそのキー値を一意のレコード項目に保存します。 |
- 複雑なフローロジックを含むビジネスプロセスとルールのオーケストレーション
- 複数のシステムへの通話の集計とその結果
- 受信メッセージと送信メッセージの両方の変換
- 複数のシステムへのコール間でトランザクションの整合性を維持する
| プロパティ | 必須 | 望ましい | 不要 |
|---|---|---|---|
| イベント処理 | X | ||
| プロトコル変換 | X | ||
| 翻訳と変換 | X | ||
| キューイングとバッファリング | X | ||
| 同期転送プロトコル | X | ||
| 非同期転送プロトコル | X | ||
| 仲介ルーティング | X | ||
| プロセス振付とサービスオーケストレーション | X | ||
| トランザクション性 (暗号化、署名、信頼性の高い配信、トランザクション管理) | X | ||
| ルーティング | X | ||
| 抽出、変換、読み込み | X | ||
| long polling | X |
- Salesforce は、Apex プロキシ クラスから Billing Account Service WSDL を使用します。
- カスタム Apex コントローラまたは外部サービスから外部 Web サービスに渡される顧客情報を使用して、Apex プロキシ クラスを実行します。
- 次に、カスタム コントローラは Apex コールアウトからの戻り値を解析し、その情報を salesforce オブジェクトに保存します。
- 顧客の状態は、Salesforce 取引先オブジェクトに保存されている取引先番号で追跡されます。
- 通話者による返信メッセージの後続の処理
- リモートシステムへのコールで、処理を続行する前に Salesforce が応答を待機する必要がありますか?リモートシステムへのコールは同期か非同期か?
- リモートシステムへのコールが同期の場合、Salesforce でコールと同じトランザクションの一部として応答を処理する必要がありますか?
- メッセージサイズが小さいか?
- インテグレーションは、Salesforce ユーザーインターフェースでのボタンのクリックなどの特定のイベントや DML ベースのイベントの発生に基づいていますか?
- Salesforce からリモートシステムへのメッセージ配信の保証は必要ですか?
- リモートシステムは、Salesforce が契約を指定する契約優先インテグレーションに参加できますか?一部のソリューションバリエーション (アウトバウンドメッセージングなど) では、Salesforce によってリモートシステムエンドポイントが実装する契約が指定されます。
- エンドポイントまたはエンタープライズサービスバス (ESB) でロングポーリングはサポートされていますか?
- カスタムApex開発よりも宣言型構成方法が優先されますか?この場合、Apex コールアウトよりもプラットフォームイベントなどのソリューションが優先されます。
| ソリューション | 適合 | コメント |
|---|---|---|
| フロー駆動型プラットフォームイベント | 最善 | プラットフォームイベントを実装するフローを宣言的に作成します。推奨される解決策は、挿入または更新イベントからリモートプロセスを呼び出すことです。 プラットフォームイベントは、アプリケーションがさらにアクションを実行するために送受信するイベントメッセージ (または通知) です。プラットフォームイベントは、変化をやり取りしてその変化に応答するためのプロセスを簡素化します。複雑なロジックを記述することはありません。1 人以上の登録者が同じイベントをリスンしてアクションを実行できます。 たとえば、ソフトウェアシステムは、プリンターのインクカートリッジに関する情報を含むイベントを送信できます。登録者はイベントに登録して、プリンターのインクレベルを監視し、インクレベルが低いカートリッジの交換を注文できます。 外部アプリケーションは、CometD を介してチャネルを登録することでイベントメッセージを聞くことができます。Lightningコンポーネントなどのプラットフォーム アプリケーションも、CometDを使用してイベント メッセージを登録できます。gRPC と HTTP/2 に基づく Salesforce PubSub Api もここで使用できます。 Salesforce ではプラットフォームイベントトリガーフローもサポートされており、Flow Builder インターフェースを使用してリスナーを効率的に作成できます。この種別のフローは、特定のプラットフォームイベントメッセージが Salesforce イベントバスに公開されたときに自動的に開始されます。 |
| Pub/Sub API | 最善 | Pub/Sub API は、外部コンシューマーがイベントバスでイベントを使用するための推奨方法です。 gRPC ベースの Pub/Sub API :
Salesforce でプラットフォームイベントが定義されると、内部消費者と外部消費者の両方が使用できるようになります。 |
| 変更データキャプチャ | 最善 | Change データキャプチャ (CDC) は、作成、更新、削除、復元操作に対応する Salesforce レコードの変更イベントを公開します。Salesforce での変更データキャプチャ (CDC) の有効化は、Apex コードを必要としない純粋な宣言型プロセスです。 通知メッセージは、クライアントが Pub/Sub API または Apex トリガーを使用して登録できるイベント バスに送信されます。イベント駆動型システムは、分散した企業システム間の通信を合理化し、拡張性を高め、リアルタイムのデータを提供します。 たとえば、注文情報が ERP システムと Salesforce の両方にある場合、注文変更イベントを Salesforce からインテグレーションアプリケーションにストリーミングできます。次に、アプリケーションは ERP システムの変更を同期します。 |
| Omnistudio インテグレーション手順 | 良い | OmniStudio Integration Procedure を使用して、Salesforce と外部のサードパーティアプリケーション間のデータインタラクションを宣言して自動化します。Integration Procedure は、複雑なデータ変換、API コール、イベント駆動型の自動化を処理し、1 回のサーバーコールで複数のアクションを実行できます。 Integration Procedure は、実行中にユーザー操作が不要で、次の場合に使用します。
Integration Procedure についての詳細は、こちらを参照してください |
| カスタマイズ駆動型プラットフォームイベント | 良い | フロー駆動型プラットフォームイベントに似ていますが、イベントは Apex トリガーまたはクラスによって作成されます。Apex または API を使用して、プラットフォーム イベントを公開および使用できます。 プラットフォーム イベントは、Apex トリガーを介して Salesforce Platform と統合されます。トリガーは、イベントメッセージを聞く Salesforce Platform のイベントコンシューマーです。 外部アプリケーションが API を使用するか、ネイティブ Salesforce アプリケーションが Apex を使用してイベント メッセージを公開すると、そのイベントに対するトリガーが起動されます。トリガーは、イベント通知に応じてアクションを実行します。 |
| フロー駆動型アウトバウンドメッセージング | 適合 | この種類のインテグレーションでは、挿入イベントまたは更新イベントからリモートプロセスを呼び出すことをお勧めします。Salesforce には、Salesforce の挿入操作または更新操作によってトリガーされるリモートシステムに SOAP メッセージを送信できるフロー駆動型アウトバウンドメッセージング機能があります。これらのメッセージは非同期で送信され、Salesforce ユーザーインターフェースからは独立しています。 送信メッセージは特定のリモートエンドポイントに送信されます。リモートサービスは、Salesforce が契約を提供する契約優先インテグレーションに参加できる必要があります。 メッセージの受信時に、リモートサービスが肯定的な確認応答を返さない場合、Salesforce はメッセージの送信を再試行し、確実な配信を実現します。 |
| Apex SOAP または HTTP 非同期コールアウトを開始するカスタム Lightning コンポーネント | 最適ではない | このソリューションは通常、ユーザーインターフェースベースのシナリオで使用されますが、カスタマイズが必要です。さらに、このソリューションでは、コード内のメッセージの保証された配信を処理する必要があります。 Remote Process Invocation — Request and Reply (要求および返信) パターンソリューションに似ています。Lightning コンポーネントと Apex コールアウトの使用を指定します。違いは、このパターンでは、Salesforce は要求の完了を待たずにユーザーに制御を渡します。 メッセージを受信すると、リモート システムは応答してメッセージの受信を示し、メッセージを非同期で処理します。リモートシステムは、メッセージの処理を開始する前に制御を Salesforce に戻します。そのため、Salesforce は処理の完了を待つ必要はありません。 |
| Apex SOAP または HTTP 非同期コールアウトを実行する Apex トリガー | 最適ではない | Apexトリガーを使用して、レコード データの変更に基づいて自動化を実行できます。 Apex プロキシ クラスは、Apex トリガーを使用して、DML 操作の結果として実行できます。ただし、トリガーコンテキスト内から実行されたすべてのコールは非同期で実行する必要があります。 |
| Apex SOAP または HTTP 非同期コールアウトを実行する Apex トリガー | 最適ではない | リモートシステムへのコールは一括処理ジョブから実行できます。このソリューションでは、一括リモートプロセス実行と、Salesforce でのリモートシステムからの応答の処理が可能です。ただし、特定のバッチコンテキストのコール数には制限があります。詳細は、『Salesforce Developer Limits and Allocations Quick Reference (Salesforce 開発者の制限と割り当てクイックリファレンス)』を参照してください。
|
 図のダウンロード
このシナリオの内容は次のとおりです。
- リモートシステムがプラットフォームイベントに登録します。
- Salesforce の特定のレコードセットで更新または挿入が実行されます。
- 一連の条件が満たされると、Salesforce フローがトリガーされます。
- このフローでは、プラットフォームイベントが作成されます。
- リモートリスナーはイベントメッセージを受信し、メッセージをローカルキューに配置します。
- キューイングアプリケーションがメッセージをリモートアプリケーションに転送して処理します。
- ユーザーインターフェース – トランザクションの結果をエンドユーザーに表示できるリモートプロセスの呼び出し
- コール元プロセスでトランザクションの結果を処理できる DML イベント開始リモートプロセスの呼び出し
| コールメカニズム | 説明 |
|---|---|
| フロー | プロセス駆動型ソリューションとカスタマイズ駆動型ソリューションの両方で使用されます。イベントは Salesforce プロセスをトリガーし、その後、リモートシステムで登録するプラットフォームイベントを公開できます。 |
| Pub / Sub API | Pub/Sub API では、リアルタイムイベント監視イベントや変更データキャプチャチャイベントなどのプラットフォームイベントを 1 つのインターフェースで公開および登録できます。Pub/Sub API は、gRPC と HTTP/2 に基づいて、バイナリイベントメッセージを Apache Avro 形式で効率的に公開および配信します。 |
| 変更データキャプチャ | Salesforce 変更データキャプチャは、Salesforce レコードへの変更を表す変更イベントを公開します。変更には、新規レコードの作成、既存のレコードの更新、レコードの削除、レコードの復元などがあります。 |
| LightningコンポーネントおよびApexコントローラ | Apex コールアウトを使用してリモート プロセスを非同期で呼び出すために使用される。 |
| フロー駆動型アウトバウンドメッセージング | アウトバウンドメッセージングソリューションでのみ使用されます。DML イベントを作成および更新すると、Salesforce ワークフロールールがトリガーされ、リモートシステムにメッセージを送信できます。 |
| Apex トリガー | トリガー駆動型プラットフォーム イベントおよびリモート プロセスの呼び出しに使用され、DML が開始するイベントからの Apex コールアウトを使用します。 |
| Apex 一括処理クラス | バッチモードでのリモートプロセスの呼び出しに使用されます。 |
| ソリューション | エラー処理と回復戦略 |
|---|---|
| フロー |
|
| Apex コールアウト |
|
| 変更データキャプチャ (CDC) / プラットフォームイベント |
|
| ソリューション | セキュリティに関する考慮事項 |
|---|---|
| Apex コールアウト | リモートシステムへのコールでは、要求の機密性、整合性、可用性を維持する必要があります。次に、このパターンでの Apex SOAP および HTTP コールの使用に固有のセキュリティ上の考慮事項を示します。
|
| 変更データキャプチャ (CDC) / プラットフォームイベント | プラットフォームイベントの場合、登録する外部システムは Salesforce ストリーミング API に対して認証できる必要があります。 プラットフォームイベントは、Salesforce 組織で設定されている既存のセキュリティモデルに準拠します。イベントに登録するには、ユーザーにイベントエンティティへの参照アクセス権が必要です。イベントを公開するには、ユーザーにイベントエンティティに対する「作成」権限が必要です。 |
| ソリューション | エンドポイントに関する考慮事項 |
|---|---|
| Apex SOAP コールアウト | エンドポイントは HTTP 経由で Web サービスコールを処理できる必要があります。Salesforce が公開インターネット経由でエンドポイントにアクセスできる必要があります。このソリューションでは、リモートシステムが Salesforce でサポートされる標準と互換性がある必要があります。この記事の執筆時点で、Salesforce で Apex SOAP コールアウト用にサポートされている Web サービス標準は次のとおりです。
|
| Apex HTTP コールアウト | エンドポイントは HTTP コールを受信でき、Salesforce によってパブリックインターネットを介してアクセスできる必要があります。 Apex HTTP コールアウトを使用して、標準の GET、POST、PUT、DELETE メソッドを使用して RESTful サービスをコールできます。 |
| 変更データキャプチャ (CDC) / プラットフォームイベント |
|
- Salesforce は、リモートレコードのリモートシステムのプライマリまたは一意の代理キーを保存します。
- リモートシステムには、Salesforce の一意のレコード ID またはその他の一意の代理キーが保存されます。
| マスター | システム 説明 |
|---|---|
| Salesforce | リモートシステムは、Salesforce RecordId または他の一意の代理キーを Salesforce レコードに保存する必要があります。 |
| リモートシステム | Salesforce は、リモートシステムに一意の識別子への参照を保存する必要があります。このプロセスは非同期であるため、この一意の識別子を保存することは元のトランザクションに含めることができません。 Salesforce は、リモートプロセスへのコールで一意の ID を指定する必要があります。その後、リモートシステムは Salesforce にコールバックして、Salesforce の一意の ID を使用してリモートシステムの一意の識別子で Salesforce のレコードを更新する必要があります。 コールバックは、リモートアプリケーションでの特定の状態の処理を暗示し、処理の完了時にそのトランザクションの Salesforce 一意の識別子をコールバックに使用するために保存します。または、Salesforce 一意の識別子をリモートシステムのレコードに保存します。 |
| ソリューション | 考慮事項 |
|---|---|
| Apex コールアウト | 場合によっては、このパターンで規定されたソリューションで、ミドルウェアを使用するか、Salesforce に複合サービスをコールさせるのに最適な複数の複雑なインテグレーションシナリオを実装する必要があります。次のシナリオがあります。
|
| 変更データキャプチャ (CDC) / プラットフォームイベント | イベントの静的で宣言的な性質上、Salesforce では集計、オーケストレーション、変換などの複雑なインテグレーションシナリオを実行できません。リモートシステムまたはミドルウェアは、次の種別の操作を処理する必要があります。 |
| OmniStudio インテグレーション手順 | Integration Procedure (OmniStudio) は、複雑な宣言型のデータ変換を実行しながら複数のバックエンドサービスを調整するためのサーバー側のステートレスなオーケストレーションを提供します。 Integration Procedure では、HTTP アクション、DataRaptor 抽出/変換/読み込み、値を設定、ループ/If、マトリックスルックアップなどのステップをチェーニングして、UI 契約や異なる API 間でペイロードを正規化、強化、集計、マッピングします。 条件付き分岐、ページネーション、タイムアウト、再試行、部分的な障害の処理、エラー発生時の継続などの堅牢なランタイム制御と、サーバー側キャッシュや応答シェーピングなどのパフォーマンスの最適化をサポートしています。 IP は、OmniScript から同期的に呼び出すことも、REST を介してヘッドレスで呼び出すこともできます。これにより、バックエンドの複雑さをチャネルから隠す、再利用可能なバージョン管理された「インテグレーションの外観」が可能になります。 |
| ソリューション | 信頼性の高いメッセージングに関する考慮事項 |
|---|---|
| Apex コールアウト | Salesforce では、信頼性の高いメッセージングプロトコル (WS-ReliableMessaging など) は明示的にサポートしていません。Salesforce メッセージを受信するリモートエンドポイントは、JMS や MQ などの信頼性の高いメッセージングシステムを実装することをお勧めします。このシステムにより、最終的にメッセージを処理するリモートシステムへの完全なエンドツーエンドの保証配信が保証されます。ただし、このシステムは Salesforce からコール元のリモートエンドポイントへの配信を保証しません。 配送の保証は、Salesforce へのカスタマイズで処理する必要があります。カスタム再試行ロジックに加えてリモートエンドポイントからの肯定応答を処理するなど、特定の技術を実装する必要があります。 |
| 変更データキャプチャ (CDC) / プラットフォームイベント | プラットフォームイベントは、イベントバスにイベントメッセージを一時的に保持することで、信頼性の高いメッセージングを提供します。登録者は、イベントメッセージのリプレイ ID を使用してイベントバスからメッセージを再生することで、見逃したイベントメッセージに気付くことができます。 イベントバスは分散システムであり、トランザクションデータベースと同じ保証はありません。そのため、Salesforce はイベント公開要求の同期応答を提供できません。イベントはキューに入れられてバッファリングされ、Salesforce はイベントを非同期で公開しようとします。まれに、初回またはその後の試行時にイベントメッセージが分散システムに保持されないことがあります。つまり、イベントは登録者に配信されず、復元できません。 |
| プロパティ | 必須 | 望ましい | 不要 |
|---|---|---|---|
| イベント処理 | X | ||
| プロトコル変換 | X | ||
| 翻訳と変換 | X | ||
| キューイングとバッファリング | X | ||
| 同期転送プロトコル | X | ||
| 非同期転送プロトコル | X | ||
| 仲介ルーティング | X | ||
| プロセス振付とサービスオーケストレーション | X | ||
| トランザクション性 (暗号化、署名、信頼性の高い配信、トランザクション管理) | X | ||
| ルーティング | X | ||
| 抽出、変換、読み込み | X | ||
| long polling | X (プラットフォームイベントで必要) |
- [コミット後に公開]: トランザクションが正常にコミットされた後にのみイベントメッセージを公開します。公開トランザクションがコミットするデータにサブスクライバーが依存している場合、このオプションを選択します。たとえば、あるプロセスがイベントメッセージを公開し、ToDo レコードを作成するとします。そのイベントに登録している 2 つ目のプロセスは起動したときに ToDo レコードがあることを想定しています。この動作を選択するもう 1 つの理由は、トランザクションが失敗した場合にイベントメッセージを公開したくない場合です。
- すぐに公開: 公開コールの実行時にイベントメッセージを公開します。トランザクションが成功したかどうかに関係なくイベントメッセージを公開する場合、このオプションを選択します。また、公開者と登録者が独立していて、登録者が公開者によってコミットされたデータに依存していない場合もこのオプションを選択します。たとえば、記録目的で使用されるイベントにはすぐに公開する動作が適しています。このオプションを使用すると、パブリッシャートランザクションによってデータがコミットされる前に、登録者がイベントメッセージを受信できます。
- 実装できるのは宣言型開発のみです。
- 商談が注文に変換された後に注文番号をすぐに通知する必要はありません。
- 組織に CometD プロトコルをサポートする ESB があり、プラットフォームイベントを登録できます。
- プラットフォームイベントを開始するフローを作成します (商談の状況が商談成立に変更された場合など)。
- 商談の詳細を公開する新しいプラットフォームイベントを作成します。
- ESB は CometD プロトコルを使用して Salesforce Platform イベントに登録します。
- ESB は、商談が注文に変換されることを示す 1 つ以上の通知を受信します。
- 注文を作成できるように、ESB がメッセージをバックエンドの ERP システムに転送します。
- 注文が ERP システムで作成されると、別のスレッドが SessionId を認証トークンとして使用して Salesforce にコールバックします。コールバックは、注文番号と状況で商談を更新します。このコールバックは、Salesforce Platform イベント、Salesforce SOAP API、REST API、Apex Web サービスなどのドキュメント化されたパターンソリューションを使用して実行できます。
- 非同期で呼び出されるリモートプロセスの実装
- エンドツーエンドの配送保証
- レコードの状態を更新する Salesforce への後続のコールバック
- 現在の CRM システムから取引先、取引先責任者、商談を抽出して変換し、データを Salesforce に読み込みます (初期データインポート)。
- 毎週 (継続的に) リモートシステムから顧客請求データを抽出、変換し、Salesforce に読み込みます。
- Salesforce から顧客活動情報を抽出し、週次 (継続) でオンプレミスデータウェアハウスにインポートします。
- データは Salesforce に保存する必要がありますか?そうでない場合、アーキテクトが考慮できるインテグレーションオプションや考慮すべきインテグレーションオプションが他にもあります (マッシュアップなど)。
- データを Salesforce に保存する必要がある場合、リモートシステムのイベントに応じてデータを更新する必要がありますか?
- データをスケジュールに従って更新する必要がありますか?
- データで主要なビジネスプロセスがサポートされているか?
- Salesforce でこのデータを使用できるかどうかによって影響を受ける分析 (レポート) 要件はありますか?
| ソリューション | 適合 | データマスター | コメント |
|---|---|---|---|
| サードパーティの ETL ツールを使用したレプリケーション | 最善 | リモートシステム | 外部システムで大量のデータを Salesforce に送信する必要がある場合は、サードパーティの ETL ツールを活用して、ソースデータに対して変更データキャプチャを実行できます。 このツールはソースデータセットの変更に対応し、データを変換してから、Salesforce Bulk API をコールして DML ステートメントを発行します。レコード数が少ない場合は、Salesforce REST API を使用して実装することもできます。 |
| サードパーティの ETL ツールを使用したレプリケーション | 良い | Salesforce | ERP および Salesforce データセットに対して変更データキャプチャを実行できるようにするサードパーティの ETL ツールを活用します。 このソリューションでは、Salesforce がデータソースであり、個々の行の時間/状況情報を使用してデータを照会し、対象結果セットを絞り込むことができます。これは、一括 API 2.0 または標準 REST API (レコード数が少ない場合) を使用して実装できます。 |
| データインポートウィザードとデータローダー | 適合 | Salesforce/外部システム | データインポートウィザードとデータローダーを使用して、データをインポート、エクスポート、移行できます。データローダーコマンドは、データのインポートとエクスポートを自動化するためにスクリプトを作成することもできますが、コマンドラインインターフェースは Windows 専用です。どちらのツールもデータインテグレーション戦略のベースとして推奨されません。代わりに、データスチュワードシップとメンテナンス戦略を補完する必要があります。 データローダーの詳細については、こちらを参照してください |
| リモートコールイン | 最適ではない | リモートシステム | リモートシステムがいずれかの API を使用して Salesforce にコールし、データの更新を必要に応じて実行できます。ただし、これにより 2 つのシステム間で大量のトラフィックが発生します。 エラー処理とロックをより重視する必要があります。このパターンは継続的に更新され、エンドユーザーのパフォーマンスに影響する可能性があります。 |
| リモートプロセスの呼び出し | 最適ではない | Salesforce | Salesforce がリモートシステムにコールし、データの更新を必要に応じて実行できます。ただし、これにより 2 つのシステム間で大量のトラフィックが発生します。 エラー処理とロックをより重視する必要があります。このパターンは継続的に更新され、エンドユーザーのパフォーマンスに影響する可能性があります。 |
 図のダウンロード
次の図は、Salesforce がデータマスターである場合のほぼリアルタイムのイベントの後続の同期を示しています。
 **結果**
次のシナリオでは、外部ソースのデータを Salesforce と統合できます。
- 外部システムがデータマスター — Salesforce は、1 つのソースシステムまたは複数のシステムによって提供されるデータのコンシューマーです。このシナリオでは、データを Salesforce にインポートする前にデータを集計するデータウェアハウスまたはデータマートを使用するのが一般的です。
- Salesforce はデータマスターです。Salesforce は特定のエンティティの記録システムであり、Salesforce 変更データキャプチャアプリケーションは Salesforce データへの変更を通知できます。
- ソースデータセットに変更データキャプチャを実装します。
- 一連のサポートデータベース構造 (制御テーブル) を中間のオンプレミスデータベースに実装します。
- 制御テーブルを参照して、ジョブの最終実行時刻を判断し、必要な他の制御値を抽出します。
- 上記の制御値を検索条件として使用し、ソースデータセットを照会します。
- 入力規則、強化規則など、定義済みの処理ルールを適用します。
- ETL ツールの使用可能なコネクタ/変換機能を使用して、対象データセットを作成します。
- データセットを Salesforce オブジェクトに書き込みます。
- 処理が成功したら、制御テーブルの制御値を更新します。
- 処理に失敗した場合は、再起動と終了を有効にする値で制御テーブルを更新します。
- ETL ジョブをチェーニングおよび順序付けして、一貫性のあるプロセスを提供します。
- 両方のシステムの主キーを使用して、受信データを照合します。
- 特定の API メソッドを使用して、更新されたデータのみを抽出します。
- 主従関係または参照関係で子レコードをインポートする場合、ロックされないように、インポートしたデータをソースの親キーを使用してグループ化します。たとえば、取引先責任者データをインポートする場合は、1 つの取引先の取引先責任者の最大数を 1 回の API コールで読み込むことができるように、必ず親取引先キーで取引先責任者データをグループ化してください。通常、インポートしたデータをグループ化しないと、最初の取引先責任者レコードが読み込まれ、その取引先の後続の取引先責任者レコードが API コールのコンテキストで失敗します。
- トリガーなどのインポート後の処理では、データのみを選択的に処理する必要があります。
- シナリオに大量のデータが含まれる場合は、この Trailhead モジュール「 Best Practices for Deployments with Large Data Volumes 」のベストプラクティスに従ってください。 をクリックします。
| エラーの場所 | エラー処理と回復戦略 |
|---|---|
| 変更データキャプチャを使用した Salesforce からの参照 |
|
| サードパーティの ETL システムを使用した Salesforce からの参照 |
|
| Salesforce への書き込み |
|
| 外部マスターシステム | エラーは、マスターシステムのベストプラクティスに従って処理する必要があります。 |
- Salesforce APIへの認証済みAPIアクセスを許可するには、「APIのみ」以上のユーザー権限を持つLightning Platformライセンスが必要です。
- パスワードアクセスの安全性を維持するために、標準の暗号化を使用することをお勧めします。
- Salesforce API をコールするときは、HTTPS プロトコルを使用します。必要に応じて、オンプレミスセキュリティソリューションを介して Salesforce API へのトラフィックをプロキシすることもできます。
- Salesforce では、特定のユーザーが編集しているレコードの状態は保持されません。
- 参照時に、データが抽出された時刻が記録されます。
- ユーザーがレコードを更新して保存すると、Salesforce は別のユーザーがそのレコードを更新しているかどうかを確認します。
- レコードが更新されている場合、更新が行われたことがユーザーに通知され、ユーザーは更新を続行する前に最新バージョンのレコードを取得する必要があります。
| プロパティ | 必須 | 望ましい | 不要 |
|---|---|---|---|
| イベント処理 | X | ||
| プロトコル変換 | X | ||
| 翻訳と変換 | X | ||
| キューイングとバッファリング | X | ||
| 同期転送プロトコル | X | ||
| 非同期転送プロトコル | X | ||
| 仲介ルーティング | X | ||
| プロセス振付とサービスオーケストレーション | X | ||
| トランザクション性 (暗号化、署名、信頼性の高い配信、トランザクション管理) | X | ||
| ルーティング | X | ||
| 抽出、変換、読み込み | X | ||
| ロングポーリング | X (Salesforce 変更データキャプチャに必要) |
- cron のようなスケジューラーは、見込み客をユーザーとチームに割り当てる一括処理ジョブを実行します。
- 一括処理ジョブが実行されてデータが更新されると、ETL ツールは変更データキャプチャを使用してこれらの変更を認識します。ETL ツールは、データストアからの変更を照合します。
- ETL コネクタでは、Salesforce REST API を使用して変更を Salesforce に読み込みます。
- Salesforce へのリモートコールの目的は、イベント駆動型アーキテクチャを使用して外部で発生したイベントを Salesforce に通知することですか?または、特定のレコードに対して CRUD 操作を実行する目的ですか?イベント駆動型アーキテクチャを使用している場合、イベントプロデューサー (リモートプロセス) は Salesforce イベントコンシューマーから分離されます。
- Salesforce へのコールでは、処理を続行する前にリモートプロセスが応答を待機する必要がありますか?Salesforce へのリモートコールは常に同期要求-応答ですが、非同期コールをシミュレートする必要がない場合、リモートプロセスで応答を破棄できます。
- 各トランザクションは 1 つの Salesforce オブジェクトに対して実行されますか? 複数の関連オブジェクトに対して実行されますか?
- メッセージの形式は? (SOAP または REST、あるいは両方を HTTP 経由など)
- メッセージサイズは比較的小さいか大きいか?
- リモートシステムが SOAP 対応の場合、Salesforce によって契約が指示される契約優先アプローチにリモートシステムが参加できますか?これは、SOAP API が使用され、定義済みの WSDL が提供されている場合に必要です。
- トランザクション処理は必要ですか?
- Salesforce でのカスタマイズに対する許容範囲は?
| ソリューション | 適合 | コメント |
|---|---|---|
| 複合 API | 最善 | Salesforce は、基本的に REST API であり、複合要求をサポートする複合 API を提供します。これは、リモートシステムで次の目的で使用できます。
同期 API — API コールが実行された後、リモートクライアントアプリケーションはサービスから応答を受信するまで待機します。 トランザクション/コミット動作 — デフォルトでは、一部のレコードがエラーでマークされている場合、複合 API では部分的な成功が許可されません。これは、「all or nothing」フラグを false としてマークすることで変更できます。これにより、部分的な成功が可能になります。 エラー処理:適切なエラー処理では、HTTP 状況コードだけでなく、レスポンスボディを調べる必要があります。複合エンドポイントは、レスポンスボディ内にいずれかのサブ要求が失敗し、トランザクションをロールバックする必要があることが示されていても、200 HTTP 状況コードで応答します。 |
| REST API | 最善 | アクセシビリティ — Salesforce では、リモートシステムで次の操作に使用できる REST API を提供しています。
同期 API — API コールが実行された後、リモートクライアントアプリケーションはサービスから応答を受信するまで待機します。 REST API では、ログインユーザーのプロファイルに基づいて Salesforce で設定されたオブジェクトレベルおよび項目レベルセキュリティが適用されます。 REST はリソース (エンティティ/オブジェクト) を URI として公開し、HTTP 動詞を使用してこれらのリソースに対する CRUD 操作を定義します。SOAP とは異なり、REST API は定義済みの契約を必要とせず、応答に XML と JSON を使用し、入力も緩いです。REST API は軽量で、Salesforce を操作するためのシンプルな方法を提供します。その利点にはインテグレーションと開発の容易さが含まれ、モバイルアプリケーションや Web アプリケーションでの使用に最適です。 トランザクション/コミット動作 — デフォルトでは、各レコードは個別のトランザクションとして扱われ、個別にコミットされます。1 つのレコードの変更に失敗しても、他のレコードの変更はロールバックされません。この動作は、「すべてまたはすべて」動作に変更することができます。REST API 複合リソースを使用して、1 回の API コールで一連の更新を行います。 一括データ — 2,000 件を超えるレコードが含まれるデータ操作は、Bulk API 2.0 で Bulk フレームワークを使用する非同期ワークフローの準備、実行、管理を正常に行うのに適しています。 |
| Bulk API 2.0 | 一括処理に最適 | Bulk API 2.0 は、大規模なデータ操作を処理するための Salesforce の最新の合理化された API です。REST ベースの Bulk API 2.0 には、Salesforce 組織で大規模なデータセットを非同期で挿入、更新/挿入、クエリ、または削除するためのプログラムオプションが用意されています。大量のデータを Salesforce に読み込んだり、組織のデータに対して一括クエリを実行したりする必要がある場合に、効率的に使用できるように設計されています。 Bulk API 1.0 とは異なり、Bulk API 2.0 では常にバッチが並列で処理され、シリアルモードはサポートされません。つまり、次のようになります。
Bulk API 2.0 の各バッチは、独自のトランザクションとして処理されます。つまり、次のようになります。
SOAP API は大量のレコードの処理にも使用できますが、データセットに数十万から数百万のレコードが含まれている場合、SOAP API は最適ではありません。これは、オーバーヘッドが比較的大きく、パフォーマンス特性が低いためです。
|
| Pub/Sub API | 最善 |
Pub/Sub API は、外部パブリッシャーがイベントバスでイベントを公開するための推奨方法です。 Pub/Sub API は、外部システムでプラットフォームイベントを公開できる gRPC ベースの API です。Pub/Sub API:
Salesforce でプラットフォームイベントが定義されると、内部消費者と外部消費者の両方が使用できるようになります。 |
| プラットフォームイベント | 最善 |
プラットフォームイベントは、Salesforce オブジェクトと同じ方法で定義されます。プラットフォームイベントは、REST API、Bulk API、SOAP API などのさまざまなメカニズムを使用して公開できます。
REST API を使用した行動の公開は、Salesforce レコードの作成と同じです。 エンドポイント形式:POST /services/data/vXX.X/sobjects/EventName__e/
Bulk API では、作成操作と挿入操作のみがサポートされます。一括処理内のイベントは、一括処理ジョブの処理時に Salesforce イベントバスに非同期で公開されます。 プラットフォームイベントは SObject であるため、標準 SOAP API 操作がサポートされています。 |
| SOAP API | 適合 |
アクセシビリティ — Salesforce は、リモートシステムで次の操作に使用できる SOAP API を提供します。
同期 API — API コールが実行された後、リモートクライアントアプリケーションはサービスから応答を受信するまで待機します。Salesforce への非同期コールはサポートされていません。 生成された WSDL — Salesforce では、リモートシステムに次の 2 つの WSDL が用意されています。
セキュリティ — SOAP API を実行するクライアントには、API コールを実行するための有効なログインとセッションの取得が必要です。API では、ログインユーザーのプロファイルに基づいて Salesforce で設定されたオブジェクトレベルおよび項目レベルセキュリティが適用されます。 トランザクション/コミット動作 — デフォルトでは、一部のレコードにエラーがマークされている場合、各 API コールで部分的な成功が許可されます。これは、エラーが発生した場合にすべての結果がロールバックされる「all or nothing」動作に変更できます。1 つのトランザクションを複数の API コールにまたがることはできません。この制限を克服するために、1 つの API コールで複数のオブジェクトに影響を与えることができます。 |
| Apex Web サービス | 最適ではない |
Apex クラスのメソッドは、Web サービスメソッドとして外部アプリケーションに公開できます。この方法は SOAP API の代替であり、通常は次の追加要件を満たす必要がある場合にのみ使用されます。
Apex Web サービスを使用する利点は、Salesforce で維持する必要がある追加コードと天秤にかける必要があります。 プラットフォームイベントには適用されません。これは、コンシューマーでのトランザクション事前挿入ロジックが イベント駆動型アーキテクチャ。イベントが発生したことを Salesforce 組織に通知するには、SOAP API、REST API、または Bulk API 2.0 を使用します。 |
| Apex RESTサービス | 最適ではない |
Apex クラスは、HTTP 動詞が定義された特定の URI に対応付けられた REST リソースとして公開できます(POST や GET など)。
REST API 複合リソースを使用して、1 つのトランザクションで複数の更新を実行できます。 SOAP とは異なり、クライアントがサービス定義/契約 (WSDL) を消費してクライアントスタブを生成する必要はありません。リモートシステムには、HTTP 要求を形成し、返された結果 (XML または JSON) を処理する機能のみが必要です。 プラットフォームイベントには適用されません。これは、コンシューマーでのトランザクション事前挿入ロジックが イベント駆動型アーキテクチャ。イベントが発生したことを Salesforce 組織に通知するには、SOAP API、REST API、または Bulk API 2.0 を使用します。 |
 _REST API を介したイベントを使用した Salesforce へのリモートシステム通知_
 **結果**
イベント駆動型アーキテクチャでは、リモートシステムは SOAP API、REST API、または Bulk API 2.0 を使用して Salesforce にコールし、イベントを Salesforce イベントバスに公開します。イベントを公開すると、すべての登録者に通知されます。イベント サブスクライバは、フロー、Lightning コンポーネント、Apex トリガーなどの Salesforce Platform 上に存在できます。イベント登録者は、CometD 登録者などの Salesforce Platform の外部にすることもできます。
Salesforce オブジェクトを直接操作する場合、このパターンに関連するソリューションでは次のことができます。
- リモートシステムは、Salesforce API をコールしてデータベースを照会し、単一オブジェクト操作 (作成、更新、削除など) を実行します。
- 一連のオブジェクト操作を実行するために Salesforce REST API 複合リソースをコールするリモートシステム。
- マルチオブジェクトトランザクション操作とカスタム前/後処理ロジックをサポートできるカスタム組み込み Salesforce API (サービス) をコールするリモートシステム。
| コールメカニズム | 説明 |
|---|---|
| SOAP API | リモートシステムは Salesforce Enterprise または Partner WSDL を使用してクライアントスタブを生成し、そのスタブを使用して標準 SOAP API を呼び出します。 |
| REST API | Apex REST サービスにアクセスする前に、リモート システムを認証する必要があります。リモートシステムは OAuth 2.0 またはユーザー名とパスワード認証を使用できます。いずれの場合も、クライアントは適切な値を使用して認証 HTTP ヘッダーを設定する必要があります (OAuth アクセストークンまたはセッション ID は SOAP API へのログインコールで取得できます)。 次に、リモートシステムは適切な動詞を使用して REST 呼び出し (HTTP 要求) を生成し、返された結果を処理します (JSON および XML データ形式がサポートされています)。 |
| Apex Web サービス | リモートシステムはカスタム Apex Web サービス WSDL を使用してクライアントスタブを生成し、そのスタブを使用してカスタム Apex Web サービスを呼び出します。 |
| Apex RESTサービス | REST API に従って、リソースの URI と該当する動詞は @RestResource、@HttpGet、および @HttpPost アノテーションを使用して定義されます。 |
| Bulk API 2.0 | Bulk API 2.0 は REST ベースの API であるため、REST API と同じコールメカニズムが適用されます。 |
| フローを呼び出すための REST API | REST API を使用して、呼び出し可能なカスタムアクションエンドポイントをコールし、自動起動フローを呼び出します。 |
- エラー処理 — すべてのリモートコールインメソッド (標準 API またはカスタム API) では、タイムアウトや再試行の管理など、後続のエラーをリモートシステムで処理する必要があります。ミドルウェアを使用して、エラー処理と回復のロジックを提供できます。
- リカバリ — サービス品質の要件によってカスタム再試行メカニズムを作成する必要があります。この場合、最適な設計特性を確保することが重要です。プラットフォームイベントにより、登録者は再生 ID を使用して、メッセージの公開後一定期間内にメッセージを取得できます。
| ソリューション | セキュリティに関する考慮事項 |
|---|---|
| SOAP API | alesforce は、Secure Sockets Layer v3 (SSL) および Transport Layer Security (TLS) プロトコルをサポートしています。暗号には 128 ビット以上の鍵長が必要です。 リモートシステムは、有効なログイン情報を使用してログインし、セッション ID を取得する必要があります。リモートシステムにすでに有効なセッション ID がある場合、明示的なログインなしで API をコールできます。これは、このドキュメントの前半で説明したコールバックパターンで使用され、前の Salesforce 送信メッセージには、後続の使用のためにセッション ID とレコード ID が含まれていました。 SOAP API をコールするクライアントは、コールごとに新しいセッション ID を取得するのではなく、パフォーマンスを最大化するためにセッション ID をキャッシュして再利用することをお勧めします。 |
| REST API | リモート システムで認可用の OAuth Trust を確立することをお勧めします。その後、HTTP 動詞を使用して特定のリソースに対して REST コールを実行できます。また、他の方法 (SOAP API をコールして取得されたセッション ID、またはアウトバウンドメッセージを介して提供されたセッション ID) で有効なセッション ID を使用して REST コールを実行することもできます。 REST API をコールするクライアントは、コールごとに新しいセッション ID を取得するのではなく、パフォーマンスを最大化するためにセッション ID をキャッシュして再利用することをお勧めします。 |
| Apex Web サービス | リモート システムで認可用の OAuth Trust を確立することをお勧めします。 |
| Apex RESTサービス | リモート システムで認可用の OAuth Trust を確立することをお勧めします。 |
| Bulk API 2.0 | リモート システムで認可用の OAuth Trust を確立することをお勧めします。 |
- セッションタイムアウト — Salesforce 組織のセッションタイムアウト設定に基づいて活動がない場合、セッションはタイムアウトします。
- クエリタイムアウト — 各 SOQL クエリには 120 秒の個々のタイムアウト制限があります。
| ソリューション | コミュニケーション種別 | 制限 |
|---|---|---|
| SOAP API または REST API | 同期 |
|
| Bulk API 2.0 | 非同期 | Bulk API 2.0 は、大量のデータを非同期でインポートおよびエクスポートできるように最適化されています。 2,000 件を超えるレコードを含むデータ操作は、Bulk API 2.0 で Bulk フレームワークを使用する非同期ワークフローを正常に準備、実行、管理するための適切な候補です。レコード数が 2,000 未満のジョブでは、REST (Composite など) または SOAP で「一括」同期コールを実行する必要があります。 Bulk API 2.0 は、一括処理要求と関連データを送信するときに同期されます。データの実際の処理は非同期で行われます。API およびバッチ処理の制限についての詳細は、「制限」を参照してください。 |
| ソリューション | エンドポイントに関する考慮事項 |
|---|---|
| SOAP API | リモートシステムは、Salesforce によって事前定義されたメッセージ形式に基づいて、Salesforce SOAP API をコールできるクライアントを実装できる必要があります。 リモートシステム (クライアント) は、Salesforce によって契約が提供される契約優先の実装 (Enterprise WSDL や Partner WSDL など) に参加する必要があります。 |
| REST API | リモートシステムは、Salesforce (定義済みの REST サービス) を呼び出して XML または JSON の結果を処理する REST クライアントを実装できる必要があります。 |
| Apex Web サービス | リモートシステムは、Salesforce で定義された定義済み形式の SOAP メッセージを呼び出すことができるクライアントを実装できる必要があります。 リモート システムは、コード ファースト実装に参加する必要があります。コード ファースト実装では、Apex Web サービスの実装後に Salesforce から契約が提供されます。各 Apex Web サービスには、独自の WSDL があります。 |
| Apex RESTサービス | REST API と同じエンドポイントの考慮事項が適用されます。 |
- Salesforce は、リモートレコードのリモートシステムのプライマリまたは一意の代理キーを保存します。
- リモートシステムには、Salesforce の一意のレコード ID またはその他の一意の代理キーが保存されます。この同期パターンでのインテグレーションキーの処理には、特定の考慮事項があります。
| マスター | システム 説明 |
|---|---|
| Salesforce | このシナリオでは、リモートシステムに Salesforce RecordId またはレコードの他の一意の代理キーが保存されます。 |
| リモートシステム | このシナリオでは、Salesforce はリモートシステムに一意の識別子への参照を保存します。プロセスは同期であるため、外部 ID 項目を使用して同じトランザクションの一部としてキーを提供できます。 |
| ソリューション | 考慮事項 |
|---|---|
| SOAP API または REST API | SOAP API と REST API は、オブジェクトに対する簡単なトランザクションを提供します。集計、オーケストレーション、変換などの複雑なインテグレーションシナリオは、Salesforce では実行できません。これらのシナリオは、リモートシステムまたはミドルウェアで処理する必要があり、推奨方法としてミドルウェアが使用されます。 |
| Apex Web サービスまたは Apex REST サービス | カスタム Web サービスでは、クロスオブジェクト機能、カスタムロジック、より複雑なトランザクションサポートを提供できます。このソリューションは慎重に使用する必要があり、変換、オーケストレーション、エラー処理ロジックに対するミドルウェアの適合性を常に考慮する必要があります。 |
| ソリューション | 制限 |
|---|---|
| SOAP API、REST API、およびカスタム Apex API |
|
| Bulk API 2.0 | 詳細は、「データボリューム」サイドバーを参照してください。 |
| プラットフォームイベント |
|
| プロパティ | 必須 | 望ましい | 不要 |
|---|---|---|---|
| イベント処理 | X | ||
| プロトコル変換 | X | ||
| 翻訳と変換 | X | ||
| キューイングとバッファリング | X | ||
| 同期転送プロトコル | X | ||
| 非同期転送プロトコル | X | ||
| 仲介ルーティング | X | ||
| プロセス振付とサービスオーケストレーション | X | ||
| トランザクション性 (暗号化、署名、信頼性の高い配信、トランザクション管理) | X | ||
| ルーティング | X | ||
| 抽出、変換、読み込み | X (一括/一括) |
- PMS は、Salesforce が契約を提供し、PMS が Salesforce サービス (Enterprise WSDL または Partner WSDL で定義) のクライアント (コンシューマー) として機能する契約優先インテグレーションに参加できます。
- Salesforce でカスタム開発を行うことはできません。
- Salesforce でプラットフォームイベントを定義し、PMS からの通知データを含めます。
- プリンターイベント通知によってトリガーされるフローを作成します。このプロセスでは、プリンター納入商品が更新され、注文が作成されます (自動起動フローを使用)。
- Enterprise WSDL または Partner WSDL をダウンロードしてリモートシステムに提供します。
- Enterprise WSDL または Partner WSDL からクライアントスタブを作成します。
- インテグレーションユーザーのログイン情報を使用して (OAuth Web サーバーまたはベアラートークンフローを介して) Salesforce に対して認証します。
- プリンター状況イベントが発生すると、PMS は API をコールしてプリンター状況プラットフォームイベント (プリンター使用状況統計を含む) を作成します。Salesforce イベントバスは、フロー登録者と他のすべての登録者に通知します。
- Salesforce 同期 API クライアント (コンシューマー) の実装。
- プラットフォームイベントを公開するための Salesforce へのコールバック (以前に説明した要求/返信プラットフォームイベントパターンと一致)。
 **結果**
**利点**
このパターンに関連するソリューションの適用には、次の利点があります。
- カスタムポーリングメカニズムを記述する必要がなくなる
- ユーザーが開始するフィードバックループが不要
- 通知の配信は保証されません。
- 通知の順序は保証されません。
- 通知は、Bulk API によって行われたレコードの変更からは生成されません。
- 状況が「Closed」で解決が「Successful」のケースが保存されるときにプラットフォームイベントを送信する Apex Trigger PushTopic を作成します。
- カスタマーサービスマネージャーが使用できるカスタムユーザーインターフェースを作成します。このユーザーインターフェースは、プラットフォームイベントを使用するイベントバスに登録します。
- そのマネージャーのカスタマーサービス担当が生成したアラートを表示するロジックをカスタムユーザーインターフェースに実装します。
- Salesforce で宣言型/ポイント & クリック型の送信インテグレーションまたは UI マッシュアップを作成しますか?
- Salesforce 組織にコピーしたくない大量のデータがありますか?
- 少量のリモートシステムデータにいつでもアクセスする必要がありますか?
- 最新データへのリアルタイムアクセスが必要ですか?
- データをクラウドまたはバックオフィスシステムに保存しますが、Salesforce 組織でそのデータを表示または処理する必要がありますか?
- Salesforce への特定の種別のデータの保存に関してデータレジデンシーの懸念がありますか?
| ソリューション | 適合 | コメント |
|---|---|---|
| Salesforce Connect | 最善 | Salesforce Connectを使用して、Salesforceデータと共に外部ソースのデータにアクセスします。Salesforce でデータのコピーを作成せずに、SAP、Microsoft、Oracle などのシステム、Snowflake などのクラウドベースのシステムからリアルタイムにデータを取得します。 Salesforce Connect は、外部システムのデータテーブルを組織の外部オブジェクトに対応付けます。外部オブジェクトはカスタムオブジェクトと似ていますが、Salesforce 組織外のデータに対応付けられる点が異なります。Salesforce Connect では、外部データへのライブ接続を使用して、常に外部オブジェクトを最新の状態に保ちます。外部オブジェクトにアクセスすると、外部システムからデータがリアルタイムで取得されます。 Salesforce Connect では、次のことができます。
|
| 要求と返信 | 最適ではない |
Salesforce Web サービス API を使用して、外部システムデータにアクセスして更新するためのアドホックデータ要求を実行します。このソリューションには、次のアプローチが含まれます。
Salesforce SOAP API を使用します。カスタムページまたはボタンは、同期方法で Apex REST/SOAP コールアウトを開始します。Salesforce では、WSDL を使用して、結果のプロキシ Apex クラスを生成できます。このクラスは、リモートサービスをコールするために必要なロジックを提供します。次に、ページでユーザーが開始するアクションは、このプロキシ Apex クラスを実行する Apex コントローラのアクションをコールして、リモートコールを実行します。ページには、Salesforce アプリケーションのカスタマイズが必要です。 Salesforce REST API を使用します。カスタムページまたはボタンは、同期方式で Apex HTTP コールアウト (REST サービス) を開始します。Salesforce では、標準の GET、POST、PUT、DELETE メソッドを使用して HTTP サービスを呼び出すことができます。 このソリューションについての詳細は、「Remote Process Invocation — Request and Reply (リモートプロセス呼び出し — 要求と応答)」を参照してください。 |
 このシナリオの内容は次のとおりです。
- ブラウザーは AJAX コールを実行し、続いて対応する外部オブジェクトアダプターでアクションを実行します。
- アダプタはアクションを Odata 要求に変換し、インテグレーション層とサービス層を介してリモートシステムに対して HTTP GET 要求を実行します。
- リモートシステムはインテグレーションレイヤーとサービスレイヤーを介して JSON 応答を Salesforce に返します。
- 応答は Odata から外部オブジェクトに変換され、ブラウザに返されます。
| コールメカニズム | 説明 |
|---|---|
| 外部オブジェクト | Salesforce Connect は、Salesforce 外部オブジェクトを外部システムのデータテーブルにマッピングします。組織にデータをコピーする代わりに、Salesforce Connect は必要なときにリアルタイムでデータにアクセスします。データが組織外に保存されていても、Salesforce Connect は Lightning プラットフォームとのシームレスなインテグレーションを提供します。外部オブジェクトは、グローバル検索、参照関係、レコードフィード、Salesforce モバイルアプリケーションなどの Salesforce ツールで使用できます。外部オブジェクトはまた、Apex、SOSL、SOQL クエリ、Salesforce API、およびメタデータ API、変更セット、パッケージを介したリリースでも使用できます。 |
| 照明コンポーネント | リモートプロセスがユーザーインターフェースを含むエンドツーエンドのプロセスの一部としてトリガーされ、その結果を Salesforce レコードに表示または更新する必要がある場合に使用されます。たとえば、クレジットカード支払を外部支払ゲートウェイに送信し、ユーザーに表示される支払結果をすぐに返すプロセスです。ユーザー インターフェイス イベントからトリガーされるインテグレーションでは、通常、カスタムLightningコンポーネントを作成する必要があります。 |
- このソリューションでは、Salesforce のデータストレージは消費されません。
- ユーザーは、外部システムと Salesforce 間で定期的にデータを同期することを心配する必要はありません。
- Odataまたは組織間アダプターを使用して、またはカスタムApexアダプターを使用して最小限のコードで迅速に実行できる宣言型設定。
- ユーザーは、外部オブジェクトの形式でカスタムオブジェクトとほぼ同じ機能を使用して外部データにアクセスできます。
- グローバル検索を使用して、接続された外部システムで統合検索を実行する機能。
- クラウドおよびオンプレミスのソースから外部データにアクセスするレポートを実行する機能。次のレポートに関する考慮事項を参照してください。
- 外部オブジェクトはカスタムオブジェクトのように動作しますが、一部の機能は外部オブジェクトでは使用できません。詳細は、「Salesforce Compatibility Considerations for Salesforce Connect」を参照してください。
- 外部オブジェクトは、レポートのパフォーマンスに影響する可能性があります。詳細は、「Report Considerations for Salesforce Connect (Salesforce Connect のレポートに関する考慮事項)」を参照してください。
- Salesforce Connect アダプタの使用に関するその他の考慮事項については、「Considerations for Salesforce Connect — All Adapters」を参照してください。
- 組織間アダプタの使用を検討している場合は、「Considerations for Salesforce Connect — Cross-Org Adapter」(Salesforce Connect — 組織間アダプタに関する考慮事項)を参照してください。
- Odata アダプタの使用を検討している場合は、「Considerations for Salesforce Connect — Odata 2.0 and 4.0 Adapters」を参照してください。
- カスタム Apex アダプタの使用を検討している場合は、「Considerations for Salesforce Connect — Custom Adapter」を参照してください。
- 通常、要求はユーザーインターフェースから呼び出されるため、このプロセスでユーザーを待たせてはなりません。
- 外部システムの可用性および外部システムへの接続によっては、外部データの取得に時間がかかることがあります。Salesforce では、外部システムからの応答を待機する最大タイムアウト値を 120 秒に設定できるようになっています。
- リモートプロセスの完了は、タイムリーに実行され、Salesforce タイムアウト制限内およびユーザーの期待以内に完了する必要があります。
| ソリューション | エンドポイントに関する考慮事項 |
|---|---|
| Salesforce Connect | Odata API — Open Data Protocolを使用して、Salesforceの外部に保存されているデータにアクセスします。外部データは、OData プロデューサー経由で公開されている必要があります。 その他のAPI — Apexコネクタ・フレームワークを使用して、使用可能な他のアダプタがニーズに適していない場合に独自のカスタム・アダプタを開発できます。カスタムアダプターは、任意のソースからデータを取得できます。たとえば、一部のデータはコールアウトを介してインターネットから取得でき、他のデータはプログラムで操作したり生成したりできます。 Salesforceへの接続 — Lightning Platform REST APIを使用して、他のSalesforce組織に保存されているデータにアクセスします。 ミドルウェアを使用した接続 Connect via Middleware:Salesforce Connectパートナー エコシステムはSalesforceと密接に連携して、ミドルウェア ゲートウェイがサービスからOdataエンドポイントを公開し、Salesforceが追加のコードを記述せずに接続できるようにします。 |
| 要求 & 返信 | Apex SOAP コールアウト - エンドポイントは HTTP 経由で Web サービスコールを受信できる必要があります。 Apex HTTP コールアウト - エンドポイントは HTTP コールを受信できる必要があります。 Apex HTTP コールアウトを使用して、標準の GET、POST、PUT、DELETE メソッドを使用して RESTful サービスをコールできます。 |
- Salesforce は、リモートレコードの主サロゲートキーまたは一意のサロゲートキーを保存します。
- リモートシステムには、Salesforce の一意のレコード ID またはその他の一意の代理キーが保存されます。この同期パターンでのインテグレーションキーの処理には、特定の考慮事項があります。
| マスターシステム | 説明 |
|---|---|
| Salesforce | リモートシステムには、Salesforce レコード ID またはレコードの他の一意の代理キーが保存されます。 |
| リモートシステム | リモートプロセスへのコールでアプリケーションから一意のキーが返され、Salesforce はそのキー値を一意のレコード項目に保存します。 |
- 複数のシステムへの通話の集計とその結果
- 受信メッセージと送信メッセージの両方の変換
- 複数のシステムへのコール間でトランザクションの整合性を維持する
- Salesforce と外部システム間のその他のプロセスオーケストレーション活動
| プロパティ | 必須 | 望ましい | 不要 |
|---|---|---|---|
| イベント処理 | X | ||
| プロトコル変換 | X | ||
| 翻訳と変換 | X | ||
| キューイングとバッファリング | X | ||
| 同期転送プロトコル | X | ||
| 非同期転送プロトコル | X | ||
| 仲介ルーティング | X | ||
| プロセス振付とサービスオーケストレーション | X | ||
| トランザクション性 (暗号化、署名、信頼性の高い配信、トランザクション管理) | X | ||
| ルーティング | X | ||
| 抽出、変換、読み込み | X | ||
| ロングポーリング | X |
| リレーション | 許可された子オブジェクト | 許可された親オブジェクト | レコードを照合する親項目 |
|---|---|---|---|
| 参照 | 標準、カスタム、外部 | 標準、カスタム | 18 文字の Salesforce レコード ID |
| 外部参照 | 標準、カスタム、外部 | 外部 | 外部 ID 標準項目 |
| 間接参照 | 外部 | 標準、カスタム | [外部 ID] 属性と [一意] 属性を持つカスタム項目を選択する |
- Odata エンドポイントを使用して外部データソースを設定します。リモート アプリケーションに Odata のネイティブ サポートが含まれている場合があります。その他のアプリケーションについては、Dell Boomi、Informatica、Jitterbit、MuleSoft、Progress Softwareなどの主要なインテグレーション ベンダーがSalesforce on Salesforce Connectと連携してアダプタを構築しています。
- Salesforce Connectで直接またはミドルウェア ソリューションを介してOdataエンドポイントを参照します。
- 外部データベーステーブルを Salesforce の外部オブジェクトと同期します。ユーザーがこれらの外部オブジェクトのデータを含むページにアクセスすると、Salesforce Connect はバックエンドアプリケーションにリアルタイムコールアウトを実行します。
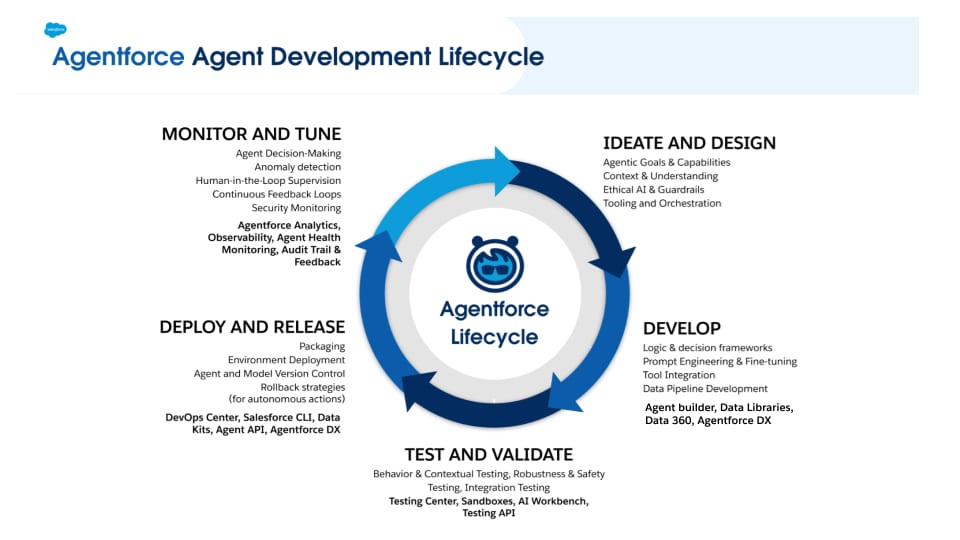 この章では、Agentforce が 1 つの統合プラットフォーム**内で** ADLC のすべてのフェーズをサポートする方法について説明します
#### フェーズ 1:アイデアとデザイン
##### アイデア
アイデア出しフェーズは、エージェントの初期ビジョンと要件が策定される ADLC の基礎フェーズです。これには、問題の理解、潜在的なソリューションの特定、エージェントのコア機能の概要説明について深く掘り下げます。
エージェントのアイデア出しプロセスを開始するには、その主要な属性を定義します。
1. **目的/目標**:エージェントの主な目的を明確に定義します。どのような問題を解決するために設計されているか、またはどのようなタスクを達成しようとしているか?エージェントは誰にサービスを提供すべきか?これは、開発プロセス全体の指針となる簡潔で測定可能なステートメントである必要があります。
2. **人格**:エージェントの詳細な人格を作成します。これには、ID、コミュニケーションスタイル、ユーザーや他のシステムとのやり取りで果たす役割の定義が含まれます。口調、格式、および意図したコンテキストで効果を発揮する特定の特性を考慮します。
3. **パターン**:関連するエージェントパターンと実装戦略を特定してリンクします。これには、エージェントの構造と動作を知らせることができるアーキテクチャ設計またはベストプラクティスが含まれます。"Salesforce Agentforce での[エージェントのパターンと実装:"テクニカルホワイトペーパー](/docs/architect/ja-jp/fundamentals/guide/agentic-patterns)』は、このステップの貴重なリソースとして役立ち、Salesforce Platform と Agentforce での効果的なエージェント設計に関するインサイトを提供します。
##### 設計
設計フェーズでは、アイデアから概念をエージェントの構築の詳細なブループリントに変換します。これには、エージェントのアーキテクチャ、ユーザーフロー、インタラクションモデル、技術仕様 (トピック、ツール、ガードレールなど) の定義が含まれます。
設計フェーズでは、エージェントの工事の詳細なブループリントを作成します。このブループリントには次のものが含まれます。
- **エージェント設計**:コンポーネント、モジュール、およびそれらがどのようにやりとりするかなど、エージェントの内部構造の概要を説明します。これには、Knowledge ベース、エージェントの動作を制御するための設定とロジック、自然言語処理 (NLP) コンポーネント、他のシステムとのインテグレーションポイントの定義が含まれる場合があります。
- **ユーザーフロー/インタラクション設計**:完全なユーザージャーニーとエージェントのインタラクションを対応付けます。会話フロー、ディシジョンツリー、エラー処理、フィードバックメカニズムを定義して、直感的で効果的な環境を作成します。
- **技術仕様**:パフォーマンス評価指標、拡張性に関する考慮事項、セキュリティプロトコル、インテグレーション仕様など、エージェントの機能以外の技術的な要件を文書化します。
- **プロトタイピング & モックアップ**:エージェントのインターフェースとインタラクションの視覚表現または対話型のプロトタイプを作成します。これにより、早期のテストとフィードバックが可能になり、本格的な開発を開始する前に設計を調整できます。
- **データ**:エージェントが必要とするデータの種別とソースを決定するときに、エージェントがアクセスする必要があるデータセット、API、データベース、リポジトリを特定します。Agentforce では、コンテキストとして提供されるデータ、構造化されたデータと構造化されていないデータ、リアルタイムデータとバッチデータのどちらであるかに焦点を絞ります。Agentforce プラットフォームは、Data 360 との緊密な統合に基づいて構築されており、Salesforce CRM やその他のソースからの構造化データと非構造化データの両方を使用できます。非構造化コンテンツはネイティブにチャンク化してインデックス付けし、RAG で使用できます。MuleSoft では、外部システムに接続できます。
- **ツール**:エージェントが実行する必要があるアクションを特定します。Agentforce アクションを使用して、ビジネス目標を達成するツールを公開します。これらのアクションは、プロンプトビルダーを介したプロンプト、MuleSoft、Apex、フロー、OpenAPI 仕様の API などの既存の Salesforce アセットを活用します。呼び出し可能なアクションはすべて Agentforce に統合してエージェントが使用でき、使い慣れたすべての Salesforce 開発ツールを Agentforce アクションとしてすぐに使用できます。
- **エージェントの入力データ**:従来の SDLC では、入力は正確に指定されます。ADLC では、入力は多くの場合、自然で非確定的な自由形式の発言です。適切な回答が得られると期待される発言の代表的なコーパスを収集する。
#### フェーズ 2:開発
開発フェーズでは、アイデアと設計フェーズで決定された定義済みのエージェントの目的、機能、および業務範囲を新しい Agentforce Agent に変換することに重点を置いています。
開発者がエージェントを作成できるように、Agentforce には **Agent Builder** と **Agentforce Developer Experience(AFDX)の両方が用意されています。**これらの基盤ツールは、エージェントを構築および設定するための主要な環境として機能します。
- **エージェントビルダー**では、エージェントのコア機能を定義するための UI 環境が提供されます。
- **AFDX は**、カスタマイズや他のシステムと統合するためのプログラム・インタフェースを提供します。
エージェントの開発と構築には、エージェントビルダーまたは AFDX を使用して実行できる次の手順が含まれます。
1. **人格の定義**:エージェント設計の重要な側面は、個別の人格を確立することです。これには、次の設定が含まれます。
- **エージェントの説明**:エージェントの役割、目的、および処理するように設計された特定のカスタマーサービス ToDo の詳細な説明。
- **トーン**:エージェントのコミュニケーションスタイル、共感のレベル、遵守する必要がある特定のブランドガイドライン。
2. **エージェントのトピックとアクションの定義**:エージェントを高度化し、多様なタスクを処理できるようにするには、その機能を個別のトピックとそれに対応するアクションに分割することが不可欠です。
- **トピック**:各トピックは、独自の指示とツールのセットを持つ独自の専門エージェントとして概念化できます。
- **モジュラー型アーキテクチャ。**トピックへのモジュラーアプローチにより、組織と拡張性が向上します。複数のトピックを定義することで、エージェントはより広範な複雑なシナリオを処理できます。たとえば、エージェントには「注文管理」、「よくある質問 (FAQ)」、「テクニカルサポート」、「請求に関する問い合わせ」という個別のトピックがあります。
- **トピックの手順 (ガードレール)**:各トピックには、ガードレールとして機能する特定の手順が付属し、エージェントがそのトピック内で議論したり実行したりできる範囲を定義します。これらの手順により、エージェントがトピックから外れたり、無関係な情報を提供したりすることがなくなります。また、回答の一貫性と正確性も維持できます。
- **アクション**:トピックには、エージェントが実行できるアクションを表す「ツール」も用意されています。次のツールを使用できます。
- **情報アクション**:Knowledge Base または外部システムからデータを取得してクエリに回答する。
- **トランザクションアクション**:ユーザーに代わってアクションを実行する (注文の実行、顧客レコードの更新、返金プロセスの開始など)。これらのアクションは、多くの場合、他のシステム (CRM、ERP など) と統合されます。
#### フェーズ 3:テストと検証
AI エージェントのパフォーマンスと信頼性を評価する場合、テスト担当者は多くの場合、ユーザーエクスペリエンスを低下させる可能性のあるさまざまな課題に直面します。これらの問題は、ユーザーインテントの誤った解釈から ToDo の適切な実行の失敗まで多岐にわたります。
##### 一般的なエージェントの失敗のシナリオ
堅牢なエージェントを構築するには、その失敗方法と原因を理解する必要があります。次の表は、欠陥のある推論から不十分な Knowledge 取得に至るまで、エージェントのライフサイクル中に発生する一般的な問題を分類したものです。これは、エージェントが機能するだけでなく、エンドユーザーにとって信頼性が高く直感的であることを確認するために、開発時の戦略ガイドやテスト時のチェックリストとして使用します。次の失敗シナリオは、テストケースを定義するのに役立ちます。
| カテゴリ | 説明 | 失敗の例 |
|---|---|---|
| トピック分類 | エージェントがユーザーのインテントまたは目標を正しく識別できなかった。 |
|
| 応答品質 | エージェントの返信の内容、正確性、および形式の失敗。 |
|
| アクションの実行 | エージェントが特定の機能またはタスクを実行しようとすると失敗します。 |
|
| ガードレールと手順 | エージェントが定義済みのルール、制約、または会話の境界に違反した。 |
|
| Knowledgeの取得 | エージェントがKnowledgeベースからの情報の調達と表示で問題が発生している。 |
|
| 構造化されたガイダンス | エージェントが複数ステップのプロセスでユーザーをガイドするのに苦労している。 |
|
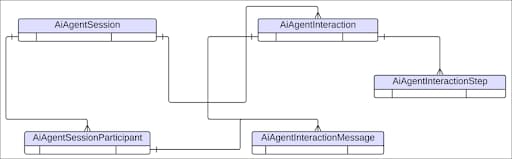
| データレークオブジェクト/データモデルオブジェクト | 説明 |
|---|---|
| AIAgentSession | 1 人以上の AI エージェントとの連続するインタラクションを取得する包括的なコンテナ。 |
| AIAgentSessionParticipant | AIAgentSession に参加するエンティティ (人間または AI)。 |
| AIAgentInteraction | セッション内のセグメント。通常、ユーザーの要求で始まり、AI エージェントがその要求に応答したときに終了します。 |
| AIAgentInteractionStep | ユーザーの要求を履行するためにインタラクション中に実行される個別のアクションまたは操作。 |
| AIAgentInteractionMessage | セッション中にユーザーが提供した、または AI エージェントが生成した 1 つのコミュニケーション。 |
 ##### 発言分析
発言分析では、Agentforce(デフォルト)ユーザーがエージェントをどのように使用しているか、何を要求しているか、およびエージェントがこれらの要求を処理できたかどうかが示されます。これらのカスタマイズ可能なレポートは、エージェントがより効果的かつ正確に応答できるようにトピックとアクションを調整するのに役立ちます。
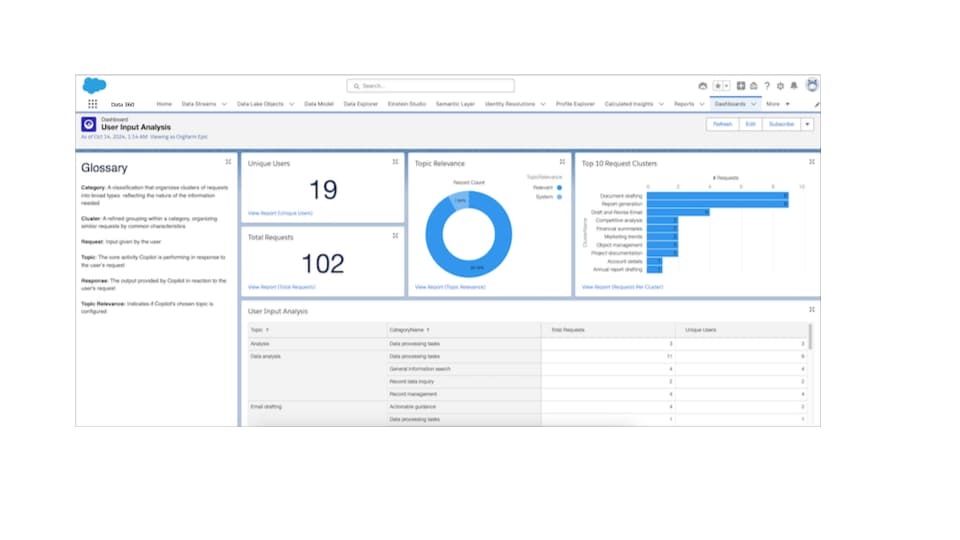 ##### Agentforce Python SDK:Data 360 インテグレーションを使用した監視
Agent SDK 実装では、Data 360 Python コネクタを使用した高度な監視と分析を使用して、Salesforce Data 360 への接続を確立し、エージェントのパフォーマンス評価指標を照会して、包括的な監視ダッシュボードを作成します。
応答時間、成功率、ユーザー満足度、コスト総計値を追跡し、エージェントを最適化するためのアクション可能なインサイトを提供します。
```py
# Data 360 Python Connector Integration
from salesforce_cdp_connector import SalesforceCDPConnector
# Initialize Data 360 Connector
cdp_connector = SalesforceCDPConnector(
client_id='your_client_id',
client_secret='your_client_secret',
username='your_username@example.com',
password='your_password'
)
# Query agent performance data
performance_data = cdp_connector.query("""
SELECT timestamp, response_time_ms, success_rate, user_satisfaction
FROM AgentPerformanceMetrics
WHERE agent_id = 'Coral_Cloud_Resorts_Resort_Manager'
""")
# Create monitoring dashboard
def create_monitoring_dashboard(performance_data):
fig = go.Figure()
fig.add_trace(go.Scatter(
x=performance_data['timestamp'],
y=performance_data['response_time_ms'],
mode='lines+markers'
))
return fig
```
##### Agentforce DX:エージェントの監視
この実装では、CLI ベースのエージェント管理で標準の AFDX コマンドを使用し、プラットフォームの変更に関する最新情報をエージェントに提供し、継続的な改善のためにユーザーのフィードバックを取り入れます。
```zsh
# List all agents and their status
sf agent list --target-org "production-org"
# Get detailed agent information
sf agent get \
--api-name "Resort_Manager" --target-org "production-org"
# Activate agent if needed
sf agent activate --api-name "Resort_Manager" --target-org "production-org"
# Query agent performance data
sf data query \
--query "SELECT Id, Name, Status, LastModifiedDate FROM BotDefinition WHERE DeveloperName = 'Resort_Manager'" \
--target-org "production-org"
```
```python
# AgentforceDX Dashboard Creation (Similar to Agent SDK)
import pandas as pd
import plotly.graph_objects as go
from salesforce_cdp_connector import SalesforceCDPConnector
# Initialize Data 360 Connector for AgentforceDX
cdp_connector = SalesforceCDPConnector(
client_id='your_client_id',
client_secret='your_client_secret',
username='your_username@example.com',
password='your_password'
)
# Query agent performance data from Data 360
performance_data = cdp_connector.query("""
SELECT timestamp, agent_id, response_time_ms, success_rate, user_satisfaction
FROM AgentPerformanceMetrics
WHERE agent_id = 'Resort_Manager'
AND timestamp >= CURRENT_DATE - 30
ORDER BY timestamp DESC
""")
```
Agent SDK と AFDX を使用した ADLC の実装については、[ここ](https://github.com/akshatasawant9699/ADLC_Whitepaper)の GitHub リポジトリを参照してください。
## ベストプラクティス
エージェント開発ライフサイクルをマスターするには、効率性、信頼性、戦略的な連携を保証する一連の基本原則に準拠する必要があります。次のガイドラインは、ADLC の各フェーズから得られた主要な教訓をアーキテクトと開発者向けの戦略的フレームワークに統合したものです。
**1\.計画とアイデア**
この初期フェーズでは、エージェントの目的をビジネス目標に合わせ、強固な基盤の上に構築することに重点を置いています。
- **ビジネスへの影響に対する優先度付け**:まず、潜在的な使用事例を戦略的なビジネス目標に直接対応付けます。優先度マトリックスを使用して潜在的な影響を評価し、明確な KPI を含む 1 つの焦点を絞った使用事例から開始します。
- **早い段階で関係者を関与させる**:問題点に関するインサイトを収集し、整合性を確保します。
- **データインサイトの活用**:エージェントは、そのデータによってのみ機能します。Data 360 を使用して、使用可能な構造化データと非構造化データを探索し、エージェントのコンテキストと機能を確認します。既存のレポートとダッシュボードを確認して、使用事例の選択に役立つ可能性がある現在のトレンドを特定します。
- **アイデア出し用のフレームワークの使用**:構造化されたアイデア出し方法を適用して、デザイン思考や SWOT 分析などの潜在的なアプリケーションをブレインストーミングし、調整します。
**2\.エージェントの作成**
このフェーズでは、パフォーマンスが高く効率的なエージェントを構築するためのベストプラクティスについて説明します。
- **トピックが多すぎます**:トピック数を制限して、エージェントを困惑させる可能性のある類似トピックや重複トピックを作成するリスクを軽減します。
- **手順とプロンプトの簡潔な維持**:直接的でシンプルな言葉を使用し、サンプル発言を提供してエージェントを効果的に誘導します。
- **変数と確定的アクションの活用**:これらのツールを使用して、エージェントの行動をガイドし、より予測可能な結果になるようにパフォーマンスを最適化します。
- **アクションの出力を小さく簡潔に**:エージェントの回答が簡潔で的確であることを確認します。出力が長いほど、使用するコンテキストが多くなり、生成が遅くなります。
- **アクションを高速:化**必要最小限のデータを返すようにフローと Apex クラスを設計します。可能な場合は前処理することで、応答を生成するために必要なアクションを減らすことを目指します。
- **Clear Scope の定義**:範囲外の質問に対してエージェントが RAG (Retrieval-Augmented Generation) をコールしないように、アクションの適切な説明、手順、範囲を記述します。
- **ハイブリッド検索の慎重な使用**:ハイブリッド検索は、遅延に悪影響を及ぼす可能性があるため、どうしても必要な場合のみ使用してください。
**3\.テスト、監視、チューニング**
この反復フェーズは、エージェントの精度とパフォーマンスを向上させるために重要です。
- **テストフローの確立**:一貫したテストサイクルに従います。
1. **バッチテストの実行**:包括的なテストセットを実行します。
2. **スコア/エラーの表示**:パフォーマンス総計値を分析し、障害を特定します。
3. **失敗:を検査**各失敗行を調べて、不一致を理解します。
4. **エージェントの更新**:エージェントまたはその評価データに必要な調整を加えます。
- **セッション追跡情報の確認**:セッション追跡データ モデルと Agentforce Interaction Explorer を使用して、問題または予期しない動作が特定されたときに根本原因分析を実行します。情報に基づいてエージェントを調整し、エージェントの反復を続行します。
## 結論
*エージェント開発ライフサイクル*は、インテリジェントな自律システムの時代に合わせて設計された従来のソフトウェア開発原則の重要な進化を表します。
- **置き換えではなく進化**:エージェント開発ライフサイクルでは、従来のアプリケーションライフサイクル管理を置き換えることなく拡張および強化できます。
- **第一級市民としてのデータ**:データは、エージェント開発においてはるかに動的で中心的な役割を果たします。
- **特殊なツールとスキル**:新しいツールと、データサイエンス、ML エンジニアリング、エージェント開発にわたるより広範な専門スキルセットが必要です。
- **継続的な学習**:エージェント開発では、システム自体の継続的*な学習*と*適応*が追加されます。
- **将来の影響**:Agentic AI は、複雑な IT 運用とソフトウェア開発ワークフローの自動化と最適化をさらに推進します。
## このホワイトペーパーについて
**エンタープライズ エージェントのアーキテクチャ**と設計パターンは、マルチエージェント アーキテクチャの可能性を構造化し、AI エージェントにとって新しい機能を組み合わせて、信頼性、反復性、拡張性、管理性に優れたエージェント ソリューションを提供する方法を特定して強調表示します。オブジェクト指向プログラミングの「デザインパターン」からヒントを得て、エージェント技術以前の従来の確定的技術で構築されたビジネスシステムの範囲外にある多くのエキサイティングな課題を解決するために組み合わせたり拡張したりできるパターンがレイアウトされています。
マルチエージェントアーキテクチャの根拠を説明した後、自然言語処理を活用してユーザーのインテントを判断する単純なパターンから、エージェント間の懸念事項を分離するマルチエージェントパターン、システム、情報、コンテンツの表示と操作にエージェントの推論をもたらす UX エージェントパターンまで、多数のエージェントパターンを紹介します。
## このドキュメントから得られるもの
何よりもまず、エージェントに関する新しい考え方を得ることができます。コンポーネントとしてのエージェント、コンポーザーとしてのエージェント、アクターとしてのエージェント、コラボレーターとしてのエージェント、そして最も重要なのは、より大きなアーキテクチャ内で意図を持って行動し、個々の関心事の範囲内で行動するエージェントです。
ユーザージャーニーにまたがるリッチなエージェントソリューションの概念を把握し、重要なエージェントエクスペリエンス (これまで不可能だったエクスペリエンス) を提供するために必要な指針を得ることができます。
このドキュメントの最初のセクションでは、マルチエージェントアーキテクチャの根拠について説明します。マルチエージェントアーキテクチャが抱える課題と機会について理解を深めるには、次の文書を参照してください。
簡単なパターンから複雑なパターンまで、エージェントパターンの定義と説明を次に示します。ここでは、インタラクションをサポートするパターン、スペシャリストエージェントのパターン、バックグラウンド操作のパターン、実行時間の長いパターンについて説明します。各パターンには、パターンを実現する主要なコンポーネントの図と、使用方法および代表的な使用事例の推奨事項が含まれています。
最後に、この付録には、カスタマーサービスや仲介販売をサポートするなど、大規模なエージェント環境をサポートする総合的なエージェントソリューションにこれらのパターンをどのように組み合わせるかの例が記載されています。このセクションを参照して、充実したエージェント環境がエージェントおよびアクションレベルで懸念事項の分解と分離をどのように活用し、支援モードと自律モードの両方で内部および外部の両方の対象者をサポートする共有エージェントを使用してインタラクションレベルで再利用を促進するかを確認してください。
## 1\.マルチエージェントシステムアーキテクチャ
エンタープライズアーキテクトは生成 AI をエコシステムに統合するときに、設計に関する一般的な質問に取り組む必要があります。
- 必要なエージェント数は?
- エージェントはどのように相互運用しますか?
- エージェントと人間の分業は?
- これらのコンポーネントはどのようにして一貫性のあるシステムに組み上げられているのでしょうか?
このドキュメントでは、エージェントソリューションを設計および構築するためのパターンベースの方法論について説明します。
*モノリス型*エージェントは、ほとんどのエージェントソリューションの出発点です。エージェント (具体的には Agentforce エージェント) は、さまざまなトピックの実行に適しています。一般的な使用事例では、1 人のエージェントから開始します。
組織が大きくなるにつれて、マルチエージェントアーキテクチャが推奨されるアプローチになります。*マルチエージェントアーキテクチャ*により、モノリス型のシングルエージェントシステムよりも拡張性、制御性、柔軟性が向上します。
マルチエージェントアーキテクチャには、次の主要な利点があります。
- **パフォーマンスの向上と複雑さの内訳**:複数の専門エージェントで構成されるシステムにより、機能が向上し、指示の遵守が簡素化されます。
- **モジュール性と拡張性**:個々のエージェントをより簡単に追加、交換、変更、テストできるため、俊敏性が向上します。
- **耐障害性とフォールトトレランス**:1 つのコンポーネントに障害が発生しても、システム全体が損なわれることはなく、全体的な復元力が向上します。
- **分散ガバナンス**:トラブルシューティングと管理を特定のエージェントと対応するアプリケーションに分離できるため、メンテナンスと監視が簡素化されます。
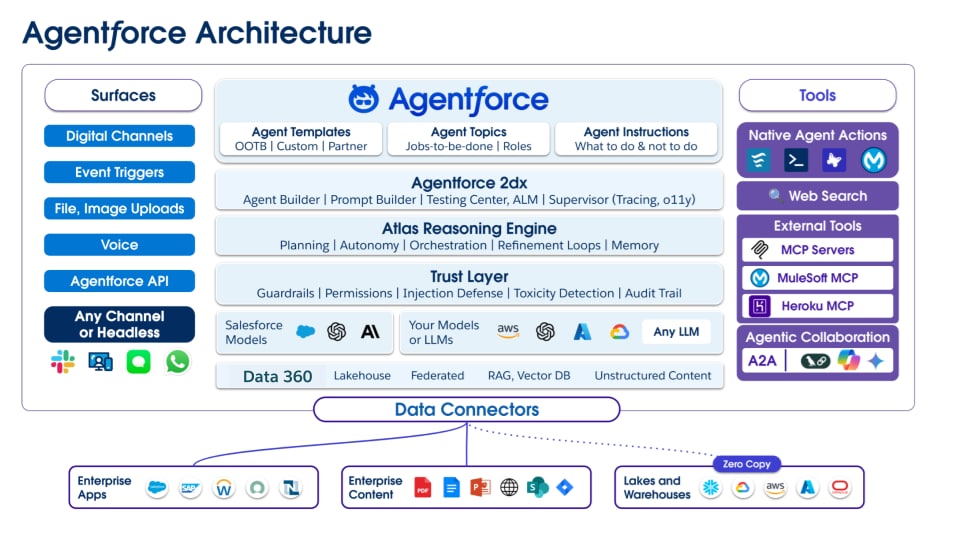 ## 2\.アーキテクチャのコア原則
マルチエージェントアーキテクチャを合理化するには、まずエージェントの機能と構造にアーキテクチャのコア原則を投影します。結果として得られるマルチエージェントアーキテクチャは、AI テクノロジー固有の「粒度」に沿ったコアシステム設計とシステムアーキテクチャの原則の現れです。
このアーキテクチャを推進する主要な原則を次に示します。
- 分解による複雑さの管理
- 分離による復元性の向上と脆性の低減
- コードの再利用による信頼性と効率の向上
- 1 人のエージェントの懸念の範囲を制限することでエージェントの信頼性を向上
- モジュール性と拡張性によるシステムのメンテナンスと進化の向上
- 特化によるエージェント管理と説明責任の簡素化
よりプリミティブなエージェント アーキテクチャ(たとえば、コア アーキテクチャ構造として LLM に焦点を絞ったアーキテクチャ)とは異なり、*Agentforce は最初*からマルチエージェント オーケストレーション用に設計されています。マルチエージェントオーケストレーションは、Atlas Reasoning エンジンとエージェントによる推論の基盤となるもので、エージェント応答内に動的で効果的なプログラミングパスを作成し、ユーザーエクスペリエンス (UX) に広範で深いエージェント増強を提供する機能を劇的に拡張します。
Agentforce 内では、次の主要なオープンで相互運用可能なプロトコルと Salesforce 製品によって、このような連携が可能になります。
- **Agentforce** は、エージェントのすべての重要な要素 (トピック、命令、アクション、ガードレール、コンテキスト、呼び出し、出力、実行の詳細、ログなど) をカプセル化するエージェントサブシステムを提供します。
- **アクション**: データへのアクセス、フローのコール、外部システムの呼び出し、および他のエージェントのコールを行うためのフックを提供します。
- **Data 360**: エージェントに特定の個人化されたコンテキストを提供するデータ仮想化レイヤーを提供します(Data 360 の統合プロファイルとキーチェーンを活用して、企業全体から特定の情報を取得)。
また、企業全体のエージェントやエージェントまたはリソースにアクセスするために、次の機能がサポートされます。
- **MCP(モデル コンテキスト プロトコル)**:エージェントをエンタープライズ ツール、データ、Knowledge に接続してコンテキストの正確性を確保する安全な通信レイヤーです。
- **エージェント間 (A2A)** プロトコル: システム、組織、ベンダー間の安全で管理された調整を可能にするエージェント間委任の標準ハンドシェイク。
これらの原則は、オーケストレーションされたインテリジェンスのスケーラブルでガバナンス可能なシステムを構築するための基盤となります。
### その他の考慮事項
堅牢なエージェントソリューションには、効果的なテクノロジーの提供を支える非機能要件に対する明確なアプローチが必要です。
- セキュリティとガバナンス (ID およびアクセス管理、データプライバシー、データセキュリティ、脅威モデリング)。
- オブザーバビリティと監視 (分散トレーシング、集中管理ログ、評価指標、ダッシュボード)。
- 運用化とライフサイクル管理 (仕様、テストケースの生成、テスト、フィードバック、継続的な学習、廃止)。
エンタープライズエージェントソリューションを構築するための主要なアーキテクチャ上の考慮事項は、このホワイトペーパーでは説明していませんが、今後の公開資料で取り上げます。
## 3\.エンタープライズエージェント分類
企業全体のエージェントの状況を管理するには、アーキテクトは、技術的な機能とビジネスへの影響という 2 つの補完的な観点からエージェントを分類する必要があります。
### 3.1 機能ロールの分類
この分類では、エージェントがアーキテクチャ内で引き受ける可能性のある機能ロールが分類されます。
- **チャネル/UX ロール**:インタラクションのモダリティ (ヘッドレス、プロンプト、チャットとメッセージ、AI で管理されるワークスペースなど) を定義します。
- **スペシャリストロール**:ディープドメインの Knowledge (ドメインエキスパート、Knowledge ミニオン、アシスタント、プランナーなど) をカプセル化します。
- **ユーティリティサービスロール**:個別のトランザクションタスク (生成、集計、変換、設定など) を実行します。
- **メンテナンスとプロアクティブなサービスの役割**:データの健全性と品質 (キュレーション、コンフォメーション、データ品質、データ強化など) に重点を置きます。
- **Long-Running Roles**:長期間のプロセス (コンシェルジュ、プロジェクトマネージャー、ナーチャラー、ウォッチャー/アラートなど) を管理します。
## 4\.エージェントマップテンプレート
明確な設計とコミュニケーションを容易にするために、**エージェントマップ**はエージェントソリューションを説明する標準テンプレートです。特定のデザインパターン内の主要なエンティティ、システム、インタラクションを定義します。
エージェントマップテンプレートコンポーネントを次に示します。
- **ユーザーレイヤーで**は、システム内のユーザーアクターを定義します (顧客、認証済み従業員 (SF ユーザー)、認証されていない従業員など)。
- **エージェントレイヤーは**、必要なエージェント、表示されるパターン、相互の関係、および特定のパターンを実現するために使用される指示を記述します。
- **コンテキスト/アクション**は、エージェントが管理またはアクセスするリソース、機能、またはアクションです。
- **ソース**は、基盤となるデータ、アプリケーション、知識ベース、およびエージェントが接続するその他のシステムです。
付録 A と付録 B は、Agentic Map Template (エージェント対応地図テンプレート) スイムレーン内の構成を示すことで、システムレベルのエージェントパターンを示しています。
## 5\.エージェントパターンフレームワーク
Salesforce では、エージェントパターンのライブラリを使用して、信頼性の高い予測可能なエージェントソリューションを整理して提供します。これらのパターンは、一般的なアーキテクチャの問題を解決するためのブループリントです。
これらは 4 つの主要なカテゴリに分類されます。
- **インタラクションパターン**:エージェントのエンゲージメントとユーザーエクスペリエンス (UX) に重点を置きます。
- **スペシャリスト/作業者パターン**:特定のドメイン内の深い Knowledge または特定のスキルをカプセル化します。
- **ユーティリティおよびデータ管理パターン**:他のエージェントやプロセスをサポートする特定の反復可能なタスクを実行します。
- **実行時間の長いパターン**:複数のステップを含む、長期間にわたって発生するプロセスとワークフローを管理します。
次のセクションでは、各カテゴリの主要なパターンについて詳しく説明します。各パターンの説明には、**概要**、**出力種別**、**パターン使用ガイダンス**、**代表的な使用**事例、**ソリューション図**のほか、**Salesforce エージェント**の成熟度ルーブリックへの対応付けが記載されています。
## 6\.インタラクションパターン
*インタラクションパターン*は、エージェントエンゲージメントとユーザーエクスペリエンスに重点を置いた基本的な設計です。
### グリーターパターン
- **概要**:*Greeter パターン*は、自然言語を使用してユーザーのインテントを判断するシンプルで実装が容易なパターンです。次に、ユーザーを適切な人間のエージェントに転送します。
- **出力タイプ**:次のリソースへの引き継ぎ/エスカレーション。
- **ビジネス価値**:サービスプロバイダーのインテントの解決とコンテキスト収集を最大化しながら、顧客へのシームレスで効率的な初回連絡を促進します。
- **パターン使用ガイダンス**:エージェントをブランドチャネルの主エンゲージメントリソースとして設定します。ユーザーのインテントに基づいて、ルーティング手順と組み合わされたブランド、商品、サービスに関する手順を提供します。エージェントは、ウォームハンドオフを提供するためにインテントを収集して集計します。
- **代表的な使用事例**:チャットボットを使用してオプションメニューを表示する Web ページで、ユーザーがすべてのオプションをクリックしてから人間に転送することを想像してください。バックオフィスの生産性と効率を向上させるために、チャットボットでは複雑で複雑な作業パスとやりとりがよく使用されます。これにより、顧客が「入力、選択、クリック」の疲労シナリオに陥り、コンテキストが使用可能なメニューオプションの範囲外である場合にストレスを感じることがよくあります。従来のチャットボットを自然言語インタラクションを使用する*エージェント型フロントドア*に置き換えることで、負担を軽減し、人間のようなインタラクションを実現します。
- **Agentforce レシピ**:
- Agentforce サービスエージェント:[サービスエージェントの構築](https://trailhead.salesforce.com/content/learn/projects/quick-start-build-your-first-agent-with-agentforce)
- パッケージサービスエージェントには、転送をサポートする設定可能な転送機能があります。
- 人間のエージェントへ
- AI エージェントへ
- 外部エージェントへ
- コード例が含まれる業界固有のパターン
- **図**:
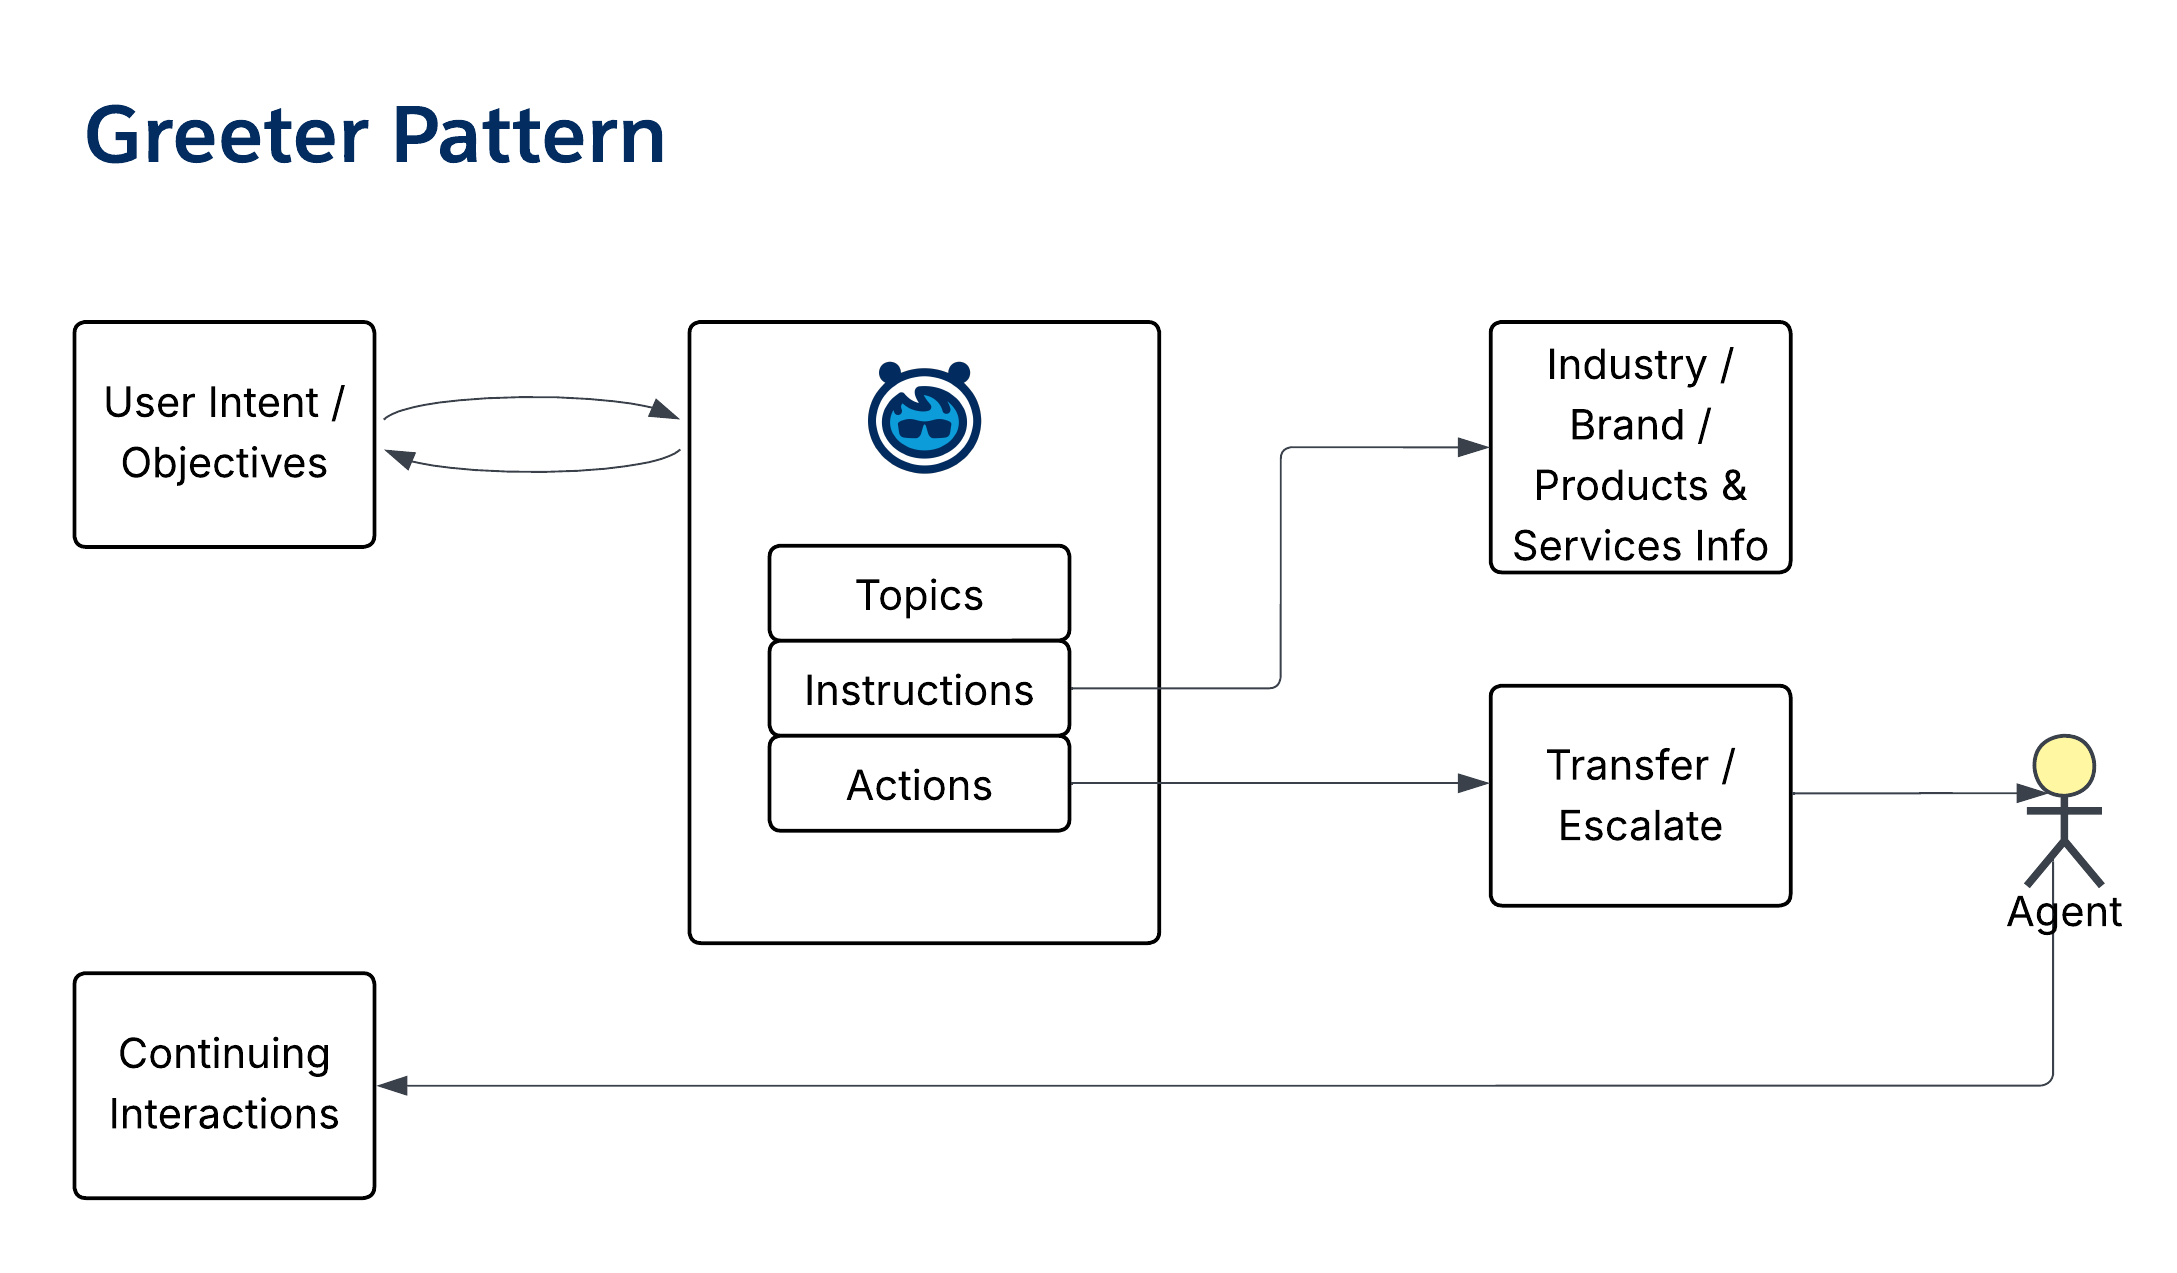 - **Salesforce Agentic Maturity**:レベル 1(転送とエスカレーションが組み込まれた標準サービスエージェントを使用している場合はレベル 0)
### 演算子パターン
- **概要**:*オペレータパターン*は、適切なスペシャリストエージェントまたは人間に要求を転送し、必要に応じてインテントをネゴシエートすることで、*グリーターパターン*に基づいて構築されます。
- **出力タイプ**:次のリソースへの引き継ぎ/転送。
- **パターン使用ガイダンス**:ブランドおよびサービス固有の手順と、インテントに基づいてユーザーをどこに派遣するかを示す手順を組み合わせます。エスカレーションリソース (人間または他のエージェント) を定義します。
- **代表的な使用事例**:*エージェント フロント ドア*は、人間または AI 担当者の専門分野が非常に高いシナリオに使用します。
- **図**:
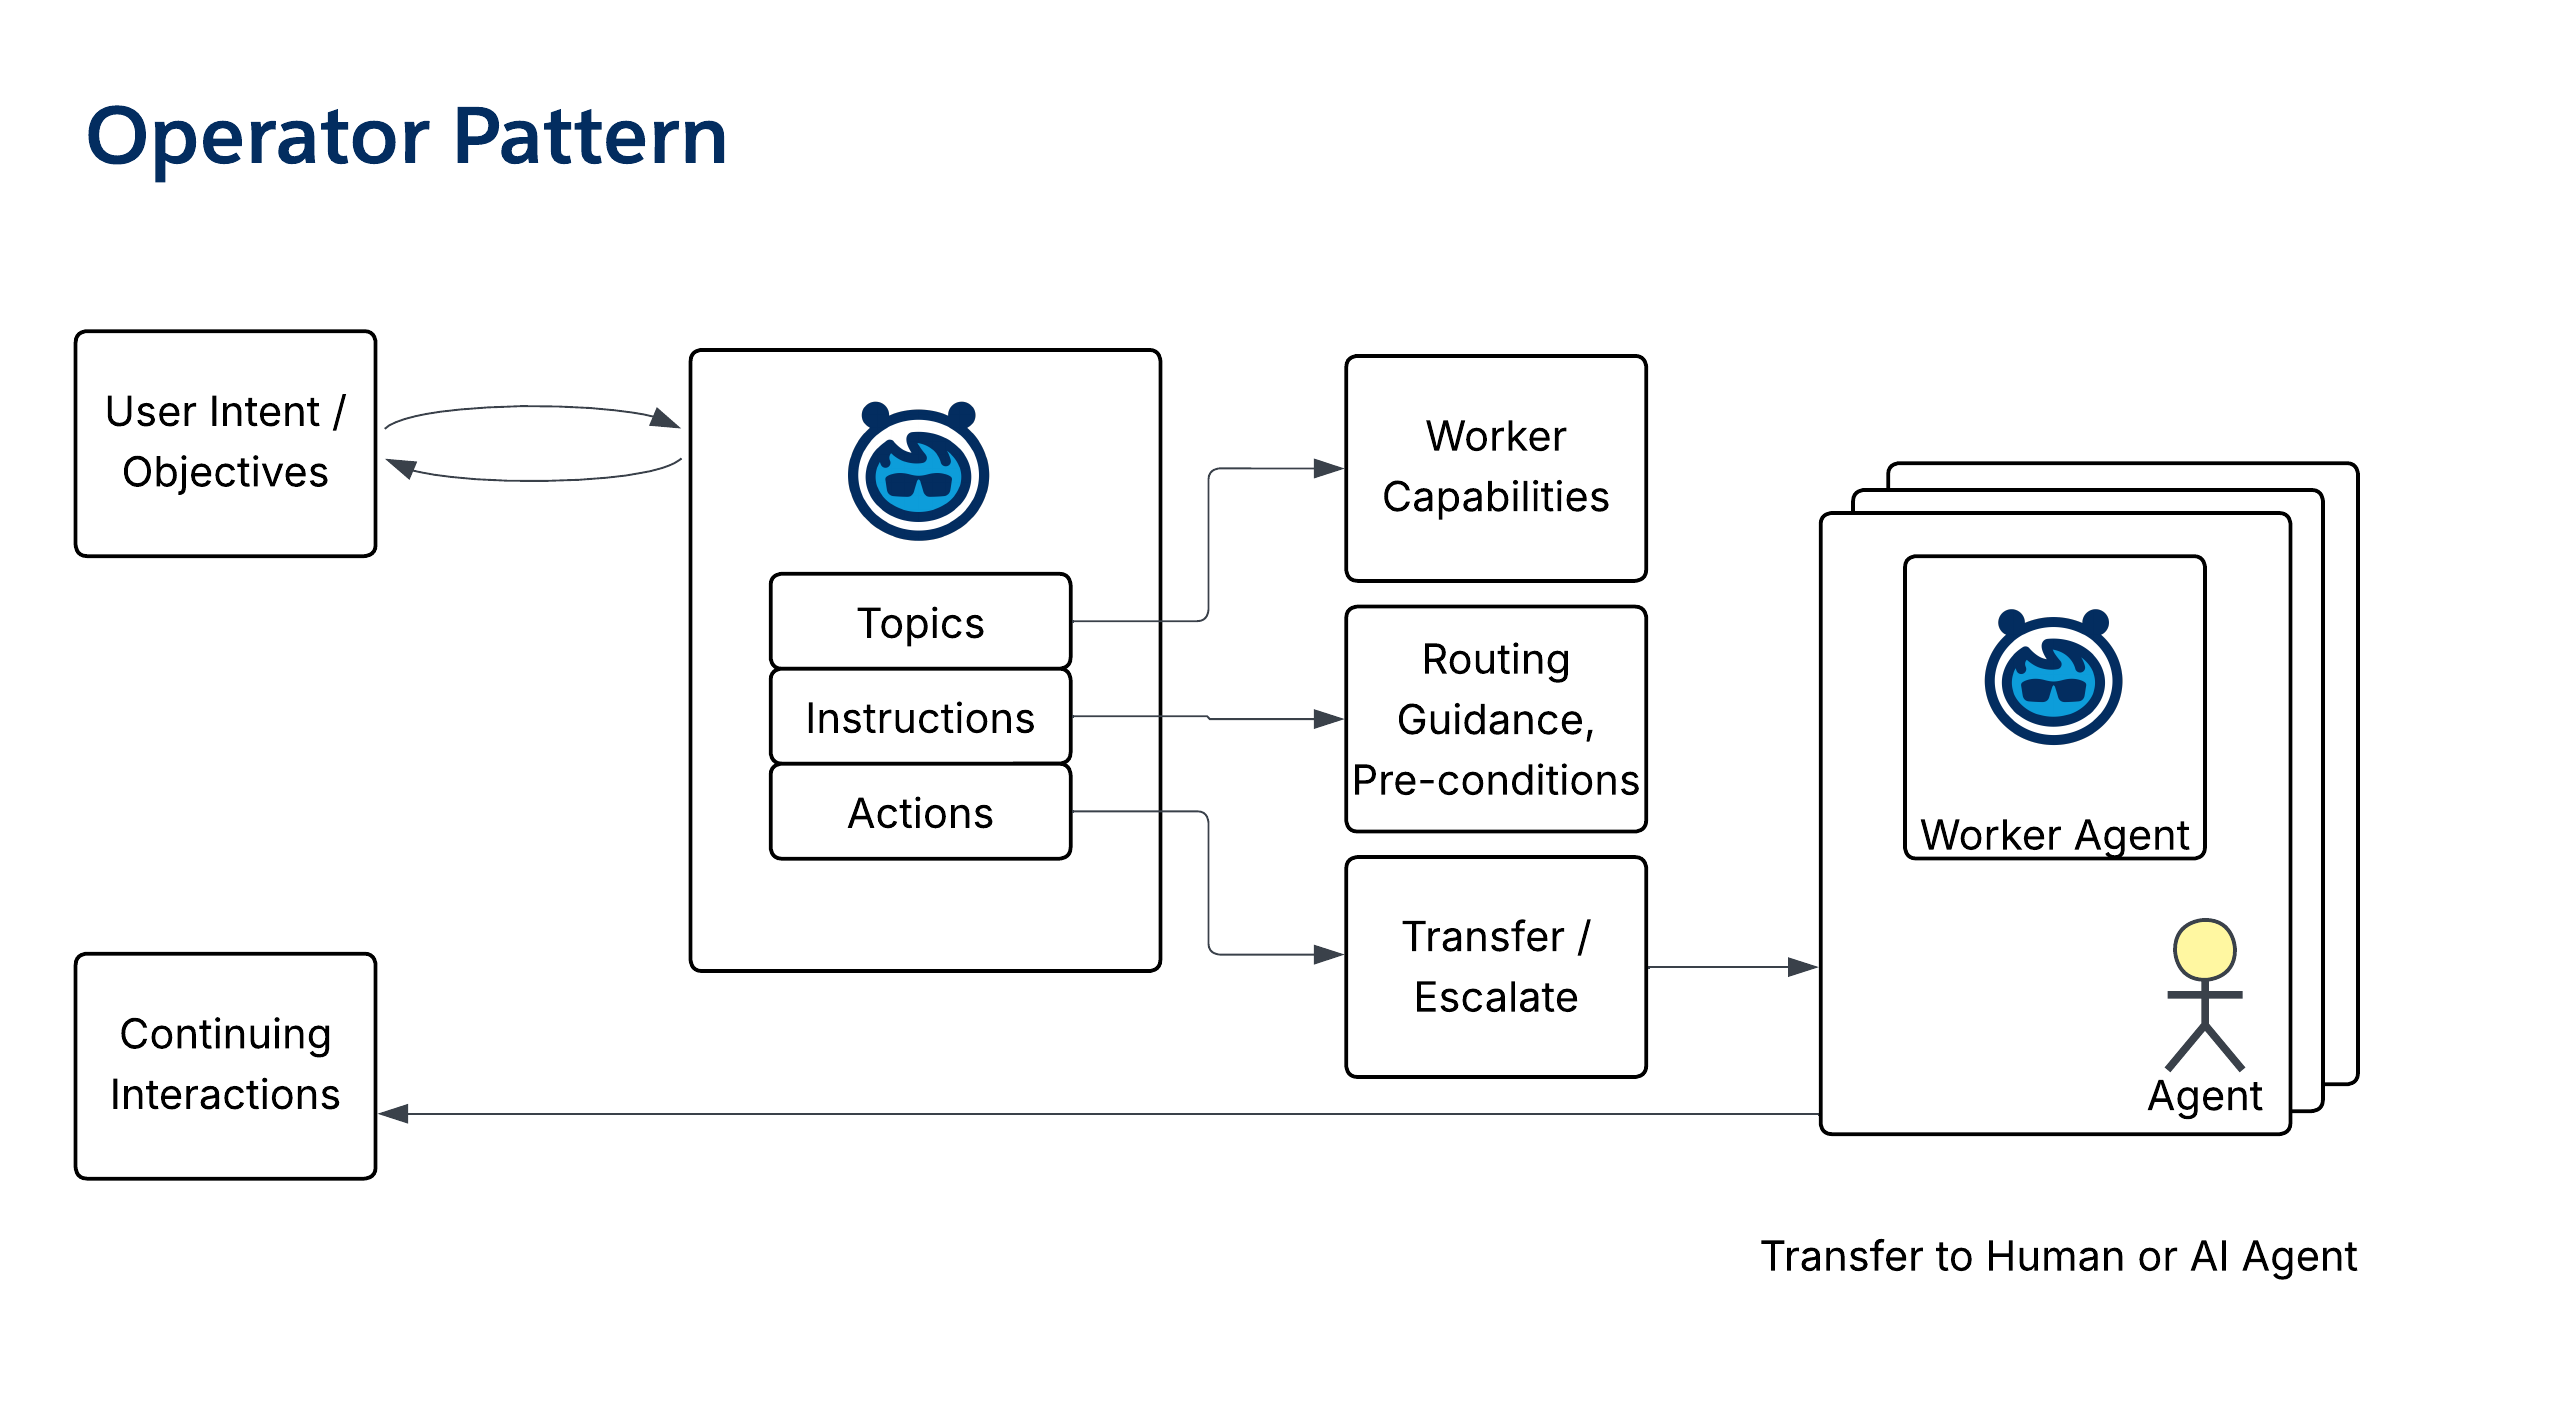 - **Salesforce Agentic Maturity**:Level 2 (レベル 2)
### Orchestrator パターン
- **概要**:*オーケストレーターパターン*では、AI エージェント「スウォーム」を管理します。ユーザー要求を受信すると、1 人以上のスペシャリストエージェントに発言を渡し、ユーザーの回答を集計します。*Operator パターン*とは異なり、最初の連絡先 (POC) のままです。
- **出力タイプ**:ワーカーエージェントからの応答を照合して準備します。
- **パターン使用ガイダンス**:プライマリエンゲージとして設定されます。オーケストレーターが発言をエージェントにリレーできるサポートワーカーエージェント (優先度設定担当者やドメイン SME など) ごとに手順を説明します。
- **代表的な使用事例**:*オーケストレーターパターン*をエージェントのフロントドアとして使用し、マルチエージェントソリューションと一貫したインタラクションを必要とする会話ごとに複数のトピックについて話し合う必要がある顧客をサポートします。マルチシステムアーキテクチャでは、複数のシステム間および外部エージェントのコラボレーションで応答を調整する*オーケストレーターパターン*を検討します。
- **図**:
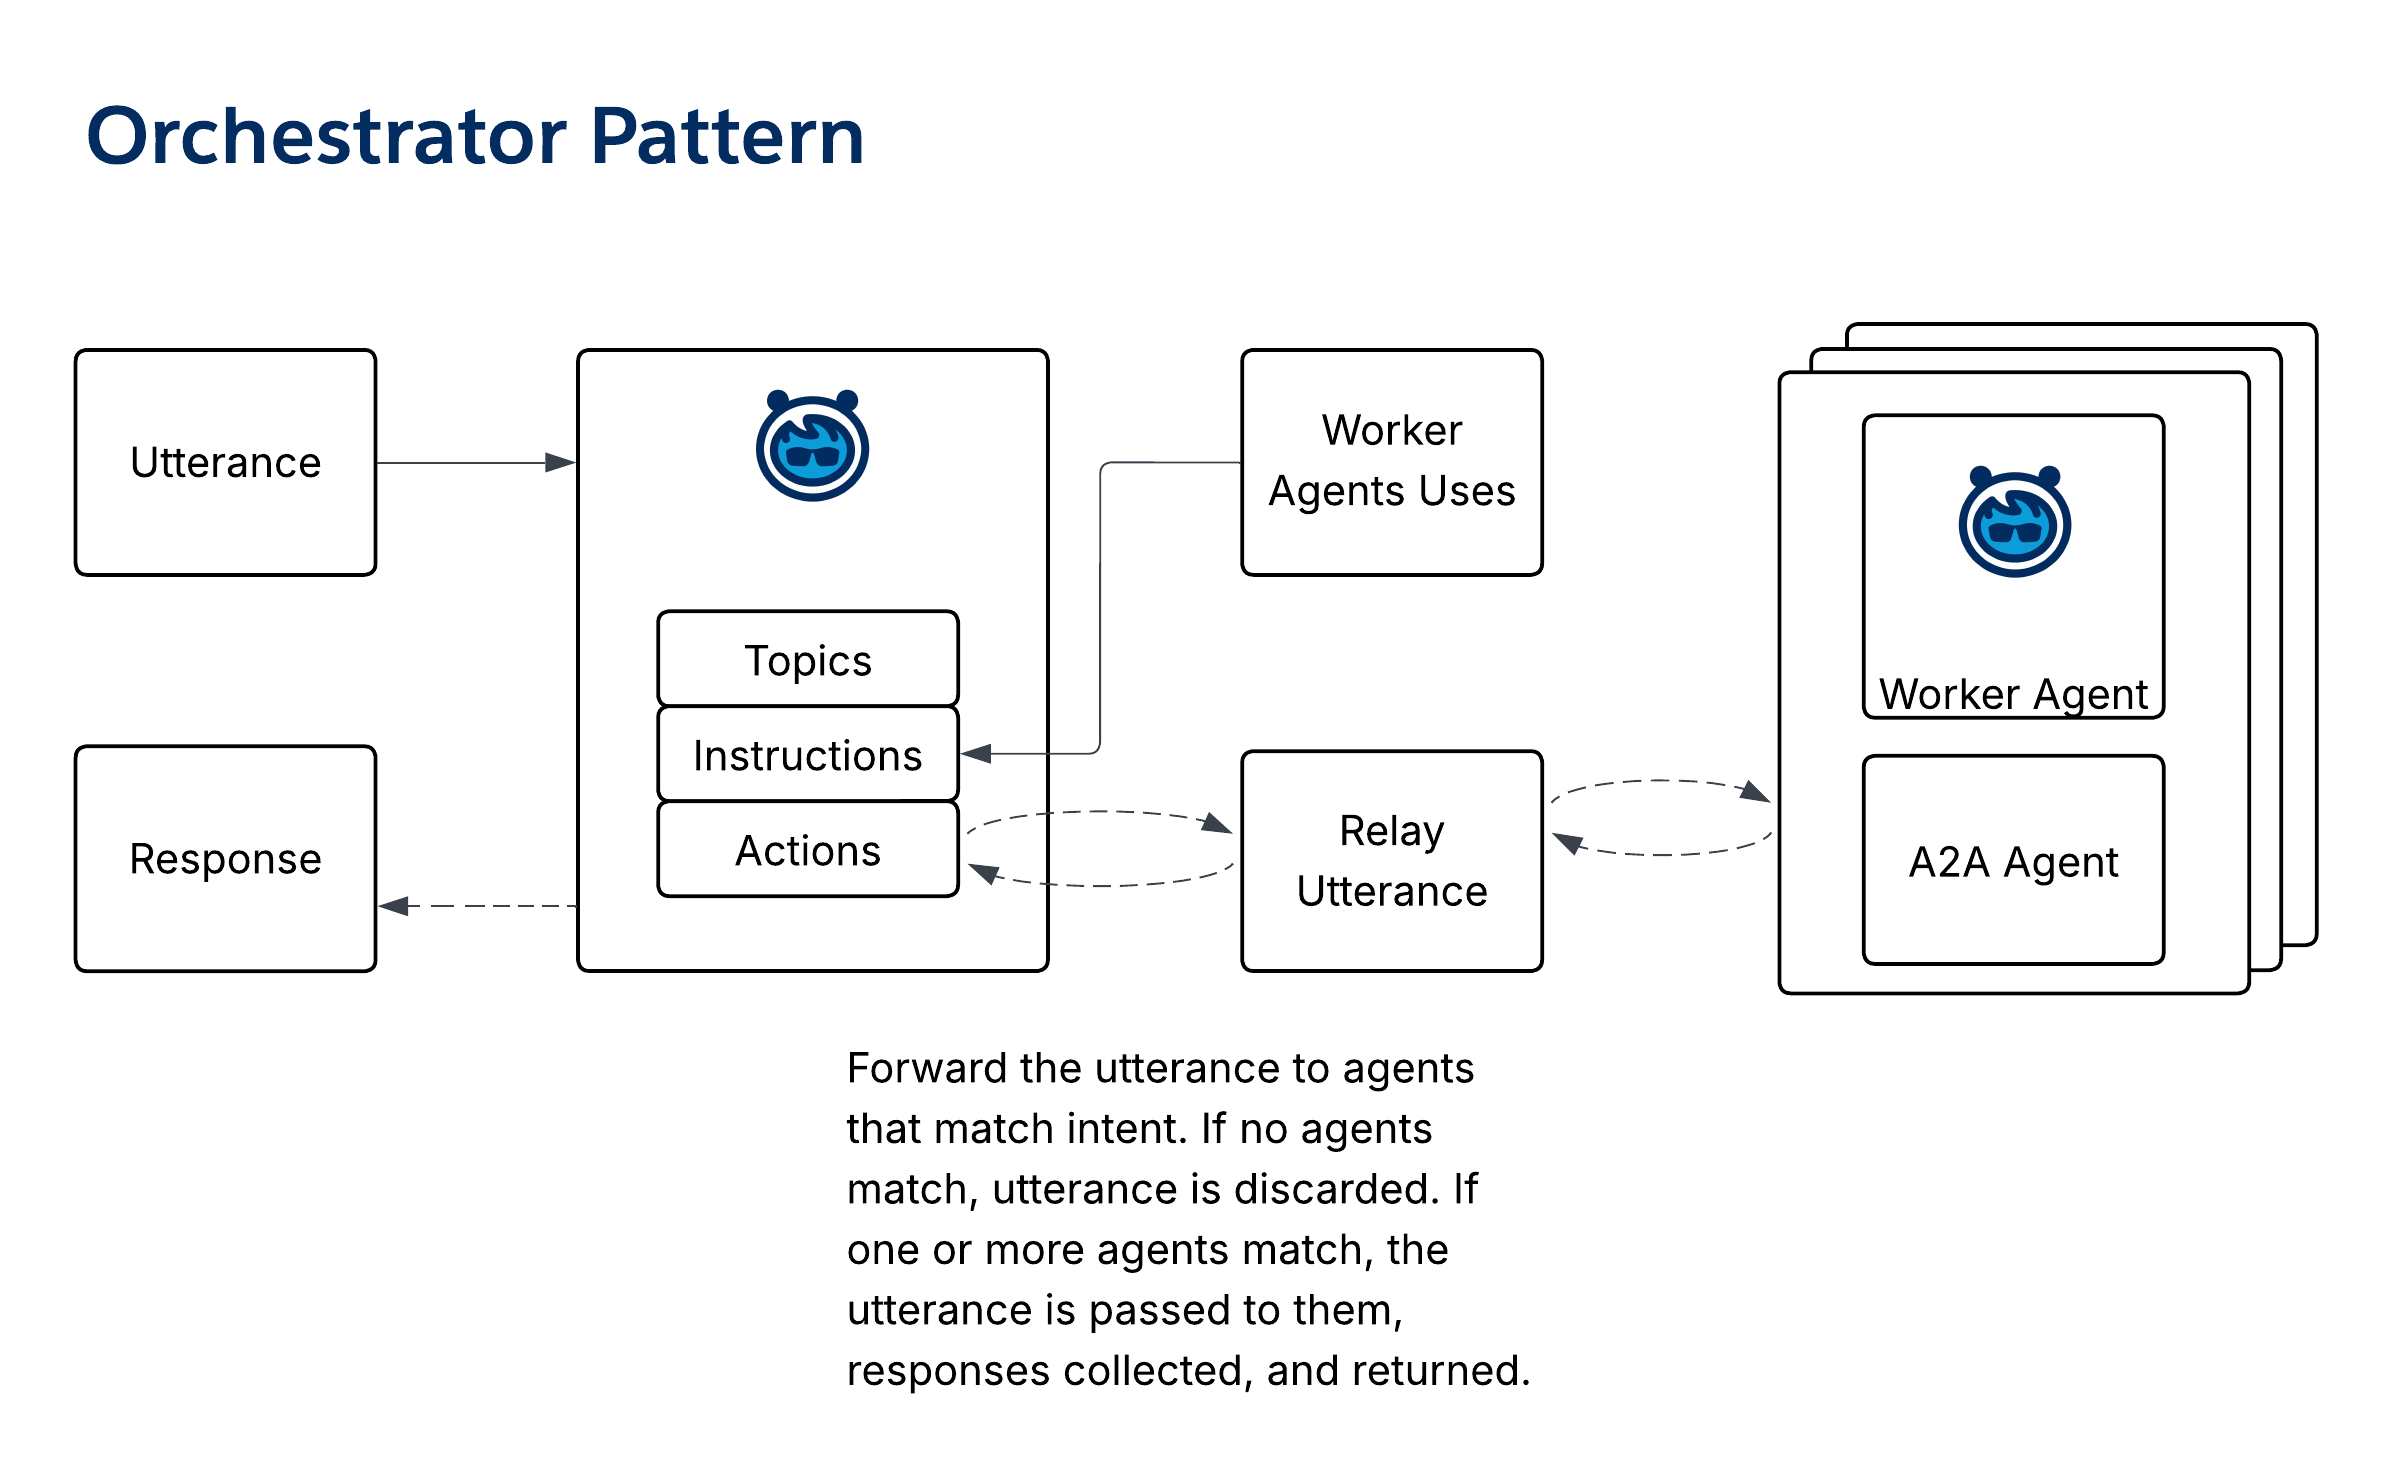 - **Salesforce Agentic Maturity**:レベル 3
### リスナー/フィードパターン
- **概要**:*リスナー/フィードパターン*は、会話のフロー中にコンテキストとインサイトを表示します。*リスナー*は、会話のターンごとにトリガーされ、従業員の関連情報を検索して表示します。
- **出力タイプ**:会話に基づいて関連するコンテキストを提供します。このコンテキストは、効果を得るために書式設定できます (たとえば、比較を行ったり、重要なポイントを強調したりできます)。
- **パターン使用ガイダンス**:リスナーをターンベースのチャネル (チャット、音声、SMS など) に接続します。各主題領域のトピックを定義します。エージェントはトランスクリプトを消費し、トピックを識別し、関連するコンテンツを検索して従業員の実行中のフィードに投稿するアクションを呼び出します。
- **代表的な使用事例**:*ユニバーサルアシスタント*を使用して、カスタマーサービスまたは営業担当をサポートします。
- **図**:
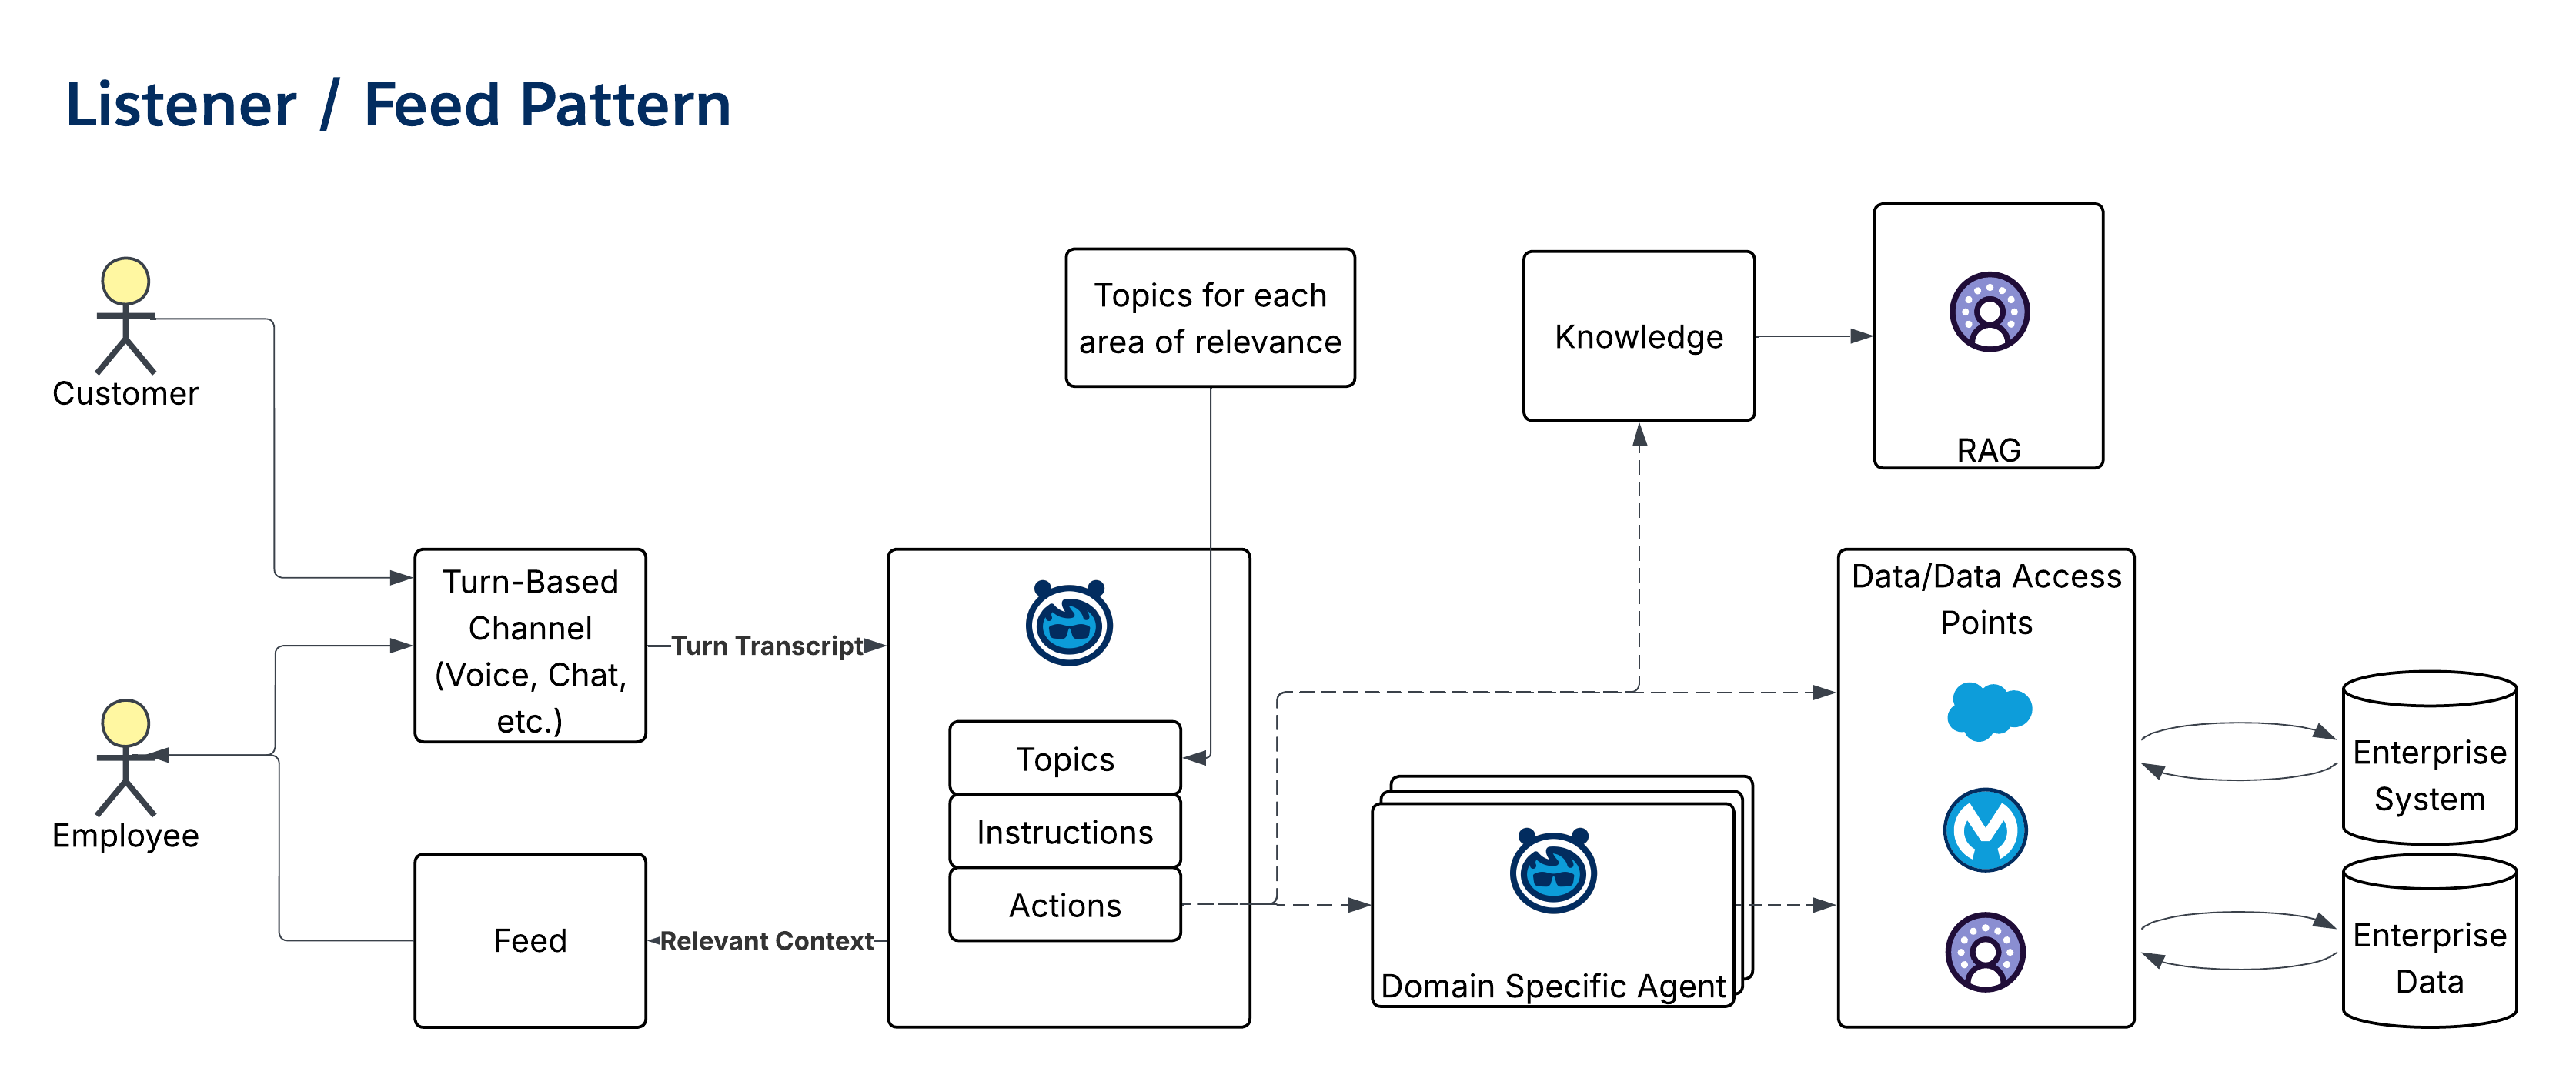 - **Salesforce Agentic Maturity**:レベル 3
### ワークスペース (Radar O'Reilly) パターン
- **概要**:ワークスペース*(Radar O'Reilly)パターン*では、会話のフローで応答性の高い単一コンソールの UX を管理します。各発言が処理され、関連するコンテンツで UX の一部が更新されます。
- **出力タイプ**:より大きな 1 か所のビュー内のポートレットで関連するコンテキストを提供します。
- **パターン使用ガイダンス**:*オーケストレーター*エージェントは、発言を一連の*トピック*エージェントに渡します。各トピックエージェントはステートメントを評価し、UX の更新が必要かどうかを判断します。その場合、動的更新が対応する LWC に転送されます。
- **代表的な使用事例**:これは高度なエージェントフロントドアのように機能します。
- **図**:
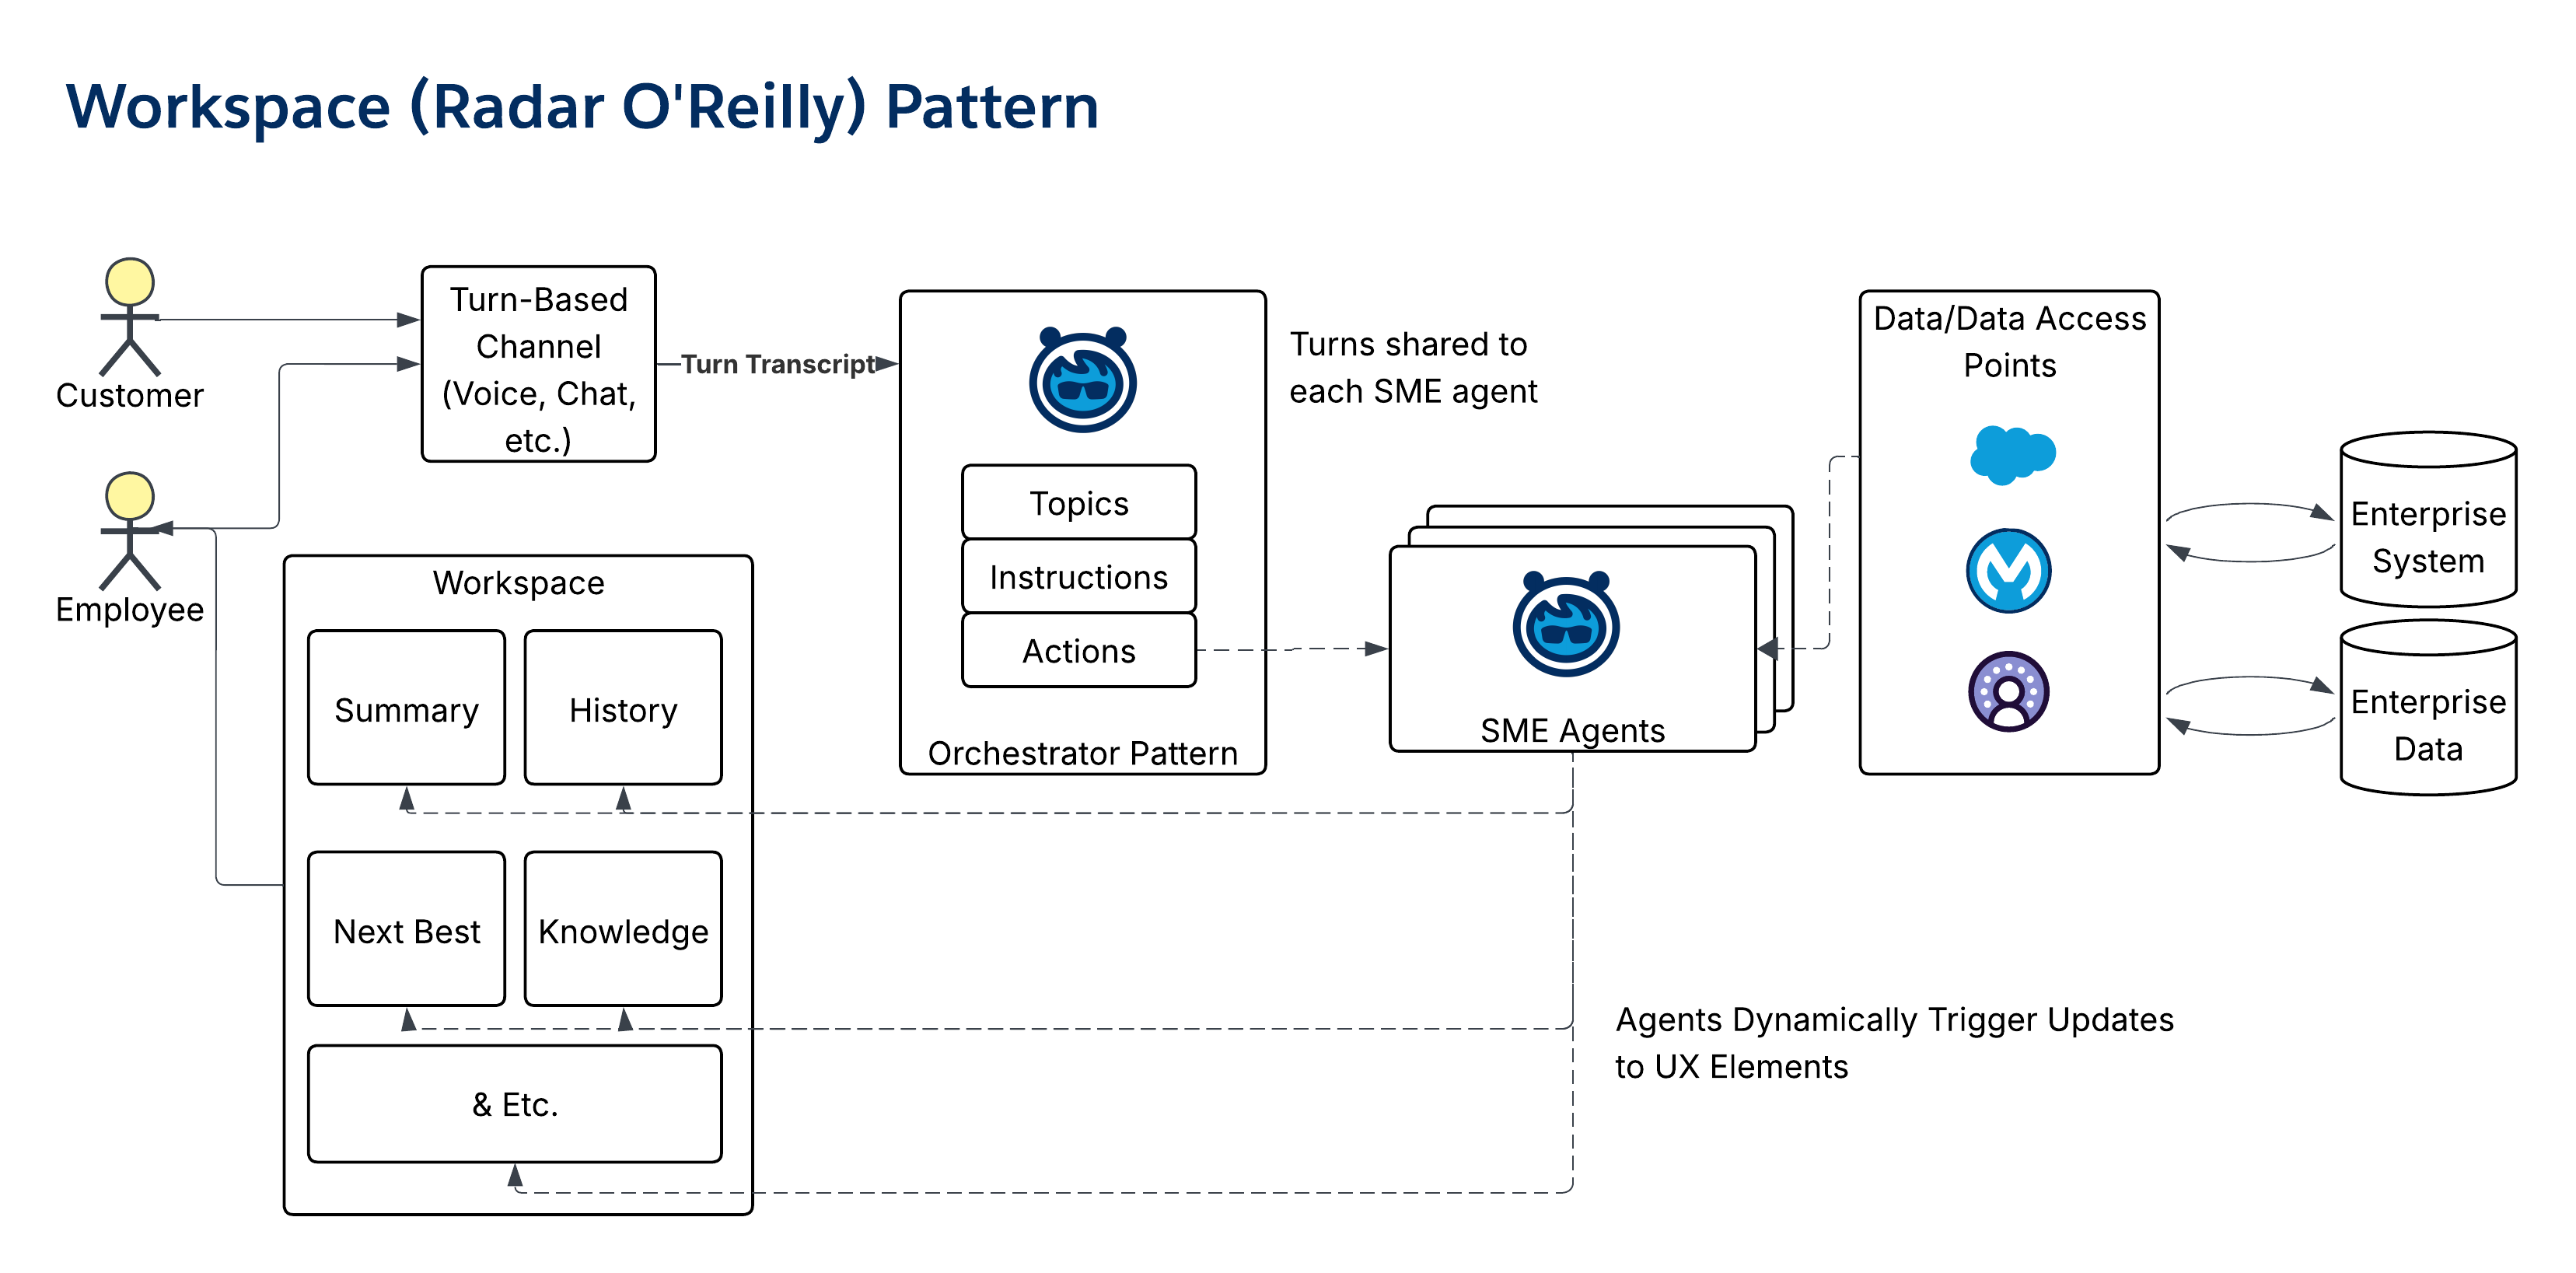 - **Salesforce Agentic Maturity**:レベル 3
## 7\.スペシャリストパターン
*スペシャリスト パターン*は、特定のドメインの深い Knowledge またはスキルをカプセル化したもので、通常は*インタラクション パターン*によってオーケストレーションされます。
### アンサーボットパターン
- **概要**:*アンサーボット パターン*は、GenAI を使用してキーワードだけでなく自然言語も判別するセルフ サービスの効果的なパターンです。
- **出力タイプ**:Knowledge とサポート資料への参照/引用の要約。
- **パターン使用ガイダンス**:信頼できるソース資料(Knowledge Store や FAQ など)を整理して取り込み、エージェントを設定します。企業 Web サイトまたは内部ポータル内にエージェントを配置します。質問を監視して、Knowledge ギャップを特定して解決します。
- **代表的な使用事例**:企業 Web サイトでの自然言語検索の促進、HR 福利厚生ボットの操作、すべての対象者へのセルフサービスコンポーネントの提供。
- **図**:
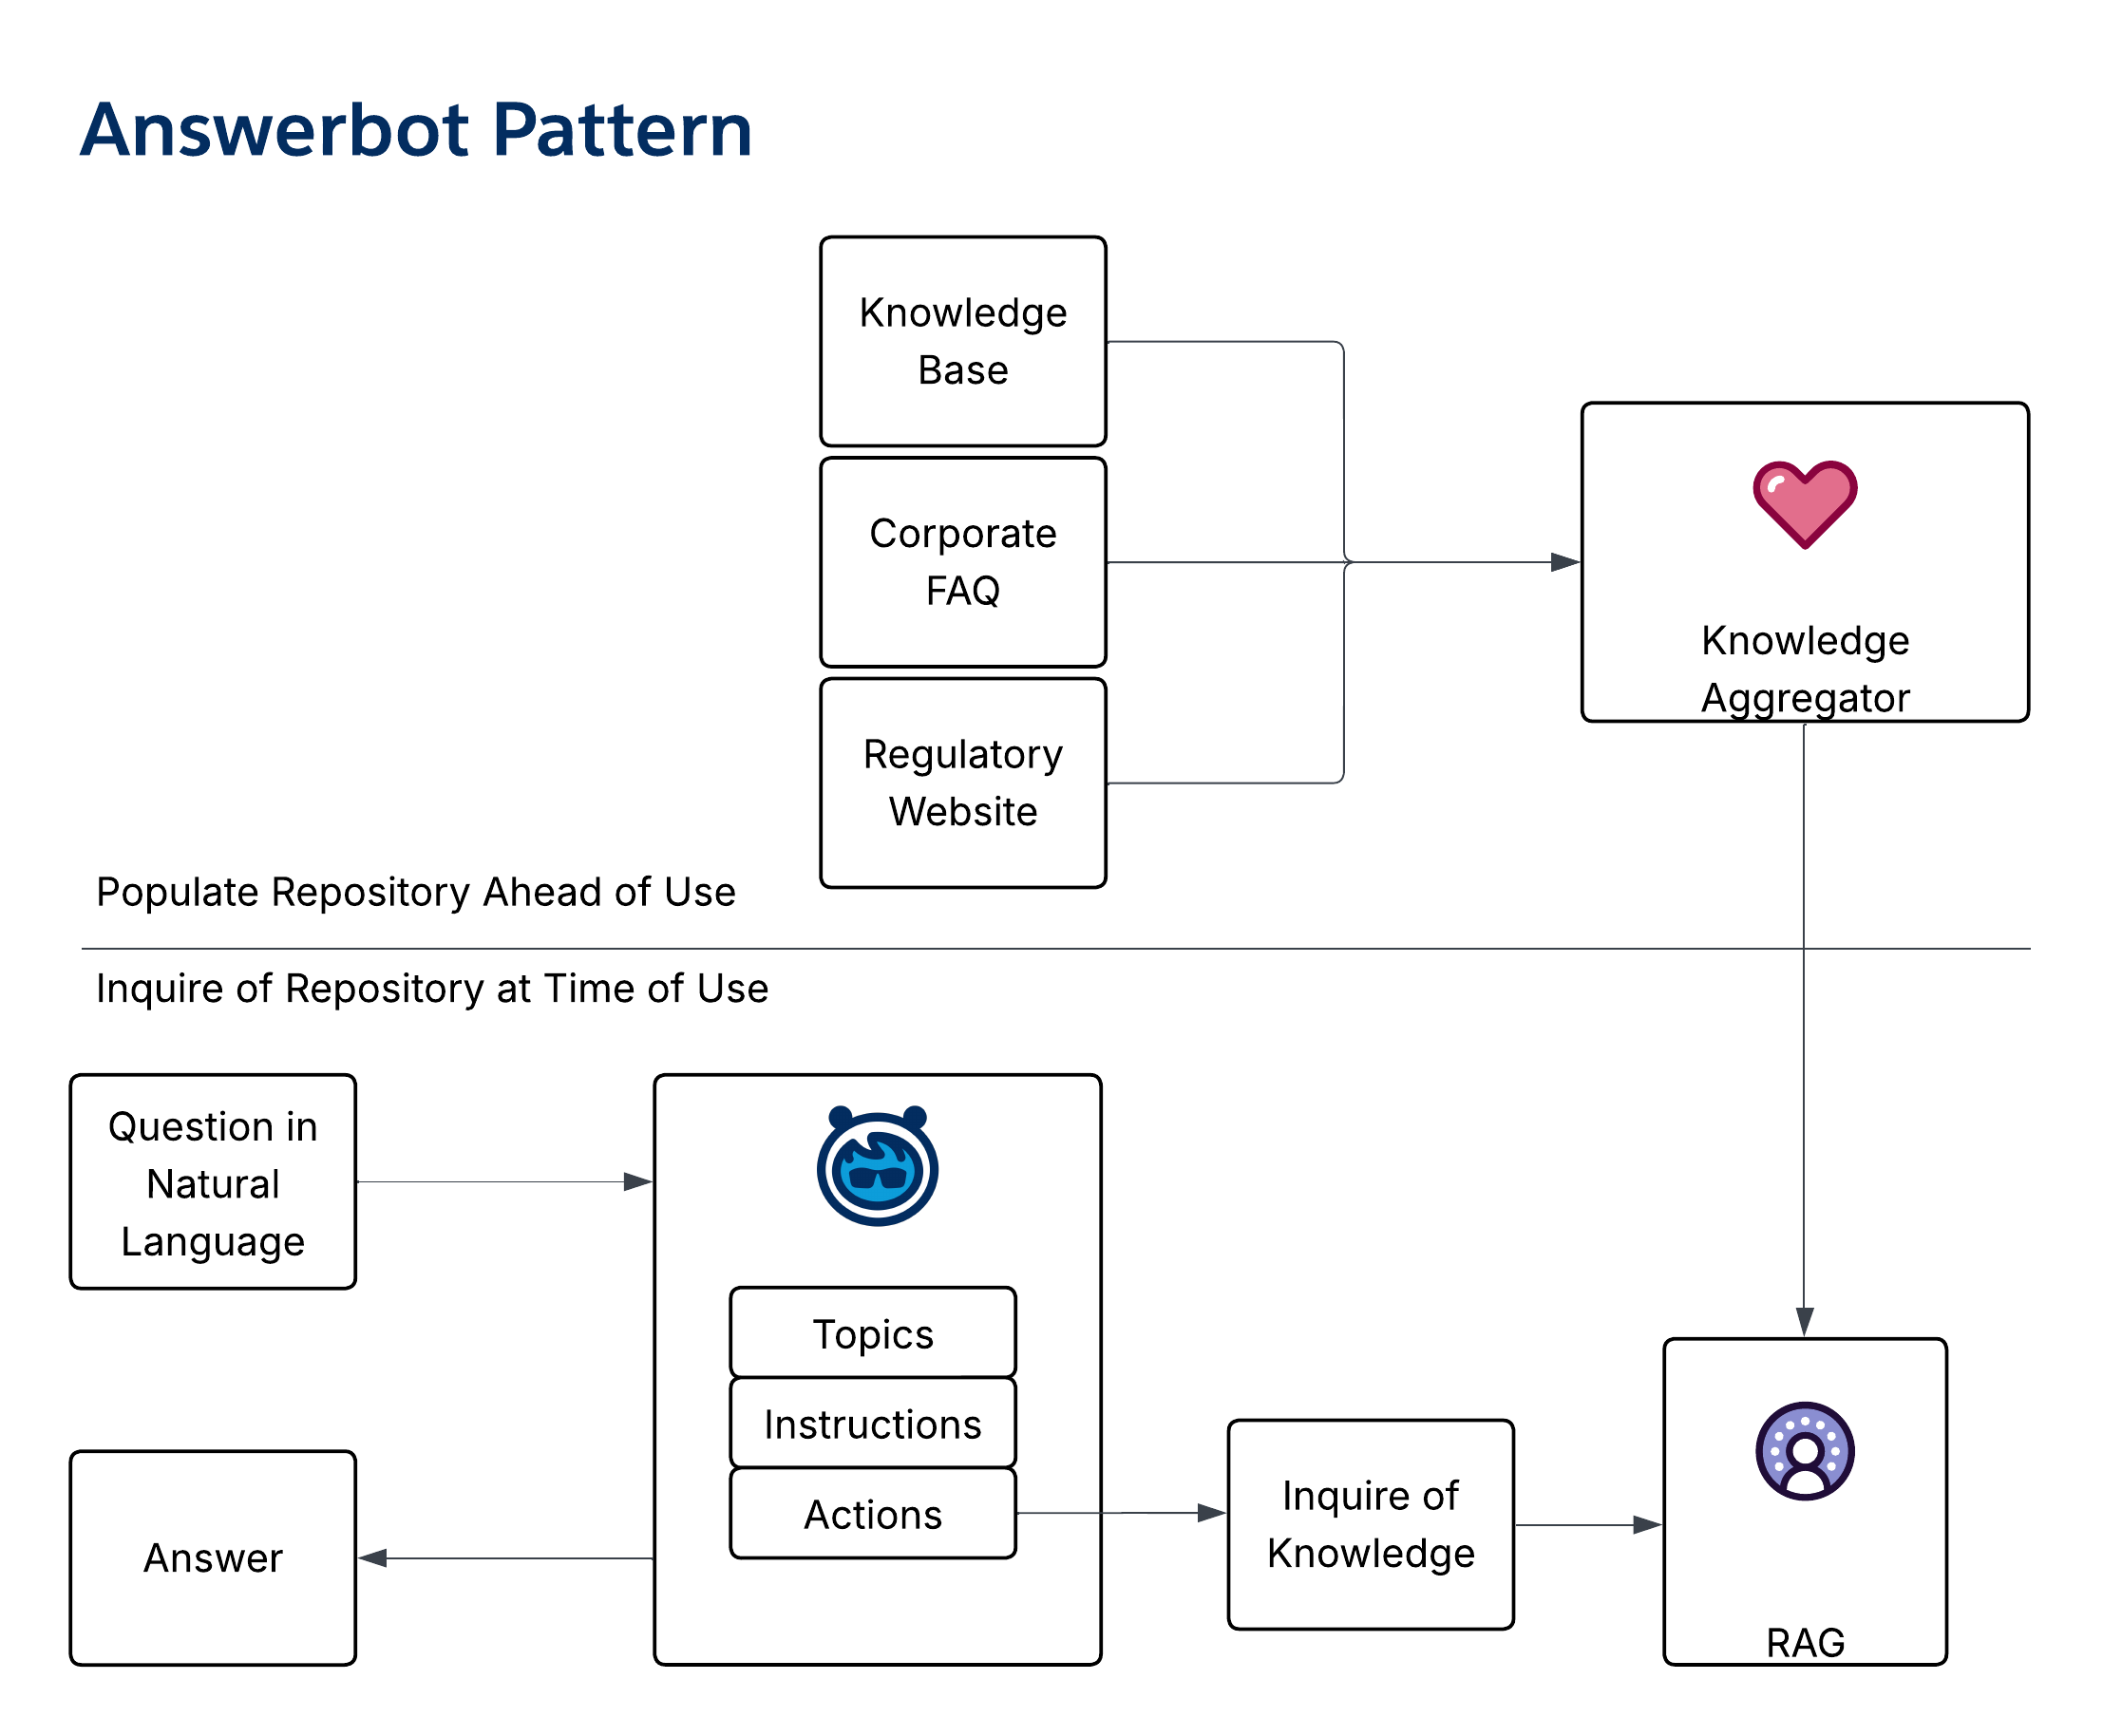 - **Salesforce Agentic Maturity**:Level 1 (レベル 1)
### ドメイン SME パターン
- **概要**:*ドメイン SME パターン*は、ビジネスドメイン (注文や請求など) の自然言語フロントエンドを提供する基本的なパターンです。
- **出力タイプ**:ドメインに関連するコンテンツ、トピック、データ、書式設定された情報を提供します。
- **パターン使用ガイダンス**:このパターンを使用して、件名またはビジネスドメインをカプセル化します。適切な CRUD 操作を実行できるようにエージェントを設定します。これらのエージェントを[_インタラクション パターン_](/docs/architect/ja-jp/fundamentals/guide/enterprise-agentic-architecture#6インタラクションパターン)(- Orchestrator や Listener など)で使用できるようにします。
- **代表的な使用事例**:ビジネスデータドメインのゲートキーピング、「注文エージェント」または「在庫エージェント」の提供、ビジネスドメインのエージェントインターフェースの提供。
- **図**:
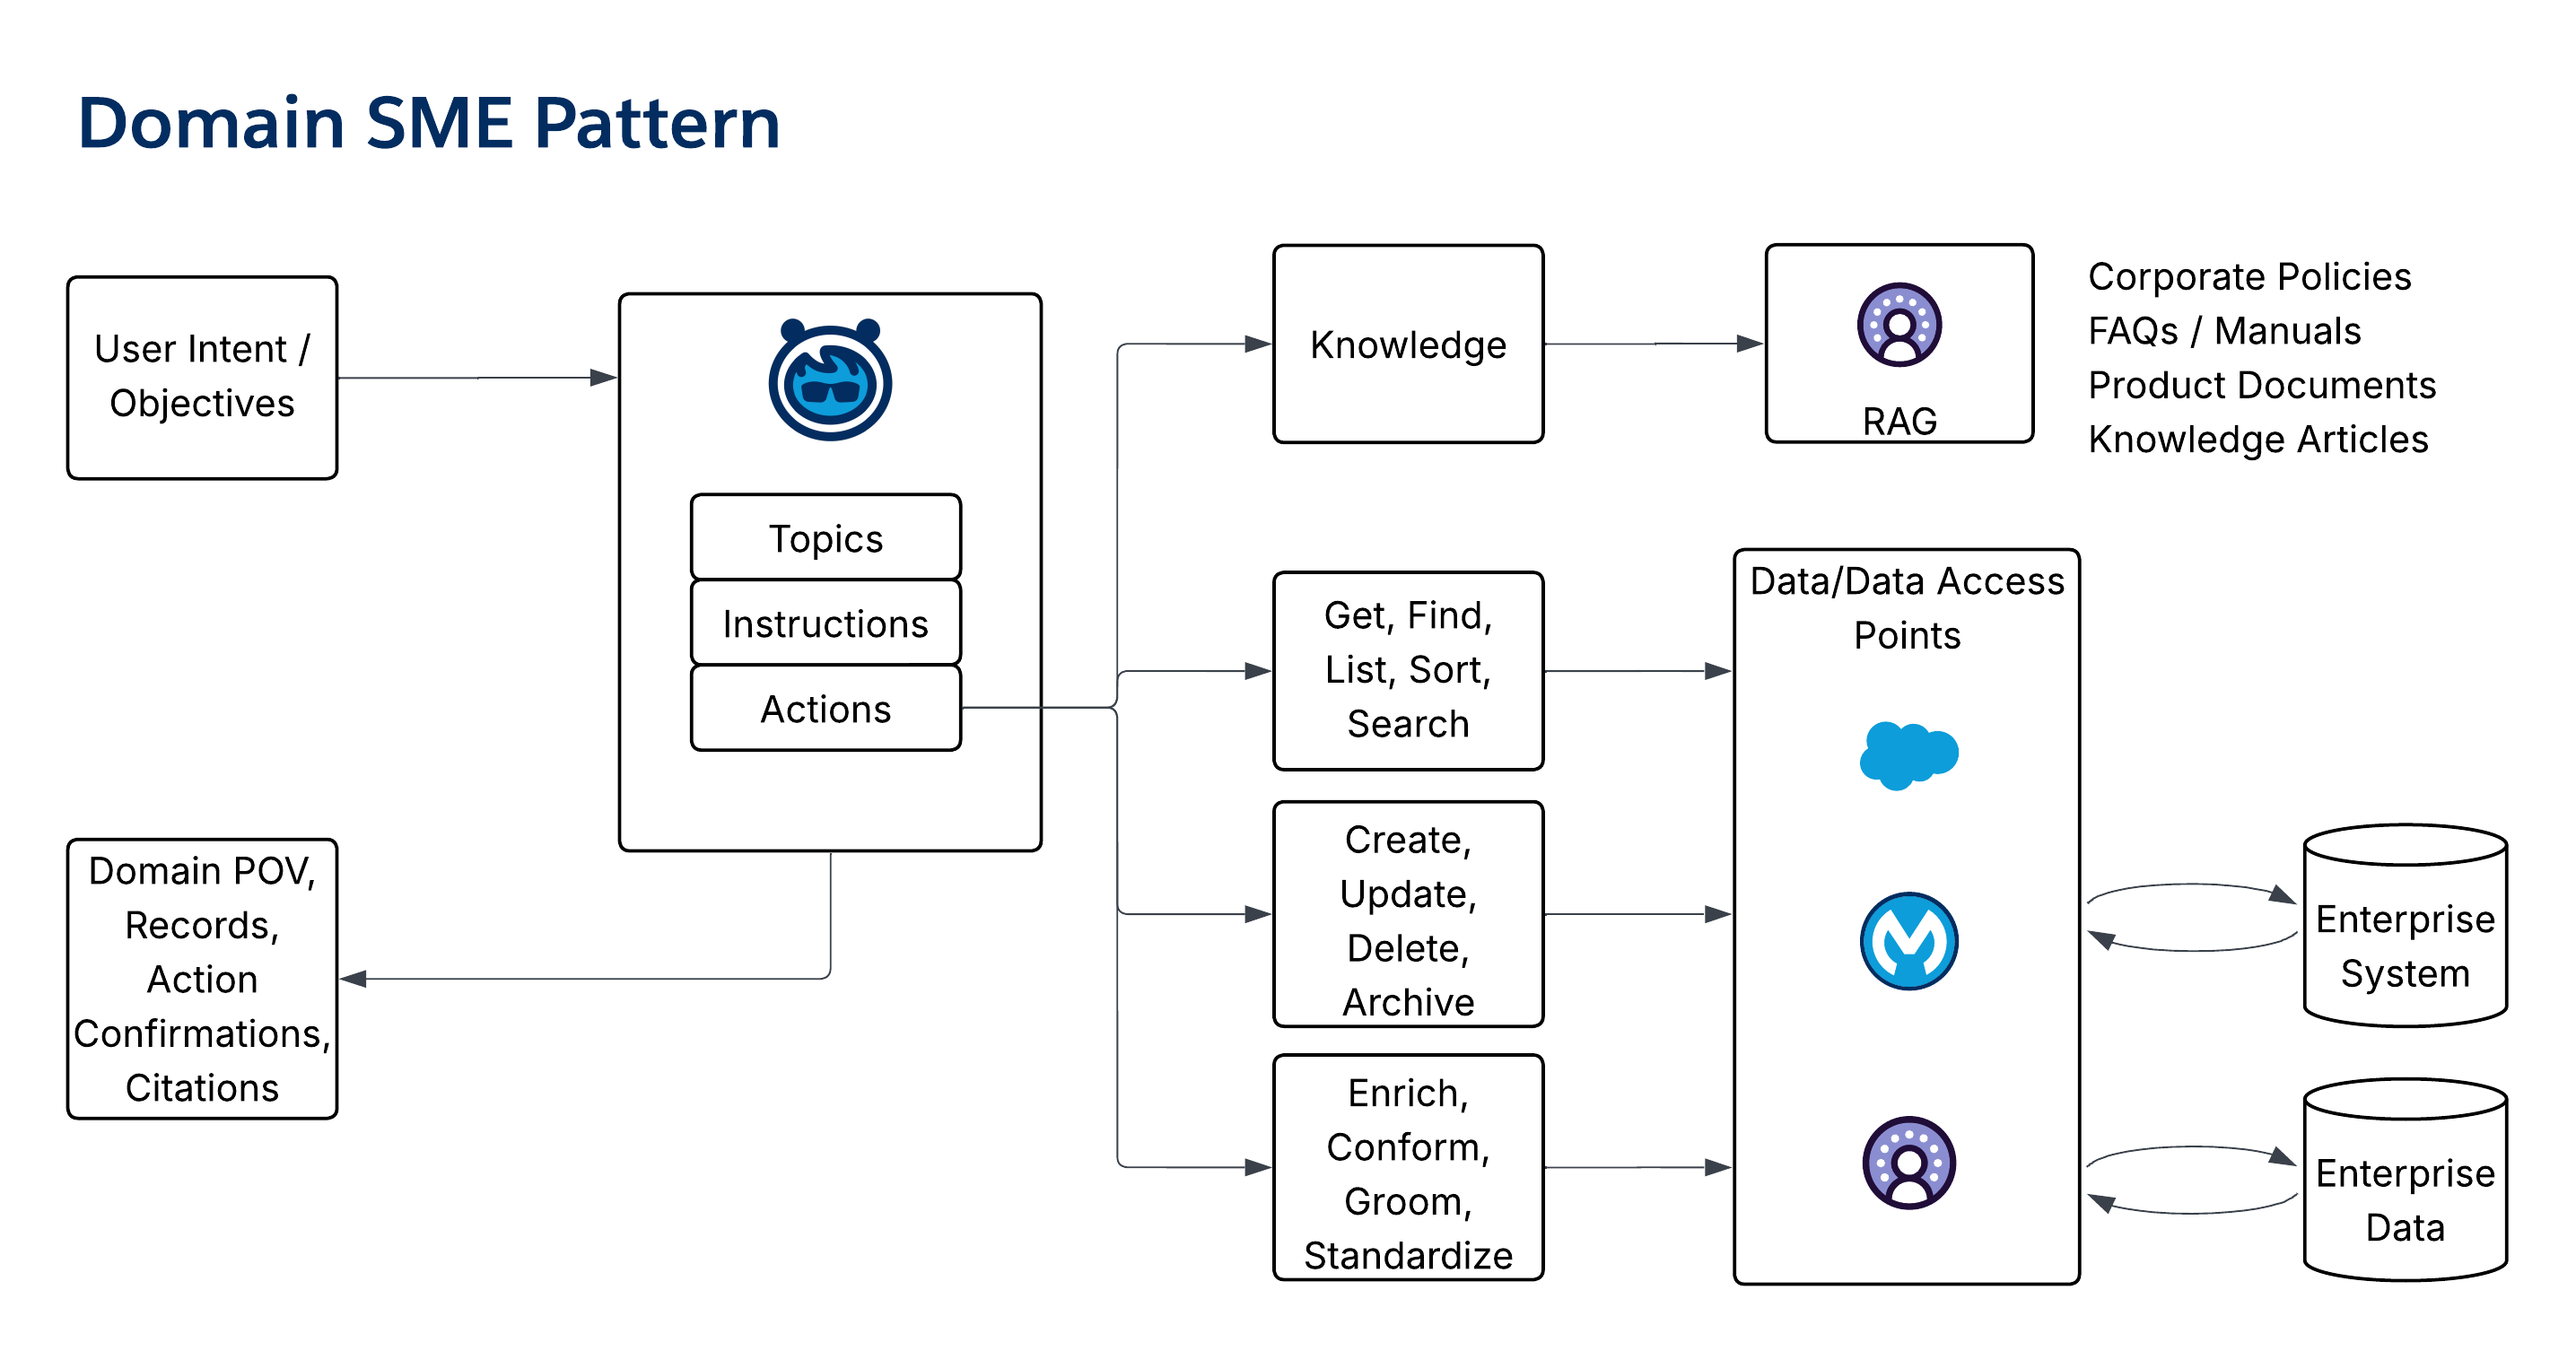 - **Salesforce Agentic Maturity**:Level 2 (レベル 2)
### 取調官パターン
- **概要**:*Interrogator パターン*は、トピックについて尋問し、複数のソースからコンテキストを作成して質問に回答できる SME エージェントです。活用される主要なエージェント機能は、コンテンツを読んで内部化した後で人間が行うように、コンテンツ全体にわたってコンテキストを取得して概念を結び付ける機能です。このパターンにより、「回転椅子インテグレーション」の必要性が軽減されます。
- **出力タイプ**:質問への回答を提供します。
- **パターン使用ガイダンス**:多くの場合、ユーザーが直接質問できるように、ユーザーの現在のコンテキストに接続されたコンソールウィジェットとして設定されます。また、FAQ、ポリシー、製品カタログなどの Knowledge リソースと組み合わせて使用されます。*Interrogator パターン*を標準プロンプトと組み合わせて、よくある質問に対する一般的な回答を拡張します。
- **代表的な使用事例**:契約アシスタントエージェント、給付問い合わせアシスタント、またはマルチエージェントパターン (リスナーやワークスペースなど) のスペシャリストワーカーエージェントとして使用します。
- **図**:
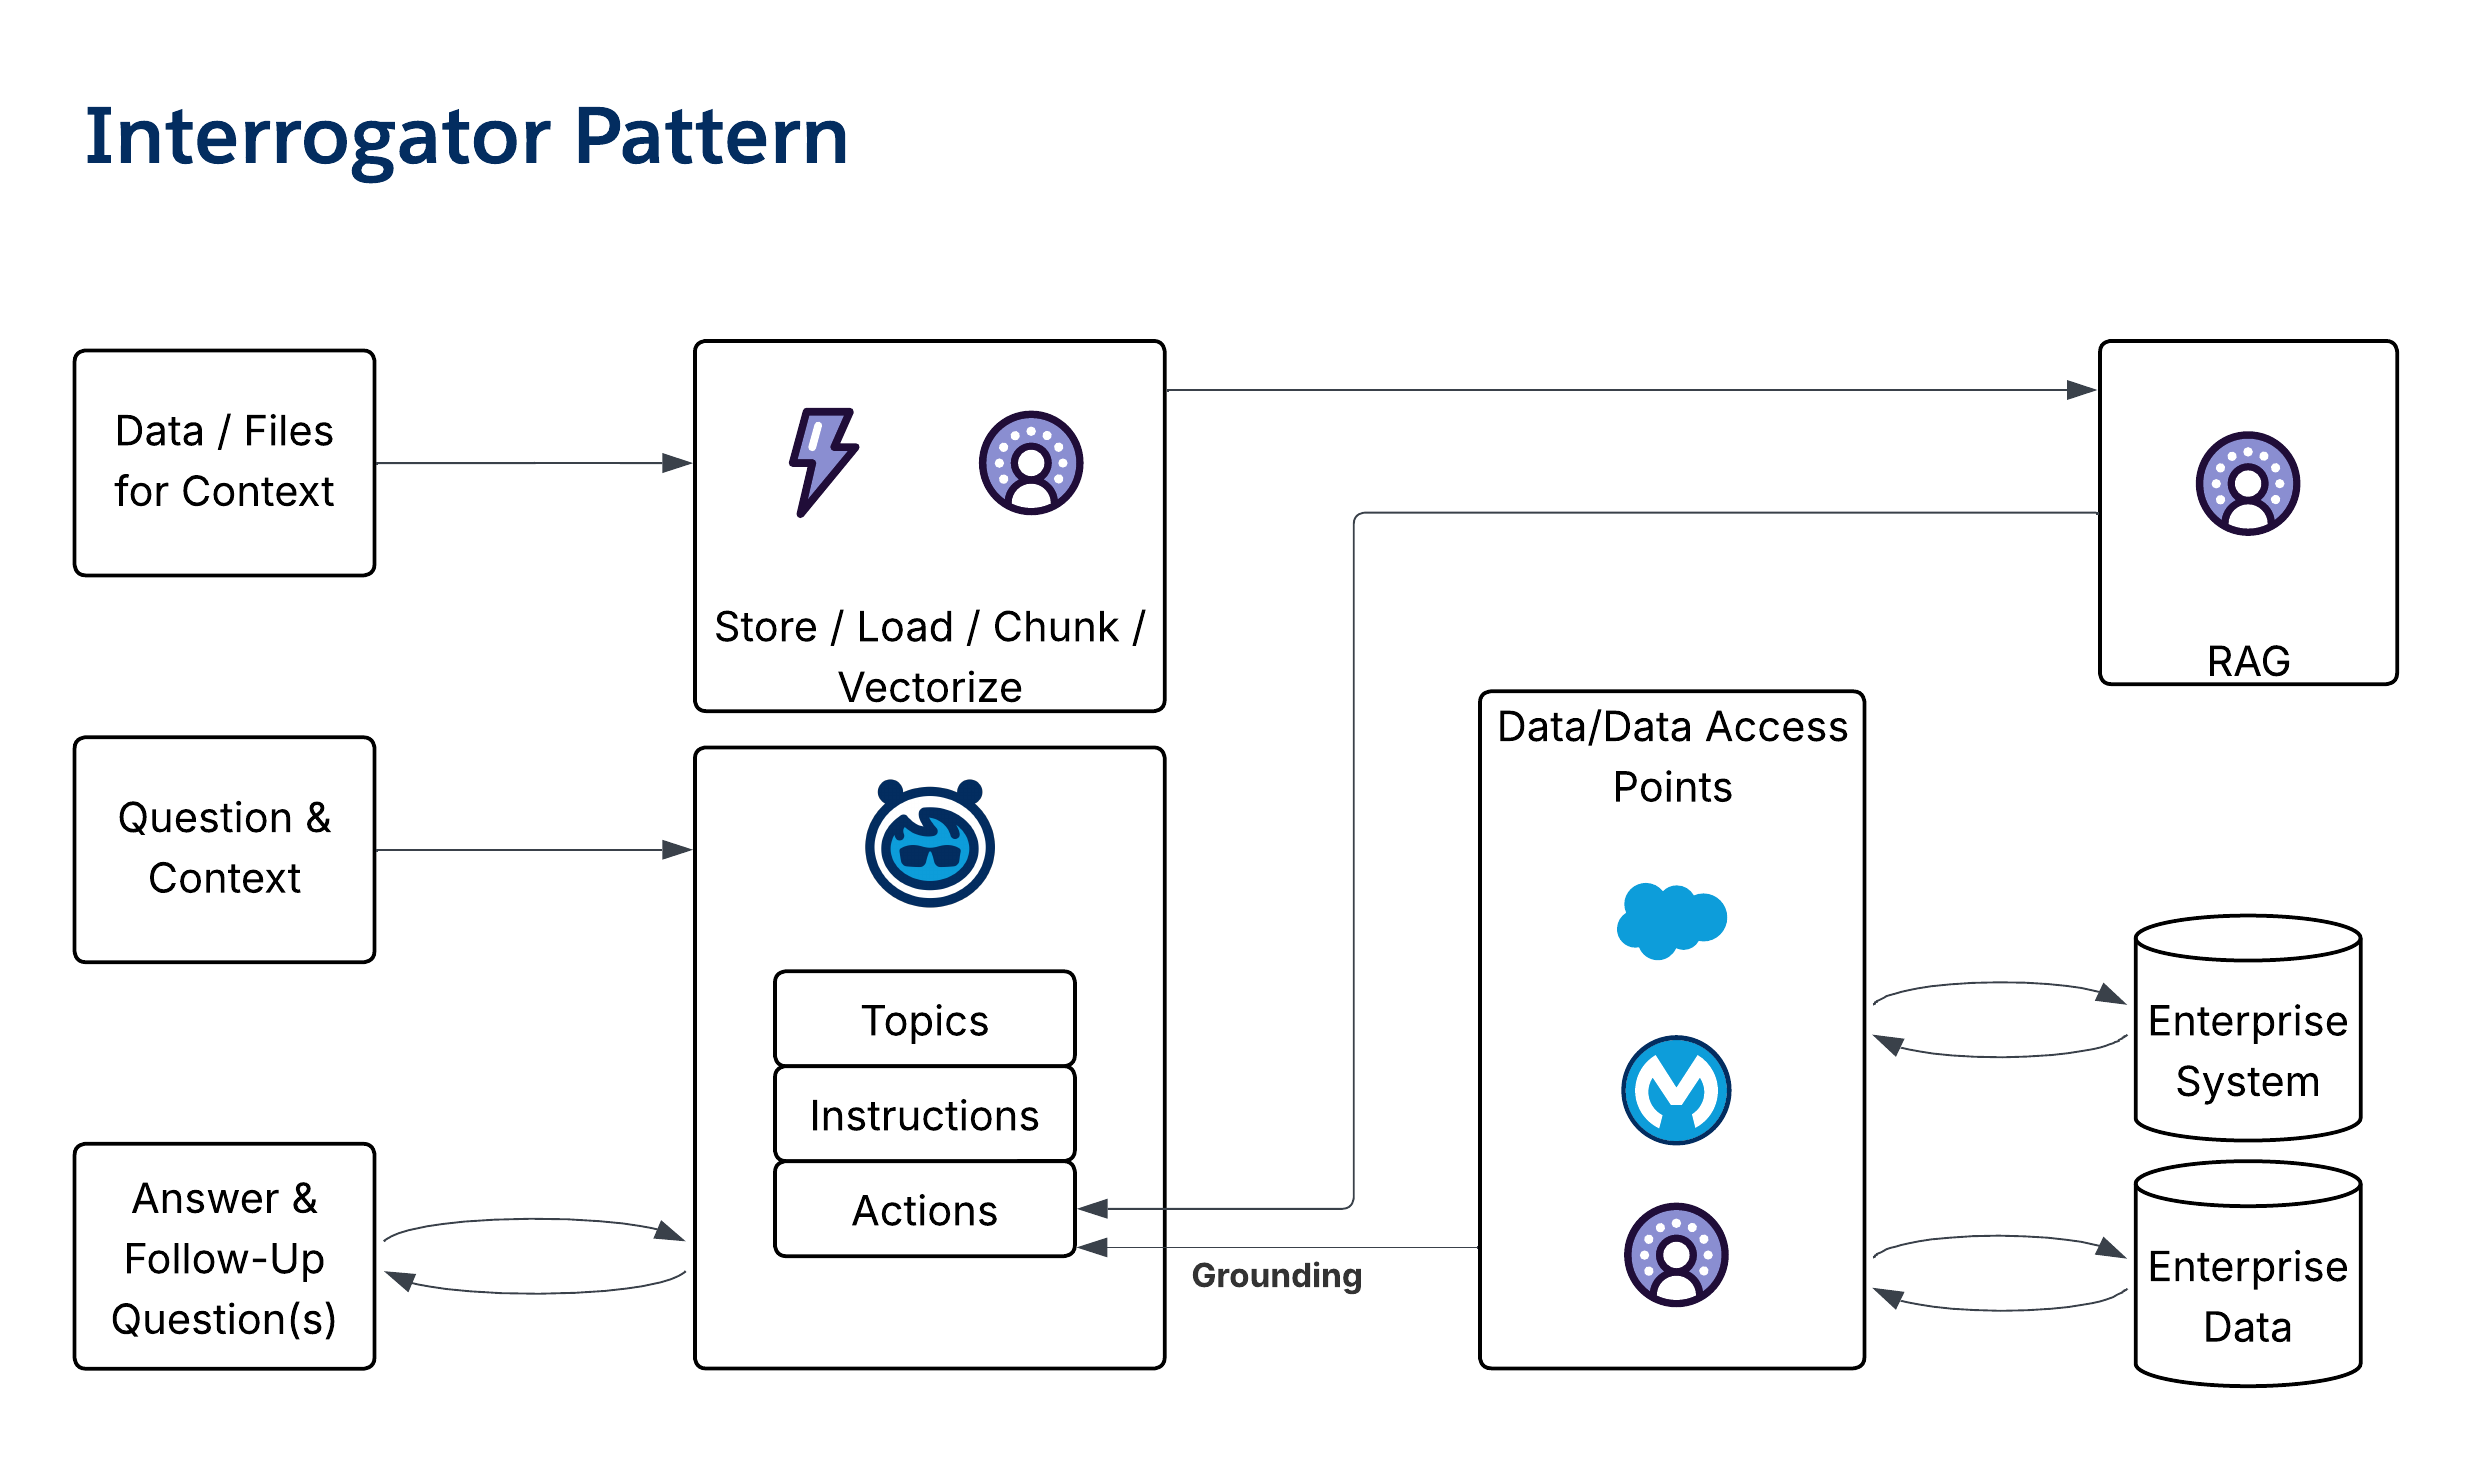 - **Salesforce Agentic Maturity**:Level 2 (レベル 2)
### Prioritizer パターン
- **概要**:*優先度パターン*は、定義された目的に基づいて一連の ToDo または作業オブジェクトを並び替えるために使用されます。GenAI を活用して、定性的な分析、非構造化データ分析、または複数のデータドメインの統合分析を行います。
- **出力タイプ**:生成インサイトを提供する。
- **パターン使用ガイダンス**:自然言語を使用して、優先順位付けに必要な資質を説明します。選択可能な一連のオプションを使用してエージェントをグラウンディングします。リスナーパターンと組み合わせて、作業フローで応答性の高い「Next Best Action」を作成します。
- **代表的な使用事例**:_Next Best Action_ ジェネレーターとして、または実行時間が長いパターンやマルチエージェントパターンで特殊な作業者エージェントとして使用します。
- **図**:
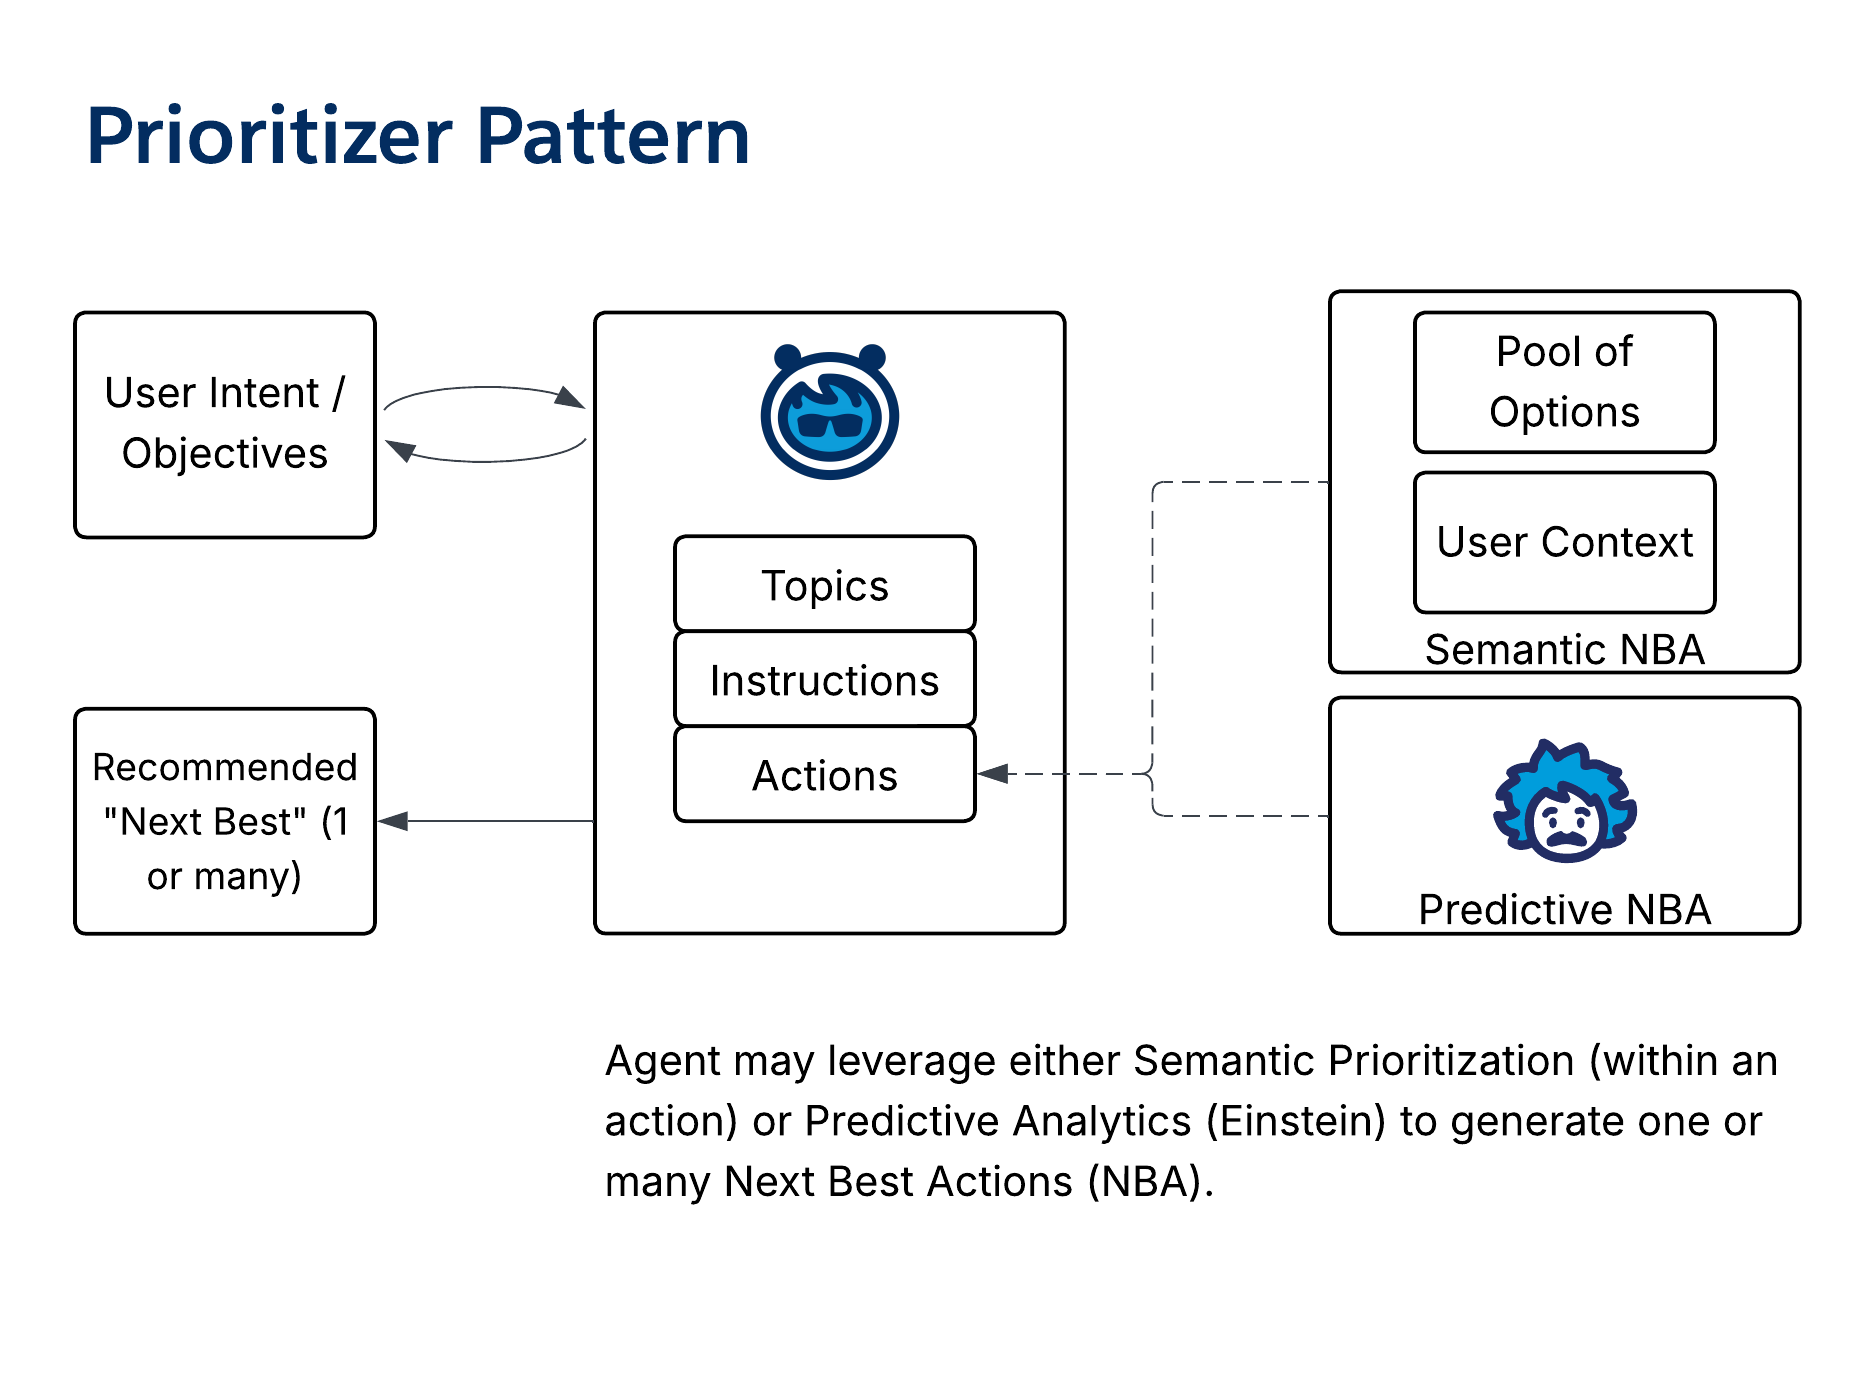 - **Salesforce Agentic Maturity**:Level 2 (レベル 2)
## 8\.ユーティリティとデータパターン
*ユーティリティパターン*は、他のエージェントまたはプロセスをサポートする特定の反復可能なタスクを実行します。
### ジェネレーターパターン
- **概要**:*ジェネレーターパターン*は、既存の入力および標準から新しいコンテンツ (ケースの概要やメールドラフトなど) を作成するための基本パターンです。多くの場合、プロンプトとして実装され、他のエージェント内に埋め込まれる可能性があります。
- **出力タイプ**:要求された形式とインテントに準拠した生成されたコンテンツを提供します。
- **パターン使用ガイダンス**:*ジェネレーターパターン*は、他のほとんどのパターン内で、またはスタンドアロンとして使用できます。コンテキストは、要求、実行中のハイドレーション、または追加の強化ステップで提供できます。
- **代表的な使用事例**:ケースの概要、メール・ドラフト、Knowledge Article、QBR への提案/回答を提供します。
- **図**:
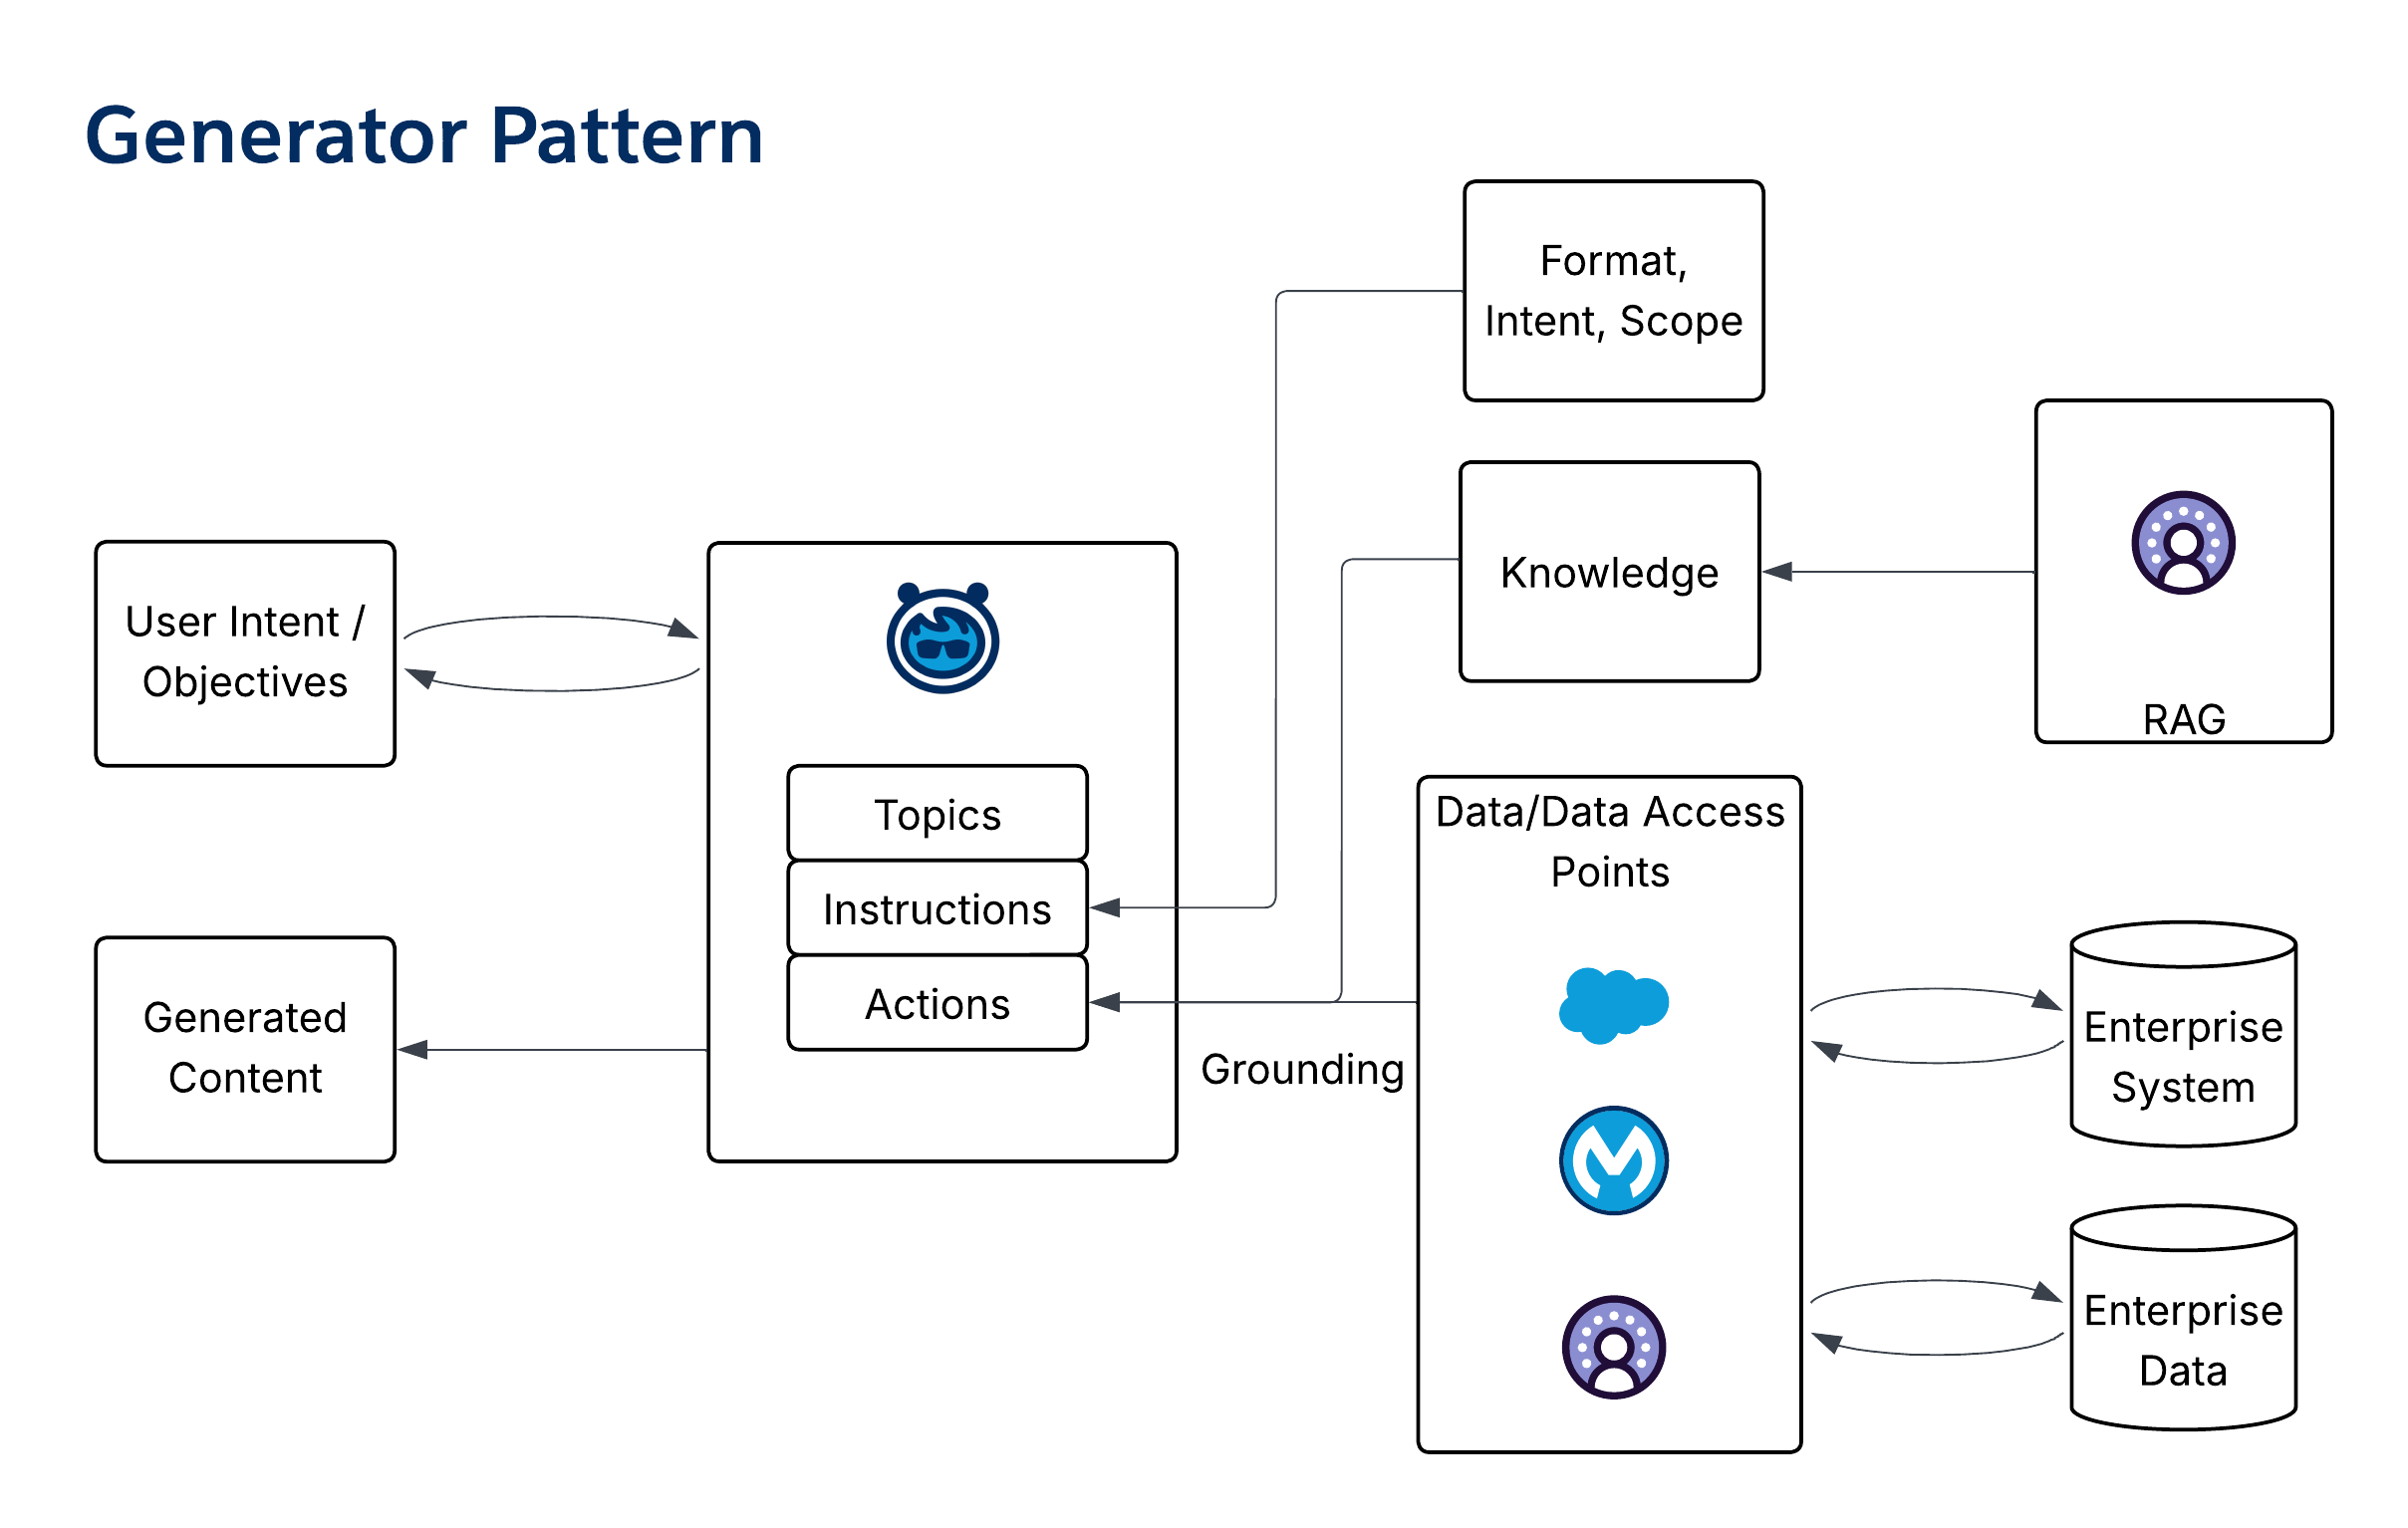 - **Salesforce Agentic Maturity**:Level 1 (レベル 1)
### データスチュワードパターン
- **概要**:*データスチュワードパターン*は、一貫したデータ品質、準拠、強化を確保するためにデータ操作にエージェントステップを導入する自律的なバックグラウンドパターンです。
- **出力タイプ**:保存する前に、更新されたレコード項目とデータ項目を提供します。
- **パターン使用ガイダンス**:データの保存前にフローを記録するデータスチュワードを追加して、データ作成時にデータ品質を組み込みます。分類データ、概要データ、都道府県データの一貫した適用に役立ちます。
- **代表的な使用事例**:一貫した「ピザトラッカー」スタイルの更新、取引先データの強化、郵便番号と住所の不一致の排除を実現します。
- **図**:
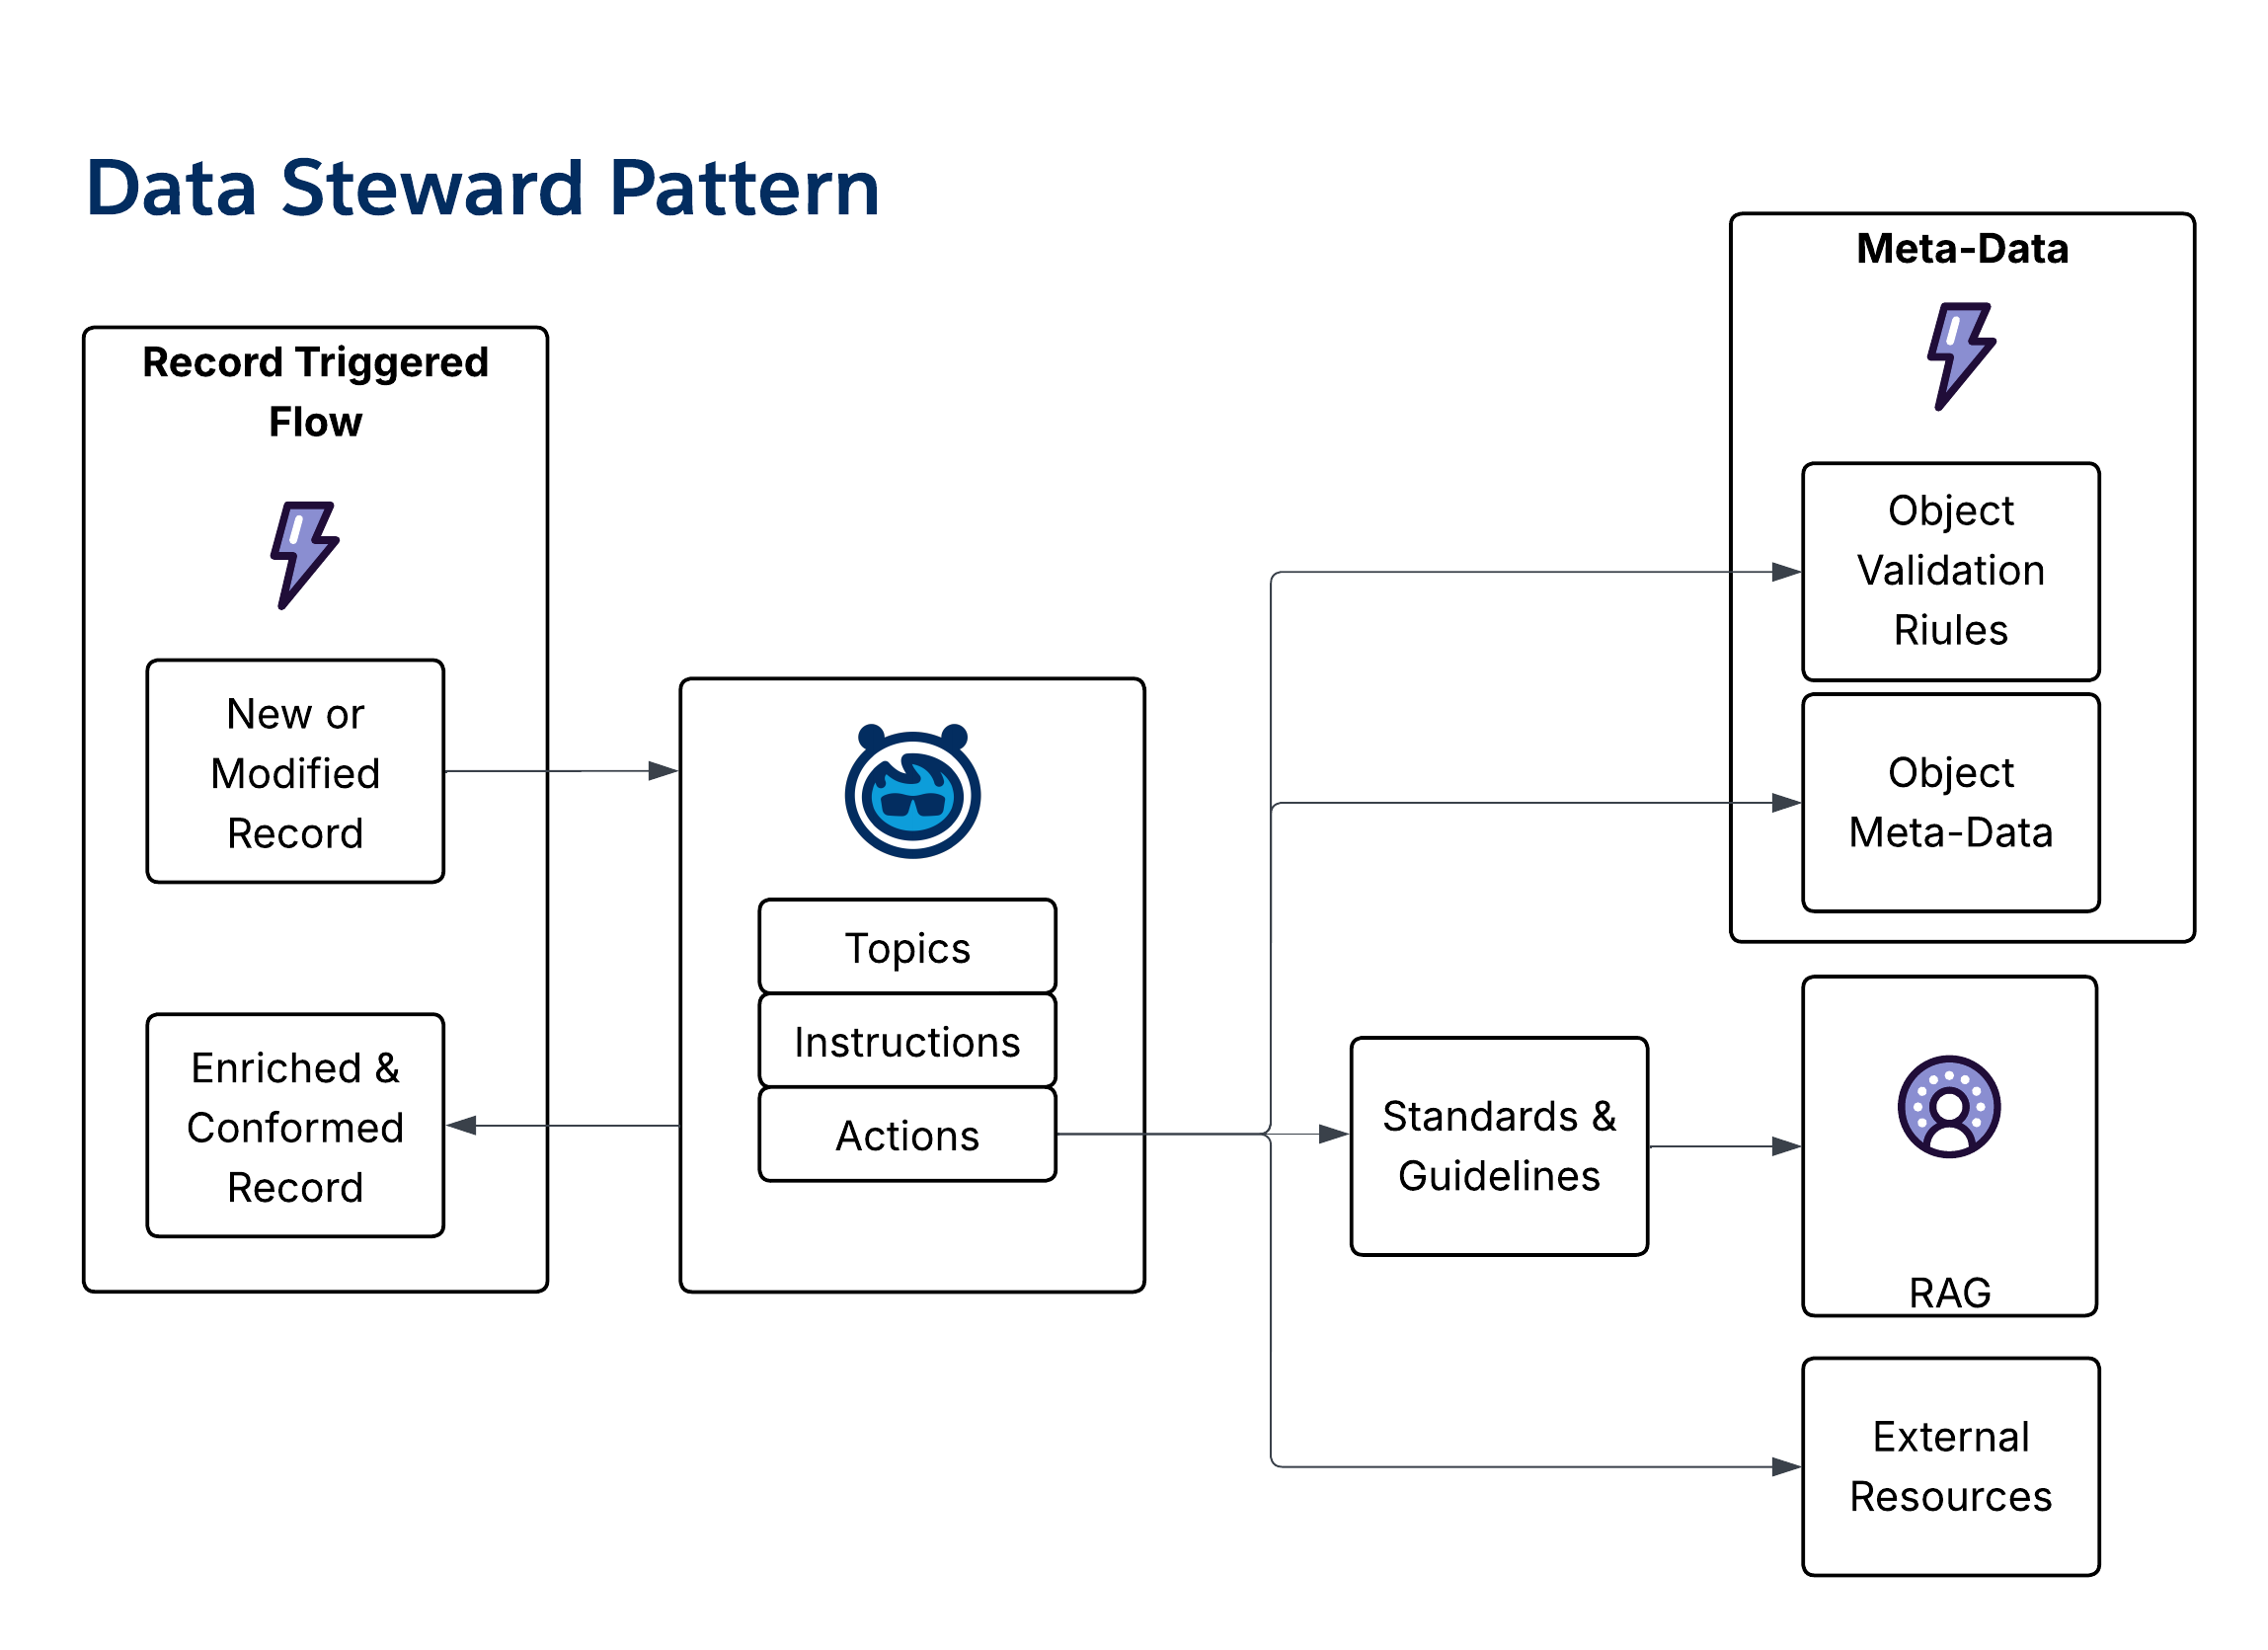 - **Salesforce Agentic Maturity**:Level 2 (レベル 2)
### Zen Data Gardener パターン
- **概要**:*Zen Data Gardener パターン*は、データのグルーミングと標準化に使用されるスケジュール済みバックグラウンド パターンで、低コストの理由を活用して、接続されていないデータ ドメイン全体でデータを検証、強化、準拠します。
- **出力タイプ**:更新されたレコードやデータ管理タスクを提供します。
- **パターン使用ガイダンス**:このパターンを使用して、定期的なデータの確認と検証を有効にします。変化の遅いデータの場合、エージェントを遅い頻度 (毎月など) でスケジュールします。[データスチュワードパターン](/docs/architect/ja-jp/fundamentals/guide/enterprise-agentic-architecture#データスチュワードパターン)と組み合わせて、見込みおよび遡及的なデータ品質操作を提供します。
- **代表的な使用事例**:販売済み報奨金と請求システムの整合性を確保し、国内レジストリに対するブローカーライセンスの定期的な検証を行います。
- **図**:
 - **Salesforce Agentic Maturity**:レベル 4
### コンフィグレーターパターン
- **概要**:*コンフィグレーターパターン*は、自然言語要件から設定アーティファクト (SQL/SOQL、JSON、CSV など) を生成します。また、要件に対して既存の設定を検証するために逆方向に実行することもできます。
- **出力タイプ**:更新されたレコードやデータ管理タスクを提供したり、修正用の問題/エラーを作成したりします。
- **パターン使用ガイダンス**:特定の標準、ガイドライン、または例を使用してエージェントをグラウンディングします。契約や商品仕様などのソースを使用してビルド要件を設定します。*コンフィグレーターパターン*をターゲットシステムに接続して、生成された構成をプッシュします。
- **代表的な使用事例**:医療保険商品の商品設定レコードを生成し、ヘルスケア提供者の契約/支払条件を検証する。
- **図**:
 - **Salesforce Agentic Maturity**:レベル 4
### 審査員と審査員のパターン
- **概要**:\[*Judge & Jury (*審査 & 陪審員)] パターンは、「陪審員」エージェントと「審査」エージェントのアンサンブルを使用して回答の収束を評価し、回答の物理的な一貫性とグラウンディングを確保することで、幻覚を最小限に抑えるように設計されています。
- *アンサンブルアプローチ*は、応答の正確性と関連性に対処するために Agentforce と Atlas Reasoning エンジンに組み込まれています。\[*Judge and Jury (*審査員)] パターンは、高レベルの精度が不可欠な場合にこの機能を基盤にします。
- _データグラウンディング_ (「これらのレコード/ドキュメントで回答を見つけてください」など) と*プロンプトエンジニアリング* (「これらのレコードで回答が見つかった場合にのみ回答を返します」や「この外部ソースに対して回答を検証してください」など) の組み合わせも、幻覚を最小限に抑える効果的な方法です。
- **出力タイプ**:生成インサイトを提供する。
- **パターン使用ガイダンス**:一貫性のあるグラウンディングされた生成出力が強く必要とされる場合に使用します。*裁判官エージェント*がグラウンディングプロンプトを作成して 2 人以上*の裁判官エージェント*に渡し、裁判官が応答を評価します。最良の結果を得るには、陪審員エージェントごとに異なるモデル (OpenAI のモデルと Anthropic のモデルなど) を使用します。
- **代表的な使用事例**:幻覚を最小限に抑えるために、忠実で事実に基づいた応答を提供します。
- **図**:
 - **Salesforce Agentic Maturity**:Level 2 (レベル 2)
### Model of Models (モデルパターンのモデル)
- **概要**:*モデルパターン*では、複数のエキスパートエージェントを活用して幅広い視点を生成し、コンセンサスを抽出します。\[[審査 & 審査員](/docs/architect/ja-jp/fundamentals/guide/enterprise-agentic-architecture#審査員と審査員のパターン)] パターンとは異なり、このパターンでは複数の視点を採用して豊かさを高めます。
- 異なる視点 (POV) を持つエキスパートモデルがタップすると便利な場合、このパターンは \[エキスパートのパネル] パターンと呼ばれることもあります。
- エージェントの応答が一般にアクセス可能な「真実」に収束するように意図する裁判官パターンと審査員パターンとは異なり、*モデルパターン*はエージェント環境の多様性を利用して応答の範囲を拡張します。
- このパターンは、個別の POV を持つエージェントが他にもいることを前提としています。たとえば、マルチ組織、マルチエージェント環境、またはベンダーが提供する複数のエージェントが技術スタックにまたがっている環境では、*モデルパターン*によって複数の見解を統合する構造が提供されます。
- このパターンを考慮する場合、他のより軽量なアプローチも考慮します。
- 複数のエキスパートエージェントを定義する代わりに、複数のプロンプトを指定して、システムがプロンプトのアンサンブルとして機能するようにします。
- コンテキストに応じて適切なデータにアクセスするアクションで「グラウンディング」を活用します。
- **出力タイプ**:生成インサイトを提供する。
- **パターン使用ガイダンス**:*アグリゲータ*エージェントの役割は、モデルエージェントが返した主要な概念に基づいて、豊富な見解を形成して返すことです。モデルエージェントは、独自の見解に基づいて回答を決定します。
- **代表的な使用事例**:異なる視点をまとめることで回答の質が向上する可能性がある状況で使用します。
たとえば、特権エージェント (*ERP エージェント*など) が貴重でアクセスできない POV を持つ可能性があるマルチシステムエージェント環境などです。
- **図**:
 - **Salesforce Agentic Maturity**:Level 2 (レベル 2)
## 9\.実行時間の長いプロセスパターン
*Long-Running Process パターン*は、長期間にわたって発生するプロセスを管理します。これには、複数のステップとアクターが含まれます。
### プロジェクトマネージャーパターン
- **概要**:*プロジェクトマネージャーパターン*は、長期にわたるプロジェクトを監視する複雑なパターンです。活動の調整、完了の追跡、ユーザーへの通知、関係者へのプロジェクト状況の表示を行います。
- **出力タイプ**:複数の出力 (ケース、ToDo、状況の更新、通知など) があります。
- **パターン使用ガイダンス**:定期的な繰り返しの複数ステップの活動をサポートする傘のパターンとして使用します。*プロジェクトマネージャーパターン*では、ToDo、ロール、連動関係を含むプロジェクトの入力テンプレート/アウトラインを取得し、ケースと活動をインスタンス化してユーザーに割り当てます。
- **代表的な使用事例**:取引先のインストール管理およびエンタープライズセールスエンゲージメントに使用します。
- **図**:
 - **Salesforce Agentic Maturity**:レベル 4
## 10\.エンタープライズオーケストレーションのアーキタイプ
パターンがエージェントの役割を説明するのに対し、*オーケストレーションの原型*では、エージェント集団がどのようにコラボレーションするかに関するシステムレベルのブループリントを定義します。これらのアーキタイプは、オーケストレーションの頭脳としての*Agentforce*とユニバーサルコネクタおよびアダプターとしての*MuleSoft*の役割を明確にします。
**アーキタイプ 1:SOMA (単一組織、複数エージェント)**
- **定義**:共有ガバナンスとデータを使用する 1 つの Salesforce 組織内で複数のエージェントがコラボレーションします。
- **アーキテクチャフロー**:Agentforce では、*スーパーバイザ エージェント*は 1 つのフロント ドアとして機能し、組織内の*スペシャリスト エージェント*に要求を転送します。外部機能の場合、エージェントは MuleSoft が MCP 対応以外の API の MCP ラッパーとして機能する _Agentforce MCP Client_ を使用します。
- **主な考慮事項**:このパターンでは、統合ガバナンス、ID、権限、およびオブザーバビリティを保持するために、オーケストレーションロジックが Salesforce (CRM コンテキストや Data 360 と同様) で一元化されます。
**アーキタイプ 2:Multi Org, Multiple Agents(MOMA; 複数組織、複数エージェント)**
- **定義**:エージェントは複数の Salesforce 組織でコラボレーションするため、データと権限の境界を越えて安全に連携する必要があります。
- **アーキテクチャフロー**:ある組織の*スーパーバイザ エージェント*が、標準化された*エージェント間 (A2A)* プロトコルを使用して別の組織のエージェントに ToDo を委任します。このハンドシェイクにより、組織レベルの Trust、ユーザー ID フロー、および共有会話コンテキストが確保されます。
- **主な考慮事項**:このパターンは、組織の自律性を維持しながら、企業全体のワークフローを可能にします。これにより、複雑な複数組織の資産で一貫したエージェント業務を行うための基盤が提供されます。
**アーキタイプ 3:マルチベンダー A2A(Salesforce 主導のオーケストレーション)**
- **定義**:Salesforce の*スーパーバイザーエージェント*は、A2A プロトコルを使用して、Salesforce ネイティブエージェントと他のベンダー (Google/Vertex や LangGraph など) のエージェントの組み合わせの作業を調整します。
- **アーキテクチャフロー**:*スーパーバイザーエージェント*は要求を処理して計画をまとめ、A2A プロトコルを使用して内部および外部ベンダーエージェントを呼び出します。A2A 対応ではない外部システムの場合、*MuleSoft*は既存のツールをラップして A2A と通信する「軽量のエージェントの外観」を公開できます。
- **主な考慮事項**:このアーキタイプでは、A2A を使用して、個別のオーケストレーション層なしでクリーンで管理可能な構成を生成することで、オーケストレーションの頭脳を CRM と Data 360 の近くに保ちます。
**アーキタイプ 4: Multi-Vendor A2A (MuleSoft-led Orchestration)**
- **定義**:オーケストレーションは Salesforce 以外のエントリポイントから開始されます。このエントリポイントでは、推論とルーティングを実行するために中立的な外部オーケストレーターが必要です。
- **アーキテクチャフロー**:外部システムの *UI エージェント*は、要求をオーケストレーションサービス (_MuleSoft Conductor_ の概念) に転送します。オーケストレーションサービスでは、インテントが解釈され、ToDo が計画されます。次に、A2A を使用して、CRM またはサービスアクション用の Agentforce エージェントを含むベンダーエージェントに通話を転送します。
- **主な考慮事項**:このパターンは、中立的なオーケストレーターがアーキテクチャ上望ましい Salesforce 以外のエントリポイントに使用します。ドメインシステムの UX を維持しながら、推論、ガバナンス、ポリシー、オブザーバビリティを MuleSoft で一元化します。
## 11\.ソリューションアセンブリ:パターンの作成
これらの個々のパターンとオーケストレーションのアーキタイプは、エンドツーエンドのソリューションで構成されるように設計されたアーキテクチャのビルディングブロックです。エージェントソリューションマップは、これらのコンポーネントがどのように接続されているかを視覚化するために使用されます。
- ヘルスケア プロバイダー向けの*メンバー サービス ソリューション*は、SOM アーキタイプの標準実装です。匿名ユーザー用の Answerbot、認証済みメンバー用の _Orchestrator_、および複数の*ドメイン SME エージェント* (ケース、請求、給付など) を使用して、特定の要求を処理します。
- *B2C ブローカー ポータル*は、ポータル _オーケストレーター_ エージェントを使用して RFP プロセスの実行時間が長い*プロジェクト マネージャー エージェント*を呼び出す複雑な構成です。次に、RFP プロセスはバックオフィス データ操作に*ヘッドレス*、_データ スチュワード_、*取調官エージェント*を使用します。
## 12\.結論
エージェント設計パターン手法は、堅牢で拡張性と保守性に優れたエンタープライズ AI システムを構築するために必要なアーキテクチャの規律を提供します。これらのパターンにより、複雑さを解消し、モジュール性を促進することで、アーキテクトは信頼性と予測性の高いエージェント型ソリューションを提供できます。
オーケストレーションのアーキタイプの選択は、ユーザーが作業する場所、コンテキストが存在する場所、および企業が人間、エージェント、システム間のやりとりをどのように管理しているかに基づいて戦略的な決定を行います。エージェントの作成とオーケストレーションの違いを理解し、*MCP*や*A2A*などのオープン プロトコルを活用することで、アーキテクトは孤立したボットの作成から、一貫性のある管理された分散型のエンタープライズ推論システムのエンジニアリングに移行できます。このアプローチでは、持続可能なエージェントアーキテクチャを構築するための共有言語と再利用可能なブループリントのセットが提供されます。
## 付録:ソリューションマップとシステムアーキテクチャ
この付録では、エージェントパターンをシステムレベルのソリューションに構成する具体的な例について説明します。
### 付録 A:基本パターン構成の例
次の図は、5 つの基本パターンを結合して共通のカスタマーサービスワークフローを作成する方法を示しています。
 1. **Answerbot**:匿名ユーザーが質問をすると、Knowledge ベースのエージェントが処理します。
2. **オペレータ**:従業員の質問はオペレータによってトリアージされ、オペレータは会話に項目を設定して、より専門的なエージェントに渡します。
3. **オーケストレーター**:認証済みユーザー (SF ユーザー) は、多面的な問い合わせを処理するために複数のエージェントを調整するオーケストレーターとエンゲージします。
4. **ドメイン SME**:スペシャリストエージェント (HR エージェントや福利厚生エージェントなど) は、オーケストレーターによって呼び出され、主題の更新を実行して特定のデータを取得します。
5. **発電**:機ユーティリティエージェントは、取引先の詳細を要約したり、やりとりの完了後にケースをラップしたりするために使用されます。
### 付録 B:エージェントソリューションマップ - メンバーサービス
このソリューションマップでは、メンバーサービスの使用事例のエージェントアーキテクチャの詳細を説明し、複数のパターンの構成を示します。
- **ユーザープロファイル**:このソリューションでは、次の 3 つの異なるユーザー種別が提供されます。匿名ユーザー、認証済みメンバー、SF ユーザー (人間の CSR など)。
- **インタラクションパターン**:*アンサーボット*は匿名の「Find-A-Doc」クエリを処理し、オーケストレーター (エージェントのフロントドア) は認証済みユーザーの問い合わせを管理します。*リスナー/フィードパターン*は、SF ユーザーを支援します。
- **Domain Agent Reuse**:特殊な*ドメイン SME エージェント* (ケースエージェント、請求エージェント、給付エージェントなど) は、さまざまなインタラクションフローで再利用されます。
- **自律 & 支援**:このシステムは、_自律エージェント_ (ユーザー操作を直接行うため) と*支援エージェント* (人間の CSR を増強するため) を組み合わせています。
- **データソース**:このアーキテクチャでは、公開データソースとエンタープライズデータソースが混在しており、接続に*は Data 360*と*MuleSoft*が広く使用されています。
 ### 付録 C:システムアーキテクチャ - コンタクトセンター
次の図は、機能レイヤーに整理されたコンタクトセンターの支援 AI ソリューションの論理アーキテクチャを示しています。
- **オーケストレーターエージェント**:さまざまな人格 (匿名、外部メンバー、CSR など) のユーザーエクスペリエンスを管理し、全体的なインタラクションフローを調整します。
- **ワーカーエージェント**:*複数の SME エージェント*が、Knowledge、ケース/請求/給付、提供者ディレクトリなどのコア・ビジネス・ドメインに重点を置いています。_Next Best Action_ エージェントも含まれます。
- **ユーティリティエージェント**:翻訳、ケースラップアップ、通話の概要など、特定の再利用可能なタスクを実行します。
インテグレーションおよびコアシステム:エージェントシステム全体は、クロスプラットフォームインテグレーションレイヤーを介して、非構造化データリソース、構造化データリソース、コアエンタープライズシステムに接続されます。
- **ガバナンス**:ガバナンスレイヤーは、エージェントが使用する LLM/SLM の監視性、評価、管理を提供します。
 ### 付録 D:エージェントソリューションマップ - ブローカーポータル
このソリューションマップでは、B2B 健康保険ブローカーポータルの複雑で実行時間の長いエージェント操作の詳細が示されます。このモデルには、複数のステップ(RFP の送信や提案の受信など)でブローカーのジャーニーを促進する*ポータル エージェント*(_オーケストレーター_)が含まれます。このオーケストレーターは、_プロジェクト マネージャー_ エージェントを呼び出します。次に、プロジェクト マネージャーは、RFP Extractor、国勢調査変換、データ スチュワードなど、バック オフィス データの品質と変換に関する複数のヘッドレス エージェントを調整します。
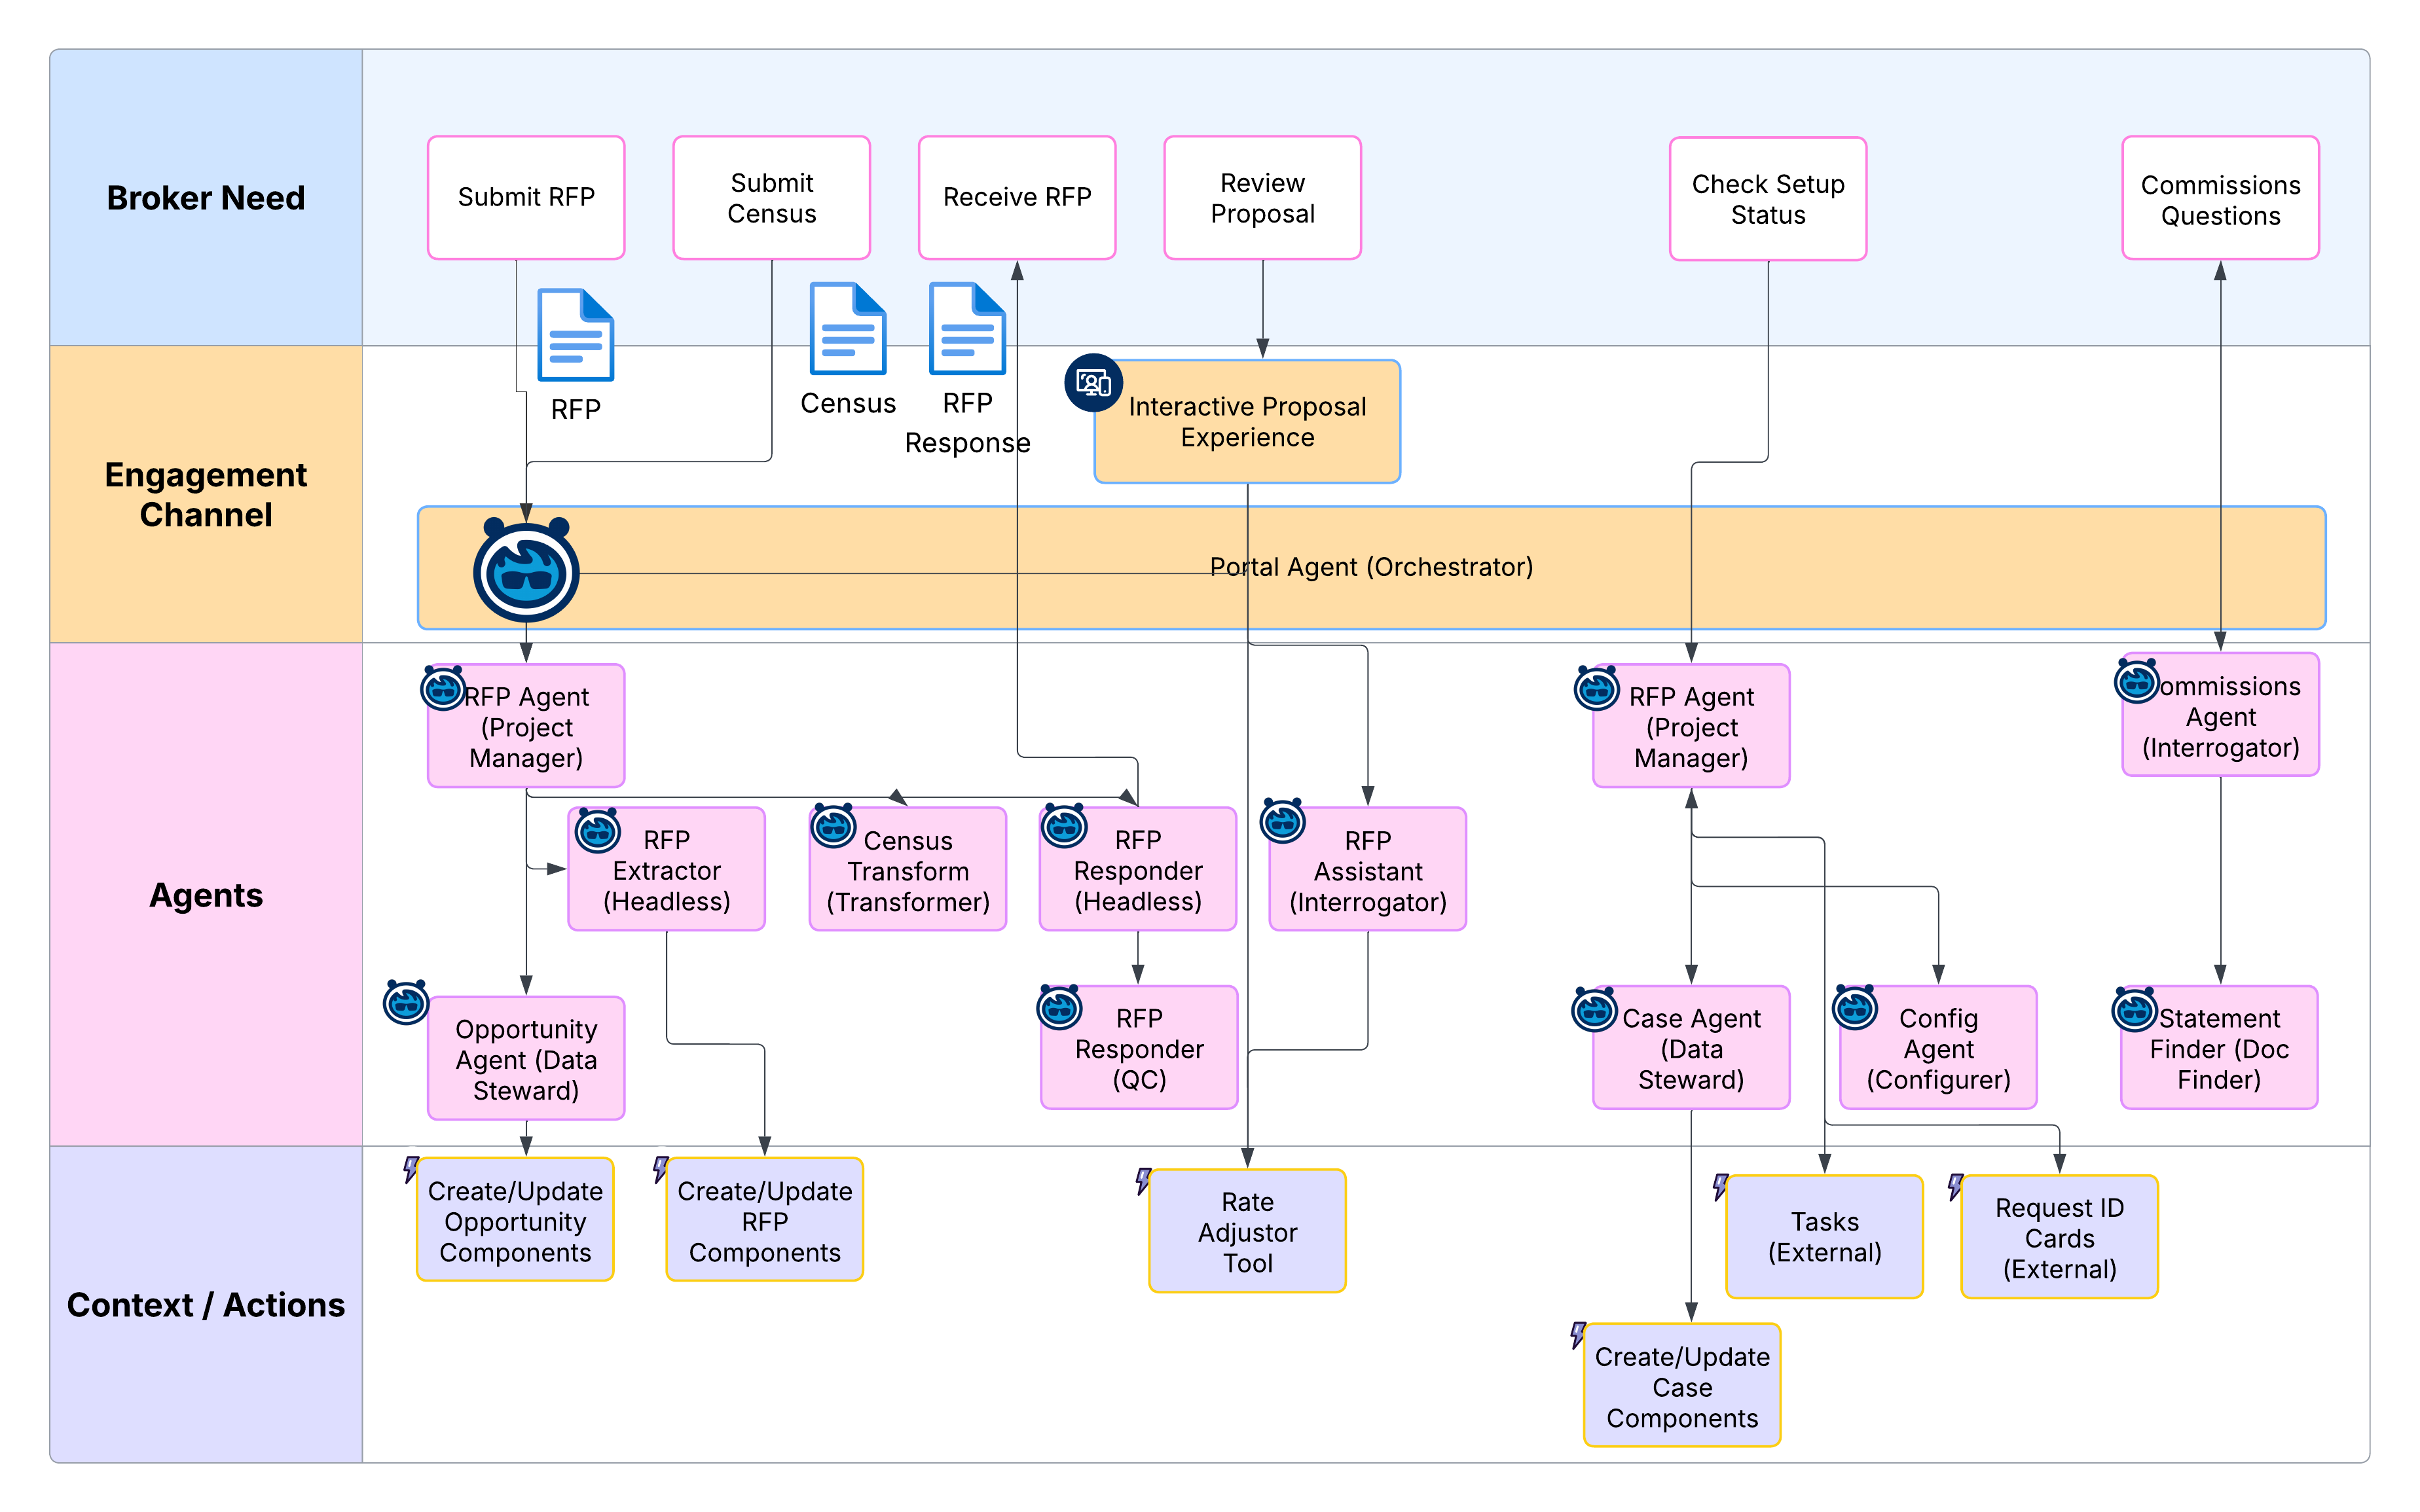 ### 付録 E:システムアーキテクチャ - B2C ブローカーエージェント
次の図は、コンタクトセンターと同様の階層化アプローチを示す B2C ブローカーソリューションの論理アーキテクチャを示しています。これには、さまざまなユーザー・人格用の*オーケストレーター・エージェント*、主要なドメイン(Knowledge、Member Services、Commissions など)用の再利用可能な*ワーカー・エージェント*、翻訳や集計などの特定の機能用の*ユーティリティ・エージェント*が含まれます。
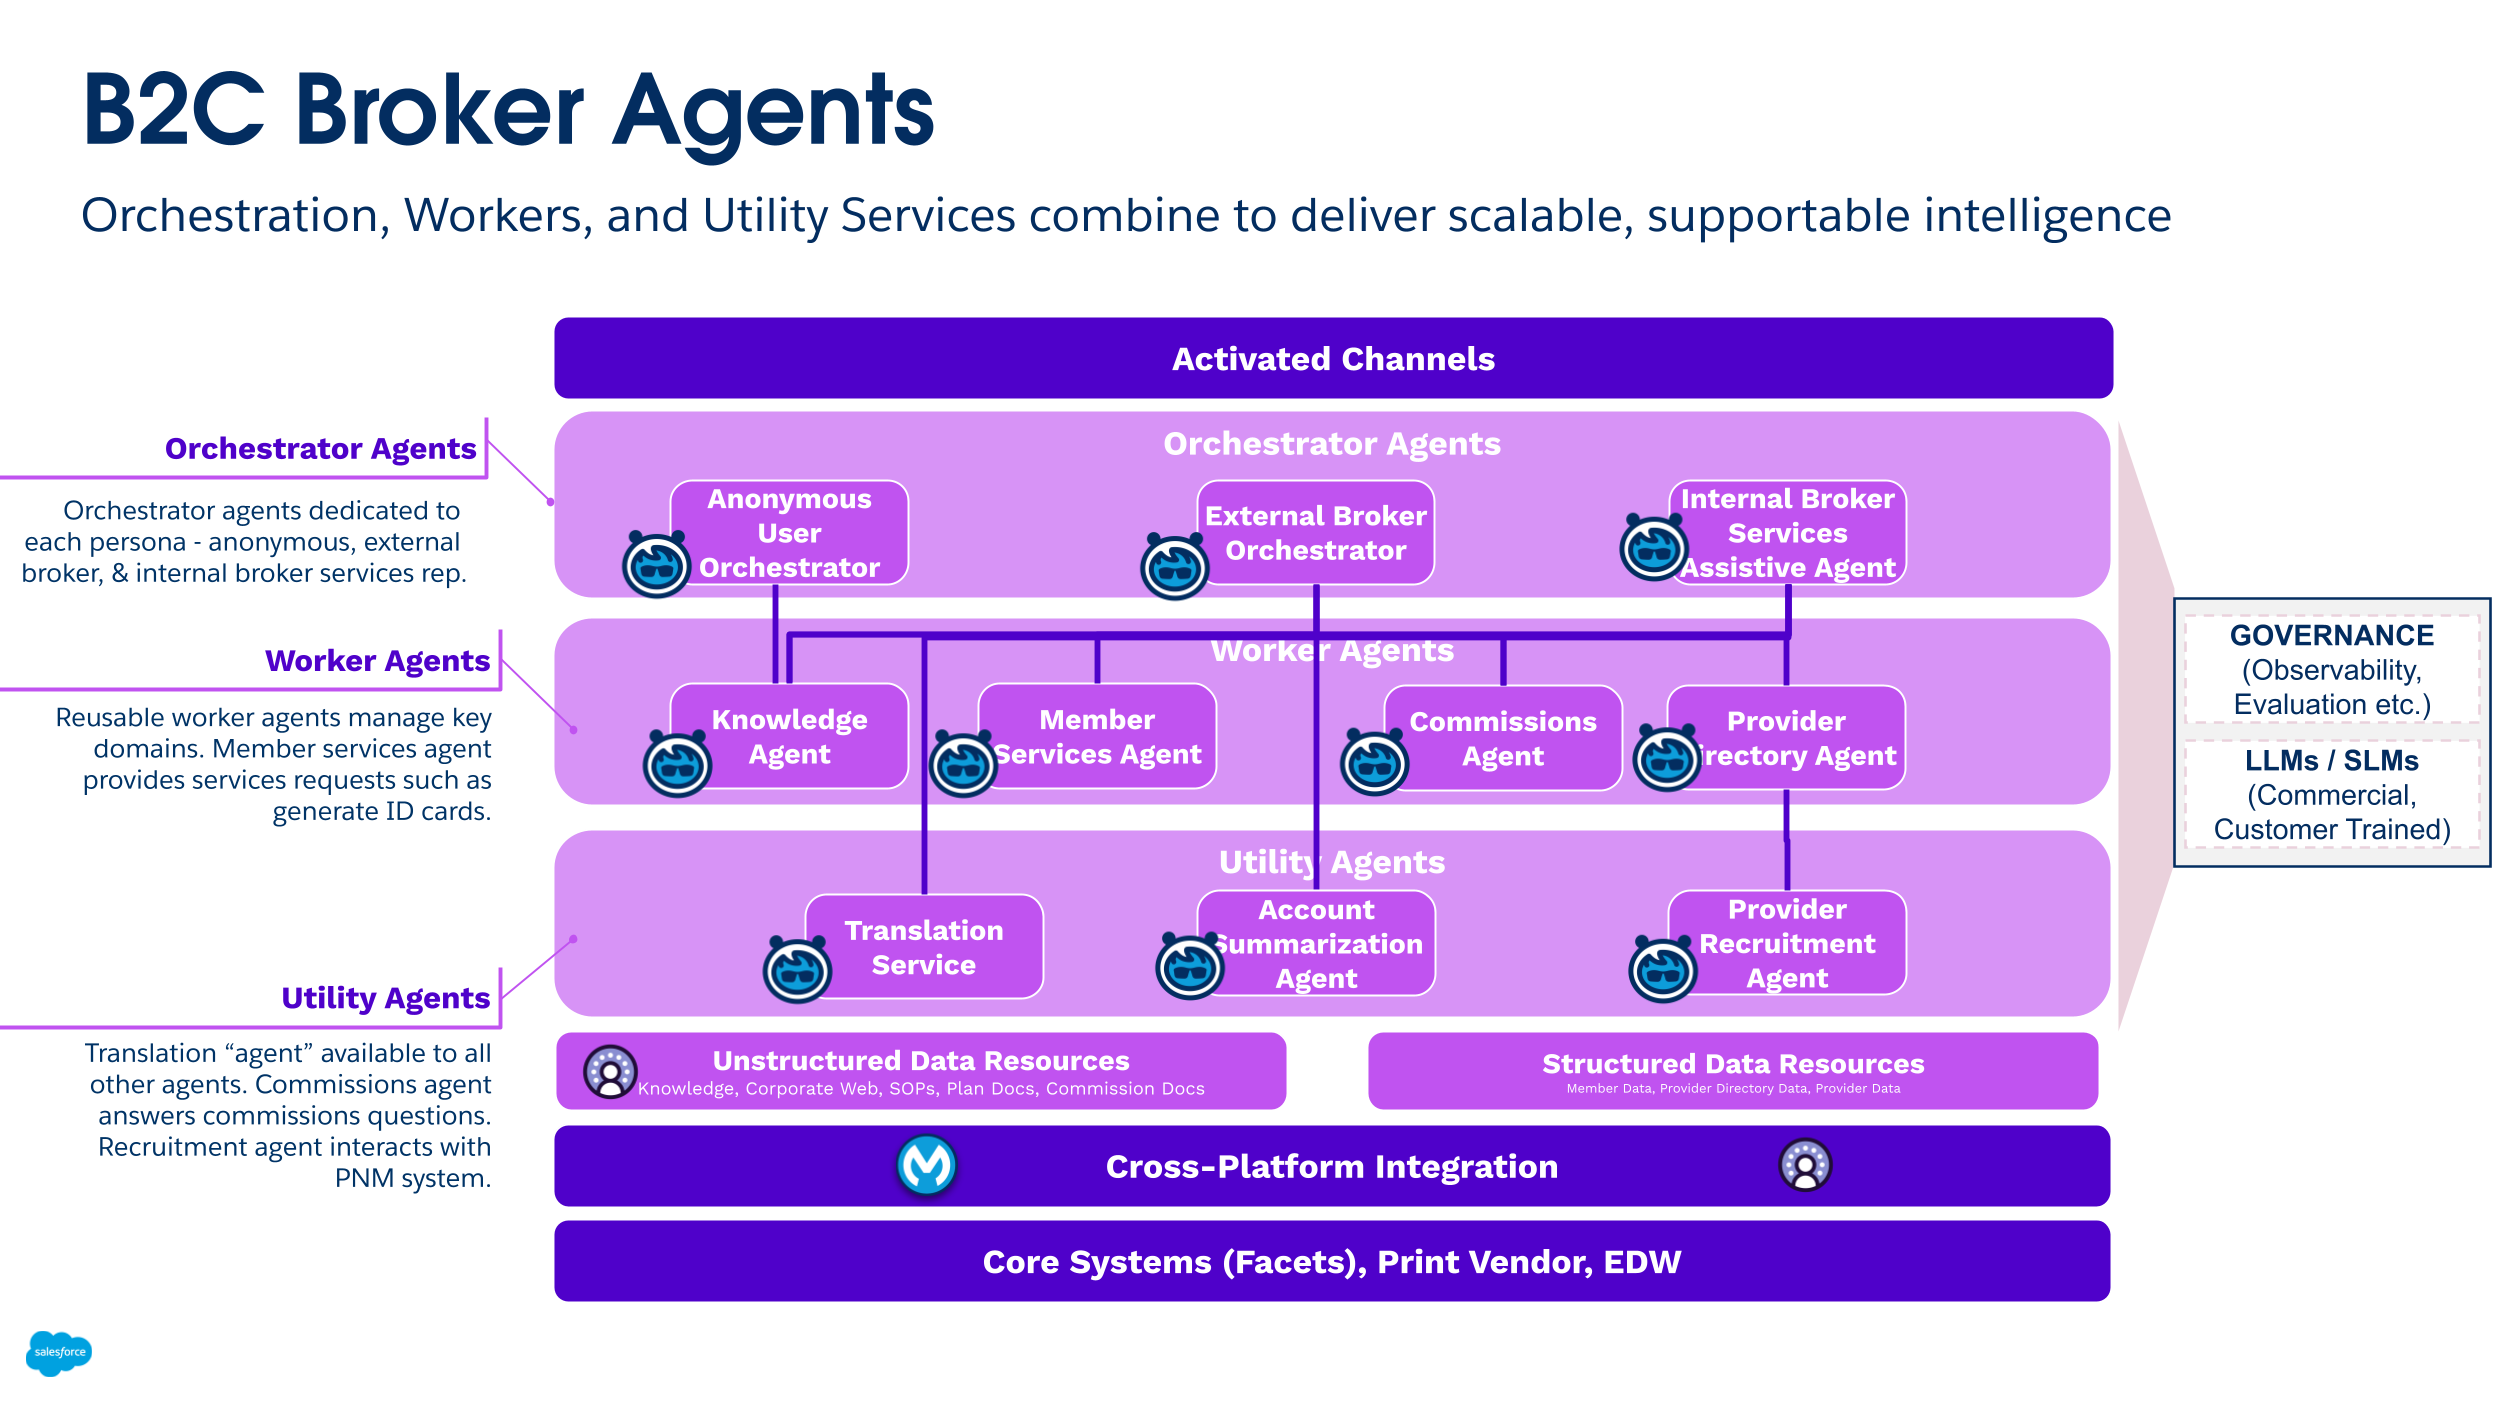 ### 付録 F:システムアーキテクチャ - プロバイダー契約
次の図は、提供者契約ソリューションの論理アーキテクチャを示しています。*オーケストレーター*エージェントは完全なインタラクションを管理し、*ワーカーエージェント*はドメイン内の特定のインテント (契約 SME エージェントなど) を管理し、*ユーティリティ*エージェントは契約の比較やインサイトの生成などの個別のタスクを実行します。
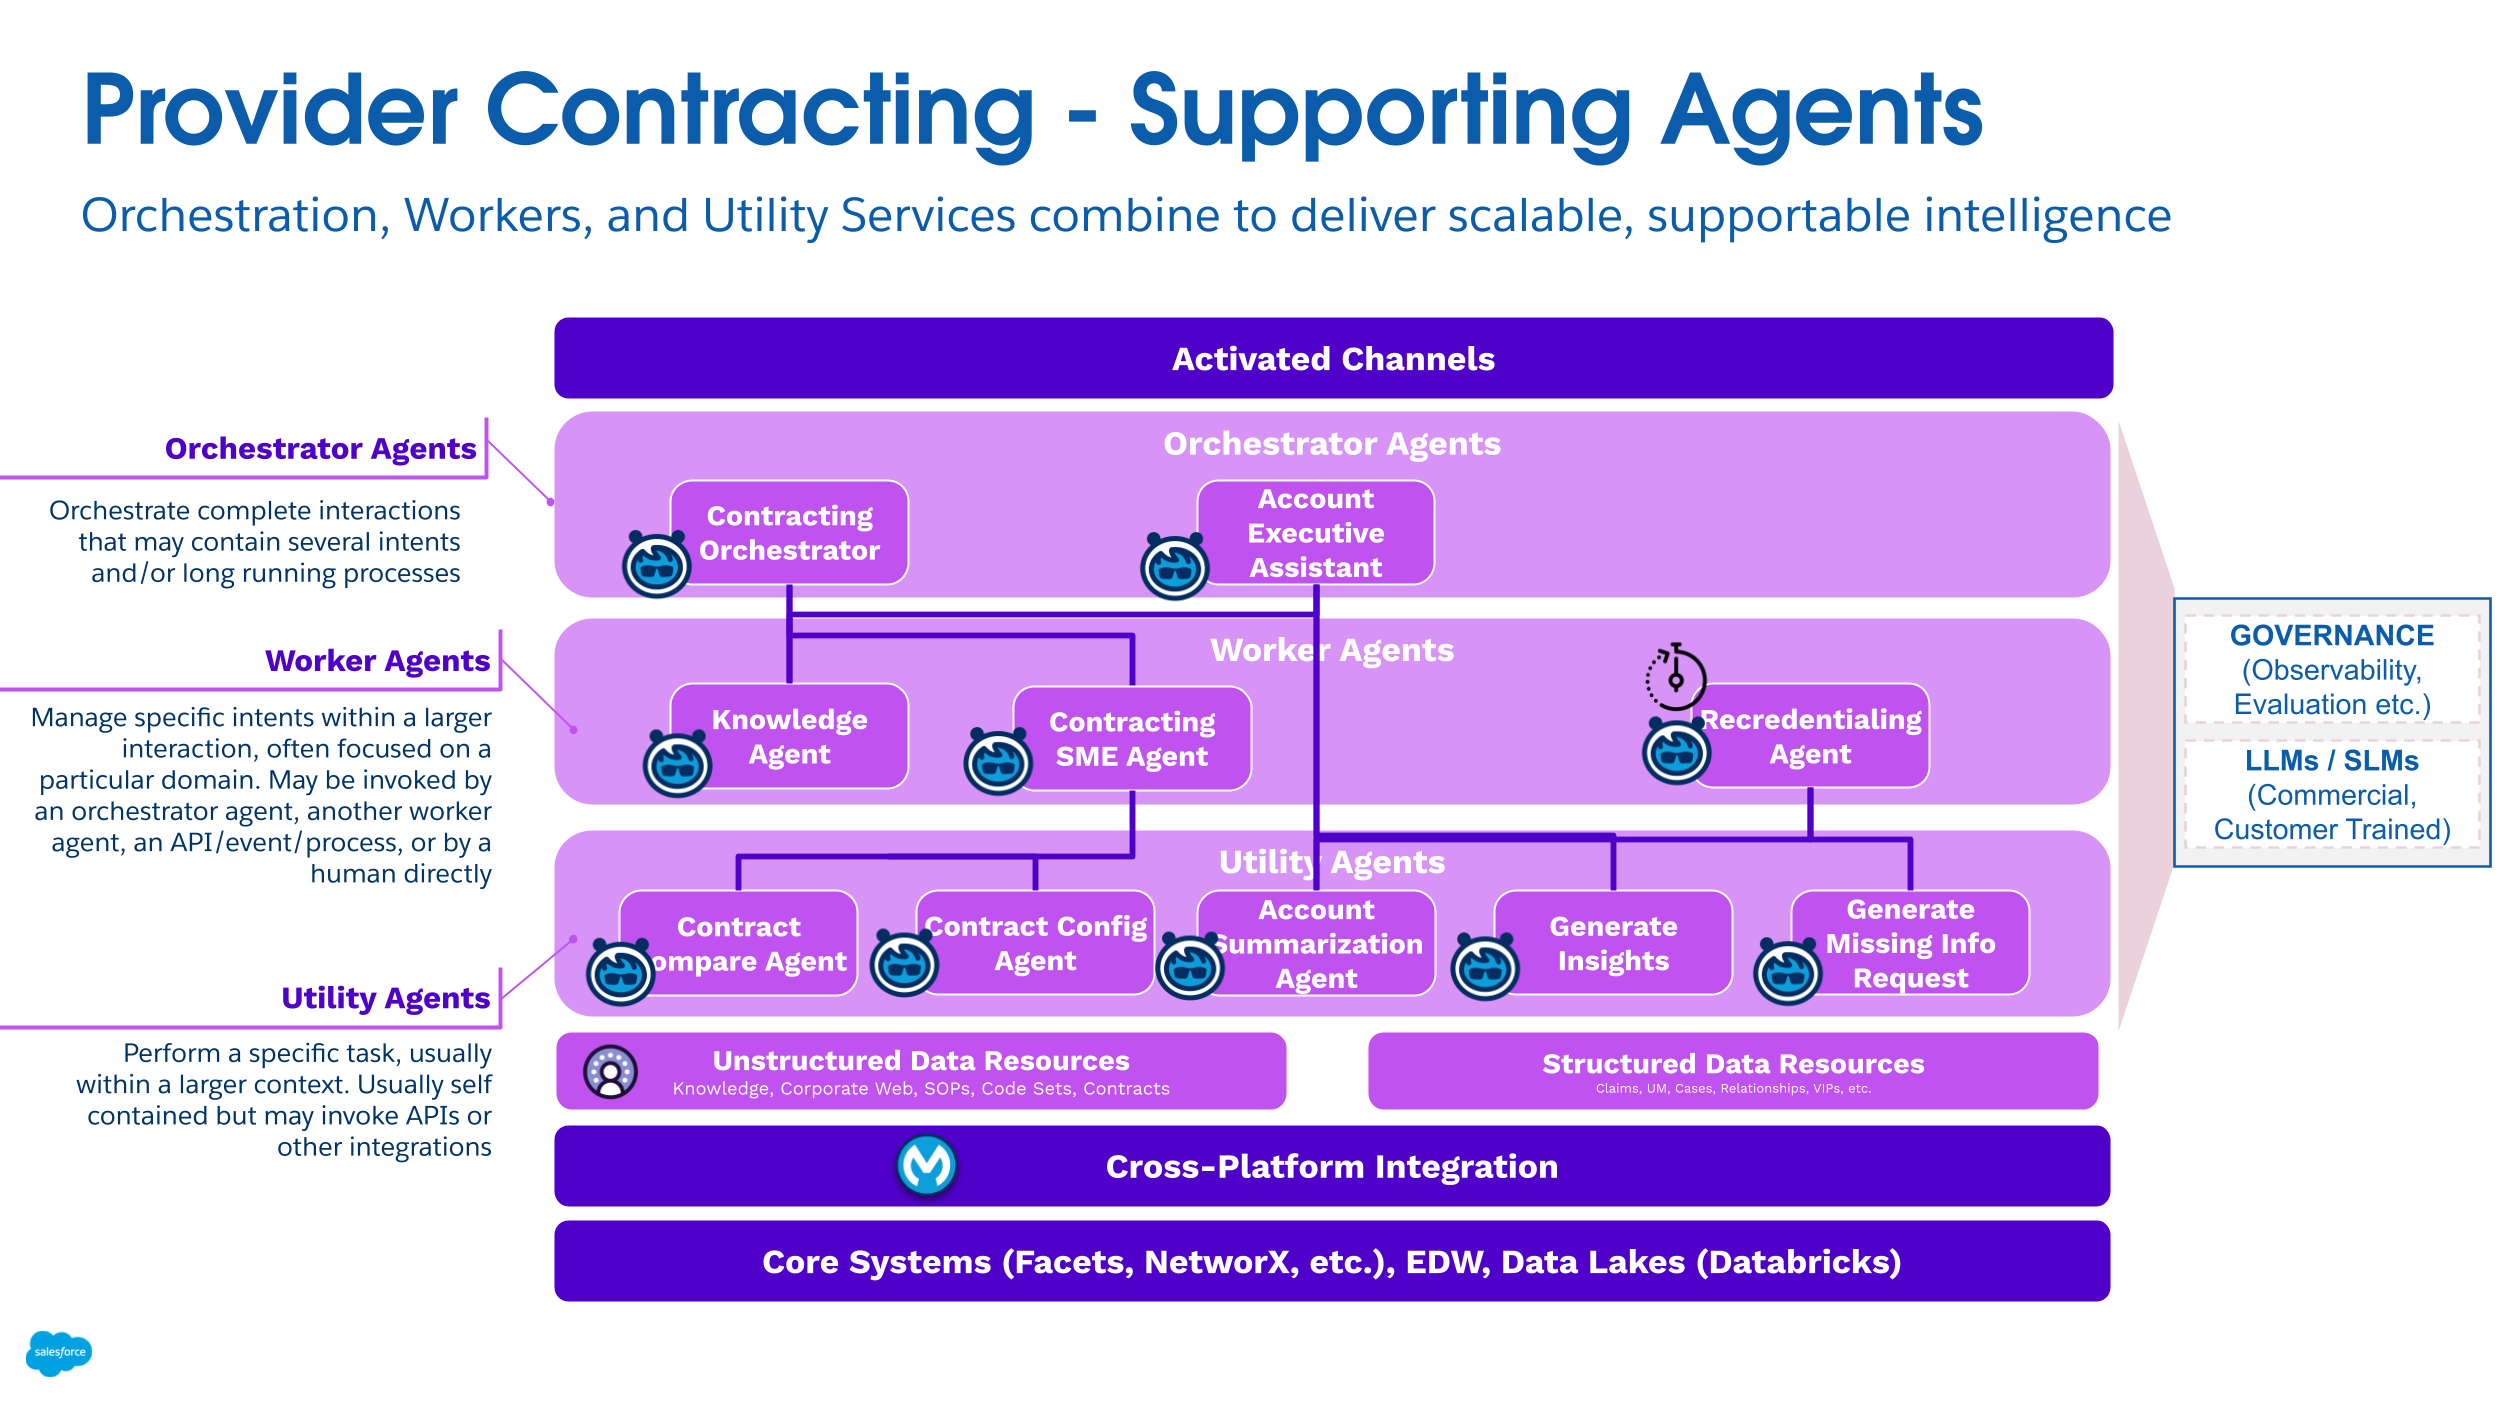 ### 付録 G:インタラクションパターン概要テーブル
次の表に、いくつかの主要なインタラクションパターン、一般的なユーザーエクスペリエンス、および主要なアーキテクチャの目的をまとめます。
| パターン | ユーザーエクスペリエンス (UX) | 目的 |
|---|---|---|
| グリーター | 応答者がインタラクションを人間に転送することで終わるターンバイターンのテキスト (チャット、音声、SMS など) | これは、ユーザーのインテントを判断し、ユーザーを適切な人間のエージェントに転送するために使用される単純なパターンです。 |
| 演算子 | 応答者がやりとりを人間またはスペシャリストエージェントに転送することで終わるターンバイターンのテキスト (チャット、音声、SMS など) | これは、要求を適切なハイブリッドエージェントに転送するために使用されます。グリーターを基盤に構築されたこのシンプルなパターンでは、インテントをネゴシエートし、インタラクションを専用の人間または AI エージェントに転送します。 |
| オーケストレーター | 回答者がスペシャリストエージェントの回答を収集および集計して UX に配信するターンバイターンのテキスト (チャット、音声、SMS など) | これは、会話の進行状況に応じて応答する管理 AI エージェント「スウォーム」を調整するために使用されます。オーケストレーターエージェントは各ターンのテキストを 1 人以上のスペシャリストエージェントに渡し、各スペシャリストエージェントの回答を集計します。 |
| アンサーボット | プロンプトと応答 | これは、Knowledgeリソース、FAQ、ポリシーなどを使用して応答を形成する自然言語インタフェースです。 |
| 取調官 | プロンプトと応答 | これは、特定のドメインまたは領域で質問するために使用する自然言語インターフェースです。 |
| リスナー/フィード | リニアフィードのオーケストレーターパターンで終わるターンバイターンのテキスト (チャット、音声、SMS など) | これは、会話の流れの中でコンテキストとインサイトを明らかにするために使用されます。 |
| ワークスペース (Radar O'Reilly) | 適応性のある 1 か所のガラス張りヘッドアップディスプレイで終わるターンバイターンのテキスト (チャット、Voice、SMS など) | これは、会話のフローで応答性の高い 1 か所の UX を管理するために使用されます。 |
| 事前クエリ選択性メジャメント | 最終的なデータベースアクセスクエリを記述します。強制... | |
| User | 検索条件 | |
| Low | Low | ...ネストされたループが結合され、ユーザーに表示される行のビューを使用してドライブ |
| Low | High (高) | ...検索条件に関連するインデックスの使用 |
| High (高) | Low | ...順序付きハッシュ結合、MT_DATA を使用したドライブ |
| High (高) | High (高) | ... インデックス関連検索条件の使用 |