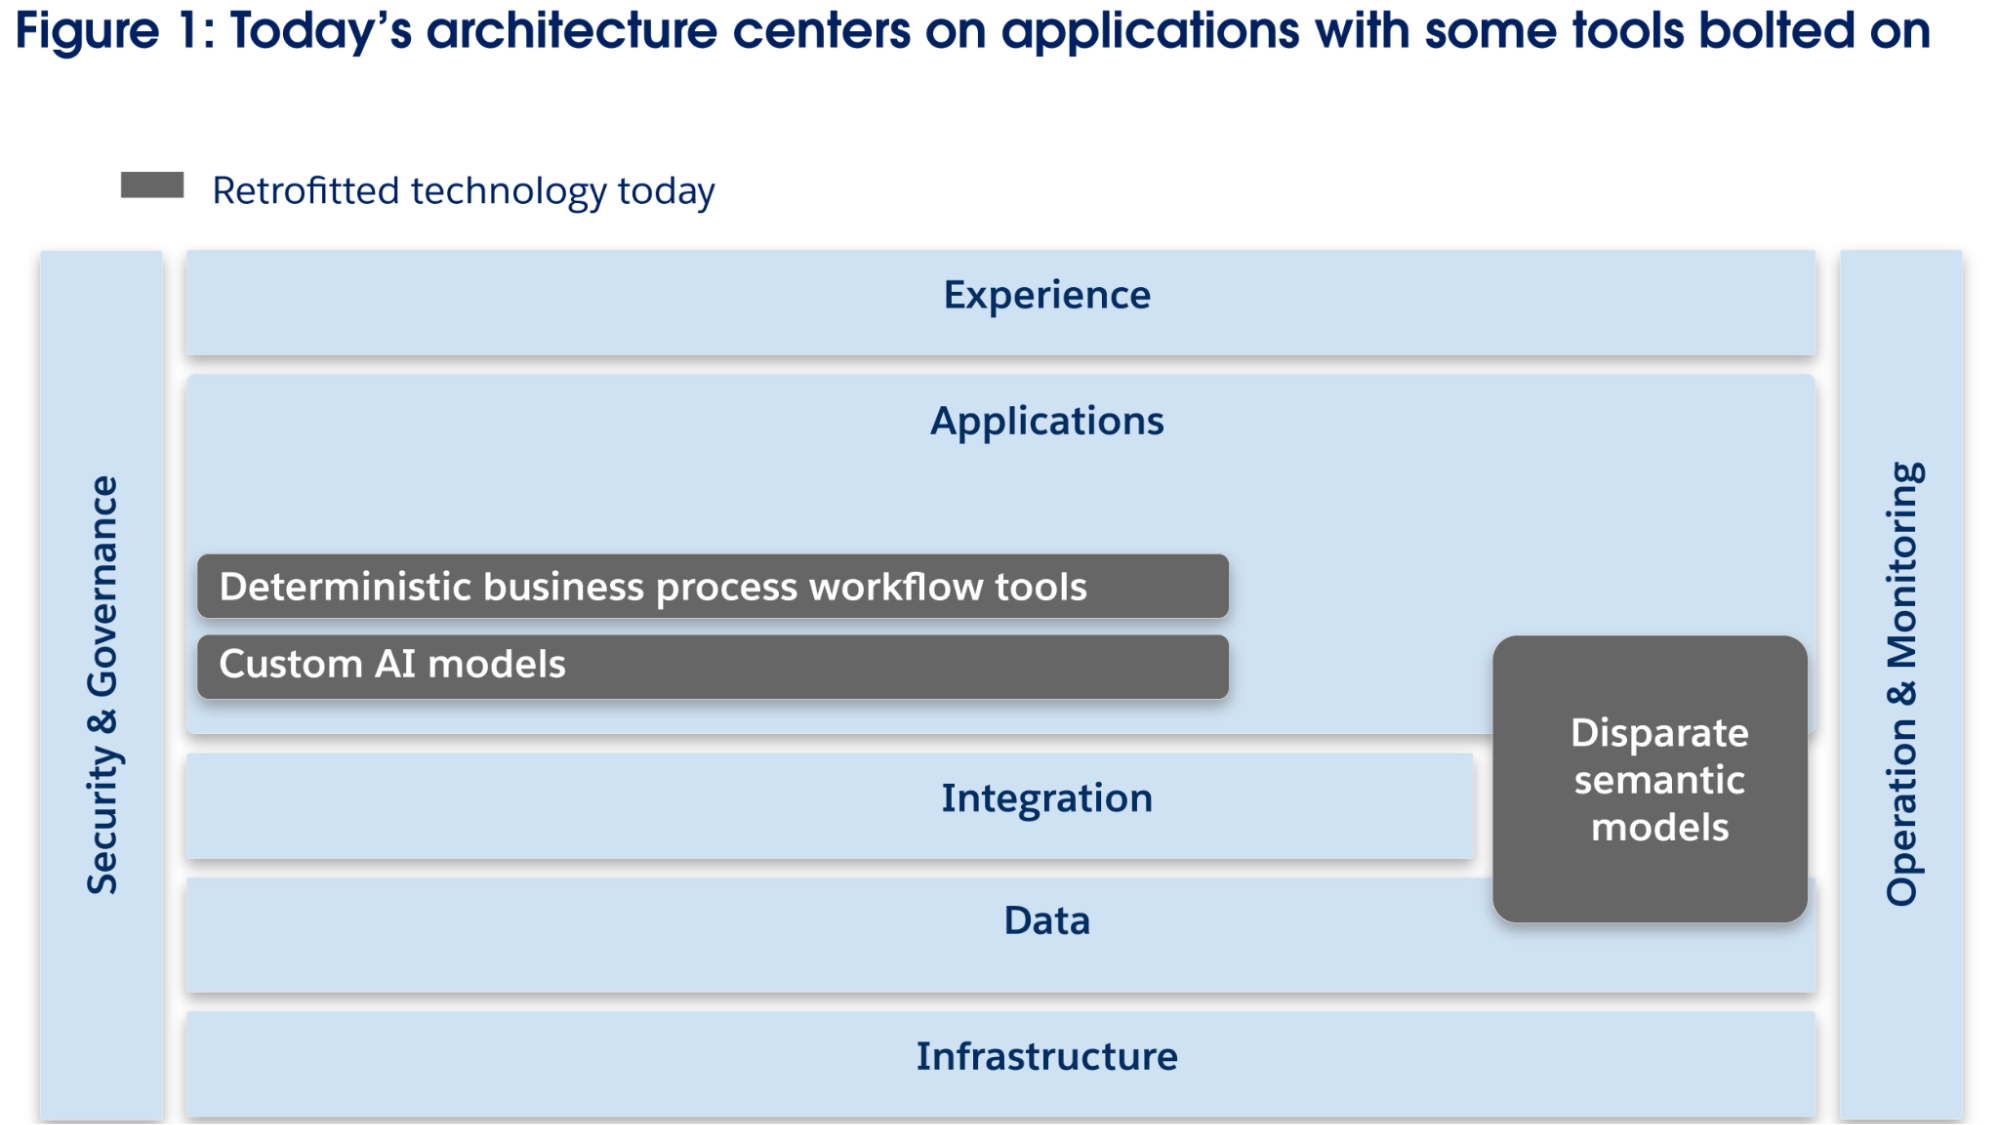
 Benché l'architettura tradizionale supporti oggi distribuzioni sottoscala di agenti AI, non è in grado di offrire appieno le funzionalità aziendali dell'organizzazione agente descritte sopra. La realizzazione di queste funzionalità richiede un'architettura IT progettata per la distribuzione su larga scala di agenti di intelligenza artificiale potenti che possono gestire casi d'uso ampi anziché essere limitati a distribuzioni limitate destinate a casi d'uso ristretti.
Gli agenti dell'intelligenza artificiale continueranno a migliorare nei prossimi 5 anni e l'architettura IT dovrà evolversi per realizzare il valore di agenti dell'intelligenza artificiale più potenti e intelligenti, per diventare a prova di futuro. In primo luogo, gli agenti diventeranno più intelligenti man mano che i modelli di intelligenza artificiale sottostanti (ad esempio, LLM multimodali) e le architetture cognitive degli agenti si evolveranno (ad esempio, pianificazione a più fasi, decomposizione delle operazioni e così via). In secondo luogo, gli agenti dell'intelligenza artificiale avranno migliori capacità di apprendimento e adattamento con miglioramenti della memoria, capacità di auto-riflessione e la capacità di imparare dai feedback. In terzo luogo, gli agenti AI avranno una maggiore capacità di interagire con altri agenti, strumenti e dati, come evidenziato dall'ecosistema in rapida evoluzione di standard tecnologici aperti (ad esempio, Model Context Protocol, Agent2Agent e così via). Sebbene queste tre tendenze tecnologiche consentiranno agli agenti dell'intelligenza artificiale di essere più potenti nell'esecuzione di operazioni più astratte e complesse, introdurranno anche numerose sfide per l'architettura IT odierna.
In primo luogo, gli agenti AI si basano fondamentalmente su modelli AI, sia sviluppati internamente che di origine esterna, che evolvono rapidamente e richiedono una gestione dei modelli AI/ML sofisticata, condivisa e standardizzata. Oggi, i modelli di intelligenza artificiale sono agganciati per casi d'uso specifici in un'applicazione, non come funzionalità condivise per il riutilizzo con strumenti comuni per la formazione, la distribuzione, la governance e la gestione del rischio. In futuro, le aziende dovranno essere in grado di utilizzare modelli di intelligenza artificiale diversi per vari casi d'uso agentici che richiedono strumenti che consentano agli agenti di sostituire i modelli sottostanti (ad esempio, modello di base e modello più piccolo specifico del dominio) in base al contesto aziendale. Ciò richiede la gestione di modelli di intelligenza artificiale sviluppati internamente o ospitati con strumenti unificati per il ciclo di vita per garantire coerenza, riutilizzabilità, scalabilità ed efficienza. Analogamente, l'accesso ai modelli di intelligenza artificiale ospitati esternamente richiede un framework di controllo a livello aziendale per garantire prestazioni, sicurezza, conformità, disponibilità e affidabilità ottimali.
In secondo luogo, gli agenti AI hanno schemi di scalabilità e requisiti operativi distinti, ad esempio hosting, sviluppo, ragionamento, apprendimento, gestione della memoria e operazioni, che richiedono un confine architettonico separato e dedicato per gli agenti. L'integrazione di questa funzionalità direttamente nell'odierna architettura di applicazione statica e deterministica introdurrebbe una complessità e un rischio architetturale inutili. Inoltre, gli agenti AI dovrebbero interagire con le applicazioni esistenti tramite interfacce standardizzate o sistemi di messaggistica per l'interazione in tempo reale.
In terzo luogo, gli agenti di intelligenza artificiale devono essere in grado di ragionare su serie di dati diverse e collaborare tra loro, spesso in pile di applicazioni in silo, ma nell'architettura odierna non esiste una funzionalità semantica comune che fornisca una comprensione condivisa per questi agenti per ragionare su serie di dati diverse. Di conseguenza, sebbene gli agenti monouso possano essere distribuiti con successo, la loro scalabilità per operare in gran numero su operazioni complesse tra silos rimane difficile e rischiosa.
Infine, l'attuale architettura IT aziendale non dispone di un modo efficace per orchestrare, ottimizzare e governare i processi aziendali end-to-end che includono i flussi di lavoro dinamici eseguiti da agenti più potenti, che aumenteranno e in alcuni casi sostituiranno il ruolo svolto dai lavoratori umani in quel processo. Oggi, gli strumenti di automazione vengono utilizzati per gestire flussi di lavoro lineari e deterministici che in genere seguono una sequenza predefinita, documentata in linguaggi specifici dei processi e si basano su una logica statica che cambia raramente. Le tecnologie AI possono migliorare alcuni di questi processi lineari (ad esempio, utilizzando modelli ML anziché regole aziendali codificate per calcolare le soglie di approvazione dei prestiti), ma gli aspetti strategici ed esecutivi della maggior parte dei processi aziendali critici rimangono per loro natura dinamici e flessibili. Operazioni come lo sviluppo di strategie di marketing, la risoluzione di problemi complessi dei clienti o la ricerca di clienti potenziali hanno obiettivi chiari (soddisfazione dei clienti, velocità di risoluzione dei casi e così via) ma non seguono una sequenza di esecuzione fissa e predefinita.
Attualmente, le aziende tradizionali si affidano principalmente agli esseri umani per coordinare ed eseguire questi processi aziendali complessi (ad esempio, impostare la strategia e gestire programmi complessi). Man mano che gli agenti dell'intelligenza artificiale continueranno a evolversi (maggiore capacità di intelligenza, apprendimento e interazione) nei prossimi 3-5 anni, la loro capacità di eseguire tali processi dinamici in autonomia aumenterà in modo significativo, introducendo complessità e sfide di integrazione che superano di gran lunga le funzionalità degli strumenti di integrazione e automazione esistenti. La natura adattiva e dinamica degli agenti AI crea un forte bisogno di nuove funzionalità di orchestrazione per garantire un controllo a livello aziendale, una visibilità completa e un allineamento coerente con gli obiettivi strategici a livello aziendale, in particolare nella gestione di flussi di lavoro complessi, lunghi e in più fasi che includono agenti AI, persone, strumenti di automazione e altri sistemi deterministici.
L'architettura IT di Agentic Enterprise stabilisce una piattaforma per azioni intelligenti integrando perfettamente lavoratori umani, agenti AI e sistemi deterministici. Questa architettura consente sia agli agenti umani che agli agenti dell'intelligenza artificiale di accedere dinamicamente a Knowledge aziendale unificata da fonti di dati diverse e di sfruttarla, arricchita da contesto semantico, per eseguire in modo efficiente flussi di lavoro e processi complessi in linea con gli obiettivi aziendali strategici. L'architettura IT esistente di un insieme di piattaforme e soluzioni puntuali in silo si evolverà verso un insieme di servizi applicativi componibili, strumenti semantici e di dati e reti di agenti AI supervisionati e governati da nuovi strumenti di orchestrazione intelligente dei processi aziendali.
Questa architettura consente agli agenti di percepire, ragionare e agire nei rispettivi ambiti, lavorare all'interno e tra i domini aziendali e imparare, migliorare e adattarsi continuamente. Ciò richiede una progettazione incentrata su meccanismi efficaci per accedere a dati e Knowledge (comprensione semantica), protocolli e interfacce di comunicazione flessibili e standardizzati (ad esempio, da agente ad agente, da agente a sistemi deterministici e da agente a umano) e, in modo critico, orchestrare flussi di lavoro e processi tra agenti, esseri umani e strumenti di automazione e sistemi deterministici.
### Principi di architettura
Per realizzare la visione architettonica di una piattaforma per azioni intelligenti, si consiglia di seguire questi principi di progettazione come procedura ottimale:
- **Componibilità e modularità:** Progettare gli elementi architettonici come componenti modulari con interfacce standardizzate per consentire un assemblaggio rapido e dinamico delle capacità degli agenti, dei flussi di lavoro e delle superfici rivolte al pubblico. Assegnare priorità a contratti di interfaccia chiari e astrazione per consentire agli agenti dell'intelligenza artificiale la massima flessibilità di composizione dei flussi di lavoro.
- **Prima i dati e la semantica:** Garantire un accesso completo, preciso, rapido, sicuro ed economico ai dati, con una comprensione semantica condivisa per consentire agli agenti di ragionare in modo efficace tra i sistemi in silo. Ciò richiede il trattamento dei dati (e dei metadati) come prodotto, con strumenti che garantiscano qualità, discendenza, governance e accesso, nonché un modo per fornire una comprensione semantica condivisa tra agenti e persone.
- **Osservabilità IT e aziendale incorporata:** Incorporare funzionalità di monitoraggio, tracciamento, valutazione e spiegabilità end-to-end nell'intera architettura per ottenere informazioni sul ragionamento, i comportamenti, le interazioni di sistema e l'impatto degli agenti sui KPI aziendali per consentire l'ottimizzazione continua delle prestazioni degli agenti. Ciò include l'ottimizzazione dei costi (FinOps), le metriche di sostenibilità e la telemetria operativa mantenendo Trust, conformità e consumo responsabile delle risorse. Poiché gli agenti AI sono per loro natura non deterministici, l'osservabilità è fondamentale per garantire che gli agenti AI possano operare in modo affidabile, conforme e controllabile con la supervisione umana.
- **Truste in tutto:** Applicare autorizzazioni dinamiche e granulari basate sull'intento delle operazioni dell'agente (accesso ai dati, azioni e così via) e implementare procedure di sicurezza complete che includono il teaming rosso, la scansione CVE automatica, il rilevamento delle vulnerabilità e i controlli di convalida basati sui rischi. Sono necessari controlli più granulari e dinamici dato il rischio che gli agenti causino rischi a catena a causa della loro capacità di operare a velocità della macchina. Assicurarsi che tutti gli output generati dall'intelligenza artificiale (da agenti o modelli) siano rigorosamente convalidati rispetto alle policy definite per conformità, sicurezza, tossicità e distorsione prima dell'uso o della consegna, richiedendo meccanismi di registrazione e spiegabilità con percorsi di controllo verificabili per decisioni, azioni, contenuti e previsioni dell'intelligenza artificiale.
- **Agente primo con supervisione umana:** Abilitare gli agenti dell'intelligenza artificiale come strumento predefinito per risolvere i casi d'uso aziendali, escludendo altre considerazioni (ad esempio, costo, preparazione tecnica) e progettare sistemi IT in modo che siano accessibili per i flussi di lavoro degli agenti. Ciò include la possibilità per gli esseri umani di monitorare, intervenire e ignorare qualsiasi fase del processo di un agente. Gli agenti richiedono capacità di auto-riflesso per cercare in modo proattivo una guida umana se la loro fiducia nel processo decisionale scende al di sotto delle soglie pre-programmate.
- **Interazione reattiva e multimodale:** Abilitare l'architettura per supportare meccanismi completi di invocazione e risposta degli agenti in tutti i tipi di interazione, inclusi protocolli da agente ad agente, input multimodali umani (voce, testo, visivo), eventi aziendali, segnali di sistema e dati in streaming. Abilitare le funzionalità di elaborazione basate sugli eventi e in tempo reale per garantire che gli agenti possano reagire a qualsiasi segnale tempestivo da qualsiasi fonte o formato.
- **Infrastruttura AI-ready:** Assicurarsi che l'infrastruttura possa scalare in modo elastico con la ridondanza incorporata per gestire carichi di lavoro AI fluttuanti e integrare le pipeline ML/LLM nell'architettura dei dati e delle applicazioni, mantenendo la conformità ai requisiti di residenza dei dati.
- **Ecosistema aperto:** Assegnare priorità all'interoperabilità ed evitare il blocco tecnologico privilegiando standard aperti, protocolli e interfacce ben definite (API, eventi) per trarre vantaggio dall'ecosistema tecnologico.
## Livelli architettura
Per abilitare e scalare con successo la trasformazione agente, le aziende devono andare oltre il semplice miglioramento dei livelli attuali; devono valutare la possibilità di introdurre esplicitamente quattro livelli architetturali aggiuntivi (Figura 2) progettati specificamente per soddisfare le esigenze degli agenti AI.
Il **livello agente** è dedicato allo sviluppo e alla gestione degli agenti AI, che comprende capacità cognitive come pianificazione, ragionamento, memoria, utilizzo degli strumenti, gestione dello stato e controllo del ciclo di vita. Questo livello soddisfa i requisiti tecnici e operativi specifici degli agenti AI, garantisce l'interoperabilità tra applicazioni e archivi di dati tramite protocolli standardizzati e facilita la collaborazione tra agenti. Il livello di applicazione esistente si evolverà in servizi di applicazione per essere composto dinamicamente per i flussi di lavoro degli agenti.
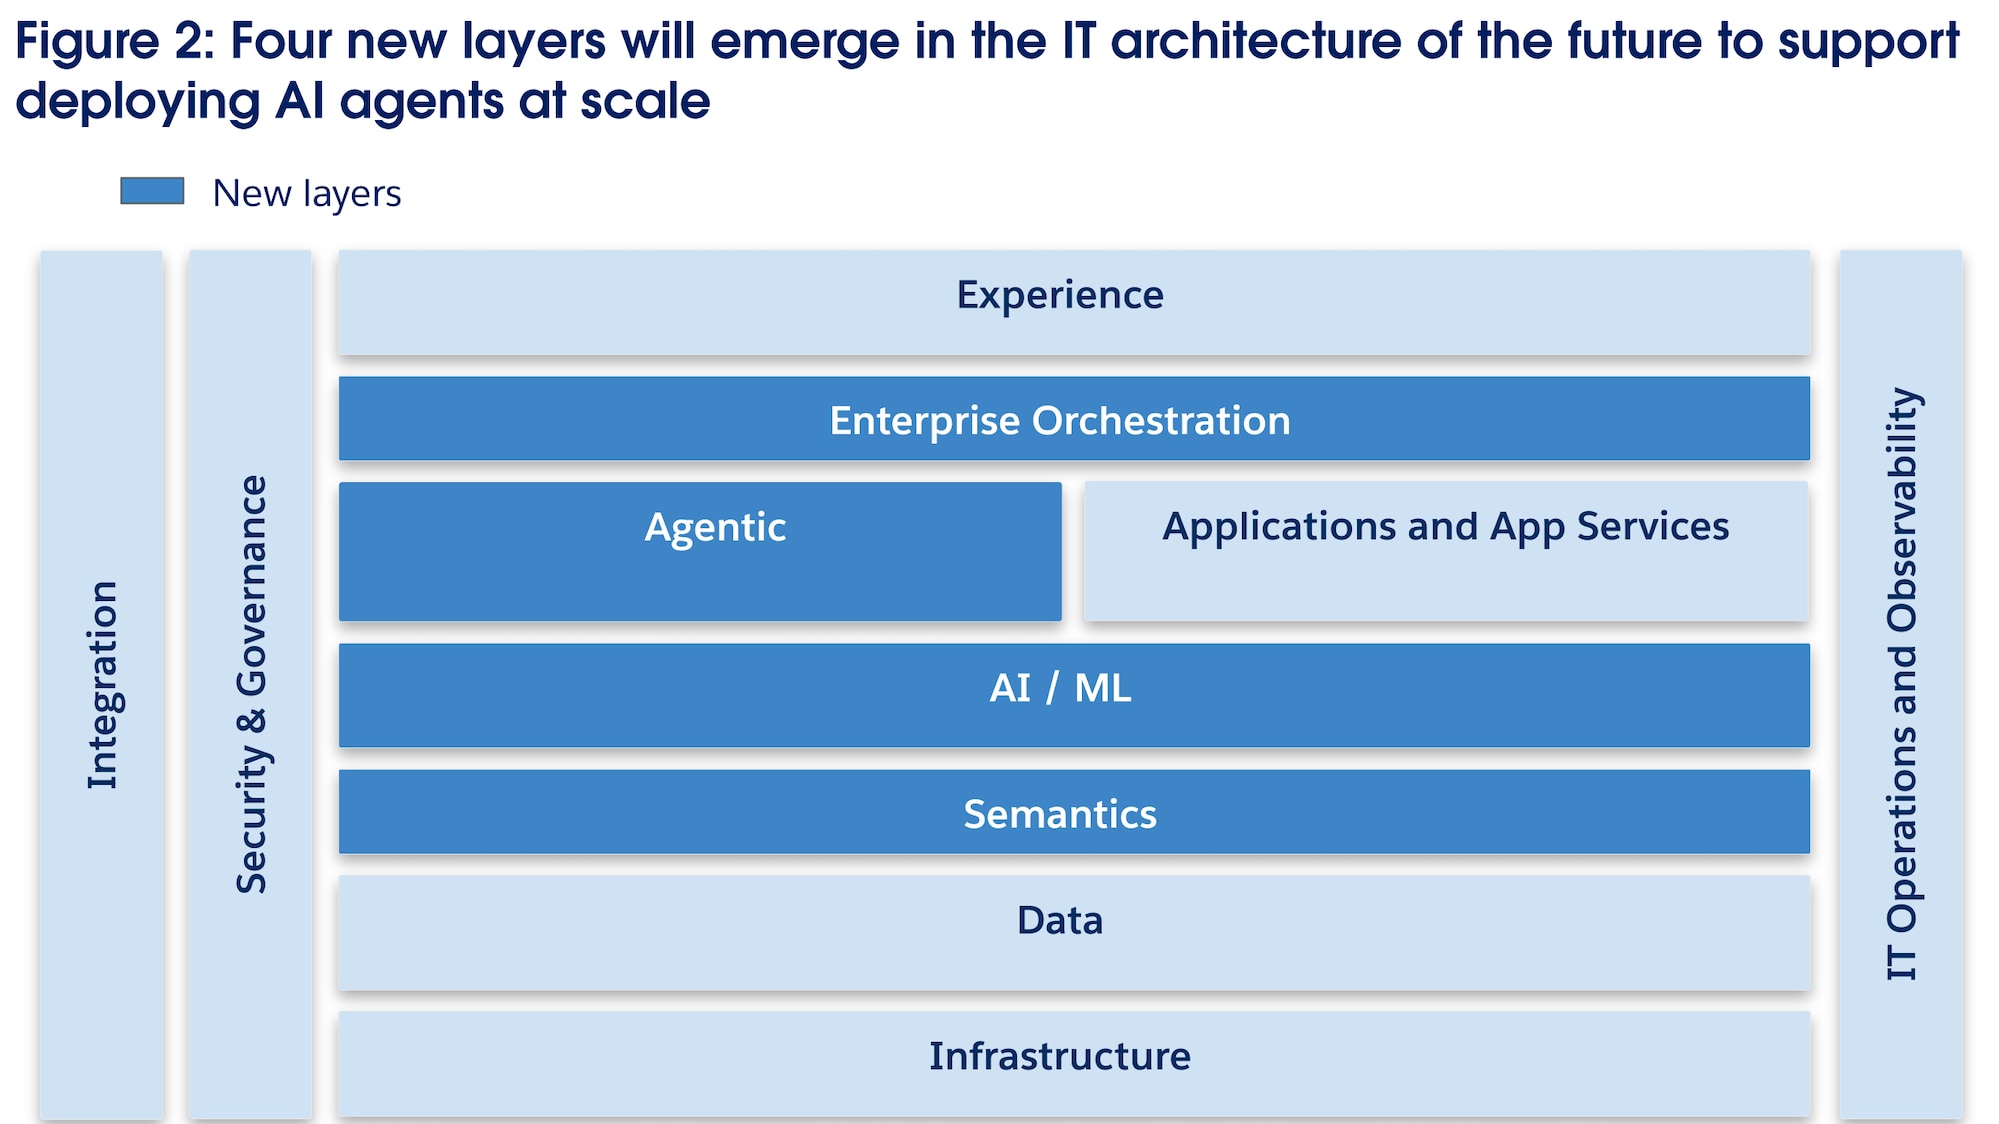 Il **livello semantico** viene introdotto per risolvere il divario tra i dati aziendali non elaborati e la comprensione semantica necessaria agli agenti dell'intelligenza artificiale. Codifica e gestisce in modo esplicito entità aziendali, concetti, definizioni e interrelazioni, creando un'ontologia aziendale e una rappresentazione di Knowledge aziendale per consentire una comprensione semantica condivisa che supporta flussi di lavoro multi-agente più complessi che eseguono operazioni di livello superiore. Oltre a un catalogo di dati, il livello semantico traduce una query per linguaggio naturale in query precise su archivi di dati specifici, armonizza i risultati e restituisce una risposta contestuale e più completa per l'agente. Nel frattempo, il livello di dati esistente viene unificato tramite l'adozione di lakehouse centralizzati e l'accesso ai dati viene ampliato tramite un data fabric predisposto per l'intelligenza artificiale per supportare i principi del modello operativo mesh di dati.
Il **livello AI/ML** centralizza la gestione delle funzionalità di intelligenza artificiale aziendali, inclusi modelli di linguaggio di grandi dimensioni, modelli di azione di grandi dimensioni e modelli ML specifici del dominio, gestendo sia i modelli di intelligenza artificiale sviluppati internamente durante il loro ciclo di vita che l'accesso/utilizzo controllato ai servizi di intelligenza artificiale esterni. A differenza delle architetture tradizionali in cui i modelli AI sono incorporati nelle applicazioni, questo livello stabilisce i modelli AI come componenti di prima classe e servizi condivisi nell'azienda. Si concentra sulle funzionalità AI controllate dall'azienda (non sulle funzionalità AI fornite da fornitori esterni). Questo livello fornisce informazioni per vari agenti e altri carichi di lavoro AI nell'azienda con meccanismi standardizzati per Trust, sicurezza, conformità e distribuzione.
L'**Enterprise Orchestration Layer** è l'astrazione funzionale per coordinare, governare e ottimizzare flussi di lavoro e processi aziendali complessi in più fasi che coprono agenti AI, persone, strumenti di automazione e sistemi deterministici. Questo livello sfrutta un modello di orchestrazione mista che consente ai singoli agenti e sistemi di gestire autonomamente le operazioni coreografate localmente utilizzando protocolli aperti come MCP e A2A, fornendo al contempo una supervisione end-to-end centralizzata e il coordinamento dell'intero processo. Per implementare il modello di orchestrazione mista, questo livello rappresenta i processi aziendali critici in formati semanticamente completi leggibili che definiscono sia le fasi deterministiche (modellate in fase di progettazione) che le fasi dinamiche (decise dagli agenti in fase di esecuzione) di un processo aziendale, creando la base del modello di processo per la governance e l'ottimizzazione.
Tradizionalmente, porzioni significative dei processi aziendali gestiti dalle persone rimangono non documentate o inaccessibili in forme leggibili dai computer. Tuttavia, l'osservabilità dettagliata delle attività degli agenti AI, che include dati completi e metadati sulle loro operazioni e azioni, consente di acquisire, documentare e integrare il lavoro dinamico, precedentemente non strutturato, con flussi di lavoro lineari deterministici per creare modelli di processo completi. La documentazione dettagliata del processo acquisisce le interdipendenze delle operazioni e i percorsi di esecuzione precedentemente invisibili, consentendo all'azienda di ottimizzare continuamente l'efficienza operativa, risolvere efficacemente i colli di bottiglia e codificare sistematicamente le procedure consigliate identificate dagli agenti in playbook riutilizzabili a livello aziendale. Ciò si traduce in un gemello digitale olistico dei singoli processi e, se scalato, dell'intera azienda.
Ad esempio, processi complessi come l'esecuzione di strategie di vendita complete o l'inserimento di nuovi dipendenti comportano numerose fasi interdipendenti in cui il livello di orchestrazione può garantire livelli appropriati di coinvolgimento umano (ad esempio, la gestione delle eccezioni), un'autonomia limitata per gli agenti AI e imporre la conformità. Durante questi processi, il livello di orchestrazione dall'alto verso il basso aggiunge prevedibilità e governance, tiene traccia e valuta continuamente gli indicatori di prestazione chiave (KPI), garantisce l'integrità transazionale dei flussi di lavoro e la logica di ritiro e mantiene la visibilità in ogni fase del flusso di lavoro per garantire l'allineamento con gli obiettivi aziendali generali. Per implementare questa funzionalità, questo livello utilizza policy, regole e guardrail del livello di sicurezza e governance (tramite policy-as-code) e obiettivi aziendali e KPI memorizzati nel livello semantico. Data la natura autonoma e rapida delle interazioni basate sull'intelligenza artificiale, affidarsi esclusivamente a una coreografia decentralizzata rischia di generare disallineamenti strategici o violazioni della conformità, soprattutto nei flussi di lavoro a più fasi di lunga durata. L'approccio di orchestrazione mitiga questi rischi integrando le regole aziendali a livello aziendale, i controlli di conformità e l'applicazione delle policy direttamente in flussi di lavoro complessi e integrando la supervisione umana nei momenti critici.
Ciascuno di questi 11 livelli contribuisce con funzionalità specifiche alla distribuzione di agenti AI su larga scala in modo sicuro, affidabile ed efficace che sblocca tutto il potenziale dell'intelligenza artificiale agente per trasformare il modo in cui viene svolto il lavoro in un'azienda. La sezione seguente descrive la funzione del livello, le nuove modifiche dovute all'aumento degli agenti AI e le sue funzionalità tecnologiche chiave.
### Livello esperienza
**Funzione:** Il Livello di esperienza funge da interfaccia principale per gli utenti umani, abilitando l'interazione multimodale acquisendo input (testo, voce, visivo) e fornendo risposte pertinenti al contesto su più dispositivi. Trasmette facilmente le intenzioni degli utenti al livello agente per l'azione, fornendo anche l'interfaccia utente dinamica e le visualizzazioni che facilitano l'inoltro al livello superiore e le approvazioni all'interno dei flussi di lavoro agentici.
**Cosa c'è di diverso rispetto a oggi:** L'intelligenza artificiale aumenterà le interfacce basate su GUI tradizionali con elaborazione del linguaggio naturale, consapevolezza contestuale e supporto proattivo alle decisioni. Gli agenti dell'intelligenza artificiale saranno in grado di avviare interazioni in modo proattivo, fornendo consigli personalizzati in tempo reale in tutti i canali e le modalità.
**Capacità tecnologiche chiave:**
- **AI conversazionale e assistenti digitali:** Abilitare l'unità operativa per impostazione predefinita per offrire assistenza AI a supporto degli utenti umani.
- **Interfaccia utente Attribuzione e trasparenza:** Rendere spiegabili le risposte nell'interfaccia utente, ad esempio visualizzare le citazioni, le fonti dei file/sistemi e l'approccio/ragionevolezza delle decisioni.
- **Servizio di notifica proattivo e ambientale:** Consente agli agenti di inviare in modo proattivo approfondimenti o avvisi agli utenti sul canale e sul fattore di forma più appropriati, in base al contesto corrente dell'utente.
- **Esperienze Omnicanale:** Offre un'esperienza unificata, coerente e senza interruzioni in tutti i canali con continuità del journey, in cui le conversazioni e le operazioni seguono la persona anziché l'app.
- **Capacità multimodali:** Consente alle persone di interagire con agenti e applicazioni tramite testo, voce, immagine, tocco, video e AR/VR in modo che gli agenti possano comprendere e presentare le informazioni nella modalità più efficiente.
- **Personalizzazione sensibile al contesto e interfaccia utente dinamica:** Abilita esperienze utente in tempo reale sensibili al contesto (tempo, posizione, azioni utente) per consentire la personalizzazione, inclusa la generazione immediata dell'interfaccia utente.
### Livello agente
**Funzione:** Il livello agentico funge da ambiente di runtime predefinito per l'esecuzione del lavoro nell'azienda in cui gli agenti AI scompongono le operazioni dal livello esperienza ed eseguono le operazioni assemblando dinamicamente i flussi di lavoro utilizzando gli strumenti del livello applicazioni e servizi app e del livello dati. Lo stato di configurazione degli agenti AI viene memorizzato e gestito in questo livello. Gli agenti vengono istanziati per operazioni specifiche e le istanze specifiche degli agenti vengono ritirate in seguito. Questa implementazione consente agli agenti di essere sempre richiamati dallo stato di configurazione più recente in base alle ottimizzazioni offline (utilizzando funzionalità AI/ML, osservabilità e livelli di orchestrazione). Questo livello è responsabile della gestione completa del ciclo di vita, del coordinamento e della governance degli agenti AI.
**Cosa c'è di diverso rispetto a oggi:** Questo livello emergerà dall'attuale serie disparata di piloti e distribuzioni di agenti limitate. Benché esistano bot basati su regole, sono pochi i programmi software adattativi, non deterministici e orientati agli obiettivi distribuiti su larga scala.
**Capacità tecnologiche chiave:**
- **Ambiente Runtime agente:** Gestisce il ciclo di vita, l'esecuzione e l'allocazione delle risorse per gli agenti AI.
- **Suite di gestione del ciclo di vita degli agenti:** Include framework di sviluppo, tool di sviluppo e test e sistemi di gestione per le attività degli agenti e il controllo delle versioni.
- **Motore di ragionamento agente:** Un framework cognitivo che consente agli agenti di scomporre gli obiettivi, pianificare e decidere quali strumenti utilizzare per risolvere problemi complessi.
- **Memoria agente e punto vendita contesto:** Consente alle istanze degli agenti di richiamare e mantenere il contesto relativo alle interazioni precedenti, garantendo coerenza e personalizzazione.
- **Protocolli di interoperabilità degli agenti:** Interfacce standardizzate per la comunicazione da agente ad agente (A2A) e per l'interfacciamento degli agenti con sistemi esterni (ad esempio tramite il protocollo contesto del modello).
- **Registro strumenti:** Insieme curato di strumenti interni ed esterni supportati che gli agenti possono invocare per eseguire una determinata operazione.
- **Registro agenti:** Un ecosistema curato di soluzioni AI e agenti predefiniti che supporta l'individuazione e l'abbinamento delle funzionalità.
- **Applicazione policy agente distribuita:** Consente una governance a livello aziendale consentendo agli agenti di autocontrollare la conformità prima di intraprendere azioni.
- **Framework di autoriflessione e adattamento degli agenti:** Fornisce un meccanismo per consentire a un agente di analizzare le proprie prestazioni e, con l'approvazione umana, attivare miglioramenti o suggerire modifiche a se stesso.
### Livello AI/ML
**Funzione:** Questo livello funziona come un hub di intelligenza centralizzato, offrendo modelli di intelligenza artificiale come un insieme di servizi condivisi che possono essere utilizzati dal livello agente (e dalle applicazioni) per potenziare le sue capacità di ragionamento e decisione con framework di sicurezza e monitoraggio integrati.
**Cosa c'è di diverso rispetto a oggi:** Tradizionalmente, i modelli AI erano incorporati in applicazioni specifiche. Nell'architettura IT di Agentic Enterprise, il livello AI/ML sarà una serie di servizi centralizzati di prima classe che supportano molte applicazioni e agenti, supportando l'intero ciclo di vita del modello dallo sviluppo al servizio in tempo reale su larga scala.
**Capacità tecnologiche chiave:**
- **Modelli di base predefiniti:** Modelli ML di grandi dimensioni addestrati su un ampio spettro di dati, in grado di eseguire un'ampia varietà di operazioni generali.
- **Generazione aumentata di recupero (RAG):** Una pipeline incentrata sull'intelligenza artificiale che basa i modelli di base in dati specifici dell'azienda per migliorare la precisione e ridurre le allucinazioni.
- **AI Trust, Safety e Governance Hub:** Una suite di strumenti integrati nel ciclo di vita del modello per applicare principi di intelligenza artificiale responsabili come il rilevamento delle distorsioni, la spiegabilità e il monitoraggio della sicurezza.
- **Gateway modello:** Motore di instradamento che funge da singolo punto di ingresso per tutte le richieste di inferenza del modello, gestendo le chiamate a vari modelli interni ed esterni per ottimizzare costi, prestazioni e conformità.
- **Area di lavoro sviluppo modello:** Un ambiente di sviluppo integrato per i data scientist con strumenti per la preelaborazione dei dati, l'addestramento del modello e la sperimentazione.
- **MLOps & Lifecycle Automation Pipeline (MLOps e pipeline di automazione del ciclo di vita):** Motore CI/CD per il machine learning, che automatizza il ciclo di vita completo dei modelli dall'addestramento alla distribuzione e al ritiro.
- **Serving del modello e runtime di inferenza:** Un ambiente scalabile e a bassa latenza per la distribuzione di modelli addestrati come endpoint API protetti per il consumo in tempo reale.
- **Registro modelli e asset:** Un repository centralizzato e controllato dalle versioni per tutti gli asset AI/ML, inclusi modelli, serie di dati e codice sorgente, che garantisce riproducibilità e verificabilità.
- **Generazione e gestione dei dati sintetici:** Strumento per generare e gestire dati sintetici che mantengono le proprietà statistiche dei dati reali senza esporre informazioni sensibili.
### Livello orchestrazione Enterprise
**Funzione:** Enterprise Orchestration Layer è il piano di controllo per il lavoro end-to-end in un'azienda agente. Garantisce che i flussi di lavoro e le interazioni degli agenti rispettino gli obiettivi aziendali e le policy di governance. Utilizza la telemetria osservabile da altri livelli per creare modelli di processi aziendali completi, consentendo l'ottimizzazione rispetto agli indicatori di prestazioni chiave tratti dal livello semantico. Questo livello fornisce il contesto condiviso e la memoria di lunga durata a ogni nuova istanza di un agente AI per i flussi di lavoro critici.
**Cosa c'è di diverso rispetto a oggi:** Questo livello offre una visibilità unificata dei processi aziendali creando modelli leggibili dai computer che acquisiscono sia fasi strutturate e deterministiche che il lavoro dinamico e non strutturato eseguito da persone e agenti. Supera i modelli di collaborazione e governance incentrati sulle persone di oggi codificando a livello di programmazione gli obiettivi aziendali e le regole di conformità come vincoli nei flussi di lavoro degli agenti per governare la forza lavoro degli agenti.
**Capacità tecnologiche chiave:**
- **Motore di esecuzione flusso di lavoro ibrido:** Runtime centrale che esegue il "modello di orchestrazione misto", fornendo una supervisione centralizzata e consentendo la coreografia degli agenti locali.
- **Process Governance & Constraint Engine:** Un servizio di governance in tempo reale che utilizza e applica regole aziendali, policy e vincoli dichiarativi a tutti i processi in volo.
- **Memoria condivisa e gestione del contesto:** Un livello di memoria condiviso accessibile a tutti gli attori di un flusso di lavoro per mantenere continuità e coerenza in più fasi.
- **Process Modeling Studio:** Un ambiente in fase di progettazione per la creazione e la gestione di modelli di processo leggibili dai computer e ricchi di contenuti semantici che definiscono fasi deterministiche e dinamiche orientate agli obiettivi.
- **Ottimizzazione e simulazione dei processi:** Una funzionalità che costruisce simulazioni digitali dei processi aziendali per analisi avanzate, simulazioni What-If e ottimizzazione predittiva.
- **Process Discovery & Health Monitoring (Rilevamento dei processi e monitoraggio dello stato):** Inserisce modelli di processo e dati in tempo reale per generare rapporti sulle metriche aziendali dello stato dei processi.
- **Digital Twin Process Modeling (Modellazione processo Digital Twin):** Uno specchio in tempo reale dei flussi di lavoro live per testare, simulare le modifiche e ottimizzare senza influire sulla produzione.
### Livello Servizi applicazione e app
**Funzione:** Questo livello espone le funzionalità delle applicazioni aziendali esistenti come strumenti e servizi componibili e modulari che gli agenti possono utilizzare. Funge anche da runtime di presentazione per l'incorporamento delle funzionalità degli agenti nell'esperienza utente. Le applicazioni continuano a essere il sistema dei record ma vengono riprogettate per essere funzionalità "headless" per gli agenti.
**Cosa c'è di diverso rispetto a oggi:** Le applicazioni si evolveranno da interfacce utente monolitiche a "servizi di back-end" che gli agenti possono chiamare dinamicamente tramite API ed eventi. Questo livello sarà integrato in modo nativo con agenti e modelli AI e la proliferazione di LLM di generazione codice porterà a un aumento del numero di micro-applicazioni personalizzate create dagli agenti.
**Capacità tecnologiche chiave:**
- **Servizi di applicazione modulari:** Logica aziendale scomposta dalle applicazioni tradizionali, pubblicate come azioni leggibili automaticamente che gli agenti possono chiamare.
- **SDK di incorporamento degli agenti:** Toolkit e librerie che consentono agli sviluppatori di incorporare in modo sicuro gli agenti direttamente nelle interfacce utente delle applicazioni.
- **Servizi di generazione interfaccia utente dinamica:** Servizi che consentono a un agente AI di generare o modificare i componenti dell'interfaccia utente in tempo reale in base al contesto dell'utente.
- **Framework dell'interfaccia utente nativi AI:** Framework front-end progettati con supporto incorporato per la gestione delle interfacce utente basate sull'intelligenza artificiale, ad esempio la gestione dei dati probabilistici e delle risposte di testo in streaming.
- **Sistemi di coinvolgimento infusi dagli agenti:** Applicazioni di produttività e collaborazione aziendali che incorporano funzionalità degli agenti AI tramite componenti visivi.
- **Sviluppo di applicazioni low-code / no-code ottimizzate AI:** Strumenti che consentono a utenti e agenti di creare app e servizi personalizzati utilizzando linguaggio naturale e prompt.
- **Guardrail dell'app per l'utilizzo da parte degli agenti:** Controlli lato applicazione per l'utilizzo da parte degli agenti, ad esempio limitazione dei tassi, autorizzazioni limitate e telemetria.
### Livello semantico
**Funzione:** Il livello semantico offre una comprensione unificata di dati e Knowledge in tutta l'azienda, consentendo sia agli esseri umani che agli agenti AI di interpretare e agire in modo coerente sulle informazioni. Utilizza strumenti di rappresentazione Knowledge come ontologie e grafici Knowledge per tradurre le query in linguaggio naturale in query di dati precise e sensibili al contesto.
**Cosa c'è di diverso rispetto a oggi:** Mentre le aziende odierne dispongono di archivi di metadati diversi, l'architettura IT di Agentic Enterprise richiede un EKG (Enterprise Knowledge Graph) centralizzato che collega i dati tra i domini con relazioni semantiche definite esplicitamente. Questo fornisce il contesto completo che gli agenti di intelligenza artificiale possono attraversare per eseguire ragionamenti complessi, creando requisiti per una serie di funzionalità tecniche che supportano i grafici Knowledge che coprono più domini funzionali.
**Capacità tecnologiche chiave:**
- **Servizio metadati:** Fornisce metadati descrittivi, tra cui discendenza dei dati, proprietà e classificazioni.
- **Glossario aziendale e gestione tassonomia:** Uno strumento che consente agli utenti aziendali di definire e concordare condizioni aziendali standard.
- **Gestione dei modelli semantici:** Area di lavoro per ingegneri Knowledge per creare, gestire e governare modelli semantici e ontologie.
- **Enterprise Knowledge Graph (EKG):** Un'istanziazione in fase di esecuzione dell'ontologia aziendale che memorizza e mappa le relazioni tra entità aziendali.
- **Motore di inserimento e armonizzazione metadati:** Una pipeline automatica che compila e gestisce Enterprise Knowledge Graph da vari sistemi di origine.
- **Motore di query semantiche**: Interpreta le query in linguaggio naturale e costruisce query strutturate basate sull'ECG per recuperare i dati da fonti diverse.
- **Motore di ragionamento semantico:** Analizza e deriva Knowledge implicito e relazioni nascoste dall'ECG.
### Livello dati
**Funzione:** Il livello di dati è la fonte fondamentale della verità e consente di gestire e fornire un accesso sicuro e regolato a tutti i dati aziendali che il livello semantico può interpretare, il livello AI/ML da utilizzare per l'addestramento, le applicazioni da utilizzare per le transazioni e gli agenti per il ragionamento.
**Cosa c'è di diverso rispetto a oggi:** Il livello di dati si evolve per essere più unificato, in tempo reale e incentrato sulla governance, spesso centrato su un data lakehouse su scala cloud. Deve gestire un volume e una varietà maggiori di dati e passare dall'elaborazione orientata ai batch allo streaming in tempo reale per supportare gli agenti reattivi. La governance e la qualità dei dati assumono un'importanza ancora maggiore per evitare che dati scadenti creino output AI difettosi.
**Capacità tecnologiche chiave:**
- **VectorDB:** Database specializzato ottimizzato per l'archiviazione e la query di incorporamenti vettoriali ad alta dimensione, fondamentali per RAG.
- **Pipeline di dati analitici intelligenti:** Un servizio automatico basato sui metadati per l'inserimento, la trasformazione e il caricamento dei dati (ETL/ELT) nel livello di dati.
- **Enterprise Data Lakehouse:** Un repository centrale per dati strutturati, semi-strutturati e non strutturati, ottimizzato per carichi di lavoro di analisi e intelligenza artificiale.
- **Federazione e ricerca dati copia zero:** Tecniche di accesso, query e ricerca dei dati in più punti vendita senza spostamento fisico dei dati.
- **Da linguaggio naturale a SQL:** Una tecnica per convertire query in linguaggio naturale in SQL.
- **Servizio Catalogo dati aziendali e Discovery:** Inventario centralizzato e ricercabile di tutti gli asset di dati dell'azienda.
- **Gestione dati master e di riferimento (MDM):** Gestisce il "golden record" per entità aziendali critiche come Cliente e Prodotto.
- **Servizio di qualità dei dati adattiva:** Un servizio di monitoraggio continuo che utilizza l'intelligenza artificiale per rilevare e risolvere automaticamente i Problemi di qualità dei dati in tempo reale.
- **Contratti sui dati:** Accordi a lettura ottica tra produttori di dati e consumatori che specificano lo schema, la semantica e gli SLA dello scambio di dati.
- **Data Store specializzati AI:** Database progettati per casi d'uso AI specifici, ad esempio serie temporali o database di grafici.
- **Fabbrica di dati AI-Ready:** Livello di astrazione dei dati logico che offre una visualizzazione unificata e virtualizzata dei dati in sistemi fisici diversi.
- **Elaborazione dei dati in tempo reale:** Funzionalità per l'elaborazione e l'analisi continua di stream di dati multimodali alla velocità della macchina.
### Livello infrastruttura
**Funzione:** Il livello Infrastruttura supporta tutti gli altri livelli, fornendo le funzionalità di elaborazione, storage, rete e cloud necessarie per eseguire carichi di lavoro AI e agenti su larga scala in modo resiliente ed economico.
**Cosa c'è di diverso rispetto a oggi:** I carichi di lavoro AI richiedono maggiore scalabilità ed elasticità per gestire la natura probabilistica dei sistemi agentici. L'infrastruttura deve supportare il provisioning rapido, hardware specializzato come le GPU e traffico di rete a bassa latenza e ad alta produttività per la comunicazione tra agenti.
**Capacità tecnologiche chiave:**
- **Infrastruttura come codice:** Provisioning e gestione automatizzati dell'infrastruttura con opportunità di distribuzione CI/CD.
- **Infrastruttura AI ibrida e multi-cloud:** Sfrutta l'elasticità del cloud pubblico e l'infrastruttura specializzata per i carichi di lavoro di intelligenza artificiale generativa.
- **Calcolazione, archiviazione e rete ottimizzati per AI:** Alloca e scala in modo dinamico le risorse dell'infrastruttura in base alla domanda variabile dei carichi di lavoro AI.
- **Infrastruttura Edge AI:** Consente la distribuzione di modelli e agenti AI ai margini della rete per i casi d'uso con requisiti di latenza o privacy specifici.
- **Infrastruttura di autoguarigione:** Utilizza l'intelligenza artificiale per gestire il ripristino del sistema senza input manuale, garantendo un'elevata disponibilità.
- **Informatica AI sostenibile:** Approcci efficienti dal punto di vista energetico per mitigare l'impatto ambientale dei carichi di lavoro AI.
- **Autoscala sensibile ai costi e alle emissioni di CO2:** Utilizza FinOps e i segnali di sostenibilità per favorire la scalabilità e il posizionamento della capacità.
### Livello di integrazione
**Funzione:** Il livello di integrazione funge da tessuto di comunicazione universale per tutti i sistemi (legacy e nuovi) tramite API, eventi, protocolli e middleware per garantire che gli agenti possano individuare e interagire con servizi, dati e strumenti in modo semplice.
**Cosa c'è di diverso rispetto a oggi:** L'integrazione deve evolvere per supportare gli schemi di comunicazione dinamici molti-a-molti degli agenti AI, anziché limitarsi a gestire interazioni statiche predeterminate tra pochi sistemi noti. Richiede l'elaborazione dei dati in tempo reale e deve adattarsi all'individuazione e alla collaborazione ad hoc tra gli agenti.
**Capacità tecnologiche chiave:**
- **Opportunità in corso di realizzazione di connettività dati operativa:** Strumenti assistiti dall'intelligenza artificiale per la mappatura automatica degli schemi, la trasformazione dei dati e la generazione di flussi di lavoro, incluse le funzionalità basate su API, basate sugli eventi e Reverse ETL.
- **Gestione API adattiva e Service Mesh:** Gateway API e tecnologia Service Mesh in grado di registrare, individuare e governare dinamicamente i servizi con l'imposizione di policy adattive per gli agenti.
- **Adattatori Semantic Knowledge:** Componente di integrazione che fornisce un vocabolario e un modello di dati condivisi tra agenti e applicazioni per un'interpretazione coerente dei dati.
- **Fabbrica di integrazione basata sugli eventi:** Backbone di messaggistica e streaming a bassa latenza e ad alta produttività che consente la comunicazione disaccoppiata e asincrona.
- **Gateway protocollo agente:** Gateway per i servizi MCP che consente agli agenti di scoprire in modo sicuro gli strumenti e attivare le azioni, collegando MCP ad API ed eventi interni.
- **Catalogo e marketplace di capacità componibili:** Un catalogo centralizzato e gestito per tutte le funzionalità aziendali (API, servizi, competenze degli agenti, modelli e serie di dati) annotato con metadati semantici per la composizione on-demand.
### Livello Operazioni IT e osservabilità
**Funzione:** Questo livello monitora e gestisce lo stato e le prestazioni operative degli agenti e dell'intero sistema (principio incorporato di osservabilità), offrendo trasparenza e controllo generando approfondimenti per consentire l'ottimizzazione di controllo, debug, spiegabilità, costi e risorse della forza lavoro dell'azienda.
**Cosa c'è di diverso rispetto a oggi**: Questo livello diventa ancora più cruciale se si considera il rischio che gli agenti dell'intelligenza artificiale creino errori alla velocità della macchina. Deve espandersi oltre il monitoraggio delle infrastrutture per includere il comportamento imprevedibile degli agenti autonomi, che richiedono nuovi tipi di telemetria e la capacità di comprendere la correttezza semantica, non solo le prestazioni tecniche.
**Capacità tecnologiche chiave:**
- **Piattaforma di monitoraggio e osservabilità in tempo reale:** Raccoglie continuamente registri, metriche e tracce in tutto l'ambiente IT, con estensioni per le metriche ML e il comportamento degli agenti.
- **Gestione dei costi di FinOps & Cloud:** Responsabile del monitoraggio, dell'analisi e dell'ottimizzazione dei costi di infrastruttura associati all'intelligenza artificiale e ai carichi di lavoro degli agenti.
- **Monitoraggio specifico di agenti e ML:** Registra ogni fase dell'esecuzione di un agente in un itinerario di controllo immutabile e profila continuamente i comportamenti degli agenti per rilevare deviazioni dalle norme stabilite.
- **AIOps, Gestione degli incidenti e del cambiamento:** Utilizza AI/ML per prevedere potenziali problemi IT, identificare le cause principali e creare flussi di lavoro di risoluzione.
- **Loop di feedback sull'apprendimento chiuso:** Integra la telemetria osservabile dagli agenti nelle opportunità in corso di realizzazione MLOps, abilitando la riconversione automatica del modello o la pronta rettifica.
- **Motore di osservabilità semantica:** Integra l'osservabilità con il livello semantico per la contestualizzazione per consentire il rilevamento di anomalie semantiche nel comportamento degli agenti.
### Livello di sicurezza e governance
**Scopo:** Questo livello incorpora Trust e sicurezza in tutta l'architettura proteggendo gli asset aziendali dalle minacce, gestendo i rischi e garantendo la conformità ai requisiti normativi. Comprende la gestione dell'identità, il rilevamento delle minacce, le misure di sicurezza specifiche di GRC e AI.
**Cosa c'è di diverso rispetto a oggi:** Il livello di sicurezza deve evolvere per gestire le nuove superfici di attacco presentate dai modelli e dagli agenti di intelligenza artificiale, ad esempio l'iniezione rapida e l'avvelenamento del modello. La gestione delle identità e degli accessi deve passare da controlli statici basati sui ruoli ad autorizzazioni dinamiche basate sugli intenti che vengono concesse just in time e revocate immediatamente dopo l'uso.
**Capacità tecnologiche chiave:**
- **Sicurezza di input/output e guardrail LLM:** I guardrail aziendali sono stati applicati al prompt e al momento della risposta per bloccare contenuti non sicuri, fughe di informazioni personali e jailbreak.
- **Architettura Zero Trust con verifica AI:** Autenticazione continua ottimizzata dall'analisi comportamentale basata su AI, con accesso just in time granulare per gli agenti in base alla loro operazione specifica.
- **Framework di sicurezza degli agenti:** Modelli di autorizzazione a grana fine, monitoraggio dei comportamenti dannosi e meccanismi di contenimento per interrompere in modo sicuro le attività degli agenti.
- **Sicurezza del modello AI:** Una strategia di difesa approfondita con controlli in ogni fase del ciclo di vita del modello per proteggersi da avvelenamento, estrazione e attacchi contrari.
- **AI che protegge la privacy:** Tecniche come l'apprendimento federato e la privacy differenziale per proteggere i dati sensibili.
- **GRC ottimizzato AI:** Utilizzo di agenti AI per monitorare continuamente la conformità dell'architettura IT ai controlli.
- **Motore di policy come codice:** Un'unica fonte di dati per definire le regole aziendali e i vincoli di conformità in un formato dichiarativo e leggibile dai computer per impostare guardrail per il comportamento degli agenti.
- **Continuo Red-Teaming:** Test automatici e in corso dei modelli e degli agenti di intelligenza artificiale per identificare le vulnerabilità prima che gli aggressori le sfruttino.
## Roadmap architetturale di riferimento per l'azienda agente
La trasformazione in Agentic Enterprise richiede di seguire un journey in più fasi, impostando le basi tecnologiche e creando al contempo un valore aziendale tangibile (vedere la Figura 3 di seguito). Sebbene la roadmap precisa dipenda dalla strategia, dalla cultura, dal modello di governance AI e dal punto di partenza dell'architettura IT dell'azienda, la maggior parte delle organizzazioni dovrebbe adottare un approccio scaglionato poiché i continui investimenti IT potenziano gli agenti con una portata, una complessità e una creazione di valore crescenti. Il [modello di maturità](https://www.salesforce.com/news/stories/agentic-maturity-model/) agenti di Salesforce offre alle aziende un utile framework di livelli di maturità per la strategia della trasformazione, descrivendo come le capacità degli agenti possono crescere dal recupero di informazioni di base (livello 1) all'orchestrazione di flussi di lavoro multi-dominio più complessi (livello 2 e 3) e multi-agente (livello 4). Per progredire con successo in queste fasi, l'architettura IT deve evolvere in modo concertato, con investimenti mirati in diversi livelli dell'architettura in ogni fase per soddisfare le esigenze delle distribuzioni più complesse e di valore più elevato degli agenti AI. Per ogni livello di maturità, le capacità tecnologiche specifiche richieste negli 11 livelli architettonici sono identificate con una logica per l'investimento.
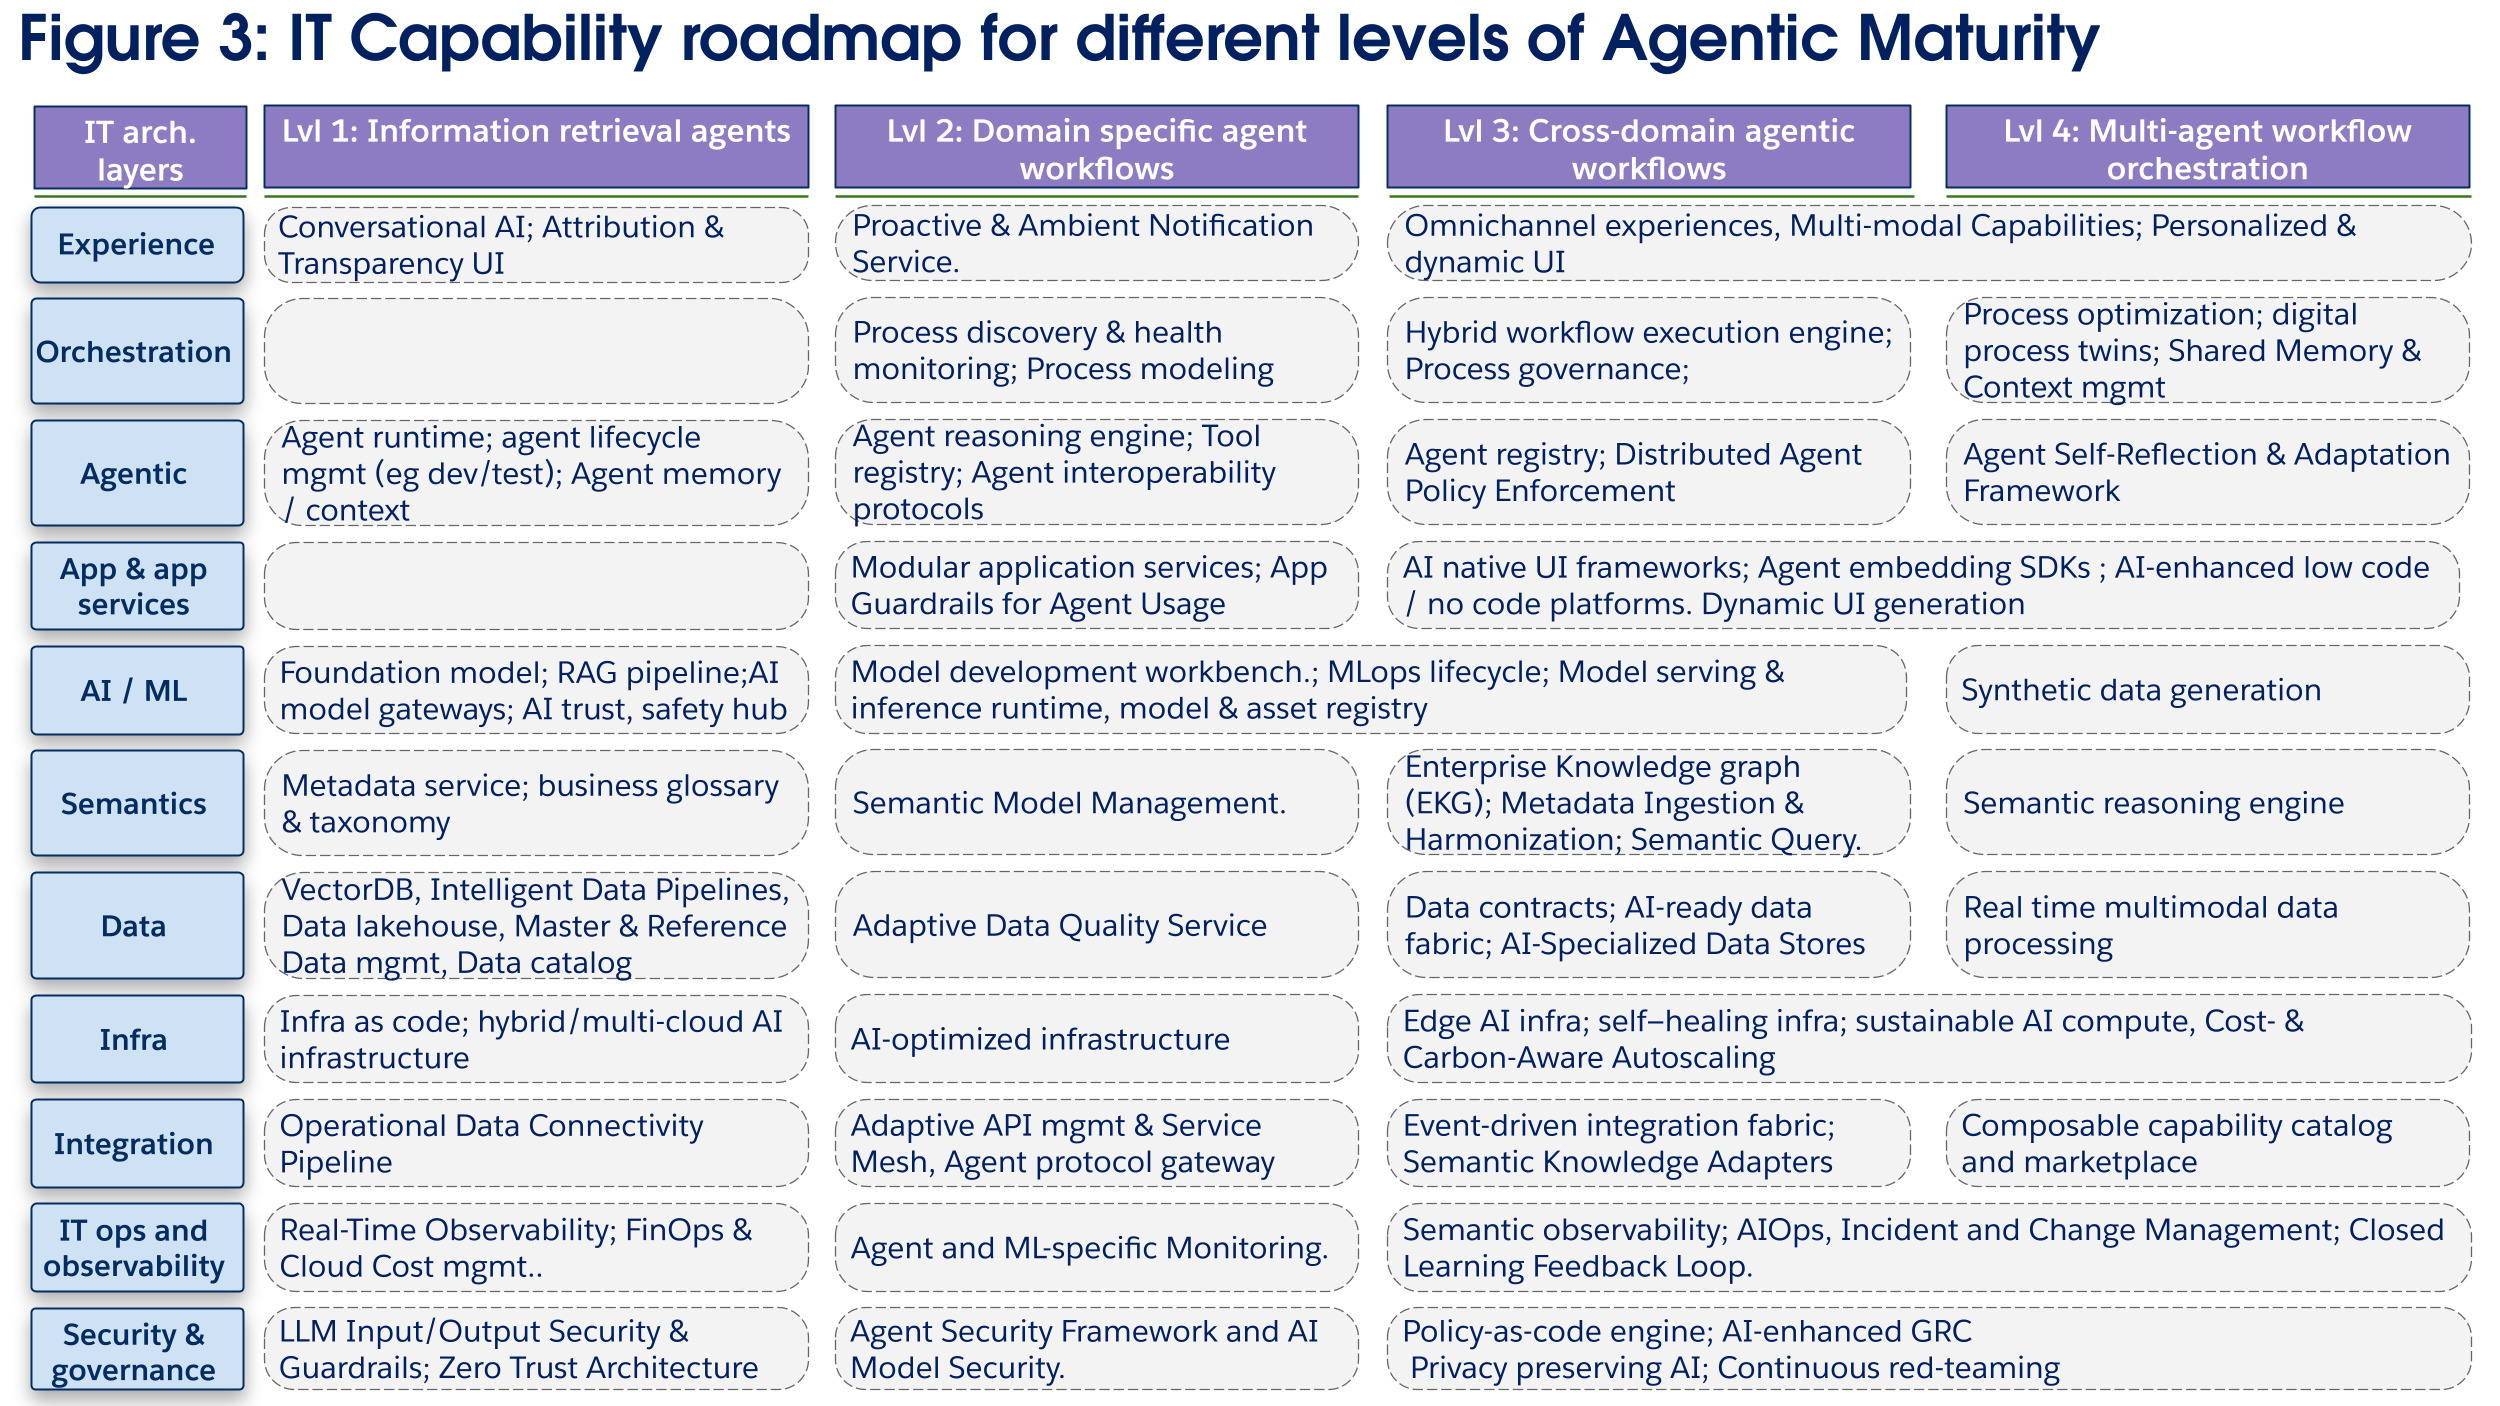 **Livello di maturità 1: Agenti di recupero** delle informazioni
**Obiettivo e valore aziendale: Migliorare la produttività dei lavoratori fornendo un'interfaccia conversazionale affidabile per interrogare Enterprise Knowledge.** Il valore principale è aumentare le capacità umane, non sostituirle. Questi agenti assistono le persone recuperando informazioni e consigliando azioni.
**Focus architettonico:** L'obiettivo è creare una base di dati sicura e affidabile e i componenti AI di base necessari per il recupero delle informazioni. Governance e osservabilità sono fondamentali fin dal primo giorno per creare Trust tra gli utenti e controllare i costi.
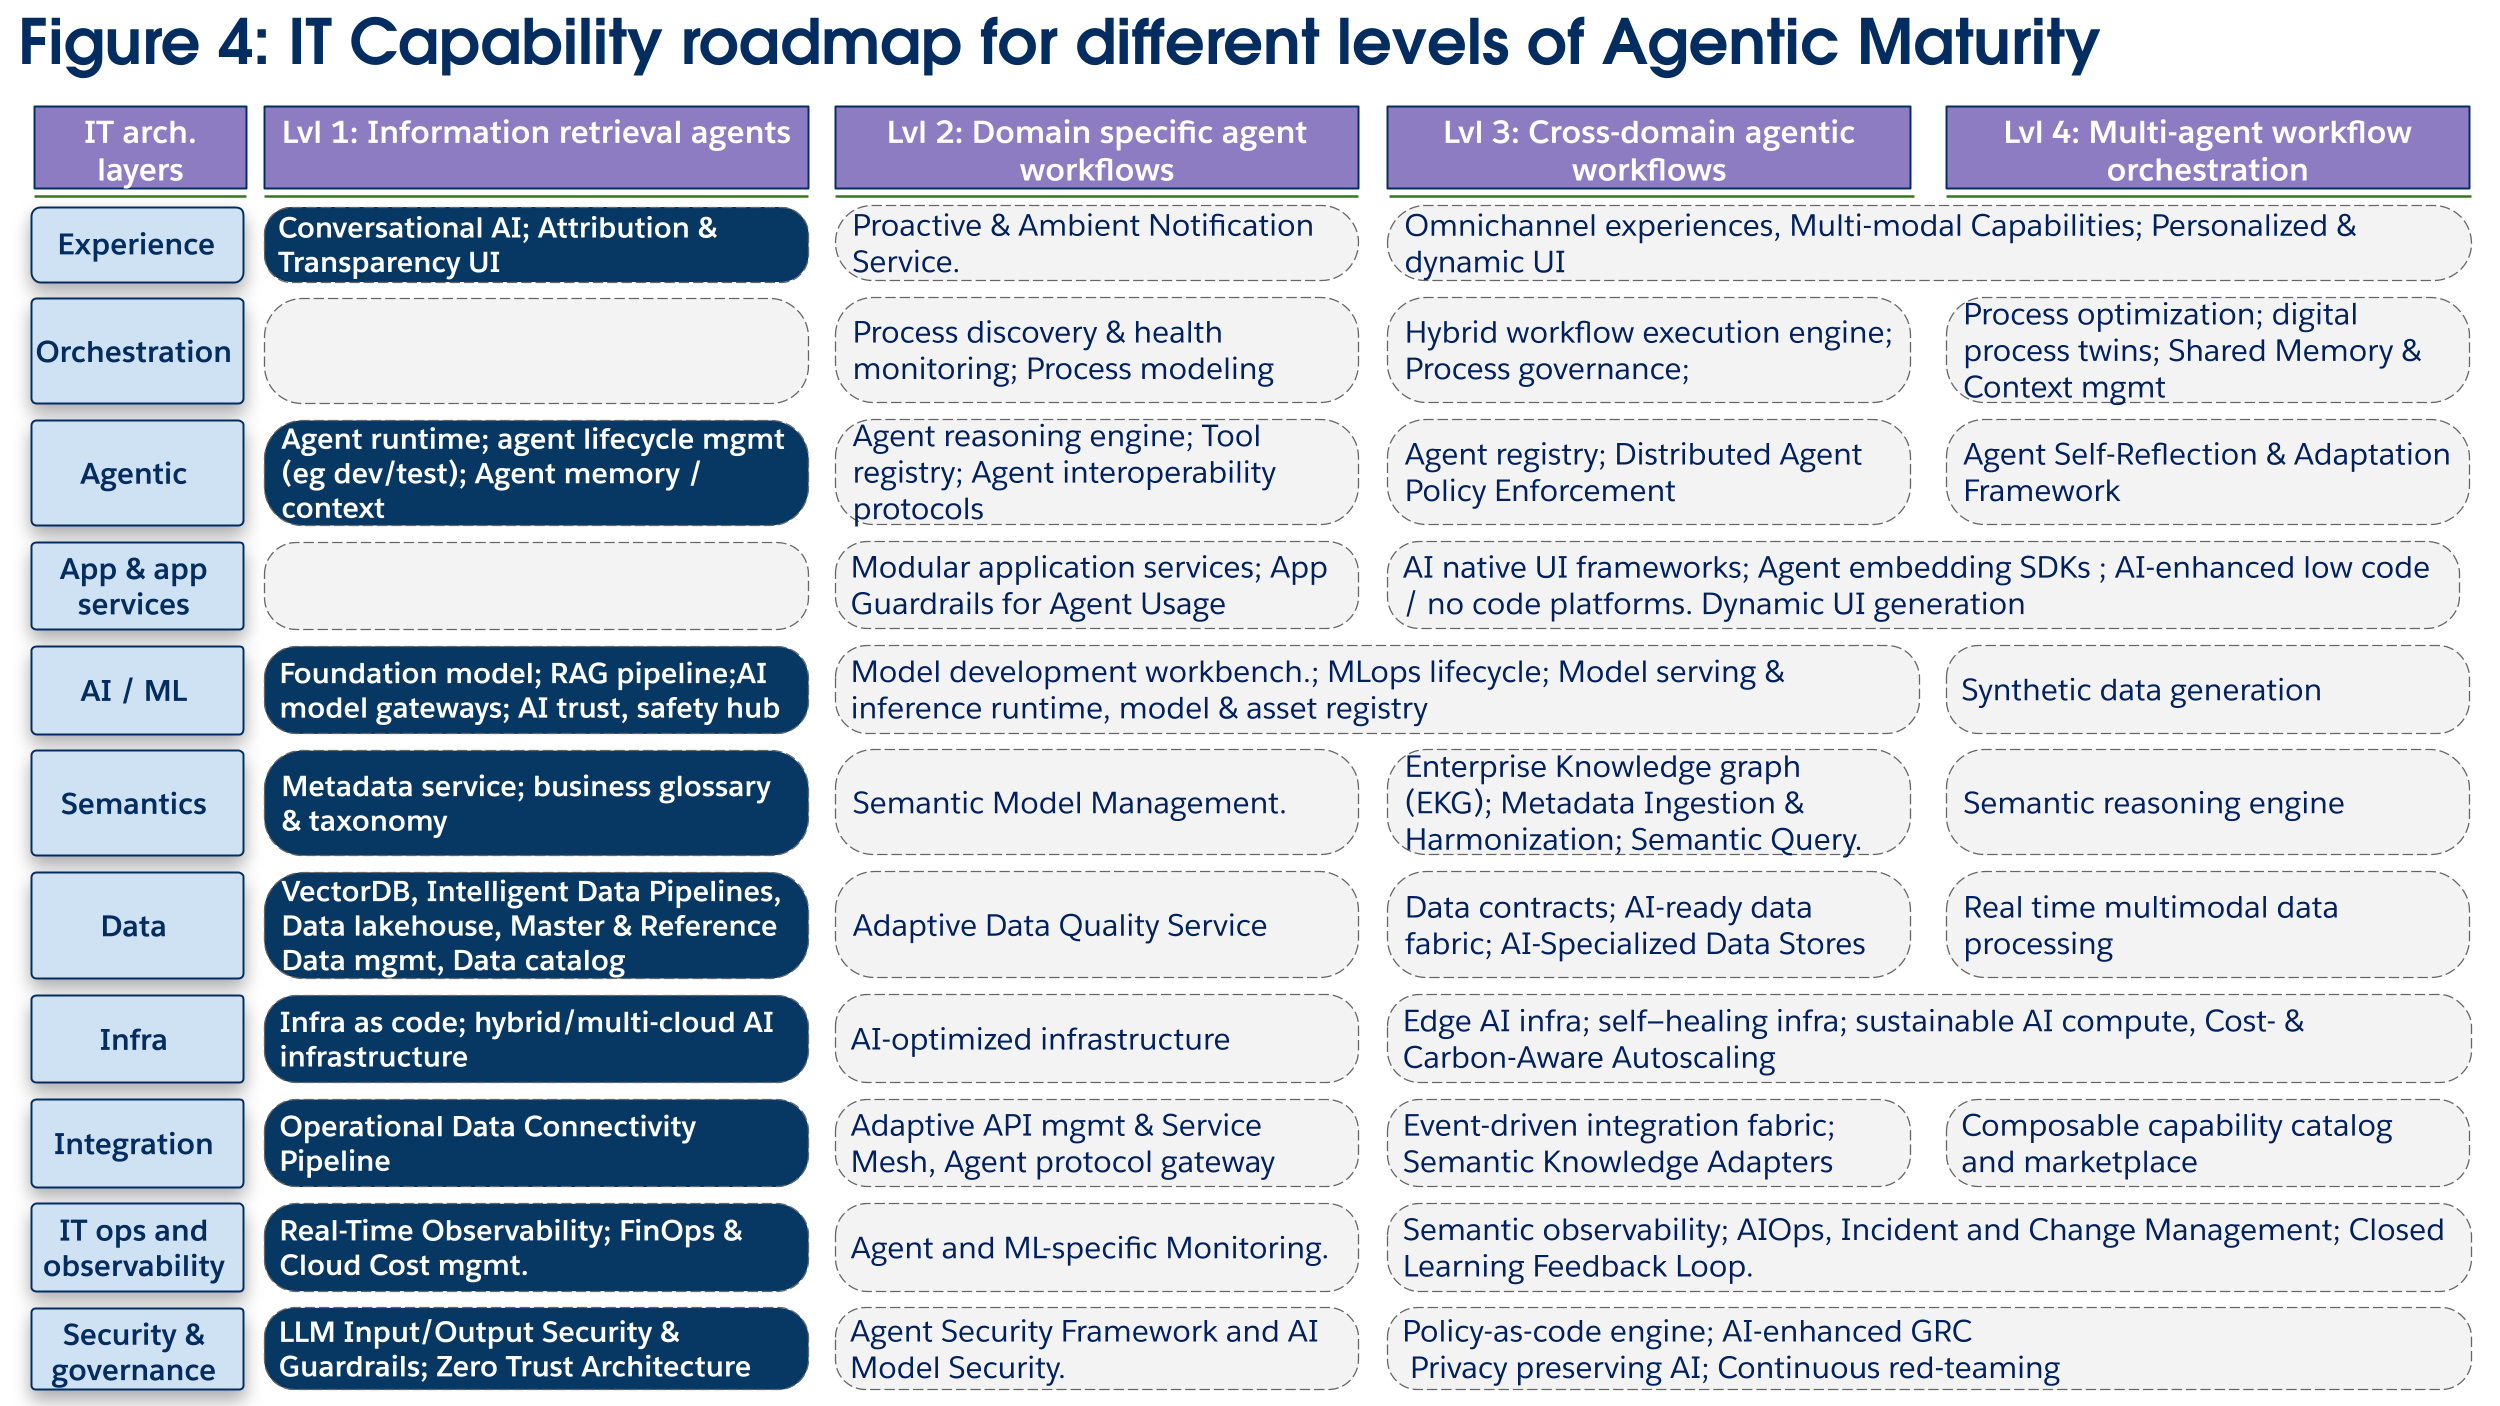
**Investimenti tecnologici chiave (figura 4):**
In questa fase, l'IT dovrebbe concentrarsi sulla creazione di una pipeline affidabile da dati ad agenti e di altre funzionalità di base. Le tecnologie nel **Data Layer**, ad esempio **VectorDB**, sono essenziali per abilitare le tecniche di generazione aumentata di recupero (RAG) che supportano gli agenti di recupero delle informazioni. Questo è abbinato a un **livello AI/ML** centralizzato che include un **gateway modello** per un accesso sicuro e a costi controllati ai modelli di base e un **AI Trust, Safety & Governance Hub** per monitorare la presenza di output non sicuri e garantire la conformità. La **gestione dei dati** master e i **glossari aziendali** nel **livello** **semantico** sono fondamentali per consentire agli agenti di recuperare informazioni accurate. Le funzionalità di runtime e ciclo di vita degli agenti sono necessarie per garantire che gli agenti creati in questa fase possano essere modificati ed estesi per i casi d'uso futuri. Per offrire valore e creare fiducia negli utenti, il **livello Experience** deve incorporare un'**interfaccia utente Attribution & Transparency** (Attribuzione e trasparenza), che rende spiegabili le risposte degli agenti visualizzando le citazioni e le fonti delle relative informazioni. Gli investimenti fondamentali in osservabilità e sicurezza (ad esempio **zero** **Trust**) devono iniziare l'implementazione per preparare il terreno per le future distribuzioni degli agenti.
 **Livello di maturità 2: Orchestrazione semplice, agenti di** dominio singolo
**Obiettivo e valore aziendale: Automatizzare le operazioni di routine e orchestrare flussi di lavoro a bassa complessità all'interno di un unico dominio aziendale.** Ciò migliora l'efficienza operativa e riduce il lavoro manuale, consentendo ai lavoratori umani di concentrarsi su attività di valore superiore.
**Focus architettonico:** Il cambiamento architetturale chiave è il recupero dei dati di sola lettura all'esecuzione di azioni. Ciò richiede l'avvio di un journey più lungo per modularizzare le funzionalità delle applicazioni (spesso esposte come API) a cui gli agenti possono accedere, l'implementazione di una sicurezza efficace per le azioni degli agenti e la creazione di funzionalità di sviluppo semantico e AI per migliorare l'intelligenza degli agenti AI.
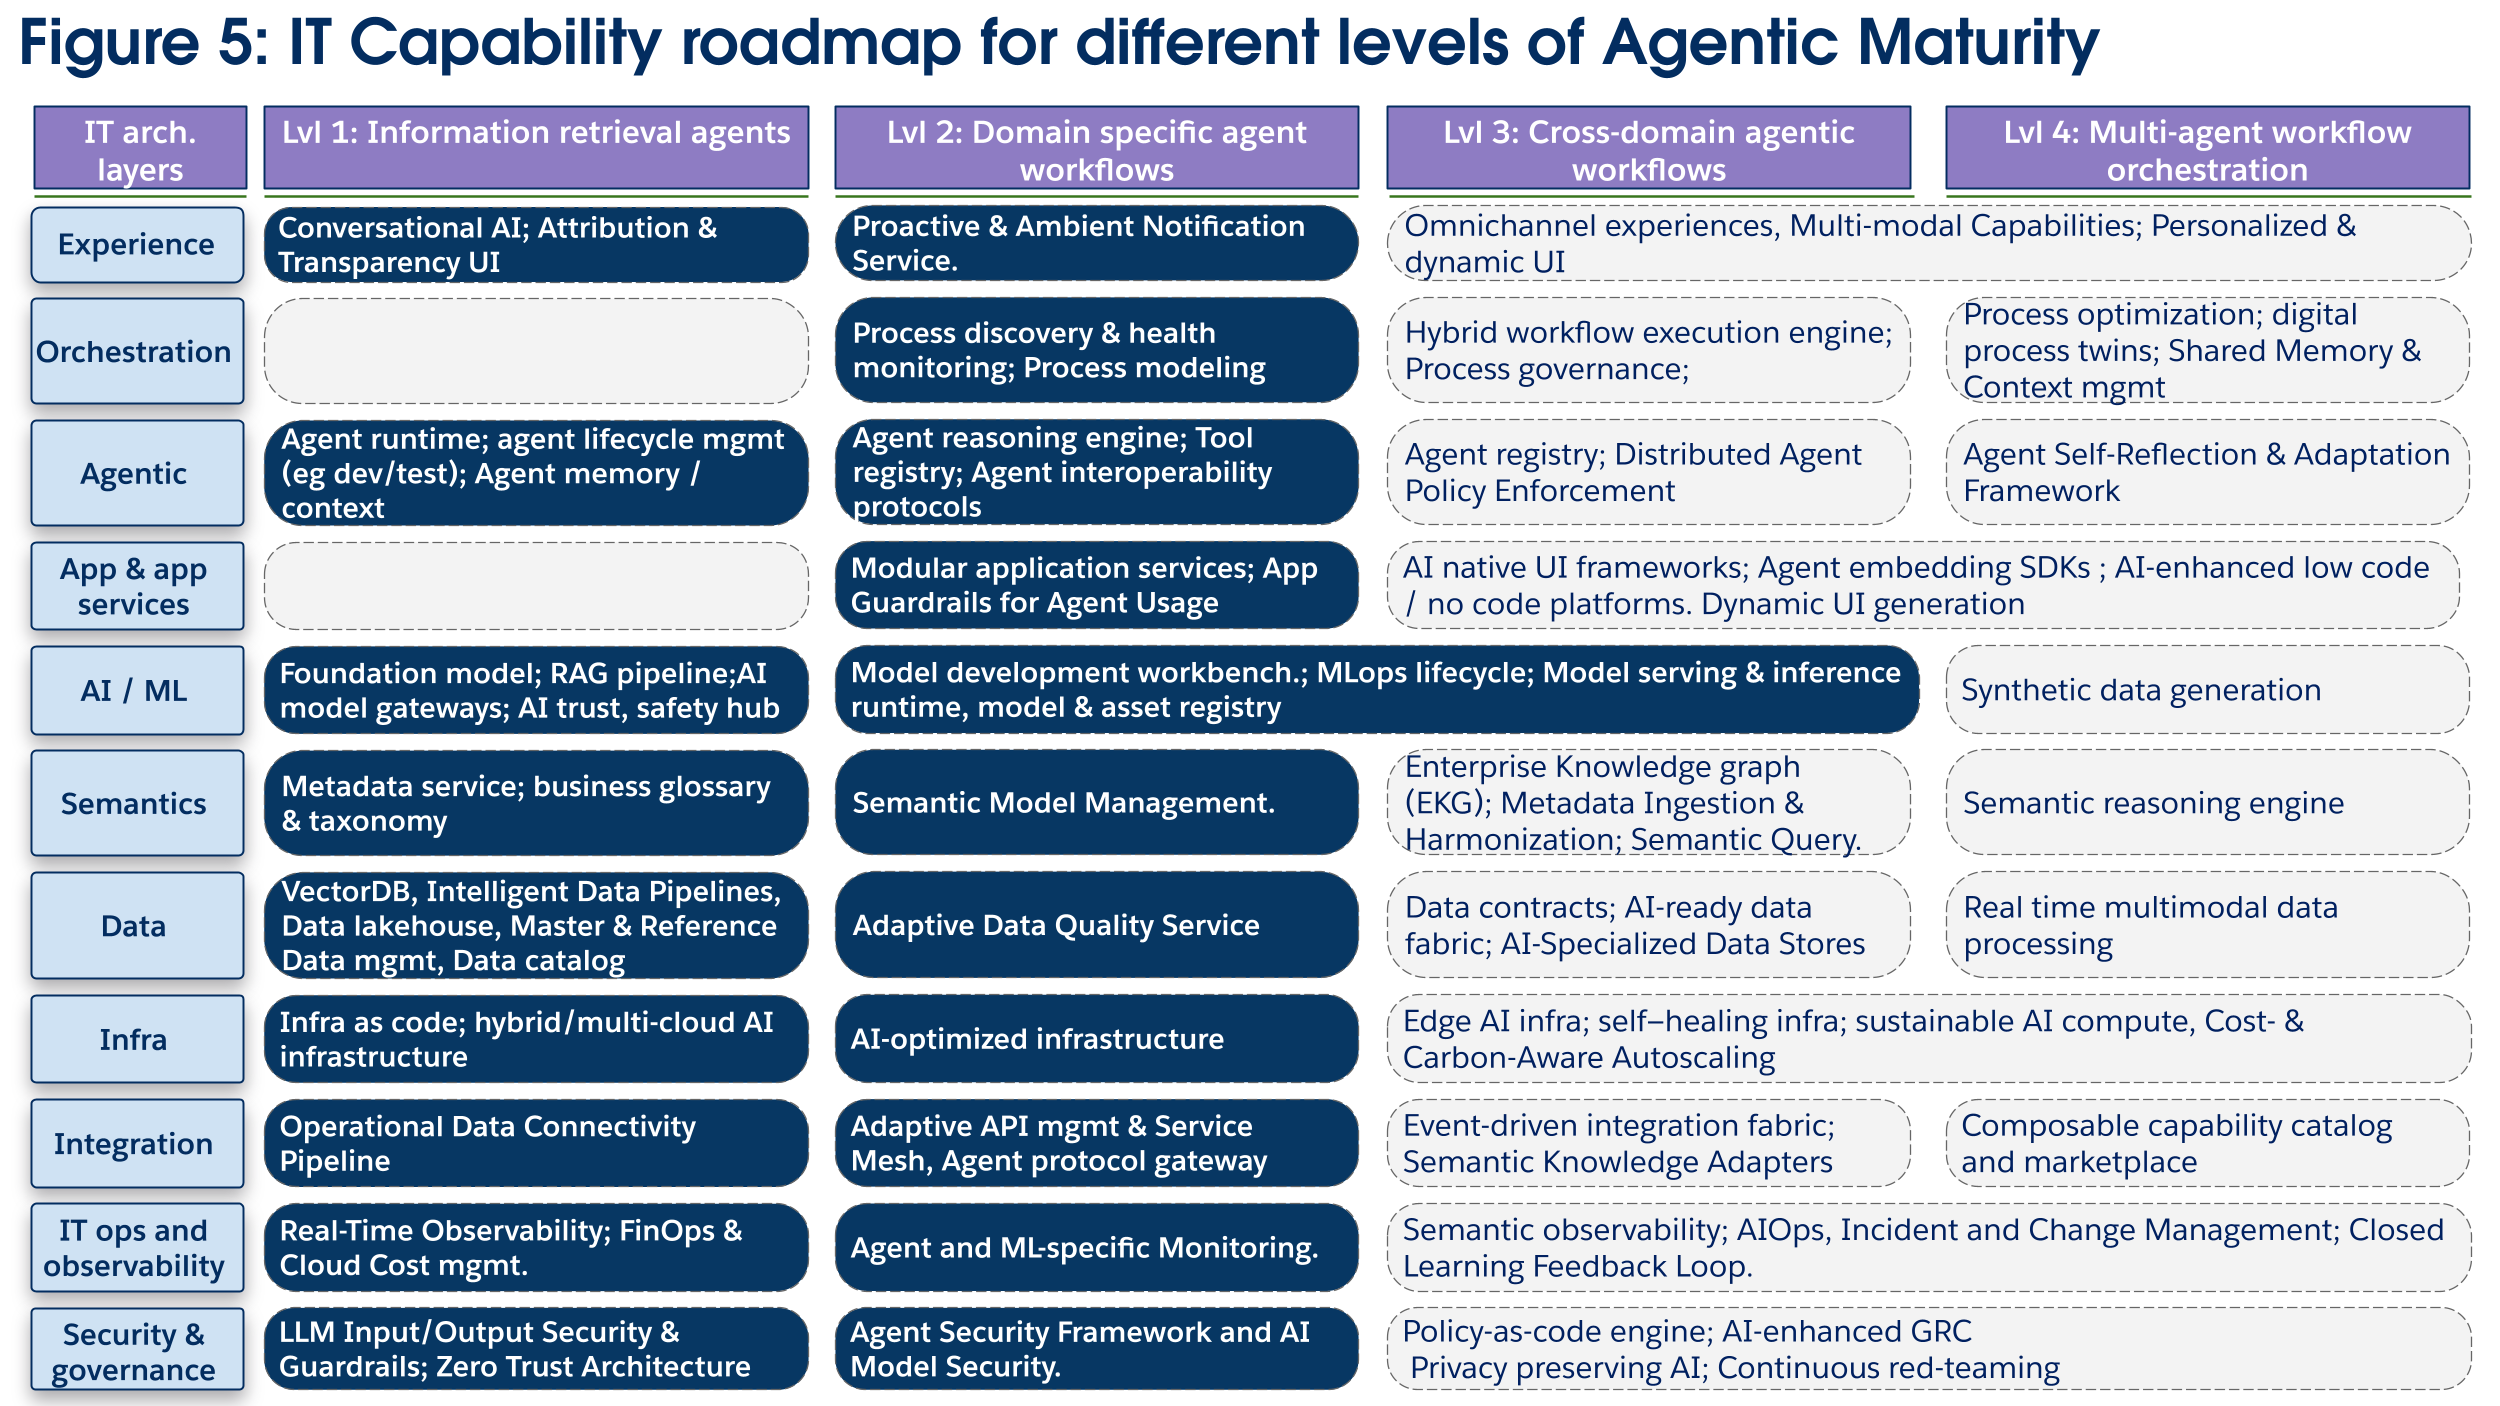
**Investimenti tecnologici chiave (figura 5):**
Gli investimenti si concentrano tematicamente sul consentire agli agenti dell'intelligenza artificiale di agire con una governance adeguata. Il livello **Applications and App Services** subisce un cambiamento critico, poiché la logica aziendale monolitica viene scomposta in **servizi applicativi modulari** (API) che gli agenti possono chiamare. Questi sono protetti dai **guardrail dell'app** per evitare che gli agenti sovraccarichino i sistemi, con integrazioni negli strumenti di osservabilità. Per potenziare questi agenti, è necessario investire nel ragionamento degli agenti, nei protocolli degli strumenti (ad esempio MCP) e nei **registri**. Ciò introduce nuovi rischi, rendendo un **Framework sicurezza agente** dedicato e un modello AI e funzionalità di monitoraggio degli agenti essenziali per la governance e la sicurezza. Infine, le aziende possono iniziare a scalare le funzionalità AI/ML per i modelli personalizzati per potenziare questi agenti che si occupano di operazioni specifiche del dominio.
 **Livello di maturità 3: Agenti dell'orchestrazione** multi-dominio
**Obiettivo e valore aziendale:** **Automatizzare processi aziendali complessi e completi che si estendono oltre i confini organizzativi e funzionali** (ad esempio "preventivo a cassa", "lead to order"). Il valore sta nello scomporre i silos, accelerare i tempi dei cicli dei processi e ottimizzare intere catene del valore all'interno dell'azienda. Sono possibili cambiamenti più elevati nella produttività dei lavoratori umani poiché le barriere organizzative iniziano a crollare e gli esseri umani iniziano a concentrarsi maggiormente sulla supervisione degli agenti AI.
**Focus architettonico:** L'architettura deve ora supportare questioni tecniche trasversali. Una comprensione semantica condivisa in tutta l'azienda, un motore di orchestrazione centralizzato per la governance e un tessuto di integrazione disaccoppiato e basato sugli eventi diventano gli elementi abilitanti critici.
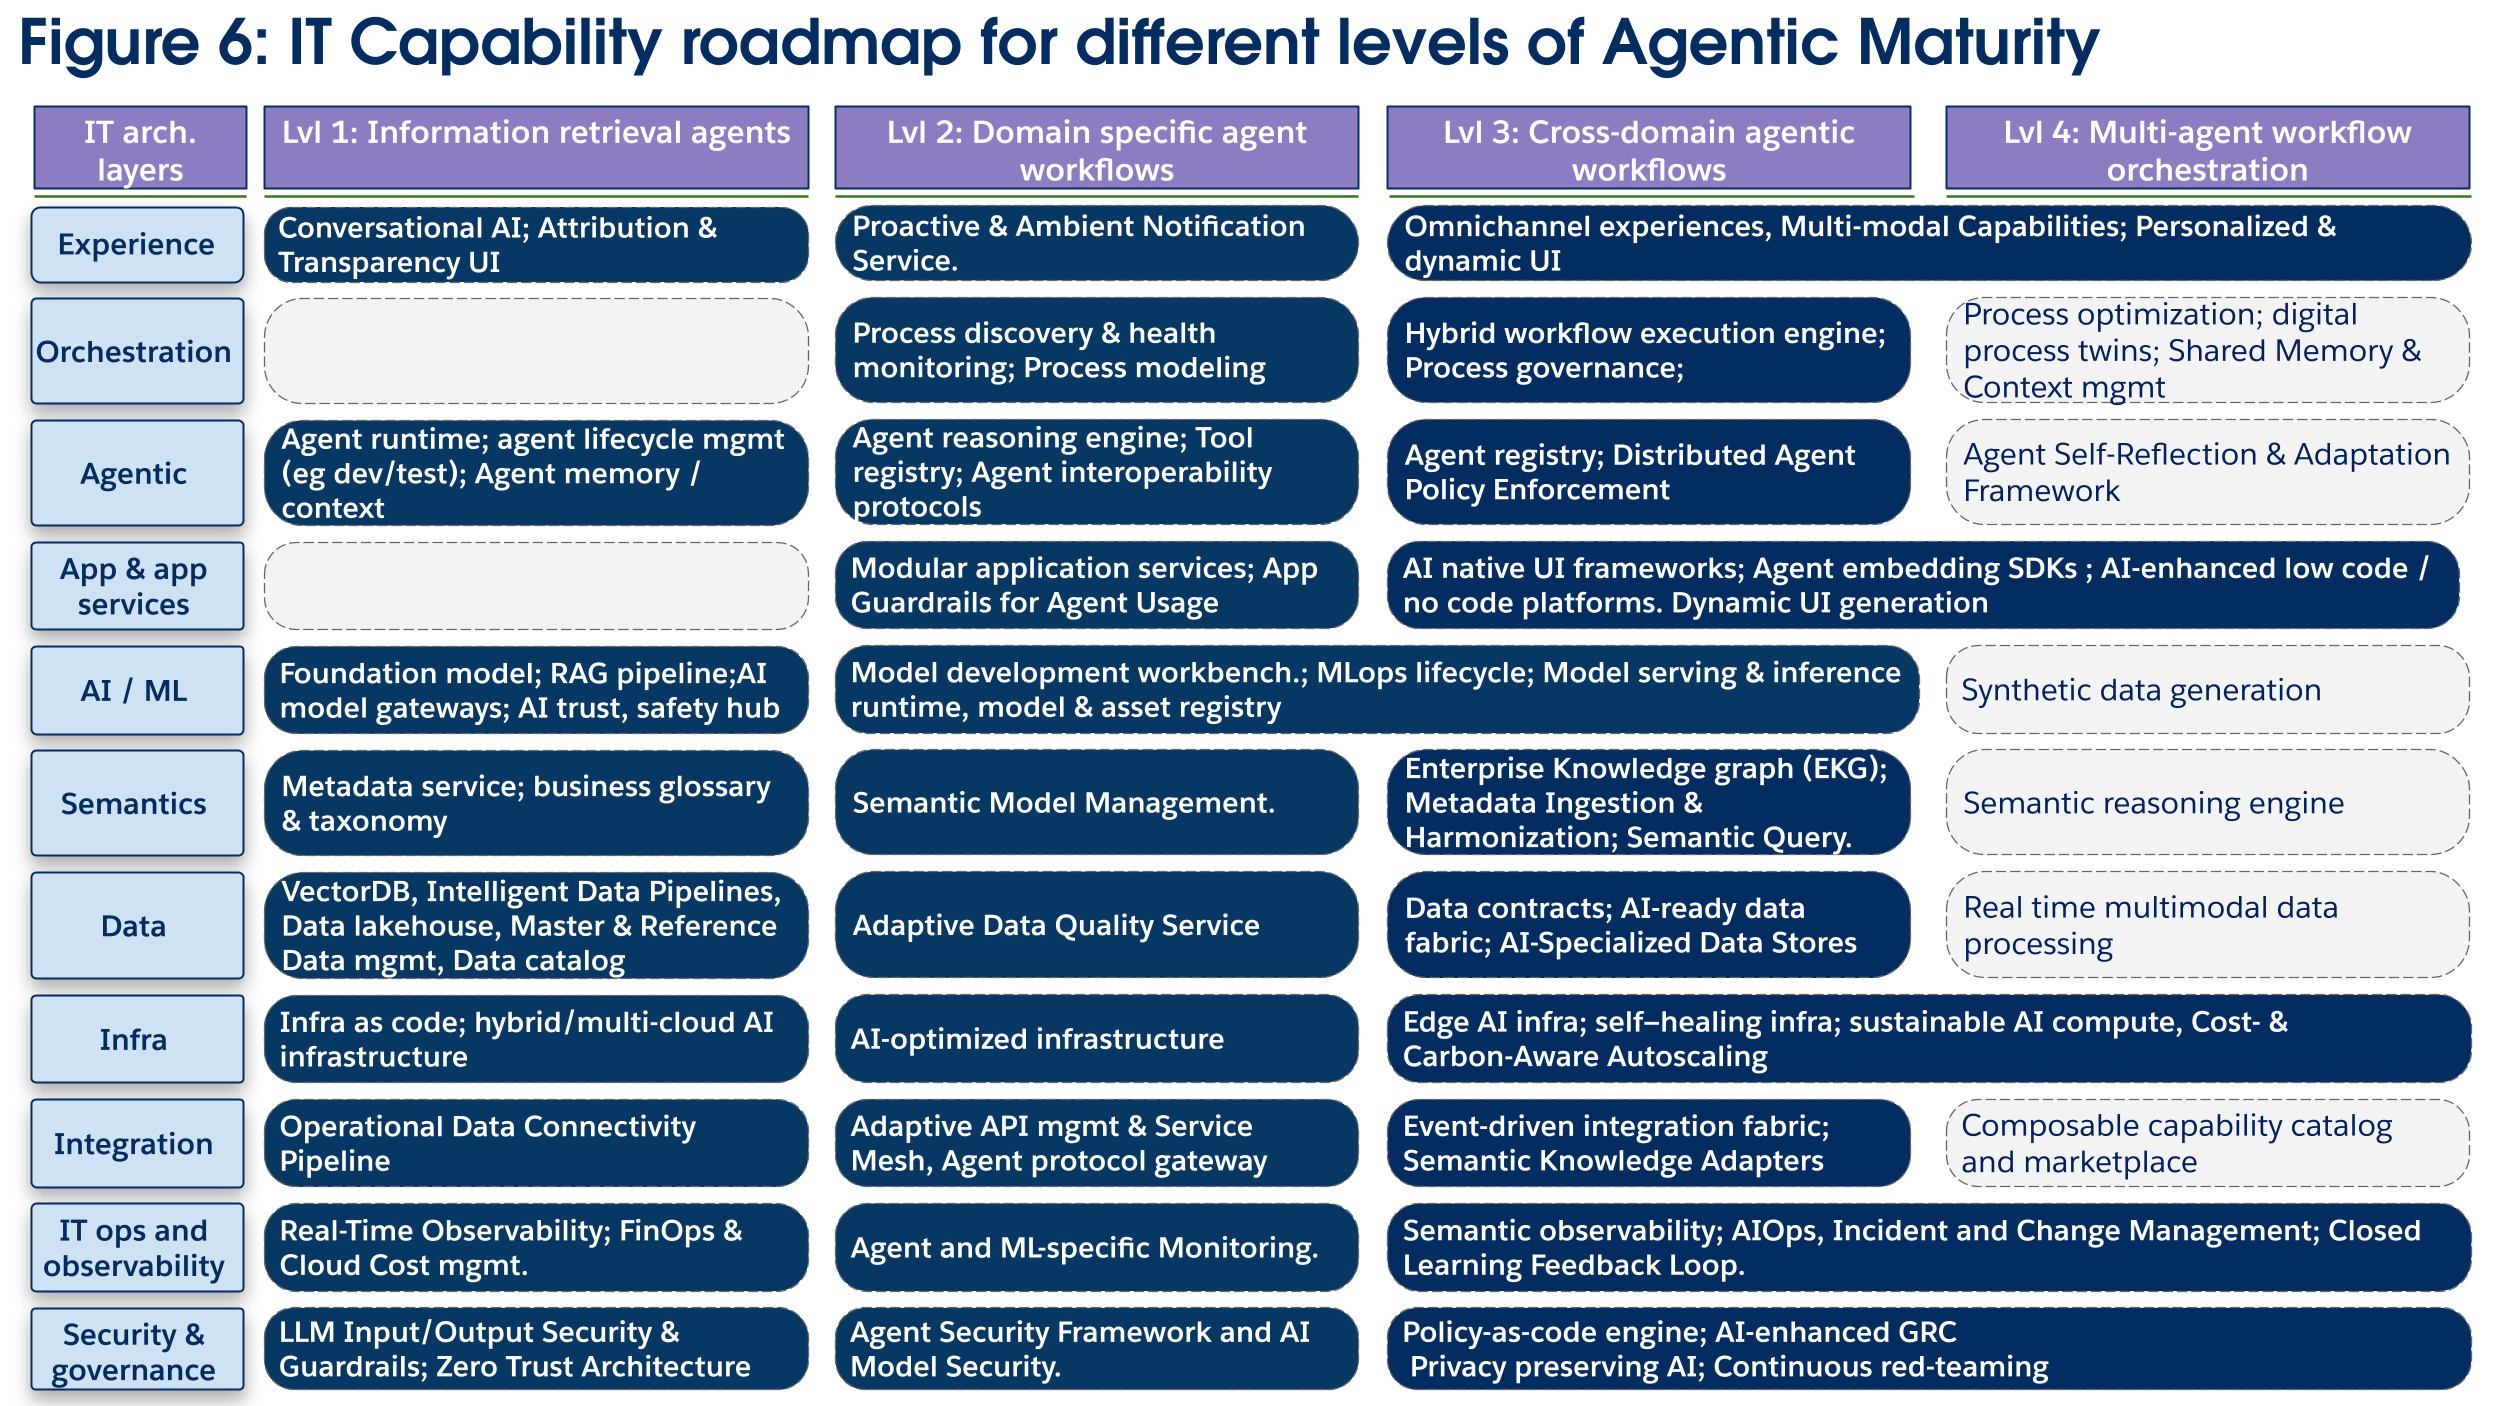 **Investimenti tecnologici chiave (figura 6):**
Gli investimenti tecnologici sono focalizzati tematicamente sull'orchestrazione di processi su scala aziendale tra persone, agenti e sistemi deterministici. L'**Enterprise Orchestration Layer** diventa il fulcro dell'investimento, richiedendo un **motore di esecuzione** del flusso di lavoro per coordinare le attività e un **motore Process Governance & Constraint** Engine per applicare le regole aziendali e le policy di conformità ai processi in volo poiché gli agenti lavorano in più domini, spesso con policy e definizioni semantiche diverse. Questo coordinamento tra domini è possibile solo con un **livello semantico** maturo dotato di un **Enterprise Knowledge Graph (**EKG), che crea una comprensione condivisa del modo in cui le entità aziendali si correlano tra i domini. Il **livello di integrazione** deve evolversi per includere un **Framework di integrazione** basato sugli eventi, che utilizza una dorsale streaming per disaccoppiare i sistemi e abilitare la comunicazione resiliente e asincrona tipica dei processi aziendali di lunga durata. Dato il valore più elevato di questi flussi di lavoro e i rischi associati, diventano fondamentali ulteriori investimenti nella sicurezza e nel monitoraggio (ad esempio **AIOps, policy-as-code**). Infine, ulteriori investimenti devono essere effettuati nel livello Applicazione e Servizi (ad esempio, LCNC **abilitato per AI,** esperienze utente più dinamiche e multimodali) man mano che gli utenti umani iniziano a monitorare e collaborare con agenti AI più capaci.
**Livello di maturità 4: Multi-agente, orchestrazione multi-dominio**
**Obiettivo e valore aziendale: Riprogettare e ottimizzare le operazioni aziendali in tutti i domini per favorire cambiamenti di produttività ed efficienza.** Questa fase consente di creare una simulazione digitale olistica (digital twin) dell'azienda per il miglioramento continuo e la pianificazione strategica nei principali processi aziendali e flussi di lavoro.
**Focus architettonico:** La fase finale si concentra sull'abilitazione di una collaborazione dinamica ed emergente tra gli agenti. Ciò richiede protocolli di comunicazione A2A avanzati, capacità di autoapprendimento degli agenti, ulteriori investimenti nella maturazione dei livelli Orchestrazione, Dati e Semantica e un'infrastruttura completamente dinamica e self-healing per supportare le crescenti esigenze dei carichi di lavoro di intelligenza artificiale dinamici man mano che gli agenti vengono ridimensionati in tutta l'azienda.
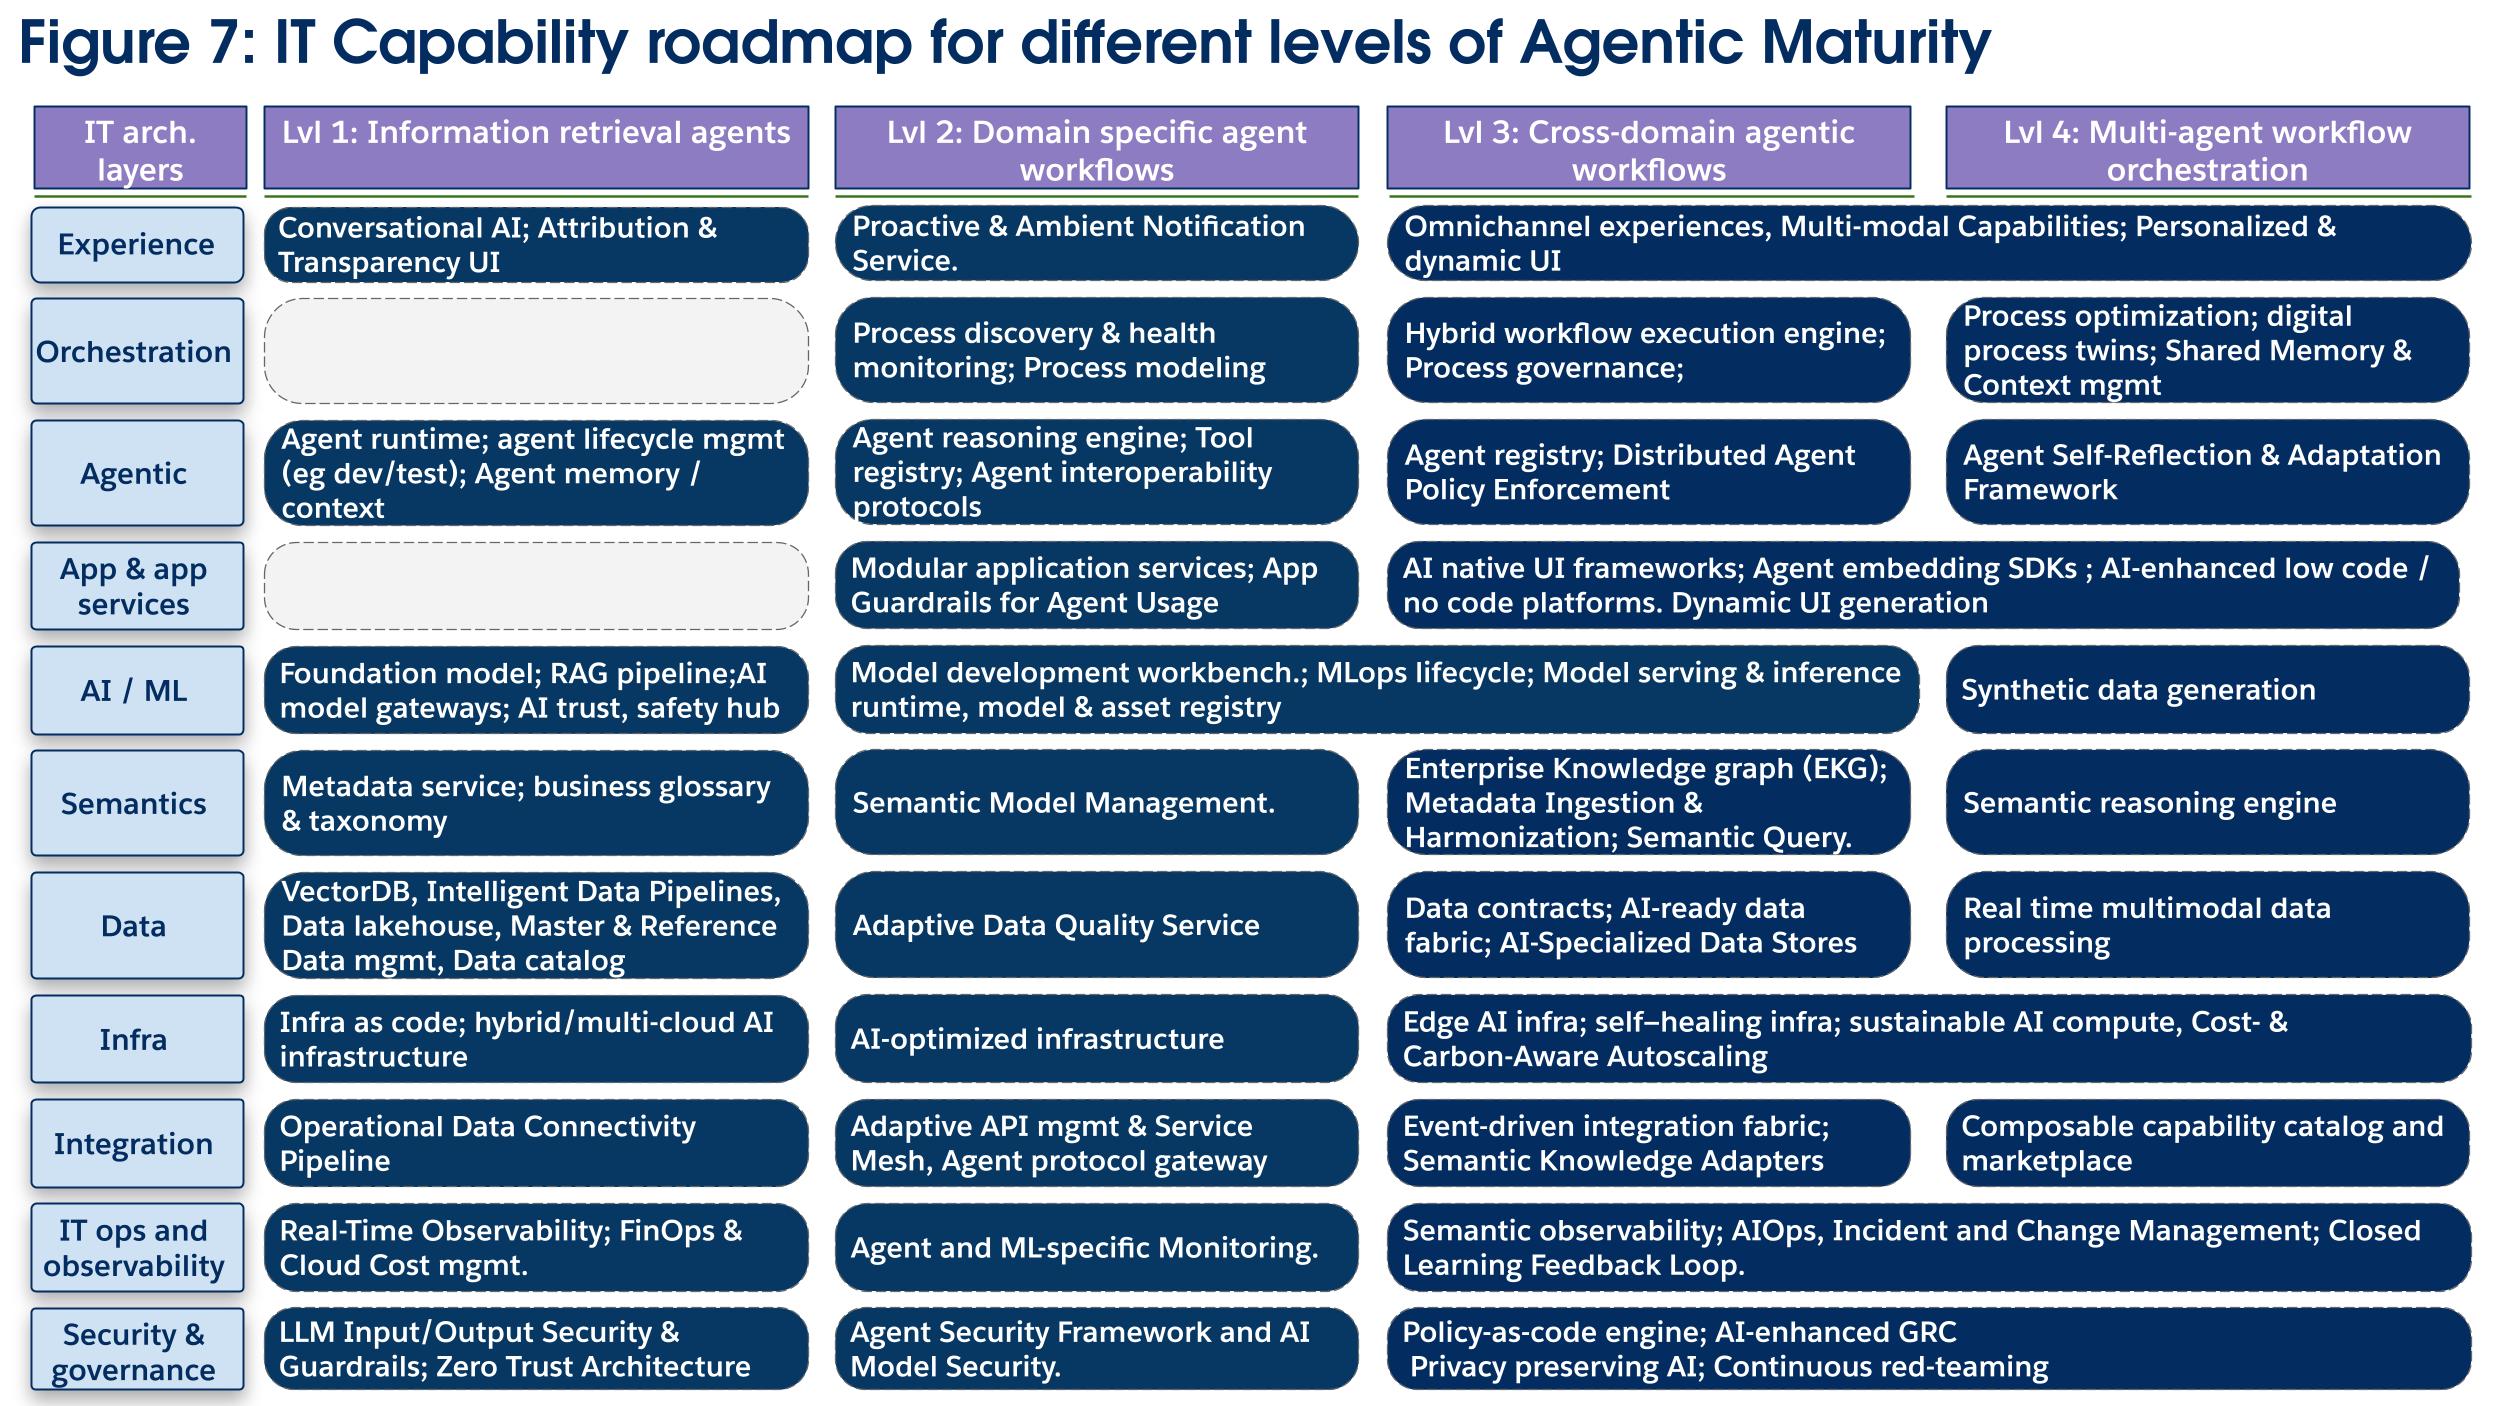 **Investimenti tecnologici chiave (figura 7):**
Gli investimenti tematici si concentrano sulla creazione di un sistema autonomo e automigliorante. Nel **livello agente**, un **Framework Autoriflessione e adattamento** fornisce un meccanismo che consente a un agente di analizzare i propri registri delle prestazioni e attivare miglioramenti. Questo apprendimento è supportato dall'**IT Operations and Observability Layer**, che implementa un **Closed Learning Feedback Loop** per reinserire automaticamente i dati osservabili nelle pipeline MLOps per la riaddestramento del modello, che può anche sfruttare la generazione di dati sintetici per ottimizzare ulteriormente le prestazioni del modello. Con le reti di agenti distribuite tra i reparti e le attività di modularizzazione delle applicazioni in corso, diventano necessari ulteriori investimenti nella sicurezza e, soprattutto, un **catalogo di funzionalità** componibile per consentire agli agenti di comporre dinamicamente le funzionalità per risolvere operazioni più astratte e di valore più elevato. Questi processi sono tutti orchestrati e ottimizzati tramite una nuova **funzionalità Digital Twin Process Modeling** che utilizza dati in tempo reale per creare simulazioni per l'analisi "what-if" e l'ottimizzazione predittiva, consentendo all'azienda di testare e distribuire in modo sicuro nuove distribuzioni agentiche.
**Conclusione**
La roadmap verso un'azienda agente segue un'evoluzione dell'architettura IT. Gli architetti Enterprise saranno i driver cruciali di questa trasformazione, guidando le decisioni di investimento critiche, insieme ad altri partner nel business e nell'IT, necessarie all'organizzazione per realizzare il valore dalle nuove capacità aziendali dell'azienda Agentic Enterprise.
## Panoramica
Questo documento descrive le opzioni correnti per la distribuzione delle applicazioni in CloudHub 2.0 per soddisfare i requisiti di disponibilità elevata e ripristino di emergenza. Utilizza la regione degli Stati Uniti come esempio e può essere applicato ad altre regioni.
CloudHub 2.0 è una piattaforma di integrazione nativa del cloud completamente gestita che elimina il sovraccarico dell'infrastruttura automatizzando la distribuzione, la scalabilità e la gestione delle API e delle integrazioni MuleSoft nel cloud. È la moderna piattaforma di distribuzione cloud di MuleSoft, eseguita sull'infrastruttura AWS Amazon.
## Requisiti per il ripristino di emergenza
Nella maggior parte dei casi, l'Alta disponibilità (HA) e il Ripristino di emergenza (DR) predefiniti forniti da CloudHub 2.0 sono sufficienti. CloudHub 2.0 fornisce HA e DR a livello regionale (per ulteriori dettagli, vedere [CloudHub 2.0 Outage Scenarys](#scenari-di-interruzione-di-cloudhub-20)). [La sezione Considerazioni chiave](#considerazioni-chiave-su-cloudhub-20) fornisce ulteriori dettagli su HA e DR supportati da CloudHub-2.0.
Le condizioni che impongono una progettazione oltre la disponibilità predefinita di CloudHub 2.0 includono:
- Un'applicazione deve garantire l'assenza di perdite di dati in uno scenario di emergenza (ad esempio, una regione dell'Amazzonia che cade).
- Un'applicazione dipende dall'Object Store e deve garantire la continuità in caso di guasto della regione di distribuzione.
## Ipotesi
- I sistemi di backend sono configurati per una disponibilità equivalente. CloudHub 2.0 può talvolta fornire affidabilità tramite aree di attesa o meccanismi simili, ma sia che l'integrazione sia in tempo reale o asincrona, i sistemi di backend devono supportare un livello comparabile di HA e DR.
- Quando un guasto a livello di regione AWS influisce sui sistemi di backend, si presume che il ripristino venga eseguito in parallelo al ripristino CloudHub 2.0.
- L'impostazione dello spazio privato è completa in più regioni.
## Fuori dall'ambito
Le opzioni di progettazione di questa guida si concentrano sulle soluzioni per la disponibilità delle applicazioni in CloudHub 2.0 quando un'intera zona o area geografica di disponibilità AWS non è disponibile.
Questa guida **non** affronta questi scenari di ripristino, anche se prende nota delle implicazioni laddove pertinenti:
- Ripristino di sistemi di backend, applicazioni, database, componenti di rete e data center gestiti e forniti all'esterno di Anypoint CloudHub, in locale o nel cloud.
- Ripristino dei link VPN tra CloudHub 2.0 e il data center privato del cliente (ad esempio, tunnel IPsec e gateway VPN). Alcune opzioni di DR in questa guida possono risolvere parzialmente questi scenari.
- Modifiche agli IP di uscita MuleSoft durante il ripristino di emergenza quando l'elenco IP consentiti viene utilizzato per le integrazioni. Alcune opzioni di DR in questa guida possono risolvere parzialmente questi scenari.
- Sistemi di messaggistica esterni utilizzati nelle soluzioni per i clienti, forniti da MuleSoft (ad esempio Anypoint MQ) o da altri fornitori (ad esempio AWS MSK o Heroku Kafka).
## Considerazioni chiave su CloudHub 2.0
Quando si valuta CloudHub 2.0 per i [requisiti di ripristino](#requisiti-per-il-ripristino-di-emergenza), tenere presenti le seguenti considerazioni chiave.
**Dipendenza CloudHub 2.0 dalla disponibilità regionale AWS**
- CloudHub 2.0 viene eseguito su AWS; la sua disponibilità è legata alle regioni AWS.
- Le distribuzioni e la disponibilità delle applicazioni sono organizzate per regione. Queste regioni corrispondono alle regioni AWS.
Se un'intera regione AWS non riesce, le applicazioni in quella regione non sono disponibili e non vengono replicate automaticamente altrove.
**Alta disponibilità delle applicazioni e gestione delle repliche**
- CloudHub 2.0 ridistribuisce automaticamente le applicazioni all'interno della stessa regione in caso di guasto hardware, ma un'applicazione con una singola replica può riscontrare tempi di inattività.
- Le applicazioni con più repliche vengono distribuite in zone di disponibilità separate per impostazione predefinita, fornendo HA in tutte le zone.
- Se la zona di disponibilità di un'applicazione a replica singola non riesce, l'applicazione viene automaticamente visualizzata in un'altra zona di disponibilità all'interno della stessa regione.
**Impatto specifico sulla regione orientale degli Stati Uniti**
- In caso di guasto della regione US East:
- L'interfaccia utente di gestione CloudHub 2.0 e i servizi REST di distribuzione non sono disponibili e non è possibile distribuire nuove applicazioni.
- Le applicazioni in altre regioni non sono interessate nella maggior parte degli scenari di errore. Queste applicazioni continuano a funzionare normalmente; tuttavia, le funzionalità di monitoraggio e gestione tramite il piano di controllo non saranno disponibili durante il guasto.
- I moduli Core CloudHub 2.0 (ad esempio le impostazioni delle applicazioni) vengono mantenuti negli Stati Uniti orientali, quindi le impostazioni non possono essere modificate durante il guasto.
**Monitoraggio e avvisi**
- Configurare gli avvisi per gli errori a livello di zona di disponibilità o di regione tramite [status.mulesoft.com](http://status.mulesoft.com).
- Utilizzare un meccanismo separato di controllo dello stato e di avviso all'esterno di CloudHub 2.0 in modo che i team ricevano una notifica se le repliche non riescono o se le applicazioni non rispondono più.
**Persistenza dei dati (Object Store V2)**
- Object Store V2 è legato alla regione in cui l'applicazione viene distribuita per la _prima volta_.
- Se si sposta l'applicazione in un'altra regione, Object Store V2 rimane nella regione originale per evitare perdite di dati.
- Se la regione in cui è distribuito Object Store V2 non riesce, l'Object Store non è disponibile.
**Controller di ingresso e spazi privati**
- I controller di ingresso di CloudHub 2.0 sono altamente disponibili a livello regionale.
- In uno spazio condiviso, se una regione non riesce, un controller di ingresso in un'altra regione rimane disponibile ma può servire solo le applicazioni distribuite in quella regione.
- In uno spazio privato, se una regione non riesce, i controller di ingresso in altre regioni non sono disponibili a meno che non siano stati impostati in precedenza.
- L'impostazione dello spazio privato è regionale; se una regione non riesce, lo spazio privato non è disponibile a meno che non sia stata impostata un'altra regione.
## Scenari di interruzione di CloudHub 2.0
### Replica / Disponibilità Zona / Regione Disservizi
#### Responsabilità Salesforce
| Stato componente | Responsabilità Salesforce |
| ------------------------------ | :-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Replica giù** | **Azione**: CloudHub 2.0 riavvia automaticamente la replica in una zona di disponibilità diversa se si verifica un errore nella zona di disponibilità corrente. Tuttavia, l'applicazione sarà offline fino a quando la nuova replica non sarà completamente avviata. **Condizione**: Configurazione predefinita. **Tempo impiegato**: Circa 2-15 minuti a seconda della complessità dell'applicazione e delle dimensioni della replica. |
| **Zona disponibilità ridotta** | **Azione**: Come la replica giù. **Condizione**: Configurazione predefinita. **Tempo impiegato**: Come la replica giù. **Notifica**: Come la replica giù. |
| **Regione giù** | **Azione**: Nessun ripristino automatico. Deve essere disponibile un progetto di failover. |
#### Responsabilità del cliente
| Stato componente | Responsabilità del cliente |
| ------------------------------ | :------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------ |
| **Replica giù** | **Notifica**: Eseguire controlli periodici dello stato utilizzando un meccanismo Heartbeat integrato nelle API. **Mitigazione**: Distribuire l'applicazione a più repliche nella stessa regione. **Test / simulazione:** Alza un ticket con il supporto MuleSoft e supporterà un test di failover per verificare se una nuova replica viene eseguita in un'AZ diversa in 1-15 minuti. |
| **Zona disponibilità ridotta** | **Notifica**: Come la replica giù. **Mitigazione**: Distribuire l'applicazione a più repliche nella stessa regione o in regioni diverse. **Test / simulazione:** Lo scenario AZ Down è difficile da simulare. Richiede il coinvolgimento di MuleSoft Engineering per supportare possibili scenari di test. |
| **Regione giù** | **Notifica**: Come la replica giù. Controllare anche gli aggiornamenti di stato all'indirizzo [https://status.aws.amazon.com](https://status.aws.amazon.com). **Mitigazione**: Come AZ Down. Piano di emergenza di ripristino: 2 spazi privati con la stessa configurazione in regioni diverse. **Test / simulazione:** Come AZ Down. |
### Gateway VPN e interruzioni del controller di ingresso
#### Responsabilità Salesforce
| Stato componente | Responsabilità Salesforce |
| :---------------------------------------------------------- | :----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Gateway VPN disattivato** | **Stato replica**: In esecuzione ma non in grado di connettersi ad alcuna risorsa ospitata in loco e raggiungibile attraverso il tunnel VPN. **Azione**: Nessun ripristino automatico. Deve essere disponibile un progetto di failover. |
| **Controllo degli ingressi (spazio condiviso) disattivato** | **Stato replica**: Il controller Ingress è un'impostazione in cluster con più istanze, simile alle repliche delle applicazioni. Se una replica dell'applicazione non riesce, viene creata e avviata automaticamente una nuova replica. Se un'istanza del controller di immissione non riesce, le applicazioni rimangono disponibili tramite l'altra istanza. Se l'intero controller Ingress non è attivo, la regione viene considerata negativa. |
| **Controllo dell'ingresso (spazio privato)** | **Stato replica:** Come il controller di ingresso nello spazio condiviso verso il basso. |
#### Responsabilità del cliente
| Stato componente | Responsabilità del cliente |
| :-------------------------------------------- | :--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Gateway VPN disattivato | **Notifica**: Eseguire controlli periodici dello stato utilizzando un meccanismo Heartbeat integrato nelle API. **Mitigazione**: I gateway VPN CloudHub 2.0 supportano l'alta disponibilità tramite un'architettura a due tunnel con failover automatico tra i tunnel; questo schema deve essere configurato dal cliente. **Test / simulazione:** Lo scenario Gateway Down VPN è difficile da simulare. Richiede il coinvolgimento di MuleSoft Engineering per supportare possibili scenari di test. |
| Controller di ingresso (spazio condiviso) giù | **Notifica**: Come Gateway VPN giù. **Mitigazione**: Come Regione giù. Eseguire la migrazione delle applicazioni in uno spazio standby o attivo in un'altra regione. **Test / simulazione:** Come Gateway VPN giù. |
| Controller di ingresso (spazio privato) giù | **Notifica**: Come Gateway VPN giù. **Mitigazione**: Come Regione giù. Eseguire la migrazione delle applicazioni in uno spazio privato in standby o attivo in un'altra regione, in coordinamento con la configurazione AWS Route 53 (o equivalente). **Test / simulazione:** Come Gateway VPN giù. |
### Punti vendita oggetti e aree di attesa persistenti
**Panoramica Servizi piattaforma Down Scenario – Object Store**
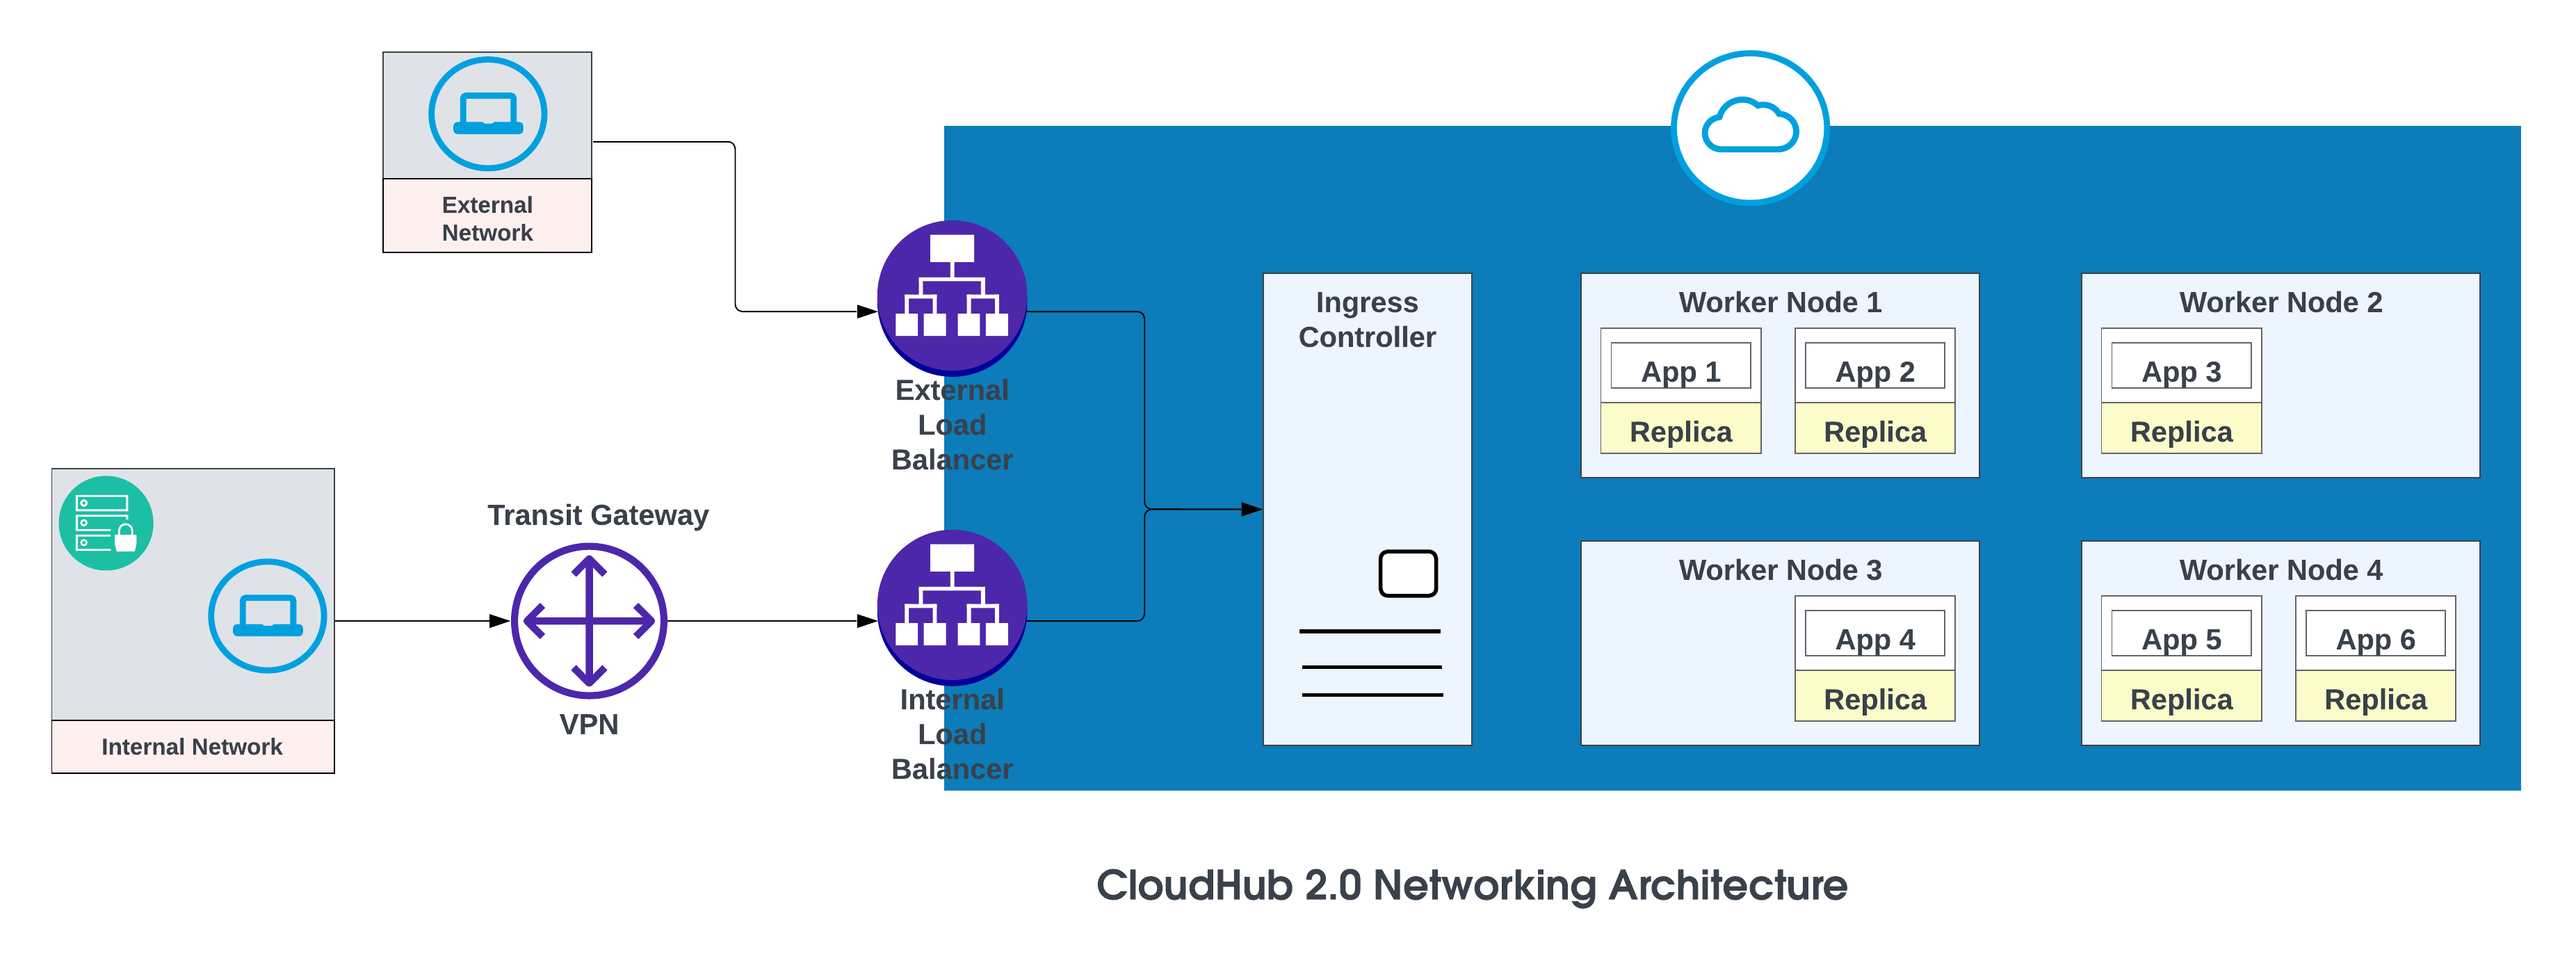 I componenti di base dell'architettura di rete CloudHub 2.0 sono:
- Un bilanciamento del carico HTTP
- Mule replica record DNS
- Spazi privati
- Servizi regionali
Per ulteriori dettagli, vedere [CloudHub 2.0 Networking Architecture](https://docs.mulesoft.com/cloudhub-2/ch2-networking-guide).
**Domini vanità**
Quando viene creato, uno spazio privato riceve un nome di destinazione DNS nel formato: \
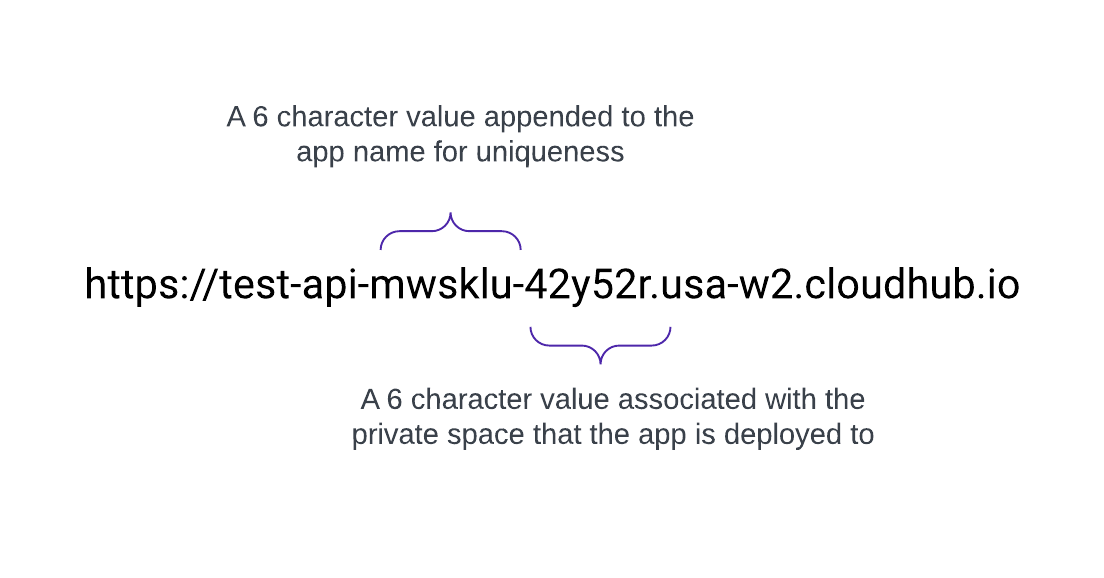 CloudHub 2.0 supporta anche i domini personalizzati, o vanity, configurandoli all'interno di uno spazio privato utilizzando contesti TLS e record DNS. Per creare un contesto TLS in Runtime Manager per uno spazio privato, caricare il certificato pubblico e la chiave privata, quindi aggiungere un endpoint personalizzato nelle impostazioni dell'applicazione per utilizzare quel dominio. Creare un record DNS (ad esempio un CNAME) che punti il dominio Vanity al nome host predefinito dello spazio privato.
Ad esempio, un'applicazione denominata test-api distribuita in us-west-2 con DNS predefinito 42y52r.usa-w2.cloudhub.io ha un endpoint API di:
https://test-api-mwsklu-42y52r.usa-w2.cloudhub.io
Questo URL non utilizza un dominio vanity o personalizzato. Per utilizzare [acme.com](https://acme.com) in modo che gli URL API compaiano come [https://test-api.acme.com](https://test-api.acme.com), seguire questa procedura.
1. Creare il contesto TLS in Runtime Manager con chiavi pubbliche e private.
2. Aggiungere un dominio di vanità nelle impostazioni dell'applicazione per utilizzare quel dominio.
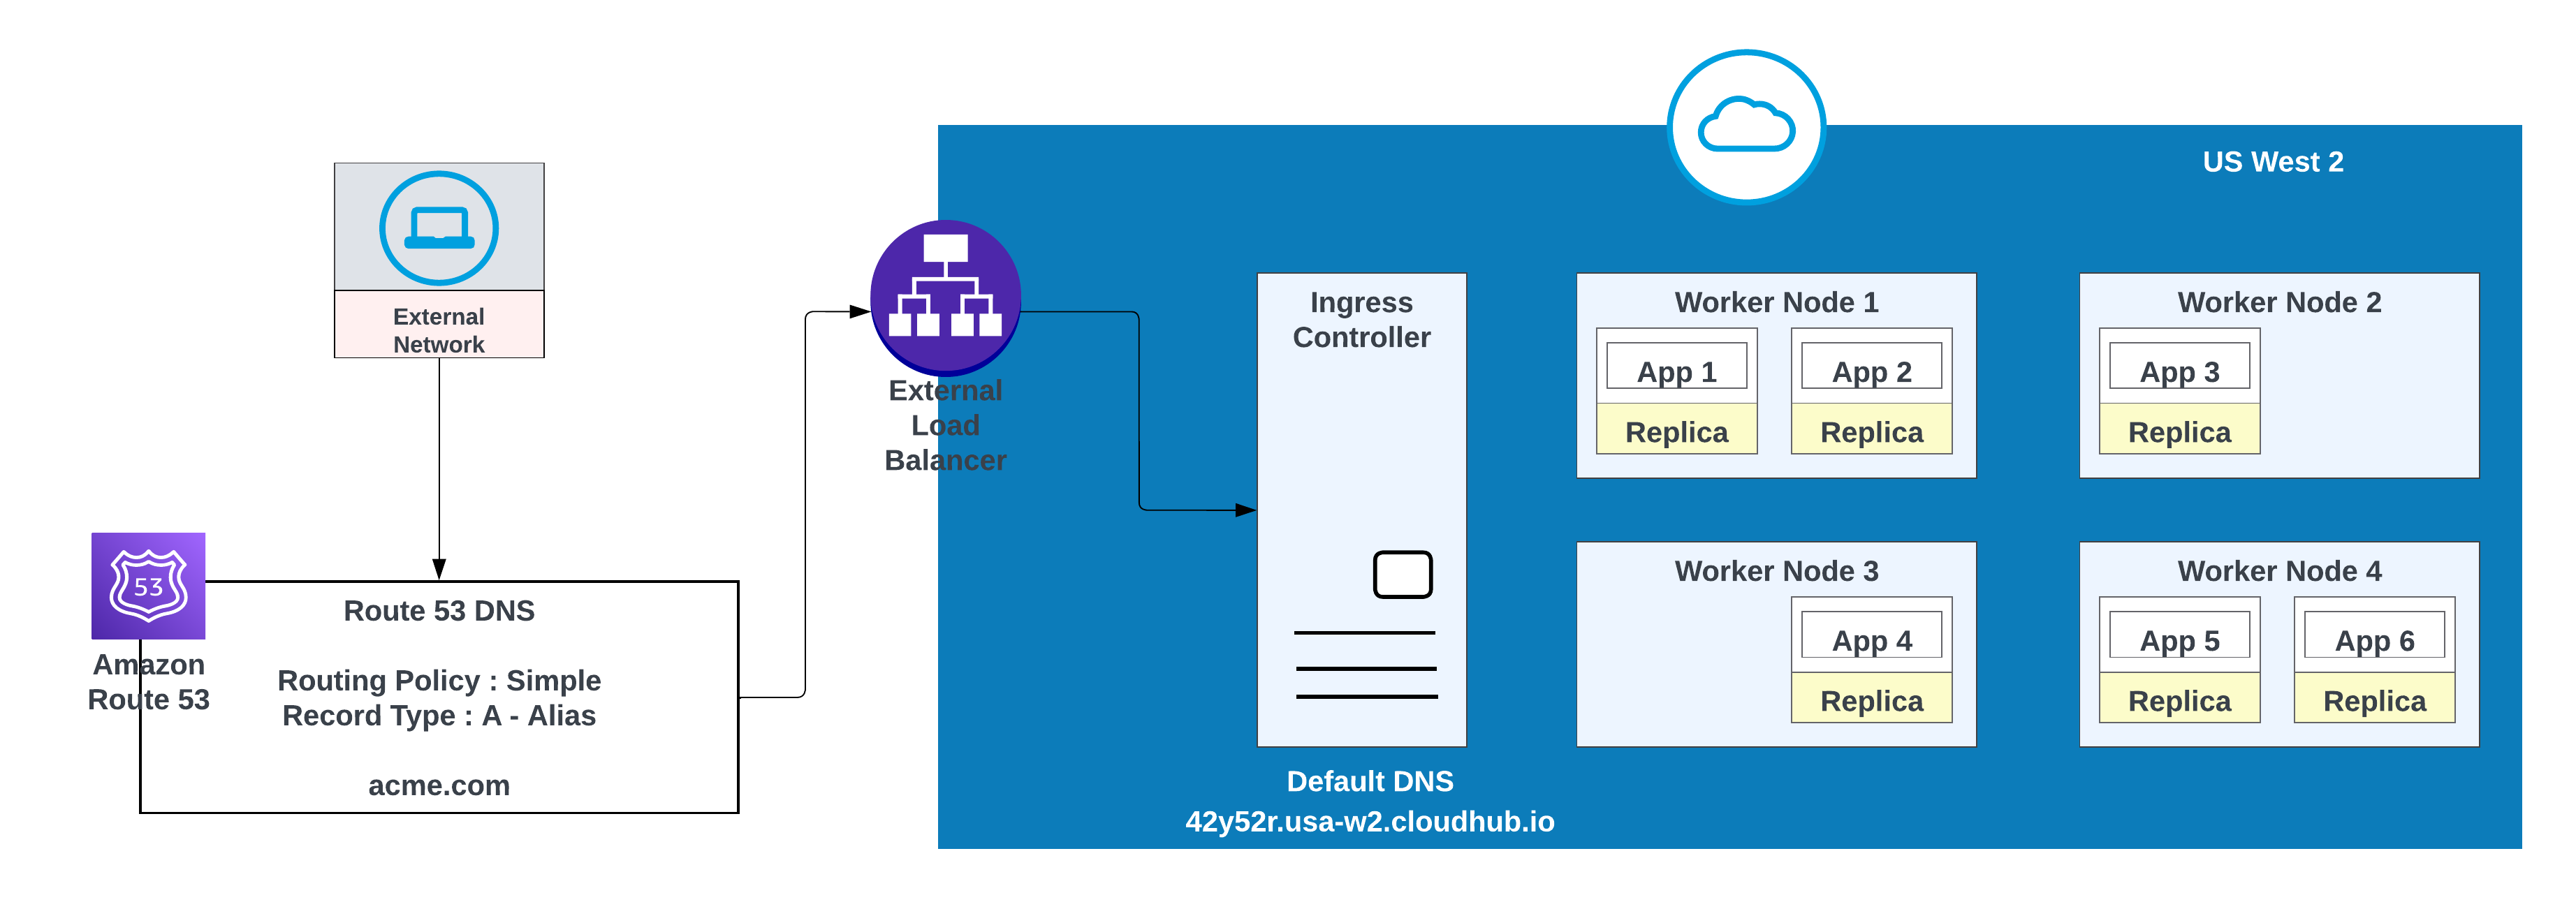
3. Creare un record DNS in AWS Route 53 e configurare una policy di instradamento semplice (ad esempio, CNAME) in modo che il vanity domain venga risolto nel nome host predefinito dello spazio privato.
Per i domini personalizzati, è possibile utilizzare AWS Route 53 o qualsiasi altro servizio CDN globale con policy di instradamento. Nel diagramma seguente, AWS Route 53 viene utilizzato con una policy di instradamento "semplice". Quando un consumatore da una rete pubblica (esterna) richiede acme.com, AWS Route 53 instrada la richiesta al controller di ingresso spazio privato MuleSoft.
 ## Strategia di failover
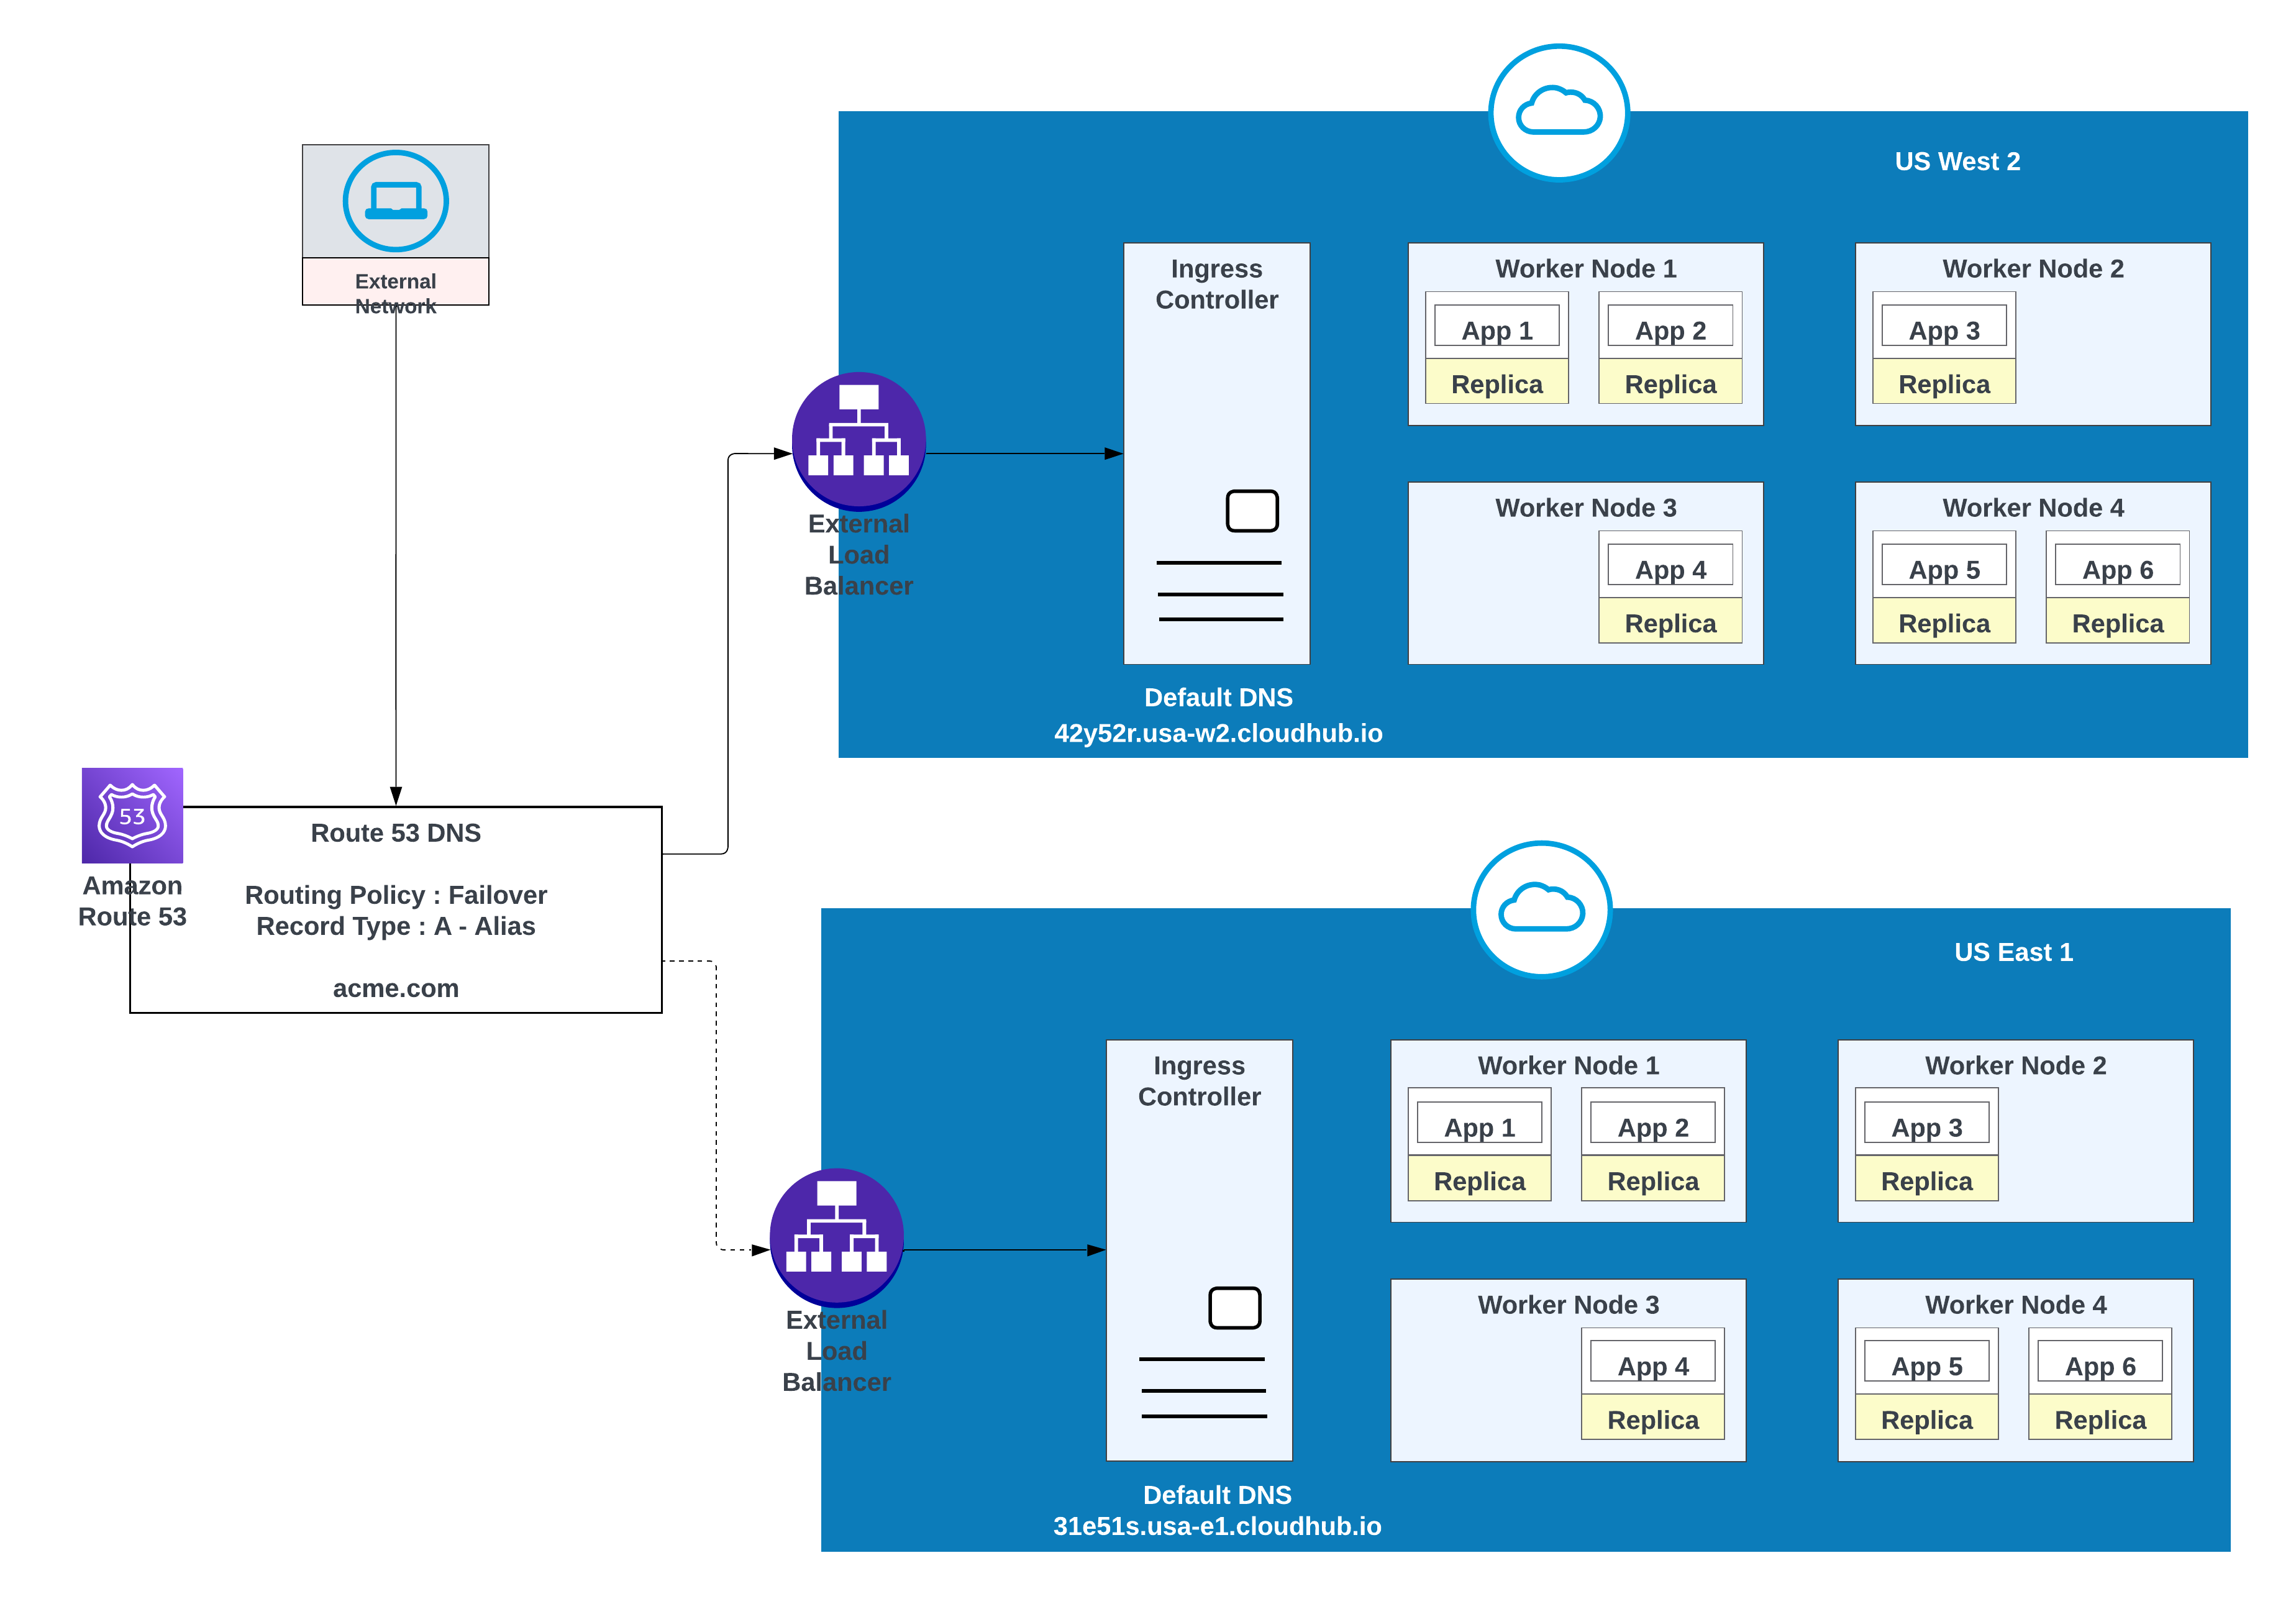
Utilizzare questa opzione quando le applicazioni richiedono il failover: distribuire un'istanza nella regione principale (ad esempio, us-west-2) e un'altra in una regione secondaria (ad esempio, us-east-1).
Ove possibile, utilizzare un ambiente esistente nella regione secondaria; la creazione di un nuovo ambiente richiede ulteriori sforzi.
**Esempio di app distribuite in una regione (Stati Uniti Ovest 2) con failover in un'altra regione ( Stati Uniti Est 1)**
 | Nome record | Valore/Instrada traffico a | Policy di instradamento | ID controllo dello stato |
| :---------: | :------------------------: | :---------------------: | :----------------------: |
| acme.com | 42y52r.usa-w2.cloudhub.io | Failover | 31s3wseq121 |
| acme.com | 31e51s.usa-e1.cloudhub.io | Failover | 43e131s131sq |
In questa configurazione, AWS Route 53 instrada il traffico ai controller di ingresso per gli spazi privati in US West 2 e US East 1. Viene configurata una policy di instradamento di failover con un controllo dello stato.
## Alta disponibilità e bassa latenza
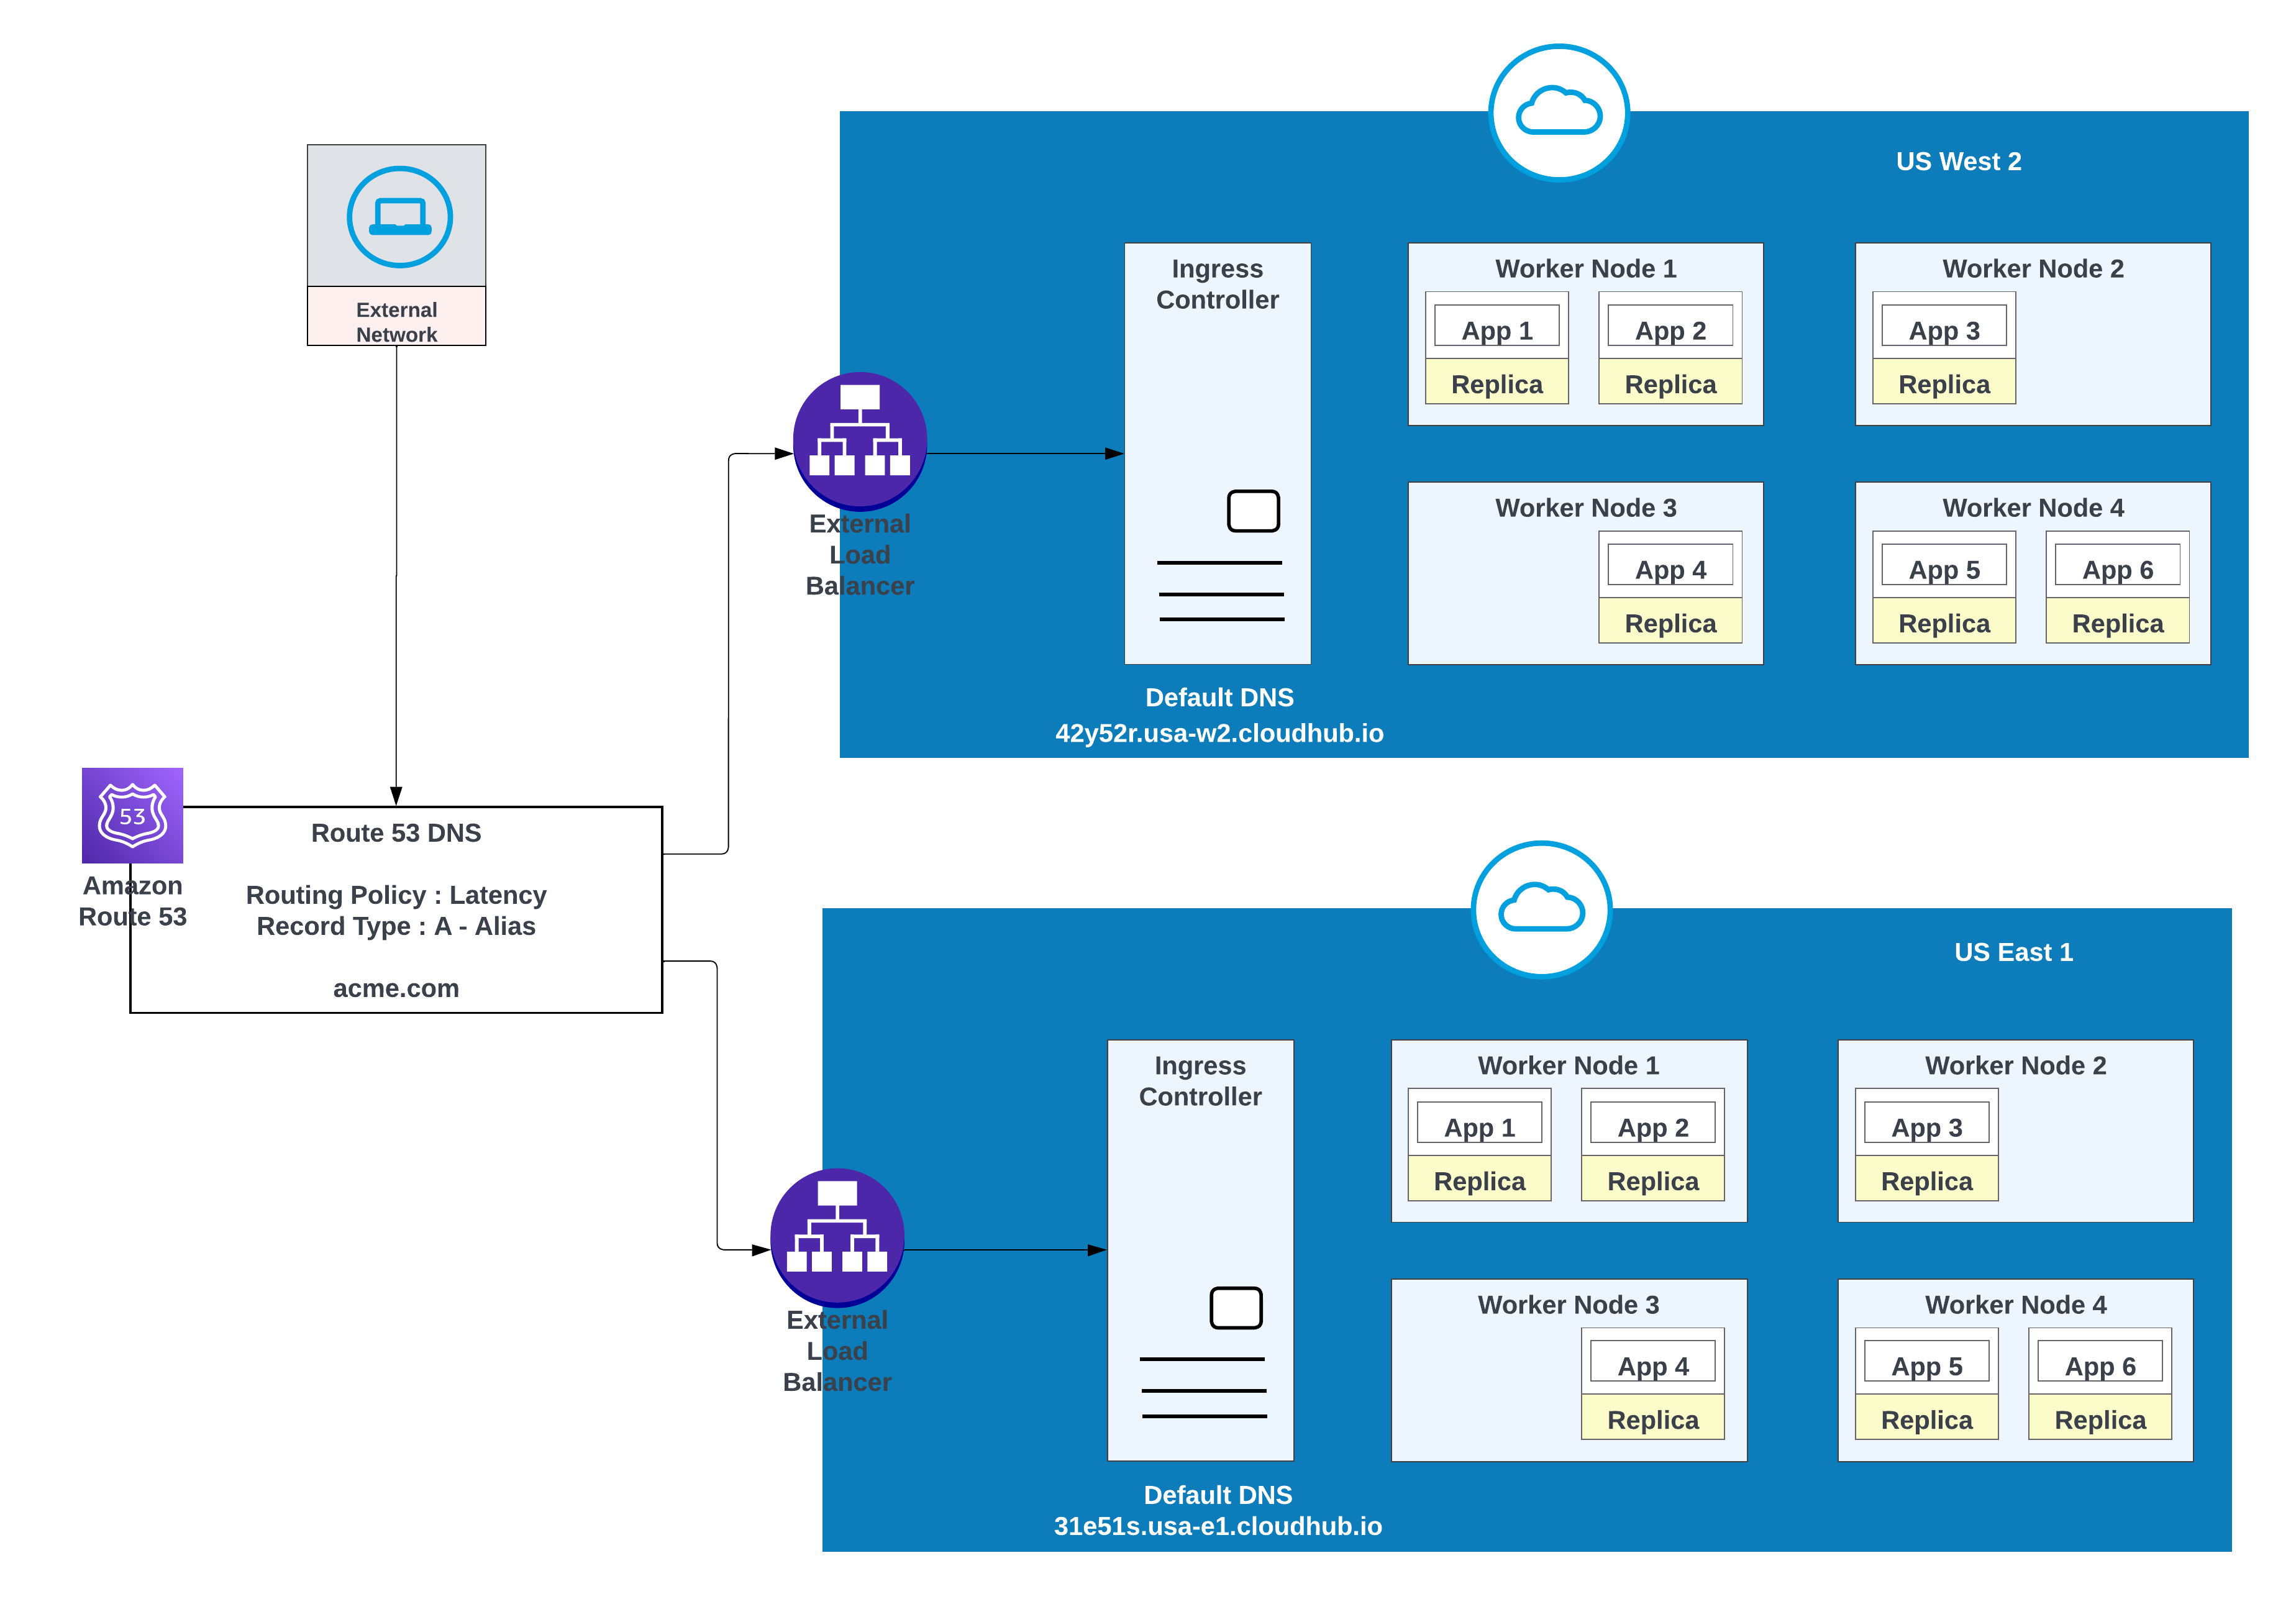
Per una latenza inferiore e una disponibilità elevata, utilizzare la strategia di distribuzione descritta nello schema. Con questa strategia, le app possono essere distribuite in due regioni (US-west-2 e US-east-1 in questo esempio).
Utilizzare la policy di instradamento della latenza in AWS Route 53 per instradare le richieste alla regione che offre la latenza più bassa mantenendo l'alta disponibilità. Policy di instradamento della "latenza" in AWS Route 53 per instradare la richiesta di latenza più bassa che ha ancora un'alta disponibilità.
**App distribuite in entrambe le regioni (Stati Uniti Ovest 2 e Stati Uniti Est 1) per una latenza inferiore e un'elevata disponibilità**
 | Nome record | Valore/Instrada traffico a | Policy di instradamento | ID controllo dello stato |
| :---------: | :------------------------: | :---------------------: | :----------------------: |
| acme.com | 42y52r.usa-w2.cloudhub.io | Latenza | 31s3wseq121 |
| acme.com | 31e51s.usa-e1.cloudhub.io | Latenza | 43e131s131sq |
## Conclusione
MuleSoft CloudHub 2.0 offre una solida base per la resilienza all'interno dell'area geografica, sfruttando principalmente la ridondanza automatica delle repliche e il bilanciamento intelligente del carico. All'interno di una singola area cloud, la distribuzione di applicazioni con più repliche garantisce che, se un'istanza non riesce, gli altri possano immediatamente assumere il carico di lavoro. Il bilanciamento del carico integrato distribuisce in modo efficiente il traffico in entrata in queste repliche sane, riducendo al minimo i tempi di inattività e garantendo una disponibilità di servizio continua in condizioni operative normali.
Tuttavia, affidarsi esclusivamente a questa architettura a una sola regione, anche con elevata ridondanza, presenta un rischio significativo di un guasto regionale generalizzato e catastrofico. La storia ha dimostrato che anche i provider di cloud più affidabili e tecnologicamente avanzati sono suscettibili di incidenti dirompenti che possono interessare un'intera area geografica. Questi singoli punti di errore, sebbene rari, possono derivare da vari eventi, tra cui:
- Incidenti infrastrutturali su larga scala
- Gravi interruzioni di corrente
- Interruzioni diffuse della rete
Pertanto, per ottenere una vera disponibilità elevata (HA) e un ripristino di emergenza (DR), è necessario progettare un'architettura che superi le limitazioni di un modello a regione singola. La strategia consigliata è la distribuzione in più regioni geograficamente distinte. Questa resilienza interregionale garantisce che se un'intera area cloud non è disponibile a causa di un disastro imprevisto, il traffico può essere trasferito senza problemi a un'istanza dell'applicazione in esecuzione in una regione separata e non interessata, garantendo interruzioni minime del servizio e raggiungendo gli obiettivi di tempo di attività massimo.
## Riferimenti
[Architettura di rete CloudHub 2.0](https://docs.mulesoft.com/cloudhub-2/ch2-networking-guide)
[Configurazione del failover tra regioni per le aree di attesa standard](https://docs.mulesoft.com/mq/mq-failover)
[Regioni di distribuzione Object Store V2](https://docs.mulesoft.com/object-store/osv2-faq#osv2-regions)
[Regione di distribuzione del punto vendita oggetti](https://docs.mulesoft.com/object-store/osv2-faq#is-object-store-v2-persistent-in-the-same-region-as-the-worker)
## Informazioni sugli autori
Gulal Kumar è un architetto di ingegneria del software presso Salesforce, con particolare attenzione all'architettura dei dati e dell'integrazione. Con oltre 20 anni di esperienza in integrazione e API, programmi di modernizzazione, sicurezza e iniziative AIML, offre una vasta gamma di competenze. Gulal si è impegnata a promuovere iniziative di trasformazione aziendale, migliorare la sicurezza e la resilienza, promuovere l'eccellenza dell'architettura e guidare iniziative AIML in vari domini.
Ajay Nagaraju è Enterprise Architect e Senior Director presso MuleSoft con oltre 28 anni di esperienza nell'architettura aziendale, nell'integrazione di sistemi e nella trasformazione digitale su larga scala. Ha diretto l'architettura e la consegna di programmi complessi multimilionari nelle organizzazioni Fortune 100 e Fortune 500, con una profonda esperienza nella connettività basata su API, SOA, tecnologie cloud e schemi di integrazione aziendale. Ajay ha collaborato strettamente con la dirigenza per modernizzare i processi aziendali, le piattaforme dati e gli ecosistemi di integrazione ed è appassionata di creare architetture scalabili, di guidare i team e di favorire risultati aziendali misurabili attraverso la tecnologia.
## Introduzione
Il modello di condivisione Salesforce è un elemento essenziale per la capacità dell'organizzazione di fornire un accesso sicuro ai dati delle applicazioni. Pertanto, è fondamentale progettare correttamente il modello di condivisione per soddisfare i requisiti di accesso ai dati attuali e futuri. In questo documento esamineremo i componenti di accessibilità dei dati, i casi d'uso dei modelli di condivisione e le soluzioni di condivisione dei clienti reali e forniremo alcune linee guida per la risoluzione dei problemi.
### Pubblico di destinazione e prerequisiti
Questo documento è destinato agli amministratori di sistema avanzati e agli architetti. Per comprendere i concetti, è necessario avere una Knowledge di funzionamento del modello di condivisione e protezione Salesforce. I prerequisiti di questa guida sono:
- Guida [di Salesforce: Impostazioni di condivisione](https://help.salesforce.com/s/articleView?id=sf.managing_the_sharing_model.htm)
- [Modulo Trailhead: Sicurezza dei dati](https://trailhead.salesforce.com/en/content/learn/modules/data_security)
- [Progettazione dell'accesso ai record su scala aziendale](https://developer.salesforce.com/docs/atlas.en-us.draes.meta/draes/draes_preface.htm)
- [Salesforce ben progettato - Sicuro](/docs/architect/it-it/well-architected/guide/secure)
### Accesso ai dati non coperto
Questa guida si concentra sulle funzioni principali utilizzate per controllare l'accesso a livello di record agli oggetti standard e personalizzati. Gli argomenti non trattati in questa guida includono:
- Accesso alle cartelle
- Accesso ai contenuti
- Accesso Chatter
- Accesso alla Knowledge Base
- Accesso Idee, Domande/Risposte
- Accessibilità dei dati mobili
## Tipi di accesso ai dati
La protezione a livello di record consente di concedere agli utenti l'accesso ad alcuni record di oggetti, ma non ad altri. Come per la maggior parte delle applicazioni, l'accesso ai dati inizia con un utente. L'applicazione deve sapere chi è l'utente prima di concedere l'accesso. Per Salesforce esistono diversi tipi di utenti e, a volte, il livello di accesso è diverso in base al tipo. Anziché esaminare ogni attributo di ogni tipo di licenza, ci concentreremo qui sugli attributi interessanti che hanno un impatto significativo sull'accesso ai dati. La proprietà dei record e l'accesso completo sono sinonimi e intercambiabili e offrono all'utente il massimo livello di accesso a un record.
### Utenti e licenze
**_Utenti a volume elevato_**
Gli utenti a volume elevato (inclusi gli utenti con i tipi di licenza Customer Community, High Volume Customer Portal e Authenticated Website) non utilizzano il modello di condivisione, perché i loro tipi di licenza non supportano i ruoli. Queste licenze hanno un proprio modello di condivisione che funziona in base alla corrispondenza della chiave esterna tra l'utente (titolare della licenza) e i dati nelle ricerche di account e referenti. Gli amministratori possono creare insiemi di condivisione o gruppi di condivisione per concedere agli utenti a volume elevato l'accesso ai record.
**_Licenze Chatter Free e Chatter External_**
Le licenze Chatter Free e Chatter External non seguono il modello di condivisione standard. Queste licenze non hanno accesso ai record CRM (oggetti standard o personalizzati) e alla funzionalità Contenuto e non supportano i ruoli, pertanto non è possibile condividere.
Per il resto di questo documento, si presuppone che un tipo di utente Salesforce utilizzi un modello di condivisione completo. Per ulteriori informazioni su ogni tipo di licenza disponibile, vedere [Licenze utente](https://help.salesforce.com/apex/HTViewHelpDoc?id=users_understanding_license_types.htm).
### Componenti
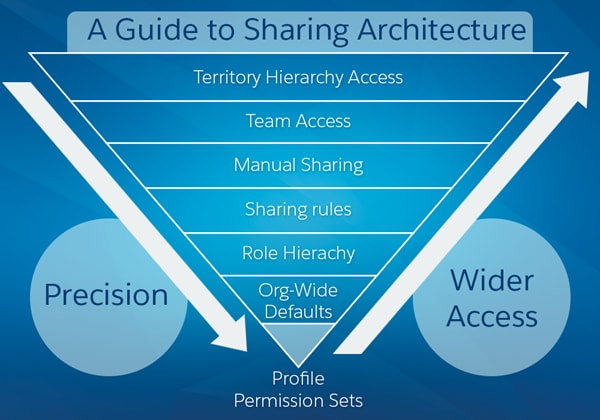
**_Profili e insiemi di autorizzazioni_**
I profili e gli insiemi di autorizzazioni offrono una protezione a livello di oggetto determinando quali tipi di dati vengono visualizzati dagli utenti e se possono modificare, creare o eliminare i record. Per ogni oggetto, le autorizzazioni "Visualizza tutto" e "Modifica tutto" ignorano le regole e le impostazioni di condivisione, consentendo agli amministratori di concedere rapidamente l'accesso ai record associati a un determinato oggetto in tutta l'organizzazione. Queste autorizzazioni sono spesso alternative preferibili alle autorizzazioni amministrative "Visualizza tutti i dati" e "Modifica tutti i dati", che consentono agli utenti di visualizzare o modificare tutte le app e i dati.
I profili e gli insiemi di autorizzazioni controllano anche la protezione a livello di campo, che determina i campi all'interno di ogni oggetto a cui gli utenti possono accedere. Ad esempio, un oggetto può avere 20 campi, ma la protezione a livello di campo può essere impostata per impedire agli utenti di visualizzare cinque dei 20 campi.
Si consiglia vivamente di utilizzare gli insiemi di autorizzazioni e i gruppi di insiemi di autorizzazioni anziché i profili per gestire le autorizzazioni oggetto degli utenti. Poiché è possibile riutilizzare componenti base di insiemi di autorizzazioni più piccoli, è possibile evitare di creare decine o persino centinaia di profili per ogni utente e funzione lavorativa.
**_Titolarità dei record e aree di attesa_**
Ogni record deve essere di proprietà di un singolo utente o di un'area di attesa. Il titolare ha accesso al record in base alle impostazioni oggetto del profilo del titolare. Ad esempio, se il profilo del titolare dispone dell'autorizzazione Crea e Lettura per un oggetto ma non dell'autorizzazione Modifica o Elimina, il titolare può creare un record per l'oggetto e visualizzare il nuovo record. Tuttavia, il titolare non potrà modificare o eliminare il record. Gli utenti di livello superiore in una gerarchia (ruolo o territorio) ereditano lo stesso accesso ai dati dei loro subordinati per gli oggetti standard. Se il subordinato dispone dell'accesso in sola lettura, lo saranno anche gli utenti che occupano una posizione superiore nella gerarchia dei ruoli. Questo accesso si applica ai record di proprietà degli utenti e ai record condivisi con loro.
Le aree di attesa consentono di assegnare priorità, distribuire e assegnare record ai team che condividono i carichi di lavoro. I membri dell'area di attesa e gli utenti di livello superiore nella gerarchia dei ruoli possono accedere alle aree di attesa dalle visualizzazioni elenco e diventare titolari dei record di un'area di attesa.
Se un singolo utente è titolare di più di 10.000 record, è consigliabile:
- Il record utente del titolare non deve avere un ruolo nella gerarchia dei ruoli.
- Se il record utente del titolare deve contenere un ruolo, posizionare il ruolo in cima alla gerarchia nel proprio ramo della gerarchia dei ruoli.
Per ulteriori informazioni, vedere [Salesforce Well-Architected - Affidabile](/docs/architect/it-it/well-architected/guide/reliable#volume-di-dati).
**_Impostazioni predefinite organizzazione_**
Le impostazioni di condivisione dell'organizzazione specificano il livello predefinito di accesso degli utenti ai record degli altri utenti. Le impostazioni di condivisione dell'organizzazione consentono di bloccare i dati al livello più restrittivo. Utilizzare gli altri strumenti di protezione e condivisione a livello di record per concedere l'accesso in modo selettivo ad altri utenti. Ad esempio, gli utenti dispongono delle autorizzazioni a livello di oggetto per leggere e modificare le opportunità e l'impostazione di condivisione a livello di organizzazione è Sola lettura. Per impostazione predefinita, questi utenti possono leggere tutti i record opportunità, ma non possono modificarli a meno che non siano titolari del record o dispongano di altre autorizzazioni.
Le impostazioni predefinite dell'organizzazione possono essere modificate da un'impostazione all'altra (Privato a Controllato da società controllante, quindi di nuovo a Privato). Tuttavia, queste modifiche richiedono un ricalcolo della condivisione e, a seconda del volume, potrebbero causare lunghi tempi di elaborazione.
Solo per gli oggetti personalizzati, è possibile configurare l'impostazione Concedi accesso tramite le gerarchie. Se l'opzione è deselezionata (è selezionata l'impostazione predefinita), agli utenti di livello superiore nella gerarchia dei ruoli viene impedito di ereditare l'accesso. Questa impostazione si trova nelle impostazioni predefinite dell'organizzazione.
**_Gerarchia dei ruoli_**
Una gerarchia dei ruoli rappresenta un livello di accesso ai dati necessario per un utente o un gruppo di utenti. La gerarchia dei ruoli garantisce che i responsabili abbiano sempre accesso agli stessi dati dei dipendenti, indipendentemente dalle impostazioni predefinite dell'organizzazione. Le gerarchie dei ruoli non devono necessariamente corrispondere esattamente all'organigramma. Ogni ruolo nella gerarchia dovrebbe invece rappresentare un livello di accesso ai dati necessario per un utente o un gruppo di utenti.
Nelle organizzazioni Salesforce create nel rilascio Spring '21 o successivi, è possibile creare fino a 5.000 ruoli. Nelle organizzazioni create prima del rilascio Spring '21, è possibile creare fino a 500 ruoli e contattare l'Assistenza clienti Salesforce per aumentare questo limite. È consigliabile mantenere il numero di ruoli interni a 25.000 e il numero di ruoli esterni a 100.000.
È consigliabile mantenere la gerarchia dei ruoli a non più di 10 livelli di rami nella gerarchia.
Quando il ruolo di un utente cambia, tutte le regole di condivisione pertinenti vengono valutate per correggere l'accesso in base alle esigenze. I pari all'interno dello stesso ruolo non garantiscono loro l'accesso reciproco ai dati.
La modellazione della gerarchia dei ruoli inizia dalla comprensione della struttura dell'organizzazione. Questo di solito si basa sulla comprensione dell'ambito di un responsabile, iniziando dall'alto. Il CEO supervisiona l'intera società. Il CEO di solito ha dei riporti diretti che possono essere segmentati per unità operativa (Vendite o Assistenza) o area geografica (EMEA, APAC). Quella persona ha quindi rapporti diretti che potrebbero essere ulteriormente segmentati e così via. Benché questo sembri molto simile a un organigramma delle risorse umane, quando si modella l'accesso ai dati, concentrarsi sull'accessibilità dei dati con una considerazione alla generazione di rapporti sulle risorse umane.
Le sovrapposizioni sono sempre la parte difficile della gerarchia. Se si trovano nella loro filiale, dovranno disporre di regole di condivisione, team o gestione dei territori per ottenere l'accesso necessario. Se vengono inseriti nella gerarchia, potrebbero esserci implicazioni in termini di rapporti.
È importante dedicare tempo alla configurazione della gerarchia dei ruoli perché è uno degli aspetti fondamentali del modello di condivisione.
| Casi d'uso della gerarchia dei ruoli |
| ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Accesso alla gestione: la possibilità per i responsabili di vedere e fare tutto ciò che i loro subordinati possono vedere e fare. |
| Rapporti gestionali: la possibilità di riportare i rapporti in modo gerarchico in modo che chiunque nella gerarchia veda più dati di quelli subordinati. |
| Segregazione tra le filiali dell'organizzazione: le diverse unità operative non hanno bisogno di visualizzare i dati l'una dell'altra; avere una gerarchia in cui è possibile definire filiali separate consente di separare la visibilità all'interno delle unità operative, continuando a estendere la visibilità ai livelli esecutivi superiori a tali unità. |
| Segregazione all'interno di un ruolo: in molte organizzazioni/applicazioni, le persone che svolgono tutte lo stesso ruolo non devono necessariamente vedere i dati degli altri. La presenza di ruoli gerarchici consente di definire un nodo “foglia” in cui tutti i dati sono essenzialmente privati e di riportare i dati a un ruolo controllante che li può visualizzare tutti. |
**_Gruppi pubblici_**
Un gruppo pubblico è un insieme di singoli utenti, ruoli, territori e così via, che hanno tutti una funzione in comune. I gruppi pubblici possono essere costituiti da:
- Utenti
- Utenti del Portale Clienti
- Utenti partner
- Ruoli
- Ruoli e subordinati interni
- Ruoli, subordinati interni e portale
- Ruoli portale
- Ruoli portale e subordinati
- Territori
- Territori e subordinati
- Altri gruppi pubblici (nidificazione)
I gruppi possono essere nidificati (Gruppo A nidificato nel Gruppo B), ma non nidificare più di cinque livelli. La nidificazione ha un impatto sulla manutenzione e sulle prestazioni dei gruppi a causa del calcolo dell'appartenenza ai gruppi. È consigliabile mantenere il numero totale di gruppi pubblici per un'organizzazione a 100.000.
| Casi d'uso di gruppi pubblici |
| --------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Quando è necessario concedere l'accesso a un gruppo arbitrario di persone, creare un gruppo pubblico per raccoglierle e quindi utilizzare altri strumenti di condivisione per concedere al gruppo l'accesso necessario. La sola appartenenza ai gruppi non fornisce l'accesso ai dati. |
| I gruppi possono anche essere nidificati l'uno all'interno dell'altro, consentendo quindi a un gruppo nidificato di ottenere lo stesso accesso del gruppo in cui è contenuto. Ciò consente la creazione di gerarchie più piccole e ad hoc che non interagiscono necessariamente con le gerarchie dei ruoli o dei territori. Se il Gruppo A è membro del Gruppo B, i membri del Gruppo A avranno accesso ai dati condivisi con il Gruppo B allo stesso livello di accesso dei membri del Gruppo B. |
| I gruppi hanno anche la possibilità di proteggere i dati condivisi nel gruppo dall'essere resi accessibili alle persone nella gerarchia dei ruoli al di sopra dei membri del gruppo. Questo (e l'accesso dei titolari dei record e della loro gerarchia di gestione) consente la creazione di gruppi in cui è possibile condividere informazioni molto riservate: i dati saranno accessibili SOLO ai membri del gruppo e a nessun altro membro dell'organizzazione. A questo scopo, utilizzare l'impostazione Concedi accesso tramite le gerarchie. |
**_Regole di condivisione basate sul titolare_**
Le regole di condivisione basate sul titolare consentono eccezioni alle impostazioni predefinite dell'organizzazione e alla gerarchia dei ruoli che consentono ad altri utenti di accedere ai record di cui non sono titolari. Le regole di condivisione basate sul titolare si basano solo sul titolare del record.
Le regole di condivisione basate sul titolare del referente non si applicano ai referenti privati o ai referenti che non sono associati a un account.
Il limite totale di regole di condivisione per oggetto è 300.
| Casi d'uso delle regole di condivisione basate sul titolare |
| ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------ |
| Gestione a matrice basata sui ruoli o situazioni di sovrapposizione: una persona in Service deve essere in grado di visualizzare alcuni dati di Sales, ma vive in rami diversi della gerarchia, quindi è possibile creare una regola che condivide i dati tra ruoli in rami diversi. |
| Fornire l'accesso ai dati a colleghi che ricoprono lo stesso ruolo o territorio. |
| Fornire l'accesso ai dati ad altri gruppi di utenti (gruppi pubblici, portale, ruoli, territori). I membri dei raggruppamenti titolari dei record possono essere condivisi con i membri di altri raggruppamenti. |
**_Regole di condivisione basate su criteri_**
Le regole di condivisione basate su criteri forniscono l'accesso ai record in base ai valori dei campi (criteri) del record. Se i criteri sono soddisfatti (uno o più valori di campo), viene creato un record condivisione per la regola. La proprietà dei record non è una considerazione.
Il limite di regole di condivisione basate su criteri e utenti guest per oggetto è 50.
| Caso d'uso delle regole di condivisione basate su criteri |
| ------------------------------------------------------------------------------------- |
| Fornire l'accesso ai dati a utenti o gruppi in base al valore di un campo del record. |
**_Regole di condivisione utenti guest_**
Una regola di condivisione utente guest è un tipo speciale di regola di condivisione basata su criteri utilizzata per concedere l'accesso ai record agli utenti guest non autenticati. Il limite di regole di condivisione basate su criteri e utenti guest per oggetto è 50.
> **Avvertenza:** Il tipo di regola di condivisione utente guest concede l'accesso agli utenti guest senza credenziali di accesso. Creando una regola di condivisione per gli utenti guest si consente a chiunque l'accesso immediato e illimitato a tutti i record che soddisfano i criteri della regola di condivisione. Per proteggere i dati Salesforce e consentire agli utenti guest di accedere a ciò di cui hanno bisogno, considerare tutti i casi d'uso e le implicazioni della creazione di questo tipo di regola di condivisione. Implementare i controlli di sicurezza che si ritengono appropriati per la riservatezza dei dati. Salesforce non è responsabile dell'esposizione dei dati a utenti non autenticati in base a questa modifica delle impostazioni predefinite.
| Caso d'uso regola di condivisione utenti guest |
| ------------------------------------------------------------ |
| Fornire l'accesso ai dati agli utenti guest non autenticati. |
**_Condivisione manuale_**
A volte è impossibile definire un gruppo coerente di utenti che necessitano dell'accesso a un determinato insieme di record. I titolari dei record o altri utenti con privilegi adeguati, ad esempio gli amministratori di sistema, possono utilizzare la condivisione manuale per concedere le autorizzazioni di lettura e modifica agli utenti che non hanno accesso in altro modo. La condivisione manuale non è automatizzata come le impostazioni di condivisione dell'organizzazione, le gerarchie dei ruoli o le regole di condivisione. Offre tuttavia ai titolari dei record la flessibilità di condividere i record con gli utenti che devono visualizzarli.
La condivisione manuale viene rimossa quando cambia il titolare del record o quando l'accesso in condivisione concesso non concede un accesso aggiuntivo oltre il livello di accesso predefinito di condivisione dell'oggetto a livello di organizzazione. Questo vale anche per le condivisioni manuali create a livello di programmazione.
I record condivisione manuale sono definiti come record condivisione con la causale riga impostata su condivisione manuale.
Tutti i record di condivisione (oggetti standard e personalizzati) con una causa riga impostata su _condivisione manuale_ possono essere modificati ed eliminati dal pulsante **_Condividi_** nel layout di pagina dell'oggetto, anche se il record di condivisione è stato creato a livello di programmazione.
| Caso d'uso di condivisione manuale |
| ----------------------------------------------------------------------------------------------------------------------------------------------- |
| Fornire all'utente la possibilità di concedere l'accesso (sola lettura o lettura/scrittura) al record corrente ad altri utenti, gruppi o ruoli. |
**_Team_**
Un team è un gruppo di utenti che lavorano insieme su un account, un'opportunità di vendita o un caso. I titolari dei record possono creare un team per ogni record di cui sono titolari. Il titolare del record aggiunge i membri del team e specifica il livello di accesso di ogni membro del team al record. Alcuni membri del team possono avere accesso in sola lettura, mentre altri hanno accesso in lettura/scrittura.
Solo i titolari, le persone di grado superiore nella gerarchia e gli amministratori possono aggiungere membri del team e fornire un accesso più ampio al membro. Un membro del team con accesso in lettura/scrittura può aggiungere un altro membro che ha già accesso al record a cui è associato il team. Il membro del team non può fornire un accesso aggiuntivo.
La creazione di un membro del team nell'app crea due record: un record team e un record condivisione associato. Se si creano membri del team a livello di programmazione, è necessario gestire sia il record team che il record condivisione associato. È presente un solo team per record (Account, Opportunità o Caso). Se sono necessari più team, a seconda delle esigenze specifiche, valutare la gestione dei territori o la condivisione a livello di programmazione
| Casi d'uso del team |
| --------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Fornire all'utente la possibilità di concedere l'accesso (sola lettura o lettura/scrittura) a un singolo gruppo di utenti (il team). |
| Se i team sono gestiti esternamente, ad esempio tramite una commissione esterna o un sistema di gestione dei territori, è possibile utilizzare l'integrazione per gestire il team account. Esistono casi in cui la gestione dei territori in un sistema esterno può allinearsi a una soluzione di team in Salesforce. |
| Il team account può gestire più titolari di un account. |
| Un singolo gruppo di utenti (team) richiede l'accesso in sola lettura o lettura/scrittura a un record opportunità. (Team opportunità) |
**_Gerarchia dei territori_**
Quando si utilizza Gestione territorio di livello aziendale, si imposta una gerarchia dei territori che mostra la struttura dei territori di un modello e funge da punto di interazione principale. Se Gestione territorio di livello aziendale è abilitata, è necessario gestire sia la gerarchia dei ruoli che la gerarchia dei territori. Per ulteriori informazioni, vedere [Gestione dei territori](https://help.salesforce.com/articleView?id=sf.tm2_intro.htm) aziendali nella Guida di Salesforce.
**_Condivisione gestita Apex_**
La condivisione gestita Apex (detta anche condivisione a livello di programmazione) consente di utilizzare il codice per creare impostazioni di condivisione sofisticate e dinamiche quando un requisito di accesso ai dati non può essere soddisfatto con altri mezzi.
Se si crea un record condivisione a livello di programmazione e viene utilizzata la causa della riga pronta all'uso (_condivisione manuale_), è possibile mantenere questo record condivisione con il pulsante **_Condividi_** nell'app. Il record condivisione è soggetto a tutte le regole con la causa della riga di condivisione manuale, ad esempio l'eliminazione al trasferimento del titolare.
È anche possibile creare i propri motivi di condivisione Apex per gli oggetti personalizzati per tenere traccia del motivo di un record con un utente o un gruppo di utenti e semplificare il codice necessario per eseguire aggiornamenti ed eliminazioni dei record di condivisione.
Per ulteriori informazioni, consultare [Condivisione di un record con Apex](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_bulk_sharing_creating_with_apex.htm) prima di valutare l'uso della condivisione a livello di programmazione.
| Casi d'uso di condivisione gestiti Apex |
| ---------------------------------------------------------------------------------------------------------------------------------------------------- |
| Nessun altro metodo di condivisione (dichiarativo) soddisfa le esigenze di accesso ai dati. |
| Esiste già un sistema di verifica esterno per le assegnazioni dell'accesso utente che continuerà a favorire l'accesso e a integrarlo con Salesforce. |
| Scarse prestazioni utilizzando componenti di condivisione nativi. (In genere si applica a volumi di dati molto elevati) |
| Funzionalità del team sugli oggetti personalizzati. |
**_Regole di restrizione_**
Nella configurazione di accesso ai dati, può essere opportuno impedire agli utenti di visualizzare record che possono contenere dati sensibili o semplicemente non essenziali per il loro lavoro. È possibile utilizzare le regole di restrizione per consentire agli utenti di accedere solo ai record che soddisfano i criteri specificati. Quando si applica una regola di restrizione a un utente, i record a cui l'utente ha accesso tramite le impostazioni predefinite dell'organizzazione, le regole di condivisione e altri meccanismi di condivisione vengono filtrati in base ai criteri specificati. Le regole di restrizione funzionano in modo opposto rispetto ai componenti di condivisione descritti in questo argomento; anziché aprire l'accesso agli utenti, lo limitano ulteriormente.
Le regole di restrizione sono disponibili per oggetti personalizzati, oggetti esterni, contratti, eventi, operazioni, schede attività e voci scheda attività. È possibile creare fino a due regole di restrizione attive per oggetto nelle versioni Enterprise Edition e Developer Edition e fino a cinque regole di restrizione attive per oggetto nelle versioni Performance Edition e Unlimited Edition. Le regole di restrizione vengono applicate alle seguenti funzioni di Salesforce:
- Visualizzazioni elenco
- Ricerche
- Elenchi correlati
- Rapporti
- Ricerca
- SOQL
- SOSL
| Casi d'uso delle regole di restrizione |
| ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Si desidera che determinati utenti visualizzino solo un insieme specifico di record. |
| Semplificare il controllo dell'accesso ai record con informazioni sensibili o riservate. |
| Rendere veramente privato l'accesso a contratti, operazioni ed eventi, poiché questo può essere difficile da ottenere utilizzando le impostazioni predefinite dell'organizzazione. |
**_Condivisione implicita_**
La condivisione implicita è automatica. Non è possibile disattivarlo né attivarlo: è nativo dell'applicazione. In altre parole, la condivisione implicita non è un'impostazione configurabile; tuttavia, è importante che ogni architetto comprenda. La condivisione implicita controllante fornisce l'accesso ai record controllanti (solo account) quando un utente ha accesso a opportunità controllate, casi o referenti per quell'account. Salesforce ha una policy di accesso ai dati che indica se un utente può visualizzare un referente (o un'opportunità, un caso o un ordine), quindi l'utente vede implicitamente l'account associato. La condivisione implicita controllata fornisce l'accesso ai record controllati di un account al titolare dell'account. Questo accesso è definito in corrispondenza del ruolo del titolare nella gerarchia dei ruoli. La condivisione implicita controllata si applica solo agli oggetti referente, opportunità e caso (controllati dell'account). I livelli di accesso che possono essere forniti sono Visualizza, Modifica e Nessun accesso per ciascuno degli oggetti secondari quando viene creato il ruolo. Impostando su Visualizza, il titolare dell'account può visualizzare implicitamente i record oggetto associati (referente, opportunità o caso). Impostando su Modifica, il titolare dell'account può modificare implicitamente l'oggetto associato (referente, opportunità o caso).
La condivisione implicita non si applica agli oggetti personalizzati.
## Scenari di implementazione del cliente
Non esiste un modello di condivisione adatto a tutte le organizzazioni Salesforce. Ogni organizzazione ha requisiti e sfide diversi quando tenta di progettare il modello di condivisione migliore. È fondamentale utilizzare i componenti di accesso ai dati più appropriati per soddisfare i requisiti di condivisione dell'organizzazione. Gli scenari seguenti sono sfide comuni quando si tenta di progettare un modello di condivisione.
### Assegnazione team gestita esternamente tramite il sistema master del cliente
| **Requisiti o sfide** | **Soluzione** |
| ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------ | --------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Due in una scatola: un responsabile vendite di un'area di copertura geografica desidera anche accedere a un'altra area di copertura geografica per fornire assistenza. | Regola di condivisione basata sul titolare: Qui funziona una regola di condivisione basata sul titolare perché questi sono casi limite e non la norma. È accettabile anche che la regola di condivisione basata sul titolare fornisca un accesso maggiore di quello realmente necessario poiché si tratta di un responsabile, ovvero di una persona affidabile. |
| Gli utenti delle operazioni basate sul paese devono poter accedere a tutti i dati di vendita del paese. | Regola di condivisione basata sul titolare: Un uso molto comune di una regola di condivisione è quando un reparto diverso (diverso dalle vendite) necessita dell'accesso ai dati di vendita. |
| Almeno l'80% delle volte, è presente un team "core 4" in un account (Dirigente account, Agente di vendita interno, Consulente di vendita, Agente di vendita tecnico). Il sistema di record per l'assegnazione del team account è esterno. Esiste sempre un solo team per un account. | Team: Poiché è sempre presente un solo team per account, anche se sono presenti molti membri diversi con ruoli diversi, la funzionalità del team account soddisfa questo requisito. |
| I responsabili del team devono avere lo stesso accesso dei loro subordinati. | Gerarchia dei ruoli: La gerarchia dei ruoli risolve questo requisito consentendo ai responsabili di accedere ai dati dei loro subordinati. |
| Il team account assegnato non deve essere modificabile. | Team: Questo requisito non viene effettivamente soddisfatto con la funzionalità del team account. Tuttavia, ciò non dovrebbe impedire di continuare a utilizzare i team account. Tuttavia, ci sono diversi modi per bloccare le squadre. In questo caso, viene utilizzata la rimozione del layout di pagina del team account. |
| Deve essere presente una funzionalità "compagno" in modo che, quando qualcuno è malato o in vacanza, qualcuno senza accesso standard a un account o a un'opportunità possa essere accessibile e coperto durante il tempo libero. | Team: Un "amico" può essere semplicemente un ruolo nel team che soddisfa questo requisito. Tuttavia, la sfida deriva dal requisito precedente in cui i team non devono essere modificabili. L'unica soluzione è avere un gruppo di persone che possono modificare i team per creare il ruolo di amico quando necessario. |
| Quando una trattativa richiede una soluzione personalizzata, altre persone (che non fanno necessariamente parte dell'organizzazione di vendita) devono avere accesso alla trattativa. | Team: Un utilizzo abbastanza standard del team opportunità ottenuto aggiungendo manualmente un nuovo membro al team opportunità (tramite elenco correlato). Può essere eseguita anche tramite un trigger se si sa sempre chi deve essere aggiunto. In questo caso, è opportunità per opportunità. |
### Gestione dei territori pronta all'uso
| **Requisiti o sfide** | **Soluzione** |
| ----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | -------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Due team opportunità diversi di due unità operative distinte (Vendite al dettaglio e Remarketing) devono accedere allo stesso record account. Devono condividere i referenti ed essere a conoscenza di tutte le attività sull'account. Queste due unità operative hanno una gerarchia e roll-up propri. | Gestione dei territori: Il modo migliore per pensare a questo requisito è avere due rami di una gerarchia che possono essere strutturati in modo diverso. Ciò che giustifica la gestione dei territori è che esistono due livelli di queste due filiali diverse (entrambi i livelli con membri = team opportunità per quell'unità operativa) che necessitano dell'accesso all'account. Anche se si sarebbe potuto soddisfare questo requisito con un concetto di Teaming, era troppo granulare. La segmentazione delle vendite non era a livello di account ma a livello di gerarchia. |
| Esiste un gruppo separato di sviluppatori aziendali a cui è assegnato l'accesso ad account specifici per un team opportunità specifico (un territorio). Gli sviluppatori aziendali sono risorse condivise per i team opportunità, il che significa che ogni sviluppatore aziendale può essere assegnato a uno o più account per uno o più team opportunità. | Gestione dei territori: Poiché si tratta di un gruppo di utenti (o di un team) e ogni team di sviluppo aziendale può essere diverso in base all'account, e poiché la gestione dei territori era necessaria per un altro motivo, l'approccio probabilmente migliore è creare sottoterritori o filiali separate che rappresentano questi team di sviluppo aziendale. |
| Esistono ruoli di assistenza alle vendite non basati su commissione che necessitano di accedere agli account una tantum. | Team: La parte chiave del requisito è "base una tantum". Ciò significa che viene eseguito account per account in modo che i team account lo forniscano in modo nativo. |
| Il reparto crediti deve poter accedere a tutti gli account di una determinata unità operativa. | Regola di condivisione basata sul titolare: Questa è una situazione in cui in generale, per una determinata unità operativa, un gruppo di utenti deve vedere tutto. Questo requisito può essere soddisfatto con una regola di condivisione per un ruolo a cui appartiene il gruppo, un ramo della gerarchia dei ruoli a cui appartiene il gruppo (ruolo e subordinati) o anche un gruppo pubblico.Gestione dei territori: È anche possibile soddisfare questo requisito modellando il reparto credito come territorio con la stessa logica per l'unità operativa specificata. |
| I responsabili devono avere lo stesso accesso dei loro subordinati. | Gerarchia dei ruoli: La gerarchia dei ruoli risolve questo requisito consentendo ai responsabili di accedere ai dati dei loro subordinati. |
## Considerazioni
### Considerazioni sull'implementazione di Gestione territorio di livello aziendale
- Che cosa accade alla gerarchia dei ruoli?
- Non accade nulla alla gerarchia dei ruoli se si utilizza anche una gerarchia dei territori. Tuttavia, se si utilizzano insieme sia le previsioni basate sul territorio che le previsioni basate sui ruoli, è necessario gestire due gerarchie. In questo caso, si consiglia di utilizzare la gerarchia dei ruoli per modellare la struttura dei rapporti HR, quindi utilizzare la gerarchia dei territori per modellare la gerarchia delle vendite effettiva. La gerarchia dei territori è più adatta per modellare una struttura di rapporti a matrice, in cui qualcuno può fare capo a più responsabili.
Se non si utilizzano insieme previsioni basate sul territorio e previsioni basate sui ruoli, è possibile utilizzare solo la gerarchia dei territori come gerarchia delle vendite. In questo scenario, è meglio semplificare o appiattire il più possibile la gerarchia.
Non è consigliabile rendere identici la gerarchia dei ruoli e la gerarchia dei territori perché si verificano attività di condivisione non necessarie.
- È ancora possibile utilizzare i team?
- Sì, sì. Tuttavia, se è possibile soddisfare i requisiti di accesso all'interno della gerarchia dei territori (ad esempio le sovrapposizioni), è meglio farlo lì che utilizzare i team. Si stanno già mantenendo più gerarchie (ruolo e territorio), quindi nel tentativo di semplificare il più possibile le cose, implementare i team solo se nessun altro componente di condivisione esistente soddisfa il requisito.
### Altre considerazioni
- Riallineamento e riassegnazione
- Esistono due tipi di modifiche: l'appartenenza a ruoli, team o territori e la struttura della gerarchia. I cambi di appartenenza possono in genere avvenire ogni giorno, anche ogni ora. I cambiamenti strutturali della gerarchia (riallineamenti) si verificano generalmente meno spesso (trimestrale, semestrale o annuale) e possono essere costosi per le risorse. Ciò che deve essere considerato sono il volume delle modifiche e il numero di modifiche a catena che ogni modifica causerà. Come regola generale, i cambiamenti strutturali non devono avvenire più di un trimestre e tutti i cambiamenti di volume elevato (cambiamenti in blocco o di massa) devono essere ben pianificati, testati e coordinati.
- Grandi volumi di dati
- Sia che si tratti di modellare per l'implementazione iniziale o di pianificare una modifica del riallineamento, è necessario prestare molta attenzione al volume dei dati. Esistono soglie in cui le prestazioni possono diventare un fattore, quindi è altamente consigliabile testare le modifiche in un Sandbox prima di procedere alla produzione. Questo test fornirà anche una base di riferimento per la durata della modifica.
Se si dispone di più di due milioni di account e sono stati implementati team o Gestione territorio di livello aziendale, è necessario prestare particolare attenzione alle prestazioni. Si tratta di componenti modello di condivisione complessi che possono generare un volume enorme di record condivisione e quindi transazioni di lunga durata.
- Rinvio dei calcoli di condivisione
- Se si dispone di un oggetto che utilizza la condivisione e ha un volume elevato di record (ad esempio più di due milioni di account) ed è necessario apportare una modifica in blocco (ad esempio un riallineamento trimestrale che richiede una modifica della gerarchia), esiste una funzione che l'Assistenza clienti Salesforce può abilitare per rinviare i calcoli automatici della condivisione. In modo nativo, ogni singola modifica alla gerarchia dei ruoli, alla gerarchia dei territori, ai gruppi, alle regole di condivisione, ai ruoli utente, all'appartenenza ai team o alla proprietà dei record può avviare calcoli di condivisione automatici. Quando viene apportata una modifica in blocco, viene avviata una serie di ricalcoli automatici della condivisione. Sospendendo temporaneamente questi ricalcoli, è possibile apportare la modifica e quindi fare in modo che i calcoli di condivisione vengano eseguiti tutti insieme. Questo metodo è in genere più efficiente e più performante per le modifiche in blocco.
- Dati e differenze di proprietà
- Le differenze di dati sono definite come pochi record controllanti con molti record controllati. Queste distorsioni possono davvero danneggiarti quando alcuni account hanno molti referenti, opportunità o casi. Il rapporto in cui iniziamo a vedere un peggioramento delle prestazioni è 1:10.000. È consigliabile mantenere il rapporto il più vicino possibile a quello (è preferibile un rapporto più basso).
Le differenze di proprietà sono simili alle differenze di dati, tranne per il fatto che ci si riferisce a un singolo utente, ruolo o gruppo titolare di molti record per un oggetto. Come per le distorsioni dei dati, anche queste possono causare transazioni di lunga durata, causando un peggioramento delle prestazioni quando si verificano modifiche. Anche il rapporto consigliato tra titolare e numero di record è 1:10.000.
Se un singolo utente è titolare di più di 10.000 record, è consigliabile:
- Il record utente del titolare non deve avere un ruolo nella gerarchia dei ruoli.
- Se il record utente del titolare deve contenere un ruolo, posizionare il ruolo in cima alla gerarchia nel proprio ramo della gerarchia dei ruoli.
- Impatto delle gerarchie account sull'accesso ai dati
- Molte persone fanno un cattivo presupposto quando implementano una gerarchia account. Presumono che gli utenti che possono accedere a un account controllante possano accedere anche agli account controllati. Il semplice fatto di avere solo una relazione controllante/controllato tra due record non determina l'accesso. Sebbene la gerarchia dei ruoli e la gerarchia dei territori funzionino in questo modo, la gerarchia degli account non funziona.
## Risoluzione dei problemi
Una volta completata l'architettura del modello di condivisione, probabilmente ci si chiederà perché un utente possa o non possa vedere un record. In genere, non si sente quando gli utenti possono vedere qualcosa che non dovrebbero, ma se necessario, esiste un modo per vedere ogni utente che ha accesso a un record e perché.
La sfida più difficile, e probabilmente più comune, è il motivo per cui un utente non può visualizzare un record. I livelli di sicurezza progettati determinano da dove iniziare. Se si conosce bene il modello di condivisione, probabilmente si sa quale componente dovrebbe aver fornito l'accesso e può iniziare da lì. Tuttavia, se si ha meno dimestichezza con il modello di condivisione, iniziare con la gerarchia dei ruoli e separare ogni livello per determinare quale deve fornire l'accesso. Di seguito è riportato un flusso per la risoluzione dei problemi.
1. Verificare che l'utente disponga delle autorizzazioni per accedere all'oggetto.
2. Identificare il ruolo dell'utente che non può visualizzare il record e annotarlo.
3. Identificare il titolare del ruolo del record e prenderne nota.
4. Esaminare la gerarchia dei ruoli e verificare che questi due ruoli si trovino in due rami diversi (dovrebbero essere).
5. Ora è necessario rivedere le regole di condivisione per l'oggetto e assicurarsi che non esista una regola che conceda l'accesso all'utente. Se necessario, cercare anche nei gruppi pubblici. Forse l'utente è stato escluso da un gruppo in cui esiste una regola di condivisione o ha senso creare una nuova regola di condivisione per concedere l'accesso all'utente? Questa scelta dipende dall'architettura che si sta tentando di mantenere e si applica sia alle regole di condivisione basate sul titolare che alle regole di condivisione basate sui criteri.
6. Se si utilizzano i team, questo utente deve essere nel team per quel record? Come vengono mantenuti i team e come si è verificato l'errore?
7. Se si utilizza la condivisione manuale, è possibile che l'utente abbia perso l'accesso perché è cambiato il titolare del record. Le condivisioni manuali vengono eliminate quando cambia la proprietà. La condivisione manuale potrebbe anche essere stata rimossa utilizzando il pulsante **Condividi**.
8. Se si utilizza Gestione territorio di livello aziendale, l'utente manca da uno dei territori? Dove viene mantenuta l'appartenenza ai territori e come si è verificata la mancanza? Oppure, forse il record non è stato assegnato al territorio di cui l'utente è membro.
9. Se si stanno creando condivisioni a livello di programmazione e sono presenti criteri per la creazione della condivisione nel codice, esaminare il codice per capire perché questo utente è stato omesso.
## Contesto
Le piattaforme dati si sono evolute per oltre tre decenni. Inizialmente, il settore era dominato da database operativi/OLTP locali, centralizzati e strutturati (per lo più relazionali). Questo si è esteso per includere piattaforme OLAP/Big Data per i data warehouse che sono state utilizzate principalmente per l'elaborazione analitica e sono rimaste relazionali e centralizzate. Lo storage cloud ha determinato architetture distribuite come data warehouse, lakehouse e storage disaggregato. Tuttavia, le piattaforme operative e le piattaforme analitiche sono rimaste separate. Oggi, il cloud computing e la rivoluzione dell'intelligenza artificiale stanno cambiando radicalmente l'architettura della piattaforma dati.
Le aziende investono già in piattaforme Big Data mature come Snowflake, Databricks, BigQuery e Redshift. Ma queste piattaforme fungono da silos di dati. I clienti non derivano valore aziendale dai loro dati perché non è possibile intervenire sui dati direttamente all'interno dei flussi aziendali e delle applicazioni. Queste soluzioni non dispongono di elaborazione dell'intelligenza artificiale generativa e non sono in grado di fornire l'accesso ai dati in tempo reale, quindi non sono in grado di offrire personalizzazione basata sull'intelligenza artificiale al momento del coinvolgimento dei clienti e di altre funzioni leader del settore.
Il futuro delle piattaforme dati è caratterizzato da un'infrastruttura dati unificata, flessibile, accessibile e aperta. Questa nuova architettura si basa sulle moderne tendenze di elaborazione e archiviazione (GPU, memoria di grandi dimensioni, SSD NVMe e cloud storage) per integrarsi con il cloud computing e l'intelligenza artificiale. Sono in grado di fornire approfondimenti in tempo reale, potenziare il processo decisionale autonomo e favorire le applicazioni in tempo reale. Ciò include l'aumento dell'intelligenza artificiale agente, dell'intelligenza artificiale predittiva, dell'analisi, dei database OLTP su larga scala in tempo reale, dei data lake e delle lakehouse. Queste moderne piattaforme dati sono progettate per offrire semplicità, scalabilità, agilità, prestazioni, sicurezza, disponibilità ed efficienza in termini di costi.
### Tendenze chiave nell'architettura di Data Platform di nuova generazione
Le seguenti tendenze dei dati determinano l'architettura della piattaforma dati di nuova generazione.
- **AI, machine learning e Analytics al centro**: L'ascesa dell'intelligenza artificiale agente modificherà in modo sostanziale lo sviluppo, la distribuzione e l'utilizzo/accesso della piattaforma dati. L'intelligenza artificiale agente comprenderà l'intento della conversazione/query, pianificherà, genererà flussi di lavoro e automatizzerà il processo decisionale. La memoria agentica (a breve e a lungo termine) è basata sulla cronologia delle conversazioni per personalizzare la pianificazione e le decisioni degli agenti, la modellazione delle conversazioni in tempo reale e il supporto della personalizzazione nelle piattaforme dati. Gli agenti aiuteranno ad automatizzare "funzionalità" operative come la governance dei dati (ad esempio, sicurezza, conformità, Trust), le prestazioni (ad esempio, scalabilità automatica per concomitanza, produttività e latenza), il failover e la disponibilità e l'osservabilità e la manutenzione. Analytics, previsioni, elaborazione del linguaggio naturale (NLP) basata su AI per le domande/risposte analitiche e analisi su dati non strutturati (testo come PDF, immagini, audio, video) saranno standard, consentendo alle aziende di derivare approfondimenti più approfonditi da fonti di dati diverse.
- **Decentralizzazione dei dati ma accesso ai dati unificato**: Gli agenti hanno bisogno di dati aziendali per ricavare approfondimenti e prendere decisioni e automatizzare le attività aziendali. I dati sono per loro natura decentralizzati nelle aziende, in applicazioni e piattaforme dati diverse. Ma non è facile unificare senza problemi i silos tra le diverse unità operative all'interno dell'azienda e con partner esterni all'azienda. L'unificazione dei dati prevede la condivisione dei dati, tramite inserimento da fonti o federazione con fonti di dati; dati grezzi provenienti da preparazione, armonizzazione e modellazione dei dati per l'elaborazione analitica e AI; archiviazione e gestione dei dati su larga scala per un accesso efficiente con bassa CTS; e accesso ai dati tramite vari meccanismi e strumenti di query e analisi, profondamente integrati con le piattaforme di archiviazione e accesso ai dati sottostanti
- **Open Lakehouse basati su cloud**: Le piattaforme OLP (Big Data) basate su cloud stanno convergendo nell'adozione di formati di file aperti (Parquet) e formati di tabella (Iceberg) che abilitano la federazione dei dati (data in) e la condivisione (data out).
- **Trattamento dati non**: strutturati Con l'emergere, l'avanzamento e l'adozione dell'intelligenza artificiale generativa, le aziende stanno iniziando a trarre informazioni preziose e valore aziendale dal corpus di dati aziendale che costituisce grandi volumi di documenti di testo, trascrizioni audio, registrazioni video e altri media. L'elaborazione di dati non strutturati, inclusi suddivisione in blocchi, vettorializzazione, ricerca semantica e grafici Knowledge, rendono possibili questi approfondimenti. Tecniche come RAG (retrieval augmented generation) e CAG (cache augmented generation) stanno diventando i principali motori della ricerca veloce e agente in tutto il corpus di dati.
- **Knowledge Management**: Knowledge va oltre il semplice contenuto grezzo (documenti, articoli, video). Rappresenta l'aumento di quel contenuto derivando significato, curando i metadati e inserendolo nel contesto per sviluppare una comprensione condivisa del contenuto in un'organizzazione o in un'azienda. Knowledge stesso è generalmente strutturato. La gestione Knowledge include la gestione dei contenuti, l'estrazione Knowledge, la rappresentazione tramite modelli come i grafici e la navigazione.
- **Accesso RTF ai dati**: Un accesso completo ai dati significa che i dati, gli strumenti di analisi e intelligenza artificiale devono essere accessibili a una varietà di profili, inclusi utenti finali, utenti aziendali, amministratori e analisti. L'accessibilità viene raggiunta attraverso meccanismi come la query insiemi (con query relazionali, parola chiave e semantica), il linguaggio naturale per la query SQL (NL2SQL), l'accesso in tempo reale e così via.
- **Elaborazione in tempo reale**: Le applicazioni agenti prendono decisioni in tempo reale in base allo stato corrente e ai nuovi eventi, personalizzando le risposte e le azioni, il che richiede l'accesso, l'elaborazione e l'utilizzo di dati in tempo reale. L'elaborazione in tempo reale richiede dati aggiornati (latenza dei dati) e accesso interattivo (latenza di accesso). Tali dati e latenza di accesso richiedono che la piattaforma dati sottostante supporti l'accesso aggiornato ai dati dagli archivi operativi e analitici, l'elaborazione a bassa latenza (ricerche di punti e query), l'elevata scalabilità dei dati e l'elevata produttività.
- **Sicurezza dei dati, governance e residenza**: L'intelligenza artificiale agentiale e conversazionale semplifica l'interfaccia utente delle applicazioni, consentendo a chiunque, dai consumatori ai dipendenti fino ad altri agenti di intelligenza artificiale, di interagire con le applicazioni conversazionalmente utilizzando un linguaggio naturale parlato o scritto. I preziosi dati personali e dei clienti che devono essere archiviati e modellati per le applicazioni Agentic devono essere protetti e governati con policy di accesso e condivisione ben definite. Sempre più spesso, molti clienti devono rispettare i regolamenti che richiedono la residenza dei dati nel proprio paese o regione, in particolare quelli governativi o che lavorano con i governi.
Salesforce Data 360 è progettato per il futuro per gestire queste tendenze dei dati. Data 360 è una piattaforma di dati nativa per il cloud basata sui metadati che unifica i dati in silo in tutta l'azienda, consentendo alle organizzazioni di archiviare, modellare ed elaborare i propri dati per abilitare applicazioni analitiche, AI, machine learning e agenti.
Questo documento è una guida essenziale per gli architetti aziendali e i CTO. Descrive l'architettura, le funzionalità, i principi di progettazione e i casi d'uso di Data 360. Introduce i fondamenti dell'architettura Data 360 come primer, seguito da una serie di approfondimenti sui suoi principali differenziatori, come l'interoperabilità con le piattaforme dati esistenti, tra cui strategia multi-organizzazioni, sicurezza, governance e privacy, attivazione in tempo reale e camere bianche dei dati.
## Principi di progettazione
Salesforce Data 360 si basa su una serie di principi fondamentali che rendono i dati aziendali operativi, affidabili e in tempo reale.
- **Apertura e interoperabilità**: Creato per gli ecosistemi multi-cloud. Si unisce a piattaforme dati come Snowflake, Databricks, BigQuery e Redshift senza duplicazioni, estendendo Customer 360 pur preservando gli investimenti esistenti.
- **Separazione memoria-calcolo**: Scala l'archiviazione e l'elaborazione (batch, streaming e interattiva) in modo indipendente. Offre elasticità ed efficienza per carichi di lavoro a volume elevato e prestazioni elevate.
- **Memoria ed elaborazione multimodello**: Supporta diversi tipi di dati strutturati e non strutturati come testo, audio immagine e video. Offre archiviazione efficiente, elaborazione in tempo reale e in batch, indicizzazione ampliabile, ricerca unificata, query e analisi.
- **Progettazione basata sui metadati**: Le applicazioni sono definite dai metadati anziché dal codice. I metadati vengono trattati come asset di prima classe, consentendo una governance unificata, flessibilità e una profonda integrazione nella piattaforma Salesforce.
- **Elaborazione ibrida in tempo reale**: Supporta query a bassa latenza e processi decisionali istantanei, oltre all'elaborazione batch e ai carichi di lavoro analitici.
- **Dati intelligenti e attivi**: Inserisce, analizza e invia continuamente approfondimenti direttamente nei flussi di lavoro aziendali. Alimenta l'automazione senza codice, low-code, pro-code e basata sull'intelligenza artificiale con il contesto più attuale.
- **Governance e privacy by Design**: Lineage, controllo degli accessi, residenza, crittografia dei dati e conformità sono integrati. Trust e fiducia normativa sono rafforzati a ogni livello.
- **Tenancy uno a molti**: Un'organizzazione Data 360 centralizzata funge da singola fonte di dati per Customer 360, supportando in modo semplice gli ambienti Salesforce multi-organizzazioni ampiamente utilizzati dai clienti Salesforce.
Questi principi garantiscono che Data 360 renda i dati aperti, intelligenti e fruibili in tempo reale.
### Dai principi alle funzionalità
Salesforce Data 360 è una piattaforma dati moderna basata su principi di progettazione che tengono conto delle tendenze attuali dei dati. Le funzionalità dell'architettura garantiscono che i dati aziendali siano affidabili, unificati e fruibili in tempo reale, in linea con i principi guida.
- **Cloud-Native Foundation**: Funziona su Hyperforce, distribuito su Hyperscalers (come AWS), con un'infrastruttura immutabile basata su microservizi. Offre scalabilità elastica, sicurezza zero Trust, consegna continua e conformità globale.
- **Gestione dei metadati di Salesforce (Core)**: I metadati sono progettati, modellati e archiviati come metadati Salesforce che consentono l'uso immediato da parte di TUTTE le applicazioni Salesforce. Tali metadati sono archiviati in un RDBMS completamente compatibile con ACID. Garantisce governance, coerenza del ciclo di vita e una profonda integrazione con Salesforce Lightning Platform.
- **Stoccaggio: Lakehouse** Basato su Apache Iceberg e Parquet, combina la scalabilità del data lake con la governance del magazzino che supporta l'evoluzione dello schema, i viaggi nel tempo e gli aggiornamenti a volume elevato. Data 360 archivia, modella ed elabora dati strutturati e non strutturati con un'archiviazione su larga scala con moderni standard aperti e con funzionalità complete di trasformazione ed elaborazione dati per carichi di lavoro basati su batch ed eventi.
- **Opportunità dati in corso di realizzazione end-to-end con inserimento flessibile**: Copre l'intero ciclo di vita (inserimento, preparazione, modellazione, unificazione, analisi e attivazione) riducendo la dipendenza da soluzioni di punti frammentate. Supporta batch, quasi in tempo reale e streaming con più di 270 connettori e MuleSoft. L'approccio ELT-first consente una rapida disponibilità dei dati con flessibilità di trasformazione a valle.
- **Interoperabilità dei dati aziendali con framework aperti e federazione**: Unisce i dati in silo in tutta l'azienda con la federazione bidirezionale Copia zero con Snowflake, Databricks, BigQuery e Redshift evitando la migrazione o la duplicazione dei dati.
- **Classificazione, modellazione e organizzazione dei dati**: Data 360 organizza i dati come dati inseriti non elaborati, dati puliti e archiviati e dati modellati in base allo schema informativo comune noto come SSOT (Single Source of Truth). Tali oggetti SSOT costituiscono la base per la definizione di modelli di dati semantici (SDM) e altri modelli curati e specifici delle applicazioni.
- **Modellazione semantica incorporata** per analisi estendibili con API di query semantiche aperte, che guidano Tableau Next e abilitano analisi specifiche dell'applicazione.
- **Motore di query** Data 360 SQL che supporta una query unificata su dati strutturati, non strutturati e grafici.
- **Memorie dati a bassa latenza**: Archiviazione dei valori chiave per i dati caldi con tempi di risposta in millisecondi. Abilita la personalizzazione e gli scenari basati sugli eventi in tempo reale. Raccoglie ed elabora i dati di coinvolgimento dei clienti in tempo reale. Unisce le identità, le interazioni e le conversazioni in un unico profilo Customer 360 e grafico del contesto affidabili.
- **Pipeline di elaborazione** dati non strutturate per un supporto flessibile ed estensibile per l'archiviazione di dati non strutturati, la suddivisione, la generazione di incorporamento (vettorializzazione), l'estrazione di metadati (aumento), il riepilogo, l'indicizzazione, l'estrazione Knowledge, l'elaborazione intelligente dei documenti, la creazione di memoria a breve e lungo termine (conversazione) e così via.
- **Indicizzazione nativa parola chiave, vettore e ibrida** per un accesso preciso ed efficiente ai dati non strutturati come ricerca rapida e agente, RAG, estrazione Knowledge, derivazione della memoria agente, ecc.
- **Servizi Profilo, Personalizzazione, Contesto** per l'abilitazione di applicazioni AI/ML e Agentic.
- **Governance e sicurezza** integrate a ogni livello per il tracciamento dei lignaggi, il mascheramento dei dati, la residenza dei dati e la sicurezza zero Trust per garantire conformità e Trust.
- **Tessuto elastico di calcolo**: Tessuto di elaborazione multi-tenant nativo di Kubernetes. Esegue Spark per l'elaborazione distribuita e Hyper per i carichi di lavoro SQL. Scala in modo elastico in processi diversi e supporta l'isolamento per l'esecuzione di codice non affidabile.
Tutto questo viene eseguito su Hyperforce, la base cloud di Salesforce. Hyperforce fornisce:
- **Sicurezza Zero Trust** con policy di crittografia, isolamento e privilegi minimi.
- **Resilienza** attraverso distribuzioni multiregione. Benché Salesforce Data 360 tragga vantaggio dalla resilienza multiregione e dalla tolleranza ai guasti a livello di piattaforma di Hyperforce, il vero disaster recovery (DR) di livello aziendale richiede un'architettura più ampia simile a qualsiasi piattaforma dati con funzionalità chiave: pipeline di inserimento riproducibili, replica e reidratazione basata sui metadati in tutti gli ecosistemi dipendenti.
- **Osservabilità** con monitoraggio, metriche e tracciamento integrati.
- **Scala automatica e consapevolezza** FinOps per l'efficienza senza overflow dei costi.
Data 360 non sostituisce gli investimenti aziendali esistenti. Data 360 rende invece i dati di cui ci si è già fidati, gestiti e fruibili, offrendo un coinvolgimento in tempo reale basato sull'intelligenza artificiale dove è più importante. In breve, Salesforce trasforma tutti i dati aziendali, inclusi i dati esterni, come oggetti basati sui metadati (Salesforce) e abilita le applicazioni Agentic per l'individuazione, il processo decisionale e l'esecuzione di azioni.
La figura seguente illustra l'architettura di riferimento di Data 360:
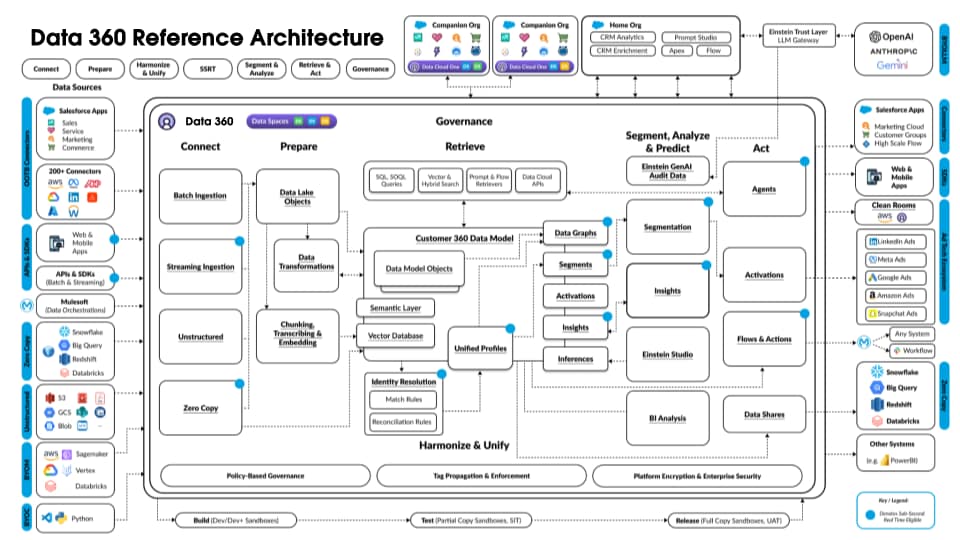 Si consideri un ipotetico Agentforce Loan Agent stratificato in Data 360 per descrivere un flusso di architettura di esempio. Si supponga che l'agente prestiti sia un agente rivolto al cliente in cui i clienti (consumatori) richiedono prestiti e ottengono approvazioni immediate dei prestiti.
Data 360 esegue questi passaggi come pianificato, preparando i dati per l'uso da parte dell'agente del prestito.
- Data 360 inserisce i dati strutturati dell'account cliente da CRM e li archivia nel data lake.
- Data 360 elabora i dati non strutturati relativi a prestiti aziendali e polizze finanziarie.
- Data 360 federa i dati personali di una fonte di dati esterna come Snowflake.
- Trasforma e modella i dati inseriti e federati in Data 360.
- Data 360 crea e gestisce il grafico dei dati del profilo.
Ogni volta che un cliente richiede un prestito, vengono eseguite queste azioni.
- Un cliente accede all'agente del prestito, che avvia una sessione del cliente nel livello in tempo reale. Il profilo unificato del cliente viene inserito nel livello in tempo reale.
- Il cliente completa una richiesta di prestito fornendo le informazioni richieste.
- Il cliente carica documenti finanziari (ad esempio dichiarazioni dei redditi, investimenti, estratti conto) in Data 360 per l'elaborazione di dati non strutturati.
- I dati caricati vengono suddivisi in blocchi e vettorializzati (generazione di incorporamento) e vengono creati gli indici (parola chiave e vettore).
- Quindi, il cliente compila il documento di richiesta di prestito e lo carica. Data 360 estrae l'ammontare e la durata del prestito in tempo reale.
- L'agente del prestito recupera i dati finanziari pertinenti utilizzando query di Data 360 e ricerca ibrida su profili e altri indici pre-creati.
- L'agente del prestito attiva un agente di approvazione con i dati del prestito e altri dati del profilo finanziario per prendere la decisione di approvazione del prestito.
- L'agente del prestito risponde al cliente con una decisione.
- Anche l'intera interazione tra il cliente e l'agente del prestito viene acquisita e archiviata in Data 360.
L'esempio precedente offre una panoramica dei componenti dell'architettura di Data 360 utilizzati per creare un'applicazione Agentic come un agente di prestito. Nella sezione successiva descriviamo i livelli e i componenti dell'architettura Data 360.
## Architettura di Data 360
In questa sezione, approfondiremo i componenti base di Salesforce Data 360, iniziando con il suo modello di archiviazione robusto e successivamente esplorando i meccanismi di connessione, inserimento e preparazione dei dati. Esamineremo quindi come vengono memorizzati, modellati ed elaborati i dati strutturati e non strutturati, culminando in una comprensione delle loro capacità di armonizzazione, unificazione, recupero e attivazione intelligente.
### Archiviazione di Data 360
Salesforce Data 360 è basato su un modello di archiviazione a livelli ma integrato che combina i punti di forza di una lakehouse con l'archiviazione in tempo reale. Il livello lakehouse offre uno spazio di archiviazione scalabile ed economico per grandi volumi di dati storici e batch, abilitando casi d'uso avanzati di analisi e machine learning. La memoria in tempo reale, invece, è ottimizzata per l'accesso a bassa latenza e gli aggiornamenti ad alta frequenza, assicurando che le interazioni con i clienti, i profili e i segnali di coinvolgimento siano sempre aggiornati. Insieme, questi livelli funzionano perfettamente, consentendo ai dati di spostarsi in modo fluido tra contesti storici e in tempo reale, offrendo profondità e immediatezza in una base di dati unificata per personalizzazione, intelligenza artificiale e attivazione.
#### Lakehouse
Data 360 dispone di un'architettura lakehouse nativa basata su Iceberg/Parquet, progettata per gestire la gestione e l'elaborazione dei dati su larga scala per scenari batch, streaming e in tempo reale che supportano dati sia strutturati che non strutturati, cruciali per le applicazioni di intelligenza artificiale e analisi.
Nei data lake basati su cloud come Azure, AWS o GCP, l'unità di archiviazione fondamentale è un file, in genere organizzato in cartelle e gerarchie. Lakehouse ottimizza questa struttura introducendo astrazioni strutturali e semantiche di livello superiore per facilitare operazioni come query ed elaborazione AI/ML. L'astrazione principale è una tabella con metadati che ne definisce la struttura e la semantica, incorporando elementi di progetti open source come Iceberg o Delta Lake, con livelli semantici aggiuntivi aggiunti da Data 360.
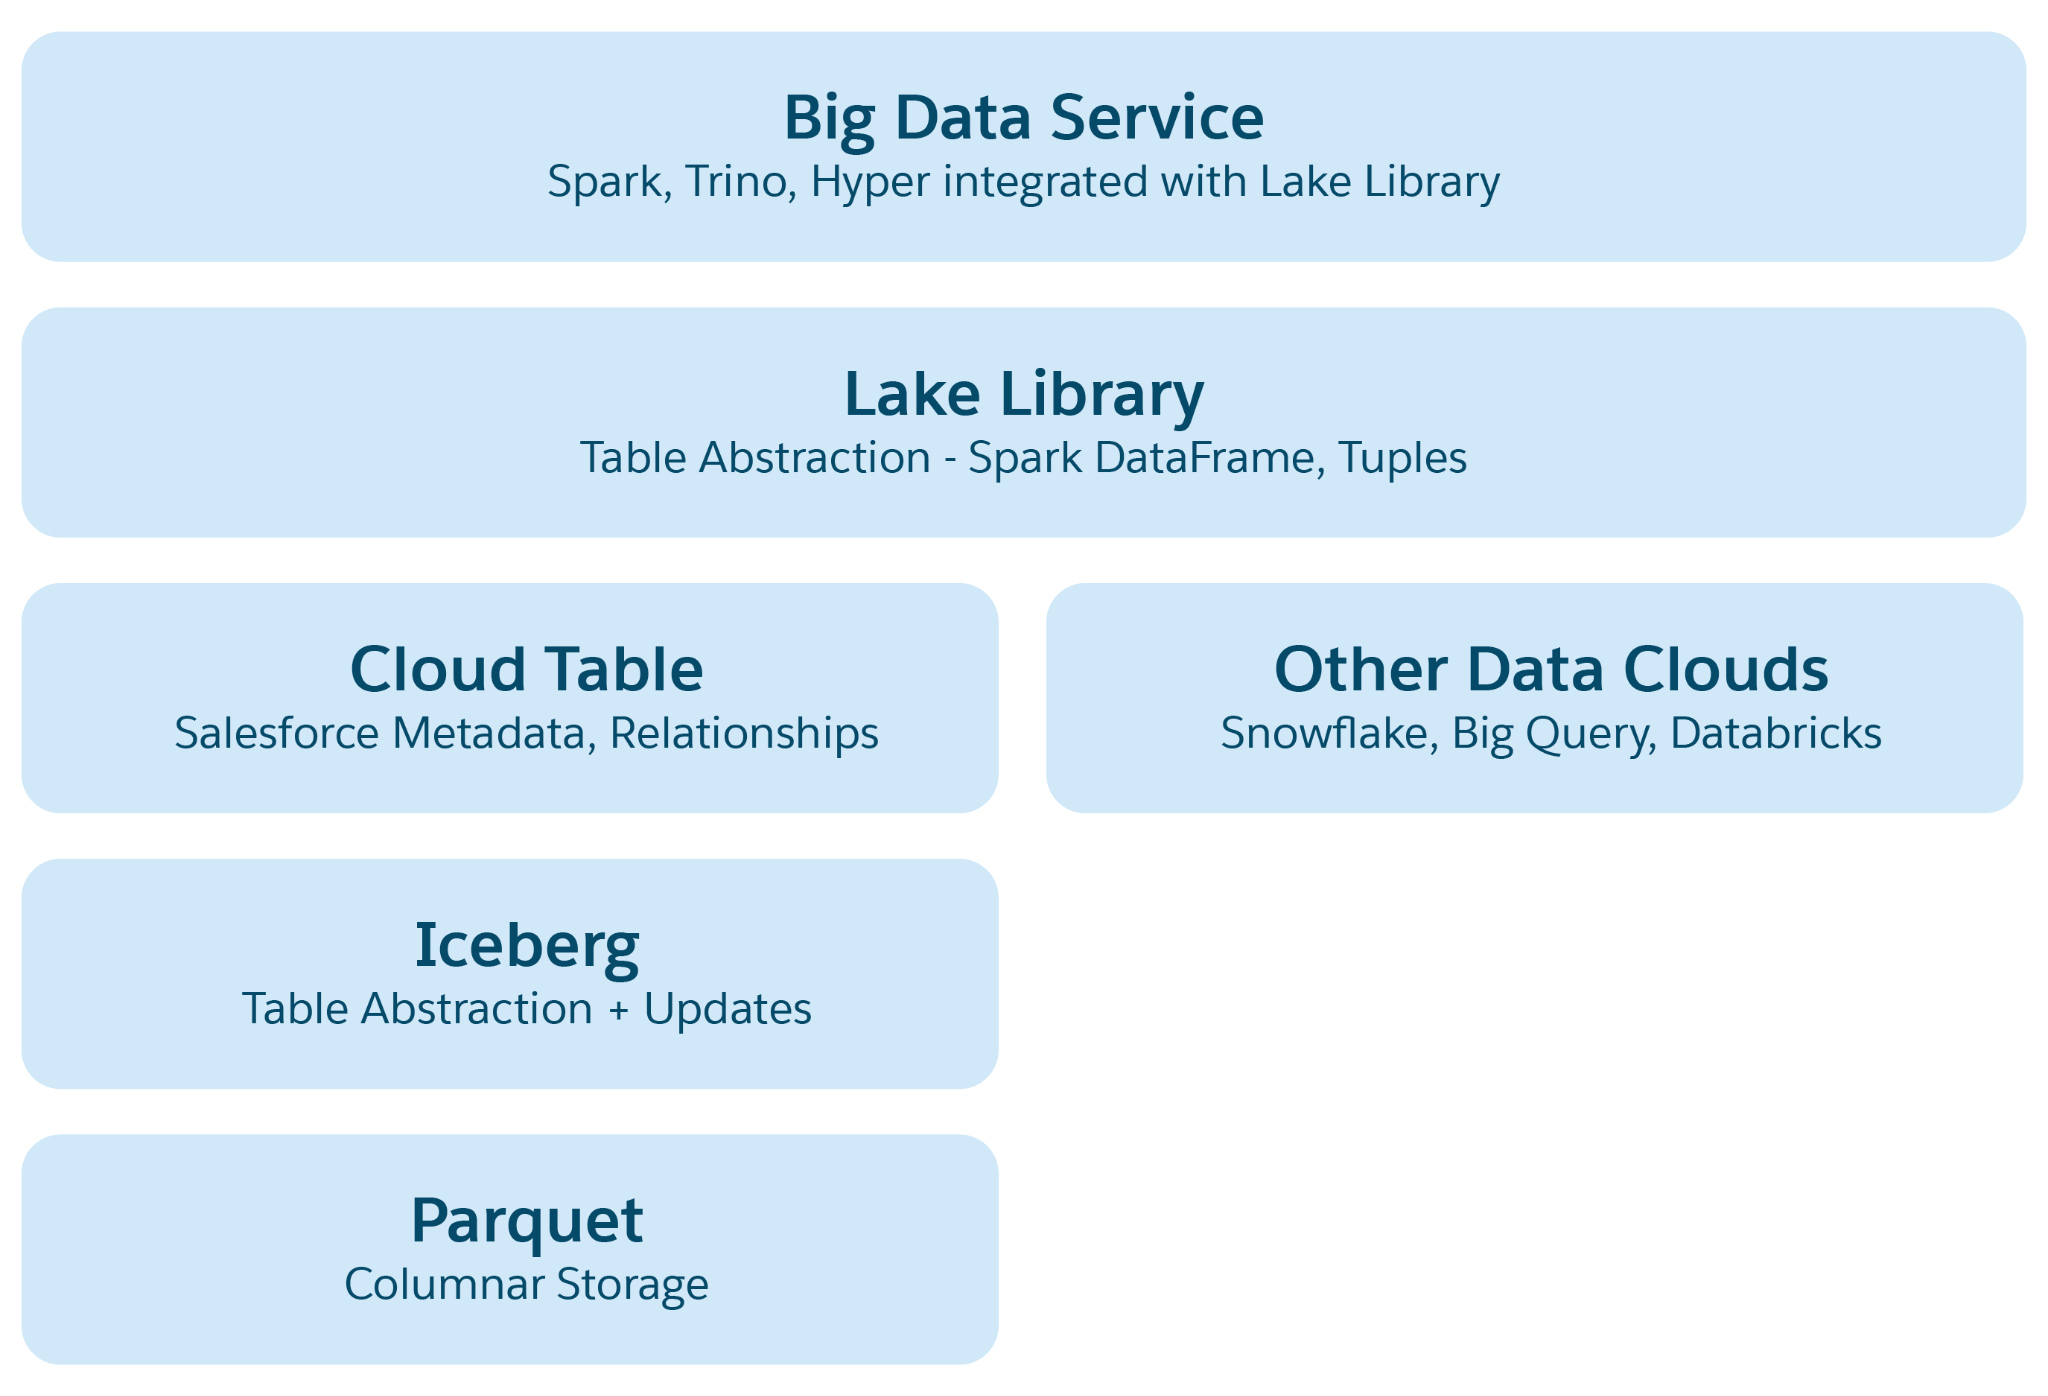 Strati di astrazione in Lakehouse:
1. **Astrazione file Parquet**: Alla base, lo storage è costituito da file data lake (ad esempio S3 in AWS o Blob in Azure) in formato Parquet. I dati di una tabella di origine sono memorizzati in più partizioni come file Parquet, e ogni tabella è una raccolta di questi file.
2. **Astrazione tabella Iceberg**: Le tabelle sono organizzate come cartelle, con partizioni di dati memorizzate come file Parquet all'interno di queste cartelle. Le modifiche apportate a una partizione generano nuovi file Parquet come istantanee. Iceberg gestisce un file di metadati per ogni tabella, descrivendo gli schemi, le specifiche delle partizioni e le istantanee.
3. **Astrazione tabella Salesforce Cloud**: Basato su Iceberg, questo livello aggiunge metadati semantici come nomi e relazioni delle colonne, oltre a configurazioni come le dimensioni e la compressione dei file di destinazione. Astrae le tabelle in varie piattaforme come Snowflake e Databricks, proteggendo le applicazioni Data 360 dalle specifiche della piattaforma di archiviazione sottostante.
4. **Libreria di accesso al lago**: Questa libreria fornisce l'accesso alla tabella Salesforce Cloud, gestendo sia i dati che i metadati e astraendo i meccanismi di archiviazione sottostanti per gli sviluppatori di applicazioni.
5. **Astrazione del servizio Big Data**: Sono inclusi framework di elaborazione come Hyper per le query e Spark per l'elaborazione in qualsiasi piattaforma di tabelle cloud.
#### Archiviazione in tempo reale
Per supportare applicazioni analitiche e agenti in tempo reale, Data 360 potenzia l'archiviazione Big Data di Lakehouse con Low Latency Store. Livello in tempo reale di Data 360 elabora i segnali in tempo reale e i dati di coinvolgimento in memoria. Tuttavia, poiché la capacità di memoria è limitata, tutti i dati non possono essere inseriti e l'elaborazione potrebbe non essere eseguita in tempo reale. Data 360 aggiunge un archivio a bassa latenza (LLS) per rimuovere tali limitazioni, abilitando l'elaborazione scalabile in tempo reale.
Il punto vendita a bassa latenza è un livello di memoria NVMe (SSD) con scala di petabyte in Lakehouse. Non tutti i dati devono essere conservati nell'archivio a bassa latenza. È una cache durevole. La maggior parte dei dati alla fine arriva a Lakehouse per la persistenza a lungo termine. I dati in sessione nel livello in tempo reale possono essere trasferiti all'archivio a bassa latenza per un successivo accesso rapido. Ad esempio, in una conversazione agente, i messaggi recenti possono essere elaborati in memoria; i messaggi più vecchi possono essere trasferiti nell'archivio a bassa latenza. Se è necessaria una conversazione precedente, è possibile accedervi entro pochi millisecondi dallo Store a bassa latenza. L'archiviazione basata su NVMe consente di archiviare e accedere a grandi quantità di dati a latenze di millisecondi. I dati possono arrivare allo spazio di archiviazione cloud Lakehouse per persistenza a lungo termine. Inoltre, i dati di Lakehouse necessari per l'elaborazione in tempo reale o per migliorare le esperienze in tempo reale vengono recuperati e conservati nell'archivio a bassa latenza. Ad esempio, il contesto del profilo cliente viene pre-recuperato o portato da Lakehouse e memorizzato nella cache nell'archivio a bassa latenza. Inoltre, tutti gli oggetti lakehouse e altri oggetti necessari per l'elaborazione in tempo reale durante l'elaborazione in sessione possono essere memorizzati nella cache anche nell'archivio a bassa latenza.
L'archivio a bassa latenza di Data 360 abilita il livello Real Timer in una vera gerarchia di memoria con livelli di memoria Lakehouse (SSD), con la migrazione dei dati tra questi livelli senza problemi. Il livello Real Time di Data 360 verrà descritto più avanti in questo documento.
### Organizzazione dei dati
Salesforce Data 360 è progettato per standardizzare, armonizzare e attivare tutti i dati dei clienti, strutturati e non, seguendo un rigoroso ciclo di vita che trasforma l'input non formattato in un modello di dati aggiornato e unificato.
#### Ciclo di vita dei dati e tipi di oggetti
Il ciclo di vita si concentra sull'acquisizione di vari input di dati esterni e la loro strutturazione in oggetti persistenti e modellati. I dati modellati possono essere armonizzati nei profili unificati Customer 360.
**Dati inseriti non elaborati e trasformazioni iniziali**
Il processo inizia con i dati non elaborati inseriti così come sono dai sistemi di origine (CRM, Marketing, file, ecc.). Sono inclusi i carichi completi di dati e gli eventi di modifica continua (delta), che vengono gestiti e uniti con dati persistenti per mantenere lo stato corrente.
Le **trasformazioni in linea** (ad esempio, tronca, normalizza, concatena) vengono applicate immediatamente durante l'inserimento per garantire la qualità e la pulizia preliminari dei dati.
##### Oggetti data lake (DLO): Il livello persistente
I **DLO** (Data Lake Objects) costituiscono il livello di memoria persistente centrale in Data 360. Memorizzano i dati puliti e trasformati e fungono da repository organizzato a lungo termine per tutte le informazioni sui clienti.
Le **trasformazioni dati avanzate** (ad esempio join, aggregazioni, approfondimenti calcolati) vengono applicate ai DLO di origine per produrre nuovi DLO derivati altamente curati.
I dati resi disponibili tramite Zero Copy Data Federation sono rappresentati direttamente come DLO.
**Organizzazione di dati e metadati non strutturati**
Per i contenuti non strutturati (come testo, media, documenti), Data 360 incorpora i dati estraendo e conservando i metadati strutturati all'interno di DLO specifici denominati oggetti data lake non strutturati (UDLO).
Questi DLO specializzati funzionano come tabelle di directory, fornendo una mappa alla posizione fisica e al contesto degli asset non strutturati. Questa funzionalità consente agli architetti di correlare in modo semplice i metadati dei dati non strutturati con il resto dei dati strutturati dei clienti, consentendo query unificate e armonizzazione.
##### Oggetti modello di dati (DMO): Il livello armonizzato
I **DMO** (Data Model Objects) rappresentano il livello di dati finale, armonizzato e strutturato.
Vengono creati mappando i campi DLO (dai DLO di origine, derivati e non strutturati) al modello di dati Customer 360 standard.
Il livello DMO funge da unica fonte di dati per tutti i dati dei clienti, consentendo la creazione, la segmentazione e l'attivazione unificate dei profili in tutto l'ecosistema più ampio.
#### Spazio dati: Il contenitore logico
Uno spazio dati è il contenitore logico fondamentale per organizzare tutti i dati e i metadati in Data 360, inclusi tutti i DLO (strutturati e non) e i DMO. Gli spazi dati offrono un ambiente sicuro e isolato per l'elaborazione e la modellazione dei dati.
Gli spazi dati fungono da confini logici e di governance, abilitando la multi-tenancy interna separando i dati per entità distinte come unità operative, regioni o marchi, pur mantenendo visibilità, discendenza e conformità a livello aziendale, fungendo da base per la definizione di un controllo degli accessi di base.
L'isolamento all'interno degli spazi dati viene applicato a più livelli della piattaforma:
- **Isolamento a livello di dati**: Ogni DLO/DMO appartiene a un unico spazio dati, il che garantisce che query, trasformazioni e mappature di oggetti non possano superare i confini dello spazio dati a meno che non siano esplicitamente autorizzate.
- **Integrazione controllo accessi**: Gli insiemi di autorizzazioni sono collegati in modo nativo agli spazi dati, consentendo il controllo sulle operazioni di lettura, scrittura e amministrazione. Ciò garantisce che solo gli utenti e i servizi autorizzati possano accedere a oggetti, approfondimenti e attivazioni all'interno di uno spazio dati.
- **Governance e audit**: Tutte le operazioni all'interno di uno spazio dati vengono registrate con percorsi di controllo di livello aziendale, consentendo la tracciabilità per conformità, gestione e rapporti normativi.
L'accesso e le autorizzazioni vengono gestiti tramite gli insiemi di autorizzazioni, garantendo visibilità granulare, aggiornamenti controllati e prevenzione di fughe di dati tra domini diversi. Integrando i confini dello spazio dati con l'architettura di sicurezza e governance di Data 360, gli architetti possono implementare con sicurezza strategie di governance sia centralizzate che decentralizzate, mantenendo la coerenza in più cloud e domini aziendali.
#### Calcola tessuto
Il tessuto di elaborazione di Data 360 offre un livello unificato per la gestione e l'esecuzione di tutti i carichi di lavoro Big Data, semplificando le complessità dell'infrastruttura sottostante. Il suo componente principale è il controller di elaborazione dati (DPC).
DPC è un servizio completo di orchestrazione dell'elaborazione dati multi-carico di lavoro che offre funzionalità Job-as-a-Service (JaaS) in diversi ambienti di cloud computing. Astrae la complessità dell'infrastruttura e unifica l'esecuzione dei processi per framework come Spark (EMR su EC2 e EMR su EKS) e carichi di lavoro Kubernetes Resource Controller (KRC). Fungendo da gateway del piano di controllo centralizzato, DPC orchestra, pianifica e monitora i processi su più piani dati, garantendo affidabilità, scalabilità, efficienza dei costi e un'esperienza dello sviluppatore coerente.
L'esigenza di DPC deriva dalle limitazioni dell'interazione diretta con sistemi di gestione dei cluster nativi come EMR.
##### Astrazione di infrastrutture e cloud
Benché EMR offra API per cluster, operazioni e fasi, continua a gravare i team clienti su operazioni critiche di gestione dell'infrastruttura come provisioning, scalabilità, ottimizzazione delle prestazioni e ottimizzazione dei costi. DPC risolve questo problema offrendo un'API semplificata a livello di piattaforma per l'invio dei processi. Supporta la gestione automatica dei guasti, i tentativi e il bilanciamento dinamico del carico. Offre efficienza in termini di costi tramite nodi basati su binpacking, spot e gravitoni. Offre una sicurezza elevata con TLS, PKI, isolamento IAM e patching automatico. Gestisce gli aggiornamenti delle versioni runtime Spark ed EMR per offrire miglioramenti delle prestazioni, patch di sicurezza e miglioramenti delle funzioni.
Inoltre, DPC fornisce un'interfaccia unificata e indipendente dal cloud per l'invio e la gestione dei processi di dati, astraendo le complessità e le API proprietarie del substrato cloud sottostante (AWS, futuri provider). Ciò garantisce che i team client interagiscano esclusivamente con un'interfaccia di invio dei processi comune basata sull'API Data 360 che elimina le complessità dei responsabili delle risorse sottostanti come Kubernetes e YARN. Ciò consente ai team client di inviare processi Spark tramite un'API semplice e unificata senza dover gestire direttamente pod, pool di nodi o configurazioni di cluster Spark.
La regolazione manuale dei parametri Spark richiede competenze specifiche e configurazioni errate possono rallentare l'esecuzione dei processi. Il team DPC centralizza questa esperienza, fornendo configurazioni ottimizzate per evitare problemi di prestazioni comuni. Questo team specializzato integra continuamente Knowledge della comunità open source per garantire prestazioni ottimali in tutti i carichi di lavoro gestiti dal controller.
DPC non è limitato a Spark; supporta un'ampia gamma di carichi di lavoro. Questi includono:
- Carichi di lavoro di elaborazione in tempo reale
- Funzione di consegna evento per le azioni dati
- Gestione di Milvus (il database vettoriale per l'indicizzazione dei dati non strutturati)
- Infrastruttura di storage a bassa latenza
DPC sfrutta anche il framework **Kubernetes Resource Controller (KRC)**, che supporta carichi di lavoro come Trino per Query, Event Delivery per le azioni dati, Processi di estrazione dati per i connettori ed elaborazione in tempo reale. Per tutti i carichi di lavoro del CCR, DPC offre funzionalità Job-as-a-Service centralizzate, che gestiscono il provisioning, la distribuzione e la gestione del calcolo con un'astrazione dei processi di alto livello.
##### Vantaggi e architettura JaaS
Il modello Job-as-a-Service, fornito da DPC, garantisce una pipeline di elaborazione dei processi conveniente e resiliente.
Gli utenti forniscono specifiche semplici per i cluster, concentrandosi su CPU, memoria, memoria, conteggi delle istanze e conteggi e tag dei cluster Min/Max necessari per la corrispondenza dei cluster. DPC gestisce automaticamente i dettagli astratti dell'infrastruttura, inclusa la selezione degli SKU VM ottimali, la gestione dei parchi istanze e la determinazione del rapporto tra Core e Core. Nodi Operazione e gestione di On-Demand vs. Individuare le istanze in base agli input. Gestisce anche la gestione delle versioni EMR e dei componenti e gli aggiornamenti senza tempi di inattività.
Fondamentalmente, il DPC supporta intrinsecamente la multi-tenancy, progettata per comprendere e applicare i confini della tenancy di Data 360 e la separazione delle risorse. Garantisce inoltre sicurezza e conformità imponendo immagini delle macchine certificate Salesforce, gestendo ruoli IAM specifici del servizio e garantendo la crittografia sia in transito che a riposo. Per l'instradamento e il controllo della capacità, l'abbinamento da processo a cluster viene gestito utilizzando i tag cluster e l'instradamento basato sulla capacità utilizza un'impostazione di concomitanza massima dei processi per controllare efficacemente l'utilizzo delle risorse.
Cloud Agnostic Client Experience è un vantaggio fondamentale, poiché la complessità degli ambienti cloud sottostanti è nascosta ai servizi client, consentendo loro di concentrarsi esclusivamente sulla logica aziendale. In questo modo si raggiunge l'obiettivo dell'astrazione del provider cloud. Infine, DPC consente un facile tracciamento dell'utilizzo e dei costi, consentendo di segmentare l'utilizzo e i costi dei cluster in base al servizio per una contabilizzazione precisa. Nel complesso, DPC segue un'architettura plug-in che consente l'integrazione senza problemi di nuovi motori di esecuzione (ad esempio Flink, Ray) e substrati cloud (GKE/Dataproc) senza esporre agli utenti i dettagli dell'infrastruttura sottostante. Questa progettazione separa il piano di controllo dal livello di esecuzione, garantendo un'API e un'esperienza operativa coerenti indipendentemente dal backend.
### Elaborazione dei dati in Data 360: Da grezzo a fruibile
Data 360 perfeziona e arricchisce i dati grezzi, colmando il divario tra informazioni grezze e consumo aziendale fruibile. Integra il ciclo di vita dell'oggetto dati preparando dati complessi per un'attivazione e un'analisi sofisticate. Data 360 supporta vari tipi di elaborazione, tra cui trasformazioni dati batch e streaming, approfondimenti calcolati batch e streaming, elaborazione dati non strutturati e risoluzione dell'identità. Per consentire queste diverse operazioni in modo efficiente, soprattutto quasi in tempo reale e in serie di dati di grandi dimensioni, è necessario un meccanismo sofisticato per gestire le modifiche dei dati in modo efficace.
#### Potenziamento dell'elaborazione incrementale
Per ottenere un'elaborazione dei dati efficiente e quasi in tempo reale, in particolare con tabelle di dimensioni pari a terabyte e milioni di potenziali aggiornamenti, Data 360 necessitava di una svolta. Richiedeva un modo per informare i sistemi con precisione quando i dati cambiano e quindi identificare in modo efficiente quali dati sono stati modificati in modo che vengano elaborati solo gli aggiornamenti pertinenti e solo quando vengono aggiornati. Questa sfida ha portato a due innovazioni complementari: Archiviazione degli eventi di modifica nativi (SNCE) per informare quando viene modificato qualcosa e del feed di dati di modifica (CDF) per identificare ciò che è cambiato.
##### Archiviazione di eventi di modifica nativi (SNCE)
SNCE ha trasformato Data 360 in una piattaforma dati reattiva e incrementale. Questo passaggio prevede il passaggio dal polling attivo del data lake al monitoraggio passivo degli eventi di conferma atomici, utilizzando un formato di evento standardizzato e un sistema di consegna dei messaggi ad alta produttività.
Ogni operazione di scrittura riuscita (INSERT, UPDATE, DELETE) in una tabella Iceberg culmina in uno scambio atomico del puntatore al file di metadati corrente della tabella nel catalogo. Il livello di memoria dell'oggetto sottostante (si supponga S3) è configurato per l'emissione di un evento di notifica nativo (ad esempio un evento S3) ogni volta che viene scritta una nuova istantanea dei metadati nella directory della tabella.
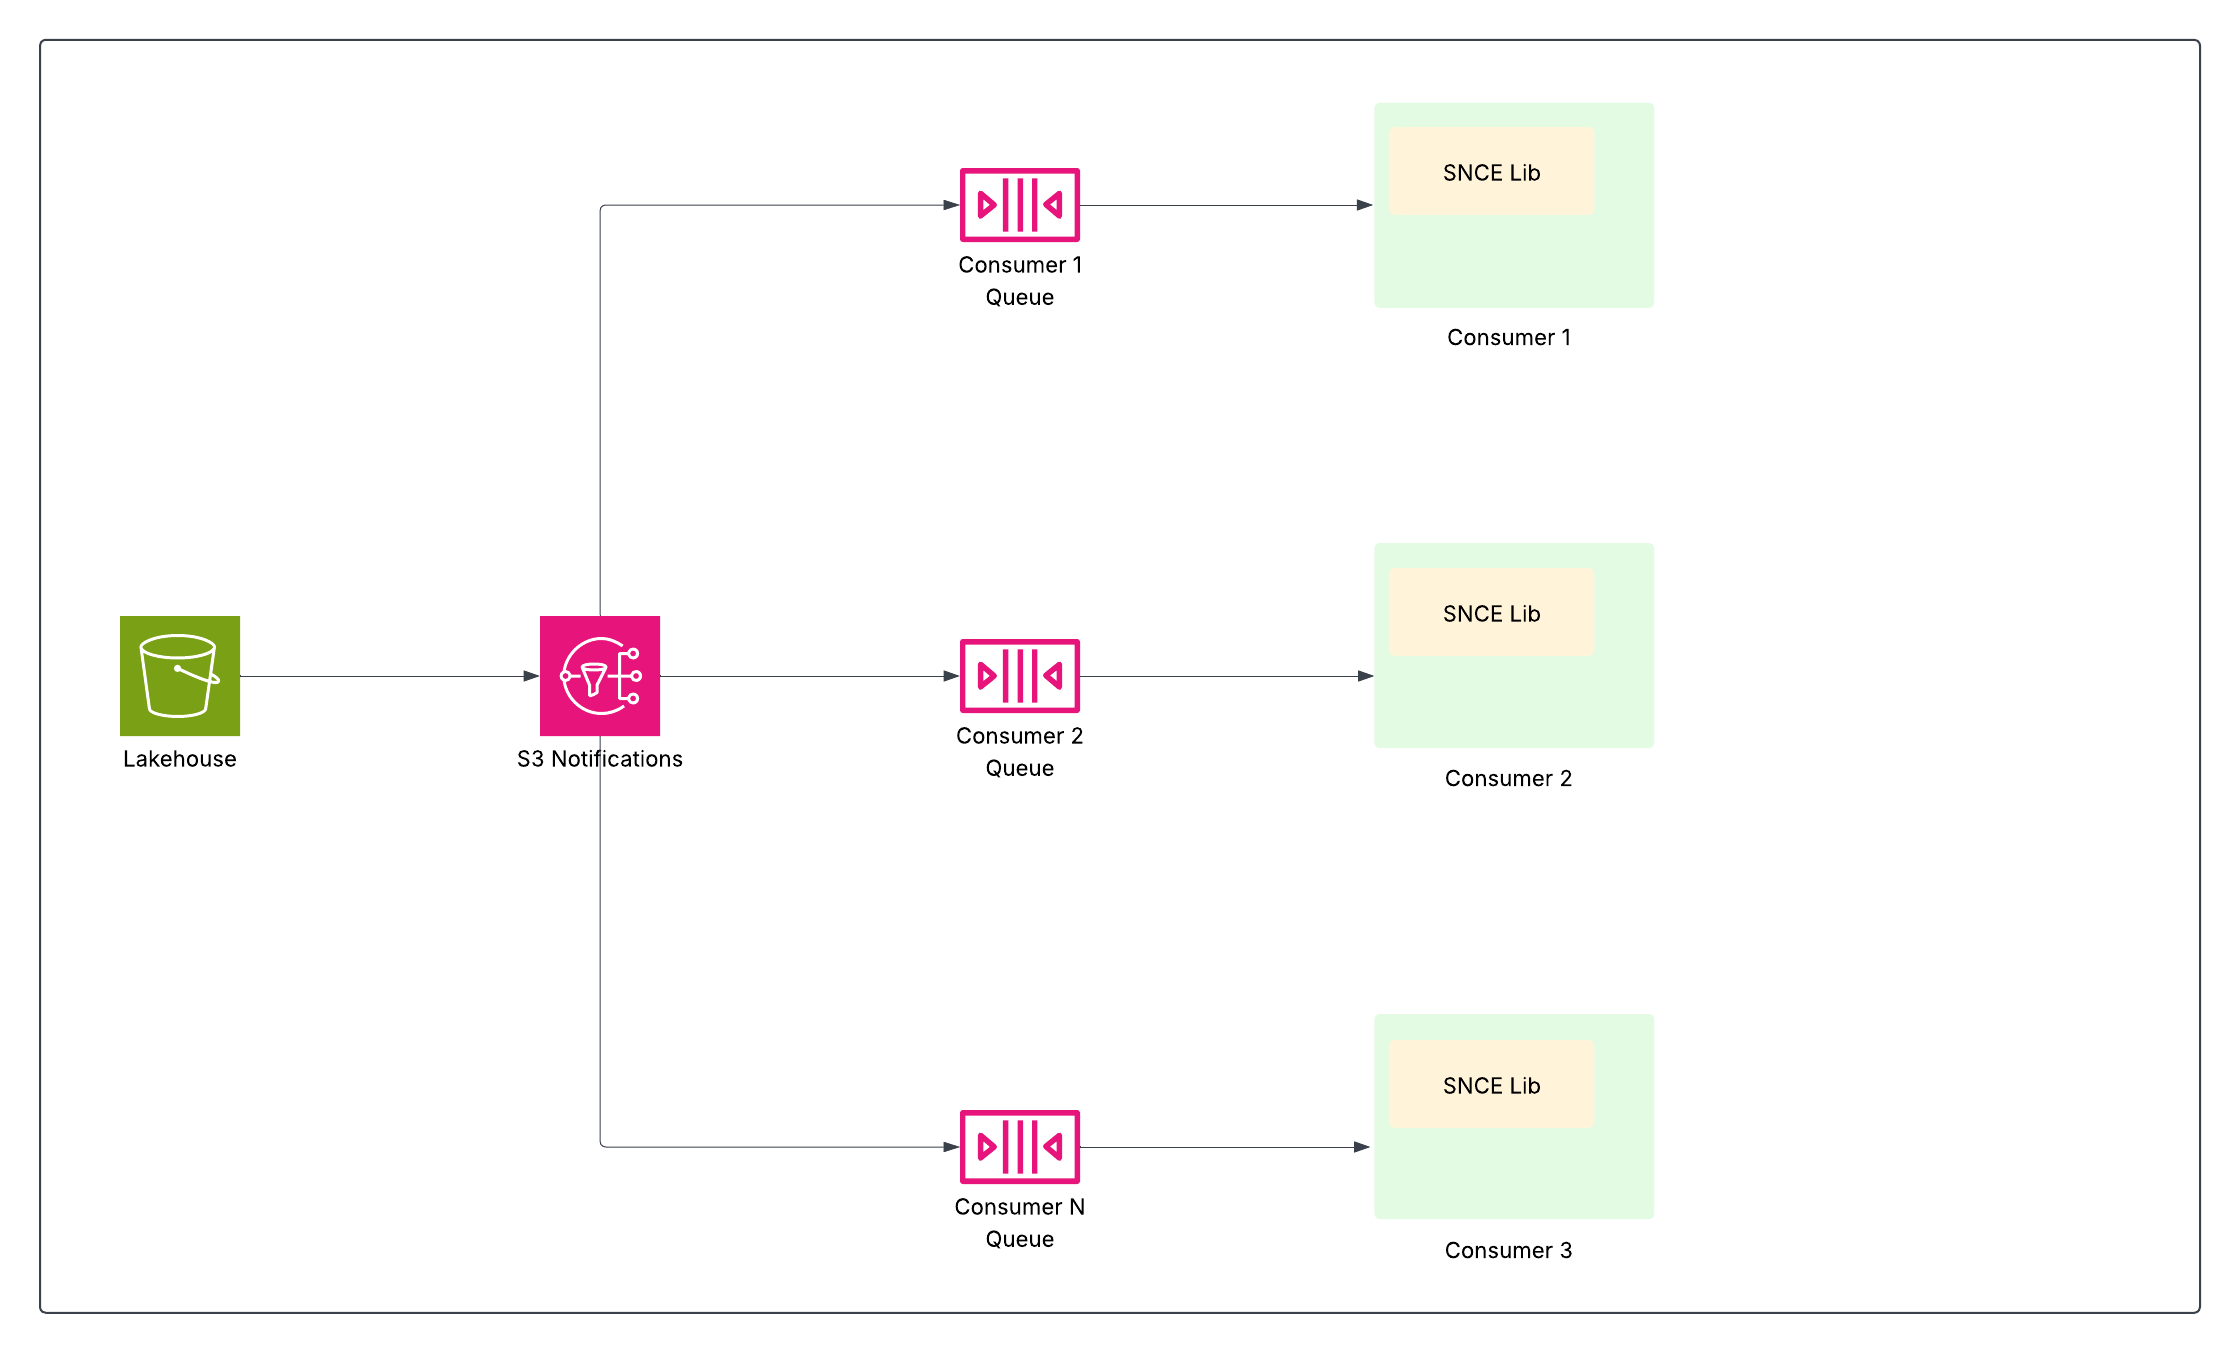 La libreria SNCE offre un metodo standardizzato per consumare questi eventi e su richiesta può anche arricchirli con metadati di istantanee.
Ciò consente alle pipeline di dati a valle, ad esempio approfondimenti calcolati in streaming, risoluzione dell'identità e segmentazione, di abbonarsi e agire solo quando i dati sono cambiati, aumentando in modo significativo l'efficienza evitando costose analisi a tabella intera.
##### Modifica feed di dati (CDF)
Basandosi su SNCE, il Change Data Feed (CDF) offre un meccanismo semplificato per consumare ed elaborare in modo incrementale le modifiche.
CDF sfrutta le istantanee Iceberg per generare in modo efficiente lo stream di modifiche. Il writer Iceberg ottimizzato di Data 360 calcola e mantiene le modifiche come parte dell'operazione di scrittura, rendendo la generazione di CDF estremamente efficiente e riducendo al minimo il sovraccarico aggiuntivo. Ciò consente ai processi di elaborazione (come le trasformazioni streaming o gli approfondimenti calcolati in streaming) di elaborare in modo selettivo solo i record alterati evitando il costoso calcolo delle differenze tra le istantanee.
Questa strategia incrementale offre diversi vantaggi per le serie di dati di grandi dimensioni, tra cui risparmio sui costi, latenza ridotta e maggiore efficienza. Abilita funzioni come le trasformazioni streaming e la risoluzione incrementale dell'identità, che a loro volta consentono approfondimenti più rapidi, caricamenti del sistema più prevedibili, prestazioni ottimizzate e minori spese operative.
### Connessione, inserimento e preparazione
Data 360 offre potenti funzionalità di inserimento con supporto nativo per i prodotti Salesforce, garantendo un flusso di dati senza interruzioni. Per le fonti esterne, offre un'ampia connettività attraverso oltre 270 connettori, API, SDK e MuleSoft. Inoltre, Data 360 è dotato di federazione copia zero, che consente di eseguire BI e analisi senza duplicazioni dei dati.
#### Framework connettore Data 360
Il framework connettore Data 360 (DCF) è la base per la maggior parte della connettività Data 360. Consente l'inserimento, la federazione e l'uscita tramite un'architettura unificata. DCF definisce gli standard per la creazione e la gestione dei connettori, dall'interfaccia utente per l'impostazione e l'amministrazione alla persistenza dei metadati, all'estrazione dei dati e alla consegna in Lakehouse o tramite query live su fonti esterne. Supporta anche opzioni di connettività privata (ad esempio link privati, VPN e tunnel protetti) per garantire la sicurezza e la conformità dei dati di livello aziendale durante la connessione agli ambienti di clienti o partner. Fornendo un approccio coerente in tutti i connettori, DCF consente a Data 360 di connettersi perfettamente all'ecosistema più ampio garantendo estensibilità, affidabilità e integrazione sicura.
#### Connettori Data 360
Data 360 offre una connettività affidabile a un vasto ecosistema di fonti di dati, supportando sia prodotti Salesforce nativi che numerosi sistemi esterni. Questa ampia connettività è fondamentale per unificare i dati aziendali in silo e abilitare le applicazioni AI/ML e Agentic.
Data 360 offre oltre 270 connettori in modo nativo o tramite MuleSoft, API e SDK per supportare le funzionalità end-to-end delle pipeline di dati con inserimento batch, streaming o in tempo reale. Questi connettori possono essere classificati in generale in base al tipo di sistema sorgente che integrano.
**Connettori Salesforce nativi**
Questi connettori garantiscono un flusso di dati nativo e senza interruzioni dai prodotti Salesforce.
Gli esempi includono connettori per Salesforce CRM, Data Cloud One, Marketing Cloud Engagement, Marketing Cloud Account Engagement e B2C Commerce.
**Applicazioni esterne e SaaS**
I connettori per varie applicazioni aziendali e servizi cloud consentono l'inserimento di dati da piattaforme software esterne.
Alcuni esempi sono Adobe Marketo Engage, Microsoft Dynamics 365, Mailchimp e Airtable.
**Banche dati e data warehouse**
Data 360 si connette a una varietà di piattaforme di archiviazione dati relazionali e basate su cloud.
Alcuni esempi sono Amazon Redshift, Amazon DynamoDB, Amazon RDS (MySQL, PostgreSQL, Oracle), Google BigQuery e Microsoft SQL Server.
**Archiviazione oggetti cloud e file system**
Questi connettori si integrano con soluzioni di archiviazione iperscala per dati strutturati e non strutturati.
Alcuni esempi sono Amazon S3, Google Cloud Storage (GCS) e Archiviazione BLOB di Azure.
**Servizi di streaming e messaggistica**
I connettori che gestiscono stream di dati continui in tempo reale sono fondamentali per gli scenari basati sugli eventi e l'elaborazione in tempo reale.
Un esempio è il connettore Amazon Kinesis.
**Piattaforme di integrazione**
Il connettore MuleSoft Anypoint estende la portata di Data 360 integrandolo con una gamma più ampia di applicazioni e database tramite Anypoint Exchange.
**Connettori di archiviazione di dati non strutturati e oggetti cloud**
Questi connettori sono fondamentali per inserire e fare riferimento a dati non strutturati (dati che non hanno un modello predefinito) per potenziare le funzionalità di intelligenza artificiale generativa.
Tutti questi connettori sono basati sul framework del connettore Data 360 che offre un'esperienza coerente.
#### Trasformazioni dati
La trasformazione dei dati è un componente architettonico fondamentale in Data 360, progettato per pulire, arricchire e modellare i dati inseriti non elaborati in asset di dati normalizzati e fruibili in linea con il modello di dati Customer 360. Questo processo è essenziale per l'armonizzazione dei dati, il miglioramento della qualità e la preparazione dei dati per casi d'uso a valle come l'unificazione, la segmentazione e l'attivazione dei profili. Le trasformazioni sfruttano sia gli oggetti data lake di origine (DLO) che gli oggetti modello di dati (DMO) come input, producendo i risultati rispettivamente per i nuovi DLO o DMO.
Data 360 fornisce due paradigmi di trasformazione principali per soddisfare diversi requisiti di velocità dei dati: trasformazioni dati batch e trasformazioni dati in streaming.
##### Trasformazioni dati batch
Le trasformazioni dati batch sono progettate per l'elaborazione a volume elevato in base a una pianificazione definita o a un trigger on-demand. Questo motore è ottimizzato per la gestione di operazioni di ristrutturazione complesse e che richiedono molte risorse.
Il processo di trasformazione batch viene configurato utilizzando un'area di disegno delle opportunità in corso di realizzazione visiva a basso codice che consente agli utenti di definire una logica di trasformazione a più fasi. Questo motore supporta in modo univoco operazioni di ristrutturazione complesse essenziali per l'allineamento del modello di dati canonico: la strutturazione e la normalizzazione dei dati. Ciò include il pivoting (decomposizione dei record denormalizzati in più record normalizzati) e l'appiattimento (ristrutturazione dei dati gerarchici, ad esempio JSON, in tabelle strutturate). La modalità di esecuzione del sistema supporta sia la sincronizzazione completa (elaborazione di tutti i record) che una modalità di elaborazione incrementale altamente efficiente. La modalità incrementale riduce in modo significativo il tempo di elaborazione e il consumo di risorse elaborando solo i record che sono cambiati dall'ultima esecuzione riuscita. Le trasformazioni batch sono ideali per le operazioni in cui gli aggiornamenti in tempo reale non sono essenziali, ad esempio aggregazioni periodiche e ristrutturazioni complesse dei dati.
##### Trasformazioni dati in streaming
Le trasformazioni dati in streaming elaborano i dati in modo continuo e incrementale quasi in tempo reale mentre fluiscono nel sistema, rendendoli essenziali per i casi d'uso a bassa latenza.
L'interfaccia principale è un approccio SQL-first, in cui le trasformazioni sono definite come una query SQL SELECT che viene eseguita continuamente sullo stream in entrata delle modifiche dei record. Questo motore supporta le principali funzioni di trasformazione, tra cui la pulitura e la standardizzazione dei dati (ad esempio, la convalida delle informazioni personali e la standardizzazione dei formati dei dati) e l'arricchimento e l'unione dei dati (utilizzando join e unioni). Supporta gli Streaming Lookup JOIN per abilitare l'arricchimento dei dati in tempo reale e le ricerche rispetto ai dati di riferimento statici o che cambiano lentamente, garantendo aggiornamenti istantanei dei profili. Per ottimizzare il cost-to-serve, l'architettura utilizza un processo ad alta densità (HD), che raggruppa più definizioni di trasformazione streaming per un singolo tenant in un unico processo di elaborazione sottostante, massimizzando l'utilizzo delle risorse. Le trasformazioni streaming sono essenziali per i casi d'uso come il monitoraggio degli eventi, la personalizzazione immediata e gli aggiornamenti dei profili in tempo reale.
### Federazione dati copia zero e condivisione dati
Data 360 rivoluziona la gestione dei dati supportando la federazione Copia zero e la condivisione dei dati, eliminando la necessità di spostare o duplicare i dati. Questa funzionalità consente agli utenti di accedere in modo semplice e diretto ai dati da fonti esterne diverse e di condividere i dati con ambienti esterni, riducendo in modo significativo la complessità, riducendo i costi di archiviazione e garantendo che tutte le decisioni siano basate sulle informazioni più aggiornate e affidabili.
 #### Federazione dei dati
Data 360 supporta la federazione copia zero con data warehouse esterni (Snowflake, Redshift), lakehouse (Google BigQuery, Databricks, Azure Fabric), database SQL e molte altre fonti. I livelli di astrazione consentono di eseguire query dirette sui dati esterni senza duplicazioni, riducendo i tempi di inserimento, i costi di archiviazione e garantendo informazioni aggiornate.
Data 360 semplifica l'accesso ai dati esterni e federati offrendo un livello di metadati unificato che astrae sia Salesforce che gli oggetti esterni. Ciò consente all'intera piattaforma Salesforce e alle relative applicazioni di utilizzare senza problemi questi dati.
Data 360 supporta la federazione basata su file e query, con query live e accelerazione dell'accesso come mostrato nella figura.
Le etichette (1) e (2) illustrano la query di Data 360 (inclusi i pushdown delle query live) e la federazione basata su file per l'accesso ai dati da data lake/warehouse/fonti di dati esterne; l'etichetta (3) evidenzia l'accelerazione dell'accesso federato da data lake/fonti di dati esterne.
##### Federazione delle query
Il cuore della funzionalità di federazione di Data 360 risiede nel suo livello di federazione delle query, che gestisce il complesso processo di accesso ai dati esterni e l'esecuzione di pushdown intelligenti delle query (illustrato dall'etichetta 1). Data 360 si connette e recupera i dati dalle fonti utilizzando il protocollo JDBC, ottimizzato con logica aggiuntiva per una maggiore efficienza. Il Query Federation Layer è responsabile della comprensione e della traduzione dei diversi dialetti SQL, della definizione della parte più ottimale della query da inviare ai sistemi esterni per un'elaborazione efficiente, del recupero dei risultati e dell'esecuzione di ogni ulteriore elaborazione necessaria per derivare approfondimenti finali.
###### Caching (accelerazione delle query)
Per l'utilità ottimizzata, Data 360 offre una funzione di accelerazione facoltativa per le sue funzionalità federate.
Quando è attivata l'accelerazione, Data 360 memorizza nella cache i dati federati per ottenere un accesso più rapido e costi inferiori, evitando accessi diretti e ripetuti a fonti esterne. Questa cache viene trattata come un livello di accelerazione e viene aggiornata in modo incrementale per riflettere rapidamente eventuali modifiche nei dati di origine esterni, assicurando che la visualizzazione accelerata rimanga quasi in tempo reale.
##### Federazione file
Data 360 supporta la federazione basata su file (illustrata dall'etichetta 2) per l'accesso ai dati da data lake e fonti esterne. La base tecnica di questa funzionalità di copia zero si basa sulla standardizzazione: i dati sottostanti devono essere nel formato di file Apache Parquet e utilizzare il formato tabulare Apache Iceberg. Data 360 può essere federato in qualsiasi fonte che espone un IRC (Iceberg REST Catalog) per l'accesso ai metadati e all'archiviazione, garantendo un accesso senza interruzioni e regolamentato ai file che risiedono all'esterno della piattaforma.
Con la federazione basata su file, Data 360 compute gestisce tutta l'elaborazione dei dati perché accede direttamente all'archiviazione sottostante. Ciò elimina la necessità di eseguire query pushdown e gestire vari dialetti SQL, che spesso sono richiesti con la federazione basata su query.
Oltre a questo, la funzionalità Copia zero si estende anche a fonti di dati non strutturate come le soluzioni di archiviazione hyperscaler (archiviazione S3/GCS/Azure), Slack e Google Drive, a cui è possibile accedere dalle pipeline di elaborazione non strutturate di Data 360.
#### Condivisione dei dati
Data 360 facilita sia la condivisione basata su query che su file dei dati che gestisce con data lake e warehouse esterni (illustrata dalle etichette 4 e 5 nel contesto della figura originale).
##### Condivisione basata su query
Per la condivisione dei dati basata su query, Data 360 espone un driver JDBC che consente a motori e applicazioni esterni di accedere in modo sicuro ai dati. Questo meccanismo consente ai sistemi esterni di connettersi, autenticarsi ed eseguire query live direttamente sui dati in Data 360.
##### Condivisione basata su file (condivisione dati e DaaS)
Il meccanismo principale per la condivisione basata su file prevede due concetti: condivisione dati e destinazione condivisione dati, che sfruttano l'API DaaS (Data as a Service).
- Controllo granulare: Il concetto di condivisione dati consente ai clienti di definire con precisione gli oggetti (DLO, DMO, CIO, ecc.) condivisi esternamente, impedendo l'esposizione involontaria dei dati.
- Targetizzazione sicura: Controlla anche la destinazione della condivisione dati, assicurando che i dati siano resi disponibili solo ad ambienti esterni, account o organizzazioni partner esplicitamente autorizzati (ad esempio, la condivisione con un'istanza specifica di Redshift o Databricks).
L'API DaaS fornisce un'interfaccia sicura e gestita per i motori esterni per l'utilizzo dei dati. Concede l'accesso sia ai metadati essenziali che all'archiviazione della tabella sottostante, conservando tutta la semantica di Data 360. Ciò garantisce che i motori esterni accedano ai dati in un contesto coerente e significativo in modo sicuro.
### Connettività privata
Molti clienti sensibili alla sicurezza, in particolare le grandi aziende, i settori regolamentati e le organizzazioni del settore pubblico, limitano l'accesso a Internet ai propri data lake come parte del loro comportamento di sicurezza. Questa policy, pur essendo essenziale per la conformità e la riduzione dei rischi, impedisce anche a Salesforce Data 360 e Agentforce di connettersi a tali ambienti tramite Internet pubblico.
La maggior parte di questi data lake viene distribuita in ambienti hyperscaler come AWS, Azure o Google Cloud. Poiché Data 360 viene eseguito su AWS, l'accesso ai data lake dei clienti ospitati su un provider cloud diverso richiede una connessione di rete tra cloud. Senza un'opzione di connettività privata sicura che ignori Internet pubblico, i clienti spesso non possono o non vogliono adottare Data 360 o Agentforce per i casi d'uso basati su tali data lake.
#### Link privati
 Per risolvere questo problema, Data 360 supporta la connettività privata a livello di rete alle fonti di dati gestite dai clienti nei cloud. In AWS, questo è abilitato tramite AWS PrivateLink, che consente a Data 360 di connettersi direttamente agli endpoint forniti dai clienti, sia all'interno dei propri account che all'interno di ambienti data lake di terze parti (ad esempio Snowflake), senza dover navigare su Internet pubblico.
Questa architettura garantisce che tutto il traffico rimanga interamente sulla backbone AWS, utilizzando indirizzi IP privati e percorsi di rete non instradabili, soddisfacendo così rigidi requisiti di sicurezza e conformità e consentendo al contempo un accesso senza interruzioni ai dati dei clienti.
#### Interconnessione privata
Per i clienti con architetture multi-cloud, Data 360 estende la connettività privata oltre AWS tramite il supporto dell'interconnessione tra cloud. Ciò consente percorsi di rete sicuri e solo backbone da Data 360 ai data lake e ai servizi ospitati in Azure o Google Cloud, mantenendo gli stessi principi di AWS PrivateLink: indirizzamento IP privato, instradamento non pubblico e zero esposizione a Internet.
I clienti possono scegliere tra due modelli di distribuzione:
- **Interconnessione gestita dal cliente**: Integrare circuiti privati esistenti come Azure ExpressRoute, Google Cloud Interconnect o Equinix Fabric direttamente con i VPC di Data 360.
- **Interconnessione gestita da Salesforce**: Utilizzare una connessione chiavi in mano completamente gestita in cui Salesforce esegue il provisioning e il funzionamento del collegamento tra cloud, esponendo gli endpoint privati nel cloud di destinazione.
In entrambi i modelli, l'esperienza è coerente: I servizi Data 360 si connettono a fonti di dati esterne tramite hyperscaler come se fossero locali, abilitando l'inserimento, l'attivazione e l'esecuzione di query sicure senza navigare in Internet pubblico.
### Governance dei dati in Data 360: Una base di Trust e Controllo
Per gli architetti aziendali, una governance dei dati efficace non è solo una casella di controllo della conformità, ma un pilastro fondamentale per creare Intelligence clienti affidabile, scalabile e fruibile. Salesforce Data 360 è progettato con un framework di governance completo che garantisce la qualità dei dati, la sicurezza e l'osservanza dei mandati normativi in tutto il ciclo di vita dei dati.
Data 360 funziona come un hub di governance centralizzato, garantendo che tutti i dati, dall'inserimento non formattato agli approfondimenti attivati, siano gestiti con integrità e controllo.
 #### Controllo accesso avanzato: Perché il controllo dell'accesso basato sugli attributi (ABAC)
Mentre lo spazio dati fornisce un controllo dell'accesso a livello di dettaglio per determinare l'accesso a tutti gli oggetti all'interno di uno spazio dati, le policy basate su ABAC forniscono un controllo dell'accesso a livello di dettaglio a singoli oggetti, campi e righe all'interno di uno spazio dati. Data 360 ha adottato l'ABAC (Attribute-Based Access Control) come modello di autorizzazione principale per il controllo degli accessi a grana fine. Questa scelta strategica offre una flessibilità e una scalabilità superiori rispetto al tradizionale controllo dell'accesso basato sui ruoli (RBAC), particolarmente cruciale per ambienti aziendali dinamici e complessi con grandi quantità di dati e diverse esigenze di accesso. ABAC consente alle decisioni di accesso di basarsi sugli attributi dell'utente (ad esempio, reparto, ruolo, posizione), sui dati (ad esempio, informazioni personali, sensibilità, spazio dati) e sull'ambiente (ad esempio, ora del giorno), anziché solo sui ruoli predefiniti. Ciò consente policy di accesso altamente granulari e contestuali che si adattano al variare dei dati e degli attributi utente.
- **Lingua: della policy CEDAR** Il cuore dell'implementazione ABAC di Data 360 è l'uso del linguaggio della policy CEDAR. Questo linguaggio formale appositamente creato per le policy offre un modo preciso e verificabile per definire regole di autorizzazione complesse, assicurando che le policy siano univoche e possano essere valutate in modo coerente su larga scala.
#### Architettura di governance: Informazioni sulle policy, applicazione e punti decisionali
Il sistema di governance di Data 360 aderisce a un'architettura ABAC standard e robusta:
- **Tag, classificazione e creazione di policy (Policy Information Point - PIP)**:
- Data 360 offre meccanismi automatici di creazione di tag e classificazione, sfruttando LLM (modello di linguaggio grande) e ML (apprendimento automatico) per identificare le categorie di dati sensibili (ad esempio, PII.Email, PII.Phone, PII.Name) e altre tassonomie create appositamente (PHI, FinancialData) sia in Dati strutturati (ad esempio, tabella Referenti) che in Dati non strutturati (ad esempio, da Google Drive).
- Fondamentalmente, la propagazione dei tag avviene lungo la discendenza dei dati (DLO -> DLO -> DMO), assicurando che le classificazioni seguano automaticamente le trasformazioni e le derivazioni dei dati, dai dati non elaborati inseriti al livello DMO armonizzato e attraverso i dati derivati creati a partire dalle definizioni dei processi.
- Infine, il riquadro di creazione della policy offre un'esperienza semplice per sfruttare i dati e gli attributi utente per definire regole di accesso dinamiche per un'organizzazione.
- Questi metadati arricchiti (inclusi tag, classificazioni, policy e discendenza) vengono inseriti nel Punto di informazione sulla policy (PIP).
- **Servizio di autorizzazione (Policy Enforcement Point - PEP)**:
- Il servizio di autorizzazione funge da punto di applicazione della policy (PEP). Intercetta tutte le richieste di accesso ai dati da vari livelli di consumo (Query strutturata/non strutturata ibrida, GenAI RAG Retrievers & Prompt, CRM Enrichment) e consulta il Policy Decision Point per determinare se l'accesso è consentito.
- **Motore di valutazione delle policy (punto di decisione delle policy - PDP)**:
- Questo motore funge da punto di decisione della policy (PDP). Prende il contesto della richiesta di accesso dal PEP, insieme alle definizioni delle policy (in CEDAR) e agli attributi dal PIP, per prendere una decisione di accesso autorevole.
#### Applicazione e integrazione delle policy chiave
- **Polizze di sicurezza granulari**: Le policy definite in CEDAR impongono vari livelli di sicurezza, tra cui:
- **Protezione a livello di oggetto**: Controllo dell'accesso a interi DLO o DMO in base ai tag associati a questi oggetti.
- **Protezione a livello**: di campo Limitazione dell'accesso a campi sensibili specifici all'interno di un oggetto in base ai tag.
- **Protezione livello riga**: Filtrare i dati su oggetti specifici per visualizzare solo le righe pertinenti in base agli attributi utente.
- **Mascheramento dati dinamico**: È possibile mascherare in modo dinamico alcuni dati (in base ai tag) nel punto di accesso, senza alterare i dati sottostanti. Ciò garantisce che le informazioni sensibili siano protette pur consentendo un'ampia utilità. Questo vale per il mascheramento dei campi nei dati strutturati e dei contenuti nei dati non strutturati.
- **Coerente applicazione**: L'intero framework ABAC garantisce l'applicazione coerente delle policy in tutti gli schemi di consumo di Data 360, ad esempio tramite query dirette sui dati, recupero per applicazioni Generative AI (RAG) o arricchimento delle esperienze Salesforce CRM tramite gli elenchi correlati.
- **Profonda integrazione con Salesforce Platform**: Le funzionalità di governance di Data 360 vengono definite e amministrate direttamente nella piattaforma centrale Salesforce. Questa integrazione consente agli amministratori di gestire le policy di accesso, le identità degli utenti e la gestione degli attributi utilizzando strumenti Salesforce familiari, garantendo un livello di governance unificato e coerente in tutto l'ecosistema Salesforce.
Con la creazione di questo sofisticato framework ABAC con policy CEDAR, Data 360 offre agli architetti un livello di controllo e flessibilità senza pari, assicurando che i dati dei clienti non siano solo fruibili ma anche sicuri, conformi e affidabili in tutta l'azienda.
### Crittografia di Data 360: Porta la tua chiave
In tutti i settori, le organizzazioni stanno ponendo maggiore enfasi sulla sicurezza dei dati end-to-end per garantire la protezione da fughe di dati, accesso non autorizzato, manomissione o distruzione. La maggior parte delle piattaforme dati, incluso Data 360, fornisce la crittografia a riposo utilizzando una chiave di crittografia gestita dal fornitore. Tuttavia, le imprese (in particolare quelle dei settori regolamentati) richiedono sempre più capacità di crittografia gestite dai clienti sia per i dati a riposo che per quelli in transito.
Questo modello consente alle aziende di controllare le proprie chiavi di crittografia, assicurando che anche nell'eventualità altamente improbabile di una violazione a livello di piattaforma o di un accesso non autorizzato, i dati rimangano protetti crittograficamente. Senza la chiave proprietaria del cliente, nessuna entità (incluso il fornitore della piattaforma) può decrittografare o ricostruire i dati, mantenendo così la massima riservatezza e controllo.
### Archiviazione ed elaborazione di dati non strutturati
Data 360 supporta l'archiviazione e la gestione di dati strutturati (tabelle), semi-strutturati (JSON) e non strutturati in modo semplice nei meccanismi di inserimento, elaborazione, indicizzazione e query dei dati. Data 360 supporta diversi tipi di dati non strutturati oltre al testo, inclusi audio, video e immagini, ampliando l'ambito della gestione e dell'analisi dei dati. La figura sotto illustra i due lati della messa a terra (inserimento e recupero).
 Data 360 gestisce i dati non strutturati archiviandoli in colonne come testo o in file per serie di dati più grandi. Supporta la federazione dei dati per i contenuti non strutturati, che consente l'integrazione e la gestione dei dati provenienti da più fonti.
I dati vengono quindi preparati e suddivisi in blocchi, gli incorporamenti vengono generati ed elaborati per l'indicizzazione delle parole chiave e l'indicizzazione vettoriale. Data 360 ospita più modelli pronti all'uso e collegabili per la generazione di blocchi e incorporamento. Data 360 supporta la trascrizione automatica e configurabile di contenuti audio e video per l'elaborazione e l'indicizzazione successive. Il servizio di ricerca viene utilizzato per l'indicizzazione delle parole chiave. Per l'indicizzazione vettoriale, Data 360 supporta sia l'indicizzazione nativa (con Hyper) che database vettoriali come Milvus open source. Data 360 si integra anche con la piattaforma di ricerca Salesforce per supportare l'indicizzazione delle parole chiave sui dati non strutturati. Questa indicizzazione multimodale integrata in Data 360 consente la ricerca su tutti i dati non strutturati, come descritto nella sezione Ricerca aziendale agente più avanti nel documento.
Per il recupero, Data 360 fornisce API per la ricerca. La query unificata Hyper-based facilita le query complessive in indici strutturati, indici di parole chiave e vettoriali, mantenendo visibilità e autorizzazioni rigorose, ottimizzando così RAG e Ricerca.
#### Pipeline estensibili
La pipeline di indicizzazione dei dati non strutturati di Data 360 è progettata come un'architettura modulare e ampliabile che comprende cinque fasi centrali:
1. Analisi
2. Pre-elaborazione
3. Suddivisione
4. Post-elaborazione
5. Incorporamento
Tutte le fasi supportano anche l'elaborazione basata su LLM che consente ai clienti di creare prompt personalizzati. Sia la fase di pre-elaborazione che la fase di post-elaborazione possono includere più fasi sequenziali, consentendo la composizione flessibile di trasformazioni complesse. Ogni fase è interamente basata sui metadati, consentendo una configurazione e un'estensione senza interruzioni senza modifiche del codice.
Gli esempi di pre-elaborazione includono operazioni come l'eliminazione del rumore, la normalizzazione del linguaggio e la comprensione delle immagini (riconoscimento ottico dei caratteri e sottotitoli), mentre le fasi di post-elaborazione possono includere l'arricchimento dei metadati, il raggruppamento semantico o tecniche avanzate come la suddivisione in blocchi di Raptor.
La pipeline supporta completamente l'estensione Data 360 Code, consentendo ai clienti e ai team interni di inserire logica personalizzata in qualsiasi fase. I componenti dell'estensione codice sono funzioni Python leggere il cui ciclo di vita (esecuzione, scalabilità e gestione degli errori) è completamente gestito da Data 360. Questo approccio garantisce che l'innovazione e l'elaborazione specifica del dominio possano essere introdotte rapidamente mantenendo la coerenza operativa e la governance in tutta la piattaforma.
##### Indicizzazione contesto
Per impostare RAG con elaborazione non strutturata, due fattori critici sono fondamentali:
1. **Iterazione rapida**: Possibilità di convalidare rapidamente con query di test di esempio.
2. **Contenuto specifico**: Capacità di configurare contenuti su misura per il profilo consumatore.
L'indicizzazione del contesto è uno strumento intuitivo progettato per gestire entrambi questi aspetti. Questa interfaccia utente interattiva è basata su una pipeline in tempo reale che esegue tutte e cinque le fasi descritte in precedenza. La pipeline utilizza le GPU quando necessario per operazioni come la generazione di incorporamento e il riconoscimento ottico dei caratteri (OCR). Inoltre, consente ai clienti di testare rapidamente la pipeline RAG con un agente prima di distribuire la configurazione per un'elaborazione completa dei contenuti.
##### AI documento
L'intelligenza artificiale dei documenti di Data 360 consente di leggere e importare dati non strutturati o semi-strutturati da documenti come fatture, curriculum, rapporti di laboratorio e ordini di acquisto. Questa funzione supporta l'elaborazione interattiva ad hoc e l'elaborazione batch in blocco. Questa è una funzionalità chiave che consente l'automazione dei processi aziendali per i nostri clienti. Questo è basato sull'intelligenza artificiale che include LLM e modelli ML.
### Enterprise Knowledge
Le aziende possiedono grandi quantità di Knowledge sparse in diversi sistemi come wiki, condivisioni di file, sistemi di gestione dei contenuti, database interni e altro ancora. Questa frammentazione rende difficile per i dipendenti (soprattutto per gli agenti dell'assistenza e di vendita) e i clienti trovare le informazioni pertinenti in modo rapido ed efficiente. I problemi principali includono: Mancanza di un'unica esperienza di ricerca unificata in tutte le fonti Knowledge; presentazione e rendering incoerenti di contenuti provenienti da fonti diverse; mancanza di governance dell'accesso alle informazioni sensibili sparse nei sistemi; difficoltà a utilizzare fonti Knowledge autorevoli all'interno dei flussi di lavoro aziendali principali (ad esempio, allegare articoli pertinenti a un caso).
Enterprise Knowledge rappresenta il contenuto che è stato curato, manualmente o automaticamente, dalla più ampia serie di dati aziendali. La cura manuale prevede azioni deliberate, ad esempio la creazione di articoli Salesforce Knowledge o lo sviluppo di Knowledge all'interno di sistemi esterni che vengono quindi inseriti. Prevediamo una gestione automatizzata che utilizza processi, come gli agenti e le trasformazioni Salesforce, che eseguono i dati inseriti per generare livelli raffinati e curati, potenzialmente mescolando contenuti strutturati e non strutturati. Sia che vengano modificati manualmente o automaticamente, internamente a Salesforce o esternamente prima dell'inserimento, il risultato è un contenuto a valore aggiunto distinto dai dati non elaborati.
La soluzione Enterprise Knowledge Hub sfrutta le funzionalità di Data 360 per:
- **Inserimento e memorizzazione**: CRM Connector inserisce articoli di Salesforce Knowledge e i connettori non strutturati DCF (Data Connector Framework) inseriscono contenuti non elaborati e metadati da fonti esterne. Il contenuto viene inserito in oggetti data lake non strutturati (UDLO) specifici della fonte mappati al contenuto in SFDrive (o origine in caso di copia zero).
- **Armonizzazione e strutturazione**: Armonizzazione in corso di realizzazione elabora i dati UDLO e file, eseguendo operazioni di pulitura, normalizzazione, arricchimento (NLP, ecc.), mascheramento delle informazioni personali e trasformazione nel formato intermedio armonizzato, memorizzato in SF Drive e in un UDLO armonizzato (HUDLO) che vi viene mappato.
- **Indicizzazione**: Pipeline non strutturate (UDS) viene attivato sopra il contenuto armonizzato e gli indici di ricerca vengono configurati per ogni HUDMO.
- **Consumo**: Le applicazioni che consumano includono la ricerca, il recupero, il rendering e il collegamento a oggetti aziendali come Caso. Il coinvolgimento da parte delle applicazioni consumate viene raccolto per fornire analisi dell'utilizzo (ad esempio clic, recensioni, ecc.)
### Approfondimenti calcolati
Gli approfondimenti calcolati in Data 360 consentono ai clienti di definire e generare metriche aggregate dai loro dati. Queste metriche vengono quindi utilizzate per il coinvolgimento, l'analisi, la segmentazione e l'attivazione puntuali dei clienti. I dati aggregati calcolati dagli approfondimento calcolato vengono scritti in Lakehouse e rappresentati come oggetto approfondimento calcolato (CIO).
Esistono due tipi principali di approfondimenti calcolati:
- **Approfondimenti calcolati in batch**: Progettato per l'aggregazione di dati complessi a volume elevato, in cui le metriche possono essere calcolate periodicamente (ad esempio, quotidianamente o settimanalmente).
- **Approfondimenti streaming**: Offrire la possibilità di generare metriche e azioni dai dati degli eventi in tempo reale, abilitando il coinvolgimento immediato dei clienti a bassa latenza.
Gli approfondimenti calcolati sono definiti per gli oggetti modello di dati (DMO) e possono essere definiti anche per altri oggetti approfondimento calcolato. Il servizio di approfondimenti calcolati gestisce l'orchestrazione dei processi batch e streaming.
Sia i calcoli batch che quelli degli approfondimenti streaming utilizzano Spark. La differenza principale è che gli approfondimenti streaming utilizzano Spark Structured Streaming, mentre gli IC batch vengono eseguiti utilizzando processi Spark batch periodici e pianificati. Per ottimizzare i costi, il servizio Approfondimenti calcolati raggruppa gli IC da calcolare insieme nello stesso processo batch CI o streaming CI, in base a fattori come le dipendenze e la sovrapposizione degli oggetti dati di origine.
SNCE e CDF svolgono un ruolo significativo nel calcolo degli approfondimenti streaming.
### Risoluzione dell'identità
La risoluzione dell'identità è responsabile della trasformazione di dati diversi provenienti da più fonti in un unico profilo unificato completo.
È importante capire che un profilo unificato non è un "golden record" e che la risoluzione dell'identità non seleziona i valori vincenti né sostituisce i dati esistenti durante l'unificazione dei profili. I profili unificati fungono da serie di chiavi che sbloccano i dati di origine identificando tutti i record corrispondenti correlati alla stessa entità, all'interno di una sola fonte di dati o in più fonti. Con queste informazioni è possibile selezionare i dati del sistema di origine giusti da utilizzare per un determinato caso d'uso aziendale.
La risoluzione dell'identità può consolidare una varietà di tipi di record, tra cui Persone, Account e Famiglie. Può essere utilizzato anche per abbinare i lead agli account esistenti. Il processo di unificazione è essenziale per ottenere una visualizzazione Customer 360 completa e favorire il coinvolgimento personalizzato in tempo reale in scenari sia B2C che B2B.
La pipeline di risoluzione dell'identità è basata su un framework nativo del cloud altamente scalabile progettato per gestire volumi elevati di dati in modo continuo. Il processo prevede tre fasi chiave, affidandosi a un potente indice di ricerca per gestire il processo di corrispondenza:
- **Corrispondenza (selezione candidato)**: L'obiettivo del processo di corrispondenza è cercare i record che possono appartenere alla stessa entità. I record vengono analizzati in base a una serie di regole personalizzabili, ciascuna delle quali contiene una serie di criteri che definiscono i dati da soddisfare a quale livello di rigore. Per recuperare in modo efficiente le potenziali corrispondenze dall'archivio dati, il sistema genera indici per trovare i record corrispondenti probabili utilizzando due tecniche:
- **Chiavi di blocco**: Una chiave di blocco è un valore generato dai dati e dalle regole di corrispondenza di un record (ad esempio le prime lettere di un nome, un numero di telefono normalizzato, ecc.) per raggruppare record potenzialmente simili. Ogni record ha più chiavi di blocco che vengono indicizzate e memorizzate come indice invertito, garantendo che il sistema esegua confronti dettagliati solo su piccoli gruppi di record, anziché sull'intera serie di dati.
- **Hashing sensibile alla località (LSH)**: Per le regole di corrispondenza con corrispondenza "fuzzy", gli hash vengono generati in base agli incorporamenti di modelli addestrati.
- **Corrispondenza profonda**: Dopo che la fase di selezione del candidato ha creato gruppi più piccoli di potenziali corrispondenze, il sistema avvia un confronto più dettagliato. In questa fase, i modelli AI e gli algoritmi avanzati analizzano ogni coppia di record per calcolare un punteggio di corrispondenza probabilistico. Questo punteggio quantifica la probabilità che due record facciano riferimento alla stessa entità confrontando in modo intelligente i campi che spesso contengono errori di ortografia, variazioni o differenze di formattazione.
- **Clustering e unificazione**: Una volta identificati i record corrispondenti dai candidati, vengono raggruppati in un cluster. Questo processo include in modo critico la risoluzione delle corrispondenze transitive. Ad esempio, se il record A corrisponde al record B e il record B corrisponde al record C, tutti e tre sono collegati nello stesso cluster anche se A e C non sono mai stati confrontati direttamente. Questi cluster completi costituiscono la struttura di base del Profilo unificato. Questo processo di clustering garantisce che tutti i record di origine correlati siano collegati correttamente sotto un unico identificatore persistente.
- **Conciliazione**: I valori dei dati di tutti i record di origine raggruppati in cluster vengono valutati utilizzando regole di riconciliazione definite (ad esempio, _Più frequente_, _Più recente_ o _Priorità fonte_) che compilano il Profilo unificato risultante con un estratto dei dati del profilo. La riconciliazione non sovrascrive alcun dato esistente, poiché tutti i dati di origine sono disponibili utilizzando le chiavi collegate al profilo unificato.
#### Tipi di risoluzione dell'identità
L'architettura supporta la risoluzione di più tipi di entità per soddisfare una varietà di casi d'uso.
- **Corrispondenza individuale**: Si concentra sulla creazione dei profili Persona unificata, che collegano tutti gli identificativi personali noti (email, numeri di telefono, ID fedeltà, cookie) a una singola persona.
- **Corrispondenza account**: Si concentra sulla creazione dei profili Account unificato, che collegano i dati sugli account. Quando esegue la corrispondenza in base ai nomi delle società, il motore utilizza un modello finemente ottimizzato quando esegue la corrispondenza "fuzzy".
- **Corrispondenza famiglia**: Estende la logica di corrispondenza per aggregare i record Persona unificata in gruppi di persone correlate.
- **Corrispondenza tra entità**: Oltre all'unificazione, la risoluzione dell'identità crea anche link tra gli oggetti profilo utilizzando le stesse regole di corrispondenza. Ad esempio, un lead può essere collegato a un account utilizzando la corrispondenza "fuzzy" su Nome account.
#### Elaborazione quasi in tempo reale
Per garantire che il Profilo unificato sia sempre aggiornato, il motore di risoluzione dell'identità funziona con un'architettura quasi in tempo reale. Questa architettura ottimizzata per il cloud è progettata per l'elaborazione continua, con tempi di elaborazione rapidi. Mentre la velocità di elaborazione varia a seconda del modo in cui vengono ricevuti i dati di origine, piccoli batch di modifiche possono essere elaborati con la risoluzione dell'identità ogni 15 minuti.
#### Collegamento profilo di origine
Il sistema mantiene gli oggetti link identità che mappano ogni ID record di origine all'ID profilo unificato corrispondente. Questa struttura di dati di base consente al motore di tenere traccia in modo efficiente delle relazioni e di propagare rapidamente modifiche e aggiornamenti al Profilo unificato, assicurando che le esperienze dei clienti, ad esempio la personalizzazione del sito Web, i consigli Next Best Action e la segmentazione, sfruttino sempre i dati dei clienti più aggiornati disponibili.
### Segmentazione
La segmentazione è il processo fondamentale per trasformare i profili cliente unificati in pubblici fruibili. Questa funzionalità è fondamentale per offrire esperienze personalizzate nei canali di marketing, commercio e assistenza. La piattaforma di segmentazione di Salesforce Data 360 è progettata per le operazioni su larga scala. Gestisce metadati complessi, utilizzando un modello di dati che comprende migliaia di oggetti e relazioni. La piattaforma supporta regole complesse, filtri basati su aggregazione e classificazione basata su finestre, il tutto garantendo un calcolo rapido e affidabile su scala petabyte.
#### Tipi di segmentazione e cadenze
Data 360 supporta diversi tipi di segmento per soddisfare requisiti aziendali distinti per velocità, complessità e gerarchia:
1. **Segmento standard**: Tipo di segmento principale elaborato in batch. La pubblicazione avviene secondo una pianificazione personalizzabile, con una cadenza di pubblicazione standard da un minimo di 12 ore a 24 ore o una cadenza di pubblicazione rapida più rapida da 1 a 4 ore, ottimizzata per i dati di coinvolgimento recenti.
2. **Segmento in tempo reale**: Questo segmento viene completato on-demand in millisecondi per un'azione immediata in base agli eventi recenti e ai dati del profilo. È altamente ottimizzato per la personalizzazione immediata ma non può utilizzare criteri di esclusione o segmenti nidificati.
3. **Segmento cascata**: Struttura gerarchica di sottosegmenti utilizzata per assegnare la priorità a un cliente in un unico segmento di maggior valore se soddisface più criteri.
4. **Segmento nidificato**: Ciò consente di riutilizzare un segmento esistente come filtro per un nuovo segmento più specifico (perfezionamento di un segmento di base), ereditando la pianificazione del segmento controllante.
#### Motore di segmentazione: Nozioni di base sull'architettura
Il motore di segmentazione opera su un'architettura robusta e nativa del cloud che garantisce velocità, scalabilità e resilienza.
 Il processo centrale è gestito da un servizio di orchestrazione processi che controlla il ciclo di vita del segmento, generando la configurazione del processo necessaria e attivando l'esecuzione. Questo livello di orchestrazione mantiene lo stato e i metadati in un database shard per la scalabilità.
Benché Query Data 360 gestisca i calcoli del conteggio della segmentazione, il livello di calcolo Spark è responsabile del calcolo dell'effettiva appartenenza ai segmenti. L'applicazione Spark esegue query Spark SQL su dati completi dei clienti. Questi dati possono risiedere in Data 360 Lakehouse, in sistemi esterni tramite la federazione dei dati Copia zero o in una combinazione di entrambi.
Il sistema è altamente ottimizzato tramite la generazione di query intelligenti, che perfeziona la query Spark SQL sottostante. Ciò include tecniche come la potatura intelligente delle partizioni per ridurre al minimo la scansione dei dati e l'eliminazione delle sottoespressioni ridondanti. Per garantire l'affidabilità del servizio, l'architettura dispone di una gestione adattiva delle risorse che regola dinamicamente le risorse di calcolo in base alle dimensioni e alla complessità del carico di lavoro. Inoltre, l'osservanza degli SLO viene gestita in modo proattivo con durate adattive e logica di tentativo. Per un'esperienza utente rapida, i conteggi accelerati dei segmenti utilizzano un approccio basato sul campionamento per fornire stime rapide delle dimensioni durante la creazione del segmento, evitando un'esecuzione completa delle query.
Infine, viene mantenuta una profonda attenzione all'osservabilità e all'attribuzione delle cause principali attraverso metriche di esecuzione Spark complete e la classificazione automatica degli errori (ad esempio, problemi lato cliente e problemi di sistema), riducendo in modo significativo i tempi di diagnosi e garantendo una piattaforma dati altamente resiliente.
### Attivazione
L'attivazione è il passaggio finale fondamentale del ciclo di vita di Data 360. La sua funzione principale è trasformare i profili cliente statici, segmentati e unificati in dati fruibili e arricchiti e fornire questi dati a endpoint interni ed esterni (ad esempio, piattaforme Marketing Cloud, Commerce Cloud e Adtech). Questo processo è progettato per attivare customer journey personalizzati e interazioni quasi in tempo reale. Supporta funzionalità avanzate come gli attributi correlati, i filtri di appartenenza all'attivazione, i filtri del consenso, la limitazione e la classificazione.
L'attivazione offre tre metodi distinti per la consegna esterna e la conformità del canale:
- **Attivazione batch**: Progettato per operazioni pianificate a volume elevato, ad esempio campagne email su larga scala e aggiornamenti del pubblico pubblicitario. I dati vengono forniti eseguendo la gestione temporanea in bucket interni protetti (Cloud Object Storage) o tramite Trasferimento file protetto, seguito da un processo di inserimento API avviato dal sistema di destinazione. Le attivazioni batch possono utilizzare una modalità di aggiornamento speciale, incrementale, per ridurre i volumi inviati ed elaborati dai partner Salesforce.
- **Attivazione streaming**: Ottimizzato per i casi d'uso quasi in tempo reale che richiedono un'automazione basata sugli eventi. La consegna avviene tramite chiamate API dirette inviate all'endpoint di destinazione.
- **Flussi attivati da attivazione**: Questo canale altamente piattaforma offre un approccio senza codice/low-code per integrare i dati del pubblico con centinaia di piattaforme di coinvolgimento abilitate per l'API del cliente. Al termine dell'attivazione, Data 360 compila un DMO Pubblico che attiva un flusso su larga scala. Il motore di flusso successivamente consuma i dati del pubblico e utilizza funzionalità della piattaforma come Servizi esterni e destinazioni Mule Outbound per effettuare chiamate alla destinazione finale basata su API. Questo metodo riduce in modo significativo il tempo necessario per l'inserimento di nuove destinazioni attivazione.
L'attivazione utilizza gli stessi schemi della segmentazione per la gestione dei processi, l'esecuzione distribuita e il monitoraggio. Ciò include i principi del servizio di orchestrazione dei processi per la gestione del ciclo di vita e del livello di elaborazione (Spark) e si basa sulla telemetria dei processi per l'osservabilità delle prestazioni e l'osservanza degli obiettivi del livello di servizio (SLO).
Oltre a quelli, l'attivazione ha -
**Gestione destinazioni attivazione** supervisiona le connessioni, le credenziali e le configurazioni protette per tutti gli endpoint di destinazione. Garantisce che i formati dei dati e i protocolli di sicurezza siano standardizzati, garantendo una consegna in uscita affidabile a varie piattaforme, inclusi Marketing Cloud, partner Adtech e altre applicazioni esterne.
L'attivazione personalizza il payload per target specifici. Per Salesforce Marketing Cloud, sono inclusi i filtri sensibili alle unità operative (BU), il supporto multi-EID e i controlli dell'impollinazione incrociata.
**La governance delle** comunicazioni agisce da gatekeeper, garantendo che l'utilizzo dei dati e la comunicazione siano conformi alle preferenze dei clienti e ai requisiti legali. Il modello di consenso centralizzato unifica tutte le preferenze dei clienti, dal rifiuto esplicito globale al consenso specifico del canale e dello scopo, e vengono memorizzati nel profilo Persona unificata. Durante l'esecuzione, la piattaforma applica rigorosamente queste policy utilizzando i filtri di esclusione per rimuovere automaticamente le persone non consenzienti dal payload finale. Inoltre, il sistema applica regole di selezione del punto di contatto per garantire che utilizzi il punto di contatto unico, più conforme e preferito per il canale previsto prima che vengano trasmessi i dati. Questo meccanismo di applicazione è protetto dal framework di governance sottostante, che utilizza misure di protezione come il mascheramento dinamico dei dati e i controlli di accesso per proteggere i campi di dati sensibili durante tutto il processo di attivazione.
### Query unificata: Accesso senza interruzioni a tutti i dati dei clienti
Il vero valore di una piattaforma di dati unificata risiede nella sua capacità di fornire un accesso semplice e coerente a tutti i suoi asset di dati, indipendentemente dalla loro origine o struttura. La funzionalità Query unificata di Salesforce Data 360 è stata progettata appositamente per offrire questo risultato, astraendo le complessità sottostanti di archivi di dati diversi per fornire un'unica e potente interfaccia di query.
Il livello Query unificata offre un accesso sofisticato per diversi modelli di consumo:
- **Query strutturate e non strutturate ibride**: Fornisce un ampio supporto SQL per eseguire query senza problemi sia sui dati strutturati che sui metadati strutturati dei dati non strutturati. Ciò è ottimizzato dall'estendibilità dell'operatore tramite le funzioni di tabella, abilitando la ricerca specializzata in tipi di testo, immagine e spazio.
- **Prestazioni accelerate con Hyper**: Sfruttando Hyper, un motore in memoria ad alte prestazioni, Data 360 accelera query analitiche complesse e cruscotti digitali interattivi, offrendo risposte quasi istantanee su serie di dati di grandi dimensioni.
- **Approccio unificato per AI e personalizzazione**: Questo accesso unificato è fondamentale per generare risultati mirati e personalizzati, facilitando direttamente risposte LLM più precise utilizzando la generazione aumentata di recupero (RAG) basando i modelli AI su dati aziendali completi.
- **Integrazione con il consumo a valle**: Funge da livello di accesso ai dati di base per esperienze basate sull'interfaccia utente, API efficaci, flussi di lavoro di intelligenza artificiale generativi e arricchimento CRM, collegando facilmente i dati all'attivazione.
Fornendo un'unica interfaccia di query intelligente e altamente performante, la query unificata di Data 360 consente agli architetti di creare applicazioni agili basate sui dati che sfruttano al meglio la gamma completa di informazioni sui clienti.
### Azioni dati
Data 360 è una piattaforma attiva che supporta l'attivazione di opportunità in corso di realizzazione in risposta a eventi dati. Ad esempio, un evento significativo, ad esempio un calo del saldo account di un cliente, può attivare un flusso Salesforce per orchestrare un'azione corrispondente. Analogamente, gli aggiornamenti alle metriche chiave, ad esempio la spesa per tutta la vita, possono essere propagati automaticamente alle applicazioni pertinenti.
Le azioni dati monitorano continuamente i dati incrementali per le modifiche utilizzando gli eventi di modifica nativi (SNCE) e il feed di dati di modifica (CDF). Questi dati vengono valutati in base alle regole di azione configurate dal cliente, ad esempio il monitoraggio della soglia o le modifiche dello stato. Quando vengono soddisfatte queste regole, viene generato un evento azione dati. Questo evento viene arricchito con informazioni aggiuntive (ad esempio, lo stato fedeltà del cliente) e inviato immediatamente alla destinazione configurata, ad esempio Flusso Salesforce o un'applicazione esterna, per attivare le orchestrazioni aziendali.
#### Customer Data Platform
Data 360 supporta funzioni native CDP (Customer Data Platform), tra cui funzionalità avanzate di risoluzione dell'identità e la creazione di identificatori e profili persona unificati, oltre a cronologie complete del coinvolgimento. Questa piattaforma è in grado di gestire sia framework business-to-business (B2B) che business-to-consumer (B2C) supportando la risoluzione dell'identità e i grafici dell'identità che utilizzano regole di corrispondenza esatte e "fuzzy", come descritto sopra. Questi grafici dell'identità sono arricchiti con dati di coinvolgimento di vari canali, che consentono di creare grafici dettagliati dei profili con approfondimenti analitici e segmenti preziosi.
Un concetto chiave che supporta il profilo del cliente è il grafico dei dati. Data 360 offre un grafico dei dati aziendali in formato JSON, ovvero un oggetto denormalizzato derivato da varie tabelle Lakehouse e dalle relative interrelazioni. Questo include un grafico dei dati "Profilo" creato da CDP che include la cronologia degli acquisti e della navigazione di una persona, la cronologia dei casi, l'utilizzo dei prodotti e altri approfondimenti calcolati ed è ampliabile da clienti e partner. Questi Grafici dati sono personalizzati per applicazioni specifiche e migliorano la precisione dei prompt generativi AI fornendo il contesto pertinente del cliente o dell'utente. Il livello in tempo reale di Data 360 utilizza il grafico Profilo per la personalizzazione e la segmentazione in tempo reale. È prevista la modellazione del contesto Agentforce che includa conversazioni, sessioni e memoria agente come Grafici dati.
Inoltre, il CDP consente una segmentazione e un'attivazione efficaci in diverse piattaforme, ad esempio Marketing Cloud, Facebook e Google di Salesforce. Elabora i profili dei clienti in batch, quasi in tempo reale e in tempo reale, consentendo decisioni e personalizzazioni immediate. Questa funzionalità migliora le interazioni sia negli scenari B2C che B2B, assicurando che le aziende possano rispondere in modo rapido e preciso alle esigenze e ai comportamenti dei clienti.
### Livello in tempo reale
Il livello in tempo reale di Data 360 è supportato dal CDP di Data 360 e ne estende i concetti per i casi d'uso in tempo reale. Il livello in tempo reale di Data 360 è progettato per elaborare eventi come clickstream Web e mobili, visite, dati del carrello e pagamenti con latenze al millisecondo, migliorando la personalizzazione dell'esperienza dei clienti. Monitora continuamente il coinvolgimento dei clienti e aggiorna il profilo cliente da Customer 360 con dati, segmenti e calcoli di coinvolgimento in tempo reale per una personalizzazione immediata.
Ad esempio, quando un consumatore acquista un articolo su un sito Web di acquisto, il livello in tempo reale rileva e inserisce rapidamente questo evento, identifica il consumatore e arricchisce il suo profilo con informazioni aggiornate sulla spesa per tutta la vita. Ciò consente la personalizzazione della loro esperienza sul sito in pochi secondi. Inoltre, questo livello include funzionalità per l'attivazione e le risposte in tempo reale, abilitando azioni immediate basate sulle interazioni con i clienti.
 La piattaforma in tempo reale Sub-Second potenzia questa trasformazione attraverso diverse funzioni chiave:
1. **Grafici dati in tempo reale**: Un profilo Customer 360 viene creato utilizzando un grafico denormalizzato che include gli oggetti chiave e i campi più pertinenti ai marchi. Questi Grafici dati consentono l'elaborazione dei dati in tempo reale e offrono contenuti e approfondimenti di immediato valore pratico in pochi millisecondi
2. **Inserimento e trasformazione in tempo reale**: Inserire eventi e profili utente in millisecondi da fonti Web e mobili.
3. **Risoluzione dell'identità in tempo reale**: È possibile unire i profili dei clienti tra i vari dispositivi, unificando immediatamente gli utenti sconosciuti e noti.
4. **Approfondimenti calcolati in tempo reale**: Calcolare metriche come il valore di durata (LTV) o la cronologia delle visite degli utenti in millisecondi per abilitare Personalizzazione o Offerte per Web, ChatBot o agente dell'assistenza.
5. **Segmentazione in tempo reale**: Segmentare i pubblici al volo, personalizzando messaggi e interazioni in tempo reale.
6. **Azioni in tempo reale**: Consentire ai marchi di valutare ogni coinvolgimento degli utenti e di intraprendere azioni tramite il flusso Salesforce o altri canali di comunicazione pertinenti.
In Data 360, abbiamo creato una nuova piattaforma in tempo reale con opportunità in corso di realizzazione in tempo reale, memoria a bassa latenza e un livello di elaborazione dati inferiore al secondo. Poiché i dati interattivi veloci vengono inseriti dai canali Web e Mobile, vengono sottoposti a una serie di processi rapidi.
I nostri SDK Web e Mobile e le API in tempo reale raccolgono i dati dalle applicazioni Web/mobili (nelle future interazioni degli agenti) e li inviano al nostro server beacon. Questi dati vengono quindi instradati al livello in tempo reale per l'elaborazione in millisecondi e al livello Lakehouse per l'integrazione con i dati batch/streaming. Il livello Real-Time elabora i dati in entrata in tempo reale nel contesto di un profilo utente (anonimo o connesso), ad esempio aggiornando la spesa totale o il valore durata dell'utente, ecc. per la personalizzazione in tempo reale in sessione. Il livello in tempo reale è supportato dalla memoria principale e dalla memoria di archiviazione NVme (SSD) per l'archiviazione di dati in tempo reale e profili cliente. Una volta inseriti nel Livello in tempo reale, i dati vengono sottoposti ai seguenti processi prima di essere aggiornati nel Grafico dati in tempo reale:
- **Inserimento semplice e trasformazioni**: I dati vengono inseriti e trasformati per un'ulteriore elaborazione.
- **Risoluzione dell'identità**: Le regole di corrispondenza esatta vengono applicate per unificare i profili con tutti gli insiemi di regole di corrispondenza esistenti, in modo che gli specialisti data-aware non debbano creare nuovi insiemi di regole di risoluzione dell'identità appositamente per il tempo reale.
- **Approfondimenti calcolati**: Ogni coinvolgimento viene valutato, vengono eseguiti calcoli semplici come somma e conteggio in millisecondi e i dati vengono aggiornati nel grafico dei dati in tempo reale.
- **Segmenti in tempo reale**: Ogni dato di coinvolgimento viene valutato per determinare se soddisfa i criteri per i segmenti in tempo reale definiti e gli utenti vengono aggiunti ai segmenti qualificanti in millisecondi.
- **Azioni e trigger in tempo reale**: Ogni coinvolgimento viene valutato in base a regole definite per attivare azioni su una serie di target in tempo reale quando le regole vengono soddisfatte in millisecondi.
- **Grafico dati in tempo reale e API**: Il grafico dei dati in tempo reale, che include anche un'API in tempo reale, consente ai marchi di recuperare dati in formato JSON aggiornati per ogni utente, assicurando che tutte le interazioni con i clienti siano informate dai dati più aggiornati.
#### Personalizzazione
La personalizzazione consiste nel sapere a chi rivolgersi, quando e dove fornire contenuti e consigli pertinenti, cosa dire e quale frequenza. Personalization Services Platform è l'orchestratore delle decisioni prese per ottimizzare il raggiungimento degli obiettivi attraverso esperienze personalizzate.
I **Servizi di personalizzazione** offrono le seguenti funzionalità:
- Insieme coerente di modelli e modi per interpretare i dati di profili, attività e asset in Data 360
- Sperimentazione integrata piattaforma (A/B/n, Bandito multibraccio)
- Integrazione degli obiettivi in fase di progettazione (configurazione), tempo di addestramento ML e runtime (inferenza ML)
- Supporto dell'interazione in tempo reale e batch con scala B2C (utenti anonimi, esterno interattivo/in tempo reale a volume elevato, batch interno a volume elevato)
- Analytics guidata da Data 360
- Schemi per integrare il modello AI e il servizio di altre parti (interne ed esterne)
- Integrazione nell'ecosistema dei metadati Core (caratteristiche PLATE)
- Implementazioni OOTB di casi d'uso basati sull'intelligenza artificiale di alto valore (consigli/decisioni con vari algoritmi ML, inclusi banditi contestuali per la selezione di promozioni/contenuti, consigli sui prodotti, decisioni sui prezzi, ecc.)
 - **Decisione in corso** di realizzazione
- Gestione delle richieste esterne per le decisioni di personalizzazione, inclusi l'aumento dei profili, la sperimentazione e i consigli.
- **Motore di consigli**
- Servizio in fase di esecuzione di consigli basati su regole o ML.
- **Index Manager**
- Gestisce/orchestra il flusso di lavoro per i processi asincroni, inclusi i corsi di ML per i modelli di consiglio
- **Servizio oggetto processo**
- Responsabile della sincronizzazione dei metadati di personalizzazione tra core e off-core
- **Motore di attribuzione e sperimentazione**
- Attribuzione Analytics e sperimentazione dei consigli di personalizzazione
### Ricerca aziendale agentica
Data 360 è progettato come una piattaforma solida e completa specificamente per supportare le esperienze degli agenti emergenti. Queste funzionalità si ottengono utilizzando vari servizi Data 360 esistenti e grazie a una profonda integrazione con Agentforce.
 #### Sfruttare i principali punti di forza di Data 360
Il nostro approccio alla ricerca aziendale agentica si basa sui seguenti principi:
- I dati aziendali vengono conservati in servizi o punti vendita in silo, con autorizzazioni protette necessarie per l'accesso. La possibilità di accedere a questi dati ed elaborarli mantenendo le autorizzazioni di origine è fondamentale per garantire Trust.
- La classificazione incrociata e la pertinenza nell'intero corpus di dati consentono risultati migliori, che a loro volta possono fornire un contesto migliore per le esperienze degli agenti.
Per offrire queste esperienze, Agentic Enterprise Search si basa sui seguenti componenti architetturali chiave:
- **Connettori**: L'ampia gamma di connettori disponibili in Data 360 consente di accedere e inserire dati da un'ampia varietà di fonti.
- **Trattamento dati non**: strutturati Questo è fondamentale per la gestione dei contenuti non tabulari, consentendo al sistema di derivare significato e contesto da dati diversi.
- **Governance**: Garantire sicurezza, conformità e controlli di accesso di livello aziendale per tutti i dati consumati dalla ricerca. Il supporto per le autorizzazioni di visibilità sorgente garantisce che i dati siano accessibili solo agli utenti autorizzati, sia per le esperienze di ricerca semplice che per quelle degli agenti. Per garantire un recupero rapido, le autorizzazioni di protezione vengono valutate e applicate in modo nativo dai backend di ricerca nella prima fase dell'accesso ai dati.
- **Livello di recupero unificato**: Per affrontare la sfida dei dati in silo, i connettori vengono inseriti in un livello di recupero unificato completo. Questo livello fornisce un unico punto di accesso a tutti i dati, sia che rimangano in sistemi esterni a cui si accede tramite Ricerca federata o che vengano gestiti in modo nativo tramite indici avanzati per i dati a copia zero e inseriti.
- **Comprensione delle query intelligenti**: Prima del recupero, il sistema utilizza meccanismi basati sull'intelligenza artificiale per interpretare l'intento dell'utente. Oltre a incorporare rappresentazioni della query per la corrispondenza semantica vettoriale, può riscrivere ed espandere le ricerche basate su parole chiave per migliorare la precisione.
- **Ricerca ibrida e query avanzate**: Per trovare le informazioni più pertinenti, la piattaforma utilizza più strategie in parallelo. La ricerca ibrida offre una corrispondenza precisa delle parole chiave con la ricerca vettoriale semantica su blocchi di dati ottimizzati, mentre la ricerca record completo recupera contemporaneamente interi documenti. Entrambi sono combinati per garantire sia la pertinenza semantica che la copertura completa del contenuto.
- **Classifica gerarchica**: Dopo il recupero dei dati, un'architettura di classificazione gerarchica a più fasi calcola il punteggio, unisce e riclassifica i risultati di ogni fonte e metodo. Questo processo crea un unico elenco unificato che mette in evidenza le informazioni più pertinenti per l'utente o l'agente.
#### Applicazioni di ricerca agentica
L'intelligenza artificiale generativa sta spostando il consumatore principale della ricerca aziendale dagli utenti umani ai modelli di linguaggio di grandi dimensioni (LLM). Data 360 Search è progettato da zero per servire entrambi. È ottimizzato per gestire le query più lunghe e complesse degli agenti e restituire i risultati completi e contestuali necessari per il consumo a livello di programmazione e i loop di ragionamento. Allo stesso tempo, il sistema è in grado di gestire le query più brevi, spesso ambigue, tipiche degli utenti umani, fornendo funzioni come gli snippet e l'evidenziazione per una valutazione rapida in un'interfaccia utente.
L'offerta finale di esperienze di ricerca agenti combina entrambi gli approcci:
1. **Risultati della ricerca diretta**: l'applicazione può visualizzare un elenco tradizionale di risultati classificati utilizzando un'API basata sui metadati basata sulla ricerca unificata di Data 360.
2. **Risposte conversazionali agentiche** a più turni: le risposte agentiche vengono implementate tramite l'integrazione nativa con Agentforce. Questa esperienza di conversazione è guidata da un agente principale che orchestra le azioni e le query, delegando tutte le operazioni di recupero delle informazioni a un agente di ricerca interno specializzato.
Questo Search Agent specializzato è ottimizzato per il recupero delle informazioni aziendali. Utilizza un loop di ragionamento per formulare ed eseguire ricerche parallele per esplorare diversi aspetti della richiesta di un utente. Utilizza un potente insieme di strumenti, tra cui la ricerca unificata di Data 360 per tutti i tipi di dati e i linguaggi di query strutturati per recuperare dati precisi da tabelle ed entità.
Attraverso questa sintesi architettonica, Data 360 consente la creazione di esperienze di ricerca aziendale altamente intelligenti, sensibili al contesto e fruibili da parte degli agenti.
### Estensione di Data 360 con codice personalizzato
L'estensibilità è una funzione chiave della piattaforma Salesforce. Code Extension offre estendibilità in Data 360, consentendo agli utenti pro-code di eseguire logica Python personalizzata direttamente nell'ambiente Data 360, integrando le sue funzionalità dichiarative e low-code. Utilizzando l'estensione codice, gli utenti possono estendere in modo sicuro le funzionalità principali di Data 360 come le trasformazioni e le opportunità in corso di realizzazione di dati non strutturati (chunking personalizzato).
La progettazione di Code Extension dà priorità a flessibilità, sicurezza, efficienza e a un'esperienza utente semplificata. Supporta due modelli di esecuzione principali, ciascuno personalizzato per esigenze architettoniche specifiche:
- **Modello di script**:
- **Scopo**: Per una logica personalizzata completa che richiede un'interazione diretta con Data 360 Lakehouse.
- **Funzionalità**: I clienti scrivono script Python completi utilizzando Code Extension SDK, abilitando l'accesso in lettura e scrittura a Lakehouse tramite le API SDK. Ideale per la preparazione di dati personalizzati/complessi o per la manipolazione dei dati su misura.
- **Isolamento e sicurezza**: Mentre gli script accedono a Lakehouse, la loro esecuzione è confinata in un ambiente sicuro e isolato all'interno del runtime di Data 360, impedendo interferenze con altri processi o accessi non autorizzati al sistema.
- **Modello di funzione**:
- **Scopo**: Analogamente a una funzione serverless, per i calcoli modulari senza stato richiamati dalle pipeline Data 360 esistenti (ad esempio, la suddivisione personalizzata in una pipeline non strutturata).
- **Funzionalità**: Le funzioni fornite dal cliente accettano input, calcolano e restituiscono output.
- **Isolamento e sicurezza**: Queste funzioni sono progettate per un rigoroso isolamento; non hanno accesso diretto a Lakehouse. La loro esecuzione è in modalità Sandbox, stateless e con risorse limitate, il che li rende adatti a fasi di elaborazione mirate e stateless, garantendo sicurezza, esecuzione prevedibile e riducendo al minimo il raggio di esplosione.
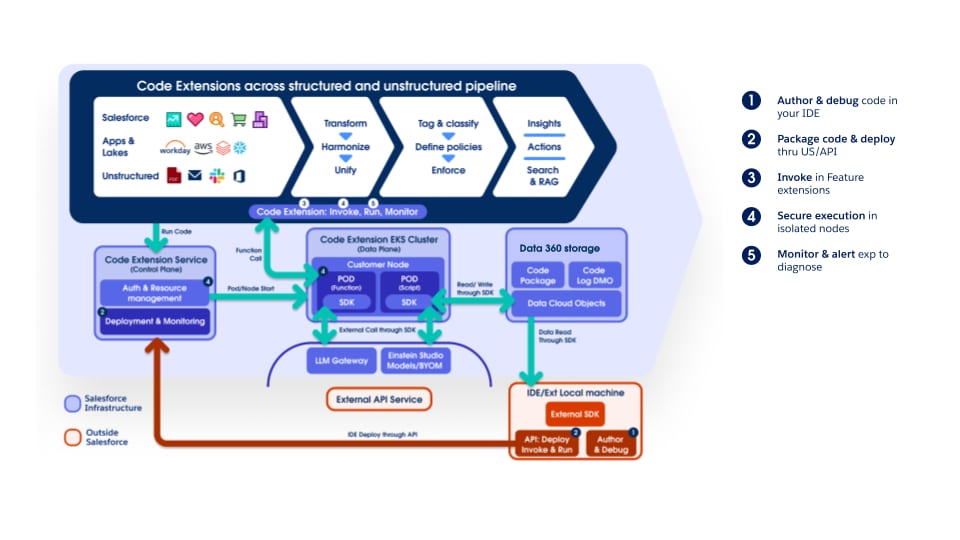 Sia il modello Script che il modello Function mirano a eseguire in modo sicuro il codice del cliente, evitando che il codice di un tenant influisca su altri o ottenga l'accesso non autorizzato ai dati di altri tenant, alle risorse Salesforce o alle risorse esterne. Questa sicurezza è ottenuta attraverso un'architettura a livelli (difesa in profondità). Questa architettura fornisce un ambiente di esecuzione isolato per il codice personalizzato di ogni tenant, incorporando vari guardrail. Questi includono l'isolamento logico a livello di Kubernetes (K8s), l'isolamento della rete, il Sandboxing in fase di esecuzione e le autorizzazioni con privilegi minimi, il tutto completato dal monitoraggio operativo e dalla preparazione alla risposta agli incidenti per il rilevamento e la risposta.
#### Esperienza degli sviluppatori e visibilità operativa
Per supportare un ciclo di vita di sviluppo efficiente, Code Extension offre:
- **Creazione esterna e debug**: Gli sviluppatori possono creare ed eseguire il debug del codice Python in ambienti familiari come VSCode, utilizzando l'SDK.
- **Distribuzione flessibile**: Il codice personalizzato può essere inserito in un pacchetto e distribuito utilizzando le utilità SDK, l'interfaccia utente di Data 360 o l'API, abilitando l'integrazione in CI/CD.
**Registri operativi**: L'accesso a registri esecuzioni dettagliati offre trasparenza e facilita la risoluzione dei problemi in produzione.
Offrendo queste funzionalità di estensione codice sicura e flessibile, Data 360 consente agli architetti di adattare la piattaforma ai loro requisiti di elaborazione dati più specifici e complessi, consolidando davvero il suo ruolo di tessuto di dati aziendale estendibile.
### Estensione di Data 360 con modelli AI personalizzati
Man mano che le aziende accelerano l'adozione dell'intelligenza artificiale, la maggior parte gestisce ecosistemi ML eterogenei, inclusi Amazon SageMaker, Google Vertex AI e ambienti Python personalizzati, che ospitano modelli che guidano previsioni mission-critical, come il calcolo del punteggio del rischio di credito, la propensione all'abbandono, i consigli sui prodotti e le decisioni Next Best Action.
Tradizionalmente, l'integrazione di questi modelli esterni in Salesforce richiedeva livelli API personalizzati, pipeline ETL o orchestrazione middleware, introducendo la duplicazione dei dati, l'overhead di governance, la latenza e la complessità operativa, sfide che contrastano con una visione CDP (Customer Data Platform) unificata, conforme e in tempo reale.
**Porta il tuo modello (BYOM)**: Fornito tramite Einstein Studio in Data 360, risolve queste sfide abilitando la chiamata diretta di modelli addestrati esternamente nei flussi di lavoro, nella logica Apex e negli strumenti di automazione di Salesforce, senza spostare o replicare i dati. Tramite la federazione copia zero, Data 360 funge da singola fonte di dati controllata, esponendo i dati Customer 360 armonizzati per l'inferenza in endpoint esterni. Gli output delle previsioni ritornano in tempo reale, potenziando i processi aziendali con un'intelligenza scalabile.
BYOM colma efficacemente il divario tra scienza dei dati ed esecuzione operativa separando lo sviluppo del modello, i dati governati e i livelli di consumo. Mantiene l'indipendenza della piattaforma, riduce la complessità dell'integrazione, accelera la distribuzione dell'intelligenza artificiale e mantiene la governance sui dati sensibili.
L'architettura funziona come segue: Data 360 fornisce una base di dati Customer 360 unificata, mentre Einstein Studio orchestra le connessioni alle piattaforme ML esterne (SageMaker, Vertex AI o endpoint personalizzati). I modelli esterni eseguono l'inferenza in tempo reale, in batch o in streaming. I livelli Salesforce (API Flusso, Apex e Query) utilizzano gli output per offrire approfondimenti personalizzati, automatizzati e analitici in Sales Cloud, Service Cloud, Marketing e Industry Cloud.
Dal punto di vista aziendale, BYOM offre:
- **Integrità e governance dei dati**: Elimina le copie dei dati non controllate e impone la conformità alle policy.
- **Democratizzazione: AI** Rende accessibili i modelli complessi agli utenti non tecnici tramite gli strumenti Salesforce.
- **Accelerazione time-to-value**: I modelli esterni si attivano immediatamente all'interno dei processi Salesforce.
- **Supporto della scalabilità e dell'architettura ibrida**: Abilita la distribuzione multi-cloud dei carichi di lavoro AI.
- **Architettura AI pronta per il futuro**: Supporta strategie di intelligenza artificiale componibili, separando i livelli di dati, modello e consumo per l'agilità operativa.
**Porta il tuo LLM (BYO-LLM)**: Offre lo stesso meccanismo di estensibilità ma per i modelli generativi. Abilitando la chiamata diretta di LLM esterni, consentiamo ai clienti di utilizzarli in Agentforce Platform al posto dei modelli forniti da Salesforce. Per le imprese BYO-LLM consente:
- Accesso ai modelli perfezionati
- Integrazione di modelli attualmente non forniti da Salesforce
- Utilizzo dei modelli negli account forniti dai clienti
### Collaborazione sui dati
Le aziende moderne operano all'interno di un panorama di dati complesso caratterizzato da due principali sfide architettoniche:
1. **Frammentazione intra-aziendale**: Le grandi organizzazioni utilizzano spesso più organizzazioni Salesforce (spesso segmentate per regione, unità operativa o acquisizione storica) e numerosi altri sistemi di dati. Questa frammentazione crea silos di dati interni, rendendo impossibile stabilire una visualizzazione unificata, affidabile e unificata del cliente per il coinvolgimento in tempo reale in tutta l'azienda. La sfida è unificare questi dati senza consolidarli fisicamente o duplicarli in tutti i sistemi, garantendo che la governance rimanga intatta.
2. **Collaborazione tra imprese**: Le aziende spesso hanno bisogno di condividere i dati con partner e fornitori per attività congiunte di marketing, misurazione e business intelligence. La sfida è abilitare questa collaborazione proteggendo i dati sensibili e proprietari e rispettando regolamenti sulla privacy come GDPR e CCPA, oltre alle barriere competitive.
Salesforce Data 360 affronta queste sfide con un framework Trust by Design a copia zero basato sul principio di condivisione dell'accesso e degli approfondimenti anziché spostare o duplicare i dati.
#### Meccanismi di collaborazione di Data 360
Salesforce Data 360 affronta le sfide legate alla frammentazione dei dati e alla collaborazione con Data Cloud One, la condivisione dei dati tra Data 360 e le Data Clean Room con priorità alla privacy. Queste soluzioni unificano i dati dei clienti, consentono lo scambio sicuro dei dati e offrono approfondimenti che salvaguardano la privacy. Con un approccio Trust by Design a copia zero, le organizzazioni possono sbloccare il potenziale dei dati per il coinvolgimento in tempo reale, partnership ottimizzate e processi decisionali intelligenti. Ciascuna di queste opzioni di collaborazione sui dati ha scopi diversi.
##### Abilitazione di Internal Enterprise con Data Cloud One
Data Cloud One è la soluzione architettonica di base per le aziende che gestiscono più organizzazioni Salesforce. Il suo scopo va oltre la semplice condivisione dei dati; è progettato per stabilire una visualizzazione cliente unica e affidabile e abilitare le funzionalità complete della piattaforma Data 360 in tutta l'organizzazione.
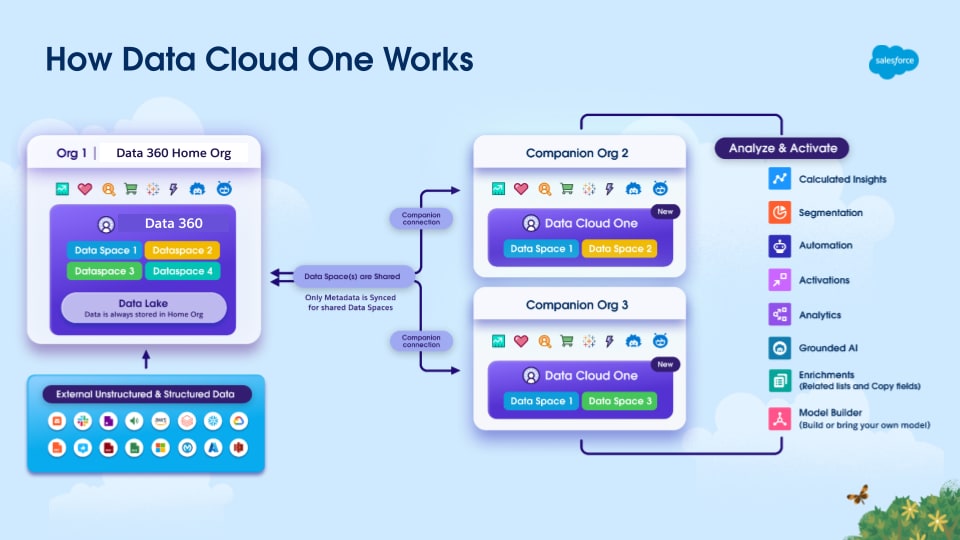 Questo meccanismo si basa su un'istanza designata di Home Org Data 360, che funge da autorità centrale per la gestione dei dati e la creazione del profilo cliente unificato. L'organizzazione iniziale è l'organizzazione di cui viene eseguito il provisioning di Data 360. Viene stabilita una connessione a Data Cloud One tra Data 360 e altre organizzazioni Salesforce, denominate organizzazioni partner. Come parte della connessione a Data Cloud One, Data 360 condivide uno o più dei suoi spazi dati con ogni organizzazione associata, fornendo l'accesso sia ai dati che ai metadati in ogni spazio dati condiviso. Questo viene ottenuto tramite un modello di federazione a copia zero e la sincronizzazione dei metadati tra organizzazioni.
Data Cloud One consente anche alle organizzazioni di supporto di sfruttare l'istanza Data 360 dell'organizzazione di residenza per le proprie esigenze di attivazione, personalizzazione e intelligenza. Questa strategia è essenziale per eliminare la frammentazione dei dati interni e garantire che tutte le unità operative si attivino in base allo stesso profilo cliente, governato e unificato, massimizzando il ROI dell'implementazione di Data 360 principale.
##### Condivisione dei dati tra organizzazioni Data 360
Per gli ambienti interni distribuiti (in cui la centralizzazione completa non è possibile) e per la collaborazione con partner esterni affidabili, la condivisione dei dati da Data 360 a Data 360 collega istanze di Data 360 indipendenti.
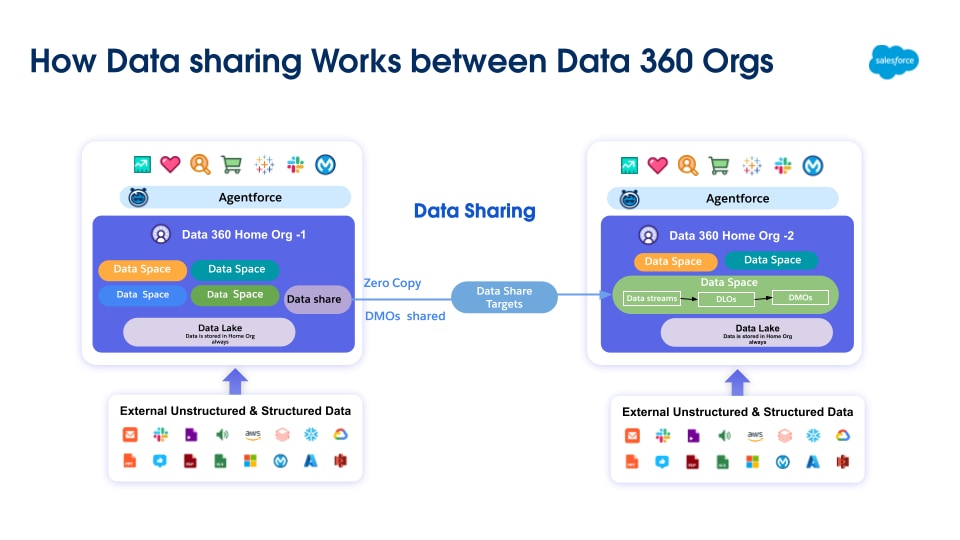 Questo modello di condivisione copia zero stabilisce una connessione tra tenant di Data 360 separati forniti in organizzazioni Salesforce diverse allo scopo di uno scambio sicuro di oggetti dati (DLO, DMO e CIO). Una volta connesso, l'intero oggetto dati diventa accessibile nel destinatario Data 360. L'amministratore di Data 360 del destinatario può quindi impostare regole di governance per gestire l'accesso degli utenti a questi dati.
##### Collaborazione Privacy-First con Data 360 Clean Room
Quando la collaborazione richiede i massimi livelli di privacy e conformità o quando le preoccupazioni della concorrenza impediscono la condivisione di dati non elaborati, le camere bianche di Data 360 sono architetturalmente obbligatorie.
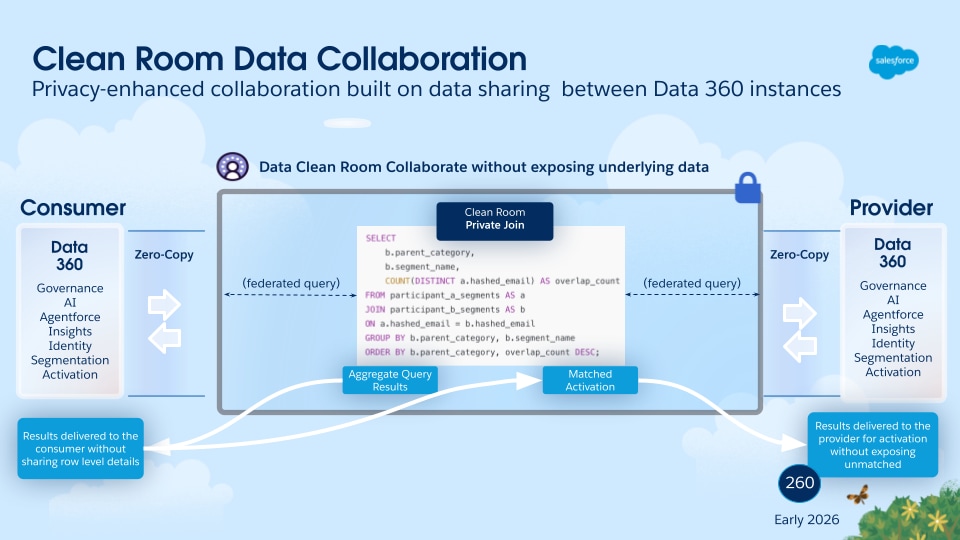 Dal punto di vista architettonico, Data 360 Clean Room Collaboration è basato sul framework di condivisione Zero-Copy utilizzato dalla condivisione dei dati da Data 360 a Data 360, ma con ulteriori livelli di governance e vincoli computazionali applicati. La Clean Room di Data 360 offre un ambiente di elaborazione sicuro e controllato in cui le parti possono unire le proprie serie di dati in base a chiavi anonime. Il suo scopo principale è consentire l'analisi congiunta e la generazione di approfondimenti senza esporre i dati proprietari sottostanti. L'ambiente applica regole rigorose e programmabili, ad esempio soglie minime di aggregazione e identificatori non esportabili. Queste regole garantiscono che solo gli approfondimenti approvati, che tutelano la privacy e aggregati vengano derivati e condivisi. Ciò rende le camere bianche essenziali per casi d'uso come la misurazione delle campagne multipiattaforma e l'analisi sensibile della sovrapposizione del pubblico.
## Conclusione: Salesforce Data 360: Backbone di dati indispensabile per l'azienda agente
Data 360 è progettato come un data fabric intelligente, ampliabile e affidabile necessario per potenziare l'intelligenza artificiale di prossima generazione. La sua progettazione architettonica affronta il problema della frammentazione dei dati, consentendo alle organizzazioni di unificare, elaborare e attivare tutti i dati dei clienti su larga scala, utilizzando Zero Copy Data Federation per garantire l'efficienza.
La sua organizzazione dei dati affidabile stabilisce una visualizzazione armonizzata dai DLO (inclusi i dati non strutturati) ai DMO, tutti protetti all'interno di spazi dati partizionati. Le versatili funzionalità di elaborazione dati di Data 360, tra cui trasformazioni batch e streaming, approfondimenti calcolati, elaborazione dati non strutturati e risoluzione dell'identità, si basano sull'architettura SNCE e CDF incrementale, garantendo un'elaborazione efficiente quasi in tempo reale e un significativo risparmio sui costi.
L'estendibilità è garantita dall'architettura Code Extension, che abilita in modo sicuro la logica Python personalizzata tramite script o funzioni isolate per esigenze specifiche. Inoltre, un framework di governance dei dati completo, basato sul controllo dell'accesso basato sugli attributi (ABAC) con policy CEDAR, garantisce una sicurezza granulare, un mascheramento dinamico dei dati e un'applicazione coerente in tutto il consumo di dati. Ciò si traduce in sofisticate funzionalità di segmentazione e attivazione, che traducono i profili cliente unificati in strategie di coinvolgimento dinamiche multicanale con reattività in tempo reale.
Fondamentalmente, la capacità di Data 360 di unificare dati vasti e diversificati, fornire contesto in tempo reale tramite la query unificata (inclusa la ricerca ibrida strutturata/non strutturata e l'accelerazione Hyper) e imporre una governance rigorosa è fondamentale per potenziare gli agenti di intelligenza artificiale intelligenti. Fornisce i dati affidabili, aggiornati e pertinenti necessari per mettere a terra i flussi di lavoro di intelligenza artificiale generativa (RAG) e per alimentare le funzionalità multi-turno orientate all'azione degli agenti basati su Agentforce, assicurando che funzionino con precisione e accuratezza.
Fornendo una piattaforma a prova di futuro in cui i dati di origine vengono trasformati in approfondimenti di immediato valore pratico, Data 360 funge da base architettonica indispensabile per le organizzazioni che creano esperienze cliente Agentic. È la spina dorsale fondamentale che trasforma i dati dei clienti in esperienze cliente sofisticate e personalizzate che guidano il successo delle organizzazioni moderne di oggi.
## Panoramica
Salesforce Data 360 trasforma il modo in cui le aziende connettono, armonizzano e attivano i dati dei clienti su larga scala. Il suo vero punto di forza, tuttavia, risiede nella sicurezza con cui i dati vengono gestiti durante il loro ciclo di vita. Questa architettura di riferimento per la sicurezza offre un modello pratico e completo per la protezione degli ambienti Data 360. Per impostazione predefinita, otteniamo questo risultato attraverso i principi fondamentali di privilegi minimi, progettazione zero Trust e governance.
Alla base di tutto, la sicurezza in Data 360 è un modello di responsabilità condiviso. Salesforce protegge l'infrastruttura, la rete, i servizi di crittografia, la piattaforma, la conformità e l'applicazione stessa in conformità a standard globali come ISO 27001, SOC 2 e Regolamento generale sulla protezione dei dati (GDPR). Gli amministratori Salesforce proteggono i dati dell'organizzazione all'interno della piattaforma definendo l'accesso, imponendo la privacy e gestendo le integrazioni. Ciò include l'implementazione di una gestione forte dell'identità e dell'accesso (IAM) che concede solo l'accesso necessario, l'imposizione dell'autenticazione a due fattori (2FA) e l'adesione al principio dei privilegi minimi e ai mandati aziendali e normativi.
Data 360 Governance collega questi livelli di responsabilità, garantendo che sicurezza e conformità rimangano allineate. Garantisce che i ruoli, le policy, le autorizzazioni e le regole di gestione dei dati siano definiti e continuamente applicati in tutto il processo, dall'inserimento all'attivazione. La discendenza dei dati, la classificazione dei metadati e la consapevolezza del consenso sono integrate in ogni oggetto e processo. Ciò trasforma la governance da una funzione di supervisione manuale a un piano di controllo operativo.
Salesforce offre una base resiliente e conforme in cui le aziende mantengono una completa autorità sul comportamento dei dati, sulle impostazioni della privacy e sui limiti dell'integrazione. Insieme, creano un tessuto di sicurezza e governance in cui ogni serie di dati, policy e azione dell'utente è tracciabile, coerente e ancorata al Trust.
La protezione in Data 360 va oltre i controlli statici. È incorporato in ogni fase del ciclo di vita dei dati. Dal momento in cui vengono inseriti, i dati vengono crittografati, convalidati e classificati nelle policy aziendali. Man mano che viene unificata e arricchita, la discendenza dei metadati e gli attributi di consenso vengono mantenuti per garantire la responsabilità. Quando vengono attivati approfondimenti per uso aziendale o AI, i flussi in uscita sono protetti attraverso canali crittografati, autenticazione e autorizzazione avanzate, governance attenta alle policy e applicazione del consenso, garantendo che i dati rimangano affidabili, conformi e sicuri dall'inserimento all'attivazione.
## Base di sicurezza di Data 360
### Basato su Hyperforce
Salesforce Data 360 è una piattaforma dati nativa per cloud creata interamente sull'architettura Hyperforce di Salesforce, che offre una base sicura, conforme e scalabile per le operazioni globali.
### Fondazione Secure-by-Design
- Hyperforce offre sicurezza e conformità come funzionalità incorporate, non come componenti aggiuntivi. Offre una serie di controlli di base comuni profondamente integrati nelle piattaforme e nelle applicazioni Salesforce, garantendo che ogni livello, dall'infrastruttura all'esperienza dell'app, sia progettato con sicurezza, privacy e conformità al centro.
- Data 360 eredita solidi controlli di accesso, crittografia e framework di conformità ai regolamenti direttamente dai controlli di base di Hyperforce.
- Questo modello predefinito riduce al minimo le vulnerabilità e semplifica l'erogazione di servizi dati affidabili e conformi.
### Architettura nativa del cloud
- Data 360 viene eseguito all'interno di un dominio funzionale dedicato ospitato in Hyperforce, una piattaforma cloud unificata che garantisce isolamento, prestazioni e sicurezza multi-tenant.
- Data 360 utilizza un'architettura di microservizi, con tutti i servizi in contenitore e orchestrati tramite Kubernetes.
- Applicando i principi di zero Trust, la mesh di servizio Istio gestisce una comunicazione interservizi sicura e offre la gestione del traffico, l'osservabilità e l'imposizione delle policy.
### Distribuzione scalabile e modulare
- I servizi di Data 360 vengono forniti e funzionano con il cloud privato virtuale gestito (VPC) di Salesforce, abilitando la separazione, il controllo efficiente e l'ottimizzazione della rete interna.
- L'architettura supporta la scalabilità orizzontale, garantendo che Data 360 possa gestire carichi di lavoro di elaborazione dati su scala petabyte.
### Integrazione ed estensibilità
- Data 360 espone API ben definite per l'integrazione con le applicazioni Salesforce CRM e altre fonti di dati.
- Supporta sia le organizzazioni first party (1P) che le organizzazioni Salesforce CRM basate su Hyperforce, garantendo un'ampia compatibilità tra gli ambienti.
- Data Cloud One consente ai clienti di connettere più organizzazioni Salesforce CRM con una singola istanza di Data 360.
### Modello di responsabilità condivisa
La protezione all'interno di Salesforce Data 360 opera in base a [un modello di responsabilità](https://compliance.salesforce.com/en/documents/a006e000010nW2FAAU) condiviso, un framework utilizzato anche dai principali provider di cloud come Amazon Web Services (AWS), Microsoft Azure e Google Cloud.
Questo modello definisce un confine chiaro: Salesforce è responsabile della sicurezza **del** cloud e i clienti sono responsabili della sicurezza **nel** cloud. Comprendere e rendere operativa questa distinzione è essenziale per mantenere un ecosistema di dati resiliente, conforme e sicuro.
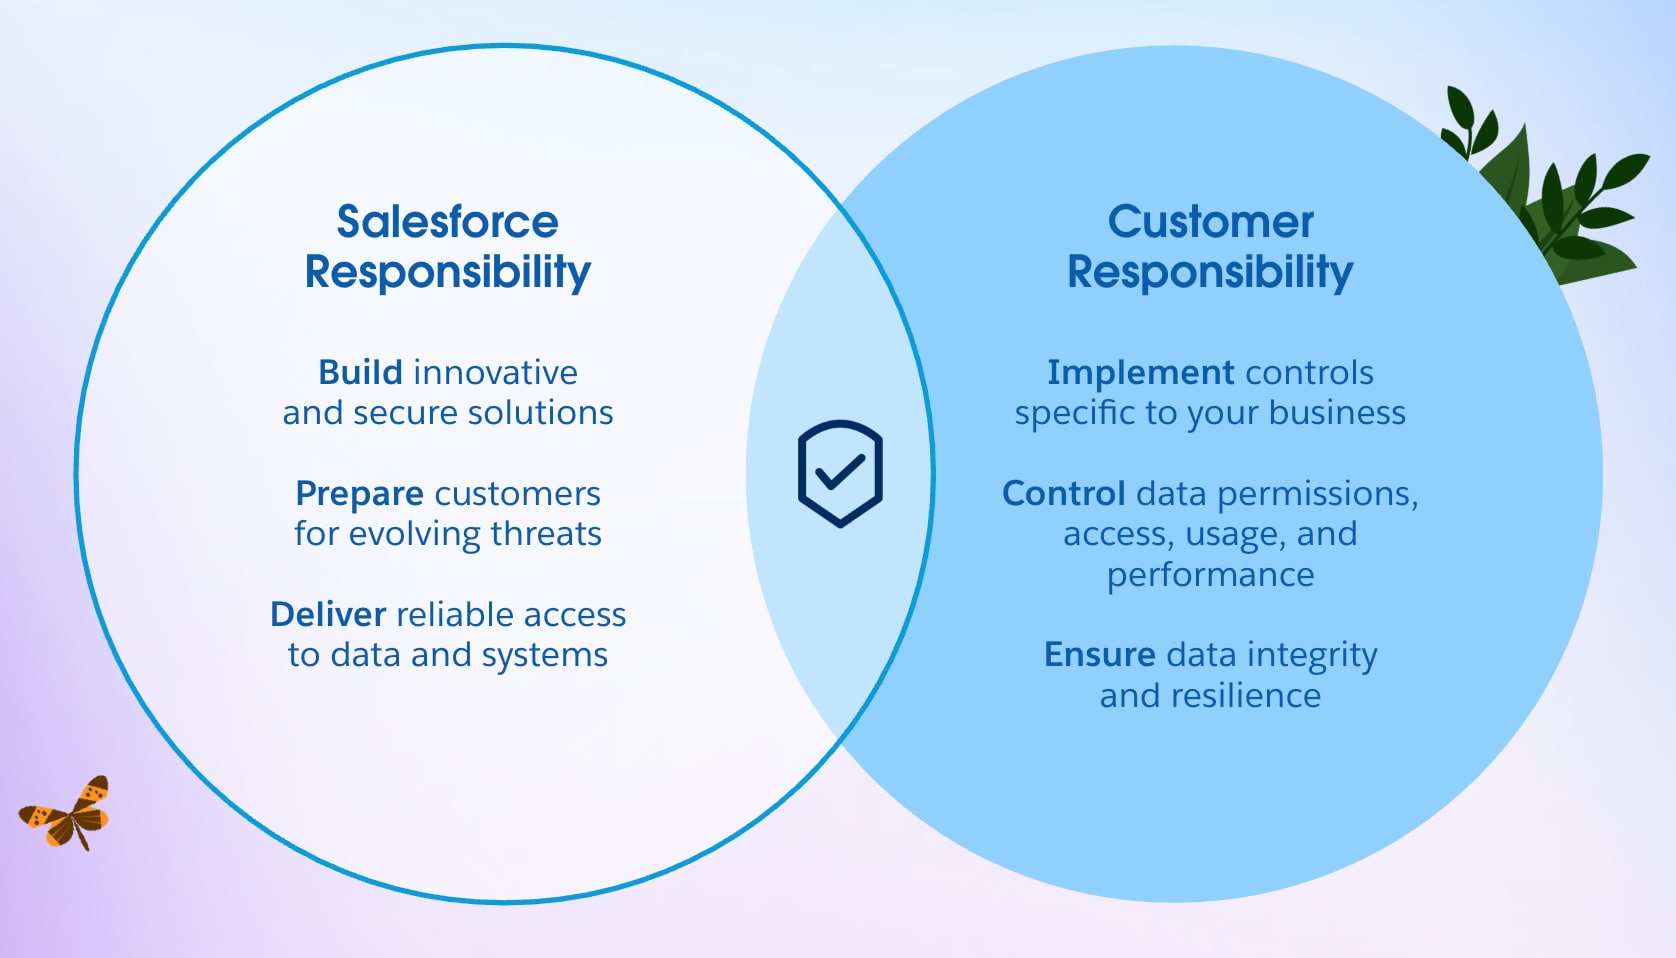 #### Salesforce: Sicurezza del cloud
Salesforce è responsabile della protezione e del mantenimento dell'integrità della piattaforma Data 360 e della relativa infrastruttura globale. Ciò include:
- **Sicurezza fisica e ambientale:** Hyperforce è ospitato nell'infrastruttura AWS e Amazon ha la responsabilità delegata della protezione dei propri data center globali attraverso controlli di accesso, sorveglianza e misure di salvaguardia ambientale.
- **Difesa della rete e del perimetro:** Mitigazione del Distributed Denial of Service (DDoS), rilevamento delle intrusioni e crittografia per tutto il traffico in transito (TLS 1.2 e versioni successive) e a riposo (AES-256).
- **Indurimento piattaforma e gestione patch:** Gestione continua delle vulnerabilità, distribuzione delle patch e protezione di base a livello di sistema operativo.
- **Conformità e certificazione:** Controlli continui rispetto a standard come SOC 1/2/3, ISO 27001, ISO 27017, ISO 27018 e preparazione per framework come GDPR.
Questi controlli assicurano che la piattaforma Data 360 rimanga sicura, affidabile e conforme, consentendo ai clienti di concentrarsi sulla logica aziendale e sulla gestione dei dati anziché sulla difesa dell'infrastruttura.
#### Cliente: Sicurezza nel cloud
I clienti sono responsabili della protezione dei dati, delle configurazioni e dei processi operativi all'interno delle loro organizzazioni Salesforce Data 360. Le principali aree di responsabilità includono:
- **Gestione dell'identità e dell'accesso (IAM):** Definire i ruoli, applicare l'autenticazione a più fattori (MFA) e il Single Sign-On (SSO) e applicare il principio dei privilegi minimi.
- **Governance dei dati:** Classificare i dati sensibili, applicare il mascheramento dove necessario e applicare controlli di accesso a livello di oggetto, campo e record.
- **Sicurezza dell'integrazione:** Gestire l'accesso API tramite OAuth 2.0, JSON Web Token JWT e altri standard di autenticazione utilizzando credenziali denominate e credenziali esterne.
- **Monitoraggio e risposta:** Utilizzare il monitoraggio degli eventi e gli itinerari di controllo e inoltrare i registri a un sistema SIEM (Security Information and Event Management) per il rilevamento avanzato delle minacce.
Salesforce fornisce le basi sicure, ma i clienti determinano il loro effettivo comportamento di sicurezza attraverso le loro configurazioni, controlli e vigilanza.
#### Responsabilità umano-centrica
La sicurezza non è solo un costrutto tecnico, è una disciplina organizzativa. La protezione dei dati in Salesforce Data 360 è garantita dalla collaborazione tra team di architettura, operativi e di governance.
**Le imprese dovrebbero:**
- Esaminare e ritirare continuamente gli account inutilizzati o con privilegi eccessivi.
- Automatizzare l'imposizione utilizzando le policy come pipeline di codice e CD/IC.
- Eseguire esercizi da tavolo che simulano incidenti come l'attivazione o l'esfiltrazione non autorizzata dei dati per migliorare la preparazione alla risposta.
L'efficacia di Data 360 non dipende solo dalle funzioni, ma anche dal modo in cui i clienti le rendono operative in modo responsabile.
#### Sicuro per impostazione predefinita: Una posizione di sicurezza proattiva
Salesforce Data 360 adotta una filosofia di sicurezza predefinita, che consiste nel passaggio dal controllo reattivo alla progettazione preventiva. Anziché iniziare ad aprirsi e stringersi in un secondo momento, ogni nuova organizzazione Data 360 inizia ora con lo stato "Nega tutto", applicando i principi zero Trust dalla prima distribuzione.
#### Dal controllo reattivo alla progettazione preventiva
Negli ambienti più datati, i clienti hanno ereditato un modello "Consenti tutto" per un orientamento più rapido. Anche se conveniente, questo creava il rischio di sovraesposizione accidentale e configurazione errata.
La nuova architettura secure-by-default inverte questo approccio:
- Nessun utente o sistema ha accesso implicito.
- Tutte le autorizzazioni devono essere esplicitamente concesse.
- I controlli di accesso ai dati, integrazione e governance vengono applicati a partire dal giorno 0.
Ciò impone privilegi minimi fin dalla progettazione, riducendo drasticamente il rischio di esposizione accidentale o di inoltro dei privilegi al livello superiore.
#### Impatto operativo e di governance
Questo modello ha implicazioni sia tecniche che comportamentali:
- I team devono pianificare deliberatamente i modelli di accesso, allineando le autorizzazioni alla conformità e ai confini aziendali.
- La governance diventa un requisito di progettazione incorporata, non un ripensamento.
- La proprietà e la responsabilità dei dati sono definite fin dall'inizio.
Per le organizzazioni Data 360 legacy che operano ancora in "Consenti tutto", gli amministratori devono restringere manualmente le configurazioni per allinearsi alla nuova base di riferimento, un passaggio fondamentale in qualsiasi modernizzazione della sicurezza o programma di maturità di Data 360.
#### Trust by Design
Per impostazione predefinita, l'accesso è zero e richiede definizioni esplicite delle policy, Salesforce Data 360 stabilisce Trust by Design, un'evoluzione fondamentale nella sicurezza dei dati aziendali.
Questo approccio garantisce che:
- L'accesso non autorizzato e i rischi di fuga di dati sono ridotti al minimo.
- I framework di governance vengono applicati in modo strutturale, non facoltativo.
- Le aziende acquisiscono un comportamento di sicurezza più prevedibile, controllabile e resiliente in tutti gli ambienti.
In sostanza, la sicurezza non è più una funzione che si aggiunge. È la base da cui si parte.
## Gestione delle identità e degli accessi: Gateway ai dati
IAM (Identity and Access Management) in **Salesforce Data 360** è il primo e più importante livello di difesa. Determina **chi** può accedere alla piattaforma e **quali** azioni possono eseguire una volta all'interno. Un framework IAM ben implementato è il controllo più efficace di cui un'azienda dispone per proteggere i dati dei propri clienti e garantire l'integrità operativa.
### Autenticazione: Verifica "Chi sei"
L'autenticazione stabilisce un **digital Trust,** confermando che ogni utente, servizio o sistema esterno che accede a Salesforce Data 360 è legittimo.
### Gestione federata delle identità
Data 360 supporta l'**autenticazione federata** con provider di identità (IdP) di livello aziendale come [**Microsoft Entra ID (Azure AD)**](https://learn.microsoft.com/en-us/entra/identity/saas-apps/salesforce-tutorial), [**Okta**](https://help.okta.com/en-us/content/topics/provisioning/salesforce/sfdc-provision.htm) o [**Ping Identity**](https://docs.pingidentity.com/configuration_guides/salesforce/config_saml_salesforce_pf.html) utilizzando [**SAML 2.0**](https://help.salesforce.com/s/articleView?id=xcloud.sso_saml.htm&type=5), OpenID Connect ([**OIDC**](https://help.salesforce.com/s/articleView?id=xcloud.sso_provider_openid_connect.htm&type=5)) o il sistema per la gestione dell'identità tra domini ([**SCIM**](https://help.salesforce.com/s/articleView?id=xcloud.identity_scim_overview.htm&type=5)).
Questa federazione estende il ciclo di vita dell'identità aziendale direttamente in Salesforce. Quando un dipendente entra, trasferisce o lascia l'azienda, il suo accesso si adegua automaticamente, riducendo gli account rimasti orfani e migliorando la preparazione alla conformità.
### Single Sign-On (SSO)
Con [**Single Sign-On (SSO)**](https://help.salesforce.com/s/articleView?id=xcloud.sso_about.htm&type=5), gli utenti eseguono l'autenticazione una volta sola utilizzando le credenziali aziendali e ottengono l'accesso sicuro alle applicazioni Salesforce senza password separate. Ciò riduce l'affaticamento delle credenziali e riduce al minimo i rischi di riutilizzo delle password o phishing.
### Accesso adattivo e condizionale
Il provider di identità (IdP) diventa l'autorità singola per le decisioni di autenticazione, imponendo l'autenticazione a più fattori (MFA), l'accesso condizionale e i controlli basati sul rischio. L'autenticazione si evolve da evento singolo a valutazione continua del Trust, reattiva al comportamento e al contesto degli utenti.
L'autenticazione federata fornisce:
- **Applicazione centralizzata delle policy:** Gli standard di autenticazione vengono gestiti in un'unica posizione in tutti gli ambienti Salesforce.
- **Tracciabilità end-to-end:** Gli itinerari di controllo unificati collegano ogni azione a un'identità verificata.
- **Esperienza umano-centrica:** Un processo di accesso sicuro e senza problemi consente ai team di concentrarsi sugli approfondimenti e non sulle credenziali.
### Autorizzazione: Definizione di "cosa si può fare"
Una volta verificato un utente, l'autorizzazione definisce gli elementi a cui può accedere, visualizzare o modificare. Definisce i confini operativi che proteggono i dati sensibili e impongono i privilegi minimi.
**Principio dei privilegi minimi (PoLP):** A ogni utente e sistema vengono concesse solo le autorizzazioni necessarie per la loro funzione lavorativa, niente di più. Questo principio limita notevolmente i danni potenziali dovuti a credenziali compromesse o configurazioni errate.
**Controllo dell'accesso basato sui ruoli (RBAC):** Salesforce Data 360 utilizza gli insiemi di autorizzazioni e i gruppi di insiemi di autorizzazioni per assegnare funzionalità granulari in linea con i ruoli aziendali. Ad esempio:
- Un ingegnere dei dati può gestire le opportunità di inserimento in corso di realizzazione e le trasformazioni con l'aiuto dell'insieme di autorizzazioni Data 360 Architect.
- Un analista marketing può eseguire query sui dati armonizzati ma non modificare i modelli con l'aiuto dell'insieme di autorizzazioni Gestore attivazione di Data 360.
- Un Responsabile attivazione può eseguire campagne in uscita ma non può accedere ai dati di origine con l'aiuto dell'insieme di autorizzazioni Responsabile attivazione di Data 360
L'accesso è gestito e controllabile a livello centrale, garantendo la responsabilità per tutto il ciclo di vita dei dati. Quando sono integrate con IdP come Entra ID, Okta o Ping Identity, le policy di accesso si estendono in modo semplice a tutta l'azienda tramite provisioning SCIM e federazione SAML/SSO.
### Informazioni sui ruoli e le autorizzazioni standard in Data 360
Salesforce fornisce insiemi di autorizzazioni predefiniti che contengono le procedure consigliate per la separazione dei compiti e la conformità agli standard di settore, ad esempio ISO 27001.
| Ruolo | Responsabilità principale | Principio di progettazione dell'accesso |
|---|---|---|
| Amministratore di sistema | Impostazione, provisioning e configurazione dell'ambiente | Nessun accesso alle serie di dati sottostanti: garantisce la separazione tra sistema e controllo dei dati |
| Architetto Data 360 | Inserimento, trasformazione, risoluzione dell'identità e modellazione dei dati | Impossibile eseguire l'attivazione dei dati per mantenere i limiti dell'esposizione ai dati |
| Gestore attivazione Data 360 | Creazione del segmento, gestione del canale e attivazione | Accesso in sola visualizzazione ai modelli di dati; nessun privilegio di modifica |
| Utente Data 360 | Consuma dati analitici e approfondimenti | Sola lettura; zero privilegi di modifica |
| Data 360 Un utente | Accesso tra organizzazioni tramite l'organizzazione compagna | Governato da autorizzazioni spazio condiviso e policy di accesso con ambito |
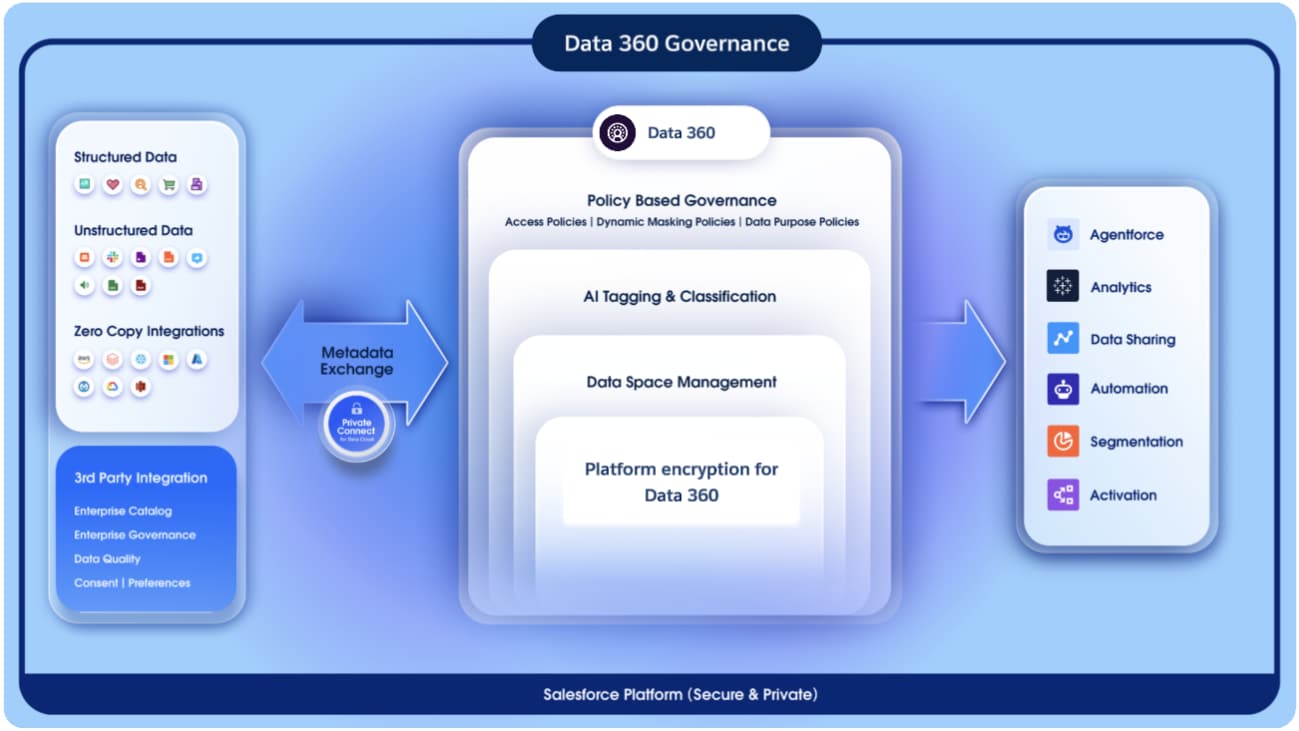 ### Governance come piano di controllo
Data 360 è strutturato attorno a un modello di governance first, che garantisce che ogni interazione con i dati, dall'inserimento all'attivazione degli approfondimenti, sia sensibile alle policy, controllabile e conforme. La governance funge da piano di controllo centrale, gestendo le modalità di rilevamento, classificazione e protezione dei dati in tutto il ciclo di vita.
Questo piano di controllo unificato garantisce che:
- L'**accesso dati è**: solo gli utenti giusti, con le policy giuste, possono agire sui dati giusti.
- La **governance è incorporata sia nel livello semantico che operativo**, garantendo la coerenza tra il modo in cui i dati vengono modellati e come vengono protetti.
- Vengono applicati i principi di **Zero Trust e Least Privilege**: dove identità, contesto e policy vengono valutati in tempo reale prima di concedere l'accesso.
Grazie a questa architettura, Salesforce Data 360 trasforma la governance da gestione delle autorizzazioni statiche in un livello di orchestrazione dinamico basato sulle policy. Una soluzione che si adatta continuamente al contesto, impone la conformità fin dalla progettazione e sostiene Trust su scala aziendale.
### Segregazione logica dei dati con gli spazi dati
A livello di macro, gli spazi dati offrono la separazione logica e l'isolamento dei domini di dati aziendali, consentendo alle organizzazioni con modelli operativi multimarca, multiregione o multi-tenant di gestire i dati all'interno di un'unica piattaforma unificata. Gli spazi dati possono essere allineati ai domini aziendali (ad esempio Vendite, Marketing o Customer Success) o ai confini normativi e geografici (ad esempio, UE, AMER o APAC), consentendo ai controlli di governance e accesso di rispecchiare la struttura operativa e di conformità dell'organizzazione senza frammentare la piattaforma dati sottostante.
- Ogni spazio dati funge da confine virtuale, definendo le raccolte di dati con cui un utente o un team può visualizzare o interagire.
- L'accesso all'interno di uno spazio dati viene concesso in modo esplicito, senza autorizzazioni implicite o contaminazione incrociata della visibilità dei dati.
- Ciò consente la proprietà federata: ogni unità operativa può governare il proprio dominio in modo indipendente, mantenendo la supervisione e la conformità centralizzate.
Per progettazione, gli spazi dati offrono il primo livello di governance, stabilendo chiarezza strutturale e responsabilità nelle serie di dati aziendali.
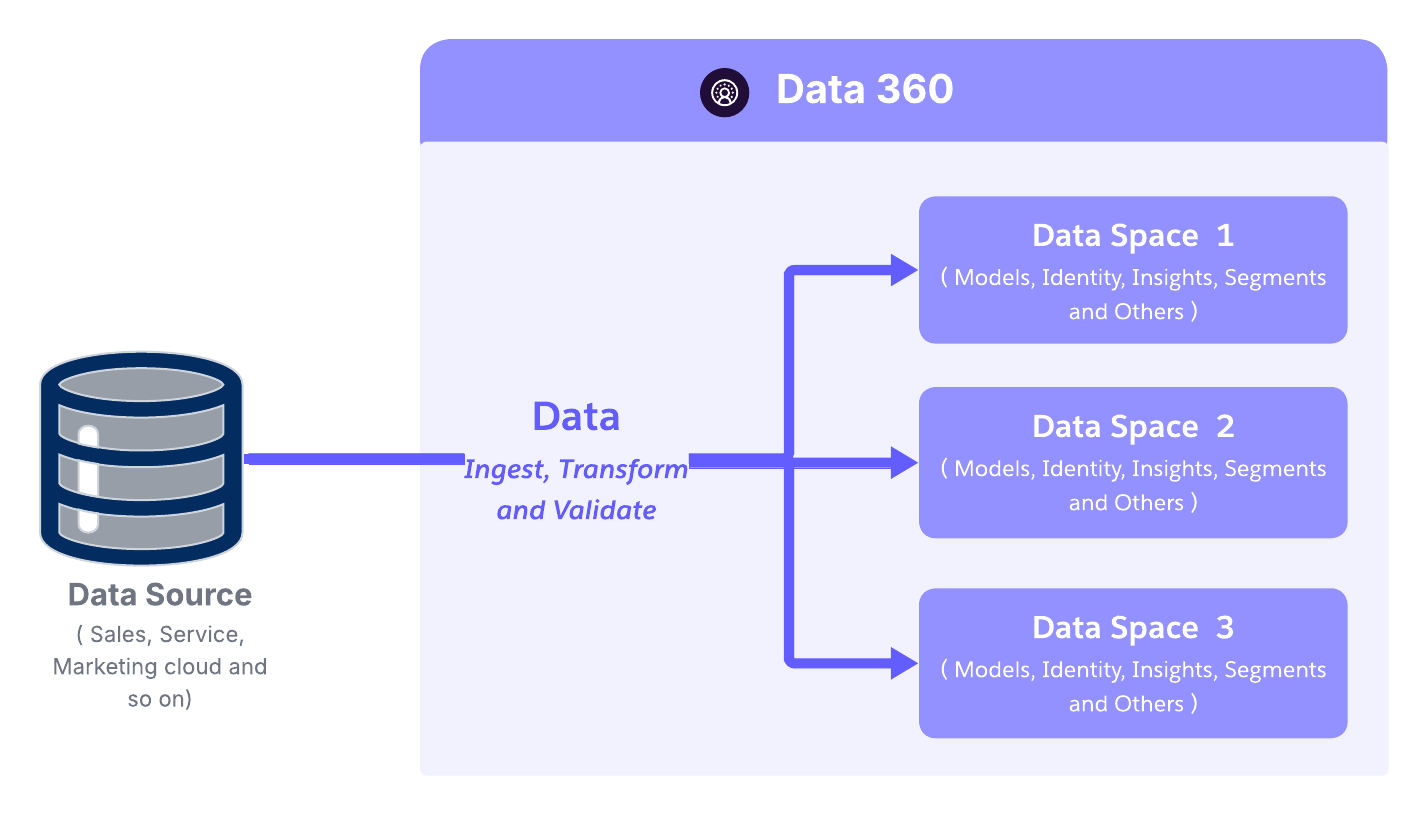 ### Da RBAC ad ABAC: Avanzamento verso l'autorizzazione contestuale
In Salesforce Data 360, RBAC e ABAC hanno scopi distinti ma complementari e vengono applicati a diversi livelli della piattaforma.
RBAC viene utilizzato principalmente per l'accesso alla piattaforma e alle funzionalità. Determina chi può accedere ai costrutti e alle funzioni di Data 360, ad esempio gli spazi dati, la creazione dei processi, le funzionalità amministrative e l'accesso agli strumenti. RBAC viene implementato tramite autorizzazioni e insiemi di autorizzazioni, ad esempio assegnando agli utenti l'accesso a uno spazio dati con funzioni specifiche abilitate.
ABAC viene utilizzato per l'imposizione dell'accesso ai dati. Le policy ABAC sono interamente responsabili della determinazione degli utenti che possono accedere a quali oggetti e attributi di dati, inclusi la protezione a livello di oggetto (OLS), l'accesso a livello di campo e i vincoli a livello di riga. Queste decisioni vengono prese dinamicamente valutando l'azione, gli attributi utente e gli attributi risorsa in fase di esecuzione.
In ABAC, le autorizzazioni rimangono parte del modello, ma è la policy stessa a determinare l'accesso, non solo il ruolo. Le policy valutano il contesto, ad esempio unità operativa, regione, riservatezza dei dati, scopo d'uso o vincoli normativi per consentire o negare l'accesso.
Ad esempio:
- RBAC consente a un utente di accedere a uno spazio dati Data 360 e alle funzioni di analisi.
- ABAC determina se lo stesso utente può leggere una serie di dati cliente specifica, quali righe può visualizzare e quali attributi sono mascherati o limitati.
Questa netta separazione consente a Data 360 di scalare in modo sicuro:
- RBAC offre un accesso controllato alle funzionalità della piattaforma e ai flussi di lavoro.
- ABAC offre un accesso ai dati preciso e basato sulle policy in linea con i requisiti di conformità, residenza e protezione dei dati.
Insieme, consentono la democratizzazione dei dati governata senza confondere le autorizzazioni piattaforma con la logica di autorizzazione dei dati.
In sostanza, RBAC impone l'accesso in base all'assegnazione delle autorizzazioni, mentre ABAC valuta le autorizzazioni nel contesto, combinando attributi di azione, utente e risorsa per offrire un controllo dell'accesso adattivo e preciso in Salesforce Data 360
### ABAC: Una gerarchia di sicurezza a più livelli
Il cuore del controllo degli accessi di Salesforce Data 360 è il controllo degli accessi basato sugli attributi (ABAC, basato sul linguaggio della policy CEDAR).
A differenza delle autorizzazioni statiche basate sui ruoli, ABAC valuta in modo dinamico _chi_ richiede l'accesso, a _cosa_ sta tentando di accedere e _a quali condizioni_, assicurando che ogni interazione con i dati sia in linea con le policy aziendali e i limiti Trust.
#### Valutazione dinamica delle policy
Il motore ABAC di Data 360 valuta le decisioni di accesso in base a una combinazione di tre tipi di attributi principali:
- **Attributi utente:** reparto, posizione, livello di autorizzazione
- **Attributi dati:** classificazione, riservatezza (PII, PHI, Dati finanziari), spazio dati
Questo modello flessibile basato sulle policy consente all'imposizione di adattarsi automaticamente all'evoluzione dei ruoli utente, delle classificazioni dei dati o delle condizioni operative, il che è essenziale per le grandi imprese distribuite e regolamentate.
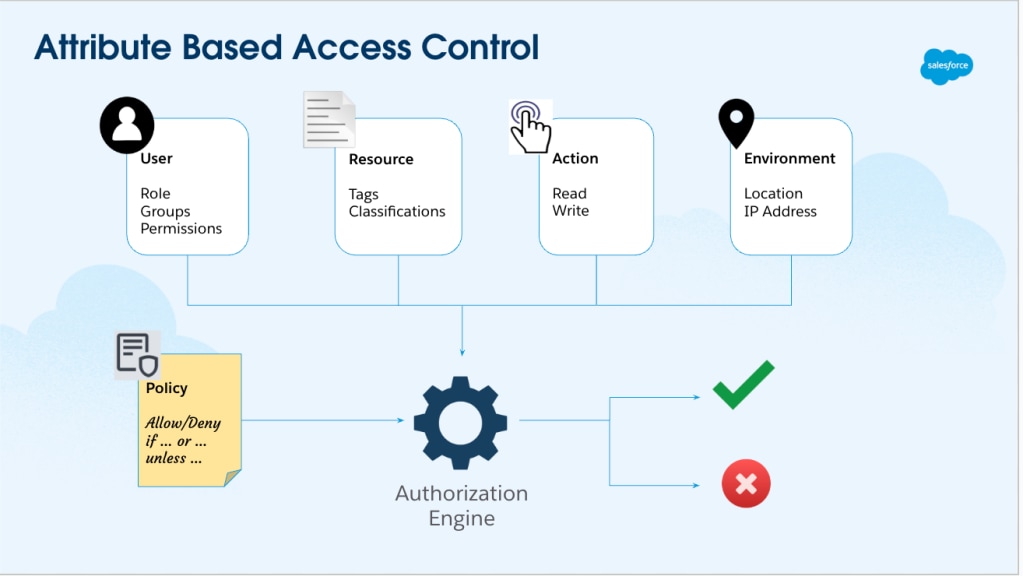 #### Componenti dell'architettura ABAC in Salesforce Data 360
Salesforce Data 360 implementa un'architettura Abac (Attribute-Based Access Control) basata su standard in linea con le procedure consigliate del settore per la governance dei dati basata sulle policy. È composto da tre componenti funzionali principali:
- **Punto di informazione sulle policy (PIP) - Policy, metadati arricchiti e classificazione:**
- Ospita le definizioni delle policy, incluse le policy di accesso, classificazione, mascheramento, conservazione e utilizzo dei dati aziendali.
- Gestisce metadati arricchiti come tag, classificazioni, contesto aziendale e discendenza end-to-end.
- Utilizza la classificazione basata su LLM e ML per assegnare automaticamente tag ai dati sensibili (ad esempio, PII.Email, PII.Phone, PHI).
- La propagazione dei tag garantisce che le classificazioni scorrano automaticamente lungo la discendenza dei dati (DLO → DLO → DMO).
- Mantenere la riservatezza e la conformità nelle trasformazioni.
- **Punto di decisione politica (PDP)**: Il PDP è il motore decisionale che interpreta le policy CEDAR.
- Inserisce input contestuali dal PEP (identità utente, metadati della richiesta) e attributi di riferimento dal PIP.
- Valuta le policy in modo deterministico per fornire decisioni di accesso coerenti, spiegabili e scalabili.
- Supporta valutazioni in tempo reale e batch, garantendo prestazioni e precisione anche in ambienti a volume elevato.
- **Punto di applicazione delle politiche (PEP)**: Il PEP è il luogo in cui le decisioni di autorizzazione vengono eseguite in fase di esecuzione.
- Intercetta le richieste di accesso ai dati in tutti i canali di interazione, ad esempio API, query dell'interfaccia utente, arricchimento CRM o pipeline GenAI Retrieval-Augmented Generation (RAG).
- Applica istantaneamente gli esiti PDP, assicurando che ogni query e recupero sia conforme alle policy di accesso aziendali.
Insieme, la triade PIP-PDP-PEP costituisce un tessuto di governance distribuito, che impone un controllo coerente basato sulle policy in tutti i servizi e le modalità di accesso di Data 360.
È importante notare che [ABAC](https://help.salesforce.com/s/articleView?id=data.c360_a_policy_based_governance_dg.htm&type=5) in Data 360 è configurato, non creato. Gli architetti non assemblano piani di controllo personalizzati o logica di applicazione. Compilano e connettono invece tre componenti architettonici nativi che operano insieme come tessuto di governance unificato.
A livello pratico, l'implementazione segue un semplice avanzamento: classificare i dati, definire le policy e consentire alla piattaforma di applicarle automaticamente. Una volta configurato, il controllo dell'accesso diventa un comportamento di sistema anziché un processo manuale o procedurale.
Questo tessuto di governance distribuito garantisce un'**applicazione coerente delle policy**, creando un confine Trust unificato in Data 360.
#### Applicazione di policy a più livelli
Il framework ABAC di Data 360 supporta i confini di accesso a livelli, garantendo che i dati siano protetti non solo a livello di oggetto, ma anche all'interno di campi e record specifici.
- **Protezione a livello di oggetto (OLS)**: Il confine più esterno del controllo degli accessi.
Gestisce l'accesso a intere strutture di dati, ad esempio oggetti data lake (DLO) o oggetti modello di dati (DMO).
Esempio: Concessione dell'accesso all'oggetto _Cliente_, ma non alle _transazioni_.
- **Protezione a livello di campo (FLS)**: Controlla l'accesso a campi specifici all'interno di un oggetto.
Esempio: Un utente marketing può visualizzare i nomi dei clienti ma non i numeri delle carte di credito o gli identificativi nazionali.
- **Record-Level Security (RLS)**: Il livello di controllo più granulare.
Determina quali singoli record all'interno di una serie di dati un utente può visualizzare o modificare.
Esempio: Un responsabile regionale può accedere solo ai dati dei clienti legati alla regione assegnata.
- **DDM (Dynamic Data Masking):** Abilita la protezione dei dati in tempo reale. A complemento di ABAC, il DDM impone l'oscuramento basato sulle policy delle informazioni sensibili senza alterare la serie di dati sottostante. In fase di query, DDM maschera automaticamente campi come informazioni personali o dati finanziari in base al ruolo utente, al contesto o alle regole di conformità.
- I dati sensibili rimangono protetti nelle visualizzazioni interfaccia utente, nelle API e nei flussi di lavoro AI.
- Riduce i rischi di fuga di dati garantendo un mascheramento coerente in tutti i livelli di consumo.
- Mantiene la possibilità di controllo. Ogni query mascherata viene registrata e tracciabile all'interno del framework di governance di Data 360.
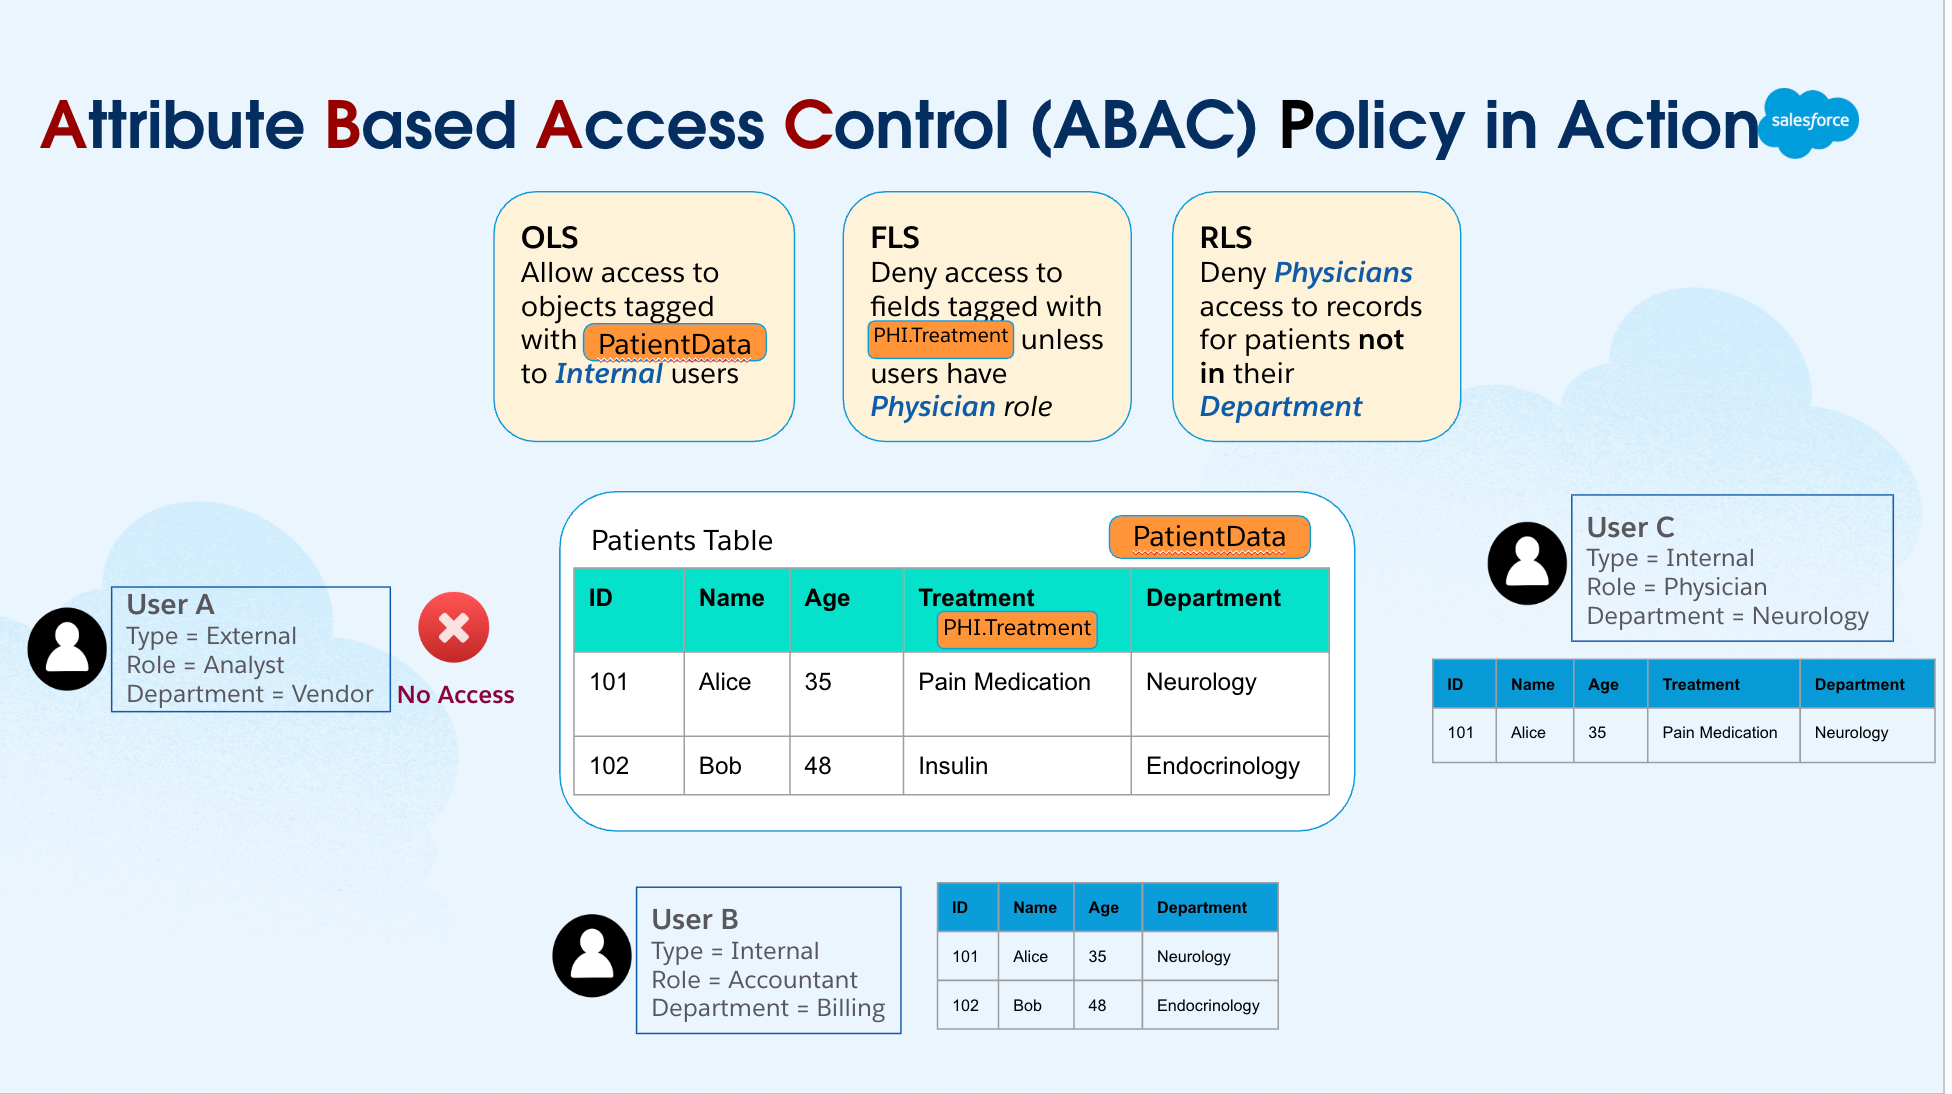 Questa architettura trasforma il controllo degli accessi da un modello di autorizzazione statico in un tessuto di policy dinamico e sensibile al contesto. Combinando la semplicità strutturata di RBAC con la profondità contestuale di ABAC, Salesforce Data 360 ottiene:
- Applicazione coerente delle policy in fase di inserimento, armonizzazione e attivazione.
- Governance adattiva che si evolve con i dati, i ruoli e le esigenze di conformità.
- Confini di Unified Trust per l'intero ciclo di vita dei dati, dall'inserimento all'attivazione dell'intelligenza artificiale.
#### Integrazione profonda con Salesforce Platform
Il modello di governance di Salesforce Data 360 è incorporato in modo nativo in Salesforce Platform, consentendo la sicurezza unificata, la conformità e il controllo dell'accesso sia ai dati operativi che analitici. Ereditando le funzionalità di base di Salesforce per la gestione delle identità e degli accessi, ad esempio la federazione delle identità, gli insiemi di autorizzazioni, la creazione centralizzata delle policy e la crittografia della piattaforma, Data 360 applica policy Trust coerenti nei cloud senza introdurre stack di governance paralleli. Anziché considerare l'isolamento, l'autorizzazione e la discendenza come preoccupazioni separate, la piattaforma li integra in un unico tessuto Trust attento all'esecuzione che copre l'intero ciclo di vita dei dati.
A livello strutturale, questo tessuto di governance è costituito da tre livelli complementari che operano di concerto:
- **Spazi dati**, che stabiliscono confini logici chiari per l'isolamento dei dati e la segmentazione normativa
- **Attribute-Based Access Control (ABAC)**, che consente decisioni di autorizzazione precise e sensibili al contesto in base agli attributi di identità, scopo e dati
- **Discendenza semantica**, che preserva il significato aziendale, la riservatezza e la tracciabilità man mano che i dati passano dall'inserimento all'approfondimento e all'attivazione
Insieme, creano un modello di governance in cui le decisioni di accesso sono spiegabili, l'applicazione è automatica e la conformità è continua anziché retroattiva. Il risultato è una piattaforma in cui la governance non è più un fattore limitante o un ripensamento. Diventa invece un livello abilitante, che consente agli architetti di progettare prodotti dati e flussi di lavoro basati sull'intelligenza artificiale con la certezza che Trust, privacy e requisiti normativi vengono applicati dal sistema stesso.
Questo approccio compositivo garantisce che i dati aziendali rimangano non solo utilizzabili, ma fruibili in modo responsabile, supportando approfondimenti, attivazione e automazione su larga scala senza compromettere la trasparenza, la sicurezza o il controllo.
## Protezione del ciclo di vita dei dati: Dall'inserimento all'attivazione
Nell'era delle aziende basate sull'intelligenza artificiale, la protezione dei dati non è un evento occasionale ma un processo continuo che protegge le informazioni dal momento in cui entrano nell'ecosistema fino a quando non vengono attivate per l'uso aziendale o AI.
Salesforce Data 360 incorpora controlli di sicurezza e governance in ogni fase del ciclo di vita dei dati, garantendo che integrità, riservatezza e Trust dei dati vengano preservati dall'inserimento all'attivazione degli approfondimenti.
### Fondamento della protezione: Crittografia a riposo e in transito
Il modello di protezione di Salesforce Data 360 si basa su Platform Encryption for Data 360, un framework di crittografia trasparente e ad alte prestazioni che protegge i dati sia a riposo che in transito, senza compromettere la fruibilità o la scalabilità.
#### Crittografia a riposo: Protezione livello di memoria
I dati conservati nel data lake di Data 360 vengono **crittografati automaticamente a livello** di memoria, assicurando che i dati rimangano illeggibili anche in caso di accesso fisico o non autorizzato. Le funzionalità principali includono:
- **Crittografia data lake trasparente:** Tutti i dati presenti nel data lake vengono crittografati a livello di memoria utilizzando le chiavi gestite dal cliente (CMK). Ciò garantisce che, anche in caso di accesso non autorizzato alla memoria fisica, i dati rimangano illeggibili e indecifrabili.
- **Chiavi gestite dal cliente (CMK):** I clienti mantengono il controllo completo sulle chiavi di crittografia, una funzionalità cruciale per i settori regolamentati come i servizi finanziari, l'assistenza sanitaria e il governo. CMK consente il controllo granulare, il controllo e la prova della sovranità dei dati, allineandosi direttamente ai mandati normativi come GDPR, HIPAA e ISO 27001.
- **Gestione esterna delle chiavi (EKM):** Con Gestione chiavi esterne, una funzione di Crittografia piattaforma per Data 360, i clienti saranno in grado di crittografare i dati in Data 360 utilizzando le chiavi memorizzate negli account AWS KMS dei clienti. Ciò offre ai clienti una maggiore flessibilità, pur mantenendo protetti e protetti i loro dati in Data 360.
- **Porta la tua chiave (BYOK):** Basandosi su CMK ed EKM, Data 360 consente ora ai clienti di caricare il proprio materiale della chiave direttamente in Salesforce per crittografare i dati a riposo e cercare gli indici. Questa ottimizzazione offre un ulteriore livello di protezione per le informazioni personali, i dati sensibili, riservati e proprietari, senza che i clienti debbano creare o gestire le chiavi in AWS KMS.
- **Rotazione delle chiavi e gestione del ciclo di vita:** La rotazione delle chiavi viene gestita con eleganza. I nuovi dati vengono crittografati con la nuova chiave, mentre i dati più vecchi rimangono crittografati con la chiave originale, evitando tempi di inattività o peggioramento delle prestazioni. Questo meccanismo di rotazione rafforza la conformità senza interruzioni operative.
#### Crittografia in transito: Protezione a livello di rete
Ogni dato trasmesso tra i servizi, le API e i connettori di Data 360 è protetto mediante TLS (Transport Layer Security) 1.2 o versione successiva, che offre una crittografia end-to-end in movimento.
Ciò garantisce che:
- I dati non possono essere intercettati o alterati durante il trasferimento.
- Le comunicazioni tra i servizi Salesforce, i connettori affidabili e gli endpoint dei clienti rimangono private e verificabili.
- La sicurezza si estende in modo coerente a opportunità di inserimento in corso di realizzazione, processi di armonizzazione, flussi di lavoro di attivazione e integrazioni API esterne.
Combinando la crittografia gestita dal cliente a riposo con la crittografia continua in transito, Salesforce Data 360 crea un'architettura di difesa che protegge i dati dei clienti sia da attacchi esterni che da minacce all'infrastruttura interna.
### Protezione dell'integrazione da sistema a sistema (Integrazione dati) in Data 360
Mentre i controlli di crittografia e accesso salvaguardano i dati all'interno di Salesforce Data 360, la protezione della circolazione dei dati tra i sistemi è altrettanto fondamentale. Le aziende moderne operano in ambienti multi-cloud e ibridi, dove i dati sensibili fluiscono tra Salesforce, piattaforme di analisi, API esterne e data lake.
Per risolvere questo problema, Salesforce ha progettato un framework di integrazione sicuro incentrato sulle credenziali denominate (NC) e sulle credenziali esterne (EC), offrendo una base basata su policy e allineata a zero Trust per una connettività sicura.
#### Framework di integrazione sicura di Salesforce
Salesforce ha progettato un solido **[framework di integrazione](https://developer.salesforce.com/docs/platform/named-credentials/guide/get-started.html)**, incentrato sulle credenziali denominate (NC) e sulle credenziali esterne (EC). Insieme, eliminano la complessità delle credenziali, impongono l'accesso con privilegi minimi e consentono una gestione dell'autenticazione coerente in tutte le integrazioni, senza esporre segreti nel codice o nella configurazione.
Questo framework astrae le complessità della sicurezza, applica le procedure consigliate e stabilisce un **piano di controllo** per tutte le connessioni esterne, in linea con i principi **Zero Trust** e **security by design** di Salesforce.
##### Credenziali denominate
Le credenziali denominate (NC) sono la chiave di volta dell'architettura di integrazione sicura di Salesforce. Forniscono un meccanismo dichiarativo centralizzato per definire gli endpoint esterni e i relativi parametri di autenticazione, eliminando la necessità di codificare credenziali sensibili come nomi utente, password o token in Apex Code o file di configurazione. Gli sviluppatori e gli amministratori fanno invece semplicemente riferimento a un alias di credenziale denominata (ad esempio SnowflakeConnector_NC) e Salesforce gestisce automaticamente l'autenticazione e la gestione delle connessioni sottostanti.
**Vantaggi architettonici e di sicurezza:**
- **Manutenzione semplificata:** Gli NC consolidano gli URL degli endpoint esterni e i parametri di autenticazione in un unico record gestito. Qualsiasi aggiornamento, ad esempio la modifica di un endpoint o la rotazione delle credenziali, richiede modifiche solo al record NC, evitando la ridistribuzione di codice o flussi tra gli ambienti.
- **Sicurezza avanzata:** Le credenziali sono archiviate in modo sicuro nell'archivio segreto crittografato di Salesforce, impedendo l'esposizione in archivi di codice, file di configurazione o registri. Il processo di autenticazione viene gestito automaticamente in fase di esecuzione, riducendo gli errori umani e il rischio di fughe.
**Conformità Adherence:** La separazione delle credenziali dalla logica aziendale semplifica la conformità a regolamenti sulla protezione dei dati come **GDPR, HIPAA e PCI DSS**. Gli auditor possono verificare facilmente che l'accesso ai dati esterni rispetti le policy di sicurezza e governance aziendali.
- **Ignora le impostazioni del sito remoto:** Gli NC eliminano il requisito legacy per le impostazioni dei siti remoti, semplificando la configurazione e la distribuzione, in particolare per le implementazioni aziendali su larga scala o multiambiente.
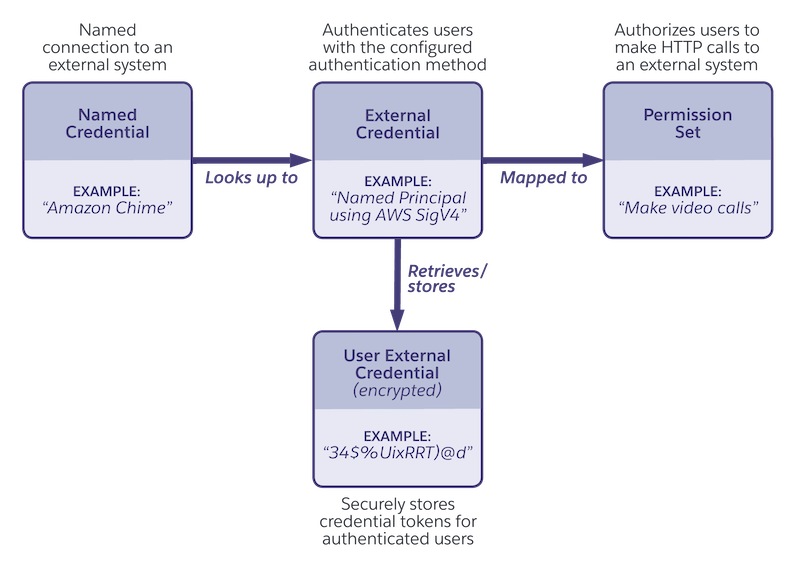 #### Credenziali esterne
Le credenziali esterne (EC) definiscono il protocollo e il flusso di autenticazione utilizzati da Salesforce per la connessione a un servizio esterno, rispondendo di fatto "come eseguire l'autenticazione". Una singola EC può essere riutilizzata in più NC che condividono lo stesso tipo di autenticazione, promuovendo il riutilizzo della configurazione e un'applicazione coerente della sicurezza.
**Protocolli di autenticazione supportati:**
- OAuth 2.0 (tutte le varianti supportate)
- JWT (JSON Web Token)
- Autenticazione di base
- AWS Signature v4
- Autenticazione personalizzata
- Nessuna autenticazione (per API aperte o endpoint pubblici)
Le credenziali esterne e le credenziali denominate sono progettate intorno a una chiara separazione dei doveri. Una credenziale esterna definisce le modalità di autenticazione, specificando il protocollo di autenticazione, il tipo di token e il comportamento di aggiornamento per la connessione ai sistemi esterni. Una credenziale denominata, invece, definisce dove connettersi, ovvero l'URL endpoint e quale credenziale esterna utilizzare per quella connessione. Questa progettazione garantisce che la logica di autenticazione e la configurazione dell'endpoint rimangano disaccoppiate, consentendo a Salesforce di supportare protocolli di integrazione diversi in modo sicuro mantenendo una gestione delle credenziali centralizzata e coerente in tutta l'azienda.
### Come i connettori Data 360 sfruttano questo framework
Mentre l'interfaccia utente di Data 360 astrae gran parte della configurazione sottostante, il framework Credenziale denominata e Credenziale esterna viene spesso utilizzato in background dai connettori e dagli stream di dati nativi. Ciò significa che, anche quando gli amministratori stanno semplicemente "aggiungendo una connessione dati" tramite un'interfaccia utente guidata, Data 360 continua ad applicare questo modello di sicurezza standardizzato in background.
Implicazioni architettoniche:
- **Modello di sicurezza unificato:** Tutti i connettori, sia quelli per un database esterno, AWS S3 o un'API aziendale, beneficiano degli stessi standard di crittografia, autenticazione e gestione delle chiavi imposti dalle credenziali denominate ed esterne.
- **Astrazione sviluppatore:** Gli sviluppatori e gli amministratori non devono gestire manualmente i flussi di autenticazione o la rotazione delle credenziali. Salesforce gestisce automaticamente il ciclo di vita, la scadenza e l'aggiornamento dei token.
- **Coerente applicazione delle policy:** Questo framework garantisce che tutti i connettori rispettino policy di autenticazione, controllo e registrazione coerenti, fondamentali per l'inserimento su larga scala di più fonti nei settori regolamentati.
- **Estendibilità a prova di futuro:** Man mano che Salesforce migliora lo stack di autenticazione (ad esempio per supportare nuovi flussi OAuth o standard FIDO2), questi miglioramenti si propagano automaticamente in tutti i connettori senza richiedere refactoring o ridistribuzioni.
### Protezione e governance del connettore Data 360
Salesforce Data 360 offre un'ampia suite di connettori pronti all'uso che semplificano l'integrazione dei dati da varie fonti. Ciò consente alle aziende di consolidare e utilizzare i propri dati in modo efficiente. Salesforce offre diversi tipi di connettori, inclusi connettori Salesforce nativi, connettori di archiviazione cloud, connettori di database e connettori API e di applicazioni. Oltre ai connettori offerti, sono supportati anche gli strumenti ETL zero. I connettori Salesforce consentono una perfetta integrazione tra i prodotti Salesforce, ad esempio Sales Cloud, Service Cloud e Marketing Cloud, con Data 360. Inoltre, viene offerta una gamma di connettori per i provider di cloud storage, tra cui Amazon S3, Google Cloud Storage e Azure Data Lake. I connettori predefiniti per database come Snowflake, Redshift e BigQuery consentono alle aziende di collegare i data warehouse esistenti a Data 360. Inoltre, Data 360 fornisce connettori per varie applicazioni e API di terze parti, ad esempio annunci Google, annunci Facebook e altre piattaforme di marketing. Per ottimizzare la flessibilità, Data 360 si integra con strumenti ETL come MuleSoft e Informatica.
 #### Connettori Data Security e Salesforce Data 360
La sicurezza dei dati archiviati in Salesforce Data 360 è stata al centro di molte conversazioni correlate a Data 360. Nell'ambito dell'impegno di Salesforce per un approccio di sicurezza improntato alla difesa, viene data pari importanza alla protezione delle modalità di inserimento dei dati nell'ambiente Data 360.
Salesforce riconosce che le aziende operano in ecosistemi di dati diversi, che spesso si estendono su più piattaforme cloud, soluzioni di archiviazione e strumenti di analisi. I connettori Data 360 fungono da ponte tra questi ambienti. Il connettore consente un'integrazione dei dati sicura, scalabile ed efficiente mantenendo gli elevati standard di sicurezza di Salesforce. Questi connettori facilitano un flusso di dati senza interruzioni senza compromettere l'integrità o la privacy.
I tre componenti essenziali della protezione del connettore Data 360 sono:
- **Mappatura di autenticazione/autorizzazione**: La gestione sicura degli accessi è fondamentale per la sicurezza dei dati. Diversi connettori cloud utilizzano meccanismi di autenticazione e autorizzazione diversi per convalidare e controllare l'accesso degli utenti. L'autenticazione garantisce che gli utenti o i sistemi siano entità legittime, mentre l'autorizzazione definisce il livello di accesso concesso. Salesforce garantisce che, ove possibile, i connettori utilizzino gli standard del settore.
- **Interoperabilità della funzione Copia zero (ZETL)**: La duplicazione dei dati presenta problemi di sicurezza e operativi. Ciò comporta anche costi di memoria inutili, incoerenze dei dati e una maggiore esposizione al rischio. L'approccio Zero Extract, Transform and Load (ZETL) di Salesforce garantisce che la condivisione dei dati in tempo reale tra le piattaforme possa avvenire senza richiedere la replica fisica dei dati. Ciò significa che i dati possono rimanere nel loro ambiente originale pur essendo accessibili per l'elaborazione, la generazione di rapporti e l'analisi. Inoltre, questo riduce in modo significativo la superficie di attacco e migliora la potenziale conformità alle leggi sulla residenza dei dati.
- **Supporto della federazione dei dati**: Negli ambienti multi-cloud odierni, le organizzazioni necessitano di un accesso completo ai dati senza inutili spostamenti dei dati. Il modello di dati federato del connettore Data 360 supporta sia la federazione dei dati basata su file che quella basata su query, consentendo alle aziende di sfruttare le fonti di dati esterne in tempo reale. Sia che si acceda a database strutturati, registri semi-strutturati o file non strutturati, i connettori Salesforce assicurano che i dati rimangano protetti per tutto il ciclo di vita.
Salesforce mira a fornire ai propri clienti la trasparenza necessaria per affrontare le complessità della sicurezza e della conformità dei dati, anche con le integrazioni. Sia che si integrino con AWS S3, Google Cloud Storage, Snowflake o altre piattaforme, i nostri connettori Data 360 sono progettati per garantire Trust, trasparenza e controllo sui dati aziendali critici.
##### Mappatura di sicurezza e autenticazione del connettore Salesforce Data 360
| Tipo di connettore | Supporto del tipo di connessione | Tipi di autenticazione principali | Aspetti e note chiave sulla sicurezza |
|---|---|---|---|
| Salesforce CRM | N/D (interno) | Basato su sessioni (interno) | Utilizza il solido modello IAM (Internal Identity & Access Management) di Salesforce. Tutti i dati vengono crittografati in transito e a riposo nell'infrastruttura Salesforce. |
| Coinvolgimento in Marketing Cloud | Solo Internet pubblico | OAuth 2.0, nome utente/password | Per l'autenticazione sicura vengono utilizzati protocolli OAuth 2.0 standard. I dati vengono crittografati in transito (TLS) su Internet pubblico. |
| B2C Commerce | Solo Internet pubblico | OAuth 2.0 | OAuth 2.0 standard. Si basa su protocolli Internet pubblici protetti (TLS) per il trasferimento dei dati. |
| App Web e mobile | Solo Internet pubblico | Chiavi API, OAuth 2.0 | Dati inseriti tramite API (API di inserimento, Streaming API). Sicurezza gestita tramite la gestione delle chiavi API e i protocolli Web standard. |
| Amazon S3 | Private Connect & Public (Connessione privata e pubblica) | Ruoli IAM, credenziali esterne | Supporta AWS PrivateLink per una connessione privata protetta. La connessione pubblica utilizza credenziali protette. I dati vengono crittografati in transito e a riposo (le chiavi gestite dal cliente in S3 sono facoltative). |
| Snowflake | Private Connect & Public (Connessione privata e pubblica) | OAuth 2.0, Autenticazione chiave privata, Nome utente/password | Supporta la connessione privata VPC (AWS PrivateLink). Connessione pubblica disponibile con metodi di autenticazione sicuri. I dati possono essere crittografati con le chiavi del cliente in Snowflake. |
| Amazon Redshift | Private Connect & Public (Connessione privata e pubblica) | Nome utente/password, autenticazione IAM | Supporta la connessione privata (AWS PrivateLink). La connessione pubblica utilizza le procedure consigliate di sicurezza standard. |
| Microsoft Azure (Memoria/SQL) | Solo Internet pubblico | Token SAS, OAuth 2.0, Nome utente/Password | Le connessioni si basano su token SAS o OAuth protetti per l'autenticazione. I dati attraversano Internet pubblico tramite canali crittografati (TLS). |
| Google Cloud Storage (GCS) | Solo Internet pubblico | OAuth 2.0, Account di servizio | Le connessioni si basano su OAuth 2.0 protetto. I dati attraversano Internet pubblico tramite canali crittografati (TLS). |
| MuleSoft (API) | Solo Internet pubblico | OAuth 2.0, chiave API | Si connette tramite API. La sicurezza è gestita tramite l'autenticazione API standard e policy di governance efficaci implementate tramite MuleSoft Anypoint Platform. |
| Fase | Meccanismo | Controlli di sicurezza / governance |
|---|---|---|
| Configurazione attivazione | Definito nell'impostazione dell'attivazione di Data 360 | Protetto tramite credenziali denominate e credenziali esterne |
| Preparazione dei dati | Filtrati e uniti dai DMO | Metadati di consenso e privacy applicati |
| Trasferimento in uscita | Crittografato tramite TLS / Private Connect | Applicazione delle policy e astrazione delle credenziali |
| Consegna esterna | SFTP / Cloud Storage / API | Accedi a una consegna controllata e controllabile |
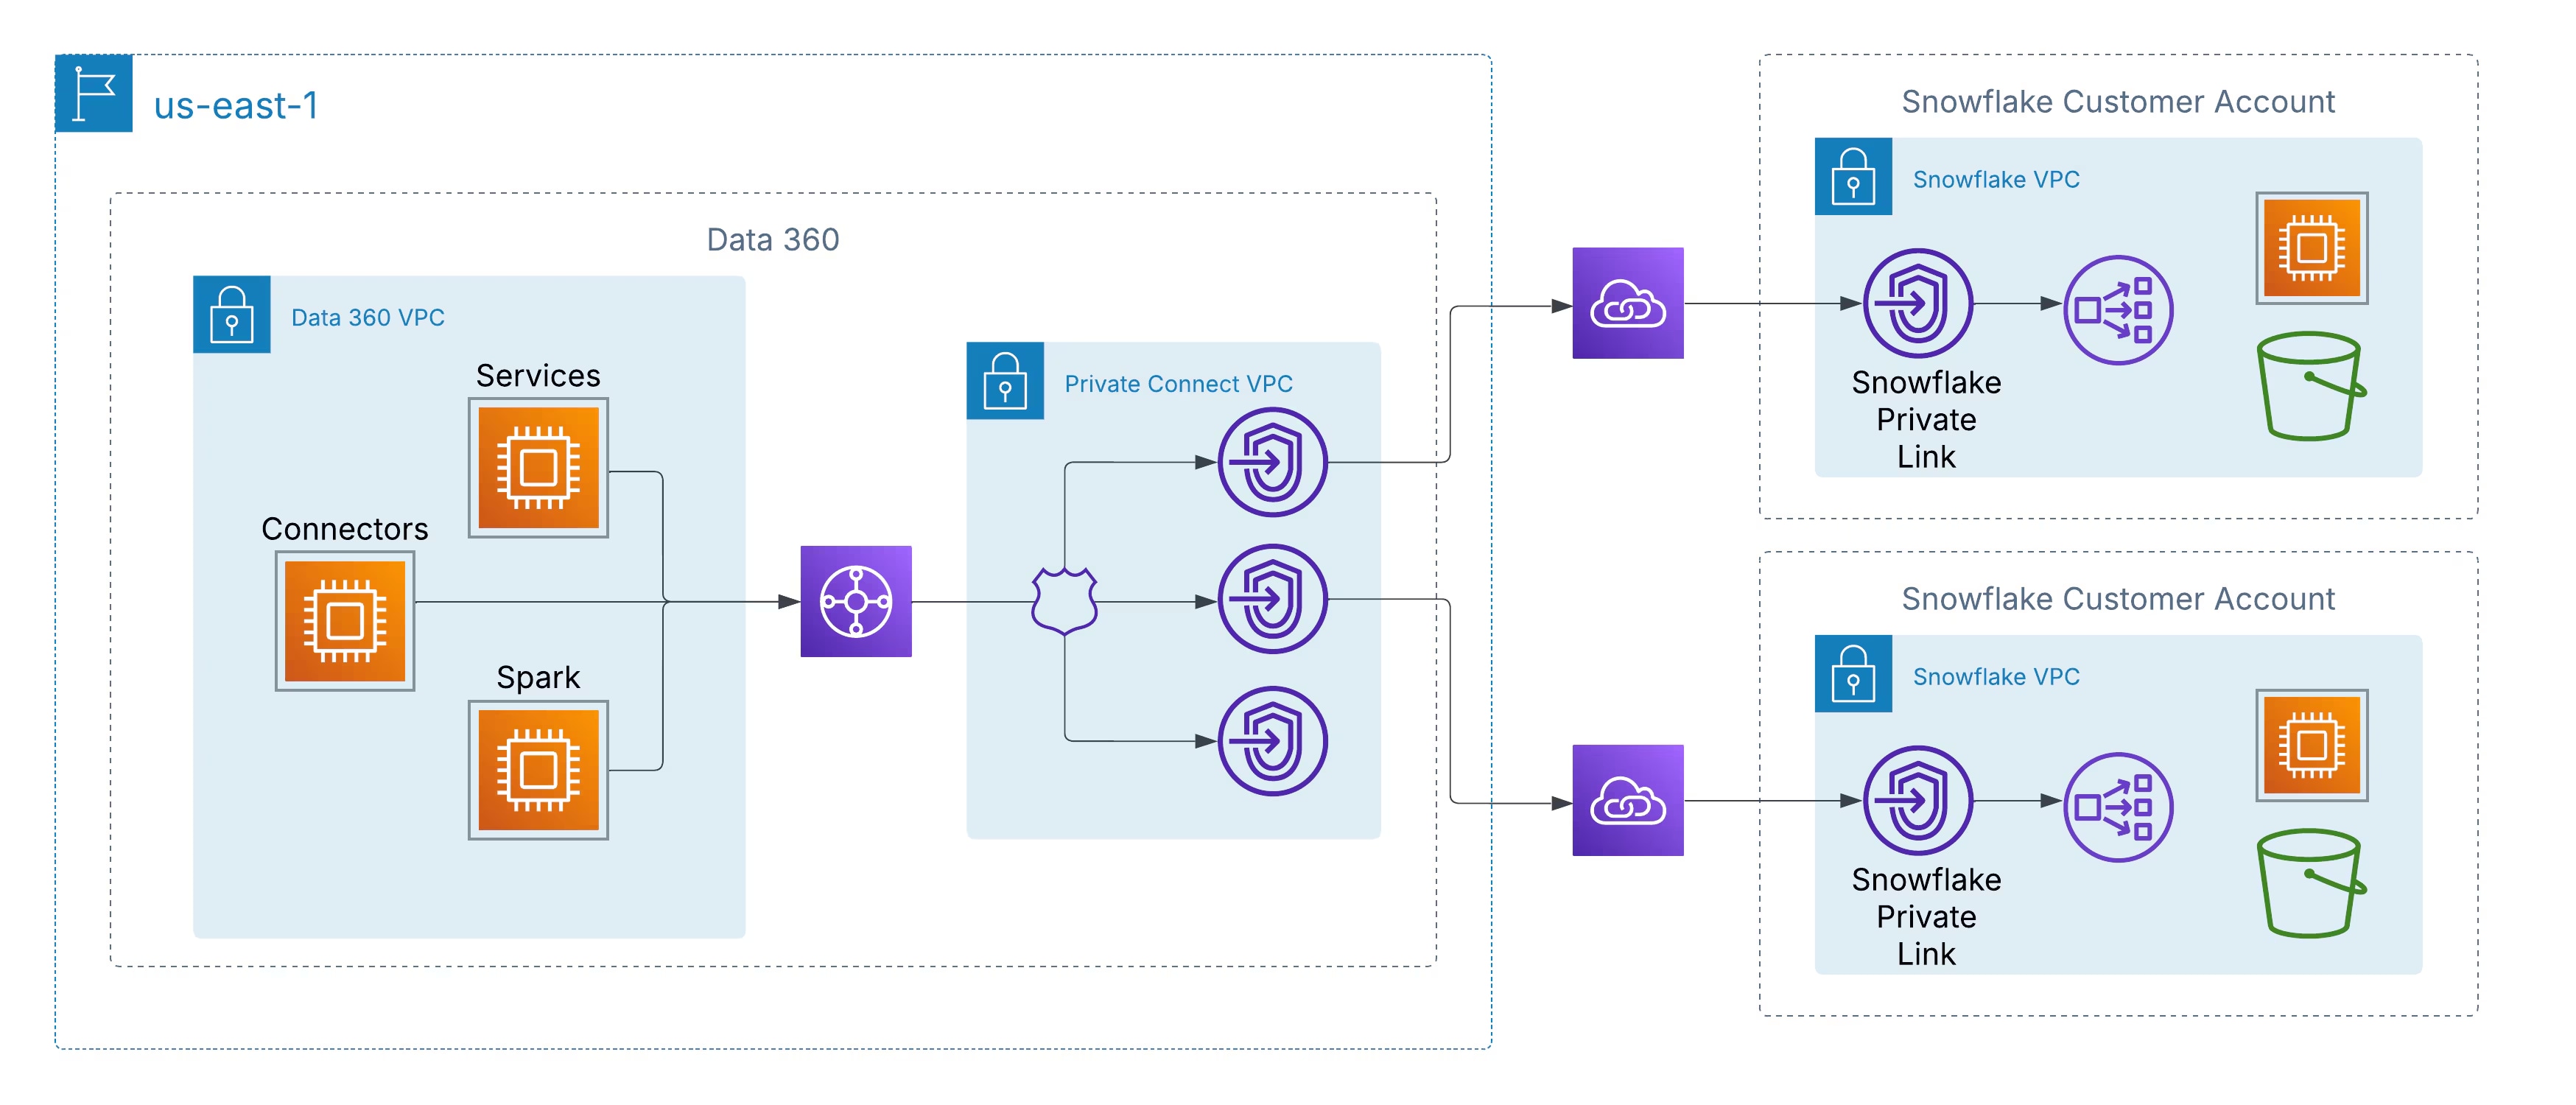 Tutte le comunicazioni rimangono all'interno della backbone AWS, utilizzando indirizzi IP privati e percorsi di rete non instradabili, eliminando così il rischio di intercettazione dei dati in transito e soddisfacendo rigorosi requisiti di sicurezza aziendali e normativi.
Questa architettura garantisce:
- **Esposizione zero a Internet:** I dati non escono mai dalla rete privata AWS.
- **Comunicazione IP privata:** Il traffico rimane isolato e non affrontabile esternamente.
- **Allineamento conformità:** Soddisfa standard di sicurezza come ISO 27001, SOC 2 e FedRAMP.
#### Interconnessione privata: Estensione della sicurezza tra i cloud
Per supportare i clienti che operano in ambienti multi-cloud, Salesforce sta estendendo gli stessi principi di sicurezza oltre AWS tramite Private Interconnect. Questa funzionalità consente la connettività privata tra cloud tra Data 360 e data lake ospitati in Azure o Google Cloud, mantenendo le stesse garanzie di instradamento privato, zero viaggi su Internet e traffico solo backbone crittografato.
Sono disponibili due modelli di distribuzione architettonica:
- **Interconnessione gestita dal cliente:** I clienti integrano i circuiti di rete privati esistenti, ad esempio Azure ExpressRoute, Google Cloud Interconnect o Equinix Fabric, direttamente con i VPC Data 360.
- **Interconnessione gestita Salesforce:** Salesforce esegue il provisioning e gestisce il collegamento tra cloud, esponendo gli endpoint del servizio privato nell'ambiente cloud di destinazione del cliente per un'impostazione chiavi in mano.
### Protezione dei cancelli: Funzionalità di sicurezza API in Salesforce Data 360
Salesforce Data 360, una potente piattaforma per l'unificazione dei dati aziendali, è dotata di controlli di sicurezza efficaci e a più livelli. Per i clienti, la gestione della sicurezza API è una parte fondamentale di una strategia di protezione dei dati completa, che consente loro di controllare l'accesso, gestire le integrazioni e monitorare l'utilizzo in modo efficace.
Di seguito sono riportate le funzionalità chiave disponibili per i clienti per configurare, controllare e gestire la protezione API in Salesforce Data 360.
#### Funzioni e funzionalità chiave di sicurezza API
I clienti possono utilizzare diverse funzioni Salesforce incorporate per garantire un accesso API sicuro alle istanze di Data 360:
##### 1\. Autenticazione e autorizzazione avanzate (OAuth 2.0)
Salesforce impone un'autenticazione rigorosa per le API Data 360, con OAuth 2.0 come protocollo standard e consigliato.
- **App connesse**: I clienti creano e configurano le applicazioni connesse per gestire l'accesso alle applicazioni esterne. Questo è il meccanismo principale per l'autenticazione e la concessione dell'accesso alle API di inserimento e query di Data 360.
- **Ambiti OAuth**: Gli amministratori possono definire ambiti OAuth specifici (ad esempio, cdp_ingest_api, api) per richiedere le autorizzazioni minime richieste, rispettando il principio dei privilegi minimi.
- **Autenticazione a più fattori (MFA)**: Salesforce Authenticator e altre soluzioni MFA possono essere applicate, aggiungendo un livello di sicurezza essenziale e assicurando che solo gli utenti verificati possano accedere al sistema, anche tramite gli accessi API.
##### 2\. Controllo dell'accesso granulare e autorizzazioni
I clienti hanno un controllo preciso su quali utenti e applicazioni possono accedere ai dati e quali azioni possono eseguire.
- **Controllo dell'accesso API (funzionalità)**: Una volta abilitata dall'Assistenza Salesforce, questa funzione consente agli amministratori di approvare esplicitamente quali applicazioni connesse possono essere utilizzate per accedere alle API. Tutte le app non approvate vengono bloccate automaticamente, riducendo in modo significativo il rischio di estrazione di dati non autorizzata.
- **Insiemi di autorizzazioni e profili**: Gli amministratori gestiscono l'accesso API assegnando l'autorizzazione "API abilitata" tramite i profili utente o gli insiemi di autorizzazioni dedicati. Ciò garantisce che gli utenti abbiano accesso solo alle funzioni lavorative.
- **Controllo dell'accesso basato sui ruoli (RBAC)**: In Data 360, i clienti possono creare e gestire policy di controllo dell'accesso basate sui ruoli per definire i livelli di accesso ai dati (protezione a livello di oggetto, campo e record), garantendo coerenza e controllo in tutta la piattaforma.
- **Utenti integrazione dedicati**: Le procedure consigliate consigliano di creare utenti "Solo API" specifici per le integrazioni, limitando le loro autorizzazioni solo a quanto necessario per la chiamata API, anziché utilizzare un account amministratore di sistema.
##### 3\. Controlli della sicurezza di rete
- **Intervalli IP di whitelisting/accesso**: I clienti possono limitare l'accesso API a un intervallo definito di indirizzi IP affidabili. Qualsiasi tentativo di accesso da un intervallo IP non approvato può essere negato o contestato per la verifica.
- **Connessione privata**: Basata su AWS PrivateLink, questa funzione consente agli amministratori di gestire i dati sensibili senza esporre gli endpoint a Internet pubblico, eliminando il rischio di attacchi agli endpoint visibili pubblicamente.
- **Crittografia in transito e a riposo**: Tutti i dati sono crittografati in transito (utilizzando TLS) e a riposo, proteggendo le informazioni sensibili da accessi non autorizzati anche se intercettati.
##### 4\. Monitoraggio, controllo e governance
La visibilità è fondamentale per la sicurezza. Salesforce offre strumenti completi per il monitoraggio e il controllo dell'attività API.
- **Monitoraggio evento**: Fornisce il tracciamento quasi in tempo reale di vari eventi, incluse le chiamate API e i tentativi di accesso. I clienti possono utilizzare questi dati per il controllo e per creare policy sulla sicurezza delle transazioni.
- **Centro di sicurezza**: Questa funzione offre una visualizzazione unica e consolidata delle metriche di sicurezza, conformità e governance in tutte le organizzazioni Salesforce, semplificando il monitoraggio e la gestione.
- **Traccia di controllo**: Aiuta i clienti a tenere traccia degli accessi e della cronologia dei campi, a monitorare le modifiche alle impostazioni e ad adempiere agli obblighi di controllo e di conservazione dei dati.
- **Funzioni di governance dei dati**: Include l'assegnazione e la classificazione dei dati, l'imposizione delle policy e il mascheramento dinamico dei dati per garantire l'applicazione di policy di governance coerenti in tutti i punti di contatto dei dati, inclusi quelli a cui si accede tramite API.
#### Impostazione e gestione della sicurezza API: Un customer journey
1. Abilita controlli centrali: Iniziare abilitando le impostazioni predefinite dell'organizzazione come la MFA e le restrizioni IP.
2. Richiedi controllo accesso API: Registrare un caso con l'Assistenza Salesforce per abilitare la funzione "Controllo accessi API" nell'organizzazione.
3. Configura applicazioni connesse: Creare applicazioni connesse specifiche per ogni integrazione, definendo gli ambiti OAuth richiesti e assegnandoli ai profili/insiemi di autorizzazioni autorizzati.
4. Implementa privilegi minimi: Assicurarsi che tutti gli utenti integrazione dispongano delle autorizzazioni "Solo API" e di un accesso minimo ai dati.
5. Monitoraggio e controllo: Utilizzare regolarmente il Centro di monitoraggio e sicurezza eventi per esaminare l'utilizzo dell'API, rilevare anomalie ed eseguire valutazioni delle vulnerabilità.
6. Applica procedure consigliate: Applicare sempre TLS, archiviare in modo sicuro i token di aggiornamento, ruotare gli ID sessione e convalidare gli input di dati.
Sfruttando queste funzionalità efficaci e configurabili dai clienti, le aziende possono mantenere un ambiente sicuro e conforme per tutte le interazioni API all'interno di Salesforce Data 360.
### Conformità, controllo e monitoraggio continuo
#### Disponibilità del servizio e residenza dei dati
Salesforce Data 360 è progettato per soddisfare i requisiti di residenza dati globale e sovranità attraverso il modello di distribuzione distribuito geograficamente. Il servizio è attualmente disponibile in più regioni regolamentate, tra cui Stati Uniti, Canada, Brasile, Germania, India, Australia e Giappone.
La residenza dei dati viene determinata mappando l'istanza Core Org di ogni cliente all'istanza regionale Data 360 corrispondente più vicina. Ad esempio, le organizzazioni centrali situate negli Stati Uniti o in Canada sono abbinate a un'istanza di Data 360 nella regione degli Stati Uniti, mentre le organizzazioni centrali all'interno dell'Unione europea sono mappate a un'istanza ospitata in Germania. Analogamente, le organizzazioni Core in India, Australia, Nuova Zelanda o Singapore sono associate a un'istanza di Data 360 ospitata in India.
L'infrastruttura Hyperforce di Salesforce è alla base di questo modello, fornendo le basi per il controllo dei dati geografici, l'isolamento della sicurezza e la conformità alle normative. Hyperforce garantisce che i dati dei clienti, inclusi metadati, backup e serie di dati derivate, rimangano entro confini regionali definiti. Questa architettura consente alle aziende di soddisfare i requisiti locali di residenza dei dati e conformità, come GDPR, FFIEC, HIPAA e le leggi regionali sulla privacy in APAC ed EMEA.
Salesforce continua a espandere la disponibilità di Data 360 in altre regioni Hyperforce per allinearsi agli standard globali in continua evoluzione in materia di privacy, ai requisiti di conformità regionali e alle aspettative dei clienti per il controllo sovrano dei dati.
#### Abilitazione della conformità normativa
Salesforce Data 360 è progettato per aiutare le aziende a soddisfare i severi requisiti globali in materia di privacy e normative come GDPR e CCPA. La piattaforma offre funzionalità native per la gestione dei diritti degli interessati (DSR), tra cui l'accesso, l'esportazione e l'eliminazione dei dati ("Diritto all'oblio"), garantendo una gestione conforme dei dati personali in tutto il suo ciclo di vita.
Mentre il cliente mantiene la responsabilità finale della conformità, Salesforce opera come "fornitore di servizi" certificato in base a regolamenti come il CCPA, offrendo i controlli a livello di piattaforma, le garanzie di sicurezza e i meccanismi contrattuali che consentono alle organizzazioni di implementare i propri framework di conformità in modo efficiente e su larga scala.
#### Foundational Trust: Certificazioni e attestazioni
Trust è la pietra angolare della piattaforma Salesforce e tale Trust si guadagna attraverso la convalida indipendente. Salesforce mantiene un ampio portafoglio di certificazioni e attestazioni di sicurezza globali che dimostrano il suo costante impegno a proteggere i dati dei clienti e a rispettare i più elevati standard di sicurezza nel cloud.
Queste certificazioni non sono semplici caselle di controllo: rappresentano controlli rigorosi e ricorrenti che verificano la solidità e la coerenza dei controlli di sicurezza, dei processi e dell'infrastruttura Salesforce. Insieme, costituiscono la spina dorsale del modello Trust fondamentale di Salesforce.
**Le certificazioni e le attestazioni chiave includono:**
- **ISO/IEC 27001:** Convalida il sistema di gestione completo della sicurezza delle informazioni di Salesforce.
- **ISO/IEC 27017:** Stabilisce le procedure consigliate per i controlli di sicurezza specifici del cloud.
- **ISO/IEC 27018:** Si concentra sulla protezione delle informazioni personali (PII) nel cloud.
- **SOC 1, SOC 2 e SOC 3:** Rapporti indipendenti che confermano la progettazione e l'efficacia operativa dei controlli di sicurezza e privacy di Salesforce.
- **PCI DSS:** Garantisce l'elaborazione e l'archiviazione sicure delle informazioni della carta di pagamento.
- **FedRAMP High & DoD Impact Livello 4:** Certifica Salesforce Government Cloud per l'utilizzo da parte delle agenzie federali degli Stati Uniti che gestiscono carichi di lavoro sensibili.
Mantenendo questo insieme completo di certificazioni, Salesforce offre ai clienti la certezza che i loro dati vengono gestiti all'interno di una piattaforma che soddisfa, e spesso supera, le aspettative di conformità e sicurezza globali.
### Massimizzare la visibilità: Registrazione, monitoraggio e osservabilità in Salesforce Data 360
Nel panorama digitale frenetico di oggi, avere una visione a 360 gradi dei dati dei clienti è fondamentale, ma altrettanto importante è avere una visione a 360 gradi della piattaforma che gestisce tali dati. Salesforce Data 360 offre funzionalità avanzate di registrazione, monitoraggio e osservabilità che consentono ai clienti di garantire qualità, sicurezza e prestazioni dei dati.
Questi strumenti consentono di passare dalla risoluzione reattiva dei problemi alla gestione proattiva, garantendo che l'implementazione di Data 360 funzioni in modo fluido ed efficiente.
#### Rilevamento e risposta proattivi alle minacce
La sicurezza non si esaurisce con la prevenzione, ma si evolve con la vigilanza. In un panorama di minacce in costante cambiamento, Salesforce combina funzionalità avanzate di monitoraggio della piattaforma con processi di revisione gestiti dai clienti per garantire una protezione continua e proattiva.
Salesforce offre potenti strumenti nativi per la visibilità e il rilevamento delle minacce:
- L'**itinerario di controllo** delle impostazioni acquisisce una cronologia completa delle modifiche amministrative, aiutando i team a tenere traccia della configurazione o degli aggiornamenti delle policy.
- **Monitoraggio evento** offre informazioni approfondite sul comportamento degli utenti, sull'attività API e sugli schemi di accesso ai dati. Questa telemetria può essere integrata perfettamente con una soluzione SIEM (**Security Information and** Event Management) per l'analisi e la correlazione centralizzate.
#### 1\. Monitoraggio evento: Il polso dell'organizzazione
Monitoraggio evento, parte dell'offerta Salesforce Shield, è l'hub centrale per tenere traccia dell'attività dettagliata degli utenti e dei dati sulle prestazioni del sistema nell'organizzazione Salesforce, incluse le azioni specifiche di Data 360. Acquisisce una vasta gamma di "eventi" in file di registro e oggetti per l'analisi.
- **File del registro eventi (ELF):** Forniscono dettagli granulari dell'attività degli utenti e degli eventi di sistema, disponibili per il download dopo un breve ritardo (ogni ora o ogni giorno). È possibile accedere a un massimo di 30 giorni di dati tramite API o il browser Event Log File, con l'opzione di esportazione per l'archiviazione a lungo termine.
- **Monitoraggio evento in tempo reale:** Per approfondimenti immediati, gli eventi in tempo reale vengono trasmessi in streaming come eventi piattaforma, consentendo di monitorare e rilevare l'attività quasi in tempo reale. Questo è fondamentale per la sicurezza e le prestazioni, consentendo di intervenire immediatamente se necessario.
- **Eventi specifici di Data 360:** Monitoraggio evento include tipi di eventi specifici per l'utilizzo di Data 360, ad esempio Visualizzazione pagina Lightning, Interazione Lightning ed Evento rapporto correlato alle pagine e ai dati di Data 360.
- **Integrazione con strumenti esterni:** Salesforce facilita l'integrazione con le più diffuse soluzioni di monitoraggio di terze parti come Splunk, Datadog, New Relic e Sumo Logic. È possibile inviare in streaming o esportare i dati di Monitoraggio evento a queste piattaforme per un'osservabilità consolidata in tutto lo stack tecnologico.
#### 2\. Monitoraggio e ottimizzazione delle prestazioni
Comprendere le prestazioni dell'implementazione di Data 360 è fondamentale per un'esperienza utente ottimale.
- **App Utilizzo Lightning:** Questa applicazione incorporata offre una visualizzazione aggregata delle metriche delle prestazioni, ad esempio i tempi di caricamento delle pagine (Experienced Page Time o EPT) e le prestazioni del browser, per le pagine Data 360 in Lightning Experience.
- **Rapporti e cruscotti digitali personalizzati:** È possibile creare rapporti e cruscotti digitali personalizzati utilizzando gli oggetti Data 360 e i dati di Monitoraggio evento, anche utilizzando un'app CRM Analytics basata su modelli gratuita denominata Monitoraggio evento Plus. Queste visualizzazioni consentono di individuare rapidamente le tendenze e i colli di bottiglia delle prestazioni.
Ma la tecnologia da sola non basta. Una vera resilienza richiede una collaborazione disciplinata tra rilevamento automatico e riesame umano. Gli avvisi automatici possono evidenziare anomalie in tempo reale, ma le minacce subdole o a lungo termine, ad esempio l'esfiltrazione lenta e non autorizzata dei dati da parte di un utente valido, vengono spesso identificate meglio attraverso controlli periodici e analisi delle tendenze.
Salesforce fornisce la telemetria, i registri di controllo e gli hook di integrazione; i clienti apportano il rigore del processo, la cadenza operativa e l'intelligenza specifica del contesto. Insieme, costituiscono un **modello di difesa** approfondita che combina automazione, analisi e supervisione umana per rilevare, analizzare e rispondere alle minacce prima che diventino incidenti.
### Guidare decisioni informate: Rapporti, cruscotti digitali, metriche e notifiche in Salesforce Data 360
Salesforce Data 360 non si limita a unificare i dati dei clienti, ma li rende intelligenti e fruibili. Una parte fondamentale di questa proposta di valore è la fornitura di rapporti efficaci, cruscotti digitali potenti, metriche approfondite e funzioni di notifica in tempo reale. Questi strumenti consentono ai clienti di monitorare lo stato dei dati, monitorare le prestazioni e automatizzare le azioni in base ai dati unificati, il tutto all'interno del familiare ambiente Salesforce.
#### Rapporti e cruscotti digitali: Hub di visualizzazione dei dati
Le funzionalità native di rapporti e cruscotti digitali di Salesforce si estendono perfettamente in Data 360, consentendo di visualizzare e analizzare i dati unificati senza uscire dalla piattaforma.
#### Creazione di rapporti sui dati unificati
È possibile creare rapporti standard e personalizzati sui dati archiviati in Data 360, inclusi dati unificati provenienti da varie fonti e approfondimenti calcolati.
- **Tipi di rapporti standard e personalizzati:** Data 360 introduce nuovi tipi di rapporto specifici per gli oggetti Data 360, ad esempio Stream di dati, Segmenti, Attivazioni, Risoluzione dell'identità e Approfondimenti calcolati. Ciò consente di eseguire query sui dati unificati con i generatori di rapporti Salesforce standard.
- **Analisi granulare:** I rapporti supportano fino a 10 raggruppamenti di righe, consentendo una segmentazione più precisa e un'analisi dettagliata degli attributi e delle tendenze dei clienti.
- **Formule e riepiloghi:** È possibile utilizzare le formule a livello di riga e di riepilogo per valutare ogni record o gruppo di record, consentendo di tenere traccia di metriche dettagliate e riepiloghi aggregati di alto livello in un unico rapporto.
#### Cruscotti digitali dinamici per visualizzazioni olistiche
I cruscotti digitali offrono una visualizzazione visiva delle principali metriche e tendenze dell'implementazione di Data 360.
- **Visualizzazione unificata:** È possibile combinare i dati di più rapporti di Data 360 o persino combinare i rapporti di Data 360 con rapporti CRM standard in un unico cruscotto digitale per una visione olistica delle attività e degli approfondimenti sui clienti.
- **Widget personalizzabili:** Utilizzare vari tipi di grafico (a barre, a linee, a torta, a indicatore, ecc.) e tabelle per visualizzare i dati del rapporto in modo efficace.
- **Approfondimenti in tempo reale:** I cruscotti digitali possono essere aggiornati per fornire informazioni aggiornate, facilitando un processo decisionale rapido e basato sui dati.
#### Metriche e KPI: Misurare il successo
Data 360 consente di definire e tenere traccia degli indicatori di prestazione chiave (KPI) pertinenti ai propri obiettivi aziendali. Questi possono essere generati tramite:
- **Approfondimenti calcolati:** Creare metriche efficaci utilizzando i dati elaborati in batch a volume elevato. Ad esempio, calcolare metriche come "Valore medio durata cliente" o "Reddito totale attivo contratto" e utilizzarle come dimensioni o misure nei rapporti e nei cruscotti digitali.
- **Approfondimenti streaming:** Elaborare i dati da fonti di streaming quasi in tempo reale per creare aggregazioni di serie temporali, ad esempio dati di coinvolgimento di siti Web o dispositivi mobili. Queste metriche possono favorire orchestrazioni immediate e azioni sui dati.
#### Notifiche e avvisi: Rimanere informati e proattivi
Salesforce offre potenti funzioni di automazione e notifica per garantire la conoscenza di eventi critici o modifiche dei dati in Data 360.
- **Notifiche basate sui flussi:** È possibile impostare Flussi di processo per attivare azioni e inviare notifiche basate sugli eventi negli oggetti Data 360 come Stream di dati, Segmenti e Attivazioni.
- **Avvisi personalizzati:** Creare notifiche personalizzate che attivano un messaggio email o vengono visualizzate nella Campana delle notifiche di Salesforce quando vengono soddisfatte condizioni specifiche. Ad esempio, è possibile ricevere un avviso se uno stream di dati non riesce, se una regola di risoluzione dell'identità rileva un errore o se una metrica chiave supera una determinata soglia.
- **Servizio di notifica degli eventi (ENS):** Per gli sviluppatori, il servizio di notifica evento API-first consente ai sistemi esterni di ricevere notifiche quando si verificano determinati eventi, consentendo un'integrazione senza interruzioni e reazioni in tempo reale in tutto lo stack tecnologico.
- **Azioni dati:** In base agli approfondimenti streaming, è possibile attivare azioni dati, che possono essere configurate per inviare avvisi, invocare eventi piattaforma o integrarsi con altre applicazioni SaaS tramite webhook.
Sfruttando queste funzionalità complete, i clienti di Salesforce Data 360 possono monitorare efficacemente il proprio ecosistema di dati, visualizzare le metriche chiave e ricevere avvisi tempestivi per favorire il coinvolgimento proattivo e l'eccellenza operativa.
### Raccomandazioni strategiche per l'adozione a livello aziendale
L'adozione di Salesforce Data 360 su scala aziendale non richiede solo l'abilitazione tecnica: richiede un'architettura deliberata e basata sulla sicurezza. I seguenti consigli strategici offrono ai CTO e agli architetti aziendali una roadmap per creare Trust, resilienza e conformità in ogni livello della distribuzione di Data 360.
- **Attuazione di un approccio "Secure by Design":** La sicurezza non deve essere adattata, deve essere fondamentale. Iniziare con la policy _"Nega tutto"_ predefinita di Salesforce e concedere esplicitamente l'accesso in base alle esigenze. Definire governance, policy e framework di accesso prima di inserire o attivare i dati. La creazione della sicurezza fin dal primo giorno elimina il rischio di esposizioni nascoste e semplifica la conformità a lungo termine.
- **Applicare una strategia di gestione dell'identità e dell'accesso (IAM) efficace:** Centralizzare l'identità tramite SSO federato e applicare l'autenticazione a più fattori (MFA) per ridurre la compromissione delle credenziali. Limitare l'accesso in base agli intervalli IP di accesso e utilizzare le funzionalità IdP (Identity Provider) di Salesforce per stabilire la responsabilità end-to-end tra gli utenti e le integrazioni. Un livello IAM unificato riduce la complessità operativa e indurisce la superficie di autenticazione.
- **Applicare il principio dei privilegi minimi :** Progettare i ruoli per precisione, non per praticità. Utilizzare gli insiemi di autorizzazioni standard di Salesforce come base per la separazione dei doveri, assicurando che gli utenti accedano solo a ciò che è necessario. Evitare un'eccessiva personalizzazione delle autorizzazioni: ogni deviazione aumenta il sovraccarico di manutenzione e il rischio di accesso non intenzionale.
- **Istituzione di un framework di governance dei dati a più livelli:** Separare i dati in base all'unità operativa o al marchio utilizzando gli spazi dati e applicare il controllo dell'accesso basato sugli attributi (ABAC) con la protezione a livello di oggetto, campo e record (OLS, FLS, RLS). Utilizzare il mascheramento dinamico dei dati per proteggere le informazioni sensibili in tempo reale senza ostacolare l'analisi o la fruibilità. Questo modello a livelli garantisce che la governance rimanga coerente man mano che i dati vengono scalati tra i domini.
- **Sfruttare strategicamente la crittografia e le integrazioni sicure:** Per i carichi di lavoro sensibili, distribuire Crittografia piattaforma con chiavi gestite dal cliente (CMK) per mantenere la sovranità sul ciclo di vita della crittografia. Utilizzare le credenziali denominate e Private Connect per proteggere tutte le integrazioni da sistema a sistema, eliminando i segreti codificati e garantendo che tutto il traffico rimanga privato, conforme e controllabile.
- **Creazione di un programma di operazioni di sicurezza continua :** La sicurezza non si esaurisce con la configurazione, ma si basa sulla disciplina operativa. Integrare il monitoraggio automatico con revisioni periodiche dei registri eventi e degli itinerari di accesso. Creare una funzione SecOps (Security Operations) dedicata per identificare le anomalie, analizzare le minacce e convalidare la conformità. L'obiettivo: rilevare precocemente, rispondere rapidamente e migliorare continuamente la postura.
### Percorso in avanti: Creazione di Data 360 affidabili e resilienti
Il percorso verso un'azienda sicura e intelligente non si conclude con la distribuzione: si evolve attraverso disciplina, design e Trust. Salesforce Data 360 fornisce le basi dell'architettura, ma il vero valore emerge quando le organizzazioni mettono in atto sicurezza, governance e intelligence come un'unica azione unificata.
Le aziende dovrebbero approcciare Data 360 non come un'altra piattaforma dati, ma come un livello Trust sicuro e componibile che collega dati, intelligenza artificiale e coinvolgimento dei clienti in un unico framework di governance. Adottando una filosofia _protetta fin dalla progettazione_, imponendo privilegi minimi a ogni livello ed estendendo la connettività privata a tutti i flussi di dati, le organizzazioni trasformano la conformità da casella di controllo a vantaggio competitivo.
Il passo successivo è la continua modernizzazione, ovvero l'integrazione dell'automazione del controllo, dell'applicazione delle policy e della gestione del ciclo di vita della crittografia nelle attività quotidiane. Man mano che le aziende si evolvono verso architetture basate sull'intelligenza artificiale, gli stessi principi che proteggono i dati oggi costituiranno la spina dorsale della governance dell'intelligenza artificiale domani, assicurando che ogni modello, agente e decisione sia spiegabile, consapevole delle policy e conforme fin dalla progettazione.
In definitiva, il Trust diventa la nuova valuta della trasformazione digitale. Con Salesforce Data 360, le aziende possono scalare con sicurezza il proprio ecosistema di dati, sapendo che ogni byte, connessione e approfondimento sono protetti, governati e attivati con integrità.
## Informazioni sugli autori
**Krishna Chalamasandra** è un esperto esperto di sicurezza informatica con oltre 25 anni di esperienza nella tecnologia e conformità della sicurezza delle informazioni. In Salesforce, svolge il ruolo di consulente di fiducia per i clienti e di leader chiave nella funzione Security and Compliance Customer Trust all'interno dell'organizzazione CISO. In precedenza, Krishna ha trascorso 10 anni in Cisco, guidando l'architettura di sicurezza in IAM, sicurezza di rete e PKI e guidando certificazioni chiave come ISO 27001, SOC 1–3, PCI, FedRAMP e FIPS 140-2. Ha inoltre trascorso oltre 8 anni in Novell implementando controlli a livello di infrastruttura e supportando revisioni della sicurezza complesse per i clienti globali regolamentati.
**Yugandhar Bora** è un architetto di ingegneria del software di Salesforce, specializzato in architettura dei dati all'interno della piattaforma Data & Intelligence Applications. Dirige iniziative del Comitato di revisione dell'architettura aziendale (EARB) incentrate sulla governance dei dati e sui modelli di dati unificati, contribuendo al contempo alle soluzioni di provisioning automatico della piattaforma.
## Informazioni su questo whitepaper
**Enterprise Agentic Architecture and Design Patterns** struttura le possibilità delle architetture multi-agente, identificando ed evidenziando come le nuove funzionalità per gli agenti AI possano essere combinate per offrire soluzioni agenti affidabili, ripetibili, scalabili e gestibili. Prendendo ispirazione dai “Design Patterns” per la programmazione orientata agli oggetti, definiamo schemi che possono essere combinati ed estesi per risolvere le molte sfide entusiasmanti che prima delle tecnologie agentiche si trovavano al di fuori dell’ambito dei sistemi aziendali basati sulle tecnologie deterministiche tradizionali.
A seguito della discussione sulla logica per le architetture multi-agente, vengono introdotti numerosi schemi agentici, da schemi semplici che sfruttano l'elaborazione del linguaggio naturale per determinare l'intento degli utenti a schemi multi-agente che prevedono la separazione delle preoccupazioni tra gli agenti, a schemi agentici UX che apportano il ragionamento agente alla presentazione e all'interazione con sistemi, informazioni e contenuti.
## Che cosa otterrete da questo documento?
Prima di tutto si otterrà un nuovo modo di pensare agli agenti - agenti come componenti, agenti come compositori, agenti come attori, agenti come collaboratori e, soprattutto, agenti all'interno di un'architettura più ampia che agiscono con intenti e agiscono nell'ambito delle loro preoccupazioni individuali.
Si otterranno i suggerimenti necessari per concepire soluzioni agentiche complete che coprono i journey degli utenti e informano esperienze agenti significative, esperienze che non sono mai state possibili prima.
Le sezioni iniziali di questo documento forniscono la logica per le architetture multi-agente. Leggere questi articoli per comprendere meglio le sfide e le opportunità che le architetture multi-agente presentano.
Di seguito sono riportate le definizioni e le descrizioni degli schemi agenti, da semplici a complessi, che coprono schemi che supportano interazioni, schemi per agenti specializzati, schemi per operazioni in background e schemi di lunga durata. Ogni schema include un diagramma dei componenti chiave che realizzano lo schema, oltre a consigli per l'utilizzo e casi d'uso rappresentativi.
Infine, l'appendice include esempi di come questi schemi vengono combinati in soluzioni agentiche olistiche a supporto di un'esperienza agente più ampia, ad esempio per supportare il Servizio clienti o le Vendite con broker. Fare riferimento a questa sezione per vedere come un'esperienza agente completa sfrutta la scomposizione e la separazione delle preoccupazioni a livello di agente e di azione per favorire il riutilizzo a livello di interazione, con agenti condivisi che supportano componenti interni ed esterni, sia in modalità assistita che autonoma.
## 1\. Architettura di sistema multiagente
Poiché gli architetti aziendali integrano l'intelligenza artificiale generativa nei loro ecosistemi, devono rispondere a una serie di domande comuni sulla progettazione:
- Quanti agenti sono richiesti?
- Come interagiranno gli agenti?
- Qual è la divisione del lavoro tra agenti e umani?
- Come vengono assemblati questi componenti in un sistema coerente?
Questo documento presenta una metodologia basata su schemi per progettare e creare soluzioni agentiche.
Gli agenti _monolitici_ sono il punto di partenza per la maggior parte delle soluzioni agentiche. Gli agenti, e più specificamente gli agenti Agentforce, sono esperti in una vasta gamma di argomenti. Per i casi d'uso più comuni, iniziare con un singolo agente.
Man mano che l'organizzazione cresce, le architetture multi-agente sono l'approccio preferito. L'_architettura multiagente_ consente una maggiore scalabilità, controllo e flessibilità rispetto ai sistemi monolitici a agente singolo.
L'architettura multiagente offre i seguenti vantaggi chiave:
- **Maggiori prestazioni e suddivisione della complessità**: Un sistema di più agenti specializzati offre maggiori funzionalità e semplifica l'osservanza delle istruzioni.
- **Modularità ed estensibilità**: I singoli agenti possono essere aggiunti, sostituiti, modificati e testati con maggiore facilità, il che promuove l'agilità.
- **Resilienza e tolleranza ai guasti**: Il guasto di un singolo componente non compromette l'intero sistema, il che porta a una migliore resilienza complessiva.
- **Governance decentralizzata**: La risoluzione dei problemi e la gestione possono essere isolate per agenti specifici e le relative applicazioni, semplificando la manutenzione e la supervisione.
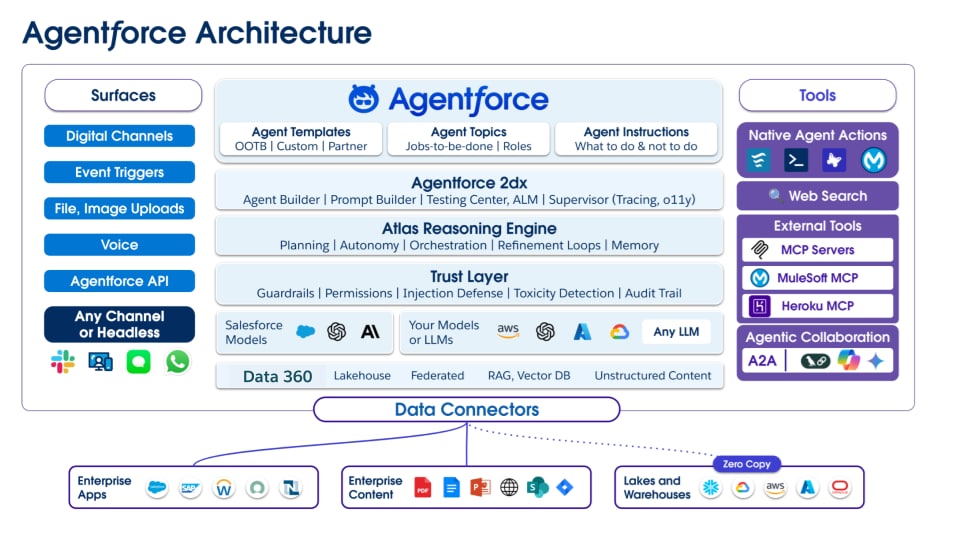 ## 2\. Principi architettonici fondamentali
La razionalizzazione di un'architettura multi-agente inizia con la proiezione dei principi fondamentali dell'architettura sulle capacità e sulla struttura degli agenti. Le architetture multi-agente risultanti sono quindi una manifestazione dei principi di progettazione di sistema e architettura di sistema fondamentali che sono allineati con il "granello" unico delle tecnologie AI.
I principi chiave che guidano questa architettura sono:
- Gestire la complessità tramite la decomposizione
- Migliorare la resilienza e ridurre la fragilità attraverso il disaccoppiamento
- Migliorare l'affidabilità e l'efficienza attraverso il riutilizzo del codice
- Migliorare l'affidabilità degli agenti limitando l'ambito delle preoccupazioni di un agente
- Migliorare la manutenzione e l'evoluzione del sistema attraverso la modularità e l'estensibilità
- Semplificare la gestione e la responsabilità degli agenti grazie alla specializzazione
A differenza delle architetture agenti più primitive (ad esempio, quelle che si concentrano sugli LLM come costrutto architettonico centrale), _Agenteforce fu progettato_ per l'orchestrazione multiagente. L'orchestrazione multi-agente è alla base del motore di ragionamento Atlas e del ragionamento agente per creare percorsi di programmazione dinamici ed efficaci all'interno di una risposta agente per espandere in modo significativo la capacità di offrire un ampio e profondo potenziamento agente all'esperienza utente (UX).
In Agentforce questo tipo di coordinamento è abilitato dai seguenti protocolli chiave aperti e interoperabili e dai prodotti Salesforce:
- **Agenteforce** fornisce un sottosistema Agente per incapsulare tutti gli elementi chiave di un agente: argomenti, istruzioni, azioni, guardrail, contesto, invocazioni, output, dettagli di esecuzione, registri, ecc.
- **Azioni**: fornire hook per accedere ai dati, chiamare flussi, invocare sistemi esterni e chiamare altri agenti.
- **Data 360**: fornisce un livello di virtualizzazione dei dati per offrire all'agente un contesto specifico e personalizzato (sfruttando il profilo unificato e la catena di chiavi di Data 360 per estrarre informazioni specifiche da tutta l'azienda).
E per gli agenti di tutta l'azienda o per accedere ad agenti o risorse, supportiamo:
- **Model Context Protocol (MCP)**: è un livello di comunicazione sicuro che collega gli agenti a strumenti aziendali, dati e Knowledge per garantire la precisione del contesto.
- **Protocollo A2A (**Agent-to-Agent): è una stretta di mano standardizzata per la delega tra agenti che consente un coordinamento sicuro e regolamentato tra sistemi, organizzazioni e fornitori.
Questi principi costituiscono la base per la creazione di un sistema scalabile e governabile di intelligenza orchestrata.
### Considerazioni aggiuntive
Soluzioni agenti solide richiedono approcci chiari ai requisiti non funzionali alla base di un'efficace fornitura di tecnologia:
- Sicurezza e governance (gestione dell'identità e degli accessi, privacy dei dati, sicurezza dei dati e modellazione delle minacce).
- Osservabilità e monitoraggio (tracciamento distribuito, registrazione centralizzata, metriche e cruscotti digitali).
- Operatività e gestione del ciclo di vita (specifica, generazione di casi di test, test, feedback, apprendimento continuo, deprecazione).
Queste sono considerazioni architetturali chiave per la creazione di soluzioni Enterprise Agentic non trattate in questo whitepaper; tuttavia, verranno affrontate nelle pubblicazioni future.
## 3\. Tassonomia degli agenti Enterprise
Per gestire un panorama agentico a livello aziendale, gli architetti devono classificare gli agenti attraverso due lenti complementari: funzione tecnica e impatto sul business.
### 3.1 Classificazione dei ruoli funzionali
Questa tassonomia classifica i ruoli funzionali che gli agenti possono assumere all'interno di un'architettura.
- **Ruoli canale/UX**: Definire la modalità di interazione (ad esempio Headless, Prompt, Chat e messaggi o Aree di lavoro gestite da AI).
- **Ruoli specialistici**: Incapsulare Knowledge di dominio profondo (ad esempio, Esperto di dominio, Minion Knowledge, Assistente o Pianificatore).
- **Ruoli servizio utilità**: Eseguire operazioni transazionali discrete (ad esempio, Generazione, Riepilogo, Trasformazione o Configurazione).
- **Ruoli di servizio proattivi e di manutenzione**: Concentrarsi sullo stato e la qualità dei dati (ad esempio, Cura, Conformazione, Qualità dei dati o Arricchimento dei dati).
- **Ruoli di lunga durata**: Gestire i processi per periodi di tempo estesi (ad esempio, Concierge, Project Manager, Nurturer o Watcher/Alerter).
## 4\. Modello di mappa agente
Per facilitare la progettazione e la comunicazione chiare, la **mappa agente** è il modello standard per descrivere le soluzioni agenti. Definisce entità, sistemi e interazioni chiave all'interno di uno schema di progettazione specifico.
Di seguito sono riportati i componenti del modello Mappa agente:
- **I livelli utente** definiscono gli attori umani del sistema (ad esempio, Clienti, Dipendenti autenticati (SF-Utenti) e Dipendenti non autenticati).
- I **Livelli agente** descrivono gli agenti richiesti, gli schemi presentati, le relazioni reciproche e le istruzioni utilizzate per attualizzare schemi specifici.
- **Contesto/Azioni** sono le risorse, le capacità o le azioni gestite o a cui l'agente accede.
- Le **fonti** sono i dati, le applicazioni, le Knowledge Base sottostanti e altri sistemi a cui gli agenti si connettono.
Le appendici A e B illustrano gli schemi agentici a livello di sistema dimostrandone la composizione all'interno delle swimlane del modello di mappa agente.
## 5\. Framework di schemi agenti
Salesforce utilizza una libreria di schemi degli agenti per organizzare e offrire soluzioni agenti affidabili e prevedibili. Questi schemi sono i nostri modelli per risolvere i problemi architettonici comuni.
Sono raggruppati in quattro categorie principali:
- **Schemi di interazione**: Concentrarsi sul coinvolgimento degli agenti e sull'esperienza utente (UX).
- **Schemi specialistici/lavoratori**: Incapsulare deep Knowledge o competenze specifiche all'interno di un dominio specifico.
- **Utilità e schemi di gestione dei dati**: Eseguire operazioni specifiche, spesso ripetibili, che supportano altri agenti o processi.
- **Schemi di lunga durata**: Gestire i processi e i flussi di lavoro che si verificano in periodi estesi, che includono più fasi.
Le sezioni seguenti descrivono gli schemi chiave di ogni categoria. Ogni descrizione dello schema fornisce una **panoramica**, un **tipo di output**, una **guida all'uso** dello schema, **casi d'uso rappresentativi** e un **diagramma della soluzione**, oltre alla mappatura alla **rubrica Salesforce Agentic Maturity**.
## 6\. Schemi di interazione
Gli _schemi di interazione_ sono strutture di base incentrate sul coinvolgimento degli agenti e sull'esperienza degli utenti.
### Schema di saluto
- **Panoramica**: Lo _schema Greeter_ è uno schema semplice e facile da implementare che utilizza il linguaggio naturale per determinare l'intento dell'utente. Quindi, instrada l'utente all'agente umano appropriato.
- **Tipo di output**: Hand-off/Inoltra al livello superiore alla risorsa successiva.
- **Valore aziendale**: Facilitare un primo contatto semplice ed efficiente per i clienti ottimizzando la risoluzione degli intenti e la raccolta del contesto per i fornitori di servizi.
- **Guida all'uso degli schemi**: Configurare l'agente come risorsa di coinvolgimento principale per i canali del marchio. Fornire istruzioni su marchio, prodotti e servizi abbinate a istruzioni di instradamento basate sull'intento dell'utente. L'agente raccoglie e riepiloga l'intento di fornire un caloroso passaggio di consegne.
- **Caso d'uso rappresentativo**: Si immagini una pagina Web che utilizza un chat bot per presentare un menu di opzioni in cui gli utenti devono fare clic su tutte le opzioni prima di essere instradati a un essere umano. Per migliorare la produttività e l'efficienza del back-office, i chatbot utilizzano spesso percorsi di lavoro e interazioni complessi e complessi. Questo porta a uno scenario di stanchezza "compila, scegli e clicca" per i clienti che spesso si traduce in frustrazione se il loro contesto non rientra nelle opzioni di menu disponibili. Sostituendo i chatbot tradizionali con _Agentic Front Door_, che utilizza interazioni basate sul linguaggio naturale, si alleggerisce il carico e si crea un'interazione simile a quella umana.
- **Procedimento Agentforce**:
- agente dell'assistenza Agentforce: [Creazione di un agente dell'assistenza](https://trailhead.salesforce.com/content/learn/projects/quick-start-build-your-first-agent-with-agentforce)
- L'agente dell'assistenza inserito nel pacchetto dispone di funzionalità di trasferimento configurabili che supportano il trasferimento:
- Per gli agenti umani
- Agli agenti AI
- Agli agenti esterni
- Modelli specifici del settore che contengono esempi di codice
- **Diagramma**:
 - **Maturità agente Salesforce**: Livello 1 (o Livello 0 se si utilizza l'agente dell'assistenza pronto all'uso con trasferimento e inoltro al livello superiore incorporati)
### Schema operatore
- **Panoramica**: Lo _schema Operatore si_ basa sullo _schema Greeter_ instradando le richieste all'agente specializzato appropriato o all'intento umano e negoziale (se necessario).
- **Tipo di output**: Passaggio di consegne/Trasferimento alla risorsa successiva.
- **Guida all'uso degli schemi**: Abbinare le istruzioni specifiche del marchio e del servizio alle istruzioni su dove inviare l'utente in base all'intento. Definire le risorse di inoltro al livello superiore, che possono essere persone o altri agenti.
- **Caso d'uso rappresentativo**: Utilizzare la _Porta principale agente_ per gli scenari in cui è presente un alto grado di specializzazione tra i rappresentanti umani o AI.
- **Diagramma**:
 - **Maturità agente Salesforce**: Livello 2
### Schema orchestratore
- **Panoramica**: Lo _schema Orchestrator_ gestisce un "intervento collettivo" dell'agente AI. Quando riceve una richiesta utente, passa l'enunciazione a uno o più agenti specializzati e quindi aggrega le risposte per l'utente. A differenza dello _schema Operatore_, rimane il primo punto di contatto (POC).
- **Tipo di output**: Raccogliere e preparare le risposte degli agenti lavoratori.
- **Guida all'uso degli schemi**: Configurato come coinvolgimento principale. Fornire istruzioni per ogni lavoratore dell'assistenza (ad esempio, un Prioritizer o una PMI del dominio) che consenta all'orchestratore di trasmettere le enunciazioni.
- **Caso d'uso rappresentativo**: Utilizzare lo _schema Orchestrator_ come porta principale dell'agente per assistere i clienti che potrebbero avere bisogno di discutere di più argomenti per conversazione, il che richiede soluzioni multi-agente e interazioni coerenti. In un'architettura multi-sistema, considerare lo _schema Orchestrator_ per coordinare le risposte tra i sistemi e con la collaborazione di agenti esterni.
- **Diagramma**:
 - **Maturità agente Salesforce**: Livello 3
### Schema listener/feed
- **Panoramica**: Lo _schema Ascoltatore/Feed_ mette in evidenza il contesto e gli approfondimenti durante il flusso di una conversazione. L'_ascoltatore_ viene attivato durante ogni turno di conversazione per trovare e visualizzare le informazioni pertinenti per un dipendente.
- **Tipo di output**: Fornire il contesto pertinente in base alla conversazione, che può essere formattata per l'effetto (ad esempio, effettuare confronti o evidenziare punti chiave).
- **Guida all'uso degli schemi**: Collegare l'ascoltatore a un canale a turni (ad esempio, chat, voce o SMS). Definire gli argomenti per ogni area tematica. L'agente consuma la trascrizione, identifica gli argomenti e invoca le azioni per cercare e pubblicare contenuti pertinenti in un feed in esecuzione per il dipendente.
- **Caso d'uso rappresentativo**: Utilizzare l'_Assistente universale_ per fornire assistenza al Servizio clienti o agli agenti di vendita.
- **Diagramma**:
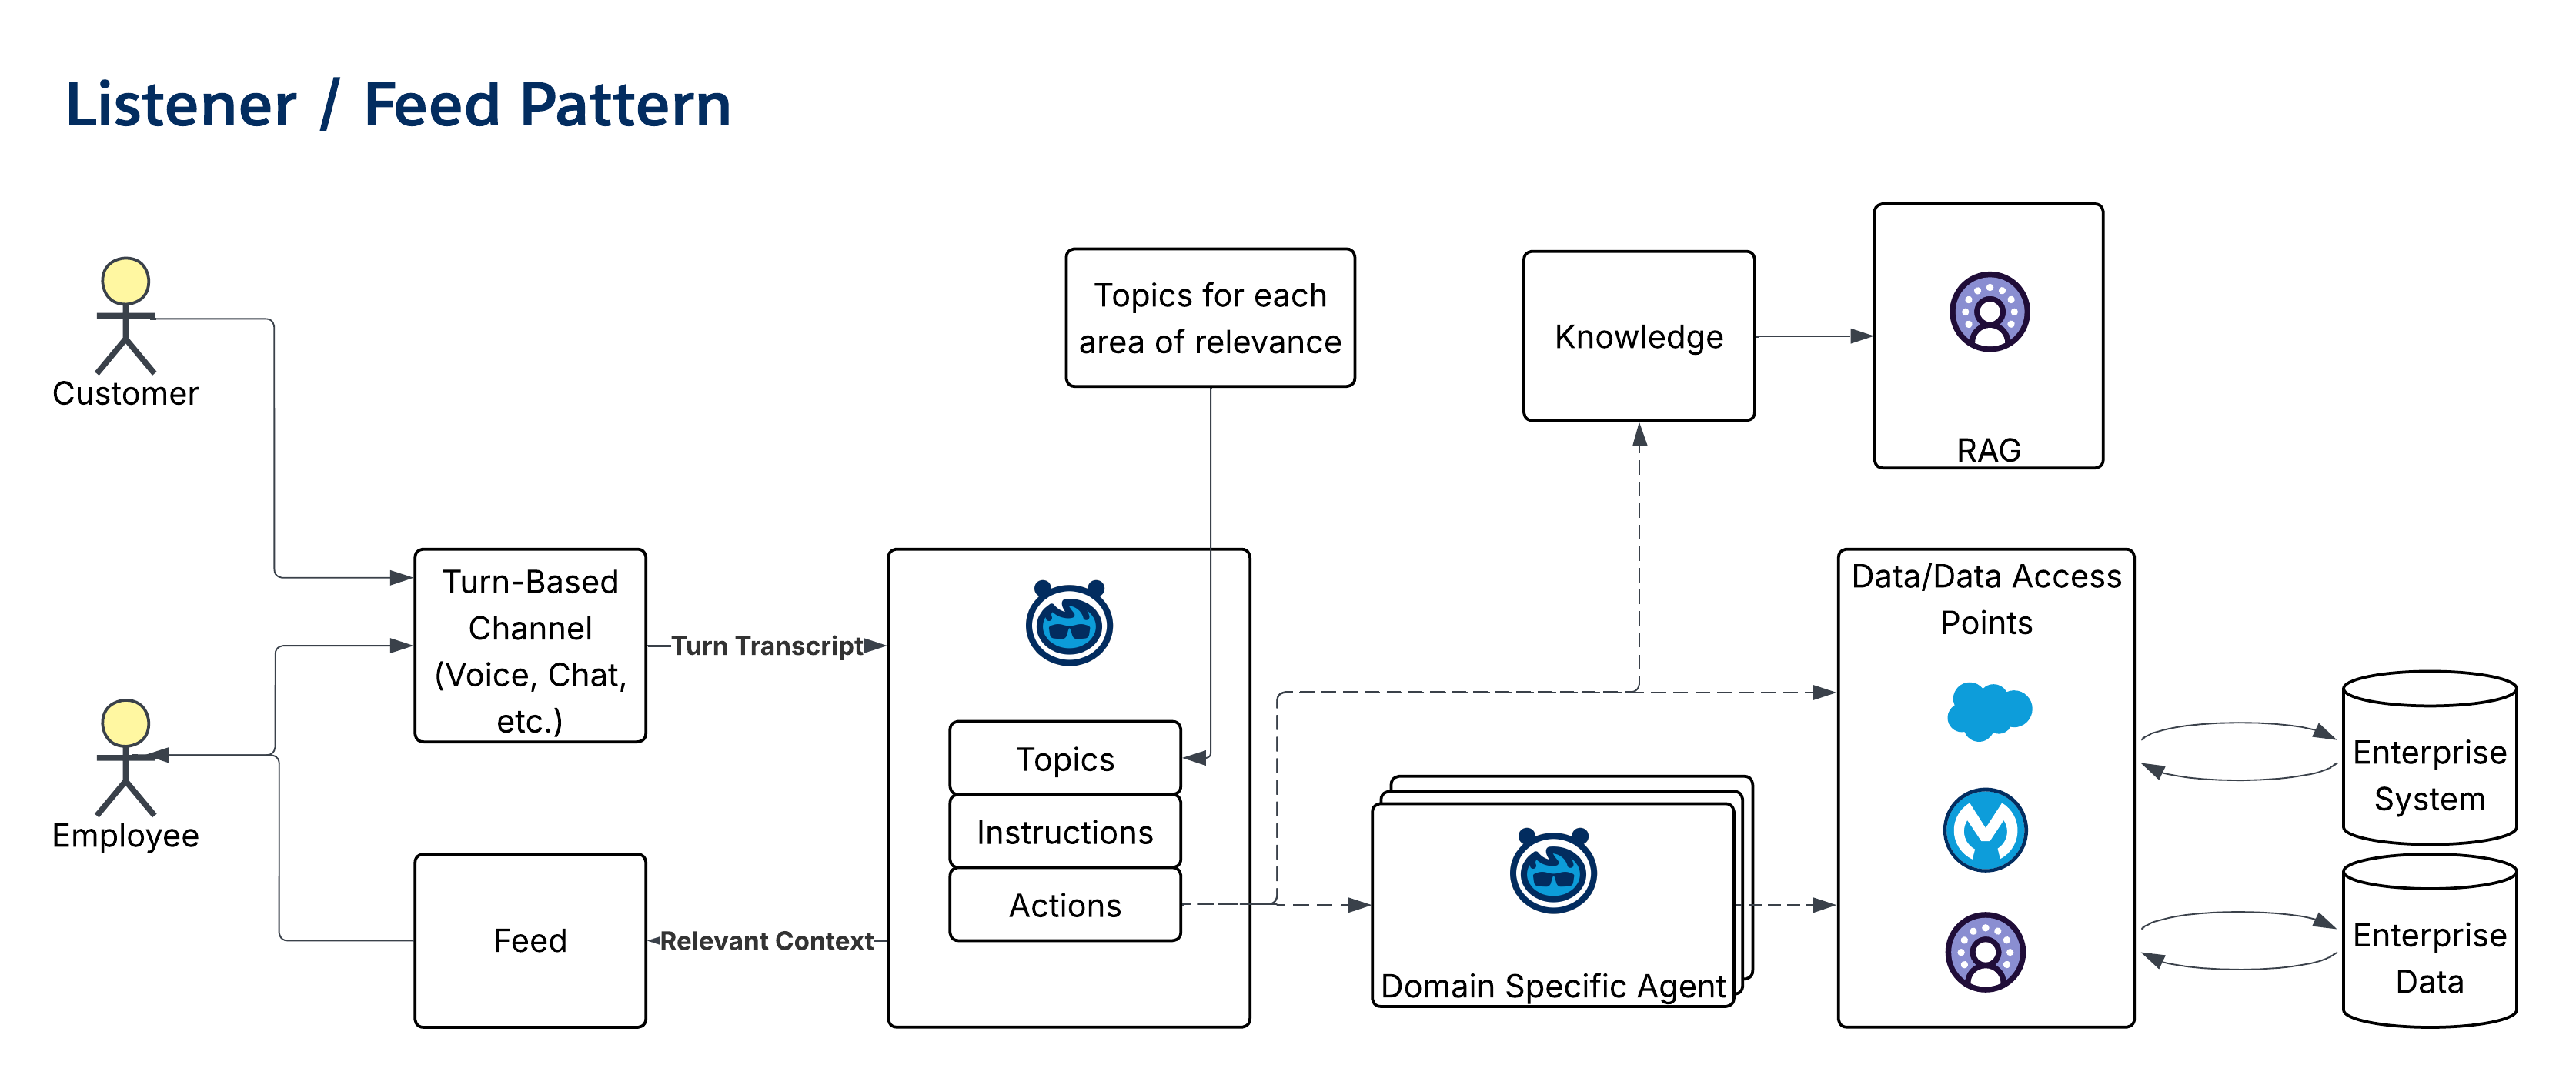 - **Maturità agente Salesforce**: Livello 3
### Schema dell'area di lavoro (Radar O'Reilly)
- **Panoramica**: Lo _schema Area di lavoro_ gestisce un'interfaccia utente reattiva a un unico riquadro di vetro nel flusso di una conversazione. Elabora ogni enunciazione per aggiornare porzioni dell'unità operativa con contenuti pertinenti.
- **Tipo di output**: Fornire il contesto pertinente che si trova in un portlet all'interno di una visualizzazione a vetro singolo più grande.
- **Guida all'uso degli schemi**: Un agente _orchestratore_ passa le enunciazioni a una suite di agenti _Argomento_. Ogni agente dell'argomento valuta l'istruzione per determinare se è necessario un aggiornamento UX. In caso affermativo, invia tramite push gli aggiornamenti dinamici al LWC corrispondente.
- **Caso d'uso rappresentativo**: Questo funziona come una porta principale agente avanzata.
- **Diagramma**:
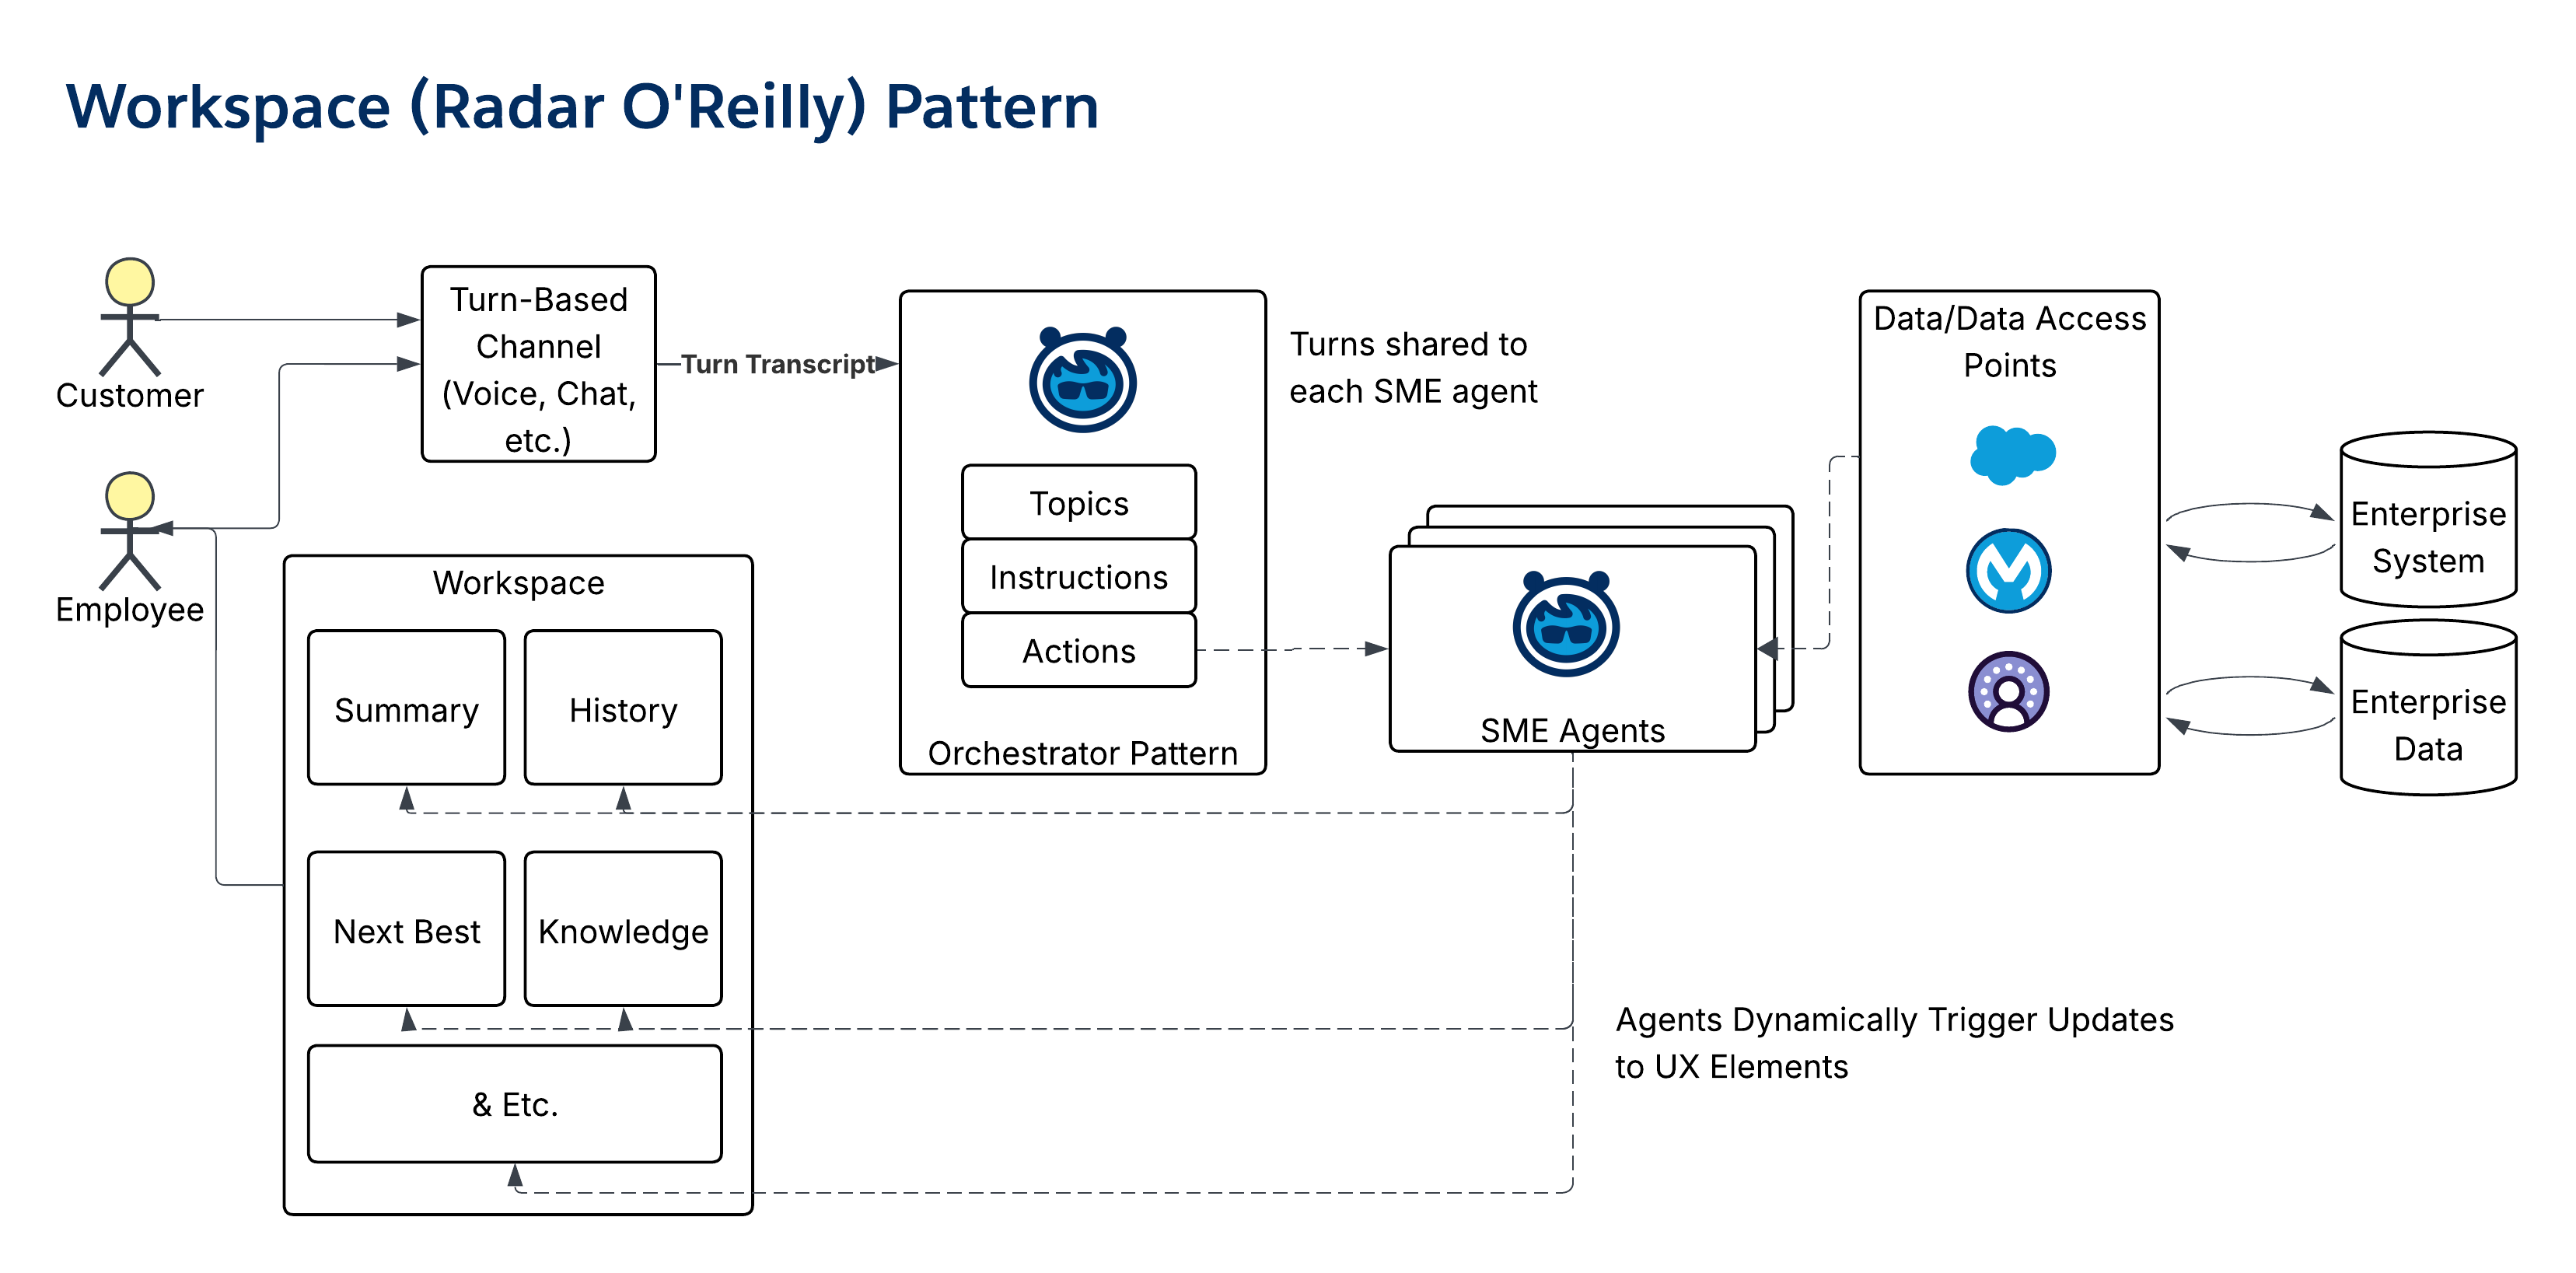 - **Maturità agente Salesforce**: Livello 3
## 7\. Schemi specialistici
Gli _schemi specialistici_ incapsulano Knowledge o competenze approfondite in un particolare dominio, e in genere sono orchestrati da _schemi di interazione_.
### Schema Answerbot
- **Panoramica**: Lo _schema di risposta_ è uno schema efficace per il self-service che utilizza GenAI per determinare il linguaggio naturale per il recupero Knowledge, non solo le parole chiave.
- **Tipo di output**: Knowledge riepilogato e riferimenti/citazioni a materiali di supporto.
- **Guida all'uso degli schemi**: Organizzare e inserire materiali di origine affidabili (ad esempio, Knowledge Store o Domande frequenti) per configurare l'agente. Posizionare l'agente sui siti Web aziendali o all'interno dei portali interni. Monitorare le domande per identificare e risolvere le lacune Knowledge.
- **Caso d'uso rappresentativo**: Facilitare le ricerche per linguaggio naturale su un sito Web aziendale, interagire con un bot vantaggi per le risorse umane e fornire componenti self-service per tutti gli studenti.
- **Diagramma**:
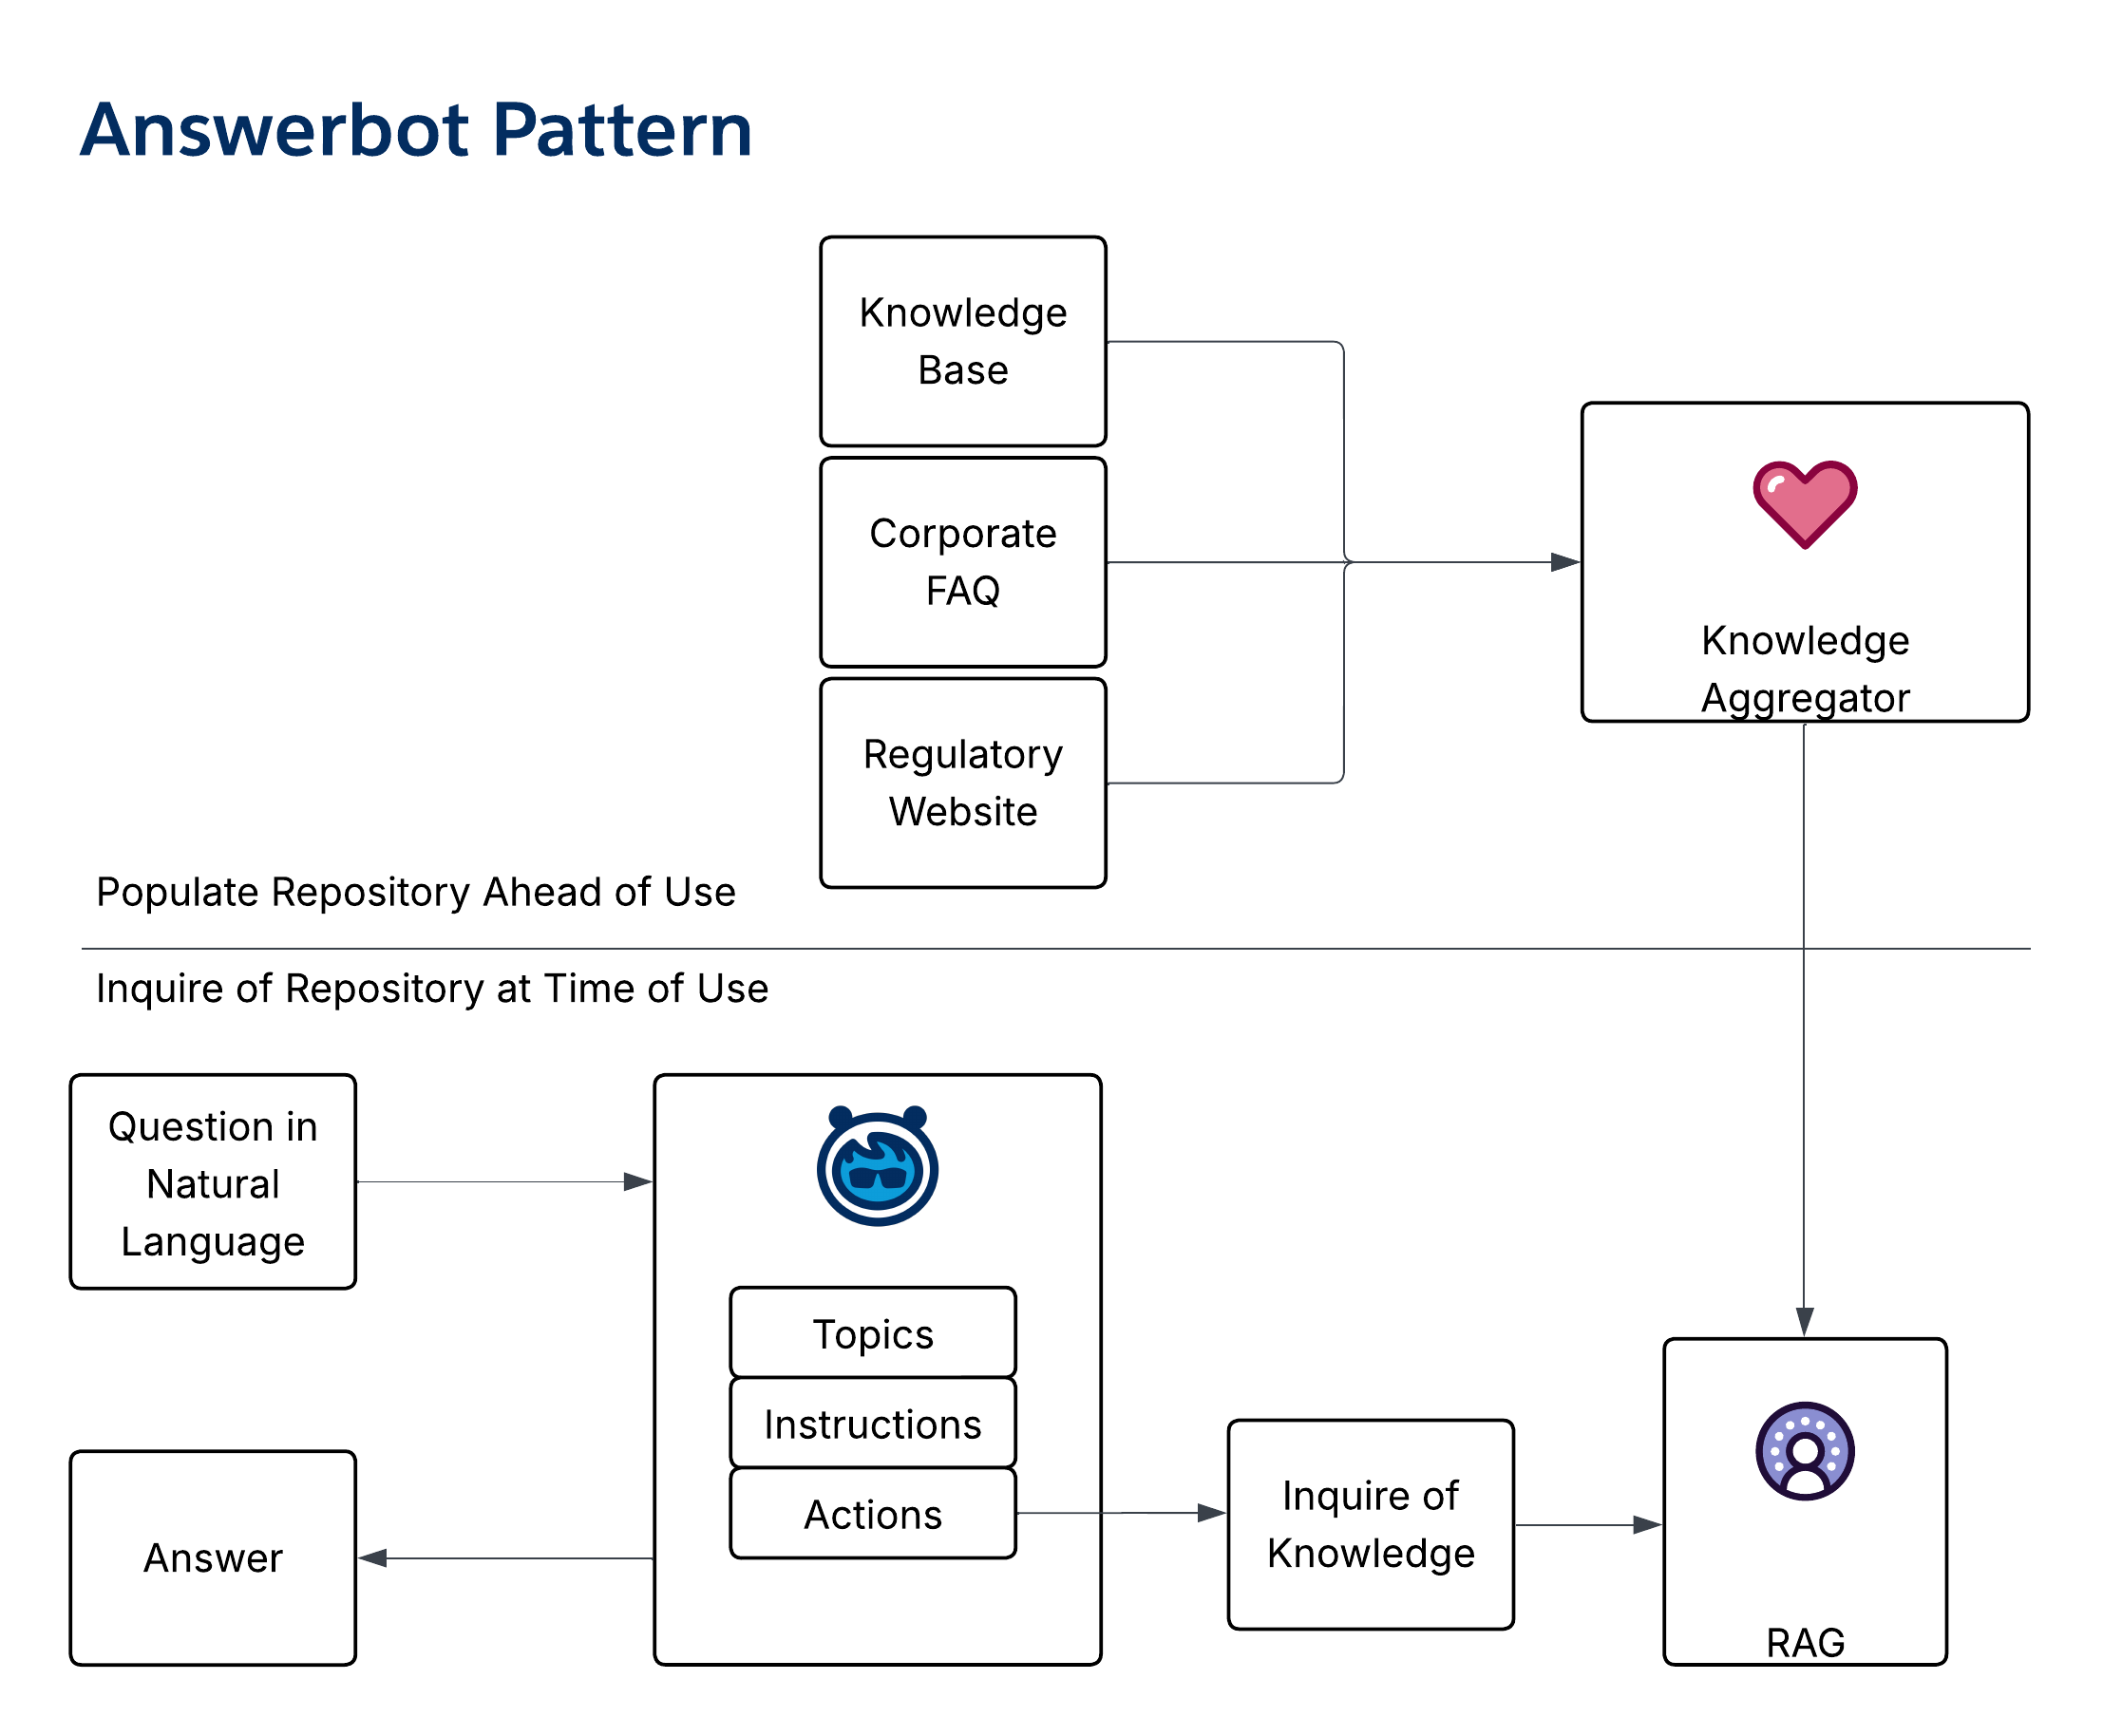 - **Maturità agente Salesforce**: Livello 1
### Schema PMI dominio
- **Panoramica**: Lo _schema PMI dominio_ è uno schema di base che fornisce un front-end per linguaggio naturale per un dominio aziendale (ad esempio, Ordini o Richieste).
- **Tipo di output**: Fornire contenuti, argomenti, dati e informazioni formattate pertinenti sul dominio.
- **Guida all'uso degli schemi**: Utilizzare questo schema per incapsulare un oggetto o un dominio aziendale. Configurare l'agente con la possibilità di eseguire operazioni CRUD appropriate. Rendere disponibili questi agenti tramite gli [_schemi di interazione_](/docs/architect/it-it/fundamentals/guide/enterprise-agentic-architecture#6-schemi-di-interazione) (ad esempio, - Orchestratore o Ascoltatore).
- **Caso d'uso rappresentativo**: Gatekeeping di un dominio di dati aziendali, fornitura di un "agente dell'ordine" o di un "agente dell'inventario" e fornitura di un'interfaccia agente per un dominio aziendale.
- **Diagramma**:
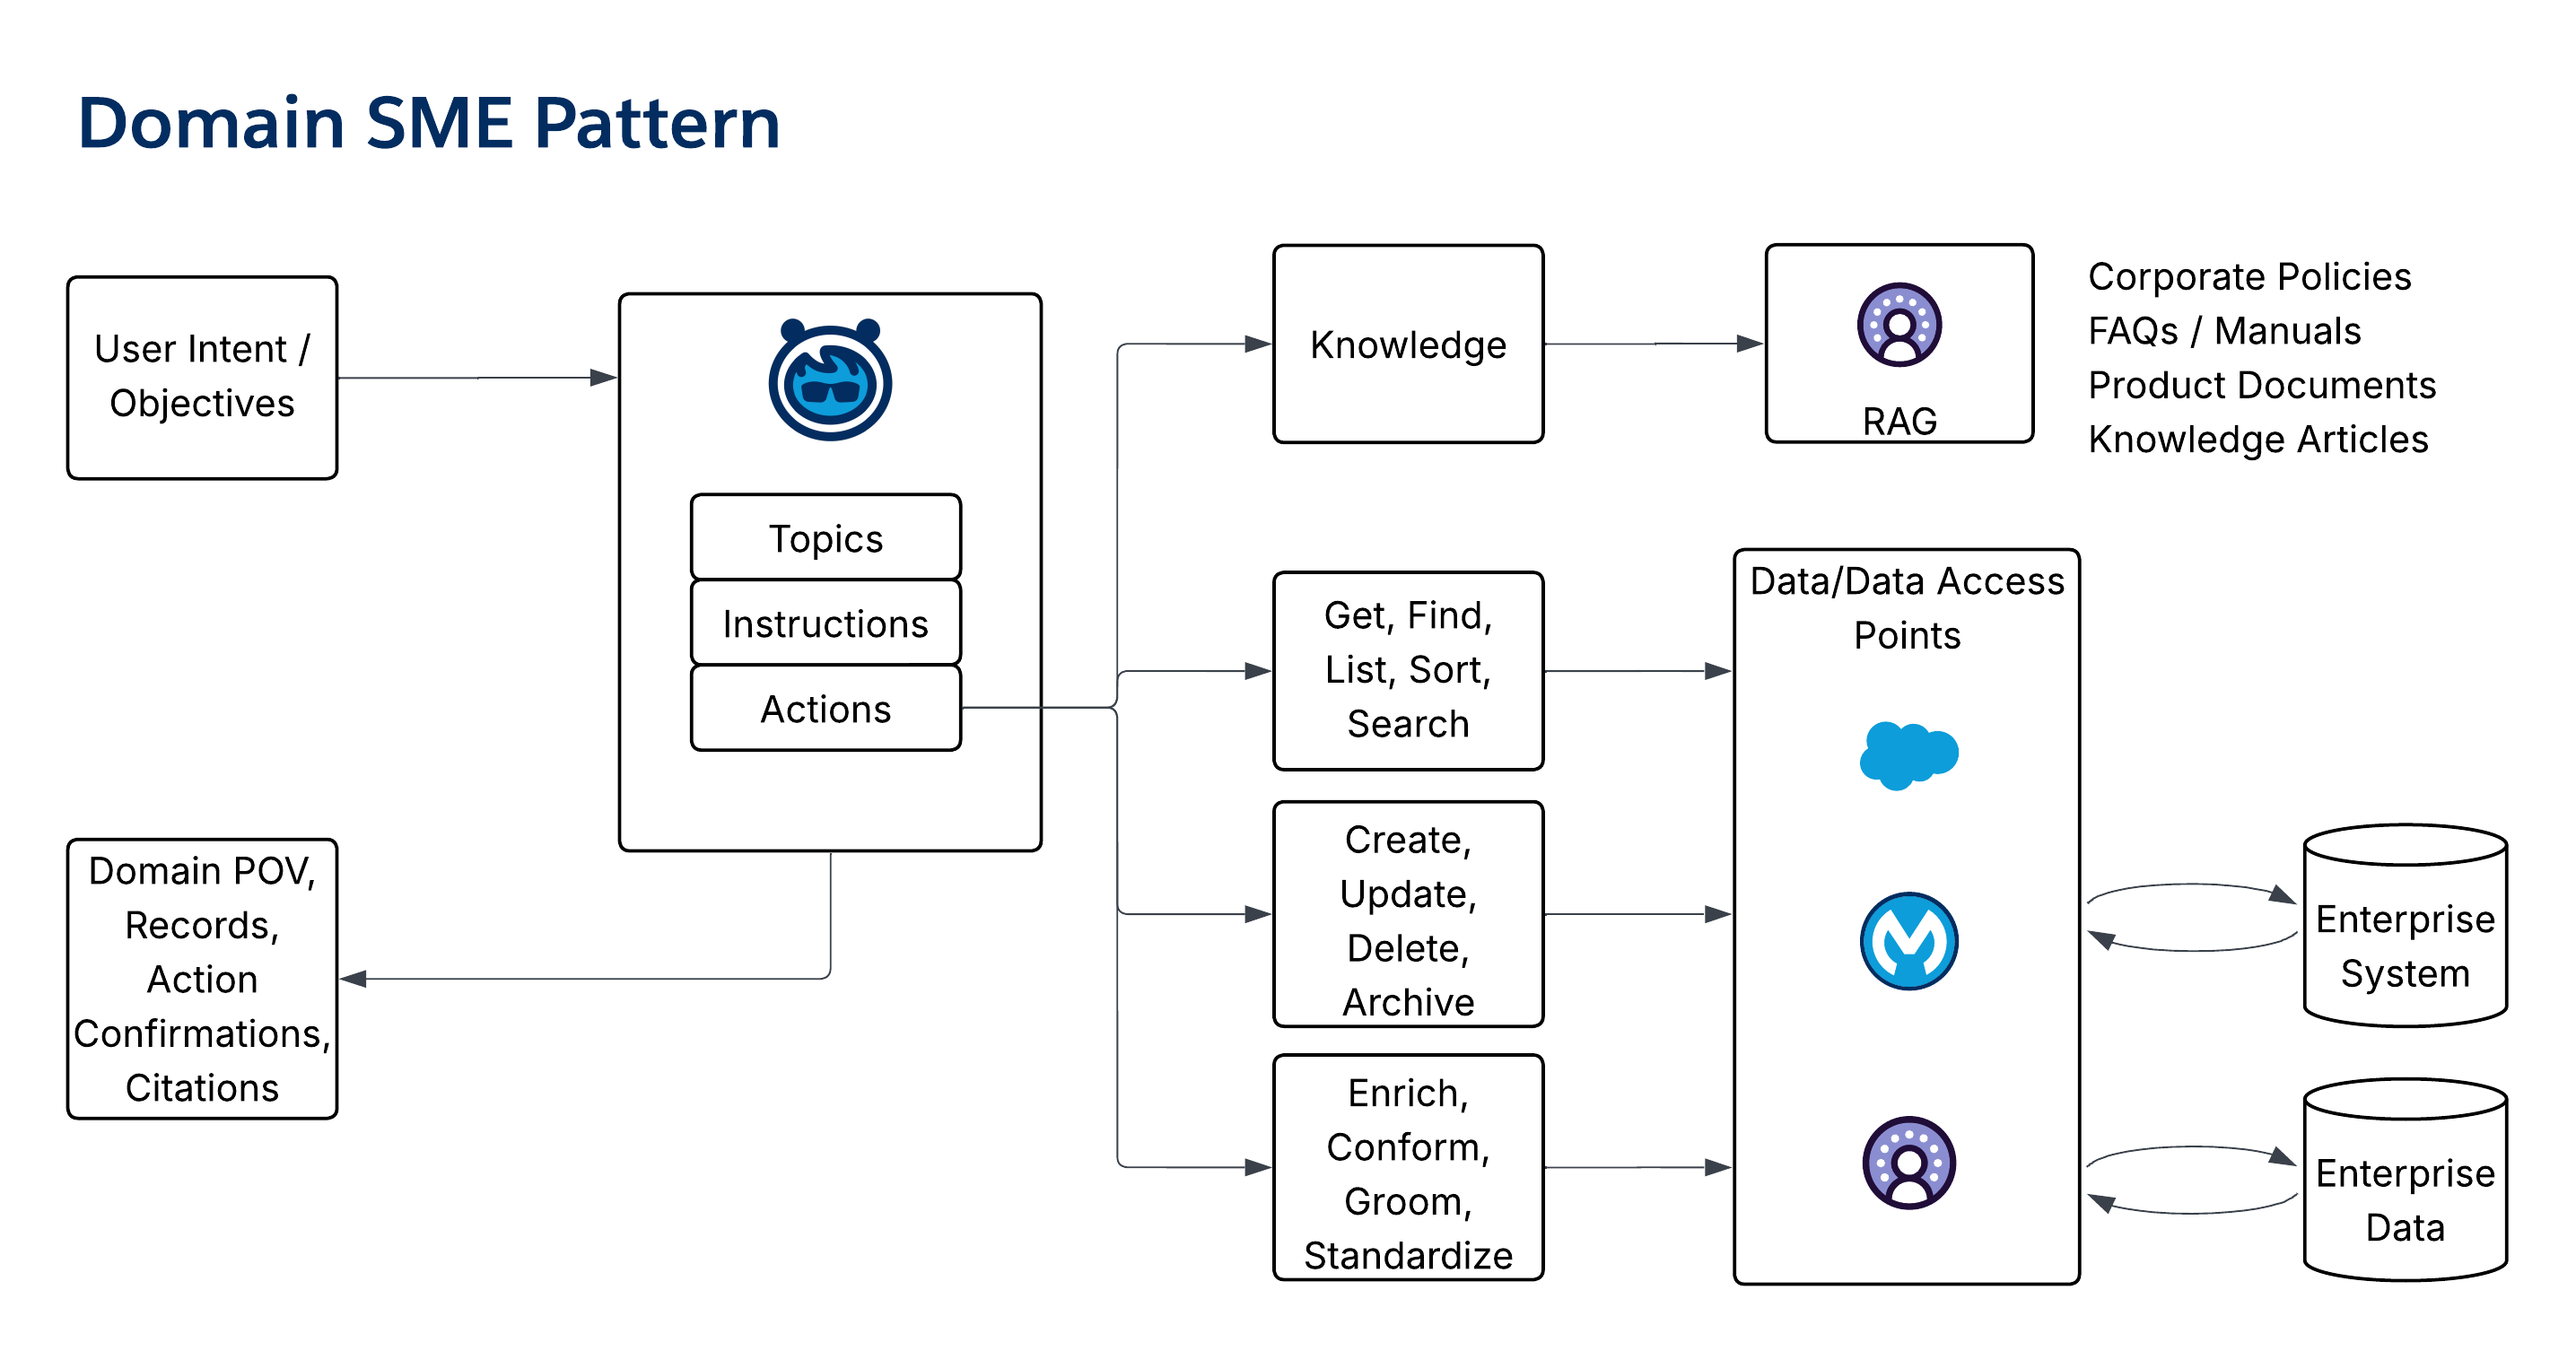 - **Maturità agente Salesforce**: Livello 2
### Schema interrogatore
- **Panoramica**: Lo _schema Interrogator_ è un agente PMI che può essere interrogato su un argomento per riunire il contesto di più fonti per rispondere alle domande. La funzionalità agente chiave sfruttata è la capacità di estrarre il contesto e connettere i concetti in un corpo di contenuto, come farebbe un essere umano dopo aver letto e interiorizzato il contenuto. Questo schema attenua la necessità di "integrazione sedia girevole".
- **Tipo di output**: Fornire risposte alle domande.
- **Guida all'uso degli schemi**: È spesso configurato come widget console collegato al contesto corrente dell'utente in modo che possa porre domande direttamente. Viene utilizzato anche in combinazione con risorse Knowledge come Domande frequenti, Policy e cataloghi di prodotti. Abbinare lo _schema Interrogator_ ai prompt standard per ridimensionare le risposte comuni alle domande comuni.
- **Caso d'uso rappresentativo**: Utilizzare come agente assistente a contratto; Assistente richieste di prestazioni o agente lavoratore specializzato in schemi multi-agente (ad esempio, Ascoltatore o Area di lavoro).
- **Diagramma**:
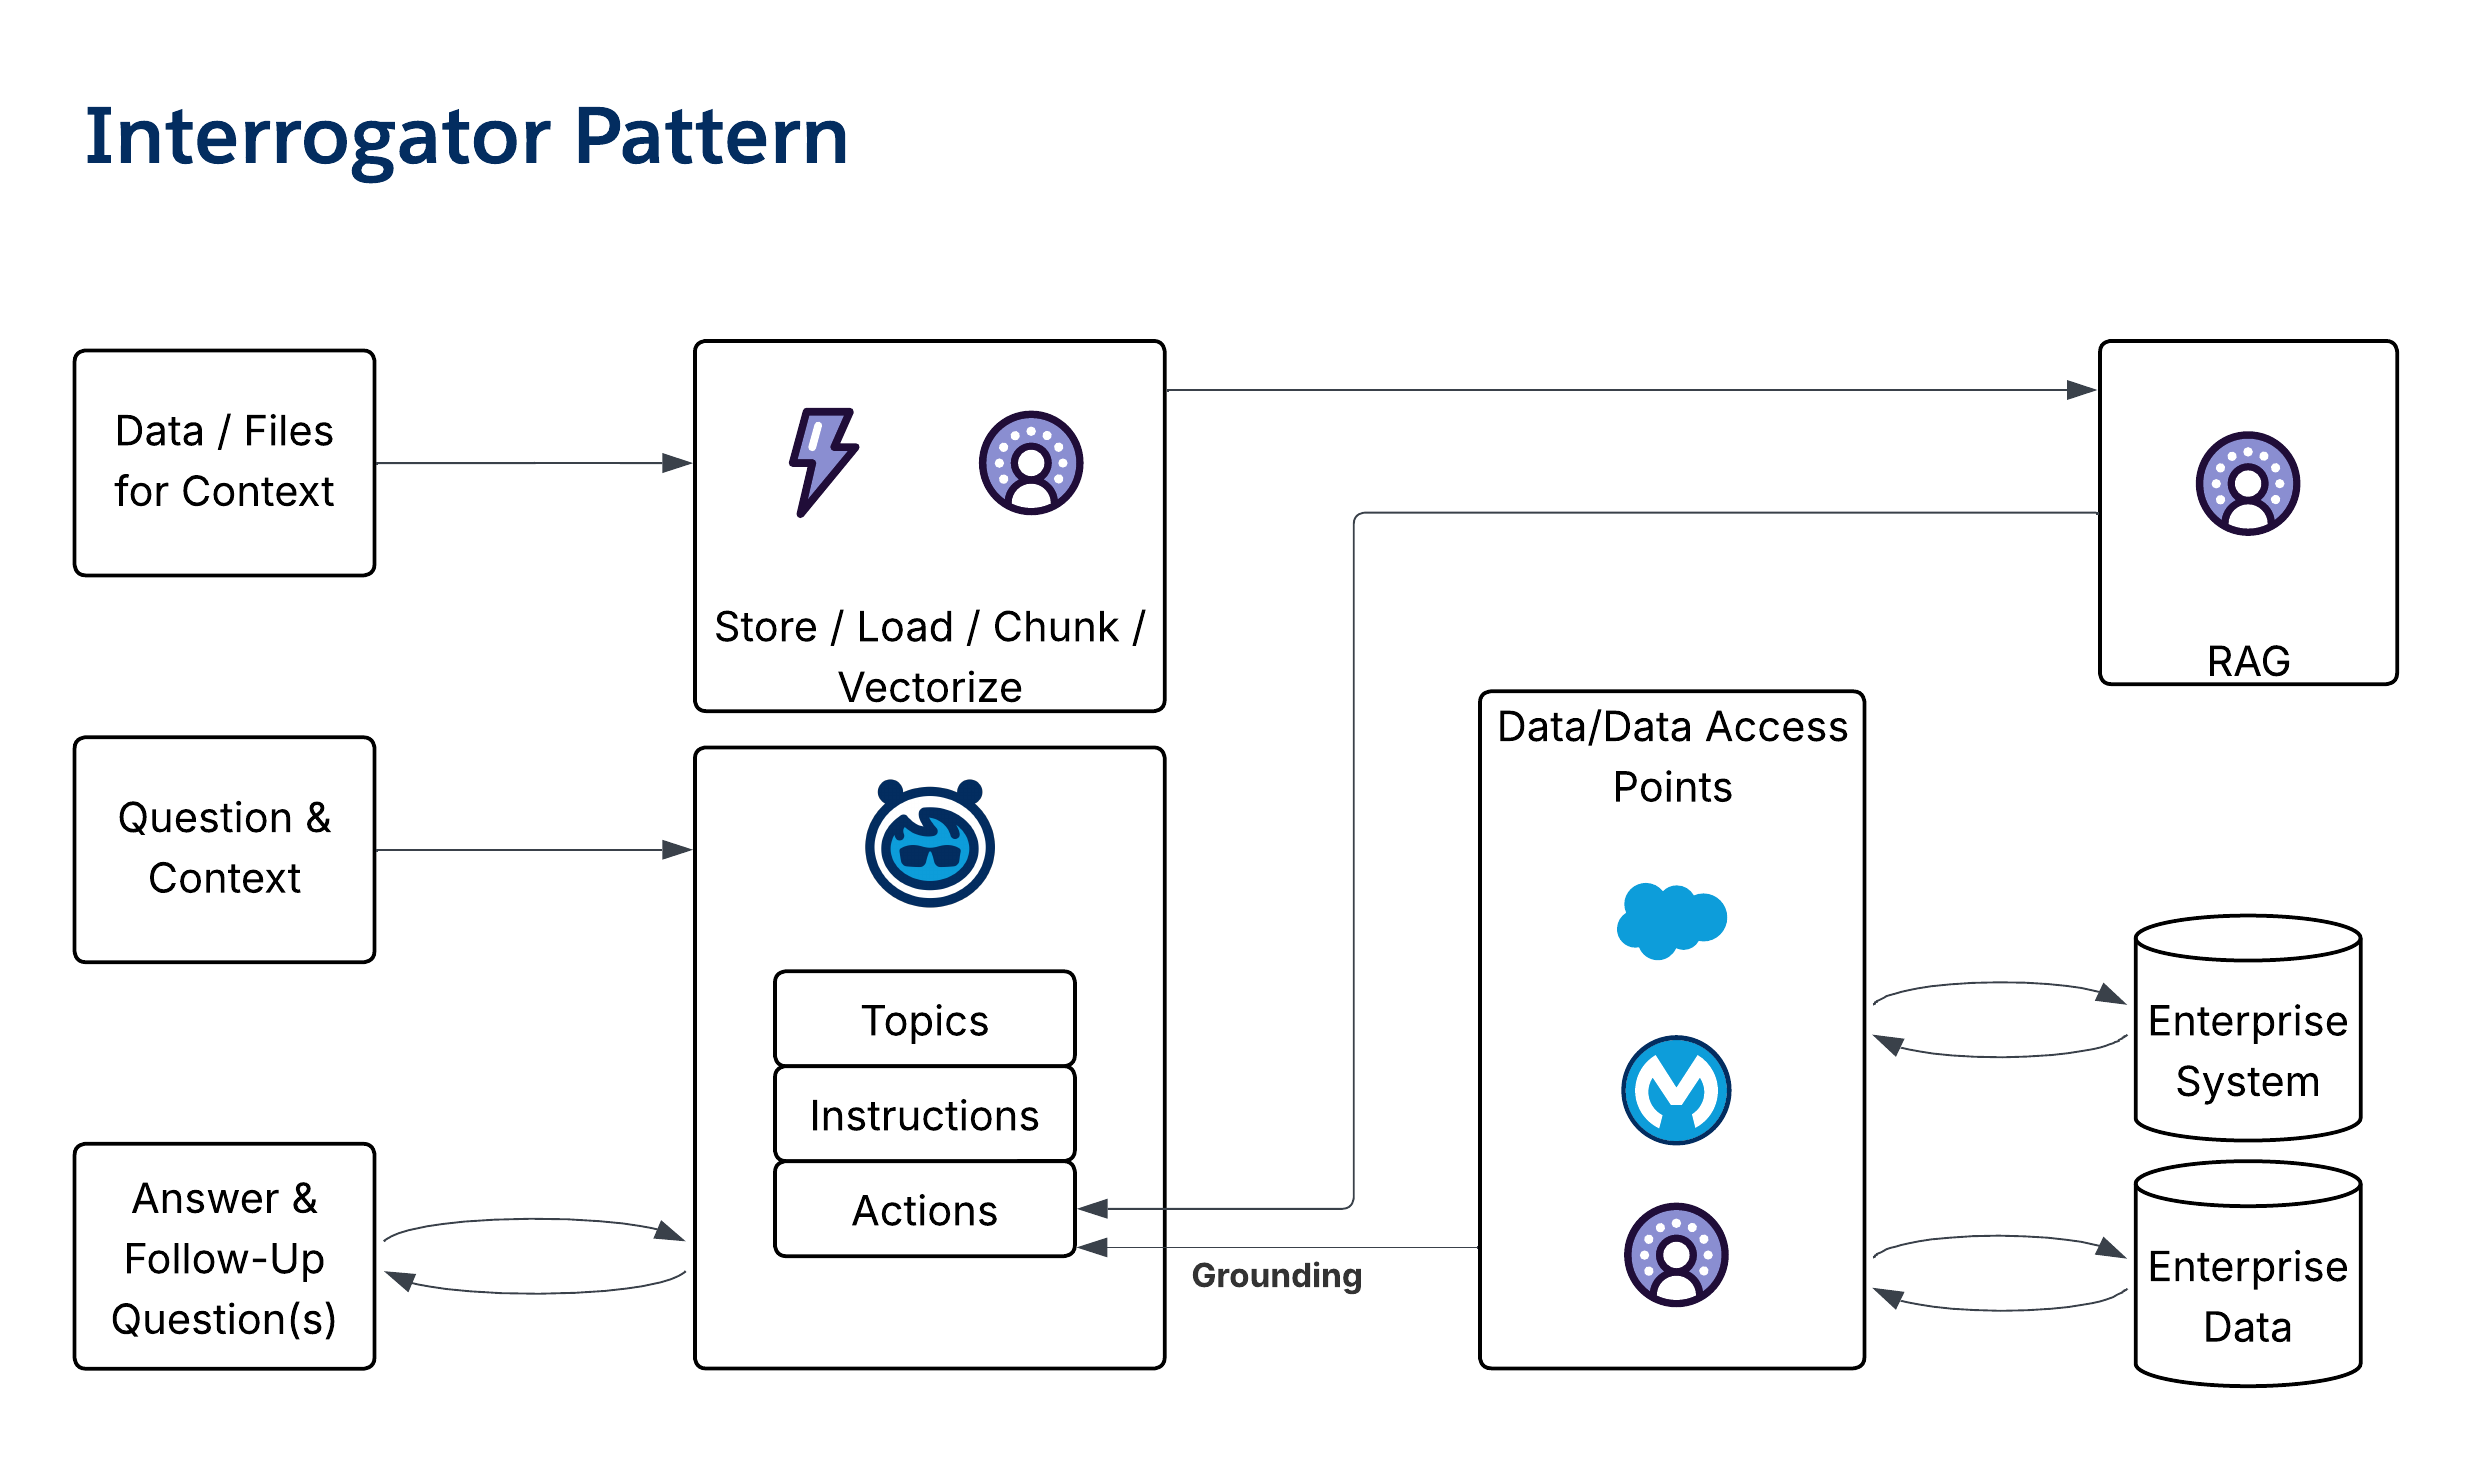 - **Maturità agente Salesforce**: Livello 2
### Schema di priorità
- **Panoramica**: Lo _schema Priority_ viene utilizzato per ordinare una serie di operazioni o oggetti di lavoro in base a un obiettivo definito. Sfrutta GenAI per analisi qualitative, analisi dei dati non strutturati o analisi integrativa in più domini di dati.
- **Tipo di output**: Fornire approfondimenti generativi.
- **Guida all'uso degli schemi**: Utilizzare il linguaggio naturale per descrivere le qualità desiderate per l'assegnazione delle priorità. Basare l'agente su una serie di opzioni selezionabili. Combinarlo con lo schema Listener per creare una "Next Best Action" reattiva nel flusso di lavoro.
- **Caso d'uso rappresentativo**: Utilizzare come generatore _Next Best Action_ o agente lavoratore specializzato in schemi di lunga durata o multi-agente.
- **Diagramma**:
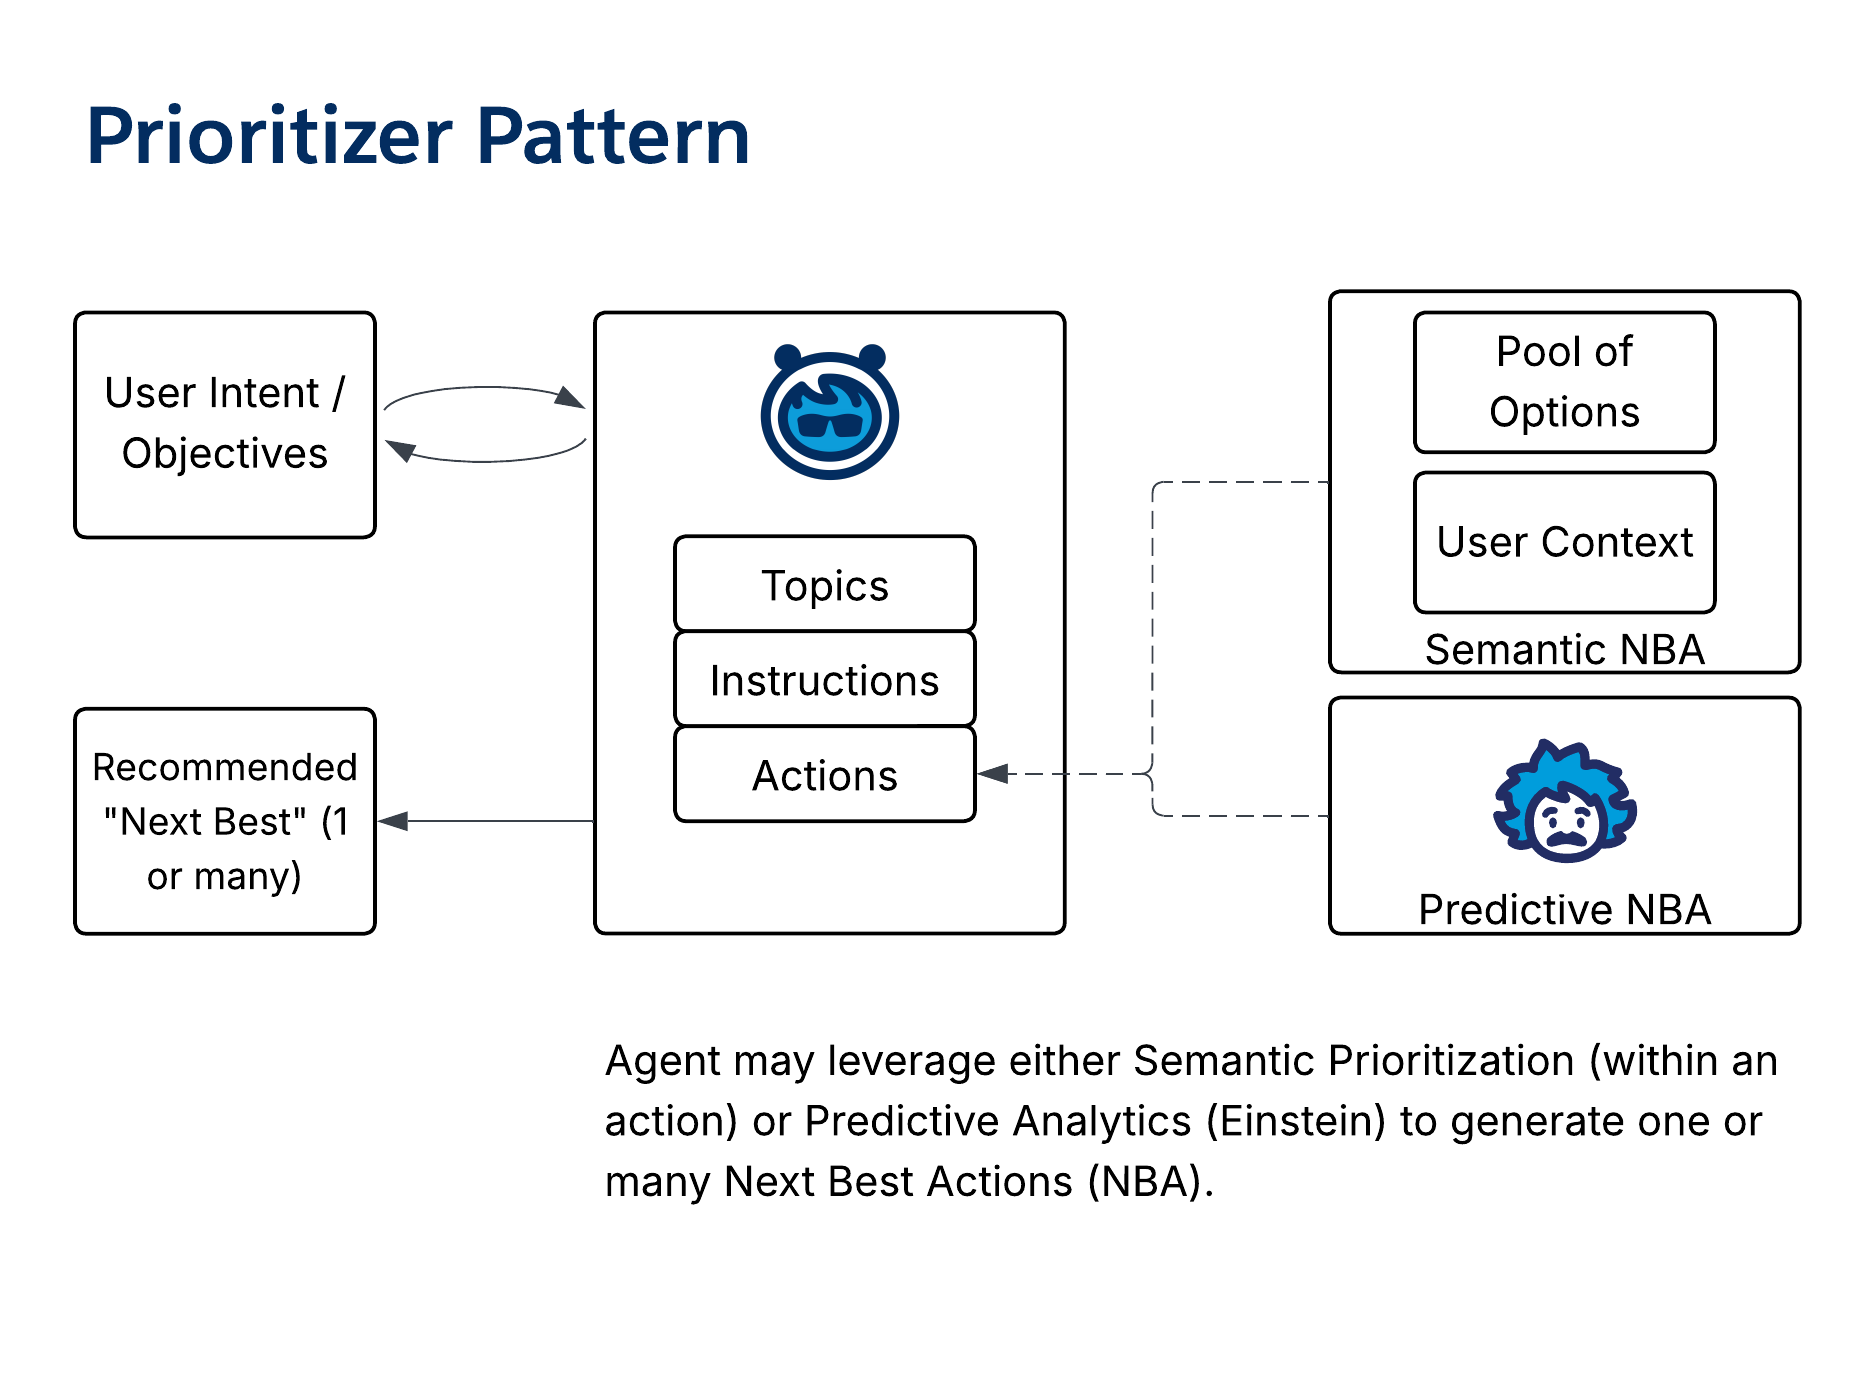 - **Maturità agente Salesforce**: Livello 2
## 8\. Utilità e schemi di dati
Gli _schemi di utilità_ eseguono operazioni specifiche e ripetibili che supportano altri agenti o processi.
### Schema generatore
- **Panoramica**: Lo _schema Generator_ è uno schema di base per la creazione di nuovo contenuto (ad esempio, riepiloghi casi o bozze di email) da input e standard esistenti. Viene spesso implementato come prompt e può essere incorporato in altri agenti.
- **Tipo di output**: Fornire contenuti generati conformi al formato e all'intento richiesti.
- **Guida all'uso degli schemi**: Lo _schema Generator_ può essere utilizzato nella maggior parte degli altri schemi o come modello indipendente. Il contesto può essere fornito tramite la richiesta, l'idratazione durante l'esecuzione o ulteriori fasi di arricchimento.
- **Caso d'uso rappresentativo**: Fornire riepiloghi dei casi, bozze di email, articoli Knowledge o proposte/risposte ai QBR.
- **Diagramma**:
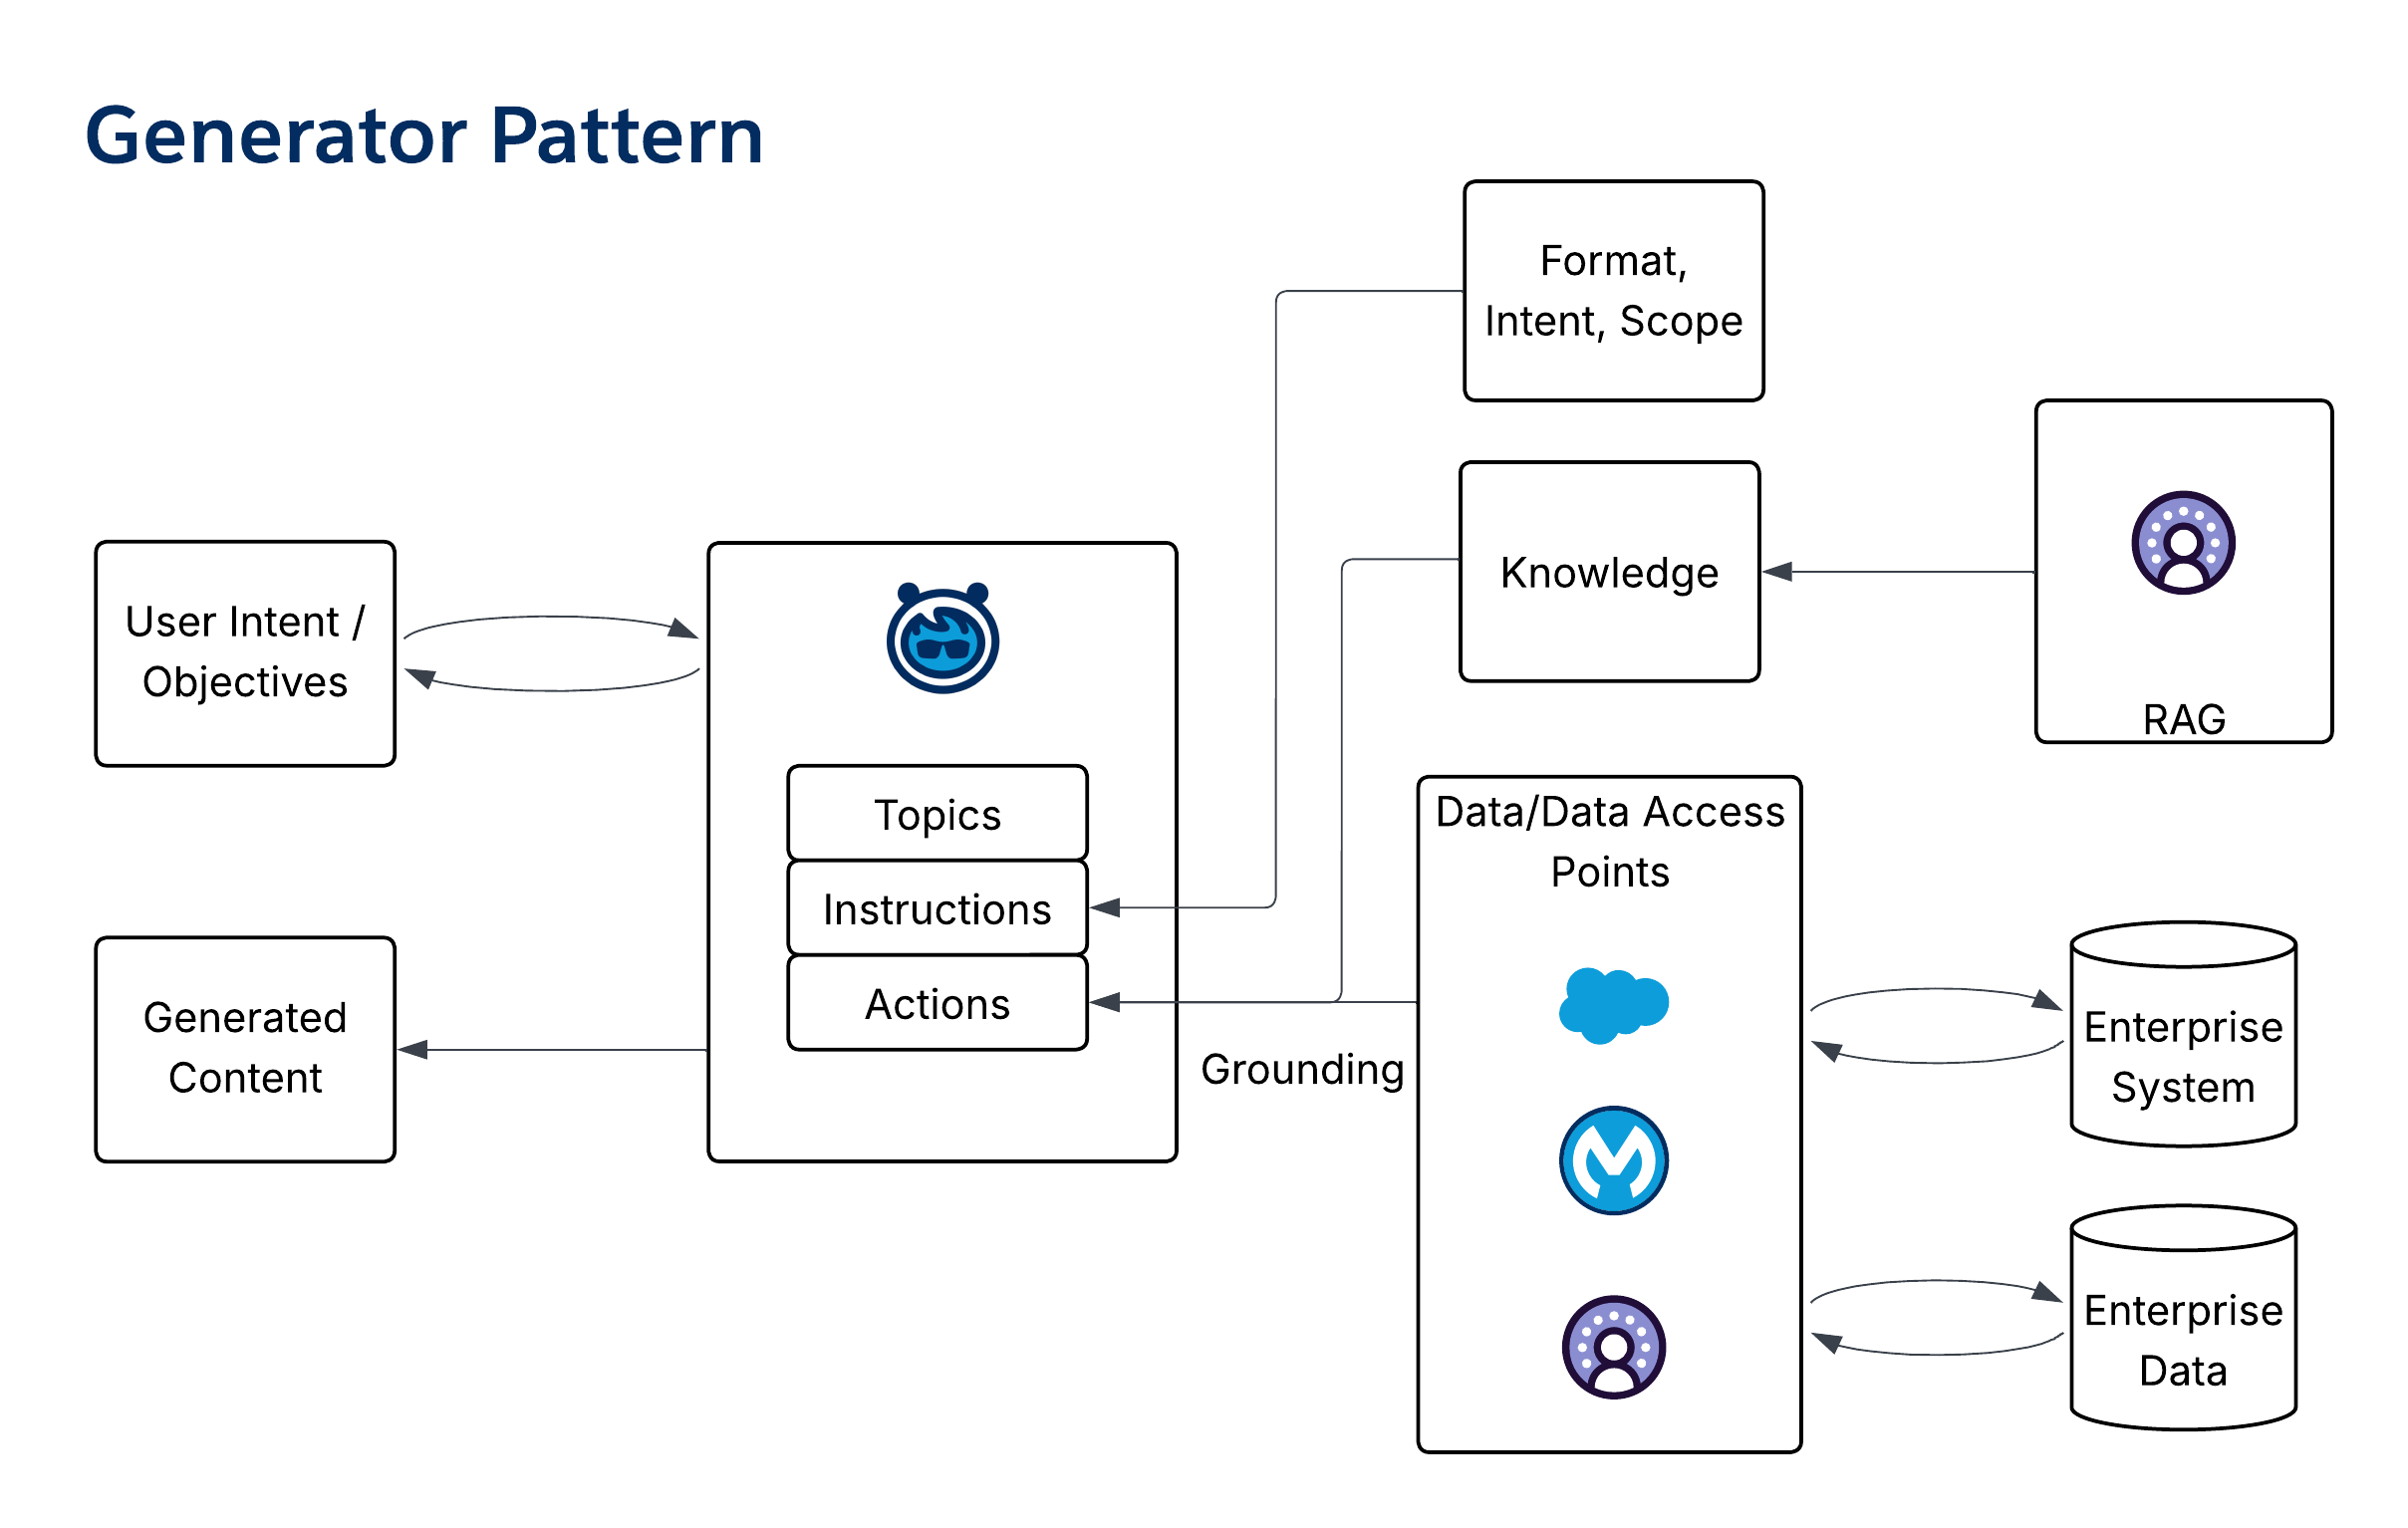 - **Maturità agente Salesforce**: Livello 1
### Schema di steward dati
- **Panoramica**: Lo _schema Data Steward_ è uno schema autonomo in background che introduce una fase agente nelle operazioni sui dati per garantire qualità, conformità e arricchimento coerenti dei dati.
- **Tipo di output**: Fornire campi record e dati aggiornati prima del salvataggio.
- **Guida all'uso degli schemi**: Incorporare la qualità dei dati al momento della creazione aggiungendo gli steward dei dati che registrano i flussi di attivazione prima di salvare i dati. Aiuta a garantire un'applicazione coerente dei dati di classificazione, riepilogo e stato.
- **Caso d'uso rappresentativo**: Garantire aggiornamenti coerenti dello stile "Pizza-Tracker", arricchire i dati degli account ed eliminare codici postali e indirizzi non corrispondenti.
- **Diagramma**:
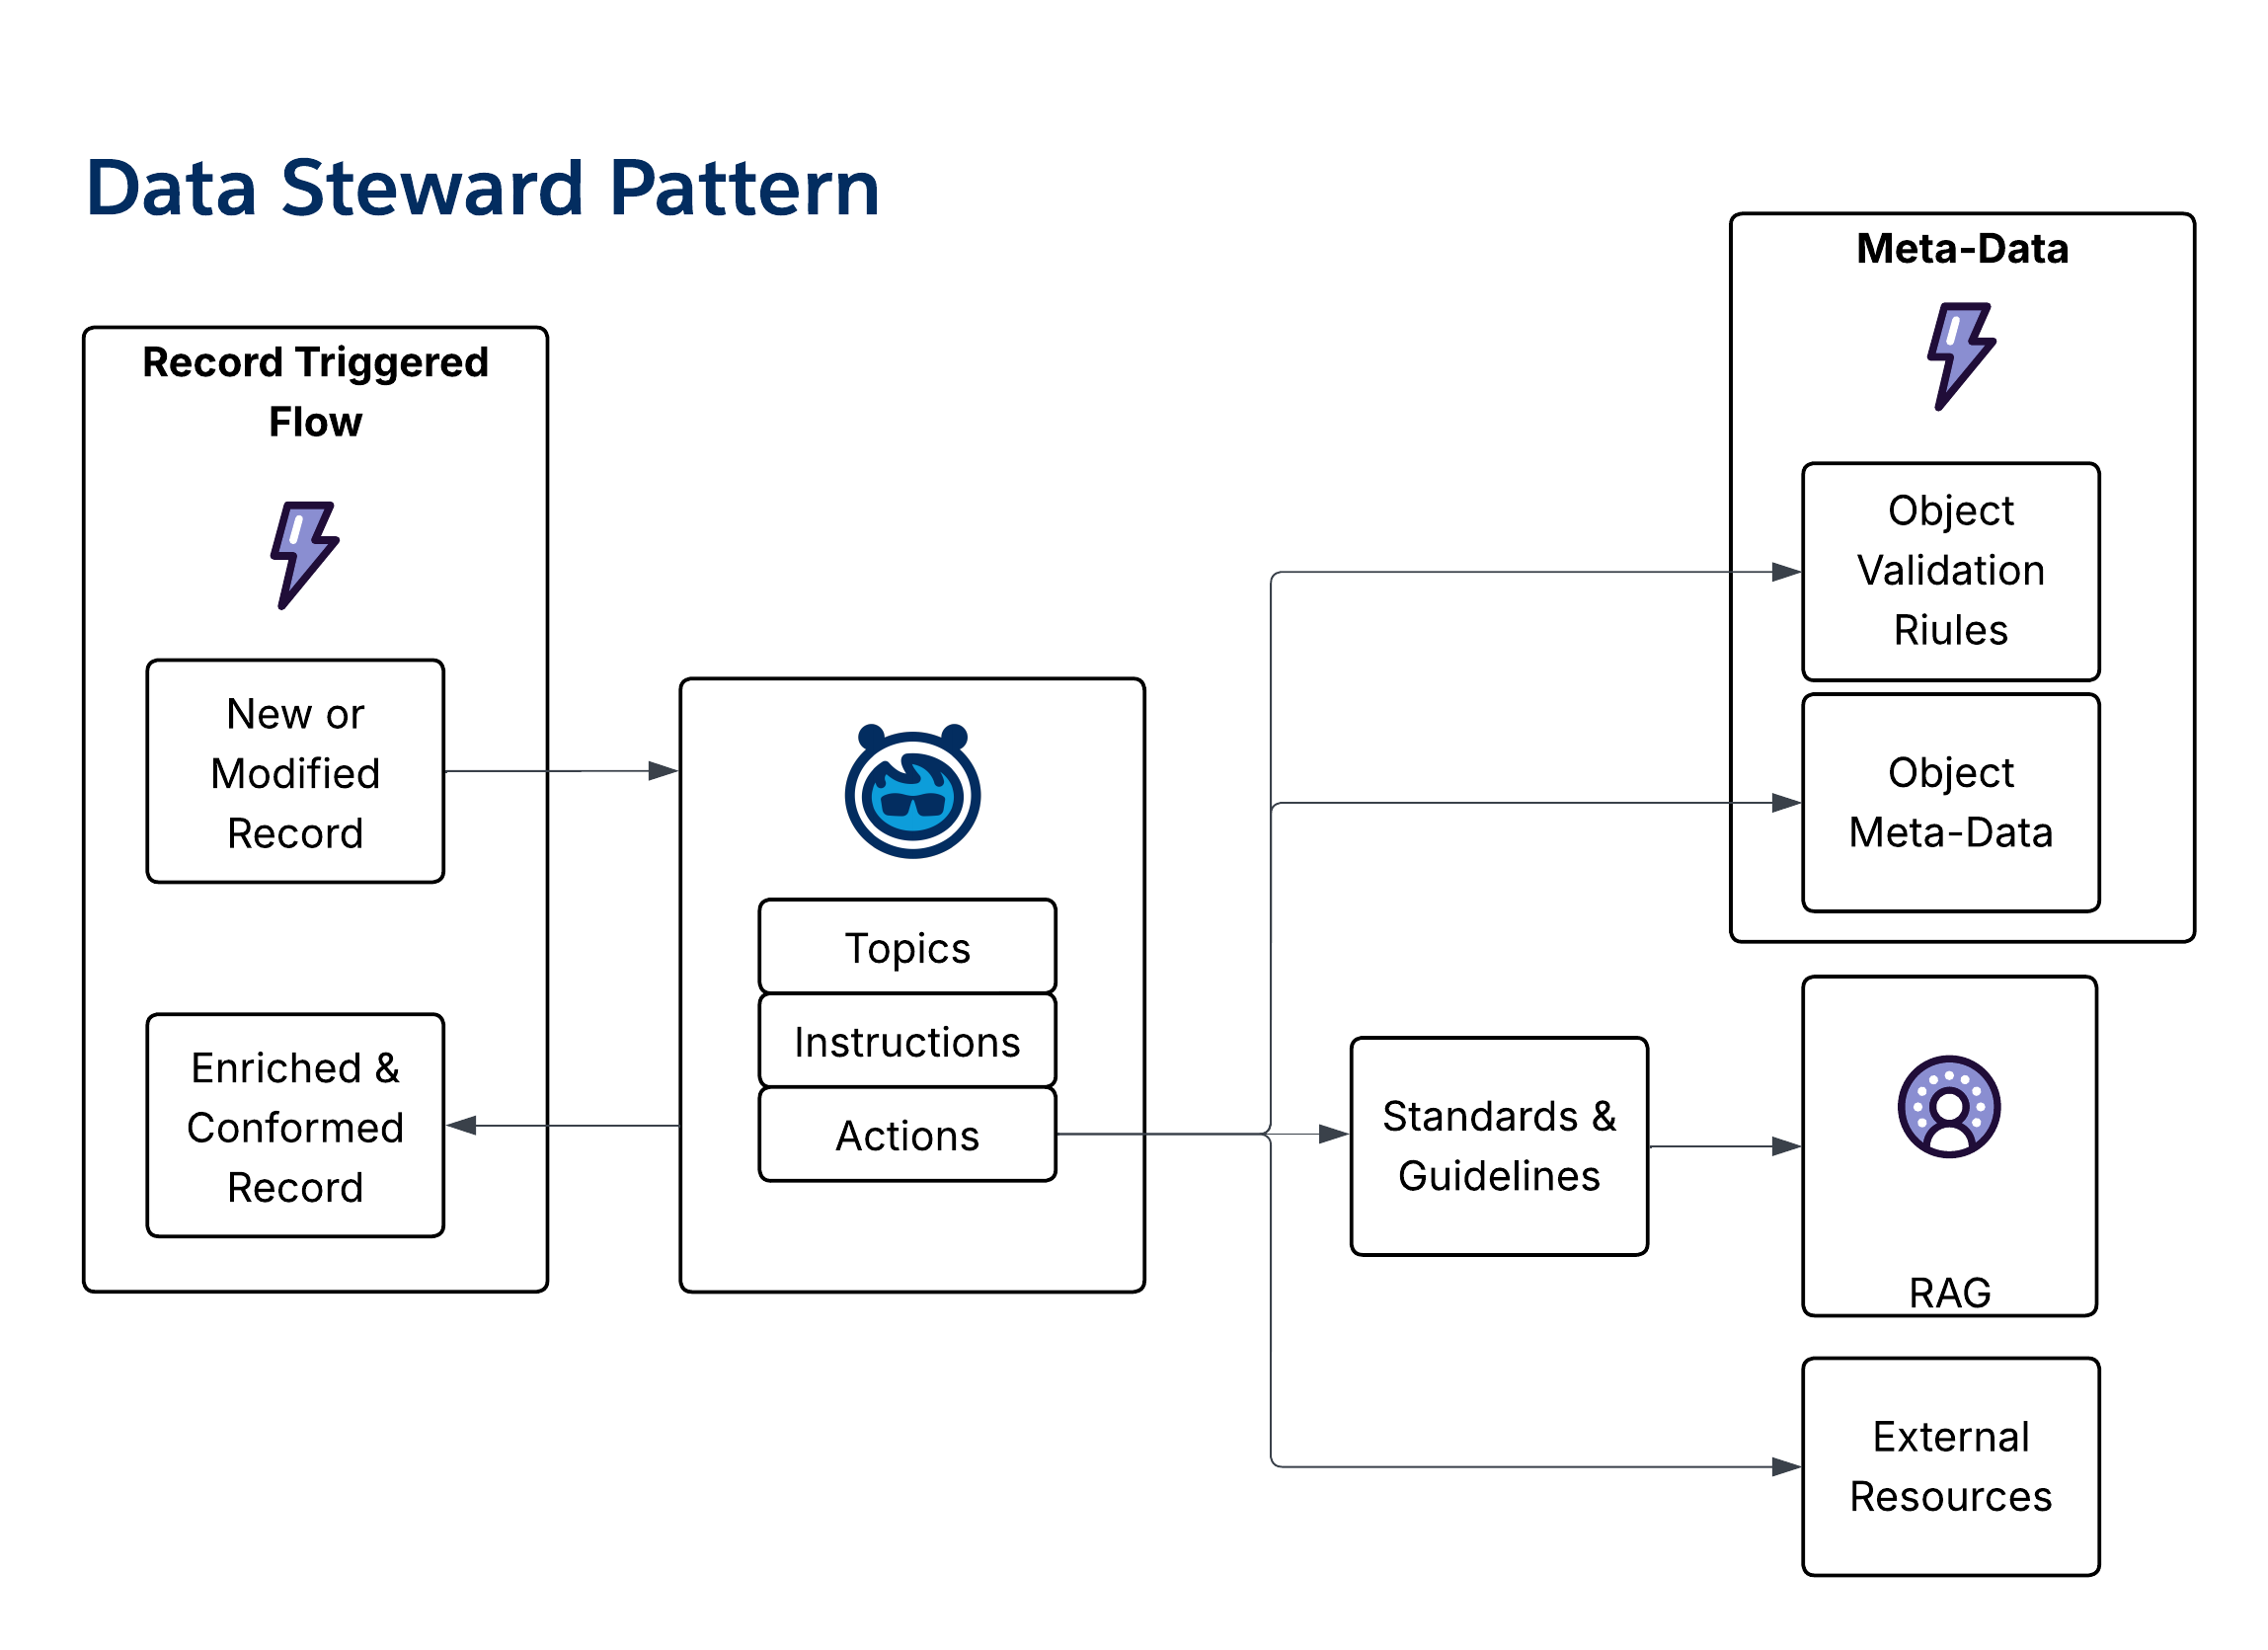 - **Maturità agente Salesforce**: Livello 2
### Schema Zen Data Gardener
- **Panoramica**: Lo _schema Zen Data Gardener_ è uno schema in background pianificato utilizzato per preparare e standardizzare i dati, utilizzando ragionamenti a basso costo per convalidare, arricchire e conformare i dati in domini di dati altrimenti non connessi.
- **Tipo di output**: Fornire record aggiornati e/o operazioni di gestione dei dati.
- **Guida all'uso degli schemi**: Utilizzare lo schema per abilitare la revisione e la convalida periodiche e periodiche dei dati. Per i dati che cambiano lentamente, pianificare l'agente con una cadenza lenta (ad esempio, mensile). Combinarla con lo [schema Data Steward](/docs/architect/it-it/fundamentals/guide/enterprise-agentic-architecture#schema-di-steward-dati) per fornire operazioni di qualità dei dati prospettiche e retrospettive.
- **Caso d'uso rappresentativo**: Garantire l'allineamento tra i vantaggi venduti e il sistema di richieste, nonché la convalida periodica delle licenze broker rispetto ai registri nazionali.
- **Diagramma**:
 - **Maturità agente Salesforce**: Livello 4
### Schema configuratore
- **Panoramica**: Lo _schema Configuratore_ genera artefatti di configurazione (ad esempio, SQL/SOQL, JSON e CSV) dai requisiti del linguaggio naturale. Può anche essere eseguito in senso inverso per convalidare una configurazione esistente in base ai requisiti.
- **Tipo di output**: Fornire record aggiornati, operazioni di gestione dei dati o creare problemi/errori per la correzione.
- **Guida all'uso degli schemi**: Basare l'agente su standard, linee guida o esempi specifici. Configurare i requisiti di creazione utilizzando fonti come contratti o specifiche di prodotto. Collegare lo _schema Configuratore_ al sistema di destinazione per inviare tramite push la configurazione generata.
- **Caso d'uso rappresentativo**: Generazione di record di configurazione prodotto per i prodotti assicurativi sanitari e convalida delle condizioni di contratto/pagamento per gli operatori sanitari.
- **Diagramma**:
 - **Maturità agente Salesforce**: Livello 4
### Schema giudice e giuria
- **Panoramica**: Lo _schema Giudice & Giuria_ è progettato per ridurre al minimo le allucinazioni utilizzando un insieme di agenti "giurati" e un agente "giudice" che valuta la congruenza delle risposte per assicurarsi che siano materialmente coerenti e fondate.
- L'_approccio Ensemble_ è incorporato in Agentforce e nel motore di ragionamento Atlas per gestire la veridicità e la pertinenza delle risposte. Lo _schema Giudice e Giuria_ si basa su questa funzionalità quando sono essenziali livelli elevati di precisione.
- Anche la combinazione di _Data Grounding_ (ad esempio, "trova la risposta in questi record/documenti") e _Prompt Engineering_ (ad esempio, "restituisci una risposta solo se è presente in questi record" o "convalida la risposta con questa fonte esterna") sono metodi efficaci per ridurre al minimo le allucinazioni.
- **Tipo di output**: Fornire approfondimenti generativi.
- **Guida all'uso degli schemi**: Utilizzare quando vi è una forte esigenza di output generativi coerenti e fondati. Un _agente giurato_ compila un prompt basato e lo passa a due o più _agenti giurati_, quindi il giudice valuta le risposte. Per risultati ottimali, utilizzare modelli diversi (ad esempio, uno di OpenAI e un altro di Anthropic) per ogni agente del giurato.
- **Caso d'uso rappresentativo**: Fornire risposte ad alta fedeltà e basate sui fatti per ridurre al minimo le allucinazioni.
- **Diagramma**:
 - **Maturità agente Salesforce**: Livello 2
### Modello di modello di modelli
- **Panoramica**: Lo _schema Modello di modelli_ sfrutta più agenti esperti per generare un'ampia gamma di prospettive e quindi estrae il consenso. A differenza dello [schema Giudice & Giuria](/docs/architect/it-it/fundamentals/guide/enterprise-agentic-architecture#schema-giudice-e-giuria), questo schema abbraccia più punti di vista per migliorare la ricchezza.
- Questo schema può anche essere chiamato schema Panel di esperti quando esistono modelli esperti con diversi punti di vista (POV) che può essere utile toccare.
- A differenza dello schema Giudice e Giuria, in cui l'intento è garantire che la risposta dell'agente converga su una "verità" comunemente accessibile, lo _schema Modello di modelli_ estende l'ambito della risposta sfruttando la diversità nell'ambiente agente.
- Questo schema presuppone che vi siano altri agenti con un POV distinto. Ad esempio, in un ambiente multi-organizzazione, multi-agente o con più agenti forniti dal fornitore in pile tecnologiche, lo _schema Modello di modelli_ fornisce una struttura per l'integrazione di più POV.
- Quando si considera questo schema, considerare anche altri approcci, spesso più leggeri:
- Anziché definire più agenti esperti, specificare più prompt e fare in modo che il sistema funzioni come un insieme di prompt.
- Sfruttare il "basamento" tramite azioni che accedono a dati appropriati per il contesto.
- **Tipo di output**: Fornire approfondimenti generativi.
- **Guida all'uso degli schemi**: Il ruolo di un agente _Aggregatore_ è quello di formare e restituire un POV completo in base ai concetti chiave restituiti dagli agenti Modello. Gli agenti modello determinano una risposta in base al loro POV univoco.
- **Caso d'uso rappresentativo**: Utilizzare in situazioni che possono trarre vantaggio dall'unione di punti di vista diversi per migliorare la qualità delle risposte.
Ad esempio, un ambiente agente multi-sistema in cui gli agenti con privilegi (ad esempio, un _agente ERP_) possono avere un POV utile e altrimenti inaccessibile.
- **Diagramma**:
 - **Maturità agente Salesforce**: Livello 2
## 9\. Schemi di processo di lunga durata
Gli _schemi di processo_ gestiscono i processi che si verificano in periodi estesi e coinvolgono più fasi e attori.
### Project Manager Pattern
- **Panoramica**: Lo _schema Project Manager_ è uno schema complesso che supervisiona un progetto di lunga durata. Coordina le attività, tiene traccia del completamento, invia notifiche agli utenti e rappresenta lo stato del progetto agli stakeholder.
- **Tipo di output**: Esistono più output (ad esempio casi, operazioni, aggiornamenti di stato e notifiche).
- **Guida all'uso degli schemi**: Utilizzare come schema ombrello per supportare attività regolari, ripetute e a più fasi. Lo _schema Project Manager_ prende un modello di input/una struttura di un progetto (comprese operazioni, ruoli e dipendenze), quindi istanzia i casi e le attività e li assegna agli utenti.
- **Caso d'uso rappresentativo**: Utilizzare per la gestione dell'installazione degli account e il coinvolgimento delle vendite aziendali.
- **Diagramma**:
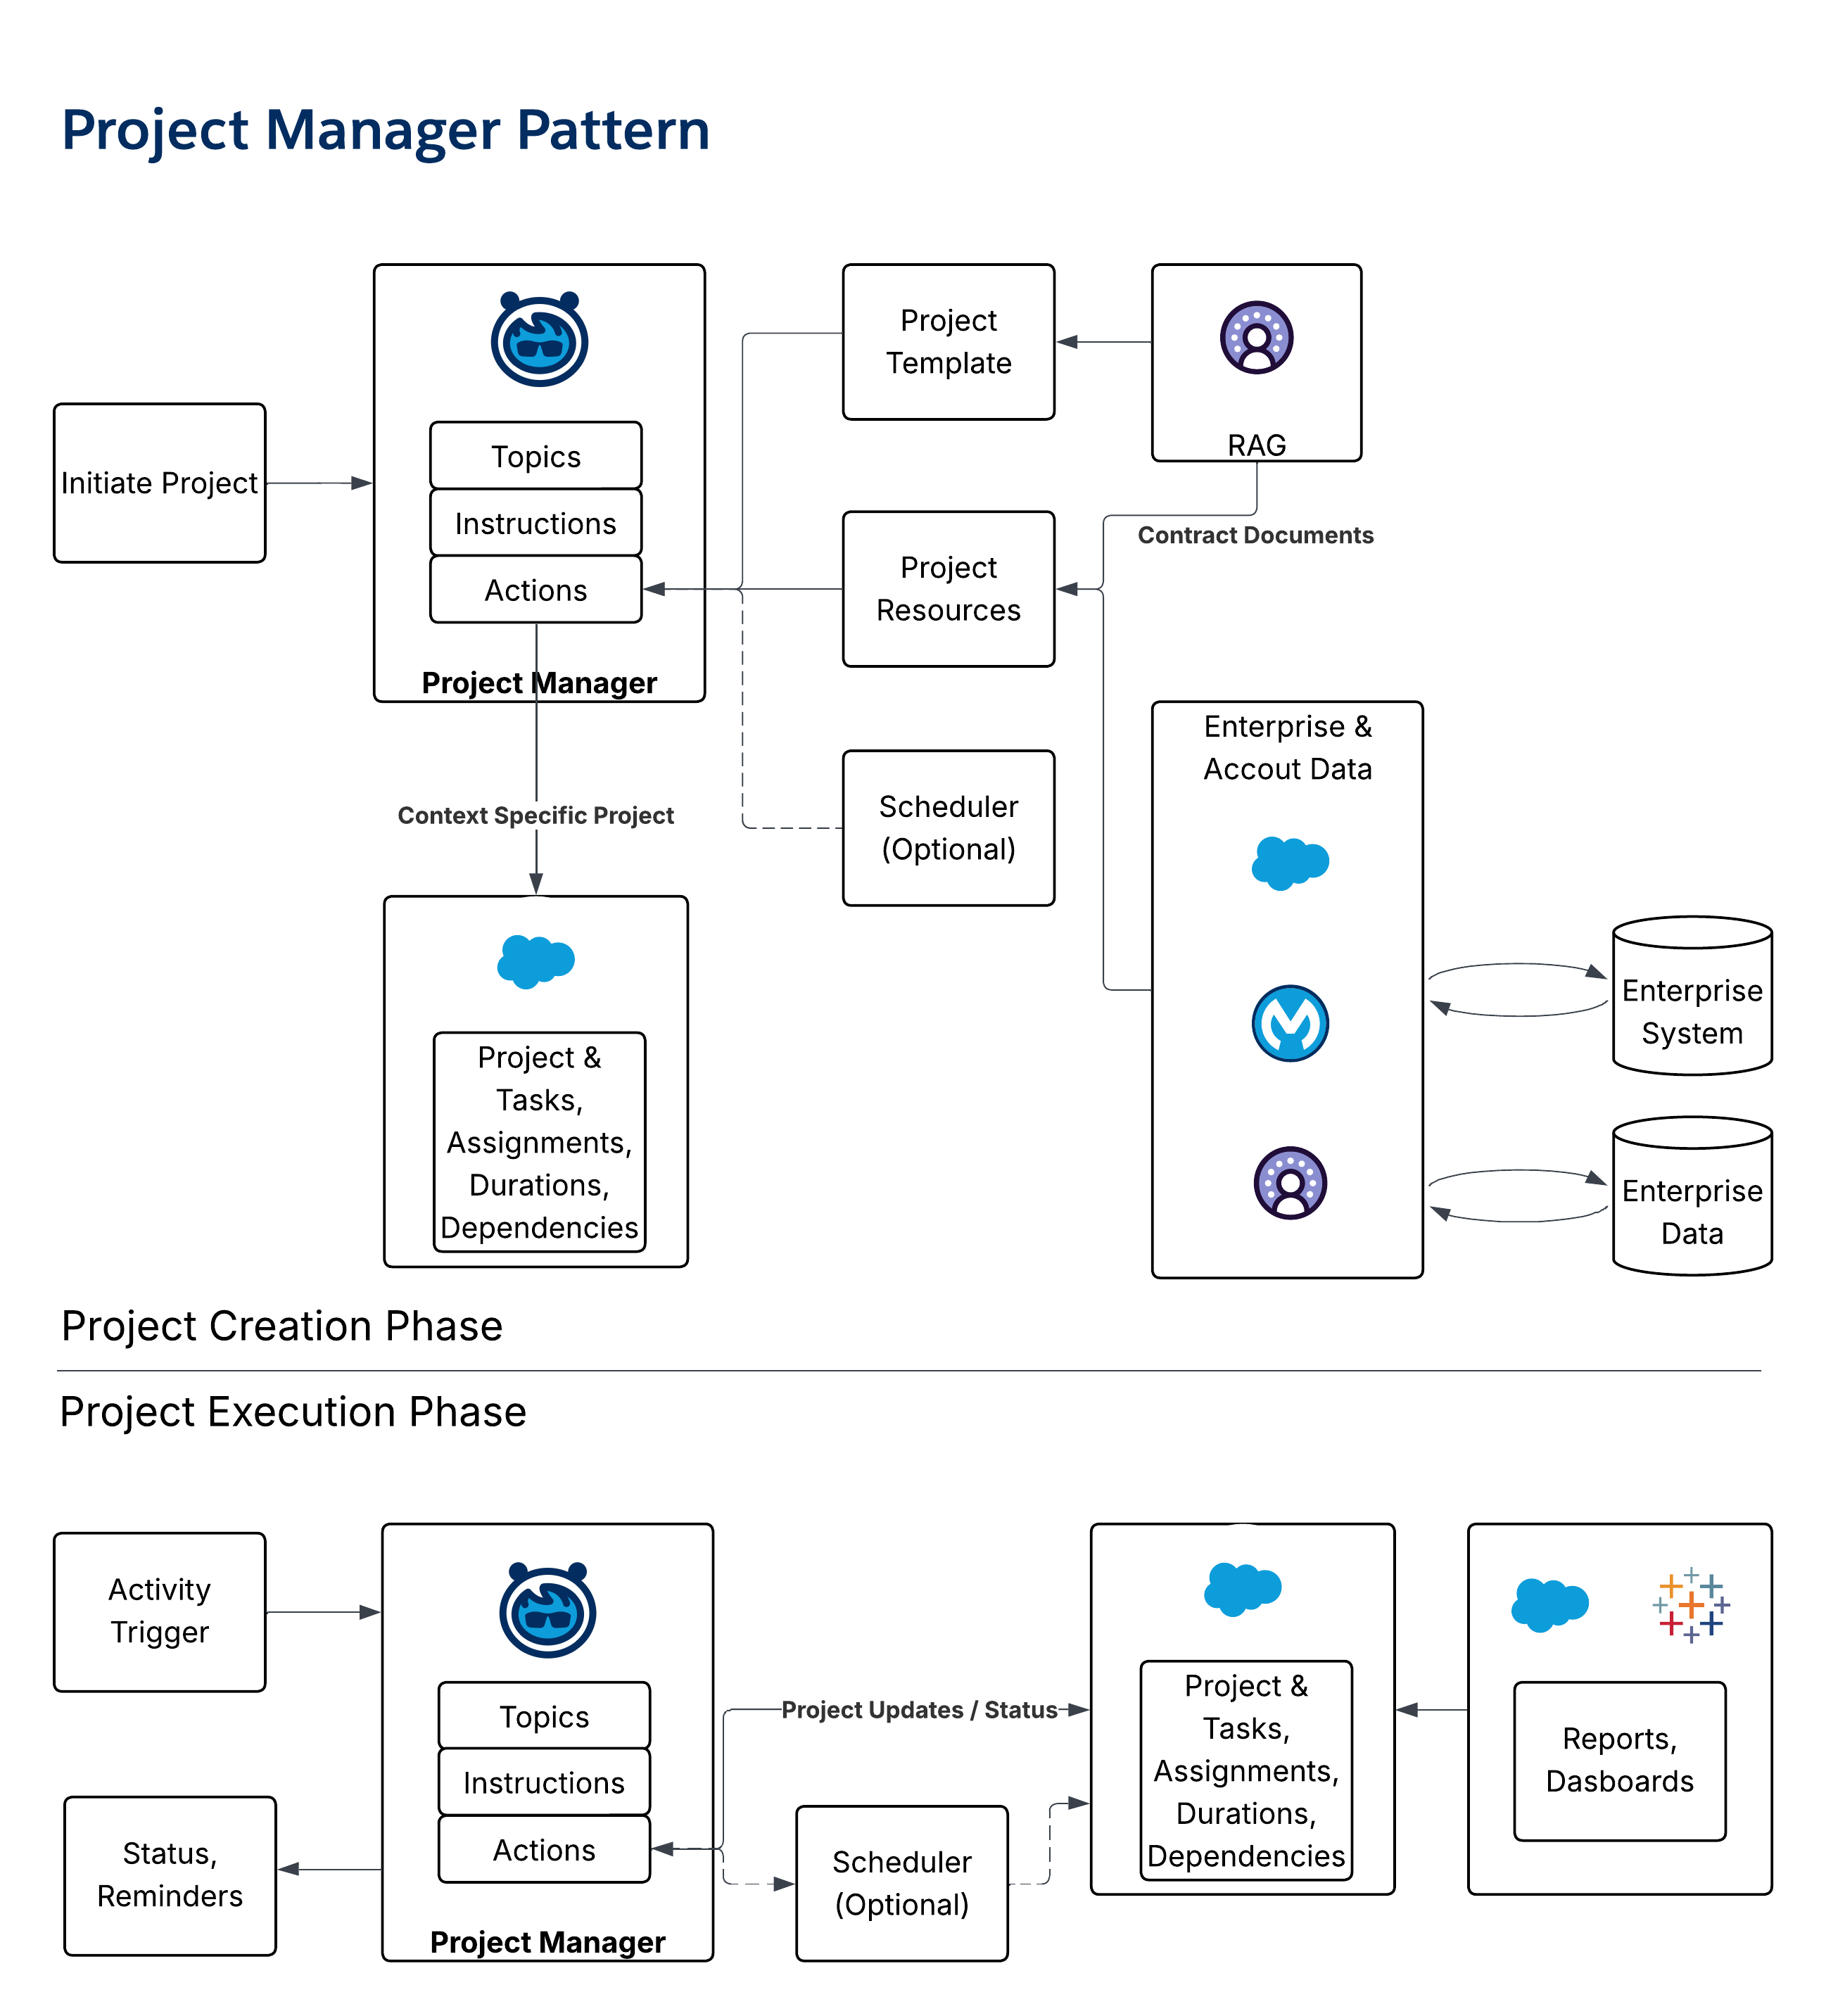 - **Maturità agente Salesforce**: Livello 4
## 10\. Archetipi di orchestrazione Enterprise
Mentre gli schemi descrivono i ruoli degli agenti, gli _archetipi di orchestrazione_ definiscono i modelli a livello di sistema per la collaborazione di un parco agenti. Questi archetipi chiariscono i ruoli di _Agenteforce_ come cervello di orchestrazione e _MuleSoft_ come connettore e adattatore universale.
**Archetipo 1: SOMA (organizzazione singola, più agenti)**
- **Definizione**: Più agenti collaborano all'interno di un'unica organizzazione Salesforce che utilizza dati e governance condivisi.
- **Flusso architettonico**: In Agentforce, un _agente supervisore_ funge da singola porta principale, instradando le richieste agli _agenti specializzati_ all'interno dell'organizzazione. Per le funzionalità esterne, gli agenti utilizzano il _client MCP Agentforce_ con MuleSoft che funge da MCP-wrapper per le API non abilitate per MCP.
- **Considerazioni chiave**: Questo schema centralizza la logica di orchestrazione in Salesforce (simile al contesto CRM e a Data 360) per mantenere governance, identità, autorizzazioni e osservabilità unificate.
**Archetype 2: MOMA (organizzazione multipla, più agenti)**
- **Definizione**: Gli agenti collaborano tra più organizzazioni Salesforce, il che richiede un coordinamento sicuro tra i confini dei dati e delle autorizzazioni.
- **Flusso architettonico**: Un _agente supervisore_ di un'organizzazione delega un'operazione a un agente di un'altra organizzazione tramite il protocollo standardizzato _da agente ad agente_. Questa stretta di mano garantisce Trust a livello di organizzazione, flusso di identità utente e contesto di conversazione condiviso.
- **Considerazioni chiave**: Questo schema mantiene l'autonomia dell'organizzazione e abilita i flussi di lavoro a livello aziendale, il che fornisce una base per operazioni agenti coerenti in strutture complesse multi-organizzazione.
**Archetype 3: A2A multi-vendor (orchestrazione guidata da Salesforce)**
- **Definizione**: Un _agente supervisore_ di Salesforce coordina il lavoro di un mix di agenti nativi di Salesforce e agenti di altri fornitori (ad esempio Google/Vertex o LangGraph) tramite il protocollo A2A.
- **Flusso architettonico**: L'_agente supervisore_ elabora la richiesta e orchestra un piano, richiamando gli agenti interni ed esterni del fornitore tramite il protocollo A2A. Per i sistemi esterni che non supportano A2A, _MuleSoft_ può esporre una "facciata agente leggera" che avvolge lo strumento esistente e comunica con A2A.
- **Considerazioni chiave**: Questo archetipo mantiene il cervello dell'orchestrazione vicino a CRM e Data 360 utilizzando A2A per produrre una composizione pulita e governabile senza un livello di orchestrazione separato.
**Archetipo 4: A2A multi-vendor (orchestrazione guidata da MuleSoft)**
- **Definizione**: L'orchestrazione viene avviata da un punto di ingresso non Salesforce, che richiede un orchestratore esterno neutrale per eseguire il ragionamento e l'instradamento.
- **Flusso architettonico**: Un _agente dell'interfaccia_ utente in un sistema esterno inoltra la richiesta a un servizio di orchestrazione (concepito come _MuleSoft Conductor_), che interpreta l'intento e pianifica l'operazione. Il conduttore utilizza quindi A2A per instradare le chiamate agli agenti del fornitore, inclusi gli agenti Agentforce per le azioni CRM o di servizio.
- **Considerazioni chiave**: Questo schema è per i punti di ingresso non Salesforce in cui è preferibile un orchestratore neutrale dal punto di vista architettonico. Mantiene l'interfaccia utente nel sistema di dominio centralizzando il ragionamento, la governance, la policy e l'osservabilità in MuleSoft.
## 11\. Assemblaggio soluzioni: Composizione di schemi
Questi schemi individuali e archetipi di orchestrazione sono componenti architettonici progettati per essere composti in soluzioni complete. La mappa delle soluzioni agentiche viene utilizzata per visualizzare come questi componenti sono cablati insieme.
- Una _soluzione Member Services_ per un operatore sanitario è un'implementazione standard dell'archetipo SOMA. Utilizza un Answerbot per gli utenti anonimi, un _Orchestrator_ per i membri autenticati e più _agenti PMI del_ dominio (ad esempio Caso, Richieste e Vantaggi) per gestire richieste specifiche.
- Un _portale Broker B2C_ è una composizione complessa che utilizza un agente _Orchestratore_ portale per invocare un _agente Project Manager_ di lunga durata per un processo RFP, che a sua volta utilizza _agenti headless_, _datasteward_ e _interrogatori_ per le operazioni sui dati di back-office.
## 12\. Conclusione
Una metodologia basata su modelli di progettazione agenti fornisce la disciplina architettonica necessaria per creare sistemi di intelligenza artificiale aziendali robusti, scalabili e manutenbili. Suddividendo la complessità e promuovendo la modularità, questi schemi consentono agli architetti di offrire soluzioni agentiche affidabili e prevedibili.
La scelta dell'archetipo di orchestrazione è una decisione strategica basata su dove lavorano gli utenti, dove risiede il contesto e come l'azienda governa l'interazione tra persone, agenti e sistemi. Comprendendo la distinzione tra agenti edili e orchestrandoli e sfruttando protocolli aperti come _MCP_ e _A2A_, gli architetti possono andare oltre la creazione di bot isolati per progettare un sistema di ragionamento aziendale coerente, governato e distribuito. Questo approccio fornisce un linguaggio condiviso e una serie di modelli riutilizzabili per creare un'architettura agente sostenibile.
## Appendice: Mappe delle soluzioni e architetture di sistema
Questa appendice fornisce esempi concreti di come gli schemi agentici sono composti in soluzioni a livello di sistema.
### Appendice A: Esempio di composizione schema di base
Questo diagramma illustra come collegare cinque schemi di base per creare un flusso di lavoro comune per l'assistenza clienti.
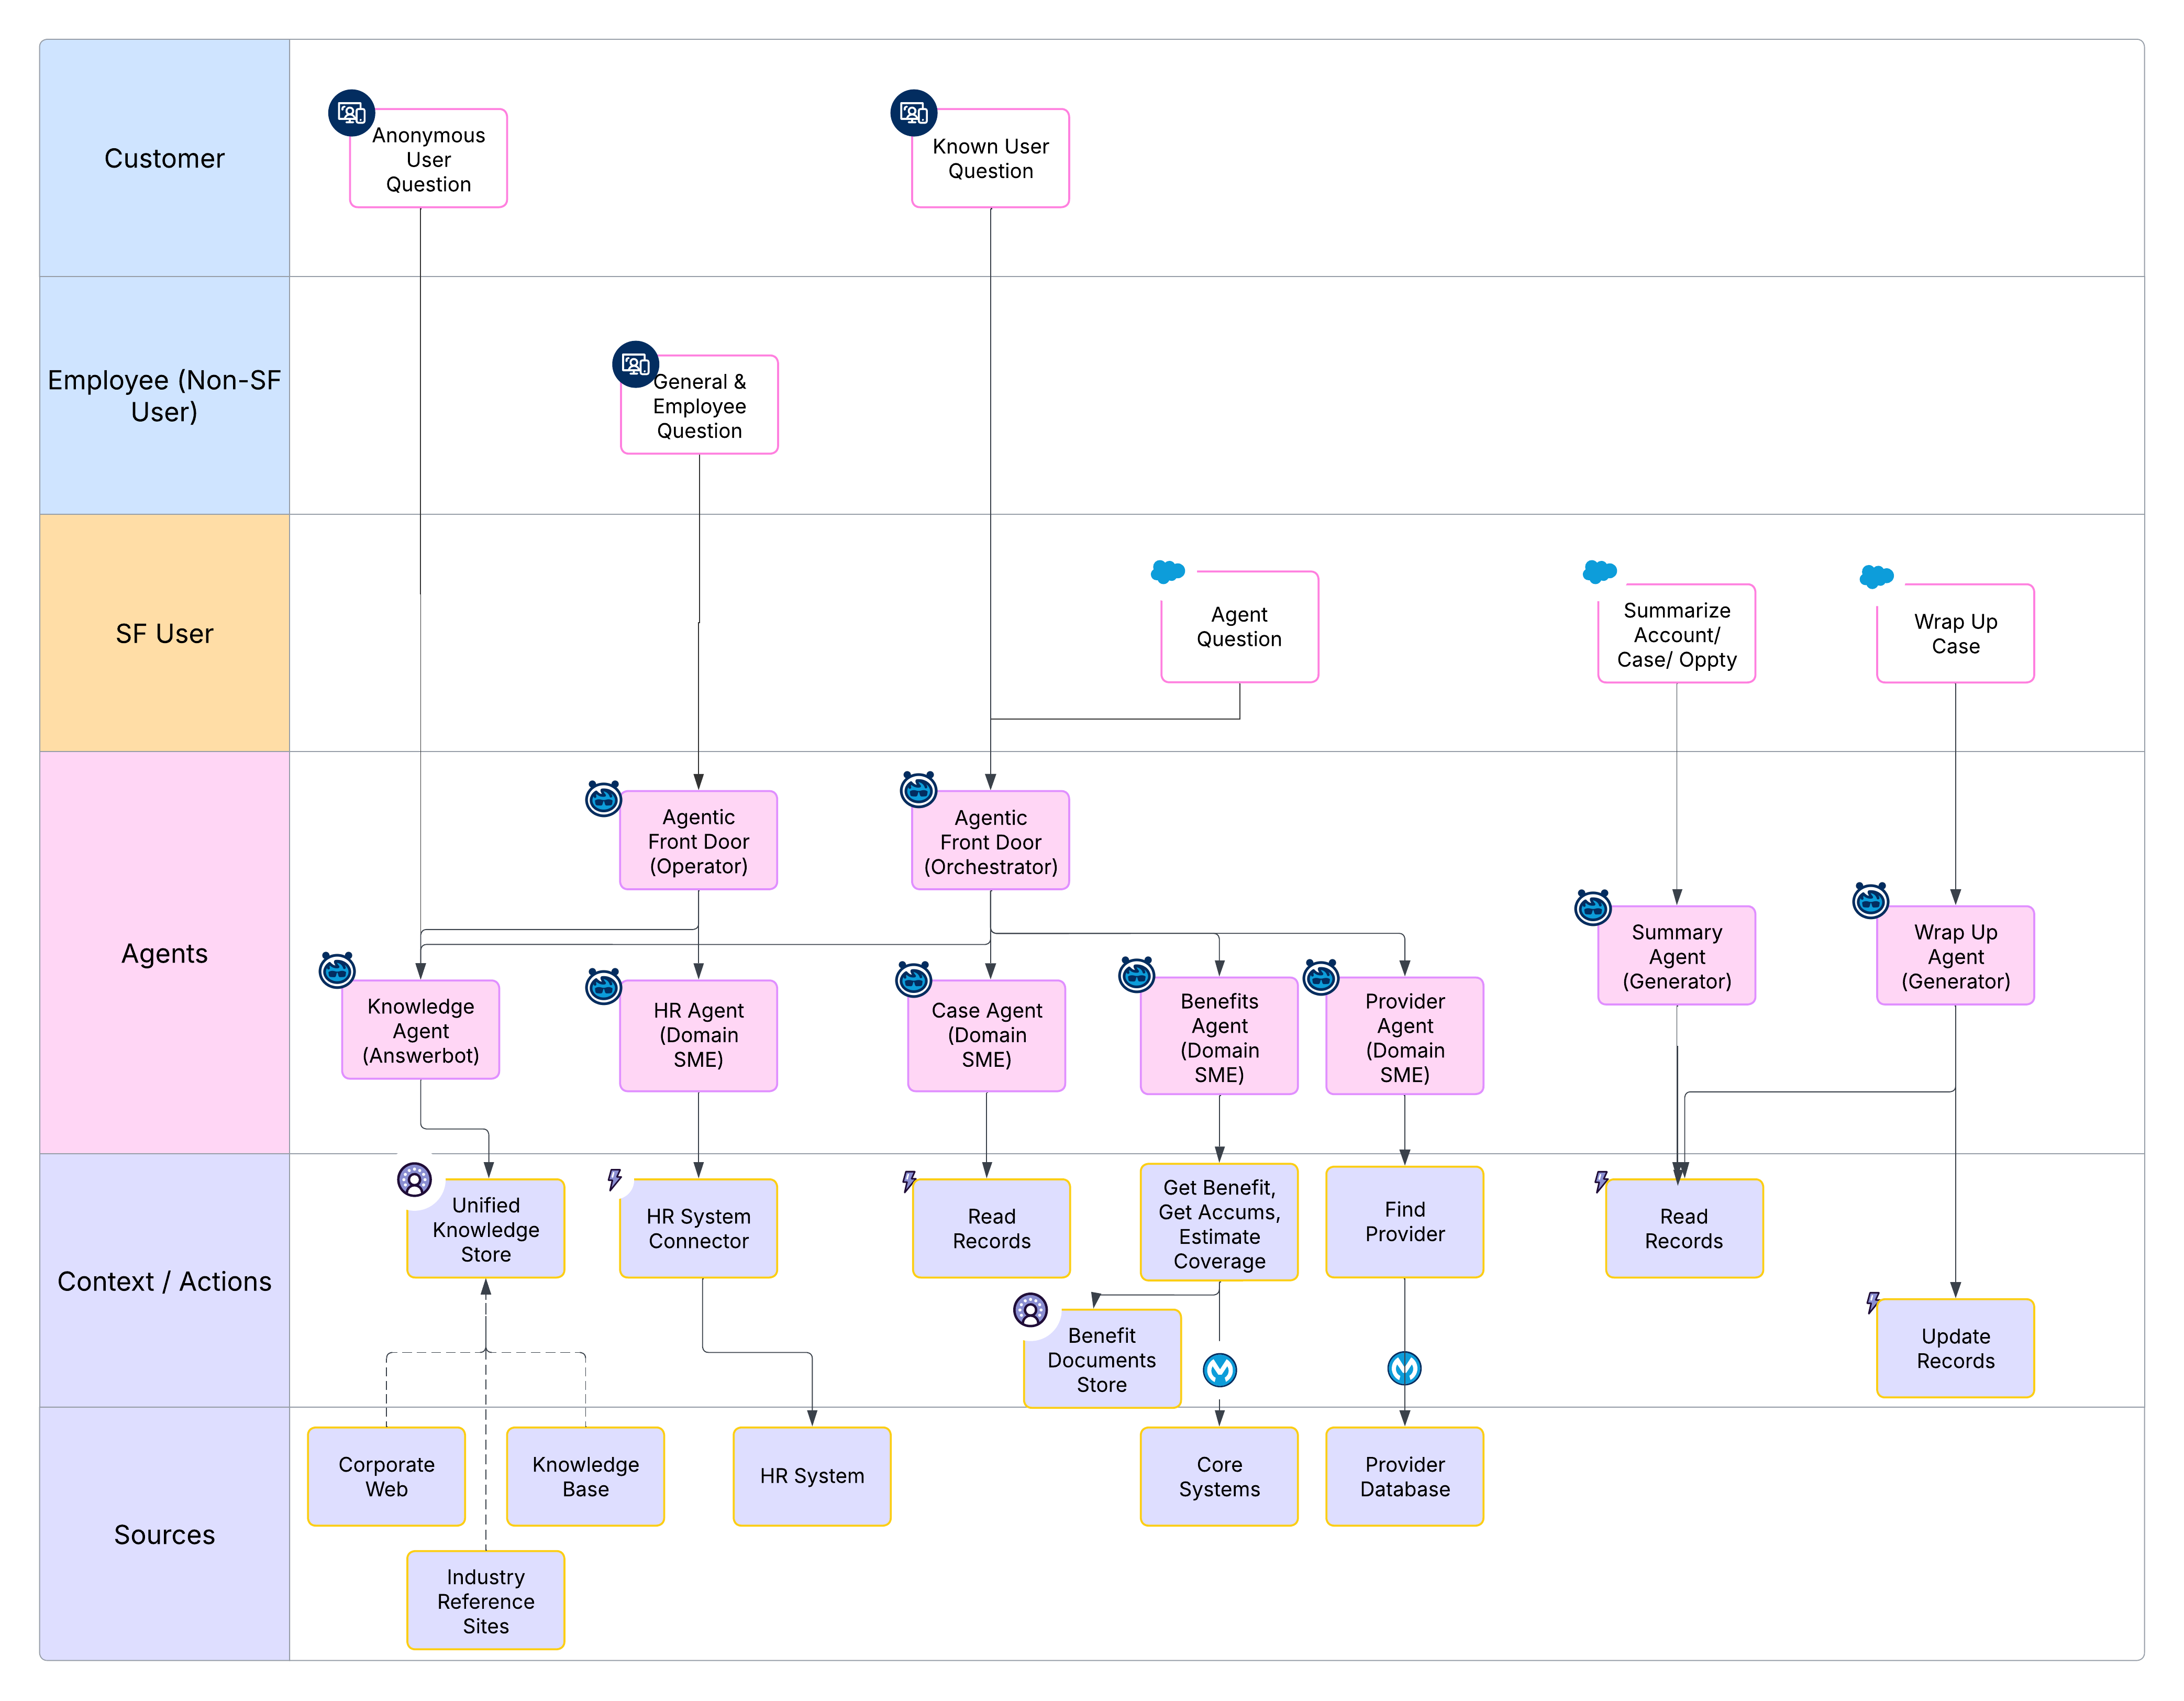 1. **Answerbot**: Un utente anonimo pone una domanda, gestita da un agente basato su Knowledge.
2. **Operatore**: La domanda di un dipendente viene analizzata da un Operatore, che la mette in campo e la passa a un agente più specializzato.
3. **Orchestratore**: Un utente autenticato (SF User) interagisce con un orchestratore che coordina più agenti per gestire una richiesta potenzialmente complessa.
4. **PMI di dominio**: Gli agenti specializzati (ad esempio, gli agenti delle risorse umane o gli agenti dei benefit) vengono richiamati dall'orchestratore per eseguire aggiornamenti dell'oggetto e recuperare dati specifici.
5. **Generatore**: Gli agenti delle utilità vengono utilizzati per riepilogare i dettagli dell'account o concludere un caso al termine dell'interazione.
### Appendice B: Mappa delle soluzioni agentiche - Servizi per i membri
Questa mappa della soluzione descrive i dettagli di un'architettura agente per un caso d'uso di Servizi per i membri, dimostrando la composizione di più schemi.
- **Profili utente**: La soluzione serve tre tipi di utenti distinti: Utente anonimo, Membro autenticato e Utente SF (ad esempio, un CSR umano).
- **Schemi di interazione**: Un _Answerbot_ gestisce le query "Find-A-Doc" anonime, mentre un Orchestrator (Agentic Front Door) gestisce le richieste degli utenti autenticati. Uno _schema Listener/Feed_ assiste l'utente SF.
- **Riutilizzo agente dominio**: Gli _agenti PMI del_ dominio specializzati (ad esempio Agente caso, Agente richieste o Agente vantaggi) vengono riutilizzati in diversi flussi di interazione.
- **Autonomo & Assistente**: Il sistema combina _agenti autonomi_ (per indirizzare l'interazione degli utenti) e _agenti ausiliari_ (per aumentare i CSR umani).
- **Fonti di dati**: L'architettura integra un mix di fonti di dati pubbliche ed aziendali, con un ampio uso di _Data 360_ e _MuleSoft_ per la connettività.
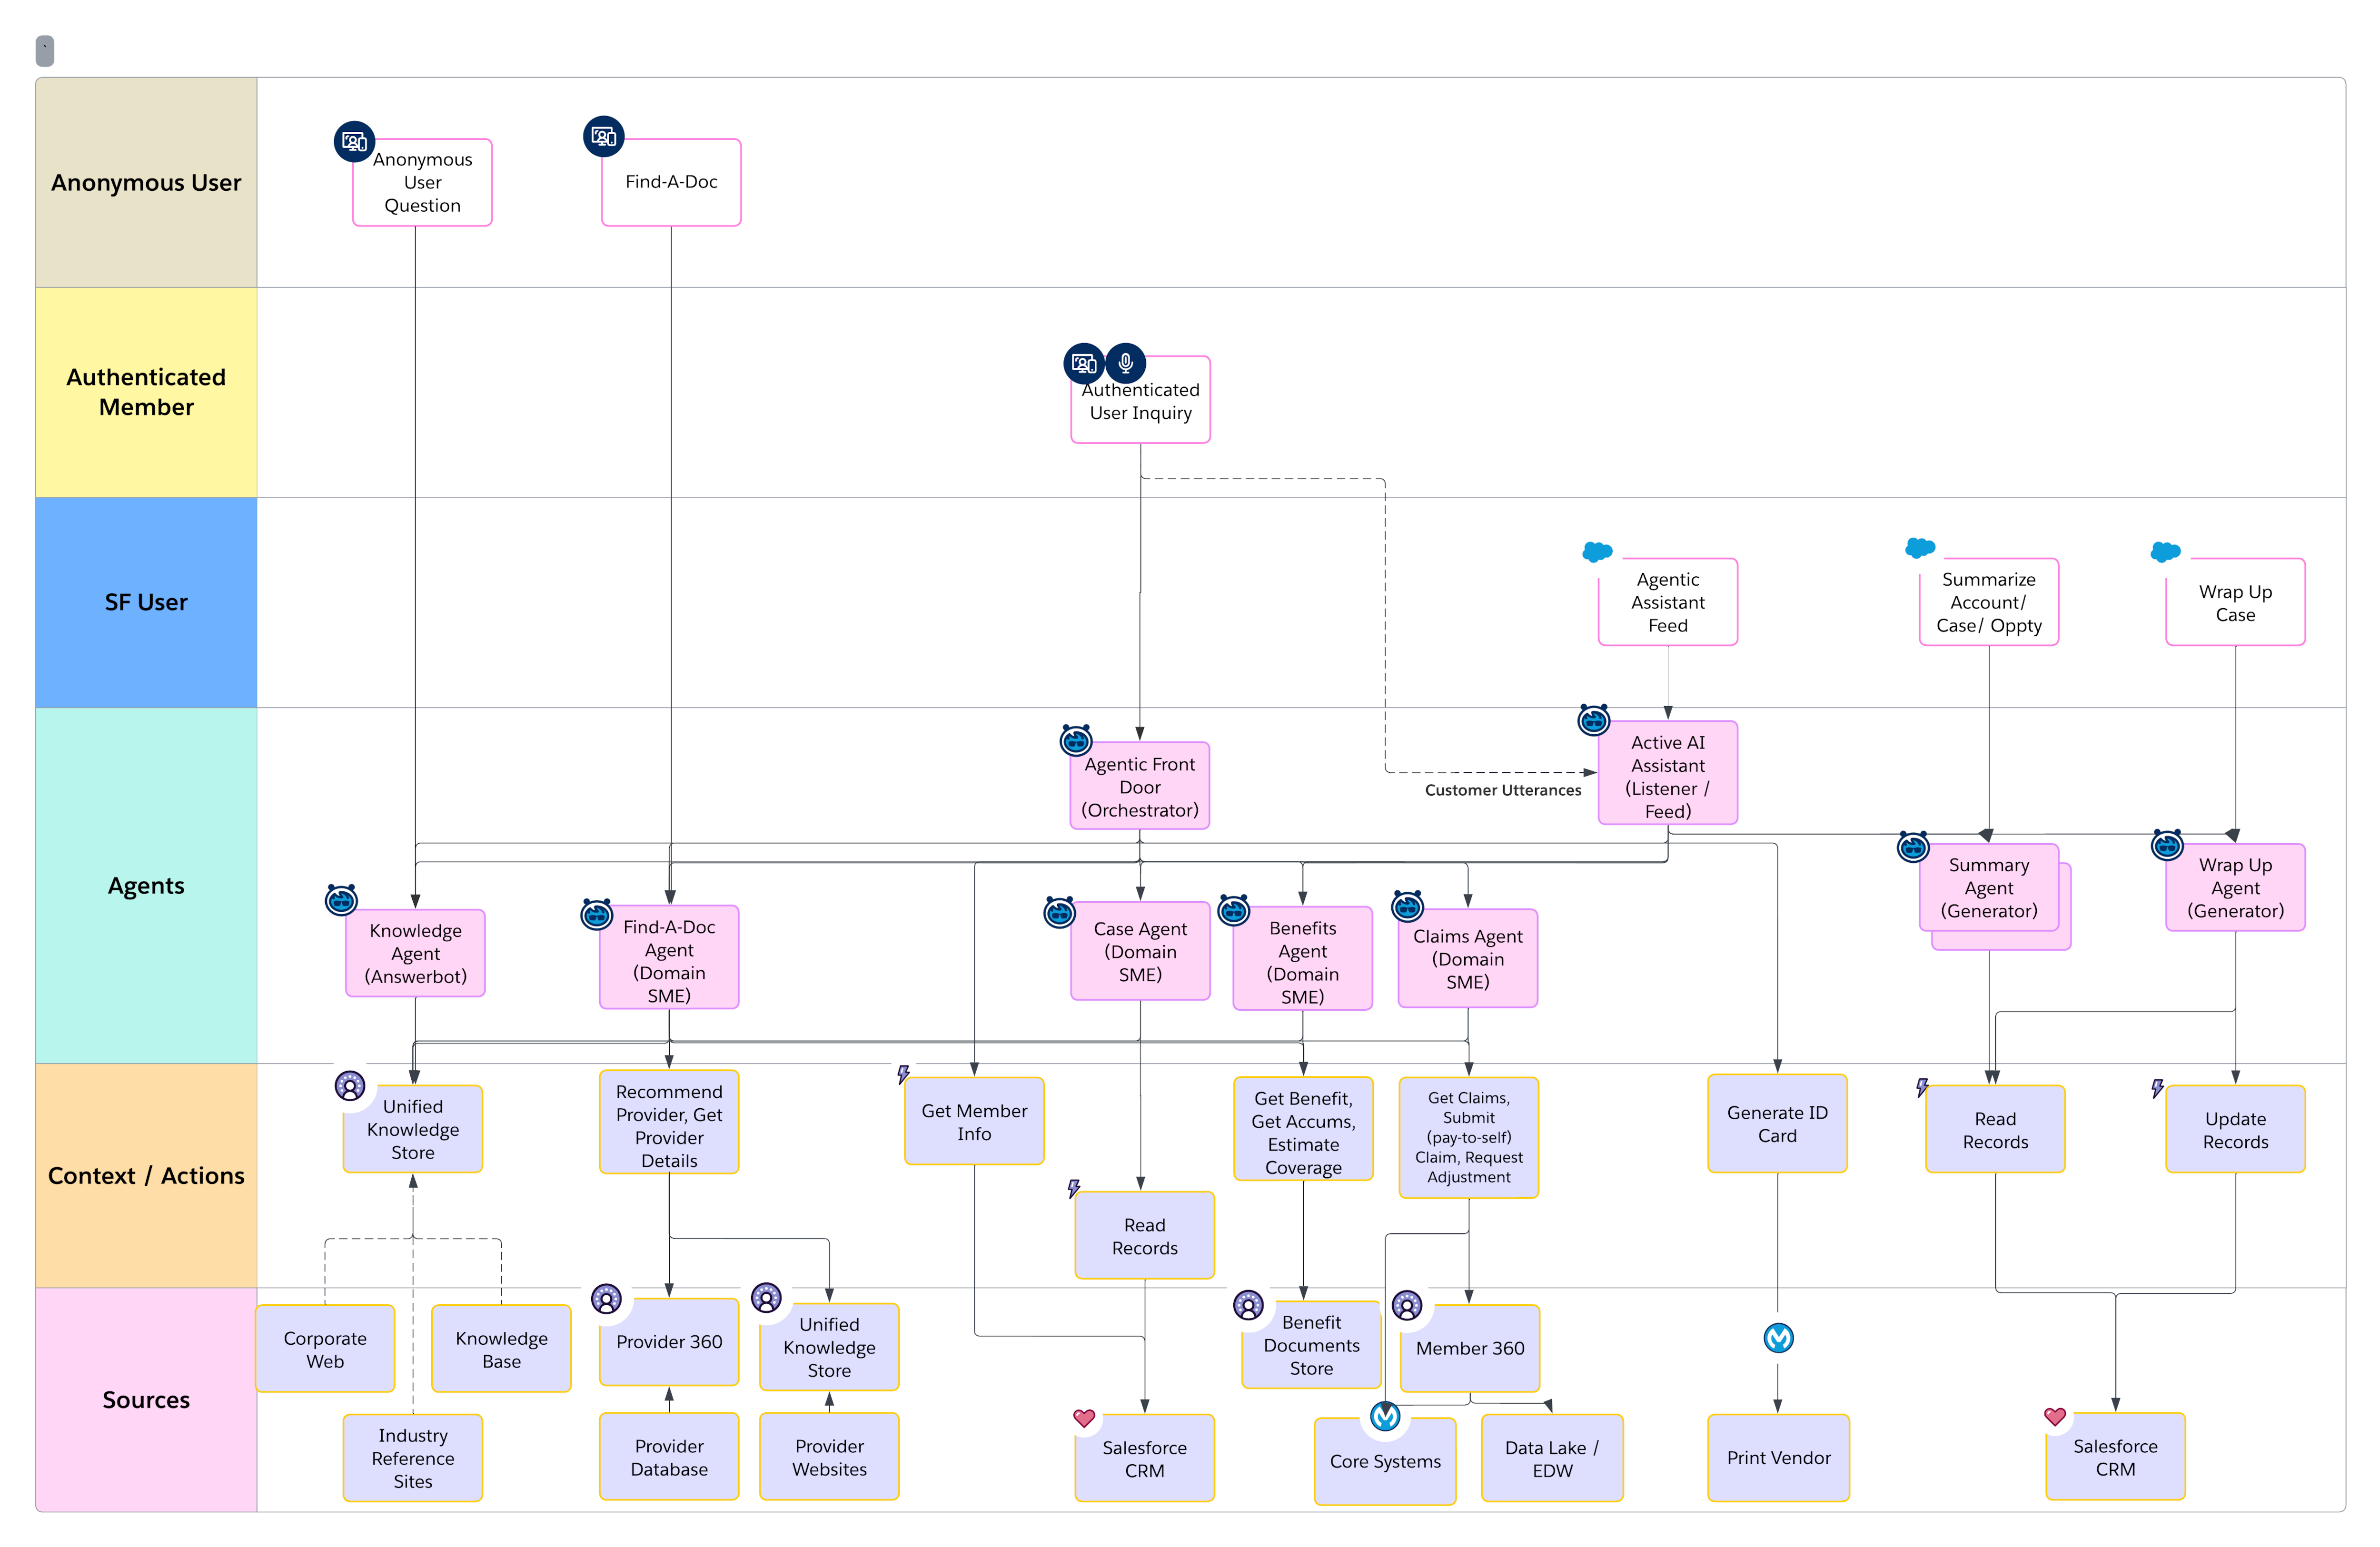 ### Appendice C: Architettura di sistema - Call center
Questo diagramma illustra un'architettura logica per una soluzione di intelligenza artificiale assistita in un call center, organizzata in livelli funzionali.
- **Agenti orchestratori**: Gestire le esperienze utente per profili diversi (ad esempio, Anonimo, Membro esterno o CSR) e orchestrare il flusso di interazione generale.
- **Agenti lavoratori**: _Più agenti PMI_ si concentrano su domini di business chiave come Knowledge, Caso/Richieste/Vantaggi e Elenco operatori. È incluso anche un agente _Next Best Action_.
- **Utilità Agenti**: Eseguire operazioni specifiche e riutilizzabili come Traduzione, Conclusione casi e Riepilogo chiamate.
Integrazione e sistemi principali: L'intero sistema agente è connesso tramite un livello di integrazione multipiattaforma alle risorse di dati non strutturate, alle risorse di dati strutturate e ai sistemi aziendali principali.
- **Governance**: Un livello di governance offre osservabilità, valutazione e gestione per gli LLM/SLM utilizzati dagli agenti.
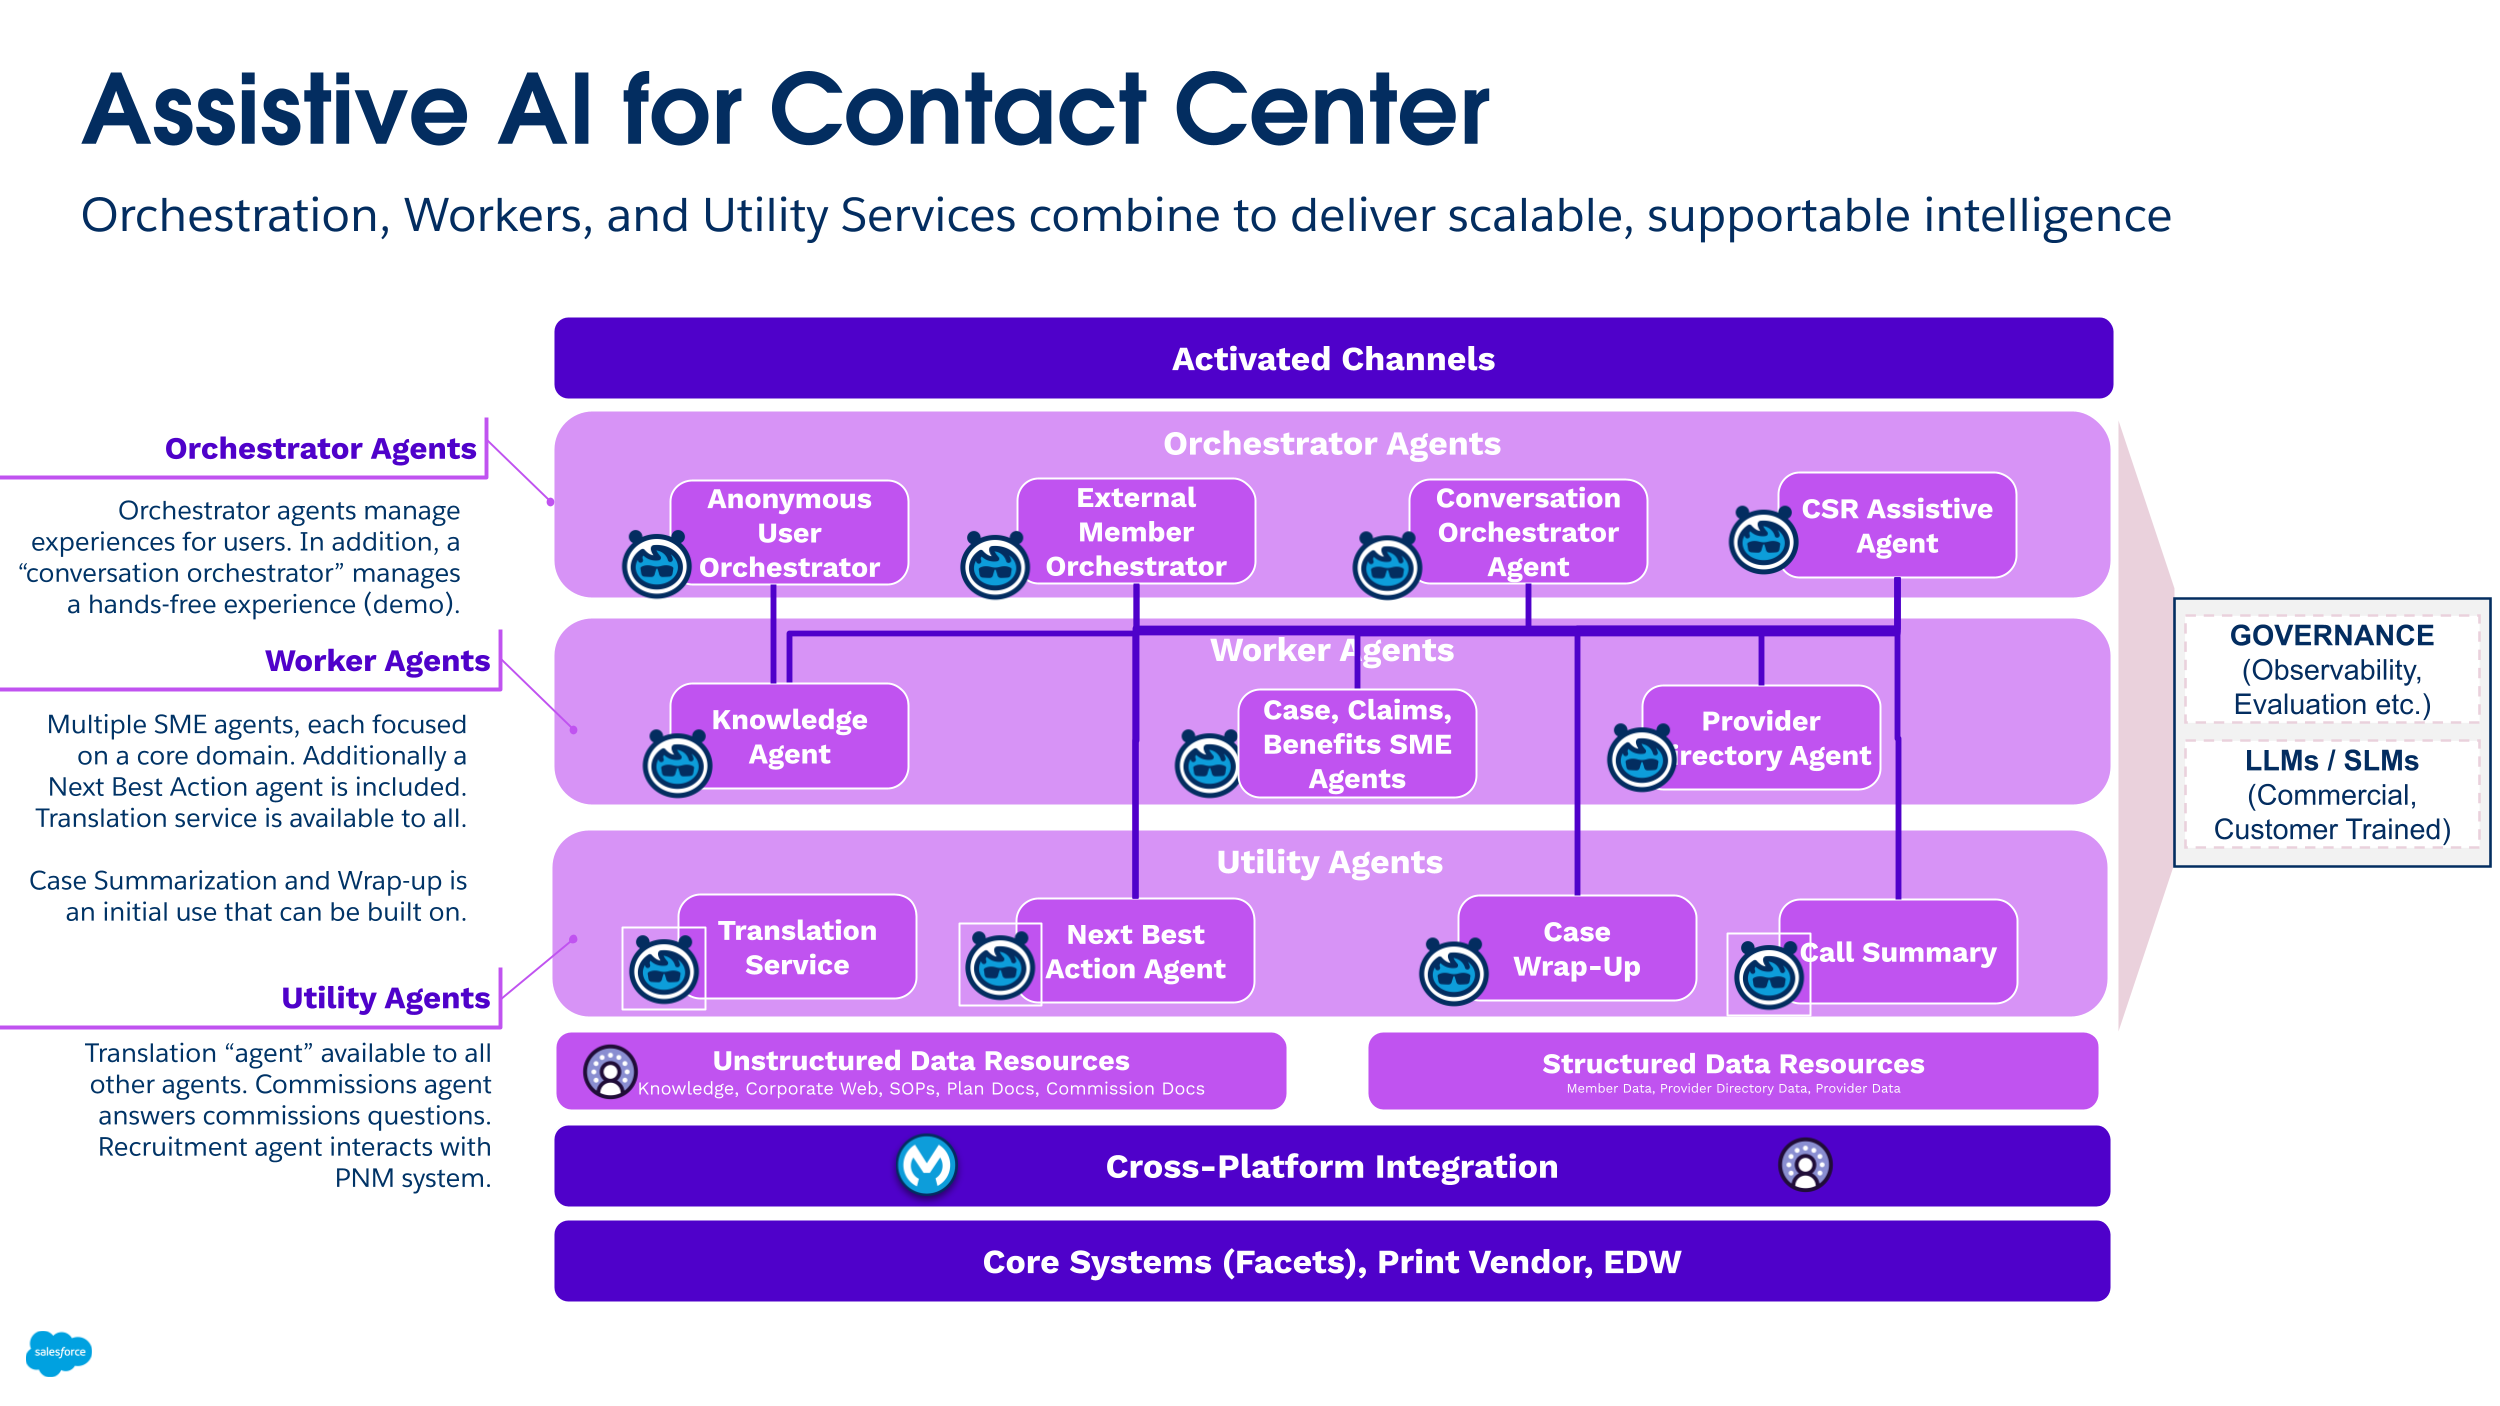 ### Appendice D: Mappa delle soluzioni agentiche - Portale broker
Questa mappa della soluzione descrive in dettaglio un'interazione agente complessa e di lunga durata per un portale broker assicurativo sanitario B2B. Il modello include un _agente del portale_ (_Orchestratore_) che facilita il percorso del broker attraverso più fasi (ad esempio, l'invio di una RFP e la ricezione di una proposta). Questo orchestratore invoca un agente _Responsabile progetto_, che a sua volta coordina diversi agenti headless per la qualità e le trasformazioni dei dati di back-office, ad esempio un estrattore RFP, una trasformazione censuaria e uno steward dati.
 ### Appendice E: Architettura di sistema - Agenti broker B2C
Questo diagramma mostra un'architettura logica per una soluzione di broker B2C, che dimostra un approccio a livelli simile al call center. Include _agenti orchestratori_ per profili utente diversi, _agenti lavoratori_ riutilizzabili per domini chiave (ad esempio, Knowledge, Servizi per i membri o Commissioni) e _agenti utilità_ per funzioni specifiche come la traduzione e il riepilogo.
 ### Appendice F: Architettura di sistema - Provider Contractor
Questo diagramma mostra un'architettura logica per una soluzione Provider Contracting. Gli agenti _orchestratori_ gestiscono interazioni complete, _gli agenti lavoratori_ gestiscono intenti specifici all'interno di un dominio (ad esempio, un agente PMI contraente) e gli agenti _delle utilità_ eseguono operazioni discrete come il confronto dei contratti o la generazione di approfondimenti.
 ### Appendice G: Tabella di riepilogo degli schemi di interazione
La tabella seguente riassume diversi schemi di interazione chiave, esperienze utente tipiche e scopi architettonici principali.
| Schema | Esperienza utente (UX) | Scopo |
|---|---|---|
| Saluto | Testo turn-by-turn (Chat, Voice, SMS e così via) che termina con il trasferimento dell'interazione a una persona | Questo è uno schema semplice utilizzato per determinare l'intento dell'utente e quindi instradarlo all'agente umano appropriato. |
| Operatore | Testo turn-by-turn (Chat, Voice, SMS e così via) che termina con il trasferimento dell'interazione da parte del risponditore a un agente umano o specialista | Viene utilizzato per instradare le richieste agli agenti ibridi appropriati. Basandosi su Greeter, è uno schema semplice che negozia l'intento e quindi trasferisce l'interazione a un agente umano o AI specializzato. |
| Orchestrator | Testo turn-by-turn (Chat, Voice, SMS e così via) con il risponditore che raccoglie e aggrega le risposte degli agenti specializzati e le consegna all'unità operativa | Viene utilizzato per coordinare un "intervento collettivo" gestito dall'agente AI che risponde a una conversazione mentre procede. Un agente orchestratore passa il testo di ogni turno a uno o più agenti specializzati e quindi aggrega le risposte di ciascuno di essi. |
| Answerbot | Prompt e risposta | Questa è un'interfaccia per linguaggio naturale che utilizza risorse Knowledge, domande frequenti, policy e così via per formare le risposte. |
| Interrogatore | Prompt e risposta | Si tratta di un'interfaccia per linguaggio naturale utilizzata per porre domande in un dominio o in un'area specifica. |
| Ascoltatore / Feed | Testo turn-by-turn (Chat, Voice, SMS e così via) che termina con lo schema Orchestrator che alimenta un feed lineare | Viene utilizzato per mettere in evidenza il contesto e gli approfondimenti nel flusso di conversazione. |
| Area di lavoro (Radar O'Reilly) | Testo turn-by-turn (Chat, Voice, SMS e così via) che termina con un head-up-display adattivo su un unico pannello di vetro | Questo viene utilizzato per gestire un'interfaccia utente reattiva a un unico riquadro nel flusso di conversazione. |
| Misure della selettività pre-query | Scrittura della query finale di accesso al database, forzando... | |
| Utente | Filtro | |
| Basso | Basso | ... loop nidificati join, drive utilizzando la visualizzazione delle righe che l'utente può vedere |
| Basso | Alto | ... utilizzo dell'indice correlato al filtro |
| Alto | Basso | ... join hash ordinato, drive con MT_DATA |
| Alto | Alto | ... utilizzo del filtro correlato all'indice |
 In questo modello, le camere bianche dei dati fungono da confine Trust delle moderne architetture dei dati. Consentono alle organizzazioni di lavorare con partner e società controllate senza perdere il controllo dei loro dati, di imporre la privacy e il consenso tramite controlli di sistema anziché la sola policy e di operare su cloud rispettando la residenza dei dati e i limiti contrattuali.
Per i casi d'uso di attivazione, analisi e intelligenza artificiale, le camere bianche offrono un modo sicuro per generare approfondimenti da dati esterni senza esporre informazioni sensibili. Consentono il passaggio dalla condivisione dei dati alla collaborazione affidabile. Per i casi d'uso di attivazione, le camere bianche offrono un modo sicuro per generare pubblici che possono essere attivati direttamente a una destinazione consentita. Tutto questo viene realizzato senza esporre alcuna informazione di identificazione personale (PII) a nessuna delle parti. Questo segna un punto di svolta nell'architettura dei dati aziendali. Le camere bianche dei dati non sono più strumenti di nicchia. Stanno diventando un'infrastruttura di base per piattaforme dati federate, rispettose della privacy e pronte per l'intelligenza artificiale.
## Personaggi degli stakeholder e protezioni tecniche
Un'architettura data clean room di successo è un sistema multiinterfaccia progettato per risolvere le pressioni concorrenti di utilità, sicurezza e velocità dei dati. Esistono tre profili principali i cui punti di attrito distinti devono essere affrontati dal progetto tecnico sottostante.
### Il responsabile della privacy e della conformità (The Risk Mitigator)
I responsabili della privacy e della conformità utilizzano la clean room dei dati come strumento di governance. La loro preoccupazione principale è la deriva della conformità, il rischio che gli ambienti di collaborazione esterni non riescano a imporre gli stessi standard rigorosi dei sistemi interni.
- **Punti di attrito:** Esposizione normativa (GDPR, CCPA, DMA) e attacchi di "phishing" in cui un partner tenta di triangolare l'identità di un utente tramite query granulari ripetute.
### Data Scientist and Analyst (Ottimizzatore delle utilità)
Gli esperti di dati considerano la camera bianca dei dati un rifugio sicuro per la modellazione avanzata. La loro preoccupazione principale è la conservazione delle utilità, assicurando che le misure di privacy non rendano i dati statisticamente inutili.
- **Punti di attrito:** Latenza elevata e accesso limitato agli attributi granulari necessari per il machine learning (ML), la modellazione lookalike e la previsione di abbandono.
### L'utente marketing e aziendale (Realizzatore di valore)
Questo profilo è incentrato esclusivamente sul time to value (TTV). La loro preoccupazione è che i progetti di data clean room spesso diventano colli di bottiglia tecnici che richiedono settimane di supporto per l'ingegneria dei dati.
- **Punti di attrito:** Processi di impostazione complessi, pulizia manuale dei dati e il problema della "pagina vuota" di dover scrivere codice per ottenere risultati di sovrapposizione semplici.
### Il modello Persona "Business First"
Mentre le architetture tradizionali si concentrano sulla creazione del livello di dati prima del livello utente, il nostro approccio strategico, in linea con la metodologia "Business First", inverte questo modello. Diamo la priorità a un approccio senza codice a pochi clic che consente agli utenti aziendali di generare approfondimenti e intraprendere azioni immediate.
**Flusso di lavoro "Approfondimenti all'azione":** L'architettura è progettata come area di lavoro attiva anziché come repository passivo. Fornendo modelli di casi d'uso (ad esempio, sovrapposizione dei segmenti, attivazione e prestazioni delle campagne), consentiamo agli utenti aziendali di offrire approfondimenti in modo self-service. Ciò garantisce che un approfondimento, ad esempio un segmento lookalike ottimizzato, sia immediatamente disponibile per l'attivazione in tutto l'ecosistema di marketing senza la necessità di un tecnico dei dati per spostare manualmente i file.
**Federazione senza copia come asset strategico:** Per ottimizzare il TTV, l'architettura adotta una logica di copia zero. Anziché il tradizionale processo ETL, che introduce rischi di latenza e sicurezza, la nostra architettura federa le query direttamente nella posizione in cui risiedono i dati (ad esempio Snowflake, BigQuery o Amazon S3). Ciò trasforma l'investimento di dati esistente dell'organizzazione in un asset strategico, consentendo agli utenti aziendali di agire sui dati più aggiornati in tempo reale, mantenendo una governance rigorosa ed eliminando il costo della ridondanza dei dati.
## Casi d'uso chiave delle clean room dei dati
Le camere bianche dei dati sono emerse nella pubblicità come risposta alla deprecazione dei cookie e alla regolamentazione della privacy, ma si sono evolute oltre misura in casi d'uso di analisi dei clienti, segmentazione del pubblico e attivazione in tutti i settori. Secondo il rapporto State of Retail Media 2025, il 66% delle organizzazioni ora utilizza le camere bianche in una certa misura, spinto dalla necessità di una collaborazione rispettosa della privacy che offra risultati aziendali misurabili.
Lo schema è coerente tra i vari settori: i dati rimangono di proprietà del titolare, il calcolo è regolato e vengono condivisi solo gli approfondimenti protetti dalla privacy.
### Marketing e pubblicità: Misurazione senza cookie di terze parti
**La sfida:** Gli esperti di marketing devono misurare l'efficacia delle campagne, evitare impressioni pubblicitarie duplicate e ottimizzare la copertura/frequenza, ma non possono più fare affidamento sui cookie o sugli identificatori di dispositivi di terze parti.
**Soluzione per camera bianca:**
- Gli inserzionisti contribuiscono con dati di esposizione di clienti o campagne con hashing
- I publisher contribuiscono con segnali di impression e coinvolgimento
- Clean Room calcola portata, frequenza, attribuzione e lift
- L'attivazione avviene tramite piattaforme approvate senza esportazioni di dati non elaborati
**Risultati aziendali:** Le camere bianche offrono un'attribuzione a ciclo chiuso che collega le impressioni degli annunci alle transazioni effettive, un'analisi dell'incrementalità che isola il vero lift della campagna e una misurazione unificata tra i canali, funzionalità che la pubblicità digitale tradizionale non può offrire.
**Prove del settore:** La misurazione è oggi il caso d'uso più affermato per le camere bianche, con le principali reti di media come Pinterest, Disney e Paramount che creano le proprie camere bianche.
### Media al dettaglio e prodotti confezionati al consumo (CPG): Monetizzazione dei dati first party senza condivisione
**La sfida:** I marchi CPG spendono molto sui media retail ma non hanno visibilità sui risultati degli acquisti. I rivenditori sono titolari di dati completi sui punti vendita ma non possono esporli senza violare gli impegni in materia di privacy.
**Soluzione per camera bianca:**
- I retailer e le aziende CPG combinano i dati dei punti vendita delle sedi di vendita con i dati di marketing per ottimizzare le attività promozionali
- I marchi contribuiscono con identificatori CRM con hashing o fedeltà
- Link alle camere bianche e esposizione ad acquisti interni/online
- L'attivazione rimane all'interno dell'ecosistema multimediale del rivenditore
**Risultati aziendali:**
- I retailer monetizzano i dati first party senza vendere informazioni sui clienti non elaborate
- I marchi ottengono l'attribuzione a circuito chiuso che mostra quali campagne hanno spinto gli acquisti
- Retail Media Networks scalabile senza rischi per la privacy
**Prove del settore:** Retail Media Network come Luminate di Walmart e Kroger Precision Marketing offrono camere bianche che aiutano i marchi CPG ad analizzare il comportamento dei clienti e a ottimizzare le strategie di marketing utilizzando i dati dei rivenditori.
### Servizi finanziari: Rilevamento collaborativo delle frodi
**La sfida:** Le reti antifrode operano tra gli istituti, ma le banche non possono condividere apertamente i dati dei clienti o delle transazioni a causa di regolamenti come la GLBA e le leggi sulla privacy emergenti.
**Soluzione per camera bianca:**
- Più banche riuniscono dati anonimizzati per identificare schemi indicativi di frode, ad esempio insolite attività tra banche
- Analisi federate o modelli eseguiti attraverso segnali di frode condivisi
- Nessun istituto vede i dati a livello di cliente di un altro
**Risultati aziendali:**
- Rilevamento precoce degli schemi di frode tra istituti
- Meno falsi positivi grazie a insiemi di segnali più completi
- Conformità normativa senza centralizzare i dati sensibili
**Prove del settore:** Le soluzioni per i servizi finanziari di Experian e TransUnion offrono tecnologie per camere bianche che consentono a banche e assicurazioni di collaborare all'individuazione delle frodi e alla valutazione del rischio mantenendo rigidi controlli sulla privacy dei dati.
### Assistenza sanitaria e scienze della vita: Ricerca senza esposizione dei dati dei pazienti
**La sfida:** Le aziende farmaceutiche hanno bisogno di risultati reali per lo sviluppo dei farmaci, ma i dati risiedono in sistemi sanitari sanitari protetti dall'HIPAA e da regolamenti simili.
**Soluzione per camera bianca:**
- Medici e ricercatori farmaceutici condividono i dati all'interno di una camera bianca per capire come i pazienti reagiscono ai trattamenti.
- I dati dei pazienti rimangono all'interno degli ambienti degli operatori.
- I ricercatori eseguono analisi statistiche approvate tramite una camera bianca.
- La privacy differenziale impedisce la reidentificazione.
**Risultati aziendali:**
- Prove del mondo reale statisticamente valide su larga scala
- Semplificare il reclutamento dei pazienti per gli studi clinici abbinando i dati anonimi dei pazienti ai criteri di sperimentazione, trovando i candidati idonei senza violare le leggi sulla privacy dell'assistenza sanitaria
- Dipendenza ridotta da popolazioni limitate di studi clinici
**Prove del settore:** Le camere bianche incentrate sull'assistenza sanitaria come Datavant offrono ambienti conformi all'HIPAA per i ricercatori e le organizzazioni sanitarie per analizzare in modo sicuro i dati dei pazienti per gli studi clinici e lo sviluppo di farmaci.
### Schemi intersettoriali: L'imperativo della collaborazione
Oltre a questi casi d'uso principali, le camere bianche consentono di:
- **Ottimizzazione della supply chain:** Produttori e fornitori collaborano per condividere i dettagli dell'inventario, le pianificazioni di produzione e le previsioni della domanda, consentendo un migliore coordinamento e proteggendo le informazioni proprietarie.
- **M&A Due Diligence:** Quando un'azienda ne acquisisce un'altra, la due diligence richiede l'esame delle proiezioni finanziarie e dei database dei clienti senza condividere direttamente informazioni sensibili; le camere bianche rivelano approfondimenti come l'allineamento dei segmenti di clienti e i rischi di conformità.
- **Media e intrattenimento:** I publisher dimostrano il valore del pubblico per gli inserzionisti proteggendo le identità degli abbonati, abilitando CPM premium supportati da misurazioni affidabili anziché dalla destinazione probabilistica
Nelle aree AdTech, retail, servizi finanziari, sanità e media, le Data Clean Room sono diventate un'infrastruttura Trust fondamentale. Consentono una collaborazione di alto valore che in precedenza era bloccata da vincoli di privacy, normativi o competitivi. Le camere bianche sono **componenti architettonici fondamentali** che consentono una collaborazione sicura e controllata, sbloccando approfondimenti e monetizzazione senza rinunciare al controllo o alla conformità dei dati.
## Data Clean Rooms (Stanze pulite dati): La base della collaborazione sui dati affidabili
Una camera bianca dei dati è un ambiente sicuro e gestito che consente a più parti di generare approfondimenti congiunti senza esporre o scambiare dati non elaborati. Anziché replicare le serie di dati, vengono eseguiti i carichi di lavoro di analisi, intelligenza artificiale e attivazione approvati e vengono restituiti solo output conformi alle policy. Se l'attivazione richiede record a livello di persona, i dati vengono consegnati direttamente alla destinazione prevista senza essere esposti alle parti che collaborano.
Dal punto di vista architettonico, le camere bianche spostano la collaborazione dalla condivisione dei dati al calcolo controllato. Ogni partecipante mantiene la custodia dei propri dati, mentre l'imposizione in fase di esecuzione regola il comportamento delle query, i vincoli di output, il consenso e le policy di utilizzo.
La collaborazione è ulteriormente abilitata attraverso meccanismi di allineamento degli identificatori che salvaguardano la privacy, consentendo la correlazione delle serie di dati di parti diverse senza esporre gli identificatori sottostanti, una funzionalità spiegata in modo più dettagliato più avanti in questo documento.
Di conseguenza, le camere bianche dei dati fungono da infrastruttura di base per le aziende regolamentate dalla privacy, multi-cloud e basate sull'intelligenza artificiale che utilizzano strategie basate su dati federati e copia zero.
 Le prime camere bianche dei dati seguivano un modello di "bunker" centralizzato. A tutti i partecipanti è stato richiesto di copiare i dati in un ambiente neutro di terze parti per l'analisi. Pur essendo semplice nel concetto, questo approccio ha introdotto un notevole attrito. Lo spostamento dei dati ha aumentato la latenza e i costi, complicato gli accordi legali e di conformità e costretto le organizzazioni a rinunciare al controllo diretto dei dati sensibili. Nei settori regolamentati, questi compromessi spesso rendevano impraticabile la collaborazione.
Le moderne camere bianche dei dati si sono evolute verso un modello distribuito e federato. I dati rimangono nell'ambiente del titolare e le analisi vengono eseguite tramite query federate. La camera bianca funziona come un livello di governance che intercetta ogni query, applica i controlli della privacy e delle policy in fase di esecuzione e restituisce solo output aggregati approvati.
| Dimensione | Camera bianca tradizionale (modello "Bunker") | Camera pulita moderna (modello distribuito/federato) |
|---|---|---|
| Posizione dati | I dati vengono copiati in un ambiente centralizzato di terze parti | I dati rimangono nell'ambiente del titolare |
| Spostamento dati | Richiede il trasferimento fisico e la duplicazione delle serie di dati | Nessun movimento di dati non elaborati, vengono eseguite query |
| Controllo e custodia | Custodia parzialmente ceduta a piattaforma di terze parti | Proprietà e custodia dei dati non elaborati conservate da ciascuna parte |
| Modello di architettura | Aggregazione centralizzata | Calcolo distribuito e federato |
| Applicazione della governance | Policy applicate dopo lo spostamento dei dati | Policy applicate in fase di esecuzione della query |
| Modello di privacy | Si basa fortemente sui controlli contrattuali e procedurali | Applicato tecnicamente tramite controlli in fase di esecuzione e soglie di aggregazione |
| Latenza | Latenza superiore dovuta all'inserimento e alla sincronizzazione | Latenza inferiore, query federate quasi in tempo reale |
| Struttura dei costi | Maggiori costi di archiviazione, trasferimento e duplicazione | Duplicazione ridotta, poiché l'elaborazione avviene dove risiedono i dati |
| Complessità della conformità | Accordi giuridici complessi dovuti alla circolazione transfrontaliera dei dati | Conformità semplificata poiché i dati non lasciano il confine della fonte |
| Scalabilità | La scalabilità richiede più memoria e replica dei dati | Scala attraverso l'elaborazione distribuita senza duplicare i dati |
| Adattamento al settore regolamentato | Spesso impraticabile a causa di problemi di custodia e residenza | Migliore allineamento ai vincoli di sovranità, consenso e regolamentazione |
 ### Fondamenti della piattaforma per le clean room dati scalabili
A livello di infrastruttura, Salesforce Data 360 viene eseguito su Hyperforce, il runtime nativo del cloud di Salesforce che astrae le risorse hyperscaler (AWS, Azure, GCP) dietro un piano di controllo unificato. Questa architettura consente ai dati di rimanere all'interno dell'area geografica per soddisfare i requisiti di sovranità e residenza, abilitando al contempo le operazioni delle camere bianche gestite a livello globale.
Questa base consente la collaborazione tra cloud nelle camere bianche, inclusa l'interoperabilità nativa con le camere bianche AWS. Utilizzando Data 360 come livello di orchestrazione e governance, le aziende possono collaborare con partner che operano direttamente su AWS senza forzare la migrazione dei dati nello storage gestito da Salesforce. Le query vengono inviate all'origine, le regole sulla privacy vengono applicate in modo coerente e solo i risultati aggregati conformi vengono scambiati tra le piattaforme.
Compliance e Trust vengono imposti a livello di infrastruttura e di esecuzione, anziché a livello di applicazione, offrendo una base durevole per la collaborazione multi-cloud e multi-parte su larga scala.
### Pipeline di Data 360 dall'inserimento all'attivazione
Data 360 implementa una pipeline di dati tracciabile end-to-end, assicurando che le operazioni nelle clean room vengano eseguite su dati armonizzati, governati e sensibili all'identità anziché su estrazioni non elaborate.
Le fasi chiave includono:
- **Connect**: Inserimento dati e virtualizzazione tramite connettori pronti all'uso, API, SDK, MuleSoft o connettori copia zero
- **Persistere**: Archiviazione di dati non elaborati in formati nativi (Parquet / Iceberg)
- **Armonizza**: Mappatura a oggetti modello di dati (DMO) canonici per join coerenti
- **Unifica**: La risoluzione dell'identità crea i Golden Record
- **Approfondimenti derivati**: Gli approfondimenti calcolati calcolano le metriche aggregate all'interno del confine governato
- **Atto**: Gli output gestiti vengono inviati alle organizzazioni Salesforce, alle piattaforme di marketing, alle reti pubblicitarie, alle piattaforme dati esterne **o ad altre** clean room, chiudendo il ciclo di approfondimenti sull'azione
Questa pipeline garantisce che le camere bianche funzionino con dati di livello aziendale, non con estrazioni ad hoc.
### Integrazione nativa e "Clicks-Not-Code"
A differenza delle piattaforme clean room dati indipendenti che richiedono provisioning separato e sviluppo SQL, le clean room Salesforce sono incorporate in modo nativo in Data 360. Ciò consente il riutilizzo di DMO, regole di identità, modelli di consenso e policy di governance, eliminando i livelli di sicurezza duplicati.
Il modello di camera bianca basato su modello di Salesforce è un acceleratore chiave che utilizza:
- **Modelli pronti all'**uso per supportare schemi di collaborazione comuni come sovrapposizione del pubblico, soppressione, raggiungimento e misurazione del lift.
- **Modelli personalizzati** che consentono ad architetti e utenti esperti di definire una logica analitica riutilizzabile su misura per esigenze specifiche del settore o dei partner, senza esporre dati non elaborati o complessità delle policy.
Questo approccio standardizza la collaborazione pur consentendo flessibilità, consentendo alle camere bianche di scalare come funzionalità aziendale ripetibile, non come progetto di analisi una tantum.
### Il “Sentiero d’oro” – Chiusura del loop Approfondimento-azione
Data 360 risolve una modalità di errore comune delle camere bianche tradizionali: l'Attivation Gap. Il framework Golden Path garantisce che gli approfondimenti generati all'interno di una camera bianca possano essere utilizzati immediatamente, senza esportare dati non elaborati.
- **Impostazione e Discovery**: I partner condividono i metadati dello schema e i modelli di leva per valutare la fattibilità prima della finalizzazione dei contratti.
- **Analisi**: I modelli predefiniti e personalizzati consentono l'analisi delle sovrapposizioni, la soppressione, la modellazione lookalike e la misurazione dell'ascensore, tutte eseguite all'interno del confine governato.
- **Attivazione**: I segmenti approvati vengono inviati direttamente a Marketing Cloud, alle piattaforme pubblicitarie o ai sistemi partner, condividendo solo i risultati aggregati e conformi.
I modelli diventano percorsi di esecuzione ponderati, garantendo che la collaborazione passi in modo prevedibile dall'analisi all'attivazione.
## Playbook per le camere bianche di Salesforce Data 360
La distribuzione di una Clean Room di Salesforce Data 360 non è solo un esercizio di configurazione: è un flusso di lavoro architetturale disciplinato che copre la preparazione dei dati, la progettazione della governance, la connettività protetta e il monitoraggio operativo.
### Fase 1: Definizione del caso d'uso di collaborazione (iniziare con l'intento)
Prima di toccare i dati o la configurazione, gli architetti devono definire chiaramente:
- A quale domanda stiamo cercando di rispondere?
- Quale esito si prevede? (ad esempio, analisi della sovrapposizione, misurazione del lift, soppressione, rilevamento delle frodi)
- Quale livello di aggregazione è richiesto?
- Quali vincoli normativi o contrattuali si applicano?
- Quale percorso di attivazione consumerà i risultati?
La comprensione dell'obiettivo del collaboratore determina tutto ciò che segue: chiavi di join, regole di identità, soglie di governance e modellazione dei costi. Le camere bianche sono ambienti creati appositamente. Devono essere progettate intorno a un obiettivo analitico definito, non all'esposizione generica dei dati.
### Fase 2: Preparazione dei dati per la collaborazione in camera bianca
Prima di iniziare la collaborazione, i dati aziendali devono essere preparati strutturalmente e semanticamente. Le camere bianche amplificano sia i punti di forza che i punti deboli dei dati sottostanti. La spazzatura dentro, la spazzatura fuori è ancora più vera qui.
**Inserimento:** Collegare sistemi di origine come Salesforce CRM, Marketing Cloud, AWS S3 e Google Cloud Storage a Data 360. Ove possibile, utilizzare connettori a copia zero (ad esempio Snowflake) per evitare movimenti o duplicazioni inutili dei dati.
**Mappatura semantica:** Mappare gli stream di dati al modello di dati Customer 360. Standardizzare campi chiave come numeri di telefono (formato E.164), codici paese/provincia (standard ISO) e indirizzi email. Un disallineamento (ad esempio, una parte che utilizza "CA" e un'altra "California") può non riuscire silenziosamente a raggiungere i join e ridurre i tassi di corrispondenza.
**Risoluzione dell'identità:** Configurare le regole deterministiche (corrispondenza esatta) e probabilistiche (corrispondenza fuzzy) per creare una Persona unificata (Golden Record). Questa entità unificata è la superficie per la corrispondenza delle camere bianche.
La qualità della risoluzione dell'identità influisce direttamente sul valore della collaborazione. Una maggiore precisione delle corrispondenze aumenta le percentuali di sovrapposizione, la confidenza analitica e riduce i falsi negativi.
### Fase 3: Provisioning della Clean Room
Una volta armonizzati i dati, è necessario eseguire il provisioning della camera bianca per definire i confini della collaborazione.
**Convalida della licenza:** Verificare che tutte le organizzazioni partecipanti dispongano dei diritti necessari per Data 360 e le camere bianche.
**Ambito spazio dati:** Gli oggetti camera bianca devono essere limitati a uno spazio dati specifico. Solo gli oggetti mappati a quello spazio dati sono visibili alla camera bianca. Ciò garantisce che la collaborazione sia logicamente isolata senza richiedere la creazione di un nuovo spazio dati esclusivamente per le camere bianche.
**Definizione delle regole di governance:** Stabilire policy in modo dichiarativo prima di eseguire le query:
- **Soglie aggregazione:** ad esempio, un minimo di 100 record per output
- **Join Keys:** ad esempio Email_Hash_SHA256
- **Operazioni consentite:** solo funzioni di aggregazione come COUNT, SUM, AVG
- **Restrizioni esplicite:** bloccare le esportazioni a livello di riga (SELECT \*)
Le regole di governance vengono applicate al momento dell'esecuzione, rendendo le proprietà di privacy e conformità a livello di sistema anziché indicazioni procedurali.
### Fase 4: Definizione di una connettività multiparte sicura
Le camere bianche spesso superano i confini dell'organizzazione e della piattaforma. La connettività deve essere esplicita e strettamente controllata.
**Collegamento account:**
- **Da Salesforce a Salesforce:** Utilizzare Data Cloud One o i meccanismi di condivisione tra organizzazioni approvati.
- **Scenari multi-cloud:** Convalidare l'allineamento delle regioni e la residenza prima di abilitare le query.
**Autenticazione e autorizzazione:** Configurare l'accesso basato su OAuth per gli utenti integrazione dedicati con il principio dei privilegi minimi: limitare l'accesso strettamente agli spazi dati necessari ed evitare le autorizzazioni amministrative.
Gli errori di sicurezza spesso derivano da utenti integrazione con autorizzazioni eccessive anziché da debolezze nella crittografia o nei controlli della piattaforma.
### Fase 5: Esecuzione, monitoraggio e controllo dei carichi di lavoro delle camere bianche
Una volta attivata, l'attenzione si sposta sulla supervisione operativa, sulla qualità delle query e sulla gestione dei costi.
**Esecuzione di query:** Gli analisti o i flussi di lavoro eseguono analisi delle sovrapposizioni e aggregazioni tramite Approfondimenti calcolati o interfacce SQL approvate. Tutte le query impongono automaticamente soglie di aggregazione e controlli della privacy.
**Audit e tracciabilità:** Le camere bianche di Salesforce Data 360 offrono percorsi di controllo sotto forma di oggetto modello di dati (DMO) di controllo. In questo modo si acquisiscono metadati sull'attività della query, incluso chi ha eseguito la query, quando è stata eseguita e quali policy sono state applicate. Il DMO Controllo abilita la creazione di rapporti sulla conformità, la convalida della governance e la tracciabilità forense, assicurando che la collaborazione sia sicura per la privacy e rivedibile.
**Monitoraggio del consumo:** Data Cloud utilizza un modello di credito basato sul consumo. I fattori chiave includono:
- Righe elaborate (ad esempio, 1M righe = unità di credito di riferimento)
- Complessità delle query
- Operazioni di risoluzione dell'identità (moltiplicatore superiore)
- Inserimento batch (moltiplicatore inferiore)
**Digital Wallet e avvisi:** Utilizzare Digital Wallet per tenere traccia del consumo in tempo reale e configurare avvisi con soglie del 50%, 75% e 90%. Correlare i picchi a carichi di lavoro specifici per evitare costi imprevisti.
Tenere presente che la copia zero non elimina i costi di calcolo. Mentre la duplicazione fisica viene rimossa, l'esecuzione avviene nel sistema di origine. Gli architetti devono gestire gli schemi di query, unire la selettività e la frequenza di esecuzione per controllare i costi e le prestazioni.
## Governance, sicurezza e conformità
### Progettazione di camere bianche per Trust su larga scala
Nelle aziende moderne, il Trust non è legato a una camera bianca dei dati. È un risultato architettonico. Salesforce Data 360 applica la governance, la sicurezza e la conformità in modo continuo e automatico, spostando le camere bianche dagli ambienti basati sulle policy ai sistemi gestiti dalla piattaforma.
I controlli del tempo di esecuzione (identità bloccate, tracciati di controllo e privacy differenziale) si applicano in modo coerente indipendentemente dal fatto che la collaborazione avvenga all'interno di Salesforce, tra partner o tra cloud.
### Execution-Time Trust e governance
Il cambiamento più importante per gli architetti è che il Trust viene imposto durante l'esecuzione, non assunto in precedenza. Salesforce Data 360 raggiunge questo obiettivo attraverso una serie di controlli centrali della piattaforma:
- **Identità bloccata:** L'accesso dei partner è crittografato alle identità verificate dell'organizzazione Salesforce, impedendo lo spoofing o la partecipazione non autorizzata.
- **Percorsi di controllo:** Ogni query, join, sovrapposizione di segmenti e attivazione viene registrata per garantire la piena verificabilità e conformità ai regolamenti.
- **Privacy differenziale:** L'ispezione a livello di riga è strutturalmente impossibile. Gli output sono aggregati e statisticamente limitati. I collaboratori visualizzano solo risultati che proteggono la privacy, ad esempio le metriche di raggiungimento o le percentuali di lift, mai singole transazioni o identità.
Questi controlli sostituiscono il Contract Trust con garanzie matematiche e applicazione a livello di piattaforma, riducendo il rischio operativo e legale.
### AI Governance tramite Einstein Trust Layer
Man mano che gli agenti AI interagiscono sempre più con i dati delle camere bianche, Salesforce introduce Einstein Trust Layer. Funge da camera stagna architetturale tra i dati aziendali sensibili e gli LLM esterni. Ciò garantisce che gli approfondimenti sulle camere bianche possano supportare in modo sicuro le decisioni basate sull'intelligenza artificiale senza esporre i dati sottostanti.
**Capacità principali:**
- **Conservazione dei dati zero:** I dati inviati agli LLM sono effimeri. I provider di modelli non possono memorizzare prompt o risposte per l'addestramento.
- **Rilevamento del linguaggio tossico e mascheramento delle informazioni personali:** Gli input e gli output vengono analizzati automaticamente e le informazioni personali vengono mascherate in base alle policy di mascheramento dei dati configurate in Data 360.
### Isolamento logico tramite spazi dati e insiemi di autorizzazioni
Gli **spazi dati** offrono un isolamento logico all'interno di un'organizzazione e dovrebbero allinearsi ai confini normativi, geografici e di partnership come:
- Spazio dati UE
- Spazio dati Nord America
Solo le serie di dati assegnate a uno spazio dati sono visibili all'interno delle sue clean room, impedendo l'esposizione accidentale oltre confine.
Gli insiemi di autorizzazioni offrono un controllo preciso su chi può creare o gestire le camere bianche, eseguire query o attivare segmenti. Le autorizzazioni data-aware impongono restrizioni a livello di campo all'interno degli oggetti modello di dati, ad esempio gli esperti di marketing possono visualizzare i nomi dei segmenti e le dimensioni del pubblico ma non gli indicatori di reddito o di salute.
La sicurezza viene applicata a livello semantico, consentendo agli utenti aziendali un self-service sicuro senza una supervisione IT costante.
### Conformità e consenso per progettazione
I segnali di consenso si propagano automaticamente attraverso Data 360 nell'esecuzione in camera bianca. Gli utenti che revocano il consenso sono esclusi dall'analisi e dall'attivazione per impostazione predefinita, garantendo che la conformità sia imposta dal sistema e non controllata manualmente.
Salesforce Data 360 considera governance, sicurezza e conformità come elementi primitivi dell'architettura di prima classe, non come componenti aggiuntivi facoltativi. Combinando la possibilità di controllare il tempo di esecuzione, le identità bloccate, la privacy differenziale, gli spazi dati, la risoluzione dell'identità consapevole del consenso e Einstein Trust Layer, le aziende possono scalare la collaborazione nelle camere bianche tra partner, sistemi multi-cloud e carichi di lavoro basati sull'intelligenza artificiale, il tutto senza compromettere Trust, privacy o conformità normativa.
## Conclusione e percorso da seguire
### Un percorso pratico per gli architetti
Per acquisire l'intero valore delle camere bianche dei dati, gli architetti devono trattarle come un'infrastruttura architettonica di base, non come strumenti di analisi isolati. Le seguenti priorità definiscono un percorso pragmatico e scalabile:
**Trasformare la collaborazione in una preoccupazione architettonica di prima classe:** La collaborazione sui dati esterni deve essere progettata con lo stesso rigore dell'integrazione interna. Le camere bianche dovrebbero essere incorporate in architetture di riferimento aziendali insieme a piattaforme dati, livelli di integrazione e sistemi AI, non distribuite come estensioni ad hoc. Man mano che l'interoperabilità si espande (ad esempio, l'integrazione delle camere bianche di Data 360 con le camere bianche AWS e la futura compatibilità tra camere bianche), gli architetti devono progettare schemi di collaborazione che anticipino gli ecosistemi multipiattaforma anziché i silos a fornitore singolo.
**Progettazione della privacy per impostazione predefinita alla fonte**
**Progettazione per la fluidità dei dati: **Piuttosto che utilizzare per impostazione predefinita ETL e replica centralizzata pesanti, gli architetti dovrebbero prima considerare la federazione e l'accesso copia zero. Lo spostamento del calcolo nei dati (quando appropriato) riduce le duplicazioni inutili, riduce i costi e preserva l'integrità della fonte della verità. “Connect vs. copy” dovrebbe essere una decisione architettonica consapevole, non un’abitudine ereditata.
**Colmare il divario tra approfondimenti e azioni:** Le camere bianche che si fermano all'analisi non offrono valore aziendale. Le architetture devono collegare in modo nativo gli output delle camere bianche ai sistemi di attivazione e ai flussi di lavoro AI. I cicli di feedback, la misurazione delle prestazioni e l'esecuzione a valle devono essere progettati fin dall'inizio.
**Prepararsi per l'Enterprise Agente:** Poiché gli agenti dell'intelligenza artificiale utilizzano sempre più i dati aziendali, le clean room fungeranno da ambienti di esecuzione controllati in cui gli agenti possono operare senza esporre dati non elaborati. Gli architetti che allineano la strategia per le camere bianche ai framework di governance e Trust AI saranno nella posizione migliore per questa fase successiva.
### Conclusione
Le moderne camere bianche dei dati rappresentano un cambiamento fondamentale nell'architettura dei dati aziendali. Risolvono l'annosa tensione tra utilità dati e privacy abilitando la collaborazione senza esposizione dei dati.
Architetture come Salesforce Data 360 dimostrano che questo compromesso non è una considerazione "o-o". Separando l'archiviazione dei dati dall'attivazione tramite schemi copia zero e incorporando tecnologie che ottimizzano la privacy direttamente nell'esecuzione, le aziende possono collaborare su analisi di alto valore senza rinunciare al controllo dei propri dati. La privacy passa dall’obbligo contrattuale alla garanzia architettonica.
Soprattutto, le camere bianche trasformano i dati da un asset statico in silo in una risorsa gestita e di immediato valore pratico. Quando sono connessi in modo nativo ai livelli di attivazione e intelligenza artificiale, gli approfondimenti non sono più in stallo nei cruscotti digitali. Confluiscono direttamente in decisioni, campagne e sistemi autonomi, chiudendo il ciclo tra dati, azioni ed esiti su scala aziendale.
## Informazioni sugli autori
**Yugandhar Bora** è un architetto di ingegneria del software di Salesforce, specializzato in architettura dei dati all'interno della piattaforma Data and Intelligence Applications. Dirige iniziative del Comitato di revisione dell'architettura aziendale (EARB) incentrate sulla governance dei dati e sui modelli di dati unificati, contribuendo al contempo alle soluzioni di provisioning automatico della piattaforma.
**Birendra Kumar Singh** è un membro principale dello staff tecnico, specializzato in piattaforma e architettura dei dati all'interno di Data 360 in Salesforce. È membro principale della piattaforma di attivazione e guida l'iniziativa Clean Room incentrata sulla fornitura di infrastrutture per camere bianche dati ai clienti di Data 360.
**Priyanka Kshirsagar** è Senior Product Manager di Salesforce, alla guida delle Clean Room di Data 360, una capacità che ha creato da zero per consentire ai clienti aziendali di collaborare sui dati first party in un ambiente che tutela la privacy. Guida la visione per i casi d'uso basati su intelligenza artificiale e ML, inclusa la modellazione lookalike e l'arricchimento dell'identità nelle camere bianche, e ha portato il prodotto attraverso la disponibilità generale e un lancio Dreamforce di livello 1.
## Introduzione
Nello sviluppo software tradizionale, il Ciclo di vita dello sviluppo software (SDLC) offre un approccio strutturato e scaglionato alla creazione di applicazioni. Stabilisce la qualità, riduce i rischi e fornisce una roadmap chiara dall'idea al rilascio. L'ADLC (Agent Development Lifecycle) è una metodologia simile che è distintamente personalizzata per affrontare le complessità specifiche della creazione di agenti autonomi.
Gli agenti non sono applicazioni passive; sono sistemi che ragionano, agiscono e apprendono all'interno di ambienti di esecuzione dinamici. Il loro comportamento non deterministico rende insufficiente il controllo di qualità tradizionale. L'ADLC (Agent Development Lifecycle), promosso da piattaforme come Agentforce, affronta questo aspetto in cinque fasi: Ideazione e progettazione, sviluppo (il "loop interno"), test e convalida, distribuzione e monitoraggio e messa a punto continui (il "loop esterno").
Questo documento funge da guida completa per gli sviluppatori e gli architetti Enterprise che hanno già familiarità con le complessità del ciclo di vita dello sviluppo software (SDLC) e desiderano espandere la loro esperienza nei sistemi basati sugli agenti. Il nostro obiettivo principale è facilitare una comprensione rapida del ciclo di vita dello sviluppo degli agenti (ADLC) evidenziandone le distinzioni chiave dalle metodologie SDLC tradizionali e fornendo un framework strutturato per concettualizzare l'intero processo di creazione, distribuzione e gestione degli agenti intelligenti.
Il documento è organizzato in tre capitoli distinti, ciascuno progettato per costruire progressivamente le tue Knowledge e abilità pratiche:
- **Capitolo 1: Framework ADLC.** Questo capitolo introduce l'ADLC (Agent Development Lifecycle), descrivendone le differenze rispetto all'SDLC a causa delle sfide specifiche dello sviluppo di agenti autonomi. Stabilisce un framework per la progettazione, lo sviluppo, il test e la distribuzione degli agenti.
- **Capitolo 2: Agentforce Platform.** Questo capitolo esplora Agentforce, una piattaforma unificata che semplifica e accelera l'intero ciclo di vita dello sviluppo degli agenti. Agentforce offre strumenti per la progettazione degli agenti, l'elaborazione dei dati, l'addestramento dei modelli, la distribuzione e il monitoraggio continuo, semplificando le operazioni complesse e migliorando l'efficienza.
- **Capitolo 3: Implementazione pro-codice.** Questa guida utilizza gli strumenti pro-code di Agentforce per fornire istruzioni pratiche e dettagliate ed esempi concreti per lo sviluppo degli agenti. Copre l'intero ciclo di vita dello sviluppo degli agenti, dalla prototipazione e l'ingegneria delle funzioni alla distribuzione del modello, al perfezionamento delle prestazioni e alla manutenzione, fornendo agli sviluppatori le competenze necessarie per creare agenti pronti per la produzione.
Questo documento si propone di fornire le Knowledge teoriche e pratiche degli strumenti pro-code di Agentforce. Imparerai a creare, distribuire e monitorare gli agenti in modo efficiente, sicuro e affidabile, acquisendo una comprensione completa dell'ADLC e massimizzando il potenziale di Agentforce nello sviluppo intelligente degli agenti.
## Capitolo 1: Presentazione del ciclo di vita di sviluppo degli agenti
La natura non deterministica degli agenti AI richiede un framework di sviluppo specializzato. Questo capitolo descrive questo framework introducendo l'ADLC (Agent Development Lifecycle). Questo capitolo offre una panoramica completa delle cinque fasi centrali dell'ADLC, dall'ideazione e progettazione iniziali al monitoraggio e alla messa a punto continui. Questo capitolo stabilisce le Knowledge di base necessarie per creare agenti affidabili e affidabili.
Questa sezione mappa i concetti SDLC alle cinque fasi dell'ADLC.
#### Fase 1: Ideazione e Design
Questa è la fase fondamentale in cui vengono definiti lo scopo strategico e i confini operativi di un agente. Una fase di progettazione ben strutturata è il passaggio più critico per il successo, poiché traduce un'esigenza aziendale in un modello tecnico. Il processo di progettazione garantisce che l'agente non sia solo funzionale ma anche responsabile e in linea con le aspettative degli utenti. È dove il "cosa" e il "perché" vengono stabiliti prima di scrivere qualsiasi codice.
1. **Definizione di obiettivi e funzionalità degli agenti**: Innanzitutto, è necessario articolare chiaramente l'obiettivo principale dell'agente e le operazioni specifiche e misurabili che eseguirà. Ciò comporta la definizione del suo ruolo (ad esempio, "Assistente dell'assistenza clienti"), delle sue funzioni centrali (ad esempio, "prenotazione di appuntamenti", "risposta a domande sui prodotti") e delle metriche di successo per ciascuno di essi.
2. **Creazione di guardrail personali ed etici**: Questo passaggio prevede la progettazione della personalità dell'agente e la definizione dei suoi confini etici per garantire che sia affidabile e sicuro. Stabilisce il tono dell'agente (ad esempio, "formale", "amichevole") e implementa regole rigorose per prevenire risposte dannose, distorte o inappropriate.
3. **Mappatura del contesto e comprensione**: È necessario determinare quali informazioni l'agente deve comprendere e ricordare per essere efficace. Ciò include la definizione dell'ambito della sua Knowledge Base e della sua memoria conversazionale, che consente di avere conversazioni coerenti e a più turni.
4. **Identificazione di strumenti e integrazioni di sistemi**: Ciò comporta l'inventario dei sistemi esterni, delle API e delle fonti di dati con cui l'agente deve connettersi per eseguire le operazioni. Ogni strumento (ad esempio, un'API di prenotazione, un database clienti) viene identificato e la sua funzione viene mappata a una funzionalità specifica dell'agente.
5. **Piano per l'inoltro al livello superiore di Human-in-the-Loop**: È fondamentale definire le condizioni in cui un agente passa a un essere umano. Ciò comporta la revisione dei potenziali punti di errore e dei "punti morti" della conversazione per determinare quando un agente deve passare a un operatore umano. La progettazione deve descrivere come verrà eseguito questo trasferimento per garantire che venga trasferito un contesto sufficiente, in modo che possa essere utilizzato rapidamente per garantire un'esperienza cliente senza interruzioni.
#### Fase 2: Sviluppo
Questa è la fase di costruzione pratica in cui il modello di progettazione viene trasformato in un agente funzionale. Gli sviluppatori creano l'agente, lo collegano ai suoi strumenti e gli forniscono i dati necessari per svolgere le proprie mansioni. Questo "anello interno" iterativo di costruzione e raffinazione è il punto in cui l'agente prende veramente vita.
1. **Configurazione della logica e del processo decisionale dell'agente**: Questo passaggio prevede la definizione del ragionamento dell'agente collegando il suo framework decisionale al contesto, agli strumenti e alle fonti di dati. Il ruolo dello sviluppatore è definire il comportamento dell'agente creando API o riutilizzando API esistenti, impostando guardrail operativi e specificando in che modo l'agente seleziona e utilizza gli strumenti disponibili per completare operazioni complesse in più fasi.
2. **Prompt tecnici e modelli di fine-tuning**: Il profilo, le istruzioni e i vincoli dell'agente vengono codificati attraverso una meticolosa progettazione rapida. Questo processo prevede la creazione del prompt principale che guida il modello Large Language (LLM) e, per i casi d'uso più avanzati, l'ottimizzazione del modello sui dati specifici del dominio per migliorarne le prestazioni.
3. **Integrazione e protezione degli strumenti AI**: Le funzioni e le API identificate durante la fase di progettazione sono collegate all'agente. Utilizzando un SDK, gli sviluppatori inseriscono le funzioni esistenti o ne creano di nuove, rendendole chiamabili in modo sicuro dall'agente e assicurando che dispongano dell'autenticazione e della gestione degli errori appropriate.
4. **Creazione di dati e opportunità in corso di realizzazione RAG**: Per fornire all'agente Knowledge esterno, gli sviluppatori creano le pipeline di dati per la generazione aumentata di recupero (RAG). Ciò implica la connessione e l'indicizzazione dei dati da fonti come archivi vettoriali, database relazionali, database grafici o documenti interni, rendendo tali informazioni accessibili all'agente per fornire risposte accurate e sensibili al contesto.
#### Fase 3: Test e convalida
Il test degli agenti AI introduce un cambiamento di paradigma rispetto alla convalida deterministica del software tradizionale. Mentre un'applicazione convenzionale viene testata per la correttezza (un input specifico deve produrre un singolo output previsto), la natura non deterministica di un agente richiede un approccio più sofisticato. L'obiettivo non è convalidare una singola risposta corretta, ma garantire che il comportamento dell'agente sia allineato allo scopo previsto, sia efficace contro input imprevisti e rimanga affidabile in una gamma di risultati accettabili.
1. **Test di unità**: Questo livello si concentra sui componenti deterministici non AI dell'agente. Include test di unità tradizionali per confermare che ogni singolo strumento e funzione funzioni funzioni correttamente isolatamente, garantendo una base affidabile prima di applicare il ragionamento complesso dell'agente.
2. **Test end-to-end (E2E)**: Questa fase valuta la capacità dell'agente di raggiungere gli obiettivi in scenari realistici, che è fondamentale data la sua natura non deterministica. Anziché cercare un output esatto, questi test end-to-end verificano che l'agente completi correttamente le operazioni e che le sue prestazioni non peggiorino man mano che vengono apportate modifiche.
3. **Test del contraddittorio e della robustezza**: Questa è la pratica di provare intenzionalmente a rompere l'agente per scoprire in modo proattivo i suoi punti deboli. I tester utilizzano richieste ambigue, prompt dannosi e altri casi limite per esporre le vulnerabilità e garantire che l'agente rimanga resiliente e sicuro sotto pressione.
4. **Valutazione Human-in-the-Loop (HITL)**: Poiché i test automatici non possono misurare qualità diverse come il tono o il flusso conversazionale, questa fase si basa sul feedback umano. I tester interagiscono con l'agente per calcolare il punteggio delle sue risposte in termini di utilità e di esperienza utente complessiva, fornendo dati essenziali per perfezionarne il comportamento.
5. **Test di prestazioni e scalabilità**: Questo è un passaggio fondamentale per evitare che le strozzature delle prestazioni abbiano effetto sugli utenti. Questo processo simula scenari di picco di utilizzo realistici per garantire che agenti e applicazioni possano gestire volumi elevati in modo fluido e prevedibile. Verifica che la soluzione non sia solo corretta, ma anche scalabile.
#### Fase 4: Distribuzione e rilascio
La distribuzione di un agente AI è un processo gestito incentrato sulla garanzia che l'agente convalidato sia quello con cui gli utenti interagiscono in modo affidabile e ripetibile. Ciò richiede un approccio strutturato che sposta l'agente da un asset controllato da versione a un servizio live e monitorato.
1. **Confezionamento e controllo delle versioni**: L'intera definizione dell'agente, inclusi i prompt e gli strumenti, viene acquisita come metadati in un file e archiviata in un sistema di controllo sorgente come Git. Questo crea un'unica fonte di dati veritieri e una cronologia controllabile di tutte le modifiche.
2. **Pipeline: CI/CD** Il percorso verso la produzione è automatizzato per eliminare gli errori umani e garantire la coerenza. Queste opportunità in corso di realizzazione promuovono automaticamente l'agente negli ambienti di sviluppo, test e produzione, eseguendo test end-to-end in ogni fase per fungere da porta di accesso alla qualità.
3. **Strategie di implementazione graduale**: Per ridurre al minimo il rischio, le nuove versioni degli agenti vengono rilasciate per la prima volta a un piccolo sottoinsieme di utenti utilizzando strategie come Rilasci Canary. Ciò consente il monitoraggio delle prestazioni del mondo reale prima di un'implementazione completa, con la possibilità di ripristinare rapidamente eventuali problemi.
4. **Attivazione e governance**: Il passaggio fondamentale nell'implementazione di un agente consiste nell'attivare in modo sicuro l'agente con le autorizzazioni corrette e assicurarsi che sia connesso agli strumenti di monitoraggio. Ciò offre una visibilità immediata dello stato e delle prestazioni dell'agente appena distribuito dal momento in cui viene reso disponibile.
#### Fase 5: Monitoraggio e ottimizzazione
La distribuzione non è la fine del ciclo di vita dello sviluppo degli agenti, ma l'inizio del suo continuo "loop esterno". Gli agenti sono sistemi dinamici che operano in ambienti reali imprevedibili. Questa fase è dedicata all'osservazione delle prestazioni live dell'agente, alla raccolta di approfondimenti dalle sue interazioni e all'utilizzo di tali dati per perfezionare e migliorare sistematicamente l'efficacia, la sicurezza e l'efficienza nel tempo.
1. **Monitoraggio delle prestazioni in tempo reale**: Si tratta della procedura di monitoraggio delle principali metriche operative dell'agente durante l'interazione con gli utenti. I cruscotti digitali vengono utilizzati per monitorare la latenza, il consumo di token (costo) e i tassi di errore API, offrendo una visione immediata e generale dello stato e dell'efficienza dell'agente.
2. **Analisi comportamentale e di successo**: Ciò comporta l'analisi dei registri di conversazione per capire in che modo l'agente sta _effettivamente_ eseguendo le proprie mansioni. Si concentra sul monitoraggio delle percentuali di completamento delle operazioni, sull'identificazione dei punti di errore comuni o dei "punti morti" conversazionali e sulla misurazione della soddisfazione degli utenti per determinare se l'agente sta raggiungendo con successo i propri obiettivi. Ad esempio, per gli agenti dell'assistenza, potrebbe fornire metriche sulla frequenza e sul motivo per cui un agente viene inoltrato a una persona.
3. **Sintonizzazione e perfezionamento intelligenti**: Si tratta del processo attivo di utilizzo degli approfondimenti del monitoraggio per migliorare l'agente. Questo può andare dalla progettazione rapida all'ottimizzazione degli strumenti.
4. **Ottimizzazione RAG basata sui dati**: La qualità della Knowledge Base dell'agente viene continuamente migliorata in base alle query del mondo reale. Il monitoraggio può rivelare che l'agente è alle prese con determinati argomenti, il che porta a un perfezionamento delle fonti di dati o del processo di recupero (perfezionamento RAG) per migliorare la precisione delle risposte.
5. **Apprendimento continuo e adattamento**: Ciò comporta la creazione di un loop di feedback in cui i dati di produzione vengono utilizzati per rendere l'agente più intelligente. Con l'etichettatura dei registri di interazione, con supervisione umana o basata su LLM, viene creata una serie di dati curata che può essere utilizzata per perfezionare il modello sottostante e consigliare ulteriori miglioramenti
## Capitolo 2: Ciclo di vita dello sviluppo degli agenti _Agenteforce_
Agentforce supporta ogni fase di ADLC con strumenti integrati per progettazione, sviluppo, test, distribuzione, monitoraggio e analisi, il tutto all'interno di un'unica piattaforma unificata per creare e testare rapidamente agenti efficaci.
Agentforce ADLC si basa sui seguenti principi guida:
- **Creato sia per codice basso che per codice pro**: Supporto per la distribuzione basata su configurazione (low-code) e l'estendibilità a livello di programma (pro-code).
- **Assistenza continua basata sull'intelligenza artificiale e loop di feedback**: Acquisisce e analizza i dati conversazionali per informare gli agenti sulla messa a punto di un miglioramento continuo basato sull'intelligenza artificiale.
- **Sviluppo basato su test a tutti i livelli**: Test rigorosi in tutte le fasi, convalidando i componenti deterministici attraverso i test di unità tradizionali e fornendo nuovi approcci per testare il ragionamento degli agenti e il comportamento non deterministico.
- **Osservabilità dei dirigenti e dei LOB**: Metriche di costo, utilizzo e prestazioni per gli stakeholder operativi e dirigenti.
 Questo capitolo mostra come Agentforce supporta ogni fase dell'ADLC all'**interno di un'unica piattaforma unificata.**
#### Fase 1: Ideazione e Design
##### Ideazione
La fase di ideazione è la fase fondamentale dell'ADLC, in cui vengono formulati la visione iniziale e i requisiti per gli agenti. Comprende un'approfondita comprensione del problema, l'identificazione delle potenziali soluzioni e la descrizione delle funzionalità principali dell'agente.
Avviare il processo di ideazione dell'agente definendone gli attributi chiave:
1. **Scopo/Obiettivo**: Definire chiaramente l'obiettivo principale dell'agente. Quale problema specifico si propone di risolvere, o quale compito si intende svolgere? Chi deve servire l'agente? Questa dovrebbe essere una dichiarazione concisa e misurabile che guida l'intero processo di sviluppo.
2. **Persona**: Sviluppare un profilo dettagliato per l'agente. Ciò include la definizione dell'identità, dello stile di comunicazione e del ruolo che svolgerà nell'interazione con gli utenti o altri sistemi. Considerare il tono, il livello di formalità e le eventuali caratteristiche specifiche che lo renderanno efficace nel contesto previsto.
3. **Schema**: Identificare e collegare gli schemi agenti e le strategie di implementazione pertinenti. Si tratta di progetti architettonici o procedure consigliate che possono influenzare la struttura e il comportamento dell'agente. "[Schemi e implementazione degli agenti in Salesforce Agentforce: Un whitepaper tecnico](/docs/architect/it-it/fundamentals/guide/agentic-patterns)", serve come risorsa preziosa per questo passaggio, offrendo approfondimenti sulla progettazione efficace degli agenti sulla piattaforma Salesforce e Agentforce.
##### Design
La fase di progettazione traduce i concetti dall'ideazione in un modello dettagliato per la costruzione dell'agente. Ciò comporta la definizione dell'architettura dell'agente, dei flussi utente, dei modelli di interazione e di specifiche tecniche come argomenti, strumenti e guardrail.
Durante la fase di progettazione, verrà creato un modello dettagliato per la costruzione dell'agente che include:
- **Progettazione agente**: Descrivere la struttura interna dell'agente, compresi i componenti, i moduli e il modo in cui interagiscono. Ciò potrebbe comportare la definizione della Knowledge Base, della configurazione e della logica per controllare il comportamento degli agenti, i componenti di elaborazione del linguaggio naturale (NLP) e i punti di integrazione con altri sistemi.
- **Flussi utente/Progettazione interazione**: Mappare il journey utente completo e le interazioni dell'agente. Definire flussi di conversazione, alberi decisionali, gestione degli errori e meccanismi di feedback per creare esperienze intuitive ed efficaci.
- **Specifiche tecniche**: Documentare i requisiti tecnici non funzionali per l'agente, ad esempio metriche delle prestazioni, considerazioni sulla scalabilità, protocolli di sicurezza e specifiche di integrazione.
- **Prototipazione e modelli**: Creare rappresentazioni visive o prototipi interattivi dell'interfaccia e delle interazioni dell'agente. Ciò consente test e feedback tempestivi, contribuendo a perfezionare la progettazione prima che inizi lo sviluppo su larga scala.
- **Dati**: Quando si determinano il tipo e le fonti di dati richieste da un agente, identificare le serie di dati, le API, i database e gli archivi a cui l'agente deve accedere. Per Agentforce, concentrarsi sui dati forniti come contesto, se sono strutturati o non strutturati e se sono in tempo reale o batch. La piattaforma Agentforce è basata su una profonda integrazione con Data 360, che consente di utilizzare sia dati strutturati che non strutturati provenienti da Salesforce CRM e da altre fonti. Il contenuto non strutturato può essere suddiviso e indicizzato in modo nativo per RAG. MuleSoft consente di connettersi a sistemi esterni.
- **Strumenti**: Identificare le azioni che l'agente deve eseguire. Utilizzare le azioni Agentforce per esporre gli strumenti che raggiungono gli obiettivi aziendali. Queste azioni sfruttano gli asset Salesforce esistenti, ad esempio Prompt tramite Generatore di prompt, MuleSoft, Apex, Flussi e API con specifiche OpenAPI. Qualsiasi azione invocabile può essere integrata in Agentforce e utilizzata dall'agente, rendendo tutti gli strumenti di sviluppo Salesforce più comuni immediatamente disponibili come azioni Agentforce.
- **Dati di input per gli agenti**: Nell'SDLC tradizionale, gli input sono specificati con precisione. Nell'ADLC, gli input sono spesso enunciazioni naturali, non deterministiche e in formato libero. Raccogliere un corpus rappresentativo di enunciazioni che dovrebbero produrre risposte appropriate.
#### Fase 2: Sviluppo
La fase di sviluppo si concentra sulla traduzione dello scopo, delle capacità e dell'ambito operativo dell'agente definito determinato nella fase di ideazione e progettazione in un nuovo agente Agentforce.
Per aiutare gli sviluppatori a creare agenti, Agentforce fornisce sia **Agent Builder** che **Agenteforce Developer Experience (AFDX).** Questi strumenti di base fungono da ambienti principali per la creazione e la configurazione dell'agente.
- **Agent Builder** offre un'esperienza dell'interfaccia utente per definire le funzionalità principali dell'agente.
- **AFDX** fornisce un'interfaccia programmatica per la personalizzazione e l'integrazione con altri sistemi.
Lo sviluppo e la creazione di un agente prevede questi passaggi che possono essere eseguiti utilizzando il Generatore di agenti o AFDX:
1. **Definizione del profilo**: Un aspetto cruciale della progettazione degli agenti è la definizione di un profilo distinto. Ciò comporta la configurazione di:
- **Descrizione agente**: Descrizione dettagliata del ruolo, degli obiettivi e delle operazioni specifiche dell'assistenza clienti che è progettato per gestire.
- **Tono**: Lo stile di comunicazione dell'agente, il livello di empatia e le eventuali linee guida specifiche del marchio a cui deve attenersi.
2. **Definizione di argomenti e azioni degli agenti**: Per rendere un agente sofisticato e in grado di gestire una vasta gamma di operazioni è essenziale suddividere le sue capacità in argomenti distinti con azioni corrispondenti.
- **Argomenti**: Ogni argomento può essere concettualizzato come il proprio agente specializzato con un insieme univoco di istruzioni e strumenti.
- **Architettura modulare.** L'approccio modulare agli argomenti consente una maggiore organizzazione e scalabilità. Definendo più argomenti, l'agente può gestire una gamma più ampia di scenari complessi. Ad esempio, un agente potrebbe avere argomenti separati per "Gestione ordini", "Domande frequenti (FAQ), "Assistenza tecnica" e "Richieste di fatturazione".
- **Istruzioni argomento (Guardrail)**: Ogni argomento viene fornito con istruzioni specifiche che fungono da guardrail, definendo l'ambito di ciò che l'agente può discutere o fare all'interno dell'argomento. Queste istruzioni evitano che l'agente si allontani dall'argomento o fornisca informazioni irrilevanti. Aiutano anche a mantenere coerenza e precisione nelle risposte.
- **Azioni**: Gli argomenti sono inoltre dotati di "strumenti", che rappresentano le azioni che l'agente può intraprendere. Questi strumenti possono essere:
- **Azioni informative**: Recupero di dati da una Knowledge Base o da un sistema esterno per rispondere a una query.
- **Azioni transazionali**: Eseguire azioni per conto dell'utente, ad esempio effettuare un ordine, aggiornare il record di un cliente o avviare un processo di rimborso. Queste azioni sono spesso integrate con altri sistemi (ad esempio CRM, ERP).
#### Fase 3: Test e convalida
Quando valutano le prestazioni e l'affidabilità degli agenti AI, i tester spesso incontrano una serie di sfide che possono compromettere l'esperienza utente. Questi problemi vanno dall'interpretazione errata dell'intento dell'utente all'esecuzione non corretta delle operazioni.
##### Scenari comuni di errore degli agenti
La creazione di un agente affidabile richiede di capire come e dove può fallire. La tabella seguente elenca i problemi più comuni riscontrati durante il ciclo di vita dell'agente, dal ragionamento errato al recupero Knowledge insufficiente. Utilizzare questa opzione come guida strategica durante lo sviluppo e come elenco di controllo durante i test per assicurarsi che l'agente non sia solo funzionale ma anche affidabile e intuitivo per l'utente finale. Questi scenari di errore dovrebbero aiutare a definire i casi di test.
| Categoria | Descrizione | Esempi di errore |
|---|---|---|
| Classificazione argomenti | L'agente non riesce a identificare correttamente l'intento o l'obiettivo dell'utente. |
|
| Qualità della risposta | Errori nel contenuto, nella precisione e nel formato delle risposte dell'agente. |
|
| Esecuzione di azioni | L'agente non riesce quando tenta di eseguire una funzione o un'operazione specifica. |
|
| Parapetti e istruzioni | L'agente viola regole, vincoli o limiti di conversazione predefiniti. |
|
| Recupero Knowledge | L'agente ha problemi a reperire e presentare informazioni dalla sua Knowledge Base. |
|
| Guida strutturata | L'agente fatica a guidare gli utenti nei processi a più fasi. |
|
| Oggetto data lake/oggetto modello di dati | Descrizione |
|---|---|
| AIAgentSession | Un contenitore overarching che acquisisce interazioni contigue con uno o più agenti AI. |
| AIAgentSessionParticipant | Un'entità (umana o AI) che partecipa a una sessione AIAgent. |
| AIAgentInteraction | Un segmento all'interno di una sessione. In genere inizia con la richiesta di un utente e termina quando l'agente AI fornisce una risposta a tale richiesta. |
| AIAgentInteractionStep | Un'azione o operazione discreta eseguita durante un'interazione per soddisfare la richiesta dell'utente. |
| AIAgentInteractionMessage | Una singola comunicazione fornita dall'utente o generata dall'agente AI durante una sessione. |
 ##### Analisi delle enunciazioni
L'analisi delle enunciazioni mostra in che modo gli utenti Agentforce (predefiniti) utilizzano gli agenti, che cosa richiedono e se l'agente è stato in grado di gestire queste richieste. Questi rapporti personalizzabili possono aiutare a perfezionare gli argomenti e le azioni in modo che gli agenti rispondano in modo più efficace e preciso.
 ##### Agentforce Python SDK: Monitoraggio con le integrazioni di Data 360
L'implementazione di Agent SDK utilizza il monitoraggio e l'analisi avanzati con il connettore Python Data 360, stabilendo la connessione a Salesforce Data 360, eseguendo query sulle metriche delle prestazioni degli agenti e creando cruscotti digitali di monitoraggio completi.
Il sistema tiene traccia dei tempi di risposta, delle percentuali di successo, della soddisfazione degli utenti e delle metriche dei costi per fornire approfondimenti concreti per l'ottimizzazione degli agenti.
```py
# Data 360 Python Connector Integration
from salesforce_cdp_connector import SalesforceCDPConnector
# Initialize Data 360 Connector
cdp_connector = SalesforceCDPConnector(
client_id='your_client_id',
client_secret='your_client_secret',
username='your_username@example.com',
password='your_password'
)
# Query agent performance data
performance_data = cdp_connector.query("""
SELECT timestamp, response_time_ms, success_rate, user_satisfaction
FROM AgentPerformanceMetrics
WHERE agent_id = 'Coral_Cloud_Resorts_Resort_Manager'
""")
# Create monitoring dashboard
def create_monitoring_dashboard(performance_data):
fig = go.Figure()
fig.add_trace(go.Scatter(
x=performance_data['timestamp'],
y=performance_data['response_time_ms'],
mode='lines+markers'
))
return fig
```
##### Agentforce DX: Monitoraggio agente
L'implementazione utilizza comandi AFDX standard con gestione degli agenti basata su CLI, mantenendo l'agente aggiornato con le modifiche della piattaforma e incorporando i commenti degli utenti per un miglioramento continuo.
```zsh
# List all agents and their status
sf agent list --target-org "production-org"
# Get detailed agent information
sf agent get \
--api-name "Resort_Manager" --target-org "production-org"
# Activate agent if needed
sf agent activate --api-name "Resort_Manager" --target-org "production-org"
# Query agent performance data
sf data query \
--query "SELECT Id, Name, Status, LastModifiedDate FROM BotDefinition WHERE DeveloperName = 'Resort_Manager'" \
--target-org "production-org"
```
```python
# AgentforceDX Dashboard Creation (Similar to Agent SDK)
import pandas as pd
import plotly.graph_objects as go
from salesforce_cdp_connector import SalesforceCDPConnector
# Initialize Data 360 Connector for AgentforceDX
cdp_connector = SalesforceCDPConnector(
client_id='your_client_id',
client_secret='your_client_secret',
username='your_username@example.com',
password='your_password'
)
# Query agent performance data from Data 360
performance_data = cdp_connector.query("""
SELECT timestamp, agent_id, response_time_ms, success_rate, user_satisfaction
FROM AgentPerformanceMetrics
WHERE agent_id = 'Resort_Manager'
AND timestamp >= CURRENT_DATE - 30
ORDER BY timestamp DESC
""")
```
Fare riferimento al repository GitHub [qui](https://github.com/akshatasawant9699/ADLC_Whitepaper) per l'implementazione di ADLC utilizzando Agent SDK e AFDX.
## Procedure consigliate
Per padroneggiare il ciclo di vita dello sviluppo degli agenti è necessario attenersi a una serie di principi fondamentali che garantiscono efficienza, affidabilità e allineamento strategico. Le seguenti linee guida sintetizzano le lezioni chiave di ogni fase dell'ADLC in un quadro strategico per architetti e sviluppatori.
**1\. Pianificazione e ideazione**
Questa fase iniziale si concentra sull'allineamento dello scopo dell'agente agli obiettivi aziendali e sulla garanzia che sia costruito su una solida base.
- **Dare priorità all'impatto sul business**: Iniziare mappando i potenziali casi d'uso direttamente agli obiettivi aziendali strategici. Utilizzare una matrice di priorità per calcolare il punteggio del loro impatto potenziale e iniziare con un unico caso d'uso mirato con KPI chiari.
- **Coinvolgere precocemente gli stakeholder**: Raccogliere approfondimenti sui punti deboli e garantire l'allineamento.
- **Sfruttare Approfondimenti dati**: Un agente è valido solo quanto i suoi dati. Utilizzare Data 360 per esplorare i dati strutturati e non strutturati disponibili per informare il contesto e le funzionalità dell'agente. Esaminare i rapporti e i cruscotti digitali esistenti per identificare le tendenze correnti che possono influenzare la selezione del caso d'uso.
- **Utilizzo dei framework per l'ideazione**: Applicare metodi di ideazione strutturati per fare brainstorming e perfezionare potenziali applicazioni, ad esempio il design thinking o l'analisi SWOT.
**2\. Agenti immobiliari**
Questa fase descrive le procedure consigliate per la creazione di un agente efficiente e ad alte prestazioni.
- **Evitare troppi argomenti**: Limitare il numero di argomenti per ridurre il rischio di creare argomenti simili o sovrapposti che potrebbero confondere l'agente.
- **Mantenere istruzioni e prompt concisi**: Utilizzare un linguaggio diretto e semplice e fornire enunciazioni di esempio per guidare l'agente in modo efficace.
- **Variabili di leva e azioni deterministiche**: Utilizzare questi strumenti per guidare il comportamento dell'agente e ottimizzarne le prestazioni per risultati più prevedibili.
- **Mantenere gli output delle azioni piccoli e concisi**: Assicurarsi che le risposte dell'agente siano brevi e pertinenti. Gli output più lunghi utilizzano più contesto e sono più lenti da generare.
- **Ottimizzazione delle azioni per la velocità**: Progettare i flussi e le classi Apex in modo che restituiscano dati minimi richiesti. Cercare di avere meno azioni necessarie per generare una risposta pre-elaborando, ove possibile.
- **Definizione di un ambito chiaro**: Scrivere descrizioni, istruzioni e ambiti di intervento appropriati per impedire all'agente di chiamare RAG (Generazione aumentata recupero) per domande fuori ambito.
- **Utilizza la ricerca ibrida con parsimonia**: Utilizzare la ricerca ibrida solo se è assolutamente necessaria, poiché può influire negativamente sulla latenza.
**3\. Test, monitoraggio e ottimizzazione**
Questa fase iterativa è fondamentale per perfezionare la precisione e le prestazioni dell'agente.
- **Creazione di un flusso di test**: Seguire un ciclo di test coerente:
1. **Esegui test batch**: Eseguire una serie completa di test.
2. **Visualizzazione di punteggi/errori**: Analizzare le metriche delle prestazioni e identificare gli errori.
3. **Ispezione degli errori**: Esaminare ogni riga di errore per capire la discrepanza.
4. **Aggiorna agente**: Apportare le modifiche necessarie all'agente o ai suoi dati di valutazione.
- **Rivedi informazioni di tracciamento della sessione**: Utilizzare il modello di dati di traccia della sessione e Agentforce Interaction Explorer per eseguire l'analisi delle cause principali quando vengono rilevati problemi o comportamenti imprevisti. Sintonizzare l'agente in base alle informazioni e continuare a ripetere l'agente.
## Conclusione
Il _ciclo di vita_ rappresenta un'evoluzione critica dei principi di sviluppo software tradizionali, progettati per l'era dei sistemi intelligenti e autonomi.
- **Evoluzione, non sostituzione**: Il Ciclo di vita dello sviluppo degli agenti estende e ottimizza la tradizionale Gestione del ciclo di vita delle applicazioni senza sostituirla.
- **Dati come cittadino di prima classe**: I dati svolgono un ruolo molto più dinamico e centrale nello sviluppo degli agenti.
- **Attrezzature e competenze specializzate**: Richiede nuovi strumenti e un insieme più ampio di competenze specialistiche in scienza dei dati, ingegneria ML e sviluppo degli agenti.
- **Apprendimento continuo**: Lo sviluppo degli agenti aggiunge _l'apprendimento_ continuo e l'_adattamento_ del sistema stesso.
- **Impatto futuro**: L'intelligenza artificiale agente promette di automatizzare e ottimizzare ulteriormente le operazioni IT complesse e i flussi di lavoro di sviluppo software.
## Panoramica della guida
L'elaborazione asincrona aumenta [la scalabilità](/docs/architect/it-it/well-architected/guide/reliable#scalabilità) consentendo limiti più elevati per contesto. Le richieste asincrone vengono eseguite nei propri thread in background, quindi gli utenti possono continuare a lavorare sul lato client mentre le operazioni asincrone vengono eseguite in background.
Salesforce Lightning Platform offre una varietà di tecnologie asincrone che possono essere utilizzate per risolvere un determinato caso d'uso. Ogni tecnologia presenta vantaggi e limiti che sarà necessario considerare quando si seleziona un approccio per ogni caso d'uso.
Quando si sceglie una tecnologia per l'implementazione, tenere presenti tre considerazioni importanti:
1. L'elaborazione asincrona non è l'approccio migliore per ogni problema. Può essere allettante pensare a qualsiasi processo che non richieda direttamente l'interazione dell'utente come a un buon candidato per l'elaborazione asincrona, ma ci sono alcuni svantaggi. In primo luogo, i processi asincroni non hanno SLA, il che significa che non vi è alcuna garanzia che un processo asincrono venga completato entro un determinato periodo di tempo. In secondo luogo, non è garantita una latenza di risposta costante. Se un processo asincrono viene completato entro un determinato periodo di tempo, il completamento di un processo successivo può richiedere un periodo di tempo diverso. Pertanto, anche se un utente non è direttamente in attesa di una risposta, l'elaborazione asincrona potrebbe non essere adatta allo scenario se si hanno processi successivi che dipendono da una risposta o se si teme che tempi di risposta eccessivi possano causare la perdita di sincronizzazione dei dati con i dati di un sistema esterno.
2. Esistono diversi modi per elaborare le richieste asincrone in Salesforce Platform, quindi assicurarsi di scegliere l'approccio migliore. Le tecnologie che supportano l'elaborazione asincrona in Salesforce Platform funzionano in modo diverso e alcune sono state progettate per casi d'uso molto specifici.
3. Se una tecnologia è asincrona sul lato client, non significa necessariamente che tutta l'elaborazione end-to-end venga eseguita in parallelo. A seconda delle scelte effettuate, a volte i messaggi del client possono comunque essere serializzati sul lato server.
Se si utilizzano tecnologie sbagliate o combinazioni di tecnologie sbagliate per un processo, possono verificarsi conseguenze indesiderate che annullano i vantaggi dell'elaborazione asincrona. Questa guida fornisce spiegazioni e consigli, nonché potenziali inconvenienti e schemi contrari per vari casi d'uso asincroni, insieme alla motivazione di tali consigli. Offre inoltre informazioni sul funzionamento e la regolamentazione di varie tecniche di implementazione asincrona in Salesforce Platform.
Se si sta decidendo quale tecnologia utilizzare, è disponibile una [Guida alle decisioni](/docs/architect/it-it/decision-guides/guide/async-processing) mirata che offre una mappatura rapida dei casi d'uso tipici alla tecnologia più adatta.
## Prodotti nell'ambito
 |
Salesforce Lightning Platform è una piattaforma completa basata sull'intelligenza artificiale che unifica dipendenti, agenti autonomi dell'intelligenza artificiale, dati aziendali e applicazioni in un unico sistema affidabile per migliorare la produttività e l'esperienza dei clienti. Consente la creazione di un'"azienda autentica" collegando le app Customer 360, Data Cloud e Slack per l'automazione end-to-end. |
 #### Utilizzo equo
Il meccanismo di utilizzo equo della piattaforma implementa un sistema basato su livelli. Il sistema garantisce che ogni organizzazione in Salesforce Platform riceva una giusta parte del tempo di elaborazione per un determinato tipo di messaggio, inclusi i tipi di messaggio Futuro, In area di attesa e Batch. Se un'organizzazione domina un determinato tipo di messaggio nello stesso periodo in cui altre organizzazioni sono in attesa di eseguire il lavoro sullo stesso tipo di messaggio, l'algoritmo di utilizzo equo riduce il numero di thread disponibili per quel particolare tipo di messaggio.
 Un vantaggio dell'utilizzo dei metodi Apex asincroni è che alcuni limiti del governor, ad esempio i limiti delle query SOQL e delle dimensioni dell'heap, sono più elevati. Tuttavia, non affidarsi troppo a questi metodi. A causa delle risorse limitate allocate all'infrastruttura asincrona, l'utilizzo intensivo di Apex futuro, accodabile e batch può causare ritardi di elaborazione dovuti a limitazioni basate su un utilizzo equo e sul controllo del flusso.
#### Considerazioni speciali per le chiamate in uscita tramite Apex asincrono
Le chiamate in uscita che utilizzano Apex asincrono vengono conteggiate nel limite Apex asincrono. Il limite giornaliero è attualmente 250.000 o 200 volte il numero di licenze utente applicabili, a seconda di quale sia il valore maggiore. Questo limite può essere un problema per i casi d'uso a volume elevato. Se si supera il limite, i processi Apex asincroni e le chiamate in uscita associate avranno esito negativo.
Inoltre, poiché la piattaforma ha un numero finito di thread asincroni disponibili, le integrazioni in uscita tramite Apex asincrono hanno una scalabilità limitata. Qualsiasi integrazione in uscita a volume elevato che supera il numero di thread disponibili può richiedere lunghi tempi di elaborazione e causare ritardi.
Per i casi d'uso a volume elevato, considerare i seguenti approcci alternativi. Le chiamate API con questi approcci vengono conteggiate nel limite giornaliero di richieste API, che è significativamente superiore al limite Apex asincrono giornaliero. Pertanto, questi approcci sono più scalabili. Tenere presente, tuttavia, che esistono ancora limitazioni fisiche al numero di richieste simultanee che qualsiasi CPU può elaborare.
- **Middleware Scheduled Pull.** Evitare ritardi associati a processi di integrazione in uscita a volume elevato utilizzando middleware per estrarre i dati su base pianificata anziché inviarli tramite Apex asincrono. Il middleware, ad esempio MuleSoft Anypoint Platform, può utilizzare l'API SOAP nativa o l'API REST in modo sincrono in modo che vengano introdotti pochi ritardi. Middleware può anche utilizzare l'API in blocco nativa per volumi di dati elevati.
 - **Trascinamento middleware tramite notifica evento piattaforma.** Anziché mettere in area di attesa Apex asincrono Future, Queueable o Batch per eseguire integrazioni in uscita, è possibile utilizzare gli eventi piattaforma. L'evento piattaforma può fornire da solo le informazioni in uscita o indicare a uno strumento middleware di estrarre le informazioni richieste tramite un'API nativa e consegnarle alla destinazione finale. Nessuno di questi approcci è soggetto ai ritardi a cui è soggetto Apex asincrono. Tuttavia, rimangono validi i [limiti degli eventi](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_events_limits_default.htm) piattaforma.
 #### Tradeoff Apex asincroni
| Prodotto/approccio | Casi d'uso | Competenze richieste | Asincrono rispetto al cliente | Asincrono rispetto al server | Tipo di limiti della piattaforma applicati |
|---|---|---|---|---|---|
| Metodi futuri Apex | Si consiglia di utilizzare Queueable Apex anziché i metodi futuri Apex. Le aree di attesa hanno gli stessi casi d'uso dei metodi futuri ma offrono ulteriori vantaggi. | Pro-code | Sì | Sì | Asynchronous |
| Apex in area di attesa | Preferiamo questo approccio ai metodi futuri. Utilizzare per processi che comportano operazioni di database di lunga durata o chiamate a servizi Web esterni. Queueable Apex offre ulteriori vantaggi rispetto ai metodi futuri, inclusi ID processo, supporto per i tipi non primitivi e concatenamento dei processi. | Pro-code | Sì | Sì | Asynchronous |
| Apex pianificato | Eseguire Apex a un'ora pianificata definita da un'espressione cron. Sebbene l'atto di pianificare Apex tramite l'espressione cron sia un processo asincrono, il codice sottostante viene eseguito in modo sincrono all'avvio del processo. | Pro-code | Sì | Sì | Synchronous |
| Chiamate continuazione Apex | Chiamate da metodi Apex eseguite in un contesto di transazione sincrona. | Pro-code | Sì | Sì | Synchronous |
 Gli eventi pubblicati sul bus tramite [publish after commit](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_events_intro.htm) vengono consegnati in ordine e possono essere elaborati in blocco dal trigger o dal flusso in un contesto sincrono separato. Il contesto è sincrono e impone tutti i limiti del governor sincrono. Scegliere con attenzione il trigger evento piattaforma/la dimensione del batch di flusso per evitare di superare i limiti.
| Prodotto/approccio | Casi d'uso | Competenze richieste | Asincrono rispetto al cliente | Asincrono rispetto al server | Tipo di limiti della piattaforma applicati |
|---|---|---|---|---|---|
| Trigger evento piattaforma | Associare liberamente Salesforce ai sistemi esterni e comunicare tra i componenti asincroni della piattaforma. | Low-code + Pro-code | Sì | Sì | Synchronous |
| Prodotto/approccio | Casi d'uso | Competenze richieste | Asincrono rispetto al cliente | Asincrono rispetto al server | Tipo di limiti della piattaforma applicati |
|---|---|---|---|---|---|
| Percorso pianificato (dopo l'impegno dei flussi) | Eseguire a orari pianificati dinamicamente dopo l'attivazione degli eventi. | Basso codice | Sì | Sì | Asynchronous |
| Percorso asincrono (flussi attivati da record) | Eseguire un'operazione che si desidera eseguire al momento opportuno per evitare errori DML misti. | Basso codice | Sì | Sì | Asynchronous |
| Prodotto/approccio | Casi d'uso | Competenze richieste | Asincrono rispetto al cliente | Asincrono rispetto al server | Tipo di limiti della piattaforma applicati |
|---|---|---|---|---|---|
| Messaggi in uscita | Condividere i dati con sistemi di terze parti quasi in tempo reale tramite il protocollo SOAP | Basso codice | N/D | Sì | N/D |
| Prodotto/approccio | Casi d'uso | Competenze richieste | Asincrono rispetto al cliente | Asincrono rispetto al server | Tipo di limiti della piattaforma applicati |
|---|---|---|---|---|---|
| Email a caso | Creare automaticamente i casi e compilare i campi dei casi in base ai valori dei messaggi email in entrata. | Basso codice | Sì | Sì* | Synchronous |
| * Email a caso viene gestito sia come sincronizzazione che come asincrono, ma con limiti Apex sincroni | |||||
| Prodotto/approccio | Casi d'uso | Competenze richieste | Asincrono rispetto al cliente | Asincrono rispetto al server | Tipo di limiti della piattaforma applicati |
|---|---|---|---|---|---|
| Batch Apex | Processi complessi e di lunga durata che coinvolgono migliaia di record | Pro-code | Sì | Sì | Asynchronous |
| Flussi attivati da pianificazione | Eseguire azioni su un batch di record in background a un'ora specificata e con frequenza ripetuta tramite un flusso. | Basso codice | Sì | Sì | Synchronous |
| Bulk API | Inserire, aggiornare, inserire con aggiornamento, eseguire query o eliminare molti record in modo asincrono. | Pro-code | Sì | Sì | Asynchronous |
| Comportamento | Data | Metadata |
|---|---|---|
| Copiato dalla produzione negli ambienti Sandbox | No* | Sì |
| Migrazione per API dei metadati | No | Sì** |
| Migrazione per caricamento dati | Sì | No |
| Può essere incluso nei pacchetti | No | Sì** |
| Conta ai fini dei limiti di memoria dati | Sì | No |
| *I Sandbox con copia completa e parziale consentono la replica dei dati dalla produzione. **Alcuni tipi di metadati non sono disponibili per l'uso con l'API dei metadati e/o i pacchetti. Le eccezioni sono disponibili nel rapporto sulla copertura dei metadati. |
||
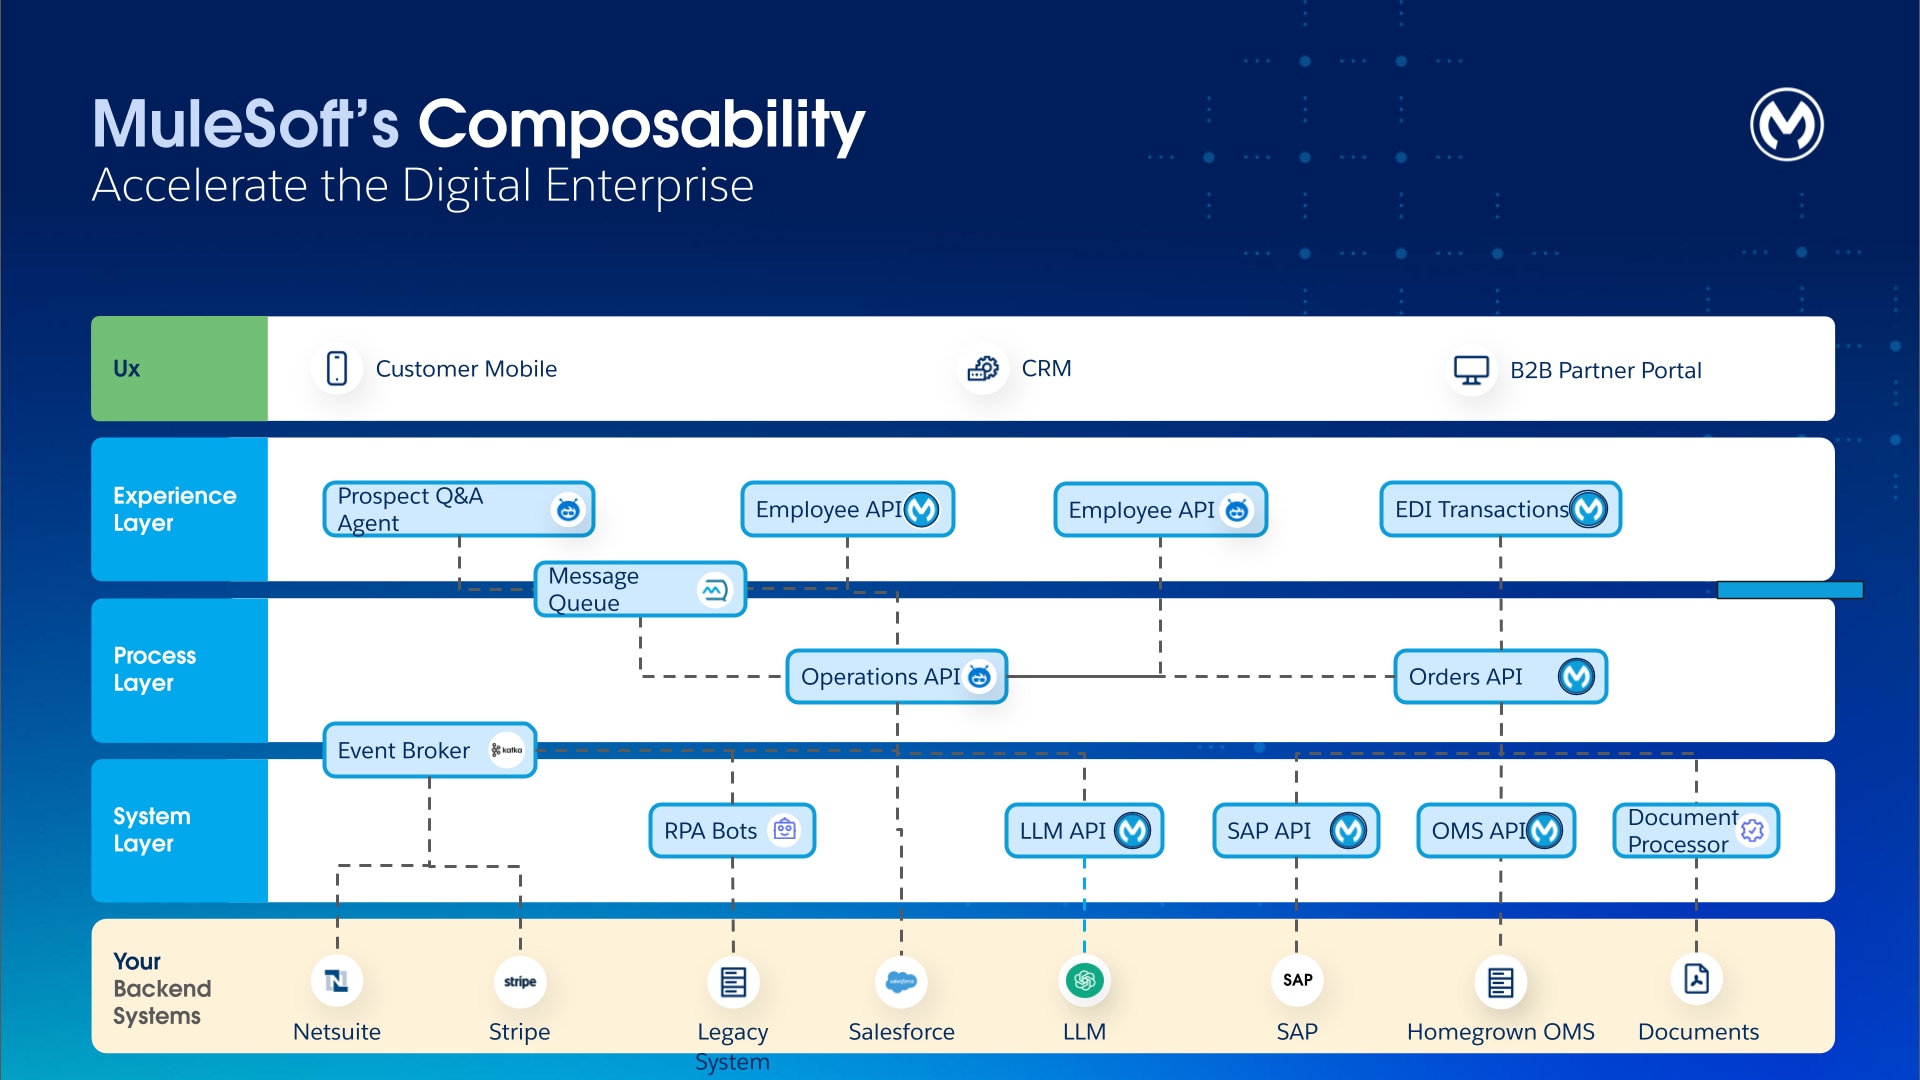 L'approccio consolidato a tre livelli della connettività basata su API - API di sistema, di processo ed Experience - offre un framework efficace per strutturare l'agibilità degli agenti.
- Le **API di sistema** offrono un'interfaccia coerente, sicura e astratta ai sistemi di record sottostanti. Disaccoppiano gli agenti dalla complessità dei protocolli di backend e dei modelli di dati, assicurando che tutte le azioni degli agenti vengano eseguite su endpoint governati e affidabili.
- Le **API dei processi** incapsulano una logica aziendale complessa in più fasi. Non è necessario che gli agenti comprendano la complessa orchestrazione che sta dietro alla creazione di ordini di vendita, al controllo dell'inventario o all'avvio delle spedizioni. Possono utilizzare le API dei processi (ad esempio, "Process Order") senza dover gestire le complessità sottostanti. Le API dei processi offrono agli agenti un meccanismo sicuro, transazionale e controllabile per l'esecuzione dei processi aziendali, che riduce notevolmente il ragionamento degli agenti richiesto e garantisce che le regole aziendali vengano applicate in modo coerente.
- Le **API Experience sono** state tradizionalmente progettate per servire applicazioni dell'interfaccia utente specifiche (ad esempio, l'app Gestione ordini); tuttavia, possono anche essere riutilizzate come azioni ricche di contesto per gli agenti. Questo fornisce agli agenti le informazioni essenziali per eseguire una determinata operazione senza richiedere più chiamate ai sistemi a valle.
## **1\. Creazione generativa: Accelerazione dello sviluppo di asset pronti per l'uso da parte degli agenti**
Per soddisfare la crescente domanda di strumenti e funzionalità pronti per gli agenti, le aziende devono accelerare lo sviluppo delle API e delle integrazioni che costituiscono la base componibile. _MuleSoft_ affronta questa sfida incorporando l'intelligenza artificiale generativa direttamente nel ciclo di vita dello sviluppo, creando un ciclo virtuoso che utilizza l'intelligenza artificiale per creare gli asset di alta qualità consumati da altri agenti.
### **1.1 MuleSoft Vibes**
Per gli sviluppatori, [MuleSoft Vibes](https://www.mulesoft.com/platform/api/anypoint-code-builder/announcing-mulesoft-vibes) funge da partner intelligente automatizzando gli aspetti più ripetitivi dello sviluppo dell'integrazione e fornendo un'interfaccia agente unificata per l'intero ciclo di vita dello sviluppo software. Tramite MuleSoft Vibes in [Anypoint Code Builder](https://docs.mulesoft.com/anypoint-code-builder/), gli sviluppatori interagiscono con le capacità generative basate sulle [affidabili _pipeline Einstein AI_](https://blogs.mulesoft.com/automation/how-mulesoft-turns-generative-output-into-value/), che rendono il processo di sviluppo assistito dall'intelligenza artificiale fluido ed efficiente. Questa pipeline - l'_Inference Graph Execution Service (IGES)_ \- è un processo a più fasi utilizzato per ottenere risultati di alta qualità. Consiste in radicamento, convalida, correzione degli errori e valutazione rigorosa.
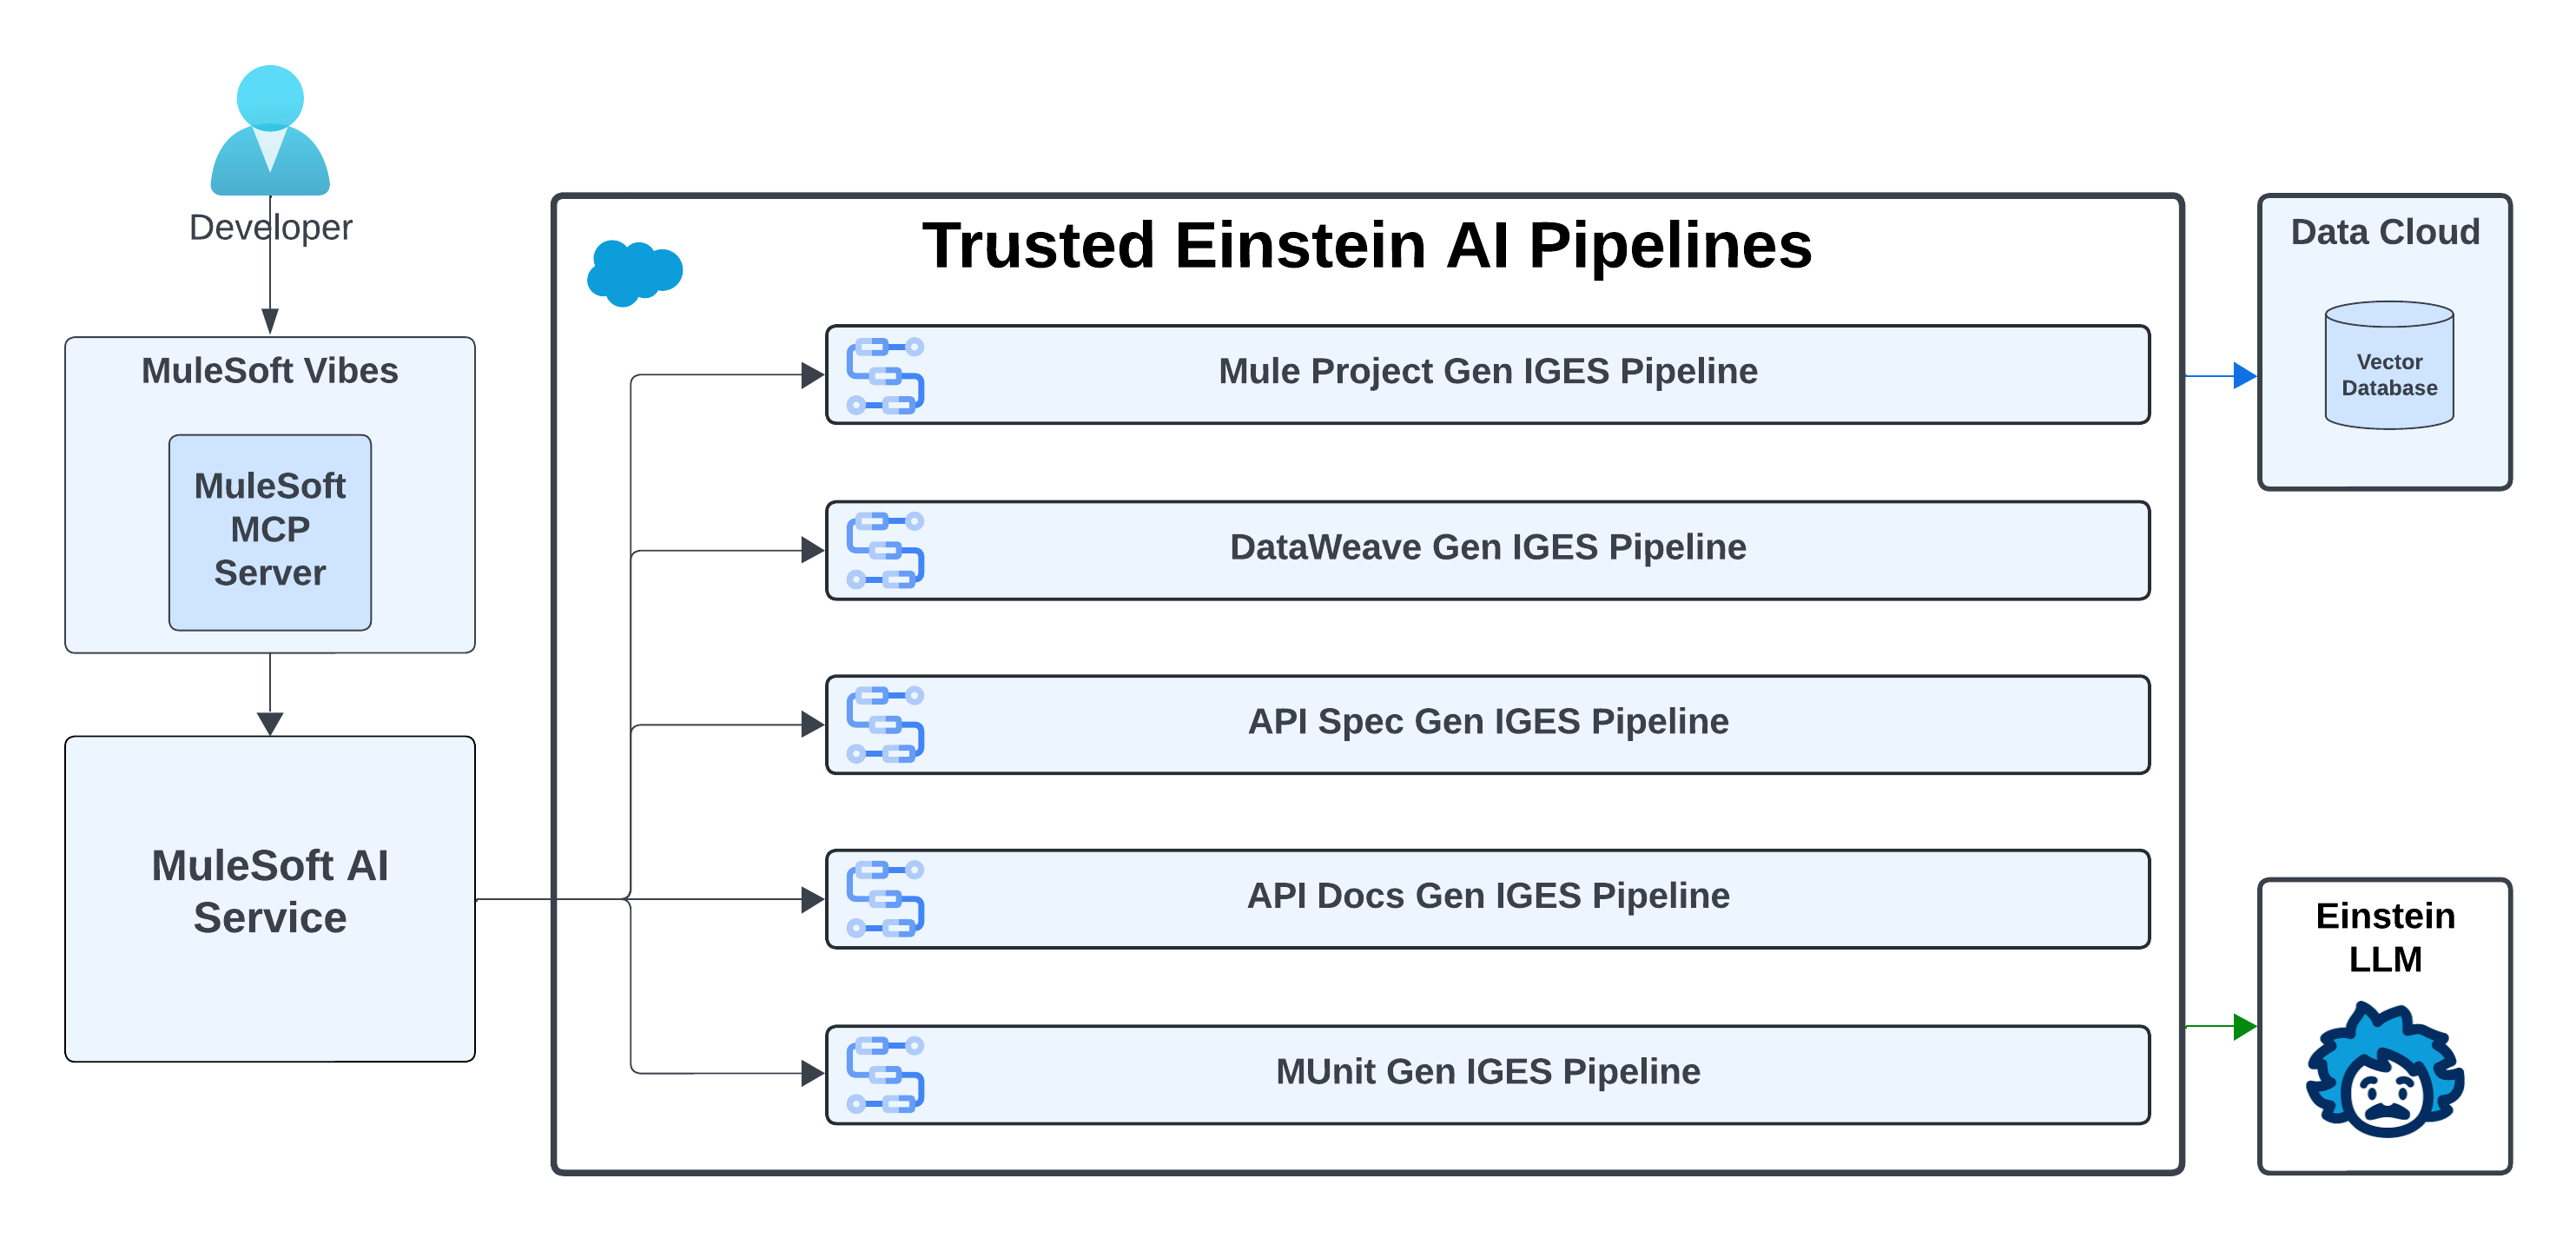 - La funzionalità dei [**flussi generativi**](https://blogs.mulesoft.com/dev-guides/einstein-for-acb/) in _MuleSoft Vibes_ è basata sul framework _AI Agentforce_. Trasforma la logica aziendale del linguaggio naturale (prompt utente) in applicazioni Mule funzionali. La _pipeline IGES si_ articola nelle seguenti fasi:
- **Riepilogo cronologia conversazioni:** LLM analizza il prompt corrente e i messaggi precedenti dell'utente per creare un prompt riepilogato che acquisisce l'intento dell'utente e la cronologia delle conversazioni. Questo prompt consolidato migliora la precisione delle fasi successive di recupero e generazione dei dati.
- **Recupero semantico dei flussi da un database vettoriale:** Il sistema riprende il prompt riepilogato del passaggio precedente ed esegue una ricerca semantica in un database vettoriale contenente oltre 200 connettori, oltre 7.000 operazioni sui connettori e oltre 7.000 snippet di codice di esempio. Recupera i connettori, le operazioni e gli esempi di codice più pertinenti per basare il processo di generazione utilizzando dati precisi e garantisce che gli output siano allineati all'ampio ecosistema di connettori di MuleSoft. Poiché MuleSoft è lo standard del settore per connettori e operazioni, questa base fornisce al modello un contesto e una precisione di dominio completi che mancano agli LLM generici.
- **Aumento:** I messaggi del contenuto e della cronologia delle conversazioni recuperati vengono quindi combinati con il prompt di riepilogo. Questo prompt aumentato guida il LLM a ridurre le allucinazioni. Include anche istruzioni per prevenire la generazione di contenuto tossico.
- **Generazione di flusso:** Questo passaggio sfrutta il modello _Einstein AI LLM_ per generare codice XML non formattato basato sul contesto e sugli esempi forniti. Questa è la fase centrale della pipeline di generazione.
- **Post-elaborazione e convalida:** Il post-processore e il validatore controllano il codice per verificare la sintassi corretta e l'uso di operazioni valide del connettore mentre un controllo della tossicità separato segnala i contenuti dannosi.
- **Correzione dell'errore in più fasi:** Se tutte le generazioni iniziali non sono valide, il meccanismo di correzione automatica degli errori analizza i messaggi di errore per rilevare gli schemi. Quindi, invia nuovamente il prompt al LLM insieme a messaggi di errore arricchiti e metadati correttivi.
- **Configura generazione file:** Questo passaggio estrae i metadati pertinenti del connettore, aumenta il prompt e li invia al componente LLM per generare configurazioni del connettore accurate. Infine, tutti gli spazi dei nomi POM e XML vengono generati in modo deterministico utilizzando la versione più recente di ogni dipendenza, eliminando le allucinazioni e garantendo coerenza.
- [**La trasformazione dati**](https://blogs.mulesoft.com/dev-guides/dataweave-generative-transformation/) è spesso la parte che richiede più tempo nello sviluppo dell'integrazione.**:** _MuleSoft Vibes_ affronta questo processo utilizzando l'approccio a più fasi simile alla generazione _XML Mule Flow_.
- **Ragionamento intenzionale:** LLM analizza gli esempi di dati di input e output degli utenti per dedurre e articolare una logica di trasformazione di alto livello in linguaggio naturale. Questo passaggio separa l'obiettivo dell'utente dai valori di dati letterali che potrebbero essere stati forniti nel prompt.
- **DataWeave Recupero semantico:** Per trovare la documentazione della funzione DataWeave più rilevante dal punto di vista semantico e gli esempi completi di trasformazione, il sistema utilizza il prompt generato dalla fase precedente come query al database vettoriale. Questo basa il processo di generazione su informazioni verificate di alta qualità.
- **Aumento:** Le funzioni e gli esempi recuperati vengono combinati con il prompt utente originale per creare una serie di istruzioni sensibili al contesto per la successiva chiamata LLM, che influenza il comportamento del LLM per ridurre le allucinazioni.
- **Generazione DataWeave:** Questo passaggio sfrutta il modello LLM per generare uno script di trasformazione DataWeave e una spiegazione basata sul contesto e sugli esempi forniti. Questa è la fase centrale della pipeline di generazione.
- **Post-elaborazione e convalida** Lo script generato viene valutato in base a due metriche specifiche: validità e correttezza. Lo script deve essere compilato senza errori di sintassi (validità) e generare l'output previsto quando viene eseguito utilizzando l'input di esempio (correttezza).
- **Correzione dell'errore in più fasi:** Se la convalida iniziale non riesce, questo plugin identifica le categorie di errore e corregge i problemi nello script generato. Questo perfezionamento consente di migliorare la percentuale di successo complessiva e la precisione del sistema.
- **Post-elaborazione e convalida** finali Lo script corretto del modulo di correzione degli errori viene sottoposto a un nuovo processo di convalida per assicurarsi che sia sintatticamente valido e funzionalmente corretto. Questo gate di qualità finale garantisce che l'output sia preciso e affidabile prima di inviarlo nuovamente all'utente.
- Gli sviluppatori di [**specifiche API**](https://docs.mulesoft.com/anypoint-code-builder/api-ai-create-spec) **e [generazione di documentazione](https://docs.mulesoft.com/exchange/generating-documentation-with-ai):** possono generare specifiche _OpenAPI (OAS)_ o _RAML_ completamente convalidate descrivendo l'API desiderata in linguaggio naturale. _MuleSoft Vibes_ inserisce il prompt (che include dettagli su risorse, metodi, schemi di sicurezza e parametri) e genera una definizione API valida e sintatticamente corretta. Dopo la generazione, può creare documentazione per l'API in _Anypoint Exchange_, che copre qualsiasi cosa, dall'autenticazione ai dettagli dell'endpoint e alla gestione degli errori, liberando gli sviluppatori da questi tipi di operazioni noiose.
- **Generazione MUnit assistita da AI:** L'assicurazione della qualità è fondamentale per gli asset consumati da agenti autonomi. _MuleSoft Vibes_ consente di generare casi di test MUnit direttamente dal codice flusso Mule. Ciò consente di ingannare le dipendenze e le asserzioni esterne e di identificare le lacune comuni nei test, riducendo drasticamente l'impegno manuale necessario per ottenere un'elevata copertura dei test e garantire l'affidabilità della logica di integrazione.
### **1.2 MuleSoft a modo tuo**
Gli sviluppatori prosperano nei loro ambienti preferiti. Ecco perché _MuleSoft_ incontra gli sviluppatori ovunque si trovino, il che consente loro di creare integrazioni nell'IDE AI preferito. [Il server MCP](https://www.npmjs.com/package/@mulesoft/mcp-server) espone le funzionalità di sviluppo, distribuzione e gestione come strumenti MCP che qualsiasi IDE nativo dell'intelligenza artificiale basato su VS Code (ad esempio, Cursore, Windsurf o Trae) può utilizzare per interagire con la _piattaforma Anypoint_ utilizzando un linguaggio naturale.
Incorporando le sue funzionalità IDE principali in un'[estensione VS Code standard](https://marketplace.visualstudio.com/items?itemName=salesforce.mule-dx-extension-pack), _MuleSoft_ disaccoppia i suoi strumenti da una shell IDE con immagine aziendale, il che consente agli strumenti di sviluppo di essere indipendenti dall'IDE. Anziché competere con la rapida evoluzione delle IDE, questa scelta di architettura consente agli strumenti di sviluppo di MuleSoft di rimanere compatibili e accessibili in tutto l'ecosistema in crescita delle moderne IDE basate sull'intelligenza artificiale.
## **2\. Abilita fruibilità: Trasformazione delle API in strumenti per gli agenti**
In un'organizzazione Agentic Enterprise, avere una solida base di API componibili è necessario, ma insufficiente. Il passaggio successivo è assicurarsi che questi asset siano individuabili, comprensibili e invocabili dagli agenti dell'intelligenza artificiale. Ciò richiede un "livello di fruibilità" basato su standard aperti progettati specificamente per la comunicazione tra agenti. _MuleSoft_ fornisce strumenti di livello aziendale per i due protocolli emergenti dominanti:
- **MCP** per le interazioni tra agenti e sistemi
- **A2A** per le interazioni tra agenti
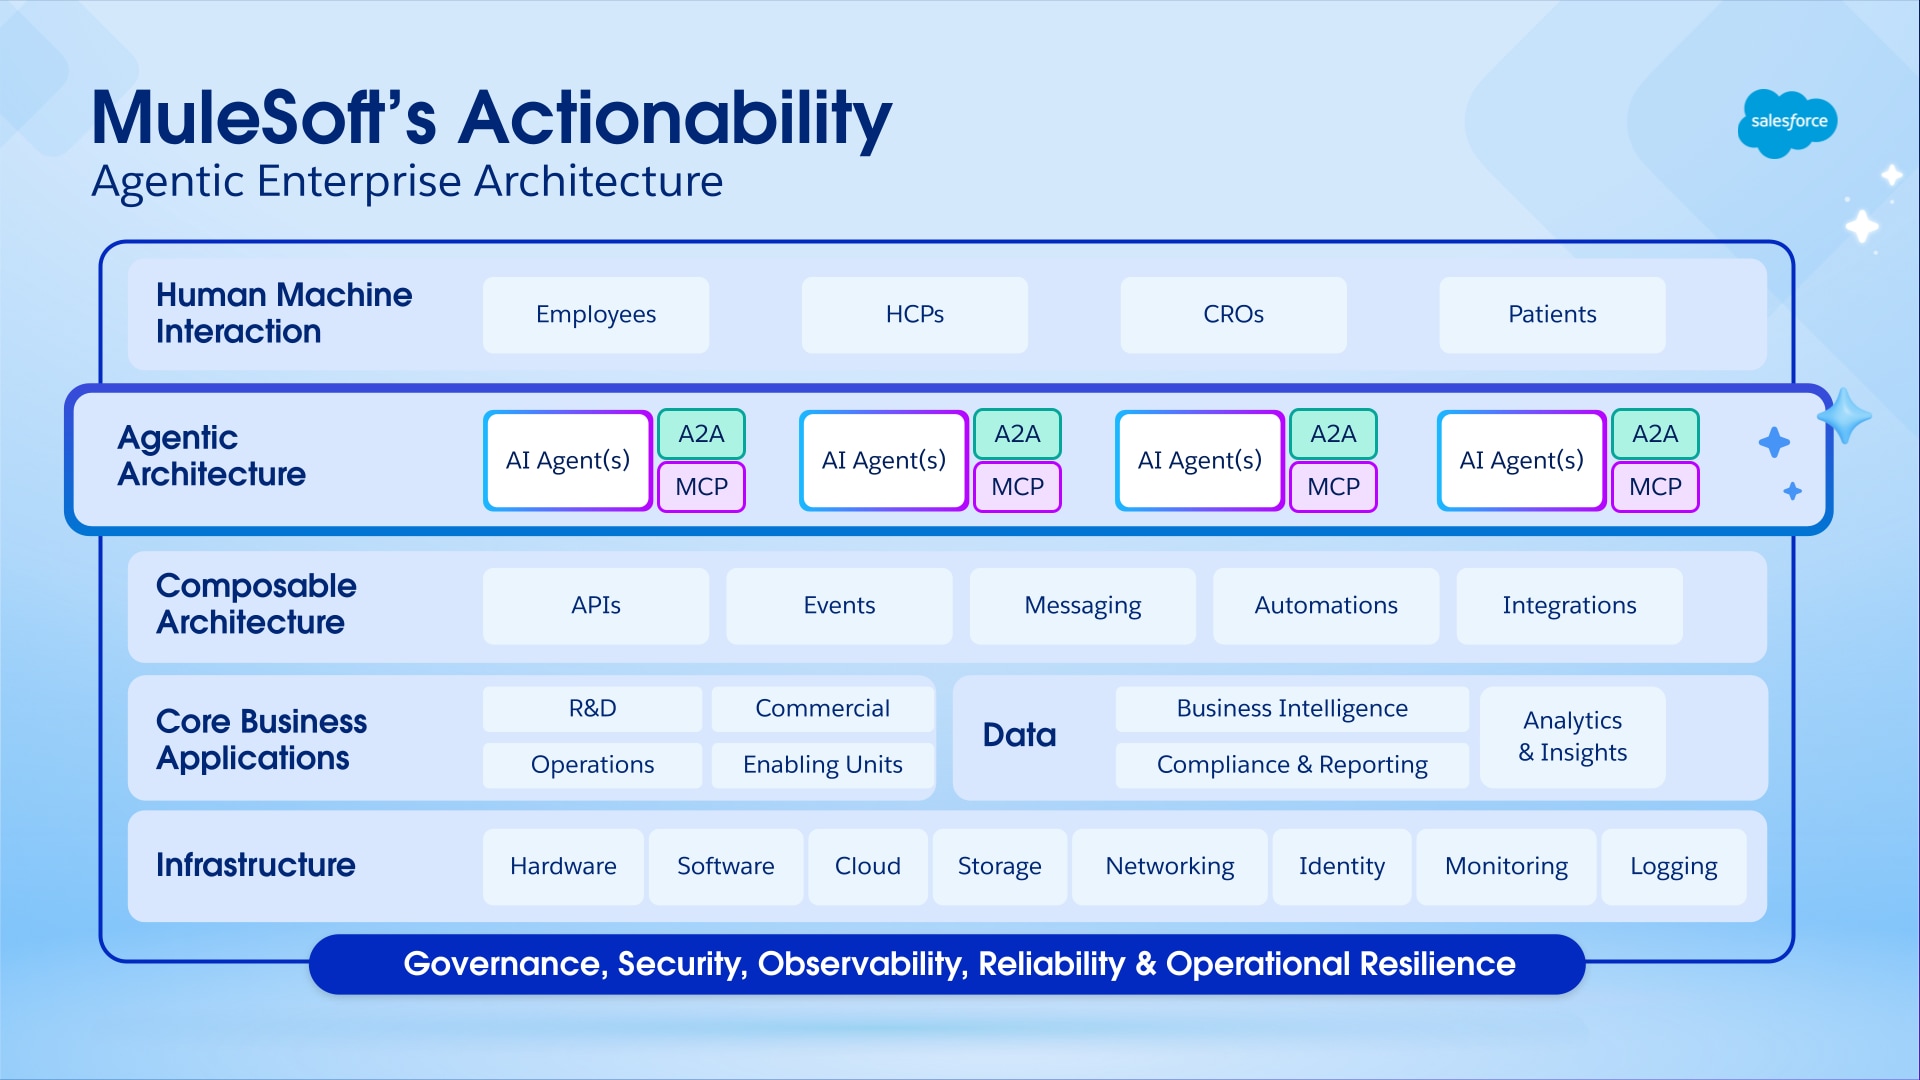 ### **2.1 Protocollo contesto modello (MCP)**
_MCP_ è rapidamente emerso come lo standard del settore per la comunicazione da agente a strumento, che è analogo a quello che _REST_ è diventato per i servizi Web. _MCP_ consente agli agenti AI di scoprire dinamicamente le funzionalità di un sistema, comprenderne gli input e gli output e invocarlo per eseguire un'azione, il tutto senza richiedere una logica pre-programmata o codificata.
Il [connettore MuleSoft MCP](https://docs.mulesoft.com/mcp-connector/latest/) consente a qualsiasi API implementata come applicazione Mule di essere pubblicata come server MCP. Poiché _MuleSoft_ fornisce centinaia di connettori predefiniti praticamente a tutti i principali sistemi aziendali (ad esempio, SaaS, legacy e database), ciò trasforma immediatamente le API e le applicazioni di un'organizzazione in una serie di strumenti pronti per l'uso da parte degli agenti. Un'API progettata per controllare l'inventario in SAP, un flusso che elabora un nuovo lead in Salesforce o un'applicazione personalizzata connessa tramite _MuleSoft_ possono essere tutti resi disponibili agli agenti AI come strumenti atomici governati utilizzando il _connettore MCP_.
### **2.2 Protocollo tra agenti (A2A)**
Mentre l'_MCP_ eccelle nelle interazioni gerarchiche tra agenti e strumenti di invocazione, i processi aziendali complessi spesso richiedono la collaborazione tra più agenti specializzati. Il protocollo _A2A (Agent-to-Agent)_ è lo standard aperto emergente progettato per facilitare la comunicazione peer-to-peer che consente flussi di lavoro sofisticati e multi-agente.
Il supporto di MuleSoft per A2A consente alle aziende di progettare e creare sistemi avanzati con lo stesso livello di governance e affidabilità che si aspettano per le loro API. Il [connettore MuleSoft A2A](https://docs.mulesoft.com/a2a-connector/latest/) consente agli sviluppatori di esporre facilmente qualsiasi agente come server A2A o di invocare qualsiasi agente compatibile con A2A da un'applicazione Mule. Ad esempio, un processo di richiesta di mutuo ipotecario può essere orchestrato in un "Agente controllo del credito", un "Agente firma documenti" e un "Agente conformità normativa", con ogni agente che scopre e invoca le capacità degli altri (in base alle esigenze) per far avanzare la richiesta.
Fornendo strumenti efficaci di livello aziendale per MCP e A2A, MuleSoft supporta la creazione di un ecosistema flessibile che consiste in interazioni dirette tra agenti e sistemi (tramite strumenti MCP) e interazioni tra agenti (A2A). Indipendentemente dall'evoluzione del panorama AI, questo approccio posiziona _MuleSoft_ come base sottostante che collega tutte le forme di comunicazione tra agenti.
## **3\. Tessuto agente MuleSoft: Il sistema nervoso centrale dell'impresa** agente
Quando le aziende adottano l'intelligenza artificiale agente, devono inevitabilmente affrontare la sfida della proliferazione degli agenti. Per evitare che questo si trasformi in caos, è necessario un livello di orchestrazione dedicato. [MuleSoft Agent Fabric](https://docs.mulesoft.com/agent-fabric/) ([demo](https://www.youtube.com/watch?v=GAqwPie16ic)) è una soluzione architettonica completa progettata per affrontare questa sfida di petto. Fornisce un piano di gestione centralizzato per scoprire, governare, orchestrare e osservare l'intera rete di agenti AI, indipendentemente da dove vengono creati o da come operano. Funzionando come "controllore del traffico aereo" per la forza lavoro digitale dell'azienda, _MuleSoft Agent Fabric_ trasforma una raccolta di agenti frammentati e isolati in una rete di intelligence coerente, sicura e ad alte prestazioni.
_MuleSoft Agent Fabric_ è basato su quattro pilastri integrati che coprono la gestione completa del ciclo di vita degli agenti come asset aziendali di prima classe.
### **3.1 Registro agenti (Discover)**
La base di qualsiasi ecosistema gestito è la possibilità di individuazione. Il _Registro agenti_ funge da catalogo universale centralizzato per ogni asset agente all'interno dell'azienda. Ciò include agenti creati su misura, agenti incorporati in applicazioni SaaS, server MCP che espongono sistemi legacy ed endpoint A2A per la collaborazione tra agenti. Fornendo un'unica fonte di dati veritieri, il _Registro agenti_ risolve il problema critico dell'individuazione impedendo ai team di creare funzionalità ridondanti e consentendo agli sviluppatori umani e ad altri agenti AI di trovare e riutilizzare dinamicamente gli asset esistenti su larga scala.
 Il _Registro agenti_ è basato su _Anypoint Exchange_ e aggiunge tre nuovi tipi di asset: Agenti, server MCP e LLM. Acquisisce informazioni su questi asset, inclusi strumenti MCP, protocolli di trasporto e schede agente, nonché le dipendenze tra gli agenti e i server MCP e gli strumenti che utilizzano. Gli sviluppatori possono creare e gestire gli asset direttamente nel registro. Possono anche scoprire e riutilizzare a livello di programmazione gli asset esistenti in MuleSoft Vibes (tramite lo strumento search*asset del \_server MCP MuleSoft*) durante la creazione di nuove orchestrazioni. Questo fornisce agli sviluppatori tutte le informazioni necessarie per comprendere e utilizzare questi asset.
### **3.2 Agent Broker (orchestrazione)**
Una volta che gli asset sono individuabili, devono essere orchestrati per eseguire un lavoro utile. L'_agente broker_ è un servizio di orchestrazione che esegue processi aziendali in più fasi. Utilizza un LLM configurabile per interpretare operazioni di alto livello e generare flussi di lavoro corrispondenti. L'_agente broker_ rileva, sequenzia e invoca dinamicamente gli agenti e gli strumenti necessari per completare questi processi.
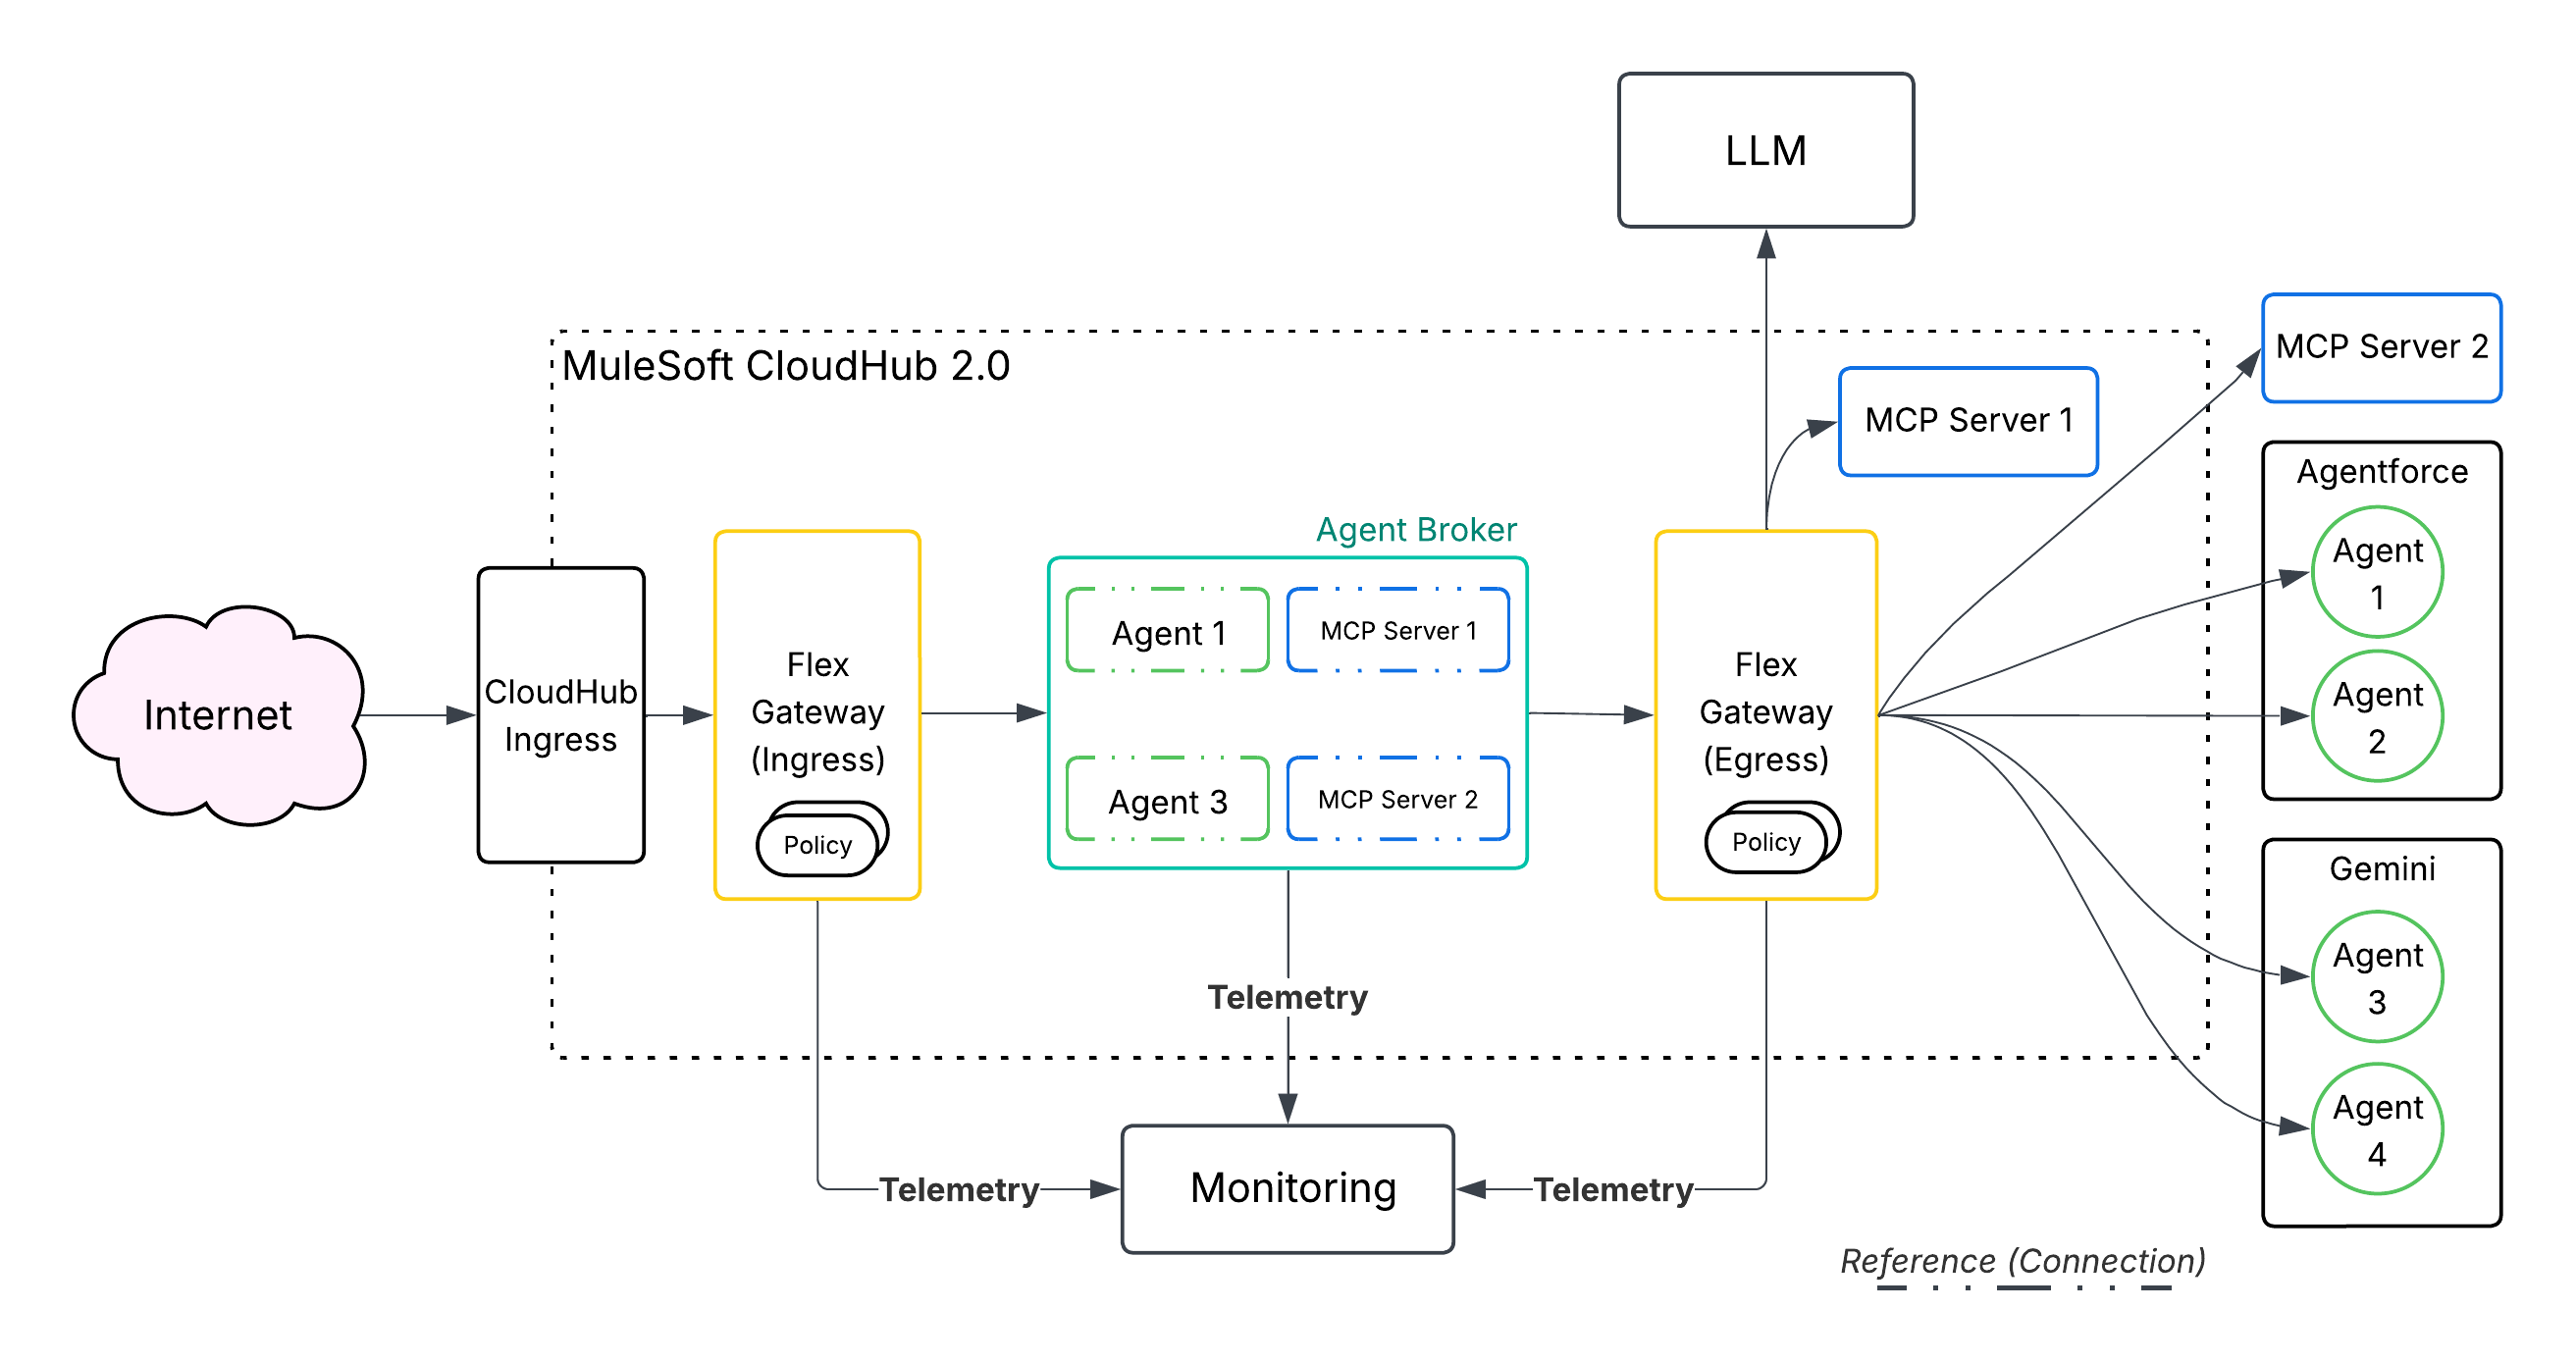 La connettività viene gestita tramite l'_MCP_ per gli strumenti e un protocollo _A2A_ per gli agenti. Ciò consente al sistema di organizzare gli agenti in domini specifici dell'azienda (ad esempio, Supply Chain o Finanza) e di instradare le operazioni in tutti i domini. Un singolo prompt in linguaggio naturale (ad esempio, "A bordo di un dipendente") viene scomposto in una sequenza di azioni discrete eseguite da agenti o strumenti diversi in più sistemi di backend. L'orchestrazione broker agente include:
- **Schema di orchestrazione dinamico:** Si tratta di uno schema Agent-Loop che determina le operazioni secondarie e le orchestra attraverso gli agenti e gli strumenti più adatti per raggiungere l'obiettivo generale. Sfruttando questo schema, è possibile creare [agenti collaborativi](/docs/architect/it-it/fundamentals/guide/agentic-patterns#15-agenti-collaborativi-intervento-collettivo-di-agenti) per risolvere casi d'uso complessi (ad esempio, [gestire un servizio](/docs/architect/it-it/fundamentals/guide/agentic-patterns#35-caso-duso-agente-collaborativo-inoltro-di-servizi-complessi-al-livello-superiore) inoltrato al livello superiore).
- **Ragionamento basato su LLM:** Utilizza un LLM per interpretare gli obiettivi del linguaggio naturale e generare piani di esecuzione, eliminando la necessità di una logica di flusso di lavoro rigida e codificata.
- **Modello LLM configurabile:** Consente agli sviluppatori di specificare il modello LLM da utilizzare, che offre il controllo su costi, prestazioni e funzionalità.
- **Sviluppo del linguaggio naturale:** La logica _di Agent Broker_ può essere definita utilizzando il linguaggio naturale tramite _MuleSoft Vibes_.
- **Osservabilità:** _Anypoint Monitoring_ fornisce registrazione e tracciamento al momento della distribuzione per aiutare gli utenti a capire e a eseguire il debug del ragionamento e delle interazioni dell'agente broker con gli strumenti _MCP_ e gli agenti _A2A_.
- **Distribuzione gestita:** _Agent Broker_ è un'applicazione containerizzata supportata da _Mule Runtime_, che gestisce la disponibilità e la scalabilità della distribuzione.
### **3.3 Gateway Flex per MCP e A2A (governativo)**
L'_Anypoint Flex Gateway_ è il meccanismo attraverso il quale vengono applicate tecnicamente determinate policy. _MuleSoft Agent Fabric_ sfrutta il _gateway Anypoint Flex_ per [proteggere, ispezionare e gestire ogni interazione](https://docs.mulesoft.com/gateway/latest/flex-agent-secure) tra agenti tramite i protocolli _MCP_ e _A2A_. Ciò consente alle organizzazioni di applicare una ricca [serie di policy](https://docs.mulesoft.com/gateway/latest/flex-agent-policies) a tutto il traffico degli agenti per garantire che ogni azione sia sicura, conforme e controllabile prima della sua esecuzione. Per scalare in modo sicuro e responsabile l'adozione dell'intelligenza artificiale, questi guardrail sono fondamentali.
| Nome polizza | Protocollo(i) | Descrizione |
| :---------------------------------------------------------------- | :------------ | :------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Policy di convalida JWT/Policy di applicazione dell'ID client** | A2A, MCP | La **JWT Validation Policy/Client ID Enforcement Policy** protegge gli agenti _A2A_ e i server _MCP_ limitando l'accesso solo ai chiamanti autenticati. |
| **Convalida dello schema** | A2A, MCP | La **convalida dello schema** garantisce che le richieste degli agenti in entrata siano conformi alla specifica _A2A_ o _MCP_, impedendo il traffico non corretto. |
| **Rilevatore di informazioni personali A2A** | A2A | **A2A PII Detector** identifica le _informazioni personali_ nelle richieste e nelle risposte e abilita la registrazione o il blocco per soddisfare i requisiti di conformità. |
| **Decoratore prompt A2A** | A2A | **A2A Prompt Decorator** inserisce contesto personalizzato o istruzioni nei prompt inviati agli agenti per guidare il loro comportamento e applicare i guardrail. |
| **Controllo dell'accesso basato sugli attributi MCP** | MCP | **MCP Attribute-Based Access Control** regola l'accesso a strumenti e risorse specifici esposti da un server _MCP in_ base agli attributi utente (ad esempio, attestazioni Tiers, IP o JWT). |
| **Registrazione SSE** | A2A, MCP | **SSE Logging** registra il contenuto degli stream _Server-Sent Events (SSE)_ utilizzati dai protocolli degli agenti per un controllo e una tracciabilità completi. |
| **Limitazione della frequenza e controllo dei picchi** | A2A, MCP | **Limitazione del tasso e controllo dei** picchi proteggono gli agenti e i sistemi di backend da picchi di traffico e attacchi Denial of Service imponendo limiti alle richieste. |
| **Scheda agente A2A** | A2A | La **scheda agente A2A** riscrive l'URL della scheda agente per garantire che tutto il traffico venga proxy correttamente attraverso l'istanza Flex Gateway governata. |
**Polizze di governance aziendale per i protocolli agenti**
Oltre a gestire le richieste in entrata, il _gateway Anypoint Flex_ gestisce anche tutte le connessioni e le richieste in uscita da un agente a servizi esterni (ad esempio, server e strumenti _MCP_ o altri agenti). Ciò include:
- **Registrazione:** Fornisce un punto di osservabilità centralizzato per monitorare e registrare tutte le richieste degli agenti in uscita per il controllo e la risoluzione dei problemi.
- **Sicurezza:** Impedisce la fuga di dati sensibili ispezionando il traffico in uscita.
- **Autenticazione:** Gestisce le credenziali per i sistemi esterni applicando meccanismi di autenticazione in uscita, tra cui chiavi API, OAuth e ClientId/ClientSecret da un unico punto.
Il _Kit Flex Gateway_ [**Policy Development Kit (**PDK)](https://docs.mulesoft.com/pdk/latest/policies-pdk-overview) consente agli utenti di creare policy personalizzate quando le policy pronte all'uso non soddisfano requisiti specifici. Utilizzando il _PDK_, gli sviluppatori possono scrivere la logica delle policy nel linguaggio di programmazione _Rust_ e compilarla in un modulo _WebAssembly (WASM)_. Il modulo autonomo viene quindi caricato in _Anypoint Flex Gateway_ per applicare regole di sicurezza univoche, trasformazioni dati personalizzate o logica di integrazione specializzata direttamente all'edge API. Questo offre un modo potente e ad alte prestazioni per estendere le funzionalità del gateway per casi d'uso unici o complessi.
Ecco i quattro componenti chiave della _PDK_:
- **Plugin Anypoint CLI PDK:** Questo plugin crea il progetto _PDK_ e carica la policy compilata in _Exchange_. Genera anche un _Makefile_ che semplifica il processo di sviluppo fornendo una serie chiara di comandi per creare e gestire la policy.
- **Modello di policy:** Quando viene creato un nuovo progetto, la _PDK_ genera un ponteggio o modello di base. Questa struttura include tutti i file e la configurazione necessari per compilare correttamente la policy, che offre agli sviluppatori un punto di partenza per la logica personalizzata.
- **Strumenti di creazione SDK:** Questi strumenti astraggono la complessa architettura basata sugli eventi del proxy _inviato_ sottostante. Utilizzando schemi di reattori ed esecutori, l'_SDK_ fornisce un metodo di codifica lineare semplice. Ciò consente di ridurre la complessità, migliorare il debug e ridurre la curva di apprendimento per gli sviluppatori.
- **Gestione delle policy:** Il [server MuleSoft MCP](https://docs.mulesoft.com/mulesoft-mcp-server/reference-mcp-tools) fornisce strumenti _MCP_ per aiutare gli utenti a gestire il ciclo di vita delle policy personalizzate. Esempi di questi strumenti sono:
- get_flex_gateway_policy_example
- manage_api_instance_policy
- manage_flex_gateway_policy_project
### **3.4 Agent Visualizer (Osserva)**
 Il _Visualizzatore agente_ fornisce una mappa dinamica in tempo reale dell'intera rete di agenti, trasformando quella che potrebbe essere una "scatola nera" di interazioni AI in un sistema completamente osservabile. Gli architetti e i team operativi possono utilizzare il _Visualizzatore agente_ per esaminare il modo in cui gli agenti sono connessi, tenere traccia dei flussi decisionali, monitorarne lo stato e le prestazioni e identificare le dipendenze. Questo livello di visibilità è fondamentale per ottimizzare le prestazioni, risolvere i problemi in modo efficiente, rilevare i colli di bottiglia e creare fiducia negli agenti distribuiti.
## **4\. Unificazione** di Salesforce Platform
### **4.1 Catalogo API e Centro argomenti**
Il _Catalogo API MuleSoft_ e il _Centro Argomenti_ sono progettati per migliorare il modo in cui le API vengono scoperte, utilizzate e gestite, in particolare in collaborazione con _Agenteforce_.
Tutte le API _MuleSoft_ progettate e pubblicate possono essere rese individuabili e consumabili tramite il [Catalogo API](https://help.salesforce.com/s/articleView?id=platform.api_catalog.htm&type=5) in _Salesforce Platform_. Il _Catalogo API_ funge da repository centralizzato e unifica tutte le API di un'organizzazione di _MuleSoft_, _Salesforce_, _Heroku_ e altri cloud in un'unica visualizzazione. Ciò semplifica la scoperta, la comprensione e il riutilizzo delle API esistenti da parte degli sviluppatori e degli amministratori, consentendone l'utilizzo nelle automazioni (ad esempio, _Agenteforce_, _Flusso_ e _Apex_).
La [MuleSoft per Agentforce: Il Centro argomenti](https://blogs.mulesoft.com/news/mulesoft-for-agentforce-topic-center/) consente agli sviluppatori di strutturare le API in base a casi d'uso aziendali specifici definendo i metadati **Argomenti** e **Azioni** Agentforce in fase di progettazione. Ciò include:
- **Le azioni**, ovvero le operazioni che un agente può eseguire
- **Istruzioni**, che guidano l'agente su come applicare determinate azioni
[Aggiungendo questo livello semantico](https://docs.mulesoft.com/anypoint-code-builder/ai-enabling-api-project-topic-center), il _Centro Argomenti_ rende le API comprensibili e utilizzabili da _Agenteforce_, il che garantisce che possa interagire efficacemente con i sistemi aziendali.
 ### **4.2 Gateway Agentforce**
L'_Agentforce Gateway_ è un livello di governance centralizzato progettato per gestire e proteggere le interazioni all'interno dell'ecosistema _Agenteforce_ in espansione. Poiché _Agenteforce_ si integra con API e strumenti di terze parti aggiuntivi tramite protocolli come _MCP_, la funzione principale dell'_Agentforce Gateway_ è quella di applicare policy (ad esempio, limiti di traffico e restrizioni degli strumenti) su tutto il traffico in uscita avviato da _Agenteforce_ e di controllare tutte le richieste in uscita.
L'_Agentforce Gateway_ sfrutta il motore di policy di governance dell'API _MuleSoft_ esistente, che è integrato in modo nativo in _Salesforce Platform_. Questo motore di policy basato su _Envoy_ intercetta il traffico degli agenti, applica policy configurate (ad esempio, controllo dell'accesso basato sugli attributi e limiti delle quote) e gestisce l'autenticazione e l'autorizzazione, il tutto senza richiedere ai clienti di installare un'infrastruttura gateway aggiuntiva.
 ### **4.3 Intelligence sull'integrazione**
La distribuzione di una rete governata di agenti è un traguardo fondamentale. Introduce tuttavia nuove sfide operative "giorno 2". Richiede un livello avanzato di intelligence operativa per monitorare, misurare e risolvere i problemi di un sistema dinamico e distribuito di attori autonomi. La visione architettonica definitiva è un sistema in cui l'intelligenza artificiale non viene utilizzata solo per eseguire i processi aziendali, ma anche per monitorare, gestire e guarire l'infrastruttura su cui viene eseguita.
_La_ visione di MuleSoft per l'intelligenza dell'integrazione sfrutta la potenza del più ampio ecosistema _Salesforce_ per fornire approfondimenti profondi e personalizzabili sulle prestazioni del tessuto di integrazione e della rete di agenti. Acquisendo e archiviando i dati [conformi a OpenTelemetry (OTEL)](https://opentelemetry.io/), lo standard emergente per l'osservabilità, in **Salesforce Data 360**, le organizzazioni possono creare un repository unificato per registri, metriche e tracce in tutto il loro panorama. Questi dati possono essere visualizzati in **Tableau** tramite cruscotti digitali predefiniti e visualizzazioni personalizzate per ottenere informazioni dettagliate sulle prestazioni API, sugli schemi di interazione degli agenti e sullo stato generale del sistema.
 Questo sistema ha tre componenti chiave:
1. **Inserimento:** Il servizio di inserimento è il punto di ingresso centralizzato per la raccolta e l'elaborazione dei dati di telemetria da varie applicazioni _Mule_, _Agent Broker_ e _Flex Gateway_. Esegue la convalida dello schema, la normalizzazione dei dati e i filtri per mantenere la qualità e la coerenza dei dati in varie applicazioni. Inoltre, impone controlli (ad esempio, autenticazione, crittografia, equità del tenant e limitazione del tasso) nella pipeline di inserimento.
2. **Memoria:** In _Data 360_ viene eseguito un processo di streaming ad alta produttività che legge i dati degli argomenti _Kafka_ multi-tenant e li trasforma nel formato _OTEL_. I dati OTEL vengono quindi confermati nei _DMO Data 360_ del tenant nei _DMO TelemetryTraceSpan_, _TelemetryLogs_ e _TelemetryMetrics_ in _Lakehouse_.
3. **Visualizzazione/consumo:** Con i dati di telemetria disponibili in _Data 360_, i clienti possono esaminare lo stato del sistema e ottenere approfondimenti utilizzando cruscotti digitali predefiniti o personalizzati tramite _Tableau Next_. I clienti possono anche utilizzare [Tableau Concierge](https://help.salesforce.com/s/articleView?id=analytics.tua_metric_questions.htm&type=5), una competenza di analisi degli agenti predefinita in _Tableau Next_, che consente agli utenti di porre domande sui dati di telemetria in linguaggio naturale e di ricevere risposte affidabili e fruibili con visualizzazioni. I clienti possono anche esportare i dati in sistemi _APM (Application Performance Management)_ esistenti (ad esempio, _DynaTrace_, _Datadog_, _Splunk_ e così via).
## **Conclusione**
Il passaggio a un'organizzazione agente non è solo un aggiornamento IT; è un punto di flessione architetturale fondamentale. Una distribuzione frammentata e in silo degli agenti AI è un percorso diretto verso il caos operativo, l'IT ombra e un debito tecnico ingestibile. L’unica strada sostenibile da percorrere è attraverso un’architettura unificata e componibile. Basandosi sulla comprovata base della connettività basata su API, il _MuleSoft Agent Fabric_ offre il "sistema nervoso centrale" necessario per gestire questa nuova forza lavoro digitale. Offre le funzionalità essenziali per l'individuazione, l'orchestrazione, la governance di livello aziendale e l'osservabilità end-to-end. È così che andiamo oltre la sperimentazione dell'intelligenza artificiale e iniziamo a progettare un'azienda davvero intelligente, automatizzata e sicura, trasformando il potenziale autonomo in risultati aziendali tangibili e governati.
## **Guide tecniche e riferimenti**
- [Suggerimenti introduttivi su Anypoint Code Builder](https://docs.mulesoft.com/anypoint-code-builder/start-acb)
- Guida [tecnica ad Einstein per il Generatore di codice Anypoint: Flussi generativi](https://blogs.mulesoft.com/dev-guides/einstein-for-acb/)
- Deep Dive della trasformazione generativa [DataWeave: Innovazione AI per una rapida trasformazione dei dati](https://blogs.mulesoft.com/dev-guides/dataweave-generative-transformation/)
- [Creazione di specifiche API con MuleSoft Dev Agent](https://docs.mulesoft.com/anypoint-code-builder/api-ai-create-spec)
- [Generazione di documentazione API con AI generativa Einstein](https://docs.mulesoft.com/exchange/generating-documentation-with-ai)
- [Panoramica di MuleSoft MCP Server](https://docs.mulesoft.com/mulesoft-mcp-server/)
- [Strumenti di MuleSoft MCP Server](https://docs.mulesoft.com/mulesoft-mcp-server/reference-mcp-tools)
- [Connettore MCP](https://docs.mulesoft.com/mcp-connector/latest/)
- [Connettore A2A](https://docs.mulesoft.com/a2a-connector/latest/)
- [Suggerimenti introduttivi su Agent Fabric](https://docs.mulesoft.com/agent-fabric/learning-map-agent-fabric)
- [Protezione delle interazioni degli agenti con Flex Gateway](https://docs.mulesoft.com/gateway/latest/flex-agent-secure)
- [Polizze Flex Gateway Agent](https://docs.mulesoft.com/gateway/latest/flex-agent-policies)
- [Panoramica del Flex Gateway Policy Development Kit (PDK)](https://docs.mulesoft.com/pdk/latest/policies-pdk-overview)
- [Catalogo API MuleSoft per Salesforce](https://help.salesforce.com/s/articleView?id=platform.api_catalog.htm&type=5)
- [Abilitazione di un progetto API per argomenti e azioni degli agenti](https://docs.mulesoft.com/anypoint-code-builder/ai-enabling-api-project-topic-center)
- [Lavoro con Tableau Next](https://help.salesforce.com/s/articleView?id=analytics.tua_consume.htm&type=5)
- [OpenTelemetry](https://opentelemetry.io/)
- [Protocollo contesto modello](https://modelcontextprotocol.io/docs/getting-started/intro)
- [Protocollo Agent2Agent (A2A)](https://a2a-protocol.org/latest/)
## Informazioni sull'autore
Nikhil Aggarwal è Principal Architect presso Salesforce, dove dirige l'architettura per MuleSoft e Salesforce Automation Clouds. Nikhil vanta oltre 18 anni di esperienza nella fornitura di prodotti su larga scala ed è appassionato di architettura scalabile, esperienze di sviluppo intuitive e creazione di team ad alte prestazioni. Prima di Salesforce, ha diretto diverse iniziative in Microsoft Power Platform, Dataverse e Office 365, dall'ideazione al lancio. Il suo lavoro continua a plasmare il modo in cui le aziende moderne connettono i sistemi, automatizzano i flussi di lavoro e sbloccano il valore aziendale nell'era dell'intelligenza artificiale.
## 1\. Introduzione
Oltre vent'anni fa, Salesforce ha aperto la strada alla prima piattaforma cloud multi-tenant, creando un precedente nel settore. Da allora, Salesforce si è evoluta in una piattaforma aziendale completa, in grado di incapsulare e automatizzare gli aspetti chiave di un'azienda e servire centinaia di migliaia di aziende e milioni di utenti in vari settori e regioni. Salesforce ha inoltre ottimizzato la suite di prodotti Customer360 attraverso acquisizioni strategiche.
Negli ultimi anni, i cambiamenti nel mercato, nel settore e nel panorama tecnologico ci hanno portato a una serie di profonde trasformazioni nella Salesforce Platform di base. Questi includono:
- L'emergere di provider di cloud pubblici che investono molto nelle infrastrutture.
- Progressi rapidi nell'intelligenza artificiale, tra cui machine learning, intelligenza artificiale generativa ed esperienze degli agenti.
- Aumento dei requisiti normativi e di residenza dei dati nei vari settori e paesi.
- Necessità di gestire i dati e le transazioni in tempo reale su scala sempre più ampia.
- Maggiore attenzione ai requisiti di sicurezza informatica, disponibilità del sistema, prestazioni e resilienza.
- La domanda dei clienti per una suite integrata che offra un'architettura altamente resiliente, vagamente accoppiata e fortemente coerente.
In risposta a questi cambiamenti, in particolare al cambiamento sismico dell'intelligenza artificiale e al suo impatto sulle aziende, Salesforce ha completamente trasformato la sua piattaforma da zero, gettando le basi per la prossima generazione di applicazioni e casi d'uso per i clienti, il tutto mantenendo i nostri obiettivi Trust.
Il lancio di Agentforce a Dreamforce 2024 e lo schema riportato sotto rappresentano il culmine di questo ampio lavoro, che ha coinvolto migliaia di membri del team di organizzazione Salesforce Technology and Product. Attualmente, oltre il 95% dei nostri clienti è passato a questa nuova piattaforma. La migrazione riuscita della maggior parte dei nostri clienti, inclusi quelli con i carichi di lavoro più impegnativi, sottolinea l'ingegno dei nostri ingegneri e riafferma i valori fondamentali di Salesforce: Trust, Customer Success e Innovazione.
Dal lancio di Agentforce, Salesforce ha continuato a essere pioniera nell'uso dell'intelligenza artificiale nelle applicazioni aziendali ed è stata leader di mercato nello sviluppo di esperienze agenti che offrono esperienze di conversazione in tempo reale per le funzionalità aziendali esistenti e nuove.
In questo white paper, realizzato in collaborazione con i migliori ingegneri, viene fornita un'esplorazione dettagliata per i costruttori che apprezzano le complessità dietro le principali trasformazioni tecnologiche. Il documento analizza i miglioramenti architetturali essenziali che consentono di mantenere la piattaforma scalabile, sicura e pronta per gestire le applicazioni future, soddisfacendo al contempo le mutevoli esigenze dei nostri clienti. Si consiglia di iniziare con il capitolo Panoramica dell'architettura per avere un quadro completo. Da qui, i lettori possono continuare in sequenza o esplorare i capitoli che catturano maggiormente il loro interesse.
_Emin Gerba_
_Chief Architect, Salesforce_
 ## 2\. Panoramica sull'architettura
I principi architettonici di Salesforce Platform riportati di seguito rappresentano la base e la differenziazione del modo in cui progettiamo le funzioni e le funzionalità:
- **Enterprise-Grade Trust**: Trust è il valore principale di Salesforce e non solo diamo priorità alla disponibilità e alla sicurezza dei nostri servizi, ma creiamo anche le funzioni di controllo dell'accesso, conformità e sicurezza in modo che i nostri clienti possano soddisfare i loro standard di conformità e sicurezza con Salesforce Platform.
- **Multitenant**: Tutti i servizi e le infrastrutture sono progettati per ospitare più clienti. Questo fornisce uno schema strategico per la scalabilità con l'uso, nonché la standardizzazione su una barra elevata comune di disponibilità e sicurezza indipendentemente dalle dimensioni dei nostri clienti.
- **Basato sui metadati**: I metadati sono alla base della personalizzazione dei nostri servizi multi-tenant. I metadati sono ampliabili in modo che amministratori e sviluppatori possano sfruttare il lavoro già svolto e beneficiare dei futuri aggiornamenti dei prodotti da Salesforce e dai partner dell'ecosistema.
- **API First:** Salesforce Platform dà priorità a un portafoglio API completo e coerente che copre tutto ciò che può essere fatto tramite le interfacce utente native di Salesforce. Ciò consente a sviluppatori e partner di sfruttare e ricomporre le funzionalità della piattaforma per integrare i sistemi o creare nuove esperienze utente.
- **Aperto e interoperabile**: Salesforce Platform può essere integrata in qualsiasi architettura aziendale dei nostri clienti. Salesforce Platform è stato progettato per funzionare con altri sistemi basati su cloud e locali, oltre a fornire API, strumenti e standard di integrazione per i sistemi esterni da integrare con Salesforce Platform.
- **Agente:** Salesforce Platform si sta evolvendo rapidamente per essere al primo posto tra gli agenti in tutta la suite di applicazioni. Vogliamo che gli utenti siano in grado di interagire con Salesforce attraverso profonde esperienze di conversazione tra agenti che consentano loro di lavorare e di interagire con i loro dati in modi sempre più naturali.
L'attuale Salesforce Platform rappresenta l'ultima fase dell'evoluzione delle funzionalità di Salesforce dal debutto di Force.com Platform nel 2008. Le trasformazioni chiave recenti includono:
- Adozione di Hyperforce e passaggio ad architetture basate su cloud.
- Evoluzione da architettura monolitica a struttura con servizi indipendenti.
- Introduzione delle tecnologie Data 360 e Lakehouse accanto ai tradizionali data store relazionali.
- Profonda integrazione delle tecnologie AI, generative e di machine learning e un’evoluzione verso le esperienze degli agenti in tutta la piattaforma.
Queste modifiche hanno ampliato e perfezionato le funzionalità della piattaforma senza interruzioni significative, grazie a solide astrazioni che consentono ai tecnici Salesforce di far progredire le nostre tecnologie senza interruzioni e senza interruzioni per i clienti. La forte astrazione continua inoltre a essere fondamentale per il valore di Salesforce Platform di semplificare le complessità tecniche del software di livello aziendale, come la sicurezza, la disponibilità e le convenzioni tecnologiche, in modo che gli sviluppatori di app possano concentrarsi sulla risoluzione delle loro sfide specifiche. Le funzionalità di Salesforce Platform sono evidenziate di seguito:
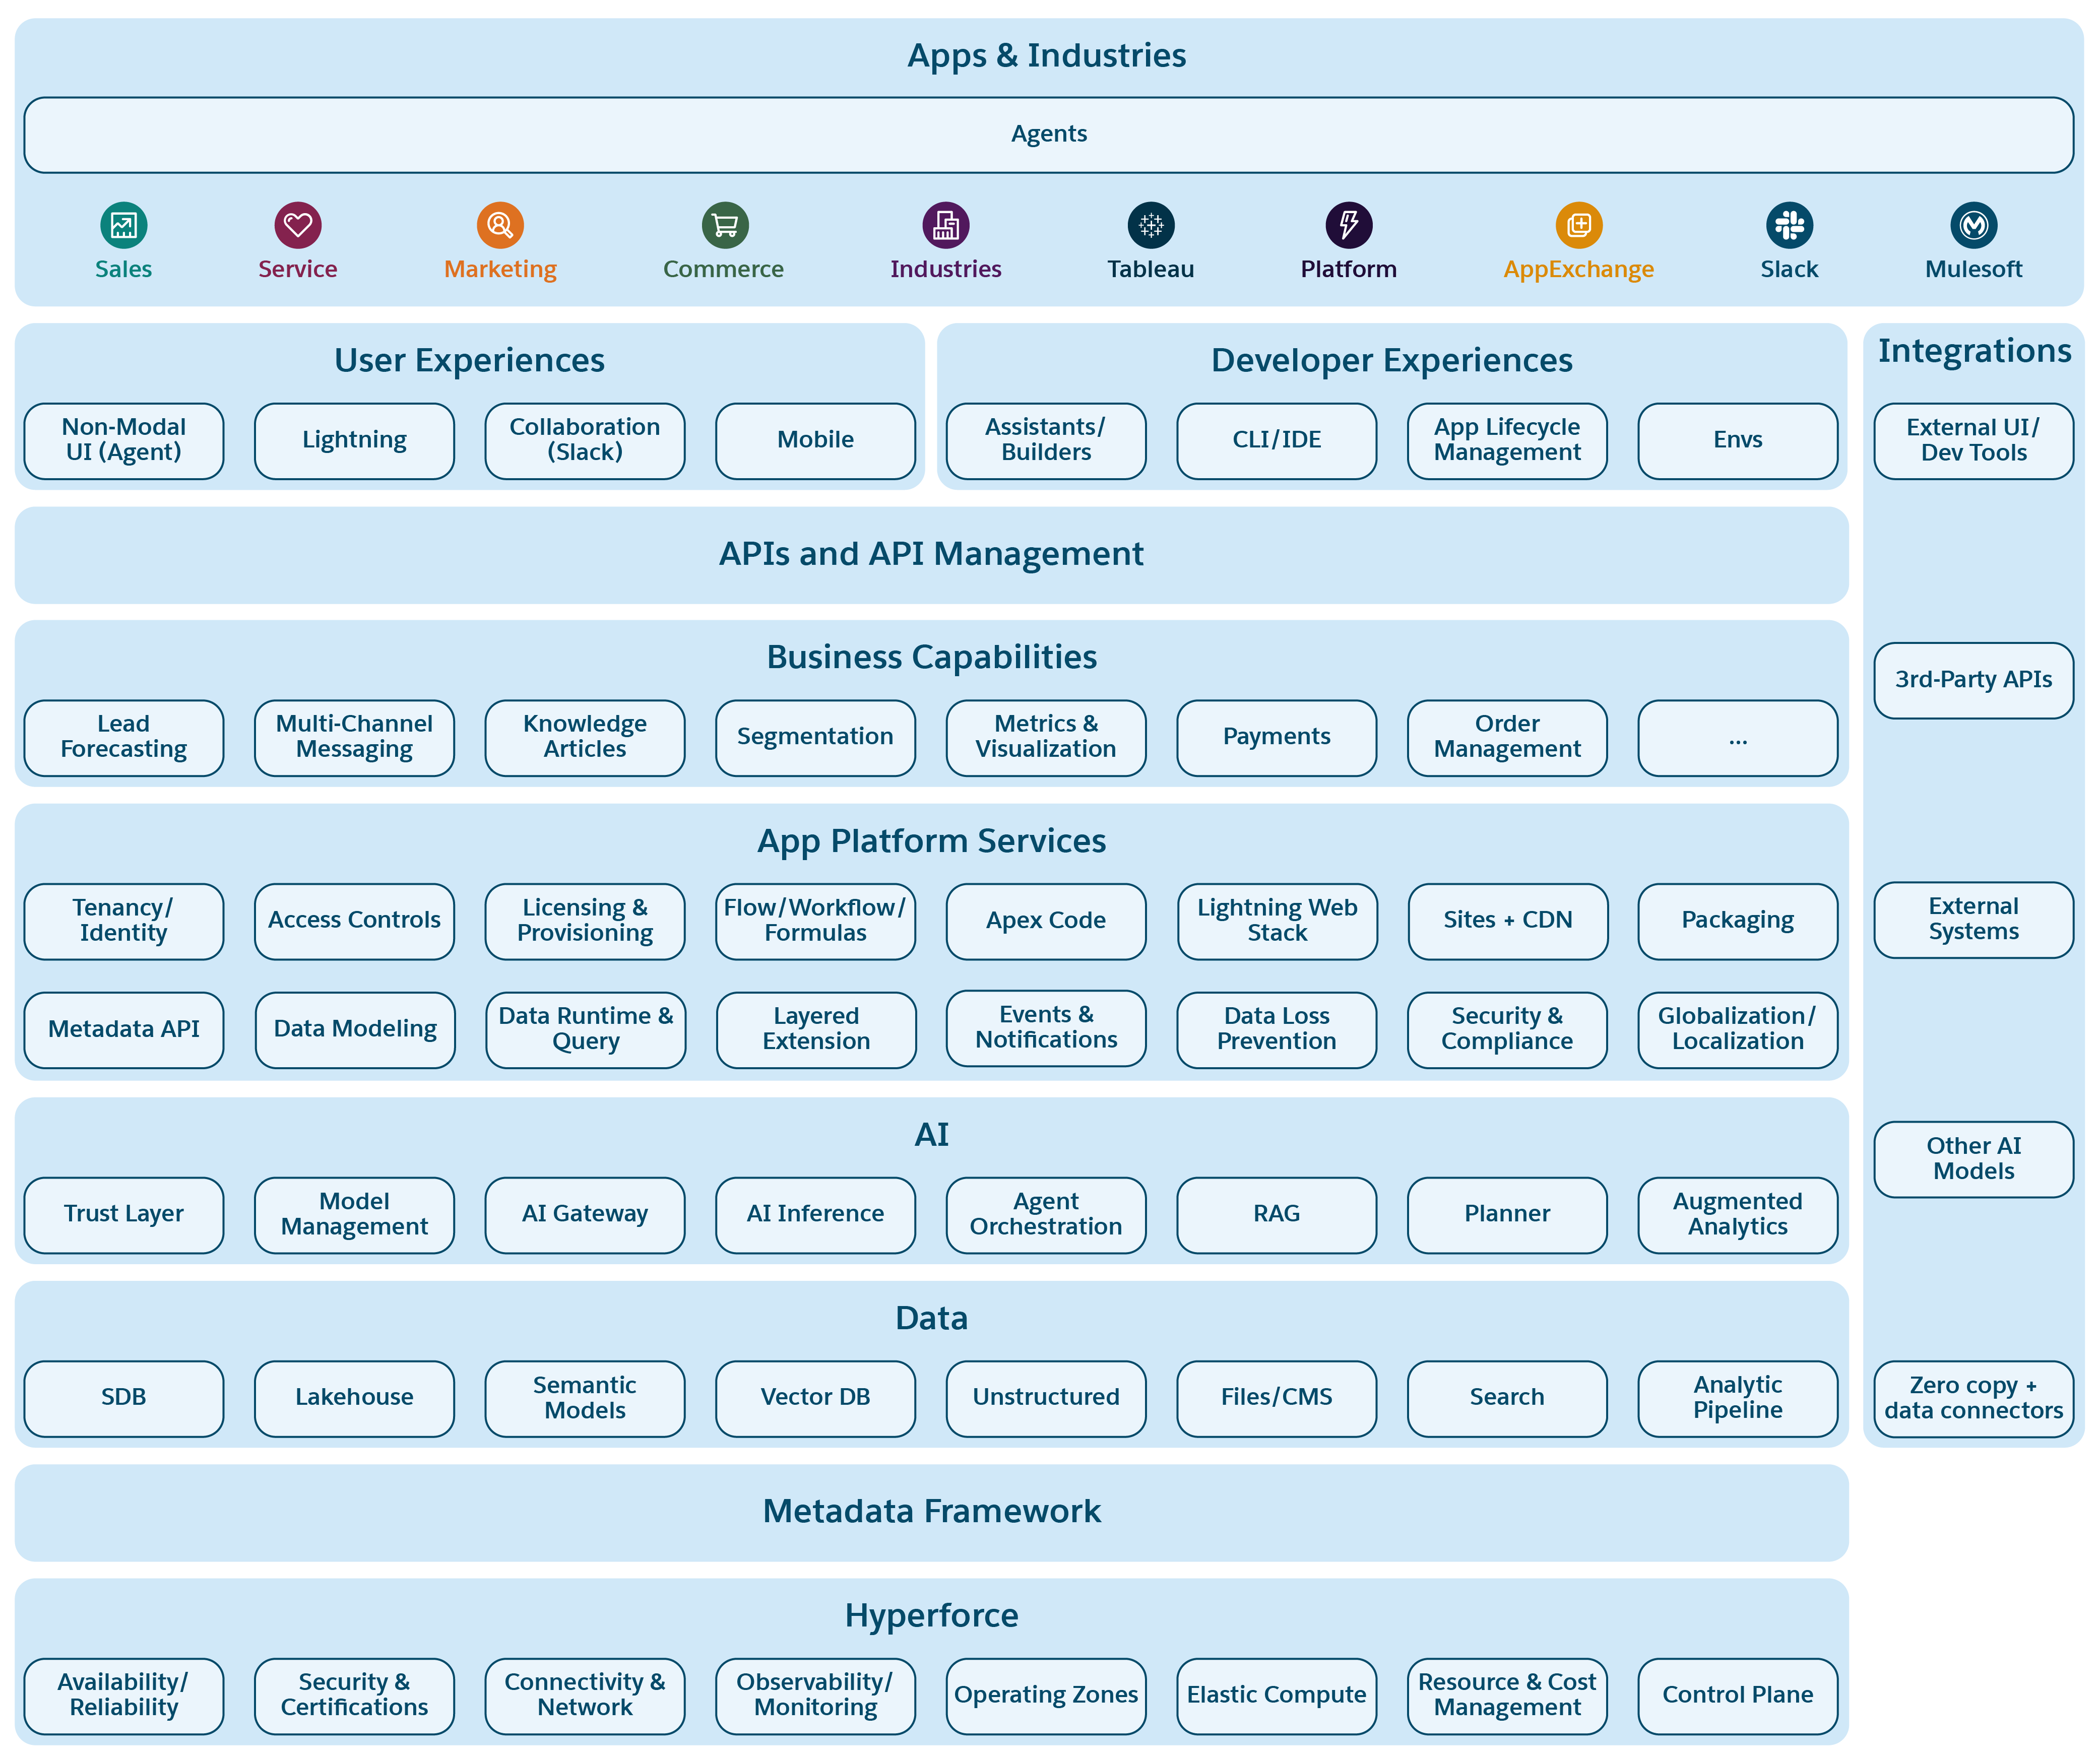 Salesforce Platform è visualizzato come un insieme di livelli che costituiscono il sistema. Ogni livello rappresenta un gruppo di funzioni correlate importanti per le applicazioni create sulla piattaforma. Le sottocaselle all'interno di ogni livello offrono esempi illustrativi di queste funzionalità. Le funzionalità di ogni livello inferiore sono integrate in tutti i livelli precedenti, garantendo un'esperienza coerente in tutta la suite di applicazioni Salesforce.
Salesforce Platform incarna trasformazioni ingegneristiche di vasta portata in tutti i livelli di una piattaforma tecnologica matura sviluppata negli ultimi 20 anni. Spinti dall'evoluzione delle esigenze dei clienti e dalle nuove tecnologie, questi cambiamenti consentono il supporto di nuovi tipi di app e soluzioni. Le trasformazioni sono interconnesse, con cambiamenti nei livelli inferiori che influenzano l'evoluzione di tutti i livelli successivi sopra.
Salesforce Platform è strutturata in più livelli, ciascuno dei quali contribuisce alle sue funzionalità complete:
- **Hyperforce**: L'infrastruttura di base si è evoluta da data center first party a provider di cloud pubblico, ottimizzata con le tecnologie Salesforce per un hosting sicuro, conforme, altamente disponibile ed economico.
- **Framework dei metadati**: Offre un'astrazione stabile su cui le app possono basarsi, anche quando le tecnologie di cui disponiamo e che utilizziamo evolvono. Include un mappatore oggetto-relazionale, un ordine di esecuzione prescrittivo e un runtime "core" che collega le definizioni dei metadati con i runtime basati sui metadati.
- **Dati**: Include un database relazionale multi-tenant e un Lakehouse su scala petabyte per la gestione dei dati Salesforce e non Salesforce, il supporto della gestione di dati e contenuti non strutturati, la ricerca avanzata, la governance e le funzionalità di elaborazione analitica.
- **AI**: Si basa sul livello di dati con tecnologie di Intelligenza artificiale affidabili e di base che sfruttano l'intelligenza artificiale predittiva e generativa per potenziare le esperienze degli agenti.
- **Servizi piattaforma app:** Fornisce strumenti ad amministratori IT, sviluppatori e fornitori per creare e personalizzare le applicazioni, offrendo un'astrazione ponderata per semplificare le operazioni comuni e complesse.
- **Funzioni aziendali**: Offre una gamma di funzionalità per soddisfare le diverse esigenze aziendali, consentendo agli sviluppatori di personalizzare le applicazioni in base alle esigenze.
- **API e gestione API**: Garantisce che tutte le funzionalità della piattaforma siano accessibili tramite API ben strutturate, facilitando le interdipendenze tra servizi e livelli.
- **Esperienza utente e sviluppatore**: Offre interfacce intuitive per gli utenti finali e una gamma di strumenti di sviluppo da low-code a pro-code per lo sviluppo e la personalizzazione delle applicazioni, con supporto per lo sviluppo moderno basato sull'intelligenza artificiale.
- **Integrazione**: Si integra con qualsiasi architettura aziendale, abilitando la compatibilità con i sistemi Salesforce e non Salesforce tramite connettori dati, integrazione dati copia zero e altri strumenti.
- **App e settori**: Offre una suite di app personalizzabili e soluzioni specifiche del settore basate sulle funzionalità integrate della piattaforma, sfruttando l'intera gamma di funzionalità di livello inferiore e con agenti di intelligenza artificiale profondamente integrati.
## 3\. Hyperforce
Salesforce ha sviluppato infrastrutture di data center globali per quasi 25 anni, precedendo molti degli attuali hyperscaler e fornitori IaaS. Hyperforce, l'attuale generazione dell'evoluzione dell'infrastruttura Salesforce, è progettata per funzionare in più provider di cloud pubblici in tutto il mondo.
È stato progettato per soddisfare le esigenze dei clienti in termini di scalabilità B2C elastica, residenza dati globale, disponibilità avanzata, sicurezza di livello superiore e conformità alle normative. Hyperforce standardizza l'infrastruttura in tutti i prodotti Salesforce, facilitando una rapida integrazione delle nuove acquisizioni.
Hyperforce garantisce la fornitura di Salesforce Platform, consentendo la distribuzione rapida di nuove funzioni e applicazioni, rispettando i requisiti di residenza dei dati e conformità alle normative in oltre 20 regioni in tutto il mondo.
### 3.1 Principi architettonici
Durante il passaggio di Salesforce a Hyperforce, sono state identificate differenze significative nei servizi, nelle interfacce e nei livelli di conformità tra gli hyperscaler. Per creare una base solida e portabile per Salesforce Platform, sono stati adottati i seguenti principi architettonici:
- **Infrastruttura come codice**: Utilizzando un'architettura basata su dominio, questo principio prevede la creazione di codice dichiarativo per l'infrastruttura, la creazione di artefatti immutabili e l'automazione dell'infrastruttura on-demand utilizzando standard come Kubernetes e Service Mesh.
- **Zero Trust Security**: Implementazione di un modello di sicurezza zero Trust con strategie di difesa complete che includono la gestione dell'identità, l'autenticazione, l'autorizzazione, l'isolamento della rete, le policy di sicurezza con privilegi minimi e la crittografia dei dati sia in transito che a riposo.
- **Servizi gestiti**: Sottolineando l'uso di servizi multi-tenant e multi-cloud, questo principio migliora la portabilità in infrastrutture e ambienti diversi, ad esempio sistemi commerciali, governativi e air gap.
- **Resilienza incorporata**: I servizi mission critical sono distribuiti in più zone di disponibilità per garantire un'elevata disponibilità. I dati vengono replicati nelle regioni Disponibilità. I servizi sono anche etichettati con livelli di disponibilità per gestire gli obiettivi dei livelli di servizio e la pianificazione della resilienza.
- **Pienamente osservabile**: Integrazione di tutti i servizi in una piattaforma di osservabilità standard per un monitoraggio efficiente, che include la raccolta dei registri, la raccolta delle metriche, gli avvisi, il tracciamento distribuito e il tracciamento di operazioni di servizio come il volume del traffico, le percentuali di errore e l'utilizzo delle risorse.
- **Operazioni automatiche**: Ciò include la gestione automatizzata del ciclo di vita dell'infrastruttura e gli AIOp predittivi (AI per le operazioni) per il mantenimento della qualità del servizio, il rilevamento e la risoluzione dei problemi del servizio e il rilevamento dei guasti.
- **Scala automatica**: Concentrandosi sulla scalabilità e l'efficienza dei costi, questo principio consente una flessibilità operativa su scale diverse senza aumentare i rischi operativi, astraendo limiti specifici degli account relativi al provider cloud.
- **Consapevole di FinOps**: Il cloud pubblico offre agilità all'infrastruttura, ma con il rischio di costi elevati. Adottiamo una cultura ingegneristica basata sull'efficienza per tutto il ciclo di vita del servizio, senza compromettere la disponibilità, la sicurezza e il Customer Trust.
Questi principi guidano lo sviluppo e il funzionamento della piattaforma Hyperforce di Salesforce, garantendo che rimanga adattabile, sicura ed efficiente in vari ambienti.
### 3.2 Concetti di infrastruttura
Salesforce Platform e i relativi servizi di supporto vengono eseguiti in Hyperforce Foundation, che comprende più istanze Hyperforce. Queste istanze sono distribuite strategicamente in vari paesi per allinearsi alle preferenze geografiche e di disponibilità dei clienti. Per soddisfare requisiti rigorosi di residenza dei dati e operativi, una o più istanze Hyperforce possono essere raggruppate e designate come zona operativa. Ogni istanza viene regolarmente aggiornata per garantire sicurezza, scalabilità e conformità agli standard locali e legali.
Le istanze Hyperforce sono costituite da diverse istanze del Dominio funzionale Hyperforce, ovvero cluster di servizi che offrono funzionalità specifiche. I domini funzionali di base offrono servizi critici come sicurezza, autenticazione, registrazione e monitoraggio, tutti essenziali per altri servizi Hyperforce. I domini funzionali aziendali supportano vari prodotti Salesforce, ad esempio Sales Cloud, Service Cloud e altri, facilitandone le funzionalità.
I servizi all'interno di un Dominio funzionale possono essere organizzati in Celle, che sono unità di erogazione del servizio scalabili e ripetibili. Hyperforce Cell corrisponde a quella che viene tradizionalmente chiamata "istanza Salesforce" in cui risiedono una o più organizzazioni Salesforce (organizzazione). Una cella è un'unità di scala oltre che un forte confine del raggio di esplosione. Le supercelle forniscono un raggruppamento logico di più celle per demarcare un raggio di esplosione più ampio dovuto ai servizi condivisi tra le celle. In un dominio funzionale possono essere presenti più supercelle. Celle e Supercelle consentono a Hyperforce di scalare orizzontalmente all'interno di un dominio funzionale mantenendo anche un forte controllo sulle dimensioni del raggio di esplosione.
Ogni istanza Hyperforce è mappata a una regione di disponibilità, un concetto presente in tutte le infrastrutture cloud pubbliche ed è in grado di funzionare indipendentemente da tutte le altre istanze Hyperforce. Tutti i servizi e i dati mission-critical dell'istanza Hyperforce vengono distribuiti e replicati in almeno tre zone di disponibilità, per ottenere tolleranza e stabilità dei guasti. Inoltre, i backup dei dati vengono copiati in altre istanze Hyperforce idonee per la continuità operativa e la conformità ai regolamenti.
L'infrastruttura Hyperforce è in continua evoluzione, poiché vengono create o aggiornate nuove istanze e celle Hyperforce. I clienti sono isolati dalle modifiche dei dettagli fisici di Hyperforce. A tutti gli endpoint cliente visibili esternamente si accede tramite Domini personali Salesforce stabili e sicuri (ad esempio, acme.my.salesforce.com) che instradano in modo sicuro il traffico ai dati e alla posizione di servizio correnti. Il traffico in uscita (ad esempio, Mail, chiamate Web) è implementato al meglio utilizzando meccanismi sicuri come Domain Keys Identified Mail (DKIM) e mTLS, per garantire che l'infrastruttura locale dei clienti non codifica i dettagli fisici dell'infrastruttura Salesforce, ad esempio gli indirizzi IP che possono cambiare nel tempo.
 ### 3.3 Sicurezza della rete
I domini funzionali Hyperforce sono progettati con misure di sicurezza efficaci. Ogni dominio è protetto al perimetro e isolato, con i servizi all'interno di un dominio separati in account dedicati per una maggiore sicurezza. La comunicazione tra i servizi è facilitata in modo sicuro tramite Service Mesh o protocolli simili. La gestione del traffico è gestita dai gateway di ingresso e uscita che ispezionano, instradano e applicano i controlli necessari, come gli interruttori automatici o i limiti di velocità, a tutto il traffico in entrata e in uscita.
I servizi all'interno di un Dominio funzionale Hyperforce sono raggruppati in Gruppi di sicurezza, con solo quelli nel gruppo edge esposti a Internet pubblico. Le policy di sicurezza in fase di esecuzione impongono regole di comunicazione tra gruppi di sicurezza diversi, rispettando il principio dei privilegi minimi per garantire che i servizi abbiano solo l'accesso necessario.
Ogni area geografica dispone di un Dominio funzionale Hyperforce Edge che interrompe la protezione del livello di trasporto e utilizza policy di firewall per applicazioni Web programmabili per gestire preventivamente le minacce. Ciò garantisce che solo il traffico legittimo raggiunga gli endpoint Hyperforce mantenendo un'esperienza cliente sicura ed efficiente. Inoltre, i link di rete interni tra le istanze Hyperforce sono strettamente controllati e tutti i dati di registro contenenti informazioni personali sono resi anonimi per rispettare gli standard del GDPR.
### 3.4 Hyperforce Grid Control Plane (Piano di controllo griglia Hyperforce)
Una griglia Hyperforce è costituita da più istanze Hyperforce che condividono lo stesso piano di controllo, progettato per isolare i carichi di lavoro sensibili laddove appropriato. Garantisce zero fughe di dati di clienti o sistemi, metadati della piattaforma o dati di monitoraggio tra le griglie. Il piano di controllo è costituito da istanze Hyperforce ridondanti che ospitano servizi essenziali per la creazione, la gestione e il monitoraggio delle istanze Hyperforce indirizzate ai clienti.
Il codice dei servizi e dell'infrastruttura per tutti i servizi Hyperforce è sviluppato in modo sicuro all'interno di un dominio funzionale del piano di controllo dedicato, utilizzando servizi di gestione del codice sorgente, integrazione continua, test e creazione di artefatti. Il codice generato viene analizzato alla ricerca di minacce e vulnerabilità prima di essere inserito in contenitori standardizzati e firmati digitalmente e archiviato in registri immagine. La distribuzione del codice viene gestita dalle opportunità in corso di realizzazione autorizzate nel sistema Hyperforce Continuous Delivery, con privilegi di distribuzione limitati ai team e agli operatori autorizzati. Un aereo di controllo con gap aereo gestisce le protezioni aggiuntive necessarie in tali ambienti.
I servizi IAM (Identity and Access Management) impongono l'approvazione just in time per limitare la durata e le azioni dell'accesso, mentre gli itinerari di controllo monitorano tutte le attività, alimentando i sistemi di rilevamento in tempo reale per identificare e avvisare in caso di attività sospette.
### 3.5 Hyperforce Cost Management (Gestione dei costi Hyperforce)
Man mano che Salesforce passa i suoi servizi a Hyperforce sui cloud pubblici dai suoi data center first party, è fondamentale rinnovare le nostre strategie di creazione del budget, visualizzazione dei costi e ottimizzazione delle risorse.
Il nostro approccio di gestione dei costi non si limita al taglio dei costi, ma è un processo strategico che distingue i prodotti mirati alla crescita da quelli stabili. Prevede prezzi basati sul consumo e margini che supportano la disponibilità dei prodotti, in linea con il nostro valore fondamentale di Trust. Gli account cloud pubblici sono organizzati gerarchicamente e collegati a prodotti e dirigenti specifici. L'assegnazione dettagliata di tag alle risorse del livello di servizio, arricchita con metadati dell'organizzazione, consente di individuare i costi per i singoli microservizi. Strumenti come Tableau e Slack, insieme a strumenti di previsione avanzati, vengono utilizzati per fornire a dirigenti e team dati in tempo reale su costi, previsioni e analisi del budget, infondendo fiducia nella pianificazione finanziaria futura.
Per garantire una gestione ottimale dei costi, Salesforce utilizza un mix di Piani di risparmio, Capacità spot e Prenotazioni capacità on-demand (ODCR), garantendo la capacità necessaria. Queste prenotazioni vengono gestite tramite previsioni avanzate basate su serie temporali e cruscotti digitali personalizzati, consentendo la supervisione umana e il processo decisionale. L'impostazione di obiettivi raggiungibili per la riduzione dei costi unitari di transazione (il costo per elaborare un volume definito di transazioni aziendali) è una strategia efficace per favorire i miglioramenti. Lo strumento Hyperforce Unit Cost Explorer consente ai team di analizzare e gestire le tendenze dei costi unitari, attribuendo i costi a servizi specifici e identificando nuove opportunità di miglioramento. L'indice di ottimizzazione Salesforce Cloud, o punteggio "COIN", valuta i servizi in base a un elenco dinamico di opportunità di risparmio, motivando i team di assistenza a mantenere l'efficienza ottimale delle risorse.
Nel nostro impegno costante per la sostenibilità, perseguiamo attivamente la riduzione delle emissioni di CO2, fissando obiettivi specifici per ridurre la nostra unità Carbon to Serve, una misura delle emissioni relative al lavoro svolto.
## 4\. Trust di livello aziendale
La sicurezza e la disponibilità sono aspetti fondamentali della nostra piattaforma di livello aziendale, essenziali per mantenere il Customer Trust. In Salesforce, questi controlli sono parte integrante di Salesforce Platform, applicati automaticamente tramite servizi condivisi e framework software. Questo approccio integrato garantisce che i singoli sistemi possano trarre vantaggio senza richiedere ulteriori sforzi.
Gestire e migliorare continuamente questa vasta gamma di controlli di sicurezza e disponibilità in migliaia di servizi e centinaia di team rappresenta una sfida significativa. Tuttavia, è fondamentale, poiché trascurare anche un piccolo dettaglio può causare una violazione della sicurezza o un guasto del sistema.
### 4.1 Sicurezza
Hyperforce è una piattaforma infrastrutturale sicura e conforme che supporta lo sviluppo e la distribuzione di servizi con funzioni di sicurezza avanzate. Offre un forte controllo degli accessi, crittografia dei dati e conformità agli standard di sicurezza. Salesforce aderisce a oltre 40 standard di sicurezza e conformità come PCI/DSS, GDPR, HIPAA, FedRamp e altri.
I principi di sicurezza chiave includono l'architettura Zero Trust (ZTA) e la crittografia end-to-end, garantendo la protezione dei dati dei clienti in tutte le fasi di elaborazione. Salesforce aderisce agli standard di sicurezza e alle procedure consigliate, dal ciclo di vita sicuro dello sviluppo software alle operazioni di produzione, nonché a solide procedure di protezione a livello di applicazione per mitigare potenziali minacce.
#### Architettura Zero Trust (ZTA)
Il paradigma di sicurezza informatica ZTA garantisce che tutti gli utenti, i dispositivi e le connessioni di servizio vengano sottoposti ad autenticazione, autorizzazione e convalida continua, indipendentemente dalla posizione. ZTA e Public Key Infrastructure (PKI) sono essenziali per la moderna sicurezza informatica, stabilendo confini Trust e comunicazioni sicure senza affidarsi alla sicurezza perimetrale.
Tuttavia, le distribuzioni PKI spesso trascurano l'importanza della revoca dei certificati e della governance sulle autorità di certificazione radice. L'implementazione della revoca dei certificati da parte di Salesforce è robusta e scalabile e supporta la protezione PKI end-to-end.
Inoltre, Hyperforce applica ZTA tramite la protezione reciproca tra i livelli di trasporto tra i servizi, utilizzando chiavi private di breve durata e accesso just in time per gli utenti con controllo dell'accesso basato sui ruoli.
#### Crittografia end-to-end
Salesforce Platform garantisce la protezione dei dati in transito utilizzando TLS con suite di cifratura a segretezza avanzata perfette, che protegge i dati mentre viaggiano nella rete tra i dispositivi utente e i servizi Salesforce, nonché all'interno dei domini dell'infrastruttura Salesforce.
Per i dati a riposo, Salesforce Platform utilizza un sistema di gestione delle chiavi supportato da moduli di sicurezza hardware. Nella sua piattaforma multi-tenant, a ogni tenant viene assegnata una chiave di crittografia univoca, impedendo qualsiasi crossover di chiavi tra tenant.
La sicurezza delle comunicazioni e della crittografia dipende fortemente dall'entropia per la generazione di chiavi o dati casuali. Riconoscendo la vulnerabilità dei protocolli crittografici agli attacchi dovuti alla generazione di chiavi prevedibile, Salesforce Platform riduce questo rischio generando entropia da più origini per tutti i processi di generazione delle chiavi. Sfruttiamo la funzione di crittografia della memoria disponibile in vari processori, abilitata da un fornitore di servizi cloud, per migliorare la protezione dagli attacchi Cold Boot.
#### Protezione del ciclo di vita dello sviluppo software
Salesforce dispone di un JDK personalizzato per soddisfare molti standard di conformità, ad esempio lo standard federale di elaborazione delle informazioni (FIPS), semplificando il processo per sviluppatori e operatori eliminando la necessità di eseguire autonomamente il lavoro di conformità. Questa personalizzazione non solo aiuta a prevenire rischi come l'XML External Entity Injection (XXE), ma migliora anche l'agilità di crittografia di Salesforce e la capacità di scambiare strategie di crittografia in base alle esigenze. Consente la trasformazione di codice non conforme, sviluppato internamente o proveniente da repository aperti, in codice conforme a FIPS senza necessità di una riscrittura completa, riducendo così il carico di lavoro dei team di sviluppo e mantenendo l'osservanza dei principi di progettazione secure-by-default.
Inoltre, Salesforce ha incorporato framework per contrastare vulnerabilità come cross-site scripting (XSS), richiesta di falsificazione (CSRF) e SQL injection integrando misure di protezione nel Secure Software Development Lifecycle (SSDL).
Per proteggere sia i servizi che l'accesso degli utenti viene implementato un sistema centralizzato di gestione dei segreti, rafforzato da controlli di accesso basati sui ruoli (RBAC). Inoltre, vengono utilizzati strumenti di scansione del codice per impedire l'esposizione accidentale di segreti negli ambienti di produzione tramite sistemi di gestione del codice sorgente.
#### Funzionalità di sicurezza operativa Hyperforce
Il phishing rimane una minaccia significativa per le organizzazioni, in quanto Salesforce ha implementato l'autenticazione a più fattori resistente al phishing (MFA) in conformità a una serie di procedure ottimali del settore, tra cui i principi CISA (Cybersecurity and Infrastructure Security Agency) Zero Trust. Sono incluse chiavi con supporto hardware per i dipendenti con accesso in produzione e un kernel sicuro per l'accesso controllato agli account dei fornitori di servizi cloud.
Per mantenere un comportamento di sicurezza efficace, Salesforce ha standardizzato i controlli di sicurezza e integrato servizi di sicurezza nativi del cloud in Hyperforce, offrendo visibilità, rilevamento delle minacce e applicazione delle policy avanzate. È disponibile un sistema completo di gestione delle informazioni di sicurezza e degli eventi per il monitoraggio, l'avviso e la generazione di rapporti in tempo reale, supportato da un programma di gestione delle vulnerabilità completo e da strumenti di gestione del comportamento di sicurezza nel cloud per identificare, valutare e correggere le vulnerabilità in modo continuo.
Inoltre, un firewall di applicazione Web filtra e monitora il traffico HTTP per proteggersi da vari attacchi e viene utilizzata una serie di strumenti di sicurezza di rete, tra cui firewall, sistemi di rilevamento e prevenzione delle intrusioni, reti private virtuali e agenti di rilevamento e risposta degli endpoint per fornire un monitoraggio continuo e il rilevamento delle minacce. La segmentazione della rete e la microsegmentazione sono implementate per ridurre al minimo la superficie di attacco e contenere potenziali violazioni.
Salesforce ha inoltre sviluppato e implementato un solido piano di risposta agli incidenti su misura per le sfide specifiche di Hyperforce, con procedure predefinite per identificare, contenere e mitigare gli incidenti di sicurezza, garantendo una risposta rapida ed efficace alle potenziali minacce alla sicurezza.
### 4.2 Disponibilità
Salesforce gestisce i carichi di lavoro mission-critical dei clienti che richiedono un'elevata disponibilità. La nostra strategia per l'alta disponibilità include vari aspetti organizzativi come il modello di proprietà del servizio, la gestione degli incidenti e le revisioni operative. Gli elementi tecnici chiave della nostra strategia includono l'architettura di monitoraggio, l'automazione delle operazioni basata sull'intelligenza artificiale e i meccanismi di sicurezza automatizzati per le modifiche della produzione.
#### Disponibilità Standard dell'architettura
Per ottenere costantemente un'elevata disponibilità in migliaia di servizi, un approccio in tre fasi gestisce i rischi tecnici su larga scala.
Innanzitutto vengono definiti gli standard dell'architettura di disponibilità, definendo procedure consigliate come:
- **Ridondanza con failover automatico**. Per gestire i continui errori che si verificano in un grande sistema basato su cloud, Salesforce crea i propri servizi con un elevato livello di ridondanza, il rilevamento dei guasti completamente automatizzato e il ripristino automatico senza interruzioni sia per i guasti completi che parziali.
- **Limita raggio esplosione**. _Si_ verificheranno errori e quindi il team progetta tutti i suoi servizi con valori massimi di raggio di esplosione intenzionale per limitare l'impatto degli errori. L'esempio più classico e visibile è quello dell'Hyperforce Cell (fka Pod).
- **Compartimentalizzare gli errori**. Impedisce la diffusione e la composizione dei guasti tra unità indipendenti del sistema. Le chiamate API tolleranti ai guasti tra i servizi sono uno schema chiave che impedisce una serie di errori nel sistema distribuito. Lungo il percorso, il team bilancia con attenzione la compartimentazione e la ridondanza.
- **Scala automaticamente**. Per servire un carico imprevedibile senza peggiorare le prestazioni, aumentare e ridurre automaticamente rapidamente senza affidarsi a operatori umani lenti e fallibili, attivati da punti di saturazione di risorse come CPU, memoria o profondità dell'area di attesa.
- **Ritiri veloci**. Vengono impostati obiettivi di ritiro in minuti per tutti i servizi e vengono testati automaticamente i ritiri negli ambienti di pre-produzione rendendo il ritiro in avanti, indietro e avanti di nuovo un'operazione predefinita. Il team fa ampio uso dei flag delle funzioni per passare a un'implementazione di emergenza ancora più rapida e dettagliata.
- **Proteggere tutti i servizi che ricevono chiamate API**. Load-shedding, limiti equi di tenant, firewall di applicazioni Web e sofisticate protezioni di livello sette sono implementate a tutti i livelli del sistema, dai servizi perimetrali più esterni esposti direttamente a Internet, fino ai servizi più interni più profondi del team che possono essere attaccati accidentalmente da bug nei servizi di chiamata di livello superiore.
- **Dipendenze deboli**. Le dipendenze tra i servizi sono progettate in modo da essere "morbide" ogni volta che sia possibile per consentire loro di fallire o di avere successo in modo indipendente. Il caching è uno degli schemi più comuni qui - spesso un risultato obsoleto da una dipendenza a valle è adeguato per il funzionamento continuo.
- **Favorire la comunicazione asincrona**. La comunicazione asincrona e intermediata tra i servizi separa questi servizi l'uno dall'altro e limita i picchi di carico tra di essi.
- **Rendere le chiamate API tolleranti ai guasti**. Per essere tolleranti nei confronti di guasti parziali e problemi di rete temporanei, vengono utilizzati diversi schemi: timeout e scadenze, interruzione del circuito e tentativi con backoff. Ove possibile, preferiamo non bloccare le chiamate per limitare il consumo e il blocco delle risorse. La compatibilità a ritroso e in avanti viene imposta con il linting a livello di schema in fase di creazione e test di integrazione.
- **Gestire quote e vincoli** del servizio. Il team imposta quote e vincoli per tutto il parco servizi, ad esempio indirizzi IP, IOp disco o la capacità di un determinato cluster Kubernetes. Il team aggrega, monitora e avvisa in caso di utilizzo di queste quote e vincoli a livello centrale per evitare che un limite in avvicinamento influisca sul sistema in fase di esecuzione.
In secondo luogo, un modello di ispezione a più livelli garantisce che i servizi soddisfino questi standard. Ciò include test automatici del caos, scansione e linting per gli schemi anti-schema e revisioni dell'architettura con architetti esperti per individuare problemi non risolti dall'automazione.
In terzo luogo, le soluzioni sono integrate in Hyperforce per facilitare l'osservanza di questi standard. Ciò include la raccolta telemetrica automatica, i meccanismi di ridondanza e failover predefiniti e le protezioni incorporate come la perdita di carico e la difesa DDoS, tutte attivate per impostazione predefinita per i singoli servizi.
#### Monitoraggio e osservabilità
Salesforce gestisce un volume immenso di dati telemetrici, tra cui metriche, registri, eventi e tracce, che le soluzioni di monitoraggio tradizionali non sempre sono in grado di gestire in modo efficace.
Per risolvere questo problema, Salesforce ha sviluppato un sistema di osservabilità completo che si integra con il ciclo di vita dello sviluppo software, le operazioni e le funzioni di assistenza. Questo sistema offre un'esperienza unificata per i team di progettazione e assistenza clienti, soddisfacendo al contempo le esigenze di scalabilità e riducendo i costi di licenza per il software di terze parti.
L'infrastruttura delle metriche di Salesforce, basata su OpenTSDB e HBase, supporta la raccolta, l'archiviazione e l'interrogazione su larga scala dei dati delle serie temporali. I casi d'uso non in tempo reale utilizzano Trino e Iceberg, che gestiscono oltre 2 miliardi di metriche al minuto per fornire informazioni sull'utilizzo della CPU, l'utilizzo della memoria e le percentuali di richieste. Per la gestione dei registri, Salesforce utilizza Splunk per le sue potenti funzionalità di indicizzazione e ricerca. Apache Druid supporta l'inserimento e l'analisi in tempo reale dei dati degli eventi su larga scala, cruciali per comprendere le interazioni degli utenti e gli eventi di sistema. Il tracciamento distribuito tra i microservizi viene gestito con OpenTelemetry ed ElasticSearch, facilitando l'identificazione di latenza e punti di errore specifici.
Salesforce ha inoltre implementato un'infrastruttura APM (Application Performance Monitoring) che si integra con i propri stack tecnologici per la raccolta dati e i punti vendita telemetrici. Questa strumentazione automatica delle applicazioni semplifica la raccolta dei dati e garantisce una telemetria coerente tra i servizi. Il cruscotto digitale unificato di APM correla diversi tipi di dati, migliorando la capacità degli ingegneri di monitorare le prestazioni, diagnosticare i problemi e ottimizzare i sistemi tramite un'interfaccia coerente.
Standardizzando gli strumenti di osservabilità, Salesforce collega diversi tipi di telemetria tra i servizi utilizzando il tracciamento distribuito. In questo modo si crea un grafico completo delle dipendenze dal servizio, che visualizza l'intero ecosistema dei servizi e traccia le richieste con precisione. Questa funzionalità è fondamentale per individuare i problemi, identificare i colli di bottiglia e supportare funzioni basate sull'intelligenza artificiale come il rilevamento delle anomalie, l'analisi predittiva e la correzione automatica.
#### Agente AIOps
Per aumentare i tempi di risoluzione degli incidenti, abbiamo sviluppato un agente delle operazioni AI (AIOps) che rileva, triage e rimedia automaticamente agli incidenti per conto degli operatori umani, con interventi solo in una minoranza di casi. AIOps Agent è un toolkit scalabile reattivo a più agenti progettato per facilitare lo sviluppo di sistemi complessi e reattivi basati sugli agenti. È altamente modulare e può essere ottimizzato con vari strumenti per estenderne le funzionalità. È progettato per essere scalabile in modo efficiente con un numero crescente di agenti. Le caratteristiche principali includono un'architettura reattiva che consente agli agenti di reagire dinamicamente ai cambiamenti nel loro ambiente, il miglioramento degli strumenti, che consente una facile integrazione degli strumenti per estendere le funzionalità degli agenti e un modulo di pianificazione inseribile in un plug-in che consente di personalizzare le strategie di pianificazione degli agenti collegando diversi moduli di pianificazione.
Il rilevamento proattivo rapido viene eseguito per il 91% (al momento della scrittura) degli incidenti principali dei nostri prodotti CRM con modelli avanzati di machine learning della nostra libreria Merlion, una libreria open source disponibile pubblicamente sviluppata dal nostro team di ricerca AI. Merlion è un insieme di modelli di machine learning come Foreste di isolamento, Statistiche, Foreste casuali e reti neurali di memoria a breve termine (LSTM) che elaborano i dati telemetrici completi generati dai nostri sistemi quasi in tempo reale.
Il 79% degli incidenti (al momento della scrittura) viene risolto automaticamente dalle azioni dell'agente. L'agente AIOps può elaborare e triage vettori di dati come registri, profilazione, diagnostica, serie temporali e artefatti specifici del servizio per consigliare azioni di riparazione. Il controller e il pianificatore dell'agente AIOps scelgono un agente con competenze specifiche per eseguire azioni in produzione.
Per gli incidenti rimanenti che richiedono il coinvolgimento umano, l'agente AIOps esegue in modo efficiente il triage dei problemi non risolti ai team di assistenza appropriati. Lo fa comprendendo in modo intelligente la natura e il contesto di ogni incidente utilizzando il modello interno perfezionato XGenOps, che viene addestrato su serie di dati operative come record di problemi, incidenti, JFR e registri, assicurando che venga indirizzato al team con l'esperienza necessaria. Ciò si traduce in oltre 2800 ore di tempo di progettazione risparmiate alla settimana, riducendo la necessità per gli ingegneri di risolvere i problemi irrisolti.
#### Distribuzione continua
Per gestire il rischio di interruzioni di quasi 250.000 modifiche di produzione apportate ogni settimana, vengono utilizzati sistemi di distribuzione completamente automatizzati per applicare procedure di modifica sicure, eliminando gli errori umani. I sistemi pronti all'uso non erano abbastanza scalabili o personalizzabili, il che ha spinto allo sviluppo di soluzioni più personalizzate.
Il sistema di distribuzione continua personalizzato garantisce la sicurezza attraverso più livelli, seguendo le strategie di distribuzione blu/verde standard del settore:
- Prove di test obbligatorie per ogni modifica.
- Test iniziale delle modifiche.
- Dispiegamento scaglionato con raggio di esplosione controllato.
- Ammollo e controlli dello stato tra le fasi di distribuzione.
- mitigare i conflitti con le moratorie e gli incidenti esistenti.
Inoltre, i sistemi di integrazione continua sono stati ottimizzati per eseguire milioni di test selezionati dall'intelligenza artificiale, consentendo rilasci rapidi e riducendo al minimo i rischi di regressione.
## 5\. Framework dei metadati
Il principio architettonico fondamentale di Salesforce Platform è la progettazione basata sui metadati. I tecnici Salesforce creano servizi multi-tenant e archivi di dati. Ogni applicazione sulla piattaforma è essenzialmente una raccolta di metadati che adatta il modo in cui questi servizi multitenant vengono utilizzati dai singoli clienti. Ecco perché una frase di marketing comune per Salesforce Platform è "si accede a tutto con i metadati".
La piattaforma pone l'accento sui metadati strutturati e fortemente tipizzati. Questi metadati fungono da livello di astrazione tra l'esperienza del cliente e l'infrastruttura e le implementazioni Salesforce sottostanti. Questo approccio migliora sia la fruibilità che la qualità delle applicazioni. Ad esempio, anziché utilizzare definizioni e query degli schemi SQL, i clienti interagiscono con metadati strutturati come entità, campi e record tramite le API oggetto Salesforce (sObject). Questo design consente alla piattaforma di integrare nuove tecnologie di archiviazione dati o di modificare quelle esistenti senza necessità di riscritture delle applicazioni, supportando così le procedure consigliate di sviluppo continuo.
 L'architettura di Salesforce Platform è caratterizzata da un approccio di "estensione a livelli" che supporta quattro profili chiave per la creazione e l'estensione delle app:
- **Salesforce Engineering:** I team sviluppano app native come Sales Cloud e Service Cloud, che vengono distribuite in tutti i servizi e runtime attraverso un ampio processo di rilascio. Queste app sono rese disponibili a tutti i tenant tramite meccanismi di licenza e provisioning.
- **Partner esterni**: I fornitori di software indipendenti (ISV) e altri partner possono estendere i metadati creati da Salesforce per creare soluzioni a valore aggiunto, ad esempio estensioni dello schema sui modelli di dati Sales Cloud o regole di convalida aggiuntive per i record caso Service Cloud. Possono inserire queste soluzioni in pacchetti per la distribuzione a più clienti.
- **Amministratori e sviluppatori IT specifici dell'organizzazione**: Possono personalizzare le loro applicazioni oltre a ciò che offrono gli ISV, adattando le soluzioni per rispondere a sfide aziendali specifiche come i processi proprietari o specifici della regione.
- **Singoli utenti finali**: Gli utenti finali possono personalizzare la loro esperienza con l'app, ad esempio modificare l'ordine delle colonne in una visualizzazione elenco o impostare una scheda predefinita.
Ogni profilo può eseguire un'iterazione indipendente sulla stessa applicazione assicurando che i livelli inferiori non dipendano dai cambiamenti dei profili nei livelli superiori e rispettando contratti di controllo delle versioni e compatibilità retroattiva efficaci.
Una funzione che evidenzia il concetto di "estensione a livelli" è l'ordine di esecuzione di salvataggio dei record, che garantisce che la logica aziendale di tutti e quattro i livelli venga applicata in una sequenza prevedibile. Ciò consente a una logica aziendale più specifica di livello superiore determinata dall'amministratore dell'organizzazione o dallo sviluppatore IT di ignorare in modo appropriato la logica di livello inferiore durante il salvataggio dei record che potrebbe essere fornita da Salesforce o da un partner esterno.
Inoltre, i framework di metadati della piattaforma utilizzano un runtime "core" e un ORM (Object-Relational Mapper) proprietario con multitenancy incorporato, collegato a un database relazionale. Questo runtime Core abilita lo stato di memoria condivisa, le convalide dell'integrità referenziale e le conferme transazionali, dando priorità alla stabilità dell'app e migliorando l'affidabilità delle distribuzioni dell'app. L'architettura è in continua evoluzione per supportare la crescente complessità delle applicazioni. Ad esempio, a partire da ottobre 2025 sono presenti oltre 85.000 entità definite da Salesforce e oltre 300 milioni di entità personalizzate definite dai nostri clienti.
Storicamente, il runtime Core ospitava la maggior parte delle funzionalità della piattaforma e dell'app. L'attuale architettura di Salesforce Platform ora include centinaia di servizi indipendenti basati sui metadati. Il runtime Core rimane il singolo sistema di record per i metadati delle applicazioni, sfruttando i vantaggi esclusivi di un'architettura monolitica per la gestione dei metadati. I metadati pertinenti vengono sincronizzati con le cache locali in servizi indipendenti, alimentando la vasta gamma di servizi scalabili per i runtime delle applicazioni.
## 6\. Data
I dati sono un asset essenziale per le organizzazioni e Hyperforce offre una base affidabile per la loro archiviazione in Salesforce. La sfida principale è memorizzare i dati in modo da ottimizzarne l'utilità per le applicazioni. Salesforce Platform ha trasformato il livello di dati adattandolo a vari requisiti di archiviazione e accesso. Bilancia efficacemente i costi, la velocità di lettura/scrittura, la capacità di archiviazione e i tipi di dati per soddisfare esigenze diverse.
Man mano che l'intelligenza artificiale e l'analisi plasmano sempre più le applicazioni aziendali, i dati sono diventati un elemento fondamentale. La sua importanza risiede nella sua capacità di consentire all'intelligenza artificiale e all'analisi di apprendere, analizzare, prendere decisioni e automatizzare i processi.
I dati hanno origine nei database SOR (System of Record) e soddisfano i requisiti operativi delle aziende. Passa quindi attraverso varie trasformazioni alle piattaforme Big Data, essenziali per potenziare l'intelligenza artificiale e le applicazioni basate sugli analytics.
Una gestione efficace dei dati, dalle informazioni sulle transazioni agli approfondimenti analitici, è fondamentale per estrarre valore e supportare applicazioni sofisticate. Salesforce Database (SalesforceDB) si distingue come database transazionale di primo livello per la gestione dei dati SOR, mentre Data 360 funge da solida piattaforma Big Data che ottimizza le funzionalità di intelligenza artificiale e analisi.
### 6.1 Database transazionale
I dati transazionali e i metadati sono essenziali per Salesforce Platform. SalesforceDB è un moderno database relazionale nativo del cloud progettato specificamente per i carichi di lavoro multi-tenant di Salesforce, simile ad altri database cloud dei principali provider ma con funzionalità personalizzate per l'architettura di Salesforce. Estende PostgreSQL, separa elaborazione e archiviazione e sfrutta Kubernetes e l'archiviazione cloud, ottimizzando le operazioni con funzionalità specifiche del tenant come la crittografia e i Sandbox.
SalesforceDB gestisce tutti i dati CRM transazionali, oltre 1,1 trilioni di transazioni al mese, oltre ai metadati per Data 360 e i servizi correlati. I suoi obiettivi principali sono garantire Trust attraverso durata, disponibilità, prestazioni e sicurezza, scalabilità per i grandi clienti e facilitare operazioni cloud semplificate e affidabili. Raggiunge questi obiettivi con un design che separa i livelli di elaborazione e archiviazione, un sistema di archiviazione distribuito immutabile e l'accesso ai dati dell'albero di unione strutturato in log. Ciò consente funzioni avanzate come la crittografia per tenant dei dati nell'archiviazione e Sandbox e migrazioni efficienti.
#### Panoramica architettonica
L'architettura del servizio SalesforceDB viene eseguita in tre zone di disponibilità, con elaborazione e archiviazione replicate in queste zone per garantire che il sistema rimanga disponibile anche in caso di perdita di un nodo o di un'intera zona. Tutti i servizi vengono eseguiti in Kubernetes per abilitare il ripristino automatico degli errori e le distribuzioni di servizi.
Per offrire livelli elevati di durata e disponibilità, il sistema di registrazione definitivo per SalesforceDB è lo storage cloud come S3 di AWS. Operazioni come l'archiviazione e la replica tra regioni vengono gestite a questo livello di cloud storage. Gli oggetti di archiviazione sono immutabili e migliorano la distribuzione e la replica dei dati per un'elevata disponibilità.
A causa dell'elevata latenza nell'archiviazione cloud, SalesforceDB utilizza le cache di archiviazione per accedere ai dati. Queste cache sono sistemi di archiviazione distribuiti che mantengono copie temporanee degli oggetti di archiviazione in un cluster di nodi, garantendo replica e durata in base alle esigenze del database. Cache separate vengono utilizzate per l'archiviazione dei registri delle transazioni e l'archiviazione dei file di dati.
Il livello di calcolo SQL è costituito da un cluster di database principale e due cluster di standby in tre diverse zone di disponibilità. Il cluster principale gestisce tutte le modifiche del database, mentre i cluster di standby gestiscono solo le operazioni di query.
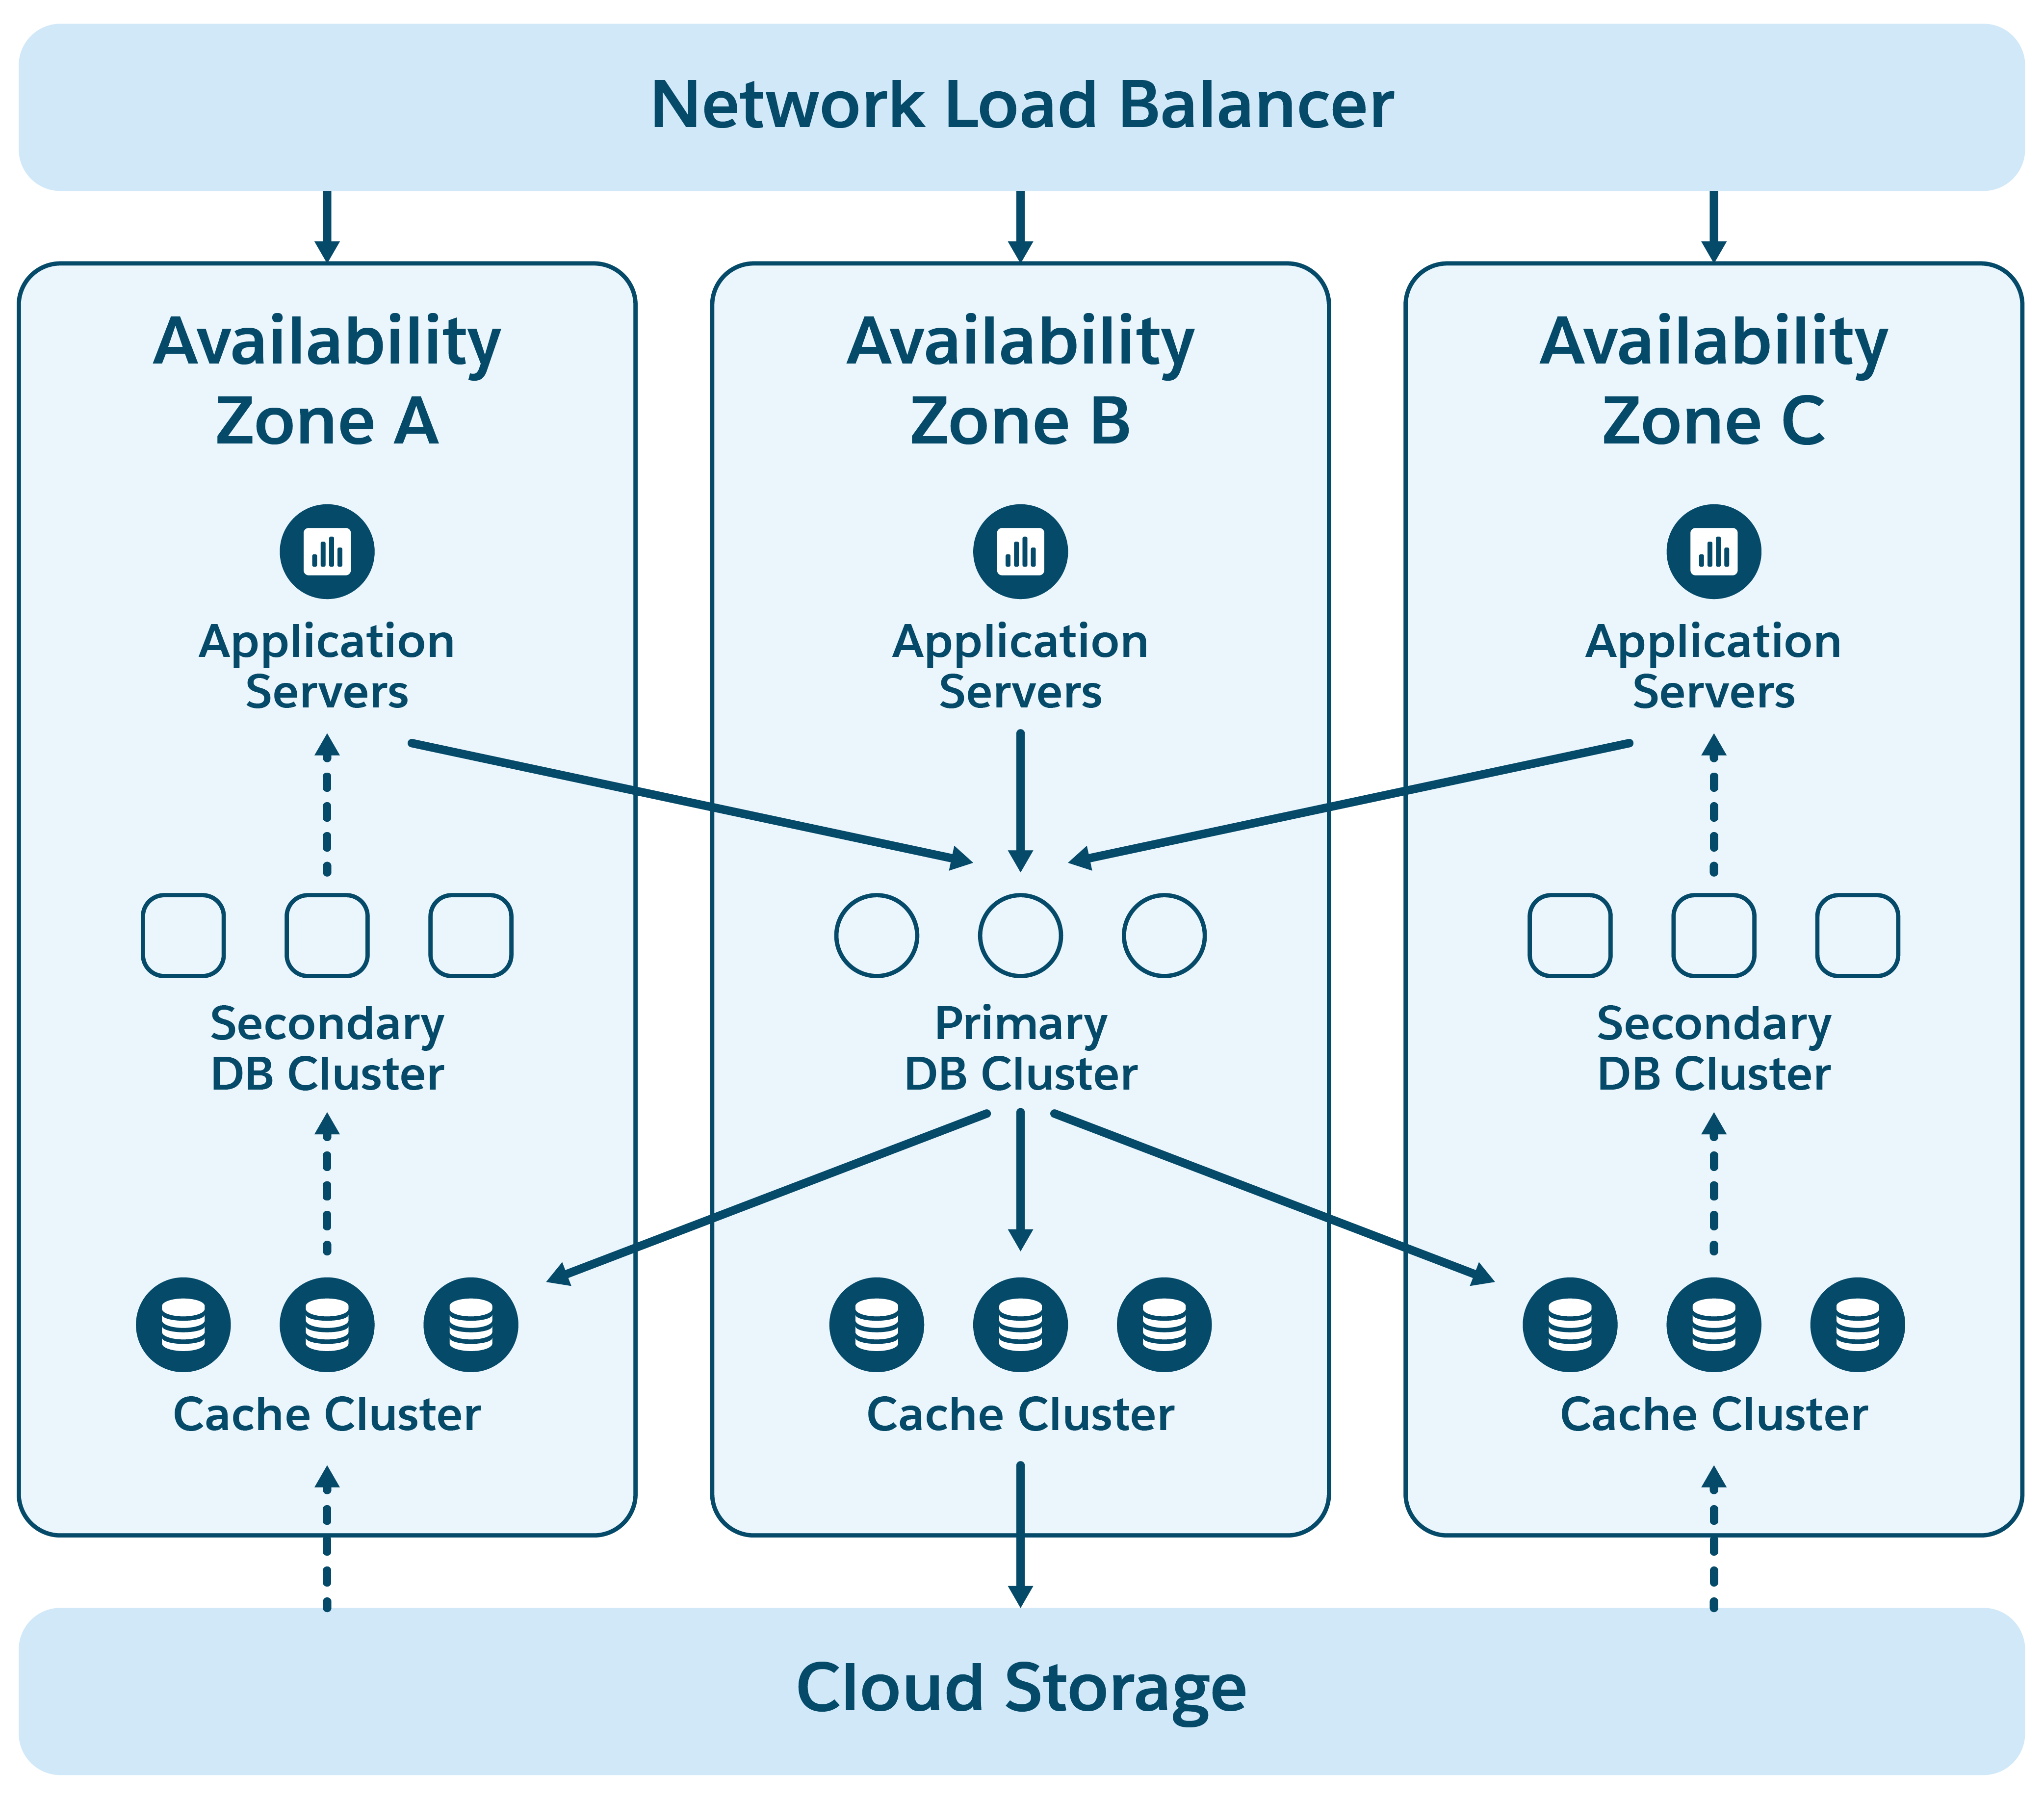 #### Archiviazione e accesso LSM
SalesforceDB utilizza una struttura di dati ad albero di unione strutturato (LSM), in cui le modifiche vengono inizialmente registrate in un registro transazioni e accumulate in memoria. Le modifiche confermate vengono quindi scritte collettivamente in file di dati ordinati per chiave, che vengono periodicamente uniti e compattati per ottimizzare l'efficienza dell'archiviazione.
Questa struttura elimina efficacemente i problemi di aggiornamento simultaneo comuni nei database che aggiornano direttamente l'archiviazione. Utilizzando l'approccio LSM, SalesforceDB supporta funzioni critiche come l'archiviazione immutabile, il che lo rende una soluzione efficace per la gestione dei carichi di lavoro Salesforce.
#### Archiviazione immutabile
I dati nella memoria sono immutabili; una volta scritti e resi visibili, i file di dati non cambiano. I registri delle transazioni sono di sola aggiunta, semplificando gli schemi di accesso ai dati e migliorando l'affidabilità. Questa struttura supporta letture non coordinate, semplifica i backup, aumenta la scalabilità e facilita la virtualizzazione dello storage, rendendolo adatto agli ambienti cloud.
#### Disponibilità e durata
Le transazioni in SalesforceDB vengono confermate in più zone di disponibilità, il che garantisce che non vi siano perdite di dati anche se un nodo o una zona non riesce. Se si verifica un errore, le transazioni in volo vengono interrotte e le transazioni confermate vengono ripristinate correttamente. Poiché gli errori non perdono i dati confermati, il failover ai nuovi nodi viene automatico.
Il software di gestione dei cluster gestisce automaticamente i failover monitorando i quorum e gestendo i trasferimenti di proprietà. Questo processo non viene utilizzato solo in caso di emergenza, ma anche durante le normali patch, migliorando l'affidabilità del sistema attraverso un uso costante. Brevi riavvii del database in genere non vengono notati dagli utenti finali, mantenendo un'esperienza utente senza interruzioni.
Salesforce esegue tre aggiornamenti principali dello schema all'anno, con aggiornamenti più piccoli ogni settimana. SalesforceDB fornisce operazioni dello schema a tempo di inattività zero che consentono di eseguire questi aggiornamenti senza alcun impatto sul cliente.
#### Sistema di record
Il nostro database transazionale funge da repository principale per i dati dei clienti, che vengono memorizzati nella cache in più zone di disponibilità e nel cloud. Ogni blocco di dati è protetto con un checksum immutabile, verificato sia dal livello di memoria che dal motore di database. Il database esegue il tracciamento della discendenza per rilevare eventuali modifiche non ordinate o versioni mancate ed esegue controlli di coerenza continui tra indici e tabelle di base.
Per la protezione dal ransomware, i database vengono archiviati in un archivio separato in un account diverso, inclusi i backup completi e incrementali dei registri delle transazioni. Questi backup vengono regolarmente convalidati tramite un processo di test di ripristino. Inoltre, l'infrastruttura cloud è preconfigurata ma non attivata, pronta per gestire le richieste di ripristino dei dati in base alle esigenze.
#### Scala
Ogni organizzazione Salesforce è ospitata in una cella Hyperforce, che include il servizio SalesforceDB. Questa impostazione consente una rapida scalabilità globale attraverso la creazione di nuove celle tramite l'architettura Hyperforce e il traffico può essere facilmente spostato tra le celle per gestire il carico. Tuttavia, con l'aumentare dei carichi di lavoro dei clienti e delle esigenze aziendali, la capacità di una singola istanza di database potrebbe essere insufficiente.
Per risolvere questo problema, SalesforceDB utilizza un'architettura di scalabilità orizzontale sia per il livello di archiviazione che per il livello di calcolo. L'archiviazione su cloud è praticamente illimitata e i livelli di cache vengono scalati automaticamente per soddisfare la domanda. Inoltre, il livello di elaborazione può espandersi aggiungendo altri nodi di elaborazione del database, che leggono in modo efficiente dallo spazio di archiviazione immutabile condiviso senza necessità di coordinamento. Questo approccio consente a SalesforceDB di raggiungere una scalabilità pari o superiore a quella delle principali architetture di database di cluster commerciali, senza richiedere reti o hardware speciali.
#### Multitenancy
Salesforce è un'applicazione multi-tenant in cui un singolo database ospita più tenant. Ogni record tabella include un ID tenant per distinguerne la proprietà e l'isolamento del tenant viene mantenuto tramite predicati di query automatici aggiunti dal livello applicazione di Salesforce.
SalesforceDB è adattato a questo modello, supportando DDL, metadati e processi di runtime specifici del tenant, migliorando affidabilità, prestazioni e sicurezza. Combina il basso sovraccarico di un modello tenant-per-row con l'efficienza di uno schema tenant-per-database.
In SalesforceDB, gli ID tenant fanno parte della chiave principale delle tabelle multitenant, che raggruppano i dati per tenant nella struttura di dati LSM, migliorando l'efficienza dell'accesso. Questa impostazione non solo facilita l'accesso efficiente ai dati e la crittografia per tenant, ma semplifica anche la gestione dei dati tenant. I tenant possono essere facilmente copiati o spostati con rettifiche minime dei metadati grazie alla struttura compatta dei metadati.
### 6.2 Data 360 e Data Lake
Le funzionalità di intelligenza artificiale, analisi e dati sono essenziali nelle aziende moderne. Le aziende investono già in piattaforme Big Data mature come Snowflake, Databricks, BigQuery e Redshift. Tuttavia, molti
i clienti non stanno derivando valore aziendale dai loro dati a causa di silos di dati, mancanza di elaborazione AI, dati non aggiornati o inazione all'interno di un processo aziendale esistente. Centralizzare i dati dei clienti in un'unica fonte di dati, con un'unica visualizzazione del coinvolgimento dei clienti, è fondamentale per un'azienda e impegnativo a causa della frammentazione dei dati e della complessità della gestione del sistema. Salesforce è leader nel facilitare una visione olistica di un cliente integrando dati, intelligenza artificiale e CRM in un circolo virtuoso, guidato da approfondimenti generativi di intelligenza artificiale e machine learning e basato sui dati.
SalesforceDB è ottimizzato per carichi di lavoro transazionali ad alte prestazioni su dati strutturati, mentre i carichi di lavoro di intelligenza artificiale e analisi richiedono la gestione di grandi volumi di dati non strutturati provenienti da varie fonti e l'esecuzione di query complesse e l'elaborazione batch. Per rispondere a queste esigenze, Salesforce ha sviluppato Data 360, una piattaforma progettata per abbattere i silos di dati, unificare, archiviare ed elaborare i dati in modo sicuro ed efficiente, supportando le esigenze di intelligenza artificiale e analisi e consentendo operazioni aziendali in tempo reale.
 Data 360, basato su Hyperforce, funge da piattaforma di base per AI e Analytics, offrendo:
- Infrastruttura integrata e piattaforma no-code per consolidare i silos di dati tramite connessioni
- Inserimento dati reale e quasi in tempo reale
- Federazione copia zero
- Pulizia, preparazione e modellazione dei dati per l'elaborazione
- Servizio di query unificato su dati strutturati e non strutturati
- Sviluppo di modelli analitici e AI/ML per la generazione di approfondimenti
- Azioni e attivazioni attivate da dati
- Supporto per la generazione aumentata di recupero AI generativo (RAG)
- Governance completa basata su policy
L'architettura di Data 360 supporta una serie di componenti e funzionalità, descritte di seguito.
#### Connettività, trasformazione e armonizzazione
Data 360 supporta pipeline di inserimento efficienti da varie fonti di dati strutturate e non strutturate, per l'elaborazione dei dati batch, quasi in tempo reale e in tempo reale. Il servizio di inserimento di Data 360 funziona secondo uno schema Extract-Load-Transform (ELT), progettato per una bassa latenza e adatto alla scala B2C. L'inserimento in tempo reale include API e stream interattivi, mentre le fonti quasi in tempo reale coprono l'utilizzo dettagliato dei prodotti. Una volta inseriti, i dati vengono ampiamente trasformati per essere preparati, armonizzati (ad esempio, unificando vari tipi di contatti) e modellati per applicazioni di query, analisi e intelligenza artificiale efficaci. La piattaforma include anche un'ampia gamma di modelli di dati armonizzati pronti all'uso.
Data 360 si integra perfettamente con applicazioni Salesforce come Sales Cloud, Service Cloud, Marketing Cloud e Commerce Cloud. Inoltre, offre centinaia di connettori per fonti di dati esterne, garantendo una perfetta integrazione dei dati.
#### Lakehouse per Big Data
Data 360 dispone di un'architettura lakehouse nativa basata su Iceberg/Parquet, progettata per gestire la gestione e l'elaborazione dei dati su larga scala per scenari batch, streaming e in tempo reale. Questa architettura supporta sia dati strutturati che non strutturati, cruciali per le applicazioni di intelligenza artificiale e analisi.
 Nei data lake basati su cloud come Azure, AWS o GCP, l'unità di archiviazione fondamentale è un file, in genere organizzato in cartelle e gerarchie. Questa lakehouse ottimizza questa struttura introducendo astrazioni strutturali e semantiche di livello superiore per facilitare operazioni come query ed elaborazione AI/ML. L'astrazione principale è una tabella con metadati che ne definisce la struttura e la semantica, incorporando elementi di progetti open source come Iceberg o Delta Lake, con livelli semantici aggiuntivi aggiunti da Data 360.
Strati di astrazione nella casa sul lago:
- **Astrazione file Parquet**: Alla base, lo storage è costituito da file data lake (ad esempio S3 in AWS o Blob in Azure) in formato Parquet. I dati di una tabella di origine sono memorizzati in più partizioni come file Parquet, e ogni tabella è una raccolta di questi file.
- **Astrazione tabella Iceberg**: Le tabelle sono organizzate come cartelle, con partizioni di dati memorizzate come file Parquet all'interno di queste cartelle. Le modifiche apportate a una partizione generano nuovi file Parquet come istantanee. Iceberg gestisce un file di metadati per ogni tabella, descrivendo gli schemi, le specifiche delle partizioni e le istantanee.
- **Astrazione tabella Salesforce Cloud**: Basato su Iceberg, questo livello aggiunge metadati semantici come nomi e relazioni delle colonne, oltre a configurazioni come le dimensioni e la compressione dei file di destinazione. Astrae le tabelle in varie piattaforme come Snowflake e Databricks, proteggendo le applicazioni Data 360 dalle specifiche della piattaforma di archiviazione sottostante.
- **Libreria di accesso al lago**: Questa libreria fornisce l'accesso alla tabella Salesforce Cloud, gestendo sia i dati che i metadati e astraendo i meccanismi di archiviazione sottostanti per gli sviluppatori di applicazioni.
- **Astrazione del servizio Big Data**: Sono inclusi framework di elaborazione come Trino e Hyper per le query e Spark per l'elaborazione in qualsiasi piattaforma di tabelle cloud.
Data 360 Lakehouse supporta la scala B2C, l'inserimento in tempo reale, l'elaborazione, l'imposizione e l'evoluzione dello schema, le istantanee e utilizza formati di archiviazione aperti.
#### Archiviazione in tempo reale
Per supportare applicazioni analitiche e agenti in tempo reale, Data 360 aumenta lo spazio di archiviazione Big Data di un lakehouse con un ulteriore punto vendita a bassa latenza (LLS). Il livello di elaborazione in tempo reale di Data 360 analizza i segnali in tempo reale e i dati di coinvolgimento in memoria. Poiché la capacità di memoria è limitata, non è possibile elaborare tutti i dati contemporaneamente. Data 360 aggiunge questo LLS per rimuovere tali limitazioni, abilitando l'elaborazione scalabile in tempo reale.
Il punto vendita a bassa latenza è uno strato di memoria NVMe (SSD) in scala di petabyte sulla casa sul lago. È una cache durevole: la maggior parte dei dati alla fine arriva al lakehouse per la persistenza a lungo termine. I dati in sessione nel livello in tempo reale possono essere trasferiti all'archivio a bassa latenza per un successivo accesso rapido. Ad esempio, in una conversazione tra agenti, i messaggi recenti possono essere elaborati in memoria; i messaggi più vecchi possono essere trasferiti in LLS. Se è necessaria una conversazione precedente, è possibile accedervi entro pochi millisecondi dall'LSL. L'archiviazione basata su NVMe consente di archiviare e accedere a grandi quantità di dati a latenze di millisecondi. I dati potrebbero arrivare alla casa sul lago per persistenza a lungo termine.
Inoltre, i dati della casa sul lago necessari per l'elaborazione in tempo reale o per migliorare le esperienze in tempo reale vengono recuperati e mantenuti in LLS. Ad esempio, il contesto del profilo cliente viene pre-recuperato o portato dalla casa sul lago e memorizzato nella cache in LLS. Inoltre, tutti gli oggetti lakehouse e altri oggetti necessari per l'elaborazione in tempo reale durante l'elaborazione in sessione possono essere memorizzati nella cache anche in LLS. LLS abilita un livello in tempo reale in una gerarchia di archiviazione reale con livelli di memoria, SSD e lakehouse, con la migrazione dei dati tra uno e l'altro.
Data 360 offre anche un supporto efficace per la sicurezza, inclusa la crittografia a livello di tenant (TLE) con chiavi gestite dai clienti, nonché la privacy e la conformità tramite le sue tecnologie di governance. Al centro c'è il supporto per il controllo dell'accesso basato sugli attributi (ABAC), che valuta dinamicamente l'accesso in base agli attributi correlati a entità, operazioni e fattori ambientali. Questo sistema supporta sia i controlli di accesso discrezionali che obbligatori.
A integrazione di ABAC, un sistema di classificazione dei dati dettagliato classifica i dati in base alla riservatezza e allo scopo, migliorando la conformità, la gestione del rischio e la risposta agli incidenti. Insieme, ABAC e questo sistema di classificazione forniscono una governance dei dati completa, garantendo che i dati all'interno di Data 360 siano gestiti in modo sicuro ed efficiente.
#### Metadata-driven
Data 360 si integra perfettamente con Salesforce Platform per i metadati, i pacchetti, l'estendibilità, l'esperienza utente e la distribuzione delle applicazioni tramite AppExchange. I clienti possono definire e gestire i metadati per stream e tabelle Lakehouse, esattamente come gli altri metadati Salesforce. Ogni oggetto dati (incluse le tabelle federate o esterne) è rappresentato come oggetto Salesforce e modellato come entità virtuali supportate dalla memoria dati in Data 360. Possono essere utilizzati dagli sviluppatori per creare applicazioni in Salesforce Platform.
#### Federazione e ampliabilità Zero-Copy
Data 360 offre un supporto completo per la federazione copia zero, consentendo agli utenti di integrarsi con data warehouse esterni come Snowflake e Redshift, lakehouse come Google BigQuery, Databricks e Azure Fabric, oltre a database SQL e vari tipi di file, tra cui Excel. Data 360 supporta la federazione basata su file e query, con query live e accelerazione dell'accesso come mostrato nella figura. Le etichette (1) e (2) illustrano la query di Data 360 (inclusi i pushdown delle query live) e la federazione basata su file per l'accesso ai dati da data lake/warehouse/fonti di dati esterne; l'etichetta (3) evidenzia l'accelerazione dell'accesso federato da data lake/fonti di dati esterne. Le etichette (4) e (5) illustrano la condivisione basata su query e file dei dati di Data 360 con data lake/warehouse esterni. La funzionalità si estende anche a fonti di dati non strutturate come Slack e Google Drive, a cui è possibile accedere dalle pipeline di elaborazione non strutturate di Data 360. Inoltre, Data 360 facilita l'astrazione degli oggetti Salesforce e l'accesso ai dati per i dati federati da fonti esterne, abilitando l'accesso a tali dati in tutta la piattaforma e le applicazioni Salesforce.
#### Customer Data Platform (CDP)
Data 360 integra un CDP che offre funzionalità avanzate di risoluzione dell'identità, creando identificatori e profili persona unificati insieme a cronologie complete del coinvolgimento. Questa piattaforma è in grado di gestire sia framework business-to-business (B2B) che business-to-consumer (B2C) supportando grafici dell'identità che utilizzano regole di corrispondenza esatte e fuzzy. Questi grafici dell'identità sono arricchiti con dati di coinvolgimento di vari canali, che consentono di creare grafici dettagliati dei profili con approfondimenti analitici e segmenti preziosi.
Inoltre, il CDP consente una segmentazione e un'attivazione efficaci in diverse piattaforme, ad esempio Marketing Cloud, Facebook e Google di Salesforce. Elabora i profili dei clienti in batch, quasi in tempo reale e in tempo reale, consentendo decisioni e personalizzazioni immediate. Questa funzionalità migliora le interazioni sia negli scenari B2C che B2B, assicurando che le aziende possano rispondere in modo rapido e preciso alle esigenze e ai comportamenti dei clienti.
#### Grafici dati
Data 360 offre un grafico dei dati aziendali in formato JSON, ovvero un oggetto denormalizzato derivato da varie tabelle lakehouse e dalle relative interrelazioni. Questo include un grafico dei dati "Profilo" creato da CDP che include la cronologia degli acquisti e della navigazione di una persona, la cronologia dei casi, l'utilizzo dei prodotti e altri approfondimenti calcolati ed è ampliabile da clienti e partner. Questi Grafici dati sono personalizzati per applicazioni specifiche e migliorano la precisione dei prompt generativi AI fornendo il contesto pertinente del cliente o dell'utente.
Inoltre, sono in atto piani per espandere questi Grafici dati per includere grafici Knowledge che acquisiscono e modellano Knowledge derivato, ad esempio entità estratte e relazioni da dati non strutturati. Il livello in tempo reale di Data 360 utilizza il grafico Profilo per la personalizzazione e la segmentazione in tempo reale.
#### Livello in tempo reale
 Il livello in tempo reale di Data 360 è progettato per elaborare eventi come clickstream Web e mobili, visite, dati del carrello e pagamenti con latenze al millisecondo, migliorando la personalizzazione dell'esperienza dei clienti. Monitora continuamente il coinvolgimento dei clienti e aggiorna il profilo cliente da CDP con dati, segmenti e calcoli di coinvolgimento in tempo reale per una personalizzazione immediata.
Ad esempio, quando un consumatore acquista un articolo su un sito Web di acquisto, il livello in tempo reale rileva e inserisce rapidamente questo evento, identifica il consumatore e arricchisce il suo profilo con informazioni aggiornate sulla spesa per tutta la vita. Ciò consente la personalizzazione della loro esperienza sul sito in pochi secondi. Inoltre, questo livello include funzionalità per l'attivazione e le risposte in tempo reale, abilitando azioni immediate basate sulle interazioni con i clienti.
#### Personalizzazione
Personalizzazione significa sapere a quale profilo rivolgersi, quando e dove fornire contenuti e consigli pertinenti, cosa dire e con quale frequenza. La funzionalità Personalization Services Platform di Data 360 è l'orchestratore delle decisioni prese per ottimizzare il raggiungimento degli obiettivi attraverso esperienze personalizzate. Questa piattaforma offre le seguenti funzionalità:
- Insieme coerente di modelli e modi per interpretare i dati di profili, attività e asset in Data 360.
- Sperimentazione integrata nella piattaforma (ad esempio, A/B/n o processo decisionale sui banditi a braccio multiplo).
- Integrazione degli obiettivi in fase di progettazione tramite configurazione, tempo di addestramento ML e runtime (inferenza ML).
- Supporto di scala B2C, interazione in tempo reale e batch (utenti anonimi, esterno interattivo/in tempo reale a volume elevato, batch interno a volume elevato).
- Analytics gestito da Data 360.
- Schemi per integrare modelli AI e servizi di altre parti (sia interne che esterne).
- Implementazioni OOTB di casi d'uso basati sull'intelligenza artificiale di alto valore (consigli e decisioni con vari algoritmi ML, inclusi banditi contestuali per la selezione di promozioni/contenuti, consigli sui prodotti e decisioni sui prezzi).
#### Azioni dati
Data 360 è una piattaforma attiva che supporta l'attivazione di opportunità in corso di realizzazione in risposta a eventi dati. Ad esempio, un evento significativo, ad esempio un calo del saldo account di un cliente, può attivare un flusso Salesforce per orchestrare un'azione corrispondente. Analogamente, gli aggiornamenti alle metriche chiave, ad esempio la spesa per tutta la vita, possono essere propagati automaticamente alle applicazioni pertinenti.
#### Tessuto di calcolo dati
Data 360 dispone di cluster di calcolo con scalabilità elastica che gestiscono in modo efficiente le operazioni di elaborazione. Offre una gestione efficace sia per gli ambienti di elaborazione multi-tenant che dedicati. Inoltre, fornisce il supporto gestito per Spark e SQL. Le funzioni BYOC (Bring Your Own Compute/Code) supportano più linguaggi di programmazione, tra cui Java, Python e Spark, consentendo l'integrazione di trasformazioni, modelli (compresi i modelli LLM) e funzioni personalizzate, migliorando l'estensibilità.
Data 360 Compute Fabric offre un livello unificato noto come Data Processing Controller (DPC) per la gestione e l'esecuzione di tutti i carichi di lavoro Big Data. DPC è un servizio completo di orchestrazione dell'elaborazione dati multi-carico di lavoro che offre funzionalità Job-as-a-Service (JaaS) in diversi ambienti di cloud computing. Astrae la complessità dell'infrastruttura e unifica l'esecuzione dei processi per framework come Spark (EMR su EC2 e EMR su EKS) e carichi di lavoro Kubernetes Resource Controller (KRC). Fungendo da gateway del piano di controllo centralizzato, DPC orchestra, pianifica e monitora i processi su più piani dati, garantendo affidabilità, scalabilità, efficienza dei costi e un'esperienza dello sviluppatore coerente.
#### Query unificate
Il servizio di query di Data 360 offre funzionalità di query avanzate, con un ampio supporto SQL per dati strutturati e non strutturati tramite Trino e Hyper. Migliora la funzionalità con l'estendibilità dell'operatore tramite le funzioni tabella, consentendo diverse operazioni di ricerca in testo, immagine, spaziale e altri tipi di dati non strutturati. Queste funzionalità sono perfettamente integrate con le operazioni relazionali, ad esempio la selezione dei record cliente. Questo approccio unificato consente la generazione di risultati mirati e personalizzati, facilitando risposte LLM più precise utilizzando RAG.
#### Elaborazione di dati non strutturati
Data 360 supporta l'archiviazione e la gestione di dati strutturati (tabelle), semi-strutturati (JSON) e non strutturati in modo semplice nei meccanismi di inserimento, elaborazione, indicizzazione e query dei dati. Data 360 supporta diversi tipi di dati non strutturati oltre al testo, inclusi audio, video e immagini, ampliando l'ambito della gestione e dell'analisi dei dati. La figura sotto illustra i due lati della messa a terra (inserimento e recupero).
Data 360 gestisce i dati non strutturati archiviandoli in colonne come testo o in file per serie di dati più grandi. Supporta la federazione dei dati per i contenuti non strutturati, che consente l'integrazione e la gestione dei dati provenienti da più fonti.
La pipeline di indicizzazione dei dati non strutturati di Data 360 è progettata come un'architettura modulare e ampliabile che comprende cinque fasi centrali: Analisi, pre-elaborazione, suddivisione, post-elaborazione e incorporamento. Queste fasi sono quindi seguite dall'indicizzazione di parole chiave e vettori. Gli esempi di pre-elaborazione includono operazioni come l'eliminazione del rumore, la normalizzazione del linguaggio e la comprensione delle immagini (riconoscimento ottico dei caratteri), mentre le fasi di post-elaborazione possono includere l'arricchimento dei metadati, il raggruppamento semantico o tecniche avanzate come la suddivisione in blocchi.
Data 360 offre diversi modelli pronti all'uso e collegabili per la generazione di blocchi e incorporamento. Le pipeline di dati in Data 360 supportano completamente le estensioni di codice, consentendo ai clienti e ai team interni di inserire logica personalizzata in qualsiasi fase. Queste fasi supportano anche l'elaborazione basata su LLM, che consente ai clienti di definire i propri prompt in base alle esigenze.
Per l'indicizzazione, Data 360 supporta l'indicizzazione con parole chiave utilizzando i servizi di ricerca e l'indicizzazione vettoriale utilizzando Milvus, un indice vettoriale nativo open source. Per l'impostazione di RAG con elaborazione non strutturata, Data 360 sfrutta l'indicizzazione del contesto per consentire un'iterazione rapida e una convalida rapida utilizzando query di test di esempio, con contenuti specifici del profilo configurati in base al profilo o all'utente che consuma.
La funzionalità Document AI di Data 360 supporta la lettura e l'importazione di dati non strutturati o semi-strutturati da documenti come fatture, curriculum, rapporti di laboratorio e ordini di acquisto. Questa funzione supporta l'elaborazione interattiva ad hoc e l'elaborazione in batch in blocco. Questa è una funzionalità chiave che consente l'automazione dei processi aziendali per i nostri clienti.
#### Livello semantico
Data 360 dispone di un livello semantico headless con API progettate per migliorare la semantica aziendale e l'analisi basata su AI/ML, in modo simile a Tableau Next. Questo livello include un servizio di modellazione semantica dei dati che arricchisce i modelli analitici tradizionali con tassonomia aziendale come misure e metriche.
Il servizio di query semantiche utilizza un linguaggio dichiarativo per interagire con questi modelli, traducendo le query in SQL per accedere ai dati da fonti di dati native e federate in Data 360.
Questa integrazione facilita esplorazioni analitiche, rapporti e cruscotti digitali scalabili e interattivi, compatibili con strumenti di visualizzazione di terze parti.
#### Governance dei dati
Data 360 funziona come un hub di governance centralizzato, garantendo che tutti i dati, dall'inserimento non formattato agli approfondimenti attivati, siano gestiti con integrità e controllo. Data 360 ha adottato il controllo dell'accesso basato sugli attributi come modello di autorizzazione principale. ABAC consente alle decisioni di accesso di basarsi sugli attributi dell'utente (reparto, ruolo, posizione), sui dati (informazioni personali, riservatezza, spazio dati) e sull'ambiente (ad esempio, ora del giorno), anziché sui ruoli predefiniti. Ciò consente policy di accesso altamente granulari e contestuali che si adattano al variare dei dati e degli attributi utente. Il cuore dell'implementazione ABAC di Data 360 è l'uso del linguaggio della policy CEDAR. Questo linguaggio di policy formale, open source e appositamente creato, offre un modo preciso e verificabile per definire regole di autorizzazione complesse, assicurando che le policy siano univoche e possano essere valutate in modo coerente su larga scala.
Il ciclo di vita della governance include funzionalità chiave per quanto riguarda le informazioni sulle politiche, l'applicazione e i punti decisionali:
- **Tagging e classificazione (punto di informazione sulla policy):** I dati vengono identificati e arricchiti con attributi critici. Data 360 offre meccanismi automatici di creazione di tag e classificazione, sfruttando il Discovery, i LLM e il machine learning per identificare le categorie di dati sensibili (ad esempio, informazioni personali come email, telefono, nome) sia in dati strutturati che non strutturati.
- **Servizio di autorizzazione (Policy Enforcement Point):** Questo servizio intercetta tutte le richieste di accesso ai dati da vari livelli di consumo (query ibride strutturate/non strutturate, retriever e prompt RAG e arricchimento CRM) e consulta il punto di decisione della policy per determinare se l'accesso è consentito.
- **Motore di valutazione delle politiche (punto decisione politica):** Questo motore prende il contesto della richiesta di accesso dal Policy Enforcement Point, insieme alle definizioni delle policy (in CEDAR) e agli attributi dal Policy Information Point, per prendere una decisione di accesso autorevole.
Il framework ABAC con policy CEDAR offre controllo e flessibilità, assicurando che i dati dei clienti non siano solo di immediato valore pratico ma anche sicuri, conformi e affidabili in tutta l'azienda.
### 6.3 Caching dei dati
Le cache sono essenziali per un accesso rapido ai dati di uso frequente. Salesforce utilizza molte cache in Salesforce Platform, inclusi i server di applicazioni principali, SalesforceDB e Edge. Salesforce Platform e le applicazioni necessitano di una soluzione di caching scalabile e tenant-aware con bassa latenza ed elevata produttività. Questa soluzione deve consentire ai tecnici Salesforce di controllare che cosa viene memorizzato nella cache e per quanto tempo, assicurando che i loro dati non vengano sfrattati dal rumore del sistema o dai dati di altri clienti. Vegacache, un servizio di caching gestito da Salesforce basato su Redis, è progettato per un ambiente poliglotta, multitenant e cloud pubblico. È ampiamente utilizzato dai servizi Salesforce e accessibile agli sviluppatori della piattaforma tramite le API del linguaggio di programmazione Apex. Operando su larga scala in Hyperforce, al momento della scrittura, Vegacache gestisce oltre 2.000 miliardi di richieste al giorno con tempi di risposta inferiori al millisecondo.
Le istanze Vegacache, eseguite in contenitori Kubernetes a cui si accede tramite Service Mesh, vengono distribuite in più zone di disponibilità per bilanciare la disponibilità dei dati e la latenza. Scala automaticamente in base al carico del sistema, garantendo la disponibilità dei dati e la conservazione degli ordini delle finestre. Vegacache offre una dimensione di cache garantita per cliente e offre protezione contro i vicini rumorosi, con resilienza contro i guasti dell'infrastruttura attraverso l'archiviazione dati replicata.
Per gli sviluppatori di Salesforce Platform, Vegacache consente agli sviluppatori di memorizzare nella cache i risultati delle query del database SOQL e degli oggetti Apex, riducendo l'utilizzo della CPU e la latenza eliminando i recuperi di dati non necessari da SalesforceDB. Supporta le operazioni Put(), Get() ed Delete(), mantenendo gli oggetti di uso frequente facilmente accessibili.
### 6.4 Elaborazione asincrona dei dati
Salesforce supporta in modo nativo i processi e le architetture di dati asincroni per una maggiore flessibilità, resilienza e scalabilità del flusso di lavoro.
I tecnici Salesforce hanno sfruttato le aree di attesa dei messaggi per separare i processi di dati in blocco da quelli di grandi dimensioni e coordinare i processi tra sistemi indipendenti. Queste aree di attesa dei messaggi sono state astratte dallo sviluppatore esterno tramite funzioni della piattaforma come le query API in blocco o Apex asincrono. Salesforce Platform ha quindi introdotto stream di eventi organizzati con registri basati su una solida infrastruttura di messaggistica di cluster Apache Kafka gestiti internamente. Questo ha abilitato un'architettura basata sugli eventi con un modello di interazione pubblicazione/abbonamento ed è stato prodotto per gli sviluppatori esterni come Eventi piattaforma.
Sia le aree di attesa dei messaggi che gli stream di eventi continuano a essere tecnologie altamente sfruttate delle app e delle soluzioni create sulla piattaforma, soprattutto perché sfruttano un maggior numero di funzioni, cloud e sistemi esterni ospitati in runtime indipendenti. La comunicazione tramite schemi di eventi con versione consente cicli di vita di sviluppo software indipendenti per i diversi runtime. Il disaccoppiamento dei sistemi tramite eventi consente anche di gestire i picchi di carico e l'elasticità/scala dei singoli runtime per supportare una maggiore resilienza complessiva e disponibilità di un'app.
### 6.5 Ricerca Enterprise
Le funzioni di ricerca di Salesforce, cruciali per applicazioni che vanno dalla ricerca globale all'intelligenza artificiale generativa, affrontano sfide uniche che modellano il nostro approccio architettonico:
- **Scala**: Supportando centinaia di migliaia di clienti e milioni di tenant, la nostra soluzione di ricerca nativa per il cloud è progettata per essere utilizzata su larga scala pur mantenendo un buon rapporto qualità-prezzo.
- **Diversità dei clienti**: La variegata base di clienti di Salesforce in diversi settori ha esigenze di ricerca uniche e complesse a causa dell'ampia personalizzazione della piattaforma, che coinvolge numerosi tipi di oggetti e campi.
- **Operabilità**: La soluzione di ricerca deve essere resiliente e altamente disponibile, supportare la residenza dei dati, le operazioni del ciclo di vita dei tenant come le migrazioni regionali e il Sandboxing e mantenere una latenza di indicizzazione bassa con equità tra i tenant.
- **Rilevanza su scala**: Migliorare la pertinenza dei risultati di ricerca per soddisfare le diverse query degli utenti è fondamentale, soprattutto perché vengono scalati gli algoritmi di pertinenza per adattarsi a vari tenant, tipi di dati e scenari di ricerca.
- **AI e funzionalità semantiche**: La ricerca supporta il machine learning e l'intelligenza artificiale generativa, in particolare per Retrieval-Augmented Generation (RAG) e Ricerca agente.
- **Integrazione perfetta**: Per garantire un'esperienza utente coerente, la tecnologia di ricerca di Salesforce si integra profondamente con la più ampia Salesforce Platform, inclusi i modelli di metadati e i servizi AI/dati.
La soluzione nativa per il cloud di Salesforce, SeaS (Search as a Service), è basata su Solr, un motore di ricerca distribuito open source. Salesforce ha esteso e ottimizzato in modo significativo Solr per rispondere alle sfide specifiche e lo ha integrato profondamente con le applicazioni e la piattaforma Salesforce, incorporando tecnologie semantiche per migliorare le applicazioni AI e la pertinenza della ricerca.
SeaS utilizza un'architettura di separazione elaborazione/stoccaggio che consente una distribuzione scalabile degli indici tra i nodi e riequilibra i carichi e la disponibilità tra le zone durante gli errori. È dotato di sharding e ridimensionamento automatici degli shard, aggiornamenti senza tempo di inattività e ottimizzazioni come il caricamento e l'archiviazione pigri delle repliche per soddisfare gli indici utilizzati raramente.
L'architettura include anche un'implementazione di indice di basso livello ottimizzata per un numero elevato di campi, il completamento automatico, la correzione ortografica e la crittografia "porta la tua chiave". Gestendo globalmente circa 6.000 nodi Solr, l'infrastruttura di ricerca Hyperforce utilizza più cluster indipendenti (celle Hyperforce) in ogni regione per bilanciare i costi e il controllo, posizionando automaticamente gli indici client in base al carico, al dominio e al tipo.
La pipeline di pertinenza della ricerca di Salesforce utilizza tecniche di apprendimento a livello di classifica, adattandosi alle diverse esigenze dei clienti e supportando funzioni come la classificazione dei risultati. Include anche le previsioni delle entità dalle query degli utenti e dalle interazioni precedenti. I modelli di pertinenza vengono continuamente perfezionati imparando dalle interazioni degli utenti e valutati tramite test A/B, migliorando la precisione dei risultati della ricerca. Questo processo supporta anche i modelli di bootstrapping per le applicazioni AI tramite trasferimento Knowledge.
Lo stack incorpora un motore di ricerca vettoriale per la ricerca semantica e le applicazioni AI, integrato con Data 360 per le funzionalità di intelligenza artificiale generativa. Ciò include una pipeline completa per la trasformazione dei dati, il supporto per la ricerca ibrida, un catalogo di classificatori configurabili, ad esempio Deep Fusion Ranker e Autodrop per escludere i risultati di ricerca di bassa rilevanza.
Poiché l'intelligenza artificiale generativa sta spostando il consumatore principale dei servizi di ricerca dagli utenti umani all'utilizzo di LLM, lo stack di ricerca Salesforce si sta adattando per trovare e restituire risultati ottimizzati per questo consumo a livello di programmazione, occupandosi di query più lunghe e complesse e restituendo risultati più descrittivi come blocchi. Ciò supporta le nuove funzionalità di Ricerca agente, in cui gli agenti Agentforce sfruttano la ricerca con un loop di ragionamento per eseguire operazioni complesse.
Le funzioni di ricerca di Salesforce coprono vari contesti, tra cui ricerca globale, ricerche, Ricerca risposte, ricerca nelle comunità, elenchi correlati, impostazione, applicazioni mobili e di intelligenza artificiale generativa. Questa ampia funzionalità è ottenuta attraverso una stretta integrazione dello stack di ricerca con il sistema di metadati e l'ecosistema dell'interfaccia utente di Salesforce, consentendo un supporto senza interruzioni sia per gli oggetti standard che personalizzati.
Inoltre, l'integrazione con Data 360 migliora le funzionalità di ricerca negli oggetti dati tramite configurazioni senza codice e consente la composizione di funzioni di ricerca all'interno delle pipeline di dati, ad esempio l'inclusione di istruzioni di ricerca nelle query SQL. Lo stack di ricerca sfrutta l'ecosistema di connettori completi di Data 360, ad esempio il connettore sensibile alle autorizzazioni Google Drive, per fornire funzionalità di ricerca aziendali complete. L'integrazione si estende alla piattaforma AI, abilitando le query di ricerca per essere utilizzate come retriever nel Generatore di prompt per il radicamento nel contesto e nella ricerca agente.
## 7\. AI e Agentforce
L'intelligenza artificiale ha rimodellato il panorama tecnologico e Salesforce Platform, con il suo livello di dati integrato e completo, posiziona Salesforce per offrire esperienze di intelligenza artificiale di impatto ai clienti. Salesforce ha iniziato la sua trasformazione dell'intelligenza artificiale quasi dieci anni fa ed è leader nel settore dal 2013, concentrandosi su ricerca, etica e sviluppo dei prodotti per consentire alle aziende di risolvere problemi complessi e favorire la crescita.
Sfruttando il valore fondamentale dell'innovazione, Salesforce ha introdotto l'intelligenza artificiale predittiva Einstein, che consente alle aziende di analizzare i dati, automatizzare i processi, comprendere i clienti e ottimizzare le operazioni con una suite completa di strumenti basati sull'intelligenza artificiale come il Generatore di previsioni Einstein e i bot AI. Con l'avvento dell'intelligenza artificiale generativa, Salesforce ha lanciato Agentforce, una piattaforma che unisce modelli predittivi e generativi per offrire funzionalità avanzate di intelligenza artificiale, privilegiando la privacy dei dati.
Con il lancio più recente di Agentforce 3.0, basato su Python con un framework basato sugli eventi, Salesforce introduce una maggiore flessibilità attraverso funzioni come la cronologia delle conversazioni integrata, il tracciamento delle sessioni end-to-end, il supporto vocale e la funzionalità del motore di ragionamento personalizzato (Bring Your Own Planner), abilitando sistemi multi-agente più scalabili, personalizzabili e intelligenti.
### 7.1 Principi fondamentali dell'intelligenza artificiale
Agentforce segue questi principi fondamentali:
- **Sicurezza dei dati ed etica**: Dà priorità alla protezione dei dati, alla conformità e ai principi etici dell'intelligenza artificiale.
- **Trasparenza e spiegabilità**: Offre una chiara comprensione e convalida degli output generati dall'intelligenza artificiale.
- **Flessibilità e personalizzazione**: Adatta le applicazioni AI a esigenze e settori specifici.
- **Integrazione perfetta**: Si integra con Salesforce CRM e altri sistemi.
- **Scalabilità**: Gestisce le distribuzioni su larga scala e offre esperienze AI in tempo reale.
- **Esperienze intelligenti e coerenti**: Offre esperienze personalizzate, ottimizzate e automatizzate tramite dati connessi e comprensione contestuale.
- **Osservabilità completa:** Offre visibilità e monitoraggio approfonditi delle interazioni degli agenti AI per consentire l'ottimizzazione proattiva e la messa a punto degli agenti che utilizzano Agentforce Interaction Explorer.
### 7.2 Panoramica sull'architettura
 Lo stack AI è costituito da diversi componenti chiave:
- **Piattaforma AI**: Questo livello piattaforma è responsabile della gestione, dell'addestramento e della messa a punto dei modelli AI utilizzati sia in applicazioni predittive che generative. Offre servizi pronti all'uso (OOTB), servizi Trust e modelli di base per l'addestramento, il test e l'esecuzione dell'inferenza sui modelli. Inoltre, supporta l'integrazione dei propri modelli predittivi e generativi, consentendo di inserire modelli personalizzati all'interno della piattaforma.
- **Servizi AI Foundational**: Sono inclusi i servizi Gateway AI, Framework di feedback, RAG, Orchestrazione agente, Valutazione agente e Ragionamento, che facilitano l'integrazione delle applicazioni aziendali con lo stack AI.
- **Esperienze utente e agente basate sull'intelligenza artificiale**: Salesforce offre applicazioni specializzate basate sull'intelligenza artificiale tramite i propri servizi cloud. I clienti possono anche creare esperienze personalizzate sfruttando qualsiasi componente della piattaforma, ad esempio Flow, Apex o persino Lightning Web Components (LWC), per creare esperienze basate sull'intelligenza artificiale perfettamente integrate nei flussi di lavoro e nei processi aziendali.
- **Agenteforce Studio**: Questo componente è dotato di strumenti come Agent Builder, Generatore di prompt, Centro di test e Generatore di modelli, progettati per creare esperienze di intelligenza artificiale sia generative che predittive. Offre supporto completo per lo sviluppo/l'addestramento, il test e la messa a punto di modelli AI. Next Gen Authoring ottimizza queste funzionalità, progettate per semplificare e accelerare la creazione di agenti AI con un'interfaccia utente migliorata e la compatibilità con SFDX.
### 7.3 Componenti di base
#### Livello Trust Agentforce
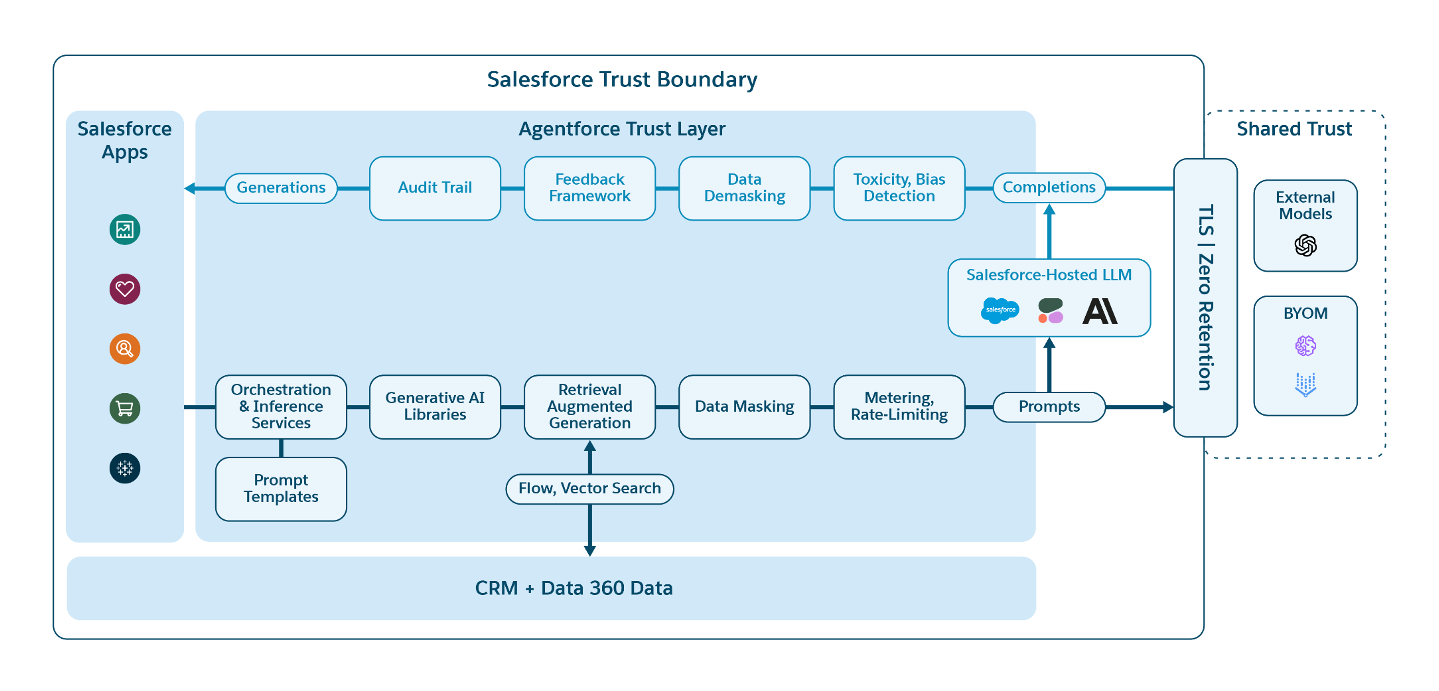 Agentforce Trust Layer è disponibile in casi d'uso selezionati per aiutare a proteggere i dati dei clienti nelle applicazioni di intelligenza artificiale generative offrendo funzionalità avanzate:
- **Privacy dei dati**: Controlli efficaci del mascheramento e della privacy proteggono le informazioni sensibili dall'accesso da parte di modelli di intelligenza artificiale esterni.
- **Sicurezza**: Garantisce un ambiente di elaborazione dati sicuro e impedisce l'accesso non autorizzato.
- **Fiducia**: Mantiene il controllo dei clienti sui dati, senza memoria AI o utilizzo da parte di terzi.
- **Guardrail:** Applicare gli standard comportamentali degli agenti e mitigare il non determinismo intrinseco degli LLM, verificando che gli agenti seguano costantemente istruzioni e flussi di lavoro predefiniti.
- **Precisione**: Ottimizza gli output AI utilizzando i dati Salesforce pertinenti per inserire i prompt a terra.
- **Moderazione dei contenuti**: Offre moderazione pre- e post-contenuto, mascheramento dei dati personalizzabile per le informazioni sensibili (PII/PCI/PHI) e classificazione della tossicità per le risposte LLM (large language model).
#### Gateway AI Agentforce
Il gateway AI fornisce un'interfaccia unificata per accedere e gestire vari LLM e modelli predittivi. Funge da ponte tra Salesforce e il mondo dei LLM, astraendo le complessità dei diversi provider di LLM e dei modelli di intelligenza artificiale predittiva dei clienti, offrendo un modo coerente per interagire con loro. Il gateway AI Agentforce si integra con più provider LLM, consentendo ai clienti di scegliere il modello migliore per le loro esigenze e incorpora misure di sicurezza dei dati efficaci per aiutare a gestire i costi associati all'utilizzo di LLM diversi.
Il servizio di feedback è un componente che raccoglie, analizza, misura e utilizza il feedback degli utenti per addestrare nuovamente e perfezionare i modelli di intelligenza artificiale. Svolge un ruolo cruciale nel miglioramento continuo delle caratteristiche e delle funzionalità basate sull'intelligenza artificiale all'interno di Salesforce Platform.
#### Recupero Generazione aumentata (RAG)
RAG è una tecnica fondamentale che migliora le funzionalità di ricerca con l'intelligenza artificiale generativa, portando a risposte più informative e accurate. Utilizzando l'ampio Salesforce Data 360 e il database vettoriale integrato, la piattaforma Agentforce recupera rapidamente i dati pertinenti per la query di un utente. Questi dati vengono quindi utilizzati come base per gli LLM per generare risposte ottimali.
Inoltre, questo metodo aumenta la velocità di risposta e il Trust degli utenti includendo i dati di origine nelle risposte. RAG è ampiamente utilizzato nella piattaforma Agentforce, in particolare per applicazioni come Agentforce per Service e Agentforce per Sales, evidenziando come metta in evidenza le informazioni pertinenti per questi casi d'uso.
### 7.4 Agentforce Platform
Man mano che i modelli di intelligenza artificiale avanzano, lo sviluppo di agenti per automatizzare le operazioni che richiedono un ragionamento è il passo successivo. Questi agenti fungono da assistenti intelligenti, in grado di comprendere e rispondere alle domande in linguaggio naturale, consentendo agli utenti di progettarli, testarli e distribuirli per varie operazioni. Un componente cruciale di questo sistema è il servizio di pianificazione, che funziona come segue:
- **Interpreta la richiesta dell'utente**: Analizza l'input dell'utente per determinare l'intento.
- **Crea un piano**: Formula un piano strutturato per soddisfare le esigenze dell'utente.
- **Lancia azioni**: Esegue il piano avviando azioni direttamente o tramite altri servizi.
Il servizio di pianificazione orchestra il processo, assicurando che l'agente soddisfi in modo efficiente le richieste degli utenti gestendo ed eseguendo i passaggi necessari.
#### Agentforce
Agentforce rappresenta una piattaforma per la creazione di agenti, che consente a clienti e ISV di creare agenti AI automatici per applicazioni come Agenti dell'assistenza e Agenti di vendita. Questi agenti possono elaborare e rispondere alle richieste dei clienti in modo naturale, gestendo un'ampia gamma di operazioni aziendali e offrendo vantaggi significativi sia alle aziende che ai loro clienti.
Il flusso di lavoro di un agente include:
- **Attivazione**: L'agente viene attivato da criteri predefiniti, ad esempio la richiesta di un cliente in vari canali.
- **Comprendere e rispondere**: Utilizza l'elaborazione del linguaggio naturale (NLP) per cogliere la domanda, l'intento e il sentiment del cliente, quindi consulta la Knowledge Base di Salesforce o altre fonti di dati per creare una risposta appropriata.
- **Gestione delle complessità**: Se si trova di fronte a un problema complesso o necessita di supervisione umana, l'agente può passare agevolmente l'interazione a un agente umano.
- **Apprendimento continuo**: L'agente impara da ogni interazione, migliorando continuamente le risposte e le prestazioni complessive.
#### Agentforce Studio
Agentforce Studio offre una piattaforma low-code che consente ai clienti di integrare l'intelligenza artificiale nelle applicazioni e nei flussi di lavoro Salesforce, rendendo accessibile la tecnologia AI oltre i data scientist.
Le caratteristiche principali dello studio includono:
- **Generatore di modelli**: Consente di creare o importare modelli di intelligenza artificiale su misura per esigenze aziendali specifiche.
- **Generatore di prompt**: Strumento senza codice/low-code che facilita la creazione e la gestione di prompt di intelligenza artificiale generativi, migliorando l'esperienza utente con una semplice interfaccia per la creazione, il test e la distribuzione di prompt.
- **Generatore di agenti**: Consente a clienti e ISV di sviluppare agenti conversazionali e autonomi personalizzati.
- **Centro test**: Supporta i test di modelli, prompt e agenti, fondamentali per garantire applicazioni AI di alta qualità e ottimizzare le prestazioni e l'economicità, migliorando al contempo le risposte deterministiche e la qualità dell'esperienza utente.
Agentforce combina intelligenza artificiale predittiva e generativa, sfruttando il framework di metadati unificato di Salesforce Platform e Data 360 per offrire soluzioni aziendali intelligenti, personalizzate ed efficaci.
### 7.5 La prossima evoluzione: Agentforce 3.0
Per soddisfare le crescenti esigenze del mercato dell'intelligenza artificiale generativa, tra cui i rapidi progressi nel ragionamento, la necessità di sistemi multi-agente scalabili e il passaggio alle interfacce multimodali, Salesforce sta evolvendo la sua architettura con Agentforce 3.0. Questa piattaforma di nuova generazione si basa su diversi progressi chiave:
- **Architettura asincrona basata sugli eventi:** Agentforce 3.0 è basato su una base Python con un framework basato sugli eventi ottimizzato. Ciò consente l'implementazione degli agenti asincrona e altamente scalabile, migliorando le prestazioni e ponendo le basi per scenari d'uso complessi e multi-agente in cui gli agenti possono comunicare tramite eventi.
- **Funzioni vocali multimodali:** Andando oltre le interazioni basate su testo, Agentforce 3.0 introduce il supporto per Voice come modalità principale. L'architettura si integra con gli operatori telefonici e i gateway WebRTC per gestire lo streaming audio in tempo reale. I nuovi servizi gestiscono la conversione dell'audio in testo (ASR) e il ritorno del testo in audio (TTS), abilitando esperienze vocali naturali e conversazionali per casi d'uso come i call center automatici.
- **Script e determinismo Agentforce:** Un meccanismo di intercettazione basato su computer dello stato che limita il comportamento degli agenti all'interno di una struttura definita esplicitamente, garantendo percorsi di esecuzione coerenti. Ciò consente di creare grafici deterministici, offre una gestione efficace dello stato per prevenire la perdita di memoria e facilita i trasferimenti condizionali e determinati da LLM, garantendo azioni degli agenti prevedibili e coerenti per i processi aziendali critici.
## 8\. Servizi piattaforma applicativa
L'ecosistema app di Salesforce Platform si distingue per l'integrazione delle funzionalità tra i livelli App Platform Services, API, User Experience ed Experience Developer. I servizi piattaforma app sono funzionalità comuni utilizzate per creare e personalizzare la maggior parte delle app in Salesforce Platform, mentre le funzionalità aziendali sono generalmente più specifiche delle soluzioni.
### 8.1 Funzionalità chiave
L'ecosistema delle app si basa su cinque funzionalità chiave, che guidano il processo di sviluppo delle app.
- **Tenancy**: Ciò comporta la separazione logica di dati e metadati all'interno di un servizio multi-tenant, consentendo agli utenti autenticati di accedere a dati e funzionalità specifiche. Questo è visibile soprattutto ai clienti che ricevono un'organizzazione Salesforce al momento della registrazione.
- **Entità**: Le entità che rappresentano le tabelle di database sono costituite da campi simili a colonne di tabella. I metadati delle entità e dei campi includono attributi per la modellazione dei dati come i tipi di dati e i nomi API, nonché attributi funzionali come se l'entità fosse eseguibile tramite query o scrivibile. Questa astrazione, anziché manipolare direttamente l'archivio dati, consente a Salesforce di introdurre e passare senza problemi alle tecnologie di archiviazione senza richiedere aggiornamenti da parte degli sviluppatori IT, garantendo una funzionalità continua dell'app.
- **Controlli di accesso**: Questi controlli regolano l'accesso degli utenti ai dati e alle funzioni, principalmente in base all'identità degli utenti e a policy specifiche. Le policy sono costituite da regole e selettori di funzioni e disciplinano le entità, i campi e le funzioni a cui è possibile accedere. Le policy e le autorizzazioni vengono acquisite in "insiemi di autorizzazioni" e l'accesso viene concesso assegnando insiemi di autorizzazioni alle identità degli utenti.
- **Estensione a livelli**: Come descritto in precedenza, ciò supporta lo sviluppo indipendente di metadati e app da parte di ruoli diversi, inclusi ingegneri Salesforce, partner esterni, amministratori IT e utenti finali, facilitato da ordini di salvataggio strutturati e spazi dei nomi dei metadati.
- **Pacchetti**: Questa funzione consente la creazione di bundle e la distribuzione di metadati tra i tenant Salesforce, semplificando il processo di aggiornamento e distribuzione delle app senza necessità di ricreazione.
Oltre a queste funzionalità chiave, App Platform Services include anche:
- **Runtime e query dei dati**: Supporta operazioni come la creazione, l'aggiornamento, l'eliminazione e l'esecuzione di query sui dati in diversi archivi di dati specializzati. Una gamma di scalabilità e prestazioni dei dati è supportata da un'architettura che consente l'esecuzione delle operazioni sui dati direttamente nell'archivio dati, tramite un'astrazione interna che può essere utilizzata dai tecnici Salesforce o tramite la convenzione "Oggetto Salesforce" o sObject rivolta al cliente.
- **Flusso / Flusso di lavoro / Formule**: Definizione ed esecuzione di logica aziendale e regole di convalida utilizzando strumenti low-code.
- **Apex Code**: Linguaggio pro-code per la logica delle app, integrato in modo nativo con le API e i runtime dei dati della piattaforma.
- **Servizi di infrastruttura nativi del cloud:** Heroku offre un ambiente solido agli sviluppatori che utilizzano linguaggi di programmazione e framework di settore per creare, distribuire e gestire applicazioni che si integrano con i dati e gli eventi della piattaforma.
- **Eventi e notifiche**: Gestisce i trigger e l'orchestrazione basata sugli eventi.
- **Globalizzazione**: Fornisce supporto per le app multilingue e multinazionali.
- **Licenze e provisioning**: Gestisce l'acquisto e la gestione dell'accesso alle funzionalità e alle app della piattaforma.
- **Stack Web Lightning**: Consente la personalizzazione delle interfacce visive utilizzando metadati strutturati come layout e tecnologie Web standard.
- **Siti + CDN**: Garantisce esperienze Web a bassa latenza e a traffico elevato, anche per gli utenti non autenticati.
- **Sicurezza e conformità**: Offre strumenti e controlli per soddisfare requisiti specifici di sicurezza organizzativa e conformità.
- **Prevenzione della perdita**: di dati Include funzioni per il backup, il ripristino e l'archiviazione dei dati.
### 8.2 Piattaforma applicativa cloud
Salesforce Platform offre una suite di strumenti e funzionalità tramite Heroku che consentono agli sviluppatori di creare, eseguire e gestire le applicazioni nel cloud utilizzando i linguaggi di programmazione e i framework desiderati. La piattaforma di applicazioni cloud gestita di Heroku fornisce runtime di applicazioni, archivi di dati, aree di attesa di messaggistica e sistemi di eventi come servizi scalabili per creare estensioni per le applicazioni Salesforce.
Le applicazioni in esecuzione su Heroku hanno accesso alla suite completa di funzionalità di Salesforce, ai dati dei clienti e alla logica aziendale, oltre alla possibilità di connettersi a sistemi e servizi di terze parti. Con Heroku, gli sviluppatori possono concentrarsi sulla fornitura di valore senza essere gravati da problemi infrastrutturali sottostanti.
## 9\. Automazione
L'automazione è ciò che rende dinamica un'app ed è fondamentale per la trasformazione digitale dei processi aziendali essenziali.
Salesforce Process Automation è stato creato per rispondere alle principali sfide che i clienti devono affrontare, inclusa la necessità di processi aziendali semplificati ed efficienti man mano che le organizzazioni scalano. Queste sfide spesso comportano flussi di lavoro che richiedono un eccessivo impegno manuale, causando inefficienze e costi operativi più elevati. I clienti cercano una soluzione in grado di automatizzare questi processi, ridurre al minimo il lavoro manuale e mantenere coerenza e precisione.
Un problema significativo è stata l'assenza di uno strumento intuitivo che consentisse agli utenti non tecnici di progettare e implementare processi aziendali senza competenze di codifica approfondite. Inoltre, era necessaria una soluzione in grado di integrarsi in modo sicuro, scalabile e senza interruzioni con le operazioni Salesforce automatizzate esistenti come l'immissione dei dati, le approvazioni, le notifiche e i processi complessi in più fasi.
Salesforce Process Automation soddisfa queste esigenze offrendo una piattaforma robusta ma intuitiva per la creazione di flussi di lavoro automatizzati. Consente agli utenti di creare e personalizzare i flussi tramite un'interfaccia visiva, accessibile sia agli utenti tecnici che a quelli non tecnici, automatizzando così le operazioni ripetitive, imponendo regole aziendali e semplificando i processi all'interno dell'ecosistema Salesforce.
Per l'automazione che richiede un'orchestrazione complessa che interagisce con i dati transazionali, Salesforce offre Apex come linguaggio pro-code per la scrittura di logica aziendale.
### 9.1 Architettura e funzionalità di automazione dei processi
**Generatore di logica visivo**: Clienti e ISV utilizzano Flow Builder, un'interfaccia con trascinamento della selezione, per creare flussi di automazione dei processi senza codifica. Questo strumento visivo è intuitivo per tutti i livelli tecnici e consente ad analisti aziendali e amministratori di progettare facilmente automazioni complesse.
Flow Builder consente ai clienti di creare flussi versatili che operano in vari contesti, supportati dal Core Flow Engine:
- **Trigger di record**: I flussi si attivano quando si aggiornano i record o si inviano moduli, abilitando modifiche dei dati, convalide e avviamenti di flussi di lavoro basati sulle azioni del cliente.
- **Flussi pianificati o basati sugli eventi**: Questi flussi possono funzionare con una pianificazione o un trigger predeterminati dopo eventi specifici e possono effettuare chiamate a servizi esterni.
- **Flussi schermata**: Fornire un'interfaccia utente per i processi guidati passo per passo con moduli, schermate e altri elementi interattivi, utili per operazioni come l'immissione dei dati, la risoluzione dei problemi o l'orientamento.
- **Flussi Orchestrator**: Gestire e integrare più processi di fase, facilitando la gestione di operazioni complesse.
Il motore di flusso offline può essere eseguito senza una connessione al server di app Salesforce. Il flusso offline supporta l'automazione dei casi d'uso mobili Field Service. Il Motore di flusso su larga scala supporta i flussi di marketing. Offre una scala B2C per l'elaborazione simultanea di un volume elevato di flussi di lunga durata.
Tutti i casi d'uso e gli ambienti sono ottimizzati da un modello di metadati unificato in Flow Builder, che supporta una varietà di potenti elementi di logica applicabili in tutti i flussi di automazione dei processi:
- **Logica e condizioni avanzate**: Gli utenti possono integrare logica complessa come elementi decisionali, loop e condizioni di attesa nei flussi di lavoro, consentendo la gestione di scenari aziendali complessi.
- **Trasformazione e gestione dei dati**: Flow Builder consente l'inserimento, la trasformazione e la gestione dei dati da varie fonti, inclusi servizi Web, organizzazioni Salesforce e Data 360. Supporta operazioni complete sui dati come la creazione, l'aggiornamento, l'eliminazione e l'esecuzione di query sui record.
### 9.2 Automazione in Salesforce Platform
Salesforce Process Automation offre una perfetta integrazione con altri prodotti Salesforce e sistemi di terze parti, garantendo un flusso di dati fluido tra le applicazioni per una visualizzazione unificata dei processi aziendali e delle interazioni con i clienti. Supporta vari metodi di integrazione, ad esempio API, chiamate Web e connettori MuleSoft.
La connettività Servizi esterni e MuleSoft in Salesforce abilita le connessioni alle API esterne e l'utilizzo dei relativi dati in Automazione processi Salesforce. La registrazione dello schema API consente la creazione di azioni invocabili che si integrano perfettamente nei flussi, facilitando l'automazione dei processi con fonti di dati esterne. Le potenti funzionalità di integrazione di MuleSoft garantiscono un flusso di dati senza interruzioni tra Salesforce e altre applicazioni, eliminando i silos di dati e offrendo una visualizzazione unificata dei processi aziendali.
**Integrazione Agentforce**: Salesforce Process Automation sfrutta Agentforce per migliorare i flussi di lavoro con processi decisionali intelligenti. Utilizza gli approfondimenti AI per indirizzare automaticamente i lead agli agenti di vendita adatti o avviare campagne di marketing personalizzate in base al comportamento dei clienti, aumentando così l'efficacia dell'automazione con una maggiore intelligenza.
**Sinergia piattaforma**: Salesforce Process Automation si integra perfettamente con altri prodotti Salesforce come Sales Cloud, Service Cloud, Commerce Cloud e Marketing Cloud. Questa integrazione consente alle organizzazioni di automatizzare i processi in vari reparti, migliorando l'efficienza operativa. Ad esempio, un flusso di lavoro può generare automaticamente un caso di assistenza in Service Cloud quando un reclamo del cliente viene inviato tramite un modulo di Marketing Cloud.
### 9.3 Automazione pro-codice con Apex
Apex è un potente linguaggio di programmazione orientato agli oggetti che consente agli sviluppatori di scrivere logica aziendale personalizzata ed eseguire operazioni complesse sulla piattaforma Salesforce. È stato un pilastro della nostra piattaforma e attualmente la piattaforma gestisce oltre 350 miliardi di transazioni Apex al mese (a ottobre 2025).
Apex viene utilizzato per sviluppare una vasta gamma di funzionalità personalizzate e integrazioni approfondite nella piattaforma Salesforce, tra cui:
- **Automazione basata su trigger**: Implementare un'automazione complessa che viene eseguita prima o dopo l'inserimento, l'aggiornamento o l'eliminazione dei record. Ciò consente una convalida complessa dei dati, aggiornamenti dei record correlati e la chiamata di altri processi in base a modifiche specifiche dei dati.
- **Servizi Web:** Creare integrazioni personalizzate con sistemi esterni e chiamare API REST o SOAP da Apex.
- **Interfacce utente personalizzate**: Creare interfacce utente ed esperienze altamente personalizzate utilizzando Visualforce e i componenti Web Lightning (LWC), dove Apex funge da controller di backend per gestire la manipolazione dei dati e la logica aziendale.
- **API personalizzate:** Gli sviluppatori possono esporre la logica personalizzata come API utilizzando Apex REST e Apex SOAP, consentendo ai sistemi esterni di interagire con i dati e i processi Salesforce a livello di programmazione.
- **Elaborazione asincrona**: Eseguire operazioni di lunga durata o che richiedono molte risorse in modo asincrono utilizzando metodi futuri, Apex in area di attesa e Apex pianificato. Ciò consente di scaricare ed elaborare in background le operazioni di lunga durata, migliorando l'esperienza utente e le prestazioni del sistema.
- **Apex pianificato:** Gli sviluppatori possono pianificare l'esecuzione delle classi Apex in orari specifici utilizzando Apex Scheduler per operazioni periodiche come la sincronizzazione notturna dei dati, la generazione di rapporti e le attività di manutenzione.
## 10\. Esperienze utente
Le funzionalità Esperienze utente di Salesforce Platform consentono agli utenti finali di interagire con le applicazioni tramite varie opzioni di distribuzione nelle applicazioni Lightning basate su browser, nei siti Experience, nell'interfaccia utente collaborativa nativa mobile, orientata all'intelligenza artificiale o nei componenti incorporati utilizzando Lightning Out.
### 10.1 Lightning Design System
SLDS (Salesforce Lightning Design System) è un framework di progettazione completo che promuove la creazione di interfacce utente coerenti e accessibili con i principi di progettazione di Salesforce per un'esperienza utente coerente in tutti i prodotti. Consente a ingegneri, clienti e partner Salesforce di creare applicazioni native in tutto l'ecosistema Salesforce.
Le caratteristiche chiave del sistema di progettazione includono:
- **Modelli di progettazione**: Soluzioni collaudate per le sfide di progettazione più comuni, che forniscono linee guida per layout, presentazione dei dati e interazioni degli utenti per garantire un'esperienza utente coerente.
- **Ganci di stile**: Variabili CSS che rappresentano le decisioni di progettazione, ad esempio colori, tipografia, spaziatura e dimensioni, garantendo la coerenza tra le applicazioni.
- **Libreria di componenti Lightning Base**: Una raccolta di componenti dell'interfaccia utente riutilizzabili, come pulsanti, elementi modulo ed elementi di navigazione, che rispettano i principi di progettazione di Salesforce, facilitando uno sviluppo rapido ed efficiente.
- **Accessibilità**: Funzionalità di accessibilità e linee guida incorporate per garantire che tutti i componenti siano utilizzabili da persone con disabilità e rispettino standard come le linee guida per l'accessibilità dei contenuti Web (WCAG).
- **Layout reattivi**: Un sistema di griglie flessibili e linee guida per il layout che consentono alle applicazioni di adattarsi perfettamente a dispositivi e schermi di dimensioni diverse.
- **Tooling**: Una raccolta di strumenti, risorse e tecnologie che supportano l'igiene dei componenti, la riduzione degli schemi e la governance del sistema di progettazione.
Il framework SLDS continua a evolversi per supportare ganci di stile più completi e funzionalità di personalizzazione più approfondite in modo che i componenti possano essere riutilizzati mentre vengono ancora personalizzati per soddisfare requisiti di immagine aziendale e temi specifici. L'obiettivo del nostro sistema di progettazione è rendere Salesforce veloce, facile e convincente da utilizzare con l'intelligenza artificiale.
### 10.2 Lightning Web Stack
L'interfaccia basata su browser di Salesforce, nota come Lightning, offre un contenitore coerente dell'interfaccia utente e un framework dell'interfaccia basato sui metadati e una raccolta di tecnologie che consentono a ingegneri, amministratori IT, sviluppatori e partner Salesforce di sviluppare rapidamente l'interfaccia utente con un'estetica Salesforce coerente, oltre a punti di estensione per un controllo completo per il restyling e il re-branding. Lightning Web Stack include diverse tecnologie:
- **Componenti Web Lightning**: Componenti Web personalizzati creati con HTML e JavaScript, conformi agli standard Web W3C.
- **Sicurezza Web Lightning**: Motore di virtualizzazione che gestisce il codice JavaScript nel browser, garantendo la conformità agli standard di sicurezza di Salesforce per il codice di terze parti.
- **Servizi dati Lightning**: Framework progettato per un'interazione efficiente con i dati lato server.
- **Lightning Web Runtime**: Garantisce un rendering dell'interfaccia utente efficiente e coerente tra i vari client.
L'ingegneria Salesforce ha incorporato le lezioni delle precedenti tecnologie dell'interfaccia utente e ha contribuito agli organismi di standardizzazione Web, influenzando lo sviluppo di implementazioni di componenti basate su standard. Ad esempio, Salesforce continua a essere membro di circa 20 gruppi di lavoro W3C. I componenti Web Lightning e Lightning Web Stack sono conformi a questi standard di settore, riducendo la complessità per gli sviluppatori.
### 10.3 Mobile
I dispositivi mobili continuano a essere un'interfaccia sempre più importante per gli utenti che interagiscono con le app Salesforce.
Salesforce fornisce un'app mobile nativa in modo che tutte le app Lightning basate su browser possano diventare app mobili senza dover scrivere nuovo codice. Salesforce offre anche una gamma di strumenti, SDK e funzionalità per la creazione di app native completamente personalizzate ottimizzate per i dispositivi. Questi includono:
- **SDK mobile**: Interfaccia pro-code per gli sviluppatori nei sistemi operativi mobili che semplifica l'integrazione con l'autenticazione, la gestione di sessioni/token, le API Salesforce e molto altro.
- **Runtime nativo mobile**: Consente agli sviluppatori di creare esperienze native basate sui metadati visualizzate dinamicamente in fase di esecuzione utilizzando tecnologie iOS e Android che sfruttano anche le funzionalità sul dispositivo.
- **Immagine aziendale**: Consente la personalizzazione dell'estetica dell'app mobile tramite Mobile Publisher Pipeline per convertire le app mobili Salesforce in app con immagine aziendale del cliente.
- **Funzioni offline**: Garantisce una funzionalità dell'app senza interruzioni con connettività a Internet incoerente o assente.
Mobile Customization Framework (MCF) migliora in modo significativo lo sviluppo delle applicazioni mobili Salesforce native offrendo facilità d'uso e numerose opzioni di personalizzazione. I principali vantaggi includono:
- **Approccio basato sui metadati**: MCF utilizza i metadati, che possono provenire da generatori visivi, archivi comuni e risorse ospitate in Salesforce, per creare esperienze utente dinamiche e adattabili in base a esigenze specifiche.
- **Sperimentazione e ottimizzazione**: Il framework supporta la sperimentazione in fase di esecuzione con diversi layout, facilitando l'ottimizzazione del coinvolgimento in corso e il perfezionamento dell'esperienza utente.
- **Estendibilità**: Progettato per la flessibilità, MCF consente l'integrazione di componenti personalizzati nel framework dei metadati principali, migliorando funzionalità e versatilità.
- **Esperienze utente composte**: Utilizzando le più recenti tecnologie iOS e Android, MCF supporta l'assemblaggio di componenti riutilizzabili come pulsanti, elenchi e schede per creare interfacce utente sofisticate.
- **Personalizzazione in fase**: di esecuzione MCF consente la personalizzazione e la sperimentazione dell'interfaccia utente in tempo reale, favorendo un'esperienza utente più personalizzata e coinvolgente.
Gli scenari offline e di bassa connettività sono una preoccupazione crescente quando si utilizzano le app sui dispositivi mobili. Lo stack di tecnologia mobile dà priorità alla creazione di app che possono essere offline. Le caratteristiche principali includono:
- **Cache prima esperienza**: Si concentra sul caching dei dati per l'utilizzo offline, garantendo prestazioni e sicurezza elevate. L'interazione dell'utente è progettata anche tenendo presenti i principi di rendering offline.
- **Gestione della cache**: Mantiene la cache pertinente e aggiornata, anche offline.
- **Cache condivisa**: Utilizza un'unica cache per le schermate native e ibride, facilitando esperienze offline senza interruzioni.
Nimbus è la soluzione pronta per la produzione della piattaforma che semplifica il processo di accesso alle funzionalità dei dispositivi per gli sviluppatori di app ibride. Tradizionalmente, colmare il divario tra JavaScript e il codice nativo mobile era un'operazione complessa. Tuttavia, con Nimbus, gli sviluppatori possono ora sfruttare tutto il potenziale dei dispositivi mobili senza approfondire la codifica a basso livello. Le caratteristiche principali includono:
- **Accesso ampio**: Offre una perfetta integrazione con una varietà di funzioni del dispositivo come fotocamera, microfono, geolocalizzazione e LiDAR.
- **Interfaccia standardizzata**: Offre un metodo uniforme per accedere alle funzionalità del dispositivo.
- **Integrazione app ibrida**: Consente alle app ibride di utilizzare completamente le funzioni del dispositivo.
- **Sviluppo efficiente**: Semplifica il processo di sviluppo dell'app, riducendo la complessità.
Poiché l'intelligenza artificiale continua a trasformare ciò che è possibile con le app Salesforce, Salesforce offre anche un'esperienza utente differenziata sfruttando modelli di intelligenza artificiale specifici del dispositivo e le soluzioni basate su cloud:
- **Modelli di piccole lingue (SLM):** Questi possono essere eseguiti su dispositivi mobili in modo efficiente e a un costo inferiore.
- **Privacy e sicurezza:** Garantisce la privacy degli utenti e mantiene Trust e sicurezza a livelli paragonabili ai modelli basati su server.
- **Funzionalità offline:** Opera in modo efficace in ambienti a bassa connettività, abilitando i casi d'uso offline.
- **Voce:** I modelli di speech-to-text, text-to-speech naturale e diarization speaker all'avanguardia vengono ora eseguiti in modo nativo sui dispositivi, offrendo interazioni vocali ad alta fedeltà con privacy completa e latenza zero.
### 10.4 AI e collaborazione
L'interfaccia utente non basata su modello per il linguaggio naturale e le interazioni a più turni con l'app continueranno a crescere in prevalenza. Gli sviluppi futuri dovrebbero migliorare l'integrazione tra modelli, funzionalità dei dispositivi e applicazioni, migliorando le interazioni degli utenti attraverso interfacce vocali e di testo più intuitive. La raccolta delle metriche sul dispositivo consentirà anche di apportare modifiche personalizzate in base alle preferenze degli utenti.
La collaborazione è essenziale per tutti gli utenti, sia umani che agenti, per sfruttare i punti di forza combinati dell'automazione e della supervisione umana. Questa collaborazione è particolarmente importante per le interazioni aziendali complesse che coinvolgono i dipendenti di un'organizzazione e i suoi clienti. Slack funge da strumento principale all'interno di Salesforce Platform, facilitando questa interazione attraverso la messaggistica diretta e i canali multiutente personalizzati per argomenti di discussione specifici. Queste discussioni possono variare da conversazioni spontanee create dagli utenti a dialoghi più strutturati incentrati su dati specifici all'interno del flusso di lavoro di un utente, ad esempio un thread dettagliato di messaggi Slack che affronta un problema significativo del cliente.
In futuro, Salesforce Platform prevede di migliorare l'esperienza di collaborazione attualmente offerta da Slack. Questa espansione mirerà a utilizzare appieno le ampie funzionalità della piattaforma, arricchendo il modo in cui gli utenti interagiscono e collaborano all'interno dell'area di lavoro digitale.
## 11\. Developer Experience (Esperienza sviluppatore)
Le funzionalità Developer Experience della piattaforma offrono strumenti per la creazione, la personalizzazione, il test e la distribuzione di app, concentrandosi sullo spettro del low-code attraverso approcci pro-code, garantendo pari opportunità per gli sviluppatori di tutti i livelli di competenza.
- **Strumenti low-code**: Questi includono il Generatore di schemi per i modelli di dati, Flusso per le regole aziendali e AppBuilder per la personalizzazione dell'interfaccia utente, tutti progettati per semplificare il processo di sviluppo manipolando i metadati strutturati e il lavoro nel linguaggio della soluzione aziendale, anziché concetti tecnici e gergo.
- **Strumenti pro-codice**: Per gli sviluppatori che necessitano di una personalizzazione più completa e complessa, la piattaforma offre strumenti come Salesforce Code Builder, un'IDE basata su cloud, un'interfaccia della riga di comando (CLI) e API per la creazione avanzata di codice e componenti. Gli sviluppatori possono codificare nella lingua che preferiscono utilizzando soluzioni per la distribuzione, la gestione e l'ottimizzazione delle app con Heroku.
- **Ambiente di sviluppo integrato**: L'ecosistema Salesforce supporta una perfetta integrazione tra strumenti low-code e pro-code, oltre a uno sviluppo coerente in cloud e in locale con strumenti standard di settore.
- **Gestione del ciclo di vita delle applicazioni (ALM)**: Offre una gamma di organizzazioni Sandbox per lo sviluppo separata dall'ambiente di produzione, incluse le organizzazioni vuote per lo sviluppo iniziale e le organizzazioni Sandbox Completo per il test con dati e scala simili a quelli di produzione.
### 11.1 AI per gli sviluppatori
L'intelligenza artificiale e gli "Assistenti sviluppatori" stanno rivoluzionando l'esperienza degli sviluppatori semplificando e accelerando la creazione di applicazioni efficienti e di alta qualità. In Salesforce, i nostri team di Ricerca e Developer Experience sull'intelligenza artificiale ripetono ed esplorano continuamente come l'intelligenza artificiale predittiva e generativa con il ragionamento agente possa essere trasformata in potenti agenti sviluppatore. Questi agenti sviluppatori sono integrati in modo nativo con strumenti già utilizzati dagli sviluppatori, come VS Code, Code Builder, riga di comando, DevOps Center e Code Analyzer, rendendoli più pertinenti e di impatto.
Abbiamo fatto progressi significativi nell'analisi del codice per identificare gli schemi anti-schemi e gli hotspot in Apex Code e quindi fornire consigli critici per migliorarne l'implementazione. I problemi identificati di solito sprecano risorse di calcolo e spesso causano incidenti su larga scala. Questo è stato lanciato come ApexGuru Insights nel gennaio 2024.
Nel primo anno successivo al lancio, oltre 2.800 organizzazioni Salesforce hanno utilizzato ApexGuru per analizzare e migliorare l'implementazione di Salesforce. Sono stati implementati con successo più di 22.000 consigli, con un risparmio di 28.000 ore di CPU ogni settimana. Questo miglioramento non solo migliora le prestazioni, ma contribuisce anche alla sostenibilità ambientale riducendo le emissioni di CO2 di 135 kg settimanalmente, in linea con il nostro valore fondamentale di sostenibilità e impegno a ridurre le emissioni di CO2.
Stiamo anche integrando l'intelligenza artificiale negli strumenti e nelle funzionalità per sviluppatori pro-code per migliorare Developer Productivity. Prodotto come "Agentforce per sviluppatori" nel 2024, gli sviluppatori possono accedere a queste nuove funzionalità all'interno dei pacchetti di estensioni Salesforce in Visual Studio Code e Code Builder. Queste estensioni consentono di:
- Suggerimenti di codice in linea durante la scrittura da parte dello sviluppatore e generazione di codice per i componenti Web Apex e Lightning (JavaScript, CSS, HTML).
- Spiegazione del codice e generazione della documentazione per i componenti Web Apex e Lightning.
- Generazione di codice test di unità Apex.
- Esperienza di chat a più turni distinta nell'IDE che può funzionare su più risposte per la generazione di codice, la spiegazione e la documentazione.
- Ottimizzazioni dei componenti Web Lighting.
- Generazione di agenti con metadati YAML in formato leggibile, incluse le funzionalità di test e debug degli agenti.
A ottobre 2025, oltre 42.000 sviluppatori utilizzano attivamente questa tecnologia ogni mese, con 17,6 milioni di righe di codice accettate. Questa suite completa garantisce un ambiente di sviluppo flessibile, integrato ed efficiente, in grado di soddisfare un'ampia gamma di esigenze di sviluppo all'interno di Salesforce Platform. Gli strumenti per sviluppatori AI sono inoltre ottimizzati con un'architettura che funziona su più modelli esterni e creati da Salesforce per scegliere il modello più efficace ed efficiente per un determinato caso d'uso.
### 11.2 Supporto MCP e codifica assistita da AI
Il Model Context Protocol (MCP) è uno standard aperto emergente progettato per consentire agli agenti AI di interagire in modo sicuro e coerente con qualsiasi strumento o fonte di dati. Salesforce sta integrando in modo nativo il supporto MCP nel toolkit sviluppatore Salesforce per aiutare gli agenti sviluppatori che possono accedere alle funzionalità e agli strumenti in tutta l'azienda. Ciò include:
- **Server MCP locale:** Un server MCP locale consente agli sviluppatori di creare, testare ed eseguire facilmente il debug delle integrazioni agenti all'interno dell'IDE locale prima di distribuirle in produzione, migliorando notevolmente la produttività. Il server MCP locale offre strumenti specializzati per le interazioni dell'organizzazione e i flussi di lavoro di sviluppo, ad esempio sviluppo mobile, test di accessibilità, migrazione da Aura a LWC e DevOps agente. Il server MCP locale include anche l'integrazione con il ragionamento agente e i componenti LLM per consentire agli sviluppatori di "codificare le vibrazioni" dell'app in modo iterativo e con linguaggio naturale.
- **Server MCP personalizzato per le API Salesforce:** Gli sviluppatori possono ora esporre in modo sicuro le API Salesforce, gli oggetti Data 360 e i flussi di automazione come "strumenti" MCP. Ciò trasforma l'intera Salesforce Platform in un insieme di funzionalità complete, affidabili e individuabili per qualsiasi agente o applicazione di intelligenza artificiale esterna, con un controllo degli accessi granulare e il potenziale per nuovi modelli di monetizzazione basati sul consumo.
- **Connettività MCP esterna nativa:** Gli sviluppatori possono anche gestire in modo sicuro la connettività ai server esterni conformi allo standard MCP. Ciò consente agli sviluppatori di creare agenti in grado di lavorare in tutta l'azienda.
## 12\. Suite di applicazioni
I nostri cloud di applicazioni, tra cui Sales Cloud, Service Cloud, Marketing Cloud, Revenue Cloud e Commerce Cloud, sono basati su Salesforce Platform e offrono funzionalità aziendali leader e compongono la nostra Suite di applicazioni per favorire il successo dei clienti. Le caratteristiche principali includono:
- **Integrazione perfetta**: Profondamente integrato e progettato per lavorare in modo coerente in tutto il customer journey e garantire un flusso fluido di dati e processi tra i punti di contatto dei clienti, migliorando l'esperienza dei clienti.
- **Personalizzazione completa**: Basate sulla nostra piattaforma, le nostre applicazioni offrono ampie opzioni di personalizzazione da no-code a pro-code, consentendo una personalizzazione precisa in base alle esigenze dei clienti.
- **Funzioni AI avanzate**: Con i nostri Agentforce Agents è possibile offrire flussi di lavoro interattivi basati su canali assistiti e autonomi dagli agenti. Incorpora l'intelligenza artificiale predittiva e generativa per migliorare l'efficienza attraverso l'automazione, l'analisi predittiva e le esperienze utente personalizzate, offrendo approfondimenti e consigli di immediato valore pratico.
- **Elaborazione dei dati in tempo reale**: Utilizza Data 360 per l'accesso e l'analisi dei dati in tempo reale, supportando un processo decisionale tempestivo e informato basato sulle informazioni più aggiornate. Ciò migliora la reattività e l'agilità in ambienti con ritmi elevati.
- **Dati unificati e Analytics**: Integra varie fonti di dati in una piattaforma centralizzata per visualizzazioni dei dati coerenti e complete, offrendo analisi accurate e migliorando il processo decisionale.
- **Sicurezza e conformità avanzate**: Offre solidi strumenti di sicurezza e conformità per proteggere i dati sensibili e soddisfare gli standard normativi.
- **Esperienza utente di livello consumatore**: Offre interfacce intuitive e intuitive che rendono le applicazioni accessibili ed efficaci in tutti i dispositivi, canali e modalità.
- **Affidabilità**: Garantisce tempi di inattività e scalabilità minimi per supportare le operazioni mission e life-critical, inclusi i servizi di emergenza e i sistemi di trasporto critici.
- **Scalabilità elastica**: Basato su Hyperforce che supporta volumi crescenti di dati e interazioni con gli utenti senza sacrificare le prestazioni o i costi di servizio.
- **Miglioramento continuo**: Integra regolarmente le innovazioni per migliorare le funzionalità senza interrompere le operazioni esistenti.
Salesforce si impegna a far progredire le proprie applicazioni unificando le funzionalità in tutta la piattaforma, basandosi sulle tecnologie di base descritte in questo white paper. Questa trasformazione è guidata da una serie di priorità chiave che definiscono la progettazione e lo sviluppo della suite di applicazioni Salesforce.
### 12.1 Scalabilità e prestazioni
I nostri team di applicazione sono specializzati in prestazioni e scalabilità, utilizzando laboratori di prestazioni avanzate per creare repliche esatte dei nostri ambienti di produzione con dati sintetici. Questa impostazione consente una simulazione approfondita dei journey utente paralleli per garantire che ogni nuova funzione sia testata a fondo sulle prestazioni e il suo impatto valutato. Quando vengono rilevati colli di bottiglia in fase di esecuzione, i limiti di traffico e altre misure per proteggere l'integrità del sistema vengono modificati dinamicamente, raccogliendo dati per favorire la risoluzione.
I nostri sistemi sono progettati per la scalabilità orizzontale per utilizzare in modo efficace la flessibilità del cloud pubblico. I controlli automatici assicurano che gli aggiornamenti o le ottimizzazioni non influiscano negativamente sulle prestazioni. Utilizziamo scaler automatici predittivi che gestiscono in modo proattivo il carico del sistema, non solo reagendo all'aumento della domanda, ma anticipando e adattando in anticipo.
La scalabilità automatica è fondamentale per ridurre al minimo i costi di servizio riducendo la capacità inutilizzata. Monitoriamo attentamente i costi di gestione del sistema, identificando e risolvendo eventuali inefficienze nella scalabilità automatica o nell'utilizzo delle risorse. Benché l'efficienza dei costi sia importante, diamo la priorità a una consegna affidabile delle applicazioni, optando per scalatori automatici che aumentano rapidamente e diminuiscono lentamente per mantenere il Trust dei clienti, anche se i costi sono più elevati.
### 12.2 Integrazione senza interruzioni
#### Modello di dati comune
I modelli di dati sono fondamentali per tutte le operazioni aziendali di Salesforce, in quanto influenzano le funzionalità aziendali, le API, la navigazione, le visualizzazioni dell'interfaccia utente e i rapporti che possono essere creati. Sono fondamentali per la funzionalità della piattaforma.
La nostra suite di applicazioni condivide un modello di dati comune in Sales Cloud, Service Cloud, Revenue Cloud, Commerce Cloud, Marketing Cloud e Industries Cloud. Questo contribuisce alla nostra suite integrata, offrendo un comportamento e un'interoperabilità coerenti e percorsi chiari per aggiornamenti ed estensioni.
Ad esempio, la condivisione delle entità Account e Prodotto in tutti i Cloud consente agli utenti di Marketing Cloud e Sales Cloud di scambiare dati, metadati, componenti dell'interfaccia utente e logica aziendale. Questa integrazione consente di abbattere i silos e favorisce la collaborazione tra le funzioni.
#### Piattaforma dati virtuale
Un modello di dati comune a tutti i Cloud Salesforce migliora in modo significativo l'integrazione ma potrebbe non soddisfare tutte le esigenze di integrazione dei partner complesse. Il modello di dati comune di Data 360 si espande estendendo i vantaggi del modello di dati condiviso oltre i confini dei dati tipici di Salesforce, offrendo scenari di integrazione più estesi.
#### Estensibilità a livelli
Il framework dei metadati di Salesforce consente a vari gruppi, come team di progettazione, ISV, partner, amministratori e utenti finali, di personalizzare ed espandere le proprie applicazioni entro livelli distinti di estendibilità senza interferire tra loro. Questa struttura supporta un ambiente scalabile in cui le modifiche apportate da un gruppo non interrompono gli altri, mantenendo l'integrità del sistema.
Un esempio lampante del framework in azione è il prodotto Knowledge unificato, che integra tutte le fonti Knowledge in un data lake. Questa impostazione include un livello semantico e dei retriever che migliorano le funzionalità di intelligenza artificiale predittiva e generativa in Sales Cloud, Service Cloud, Revenue Cloud, Marketing Cloud e Commerce Cloud. Incorpora un modello di dati per Knowledge non strutturato e semi-strutturato collegato al modello di Knowledge strutturato esistente.
Inoltre, il framework utilizza i metadati per definire relazioni personalizzate tra i tipi di dati, facilitando la generazione avanzata di query. Ciò consente ai team di applicazione di creare applicazioni personalizzabili che sfruttano questa Knowledge Base completa, mentre ISV, partner e clienti possono migliorare ulteriormente le funzionalità delle applicazioni modificando le relazioni tra i metadati o sviluppando retriever personalizzati per casi d'uso aziendali specifici.
#### Ottimizzazione della piattaforma dati comune
I dati dei clienti sono archiviati in modo sicuro su varie piattaforme come SalesforceDB e Data 360 e sono standardizzati e normalizzati indipendentemente dal formato strutturato o non strutturato. Ciò garantisce una gestione coerente dei dati attraverso un formato unificato noto come sObject, che supporta una piattaforma dati coerente in tutti i dati dei clienti.
Questa standardizzazione consente un'unica API per tutte le operazioni sui dati, un'interfaccia unificata per i trigger in Apex e la creazione di flussi di lavoro personalizzati con Flusso. Supporta anche Tableau Next, consentendo visualizzazioni dati personalizzate e l'integrazione con strumenti di intelligenza artificiale generativi come Generatore di prompt per la generazione di risposte intelligenti basate sui dati dei clienti.
Inoltre, le applicazioni Salesforce si integrano con vari data store per migliorare la flessibilità dei processi aziendali all'interno dei prodotti. Ad esempio, in Marketing Cloud, Flusso viene utilizzato per gestire le esperienze cliente multi-touch, con opzioni per utilizzare modelli predefiniti o creare flussi personalizzati che integrano il marketing con altri processi aziendali, tutti basati sui dati dei clienti sottostanti.
### 12.3 Funzionalità aziendali condivise
Le applicazioni sfruttano e ottimizzano servizi condivisi come la risoluzione dell'identità, l'orchestrazione dei contenuti, la personalizzazione, l'analisi, il gateway LLM e i servizi di ragionamento, consentendo una rapida innovazione e consegna. Questi servizi supportano l'elaborazione dei dati in tempo reale, approfondimenti basati sull'intelligenza artificiale ed esperienze utente arricchite, offrendo una visione completa a 360 gradi dei clienti.
I vantaggi includono una maggiore efficienza attraverso l'automazione intelligente e l'analisi predittiva, la scalabilità per aumentare le interazioni tra dati e utenti e una sicurezza e una conformità avanzate. Le funzionalità di personalizzazione della piattaforma consentono alle organizzazioni di adattarsi rapidamente alle mutevoli esigenze, favorendo la crescita e l'eccellenza operativa.
L'innovazione a livello di applicazione è spinta da Salesforce Platform e dalle singole applicazioni, migliorando l'ecosistema Salesforce e affermando le applicazioni come leader del settore.
### 12.4 Multicanale e ottimizzato per i canali
Le applicazioni Salesforce sono progettate per soddisfare gli utenti su una varietà di piattaforme, tra cui Web, dispositivi mobili, email, SMS, WhatsApp e altri canali. Ottimizzano le funzionalità native di ogni canale per migliorare l'esperienza e l'efficienza degli utenti.
Le funzionalità includono funzionalità offline su più mesi per gli utenti di Salesforce Field Service, notifiche push del browser e layout a schermo panoramico per gli agenti dell'assistenza in Lightning Service Console e storefront e copiloti ad alte prestazioni per i clienti di Commerce.
La piattaforma dei metadati garantisce che Salesforce, i suoi partner e clienti possano usufruire immediatamente di queste funzionalità.
### 12.5 Rapida attuazione dell'innovazione
I servizi Foundation, la piattaforma e le funzionalità aziendali condivise di Salesforce consentono alle applicazioni di adattarsi rapidamente ai cambiamenti del mercato e alle tendenze tecnologiche, consentendo una rapida implementazione dell'innovazione. Ad esempio, con l'avvento dell'intelligenza artificiale generativa, Salesforce ha rapidamente utilizzato servizi di intelligenza artificiale esistenti come il Trust Layer NLP e il rilevamento degli intenti per incorporare modelli di prompt in Universal Communications Platform. Questa integrazione migliora le funzionalità di messaggistica e telefono tra i prodotti, facilitando connessioni client più personali.
Seguendo la tendenza verso l'intelligenza artificiale autonoma, Salesforce ha lanciato Agentforce, una soluzione che sfrutta questi investimenti esistenti per automatizzare i casi d'uso aziendali con gli agenti in modo efficiente, senza la necessità di creare da zero.
### 12.6 Percorso verso Application Suite
Abbiamo ricreato Marketing Cloud, Revenue Cloud e Commerce Cloud in Salesforce Platform, consentendo a questi Cloud di condividere la stessa infrastruttura, piattaforma, metadati, dati, intelligenza artificiale, componenti dell'interfaccia utente e logica aziendale, sfruttando al contempo tutta la potenza di Salesforce Platform. Ad esempio, abbiamo preso le funzioni da Revenue Cloud e le funzionalità principali incorporate, come il configuratore basato sui vincoli, i motori di calcolo dei prezzi e la gestione del catalogo, rendendoli servizi di base disponibili in tutta la suite. Questo ci consente anche di avere una perfetta integrazione in tutti i nostri cloud e le funzionalità offerte da Commerce Cloud e Marketing Cloud diventano parte delle funzionalità aziendali condivise che possono essere sfruttate dalle altre applicazioni. Questa è la visione della suite di applicazioni integrata fornita.
Il journey di Salesforce Platform ha portato allo sviluppo di una suite di applicazioni integrata che combina Sales Cloud, Service Cloud, Marketing Cloud, Revenue Cloud e Commerce Cloud in una soluzione unificata. Disponibile a partire dalla versione Salesforce Starter Edition, questa suite offre un unico pacchetto di supporto multicanale, gestione delle relazioni con i clienti e approfondimenti aziendali. Indipendentemente dalla versione scelta, gli utenti possono accedere alle funzionalità principali di Sales Cloud, Service Cloud, Marketing Cloud e Commerce Cloud, garantendo un'esperienza coerente a tutti i livelli.
## 13\. Soluzioni specifiche del settore
I prodotti Salesforce Industries per Financial Services, Health, Life Sciences, Media, Energy and Utilities, Manufacturing, Auto, Consumer Goods, Retail, Net Zero, Public Sector, Education e Nonprofit estendono i prodotti e la piattaforma applicativi per offrire soluzioni personalizzate che affrontano le sfide specifiche dei settori. Semplificano le operazioni e migliorano la produttività incorporando flussi di lavoro, misure di conformità e modelli di dati specifici del settore.
Il portafoglio Settori è stato ricreato in Salesforce Platform per consentire la componibilità tra i verticali. I clienti possono ora assemblare una o più funzionalità del settore in soluzioni personalizzate, sfruttando i metadati, le API e i servizi aziendali condivisi. Questo approccio bilancia la differenziazione verticale con la coerenza della piattaforma, garantendo adattabilità e scalabilità in diversi contesti normativi e aziendali.
### 13.1 Approccio all'architettura a livelli
I nostri prodotti utilizzano un'architettura a livelli. Alla base c'è Salesforce Platform e applicazioni orizzontali come Sales Cloud e Service Cloud, che fungono da base per tutte le soluzioni del settore. A questo scopo, Salesforce dispone di servizi comuni a valore aggiunto che ottimizzano i componenti riutilizzabili incorporati nella maggior parte dei settori. Esempi di questi sono le funzionalità per l'automazione digitale, le sequenze temporali, i piani di azione e altro ancora. Al di sopra di questo livello, è presente un livello di logica aziendale riutilizzabile che incapsula funzionalità orizzontali come la gestione dei commenti, CPQ (configurazione, prezzo, preventivo) e la gestione dei servizi.
Il livello superiore presenta personalizzazioni specifiche del dominio personalizzate per soddisfare requisiti specifici del settore, sfruttando la piattaforma sottostante per una maggiore scalabilità ed efficienza. Ad esempio, nella produzione verticale, questa impostazione ottimizza la pianificazione della produzione attraverso previsioni accurate. Nel settore delle scienze della vita, offre ai team di vendita del settore farmaceutico soluzioni mobili offline che gestiscono in modo efficiente i flussi di lavoro e la gestione dei campioni nel rispetto di vari requisiti normativi geografici.
### 13.2 Funzionalità specifiche del settore
**Eccellenza: AI affidabile** Le nostre affidabili soluzioni di intelligenza artificiale generativa offrono funzionalità di intelligenza artificiale specifiche del settore. Questi includono gli agenti e l'ingegneria rapida, che facilitano l'automazione e la digitalizzazione a basso codice/senza codice in settori come l'assistenza sanitaria, le scienze della vita e i servizi finanziari. Inoltre, funzioni come il mining di documenti/testi e la riepilogazioni si rivolgono ai settori che gestiscono volumi elevati di dati, facilitando l'estrazione di informazioni e la raccolta di approfondimenti.
Gli agenti personalizzati ottimizzano la comunicazione a tre vie tra agenti e clienti, consentendo risoluzioni più rapide. Il livello Trust di Salesforce Platform facilita il rispetto di tutti gli standard di conformità e normativi in tutti i settori.
**Dati, approfondimenti e intelligence con conformità e sicurezza normative**: Salesforce Industries offre una visione completa a 360° con rigorose misure di privacy, condivisione e sicurezza dei dati personalizzate in base a normative di settore specifiche come GDPR, HIPAA e FedRamp. Salesforce integra i dati di varie fonti, abilitando la conformità e la sicurezza, e ottimizza queste soluzioni con funzioni aggiuntive come Shield Encryption BYOK (Bring Your Own Keys) per la crittografia dei dati tenant.
**Esperienza utente elevata**: Salesforce Industries enfatizza un'esperienza utente senza interruzioni personalizzata in base alle esigenze specifiche del settore per migliorare il percorso dell'utente. Sono inclusi strumenti come il Centro risorse fruibile, i modelli Experience Cloud e le soluzioni basate su OmniStudio.
**Digitalizzazione, integrazione e orientamento**: Salesforce Industries offre digitalizzazione, integrazione e orientamento tramite soluzioni da low-code a no-code, sfruttando strumenti come Flussi e Omnistudio per i nuovi clienti e offrendo soluzioni di migrazione per i sistemi CRM esistenti. L'integrazione con sistemi e dati esterni viene semplificata tramite i connettori offerti da MuleSoft. Salesforce include anche processi di assistenza specifici del settore, ad esempio la gestione delle controversie per Retail Banking.
**Mobile e offline**: Salesforce Industries offre un supporto efficace specifico del dominio per l'app mobile Salesforce e l'app mobile Field Service. Per i domini altamente specializzati che richiedono un supporto offline avanzato, Industries offre app mobili personalizzate basate su SDK mobili Salesforce.
**Funzioni aziendali comuni**: Salesforce Industries si basa su capacità aziendali comuni, consentendo coerenza e produttività e adattando le soluzioni alle esigenze specifiche del settore, ad esempio diversi sistemi di prenotazione degli appuntamenti per banche e ospedali. Integrato con il più ampio ecosistema Salesforce, Salesforce offre una visione Customer 360 completa, che lo rende una parte essenziale della suite di prodotti Salesforce.
## 14\. Analytics
Per anni, il mercato delle piattaforme di Analytics e Business Intelligence (BI) ha promosso approfondimenti visivi self-service e automatizzati basati sull'intelligenza artificiale per gli utenti finali per aiutarli a prendere decisioni più rapide e basate sui dati. Tuttavia, sappiamo che non tutti hanno visto questo risultato a causa di diverse sfide:
- **Approfondimenti disconnessi**: Gli approfondimenti non sono integrati nei flussi di lavoro degli utenti, il che rende difficile intervenire sugli approfondimenti, nonostante il loro potenziale di influenzare il processo decisionale.
- **Sovraccarico di dati e silos**: I dati continuano a crescere rapidamente e rimangono compartimentati, causando rischi per la disorganizzazione e la sicurezza. Le organizzazioni si trovano di fronte a un dilemma tra un ambiente dati self-service caotico e un ambiente dati restrittivo e ben gestito.
- **Sfiducia nei dati**: L'espansione e la frammentazione dei dati ha eroso il Trust degli utenti negli approfondimenti derivati dai dati aziendali.
- **Mancanza di componibilità**: Esiste una significativa assenza di componibilità e riutilizzo nei processi di lavoro, costringendo gli utenti a ripetere le operazioni e senza strade chiare per la monetizzazione.
Tableau Next è progettato per ampliare il ciclo di analisi visiva riunendo utenti aziendali e professionisti dei dati in modi nuovi e collaborativi, tutti ottimizzati con l'intelligenza artificiale. Fornisce metriche e approfondimenti tempestivi e affidabili tramite Salesforce Platform, facilitando l'accesso onnipresente agli approfondimenti fruibili.
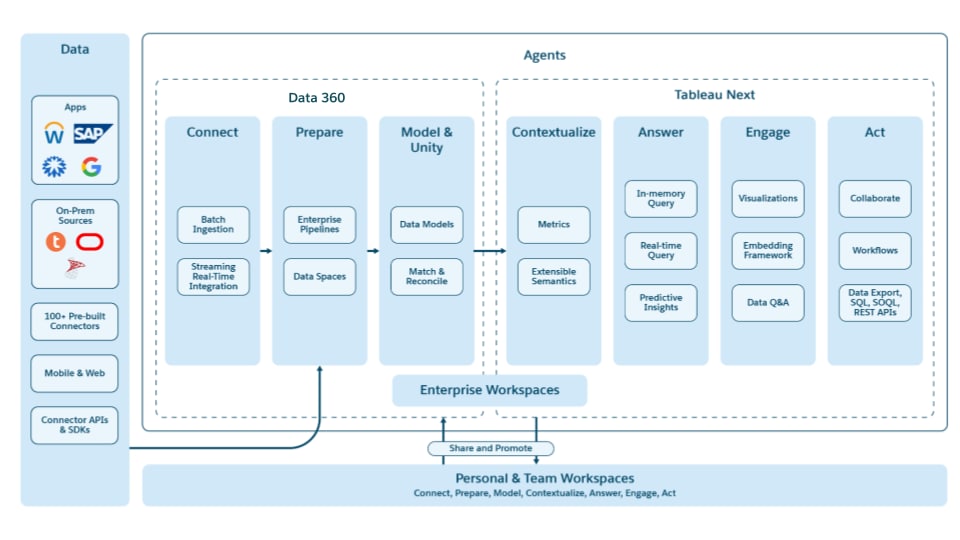 Tableau Next affronta queste sfide:
- Creazione di una piattaforma aperta, componibile e API-first per le esperienze connesse, dalla connessione dati all'azione. Fornisce strumenti per lo sviluppo, componenti componibili per applicazioni analitiche complete e funzionalità per la gestione della loro creazione e distribuzione.
- Creare utilizzando l'intelligenza artificiale al centro dell'attenzione e fornendo approfondimenti contestuali e pertinenti, con strumenti che i professionisti dei dati possono esaminare e convalidare in modo efficiente per garantire Trust.
- Basandosi su Tableau Semantics come livello semantico universale per un'analisi dei dati rapida, self-service e gestita all'interno di un ecosistema controllato ma flessibile.
- Offre funzionalità di dati su scala cloud in tempo reale tramite Data 360 per un accesso ai dati affidabile, scalabile e governato.
- Offrire agli sviluppatori un ambiente e un marketplace completi per creare e monetizzare le applicazioni.
- Integrare l'intelligence al suo centro, apportando la potenza della semantica e della Knowledge dell'organizzazione agli agenti che vi forniscono le competenze necessarie.
- Assegnare priorità al Trust, in modo da avere fiducia nei carichi di lavoro di dati, analytics e agenti e nella distribuzione, attraverso il controllo diretto e la visibilità delle loro attività ed efficacia.
- Sfruttare la collaborazione come principio di progettazione di prim'ordine, con integrazioni approfondite e complete con Slack e qualsiasi altro strumento collaborativo per l'organizzazione.
### 14.1 Esperienze Analytics al top della categoria
Tableau Next si basa sulla leadership di Tableau negli strumenti di analisi dei dati offrendo una piattaforma aperta che ottimizza le funzionalità e integra le esperienze. Le caratteristiche principali includono:
- **Visualizzazione dati completi**: Utilizza la tecnologia VizQL di Tableau per un'analisi visiva espansiva.
- **Aree di lavoro collaborative e gestite**: Offre un'interfaccia unificata per le operazioni di analisi, si integra con Slack per la collaborazione in tempo reale.
- **Dati affidabili e gestiti**: Supporta l'analisi self-service con percorsi di promozione strutturati per la gestione globale in un ambiente sicuro.
- **Creazione avanzata delle metriche**: Consente agli analisti di creare e riutilizzare i KPI in modo efficiente in tutta l'organizzazione, facilitando la coerenza e l'affidabilità.
### 14.2 Agentic Analytics
Tableau Next è fondamentalmente costruito con Agentforce come struttura architettonica di base, migliorando la capacità di Tableau Next di fornire strumenti di dati altamente connessi, affidabili e collaborativi basati sull'intelligenza artificiale.
- **Strumenti BI**: Migliora l'efficienza nell'analisi self-service per i lavoratori dei dati, concentrandosi sulla preparazione dei dati e la gestione dei metadati visivi e semantici.
- **Esperienze contestuali**: Porta approfondimenti sui dati, esperienze e intelligenza artificiale trasparente nel contesto in cui lavora la maggior parte delle organizzazioni (ad esempio Slack).
- **Architettura Agentforce**: Basato sullo stack Agentforce, offre a Tableau Next un contesto completo su un'architettura agente avanzata.
- **Catalogo semantico**: Offre un sistema centralizzato per la gestione dei metadati, della discendenza e della ricerca, abilitando le esperienze condivise tra gli utenti Tableau Next.
- **Metadati condivisi e generati**: Facilita flussi di lavoro senza interruzioni tra l'analisi self-service e i contenuti gestiti all'interno di un ecosistema completo.
- **Quadro di azione**: Approfondisce l'azione tramite flussi di lavoro preconfezionati, gestiti dall'uomo o generati.
- **Approfondimenti personalizzati**. Acquisisce le preferenze relative ai dati, il ruolo dell'utente e molto altro (nella misura consentita dall'utente) per offrire immediatamente approfondimenti sui dati altamente contestualizzati e personalizzati.
- **Approfondimenti proattivi**. Esplora in modo intelligente l'ecosistema di dati, alla ricerca di punti di interesse statistico per l'utente, comprendendo in modo proattivo i fattori che determinano il cambiamento, cosa fare e consigliando le azioni da intraprendere come fasi successive.
- **Agenti dati affidabili**. Restituisce all'utente, in qualità di motore degli agenti dati, la possibilità di creare e perfezionare l'applicazione attraverso esperienze integrate. Fornisce inoltre strumenti di test per valutare preventivamente le modifiche ai dati e il loro impatto sulla precisione e l'efficacia degli agenti.
### 14.3 Esperienze utente aziendali basate su soluzioni integrate
Tableau Next migliora le esperienze degli utenti aziendali su varie piattaforme come Slack e Salesforce e tramite nuove funzioni di analisi come Tableau Pulse, tutte accessibili tramite esperienze degli agenti per semplificare il coinvolgimento degli utenti nelle analisi. Gli aspetti chiave includono:
- **Collaborazione**: Centrale nell'analisi affidabile, facilita l'interazione tra diversi componenti analitici e integra strumenti di convalida nel flusso di lavoro degli utenti.
- **Metriche impulso**: Offre approfondimenti sia curati che automatizzati in modo più efficiente rispetto ai cruscotti digitali tradizionali creati dagli analisti.
- **Esperienze basate sull'intelligenza artificiale**: Utilizza l'intelligenza artificiale per ridurre la necessità di competenze tecniche nell'analisi avanzata, contribuendo a garantire l'affidabilità con metadati deterministici e dati governati.
- **Consegna approfondimenti multigiocatore**: Consentendo agli utenti aziendali di collaborare con gli analisti per acquisire Knowledge e Trust negli approfondimenti offerti dal sistema.
- **Integrazione profonda**: Basato su una piattaforma di metadati e dati condivisa, che offre la componibilità tra sistemi ed esperienze diversi per consentire la componibilità per la promozione, il flusso di dati e per profili diversi che si aiutano reciprocamente a rivedere e completare il lavoro.
### 14.4 Semantica di Tableau
Il livello semantico Tableau funge da ponte cruciale tra i dati non elaborati e l'interpretazione degli utenti, semplificando l'analisi dei dati, il processo decisionale e lo sviluppo delle applicazioni e migliorando il contesto e il recupero basati sull'intelligenza artificiale. Le caratteristiche principali includono:
- **Gestione integrata dei metadati**: Supporta sia i metadati self-service che quelli gestiti, facilitando l'analisi ad hoc con percorsi strutturati per diventare l'unica fonte di dati dell'organizzazione.
- **Le migliori funzionalità di Tableau**: Incluso il supporto di oggetti multilogici, la componibilità del modello, le dimensioni condivise, la gerarchia geospaziale complessa e la modellazione temporale.
- **Dati e Analytics diversi**: Aiuta a collegare dati non strutturati e strutturati, ad esempio correlando categorie di prodotti basate su immagini a dati di vendita strutturati e incorporando analisi del sentiment da recensioni di prodotti semi-strutturate.
- **Integrazione Salesforce Platform**: Stabilisce una fonte unificata di dati, facilitando una semantica aziendale coerente e un'integrazione senza interruzioni tra le applicazioni e un modello di metadati coerente che supporta varie esperienze utente e casi d'uso.
- **Intelligenza agente**: Il livello semantico è una delle aree chiave in cui gli agenti acquisiscono intelligenza comprendendo non solo i dati e i metadati alla base dell'azienda, ma anche la semantica che la definisce, incluse descrizioni e preferenze più approfondite personalizzate per l'organizzazione.
### 14.5 Flussi di lavoro integrati e approfondimenti fruibili
Tableau Next offre soluzioni integrate che ottimizzano il processo decisionale basato sui dati e l'automazione affidabile, con azioni semplici, flussi predefiniti, pianificazione e integrazioni API. I componenti chiave includono:
- **Azioni aziendali standardizzate e intelligenti**: Facilita le comunicazioni urgenti e specifiche del contesto all'interno delle aziende, che sono essenziali ma complesse.
- **Pianificazioni dei flussi predefinite e generate**: Abilita sia azioni ad hoc che pianificate tramite flussi statici e generati dinamicamente affidabili ma verificabili.
- **Agentforce**: Supporta le conversazioni e le interazioni basate sull'intelligenza artificiale, consentendo agli utenti di interagire con approfondimenti ed eseguire azioni simili a quelle di un'interfaccia utente tradizionale, sia all'interno che all'esterno delle loro applicazioni aziendali, e semplificate tramite la conversazione.
### 14.6 Piattaforma per sviluppatori componibile
Tableau Next offre una piattaforma per sviluppatori componibile con opzioni no-code, low-code e pro-code per lo sviluppo di applicazioni, tutte basate su Tableau Semantics in Data 360. Le principali offerte includono:
- **Settore preconfezionato/applicazioni intelligenti**: Fornisce applicazioni analitiche basate su modelli e personalizzabili personalizzate in base alle esigenze specifiche del settore.
- **Applicazioni di terze parti e ISV**: Supporta la creazione di applicazioni dinamiche e interattive per scopi analitici, specifici del settore e personalizzati.
- **Mercato e scambio**: Consente a ISV e sviluppatori di inserire in pacchetti e distribuire le loro applicazioni nell'ecosistema di sviluppo di applicazioni aziendali più ampio e affidabile.
### 14.7 Profonda collaborazione
Tableau Next è progettato sia per gli utenti aziendali che per i professionisti dei dati, promuovendo un approccio collaborativo alla comprensione dei dati. Sia tecnici che non tecnici, tutti i membri del team, dagli utenti aziendali agli esperti di dati, possono esaminare gli approfondimenti sui dati degli altri. Inoltre, questi approfondimenti non sono limitati a una scheda del browser all'interno di una piattaforma di BI.
In qualità di piattaforma di BI, Tableau Next è:
- **Componibile tra piattaforme**. Gli approfondimenti vengono visualizzati nello stesso modo, indipendentemente dalla piattaforma in cui vengono visualizzati. Questa coerenza è un principio di progettazione dei pilastri quando si utilizzano visivamente i dati.
- **Profondamente integrato con Slack**. Lo sviluppo dell'integrazione con Slack ha garantito una delle esperienze di dati collaborative più intuitive e coinvolgenti sul mercato oggi.
- **Aperto per qualsiasi strumento**. L'applicazione del nostro principio API-first, sulla nostra piattaforma profondamente unificata, garantisce che l'integrazione possa estendersi ad altri strumenti di collaborazione e di terze parti, conservando la ricchezza in tutto.
## 15\. Integrazione
Mentre Salesforce Platform offre una suite completa di funzionalità di integrazione per affrontare un'ampia gamma di sfide digitali, molti clienti operano all'interno di architetture aziendali che si sono sviluppate nel tempo attraverso l'uso di vari fornitori e tecnologie.
Le aziende moderne affrontano sfide legate all'integrazione dei sistemi e all'automazione dei processi aziendali, spesso causando silos di dati e inefficienze. Salesforce Integration Platform, sfruttando la potenza di MuleSoft, affronta questi problemi facilitando il rapido sviluppo e il miglioramento dei processi automatizzati. Garantisce una connettività di sistema senza interruzioni, migliora il flusso di informazioni e supporta il processo decisionale su diverse piattaforme, riducendo così i costi di manodopera e le spese di automazione. Questo livello è fondamentale per creare, gestire, governare e monitorare le integrazioni tra i servizi Salesforce e altri servizi personalizzati o di terze parti.
I sistemi sono definiti tramite API, che servono a:
- Accedere ai dati da sistemi essenziali come ERP, sistemi di fatturazione e clienti e database proprietari.
- Facilitare l'interazione e l'integrazione dei dati, contribuendo a eliminare i silos di dati.
- Aggiungere contesto aziendale ai dati e ai processi gestiti dalle API di sistema e di processo.
Per una comunicazione efficace, le API sono descritte utilizzando:
- Specifica OpenAPI (OAS) per scambi sincroni immediati
- API asincrona per le comunicazioni asincrone basate sugli eventi
- MCP (Model Context Protocol) per interazioni strutturate modello-contesto
- Protocollo A2A (Agent-to-Agent) per le integrazioni dirette tra agenti.
Salesforce Integration Layer offre funzionalità avanzate per integrare e gestire qualsiasi sistema, migliorando la connettività con le funzionalità dati, AI e app di Salesforce, indipendentemente dal fatto che i sistemi siano nativi di Salesforce o di altri provider.
Le integrazioni complesse richiedono trasformazioni avanzate e strumenti efficaci, tra cui connettività universale, gestione e governance API, un ambiente di sviluppo integrato (IDE) per la creazione di carichi di lavoro di integrazione, una piattaforma di runtime per distribuire, gestire e supervisionare queste integrazioni e una piattaforma osservabile per fornire visibilità end-to-end su queste integrazioni.
Per velocizzare ulteriormente il processo di integrazione, sono disponibili acceleratori e modelli specifici del settore che codificano gli schemi e le esigenze di integrazione comuni.
### 15.1 Schemi di integrazione con Salesforce
Due schemi di integrazione principali gestiscono il flusso di dati e processi tra Salesforce e l'ecosistema più ampio: integrazione in uscita e integrazione in entrata.
**Connessione di Salesforce a sistemi esterni (in uscita):** Questo schema prevede processi provenienti da Salesforce che accedono ai dati o attivano azioni in sistemi esterni.
- **Gestione endpoint sicura (credenziali denominate):** Le credenziali denominate offrono una posizione sicura e centralizzata per memorizzare i dettagli dell'endpoint e dell'autenticazione. Le applicazioni e le automazioni fanno riferimento a un nome logico, mentre la piattaforma gestisce le complessità del ciclo di vita dell'autenticazione.
- **Integrazione dichiarativa (servizi esterni):** Per i sistemi esterni che offrono una specifica OpenAPI standard, un amministratore può utilizzare Servizi esterni per registrare l'API in modo dichiarativo. La piattaforma elabora quindi la specifica, rendendo automaticamente disponibili le operazioni del servizio come azioni native in strumenti come Flusso o come oggetti nativi in Apex.
- **Integrazione di sistemi complessi (MuleSoft)**: Per i sistemi che non dispongono di interfacce moderne, MuleSoft crea un livello API standard riutilizzabile. Ciò elimina la complessità legacy e porta i dati e i processi locali nell'ecosistema Salesforce.
- **Accesso ai dati in tempo reale (oggetti esterni):** Rappresenta le tabelle di sistemi esterni come oggetti virtuali all'interno del modello di dati Salesforce, rendendo accessibili i dati esterni tramite query standard e componenti dell'interfaccia utente senza replica.
- **Gestione centralizzata delle capacità (Catalogo API unificato):** Il Catalogo API unificato è un repository centralizzato e l'unica fonte di dati veritieri per tutte le specifiche API e i metadati associati, ad esempio la posizione e i protocolli di sicurezza. Garantisce che, indipendentemente dalla posizione in cui si trova un dato o una logica aziendale, il dato possa essere scoperto, connesso in modo sicuro e inserito in nuove applicazioni e automazioni potenti in tutto l'ecosistema Salesforce.
- **Logica pro-codice personalizzata (Apex REST):** Gli sviluppatori possono esporre la logica aziendale personalizzata scritta in Apex come API e azione REST. L'azione sarà quindi disponibile come fase di un flusso o come strumento per un agente AI.
**Connessione di sistemi esterni a Salesforce (in entrata):** Questo schema consente a sistemi e applicazioni esterni di connettersi a Salesforce Platform per accedere ai dati, attivare la logica aziendale e orchestrare i processi. Questa funzionalità si basa su API collaudate di livello aziendale che operano su larga scala. A partire da ottobre 2025:
- L'API Query (SOQL) gestisce oltre 50 miliardi di richieste al giorno.
- L'API REST serve quasi 5 miliardi di chiamate al giorno da sistemi esterni, con un utilizzo in crescita del 30% anno su anno.
- L'API in blocco elabora quotidianamente centinaia di miliardi di record per operazioni sui dati su larga scala.
Questa comprovata affidabilità e scalabilità sono alla base delle seguenti funzionalità:
- **Un'esperienza API unificata:** L'accesso a tutte le funzionalità di Salesforce viene unificato tramite una struttura endpoint coerente (api.salesforce.com), eliminando la necessità per gli sviluppatori di apprendere schemi o flussi di autenticazione diversi per ogni prodotto.
- **Portafoglio API completo e appositamente creato:** La piattaforma offre una vasta gamma di API personalizzate in base a esigenze specifiche, tra cui API REST e SOAP per le operazioni transazionali, API in blocco per l'elaborazione di dati a volume elevato, API Pub/Sub per le applicazioni basate sugli eventi e API Apex di prodotti specializzati o personalizzate.
- **Prontezza al futuro per l'integrazione degli agenti:** Attraverso standard come l'MPC, i clienti possono esporre in modo sicuro i propri dati e le proprie azioni Salesforce come "strumenti" per gli agenti di intelligenza artificiale esterni, trasformando un'istanza di Salesforce in un insieme estensibile di competenze per una forza lavoro digitale.
### 15.2 Integrazione degli agenti con MCP
Oltre agli schemi in entrata e in uscita stabiliti per l'integrazione di dati e processi, sta emergendo un nuovo schema per l'era degli agenti. Salesforce Platform sta implementando una strategia MCP completa, posizionandosi sia come consumatore che come fornitore di servizi basati sull'intelligenza artificiale. Questo approccio bidirezionale consente l'interoperabilità degli agenti, consentendo alle aziende di integrare perfettamente i dati e le funzionalità di Salesforce con l'ecosistema in evoluzione degli agenti e degli strumenti di intelligenza artificiale, pur mantenendo una sicurezza e una governance di livello aziendale.
**Salesforce come client MCP:** Gli agenti possono agire come client MCP sfruttando in modo intelligente e dinamico i sistemi esterni e le API. Questa funzionalità consente alle organizzazioni di estendere la portata di Agentforce oltre i confini di Salesforce, orchestrando le azioni in qualsiasi sistema, sia che disponga di un'API moderna o richieda la connessione tramite MuleSoft a sistemi legacy o bot RPA. La configurazione viene gestita attraverso una familiare esperienza di impostazione dichiarativa basata sugli argomenti, che consente una rapida integrazione senza sviluppo personalizzato. Un meccanismo di individuazione semplificato per i server MCP forniti dai partner semplifica ulteriormente l'integrazione delle funzionalità esterne. Astraendo le complessità della connettività esterna tramite uno stack su larga scala, le aziende possono integrare rapidamente Agentforce con il panorama tecnologico più ampio.
**Salesforce come server MCP:** In qualità di server MCP, la piattaforma espone la propria logica e i propri asset, tra cui API REST standard, endpoint personalizzati, Azioni invocabili e Flussi, come "strumenti" individuabili per gli agenti esterni. Tramite un'interfaccia dichiarativa, clienti e ISV possono creare e configurare i propri server MCP personalizzati, curando le funzionalità in raccolte di strumenti su misura per processi aziendali specifici. Questo si estende ai prompt MCP, creando sinergie naturali con le funzionalità del modello di prompt della piattaforma e consentendo alle organizzazioni di rendere accessibile il proprio investimento in progettazione rapida a qualsiasi sistema AI esterno.
Questa funzionalità è governata da un modello di sicurezza a più livelli:
- **Controllo applicazione:** Il costrutto External Client App (App client esterna) offre agli amministratori un controllo completo sulle applicazioni degli agenti esterni che possono accedere alla loro organizzazione Salesforce.
- **Autorizzazioni limitate:** L'autenticazione viene aumentata con ambiti OAuth granulari, che consentono un tracciamento preciso e l'imposizione delle azioni che un agente autenticato è autorizzato a eseguire.
- **Autorizzazione Core Platform:** Questi nuovi controlli si basano sul solido modello di autorizzazione di Salesforce, che include controlli di accesso ai record, autorizzazioni a livello di entità e di campo e altre autorizzazioni definite in Profili e insiemi di autorizzazioni.
Gli ISV e i partner possono anche inserire in pacchetti e distribuire configurazioni di server MCP, consentendo la distribuzione rapida di integrazioni pronte per l'intelligenza artificiale in tutto l'ecosistema Salesforce.
### 15.3 Connettività universale
L'approccio moderno di Salesforce alla connettività universale è la _connettività interpretata_, un approccio incentrato sui metadati per lo sviluppo di connettori che possono essere eseguiti in qualsiasi piattaforma (MuleSoft, Flow o Data 360) per qualsiasi caso d'uso senza programmazione. I modelli di metadati comprendono come connettersi ai servizi remoti per autenticare una richiesta, modellare i dati restituiti, creare query, visualizzare i risultati e ricevere eventi (trigger) per automatizzare un processo.
Per i sistemi che non utilizzano API basate su HTTP, Salesforce offre centinaia di connettori predefiniti e un SDK completo per la creazione di connettori personalizzati. Per i sistemi senza accesso API, Salesforce offre l'automazione robotica dei processi (RPA) che utilizza gli agenti per automatizzare le operazioni ripetitive basate su regole che vengono in genere eseguite dagli esseri umani. Queste operazioni possono includere l'immissione dei dati, l'elaborazione delle transazioni e la risposta a semplici query dell'assistenza clienti. Per estrarre informazioni dai documenti, Salesforce offre il nostro IDP (Intelligent Document Processing) che sfrutta l'intelligenza artificiale per estrarre, classificare ed elaborare automaticamente i dati da vari tipi di documenti, ad esempio fatture, contratti e moduli. Indipendentemente dall'esistenza delle informazioni, Salesforce offre un modo automatico per recuperarle e manipolarle.
Con i recenti progressi nell'intelligenza artificiale, Salesforce fornisce componenti base per abilitare rapidamente le funzionalità degli agenti nell'organizzazione:
- Il **connettore Model Context Protocol (MCP)** consente alle organizzazioni di esporre rapidamente le API come strumenti MCP e di semplificare l'individuazione di API e risorse per il consumo da parte degli agenti.
- Il **connettore Agent to** Agent (A2A) consente alle organizzazioni di standardizzare la comunicazione da agente ad agente fornendo il supporto del protocollo A2A per gli agenti. Ogni agente (un esperto funzionale del dominio) può individuare e delegare la query di un cliente all'agente più adatto al dominio.
- **Il connettore Inference** fornisce componenti base per creare un agente da zero fornendo chiamate LLM, incorporamento e ricerca vettoriale, recupero RAG e supporto per gli strumenti MCP.
### 15.4 Gestione API
La gestione API di MuleSoft, fornita tramite Anypoint API Manager, offre una piattaforma completa per progettare, proteggere, governare, monitorare e scalare API e microservizi in qualsiasi ambiente di distribuzione. Le organizzazioni possono gestire le API e i microservizi con controlli e approfondimenti coerenti di livello aziendale da un'unica schermata, indipendentemente dalla piattaforma, con una gestione centralizzata dalla distribuzione al controllo delle versioni. Le funzionalità principali includono:
- **Anypoint Flex Gateway** è un gateway API a livello di applicazione per gestire e proteggere le API, applicando policy per la limitazione dei tassi, il caching, l'autenticazione, l'autorizzazione, la protezione dalle minacce, il monitoraggio e la registrazione a livello HTTP/S. È un gateway leggero, ad alte prestazioni, basato su Envoy progettato per gli ambienti distribuiti basati su microservizi ed è progettato per integrarsi perfettamente con i flussi di lavoro DevOps e CI/CD, offrendo sicurezza e gestibilità aziendali in qualsiasi ambiente e supportando sia le policy in entrata che in uscita.
- Gli **avvisi API** consentono alle organizzazioni di definire e monitorare soglie o condizioni specifiche per le API per rilevare comportamenti insoliti o indesiderati. Gli esempi includono avvisi quando il tempo di risposta supera un limite (ad esempio, 60 secondi), quando il numero di richieste in un periodo di tempo è troppo alto, quando vengono restituiti alcuni codici di risposta HTTP o quando si verificano violazioni delle policy.
- **API Analytics** offre visibilità sull'utilizzo delle API e sulle loro prestazioni. Il cruscotto digitale Analytics consente alle organizzazioni di tenere traccia e visualizzare le metriche generali, visualizzare i dettagli dei grafici, creare e personalizzare cruscotti digitali e rapporti per comprendere le tendenze di utilizzo, le violazioni delle policy, i tempi di risposta, i codici di richiesta/risposta e altro ancora.
### 15.5 Ambiente di sviluppo integrazione di nuova generazione
MuleSoft Anypoint Code Builder (ACB) è la nostra IDE di nuova generazione progettata per lo sviluppo di API e integrazione, con un'esperienza moderna e unificata con VS Code come backend.
- **Ambiente di sviluppo unificato:** Consolida l'intero processo di sviluppo dell'API e dell'integrazione in un unico strumento, supportando API AsyncAPI, OAS e RAML, set di regole di governance, un'area di disegno Flusso a basso codice, connettori predefiniti e opzioni di test e distribuzione integrate. Inoltre, ACB supporta il debug, la risoluzione dei problemi e la manutenzione continua con suggerimenti intelligenti e contestuali.
- **Esperienza di sviluppo agente:** Offre esperienze agenti in tutto il ciclo di vita dello sviluppo delle applicazioni. Il nucleo è MuleSoft MCP Server, che consente lo sviluppo dell'integrazione agente. MuleSoft MCP Server offre potenti strumenti per la generazione di specifiche API e integrazioni dal linguaggio naturale, la creazione di trasformazioni dati, la gestione degli asset in MuleSoft Exchange e l'amministrazione di applicazioni e policy API. Gli strumenti del server MCP MuleSoft potenziano le specifiche API e lo sviluppo dell'integrazione degli utenti in qualsiasi editor di codice AI basato su VS Code, inclusi Cursore, Windsurf e molti altri.
- **Integrazioni AI:** MuleSoft ottimizza lo sviluppo dell'integrazione con le funzionalità degli agenti utilizzando MuleSoft Topic Center, che converte le chiamate API in azioni Agentforce per l'accesso al sistema aziendale. Il connettore Agentforce incorpora l'automazione del linguaggio naturale nelle integrazioni. Il connettore di inferenza integra in modo sicuro i provider LLM esterni, abilitando la logica basata sull'intelligenza artificiale nelle applicazioni MuleSoft. Le organizzazioni possono utilizzare queste funzionalità combinate per creare integrazioni intelligenti e adattive.
### 15.6 Runtime Platform
Runtime Platform di MuleSoft offre opzioni di distribuzione flessibili per l'esecuzione di applicazioni MuleSoft, API e integrazioni in tutti gli ambienti. Le organizzazioni possono scegliere il modello di runtime più adatto alle loro esigenze operative, di conformità e di scalabilità, mantenendo una gestione e una governance coerenti tramite Anypoint Platform. Questa flessibilità garantisce che le applicazioni possano essere eseguite vicino alle fonti di dati, conformi ai regolamenti regionali e scalabili in modo semplice in base alla domanda.
 Le opzioni di hosting principali includono:
- **Cloud:** L'integrazione multi-tenant Platform-as-a-Service (iPaaS) completamente gestita di MuleSoft che elimina il sovraccarico di gestione dell'infrastruttura. CloudHub 2.0 offre scalabilità elastica, alta disponibilità e aggiornamenti senza tempi di inattività, con esigenze di osservabilità incorporate e certificazioni di conformità. Gli sviluppatori possono concentrarsi sulla creazione di API e integrazioni mentre MuleSoft gestisce l'infrastruttura di runtime, garantendo sicurezza, affidabilità ed elevata disponibilità di livello aziendale.
- **Ibrido:** Per le organizzazioni che necessitano di ospitare autonomamente le proprie applicazioni per un maggiore controllo, MuleSoft offre Runtime Fabric, un servizio contenitore che automatizza la distribuzione e l'orchestrazione dei runtime MuleSoft in Kubernetes o nelle macchine virtuali. Supporta la scalabilità orizzontale, le distribuzioni senza tempo di inattività, i controlli di sicurezza integrati e la gestione semplificata dei cluster.
- **Private Cloud Edition (PCE):** La versione Private Cloud Edition di MuleSoft fornisce una versione completamente autogestita e locale di Anypoint Platform (inclusi Control e Runtime Planes), consentendo alle organizzazioni di soddisfare rigidi requisiti normativi, di residenza dei dati e di sicurezza. Consente alle grandi aziende di mantenere il controllo completo sull'infrastruttura pur beneficiando dell'integrazione unificata e delle funzionalità di gestione API di Anypoint Platform.
### 15.7 Osservabilità
MuleSoft offre soluzioni complete di osservabilità che offrono visibilità end-to-end su API, integrazioni e applicazioni in qualsiasi modello di distribuzione. Le funzionalità di osservabilità sono coerenti indipendentemente da dove vengono eseguiti i carichi di lavoro, offrendo una visualizzazione unificata degli ambienti. Acquisendo dati di telemetria sia in tempo reale che storici, MuleSoft consente alle organizzazioni di rilevare, analizzare e risolvere più rapidamente i problemi di produzione in tutta la rete di applicazioni. I dati di osservabilità possono essere visualizzati in modo nativo in Anypoint Platform o esportati tramite OpenTelemetry nell'APM preferito dal cliente, consentendo una perfetta integrazione con gli ecosistemi di monitoraggio esistenti. Ciò consente alle organizzazioni di rafforzare in modo proattivo la resilienza dell'infrastruttura e migliorare l'affidabilità delle applicazioni mission-critical.
MuleSoft offre osservabilità attraverso due offerte principali:
- **Anypoint Monitoring** è l'attuale soluzione di osservabilità interna al mercato integrata in Anypoint Platform. Offre cruscotti digitali pronti all'uso e personalizzabili per monitorare lo stato delle applicazioni, la ricerca avanzata dei registri per la gestione dei registri e funzionalità di avviso che informano i team quando si verificano soglie definite o anomalie.
- **Integration Intelligence** è la piattaforma di osservabilità di nuova generazione, basata sull'intelligenza artificiale, per MuleSoft reimmaginata e creata in modo nativo in Salesforce Platform. Questa offerta utilizza Data 360 come livello di dati unificato per i dati di telemetria; Tableau Semantics come livello semantico affidabile per consentire approfondimenti intelligenti e di immediato valore pratico; Tableau Concierge per la risoluzione dei problemi assistita dall'intelligenza artificiale e Tableau Next Dashboards per offrire interfacce visive interattive che riuniscono più visualizzazioni di dati completi in un'unica visualizzazione coerente. Tableau Next offre inoltre ai clienti la possibilità di creare cruscotti digitali personalizzati basati sul modello di dati semantico fornito con funzioni di osservabilità.
Questo stack consente anche il tracciamento incentrato sull'agente che offre ai clienti una trasparenza completa nel percorso di invocazione agente end-to-end non deterministico, consentendo loro di osservare l'agente che lavora a ogni fase intermedia, consentendo agli utenti di arrivare più rapidamente alla causa principale degli errori e di identificare eventuali colli di bottiglia nelle prestazioni.
## 16\. Ecosistema e AppExchange
L'ecosistema Salesforce esemplifica la potenza della piattaforma. I System Integrator (SI) e i partner consulenti supportano i clienti sviluppando, configurando e ottimizzando le complesse soluzioni Salesforce. I fornitori di software indipendenti (ISV) creano applicazioni e soluzioni innovative sulla piattaforma, che i clienti possono poi installare nelle loro organizzazioni Salesforce. Queste app ISV sono disponibili su AppExchange, lo store di applicazioni di Salesforce lanciato nel 2006, che ora dispone di oltre 10.000 applicazioni con più di 14,3 milioni di installazioni a partire da ottobre 2025.
Per aiutare i clienti a navigare nel vasto mercato e scoprire le applicazioni pertinenti, l'esperienza di ricerca AppExchange è stata riprogettata nel 2025 per sfruttare Data 360. Le funzionalità di ricerca vettoriale di Salesforce Data 360 funzionano in combinazione con la corrispondenza tradizionale delle parole chiave per offrire risultati più rilevanti dal punto di vista semantico comprendendo l'intento di un utente attraverso il linguaggio naturale. La visione finale è quella di evolvere questa base integrandola con la piattaforma Agentforce, abilitando un'interfaccia completamente agente "chiedi qualsiasi cosa" in cui i clienti possono descrivere conversazionalmente le loro sfide aziendali per ricevere consigli sulle soluzioni altamente personalizzati.
AppExchange garantisce soluzioni di alta qualità attraverso un rigoroso processo di revisione che coinvolge analizzatori di codice, scanner di sicurezza e guide all'implementazione di riferimento, il tutto in stretta collaborazione con Salesforce. Questa piattaforma fornisce inoltre agli ISV strumenti di gestione delle licenze per personalizzare le licenze e la monetizzazione delle applicazioni, supportando vari modelli di prezzo, tra cui opzioni basate sugli utenti e sul consumo.
I principi della "piattaforma basata sui metadati" consentono agli ISV di estendere le app e i metadati nativi di Salesforce, facilitando lo sviluppo di modelli di dati, logica aziendale e interfacce utente. Salesforce Platform supporta un'ampia gamma di soluzioni, dalle applicazioni specifiche del settore alle app con immagine aziendale altamente personalizzate che utilizzano tecnologie come Lightning Web Components per l'interfaccia utente e Apex Code per la logica aziendale.
Il concetto di "packaging" è fondamentale per la distribuzione di queste app nelle varie organizzazioni Salesforce. La creazione di pacchetti prevede la serializzazione dei metadati in un artefatto che può essere installato da qualsiasi cliente Salesforce, utilizzando tecnologie sottostanti progettate per la gestione dei metadati in vari ambienti. Un aspetto unico del pacchetto è che consente installazioni in ambienti sconosciuti allo sviluppatore.
Per migliorare il controllo e la sicurezza, le funzioni di "gestibilità" all'interno dei pacchetti consentono agli ISV di aggiornare in modo sicuro le parti di un'applicazione perché altre non possono dipendere da queste parti, consentendo al contempo ai clienti di possedere e gestire altre parti. Ad esempio, gli ISV possono impostare alcuni metadati, ad esempio le impostazioni personalizzate, su "gestito", rendendoli invisibili e non modificabili dal cliente, evitando così interruzioni nell'ambiente del cliente. I pacchetti gestiti includono questi controlli di gestibilità, mentre i pacchetti non gestiti considerano i metadati distribuiti come creati dal cliente, che non possono essere aggiornati dopo la distribuzione.
Dall'inizio di AppExchange e Salesforce Platform, si è verificato un notevole aumento sia del numero che della complessità dei pacchetti creati e installati. In risposta a queste esigenze, la piattaforma ha introdotto l'architettura di packaging di seconda generazione nel 2020. Questa nuova architettura migliora la modularità dei pacchetti gestiti, migliora la flessibilità di controllo delle versioni, consente la condivisione degli spazi dei nomi e supporta le dipendenze dichiarative, tra gli altri progressi nel ciclo di vita dello sviluppo software. L'architettura di distribuzione del pacchetto presentava anche diversi miglioramenti significativi per una maggiore efficienza e scalabilità, ad esempio la determinazione dei metadati modificati e la distribuzione solo dei delta.
Una misura fondamentale per lo sviluppo di nuovi prodotti e funzionalità è la loro compatibilità con il packaging e la preparazione all'uso ISV. La piattaforma sottolinea la rapida disponibilità delle sue funzionalità per i partner, consentendo all'ecosistema Salesforce di sfruttare il potenziale innovativo di Salesforce Platform in modo efficace e oltre l'offerta pronta all'uso di Salesforce. Questa, tuttavia, è un'area di investimento in corso per garantire che tutte le funzionalità descritte in questo documento disponibili per gli sviluppatori interni Salesforce siano disponibili anche per gli sviluppatori ISV.
Inoltre, Heroku Marketplace e Slack Marketplace offrono una vasta gamma di integrazioni e componenti aggiuntivi di terze parti che possono migliorare le funzionalità delle applicazioni Salesforce. Heroku Marketplace offre strumenti e servizi per funzionalità aggiuntive delle app, oltre a migliorare il modo in cui gli sviluppatori creano, distribuiscono e gestiscono le applicazioni. Slack Marketplace offre integrazioni in grado di semplificare i flussi di lavoro e migliorare la collaborazione all'interno degli ambienti Salesforce.
## 17\. Salesforce su Salesforce
Nello spirito del nostro valore fondamentale, il Customer Success, Salesforce agisce come "Customer Zero" per tutte le applicazioni e i servizi di Salesforce Platform, sfruttando i prodotti indirizzati ai clienti internamente ove possibile. Ciò offre vantaggi significativi:
- **Test di prodotto rigorosi**: Utilizzando quotidianamente la suite di prodotti, i dipendenti Salesforce espongono la piattaforma a sfide reali, migliorando la qualità dei prodotti e identificando le aree di miglioramento.
- **Prodotti raffinati**: Il feedback immediato da parte dell'uso interno consente un rapido perfezionamento delle funzioni e della fruibilità, nonché una rapida identificazione e risoluzione di eventuali bug, creando prodotti che soddisfano meglio le esigenze dei clienti al momento del rilascio.
- **Profonda esperienza nel settore**: L'uso interno in varie funzioni offre a Salesforce informazioni preziose su specifiche sfide di prodotto e settore, in particolare nei settori high-tech.
- **Migliore empatia dei clienti**: L'esperienza in prima persona con la piattaforma consente ai dipendenti di comprendere e gestire meglio i punti deboli dei clienti.
- **Approfondimenti di marketing e vendite**: L'utilizzo quotidiano dei prodotti informa le strategie di vendita e marketing, contribuendo ad adattare la piattaforma alle esigenze dei clienti.
- **Strategia Go-to-Market più forte**: Una corretta implementazione interna consente a Salesforce di commercializzare la suite come soluzione collaudata.
Inoltre, tutti gli aggiornamenti software destinati all'ambiente di produzione vengono inizialmente distribuiti a un'istanza Hyperforce "Salesforce on Salesforce" dedicata nell'ambito di un processo di distribuzione scaglionato. Da agosto 2020, questa istanza ospita con successo GUS, l'organizzazione Salesforce per i team di progettazione, e le attività CRM di Salesforce, dimostrando la solidità e la preparazione di Hyperforce per qualsiasi cliente. Questa strategia consente ai team interni di testare ed evidenziare eventuali problemi ben prima delle distribuzioni di produzione ai clienti esterni.
L'organizzazione Salesforce Technology ha pienamente adottato Agentforce come piattaforma interna per una maggiore produttività e qualità in tutto l'SDLC. Questo ci ha permesso non solo di migliorare la qualità del codice che spediamo ai nostri clienti rilevando e mitigando tempestivamente i bug, ma ci ha anche permesso di ripetere rapidamente le esperienze degli agenti in base a feedback interni di prima mano.
## 18\. Trasformazione su larga scala
Dalla sua fondazione nel 1999, Salesforce ha vissuto molteplici trasformazioni tecnologiche. Tuttavia, la trasformazione che ha coinvolto Salesforce Platform è stata particolarmente significativa a causa della sua portata e del ritmo rapido con cui sono state implementate le modifiche. Questa trasformazione ha richiesto un'evoluzione simultanea di tutti i principali componenti architettonici per ottenere una piattaforma integrata. Per garantire che questa trasformazione fosse iterativa e dirompente per gli stakeholder e i pionieri, l'organizzazione Salesforce Technology ha dovuto anche evolvere le proprie procedure di ingegneria e consegna dei prodotti.
L'organizzazione Salesforce Technology è un team ampio e diversificato, che comprende oltre 2500 team dislocati in più di 20 sedi in 14 paesi diversi. Questo gruppo opera su larga scala, fornendo oltre 200 rilasci di prodotti e implementando 250.000 modifiche di sistema ogni settimana. In linea con l’ethos aziendale più ampio, il gruppo Technology è guidato da cinque valori fondamentali: Trust, Customer Success, Innovazione, Uguaglianza e Sostenibilità. Questi valori sono fondamentali per definire la strategia del gruppo, guidarne l'esecuzione e influenzare le decisioni quotidiane.
Aderendo ai nostri valori fondamentali, il framework Salesforce Engineering 360 offre ai team di progettazione cruscotti digitali orientati all'azione e approfondimenti completi sulle loro operazioni, definendo chiare aspettative per gli standard e le procedure consigliate all'interno dell'organizzazione. Questa visione olistica comprende varie aree critiche, tra cui disponibilità, sicurezza, conformità, qualità, accessibilità, Developer Productivity, sviluppo agile dei prodotti ed efficienza dei costi. Per fornire questi approfondimenti, il framework elabora miliardi di record da centinaia di sistemi di ingegneria interna, ad esempio sistemi di sicurezza, registri sanitari di produzione, repository di codice, ambienti di sviluppo, CI/CD e sistemi di pianificazione e tracciamento dei rilasci/del lavoro, tutti basati su Salesforce Platform utilizzando le ultime innovazioni di Agentforce, Data 360, Tableau e Slack.
Radicata in questi e altri dati, l'organizzazione Salesforce Technology sfrutta l'intelligenza artificiale e le tecnologie agentiche per accelerare la produttività. Abbiamo oltre 10.000 utenti attivi ogni giorno di strumenti di intelligenza artificiale interni e abbiamo creato oltre 100 agenti di intelligenza artificiale che fanno parte del nostro programma AgentExchange interno, promuovendo miglioramenti della produttività in tutta l'organizzazione.
Grazie al nostro valore principale di Trust, la proprietà dei servizi è profondamente radicata nella nostra cultura ingegneristica. Ogni servizio e prodotto è progettato non solo per soddisfare ma anche per superare gli obiettivi del livello di servizio (SLO) relativi alla disponibilità e alle metriche di gestione degli incidenti come Time To Detect (TTD) e Time To Restore (TTR). Il nostro approccio alla gestione del cambiamento, alla preparazione al rilascio e alla gestione dei problemi rispetta standard elevati. La sicurezza è integrata in ogni fase del nostro ciclo di vita di sviluppo sicuro, aderendo al principio secure-by-default. Qualità e prestazioni sono considerate prioritarie attraverso la Metodologia di test agile, che include milioni di test automatici, tra test di unità, funzionali, di integrazione e di carico/scala all'interno delle nostre pipeline CI/CD.
Architettonicamente, ci concentriamo sullo sviluppo di funzionalità condivise per migliorare la leva e l'efficienza, migliorando così la qualità. Ad esempio, abbiamo sviluppato servizi gestiti all'interno di Hyperforce per soddisfare esigenze diverse come l'elaborazione e la gestione dei dati, consentendo ai team di prodotto di concentrarsi sull'innovazione dei prodotti, mentre i team centrali ottimizzano questi servizi in termini di sicurezza, disponibilità ed economicità.
Le nostre attività sono agili e promuovono la consegna di innovazione ai clienti. Ciascuno degli oltre 3000 team ha l'autonomia necessaria per implementare il framework agile, utilizzando Scrum o Kanban. La pianificazione dello sviluppo dei prodotti in tutta l'organizzazione è strutturata con varie tempistiche, tra cui un piano a lungo termine triennale per la direzione strategica, seguito da piani di esecuzione annuali e ulteriormente suddiviso in piani di rilascio dei prodotti di 4 mesi, che informano i piani sprint bisettimanali. I prodotti, le funzioni e le correzioni dei bug vengono distribuiti attraverso più veicoli di rilascio per soddisfare le diverse esigenze dei clienti, inclusi tre rilasci annuali principali, rilasci bisettimanali e rilasci giornalieri.
La produttività è di fondamentale importanza data la nostra scala. Utilizziamo il framework SPACE per misurare la produttività in modo efficace, supportato da una serie completa di metriche fornite dal sistema Engineering 360. Ci concentriamo anche sul miglioramento degli strumenti e delle esperienze per gli sviluppatori interni per semplificare il ciclo di vita dello sviluppo, con investimenti in esperienze degli agenti e intelligenza artificiale, flusso di lavoro, strumenti di creazione, impostazioni di sviluppo, rilasci più sicuri e servizi di sicurezza che offrono vantaggi significativi.
## 19\. Conclusione
In conclusione, Salesforce Platform ha subito una notevole trasformazione negli ultimi cinque anni, evolvendosi dalla piattaforma cloud multitenant pionieristica a una piattaforma affidabile, integrata, agente e basata sui dati che supporta una suite di applicazioni e servizi nella regione di loro scelta. Questa evoluzione è stata guidata dalla necessità di affrontare sfide emergenti come l'ascesa dei provider di cloud pubblici, le crescenti richieste normative e i progressi nell'intelligenza artificiale generativa e nel machine learning.
L'introduzione di Hyperforce, Data 360 e Agentforce ha migliorato in modo significativo le funzionalità della piattaforma, garantendo che rimanga all'avanguardia nell'innovazione pur mantenendo Trust e affidabilità. Il successo della migrazione della maggior parte dei nostri clienti a questa nuova piattaforma sottolinea l'ingegno e la dedizione dei nostri ingegneri.
Mentre continuiamo a innovare e ad adattarci alle mutevoli richieste del mercato, Salesforce Platform è ben posizionata per supportare la prossima generazione di applicazioni e casi d'uso dei clienti, riaffermando il nostro impegno per il successo dei clienti e l'eccellenza tecnologica.
## Abstract
Il paradigma del software sta passando dalla manipolazione diretta alla delega orientata agli obiettivi. In prima linea in questa trasformazione ci sono gli agenti dell'intelligenza artificiale, entità autonome e intelligenti in grado di comprendere, ragionare e agire per conto degli utenti. Questo whitepaper offre un'esplorazione tecnica dei principali tipi di agenti AI: Conversazionale, proattivo, ambientale, autonomo e collaborativo. Definisce ogni tipo, presenta casi d'uso specifici di Customer Relationship Management (CRM) e fornisce un modello architetturale per la creazione di questi agenti sulla Salesforce _Agent_ Platform, completo di esempi tecnici che sfruttano la comunicazione Flow, Apex, Data 360, Agent2Agent (A2A) e l'interoperabilità del protocollo contesto del modello (MCP).
## Capitolo 1: Tassonomia degli agenti AI
Un agente AI è un sistema che percepisce il proprio ambiente e intraprende azioni per raggiungere obiettivi specifici. Anche se il concetto non è nuovo, l'avvento dei potenti Large Language Models (LLM) ha potenziato le loro capacità. È possibile classificare gli agenti in base alla modalità operativa principale e all'interazione.
### 1.1 Agenti conversazionali
**Definizione:** Gli agenti conversazionali sono il tipo di agente più familiare. Operano in modo reattivo, richiesta-risposta, principalmente attraverso interfacce di linguaggio naturale (testo o voce). La loro funzione principale è comprendere l'intento dell'utente e fornire una risposta pertinente, sia che si tratti di rispondere a una domanda, recuperare informazioni o eseguire un semplice comando.
**Importanza:** Gli agenti conversazionali sono le porte digitali di accesso a un'organizzazione. Eccellono nel gestire operazioni ben definite e ripetitive, liberando così risorse umane. La loro efficacia si misura dalla loro capacità di risolvere gli intenti degli utenti in modo rapido e preciso e di intraprendere azioni per conto degli utenti.
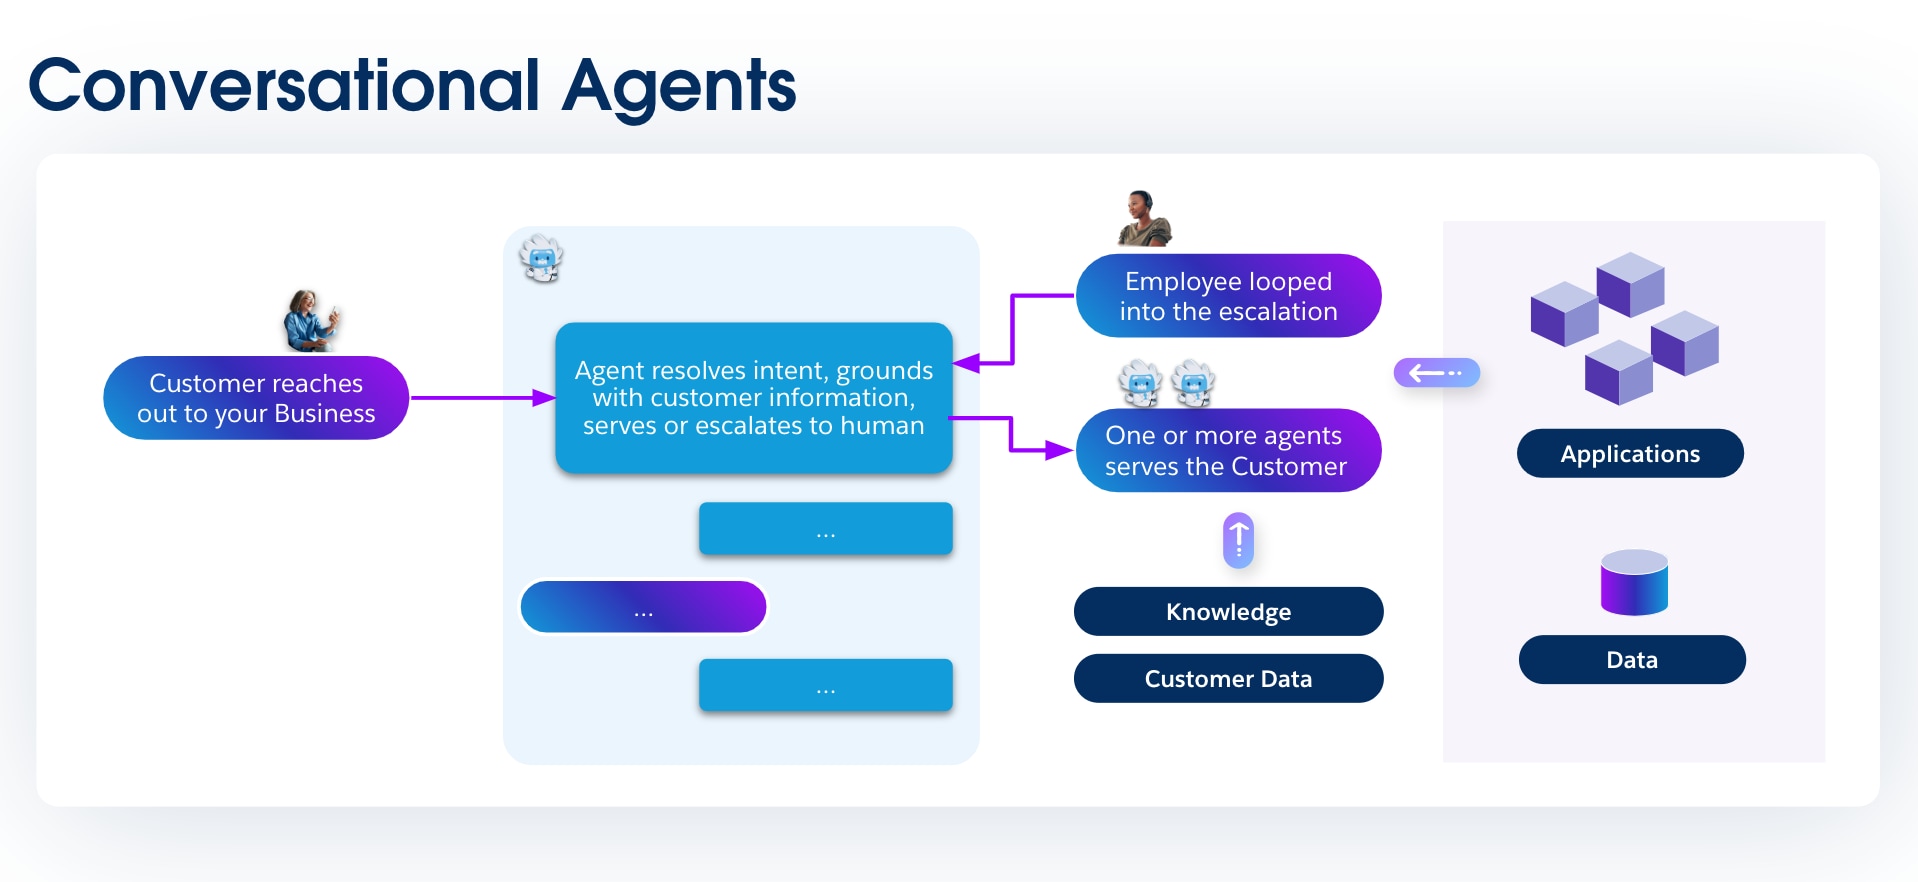 ### 1.2 Agenti proattivi
**Definizione:** A differenza degli agenti conversazionali che attendono un prompt, gli agenti proattivi agiscono come osservatori vigili. Vengono attivati da eventi specifici, modifiche dei dati o condizioni predefinite all'interno di un sistema. Quando vengono attivati, eseguono un'operazione o avviano un flusso di lavoro senza richiedere l'interazione diretta dell'utente.
**Importanza:** Gli agenti proattivi trasformano un sistema da archivio passivo di dati a partecipante attivo ai processi aziendali. Identificano opportunità e rischi man mano che emergono, consentendo alle aziende di agire sui segnali critici in tempo reale.
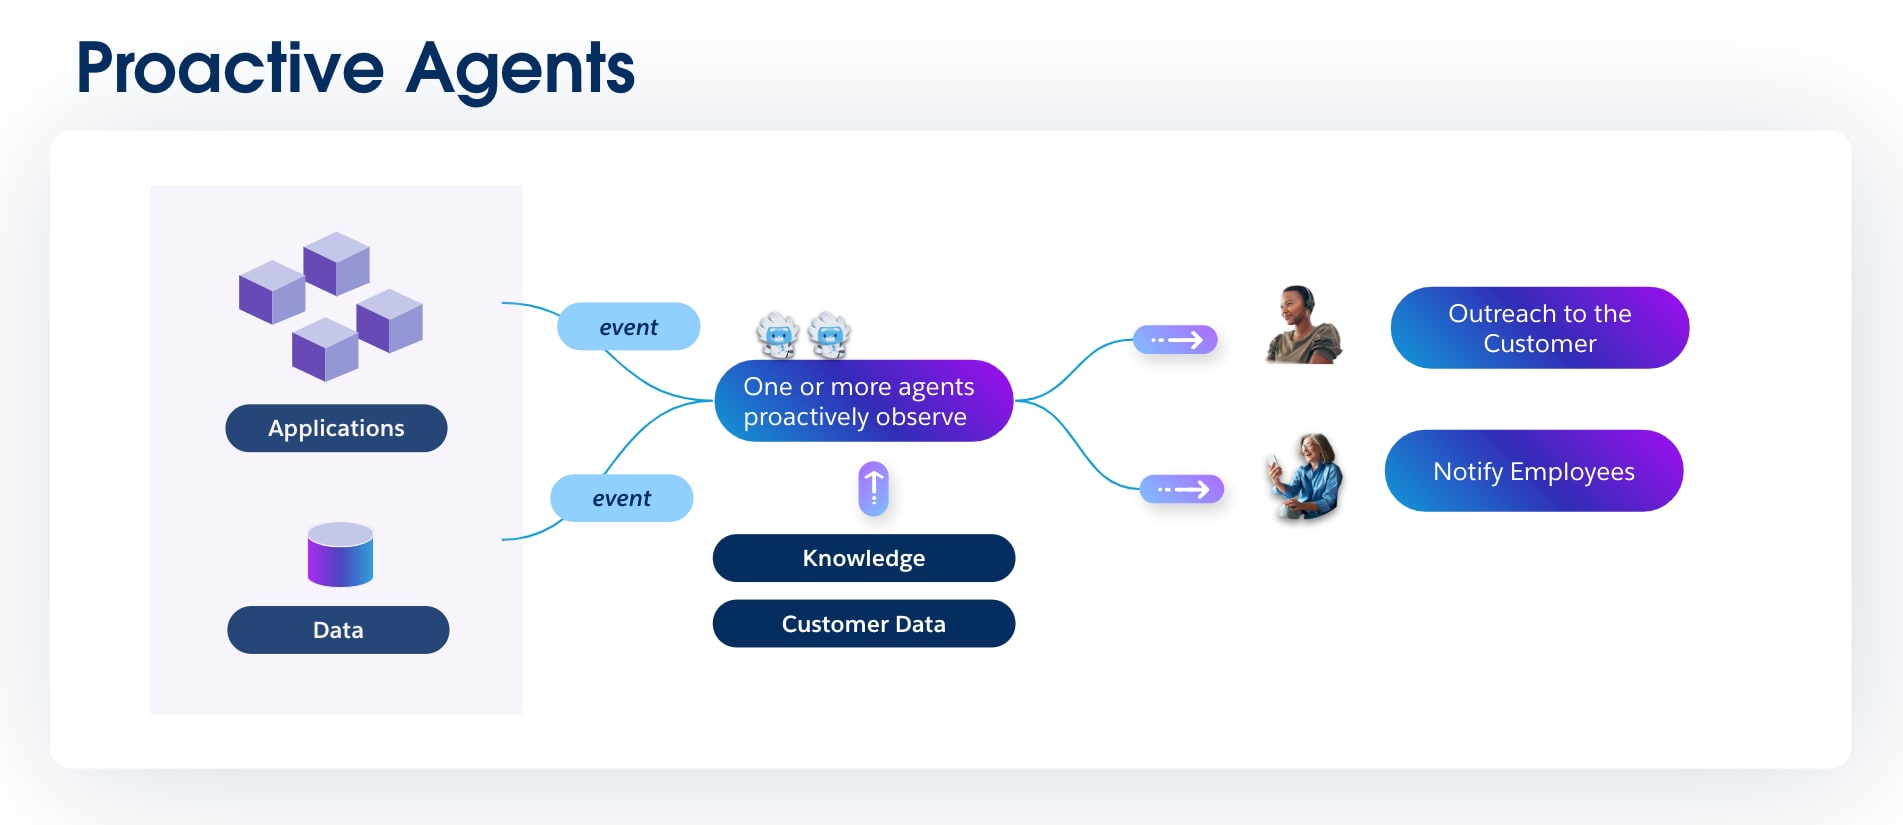 ### 1.3 Agenti ambientali
**Definizione:** Gli agenti ambientali sono un tipo specifico di agenti proattivi che operano continuamente in background nel flusso di lavoro di un utente senza richiedere comandi espliciti. Gli utenti spesso traggono vantaggio dalle loro azioni senza essere consapevoli del loro funzionamento, perché sono progettati per aumentare le capacità umane mantenendo un basso profilo.
**Importanza:** L'obiettivo di un agente ambientale è ridurre il carico cognitivo sugli utenti automatizzando il banale "lavoro sul lavoro". Rendono i processi più efficienti integrandosi perfettamente negli strumenti che i dipendenti utilizzano quotidianamente, acquisendo e strutturando automaticamente le informazioni.
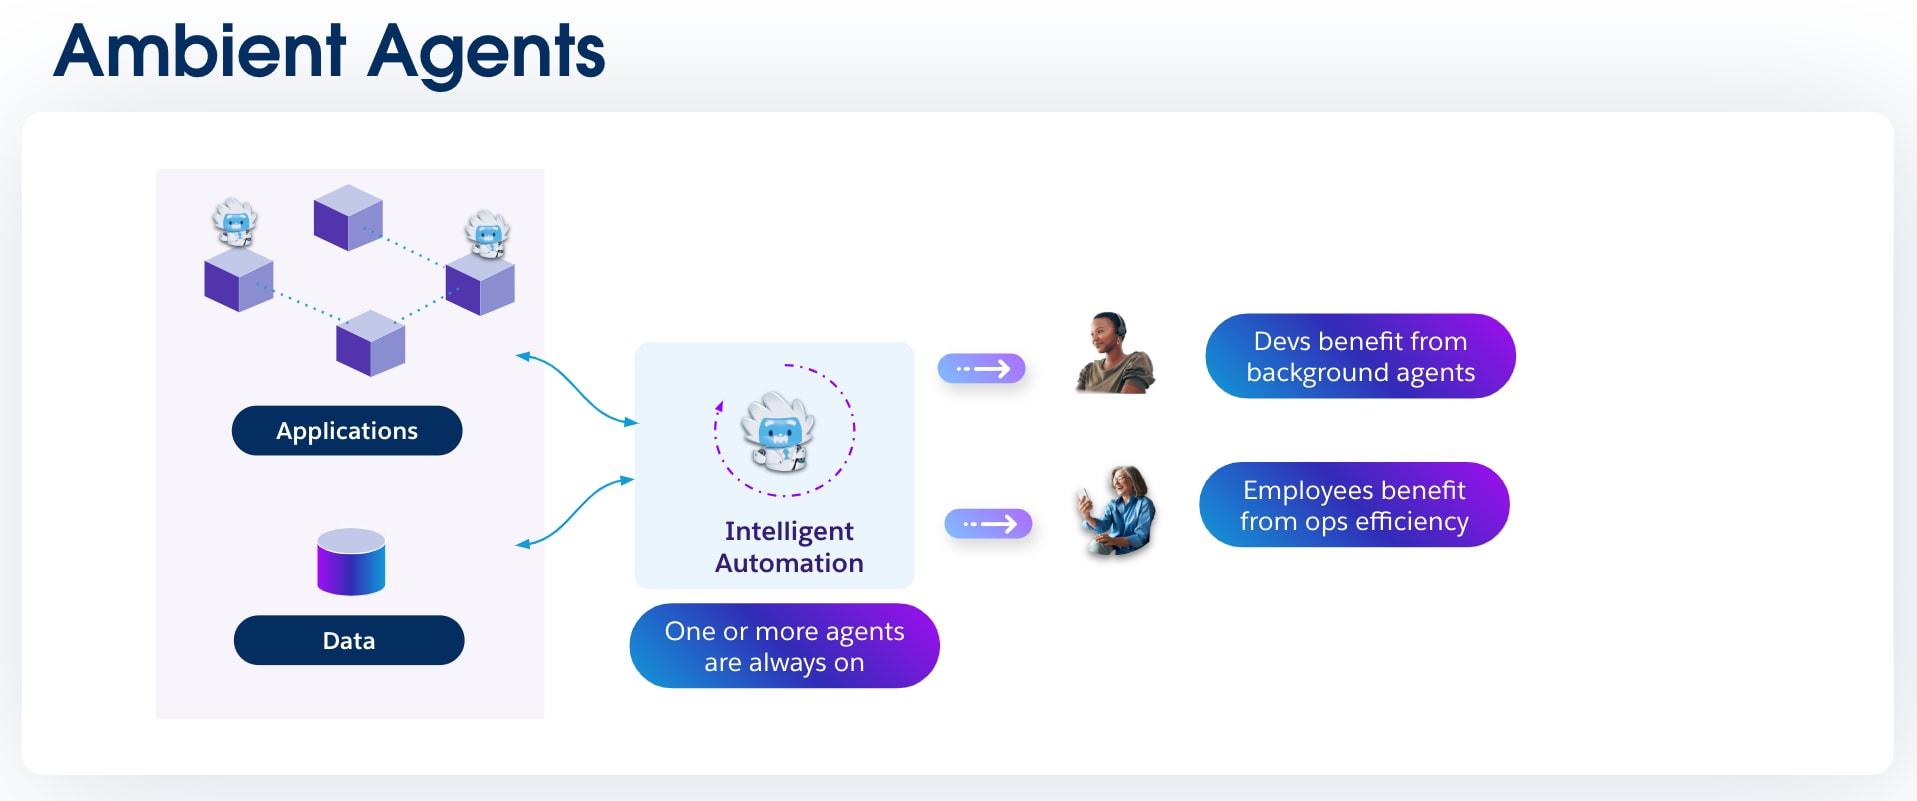 ### 1.4 Agenti autonomi
**Definizione:** Gli agenti autonomi rappresentano un salto significativo nella complessità. Viene loro assegnato un obiettivo di alto livello e sono in grado di pianificare ed eseguire in modo indipendente una sequenza di fasi per raggiungere tale obiettivo. Possono ragionare, prendere decisioni e persino imparare dalle loro azioni per migliorare le prestazioni nel tempo.
**Importanza:** Questo è il modo in cui ci avviciniamo di più a un vero dipendente digitale. Agli agenti autonomi può essere delegato un obiettivo complesso in più fasi, ad esempio "Generare 50 nuovi lead qualificati nel settore manifatturiero questo trimestre", e può essere affidato il compito di formulare ed eseguire un piano per raggiungerlo.
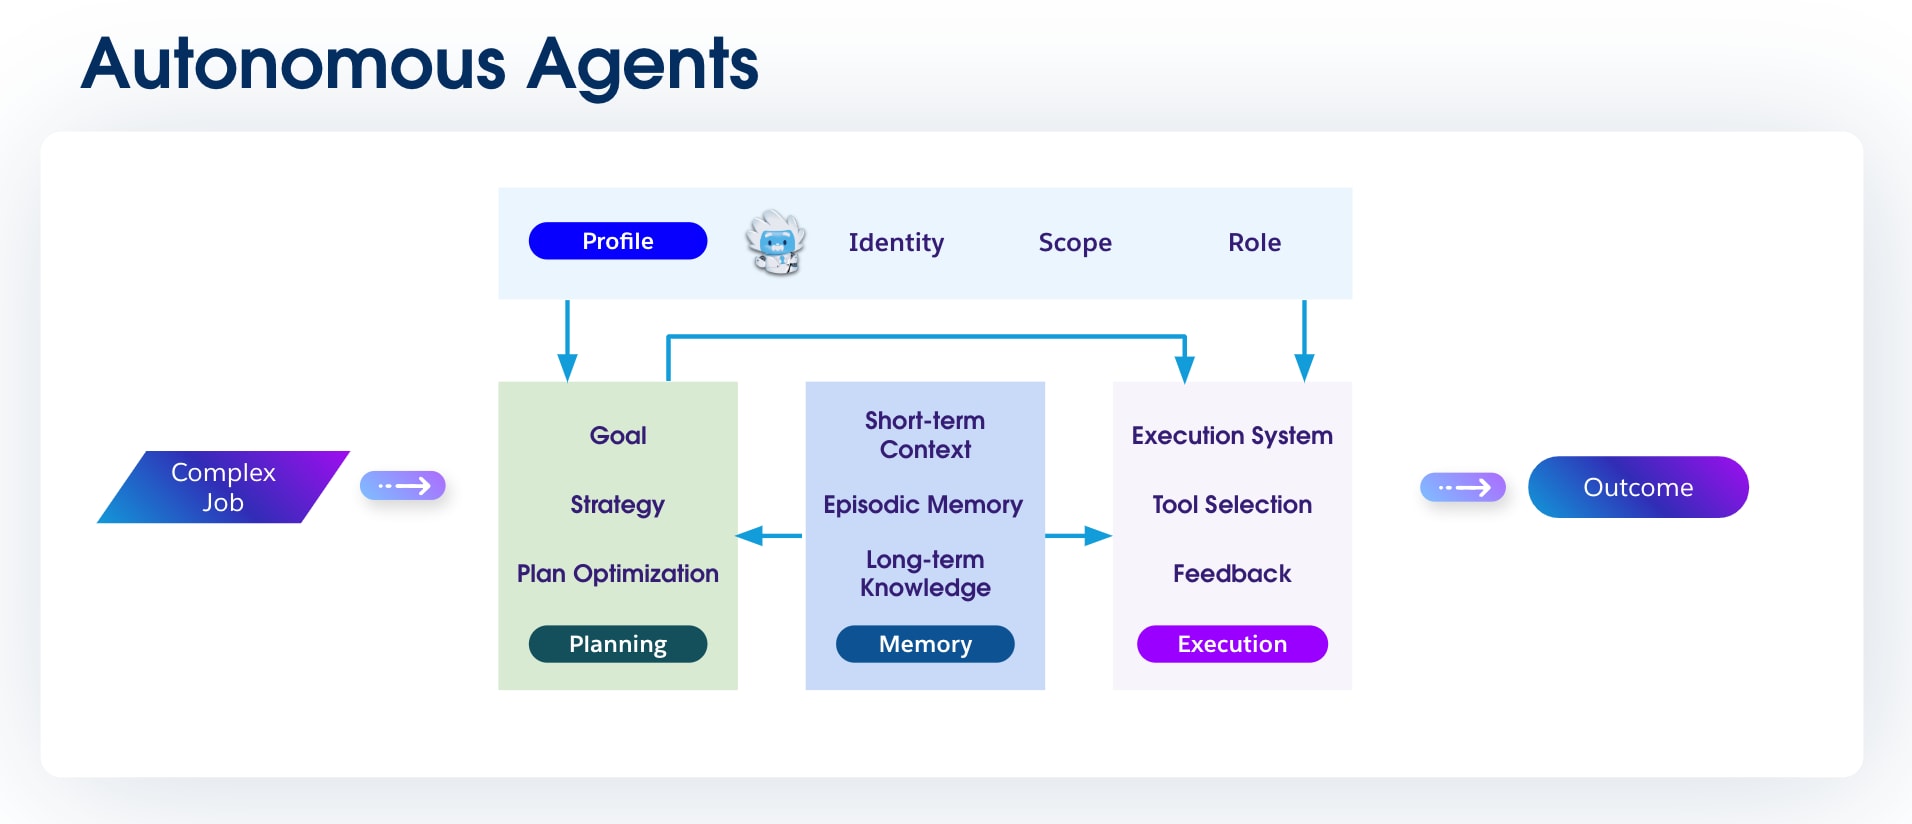 ### 1.5 Agenti collaborativi (intervento collettivo di agenti)
**Definizione:** Gli agenti collaborativi, spesso chiamati "interventi collettivi di agenti", sono una raccolta di agenti specializzati che lavorano insieme per risolvere un problema troppo complesso per essere gestito da un singolo agente. Un agente "orchestratore" o "master" spesso scompone un'operazione di grandi dimensioni, delega operazioni secondarie agli agenti specializzati appropriati e quindi sintetizza i loro output. Un protocollo di comunicazione Agent2Agent (A2A) efficace consente di raggiungere questo obiettivo.
**Importanza:** Questo approccio rispecchia un team umano. Suddividendo un problema complesso, ogni agente specializzato può mettere a frutto le proprie competenze specifiche: uno specializzato nell'analisi dei dati, un altro nella comunicazione con i clienti e un terzo nell'integrazione dei sistemi, per una soluzione più efficace e completa.
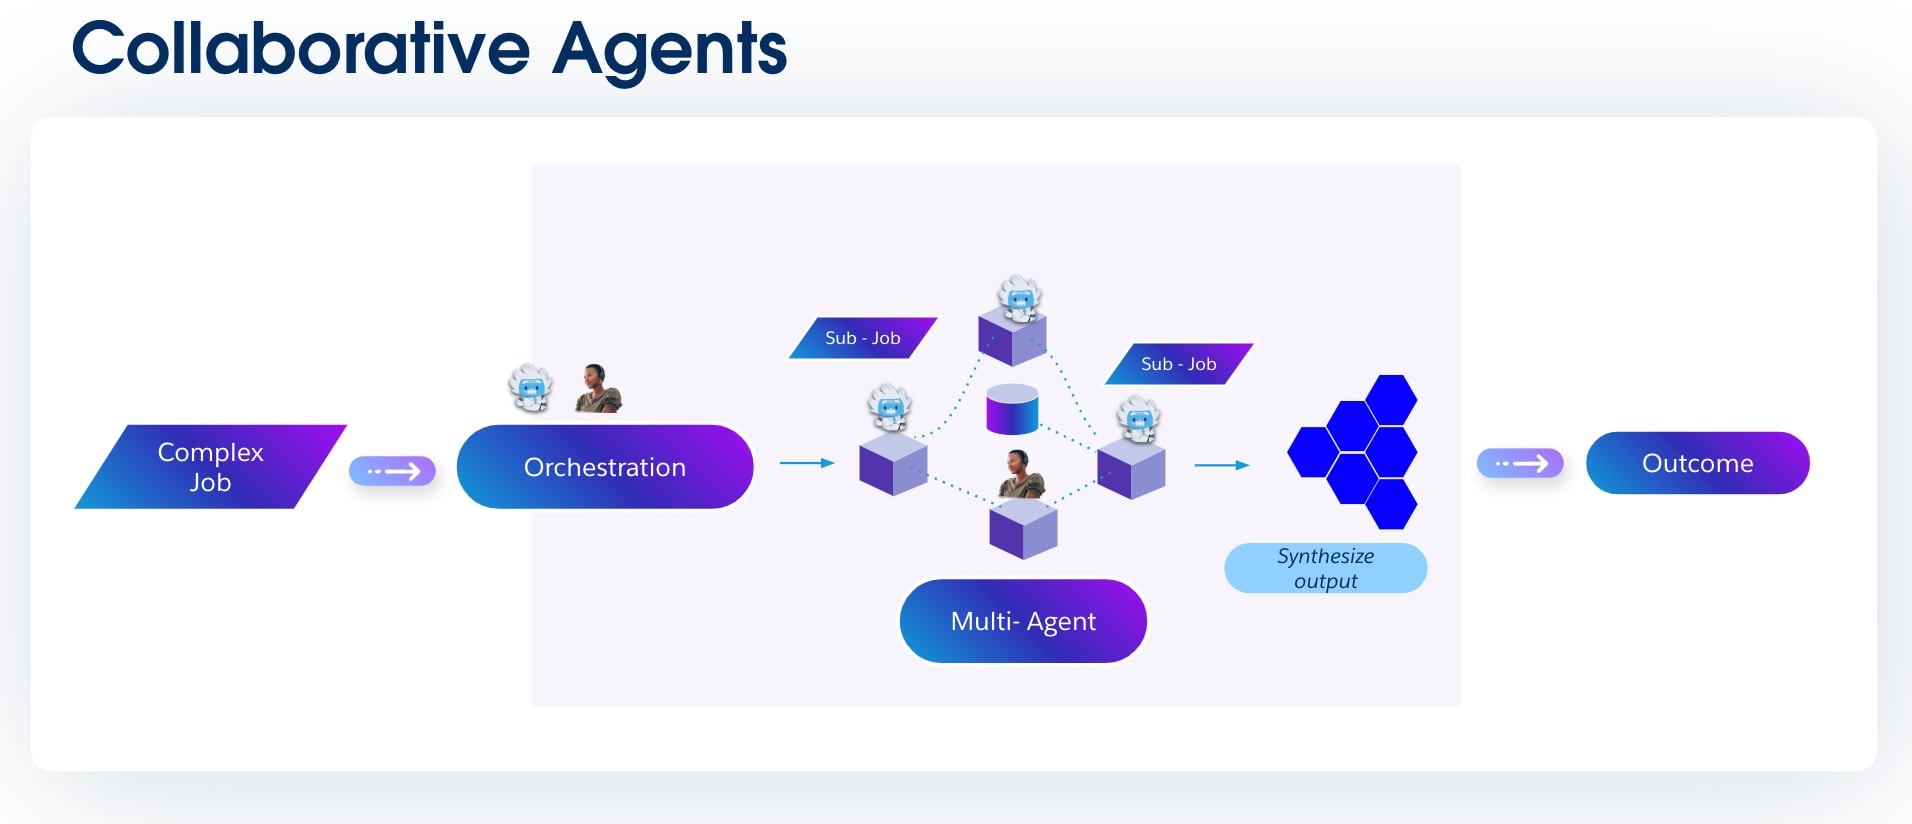 ## Capitolo 2: Schemi dell'architettura Agentforce
Dopo aver esplorato la tassonomia degli agenti AI, rimane una domanda cruciale: come combinare questi elementi per risolvere i problemi aziendali reali in modo efficiente e affidabile? Questo capitolo risponde a questa domanda fornendo un repository di schemi di progettazione agenti comuni. Ogni schema è una soluzione collaudata a una sfida ricorrente, offrendo un modello per qualsiasi cosa, dagli agenti semplici e monouso agli interventi collettivi di agenti complessi e collaborativi.
### 2.1 Schemi conversazionali degli agenti
Gli agenti conversazionali sono spesso la porta principale per le funzionalità di intelligenza artificiale di un'organizzazione. Sono definiti dalla loro capacità di impegnarsi in un dialogo statico a più turni, fungendo da interfaccia principale attraverso la quale gli utenti eseguono operazioni e recuperano informazioni utilizzando il linguaggio naturale. Questa sezione presenta due procedimenti essenziali per la creazione di agenti conversazionali, ciascuno adattato a un canale specifico: uno per gli scambi rapidi e interattivi di client di messaggistica e un altro per la natura strutturata e asincrona dell'email.
L'intelligenza di un agente conversazionale deriva dalla sua capacità di accedere e ragionare sui dati giusti al momento giusto. Questo schema si basa su una base di dati sofisticata che si collega a record cliente, articoli Knowledge e analisi aziendali. I procedimenti completi e riutilizzabili per queste integrazioni sono disponibili nel [capitolo 4: Schemi di integrazione](#capitolo-4-schemi-di-integrazione-per-gli-agenti).
#### 2.1.a Agente conversazionale: Schema client di messaggistica interattivo
**Problema**
I clienti interagiscono su molti canali digitali e si aspettano **risposte istantanee, contestuali e intelligenti.** I chatbot tradizionali sono **con script** o **senza dati,** il che comporta una scarsa personalizzazione, inoltri precoci al livello umano e costi di servizio elevati.
**Context**
- L'organizzazione ha un coinvolgimento digitale multicanale (WhatsApp, SMS, Slack e Salesforce Experience Cloud).
- I clienti dell'organizzazione interagiscono con l'organizzazione in [più lingue](https://help.salesforce.com/s/articleView?id=ai.service_agent_considerations.htm&type=5).
- L'organizzazione deve potenziare i flussi di lavoro di assistenza e vendita con agenti che:
- Estrarre i dati dei clienti affidabili in tempo reale
- Rispettare i guardrail e i requisiti di conformità
- Inoltrare al livello superiore agli agenti umani solo quando necessario
 **Componenti chiave**
- **Astrazione canale:** Service Cloud Enhanced Chat (precedentemente Messaggistica per Web e in app) consente all'agente di comunicare su più canali attraverso una singola esperienza.
- **Agente dell'assistenza Agentforce:** Il comportamento e lo scopo dell'agente sono definiti dai seguenti componenti.
- **Argomenti e istruzioni:** Definisce il profilo dell'agente e lo scopo della conversazione per l'interazione diretta con l'utente. Ciò include la sua missione principale (ad esempio, "Sei un esperto nel risolvere i problemi di assistenza clienti"), le istruzioni per mantenere un tono empatico e professionale e i guardrail chiari sull'ambito delle richieste che è autorizzato a gestire.
- **Azioni:** Azioni orientate al servizio, ovvero strumenti utilizzati dall'agente per diagnosticare e risolvere i problemi dei clienti in tempo reale. Questi strumenti sono progettati per eseguire operazioni come il controllo dello stato di un ordine, la ricerca di soluzioni in una Knowledge Base o la creazione di un nuovo caso di assistenza direttamente dall'interfaccia conversazionale.
- **Guardrail:** I guardrail fungono da insieme di regole configurabili e controlli in fase di esecuzione che limitano il comportamento dell'agente. Funge da livello di sicurezza in grado di intercettare i prompt, convalidare le azioni proposte dall'agente e filtrare la risposta finale per prevenire contenuti dannosi, applicare le regole aziendali e garantire che l'agente operi nell'ambito designato.
- **Modelli di prompt:** Modelli riutilizzabili popolati dinamicamente con dati CRM live tramite campi di unione o dati semantici di Data 360 RAG Retrievers. Questi modelli consentono agli agenti di generare contenuti contestuali e di immagine aziendale mentre Einstein Trust Layer maschera in modo sicuro le informazioni sensibili prima che le istruzioni vengano inviate al componente LLM.
- **Data 360**
- I componenti Data 360, inclusi DLO, DMO, vector store e RAG retriever, offrono all'agente una visualizzazione unificata di tutti i dati aziendali pertinenti, dai record cliente strutturati agli articoli Knowledge non strutturati, garantendo risposte accurate e basate sul contesto.
- **Service Cloud**
- **Dati CRM:** Collega l'agente alla cronologia completa dei casi, fornendo un contesto cruciale per i dettagli dell'account, i record referente e i diritti
- **Area di attesa Live Agent:** Supporto per l'inoltro al livello superiore e l'instradamento a un agente dell'assistenza umana con il contesto della conversazione completo inserito
**Interazioni**
1. Il cliente dell'organizzazione avvia la conversazione tramite un canale.
2. Il messaggio viene instradato ad **Agenteforce,** che determina l'ambito (argomenti) e applica i guardrail.
3. L'intelligenza artificiale compone le risposte utilizzando **modelli di prompt** mentre Flusso o Apex possono attivare la logica di backend.
4. Il contesto viene recuperato da **oggetti Data 360,** vector store e CRM tramite RAG retriever.
5. L'intelligenza artificiale restituisce una risposta contestuale.
6. Se l'intelligenza artificiale non può essere risolta, la conversazione viene inoltrata al livello di **Service Cloud Live Agent.**
**Scambi**
| Aspetto | Guadagno | Costo |
|---|---|---|
| Velocità di risposta | Risposte istantanee sempre attive | Latenza di oltre 2 secondi per query complesse |
| Precisione | Basato su dati reali tramite RAG | Richiede un vector store curato e aggiornato |
| Scalabilità | Conversazioni simultanee quasi infinite | I costi devono essere ottimizzati tramite il caching, la qualifica e i filtri |
| Flessibilità | Gestisce le query aperte | Richiede un sofisticato prompt engineering |
| Tocco umano | Gli agenti dell'assistenza gestiscono solo casi complessi | Frustrazione del cliente se le soglie di inoltro al livello superiore sono sbagliate |
| Diversità delle conversazioni | Numero elevato di intenti che richiede Knowledge, competenze e strumenti diversi | Richiede una regolazione continua degli argomenti e delle istruzioni per ottimizzare la precisione e la latenza |
 **Componenti chiave**
- **Canale email:** Gestisce l'acquisizione dei messaggi in entrata, l'analisi del contenuto e degli allegati e il mantenimento della continuità del thread per abilitare le conversazioni asincrone.
- **Agente Agentforce SDR:** Il comportamento e lo scopo dell'agente sono definiti dai seguenti componenti.
- **Argomenti e istruzioni:** Definisce la missione dell'agente di coinvolgere e qualificare i lead in entrata attraverso la conversazione. Sono incluse le istruzioni per comprendere le esigenze dei clienti potenziali, raccogliere dati chiave sulle qualifiche (ad esempio budget, autorità e tempistica) e guidare la conversazione verso una fase successiva chiara, ad esempio la pianificazione di un incontro con un responsabile account.
- **Azioni:** Azioni di vendita specializzate che consentono all'agente di gestire il ciclo di vita del lead. Questi strumenti sono progettati per eseguire operazioni DSP principali, ad esempio arricchire i dati dei lead, inviare email di follow-up basate su modelli o integrarsi con i sistemi di calendario per prenotare le chiamate Discovery.
- **Guardrail:** I guardrail fungono da insieme di regole configurabili e controlli in fase di esecuzione che limitano il comportamento dell'agente. Funge da livello di sicurezza in grado di intercettare i prompt, convalidare le azioni proposte dall'agente e filtrare la risposta finale per prevenire contenuti dannosi, applicare le regole aziendali e garantire che l'agente operi nell'ambito designato.
- **Modelli di prompt:** Modelli riutilizzabili popolati dinamicamente con dati CRM live tramite campi di unione o dati semantici di Data 360 RAG Retrievers. Questi modelli consentono agli agenti di generare contenuti contestuali e di immagine aziendale mentre Einstein Trust Layer maschera in modo sicuro le informazioni sensibili prima che le istruzioni vengano inviate al componente LLM.
- **Data 360**
- I componenti Data 360, inclusi DLO, DMO, vector store e RAG retriever, offrono all'agente una visualizzazione unificata di tutti i dati aziendali pertinenti, dai record cliente strutturati agli articoli Knowledge non strutturati, garantendo risposte accurate e basate sul contesto.
- **Sales Cloud**
- **Dati CRM:** Collega l'agente alla cronologia completa dei casi, fornendo un contesto cruciale per i dettagli dell'account, i record referente e i diritti
- **Pianificazione dell'incontro tra cliente e DSP:** La consegna di DSP Live Agent può essere configurata per impostare una riunione live utilizzando Operazione e Pianificazione riunione (azioni successive).
- **Registrazione attività:** Acquisire eventi, operazioni e attività email e correlarle a lead, account e opportunità in seguito alle interazioni degli agenti DSP.
**Interazioni**
1. Il cliente invia e riceve email attraverso il canale, che vengono instradate ad Agentforce.
2. Agentforce applica argomenti, azioni e guardrail per analizzare l'intento.
3. Agentforce crea bozze di risposte contestuali utilizzando modelli di prompt arricchiti con contesto CRM e Data 360.
4. Una conversazione email a più turni continua fino alla risoluzione o alle linee guida della policy.
5. Per i lead qualificati, Agentforce pianifica un incontro e aggiorna CRM.
6. Se l'intento supera l'ambito AI, Agentforce passa al livello superiore al DSP Sales Cloud per una risposta dell'agente dell'assistenza.
**Scambi**
| Aspetto | Guadagno | Costo |
|---|---|---|
| Velocità di risposta | <5 min prima risposta (vs. 8–24 ore) | Un contatto iniziale meno personalizzato rispetto al telefono |
| Capacità DSP | Aumento di 2-5 volte della copertura dei lead | Perdita di punti di contatto precoci per la costruzione di relazioni |
| Coerenza delle qualifiche | Acquisire in modo asincrono la copertura di budget, autorità, necessità e tempistica (BANT) | Può mancare segnali con sfumature |
| Accuratezza del contenuto | RAG garantisce informazioni aggiornate | Richiede una libreria di prodotti di vendita e abilitazione curata. Multi-turn può essere faticoso |
| Conversione riunione | Conversione significativamente più alta | Alcuni incontri con lead di qualità inferiore se sono presenti lacune BANT |
| Efficienza dei costi | Più conveniente rispetto ai DSP umani | Costi di sviluppo e manutenzione |
 **Componenti chiave**
- **Origine evento**
- Eventi attivati da azioni dati dopo l'inserimento di dati esterni in Data 360
- Server MCP Heroku di terze parti o Salesforce in grado di inviare eventi a Salesforce tramite l'API Salesforce Pub/Sub
- Applicazione esterna in grado di inviare notifiche di eventi tramite l'API Salesforce Pub/Sub
- **Middleware facoltativo:** MuleSoft o Data 360 per le trasformazioni
- **Agente Agentforce:** Il comportamento e lo scopo dell'agente sono definiti dai seguenti componenti.
- **Argomenti e istruzioni:** Specifica la missione principale dell'agente e i relativi trigger, inclusa la definizione dell'obiettivo principale (ad esempio, "Monitorare tutti i casi con priorità alta e prevenire violazioni degli accordi sul livello di servizio"). Contiene gli eventi specifici o le condizioni dei dati che l'agente deve ascoltare per avviare le proprie operazioni
- **Azioni:** Azioni attivate da eventi e pianificate progettate per rispondere a eventi esterni. Benché queste azioni operino in modo autonomo per le operazioni di routine, spesso includono la capacità di orchestrare flussi di lavoro che comportano l'intervento umano, inoltrandoli agli utenti per la revisione, l'approvazione o la gestione di scenari che richiedono un giudizio umano.
- **Guardrail:** I guardrail fungono da insieme di regole configurabili e controlli in fase di esecuzione che limitano il comportamento dell'agente. Funge da livello di sicurezza in grado di intercettare i prompt, convalidare le azioni proposte dall'agente e filtrare la risposta finale per prevenire contenuti dannosi, applicare le regole aziendali e garantire che l'agente operi nell'ambito designato.
- **Modelli di prompt:** Modelli riutilizzabili popolati dinamicamente con dati CRM live tramite campi di unione o dati semantici di Data 360 RAG Retrievers. Questi modelli consentono agli agenti di generare contenuti contestuali e di immagine aziendale mentre Einstein Trust Layer maschera in modo sicuro le informazioni sensibili prima che le istruzioni vengano inviate al componente LLM.
- **Data 360**
- Componenti di Data 360, inclusi **DLO e DMO,** che memorizzano i dati degli eventi [generati da sistemi esterni e inviati a Salesforce](https://developer.salesforce.com/docs/data/data-cloud-int/guide/c360-a-create-eventbusconnector-data-stream.html), trasformando e creando approfondimenti streaming o in tempo reale
- **Approfondimenti calcolati, streaming e in tempo reale** forniscono agli agenti dati immediati e pertinenti sui clienti. Ciò consente la risoluzione preventiva dei problemi, mitigando l'inoltro al livello superiore. **Grafici dati** che mettono in evidenza in modo proattivo relazioni e approfondimenti da fonti di dati diverse, consentendo il rilevamento precoce di schemi o anomalie relativi al coinvolgimento, all'attività e al profilo del cliente.
- I recuperatori vettoriali **Data 360 e RAG** offrono all'agente una visualizzazione unificata di tutti i dati aziendali pertinenti e degli articoli Knowledge non strutturati, garantendo risposte accurate e basate sul contesto.
- **Destinazioni evento**
- Avvisare in modo proattivo i dipendenti o contattare i clienti
- Estensibile agli agenti (vedere Modelli [di agenti ambientali](#23-schemi-degli-agenti-ambientali) e [di agenti autonomi](#25-schemi-degli-agenti-autonomi))
**Interazioni**
1. Un cambiamento notevole si verifica nel sistema esterno.
2. Il sistema esterno emette un evento e lo pubblica in Salesforce Event Bus tramite API (crea un evento piattaforma) o API Pub/Sub oppure i dati degli eventi vengono trasmessi in streaming a Data 360.
3. Vengono attivati gli abbonati all'evento. Viene attivato un flusso.
4. Il flusso chiama [Azione agente](https://help.salesforce.com/s/articleView?id=platform.automate_flow_ref_elements_actions_generate_ai_agent_response.htm&type=5) con i dati dell'evento. L'agente determina la linea di condotta corretta e la esegue.
5. Il risultato è una notifica o un flusso di lavoro attivato. Le notifiche vengono inviate a un utente in uno strumento di collaborazione (ad esempio Slack). Vengono generate anche operazioni o eventi. Inoltre, le azioni possono chiamare sistemi esterni. Gli eventi, quindi, non vengono persi ma vengono eseguiti, segnalati e attivati in modo proattivo, rimuovendo l'overhead umano o l'automazione complessa per scoprirli.
**Scambi**
| Aspetto | Guadagno | Costo |
|---|---|---|
| Integrazione in tempo reale | Gli eventi attivano le azioni in pochi secondi. | Complessità di inserimento API (variabilità SLA partner) |
| Risposta intelligente | Decisioni basate sull'intelligenza artificiale con CRM e contesto esterno | L'arricchimento aggiunge latenza e dati non aggiornati (ad esempio eventi fuori ordine). |
| Accoppiamento allentato | Sistemi esterni indipendenti dalla logica Salesforce | L'elaborazione asincrona porta a una coerenza finale. |
| Scalabilità | Gestisce gli eventi burst | Limiti API, costi di archiviazione degli eventi |
| Bidirezionale | Salesforce può rispondere a sistemi esterni. | Dipendenze API esterne, scenari di errore |
| Sicurezza | Eventi verificati firmati, accesso con privilegi minimi (o nulli) da parte di sistemi esterni | Protezione dal replay, rotazione delle chiavi e sovraccarico operativo |
 **Componenti chiave**
- **Livello origine evento**
- Dati CRM, Eventi piattaforma, Acquisizione dati di modifica (CDC) e Monitoraggio evento in tempo reale (RTEM) da attività di piattaforma di basso livello
- **Data 360**
- Componenti di Data 360, inclusi **DLO e DMO,** che memorizzano i dati degli eventi [generati da eventi CRM o piattaforma](https://developer.salesforce.com/docs/data/data-cloud-int/guide/c360-a-create-eventbusconnector-data-stream.html), trasformando e creando approfondimenti streaming o in tempo reale
- **Approfondimenti calcolati, streaming e in tempo reale** forniscono agli agenti dati immediati e pertinenti relativi al cliente, all'attività dei dipendenti o alle modifiche dei metadati nel sistema. Ciò consente la risoluzione preventiva dei problemi, mitigando l'inoltro al livello superiore. Questa consapevolezza della situazione in tempo reale consente agli agenti di offrire interventi tempestivi per la governance e la conformità.
- **Grafici dati** evidenziano in modo proattivo relazioni e approfondimenti da fonti di dati diverse, consentendo il rilevamento precoce di schemi o anomalie relativi al coinvolgimento, all'attività e al profilo del cliente.
- I recuperatori vettoriali **Data 360 e RAG** offrono all'agente una visualizzazione unificata di tutti i dati aziendali pertinenti e degli articoli Knowledge non strutturati, garantendo risposte accurate e basate sul contesto.
- **Agente Agentforce:** Il comportamento e lo scopo dell'agente sono definiti dai seguenti componenti.
- **Argomenti e istruzioni:** Specifica la missione dell'agente di applicare le regole aziendali e automatizzare i processi in base alle modifiche dei dati all'interno di Salesforce. Definisce l'obiettivo dell'agente (ad esempio, "Assicurarsi che tutte le opportunità vengano aggiornate con un referente principale prima di raggiungere la fase di negoziazione") e le specifiche creazioni di record, gli aggiornamenti di campo e così via che attivano l'agente.
- **Azioni:** Azioni attivate da eventi e pianificate progettate per rispondere agli eventi Salesforce interni. Benché queste azioni operino in modo autonomo per le operazioni di routine, spesso includono la capacità di orchestrare flussi di lavoro che comportano l'intervento umano, inoltrandoli agli utenti per la revisione, l'approvazione o la gestione di scenari che richiedono un giudizio umano.
- **Guardrail:** I guardrail fungono da insieme di regole configurabili e controlli in fase di esecuzione che limitano il comportamento dell'agente. Funge da livello di sicurezza in grado di intercettare i prompt, convalidare le azioni proposte dall'agente e filtrare la risposta finale per prevenire contenuti dannosi, applicare le regole aziendali e garantire che l'agente operi nell'ambito designato.
- **Modelli di prompt:** Modelli riutilizzabili popolati dinamicamente con dati CRM live tramite campi di unione o dati semantici di Data 360 RAG Retrievers. Questi modelli consentono agli agenti di generare contenuti contestuali e di immagine aziendale mentre Einstein Trust Layer maschera in modo sicuro le informazioni sensibili prima che le istruzioni vengano inviate al componente LLM.
- **Destinazioni evento**
- Avvisare in modo proattivo i dipendenti o contattare i clienti.
- Estensibile per chiamare altri agenti (vedere [intelligenza artificiale ambientale](#23-schemi-degli-agenti-ambientali) e schemi [di intelligenza artificiale autonomi](#25-schemi-degli-agenti-autonomi))
**Interazioni**
1. Nel sistema interno si verifica una modifica notevole, ad esempio un aggiornamento di un record CRM, una modifica dei metadati o un'azione dati attivata da Data 360.
2. Il sistema interno emette un evento e lo pubblica in Salesforce Event Bus tramite API (crea un evento piattaforma) o API Pub/Sub, oppure i dati degli eventi vengono trasmessi in streaming a Data 360.
3. Gli abbonati all'evento vengono attivati e attivano un flusso o Apex.
4. Il flusso o Apex attivato chiama [Azione agente](https://help.salesforce.com/s/articleView?id=platform.automate_flow_ref_elements_actions_generate_ai_agent_response.htm&type=5).
5. Il risultato è una notifica o un flusso di lavoro attivato. Le notifiche vengono inviate a un utente in uno strumento di collaborazione (ad esempio Slack). Vengono generate anche operazioni o eventi. Inoltre, le azioni possono chiamare sistemi esterni.
6. Gli eventi, quindi, non vengono persi ma vengono eseguiti, segnalati e attivati in modo proattivo, rimuovendo l'overhead umano o l'automazione complessa per scoprirli.
**Scambi**
| Aspetto | Guadagno | Costo |
|---|---|---|
| Integrazione in tempo reale | Gli eventi attivano le azioni in pochi secondi. | Un maggior numero di livelli può causare latenza per una semplice gestione degli eventi. |
| Risposta intelligente | Decisioni basate sull'intelligenza artificiale con CRM e contesto esterno | L'arricchimento aggiunge dati di latenza e non aggiornati (ad esempio, eventi fuori ordine). |
| Accoppiamento allentato | Fan out (più abbonati) e ampliabile | L'elaborazione asincrona porta a una coerenza finale tra gli abbonati. |
| Scalabilità | Gestione degli eventi burst | Limiti API |
| Sicurezza | Livello Trust fornito dalla piattaforma | Spese generali operative non negoziabili |
| Aspetto | Guadagno | Costo |
|---|---|---|
| Dimensioni finestra | Finestra ridotta: latenza più bassa, formazione più rapida | Inoltre ha meno contesto, minore precisione |
| Modalità di elaborazione | In tempo reale si presenta un'opportunità immediata per l'assistente. | Intensivo di risorse |
| Risoluzione stream | Audio e video di alta qualità possono avere una maggiore precisione ma aumentare la latenza. | Più memoria ed elaborazione |
| Periodo di conservazione | È possibile utilizzare grandi quantità di dati per la formazione e la conformità. | Più costi di stoccaggio, può causare rumore |
| Multimodale | Contesto più ricco, comprensione olistica | Complessità di sincronizzazione |
| Ambiente | Può fornire un supporto coerente all'utente umano | Applicazione della privacy/policy |
| Aspetto | Guadagno | Costo |
|---|---|---|
| Ambito | Ampia gamma di copertura delle attività, l'agente può condividere il contesto in diverse modalità (email, calendari, pagine dell'app) | Costo calcolo |
| Automazione intelligente | Può essere un modulo ed estendersi all'intelligenza artificiale completamente autonoma e può eliminare gli esseri umani dal loop in cui la policy è chiara | Più valutazione degli agenti. Il rischio di falsi positivi o errori, può non essere rilevato in un intervallo di tempo ragionevole |
| Complessità delle intercettazioni | Può trarre vantaggio dall'analisi in tempo reale. Ad esempio, può rilevare frodi o minacce e impedire che si verifichino transazioni | Necessità di sincronizzare i flussi di lavoro di agenti e persone |
| Profondità contesto | Contesto più profondo porta a decisioni intelligenti | Deve essere completo del contesto |
| Autonomia agente | Gli agenti headless lavorano in background senza richiedere all'utente, quindi riducono l'attrito | Meno trasparenza nel processo decisionale degli agenti, più tracce di controllo |
| Multi-agente | Gli agenti headless possono lavorare insieme per formare agenti specializzati | Orchestrazione headless e complessità aggiuntiva |
| Aspetto | Guadagno | Costo |
|---|---|---|
| Superfici di collaborazione native | Gli agenti possono partecipare e contribuire immediatamente al flusso di lavoro umano | L'adozione degli utenti richiede ulteriore formazione e abilitazione |
| Condivisione contesto bidirezionale | Gli agenti possono presentare e condividere il contesto con tutte le parti, rendendo le informazioni disponibili a tutti. | Le informazioni sensibili intenzionali asimmetriche richiedono ulteriori garanzie. |
| Collaborazione | Gli agenti consentono la collaborazione in tempo reale, offrendo un feedback immediato e tempi di risoluzione più rapidi. | Risoluzioni più rapide significa un lavoro più attivo nell'area di attesa per gli esseri umani che può causare stanchezza |
| Specializzazione | Gli agenti specifici del dominio offrono un'assistenza di valore elevato. | Aumento delle esigenze di contesto limitato e della specificità del dominio. Complessità per adattarsi ai cambiamenti |
| Osservabilità | Fornire ragionamenti, itinerari di controllo, valutazioni degli agenti per creare Trust | Aumento dei costi di telemetria |
| Aspetto | Guadagno | Costo |
|---|---|---|
| Velocità | Gli agenti completano le operazioni da ore a giorni anziché da settimane a mesi | Richiede l'abilitazione per il funzionamento agente autonomo |
| Autonomy | Gli agenti raggiungono l'esecuzione completa senza intervento umano | L'intervento è limitato e costoso durante l'esecuzione |
| Scalabilità | Gli agenti scalano facilmente | È necessario stabilire limiti di traffico per evitare il blocco delle risorse. |
| Coerenza | Gli agenti aderiscono alle policy tramite guardrail | La gestione dei nuovi scenari richiede un'ispezione per garantire l'esito corretto. |
| Costo | Gli agenti evitano gli umani nel loop | Il processo è costoso da creare |
| Risorse umane | Gli agenti liberano risorse critiche ed esperte | Gli esperti non hanno visibilità esperienziale attraverso il fare, riducendo la capacità di identificare i miglioramenti dei processi |
| Controllo di qualità | Può monitorare e rivedere | I costi di riparazione sono elevati se gli errori degli agenti non vengono rilevati immediatamente |
| Precisione | Gli agenti possono utilizzare il contesto e le policy per prendere la decisione giusta. | Il contesto e i dati devono essere curati e mantenuti per eliminare qualsiasi ambiguità o immobilità. |
-
Impostare un agente di conversazione.
Impostazione della chat ottimizzata → Crea agente dell'assistenza → Argomento Definisci ordini di assistenza → Azione Crea Ottieni ordine ↓ Aggiunta del flusso Omnicanale di inoltro al livello superiore in uscita ← Argomento Crea inoltro al livello superiore ← Aggiunta di azioni agli argomenti ← Azione Crea Ottieni stato ↓ Pubblicazione dell'agente - Impostare Chat ottimizzata come punto di ingresso chat di Jane in modo che possa aprire la finestra Agentforce nella pagina Web.
- Abilitare Agentforce e creare un agente dell'assistenza in Agentforce Builder per gestire le conversazioni e attivare azioni personalizzate.
-
Definire un argomento Ordini di assistenza con una descrizione e le istruzioni in modo che l'agente riconosca automaticamente "Dov'è il mio ultimo ordine?".
-
Creare azioni personalizzate per gli agenti:
- Azione Ottieni ultimo ordine di contatto per recuperare l'ordine più recente di Jane
- Azione Get Shipping Status by Order ID (Ottieni stato spedizione per ID ordine) per recuperare le informazioni di tracciamento tramite MuleSoft
- Se si desidera, orchestrare entrambe le azioni in Flusso (recupero dell'ordine più recente e chiamata MuleSoft) utilizzando azioni esterne.
- Aggiungere entrambe le azioni all'agente dell'assistenza nel Generatore, collegarle all'argomento Ordini e tracciamento e pubblicare.
-
Creare azioni personalizzate per gli agenti:
-
Definire un argomento Inoltro al livello superiore con una descrizione da inoltrare a un agente dell'assistenza.
- Creare e attivare un flusso Omnicanale in uscita.
- Aggiungerlo alla scheda Connessioni del generatore per l'inoltro al livello superiore con un messaggio di inoltro al livello superiore.
-
Impostare Omnicanale.
Configurazione di Omnicanale → Definire le regole di inoltro al livello superiore nelle istruzioni → Impostare le priorità e la capacità → Testare e convalidare - Abilitare l'inoltro senza interruzioni agli agenti dell'assistenza quando l'agente AI non è in grado di risolvere la query. Configurare l'instradamento Omnicanale per assegnare le chat agli agenti dell'assistenza e trasferire la trascrizione completa per il contesto.
- Integrare la logica di inoltro al livello superiore nelle istruzioni Agentforce e in un'azione di inoltro al livello superiore in modo che l'agente sappia quando trasferire i casi complessi. Gestire priorità e capacità di instradamento tramite il supervisore Omni.
- Testa l'esperienza completa: Jane apre la chat e l'agente la saluta, identifica il suo ordine, recupera i dati di spedizione e inoltra il tutto al livello superiore senza problemi quando è necessario l'intervento umano (vedere anche Abilitazione dei registri eventi ottimizzati).
-
Impostare l'integrazione dei dati.
Mappatura dei dati di contesto → Creazione delle credenziali API MuleSoft → Registrazione del servizio esterno MuleSoft - È possibile collegare l'agente al contesto Salesforce di Jane mappando i record referente e ordine tramite chat autenticata o moduli pre-chat.
- Connettere Salesforce in modo sicuro all'API spedizioni MuleSoft utilizzando credenziali esterne e denominate per l'autenticazione.
- Se MuleSoft espone una specifica OpenAPI, registrarla come servizio esterno in modo che Flusso e l'agente possano chiamarla in modo dichiarativo.
-
Impostare l'integrazione dei dati non strutturati.
- Creare una nuova libreria dati da Imposta. Assegnarle il nome "Ordine e politica di spedizione".
- Aggiungere i PDF dei documenti della polizza che contengono le eccezioni della polizza di spedizione.
- Dietro le quinte, i documenti vengono automaticamente suddivisi in blocchi, indicizzati e resi pronti per l'uso.
-
Impostare un evento carrello abbandonato da attivare quando John, un cliente VIP, lascia il carrello abbandonato.
Crea campo Referente personalizzato → Definizione di un nuovo evento piattaforma - Creare un evento piattaforma
Cart_Abandoned__e con i campi ID referente, Valore carrello, DateTime ultimo aggiornamento carrello e Dettagli carrello. - Configurare l'evento di abbandono: Utilizzando Commerce Cloud, creare un evento piattaforma per le notifiche degli eventi Checkout. L'abbandono viene rilevato quando lo stato della sessione di Checkout carrello è intermedio e la sessione scade dopo una soglia. In alternativa, se l'ecommerce è un sistema esterno, pubblicare l'evento in Salesforce utilizzando uno dei metodi seguenti: Flussi, Apex, API Salesforce o API Pub/Sub.
- Nell'oggetto Referente, creare un nuovo campo,
Customer_Tier__c , con i valori dell'elenco di selezioneStandard ,Premium eVIP .
- Creare un evento piattaforma
-
Impostare l'inserimento di dati non strutturati in Data 360: Aggiungere un documento della policy sugli sconti proveniente da un archivio di documenti a Data 360 tramite Amazon S3.
Creazione delle credenziali AWS S3 → Creazione di un nuovo stream di dati S3 → Configurazione e distribuzione dello stream → Crea indice di ricerca ↓ Funzione di recupero test ← Configurazione e distribuzione dell'indice - Creare credenziali esterne per accedere a S3: Creare un nuovo insieme di chiavi di accesso e segreti per un utente IAM o IAM Amazon Resource Name (ARN) per un IdP.
- Creare un nuovo stream di dati S3: Nella scheda Stream di dati, creare lo stream di dati Policy Documents Stream (Stream documenti policy), selezionare l'origine S3, scegliere il tipo di file PDF, impostare la frequenza di aggiornamento, mappare i campi dei metadati (nome e dimensione del file) e quindi distribuire.
- Al termine dello stream di dati, creare un indice di ricerca: Utilizzare l'estrazione del passaggio per suddividere, il modello di incorporamento E5-large-v2 e il tipo di ricerca ibrida e quindi distribuire l'indice.
- Testare la funzione di recupero creata.
-
Impostare l'agente VIP Cart Recovery.
Crea agente dal modello → Aggiungi argomento Recupera carrello VIP → Aggiungi istruzioni argomento → Azione di avviso Crea Slack ↓ Aggiunta di azioni all'argomento ← Creazione di un'azione di iscrizione al journey ← Azione Crea offerta sconto ← Crea operazione di ripristino carrello - Creare un agente dal modello Agentforce Employee Agent.
- Aggiungere un nuovo argomento, Recupera carrello VIP, con la descrizione che questo agente gestisce l'abbandono del carrello di valore elevato per i clienti VIP.
- Aggiungere istruzioni sull'argomento per convalidare lo stato VIP, qualificare il carrello, informare il responsabile account in Slack, consigliare un'offerta di sconto e iscrivere il cliente al journey email di recupero carrello.
- Creare azioni e un'operazione.
- Azione Avvisa responsabile account: Invia una notifica Slack proattiva
- Operazione Recupera carrello abbandonato, assegnata al responsabile con i dettagli del carrello
- Azione Ottieni offerta di sconto: Analizza la cronologia delle polizze e degli acquisti precedenti. Creare un modello di prompt con radicamento nel contesto, fare riferimento alla funzione di recupero nel modello di prompt e utilizzare i dati.
- Azione Iscriviti al journey di ripristino: Si iscrive al journey di ripristino di Marketing Cloud tramite l'API e riceve tutti i dati dell'abbonato e il messaggio email dell'offerta scontata generato dall'agente.
- Aggiungere le azioni all'argomento.
- Creare un journey di ripristino del carrello del cliente VIP utilizzando i modelli in Marketing Cloud o creare un nuovo journey.
-
Collegare un evento piattaforma per chiamare l'agente.
Crea flusso attivato da evento → Abbonamento all'evento piattaforma → Aggiungi azione invocabile agente → Passare i dati degli eventi all'agente - Creare un nuovo flusso attivato da evento piattaforma, VIP Cart Abandonment Recovery.
- Selezionare l'evento Carrello abbandonato a cui deve abbonarsi il flusso.
- Impostare un'azione invocabile in Flow Builder e selezionare l'agente VIP Cart Recovery. Inviare la richiesta per avviare il recupero di un carrello abbandonato VIP per il cliente e inviare il payload dell'evento piattaforma.
| Il cliente abbandona il carrello | → | Commerce Cloud pubblica l'evento | → | Trigger evento piattaforma Flusso | → | Il flusso invoca Agente dipendente |
| ↓ | ||||||
| Analizza l'offerta di sconto | ← | Crea operazione per il responsabile | ← | Responsabile avvisi in Slack | ← | L'agente esegue l'argomento Ripristino |
| ↓ | ||||||
| Iscrive il cliente al journey | → | Il cliente utilizza l'offerta | → | L'agente analizza l'esito per un feedback |
-
Impostare un agente Sales Call Realtime Response.
Crea agente dal modello → Aggiungi argomento chiamata assistita → Aggiungi istruzioni argomento → Creazione di un'azione di analisi della trascrizione ↓ Aggiunta di azioni all'argomento ← Azione Crea approfondimenti Slack ← Creazione di un'azione specifica prodotto - Creare un agente dal modello Agentforce Employee Agent.
- Aggiungere un nuovo argomento, Chiamata di assistenza, con la descrizione che l'agente ascolta le trascrizioni live, comprende l'intento e aiuta con i dati dei prodotti.
- Aggiungere istruzioni sull'argomento per analizzare le trascrizioni, recuperare le specifiche del prodotto e inviare messaggi Slack.
- Creare azioni.
- Azione Analizza trascrizione chiamata: Analizza i dati delle trascrizioni delle chiamate ricevute in tempo reale ed estrae le domande o le azioni chiave
- Azione Get Product Spec (Ottieni specifiche prodotto): Esegue query sugli articoli di Product Knowledge
- Inviare approfondimenti Slack all'utente "interno"
- Aggiungere le azioni all'argomento.
-
Impostare una libreria di dati Product Knowledge.
Creazione di una nuova libreria di dati → Aggiunta di articoli Knowledge → Blocchi e indici di sistema → Libreria di terra in azione - Creare una nuova libreria dati da Imposta. Chiamalo "Product Knowledge".
- Aggiungere gli articoli Knowledge che contengono le informazioni sul prodotto.
- Dietro le quinte, i documenti vengono automaticamente suddivisi in blocchi, indicizzati e resi pronti per l'uso.
- Utilizzare la base nell'azione Ottieni specifica prodotto.
-
Pubblicare la trascrizione in tempo reale in Salesforce tramite l'API Pub/Sub.
Il server riceve la trascrizione audio → Il server pubblica l'evento piattaforma - Creare un evento piattaforma,
Transcript_Segment__e , con i campiID chiamata ,Sequenza ,Relatori ,Ora iniziale segmento ,Ora finale segmento ,Durata eDati di trascrizione . - Nel server di segnalazione (vedere la sezione dei prerequisiti), una volta ricevuto il testo trascritto dall'audio, pubblicare immediatamente i dati tramite l'evento
Transcript_Segment__e . È possibile pubblicare l'evento in Salesforce utilizzando uno dei metodi seguenti: Flussi, Apex, API Salesforce o API Pub/Sub.
- Creare un evento piattaforma,
-
Flusso di fili per abbonarsi all'evento
Transcript_Segment__e pubblicato.Crea flusso attivato da evento → Evento Abbonati alla trascrizione → Aggiungi azione invocabile agente → Invia payload all'agente ↓ L'agente invia il DM Slack - Creare un nuovo flusso attivato da evento piattaforma, Discovery Call Insights.
- Selezionare l'evento
Transcript_Segment__e a cui deve abbonarsi il flusso. - Impostare un'azione invocabile in Flow Builder e selezionare l'agente Sales Call Realtime Response. Inviare il payload dell'evento per l'instradamento all'argomento Chiamata di assistenza. Dopo aver derivato la domanda dall'argomento, la domanda viene inviata all'azione Ottieni specifica prodotto per una risposta.
- La risposta finale viene compilata e inviata immediatamente all'utente tramite un DM Slack.
| L'utente avvia la chiamata Zoom | → | Server trascrive e pubblica | → | Il flusso invoca l'agente Response | → | L'agente esegue query nella Knowledge Base |
| ↓ | ||||||
| Analytics perfeziona le prestazioni degli agenti | ← | L'agente compila il riepilogo delle chiamate | ← | L'agente continua ad ascoltare | ← | L'agente invia il DM Slack |
-
Impostare l'architettura multi-agente.
L'agente di ricerca raccoglie informazioni → L'agente qualificato calcola il punteggio del lead → L'agente DSP inizia il contatto - Agente di ricerca: Esegue query su Data 360 e fonti esterne tramite MuleSoft
- Agente qualificato: Assegna priorità, calcola il punteggio e arricchisce i lead
- Agente DSP: Ottiene le assegnazioni dei lead, esegue il contatto, segue e pianifica gli incontri. Monitorare l'attività e l'avanzamento degli agenti SDR con Agentforce Analytics per gli agenti SDR.
-
Scoprire e inserire nuovi dati aziendali.
Creazione di un nuovo spazio dati → Inserimento di dati Salesforce CRM → Inserimento di dati ZoomInfo → Inserimento dei dati del database dei fornitori - Impostare un nuovo spazio dati denominato Vendite e marketing. Questo nuovo spazio dati conterrà tutti i dati necessari per gli agenti autonomi.
- Utilizzare i connettori Salesforce per far fluire i dati di Lead, Account, Referente e Opportunità CRM nello spazio dati.
- Configurare un connettore Data 360 per ZoomInfo. Far fluire i dati nello spazio dati di vendita e marketing di Data 360.
- Configurare il connettore Anypoint Salesforce Data 360 per connettersi al database dei fornitori e inserire i dati in Data 360.
-
Impostare un evento piattaforma per avviare l'agente Ricerca e qualifica headless.
Crea nuovo evento piattaforma - Creare un nuovo evento piattaforma
AgentGoal__e con l'obiettivo sul campo che acquisisce l'obiettivo generale dell'utente umano.
- Creare un nuovo evento piattaforma
-
Impostare un agente Goal Orchestrator, un agente di intelligenza artificiale conversazionale che riceve l'obiettivo dell'utente e lo orchestra ad altri agenti.
Crea agente dal modello → Aggiungi argomento Obiettivo analisi → Aggiungi istruzioni argomento → Azione Crea evento obiettivo ↓ Aggiungi azione all'argomento - Creare un agente dal modello Agentforce Employee Agent.
- Aggiungere un nuovo argomento, Analizza obiettivo, con la descrizione che l'agente comprende l'intento dell'obiettivo ed è in grado di chiamare altri agenti in base alle esigenze.
- Aggiungere istruzioni sull'argomento per analizzare l'obiettivo e attivare eventi per altri agenti.
- Creare un evento Obiettivo,
AgentGoal__e .
-
Impostare un agente Ricerca e qualifica lead, attivato da un agente orchestratore.
Crea argomento di ricerca → Creazione di un'azione di deduplica → Creazione di un'azione di arricchimento lead → Creazione di un'azione di calcolo del punteggio lead ↓ Aggiunta di azioni all'argomento ← Creazione di un'azione di qualificazione lead - Creare un argomento Ricerca di potenziali clienti con la descrizione "Ricerca di nuovi lead in una regione o in uno stato".
- Creare azioni.
- Azione Apex lead duplicato: Controllare e convalidare i nuovi lead rispetto ai clienti esistenti
- Azione Arricchisci lead Apex, che utilizza un modello di prompt: Esamina l'approfondimento marketing non strutturato e i dati del database dei fornitori per arricchire i dati dei lead
- Azione Punteggio lead: Calcolo del punteggio proattivo di un lead con i dati dei lead aggiornati
- Azione Qualifica lead per agente: In base al punteggio, assegnare i parametri che qualificano il lead per un agente DSP
-
Impostare un agente SDR Agentforce per eseguire attività di contatto, lead nurturing e pianificazione degli incontri.
Creazione di un agente DSP dal modello → Configurazione della Knowledge Base agente → Configurazione delle impostazioni email degli agenti → Impostazione delle regole di assegnazione dei lead ↓ Definire criteri per i lead qualificanti - Creare un nuovo agente DSP dalla pagina Imposta utilizzando il modello Agente lead Nurture preconfigurato. Configurare le impostazioni email e le regole di assegnazione dei lead selezionando l'oggetto Lead o Referente e definendo i criteri di qualificazione (punteggio lead soglia e nuovo lead) per le regole di assegnazione.
- Impostare Agentforce Lead Nurturing configurando l'agente, assegnando le autorizzazioni e impostando la cadenza e le regole di assegnazione.
- Configurare Knowledge necessario per l'agente SDR per rispondere alle domande.
-
Impostare un nuovo flusso per abbonarsi all'evento
AgentGoal__e pubblicato.Crea flusso attivato da evento → Evento Abbonati all'obiettivo agente → Aggiungi azione invocabile agente - Creare un nuovo flusso attivato da evento piattaforma denominato Instrada obiettivi agli agenti.
- Selezionare l'evento Obiettivo agente a cui il flusso deve abbonarsi.
- Impostare un'azione invocabile in Flow Builder e selezionare l'agente Ricerca e qualifica lead.
| L'utente assegna un obiettivo di alto livello | → | L'agente orchestratore crea l'evento | → | Il flusso instrada l'obiettivo all'agente | → | L'agente di ricerca qualifica il lead |
| ↓ | ||||||
| Monitoraggio dell'agente con Analytics | ← | L'agente DSP pianifica la riunione | ← | L'agente DSP inizia il contatto |
- Impostare Chat ottimizzata come punto di ingresso chat del cliente in modo che possa aprire la finestra Agentforce nella pagina Web.
-
Impostare un Agentforce Billing Agent, un agente specializzato headless che può ricevere un ordine o una fattura ed eseguire una richiesta di fatturazione.
Crea agente dal modello → Definizione dell'argomento Richiesta di informazioni sulla fatturazione → Creazione di un'azione di flusso personalizzata → Aggiungi azione all'argomento - Abilitare Agentforce e creare un agente dipendente a partire dal modello Agentforce Employee Agent.
- Definire un argomento, Richiesta di fatturazione, con la descrizione "Indagare sulle discrepanze delle fatture, sui problemi di pagamento e sugli errori di fatturazione".
- Aggiungere un'azione di flusso personalizzata, Controlla discrepanza fattura, con un input di
Numero fattura ,ID cliente eIntervallo di date e un output diAmmontare discrepanza ,Causa principale eTransazioni interessate .
- Aggiungere un'azione di flusso personalizzata, Controlla discrepanza fattura, con un input di
-
Impostare un Agentforce Logistics Agent, un agente specializzato headless in grado di verificare le spedizioni, tenere traccia delle spedizioni e controllare l'inventario.
Crea agente dal modello → Argomento Definisci verifica spedizioni → Creazione di un'azione di flusso personalizzata → Aggiungi azione all'argomento - Abilitare Agentforce e creare un agente dipendente a partire dal modello Agentforce Employee Agent.
- Definire un argomento: Verifica spedizioni, con una descrizione per verificare la spedizione per la fattura.
- Aggiungere un'azione personalizzata Flusso, Verifica dettagli di spedizione, con l'immissione di
Numero fattura ,ID cliente eIntervallo di date e un output diParte spedita ,Data eStato inventario .
- Aggiungere un'azione personalizzata Flusso, Verifica dettagli di spedizione, con l'immissione di
-
Impostare un Agentforce Provisioning Agent, un agente specializzato headless in grado di verificare lo stato del provisioning e del servizio.
Crea agente dal modello → Argomento Definisci controllo del servizio → Creazione di azioni di flusso personalizzate → Aggiungi azione all'argomento - Abilitare Agentforce e creare un agente dipendente a partire dal modello Agentforce Employee Agent.
- Definire un argomento, Controllo del servizio, con una descrizione per verificare la connettività del servizio e lo stato dell'account.
- Aggiungere un'azione di flusso personalizzata, Verifica servizio, con un input di
ID cliente eID asset e un output diStato servizio eMotivo eccezione servizio .
- Aggiungere un'azione di flusso personalizzata, Verifica servizio, con un input di
-
Esporre gli agenti di fatturazione, logistica e provisioning come server A2A e registrarli nel Registro agenti.
Esporre gli agenti tramite MuleSoft → Registrazione degli agenti nel registro - In assenza di supporto A2A diretto sugli agenti Agentforce, i connettori MuleSoft possono essere utilizzati per esporre API agenti come server A2A.
- Registrare questi server A2A nel Registro agenti.
- Utilizzare Anypoint Agent Fabric per l'orchestrazione degli agenti.
- MuleSoft Agent Broker può aiutare a orchestrare qualsiasi agente tra le piattaforme in base alle funzionalità degli agenti menzionate nelle schede degli agenti.
-
Impostare un Agentforce Help Agent, un agente di intelligenza artificiale conversazionale che interagisce con i clienti, valuta la complessità e si coordina con più agenti specializzati per risolvere il problema.
Creazione di un agente dell'assistenza → Definisci argomento di indagine → Azione Crea notifica → Argomento Definizione dell'orchestrazione ↓ Definizione dell'argomento Inoltro al livello superiore ← Azione Crea Crea caso ← Azione Crea agente chiamata ← Creazione di un flusso di orchestrazione agente ↓ Crea flusso Omnicanale → Flusso Connect per l'inoltro al livello superiore - Abilitare Agentforce e creare un agente dell'assistenza in Agentforce Builder per gestire le conversazioni e attivare azioni personalizzate.
- Definire un argomento, Indagine sul servizio, con una descrizione e istruzioni in modo che l'agente riconosca naturalmente un argomento complesso con, in genere, più problemi simultanei.
- Creare azioni agente personalizzate.
- Azione Notifica stato per confermare il problema e fornire aggiornamenti sull'avanzamento
- Creare azioni agente personalizzate.
- Definire un argomento Orchestrazione che può chiamare altri agenti tramite azioni.
- Creare un'azione Chiama agente che chiama un'azione Flusso. L'azione Flusso include diverse azioni agente e può avviare ciascuno degli agenti headless: l'agente fatturazione, l'agente logistico e l'agente provisioning.
- Creare un'azione Crea caso che crea un caso, aggiunge dettagli e imposta lo stato.
- Definire un argomento Inoltro al livello superiore con una descrizione da inoltrare a un agente dell'assistenza.
- Creare e attivare un flusso Omnicanale in uscita.
- Aggiungerlo alla scheda Connessioni dell'agente per l'inoltro al livello superiore con un messaggio di inoltro al livello superiore.
| Agente dell'assistenza Agentforce | → | Broker agente MuleSoft | → | Agente fatturazione come server A2A | → | Agente logistico come server A2A |
| ↓ | ||||||
| L'agente della Guida riceve risposta | ← | Broker aggrega la risposta | ← | Agente procurement come server A2A |
| Il cliente avvia la chat | → | Il cliente segnala più problemi | → | L'agente esamina i dettagli dell'ordine | → | L'orchestratore chiama gli agenti specializzati |
| ↓ | ||||||
| Orchestrator sintetizza il piano di risoluzione | ← | L'agente provisioning rileva un problema | ← | L'agente logistico conferma l'errore | ← | L'agente fatturazione rileva una discrepanza |
| ↓ | ||||||
| L'agente passa al livello superiore all'agente dell'assistenza | → | L'agente dell'assistenza offre la risoluzione | → | L'agente di sistema esegue le operazioni | → | L'agente aggiorna e chiude il caso |
 **Procedimento 1:** **Abilitazione degli strumenti esterni con MCP**
**Problema**
Le organizzazioni utilizzano un mix di ERP legacy e SaaS moderni, ma integrarli con un agente è difficile perché non esiste un protocollo comune: ogni strumento ha le proprie API, autenticazione e modello di dati. Gli sviluppatori finiscono per creare e gestire connettori point-to-point personalizzati per ogni strumento, producendo integrazioni fragili, non scalabili e costose.
**Schema**
L'agente invoca uno strumento esterno (esposto tramite MCP) tramite un'azione strutturata, consentendogli di utilizzare strumenti specializzati al di fuori della piattaforma Salesforce.
**Context**
- L'agente funge da proxy per una serie di strumenti esistenti all'esterno della piattaforma Salesforce.
- Questi strumenti esterni possono avere API, meccanismi di autenticazione e formati di dati diversi.
- È necessario un protocollo di comunicazione standardizzato per consentire un'interazione senza interruzioni tra l'agente e questi strumenti esterni.
- La riutilizzabilità è una preoccupazione fondamentale, poiché gli stessi strumenti esterni possono essere utilizzati da più agenti per scopi diversi.
**Interazioni**
1. **Trigger:** Una richiesta dell'utente o un evento interno in Agentforce richiede l'uso di uno strumento esterno.
2. **Intento di agire:** L'agente Agentforce identifica l'intento e determina che è necessario uno strumento basato su MCP esterno.
3. **Planner (interno):** Il pianificatore Agentforce seleziona lo strumento o l'azione MCP appropriata in base alle istruzioni configurate e agli strumenti disponibili.
4. **Esecuzione:** L'agente Agentforce invia una richiesta compatibile con MCP al server MCP esterno (ad esempio, tramite una chiamata Apex a un endpoint MuleSoft, che quindi viene instradato al server MCP esterno).
5. **Elaborazione esterna:** Il server MCP esterno elabora la richiesta, interagisce con l'applicazione esterna sottostante e prepara una risposta conforme a MCP.
6. **Risultato**: Il server MCP esterno restituisce la risposta all'agente Agentforce.
7. **Seguito:** L'agente Agentforce elabora la risposta, ne aggiorna lo stato interno e continua l'operazione o fornisce un feedback all'utente.
**Scambi**
| Aspetto | Guadagno | Costo |
|---|---|---|
| Flessibilità | Accesso a diverse funzionalità esterne | Sviluppo iniziale per il server MCP/livello di integrazione |
| Modularità | Le funzionalità degli agenti sono disaccoppiate dagli strumenti esterni | Richiede un'attenta progettazione e controllo delle versioni API |
| Scalabilità | Utilizza la scalabilità del sistema esterno | Le prestazioni del sistema esterno diventano una dipendenza |
| Standardization | Protocollo standardizzato (MCP) | Adozione e/o confezionamento |
| Sicurezza | Protezione centralizzata per l'accesso esterno | Gestione delle credenziali e delle policy di accesso per i sistemi esterni |
| Manutenibilità | Gli aggiornamenti degli strumenti esterni non richiedono modifiche degli agenti. MCP può segnalare modifiche | Costo delle modifiche frequenti |
| Aspetto | Guadagno | Costo |
|---|---|---|
| Velocità | Una chiamata strumento | Maggiore sovraccarico di governance |
| Idempotenza e sicurezza | Tentativi sicuri | Implementazione a supporto della deduplica e dell'impotenza |
| Scalabilità | Può scalare facilmente | Overhead di connessione |
| Coerenza | Chiaro ed esplicito | Atomico |
| Sicurezza | Guardrail e politiche possono essere implementati. | Operazione overhead per modificare le policy a catena |
| Osservabilità | Correlazione e controllo sono disponibili per il funzionamento. | Aumento dei costi di telemetria |
| Aspetto | Guadagno | Costo |
|---|---|---|
| Velocità | Una chiamata per più operazioni distribuite | Spese generali di sviluppo e operative |
| Idempotenza e sicurezza | Prove sicure/Supporto SAGA | Complessità |
| Scalabilità | Può scalare facilmente, può essere asincrono | Eventuale coerenza per Asincrono |
| Sicurezza | Policy nel livello API | Operazione overhead per modificare le policy a catena |
| Osservabilità | Correlazione e controllo disponibili per il tracciamento | Aumento dei costi di telemetria |
| Aspetto | Guadagno | Costo |
|---|---|---|
| Movimento dati | Nessuno; copia zero | Calcola costo |
| Latenza | Da giorni o settimane a quasi tempo reale | SLA |
| Scalabilità | Volume di dati illimitato | Calcola costo |
| Aspetto | Guadagno | Costo |
|---|---|---|
| Latenza | Disponibile in pochi secondi | Costo di calcolo e implementazione |
| Accoppiamento | I produttori sono indipendenti dai consumatori. | Più difficile da eseguire debug e tracciamento |
| Scalabilità | Può scalare | Limiti |
| Ordinazione | Creazione contesto incrementale | Arrivo fuori ordine |
| Valore | Approfondimento quasi in tempo reale | Governance e conformità |
| Aspetto | Guadagno | Costo |
|---|---|---|
| Precisione | Higher Trust (risposte basate su citazione) | Gestione e igiene dei documenti |
| Recupero | Gestisce il linguaggio naturale e le parole chiave | Più memoria, sforzo di ottimizzazione |
| Sicurezza | Può imporre l'accesso con privilegi | Overhead di runtime, complessità della cache |
| Suddivisione | Migliore pertinenza | Più pre-elaborazione e ottimizzazione |
| Versioni | Filtra Knowledge superato | Costi di manutenzione e governance |
| Aspetto | Guadagno | Costo |
|---|---|---|
| Precisione | Higher Trust (risposte basate su relazioni verificabili) | Armonizzazione dei dati e attività di modellazione grafica |
| Recupero | Gestisce query relazionali complesse | L'attraversamento dei grafici può essere computazionalmente costoso per i grafici molto grandi |
| Sicurezza | Può imporre l'accesso con privilegi in base alle relazioni | Overhead di runtime, controllo dell'accesso complesso |
| Profondità contesto | Comprensione completa delle entità e delle loro connessioni | Più preelaborazione e ottimizzazione per l'ottimizzazione dei grafici |
| Manutenibilità | Modello di dati centralizzato per le relazioni | Allineamento continuo dei DMO alle esigenze aziendali in continua evoluzione |
| Schemi | Scenario |
|---|---|
| Invocazione processo remoto: richiesta e risposta | Salesforce invoca un processo in un sistema remoto, attende il completamento del processo e quindi tiene traccia dello stato in base alla risposta dal sistema remoto. |
| Invocazione processo remoto: attivazione e dimenticanza | Salesforce invoca un processo in un sistema remoto ma non attende il completamento del processo. Il processo remoto riceve e conferma la richiesta e quindi passa il controllo a Salesforce. |
| Sincronizzazione dati batch | I dati memorizzati in Lightning Platform vengono creati o aggiornati in modo da riflettere gli aggiornamenti di un sistema esterno e quando le modifiche di Lightning Platform vengono inviate a un sistema esterno. Gli aggiornamenti in entrambe le direzioni vengono eseguiti in modo batch. |
| Chiamata remota | I dati memorizzati in Salesforce Platform vengono creati, recuperati, aggiornati o eliminati da un sistema remoto. |
| Aggiornamento dell'interfaccia utente in base alle modifiche dei dati | L'interfaccia utente di Salesforce deve essere aggiornata automaticamente in seguito alle modifiche apportate ai dati Salesforce. |
| Virtualizzazione dei dati | Salesforce accede ai dati esterni in tempo reale. Ciò elimina la necessità di mantenere i dati in Salesforce e quindi di riconciliare i dati tra Salesforce e il sistema esterno. |
| Aspetto | Descrizione |
|---|---|
| Tipo | Specifica lo stile dell'integrazione: Processo, Dati o Virtuale.
|
| Tempistica | Specifica lo stile dell'integrazione: Processo, Dati o Virtuale.
|
| Tipo | Tempistica | Schema chiave da considerare |
|---|---|---|
| Integrazione dei processi | Synchronous | Invocazione processo remoto: richiesta e risposta |
| Integrazione dei processi | Asynchronous | Invocazione processo remoto: attivazione e dimenticanza |
| Integrazione dei dati | Synchronous | Invocazione processo remoto: richiesta e risposta |
| Integrazione dei dati | Asynchronous | Aggiornamento dell'interfaccia utente in base alle modifiche dei dati |
| Integrazione virtuale | Synchronous | Virtualizzazione dei dati |
| Tipo | Tempistica | Schema chiave da considerare |
|---|---|---|
| Integrazione dei processi | Synchronous | Chiamata remota |
| Integrazione dei processi | Asynchronous | Chiamata remota |
| Integrazione dei dati | Synchronous | Chiamata remota |
| Integrazione dei dati | Asynchronous | Sincronizzazione dati batch |
| Termine | Definizione |
|---|---|
| Gestione degli eventi | La gestione degli eventi è la ricezione di un evento identificabile presso un destinatario designato ("handler"). I processi chiave coinvolti nella gestione degli eventi includono:
Tenere presente che l'handler evento può in ultima analisi inoltrare l'evento a un consumatore evento. Gli usi comuni di questa funzione con middleware possono essere estesi per includere la popolare funzionalità "pubblica/abbonati" o "pub/sub". In uno scenario di pubblicazione/abbonamento, il middleware instrada le richieste o i messaggi agli abbonati agli eventi dati attivi dai publisher di eventi dati attivi. Questi consumatori con ascoltatori attivi possono quindi recuperare gli eventi man mano che vengono pubblicati. Nelle integrazioni Salesforce che utilizzano middleware, il livello middleware assume il controllo della gestione degli eventi. Raccoglie tutti gli eventi pertinenti, sincroni o asincroni, e gestisce la distribuzione a tutti gli endpoint, incluso Salesforce. In alternativa, questa funzionalità può essere raggiunta con la piattaforma di messaggistica aziendale Salesforce utilizzando il bus degli eventi con gli eventi piattaforma. |
| Conversione protocollo | La conversione di protocollo è in genere un'applicazione software che converte il protocollo standard o proprietario di un dispositivo nel protocollo adatto a un altro dispositivo per ottenere l'interoperabilità. Nel contesto del middleware, la connettività a un particolare sistema di destinazione può essere limitata dal protocollo. In questi casi, il formato del messaggio deve essere convertito o incapsulato nel formato del sistema di destinazione in cui è possibile estrarre il payload. Questo è anche noto come tunneling. Salesforce non supporta la conversione del protocollo nativo, quindi si presume che tali requisiti siano soddisfatti dal livello middleware o dall'endpoint. |
| Traduzione e trasformazione | La trasformazione è la capacità di mappare un formato di dati a un altro per garantire l'interoperabilità tra i vari sistemi integrati. In genere, il processo prevede la riformattazione dei messaggi in arrivo per soddisfare i requisiti del mittente o del destinatario. In casi più complessi, un'applicazione può inviare un messaggio nel proprio formato nativo e altre due o più applicazioni possono ricevere una copia del messaggio nel proprio formato nativo. Gli strumenti di traduzione e trasformazione middleware spesso includono la possibilità di creare facciate di servizio per endpoint legacy o altri endpoint non standard. Queste facciate di servizio consentono a tali endpoint di apparire indirizzabili al servizio. Con le integrazioni Salesforce, si presuppone che tali requisiti siano soddisfatti dal livello middleware o dall'endpoint. La trasformazione dei dati può essere codificata in Apex, ma non è consigliabile per motivi di manutenzione e prestazioni. |
| Messa in attesa e buffering | L'area di attesa e il buffering in genere si basano sul passaggio di messaggi asincroni, anziché su un'architettura richiesta-risposta. Nei sistemi asincroni, le aree di attesa dei messaggi forniscono memoria temporanea quando il programma di destinazione è occupato o la connettività è compromessa. Inoltre, la maggior parte dei sistemi middleware asincroni fornisce memoria permanente per il backup dell'area di attesa dei messaggi. Il vantaggio principale di un processo di messaggio asincrono è che se l'applicazione del destinatario non riesce per qualsiasi motivo, i mittenti possono continuare senza alcun effetto. I messaggi inviati vengono semplicemente accumulati nell'area di attesa per essere elaborati in seguito quando il destinatario viene riavviato. Salesforce fornisce solo funzionalità di area di attesa esplicita sotto forma di messaggistica in uscita basata sul flusso di lavoro. Per fornire vera area di attesa dei messaggi per altri scenari di integrazione, tra cui orchestrazione, coreografia del processo e qualità del servizio, è necessaria una soluzione middleware. |
| Protocolli di trasporto sincrono | I protocolli di trasporto sincrono si riferiscono a protocolli che supportano attività in cui un "singolo thread del chiamante invia il messaggio di richiesta, blocca l'attesa del messaggio di risposta e quindi elabora la risposta... Il thread di richiesta in attesa della risposta implica che vi sia solo una richiesta in sospeso o che il canale di risposta per questa richiesta sia privato per questo thread". |
| Protocolli di trasporto asincrono | I protocolli di trasporto asincrono si riferiscono ai protocolli che supportano le attività in cui "un thread del chiamante invia il messaggio di richiesta e imposta una richiamata per la risposta. Un thread separato ascolta i messaggi di risposta. Quando arriva un messaggio di risposta, il thread di risposta richiama la richiamata appropriata, che ristabilisce il contesto del chiamante ed elabora la risposta. Questo approccio consente a più richieste in sospeso di condividere un unico thread di risposta". |
| Instradamento della mediazione | L'instradamento della mediazione è la specifica di un "flusso" complesso di messaggi da componente a componente. Ad esempio, molte soluzioni basate su middleware dipendono da un sistema di area di attesa messaggi. Mentre alcune implementazioni consentono di fornire la logica di instradamento dal livello di messaggistica stesso, altre dipendono dalle applicazioni client per fornire informazioni di instradamento o consentire un mix di entrambi i paradigmi. In questi casi complessi, la mediazione da parte del middleware semplifica lo sviluppo, l'integrazione e la convalida. L'ordinatore [Mediatore] può assicurarsi che il messaggio giusto arrivi al consumatore giusto." |
| Coreografia del processo e orchestrazione del servizio | La coreografia del processo e l'orchestrazione del servizio sono tutte forme di "composizione del servizio" in cui vengono coordinati un numero qualsiasi di endpoint e funzionalità.
La differenza tra coreografia e orchestrazione di servizio è:
Porzioni delle coreografie dei processi aziendali possono essere create nei flussi di lavoro Salesforce o utilizzando Apex. Si consiglia di implementare tutte le orchestrazioni complesse nel livello middleware a causa dei valori di timeout di Salesforce e dei limiti del governor, soprattutto nelle soluzioni che richiedono una vera gestione delle transazioni. |
| Transazionalità (crittografia, firma, consegna affidabile, gestione delle transazioni) | La transazionalità può essere definita come la capacità di supportare transazioni globali che comprendono tutte le operazioni necessarie per ogni risorsa richiesta. La transazionalità implica il supporto di tutte e quattro le proprietà ACID, atomicità, coerenza, isolamento, durata, dove l'atomicità garantisce risultati "tutto o niente" per l'unità di lavoro (transazione).
Benché Salesforce sia transazionale di per sé, non è in grado di partecipare a transazioni distribuite o avviate all'esterno di Salesforce. Pertanto, si presume che per le soluzioni che richiedono transazioni multi-sistema complesse, la transazionalità e i meccanismi di ritiro/compensazione associati siano implementati a livello middleware. |
| Instradamento | L'instradamento può essere definito come la specifica del flusso complesso di messaggi da componente a componente. Nelle moderne soluzioni basate sui servizi, tali flussi di messaggi possono essere basati su una serie di criteri, tra cui intestazione, tipo di contenuto, regola e priorità.
Con le integrazioni Salesforce, si presuppone che tali requisiti siano soddisfatti dal livello middleware o dall'endpoint. L'instradamento dei messaggi può essere codificato in Apex, ma non è consigliabile per motivi di manutenzione e prestazioni. |
| Estrazione, trasformazione e caricamento | Estrazione, trasformazione e caricamento (ETL) si riferisce a un processo che prevede:
Salesforce ora supporta anche Acquisizione dati di modifica, ovvero la pubblicazione di eventi di modifica che rappresentano modifiche ai record Salesforce. Con Acquisizione dati di modifica, il sistema client o esterno riceve le modifiche quasi in tempo reale dei record Salesforce. Con queste informazioni, il client o il sistema esterno può sincronizzare i record corrispondenti in un archivio dati esterno. |
| Sondaggio lungo | Il long polling, detto anche programmazione Comet, emula un push di informazioni da un server a un client. Come in un normale sondaggio, il client si connette e richiede informazioni al server. Tuttavia, anziché inviare una risposta vuota se le informazioni non sono disponibili, il server mantiene la richiesta e attende che le informazioni siano disponibili (si verifica un evento). Il server invia quindi una risposta completa al client. Il cliente richiede immediatamente le informazioni. Il client mantiene continuamente una connessione al server, quindi è sempre in attesa di ricevere una risposta. Se il server scade, il client si connette di nuovo e ricomincia. L'API Streaming Salesforce utilizza il protocollo Bayeux e CometD per il polling lungo.
|
| Soluzione | Adatta | Commenti |
|---|---|---|
| Servizi esterni invoca una chiamata API REST | Best | Servizi esterni consente di invocare un servizio ospitato esternamente in modo dichiarativo (non è richiesto alcun codice). Questa funzione è particolarmente indicata quando sono soddisfatte le seguenti condizioni:
|
| Salesforce Lightning: il componente o la pagina Lightning avvia una chiamata Apex REST o SOAP sincrona.</ Se l'endpoint remoto presenta un rischio di risposta con latenza elevata (vedere la documentazione sui limiti più recenti per i limiti applicabili qui), si consiglia di eseguire una chiamata asincrona, detta anche continuazione, per evitare di superare i limiti del regolatore di transazioni Apex sincrono. |
Best | Salesforce consente di utilizzare un WSDL e generare una classe Apex proxy risultante. Questa classe fornisce la logica necessaria per chiamare il servizio remoto. Salesforce consente anche di invocare i servizi HTTP (REST) utilizzando i metodi GET, POST, PUT e DELETE standard. Un'azione avviata dall'utente in una pagina Lightning chiama quindi un'azione del controller Apex che esegue questa classe Apex proxy per eseguire la chiamata remota. Le pagine Lightning richiedono la personalizzazione dell'applicazione Salesforce. |
| Un trigger sincrono richiamato dalle modifiche dei dati Salesforce esegue una chiamata Apex SOAP o HTTP asincrona. | Non ottimale | È possibile utilizzare i trigger Apex per eseguire l'automazione in base alle modifiche dei dati dei record. Una classe proxy Apex può essere eseguita come risultato di un'operazione DML utilizzando un trigger Apex. Tuttavia, tutte le chiamate effettuate dal contesto trigger devono essere eseguite in modo asincrono dall'evento di avvio. Pertanto, questa soluzione non è consigliata per questo problema di integrazione. Questa soluzione è più adatta per lo schema Remote Process Invocation — Fire and Forget. |
| Un processo batch Apex esegue una chiamata Apex SOAP o HTTP sincrona. | Non ottimale | È possibile effettuare chiamate a un sistema remoto da un processo batch. Questa soluzione consente l'esecuzione e l'elaborazione in batch della risposta dal sistema remoto in Salesforce. Tuttavia, un determinato batch ha dei limiti al numero di chiamate. Per ulteriori informazioni, vedere Limitazioni dei governanti. Una determinata esecuzione batch può eseguire più contesti di transazione (in genere a intervalli di 200 record). I limiti del governor vengono reimpostati in base al contesto della transazione. |
 Scarica diagramma
In questo scenario: - Viene avviata un'azione nella pagina Lightning (ad esempio, un clic su un pulsante). - Il browser (tramite un controller lato client nel caso di un componente Lightning) esegue un POST HTTP che a sua volta esegue un'azione sul controller Apex corrispondente. - Il controller richiama la chiamata effettiva al servizio Web remoto. - La risposta dal sistema remoto viene restituita al controller Apex. Il controller elabora la risposta, aggiorna i dati in Salesforce in base alle esigenze e visualizza nuovamente la pagina. Nei casi in cui è necessario tenere traccia dello stato successivo, il sistema remoto restituisce un identificatore univoco memorizzato nel record Salesforce. **Risultati** L'applicazione delle soluzioni correlate a questo schema consente le invocazioni di processi remoti avviate da eventi in cui Salesforce gestisce l'elaborazione. **Meccanismi di chiamata** Il meccanismo di chiamata dipende dalla soluzione scelta per implementare questo schema.
| Meccanismo di chiamata | Descrizione |
|---|---|
| Servizio esterno ottimizzato incorporato in un flusso o Componente Lightning o Controller Apex |
Utilizzato quando il processo remoto viene attivato nell'ambito di un processo end-to-end che coinvolge l'interfaccia utente e il risultato deve essere visualizzato o aggiornato in un record Salesforce. Ad esempio, l'invio di un pagamento con carta di credito a un gateway di pagamento esterno e i risultati del pagamento vengono immediatamente restituiti e visualizzati all'utente. |
| Trigger Apex | Utilizzato principalmente per invocare processi remoti utilizzando chiamate Apex da eventi avviati da DML. Per ulteriori informazioni su questo meccanismo di chiamata, vedere Schema Remote Process Invocation — Fire and Forget. |
| Classi batch Apex | Utilizzato per invocare processi remoti in batch. Per ulteriori informazioni su questo meccanismo di chiamata, vedere Schema Remote Process Invocation — Fire and Forget. |
| Soluzione | Considerazioni sugli endpoint |
|---|---|
| Chiamate HTTP Apex | L'endpoint deve essere in grado di ricevere chiamate HTTP. Salesforce deve essere in grado di accedere all'endpoint tramite Internet pubblico. Per le comunicazioni private e protette, Salesforce ha ora iniziato a supportare anche Salesforce Private Connect tramite la piattaforma Hyperforce in modo sicuro. Per ulteriori dettagli, vedere Salesforce Private Connect.
È possibile utilizzare le chiamate HTTP Apex per chiamare i servizi REST utilizzando i metodi GET, POST, PUT, DELETE e PATCH standard. |
| Chiamate SOAP Apex | L'endpoint deve essere in grado di ricevere chiamate HTTP. Salesforce deve essere in grado di accedere all'endpoint tramite Internet pubblico. Per le comunicazioni private e protette, Salesforce ha ora iniziato a supportare anche Salesforce Private Connect tramite la piattaforma Hyperforce in modo sicuro. Per ulteriori dettagli, vedere Salesforce Private Connect.
Questa soluzione richiede che il sistema remoto sia compatibile con gli standard supportati da Salesforce. Al momento della scrittura, gli standard dei servizi Web supportati da Salesforce per le chiamate SOAP Apex sono:
|
- Salesforce memorizza la chiave surrogata principale o univoca del sistema remoto per il record remoto.
- Il sistema remoto memorizza l'ID record univoco Salesforce o un'altra chiave surrogata univoca.
| Master | Sistema Descrizione |
|---|---|
| Salesforce | Il sistema remoto memorizza il RecordId Salesforce o un'altra chiave surrogata univoca del record. |
| Sistema remoto | La chiamata al processo remoto restituisce la chiave univoca dell'applicazione e Salesforce memorizza il valore della chiave in un campo record univoco. |
- Orchestrazione di processi aziendali e regole che comportano una logica di flusso complessa
- Aggregazione delle chiamate e dei relativi risultati nelle chiamate a più sistemi
- Trasformazione dei messaggi in entrata e in uscita
- Mantenere l'integrità delle transazioni tra le chiamate a più sistemi
| Proprietà | Obbligatorio | Auspicabile | Non richiesto |
|---|---|---|---|
| Gestione degli eventi | X | ||
| Conversione protocollo | X | ||
| Traduzione e trasformazione | X | ||
| Messa in attesa e buffering | X | ||
| Protocolli di trasporto sincrono | X | ||
| Protocolli di trasporto asincrono | X | ||
| Instradamento della mediazione | X | ||
| Coreografia del processo e orchestrazione del servizio | X | ||
| Transazionalità (crittografia, firma, consegna affidabile, gestione delle transazioni) | X | ||
| Instradamento | X | ||
| Estrazione, trasformazione e caricamento | X | ||
| polling lungo | X |
- Salesforce utilizza il servizio account di fatturazione WSDL da una classe proxy Apex.
- Eseguire la classe proxy Apex con le informazioni sul cliente passate al servizio Web esterno da un controller Apex personalizzato o da un servizio esterno.
- Il controller personalizzato analizza quindi i valori restituiti dalla chiamata Apex e memorizza tali informazioni nell'oggetto Salesforce.
- Lo stato del cliente viene tracciato con un numero di account memorizzato nell'oggetto account Salesforce.
- Elaborazione successiva del messaggio di risposta da parte del chiamante
- La chiamata al sistema remoto richiede che Salesforce attenda una risposta prima di continuare l'elaborazione? La chiamata al sistema remoto è sincrona o asincrona?
- Se la chiamata al sistema remoto è sincrona, la risposta deve essere elaborata da Salesforce nell'ambito della stessa transazione della chiamata?
- Le dimensioni del messaggio sono piccole?
- L'integrazione si basa sul verificarsi di un evento specifico, ad esempio un clic su un pulsante nell'interfaccia utente di Salesforce, o di eventi basati su DML?
- La consegna garantita dei messaggi da Salesforce al sistema remoto è un requisito?
- Il sistema remoto è in grado di partecipare a un'integrazione contract-first in cui Salesforce specifica il contratto? In alcune varianti di soluzione (ad esempio, messaggistica in uscita), Salesforce specifica un contratto implementato dall'endpoint di sistema remoto.
- L'endpoint o l'Enterprise Service Bus (ESB) supporta il polling lungo?
- I metodi di configurazione dichiarativi sono preferiti allo sviluppo Apex personalizzato? In questo caso, soluzioni come gli eventi piattaforma sono preferite alle chiamate Apex.
| Soluzione | Adatta | Commenti |
|---|---|---|
| Eventi piattaforma basati sui flussi | Best | Creare flussi in modo dichiarativo per implementare gli eventi piattaforma. La soluzione consigliata è quando il processo remoto viene richiamato da un evento di inserimento o aggiornamento. Gli eventi piattaforma sono i messaggi di evento (o notifiche) che le app inviano e ricevono per intraprendere ulteriori azioni. Gli eventi piattaforma semplificano il processo di comunicazione delle modifiche e di risposta senza scrivere logica complessa. Uno o più abbonati possono ascoltare lo stesso evento ed eseguire azioni. Ad esempio, un sistema software può inviare eventi contenenti informazioni sulle cartucce di inchiostro della stampante. Gli abbonati possono abbonarsi agli eventi per monitorare i livelli di inchiostro della stampante ed effettuare ordini per sostituire le cartucce con bassi livelli di inchiostro. Le app esterne possono ascoltare i messaggi degli eventi abbonandosi a un canale tramite CometD. Le app piattaforma, ad esempio i componenti Lightning, possono abbonarsi ai messaggi di evento anche con CometD. L'API Salesforce PubSub basata su gRPC e HTTP/2 può essere utilizzata anche qui. Salesforce supporta anche i flussi attivati da eventi piattaforma, che consentono di creare un listener utilizzando l'interfaccia di Flow Builder. Questo tipo di flusso viene avviato automaticamente quando viene pubblicato un messaggio evento piattaforma specifico in Salesforce Event Bus. |
| API Pub/Sub | Best | L'API Pub/Sub è il modo consigliato per i consumatori esterni di utilizzare gli eventi sul bus degli eventi. API Pub/Sub basata su gRPC:
Una volta definito in Salesforce, un evento piattaforma diventa disponibile sia per i consumatori interni che esterni. |
| Modifica acquisizione dati | Best | Acquisizione dati di modifica (CDC) pubblica gli eventi per le modifiche nei record Salesforce corrispondenti alle operazioni di creazione, aggiornamento, eliminazione e annullamento dell'eliminazione. L'abilitazione dell'acquisizione dati di modifica (CDC) in Salesforce è un processo puramente dichiarativo che non richiede Apex Code. I messaggi di notifica vengono inviati al bus degli eventi a cui i client possono abbonarsi utilizzando l'API Pub/Sub o i trigger Apex. I sistemi basati sugli eventi semplificano la comunicazione tra i sistemi aziendali distribuiti, aumentano la scalabilità e forniscono dati in tempo reale. Ad esempio, se le informazioni sull'ordine si trovano sia nel sistema ERP che in Salesforce, è possibile trasmettere gli eventi di modifica ordine da Salesforce a un'app di integrazione. L'app sincronizza quindi le modifiche nel sistema ERP |
| Procedure di integrazione OmniStudio | Bene | Utilizzare le procedure di integrazione OmniStudio per automatizzare in modo dichiarativo le interazioni dei dati tra Salesforce e le applicazioni esterne di terze parti. Le procedure di integrazione gestiscono trasformazioni dati complesse, chiamate API e automazione basata sugli eventi e possono eseguire più azioni in una singola chiamata al server. Utilizzare le procedure di integrazione quando non è richiesta alcuna interazione dell'utente durante l'esecuzione e si desidera:
Ulteriori dettagli sulle procedure di integrazione sono disponibili qui. |
| Eventi piattaforma basati sulla personalizzazione | Bene | Simile agli eventi piattaforma basati sui flussi, ma gli eventi vengono creati da trigger Apex o classi. È possibile pubblicare e utilizzare gli eventi piattaforma utilizzando Apex o un'API. Gli eventi piattaforma si integrano con Salesforce Platform tramite trigger Apex. I trigger sono i consumatori di eventi della piattaforma Salesforce che ascoltano i messaggi degli eventi. Quando un'applicazione esterna utilizza l'API o un'applicazione Salesforce nativa utilizza Apex per pubblicare il messaggio di evento, viene attivato un trigger per quell'evento. I trigger eseguono le azioni in risposta alle notifiche degli eventi. |
| Messaggistica in uscita basata sui flussi | Adatta | La soluzione consigliata per questo tipo di integrazione è quando il processo remoto viene richiamato da un evento di inserimento o aggiornamento. Salesforce fornisce una funzionalità di messaggistica in uscita basata sul flusso che consente di inviare messaggi SOAP a sistemi remoti attivati da un'operazione di inserimento o aggiornamento in Salesforce. Questi messaggi vengono inviati in modo asincrono e sono indipendenti dall'interfaccia utente di Salesforce. Il messaggio in uscita viene inviato a un endpoint remoto specifico. Il servizio remoto deve essere in grado di partecipare a un'integrazione contract-first in cui Salesforce fornisce il contratto. Al ricevimento del messaggio, se il servizio remoto non risponde con una conferma positiva, Salesforce tenta nuovamente di inviare il messaggio, fornendo una forma di consegna garantita. |
| Componente Lightning personalizzato che avvia una chiamata asincrona Apex SOAP o HTTP | Non ottimale | Questa soluzione viene in genere utilizzata negli scenari basati sull'interfaccia utente, ma richiede una personalizzazione. Inoltre, la soluzione deve gestire la consegna garantita del messaggio nel codice. Analogamente alla soluzione per lo schema Remote Process Invocation — Request and Reply che specifica l'utilizzo di un componente Lightning, insieme a una chiamata Apex. La differenza è che in questo schema Salesforce non attende il completamento della richiesta prima di passare il controllo all'utente. Dopo aver ricevuto il messaggio, il sistema remoto risponde e indica la ricezione del messaggio, quindi elabora il messaggio in modo asincrono. Il sistema remoto controlla di nuovo Salesforce prima di iniziare a elaborare il messaggio; pertanto, Salesforce non deve attendere il completamento dell'elaborazione. |
| Trigger Apex per effettuare chiamate asincrone Apex SOAP o HTTP | Non ottimale | È possibile utilizzare i trigger Apex per eseguire l'automazione in base alle modifiche dei dati dei record. Una classe proxy Apex può essere eseguita come risultato di un'operazione DML utilizzando un trigger Apex. Tuttavia, tutte le chiamate effettuate dal contesto del trigger devono essere eseguite in modo asincrono. |
| Trigger Apex per effettuare chiamate asincrone Apex SOAP o HTTP | Non ottimale | Le chiamate a un sistema remoto possono essere eseguite da un processo batch. Questa soluzione consente l'esecuzione di processi batch remoti e l'elaborazione della risposta dal sistema remoto in Salesforce. Tuttavia, esistono limiti al numero di chiamate per un determinato contesto batch. Per ulteriori informazioni, vedere il Riferimento rapido Salesforce Developer Limits and Allocations.
|
 Scarica diagramma
In questo scenario:
- Un sistema remoto si abbona all'evento piattaforma.
- Viene eseguito un aggiornamento o un inserimento in un determinato insieme di record in Salesforce.
- Un flusso Salesforce viene attivato quando viene soddisfatta una serie di condizioni.
- Questo flusso crea un evento piattaforma.
- L'ascoltatore remoto riceve il messaggio di evento e lo inserisce in un'area di attesa locale.
- L'applicazione di area di attesa inoltra il messaggio all'applicazione remota per l'elaborazione.
- Interfaccia utente: chiamate a processi remoti avviate dall'interfaccia utente in cui il risultato della transazione può essere visualizzato all'utente finale
- Chiamate a processi remoti avviate da eventi DML in cui il risultato della transazione può essere elaborato dal processo chiamante
| Meccanismo di chiamata | Descrizione |
|---|---|
| Flusso | Utilizzato sia dalle soluzioni basate sui processi che sulle personalizzazioni. Gli eventi attivano il processo Salesforce, che può quindi pubblicare un evento piattaforma per l'abbonamento da un sistema remoto. |
| API Pub / Sub | L'API Pub/Sub offre un'unica interfaccia per la pubblicazione e l'abbonamento agli eventi piattaforma, inclusi gli eventi di monitoraggio degli eventi in tempo reale e gli eventi di acquisizione dati di modifica. Basata su gRPC e HTTP/2, l'API Pub/Sub pubblica e fornisce in modo efficiente messaggi di eventi binari nel formato Apache Avro. |
| Modifica acquisizione dati | Acquisizione dati di modifica Salesforce pubblica gli eventi di modifica, che rappresentano le modifiche ai record Salesforce. Le modifiche includono la creazione di un nuovo record, gli aggiornamenti di un record esistente, l'eliminazione di un record e l'annullamento dell'eliminazione di un record. |
| Componente Lightning e controller Apex | Utilizzato per invocare un processo remoto in modo asincrono utilizzando una chiamata Apex. |
| Messaggistica in uscita basata sul flusso | Utilizzato solo per la soluzione di messaggistica in uscita. Gli eventi DML di creazione e aggiornamento attivano le regole di flusso di lavoro di Salesforce, che possono quindi inviare un messaggio a un sistema remoto. |
| Trigger Apex | Utilizzato per eventi piattaforma basati su trigger e invocazione di processi remoti, utilizzando chiamate Apex da eventi avviati da DML. |
| Classi batch Apex | Utilizzato per invocare processi remoti in modalità batch. |
| Soluzione | Gestione degli errori e strategia di ripristino |
|---|---|
| Flusso |
|
| Chiamate Apex |
|
| Acquisizione dati di modifica (CDC) / Eventi piattaforma |
|
| Soluzione | Considerazioni sulla sicurezza |
|---|---|
| Chiamate Apex | Una chiamata a un sistema remoto deve mantenere la riservatezza, l'integrità e la disponibilità della richiesta. Di seguito sono riportate considerazioni sulla sicurezza specifiche per l'utilizzo di chiamate Apex SOAP e HTTP in questo schema.
|
| Acquisizione dati di modifica (CDC) / Eventi piattaforma | Per gli eventi piattaforma, il sistema esterno abbonato deve essere in grado di eseguire l'autenticazione in Salesforce Streaming API. Gli eventi piattaforma sono conformi al modello di sicurezza esistente configurato nell'organizzazione Salesforce. Per abbonarsi a un evento, l'utente deve disporre dell'accesso in lettura all'entità evento. Per pubblicare un evento, l'utente deve disporre dell'autorizzazione "Crea" per l'entità evento. |
| Soluzione | Considerazioni sugli endpoint |
|---|---|
| Chiamate SOAP Apex | L'endpoint deve essere in grado di elaborare una chiamata al servizio Web tramite HTTP. Salesforce deve essere in grado di accedere all'endpoint tramite Internet pubblico. Questa soluzione richiede che il sistema remoto sia compatibile con gli standard supportati da Salesforce. Al momento della scrittura, gli standard dei servizi Web supportati da Salesforce per le chiamate SOAP Apex sono:
|
| Chiamate HTTP Apex | L'endpoint deve essere in grado di ricevere chiamate HTTP ed essere accessibile su Internet pubblico da Salesforce. Le chiamate HTTP Apex possono essere utilizzate per chiamare servizi RESTful utilizzando i metodi GET, POST, PUT e DELETE standard. |
| Acquisizione dati di modifica (CDC) / Eventi piattaforma |
|
- Salesforce memorizza la chiave surrogata principale o univoca del sistema remoto per il record remoto.
- Il sistema remoto memorizza l'ID record univoco Salesforce o un'altra chiave surrogata univoca.
| Master | Sistema Descrizione |
|---|---|
| Salesforce | Il sistema remoto deve memorizzare Salesforce RecordId o un'altra chiave surrogata univoca nel record Salesforce. |
| Sistema remoto | Salesforce deve memorizzare un riferimento all'identificatore univoco nel sistema remoto. Poiché il processo è asincrono, la memorizzazione di questo identificatore univoco non può far parte della transazione originale. Salesforce deve fornire un ID univoco nella chiamata al processo remoto. Il sistema remoto deve quindi richiamare Salesforce per aggiornare il record in Salesforce con l'identificatore univoco del sistema remoto, utilizzando l'ID univoco Salesforce. La richiamata implica una gestione specifica dello stato nell'applicazione remota per memorizzare l'identificatore univoco Salesforce per quella transazione da utilizzare per la richiamata al termine dell'elaborazione, oppure l'identificatore univoco Salesforce viene memorizzato nel record del sistema remoto. |
| Soluzione | Considerazioni |
|---|---|
| Chiamate Apex | In alcuni casi, le soluzioni prescritte da questo schema richiedono l'implementazione di diversi scenari di integrazione complessi meglio serviti utilizzando middleware o facendo in modo che Salesforce chiami un servizio composito. Questi scenari includono:
|
| Acquisizione dati di modifica (CDC) / Eventi piattaforma | Data la natura statica e dichiarativa degli eventi, in Salesforce non è possibile eseguire scenari di integrazione complessi come aggregazione, orchestrazione o trasformazione. Il sistema remoto o il middleware deve gestire questi tipi di operazioni. |
| Procedure di integrazione OmniStudio | Le procedure di integrazione (OmniStudio) offrono un'orchestrazione stateless lato server per coordinare più servizi di back-end durante l'esecuzione di trasformazioni dati complesse e dichiarative. Procedure di integrazione concatena fasi come Azioni HTTP, Estrazione/Trasformazione/Caricamento di DataRaptor, Imposta valori, Loop/If e ricerche a matrice per normalizzare, arricchire, aggregare e mappare i payload tra i contratti dell'interfaccia utente e le diverse API. Supportano controlli di runtime efficaci come la ramificazione condizionale, la paginazione, i timeout, i tentativi, la gestione parziale degli errori e il continuo errore, nonché ottimizzazioni delle prestazioni come il caching lato server e la definizione della risposta. Gli IP possono essere richiamati in modo sincrono da OmniScript o headless tramite REST, abilitando "facciate di integrazione" riutilizzabili e con versione che nascondono la complessità back-end dai canali. |
| Soluzione | Considerazioni sulla messaggistica affidabile |
|---|---|
| Chiamate Apex | Salesforce non fornisce un supporto esplicito per protocolli di messaggistica affidabili (ad esempio, WS-ReliableMessaging). È consigliabile che l'endpoint remoto che riceve il messaggio Salesforce implementi un sistema di messaggistica affidabile, ad esempio JMS o MQ. Questo sistema garantisce la consegna completa end-to-end garantita al sistema remoto che elabora il messaggio. Tuttavia, questo sistema non garantisce la consegna garantita da Salesforce all'endpoint remoto che chiama. La consegna garantita deve essere gestita tramite le personalizzazioni in Salesforce. Devono essere implementate tecniche specifiche, ad esempio l'elaborazione di una conferma positiva dall'endpoint remoto, oltre alla logica di tentativo personalizzata. |
| Acquisizione dati di modifica (CDC) / Eventi piattaforma | Eventi piattaforma tenta di fornire una messaggistica affidabile mantenendo temporaneamente i messaggi di evento nel bus degli eventi. Gli abbonati possono recuperare i messaggi degli eventi mancati riproducendo i messaggi dal bus degli eventi utilizzando il Replay ID dei messaggi degli eventi. Il bus degli eventi è un sistema distribuito e non offre le stesse garanzie di un database transazionale. Di conseguenza, Salesforce non è in grado di fornire una risposta sincrona per una richiesta di pubblicazione evento. Gli eventi vengono inseriti in area di attesa e bufferizzati e Salesforce tenta di pubblicarli in modo asincrono. In rari casi, il messaggio di evento potrebbe non essere mantenuto nel sistema distribuito durante i tentativi iniziali o successivi. Ciò significa che gli eventi non vengono consegnati agli abbonati e non sono recuperabili. |
| Proprietà | Obbligatorio | Auspicabile | Non richiesto |
|---|---|---|---|
| Gestione degli eventi | X | ||
| Conversione protocollo | X | ||
| Traduzione e trasformazione | X | ||
| Messa in attesa e buffering | X | ||
| Protocolli di trasporto sincrono | X | ||
| Protocolli di trasporto asincrono | X | ||
| Instradamento della mediazione | X | ||
| Coreografia del processo e orchestrazione del servizio | X | ||
| Transazionalità (crittografia, firma, consegna affidabile, gestione delle transazioni) | X | ||
| Instradamento | X | ||
| Estrazione, trasformazione e caricamento | X | ||
| polling lungo | X (obbligatorio per gli eventi piattaforma) |
- Pubblica dopo l'impegno per fare in modo che il messaggio dell'evento venga pubblicato solo dopo che una transazione è stata confermata correttamente. Selezionare questa opzione se gli abbonati si basano sui dati confermati dalla transazione di pubblicazione. Ad esempio, un processo pubblica un messaggio di evento e crea un record operazione. Viene attivato un secondo processo abbonato all'evento che prevede di trovare il record operazione. Un altro motivo per scegliere questo comportamento è quando non si desidera che il messaggio di evento venga pubblicato se la transazione non riesce.
- Pubblica immediatamente per fare in modo che il messaggio di evento venga pubblicato quando viene eseguita la chiamata di pubblicazione. Selezionare questa opzione se si desidera che il messaggio dell'evento venga pubblicato indipendentemente dal fatto che la transazione abbia esito positivo. Scegliere anche questa opzione se il publisher e gli abbonati sono indipendenti e gli abbonati non si basano sui dati confermati dal publisher. Ad esempio, il comportamento di pubblicazione immediata è adatto a un evento utilizzato per la registrazione. Con questa opzione, un abbonato potrebbe ricevere il messaggio di evento prima che i dati vengano confermati dalla transazione publisher.
- Solo lo sviluppo dichiarativo può essere implementato.
- Non è necessaria una notifica immediata del numero d'ordine dopo che l'opportunità è stata convertita in ordine.
- L'organizzazione dispone di un ESB che supporta il protocollo CometD ed è in grado di abbonarsi agli eventi piattaforma.
- Creare un flusso per avviare l'evento piattaforma (ad esempio, quando lo stato dell'opportunità diventa Chiusa-conseguita).
- Creare un nuovo evento piattaforma che pubblica i dettagli dell'opportunità.
- L'ESB si abbona all'evento piattaforma Salesforce utilizzando il protocollo CometD.
- L'ESB riceve una o più notifiche che indicano che l'opportunità deve essere convertita in ordine.
- L'ESB inoltra il messaggio al sistema ERP di back-end in modo che l'ordine possa essere creato.
- Dopo che l'ordine è stato creato nel sistema ERP, un thread separato richiama Salesforce utilizzando SessionId come token di autenticazione. La richiamata aggiorna l'opportunità con il numero d'ordine e lo stato. È possibile eseguire questa richiamata utilizzando soluzioni basate su schemi documentati, ad esempio eventi piattaforma Salesforce, API SOAP Salesforce, API REST o un servizio Web Apex.
- Implementazione di un processo remoto invocato in modo asincrono
- Consegna garantita end-to-end
- Richiamata successiva a Salesforce per aggiornare lo stato del record
- Estrarre e trasformare account, referenti e opportunità dal sistema CRM corrente e caricare i dati in Salesforce (importazione dati iniziale).
- Estrarre, trasformare e caricare i dati di fatturazione dei clienti in Salesforce da un sistema remoto su base settimanale (in corso).
- Estrarre le informazioni sulle attività dei clienti da Salesforce e importarle in un data warehouse locale su base settimanale (in corso).
- I dati devono essere memorizzati in Salesforce? In caso contrario, esistono altre opzioni di integrazione che un architetto può e deve considerare (ad esempio, i mashup).
- Se i dati devono essere archiviati in Salesforce, è necessario aggiornarli in risposta a un evento nel sistema remoto?
- I dati devono essere aggiornati su base pianificata?
- I dati supportano i processi aziendali principali?
- Esistono requisiti di analisi (reportistica) che risentono della disponibilità di questi dati in Salesforce?
| Soluzione | Adatta | Master di dati | Commenti |
|---|---|---|---|
| Replica tramite strumento ETL di terze parti | Best | Sistema remoto | Quando un sistema esterno deve inviare una grande quantità di dati a Salesforce, utilizzare uno strumento ETL di terze parti che consente di eseguire l'acquisizione dati di modifica rispetto ai dati di origine. Lo strumento reagisce alle modifiche nella serie di dati di origine, trasforma i dati e quindi chiama l'API in blocco Salesforce per emettere istruzioni DML. Questo può essere implementato anche utilizzando le API REST Salesforce se il numero di record è inferiore. |
| Replica tramite strumento ETL di terze parti | Bene | Salesforce | Sfruttare uno strumento ETL di terze parti che consente di eseguire acquisizione dati di modifica con le serie di dati ERP e Salesforce. In questa soluzione, Salesforce è la fonte di dati ed è possibile utilizzare le informazioni sull'ora/lo stato sulle singole righe per eseguire query sui dati e filtrare l'insieme di risultati di destinazione. Questo può essere implementato utilizzando l'API in blocco 2.0 o le API REST standard (se il numero di record è minore). |
| Importazione guidata dati e Data Loader | Adatta | Salesforce / Sistema esterno | Importazione guidata dati e Data Loader possono essere utilizzati per importare, esportare e migrare i dati. Benché i comandi di Data Loader possano anche essere scriptati per automatizzare l'importazione e l'esportazione dei dati, l'interfaccia della riga di comando è solo per Windows. Nessuno di questi due strumenti è una base consigliata per una strategia di integrazione dei dati. Dovrebbero invece integrare la strategia di gestione e manutenzione dei dati. Per ulteriori informazioni su Data Loader, vedere qui. |
| Chiamata remota | Non ottimale | Sistema remoto | È possibile che un sistema remoto chiami in Salesforce utilizzando una delle API ed esegua aggiornamenti ai dati non appena si verificano. Tuttavia, ciò causa un notevole traffico continuo tra i due sistemi. È opportuno porre maggiore enfasi sulla gestione e il blocco degli errori. Questo schema può causare aggiornamenti continui, con possibili conseguenze sulle prestazioni per gli utenti finali. |
| Chiamata processo remoto | Non ottimale | Salesforce | È possibile che Salesforce chiami in un sistema remoto ed esegua aggiornamenti ai dati non appena si verificano. Tuttavia, ciò causa un notevole traffico continuo tra i due sistemi. È opportuno porre maggiore enfasi sulla gestione e il blocco degli errori. Questo schema può causare aggiornamenti continui, con possibili conseguenze sulle prestazioni per gli utenti finali. |
 Scarica diagramma
Il diagramma seguente illustra la successiva sincronizzazione degli eventi quasi in tempo reale, in cui Salesforce è il master dei dati.
 **Risultati**
È possibile integrare i dati provenienti dall'esterno con Salesforce nei seguenti scenari:
- Il sistema esterno è il master dei dati: Salesforce è un consumatore di dati forniti da un singolo sistema di origine o da più sistemi. In questo scenario, è comune avere un data warehouse o un data mart che aggrega i dati prima che i dati vengano importati in Salesforce.
- Salesforce è il master dei dati: Salesforce è il sistema di registrazione di determinate entità e le applicazioni client Acquisizione dati di modifica Salesforce possono essere informate delle modifiche ai dati Salesforce.
- Implementare l'acquisizione dati di modifica nella serie di dati di origine.
- Implementare una serie di strutture di database di supporto, dette tabelle di controllo, in un database locale intermedio.
- Leggere una tabella di controllo per determinare l'ultimo tempo di esecuzione del processo ed estrarre eventuali altri valori di controllo necessari.
- Utilizzare i valori di controllo indicati sopra come filtri ed eseguire query sulla serie di dati di origine.
- Applicare regole di elaborazione predefinite, tra cui convalida, arricchimento e così via.
- Utilizzare i connettori/le funzionalità di trasformazione disponibili dello strumento ETL per creare la serie di dati di destinazione.
- Scrivere la serie di dati negli oggetti Salesforce.
- Se l'elaborazione ha esito positivo, aggiornare i valori di controllo nella tabella di controllo.
- Se l'elaborazione non riesce, aggiornare le tabelle di controllo con valori che consentono il riavvio e l'uscita.
- Concatenare e mettere in sequenza i processi ETL per offrire un processo coerente.
- Utilizzare le chiavi principali di entrambi i sistemi per abbinare i dati in entrata.
- Utilizzare metodi API specifici per estrarre solo i dati aggiornati.
- Se si importano record controllati in una relazione record principale-record dettaglio o di ricerca, raggruppare i dati importati utilizzando la chiave controllante all'origine per evitare il blocco. Ad esempio, se si importano i dati dei referenti, assicurarsi di raggruppare i dati dei referenti in base alla chiave account controllante in modo che sia possibile caricare il numero massimo di referenti per un singolo account in una sola chiamata API. Se non si raggruppano i dati importati, in genere il primo record referente viene caricato e i successivi record referente di quell'account non vengono visualizzati nel contesto della chiamata API.
- Qualsiasi elaborazione post-importazione, ad esempio i trigger, deve elaborare i dati solo in modo selettivo.
- Se lo scenario prevede grandi volumi di dati, seguire le procedure consigliate di questo modulo Trailhead Best Practices for Deployments with Large Data Volumes (Migliori pratiche per le distribuzioni con grandi volumi di dati) .
| Posizione errore | Strategia di gestione e ripristino degli errori |
|---|---|
| Lettura da Salesforce con Acquisizione dati modifica |
|
| Lettura da Salesforce utilizzando un sistema ETL di terze parti |
|
| Scrivi a Salesforce |
|
| Sistema master esterno | Gli errori devono essere gestiti in conformità alle procedure consigliate del sistema principale. |
- Per consentire l'accesso API autenticato all'API Salesforce è necessaria una licenza Lightning Platform con almeno le autorizzazioni utente "Solo API".
- Si consiglia di utilizzare la crittografia standard per garantire la sicurezza dell'accesso con password.
- Utilizzare il protocollo HTTPS quando si effettuano chiamate alle API Salesforce. Se necessario, è anche possibile delegare il traffico alle API Salesforce tramite una soluzione di sicurezza locale.
- Salesforce non mantiene lo stato di un record modificato da un utente specifico.
- Durante la lettura, registra l'ora in cui i dati sono stati estratti.
- Se l'utente aggiorna il record e lo salva, Salesforce verifica se un altro utente ha aggiornato il record nel frattempo.
- Se il record è stato aggiornato, il sistema notifica all'utente che è stato eseguito un aggiornamento e l'utente deve recuperare la versione più recente del record prima di procedere con gli aggiornamenti.
| Proprietà | Obbligatorio | Auspicabile | Non richiesto |
|---|---|---|---|
| Gestione degli eventi | X | ||
| Conversione protocollo | X | ||
| Traduzione e trasformazione | X | ||
| Messa in attesa e buffering | X | ||
| Protocolli di trasporto sincrono | X | ||
| Protocolli di trasporto asincrono | X | ||
| Instradamento della mediazione | X | ||
| Coreografia del processo e orchestrazione del servizio | X | ||
| Transazionalità (crittografia, firma, consegna affidabile, gestione delle transazioni) | X | ||
| Instradamento | X | ||
| Estrazione, trasformazione e caricamento | X | ||
| Sondaggio lungo | X (obbligatorio per Acquisizione dati di modifica Salesforce) |
- Uno strumento di pianificazione simile a una cronologia esegue un processo batch che assegna clienti potenziali a utenti e team.
- Dopo l'esecuzione del processo batch e l'aggiornamento dei dati, lo strumento ETL riconosce queste modifiche utilizzando l'acquisizione dati di modifica. Lo strumento ETL confronta le modifiche dall'archivio dati.
- Il connettore ETL utilizza l'API REST Salesforce per caricare le modifiche in Salesforce.
- Lo scopo della chiamata remota a Salesforce è informare Salesforce di un evento che si è verificato esternamente utilizzando un'architettura basata sugli eventi? Oppure lo scopo è eseguire operazioni CRUD su record specifici? Se si utilizza un'architettura basata sugli eventi, il produttore dell'evento (il processo remoto) viene disaccoppiato dal consumatore dell'evento Salesforce.
- La chiamata a Salesforce richiede che il processo remoto attenda una risposta prima di continuare l'elaborazione? Le chiamate remote a Salesforce sono sempre richieste-risposte sincrone, anche se il processo remoto può scartare la risposta se non è necessario simulare una chiamata asincrona.
- Ogni transazione funziona per un singolo oggetto Salesforce o per più oggetti correlati?
- Qual è il formato del messaggio (ad esempio, SOAP o REST o entrambi su HTTP)?
- Le dimensioni del messaggio sono relativamente piccole o grandi?
- Se il sistema remoto è compatibile con SOAP, è in grado di partecipare a un approccio basato sul contratto, in cui Salesforce detta il contratto? Questo è necessario dove viene utilizzata la nostra API SOAP, per la quale viene fornito un WSDL predefinito.
- È necessaria l'elaborazione delle transazioni?
- Qual è la misura in cui si tollera la personalizzazione in Salesforce?
| Soluzione | Adatta | Commenti |
|---|---|---|
| API composta | Best | Salesforce fornisce un'API composta che è fondamentalmente un'API REST e supporta le richieste composte. Può essere utilizzato dai sistemi remoti per:
API sincrona: dopo aver effettuato la chiamata API, l'applicazione client remota attende di ricevere una risposta dal servizio. Transaction/Commit Behavior (Comportamento transazione/impegno): per impostazione predefinita, l'API composta non consente un esito positivo parziale se alcuni record sono contrassegnati da errori. Questo può essere modificato contrassegnando il flag “tutto o niente” come false, il che consentirà un successo parziale. Gestione errori: Una corretta gestione degli errori deve esaminare il corpo della risposta, non solo i codici di stato HTTP. Un endpoint composito risponde con 200 codice di stato HTTP anche se all'interno del corpo della risposta indica che una delle sottorichieste non è riuscita e che la transazione è stata ritirata. |
| API REST | Best | Accessibilità: Salesforce fornisce un'API REST che i sistemi remoti possono utilizzare per:
API sincrona: dopo aver effettuato la chiamata API, l'applicazione client remota attende di ricevere una risposta dal servizio. L'API REST rispetta la protezione a livello di oggetto e a livello di campo configurata in Salesforce in base al profilo dell'utente connesso. REST espone le risorse (entità/oggetti) come URI e utilizza i verbi HTTP per definire le operazioni CRUD su queste risorse. A differenza di SOAP, l'API REST non richiede alcun contratto predefinito, utilizza XML e JSON per le risposte e ha tipizzazioni non definite. L'API REST è leggera e offre un metodo semplice per interagire con Salesforce. I suoi vantaggi includono la facilità di integrazione e sviluppo ed è una scelta eccellente per l'uso con app mobili e app Web. Comportamento transazione/impegno: per impostazione predefinita, ogni record viene trattato come una transazione separata e confermato separatamente. L'errore di una modifica del record non causa il ritiro di altre modifiche del record. Questo comportamento può essere modificato in un comportamento "tutto o niente". Utilizzare le risorse composite dell'API REST per eseguire una serie di aggiornamenti in una sola chiamata API. Dati in blocco: qualsiasi operazione sui dati che include più di 2.000 record è un buon candidato per l'API in blocco 2.0 per preparare, eseguire e gestire correttamente un flusso di lavoro asincrono che utilizza il framework in blocco. |
| API in blocco 2.0 | Ideale per le operazioni in blocco | L'API in blocco 2.0 è l'API moderna e semplificata di Salesforce per la gestione di operazioni sui dati su larga scala. L'API in blocco 2.0 basata su REST offre un'opzione di programmazione per inserire, inserire con aggiornamento, eseguire query o eliminare in modo asincrono serie di dati di grandi dimensioni nell'organizzazione Salesforce. È progettato per garantire l'efficienza quando è necessario caricare grandi quantità di dati in Salesforce o eseguire query in blocco sui dati dell'organizzazione. A differenza dell'API in blocco 1.0, l'API in blocco 2.0 elabora sempre i batch in parallelo e non supporta la modalità seriale. Ciò significa che:
Ogni batch nell'API in blocco 2.0 viene elaborato come transazione separata. Ciò significa:
Sebbene l'API SOAP possa essere utilizzata anche per l'elaborazione di un numero elevato di record, diventa meno ottimale quando le serie di dati contengono da centinaia di migliaia a milioni di record. Ciò è dovuto al suo sovraccarico relativamente elevato e alle sue caratteristiche di prestazioni inferiori.
|
| API Pub/Sub | Best |
L'API Pub/Sub è il modo consigliato per i publisher esterni per pubblicare gli eventi sul bus degli eventi. L'API Pub/Sub è un'API basata su gRPC che consente ai sistemi esterni di pubblicare eventi piattaforma. API Pub/Sub:
Una volta definito in Salesforce, un evento piattaforma diventa disponibile sia per i consumatori interni che esterni. |
| Eventi piattaforma | Best |
Gli eventi piattaforma vengono definiti nello stesso modo in cui si definiscono gli oggetti Salesforce. Gli eventi piattaforma possono essere pubblicati utilizzando diversi meccanismi come le API REST, l'API in blocco e le API SOAP.
Pubblicare un evento tramite l'API REST equivale a creare un record Salesforce. Formato endpoint: POST /services/data/vXX.X/sobjects/EventName__e/
Con l'API in blocco sono supportate solo le operazioni di creazione e inserimento. Gli eventi all'interno di un batch vengono pubblicati nel bus degli eventi Salesforce in modo asincrono durante l'elaborazione del processo batch. Poiché gli eventi piattaforma sono SObject, sono supportate le operazioni API SOAP standard. |
| API SOAP | Adatta |
Accessibilità: Salesforce fornisce un'API SOAP che i sistemi remoti possono utilizzare per:
API sincrona: dopo aver effettuato la chiamata API, l'applicazione client remota attende di ricevere una risposta dal servizio. Le chiamate asincrone a Salesforce non sono supportate. WSDL generato: Salesforce fornisce due WSDL per i sistemi remoti:
Sicurezza: il client che esegue l'API SOAP deve disporre di un accesso valido e ottenere una sessione per eseguire eventuali chiamate API. L'API rispetta la protezione a livello di oggetto e a livello di campo configurata in Salesforce in base al profilo dell'utente connesso. Transaction/Commit Behavior (Comportamento transazione/impegno): per impostazione predefinita, ogni chiamata API consente una riuscita parziale se alcuni record sono contrassegnati da errori. Questo può essere modificato in un comportamento "tutto o niente" in cui tutti i risultati vengono ritirati se si verifica un errore. Non è possibile estendere una transazione a più chiamate API. Per superare questa limitazione, è possibile che una singola chiamata API abbia effetto su più oggetti. |
| Servizi Web Apex | Non ottimale |
I metodi delle classi Apex possono essere esposti come metodi di servizi Web ad applicazioni esterne. Questo metodo è un'alternativa all'API SOAP e viene in genere utilizzato solo dove devono essere soddisfatti i seguenti requisiti aggiuntivi.
I vantaggi dell'utilizzo di un servizio Web Apex devono essere confrontati con il codice aggiuntivo che deve essere mantenuto in Salesforce. Non applicabile agli eventi piattaforma perché la logica di preinserimento delle transazioni presso il consumatore non si applica in un architettura basata sugli eventi. Per informare un'organizzazione Salesforce che si è verificato un evento, utilizzare l'API SOAP, l'API REST o l'API in blocco 2.0. |
| Servizi REST Apex | Non ottimale |
Una classe Apex può essere esposta come risorse REST mappate a URI specifici con un verbo HTTP definito (ad esempio, POST o GET).
È possibile utilizzare le risorse composite API REST per eseguire più aggiornamenti in una singola transazione. A differenza di SOAP, non è necessario che il client utilizzi una definizione/contratto di servizio (WSDL) e generi stub client. Il sistema remoto richiede solo la capacità di formare una richiesta HTTP ed elaborare i risultati restituiti (XML o JSON). Non applicabile agli eventi piattaforma perché la logica di preinserimento delle transazioni presso il consumatore non si applica in un architettura basata sugli eventi. Per informare un'organizzazione Salesforce che si è verificato un evento, utilizzare l'API SOAP, l'API REST o l'API in blocco 2.0. |
 _Notifica del sistema remoto a Salesforce con gli eventi tramite l'API REST_
 **Risultati**
In un'architettura basata sugli eventi, il sistema remoto chiama Salesforce utilizzando l'API SOAP, l'API REST o l'API in blocco 2.0 per pubblicare un evento nel bus degli eventi Salesforce. La pubblicazione di un evento invia una notifica a tutti gli abbonati. Gli abbonati agli eventi possono trovarsi in Salesforce Platform, ad esempio Flussi o Componenti Lightning, trigger Apex. Gli abbonati agli eventi possono anche essere esterni a Salesforce Platform, ad esempio gli abbonati CometD.
Quando si lavora direttamente con gli oggetti Salesforce, le soluzioni correlate a questo schema consentono di:
- Il sistema remoto chiama le API Salesforce per eseguire query sul database ed eseguire operazioni su singoli oggetti (creazione, aggiornamento, eliminazione e così via).
- Sistema remoto per chiamare le risorse composite dell'API REST Salesforce per eseguire una serie di operazioni sugli oggetti.
- Sistema remoto per chiamare API Salesforce personalizzate (servizi) che possono supportare operazioni transazionali multi-oggetto e logica di pre/post-elaborazione personalizzata.
| Meccanismo di chiamata | Descrizione |
|---|---|
| API SOAP | Il sistema remoto utilizza Salesforce Enterprise o Partner WSDL per generare stub client che a loro volta vengono utilizzati per invocare l'API SOAP standard. |
| API REST | Il sistema remoto deve eseguire l'autenticazione prima di accedere a qualsiasi servizio REST Apex. Il sistema remoto può utilizzare OAuth 2.0 o l'autenticazione con nome utente e password. In entrambi i casi, il client deve impostare l'intestazione HTTP di autorizzazione con il valore appropriato (è possibile acquisire un token di accesso OAuth o un ID sessione tramite una chiamata di accesso all'API SOAP). Il sistema remoto genera quindi invocazioni REST (richieste HTTP) con i verbi appropriati ed elabora i risultati restituiti (sono supportati i formati di dati JSON e XML). |
| Servizio Web Apex | Il sistema remoto utilizza il servizio Web Apex personalizzato WSDL per generare stub client che a loro volta vengono utilizzati per invocare il servizio Web Apex personalizzato. |
| Servizio REST Apex | Secondo l'API REST, l'URI della risorsa e i verbi applicabili vengono definiti utilizzando le annotazioni @RestResource, @HttpGet e @HttpPost. |
| API in blocco 2.0 | Poiché l'API in blocco 2.0 è un'API basata su REST, si applicano gli stessi meccanismi di chiamata dell'API REST. |
| API REST per invocare Flusso | Utilizzare l'API REST per chiamare un endpoint azioni invocabili personalizzate per invocare un flusso AutoLaunched. |
- Gestione degli errori: tutti i metodi di chiamata remota, API standard o personalizzate, richiedono che il sistema remoto gestisca eventuali errori successivi, ad esempio i timeout e la gestione dei tentativi. Middleware può essere utilizzato per fornire la logica per la gestione e il ripristino degli errori.
- Ripristino: è necessario creare un meccanismo di tentativo personalizzato se richiesto dai requisiti di qualità del servizio. In questo caso, è importante garantire caratteristiche di progettazione idempotenti. L'evento piattaforma consente agli abbonati di utilizzare il replay ID per recuperare i messaggi entro un determinato periodo di tempo dopo la pubblicazione di tali messaggi.
| Soluzione | Considerazioni sulla sicurezza |
|---|---|
| API SOAP | alesforce supporta i protocolli Secure Sockets Layer v3 (SSL) e Transport Layer Security (TLS). I cifrari devono avere una lunghezza della chiave di almeno 128 bit. Il sistema remoto deve eseguire l'accesso utilizzando credenziali valide per ottenere un ID sessione. Se il sistema remoto ha già un ID sessione valido, può chiamare l'API senza un accesso esplicito. Questo è utilizzato negli schemi di richiamata descritti in precedenza in questo documento, dove un messaggio in uscita Salesforce precedente conteneva un ID sessione e un ID record per un uso successivo. Si consiglia ai client che chiamano l'API SOAP di memorizzare nella cache e riutilizzare l'ID sessione per ottimizzare le prestazioni, anziché ottenere un nuovo ID sessione per ogni chiamata. |
| API REST | Si consiglia al sistema remoto di stabilire un Trust OAuth per l'autorizzazione. Le chiamate REST possono quindi essere effettuate su risorse specifiche utilizzando verbi HTTP. È anche possibile effettuare chiamate REST con un ID sessione valido che potrebbe essere stato ottenuto con altri mezzi (ad esempio, recuperato chiamando l'API SOAP o fornito tramite un messaggio in uscita). Si consiglia ai client che chiamano la cache dell'API REST e riutilizzano l'ID sessione per ottimizzare le prestazioni, anziché ottenere un nuovo ID sessione per ogni chiamata. |
| Servizio Web Apex | Si consiglia al sistema remoto di stabilire un Trust OAuth per l'autorizzazione. |
| Servizio REST Apex | Si consiglia al sistema remoto di stabilire un Trust OAuth per l'autorizzazione. |
| API in blocco 2.0 | Si consiglia al sistema remoto di stabilire un Trust OAuth per l'autorizzazione. |
- Timeout sessione: la sessione scade se non è presente alcuna attività in base all'impostazione di timeout sessione dell'organizzazione Salesforce.
- Timeout della query: ogni query SOQL ha un limite di timeout individuale di 120 secondi.
| Soluzione | Tipo di comunicazione | Limiti |
|---|---|---|
| API SOAP o API REST | Synchronous |
|
| API in blocco 2.0 | Asynchronous | L'API in blocco 2.0 è ottimizzata per l'importazione e l'esportazione asincrona di grandi serie di dati. Qualsiasi operazione sui dati che include più di 2.000 record è un buon candidato per l'API in blocco 2.0 per preparare, eseguire e gestire correttamente un flusso di lavoro asincrono che utilizza il framework in blocco. I processi con meno di 2.000 record devono includere chiamate sincrone "in blocco" in REST (ad esempio, Composite) o SOAP. L'API in blocco 2.0 è sincrona quando si invia la richiesta batch e i dati associati. Il trattamento effettivo dei dati avviene in modo asincrono. Per ulteriori informazioni sui limiti dell'API e dell'elaborazione batch, vedere Limiti. |
| Soluzione | Considerazioni sugli endpoint |
|---|---|
| API SOAP | Il sistema remoto deve essere in grado di implementare un client in grado di chiamare l'API SOAP Salesforce, in base a un formato di messaggio predefinito da Salesforce. Il sistema remoto (client) deve partecipare a un'implementazione contract-first in cui il contratto è fornito da Salesforce (ad esempio, Enterprise o WSDL partner). |
| API REST | Il sistema remoto deve essere in grado di implementare un client REST che invoca i servizi REST definiti da Salesforce ed elabora i risultati XML o JSON. |
| Servizio Web Apex | Il sistema remoto deve essere in grado di implementare un client in grado di invocare messaggi SOAP di un formato predefinito, definito da Salesforce. Il sistema remoto deve partecipare a un'implementazione code-first, in cui il contratto viene fornito da Salesforce dopo l'implementazione del servizio Web Apex. Ogni servizio Web Apex ha il proprio WSDL. |
| Servizio REST Apex | Valgono le stesse considerazioni sull'endpoint dell'API REST. |
- Salesforce memorizza la chiave surrogata principale o univoca del sistema remoto per il record remoto.
- Il sistema remoto memorizza l'ID record univoco Salesforce o un'altra chiave surrogata univoca. Esistono considerazioni specifiche sulla gestione delle chiavi di integrazione in questo schema sincrono.
| Master | sistema Descrizione |
|---|---|
| Salesforce | In questo scenario, il sistema remoto memorizza Salesforce RecordId o un'altra chiave surrogata univoca del record. |
| Sistema remoto | In questo scenario, Salesforce memorizza un riferimento all'identificatore univoco nel sistema remoto. Poiché il processo è sincrono, la chiave può essere fornita nell'ambito della stessa transazione utilizzando campi ID esterni. |
| Soluzione | Considerazioni |
|---|---|
| API SOAP o API REST | L'API SOAP e l'API REST consentono transazioni semplici sugli oggetti. Scenari di integrazione complessi come aggregazione, orchestrazione e trasformazione non possono essere eseguiti in Salesforce. Questi scenari devono essere gestiti dal sistema remoto o middleware, con middleware come metodo preferito. |
| Servizio Web Apex o servizio REST Apex | I servizi Web personalizzati possono fornire funzionalità oggetti incrociate, logica personalizzata e supporto delle transazioni più complesso. Questa soluzione deve essere usata con attenzione e si dovrebbe sempre considerare l'idoneità del middleware per qualsiasi trasformazione, orchestrazione e gestione degli errori. |
| Soluzione | Limiti |
|---|---|
| API SOAP, API REST e API Apex personalizzate |
|
| API in blocco 2.0 | Per ulteriori informazioni, vedere Intestazione laterale Volumi di dati. |
| Eventi piattaforma |
|
| Proprietà | Obbligatorio | Auspicabile | Non richiesto |
|---|---|---|---|
| Gestione degli eventi | X | ||
| Conversione protocollo | X | ||
| Traduzione e trasformazione | X | ||
| Messa in attesa e buffering | X | ||
| Protocolli di trasporto sincrono | X | ||
| Protocolli di trasporto asincrono | X | ||
| Instradamento della mediazione | X | ||
| Coreografia del processo e orchestrazione del servizio | X | ||
| Transazionalità (crittografia, firma, consegna affidabile, gestione delle transazioni) | X | ||
| Instradamento | X | ||
| Estrazione, trasformazione e caricamento | X (per rinfuse/batch) |
- Il PMS può partecipare a un'integrazione contract-first, in cui Salesforce fornisce il contratto e il PMS agisce come cliente (consumatore) del servizio Salesforce (definito tramite il WSDL Enterprise o Partner).
- Non dovrebbe esserci sviluppo personalizzato in Salesforce.
- Definire un evento piattaforma in Salesforce per contenere i dati di notifica provenienti dal PMS.
- Creare un flusso attivato dalla notifica dell'evento stampante. Il processo aggiorna l'asset stampante e crea un ordine (utilizzando un flusso AutoLaunched).
- Scaricare il WSDL Enterprise o Partner e fornirlo al sistema remoto.
- Creare uno stub client dal WSDL Enterprise o Partner.
- Eseguire l'autenticazione in Salesforce (tramite server Web OAuth o flusso token bearer) utilizzando le credenziali dell'utente integrazione.
- All'evento stato stampante, il PMS chiama l'API per creare l'evento piattaforma stato stampante (con statistiche di utilizzo della stampante). Il bus degli eventi Salesforce invia una notifica all'abbonato Flusso e a tutti gli altri abbonati.
- Implementazione di un client API sincrono Salesforce (consumer).
- Una richiamata a Salesforce per pubblicare un evento piattaforma (in linea con gli schemi di evento piattaforma richiesta/risposta descritti in precedenza).
 **Risultati**
**Vantaggi**
L'applicazione della soluzione correlata a questo schema presenta i seguenti vantaggi:
- Elimina la necessità di scrivere meccanismi di polling personalizzati
- Elimina la necessità di un loop di feedback avviato dall'utente
- La consegna delle notifiche non è garantita.
- L'ordine delle notifiche non è garantito.
- Le notifiche non vengono generate dalle modifiche ai record apportate dall'API in blocco.
- Creare un PushTopic Trigger Apex che invia un evento piattaforma quando un caso viene salvato con stato "Chiuso" e risoluzione "Riuscito".
- Creare un'interfaccia utente personalizzata disponibile per i responsabili dell'assistenza clienti. Questa interfaccia utente si abbona al bus degli eventi per utilizzare gli eventi piattaforma.
- Implementare la logica nell'interfaccia utente personalizzata che mostra gli avvisi generati dagli agenti dell'assistenza clienti del responsabile.
- Si desidera creare un'integrazione dichiarativa/point-and-click in uscita o un mashup dell'interfaccia utente in Salesforce?
- Si dispone di una grande quantità di dati che non si desidera copiare nell'organizzazione Salesforce?
- È necessario accedere contemporaneamente a piccole quantità di dati di sistema remoti?
- È necessario accedere in tempo reale ai dati più recenti?
- I dati vengono archiviati nel cloud o in un sistema di back-office ma si desidera visualizzare o elaborare i dati nell'organizzazione Salesforce?
- Si hanno problemi di residenza dei dati per l'archiviazione di alcuni tipi di dati in Salesforce?
| Soluzione | Adatta | Commenti |
|---|---|---|
| Salesforce Connect | Best | Utilizzare Salesforce Connect per accedere ai dati da fonti esterne, insieme ai dati Salesforce. Estrarre i dati da sistemi come SAP, Microsoft, Oracle e altri sistemi basati su cloud come Snowflake in tempo reale senza creare una copia dei dati in Salesforce. Salesforce Connect mappa le tabelle di dati nei sistemi esterni agli oggetti esterni dell'organizzazione. Gli oggetti esterni sono simili agli oggetti personalizzati, tranne per il fatto che vengono mappati a dati situati all'esterno dell'organizzazione Salesforce. Salesforce Connect utilizza una connessione live ai dati esterni per mantenere sempre aggiornati gli oggetti esterni. L'accesso a un oggetto esterno recupera i dati dal sistema esterno in tempo reale. Salesforce Connect consente di:
|
| Richiesta e risposta | Non ottimale |
Utilizzare le API dei servizi Web Salesforce per effettuare richieste di dati ad hoc per accedere e aggiornare i dati di sistema esterni. Questa soluzione include i seguenti approcci:
Utilizzare l'API SOAP Salesforce. Una pagina o un pulsante personalizzato avvia una chiamata Apex REST/SOAP in modo sincrono. In Salesforce è possibile utilizzare un WSDL e generare una classe Apex proxy risultante. Questa classe fornisce la logica necessaria per chiamare il servizio remoto. Un'azione avviata dall'utente in una pagina chiama quindi un'azione del controller Apex che esegue questa classe Apex proxy per eseguire la chiamata remota. Le pagine richiedono la personalizzazione dell'app Salesforce. Utilizzare l'API REST Salesforce. Una pagina o un pulsante personalizzato avvia una chiamata HTTP Apex (servizio REST) in modo sincrono. In Salesforce, è possibile invocare i servizi HTTP utilizzando i metodi GET, POST, PUT e DELETE standard. Per ulteriori informazioni su questa soluzione, vedere Remote Process Invocation — Request and Reply (Richiesta e risposta processo remoto). |
 In questo scenario:
- Il browser esegue una chiamata AJAX che a sua volta esegue un'azione sull'adattatore oggetto esterno corrispondente.
- L'adattatore traduce l'azione in una richiesta OData ed effettua una richiesta GET HTTP al sistema remoto tramite i livelli Integrazione e Servizi.
- Il sistema remoto restituisce una risposta JSON a Salesforce tramite i livelli Integrazione e Servizi.
- La risposta viene tradotta da OData in un oggetto esterno e ripresentata al browser.
| Meccanismo di chiamata | Descrizione |
|---|---|
| Oggetti esterni | Salesforce Connect mappa gli oggetti esterni Salesforce alle tabelle di dati nei sistemi esterni. Anziché copiare i dati nell'organizzazione, Salesforce Connect accede ai dati su richiesta e in tempo reale. Anche se i dati sono memorizzati all'esterno dell'organizzazione, Salesforce Connect offre un'integrazione perfetta con Lightning Platform. Gli oggetti esterni sono disponibili per gli strumenti Salesforce, ad esempio la ricerca globale, le relazioni di ricerca, i feed dei record e l'app mobile Salesforce. Gli oggetti esterni sono disponibili anche per Apex, SOSL, query SOQL, API Salesforce e distribuzione tramite l'API dei metadati, le serie di modifiche e i pacchetti. |
| Componenti di illuminazione | Utilizzato quando il processo remoto viene attivato nell'ambito di un processo end-to-end che coinvolge l'interfaccia utente e il risultato deve essere visualizzato o aggiornato in un record Salesforce. Ad esempio, un processo che invia i pagamenti con carta di credito a un gateway di pagamento esterno e restituisce immediatamente i risultati dei pagamenti visualizzati all'utente. L'integrazione attivata da eventi dell'interfaccia utente richiede in genere la creazione di componenti Lightning personalizzati. |
- Questa soluzione non consuma memoria dati in Salesforce.
- Gli utenti non devono preoccuparsi di sincronizzare regolarmente i dati tra il sistema esterno e Salesforce.
- Un'impostazione dichiarativa che può essere eseguita rapidamente con OData o un adattatore tra organizzazioni o utilizzando codice minimo con un adattatore Apex personalizzato.
- Gli utenti possono accedere ai dati esterni con molte delle stesse funzionalità degli oggetti personalizzati sotto forma di oggetti esterni.
- Possibilità di effettuare una ricerca federata nel sistema esterno connesso utilizzando la ricerca globale.
- Possibilità di eseguire rapporti che accedono a dati esterni da fonti cloud e locali. Fare riferimento alle considerazioni sui rapporti riportate di seguito.
- Gli oggetti esterni si comportano come oggetti personalizzati, ma alcune funzioni non sono disponibili per gli oggetti esterni. Per ulteriori informazioni, vedere Considerazioni sulla compatibilità.
- Gli oggetti esterni possono influire sulle prestazioni dei rapporti. Per ulteriori informazioni, vedere Considerazioni sui rapporti per Salesforce Connect.
- Per ulteriori considerazioni sull'utilizzo degli adattatori Salesforce Connect, vedere Considerazioni per Salesforce Connect — Tutti gli adattatori.
- Se si sta pensando di utilizzare un adattatore tra organizzazioni, vedere Considerazioni per Salesforce Connect — Adattatore tra organizzazioni.
- Se si sta pensando di utilizzare un adattatore OData, vedere Considerazioni per Salesforce Connect — Adattatori OData 2.0 e 4.0.
- Se si sta pensando di utilizzare un adattatore Apex personalizzato, vedere Considerazioni per Salesforce Connect — Adattatore personalizzato.
- La richiesta viene in genere richiamata dall'interfaccia utente, quindi il processo non deve far attendere l'utente.
- A seconda della disponibilità e della connessione al sistema esterno, il recupero dei dati esterni può richiedere molto tempo. Salesforce ha un valore di timeout massimo configurabile di 120 secondi per attendere una risposta dal sistema esterno.
- Il completamento del processo remoto deve essere eseguito in modo tempestivo ed entro il limite di timeout di Salesforce e nel rispetto delle aspettative degli utenti.
| Soluzione | Considerazioni sugli endpoint |
|---|---|
| Salesforce Connect | API OData: utilizzare il protocollo Open Data per accedere ai dati archiviati all'esterno di Salesforce. I dati esterni devono essere esposti tramite i produttori OData. Altre API: utilizzare Apex Connector Framework per sviluppare il proprio adattatore personalizzato quando gli altri adattatori disponibili non sono adatti alle proprie esigenze. Un adattatore personalizzato può ottenere dati da qualsiasi fonte. Ad esempio, alcuni dati possono essere recuperati da Internet tramite chiamate, mentre altri dati possono essere manipolati o addirittura generati a livello di programmazione. Connetti a Salesforce: utilizza l'API REST Lightning Platform per accedere ai dati archiviati in altre organizzazioni Salesforce. Connessione tramite Middleware Connessione tramite Middleware — L'ecosistema di partner Salesforce Connect ha lavorato a stretto contatto con Salesforce per assicurarsi che i gateway middleware espongano gli endpoint OData del servizio in modo che Salesforce possa connettersi con loro senza scrivere codice aggiuntivo. |
| Richiesta e risposta | Chiamate SOAP Apex - L'endpoint deve essere in grado di ricevere una chiamata al servizio Web tramite HTTP. Chiamate HTTP Apex - L'endpoint deve essere in grado di ricevere chiamate HTTP. È possibile utilizzare chiamate HTTP Apex per chiamare servizi RESTful utilizzando i metodi GET, POST, PUT e DELETE standard |
- Salesforce memorizza la chiave surrogata principale o univoca per il record remoto.
- Il sistema remoto memorizza l'ID record univoco Salesforce o un'altra chiave surrogata univoca. Esistono considerazioni specifiche sulla gestione delle chiavi di integrazione in questo schema sincrono.
| Sistema principale | Descrizione |
|---|---|
| Salesforce | Il sistema remoto memorizza l'ID record Salesforce o un'altra chiave surrogata univoca del record. |
| Sistema remoto | La chiamata al processo remoto restituisce la chiave univoca dell'applicazione e Salesforce memorizza il valore della chiave in un campo record univoco. |
- Aggregazione delle chiamate e dei relativi risultati nelle chiamate a più sistemi
- Trasformazione dei messaggi in entrata e in uscita
- Mantenere l'integrità delle transazioni tra le chiamate a più sistemi
- Altre attività di orchestrazione dei processi tra Salesforce e il sistema esterno
| Proprietà | Obbligatorio | Auspicabile | Non richiesto |
|---|---|---|---|
| Gestione degli eventi | X | ||
| Conversione protocollo | X | ||
| Traduzione e trasformazione | X | ||
| Messa in attesa e buffering | X | ||
| Protocolli di trasporto sincrono | X | ||
| Protocolli di trasporto asincrono | X | ||
| Instradamento della mediazione | X | ||
| Coreografia del processo e orchestrazione del servizio | X | ||
| Transazionalità (crittografia, firma, consegna affidabile, gestione delle transazioni) | X | ||
| Instradamento | X | ||
| Estrazione, trasformazione e caricamento | X | ||
| Sondaggio lungo | X |
| Relazione | Oggetti secondari consentiti | Oggetti controllanti consentiti | Campo controllante per i record corrispondenti |
|---|---|---|---|
| Ricerca | Standard, personalizzato, esterno | Standard, personalizzato | ID record Salesforce di 18 caratteri |
| Ricerca esterna | Standard, personalizzato, esterno | Esterno | Campo standard ID esterno |
| Ricerca indiretta | Esterno | Standard, personalizzato | Selezionare un campo personalizzato con gli attributi ID esterno e Univoco |
- Configurare la fonte di dati esterna con un endpoint OData. L'applicazione remota può includere il supporto nativo per OData. Per altre applicazioni, i principali fornitori di integrazione come Dell Boomi, Informatica, Jitterbit, MuleSoft e Progress Software hanno collaborato con Salesforce su Salesforce Connect per creare adattatori.
- Puntare Salesforce Connect all'endpoint OData, direttamente o tramite una soluzione middleware.
- Sincronizzare le tabelle del database esterno con gli oggetti esterni in Salesforce. Quando un utente accede a una pagina con i dati di questi oggetti esterni, Salesforce Connect effettua chiamate in tempo reale alle applicazioni di back-end.
| Schema livello1 | Schema livello2 | Schema | Secenario |
|---|---|---|---|
| Schemi di inserimento dati - Dati in entrata | Schemi di inserimento batch | Inserimento di dati in blocco da Cloud Storage | I dati vengono inseriti da una fonte di archiviazione cloud aziendale come Amazon S3, Azure Blob o Google Cloud Storage in Data 360 sotto forma di grandi batch di dati non elaborati (ad esempio transazioni o registri di prodotti). |
| Inserimento di dati in blocco da Salesforce Clouds | Data 360 riceve i dati CRM in blocco da più organizzazioni Salesforce (ad esempio Sales Cloud, Service Cloud) per creare profili cliente unificati. | ||
| Streaming e schemi di inserimento in tempo reale | Inserimento basato sugli eventi tramite l'API di inserimento--Streaming | Data 360 si abbona agli endpoint di inserimento streaming che ricevono payload di eventi continui (ad esempio, eventi di acquisto, telemetria IoT) dai sistemi aziendali per gli aggiornamenti dei profili in tempo reale. | |
| Inserimento di comportamenti Web e mobili in tempo reale | Data 360 raccoglie ed elabora i dati comportamentali in tempo reale dei siti Web e delle app mobili tramite SDK per arricchire le metriche di coinvolgimento e i modelli di personalizzazione. | ||
| Sincronizzazione CRM quasi in tempo reale tramite streaming | Data 360 riceve gli aggiornamenti dei dati CRM (ad esempio, le modifiche di referenti, casi e opportunità) quasi in tempo reale tramite stream di eventi per mantenere una visualizzazione Customer 360 sincronizzata in modo continuo. | ||
| Inserimento di stream di eventi dalle piattaforme di messaggistica cloud - Kinesis e MSK | Data 360 utilizza i dati in streaming direttamente da piattaforme di eventi cloud come AWS Kinesis o Kafka (MSK) per elaborare eventi operativi o IoT ad alta frequenza. | ||
| Schemi copia zero - In entrata e in uscita | Copia zero in entrata - Piattaforme esterne in Data 360 | Data 360 esegue query su serie di dati esterne (ad esempio Snowflake, BigQuery) su richiesta tramite l'inserimento copia zero, senza spostare fisicamente i dati in Salesforce. | |
| Copia zero in uscita - Dati 360 su piattaforme esterne | I sistemi esterni come Databricks o Tableau accedono a segmenti e approfondimenti arricchiti in Data 360 tramite connessioni Copia zero in uscita senza replica dei dati. | ||
| Piattaforma dati unificata multi-organizzazione con Data Cloud One | Data Cloud One unifica più organizzazioni Salesforce e fonti di dati esterne in un modello semantico e di metadati condiviso, offrendo Customer 360 coerente senza duplicazione dei dati. | ||
| Schemi di attivazione dei dati - Dati in uscita | Schemi di attivazione batch | Attivazione del segmento nelle piattaforme di marketing e pubblicità | Data 360 attiva i segmenti di clienti curati direttamente in Marketing Cloud, Meta, Google Ads o altre piattaforme pubblicitarie per la consegna personalizzata delle campagne |
| Esportazione di dati in Cloud Storage | Data 360 esporta le serie di dati unificate o filtrate (ad esempio, i record cliente consenzienti) come file CSV o Parquet nell'archiviazione cloud aziendale per l'analisi o l'archiviazione della conformità. | ||
| Attivazione basata su API on-demand | Integrazione di applicazioni personalizzate tramite API Connect | Le applicazioni esterne richiamano l'API Data 360 Connect in tempo reale per recuperare o attivare azioni personalizzate (ad esempio, il controllo del saldo fedeltà o la generazione di offerte AI) in base ai dati correnti dei clienti.Le applicazioni Web o mobili personalizzate recuperano gli approfondimenti armonizzati di Data 360 in modo sicuro tramite l'API REST Connect per visualizzarli nelle interfacce utente aziendali o dei partner. | |
| Completamento del recupero del profilo cliente tramite l'API Data Graph | Un sistema recupera il profilo unificato di un cliente utilizzando l'API Data Graph, restituendo una rappresentazione JSON pre-unita in tempo reale della visualizzazione completa a 360° per le decisioni o la personalizzazione. | ||
| Azioni dati in tempo reale | Azione dati in tempo reale Trasformazione dei segnali dei clienti in azione immediata | Data 360 rileva ed elabora un evento live (ad esempio, aggiornamento del consenso, trigger di acquisto) e richiama immediatamente un sistema connesso o un flusso Salesforce per un'azione a valle.Un segnale di attività del cliente (ad esempio, il rischio di abbandono rilevato) in Data 360 attiva un'azione istantanea in tempo reale, ad esempio aggiornare CRM, invocare il calcolo del punteggio Einstein o avviare un journey di fidelizzazione. |
| Tipo | Tempistica | Considerazioni in uscita |
|---|---|---|
| Integrazione dei dati | Asynchronous | Attivazione del segmento nelle piattaforme di marketing e pubblicità |
| Integrazione processi/dati | Synchronous | Integrazione di applicazioni personalizzate tramite API Connect Completamento del recupero del profilo cliente tramite l'API Data Graph |
| Integrazione dei dati | Synchronous | Azione dati in tempo reale Trasformazione dei segnali dei clienti in azione immediata |
| Integrazione virtuale (utilizzo di copia zero) | Asynchronous | Copia zero in uscita - Dati 360 su piattaforme esterne |
| Integrazione virtuale | Asynchronous | Piattaforma dati unificata multi-organizzazione con Data Cloud One |
| Tipo | Tempistica | Considerazioni in entrata |
|---|---|---|
| Integrazione dei dati | Asynchronous | Inserimento di dati in blocco da Cloud Storage Inserimento di dati in blocco da Salesforce Clouds |
| Integrazione dei dati | Asynchronous | Inserimento di stream di eventi dalle piattaforme di messaggistica cloud - Kinesis e MSK Sincronizzazione CRM quasi in tempo reale tramite streaming |
| Integrazione dei processi | Synchronous | Inserimento basato sugli eventi tramite l'API di inserimento--Streaming Inserimento di comportamenti Web e mobili in tempo reale |
| Integrazione virtuale | Asynchronous | Copia zero in entrata - Piattaforme esterne in Data 360 |
| Termine | Definizione |
|---|---|
| Gestione eventi | La gestione degli eventi si riferisce alla ricezione, all'instradamento e alla risposta a occorrenze identificabili da un sistema o da un'applicazione di origine. Middleware gestisce gli eventi identificando l'endpoint di destinazione, inoltrando l'evento e attivando l'azione aziendale richiesta (ad esempio, registrazione, tentativi o attivazione di servizi a valle). Nelle architetture Data 360, la gestione degli eventi è fondamentale per l'inserimento dati in tempo reale, i trigger di attivazione e gli schemi di pubblicazione/abbonamento. Gli eventi possono provenire da sistemi esterni (Kafka, AWS Kinesis) o da eventi Salesforce Platform e vengono instradati dal middleware o dal bus degli eventi di Data 360 per l'elaborazione immediata. |
| Conversione protocollo | La conversione del protocollo consente la comunicazione tra sistemi che utilizzano standard di trasporto dati diversi. Middleware traduce protocolli proprietari o legacy (come AMQP, MQTT, FTP) in protocolli Data 360 supportati (REST, gRPC o HTTPS). Ciò garantisce l'interoperabilità tra sistemi eterogenei. Poiché Data 360 non gestisce in modo nativo la conversione del protocollo, il middleware fornisce il livello di adattamento, incapsulando o trasformando i messaggi in un formato che le API e i connettori di Data 360 possono interpretare. |
| Traduzione e trasformazione | La traduzione e la trasformazione garantiscono l'interoperabilità mappando un formato di dati o uno schema a un altro. Middleware esegue queste trasformazioni per allineare diversi payload di dati (CSV, XML, JSON) agli oggetti modello di dati (DMO) e agli oggetti livello di dati (UDLO) di Data 360. Ciò include la pulitura, l'arricchimento e l'applicazione di mappature semantiche o basate sull'ontologia prima dell'inserimento. Mentre Salesforce offre strumenti di trasformazione come i procedimenti di Preparazione dati, le trasformazioni complesse (soprattutto per l'armonizzazione semantica) sono gestite meglio nel middleware. |
| Area di attesa e buffering | L'area di attesa e il buffering si basano sul passaggio di messaggi asincroni per garantire una comunicazione resiliente e disaccoppiata. Le piattaforme middleware (ad esempio MuleSoft, Kafka o Azure Event Hub) forniscono aree di attesa persistenti che memorizzano temporaneamente i dati quando Data 360 o i sistemi a valle sono occupati o non raggiungibili. Ciò evita la perdita di dati e supporta l'inserimento o i tentativi di attivazione quasi in tempo reale. Data 360 supporta l'inserimento in streaming e la messaggistica in uscita basata sul flusso, ma le aree di attesa durevoli e la consegna garantita sono in genere gestite dal middleware. |
| Protocolli di trasporto sincroni | I protocolli di trasporto sincrono prevedono il blocco delle operazioni di richiesta/risposta in tempo reale. Il mittente attende una risposta prima di procedere. In Data 360, vengono utilizzati per attivazioni basate su API on-demand, arricchimento in tempo reale o ricerche di profili, in cui le risposte sono richieste immediatamente. Middleware garantisce l'affidabilità della connessione e gestisce i tentativi o la gestione di fallback per le chiamate API Data 360 sincrone. |
| Protocolli di trasporto asincrono | I protocolli di trasporto asincroni supportano la comunicazione non bloccante e disaccoppiata in cui il mittente continua l'elaborazione senza attendere una risposta. Middleware gestisce i flussi asincroni per le attivazioni batch, l'inserimento in streaming e l'attivazione basata sugli eventi. Ciò consente un'elevata produttività e resilienza, fondamentali per lo streaming degli eventi e gli schemi di inserimento dati quasi in tempo reale in Data 360. |
| Instradamento della mediazione | L'instradamento della mediazione definisce un flusso di messaggi complesso tra i sistemi, assicurando che i dati o gli eventi corretti raggiungano il consumatore corretto. Middleware funge da mediatore, gestendo la logica di instradamento in base a regole, intestazioni, contenuti o tipi di evento. Nelle integrazioni Data 360, la mediazione garantisce che gli eventi e gli aggiornamenti dei profili di più sistemi vengano instradati correttamente alle API di inserimento dati, agli endpoint di attivazione o ai consumatori esterni. Ciò semplifica l'orchestrazione e supporta la sincronizzazione dei dati multi-sistema. |
| Coreografia del processo e orchestrazione del servizio | La coreografia e l'orchestrazione del processo coordinano i processi multi-sistema. La coreografia supporta flussi autonomi e asincroni basati sugli eventi, in cui i sistemi agiscono in base a regole condivise senza un controller centrale. L'orchestrazione è un flusso gestito centralmente che dirige l'esecuzione del servizio. Nelle architetture Data 360, il middleware gestisce l'orchestrazione per l'inserimento e l'attivazione tra i sistemi, mentre i flussi di lavoro o i flussi di Salesforce gestiscono coreografie leggere all'interno della piattaforma. Un'orchestrazione complessa, che richiede il coordinamento delle transazioni o la gestione dello stato, è consigliata a livello middleware. |
| Transazionalità (crittografia, firma, consegna affidabile, gestione delle transazioni) | La transazionalità garantisce operazioni atomiche, coerenti, isolate e durature (ACID) in tutti i sistemi. Salesforce e Data 360 sono transazioni all'interno dei loro confini ma non supportano le transazioni distribuite tra i sistemi esterni. Middleware gestisce il controllo delle transazioni globali, incluse crittografia, firma dei messaggi, ritiro, compensazione e consegna affidabile. Per i flussi di dati mission-critical (ad esempio, aggiornamenti finanziari o consenso), il middleware garantisce l'integrità e il ripristino end-to-end in Data 360 e nei sistemi esterni. |
| Instradamento | L'instradamento specifica il flusso controllato di messaggi o dati tra i componenti. Può essere basato su intestazioni, tipo di contenuto, priorità o regole. Middleware gestisce la logica di instradamento per gli eventi e le attivazioni che coinvolgono Data 360, ad esempio l'indirizzamento di segmenti di pubblico arricchiti a diversi sistemi a valle (piattaforme pubblicitarie, magazzini, app CRM). Sebbene l'instradamento possa essere implementato in Salesforce (Apex, flussi), l'instradamento middleware è preferito per la scalabilità, la flessibilità e la governance. |
| Estrazione, trasformazione e caricamento (ETL) | ETL consiste nell'estrarre i dati dai sistemi di origine, trasformarli in uno schema coerente e caricarli in una destinazione (ad esempio Data 360). Gli strumenti middleware o ETL gestiscono queste operazioni prima dell'inserimento dei dati. Data 360 può ricevere output ETL tramite API, connettori o pipeline di inserimento in blocco e supporta anche la sincronizzazione quasi in tempo reale per l'acquisizione dati di modifica. I processi ETL middleware sono essenziali per integrare i sistemi legacy e garantire la qualità dei dati prima dell'unificazione in Data 360. |
| Sondaggio lungo | Il long polling (programmazione Comet) è un metodo per mantenere aperta la comunicazione tra i sistemi per gli aggiornamenti in tempo reale. Il client invia una richiesta e il server la mantiene finché non si verifica un evento, quindi risponde e riapre una nuova connessione. Salesforce lo utilizza nei protocolli Streaming API e CometD/Bayeux per la sincronizzazione dei dati basata sugli eventi. Middleware può abbonarsi a questi eventi e inoltrarli a Data 360 per l'inserimento in tempo reale o i trigger di attivazione, garantendo una latenza minima tra i sistemi aziendali. |
| Soluzione | Adatta | Commenti |
|---|---|---|
| Utilizzo di connettori di archiviazione cloud nativi (Amazon S3, Google Cloud Storage, Archiviazione BLOB di Azure) | Best | Questo è lo schema consigliato e più affidabile per l'inserimento su larga scala e ricorrente basato su file in Data 360\. I connettori nativi forniscono l'autenticazione gestita, la mappatura dello schema e lo spostamento sicuro dei dati direttamente negli oggetti data lake (DLO) di Data 360. Ideale per i carichi batch pianificati in cui la latenza non è critica (ad esempio, la pianificazione ogni ora o ogni giorno). |
| Gestione di serie di dati di grandi dimensioni (oltre i limiti del connettore) | Migliore con la preelaborazione | Ogni connettore impone dei limiti di inserimento (ad esempio, S3: 100 milioni di righe o 50 GB per oggetto). Per le serie di dati più grandi, implementare una fase di preelaborazione ETL per suddividere i dati in file/cartelle più piccoli che rientrano in queste soglie. Quindi, configurare più stream di dati per inserire ogni partizione in parallelo e utilizzare il nodo append in una trasformazione dati batch) in Data 360 per ricombinare le partizioni in una serie di dati unificata. |
| Sicurezza e governance | Best | Tutti i connettori supportano l'autenticazione protetta tramite metodi nativi cloud (ruoli IAM, account di servizio o chiavi di accesso). Per un maggiore controllo, limitare l'accesso agli intervalli IP di Data 360 tramite l'elenco consentiti del provider cloud. Il trasferimento dei dati avviene su canali crittografati, con file memorizzati in un livello di gestione temporanea e sicuro durante l'inserimento. |
| Quando non utilizzare | Non ottimale | Questo schema non è ottimale per:
|
 In questo scenario:
- L'amministratore configura una connessione all'archiviazione cloud tramite l'interfaccia di impostazione di Data 360 (specificando l'autenticazione, i dettagli del bucket, i ruoli IAM e la whitelist).
- L'interfaccia di impostazione di Data Cloud esegue l'autenticazione con Cloud Storage Platform, verificando le credenziali e l'accesso.
- L'amministratore crea uno stream di dati in Data 360, collegandolo all'oggetto/cartella in Cloud Storage e definendo la pianificazione dell'inserimento.
- Al trigger di pianificazione, lo stream di dati richiede i file di origine (ad esempio, CSV, Parquet) da Cloud Storage Platform.
- Cloud Storage Platform fornisce file, inclusi schema_sample.csv validi e altri file di dati conformi alle convenzioni di denominazione.
- Stream di dati trasferisce i file all'ambiente di gestione temporanea interno in Data 360.
- Pipeline di Data 360 elabora i file: Utilizza la definizione schema di schema_sample.csv Convalida la struttura, i nomi dei campi e divide il carico se supera le soglie di inserimento (100 milioni di righe/50 GB per file). Se vengono rilevati file di grandi dimensioni, viene eseguita esternamente una fase di partizionamento di preelaborazione (notificata all'amministratore per l'esecuzione successiva).
- I record vengono importati dalla gestione temporanea in un oggetto data lake (DLO).
- Se necessario e i dati sono partizionati, utilizzare il nodo append in una trasformazione dati batch per combinare più DLO.
- Data 360 registra gli esiti positivi/negativi, aggiorna lo stato per il monitoraggio e segnala che i dati sono pronti per mappatura, armonizzazione e unificazione.
##### Risultati
L'applicazione di questo schema consente l'inserimento sicuro, pianificato e su larga scala di file strutturati o non strutturati dalle piattaforme di archiviazione cloud aziendali in Data 360. Il processo è automatizzato, scalabile e resiliente: fornisce dati non elaborati in oggetti data lake (DLO) che fungono da base per l'armonizzazione e la mappatura al modello di dati Customer 360.
###### Meccanismi di inserimento
Il meccanismo di inserimento dipende dal connettore e dalla strategia di pianificazione definiti in Data 360.
| Meccanismo di inserimento | Descrizione |
|---|---|
| Connettore Cloud Storage nativo (Amazon S3, GCS, Azure) | Consigliato per l'inserimento diretto di file in formato CSV o Parquet dal data lake cloud dell'azienda. Questi connettori supportano pianificazioni di aggiornamento incrementali e complete. Ad esempio, una banca può configurare una sincronizzazione giornaliera dei file delle transazioni dei clienti da un bucket S3 a un DLO. |
| Strategia file partizionati | Per le serie di dati molto grandi (oltre 100 milioni di righe o 50 GB per oggetto), i dati vengono partizionati in serie logiche più piccole (ad esempio, per mese o regione). Ogni partizione viene gestita come stream di dati separato e in seguito ricombinata utilizzando una trasformazione dati batch con un nodo Aggiungi in coda. |
| Sincronizzazione pianificata automatica | Data 360 offre uno strumento di pianificazione dichiarativo (ogni ora, ogni giorno o cadenza personalizzata) che attiva automaticamente i processi di inserimento, garantendo la freschezza dei dati senza intervento manuale. |
| Tipo di connettore | Requisiti degli endpoint |
|---|---|
| Connettore Amazon S3 | bucket S3 con policy IAM e file schema\_sample.csv appropriati che definiscono lo schema. |
| Connettore Google Cloud Storage | Credenziali account di servizio e accesso bucket con convenzioni di denominazione uniformi. |
| Connettore Azure Storage | Chiave di accesso o autenticazione basata su token SAS; la struttura dei BLOB o delle cartelle deve seguire le convenzioni di Data 360. |
| Area soluzioni | Adatta | Commenti / Dettagli implementazione |
|---|---|---|
| Soluzione adatta | Best | Utilizzare il connettore Salesforce CRM nativo e il connettore Marketing Cloud Engagement in Data 360\. Iniziare con i pacchetti di dati Starter per i casi d'uso standard e accelerare l'orientamento. Utilizzare la personalizzazione manuale degli stream per modelli di dati personalizzati o specifici del dominio. |
| Gestione delle istanze CRM altamente personalizzate | Migliori con il workshop di mappatura | Considerare i pacchetti Starter come base di riferimento e condurre un workshop di mappatura per identificare: Oggetti e relazioni personalizzati. Formula o campi calcolati. Estensioni di pacchetti gestiti. Per i campi formula pesanti, calcolare i valori in un ETL pre-fase o all'interno delle trasformazioni Data 360 per ridurre al minimo il carico API nelle organizzazioni di origine. |
| Quando non utilizzare | Scenari non ottimali | Evitare questo schema se: È necessario l'inserimento di eventi ad alta frequenza o in tempo reale (utilizzare invece Streaming Connectors, Platform Events o Zero-Copy Federation). L'organizzazione di origine ha una capacità API limitata e non può supportare le estrazioni pianificate senza limitazioni o ritardi nell'area di attesa. |
| Sicurezza e governance | Controlli obbligatori | Principio dei privilegi minimi: utilizzare un utente integrazione dedicato con accesso in lettura minimo. Non utilizzare mai gli amministratori dell'organizzazione. Autenticazione: utilizzare OAuth 2.0 e le applicazioni connesse; ruotare regolarmente i segreti client e monitorare l'utilizzo dei token di aggiornamento. Controllo e tracciabilità: registrare tutte le esecuzioni dell'inserimento, le modifiche dello schema e gli eventi del connettore. Inoltrare i registri a SIEM o ai sistemi di conformità per la preparazione al controllo. Classificazione dei dati: applicare il tag PII/PHI e il controllo dell'accesso basato sugli attributi (ABAC) utilizzando policy CEDAR immediatamente dopo l'inserimento per applicare mascheramento, consenso e conformità a valle. |
 In questo scenario:
- L'**amministratore esegue provisioning** e assegna gli insiemi di autorizzazioni connettore nelle organizzazioni di origine.
- L'**amministratore configura i connettori** in Imposta in Data 360 (si connette a Salesforce CRM e Marketing Cloud tramite OAuth/applicazione connessa).
- L'**amministratore crea stream di dati** selezionando oggetti ed estensioni dati, sceglie l'aggiornamento completo o delta e imposta le pianificazioni.
- **All'esecuzione pianificata**, Data 360 richiede lo schema e i token delta alle fonti.
- I **sistemi di origine restituiscono record** (delta o payload completo). Marketing Cloud può fornire estratti; CRM può restituire risultati JSON/Query.
- **Data 360 inserisce file** nella propria area di gestione temporanea protetta interna e li convalida in base allo schema mappato.
- **Se la convalida** non riesce, l'inserimento registra l'errore, avvisa l'amministratore e interrompe la conferma. Se la convalida riesce, Data 360 conferma i record in modo atomico nel DLO di destinazione.
- I **registri monitoraggio e controllo** vengono aggiornati con discendenza, durata dell'esecuzione, conteggi delle righe e utilizzo delle credenziali. Avvisi inviati agli amministratori se vengono attivate soglie o errori.
##### Risultati
I dati principali sulle relazioni con i clienti e sul coinvolgimento nel marketing vengono inseriti in Data 360 come oggetti data lake (DLO). In questo modo si ottiene:
- **Serie di dati** contenente profili, casi, opportunità e metriche di email/coinvolgimento.
- **Fondazione per la risoluzione** dell'identità e la costruzione di profili Persona unificata.
- **Prontezza operativa** per armonizzazione, arricchimento, modellazione AI e attivazione a valle, preservando governance e controllabilità.
###### Meccanismi di inserimento
Il meccanismo di inserimento dipende dal connettore e dalla strategia di pianificazione definiti in Data 360.
| Meccanismo | Quando utilizzare |
|---|---|
| Connettore Salesforce CRM (nativo) | Ideale per oggetti CRM standard/personalizzati; supporta l'aggiornamento completo e delta. |
| Connettore Marketing Cloud Engagement (nativo) | Ideale per estensioni dati, invii e tracciamento delle estrazioni; supporta le modalità full/delta. |
| Pacchetti di dati Starter | Accelerare l'orientamento per gli oggetti Sales/Service/Marketing più comuni. |
| Stream personalizzati + preelaborazione | Utilizzare quando sono necessarie trasformazioni complesse o una pesante normalizzazione dello schema. |
| Connettore | Requisiti degli endpoint |
|---|---|
| Connettore Salesforce CRM | L'organizzazione di origine deve consentire un'applicazione connessa, token OAuth e un utente integrazione dedicato con autorizzazioni di lettura. |
| Connettore Marketing Cloud | Credenziali API Marketing Cloud o pacchetto installato; le estensioni dati devono esporre i dati tramite Estrazioni/API. |
| Area soluzioni | Adatta | Commenti / Dettagli implementazione |
|---|---|---|
| Soluzione adatta | Ideale per l'acquisizione di eventi a bassa latenza | Utilizzare l'API inserimento Data 360 (JSON streaming) per inviare tramite push singoli eventi o micro batch. Configurare il connettore API di inserimento con uno schema OAS 3.0 rigoroso (.yaml). Utilizzare l'inserimento CSV in blocco per sincronizzazioni più grandi e meno frequenti. |
| Gestione delle modifiche dello schema | Rigoroso / Gestito | Le modifiche dello schema si stanno interrompendo: aggiornare il file .yaml OAS, modificare il connettore ed eseguire i test dei contratti. Implementare la migrazione dello schema continuativo se i produttori non possono modificare contemporaneamente. |
| Quando non utilizzare | Non ottimale | Non è ideale se è necessaria una preelaborazione (es:deduplicazione, ordine garantito, ecc.) o per carichi in blocco molto grandi (utilizzare connettori in blocco nativi o batch ETL). Se l'origine non è in grado di generare payload validi per lo schema o non è in grado di eseguire l'autenticazione in modo sicuro, utilizzare metodi di inserimento alternativi. |
| Sicurezza e governance | Obbligatorio | Utilizzare OAuth 2.0 con ambiti con privilegi minimi, ruotare le chiavi, registrare l'utilizzo dei token. Applicare TLS 1.2+, convalidare gli IP client se necessario e garantire la creazione di tag delle informazioni personali del payload. Tutti gli eventi devono contenere metadati di provenienza (origine, indicazione oraria, versione dello schema, chiave idempotency). |
 **In questo scenario:**
- Sistema esterno richiede l'autenticazione tramite OAuth/JWT dal server di autenticazione.
- Il server di autenticazione restituisce il token di accesso al sistema esterno.
- Sistema esterno invia la richiesta POST di inserimento dati all'API di inserimento Data 360 con autorizzazione e payload JSON.
- L'API di inserimento convalida lo schema della richiesta e l'autenticazione tramite il modulo Staging & Validation (Stage e convalida).
- In caso di errore di schema/autenticazione:
- Errore restituito al sistema esterno.
- Rifiuto registrato per il monitoraggio e l'avviso.
- In caso di convalida riuscita:
- Record inseriti e confermati nell'oggetto data lake (DLO).
- Riuscito registrato per il monitoraggio.
- Se abilitata, la propagazione dei dati al grafico dati in tempo reale (DMO) attiva flussi di lavoro a valle.
- In caso contrario, i dati elaborati tramite batch standard o pipeline a latenza più alta.
- L'API di inserimento conferma l'esito positivo di Sistema esterno.
- Avviso sui componenti di monitoraggio Amministratore in caso di aree di attesa senza risposta, percentuali di rifiuto o problemi di latenza.
##### Risultati
I dati degli eventi esterni vengono inseriti nei DLO di Data 360 con bassa latenza. Quando il DMO di destinazione fa parte del grafico in tempo reale, i dati sono disponibili per la segmentazione istantanea, i flussi di lavoro degli agenti, i modelli AI e l'attivazione operativa. Ciò consente risposte aziendali rapide agli eventi provenienti da qualsiasi sistema connesso.
###### Meccanismi di inserimento
Il meccanismo di inserimento dipende dal connettore e dalla strategia di pianificazione definiti in Data 360.
| Meccanismo | Quando utilizzare |
|---|---|
| Streaming JSON (API di inserimento) | Eventi singoli, micro batch, eventi comportamentali, stream di clic, telemetria IoT, quando è richiesta una latenza bassa. |
| CSV in blocco (modalità in blocco dell'API di inserimento) | Caricamenti periodici più ampi in cui i requisiti di latenza vengono ridotti. |
| Bordio / middleware | Utilizzare quando è necessaria la convalida, la trasformazione, l'arricchimento o la limitazione della percentuale prima di passare all'API di inserimento. |
| Area soluzioni | Adatta | Commenti / Dettagli implementazione |
|---|---|---|
| Acquisizione evento basata su SDK | Best | Distribuire Salesforce Interactions SDK (web) o SDK nativo (mobile). Queste librerie leggere acquisiscono e serializzano le interazioni degli utenti in tempo reale, allegando metadati (ID sessione, indicazione oraria, contesto). |
| Streaming di eventi in corso di realizzazione | Best | Gli eventi vengono inviati al servizio di streaming eventi di Personalizzazione Marketing Cloud su HTTPS protetto. Questo livello è scalabile orizzontalmente e ottimizzato per la trasmissione a bassa latenza (<2s). |
| Integrazione con Data 360 | Best | Il connettore Personalizzazione di Data 360 si abbona al feed in streaming, inserendo ogni evento in un oggetto data lake (DLO) in nearReal-Time. |
| Mappatura del modello di dati | Best Practice | Il DLO inserito viene mappato agli oggetti modello di dati (DMO) Customer 360. Ciò consente di collegare utenti anonimi e noti tramite la risoluzione dell'identità. |
| Abilitazione del grafico in tempo reale | Facoltativo / Consigliato | Includere i DMO mappati nel grafico in tempo reale per una segmentazione istantanea, attivando azioni personalizzate tramite flussi di lavoro Einstein o Agentforce. |
| Quando non utilizzare | Non ottimale | Questo schema non è ideale quando: I dati di origine sono client Web ed eventi (utilizzare invece l'API di inserimento). L'organizzazione non ha il controllo sui client Web/mobili. Il tracciamento del comportamento in tempo reale non è necessario (utilizzare l'inserimento batch). |
| Gestione delle modifiche dello schema | Evoluzione gestita | Gli schemi degli eventi evolvono man mano che vengono aggiunte nuove interazioni. Gli SDK devono eseguire la versione delle definizioni degli eventi. Le modifiche compatibili con le versioni precedenti (aggiunta di campi facoltativi) sono sicure; l'interruzione delle modifiche richiede la riconfigurazione del connettore e il test del contratto. |
 **In questo scenario:**
- Distribuire l'SDK nei canali Web o mobili (acquisizione dell'interazione utente).
- Configurare SDK con ID tenant, ambiente e controlli consenso.
- Inviare in streaming gli eventi JSON acquisiti (metadati + attributi) all'endpoint di streaming di Marketing Cloud.
- In Imposta in Data 360, creare e configurare il connettore Personalizzazione per il tenant.
- Inserire gli eventi in un DLO e mappare il DLO → DMO in Data 360.
- Abilitare il DMO nel grafico in tempo reale per l'attivazione immediata.
- Monitorare la latenza, la conformità dello schema, i flag di consenso, la produttività, le percentuali di errore.
- Distribuire in produzione e monitorare continuamente.
##### Risultati
Un flusso continuo a bassa latenza di eventi comportamentali fluisce dai canali digitali a Data 360. In pochi secondi, ogni azione utente diventa disponibile per la segmentazione in tempo reale, la modellazione predittiva o la personalizzazione attivata, abilitando esperienze cliente davvero adattive.
###### Meccanismi di inserimento
Il meccanismo di inserimento dipende dal connettore e dalla strategia di pianificazione definiti in Data 360.
| Meccanismo | Quando utilizzare |
|---|---|
| Interactions SDK (Web) | Acquisizione in tempo reale da browser Web e SPA. |
| SDK mobile | Acquisizione in tempo reale da applicazioni mobili native. |
| Connettore Personalizzazione | Abbonamento gestito tra Marketing Cloud e Data 360\. |
| Mappatura del grafico in tempo reale | Abilita l'attivazione immediata in Segmentazione, Einstein e Journey. |
| Area soluzioni | Adatta | Commenti / Dettagli implementazione |
|---|---|---|
| Connettore streaming basato su CDC | Best | Meccanismo Salesforce nativo; completamente gestito e integrato con l'infrastruttura degli eventi piattaforma. |
| Abbonamento e consegna evento | Best | Il connettore si abbona ai canali ChangeEvent (ad esempio, /data/ContactChangeEvent) tramite ID replay durevoli. |
| Mappatura dei dati ed evoluzione degli schemi | Procedure consigliate | Mappare i payload in streaming al DLO corrispondente; gestire il controllo delle versioni dello schema nei metadati per evitare interruzioni dell'inserimento. |
| Replay e ripristino dei guasti | Consigliato | Utilizzare replay ID e chiavi idempotency per evitare duplicazioni e ripristinare errori temporanei. |
| Modalità ibrida (streaming + batch) | Facoltativo | Per gli oggetti non supportati o il caricamento in blocco iniziale, utilizzare l'inserimento in batch in combinazione con lo streaming CDC. |
| Quando non utilizzare | Non ottimale | Questo schema può essere non ottimale quando: L'oggetto di origine non è abilitato per CDC. Il caso d'uso non richiede aggiornamenti in tempo reale (batch è sufficiente). L'uscita della rete dall'organizzazione di origine è limitata o vengono superati i limiti degli eventi. |
 **In questo scenario:**
- La modifica avviene in Salesforce CRM (creazione/aggiornamento/eliminazione/annullamento eliminazione).
- CDC pubblica un ChangeEvent nel bus degli eventi Salesforce interno.
- Il connettore Data 360 CRM si abbona al bus degli eventi utilizzando un cursore di riproduzione durevole.
- Il payload evento viene convalidato per lo schema, le autorizzazioni e l'integrità dei dati.
- Data 360 scrive l'evento convalidato nel **Data Lake Object (DLO)** mappato.
- Se abilitati, i **DMO (Data Model Objects)** mappati vengono aggiornati in nearReal-Time, alimentando la segmentazione e l'attivazione.
##### Risultati
Data 360 mantiene un mirror continuamente sincronizzato dei dati CRM chiave.
Ciò consente di:
- Trigger in tempo reale (ad esempio, il journey viene avviato quando viene creato un caso).
- Segmentazione aggiornata (ad esempio, spostare i clienti nel segmento "Oro" quando viene modificato lo stato dell'account).
- Analisi e personalizzazione più accurate in base al contesto CRM live.
###### Meccanismi di inserimento
Il meccanismo di inserimento di questo schema viene gestito in modo nativo tramite Salesforce CRM Connector con Acquisizione dati di modifica (CDC) abilitato. Data 360 funge da abbonato allo stream di eventi CDC, garantendo una sincronizzazione affidabile a bassa latenza tra l'organizzazione CRM di origine e Data 360.
| Meccanismo | Quando utilizzare |
|---|---|
| Streaming tramite CDC (preferito) | Per tutti gli oggetti Salesforce standard e personalizzati supportati in cui è richiesta una sincronizzazione quasi in tempo reale. |
| Modalità ibrida (CDC + batch) | Per gli oggetti non ancora abilitati per CDC o per i quali è richiesto il caricamento storico iniziale. |
| Modalità abbonamento Replay | Per la risincronizzazione dopo il tempo di inattività o la distribuzione. |
| Modalità di isolamento degli errori | Per gli ambienti di test e convalida. |
| Area soluzioni | Adatta | Commenti / Dettagli implementazione |
|---|---|---|
| Connettore nativo Kinesis | Best | Integrazione first party con AWS Kinesis; supporta l'inserimento continuo a elevata produttività. |
| Connettore nativo MSK | Best | Inserimento Kafka gestito con supporto per OIDC e autenticazione basata su chiave. |
| Mappatura e convalida degli schemi | Procedure consigliate | Carica schema (.json/.avro) che definisce la struttura degli eventi; impone la coerenza durante l'inserimento. |
| Configurazione IAM | Consigliato | Assegnare il ruolo IAM con privilegi minimi con accesso di sola lettura allo stream Kinesis di destinazione o all'argomento MSK. |
| Instradamento rete privata | Facoltativo | Configurare gli endpoint PrivateLink/VPC per un instradamento interno sicuro. |
| Schema ibrido (Streaming + batch) | Facoltativo | Utilizzare lo streaming per i delta e l'inserimento batch per i riempimenti o i carichi storici. |
| Modalità di isolamento degli errori | Consigliato | Rifiuti dello schema di instradamento ed errori temporanei a DLQ per la riproduzione |
 **In questo scenario:**
- Le applicazioni o i dispositivi pubblicano gli eventi in Kinesis Stream o Argomento MSK.
- Il connettore Data 360 esegue l'autenticazione utilizzando le credenziali AWS o il token OIDC.
- Il connettore esegue continuamente il sondaggio o si abbona allo stream.
- Gli eventi vengono messi in scena, convalidati per lo schema e la policy e quindi confermati nell'oggetto data lake (DLO).
- Se mappati, i DMO (Data Model Object) vengono aggiornati quasi in tempo reale per l'attivazione.
- Monitoring Layer tiene traccia delle metriche, degli schemi rifiutati e della latenza.
##### Risultati
Inserimento continuo e a bassa latenza di dati strutturati direttamente da AWS Kinesis o MSK in Data 360. I dati sono immediatamente disponibili per:
- Risoluzione dell'identità
- Segmentazione in tempo reale
- Attivazione Einstein AI
- Trigger basati su Agentforce
Elimina la dipendenza da ETL batch, abilitando architetture basate su stream in linea con le strutture aziendali basate sugli eventi.
###### Meccanismi di inserimento
| Meccanismo | Quando utilizzare |
|---|---|
| Connettore Kinesis (preferito) | Per le fonti di streaming native AWS che richiedono l'inserimento continuo di dati strutturati a volume elevato. |
| Connettore MSK | Per le organizzazioni che eseguono opportunità in corso di realizzazione su piattaforme compatibili con Kafka. |
| Ibrido (Streaming + batch) | Per l'inserimento incrementale di eventi combinato con carichi in blocco periodici. |
| Area soluzioni | Adatta | Commenti / Dettagli implementazione |
|---|---|---|
| Snowflake Zero Copy Connector | Best | Integrazione nativa first party; stabilisce la federazione delle query live tramite le API di condivisione dati o tabelle esterne Snowflake. |
| Connettore Databricks Zero Copy | Best | Supporta l'accesso live diretto alle tabelle/visualizzazioni in Delta Lake; le query pushdown vengono eseguite in fase di esecuzione di Databricks. |
| Federazione file (Apache Iceberg / Delta / Parquet) | Best practice emergenti | Data 360 legge direttamente i formati delle tabelle aperte dalla memoria degli oggetti senza dipendenza di elaborazione esterna. Ideale per serie di dati di grandi dimensioni. |
| Configurazione di rete privata | Consigliato | Utilizzare Salesforce Private Connect o VPC peering per una federazione protetta a livello di rete. |
| Autenticazione e gestione delle chiavi | Best Practice | Implementare l'autenticazione protetta basata su chiave o OAuth con rotazione periodica e gestione del vault. |
| Registrazione schema | Obbligatorio | Data 360 recupera lo schema esterno e lo mappa a un oggetto data lake esterno (DLO esterno). |
| Metadati gestiti | Consigliato | Tutti i DLO esterni ereditano i metadati di classificazione, consenso e discendenza per la visibilità della conformità. |
 In questo scenario:
- L'amministratore configura una connessione Copia zero nell'impostazione di Data 360 (Snowflake, Databricks o Federazione file).
- Vengono stabiliti l'autenticazione protetta e l'instradamento di rete (Private Connect / OAuth / coppia di chiavi).
- L'amministratore crea uno stream di dati selezionando l'origine esterna, ovvero esplorando database, schemi e tabelle live.
- Anziché copiare i dati, Data 360 crea un DLO esterno (oggetto data lake), un puntatore ai metadati che fa riferimento alla tabella live o al file Iceberg.
- I DLO esterni vengono mappati alle entità Customer 360 (ad esempio, Cliente, Transazione, Prodotto).
- Data 360 esegue una query sulla fonte durante la segmentazione, l'attivazione o il calcolo degli approfondimenti.
- Tutti gli accessi, la discendenza delle query e i metadati vengono controllati all'interno del livello Trust di Data 360.
##### Risultati
- I dati esterni rimangono in Snowflake, Databricks o S3: nessun ETL, nessuna duplicazione, nessuna memoria aggiuntiva.
- Data 360 ottiene l'accesso in tempo reale e in lettura ai dati su scala aziendale per la risoluzione dell'identità, gli approfondimenti calcolati e l'attivazione.
- Le organizzazioni mantengono il controllo completo nei framework di governance, crittografia e conformità esistenti.
- Questo schema consente una vera e propria architettura Zero Copy, che combina le prestazioni dell'accesso locale con la governance dello storage federato.
###### Meccanismi di chiamata
Il meccanismo di chiamata dipende dalla soluzione scelta per implementare questo schema.
| Meccanismo | Quando utilizzare |
|---|---|
| Snowflake Federation (Preferito) | Per la federazione delle query live e ad alte prestazioni con data warehouse aziendali gestiti. |
| Federazione Databricks | Per gli ambienti di analisi unificata e lakehouse con serie di dati Delta o Parquet. |
| Federazione file (Apache Iceberg / Delta Lake) | Per le serie di dati su larga scala nell'archiviazione di oggetti in cui lo scollamento del calcolo e l'ottimizzazione dei costi sono fondamentali. |
| Modalità ibrida (copia zero + inserimento) | Quando i dati storici richiedono un inserimento singolo ma l'accesso ai dati live avviene tramite Copia zero. |
| Area soluzioni | Adatta | Commenti / Dettagli implementazione |
|---|---|---|
| Creazione di condivisioni dati | Best | L'amministratore crea una condivisione dati in Data 360, aggiungendo DMO e CIO selezionati (ad esempio, Persona unificata, Punteggio di salute del cliente). |
| Configurazione target | Best | Creare una destinazione condivisione dati specificando gli identificatori account Snowflake o Databricks e i parametri di autenticazione. |
| Condivisione pubblicazione | Best Practice | Collegare la condivisione dati alla destinazione condivisione dati per pubblicare in modo sicuro. |
| Accettazione magazzino | Obbligatorio | L'amministratore esterno accetta la condivisione, materializzando gli oggetti condivisi come visualizzazioni/tabelle di sola lettura nel magazzino. |
| Controllo dell'accesso granulare | Consigliato | Applicare le autorizzazioni basate su oggetti e ruoli in Data 360; allinearsi al controllo dell'accesso basato sui ruoli a livello di magazzino. |
| Accesso federato alle query | Best | Gli analisti eseguono query sui dati condivisi in tempo reale tramite SQL standard; join con i dati nativi del magazzino per analisi e ML a valle. |
| Opzione federazione file | Facoltativo | Per le serie di dati di grandi dimensioni, utilizzare la federazione basata su Apache Iceberg per le letture dirette S3 o Delta Lake senza dipendenza di calcolo. |
 **In questo scenario:**
- L'amministratore di Data 360 definisce una condivisione dati che include gli oggetti Cliente unificato e Approfondimento calcolato.
- Viene registrata una destinazione condivisione dati (account Snowflake o Databricks) con credenziali e policy di governance protette.
- Data 360 pubblica la condivisione; gli amministratori Snowflake/Databricks la accettano.
- I dati condivisi vengono visualizzati come tabelle protette di sola lettura all'interno del magazzino.
- Analisti, strumenti di BI o pipeline ML eseguono query sui dati live unificati dei clienti senza copiare o sincronizzare.
- Tutto l'accesso viene controllato all'interno del Trust Layer di Data 360 e dei registri di governance del magazzino.
##### Risultati
- I warehouse esterni ottengono l'accesso in tempo reale e interrogabile ai dati armonizzati di Data 360.
- Elimina le pipeline ETL inverse, riducendo il carico operativo e la latenza.
- Consente l'addestramento AI/ML, la modellazione predittiva e la BI avanzata direttamente sui dati unificati.
- Mantiene zero duplicazioni, governance forte e controllo dell'accesso secure-by-design.
- Completa il loop bidirezionale Copia zero, in cui federazione in entrata e condivisione in uscita coesistono sotto un unico modello di governance.
###### Meccanismi di chiamata
Il meccanismo di chiamata dipende dalla soluzione scelta per implementare questo schema.
| Meccanismo | Quando utilizzare |
|---|---|
| Condivisione dati protetta Snowflake (preferita) | Utilizzare quando il warehouse aziendale è Snowflake e si necessita di un accesso live e controllato alle serie di dati Data 360 armonizzate senza spostamento o duplicazione dei dati. Ideale per carichi di lavoro basati su analisi, intelligenza artificiale e conformità che richiedono la condivisione a latenza zero e l'imposizione di linee native. |
| Databricks Delta Share | Utilizzare quando i consumatori a valle operano in ambienti Databricks o Delta Lake e richiedono l'accesso in tempo reale in sola lettura alle serie di dati unificate o attivate tramite il protocollo di condivisione Delta aperto. |
| Condivisione tabella esterna (Apache Iceberg / Parquet) | Utilizzare quando si gestiscono architetture in formato aperto nell'archiviazione di oggetti (S3, ADLS o GCS) e si necessita di una condivisione interoperabile e a basso costo tra motori di analisi come Athena, BigQuery o Snowflake-on-Iceberg. |
| API condivisione dati (accesso programmatico) | Utilizzare quando le app personalizzate o il middleware (ad esempio MuleSoft) devono scoprire, abbonarsi o utilizzare le serie di dati condivise in modo sicuro tramite le API, con notifiche di aggiornamento basate sugli eventi e un controllo dell'accesso preciso. |
| Condividi ibrida (Zero copie + Condividi in uscita) | Utilizzare quando si implementano schemi di scambio bidirezionali: sfruttare Copia zero per i dati in entrata e Quota dati in uscita per pubblicare approfondimenti, garantendo la coerenza semantica e di governance tra i piani dati aziendali. |
| Area soluzioni | Adatta | Commenti / Dettagli implementazione |
|---|---|---|
| Provisioning organizzazione iniziale | Best | Designare un'organizzazione Salesforce come organizzazione di residenza in cui viene eseguito il provisioning di Data 360, che diventa l'archivio dati centrale e l'hub di governance. |
| Connessione organizzazione compagna | Best | Configurare le connessioni aziendali dall'organizzazione di residenza a una o più organizzazioni aziendali tramite l'app Data Cloud One: non è necessario alcun codice personalizzato. |
| Definizione spazio dati | Best Practice | Definire gli spazi dati all'interno dell'organizzazione di residenza per segmentare logicamente i dati (ad esempio Retail, Service, Marketing) e isolare i confini di accesso. |
| Condivisione spazio dati | Best | Condividere in modo esplicito spazi dati selezionati dall'organizzazione di residenza alle organizzazioni di compagnia, garantendo una visibilità dei dati unificati governata e basata sui ruoli. |
| Configurazione dell'accesso | Obbligatorio | Nelle organizzazioni partner, abilitare l'app Data Cloud One e assegnare le autorizzazioni utente per l'accesso a profili, approfondimenti e segmenti. |
| Governance e controllo delle policy | Consigliato | Centralizzare tutte le configurazioni di inserimento, risoluzione dell'identità e Trust nell'organizzazione Home, mantenendo una governance end-to-end. |
| Sincronizzazione multi-organizzazione | Best | Le modifiche dei dati e gli approfondimenti calcolati nell'organizzazione di origine si riflettono in tempo reale nelle organizzazioni partner tramite le opportunità di sincronizzazione gestite. |
| Opzione di distribuzione ibrida | Facoltativo | Per le grandi aziende, più organizzazioni partner possono connettersi a una singola organizzazione di residenza mantenendo il contesto locale e i limiti di conformità. |
 **In questo scenario:**
- **Home Admin**: creare lo spazio dati e definire la condivisione dati (selezionare DMO/CIO, segmenti).
- **Home Admin**: creare la destinazione condivisione dati per le organizzazioni partner e configurare Trust (client OAuth, ID organizzazione consentiti).
- **Home Admin**: pubblicare la condivisione dati nella destinazione; allegare policy ABAC (CEDAR) e controlli di crittografia/chiave (CMK, se necessario).
- **Companion Org Admin**: riceve l'invito, convalida la mappatura dell'identità e accetta la condivisione.
- **Organizzazione di compagnia**: Data Cloud One Bridge esegue il provisioning di un utente Data Cloud One e applica la visibilità Insiemi di autorizzazioni e spazio dati.
- **App dell'organizzazione compagna (flussi / Einstein / Apex)**: Eseguire una query su un grafico dati o chiamare le API Data Cloud One per leggere i DMO o i segmenti condivisi.
- **Attivazione**: L'organizzazione compagna attiva l'attivazione o esegue il writeback tramite azioni dati (se consentito).
##### Risultati
- Un'**unica fonte di dati** per i dati dei clienti (Customer 360) in tutte le organizzazioni connesse, senza istanze di Data 360 ridondanti.
- **Tempo più rapido per il** calcolo: le organizzazioni associate possono accedere ai dati unificati e alle funzioni basate su Data 360 in pochi minuti, non in settimane di codice personalizzato.
- **Condivisione controllata dei dati.** Vengono condivisi solo gli spazi dati autorizzati, preservando la sicurezza e la governance e abilitando l'agilità aziendale.
- Le funzioni aziendali (vendite, assistenza, marketing) operano sulla stessa base di dati unificata, consentendo metriche, attivazioni e approfondimenti coerenti in tutta l'azienda.
###### Meccanismi di chiamata
Il meccanismo di chiamata dipende dalla soluzione scelta per implementare questo schema.
| Meccanismo | Quando utilizzare |
|---|---|
| Data Cloud One Native Share (Preferito) | Utilizzare quando più organizzazioni Salesforce (Sales, Service o Industry Cloud) necessitano dell'accesso in tempo reale ai dati unificati dei clienti direttamente da Data 360\. In questo modo si eliminano le repliche e si abilita l'accesso a latenza zero a Golden Record, segmenti e approfondimenti calcolati. |
| Condivisione da organizzazione a organizzazione tramite Data Cloud One Bridge | Utilizzare quando più unità operative o società controllate operano in organizzazioni Salesforce separate ma necessitano di un accesso condiviso ai dati e ai segmenti comuni dei clienti da un'istanza centrale di Data 360. Ideale per le aziende multi-organizzazioni che gestiscono sistemi operativi indipendenti. |
| API di query piattaforma Einstein 1 | Utilizzare quando le app Salesforce, Flusso o Einstein Copilot devono eseguire query o attivare i dati di Data 360 a livello di programmazione. Consente il recupero in tempo reale di profili, metriche o risultati di attivazione unificati in altre applicazioni Salesforce senza esportazioni batch. |
| Attivazione ai canali Salesforce | Utilizzare quando è necessario attivare i dati di Data 360 (segmenti, approfondimenti o attributi) in Marketing Cloud, Service Cloud o Commerce Cloud per la personalizzazione, l'esecuzione di campagne o le esperienze di assistenza agli agenti. |
| Accesso grafico dati (livello query semantica) | Utilizzare quando è necessario l'accesso a livello semantico al modello di dati unificato tramite il grafico dati Salesforce, supportando Copilota, flussi di lavoro AI e analisi cross-cloud in tempo reale, senza join o trasformazioni manuali. |
| Area soluzioni | Adatta | Commenti / Dettagli implementazione |
|---|---|---|
| Creazione segmento | Best | Un esperto di marketing o un analista crea un segmento nell'area di disegno di segmentazione visiva applicando filtri a qualsiasi oggetto modello di dati (DMO) o oggetto approfondimento calcolato (CIO). Definisce il pubblico di destinazione per l'attivazione. |
| Impostazione attivazione | Best | L'utente crea un'attivazione e seleziona il segmento appena creato come origine. Questo definisce il pubblico che Data 360 esporterà nei sistemi a valle. |
| Selezione della destinazione attivazione | Best Practice | L'esperto di marketing seleziona una destinazione attivazione preconfigurata (ad esempio, Marketing Cloud, Google Ads, LinkedIn Ads). Ogni destinazione è registrata in Data 360 con credenziali di autenticazione e mappature di campi. |
| Definizione payload | Obbligatorio | L'esperto di marketing definisce il payload scegliendo identificatori di referente (ad esempio, email, cellulare, ID con hashing) e selezionando attributi di profilo aggiuntivi (ad esempio, nome, livello di fedeltà o CLV) per l'arricchimento nel sistema di destinazione. |
| Pianificazione e frequenza | Consigliato | L'esecuzione delle attivazioni può essere pianificata una sola volta o su base ricorrente (ad esempio, giornaliera o settimanale). La pianificazione garantisce che i pubblici a valle rimangano sincronizzati e aggiornati. |
| Esecuzione ed esportazione | Best | Quando viene eseguito il processo di attivazione, Data 360 esegue una query sul segmento, raccoglie gli attributi selezionati, applica filtri di consenso ed esporta i dati nella piattaforma di destinazione. Per Marketing Cloud, ciò si traduce in genere nella creazione o nell'aggiornamento di un'estensione dati condivisa. |
| Governance e conformità | Obbligatorio | Il Trust Layer applica la convalida dello schema, i metadati del consenso e i controlli delle policy per garantire la conformità ai regolamenti sulla protezione dei dati e il marketing (ad esempio, GDPR, CCPA). |
| Monitoraggio e verificabilità | Best Practice | Ogni esecuzione di attivazione viene monitorata con metriche di successo/fallimento, registri esecuzioni e visibilità delle discendenze nel cruscotto digitale Trust Layer Monitoring (Monitoraggio livello trust), abilitando la trasparenza operativa e la garanzia degli accordi sul livello di servizio. |
 ##### Risultati
- I segmenti di pubblico mirati e arricchiti di Data 360 vengono resi disponibili direttamente nelle piattaforme di marketing e pubblicità a valle.
- I pubblici vengono automaticamente aggiornati e sincronizzati con i dati unificati più recenti dei clienti, mantenendo la pertinenza della campagna in tempo reale.
- Gli esperti di marketing possono utilizzare questi pubblici attivati come fonti di accesso per journey di Marketing Cloud, campagne email o pubblici personalizzati nelle piattaforme pubblicitarie digitali come Google Ads, Meta o LinkedIn Ads.
- Ogni esecuzione di attivazione mantiene una discendenza end-to-end, garantendo conformità, tracciabilità e coerenza tra Data 360 e i sistemi esterni.
- Gli utenti aziendali possono offrire esperienze altamente personalizzate e basate sui dati basate su una visualizzazione Customer 360 completa e affidabile.
###### Meccanismi di chiamata
Il meccanismo di chiamata dipende dalla piattaforma di destinazione e dalla configurazione della destinazione attivazione.
| Meccanismo | Quando utilizzare |
|---|---|
| Attivazione di Marketing Cloud Engagement (preferito) | Utilizzare quando si eseguono journey email o tra canali che richiedono segmenti dinamici, attributi personalizzati e aggiornamenti in tempo reale in Marketing Cloud. Data 360 viene esportato direttamente nelle estensioni dati condivise per l'attivazione delle campagne. |
| Attivazione piattaforma pubblicitaria (Google Ads, LinkedIn Ads, Meta Ads) | Utilizzare quando si attivano segmenti di Data 360 come pubblici personalizzati nelle piattaforme pubblicitarie per il retargeting o la modellazione lookalike. Supporta gli identificatori con hashing e la consegna sensibile al consenso. |
| Attivazione CRM (Vendite o Service Cloud) | Utilizzare per condividere dati, approfondimenti o punteggi di propensione arricchiti dei clienti con gli utenti CRM per interazioni personalizzate di coinvolgimento nelle vendite o assistenza. I dati vengono resi disponibili come record o approfondimenti arricchiti tramite Azioni dati o Componenti profilo unificato. |
| Attivazione esterna tramite MuleSoft o API | Utilizzare quando l'attivazione deve raggiungere sistemi non Salesforce come i data warehouse fedeltà, eCommerce o di terze parti. MuleSoft o l'API di attivazione di Data 360 garantisce una consegna sicura e basata sulle policy con opzioni di aggiornamento basate sugli eventi. |
| Attivazione ibrida (batch + attivata da evento) | Utilizzare quando si combinano attivazioni batch pianificate con trigger basati sugli eventi, abilitando la personalizzazione "sempre attiva" per le campagne sensibili al tempo come gli avvisi di carrello abbandonato o di rischio di abbandono. |
| Area soluzioni | Adatta | Commenti / Dettagli implementazione |
|---|---|---|
| Selezione segmento | Best | Gli analisti selezionano una definizione di segmento o query esistente in Data 360\. Il segmento determina quali record e attributi vengono esportati. |
| Impostazione attivazione | Best | Gli utenti creano una nuova attivazione, scegliendo il segmento come origine e la destinazione Cloud Storage (ad esempio, S3). |
| Configurazione della destinazione attivazione | Obbligatorio | Gli amministratori preconfigurano la destinazione con credenziali, ruoli IAM e percorso di output. I formati supportati sono CSV, Parquet e JSON. |
| Definizione payload | Best Practice | Definire lo schema di esportazione selezionando gli attributi richiesti (ad esempio ID, Nome, Email, Regione, Flag di consenso). Il sistema applica la governance a livello di attributo. |
| Pianificazione e frequenza | Consigliato | L'esecuzione delle esportazioni può essere pianificata secondo una cadenza definita (giornaliera, settimanale, mensile) o attivata manualmente in base alle esigenze. |
| Esecuzione & consegna | Best | All'esecuzione, Data 360 esegue una query sul segmento, compila il file di esportazione, lo crittografa e lo scrive nel bucket/cartella configurato utilizzando l'API del provider cloud. |
| Governance e conformità | Obbligatorio | Trust Layer di Data 360 garantisce che tutte le esportazioni rispettino le policy di consenso, la convalida dello schema e i filtri di conformità. |
| Monitoraggio e verificabilità | Best Practice | Ogni esportazione viene tracciata nel cruscotto digitale Trust Layer Monitoring (Monitoraggio livello Trust) con lo stato, i registri esecuzioni e i metadati dei lignaggi. |
 ##### Risultati
- I segmenti di pubblico mirati e arricchiti di Data 360 vengono resi disponibili direttamente nelle piattaforme di marketing e pubblicità a valle.
- I pubblici vengono automaticamente aggiornati e sincronizzati con i dati unificati più recenti dei clienti, mantenendo la pertinenza della campagna in tempo reale.
- Gli esperti di marketing possono utilizzare questi pubblici attivati come fonti di accesso per journey di Marketing Cloud, campagne email o pubblici personalizzati nelle piattaforme pubblicitarie digitali come Google Ads, Meta o LinkedIn Ads.
- Ogni esecuzione di attivazione mantiene una discendenza end-to-end, garantendo conformità, tracciabilità e coerenza tra Data 360 e i sistemi esterni.
- Gli utenti aziendali possono offrire esperienze altamente personalizzate e basate sui dati basate su una visualizzazione Customer 360 completa e affidabile.
###### Meccanismi di chiamata
Il meccanismo di chiamata dipende dalla piattaforma di archiviazione cloud di destinazione e dalla configurazione di attivazione.
| Meccanismo | Quando utilizzare |
|---|---|
| Attivazione di Amazon S3 | Utilizzare quando il data lake aziendale è ospitato in AWS. Data 360 scrive direttamente in un bucket S3 utilizzando ruoli IAM o credenziali temporanee, garantendo un'esportazione sicura e scalabile. |
| Attivazione di Archiviazione BLOB Azure | Utilizzare quando l'organizzazione opera in Microsoft Azure. Data 360 utilizza token SAS o entità di servizio per scrivere file crittografati nei contenitori Blob. |
| Attivazione di Google Cloud Storage (GCS) | Utilizzare quando i carichi di lavoro di data science o analytics vengono eseguiti su GCP. Data 360 utilizza le credenziali OAuth per esportare i file in bucket GCS in formato CSV o Parquet. |
| SFTP o gateway file esterno | Utilizzare quando i sistemi normativi o legacy richiedono la consegna sicura dei file tramite endpoint SFTP o piattaforme di trasferimento file gestite dall'azienda. |
| Esportazione ibrida (File + API) | Utilizzare quando un'applicazione a valle richiede sia l'esportazione basata su file per l'analisi che un trigger API per l'orchestrazione del flusso di lavoro (ad esempio, il flusso MuleSoft). |
| Area soluzioni | Adatta | Commenti / Dettagli implementazione |
|---|---|---|
| Autenticazione e registrazione app | Obbligatorio | Creare un'applicazione connessa in Salesforce per l'autenticazione basata su OAuth 2.0. Configurare gli ambiti per l'accesso all'API Data 360. |
| Accesso ai dati (profili, segmenti, approfondimenti) | Best | Utilizzare gli endpoint API Connect (/services/data/vXX.X/connect) per eseguire query sui dati armonizzati di Data 360, sui profili unificati e sugli approfondimenti calcolati. |
| Integrazione dell'interfaccia utente | Best | Le app front-end (React, Angular, iOS, Android) chiamano l'API Connect per visualizzare i dati di Data 360 in cruscotti digitali, portali o interfacce mobili. |
| Query sul grafico dati | Consigliato | Combinare l'API Connect con l'API grafico dati per query a livello semantico che semplificano join e relazioni complessi. |
| Aggiornamento in tempo reale | Facoltativo | Utilizzare l'API Connect con estensioni WebSocket o streaming per gli aggiornamenti dei dati live. |
| Sicurezza e governance | Obbligatorio | Applicare la visibilità dei dati utilizzando gli ambiti OAuth, le policy Data 360 e il framework di controllo Trust Layer. |
 ##### Risultati
Gli sviluppatori possono creare applicazioni protette con immagine aziendale personalizzata strettamente integrate con Data 360. Queste app possono:
- È possibile presentare profili cliente e approfondimenti armonizzati in tempo reale.
- Visualizzare i dati di Data 360 insieme a oggetti CRM o personalizzati tramite API unificate.
- Sfruttare controlli di autenticazione, autorizzazione e controllo coerenti tramite il livello Trust.
- Offrire a utenti aziendali o partner un accesso senza interruzioni e regolamentato a Intelligence clienti affidabile in tutte le esperienze.
##### Meccanismi di chiamata
Il meccanismo di chiamata dipende dalla piattaforma di archiviazione cloud di destinazione e dalla configurazione di attivazione.
| Meccanismo | Quando utilizzare |
|---|---|
| API REST Connect (preferita) | Utilizzare quando si creano app Web, mobili o di terze parti che richiedono l'accesso in tempo reale ai dati di Data 360 in un formato JSON intuitivo. |
| API grafico dati | Utilizzare quando l'app deve eseguire query a livello semantico su più oggetti (ad esempio, Cliente → Transazioni → Campagne). |
| API Query | Utilizzare quando si eseguono query simili a SOQL per recuperare serie di dati armonizzate con elevata precisione. |
| API piattaforma Einstein 1 | Utilizzare quando si integrano approfondimenti basati sull'intelligenza artificiale o consigli generati da Copilota all'interno di interfacce utente personalizzate. |
| Wrapper di gateway MuleSoft o Apex | Utilizzare quando è necessaria un'ulteriore orchestrazione, caching o applicazione delle policy tra l'app e l'API Connect. |
| Area soluzioni | Adatta | Commenti / Dettagli implementazione |
|---|---|---|
| Definizione grafico dati | Obbligatorio | Gli architetti definiscono un grafico dei dati che combina più DMO in un'unica entità semantica (ad esempio, UnifiedCustomerProfile). |
| Recupero ricerca profilo | Best | Le applicazioni chiamano GET /api/v1/dataGraph/{entity}/{id} per recuperare profili completi e denormalizzati in base a ID o chiave univoci. |
| Utilizzo dei parametri live | Facoltativo | Aggiungere ?live=true per forzare il calcolo anziché il recupero nella cache; adatto per decisioni di valore elevato. |
| Autenticazione | Obbligatorio | Utilizzare OAuth 2.0 tramite applicazioni connesse per autenticare le chiamate API in modo sicuro. |
| Analisi delle risposte | Procedure consigliate | Le applicazioni analizzano la risposta JSON direttamente nell'interfaccia utente o nel motore decisionale; non sono necessari ulteriori join. |
| Strategia di caching | Consigliato | Implementare il caching locale a breve termine (ad esempio, in memoria o CDN) per ricerche ripetute di profili. |
| Monitoraggio e osservabilità | Obbligatorio | Utilizzare i cruscotti digitali Trust Layer per monitorare le prestazioni delle query, i tempi di risposta e l'osservanza delle policy. |
 ##### Risultati
Le applicazioni ora possono recuperare istantaneamente un profilo cliente completo e pre-unito, ottimizzando interazioni in tempo reale come personalizzazione, assistenza e automazione delle decisioni.
Questo schema garantisce:
- Tempi di risposta inferiori al secondo per le decisioni sul momento.
- Recupero dei dati gestito coerente e in linea con il modello semantico di Data 360.
- Logica di applicazione semplificata: nessun join, nessuna riconciliazione dello schema.
- Accesso tracciabile e conforme tramite il Trust Layer per controllo e osservabilità.
###### Meccanismi di chiamata
Il meccanismo di chiamata dipende dalla piattaforma di archiviazione cloud di destinazione e dalla configurazione di attivazione.
| Meccanismo | Quando utilizzare |
|---|---|
| API grafico dati (preferita) | Utilizzare per recuperare istantaneamente profili completi e pre-materializzati in base all'ID o alla chiave. |
| API grafico dati con live=true | Utilizzare per casi d'uso di valore elevato (ad esempio, rilevamento di frodi, offerte live) in cui sono necessari i dati più aggiornati, accettando una latenza leggermente superiore. |
| API Connect (Fallback) | Utilizzare per scenari di applicazioni composte che combinano i recuperi di Grafico dati con altri dati Salesforce. |
| API Query | Utilizzare quando si creano query ad hoc o letture analitiche anziché recuperare istantaneamente i profili. |
| Proxy API MuleSoft | Utilizzare quando si instradano le chiamate di Data Graph attraverso gateway aziendali o quando è necessaria un'ulteriore orchestrazione/imposizione delle policy. |
| Area soluzioni | Adatta | Commenti / Dettagli implementazione |
|---|---|---|
| Azione dati in tempo reale | Best | Esporre l'endpoint per i trigger di lettura/scrittura e azione a record singolo. Autenticazione tramite OAuth/JWT. |
| Risoluzione dell'identità | Obbligatorio | Risolvere gli identificatori in entrata (email, externalId, cookie) in ID persona unificata in linea. Utilizzare un risolutore deterministico con cache. |
| Applicazione delle policy (CEDAR) | Best Practice | Valutare il consenso, l'ABAC e le policy di mascheramento al momento della richiesta; negare o mascherare i campi in base alle decisioni delle policy. |
| Livello Edge/Cache | Consigliato | Utilizzare cache TTL brevi per i frammenti di profilo e gli approfondimenti calcolati per ridurre la latenza; invalidare gli eventi di modifica. |
| Trasformazioni Lightweight | Consigliato | Applicare arricchimenti semplici o campi calcolati nel percorso azione; le trasformazioni pesanti devono essere precalcolate. |
| Orchestrazione azione | Best | Supportare le azioni sincrone a fase singola (ad esempio, il token di offerta restituito) e le orchestrazioni asincrone (webhook area di attesa \+) per i flussi complessi. |
| Osservabilità e tracciamento | Obbligatorio | Registrare le richieste/risposte, le decisioni delle policy e la discendenza nel Trust Layer/SIEM per il controllo e il debug. |
| Limitazione e limitazione delle tariffe | Obbligatorio | Applicare le quote dei clienti e strategie di degrado graziose per i momenti di traffico elevato. |
 ##### Risultati
- Le applicazioni ricevono l'accesso immediato e regolato dalle policy alle letture/scritture unificate dei profili e ai trigger di azione con latenza da subseconda a seconda.
- Personalizzazione in tempo reale, decisioni e flussi di lavoro operativi (ad esempio offerte, assistenza agli agenti, aggiornamenti dell'inventario) vengono abilitati senza ritardi batch.
- Tutte le azioni sono controllabili, sensibili al consenso e impongono il mascheramento a livello di attributo per mantenere la privacy e la conformità.
###### Meccanismi di chiamata
Il meccanismo di chiamata dipende dalla piattaforma di destinazione e dalla configurazione della destinazione attivazione.
| Meccanismo | Quando utilizzare |
|---|---|
| API Azioni dati RESTful | Preferito per app Web/mobili e middleware che richiedono letture di profili sincroni o risposte azioni. |
| gRPC / Binary RPC | Utilizzare per i servizi aziendali a latenza ultra bassa o i microservizi interni con connessioni persistenti. |
| Query a record singolo GraphQL | Utilizzare quando i clienti necessitano di una selezione flessibile dei campi e desiderano ridurre al minimo i payload. |
| Webhook attivati da eventi | Utilizzare per i flussi di lavoro asincroni in cui l'azione attiva processi a valle (ad esempio, avvia un journey). |
| Platform Events / PubSub | Utilizzare per scenari di fan-out in cui più sistemi devono reagire a un singolo evento azione. |
| Edge SDK (librerie client) | Utilizzare per i client a bassa latenza che memorizzano nella cache i frammenti di profilo e chiamano l'API Azioni dati solo quando necessario. |
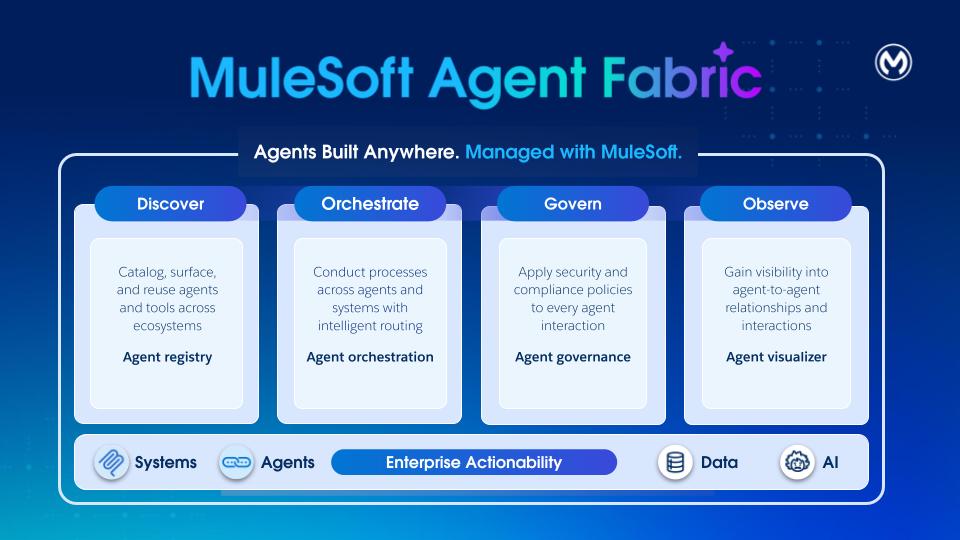 **Scopri:** Registro agenti offre un catalogo centralizzato di tutti gli agenti e gli strumenti di intelligenza artificiale dell'organizzazione. Consente l'individuazione e il riutilizzo di asset interni, incorporati SaaS ed esterni. Fornendo un'unica fonte di dati per tutti gli asset agenti, Registro agenti elimina la ridondanza e garantisce che gli sviluppatori possano sfruttare le funzionalità esistenti su larga scala.
**Orchestra:** MuleSoft Agent Broker è una soluzione di instradamento intelligente che abbina dinamicamente le operazioni all'agente o allo strumento più adatto. Basato su un LLM a scelta, coordina gli agenti e gli strumenti per garantire che le richieste a più fasi e i processi aziendali complessi vengano eseguiti con risultati tracciabili e di elevata affidabilità.
**Govern:** [MuleSoft Agent Governance](https://www.mulesoft.com/platform/ai/ai-agent-governance) utilizza Flex Gateway e il relativo supporto per [Model Context Protocol (MCP)](https://www.mulesoft.com/platform/ai/model-context-protocol) e [Agent2Agent (A2A)](https://www.mulesoft.com/platform/ai/a2a-support). Con Flex Gateway, le aziende possono applicare policy di sicurezza e conformità a ogni interazione agente-agente e agente-strumento.
**Osserva:** Agent Visualizer offre un'osservabilità in tempo reale attraverso una mappa dinamica e interattiva delle interazioni degli agenti. Traccia le decisioni, monitora lo stato del sistema, consentendo così un'ottimizzazione continua e una supervisione affidabile dell'intero ecosistema degli agenti.
Agent Fabric promuove un approccio YAML (specific-first) in cui gli utenti definiscono le reti degli agenti tramite un descrittore di metadati (il "file YAML"). Questo file YAML non è indipendente da MuleSoft e separa la definizione della rete agente dalla sua esecuzione.
## Specifica della rete agente (descrittore dei metadati)
Ogni rete di agenti (YAML) definisce un'area funzionale specifica con i relativi asset agenti, incluse le relative regole operative e policy. YAML viene utilizzato per abilitare i quattro pilastri del tessuto agente:
1. Scopri: Compilare il Registro agenti con asset agenti esistenti, ad esempio:
1. Agenti distribuiti su varie piattaforme (MuleSoft o altre)
2. Server MCP
3. Provider LLM
2. Orchestra: Creazione di broker agenti per l'orchestrazione
3. Governa: Applicare policy sugli asset per la sicurezza e la governance
4. Osserva: Definire e riutilizzare le connessioni agli asset definiti. Sono inoltre disponibili funzionalità di osservabilità e monitoraggio per le reti di agenti.
### Creazione
Il journey utente inizia in Anypoint Code Builder. Utilizzare il nuovo comando disponibile tramite la tavolozza dei comandi denominata "MuleSoft: Creare un progetto di rete agente" per creare un nuovo progetto. Questo comando crea un nuovo progetto (la “rete degli agenti”) contenente due file.
- **agent-network.yaml:** Questo file definisce la configurazione per il sistema multi-agente, abilitando l'orchestrazione di agenti AI con strumenti esterni (tramite MCP) e agenti (tramite protocollo A2A). Questo formato è un modo dichiarativo per definire le funzionalità, le dipendenze e le integrazioni degli agenti.
- **exchange.json:** Tutti i progetti di rete degli agenti hanno anche un file exchange.json. Questo file contiene i metadati degli asset disponibili in Anypoint Exchange dopo la pubblicazione degli asset di rete degli agenti.
Lo sviluppo della rete di agenti segue un ciclo di vita di sviluppo software (SDLC) standard che prevede quattro fasi principali:
1. **Impostazione ambiente:** Impostazione dell'ambiente di runtime e dei gateway
2. **Creazione e progettazione di progetti**: Creazione della specifica del progetto Agent Network
3. **Creazione e pubblicazione:** Creare e pubblicare asset nel Registro agenti
4. **Distribuzione:** Distribuire o promuovere la rete degli agenti in un determinato ambiente
Dopo aver creato il progetto e generato l'applicazione MuleSoft e gli asset richiesti, renderli disponibili in Exchange. In Anypoint Code Builder, attivare il processo di creazione e pubblicazione utilizzando **_"MuleSoft: Comando Publish Agent Broker Project to Exchange”_** disponibile tramite tavolozza dei comandi.
La fase di pubblicazione trasforma ogni asset agente nel file YAML in una specifica A2A, MCP o LLM e lo pubblica in Exchange.
Inoltre, il sistema **pubblica** YAML in Exchange utilizzando un nuovo tipo di asset di rete agente. È possibile **visualizzare** questo asset nell'interfaccia utente del Registro agenti e **cercarlo** tramite l'API Exchange.
### Esempio
Fare riferimento a un [file Agent Network](https://docs.mulesoft.com/anypoint-code-builder/af-project-files) che definisce una rete di agenti per un'azienda. Questa rete di agenti attiva la rete per l'evasione degli ordini in Salesforce, Stripe, un altro agente dell'evasione ordini e un server MCP dell'inventario con un'unica esperienza basata su policy.
- **Scopri**
Pubblicare gli agenti e gli strumenti esistenti (ad esempio Salesforce, Stripe, Evasione ordini e Inventario) come asset Exchange da riutilizzare. Inoltre, la definizione di evasione ordine (YAML), che è disponibile in versione e condivisibile, consentendo un rapido adattamento per ruoli, regioni o società controllate senza ricreare i flussi.
- **Orchestra**
Un broker agente utilizza un LLM per scomporre il processo di evasione dell'ordine in una sequenza di operazioni, ad esempio la verifica dei dettagli del cliente, l'allocazione dell'inventario e il calcolo dei costi di spedizione. Quindi esegue questo flusso di lavoro chiamando gli agenti MCP e A2A, assicurando che le approvazioni human-in-the-loop vengano richieste ogni volta che necessario.
- **Governato**
Anypoint Flex Gateway impone l'autenticazione, l'accesso con privilegi minimi e i guardrail. Le policy Gestore API garantiscono controlli coerenti in tutte le chiamate e gli scambi di dati.
- **Osserva**
Il monitoraggio e le tracce offrono una visibilità completa su avanzamento, errori e latenza. La visualizzazione mostra quali agenti hanno interagito e dove si sono verificati colli di bottiglia.
- **Trust e conformità**
Le credenziali centralizzate, gli itinerari di controllo e l'eredità delle polizze supportano la sicurezza, la privacy e i requisiti normativi (gestione delle informazioni personali, approvazioni e separazione delle mansioni).
Il diagramma mostra i diversi nodi della rete di agenti (metadati) definiti in YAML.
 ## Registro agenti (Discover)
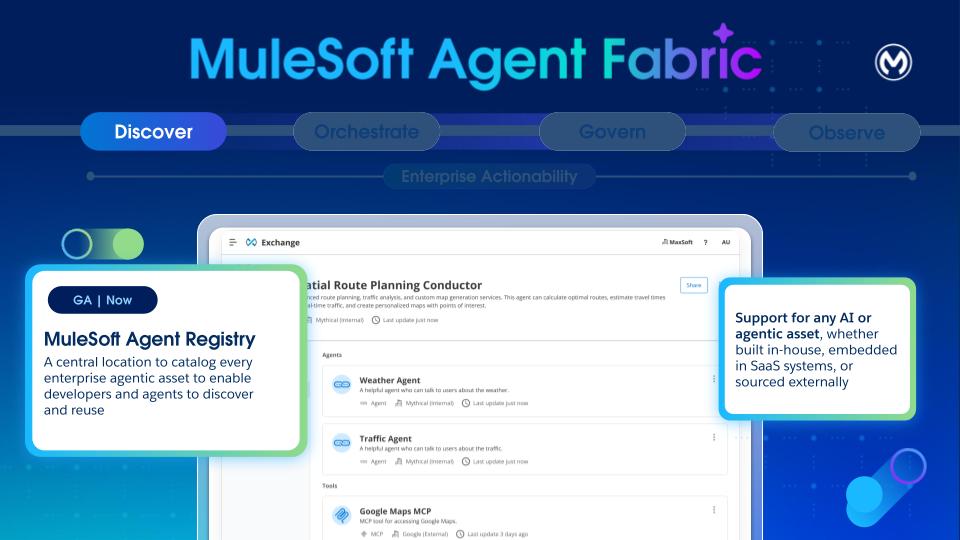 - **Scopo**: Exchange è il catalogo per agenti, strumenti e altri asset. Il suo obiettivo principale è risolvere la "diffusione degli agenti" fornendo un unico catalogo governato per la scoperta, la cura e la gestione del ciclo di vita di agenti eterogenei. Consente agli sviluppatori di trovare e riutilizzare gli agenti, ai titolari della piattaforma di mantenere la visibilità e agli orchestratori di scoprire le funzionalità.
- **Eterogeneo per progettazione**: Anypoint Exchange ora supporta tre nuovi asset: agenti, MCP e LLM. Exchange è progettato per essere un catalogo universale, per registrare e gestire qualsiasi tipo di agente. Supporta agenti, server MCP e provider LLM compatibili con A2A da qualsiasi fonte, inclusi agenti MuleSoft di terze parti, Agentforce e personalizzati.
- **Metadati principali**: Ogni asset registrato ha un insieme di base di metadati immutabili, inclusi Nome e versione univoci, Proprietà e Publisher. Vengono tracciati anche gli stati del ciclo di vita (sviluppo, gestione temporanea, produzione, deprecato).
- **Scoperta**:
- **Design-Time**: Gli sviluppatori possono scoprire gli agenti registrati tramite l'interfaccia utente Exchange esistente o tramite la ricerca per linguaggio naturale con Vibes nel Generatore di codici Anypoint.
- **Tag e classificazione**: Gli asset possono essere classificati in base al tipo (agente, MCP, LLM, broker) e al dominio (ad esempio, risorse umane, meteo) utilizzando un sistema di assegnazione di tag chiave-valore di base, abilitando policy dinamiche di collegamento, ricerca e selezione.
- **Catalogo**: L'archivio supporta modelli di catalogo sia privati che interni per la condivisione degli agenti all'interno di un'organizzazione.
- **Visualizzazione**: Fornisce uno strumento visivo per supportare le visualizzazioni rete, mostrando le connessioni per singoli asset o l'intera mappa di nodi e link in tutta l'organizzazione, con funzionalità di filtro.
I broker all'interno di una rete di agenti possono fare riferimento ad agenti registrati, server MCP e provider LLM memorizzati in Anypoint Exchange. Tuttavia, se non sono già registrati, possono essere dichiarati nei metadati di Agent Network (YAML) e vengono registrati automaticamente. Nell'esempio, più agenti, server MCP e provider LLM vengono dichiarati e registrati in Anypoint Exchange.
```
agents:
orders-agent:
label: Order Fulfilment Agent
metadata:
protocol: a2a
platform: OpenAI
salesforce-agent:
label: Salesforce Agent
metadata:
protocol: a2a
platform: OpenAI
stripe-agent:
label: Stripe Payment Agent
metadata:
protocol: a2a
platform: OpenAI
mcpServers:
inventory:
label: Inventory MCP
metadata:
transport:
kind: streamableHttp
path: /mcp
llmProviders:
open-ai:
label: OpenAI
description: OpenAI LLM Provider
metadata:
platform: OpenAI
```
## Agent Broker (orchestrazione)
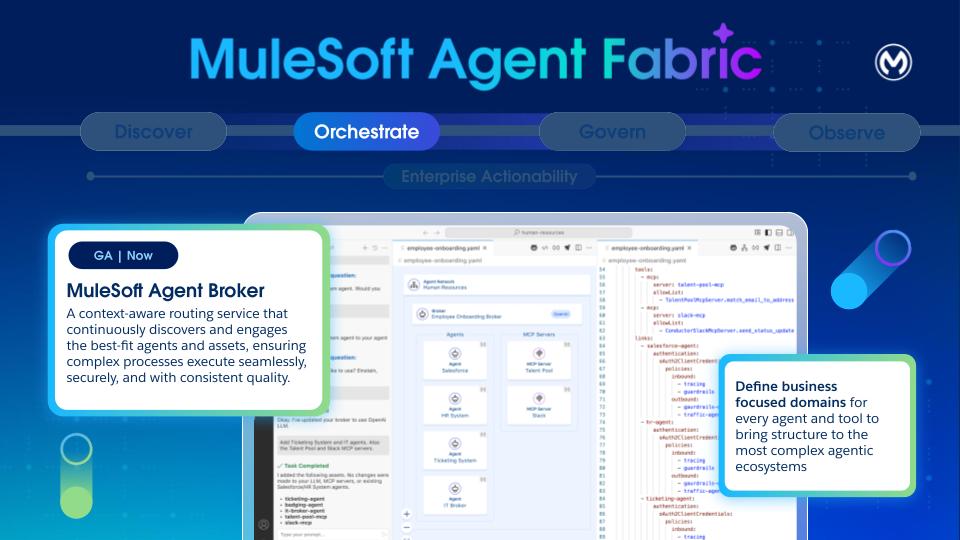 Un broker agente è un agente di instradamento intelligente che coordina la delega delle operazioni tra gli agenti specializzati di un'azienda. È definito dagli agenti e dai server MCP utilizzati per eseguire le operazioni.
Un broker è un agente specializzato che appare in Anypoint Exchange dopo la pubblicazione di un asset di rete agente e il riutilizzo da parte di altri broker.
I broker sono definiti nella sezione _broker_ di YAML. I broker definiti vengono "compilati" in modo trasparente in un'applicazione, senza richiedere alcuna Knowledge precedente su Mule. Questa applicazione generata viene distribuita in CloudHub 2.0 (CH2) e sfrutta la solida infrastruttura CH2.
Ciò significa che gli Agent Broker beneficiano delle caratteristiche di prestazione consolidate di CloudHub 2.0, incluse le funzionalità di registrazione e metriche. Gli aspetti operativi, ad esempio "Costo operativo" e "Monitoraggio/Avviso/Strumentazione", sono gli stessi di qualsiasi altro carico di lavoro.
Per gli scenari che richiedono l'intervento umano (Human-in-the-Loop), lo stato di ogni interazione viene mantenuto utilizzando MuleSoft Object Store, una soluzione distribuita progettata per una gestione efficace dello stato in ambienti molto simultanei.
Una definizione broker è composta da due sezioni: scheda e specifica.
### Scheda
La sezione della scheda segue la [specifica A2A](https://a2a-protocol.org/v0.2.5/specification/). Tra le altre cose, descrive il contratto, le competenze e le capacità dell'agente broker. L'URL della scheda viene popolato automaticamente con il valore ${ingressgw.url}/broker-name. Al momento della distribuzione, il segnaposto ${ingressgw.url} viene sostituito automaticamente con l'URL del gateway Anypoint Flex che visualizza le richieste di immissione degli agenti.
### Specifica
La sezione delle specifiche configura il "codice sorgente" del broker. Qui, lo sviluppatore può specificare il LLM da utilizzare, le istruzioni, gli strumenti disponibili, la gestione degli errori e, soprattutto, i vari agenti e strumenti MCP disponibili per questo broker.
**Fornitori LLM**
Questa sezione fa parte della specifica di ogni broker. Si tratta di un riferimento a uno dei LLM definiti nella sezione Servizi. Possiamo scegliere se condividere un LLM in tutti i broker o, se necessario, fare in modo che diversi broker utilizzino il LLM più adatto alle sue attività.
I broker possono puntare ai provider LLM. Possiamo scegliere i modelli di questi provider a seconda delle nostre esigenze.
```
llmProviders:
open-ai:
label: OpenAI
description: OpenAI LLM Provider
metadata:
platform: OpenAI
```
**Istruzioni**
Questa sezione è facoltativa ed è possibile utilizzarla per specificare istruzioni specifiche per questo agente broker. Queste istruzioni spesso si concentrano su preoccupazioni specifiche orientate al business. Si immagini ad esempio un agente dell'assistenza clienti che coordina la gestione degli incidenti segnalati dai clienti:
```
instructions:
- |
You are an Incident Management Orchestrator Agent. Your primary responsibility is to coordinate the resolution of incidents reported by customers.
The process for incident management is:
1. Fetch Salesforce Case Details: Retrieve the latest critical case details for the given customer.
2. Fetch Entitlement Details: Obtain the customer's entitlement information.
3. Fetch On-Call Engineer: Identify the current on-call engineer for the incident.
4. Create Slack War Room and invite on-call engineer: Set up a Slack war room channel and invite the on-call engineer.
5. Summarize Actions: Provide a clear, human-readable summary of the steps performed, including information about the created slack channel and the on-call engineer assigned
```
Si noti che non è necessario fornire istruzioni esplicite, ad esempio **'dividere il prompt in operazioni' o 'selezionare lo strumento migliore'**, poiché il broker gestisce la cosa da solo. Queste istruzioni sono necessarie solo quando si descrivono processi aziendali specifici.
**Configurazione strumenti**
Gli strumenti offrono agli agenti funzionalità esterne. Ogni volta che un broker deve accedere a un sistema esterno (che non è un altro agente, ad esempio un'API esistente o un servizio SaaS), contatta un server MCP (Model Context Protocol):
```
tools:
- mcp:
server: collaboration-mcp # MCP server reference
allowed: # Allowlist specific tools
- create_channel
- invite_user
```
Al server MCP viene fatto riferimento dal nome dell'asset exchange. I relativi dettagli di connettività sono specificati nella sezione Servizi.
Per impostazione predefinita, il broker ha accesso a tutti gli strumenti disponibili nel server MCP. Secondo la nostra osservazione, i LLM più moderni possono gestire solo circa 20 - 25 strumenti per contesto prima di iniziare a generare imprecisioni (o perdere contesto). Per questo motivo, è generalmente buona norma limitare gli strumenti disponibili al minimo indispensabile. È possibile applicare questo filtro attraverso gli elenchi consentiti.
**Link agenti**
Questa sezione è la parte più importante dell'intera definizione. La sezione dei link consente la comunicazione e l'orchestrazione tra gli agenti. Ciò significa che questo broker si affida agli agenti collegati qui per eseguire le azioni appropriate per completare l'obiettivo dell'utente.
```
links:
- agent:
ref:
name: orders-agent
- agent:
ref:
name: salesforce-agent
- agent:
ref:
name: stripe-agent
```
In effetti, questa sezione definisce una rete di agenti per la collaborazione.
## Flex Gateway (governativo)
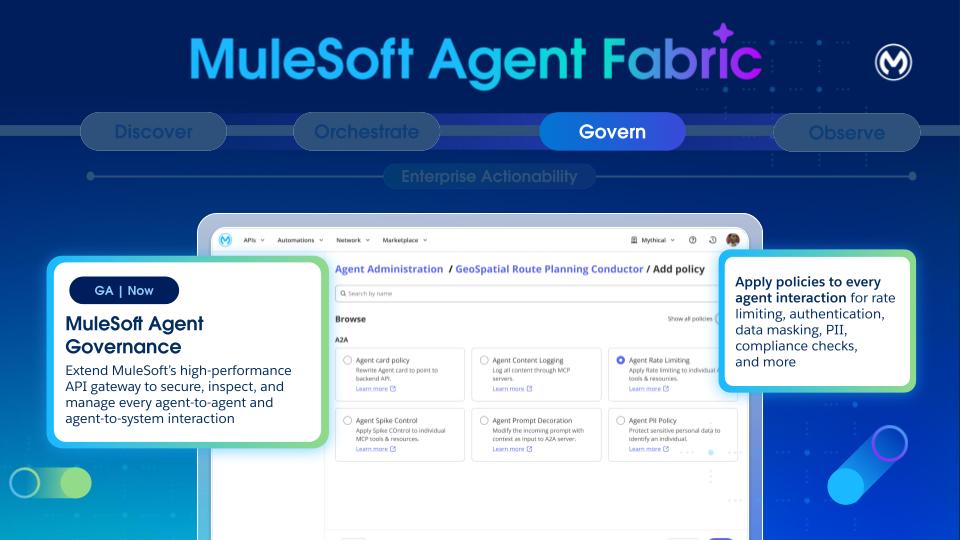 La governance degli agenti è un pilastro fondamentale per il fabric degli agenti, fondamentale per creare una rete di agenti affidabile e garantire sicurezza e conformità.
Per la governance, sono necessari un totale di due gateway Flex (1 ingresso e 1 uscita) all'interno dello spazio privato.
La governance stabilisce le strutture, i controlli e le prove necessarie per scalare in modo sicuro l'intero ciclo di vita dello sviluppo agente (ADLC). In particolare, la governance implementa processi chiave come la certificazione degli agenti, la catalogazione, le decisioni relative al ciclo di vita e l'applicazione delle policy di runtime.
- **Catalogo:**
- Exchange: Supporta la registrazione degli scopi, dei titolari, degli ambienti e dei confini di dati e classificazione degli agenti. Registra anche funzionalità, strumenti, risorse, prompt e dipendenze esterne con le versioni.
- **Versione e ciclo di vita:**
- Documentare e gestire il controllo semantico di agenti, strumenti e asset durante l'intero ciclo di vita dello sviluppo degli agenti.
- Il controllo delle versioni consente di gestire le tempistiche di deprecazione degli agenti e supporta la doppia esecuzione (ove possibile) per garantire migrazioni senza problemi.
- **Applicazione delle policy**:
- L'architettura di intelligenza artificiale agente espande la superficie di attacco (interfaccia delle conversazioni, prompt e nuovi protocolli come MCP). Qualsiasi compromesso di qualsiasi componente può causare effetti a catena su più sistemi che forniscono componenti come protocollo, prompt, API o strumento.
- La protezione delle distribuzioni di intelligenza artificiale degli agenti aziendali richiede un approccio specializzato, poiché questi ambienti autonomi e imprevedibili ampliano per loro natura la superficie di attacco attraverso le interazioni tra agenti. Benché gli strumenti di protezione esistenti per i sistemi statici siano essenziali, non sono più sufficienti da soli. Le aziende devono pianificare e implementare in modo proattivo quattro soluzioni di sicurezza specifiche, ognuna delle quali affronta direttamente un rischio aziendale critico associato all'intelligenza artificiale degli agenti.
- Flex Gateway: Tutto il traffico A2A e MCP viene instradato attraverso Flex Gateway, anche se il sistema di destinazione non è protetto, per garantire che le policy vengano applicate su ogni endpoint. Questo instradamento è fondamentale per proteggere le comunicazioni degli agenti e l'integrazione con i server di autorizzazione.
- Policy Bundles (Bundle di polizze): Gli utenti possono definire e applicare pacchetti di policy predefinite ai flussi di lavoro prima dell'esecuzione, applicando una serie coerente di policy di sicurezza e operative.
- Tipi di polizze: La piattaforma supporta varie policy in entrata e in uscita, tra cui:
- Policy A2A: Scheda agente, Rilevatore informazioni personali, Decoratore prompt, Convalida schema.
- Policy MCP: Controllo dell'accesso basato sugli attributi, Convalida dello schema, Supporto MCP.
- Policy LLM/AI: AI Prompt Decorator (Decoratore prompt AI), AI Prompt Guard (filtraggio di contenuti dannosi), AI Prompt Template (applicazione di modelli predefiniti), AI Basic Token Rate Limiting (Limitazione della frequenza token di base AI).
- Policy sulla telemetria: Telemetria A2A e MCP per estendere le soluzioni Open Telemetry per la raccolta e l'esportazione dei dati di registro.
- **Registrazione**: Grazie al tracciamento automatico, i registri in tutta la rete degli agenti sono disponibili per tenere traccia di ogni interazione degli agenti, spiegando i comportamenti e creando Trust.
L'esempio illustra una policy per la registrazione dei messaggi, configurata utilizzando i metadati della rete dell'agente. Il broker Orderfullfillment fa riferimento a un agente esistente denominato agente Salesforce e la policy per la messaggistica viene configurata utilizzando i metadati. Tenere presente che Agent Fabric configura automaticamente tutte le policy menzionate nella sezione "specifiche" di Flex Gateway. Non sono necessari passaggi aggiuntivi.
```
salesforce-agent-connection:
kind: agent
ref:
name: salesforce-agent
spec:
url: ${salesforce-agent.cardUrl}
policies:
- ref:
name: message-logging
namespace: 68ef9520-24e9-4cf2-b2f5-620025690913
configuration:
loggingConfiguration:
- itemName: "Payload"
itemData:
message: "#[payload]"
firstSection: true
secondSection: true
level: "INFO"
- itemName: "Headers"
itemData:
message: "#[attributes.headers]"
firstSection: true
secondSection: true
level: "INFO"
```
## Agent Visualizer (Osserva)
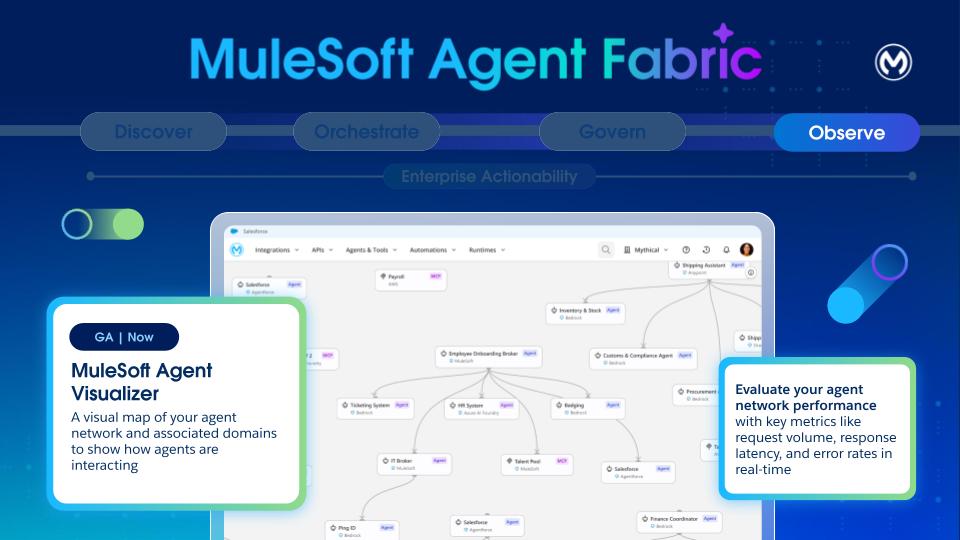 Data la natura non deterministica e la complessità degli agenti LLM e delle distribuzioni multi-agente, l'osservabilità e il monitoraggio sono fondamentali.
- **Registri e tracce di base**: Il ragionamento e il tracciamento dell'esecuzione dello strumento vengono forniti tramite i registri. I registri e le tracce delle esecuzioni dei flussi di lavoro sono visibili dopo l'esecuzione in Runtime Manager.
- **Metriche**: Nella fase iniziale, la piattaforma pubblica a2a_total_calls e mcp_total_calls come contatori con etichette (ad esempio, percorso, stato, metodo, strumento) per determinare le chiamate totali, riuscite e non riuscite. Queste metriche vengono pubblicate dal codice della policy utilizzando l'interfaccia nativa delle statistiche di Envoy (Flex Gateway), preferibilmente tramite policy esistenti come mcp_support_policy e a2a_agent_card_policy.
- **Osservabilità ottimizzata (futura)**: I piani includono l'utilizzo della telemetria aperta per il tracciamento distribuito nelle versioni future. L'osservabilità più avanzata include:
- **Tracciamento dettagliato delle richieste**: Ottenere visibilità completa sulle richieste, che include prompt, processi di pianificazione, azioni richiamate e interazioni con gli agenti secondari.
- **Monitoraggio dello stato degli agenti**: Monitoraggio del tempo di attività degli agenti, della latenza delle risposte, della produttività, delle percentuali di errore e dell'utilizzo delle risorse sottostanti (CPU, memoria, rete, GPU).
- **Monitoraggio coordinamento multi-agente**: Acquisizione delle percentuali di successo e di errore delle interazioni da agente ad agente, rilevamento degli schemi di chiamata circolari (loop) e tracciamento di metriche per agente come il completamento delle operazioni e il conteggio delle chiamate.
- **Tracciamento dei costi**: Monitoraggio dell'utilizzo dei token e dei costi associati per ogni chiamata LLM, idealmente per agente, con cruscotti digitali e avvisi.
- **Tracciamento cognitivo**: Acquisizione e visualizzazione di una traccia dettagliata della sessione di un agente, inclusi i processi di pensiero interni e tutte le chiamate agli strumenti, che funge da itinerario di controllo immutabile.
- **Riproduzione sessione agente**: Interfaccia utente che consente di "riprodurre" visivamente la traccia cognitiva di un agente passo per passo per un debug profondo.
- **Visualizzazione DAG**: Fornire una visualizzazione del grafico aciclico diretto (DAG) dell'esecuzione del flusso di lavoro dell'agente per interazioni complesse tra più agenti.
Agent Visualizer viene utilizzato per identificare le parti della rete di agenti e vedere come funzionano insieme.
- Distinguere i tipi di nodo (agenti e server MCP).
- Visualizzare i bordi per visualizzare le interazioni dichiarate e in fase di esecuzione.
- Utilizzare i livelli per concentrare le visualizzazioni su ambienti specifici
- Aprire le schede dei dettagli per esaminare i metadati e le metriche alla ricerca di nodi e accedere a registri e tracce
- Esaminare gli indicatori di governance come la protezione dal gateway Flex e le policy applicate.
[Qui](https://docs.mulesoft.com/agent-visualizer/agent-visualizer-components) sono disponibili i dettagli sui componenti di Agent Visualizer.
## Tessuto agente: Quattro pilastri insieme
Con questi quattro pilastri, MuleSoft Agent Fabric estende la sicurezza e il controllo a qualsiasi agente con governance incorporata. Consente agli agenti di agire ovunque sfruttando nuovi protocolli come A2A (Agent to Agent) e MCP (Model Context Protocol) per creare ed estendere i processi aziendali. Connettiamo tutto - applicazioni, dati e sistemi - per responsabilizzare e governare gli agenti mentre agiscono in tutta l'azienda. Gli strumenti intelligenti supportano la creazione e l'estensione di processi aziendali o API utilizzando l'intelligenza artificiale in modo nativo o utilizzando strumenti di intelligenza artificiale di terze parti.
L'uso di tutti e quattro i pilastri non è obbligatorio, ma consigliato. È possibile scegliere i pilastri in modo indipendente in base alle esigenze. Ad esempio, è possibile utilizzare Agent Fabric per la registrazione e la governance, senza utilizzare il livello di orchestrazione. Analogamente, è possibile utilizzare il broker per orchestrare gli agenti gestiti tramite un'altra piattaforma.
Il diagramma mostra come tutti e quattro i componenti interagiscono tra loro:
 1. Pubblicare gli asset agenti in Anypoint Exchange per individuarli e riutilizzarli dopo aver definito la rete di agenti (broker, agenti, server MCP) nella rete di agenti YAML in Anypoint Code Builder.
2. Distribuire gli asset agenti in CloudHub 2.0 (gestito in Runtime Manager).
3. Applicare policy sul traffico in entrata alla rete con un gateway Flex di ingresso, posizionato di fronte agli endpoint broker e API.
4. Applicare policy, gestire connessioni ed emettere dati di telemetria con un gateway Flex in uscita. Questo gateway si trova sui percorsi in uscita da broker e agenti a servizi esterni.
5. Raccogliere registri, metriche e tracce da Flex Gateway e dai runtime in Anypoint Monitoring.
## Schemi di progettazione dell'orchestrazione degli agenti
È allettante rendere immediatamente accessibile ogni agente specializzato in un'architettura piatta e senza restrizioni, con un unico orchestratore in grado di affrontare qualsiasi operazione avendo accesso a ogni asset AI disponibile. Tuttavia, questo approccio si rivela rapidamente dannoso per l'efficienza e l'affidabilità complessive del sistema. Proprio come il principio applicato a un eccesso di singoli strumenti, molte opzioni degli agenti introducono rumore e complessità significativi per l'**agente broker** centrale (o orchestratore). Questa maggiore complessità porta direttamente a una notevole diminuzione sia dell'accuratezza del processo decisionale del broker (selezione dell'agente giusto per il lavoro) che del determinismo della risposta del sistema (esiti prevedibili e coerenti per query simili). L'agente broker soffre effettivamente di paralisi delle opzioni, che porta a un instradamento più lento e meno affidabile.
Anziché una struttura piatta, sosteniamo fortemente un **approccio gerarchico multilivello** alla strutturazione della rete degli agenti. Questo principio organizzativo offre numerosi vantaggi critici. In primo luogo, favorisce intrinsecamente la **tracciabilità e gestione**. Una struttura gerarchica rispecchia le procedure ottimali dell'organizzazione, semplificando il controllo del flusso di una richiesta, il debug dei problemi individuando il livello di errore e la gestione della distribuzione e del ritiro di agenti o sottoreti specifici.
In secondo luogo, e soprattutto nel contesto dei modelli linguistici di grandi dimensioni (LLM) che supportano questi agenti, una gerarchia aiuta in modo significativo a **tenere sotto controllo** le dimensioni del contesto. Segmentando il panorama degli agenti, l'agente broker a qualsiasi livello considera solo l'insieme limitato di agenti o sub-broker direttamente sotto di esso. Questa struttura impedisce all'orchestratore principale di caricare la descrizione, le funzionalità e il contesto storico di _ogni agente_ nella memoria di lavoro, **evitando** il rischio di **superare** rapidamente i limiti della finestra di contesto di LLM e **di incorrere** in costi e latenza proibitivi.
 La rete degli agenti può essere implementata in diversi modi. Due di essi sono:
1. Legge di Conway: modo intuitivo per mapparla alla struttura gerarchica del mondo reale.
2. Progettazione basata sul dominio - Più focalizzata sui domini aziendali
# Opzione 1: Mappatura con una struttura gerarchica reale
In un'organizzazione gerarchica, la comunicazione scorre verticalmente - dai responsabili ai subordinati - e le decisioni sono spesso centralizzate. Secondo la legge di Conway:
- I sistemi o le architetture software creati da tali organizzazioni tendono a essere a livelli e gerarchici.
- Ogni team tende a progettare sottosistemi che riflettano i propri confini e autorità.
- Le interfacce tra i sistemi rispecchiano i canali di comunicazione tra i reparti.
La rete di agenti può anche essere mappata in modo intuitivo alla **struttura gerarchica reale di** una grande azienda seguendo la legge di Conway.
- **Il modello concettuale:** Così come una società ha divisioni, reparti e livelli di gestione distinti (ad esempio, C-suite, VP, direttori, responsabili), una rete di agenti che opera all'interno di un dominio specifico può essere modellata come organigramma parallelo.
- **I nodi e le foglie:** In questa gerarchia:
- **Le Foglie** della struttura ad albero sono gli **Agenti Specialisti** o **MCP**. Sono le unità funzionali che eseguono il lavoro effettivo (ad esempio, un "Agente query database", un "Agente autenticazione cliente" e un "Agente analisi del sentiment"). Rappresentano i singoli contributori o unità di lavoro dell'organizzazione.
- **Tutti gli altri nodi** della gerarchia, inclusi i livelli radice e intermedi, sono **agenti broker** (o suborchestratori). Questi agenti non eseguono l'operazione finale ma sono responsabili dell'instradamento, della delega, dell'aggregazione e della risoluzione dei conflitti all'interno del loro dominio o livello specifico. Un broker di alto livello delega un'operazione a un "Broker di domini di vendita", che a sua volta delega a un "Broker di gestione opportunità", che esegue l'operazione tramite un "Agente aggiornamento stato opportunità" (la foglia).
Questa struttura garantisce che la complessità sia gestita localmente, che il contesto sia contenuto e che il sistema venga scalato in modo prevedibile e affidabile. È possibile introdurre nuovi agenti specializzati in rami specifici e appropriati dell'albero organizzativo.
 Si consideri l'analogia di un organigramma per la manodopera digitale. Ogni file YAML rappresenta ciascuna delle organizzazioni interne (Employee Success, Security, Finance e così via). All'interno di ogni organizzazione (rete di agenti) può esistere una struttura gerarchica attraverso la quale gli attori collaborano, i processi vengono suddivisi in operazioni e assegnati. Nel diagramma precedente, la comunicazione scorre dall'alto verso il basso. E le foglie non sono limitate al consumo solo da un insieme di agenti broker.
## Opzione 2: Progettazione basata su dominio e implementazione dell'intelligenza artificiale agente
Modellare le reti di agenti in base all'organigramma umano comporta il rischio di richiedere frequenti riorganizzazioni, in particolare nelle aziende che subiscono frequenti riorganizzazioni. Un approccio alternativo consiste nell'organizzare gli agenti in base al dominio funzionale. Questo raggruppamento può richiedere l'attraversamento dei tradizionali confini dell'organizzazione umana. Ad esempio, l'orientamento dei nuovi dipendenti prevede operazioni IT per il provisioning di hardware e utenti, mentre una richiesta di vendita richiede sia operazioni che marketing.
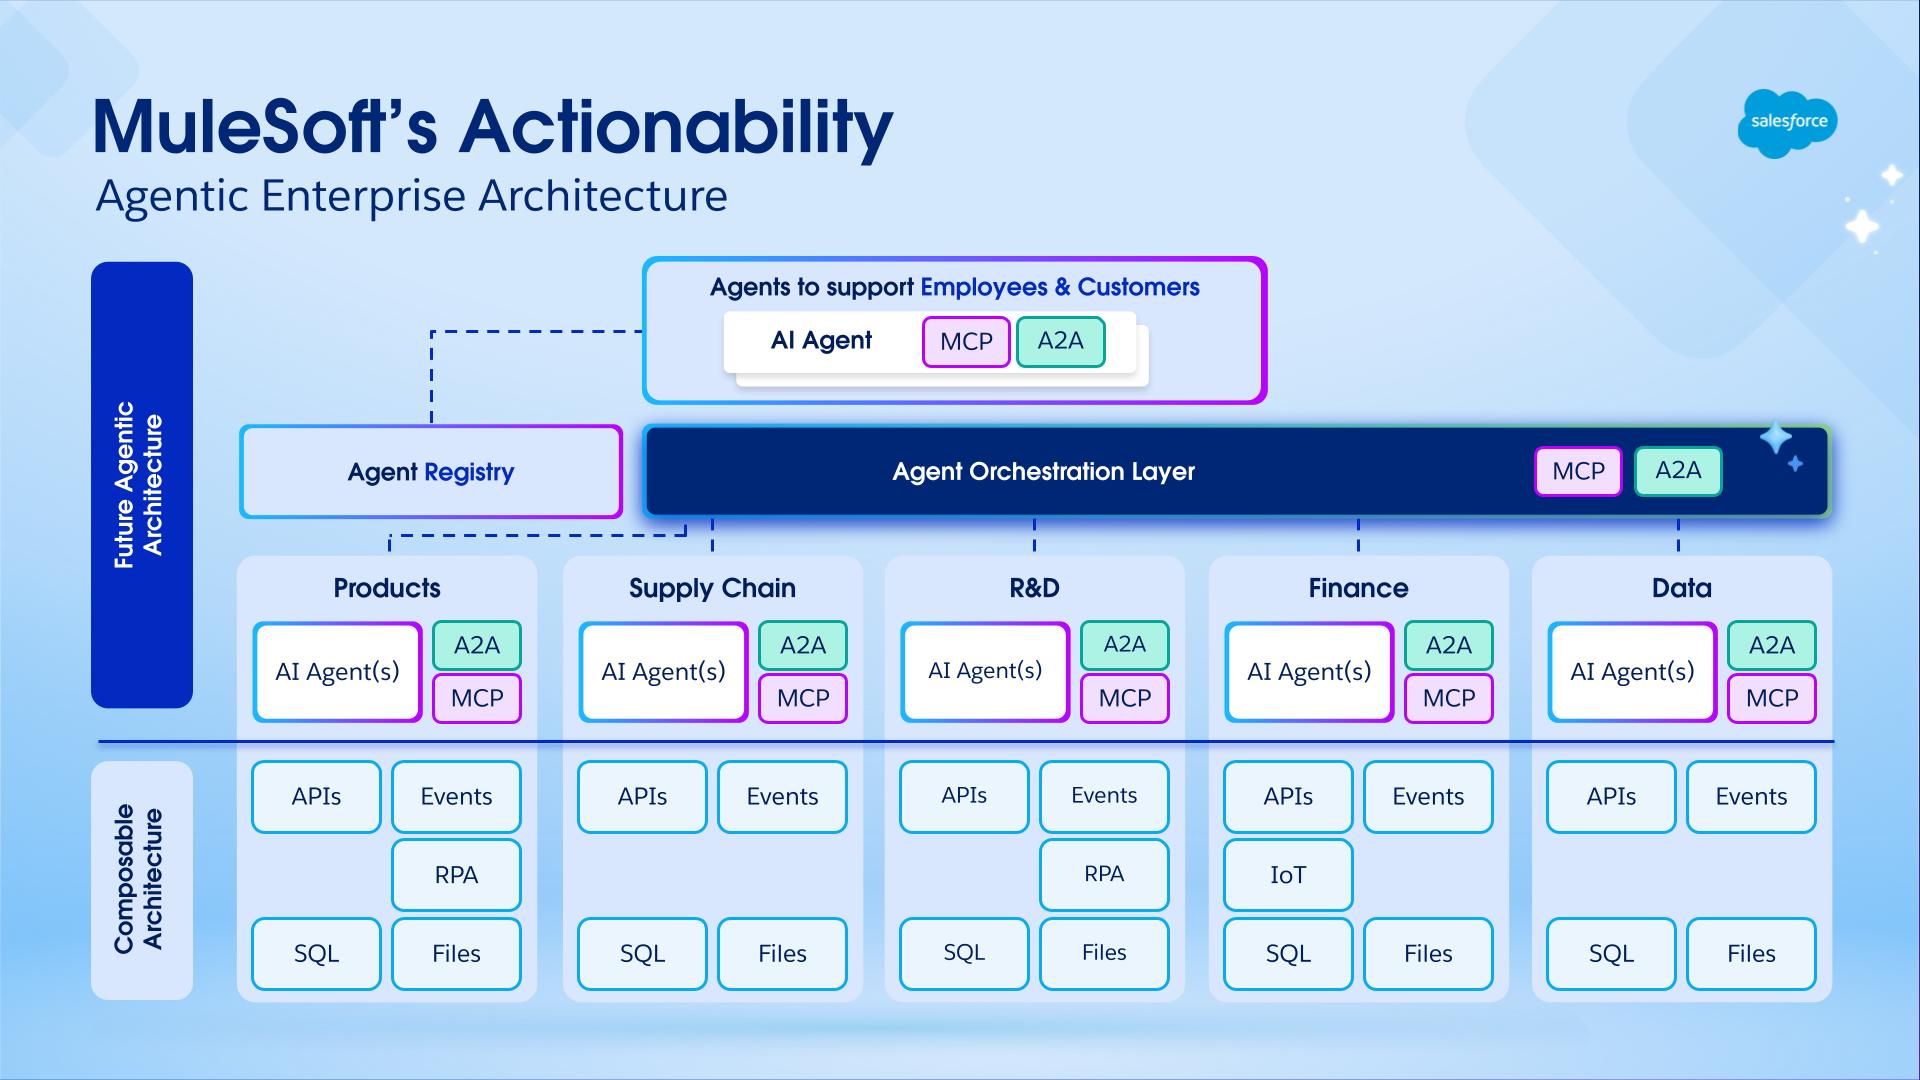 ## Informazioni sugli autori
Nikhil Aggarwal è Principal Architect presso Salesforce, dove dirige l'architettura per MuleSoft e Salesforce Automation Clouds. Nikhil vanta oltre 18 anni di esperienza nella fornitura di prodotti su larga scala ed è appassionato di architettura scalabile, esperienze di sviluppo intuitive e creazione di team ad alte prestazioni. Prima di Salesforce, ha diretto diverse iniziative in Microsoft Power Platform, Dataverse e Office 365, dall'ideazione al lancio. Il suo lavoro continua a plasmare il modo in cui le aziende moderne connettono i sistemi, automatizzano i flussi di lavoro e sbloccano il valore aziendale nell'era dell'intelligenza artificiale.
Mariano Gonzalez è entrato a far parte di MuleSoft nel 2011, specializzandosi in sistemi distribuiti mission critical, integrazione, PaaS e cloud computing. Oggi, il focus di Mariano è sul progresso delle piattaforme AI, con particolare attenzione alla governance, all'orchestrazione, alla scoperta e all'osservabilità. Con oltre 20 anni nel settore IT, Mariano ha lavorato come architetto software e team leader, progettando e fornendo soluzioni BPM, ERP e integrazione nei settori agricolo, energetico, governativo, IT, telecomunicazioni e gestione dei contenuti.
Pedro Colunga è un architetto ingegnere software di Salesforce, specializzato in API e architettura dei metadati. Concentrandosi sull'intero ciclo di vita della piattaforma, Pedro svolge un ruolo chiave nel definire il modo in cui le organizzazioni interagiscono con l'intelligenza di sistema, la semantica e le soluzioni basate sui metadati. La carriera ventennale di Pedro, che include esperienze imprenditoriali, si estende su aziende come Fuego, BEA Systems, Oracle e TekGenesis, una società successivamente acquisita da MuleSoft, dove ha costantemente guidato l'architettura platform, fornendo una profonda esperienza in aree come BPM, RAD e Integrations.
Gulal Kumar è un architetto di ingegneria del software presso Salesforce, con particolare attenzione all'architettura dei dati e dell'integrazione. Con oltre 20 anni di esperienza in integrazione e API, programmi di modernizzazione, sicurezza e iniziative AIML, offre una vasta gamma di competenze. Gulal si è impegnata a promuovere iniziative di trasformazione aziendale, migliorare la sicurezza e la resilienza, promuovere l'eccellenza dell'architettura e guidare iniziative AIML in vari domini.