# architect Guide alle decisioni (decision-guides) - Full Documentation # Utilizzo degli strumenti e degli schemi giusti per le architetture basate sugli eventi ## Panoramica Le architetture basate sugli eventi supportano la produzione e il consumo efficienti degli eventi, che comunicano le modifiche dello stato del sistema o dell'applicazione. Queste architetture consentono connessioni flessibili tra i sistemi e supportano processi e aggiornamenti quasi in tempo reale che funzionano tra i sistemi. Benché i vantaggi delle architetture basate sugli eventi siano facili da vedere, i dettagli dell'implementazione non sono sempre altrettanto chiari. Quali funzionalità è necessario considerare negli schemi architettonici basati sugli eventi? Quali problemi specifici risolvono questi schemi? Quali considerazioni speciali valgono per le soluzioni e quali sono gli schemi ottimali per affrontarle? Questa guida presenta gli schemi utilizzati per creare architetture basate sugli eventi ottimali quando si utilizzano le tecnologie Salesforce. Vengono inoltre discussi gli strumenti per gli eventi disponibili in Salesforce e vengono forniti consigli sugli strumenti per una selezione di casi d'uso. Per informazioni sulle integrazioni a livello di dati che coinvolgono Salesforce, vedere la nostra [Guida alle decisioni](/docs/architect/it-it/decision-guides/guide/data-integration). ## Takeaway - **Utilizzare architetture basate sugli eventi per i processi che non richiedono risposte sincrone alle richieste.** Gli schemi descritti in questa guida sono progettati per la coerenza, la scalabilità e il riutilizzo dei dati, che consentono di ridurre al minimo l'indebitamento tecnico man mano che il panorama applicativo dell'organizzazione si evolve. (Per ulteriori informazioni, vedere [Well-Architected - Throughput](/docs/architect/it-it/well-architected/guide/reliable#rendimento)). - **Se MuleSoft o un'altra soluzione Enterprise Service Bus (ESB) fa parte del panorama esistente, utilizzarla dove possibile.** Queste soluzioni sono progettate appositamente per supportare schemi di architettura basati sugli eventi e dispongono di potenti funzionalità che consentono di riutilizzare le integrazioni in tutta l'azienda. - **Utilizzare l'API Pub/Sub per qualsiasi schema di pubblicazione/abbonamento futuro anziché creare i propri handler eventi utilizzando altre API, inclusa Streaming API.** Ora che l'API Pub/Sub è disponibile in generale, utilizzarla per eventuali nuovi schemi di pubblicazione/abbonamento. Pianificare la migrazione delle comunicazioni degli eventi esistenti utilizzando altre API piattaforma, ad esempio Streaming API o servizi Apex personalizzati, all'API Pub/Sub quando possibile. - **Eventi piattaforma e Acquisizione dati di modifica (CDC) sono i meccanismi preferiti per pubblicare le modifiche di record e campi che devono essere consumate da altri sistemi.** Non è consigliabile utilizzare PushTopic ed eventi generici per le nuove implementazioni. Salesforce continuerà a supportare PushTopic ed eventi generici nell'ambito delle funzionalità correnti, ma non prevede di effettuare ulteriori investimenti in questa tecnologia. ## Prodotti nell'ambito
Salesforce Platform Salesforce Platform è una piattaforma completa basata sull'intelligenza artificiale che unifica dipendenti, agenti autonomi dell'intelligenza artificiale, dati aziendali e applicazioni in un unico sistema affidabile per migliorare la produttività e l'esperienza dei clienti. Consente la creazione di un'"azienda autentica" collegando le app Customer 360, Data Cloud e Slack per l'automazione end-to-end.
MuleSoft MuleSoft è la piattaforma di integrazione leader di Salesforce che consente alle organizzazioni di connettere applicazioni, dati e dispositivi in ambienti locali e cloud. MuleSoft è una piattaforma che offre all'IT le piattaforme per sbloccare i dati tra i sistemi, sviluppare framework di integrazione e automazione scalabili e creare esperienze connesse e differenziate in modo rapido.
## Punti decisione Le architetture basate sugli eventi (EDA) sono consigliate per gli scenari che richiedono notifiche quasi in tempo reale, la distribuzione del carico di elaborazione per messaggi a volume elevato o complessi e l'integrazione di sistemi come IoT e dispositivi mobili che richiedono la resilienza della connettività tramite l'area di attesa. Tuttavia, le AED non dovrebbero essere implementate per i processi che richiedono risposte umane immediate e sincrone, poiché sono progettate per l'esecuzione asincrona. Né sono adatti se i dati di origine cambiano così raramente che uno schema più semplice come l'elaborazione batch sarebbe sufficiente. ### Quando utilizzare un'architettura basata sugli eventi Di seguito sono riportati alcuni scenari comuni che spesso sono adatti a un'architettura basata sugli eventi:
Punto DecisioneGuida
Notifiche quasi in tempo realeGli schemi di architettura basati sugli eventi come pubblicazione/abbonamento, fanout e streaming tendono a funzionare bene negli scenari in cui più applicazioni devono essere informate delle modifiche dello stato o degli aggiornamenti dei record quasi in tempo reale.
Elaborazione parallelaSchemi come pubblicazione/abbonamento tendono a funzionare bene negli scenari in cui volumi elevati di dati o messaggi molto complessi richiedono la distribuzione del carico di elaborazione tra più sistemi.
Letture a volume elevatoGli schemi Messaggi passati e Area di attesa sono comunemente utilizzati negli scenari in cui le organizzazioni subiscono picchi e il volume dei messaggi prodotti può superare la capacità degli abbonati di elaborarli immediatamente.
Scritture a volume elevatoGli schemi Streaming e Area di attesa funzionano bene in molti scenari in cui le organizzazioni sperimentano un aumento del numero di messaggi prodotti.
Invio degli stessi dati a sistemi diversiBenché la pubblicazione/abbonamento sia una soluzione piuttosto comune per le organizzazioni che necessitano di inviare gli stessi dati a più sistemi, può essere affrontata dalla maggior parte degli schemi descritti qui. Assicurarsi di esaminarli in dettaglio per trovare la misura migliore.
Introduzione frequente di nuovi sistemi o dispositiviGli schemi di pubblicazione/abbonamento, streaming e inserimento in area di attesa tendono a funzionare bene per gli scenari in cui il panorama generale tende a essere in movimento, con nuovi sistemi e dispositivi aggiunti regolarmente. In questo scenario, un nuovo sistema o dispositivo deve semplicemente diventare abbonato al bus degli eventi o associato a un'area di attesa per iniziare a ricevere messaggi anziché richiedere un'integrazione point-to-point personalizzata.
Dispositivi IoTPoiché i dispositivi IoT in genere forniscono aggiornamenti frequenti e possono anche generare un'impennata di messaggi in alcuni scenari, gli schemi Streaming e Area di attesa tendono a funzionare bene quando li integrano in un panorama IT.
Dispositivi e sistemi mobili offlineI dispositivi mobili che devono lavorare in aree con accesso a Internet di bassa qualità o inesistente o sistemi che potrebbero essere offline al momento della consegna dei messaggi beneficeranno dello schema di inserimento in area di attesa, che consente loro di connettersi alle aree di attesa e recuperare tutti i messaggi pertinenti una volta che sono di nuovo online.
La maggior parte delle organizzazioni di grandi dimensioni dispone di ambienti IT complessi con una combinazione di sistemi con funzionalità diverse. È possibile, o forse probabile, che l'organizzazione disponga di sistemi legacy che non supportano le integrazioni basate sugli eventi. Si potrebbero anche avere casi d'uso in cui le integrazioni basate sugli eventi non hanno senso, anche se i sistemi le supporteranno (ad esempio, i trasferimenti di file SFTP da terze parti). Se si fa un passo indietro e si esamina il panorama IT dell'organizzazione nel suo complesso, è probabile che, proprio come con altre soluzioni architettoniche, si utilizzi una combinazione di schemi per supportare scenari diversi. Quando si decide di utilizzare l'approccio alle integrazioni basato sugli eventi come approccio preferito, considerarlo come un altro strumento nella propria casella degli strumenti. Può e deve essere utilizzato negli scenari giusti, ma non è un approccio da imporre a tutti i sistemi. Sviluppare una strategia di integrazione completa aiuterà a determinare quando gli schemi descritti in questa guida possono essere appropriati o meno. ### Quando non utilizzare un'architettura basata sugli eventi Molti scenari richiedono architetture basate sugli eventi e, in alcuni scenari, le architetture basate sugli eventi funzionano anche se non sono particolarmente adatte. Tuttavia, in alcuni scenari, le architetture basate sugli eventi semplicemente non dovrebbero essere utilizzate. Di seguito sono riportate alcune domande sui punti decisionali che consentono di identificare questi scenari:
Punto DecisioneGuida/Domande da porre
Requisiti aziendaliEsiste una reale esigenza aziendale per una delle funzionalità descritte nella sezione [Quando utilizzare un'architettura basata sugli eventi] (#when-to-use-an-event-driven-architecture)?
Requisiti tecniciL'integrazione che si sta progettando è adatta a uno schema diverso, ad esempio virtualizzazione dei dati, batch o richiesta/risposta? In altre parole, stai cercando di inserire un piolo quadrato in un foro rotondo?
Processi che richiedono agli esseri umani di attendere le risposteQualsiasi integrazione che prevede un essere umano in attesa di una risposta dal sistema di destinazione non è adatta alle architetture basate sugli eventi, poiché sono progettate per l'esecuzione asincrona e non possono garantire un tempo di risposta. Prima di implementare le soluzioni tecniche, valutare se processi di questo tipo sono ottimali per la propria organizzazione. Vedere [Well-Architected - Process Design](/docs/architect/it-it/well-architected/guide/automated#progettazione-dei-processi) per ulteriori informazioni.
Modificare raramente i dati di origineSe i dati nel sistema di origine cambiano così di rado che gli aggiornamenti periodici sono sufficienti, è probabile semplificare l'architettura utilizzando [batch pattern] (https://developer.salesforce.com/docs/atlas.en-us.integration_patterns_and_practices.meta/integration_patterns_and_practices/integ_pat_batch_data_sync.htm) anziché schemi basati sugli eventi.
Requisiti di implementazioneLa maggior parte dei sistemi coinvolti nella soluzione supporta architetture basate sugli eventi? Che cosa sarebbe necessario per utilizzare architetture basate sugli eventi con i sistemi che non le supportano (ad esempio, aggiornamenti, personalizzazioni o middleware)? Quale livello di impegno sarebbe necessario per soddisfare tali requisiti?
Stabilità della struttura del messaggioCon che frequenza sarà necessario modificare le strutture dei messaggi? Quali sistemi saranno interessati da tale modifica e quale sarà il processo di risanamento?
Governance organizzativaEsiste una struttura di governance per garantire che tutti gli stakeholder siano informati e in grado di intervenire sulle modifiche alle strutture dei messaggi, ai trigger e ad altre decisioni relative all'architettura e ai processi?
Insiemi di competenze richiestiIl personale ha esperienza con le architetture basate sugli eventi e sa come supportarle?
## Casi d'uso Esistono diversi schemi di architettura basati sugli eventi. Alcuni sono schemi di uso generale che possono essere applicati in casi d'uso che non hanno requisiti speciali oltre a essere basati sugli eventi; ad esempio, vedere [Ben progettato - Interoperabilità](/docs/architect/it-it/well-architected/guide/composable#interoperabilità). Altri schemi sono applicabili ai casi d'uso specifici descritti qui, ad esempio integrazioni che comportano volumi elevati di dati o scenari che richiedono una conservazione dei messaggi più lunga. ### Schemi a colpo d'occhio La tabella seguente confronta gli attributi degli schemi descritti in questo documento. Utilizzarlo come riferimento rapido quando è necessario identificare potenziali schemi per un determinato caso d'uso.
SchemaQuasi in tempo realeCopia messaggio univocoConsegna garantitaRidurre le dimensioni dei messaggiTrasforma dati
Pubblica / Abbonati✓✓✓
Fanout✓✓✓
Messaggi passati✓✓✓✓
Streaming✓✓✓
Area di attesa✓✓✓
### Strumenti per l'architettura basata sugli eventi Salesforce offre diversi strumenti per gestire i casi d'uso basati sugli eventi. Questa tabella contiene una panoramica generale degli strumenti disponibili.
StrumentoDescrizioneCompetenze richieste
MuleSoftAnypoint PlatformPiattaforma che consente l'integrazione dei dati utilizzando livelli di API.Pro-code
Connettore Salesforce Pub/SubConnettore per l'API Pub/Sub, che offre un'unica interfaccia per la pubblicazione e l'abbonamento a eventi piattaforma, eventi di monitoraggio evento in tempo reale ed eventi di acquisizione dati di modifica.Pro-code
Connettore JMS MuleSoft AnypointConnettore che consente di inviare e ricevere messaggi ad aree di attesa e argomenti per qualsiasi servizio di messaggistica che implementa la specifica JMS (Java Message Service).Pro-code
MuleSoft Anypoint Apache Kafka ConnectorConnettore per spostare i dati tra Apache Kafka e applicazioni e servizi aziendali.Pro-code
Connettore MuleSoft Anypoint SolaceUn connettore per i broker di eventi Solace PubSub+ con integrazione API nativa utilizzando JCSMP Java SDKPro-code
Connettore MuleSoft Anypoint MQUn servizio di messaggistica cloud multi-tenant che consente ai clienti di eseguire messaggi asincroni avanzati tra le loro applicazioni.Pro-code
Connettore MuleSoft Anypoint MQTTUn'estensione MuleSoft compatibile con il protocollo MQTT (Message Queuing Telemetry Transport) v3.x.Pro-code
Connettore MuleSoft Anypoint AMQPUn connettore che consente all'applicazione di pubblicare e utilizzare messaggi utilizzando un broker compatibile con AMQP 0.9.1.Pro-code
API MuleSoft Anypoint basata sugli eventi (sincronizzazione)Linguaggio indipendente dal settore che supporta la pubblicazione di API basate sugli eventi separandole in livelli evento, canale e trasporto.Pro-code
MuleSoft Anypoint MQServizio di messaggistica cloud multitenant che consente ai clienti di eseguire messaggi asincroni avanzati tra le loro applicazioni.Pro-code
Stream di dati MuleSoft AnypointFramework disponibile in MuleSoft Anypoint per la pubblicazione e l'abbonamento ai dati in streaming.Pro-code
Salesforce PlatformApache Kafka su HerokuComponente aggiuntivo Heroku che fornisce Apache Kafka come servizio con integrazione completa della piattaforma nella piattaforma Heroku.Pro-code
Modifica acquisizione datiRegistro eventi di modifica, che pubblica le modifiche ai record Salesforce. Le modifiche includono la creazione di un nuovo record, gli aggiornamenti di un record esistente, l'eliminazione di un record e l'annullamento dell'eliminazione di un record.Da codice basso a codice pro
Messaggi in uscitaAzioni che inviano messaggi XML a endpoint esterni quando i valori dei campi vengono aggiornati in Salesforce.Basso codice
Eventi piattaformaMessaggi sicuri e scalabili contenenti dati di eventi personalizzati.Da codice basso a codice pro
Pub/Sub APIAPI che abilita abbonamenti a eventi piattaforma, eventi di acquisizione dati di modifica e/o eventi di Monitoraggio evento in tempo reale.Pro-code
Relay eventoAbilita l'invio di eventi piattaforma ed eventi acquisizione dati di modifica da Salesforce ad Amazon EventBridge. Tenere presente che i relay evento si connettono solo ad AWS Eventbridge.Basso codice
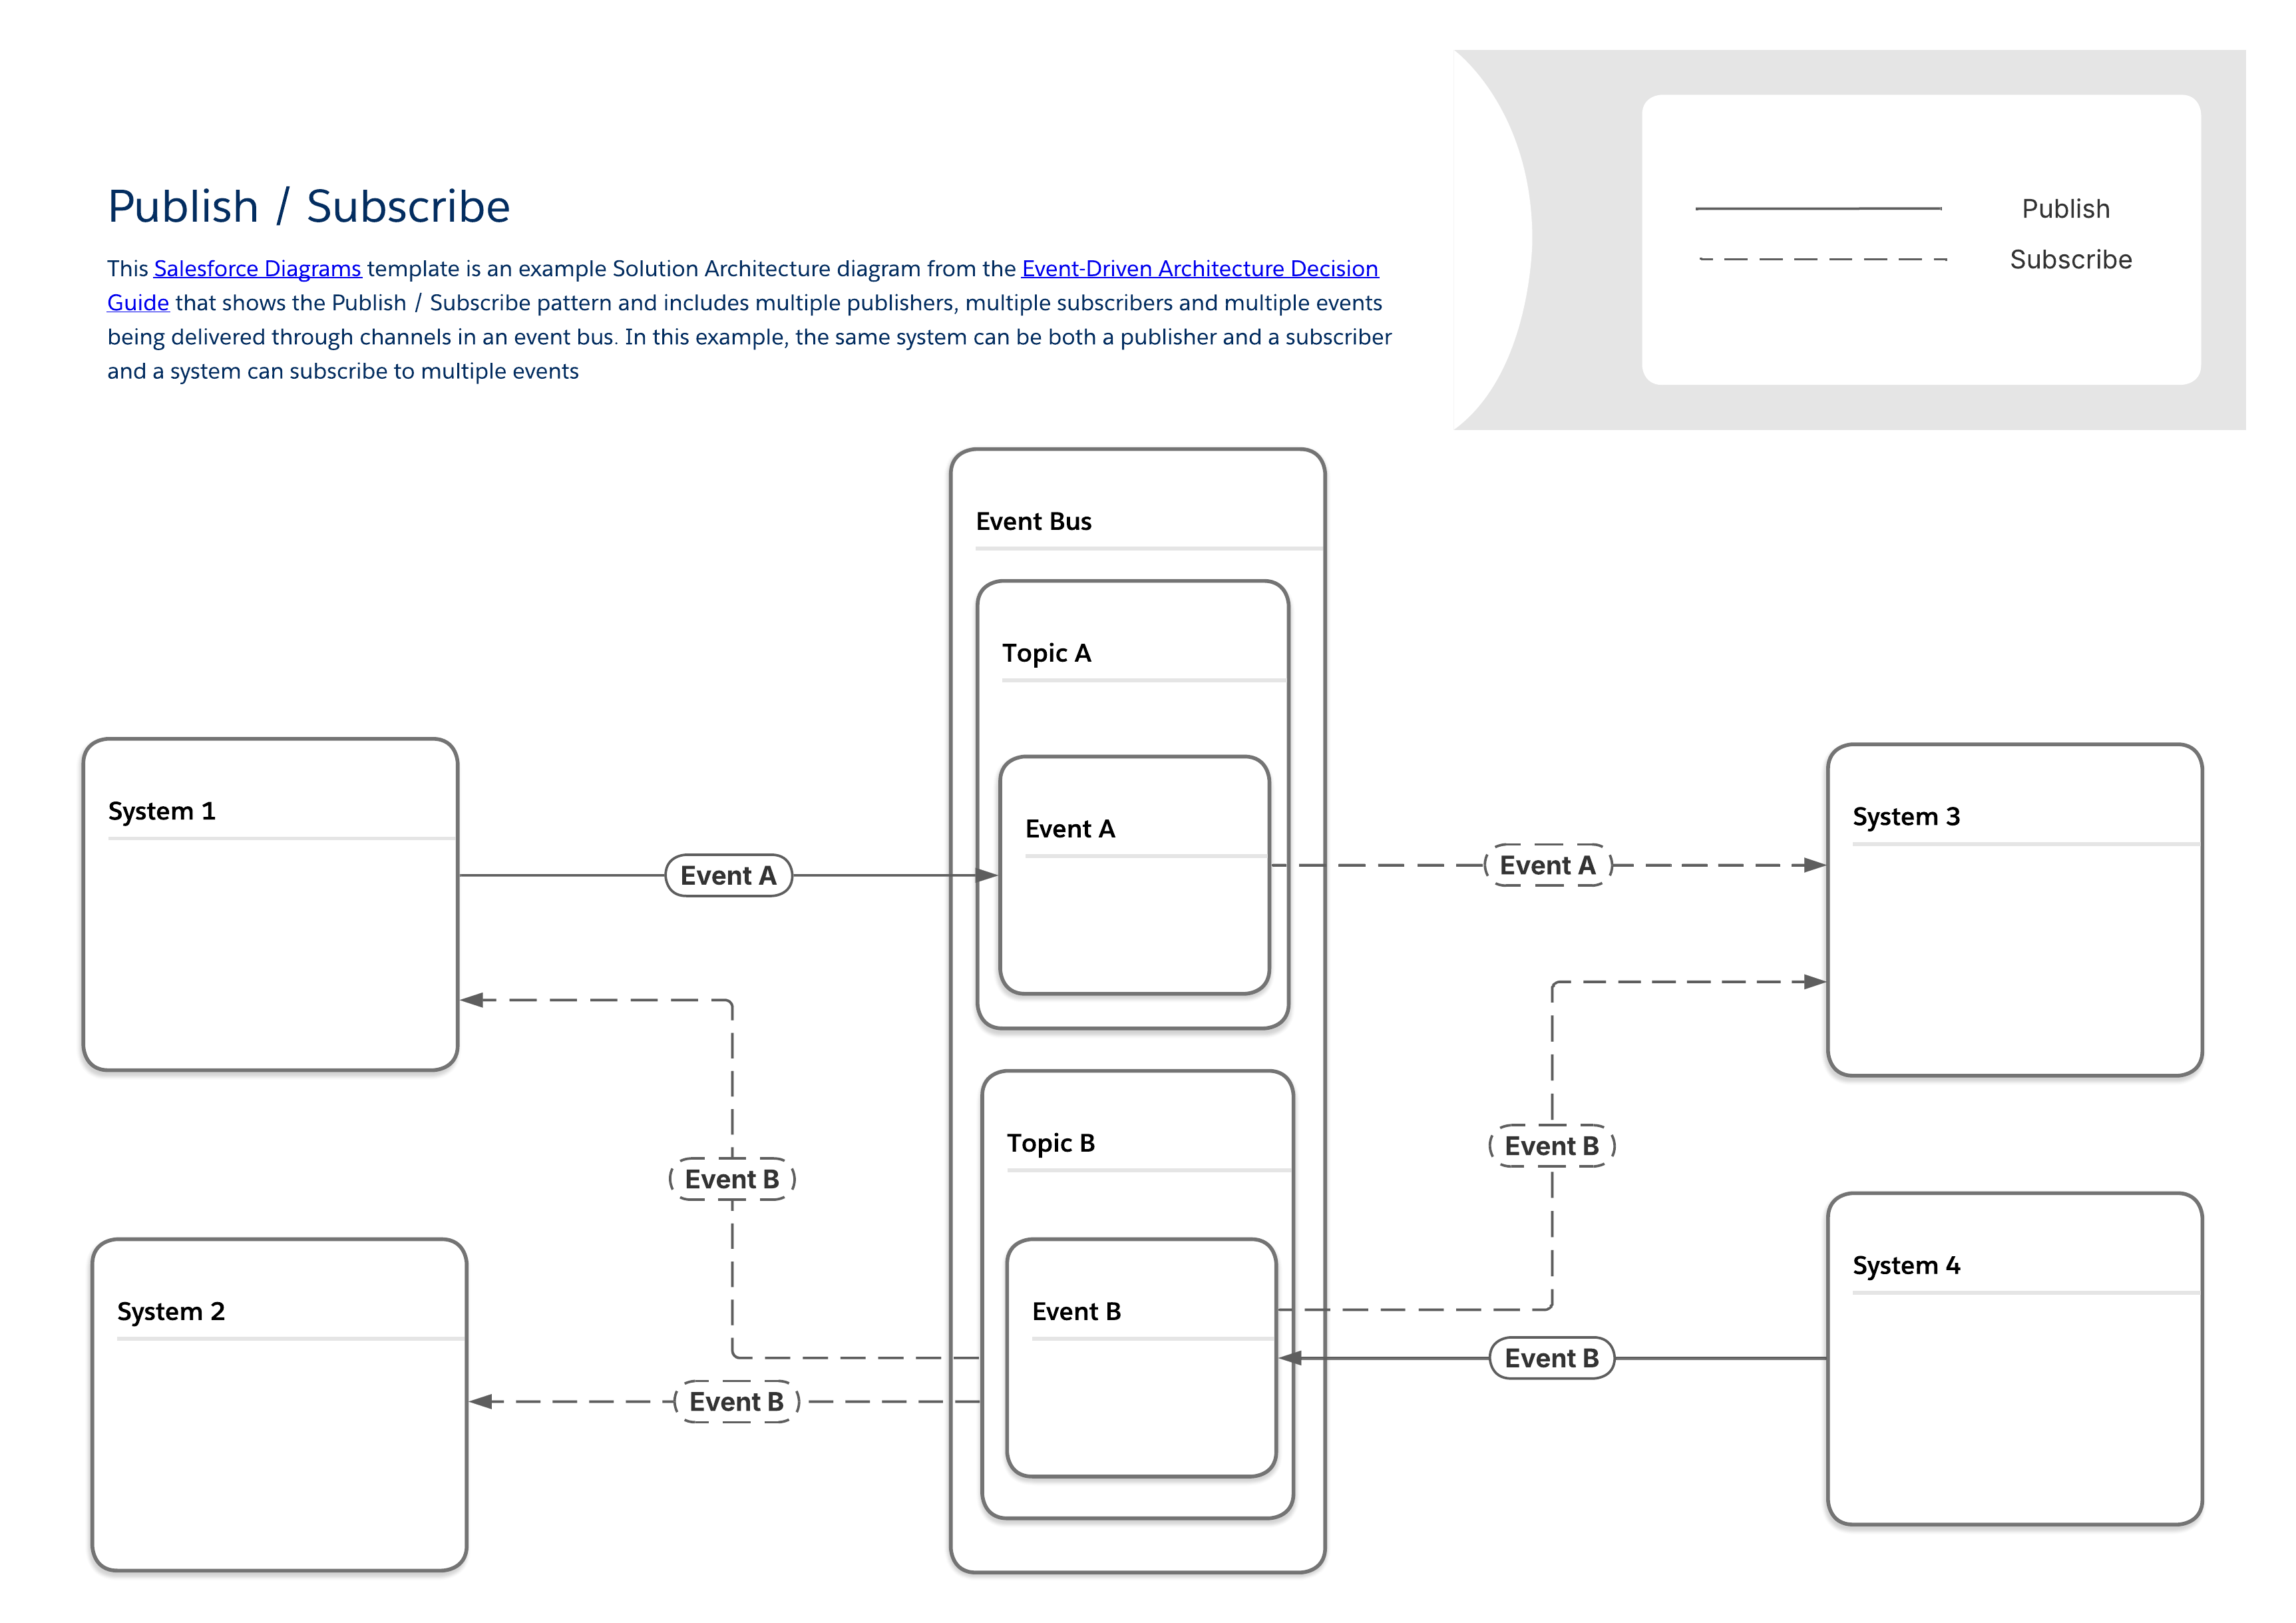
### Pubblica/Abbonati Quando un record critico cambia stato all'interno di un'applicazione centrale, ad esempio lo stato di un ordine passa da "Elaborazione" a "Spedito", è probabile che più altri sistemi richiedano una notifica quasi in tempo reale per eseguire le rispettive operazioni. Quando il volume di questi cambiamenti è elevato e i messaggi sono complessi, si pone una specifica esigenza aziendale, rendendo le integrazioni tradizionali da punto a punto onerose e difficili da gestire. La creazione di connessioni fragili e personalizzate per ogni singola applicazione dipendente comporta un indebitamento tecnico e impedisce all'organizzazione di scalare rapidamente. È necessario un approccio di integrazione efficace per gestire queste frequenti sincronizzazioni dei dati senza associare il sistema di origine direttamente a ogni sistema che utilizza. #### Schema di pubblicazione/abbonamento Lo schema riportato sotto rappresenta un tipico schema di pubblicazione/abbonamento in cui più publisher e abbonati condividono i dati tramite un bus degli eventi. Questo schema di base costituisce la base per gli schemi più specifici che si possono trovare nel resto di questa guida. Alcune caratteristiche chiave di questo schema sono: - Non esiste una connessione diretta tra publisher e abbonati. I publisher inviano semplicemente messaggi a un bus degli eventi, che li trasmette a qualsiasi altro sistema che desideri ascoltarli. - Lo stesso sistema può essere sia un publisher che un abbonato. - I sistemi possono pubblicare o abbonarsi a più tipi di eventi. - Come per tutti gli schemi di questa guida, lo schema di pubblicazione/abbonamento rientra in una categoria di schema di integrazione generale nota come invocazione di procedure remote (RPI) o semplicemente ["fire and forget".](/docs/architect/it-it/fundamentals/guide/integration-patterns#invocazione-di-processi-remoti--fire-and-forget) Questo diagramma di livello 2 mostra un esempio di schema di pubblicazione/abbonamento che include più publisher, più abbonati e più eventi distribuiti attraverso i canali in un bus degli eventi. In questo schema, lo stesso sistema può essere sia un publisher che un abbonato e un sistema può abbonarsi a più eventi. #### Strumenti pertinenti allo schema di pubblicazione/iscrizione
Flusso e comportamento dell'eventoConsiderazioni sul payload
Strumenti disponibiliCompetenze richiestePubblica tramiteAbbonamento tramitePeriodo di riproduzioneStruttura payloadLimiti del payload
MuleSoftAnypoint PlatformPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
Connettore Salesforce Pub/SubPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
Connettore JMS MuleSoft AnypointPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
MuleSoft Anypoint Apache Kafka ConnectorPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
Connettore MuleSoft Anypoint SolacePro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
Connettore MuleSoft Anypoint MQPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
Connettore MuleSoft Anypoint MQTTPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
Connettore MuleSoft Anypoint AMQPPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
API MuleSoft Anypoint basata sugli eventi (sincronizzazione)Pro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
MuleSoft Anypoint MQPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
Salesforce PlatformApache Kafka su HerokuPro-codeAPI, modifiche dei record in Heroku PostgresN/D1-6 settimaneDefinito dall'utenteDefinito dall'utente
Modifica acquisizione datiDa codice basso a codice proModifiche recordApex, API, componenti Web Lightning (LWC)3 giorniPredefinito1 MB
Messaggi in uscita*Basso codiceRegole di flusso e di flusso di lavoroN/D24 oreDefinito dall'utente100 notifiche per messaggio
Eventi piattaformaDa codice basso a codice proAPI, Apex, FlussoApex, API, Flusso, LWC3 giorniDefinito dall'utente1 MB
Pub/Sub APIPro-codeAPI o API Pub/Sub, Apex, FlussoAPI Pub/Sub3 giorniDefinito dall'utente1 MB
Relay evento**Basso codiceEventi piattaforma, Acquisizione dati modificaAPI3 giorniDefinito dall'utente1 MB
*Salesforce continuerà a supportare i messaggi in uscita nell'ambito delle attuali funzionalità, ma non prevede di effettuare ulteriori investimenti in questa tecnologia. **I relay evento si connettono solo ad AWS Eventbridge
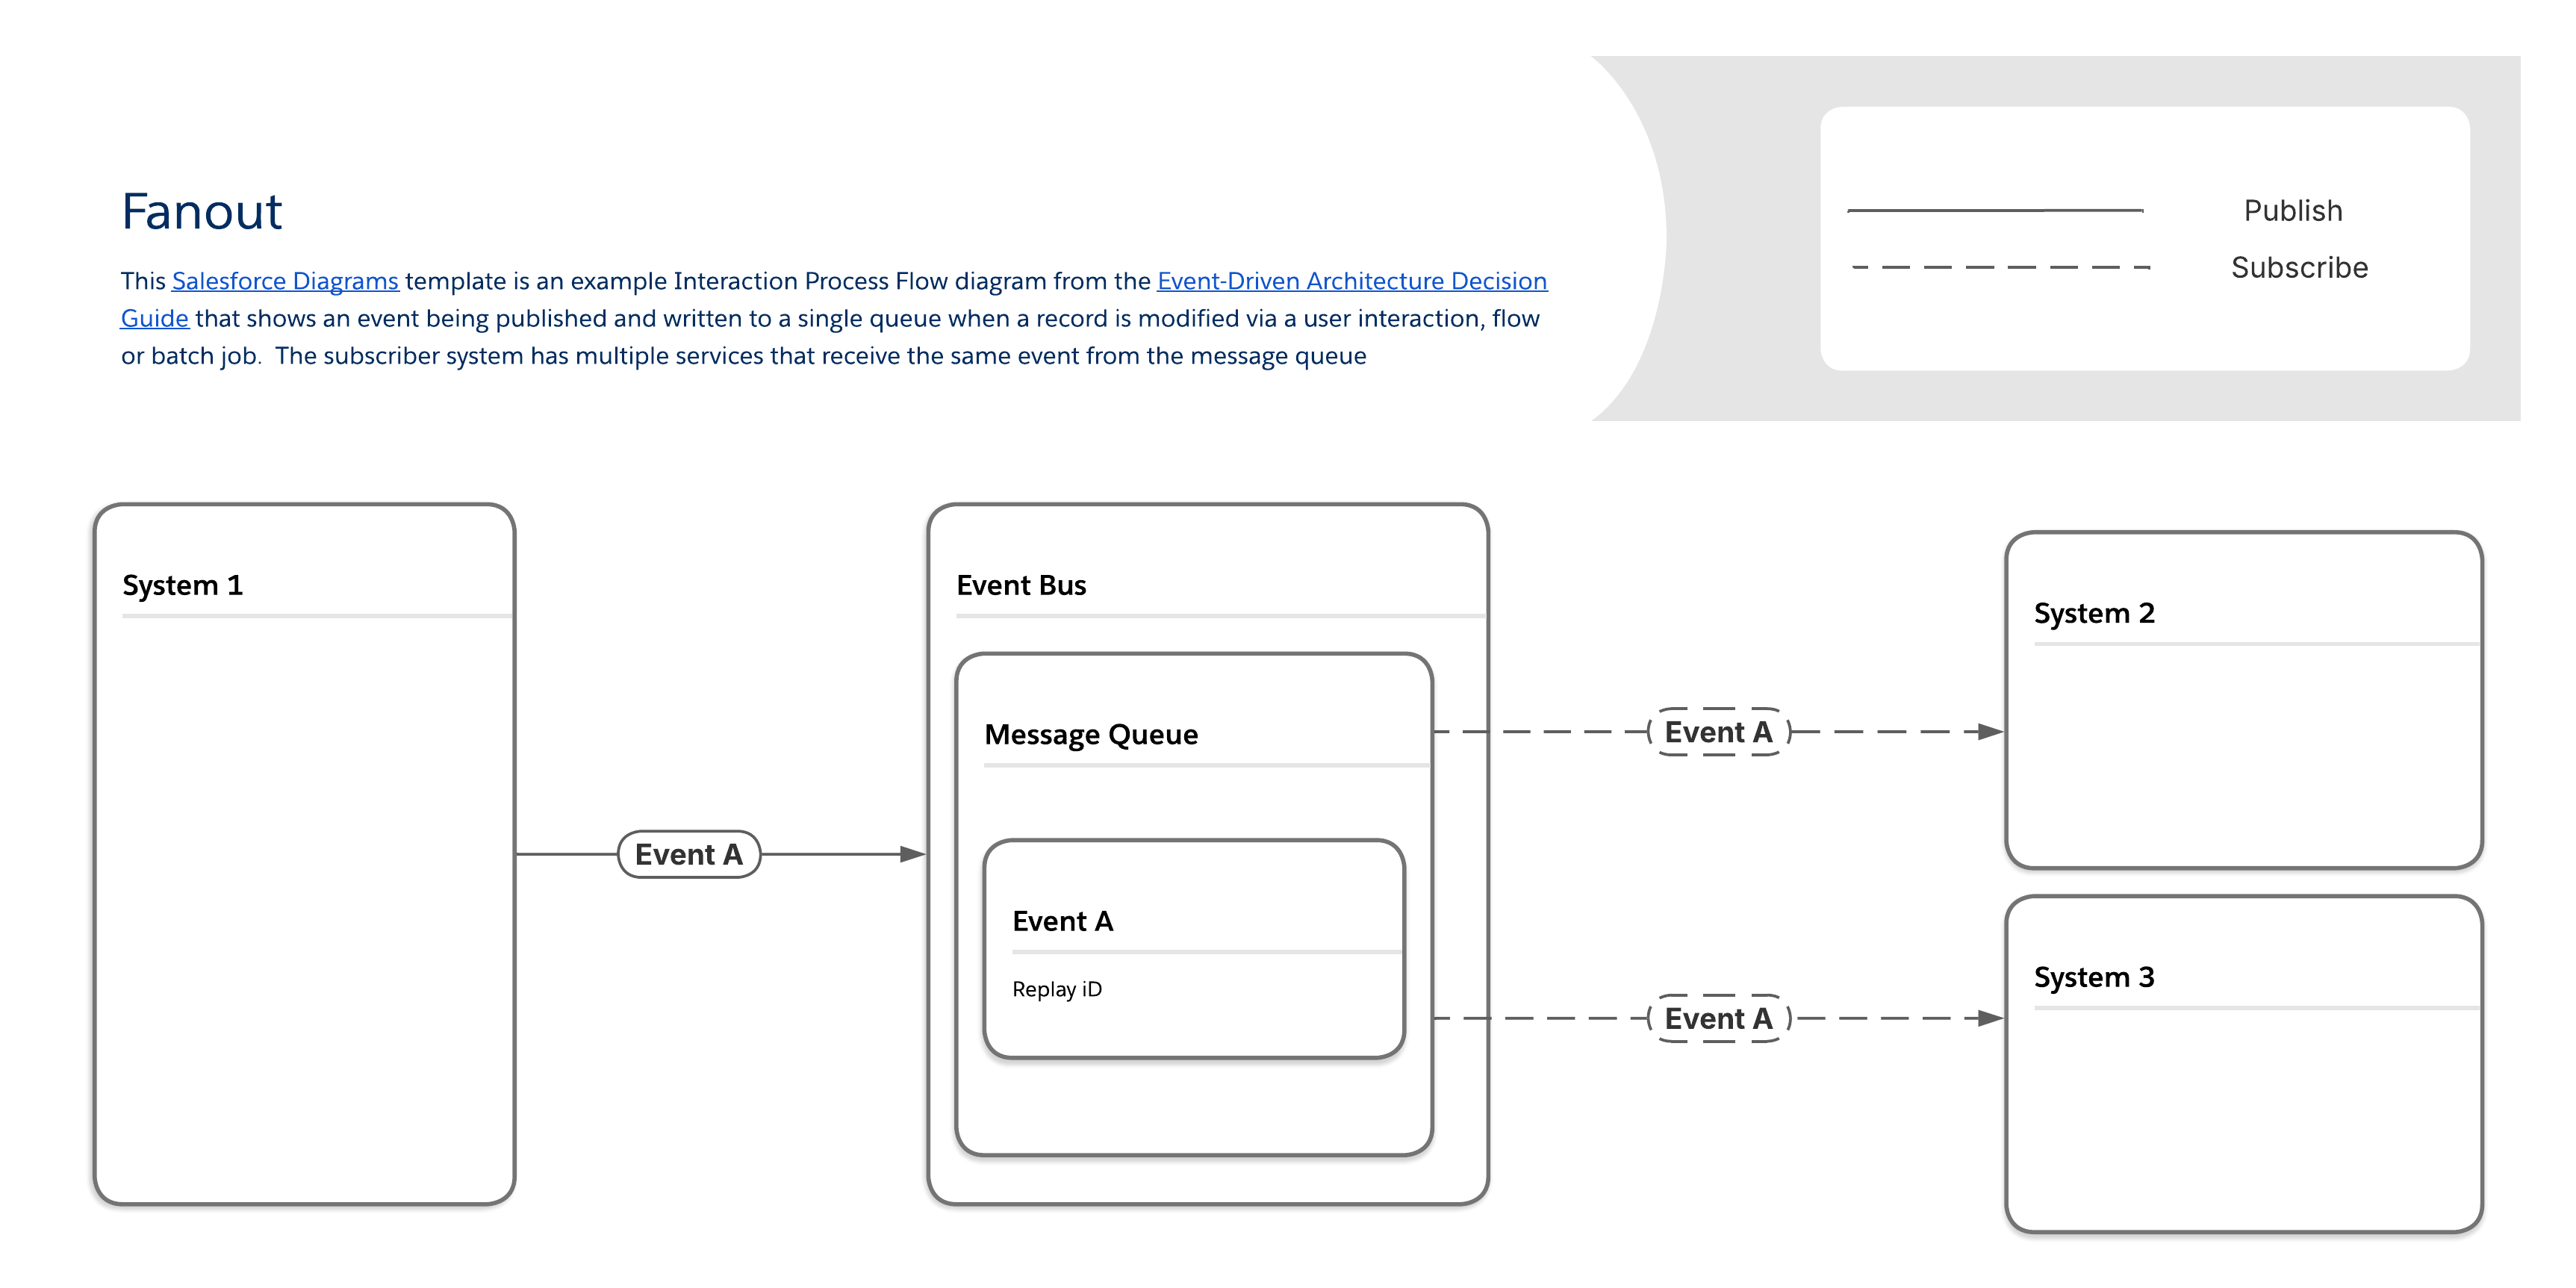
### Fanout Quando un'organizzazione deve inviare aggiornamenti istantanei a un numero elevato di applicazioni client, ad esempio notifiche push o messaggi SMS ai dispositivi mobili, il processo tradizionale di creazione di trasmissioni univoche per ogni singolo destinatario diventa rapidamente un collo di bottiglia nella scalabilità. In questo caso, l'esigenza principale del business è la distribuzione rapida e ad alte prestazioni di una singola informazione, ad esempio un avviso account o un avviso di modifica critica del servizio, a numerose applicazioni endpoint contemporaneamente. Un approccio semplificato per soddisfare questo requisito prevede l'instradamento di tutti i messaggi attraverso un'unica area di attesa, che funge da punto centrale delle informazioni sull'evento per tutti i sistemi che consumano. Questo approccio migliora le prestazioni eliminando la necessità di gestire molte copie separate dei messaggi. #### Lo schema Fanout Con lo schema di fanout, i messaggi vengono consegnati a una o più destinazioni (ovvero client o abbonati in ascolto) tramite un'unica area di attesa messaggi. Gli abbonati recuperano lo stesso messaggio dall'area di attesa anziché la propria copia univoca. Tenere presente che, sebbene ciò migliori le prestazioni, può anche rendere più difficile verificare se un determinato abbonato ha ricevuto o meno il messaggio. Questo diagramma di documentazione e implementazione di livello 3 mostra un esempio di schema di fanout. Rappresenta un evento che viene pubblicato e scritto in una singola area di attesa quando un record viene modificato tramite un'interazione utente, un flusso o un processo batch. Il sistema abbonato dispone di più servizi che ricevono lo stesso evento dall'area di attesa dei messaggi. #### Strumenti pertinenti allo schema Fanout
Flusso e comportamento dell'eventoConsiderazioni sul payload
Strumenti disponibiliCompetenze richiestePubblica tramiteAbbonamento tramitePeriodo di riproduzioneStruttura payloadLimiti del payload
MuleSoftConnettore JMS MuleSoft AnypointPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
Connettore Salesforce Pub/SubPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
MuleSoft Anypoint Apache Kafka ConnectorPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
Connettore MuleSoft Anypoint SolacePro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
Connettore MuleSoft Anypoint MQPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
Connettore MuleSoft Anypoint MQTTPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
Connettore MuleSoft Anypoint AMQPPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
MuleSoft Anypoint MQPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
Salesforce PlatformApache Kafka su HerokuPro-codeAPI, modifiche dei record in Heroku PostgresN/D1-6 settimaneDefinito dall'utenteDefinito dall'utente
Modifica acquisizione datiDa codice basso a codice proModifiche recordApex, API, componenti Web Lightning (LWC)3 giorniPredefinito1 MB
Eventi piattaformaDa codice basso a codice proAPI, Apex, FlussoApex, API, Flusso, LWC3 giorniDefinito dall'utente1 MB
Pub/Sub APIPro-codeAPI Pub/Sub o Apex, API, FlussoAPI Pub/Sub3 giorniDefinito dall'utente1 MB
Relay evento*Basso codiceEventi piattaforma, Acquisizione dati modificaAPI3 giorniDefinito dall'utente1 MB
*I relay evento inviano i dati solo ad AWS Eventbridge
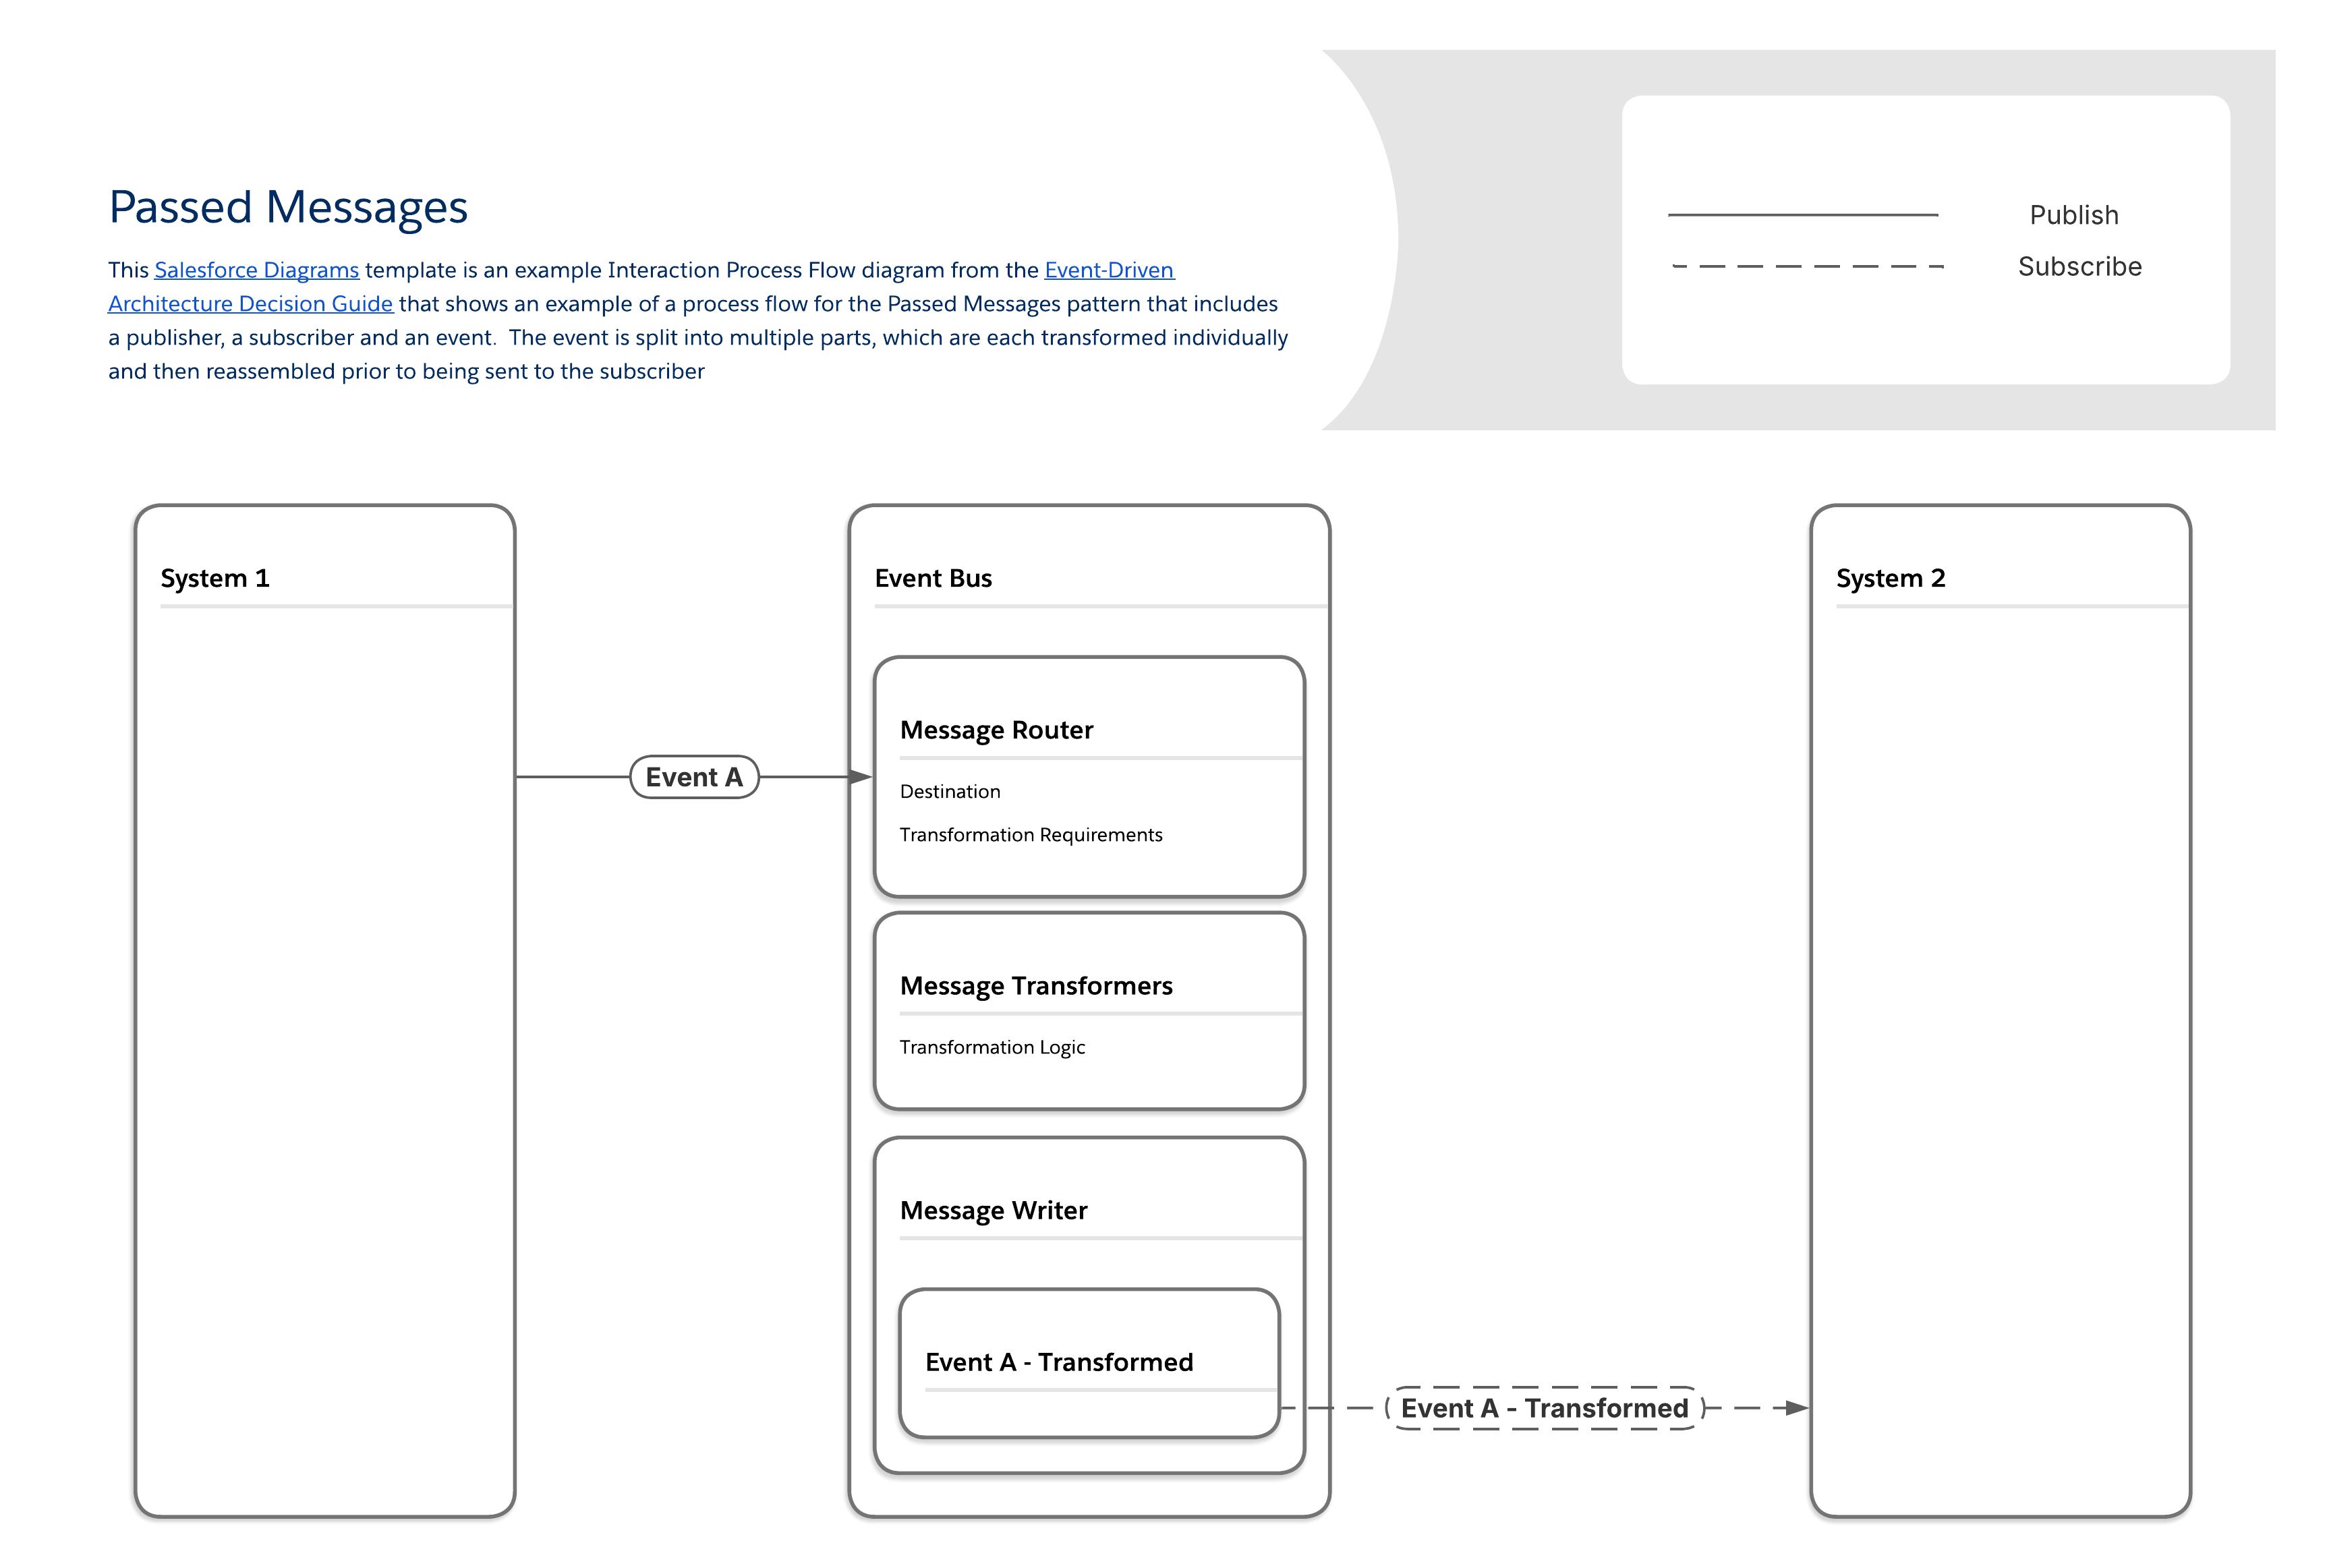
### Messaggi passati Alcuni scenari di eventi sono caratterizzati da un notevole afflusso di volume di messaggi che minaccia di sovraccaricare la capacità dei processi di sincronizzazione e trasformazione o da una logica complessa a più fasi necessaria per elaborare e trasformare i dati degli eventi. Alcuni esempi sono: - **Picchi di volume stagionali:** Ci possono essere picchi di volume che i rivenditori online sperimentano quando una selezione dei loro prodotti è "di stagione". Quando un numero elevato di clienti effettua acquisti contemporaneamente, il numero di eventi generati può superare temporaneamente la capacità dei processi di sincronizzazione e trasformazione. Per ulteriori informazioni, vedere [Ben progettato - Gestione dati](/docs/architect/it-it/well-architected/guide/automated#gestione-dei-dati). - **Gestione di casi o richieste:** Le aziende di servizi possono riscontrare un aumento del numero di casi o richieste durante le interruzioni. - **Trasformazioni dati complesse:** Le organizzazioni che richiedono una logica complessa per trasformare i messaggi spesso temono che gli eventi vengano generati più velocemente di quanto possano essere trasformati. #### Schema dei messaggi passati Questo schema affronta la sfida di generare i messaggi più velocemente di quanto possano essere trasformati. Garantisce che volumi elevati di messaggi e manipolazioni dei dati richieste possano essere gestiti in modo affidabile, incorporando una piattaforma di messaggi in streaming e segmentando la logica di gestione dei messaggi in componenti dedicati. Lo schema Messaggi passati funziona segmentando la logica di gestione dei messaggi in più componenti: - Un componente gestisce l'instradamento dei messaggi, determinando le trasformazioni richieste e la destinazione finale. - Un insieme separato di componenti gestisce diversi livelli di trasformazione dei messaggi (ad esempio, mappature di campi, relazioni tra oggetti e così via). - L'ultimo componente scrive il messaggio finale modificato. Questo diagramma di documentazione e implementazione di livello 3 mostra un esempio di flusso di processo per lo schema dei messaggi passati che include un publisher, un abbonato e un messaggio. Il messaggio viene suddiviso in più parti, che vengono trasformate singolarmente e quindi riassemblate prima di essere inviate all'abbonato. #### Strumenti pertinenti allo schema dei messaggi passati
Flusso e comportamento dell'eventoConsiderazioni sul payload
Strumenti disponibiliCompetenze richiestePubblica tramiteAbbonamento tramitePeriodo di riproduzioneStruttura payloadLimiti del payload
MuleSoftMuleSoft Anypoint Apache Kafka ConnectorPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
Connettore Salesforce Pub/SubPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
Salesforce PlatformApache Kafka su HerokuPro-codeAPI, modifiche dei record in Heroku PostgresN/D1-6 settimaneDefinito dall'utenteDefinito dall'utente
Modifica acquisizione datiDa codice basso a codice proModifiche recordApex, API, componenti Web Lightning (LWC)3 giorniPredefinito1 MB
Eventi piattaformaDa codice basso a codice proAPI, Apex, FlussoApex, API, Flusso, LWC3 giorniDefinito dall'utente1 MB
Pub/Sub APIPro-codeAPI Pub/Sub o API, flusso ApexAPI Pub/Sub3 giorniDefinito dall'utente1 MB
Relay evento*Basso codiceEventi piattaforma, Acquisizione dati modificaAPI3 giorniDefinito dall'utente1 MB
*I relay evento inviano i dati solo ad AWS Eventbridge
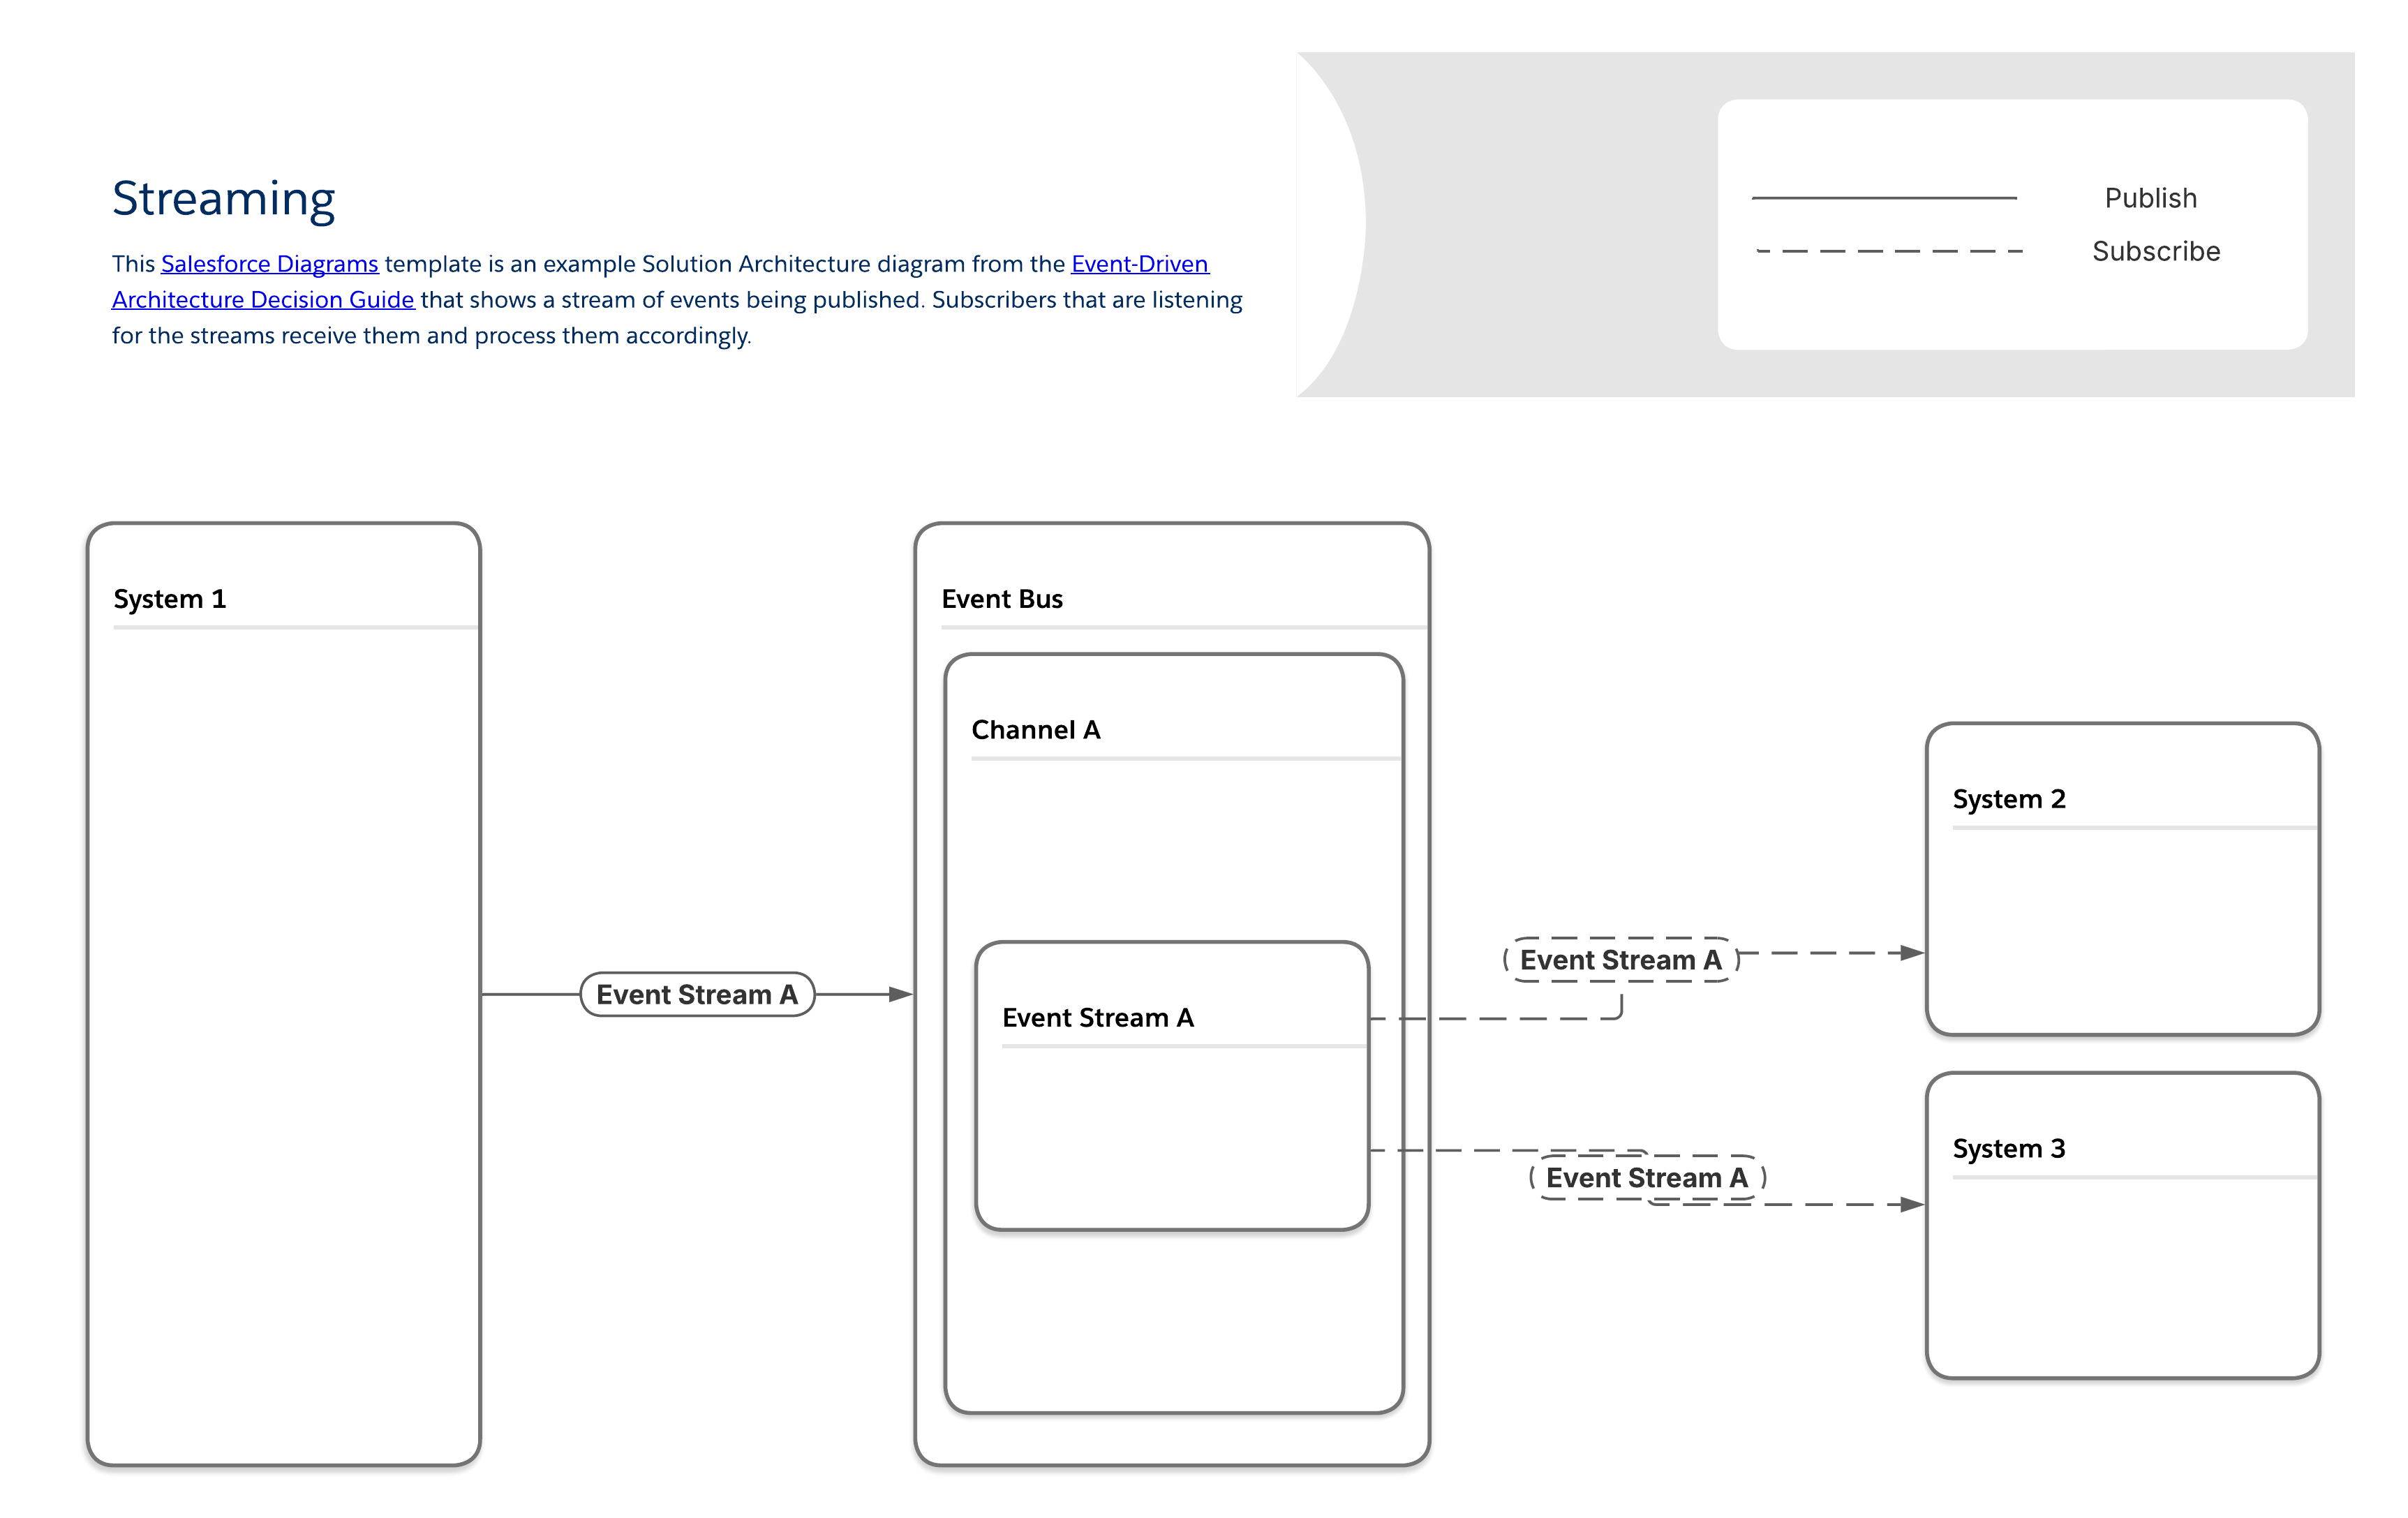
### Streaming Alcuni produttori generano uno stream continuo di eventi. Un esempio comune è lo streaming multimediale, che prevede interazioni utente che si verificano naturalmente come eventi discreti. Più sistemi devono reagire contemporaneamente allo stesso comportamento dell'utente senza bloccare l'esperienza di streaming core. Considerare gli eventi per una piattaforma di streaming musicale. Questi possono includere: - Monitoraggio degli eventi avviati/messi in pausa/saltati - Eventi della sessione di ascolto con indicazioni orarie - Eventi di creazione/modifica della playlist - Eventi di condivisione sociale - Download per l'ascolto offline #### Schema di streaming Nello schema Streaming, gli abbonati accedono a ogni stream di eventi ed elaborano gli eventi nell'ordine esatto in cui vengono ricevuti. Copie univoche di ogni stream di messaggi vengono inviate a ogni abbonato, consentendo di fornire contenuti specifici dell'abbonato e di identificare gli abbonati che ricevono quali stream. Questo diagramma di documentazione e implementazione di livello 3 mostra un esempio di schema di streaming che rappresenta uno stream di eventi in corso di pubblicazione. Gli abbonati che sono in ascolto degli stream li ricevono ed elaborano di conseguenza. #### Strumenti pertinenti allo schema di streaming
Flusso e comportamento dell'eventoConsiderazioni sul payload
Strumenti disponibiliCompetenze richiestePubblica tramiteAbbonamento tramitePeriodo di riproduzioneStruttura payloadLimiti del payload
MuleSoftStream di dati MuleSoft AnypointPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
Connettore Salesforce Pub/SubPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
MuleSoft Anypoint Apache Kafka ConnectorPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
Salesforce PlatformApache Kafka su HerokuPro-codeAPI, modifiche dei record in Heroku PostgresN/D1-6 settimaneDefinito dall'utenteDefinito dall'utente
Pub/Sub APIPro-codeAPI Pub/Sub o API, flusso ApexAPI Pub/Sub3 giorniDefinito dall'utente1 MB
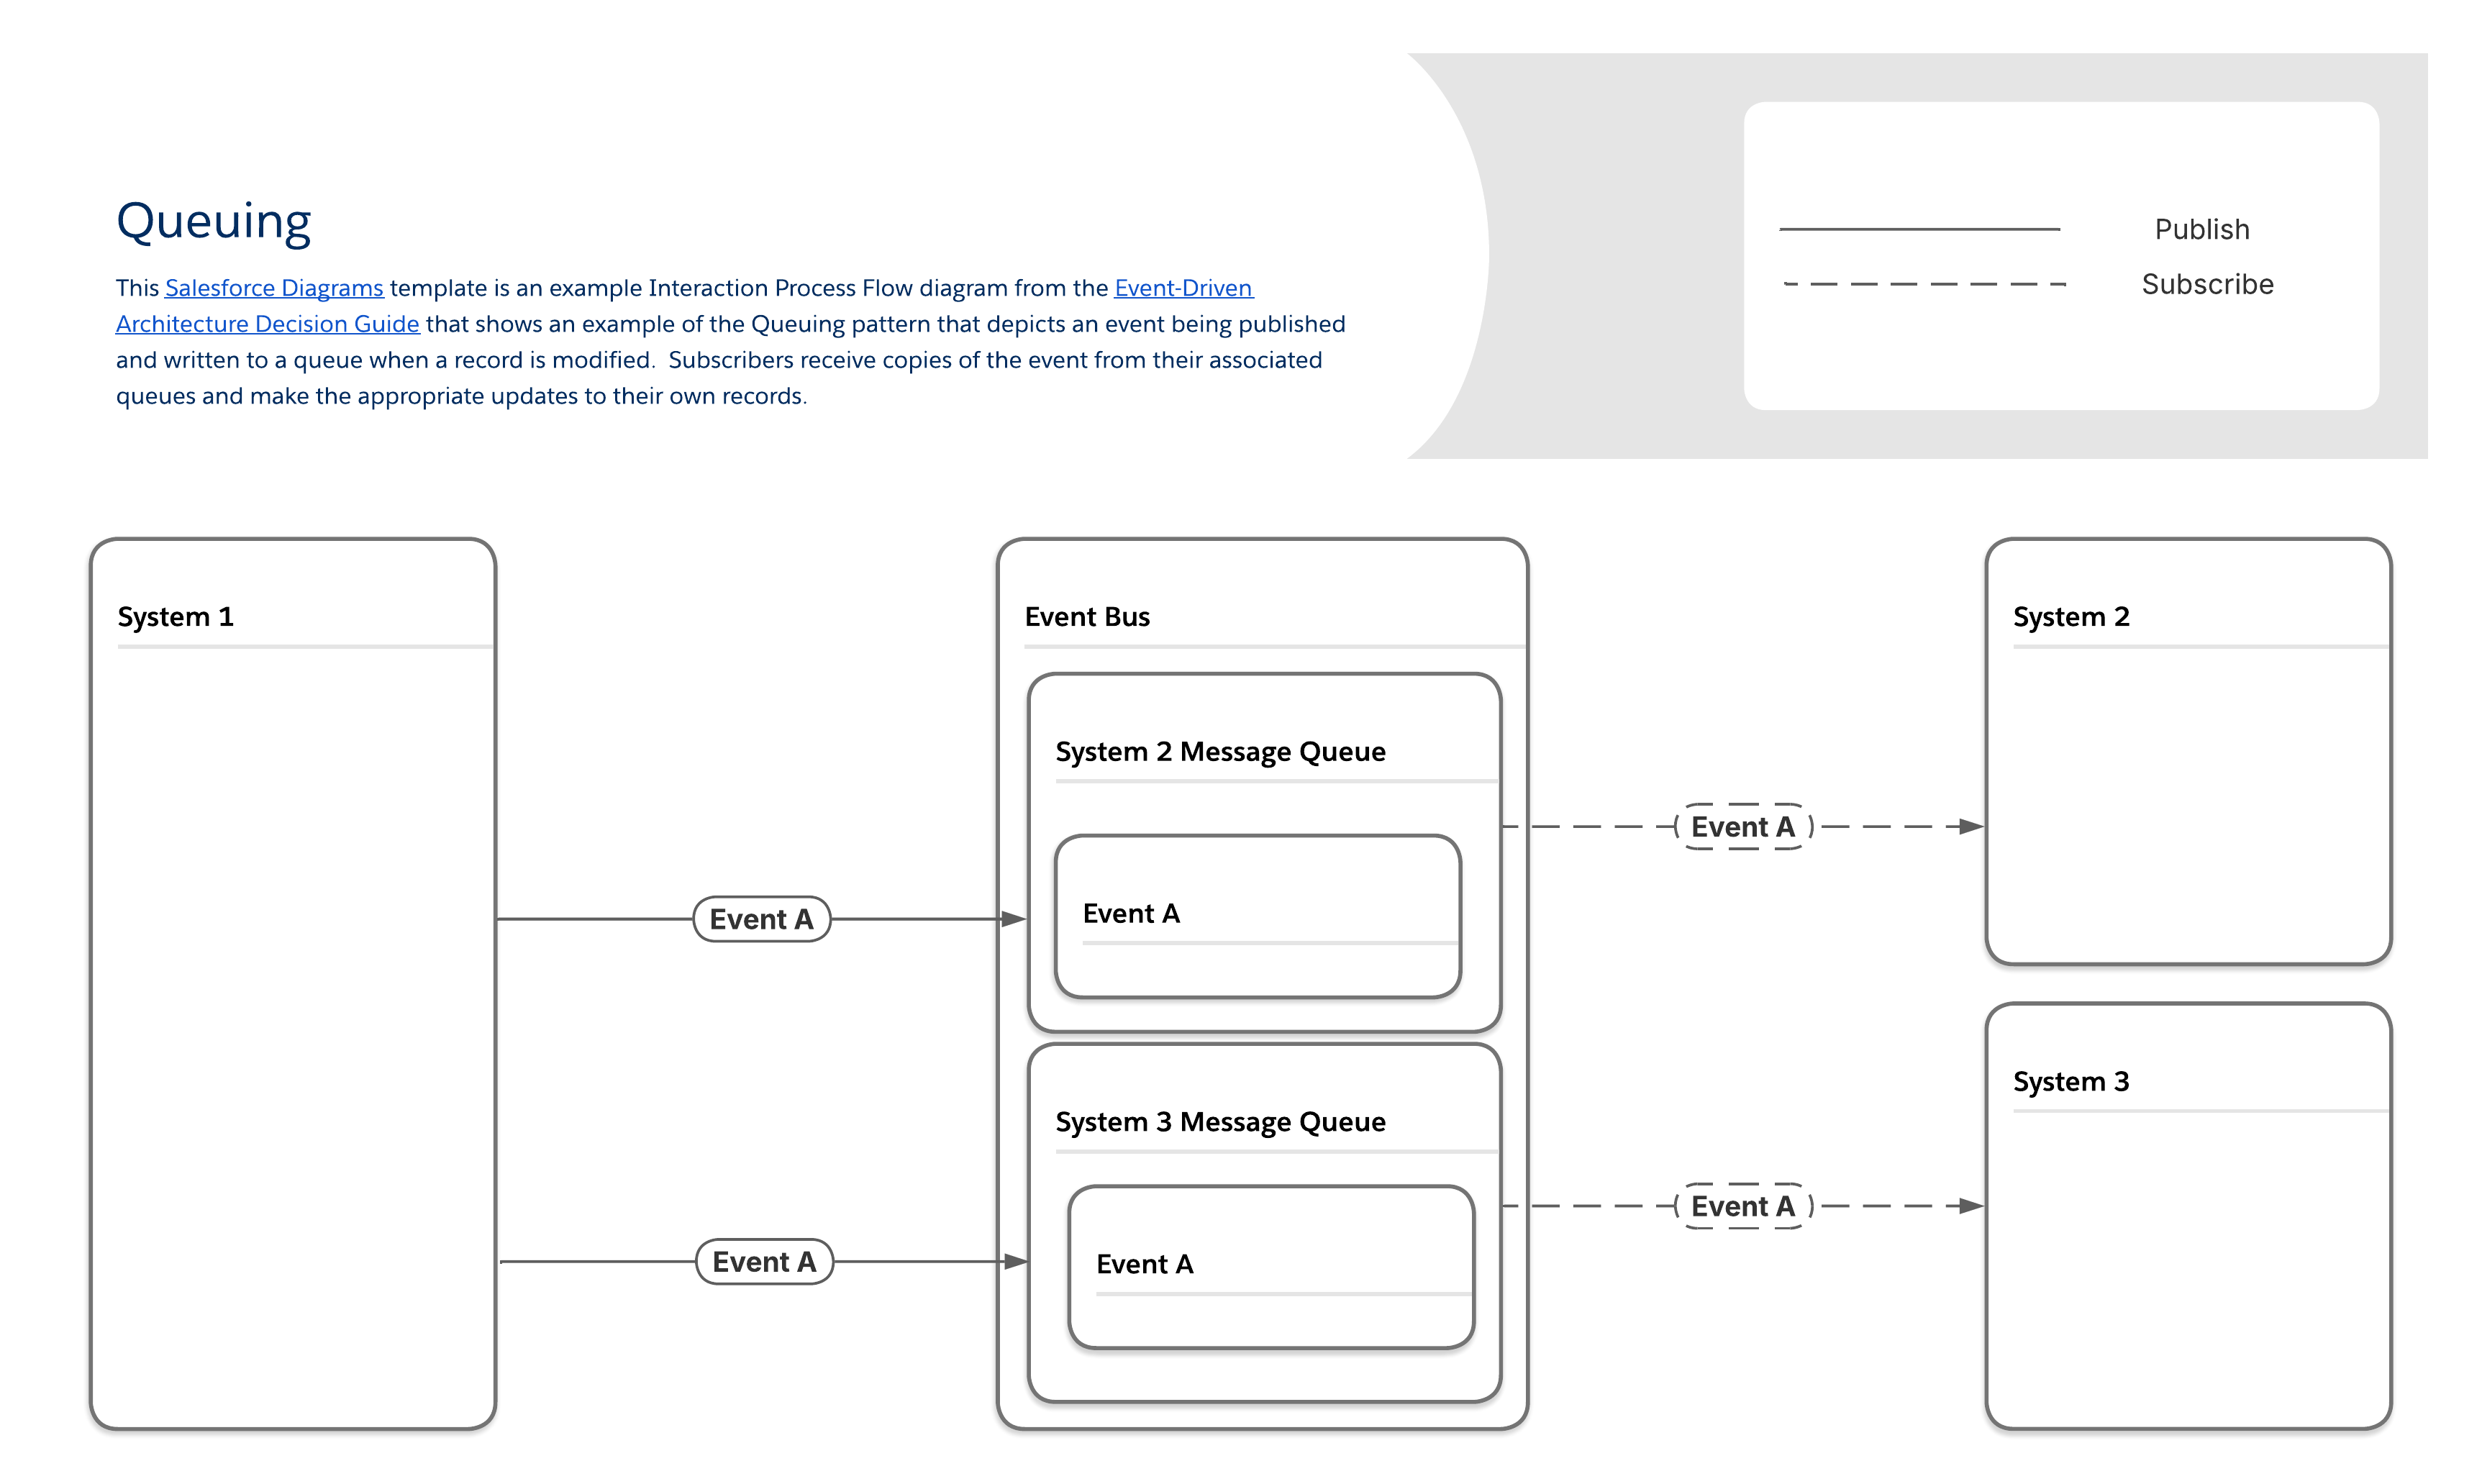
#### Gestione ordini di eventi in streaming Perché uno stream abbia senso, tutti gli eventi e i messaggi associati devono essere nell'ordine corretto. Se i dati provengono da stream di sistemi diversi, sarà necessario incorporare ulteriore logica di ordinamento come parte del processo di progettazione. ### Messa in attesa I casi d'uso di aree di attesa sono onnipresenti. Gli esempi includono: - **Connessioni Internet di bassa qualità:** Le organizzazioni di Field Service o altre organizzazioni in cui i team con dispositivi mobili devono lavorare in aree con accesso a Internet di bassa qualità o intermittente traggono vantaggio dall'inserimento in area di attesa poiché le applicazioni su questi dispositivi possono connettersi alle aree di attesa e recuperare tutti i messaggi pertinenti quando viene ripristinata la connettività. - **Buffering dei messaggi:** Quando il volume dei messaggi occasionalmente supera la capacità di elaborazione di un abbonato e la latenza aumentata non crea ulteriori problemi, le aree di attesa possono fungere da buffer per memorizzare i messaggi in eccesso e impedire la perdita di dati. - **Gestione dei trasporti:** Le organizzazioni logistiche che devono monitorare i propri parchi veicoli possono utilizzare questo schema per visualizzare i percorsi che ogni veicolo sta seguendo quasi in tempo reale e assicurarsi che i conducenti siano il più efficienti possibile. - **Dispositivi IoT:** I produttori utilizzano spesso sistemi che generano flussi rapidi di dati e questi flussi possono avere effetti a valle su sistemi aggiuntivi. Questo schema può essere utilizzato per identificare sequenze di eventi che richiedono l'intervento umano prima che si verifichino guasti catastrofici che interessano più sistemi. #### Schema dell'area di attesa Nello schema Area di attesa, i produttori inviano messaggi alle aree di attesa, che li conservano fino a quando gli abbonati non li recuperano. La maggior parte delle aree di attesa dei messaggi segue l'ordine first-in, first-out (FIFO) ed elimina ogni messaggio dopo che è stato recuperato. Ogni abbonato ha un'area di attesa univoca, che richiede ulteriori fasi di impostazione ma consente di garantire la consegna e identificare gli abbonati che hanno ricevuto quali messaggi. Questo diagramma di documentazione e implementazione di livello 3 mostra un esempio di schema di area di attesa che rappresenta un evento pubblicato e scritto in un'area di attesa quando un record viene modificato. Gli abbonati ricevono copie dell'evento dalle aree di attesa associate ed eseguono gli aggiornamenti appropriati ai propri record. #### Strumenti pertinenti allo schema di area di attesa
Flusso e comportamento dell'eventoConsiderazioni sul payload
Strumenti disponibiliCompetenze richiestePubblica tramiteAbbonamento tramitePeriodo di riproduzioneStruttura payloadLimiti del payload
MuleSoftMuleSoft Anypoint MQPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
Connettore Salesforce Pub/SubPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
MuleSoft Anypoint Apache Kafka ConnectorPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
Connettore MuleSoft Anypoint MQPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
Connettore MuleSoft Anypoint MQTTPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
Connettore MuleSoft Anypoint AMQPPro-codeAPIsAPIsCome configuratoDefinito dall'utenteNessuno
Salesforce PlatformApache Kafka su HerokuPro-codeAPI, modifiche dei record in Heroku PostgresN/D1-6 settimaneDefinito dall'utenteDefinito dall'utente
Modifica acquisizione datiDa codice basso a codice proModifiche recordApex, API, componenti Web Lightning (LWC)3 giorniPredefinito1 MB
Eventi piattaformaDa codice basso a codice proAPI, Apex, FlussoApex, API, Flusso, LWC3 giorniDefinito dall'utente1 MB
Pub/Sub APIPro-codeAPI o API Pub/Sub, Apex, FlussoAPI Pub/Sub3 giorniDefinito dall'utente1 MB
Relay evento*Basso codiceEventi piattaforma, Acquisizione dati modificaAPI3 giorniDefinito dall'utente1 MB
*I relay evento inviano i dati solo ad AWS Eventbridge
#### Gestione della memoria e dell'archiviazione A causa della natura asincrona dello schema di inserimento in area di attesa, può verificarsi un lungo ritardo tra l'aggiunta di un messaggio a un'area di attesa e il recupero del messaggio. Le aree di attesa richiedono memoria o spazio di memoria per contenere i messaggi, quindi non possono crescere all'infinito, il che significa che un abbonato offline a tempo indeterminato può causare un errore se nell'area di attesa si accumula un numero sufficiente di messaggi. Il buffering dei messaggi può avere lo stesso effetto se i tempi di elaborazione dell'abbonato diventano troppo lunghi, causando volumi elevati di messaggi nelle aree di attesa. Per ridurre questi rischi, eseguire un'analisi approfondita dei requisiti di memoria per tutte le aree di attesa dei messaggi e, se necessario, progettare processi che eliminino e disabilitino le aree di attesa se i messaggi non vengono recuperati entro un determinato periodo di tempo o raggiungono un volume predeterminato. ## Considerazioni non funzionali ### Migrazione da integrazioni da punto a punto Anche se si è pienamente convinti che un'architettura basata sugli eventi sia adatta alla propria organizzazione, è possibile iniziare con un panorama che include già un gran numero di integrazioni da punto a punto. Ottenere finanziamenti per un progetto che sostituisca tutte le integrazioni contemporaneamente può essere difficile e potrebbe anche non essere possibile utilizzare un'architettura basata sugli eventi direttamente con alcuni sistemi legacy. In questi scenari, è possibile adottare un approccio incrementale alla migrazione a un'architettura più vagamente accoppiata convertendo prima le applicazioni più critiche per l'azienda, quindi convertendo altri sistemi man mano che vengono aggiornati o sostituiti nei progetti futuri. Questo approccio semplifica l'aggiunta di nuove applicazioni al bus degli eventi e consente al panorama IT complessivo di rimanere scalabile e resiliente man mano che i sistemi continuano ad essere aggiunti nel tempo. ### Scambi all'interno di sistemi accoppiati liberamente Come architetti, sappiamo che ogni architettura ha dei compromessi. Un'architettura basata sugli eventi non fa eccezione. Mentre un panorama pieno di sistemi vagamente accoppiati è altamente scalabile e resistente, ci sono anche alcuni compromessi da considerare: - **Strategia di integrazione generale:** Indipendentemente dagli strumenti e dagli schemi che si decide di utilizzare, è importante iniziare creando una strategia per la condivisione dei dati tra i vari sistemi nel panorama dell'organizzazione. Questa strategia deve includere gli obiettivi dell'organizzazione per i propri dati, il modo in cui i dati possono essere condivisi e gli schemi utilizzati, nonché le fonti di dati, i target, le strutture e i requisiti di proprietà e accesso. - **Supporto per i sistemi legacy:** L'organizzazione potrebbe avere sistemi legacy che semplicemente non supportano schemi di architettura basati sugli eventi. Benché sia possibile creare soluzioni alternative (ad esempio, con un processo che funge da pass-through abbonandosi agli eventi e quindi inviando l'output al sistema di destinazione tramite un mezzo diverso di trasferimento dei dati), è possibile considerare altri metodi di integrazione in questo caso. - **Modifiche strutturali ai messaggi:** Una volta definita e concordata la struttura iniziale dei messaggi tra publisher e abbonati, può essere difficile modificarla, soprattutto se gli abbonati sono esterni. Esistono diversi modi per risolvere questo problema. È possibile utilizzare gli endpoint con versione, ma assicurarsi di definire e comunicare un ciclo di vita chiaro per ogni versione in modo che gli sviluppatori non debbano gestire troppe versioni contemporaneamente. Se Apache Kafka su Heroku fa parte del paesaggio, è anche possibile considerare un registro di schema o uno strumento simile, ma assicurarsi che anche gli altri sistemi nel paesaggio supportino (e utilizzino). - **Mancanza di visibilità tra publisher e abbonati:** Nella maggior parte degli schemi di architettura basati sugli eventi, i publisher non sono consapevoli dello stato dei propri abbonati. Pertanto, se un publisher invia un messaggio critico mentre tutti gli abbonati sono offline, il messaggio potrebbe non essere mai consegnato. È possibile risolvere questo problema utilizzando la funzionalità replay o aggiungendo abbonati ridondanti eseguiti su server separati per tutti i messaggi critici. - **Colli di bottiglia delle prestazioni:** Man mano che un'architettura basata sugli eventi aumenta, il bus degli eventi può diventare un collo di bottiglia per la consegna dei messaggi se viene sovraccaricato da troppi publisher che tentano di inviare messaggi a troppi abbonati contemporaneamente. È possibile risolvere questo problema aumentando la memoria e le risorse di elaborazione allocate al bus degli eventi o utilizzando più bus degli eventi per elaborare diversi tipi di messaggi in parallelo. ## Procedure consigliate correlate ### Implementazione di architetture basate sugli eventi Prima di implementare un'architettura basata sugli eventi, valutare se è davvero necessario utilizzarne una. La sezione precedente descrive scenari aziendali comuni adatti a ogni schema di architettura basato sugli eventi. Ulteriori informazioni sono disponibili in [Ben progettato - Interoperabilità](/docs/architect/it-it/well-architected/guide/composable#interoperabilità). Esaminare le sfide da considerare durante l'implementazione delle architetture basate sugli eventi per determinare se gli schemi previsti sono più adatti ai propri casi d'uso specifici. Tenere presente che, sebbene la maggior parte degli scenari descritti in questa guida preveda integrazioni, le architetture basate sugli eventi possono essere utilizzate anche per inviare messaggi all'interno di una singola organizzazione Salesforce, ad esempio tramite l'uso di eventi piattaforma. Assicurarsi di tenere presenti gli eventuali [limiti di allocazione](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_event_limits.htm) applicabili quando si progettano processi che utilizzano gli eventi piattaforma come sistema di messaggistica interno. ### Evitare gli anti-schemi Spesso, gli schemi anti-pattern relativi alle architetture basate sugli eventi derivano dall'utilizzo degli eventi come soluzione per le comunicazioni interne all'interno di un'organizzazione Salesforce. Gli anti-schemi comuni includono: - **Pubblicazione di eventi da trigger Apex associati allo stesso oggetto evento:** Questo risulterà in un loop trigger infinito. - **La pubblicazione di eventi da Apex prima che una transazione DML completi:** Se una transazione non riesce e viene ritirata, tutti gli eventi pubblicati con il comportamento di pubblicazione Pubblica immediatamente non verranno inclusi nel comportamento di ritiro. - **Pubblicazione di eventi in Flusso per orchestrare l'automazione successiva:** Il modo migliore per coordinare la logica in più automazioni è utilizzare i [sottoflussi](https://developer.salesforce.com/docs/atlas.en-us.salesforce_vpm_implementation_guide.meta/salesforce_vpm_implementation_guide/vpm_designer_elements_subflow.htm) o [Flow Orchestrator](https://help.salesforce.com/s/articleView?id=sf.orchestrator_flow_orchestrator.htm). - **Creazione di dipendenze di runtime:** Non pubblicare eventi per facilitare la comunicazione tra i pacchetti senza eseguire i [passaggi](https://medium.com/salesforce-architects/5-anti-patterns-in-package-dependency-design-and-how-to-avoid-them-87bb50331cb8) appropriati per eliminare le dipendenze in fase di esecuzione. - **Carichi utili non necessari:** Quando si effettuano richieste, è consigliabile inviare e ricevere la minor quantità di dati possibile nel payload. Ogni azione di un utente potrebbe generare più richieste ed è importante che vengano elaborate in modo efficiente. L'invio di più dati del necessario può contribuire a rallentare il trasporto e ad aumentare il tempo di elaborazione. - **Gestione non selettiva degli eventi applicazione:** Quando sono presenti più componenti in ascolto per un evento applicazione, gli sviluppatori devono assicurarsi che l'handler evento venga eseguito solo quando è effettivamente desiderato e utile. Ad esempio, in Lightning Console, i componenti contenuti nelle schede che non sono attivati possono essere ancora in ascolto anche se non sono visibili. Uno sviluppatore può utilizzare varie tecniche, ad esempio utilizzare un elemento utilità in background come unico ascoltatore o chiamare getEnclosingTabId() per determinare se questa istanza del componente è racchiusa nella scheda attivata per garantire che ogni evento venga gestito solo quando previsto. - **Il comportamento di pubblicazione degli eventi piattaforma non è corretto:** Gli eventi piattaforma hanno due comportamenti di pubblicazione: Pubblica immediatamente e Pubblica dopo l'impegno. Può essere utile utilizzare gli eventi piattaforma in tempo reale per casi d'uso come Registrazione, in cui si desidera pubblicare l'evento di registrazione indipendentemente dal fatto che la transazione abbia esito positivo o meno. Tuttavia, utilizzare con molta attenzione Pubblica immediatamente con gli eventi piattaforma in tempo reale. Gli eventi possono essere consumati dagli abbonati all'interno della stessa transazione e causare blocchi delle righe o altre condizioni di gara. ### Progettazione di eventi efficaci Quando si implementa un'architettura basata sugli eventi, una delle chiavi del successo è definire gli standard per la progettazione degli eventi stessi. Le specifiche variano a seconda dei casi d'uso dell'organizzazione, ma di seguito sono riportate alcune linee guida generali: - **Determinare la struttura ottimale per i payload degli eventi.** Mentre le dimensioni più piccole dei messaggi riducono i tempi di elaborazione, bombardare gli abbonati con volumi elevati di messaggi può causare colli di bottiglia nelle prestazioni. Può essere necessario ripetere le dimensioni e le strutture del payload per trovare il giusto equilibrio. MuleSoft e strumenti ESB simili offrono la possibilità di progettare payload personalizzati nei messaggi associati agli eventi, che possono aiutare a visualizzare le strutture di dati per migliorare le prestazioni sul lato abbonato. (Per ulteriori informazioni, vedere [Ben progettato - Gestione API](/docs/architect/it-it/well-architected/guide/composable#gestione-api)). - **Pensare ai processi end-to-end.** Assicurarsi di non creare scenari di "loop senza fine", che possono essere difficili da individuare una volta implementate le integrazioni. Ad esempio, due sistemi pubblicano gli eventi quando i record vengono aggiornati, ascoltando anche gli eventi degli altri, che attivano ulteriori eventi pubblicati quando vengono elaborati. È possibile correggere questo tipo di anti-schema aggiungendo una logica a entrambi i sistemi che garantisca che le modifiche apportate a seguito di un evento consumato non determinino la pubblicazione di un nuovo evento. Assicurarsi inoltre di documentare tutti gli eventi, i trigger associati e i sistemi a valle che potrebbero essere interessati. Utilizzare questa documentazione come riferimento durante le sessioni di progettazione per individuare i loop infiniti e gli scenari simili il prima possibile. (Per ulteriori informazioni, vedere [Progettazione di processi](/docs/architect/it-it/well-architected/guide/automated#progettazione-dei-processi) ben progettata). - **Utilizzare le convenzioni di denominazione comuni nei vari sistemi.** Convenzioni di denominazione coerenti sono una procedura ottimale per tutto lo sviluppo software, incluse le architetture basate sugli eventi. Documentare una serie di standard per i nomi degli eventi, le strutture, gli oggetti associati e i processi di gestione degli errori per garantire la coerenza tra i sistemi. (Per ulteriori informazioni, vedere [Well-Architected - Design Standards](/docs/architect/it-it/well-architected/guide/intentional#design-standards)). ## Risorse
SchemaRisorse
Pubblica/ AbbonatiSalesforce ben progettato - Produzione
Salesforce ben progettato - Gestione dei dati
Salesforce ben progettato - Interoperabilità
Post del blog: Come ottenere efficienza architettonica con i relay evento
Post del blog: Annuncio dell'API Pub/Sub disponibile in generale
Post del blog: Passaggio da RESTful a EVENTful
Post del blog: Architetture basate sugli eventi e specifica AsyncAPI
Video: Tour dimostrativo Pubblica / Abbonati
FanoutPost del blog: Come lavorare entro i limiti di consegna degli eventi piattaforma
Video: Tour dimostrativo dello schema Fanout
Messaggi passatiVideo: Tour dimostrativo sullo schema Messaggi passati
StreamingPost del blog: Progettazione di scritture a volume elevato in Salesforce
Video: Streaming Pattern Walkthrough (Guida allo schema di streaming)
Documentazione: Streaming nelle app Mule
Messa in attesaPost del blog: Progettazione di scritture a volume elevato in Salesforce
Post del blog: Come progettare architetture di pagamento con le API Evented
Video: Tour dimostrativo dello schema di area di attesa
## Panoramica Salesforce Platform ha continuamente avanzato la propria architettura di automazione per soddisfare le esigenze dei processi aziendali complessi. Le generazioni precedenti (Regole di flusso di lavoro e Process Builder) hanno fornito i passaggi iniziali della logica basata sugli eventi, ampliando le funzionalità di automazione per la logica basata sugli eventi e ampliando la portata a una gamma più ampia di generatori. Questa evoluzione è culminata in un’architettura consolidata e ad alte prestazioni incentrata su due pilastri complementari: Flusso attivato da record e trigger Apex. Questo documento fornisce il framework e le linee guida per prendere decisioni informate durante la progettazione delle automazioni dei trigger. ## Prodotti nell'ambito
Flusso Salesforce Flow è un potente strumento di automazione point-and-click che consente agli utenti di creare processi aziendali complessi, schermate e logica visivamente utilizzando Flow Builder, senza scrivere codice. Automatizza operazioni come l'aggiornamento dei dati, l'invio di email e la guida degli utenti, offrendo flessibilità attraverso tipi come Flussi schermata (interazione dell'utente) e Flussi attivati (eventi record/pianificati).
Apex Salesforce Apex è un linguaggio di programmazione proprietario orientato agli oggetti per la piattaforma Salesforce, simile a Java, utilizzato per creare logiche aziendali personalizzate, automatizzare i processi ed estendere le funzionalità CRM principali oltre gli strumenti dichiarativi.
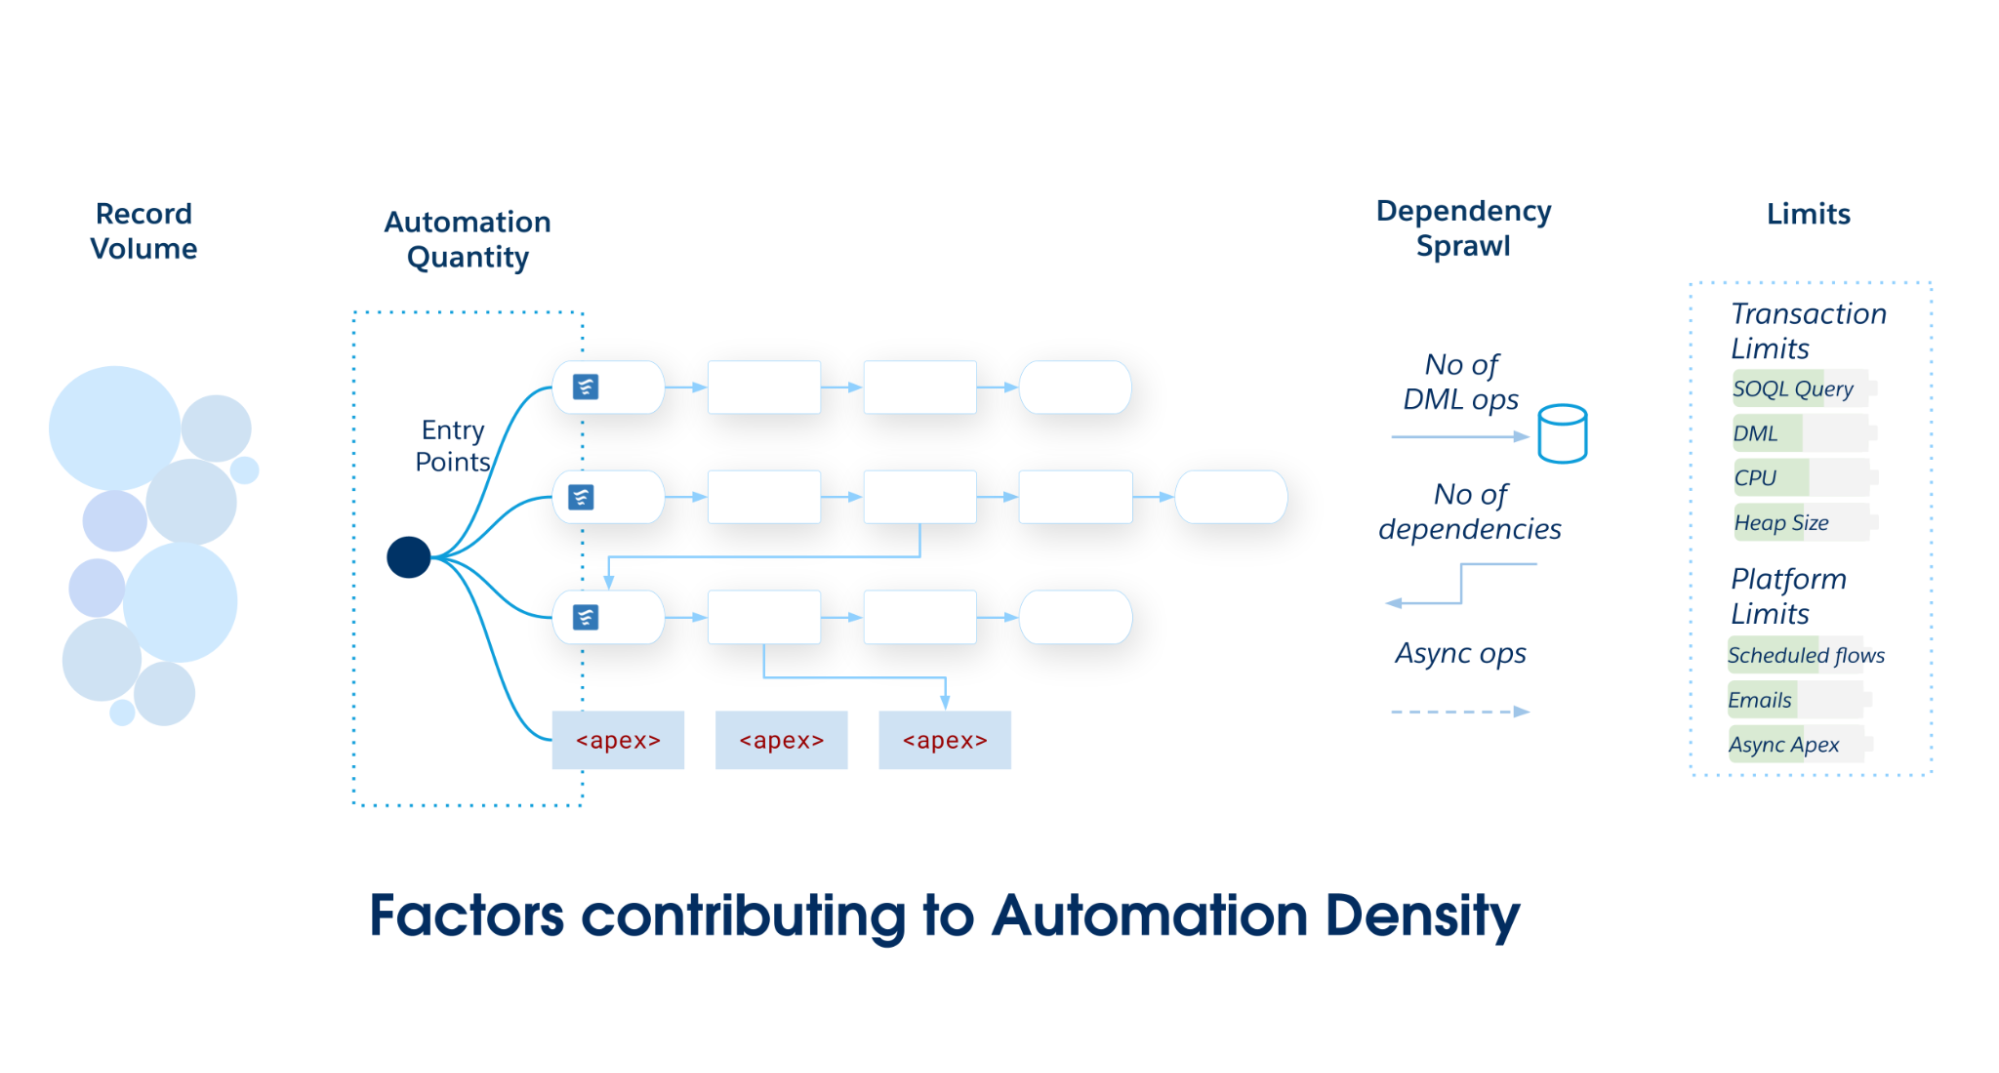
## Takeaway La creazione di un'automazione attivata da record scalabile, manutenibile e performante in Salesforce Platform richiede un approccio disciplinato e basato sull'architettura. La scelta tra Flusso e Apex, e l'implementazione di ciascuno, è guidata da un chiaro insieme di principi. Questi punti riassumono questi principi e fungono da regole di base per la moderna progettazione dell'automazione. - **Scegliere lo strumento giusto per il lavoro in base alla densità di automazione di Salesforce Object.** - Utilizzare Flusso attivato da record per gli oggetti Salesforce per le automazioni **a bassa densità**. - Migliorare la logica dei flussi attivati da record con Apex invocabile per le automazioni **a media densità**. - Utilizzare trigger Apex per gli oggetti Salesforce per le automazioni **ad alta densità**. - **Prestare attenzione quando si attivano processi asincroni.** Questa regola si applica sia quando si invocano processi asincroni in un flusso attivato da record sia quando si inserisce in area di attesa un processo accodabile da Apex. Sebbene questo schema possa essere allettante per scaricare il lavoro, può introdurre scenari complessi di gestione degli errori e aumentare il rischio di superare i limiti del governor. - **Utilizzare un punto di ingresso per ogni oggetto Salesforce.** Per un determinato oggetto Salesforce, utilizzare un meccanismo come punto di ingresso nell'automazione. Cercare di evitare di mescolare trigger Flusso e Apex come punti di ingresso per lo stesso oggetto. ## Punti decisione ### Implementazione dichiarativa e implementazione programmatica Flusso e Apex condividono una serie di funzionalità fondamentali. Ogni strumento può eseguire query sui record, eseguire logica condizionale, assegnare variabili ed eseguire operazioni DML come la creazione, l'aggiornamento e l'eliminazione di record, in sequenza per l'esecuzione in un ordine specificato. Tuttavia, questa sovrapposizione funzionale non implica che gli strumenti siano intercambiabili. La scelta architetturale non riguarda _se_ un'operazione può essere eseguita, ma _come_ viene eseguita e quali sono le implicazioni a lungo termine per prestazioni, scalabilità e manutenibilità. Il flusso eccelle in chiarezza dichiarativa e velocità di implementazione per i processi semplici, mentre Apex offre il controllo granulare e la potenza grezza necessari per le soluzioni complesse. ### Densità automazione La **densità di automazione** è il carico posto su un oggetto Salesforce specifico. Serve come euristica per determinare l'implementazione ottimale dell'oggetto. Man mano che la densità dell'automazione aumenta, la probabilità di superare i limiti delle transazioni aumenta. Calcolare la densità di automazione esaminando tre dimensioni specifiche di volume e complessità: - **Quantità di automazione:** Numero non formattato di voci di metadati di automazione univoche (flussi, azioni di trigger e così via) eseguite durante un singolo evento DML (Data Manipulation Language). - **Volume record:** I record per transazione elaborati tramite caricamenti API o elaborazione batch pesante, in cui le prestazioni diventano critiche. - **Diffusione delle dipendenze:** Misura delle operazioni DML a valle attivate dall'operazione CRUD iniziale. Quantifica la profondità del grafico in cui un aggiornamento si trasforma in aggiornamenti sugli oggetti correlati (ad esempio, caso → account → referente → roll-up personalizzato). Dimensioni densità automazione Man mano che l'ambito e la complessità dell'applicazione Salesforce aumentano, impegnarsi in un unico punto di ingresso principale, Flusso attivato da record o Trigger Apex. Evitare di suddividere le automazioni in più meccanismi in un unico oggetto Salesforce, poiché ciò causa una scarsa manutenibilità e una governance frammentata. ### La matrice di selezione della densità Utilizzare questa matrice per determinare lo standard architettonico richiesto per l'oggetto Salesforce. - Il **flusso attivato da** record è la soluzione preferita per una bassa densità di automazione. Offre un equilibrio di potenza e accessibilità ideale per automazioni semplici e indipendenti l'una dall'altra. - **Lo schema ibrido (Record-Triggered Flow with Invocable Apex)** è una scelta potente e manutenibile per le automazioni a media densità con complessità crescente. Questo schema consente ai team di mantenere coreografie ordinate in un flusso dichiarativo delegando al contempo le operazioni complesse di calcolo ad Apex, bilanciando l'accessibilità con le prestazioni. - **I trigger Apex** forniscono i componenti base necessari per una solida base architettonica per supportare automazioni ad alta densità. Le prestazioni, il controllo granulare e l'astrazione e il polimorfismo orientati agli oggetti di Apex sono più adatti per gestire la complessità e la scala di questi scenari.
Livello di densità Quantità automazione Volume di dati (dimensioni batch) Dependance Sprawl (Diffusione delle dipendenze) Standard architettonico
Basso < 15
Automazioni
Standard
Interazioni dell'interfaccia utente basate sugli utenti o piccoli carichi API (1-200 record)
Discreto
Logica autonoma. 0–1 operazioni DML a valle sullo stesso oggetto o su un oggetto correlato.
Flusso attivato da record
Medio 15–30
Automazioni
Modera
Elaborazione batch standard (con logica che richiede un'attenta messa in blocco)
Accoppiato
Parent/Child aggiorna da 2 a 4 operazioni DML a valle. Rischio di ricorsione
Schema ibrido
Flusso + Apex invocabile
Alto > 30
Automazioni
Alto
Grandi volumi di dati con caricamenti API in blocco (2.000 - 10.000+ record)
Complesso e ricorsivo
Grafico delle dipendenze profonde (5+ operazioni DML a valle). Rischio di loop di ricorsione triangolari
Framework di metadati trigger Apex
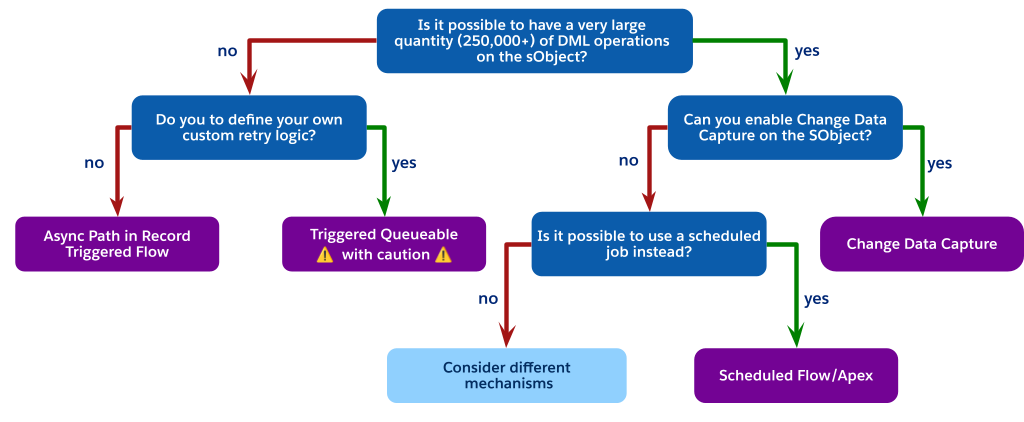
Le decisioni architettoniche del mondo reale richiedono la ponderazione collettiva di tutte le dimensioni della densità di automazione. Considerare il potenziale ambito futuro quando si seleziona un meccanismo di automazione per un determinato oggetto Salesforce. Considerare inoltre il numero totale giornaliero di operazioni DML poiché Salesforce impone la gestione delle risorse condivise in un ambiente multi-tenant e i [limiti del governor](https://developer.salesforce.com/docs/atlas.en-us.salesforce_app_limits_cheatsheet.meta/salesforce_app_limits_cheatsheet/salesforce_app_limits_platform_apexgov.htm) per impedire che le automazioni incontrollate monopolizzino le risorse condivise. Gli oggetti Salesforce con elevati volumi giornalieri di DML richiedono un'accurata selezione dell'automazione. Ad esempio, i limiti asincroni per il tempo CPU (60.000 ms) e le dimensioni dell'heap (12 MB) sono superiori ai limiti sincroni. Inoltre, il limite di 24 ore dell'organizzazione per le esecuzioni asincrone, calcolato come 250.000 o 200 volte le licenze utente, richiede di considerare il DML giornaliero totale nella progettazione architettonica per evitare eccezioni in fase di esecuzione. ## Confronto dei prodotti Flusso attivato da record è lo strumento dichiarativo principale della piattaforma per l'automazione attivata da record. La facilità d'uso e le protezioni della piattaforma incorporate di Flow consentono ai team di creare facilmente soluzioni scalabili e affidabili. È la scelta ideale per la maggior parte dei team che creano soluzioni su Salesforce Platform. Apex è il linguaggio di programmazione proprietario, fortemente tipizzato e orientato agli oggetti della piattaforma. Utilizzare Apex per gli oggetti Salesforce con elevata densità di automazione e per i casi d'uso che richiedono prestazioni elevate, logica sofisticata o un controllo granulare sulle transazioni. Per facilitare il processo decisionale, questa matrice offre un confronto diretto tra Flusso e Apex nelle principali funzionalità architetturali.
Capacità Flusso attivato da record Trigger Apex
Velocità di consegna e manutenzione Consigliato
L'interfaccia utente visiva di Flow Builder consente agli amministratori e ad altri generatori dichiarativi di creare e modificare l'automazione più rapidamente rispetto alla scrittura, al test e alla distribuzione di Apex Code. Questa interfaccia consente a una gamma più ampia di membri del team di offrire valore aziendale e riduce la dipendenza da risorse per sviluppatori specializzate per operazioni semplici.
Richiede esperienza
Apex richiede sviluppatori di software esperti per implementare, testare e gestire il codice.
Modularità Disponibile
I flussi attivati da record sono modulari per impostazione predefinita. Anziché la logica monolitica, i team creano flussi discreti per esigenze specifiche e li coreografano insieme utilizzando Explorer trigger di flusso. Questa modularità consente la modifica isolata e l'estensione semplice, riducendo notevolmente il costo di proprietà a lungo termine.
Disponibile
Apex è suddiviso in moduli funzionali in base alla progettazione. Ogni classe Apex è destinata a implementare un singolo modulo di funzionalità.
Visibilità e governance Consigliato
La natura visiva del flusso offre una rappresentazione intuitiva della logica aziendale. Explorer trigger di flusso offre una visualizzazione consolidata di tutti i flussi di un oggetto, semplificando la comprensione, il governo e la risoluzione dei problemi per architetti e amministratori senza leggere il codice.
Richiede esperienza
L'utilizzo di un framework di metadati per organizzare i trigger è vantaggioso, ma Apex richiede un team di sviluppo disciplinato per mantenere il codice organizzato e manutenibile.
Elaborazione in blocco dei dati ad alte prestazioni Sconsigliato
Esiste un rischio elevato di superare i limiti del governor quando si ha a che fare con logica complessa o volumi di dati elevati.
Consigliato
Apex Code viene eseguito più vicino ai servizi principali della piattaforma e offre agli sviluppatori un controllo avanzato sull'ottimizzazione delle query, la gestione dei dati e l'efficienza algoritmica. Ciò si traduce in prestazioni e scalabilità migliori, soprattutto in scenari complessi che coinvolgono volumi di dati elevati.
Logica e strutture di dati solide Disponibile
L'elemento Trasforma flusso può essere utile per alcune operazioni di elaborazione complesse. Tuttavia, il flusso non dispone di strutture di dati native Map and Set (Mappa e imposta), il che rende l'elaborazione dei dati complessa complessa complessa e inefficiente dal punto di vista computazionale.
Consigliato
Apex offre accesso completo ai loop Map, Set e programmatic per una manipolazione dei dati altamente efficiente e sicura in blocco. Essendo un linguaggio di programmazione completo, Apex offre anche l'accesso a costrutti logici complessi, strutture di dati e schemi di progettazione che possono aiutare a risolvere problemi aziendali complessi in modo manutenibile ed efficiente. Apex include una ricca libreria standard di funzioni avanzate (ad esempio, BusinessHours, Crypto) attualmente non disponibili negli strumenti dichiarativi.
Controllo delle transazioni Non disponibile
Il flusso non fornisce alcun accesso a `Database.savepoint`, `Database.rollback` o a operazioni DML parzialmente riuscite per conferme o rollback parziali delle transazioni.
Disponibile
Apex offre un controllo completo e granulare sull'integrità delle transazioni e su scenari di ripristino degli errori complessi.
Distribuzione email Consigliato
L'invio di avvisi tramite email preconfigurati da un flusso attivato da record è semplice e scalabile. Gli avvisi tramite email personalizzati possono essere creati e distribuiti in fase di esecuzione. I messaggi email personalizzati sono soggetti a limiti giornalieri.
Disponibile
Apex può generare e inviare messaggi email personalizzati. Tutte le email inviate da Apex sono soggette ai limiti giornalieri.
Applicazione di protezioni piattaforma Consigliato
Il flusso include protezioni incorporate, ad esempio la bulkificazione automatica e i tentativi automatici. Queste protezioni aumentano la velocità di calcolo e impediscono insidie nelle prestazioni che altrimenti richiedono una codifica manuale complessa.
Implementazione manuale richiesta
Le protezioni come la creazione in blocco devono essere codificate in modo esplicito (ad esempio, la gestione delle raccolte ed evitare SOQL all'interno dei loop). I tentativi automatici non sono nativi dei trigger e richiedono una complessa logica personalizzata per essere implementati.
Elaborazione asincrona Disponibile
Il flusso offre meccanismi semplici per le automazioni che richiedono una transazione separata in un percorso asincrono. Queste automazioni sono soggette a limiti giornalieri.
Disponibile
Apex consente il controllo completo tramite Acquisizione dati di modifica ed eventi in area di attesa gestiti da un abbonato trigger disaccoppiato.
Elaborazione pianificata Consigliato
I percorsi pianificati del flusso offrono una funzionalità di pianificazione unica e potente (ad esempio, "attiva 3 giorni prima della data di chiusura"). Questa funzionalità include l'annullamento automatico e la riprogrammazione se i dati del record cambiano. Queste automazioni sono soggette a limiti giornalieri.
Non disponibile
Un trigger Apex non può pianificare in modo nativo un evento temporale specifico del record con annullamento automatico. Sebbene esista Apex pianificato, si tratta di un meccanismo fondamentalmente diverso che viene eseguito in un momento specifico e non viene pianificato durante l'elaborazione di un singolo record come parte di un trigger.
Ordinamento e coreografia Disponibile
Explorer trigger di flusso consente agli amministratori di definire un ordine di esecuzione relativo per più flussi sullo stesso oggetto.
Disponibile
Un framework trigger offre un controllo granulare sull'ordine esatto delle automazioni.
Aggiornamenti di campo dello stesso record Disponibile (prima del salvataggio)
Il flusso attivato da record è l'opzione dichiarativa più efficace per aggiornare il record di attivazione prima della conferma DML iniziale.
Disponibile (prima del salvataggio)
Apex offre le prestazioni più elevate con un sovraccarico minimo.
CRUD oggetti incrociati Disponibile (dopo il salvataggio)
Il flusso è adatto per operazioni DML tra oggetti semplici, di bassa complessità.
Disponibile (dopo il salvataggio)
Apex offre un controllo superiore su deduplica, gestione degli errori e prestazioni per le operazioni DML oggetti incrociate.
Deduplicazione di calcoli costosi Disponibile
Il flusso eccelle nell'eliminazione delle query ridondanti e delle istruzioni DML tramite il blocco automatico. Tuttavia, lo stato non può essere memorizzato nella cache o condiviso tra trigger di flusso diversi o tra più chiamate dello stesso flusso all'interno di una sola transazione. Questa limitazione può diventare importante in scenari di prestazioni estreme.
Consigliato
Apex fornisce meccanismi per deduplicare operazioni costose. Gli sviluppatori possono sfruttare il caching transazionale utilizzando proprietà e variabili statiche e il caching a livello di piattaforma utilizzando la cache piattaforma per archiviare e riutilizzare i dati. Queste tecniche sono importanti per ridurre il consumo dei limiti del governor transazionale, ad esempio le query SOQL, e garantire prestazioni e scalabilità elevate.
Gestione errori personalizzati Disponibile
L'elemento CustomError può bloccare un'operazione di salvataggio e visualizzare un messaggio all'utente.
Consigliato
Il metodo addError() offre una messaggistica di errore flessibile a livello di campo e condizionale.
## Casi d'uso ### Consigli migliori Questa tabella fornisce consigli generali "migliori" per i casi d'uso generali, in base alle funzionalità presentate. Infine, si terranno presenti ulteriori considerazioni per individuare la soluzione più adatta ai propri scenari specifici, ad esempio quelli inclusi nella sezione _Procedure consigliate correlate_ di questo documento. Qui, imparerai di più su quando una particolare combinazione di Flusso e Apex offre l'approccio migliore.
Caso d'uso Descrizione Best-Fit Motivo
Elaborazione batch ad alte prestazioni Qualsiasi automazione che deve elaborare migliaia di record in modo efficiente Apex Apex fornisce API complete per l'interfacciamento con la piattaforma e per la velocità di stampa.
Elaborazione dati complessa Scenari che richiedono una manipolazione avanzata dei dati Apex Apex fornisce strutture di dati, ad esempio Mappa e Imposta, che non sono disponibili in modo nativo in Flusso e possono essere fondamentali per scrivere codice efficiente e sicuro in blocco.
Controllo transazionale Meccanismi di controllo come savepoint, rollback e conferme parziali Apex Apex fornisce l'accesso a meccanismi come Database.savepoint e Database.rollback e ha la capacità di elaborare operazioni DML parzialmente riuscite.
Convalida personalizzata sofisticata Convalida dei dati in più campi di un record Apex Sebbene il flusso possa impedire il salvataggio con l'elemento 'CustomError', non è disponibile in tutti i tipi di flusso, inclusi i sottoflussi. Il metodo Apex addError() fornisce più messaggi di errore specifici del campo che possono essere aggiunti a un record in qualsiasi momento durante l'elaborazione del trigger.
Logica moderatamente complessa in un processo semplice Logica e manipolazione dei dati di moderata complessità, semplificate da una libreria standard di funzioni avanzate, che si verificano nell'ambito di un processo semplice Flusso + Apex Il flusso attivato da record funge da livello di orchestrazione, mentre le operazioni di elevata complessità sono incapsulate in Apex invocabile.
Logica da semplice a moderatamente complessa Manipolazione dei dati di complessità da bassa a moderata, con aggiornamenti dei trigger sia agli oggetti dati principali che a quelli correlati Flusso Il flusso è in genere l'opzione da seguire, poiché è basato su un modello dichiarativo che lo rende accessibile sia agli amministratori che agli sviluppatori.
Notifiche e messaggi in uscita Invio di email e messaggi in uscita Flusso Il flusso consente di inviare avvisi tramite email e messaggi in uscita sulle modifiche dei record in modo semplice e altamente scalabile.
Elaborazione pianificata Automazione in una data futura e dinamica (ad esempio, 3 giorni prima di una data di chiusura) Flusso I percorsi pianificati rappresentano un punto di forza unico per il flusso, poiché la piattaforma gestisce automaticamente la pianificazione, l'annullamento e la riprogrammazione di questi percorsi se i dati del record cambiano.
### Elaborazione scalabile: Casi d'uso asincroni in dettaglio La scalabilità è una considerazione fondamentale quando si progetta l'implementazione. Quando la logica aziendale di un'automazione attivata da record diventa complessa, di lunga durata o comporta volumi di dati elevati, i limiti del governor centrale della piattaforma Salesforce diventano un vincolo architettonico. Operazioni come aggiornamenti globali dei dati, chiamate API complesse o calcoli complessi aumentano il rischio di superare i limiti, ad esempio il tempo totale della CPU o il numero di istruzioni DML all'interno di una singola transazione del database. Un errore in un trigger sincrono dovuto a un'eccezione del limite causerà il ritiro dell'intera transazione di salvataggio dell'utente, causando una scarsa esperienza utente e una potenziale perdita di dati. Questo rischio intrinseco impone a uno schema architettonico di scaricare il lavoro complesso. L'automazione asincrona diventa essenziale in questo caso. Utilizzando meccanismi asincroni, gli architetti possono disaccoppiare efficacemente il lavoro di lunga durata o a volume elevato dalla transazione di salvataggio dei record principale sincrona. I salvataggi vengono completati in modo rapido e affidabile, mentre l'elaborazione pesante viene delegata a una transazione separata gestita dalla piattaforma che viene eseguita in seguito. Il disaccoppiamento migliora la stabilità, previene gli errori delle transazioni ed è fondamentale per la creazione di applicazioni aziendali scalabili. La piattaforma offre diversi strumenti specializzati per questo, ciascuno con vantaggi e compromessi distinti in termini di affidabilità, volume e complessità. ### Percorso asincrono del flusso Il percorso Esegui in modo asincrono in un flusso attivato da record offre il meccanismo più semplice per la logica asincrona "attiva e dimentica". Questo percorso viene eseguito in una transazione separata dopo che la transazione di salvataggio dei record originale è stata confermata correttamente nel database. - **Caso d'uso ideale**: Questo è adatto per le operazioni che non richiedono un'esecuzione immediata o la gestione personalizzata degli errori. Gli esempi includono l'invio di una notifica tramite email, la creazione di un'operazione di follow-up o una semplice chiamata a un sistema esterno. - **Limitazioni**: Questo meccanismo condivide gli stessi limiti giornalieri del governor delle altre interviste del flusso asincrono. Non è progettato per l'elaborazione a volume estremamente elevato. ### Acquisizione dati di modifica (CDC) Acquisizione dati di modifica (CDC) è uno schema ad alta produttività, scalabile e resiliente per la gestione della logica asincrona attivata da una modifica record in scenari a volume elevato. In questo modello, l'unica responsabilità del trigger è salvare il record in modo sincronizzato. La piattaforma pubblica quindi un messaggio di evento dettagliato che contiene le modifiche apportate dal record a un bus degli eventi a volume elevato. Un trigger Apex dedicato separato si abbona a questo evento di modifica. Esegue lavori complessi, di lunga durata o asincroni. - **Vantaggio**: Questo schema separa il processo asincrono dalla transazione utente iniziale. Un errore nell'elaborazione asincrona non causerà il ritiro del salvataggio del record dell'utente. Lo schema fornisce anche uno stream di eventi durevole che può essere utilizzato da più abbonati interni o sistemi esterni e gli eventi possono essere riprodotti per un massimo di 72 ore, offrendo una forte resilienza. - **Limitazioni**: I messaggi degli eventi CDC non contengono lo stato precedente del record, l'equivalente di un `Trigger.oldMap` Apex. Il payload dell'evento include i nuovi valori dei campi, ma non i valori da cui sono stati modificati. Ciò rende difficile implementare una logica basata su una transizione di stato specifica (ad esempio, eseguire solo se il `Status__c` è cambiato da "In sospeso" a "Approvato"). È possibile mitigare questo problema eseguendo query nella cronologia dei campi dell'oggetto nell'abbonato evento, ma questo aumenta la complessità del processo e il tracciamento della cronologia dei campi potrebbe non essere disponibile per il campo specifico di interesse. Ciò può limitare i tipi di automazione che è possibile scaricare in CDC. Per impostazione predefinita, CDC può essere abilitato su un massimo di cinque oggetti Salesforce. Le organizzazioni che necessitano di più possono acquistare una licenza aggiuntiva che rimuove questo limite e aumenta le allocazioni di consegne degli eventi. ### Apex in area di attesa da un trigger L'inserimento di un processo Apex in area di attesa direttamente da un trigger deve essere considerato uno schema rischioso, utilizzato solo quando è necessario un controllo fornito da Apex (ad esempio, per logica complessa o meccanismi di tentativo personalizzati) e CDC non è un'opzione praticabile. Se è necessario Queueable Apex, l'implementazione deve includere adeguate misure di protezione: - **Limita controlli**: Il codice deve controllare il numero di processi già presenti nell'area di attesa della transazione prima di tentare di aggiungerne un altro. ``` if (Limits.getQueueableJobs() < Limits.getLimitQueueableJobs()) { ... } ``` - **Consapevolezza contesto**: Il codice deve rilevare se viene eseguito in un contesto asincrono, ad esempio un processo batch (`System.isBatch()`), e modificarne il comportamento per rispettare il limite più rigoroso di un processo per transazione in quel contesto. ### Considerazioni sui limiti per Apex asincrono attivato L'invocazione di Apex asincrono da un trigger sincrono introduce rischi per la stabilità. Per evitare l'impatto a livello di organizzazione (ad esempio, il superamento dei limiti), questo schema richiede progettazione e test rigorosi. - Il limite giornaliero per le esecuzioni Apex asincrone (`Batch`, `Queueable`, `@Future`) è condiviso in tutta l'organizzazione (in genere 250.000 o un calcolo basato sulle licenze utente). Un caricamento di dati in blocco di 20.000 record causerà l'esecuzione di un trigger in blocchi di 200, dando luogo a 100 chiamate di trigger separate, anche di più se la dimensione del batch in blocco è inferiore a 200 record. Se ogni chiamata inserisce in area di attesa un processo asincrono, è possibile che venga utilizzata una parte significativa del limite giornaliero di un singolo caricamento di dati. Questo consumo può potenzialmente ridurre alla fame altri processi aziendali critici di risorse asincrone. - I limiti del governor per l'inserimento in area di attesa dei processi sono drasticamente diversi a seconda del contesto. Da un trigger attivato da un'azione utente nell'interfaccia utente (una transazione _sincrona_) è possibile inserire in area di attesa fino a 50 processi. Tuttavia, da un trigger attivato all'interno del metodo `execute` di una classe Batch Apex — una transazione _asincrona_ — può essere inserito in area di attesa un solo processo. Non tenere conto di questa differenza è un punto di errore comune e critico, che causa errori di `LimitException` durante le grandi operazioni sui dati. - Chiamare Apex pianificabile (`System.schedule`) o Apex batch (`Database.executeBatch`) direttamente da un contesto trigger costituisce un anti-schema. Questi metodi non sono progettati per essere richiamati dal contesto del trigger. In questo modo si determinerà un rapido consumo dell'allocazione Apex asincrona, con conseguenti eccezioni limite. ### Scelta dello schema asincrono corretto Ogni meccanismo asincrono ha compromessi specifici in termini di prestazioni, limiti del governor e affidabilità. Utilizzare questo albero decisionale come guida per spostarsi tra queste opzioni e scegliere il meccanismo giusto per il proprio caso d'uso. Albero decisionale schema asincrono ### L'alternativa al lavoro pianificato Come indica il diagramma di flusso, quando ci si trova di fronte a operazioni DML a volume elevato ma non è possibile utilizzare Acquisizione dati di modifica (forse a causa dei limiti degli oggetti), la scelta architettonica migliore è spesso evitare completamente un processo invocato da trigger. Valutare invece la possibilità di utilizzare un processo pianificato. Può essere un flusso pianificato o Apex pianificato. I passaggi obbligatori sono: 1. Eseguire un aggiornamento semplice e a basso costo nel trigger sincrono. Ad esempio, impostare un campo `Status__c` su "elaborazione in sospeso" o inserire un record correlato a basso costo, ad esempio un post Chatter, per indicare che il record deve essere elaborato. 2. Creare un processo pianificato, un flusso pianificato o Apex pianificato, che viene eseguito periodicamente, ad esempio ogni 15 minuti o ogni ora. 3. Fare in modo che la query del processo pianificata per tutti i record nello stato In sospeso, eseguire la logica complessa in un contesto controllato a volume elevato e quindi aggiornare i record come elaborati. Questo schema separa completamente l'elaborazione pesante dal salvataggio sincrono dell'utente, non è soggetto al limite di un processo per transazione di un batch attivato da trigger e offre una soluzione altamente scalabile e governabile per i requisiti non in tempo reale. Se la latenza di un processo pianificato non è accettabile per i requisiti aziendali e si è ancora costretti a non utilizzare CDC o un trigger in attesa, ciò indica una significativa non corrispondenza architettonica. A questo punto occorre considerare diversi meccanismi. Rivalutando la progettazione dell'applicazione di base si possono trarre alcune conclusioni, ad esempio: - Acquisto del componente aggiuntivo per rimuovere i limiti degli oggetti CDC. - È fondamentale mettere in discussione il requisito aziendale di determinare se l'elaborazione quasi in tempo reale è davvero un "must-have" o se la latenza di un processo pianificato è un compromesso accettabile per la stabilità della piattaforma. ## Considerazioni non funzionali ### Complessità Il livello di complessità di un'implementazione fa parte del costo totale di proprietà di una soluzione, nonché della sua capacità di adattarsi alle mutevoli esigenze aziendali. La complessità può influire su qualsiasi implementazione se non vengono seguite le procedure consigliate. Nella sezione _Procedure consigliate correlate_ di questo documento sono riportati i consigli per ridurre la complessità della soluzione, inclusi questi schemi: - Schema ibrido: Apex invocabile per logica complessa nel flusso - Utilizzo di un framework di metadati per trigger Apex - Mega-flussi vs. Più flussi ### Processi e standard La documentazione è importante tanto quanto l'automazione stessa. Non solo garantisce la manutenibilità, ma è anche fondamentale per l'intelligenza artificiale e gli strumenti basati sugli agenti. La documentazione consente di comprendere e gestire i processi aziendali. **Nel flusso** - Stabilire una convenzione di denominazione coerente per tutti gli elementi e le variabili. - Utilizzare il campo Descrizione del flusso per spiegarne lo scopo generale, i criteri di attivazione e l'esito previsto. - Utilizzare il campo Descrizione per ogni singolo elemento (ad esempio, `Get Records`, `Action`, `Transform`). Questa procedura è il modo migliore per trasmettere l'intento. È particolarmente importante per le azioni invocabili e i sottoflussi, dove la descrizione è il punto principale per spiegare la complessa logica eseguita dall'azione. **In Apex** - Commentare chiaramente il codice per spiegare il _perché_ della logica, non solo il _cosa_. - Se si utilizza un framework basato sui metadati, assicurarsi che i record dei metadati includano e compilino un campo Descrizione in formato leggibile per spiegare le operazioni di ogni classe di handler e quando deve essere eseguita. DevOps e il controllo sorgente fanno parte di un ciclo di vita di sviluppo maturo. Utilizzare sempre uno strumento di controllo sorgente come Git per i progetti Salesforce. Sia le classi Apex che i flussi Salesforce sono metadati che definiscono la logica aziendale e devono essere modificati e gestiti. Nel contesto della gestione delle automazioni attivate da record, una pipeline DevOps moderna offre vantaggi essenziali. - **Controlli di qualità automatici:** Strumenti come [Salesforce Code Analyzer](https://developer.salesforce.com/docs/platform/salesforce-code-analyzer/overview) possono essere configurati per l'esecuzione automatica nelle opportunità in corso di realizzazione. L'analisi statica può rilevare schemi problematici in entrambi gli strumenti di automazione prima che vengano promossi, segnalando problemi come elementi di `Get Records` inefficienti all'interno di un loop di flusso o query di `SOQL` all'interno di un loop Apex per il loop, che sono cause comuni di deterioramento delle prestazioni. - **Prevenzione della regressione:** Man mano che la densità di automazione aumenta, la modifica a una classe Flusso o Apex può avere conseguenze indesiderate per altre automazioni sullo stesso oggetto. Una strategia di test DevOps efficace, in cui i test Apex automatici vengono eseguiti in base a qualsiasi modifica proposta, è il modo più affidabile per assicurarsi che una nuova versione del flusso non interrompa la logica Apex esistente (e viceversa). - **Collaborazione e visibilità:** Il controllo sorgente è la "singola fonte della verità". Consente ad amministratori e sviluppatori di lavorare sull'automazione per lo stesso oggetto in parallelo. Offre anche un itinerario di controllo prezioso: quando un processo di produzione si interrompe, è possibile vedere immediatamente _chi_ ha modificato l'automazione, _quando_ l'ha modificata e, tramite messaggi di conferma, _perché_ l'ha modificata. Per i team con un mix di amministratori e sviluppatori, [DevOps Center](https://help.salesforce.com/s/articleView?id=platform.devops_center_overview.htm&type=5) fornisce un'interfaccia unificata che aiuta a coreografare tutte queste fasi, rendendo un processo di sviluppo scalabile e basato sul controllo sorgente accessibile a tutti i membri del team. Questa disciplina combinata di documentazione e DevOps garantisce la salute e la manutenibilità a lungo termine dell'organizzazione, a vantaggio di ogni architetto e amministratore che vi segue. ## Procedure consigliate correlate La guida alle decisioni riportata sopra è consigliabile prima di pianificare l'implementazione. Ha lo scopo di aiutare l'utente a scegliere il prodotto migliore per i propri casi d'uso. Dopo la selezione del prodotto, è importante conoscere le procedure consigliate esistenti per l'implementazione. ### Sfruttare lo schema ibrido: Apex invocabile per logica complessa nel flusso Il principio _One Tool Per Object_ è fondamentale per la gestione dell'automazione ad alta densità, ma non lo si interpreta come una scelta binaria tra uno stack puramente dichiarativo o puramente programmatico. Un modello architetturale più efficace e manutenibile sfrutta un modello ibrido: posizionare il flusso attivato da record come livello di orchestrazione, incapsulando al contempo le operazioni di elevata complessità in Apex invocabile. Schema schema ibrido #### Il livello orchestrazione: Flusso Il flusso attivato da record funge da livello di orchestrazione per il processo aziendale. È titolare dei criteri di immissione e del contesto di esecuzione (_cosa_ e _quando_). Mantenendo la logica decisionale e l'instradamento all'interno di questo livello, la topologia dei processi dell'architettura rimane trasparente e gestibile tramite Explorer trigger di flusso, evitando che la logica aziendale critica venga oscurata nel codice. #### Il componente complesso: Apex invocabile Un esempio comune di componente complesso è l'implementazione dei calcoli del contratto sul livello di servizio (SLA) per i record Caso. Poiché l'oggetto BusinessHours e la relativa logica, essenziali per calcoli accurati che escludono le ore non lavorative e i giorni festivi, non sono accessibili in modo nativo in Flusso, viene utilizzata una classe Apex dedicata. Questa classe, spesso denominata `ServiceLevelAgreementCalculator`, è progettata con un unico metodo statico, annotato con `@InvocableMethod`, per calcolare l'orario di ufficio trascorso, determinare se il contratto sul livello di servizio è "Entro il target" o "Violato" e restituire un output strutturato. Questo approccio incapsula la complessa logica ad alte prestazioni di Apex consentendo al contempo di eseguirla e integrarla senza problemi nel livello di orchestrazione dichiarativa di un flusso attivato da record. Una volta definita, la classe di `ServiceLevelAgreementCalculator` Apex è disponibile per l'uso all'interno di un flusso attivato da record: Questo schema dimostra una rigorosa separazione delle preoccupazioni. Il livello dichiarativo viene utilizzato per gestire il ciclo di vita delle transazioni e l'orchestrazione, mentre il codice viene utilizzato per l'esecuzione di elevata complessità. Considerando il codice come un'utilità funzionale anziché come la base, bilanciamo prestazioni e manutenibilità. #### Vantaggi chiave con lo schema ibrido **Modularità**: La decisione si allontana dalla singolarità dell'utilizzo di Apex o Flusso per l'intero processo. L'architettura incapsula invece la logica complessa in unità discrete, sicure in blocco e testabili in modo indipendente. Queste unità funzionano come componenti riutilizzabili consumati dallo strato dichiarativo, garantendo le scale di automazione senza complicare la progettazione architettonica. **Riutilizzabilità**: La logica viene disaccoppiata dall'evento trigger. Un'unità di codice ben progettata (ad esempio un `InvocableMethod`) viene scritta una sola volta ma utilizzata in più punti di ingresso: Flussi attivati da record, flussi schermata o integrazioni esterne. Questo riutilizzo del codice elimina lo sviluppo ridondante. **Gestibilità**: La logica del flusso del processo rimane visibile e gestibile all'interno del flusso dichiarativo. Questa centralizzazione riduce drasticamente il sovraccarico di debug e garantisce che l'ordine di esecuzione del sistema sia deterministico e trasparente. #### Limitazioni e compromessi dello schema ibrido Sebbene il modello ibrido di utilizzo di Apex invocabile da Flusso sia potente, non è un approccio adatto a tutti. Gli architetti devono essere consapevoli delle limitazioni e dei compromessi specifici prima di impegnarsi in una soluzione ibrida. - **Nessun supporto prima del salvataggio**: Questa è la limitazione più importante. Le azioni invocabili sono disponibili solo nel contesto dopo il salvataggio (flussi per azioni e record correlati). Non possono essere utilizzati nel contesto prima del salvataggio ad alte prestazioni (flussi per aggiornamenti rapidi dei campi). Pertanto, questo schema non può essere utilizzato per delegare gli aggiornamenti di campo dello stesso record. Eseguire questo lavoro ad alte prestazioni utilizzando elementi Flusso nativi in un flusso before-save o all'interno di un trigger Apex before-context. - **Nessun supporto dopo l'annullamento dell'eliminazione:** Attualmente, il flusso attivato da record non supporta il contesto di annullamento dell'eliminazione. Se un oggetto Salesforce ha un requisito aziendale per eseguire l'automazione quando un record viene ripristinato dal Cestino, l'unica soluzione è un trigger Apex. - **Overhead delle prestazioni in scenari a volume elevato:** La transizione dal runtime del flusso al runtime Apex non è un'operazione a costo zero. Benché in genere sia veloce, l'esecuzione di un'azione invocabile dal runtime del flusso non è altrettanto veloce dal punto di vista computazionale dell'esecuzione nativa che rimane interamente all'interno di un trigger Apex. Per la maggior parte delle automazioni a media densità, questo micro-overhead è un compromesso trascurabile e utile per una maggiore accessibilità. Tuttavia, per gli scenari estremamente performanti e a volume elevato, un framework solo Apex puro avrà un vantaggio in termini di velocità di calcolo. ### Strategie per l'automazione legacy Mentre l'euristica della densità di automazione fornisce indicazioni definitive per la nuova architettura greenfield, la realtà degli ambienti Salesforce aziendali è spesso più sfumata. Nelle organizzazioni mature, è comune trovare flussi attivati da record e trigger Apex che operano sullo stesso oggetto Salesforce. Questo scenario è distinto dallo schema ibrido spiegato in precedenza: qui, i flussi e i trigger Apex non sono accoppiati né progettati per funzionare insieme. Questa coesistenza è spesso il risultato dell'evoluzione delle capacità della piattaforma o del debito tecnico legacy. Sebbene questo sia uno stato operativo tollerato, gli architetti devono trattarlo come un compromesso calcolato anziché come uno stato finale. L'orchestrazione frammentata causa un notevole sovraccarico di governance e manutenzione, rendendo le attività di sviluppo, test e gestione degli incidenti disgiunte e farraginose. Ciò determina un aumento del Time to Resolution (TTR) e della complessità operativa. - Per i nuovi oggetti Salesforce, attenersi al principio della densità di automazione come guida principale. - Per gli oggetti Salesforce esistenti con impronta ibrida e doppio trigger Apex e punti di ingresso del flusso attivati da record, valutare la densità e quindi eseguire l'architettura per il refactoring a uno stato ibrido manutenibile. - Per una bassa densità, rifattorizzare i trigger Apex in flussi attivati da record e specificare l'ordine di esecuzione, riportandoli a un unico punto di ingresso dell'automazione. - Per una densità media, rifattorizzare i flussi mega complessi in un sottoinsieme di flussi, con il giusto ordine di esecuzione. Introdurre trigger Apex solo quando è assolutamente necessario, ad esempio per supportare dopo l'annullamento dell'eliminazione del contesto. - Per una densità elevata, preferire l'implementazione dei trigger Apex. ### Utilizzo di un framework di metadati per trigger Apex Man mano che i processi aziendali di un'organizzazione sulla piattaforma Salesforce maturano, il volume e la complessità dell'automazione attivata da record aumentano inevitabilmente. Una procedura ottimale fondamentale è mantenere _un trigger Apex per oggetto Salesforce_. Questa regola è fondamentale perché la piattaforma non garantisce l'ordine di esecuzione di più trigger sullo stesso oggetto per lo stesso evento. Questa limitazione può causare comportamenti non deterministici, condizioni di gara e problemi di difficile risoluzione dei problemi. Tuttavia, l’adesione al principio _one trigger_ introduce una sfida architettonica: come gestire e orchestrare tutta la logica aziendale richiamata da quel singolo punto di ingresso in modo manutenibile e scalabile. #### Limitazioni degli handler trigger Classic La prima evoluzione di questa architettura è stato lo schema Classic Trigger Handler. In questo approccio, il singolo trigger Apex delega tutta la sua logica a una classe di handler corrispondente (ad esempio, `OpportunityTriggerHandler`). Questo metodo separa la logica dal file trigger e offre agli sviluppatori un controllo deterministico sull'ordine di esecuzione all'interno dei metodi della classe handler (ad esempio, `afterInsert()`). Sebbene sia un miglioramento, questo schema spesso porta a classi di handler monolitici. Con il passare del tempo, man mano che si aggiungono ulteriori requisiti aziendali, la classe diventa grande, difficile da gestire e difficile da testare isolatamente. L'ordine di esecuzione di tutti i singoli processi è codificato all'interno di un unico metodo, rendendo la classe soggetta a conflitti di unione, aumentando notevolmente il sovraccarico di governance e manutenzione in un ambiente aziendale di grandi dimensioni. #### Soluzione: Framework di trigger basato sui metadati Per risolvere i problemi principali della modularità e dell'orchestrazione, gli architetti passano a un **trigger framework basato** sui metadati. Si tratta di un salto architettonico significativo che separa la logica di automazione stessa dalla configurazione di _come_ e _quando_ viene eseguita. Questo framework si basa su tre vantaggi chiave: - **Partizionamento:** Anziché una singola classe di handler, la logica aziendale centrale è suddivisa in piccole classi Apex atomiche (ad esempio, una classe `RecalculateAccountValues` o una classe `NotifySalesLeads`), con ciascuna classe che aderisce al _principio responsabilità unica_. Questa modularità semplifica il test, il debug e la comprensione della logica separatamente. - **Ordine e coreografia:** L'ordine di esecuzione non è più codificato in Apex. È invece definito in modo dichiarativo dai record di configurazione, in genere memorizzati in un tipo di metadati personalizzato (ad esempio, `TriggerAction__mdt`). Ciò consente agli amministratori di riordinare, aggiungere o rimuovere le azioni di automazione semplicemente modificando un record di metadati, che non richiede una distribuzione o una modifica del codice. - **Funzionalità di bypass:** Il framework offre funzionalità di bypass granulari standardizzate. Ogni azione di automazione può essere configurata tramite il relativo record di metadati per essere disattivata globalmente o ignorata per utenti amministrativi specifici facendo riferimento a un'autorizzazione personalizzata. Il trigger Apex singolo per l'oggetto funge quindi solo da dispatcher dinamico. Non contiene alcuna logica aziendale, ma istanzia una classe di `MetadataTriggerHandler` centrale. Questo handler esegue query sui record di metadati personalizzati per determinare dinamicamente la sequenza di esecuzione e invocare le classi Apex atomiche corrette nell'ordine prescritto. L'automazione è unificata sotto un unico livello trasparente e controllabile. ### Deduplicazione di operazioni costose nella transazione Un vantaggio importante dell'utilizzo di Apex in un framework solido è la possibilità di gestire lo stato delle transazioni e ottimizzare le prestazioni eliminando il lavoro ridondante. Man mano che la logica si accumula, è comune che automazioni diverse all'interno dell'ordine di salvataggio eseguano in modo indipendente le stesse operazioni costose, consumando limiti del governor preziosi e aumentando il tempo di operazione DML. Il framework è progettato per affrontare questo problema con due strategie principali: - **Gestione condivisa dello stato:** Nell'ambito di una singola transazione Apex, le proprietà statiche e le variabili vengono utilizzate per memorizzare nella cache i dati. Ciò garantisce che un'operazione costosa, ad esempio una query `SOQL` per un'impostazione di configurazione, venga eseguita una sola volta, anche se la logica di automazione viene richiamata più volte in diversi record o fasi del trigger. Il consumo dei limiti delle transazioni è significativamente ridotto. - **Utilizzo della cache piattaforma:** Per andare oltre il semplice caching intra-transazioni, utilizzare la cache della piattaforma per evitare di eseguire query sull'intero database per determinati dati. Questa cache in memoria gestita è ideale per recuperare dati non primitivi, letti spesso nella codebase e immutabili nel corso di una transazione (ad esempio profili, ruoli, orari di ufficio). Utilizzando l'interfaccia `Cache.CacheBuilder`, il sistema controlla prima la cache ed esegue la query sul database solo se i dati non sono presenti, ottimizzando le prestazioni e la scalabilità. ### Utilizzo di Prima del salvataggio per gli aggiornamenti dello stesso record Utilizzare sempre un aggiornamento prima del salvataggio quando l'automazione deve solo modificare i valori dei campi del record che avvia la transazione. Questo vale sia per gli aggiornamenti di campo veloce nel flusso (che vengono eseguiti prima del salvataggio) che per la logica before-context nei trigger Apex (prima dell'inserimento, prima dell'aggiornamento). Questo schema è performante, indipendentemente dallo strumento utilizzato, perché evita una seconda operazione DML e un ciclo di salvataggio ricorsivo. Le modifiche vengono apportate al record in memoria _prima_ che venga confermato nel database e vengono salvate come parte della transazione originale. Viene eliminato il sovraccarico di un secondo salvataggio, che altrimenti eseguirebbe nuovamente l'intero ordine di salvataggio e attiverebbe nuovamente tutta l'automazione. ### Impedire la ricorsione incontrollata La ricorsione incontrollata è un'insidia comune nei trigger dopo l'aggiornamento, in cui la logica di un trigger esegue un aggiornamento DML che a sua volta provoca la riattivazione dello stesso trigger. Questo crea un loop infinito che alla fine termina con un'eccezione del limite governor. Mentre i flag booleani statici o le raccolte di ID record elaborati sono stati storicamente utilizzati per impedire tale ricorsione, uno schema più preciso e robusto è quello di bloccare la logica confrontando i valori dei campi tra la nuova e la vecchia versione del record stesso. Eseguire la logica solo se un campo specifico di interesse è stato effettivamente modificato. Ciò impedisce al trigger di eseguire la sua logica nelle operazioni DML successive all'interno della stessa transazione in cui i dati critici rimangono invariati. #### Controllo della ricorsione nel flusso attivato da record In un flusso attivato da record, impedire la ricorsione incontrollata impostando l'esecuzione del flusso solo quando il record viene aggiornato per soddisfare i requisiti della condizione: Controllo della ricorsione nel flusso attivato da record Se si sceglie di utilizzare una formula di criteri di immissione nel flusso, è possibile evitare la ricorsione in fuga confrontando la variabile globale `$Record` (che rappresenta i nuovi valori) con la variabile globale `$RecordPrior` (che rappresenta i valori originali prima del salvataggio). Ad esempio, per assicurarsi che un flusso venga eseguito solo se il campo Ammontare di un'opportunità è stato modificato, utilizzare questo criterio nei criteri di immissione: ``` $Record.Amount != $Record__Prior.Amount ``` #### Controllo della ricorsione in Apex Confrontare i valori dei campi della nuova versione del record, `Trigger.new`, con i valori dei campi della vecchia versione del record, `Trigger.oldMap`, per vedere se si è verificata la modifica specifica desiderata. Questo approccio garantisce che l'automazione sia idempotente e venga eseguita solo quando necessario, rendendo il sistema più efficiente e prevenendo loop ricorsivi catastrofici. ### Ignorare l'automazione Un'organizzazione Salesforce ben progettata richiede un meccanismo coerente e affidabile per ignorare l'automazione. Non si tratta di una funzione facoltativa, ma di un requisito operativo fondamentale per mantenere l'integrità dei dati e abilitare le operazioni amministrative. Un framework di bypass è essenziale per alcuni scenari: - Quando si caricano grandi volumi di dati, l'attivazione di trigger per ogni record può rallentare drasticamente il processo, causare eccezioni ai limiti e creare record e notifiche correlati errati. Un bypass consente di inserire i dati in modo pulito ed efficiente. - Un utente integrazione può avere la necessità di sincronizzare i dati di un sistema di record esterno. L'automazione che normalmente viene attivata per una modifica avviata dall'utente (ad esempio, l'invio di un messaggio email, la creazione di un'operazione) può essere indesiderata o ridondante quando la modifica ha origine da un altro sistema. - Gli amministratori o il personale di assistenza potrebbero dover eseguire aggiornamenti correttivi sui record. Un meccanismo di bypass consente di apportare queste modifiche senza attivare l'automazione aziendale standard, che potrebbe avere conseguenze indesiderate. **Autorizzazioni personalizzate**: Lo standard moderno e scalabile per l'implementazione della logica di bypass sono le autorizzazioni personalizzate. Questi sono superiori ai metodi precedenti per diversi motivi: - **Flessibilità:** Le autorizzazioni personalizzate possono essere assegnate agli utenti tramite gli insiemi di autorizzazioni. Questa procedura è in linea con il moderno modello di sicurezza e accesso di Salesforce, consentendo un'assegnazione granulare e flessibile. Un bypass può essere concesso a un utente specifico o anche temporaneamente con una data/ora di scadenza specifica. - **Gestibilità:** L'uso delle autorizzazioni personalizzate evita il codificaggio dei profili o degli utenti in una logica di automazione. Se il ruolo di un utente cambia o un nuovo profilo deve ignorare l'accesso, la modifica è una semplice assegnazione di insiemi di autorizzazioni, non una modifica del codice o del flusso che richiede una distribuzione. - **Scalabilità:** Le autorizzazioni personalizzate offrono un framework scalabile per la gestione delle eccezioni in una base di utenti complessa. Possono essere assegnati agli utenti tramite insiemi di autorizzazioni, gruppi di insiemi di autorizzazioni o profili. La loro associazione a un insieme di autorizzazioni o a un profilo è rappresentabile anche nei metadati di origine. **Modelli di implementazione**: Applicare uno schema di bypass coerente a tutte le automazioni attivate da record dell'organizzazione. **Ignorare un flusso attivato da record**: Il modo più efficiente per ignorare un flusso è impedirne l'esecuzione. A questo scopo, aggiungere una condizione ai criteri di immissione del flusso. - Nell'elemento iniziale del flusso attivato da record, impostare Requisiti della condizione su La formula valuta True. - Nel Generatore di formule, incorporare una verifica dell'autorizzazione personalizzata utilizzando la variabile globale `$Permission`. Combinare il controllo con i criteri di immissione esistenti. - Schema di formula: ``` ( ) && NOT($Permission.Bypass_This_Flow) ``` - Questo schema garantisce che il flusso venga eseguito solo se all'utente _non_ è assegnata l'autorizzazione personalizzata specificata. Questo controllo viene eseguito prima ancora di creare l'intervista del flusso, rendendolo l'approccio più efficace. **Ignorare un trigger framework Apex**: In Apex, integrare la logica di bypass direttamente nel framework di trigger basato sui metadati, consentendo un controllo granulare. - Il tipo di metadati personalizzato `TriggerAction__mdt` deve includere un campo di testo, ad esempio `BypassPermission__c`. - Nella classe `MetadataTriggerHandler`, prima di eseguire dinamicamente un'azione, il codice deve leggere il valore di questo campo. - Se il campo è compilato, l'handler utilizza il metodo `FeatureManagement.checkPermission()` per determinare se l'utente corrente in esecuzione dispone dell'autorizzazione personalizzata specificata. - Se `checkPermission()` restituisce true, l'handler salta quell'azione specifica e passa a quella successiva nella sequenza. - Questo schema è efficace perché consente sia un bypass globale (se tutti i record `TriggerAction__mdt` fanno riferimento alla stessa autorizzazione) che un bypass granulare per azione (se record diversi fanno riferimento a autorizzazioni diverse o se alcuni non dispongono di alcuna autorizzazione di bypass). ### Mega-flussi vs. Più flussi È un anti-schema per consolidare tutta l'automazione di un oggetto in un unico enorme flusso. Il consolidamento in un flusso anziché la suddivisione della logica in più flussi ben condizionati non ha un impatto significativo sulle prestazioni. I guadagni di prestazioni più significativi provengono da: - Utilizzo dei flussi before-save per gli aggiornamenti di campo dello stesso record. - Scrivere condizioni di immissione precise per garantire che i flussi siano esclusi dall'esecuzione per le modifiche che non influiscono sul loro caso d'uso specifico. [Flow Trigger Explorer](https://trailhead.salesforce.com/content/learn/modules/record-triggered-flows/meet-flow-trigger-explorer) consente di assegnare un valore ordine a ogni flusso di un oggetto, garantendo un ordine di esecuzione sequenziale. Explorer trigger di flusso ## Risorse
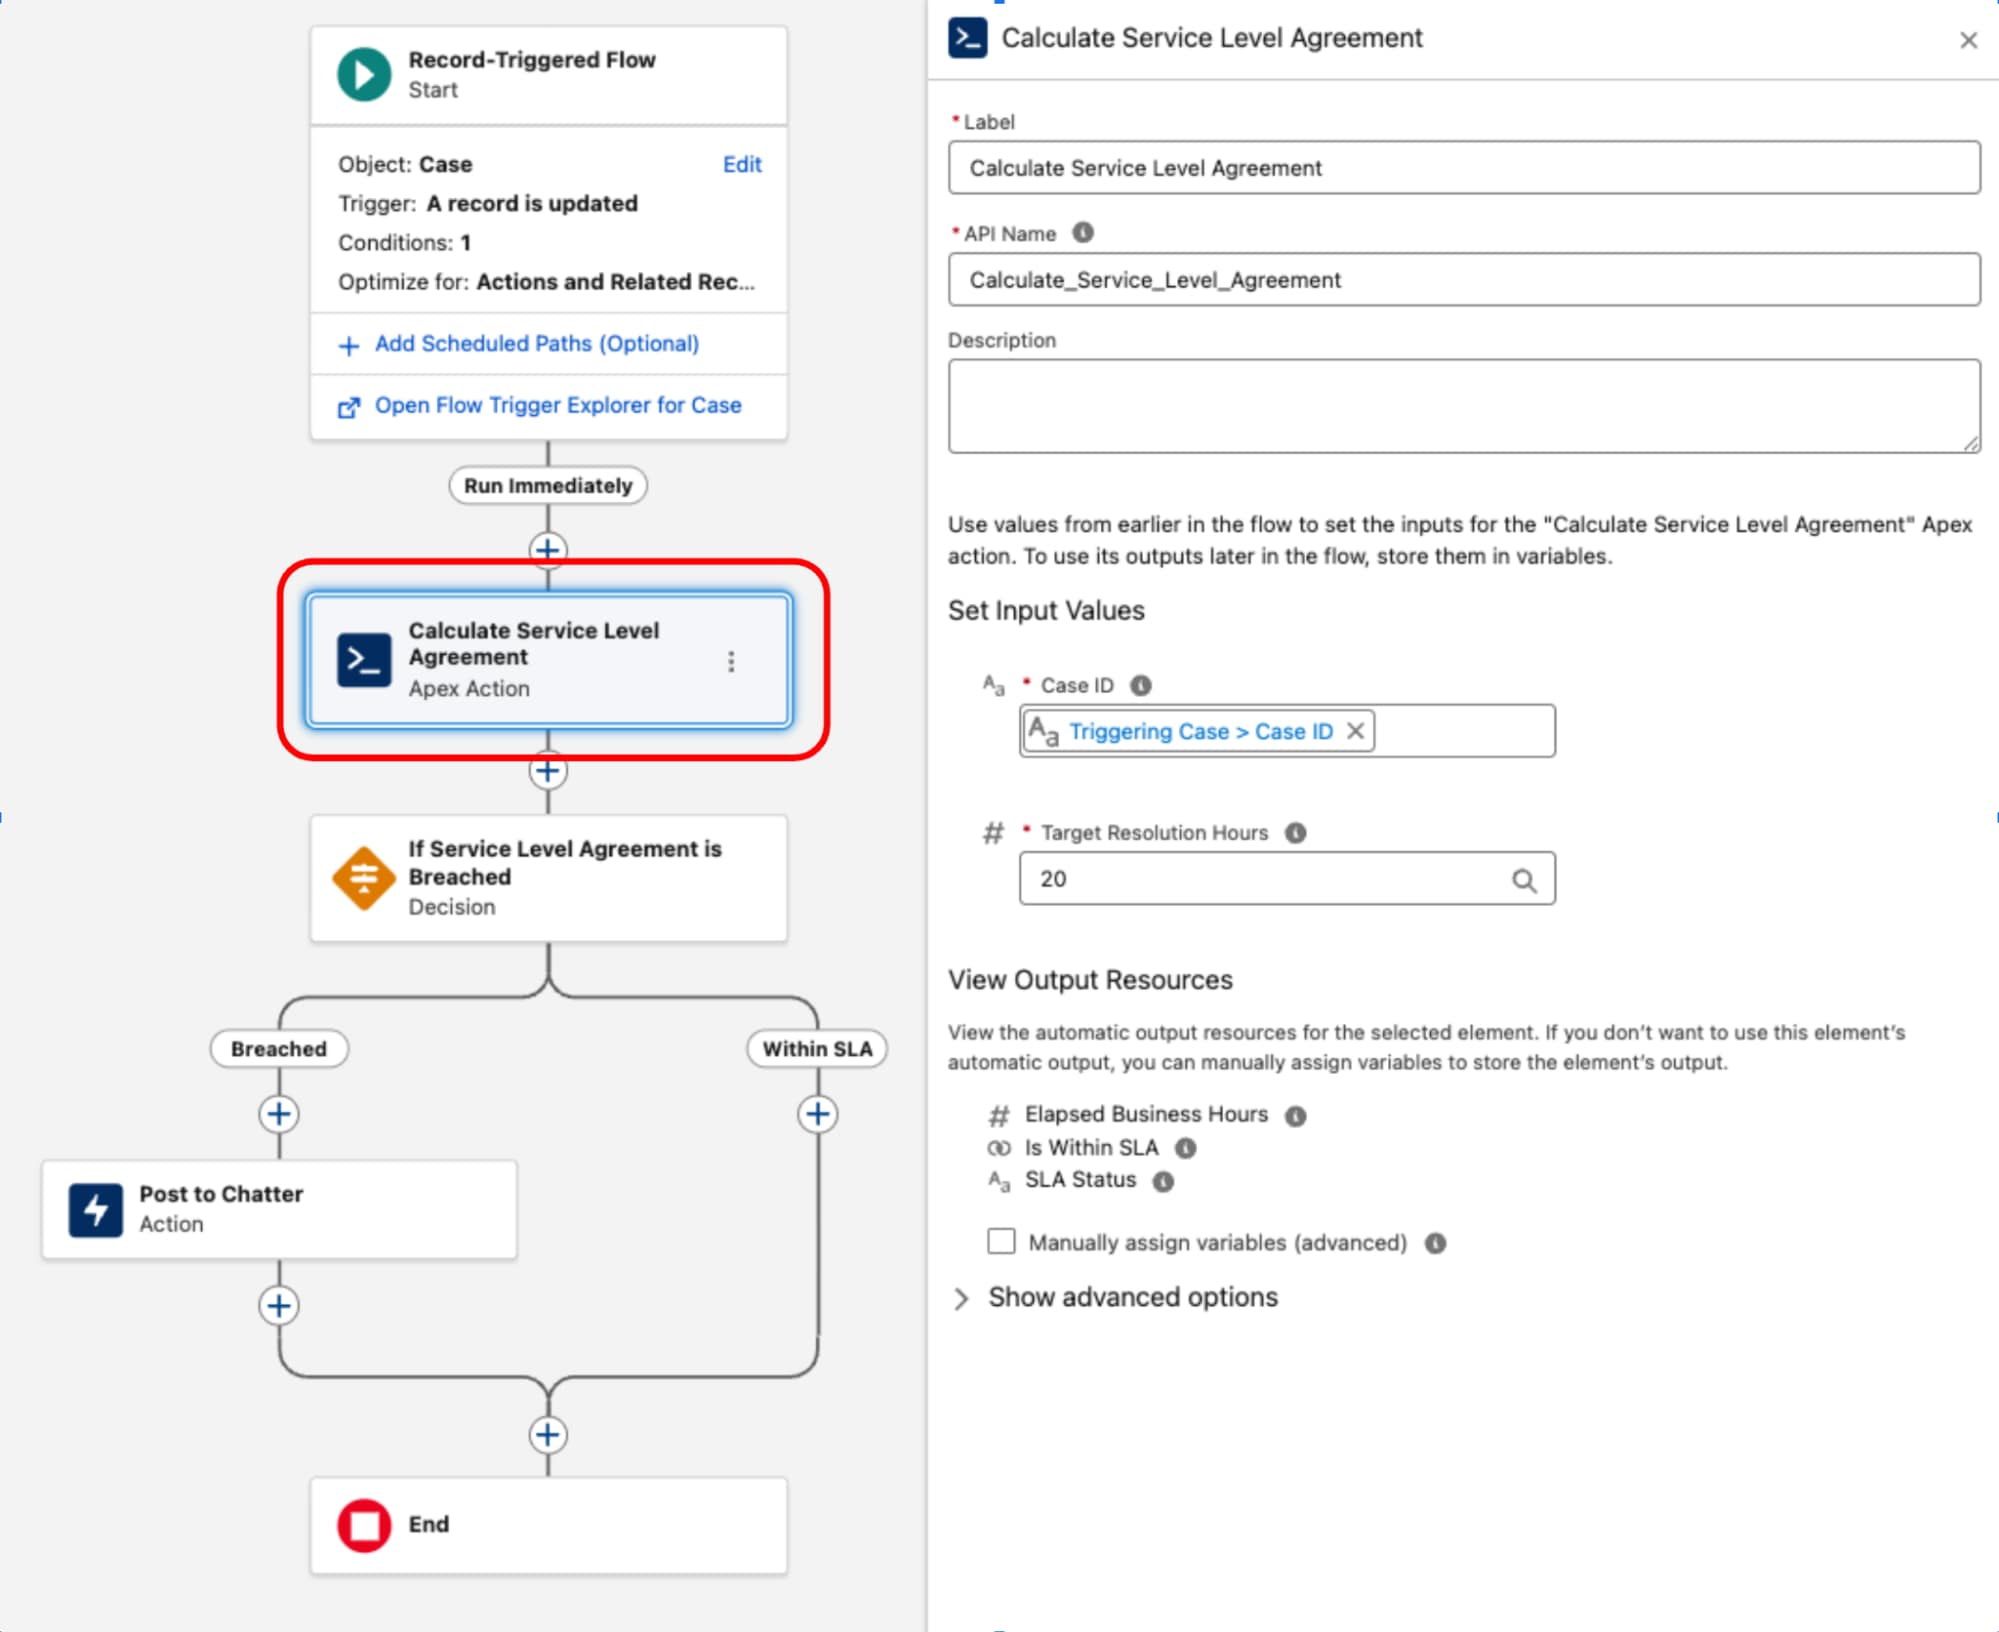
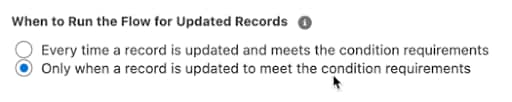
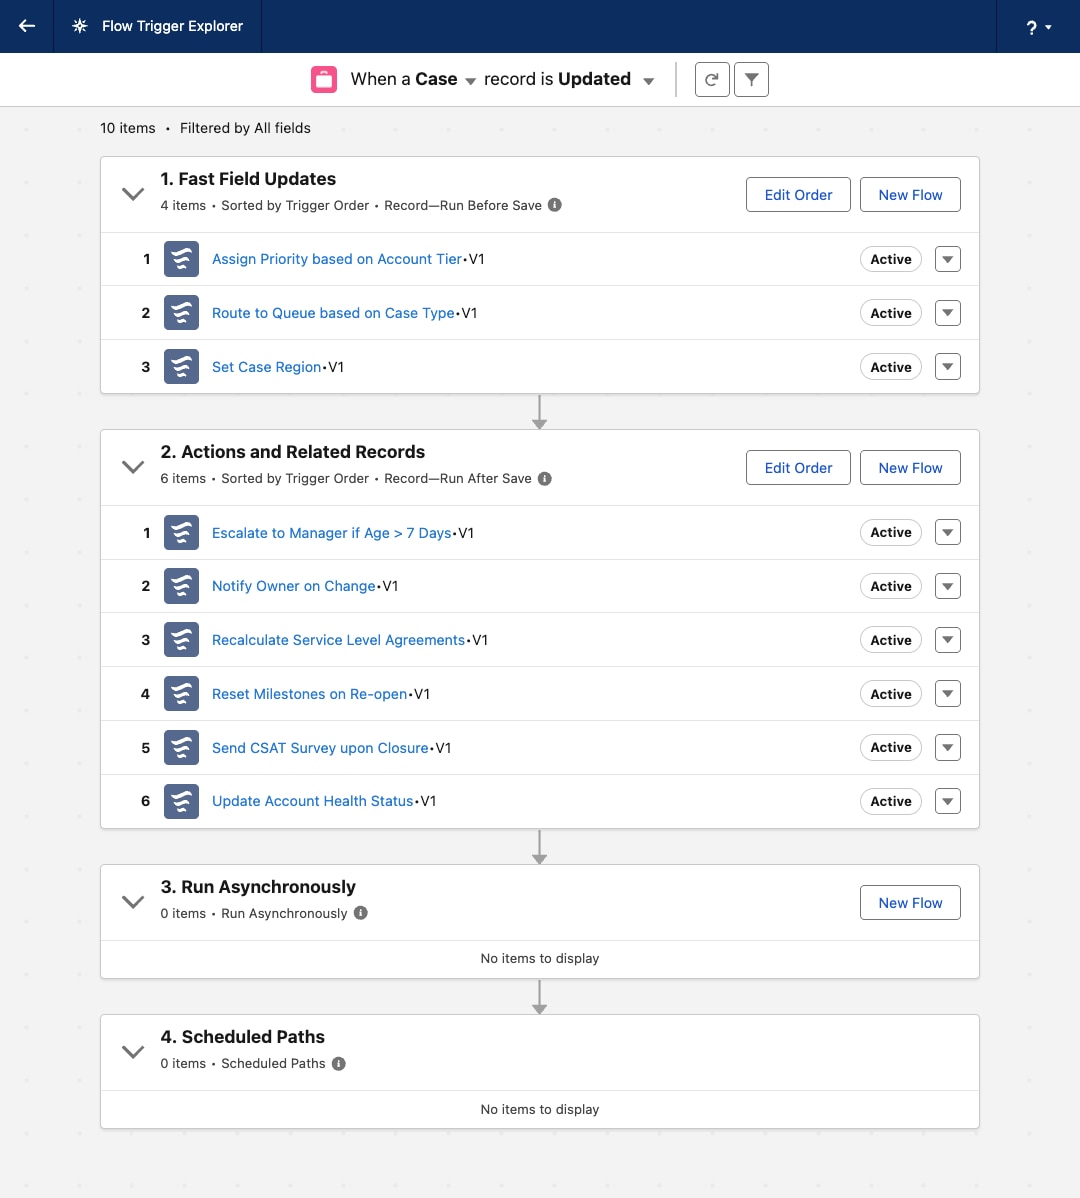
Apex Flusso Operazioni
## Panoramica della guida Si desidera creare moduli in Salesforce Platform? Sono disponibili più opzioni, che si estendono dall'intero low-code al continuum pro-code. I moduli dinamici nel Generatore di app Lightning e i flussi schermata in Flow Builder sono una rappresentazione low-code. A metà del continuum si trova la possibilità di estendere i flussi schermata con i componenti LWC e di creare moduli indirizzati ai clienti con OmniStudio. E a rappresentare pro-code è il framework LWC e la sua libreria in continua crescita di componenti di base. Le opzioni sono ottime, ma come determinare quale (o quale combinazione) è l'opzione giusta? È qui che entra in gioco questa guida. ## Punti salienti - **Takeaway #1: Quando si creano/modificano/visualizzano layout per le pagine Lightning, utilizzare i moduli dinamici.** Si può notare che i layout di pagina mancano nelle tabelle di confronto di questa guida. In futuro, il modo consigliato per configurare le pagine dei dettagli dei record è utilizzare i moduli dinamici nel Generatore di app Lightning. Vedere la sezione sui [layout di pagina](#layout-di-pagina) per ulteriori informazioni sul motivo per cui non prevediamo di migliorarli ulteriormente. - **Takeaway #2: Se è necessario creare un modulo di creazione o modifica per un solo oggetto, iniziare con le pagine Lightning e i moduli dinamici.** Questo è il modo più semplice per creare moduli nella piattaforma Salesforce. Fornisce anche alcune funzionalità aggiuntive, ad esempio la possibilità di controllare la visibilità dei campi. Se i requisiti sono più avanzati, continuare a leggere. Flusso schermata, OmniStudio o componenti Web Lightning (LWC) possono essere più adatti. - **Takeaway #3: Se si crea un modulo multipagina o una procedura guidata e non si hanno requisiti rigorosi per l'utilizzo dell'interfaccia utente o l'immagine aziendale, iniziare con un flusso schermata.** I flussi schermata offrono un framework di navigazione lineare per orchestrare più moduli insieme. È possibile utilizzare LWC per creare il proprio framework per spostarsi tra i moduli, ma si consiglia di lasciare che sia il Flusso a fare il lavoro più impegnativo, in modo da potersi concentrare sui moduli stessi anziché preoccuparsi dello [stato del modulo](/docs/architect/it-it/well-architected/guide/engaging#moduli). - **Takeaway #4: Se sono necessarie ulteriori azioni o logica _dietro il modulo_, utilizzare un flusso schermata, OmniStudio o LWC.** Tutti e tre gli strumenti offrono alla soluzione modi per fare di più che creare o modificare un singolo record. Quel "più" potrebbe essere una logica più avanzata, ad esempio la ramificazione o l'iterazione, o potrebbe essere più azioni come l'integrazione con sistemi esterni, l'invio di email o l'invio di notifiche push all'app mobile di un utente. - **Takeaway #5: Hai dei requisiti UX sofisticati? Hai bisogno di gestire dinamicamente più della visibilità? Utilizzare LWC o OmniScript.** Se i propri requisiti possono essere soddisfatti con semplici layout basati su temi e colonne, è possibile creare i moduli direttamente in un generatore low-code. Per un controllo più preciso sullo stile della tua forma, avrai bisogno della massima flessibilità di LWC. Se si è un cliente di Settori e si necessita di un'immagine aziendale perfetta o di dati gerarchici complessi, utilizzare OmniStudio, che consentirà di creare moduli di livello consumer in grado di gestire logiche aziendali complesse e trasformazioni dei dati. - **Takeaway #6: Se è necessaria l'automazione dei test, iniziare con i componenti Web Lightning.** È possibile scrivere test di unità per qualsiasi LWC, indipendentemente da dove si prevede di incorporarlo. Ciò consente di creare una strategia di test più efficace, che può includere test in blocco con più record e test negativi. [Vedere Salesforce Well-Architected - Testing Strategy](/docs/architect/it-it/well-architected/guide/resilient#strategia-di-test) per ulteriori informazioni sulla creazione di test che consentono di vedere in che misura i moduli saranno allineati ai requisiti funzionali e non funzionali. Tenere presente che la scelta non deve necessariamente essere una o l'altra: è possibile combinare la potenza di più opzioni. Ad esempio, se sono necessari sia il sistema di navigazione integrato di Flow che la completa flessibilità di stile offerta da LWC, utilizzarli insieme. ## Strumenti per la creazione di moduli con Salesforce La tabella seguente descrive gli strumenti disponibili per la creazione di moduli con Salesforce, insieme alle competenze richieste e alle considerazioni sulla licenza. Più avanti approfondiremo le funzioni specifiche supportate per ogni strumento, oltre a capire come scegliere tra strumenti basati su clic e strumenti basati su codice (e quando combinarli):
Competenze richieste Requisiti di licenza aggiuntivi
Moduli dinamici Codice basso No
Flusso schermata Codice basso No
OmniStudio Codice basso + Codice pro Richiede il pacchetto Settori
Flusso schermata + componenti Web Lightning Codice basso + Codice pro No
Componenti Web Lightning Codice professionale No
## Punti di decisione a colpo d'occhio La tabella seguente contiene una panoramica dei punti su cui riflettere quando si selezionano i prodotti, oltre alle domande che ci si dovrebbe porre su ciascuno di essi. Approfondiremo ciascuno di questi argomenti nel resto di questa guida.
Impatto oggetto Determinare se il modulo funzionerà su un singolo oggetto o se dovrà funzionare su più oggetti.
Ambito e navigazione del modulo Determinare se tutti i campi del modulo si adatteranno logicamente a un'unica schermata o se gli utenti devono essere in grado di spostarsi tra più schermate.
Posizione Identificare la posizione o le posizioni in cui si desidera incorporare il modulo, che può variare da un'app Salesforce a un'app mobile o persino a un sito Web esterno.
Controller Identificare le azioni o la logica da eseguire in background mentre gli utenti interagiscono con il modulo, incluse le trasformazioni dei dati e le integrazioni con sistemi esterni.
Convalida Determinare se sono presenti ulteriori requisiti di convalida degli input che vanno oltre la convalida a livello di sistema standard fornita da Salesforce.
Sicurezza Determinare se il modulo deve controllare l'accesso dell'utente prima di eseguire determinate operazioni, se si desidera controllare chi può accedere al modulo e se si desidera controllare dove può essere incorporato il modulo.
Progettazione di interazioni Identificare i tipi di interazioni o condizioni che devono attivare risposte dinamiche all'interno del modulo.
Stile Determinare il livello di sofisticazione per lo stile desiderato e CSS.
Layout Identificare i requisiti di layout del modulo in termini di numero richiesto di colonne, schede, fisarmoniche e capacità di visualizzare blocchi di dati ripetuti.
Traduzione Determinare se il modulo dovrà essere localizzato in altre lingue.
Automazione test interfaccia utente Determinare se i processi DevOps richiederanno che il modulo venga sottoposto a test di unità automatici o a test end-to-end automatici
Metriche Identificare i modi in cui si desidera tenere traccia dell'utilizzo del modulo, incluse le visualizzazioni pagina, la quantità di tempo trascorso sul modulo, le percentuali di completamento e le percentuali di successo
Imballaggio e distribuzione Determinare come distribuire o distribuire il modulo dopo che è stato creato.
Di seguito sono riportati i termini utilizzati nelle tabelle di confronto insieme alle relative definizioni: - **Disponibile:** Funziona bene con le considerazioni di base. - **Non ideale:** Può funzionare ma non è lo strumento ottimale. - **Roadmap:** Sostegno stimato entro i prossimi dodici mesi (giugno 2025). - **Futuro**: Stimata per il supporto oltre i prossimi dodici mesi. - **Non disponibile:** Non si prevede di supportare questa funzionalità nei prossimi dodici mesi. ## Tour dimostrativi per punti decisione Come promesso, iniziamo un'analisi approfondita di una varietà di punti di confronto e differenze funzionali tra moduli dinamici, flussi schermata, OmniStudio, flussi schermata con LWC incorporati e il framework LWC stesso. ### Impatto oggetto Se il modulo funziona con un singolo oggetto Salesforce, tutti gli strumenti che stiamo confrontando funzioneranno. Le cose si complicano leggermente con le forme oggetti incrociate o indipendenti dagli oggetti. Per indipendente dagli oggetti si intendono gli input che non vengono mappati ad alcun oggetto Salesforce. È possibile che il modulo rappresenti una struttura di dati che verrà inviata a un servizio esterno, ad esempio Stripe o DocuSign. Oppure si utilizzano diversi input nel modulo per calcolare un valore e quindi confermare quel valore nel database. #### Domande da porre: - Contro quali oggetti opererà il modulo? - È solo un oggetto o ci sono più oggetti? - Si lavora con oggetti specifici (ad esempio Account, Referente, Opportunità, Lead e Caso) o il modulo dovrà funzionare anche con altri oggetti?
Oggetto singolo Oggetto incrociato Oggetto Agnostico
Moduli dinamici Disponibile Disponibile Non disponibile
Flusso schermata Disponibile Disponibile Disponibile
OmniStudio Disponibile Disponibile Disponibile
Flusso schermata + LWC Disponibile Disponibile Disponibile
LWC Disponibile Disponibile Disponibile
Sia per i moduli oggetti incrociati che per quelli indipendenti dagli oggetti, Flusso e OmniStudio sono entrambe opzioni solide. Poiché i componenti disponibili nelle schermate dei flussi non sono di natura agnostica, è possibile scegliere cosa fare con i dati in background. Ad esempio, utilizzare i dati immessi in un modulo per creare più record in background, oppure utilizzarli per eseguire altre azioni come generare post Chatter, inviare messaggi Slack, inviare email o connettersi a servizi esterni. Per i casi semplici, l'uso di componenti LWC esistenti, ad esempio Lightning-record-form, può essere un modo semplice per ridurre il codice necessario per fornire una soluzione efficace. Tuttavia, per gli scenari in cui sono coinvolti più oggetti, Flusso offre un controllo completo per tutti gli oggetti ed elimina la necessità per gli sviluppatori di attraversare relazioni e dipendenze complesse. OmniStudio fa un ulteriore passo avanti ed è completamente indipendente dagli oggetti: separa il modulo visualizzato da un utente dal modello di dati sottostante. OmniStudio manipola invece il JSON sottostante che viene mappato agli oggetti Salesforce (o ai dati esterni) utilizzando strumenti come [Data Mapper](https://help.salesforce.com/s/articleView?id=sf.os_dataraptors.htm&type=5) e [Procedure di integrazione](https://help.salesforce.com/s/articleView?id=sf.os_omnistudio_integration_procedures_48334.htm&type=5). Data Mapper e Procedure di integrazione sono due componenti chiave per la connessione dei moduli OmniStudio con i dati interni ed esterni a Salesforce. Utilizzando gli elementi di trascinamento della selezione, è possibile utilizzare dati gerarchici complessi in un sistema esterno e quindi trasformare i dati in base alle proprie esigenze a seconda di dove devono andare a finire i dati. Consentono anche di utilizzare le formule per eseguire operazioni matematiche e logiche su matrici o elenchi di dati, come Apex. [Integrazioni OmniStudioIntegrazioni _OmniStudio_](/docs/architect/it-it/reference-diagrams/guide/omnistudio-integrations) ### Ambito e navigazione del modulo Se è possibile ottenere tutti gli input utente da un modulo a schermata singola, iniziare con i moduli dinamici. Tuttavia, sebbene i moduli dinamici nelle pagine dei record possano utilizzare la funzione Percorso per rappresentare in modo poco chiaro le varie fasi del processo aziendale, è possibile che non si adatti alla maggior parte dei casi d'uso. #### Domande da porre: - È necessaria una schermata singola o l'utente dovrà spostarsi tra più schermate per completare un'operazione? - Si desidera che gli utenti visualizzino una rappresentazione visiva dello stato di avanzamento della compilazione del modulo? - Agli utenti verrà richiesto di compilare le informazioni su ogni schermata in un ordine specifico o di spostarsi avanti e indietro tra le schermate in base alle esigenze?
Schermata singola Modulo multischermo Indicatori di avanzamento Navigazione saltata tra fasi / schermate
Moduli dinamici Disponibile Non disponibile Disponibile Non disponibile
Flusso schermata Disponibile Disponibile Disponibile Non disponibile
OmniStudio Disponibile Disponibile Disponibile Disponibile
Flusso schermata + LWC Disponibile Disponibile Disponibile Disponibile
LWC Disponibile Non ideale Non ideale Non ideale
Se sono necessarie più funzionalità rispetto a quelle offerte dai moduli dinamici, la scelta tra Flusso, OmniStudio e LWC dipenderà anche da alcune altre domande: - Quali competenze ha il team? Per un'organizzazione più complessa per gli amministratori, si consiglia di iniziare con Flusso. Se si dispone di soluzioni per i settori, il team ha già familiarità con OmniStudio e il progetto ha requisiti UX rigorosi, iniziare con OmniStudio. - È possibile visualizzare una barra di navigazione in fondo al modulo? Se il flusso schermata e l'esperienza di navigazione OmniScript non sono desiderati, propendere per LWC. - Cosa deve accadere dietro il modulo? Se è necessario che il comportamento sia configurabile da un amministratore, creare un flusso o, per le modifiche di base come la modifica delle etichette dei campi, un OmniScript. In caso contrario, per relazioni complesse tra più oggetti creare un OmniScript o LWC. - Se si sceglie Flusso o OmniStudio, può essere necessario creare comunque un LWC per ottenere l'interfaccia utente corretta. Se si sta già creando un componente LWC per definire correttamente lo stile del modulo, valutare se [incorporare quel componente in un flusso](https://developer.salesforce.com/docs/platform/lwc/guide/use-flow-embed-component.html) è eccessivo. Se invece la soluzione si presenta come una procedura guidata, in cui l'utente naviga tra più schermate, considerare Flusso o OmniStudio. I flussi e OmniStudio sono dotati di un modello di navigazione integrato, quindi non è necessario creare e gestire componenti LWC collegati tra loro. La navigazione è lineare, con azioni di spostamento in avanti, azioni di spostamento all'indietro e un meccanismo per salvare il modulo per un secondo momento. È anche possibile creare un modulo con navigazione non lineare se adatto alle proprie esigenze. Per un ottimo esempio di utilizzo dei flussi schermata, consultare il pacchetto [Digital Store Audit](https://appexchange.salesforce.com/appxListingDetail?listingId=a0N3A00000FMkOtUAL) di Salesforce Labs. OmniStudio offre un vantaggio di navigazione chiave fornendo indicatori di avanzamento dalla navigazione standard che evidenziano "passaggi" nel modulo. Questa visualizzazione fase visualizza automaticamente la posizione di un utente in un determinato modulo a più fasi. A differenza di Flusso, consente agli utenti di "saltare" tra le schermate facendo clic su varie fasi del modulo. Indipendentemente dal fatto che si creino moduli a schermata singola o multischermo, assicurarsi che i moduli siano [snelliti](/docs/architect/it-it/well-architected/guide/engaging#moduli) in modo che siano facili da navigare per gli utenti. ### Posizione Se si incorpora un modulo in una pagina di record Lightning standard, tutti gli strumenti che stiamo confrontando funzioneranno, con l'avvertenza che i moduli dinamici sono attualmente disponibili solo su desktop. Tuttavia, se si desidera offrire un'esperienza che consenta agli utenti di accedere ai moduli da altre posizioni, potrebbe essere necessario considerare opzioni alternative. #### Domande da porre: - Gli utenti avranno bisogno di accedere al modulo tramite desktop, dispositivo mobile o entrambi? - Gli utenti devono essere in grado di accedere al modulo da qualsiasi punto dell'app tramite una barra delle utilità? - Si desidera utilizzare le azioni per consentire agli utenti di compilare il modulo senza dover uscire dalla pagina in cui si trovano attualmente? - Il modulo deve essere disponibile su un sito Web esterno?
Pagina record Lightning Pagina iniziale o pagina dell'app Lightning Siti Experience Cloud Aura Siti Experience Cloud LWR Snap incorporati Barra delle utilità Azione specifica dell'oggetto Azione globale App mobile Salesforce** Field Service Mobile Mobile SDK App e siti esterni LWC personalizzato
Moduli dinamici Disponibile Non disponibile Non disponibile Non disponibile Non disponibile Non disponibile Non disponibile Non disponibile Disponibile Non disponibile Non disponibile Non disponibile Non disponibile
Flusso schermata Disponibile Disponibile Disponibile Disponibile Disponibile Disponibile Disponibile Roadmap Disponibile Disponibile*** Non disponibile Roadmap Disponibile
OmniStudio Disponibile Disponibile Disponibile Non disponibile Non disponibile Disponibile Non disponibile Non disponibile Disponibile Non disponibile Non disponibile Disponibile Disponibile
Flusso schermata + LWC Disponibile Disponibile Disponibile Disponibile Disponibile Disponibile Disponibile Roadmap Disponibile Non disponibile Non disponibile Non ideale Disponibile
LWC Disponibile Disponibile Disponibile Disponibile Disponibile Disponibile Roadmap Roadmap Disponibile Roadmap Roadmap Disponibile Disponibile
*I flussi possono essere incorporati nei siti Experience Cloud LWR, ma è necessario tenere presenti alcune considerazioni.
**I flussi e i componenti LWC sono supportati nell'app mobile Salesforce, ma l'app mobile Salesforce non supporta tutti i modi in cui è possibile incorporare flussi e componenti LWC. Ad esempio, le azioni specifiche degli oggetti sono supportate nell'app mobile, ma le voci della barra delle utilità non lo sono.
***L'app mobile Field Service non supporta molte delle funzionalità più recenti del flusso poiché è progettata a partire da un Motore di flusso e Runtime flusso schermata precedenti e presenta modifiche speciali per il funzionamento offline.
Poiché richiedono contesto record, i moduli dinamici sono supportati solo nelle pagine di record Lightning. Tuttavia, i moduli dinamici non sono supportati nelle pagine Experience Cloud. Questa limitazione è attiva perché Experience Cloud non utilizza il framework sottostante da cui dipendono i moduli dinamici: Pagine Lightning. Questo aspetto viene valutato in base alle richieste di moduli dinamici in Experience Cloud. È possibile creare flussi che richiedono un contesto record o flussi che funzionano a livello globale. Pertanto, è possibile incorporare i flussi in una varietà di posizioni. Per i flussi contestuali di record, che possono essere una pagina di record Lightning, una pagina di record Experience Cloud, un'azione specifica di un oggetto o una distribuzione Azioni e Consigli. Per il flusso globale, ad esempio la barra delle utilità, altre pagine Lightning o Generatore di esperienze, uno Snap o un'applicazione esterna. I flussi non sono attualmente supportati come azioni globali, ma come soluzione è possibile racchiudere il flusso in un componente Aura. OmniStudio consente di creare FlexCard e OmniScript componibili che possono essere posizionati praticamente ovunque sia possibile inserire un flusso. Tuttavia, sebbene siano componibili, non sono inseribili in pacchetti. LWC supporta un elevato grado di riutilizzo, poiché si creano componenti che possono essere associati ai target tramite metadati in Salesforce, nelle comunità e persino nei progetti open source. I componenti LWC possono anche essere incorporati all'interno del proprio sito Web tramite [Lightning Out](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lightning_out). [Lightning Out sui siti esterni_Lightning Out sui siti esterni_](/docs/architect/it-it/reference-diagrams/guide/lightning-out-on-external-sites) I componenti Web Lightning non sono attualmente supportati come azioni (specifiche degli oggetti o globali), ma come soluzione si può racchiudere un componente LWC in un componente Aura (in modo molto simile ai flussi). I componenti LWC possono anche lanciare flussi con il componente [Lightning-flow](https://developer.salesforce.com/docs/component-library/bundle/lightning-flow/documentation). OmniStudio eccelle nell'esposizione dei contenuti ai siti esterni tramite la funzione OmniOut. Con OmniStudio e OmniOut è possibile compilare i moduli OmniScript e i componenti FlexCard in componenti standard ed eseguirli fuori piattaforma in siti o app di terze parti. Nessuna delle tecnologie dei moduli trattate in questa guida è oggi ufficialmente supportata nei modelli Mobile SDK. Se Mobile SDK è essenziale per il proprio caso d'uso, è meglio creare il modulo in modo nativo nell'applicazione mobile o creare una pagina Visualforce, pur tenendo presente la guida al [fattore di forma](/docs/architect/it-it/well-architected/guide/engaging#fattore-di-forma) ben progettato di Salesforce. **Nota sulla roadmap:** Il team Mobile SDK sta lavorando attivamente al supporto dei componenti LWC all'interno delle pagine Visualforce. ### Controller I moduli dinamici sono perfetti se è necessario utilizzare i valori del modulo per creare o aggiornare un record. Per qualsiasi funzionalità oltre a questa, è necessario utilizzare Flusso, OmniStudio o LWC. Queste funzionalità possono includere un livello di decisione o iterazione o la generazione di post o email Slack utilizzando gli input del modulo. #### Domande da porre: - Quali azioni o logica si desidera eseguire dietro le quinte? - Il modello di dati contiene dati gerarchici? - Il modulo dovrà completare le operazioni all'interno di una singola transazione o in più transazioni? - È necessario integrarsi con sistemi esterni? - Quali sono i requisiti di riutilizzabilità e modularità?
Registro & azioni Gestione gerarchica dei dati Operazione con una sola transazione Operazione su più transazioni Integrazione Design modulare e riutilizzo Pacchetti
Moduli dinamici Non disponibile Non disponibile Non disponibile Non disponibile Non disponibile Non disponibile Disponibile
Flusso schermata Disponibile Roadmap Disponibile Disponibile Disponibile Disponibile Disponibile
OmniStudio Disponibile Disponibile Disponibile Disponibile Disponibile Disponibile Non disponibile
Flusso schermata + LWC Disponibile Disponibile Disponibile Disponibile Disponibile Disponibile Disponibile
LWC Disponibile Disponibile Disponibile Disponibile Disponibile Disponibile Disponibile
Il flusso offre azioni standard per la pubblicazione in Slack, l'invio di email e l'interazione con i documenti Quip, quindi non è necessario scrivere codice per queste operazioni. LWC offre interazioni complete con singoli record e oggetti correlati tramite l'uso di adattatori di fili che interagiscono con l'[API interfaccia utente](https://developer.salesforce.com/docs/atlas.en-us.uiapi.meta/uiapi/ui_api_get_started.htm). LWC può anche interagire con più record quando si utilizza il wire per [getListInfoByName](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/reference_get_list_info_by_name.html). [Interazione LWC tramite adattatori per cavi_Interazione dei componenti Web Lightning tramite adattatori per cavi_](/docs/architect/it-it/reference-diagrams/guide/lightning-web-components-interaction-via-wire-adapters) Come accennato in precedenza, OmniStudio utilizza Procedure di integrazione e Data Mapper per acquisire e trasformare facilmente i dati esterni e interni a Salesforce. Brilla nell'appiattimento e nell'espansione delle serie di dati con vari livelli di relazioni grazie a numerose funzioni senza codice che è possibile utilizzare. **Nota sulla roadmap:** Il flusso supporterà presto la possibilità di up-inserire raccolte di record e di gestire i dati gerarchici. Flusso, OmniStudio e LWC si integrano tutti con Apex, quindi è possibile chiudere facilmente eventuali lacune in qualsiasi soluzione si scelga. Ad esempio, se è necessario filtrare i record da un LWC è sempre possibile utilizzare l'adattatore per fili per Apex per creare query SOQL complesse. Se si è influenzati dalla storia basata sui clic, considerare Flusso o OmniStudio come valide alternative a un controller Apex per le esigenze lato server. Una domanda secondaria è se si desidera confermare immediatamente le azioni o rinviarle a una particolare parte del modulo. Questo è particolarmente rilevante se si utilizza un modulo multipagina. Il flusso consente di combinare facilmente gli input di più moduli (schermate del flusso) e di utilizzarli molto più avanti nella procedura guidata (flusso) per eseguire alcune operazioni. Si consiglia infatti di progettare i flussi proprio in questo modo (eseguire le azioni alla fine) nel caso in cui l'utente salti avanti e indietro tra le schermate, modificando le risposte. #### Controllo delle operazioni Le transazioni e i [limiti del governor](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_gov_limits.htm) sono uno stile di vita in Salesforce Platform. Se il caso d'uso è abbastanza semplice, potrebbe non essere altrettanto importante controllare in quale transazione si verifica una determinata operazione. Tuttavia, esistono alcuni casi d'uso in cui è possibile combinare più operazioni in un'unica [transazione](/docs/architect/it-it/fundamentals/guide/architecture-basics#transazioni) anziché eseguirle in più transazioni. Alcuni esempi: - **Per ritirare o non ritirare**: Questa è la domanda. Si supponga che il modulo crei più record in background. Se non viene creato il terzo record, è necessario ritirarne i primi due? Se ogni azione è indipendente l'una dall'altra, è possibile eseguirla in transazioni separate. Tuttavia, se sono dipendenti e si desidera che l'errore di uno esegua anche il ritiro degli altri, implementarli in un'unica transazione. Se il modulo è in Flusso, è possibile utilizzare l'elemento Rollback in un percorso di errore per ritirare la transazione e garantire l'integrità dei dati. - **Impatto a valle sui limiti del governor**: Soprattutto quando il modulo crea o aggiorna un record, tenere presenti le implicazioni a valle di tale operazione. Quali processi, regole di flusso di lavoro, trigger di flusso, trigger Apex o altri elementi dell'ordine di salvataggio verranno attivati in base a questa modifica del record? E in che modo queste modifiche collettive influiscono sui limiti del governor consumati in quella transazione? Se una particolare modifica del record comporterebbe numerose modifiche a valle che influiscono sui limiti, valutare se è opportuno isolare la modifica del record nella propria transazione. - **Elaborazione batch**: Anche nel contesto di un'interfaccia utente, può essere necessario raggruppare in batch più aggiornamenti. Si supponga che il modulo multischermo esegua l'iterazione su un gruppo di record di grandi dimensioni. Anziché confermare un aggiornamento di record dopo ogni schermata, attendere di aver raccolto gli aggiornamenti per tutti i record e quindi inviare una richiesta per aggiornare tutti i record. Quando si utilizzano i moduli dinamici per creare o modificare un record, si esegue sempre una sola operazione, che è sempre l'inizio di una nuova transazione. Quando si crea un flusso schermata, si ha un controllo significativo su ciò che accade in una determinata transazione. Le schermate e le azioni locali fungono da confini tra le transazioni. Di seguito è riportato un riepilogo generale della gestione delle transazioni nell'architettura del flusso schermata. 1. L'utente finale interagisce con una schermata e quindi fa clic su **Avanti**. 2. Il client invia una richiesta all'API con gli input. 3. L'API riceve la richiesta e viene aperta una transazione e una connessione al database. L'API chiama quindi il motore di flusso per invocare la richiesta. 4. Il motore di flusso prende il sopravvento e segue il percorso appropriato nella definizione del flusso, fino a quando non colpisce un nodo Schermata o Azione locale. Il motore restituisce quindi le informazioni su quel nodo all'API. 5. L'API crea un oggetto risposta che contiene i dettagli della schermata successiva da visualizzare e restituisce l'oggetto al client. A questo punto vengono confermate le modifiche al database (avvio dell'[esecuzione dell'ordine](/docs/architect/it-it/fundamentals/guide/architecture-basics#manipolazione-del-database) di salvataggio) e la connessione al database e la transazione vengono chiuse. 6. Il client utilizza la risposta API per visualizzare la schermata successiva con cui l'utente può interagire. 7. Ripetere il passaggio 1. In altre parole, le schermate "interrompono" le transazioni. In questo caso, vengono confermate tutte le azioni in sospeso o DML, la transazione precedente viene chiusa e viene avviata una nuova transazione.
flusso multischermo La progettazione corretta, ovvero le operazioni raggruppate in una determinata transazione, è la chiamata. Vediamo alcuni esempi.
flusso schermata con transazioni separate
A sinistra è visibile un flusso che raccoglie gli input in più schermate ed esegue diverse azioni in un'unica transazione.
Il flusso a destra esegue ogni operazione in una transazione separata.
Il team Flusso ha recentemente introdotto un nuovo elemento: L'elemento Ritira record consente di ritirare un'intera transazione se una singola operazione non riesce in una serie di operazioni del database.
Flusso schermata con più record di creazione

Si supponga di avere un flusso che crea record, aggiorna record e quindi crea altri record, come illustrato nel flusso successivo a destra.
In questo scenario, se i primi due elementi hanno esito positivo e l'ultimo ha esito negativo, le prime due operazioni DML continueranno a creare e aggiornare tali record, mentre il terzo non lo farà.
Flusso schermata con rollback
Utilizzando l'elemento Ritira record, è possibile assicurarsi che l'intera transazione venga ritirata se tutte e tre le operazioni devono avvenire in tandem, come illustrato nel flusso finale a sinistra. Per ulteriori informazioni, vedere [Flussi nelle transazioni](https://help.salesforce.com/articleView?id=flow_concepts_transaction.htm) e [Bulkificazione dei flussi](https://help.salesforce.com/articleView?id=flow_concepts_bulkification.htm). Anche la sezione Automatica di Salesforce Well-Architected approfondisce questo aspetto in [Gestione dei dati](/docs/architect/it-it/well-architected/guide/automated#gestione-dei-dati). La possibilità di controllare la transazione da un LWC si riduce ai servizi sottostanti utilizzati da LWC per eseguire le proprie operazioni. Se si utilizza il componente Lightning-record-form base, l'operazione sottostante (creazione o aggiornamento del record) avviene in una transazione indipendente non appena viene inviato il modulo. In generale, valgono le seguenti regole: - Ogni chiamata API dell'interfaccia utente è isolata nella propria transazione. - Se è necessario eseguire più operazioni all'interno di una singola transazione, inviare gli input a una tecnologia lato server, ad esempio un controller Apex o un flusso. Si applicano le normali regole di transazione per quella tecnologia. #### Integrazioni esterne Flusso, OmniStudio e LWC supportano tutti gli eventi piattaforma (per l'[architettura basata sugli eventi](/docs/architect/it-it/decision-guides/guide/event-driven)) e le integrazioni API. Oltre all'Apex Code personalizzato, sia Flow che OmniStudio supportano meccanismi dichiarativi per integrare un'API. Se è necessario connettersi a un'API MuleSoft o a un bot RPA, utilizzare i Servizi MuleSoft. Questo genera un servizio esterno. [Integrazioni esterne tramite MuleSoft_Integrazioni esterne tramite API MuleSoft e bot RPA_](/docs/architect/it-it/reference-diagrams/guide/external-integrations-via-mulesoft-apis-and-rpa-bots) Se l'API ha uno schema OpenAPI, creare un servizio esterno. Integrazioni esterne tramite OpenAPIIntegrazioni esterne alle API con schemi OpenAPI [\_\_](/docs/architect/it-it/reference-diagrams/guide/external-integrations-to-apis-with-openapi-schemas) In caso contrario, utilizzare la funzione Chiamata HTTP nel flusso o Azione HTTP in OmniStudio. La chiamata HTTP del flusso è basata su Servizi esterni. Integrazioni esterne tramite HTTPIntegrazioni esterne tramite HTTP [\_\_](/docs/architect/it-it/reference-diagrams/guide/external-integrations-via-http) OmniStudio dispone di una serie completa di funzionalità di integrazione che possono effettuare chiamate a sistemi esterni con le procedure di integrazione e trasformare i dati con Data Mapper. (Per ulteriori informazioni, vedere [Impatto sugli oggetti](#impatto-oggetto)) Indipendentemente dal fatto che venga implementata con Apex personalizzato o un servizio esterno, una chiamata è una chiamata. Ecco cosa devi sapere. 1. Una chiamata può richiedere molto tempo. 2. Quando una chiamata viene eseguita in modo sincrono, viene eseguita mentre è aperta una transazione del database. 3. Salesforce non consente di mantenere aperta una transazione del database se sono presenti operazioni del database in sospeso. La limitazione principale da tenere presente è il pericolo delle cosiddette **_transazioni sporche_**, in cui si esegue un'operazione di creazione, aggiornamento o eliminazione e quindi, nella stessa transazione, si esegue una chiamata. Questo schema non è consentito a causa della considerazione #3 di cui sopra, che ovviamente esiste a causa delle considerazioni #1 e #2. In Flusso, è possibile aggirare questa limitazione interrompendo la transazione. Ricordare che sia le schermate che le azioni locali reintroducono il contesto del browser, interrompendo la transazione. Sebbene sia possibile utilizzare schermate e azioni locali quando si utilizzano chiamate esterne, si consiglia di abilitare Controllo transazione nelle impostazioni avanzate invocabili. Controllo transazione è una funzione delle azioni invocabili che consente di terminare automaticamente la transazione prima di effettuare una chiamata. È possibile abilitare il controllo delle transazioni selezionando Avvia sempre una nuova transazione nella sezione Avanzate di un'azione invocata. Integrazioni esterne tramite callout L'impatto delle chiamate sulla transazione è meno complicato con LWC. In generale, le operazioni sui dati verranno eseguite utilizzando Lightning Data Service (LDS) e quindi un controller Apex per effettuare la chiamata esterna. Questo design protegge dalle transazioni sporche, poiché la chiamata LDS è isolata in una transazione separata dalla chiamata Apex. _Per una guida più approfondita sulle chiamate Apex, i servizi esterni e le funzionalità di integrazione dei dati in generale, vedere la [Architect's Guide to Data Integration with Salesforce](/docs/architect/it-it/decision-guides/guide/data-integration)._ #### Riutilizzabilità e modularità I moduli dinamici non supportano il riutilizzo. Ogni modulo dinamico è collegato a una pagina di record Lightning specifica per un oggetto specifico (anche se è possibile assegnare la pagina di record Lightning a più app, profili e così via). Così come è possibile scrivere librerie, utilità e componenti destinati a essere utilizzati in più altri componenti, è possibile applicare schemi di progettazione simili quando si creano flussi con la potenza dei **_sottoflussi_**. Salvare i flussi in bucket più piccoli e modulari e quindi chiamarli da altri flussi utilizzando l'elemento Sottoflusso. Se la progettazione lo richiede, è possibile creare un flusso che sia indipendente che utile come sottoflusso di un altro flusso. OmniStudio è per sua natura progettato per la modularità. Mappatori di dati, OmniScript, FlexCard e Procedure di integrazione sono tutti creati in modo indipendente e possono funzionare in modo intercambiabile. Inoltre, le FlexCard possono essere create come componenti LWC che possono essere incorporati in altri LWC, OmniScript, pagine di record e siti Experience Cloud. Flussi schermata, OmniScript e LWC possono essere tutti creati per essere riutilizzati e incorporati in una varietà di posizioni, inclusi siti esterni e applicazioni Lightning Out. Quando si progettano le soluzioni in modo che siano [componibili](/docs/architect/it-it/well-architected/guide/composable) si ottengono ulteriori vantaggi come l'adattabilità e la stabilità. ### Convalida Tutte le tecnologie utilizzate per creare o aggiornare un record sono conformi alla convalida a livello di sistema, sia che si tratti di regole di convalida classiche o di convalida personalizzate incorporate in un trigger Apex. Indipendentemente dalla tecnologia utilizzata per eseguire una modifica del record, ogni modifica passa attraverso l'ordine di salvataggio. Ciò significa che, oltre alle regole di convalida, la modifica del record viene elaborata da un numero qualsiasi di flussi prima o dopo il salvataggio, prima o dopo trigger, regole di inoltro al livello superiore, regole di assegnazione e altro ancora. Se non l'avete già fatto, assicuratevi di inserire nei preferiti e di acquisire familiarità con l'[ordine di esecuzione](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_triggers_order_of_execution.htm) Apex. #### Domande da porre: - Il modulo ha ulteriori requisiti oltre alla convalida a livello di sistema? - Sarà necessario impostare i campi in modo che siano obbligatori o di sola lettura in modo dinamico all'interno del modulo?
Rispettare la convalida a livello di sistema Convalida a livello di campo personalizzata specifica di questo modulo Convalida a livello di campo personalizzata
Moduli dinamici Disponibile Non disponibile Non disponibile
Flusso schermata Disponibile Non disponibile Roadmap
OmniStudio Disponibile Disponibile Disponibile
Flusso schermata + LWC Disponibile Disponibile Disponibile
LWC Disponibile Disponibile Disponibile
Gli input in una schermata del flusso o in una fase OmniScript non sono per loro natura vincolati, quindi il modulo stesso non aderisce in modo nativo alla convalida a livello di sistema associata a un particolare oggetto. I valori utilizzati per creare o aggiornare i record, tuttavia, vengono elaborati dall'ordine di salvataggio, ovvero passano attraverso la convalida a livello di sistema dell'oggetto. Tenere presente, tuttavia, che non tutti i componenti del flusso schermata supportano la convalida degli input. A partire dal rilascio Summer '24, i componenti schermata rimanenti che non supportano la convalida degli input sono Pulsanti di opzione, Elenco di selezione, Elenco di selezione a selezione multipla, Gruppo caselle di controllo e Ricerca scelte. Proprio come i layout di pagina, i moduli dinamici consentono di impostare l'obbligatorietà e lo stato di sola lettura a livello di pagina. Tuttavia, non è possibile ignorare le impostazioni a livello di sistema. Il flusso offre flessibilità per personalizzare la convalida sugli input di un modulo. Benché vengano eseguiti alcuni controlli nel client (ad esempio, la segnalazione di campi obbligatori mancanti o valori incompatibili), nessuna convalida lato client impedisce all'utente di provare a navigare. La vera convalida avviene sul server. Quando un utente fa clic su **Avanti**, Flusso invia gli input al server per la convalida. Se uno degli input viene restituito come non valido, la navigazione viene bloccata e viene visualizzato l'errore appropriato. Il server convalida gli input controllando: 1. L'impostazione della obbligatorietà dell'input o se il valore immesso è compatibile con il tipo di dati sottostante. 2. Convalida personalizzata per quell'input: Diversi componenti standard (casella di controllo, valuta, data, data/ora, area di testo lungo, numero, password e testo) supportano la convalida personalizzata per schermata. Fornire un'espressione di formula booleana e un messaggio di errore da visualizzare quando l'espressione di formula non viene soddisfatta. 3. Convalida personalizzata del componente sottostante: Se si sta creando un LWC personalizzato per un flusso, aggiungere il proprio codice di convalida al metodo validate(). OmniStudio offre una gestione completa degli errori e della convalida tramite l'azione [Imposta errore](https://help.salesforce.com/s/articleView?id=sf.os_set_errors_in_an_omniscript.htm&type=5) in combinazione con [Visualizzazioni condizionali](https://help.salesforce.com/s/articleView?id=sf.os_conditionally_display_elements_using_the_conditional_view_property.htm&type=5) e il componente [Messaggistica](https://help.salesforce.com/s/articleView?id=sf.os_display_messages_in_omniscripts_19551.htm&type=5). Sul lato LWC, la maggior parte dei componenti di base esegue le proprie convalide lato client. Ad esempio, Lightning-record-form rispetta l'obbligatorietà a livello di sistema, ma non l'obbligatorietà a livello di pagina. Per i componenti personalizzati, è possibile Build Your Own meccanismi di convalida. I campi che richiedono l'inserimento di dati da parte degli utenti devono essere visualizzati nelle prime fasi dei moduli. Ove possibile, convalidare gli input degli utenti sul lato client prima di inviare i moduli. Per ulteriori procedure consigliate per semplificare i moduli, vedere la guida [ai moduli](/docs/architect/it-it/well-architected/guide/engaging#moduli) in Salesforce Well-Architected - Engaging. ### Sicurezza La sicurezza è un argomento complesso in generale, e quando si tratta di creare moduli, ci sono una serie di considerazioni che potresti non aver nemmeno pensato. A livello di base, assicurarsi che il modulo venga eseguito nel contesto corretto e che gli utenti dispongano delle autorizzazioni necessarie per utilizzare i dati sottostanti. Ma oltre a ciò, è anche possibile adottare misure aggiuntive per eliminare codice o URL potenzialmente dannosi dai campi di testo RTF, impedire a determinati utenti di accedere al modulo o porre limitazioni ai tipi di posizioni in cui gli amministratori possono potenzialmente incorporare il modulo in futuro. Assicurarsi di documentare accuratamente i requisiti di sicurezza prima di scegliere uno strumento. Il [modello Policy sulla](/docs/architect/it-it/resources/guide/security-policy-template) sicurezza ben architettata di Salesforce contiene le linee guida per questo tipo di documentazione. #### Domande da porre: - Il modulo deve controllare l'accesso dell'utente prima di eseguire determinate operazioni? - È necessario disinfettare gli input degli utenti? - Si desidera controllare chi può accedere al modulo? - Si desidera controllare dove può essere incorporato il modulo?
Elevazione delle autorizzazioni utente Controllo degli utenti autorizzati Limitazione delle posizioni consentite
Moduli dinamici Non disponibile Disponibile Non disponibile
Flusso schermata Disponibile Disponibile Non disponibile
OmniStudio Non disponibile Disponibile Non disponibile**
Flusso schermata + LWC Disponibile Disponibile Non disponibile
LWC Disponibile* Disponibile Disponibile
* Richiede Apex
**Anche se gli OmniScript non possono avere un insieme specificato di posizioni di destinazione, le FlexCard possono averlo.
#### Elevazione delle autorizzazioni utente Quando qualcosa viene eseguito nel **_contesto dell'utente_**, Salesforce impone una serie di controlli dell'accesso, tra cui la verifica della protezione a livello di campo, delle autorizzazioni CRUD e dell'accesso ai record in base alle regole di condivisione dell'organizzazione. Quindi, ad esempio, gli utenti potrebbero eseguire un modulo di aggiornamento caso solo se hanno la possibilità di aggiornare i casi, la protezione a livello di campo appropriata e l'accesso al record in questione. Ma se si desidera che gli utenti siano in grado di eseguire una determinata operazione quando utilizzano _il_ modulo, ma non tramite qualsiasi altro modulo o interazione? Qui entra in gioco il **_contesto di sistema_**. Il contesto di sistema è un modo per elevare le autorizzazioni dell'utente in esecuzione per la durata della sessione, in modo che l'utente non debba, ad esempio, aggiornare l'accesso all'oggetto Caso per completare correttamente il modulo di aggiornamento del caso. Questo è particolarmente utile per le comunità non autenticate. Anziché concedere agli utenti guest competenze potenzialmente pericolose, impostare il modulo in modo che venga eseguito nel contesto di sistema. Naturalmente, il contesto di sistema è un'arma a doppio taglio e si dovrebbe utilizzarlo solo quando necessario. Quando un modulo viene eseguito nel contesto di sistema, ogni singola operazione CRUD ignora la protezione e la condivisione a livello di oggetto e di campo, non solo l'operazione specifica che interessa. Si noti inoltre che il contesto di sistema non influisce su chi Salesforce considera l'attore, ovvero il nome visualizzato nel campo Ultima modifica di. Per ogni operazione eseguita dal modulo, ad esempio l'aggiornamento del caso, l'attore è l'utente in esecuzione anche se il modulo viene eseguito in un contesto diverso. I moduli dinamici, gli OmniScript e i componenti LWC vengono sempre eseguiti nel contesto dell'utente e non è possibile ignorare questo comportamento. I flussi schermata vengono eseguiti nel contesto dell'utente per impostazione predefinita, ma è possibile impostarli in modo che vengano eseguiti nel contesto di sistema. È l'utente a scegliere se il flusso deve concedere l'accesso a tutti i dati o se deve comunque imporre l'accesso a livello di record come la condivisione. - Se si incorpora un componente Lightning in un flusso eseguito nel contesto di sistema, il flusso non sostituisce il contesto del componente. Se è necessario ignorare i controlli dell'accesso degli utenti, si consiglia di utilizzare il flusso per eseguire tali operazioni e trasmettere i dati appropriati al componente Lightning o al suo esterno. Alcuni componenti pronti all'uso (ad esempio Ricerca) non possono funzionare nel contesto di sistema. - Se il flusso chiama azioni Apex, è necessario individuare altre differenze. Se la classe Apex è impostata sulla condivisione ereditata, viene eseguita nel contesto di sistema con la condivisione indipendentemente dall'impostazione del flusso. Se la classe non ha una dichiarazione di condivisione esplicita, viene eseguita nel contesto di sistema senza condivisione indipendentemente da quale sia l'impostazione del flusso. Se la classe è impostata su con condivisione o senza condivisione, lo fa e ignora il contesto del flusso. **Query per i record nel contesto di sistema con i siti Experience Cloud:** Se si esegue un flusso nel contesto di sistema in un sito Experience Cloud, **soprattutto non autenticato**, si consiglia di memorizzare solo campi specifici negli elementi Ottieni record. Quando si utilizza Flusso e si passano i risultati di un elemento Ottieni record in un sottoflusso, in un'azione invocabile o in un componente Lightning, tutti i campi di quell'oggetto possono essere esaminati tramite gli strumenti per sviluppatori del browser. Ciò potrebbe rendere disponibili i campi agli utenti del sito Experience Cloud che potrebbero non essere intenzionati. Specificando campi specifici negli elementi Ottieni record, è possibile assicurarsi che vengano visualizzati solo i campi corretti anche con il contesto di sistema abilitato. Si noti che la logica OmniScript viene eseguita sul lato client, il che consente agli aggressori di modificare l'esecuzione prevista di un OmniScript _e_ di visualizzare le risposte alle procedure di integrazione, ai data mapper e alle chiamate al metodo Apex utilizzando gli strumenti per sviluppatori del browser. Quando si utilizza OmniScript, si consiglia di eseguire la logica aziendale sul lato server quando possibile e di implementare regole di convalida degli input su qualsiasi metodo Apex esposto tramite un'[annotazione @InvocableMethod](https://help.salesforce.com/s/articleView?id=sf.os_integration_procedure_invocation_55721.htm&type=5). **Input sanificanti:** Per proteggere l'organizzazione dai malintenzionati, considerare anche la disinfettazione degli input. Si supponga di avere un input in un modulo accessibile pubblicamente che potrebbe essere mappato a un campo di testo RTF nell'organizzazione. Si consiglia di considerare un'automazione che elimini qualsiasi codice HTML che potrebbe nascondere URL dannosi. In generale, non è consigliabile implementare questa sanificazione a livello di modulo, poiché è possibile che un numero qualsiasi di fonti scriva in questi campi. Si consiglia di creare un flusso di aggiornamento rapido dei campi (prima del salvataggio) o di utilizzare un trigger Apex esistente sull'oggetto per eliminare o modificare il potenziale HTML che potrebbe essere immesso nel modulo. **_Best practice:_** - _Lasciare che i flussi vengano eseguiti nel loro contesto predefinito a meno che non sia necessario elevare l'accesso dell'utente in esecuzione per un'operazione specifica._ - _Evitare di eseguire flussi nel contesto di sistema per gli utenti guest per motivi di sicurezza. Creare invece insiemi di autorizzazioni con accesso limitato ai campi assegnati al profilo utente guest del sito Experience Cloud._ - _Quando si eseguono query sui record nei flussi di sistema eseguiti dal contesto nei siti Experience Cloud, memorizzare solo i campi necessari nell'elemento Ottieni record o nelle azioni invocabili._ - _Se un flusso esegue varie operazioni e non tutte richiedono un accesso elevato, utilizzare i sottoflussi per isolare le operazioni che devono essere eseguite nel contesto di sistema._ - _Se si prevede di incorporare un modulo in una pagina Web esterna, valutare la possibilità di disinfettare gli input degli utenti per rimuovere l'HTML utilizzando un flusso di aggiornamento rapido dei campi o un trigger Apex se alla fine verranno mappati a campi di testo RTF per prevenire potenziali attacchi di phishing da parte di malintenzionati._ #### Note aggiuntive: - OmniScript, FlexCard e LWC vengono eseguiti nel contesto dell'utente per impostazione predefinita. - I componenti LWC vengono eseguiti nel contesto dell'utente per impostazione predefinita e i flussi nel contesto dell'utente, ma è possibile ignorarli in un controller Apex. - Le operazioni eseguite tramite l'API dell'interfaccia utente vengono eseguite nel contesto dell'utente. - Le operazioni eseguite tramite un controller Apex dipendono da quella classe. Per eseguire queste operazioni in modalità di sistema, impostare la classe Apex su con condivisione o senza condivisione. #### Controllo dell'accesso Se è necessario controllare chi può accedere al modulo, è spesso possibile esaminare il contenitore in cui è incorporato il modulo. Ad esempio, è possibile assegnare pagine Lightning in modo che siano disponibili per applicazioni, tipi di record o profili specifici. Se alcuni input del modulo sono sensibili, utilizzare le regole di visibilità per controllare ulteriormente cosa viene visualizzato a chi; questa funzione si applica sia ai moduli dinamici che ai flussi schermata. È possibile [limitare un flusso](https://help.salesforce.com/articleView?id=flow_distribute_security.htm) a particolari profili o insiemi di autorizzazioni, esattamente come si può fare con una classe Apex o una pagina Visualforce. Per impostazione predefinita, i flussi non sono soggetti a restrizioni, il che significa che tutti gli utenti con l'autorizzazione utente Esegui flussi possono eseguirli. Se si utilizza OmniStudio, è possibile configurare un [controllo autorizzazioni classe Apex](https://help.salesforce.com/s/articleView?id=sf.os_add_an_apex_class_permissions_checker_1.htm&type=5) per assicurarsi che gli utenti richiedano un accesso esplicito alla classe Apex che amministra l'azione remota chiamata da un'API OmniScript, FlexCard, Classic Card o REST. - Nota I controlli delle autorizzazioni delle classi Apex sono abilitati per impostazione predefinita per gli script appena creati. Tuttavia, devono essere abilitati manualmente per tutti gli script esistenti - Tenere presente inoltre che i controlli delle autorizzazioni delle classi Apex si applicano solo alle classi Apex. Si consiglia di impostare le autorizzazioni a livello di profilo anche per [Procedure di integrazione e Data Mappers](https://help.salesforce.com/s/articleView?id=sf.os_security_for_dataraptors_and_integration_procedures_48147.htm&type=5). Per ulteriori dettagli e procedure consigliate sulle autorizzazioni utente guest, vedere: - [Procedure consigliate per l'accesso record utente guest](https://www.learnexperiencecloud.com/s/article/Guest-User-Record-Access-Development-Best-Practices#Pattern6) - [Sviluppo di siti sicuri: Utenti autenticati e guest](https://developer.salesforce.com/docs/atlas.en-us.communities_dev.meta/communities_dev/communities_dev_security_authenticated_and_guest_users.htm) **_Best practice:_** - _Se si espone un flusso agli utenti guest, concedere al profilo utente guest l'accesso solo ai flussi di cui ha bisogno. Sebbene sia possibile aggiungere Esegui flussi al profilo utente guest, riteniamo che sia una procedura rischiosa._ - _Prestare particolare attenzione ai flussi che operano nel contesto di sistema. Si consiglia vivamente di limitare tali flussi a un determinato gruppo di utenti, poiché dispongono di meno controlli e bilanciamenti per proteggere i dati._ - _Assicurarsi che qualsiasi OmniScript che esegue Apex in una comunità di utenti guest abbia "con condivisione" nella definizione della classe Apex._ - _Nel profilo Utente guest, assegnare solo le classi Apex che si desidera vengano chiamate dagli utenti guest, altrimenti si rischia di esporre involontariamente ulteriore logica aziendale agli utenti guest._ Per i componenti LWC, è possibile controllare le assegnazioni delle autorizzazioni dell'utente in esecuzione per verificare se dispone di una determinata autorizzazione standard o personalizzata. Direttamente da JavaScript, è possibile importare le autorizzazioni Salesforce dai moduli con ambito @salesforce/userPermission e @salesforce/customPermission. Oppure si può utilizzare Apex per controllare lo stesso. #### Controllo incorporamento I componenti Web Lightning sono disponibili in una determinata posizione solo quando sono stati aggiunti come [destinazione](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.reference_configuration_tags) valida. Ad esempio, è possibile rendere un componente disponibile nelle pagine dei record e non come elemento della barra delle utilità. Una volta attivato, un flusso schermata è disponibile in tutte le posizioni in cui sono supportati i flussi schermata, indipendentemente dal fatto che sia disponibile ovunque. Detto questo, Flow Builder supporta più tipi di flussi con schermate. Il tipo pane e burro è Flusso schermata, ma esistono altri tipi specializzati limitati a posizioni specifiche. Ad esempio, l'app mobile Field Service supporta solo i flussi Field Service Mobile. Lo stesso vale per i flussi di richiesta di contatto, supportati solo in Experience Cloud. Indipendentemente dal tipo di flusso, la persona che crea il flusso non ha alcun controllo sulla posizione in cui il flusso può essere incorporato. Il flusso sarà disponibile in tutte le posizioni supportate per quel tipo di flusso. Se si utilizza Salesforce Industries, viene visualizzato un piccolo avvertimento quando si tratta di OmniScript: Benché non sia possibile specificare una destinazione per un OmniScript, è possibile specificarne una per le FlexCard che si desidera incorporarvi. ### Progettazione di interazioni Le forme statiche appartengono al passato. Oggi, si tratta di aggiornare dinamicamente il modulo con le proprietà e i valori giusti per questo utente, questa volta, questo posto. Parliamo di ciò che è possibile fare in questo senso per gli strumenti di creazione di moduli di Salesforce. #### Domande da porre: - Quali tipi di interazioni o condizioni devono attivare risposte dinamiche all'interno del modulo? - Sarà necessario eseguire operazioni fuori campo in background durante la compilazione del modulo? - Sarà necessario impostare i campi come visibili, obbligatori, di sola lettura o disabilitati o modificare la formattazione in base agli input del modulo?
Esecuzione di operazioni sui dati fuori schermo Valori condizionali e calcoli Visibilità condizionale Requisito condizionale Formattazione condizionale Stato di sola lettura condizionale Stato disabilitato condizionale
Moduli dinamici Non disponibile Non disponibile Disponibile Non disponibile Roadmap Non disponibile Non disponibile
Flusso schermata Disponibile Disponibile** Disponibile Disponibile* Non disponibile Disponibile** Disponibile**
OmniStudio Disponibile Disponibile Disponibile Disponibile Disponibile Disponibile Disponibile
Flusso schermata + LWC Disponibile Disponibile Disponibile Disponibile Disponibile Disponibile Disponibile
LWC Disponibile Disponibile Disponibile Disponibile Disponibile Disponibile Disponibile
*Limitato ai componenti che utilizzano un selettore di risorse e non una casella di controllo statica
** Beta limitata
L'interattività dei flussi schermata è ora una realtà grazie alle schermate reattive. La reattività consente ai singoli componenti di una schermata del flusso di comunicare tra loro, rendendo i flussi schermata infinitamente più potenti. **Esegui operazioni sui dati fuori schermata:** I flussi schermata offrono un approccio dichiarativo per recuperare i dati nella stessa schermata tramite Azioni schermata. Le azioni schermata possono consentire di attivare flussi AutoLaunched su qualsiasi modifica della schermata o quando un utente fa clic su un componente Pulsante di azione. È quindi possibile mappare i risultati di questi flussi AutoLaunched alla stessa schermata, eliminando la necessità per gli utenti di passare a un'altra schermata. LWC offre una gamma completa di adattatori per cavi che consentono di accedere ai dati Salesforce per compilare dinamicamente i dati nei componenti del modulo e consente agli sviluppatori di aggiornare, eliminare e creare record tramite controller Apex. Componenti Web Lightning Operazioni sui dati fuori schermoComponenti Web Lightning Operazioni sui dati fuori schermo [\_\_](/docs/architect/it-it/reference-diagrams/guide/lightning-web-components-off-screen-data-operations) **Visibilità:** La visibilità può essere controllata dinamicamente in tutti gli strumenti di creazione dei moduli. I moduli dinamici, Flow Builder e OmniStudio risolvono questo problema con le funzioni di visibilità dei componenti. In questo modo è possibile visualizzare o nascondere i campi in modo dichiarativo in base ad altri valori del modulo o indipendentemente dal fatto che l'utente si trovi su un dispositivo mobile. - Con i moduli dinamici, la visibilità può essere controllata in base ai valori dei campi dei record, ai record correlati tramite campi di ricerca e al fattore di forma. - Con Flusso, è possibile basare una regola di visibilità su altri input nella schermata, nonché su altre risorse compilate in precedenza nel flusso come formule o valori di altri record. - **Regole basate sul dispositivo:** Non è ovvio fin dall'inizio, ma è possibile utilizzare una formula per visualizzare o nascondere un particolare campo quando l'utente è su un dispositivo mobile. Scrivere una formula del flusso che controlli il valore della variabile globale \$User.UIThemeDisplayed. Se il valore è Theme4t, l'utente si trova nell'app mobile Salesforce. - **Valutazione di altre risorse:** I riferimenti manuali alle variabili e alle formule vengono valutati solo sul server. Quindi, qualsiasi valore abbia quella risorsa quando la schermata viene visualizzata per la prima volta è il valore che avrà finché non si passa a un'altra schermata. Durante la navigazione, il runtime del flusso invia una richiesta al motore di flusso (il server) e recupera i valori più recenti delle variabili e delle formule manuali. Se si prevede che la regola di visibilità si aggiorni quando l'utente passa attraverso una singola schermata (ad esempio, onblur), assicurarsi di fare riferimento solo ai valori degli altri componenti della schermata. - Con OmniStudio, è possibile visualizzare o nascondere i componenti in modo condizionale impostando una proprietà di visualizzazione condizionale. Tuttavia, non è possibile aggiungere più di una proprietà di visualizzazione condizionale per un input. **Stati di input condizionali:** Se è necessario controllare dinamicamente altre proprietà, ad esempio se un campo è obbligatorio, disabilitato o di sola lettura, sono disponibili alcune opzioni. Come previsto, LWC offre un controllo completo e reattivo sullo stato di input. Con i componenti Flusso schermata reattivi, è possibile controllare dinamicamente attributi di componenti come Sola lettura, Disabilitato e Obbligatorio per i componenti standard che lo supportano, mentre OmniStudio supporta l'intera gamma di attributi specifici dei componenti. Se le proprie esigenze richiedono Flusso e il componente non supporta uno stato attributo specifico, è possibile creare un componente LWC incorporabile per ottenere uno stato di input dinamico. Se è necessario controllare dinamicamente qualsiasi altra proprietà, ad esempio se un campo è obbligatorio o di sola lettura, la soluzione migliore a breve termine è LWC, in cui si ha il controllo completo. Ciò è particolarmente vero se sono presenti requisiti personalizzati per la gestione di onblur o onclick. LWC reattivi nei flussi schermata: Quando si creano componenti LWC che possono sia reagire che modificare altri componenti in un flusso schermata, consultare questa guida alle [procedure consigliate per](https://developer.salesforce.com/blogs/2023/02/lwc-best-practices-for-screen-flows) i flussi schermata per assicurarsi che i componenti si integrino bene nel motore di runtime del flusso e funzionino come previsto in futuro.
Gestione eventi standard (onblur, onfocus) Gestione evento personalizzata
Moduli dinamici Non disponibile Non disponibile
Flusso schermata Non disponibile Non disponibile
OmniStudio Non disponibile Disponibile*
Flusso schermata + LWC Disponibile Disponibile
LWC Disponibile Disponibile
* Runtime standard OmniStudio non supporta Pub/Sub, ma supporta Windows postMessage
Ora per gli eventi personalizzati. Se alcuni input o l'intero modulo devono comunicare con un'altra voce della pagina, LWC è l'unica opzione possibile. - Per comunicare all'interno dello stesso albero DOM, utilizzare l'[**interfaccia CustomEvent**](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.events). - Per comunicare nel DOM, utilizzare [**Lightning Messaging Service**](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.use_message_channel). - Se il servizio di messaggistica Lightning [non è supportato](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.use_message_channel_considerations) per il contenitore di destinazione, utilizzare il **modulo pub/sub**. #### Risorse aggiuntive - Per ulteriori dettagli, vedere [Comunicazione con eventi](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/events) e [Comunicazione attraverso il DOM](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.events_pubsub) nella _Guida Lightning Web Components Dev_ Guide. - Per OmniStudio, consultare [Comunicazione con OmniScript da un componente Web Lightning.](https://help.salesforce.com/s/articleView?id=sf.os_communicate_with_omniscript_from_a_lightning_web_component_18222.htm&type=5) ### Styling Per offrire la migliore esperienza utente è necessario assicurarsi che lo stile del modulo sia coerente con il resto dell'app o del sito in cui è incorporato. Raggiungere questo obiettivo può significare qualsiasi cosa, dall'utilizzo dei modelli standard forniti da Salesforce alla creazione di CSS personalizzati che utilizzano completamente ogni pixel nella progettazione per offrire un aspetto più nitido. #### Domande da porre: - Quanto sono sofisticati lo stile desiderato e CSS? - Hai bisogno di uno stile personalizzato e pixel-perfetto o ti vanno bene i temi standard?
Stile diretto Temi di organizzazioni e Generatore di esperienze Stile pixel perfetto
Moduli dinamici Non disponibile Disponibile Non disponibile
Flusso schermata Non disponibile Disponibile Roadmap
OmniStudio Disponibile* Non disponibile Disponibile
Flusso schermata + LWC Non disponibile Disponibile Disponibile
LWC Non disponibile Disponibile Disponibile
* Solo schede Flex
FlexCard è l'unico prodotto trattato in questa guida che consente di controllare in modo dichiarativo lo stile e il layout dell'interfaccia utente che si sta creando nello strumento direttamente, che si tratti di margini e imbottitura, tipografia, colori, ecc. Sia i moduli dinamici che i flussi rispettano le funzioni dei temi dichiarativi. Se si necessita di un controllo che vada oltre il supporto [dei temi Salesforce](https://help.salesforce.com/articleView?id=brand_your_org_in_lightning_experience.htm&mode=1), dei [set di immagini](https://help.salesforce.com/articleView?id=community_designer_brandsets.htm) aziendali o dei [siti Experience Cloud LWR](https://developer.salesforce.com/docs/atlas.en-us.exp_cloud_lwr.meta/exp_cloud_lwr/brand_overview.htm), valutare la possibilità di utilizzare una soluzione a livello di programmazione. Per i team che utilizzano CSS, sono disponibili due opzioni: - I flussi e i componenti LWC ereditano i [token di progettazione](https://developer.salesforce.com/docs/atlas.en-us.lightning.meta/lightning/tokens_standard.htm). - OmniScript e FlexCard includono il supporto per un sistema di progettazione personalizzabile: [Newport](https://help.salesforce.com/s/articleView?id=sf.os_customize_omniscripts_and_flexcards_with_the_newport_design_system.htm&type=5). - Con LWC è possibile scrivere i propri componenti e controllare completamente HTML e CSS per essi. Ove possibile, si consiglia di utilizzare temi e sistemi di progettazione, in modo che l'aspetto sia applicato in modo coerente a tutti i contenuti. Promemoria: È possibile incorporare componenti Lightning nei flussi. Quindi, se è necessario un controllo pixel perfetto sull'aspetto della forma ma si desidera utilizzare gli altri vantaggi dei flussi, ad esempio il modello di navigazione, è possibile utilizzare il meglio di entrambi i mondi. Lo stesso principio vale per OmniScript e FlexCard. ### Layout La scelta di un buon layout è fondamentale per progettare moduli semplificati che consentano un'immissione rapida ed efficiente dei dati e aumentino l'integrità dei dati. Per ulteriori informazioni su questo argomento, vedere [Salesforce Well-Architected - Forms](/docs/architect/it-it/well-architected/guide/engaging#moduli). #### Domande da porre: - Come utilizzare il layout del modulo per ottimizzare le esperienze utente? - Come si possono presentare i dati esistenti agli utenti in modo da semplificare l'immissione di nuovi dati nei moduli?
2 colonne 4 colonne Oltre 4 colonne Blocchi ripetuti di dati Contenitori scheda Contenitori per fisarmonica
Moduli dinamici Disponibile Non disponibile Non disponibile Non disponibile Disponibile Disponibile
Flusso schermata Disponibile Disponibile Non disponibile Disponibile Non disponibile Disponibile
OmniStudio Disponibile Disponibile Disponibile Disponibile Disponibile* Disponibile
Flusso schermata + LWC Disponibile Disponibile Disponibile Disponibile Disponibile Disponibile
LWC Disponibile Disponibile Disponibile Disponibile Disponibile Disponibile
*Le schede possono essere utilizzate se si incorporano dati in una FlexCard in un OmniScript
I moduli dinamici supportano i layout a due colonne e possono essere suddivisi in singole sezioni con campi. Queste sezioni possono essere inserite in componenti come schede e fisarmoniche per creare layout facili da usare e organizzati. Se si desidera, il rendering dei flussi può essere eseguito utilizzando il componente Sezione. Con le sezioni è possibile aggiungere fino a quattro colonne e tutte le sezioni desiderate nella schermata del flusso. Il componente è anche reattivo alla larghezza dello schermo, quindi può funzionare su schermi più piccoli. Infine, consente di applicare la visibilità condizionale all'intera sezione, semplificando l'applicazione globale della visibilità a più campi all'interno della sezione. Le sezioni dei flussi supportano anche le intestazioni di colonna e offrono un'esperienza simile a una fisarmonica in cui gli utenti possono comprimere l'intera sezione facendo clic sull'etichetta. Gli OmniScript offrono una varietà di opzioni di layout per la visualizzazione di campi e dati. È possibile creare sezioni di dati con un massimo di 12 colonne, incluse le fisarmoniche comprimibili in modo condizionale. Con LWC, è possibile utilizzare Lightningrecord-\[edit|view]-form e il campo Lightning\[input|output]-supportato per controllare il layout. Le uniche limitazioni del layout sono quelle di HTML/CSS. Lightning-record-form rispetta la configurazione della sezione nel layout di pagina associato; ad esempio, se una sezione è a due colonne nel layout di pagina, è a due colonne in questo componente. ### Traduzione Se il modulo sarà accessibile da utenti di regioni diverse o che parlano lingue diverse, è necessario assicurarsi che lo strumento che si utilizzerà per crearlo soddisfi i requisiti di localizzazione. Vedere [Salesforce Well-Architected - Localization](/docs/architect/it-it/well-architected/guide/compliant#localizzazione) per ulteriori indicazioni e consigli. Nel caso specifico dei moduli, i requisiti di localizzazione in genere includono la traduzione di elementi di testo in altre lingue. #### Domande da porre: - Il modulo verrà utilizzato in più di un paese o di una regione? - Il testo nel modulo deve essere localizzato in altre lingue?
Etichette immesse nel Generatore Etichette nel codice
Moduli dinamici Disponibile* Non disponibile
Flusso schermata Disponibile Disponibile
OmniStudio Disponibile Disponibile
Flusso schermata + LWC Disponibile Disponibile
LWC Non disponibile Disponibile
*Solo intestazioni sezione campo
Se sono stati localizzati i campi personalizzati, le etichette tradotte vengono rispettate nei moduli dinamici. I moduli dinamici rispettano anche le [etichette personalizzate assegnate alle etichette e agli attributi](https://help.salesforce.com/s/articleView?id=platform.lightning_page_components_use_expressions_for_labels.htm&type=5) dei componenti nel Generatore di app Lightning. Con la potenza dell'Area di lavoro traduzione, Flusso supporta la traduzione delle etichette rivolte agli utenti per tutti i componenti schermata standard e personalizzati. È possibile localizzare l'etichetta, il testo della guida e il messaggio di errore dei seguenti componenti schermata: Testo, Area di testo lungo, Numero, Valuta, Casella di controllo, Pulsanti di opzione, Elenco di selezione, Elenco di selezione a selezione multipla, Gruppo caselle di controllo, Password, Data e Data/ora. Non è disponibile un supporto per la traduzione incorporato per le azioni pronte all'uso, ad esempio Invia email o Pubblica su Chatter. Tuttavia, c'è una soluzione! Se si definiscono le etichette tradotte con un'[etichetta personalizzata](https://help.salesforce.com/articleView?id=cl_about.htm), è possibile fare riferimento a tale etichetta personalizzata nell'azione o nel componente quando si configura in Flow Builder. Creare una formula del flusso che faccia riferimento all'etichetta personalizzata e fare riferimento a tale formula nelle posizioni appropriate del flusso. Gli OmniScript utilizzano etichette personalizzate per le traduzioni. Fare riferimento a [questo documento](https://help.salesforce.com/s/articleView?id=sf.os_create_multi_language_omniscripts.htm) per preparare gli OmniScript multilingue. Ora per LWC. Alcuni componenti di base ereditano automaticamente le traduzioni dei campi, del testo della guida e dei messaggi di convalida dell'oggetto associato se sono stati configurati nell'Area di lavoro traduzione (ad esempio Lightning-record-form). Se è necessario introdurre nuove etichette traducibili nel codice, le etichette personalizzate sono ancora l'eroe non cantato. Dichiarare l'etichetta personalizzata necessaria e quindi importarla nel componente dal modulo @salesforce/label scoped. ### Automazione test interfaccia utente Sono disponibili diversi strumenti di automazione dei test end-to-end (ad esempio, Selenium) che consentono di simulare come l'utente interagisce con il modulo. È possibile scrivere questi test per qualsiasi interfaccia utente standard o personalizzata, incluse le pagine Lightning e i flussi schermata. Tuttavia, è importante notare che questi tipi di test non possono verificare gli output di ogni metodo in esecuzione. Assicurarsi di tenerne conto quando si esaminano i requisiti per l'automazione dei test dell'interfaccia utente. #### Domande da porre: - Sono necessari test automatici per il modulo? - Quali tipi di test è necessario eseguire? - Quale livello di dettaglio è necessario nelle automazioni di test?
Test di unità Automazione end-to-end
Moduli dinamici Non disponibile Disponibile*
Flusso schermata Non disponibile Disponibile*
OmniStudio Disponibile* Disponibile*
Flusso schermata + LWC Disponibile* Disponibile*
LWC Disponibile Disponibile
* Richiede codice
Considerare i propri requisiti per l'automazione dei test dell'interfaccia utente. I **test di unità** consentono un'automazione e una convalida più granulari che funzionano con i sistemi e gli strumenti standard del settore per i CD/informatici, in grado di testare la logica aziendale dei componenti, il relativo controller JavaScript e i relativi output. Se si utilizza esclusivamente low-code non sarà possibile creare test autonomamente, ma Salesforce testa rigorosamente le nostre offerte end-to-end. Se i metodi del componente sono abbastanza complessi da voler essere testati singolarmente, inserirli in file JavaScript dedicati. In questo modo è possibile importarli in un LWC e in un test Jest con qualcosa come `import { sort } from 'c/utils';`. Vedere [Automazione test interfaccia utente](https://developer.salesforce.com/blogs/2020/01/ui-test-automation-on-salesforce.html) per un confronto delle varie opzioni disponibili per creare un'automazione end-to-end in Salesforce. Sono incluse considerazioni su quando utilizzare una soluzione senza codice da un ISV, Build Your Own soluzione di automazione dei test personalizzata o utilizzare un framework di test open source come Selenium WebDriver o WebdriverIO. Queste soluzioni sono valide per qualsiasi interazione dell'interfaccia utente in Salesforce, sia che si tratti di un modulo dinamico in una pagina Lightning, di un flusso schermata in una barra delle utilità o di un LWC in un flusso in un'azione. ### Metriche Dopo aver distribuito il modulo in un ambiente di produzione, è consigliabile assicurarsi che venga utilizzato in modo efficace. A seconda del caso d'uso, questo può significare qualsiasi cosa, dal semplice tracciamento del numero di volte in cui è stato compilato alla quantità di tempo che gli utenti trascorrono compilandolo prima di inviare le loro informazioni. Assicurarsi di identificare i KPI di cui si desidera tenere traccia prima di scegliere uno strumento. #### Domande da porre: - È necessario tenere traccia dell'utilizzo del modulo? - Quali KPI determinano se il modulo viene utilizzato in modo efficace?
Visualizzazioni pagina Tempo trascorso sul modulo Tracciamento del completamento del modulo Monitoraggio della percentuale di successo
Moduli dinamici Disponibile** Non disponibile Non disponibile Non disponibile
Flusso schermata Disponibile Disponibile* Disponibile Disponibile
OmniStudio Disponibile Disponibile* Disponibile Disponibile
Flusso schermata + LWC Disponibile Disponibile* Disponibile Disponibile
LWC Disponibile** Disponibile* Disponibile Disponibile
*Disponibile quando è abilitato Runtime OmniStudio basato su pacchetto
** Disponibile monitorando l'utilizzo delle pagine Lightning controllanti
Se è necessario tenere traccia dell'utilizzo complessivo e dell'adozione del modulo, iniziare con gli strumenti low-code. Sia i moduli dinamici che i flussi schermata sono tracciabili utilizzando tipi di rapporti personalizzati pronti all'uso, anche se i rapporti di tracciamento dei flussi schermata offrono una maggiore chiarezza. Se è necessario tenere traccia dell'utilizzo di un LWC, la disponibilità pronta all'uso dipende da dove si utilizza quel LWC. Se si trova in una pagina Lightning, qualsiasi elemento disponibile per il tracciamento dell'utilizzo delle pagine Lightning si applica al componente LWC. Lo stesso vale per i componenti LWC incorporati nei flussi. I moduli dinamici non sono tracciabili immediatamente, anche se è possibile tenere traccia dell'utilizzo della pagina Lightning controllante tramite gli [oggetti Utilizzo Lightning](https://help.salesforce.com/articleView?id=lex_usage_reports.htm). Per tenere traccia delle pagine Lightning standard, utilizzare il tipo di rapporto personalizzato _Utenti con Lightning Usage by Page Metrics_. Per lo stesso motivo nelle pagine Lightning personalizzate, utilizzare il tipo di rapporto personalizzato _Utenti con utilizzo Lightning_ per metriche FlexiPage. Per tenere traccia dell'adozione del modulo specifico (non solo della pagina in cui si trova), Flusso offre una copertura completa. Utilizzare il "Rapporto flusso di esempio: Screen Flows" per rispondere a domande come: - Qual è la percentuale di completamento di questo modulo? È stato adottato bene? - Quanto tempo impiegano gli utenti a compilare questo modulo? - Su quale schermata gli utenti trascorrono più tempo? - Con che frequenza gli utenti navigano all'indietro? - Con che frequenza si verificano gli errori? Se il rapporto standard non soddisfa le proprie esigenze, clonarlo per apportare le proprie modifiche o Build Your Own da zero utilizzando il tipo di rapporto _Flussi schermata_. Se si utilizza il runtime OmniScript basato su pacchetto, è possibile utilizzare [OmniStudio per Vlocity Tracking Service](https://help.salesforce.com/s/articleView?id=sf.os_vlocity_tracking_service.htm&type=5). Questo servizio tiene traccia di qualsiasi tipo di evento. Ad esempio, è possibile tenere traccia del tempo necessario per completare i passaggi di un OmniScript per identificare i miglioramenti del processo. La roadmap del team OmniStudio prevede il supporto di questo servizio in OmniStudio standard. Per tenere traccia dello stesso per un LWC non incorporato in un flusso schermata, OmniScript o pagina Lightning, non è disponibile un'opzione pronta all'uso. È possibile creare una soluzione personalizzata utilizzando Apex. ### Imballaggio e distribuzione Quando è necessario distribuire la soluzione in ambienti superiori per il test o la distribuzione in produzione, è possibile che si sia abituati a utilizzare le serie di modifiche o DevOps Center per farlo. I moduli dinamici, i flussi e i componenti LWC sono completamente supportati in queste opzioni di distribuzione. OmniStudio richiede uno strumento separato: Area di [lavoro IDX](https://help.salesforce.com/s/articleView?language=en_US&id=sf.os_idx_workbench_desktop_application.htm&type=5). #### Domande da porre: - Come si prevede di distribuire il modulo? - Il modulo verrà distribuito a più di un'organizzazione Salesforce?
Pacchetti gestiti di prima generazione (1GP) Pacchetti gestiti di seconda generazione (2GP) Pacchetti sbloccati Serie di modifiche DevOps Center
Moduli dinamici Disponibile Disponibile Disponibile Disponibile Disponibile
Flusso schermata Disponibile Disponibile Disponibile Disponibile Disponibile
OmniStudio Non disponibile Non disponibile Non disponibile Non disponibile* Non disponibile*
Flusso schermata + LWC Disponibile Disponibile Disponibile Disponibile Disponibile
LWC Disponibile Disponibile Disponibile Disponibile Disponibile
*Utilizzare Area di lavoro IDX per distribuire le soluzioni OmniStudio ad altre organizzazioni.
Se si è un ISV o un partner che prevede di inserire la soluzione in un pacchetto per la distribuzione su AppExchange, si consiglia di esaminare prima i moduli dinamici, i flussi e i componenti LWC. OmniStudio non supporta i pacchetti. ## Argomenti aggiuntivi ### Navigazione dal codice basso al continuo pro-codice Questa guida si concentra sull'aiutare a capire quali funzionalità e livelli di personalizzazione sono possibili con moduli dinamici, flussi schermata, OmniStudio e LWC. Ad un livello elevato: Da Low Code a Pro-Code Continuum
- LWC è l'opzione più personalizzabile e robusta per la creazione di un modulo, ma ha il minor numero di guardrail. Spetta all'utente creare un componente in modo da garantire [la sicurezza](/docs/architect/it-it/well-architected/guide/secure) e la [scalabilità](/docs/architect/it-it/well-architected/guide/reliable#scalabilità). - I moduli dinamici sono i meno flessibili, ma le opportunità di errore sono molto meno numerose. - Flusso e OmniStudio si trovano da qualche parte nel mezzo, più potenti dei moduli dinamici ma non proprio al livello di LWC. Allo stesso modo, hanno meno guardrail rispetto ai moduli dinamici ma sono più difficili da violare rispetto al codice personalizzato. Se più strumenti sono adatti alla fattura, la decisione dipende da quale strumento è quello giusto per il team. Altre [Guide alle decisioni](/decision-guides) introducono ulteriori aspetti da considerare quando si prende quella decisione. Non entreremo qui nei dettagli di ciascuno di questi aspetti, ma quello che faremo è interpretarli per gli strumenti specifici che questo documento sta valutando. **Competenze specializzate**: Quanta esperienza ha il team negli strumenti che si confrontano? Quanti produttori sono esperti e hanno familiarità con LWC o JavaScript? Che ne dici dei produttori esperti in Flow Builder o che hanno espresso interesse a immergere le dita dei piedi? In generale, le competenze relative a moduli dinamici e flussi sono più accessibili per una popolazione più ampia di persone che creano moduli. I moduli dinamici sono lo strumento più dichiarativo per la creazione di moduli e saranno sempre più facili da imparare rispetto al flusso. Detto questo, il team del flusso si impegna a ridurre al minimo la barra. In termini di complessità, OmniStudio si trova a metà strada tra Flusso e LWC e offre notevoli poteri di creazione della forma. **Delega di consegna**: Solo perché alcuni requisiti richiedono LWC, non significa che l'intera soluzione debba essere creata con LWC. Considerare come creare la soluzione in modo modulare, in modo che le parti che richiedono LWC siano codificate e quelle che non lo richiedono siano in una soluzione low-code. In questo modo si massimizza l'efficienza di un team diversificato e si garantisce che ogni persona stia risolvendo i problemi appropriati per la propria specializzazione. Parliamo ora di Flusso e LWC. Con i componenti schermata reattivi, i componenti del flusso schermata possono ora comunicare tra loro sulla stessa schermata sbloccando una nuova cassetta degli strumenti per architetti, amministratori e sviluppatori. Gli sviluppatori possono ora creare componenti modulari mirati che possono essere riutilizzati in tutta l'organizzazione, aumentando la produttività per tutti i membri del team. Gli sviluppatori possono concentrarsi sulla risoluzione di nuove sfide e risparmiare tempo utilizzando un mix di componenti Flusso standard e personalizzati per ottenere dinamismo della forma. Con i componenti reattivi in Flusso, non c'è mai stato un momento più appropriato per combinare Flusso e LWC durante la creazione dei moduli. **Gestibilità e proprietà a lungo termine**: Se si dispone di un modulo a più fasi, è consigliabile iniziare con Flusso o un mix di Flusso e LWC. Se è presente un team low-code che gestisce la soluzione, pensare a come rendere la soluzione il più configurabile e ampliabile possibile per quel pubblico. Qualunque sia lo strumento scelto, organizzare la soluzione in unità [componibili](/docs/architect/it-it/well-architected/guide/composable) per migliorare la manutenibilità e la stabilità. ### Layout di pagina In futuro, il modo consigliato per configurare le pagine dei dettagli dei record è Moduli dinamici nel Generatore di app Lightning utilizzando le pagine Lightning. È passato molto tempo da quando abbiamo ottimizzato i layout di pagina e questa tendenza continuerà. Ecco perché: - I moduli dinamici sono più flessibili: è possibile posizionare campi e sezioni dove si desidera direttamente nel Generatore di app Lightning, dove è possibile utilizzare sezioni, schede e fisarmoniche. E proprio come si può fare con i componenti nella pagina Lightning, è possibile controllare la visibilità dei campi e delle sezioni senza definire più layout di pagina o tipi di record. - Con i componenti Fisarmonica e Scheda è possibile limitare la quantità di campi visualizzati inizialmente. Indovina cosa significa? Tempi di caricamento delle pagine più rapidi. - La gestione dei layout è più semplice con le pagine Lightning, poiché è possibile gestire tutto ciò che riguarda le pagine dal Generatore di app Lightning, sia che si tratti dei contenuti della pagina o degli utenti che hanno accesso alla pagina. Non è più necessario eseguire aggiornamenti nel layout di pagina per apportare una modifica nella pagina Lightning. Per non parlare del fatto che, grazie alle potenti regole di visibilità, non è più necessario creare più pagine (o layout di pagina) per controllare chi vede quali campi quando. Ciò significa anche che è sufficiente assegnare agli utenti una pagina Lightning anziché assegnare sia una pagina Lightning che un layout di pagina. Si consiglia di utilizzare i moduli dinamici dove possibile e di tornare ai layout di pagina solo quando necessario. Come sempre, accogliamo con favore il feedback nello [scambio di idee](https://ideas.salesforce.com/s/) sui miglioramenti che avrebbero maggior impatto sulla vostra organizzazione. ### Prestazioni Tutte le considerazioni sulle prestazioni relative a moduli dinamici, flussi schermata, OmniStudio e LWC si basano sul framework in cui si trovano le tecnologie. Quelli basati su LWC (oltre, ovviamente, a un LWC) supereranno quelli basati su Aura. Il framework LWC offre prestazioni migliori perché le funzionalità principali sono implementate in modo nativo nei motori Web anziché in JavaScript tramite astrazioni del framework. Se non si ha dimestichezza, leggere [questo post](https://developer.salesforce.com/blogs/2018/12/introducing-lightning-web-components.html). Nel 2019 abbiamo condotto un [caso di studio](https://developer.salesforce.com/blogs/2019/06/case-study-dreamhouse-gains-speed-by-switching-to-lwc.html) confrontando le prestazioni delle stesse funzionalità in Aura e in LWC. Con la conversione di DreamHouse da Aura a LWC, non solo l'esperienza di sviluppo è stata molto più allineata agli attuali standard e schemi di sviluppo front-end Web, ma i miglioramenti delle prestazioni sono stati significativi. Le misurazioni di laboratorio hanno mostrato guadagni nell'intervallo dal **2,4% al 24,7%** per la cache fredda e guadagni nell'intervallo dal **31,83% al** **63,32%** per la cache calda sulle stesse due pagine. Ora, quale framework stanno utilizzando le nostre tecnologie dei moduli? In altre parole, quali tecnologie di forma traggono vantaggio da queste prestazioni superiori? - I moduli dinamici, integrati nei metadati delle pagine Lightning, sono basati sullo stack LWC, che ci consentirà di implementare alcune funzionalità richieste da tempo. Come bonus di prestazioni, i moduli dinamici utilizzano il rendering progressivo, che si traduce in un tempo di caricamento delle pagine migliorato per le pagine con un numero elevato di campi. - I flussi schermata sono basati su LWC, con la maggior parte dei singoli componenti pronti all'uso ora convertiti in LWC, ad eccezione di due componenti pronti all'uso: Caricamento file e immagine. Anche se il team Flusso ha convertito il client di runtime del flusso in LWC e la maggior parte dei suoi componenti, i clienti devono comunque convertire i componenti schermata Aura in LWC. Non solo, ma Salesforce supporta solo i componenti LWC nel nuovo framework dei componenti reattivi nei flussi schermata. C'è un ottimo modulo Trailhead che spiega come farlo: [Componenti Web Lightning per sviluppatori Aura](https://trailhead.salesforce.com/en/content/learn/modules/lightning-web-components-for-aura-developers). Va da sé: Se si sta pensando di creare un componente personalizzato per un flusso schermata o qualsiasi altro contenitore, passare sempre a LWC. - Sono disponibili alcune versioni di OmniStudio. Se si è un cliente di lunga data, è possibile che si utilizzi Angular. Invitiamo tutti i nuovi clienti a iniziare con OmniScript e FlexCard basati su LWC e a migrare i clienti esistenti da Angular. - LWC è costruito su ... LWC ovviamente. Questo è un omaggio. 🤓 ## Osservazioni di chiusura In qualità di architetto, è importante avere una solida conoscenza di tutte le opzioni disponibili e di come applicarle nel proprio caso d'uso specifico. Per la creazione di moduli in Salesforce, le opzioni variano da low-code (utilizzando moduli dinamici nel Generatore di app Lightning, flussi schermata in Flow Builder e OmniScript in OmniStudio) a pro-code (utilizzando il framework LWC), con una combinazione di flussi schermata o OmniScript e LWC nel mezzo. Tenere presente questa guida e utilizzarla come riferimento quando si prevede di creare o riprogettare i moduli in Salesforce. Per istruzioni su come progettare moduli semplificati e utili, consultare [Salesforce Well-Architected: Coinvolgente](/docs/architect/it-it/well-architected/guide/engaging). ### Dicci cosa ne pensi Aiutaci a pubblicare ciò che è più rilevante per te: [partecipa al sondaggio](https://forms.gle/FCFCES6vsRbKv4E29) per fornire un feedback su questo contenuto e dicci cosa vorresti vedere dopo. ## Panoramica della guida Questa guida consente di valutare l'approccio corretto per i requisiti di elaborazione asincrona nella piattaforma Salesforce. Spiega ogni approccio, descrivendone i punti di forza e le limitazioni. La maggior parte degli approcci sono allineati a una funzione del prodotto, ma alcuni utilizzano più funzioni in coordinamento. La guida include casi d'uso per evidenziare quando utilizzare ogni approccio. L'elaborazione asincrona offre due vantaggi principali per l'architettura. Innanzitutto, aumenta la scalabilità perché i processi asincroni hanno limiti governor più elevati. In secondo luogo, le richieste asincrone vengono eseguite nei propri thread in modo che gli utenti possano eseguire altro lavoro mentre le operazioni asincrone vengono eseguite in background. Tenere presente che questa guida si concentra esclusivamente sulla scelta di una tecnologia di elaborazione asincrona all'interno di Salesforce Platform. Altre risorse utili per il processo decisionale sono elencate nella [sezione Risorse](#risorse). ## Prodotti nell'ambito di questa guida
Salesforce Platform Salesforce Lightning Platform è una piattaforma completa basata sull'intelligenza artificiale che unifica dipendenti, agenti autonomi dell'intelligenza artificiale, dati aziendali e applicazioni in un unico sistema affidabile per migliorare la produttività e l'esperienza dei clienti. Consente la creazione di un'"azienda autentica" collegando le app Customer 360, Data Cloud e Slack per l'automazione end-to-end.
Questo documento non tratta le tecnologie in altri ecosistemi come MuleSoft, Informatica, Commerce Cloud, Tableau e Marketing Cloud. ## Takeaway - **Prima di utilizzare l'elaborazione asincrona, assicurarsi che i casi d'uso corrispondano allo schema.** Gli schemi asincroni non hanno SLA, sono soggetti a più meccanismi governor, possono avere limiti di capacità definiti in base alle licenze e possono causare ritardi di elaborazione a causa della natura finita delle risorse allocate all'infrastruttura asincrona all'interno di Salesforce Platform. Tenere presenti le seguenti limitazioni quando si utilizza l'elaborazione asincrona in scenari in cui un utente richiede una risposta dal sistema prima di poter continuare a lavorare. - **L'elaborazione asincrona con Salesforce non è una soluzione per esigenze di scalabilità infinite.** Salesforce Platform non scala all'infinito e gli schemi asincroni sono soggetti a limitazioni. L'elaborazione asincrona utilizza i thread, che contengono le informazioni contestuali necessarie a una CPU per eseguire un flusso di istruzioni. I thread possono essere eseguiti in parallelo. Il numero di thread disponibili in qualsiasi CPU è limitato, quindi la piattaforma dispone di meccanismi per utilizzare i thread disponibili nel modo più efficiente possibile. Il [meccanismo di controllo](/docs/architect/it-it/fundamentals/guide/async-fundamentals#controllo-del-flusso) del flusso della piattaforma evita che le organizzazioni consumino troppi thread e influiscano negativamente sulle altre organizzazioni. L'[algoritmo di fair use](/docs/architect/it-it/fundamentals/guide/async-fundamentals#utilizzo-equo) della piattaforma controlla anche il numero di thread disponibili per un'organizzazione per ogni tipo di messaggio specifico. - **Tenere conto degli eventi che possono causare carichi estremi.** Quando si progettano processi asincroni, assicurarsi che siano in grado di gestire in modo prevedibile picchi e pause del carico di lavoro. Considerare il modo in cui l'implementazione gestisce gli eventi imprevisti, ad esempio le interruzioni di corrente, e progettare misure di protezione che riducono la perdita di dati o di funzionalità. ## Confronto dei prodotti Questa tabella descrive gli strumenti disponibili per l'elaborazione asincrona con Salesforce. Fare riferimento a questa tabella per esaminare le principali caratteristiche di ogni strumento durante il processo decisionale. Vedere [Casi d'uso](#casi-duso) e [punti decisionali](#punti-decisione) per informazioni sulla scelta degli strumenti più adatti alla propria architettura.
Approccio Descrizione Competenze richieste Licenze e limiti
Apex in area di attesa Utilizzare per processi che comportano operazioni di database di lunga durata o chiamate a servizi Web esterni. Queueable Apex offre funzioni come ID processo, supporto per tipi non primitivi e concatenamento dei processi. Pro-code Il numero di licenze può aumentare i limiti.
Batch Apex Creare processi complessi e di lunga durata che coinvolgono milioni di record suddividendo l'insieme di record ed elaborandolo in blocchi gestibili. Pro-code Il numero di licenze può aumentare i limiti.
Apex pianificato Eseguire Apex a un'ora pianificata definita da un'espressione cron. Sebbene l'atto di pianificare Apex tramite l'espressione cron sia un processo asincrono, il codice sottostante viene eseguito in modo sincrono all'avvio del processo. Pro-code Il numero di licenze può aumentare i limiti.
Chiamate continuazione Apex Eseguire chiamate dai metodi Apex in esecuzione in un contesto di transazione sincrona. Pro-code No
Percorso asincrono (flussi attivati da record) Eseguire un'operazione che si desidera eseguire nel proprio tempo. Evitare errori DML misti che si verificano quando si aggiorna un valore di un record correlato che non fa parte del record che ha attivato un flusso. Basso codice Il numero e il tipo di licenze possono aumentare i limiti.
Percorso pianificato (dopo l'impegno dei flussi) Eseguire l'esecuzione in un momento pianificato dinamicamente dopo un evento di attivazione, ad esempio quando viene creato, aggiornato o eliminato un record. Basso codice Il numero e il tipo di licenze possono aumentare i limiti.
Flussi pianificati Eseguire un flusso in background a un'ora specificata e con una frequenza ripetuta (giornaliera, settimanale o una volta) per eseguire azioni su un batch di record. Basso codice Il numero e il tipo di licenze possono aumentare i limiti.
Trigger evento piattaforma Associare liberamente Salesforce a sistemi esterni e comunicare tra componenti asincroni all'interno di Salesforce Platform. Low-code + Pro-code Per i casi d'uso di eventi piattaforma a volume elevato è necessaria una licenza aggiuntiva
Modifica acquisizione dati Acquisire ed elaborare gli eventi di modifica in modo asincrono dopo la conferma della transazione del database. Pro-code Per scalare al di sopra dell'allocazione di base è necessaria una licenza aggiuntiva.
Bulk API Inserire, aggiornare, inserire con aggiornamento, eseguire query o eliminare molti record in modo asincrono ed elaborare i risultati in un secondo momento. Pro-code Ci sono dei limiti.
Azioni Lightning Consente alle pagine Lightning di interagire con il server senza costringere gli utenti ad aggiornare completamente la pagina. Basso codice No
## Punti decisione Questa tabella contiene una panoramica dei punti da considerare quando si decide quale strumento asincrono utilizzare.
Competenze richieste Alcuni degli strumenti descritti in questa guida richiedono codice, mentre altri possono essere configurati in modo dichiarativo. Quando si valutano le opzioni disponibili, pensare alle competenze dei membri del team. Tenere presente che anche se gli sviluppatori sono disponibili per l'implementazione iniziale (ad esempio tramite un partner di implementazione), potrebbe essere necessario modificare le soluzioni in futuro. Se il team di manutenzione non dispone di sviluppatori, un'opzione low-code può essere più adatta.
Tipo di limiti della piattaforma applicati Determinare il tipo di limiti che si applicano all'esecuzione. Durante la progettazione delle soluzioni, riflettere attentamente su come il volume e la frequenza delle transazioni verranno conteggiati ogni giorno nei limiti stabiliti dal governor per l'approccio scelto. Calcolare il numero di esecuzioni che si verificheranno ogni giorno. Assicurarsi che i valori calcolati rientrino nei limiti associati agli strumenti selezionati.
Latenza Determinare la velocità con cui i risultati dell'elaborazione saranno disponibili nella piattaforma. Per alcuni approcci, i cambiamenti saranno quasi immediati, mentre per altri possono essere minuti o ore.
## Casi d'uso Quando si seleziona uno strumento per l'elaborazione asincrona, valutare innanzitutto i requisiti dell'organizzazione e le risorse disponibili. L'obiettivo è selezionare lo strumento o gli strumenti che riducono al minimo i costi di implementazione e manutenzione, garantendo al contempo la scalabilità e riducendo al minimo la probabilità di violazioni dei limiti. Questo obiettivo dipende dalle considerazioni tecniche descritte in precedenza e dalla composizione del team. Si consideri un processo di ordinazione asincrono in Salesforce. Quando un ordine viene salvato, viene attivato un messaggio a un sistema di gestione del magazzino esterno con istruzioni speciali su come imballare e spedire un articolo. Poiché l'utente che effettua l'ordine non necessita di una risposta immediata dal sistema di gestione del magazzino, la richiesta può essere inviata in modo asincrono. L'elaborazione asincrona consente all'utente di continuare il lavoro senza attendere una risposta. Per questo caso d'uso, può essere utile implementare Apex. Questo approccio funzionerà solo se nel team sono presenti sviluppatori Apex in grado di gestire la soluzione pro-code. In caso contrario, un approccio dichiarativo ha più senso. Inoltre, tenere presente che diversi insiemi di [limiti si](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_gov_limits.htm) applicano a strumenti diversi. In questa tabella sono elencati i casi d'uso comuni nella colonna più a sinistra, seguiti da una descrizione. La colonna _Prima scelta_ fornisce l'approccio più tipico utilizzato per soddisfare un caso d'uso di questo tipo, insieme alla logica dell'approccio Prima scelta. Utilizzarlo come punto di partenza nell'analisi: l'approccio Prima scelta potrebbe avere limitazioni che non funzioneranno per il proprio caso d'uso.
Caso d'uso Descrizione Approccio di prima scelta Motivo
Elaborazione batch ad alte prestazioni Qualsiasi automazione che deve elaborare migliaia o milioni di record in modo efficiente Batch Apex Batch Apex fornisce API complete per l'interfacciamento con la piattaforma e per la velocità di stampa.
Processo di pulitura dati Un processo eseguito regolarmente o su richiesta che pulisce i dati. Gli esempi includono l'annullamento della duplicazione, la verifica dell'indirizzo o il consolidamento dei dati. Batch Apex Batch Apex fornisce API complete per l'interfacciamento con la piattaforma e per la velocità di stampa.
Nightly Roll-up Job (Lavoro di roll-up notturno) Processo che calcola i dati di roll-up al termine di una giornata lavorativa. Batch Apex Batch Apex fornisce API complete per l'interfacciamento con la piattaforma e per la velocità di stampa.
Logica attivata da record Eseguire la logica in risposta a un aggiornamento di record. Varia Vedere la guida alle decisioni associata, Automazione eventi attivati da record. Include un albero decisionale per i casi d'uso asincroni, tra cui Apex inseribile in area di attesa, Apex batch, Apex pianificato, Flusso pianificato, Flussi percorso asincrono e Acquisizione dati di modifica.
Aggiornamenti a catena tramite un grafico a oggetti Consente di completare rapidamente l'azione di salvataggio di un utente, rinviando l'esecuzione asincrona degli aggiornamenti a catena ad altri oggetti. Apex in area di attesa Queueable Apex dispone di potenti funzioni di concatenazione che consentono alla logica di suddividere una catena di aggiornamenti in una serie di transazioni asincrone.
Elaborazione pianificata specifica del record Automazione in una data futura e dinamica specifica del record (ad esempio, 3 giorni prima di una data di chiusura). Flusso con un percorso pianificato I percorsi pianificati rappresentano un punto di forza unico per il flusso, poiché la piattaforma gestisce automaticamente la pianificazione, l'annullamento e la riprogrammazione di questi percorsi se i dati del record cambiano.
Invocazione di più servizi esterni lenti in parallelo Durante un'esecuzione sincrona, più servizi esterni vengono richiamati in parallelo per ottimizzare il tempo di esecuzione complessivo. Chiamate continuazione Apex Consentendo l'esecuzione parallela di più callout a esecuzione lenta si riduce al minimo il tempo complessivo per completare il lavoro.
Migrazione dei dati dei record da un sistema esterno Spostare grandi quantità di record in Salesforce Platform da un sistema esterno. Un processo singolo o pianificato regolarmente. API in bulco Questo è l'approccio più efficiente e rispettoso dei limiti per la migrazione dei dati.
Esecuzione di logica aggiuntiva in un sistema esterno Schema Fire-and-forget che prevede la notifica di un evento sulla piattaforma a un sistema esterno e quindi l'elaborazione asincrona dell'evento. Eventi piattaforma o acquisizione dati modifica Un modello pub-sub funziona meglio qui e consente al sistema esterno di elaborare l'evento quando è pronto. Per ulteriori dettagli su questo schema, vedere Architettura basata sugli eventi.
La tabella Casi d'uso è una guida all'approccio più adatto per ogni caso d'uso. Tuttavia, sarà necessario verificare se la tecnologia First Choice soddisfa le esigenze specifiche del proprio caso d'uso. In particolare, determinare se l'approccio scelto può rispettare i limiti del governor per l'organizzazione. Dopo aver identificato un approccio candidato per il proprio caso d'uso, la [Guida ai fondamenti](/docs/architect/it-it/fundamentals/guide/async-fundamentals) sull'elaborazione asincrona può essere utile per un controllo completo della soluzione. ## Risorse Queste risorse aggiuntive possono essere utili per il processo decisionale: - Approfondisci la conoscenza di ciascuna delle tecnologie asincrone della piattaforma: [Nozioni di base sull'elaborazione asincrona](/docs/architect/it-it/fundamentals/guide/async-fundamentals) - Scegliere tra Apex e Flusso per i trigger di record: [Automazione degli eventi attivati da record](/docs/architect/it-it/decision-guides/guide/record-triggered) - Informazioni sugli schemi di integrazione asincrona: [Architettura basata sugli eventi](/docs/architect/it-it/decision-guides/guide/event-driven) ## Panoramica Le moderne architetture Salesforce sono sempre più basate sull'elaborazione asincrona, non come comodità, ma come requisito strategico per la scalabilità. Negli ultimi anni, abbiamo visto sempre più aziende alle prese con volumi di dati crescenti, integrazioni complesse che coinvolgono più touchpoint e l'ascesa di sistemi autonomi in esecuzione 24/7/365. Tutte queste cose spingono gli architetti verso la progettazione di sistemi che sono asincroni. L'elaborazione asincrona in Salesforce spesso implica la necessità di aggirare i limiti e la complessità del governor. Questi limiti fungono da guardrail e vincoli architetturali che aiutano a produrre sistemi scalabili e sicuri in blocco. Benché nessun limite della piattaforma serva direttamente a gestire la complessità, gli [schemi di progettazione](https://refactoring.guru/design-patterns) possono contribuire a mitigare i rischi su questo fronte. Internamente, Salesforce spesso supera i limiti della piattaforma per testare in avanti le nuove funzioni e automatizzare i processi aziendali complessi. Abbiamo creato un framework di elaborazione asincrona basato su fasi per l'esecuzione di processi asincroni con un numero arbitrario di passaggi. Ogni fase può essere eseguita, riprovata e riavviata in modo indipendente con controlli di governance condivisi e visibilità operativa completa tramite la registrazione centralizzata. Questo documento ne descrive i componenti architettonici chiave: Apex e finalizzatori in area di attesa, flusso pianificato, cursori Apex, azioni invocabili e integrazioni con Slack. Insieme, questi componenti offrono un'architettura modulare, scalabile e osservabile adatta alle esigenze aziendali in evoluzione. ## Punti salienti - Le moderne architetture Salesforce dovrebbero adottare un approccio asincrono per ottenere scalabilità, affidabilità e trasparenza operativa. - Suddividere il lavoro complesso in fasi eseguibili in modo indipendente consente prestazioni prevedibili, tentativi più sicuri, checkpointing, ritiro ed evoluzione modulare senza riprogettare i flussi di lavoro principali. - Il framework offre un'alternativa scalabile ai processi batch monolitici e datati, alle chiamate asincrone concatenate e ai flussi profondamente nidificati ed è creato per carichi di lavoro a volume elevato che devono essere scalati orizzontalmente all'interno di Salesforce senza orchestrazione esterna alla piattaforma. - L'esecuzione deterministica e osservabile garantisce il tracciamento dell'avanzamento, il monitoraggio degli SLA, la diagnostica dei guasti e la trasparenza a livello di controllo tramite la registrazione e la governance centralizzate. - Progettato per un rigore di livello aziendale, che include governance unificata, conformità e controllo statale distribuito in processi aziendali di lunga durata. ## Procedure consigliate per la piattaforma Prima di rivedere i requisiti, di seguito sono riportate alcune cose da fare e da non fare per quando utilizzare un framework come questo. Soprattutto, considerare quale sistema è l'unica fonte di verità. Se l'organizzazione Salesforce si basa in minima parte su dati esterni ma deve scalare da centinaia a milioni di record, considerare un framework asincrono basato su fasi. Utilizzare questo framework se**:** - La maggior parte (o tutte) le informazioni su cui intervenire esistono già nel CRM. - Il costo iniziale o continuativo del mantenimento di un processo ETL (Extract Transform Load) per armonizzare i dati esterni è troppo elevato. - È necessario rinviare l'elaborazione di un numero elevato di record Salesforce secondo una pianificazione impostata. - È possibile suddividere l'elaborazione in fasi discrete. Ad esempio, è possibile creare un insieme di record gerarchico o basato su albero, in particolare se il volume di dati si estende verso il basso nella gerarchia o nella struttura. **Non** utilizzare questo framework se: - La creazione o l'aggiornamento dei record richiede un ricalcolo immediato. - L'integrazione è difficile perché i sistemi esterni ospitano i dati principali per gli aggiornamenti dei record. Considerare la possibilità di inviare i dati aggiornati a Salesforce con l'API in blocco. Tenendo presenti queste procedure, rivedere i requisiti e iniziare a creare. ## Suddivisione dei requisiti Considerare l'istruzione del problema: > Dato un processo che deve essere eseguito quotidianamente, verificare se alcuni record soddisfano criteri prestabiliti per un'ulteriore elaborazione. Se lo fanno, avviare quei processi di elaborazione. L'elaborazione dei record può richiedere l'estrazione di dati da più sistemi esterni per eseguire calcoli. Le fasi dei processi devono informare le persone tramite Slack che i record elaborati sono pronti per la revisione. Le fasi dovrebbero anche inoltrare le notifiche ai responsabili e ai livelli superiori della gerarchia dei ruoli in base a un ritardo configurabile dopo la prima serie di notifiche. Questo problema comporta diversi passaggi, alcuni dei quali possono verificarsi indipendentemente l'uno dall'altro. Esistono molti modi per suddividere il lavoro. Ecco un raggruppamento: - Il pianificatore. - L'interfaccia della fase e le implementazioni concrete che elaborano i record (indipendentemente dal tipo di elaborazione). - Processore che organizza le fasi. - Apex invocabile chiamato dallo strumento di pianificazione. - Il pezzo di notifica. Usiamo l'[Apex Slack SDK](https://developer.salesforce.com/docs/platform/salesforce-slack-sdk/guide/overview.html). - C'è una certa complessità nascosta nella frase "ritardo configurabile". Esamineremo questa complessità più avanti in questo articolo. Di seguito è riportato un diagramma ponderato per il framework predefinito: Schema architettonico che mostra Flow Scheduler, l'elaborazione asincrona Apex e le diverse implementazioni possibili delle fasi Ora, scomponi il diagramma e inizia a costruire i pezzi. ## Pianificazione con flusso pianificato Flusso pianificato offre diversi vantaggi come meccanismo di pianificazione: - I flussi pianificati possono essere inseriti in pacchetti e distribuiti come metadati. Questo non è vero per i processi pianificati tramite Apex (o tramite la pagina Processi pianificati). - L'elemento Attesa è fondamentale per i framework che richiedono chiamate. Utilizzandola nel flusso, le chiamate non sono necessarie nella parte Invocabile del framework. - La granularità della pianificazione soddisfa i requisiti: l'intervallo minimo per i flussi pianificati è giornaliero. Se è necessaria una frequenza più alta (ad esempio, oraria), riconsiderare Flusso pianificato per questo requisito. Un'altra considerazione quando si configura il flusso pianificato è il gating dell'ambiente. Prima di invocare l'azione Apex, aggiungere un elemento Decisione che valuta la variabile `{!$Api.Enterprise_Server_URL_100}`. Ciò garantisce che il processo venga eseguito solo negli ambienti previsti, ad esempio UAT e Produzione. Questo schema è importante perché i Sandbox vengono aggiornati di frequente o creati di recente durante l'SDLC e, senza un controllo esplicito dell'ambiente, un flusso pianificato potrebbe essere eseguito involontariamente in ambienti in cui il framework non è progettato per l'esecuzione. L'uso dell'operatore `contains` nell'elemento Decisione rende l'impostazione resiliente alle future creazioni Sandbox o modifiche degli URL. Infine, considerare in che modo il framework dovrebbe acquisire gli errori. Aggiungere sempre un percorso di errore quando il flusso chiama un'azione; ad esempio, è possibile collegare i guasti all'azione "Aggiungi voce registro" [di Nebula Logger](https://www.nebulalogger.com/). Nebula Logger scrive i registri negli oggetti personalizzati, quindi i clienti devono sapere che i dati dei registri consumano memoria dell'organizzazione: per impostazione predefinita, i registri vengono memorizzati per 14 giorni all'interno di un'organizzazione e quindi puliti; questo periodo di conservazione è configurabile. Nebula Logger utilizza anche Eventi piattaforma per pubblicare i registri, quindi le voci di registro vengono salvate indipendentemente dalla transazione di elaborazione dati principale, in modo da garantire l'acquisizione degli errori anche se l'azione Flusso principale o Apex viene ritirata. I clienti devono valutare il volume dei registri previsto e i requisiti di conservazione quando valutano l'aggiunta di un framework di registrazione. Ecco come si presenta il flusso: Il flusso pianificato contenente un elemento Decisione per l'esecuzione o meno, un elemento Pausa per consentire le chiamate e l'azione Apex invocabile chiamata insieme al percorso di errore Nebula Logger Passiamo alle prime parti di Apex Code con il requisito di pianificazione ora soddisfatto. ## Creazione di un'interfaccia fase Definire un'interfaccia `Step`: ```java public interface Step { void execute(); void finalize(); String getName(); Boolean shouldRestart(); } ``` Per questo articolo, l'interfaccia `step` viene visualizzata come classe esterna per chiarezza. Il framework è flessibile: i team possono organizzare l'interfaccia e le relative implementazioni utilizzando qualsiasi schema di creazione pacchetti Apex preferito, a condizione che tutte le classi Fase facciano riferimento alla stessa interfaccia. Ci sono alcune cose da notare sui metodi definiti nella nostra interfaccia: - La `execute`, anche se al momento non richiede argomenti, migliora quando si passa una classe di `State` (o interfaccia) per orchestrare i dati tra le fasi quando l'ordine è importante. - `getName` potrebbe restituire un valore `System.Type` anziché un `String`. L'obiettivo è fornire al livello di orchestrazione un modo per registrare i nomi delle fasi senza esporre altre proprietà. Ecco la prima implementazione concreta che mostra come questi pezzi si adattano. Con un'eccezione in seguito, si consiglia di utilizzare Queueable Apex per implementare l'elaborazione asincrona in Apex; Batch Apex è in genere inutile (e i metodi di `@future` sono scoraggiati). Queueable Apex si avvia rapidamente e, con i cursori Apex, presenta molti vantaggi rispetto a Batch Apex. ### Un'implementazione Apex Cursor-Like I [cursori Apex](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_cursors.htm) offrono un'alternativa moderna al modello Apex batch tradizionale. Analogamente all'elaborazione batch, un'implementazione Cursore può recuperare i record in blocchi (fino a 2.000 per batch). Tuttavia, i Cursori consentono più recuperi all'interno di una singola transazione, consentendo una produttività significativamente superiore per le operazioni a volume elevato. Quando si adottano i Cursori come parte di questo framework, i team devono essere consapevoli delle limitazioni attuali dei test e della possibilità di falsificazione. Il comportamento del cursore nei test può essere diverso dal comportamento di produzione, quindi è importante progettare strategie di test che evitino di affidarsi ai componenti interni del cursore e convalidino invece la logica di orchestrazione ai confini. Man mano che la piattaforma si evolve, queste aree continueranno a migliorare, ma le linee guida principali rimangono: I cursori offrono prestazioni superiori e un sovraccarico di orchestrazione ridotto rispetto ad Apex batch per molti casi d'uso. Per definire un confine chiaro tra il Cursore fornito dal sistema e il proprio codice, si consiglia di creare una rappresentazione simile al Cursore quando si implementa l'interfaccia `Step`. Considerare questo codice: ```java public inherited sharing abstract class CursorStep implements Step { private static final Integer MAX_CHUNK_SIZE = 2000; protected Cursor cursor; private Integer chunkSize = System.Limits.getLimitDMLRows(); private Integer position = 0; protected abstract Cursor getCursor(); protected abstract void innerExecute(List records); public abstract String getName(); public virtual CursorStep withChunkSize(Integer chunkSize) { this.chunkSize = chunkSize; return this; } public void execute() { this.cursor = this.cursor ?? this.getCursor(); this.cursor.setFetchesPerTransaction(this.getFetchesPerTransaction()); List records = new List(); if (this.shouldAdvance()) { records = this.cursor.fetch(this.position, this.chunkSize); this.position += this.chunkSize; } this.innerExecute(records); } public virtual void finalize() { Logger.info('finished cursor step for ' + this.getName()); } public virtual Boolean shouldRestart() { return this.position < this.cursor.getNumRecords(); } protected virtual Integer getFetchesPerTransaction() { Integer maxRecordsPerFetchCall = 2000; if (this.chunkSize < maxRecordsPerFetchCall) { return this.chunkSize; } // Integer division rounds down // which is perfect for our use-case return this.chunkSize / maxRecordsPerFetchCall; } protected virtual Boolean shouldAdvance() { return true; } } ``` Notare la classe `Cursor`. I cursori Apex sono esempi di `Database.Cursor`, ma la nostra implementazione di `Cursor` ci offre flessibilità per risolvere le carenze dei cursori. Ecco l'implementazione: ```java public virtual without sharing class Cursor { private static final Integer MAX_FETCHES_PER_TRANSACTION = Limits.getLimitFetchCallsOnApexCursor(); @TestVisible private static Integer maxRecordsPerFetchCall = 2000; private Integer cursorNumRecords; private Integer fetchesPerTransaction = MAX_FETCHES_PER_TRANSACTION; private final Database.Cursor cursor; public Cursor( String finalQuery, Map bindVars, System.AccessLevel accessLevel ) { try { this.cursor = Database.getCursorWithBinds(finalQuery, bindVars, accessLevel); } catch (FatalCursorException e) { Logger.newEntry( System.LoggingLevel.WARN, 'Error creating cursor. This can happen if there' + ' are no records returned by the query: ' + e.getMessage() ); } } public Cursor setFetchesPerTransaction(Integer possibleFetchesPerTransaction) { // Handle accidental round downs from Integer division if (possibleFetchesPerTransaction == 0) { return this; } if (possibleFetchesPerTransaction > MAX_FETCHES_PER_TRANSACTION) { Logger.newEntry( System.LoggingLevel.DEBUG, 'Fetches per transaction: ' + possibleFetchesPerTransaction + ' exceeded platform max fetches per transaction: ' + MAX_FETCHES_PER_TRANSACTION + ', defaulting to platform max' ); possibleFetchesPerTransaction = MAX_FETCHES_PER_TRANSACTION; } this.fetchesPerTransaction = possibleFetchesPerTransaction; return this; } @SuppressWarnings('PMD.EmptyStatementBlock') protected Cursor() { } public virtual List fetch(Integer start, Integer advanceBy) { if (this.getNumRecords() == 0) { Logger.newEntry( System.LoggingLevel.DEBUG, 'Bypassing fetch call, no records to fetch' ); return new List(); } Integer localStart = start; List results = new List(); while ( Limits.getFetchCallsOnApexCursor() < this.fetchesPerTransaction && results.size() < this.getNumRecords() && localStart < start + advanceBy ) { Integer actualAdvanceBy = this.getAdvanceBy(localStart, advanceBy); results.addAll(this.cursor?.fetch(localStart, actualAdvanceBy) ?? new List()); localStart += actualAdvanceBy; } return results; } public virtual Integer getNumRecords() { this.cursorNumRecords = this.cursorNumRecords ?? this.cursor?.getNumRecords() ?? 0; return this.cursorNumRecords; } protected Integer getAdvanceBy(Integer start, Integer advanceBy) { Integer possibleFetchSize = Math.min(advanceBy, this.getNumRecords() - start); if (possibleFetchSize > maxRecordsPerFetchCall) { Logger.newEntry( System.LoggingLevel.DEBUG, 'Fetch size: ' + possibleFetchSize + ' exceeded platform max fetch size of ' + maxRecordsPerFetchCall + ', defaulting to max fetch size' ); possibleFetchSize = maxRecordsPerFetchCall; } else if (possibleFetchSize < 0) { possibleFetchSize = 0; } return possibleFetchSize; } } ``` Per il resto di questo articolo, omettiamo le dichiarazioni `sharing` quando ci riferiamo alle classi Apex. In pratica, assicurarsi che le classi di livello superiore utilizzino esplicitamente con o senza condivisione per conformarsi al modello di oggetto e alle autorizzazioni. Si noti inoltre che l'implementazione di `Cursor` delega all'`Database.Cursor` piattaforma, con ulteriori vantaggi descritti di seguito. Innanzitutto, ecco i test corrispondenti: ```java @IsTest private class CursorTest { @IsTest static void itCapsAdvanceByArgument() { String accountName = 'helloWorld!'; insert new Account(Name = accountName); String query = 'SELECT Name FROM Account WHERE Name = :bindVar0'; Map bindVars = new Map{ 'bindVar0' => accountName }; Cursor instance = new Cursor(query, bindVars, System.AccessLevel.SYSTEM_MODE); Assert.areEqual(1, instance.getNumRecords()); Assert.areEqual(accountName, instance.fetch(0, 1000).get(0).get('Name')); Assert.areEqual(1, System.Limits.getApexCursorRows()); } @IsTest static void itCapsMaxRecordsPerFetchCall() { Cursor.maxRecordsPerFetchCall = 20; Integer oneMoreThanMaxFetch = Cursor.maxRecordsPerFetchCall + 1; List accounts = new List(); for (Integer i = 0; i < oneMoreThanMaxFetch; i++) { accounts.add(new Account(Name = 'Fetch ' + i)); } insert accounts; Exception ex; List results; Cursor instance = new Cursor( 'SELECT Id FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ); try { results = instance.fetch(0, oneMoreThanMaxFetch); } catch (System.InvalidParameterValueException e) { ex = e; } Assert.areEqual(null, ex?.getMessage()); Assert.areEqual(2, Limits.getFetchCallsOnApexCursor()); Assert.areEqual(oneMoreThanMaxFetch, results.size()); } @IsTest static void itFetchesMultipleTimesPerTransactionWhenMoreThanMaxFetch() { Cursor.maxRecordsPerFetchCall = 20; List accounts = new List(); Set expectedFetchNames = new Set(); for (Integer i = 0; i < Cursor.maxRecordsPerFetchCall + 1; i++) { String accountName = 'Fetch' + i; expectedFetchNames.add(accountName); accounts.add(new Account(Name = accountName)); } insert accounts; Integer oneMoreThanMaxFetch = Cursor.maxRecordsPerFetchCall + 1; Cursor instance = new Cursor( 'SELECT Name FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ); List results = instance.setFetchesPerTransaction(2).fetch(0, oneMoreThanMaxFetch); Assert.areEqual(Cursor.maxRecordsPerFetchCall + 1, results.size()); Assert.areEqual(2, Limits.getFetchCallsOnApexCursor()); Set actuallyFetchedNames = new Set(); for (Account account : (List) results) { actuallyFetchedNames.add(account.Name); } Assert.areEqual(expectedFetchNames, actuallyFetchedNames); } @IsTest static void itFetchesMultipleTimesPerTransaction() { Cursor.maxRecordsPerFetchCall = 1; insert new List{ new Account(Name = 'One'), new Account(Name = 'Two') }; Cursor instance = new Cursor( 'SELECT Id FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ) .setFetchesPerTransaction(2); List results = instance.fetch(0, 2); Assert.areEqual(2, instance.getNumRecords()); Assert.areEqual(2, results.size()); results = instance.fetch(2, 1); Assert.areEqual(0, results.size()); } @IsTest static void fetchesCorrectAmountOfRecords() { List accounts = new List(); for (Integer i = 0; i < 10; i++) { accounts.add(new Account(Name = 'Fetch ' + i)); } insert accounts; Cursor instance = new Cursor( 'SELECT Id FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ) .setFetchesPerTransaction(10); List results = instance.fetch(0, 2); Assert.areEqual(2, results.size(), '' + results); Assert.areEqual(1, Limits.getFetchCallsOnApexCursor()); } @IsTest static void doesNotExceedPlatformMaxFetch() { List accounts = new List(); for (Integer i = 0; i < 101; i++) { accounts.add(new Account(Name = 'Fetch ' + i)); } insert accounts; Test.startTest(); Cursor instance = new Cursor( 'SELECT Id FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ) .setFetchesPerTransaction(100); Integer counter = 0; List results; while (counter <= 100) { results = instance.fetch(counter, counter + 1); counter++; } Test.stopTest(); Assert.areEqual(101, counter); Assert.areEqual(0, results.size()); } } ``` Rendendo virtuali i `Cursor`, le implementazioni di `CursorStep` concrete possono funzionare senza `Database.Cursor` quando non è necessario ripetere un insieme di record di grandi dimensioni, come quando si restituisce un `System.Iterable` anziché un `Database.QueryLocator` in Batch Apex. Ecco un esempio: ```java public abstract class CursorLikeImplementation extends CursorStep { private final Cursor cursorLike; public CursorLikeImplementation(List previouslyRetrievedRecords) { this.cursorLike = new CursorLike(previouslyRetrievedRecords); } public override String getName() { return CursorLikeImplementation.class.getName(); } public override Cursor getCursor() { return this.cursorLike; } private class CursorLike extends Cursor { private final List records; public CursorLike(List records) { super(); this.records = records; } public override List fetch(Integer position, Integer chunkSize) { // clone, to keep the underlying list type List clonedRecords = this.records.clone(); clonedRecords.clear(); for (Integer i = position; i < this.getAdvanceBy(position, chunkSize); i++) { clonedRecords.add(this.records[i]); } return clonedRecords; } public override Integer getNumRecords() { return this.records.size(); } } } ``` Tenere presente che, poiché questa classe è anche astratta, lascia l'implementazione concreta di `innerExecute` alle sottoclassi. Esiste anche un'alternativa alla sottoclasse interna `CursorLike`. Se si sa che le versioni concrete di un passaggio come questo non supereranno altri limiti del governor, è possibile restituire `this.records` da `CursorLike.fetch` e sostituire il `CursorStep.shouldRestart()` controllante per restituire false. Ciò consente di eseguire l'iterazione su un elenco delimitato solo dal limite di heap Apex di 12 MB per transazione asincrona. ### Altre possibili implementazioni basate su fasi La nostra implementazione basata sul cursore offre molta flessibilità quando si esegue la paginazione su grandi quantità di dati. L'interfaccia `Step`, nel frattempo, ci offre la flessibilità di descrivere e incapsulare fasi di ogni tipo. Considerare una fase basata su flusso: ```java public virtual class FlowStep implements Step { private final Invocable.Action specificFlow; private Boolean shouldRestart = false; public FlowStep(String specificFlowName, Map inputs) { this.specificFlow = Invocable.Action.createCustomAction('flow', specificFlowName); this.specificFlow.setInvocations(new List>{ inputs }); } public void execute() { List results = this.specificFlow.invoke(); for (Invocable.Action.Result result : results) { if (result.isSuccess()) { Map outputParams = result.getOutputParameters(); Object potentialShouldRestartValue = outputParams.get('shouldRestart'); // Flow does not enforce Booleans being initialized // so a null check is sadly necessary here if (potentialShouldRestartValue != null) { this.shouldRestart = this.shouldRestart || Boolean.valueOf(potentialShouldRestartValue); } } else { List errorMessages = new List(); for (Invocable.Action.Error error : result.getErrors()) { errorMessages.add( 'Error code: ' + error.getCode() + ', error message: ' + error.getMessage() ); } Logger.error( 'An error occurred within your auto-launched flow:\n' + String.join(errorMessages, '\n\t') ); } } } public virtual void finalize() { Logger.info(this.getName() + ' finished processing'); } public String getName() { return FlowStep.class.getName() + ':' + this.specificFlow.getName(); } public Boolean shouldRestart() { return this.shouldRestart; } } ``` Poiché i flussi non possono restituire parametri di output conformi a un tipo definito da Apex, viene verificato un parametro di output `shouldRestart` prima di utilizzarlo. Alcuni passaggi potrebbero essere contrassegnati dalla funzione. È possibile implementare la logica per decidere quali fasi includere, oppure utilizzare una fase no-op per una funzione disabilitata. Lo [schema Oggetto nullo](https://refactoring.guru/introduce-null-object) è un metodo comune per ridurre la complessità all'interno del livello di orchestrazione: ```java @SuppressWarnings('PMD.EmptyStatementBlock') public class NoOpStep implements Step { // The null object pattern is commonly implemented // as a singleton to reduce memory consumption public static final NoOpStep SELF { get { SELF = SELF ?? new NoOpStep(); } private set; } public void execute() { } public void finalize() { } String getName() { return NoOpStep.class.getName(); } Boolean shouldRestart() { return false; } } ``` Ora abbiamo un bel po' di elementi base su cui lavorare. Vediamo il livello di orchestrazione responsabile dell'iterazione delle fasi. ## Creazione di un processore di fase Il processore è un punto di flessione nell'architettura. Dobbiamo decidere chi definisce quali fasi vengono inizializzate e dove. Le opzioni includono: - Chiedere al processore di definire le fasi da mappare alla logica aziendale. Questa opzione è semplice, ma la scalabilità è scarsa. - Definire la mappatura con i metadati personalizzati (CMDT). I campi Relazione metadati non supportano `ApexClass`, che associa in modo non preciso l'ortografia dei nomi delle classi nell'impostazione dei processi aziendali. È possibile ridurre il rischio per l'amministratore impostando il campo come elenco di selezione e convalidando l'esistenza del tipo (`Type.forName()` o eseguendo query su `ApexClass`), ma poiché i record CMDT non supportano i trigger, la convalida avviene in fase di esecuzione. Questo percorso è testabile, ma gli amministratori possono comunque creare record CMDT solo in produzione. - Definire la mappatura con i record. I non amministratori possono configurare le fasi, ma le distribuzioni diventano più complesse e gli ambienti possono andare alla deriva. Procedere con cautela. C'è una famosa citazione da [Clean Code](https://www.oreilly.com/library/view/clean-code-a/9780136083238/) su come gestire questo particolare pezzo di complessità: > La soluzione a questo problema è seppellire la dichiarazione di `switch` [per fare oggetti] nel seminterrato di una fabbrica astratta, e non farla mai vedere a nessuno. Tenendo presente ciò, e poiché il nostro numero attuale di fasi è ben definito e difficilmente crescerà troppo, è normale che il processore di fasi sia anche la fabbrica per le fasi. Questo può utilizzare un enum per guidare l'istruzione switch: ```java public enum StepType { TYPE_ONE, TYPE_TWO, TYPE_THREE, TYPE_FOUR // etc ... } ``` E poi per la nostra `StepProcessor`: ```java public StepProcessor implements System.Queueable, System.Finalizer, Database.AllowsCallouts { private final List steps = new List(); private Step currentStep; public StepProcessor setSteps(List stepTypes) { for (StepType type : stepTypes) { switch on type { WHEN TYPE_ONE { this.addTypeOneSteps(); } WHEN TYPE_TWO { this.addTypeTwoSteps(); } // ... etc } } this.cleanSteps(); return this; } public void execute(System.QueueableContext context) { this.currentStep = this.currentStep ?? this.steps.remove(0); if (context != null) { System.attachFinalizer(this); Logger.setAsyncContext(context); } Logger.info('Executing step ' + this.currentStep.getName()); try { this.currentStep.execute(); } catch (Exception e) { Logger.exception('Unexpected exception', e); } Logger.info('Finished executing step ' + this.currentStep.getName()); Logger.saveLog(); } public void execute(System.FinalizerContext context) { Logger.info('Executing finalizer for step ' + this.currentStep.getName()); Logger.setAsyncContext(context); switch on context?.getResult() { when UNHANDLED_EXCEPTION { // see the note below about this logging paradigm Logger.warn( 'Failed to run on step' + this.currentStep, context?.getException() ); } when else { this.currentStep.finalize(); if (this.currentStep.shouldRestart()) { this.kickoff(); } else if (this.steps.isEmpty() == false) { this.currentStep = this.steps.remove(0); this.kickoff(); } else { Logger.info('Finished executing steps'); } } } Logger.info( 'Finished executing finalizer for step ' + this.currentStep.getName() ); Logger.saveLog(); } public String kickoff() { return this.steps.isEmpty() ? null : System.enqueueJob(this); } private void cleanSteps() { for (Integer reverseIndex = this.steps.size() - 1; reverseIndex >= 0; reverseIndex--) { if (this.steps[reverseIndex] instanceof NoOpStep) { this.steps.remove(reverseIndex); } } } private void addTypeOneSteps() { this.steps.addAll( new List { new ExampleCursorStepOne(), new ExampleCursorStepTwo() } ); } private void addTypeTwoSteps() { this.steps.addAll( new List { new FlowStep(' ExampleInvocableName', new Map( 'exampleParameter' => true) ), new ExampleCursorStepThree() } ); } } ``` I metodi di fabbrica visualizzati, ad esempio `addTypeOneSteps()`, possono delegare preoccupazioni come la segnalazione delle funzioni; `cleanSteps()` esegue un controllo singolo sulle fasi raccolte per assicurarsi che non vi siano fasi "vuote" prima di passare alla vera asincrona. Potrebbe essere simile a questo: ```java private Step getStepOrDefault(String customPermissionName, Step defaultStep) { if (System.FeatureManagement.checkPermission(customPermissionName)) { return defaultStep; } return NoOpStep.SELF; } ``` Non abbiamo più discusso della gestione degli errori dopo aver menzionato Nebula Logger nella sezione Flusso pianificato. Questo perché `System.Finalizer` ci consente di coprire la registrazione per tutte le condizioni di errore senza aggiungere una gestione specifica degli errori in ogni fase. Ogni `Step` si concentra sull'esecuzione, mentre noi registriamo e revochiamo eventuali percorsi non felici in modo che emergano nei test di unità. Questo supporta l'iterazione sicura e gli avvisi a livello di produzione (utilizzando il [plug-in Slack Logger per Nebula](https://github.com/jongpie/NebulaLogger/tree/main/nebula-logger/plugins/slack) per tutti i registri WARN ed ERROR). Una nota sulla registrazione degli errori: il passaggio dell'istanza della fase nei messaggi di registro presuppone un livello di Trust in ciò che diventa visibile nei registri. Il `toString()` predefinito per le classi Apex include tutte le proprietà statiche e a livello di istanza nel messaggio. Questo può essere auspicabile, oppure può far trapelare informazioni sensibili. Anche se la registrazione e la sicurezza non sono al centro dell'attenzione, tenere presente che per alcuni sistemi, l'osservanza di un'interfaccia come `Step` può anche comportare la forzatura di una sostituzione per `toString()`. ```java public interface Step { void execute(); void finalize(); String getName(); Boolean shouldRestart(); String toString(); } ``` Tale metodo impone a ogni creatore di oggetti di decidere che cosa è consentito stampare, il che può essere auspicabile. A livello di registrazione: a livello di `StepProcessor`, viene utilizzato `INFO`, il livello massimo senza errori. Man mano che si aumenta la granularità dell'applicazione, i livelli di registrazione dovrebbero diminuire di conseguenza. Singole fasi potrebbero utilizzare `DEBUG` per informazioni di alto livello, con `FINE`, `FINER` e `FINEST` riservati a output sempre più dettagliati. Registrare è un'arte quanto una scienza, ma seguire questi principi aiuta a mantenere i registri coerenti e utili. ### Gestione di ulteriori complessità all'interno del Processore fase Prima di procedere, riflettiamo brevemente sulla decisione di fare in modo che il nostro processore di fasi ospiti la logica per cui vengono utilizzati i passaggi. In una base di codice di grandi dimensioni, valutare la possibilità di rendere i `StepProcessor` virtuali o astratti e fare in modo che le sottoclassi individuino passaggi specifici per stabilire una separazione corretta delle preoccupazioni. ## Livello invocabile Apex Lo strumento di pianificazione alla fine invoca Apex. Con il resto dell'impostazione completato, la sezione Apex invocabile può decidere quali fasi eseguire e passare il `List` al processore: ```java public class DailyJobExecutor { @InvocableMethod(label='Execute Daily Job') public static void executeJob() { Logger.info('Executing daily Job'); List correspondingTypes = new List(); // based on [business logic], determine which step types // should be included for any daily invocation if (correspondingTypes.isEmpty() == false) { try { new StepProcessor().setSteps(correspondingTypes).kickoff(); } catch (Exception ex) { Logger.exception('Error starting job', ex); } } } Logger.saveLog(); } ``` Questa è una parte semplice dell'equazione: utilizzare record, dati o logica per determinare quali tipi di fasi eseguire. L'azione invocabile è semplice perché la complessità è stata incapsulata altrove. Abbiamo anche protetto da eccezioni impreviste e reso ogni pezzo facile da testare in isolamento. ## Gestione dei ritardi prima della chiamata a Slack L'[SDK Apex Slack](https://developer.salesforce.com/docs/platform/salesforce-slack-sdk/guide/overview.html) esula dall'ambito di questo articolo, ma vale la pena rivedere un potenziale intoppo dei requisiti: informare le persone in alto nella gerarchia dei ruoli in base a un ritardo configurabile. Sulla carta, questo è semplice e potresti (correttamente) considerare la `System.enqueueJob(this)` nel `StepProcessor`. Con [System.AsyncOptions](https://developer.salesforce.com/docs/atlas.en-us.apexref.meta/apexref/apex_class_System_AsyncOptions.htm), la nostra inclinazione iniziale era di utilizzare il sovraccarico di `enqueueJob` per soddisfare questo requisito. Per ora, invece, il ritardo massimo via `System.AsyncOptions.MinimumQueueableDelayInMinutes` è di 10 minuti. Poiché il requisito è 120 minuti, rimangono alcune opzioni. Un approccio ingenuo potrebbe essere il seguente: ```java public class ExampleDelayedNotifier implements Step { private final List notifications = new List(); private final Slack.BotClient botClient = Slack.App .getAppByKey('some-slack-app-key') .getBotClientForTeam('slack team id'); // account for the initial delay, // so 120 - 10 = 110 private Integer delayMinutes = 110; public void execute() { if ( this.delayInMinutes > 0) { return; } Integer maximumAllowedCallouts = 100; while (this.notifications.isEmpty() == false && maximumAllowedCallouts > 0) { this.botClient.chatPostMessage(this.notifications.remove(0)); maximumAllowedCallouts--; } } public void finalize() { this.delayInMinutes -= 10; } public String getName() { return ExampleDelayedNotifier.class.getName(); } public Boolean shouldRestart() { return this.delayInMinutes > 0 || this.notifications.isEmpty() == false; } } ``` In pratica, il ritardo verrebbe passato a questa classe perché è determinato dalla configurazione. Questo approccio non è consigliabile a meno che non si sia certi che sarà sempre presente un solo tipo di notifica ritardata. Viene masterizzato in 11 processi asincroni aggiuntivi prima di iniziare (o più, se il ritardo aumenta). Quel costo potrebbe andare bene per un lavoro, non per molti. È anche necessario aggiungere un metodo all'interfaccia `Step` in modo che ogni fase possa indicare al processore quanto tempo attendere prima di riavviare, il che aggiunge rumore. Questo ci lascia con due possibilità interessanti: - È possibile inserire la fase ritardata nel framework lavorativo esistente se è già stato pianificato un processo di polling a un intervallo appropriato. Dovrebbe anche essere possibile che il ritardo specificato arrivi fino a 15 minuti dopo (15 minuti è l'intervallo di aggiornamento minimo per un'espressione CRON pianificata Apex). Corrisponde grosso modo all'esempio Apex invocabile; la pianificazione viene eseguita tramite Apex. In altre parole, è possibile riutilizzare la stessa architettura basata su `Step` per elaborare i record in base a un'indicazione oraria "Inizia dopo" e decidere quali fasi utilizzare in base a un elenco di selezione o a una mappatura elenco di selezione a selezione multipla ai valori `StepType` enum visualizzati in precedenza. - In alternativa, se si preferisce definire una classe Apex esterna aggiuntiva, ripiegare su Batch Apex (a differenza di Queueable Apex, che supporta le classi interne, le classi Batch Apex devono essere classi esterne) utilizzando `System.scheduleBatch()`. Si consideri l'esempio Batch Apex. Benché in genere si raccomandi Queueable Apex per flessibilità e controllo, questo è un caso in cui Batch Apex regna ancora sovrano: ```java public class DelayedNotifier implements Database.Batchable { private final StepProcessor processor = new StepProcessor(); public Iterable start(Database.BatchableContext bc) { return new List(); } @SuppressWarnings('PMD.EmptyStatementBlock') public void execute(Database.BatchableContext bc, Object scope) { // we don't need to actually do anything in execute, // we just need to start up the processor in finish } public void finish(Database.BatchableContext bc) { try { // you can imagine Notifier as an elided, // simpler version of the naive implementation // we showed above, now only focused on sending messages this.processor.setSteps(new List{ new Notifier() }).kickoff(); } catch (Exception ex) { Logger.exception('Unexpected error', ex); } finally { Logger.saveLog(); } } } ``` E poi, nel `StepProcessor`, si immagini che il metodo di `addTypeOneSteps()` mostrato in precedenza venga aggiornato con questo passaggio ritardato: ```java public StepProcessor implements System.Queueable, System.Finalizer, Database.AllowsCallouts { // .... unchanged top of class elided private void addTypeOneSteps() { this.steps.addAll( new List { new ExampleCursorStepOne(), new ExampleCursorStepTwo(), new DelayedNotifierStep() } ); } // ... private class DelayedNotifierStep implements Step { private final DelayedNotifier delayedNotifier = new DelayedNotifier(); // again — in practice this value would also be passed in private final Integer delayInMinutes = 120; public void execute() { System.scheduleBatch( this.delayedNotifier, 'Delayed notifier: ' + System.now().getTime(), this.delayInMinutes ); } public void finalize() { Logger.debug('Nothing to finalize, batch scheduled'); } public String getName() { return DelayedNotifierStep.class.getName(); } public Boolean shouldRestart() { return false; } } } ``` Anche se in genere non raccomandiamo di fare così tanti salti mortali, questo ritardo della fase diventa un altro elemento fondamentale riutilizzabile. Finché non sono consentiti ritardi più lunghi in Queueable Apex, rappresenta anche il modo più semplice per produrre questo effetto (senza un meccanismo di polling, come discusso). ## Conclusione Per soddisfare i requisiti, abbiamo utilizzato la progettazione orientata agli oggetti e creato un sistema che si espanderà bilanciando i costi di costruzione e manutenzione a lungo termine. Benché la dichiarazione e l'istanziazione delle fasi possano in ultima analisi superare il loro posto in `StepProcessor`, in questo caso l'indebitamento tecnico aggiuntivo è minimo. Con `FlowStep`, amministratori e sviluppatori possono decidere insieme quando le soluzioni no-code o pro-code hanno più senso. Utilizzando l'interfaccia `System.Finalizer` all'interno del framework Queueable di Apex, insieme a Nebula Logger, abbiamo creato un sistema robusto e testabile che ci avvisa in caso di errori imprevisti anche se le fasi future non prevedono una registrazione esplicita. Per noi, questo sistema sta felicemente snocciolando numeri e riducendo costi e complessità. Ci ha anche fornito informazioni preziose sul comportamento dei Cursori Apex sotto carichi di lavoro reali, aiutandoci a perfezionare il nostro approccio e migliorando la funzione stessa. Scomponendo carichi di lavoro complessi a volume elevato in fasi di esecuzione modulari, il framework di elaborazione asincrona basata su fasi trasforma i vincoli della piattaforma in vantaggi ingegnerizzati, consentendo prestazioni, osservabilità e governance prevedibili su scala aziendale. Le fasi possono essere impostate sia dagli amministratori che dagli sviluppatori e, in entrambi i casi, gli autori delle fasi possono concentrarsi tranquillamente sull'osservanza dei limiti di base del governor della piattaforma (ad esempio le righe DML e le righe di query recuperate) senza doversi preoccupare di come scalare ogni fase. ## Percorso in avanti Per rendere operativo e adottare questo schema nelle implementazioni aziendali, gli architetti dovrebbero: - **Valutare le automazioni esistenti** per identificare le aree in cui l'orchestrazione asincrona può contribuire a migliorare le prestazioni e l'osservabilità. - **Suddividere grandi processi** in fasi eseguibili discrete e indipendenti con obiettivi di elaborazione chiari e punti autore discreti (come Flusso o Apex). - **Definire e raggruppare** i tipi di fasi per accelerare il riutilizzo e la standardizzazione delle fasi nelle unità operative. - È possibile **pilotare l'approccio** con nuovi processi o automazioni esistenti. Potresti essere sorpreso di scoprire quanti casi edge trovi gratuitamente a portata di mano, cura della registrazione integrata e osservabilità! ## Informazioni sull'autore James Simone è un Principal Software Engineer di Salesforce e ha più di un decennio di esperienza di lavoro sulla piattaforma. Era un cliente Salesforce — e titolare di un prodotto — prima di passare allo sviluppo e dal 2019 scrive approfondimenti tecnici su Salesforce all’interno [di The Joys Of Apex](https://www.joysofapex.com/). In precedenza ha pubblicato articoli sul [blog Salesforce Developer](https://developer.salesforce.com/content-archive?authors=James%20Simone&content-type=Blogs&language=English) e anche [sul blog Salesforce Engineering](https://engineering.salesforce.com/author/james-simone/). ## Panoramica della guida Esistono molti modi per accedere, sincronizzare e condividere i dati tra Salesforce e i sistemi esterni. Ma non tutti gli strumenti sono adatti al tuo progetto specifico. Questa guida illustra il panorama degli strumenti di integrazione dei dati disponibili in Salesforce. Offre anche consigli sugli strumenti (o combinazioni di strumenti) più appropriati in un determinato caso d'uso, nonché indicazioni sugli strumenti da evitare per scenari specifici. Questa guida alle decisioni si concentra sulle integrazioni a livello di dati che coinvolgono Salesforce. In particolare, copre i seguenti casi d'uso di integrazione dei dati: - Da Salesforce a sistemi esterni - Sistemi esterni a Salesforce - Da organizzazione Salesforce a organizzazione Salesforce Questi sono solo alcuni dei problemi di integrazione che Salesforce Architects deve affrontare, quindi prevediamo di aggiungere altre guide alle decisioni incentrate sull'integrazione basata sugli eventi, sulla creazione di flussi di lavoro efficaci rivolti ai clienti o ai dipendenti utilizzando l'integrazione dei processi e così via. Infine, è importante notare che molti degli strumenti e degli approcci descritti qui possono essere utilizzati per risolvere le sfide di integrazione in tutta l'azienda, ma tali utilizzi esulano dall'ambito di questa guida. ### Takeaway - **Evitare repliche inutili dei dati.** A meno che i dati non debbano risiedere assolutamente in Salesforce, considerare invece la virtualizzazione dei dati con Salesforce Connect. Un maggior numero di dati nell'organizzazione determina volumi di dati più elevati, che possono influire negativamente [sulle prestazioni](/docs/architect/it-it/well-architected/guide/reliable#prestazioni) e aumentare l'indebitamento tecnico. Se i dati si trovano già in Salesforce e sono necessari in un sistema esterno, evitare di copiarli in un sistema esterno a meno che non siano assolutamente necessari. Chiedere invece al sistema esterno di accedere ai dati tramite le API Salesforce. - **Utilizzare MuleSoft o altre soluzioni Enterprise Service Bus (ESB) o Extract-Transform-Load (ETL), se disponibili e parte del panorama esistente.** Poiché questi strumenti sono creati per supportare la migrazione e la trasformazione dei dati, spesso dispongono di potenti funzionalità che consentono di riutilizzare le integrazioni in tutta l'azienda, mantenere una governance più forte e centralizzare la gestione delle integrazioni. In questa guida, ovunque MuleSoft Anypoint sia consigliato, valutare se la soluzione ESB/ETL esistente sarà sufficiente. - **Armonizzare i dati provenienti da fonti diverse con Data 360 e Data Cloud One.** Tramite il modello di dati Customer 360, la risoluzione dell'identità, la federazione dei dati e altre funzioni, Data 360 consolida i dati di Salesforce e di altri sistemi esterni in una visualizzazione unificata del cliente. Inoltre, con [Data Cloud One](/docs/architect/it-it/fundamentals/guide/data360_integration_patterns_and_practices.html#unified-multi-org-data-platform-with-data-cloud-one), gli utenti di altre organizzazioni Salesforce possono accedere in modo sicuro ai dati condivisi virtualmente da Data 360 tramite gli spazi dati. - Spostare i dati tra le organizzazioni utilizzando **azioni e attivazioni Data 360.** Dopo che i dati sono stati inseriti da organizzazioni diverse in Data 360, le [azioni e attivazioni](/docs/architect/it-it/fundamentals/guide/data360_integration_patterns_and_practices.html#data-activation-patterns--data-outbound) dei dati possono sincronizzarli con un'altra organizzazione. Questo approccio può essere molto utile per le integrazioni con le organizzazioni Marketing Cloud. - Estrarre e spostare i dati utilizzando **MuleSoft Anypoint.** MuleSoft Anypoint può essere utilizzato per estrarre i dati da Data 360 utilizzando l'API Connect e l'API Data Graph e spostarli in un'altra organizzazione Salesforce. Senza Data 360, MuleSoft Anypoint può essere utilizzato anche quando i dati devono essere spostati tra le organizzazioni senza essere replicati in Data 360. - **Prestare attenzione se si sceglie di creare con Messaggistica in uscita.** Salesforce continuerà a supportare Messaggistica in uscita entro le attuali capacità funzionali, ma non prevede di effettuare ulteriori investimenti in questa tecnologia. - **La licenza utente integrazione con profilo "Solo API" è sempre consigliata per tutte le integrazioni.** Salesforce consiglia inoltre di utilizzare le applicazioni client esterne (a favore delle applicazioni connesse o dell'accesso SOAP) come schemi AuthN e AuthZ correttamente autorizzati per tutte le integrazioni. ## Considerazioni comuni per la scelta degli strumenti di integrazione dei dati Prima di esaminare gli strumenti di integrazione dei dati disponibili, è importante tenere presenti alcune considerazioni comuni quando si sceglie uno strumento. Come è tipico dell'architettura, non esiste una risposta prescrittiva a ogni sfida aziendale. Se hai pronunciato le parole "dipende" quando fai le scelte di integrazione, allora sei nel posto giusto.
Area da considerare Domande comuni
Strumenti e paesaggio esistenti Esiste già una soluzione ESB o ETL? I dati interessati hanno requisiti normativi o di conformità? Dove si trovano i sistemi che si sta tentando di integrare (nel cloud o in locale)?
Flusso di dati (tempistica, esperienza utente prevista, direzionalità) I dati devono essere spostati in modo sincrono, asincrono o possono essere raggruppati in batch/pianificati? È necessaria la replica dei dati? Quale sistema dovrebbe essere la fonte della verità? Qual è la fonte di dati? Qual è la destinazione? È necessaria l'interazione dell'utente? L'utente deve visualizzare il risultato dell'integrazione? Quali sono le esigenze relative alla gestione delle eccezioni (riprovare, notificare, non riuscire)? Quanto dovrebbero essere stretti i sistemi?
Implementazione Qual è il livello di impegno per i sistemi non Salesforce? Quali team sono responsabili dell'implementazione delle integrazioni? Quali strumenti preferiscono utilizzare?
Gestibilità Quali team dovranno mantenere l'integrazione? Quali competenze hanno attualmente? Quali competenze avranno bisogno in futuro? Qual è il costo totale di proprietà nel tempo? Quanto è importante la capacità di testare, eseguire il debug, risolvere i problemi con strumenti di codice basso o professionale?
Volume di dati Quanti dati sono coinvolti nell'integrazione? Lavorerai con grandi volumi di dati (LDV)? Con che frequenza avverranno le modifiche in blocco? Che tipo di impatto avranno gli aggiornamenti Singleton? Con che frequenza si verificheranno?
Limiti I dati dovranno subire trasformazioni complesse? È necessario combinare i dati di più sistemi di origine? Con che frequenza avverrà un'integrazione per utente? Quanti utenti totali? Sono stati pianificati in anticipo i caricamenti di dati in blocco (esempio: caricamento dati iniziale per una nuova istanza)?
## Confronto dei prodotti Di seguito è riportata una panoramica generale degli strumenti disponibili per l'integrazione dei dati e alcune considerazioni per iniziare a valutare ogni opzione. Le sezioni seguenti includono casi d'uso approfonditi e dettagli sulle funzionalità di questi strumenti.
Da Salesforce al sistema esterno Dal sistema esterno a Salesforce Esecuzione Licenza aggiuntiva richiesta
Azioni Apex Disponibile Disponibile Lato server No
Modifica acquisizione dati Disponibile Non disponibile Lato server No*
Apex personalizzato (servizi Web REST e SOAP) Disponibile Disponibile Lato server No
Servizi esterni Disponibile Non disponibile Lato server No
Heroku Connect Disponibile Disponibile Lato server Sì
Data 360 Disponibile Disponibile Lato server Sì
MuleSoft Anypoint Disponibile Disponibile Lato server Sì
API native Salesforce Non disponibile Disponibile Lato server No
OmniScript Disponibile Disponibile Lato client*** Sì
Procedura di integrazione OmniStudio Disponibile Disponibile Lato server Sì
Messaggi in uscita Non ideale Non disponibile Lato server No
Eventi piattaforma Disponibile Disponibile Lato server No**
Salesforce Connect/Oggetti esterni Disponibile Disponibile Lato server Sì
[\*Componente aggiuntivo richiesto per i casi d'uso di eventi di acquisizione dati di modifica a volume elevato](https://developer.salesforce.com/docs/atlas.en-us.change_data_capture.meta/change_data_capture/cdc_allocations.htm) [\*\*Componente aggiuntivo richiesto per i casi d'uso di eventi piattaforma a volume elevato](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_event_limits.htm) \*\*\*Adatto in situazioni in cui è possibile eseguire la logica aziendale all'interno del browser Web. Legenda colonne: - **Disponibile**: funziona bene per la maggior parte dei casi d'uso - **Non ideale**: possibile ma considerare uno strumento alternativo - **Non disponibile**: nessun piano di assistenza nei prossimi dodici mesi ### Altri strumenti che possono essere coinvolti nello spostamento dei dati all'interno e all'esterno di Salesforce: Esistono altri strumenti che possono supportare alcuni aspetti di un'integrazione a livello di dati, ma non devono essere considerati un mezzo principale per risolvere i problemi di integrazione. Diamo ora un'occhiata a questi strumenti. I **componenti Web Lightning** vengono in genere utilizzati per le integrazioni dei processi, ma possono effettuare chiamate utilizzando la funzionalità JavaScript, quindi i dati potrebbero essere coinvolti in queste transazioni. **Il flusso Salesforce** può essere utilizzato per orchestrare chiamate esterne con Servizi esterni o Azioni Apex. Flusso Salesforce da solo non è considerato uno strumento di integrazione dei dati indipendente. **Importazione guidata dati e Data Loader** possono essere utilizzati per sincronizzare, importare e migrare i dati. Benché i comandi di Data Loader possano anche essere scriptati per automatizzare l'importazione e l'esportazione dei dati, l'[interfaccia della riga](https://developer.salesforce.com/docs/atlas.en-us.dataLoader.meta/dataLoader/command_line_intro.htm) di comando è solo per Windows e nessuno di questi strumenti è una base consigliata per una strategia di integrazione dei dati. Utilizzarli invece per integrare la strategia di gestione e manutenzione dei dati. I comandi dati [**Salesforce CLI**](https://developer.salesforce.com/docs/atlas.en-us.sfdx_cli_reference.meta/sfdx_cli_reference/cli_reference_force_data.htm) possono essere utilizzati per manipolare i record nell'organizzazione. Sono disponibili comandi che consentono di importare ed esportare i dati con l'API in blocco e l'API di salvataggio ad albero SObject ed eseguire semplici operazioni CRUD su singoli record con l'API REST. Salesforce CLI da solo non è considerato uno strumento di integrazione dei dati indipendente. **OmniStudio Data Mapper** può essere utilizzato come strumento ETL dichiarativo per spostare i dati tra oggetti Salesforce e strutture di dati JSON. Mentre viene creata automaticamente un'interfaccia REST per ogni interfaccia di Data Mapper, che fornisce un modo dichiarativo per spostare i dati dai sistemi esterni agli oggetti Salesforce, Data Mapper indipendente non è una base consigliata per una strategia di integrazione dei dati. Le azioni di Data Mapper sono disponibili nelle procedure di integrazione OmniStudio. [**Dataloader.io**](http://dataloader.io/) è un altro strumento di caricamento dati per Salesforce basato su Anypoint Platform di MuleSoft che consente di importare, esportare ed eliminare in modo rapido e sicuro quantità illimitate di dati per la propria azienda. Dataloader.io non è una base consigliata per una strategia di integrazione dei dati. ## Da Salesforce a sistemi esterni (integrazione in uscita) Per le integrazioni in uscita da Salesforce, è possibile considerare diversi tipi di strumenti: low-code, pro-code o ibrido. Le sezioni seguenti offrono indicazioni per ciascuno di questi tipi di utensili e soluzioni di esempio. - [Strumenti low-code per le integrazioni in uscita](#strumenti-low-code-per-le-integrazioni-in-uscita-da-salesforce) - [Strumenti ibridi per le integrazioni in uscita](#strumenti-ibridi-per-le-integrazioni-in-uscita-da-salesforce) - [Strumenti pro-codice per le integrazioni in uscita](#strumenti-pro-code-per-le-integrazioni-in-uscita-da-salesforce) ### Strumenti low-code per le integrazioni in uscita da Salesforce
Guida Licenze Tempistica Volume e scala Consegna e manutenzione Privacy e sicurezza
Quando utilizzare Licenza aggiuntiva Sincronizzazione (Richiesta/Risposta) o Asincrona (Attiva/Dimentica) Supporto multi-oggetto LDV/Bulk Test e distribuzione** Debug Comportamento di gestione/riprova degli errori incorporato Può essere utilizzato con dati crittografati a riposo Protocollo di autenticazione
Modifica acquisizione dati Quando è necessario pubblicare le modifiche a livello di record apportate in Salesforce in un sistema esterno e non è necessario un payload personalizzato. Obbligatorio Asincrono No No Sì Con strumenti pro-code Sì Sì OAuth
Servizi esterni Quando si orchestra un processo utilizzando Flusso, Apex, Bot Einstein o OmniStudio e le API del sistema esterno sono descritte utilizzando specifiche OpenAPI. Non richiesto Sincronizzazione Sì No Sì Con strumenti pro-code No N/D Credenziali denominate
Heroku Connect Quando si desidera estendere i dati con la sincronizzazione bidirezionale per abilitare le app mobili e di altro tipo in Heroku e si desidera che i dati vengano replicati anche in Salesforce. Obbligatorio Asincrono Sì Sì No Con strumenti pro code Sì Sì, tramite Shield Connect OAuth
Procedura di integrazione OmniStudio Quando è necessario trasformare i dati senza l'interazione dell'utente e migliorare le prestazioni elaborandoli sul server anziché sul browser. Obbligatorio Entrambi Sì Sì Sì Supporto dichiarativo Sì Sì Credenziali denominate
Salesforce Connect/Oggetti esterni Quando si desidera che i dati compaiano nell'interfaccia utente di Salesforce ma si desidera che i dati vengano memorizzati in un sistema esterno. I dati non vengono replicati in Salesforce. Obbligatorio Sincronizzazione No Sì* Sì Con strumenti pro-code e un tracciatore dichiarativo No N/D Credenziali denominate
*Gli adattatori OData precedenti alla versione 4.01 sono soggetti a limiti di chiamata. Per ulteriori dettagli, vedere Considerazioni sui limiti di traffico delle chiamate OData. ** Test e distribuzione si riferiscono alla capacità di creare in un ambiente inferiore e distribuire tramite l'API dei metadati pacchetti o serie di modifiche all'ambiente di produzione.
### Caso d'uso: Integrazione in uscita con strumenti low-code > Quando le opportunità vengono conseguite, è necessario creare un ordine per i prodotti associati nel sistema ERP o nel sistema di gestione ordini della società. **Modifica acquisizione dati** Man mano che i record Opportunità vengono aggiornati, Modifica acquisizione dati pubblica gli eventi di modifica che contengono gli aggiornamenti agli oggetti. Gli eventi di modifica vengono consumati sul lato del cliente tramite una connessione CometD (o tramite un connettore MuleSoft) e utilizzati per aggiornare il sistema ERP o di gestione ordini del cliente. Gli eventi di modifica possono essere arricchiti in modo da includere sempre ID record esterni o altri dati dell'oggetto (ad esempio la regione) necessari per l'integrazione. Gli stream degli eventi di modifica per più oggetti possono essere combinati in _canali_ per semplificare l'abbonamento e l'elaborazione degli stream (in modo da potersi abbonare ed elaborare uno stream anziché molti). **Servizi esterni** Se si dispone di un servizio Web che supporta la specifica OpenAPI 2.0 o 3.0, è possibile esporre le operazioni e i servizi come servizio esterno in Salesforce. Le operazioni API (ad esempio, l'ordine di creazione) possono essere chiamate come Azione invocabile in un flusso creato con Flow Builder quando la fase dell'opportunità viene modificata in "Conseguita". **Heroku Connect** Heroku Connect viene in genere utilizzato per mantenere sincronizzati un database Heroku Postgres e Salesforce. Se il cliente utilizza Heroku Postgres come punto vendita transazionale di origine, è possibile sincronizzare i record e le modifiche da Salesforce a Heroku Postgres utilizzando Heroku Connect. Da qui, è possibile utilizzare i connettori streaming Heroku per pubblicare le modifiche in Apache Kafka e inviarle come eventi alle applicazioni a valle, incluso il sistema ERP o di gestione degli ordini. Quando viene inviato un ordine, l'OmniScript che orchestra il processo può inviare i dettagli dell'ordine a un connettore ERP o MuleSoft.\*\*\*\* Il post può essere eseguito direttamente dall'OmniScript (lato client) o indirettamente tramite una procedura di integrazione (lato server). Se il sistema ERP genera un errore di convalida, l'interfaccia utente OmniScript deve informare l'utente e, se necessario, tradurre e contestualizzare l'errore per l'utente. **Salesforce Connect/Oggetti esterni** È possibile creare un flusso attivato da record in Salesforce che inserisce un record negli oggetti esterni correlati quando la fase dell'opportunità viene modificata in "Conseguita". Poiché si tratta di una [transazione mista](https://help.salesforce.com/articleView?id=000328873&type=1&mode=1), per evitare errori aggiungere un elemento di pausa per zero secondi tra l'aggiornamento opportunità e gli inserimenti di oggetti esterni correlati in modo da chiudere un contesto transazione prima di avviarne uno nuovo. ### Strumenti ibridi per le integrazioni in uscita da Salesforce
Guida Licenze Tempistica Volume e scala Consegna e manutenzione Privacy e sicurezza
Quando utilizzare Licenza aggiuntiva Sincronizzazione (Richiesta/Risposta) o Asincrona (Attiva/Dimentica) Supporto multi-oggetto LDV/Bulk Test e distribuzione** Debug Comportamento di gestione/riprova degli errori incorporato Può essere utilizzato con dati crittografati a riposo Protocollo di autenticazione
Azioni Apex Quando si desidera automatizzare le chiamate a un altro sistema tramite Flusso Salesforce. Uno sviluppatore può scrivere una classe Apex che un flusso può invocare oppure scaricare una soluzione predefinita da AppExchange. Non richiesto Entrambi Sì No Sì Con strumenti pro-code No Sì Più
Relay evento Quando è necessario inviare eventi piattaforma ed eventi di acquisizione dati di modifica ad Amazon EventBridge da Salesforce. I relay evento si connettono solo ad AWS Eventbridge No Asincrono Sì No Sì Sì Sì Sì HTTP/1.1 con TLS
Messaggi in uscita Quando è necessario inviare messaggi SOAP su HTTP(S) a un endpoint designato con ricezione garantita quando attivato da una regola di flusso di lavoro. Non richiesto Asincrono No No Sì Supporto dichiarativo Sì Sì TLS bidirezionale
Eventi piattaforma Quando è necessario un payload strutturato e definito su misura per le modifiche quasi in tempo reale in Salesforce o in un sistema esterno. Non obbligatorio* Asincrono Sì No Sì Con strumenti pro-code Sì Sì OAuth
Salesforce Connect/Oggetti esterni (con adattatori Apex personalizzati) Quando si desidera che i dati compaiano nell'interfaccia utente di Salesforce ma si desidera che vengano memorizzati in un sistema esterno che non può utilizzare protocolli standard come OData o GraphQL. Obbligatorio Entrambi Sì Sì Sì Con strumenti pro-code No N/D Più
Data 360 Quando si desidera armonizzare i dati di fonti diverse in un unico archivio dati o replicare i dati in altre organizzazioni Salesforce o in altri sistemi esterni. Obbligatorio Entrambi Sì Sì Sì Sì Sì Sì Più
[\*Componente aggiuntivo](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_event_limits.htm) richiesto per i casi d'uso a volume elevato. \*\*Test e distribuzione si riferisce alla capacità di creare in un ambiente inferiore e distribuire tramite l'[API dei metadati](https://developer.salesforce.com/docs/metadata-coverage/), pacchetti o serie di modifiche in produzione. ### Caso d'uso: Integrazione in uscita con strumenti ibridi > Quando le opportunità vengono conseguite, è necessario creare un ordine per i prodotti associati nel sistema ERP o di gestione degli ordini della società. **Azioni Apex** Un flusso attivato da record in base allo stato dell'opportunità può essere attivato automaticamente quando un'opportunità viene conseguita. Il flusso esegue un'azione invocabile che utilizza una chiamata esterna per inviare l'ordine al sistema di gestione ordini o alla soluzione ERP. Gli invii a volume elevato e gli ordini multisito sono gestiti da meccanismi batch e di area di attesa Apex. **Messaggi in uscita** Dopo aver [impostato la messaggistica](https://developer.salesforce.com/docs/atlas.en-us.api.meta/api/sforce_api_om_outboundmessaging_setting_up.htm), è possibile definire una regola di flusso di lavoro attivata dall'aggiornamento dell'opportunità per inviare un messaggio SOAP su HTTP(S) a un URL endpoint specificato che ospita l'ascoltatore. Il messaggio conterrà i campi specificati al momento della creazione del messaggio in uscita. Se le informazioni nell'oggetto cambiano dopo che la notifica è stata inserita nell'area di attesa, ma prima di essere inviata, verranno consegnate solo le informazioni aggiornate e i messaggi rimarranno nell'area di attesa fino a quando non vengono inviati correttamente o fino a 24 ore prima. Dopo 24 ore, i messaggi vengono eliminati dall'area di attesa. Se il sistema ERP richiede dati aggiuntivi, è possibile passare sessionId nei messaggi in uscita in modo che il sistema esterno possa effettuare una richiesta di richiamata. **Eventi piattaforma** È possibile definire un evento piattaforma che include il payload personalizzato con i dati necessari per creare i record nel sistema esterno. Poiché gli eventi piattaforma non vengono pubblicati automaticamente alla modifica del record, è necessario pubblicare l'evento tramite Apex, Flusso Salesforce o Process Builder quando la fase dell'opportunità viene modificata in "Conseguita". Un servizio esterno ascolta il canale degli eventi piattaforma utilizzando CometD (o un connettore MuleSoft) e crea i record appropriati nel sistema esterno. **Salesforce Connect/Oggetti esterni (con adattatori Apex personalizzati)** Una soluzione basata su Salesforce Connect/Oggetti esterni non è perfettamente adatta a un caso d'uso che richiede semplicemente la sincronizzazione dei dati. Tuttavia, questa soluzione può essere applicata nei casi in cui gli utenti di Salesforce devono visualizzare e potenzialmente interagire con i dati del sistema esterno e i dati non possono essere replicati in Salesforce. Se il sistema ERP o di gestione degli ordini non supporta i protocolli OData o GraphQL, il team di sviluppo può utilizzare l'[Apex Connector Framework](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_connector_start.htm) per scrivere classi Apex che gestiscono la comunicazione con il sistema esterno tramite un protocollo supportato. **Data 360** Una soluzione basata su Data 360 è perfettamente adatta per i casi d'uso in cui è necessario armonizzare i dati provenienti da fonti diverse in un unico data store. Può essere utilizzato anche quando è necessario replicare i dati da un'organizzazione Salesforce a più organizzazioni Salesforce o ad altri sistemi esterni utilizzando Data 360 come hub di dati. Quando un'opportunità viene conseguita e aggiornata nell'organizzazione di origine, i dati dell'opportunità vengono sincronizzati con Data 360, dove possono essere replicati in altri sistemi, incluse le organizzazioni Salesforce, utilizzando meccanismi diversi come azioni, attivazioni e API. Analogamente, è possibile segnalare un'opportunità senza replicare i dati in altre organizzazioni Salesforce utilizzando Data Cloud One. Tuttavia, Data Cloud One non supporta le piattaforme non Salesforce. ### Strumenti pro-code per le integrazioni in uscita da Salesforce
Guida Licenze Tempistica Volume e scala Consegna e manutenzione Privacy e sicurezza
Quando utilizzare Licenza aggiuntiva Sincronizzazione (Richiesta/Risposta) o Asincrona (Attiva/Dimentica) Supporto multi-oggetto LDV/Bulk Test e distribuzione** Debug Comportamento di gestione/riprova degli errori incorporato Può essere utilizzato con dati crittografati a riposo Protocollo di autenticazione
Apex personalizzato Quando sono necessarie più funzionalità di quelle disponibili negli strumenti low-code. Non richiesto Entrambi Sì Sì Sì Con strumenti pro-code No Sì* Più
Servizi esterni L'integrazione da codice con le API di sistema esterne è descritta utilizzando le specifiche OpenAPI. Non richiesto Sincronizzazione Sì No Sì Con strumenti pro-code No N/D Più
MuleSoft Anypoint Quando è necessaria una singola soluzione unificata di livello aziendale per creare, orchestrare e gestire le integrazioni, quando è necessario sostituire un'architettura point-to-point legacy o quando è necessario il supporto per la gestione API. Obbligatorio Entrambi Sì Sì Sì Con strumenti pro-code No Sì* Più
\*L'abilitazione di Shield Platform Encryption modifica alcuni comportamenti, vedere [Considerazioni generali Shield Platform Encryption](https://help.salesforce.com/articleView?id=sf.security_pe_considerations_general.htm&type=5) per ulteriori dettagli. \*\*Test e distribuzione si riferisce alla capacità di creare in un ambiente inferiore e distribuire tramite l'[API dei metadati](https://developer.salesforce.com/docs/metadata-coverage/), pacchetti o serie di modifiche in produzione. ### Caso d'uso: Integrazione in uscita con strumenti Pro-Code > Quando le opportunità vengono conseguite, è necessario creare un ordine per i prodotti associati nel sistema ERP o di gestione degli ordini della società. **Apex personalizzato** È possibile creare un trigger Apex e uno o più handler trigger nell'opportunità che effettua una chiamata al sistema ERP o di gestione degli ordini quando la fase dell'opportunità viene modificata in "Conseguita". Tenere presente che se si effettuano chiamate da un trigger o dopo aver eseguito un'operazione DML, è necessario utilizzare un metodo annotato come future o area di attesa. Una chiamata in un trigger mantiene aperta la connessione al database per l'intera durata della chiamata. Tutto l'Apex Code è vincolato dai [limiti Apex Governor e API](https://developer.salesforce.com/docs/atlas.en-us.salesforce_app_limits_cheatsheet.meta/salesforce_app_limits_cheatsheet/salesforce_app_limits_overview.htm), che vengono rivisti su base continuativa. **Servizi esterni** Se il sistema ERP esterno o il sistema di gestione ordini dell'azienda sono definiti tramite una specifica OpenAPI, le chiamate ai servizi eseguiti nel metodo futuro o nel processo di area di attesa potrebbero essere semplificate. I servizi esterni registrati possono essere chiamati direttamente da Apex senza necessità di scrivere codice boilerplate. Nell'esempio, la chiamata per creare l'ordine può essere gestita dal servizio esterno. **MuleSoft Anypoint** MuleSoft Anypoint offre una gestione API di livello aziendale. MuleSoft Anypoint può creare API per abilitare l'accesso in lettura (e/o scrittura) ai dati per Salesforce e molti altri sistemi aziendali. Sono [disponibili molti connettori predefiniti](https://www.mulesoft.com/platform/cloud-connectors) per semplificare l'implementazione e le aziende possono anche creare e pubblicare i propri connettori. Queste API possono essere distribuite in Anypoint con policy di sicurezza flessibili, che supportano la gestione e la governance centralizzate. Non esistono restrizioni sul volume delle transazioni, a condizione che l'API sia stata dimensionata correttamente per il picco di utilizzo (misurato in vCores). ## Dati dei sistemi esterni a Salesforce (integrazione in entrata) Per le integrazioni in entrata in Salesforce, è possibile considerare diversi tipi di strumenti: low-code, pro-code o ibrido. Le sezioni seguenti offrono indicazioni per ciascuno di questi tipi di utensili e soluzioni di esempio. - [Strumenti low-code per le integrazioni in entrata](#strumenti-low-code-per-le-integrazioni-in-entrata-in-salesforce) - [Strumenti ibridi per le integrazioni in entrata](#strumenti-ibridi-per-le-integrazioni-in-entrata-in-salesforce) - [Strumenti pro-codice per le integrazioni in entrata](#strumenti-pro-code-per-le-integrazioni-in-entrata-in-salesforce) ### Strumenti low-code per le integrazioni in entrata in Salesforce
Guida Licenze Tempistica Volume e scala Consegna e manutenzione Privacy e sicurezza
Quando utilizzare Licenza aggiuntiva Sincronizzazione (Richiesta/Risposta) o Asincrona (Attiva/Dimentica) Supporto multi-oggetto LDV/Bulk Test e distribuzione* Debug Comportamento di gestione/ritentativo degli errori incorporato Può essere utilizzato con dati crittografati a riposo Protocollo di autenticazione
Heroku Connect Quando si desidera estendere i dati con la sincronizzazione bidirezionale per abilitare le app mobili e di altro tipo in Heroku e si desidera che i dati vengano replicati anche in Salesforce. Obbligatorio Asincrono Sì Sì No Con strumenti pro-code Sì Sì, tramite Shield Connect OAuth
Procedura di integrazione OmniStudio Quando è necessario importare e trasformare dati da fonti di terze parti senza interazione dell'utente. Obbligatorio Entrambi Sì Sì Sì Supporto dichiarativo No Sì Credenziali denominate
Salesforce Connect/Oggetti esterni Quando si desidera che i dati compaiano nell'interfaccia utente di Salesforce ma si desidera che vengano memorizzati in un sistema esterno che può utilizzare protocolli standard come OData o GraphQL. Obbligatorio Sincronizzazione Sì Sì Sì Con strumenti pro-code No N/D Più
\*Test e distribuzione si riferisce alla capacità di creare in un ambiente inferiore e distribuire tramite l'[API dei metadati](https://developer.salesforce.com/docs/metadata-coverage/), pacchetti o serie di modifiche in produzione. ### Caso d'uso: Integrazione in entrata con strumenti low-code > Un referente viene aggiornato nel sistema ERP dell'organizzazione. Queste informazioni di contatto devono essere aggiornate in Salesforce. **Heroku Connect** Heroku Connect viene in genere utilizzato per mantenere sincronizzati un database Heroku Postgres e Salesforce. A meno che il sistema ERP non utilizzi Heroku Postgres come punto vendita delle transazioni, questo caso d'uso non è possibile. Se utilizza Heroku Postgres, le modifiche apportate nelle tabelle di Postgres possono essere sincronizzate con gli oggetti in Salesforce utilizzando Heroku Connect. **Procedura di integrazione** Dopo che il sistema ERP ha aggiornato il record referente, è possibile chiamare una procedura di integrazione OmniStudio con un'azione di caricamento del data mapper e un'azione di risposta tramite l'API REST generata da Data mapper. Per prima cosa, un'azione Data Mapper Load invia un payload JSON o XML, che viene utilizzato per eseguire l'upset dei record referente in base a un campo ID esterno o tramite una [chiave Inserisci con aggiornamento](https://trailhead.salesforce.com/content/learn/modules/omnistudio-data-tools-and-internal-data/build-an-integration-procedure-with-conditional-dataraptor-loads?trail_id=build-guided-experiences-with-omnistudio). Se una risposta semplice in JSON è tutto ciò che è previsto, un'azione di risposta può inviare tutte le informazioni pertinenti delle azioni precedenti per indicare l'esito positivo o negativo. Se il sistema ERP prevede una risposta specifica, è possibile utilizzare una trasformazione Data Mapper o un'azione Estrai per generare una risposta JSON o XML con funzioni aggiuntive per includere in modo dichiarativo i dati generati nei trigger dall'aggiornamento del record referente. La sfida principale di questo scenario è la concomitanza: Più chiamate per aggiornare simultaneamente lo stesso record referente causeranno problemi poiché l'API esiste direttamente in Salesforce. **Salesforce Connect / Oggetti esterni** Salesforce Connect e gli oggetti esterni non sono consigliati per questo caso d'uso, poiché lo scenario richiede specificamente la replica dei dati in Salesforce. Se si dispone di un'integrazione Salesforce Connect preesistente integrata nell'ERP, è possibile configurare il connettore OData 4.0 per supportare acquisizione dati di modifica esterni se l'ERP può supportare acquisizione dati di modifica. Inoltre, è necessario configurare in Salesforce l'abbonamento allo stream di modifiche dall'ERP, utilizzando l'API Pub/Sub. ### Strumenti ibridi per le integrazioni in entrata in Salesforce
Guida Licenze Tempistica Volume e scala Consegna e manutenzione Privacy e sicurezza
Quando utilizzare Licenza aggiuntiva Sincronizzazione (Richiesta/Risposta) o Asincrona (Attiva/Dimentica) Supporto multi-oggetto LDV/Bulk Test e distribuzione** Debug Comportamento di gestione/ritentativo degli errori incorporato Può essere utilizzato con dati crittografati a riposo Protocollo di autenticazione
Eventi piattaforma Quando è necessario un payload strutturato e definito su misura per le modifiche quasi in tempo reale in Salesforce o in un sistema esterno. Non obbligatorio* Asincrono Sì No Sì Con strumenti pro-code Sì Sì OAuth
Salesforce Connect/Oggetti esterni (con adattatori Apex personalizzati) Quando è necessario che i dati compaiano nell'interfaccia utente di Salesforce ma si desidera archiviarli in un sistema esterno che non può utilizzare i protocolli OData 2.0/4.0. Obbligatorio Entrambi Sì Sì Sì Con strumenti pro-code No N/D Più
Data 360 Quando si desidera armonizzare i dati di fonti diverse in un unico archivio dati o replicare i dati di altre organizzazioni Salesforce o di altri sistemi esterni. Data 360 supporta anche la virtualizzazione per alcune piattaforme. Obbligatorio Entrambi Sì Sì Sì No Sì Sì Più
\*[Componente aggiuntivo](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_event_limits.htm) richiesto per i casi d'uso a volume elevato. \*\*Test e distribuzione si riferisce alla capacità di creare in un ambiente inferiore e distribuire tramite l'[API dei metadati](https://developer.salesforce.com/docs/metadata-coverage/), pacchetti o serie di modifiche in produzione. ### Caso d'uso: Integrazione in entrata con strumenti ibridi > Un referente viene aggiornato nel sistema ERP dell'organizzazione. Queste informazioni di contatto devono essere aggiornate in Salesforce. Il codice personalizzato in un sistema esterno pubblica un Evento piattaforma quando il record referente viene aggiornato nell'ERP.\*\*\*\* Un trigger, un processo o un flusso in Salesforce può abbonarsi all'evento piattaforma e aggiornare gli oggetti Salesforce corrispondenti quando un evento viene elaborato. L'Evento piattaforma può funzionare semplicemente come segnale che si è verificata una modifica nel sistema ERP del cliente senza contenere alcun dato oppure può contenere i dati effettivi necessari per aggiornare l'oggetto Salesforce. **Salesforce Connect/Oggetti esterni (con adattatori Apex personalizzati)** Questa soluzione non è applicabile in un caso d'uso che richiede la replica dei dati. Questa soluzione è applicabile se gli utenti di Salesforce devono visualizzare le informazioni di un sistema esterno che non deve o non può essere replicato in Salesforce e il sistema esterno non può supportare protocolli standard come OData o GraphQL. Vedere Caso d'[uso: Integrazione in uscita mediante strumenti ibridi](#caso-duso-integrazione-in-uscita-con-strumenti-ibridi) per un caso d'uso di esempio per un adattatore personalizzato Apex. **Data 360** Quando un referente viene aggiornato in sistemi esterni come ERP, gli aggiornamenti del referente possono essere sincronizzati con Data 360 utilizzando connettori pronti all'uso o utilizzando API e strumenti pro-code come MuleSoft. È anche possibile fare riferimento al referente in Data 360 utilizzando il meccanismo copia zero (disponibile con alcune piattaforme). Una volta che i dati sono disponibili in Data 360, è possibile utilizzare diversi meccanismi di integrazione pronti all'uso per sincronizzare i dati con altre organizzazioni Salesforce. È possibile accedere ai dati per riferimento utilizzando Data Cloud One. I dati possono essere replicati anche utilizzando attivazioni e altre API utilizzando connettori pronti all'uso o con l'aiuto di strumenti pro-code come MuleSoft Anypoint Platform. ### Strumenti pro-code per le integrazioni in entrata in Salesforce
Guida Licenze Tempistica Volume e scala Consegna e manutenzione Privacy e sicurezza
Quando utilizzare Licenza aggiuntiva Sincronizzazione (Richiesta/Risposta) o Asincrona (Attiva/Dimentica) Supporto multi-oggetto LDV/Bulk Test e distribuzione**** Debug Comportamento di gestione/ritentativo degli errori incorporato Può essere utilizzato con dati crittografati a riposo Protocollo di autenticazione
Servizi Web Apex REST & SOAP personalizzati Quando sono necessarie più funzionalità di quelle fornite dagli endpoint API nativi, ad esempio l'elaborazione oggetti incrociata o un'altra logica complessa. Non richiesto Entrambi Sì Sì Sì Con strumenti pro-code No Sì*** Più
MuleSoft Anypoint Quando è necessaria una singola soluzione unificata di livello aziendale per creare, orchestrare e gestire le integrazioni, quando è necessario sostituire un'architettura point-to-point legacy o quando è necessario il supporto per la gestione API. Obbligatorio Entrambi Sì Sì Sì Con strumenti pro-code No Sì*** Più
API native Salesforce Quando si necessita di un maggiore controllo o si dispone di competenze professionali per creare integrazioni tramite API REST, API SOAP, API in blocco o API GraphQL o gRPC. Non obbligatorio* Entrambi Sì***** Sì Sì Con strumenti pro-code Sì** Sì*** Più
\*Si applicano i [limiti e le](https://developer.salesforce.com/docs/atlas.en-us.salesforce_app_limits_cheatsheet.meta/salesforce_app_limits_cheatsheet/salesforce_app_limits_platform_api.htm) allocazioni delle richieste API. \*\*Le API in blocco hanno aspetti del comportamento di un nuovo tentativo e un certo numero di API offrono protezione _dal ritiro_ tramite l'impostazione allOrNone (ad esempio, vedere [parametri allOrNone in richieste composite e raccolte](https://developer.salesforce.com/docs/atlas.en-us.api_rest.meta/api_rest/resources_composite_allornone.htm)) \*\*\*L'abilitazione di Shield Platform Encryption modifica alcuni comportamenti, vedere [Considerazioni generali Shield Platform Encryption](https://help.salesforce.com/articleView?id=sf.security_pe_considerations_general.htm&type=5) per ulteriori dettagli. \*\*\*\*Test e distribuzione si riferisce alla capacità di creare in un ambiente inferiore e distribuire tramite l'[API dei metadati](https://developer.salesforce.com/docs/metadata-coverage/), pacchetti o serie di modifiche in produzione. \*\*\*\*\*Le API composite hanno il supporto multi-oggetto. ### Caso d'uso: Integrazione in entrata con strumenti Pro-Code > Un referente viene aggiornato nel sistema ERP dell'organizzazione. Queste informazioni di contatto devono essere aggiornate in Salesforce. **Servizi Web Apex e** REST personalizzati È possibile creare un servizio Web utilizzando Apex Code che potrebbe eseguire operazioni CRUD (creazione, lettura, aggiornamento, eliminazione) sull'oggetto Referente. Questo servizio verrà richiamato tramite SOAP o REST dal sistema esterno (ERP). **MuleSoft Anypoint** L'intento di MuleSoft Anypoint è fornire una gestione API di livello aziendale. MuleSoft Anypoint offre un [ampio set di connettori](https://www.mulesoft.com/platform/cloud-connectors) che è possibile utilizzare per l'integrazione con molti sistemi ERP tra cui SAP, Oracle EBS, Oracle ERP e NetSuite. È possibile creare un flusso per ascoltare gli eventi in questi sistemi ERP (in questo caso, quando viene creato un nuovo referente). Quando il flusso viene avviato, utilizza il connettore Salesforce per creare un nuovo record Referente (o aggiornarne uno se il referente esiste già). Inoltre, è possibile integrarsi con altri sistemi, se la transazione di replica prevede la sindacazione del referente in altri sistemi. Se necessario, è possibile utilizzare il linguaggio di mappatura e trasformazione (DataWeave) per eseguire logica e calcoli complessi mentre le informazioni fluiscono in più sistemi diversi. L'autenticazione per questi sistemi può essere eseguita tramite molti meccanismi di autenticazione diversi, ad esempio l'autenticazione di base e OAuth. Non esistono restrizioni sul volume delle transazioni a condizione che il flusso sia stato dimensionato correttamente per il picco di utilizzo (misurato in vCores). **API native Salesforce** Al termine (o immediatamente dopo) della transazione di aggiornamento nel sistema ERP, è possibile eseguire un'operazione di inserimento con aggiornamento sull'oggetto Referente tramite l'API SOAP o eseguire una [PATCH](https://developer.salesforce.com/docs/atlas.en-us.api_rest.meta/api_rest/dome_update_fields.htm) sull'API REST sObjects Contact nell'organizzazione Salesforce. ## Integrazioni da Salesforce a Salesforce Il prodotto Salesforce a Salesforce è giunto al termine del suo ciclo di vita. Salesforce a Salesforce ha semplificato la vendita e l'assistenza ai clienti comuni da parte dei partner che lavorano insieme, ma Salesforce investirà per portare maggiore innovazione ad altri strumenti. In futuro, per la condivisione dei dati tra le organizzazioni Salesforce si consigliano i seguenti approcci. ### Strumenti per l'integrazione dei dati nelle organizzazioni Salesforce
Guida Costo Tempistica Volume e scala Consegna e manutenzione Privacy e sicurezza Strumenti da implementare
Quando utilizzare Licenza aggiuntiva Sincronizzazione (Richiesta/Risposta) o Asincrona (Attiva/Dimentica) Supporto multi-oggetto LDV/Bulk Test e distribuzione* Debug Comportamento di gestione/riprova degli errori incorporato Può essere utilizzato con dati crittografati a riposo Protocollo di autenticazione Codice basso → Pro Code
Heroku Connect Quando si desidera estendere i dati con la sincronizzazione bidirezionale tra le organizzazioni Salesforce e abilitare l'accesso ai dati anche da dispositivi mobili e altre app in esecuzione su Heroku Obbligatorio Asincrono Sì Sì No Con strumenti pro-code Sì Sì, tramite Shield Connect OAuth Codice basso
MuleSoft Anypoint Quando si necessita di una singola soluzione unificata di livello aziendale per creare, orchestrare e gestire le integrazioni, quando si deve sostituire un'architettura point-to-point legacy o quando si necessita del supporto per la gestione API Obbligatorio Entrambi Sì Sì Sì Con strumenti pro-code No Sì** Più Codice professionale
API native Salesforce Quando Salesforce o Heroku Connect non sono un'opzione o è necessaria un'elaborazione più complessa Non richiesto Entrambi No Sì Sì Con strumenti pro-code No Sì** Più Codice professionale
Modifica acquisizione dati Quando è necessario pubblicare le modifiche a livello di record apportate in Salesforce in un sistema esterno e non è necessario un payload personalizzato. Obbligatorio Asincrono No No Sì Con strumenti pro-code Sì Sì OAuth
Salesforce Connect con adattatore tra organizzazioni Quando si desidera che gli utenti di un'organizzazione visualizzino o modifichino i record di un'organizzazione diversa senza replica dei dati Obbligatorio Asincrono Sì Sì Sì Con strumenti pro-code N/D N/D Più Codice basso
Data 360 Quando si desidera che gli utenti di un'organizzazione visualizzino o modifichino i record di un'organizzazione diversa con dati replicati in Data 360. Obbligatorio Entrambi Sì Sì Sì Con strumenti pro-code Sì Sì Più Ibrido
\*Test e distribuzione si riferisce alla capacità di creare in un ambiente inferiore e distribuire tramite l'[API dei metadati](https://developer.salesforce.com/docs/metadata-coverage/), pacchetti o serie di modifiche all'ambiente di produzione \*\*L'abilitazione di Shield Platform Encryption modifica alcuni comportamenti, vedere [Considerazioni generali Shield Platform Encryption](https://help.salesforce.com/articleView?id=sf.security_pe_considerations_general.htm&type=5) per ulteriori dettagli. _Gli eventi piattaforma non sono ottimali per integrare i dati da un'organizzazione Salesforce a un'altra, poiché non possono "ascoltare" tra le organizzazioni per lo stesso evento. Anche l'Apex personalizzato non è un approccio consigliato per questo tipo di integrazione._ ### Caso d'uso: Connessione di più organizzazioni Salesforce > Una grande azienda opera in più unità operative (BU). Ogni unità operativa ha la propria organizzazione Salesforce. Un singolo cliente tratta con più unità operative dell'azienda e dispone quindi dei dati di account e opportunità in più organizzazioni. L'azienda deve accedere a una visualizzazione aggregata di tutti i dati di account e opportunità in tutte le unità operative in un'unica organizzazione. _Nota: Tutte le soluzioni seguenti sono progettate per la minima quantità di replica dei dati, in conformità con [Takeaway #1](#takeaway)._ I dati di account e opportunità **di Data 360** provenienti da organizzazioni Salesforce diverse possono essere inseriti in Data 360 utilizzando connettori Salesforce pronti all'uso. Possono anche essere aggregati e armonizzati (se necessario). Una volta aggregati in Data 360, i dati sono accessibili in altre organizzazioni Salesforce utilizzando Data Cloud One senza replica dei dati. **Heroku Connect** Per le singole organizzazioni di ogni unità operativa, è possibile utilizzare Heroku Connect per sincronizzare le modifiche da Salesforce in un unico database Heroku Postgres. In questo scenario, la sincronizzazione bidirezionale non è abilitata, ma solo da Salesforce a Postgres. Quindi, in Heroku Connect, è possibile abilitare il provider OData e selezionare le tabelle da esporre come oggetti esterni nell'organizzazione Salesforce in cui si desidera una visualizzazione aggregata. Dall'interno di Salesforce, si definisce una fonte di dati esterna che punta al provider OData in Heroku. **MuleSoft Anypoint** MuleSoft Anypoint offre una gestione API di livello aziendale. Un'API MuleSoft Anypoint può essere configurata in modo che legga le informazioni di più organizzazioni Salesforce correlate utilizzando il connettore Salesforce con più connessioni alle organizzazioni. Il flusso MuleSoft può eseguire query nelle diverse organizzazioni Salesforce e restituire una struttura specifica che viene ottimizzata o arricchita con altre informazioni di terze parti, se necessario. Quando viene richiamata, l'API eseguirà tutte le chiamate appropriate all'organizzazione Salesforce (in questo esempio interrogando le informazioni su account e opportunità) in modo che i dati possano essere elaborati dal consumatore (probabilmente un'interfaccia utente). L'autenticazione per questi sistemi può essere eseguita tramite vari meccanismi di autenticazione, tra cui l'autenticazione di base e OAuth. Non esistono restrizioni sul volume delle transazioni, a condizione che il flusso sia stato dimensionato correttamente per il picco di utilizzo (misurato in vCores o Core). Le operazioni di query delle **API Salesforce native** possono essere inviate a ciascuna delle organizzazioni di interesse, in particolare tramite l'API in blocco Salesforce 2.0, che è adatta per estrarre in modo efficiente migliaia di record. È possibile recuperare i risultati delle query da ogni singola organizzazione e aggregarli con un'applicazione personalizzata o un middleware in base alle esigenze del cliente. **Salesforce Connect con adattatore** tra organizzazioni L'adattatore tra organizzazioni Salesforce Connect non è adatto a questo scenario, poiché gli account o le opportunità di organizzazioni remote appariranno tutti nell'organizzazione centrale come oggetti _diversi_. Ad esempio, non è possibile sommare un totale complessivo per gli importi di tutte le opportunità in tutte le organizzazioni. **Scenario tra organizzazioni con aggiornamenti selettivi:** Un agente di vendita che utilizza l'organizzazione Salesforce A deve visualizzare e aggiornare i dati del caso dell'organizzazione Salesforce B e aggiungere commenti al caso controllante nell'organizzazione Salesforce B mentre lavora nell'organizzazione A. I dati non devono essere replicati nell'organizzazione A. **Heroku Connect** È possibile utilizzare lo stesso approccio descritto nello _scenario di aggregazione_ dati precedente. Tuttavia, è necessario abilitare CRUD sull'oggetto esterno tramite il connettore OData e scrivere nuovamente le modifiche in Heroku Postgres. **MuleSoft Anypoint** MuleSoft Anypoint offre una gestione API di livello aziendale. È possibile utilizzare lo stesso approccio descritto nello _scenario di aggregazione_ dati precedente. Le **API Salesforce native** utilizzano le credenziali denominate e invocano le API Salesforce native per leggere e aggiornare i dati nell'organizzazione Salesforce correlata. Un componente deve essere progettato per visualizzare i dati. **Salesforce Connect con adattatore tra organizzazioni** La possibilità di visualizzare i dati in un oggetto esterno (nonché di modificarli se per l'oggetto esterno è abilitato il CRUD) è supportata tramite l'[adattatore tra organizzazioni](https://help.salesforce.com/articleView?id=sf.xorg_adapter_about.htm&type=5) Salesforce. Le relazioni sono supportate anche tra gli oggetti esterni in modo da potersi collegare al caso controllante nell'oggetto esterno. Tuttavia, la creazione di relazioni è oggi un processo manuale in cui si converte un tipo di dati esistente in un tipo di dati di relazione. Inoltre, le ottimizzazioni apportate in Service Cloud per lavorare con i casi in modo più efficace non vengono trasferite all'organizzazione remota. Salesforce consiglia vivamente di testare l'adattatore tra organizzazioni e di valutare i compromessi nell'utilizzo degli oggetti esterni rispetto agli oggetti standard per il proprio caso d'uso. **Sincronizzazione dei dati tra organizzazioni**: Quando un account di un cliente viene aggiornato in una delle unità operative dell'organizzazione Salesforce, è necessario aggiornare gli altri oggetti Account dell'organizzazione Salesforce per mantenere coerenti le informazioni sull'account. **Data 360** Data 360 può essere utilizzato per la replica dei dati da un'organizzazione a un'altra organizzazione Salesforce. I dati degli account di un'organizzazione Salesforce possono essere inseriti in Data 360 utilizzando connettori Salesforce pronti all'uso. È anche possibile utilizzare meccanismi di attivazione dei dati come l'attivazione batch, le azioni dati quasi in tempo reale o le attivazioni basate su API per spostare i dati da Data 360 all'organizzazione Salesforce. **Heroku Connect** È possibile utilizzare lo stesso approccio descritto nello _scenario di aggregazione_ dati precedente. Tuttavia, è necessario abilitare la sincronizzazione bidirezionale e non è più necessario abilitare Salesforce Connect poiché la sincronizzazione bidirezionale manterrà aggiornate tutte le organizzazioni quando vengono apportate modifiche alla tabella di Postgres. **MuleSoft Anypoint** MuleSoft Anypoint offre una gestione API di livello aziendale. È possibile [configurare un'applicazione Mule](https://docs.mulesoft.com/design-center/about-designing-a-mule-application) con Flow Designer in MuleSoft Anypoint per l'ascolto di eventi di oggetti standard e personalizzati per avviare un flusso AutoLaunched in Salesforce. Quando l'applicazione Mule viene attivata, può invocare il connettore Anypoint per Salesforce per comunicare con un numero qualsiasi di organizzazioni Salesforce. In questo caso d'uso, quando un record Account viene aggiornato in un'organizzazione Salesforce, l'app Mule può aggiornare i record Account nelle organizzazioni Salesforce correlate. Ogni organizzazione Salesforce correlata avrebbe una fase di aggiornamento univoca integrata nel flusso di applicazione generale in MuleSoft. L'autenticazione per questi sistemi può essere eseguita tramite vari meccanismi di autenticazione, tra cui l'autenticazione di base e OAuth. Non esistono restrizioni sul volume delle transazioni a condizione che il flusso sia stato dimensionato correttamente per il picco di utilizzo (misurato in vCores o Core). **API native Salesforce** L'[API replica](https://developer.salesforce.com/docs/atlas.en-us.api.meta/api/sforce_api_guidelines_datareplication.htm) (operazioni getUpdated, getDeleted) potrebbe essere utilizzata per sincronizzare i dati tra le organizzazioni, ma questo approccio non è consigliabile. **Salesforce Connect con adattatore tra organizzazioni** È possibile utilizzare flussi attivati da record e oggetti esterni per mantenere sincronizzati alcuni dati tra le organizzazioni Salesforce. Ad esempio, l'aggiornamento di un record account nell'organizzazione A attiva un flusso che aggiorna il record corrispondente nell'oggetto esterno Account, che scrive tali aggiornamenti nel record account nell'organizzazione B. Ciò richiede l'uso corretto della semantica del flusso per evitare [transazioni DML miste](https://help.salesforce.com/articleView?id=000328873&type=1&mode=1). Tenere inoltre presente che le regole di convalida e i flussi nell'organizzazione B verranno attivati allo stesso modo delle modifiche apportate dalle API REST/SOAP. ## Osservazioni di chiusura Tenere presente questa guida e farvi riferimento quando si pianifica una nuova integrazione dei dati con Salesforce. È sempre consigliabile comprendere l'intera gamma di opzioni disponibili e il modo in cui possono adattarsi al proprio caso d'uso specifico. ### Dicci cosa ne pensi Aiutaci a pubblicare ciò che è più rilevante per te. [Rispondere al sondaggio](https://sfdc.co/J0cWb) per fornire un feedback su questo contenuto e dirci cosa si desidera vedere dopo. ## Panoramica Le aziende spesso archiviano i dati sia in Salesforce che in altri data lake esterni come Snowflake, Google BigQuery, Databricks, Redshift o cloud storage come Amazon S3. Questo insilamento dei dati in sistemi di origine diversi rappresenta una sfida per le aziende che desiderano sfruttare tutta la potenza dei propri dati. Gli architetti che lavorano per riunire i dati in più data lake devono affrontare le principali decisioni architettoniche su come integrare al meglio i dati. Data 360 offre diverse opzioni per l'integrazione dei dati, ognuna delle quali offre diversi pro e contro. Questa guida fornisce un framework per valutare quale schema si adatta meglio alle proprie esigenze in termini di latenza, costo, scalabilità, governance e complessità durante l'integrazione dei dati, consentendo di scegliere quando utilizzare l'inserimento dati, la federazione dati Copia zero o un approccio ibrido. La guida consente inoltre di scegliere tra diversi metodi di inserimento dati e federazione dei dati, ognuno dei quali risponde a esigenze diverse. L'integrazione di data lakehouse esterni con Data 360 richiede un'attenta considerazione dei compromessi tra aggiornamento dei dati, governance ed efficienza delle opportunità in corso di realizzazione. Ad esempio, l'utilizzo delle query live della federazione dei dati Copia zero ottimizza la freschezza dei dati ma può ridurre l'efficienza delle opportunità in corso di realizzazione man mano che si spostano più dati nella rete. Pertanto, per la maggior parte delle implementazioni del mondo reale, una combinazione di inserimento e federazione all'interno di un ecosistema lakehouse multi-cloud è il percorso ottimale. Questo approccio ibrido garantisce un'architettura scalabile, gestita e interoperabile che supporta in modo semplice sia carichi di lavoro operativi a bassa latenza come la personalizzazione in tempo reale e il rilevamento delle frodi, sia carichi di lavoro analitici come la reportistica normativa e l'analisi del trend storico. Questa guida alle decisioni ti aiuterà a capire come gestire questi compromessi e a selezionare la strategia giusta. ## Takeaway - **Inserimento dati:** Copia i dati in Salesforce Data 360, creando modelli di dati canonici e governati. Ideale quando è necessario: - **Creare un Customer 360 completo:** Unificare e trasformare fonti diverse in un unico profilo affidabile. - **Rispettare la rigorosa conformità normativa:** Creare una copia controllabile centralizzata in cui l'accesso ai dati e la discendenza possono essere controllati in modo rigoroso. - **Federazione copia zero:** Esegue query sulle fonti esterne in tempo reale senza duplicazioni, abilitando la personalizzazione in tempo reale, i cruscotti digitali live e l'orientamento rapido delle fonti. È necessario bilanciare due opzioni principali con compromessi: - **Live & caching (query accelerata):** Ideale per l'analisi interattiva e i cruscotti digitali in tempo reale sui dati presenti in piattaforme dati esterne come Snowflake, Google BigQuery, Redshift o Databricks. Evita la duplicazione lenta e costosa dei dati inviando l'elaborazione al sistema di origine. - **Federazione file:** Ideale per l'elaborazione batch su larga scala e l'addestramento del modello AI sui dati nel data lake cloud (S3, ADLS). Evita l'inserimento lento e costoso eseguendo query dirette sui file in formati di tabella aperti, sbloccando serie di dati di grandi dimensioni per carichi di lavoro ETL e di data science. - **Modello ibrido:** Combinare l'inserimento per Profili unificati con la federazione per la freschezza, supportando il coinvolgimento Omnicanale, le azioni basate su Agentforce e l'addestramento AI/ML. ### Considerazioni importanti - **Architettura ibrida:** Spesso è necessario combinare l'inserimento dei dati e la federazione dei dati. - Utilizzare l'inserimento dati sui dati critici per i modelli di dati canonici e la governance di base. - Federare tutti gli altri dati tramite Copia zero per ridurre al minimo il sovraccarico operativo di creazione e manutenzione delle opportunità in corso di realizzazione dei dati di inserimento. - **Questioni di frequenza di inserimento dati:** Scegliere la frequenza in base al valore aziendale, alle esigenze di latenza e alla complessità operativa. - Utilizzare in tempo reale i flussi di lavoro sensibili al tempo (personalizzazione, cruscotti digitali live, azioni Agentforce). - Quasi in tempo reale per i processi moderatamente urgenti (campagne, rapporti operativi). - Batch per le serie di dati storiche o a bassa velocità. - **Abbinare lo schema federazione a latenza e prestazioni:** Scegliere quello che meglio soddisfa i propri schemi di accesso e i requisiti di freschezza, prestazioni e costo. - Utilizzare Live Query per i cruscotti digitali operativi e la personalizzazione in tempo reale in cui la latenza bassa è fondamentale. - Utilizzare il caching (query accelerata) quando le query sono frequenti ma i risultati leggermente obsoleti sono accettabili, bilanciando prestazioni e costi. - Utilizzare Federazione file per carichi di lavoro analitici o batch su larga scala e molto produttivi, ideali per le serie di dati storiche o meno sensibili al tempo. - **Allineamento della governance ai requisiti di residenza dei dati:** - Utilizzare l'inserimento dove la governance centralizzata è fondamentale. - Utilizzare Federation dove la governance decentralizzata è accettabile, imponendo al contempo una governance rigorosa alla fonte esterna. Copia zero rispetta le policy a livello di origine, ad esempio la protezione a livello di riga e il mascheramento dei dati. - **Dare priorità all'inserimento per i flussi di lavoro di alto valore:** Applicare l'inserimento in modo selettivo a processi critici come la risoluzione dell'identità, la generazione di rapporti normativi e l'attivazione operativa. - **Costo e complessità determinano la decisione:** L'inserimento in tempo reale può essere costoso e complesso. Gli architetti devono valutare il costo dell'orientamento, dell'archiviazione e della trasformazione dei dati rispetto al costo dell'esecuzione di query direttamente tramite Copia zero. La scelta dello schema di integrazione corretto (inserimento dati, copia zero o approccio ibrido) influisce direttamente su latenza, governance, efficienza operativa e costi nelle piattaforme multi-cloud. Questa decisione determina in che modo gli approfondimenti in tempo reale, l'attivazione basata sull'intelligenza artificiale e il coinvolgimento personalizzato possono essere forniti in modo affidabile e su larga scala. ## Confronto dei prodotti Questa tabella offre un confronto tecnico tra gli schemi di inserimento dati e Copia zero in Salesforce Data 360, concentrandosi su funzionalità, compromessi e vantaggi, oltre a casi d'uso e risultati aziendali. Gli architetti possono utilizzarlo come riferimento per progettare piattaforme dati ibride multi-cloud che bilanciano prestazioni, costi e conformità.
Tipo di schema Modalità / Strumento Vantaggi Considerazioni Esiti
Inserimento dati Real-Time: Inserimento di latenza al di sotto del secondo tramite le API di inserimento con supporto CDC. Pipeline di streaming continue. - Approfondimenti immediati
- Ideale per casi d'uso operativi e di personalizzazione a bassa latenza
- Supporta flussi di lavoro basati sugli eventi
- Costo elevato
- Architettura complessa
- Richiede sistemi di origine a bassa latenza
- Fonti a volume elevato possono causare uno streaming eccessivo che porta a pipeline sature
- I/O intensivo
Considerare i campi selettivi e i filtri per ridurre l'overhead
Agenteforce:
- Avvisi frodi in tempo reale, personalizzazione della vendita al dettaglio, avvisi operativi
Analytics:
- Cruscotti digitali sub-secondi, monitoraggio KPI
Conformità:
Aggiornamenti continui dei record cliente per i flussi di lavoro regolamentati
Streaming: Inserimento di micro batch ogni 1–3 minuti tramite connettori nativi - Costo bilanciato vs freschezza
- Architettura più semplice rispetto al tempo reale
- Supporta aggiornamenti incrementali
- Lieve latenza
- Può non essere adatto per decisioni critiche sub-secondi
- Le dimensioni del batch influiscono sulla memoria/calcolo
- I/O è moderato
- Ideale per schemi di aggiornamento prevedibili e ripetuti
- Considerare l'aggregazione finestrata per ridurre il carico di elaborazione
Agenteforce:
- Trigger campagna tempestivi, coinvolgimento quasi live
Analytics:
- Motori di consiglio, cruscotti digitali quasi live
Conformità:
- Aggiornamenti frequenti con verificabilità
Batch: carichi a volume elevato pianificati tramite connettori o API. Supporta l'archiviazione di oggetti e le opportunità in corso di realizzazione ETL/ELT. - Economico per serie di dati di grandi dimensioni
- Facile da implementare
- Affidabile per l'analisi storica
- Latenza dei dati
- Inadatto per operazioni sensibili al tempo
- I/O intensivo durante le finestre di carico
- La produttività della rete può diventare un collo di bottiglia per i file di grandi dimensioni
- Ideale per l'aggregazione storica o i flussi di lavoro di generazione di rapporti regolamentati
Agenteforce:
- ticket di assistenza IT (Jira/ServiceNow), flussi di lavoro aggregati
Analytics:
- Analisi storica, valutazione del trend
Reclamo:
- Reportistica normativa, aggregazione dati paziente/richiesta
Copia zero Live Query: query dirette su sistemi esterni; schema in lettura; nessuna duplicazione dei dati - Massima freschezza
- Overhead di memoria minimo; supporta approfondimenti operativi in tempo reale
- A seconda delle prestazioni della fonte
- Volume di query elevato può influire sulla latenza
Ideale per query con pushdown e aggregazione del predicato per ridurre al minimo gli I/O
- Evitare query non filtrate su serie di dati di grandi dimensioni
Agenteforce:
Flussi di lavoro dinamici che si adattano all'attività live
Analytics:
- Cruscotti digitali operativi, reportistica live
Conformità:
Rispetta la protezione a livello di riga e il mascheramento alla fonte
Query accelerata (Caching): copie locali memorizzate nella cache per le query federate. Configurabile da 15 min a 7 giorni. Esecuzione di query ottimizzata - Riduce la latenza
- Costo inferiore rispetto alle query live ripetute
Migliora le prestazioni per gli schemi di accesso frequenti
- Gestione della cache richiesta
- Stabilità dipende dall'intervallo di cache
- Ideale per query ad alta frequenza
- Non adatto per decisioni sub-secondarie
Agenteforce:
- Metriche di coinvolgimento pre-aggregate per decisioni rapide
Analytics:
- Cruscotti digitali BI, segmentazione, reportistica analitica
Conformità:
- Cruscotti digitali regolamentati coerenti con i registri di controllo
Federazione file: accesso diretto a grandi serie di dati storici in negozi di oggetti o laghi (S3, Iceberg, Google BigQuery, Redshift). - Gestisce serie di dati su larga scala
- Memoria minima in Data 360
- Supporta i carichi di lavoro AI/ML
- Sola lettura
- Le prestazioni delle query dipendono dalla produttività del sistema esterno
- Ottimizzato per processi batch-heavy, throughput-intensive
- Non adatto per cruscotti digitali in tempo reale
Agenteforce:
- (Non tipico — pesante in batch)
Analytics:
- Formazione ML/AI, analisi storica, reportistica su scala petabyte
Conformità:
- Accesso governato alle serie di dati esterne senza duplicazione
## Schemi di integrazione di Data 360 ### Inserimento dati Con l'inserimento dei dati, i dati vengono copiati fisicamente in Data 360 e completamente gestiti, a differenza di Copia zero in cui i dati rimangono all'origine. Il calcolo delle trasformazioni avviene all'interno di Data 360, che consente una governance e un controllo centralizzati. #### Casi d'uso di inserimento dati Utilizzare l'inserimento dati per archiviare le serie di dati canoniche governate in Salesforce Data 360 per la conformità e il controllo operativo. Utilizzare l'inserimento quando sono necessari controllo completo, controllo e tracciabilità. Ideale per flussi di lavoro regolamentati o di valore elevato in cui l'elaborazione centralizzata e la governance sono fondamentali. L'inserimento è ideale per creare una base affidabile per la risoluzione dell'identità, la generazione di rapporti normativi e i flussi di lavoro mission-critical basati sull'intelligenza artificiale e sul coinvolgimento dei clienti. Panoramica dell'inserimento dati #### Metodi di inserimento dati I metodi di inserimento dati variano a seconda del connettore utilizzato per inserire i dati. Alcuni connettori offrono una varietà di metodi di inserimento, mentre altri funzionano solo in modalità batch o streaming. Vedere [Data 360: Integrazioni e connettori](https://help.salesforce.com/s/articleView?id=data.c360_a_sources_targets.htm&type=5) per un elenco completo dei connettori Data 360 e dei relativi metodi disponibili. - **In tempo reale** - Inserimento al di sotto del secondo utilizzando le opportunità in corso di realizzazione in streaming o Acquisizione dati di modifica (CDC). - Ideale per i flussi di lavoro sensibili al tempo (rilevamento di frodi, personalizzazione, cruscotti digitali operativi). - Trasformazioni push e aggregazioni in Data 360 per ridurre l'I/O a valle e ottimizzare l'utilizzo dell'elaborazione. Utilizzare CDC incrementale per ridurre al minimo il rimescolamento dei dati. - **Streaming** - Inserimento ogni 1–3 minuti a piccoli incrementi. - Bilancia freschezza e costo, adatto per l'orchestrazione delle campagne, il coinvolgimento quasi live e la generazione di rapporti operativi. - Utilizzare i micro batch per controllare i picchi di I/O. Se possibile, aggregare i dati alla fonte per ridurre i volumi di trasferimento e ottimizzare l'archiviazione. - **Batch (carichi pianificati)** - Inserimento periodico di serie di dati di grandi dimensioni (orarie, giornaliere, settimanali). - Economico e affidabile per le serie di dati storiche, i rapporti normativi e i casi d'uso di conformità. - Assicurarsi che la posizione di calcolo si trovi nella stessa regione dello spazio di archiviazione sorgente per ottimizzare le prestazioni e i costi. #### Playbook architetto - **Casi d'uso per l'inserimento dati** - **Generazione di profili unificati Customer 360:** Creare un'unica fonte di dati per l'identità e gli attributi dei clienti. - **Gestire le serie di dati di conformità ai regolamenti:** Imponendo governance, discendenza e verificabilità per i dati sensibili. - **Centralizzare l'orchestrazione delle campagne:** Garantire che marketing, vendite e assistenza operino tutti da serie di dati coerenti e affidabili. - **Processi di progettazione** - Favorire l'inserimento in batch per esigenze storiche o tolleranti la bassa latenza, ad esempio rapporti di archiviazione o istantanee periodiche. - Utilizzare le API CDC o streaming per mantenere aggiornati i flussi di lavoro operativi e di personalizzazione, garantendo aggiornamenti quasi in tempo reale. - Controllare la crescita dello storage e del calcolo applicando carichi incrementali anziché ricaricare intere serie di dati per ottimizzare i costi e l'efficienza. - Allineare le opportunità di inserimento in corso di realizzazione con la località di calcolo e l'elaborazione incrementale per ridurre gli I/O della rete. Applicare trasformazioni all'interno di Data 360 per evitare di spostare dati non elaborati inutilmente. - **Considerazioni sui costi** - **Inserimento in tempo reale:** Costi di elaborazione e pipeline più elevati; giustificati per flussi di lavoro di valore elevato e sensibili al tempo come personalizzazione, cruscotti digitali operativi o azioni basate su Agentforce. - **Inserimento streaming:** Moderare i costi di calcolo e archiviazione; adatto per aggiornamenti frequenti che possono tollerare lievi ritardi, come l'orchestrazione delle campagne o la generazione di rapporti operativi. - **Inserimento batch:** Minori costi di calcolo, memoria prevedibile; ideale per le serie di dati storiche o gli aggiornamenti a bassa frequenza. L'inserimento di dati batch da organizzazioni Salesforce utilizzando determinati connettori è gratuito. - **Modalità di aggiornamento:** La selezione della modalità Aggiornamento incrementale riduce i costi totali di inserimento e calcolo. Si consiglia di utilizzare l'aggiornamento incrementale ove possibile per ottimizzare l'efficienza in tutti i tipi di inserimento. - Il costo è influenzato anche dal volume di I/O dalla fonte a Data 360. L'ottimizzazione delle dimensioni dei batch, delle partizioni e dell'allineamento regionale riduce i costi di trasferimento e migliora le prestazioni. - **Scenari di settore** - **Finanza:** Inserire le serie di dati necessarie per conoscere il cliente (KYC), l'Antiriciclaggio (AML) e il rilevamento delle frodi, in cui la verificabilità e la conformità non sono negoziabili. - **Assistenza sanitaria:** Utilizzare l'inserimento per la risoluzione dell'identità del paziente e i record conformi all'HIPAA, abilitando visualizzazioni unificate sicure. - **Retail:** Consolidare i dati dei punti vendita (POS), dell'eCommerce e dei programmi fedeltà in profili unificati per segmentazione e personalizzazione - **Telecom:** Supportare la prevenzione dell'abbandono e l'analisi dell'utilizzo con dati canonici degli abbonati regolati. #### Criteri decisionali del metodo di inserimento dati
Funzione Inserimento in tempo reale Inserimento streaming Inserimento batch
Latenza e freschezza Inserimento di latenza inferiore al secondo tramite le API di inserimento con supporto CDC (Cambia acquisizione dati). Fornisce opportunità in streaming continue. Ideale per i casi d'uso operativi a bassa latenza. Inserimento in micro batch ogni 1–3 minuti tramite connettori nativi. Supporta gli aggiornamenti incrementali. È prevista una leggera latenza. La latenza dei dati è prevista. Carichi a volume elevato pianificati. Inserimento periodico (orario, giornaliero, settimanale). Non adatto per operazioni sensibili al tempo.
Casi d'uso principali Ideale per casi d'uso operativi e di personalizzazione a bassa latenza. Utilizzato per i flussi di lavoro sensibili al tempo. Supporta i flussi di lavoro basati sugli eventi. Utilizzato per gli avvisi di frode in tempo reale e gli avvisi operativi. Adatto per processi moderatamente urgenti. Utilizzato per l'orchestrazione delle campagne, il coinvolgimento quasi live e la generazione di rapporti operativi. Utilizzato per trigger campagna puntuali. Economico per serie di dati di grandi dimensioni. Affidabile per l'analisi storica. Utilizzato per l'aggregazione storica o i flussi di lavoro di generazione di rapporti regolamentati. Ideale per le serie di dati storiche o a bassa velocità.
Complessità architettonica e I/O Costo elevato e architettura complessa. Richiede sistemi di origine a bassa latenza. I/O intensivo. Fonti a volume elevato possono causare pipeline sature. Architettura più semplice che in tempo reale. I/O è moderato. Ideale per schemi di aggiornamento prevedibili e ripetuti. Le dimensioni del batch influiscono sulla memoria/calcolo. Facile da implementare. I/O intensivo durante le finestre di carico. La produttività della rete può diventare un collo di bottiglia per batch di grandi dimensioni.
Considerazioni sui costi Massimi costi di calcolo e pipeline. Giustificato solo per i flussi di lavoro di valore elevato e sensibili al tempo. Moderare i costi di elaborazione e memoria. Offre un approccio bilanciato tra costo e freschezza. Adatto per aggiornamenti frequenti che possono tollerare lievi ritardi. Minori costi di calcolo e memoria prevedibile. Consigliato per le serie di dati storiche o gli aggiornamenti a bassa frequenza. L'inserimento tramite pipeline interne Salesforce è gratuito.
Processi di progettazione Utilizzare CDC incrementale per ridurre al minimo il rimescolamento dei dati. Filtrare e utilizzare i campi selettivi per ridurre il sovraccarico. Utilizzare i micro batch per controllare i picchi di I/O. Considerare l'aggregazione con finestre per ridurre il carico di elaborazione. Privilegiare questa opzione per i rapporti di archivio o le istantanee periodiche. Assicurarsi che la posizione di calcolo sia nella stessa regione dello spazio di archiviazione sorgente per ottimizzare i costi.
### Federazione dati copia zero #### Casi d'uso copia zero Utilizzare Copia zero per eseguire query in tempo reale su sistemi esterni senza duplicazione dei dati, abilitando agilità, freschezza e accesso scalabile a serie di dati di grandi dimensioni o temporanee. È ideale per cruscotti digitali live, analisi esplorative, formazione sui modelli AI/ML e coinvolgimento dei clienti in tempo reale direttamente tramite Salesforce Data 360. Panoramica della federazione dei dati con copia zero #### Metodi copia zero Quando si utilizza Copia zero, gli architetti devono scegliere ulteriormente tra tre metodi di federazione dei dati disponibili, ciascuno dei quali offre i propri compromessi tra freschezza, prestazioni e costo. - **Query live** - Esegue query direttamente su sistemi esterni (Snowflake, Google BigQuery, Redshift, Databricks, ecc.) senza duplicazione dei dati. - Ottimale quando predicati e aggregazioni possono essere spostati verso il basso, riducendo al minimo lo spostamento dei dati sulla rete e l'I/O nell'elaborazione di Salesforce Data 360. - Ideale per approfondimenti in tempo reale e cruscotti digitali operativi a bassa latenza. Dipende dalle prestazioni del sistema esterno. - **Caching (query accelerata)** - Memorizza temporaneamente le copie memorizzate nella cache dei dati federati in Salesforce Data 360. - Riduce i costi di query ripetute e la latenza per le serie di dati a cui si accede di frequente, con durata configurabile (da minuti a giorni). - I dati non vengono copiati in modo permanente o completamente governati; la freschezza viene gestita tramite aggiornamenti pianificati dall'origine. - **Federazione file** - Fornisce accesso diretto in sola lettura alle serie di dati su larga scala negli archivi di oggetti (ad esempio, S3, GCS con Iceberg). - Ideale per carichi di lavoro AI/ML, analisi storica e rapporti su scala petabyte senza spostare i dati. - Le prestazioni delle query dipendono fortemente dal formato dell'oggetto, dal partizionamento e dall'ingresso/uscita di rete. Scansioni di grandi dimensioni possono generare I/O sostanziali se non ottimizzate. #### Playbook architetto - **Casi d'uso** - **Personalizzazione in tempo reale e flussi di lavoro adattivi:** Offrire offerte dinamiche, consigli e azioni Next Best man mano che il comportamento dei clienti cambia. - **Cruscotto digitale live e analytics operativo:** Consente di alimentare i cruscotti digitali e i KPI business critical direttamente dai magazzini esterni. - **Addestramento del modello AI/ML con serie di dati esterne di grandi dimensioni:** Sfruttare i dati su scala petabyte di data lake e warehouse utilizzando federazione file senza spostarli. - **Scenari di settore** - **Retail/Media:** Abilitare i consigli personalizzati e il coinvolgimento dei clienti in tempo reale federando i dati di clickstream o di interazione con i contenuti. - **Finanza:** Eseguire il rilevamento delle frodi e il calcolo del punteggio del rischio quasi in tempo reale eseguendo query sui magazzini esterni senza duplicare dati sensibili. - **Tecnologia/impresa:** Supportare i rapporti tra cloud, i cruscotti digitali dei servizi IT e le analisi operative in cui le serie di dati risiedono in più sistemi. - **Processi di progettazione** - **Query live** - Utilizzare per query con QPS elevato e bassa latenza quando la freschezza è critica. - Inviare tramite push predicati e aggregazioni al sistema esterno per ridurre il rimescolamento dei dati sulla rete. - Evitare le query che eseguono la scansione di volumi di dati elevati inutilmente; considerare la potatura delle partizioni e i filtri. - **Federazione file** - Accedere alle serie di dati su scala petabyte negli archivi di oggetti senza inserimento. - Mantenere la memoria degli oggetti nella stessa area cloud utilizzata da Salesforce per ridurre al minimo i costi di latenza e uscita. - Utilizzare formati partizionati e colonnari (Parquet/ORC) e filtri pushdown per ridurre il trasferimento di I/O e di rete. - Sfruttare il pushdown di query e predicati per filtrare e aggregare i dati alla fonte, riducendo lo spostamento dei dati. - Evitare l'accesso ai dati tra regioni, a meno che non sia necessario, poiché aumenta I/O, latenza e costi. - **Caching (query accelerata)** - Inserire nella cache le serie di dati a cui si accede di frequente per bilanciare costi e prestazioni. - Configurare gli intervalli di aggiornamento per bilanciare freschezza e costo delle query. - **Conformità:** Applicare la governance all'origine sfruttando la protezione a livello di riga (RLS) e mascherando le policy direttamente all'interno dei sistemi federati. Di seguito sono riportate le procedure consigliate per uniformare il mascheramento e l'utilizzo di RLS tra le piattaforme. - **Utilizzare un ID Enterprise centralizzato:** Mappare utenti ed entità in Salesforce Data 360 a un identificatore aziendale centralizzato univoco che corrisponde alle identità nei sistemi esterni. - **Allinea policy di sicurezza:** Assicurarsi che le policy di protezione e mascheramento a livello di riga nei sistemi federati vengano applicate in base all'identità mappata. Ciò mantiene la conformità durante le query sui dati esterni. - **Standardizzazione degli schemi di identità:** Mantenere attributi di identità coerenti (email, ID utente, ID cliente, ecc.) in tutte le fonti di dati per evitare mancate corrispondenze e violazioni dell'accesso. - **Considerazioni sui costi** - **Query live:** Modello pay-per-query: i costi si accumulano sul calcolo lakehouse esterno e possono aumentare con un QPS elevato. Ideale per i casi d'uso critici per la freschezza in cui il valore è maggiore della variabilità dei costi. - **Query accelerata (Caching):** Riduce il costo delle query rispetto a Live Query riducendo gli attacchi al sistema di origine, ma aumenta i costi di inserimento dati batch per il riempimento e l'aggiornamento della cache. Ideale per le serie di dati con accesso frequente. - **Federazione file:** Opzione di archiviazione più economica come dati in Object Store, ma i costi delle query dipendono dalle dimensioni del file, dal partizionamento e dalla potatura. Ideale per dati storici o in blocco su scala petabyte. #### Criteri decisionali metodo copia zero
Punto Decisione Live query Caching (query accelerata) Federazione file
Posizione fonte di dati Data lakehouse esterni (Snowflake, Google BigQuery, Redshift, Databricks). Data lakehouse esterni (Snowflake, Google BigQuery, Redshift, Databricks) Archivi di oggetti o data lake cloud (S3, ADLS, GCS), spesso utilizzando formati di tabelle aperte come Iceberg.
Scopo/Caso d'uso Ideale per analisi interattive e cruscotti digitali in tempo reale. Ideale per la personalizzazione in tempo reale e i flussi di lavoro dinamici. Ideale per quando le query sono frequenti ma i risultati leggermente obsoleti sono accettabili. Adatto per cruscotti digitali BI e segmentazione. Ideale per l'elaborazione batch su larga scala e l'addestramento del modello AI/ML. Ideale per l'analisi storica e i rapporti su scala petabyte.
Freschezza/latenza Massima freschezza; le query vengono eseguite direttamente in tempo reale. Supporta le decisioni subsecondarie. Risultati leggermente obsoleti sono accettabili. La freschezza dipende dall'intervallo di cache, configurabile da 15 minuti a 7 giorni. Ottimizzato per i processi intensivi e di produzione. Non adatto per il cruscotto digitale in tempo reale.
Schema di accesso Ideale per query poco frequenti o personalizzate. Utilizzare per query con QPS elevato (query al secondo) e bassa latenza in cui la freschezza è fondamentale. Ideale per gli scenari di lettura ad alta frequenza. Migliora le prestazioni per gli schemi di accesso frequenti. Accesso in sola lettura. Adatto per serie di dati su scala petabyte senza inserimento.
Driver delle prestazioni Molto dipendente dalle prestazioni del sistema di origine esterno. Ottimizzato quando predicati e aggregazioni possono essere inviati all'origine. Riduce la latenza rispetto alle query live ripetute. Le prestazioni dipendono dalla gestione della cache e dall'intervallo. Le prestazioni dipendono fortemente dal formato dell'oggetto, dal partizionamento e dalla produttività del sistema esterno. Utilizzare formati partizionati e colonnari (Parquet/ORC).
Implicazioni sui costi Modello pay-per-query. I costi vengono accumulati per il calcolo esterno della lakehouse. Economico per le query poco frequenti, ma le spese possono aumentare con un volume elevato di query al secondo (QPS). Costo inferiore rispetto alle query live ripetute. Riduce la necessità di eseguire ripetutamente query sulla fonte esterna. Aggiunge memoria cache e overhead di aggiornamento. Opzione di memoria più economica. I costi delle query dipendono dalle dimensioni del file e dal partizionamento.
Considerazione chiave Evitare le query non filtrate che eseguono la scansione di volumi di dati elevati inutilmente. Richiede la gestione della cache. Non adatto per decisioni subsecondarie. Le prestazioni delle query dipendono fortemente dall'ottimizzazione tramite partizionamento e pushdown del predicato.
### Approccio ibrido Le architetture ibride consentono agli architetti di ancorare le serie di dati critiche in Data 360 per una governance centralizzata, sfruttando al contempo le query federate per garantire freschezza, riduzione delle duplicazioni e accesso scalabile a serie di dati esterne di grandi dimensioni. Questo approccio bilancia I/O, località di calcolo, costi e requisiti di conformità. #### Casi d'uso ibridi Utilizzare un approccio ibrido per una governance equilibrata, freschezza ed efficienza operativa combinando l'inserimento dei dati e la copia zero per offrire approfondimenti fruibili in tempo reale. Utilizzare l'inserimento per le serie di dati regolamentate di valore elevato in cui sono richiesti tracciabilità, RLS e mascheramento e la federazione per le serie di dati effimere o a volume elevato in cui freschezza e prestazioni sono fondamentali. Panoramica dell'approccio ibrido #### Playbook architetto - **Casi d'uso** - **Coinvolgimento Omnicanale:** Combinare i dati storici dei clienti con il comportamento in tempo reale per offrire esperienze coerenti e sensibili al contesto. - **Condotte AI/ML:** Addestrare i modelli su serie di dati canoniche curate arricchendole con segnali grezzi o in tempo reale provenienti da fonti esterne. - **Esigenze miste di conformità e agilità:** Applicare una governance rigorosa per i dati sensibili ma federarsi per l'agilità operativa. - **Scenari di settore** - **Retail:** Utilizzare l'inserimento per la risoluzione dell'identità e l'unificazione dei profili; la federazione per le offerte e la personalizzazione in tempo reale. - **Assistenza sanitaria:** Gestire le cartelle cliniche dei pazienti tramite inserimento federando gli stream di dispositivi IoT e i dati dei sensori per il contesto immediato. - **Servizi finanziari:** Inserire i dati regolamentati in un lago regolamentato dalla conformità durante la federazione delle query esterne per il rilevamento delle frodi e il monitoraggio dei rischi. - **Processi di progettazione** - **Ancora governance con inserimento:** Inserire dati di valore elevato o regolamentati nei modelli canonici per garantire Trust e conformità. - **Utilizza Federation for Freshness:** Consentire ai lakehouse esterni di fornire l'accesso ai dati in tempo reale o su larga scala senza duplicazioni. - **Costo del saldo vs. Prestazioni:** Profilare i carichi di lavoro per decidere cosa inserire e cosa federare, riducendo al minimo i costi di archiviazione o query non necessari. - **Applica governance a livelli:** Applicare una governance centralizzata per i dati inseriti, sfruttando i controlli di sicurezza dei sistemi federati (ad esempio, RLS, mascheramento). - Quando si progettano opportunità ibride in corso di realizzazione, assicurarsi dell'inserimento incrementale per le serie di dati storiche e inviare aggregazioni push o filtri alle fonti federate per ottimizzare l'utilizzo di I/O e calcolo. - **Considerazioni sui costi** - Ottimizzare il costo totale rispetto alle prestazioni combinando l'inserimento per la conformità o i dati critici con la federazione quando è necessario un aggiornamento. - Tenere conto degli I/O e della distribuzione dei calcoli quando si combinano inserimento e federazione. Per ridurre i costi di calcolo nei sistemi di origine di query ripetute, utilizzare il caching (Query accelerata) per le serie di dati federate di lettura elevata e accesso frequente. ## Guida alle decisioni dei casi d'uso Di seguito sono riportati alcuni archetipi comuni che illustrano come applicare questa logica. 1. **L'archetipo "Un'unica fonte di verità": Centralizzare e gestire** - **Scenario:** È necessario creare profili Customer 360 unificati conformi per l'intera azienda globale. I dati provengono da una dozzina di sistemi diversi, devono rispettare rigidi regolamenti GDPR e CCPA e fungeranno da fonte affidabile per tutte le interazioni di marketing e assistenza. - **Schema consigliato:** **Inserimento dati.** La priorità è governance, Trust e controllo. L'inserimento dei dati in Data 360 è l'unico modo per creare un profilo canonico completamente controllabile e isolato dai sistemi di origine. 2. Archetipo **di "Approfondimenti in tempo reale": Analisi senza spostamento** - **Scenario:** Il team di data science deve eseguire query esplorative su una tabella di transazioni massiccia e in continuo aggiornamento in Snowflake. Allo stesso tempo, il team direttivo desidera un cruscotto digitale di BI live basato sugli stessi dati. Lo spostamento giornaliero di petabyte di dati è troppo lento e costoso. - **Schema consigliato:** **Federazione copia zero.** La priorità sono velocità, agilità ed efficienza economica su larga scala. Copia zero consente di sfruttare l'immensa potenza del data warehouse esistente per eseguire query in tempo reale senza sovraccarico e latenza di duplicazione dei dati. 3. Archetipo **di "Intelligenza ibrida": Governare il core, federare l'edge** - **Scenario:** Si desidera arricchire i profili cliente gestiti e inseriti con segnali comportamentali in tempo reale (ad esempio i clic sul sito Web) provenienti da un data lake. È necessaria la stabilità del profilo centrale ma l'immediatezza dei dati live per favorire la personalizzazione immediata. - **Schema consigliato:** **Un approccio ibrido.** Utilizzare l'inserimento dati per creare il nucleo stabile e controllato dei dati dei clienti. Quindi, utilizzare Copia zero per federare i dati volatili in tempo reale, unendoli al momento della query per una visualizzazione completa e aggiornata. ## Percorso in avanti La strategia per i dati aziendali non consiste più nella scelta di un unico modello di integrazione, ma nell'architettura di una flessibilità controllata all'interno di un ecosistema di dati interoperabile. La selezione del metodo di integrazione dei dati giusto per ogni sistema di dati di origine in base alle esigenze aziendali spesso porta a un approccio ibrido che combina i punti di forza sia dell'inserimento dei dati che della federazione dei dati.: - Inserimento di serie di dati governate mission-critical in Salesforce Data 360 per la conformità, la risoluzione dell'identità e i flussi di lavoro operativi. - Federare i dati tramite Copia zero per analisi live, esplorative e basate sull'intelligenza artificiale senza duplicare l'archiviazione. Salesforce Data 360 su Hyperforce offre resilienza e scalabilità multi-regione. L'open lakehouse con tabelle Iceberg consente la separazione dei calcoli e l'interoperabilità con piattaforme come Snowflake, Databricks e S3 Iceberg, costituendo la spina dorsale di un ecosistema di dati multi-cloud davvero interoperabile. Man mano che gli ecosistemi di dati si evolvono, bilanciare costantemente freschezza, costo, prestazioni e conformità per mantenere l'agilità dell'architettura. È possibile rendere la piattaforma a prova di futuro unificando i dati gestiti inseriti con accesso federato. Ciò consente l'intelligenza in tempo reale, l'attivazione dell'intelligenza artificiale e la personalizzazione su scala aziendale in cloud, regioni e domini aziendali. Le soluzioni valide per tutti non sono adatte alla maggior parte delle aziende. La strategia ottimale mappa lo schema giusto al giusto driver aziendale. ## Informazioni sugli autori Yugandhar Bora è un architetto di ingegneria del software di Salesforce, specializzato in architettura dei dati all'interno della piattaforma Data & Intelligence Applications. Dirige iniziative del Comitato di revisione dell'architettura aziendale (EARB) incentrate sulla governance dei dati e sui modelli di dati unificati, contribuendo al contempo alle soluzioni di provisioning automatico della piattaforma. Jan Fernando è Principal Architect presso lo Studio del Chief Architect di Salesforce. È entrato in Salesforce nel 2012, apportando una vasta esperienza nel settore delle startup. Prima di entrare nello Studio del Chief Architect, ha trascorso oltre un decennio nell'organizzazione Platform, dove ha guidato diverse trasformazioni tecnologiche chiave. ## Panoramica Salesforce Data 360 è una piattaforma dati basata su Hyperforce che unifica Salesforce e i dati esterni in una visione chiara, completa e affidabile a 360 gradi di ogni cliente o account. Le aziende spesso gestiscono più organizzazioni Salesforce a causa di fusioni e acquisizioni, operazioni regionali, separazione funzionale o per motivi storici. Gli architetti devono decidere non solo se eseguire il provisioning di più istanze di Data 360 indipendenti, utilizzare Data Cloud One per unificare le organizzazioni in un'unica istanza o collaborare tra istanze di Data 360 indipendenti utilizzando la condivisione dei dati tra Data 360 (Data 360-to-Data 360 data sharing). Queste scelte influiscono su governance, conformità, costo, latenza e capacità dell'organizzazione di scalare l'intelligenza artificiale e le funzionalità tra organizzazioni. Data 360 viene eseguito automaticamente il provisioning in qualsiasi organizzazione di produzione che riceve una licenza Data 360. Data Cloud One è l'architettura di connettività multi-organizzazioni di Salesforce che consente a una singola organizzazione Home di ospitare l'istanza di Data 360, mentre le altre organizzazioni Salesforce si connettono come organizzazioni Companion. La scelta dell'organizzazione che detiene la licenza Data 360 e che quindi diventa un'organizzazione di casa Data 360 è una decisione architettonica critica con conseguenze a lungo termine. Il modo in cui si esegue il provisioning di Salesforce Data 360 è una decisione architetturale fondamentale poiché determina in che modo l'azienda unifica i dati dei clienti, impone la governance e abilita le funzioni essenziali della piattaforma, in particolare AI, Agentforce e Analytics, in tutta l'organizzazione. L'ancoraggio di un cluster di organizzazioni a un unico Data 360 offre un modello di dati unificato, una governance centralizzata e la preparazione all'intelligenza artificiale a livello aziendale, consentendo al contempo alle organizzazioni partner di accedere ai metadati e alle funzioni condivise come se i dati fossero locali. Al contrario, più istanze di Data 360 indipendenti sono appropriate quando i requisiti normativi, di conformità o di autonomia impediscono la centralizzazione, con la condivisione dei dati tra le organizzazioni Data 360 che abilita la collaborazione selettiva e copia zero tra queste istanze. Per gli architetti, questa decisione è fondamentale. Definisce chi controlla la governance dei dati, dove risiedono i dati, come sono abilitate le funzioni della piattaforma e quanto facilmente le integrazioni e le iniziative AI future possono scalare. Anche per le organizzazioni che attualmente non dispongono di Data 360, può essere importante sviluppare una strategia per aggiungere l'accesso a Data 360 in futuro. Le funzioni di Salesforce in Sales, Service, Marketing, Commerce, Industries e Agentforce sono sempre più basate su Data 360. Le organizzazioni che desiderano utilizzare queste funzioni della piattaforma devono eseguire il provisioning di Data 360 o connettersi a Data 360 condiviso come organizzazioni secondarie. Questa guida aiuta gli architetti a progettare una strategia di provisioning che bilancia semplicità, coerenza a livello aziendale, conformità e scalabilità, garantendo che l'organizzazione possa sfruttare con sicurezza Data 360 per Customer 360, AI e innovazione multipiattaforma. Vi aiuterà a decidere come selezionare le organizzazioni in cui eseguire il provisioning di Data 360 e come scegliere tra Data Cloud One e Condivisione dati tra organizzazioni Data 360, contribuendo a gettare le basi per far avanzare il business in un futuro incentrato su Data 360. --- ## Considerazioni sul provisioning Ogni scelta di provisioning, ad esempio la scelta tra Data Cloud One e la condivisione dei dati tra le organizzazioni Data 360 o l'organizzazione da designare come organizzazione di residenza, deve essere valutata in base alle seguenti considerazioni trasversali:
Considerazione Perché è importante Scenari di esempio
Residenza e conformità dei dati Determina dove vengono memorizzati ed elaborati i dati. Le norme normative possono richiedere regioni specifiche o più istanze. Una banca globale esegue il provisioning di un tenant Data 360 in un'organizzazione Salesforce geolocalizzata a Francoforte per la conformità al GDPR e di un altro tenant in un'organizzazione in Virginia per la divisione statunitense.
Governance e sicurezza Chi possiede e amministra Data 360? Le polizze devono essere gestite a livello centrale o delegate per unità operativa? Una multinazionale con una forte centralità IT crea una Home Org dedicata gestita da un Centro di Eccellenza.
Autonomia vs. Centralizzazione Leader diversi possono volere una proprietà separata dei dati. L'autonomia favorisce più Data 360; la centralizzazione favorisce Data Cloud One. Una holding con società controllate indipendenti consente a ogni unità operativa di eseguire il proprio Data 360.
Latenza e prestazioni Influisce sulla velocità e l'esperienza delle query, in particolare per le organizzazioni partner connesse a un tenant di Data 360 in tutte le regioni. Un team di vendita di Londra che esegue query sui dati di un tenant di Data 360 negli Stati Uniti può riscontrare una latenza più elevata.
Complessità dell'integrazione Altri tenant di Data 360 = altre opportunità in corso di realizzazione, API e middleware. Il consolidamento semplifica l'integrazione. Un rivenditore evita la creazione di 10 pipeline ETL consolidandole in una configurazione Data Cloud One.
Regione fonte di dati copia zero I connettori Zero Copy possono avere requisiti di accesso tra regioni che limitano le regioni in cui può trovarsi Data 360. Una società ha un'istanza Snowflake nella regione AWS eu-west-1. Possono utilizzare Copia zero per federare i dati in un Data 360 nella loro regione, ma non possono utilizzare Copia zero per federare in un Data 360 nella regione degli Stati Uniti.
Compatibilità tra regioni di Private Connect In alcuni casi, il supporto di Private Connect dipende dal fatto che la fonte di dati si trovi nella stessa regione del tenant di Data 360. Un'azienda ha un'istanza Snowflake nella regione aws-east-1 a cui vuole connettersi tramite copia zero. Possono stabilire una connessione di rete Private Connect solo se l'organizzazione Data 360 Home si trova nella stessa regione.
Costo e licenze Ogni tenant di Data 360 aggiunge un costo. Il raggruppamento in meno istanze ottimizza la spesa. Un operatore sanitario riduce i costi delle licenze adottando Data Cloud One anziché più istanze di Data 360 indipendenti.
Scalabilità futura Le scelte di provisioning oggi gettano le basi per la crescita. Una società SaaS inizia con una singola istanza di Data 360 ma prevede di espandersi a Data Cloud One quando acquisisce società controllate con organizzazioni Salesforce.
Prontezza AI a livello aziendale Le funzioni AI e Agentforce richiedono un tenant Data 360 connesso in ogni organizzazione. Le decisioni di provisioning influiscono sul modo in cui i modelli di intelligenza artificiale si addestrano e si attivano in tutta l'azienda. Una società di servizi finanziari unifica i dati in Data Cloud One in modo che i suoi modelli Einstein AI abbiano accesso ai dati dei clienti a livello aziendale.
### Considerazioni importanti
  • Il provisioning è legato alla licenza: Data 360 viene fornito nell'organizzazione in cui viene acquistata la licenza Data 360 e la regione è determinata dalla posizione di tale organizzazione al momento del provisioning.
  • Mantenere aperte le opzioni pianificando per Data 360 anche se non è necessario ora. Le decisioni prese ora possono semplificare il percorso se in seguito si implementa Data 360 per potenziare funzioni della piattaforma come Agentforce.
  • Clienti a organizzazione singola: Eseguire il provisioning di Data 360 nell'organizzazione di produzione esistente per ottimizzare il time-to-value.
  • Clienti multi-organizzazioni: Ridurre al minimo la complessità creando il minor numero possibile di istanze di Data 360, idealmente utilizzando la configurazione Data Cloud One.
  • Più istanze Data 360 devono essere utilizzate solo quando richiesto dalla conformità, dalla residenza o dall'autonomia organizzativa. In questi casi, utilizzare la condivisione dei dati tra le organizzazioni Data 360 per consentire una collaborazione sicura.
  • Fonti di dati: Prestare molta attenzione alle regioni supportate per i vari cloud pubblici e le fonti di dati Copia zero. Determinare inoltre se Private Connect è necessario per il proprio comportamento di sicurezza per connettersi a tali fonti di dati e se sono supportate le connessioni in-region o tra regioni.
  • Governance e autonomia sono concetti centrali: decidere se Data 360 deve essere gestito centralmente (modello Centro di eccellenza) o se le singole linee di business necessitano di istanze di Data 360 gestite separatamente.
--- ## Sezione 1: Provisioning di Data 360 - Scelta dell'organizzazione di origine ### 1.1 Che cos'è un'organizzazione Data 360 Home? Quando si acquista una licenza Data 360, l'istanza di Data 360 viene fornita nell'organizzazione Salesforce associata a quella licenza. Questa organizzazione è denominata organizzazione Data 360 Home. Schema decisionale che mostra l'organizzazione iniziale Data 360 L'organizzazione iniziale è l'anchor per l'istanza di Data 360. È dove: - L'archiviazione e l'elaborazione di Data 360 vengono gestite (nella regione selezionata al momento del provisioning). - Vengono applicate le policy di amministrazione, governance e sicurezza. - Vengono eseguite operazioni di inserimento, armonizzazione, risoluzione dell'identità, segmentazione e attivazione dei dati. Negli scenari multi-organizzazioni, l'organizzazione di residenza gestisce l'istanza centrale di Data 360 per le altre organizzazioni Salesforce "Compagne". Perché l'organizzazione di residenza è importante: - Determina la posizione geografica dell'istanza di Data 360. - Determina chi è titolare e chi amministra l'istanza di Data 360. Gli amministratori dell'organizzazione Data 360 Home possono accedere a tutti i dati inseriti in Data 360. - Controlla le connessioni dell'organizzazione compagna in una configurazione Data Cloud One. - È la base della strategia per i dati aziendali: modificarla in seguito è difficile e sconvolgente. ### 1.2 Decisione: Organizzazione esistente o Nuova organizzazione come organizzazione di origine? La prima decisione importante è se eseguire il provisioning di Data 360 in un'organizzazione di produzione esistente o creare una nuova organizzazione dedicata che funga da organizzazione di origine. Diagramma decisioni che mostra l'organizzazione esistente rispetto alla nuova organizzazione come organizzazione iniziale #### Opzione A: Provisioning di Data 360 in un'organizzazione esistente **Funziona meglio per:** Clienti con una singola organizzazione Salesforce o clienti multi-organizzazione che hanno già un'organizzazione centralizzata principale in cui viene eseguita la maggior parte delle attività. Schema che mostra il provisioning di Data 360 nell'organizzazione esistente - **Pro**: - Percorso più semplice: Data 360 viene eseguito il provisioning dove sono già presenti i dati CRM. - Accesso immediato ai dati di vendita, assistenza e marketing locali. - Nessuna integrazione aggiuntiva richiesta. - Meno licenze e ambienti da gestire. - Accelera l'adozione precoce, i casi d'uso pilota e di produzione. - **Contro**: - Può ereditare la governance o il debito tecnico dell'organizzazione esistente. - Se non esiste una singola "organizzazione principale", la selezione di una può creare dibattiti sulla proprietà. - Le prestazioni sono legate alla posizione dell'organizzazione; potrebbero non essere in linea con le esigenze di residenza a livello aziendale. - Se più unità operative utilizzano organizzazioni diverse, il provisioning locale può causare frammentazione se non abbinato a Data Cloud One. **Esempio:** Una società SaaS con un'organizzazione Salesforce esegue il provisioning di Data 360 in tale organizzazione per unificare i dati di abbonamento e assistenza dei clienti. #### Opzione B: Provisioning di Data 360 in una nuova organizzazione dedicata **Funziona meglio per:** Clienti con più organizzazioni Salesforce che non possono allinearsi su una singola organizzazione principale o aziende con un modello di Centro di eccellenza (CoE) forte. Schema che mostra il provisioning di Data 360 nella nuova organizzazione dedicata - **Pro**: - Parte pulita per la governance, senza complessità dell'organizzazione ereditate. - Controllo centralizzato in più linee di business. - Flessibilità di scegliere una regione in base alle esigenze di conformità. - Agisce come un'organizzazione di "servizio condiviso" neutrale, non collegata a un'unità operativa. - Impostazione per la futura architettura Data Cloud One (organizzazione Home con più organizzazioni Companion). - **Contro**: - I clienti devono disporre della licenza per una nuova organizzazione Salesforce in cui eseguire il provisioning di Data 360. - Integrazione aggiuntiva necessaria per connettere l'organizzazione a Data 360 tramite una connessione Data Cloud One. - Può aggiungere spese amministrative (gestione utenti, sicurezza, identità). - Time-to-value più lento rispetto al provisioning in un'organizzazione di produzione esistente. **Esempio:** Una società multinazionale di servizi finanziari crea un'organizzazione domestica dedicata per il provisioning di Data 360. Tutte le organizzazioni di unità operative (Retail, Wealth, Commercial Banking) si connettono come organizzazioni di compagnia tramite Data Cloud One. #### Criteri decisionali
Considerazione Organizzazione esistente come organizzazione iniziale (predefinita preferita) Nuova organizzazione come organizzazione iniziale (alternativa)
Semplicità Si basa sulla struttura di utenti e dati esistente per un'impostazione più rapida; Data 360 è integrato per impostazione predefinita con l'organizzazione iniziale. Richiede la licenza e l'impostazione della nuova organizzazione Salesforce e ulteriori oneri amministrativi per la gestione.
Time-to-Value Utilizzo immediato dei dati CRM locali. Rampa più lenta; integrazione richiesta.
Governance Eredita il modello di governance di base dell'organizzazione esistente: utenti e insiemi di autorizzazioni esistenti. Questo può andare bene se l'organizzazione è già centrale. Tabula rasa per la governance; ideale per i modelli guidati da CdE.
Conformità Residenza legata alla regione dell'organizzazione esistente. Flessibilità di selezionare una regione indipendente dalle organizzazioni esistenti.
Prestazioni Migliori prestazioni per le query CRM locali. Dipende dalla connettività dell'organizzazione compagna, sia che si tratti della stessa regione o di un'area trasversale alle altre organizzazioni.
Scalabilità futura Funziona bene se abbinato a Data Cloud One; più difficile spostarsi in seguito se viene scelta l'organizzazione sbagliata. Scala facilmente con Data Cloud One ; progettato per la neutralità.
Costo Minor costo incrementale. Maggiore sovraccarico da ambienti aggiuntivi.
### 1.3 Raccomandazioni Come principio generale, preferire utilizzare un'organizzazione principale esistente come organizzazione di residenza per ridurre al minimo l'impegno iniziale e accelerare l'adozione. Creare una nuova organizzazione di residenza dedicata solo se la strategia di governance o conformità a lungo termine lo richiede. La creazione di una nuova organizzazione domestica dedicata è una scelta comune per le aziende più grandi con un Centro di Eccellenza (COE). **Ambiente organizzazione singola** Eseguire il provisioning di Data 360 nell'organizzazione di produzione esistente. Ciò massimizza la semplicità e il valore immediato. Evita inutili sovraccarichi di integrazione. **Ambiente con più organizzazioni** Preferire selezionare una delle organizzazioni principali, in genere quella in cui opera la maggior parte della propria azienda o quella che funge già da CRM centralizzato, per fungere da organizzazione di residenza. Ciò riduce la complessità, riduce al minimo il lavoro di impostazione e consente di realizzare rapidamente il valore di Data 360. L'utilizzo di un'organizzazione principale esistente evita inoltre i costi e le operazioni di integrazione della gestione di un nuovo ambiente. **Quando considerare una nuova organizzazione domestica dedicata** Se l'organizzazione ha un Centro di eccellenza (CdE) forte e desidera una governance separata dalle organizzazioni delle unità operative. Se nessuna organizzazione esistente è adatta per motivi di conformità o vincoli organizzativi. In questi casi, la creazione di una nuova organizzazione di residenza offre flessibilità e neutralità, ma con un time-to-value più lento. --- ## Sezione 2: Strategia multi-organizzazioni e Data Cloud One ### 2.1 La sfida multi-organizzazioni Le aziende spesso gestiscono più organizzazioni Salesforce, e questo non è un caso limite, ma la norma. A febbraio 2024, circa 19.000 clienti Salesforce gestivano già più di un'organizzazione Salesforce. Perché succede? - **Acquisizioni e fusioni:** Le società appena acquisite apportano le proprie istanze Salesforce. - **Operazioni regionali:** Organizzazioni separate per UE, Nord America, Asia-Pacifico, ecc., spesso per soddisfare le leggi sulla residenza dei dati. - **Separazione funzionale:** Diverse unità operative (ad esempio Retail Banking, Wealth Management, Insurance) mantengono le proprie organizzazioni per l'autonomia. - **Isolamento normativo o di sicurezza:** Alcuni settori impongono organizzazioni logicamente distinte per motivi di conformità. - **Motivi storico/tecnici:** Nel tempo, i clienti accumulano organicamente più organizzazioni. Ogni motivo ha senso singolarmente, ma insieme creano una frammentazione dei dati. Senza un livello di unificazione, ogni organizzazione ha solo una visione parziale del cliente. La sfida architettonica: Come si uniscono i dati di tutte le organizzazioni in un'unica fonte di dati veritieri rispettando i requisiti di conformità, governance e autonomia? --- ### 2.2 Che cos'è Data Cloud One? Data Cloud One è l'architettura di connettività multi-organizzazione di Salesforce che consente a più organizzazioni Salesforce di condividere una singola istanza di Data 360. È lo schema consigliato per le aziende con più organizzazioni Salesforce. In qualsiasi cluster Data Cloud One, un'organizzazione Salesforce è designata come organizzazione di residenza, che ospita l'istanza di Data 360. Le altre organizzazioni Salesforce si connettono come organizzazioni di compagnia, utilizzando i dati unificati e i metadati di Data 360 dell'organizzazione di residenza. Schema che mostra l'architettura di Data Cloud One #### Funzionamento di Data Cloud One
  1. Inserimento e unificazione dei dati (organizzazione iniziale)
    • Tutte le configurazioni di inserimento dati (Salesforce CRM, fonti esterne, streaming, batch) avvengono solo dall'organizzazione di origine.
    • Il tenant di Data 360 legato all'organizzazione Home esegue operazioni di risoluzione dell'identità, armonizzazione, modellazione e unificazione in profili Customer 360 affidabili.
    • L'amministrazione, le policy di governance, i tag e il mascheramento di Data 360 vengono applicati centralmente dall'organizzazione di origine.
  2. Architettura spazio dati
    • Dall'organizzazione iniziale, i dati sono organizzati in spazi dati, che fungono da contenitori logici per dati, metadati e processi.
    • Le aziende possono creare spazi dati per marchi, regioni o linee di business.
    • Condivisione spazio dati: Dall'organizzazione di origine, spazi dati specifici vengono condivisi in modo selettivo con le organizzazioni partner. Ciò garantisce che solo i dati pertinenti (e i metadati associati) vengano trasferiti alle organizzazioni giuste.
  3. Condivisione dei metadati
    Le organizzazioni accompagnate ricevono definizioni dei metadati dall'organizzazione di origine, inclusi oggetti modello di dati (DMO), schema del profilo unificato, approfondimenti calcolati, segmenti e altro ancora. Questi vengono visualizzati in modo nativo all'interno dell'organizzazione compagna come se fossero asset locali, ma in realtà sono collegati all'organizzazione di origine.
  4. Processi da eseguire nell'organizzazione domestica rispetto a Organizzazioni di compagnia
  5. L'accesso alle funzioni è diverso tra le organizzazioni Home e Companion. Le organizzazioni di supporto non possono inserire o unificare i dati e si affidano all'organizzazione di residenza per l'inserimento, la modellazione e l'unificazione. Le organizzazioni associate possono accedere ai dati di Data 360 per potenziare le funzioni della piattaforma basate su Data 360 e possono creare approfondimenti locali, segmenti e flussi oltre ai dati condivisi e affidabili. Nella visione futura, possono anche accedere alle funzioni di attivazione.
    Capacità Organizzazione iniziale Organizzazione compagna
    Connessione Configurare i connettori, creare stream di dati, inserire o federare i dati ✅ ❌
    Creazione ed esecuzione di trasformazioni dati e risoluzione dell'identità ✅ ❌
    Gestisci Proteggi i dati con spazio dati e autorizzazioni ✅ ✅
    Segmentazione e previsione Creazione di segmenti, approfondimenti e modelli Einstein Studio ✅ ✅
    Attivazioni ovunque, azioni dati ✅ ✅
    Generatore di prompt, flussi, rapporti, arricchimento della piattaforma e altro ancora ✅ ✅
    Funzioni di Data 360 Prospecting Center, Sales e Service Cloud, Agentforce e altro ancora ✅ ✅
  6. Parità delle funzioni piattaforma
    Dal punto di vista di utenti e generatori, una volta condivisi i metadati, esistono alcune differenze funzionali tra le organizzazioni Home e Companion in termini di utilizzo delle funzioni della piattaforma Salesforce. L'elenco delle funzioni supportate è disponibile in Funzioni Data 360 nelle organizzazioni partner.
    • Le funzioni della piattaforma Salesforce, ad esempio flussi, rapporti, Generatore di prompt, cruscotti digitali e altri strumenti nativi della piattaforma, funzionano sia nella pagina iniziale che nelle organizzazioni di supporto quando i metadati sono disponibili.
    • Le funzioni basate su Data 360, ad esempio Agentforce, Prospecting Center, Sales Cloud Einstein e Service Cloud AI, funzionano perfettamente anche nelle organizzazioni Home e Companion. Alcune funzioni potrebbero essere in procinto di raggiungere la completa compatibilità, ma l'obiettivo generale è avere la parità di funzioni tra le organizzazioni Home e Companion per tutte le funzioni Cross-Cloud che dipendono da Data 360.
  7. Modello di consumo
    Tutta l'attività dell'organizzazione compagna (query, esecuzioni di segmenti, flussi attivati da Data 360, utilizzo dell'intelligenza artificiale, registrazione Einstein Trust Layer, ecc.) consuma i crediti di Data 360 dell'organizzazione di residenza. I flussi di consumo sono unidirezionali: i crediti vengono centralizzati, fatturati e tracciati rispetto all'allocazione di credito dell'organizzazione di residenza. Tuttavia, è possibile visualizzare i dettagli per vedere quanti crediti ogni singola organizzazione ha utilizzato in Digital Wallet.
  8. Principio di progettazione: Costruzione orizzontale
    Data Cloud One è progettato come un costrutto orizzontale della piattaforma Salesforce, proprio come i Sandbox. L'obiettivo è che ogni nuova funzione rilasciata da Salesforce funzioni sia nella pagina iniziale che nelle organizzazioni di supporto senza impostazione aggiuntiva. Ciò garantisce che Data Cloud One non sia solo una scelta dell'architettura dei dati, ma un elemento fondamentale della piattaforma Salesforce in futuro.
--- ### 2.3 Decisione: Più Data 360 indipendenti rispetto a One Shared Data 360 (Data Cloud One) Le aziende con più organizzazioni devono scegliere come e dove localizzare Data 360 all'interno del proprio ecosistema. Vogliono eseguire il provisioning di Data 360 indipendenti in ogni organizzazione o utilizzare Data Cloud One per unificare le organizzazioni in un'unica organizzazione Home? #### Opzione A: Più Data 360 indipendenti Ogni organizzazione Salesforce esegue il provisioning della propria istanza di Data 360. **Pro**: - **Autonomia**: Ogni unità operativa o area geografica controlla il proprio Data 360. - **Semplicità** all'interno di ogni organizzazione: Governance, sicurezza e personalizzazioni sono localizzate. - **Conformità normativa**: Utile quando è necessaria una rigorosa separazione normativa (ad esempio, i dati non devono attraversare le frontiere). **Contro**: - **Silos di dati:** Customer 360 non può essere raggiunto tra le organizzazioni. - **Costo maggiore**: Ogni istanza richiede licenza, amministrazione e integrazione. I clienti finiscono per inserire più volte gli stessi dati di origine per ottenere una visualizzazione C360 completa in più organizzazioni diverse. - **Lavoro duplicato:** La risoluzione dell'identità, la segmentazione e l'arricchimento devono essere ripetuti in ogni Data 360. #### Opzione B: One Shared Data 360 (Data Cloud One Cluster) Viene eseguito il provisioning di un singolo Data 360 in un'organizzazione Home, con altre organizzazioni Salesforce connesse come organizzazioni Companion. **Pro**: - **Singola fonte di verità (SSOT):** Tutte le organizzazioni condividono lo stesso modello di dati unificato. - **Efficienza dei costi:** Una sola licenza e infrastruttura Data 360 da gestire. - **Governance unificata:** Policy, sicurezza e controlli di conformità vengono applicati a livello centrale. - **Arricchimento tra organizzazioni:** Le organizzazioni partner possono accedere a profili, approfondimenti e segmenti armonizzati. - **Preparazione AI:** Le serie di dati a livello aziendale consentono una migliore formazione e attivazione dei modelli AI. - **Prova futura:** L'aggiunta di nuove organizzazioni partner è semplice; non sono necessarie nuove Data 360. **Contro**: - **Preparazione aggiuntiva:** Richiede la pianificazione della connettività organizzazione-a-casa. - **Considerazioni sulla latenza:** Le organizzazioni di supporto in regioni diverse possono visualizzare query più lente. - **Governance complessa:** Se ogni organizzazione ha esigenze di personalizzazione molto diverse, la governance può essere complessa. #### Opzione C: Più cluster Data Cloud One In alcuni casi, la governance, la conformità o altri requisiti aziendali possono rendere impossibile raggruppare tutte le organizzazioni. Ciò può comportare la necessità di implementare una soluzione ibrida in cui l'azienda gestisca più Data 360, ciascuna delle quali è l'organizzazione di residenza per un cluster diverso di organizzazioni partner. #### Esempio: Una società multinazionale ha organizzazioni Salesforce in diverse regioni, tra cui Europa, Stati Uniti e Asia. Per rispettare i regolamenti regionali sulla residenza dei dati, forniscono un Data 360 per ogni regione separata. #### Criteri decisionali
Considerazione Più Data 360 indipendenti One Shared Data 360 (Data Cloud One )
Autonomia Elevata autonomia per ogni organizzazione o unità operativa. Governance centralizzata, minore autonomia per organizzazione.
Conformità Utile quando è richiesta una separazione rigorosa (ad esempio, leggi regionali). Funziona meglio quando la residenza consente la centralizzazione.
Costo Licenze e costi amministrativi più elevati. Più conveniente; una licenza per molte organizzazioni.
Governance Frammentato; le policy variano a seconda dell'organizzazione. Policy centralizzate e coerenti tra le organizzazioni.
Silos di dati Ogni organizzazione ha una propria visualizzazione; nessuna Enterprise 360. Serie di dati unificata, senza duplicazioni.
AI/Analytics Limitato ai dati di ogni organizzazione. Modelli Enterprise con una maggiore precisione.
Complessità Più istanze da gestire, più integrazioni. Architettura più semplice, meno parti mobili.
Prestazioni Ideale per i casi d'uso interni all'organizzazione. L'accesso all'organizzazione compagna può introdurre latenza.
--- ### 2.4 Raccomandazioni **Schema preferito:** **Data Cloud One** Per impostazione predefinita, utilizzare una singola organizzazione di residenza con organizzazioni di supporto connesse per le aziende multi-organizzazioni. Questo crea un Customer 360 aziendale, semplifica la governance e ottimizza i costi. **Quando si utilizzano più Data 360:** Solo se la conformità, la residenza o l'autonomia organizzativa lo richiedono strettamente. Ad esempio, se le operazioni europee devono rimanere completamente separate dalle operazioni degli Stati Uniti a causa della regolamentazione. **Come scegliere l'organizzazione iniziale in Data Cloud One:** Iniziare prendendo in considerazione una delle organizzazioni principali, in genere quella in cui opera la maggior parte delle attività. Il provisioning di Data 360 può ridurre al minimo la complessità e ottimizzare il valore iniziale. Solo se non esiste un'organizzazione idonea, valutare la possibilità di creare un'organizzazione di residenza dedicata gestita da un team del Centro di eccellenza. **Principio generale:** Negli ambienti multi-organizzazioni, ridurre al minimo il numero di Data 360. Privilegiare Data Cloud One come schema predefinito per ridurre le duplicazioni, abilitare la preparazione all'intelligenza artificiale e semplificare la governance. --- ## Sezione 3: Più Data 360 e condivisione dei dati tra le organizzazioni Data 360 ### 3.1 Che cos'è la condivisione dei dati tra le organizzazioni Data 360? Benché Data Cloud One sia l'approccio consigliato per la maggior parte delle aziende, esistono scenari in cui i clienti potrebbero dover eseguire il provisioning di più istanze di Data 360. Quando esistono più Data 360, l'unificazione tra di essi non è automatica. La condivisione dei dati da Data 360 a Data 360 consente ai clienti di condividere oggetti specifici tra le istanze di Data 360 senza duplicazioni o opportunità in corso di realizzazione personalizzate. Si tratta di un meccanismo di condivisione dei metadati a copia zero progettato per la collaborazione in Data 360. #### Come funziona - Ogni Data 360 viene fornito nella propria organizzazione di residenza. - Gli amministratori possono creare una condivisione dati, un raggruppamento di oggetti specifici che desiderano condividere. - L'accesso ai dati selezionati è condiviso con Data 360 di un'organizzazione di destinazione, dove gli oggetti vengono visualizzati come se fossero definiti localmente. I dati sottostanti rimangono in Data 360 di origine; viene condiviso solo l'accesso. - I tag non sono condivisi. Vengono resi disponibili solo gli oggetti non elaborati; l'organizzazione di destinazione deve riapplicare tutti i tag di governance, operativi o AI in base alle esigenze. #### Differenza chiave da Data Cloud One - In Data Cloud One, più organizzazioni partner condividono una singola istanza di Data 360. Le funzioni della piattaforma (Agentforce, Prospecting Center, Tableau Next, ecc.) vengono eseguite sugli stessi dati sottostanti, garantendo la coerenza. - Quando si utilizza la condivisione dei dati tra le organizzazioni Data 360, ogni organizzazione ha il proprio Data 360. Funzionalità come Agentforce nell'organizzazione A e nell'organizzazione B operano ciascuna indipendentemente dalla propria istanza locale. Non viene eseguita automaticamente alcuna condivisione: è necessario creare condivisioni dati volontarie solo per collaborare su oggetti specifici. --- ### 3.2 Casi d'uso per la condivisione dei dati tra organizzazioni Data 360 **Conformità regionale:** Un rivenditore multinazionale fornisce un Data 360 nell'UE e un altro negli Stati Uniti. La condivisione dei dati da Data 360 a Data 360 consente all'azienda di aggregare approfondimenti (ad esempio, KPI fedeltà) da condividere con la sede centrale degli Stati Uniti mentre i dati non elaborati rimangono locali. **Collaborazione tra unità operative:** Un conglomerato gestisce Data 360 separati per Retail e Insurance. La condivisione dei dati tra Data 360 consente agli utenti di accedere a un'unica fonte autorevole di dati senza doverla spostare o copiare. Con la condivisione dei dati tra le organizzazioni Data 360, l'organizzazione Insurance riceve il segmento "High Value Customer" di Retail per le campagne di cross-selling mirate. **Fusioni e acquisizioni:** Una società controllante acquisisce una società controllata con il proprio Data 360. Con due istanze da gestire, la conservazione dei silos di dati a breve termine preserva la sicurezza dei dati e l'integrità SSOT. Contemporaneamente, la condivisione dei dati tra due istanze di Data 360 consente la collaborazione necessaria durante la transizione. **Cruscotto digitale esecutivo federato:** Una multinazionale diffusa in tutti i continenti fornisce singoli Data 360 per regione. I dirigenti desiderano una visualizzazione federata delle prestazioni trimestrali. Ogni Data 360 regionale condivide gli approfondimenti calcolati aggregati con un'"organizzazione esecutiva", abilitando la generazione di rapporti a livello aziendale. #### Pro e contro della condivisione dei dati tra le organizzazioni Data 360
Fattore Pro Contro
Residenza dati Supporta la separazione regionale abilitando la collaborazione. Non elimina la necessità di gestire più Data 360.
Duplicazione dei dati Copia zero; nessuna duplicazione di oggetti. Richiede la selezione deliberata degli oggetti da includere in ogni condivisione dati.
Governance La condivisione è esplicita e deliberata (a livello di oggetto). Nessun flusso di tag o policy; l'organizzazione di destinazione deve riapplicare la governance.
Complessità Abilita la collaborazione selettiva senza centralizzazione. Richiede la gestione di più Data 360 e condivisioni dati.
AI/Analytics Analisi artificiale regionale possibile; gli approfondimenti possono essere condivisi tra le organizzazioni. Nessuna intelligenza artificiale a livello aziendale a meno che i dati non vengano deliberatamente condivisi.
Funzioni della piattaforma Le funzioni basate su Data 360 di ogni organizzazione vengono eseguite in modo indipendente. Nessuna condivisione automatica — rischio di duplicazione se non accuratamente progettato.
Costo Può ridurre la necessità di pipeline ETL. Sostiene comunque il costo di più Data 360. Consuma crediti per le query sui dati e la condivisione dei dati.
#### Criteri decisionali
Considerazione Data Cloud One (Preferito per più organizzazioni) Condivisione dei dati tra organizzazioni Data 360
Singola fonte di verità ✅ Sì: tutte le organizzazioni condividono lo stesso DC. ❌ No: ogni Data 360 ha il proprio modello di dati.
Conformità Funziona solo quando la residenza consente la centralizzazione. Necessario quando le leggi sulla residenza impediscono la centralizzazione.
Governance Centralizzato, coerente. Federato; condivisioni deliberate a livello di oggetto.
Complessità Meno parti mobili, più semplice. ore complex: richiede condivisioni dati di configurazione e più Data 360.
AI/Analytics Modelli di intelligenza artificiale a livello aziendale. AI regionale; gli approfondimenti possono essere condivisi in modo selettivo.
Funzioni della piattaforma Shared Data 360 significa che tutte le funzioni funzionano in modo coerente in Home + Companions. Le funzioni vengono eseguite in modo indipendente in ogni Data 360; la condivisione deve essere esplicita.
### 3.3 Best practice **Se l'azienda ha più Data 360:** - Utilizzare la condivisione dei dati tra le organizzazioni Data 360 per collaborare tra loro anziché creare opportunità in corso di realizzazione personalizzate o duplicare i dati. - Condividere oggetti specifici (DMO, approfondimenti calcolati, segmenti) creando condivisioni dati e concedendole alle organizzazioni di destinazione. - Tenere presente che i tag non sono condivisi: l'organizzazione destinataria deve riapplicare i tag (ad esempio, governance, classificazione, arricchimento AI). **Quando utilizzare la condivisione dei dati tra le organizzazioni Data 360:** - Per soddisfare i requisiti normativi che impediscono la centralizzazione. - Mantenere l'autonomia dell'unità operativa abilitando la collaborazione selettiva. - Fornire cruscotti digitali esecutivi federati in più regioni. - Collegare scenari di M&A in cui il consolidamento non è immediatamente possibile. **Progettare con attenzione** La condivisione deve essere deliberata e specifica dell'oggetto. Evitare la condivisione eccessiva: allineare le condivisioni dati alle esigenze aziendali e di conformità. Considerare la condivisione dei dati da 360 a Data 360 come una strategia di federazione, non come un sostituto di Data Cloud One. --- ## Riepilogo
  1. Ogni organizzazione deve pianificare l'accesso a Data 360
    • In futuro, tutte le funzioni della piattaforma Salesforce, da Sales Cloud e Service Cloud ad Agentforce, richiederanno la connettività Data 360. Ogni organizzazione deve ospitare un'organizzazione Data 360 Home o essere un'organizzazione di compagnia connessa tramite Data Cloud One.
  2. Pensare a livello aziendale, non organizzazione per organizzazione
    • Evitare decisioni unilaterali sulla linea di business prese isolatamente.
    • Il provisioning dovrebbe essere deciso collettivamente, idealmente da un'architettura aziendale o da un consiglio di governance dei dati. Anticipare sempre le esigenze future di intelligenza artificiale e analisi, che dipendono da serie di dati ampie e unificate.
  3. Ridurre al minimo i silos di dati
    • Favorire il provisioning di Data 360 in un'organizzazione principale esistente per semplicità e velocità.
    • Negli ambienti multi-organizzazioni, Data Cloud One è lo schema predefinito per unificare le organizzazioni in un unico Data 360.
    • Eseguire il provisioning di più Data 360 solo se strettamente necessario per motivi di conformità, residenza o autonomia organizzativa.
  4. Progettare deliberatamente se è necessario eseguire più Data 360
    • Impostare la condivisione dei dati tra le organizzazioni Data 360 per la collaborazione, non per le pipeline ETL personalizzate.
    • Condividere oggetti specifici (DMO, approfondimenti calcolati, segmenti) tramite condivisioni dati.
    • Ricorda: i tag non vengono condivisi e il consumo viene fatturato all'organizzazione di origine.
  5. Governance e proprietà del piano in anticipo
    • Decidere se Data 360 sarà gestito a livello centrale (modello Centro di eccellenza) o delegato a linee di business. Definire i ruoli per amministratori, team di sicurezza e lead di conformità.
    • Evitare ambiguità: la proprietà poco chiara è una fonte comune di attrito.
  6. Evitare le scelte rapide
    • Non creare più Data 360 per i POC senza un piano a lungo termine, perché in seguito si creeranno problemi di consolidamento.
    • Allineare invece le distribuzioni pilota e iniziali alla strategia di provisioning a livello aziendale.
Queste scelte di provisioning sono fondamentali perché la piattaforma Salesforce si sta evolvendo verso un modello Data 360-first, in cui ogni funzione, dalla segmentazione dei clienti al radicamento degli agenti AI, dipenderà da questo. Le decisioni che prenderete oggi getteranno le basi per l'efficacia con cui l'azienda unificherà i dati dei clienti, la rapidità con cui potrete adottare le nuove funzioni di Salesforce e la fiducia con cui potrete scalare l'intelligenza artificiale in tutta l'azienda. Per riuscire, è necessario eseguire il provisioning con attenzione, ridurre al minimo le duplicazioni, conformarsi ai requisiti di conformità, governare deliberatamente e pensare a lungo termine. In definitiva, il provisioning di Data 360 è il primo passo per fare in modo che dati, intelligenza artificiale e CRM funzionino insieme come un'unica piattaforma coerente. # ## Informazioni sugli autori Kunal Goyal è direttore della gestione dei prodotti di Salesforce, con l'obiettivo di migliorare l'architettura multi-organizzazioni e la scalabilità in Data 360. Dal 2017, ha diretto molteplici iniziative e prodotti incentrati sulla collaborazione tra organizzazioni e sulla progettazione di sistemi multi-tenant. Kunal è uno dei lead di Data 360 Best Practices Architecture e titolare del prodotto per le esperienze di Data Cloud One, impostazione, provisioning e amministrazione. Erin Wagner Tidwell è la principale scrittrice tecnica e designer di contenuti per Data 360. Lavora in Salesforce dal 2013. Si dedica a rendere Data 360 più facile da capire e da utilizzare attraverso una documentazione tecnica e una comunicazione in app chiare, coerenti e accurate. Yugandhar Bora è un architetto di ingegneria del software di Salesforce, specializzato in architettura dei dati all'interno della piattaforma Data & Intelligence Applications. Dirige iniziative del Comitato di revisione dell'architettura aziendale (EARB) incentrate sulla governance dei dati e sui modelli di dati unificati, contribuendo al contempo alle soluzioni di provisioning automatico della piattaforma. Samarpan Jain è un Principal Architect di Salesforce specializzato in Commerce Cloud, integrazione di piattaforme e architettura tra organizzazioni. Uno dei dipendenti di Salesforce più longevi, dirige iniziative chiave tra cui la conformità della residenza dati per i clienti governativi e i sistemi di attribuzione dell'utilizzo di Data 360. # Suggerimenti introduttivi sulle guide alle decisioni di Data 360 Questa sezione fornisce indicazioni pratiche per prendere decisioni critiche sull'architettura di Salesforce Data 360, incluse le strategie di provisioning, la connettività multi-organizzazione e gli schemi di integrazione. Utilizzare queste guide per progettare e implementare architetture di dati efficaci che unifichino i dati dei clienti e abilitino funzioni basate sull'intelligenza artificiale. --- ## Provisioning di Data 360 [Il provisioning Data 360](/docs/architect/it-it/decision-guides/guide/data-360-provisioning) copre le decisioni fondamentali durante il provisioning di Salesforce Data 360: - **Selezione dell'organizzazione iniziale**: Decidere se eseguire il provisioning di Data 360 in un'organizzazione di produzione esistente o creare un'organizzazione dedicata, considerando governance, conformità e time-to-value. - **Strategia multi-organizzazioni**: Scegliere tra più istanze di Data 360 indipendenti o utilizzare Data Cloud One per unificare più organizzazioni Salesforce, bilanciando autonomia, conformità e costi. - **Architettura Data Cloud One**: Abilitare più organizzazioni partner per condividere una singola istanza di Data 360 con governance centralizzata, condivisione dei metadati e parità di funzioni tra le organizzazioni. - **Condivisione dei dati tra organizzazioni Data 360**: Utilizzare la condivisione dati copia zero tra istanze indipendenti per la conformità regionale, la collaborazione tra unità operative o i cruscotti digitali esecutivi federati. - **Considerazioni sul provisioning**: Fattori come residenza dei dati, modelli di governance, latenza, complessità dell'integrazione, costo e preparazione dell'intelligenza artificiale per le distribuzioni a livello aziendale. Aiuta gli architetti a progettare strategie di provisioning che garantiscano semplicità, coerenza aziendale, conformità e scalabilità per Customer 360, AI e innovazione multipiattaforma. --- ## Interoperabilità di Data 360 [Data 360 Interoperability](/docs/architect/it-it/decision-guides/guide/data-360-interoperability) fornisce un framework per l'integrazione di Data 360 con piattaforme esterne e data lake: - **Schemi di inserimento**: Inserimento in tempo reale, streaming e batch per la creazione di serie di dati canoniche governate ideali per Customer 360, conformità e governance centralizzata. - **Federazione dati copia zero**: Metodi di query live, query accelerate (caching) e federazione file per accedere a sistemi esterni in tempo reale senza duplicazioni, abilitando personalizzazione, cruscotti digitali e carichi di lavoro AI/ML. - **Approccio ibrido**: Combinare l'inserimento governato per le serie di dati principali con la federazione copia zero per freschezza e scalabilità, supportando il coinvolgimento Omnicanale, le azioni basate su Agentforce e l'analisi aziendale. - **Quadro decisionale**: Valutare i compromessi in latenza, costo, scalabilità, governance e complessità per selezionare lo schema di integrazione corretto per fonte di dati. - **Architect Playbook**: Linee guida specifiche del settore, procedure di progettazione e considerazioni sui costi per gli scenari finanziari, sanitari, di vendita al dettaglio e delle telecomunicazioni. Guida gli architetti nel bilanciare la freschezza dei dati, la governance e l'efficienza delle opportunità in corso di realizzazione per creare architetture di dati scalabili, interoperabili e pronte per l'intelligenza artificiale che supportano carichi di lavoro operativi e analitici. # Suggerimenti introduttivi sulle guide alle decisioni di integrazione Questa sezione fornisce indicazioni pratiche per scegliere gli strumenti e gli approcci di integrazione dei dati giusti per Salesforce. Include integrazioni in uscita, integrazioni in entrata e scenari tra organizzazioni, aiutando gli architetti a progettare e implementare integrazioni a livello di dati che bilanciano prestazioni, manutenibilità e costi. --- ## Integrazione dei dati con Salesforce L'[integrazione dati con Salesforce](/docs/architect/it-it/decision-guides/guide/data-integration) offre una panoramica completa degli strumenti e delle procedure consigliate per l'integrazione dei dati Salesforce: - **Paesaggio strumento integrazione**: Panoramica degli strumenti di integrazione dei dati di Salesforce, incluse le opzioni low-code, ibride e pro-code, con indicazioni sulla selezione dello strumento giusto per casi d'uso specifici. - **Integrazioni in uscita**: Metodi per inviare dati da Salesforce a sistemi esterni, tra cui Acquisizione dati di modifica, Servizi esterni, Heroku Connect, Procedure di integrazione OmniStudio, Salesforce Connect, MuleSoft Anypoint e soluzioni Apex personalizzate. - **Integrazioni in entrata**: Approcci per l'inserimento di dati esterni in Salesforce, con indicazioni sulla replica dei dati rispetto alla virtualizzazione e su quando utilizzare ogni strumento. - **Integrazioni tra organizzazioni**: Metodi consigliati per la condivisione dei dati tra le organizzazioni Salesforce, tra cui MuleSoft Anypoint, Heroku Connect, API Salesforce native, Acquisizione dati di modifica e Salesforce Connect con adattatore tra organizzazioni, incluse istruzioni per la sostituzione delle implementazioni Salesforce a Salesforce precedenti. - **Quadro decisionale**: Considerazioni chiave per la selezione degli strumenti di integrazione, ad esempio gli strumenti esistenti e la panoramica, i requisiti dei flussi di dati (tempistica, direzionalità, esperienza utente prevista), la complessità dell'implementazione, la manutenibilità, il volume di dati e i limiti della piattaforma. Consente agli architetti di scegliere gli strumenti e gli schemi di integrazione giusti per ogni scenario, riducendo al minimo la replica inutile dei dati, sfruttando le soluzioni ESB/ETL esistenti e garantendo integrazioni scalabili e manutenibili in linea con i principi dell'architettura aziendale. # Suggerimenti introduttivi sulle guide alle decisioni per la piattaforma Questa sezione fornisce indicazioni pratiche per prendere decisioni critiche sull'architettura riguardo alle funzionalità di Salesforce Platform. Copre l'elaborazione asincrona, gli eventi attivati da record, la creazione di moduli, l'architettura basata sugli eventi e i framework asincroni basati su fasi per aiutare gli architetti a progettare soluzioni di piattaforma scalabili, manutenibili e ad alte prestazioni. --- ## Elaborazione asincrona [Elaborazione asincrona](/docs/architect/it-it/decision-guides/guide/async-processing) fornisce indicazioni sugli strumenti e gli approcci per le operazioni asincrone in Salesforce: - **Strumenti di elaborazione**: asincrona Confronto tra Apex in area di attesa, Apex pianificato, Trigger di eventi piattaforma, Acquisizione dati di modifica, Percorso pianificato (dopo l'impegno dei flussi) e Percorso asincrono (flussi attivati da record), con indicazioni sui casi d'uso appropriati. - **Elaborazione asincrona lato server**: Schemi per operazioni di database di lunga durata, chiamate esterne ed elaborazione di record a volume elevato. - **Elaborazione asincrona lato client**: Tecniche come le chiamate continuazione Apex e l'elaborazione asincrona lato client che può essere eseguita nei browser o nelle app mobili. - **Quadro decisionale**: Valutare la convalida dei casi d'uso, la scalabilità, la comprensione dei casi in cui le transazioni sono realmente asincrone, il monitoraggio e la gestione di eventi di carico estremo. - **Best practice e anti-schemi**: Guida per un uso corretto, incluse le integrazioni in uscita, il monitoraggio e l'eliminazione delle insidie comuni. Consente agli architetti di implementare schemi asincroni scalabili, affidabili e mantenibili, evitando insidie che compromettono le prestazioni. --- ## Creazione di moduli [Building Forms](/docs/architect/it-it/decision-guides/guide/build-forms) guida gli architetti nelle opzioni di creazione dei moduli Salesforce: - **Strumenti di creazione**: moduli Confronto tra moduli dinamici, flusso schermata, OmniStudio, flusso schermata con componenti Web Lightning (LWC) e LWC, incluse le competenze e le considerazioni sulle licenze. - **Quadro decisionale**: Considerare l'impatto degli oggetti, l'ambito del modulo, la navigazione, la posizione (app, dispositivi mobili, Web), l'esperienza utente e l'automazione dei test. - **Guida alla selezione degli strumenti**: Consigli da layout di record semplici a procedure guidate multipagina e moduli indirizzati ai clienti con immagine aziendale. - **Schemi combinati**: Guida per la combinazione di strumenti, ad esempio la navigazione del flusso schermata con lo stile LWC. - **Funzioni avanzate**: Approfondimenti sulle funzionalità e le limitazioni per orientare la scelta degli strumenti. Aiuta gli architetti a selezionare l'approccio di creazione delle forme giusto per i loro requisiti specifici di integrazione, funzionalità e interfaccia utente. --- ## Architettura basata sugli eventi [Event-Driven Architecture](/docs/architect/it-it/decision-guides/guide/event-driven) fornisce una guida completa agli strumenti e agli schemi di evento Salesforce: - **Strumenti per eventi**: Panoramica di eventi piattaforma, acquisizione dati di modifica, API Pub/Sub, MuleSoft Anypoint, Streaming API e considerazioni sull'integrazione. - **Schemi basati sugli eventi**: Include schemi di pubblicazione/abbonamento, fanout, messaggi passati, streaming e aree di attesa per vari casi d'uso basati sugli eventi. - **Integrazione con MuleSoft**: Utilizzo di connettori Anypoint (Pub/Sub, JMS, Kafka, Solace, MQ, MQTT, AMQP) per architetture aziendali. - **Eventi piattaforma e acquisizione dati di modifica**: Guida sui meccanismi preferiti per la pubblicazione delle modifiche di record e campi, con migrazione da PushTopic/Eventi generici. - **Schemi di implementazione**: Procedure consigliate per scalabilità, coerenza, gestione degli errori e monitoraggio. Consente agli architetti di progettare sistemi scalabili, quasi in tempo reale, basati sugli eventi, che connettono più sistemi in modo efficiente. --- ## Framework asincrono basato su fasi Il [framework asincrono step-based](/docs/architect/it-it/decision-guides/guide/step-based-async-framework) fornisce un framework per l'elaborazione modulare e scalabile dei processi asincroni: - **Architettura frame**: I componenti includono Apex in area di attesa, Finalizzatori, Flusso pianificato, Cursori Apex, Azioni invocabili e integrazioni Slack. - **Elaborazione basata su fasi**: Le interruzioni funzionano in fasi indipendenti che possono essere eseguite, riprovate e riavviate con governance condivisa e visibilità operativa. - **Guida all'implementazione**: Schemi per interfaccia fase, Processore fase, livello Apex invocabile, gestione dei ritardi e notifiche. - **Best practice**: Consigliato quando la maggior parte delle informazioni è presente in CRM, per carichi di lavoro a volume elevato ed elaborazione dei record gerarchica o ad albero; indicazioni su quando non utilizzarlo. - **Funzioni di livello aziendale**: Governance, conformità, stato distribuito, tracciamento dell'avanzamento, monitoraggio degli SLA, diagnostica dei guasti e registrazione a livello di controllo. Offre agli architetti un'alternativa scalabile ai processi batch monolitici e alle chiamate asincrone concatenate, supportando carichi di lavoro Salesforce a volume elevato con piena trasparenza operativa. --- ## Automazione attivata da record [Record-Triggered Automation](/docs/architect/it-it/decision-guides/guide/record-triggered) fornisce il framework per progettare l'automazione attivata da record in Salesforce Platform: - **Selezione strumento**: Quando utilizzare il flusso attivato da record rispetto ai trigger Apex, in base alla densità di automazione (bassa, media, alta) e alla matrice di selezione della densità. - **Densità di automazione**: Come valutare la quantità dell'automazione, il volume dei record e l'espansione delle dipendenze per scegliere trigger Flusso, ibrido (flusso con Apex invocabile) o Apex. - **Punti di ingresso e governance**: Un punto di ingresso per oggetto Salesforce; istruzioni sulle condizioni di immissione, il controllo della ricorsione e l'esecuzione ordinata. - **Invocazione asincrona**: Quando e come invocare i processi asincroni dai flussi attivati da record o Apex, con cautela nella gestione degli errori e nei limiti del governor. - **Best practice**: Schemi per la messa in blocco, progettazione ibrida FlussoApex ed evitare le insidie comuni nell'automazione dei trigger. Consente agli architetti di progettare un'automazione attivata da record scalabile, manutenibile e performante in linea con gli standard della piattaforma.