# architect Guides de décision (decision-guides) - Full Documentation # Utilisation des outils et schémas appropriés pour les architectures pilotées par les événements ## Vue d'ensemble Les architectures pilotées par l'événement prennent en charge la production et la consommation efficaces d'événements, qui communiquent les changements d'état du système ou de l'application. Ces architectures permettent des connexions flexibles entre les systèmes, et prennent en charge les processus et les mises à jour en temps quasi réel qui fonctionnent entre les systèmes. Les avantages des architectures pilotées par l'événement sont faciles à voir, mais les détails d'implémentation ne sont pas toujours aussi clairs. Quelles capacités devez-vous prendre en compte dans les modèles architecturaux pilotés par l'événement ? Quels problèmes spécifiques ces schémas résolvent-ils ? Quelles considérations particulières s'appliquent à vos solutions et quels sont les modèles optimaux pour les résoudre ? Ce guide présente les modèles utilisés pour élaborer des architectures pilotées par les événements optimales lors de l'utilisation de technologies Salesforce. Il traite également des outils de concours complet disponibles dans Salesforce et fournit des recommandations d'outils pour une sélection de cas d'utilisation. Pour plus d'informations sur les intégrations au niveau des données impliquant Salesforce, consultez notre [Data Integration Decision Guide](/docs/architect/fr-fr/decision-guides/guide/data-integration). ## Points à retenir - **Utilisez des architectures pilotées par l'événement pour les processus qui ne nécessitent pas de réponses synchrones aux requêtes.** Les schémas présentés dans ce guide sont conçus pour la cohérence, l'évolutivité et la réutilisation des données, ce qui permet de réduire au minimum les dettes techniques à mesure que le paysage applicatif de votre organisation évolue. (Pour plus d'informations, consultez [Bien archivé - Débit](/docs/architect/fr-fr/well-architected/guide/reliable#débit)). - **Si MuleSoft ou une autre solution Enterprise Service Bus (ESB) fait partie de votre paysage existant, utilisez-la dans la mesure du possible.** Ces solutions sont spécialement conçues pour prendre en charge les modèles d'architecture pilotée par l'événement et offrent de puissantes capacités qui permettent de réutiliser les intégrations dans votre entreprise. - **Utilisez l'API Pub/Sub pour les futurs modèles de publication/abonnement au lieu d'élaborer vos propres gestionnaires d'événements en utilisant d'autres API, notamment l'API Streaming.** L'API Pub/Sub étant désormais globalement disponible, utilisez-la pour tous les nouveaux modèles de publication/abonnement. Planifiez la migration des communications d'événements existantes en utilisant d'autres API de plate-forme, telles que l'API Streaming ou des services Apex personnalisés, vers l'API Pub/Sub lorsque cela est possible. - **Les événements de plate-forme et la Capture des données de modification (CDC) sont les mécanismes privilégiés pour publier les modifications des enregistrements et des champs qui doivent être consommés par d'autres systèmes.** Nous recommandons de ne pas utiliser PushTopic et des événements génériques pour les nouvelles implémentations. Salesforce continuera de prendre en charge PushTopic et les événements génériques dans les limites des capacités fonctionnelles actuelles, mais n'envisage pas d'autres investissements dans cette technologie. ## Produits dans la portée
Salesforce Platform Salesforce Platform est une plate-forme complète pilotée par l’IA qui unifie les employés, les agents IA autonomes, les données de l’entreprise et les applications dans un système unique et de confiance pour améliorer la productivité et l’expérience client. Il permet la création d'une "entreprise agentique" en connectant les applications Customer 360, Data Cloud, et Slack pour une automatisation de bout en bout.
MuleSoft MuleSoft est la plate-forme d'intégration leader de Salesforce qui permet aux organisations de connecter des applications, des données et des appareils à travers des environnements sur site et cloud. MuleSoft est une plate-forme qui fournit aux TI les plates-formes nécessaires pour déverrouiller les données entre les systèmes, développer des infrastructures d'intégration et d'automatisation évolutives, et créer rapidement des expériences connectées différenciées.
## Points de décision Les architectures pilotées par l'événement (EDA) sont recommandées pour les scénarios qui nécessitent des notifications en temps quasi réel, la distribution de la charge de traitement pour les messages à haut volume ou complexes, et l'intégration de systèmes tels que l'Internet des objets et les appareils mobiles qui nécessitent une résilience de la connectivité via la mise en file d'attente. Cependant, les AED ne devraient pas être mises en oeuvre pour des processus qui nécessitent des réponses humaines immédiates et synchrones, car elles sont conçues pour une exécution asynchrone. Elles ne conviennent pas non plus si les données sources changent si rarement qu'un schéma plus simple, tel que le traitement par lot, suffit. ### Quand utiliser une architecture pilotée par l'événement Voici plusieurs scénarios courants qui conviennent souvent à une architecture pilotée par l'événement :
Point de décisionGuide
Notifications en temps quasi réelLes modèles d'architecture pilotée par l'événement, tels que publier/s'abonner, fanout et streaming, fonctionnent généralement bien dans les scénarios où plusieurs applications doivent être notifiées en temps quasi réel des changements de statut ou des mises à jour d'enregistrement.
Traitement parallèleLes modèles tels que publier/s'abonner fonctionnent généralement bien dans les scénarios où des volumes de données importants ou des messages très complexes nécessitent de distribuer la charge de traitement entre plusieurs systèmes.
Lectures à haut volumeLes modèles Messages transmis et File d'attente sont fréquemment utilisés dans les situations où les organisations subissent des augmentations et où le volume de messages produits peut dépasser la capacité des abonnés à les traiter immédiatement.
Écritures à haut volumeLes schémas Streaming et Queuing fonctionnent bien dans de nombreux scénarios où les organisations subissent une augmentation du nombre de messages produits.
Envoi des mêmes données à différents systèmesBien que publier/s'abonner tende à être une solution assez courante pour les organisations qui doivent envoyer les mêmes données à plusieurs systèmes, elle peut être traitée par la plupart des modèles couverts ici. Assurez-vous de les examiner en détail pour trouver le meilleur ajustement.
Introduction fréquente de nouveaux systèmes ou dispositifsLes schémas Publier/S'abonner, Streaming et File d'attente fonctionnent généralement bien dans les scénarios où le paysage global tend à évoluer, avec de nouveaux systèmes et appareils ajoutés régulièrement. Dans ce scénario, un nouveau système ou appareil doit simplement devenir abonné au bus d'événement ou associé à une file d'attente, pour commencer à recevoir des messages plutôt que de demander une intégration point à point personnalisée.
Appareils Internet des objetsLes appareils Internet des objets fournissent généralement des mises à jour fréquentes et peuvent également générer une augmentation des messages dans certains scénarios. Par conséquent, les modèles Streaming et Queuing fonctionnent généralement bien lors de leur intégration dans un paysage informatique.
Appareils et systèmes mobiles hors ligneLes appareils mobiles qui doivent travailler dans des zones avec un accès Internet de faible qualité ou inexistant, ou des systèmes qui peuvent être hors ligne au moment de la remise des messages, bénéficieront du modèle Queuing, qui leur permet de se connecter à leurs files d'attente et de récupérer tous les messages pertinents une fois de retour en ligne.
La plupart des grandes organisations ont des paysages informatiques complexes qui combinent des systèmes avec différentes capacités. Il est possible, ou peut-être probable, que votre organisation ait des systèmes hérités qui ne prennent pas en charge les intégrations pilotées par l'événement. Vous pouvez également avoir des cas d'utilisation où les intégrations pilotées par l'événement ne sont pas logiques, même si les systèmes les prennent en charge (par exemple, les transferts de fichiers SFTP de tiers). Si vous prenez un peu de recul et examinez le paysage informatique de votre organisation dans son ensemble, il est probable que, comme avec d'autres solutions architecturales, vous emploierez une combinaison de modèles pour prendre en charge différents scénarios. Lorsque vous choisissez de définir l'approche pilotée par l'événement comme votre approche préférée des intégrations, considérez-la comme un autre outil dans votre boîte à outils. Elle peut et doit être utilisée dans les scénarios appropriés, mais ce n'est pas une approche à imposer à chaque système. Le développement d'une stratégie d'intégration complète vous aidera à déterminer quand les modèles décrits dans ce guide peuvent être appropriés ou non. ### Quand ne pas utiliser une architecture pilotée par l'événement De nombreux scénarios font appel à des architectures pilotées par l'événement, et dans certains cas, les architectures pilotées par l'événement fonctionnent même si elles ne sont pas adaptées. Cependant, dans certains scénarios, les architectures pilotées par l'événement ne doivent tout simplement pas être utilisées. Voici quelques questions de point de décision pour vous aider à identifier les scénarios suivants :
Point de décisionGuide/Questions à poser
Exigences métiersExiste-t-il un réel besoin métier pour l'une des fonctionnalités décrites dans la section [Quand utiliser une architecture pilotée par un événement] (#quand-utiliser-une-architecture-pilotée-par-un-événement) ?
Prescriptions techniquesL'intégration que vous concevez correspond-elle à un schéma différent, par exemple virtualisation des données, lot ou requête/réponse ? En d'autres termes, essayez-vous d'insérer une cheville carrée dans un trou rond ?
Processus exigeant que les humains attendent des réponsesToute intégration impliquant un humain attendant une réponse du système cible n'est pas adaptée aux architectures pilotées par l'événement, car elles sont conçues pour une exécution asynchrone et ne peuvent pas garantir un temps de réponse. Déterminez si de tels processus sont optimaux pour votre organisation avant d'implémenter des solutions techniques. Pour plus d'informations, consultez [Well-Architected - Process Design](/docs/architect/fr-fr/well-architected/guide/automated#conception-de-processus).
Données sources souvent modifiéesSi les données de votre système source changent si rarement que les mises à jour périodiques sont suffisantes, vous pouvez probablement simplifier votre architecture en utilisant [batch patterns] (https://developer.salesforce.com/docs/atlas.en-us.integration_patterns_and_practices.meta/integration_patterns_and_practices/integ_pat_batch_data_sync.htm) au lieu de modèles pilotés par l'événement.
Exigences de mise en œuvreLa majorité des systèmes impliqués dans votre solution prennent-ils en charge les architectures pilotées par les événements ? Que faudrait-il pour utiliser des architectures pilotées par l'événement avec les systèmes qui ne les prennent pas en charge (par exemple, mises à niveau, personnalisations ou middleware) ? Quel niveau d'effort serait nécessaire pour satisfaire à ces exigences?
Stabilité de la structure du messageÀ quelle fréquence vos structures de messages doivent-elles changer ? Quels systèmes seront touchés par un tel changement et quel sera le processus d'assainissement?
Gouvernance organisationnelleAvez-vous mis en place une structure de gouvernance pour vous assurer que toutes les parties prenantes sont informées des changements apportés aux structures de messages, aux déclencheurs et à d'autres décisions liées à l'architecture et aux processus, et qu'elles sont en mesure d'y contribuer ?
Ensembles de compétences requisVotre personnel a-t-il de l'expérience avec les architectures pilotées par les événements et saura-t-il comment les prendre en charge ?
## Cas d'utilisation Il existe divers modèles d'architecture pilotée par l'événement. Certains modèles à usage général peuvent être appliqués dans des cas d'utilisation qui n'ont pas d'exigences particulières en plus d'être pilotés par l'événement. Par exemple, consultez [Bien archivé - Interopérabilité](/docs/architect/fr-fr/well-architected/guide/composable#interopérabilité). D'autres modèles s'appliquent aux cas d'utilisation spécifiques discutés ici, tels que les intégrations impliquant des volumes de données importants ou les scénarios qui nécessitent une rétention plus longue des messages. ### Modèles en un coup d'œil Le tableau ci-dessous compare les attributs des modèles décrits dans ce document. Utilisez-le comme référence rapide lorsque vous devez identifier des modèles potentiels pour un cas d'utilisation donné.
ModèleTemps quasi réelCopie de message uniqueGarantie de livraisonRéduire la taille du messageTransformation des données
Publier / S'abonner✓✓✓
Fanout✓✓✓
Messages transmis✓✓✓✓
Streaming✓✓✓
Mise en file d'attente✓✓✓
### Outils pour l'architecture pilotée par les événements Salesforce offre plusieurs outils pour vous aider à gérer vos cas d'utilisation pilotés par l'événement. Le tableau ci-dessous présente une vue d'ensemble des outils disponibles.
OutilDescriptionCompétences requises
MuleSoftAnypoint PlatformPlate-forme qui active l'intégration de données en utilisant des couches d'API.Pro-code
Connecteur Salesforce Pub/SubConnecteur pour l'API Pub/Sub, qui fournit une interface unique de publication et d'abonnement aux événements de plate-forme, aux événements de surveillance des événements en temps réel et aux événements de capture des données de modification.Pro-code
Connecteur MuleSoft Anypoint JMSConnecteur qui permet d'envoyer et de recevoir des messages dans des files d'attente et des rubriques pour n'importe quel service de messagerie qui implémente la spécification Java Message Service (JMS).Pro-code
Connecteur MuleSoft Anypoint Apache KafkaConnecteur permettant de déplacer des données entre Apache Kafka et des applications et services d'entreprise.Pro-code
MuleSoft Anypoint Solace ConnecteurUn connecteur pour les courtiers d'événements Solace PubSub+ avec une intégration d'API native utilisant le kit de développement Java JCSMPPro-code
Connecteur MuleSoft Anypoint MQUn service de messagerie cloud multilocataire qui permet aux clients d'effectuer une messagerie asynchrone avancée entre leurs applications.Pro-code
Connecteur MQTT MuleSoft AnypointUne extension MuleSoft conforme au protocole MQTT (Message Queuing Telemetry Transport) v3.x.Pro-code
Connecteur MuleSoft Anypoint AMQPUn connecteur qui permet à votre application de publier et de consommer des messages en utilisant un courtier conforme AMQP 0.9.1.Pro-code
API MuleSoft Anypoint Event-Driven (ASync)Langage agnostique du secteur d'activité qui prend en charge la publication d'API pilotées par l'événement en les séparant en couches événement, canal et transport.Pro-code
MuleSoft Anypoint MQService de messagerie cloud multitenant qui permet aux clients d'effectuer une messagerie asynchrone avancée entre leurs applications.Pro-code
Flux de données MuleSoft AnypointInfrastructure disponible dans MuleSoft Anypoint pour la publication et l'abonnement à des données en continu.Pro-code
Salesforce PlatformApache Kafka sur HerokuComplément Heroku qui fournit Apache Kafka en tant que service avec une intégration complète de la plate-forme à la plate-forme Heroku.Pro-code
Capture des donnéesJournal des événements de modification, qui publie les modifications apportées aux enregistrements Salesforce. Les modifications comprennent la création d'un enregistrement, la mise à jour d'un enregistrement existant, la suppression d'un enregistrement et l'annulation de la suppression d'un enregistrement.Code faible à code pro
Messages sortantsActions qui envoient des messages XML à des points de terminaison externes lorsque les valeurs de champ sont mises à jour dans Salesforce.Code faible
Événements de plate-formeMessages sécurisés et évolutifs contenant des données d'événement personnalisées.Code faible à code pro
API Pub/SubAPI qui active les abonnements aux événements de plate-forme, aux événements Capture des données de modification et/ou aux événements Surveillance des événements en temps réel.Pro-code
Relais d'événementsPermet l'envoi d'événements de plate-forme et d'événements de capture des données de modification depuis Salesforce vers Amazon EventBridge. Notez que les relais d'événements se connectent uniquement à AWS Eventbridge.Code faible
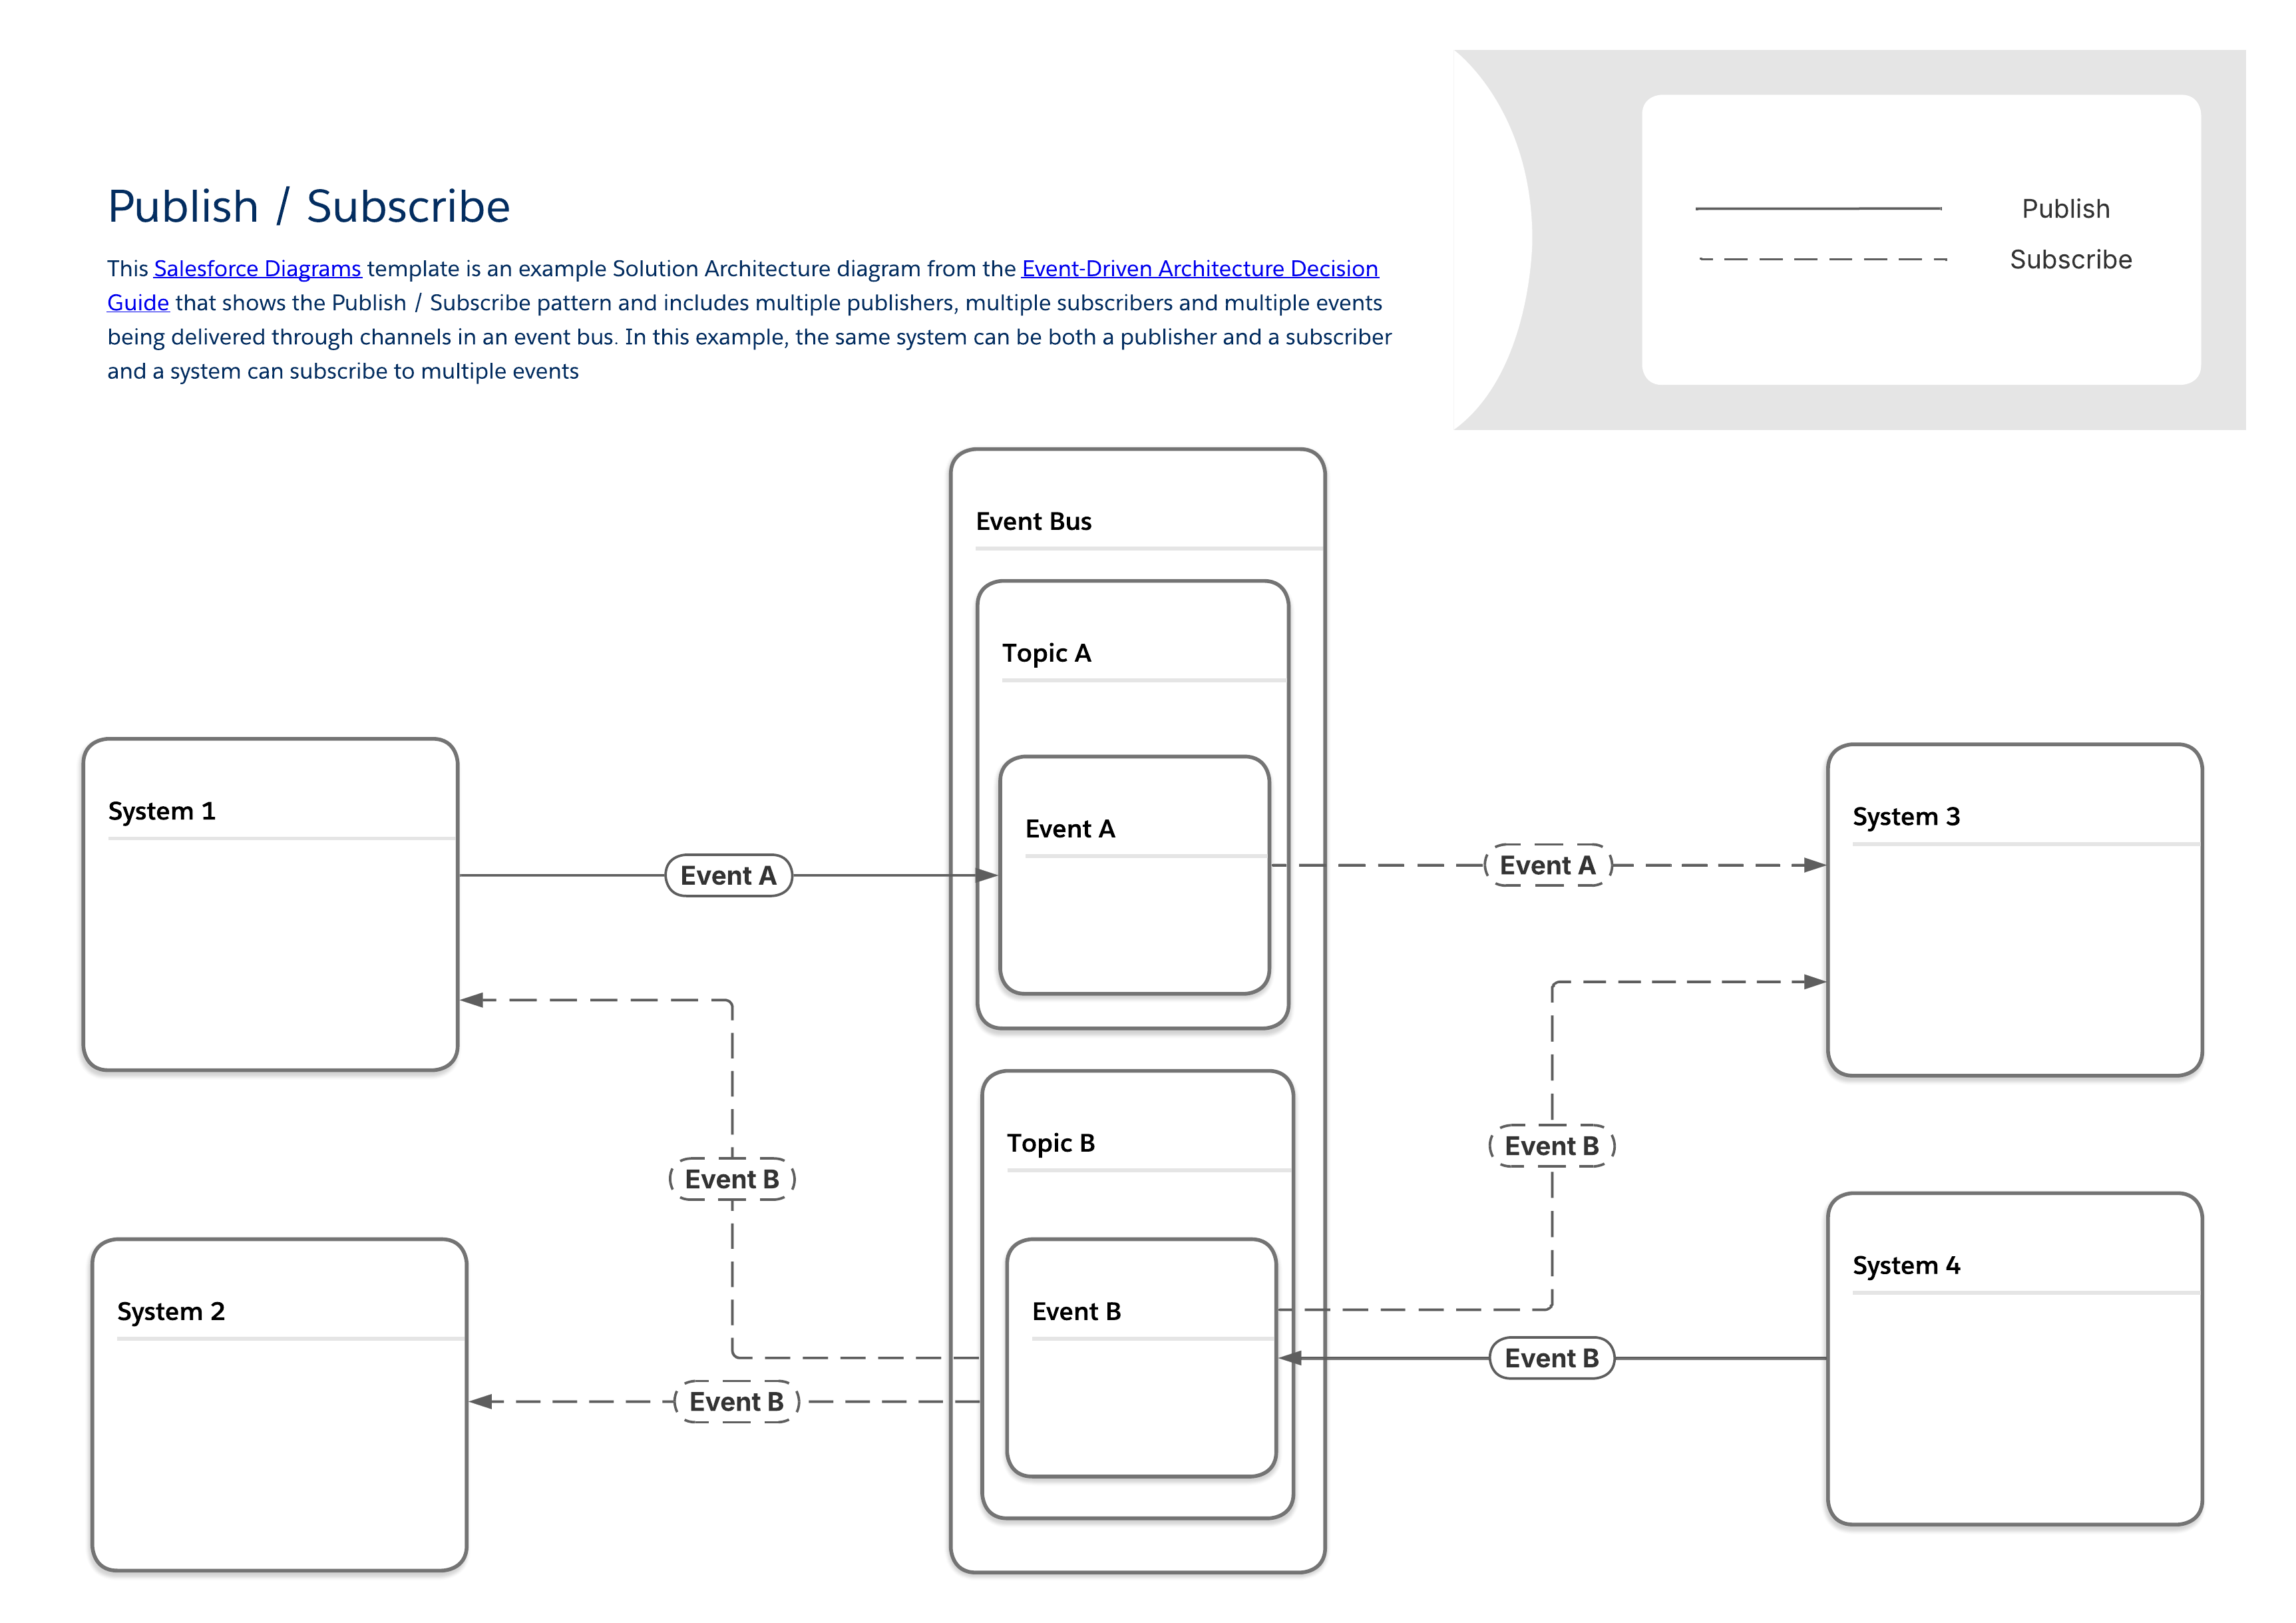
### Publier/S'abonner Lorsqu'un enregistrement critique change d'état dans une application principale (par exemple, le statut d'une commande passe de « Traitement » à « Expédié »), plusieurs autres systèmes nécessitent probablement une notification en temps quasi réel pour effectuer leurs tâches respectives. Un besoin métier spécifique survient lorsque le volume de ces changements est élevé et que les messages sont complexes, ce qui rend les intégrations point à point traditionnelles difficiles à gérer. L'établissement de connexions fragiles et personnalisées pour chaque application dépendante entraîne une dette technique et empêche l'organisation d'évoluer rapidement. Une approche d'intégration robuste est nécessaire pour gérer ces synchronisations de données fréquentes sans coupler le système source directement à chaque système consommateur. #### Le schéma Publier/S'abonner Le diagramme ci-dessous montre un modèle typique de publication/abonnement avec plusieurs éditeurs et abonnés qui partagent des données via un bus d'événement. Ce schéma de base constitue la base des schémas plus spécifiques que l'on peut trouver dans le reste de ce guide. Voici quelques caractéristiques clés de ce schéma : - Il n'existe aucun lien direct entre les éditeurs et les abonnés. Les éditeurs envoient simplement des messages à un bus d'événement, qui les diffuse vers tout autre système qui souhaite les écouter. - Le même système peut être à la fois éditeur et abonné. - Les systèmes peuvent publier ou s'abonner à plusieurs types d'événement. - Comme avec tous les modèles de ce guide, le modèle publier/s'abonner appartient à une catégorie générale de modèle d'intégration appelée invocation de procédure à distance (RPI) ou simplement [« virer et oublier ».](/docs/architect/fr-fr/fundamentals/guide/integration-patterns#invocation-de-processus-distant---feu-et-oubli) Ce diagramme de niveau 2 montre un exemple de modèle Publier / S'abonner qui inclut plusieurs éditeurs, plusieurs abonnés et plusieurs événements livrés via des canaux dans un bus d'événement. Dans ce modèle, le même système peut être à la fois un éditeur et un abonné et un système peut s'abonner à plusieurs événements. #### Outils relatifs au schéma Publier/S'abonner
Flux et comportement des événementsConsidérations relatives à la charge de travail
Outils disponiblesCompétences requisesPublier viaS'abonner viaPériode de relectureStructure de la charge utileLimites de charge utile
MuleSoftAnypoint PlatformPro-codeAPIAPIConfiguréUtilisateur définiAucun
Connecteur Salesforce Pub/SubPro-codeAPIAPIConfiguréUtilisateur définiAucun
Connecteur MuleSoft Anypoint JMSPro-codeAPIAPIConfiguréUtilisateur définiAucun
Connecteur MuleSoft Anypoint Apache KafkaPro-codeAPIAPIConfiguréUtilisateur définiAucun
MuleSoft Anypoint Solace ConnecteurPro-codeAPIAPIConfiguréUtilisateur définiAucun
Connecteur MuleSoft Anypoint MQPro-codeAPIAPIConfiguréUtilisateur définiAucun
Connecteur MQTT MuleSoft AnypointPro-codeAPIAPIConfiguréUtilisateur définiAucun
Connecteur MuleSoft Anypoint AMQPPro-codeAPIAPIConfiguréUtilisateur définiAucun
API MuleSoft Anypoint Event-Driven (ASync)Pro-codeAPIAPIConfiguréUtilisateur définiAucun
MuleSoft Anypoint MQPro-codeAPIAPIConfiguréUtilisateur définiAucun
Salesforce PlatformApache Kafka sur HerokuPro-codeAPI, changements d'enregistrement dans Heroku PostgresS.O.1 à 6 semainesUtilisateur définiUtilisateur défini
Capture des donnéesCode faible à code proModifications d'enregistrementApex, API, Composants Web Lightning (LWC)3 joursPrédéfini1 MB
Messages sortants*Code faibleRègles de flux et de workflowS.O.24 heuresUtilisateur défini100 notifications par message
Événements de plate-formeCode faible à code proAPI, Apex, FluxApex, API, flux, LWC3 joursUtilisateur défini1 MB
API Pub/SubPro-codeAPI Pub/Sub ou API, Apex, FluxAPI Pub/Sub3 joursUtilisateur défini1 MB
Relais d'événements**Code faibleÉvénements de plate-forme, Capture des données de modificationAPI3 joursUtilisateur défini1 MB
*Salesforce continuera de prendre en charge les messages sortants dans les limites des capacités fonctionnelles actuelles, mais n'envisage pas d'autres investissements dans cette technologie. **Les relais d'événements se connectent uniquement à AWS Eventbridge
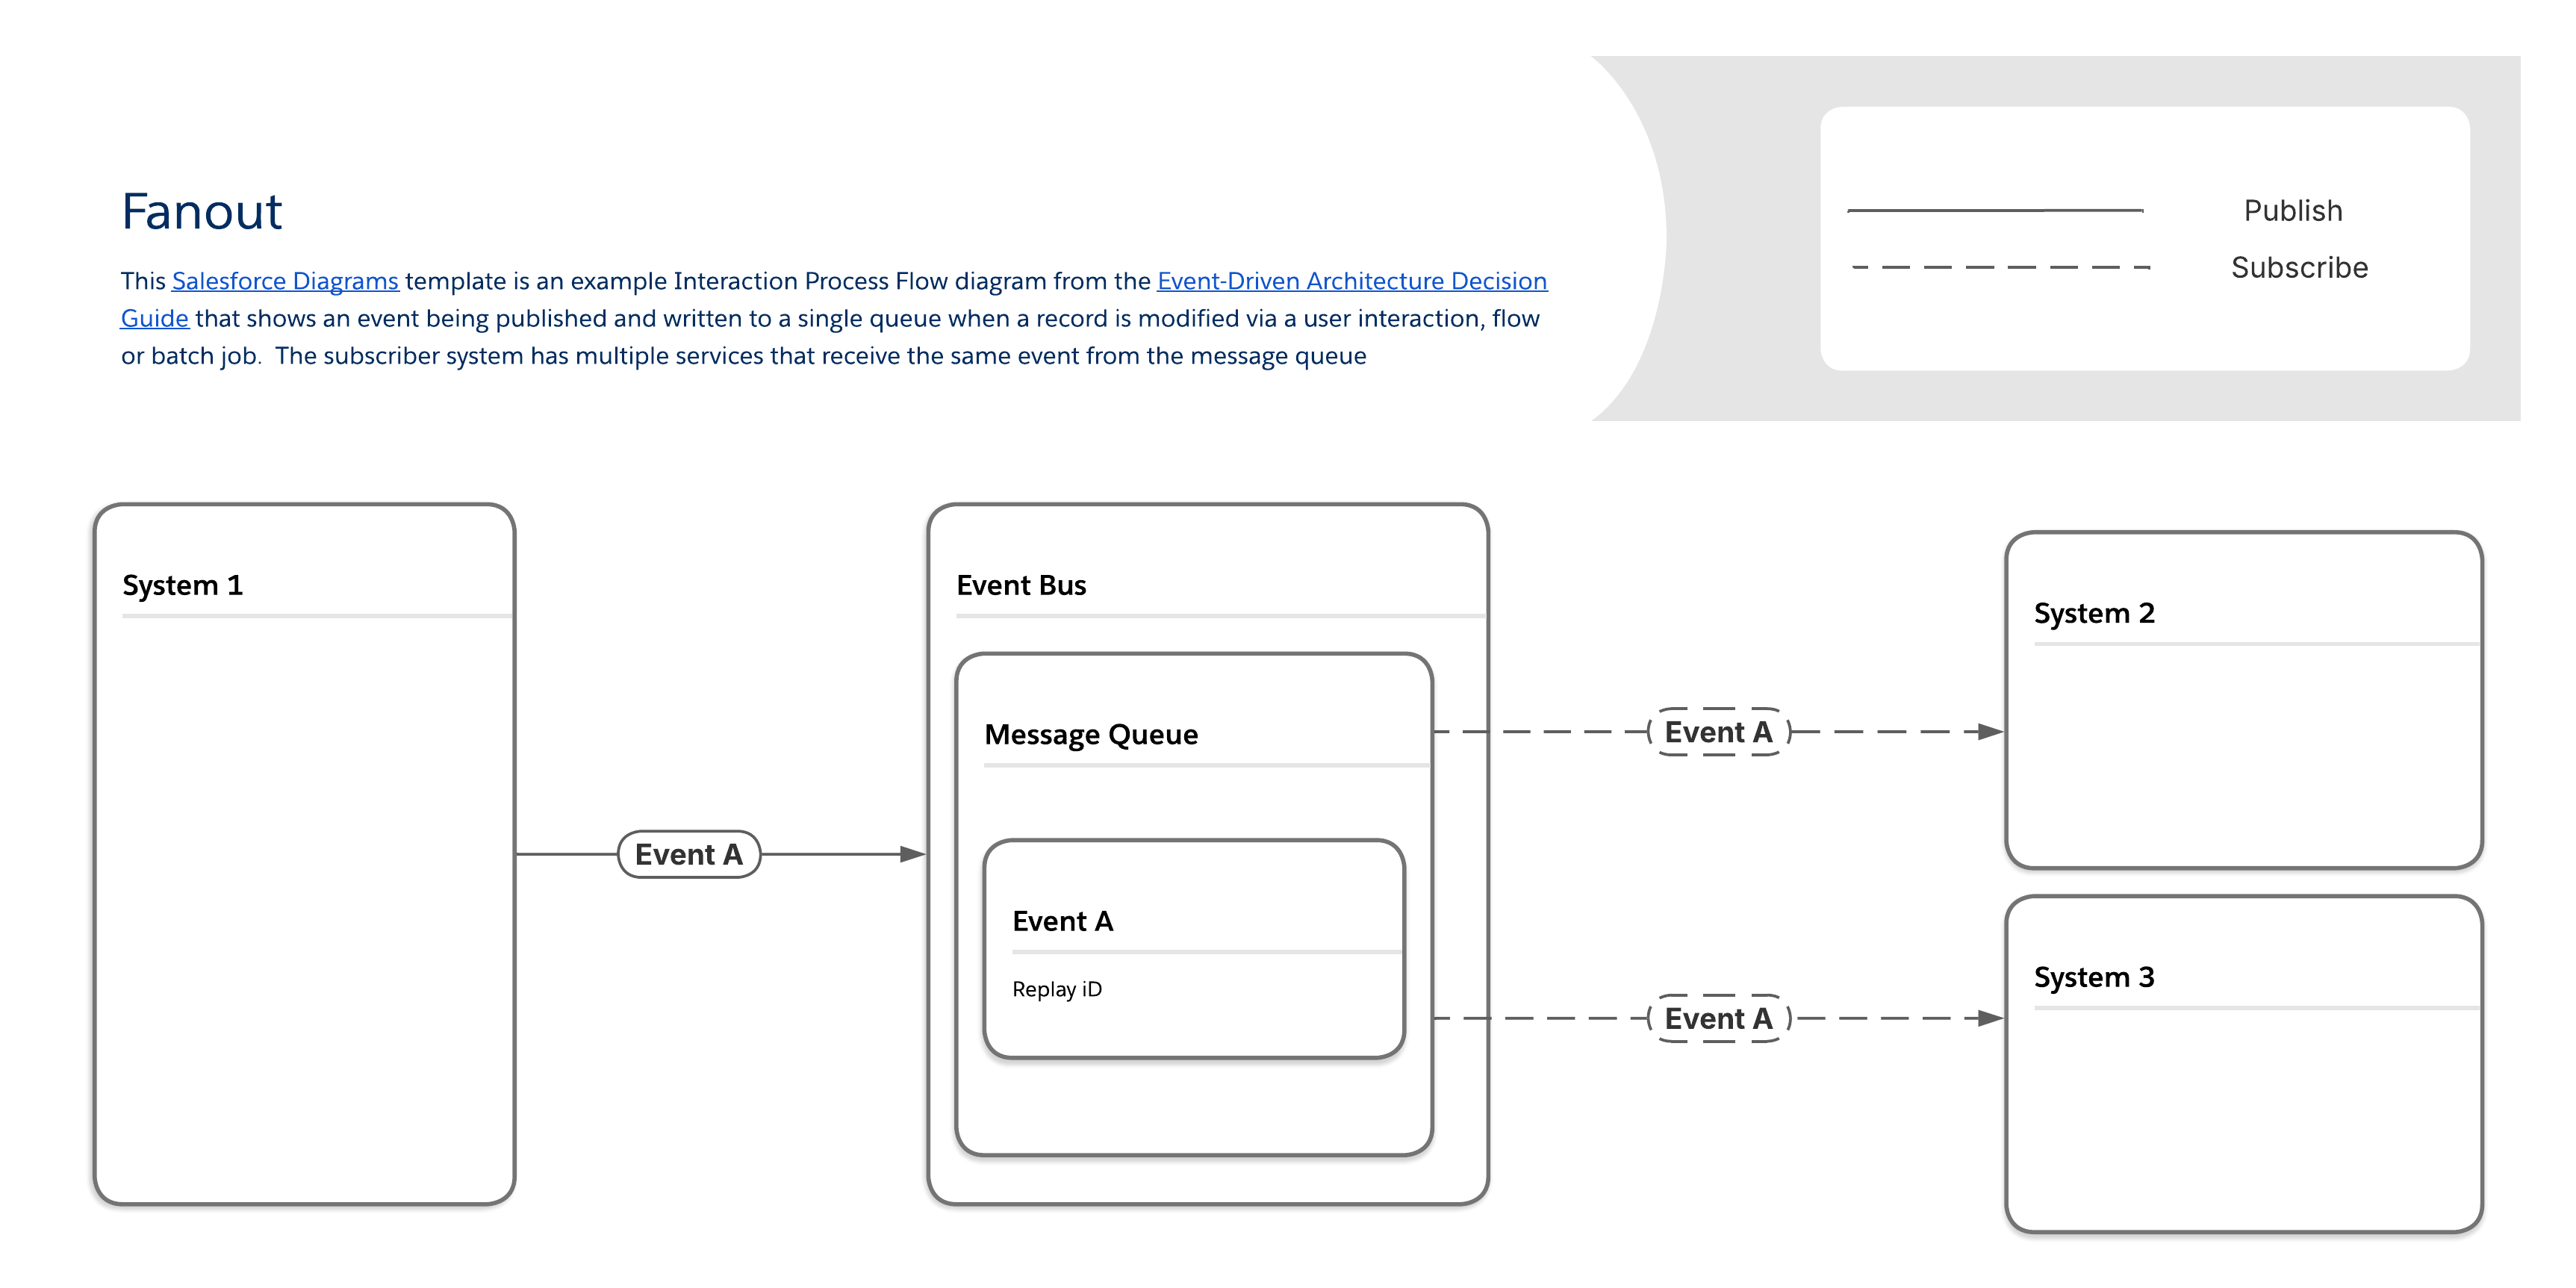
### Fanout Lorsqu'une organisation doit envoyer des mises à jour instantanées à un grand nombre d'applications clientes, par exemple des notifications push ou des SMS sur des appareils mobiles, le processus traditionnel de création de transmissions uniques pour chaque destinataire devient rapidement un obstacle à l'évolutivité. Dans ce cas, le besoin métier principal est la distribution rapide et performante d'un seul élément d'information, par exemple une alerte de compte ou un avis de changement de service critique, simultanément à de nombreuses applications de point de terminaison. Une approche rationalisée pour satisfaire à cette exigence consiste à acheminer tous les messages à travers une file d'attente unique, qui agit comme le point central des informations sur les événements pour tous les systèmes consommateurs. Cette approche améliore les performances en éliminant la nécessité de gérer de nombreuses copies de messages séparées. #### Le modèle Fanout Avec le modèle fanout, les messages sont livrés à une ou plusieurs destinations (c'est-à-dire des clients ou des abonnés à l'écoute) via une file d'attente de messages unique. Les abonnés récupèrent le même message dans la file d'attente, plutôt que leur propre copie unique. (Notez que même si cela améliore les performances, il peut également être plus difficile de vérifier si un abonné particulier a reçu ou non le message). Ce diagramme de documentation et d'implémentation de niveau 3 montre un exemple de schéma de fanout. Il montre un événement publié et écrit dans une file d'attente unique lorsqu'un enregistrement est modifié via une interaction utilisateur, un flux ou une tâche par lot. Le système abonné a plusieurs services qui reçoivent le même événement de la file d'attente des messages. #### Outils relatifs au modèle Fanout
Flux et comportement des événementsConsidérations relatives à la charge de travail
Outils disponiblesCompétences requisesPublier viaS'abonner viaPériode de relectureStructure de la charge utileLimites de charge utile
MuleSoftConnecteur MuleSoft Anypoint JMSPro-codeAPIAPIConfiguréUtilisateur définiAucun
Connecteur Salesforce Pub/SubPro-codeAPIAPIConfiguréUtilisateur définiAucun
Connecteur MuleSoft Anypoint Apache KafkaPro-codeAPIAPIConfiguréUtilisateur définiAucun
MuleSoft Anypoint Solace ConnecteurPro-codeAPIAPIConfiguréUtilisateur définiAucun
Connecteur MuleSoft Anypoint MQPro-codeAPIAPIConfiguréUtilisateur définiAucun
Connecteur MQTT MuleSoft AnypointPro-codeAPIAPIConfiguréUtilisateur définiAucun
Connecteur MuleSoft Anypoint AMQPPro-codeAPIAPIConfiguréUtilisateur définiAucun
MuleSoft Anypoint MQPro-codeAPIAPIConfiguréUtilisateur définiAucun
Salesforce PlatformApache Kafka sur HerokuPro-codeAPI, changements d'enregistrement dans Heroku PostgresS.O.1 à 6 semainesUtilisateur définiUtilisateur défini
Capture des donnéesCode faible à code proModifications d'enregistrementApex, API, Composants Web Lightning (LWC)3 joursPrédéfini1 MB
Événements de plate-formeCode faible à code proAPI, Apex, FluxApex, API, flux, LWC3 joursUtilisateur défini1 MB
API Pub/SubPro-codeAPI Pub/Sub ou Apex, API, fluxAPI Pub/Sub3 joursUtilisateur défini1 MB
Relais d'événements*Code faibleÉvénements de plate-forme, Capture des données de modificationAPI3 joursUtilisateur défini1 MB
*Les relais d'événements envoient uniquement des données à AWS Eventbridge
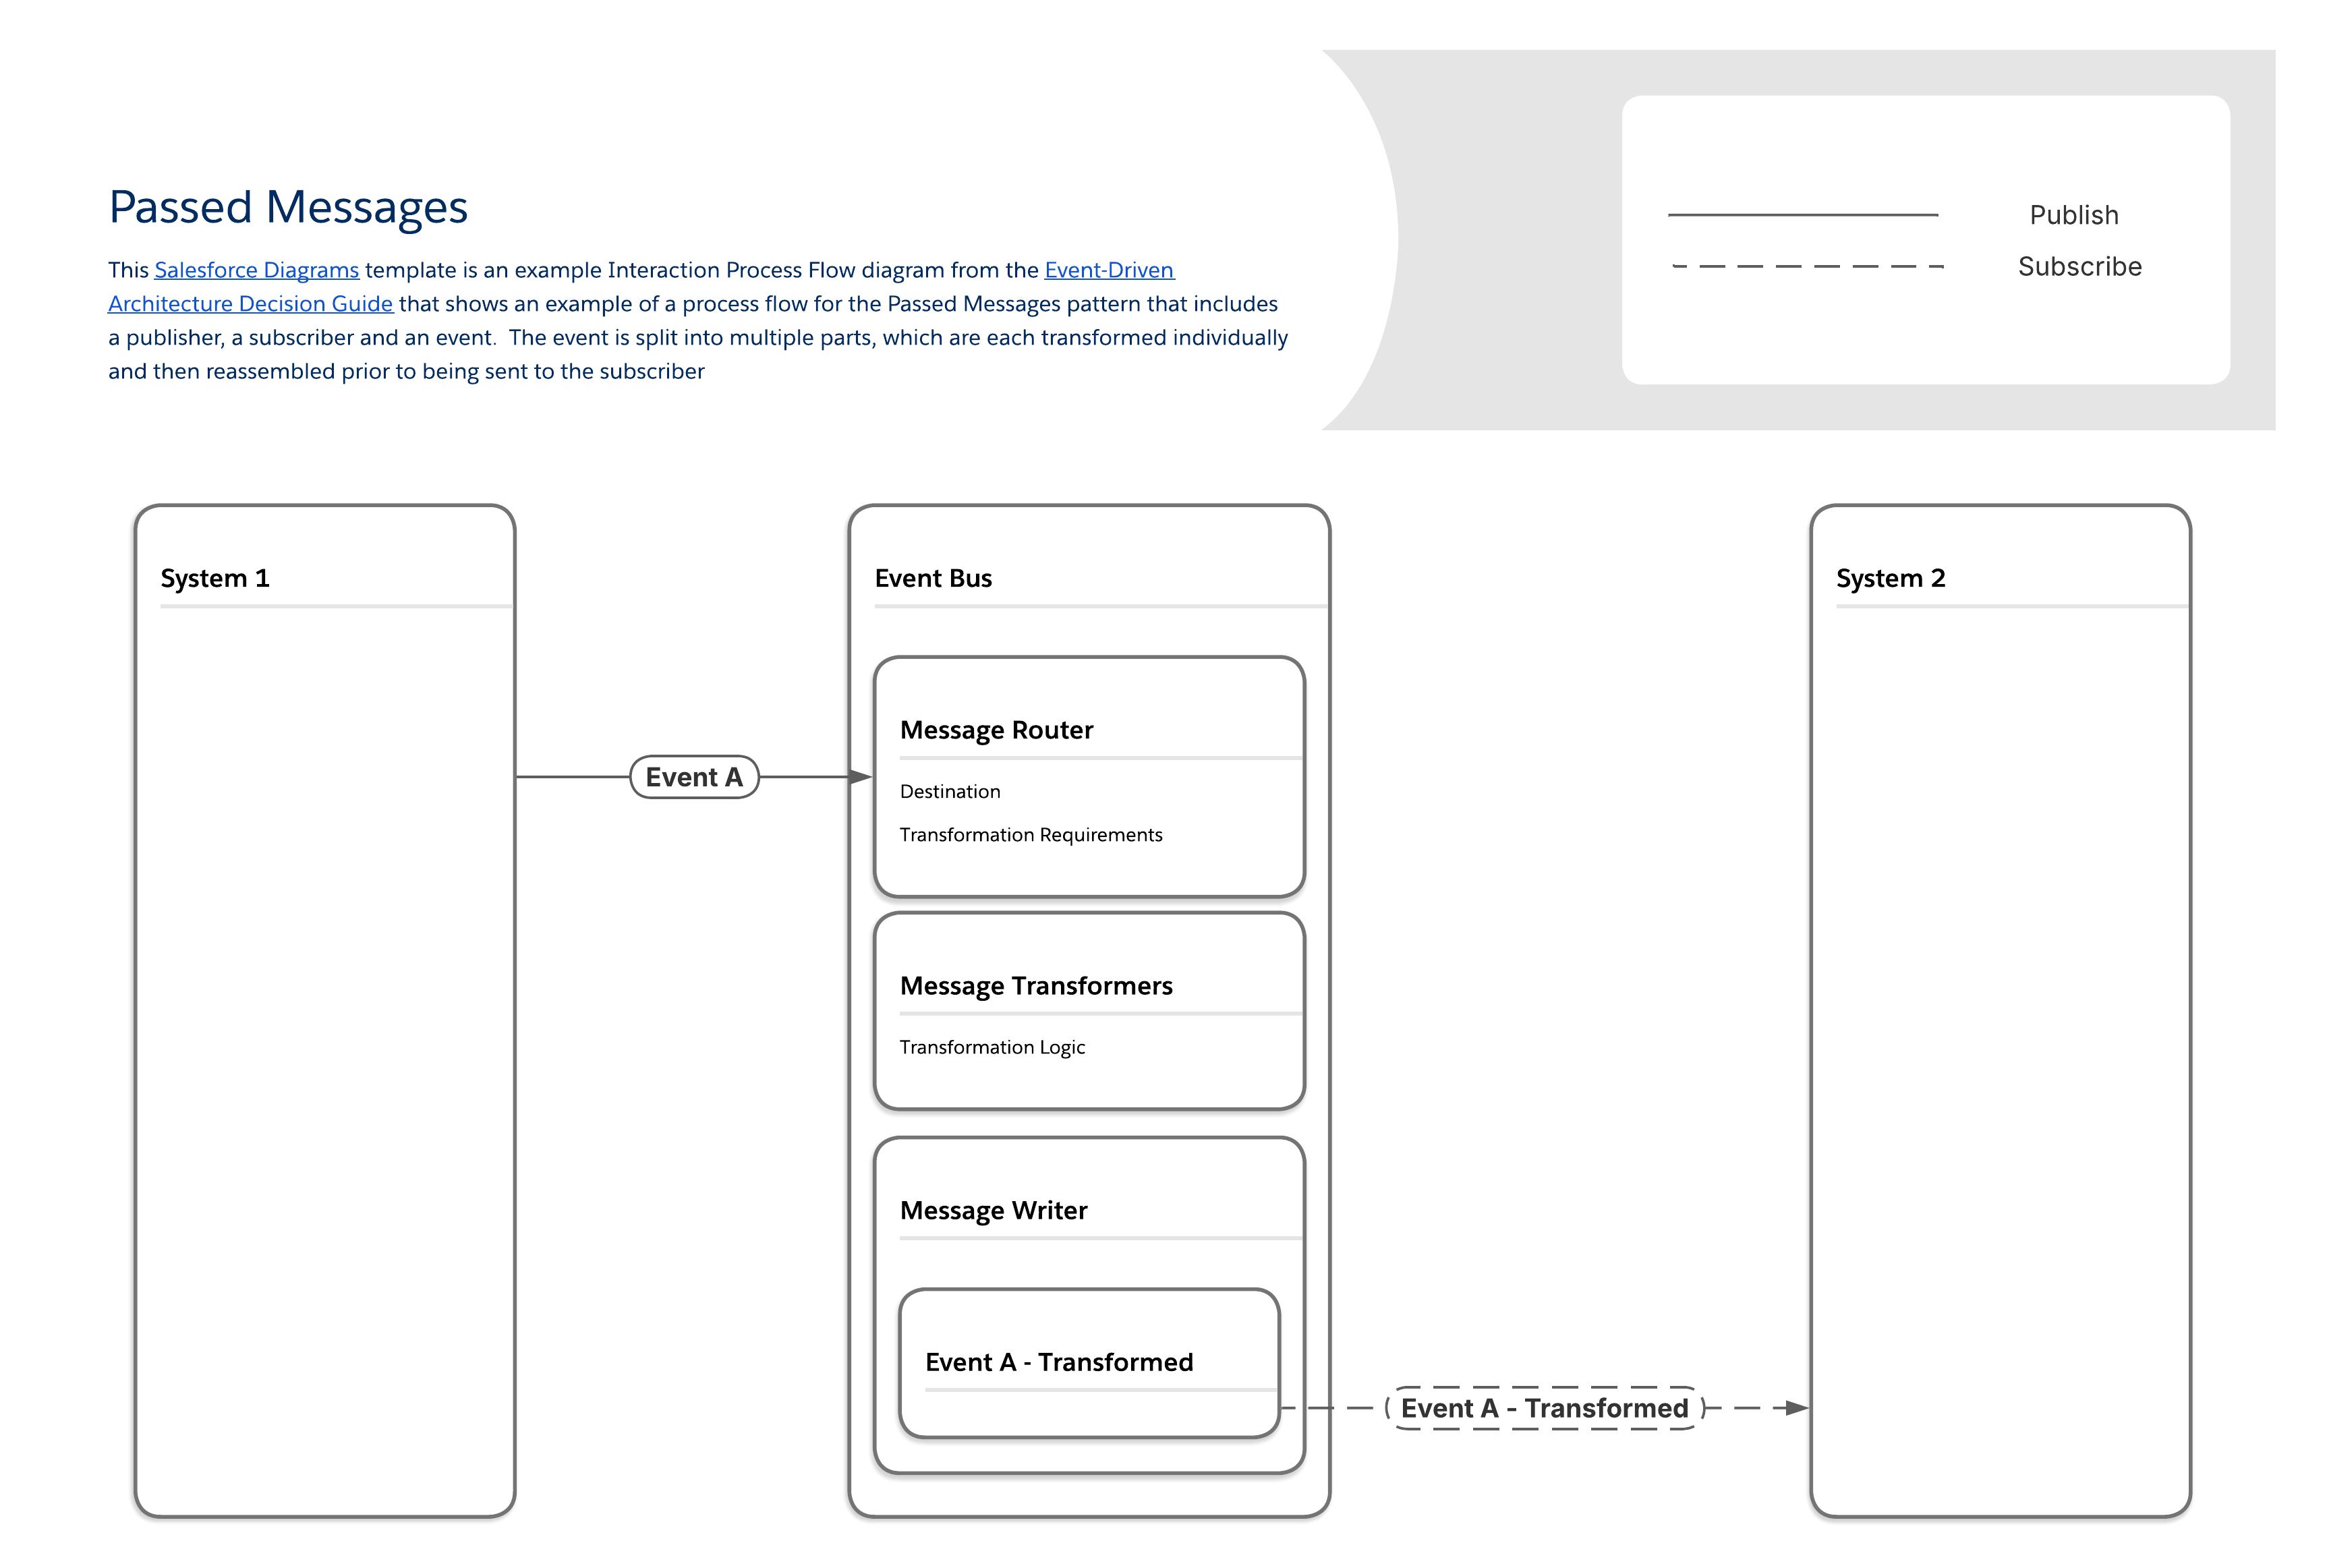
### Messages transmis Certains scénarios d'événement sont caractérisés par un afflux important de volume de messages qui menace de submerger la capacité des processus de synchronisation et de transformation, ou par une logique complexe à plusieurs étapes requise pour traiter et transformer les données d'événements. Voici quelques exemples : - **Pics de volume saisonniers :** Il peut y avoir des pics de volume que les détaillants en ligne connaissent lorsqu'une sélection de leurs produits sont « en saison ». Lorsqu'un grand nombre de clients effectuent des achats en même temps, le nombre d'événements générés peut temporairement dépasser la capacité des processus de synchronisation et de transformation. Pour plus d'informations, consultez [Bien archivé - Traitement](/docs/architect/fr-fr/well-architected/guide/automated#traitement-des-données) des données. - **Gestion des requêtes ou des réclamations :** Les entreprises basées sur des services peuvent rencontrer des augmentations du nombre de requêtes ou de déclarations pendant les pannes. - **Transformations de données complexes :** Les organisations qui nécessitent une logique complexe pour transformer les messages craignent souvent que les événements soient générés plus rapidement qu'ils ne peuvent être transformés. #### Modèle de messages transmis Ce schéma répond au défi de générer des messages plus rapidement qu'ils ne peuvent être transformés. Il garantit que les volumes importants de messages et les manipulations de données requises peuvent être traités de façon fiable, en incorporant une plate-forme de messagerie en continu et en segmentant la logique de traitement des messages dans des composants dédiés. Le modèle Messages transmis fonctionne en segmentant la logique de traitement des messages en plusieurs composants : - Un composant gère l'acheminement des messages, détermine les transformations requises et la destination finale. - Un ensemble séparé de composants gère différentes couches de transformation de message (par exemple, mappages de champs, relations d'objet, etc.). - Le dernier composant écrit le message final modifié. Ce diagramme de documentation et d'implémentation de niveau 3 montre un exemple de flux de processus pour le modèle de messages transmis qui comprend un éditeur, un abonné et un message. Le message est divisé en plusieurs parties, qui sont transformées individuellement, puis réassemblées avant d'être envoyées à l'abonné. #### Outils relatifs au modèle Messages transmis
Flux et comportement des événementsConsidérations relatives à la charge de travail
Outils disponiblesCompétences requisesPublier viaS'abonner viaPériode de relectureStructure de la charge utileLimites de charge utile
MuleSoftConnecteur MuleSoft Anypoint Apache KafkaPro-codeAPIAPIConfiguréUtilisateur définiAucun
Connecteur Salesforce Pub/SubPro-codeAPIAPIConfiguréUtilisateur définiAucun
Salesforce PlatformApache Kafka sur HerokuPro-codeAPI, changements d'enregistrement dans Heroku PostgresS.O.1 à 6 semainesUtilisateur définiUtilisateur défini
Capture des donnéesCode faible à code proModifications d'enregistrementApex, API, Composants Web Lightning (LWC)3 joursPrédéfini1 MB
Événements de plate-formeCode faible à code proAPI, Apex, FluxApex, API, flux, LWC3 joursUtilisateur défini1 MB
API Pub/SubPro-codeAPI Pub/Sub ou API, flux ApexAPI Pub/Sub3 joursUtilisateur défini1 MB
Relais d'événements*Code faibleÉvénements de plate-forme, Capture des données de modificationAPI3 joursUtilisateur défini1 MB
*Les relais d'événements envoient uniquement des données à AWS Eventbridge
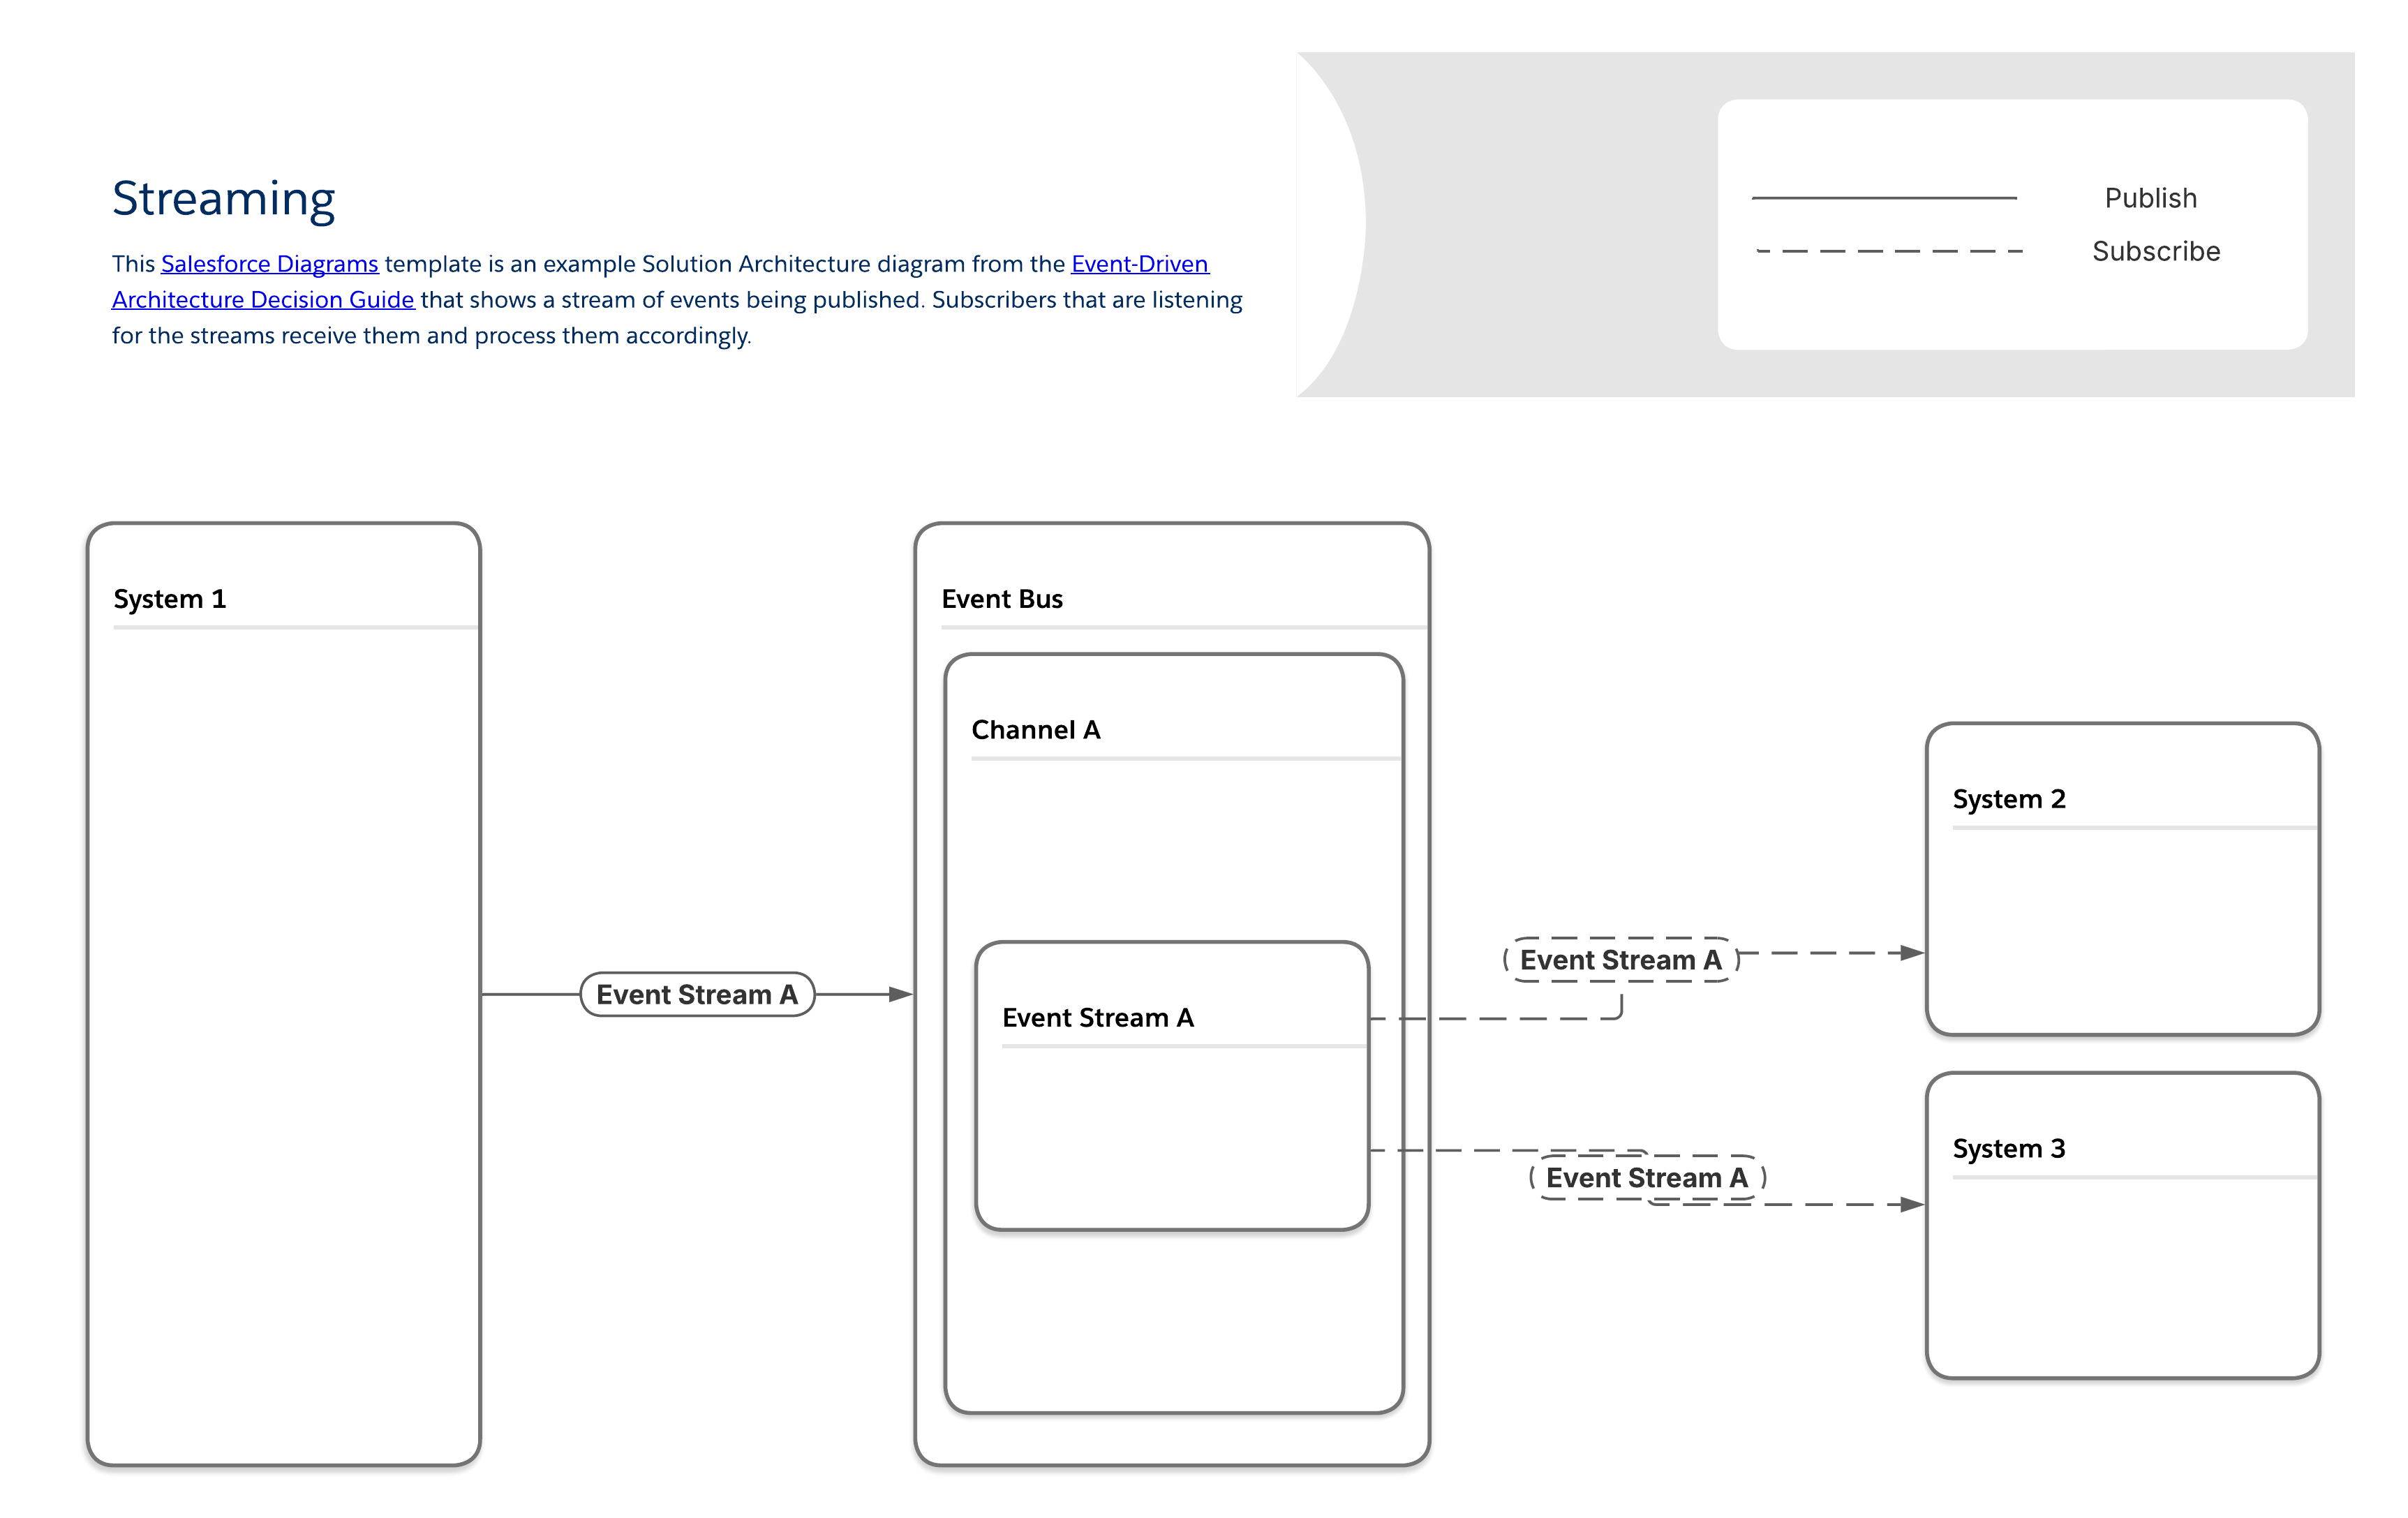
### Streaming Certains producteurs génèrent un flux continu d'événements. Un exemple courant est le streaming média, qui implique des interactions utilisateur qui se produisent naturellement sous forme d'événements discrets. Plusieurs systèmes doivent réagir simultanément au même comportement des utilisateurs sans bloquer l'expérience principale de diffusion en continu. Tenez compte des événements d'une plate-forme de streaming musical. Il peut s'agir de : - Suivre les événements démarrés/interrompus/ignorés - Événements de session d'écoute avec horodatage - Événements de création/modification de listes de lecture - Événements de partage social - Télécharger pour l'écoute hors ligne #### Le schéma de streaming Dans le schéma Streaming, les abonnés accèdent à chaque flux d'événements et traitent les événements dans l'ordre exact de réception. Des copies uniques de chaque flux de messages sont envoyées à chaque abonné, ce qui permet de livrer des contenus spécifiques à l'abonné et d'identifier les abonnés qui reçoivent les flux. Ce diagramme de documentation et d'implémentation de niveau 3 montre un exemple de schéma de diffusion en continu qui représente un flux d'événements en cours de publication. Les abonnés qui écoutent les flux les reçoivent et les traitent en conséquence. #### Outils correspondant au schéma de diffusion en continu
Flux et comportement des événementsConsidérations relatives à la charge de travail
Outils disponiblesCompétences requisesPublier viaS'abonner viaPériode de relectureStructure de la charge utileLimites de charge utile
MuleSoftFlux de données MuleSoft AnypointPro-codeAPIAPIConfiguréUtilisateur définiAucun
Connecteur Salesforce Pub/SubPro-codeAPIAPIConfiguréUtilisateur définiAucun
Connecteur MuleSoft Anypoint Apache KafkaPro-codeAPIAPIConfiguréUtilisateur définiAucun
Salesforce PlatformApache Kafka sur HerokuPro-codeAPI, changements d'enregistrement dans Heroku PostgresS.O.1 à 6 semainesUtilisateur définiUtilisateur défini
API Pub/SubPro-codeAPI Pub/Sub ou API, flux ApexAPI Pub/Sub3 joursUtilisateur défini1 MB
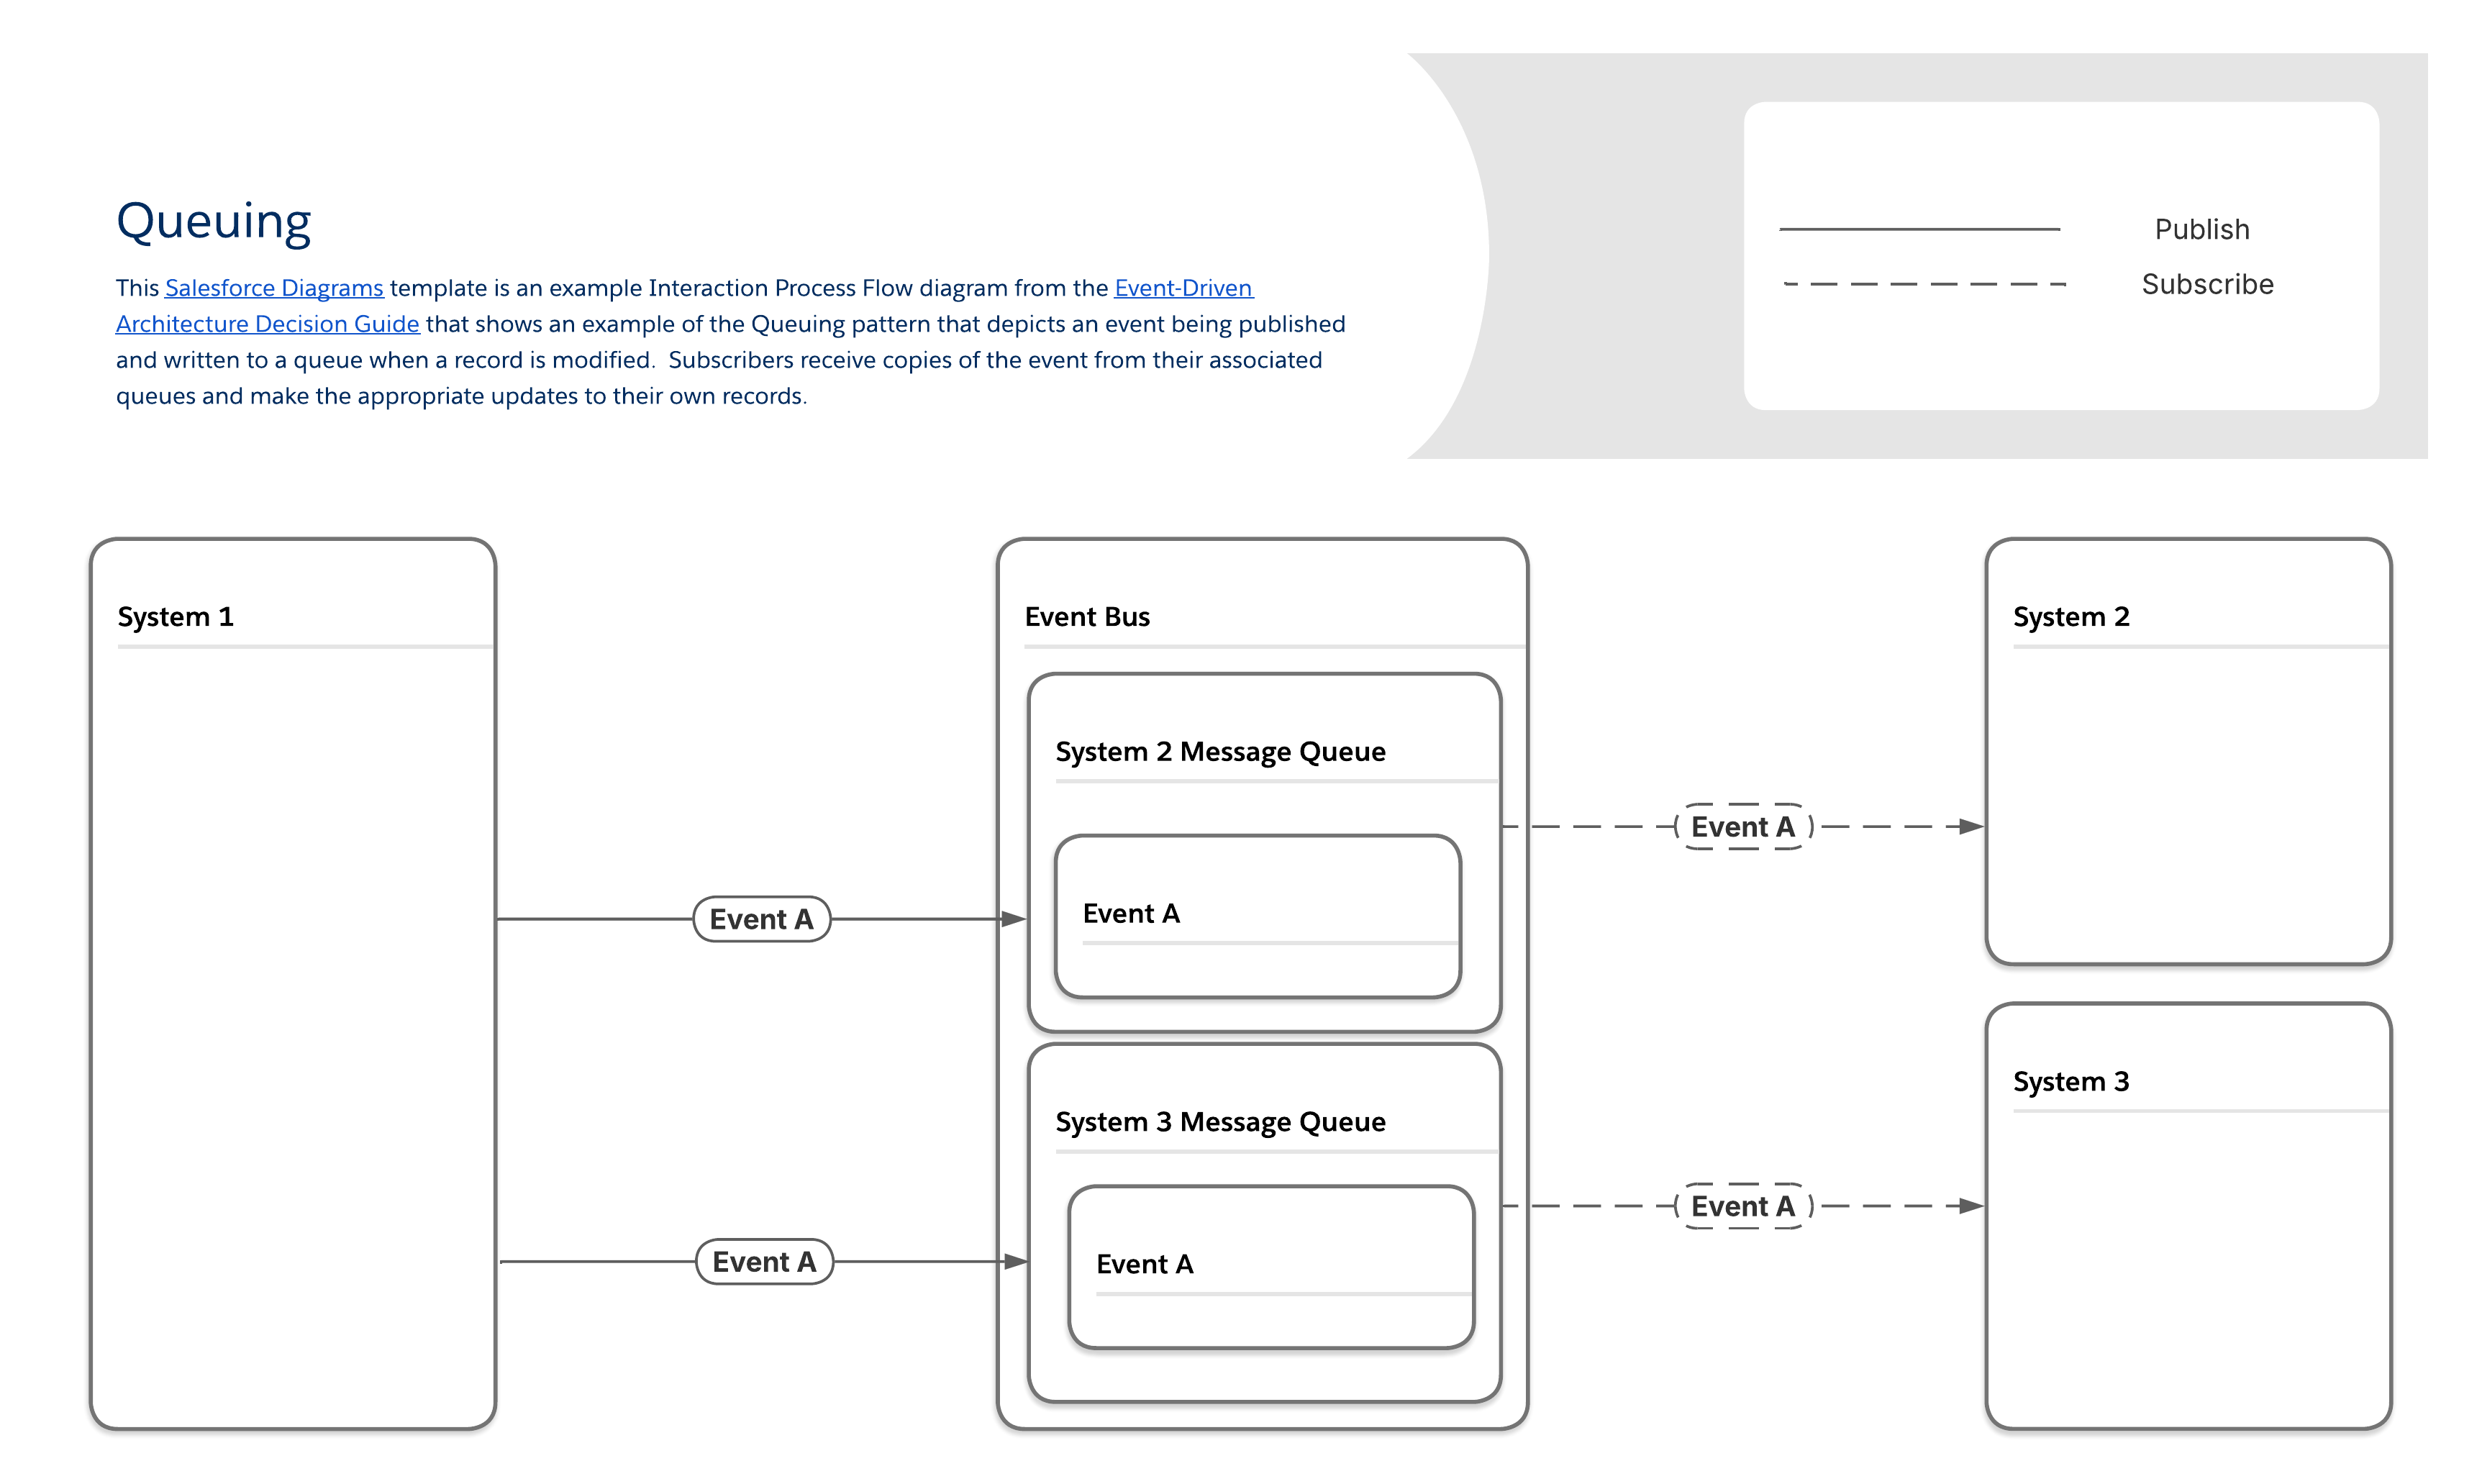
#### Gestion des commandes d'événements en continu Pour qu'un flux soit pertinent, tous ses événements et leurs messages associés doivent être dans l'ordre approprié. Si vous générez les données dans un flux à partir de différents systèmes, vous devez incorporer une logique de commande supplémentaire dans le processus de conception. ### Mise en file d'attente Les cas d'utilisation de mise en file d'attente sont omniprésents. Exemples : - **Connexions Internet de faible qualité:** Les organisations d'assistance sur site ou les autres organisations dans lesquelles les équipes avec des appareils mobiles doivent travailler dans des zones avec un accès Internet de mauvaise qualité ou intermittent bénéficient de la mise en file d'attente, car les applications sur ces appareils peuvent se connecter à leurs files d'attente et récupérer tous les messages pertinents lorsque la connectivité est rétablie. - **Tamponnage du message :** Lorsque le volume de messages dépasse occasionnellement la capacité de traitement d'un abonné et que l'augmentation de la latence ne crée pas de problèmes supplémentaires, les files d'attente peuvent servir de tampon pour stocker les messages excédentaires et éviter la perte de données. - **Gestion des transports :** Les organisations logistiques qui doivent surveiller leur flotte peuvent utiliser ce modèle pour visualiser les itinéraires que chaque véhicule suit en temps quasi réel et s'assurer que les conducteurs sont aussi efficaces que possible. - **Appareils Internet des objets :** Les fabricants utilisent souvent des systèmes qui génèrent des flux de données rapides, et ces flux peuvent avoir des effets en aval sur des systèmes supplémentaires. Ce schéma peut être utilisé pour identifier des séquences d'événements qui nécessitent une intervention humaine avant que des pannes catastrophiques ne surviennent dans plusieurs systèmes. #### Le schéma de mise en file d'attente Dans le schéma File d'attente, les producteurs envoient des messages aux files d'attente, qui conservent les messages jusqu'à ce que les abonnés les récupèrent. La plupart des files d'attente de messages suivent l'ordre premier entré, premier sorti (FIFO) et suppriment chaque message une fois récupéré. Chaque abonné a une file d'attente unique, qui nécessite des étapes de configuration supplémentaires mais permet de garantir la livraison et d'identifier les abonnés qui ont reçu les messages. Ce diagramme de documentation et d'implémentation de niveau 3 montre un exemple de schéma de mise en file d'attente qui représente un événement publié et écrit dans une file d'attente lorsqu'un enregistrement est modifié. Les abonnés reçoivent des copies de l'événement depuis leur file d'attente associée et effectuent les mises à jour appropriées sur leurs propres enregistrements. #### Outils relatifs au schéma de mise en file d'attente
Flux et comportement des événementsConsidérations relatives à la charge de travail
Outils disponiblesCompétences requisesPublier viaS'abonner viaPériode de relectureStructure de la charge utileLimites de charge utile
MuleSoftMuleSoft Anypoint MQPro-codeAPIAPIConfiguréUtilisateur définiAucun
Connecteur Salesforce Pub/SubPro-codeAPIAPIConfiguréUtilisateur définiAucun
Connecteur MuleSoft Anypoint Apache KafkaPro-codeAPIAPIConfiguréUtilisateur définiAucun
Connecteur MuleSoft Anypoint MQPro-codeAPIAPIConfiguréUtilisateur définiAucun
Connecteur MQTT MuleSoft AnypointPro-codeAPIAPIConfiguréUtilisateur définiAucun
Connecteur MuleSoft Anypoint AMQPPro-codeAPIAPIConfiguréUtilisateur définiAucun
Salesforce PlatformApache Kafka sur HerokuPro-codeAPI, changements d'enregistrement dans Heroku PostgresS.O.1 à 6 semainesUtilisateur définiUtilisateur défini
Capture des donnéesCode faible à code proModifications d'enregistrementApex, API, Composants Web Lightning (LWC)3 joursPrédéfini1 MB
Événements de plate-formeCode faible à code proAPI, Apex, FluxApex, API, flux, LWC3 joursUtilisateur défini1 MB
API Pub/SubPro-codeAPI Pub/Sub ou API, Apex, FluxAPI Pub/Sub3 joursUtilisateur défini1 MB
Relais d'événements*Code faibleÉvénements de plate-forme, Capture des données de modificationAPI3 joursUtilisateur défini1 MB
*Les relais d'événements envoient uniquement des données à AWS Eventbridge
#### Gestion de la mémoire et du stockage En raison de la nature asynchrone du modèle Queuing, un délai important peut exister entre l'ajout d'un message à une file d'attente et sa récupération. Les files d'attente nécessitent de la mémoire ou de l'espace de stockage pour contenir leurs messages. Par conséquent, elles ne peuvent pas s'allonger indéfiniment, ce qui signifie qu'un abonné hors ligne indéfiniment peut entraîner un échec si suffisamment de messages s'accumulent dans la file d'attente. La mise en mémoire tampon des messages peut avoir le même effet si les temps de traitement des abonnés deviennent trop longs, ce qui entraîne l'accumulation de volumes importants de messages dans leurs files d'attente. Pour atténuer ces risques, effectuez une analyse approfondie des besoins en stockage de toutes les files d'attente de messages et, si nécessaire, concevez des processus qui purgent et désactivent les files d'attente si les messages ne sont pas récupérés dans un délai donné ou lorsqu'ils atteignent un volume prédéterminé. ## Considérations non fonctionnelles ### Migration depuis les intégrations de point à point Même si vous êtes convaincu qu'une architecture pilotée par l'événement convient à votre organisation, vous commencez peut-être par un paysage qui contient déjà un grand nombre d'intégrations de point à point. Obtenir le financement d'un projet pour remplacer toutes vos intégrations à la fois peut s'avérer difficile, et il peut même ne pas être possible d'utiliser une architecture pilotée par l'événement directement avec certains systèmes hérités. Dans ces scénarios, vous pouvez adopter une approche incrémentielle pour migrer vers une architecture plus vaguement couplée en convertissant d'abord les applications les plus critiques de l'entreprise, puis en convertissant d'autres systèmes à mesure qu'ils sont mis à jour ou remplacés dans de futurs projets. Cette approche facilite l'ajout de nouvelles applications au bus d'événements, et permet à votre paysage informatique global de rester évolutif et résilient à mesure que les systèmes s'ajoutent au fil du temps. ### Compromis dans les systèmes à faible couplage En tant qu'architectes, nous savons que chaque architecture est associée à des compromis. Une architecture pilotée par l'événement ne fait pas exception. Bien qu'un paysage rempli de systèmes peu couplés soit hautement évolutif et résilient, il y a aussi quelques compromis à prendre en compte : - **Stratégie globale d'intégration :** Quels que soient les outils et les modèles que vous choisissez d'utiliser, il est important de commencer par créer une stratégie pour le partage des données entre les divers systèmes du paysage de votre organisation. Cette stratégie doit inclure les objectifs de votre organisation concernant ses données, la façon dont les données peuvent être partagées et les modèles utilisés, ainsi que les sources de données, les cibles, les structures, et les exigences de propriété et d'accès. - **Prise en charge des systèmes hérités :** Votre organisation peut avoir des systèmes hérités qui ne prennent tout simplement pas en charge les modèles d'architecture pilotée par l'événement. Bien qu'il soit possible d'élaborer des contournements (par exemple, avec un processus qui agit comme une transmission en s'abonnant à des événements, puis en envoyant la sortie au système cible via un autre moyen de transfert de données), vous pouvez envisager d'autres méthodes d'intégration dans ce cas. - **Modifications structurelles des messages :** Une fois la structure initiale des messages définie et acceptée entre les éditeurs et les abonnés, il peut être difficile de la modifier, en particulier si les abonnés sont externes. Il existe plusieurs façons de résoudre ce problème. Vous pouvez utiliser des points de terminaison versionnés, mais assurez-vous de définir et de communiquer un cycle de vie clair pour chaque version afin d'éviter à vos développeurs de gérer un trop grand nombre de versions simultanément. Si Apache Kafka on Heroku fait partie de votre paysage, vous pouvez également envisager un registre de schéma ou un outil similaire, mais assurez-vous que les autres systèmes de votre paysage le prennent en charge (et l'utilisent également). - **Manque de visibilité entre les éditeurs et les abonnés :** Dans la plupart des modèles d'architecture pilotée par l'événement, les éditeurs ne connaissent pas le statut de leurs abonnés. Par conséquent, si un éditeur envoie un message critique alors que tous les abonnés sont hors ligne, le message peut ne jamais être remis. Vous pouvez résoudre ce problème en utilisant la fonctionnalité de relecture ou en ajoutant des abonnés redondants exécutés sur des serveurs séparés pour tous les messages critiques. - **Goulots d'étranglement des performances :** À mesure qu'une architecture pilotée par l'événement évolue, le bus d'événement peut devenir un goulot d'étranglement pour la remise de messages s'il est submergé par un trop grand nombre d'éditeurs qui tentent d'envoyer simultanément des messages à un trop grand nombre d'abonnés. Vous pouvez y remédier en augmentant la mémoire et les ressources de traitement allouées au bus d'événement ou en utilisant plusieurs bus d'événement pour traiter différents types de message en parallèle. ## Meilleures pratiques associées ### Implémentation d'architectures pilotées par l'événement Avant d'implémenter une architecture pilotée par l'événement, déterminez si vous devez vraiment l'utiliser. La section précédente décrit des scénarios métiers courants adaptés à chaque modèle d'architecture pilotée par l'événement. Vous pouvez également lire plus dans [Bien Architecté - Interopérabilité](/docs/architect/fr-fr/well-architected/guide/composable#interopérabilité). Examinez les défis à prendre en compte lors de l'implémentation d'architectures pilotées par l'événement afin de déterminer si les modèles que vous envisagez conviennent le mieux à vos cas d'utilisation spécifiques. Notez que bien que la majorité des scénarios présentés dans ce guide impliquent des intégrations, les architectures pilotées par l'événement peuvent également être utilisées pour envoyer des messages dans une seule organisation Salesforce en utilisant par exemple des événements de plate-forme. Assurez-vous de tenir compte des [limites en allocations](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_event_limits.htm) d'événements applicables lors de la conception de processus qui utilisent des événements de plate-forme en tant que système de messagerie interne. ### Éviter les anti-modèles Souvent, les anti-modèles autour des architectures pilotées par l'événement proviennent de l'utilisation d'événements comme contournement pour les communications internes dans une organisation Salesforce. Les anti-modèles courants comprennent : - **La publication d'événements à partir de déclencheurs Apex associés au même objet événement:** Cela entraînera une boucle de déclenchement infinie. - **La publication d'événements depuis Apex avant la fin d'une transaction DML:** Si une transaction échoue et est annulée, tous les événements publiés qui ont le comportement Publier immédiatement ne sont pas inclus dans le comportement d'annulation. - **Publication d'événements dans Flux pour orchestrer une automatisation ultérieure :** Pour coordonner la logique entre plusieurs automatisations, la meilleure méthode consiste à utiliser [des flux secondaires](https://developer.salesforce.com/docs/atlas.en-us.salesforce_vpm_implementation_guide.meta/salesforce_vpm_implementation_guide/vpm_designer_elements_subflow.htm) ou [des Orchestrateurs de](https://help.salesforce.com/s/articleView?id=sf.orchestrator_flow_orchestrator.htm) flux. - **Création de dépendances d'exécution :** Ne publiez pas d'événements pour faciliter la communication entre les packages sans prendre les [mesures](https://medium.com/salesforce-architects/5-anti-patterns-in-package-dependency-design-and-how-to-avoid-them-87bb50331cb8) appropriées pour éliminer les dépendances à l'exécution. - **Charges utiles inutilement importantes :** Lors de requêtes, il est préférable d'envoyer et de recevoir le plus petit volume de données possible dans la charge utile. Chaque action d'un utilisateur peut potentiellement générer plusieurs requêtes, et il est important que celles-ci soient traitées efficacement. L'envoi d'un plus grand nombre de données que nécessaire peut ralentir le transport et augmenter le temps de traitement. - **Traitement non sélectif des événements d'application :** Lorsque plusieurs composants écoutent un événement d'application, les développeurs doivent s'assurer que le gestionnaire d'événements est exécuté uniquement lorsque cela est réellement souhaité et utile. Par exemple, dans Lightning Console, les composants contenus dans des onglets qui ne sont pas au point peuvent toujours être en écoute même s'ils ne sont pas visibles. Un développeur peut utiliser diverses techniques, par exemple utiliser un élément utilitaire en arrière-plan comme seul auditeur, ou appeler getEnclosingTabId() pour déterminer si cette instance du composant est incluse dans l'onglet ciblé afin de s'assurer que chaque événement est géré uniquement lorsqu'il est prévu. - **Le comportement de publication des événements de plate-forme est incorrect :** Les événements de plate-forme ont deux comportements de publication : Publier immédiatement et Publier après validation. Il peut être utile d'utiliser des événements de plate-forme en temps réel pour des cas d'utilisation tels que la consignation, dans lesquels vous souhaitez publier l'événement de consignation, que la transaction réussisse ou non et qu'elle s'engage. Cependant, utilisez Publier immédiatement avec précaution avec des événements de plate-forme en temps réel. Les événements peuvent être consommés par les abonnés dans la même transaction et entraîner des verrouillages de ligne ou d'autres conditions de course. ### Conception d'événements efficaces Lors de l'implémentation d'une architecture pilotée par l'événement, l'une des clés du succès est de définir des normes pour la conception des événements eux-mêmes. Les détails varient selon les cas d'utilisation de votre organisation, mais voici quelques consignes générales : - **Déterminez la structure optimale pour vos charges de travail d'événements.** Bien que les tailles de message plus petites réduisent les temps de traitement, bombarder les abonnés avec des volumes massifs de messages peut entraîner des blocages dans les performances. Il peut être nécessaire d'itérer sur vos tailles et structures de charge utile pour trouver le bon équilibre. MuleSoft et les outils ESB similaires permettent de concevoir des charges de travail personnalisées dans les messages associés à vos événements, ce qui peut vous aider à visualiser les structures de données pour améliorer les performances côté abonné. (pour plus d'informations, consultez [Bien archivé - Gestion](/docs/architect/fr-fr/well-architected/guide/composable#gestion-des-api) des API). - **Pensez à vos processus de bout en bout.** Assurez-vous de ne pas créer de scénarios de « boucle sans fin », qui peuvent être difficiles à retrouver une fois les intégrations déployées. Par exemple, deux systèmes publient des événements lorsque les enregistrements sont mis à jour, tout en écoutant les événements de l'autre, qui déclenchent des événements publiés supplémentaires lorsqu'ils sont traités. Vous pouvez corriger ce type d'anti-modèle en ajoutant une logique aux deux systèmes qui garantit que les modifications effectuées suite à un événement consommé n'entraînent pas la publication d'un nouvel événement. Assurez-vous également de documenter tous vos événements, leurs déclencheurs associés et les systèmes en aval qui peuvent être affectés. Utilisez cette documentation comme référence pendant les sessions de conception pour identifier le plus tôt possible des boucles interminables et des scénarios similaires. (Pour plus d'informations, consultez [Bien archivé - Conception](/docs/architect/fr-fr/well-architected/guide/automated#conception-de-processus) de processus). - **Utilisez des conventions de nommage communes entre les systèmes.** Des conventions de nommage cohérentes sont une meilleure pratique pour tous les développements de logiciels, y compris les architectures pilotées par les événements. Prenez le temps de documenter une série de normes pour les noms d'événements, les structures, les objets associés et les processus de traitement des erreurs afin de garantir la cohérence entre les systèmes. (Pour plus d'informations, consultez [Bien archivé - Normes](/docs/architect/fr-fr/well-architected/guide/intentional#normes-de-conception) de conception). ## Ressources
ModèleRessources
Publier/ S'abonnerSalesforce Bien Architecté - Débit
Salesforce Well-Architected - Traitement des données
Salesforce bien architecturée - Interopérabilité
Blog Post: Efficacité architecturale avec les relais d'événements
Blog Post: Annonce de l'API Pub/Sub globalement disponible
Blog Post: Passage de RESTful à EVENTful
Blog Post: Architectures pilotées par l'événement et spécification AsyncAPI
Vidéo : Procédure pas à pas Publier / S'abonner au schéma
FanoutBlog Post: Comment respecter les limites en livraisons d'événements de plate-forme
Vidéo : Procédure pas à pas du modèle Fanout
Messages transmisVidéo : Procédure pas à pas du modèle Messages transmis
StreamingBlog Post: Conception d'écritures à haut volume dans Salesforce
Vidéo : Procédure pas à pas du schéma de streaming
Documentation : Diffusion en continu dans des applications Mule
Mise en file d'attenteBlog Post: Conception d'écritures à haut volume dans Salesforce
Blog Post: Comment concevoir des architectures de paiement avec des API Evented
Vidéo : Procédure pas à pas du schéma de mise en file d'attente
## Vue d'ensemble Salesforce Platform a continuellement amélioré son architecture d'automatisation pour répondre aux exigences des processus métiers complexes. Les générations précédentes – Règles de workflow et Générateur de processus – ont fourni les premières étapes de la logique pilotée par l'événement, en élargissant les capacités d'automatisation de la logique pilotée par l'événement et en élargissant la portée à un plus grand nombre de générateurs. Cette évolution a abouti à une architecture consolidée et performante centrée sur deux piliers complémentaires : Flux déclenché par un enregistrement et déclencheurs Apex. Ce document fournit le cadre et les consignes nécessaires pour prendre des décisions informées lors de la conception d'automatisations de déclencheur. ## Produits dans la portée
Flux Salesforce Flow est un puissant outil d'automatisation par pointer-cliquer qui permet aux utilisateurs d'élaborer visuellement des processus métiers, des écrans et une logique complexes en utilisant Flow Builder, sans écrire de code. Il automatise des tâches telles que la mise à jour des données, l'envoi d'e-mails et le guidage des utilisateurs, offrant ainsi de la flexibilité à travers des types tels que Flux d'écran (interaction utilisateur) et Flux déclenchés (enregistrement/événements planifiés).
Apex Salesforce Apex est un langage de programmation propriétaire et orienté objet pour la plate-forme Salesforce, similaire à Java, utilisé pour élaborer une logique métier personnalisée, automatiser les processus et étendre les fonctionnalités CRM de base au-delà des outils déclaratifs.
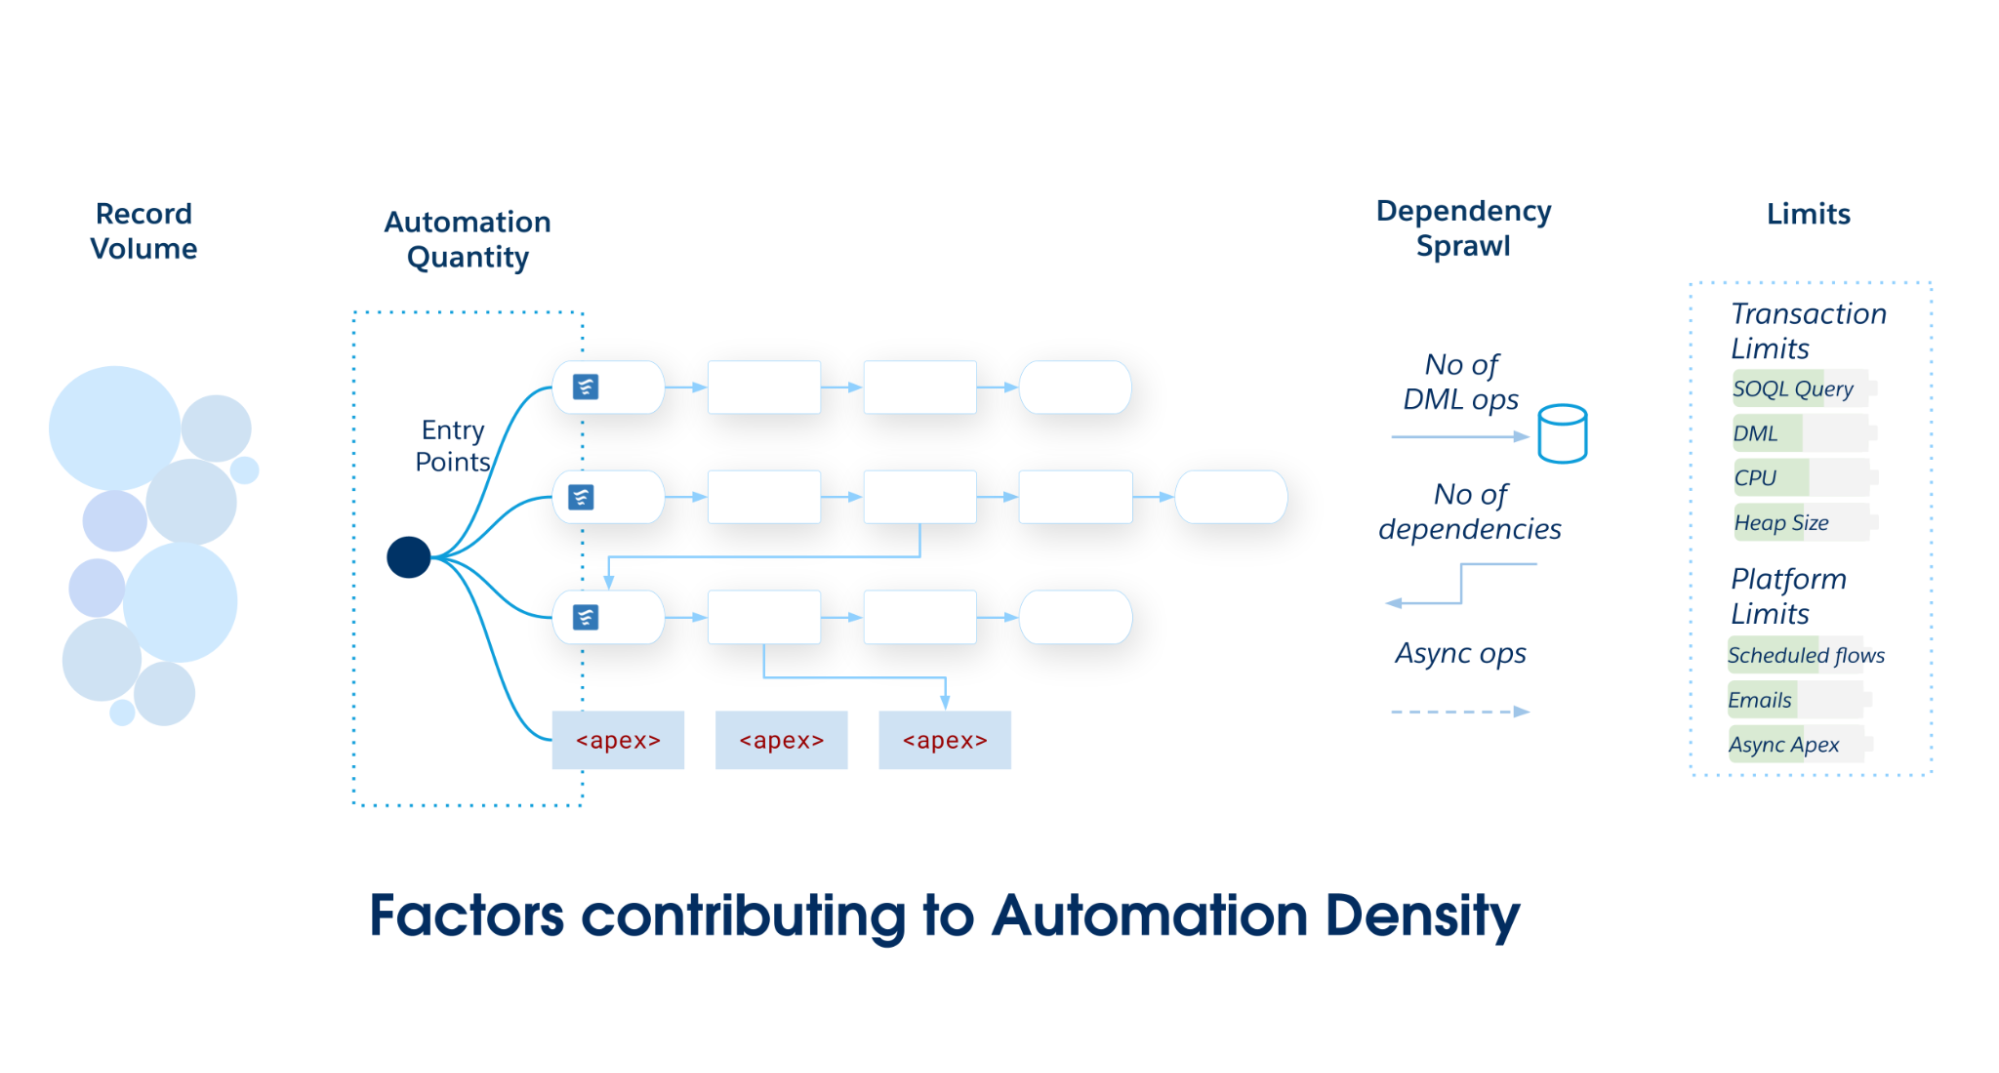
## Points à retenir L'élaboration d'une automatisation déclenchée par un enregistrement évolutive, maintenable et performante sur Salesforce Platform nécessite une approche disciplinée et pilotée par l'architecture. Le choix entre Flux et Apex, et l'implémentation de chacun, est guidé par une série de principes clairs. Ces points résument ces principes et servent de règles de base pour la conception moderne de l'automatisation. - **Choisissez l'outil adapté à votre tâche en fonction de la densité d'automatisation des objets Salesforce.** - Utilisez Flux déclenché par un enregistrement pour des objets Salesforce afin d'automatiser **la faible densité**. - Augmenter la logique de flux déclenché par un enregistrement avec Apex invocable pour des automatisations **de densité moyenne**. - Utilisez des déclencheurs Apex pour des objets Salesforce pour des automatisations **à haute densité**. - **Faites preuve de prudence en déclenchant des processus asynchrones.** Cette règle s'applique que vous invoquiez des processus asynchrones dans un flux déclenché par un enregistrement ou mettiez en file d'attente une tâche depuis Apex. Bien que ce schéma puisse être tentant pour le délestage du travail, il peut introduire des scénarios complexes de traitement des erreurs et augmenter le risque d'atteindre les limites du gouverneur. - **Utilisez un point d'entrée par objet Salesforce.** Pour un objet Salesforce donné, utilisez un mécanisme comme point d'entrée dans l'automatisation. Essayez d'éviter de mélanger des déclencheurs Flux et Apex comme points d'entrée d'un même Objet. ## Points de décision ### Implémentation déclarative par rapport à programmatique Flux et Apex partagent un ensemble commun de capacités fondamentales. Chaque outil peut interroger des enregistrements, exécuter une logique conditionnelle, attribuer des variables et exécuter des opérations DML telles que la création, la mise à jour et la suppression d'enregistrements, séquencés pour être exécutés dans un ordre spécifié. Cependant, ce chevauchement fonctionnel n'implique pas que les outils soient interchangeables. Le choix architectural ne concerne pas _si_ une tâche peut être réalisée, mais _comment_ elle est réalisée et quelles sont les implications à long terme pour les performances, l'évolutivité et la maintenabilité. Le flux excelle dans la clarté déclarative et la rapidité d'implémentation pour des processus simples, tandis qu'Apex fournit le contrôle granulaire et la puissance brute nécessaires pour des solutions complexes. ### Densité d'automatisation La **densité d'automatisation** est la charge imposée à un objet Salesforce spécifique. Il sert d'heuristique pour déterminer l'implémentation optimale de l'objet. À mesure que la densité de l'automatisation augmente, la probabilité d'infraction aux limites transactionnelles augmente. Calculez la densité d'automatisation en inspectant trois dimensions spécifiques de volume et de complexité : - **Quantité d'automatisation :** Le nombre brut d'entrées de métadonnées d'automatisation uniques (flux, actions de déclencheur, etc.) exécutées pendant un événement DML (Data Manipulation Language) unique. - **Volume d'enregistrement :** Les enregistrements par transaction traités via des chargements d'API ou un traitement par lot lourd, où les performances deviennent critiques. - **Étendue de la dépendance :** Une mesure des opérations DML en aval déclenchées par l'opération CRUD initiale. Il quantifie la profondeur du graphique où une mise à jour est mise à jour en cascade dans des objets associés (par exemple, requête → compte → contact → cumul personnalisé). Dimensions de densité d'automatisation À mesure que l'étendue et la complexité de votre application Salesforce augmentent, engagez-vous vers un point d'entrée principal unique, soit Flux déclenché par un enregistrement, soit Déclencheurs Apex. Évitez de partitionner les automatisations entre plusieurs mécanismes dans un seul objet Salesforce, car cela entraîne une mauvaise maintenabilité et une gouvernance fragmentée. ### Matrice de sélection de la densité Utilisez cette matrice afin de déterminer la norme architecturale requise pour votre objet Salesforce. - Le **flux déclenché par** un enregistrement est la solution préférée pour une faible densité d'automatisation. Il offre un équilibre de puissance et d'accessibilité idéal pour des automatisations simples et indépendantes les unes des autres. - **Le schéma hybride (flux déclenché par un enregistrement avec Apex invocable)** est un choix puissant et maintenable pour les automatisations à densité moyenne avec une complexité croissante. Ce schéma permet aux équipes de maintenir une chorégraphie ordonnée dans Flux déclaratif tout en déléguant des opérations lourdes en calcul à Apex, en équilibrant l'accessibilité avec les performances. - Les **déclencheurs Apex** fournissent les blocs de construction nécessaires à une fondation architecturale solide pour soutenir les automatisations à haute densité. Les performances, le contrôle granulaire, ainsi que l'abstraction orientée objet et le polymorphisme d'Apex sont mieux adaptés pour gérer la complexité et l'échelle de ces scénarios.
Niveau de densité Quantité d'automatisation Volume de données (taille du lot) Sprawl de dépendance Norme architecturale
Faible < 15
Automatisations
Standard
Interactions de l'interface utilisateur pilotées par l'utilisateur ou petites charges d'API (1 à 200 enregistrements)
Discret
Logique autonome. 0 à 1 opérations DML en aval sur le même objet ou un objet associé.
Flux déclenché par un enregistrement
Moyen 15–30
Automatisations
Modérer
Traitement par lot standard (avec une logique nécessitant un traitement en masse minutieux)
Couplé
Parent/Enfant met à jour 2 à 4 opérations DML en aval. Risque de récursion
Modèle hybride
Flux + Apex invocable
Élevée > 30
Automatisations
Élevée
Volumes de données importants avec des chargements d'API en masse (2 000 à plus de 10 000 enregistrements)
Complexe et récursif
Graphique de dépendance profonde (5+ opérations DML en aval). Risque de boucles de récursion triangulaires
Infrastructure de métadonnées de déclencheur Apex
Les décisions architecturales réelles nécessitent de peser collectivement toutes les dimensions de la densité de l'automatisation. Tenez compte de l'étendue future potentielle en sélectionnant un mécanisme d'automatisation pour un objet Salesforce donné. Tenez également compte du nombre total d'opérations DML quotidiennes, car Salesforce applique automatiquement la gestion des ressources partagées dans un environnement multilocataire et les [limites du gouverneur](https://developer.salesforce.com/docs/atlas.en-us.salesforce_app_limits_cheatsheet.meta/salesforce_app_limits_cheatsheet/salesforce_app_limits_platform_apexgov.htm) afin d'empêcher les automatisations galopantes de monopoliser les ressources partagées. Les objets Salesforce avec un volume DML quotidien élevé nécessitent une sélection rigoureuse de l'automatisation. Par exemple, les limites en temps processeur (60 000 ms) et en taille de tas (12 Mo) sont supérieures aux limites synchrones. De plus, la limite en exécutions asynchrones sur 24 heures à l'échelle de l'organisation (calculée à 250 000, soit 200 fois vos licences utilisateur) nécessite de prendre en compte le DML total quotidien dans votre conception architecturale afin d'éviter les exceptions à l'exécution. ## Comparaison des produits Le flux déclenché par un enregistrement est le principal outil déclaratif de la plate-forme pour l'automatisation déclenchée par un enregistrement. La facilité d'utilisation de Flow et les garanties de plate-forme intégrées permettent aux équipes d'élaborer aisément des solutions évolutives et fiables. C'est le choix idéal pour la plupart des équipes qui élaborent des solutions sur Salesforce Platform. Apex est le langage de programmation propriétaire, fortement typé et orienté objet de la plate-forme. Utilisez Apex pour les objets Salesforce à forte densité d'automatisation, et pour les cas d'utilisation qui nécessitent des performances élevées, une logique sophistiquée ou un contrôle granulaire des transactions. Pour faciliter le processus de prise de décision, cette matrice fournit une comparaison directe de Flux et Apex entre les capacités architecturales clés.
Capacité Flux déclenché par un enregistrement Déclencheur Apex
Rapidité de livraison et d'entretien Recommandé
L'interface utilisateur visuelle de Flow Builder permet aux administrateurs et autres générateurs déclaratifs de créer et de modifier des automatisations plus rapidement que l'écriture, le test et le déploiement d'un code Apex. Cette interface permet à un plus grand nombre de membres de l'équipe d'offrir de la valeur métier et réduit la dépendance aux ressources spécialisées pour les développeurs pour de simples tâches.
Expertise requise
Apex nécessite des développeurs de logiciels correctement qualifiés pour implémenter, tester et maintenir le code.
Modularité Disponible
Les flux déclenchés par un enregistrement sont modulaires par défaut. Au lieu d'une logique monolithique, les équipes élaborent des flux discrets pour des exigences spécifiques et les chorégraphient ensemble en utilisant l'Explorateur de déclencheur de flux. Cette modularité permet une modification isolée et une extension simple, réduisant considérablement le coût à long terme de propriété.
Disponible
Apex est divisé en modules fonctionnels par conception. Chaque classe Apex est destinée à implémenter un seul module de fonctionnalité.
Visibilité et gouvernance Recommandé
La nature visuelle de Flux offre une représentation intuitive de la logique métier. L'Explorateur de déclencheur de flux fournit une vue consolidée de tous les flux d'un objet, ce qui facilite la compréhension, la gouvernance et le dépannage des architectes et des administrateurs sans lire de code.
Expertise requise
L'utilisation d'une infrastructure de métadonnées pour organiser les déclencheurs est avantageuse, mais Apex nécessite une équipe de développement disciplinée pour garder le code organisé et maintenable.
Traitement en masse des données haute performance Non recommandé
Le risque d'atteindre les limites du gouverneur est élevé lorsqu'il s'agit d'une logique complexe ou de volumes de données importants.
Recommandé
Le code Apex exécute au plus près des services de base de la plate-forme et offre aux développeurs un contrôle renforcé sur l'optimisation des requêtes, le traitement des données et l'efficacité algorithmique. Cela améliore les performances et l'échelle, en particulier dans les scénarios complexes impliquant des volumes de données importants.
Logique robuste et structures de données Disponible
L'élément Transformation de flux peut faciliter certaines tâches de traitement complexes. Cependant, Flow n'a pas de structures de données Map et Set natives, ce qui rend le traitement des données complexes lourd et inefficace sur le plan informatique.
Recommandé
Apex fournit un accès complet aux boucles Map, Set et programmatic pour une manipulation des données très efficace et sécurisée en masse. En tant que langage de programmation complet, Apex permet également d'accéder à des constructions logiques complexes, des structures de données et des modèles de conception qui peuvent aider à résoudre des problèmes métiers complexes de manière maintenable et efficace. Apex inclut une riche bibliothèque standard de fonctions avancées (par exemple, BusinessHours, Crypto) qui n'est pas disponible actuellement dans les outils déclaratifs.
Contrôle des transactions Non disponible
Le flux ne fournit aucun accès à `Database.savepoint`, `Database.rollback` ou aux opérations DML partiellement réussies pour des validations de transaction partielles ou des annulations.
Disponible
Apex fournit un contrôle complet et précis de l'intégrité des transactions et des scénarios complexes de reprise après erreur.
Distribution des e-mails Recommandé
L'envoi d'alertes par e-mail préconfigurées à partir d'un flux déclenché par un enregistrement est facile et évolutif. Des alertes par e-mail personnalisées peuvent être élaborées et distribuées à l'exécution. Les e-mails personnalisés sont soumis à des limites quotidiennes en envois.
Disponible
Apex peut générer et envoyer des e-mails personnalisés. Tous les e-mails envoyés depuis Apex sont soumis aux limites quotidiennes en envois.
Application des garanties de la plate-forme Recommandé
Le flux inclut des protections intégrées, telles que la mise en masse automatique et les tentatives automatiques. Ces mesures augmentent la vitesse de valorisation et évitent les problèmes de performance qui nécessitent un codage manuel complexe.
Application manuelle requise
Les mesures de protection telles que le traitement en masse doivent être explicitement codées (par exemple, gérer les collections et éviter le SOQL dans les boucles). Les tentatives automatiques ne sont pas natives de déclencheurs et nécessitent une logique personnalisée complexe à implémenter.
Traitement asynchrone Disponible
Le flux offre des mécanismes faciles pour les automatisations qui nécessitent une transaction séparée dans un parcours asynchrone. Ces automatisations sont soumises à des limitations quotidiennes.
Disponible
Apex permet un contrôle total via la Capture des données de modification et les événements qui peuvent être mis en file d'attente et qui sont gérés par un abonné au déclencheur découplé.
Traitement planifié Recommandé
Les parcours planifiés du flux offrent une capacité de planification unique et puissante (par exemple, « déclencher 3 jours avant la date de fermeture »). Cette capacité inclut l'annulation et la replanification automatiques si les données de l'enregistrement changent. Ces automatisations sont soumises à des limitations quotidiennes.
Non disponible
Un déclencheur Apex ne peut pas planifier nativement un événement temporel, spécifique à un enregistrement, avec une annulation automatique. Apex planifié existe, mais il s'agit d'un mécanisme fondamentalement différent qui est exécuté à une heure spécifique et qui n'est pas planifié pendant le traitement d'un enregistrement individuel dans le cadre d'un déclencheur.
Commande et chorégraphie Disponible
L'Explorateur de déclencheur de flux permet aux administrateurs de définir un ordre d'exécution relatif pour plusieurs flux dans le même objet.
Disponible
Une infrastructure de déclencheur permet de contrôler avec précision l'ordre exact des automatisations.
Mises à jour du même champ d'enregistrement Disponible (avant la sauvegarde)
Le flux déclenché par un enregistrement est l'option déclarative la plus performante pour mettre à jour l'enregistrement déclenchant avant l'engagement DML initial.
Disponible (avant la sauvegarde)
Apex fournit l'offre la plus performante avec un minimum de frais généraux.
CRUD inter-objets Disponible (après la sauvegarde)
Le flux convient aux opérations DML inter-objets simples et peu complexes.
Disponible (après la sauvegarde)
Apex offre un contrôle supérieur de la déduplication, du traitement des erreurs et des performances pour les opérations DML inter-objets.
Déduplication du calcul coûteux Disponible
Le flux excelle dans l'élimination des requêtes redondantes et des instructions DML via le traitement en masse automatique. Cependant, l'état ne peut pas être mis en cache ou partagé entre différents déclencheurs de flux ou entre plusieurs invocations du même flux dans une seule transaction. Cette limitation peut devenir importante dans des scénarios de performance extrême.
Recommandé
Apex fournit des mécanismes de déduplication des opérations coûteuses. Les développeurs peuvent exploiter la mise en cache transactionnelle en utilisant des propriétés et des variables statiques, et la mise en cache au niveau de la plate-forme en utilisant Cache de la plate-forme, pour stocker et réutiliser des données. Ces techniques sont importantes pour réduire la consommation des limites du gouverneur transactionnel, telles que les requêtes SOQL, et garantir des performances et une évolutivité élevées.
Gestion des erreurs personnalisées Disponible
L'élément CustomError peut bloquer une opération d'enregistrement et afficher un message pour l'utilisateur.
Recommandé
La méthode addError() fournit un message d'erreur flexible au niveau du champ et conditionnel.
## Cas d'utilisation ### Recommandations les plus adaptées Le tableau ci-dessous présente des recommandations générales « les plus adaptées » pour les cas d'utilisation généraux, en fonction des capacités présentées. En fin de compte, vous prendrez en compte d'autres considérations afin d'arriver à la meilleure adéquation à vos scénarios particuliers, par exemple ceux inclus dans la section _Meilleures pratiques connexes_ du présent document. Vous y apprendrez quand une combinaison particulière de flux et Apex fournit la meilleure approche.
Cas d'utilisation Description Best-Fit Justification
Traitement par lot hautement performant Toute automatisation qui doit traiter efficacement des milliers d'enregistrements Apex Apex fournit des API riches pour l'interface avec la plate-forme et pour la vitesse brute.
Traitement complexe des données Scénarios qui nécessitent une manipulation avancée des données Apex Apex fournit des structures de données, telles que Map et Set, qui ne sont pas disponibles en natif dans Flow, et peuvent être critiques pour écrire un code performant et sécurisé en masse.
Contrôle transactionnel Mécanismes de contrôle tels que les points de sauvegarde, les annulations et les validations partielles Apex Apex permet d'accéder à des mécanismes tels que Database.savepoint et Database.rollback, et a la possibilité de traiter les opérations DML partiellement réussies.
Validation personnalisée sophistiquée Validation des données dans plusieurs champs d'un enregistrement Apex Bien que Flux puisse empêcher l'enregistrement avec l'élément `CustomError`, il n'est pas disponible dans tous les types de flux, y compris les flux secondaires. La méthode Apex addError() fournit plusieurs messages d'erreur spécifiques à un champ qui peuvent être ajoutés à un enregistrement à tout moment pendant le traitement du déclencheur.
Logique moyennement complexe dans un processus simple Logique et manipulation de données de complexité modérée, simplifiée par une bibliothèque standard de fonctions avancées, survenant dans le cadre d'un processus simple Flux + Apex Le flux déclenché par un enregistrement agit en tant que couche d'orchestration, tandis que les opérations hautement complexes sont encapsulées dans Apex invocable.
Logique simple à moyennement complexe Manipulation de données de complexité faible à modérée, avec des mises à jour de déclencheur pour les objets de données principaux et associés Flux Le flux est généralement l'option incontournable, car il est basé sur un modèle déclaratif qui le rend accessible aux administrateurs et aux développeurs.
Notifications et messages sortants Envoi d'e-mails et de messages sortants Flux Le flux facilite et adapte considérablement l'envoi d'alertes par e-mail et de messages sortants lors de modifications d'enregistrement.
Traitement planifié Automatisation à une date future et dynamique (par exemple, 3 jours avant une date de fermeture) Flux Les parcours planifiés offrent une force unique à Flux, car la plate-forme gère automatiquement la planification, l'annulation et la replanification de ces parcours si les données de l'enregistrement changent.
### Traitement évolutif : Cas d'utilisation asynchrones en profondeur L'évolutivité est une considération essentielle lors de la conception de votre implémentation. Lorsque la logique métier d'une automatisation déclenchée par un enregistrement devient complexe, longue ou implique des volumes de données importants, les limites du gouverneur principal de Salesforce Platform deviennent une contrainte architecturale. Des opérations telles que des mises à jour de données en masse, des appels d'API complexes ou des calculs lourds augmentent le risque de dépassement des limites, par exemple le temps processeur total ou le nombre d'instructions DML dans une seule transaction de base de données. Un échec d'un déclencheur synchrone dû à une exception de limite entraîne l'annulation de la transaction d'enregistrement complète de l'utilisateur, ce qui entraîne une mauvaise expérience utilisateur et une perte potentielle de données. Ce risque inhérent exige un modèle architectural pour décharger des travaux complexes. L'automatisation asynchrone devient dans ce cas indispensable. En utilisant des mécanismes asynchrones, les architectes peuvent efficacement dissocier le travail de longue durée ou à haut volume de la transaction principale et synchrone d'enregistrement. Les enregistrements sont effectués rapidement et de façon fiable, tandis que le traitement lourd est délégué à une transaction séparée gérée par la plate-forme qui est exécutée plus tard. Le découplage améliore la stabilité, évite les échecs de transaction et est essentiel pour élaborer des applications d'entreprise évolutives. La plate-forme offre plusieurs outils spécialisés pour cela, chacun avec des avantages et des compromis distincts en termes de fiabilité, de volume et de complexité. ### Chemin asynchrone du flux Le parcours Exécuter de façon asynchrone dans un flux déclenché par un enregistrement fournit le mécanisme le plus simple pour la logique asynchrone « feu et oubli ». Ce chemin est exécuté dans une transaction séparée lorsque la transaction d'enregistrement d'origine a été engagée avec succès dans la base de données. - **Cas d'utilisation idéal**: Il convient parfaitement aux tâches qui ne nécessitent pas d'exécution immédiate ou de traitement personnalisé des erreurs. Par exemple, envoyer une notification par e-mail, créer une tâche de suivi ou passer un simple appel externe à un système externe. - **Limites**: Ce mécanisme partage les mêmes limites quotidiennes du gouverneur que les autres interviews de flux asynchrones. Il n'est pas conçu pour le traitement à très haut volume. ### Capture des données de modification (CDC) La Capture des données de modification (CDC) est un modèle à haut débit, évolutif et résilient qui permet de gérer une logique asynchrone déclenchée par un changement d'enregistrement dans des scénarios à haut volume. Dans ce modèle, la seule responsabilité du déclencheur est d'enregistrer l'enregistrement de façon synchrone. La plate-forme publie ensuite un message d'événement détaillé qui contient les modifications apportées à l'enregistrement dans un bus d'événement à haut volume. Un déclencheur Apex séparé et dédié s'abonne à cet événement de modification. Il effectue des tâches complexes, longues ou asynchrones. - **Avantage**: Ce schéma découple le processus asynchrone de la transaction utilisateur initiale. Un échec du traitement asynchrone n'entraîne pas l'annulation de l'enregistrement de l'utilisateur. Le modèle fournit également un flux d'événements durable que plusieurs abonnés internes ou systèmes externes peuvent consommer, et les événements peuvent être rejoués pendant 72 heures, offrant une forte résilience. - **Limites**: Les messages d'événement du CDC ne contiennent pas l'état antérieur de l'enregistrement - l'équivalent d'un `Trigger.oldMap` Apex. La charge de travail de l'événement inclut les nouvelles valeurs de champ, mais pas les valeurs à partir desquelles elles ont changé. Il est donc difficile d'implémenter une logique basée sur une transition d'état spécifique (par exemple, exécutée uniquement si la `Status__c` change de « En attente » à « Approuvé »). Vous pouvez atténuer ce problème en interrogeant l'historique des champs de l'objet dans l'abonné à l'événement, mais cela ajoute de la complexité au processus, et le suivi de l'historique des champs peut ne pas être disponible pour le champ d'intérêt spécifique. Cela peut limiter les types d'automatisation que vous pouvez décharger vers le CDC. Par défaut, le CDC peut être activé dans cinq objets Salesforce maximum. Les organisations qui en ont besoin peuvent acheter une licence complémentaire qui retire cette limite et augmente les allocations de livraison d'événements. ### Apex Queueable à partir d'un déclencheur La mise en file d'attente d'une tâche Apex Queueable directement à partir d'un déclencheur doit être considérée comme un schéma risqué, utilisé uniquement lorsque le contrôle fourni par Apex est nécessaire (par exemple, pour une logique complexe ou des mécanismes de nouvelle tentative personnalisés), et CDC n'est pas une option viable. Si Apex Queueable est requis, l'implémentation doit inclure les garanties appropriées: - **Limiter les contrôles**: Le code doit vérifier le nombre de tâches déjà mises en file d'attente dans la transaction avant de tenter d'en ajouter une autre. ``` if (Limits.getQueueableJobs() < Limits.getLimitQueueableJobs()) { ... } ``` - **Connaissance du contexte**: Le code doit détecter s'il est exécuté dans un contexte asynchrone, par exemple une tâche par lot (`System.isBatch()`), et modifier son comportement pour respecter la limite plus stricte d'une tâche par transaction dans ce contexte. ### Considérations relatives aux limites pour Apex asynchrone déclenché Invoquer Apex asynchrone à partir d'un déclencheur synchrone introduit des risques de stabilité. Pour éviter l'impact au niveau de l'organisation (par exemple, dépassement des limites), ce schéma nécessite une conception et des tests rigoureux. - La limite quotidienne en exécutions Apex asynchrones (`Batch`, `Queueable`, `@Future`) est partagée entre l'organisation (généralement 250 000 ou un calcul basé sur les licences utilisateur). Un chargement de données en masse de 20 000 enregistrements entraînera l'exécution d'un déclencheur par segments de 200, entraînant 100 invocations de déclencheur séparées - encore plus si la taille du lot en masse est inférieure à 200 enregistrements. Si chaque invocation met en file d'attente une tâche asynchrone, une partie importante de la limite quotidienne d'un chargement de données unique peut être consommée. Cette consommation peut potentiellement affamer d'autres processus métiers critiques des ressources asynchrones. - Les limites du gouverneur pour la mise en file d'attente des tâches sont radicalement différentes selon le contexte. Depuis un déclencheur déclenché par une action utilisateur dans l'interface utilisateur (une transaction _synchrone_), jusqu'à 50 tâches pouvant être mises en file d'attente peuvent être mises en file d'attente. Cependant, à partir d'un déclencheur déclenché par la méthode `execute` d'une classe Apex par lot - une transaction _asynchrone_ - une seule tâche pouvant être mise en file d'attente peut être mise en file d'attente. Ne pas tenir compte de cette différence est un point d'échec commun et critique, qui entraîne des erreurs de `LimitException` lors d'opérations de données volumineuses. - Appeler Apex planifiable (`System.schedule`) ou Apex par lot (`Database.executeBatch`) directement à partir d'un contexte de déclenchement constitue un antischéma. Ces méthodes ne sont pas conçues pour être invoquées à partir du contexte du déclencheur. Cela entraînera une consommation rapide de votre allocation Apex asynchrone, entraînant des exceptions de limite. ### Choix du modèle asynchrone approprié Chaque mécanisme asynchrone a des compromis spécifiques en termes de performance, de limites du gouverneur et de fiabilité. Utilisez cet arbre de décision comme guide pour vous aider à parcourir ces options et à choisir le mécanisme adapté à votre cas d'utilisation. Arbre de décision de schéma asynchrone ### Alternative de tâche planifiée Comme l'indique le diagramme, lorsque vous êtes confronté à des opérations DML à haut volume, mais que vous ne pouvez pas utiliser la Capture des données de modification (peut-être en raison des limitations des objets), le meilleur choix architectural est souvent d'éviter entièrement un processus invoqué par le déclencheur. Vous pouvez à la place utiliser un processus planifié. Cela peut être soit un flux planifié, soit Apex planifié. Les étapes requises sont : 1. Effectuez une mise à jour simple et économique dans le déclencheur synchrone. Par exemple, définissez un champ de `Status__c` sur « traitement en attente » ou insérez un enregistrement associé peu coûteux, par exemple une publication Chatter, pour indiquer que l'enregistrement doit être traité. 2. Créez une tâche planifiée, soit un flux planifié ou Apex planifié, qui est exécutée périodiquement, par exemple toutes les 15 minutes ou toutes les heures. 3. Définissez la requête de tâche planifiée pour tous les enregistrements à l'état en attente, exécutez la logique complexe dans un contexte contrôlé à haut volume, puis mettez à jour les enregistrements tels qu'ils sont traités. Ce schéma découple totalement le traitement lourd de l'enregistrement synchrone de l'utilisateur, n'est pas soumis à la limite d'une tâche par transaction d'un lot déclenché par un déclencheur, et offre une solution hautement évolutive et gouvernable pour les exigences en temps réel. Si la latence d'une tâche planifiée n'est pas acceptable pour les exigences métiers, et que vous êtes toujours contraint d'utiliser CDC ou une file d'attente déclenchée par un déclencheur, cela indique un décalage architectural important. À ce stade, différents mécanismes doivent être envisagés. La réévaluation de la conception de l'application principale peut conduire à certaines conclusions, notamment : - Achat du complément pour retirer les limites en objets CDC. - Défiant fondamentalement l'exigence métier de déterminer si le traitement en temps quasi réel est vraiment un « must-have » ou si la latence d'une tâche planifiée est un compromis acceptable pour la stabilité de la plate-forme. ## Considérations non fonctionnelles ### Complexité Le niveau de complexité d'une implémentation fait partie du coût total de possession d'une solution, ainsi que de sa capacité à s'adapter aux exigences métiers changeantes. La complexité peut impacter n'importe quelle implémentation si les meilleures pratiques ne sont pas respectées. La section _Meilleures pratiques connexes_ de ce document contient des recommandations pour réduire la complexité de votre solution, notamment les modèles suivants : - Modèle hybride : Apex invocable pour une logique complexe dans un flux - Utilisation d'une infrastructure de métadonnées pour les déclencheurs Apex - Mega-Flows vs. Flux multiples ### Processus et normes La documentation est aussi importante que l'automatisation elle-même. Il garantit non seulement la maintenabilité, mais il est également essentiel pour l'IA et les outils basés sur l'agent. La documentation vous aide à comprendre et à gérer vos processus métiers. **Dans Flux** - Établissez une convention de nommage cohérente pour tous les éléments et variables. - Utilisez le champ Description du flux pour expliquer son objet global, les critères de déclenchement et le résultat escompté. - Utilisez le champ Description de chaque élément individuel (par exemple, `Get Records`, `Action`, `Transform`). Cette pratique est la meilleure façon de transmettre l'intention. Elle est particulièrement importante pour les actions invocables et les flux secondaires, où la description est l'emplacement principal pour expliquer la logique complexe exécutée par l'action. **Dans Apex** - Commentez clairement votre code pour expliquer le _pourquoi_ de votre logique, pas seulement le _quoi_. - Si vous utilisez une infrastructure pilotée par les métadonnées, assurez-vous que vos enregistrements de métadonnées contiennent et remplissent un champ Description lisible par l'utilisateur pour expliquer ce que fait chaque classe gestionnaire et quand elle doit être exécutée. Le DevOps et le contrôle du code source font partie d'un cycle de vie de développement mature. Utilisez toujours un outil de contrôle de code source tel que Git pour des projets Salesforce. Les classes Apex et les flux Salesforce sont des métadonnées qui définissent votre logique métier, et ils doivent être contrôlés et gérés par version. Dans le contexte de la gestion des automatisations déclenchées par un enregistrement, un pipeline DevOps moderne offre des avantages essentiels. - **Contrôles de qualité automatisés :** Des outils tels que [Salesforce Code Analyzer](https://developer.salesforce.com/docs/platform/salesforce-code-analyzer/overview) peuvent être configurés pour être exécutés automatiquement dans votre pipeline. L ' analyse statique peut détecter des modèles problématiques dans les deux outils d ' automatisation avant qu ' ils ne soient promus, en signalant des problèmes tels que des éléments de `Get Records` inefficaces dans une boucle de flux ou des requêtes `SOQL` dans une boucle Apex for, qui sont des causes courantes de dégradation des performances. - **Prévention de la régression :** À mesure que votre densité d'automatisation augmente, un changement vers une classe Flux ou Apex peut avoir des conséquences involontaires sur d'autres automatisations dans le même objet. Une stratégie de test DevOps robuste, dans laquelle des tests Apex automatisés sont exécutés contre toute modification proposée, est la méthode la plus fiable pour s'assurer qu'une nouvelle version de flux ne rompe pas la logique Apex existante (et inversement). - **Collaboration et visibilité :** Le contrôle de la source est la « source unique de vérité ». Il permet aux administrateurs et aux développeurs de travailler en parallèle sur l'automatisation d'un même objet. Il fournit également une piste d'audit inestimable : lorsqu'un processus de production est rompu, vous pouvez déterminer instantanément _qui_ a modifié l'automatisation, _quand_ ils l'ont modifiée et - via des messages d'engagement - _pourquoi_ ils l'ont modifiée. [DevanOps Center](https://help.salesforce.com/s/articleView?id=platform.devops_center_overview.htm&type=5) fournit une interface unifiée qui facilite la chorégraphie de toutes ces étapes pour permettre à tous les membres de l ' équipe d ' accéder à un processus de développement évolutif, basé sur le contrôle des sources. Cette discipline combinée de documentation et de DevOps garantit la santé et la maintenance à long terme de votre organisation, ce qui profitera à chaque architecte et administrateur qui vous suit. ## Meilleures pratiques associées Le guide de décision ci-dessus est préférable avant de planifier votre implémentation. Il vise à vous aider à choisir le meilleur produit pour vos cas d'utilisation. Après la sélection du produit, il est important de comprendre les meilleures pratiques existantes pour votre implémentation. ### Exploitez le modèle hybride : Apex invocable pour une logique complexe dans un flux Le principe _Un outil par objet_ est essentiel pour gérer l'automatisation à haute densité, mais ne l'interprètez pas comme un choix binaire entre une pile purement déclarative ou purement programmatique. Un schéma architectural plus efficace et plus maintenable exploite un modèle Hybride: positionnez Flux déclenché par un enregistrement en tant que couche d'orchestration, tout en encapsulant les opérations hautement complexes au sein d'Apex invocable. Diagramme de schéma hybride #### La couche Orchestration : Flux Le flux déclenché par un enregistrement sert de couche orchestrative au processus métier. Il est propriétaire des critères d'entrée et du contexte d'exécution (le _quoi_ et _quand_). En conservant la logique de décision et l'acheminement au sein de cette couche, la topologie des processus de l'architecture reste transparente et gérable via l'Explorateur de déclencheur de flux, ce qui évite que la logique métier critique soit masquée dans le code. #### Le composant Complexe : Apex invocable Un exemple courant de composant complexe est l'implémentation de calculs d'accord de niveau de service (SLA) pour des enregistrements Requête. Comme l'objet BusinessHours et sa logique associée — critique pour des calculs précis qui excluent les heures non travaillées et les congés — n'est pas accessible en natif dans Flux, une classe Apex dédiée est utilisée. Cette classe, souvent appelée `ServiceLevelAgreementCalculator`, est conçue avec une méthode statique unique, annotée avec `@InvocableMethod`, pour calculer les heures ouvrables écoulées, déterminer si l'accord de niveau de service est « Dans les limites de l'objectif » ou « Atteint », et renvoyer une sortie structurée. Cette approche encapsule la logique complexe et performante dans Apex tout en permettant son exécution transparente et son intégration dans la couche d'orchestration déclarative d'un flux déclenché par un enregistrement. Une fois la classe `ServiceLevelAgreementCalculator` Apex définie, elle peut être utilisée dans un flux déclenché par un enregistrement : Ce schéma démontre une stricte séparation des préoccupations. La couche déclarative est utilisée pour gérer le cycle de vie et l'orchestration des transactions, tandis que le code est utilisé pour l'exécution complexe. En traitant le code comme un utilitaire fonctionnel plutôt que comme la fondation, nous équilibrons les performances et la maintenabilité. #### Principaux gains avec le schéma hybride **Modularité**: La décision pivote loin de la singularité d'utiliser Apex ou Flux pour l'ensemble du processus. À la place, l'architecture encapsule une logique complexe dans des unités discrètes, sûres en masse et testables indépendamment. Ces unités fonctionnent comme des composants réutilisables consommés par la couche déclarative, assurant les échelles d'automatisation sans compliquer la conception architecturale. **Réutilisabilité**: La logique est découplée de l'événement déclencheur. Une unité de code bien conçue (telle qu'une `InvocableMethod`) est écrite une seule fois, mais exploitée à travers plusieurs points d'entrée : Flux déclenchés par un enregistrement, flux d'écran ou intégrations externes. Cette réutilisation de code élimine les développements redondants. **Maintenabilité**: La logique de flux de processus reste visible et gérable dans le flux déclaratif. Cette centralisation réduit considérablement les frais de débogage et garantit que l'ordre d'exécution du système est déterministe et transparent. #### Limitations et compromis du modèle hybride Bien que le modèle hybride d'utilisation Apex invocable de Flux soit puissant, il ne s'agit pas d'une approche unique. Les architectes doivent être conscients des limitations et des compromis spécifiques avant de s'engager dans une solution hybride. - **Aucun support avant la sauvegarde**: C'est la limite la plus critique. Les actions invocables sont disponibles uniquement dans le contexte après la sauvegarde (flux d'actions et d'enregistrements associés). Ils ne peuvent pas être utilisés dans le contexte très performant avant la sauvegarde (flux de mises à jour de champ rapides). Par conséquent, ce modèle ne peut pas être utilisé pour déléguer les mises à jour de champ du même enregistrement. Exécutez ce travail très performant en utilisant des éléments Flux natifs dans un flux avant la sauvegarde ou dans un déclencheur Apex avant le contexte. - **Aucun support after-undelete :** Actuellement, le flux déclenché par un enregistrement ne prend pas en charge le contexte after-undelete. Si un Objet Salesforce a une exigence métier pour exécuter une automatisation lorsqu'un enregistrement est restauré depuis la corbeille, un déclencheur Apex est la seule solution. - **Frais généraux de performance dans les scénarios à haut volume :** Le passage de l'exécution Flux à l'exécution Apex n'est pas une opération à coût nul. Bien que généralement rapide, l'action de tomber dans une Action invocable à partir de l'exécution de Flux n'est pas aussi rapide en calcul que l'exécution native qui reste entièrement dans un déclencheur Apex. Pour la plupart des automatisations à densité moyenne, ce micro-coût est un compromis négligeable et intéressant pour l'accessibilité accrue. Cependant, pour des scénarios extrêmement performants et à haut volume, une infrastructure Apex uniquement pure aura un avantage de vitesse de calcul brute. ### Stratégies pour l'automatisation héritée Bien que l'heuristique de densité de l'automatisation fournisse des orientations définitives pour une architecture nouvelle, la réalité des environnements Salesforce d'entreprise est souvent plus nuancée. Dans les organisations matures, il est courant de trouver des flux déclenchés par un enregistrement et des déclencheurs Apex fonctionnant sur le même Objet Salesforce. Ce scénario est distinct du schéma hybride expliqué précédemment: ici, les flux et les déclencheurs Apex ne sont pas couplés ni conçus pour fonctionner ensemble. Cette coexistence est souvent le résultat de l'évolution des capacités de la plate-forme ou de la dette technique héritée. Bien que cet état opérationnel soit toléré, les architectes doivent le traiter comme un compromis calculé plutôt que comme un état final. L'orchestration fragmentée entraîne des coûts de gouvernance et de maintenance importants, ce qui rend les activités de développement, de test et de gestion des incidents difficiles et complexes. Cela entraîne une augmentation du délai de résolution (TTR) et de la complexité opérationnelle. - Pour les nouveaux objets Salesforce, suivez le principe de densité d'automatisation comme guide principal. - Pour les objets Salesforce existants avec une empreinte hybride et un déclencheur Apex double et des points d'entrée de flux déclenchés par un enregistrement, évaluez la densité, puis architectez pour refactoriser à un état hybride maintenable. - Pour une faible densité, refactorisez Apex déclenche des flux déclenchés par un enregistrement, et spécifiez l'ordre d'exécution, en les amenant à un point d'entrée d'automatisation unique. - Pour une densité moyenne, refactorisez les méga-flux complexes dans un sous-ensemble de flux, avec le bon ordre d'exécution. Introduisez des déclencheurs Apex uniquement lorsque cela est absolument nécessaire, par exemple pour prendre en charge le contexte after undelete. - Pour une densité élevée, privilégiez l'implémentation de déclencheurs Apex. ### Utilisation d'une infrastructure de métadonnées pour les déclencheurs Apex À mesure que les processus métiers d'une organisation sur Salesforce Platform mûrissent, le volume et la complexité de l'automatisation déclenchée par un enregistrement augmentent inévitablement. Une meilleure pratique fondamentale consiste à maintenir _un déclencheur Apex par objet Salesforce_. Cette règle est critique, car la plate-forme ne garantit pas l'ordre d'exécution de plusieurs déclencheurs sur le même objet pour le même événement. Cette limitation peut entraîner un comportement non déterministe, des conditions de course et des problèmes difficiles à déboguer. Cependant, adhérer au principe du _unique déclencheur_ introduit un défi architectural: comment gérer et orchestrer de manière maintenable et évolutive toute la logique métier invoquée à partir de ce point d'entrée unique. #### Limitations des gestionnaires de déclencheur Classic La première évolution de cette architecture a été le modèle Classic Trigger Handler. Dans cette approche, le déclencheur Apex unique délègue toute sa logique à une classe gestionnaire correspondante (par exemple, `OpportunityTriggerHandler`). Cette méthode sépare la logique du fichier déclencheur et fournit aux développeurs un contrôle déterministe sur l'ordre d'exécution dans les méthodes de la classe gestionnaire (par exemple, `afterInsert()`). Bien qu'une amélioration, ce modèle conduit souvent à des classes de gestionnaire monolithiques. Au fil du temps, à mesure que les exigences métiers augmentent, la classe devient grande, difficile à gérer et difficile à tester isolément. L'ordre d'exécution de tous les processus individuels est codé en dur dans une seule méthode, ce qui rend la classe sujette aux conflits de fusion, augmentant considérablement les coûts de gouvernance et de maintenance dans un environnement de grande entreprise. #### La solution : Infrastructure de déclencheurs pilotés par les métadonnées Pour résoudre les problèmes fondamentaux de modularité et d'orchestration, les architectes adoptent une **infrastructure de déclencheurs** pilotée par les métadonnées. Il s'agit d'un saut architectural important qui dissocie la logique d'automatisation elle-même de la configuration de _son_ exécution et _de sa date_ d'exécution. Ce cadre repose sur trois avantages clés : - **Partitionnement :** Au lieu d ' une seule classe gestionnaire, la logique métier de base est divisée en petites classes Apex atomiques (par exemple, une classe `RecalculateAccountValues` ou une classe `NotifySalesLeads`), chaque classe adhérant au _principe de responsabilité_ unique. Cette modularité facilite le test, le débogage et la compréhension isolés de la logique. - **Ordre et chorégraphie :** L'ordre d'exécution n'est plus codé en dur dans Apex. À la place, il est défini par déclaration par des enregistrements de configuration, généralement stockés dans un type de métadonnées personnalisées (par exemple, `TriggerAction__mdt`). Cela permet aux administrateurs de réorganiser, d'ajouter ou de retirer des actions d'automatisation simplement en modifiant un enregistrement de métadonnées, ce qui ne nécessite pas de déploiement ni de changement de code. - **Contourner la fonctionnalité :** L'infrastructure fournit une fonctionnalité de contournement standardisée et précise. Chaque action d'automatisation peut être configurée via son enregistrement de métadonnées pour être désactivée globalement, ou contournée pour des utilisateurs administratifs spécifiques en référençant une autorisation personnalisée. Le déclencheur Apex unique de l'objet sert alors uniquement de répartiteur dynamique. Il ne contient aucune logique métier, mais instancie à la place une classe `MetadataTriggerHandler` centrale. Ce gestionnaire interroge les enregistrements de métadonnées personnalisées pour déterminer dynamiquement la séquence d'exécution et invoquer les classes Apex atomiques correctes dans l'ordre prescrit. L'automatisation est unifiée sous une couche unique, transparente et gouvernable. ### Déduplication des opérations coûteuses dans la transaction Un avantage important de l'utilisation Apex dans une infrastructure robuste est la possibilité de gérer l'état transactionnel et d'optimiser les performances en éliminant le travail redondant. À mesure que la logique s'accumule, il est fréquent que différentes automatisations dans l'ordre d'enregistrement exécutent indépendamment les mêmes opérations coûteuses, ce qui consomme des limites importantes du gouverneur et augmente le temps d'opération DML. Le cadre est conçu pour répondre à ce besoin avec deux stratégies principales : - **Gestion d'état partagée :** Dans le cadre d'une transaction Apex unique, les propriétés et les variables statiques sont exploitées pour mettre en cache les données. Ainsi, une opération coûteuse, par exemple une requête `SOQL` pour un paramètre de configuration, n'est exécutée qu'une seule fois, même si la logique d'automatisation est invoquée plusieurs fois dans différents enregistrements ou phases du déclencheur. La consommation de limites transactionnelles est considérablement réduite. - **Utilisation du cache de la plate-forme :** Pour aller au-delà de la simple mise en cache intra-transaction, utilisez le cache de la plate-forme afin d'éviter d'interroger certaines données dans la base de données complète. Ce cache géré en mémoire est idéal pour récupérer des données non primitives, lues fréquemment dans la base de code et immuables tout au long d'une transaction (par exemple, profils, rôles, heures ouvrables). En utilisant l'interface `Cache.CacheBuilder`, le système vérifie d'abord le cache et exécute la requête de base de données uniquement si les données sont absentes, ce qui optimise les performances et l'évolutivité. ### Utilisation de Before-Save pour les mises à jour du même enregistrement Utilisez toujours une mise à jour avant la sauvegarde lorsque votre automatisation doit modifier uniquement les valeurs de champ dans l'enregistrement qui démarre la transaction. Cela s'applique aussi bien aux mises à jour de champ rapide dans Flux (qui s'exécutent avant la sauvegarde) qu'à la logique avant le contexte dans Déclencheurs Apex (avant l'insertion, avant la mise à jour). Ce schéma est performant, quel que soit l'outil utilisé, car il évite une deuxième opération DML et un cycle d'enregistrement récursif. Les modifications sont apportées à l'enregistrement en mémoire _avant_ son engagement dans la base de données et sont enregistrées dans le cadre de la transaction d'origine. Les frais généraux d'une deuxième sauvegarde, qui autrement réexécuterait l'ordre de sauvegarde complet et déclencherait de nouveau toute l'automatisation, sont éliminés. ### Prévention de la récursion incontrôlée La récursion non contrôlée est un piège courant dans les déclencheurs après mise à jour, où la logique d'un déclencheur effectue une mise à jour DML qui entraîne à son tour le déclenchement du même déclencheur. Cela crée une boucle infinie qui se termine par une exception de limite du gouverneur. Bien que des indicateurs booléens statiques ou des collections d'ID d'enregistrement traités aient toujours été utilisés pour empêcher une telle récursion, un modèle plus précis et plus robuste consiste à lier la logique en comparant les valeurs de champ entre la nouvelle et l'ancienne version de l'enregistrement lui-même. Exécutez la logique uniquement si un champ d'intérêt spécifique a changé. Cela empêche le déclencheur d'exécuter sa logique sur les opérations DML suivantes dans la même transaction où les données critiques restent inchangées. #### Contrôle de la récursion dans un flux déclenché par un enregistrement Dans un flux déclenché par un enregistrement, empêchez la récursion incontrôlée en définissant l'exécution du flux uniquement lorsque l'enregistrement est mis à jour pour remplir les conditions requises : Contrôle de la récursion dans un flux déclenché par un enregistrement Si vous choisissez d'utiliser une formule de critères d'entrée dans votre flux, vous pouvez empêcher une récursion galopante en comparant la variable globale `$Record` (représentant les nouvelles valeurs) à la variable globale `$RecordPrior` (représentant les valeurs d'origine avant l'enregistrement). Par exemple, pour vous assurer qu'un flux est exécuté uniquement si le champ Montant d'une opportunité a changé, utilisez-le dans les critères d'entrée : ``` $Record.Amount != $Record__Prior.Amount ``` #### Contrôle de la récursion dans Apex Comparez les valeurs de champ de la nouvelle version de l'enregistrement, `Trigger.new`, aux valeurs de champ de l'ancienne version de l'enregistrement, `Trigger.oldMap`, pour déterminer si la modification spécifique que vous recherchez s'est produite. Cette approche garantit que l'automatisation est idempotente et exécutée uniquement lorsque nécessaire, ce qui rend le système plus efficace et évite les boucles récursives catastrophiques. ### Contournement de l'automatisation Une organisation Salesforce bien architecturée nécessite un mécanisme cohérent et fiable pour contourner l'automatisation. Il ne s'agit pas d'une fonctionnalité facultative, mais d'une exigence opérationnelle essentielle pour préserver l'intégrité des données et activer les tâches administratives. Un cadre de contournement est essentiel pour certains scénarios : - Lors du chargement de volumes de données importants, le déclenchement de déclencheurs pour chaque enregistrement peut ralentir considérablement le processus, entraîner des exceptions de limite et créer des enregistrements et des notifications associés erronés. Un contournement permet d'insérer les données proprement et efficacement. - Un utilisateur de l'intégration peut avoir besoin de synchroniser des données à partir d'un système d'enregistrement externe. L'automatisation normalement déclenchée pour une modification initiée par l'utilisateur (par exemple, envoyer un e-mail, créer une tâche) peut être indésirable ou redondante lorsque la modification provient d'un autre système. - Les administrateurs ou le personnel de support peuvent avoir à effectuer des mises à jour correctives sur les enregistrements. Un mécanisme de contournement leur permet d'effectuer ces modifications sans déclencher l'automatisation métier standard, ce qui pourrait avoir des conséquences inattendues. **Autorisations personnalisées**: La norme moderne et évolutive pour l'implémentation d'une logique de contournement est celle des autorisations personnalisées. Elles sont supérieures aux anciennes méthodes pour plusieurs raisons : - **Flexibilité :** Des autorisations personnalisées peuvent être attribuées à des utilisateurs via des ensembles d'autorisations. Cette pratique s'aligne sur le modèle moderne de sécurité et d'accès de Salesforce, ce qui permet une attribution granulaire et flexible. Un contournement peut être accordé à un utilisateur spécifique, ou même temporairement avec une date/heure d'expiration spécifique. - **Maintenabilité :** L'utilisation d'autorisations personnalisées évite de coder en dur des profils ou des utilisateurs dans une logique d'automatisation. Si le rôle d'un utilisateur change ou si un nouveau profil doit contourner l'accès, la modification est une simple attribution d'ensemble d'autorisations, pas une modification de code ou de flux qui nécessite un déploiement. - **Évolutivité :** Les autorisations personnalisées offrent une infrastructure évolutive pour gérer les exceptions dans une base d'utilisateurs complexe. Ils peuvent être attribués à des utilisateurs via un ensemble d'autorisations, des groupes d'ensembles d'autorisations ou des profils. Leur association à un ensemble d'autorisations ou à un profil peut également être représentée dans les métadonnées sources. **Schémas d'implémentation**: Appliquez un modèle de contournement cohérent à toutes les automatisations déclenchées par un enregistrement dans l'organisation. **Contournement d'un flux déclenché par un enregistrement**: La méthode la plus efficace pour contourner un flux est d'empêcher son exécution. Pour ce faire, ajoutez une condition aux critères d'entrée du flux. - Dans l'élément Démarrer du flux déclenché par l'enregistrement, définissez Exigences de condition sur Formule évalue sur True. - Dans le générateur de formule, incorporez une vérification de l'autorisation personnalisée en utilisant la variable globale `$Permission`. Combinez la vérification à vos critères d'entrée existants. - Modèle de formule : ``` ( ) && NOT($Permission.Bypass_This_Flow) ``` - Ce modèle garantit que le flux est exécuté uniquement si l'utilisateur _n'_a pas l'autorisation personnalisée spécifiée attribuée. Ce contrôle est effectué avant même la création de l'interview de flux, ce qui en fait l'approche la plus performante. **Contournement d'une infrastructure de déclencheurs Apex**: Dans Apex, intégrez la logique de contournement directement à l'infrastructure de déclencheur pilotée par les métadonnées, ce qui permet un contrôle granulaire. - Le type de métadonnées personnalisées `TriggerAction__mdt` doit inclure un champ de texte, par exemple `BypassPermission__c`. - Dans la classe `MetadataTriggerHandler`, avant d'exécuter dynamiquement une action, le code doit lire la valeur de ce champ. - Si le champ est rempli, le gestionnaire utilise la méthode `FeatureManagement.checkPermission()` pour déterminer si l'utilisateur actif actuel dispose de l'autorisation personnalisée spécifiée. - Si `checkPermission()` renvoie true, le gestionnaire ignore cette action spécifique et passe à la suivante dans la séquence. - Ce modèle est puissant, car il permet à la fois un contournement global (si tous les enregistrements `TriggerAction__mdt` référencent la même autorisation) et un contournement granulaire par action (si différents enregistrements référencent différentes autorisations, ou si certains n'ont aucune autorisation de contournement du tout). ### Mega-Flows vs. Flux multiples C'est un anti-schéma pour consolider toute l'automatisation d'un objet en un seul méga-flux massif. La consolidation en un seul flux par opposition à la séparation d'une logique en plusieurs flux bien conditionnés n'a pas d'impact majeur sur les performances. Les gains de performance les plus importants proviennent des éléments suivants : - Utilisation de flux avant la sauvegarde pour les mises à jour de champ du même enregistrement. - Écriture de conditions d'entrée précises afin d'empêcher l'exécution de flux avec des modifications qui n'impactent pas leur cas d'utilisation spécifique. [L'Explorateur de déclencheur](https://trailhead.salesforce.com/content/learn/modules/record-triggered-flows/meet-flow-trigger-explorer) de flux permet d'attribuer une valeur d'ordre à chaque flux d'un objet, garantissant ainsi un ordre d'exécution séquentiel. Explorateur de déclencheur de flux ## Ressources
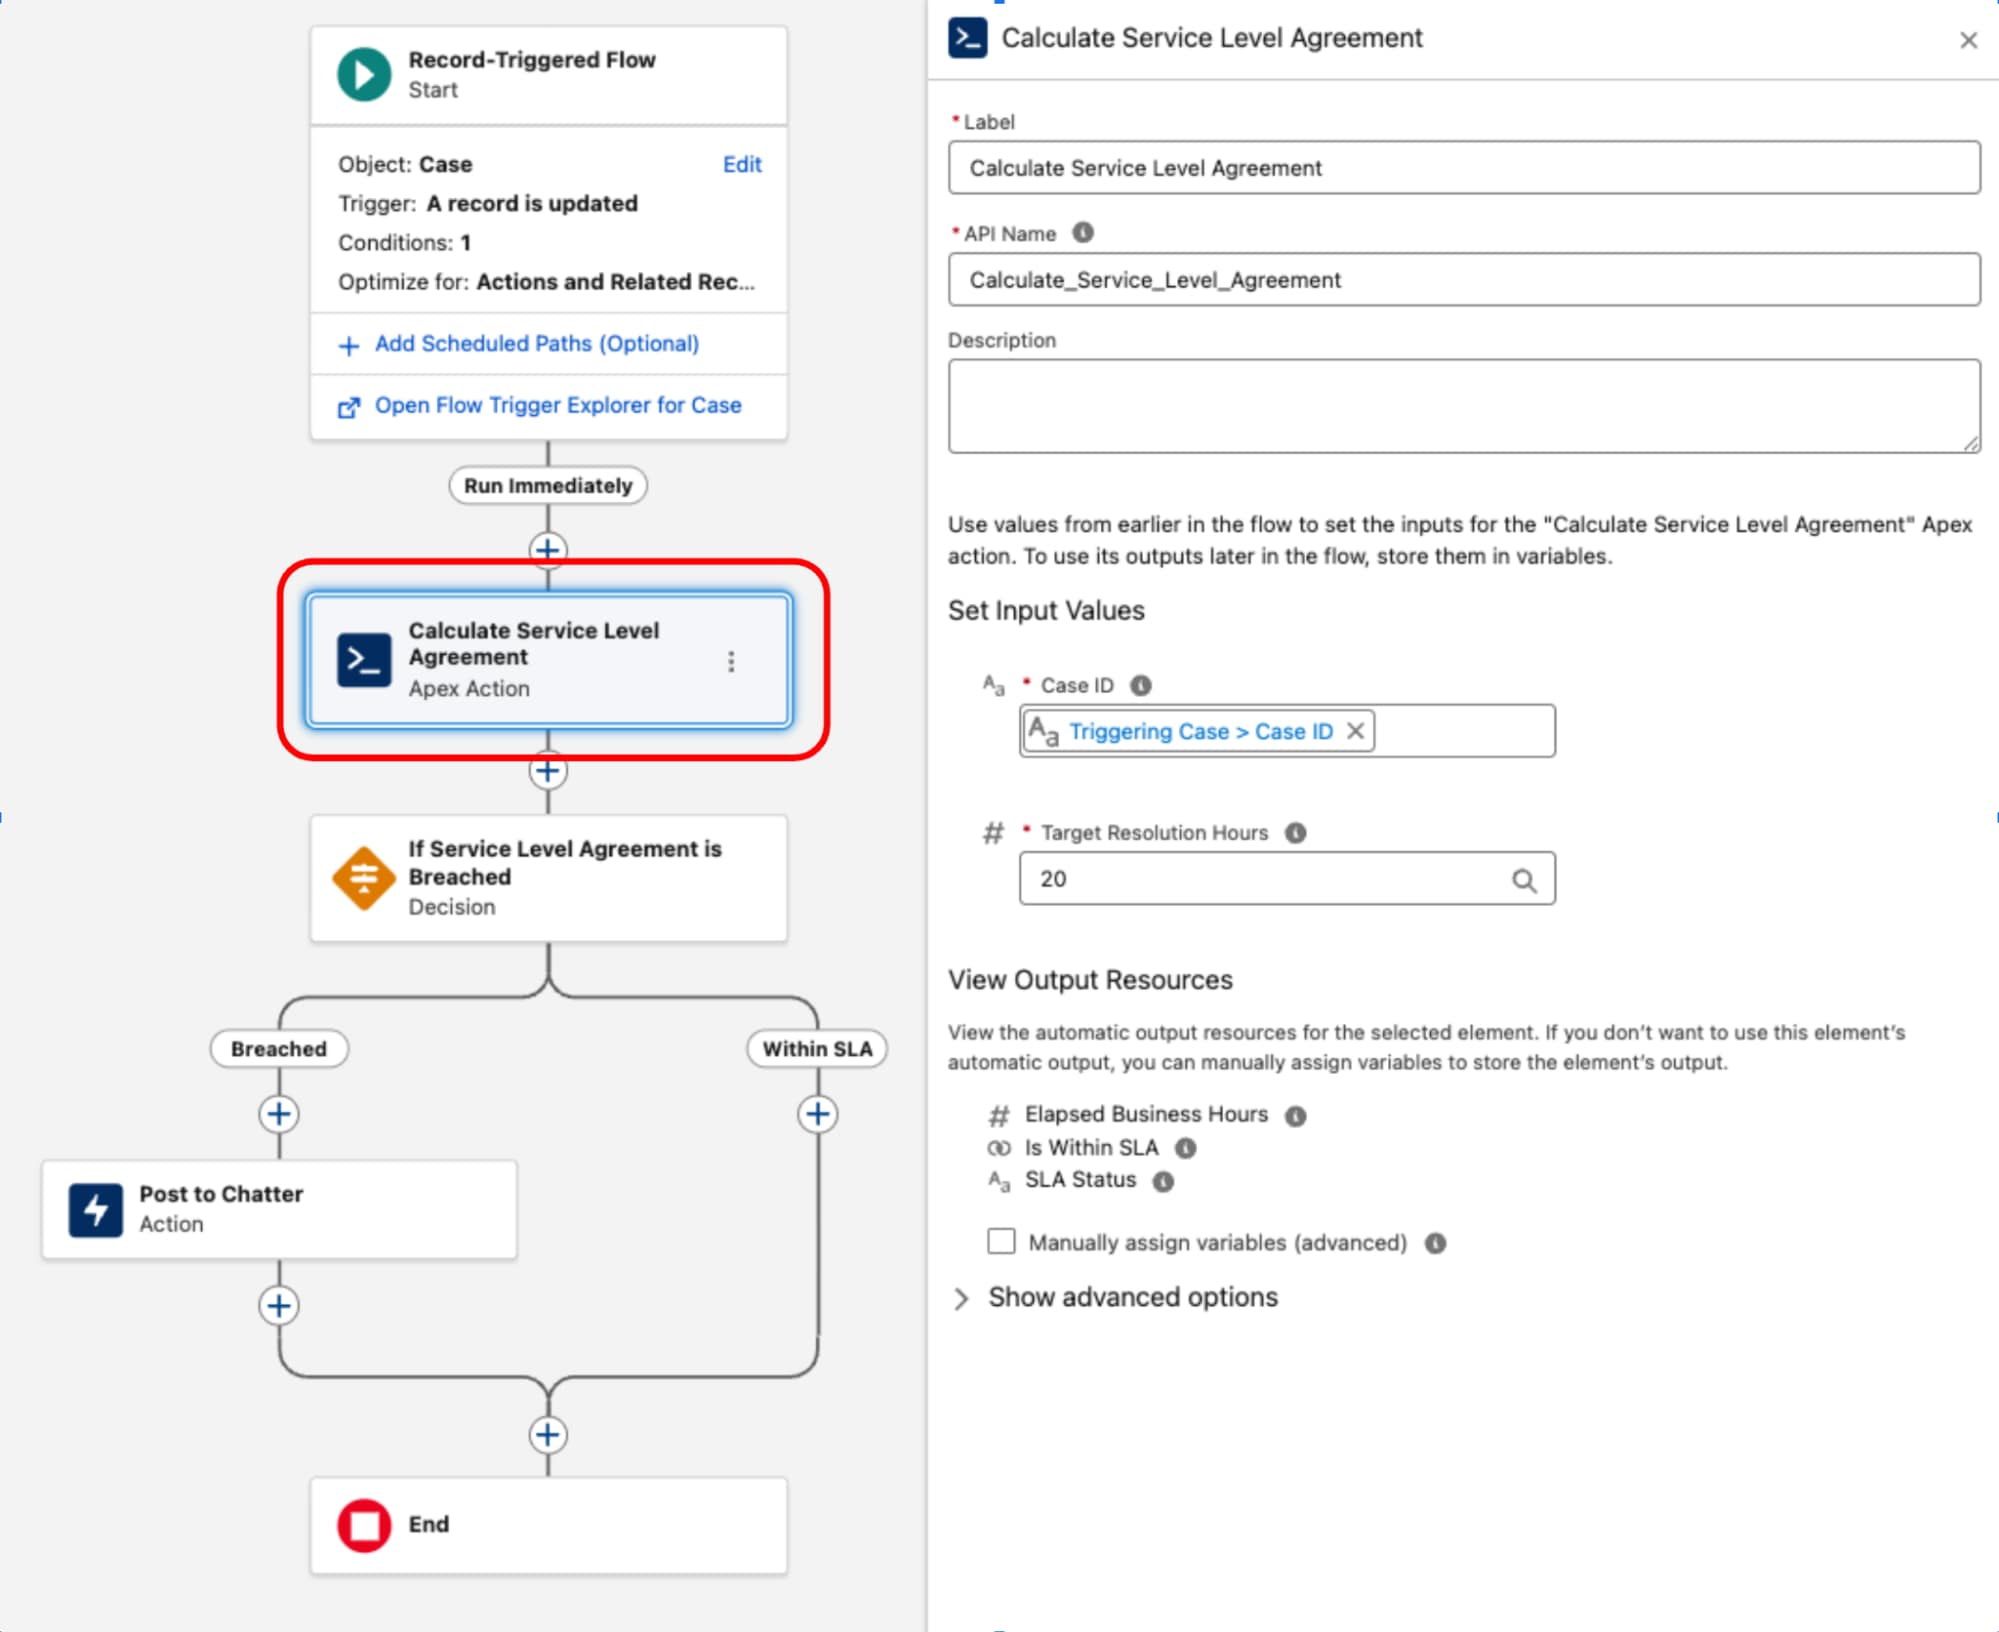
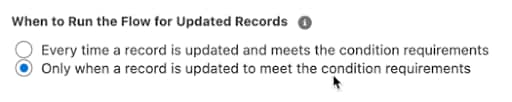
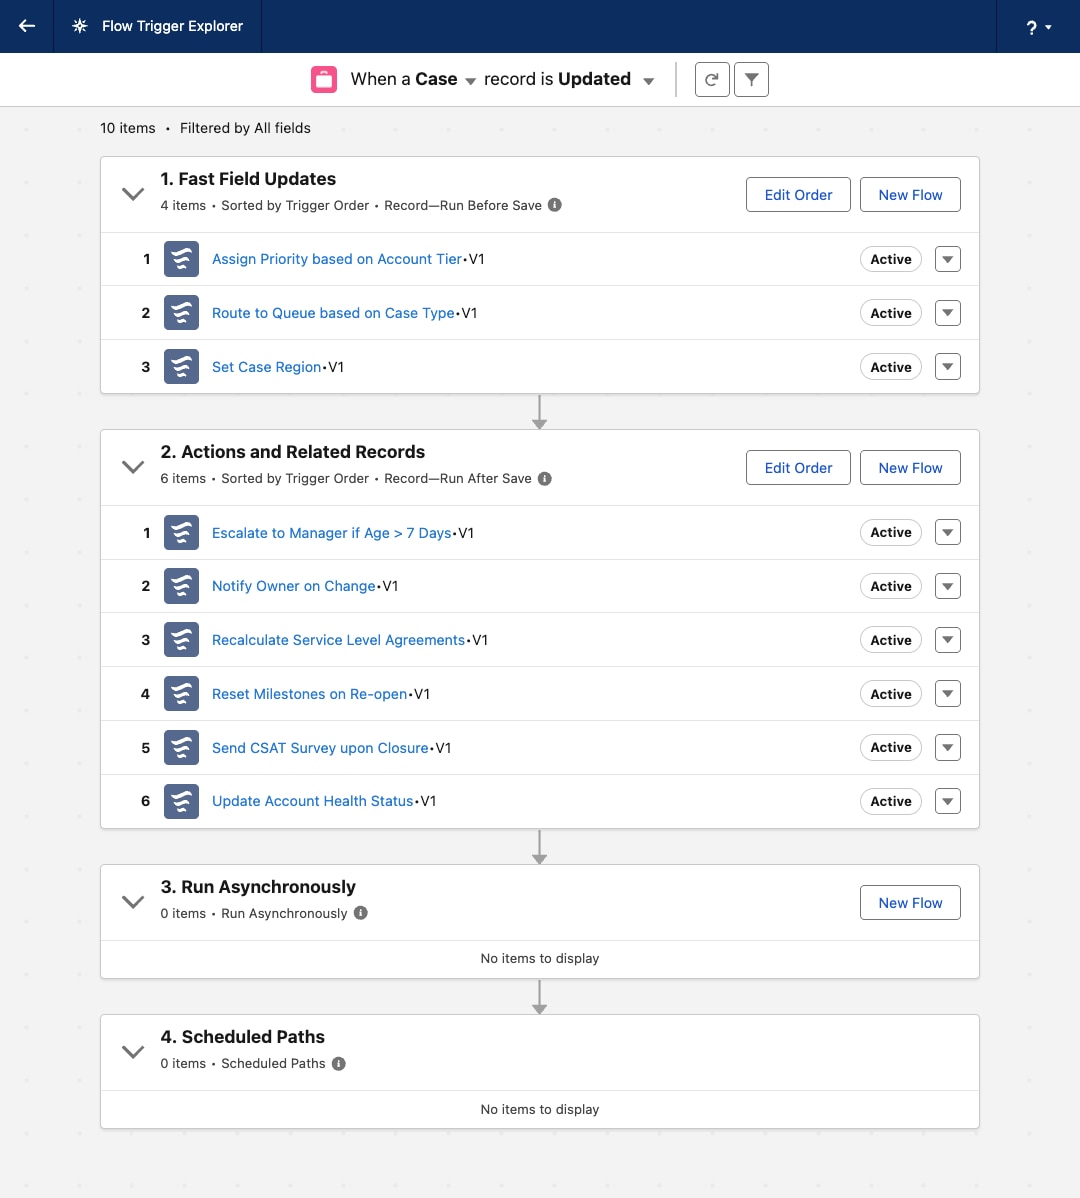
Apex Flux Opérations
## Présentation du guide Vous souhaitez élaborer des formulaires sur Salesforce Platform ? Vous avez plusieurs options, couvrant tout le continuum code faible à pro-code. Les formulaires dynamiques dans le Générateur d'applications Lightning et les flux d'écran dans Flow Builder représentent le code faible. Au milieu du continuum, vous pouvez étendre les flux d'écran avec des composants Web Lightning et élaborer des formulaires accessibles aux clients avec OmniStudio. Et le pro-code est représenté par l'infrastructure LWC et sa bibliothèque sans cesse croissante de composants de base. Les options sont excellentes, mais comment déterminer laquelle (ou quelle combinaison) est la bonne option ? C'est là que ce guide intervient. ## Principaux points à retenir - **Leçon à retenir #1 : Lors de l'élaboration de présentations Créer/Modifier/Afficher pour des pages Lightning, utilisez des Formulaires dynamiques.** Vous remarquerez que les présentations de page sont manquantes dans les tableaux de comparaison de ce guide. À l'avenir, la méthode recommandée pour configurer les pages de détail d'enregistrement est d'utiliser des Formulaires dynamiques dans le Générateur d'applications Lightning. Pour plus d'informations sur les raisons pour lesquelles nous ne prévoyons pas de les améliorer, consultez la section sur les [présentations de page](#présentations-de-page). - **A retenir #2 : Si vous devez créer ou modifier un formulaire pour un seul objet, commencez par les pages Lightning et les formulaires dynamiques.** Cette méthode est la plus simple pour élaborer des formulaires sur Salesforce Platform. Il fournit également des fonctionnalités supplémentaires, notamment la possibilité de contrôler la visibilité du champ. Si vos exigences sont plus avancées, continuez à lire. Flux d'écran, OmniStudio ou Composants Web Lightning (LWC) peuvent être plus adaptés. - **A retenir #3 : Si vous élaborez un formulaire de plusieurs pages ou un assistant et que vous n'avez pas d'exigences strictes en matière d'utilisation de l'image de marque, commencez par un flux d'écran.** Les flux d'écran fournissent une infrastructure de navigation linéaire pour orchestrer plusieurs formulaires ensemble. Vous pouvez utiliser LWC pour construire votre propre infrastructure de navigation entre les formulaires, mais nous recommandons de laisser Flow faire le travail difficile pour vous, afin de vous concentrer sur les formulaires eux-mêmes au lieu de vous soucier de l'[état des formulaires](/docs/architect/fr-fr/well-architected/guide/engaging#formulaires). - **A retenir #4 : Si vous avez besoin d'une logique ou d'actions supplémentaires _derrière le formulaire_, utilisez un flux d'écran, OmniStudio ou LWC.** Les trois outils offrent à votre solution d'autres possibilités que de créer ou de modifier un seul enregistrement. Ce « plus » peut correspondre à une logique plus avancée, par exemple branchement ou itération, ou à des actions plus poussées, par exemple intégration à des systèmes externes, envoi d'e-mails ou notifications automatiques à l'application mobile d'un utilisateur. - **A retenir #5 : Vous avez des exigences UX sophistiquées ? Vous devez gérer dynamiquement plus que la visibilité ? Utilisez LWC ou Omniscript.** Si vous pouvez répondre à vos besoins avec un thème simple et des présentations basées sur des colonnes, vous pouvez élaborer vos formulaires directement dans un générateur à faible code. Pour mieux contrôler le style de votre formulaire, vous aurez besoin de la flexibilité ultime de LWC. Si vous êtes un client de Industries et que vous avez besoin d'une marque parfaite en pixels ou si vous avez des données hiérarchiques complexes, utilisez OmniStudio, qui vous permettra d'élaborer des formulaires de niveau consommateur capables de gérer une logique métier complexe et des transformations de données. - **A retenir #6 : Si vous avez besoin d'automatisation test, commencez par Lightning Web Components.** Vous pouvez écrire des tests unitaires pour n'importe quel LWC, quel que soit l'emplacement où vous envisagez de l'incorporer. Vous pouvez ainsi créer une stratégie de test plus robuste, qui peut inclure des tests en masse avec plusieurs enregistrements et des tests négatifs. Pour plus d'informations sur la création de tests, [consultez Salesforce Well-Architected - Testing Strategy](/docs/architect/fr-fr/well-architected/guide/resilient#stratégie-de-test) qui vous aidera à déterminer si vos formulaires répondent à vos exigences fonctionnelles et non fonctionnelles. Gardez à l'esprit que votre choix ne doit pas nécessairement être un ou deux - vous pouvez combiner la puissance de plusieurs options. Par exemple, si vous avez besoin à la fois du système de navigation intégré de Flow et de la flexibilité de style totale offerte par LWC, utilisez-les ensemble. ## Outils d'élaboration de formulaires avec Salesforce Le tableau ci-dessous présente les outils disponibles pour élaborer des formulaires avec Salesforce, ainsi que leurs compétences requises et les considérations relatives aux licences. Plus loin, nous approfondirons les fonctionnalités spécifiques prises en charge pour chaque outil, ainsi que la façon de choisir entre les outils basés sur le clic et les outils basés sur le code (et quand les combiner) :
Compétences requises Exigences de licence supplémentaires
Formulaires dynamiques Code faible Non
Flux d'écran Code faible Non
OmniStudio Code bas + Code pro Package Industries requis
Flux d'écran + Composants Web Lightning Code bas + Code pro Non
Composants Web Lightning Code Pro Non
## Points de décision en un coup d'œil Le tableau ci-dessous présente un aperçu des points de décision à prendre en compte lors de vos sélections de produits, ainsi que les questions que vous devriez vous poser sur chacun d'eux. Nous approfondirons chacun de ces sujets dans le reste de ce guide.
Impact sur l'objet Déterminez si votre formulaire fonctionne avec un seul objet ou doit fonctionner avec plusieurs objets.
Étendue du formulaire et navigation Déterminez si tous les champs de votre formulaire s'adapteront logiquement à un seul écran ou si les utilisateurs doivent pouvoir naviguer entre plusieurs écrans.
Emplacement Identifiez l'emplacement ou les emplacements où vous souhaitez incorporer le formulaire, qui peut aller d'une application Salesforce à une application mobile ou même à un site Web externe.
Contrôleur Identifiez les actions ou la logique à exécuter en arrière-plan lorsque les utilisateurs interagissent avec votre formulaire, y compris les transformations de données et les intégrations à des systèmes externes.
Validation Déterminez si vous avez ou non des exigences de validation d'entrée supplémentaires qui vont au-delà de la validation au niveau système standard fournie par Salesforce.
Sécurité Déterminez si votre formulaire doit vérifier l'accès de l'utilisateur avant d'effectuer certaines opérations, si vous souhaitez contrôler qui peut accéder au formulaire et si vous souhaitez contrôler l'emplacement où le formulaire peut être incorporé.
Conception des interactions Identifiez les types d'interaction ou de condition qui doivent déclencher des réponses dynamiques dans votre formulaire.
Style Déterminez le niveau de sophistication de votre style et CSS souhaité.
Présentation Identifiez les exigences de présentation de votre formulaire en termes de nombre requis de colonnes, d'onglets, d'accordéons et de possibilité d'afficher des blocs de données récurrents.
Traduction Déterminez si votre formulaire doit être traduit dans d'autres langues.
Automatisation des tests d'interface utilisateur Déterminez si vos processus DevOps nécessitent que votre formulaire soit soumis à des tests unitaires automatisés ou à des tests de bout en bout automatisés.
Métriques Identifiez comment vous souhaitez suivre l'utilisation de votre formulaire, notamment les vues de page, le temps consacré au formulaire, les taux de réalisation et les taux de réussite
Empaquetage et déploiement Déterminez comment vous souhaitez distribuer ou déployer votre formulaire une fois élaboré.
Voici les termes que nous utilisons dans les tableaux de comparaison avec leurs définitions : - **Disponible :** Fonctionne bien avec les considérations de base. - **Pas idéal :** Peut fonctionner, mais n'est pas l'outil optimal. - **Feuille de route :** Appui estimé dans les douze prochains mois (juin 2025). - **Futur**: Estimation du support au-delà des douze prochains mois. - **Non disponible :** Il n'est pas prévu de prendre en charge cette capacité dans les douze prochains mois. ## Procédures pas à pas de point de décision Comme promis, commençons par explorer une variété de points de comparaison et de différences fonctionnelles entre les formulaires dynamiques, les flux d'écran, OmniStudio, les flux d'écran avec des composants Web Lightning incorporés et l'infrastructure LWC elle-même. ### Impact de l'objet Si votre formulaire fonctionne avec un seul objet Salesforce, tous les outils que nous comparons fonctionnent. Les choses se compliquent un peu avec les formulaires inter-objets ou agnostiques aux objets. Par agnostique d'objet, nous entendons les entrées qui ne sont mappées avec aucun objet Salesforce. Votre formulaire peut représenter une structure de données que vous allez envoyer à un service externe, par exemple Stripe ou DocuSign. Alternativement, vous utilisez plusieurs entrées dans votre formulaire pour calculer une valeur, puis validez cette valeur dans la base de données. #### Questions à poser : - Avec quels objets le formulaire fonctionnera-t-il ? - Est-ce un seul objet ou existe-t-il plusieurs objets ? - Vous travaillez avec des objets spécifiques (par exemple Compte, Contact, Opportunité, Piste et Requête) ou votre formulaire doit-il également fonctionner avec d'autres objets ?
Objet unique Objet croisé Objet agnostique
Formulaires dynamiques Disponible Disponible Non disponible
Flux d'écran Disponible Disponible Disponible
OmniStudio Disponible Disponible Disponible
Flux d'écran + Composant Web Lightning Disponible Disponible Disponible
LWC Disponible Disponible Disponible
Pour les formulaires inter-objets et agnostiques aux objets, Flow et OmniStudio sont des options solides. Les composants disponibles dans les écrans de flux sont agnostiques par nature. Par conséquent, vous pouvez choisir quoi faire en arrière-plan avec ces données. Utilisez par exemple les données saisies dans un formulaire pour créer plusieurs enregistrements en arrière-plan, ou utilisez les données pour exécuter d'autres actions telles que générer des publications Chatter, envoyer des messages Slack, envoyer des e-mails ou vous connecter à des services externes. Pour des cas simples, l'utilisation de composants LWC existants, tels que Lightning, peut être un moyen simple de réduire le code nécessaire pour fournir une solution robuste. Cependant, pour les scénarios dans lesquels plusieurs objets sont impliqués, Flow fournit un contrôle complet de tous les objets et élimine la nécessité pour les développeurs de traverser des relations et des dépendances complexes. OmniStudio va plus loin et est complètement agnostique en matière d'objets : il sépare le formulaire affiché par l'utilisateur du modèle de données sous-jacent. À la place, OmniStudio manipule le JSON sous-jacent qui est ensuite mappé avec des objets Salesforce (ou des données externes) en utilisant des outils tels que [Data Mapper](https://help.salesforce.com/s/articleView?id=sf.os_dataraptors.htm&type=5) et [Procédures d'intégration](https://help.salesforce.com/s/articleView?id=sf.os_omnistudio_integration_procedures_48334.htm&type=5). Data Mapper et les procédures d'intégration sont deux composants clés pour connecter vos formulaires OmniStudio à des données internes et externes à Salesforce. En utilisant des éléments par glisser-déposer, vous pouvez travailler avec des données hiérarchiques complexes dans un système externe, puis transformer les données pour les adapter à vos besoins en fonction de l'emplacement où les données doivent aller. Ils permettent également d'utiliser des formules pour effectuer des calculs mathématiques et logiques sur des tableaux, ou des listes de données, un peu comme Apex. [Intégrations OmniStudio_Intégrations OmniStudio_](/docs/architect/fr-fr/reference-diagrams/guide/omnistudio-integrations) ### Étendue et navigation du formulaire Si vous pouvez obtenir toutes vos entrées utilisateur à partir d'un formulaire à écran unique, commencez par les Formulaires dynamiques. Cependant, bien que les formulaires dynamiques dans les pages d'enregistrement puissent utiliser la fonctionnalité Parcours pour représenter vaguement les diverses étapes de votre processus métier, elle peut ne pas correspondre à la majorité de vos cas d'utilisation. #### Questions à poser : - Avez-vous besoin d'un seul écran ou l'utilisateur doit-il naviguer entre plusieurs écrans pour réaliser une tâche ? - Voulez-vous que vos utilisateurs affichent une représentation visuelle de leur progression dans le processus de remplissage de votre formulaire ? - Vos utilisateurs devront-ils remplir les informations de chaque écran dans un ordre spécifique ou pourront-ils passer d'un écran à l'autre si nécessaire ?
Écran unique Formulaire à écrans multiples Indicateurs de progression Navigation entre les étapes / les écrans
Formulaires dynamiques Disponible Non disponible Disponible Non disponible
Flux d'écran Disponible Disponible Disponible Non disponible
OmniStudio Disponible Disponible Disponible Disponible
Flux d'écran + Composant Web Lightning Disponible Disponible Disponible Disponible
LWC Disponible Pas idéal Pas idéal Pas idéal
Si vous avez besoin de fonctionnalités supplémentaires que celles offertes par les formulaires dynamiques, le choix entre Flow, OmniStudio et LWC dépendra également de quelques autres questions : - Quelles sont les compétences de votre équipe ? Pour une organisation plus lourde en administrateurs, nous recommandons de commencer par Flux. Si vous avez des solutions Industries, que votre équipe connaît déjà OmniStudio et que votre projet a des exigences UX strictes, commencez par OmniStudio. - Vous pouvez afficher une barre de navigation en bas de votre formulaire ? Si le flux d'écran et l'expérience de navigation Omniscript sont indésirables UX, penchez-vous vers LWC. - Que doit-il se passer derrière le formulaire ? Si vous souhaitez que le comportement soit configurable par un administrateur, élaborez un flux ou, pour des modifications de base telles que la modification des étiquettes de champ, un Omniscript. Sinon, pour des relations complexes et multi-objets, élaborez un Omniscript ou Composant Web Lightning. - Si vous choisissez Flow ou OmniStudio, il peut être nécessaire d'élaborer un LWC de toute façon pour obtenir l'expérience utilisateur appropriée. Si vous élaborez déjà un composant Web Lightning pour appliquer un style correct à votre formulaire, déterminez si l'[incorporation de ce composant dans un flux](https://developer.salesforce.com/docs/platform/lwc/guide/use-flow-embed-component.html) est excessive. Si, par contre, votre solution ressemble à un assistant, où l'utilisateur navigue entre plusieurs écrans, pensez à Flow ou OmniStudio. Les flux et OmniStudio sont fournis avec un modèle de navigation intégré. Il n'est pas nécessaire d'élaborer et de gérer des composants Web Lightning enchaînés. La navigation est linéaire, avec des actions d'avance, des actions de recul et un mécanisme de sauvegarde du formulaire pour plus tard. Vous pouvez également élaborer un formulaire avec une navigation non linéaire si cela vous convient. Par exemple, en utilisant des flux d'écran, consultez le package [Digital Store Audit](https://appexchange.salesforce.com/appxListingDetail?listingId=a0N3A00000FMkOtUAL) de Salesforce Labs. OmniStudio offre un avantage de navigation clé en fournissant des indicateurs de progression à partir de la navigation standard qui exposent des « étapes » dans le formulaire. Cette vue d'étape affiche automatiquement l'emplacement d'un utilisateur dans un formulaire à plusieurs étapes donné. Contrairement à Flux, il permet aux utilisateurs de « sauter » entre les écrans en cliquant sur diverses étapes du formulaire. Que vous élaboriez des formulaires à écran unique ou multi-écrans, assurez-vous que vos formulaires sont [rationalisés](/docs/architect/fr-fr/well-architected/guide/engaging#formulaires) afin de faciliter leur navigation pour vos utilisateurs. ### Emplacement Si vous incorporez un formulaire à une page d'enregistrement Lightning standard, n'importe quel outil que nous comparons fonctionnera, avec la mise en garde que les Formulaires dynamiques ne sont actuellement disponibles que sur ordinateur de bureau. Cependant, si vous souhaitez offrir une expérience permettant aux utilisateurs d'accéder aux formulaires à partir d'autres emplacements, il peut être nécessaire d'envisager d'autres options. #### Questions à poser : - Les utilisateurs devront-ils accéder au formulaire par ordinateur de bureau, appareil mobile ou les deux ? - Les utilisateurs doivent-ils pouvoir accéder au formulaire n'importe où dans votre application via une barre d'utilitaires ? - Voulez-vous utiliser des actions rapides pour permettre aux utilisateurs de remplir votre formulaire sans quitter la page où ils se trouvent actuellement ? - Votre formulaire doit-il être disponible sur un site Web externe ?
Page d'enregistrement Lightning Page d'accueil Lightning ou page d'application Sites Experience Cloud Aura Sites Experience Cloud LWR Snap incorporés Barre d'utilitaires Action spécifique à un objet Action globale Application mobile Salesforce** Field Service Mobile Mobile SDK Sites et applications externes Composant Web Lightning personnalisé
Formulaires dynamiques Disponible Non disponible Non disponible Non disponible Non disponible Non disponible Non disponible Non disponible Disponible Non disponible Non disponible Non disponible Non disponible
Flux d'écran Disponible Disponible Disponible Disponible Disponible Disponible Disponible Roadmap Disponible Disponible*** Non disponible Roadmap Disponible
OmniStudio Disponible Disponible Disponible Non disponible Non disponible Disponible Non disponible Non disponible Disponible Non disponible Non disponible Disponible Disponible
Flux d'écran + Composant Web Lightning Disponible Disponible Disponible Disponible Disponible Disponible Disponible Roadmap Disponible Non disponible Non disponible Pas idéal Disponible
LWC Disponible Disponible Disponible Disponible Disponible Disponible Roadmap Roadmap Disponible Roadmap Roadmap Disponible Disponible
*Les flux peuvent être incorporés à des sites Experience Cloud LWR, mais vous devez tenir compte des considérations ci-dessous.
**Les flux et les composants Web Lightning sont pris en charge dans l'application mobile Salesforce, mais l'application mobile Salesforce ne prend pas en charge toutes les méthodes d'incorporation de flux et de composants Web Lightning. Par exemple, les actions spécifiques à un objet sont prises en charge sur un appareil mobile, mais pas les éléments de la barre d'utilitaires.
***L'application mobile Field Service ne prend pas en charge la plupart des dernières fonctionnalités de flux, car elle est conçue à partir d'un ancien Moteur de flux et d'une ancienne Exécution de flux d'écran. Elle a été spécialement modifiée pour fonctionner hors ligne.
Comme ils nécessitent un contexte d'enregistrement, les Formulaires dynamiques sont pris en charge uniquement dans les pages d'enregistrement Lightning. Cependant, les formulaires dynamiques ne sont pas pris en charge dans les pages Experience Cloud. Cette limitation est en place, car Experience Cloud n'utilise pas l'infrastructure sous-jacente dont dépendent les Formulaires dynamiques : Pages Lightning. Nous évaluons cela en fonction des demandes de Formulaires dynamiques dans Experience Cloud. Vous pouvez élaborer des flux qui nécessitent un contexte d'enregistrement ou des flux qui fonctionnent globalement. Vous pouvez ainsi incorporer des flux à divers emplacements. Pour des flux contextuels d'enregistrement, il peut s'agir d'une page d'enregistrement Lightning, d'une page d'enregistrement Experience Cloud, d'une action spécifique à un objet ou d'un déploiement Actions et recommandations. Pour le flux global, il peut s'agir de la barre d'utilitaires, d'autres pages Lightning ou Générateur d'expérience, d'un Snap ou d'une application externe. Actuellement, les flux ne sont pas pris en charge en tant qu'actions globales, mais en tant que solution de contournement, vous pouvez inclure le flux dans un composant Aura. OmniStudio permet d'élaborer des FlexCards et des Omniscripts composables que vous pouvez placer presque partout où vous pouvez placer un flux. Cependant, bien que composables, ils ne peuvent pas être empaquetés. LWC prend en charge un degré élevé de réutilisation, car vous créez des composants qui peuvent être associés à des cibles via des métadonnées dans Salesforce, des communautés et même dans des projets open-source. Les composants LWC peuvent également être incorporés à votre propre site Web via [Lightning Out](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lightning_out). [Lightning Out sur les sites externes_Lightning Out sur les sites externes_](/docs/architect/fr-fr/reference-diagrams/guide/lightning-out-on-external-sites) Actuellement, les composants Web Lightning ne sont pas pris en charge en tant qu'actions rapides (spécifiques à un objet ou globales), mais comme solution de contournement, vous pouvez envelopper un composant LWC dans un composant Aura (un peu comme vous le pouvez avec des flux). Les composants LWC peuvent également lancer des flux avec le composant [Lightning-flow](https://developer.salesforce.com/docs/component-library/bundle/lightning-flow/documentation). OmniStudio excelle dans l'exposition de contenus à vos sites externes via la fonctionnalité OmniOut. Avec OmniStudio et OmniOut, vous pouvez compiler vos formulaires Omniscript et composants FlexCard dans des composants standard et les exécuter hors plate-forme dans des sites ou des applications tiers. Aucune des technologies de formulaire présentées dans ce guide n'est officiellement prise en charge dans les modèles Mobile SDK aujourd'hui. Si le kit de développement Mobile SDK est essentiel à votre cas d'utilisation, vous feriez mieux d'élaborer votre formulaire en natif dans votre application mobile ou d'élaborer une page Visualforce, tout en gardant à l'esprit le guide du [facteur de forme](/docs/architect/fr-fr/well-architected/guide/engaging#facteur-de-forme) Salesforce Well-Architected. **Note de la feuille de route :** L'équipe Mobile SDK travaille activement sur la prise en charge des composants Web Lightning dans les pages Visualforce. ### Contrôleur Les formulaires dynamiques sont parfaits si vous devez utiliser les valeurs de votre formulaire pour créer ou mettre à jour un enregistrement. Pour toutes les capacités au-delà, vous devez exploiter Flow, OmniStudio ou LWC. Ces capacités peuvent inclure une couche de décision ou d'itération, ou la génération de publications ou d'e-mails Slack en utilisant les entrées du formulaire. #### Questions à poser : - Quelles actions ou logiques souhaitez-vous exécuter en arrière-plan ? - Votre modèle de données contient-il des données hiérarchiques ? - Votre formulaire devra-t-il effectuer ses opérations dans une seule transaction ou dans plusieurs transactions ? - Avez-vous besoin d'intégrer des systèmes externes ? - Quelles sont vos exigences en matière de réutilisabilité et de modularité ?
Journal et actions Gestion des données hiérarchiques Fonctionnement dans une seule transaction Opération sur plusieurs transactions Intégration Conception et réutilisation modulaires Emballage
Formulaires dynamiques Non disponible Non disponible Non disponible Non disponible Non disponible Non disponible Disponible
Flux d'écran Disponible Roadmap Disponible Disponible Disponible Disponible Disponible
OmniStudio Disponible Disponible Disponible Disponible Disponible Disponible Non disponible
Flux d'écran + Composant Web Lightning Disponible Disponible Disponible Disponible Disponible Disponible Disponible
LWC Disponible Disponible Disponible Disponible Disponible Disponible Disponible
Flow offre des actions standard pour publier dans Slack, envoyer un e-mail et interagir avec des documents Quip. Il n'est pas nécessaire d'écrire de code pour ces opérations. LWC offre des interactions enrichies avec des enregistrements uniques et des objets associés en utilisant des adaptateurs wire qui interagissent avec l'[API Interface utilisateur](https://developer.salesforce.com/docs/atlas.en-us.uiapi.meta/uiapi/ui_api_get_started.htm). LWC peut également interagir avec plusieurs enregistrements en utilisant le wire pour [getListInfoByName](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/reference_get_list_info_by_name.html). Interaction LWC via des adaptateurs WireInteraction des composants Web Lightning via des adaptateurs Wire [\_\_](/docs/architect/fr-fr/reference-diagrams/guide/lightning-web-components-interaction-via-wire-adapters) Comme mentionné ci-dessus, OmniStudio utilise des procédures d'intégration et Data Mapper pour récupérer et transformer aisément des données externes et internes à Salesforce. Il brille dans l'aplatissement et l'expansion des jeux de données avec divers niveaux de relations grâce à de nombreuses fonctions sans code que vous pouvez utiliser. **Note de la feuille de route :** Flow va bientôt prendre en charge la mise à jour/insertion de collections d'enregistrements, ainsi que la gestion des données hiérarchiques. Flow, OmniStudio et LWC s'intègrent tous à Apex. Par conséquent, vous pouvez aisément combler les écarts dans la solution que vous choisissez. Par exemple, si vous avez besoin de filtrer les enregistrements d'un LWC vous pouvez toujours utiliser l'adaptateur wire pour Apex afin de créer des requêtes SOQL complexes. Si vous êtes influencé par le récit basé sur le clic, considérez Flow ou OmniStudio comme des alternatives viables à un contrôleur Apex pour vos besoins côté serveur. Une deuxième question est de savoir si vous souhaitez engager immédiatement des actions ou les reporter à une partie particulière de votre formulaire. Cela est particulièrement important si vous utilisez un formulaire de plusieurs pages. Le flux facilite la combinaison des entrées de plusieurs formulaires (écrans de flux) et leur utilisation beaucoup plus tard dans l'assistant (flux) pour effectuer certaines opérations. En fait, nous recommandons de concevoir des flux de cette façon (exécuter des actions à la fin) au cas où l'utilisateur rebondirait entre les écrans, changeant ses réponses. #### Contrôle des opérations Les transactions et les [limites du gouverneur](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_gov_limits.htm) sont un mode de vie sur Salesforce Platform. Si votre cas d'utilisation est assez simple, il peut ne pas être aussi important de contrôler la transaction dans laquelle une opération particulière se produit. Cependant, il existe quelques cas d'utilisation dans lesquels vous pouvez combiner plusieurs opérations dans une seule [transaction](/docs/architect/fr-fr/fundamentals/guide/architecture-basics#transactions) plutôt que de les exécuter dans plusieurs transactions. Quelques exemples : - **Pour annuler ou ne pas annuler**: Telle est la question. Supposons que votre formulaire crée plusieurs enregistrements en arrière-plan. Si la création du troisième enregistrement échoue, les deux premiers enregistrements doivent-ils être annulés ? Si chacune de vos actions est indépendante, n'hésitez pas à les exécuter dans des transactions séparées. Cependant, si elles sont dépendantes et que vous souhaitez que l'échec de l'une annule également les autres, implémentez-les dans une transaction unique. Si votre formulaire est dans Flux, vous pouvez utiliser l'élément Restaurer dans un chemin Défaut pour annuler votre transaction et garantir l'intégrité des données. - **Impact en aval sur les limites du gouverneur**: En particulier, lorsque votre formulaire crée ou met à jour un enregistrement, tenez compte des implications en aval de cette opération. Quels processus, règles de workflow, déclencheurs de flux, déclencheurs Apex ou autres éléments de l'ordre d'enregistrement vont se déclencher en fonction de ce changement d'enregistrement ? Quel est l'impact de ces changements collectifs sur les limites du gouverneur consommées dans cette transaction ? Si un changement d'enregistrement particulier entraîne de nombreuses modifications en aval qui impactent vos limites, vous pouvez isoler ce changement d'enregistrement dans sa propre transaction. - **Traitement par lot**: Même dans un contexte d'interface utilisateur, il peut être nécessaire de regrouper plusieurs mises à jour par lot. Supposons que votre formulaire à écrans multiples itère sur un grand nombre d'enregistrements. Au lieu de valider une mise à jour d'enregistrement après chaque écran, attendez d'avoir collecté les mises à jour de tous les enregistrements, puis soumettez une requête pour mettre à jour tous les enregistrements. Lorsque vous utilisez des Formulaires dynamiques pour créer ou modifier un enregistrement, vous n'exécutez qu'une seule opération, qui marque toujours le début d'une nouvelle transaction. Lors de l'élaboration d'un flux d'écran, vous avez un contrôle important sur ce qui se passe dans une transaction donnée. Les écrans et les actions locales agissent en tant que frontières entre les transactions. Voici un résumé général de la gestion des transactions dans l'architecture de flux d'écran. 1. L'utilisateur interagit avec un écran, puis clique sur **Suivant**. 2. Le client publie une requête à l'API avec les entrées. 3. L'API reçoit la requête, et une transaction et une connexion à la base de données sont ouvertes. L'API appelle ensuite le moteur de flux pour invoquer la requête. 4. Le moteur de flux prend le relais et suit le chemin approprié dans la définition du flux, jusqu'à ce qu'il atteigne un nœud Écran ou Action locale. Le moteur renvoie ensuite des informations sur ce nœud à l'API. 5. L'API crée un objet de réponse qui contient les détails de l'écran suivant à restituer, puis renvoie cet objet au client. À ce stade, les modifications de la base de données sont validées (récupérer l'[exécution de commande](/docs/architect/fr-fr/fundamentals/guide/architecture-basics#manipulation-de-la-base-de-données)), et la connexion à la base de données et la transaction sont fermées. 6. Le client utilise la réponse d'API pour restituer l'écran suivant avec lequel l'utilisateur peut interagir. 7. Répétez l'étape 1. En d'autres termes, les écrans « cassent » les transactions. Dans ce cas, toutes les actions en attente ou DML sont engagées, la transaction précédente est fermée et une nouvelle transaction démarre.
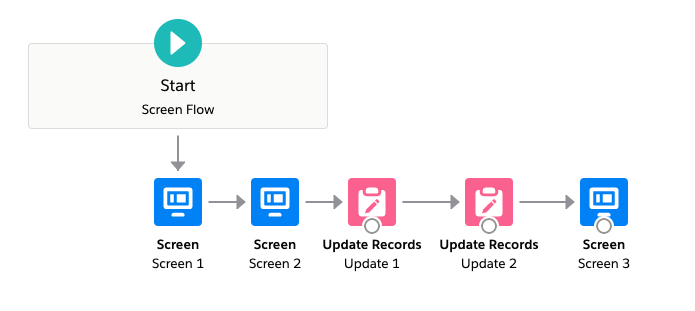
flux multi-écrans La conception appropriée, c'est-à-dire les opérations que vous regroupez dans une transaction donnée, est votre choix. Examinons quelques exemples.
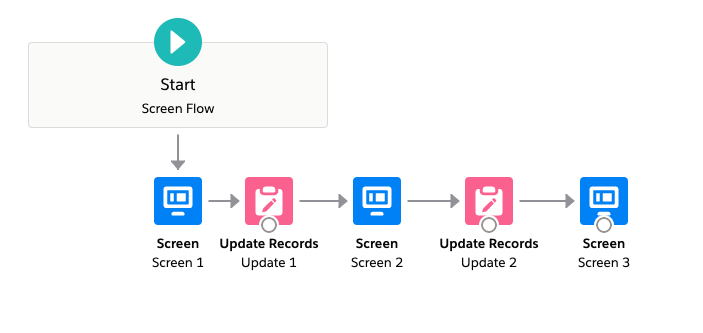
flux d'écran avec des transactions séparées
À gauche, vous pouvez voir un flux qui collecte les entrées sur plusieurs écrans, puis exécute plusieurs actions dans une seule transaction.
Le flux à droite effectue chaque opération dans une transaction séparée.
L'équipe Flux a récemment introduit un nouvel élément : L'élément Restaurer les enregistrements permet d'annuler une transaction complète si une seule opération échoue dans une série d'opérations de base de données.
Flux d'écran avec plusieurs enregistrements Créer

Supposons que vous avez un flux qui crée des enregistrements, met à jour des enregistrements, puis crée d'autres enregistrements, comme illustré dans le flux suivant à droite.
Dans ce scénario, si les deux premiers éléments réussissent et que le dernier échoue, les deux premières opérations DML créeront et mettront à jour ces enregistrements, alors que le troisième échouera.
Flux d'écran avec l'annulation
En utilisant l'élément Restaurer les enregistrements, vous pouvez vous assurer que la transaction complète est annulée si les trois opérations doivent être exécutées simultanément, comme indiqué dans le flux final à gauche. Pour plus d'informations, consultez [Flux dans Transactions](https://help.salesforce.com/articleView?id=flow_concepts_transaction.htm) et [En masse dans Transactions](https://help.salesforce.com/articleView?id=flow_concepts_bulkification.htm). La section Automatisé de Salesforce Well-Architected approfondit également ce point dans [Data Handling](/docs/architect/fr-fr/well-architected/guide/automated#traitement-des-données). Votre capacité à contrôler la transaction à partir d'un LWC se résume aux services sous-jacents que LWC utilise pour effectuer ses opérations. Si vous utilisez le composant de base Lightning, l'opération sous-jacente (création ou mise à jour de l'enregistrement) se produit dans une transaction autonome dès que le formulaire est soumis. En général, les règles suivantes s'appliquent : - Chaque appel d'API d'interface utilisateur est isolé dans sa propre transaction. - Si vous devez effectuer plusieurs opérations dans la même transaction, envoyez les entrées à une technologie côté serveur, par exemple un contrôleur Apex ou un flux. Les règles de transaction habituelles de cette technologie s'appliquent. #### Intégrations externes Flow, OmniStudio et LWC prennent tous en charge les événements de plate-forme (pour l'[architecture pilotée par événement](/docs/architect/fr-fr/decision-guides/guide/event-driven)) et les intégrations d'API. En plus d'un code Apex personnalisé, Flow et OmniStudio prennent en charge des mécanismes déclaratifs pour intégrer une API. Si vous devez vous connecter à une API MuleSoft ou à un robot RPA, utilisez les Services MuleSoft. Cela génère un Service externe. [Intégrations externes via MuleSoft_Intégrations externes via des API MuleSoft et des robots RPA_](/docs/architect/fr-fr/reference-diagrams/guide/external-integrations-via-mulesoft-apis-and-rpa-bots) Si l'API a un schéma OpenAPI, créez un Service externe. [Intégrations externes via OpenAPI_Intégrations externes à des API avec des schémas OpenAPI_](/docs/architect/fr-fr/reference-diagrams/guide/external-integrations-to-apis-with-openapi-schemas) Sinon, utilisez la fonctionnalité Appel externe HTTP dans Flux ou Action HTTP dans OmniStudio. L'appel externe HTTP du flux est piloté par les Services externes. [Intégrations externes via HTTP_Intégrations externes via HTTP_](/docs/architect/fr-fr/reference-diagrams/guide/external-integrations-via-http) OmniStudio offre un riche ensemble de capacités d'intégration qui peuvent appeler des systèmes externes avec des procédures d'intégration et transformer les données avec Data Mapper. (pour plus d'informations, consultez [Impact sur l'](#impact-de-lobjet)objet) Que vous l'implémentiez avec Apex personnalisé ou un service externe, un appel externe est un appel externe. Voici ce que vous devez savoir. 1. Un appel externe peut être long. 2. Lorsqu'un appel externe est exécuté de façon synchrone, il est exécuté alors qu'une transaction de base de données est ouverte. 3. Salesforce ne permet pas de garder une transaction de base de données ouverte si vous avez des opérations de base de données en attente. La principale limitation à prendre en compte est le danger des **_transactions sales_**, dans lesquelles vous effectuez une opération de création, de mise à jour ou de suppression, puis exécutez un appel externe dans la même transaction. Ce modèle n'est pas autorisé en raison de la considération #3 ci-dessus, qui existe bien sûr en raison des considérations #1 et #2. Dans Flux, vous pouvez contourner cette limitation en rompant la transaction. Notez que les écrans et les actions locales réintroduisent le contexte du navigateur, ce qui rompt la transaction. Bien que vous puissiez utiliser des écrans et des actions locales lors de l'utilisation d'appels externes, nous recommandons d'activer le Contrôle des transactions dans les paramètres avancés invocables. Le contrôle des transactions est une fonctionnalité d'actions invocables qui permet de terminer automatiquement la transaction avant qu'un appel externe soit passé. Vous pouvez activer le Contrôle des transactions en sélectionnant Toujours démarrer une nouvelle transaction dans la section Avancé d'une action invoquée. Intégrations externes via des appels externes L'impact des appels externes sur la transaction est moins compliqué avec LWC. D'une manière générale, vous effectuez vos opérations de données en utilisant le Lightning Data Service (LDS), puis utilisez un contrôleur Apex pour passer l'appel externe. Cette conception vous protège des transactions sales, puisque l'appel LDS est isolé dans sa propre transaction séparée de l'appel externe Apex. _Pour plus d'informations sur les appels externes Apex, les services externes et les capacités d'intégration de données en général, consultez le [Architect's Guide to Data Integration with Salesforce](/docs/architect/fr-fr/decision-guides/guide/data-integration)._ #### Réutilisabilité et modularité Les formulaires dynamiques ne prennent pas en charge la réutilisation. Chaque Formulaire dynamique est lié à une page d'enregistrement Lightning spécifique pour un objet spécifique (vous pouvez toutefois attribuer cette page d'enregistrement Lightning à plusieurs applications, profils, etc.). De la même façon que vous pouvez écrire des bibliothèques, des utilitaires et des composants destinés à être utilisés dans plusieurs autres composants, vous pouvez appliquer des modèles de conception similaires en créant des flux avec la puissance des **_flux secondaires_**. Enregistrez vos flux dans des compartiments plus petits et plus modulaires, puis appelez-les à partir d'autres flux en utilisant l'élément Flux secondaire. Si votre conception l'exige, vous pouvez élaborer un flux autonome et utile en tant que flux secondaire d'un autre flux. OmniStudio est intrinsèquement construit pour la modularité. Les mappeurs de données, les Omniscripts, les FlexCards et les procédures d'intégration sont tous élaborés indépendamment et peuvent fonctionner de façon interchangeable. En plus de cela, les FlexCards peuvent être élaborées en tant que composants LWC qui peuvent être incorporés à d'autres composants LWC, Omniscripts, pages d'enregistrement et sites Experience Cloud. Les flux d'écran, les Omniscripts et les Composants Web Lightning peuvent tous être conçus pour être réutilisés et incorporés à divers emplacements, y compris des sites externes et des applications Lightning Out. Lorsque vous concevez vos solutions pour qu'elles soient [composables](/docs/architect/fr-fr/well-architected/guide/composable), vous bénéficiez d'avantages supplémentaires tels que l'adaptabilité et la stabilité. ### Validation Toutes les technologies utilisées pour créer ou mettre à jour un enregistrement adhèrent à la validation au niveau du système, qu'il s'agisse de règles de validation classiques ou d'une validation personnalisée intégrée à un déclencheur Apex. Quelle que soit la technologie utilisée pour effectuer un changement d'enregistrement, chaque modification passe par l'ordre d'enregistrement. Cela signifie qu'en plus des règles de validation, le changement d'enregistrement est traité par n'importe quel nombre de flux avant ou après la sauvegarde, avant ou après les déclencheurs, les règles d'escalade, les règles d'attribution, et plus encore. Si ce n’est déjà fait, assurez-vous de mettre l’[ordre d’exécution](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_triggers_order_of_execution.htm) Apex dans vos favoris et de vous familiariser avec lui. #### Questions à poser : - Votre formulaire a-t-il des exigences supplémentaires que la validation au niveau système ? - Devrez-vous définir dynamiquement des champs obligatoires ou en lecture seule dans le formulaire ?
Respecter la validation au niveau système Validation au niveau du champ personnalisée spécifique à ce formulaire Validation au niveau du champ personnalisée
Formulaires dynamiques Disponible Non disponible Non disponible
Flux d'écran Disponible Non disponible Roadmap
OmniStudio Disponible Disponible Disponible
Flux d'écran + Composant Web Lightning Disponible Disponible Disponible
LWC Disponible Disponible Disponible
Les entrées dans un écran de flux ou une étape Omniscript sont par nature non liées. Par conséquent, le formulaire lui-même n'adhère pas nativement à la validation au niveau système associée à un objet particulier. Cependant, les valeurs que vous utilisez pour créer ou mettre à jour des enregistrements sont traitées par l'ordre d'enregistrement, ce qui signifie qu'elles sont transmises par la validation au niveau système de l'objet. Notez toutefois que les composants de flux d'écran ne prennent pas tous en charge la validation des entrées. À compter de la version Summer '24, les autres composants d'écran qui ne prennent pas en charge la validation des entrées sont les cases d'option, les listes de sélection, les listes à sélection multiple, les groupes de cases à cocher et les références de choix. De la même façon que les présentations de page, les formulaires dynamiques permettent de définir l'exigence et l'état en lecture seule au niveau de la page. Cependant, vous ne pouvez pas remplacer les paramètres au niveau système. Le flux offre la flexibilité nécessaire pour personnaliser la validation dans les entrées d'un formulaire. Bien que certaines vérifications soient effectuées dans le client (notamment le marquage de champs obligatoires manquants ou de valeurs incompatibles), aucune validation côté client n'empêche l'utilisateur d'essayer de naviguer. La véritable validation se produit sur le serveur. Lorsqu'un utilisateur clique sur **Suivant**, Flux envoie les entrées au serveur pour validation. Si des entrées sont renvoyées comme non valides, la navigation est bloquée et l'erreur appropriée est affichée. Le serveur valide les entrées en cochant : 1. Le paramètre d'exigence de l'entrée, ou si la valeur saisie est compatible avec le type de données sous-jacent. 2. Validation personnalisée sur cette entrée : Plusieurs composants standard (case à cocher, devise, date, date/heure, zone de texte longue, numérique, mot de passe et texte) prennent en charge la validation personnalisée par écran. Saisissez une expression de formule booléenne et un message d'erreur à afficher lorsque l'expression de formule n'est pas remplie. 3. Validation personnalisée dans le composant sous-jacent : Si vous élaborez un composant Web Lightning personnalisé pour un flux, ajoutez votre propre code de validation à la méthode validate(). OmniStudio offre un traitement enrichi des erreurs et de la validation via l'action [Définir l'erreur](https://help.salesforce.com/s/articleView?id=sf.os_set_errors_in_an_omniscript.htm&type=5) combinée à des [vues conditionnelles](https://help.salesforce.com/s/articleView?id=sf.os_conditionally_display_elements_using_the_conditional_view_property.htm&type=5) et au composant [Messagerie](https://help.salesforce.com/s/articleView?id=sf.os_display_messages_in_omniscripts_19551.htm&type=5). Du côté LWC, la plupart des composants de base effectuent leurs propres validations côté client. Par exemple, Lightning respecte l'exigence au niveau système, mais pas au niveau de la page. Pour vos composants personnalisés, vous pouvez Build Your Own mécanismes de validation. Les champs qui nécessitent que les utilisateurs saisissent des données doivent être affichés tôt dans vos formulaires. Dans la mesure du possible, validez les entrées des utilisateurs côté client avant de soumettre les formulaires. Pour plus d'informations sur les meilleures pratiques de rationalisation de vos formulaires, consultez le guide des [formulaires](/docs/architect/fr-fr/well-architected/guide/engaging#formulaires) dans Salesforce Well-Architected - Engaging. ### Sécurité La sécurité est un sujet complexe en général, et quand il s'agit d'élaborer des formulaires, il y a un certain nombre de considérations auxquelles vous n'avez peut-être même pas pensé. Au niveau fondamental, vous devez vous assurer que le formulaire est exécuté dans le contexte approprié et que les utilisateurs disposent des autorisations requises pour utiliser ses données sous-jacentes. Au-delà de cela, vous pouvez également prendre des mesures supplémentaires pour retirer les codes ou URL potentiellement malveillants des champs de texte enrichi, empêcher certains utilisateurs d'accéder au formulaire ou limiter les types d'emplacement où les administrateurs peuvent incorporer le formulaire à l'avenir. Assurez-vous de bien documenter vos exigences de sécurité avant de choisir un outil. Le [modèle de stratégie](/docs/architect/fr-fr/resources/guide/security-policy-template) Salesforce Well-Architected contient des consignes relatives à ce type de documentation. #### Questions à poser : - Le formulaire doit-il vérifier l'accès de l'utilisateur avant d'effectuer certaines opérations ? - Devriez-vous désinfecter les entrées des utilisateurs ? - Voulez-vous contrôler qui peut accéder au formulaire ? - Voulez-vous contrôler l'emplacement où le formulaire peut être incorporé ?
Augmentation des autorisations utilisateur Contrôle des utilisateurs qui ont accès Restriction des emplacements autorisés
Formulaires dynamiques Non disponible Disponible Non disponible
Flux d'écran Disponible Disponible Non disponible
OmniStudio Non disponible Disponible Non disponible**
Flux d'écran + Composant Web Lightning Disponible Disponible Non disponible
LWC Disponible* Disponible Disponible
* Nécessite Apex
**Les Omniscripts ne peuvent pas avoir un ensemble d'emplacements cibles spécifié, mais les FlexCards peuvent.
#### Augmentation des autorisations utilisateur Lorsqu'un élément est exécuté dans le **_contexte utilisateur_**, Salesforce applique une série de contrôles d'accès, notamment la vérification de la sécurité au niveau du champ, des autorisations CRUD et de l'accès aux enregistrements en fonction des règles de partage de votre organisation. Par exemple, les utilisateurs peuvent exécuter un formulaire de mise à jour de requête uniquement s'ils ont la possibilité de mettre à jour les requêtes, la sécurité au niveau du champ appropriée et l'accès à l'enregistrement en question. Que se passe-t-il si vous souhaitez que les utilisateurs puissent exécuter une opération particulière lorsqu'ils utilisent _votre_ formulaire, mais pas via un autre formulaire ou une autre interaction ? C'est là qu'intervient le **_contexte système_**. Le contexte système permet d'augmenter les autorisations de l'utilisateur actif pendant la durée de la session, afin qu'il n'ait pas besoin, par exemple, de mettre à jour l'accès à l'objet Requête pour remplir votre formulaire de mise à jour de requête. Ceci est particulièrement utile pour les communautés non authentifiées. Au lieu d'accorder aux utilisateurs invités des capacités potentiellement dangereuses, définissez l'exécution de votre formulaire dans le contexte système. Bien sûr, le contexte système est une arme à double tranchant et vous devez l'utiliser uniquement lorsque nécessaire. Lorsqu'un formulaire est exécuté dans le contexte système, chaque opération CRUD contourne la sécurité et le partage au niveau de l'objet et du champ, pas seulement l'opération spécifique qui vous intéresse. Notez également que le contexte système n'a aucune incidence sur qui Salesforce considère l'acteur, le nom affiché dans le champ Dernière modification par. Pour chaque opération que votre formulaire effectue, par exemple la mise à jour de requête, l'acteur est l'utilisateur actif, même si le formulaire est exécuté dans un contexte différent. Les formulaires dynamiques, les Omniscripts et les composants Web Lightning sont toujours exécutés dans le contexte de l'utilisateur, et il n'est pas possible de remplacer ce comportement. Les flux d'écran sont exécutés par défaut dans le contexte de l'utilisateur, mais vous pouvez les définir pour les exécuter dans le contexte système. Vous pouvez choisir si le flux doit accorder l'accès à toutes les données ou s'il doit toujours appliquer l'accès au niveau de l'enregistrement, par exemple le partage. - Si vous incorporez un composant Lightning à un flux exécuté dans le contexte système, le flux ne remplace pas le contexte du composant. Si vous devez contourner les contrôles d'accès des utilisateurs, nous recommandons d'utiliser le flux pour effectuer ces opérations et transmettre les données appropriées dans ou hors du composant Lightning. Certains composants prêts à l'emploi (tels que Référence) ne peuvent pas fonctionner dans le contexte système. - Si votre flux appelle des actions Apex, il y a quelques nuances supplémentaires à comprendre. Si la classe Apex est définie sur le partage hérité, elle est exécutée dans le contexte système avec partage quel que soit le flux défini. Si la classe n'a pas de déclaration de partage explicite, elle est exécutée dans le contexte système sans partage, quel que soit le flux défini. Si la classe est définie sur avec partage ou sans partage, elle le fait et remplace le contexte du flux. **Interrogation d'enregistrements dans le contexte système avec des sites Experience Cloud :** Si vous exécutez un flux en contexte système sur un site Experience Cloud, **notamment non authentifié**, nous recommandons de stocker uniquement des champs spécifiques dans vos éléments Obtenir des enregistrements. Lorsque vous travaillez avec Flow et transmettez les résultats d'un élément Obtenir des enregistrements dans un flux secondaire, une action invocable ou un composant Lightning, tous les champs de cet objet peuvent être inspectés via les outils pour développeur du navigateur. Cela peut rendre les champs disponibles pour les utilisateurs de votre site Experience Cloud que vous n'avez peut-être pas l'intention. En spécifiant des champs spécifiques dans vos éléments Obtenir des enregistrements, vous pouvez vous assurer que seuls les champs appropriés sont exposés, même lorsque le contexte système est activé. Notez que la logique Omniscript est exécutée côté client, ce qui permet aux assaillants de modifier l'exécution attendue d'un Omniscript \_et d'\_afficher les réponses aux appels de méthode Procédures d'intégration, Mappeurs de données et Apex en utilisant les outils de développement du navigateur. Lorsque vous utilisez Omniscript, nous recommandons d'exécuter une logique métier côté serveur dans la mesure du possible et d'implémenter des règles de validation d'entrée dans toutes les méthodes Apex exposées via une [annotation @InvocableMethod](https://help.salesforce.com/s/articleView?id=sf.os_integration_procedure_invocation_55721.htm&type=5). **Intrants d'assainissement :** Pour protéger votre organisation contre les mauvais acteurs, pensez également à la désinfection des entrées. Supposons que vous avez une entrée dans un formulaire accessible au public qui peut être mappée avec un champ Texte enrichi dans votre organisation. Vous pouvez envisager une automatisation qui supprime tout code HTML susceptible de masquer des URL malveillantes. En général, il n'est pas idéal d'implémenter cette désinfection au niveau du formulaire, car vous pouvez avoir n'importe quel nombre de sources qui écrivent dans ces champs. Nous recommandons de créer un flux de mise à jour de champ rapide (avant la sauvegarde) ou d'utiliser un déclencheur Apex existant dans l'objet pour retirer ou modifier tout code HTML potentiel qui pourrait être saisi dans le formulaire. **_Meilleures pratiques :_** - _Laissez les flux s'exécuter dans leur contexte par défaut, sauf si vous devez augmenter l'accès de l'utilisateur actif à une opération spécifique._ - _Évitez d'exécuter des flux dans le contexte système pour les utilisateurs invités pour des raisons de sécurité. Créez à la place des ensembles d'autorisations avec un accès limité aux champs attribué au profil utilisateur invité du site Experience Cloud._ - _Lorsque vous interrogez des enregistrements dans des flux exécutés en contexte système sur des sites Experience Cloud, stockez uniquement les champs dont vous avez besoin dans votre élément Obtenir des enregistrements ou Actions invocables._ - _Si un flux exécute diverses opérations et qu'elles ne nécessitent pas toutes un accès élevé, utilisez des flux secondaires pour isoler les opérations qui doivent être exécutées dans le contexte système._ - _Si vous envisagez d ' incorporer un formulaire à une page Web externe, envisagez d ' assainir les entrées des utilisateurs pour retirer le code HTML en utilisant un flux de mise à jour rapide des champs ou un déclencheur Apex s ' ils sont mappés avec des champs de texte enrichi afin d ' éviter toute attaque potentielle par hameçonnage de la part de mauvais acteurs._ #### Notes complémentaires : - Les Omniscripts, les FlexCards et les Composants Web Lightning sont exécutés par défaut dans le contexte de l'utilisateur. - Les LWC sont exécutés dans le contexte utilisateur par défaut et les flux sont exécutés dans le contexte utilisateur mais vous pouvez remplacer cela dans un contrôleur Apex. - Les opérations effectuées via l'API UI sont exécutées dans le contexte de l'utilisateur. - Les opérations effectuées via un contrôleur Apex dépendent de cette classe. Pour effectuer ces opérations en mode système, définissez la classe Apex sur avec partage ou sans partage. #### Contrôle d'accès Si vous avez besoin de contrôler qui peut accéder à votre formulaire, vous pouvez souvent consulter le conteneur dans lequel le formulaire est incorporé. Vous pouvez par exemple attribuer des pages Lightning pour qu'elles soient disponibles pour des applications, des types d'enregistrement ou des profils particuliers. Si certaines entrées de votre formulaire sont confidentielles, utilisez des règles de visibilité pour mieux contrôler les éléments affichés pour qui. Cette fonctionnalité s'applique aux Formulaires dynamiques et aux flux d'écran. Vous pouvez [limiter un flux](https://help.salesforce.com/articleView?id=flow_distribute_security.htm) à des profils ou des ensembles d'autorisations particuliers, de la même façon qu'une classe Apex ou une page Visualforce. Par défaut, les flux ne sont pas restreints, ce qui signifie que tout utilisateur disposant de l'autorisation Exécuter des flux peut les exécuter. Si vous utilisez OmniStudio, vous pouvez configurer un [vérificateur d'autorisations](https://help.salesforce.com/s/articleView?id=sf.os_add_an_apex_class_permissions_checker_1.htm&type=5) pour vous assurer que les utilisateurs ont besoin d'un accès explicite à la classe Apex qui administre l'action distante appelée à partir d'une API Omniscript, Flexcard, Classic Card ou REST. - Remarque Les contrôles d'autorisation de classe Apex sont activés par défaut pour les scripts nouvellement créés. Cependant, ils doivent être activés manuellement pour tous les scripts existants - Notez également que les contrôles d'autorisation des classes Apex s'appliquent uniquement aux classes Apex. Nous recommandons de définir également des autorisations au niveau du profil pour les [Procédures d'intégration et](https://help.salesforce.com/s/articleView?id=sf.os_security_for_dataraptors_and_integration_procedures_48147.htm&type=5) les Mappeurs de données. Pour plus d'informations et les meilleures pratiques sur les autorisations utilisateur invité, consultez : - [Meilleures pratiques d'accès aux enregistrements utilisateur invité](https://www.learnexperiencecloud.com/s/article/Guest-User-Record-Access-Development-Best-Practices#Pattern6) - [Développer des sites sécurisés : Utilisateurs](https://developer.salesforce.com/docs/atlas.en-us.communities_dev.meta/communities_dev/communities_dev_security_authenticated_and_guest_users.htm) authentifiés et invités **_Meilleures pratiques :_** - _Si vous exposez un flux à des utilisateurs invités, accordez au profil utilisateur invité l'accès uniquement aux flux dont il a besoin. Bien qu'il soit possible d'ajouter Exécuter des flux au profil utilisateur invité, nous considérons cette pratique comme risquée._ - _Soyez particulièrement prudent avec les flux qui fonctionnent dans le contexte système. Nous recommandons vivement de limiter ces flux à un groupe particulier d'utilisateurs, car ils ont moins de freins et contrepoids en place pour protéger vos données._ - _Assure-toi que tout Omniscript qui exécute Apex dans une communauté d'utilisateurs invités a "avec partage" dans la définition de la classe Apex._ - _Dans votre profil Utilisateur invité, attribuez uniquement les classes Apex que les utilisateurs invités peuvent appeler, sinon vous risquez d'exposer involontairement une logique métier supplémentaire aux utilisateurs invités._ Pour les composants Web Lightning, vous pouvez vérifier les attributions d'autorisations de l'utilisateur actif afin de vérifier s'il dispose d'une autorisation standard ou personnalisée particulière. Directement depuis JavaScript, vous pouvez importer des autorisations Salesforce à partir des modules d'étendue @salesforce/userPermission et @salesforce/customPermission. Ou vous pouvez utiliser Apex pour vérifier la même chose. #### Contrôle d'incorporation Les composants Web Lightning sont disponibles à un emplacement donné uniquement lorsqu'ils ont été ajoutés en tant que [cible](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.reference_configuration_tags) valide. Vous pouvez par exemple rendre un composant disponible dans des pages d'enregistrement et non disponible en tant qu'élément de la barre d'utilitaires. Lorsqu'un flux d'écran est activé, il est disponible à tous les emplacements où les flux d'écran sont pris en charge, que vous souhaitiez ou non qu'il soit disponible partout. Cela dit, Flow Builder prend en charge plusieurs types de flux qui ont des écrans. Le type pain et beurre est Flux d'écran, mais il existe d'autres types spécialisés limités à des emplacements spécifiques. Par exemple, l'application mobile Field Service prend en charge uniquement - vous l'aurez deviné - les flux mobiles Field Service. Il en va de même pour les flux de demande de contact, qui sont pris en charge uniquement dans Experience Cloud. Quel que soit le type de flux, l'individu qui crée le flux n'a aucun contrôle sur l'emplacement où le flux peut être incorporé. Le flux sera disponible à chaque emplacement pris en charge pour ce type de flux. Si vous utilisez Salesforce Industries, une petite mise en garde s'applique à Omniscript : Vous ne pouvez pas spécifier une cible pour un Omniscript lui-même, mais vous pouvez en spécifier une pour les FlexCards que vous souhaitez incorporer. ### Conception des interactions Les formes statiques appartiennent au passé. Aujourd'hui, il s'agit de mettre à jour dynamiquement le formulaire avec les propriétés et les valeurs appropriées pour cet utilisateur, cette fois, cet endroit. Parlons de ce qui est possible dans cette veine pour les outils de création de formulaires de Salesforce. #### Questions à poser : - Quels types d'interaction ou de condition doivent déclencher des réponses dynamiques dans votre formulaire ? - Vous devrez exécuter des opérations hors écran en arrière-plan pendant que votre formulaire est rempli ? - Devrez-vous définir des champs comme visibles, obligatoires, en lecture seule ou désactivés, ou changer la mise en forme en fonction des entrées de formulaire ?
Exécution d'opérations de données hors écran Valeurs conditionnelles et calculs Visibilité conditionnelle Exigence conditionnelle Mise en forme conditionnelle État Lecture seule conditionnelle État désactivé conditionnel
Formulaires dynamiques Non disponible Non disponible Disponible Non disponible Roadmap Non disponible Non disponible
Flux d'écran Disponible Disponible** Disponible Disponible* Non disponible Disponible** Disponible**
OmniStudio Disponible Disponible Disponible Disponible Disponible Disponible Disponible
Flux d'écran + Composant Web Lightning Disponible Disponible Disponible Disponible Disponible Disponible Disponible
LWC Disponible Disponible Disponible Disponible Disponible Disponible Disponible
*Limité aux composants qui utilisent un sélecteur de ressource et non une case à cocher statique
**Bêta limitée
L'interactivité des flux d'écran est désormais une réalité grâce aux écrans réactifs. La réactivité permet aux composants individuels d'un écran de flux de communiquer entre eux, ce qui augmente infiniment la puissance des flux d'écran. **Exécuter des opérations de données hors écran :** Les flux d'écran offrent une approche déclarative pour récupérer des données sur le même écran via des Actions d'écran. Les actions d'écran peuvent vous permettre de déclencher des flux lancés automatiquement lors de n'importe quelle modification à l'écran ou lorsqu'un utilisateur clique sur un composant Bouton d'action. Vous pouvez ensuite mapper les résultats de ces flux lancés automatiquement avec le même écran, ce qui évite aux utilisateurs d'accéder à un autre écran. LWC offre une gamme complète d'adaptateurs wire qui permettent d'accéder aux données Salesforce pour remplir dynamiquement les données des composants de votre formulaire, et permet aux développeurs de mettre à jour, de supprimer et de créer des enregistrements via des contrôleurs Apex. [Composants Web Lightning Opérations de données hors écran_Composants Web Lightning Opérations de données hors écran_](/docs/architect/fr-fr/reference-diagrams/guide/lightning-web-components-off-screen-data-operations) **Visibilité :** La visibilité peut être contrôlée dynamiquement dans tous les outils de création de formulaires. Les formulaires dynamiques, Flow Builder et OmniStudio répondent à ce problème avec les fonctionnalités de visibilité des composants. Vous pouvez ainsi afficher ou masquer par déclaration des champs basés sur d'autres valeurs du formulaire ou si l'utilisateur est sur un appareil mobile ou non. - Avec les formulaires dynamiques, la visibilité peut être contrôlée en fonction des valeurs de champ d'enregistrement, des enregistrements associés via des champs de référence et du facteur de forme. - Avec Flux, vous pouvez baser une règle de visibilité sur d'autres entrées à l'écran, ainsi que sur d'autres ressources remplies précédemment dans le flux, notamment des formules ou des valeurs d'autres enregistrements. - **Règles basées sur l'appareil :** Ce n'est pas évident dès le départ, mais vous pouvez utiliser une formule pour afficher ou masquer un champ particulier lorsque l'utilisateur est sur un appareil mobile. Écrivez une formule de flux qui vérifie la valeur de la variable globale \$User.UIThemeDisplayed. Si la valeur est Theme4t, l'utilisateur est dans l'application mobile Salesforce. - **Évaluation d'autres ressources :** Les références manuelles de variables et de formules sont évaluées uniquement sur le serveur. Par conséquent, quelle que soit la valeur de cette ressource lors de la restitution initiale de l'écran, elle sera définie jusqu'à ce que vous accédiez à un autre écran. Lors de la navigation, l'exécution du flux soumet une requête au moteur de flux (le serveur) et récupère les toutes dernières valeurs des variables manuelles et des formules. Si vous souhaitez que votre règle de visibilité soit mise à jour lorsque l'utilisateur traverse un écran unique (par exemple, onblur), assurez-vous de référencer uniquement les valeurs des autres composants de l'écran. - Avec OmniStudio, vous pouvez afficher ou masquer des composants sous certaines conditions en configurant une Propriété Vue conditionnelle. Cependant, vous ne pouvez pas ajouter plusieurs propriétés de vue conditionnelle pour une entrée. **États d'entrée conditionnels :** Si vous devez contrôler dynamiquement d'autres propriétés, par exemple si un champ est obligatoire, désactivé ou en lecture seule, vous avez plusieurs options. Comme prévu, LWC vous donne un contrôle complet et réactif de votre état d'entrée. Avec les composants Flux d'écran réactifs, vous pouvez contrôler dynamiquement les attributs de composants tels que Lecture seule, Désactivé et Obligatoire pour les composants standard qui le prennent en charge, tandis qu'OmniStudio prend en charge l'éventail complet des attributs spécifiques au composant. Si vos exigences exigent un flux et que le composant ne prend pas en charge un état d'attribut spécifique, vous pouvez créer un composant Web Lightning incorporable pour obtenir un état d'entrée dynamique. Si vous devez contrôler dynamiquement d'autres propriétés, par exemple si un champ est obligatoire ou en lecture seule, votre meilleur pari à court terme est LWC, où vous avez le contrôle total. Cela est particulièrement vrai si vous avez des exigences sur mesure pour gérer onblur ou onclick. Composants Web Lightning réactifs dans les flux d'écran : Lors de l'élaboration de composants Web Lightning capables de réagir et de modifier d'autres composants dans un flux d'écran, consultez ce guide [LWC Best Practices for Screen Flows](https://developer.salesforce.com/blogs/2023/02/lwc-best-practices-for-screen-flows) pour vous assurer que vos composants s'intègrent correctement au moteur d'exécution du flux et fonctionnent normalement à l'avenir.
Traitement des événements standard (onblur, onfocus) Traitement des événements personnalisés
Formulaires dynamiques Non disponible Non disponible
Flux d'écran Non disponible Non disponible
OmniStudio Non disponible Disponible*
Flux d'écran + Composant Web Lightning Disponible Disponible
LWC Disponible Disponible
*L'exécution OmniStudio Standard ne prend pas en charge Pub/Sub, mais prend en charge Windows postMessage
Maintenant pour les événements personnalisés. Si certaines de vos entrées ou le formulaire complet doivent communiquer avec autre chose dans la page, LWC est votre seule option. - Pour communiquer dans la même arborescence DOM, utilisez l'[**interface CustomEvent**](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.events). - Pour communiquer à travers le DOM, utilisez [**Lightning Messaging Service**](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.use_message_channel). - Si Lightning Messaging Service [n'est pas pris](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.use_message_channel_considerations) en charge pour votre conteneur cible, utilisez le **module pub/sub**. #### Ressources supplémentaires - Pour plus de détails, consultez [Communicating with Events](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/events) and [Communicate Across the DOM](https://developer.salesforce.com/docs/component-library/documentation/en/lwc/lwc.events_pubsub) dans le _Lightning Web Components Dev Guide_. - Pour OmniStudio, consultez [Communiquer avec Omniscript à partir d'un composant Web Lightning.](https://help.salesforce.com/s/articleView?id=sf.os_communicate_with_omniscript_from_a_lightning_web_component_18222.htm&type=5) ### Style Pour offrir la meilleure expérience utilisateur, vous devez vous assurer que le style de votre formulaire est cohérent avec le reste de l'application ou du site dans lequel il est incorporé. Cela peut signifier n'importe quoi, depuis l'utilisation de modèles standard fournis par Salesforce jusqu'à la création de CSS personnalisées qui utilisent entièrement chaque pixel de la conception pour offrir une présentation plus nette. #### Questions à poser : - Quel est le niveau de sophistication de votre style et CSS ? - Avez-vous besoin d'un style personnalisé et parfait pour les pixels ou êtes-vous d'accord avec les thèmes standard ?
Style direct Thèmes d'organisation et Générateur d'expérience Style parfait
Formulaires dynamiques Non disponible Disponible Non disponible
Flux d'écran Non disponible Disponible Roadmap
OmniStudio Disponible* Non disponible Disponible
Flux d'écran + Composant Web Lightning Non disponible Disponible Disponible
LWC Non disponible Disponible Disponible
* Cartes Flex uniquement
FlexCards est le seul produit couvert dans ce guide qui permet de contrôler par déclaration le style et la présentation de l'interface utilisateur que vous élaborez directement dans l'outil, que ce soit les marges et le remplissage, la typographie, les couleurs, etc. Les formulaires dynamiques et les flux respectent les fonctionnalités de thème déclaratif. Si vous avez besoin d'un contrôle au-delà des [Thèmes Salesforce](https://help.salesforce.com/articleView?id=brand_your_org_in_lightning_experience.htm&mode=1), des [Ensembles de personnalisations](https://help.salesforce.com/articleView?id=community_designer_brandsets.htm) Générateur d'expérience ou des [Sites Experience Cloud](https://developer.salesforce.com/docs/atlas.en-us.exp_cloud_lwr.meta/exp_cloud_lwr/brand_overview.htm) LWR, envisagez une solution par programmation. Pour les équipes qui maîtrisent le CSS, vous avez deux options : - Les flux et les composants Web Lightning héritent de [jetons de conception](https://developer.salesforce.com/docs/atlas.en-us.lightning.meta/lightning/tokens_standard.htm) standard. - Les Omniscripts et les FlexCards prennent en charge un système de conception personnalisable : [Newport](https://help.salesforce.com/s/articleView?id=sf.os_customize_omniscripts_and_flexcards_with_the_newport_design_system.htm&type=5). - Avec LWC, vous pouvez écrire vos propres composants et contrôler entièrement le code HTML et CSS. Dans la mesure du possible, nous recommandons d'utiliser des thèmes et des systèmes de conception afin d'appliquer votre présentation de façon cohérente à l'ensemble de vos contenus. Rappel : Vous pouvez incorporer des composants Lightning dans des flux. Par conséquent, si vous avez besoin d'un contrôle parfait de la présentation de votre formulaire, mais souhaitez utiliser les autres avantages des flux, tels que le modèle de navigation, vous pouvez avoir le meilleur des deux mondes. Le même principe s'applique aux Omniscripts et aux FlexCards. ### Présentation Le choix d'une bonne présentation est crucial pour concevoir des formulaires rationalisés qui permettent une saisie rapide et efficace des données et augmentent leur intégrité. Pour plus d'informations sur cette rubrique, consultez [Salesforce Well-Architected - Forms](/docs/architect/fr-fr/well-architected/guide/engaging#formulaires). #### Questions à poser : - Comment utiliser la présentation de votre formulaire pour optimiser l'expérience utilisateur ? - Comment présenter à vos utilisateurs des données existantes qui facilitent la saisie de nouvelles données dans vos formulaires ?
2 colonnes 4 colonnes Au-delà de 4 colonnes Répéter des blocs de données Conteneurs d'onglets Conteneurs en accordéon
Formulaires dynamiques Disponible Non disponible Non disponible Non disponible Disponible Disponible
Flux d'écran Disponible Disponible Non disponible Disponible Non disponible Disponible
OmniStudio Disponible Disponible Disponible Disponible Disponible* Disponible
Flux d'écran + Composant Web Lightning Disponible Disponible Disponible Disponible Disponible Disponible
LWC Disponible Disponible Disponible Disponible Disponible Disponible
*Les onglets peuvent être utilisés en incorporant des données à une FlexCard dans un Omniscript
Les formulaires dynamiques prennent en charge les présentations à deux colonnes et peuvent être divisés en sections individuelles avec des champs. Ces sections peuvent être placées dans des composants tels que des onglets et des accordéons pour créer des présentations faciles à utiliser et organisées. Les flux peuvent être restitués en utilisant le composant Section. Avec des sections, vous pouvez ajouter jusqu'à quatre colonnes et autant de sections que vous le souhaitez à l'écran de flux. Le composant est également réactif à la largeur de l'écran, ce qui lui permet de travailler sur des écrans plus petits. Enfin, il permet d'appliquer une visibilité conditionnelle à toute la section, ce qui facilite l'application en masse de la visibilité à plusieurs champs de la section. Les sections de flux prennent également en charge les en-têtes de colonne et offrent une expérience en accordéon dans laquelle les utilisateurs peuvent réduire la section complète en cliquant sur l'étiquette. Les Omniscripts offrent diverses options de présentation pour l'affichage des champs et des données. Vous pouvez créer des sections de données contenant jusqu'à 12 colonnes, y compris des accordéons réductibles sous certaines conditions. Avec LWC, vous pouvez utiliser Lightning-\[edit|view]-form et le champ Lightning-\[input|output]-field de support pour contrôler la présentation. Les seules restrictions de présentation sont celles de HTML/CSS. Lightning respecte la configuration de la section dans la présentation de page associée. Par exemple, si une section est à deux colonnes dans la présentation de page, elle est à deux colonnes dans ce composant. ### Translation Si votre formulaire est accessible par des utilisateurs de différentes régions ou qui parlent différentes langues, vous devez vous assurer que l'outil que vous allez utiliser pour l'élaborer répond à vos exigences de traduction. Pour plus d'informations et des recommandations, consultez [Salesforce Well-Architected - Localization](/docs/architect/fr-fr/well-architected/guide/compliant#localisation). Dans le cas des formulaires en particulier, les exigences de localisation impliquent généralement la traduction d'éléments de texte dans d'autres langues. #### Questions à poser : - Votre formulaire sera-t-il utilisé dans plusieurs pays ou régions ? - Le texte de votre formulaire doit-il être traduit dans d'autres langues ?
Étiquettes saisies dans le Générateur Étiquettes dans le code
Formulaires dynamiques Disponible* Non disponible
Flux d'écran Disponible Disponible
OmniStudio Disponible Disponible
Flux d'écran + Composant Web Lightning Disponible Disponible
LWC Non disponible Disponible
*En-têtes de section de champ uniquement
Si vous avez traduit vos champs personnalisés, ces étiquettes traduites sont respectées dans les Formulaires dynamiques. Les formulaires dynamiques respectent également les [étiquettes personnalisées que](https://help.salesforce.com/s/articleView?id=platform.lightning_page_components_use_expressions_for_labels.htm&type=5) vous avez attribuées aux étiquettes et aux attributs des composants dans le Générateur d'applications Lightning. Grâce à la puissance du Système de traduction, Flow prend en charge la traduction des étiquettes accessibles à l'utilisateur pour tous les composants d'écran standard et personnalisés. Vous pouvez localiser l'étiquette, le texte d'aide et le message d'erreur des composants d'écran suivants : Texte, Zone de texte longue, Numérique, Devise, Case à cocher, Cases d'option, Liste de sélection, Liste à sélection multiple, Groupe de cases à cocher, Mot de passe, Date et Date/heure. Il n'y a pas de prise en charge de la traduction intégrée pour les actions prêtes à l'emploi, telles que Envoyer un e-mail ou Publier dans Chatter. Cependant, il existe une solution de contournement ! Si vous définissez les étiquettes traduites avec une [étiquette personnalisée](https://help.salesforce.com/articleView?id=cl_about.htm), vous pouvez référencer cette étiquette personnalisée dans l'action ou le composant en la configurant dans Flow Builder. Créez une formule de flux qui référence l'étiquette personnalisée, puis référencez cette formule aux emplacements appropriés de votre flux. Les Omniscripts utilisent des étiquettes personnalisées pour les traductions. Consultez [ce document](https://help.salesforce.com/s/articleView?id=sf.os_create_multi_language_omniscripts.htm) pour préparer vos Omniscripts multilingues. Maintenant pour LWC. Certains composants de base héritent automatiquement des traductions des champs, du texte d'aide et des messages de validation de l'objet associé s'ils ont été configurés dans le Système de traduction (par exemple : Lightning). Si vous devez introduire de nouvelles étiquettes traduisibles dans votre code, les étiquettes personnalisées restent le héros méconnu. Déclarez l'étiquette personnalisée dont vous avez besoin, puis importez-la dans votre composant depuis le module d'étendue @salesforce/label. ### Automatisation des tests d'interface utilisateur Plusieurs outils d'automatisation de test de bout en bout sont disponibles (par exemple, Selenium), qui vous permettront de simuler l'interaction de l'utilisateur avec votre formulaire. Vous pouvez écrire ces tests pour n'importe quelle interface utilisateur standard ou personnalisée, y compris les pages Lightning et les flux d'écran. Cependant, il est important de noter que ces types de test ne peuvent pas vérifier les sorties de chaque méthode exécutée. Assurez-vous d'en tenir compte en réfléchissant à vos exigences en matière d'automatisation des tests d'interface utilisateur. #### Questions à poser : - Avez-vous besoin de tests automatisés pour votre formulaire ? - Quels types de test devez-vous effectuer ? - Quel niveau de granularité faut-il pour vos automatisations de test ?
Tests unitaires Automatisation de bout en bout
Formulaires dynamiques Non disponible Disponible*
Flux d'écran Non disponible Disponible*
OmniStudio Disponible* Disponible*
Flux d'écran + Composant Web Lightning Disponible* Disponible*
LWC Disponible Disponible
*Nécessite un code
Tenez compte de vos exigences en matière d'automatisation des tests d'interface utilisateur. **Les tests unitaires** permettent une automatisation et une validation plus précises qui fonctionnent avec les systèmes et les outils CI/CD standard de l'industrie, qui peuvent tester la logique métier des composants, son contrôleur JavaScript et ses sorties. En utilisant exclusivement le code faible, vous ne pourrez pas créer vous-même des tests, mais Salesforce teste rigoureusement nos offres de bout en bout. Si les méthodes de votre composant sont suffisamment complexes pour être testées individuellement, placez-les dans des fichiers JavaScript dédiés. Vous pouvez ainsi les importer dans un LWC et dans un test Jest avec quelque chose comme `import { sort } from 'c/utils';`. Consultez [Interface utilisateur Test Automation on Salesforce](https://developer.salesforce.com/blogs/2020/01/ui-test-automation-on-salesforce.html) pour comparer les diverses options disponibles pour élaborer une automatisation de bout en bout dans Salesforce. Les considérations comprennent quand utiliser une solution sans code d'un éditeur de logiciels, Build Your Own solution d'automatisation de test personnalisée ou utiliser une infrastructure de test de source ouverte telle que Selenium WebDriver ou WebdriverIO. Ces solutions sont valables pour n'importe quelle interaction d'interface utilisateur dans Salesforce, qu'il s'agisse d'un Formulaire dynamique dans une page Lightning, d'un flux d"écran dans une barre d'utilitaires ou d'un LWC dans un flux dans une action rapide. ### Métriques Après avoir déployé votre formulaire dans un environnement de production, vous devez vous assurer qu'il est utilisé efficacement. Selon votre cas d'utilisation, cela peut signifier n'importe quoi, du simple suivi du nombre de fois qu'il a été rempli au temps que les utilisateurs passent à le remplir avant de soumettre leurs informations. Assurez-vous d'identifier les indicateurs de performance clés que vous souhaitez suivre avant de choisir un outil. #### Questions à poser : - Avez-vous besoin de suivre l'utilisation de votre formulaire ? - Quels indicateurs de performance clés détermineront si votre formulaire est utilisé efficacement ?
Vues de page Temps passé sur le formulaire Suivre la saisie du formulaire Suivi du taux de réussite
Formulaires dynamiques Disponible** Non disponible Non disponible Non disponible
Flux d'écran Disponible Disponible* Disponible Disponible
OmniStudio Disponible Disponible* Disponible Disponible
Flux d'écran + Composant Web Lightning Disponible Disponible* Disponible Disponible
LWC Disponible** Disponible* Disponible Disponible
*Disponible lorsque Exécution OmniStudio basée sur un package est activée
** Disponible en suivant l'utilisation de la page Lightning parente
Si vous devez suivre l'utilisation globale et l'adoption de votre formulaire, commencez par les outils à faible code. Les formulaires dynamiques et les flux d'écran peuvent être suivis en utilisant des types de rapport personnalisés prêts à l'emploi, mais les rapports de suivi des flux d'écran offrent plus de précision. Si vous devez suivre l'utilisation d'un Composant Web Lightning, la disponibilité prête à l'emploi dépend de l'emplacement où vous utilisez ce Composant Web Lightning. S'il se trouve dans une page Lightning, les éléments disponibles pour le suivi de l'utilisation des pages Lightning s'appliquent à vos composants Web Lightning. Même chose pour les composants Web Lightning incorporés à des flux. Les formulaires dynamiques eux-mêmes ne peuvent pas être suivis prêts à l'emploi, mais vous pouvez suivre l'utilisation de la page Lightning parente via des [objets Lightning](https://help.salesforce.com/articleView?id=lex_usage_reports.htm) Pour suivre les pages Lightning standard, utilisez le type de rapport personnalisé _Utilisateurs avec Lightning Usage by Page Metrics_ (Utilisation de Lightning par métriques de page). Pour les mêmes pages Lightning personnalisées, utilisez le type de rapport personnalisé _Users with Lightning Usage by FlexiPage Metrics_. Pour suivre l'adoption de votre formulaire spécifique (pas seulement de la page dans laquelle il réside), Flow s'occupe de vous. Utilisez « Exemple de rapport de flux : Flux d'écran » pour répondre à des questions telles que : - Quel est le taux de remplissage de ce formulaire ? Est-ce bien adopté? - Combien de temps faut-il aux utilisateurs pour remplir ce formulaire ? - Sur quel écran les utilisateurs passent-ils le plus de temps ? - À quelle fréquence les utilisateurs reculent-ils ? - À quelle fréquence les erreurs se produisent-elles ? Si le rapport standard ne répond pas à vos besoins, clonez-le pour apporter vos propres modifications ou Build Your Own en utilisant le type de rapport _Screen Flows_ (flux d'écran). Si vous utilisez l'exécution Omniscript basée sur un package, vous pouvez utiliser le [service OmniStudio pour](https://help.salesforce.com/s/articleView?id=sf.os_vlocity_tracking_service.htm&type=5) Vlocity Tracking. Ce service suit n'importe quel type d'événement. Vous pouvez par exemple suivre le temps nécessaire pour suivre les étapes d'un Omniscript afin d'identifier les améliorations à apporter au processus. Il figure sur la feuille de route de l'équipe OmniStudio pour prendre en charge ce service dans OmniStudio standard. Pour suivre la même chose pour un LWC qui n'est pas incorporé à un flux d'écran, un Omniscript ou une page Lightning, aucune option prête à l'emploi n'existe. Vous pouvez élaborer en utilisant Apex une solution personnalisée. ### Empaquetage et déploiement Lorsque vous devez déployer votre solution dans des environnements supérieurs pour la tester ou la déployer en production, vous pouvez être habitué à utiliser pour cela des ensembles de modifications ou DevOps Center. Les formulaires dynamiques, les flux et les composants Web Lightning sont entièrement pris en charge dans ces options de déploiement. OmniStudio nécessite un outil séparé : [IDX Workbench](https://help.salesforce.com/s/articleView?language=en_US&id=sf.os_idx_workbench_desktop_application.htm&type=5). #### Questions à poser : - Comment comptez-vous déployer votre formulaire ? - Votre formulaire sera-t-il distribué à plusieurs organisations Salesforce ?
Packages gérés de première génération (1GP) Packages gérés de deuxième génération (2GP) Packages déverrouillés Ensembles de modifications DevOps Center
Formulaires dynamiques Disponible Disponible Disponible Disponible Disponible
Flux d'écran Disponible Disponible Disponible Disponible Disponible
OmniStudio Non disponible Non disponible Non disponible Non disponible* Non disponible*
Flux d'écran + Composant Web Lightning Disponible Disponible Disponible Disponible Disponible
LWC Disponible Disponible Disponible Disponible Disponible
* Utilisez le Workbench IDX pour déployer les solutions OmniStudio dans d'autres organisations.
Si vous êtes un éditeur de logiciels ou un partenaire qui envisage d'empaqueter votre solution pour la distribuer sur AppExchange, nous recommandons d'examiner d'abord les formulaires dynamiques, les flux et les composants Web Lightning. OmniStudio ne prend pas en charge l'empaquetage. ## Rubriques supplémentaires ### Navigation dans le continuum code faible à code pro Ce guide vise à vous aider à comprendre les fonctionnalités et le niveau de personnalisation possibles avec les formulaires dynamiques, les flux d'écran, OmniStudio et LWC. À un niveau élevé : Continuum code bas à code pro
- LWC est l'option la plus personnalisable et robuste pour construire un coffrage, mais il a le moins de garde-fous en place. Il vous revient d'élaborer un composant de manière à garantir [la sécurité](/docs/architect/fr-fr/well-architected/guide/secure) et [l'évolutivité](/docs/architect/fr-fr/well-architected/guide/reliable#évolutivité). - Les formulaires dynamiques sont les moins flexibles, mais les possibilités de faux pas sont beaucoup moins nombreuses. - Flow et OmniStudio se situent quelque part au centre – plus puissants que les formulaires dynamiques, mais pas tout à fait au niveau des composants Web Lightning. De la même façon, ils ont moins de garde-fous que les formulaires dynamiques, mais sont plus difficiles à briser que le code personnalisé. Si plusieurs outils correspondent à la facture, la décision dépend de l'outil approprié pour votre équipe. D'autres [guides de décision](/decision-guides) introduisent des aspects supplémentaires à prendre en compte lors de la prise de décision. Nous n’entrerons pas dans les détails de chacun de ces aspects ici, mais nous les interpréterons pour les outils spécifiques que ce document évalue. **Compétences spécialisées**: Quelle est l'expertise de votre équipe dans les outils que vous comparez ? Combien de fabricants connaissent bien et maîtrisent LWC ou JavaScript ? Que diriez-vous des fabricants experts en Flow Builder ou qui ont exprimé leur intérêt à tremper leurs orteils ? Généralement, les compétences Formulaires dynamiques et Flux sont plus accessibles pour une population élargie de personnes qui élaborent des formulaires. Formulaires dynamiques est l'outil de création de formulaire le plus déclaratif et sera toujours plus facile à apprendre que Flux. Cela dit, l'équipe de Flow s'engage à réduire cette barre au maximum. En termes de complexité, OmniStudio se situe quelque part entre Flow et LWC et offre d'importants superpouvoirs de création de formulaire. **Délégation de livraison**: Ce n'est pas parce que certaines de vos exigences nécessitent des composants Web Lightning que votre solution complète doit être élaborée avec des composants Web Lightning. Examinez comment élaborer votre solution de façon modulaire, de sorte que les pièces qui nécessitent un composant Web Lightning soient codées et celles qui ne le nécessitent pas soient élaborées dans une solution à faible code. Cela optimise l'efficacité d'une équipe diversifiée et garantit que chaque individu résout les problèmes appropriés à sa spécialisation. Parlons maintenant de Flow et de LWC. Avec les composants d'écran réactifs, les composants de flux d'écran peuvent désormais se parler sur le même écran, ce qui libère un tout nouveau coffre à outils pour les architectes, les administrateurs et les développeurs. Les développeurs peuvent désormais créer des composants modulaires et utiles qui peuvent être réutilisés dans l'ensemble de l'organisation, ce qui augmente la productivité de tous les membres de l'équipe. Les développeurs peuvent se concentrer sur la résolution de nouveaux défis et gagner du temps en utilisant une combinaison de composants Flux standard et personnalisés pour obtenir un dynamisme de forme. Avec des composants réactifs dans Flux, il n'a jamais été aussi opportun de mélanger Flux et Composants Web Lightning lors de l'élaboration de vos formulaires. **Maintenabilité et propriété à long terme**: Si vous avez un formulaire à plusieurs étapes, il est recommandé de commencer par Flux ou un mélange de Flux et de Composants Web Lightning. Si vous avez une équipe low-code qui gère la solution, pensez à comment la rendre aussi configurable et extensible que possible pour cette audience. Quel que soit l'outil choisi, organisez votre solution en unités [composables](/docs/architect/fr-fr/well-architected/guide/composable) pour améliorer la maintenabilité et la stabilité. ### Présentations de page À l'avenir, la méthode recommandée pour configurer les pages de détail d'enregistrement est Formulaires dynamiques dans le Générateur d'applications Lightning utilisant des pages Lightning. Il y a longtemps que nous n'avons pas amélioré les présentations de page, et cette tendance va se poursuivre. Voici pourquoi : - Les formulaires dynamiques sont plus flexibles. Vous pouvez placer des champs et des sections où vous le souhaitez directement dans le Générateur d'applications Lightning, où vous pouvez tirer parti des sections, des onglets et des accordéons. Et tout comme vous pouvez le faire avec des composants de la page Lightning, vous pouvez contrôler la visibilité de vos champs et sections sans définir plusieurs présentations de page ou types d'enregistrement. - Avec les composants Accordéon et Onglet, vous pouvez limiter le nombre de champs initialement affichés. Devine ce que ça veut dire ? Accélération des temps de chargement de page. - La gestion des présentations est plus simple avec les pages Lightning, puisque vous pouvez tout gérer sur vos pages depuis le Générateur d'applications Lightning - que ce soit le contenu de la page ou les utilisateurs qui ont accès à la page. Il n'est plus nécessaire d'effectuer des mises à jour dans votre présentation de page pour effectuer une modification dans votre page Lightning. Sans oublier que grâce à la puissance des règles de visibilité, il n'est plus nécessaire de créer plusieurs pages (ou présentations de page) pour contrôler qui voit quels champs quand. Et cela signifie également que vous devez seulement attribuer aux utilisateurs une page Lightning plutôt que d'attribuer à la fois une page Lightning et une présentation de page. Nous recommandons d'utiliser des Formulaires dynamiques dans la mesure du possible et de revenir aux présentations de page uniquement si nécessaire. Comme toujours, nous accueillons les commentaires dans l'[Échange d'idées](https://ideas.salesforce.com/s/) sur les améliorations qui auraient le plus d'impact pour votre organisation. ### Performances Toutes les considérations relatives aux performances liées aux formulaires dynamiques, aux flux d'écran, à OmniStudio et aux composants Web Lightning sont centrées sur l'infrastructure dans laquelle ces technologies s'inscrivent. Ceux qui sont basés dans LWC (en plus, bien sûr, un LWC) vont surpasser ceux qui sont basés à Aura. L'infrastructure LWC offre de meilleures performances, car les fonctionnalités principales sont implémentées nativement dans les moteurs Web au lieu de JavaScript via des abstractions d'infrastructure. Si vous ne connaissez pas, lisez [ce billet](https://developer.salesforce.com/blogs/2018/12/introducing-lightning-web-components.html) de blog. En 2019, nous avons réalisé une [étude de cas](https://developer.salesforce.com/blogs/2019/06/case-study-dreamhouse-gains-speed-by-switching-to-lwc.html) comparant les performances de la même fonctionnalité dans Aura par rapport à LWC. Grâce à la conversion de DreamHouse depuis Aura vers LWC, non seulement l'expérience de développement était beaucoup plus conforme aux normes et modèles actuels de développement frontal Web, mais les gains de performance étaient importants. Les mesures de laboratoire ont montré des gains de **2,4 % à 24,7 %** pour la cache froide et des gains de **31,83 % à** **63,32 %** pour la cache chaude sur les deux mêmes pages. Quelle infrastructure nos technologies de formulaire utilisent-elles ? En d'autres termes, quelles technologies de forme bénéficient de ces performances supérieures ? - Les Formulaires dynamiques, qui sont intégrés dans les métadonnées des pages Lightning, reposent sur une fondation qui utilise la pile LWC, ce qui va nous permettre d'implémenter certaines fonctionnalités demandées depuis longtemps. En prime aux performances, les formulaires dynamiques utilisent un rendu progressif, ce qui améliore le temps de chargement des pages qui contiennent un grand nombre de champs. - Les flux d'écran sont construits sur LWC, avec la plupart des composants prêts à l'emploi individuels désormais convertis en LWC, à l'exception de deux composants prêts à l'emploi : Chargement de fichier et image. L'équipe de Flow a converti le client d'exécution de flux en Composants Web Lightning ainsi que la plupart de ses composants, mais les clients doivent encore convertir leurs composants d'écran Aura en Composants Web Lightning. Non seulement cela, mais Salesforce prend en charge uniquement les composants LWC dans la nouvelle infrastructure de composants réactifs dans les flux d'écran. Il existe un excellent module Trailhead qui explique comment procéder: [Composants Web Lightning pour développeurs Aura](https://trailhead.salesforce.com/en/content/learn/modules/lightning-web-components-for-aura-developers). Il va sans dire : Si vous envisagez d'élaborer un composant personnalisé pour un flux d'écran ou un autre conteneur, choisissez toujours LWC. - Il existe quelques versions d'OmniStudio disponibles. Si vous êtes un client de longue date, vous utilisez peut-être Angular. Nous encourageons tous les nouveaux clients à commencer avec les Omniscripts et les FlexCards basés sur LWC, et les clients existants à migrer hors d'Angular. - LWC est construit sur ... LWC bien sûr. C’est un freebie. 🤓 ## Mot de la fin En tant qu'architecte, il est important de bien comprendre toutes les options qui s'offrent à vous et comment les appliquer à votre cas d'utilisation spécifique. Pour élaborer des formulaires sur Salesforce, les options vont du low-code (utilisation de Formulaires dynamiques dans le Générateur d'applications Lightning, de Flux d'écran dans Flow Builder et d'Omniscripts dans OmniStudio) au pro-code (utilisation de l'infrastructure LWC), avec une combinaison de flux d'écran ou d'Omniscripts et LWC au milieu. Tenez compte de ce guide et utilisez-le comme référence lorsque vous envisagez d'élaborer ou de reconcevoir des formulaires dans Salesforce. Si vous recherchez des conseils pour concevoir des formulaires rationalisés et utiles, consultez [Salesforce Well-Architected: Engagé.](/docs/architect/fr-fr/well-architected/guide/engaging) ### Dites-nous ce que vous pensez Aidez-nous à publier ce qui vous intéresse le plus : [répondez à notre sondage](https://forms.gle/FCFCES6vsRbKv4E29) pour nous faire part de vos commentaires sur ce contenu et nous dire ce que vous aimeriez voir ensuite. ## Vue d'ensemble Les architectures Salesforce modernes sont de plus en plus pilotées par le traitement asynchrone, non pas comme une commodité, mais comme une exigence stratégique d'échelle. Ces dernières années, nous avons vu de plus en plus d'entreprises faire face à des volumes de données en augmentation, à des intégrations complexes impliquant plusieurs points de contact et à l'essor des systèmes autonomes fonctionnant 24/7/365. Toutes ces choses poussent les architectes à concevoir des systèmes qui sont d'abord asynchrones. Le traitement asynchrone dans Salesforce implique souvent de concevoir en fonction des limites et de la complexité du gouverneur. Ces limites agissent comme des garde-fous et des contraintes architecturales qui aident à produire des systèmes évolutifs et sûrs en masse. Bien qu'aucune limite de plate-forme ne serve directement à gérer la complexité, les [modèles de conception](https://refactoring.guru/design-patterns) peuvent aider à atténuer les risques sur ce front. En interne, Salesforce repousse souvent les limites de la plate-forme pour tester de nouvelles fonctionnalités et automatiser des processus métiers complexes. Nous avons élaboré une infrastructure de traitement asynchrone basée sur une étape pour exécuter des tâches asynchrones avec un nombre arbitraire d'étapes. Chaque étape peut être exécutée, réessayée et redémarrée indépendamment avec des contrôles de gouvernance partagés et une visibilité opérationnelle totale via la consignation centralisée. Le présent document décrit ses principaux éléments architecturaux : Apex et finaliseurs Queueable, flux planifié, curseurs Apex, actions invocables et intégrations à Slack. Ensemble, ces composants offrent une architecture modulaire, évolutive et observable adaptée à l'évolution des besoins de l'entreprise. ## Principaux points à retenir - Les architectures Salesforce modernes doivent adopter une approche asynchrone avant tout pour atteindre l'échelle, la résilience et la transparence opérationnelle. - La division d'un travail complexe en étapes exécutables indépendantes permet d'obtenir des performances prévisibles, des tentatives plus sûres, un pointage, une restauration et une évolution modulaire sans reconcevoir les workflows de base. - L'infrastructure offre une alternative évolutive aux tâches par lot monolithiques et vieillissantes, aux appels asynchrones enchaînés et aux flux profondément imbriqués, et est conçue pour les charges de travail à haut volume qui doivent évoluer horizontalement dans Salesforce sans orchestration hors plate-forme. - Une exécution déterministe et observable garantit le suivi des progrès, la surveillance des accords de niveau de service, les diagnostics d'échec et la transparence au niveau de l'audit grâce à une consignation et une gouvernance centralisées. - Conçu pour la rigueur de l'entreprise, notamment la gouvernance unifiée, la conformité et le contrôle de l'État distribué à travers des processus métiers à long terme. ## Meilleures pratiques de la plate-forme Avant de passer en revue les exigences, voici quelques recommandations à ne pas faire pour utiliser une infrastructure de ce type. Réfléchissez surtout au système qui est la source unique de vérité. Si votre organisation Salesforce s'appuie peu sur des données externes, mais doit passer de centaines à des millions d'enregistrements, envisagez une infrastructure asynchrone basée sur une étape. **N'**utilisez cette infrastructure que si : - La plupart (ou toutes) les informations sur lesquelles agir existent déjà dans votre CRM. - Le coût initial ou permanent de la maintenance d'une tâche ETL (Extract Transform Load) pour harmoniser les données externes est trop élevé. - Vous devez reporter le traitement d'un grand nombre d'enregistrements Salesforce selon une planification définie. - Vous pouvez décomposer le traitement en étapes discrètes. Par exemple, vous pouvez créer un ensemble d'enregistrements hiérarchiques ou arborescents, en particulier si le volume de données s'étend à la hiérarchie ou à l'arborescence. **N'**utilisez pas cette infrastructure si : - La création ou la mise à jour d'enregistrements nécessite un recalcul immédiat. - L'intégration est difficile, car les systèmes externes hébergent les données principales pour les mises à jour d'enregistrements. (vous pouvez envoyer automatiquement des données mises à jour à Salesforce avec l'API de transfert en masse). Avec ces pratiques à l'esprit, révisons nos exigences et commençons à élaborer. ## Répartition des exigences Tenez compte de l'énoncé du problème : > Avec une tâche qui doit être exécutée quotidiennement, vérifiez si certains enregistrements remplissent des critères préétablis pour un traitement ultérieur. S'ils le font, lancez ces tâches de traitement. Le traitement d'enregistrements peut impliquer l'extraction de données de plusieurs systèmes externes pour effectuer des calculs. Les étapes des tâches doivent notifier les personnes via Slack que les enregistrements traités sont prêts à être révisés. Les étapes doivent également escalader les notifications aux responsables et aux échelons supérieurs de la hiérarchie des rôles en fonction d'un délai configurable après la première série de notifications. Ce problème implique plusieurs étapes différentes, dont certaines peuvent se produire indépendamment les unes des autres. Il existe de nombreuses façons de répartir le travail. Voici un regroupement : - Le planificateur. - L'interface de l'étape et les implémentations concrètes qui traitent les enregistrements (quel que soit le type de traitement). - Le processeur qui organise les étapes. - L'Apex Invocable appelé par le planificateur. - L'élément de notification. On utilise le [SDK Apex Slack](https://developer.salesforce.com/docs/platform/salesforce-slack-sdk/guide/overview.html). - L'expression « délai configurable » cache une certaine complexité. Nous allons examiner cette complexité plus loin dans cet article. Voici un diagramme de l'infrastructure élaborée : Diagramme architectural montrant Planificateur de flux, traitement asynchrone Apex et différentes implémentations d ' étapes possibles Maintenant, décomposez ce diagramme et commencez à construire les pièces. ## Planification avec un flux planifié Le flux planifié offre plusieurs avantages en tant que mécanisme de planification : - Les flux planifiés peuvent être empaquetés et déployés en tant que métadonnées. Ce n'est pas vrai pour les tâches planifiées via Apex (ou via la page Tâches planifiées). - L'élément Attente est essentiel pour les infrastructures qui nécessitent une légende. En l'utilisant dans Flux, les appels externes ne sont pas nécessaires dans la partie Invocable de l'infrastructure. - La granularité de la planification remplit les exigences : l'intervalle minimal pour les flux planifiés est quotidien. Si vous avez besoin d'une fréquence plus élevée (par exemple, toutes les heures), reconsidérez Flux planifié pour cette exigence. Une autre considération lors de la configuration du flux planifié est le portage de l'environnement. Avant d'invoquer l'action Apex, ajoutez un élément Décision qui évalue la variable `{!$Api.Enterprise_Server_URL_100}`. Cela garantit que la tâche est exécutée uniquement dans les environnements prévus, tels que UAT et Production. Ce schéma est important, car les sandbox sont fréquemment actualisées ou créées pendant le développement de l'infrastructure, et sans vérification explicite de l'environnement, un flux planifié peut involontairement être exécuté dans des environnements où l'infrastructure n'est pas conçue pour être exécutée. L'utilisation de l'opérateur `contains` dans l'élément Décision rend la configuration résiliente aux futures créations de sandbox ou aux changements d'URL. Enfin, déterminez comment l'infrastructure doit capturer les échecs. Ajoutez toujours un chemin de défaut lorsque Flux appelle n'importe quelle action. Vous pouvez par exemple câbler les défauts à l'action « Ajouter une entrée au journal » [de Nebula Logger](https://www.nebulalogger.com/). Nebula Logger écrit des journaux dans des objets personnalisés. Par conséquent, les clients doivent savoir que les données des journaux consomment du stockage dans l'organisation. Par défaut, les journaux sont stockés pendant 14 jours dans une organisation, puis nettoyés. Cette période de rétention est configurable. Nebula Logger utilise également les événements de plate-forme pour publier des journaux. Par conséquent, les entrées dans les journaux sont enregistrées indépendamment de la transaction de traitement des données principale. Cela garantit la capture des échecs, même si l'action principale Flux ou Apex est annulée. Les clients doivent évaluer le volume de consignation attendu et les exigences de rétention en envisageant l'ajout d'une infrastructure de consignation. Le flux se présente comme suit : Le flux planifié contenant un élément Décision d ' exécution ou non, un élément Interrompre pour autoriser les appels externes, et l ' action Apex Invocable appelée avec le chemin d ' interruption de l ' Enregistreur Nebula Passons aux premiers bouts de code Apex avec l'exigence de planification désormais satisfaite. ## Création d'une interface d'étape Définissez une interface de `Step` : ```java public interface Step { void execute(); void finalize(); String getName(); Boolean shouldRestart(); } ``` Pour cet article, l'interface de `step` est affichée en tant que classe externe pour plus de clarté. L'infrastructure elle-même est flexible. Les équipes peuvent organiser l'interface et ses implémentations en utilisant n'importe quel modèle d'empaquetage Apex de leur choix, à condition que toutes les classes Étape référencent la même interface. Voici quelques points à noter concernant les méthodes définies dans notre interface : - La `execute`, bien que sans argument pour le moment, s'améliore lorsque nous passons une classe (ou interface) de `State` pour orchestrer les données entre les étapes lorsque l'ordre importe. - `getName` peut renvoyer une valeur de `System.Type` au lieu d'une `String`. L'objectif est de fournir à la couche d'orchestration un moyen de consigner les noms d'étape sans exposer d'autres propriétés. Voici la première mise en œuvre concrète qui montre comment ces pièces s’agencent. À une exception près plus loin, nous recommandons d'utiliser Apex Queueable pour implémenter le traitement asynchrone dans Apex; Apex par lot est généralement inutile (et les méthodes de `@future` sont déconseillées). Apex Queueable démarre rapidement et présente, avec les curseurs Apex, de nombreux avantages par rapport aux Apex batch. ### Une implémentation Apex semblable à un curseur Les [curseurs Apex](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_cursors.htm) offrent une alternative moderne au modèle Apex traditionnel par lot. De la même façon qu'un traitement par lot, une implémentation de curseur peut récupérer des enregistrements par segments (jusqu'à 2000 par lot). Cependant, les curseurs autorisent plusieurs récupérations dans une seule transaction, ce qui augmente considérablement le débit pour les opérations à grand volume. Lors de l'adoption des curseurs dans ce cadre, les équipes doivent être conscientes des limitations actuelles en matière de test et de moquabilité. Le comportement du curseur dans les tests peut différer de celui de la production. Par conséquent, il est important de concevoir des stratégies de test qui évitent de dépendre des internes du curseur et valident à la place la logique d'orchestration aux frontières. À mesure que la plate-forme évoluera, ces domaines continueront de s'améliorer, mais les orientations principales demeurent les suivantes : Les curseurs offrent des performances supérieures et réduisent les surcharges d'orchestration par rapport à Apex par lot pour de nombreux cas d'utilisation. Pour définir une frontière claire entre le curseur fourni par le système et votre propre code, nous recommandons de créer une représentation de type curseur lors de l'implémentation de l'interface de `Step`. Tenez compte du code suivant : ```java public inherited sharing abstract class CursorStep implements Step { private static final Integer MAX_CHUNK_SIZE = 2000; protected Cursor cursor; private Integer chunkSize = System.Limits.getLimitDMLRows(); private Integer position = 0; protected abstract Cursor getCursor(); protected abstract void innerExecute(List records); public abstract String getName(); public virtual CursorStep withChunkSize(Integer chunkSize) { this.chunkSize = chunkSize; return this; } public void execute() { this.cursor = this.cursor ?? this.getCursor(); this.cursor.setFetchesPerTransaction(this.getFetchesPerTransaction()); List records = new List(); if (this.shouldAdvance()) { records = this.cursor.fetch(this.position, this.chunkSize); this.position += this.chunkSize; } this.innerExecute(records); } public virtual void finalize() { Logger.info('finished cursor step for ' + this.getName()); } public virtual Boolean shouldRestart() { return this.position < this.cursor.getNumRecords(); } protected virtual Integer getFetchesPerTransaction() { Integer maxRecordsPerFetchCall = 2000; if (this.chunkSize < maxRecordsPerFetchCall) { return this.chunkSize; } // Integer division rounds down // which is perfect for our use-case return this.chunkSize / maxRecordsPerFetchCall; } protected virtual Boolean shouldAdvance() { return true; } } ``` Notez la classe `Cursor`. Les curseurs Apex sont des instances de `Database.Cursor`, mais notre implémentation `Cursor` nous donne la flexibilité nécessaire pour contourner les lacunes des curseurs. Voici l'implémentation : ```java public virtual without sharing class Cursor { private static final Integer MAX_FETCHES_PER_TRANSACTION = Limits.getLimitFetchCallsOnApexCursor(); @TestVisible private static Integer maxRecordsPerFetchCall = 2000; private Integer cursorNumRecords; private Integer fetchesPerTransaction = MAX_FETCHES_PER_TRANSACTION; private final Database.Cursor cursor; public Cursor( String finalQuery, Map bindVars, System.AccessLevel accessLevel ) { try { this.cursor = Database.getCursorWithBinds(finalQuery, bindVars, accessLevel); } catch (FatalCursorException e) { Logger.newEntry( System.LoggingLevel.WARN, 'Error creating cursor. This can happen if there' + ' are no records returned by the query: ' + e.getMessage() ); } } public Cursor setFetchesPerTransaction(Integer possibleFetchesPerTransaction) { // Handle accidental round downs from Integer division if (possibleFetchesPerTransaction == 0) { return this; } if (possibleFetchesPerTransaction > MAX_FETCHES_PER_TRANSACTION) { Logger.newEntry( System.LoggingLevel.DEBUG, 'Fetches per transaction: ' + possibleFetchesPerTransaction + ' exceeded platform max fetches per transaction: ' + MAX_FETCHES_PER_TRANSACTION + ', defaulting to platform max' ); possibleFetchesPerTransaction = MAX_FETCHES_PER_TRANSACTION; } this.fetchesPerTransaction = possibleFetchesPerTransaction; return this; } @SuppressWarnings('PMD.EmptyStatementBlock') protected Cursor() { } public virtual List fetch(Integer start, Integer advanceBy) { if (this.getNumRecords() == 0) { Logger.newEntry( System.LoggingLevel.DEBUG, 'Bypassing fetch call, no records to fetch' ); return new List(); } Integer localStart = start; List results = new List(); while ( Limits.getFetchCallsOnApexCursor() < this.fetchesPerTransaction && results.size() < this.getNumRecords() && localStart < start + advanceBy ) { Integer actualAdvanceBy = this.getAdvanceBy(localStart, advanceBy); results.addAll(this.cursor?.fetch(localStart, actualAdvanceBy) ?? new List()); localStart += actualAdvanceBy; } return results; } public virtual Integer getNumRecords() { this.cursorNumRecords = this.cursorNumRecords ?? this.cursor?.getNumRecords() ?? 0; return this.cursorNumRecords; } protected Integer getAdvanceBy(Integer start, Integer advanceBy) { Integer possibleFetchSize = Math.min(advanceBy, this.getNumRecords() - start); if (possibleFetchSize > maxRecordsPerFetchCall) { Logger.newEntry( System.LoggingLevel.DEBUG, 'Fetch size: ' + possibleFetchSize + ' exceeded platform max fetch size of ' + maxRecordsPerFetchCall + ', defaulting to max fetch size' ); possibleFetchSize = maxRecordsPerFetchCall; } else if (possibleFetchSize < 0) { possibleFetchSize = 0; } return possibleFetchSize; } } ``` Pour la suite de cet article, nous omettons les déclarations de `sharing` en faisant référence à des classes Apex. En pratique, assurez-vous que les classes de niveau supérieur sont explicitement utilisées avec ou sans partage pour être conformes à votre modèle d'objet et à vos autorisations. Notez également que notre implémentation `Cursor` délègue à la `Database.Cursor` de plate-forme, avec des avantages supplémentaires discutés ci-dessous. Pour commencer, voici les tests correspondants : ```java @IsTest private class CursorTest { @IsTest static void itCapsAdvanceByArgument() { String accountName = 'helloWorld!'; insert new Account(Name = accountName); String query = 'SELECT Name FROM Account WHERE Name = :bindVar0'; Map bindVars = new Map{ 'bindVar0' => accountName }; Cursor instance = new Cursor(query, bindVars, System.AccessLevel.SYSTEM_MODE); Assert.areEqual(1, instance.getNumRecords()); Assert.areEqual(accountName, instance.fetch(0, 1000).get(0).get('Name')); Assert.areEqual(1, System.Limits.getApexCursorRows()); } @IsTest static void itCapsMaxRecordsPerFetchCall() { Cursor.maxRecordsPerFetchCall = 20; Integer oneMoreThanMaxFetch = Cursor.maxRecordsPerFetchCall + 1; List accounts = new List(); for (Integer i = 0; i < oneMoreThanMaxFetch; i++) { accounts.add(new Account(Name = 'Fetch ' + i)); } insert accounts; Exception ex; List results; Cursor instance = new Cursor( 'SELECT Id FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ); try { results = instance.fetch(0, oneMoreThanMaxFetch); } catch (System.InvalidParameterValueException e) { ex = e; } Assert.areEqual(null, ex?.getMessage()); Assert.areEqual(2, Limits.getFetchCallsOnApexCursor()); Assert.areEqual(oneMoreThanMaxFetch, results.size()); } @IsTest static void itFetchesMultipleTimesPerTransactionWhenMoreThanMaxFetch() { Cursor.maxRecordsPerFetchCall = 20; List accounts = new List(); Set expectedFetchNames = new Set(); for (Integer i = 0; i < Cursor.maxRecordsPerFetchCall + 1; i++) { String accountName = 'Fetch' + i; expectedFetchNames.add(accountName); accounts.add(new Account(Name = accountName)); } insert accounts; Integer oneMoreThanMaxFetch = Cursor.maxRecordsPerFetchCall + 1; Cursor instance = new Cursor( 'SELECT Name FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ); List results = instance.setFetchesPerTransaction(2).fetch(0, oneMoreThanMaxFetch); Assert.areEqual(Cursor.maxRecordsPerFetchCall + 1, results.size()); Assert.areEqual(2, Limits.getFetchCallsOnApexCursor()); Set actuallyFetchedNames = new Set(); for (Account account : (List) results) { actuallyFetchedNames.add(account.Name); } Assert.areEqual(expectedFetchNames, actuallyFetchedNames); } @IsTest static void itFetchesMultipleTimesPerTransaction() { Cursor.maxRecordsPerFetchCall = 1; insert new List{ new Account(Name = 'One'), new Account(Name = 'Two') }; Cursor instance = new Cursor( 'SELECT Id FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ) .setFetchesPerTransaction(2); List results = instance.fetch(0, 2); Assert.areEqual(2, instance.getNumRecords()); Assert.areEqual(2, results.size()); results = instance.fetch(2, 1); Assert.areEqual(0, results.size()); } @IsTest static void fetchesCorrectAmountOfRecords() { List accounts = new List(); for (Integer i = 0; i < 10; i++) { accounts.add(new Account(Name = 'Fetch ' + i)); } insert accounts; Cursor instance = new Cursor( 'SELECT Id FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ) .setFetchesPerTransaction(10); List results = instance.fetch(0, 2); Assert.areEqual(2, results.size(), '' + results); Assert.areEqual(1, Limits.getFetchCallsOnApexCursor()); } @IsTest static void doesNotExceedPlatformMaxFetch() { List accounts = new List(); for (Integer i = 0; i < 101; i++) { accounts.add(new Account(Name = 'Fetch ' + i)); } insert accounts; Test.startTest(); Cursor instance = new Cursor( 'SELECT Id FROM Account', new Map(), System.AccessLevel.SYSTEM_MODE ) .setFetchesPerTransaction(100); Integer counter = 0; List results; while (counter <= 100) { results = instance.fetch(counter, counter + 1); counter++; } Test.stopTest(); Assert.areEqual(101, counter); Assert.areEqual(0, results.size()); } } ``` En rendant les `Cursor` virtuelles, les implémentations `CursorStep` concrètes peuvent fonctionner sans `Database.Cursor` lorsqu’elles n’ont pas besoin d’itérer un ensemble d’enregistrements volumineux, de la même façon qu’en renvoyant un `System.Iterable` au lieu d’un `Database.QueryLocator` dans Apex batch. Voici un exemple : ```java public abstract class CursorLikeImplementation extends CursorStep { private final Cursor cursorLike; public CursorLikeImplementation(List previouslyRetrievedRecords) { this.cursorLike = new CursorLike(previouslyRetrievedRecords); } public override String getName() { return CursorLikeImplementation.class.getName(); } public override Cursor getCursor() { return this.cursorLike; } private class CursorLike extends Cursor { private final List records; public CursorLike(List records) { super(); this.records = records; } public override List fetch(Integer position, Integer chunkSize) { // clone, to keep the underlying list type List clonedRecords = this.records.clone(); clonedRecords.clear(); for (Integer i = position; i < this.getAdvanceBy(position, chunkSize); i++) { clonedRecords.add(this.records[i]); } return clonedRecords; } public override Integer getNumRecords() { return this.records.size(); } } } ``` Notez que cette classe est également abstraite, elle laisse l'implémentation concrète de `innerExecute` à des sous-classes. Il existe également une alternative à la sous-classe interne `CursorLike`. Si vous savez que les versions concrètes d'une étape comme celle-ci ne brûleront pas à travers les autres limites du gouverneur, vous pouvez renvoyer `this.records` depuis `CursorLike.fetch` et remplacer le `CursorStep.shouldRestart()` parent pour renvoyer false. Cela permet d'itérer sur une liste limitée uniquement par la limite en heap Apex de 12 Mo par transaction asynchrone. ### Autres implémentations basées sur une étape possibles Notre implémentation basée sur le curseur nous offre beaucoup de flexibilité lors de la pagination sur de grandes quantités de données. L'interface de `Step`, quant à elle, nous offre la flexibilité nécessaire pour décrire et encapsuler toutes sortes d'étapes. Prenons une étape basée sur un flux : ```java public virtual class FlowStep implements Step { private final Invocable.Action specificFlow; private Boolean shouldRestart = false; public FlowStep(String specificFlowName, Map inputs) { this.specificFlow = Invocable.Action.createCustomAction('flow', specificFlowName); this.specificFlow.setInvocations(new List>{ inputs }); } public void execute() { List results = this.specificFlow.invoke(); for (Invocable.Action.Result result : results) { if (result.isSuccess()) { Map outputParams = result.getOutputParameters(); Object potentialShouldRestartValue = outputParams.get('shouldRestart'); // Flow does not enforce Booleans being initialized // so a null check is sadly necessary here if (potentialShouldRestartValue != null) { this.shouldRestart = this.shouldRestart || Boolean.valueOf(potentialShouldRestartValue); } } else { List errorMessages = new List(); for (Invocable.Action.Error error : result.getErrors()) { errorMessages.add( 'Error code: ' + error.getCode() + ', error message: ' + error.getMessage() ); } Logger.error( 'An error occurred within your auto-launched flow:\n' + String.join(errorMessages, '\n\t') ); } } } public virtual void finalize() { Logger.info(this.getName() + ' finished processing'); } public String getName() { return FlowStep.class.getName() + ':' + this.specificFlow.getName(); } public Boolean shouldRestart() { return this.shouldRestart; } } ``` Les flux ne peuvent pas renvoyer des paramètres de sortie conformes à un type défini par Apex. Par conséquent, nous vérifions la présence d'un paramètre de sortie `shouldRestart` avant de l'utiliser. Certaines étapes peuvent être signalées par une fonctionnalité. Vous pouvez implémenter une logique pour décider des étapes à inclure ou utiliser une étape sans option pour une fonctionnalité désactivée. Le [modèle Objet nul](https://refactoring.guru/introduce-null-object) est un moyen courant de réduire la complexité dans la couche d'orchestration : ```java @SuppressWarnings('PMD.EmptyStatementBlock') public class NoOpStep implements Step { // The null object pattern is commonly implemented // as a singleton to reduce memory consumption public static final NoOpStep SELF { get { SELF = SELF ?? new NoOpStep(); } private set; } public void execute() { } public void finalize() { } String getName() { return NoOpStep.class.getName(); } Boolean shouldRestart() { return false; } } ``` Nous avons maintenant plusieurs blocs de construction à travailler. Examinons la couche d'orchestration responsable de l'itération des étapes. ## Création d'un processeur d'étape Le processeur est un point d'inflexion dans l'architecture. Nous devons décider qui définit les étapes à initialiser et où. Les options comprennent : - Demandez au processeur de définir les étapes à mapper avec une logique métier. Cette option est simple, mais son échelle est faible pour la lisibilité. - Définissez le mappage avec des métadonnées personnalisées (CMDT). Les champs Relation des métadonnées ne prennent pas en charge les `ApexClass`, qui couplent vaguement l'orthographe du nom de classe dans la configuration de vos processus métiers. Vous pouvez réduire le risque administrateur en définissant le champ en tant que liste de sélection et en validant l'existence du type (`Type.forName()` ou en interrogeant des `ApexClass`), mais comme les enregistrements CMDT ne prennent pas en charge les déclencheurs, la validation est effectuée à l'exécution. Cet itinéraire peut être testé, mais les administrateurs peuvent créer des enregistrements CMDT uniquement en production. - Définissez le mappage avec des enregistrements. Les non-administrateurs peuvent configurer des étapes, mais les déploiements deviennent plus difficiles et les environnements peuvent dériver. Procédez avec précaution. Il y a une citation célèbre de [Clean Code](https://www.oreilly.com/library/view/clean-code-a/9780136083238/) sur la façon de gérer cette partie particulière de complexité : > La solution à ce problème est d'enterrer l'instruction `switch` [pour fabriquer des objets] dans le sous-sol d'une usine abstraite, et de ne jamais laisser personne la voir. Avec cela à l'esprit, et parce que notre nombre actuel d'étapes est bien défini et qu'il est peu probable qu'il augmente trop, il est correct que le processeur d'étape soit également l'usine pour les étapes. Cela peut utiliser une énumération pour piloter l'instruction switch : ```java public enum StepType { TYPE_ONE, TYPE_TWO, TYPE_THREE, TYPE_FOUR // etc ... } ``` Et puis pour notre `StepProcessor`: ```java public StepProcessor implements System.Queueable, System.Finalizer, Database.AllowsCallouts { private final List steps = new List(); private Step currentStep; public StepProcessor setSteps(List stepTypes) { for (StepType type : stepTypes) { switch on type { WHEN TYPE_ONE { this.addTypeOneSteps(); } WHEN TYPE_TWO { this.addTypeTwoSteps(); } // ... etc } } this.cleanSteps(); return this; } public void execute(System.QueueableContext context) { this.currentStep = this.currentStep ?? this.steps.remove(0); if (context != null) { System.attachFinalizer(this); Logger.setAsyncContext(context); } Logger.info('Executing step ' + this.currentStep.getName()); try { this.currentStep.execute(); } catch (Exception e) { Logger.exception('Unexpected exception', e); } Logger.info('Finished executing step ' + this.currentStep.getName()); Logger.saveLog(); } public void execute(System.FinalizerContext context) { Logger.info('Executing finalizer for step ' + this.currentStep.getName()); Logger.setAsyncContext(context); switch on context?.getResult() { when UNHANDLED_EXCEPTION { // see the note below about this logging paradigm Logger.warn( 'Failed to run on step' + this.currentStep, context?.getException() ); } when else { this.currentStep.finalize(); if (this.currentStep.shouldRestart()) { this.kickoff(); } else if (this.steps.isEmpty() == false) { this.currentStep = this.steps.remove(0); this.kickoff(); } else { Logger.info('Finished executing steps'); } } } Logger.info( 'Finished executing finalizer for step ' + this.currentStep.getName() ); Logger.saveLog(); } public String kickoff() { return this.steps.isEmpty() ? null : System.enqueueJob(this); } private void cleanSteps() { for (Integer reverseIndex = this.steps.size() - 1; reverseIndex >= 0; reverseIndex--) { if (this.steps[reverseIndex] instanceof NoOpStep) { this.steps.remove(reverseIndex); } } } private void addTypeOneSteps() { this.steps.addAll( new List { new ExampleCursorStepOne(), new ExampleCursorStepTwo() } ); } private void addTypeTwoSteps() { this.steps.addAll( new List { new FlowStep(' ExampleInvocableName', new Map( 'exampleParameter' => true) ), new ExampleCursorStepThree() } ); } } ``` Les méthodes d'usine affichées, par exemple `addTypeOneSteps()`, peuvent déléguer des problèmes tels que le marquage des fonctionnalités. `cleanSteps()` effectue un contrôle unique des étapes rassemblées pour s'assurer qu'il n'y a pas d'étapes « vides » avant la synchronisation. Ça pourrait ressembler à ça : ```java private Step getStepOrDefault(String customPermissionName, Step defaultStep) { if (System.FeatureManagement.checkPermission(customPermissionName)) { return defaultStep; } return NoOpStep.SELF; } ``` Nous n'avons pas abordé le traitement des erreurs depuis que nous avons mentionné Nebula Logger dans la section Flux planifié. En effet, `System.Finalizer` nous permet de couvrir la consignation de toutes les conditions d'erreur sans ajouter de traitement spécifique des erreurs à chaque étape. Chaque `Step` se concentre sur la course à pied, tandis que nous consignons et renversons tous les chemins malheureux afin qu'ils soient exposés dans des tests unitaires. Cela prend en charge l'itération sécurisée et les alertes au niveau de la production (en utilisant le [plug-in Slack Logger pour Nebula](https://github.com/jongpie/NebulaLogger/tree/main/nebula-logger/plugins/slack) pour tous les journaux WARN et ERROR). Une remarque concernant la consignation des erreurs: transmettre l'instance de l'étape dans des messages de consignation suppose un niveau de Trust dans ce qui devient visible dans les journaux. La `toString()` par défaut des classes Apex inclut dans le message toutes les propriétés statiques et au niveau de l'instance. Cela peut être souhaitable — ou cela peut divulguer des informations confidentielles. Bien que la consignation et la sécurité ne soient pas au centre des préoccupations ici, notez que pour certains systèmes, l'adhésion à une interface telle que `Step` peut également impliquer de forcer un remplacement pour `toString()`. ```java public interface Step { void execute(); void finalize(); String getName(); Boolean shouldRestart(); String toString(); } ``` Une telle méthode impose à chaque créateur d'objet de décider ce qui est autorisé à imprimer, ce qui peut être souhaitable. Au niveau de la consignation : au niveau `StepProcessor`, nous utilisons `INFO`, le niveau sans erreur le plus élevé. À mesure que vous gagnez en précision dans l'application, les niveaux de consignation devraient diminuer en conséquence. Les étapes individuelles peuvent utiliser des `DEBUG` pour des informations générales, les `FINE`, `FINER` et `FINEST` étant réservés à des produits de plus en plus détaillés. La consignation est autant un art qu'une science, mais suivre ces principes permet de garder les journaux cohérents et utiles. ### Traitement de complexité supplémentaire dans le processeur de l'étape Avant de passer à autre chose, réfléchissons brièvement à la décision de laisser notre processeur d'étape héberger la logique pour laquelle les étapes sont utilisées. Dans une vaste base de codes, vous pouvez définir des `StepProcessor` virtuelles ou abstraites, et demander aux sous-classes d'identifier des étapes spécifiques pour établir une séparation appropriée des préoccupations. ## La couche invocable Apex Le planificateur finit par invoquer Apex . Une fois le reste de la configuration terminée, la section Apex invocable peut décider quelles étapes doivent être exécutées et transmettre le `List` au processeur : ```java public class DailyJobExecutor { @InvocableMethod(label='Execute Daily Job') public static void executeJob() { Logger.info('Executing daily Job'); List correspondingTypes = new List(); // based on [business logic], determine which step types // should be included for any daily invocation if (correspondingTypes.isEmpty() == false) { try { new StepProcessor().setSteps(correspondingTypes).kickoff(); } catch (Exception ex) { Logger.exception('Error starting job', ex); } } } Logger.saveLog(); } ``` Il s'agit d'une partie simple de l'équation, qui utilise des enregistrements, des données ou une logique pour déterminer les types d'étape à exécuter. L'action invocable est simple, car nous avons encapsulé la complexité ailleurs. Nous avons également protégé contre les exceptions inattendues et facilité le test de chaque pièce isolée. ## Traitement des délais avant d'appeler Slack Le [Kit de développement Apex Slack](https://developer.salesforce.com/docs/platform/salesforce-slack-sdk/guide/overview.html) dépasse le cadre de cet article, mais il convient de revenir sur l ' un des problèmes potentiels liés aux exigences : notifier les personnes de rang supérieur dans la hiérarchie des rôles en fonction d ' un délai configurable. Sur le papier, c'est simple, et vous pourriez (correctement) considérer la `System.enqueueJob(this)` dans le `StepProcessor`. Avec [System.AsyncOptions](https://developer.salesforce.com/docs/atlas.en-us.apexref.meta/apexref/apex_class_System_AsyncOptions.htm), notre penchant initial était d'utiliser la surcharge de `enqueueJob` pour satisfaire cette exigence. Pour le moment, cependant, le délai maximal via `System.AsyncOptions.MinimumQueueableDelayInMinutes` est de 10 minutes. Comme l'exigence est de 120 minutes, il reste quelques options. Une approche naïve pourrait ressembler à ceci : ```java public class ExampleDelayedNotifier implements Step { private final List notifications = new List(); private final Slack.BotClient botClient = Slack.App .getAppByKey('some-slack-app-key') .getBotClientForTeam('slack team id'); // account for the initial delay, // so 120 - 10 = 110 private Integer delayMinutes = 110; public void execute() { if ( this.delayInMinutes > 0) { return; } Integer maximumAllowedCallouts = 100; while (this.notifications.isEmpty() == false && maximumAllowedCallouts > 0) { this.botClient.chatPostMessage(this.notifications.remove(0)); maximumAllowedCallouts--; } } public void finalize() { this.delayInMinutes -= 10; } public String getName() { return ExampleDelayedNotifier.class.getName(); } public Boolean shouldRestart() { return this.delayInMinutes > 0 || this.notifications.isEmpty() == false; } } ``` En pratique, le délai serait transmis dans cette classe, car il est piloté par la configuration. Nous recommandons cette approche, sauf si vous êtes certain qu'il n'y aura jamais qu'un seul type de notification retardée. Il brûle 11 tâches asynchrones supplémentaires avant de démarrer (ou plus, si le délai augmente). Ce coût peut convenir pour un seul travail, pas pour beaucoup. Vous devez également ajouter une méthode à l'interface de `Step` afin que chaque étape indique au processeur le temps d'attente avant le redémarrage, ce qui ajoute du bruit. Cela nous laisse deux possibilités intéressantes : - Vous pouvez insérer l'étape retardée dans votre infrastructure de travail existante si vous avez déjà planifié une tâche d'interrogation à un intervalle approprié. Vous devriez également être d'accord avec le délai spécifié frappant jusqu'à 15 minutes plus tard (15 minutes est l'intervalle d'actualisation minimum pour une expression CRON planifiée Apex). Cela correspond à peu près à l'exemple Apex invocable; la planification est effectuée à la place via Apex. En d'autres termes, vous pouvez réutiliser la même architecture basée sur l'`Step` pour traiter les enregistrements basés sur un horodatage « Commencer après » et choisir les étapes à utiliser en fonction d'un mappage de liste de sélection ou de liste à sélection multiple avec les valeurs d'énumération `StepType` précédemment affichées. - Alternativement, si vous êtes à l’aise pour définir une classe Apex externe supplémentaire, rabattez-vous sur Apex par lot (contrairement à Apex Queueable, qui prend en charge les classes internes, les classes Apex par lot doivent être des classes externes) en utilisant `System.scheduleBatch()`. Prenons l'exemple Apex par lot. Bien que nous recommandons généralement Apex Queueable pour la flexibilité et le contrôle, c'est un cas où Apex Batch règne toujours en maître: ```java public class DelayedNotifier implements Database.Batchable { private final StepProcessor processor = new StepProcessor(); public Iterable start(Database.BatchableContext bc) { return new List(); } @SuppressWarnings('PMD.EmptyStatementBlock') public void execute(Database.BatchableContext bc, Object scope) { // we don't need to actually do anything in execute, // we just need to start up the processor in finish } public void finish(Database.BatchableContext bc) { try { // you can imagine Notifier as an elided, // simpler version of the naive implementation // we showed above, now only focused on sending messages this.processor.setSteps(new List{ new Notifier() }).kickoff(); } catch (Exception ex) { Logger.exception('Unexpected error', ex); } finally { Logger.saveLog(); } } } ``` Imaginez ensuite, dans le `StepProcessor`, que la méthode de `addTypeOneSteps()` précédemment montrée soit mise à jour avec cette étape retardée : ```java public StepProcessor implements System.Queueable, System.Finalizer, Database.AllowsCallouts { // .... unchanged top of class elided private void addTypeOneSteps() { this.steps.addAll( new List { new ExampleCursorStepOne(), new ExampleCursorStepTwo(), new DelayedNotifierStep() } ); } // ... private class DelayedNotifierStep implements Step { private final DelayedNotifier delayedNotifier = new DelayedNotifier(); // again — in practice this value would also be passed in private final Integer delayInMinutes = 120; public void execute() { System.scheduleBatch( this.delayedNotifier, 'Delayed notifier: ' + System.now().getTime(), this.delayInMinutes ); } public void finalize() { Logger.debug('Nothing to finalize, batch scheduled'); } public String getName() { return DelayedNotifierStep.class.getName(); } public Boolean shouldRestart() { return false; } } } ``` Nous recommandons généralement de ne pas sauter autant, mais ce délai d'étape devient un autre bloc de construction réutilisable. Tant que des délais plus longs ne sont pas autorisés dans Apex Queueable, cela représente également la méthode la plus simple pour produire cet effet (sans mécanisme d'interrogation, comme discuté). ## Conclusion Nous avons utilisé la conception orientée objet pour répondre aux exigences et créé un système qui s'adapte tout en équilibrant les coûts à long terme de construction et de maintenance. Bien que la déclaration et l'instanciation d'étapes finissent par l'emporter sur leur place dans le `StepProcessor`, il n'y a guère de dette technique supplémentaire ici. Avec `FlowStep`, les administrateurs et les développeurs peuvent décider ensemble quand les solutions sans code ou pro-code sont les plus pertinentes. En utilisant l'interface `System.Finalizer` dans l'infrastructure Queueable d'Apex, avec Nebula Logger, nous avons construit un système robuste et testable qui nous alerte des échecs imprévus même si les étapes futures n'ont pas de consignation explicite. Pour nous, ce système réduit heureusement les chiffres et réduit les coûts et la complexité. Il nous a également fourni des connaissances précieuses sur le comportement des curseurs Apex sous de réelles charges de travail, nous aidant à affiner notre approche tout en améliorant la fonctionnalité elle-même. En décomposant les charges de travail complexes et à haut volume en étapes d'exécution modulaires, l'infrastructure de traitement asynchrone basé sur des étapes transforme les contraintes de la plate-forme en avantages techniques, ce qui permet des performances prévisibles, l'observabilité et la gouvernance à l'échelle de l'entreprise. Les étapes peuvent être configurées par les administrateurs et les développeurs, et dans les deux cas, les auteurs d'étapes peuvent se concentrer en toute sécurité sur le respect des limites du gouverneur de plate-forme de base (par exemple les lignes DML et les lignes de requête récupérées) sans se soucier de la mise à l'échelle de chaque étape. ## Chemin à suivre Pour rendre opérationnel et adopter ce schéma dans toutes les implémentations d'entreprise, les architectes doivent : - **Évaluez les automatisations existantes** afin d'identifier les zones dans lesquelles l'orchestration asynchrone peut aider à améliorer les performances et l'observabilité. - **Décomposez les grands processus** en étapes exécutables discrètes et indépendantes avec des objectifs de traitement clairs et des points d'auteur discrets (comme Flow ou Apex). - **Définissez et regroupez les types** d'étape pour accélérer la réutilisation et la normalisation des étapes entre les unités commerciales. - **Pilote l'approche** avec de nouveaux processus ou des automatisations existantes. Vous serez peut-être surpris de constater le nombre de cas de bord que vous trouvez gratuitement dans les étapes, les soins de votre consignation intégrée et l'observabilité ! ## À propos de l'auteur James Simone est ingénieur logiciel principal chez Salesforce et possède plus d'une décennie d'expérience sur la plate-forme. Il était client de Salesforce – et propriétaire de produits – avant de se lancer dans le développement, et écrit des plongées techniques approfondies sur Salesforce depuis 2019 dans [Les Joies d’Apex](https://www.joysofapex.com/). Il a déjà publié des articles sur [le blog Salesforce Developer](https://developer.salesforce.com/content-archive?authors=James%20Simone&content-type=Blogs&language=English) et [le blog Salesforce Engineering](https://engineering.salesforce.com/author/james-simone/) également. ## Présentation du guide Il existe une multitude de méthodes pour accéder à, synchroniser et partager des données entre Salesforce et des systèmes externes. Cependant, tous les outils ne sont pas adaptés à votre projet particulier. Ce guide présente le paysage des outils d'intégration de données disponibles dans Salesforce. Il propose également des recommandations sur les outils (ou combinaisons d'outils) les plus appropriés compte tenu d'un cas d'utilisation particulier, ainsi que des conseils sur les outils à éviter pour des scénarios spécifiques. Ce guide de décision se concentre sur les intégrations au niveau des données impliquant Salesforce. Plus précisément, il couvre les cas d'utilisation d'intégration de données suivants : - Salesforce vers des systèmes externes - Systèmes externes à Salesforce - Organisation Salesforce vers organisation Salesforce Il ne s'agit que d'un sous-ensemble des défis auxquels Salesforce Architects est confrontée. Par conséquent, nous envisageons d'ajouter d'autres guides de décision axés sur l'intégration pilotée par l'événement, l'élaboration de workflows efficaces pour les clients ou les employés en utilisant l'intégration de processus, etc. Enfin, il est important de noter que de nombreux outils et approches décrits ici peuvent être utilisés pour résoudre des défis d'intégration dans l'ensemble de l'entreprise, mais ces utilisations dépassent la portée de ce guide. ### Points à retenir - **Évitez les réplications de données inutiles.** Sauf si les données doivent absolument résider dans Salesforce, pensez à la place à la virtualisation des données avec Salesforce Connect. Au final, un plus grand nombre de données dans votre organisation entraîne des volumes de données plus importants, ce qui peut affecter [les performances](/docs/architect/fr-fr/well-architected/guide/reliable#performances) et augmenter la dette technique. Si vos données résident déjà dans Salesforce et que vous en avez besoin dans un système externe, évitez de les copier dans un système externe, sauf en cas de nécessité absolue. À la place, demandez au système externe d'accéder aux données via les API Salesforce. - **Utilisez MuleSoft ou d'autres solutions Enterprise Service Bus (ESB) ou Extraire-Transformer-Load (ETL), si elles sont disponibles et font partie de votre paysage existant.** Ces outils sont conçus pour prendre en charge la migration et la transformation des données. Par conséquent, ils sont souvent dotés de puissantes capacités qui permettent de réutiliser les intégrations dans l'entreprise, de renforcer la gouvernance et de centraliser la gestion des intégrations. Dans ce guide, partout où MuleSoft Anypoint est recommandé, déterminez si votre solution ESB/ETL existante suffit. - **Harmonisez les données de différentes sources avec Data 360 et Data Cloud One.** Grâce au modèle de données Customer 360, à la résolution de l'identité, à la fédération des données et à d'autres fonctionnalités, Data 360 consolide les données de Salesforce et d'autres systèmes externes dans une vue unifiée de votre client. Avec [Data Cloud One](/docs/architect/fr-fr/fundamentals/guide/data360_integration_patterns_and_practices.html#unified-multi-org-data-platform-with-data-cloud-one), les utilisateurs d'autres organisations Salesforce peuvent accéder en toute sécurité aux données partagées virtuellement depuis Data 360 via des espaces de données. - Déplacez des données entre les organisations en utilisant des **actions et des activations Data 360.** Une fois les données ingérées depuis différentes organisations dans Data 360, les [actions et activations](/docs/architect/fr-fr/fundamentals/guide/data360_integration_patterns_and_practices.html#data-activation-patterns--data-outbound) de données peuvent synchroniser les données vers une autre organisation. Cette approche peut s'avérer très utile pour les intégrations à des organisations Marketing Cloud. - Extrayez et déplacez des données en utilisant **MuleSoft Anypoint.** MuleSoft Anypoint peut être utilisé pour extraire des données de Data 360 en utilisant l'API Connect et l'API Data Graph et les déplacer vers une autre organisation Salesforce. Sans Data 360, MuleSoft Anypoint peut également être utilisé lorsque les données doivent être déplacées entre les organisations sans être répliquées dans Data 360. - **Faites preuve de prudence si vous choisissez d'élaborer avec Messagerie sortante.** Salesforce continuera de prendre en charge Messagerie sortante dans les limites des capacités fonctionnelles actuelles, mais n'envisage pas d'autres investissements dans cette technologie. - **Une licence utilisateur d'intégration avec le profil « API uniquement » est toujours recommandée pour toutes les intégrations.** Salesforce recommande également d'utiliser des applications clientes externes (en faveur des applications connectées ou de la connexion SOAP) en tant que modèles AuthN et AuthZ correctement autorisés pour toutes les intégrations. ## Considérations courantes relatives au choix d'outils d'intégration de données Avant d'explorer les outils d'intégration de données disponibles, il est important de tenir compte de quelques considérations courantes lors du choix d'un outil. Comme c'est le cas avec l'architecture, il n'y a pas de réponse prescriptive à chaque défi métier. Si vous avez prononcé les mots « ça dépend » en faisant des choix d'intégration, vous êtes au bon endroit.
Domaine à considérer Questions courantes
Outils et paysage existants Existe-t-il une solution ESB ou ETL existante ? Les données concernées ont-elles des exigences réglementaires ou de conformité ? Où se situent les systèmes que vous essayez d'intégrer (dans le cloud ou sur site) ?
Flux de données (Temps, Expérience utilisateur attendue, Directionnalité) Les données doivent-elles être déplacées de façon synchrone, asynchrone ou peuvent-elles être regroupées par lot ou planifiées ? La réplication des données est-elle requise ? Quel système doit être la source de la vérité ? Quelle est la source de données ? Quelle est la destination cible ? Une interaction utilisateur est-elle requise ? L'utilisateur doit-il afficher le résultat de l'intégration ? Quels sont les besoins liés au traitement des exceptions (réessayer, notifier, échouer) ? Quel est le degré de couplage des systèmes ?
Implémentation Quel est le niveau d'effort pour les systèmes non-Salesforce ? Quelles sont les équipes responsables de la livraison des intégrations ? Quels outils préfèrent-ils utiliser ?
Maintenabilité Quelles équipes devront maintenir l'intégration ? Quelles sont leurs compétences actuelles ? De quelles compétences auront-ils besoin à l'avenir? Quel est le coût total de possession au fil du temps ? Quelle est l'importance de pouvoir tester, déboguer, dépanner avec des outils à code faible ou pro ?
Volume de données Quel volume de données est impliqué dans l'intégration ? Travaillerez-vous avec les gros volumes de données (LDV) ? À quelle fréquence les changements se produiront-ils en masse? Quel impact les mises à jour singleton auront-elles ? À quelle fréquence se produiront-elles?
Limites Les données devront-elles subir une transformation complexe ? Les données doivent-elles être combinées à partir de plusieurs systèmes sources ? À quelle fréquence une intégration sera-t-elle effectuée par utilisateur ? Combien d'utilisateurs au total ? Avez-vous prévu des chargements de données en masse (exemple : chargement initial de données pour une nouvelle instance) ?
## Comparaison des produits Voici une vue d'ensemble des outils disponibles pour l'intégration de données et quelques considérations pour commencer à évaluer chaque option. Les sections suivantes présentent des cas d'utilisation détaillés et des détails sur les capacités de ces outils.
De Salesforce au système externe Du système externe à Salesforce Exécution Licence supplémentaire requise
Actions Apex Disponible Disponible Côté serveur Non
Capture des données Disponible Non disponible Côté serveur Non*
Apex personnalisé (services Web REST et SOAP) Disponible Disponible Côté serveur Non
Services externes Disponible Non disponible Côté serveur Non
Heroku Connect Disponible Disponible Côté serveur Oui
Data 360 Disponible Disponible Côté serveur Oui
MuleSoft Anypoint Disponible Disponible Côté serveur Oui
API Salesforce natives Non disponible Disponible Côté serveur Non
Omniscript Disponible Disponible Côté client*** Oui
Procédure d'intégration OmniStudio Disponible Disponible Côté serveur Oui
Messagerie sortante Pas idéal Non disponible Côté serveur Non
Événements de plate-forme Disponible Disponible Côté serveur Non**
Salesforce Connect/Objets externes Disponible Disponible Côté serveur Oui
[\*Complément requis pour les cas d ' utilisation d ' événements de capture de données volumineux](https://developer.salesforce.com/docs/atlas.en-us.change_data_capture.meta/change_data_capture/cdc_allocations.htm) [\*\*Complément requis pour les cas d'utilisation d'événements de plate-forme à haut volume](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_event_limits.htm) \*\*\*Convient dans les situations où la logique métier peut être exécutée dans le navigateur Web. Légende de colonne : - **Disponible** : fonctionne bien pour la plupart des cas d'utilisation - **Pas idéal** : possible mais envisager un outil alternatif - **Non disponible** : aucun projet de support dans les douze prochains mois ### Autres outils qui peuvent être impliqués dans le déplacement de données vers et hors de Salesforce : D'autres outils peuvent prendre en charge certains aspects d'une intégration de couche de données, mais ne doivent pas être considérés comme un moyen principal de résoudre les problèmes d'intégration. Examinons maintenant rapidement ces outils. Les **composants Web Lightning** sont généralement utilisés pour l ' intégration de processus, mais ils peuvent passer des appels externes en utilisant la fonctionnalité JavaScript. **Salesforce Flow** peut être utilisé pour orchestrer des appels externes avec des Services externes ou des Actions Apex. Salesforce Flow en soi n'est pas considéré comme un outil d'intégration de données autonome. L'**assistant d'importation de données et** Data Loader peuvent être utilisés pour synchroniser, importer et migrer des données. Les commandes Data Loader peuvent également être scriptées pour automatiser l'importation et l'exportation de données, mais l'[interface de ligne](https://developer.salesforce.com/docs/atlas.en-us.dataLoader.meta/dataLoader/command_line_intro.htm) de commande est uniquement pour Windows et aucun de ces outils n'est recommandé pour une stratégie d'intégration de données. Utilisez-les à la place pour compléter votre stratégie de gestion et de maintenance des données. Les commandes de données [**Salesforce CLI**](https://developer.salesforce.com/docs/atlas.en-us.sfdx_cli_reference.meta/sfdx_cli_reference/cli_reference_force_data.htm) peuvent être utilisées pour manipuler des enregistrements dans votre organisation. Des commandes sont disponibles pour vous aider à importer et à exporter des données avec l'API de transfert en masse et l'API d'enregistrement d'arborescence SObject, et à exécuter de simples opérations CRUD sur des enregistrements individuels avec l'API REST. La Salesforce CLI en soi n'est pas considérée comme un outil d'intégration de données autonome. **OmniStudio Data Mapper** peut être utilisé comme outil ETL déclaratif pour déplacer des données entre des objets Salesforce et des structures de données JSON. Bien qu'une interface REST soit automatiquement créée pour chaque interface Data Mapper, ce qui fournit une méthode déclarative pour déplacer des données depuis des systèmes externes vers des objets Salesforce, Data Mapper autonome n'est pas une base recommandée pour une stratégie d'intégration de données. Les actions Data Mapper sont disponibles dans Procédures d'intégration OmniStudio. [**Dataloader.io**](http://dataloader.io/) est un autre outil de chargement de données pour Salesforce propulsé par Anypoint Platform de MuleSoft qui permet d'importer, d'exporter et de supprimer rapidement et en toute sécurité des quantités illimitées de données pour votre entreprise. Dataloader.io n'est pas une base recommandée pour une stratégie d'intégration de données. ## Salesforce vers des systèmes externes (intégration sortante) Pour les intégrations sortantes depuis Salesforce, vous pouvez envisager différents types d'outil : low-code, pro-code ou hybride. Les sections suivantes fournissent des conseils pour chaque type d'outil et offrent des exemples de solutions. - [Outils à faible code pour les intégrations sortantes](#outils-à-faible-code-pour-les-intégrations-sortantes-depuis-salesforce) - [Outils hybrides pour les intégrations sortantes](#outils-hybrides-pour-les-intégrations-sortantes-depuis-salesforce) - [Outils Pro-Code pour les intégrations sortantes](#outils-pro-code-pour-les-intégrations-sortantes-depuis-salesforce) ### Outils à faible code pour les intégrations sortantes depuis Salesforce
Guide Licence Calendrier Volume et échelle Livraison et maintenance Confidentialité et sécurité
Quand utiliser Licence supplémentaire Synchronisation (demande/réponse) ou asynchrone (incendie/oubli) Support multi-objets LDV/En masse Test et déploiement** Débogage Comportement intégré de traitement des erreurs/réessayer Peut être utilisé avec des données cryptées au repos Protocole d'authentification
Capture des données Lorsque vous devez publier des modifications au niveau de l'enregistrement effectuées dans Salesforce sur un système externe et que vous n'avez pas besoin d'une charge de travail personnalisée. Obligatoire Asynchrone Non Non Oui Avec des outils pro-code Oui Oui OAuth
Services externes Lorsque vous orchestrez un processus en utilisant Flow, Apex, Robots Einstein ou OmniStudio et que les API système externes sont décrites en utilisant les spécifications OpenAPI. Non requis Synchronisation Oui Non Oui Avec des outils pro-code Non S.O. Identifiants nommés
Heroku Connect Lorsque vous souhaitez étendre vos données avec la synchronisation bidirectionnelle pour activer les applications mobiles et autres dans Heroku, et que vous souhaitez également répliquer les données dans Salesforce. Obligatoire Asynchrone Oui Oui Non Avec des outils de code pro Oui Oui, via Shield Connect OAuth
Procédure d'intégration OmniStudio Lorsque vous devez transformer des données sans interaction de l'utilisateur et améliorer les performances en traitant sur le serveur au lieu du navigateur. Obligatoire Les deux Oui Oui Oui Appui déclaratif Oui Oui Identifiants nommés
Salesforce Connect/Objets externes Lorsque vous souhaitez afficher des données dans l'interface utilisateur de Salesforce, mais que les données sont stockées dans un système externe. Les données ne sont pas répliquées dans Salesforce. Obligatoire Synchronisation Non Oui* Oui Avec des outils pro-code et un traceur déclaratif Non S.O. Identifiants nommés
*Les adaptateurs Odata antérieurs à la version 4.01 sont soumis à des limitations en appels externes. Pour plus de détails, voir Odata Callout Rate Limit Considérations. ** Testing and Deployment désigne la possibilité d'élaborer dans un environnement inférieur et de déployer via l'API de métadonnées, des packages ou des ensembles de modifications en production.
### Cas d'utilisation : Intégration sortante en utilisant des outils à faible code > Lorsque des opportunités sont gagnées, une commande pour les produits associés doit être créée dans le système ERP ou le système de gestion des commandes de l'entreprise. **Capture des données** modifiées À mesure que les enregistrements Opportunité sont mis à jour, la Capture des données modifiées publie les événements de modification qui contiennent les mises à jour des objets. Les événements de modification sont consommés du côté du client via une connexion CometD (ou via un connecteur MuleSoft) et utilisés pour mettre à jour le système ERP ou de gestion des commandes du client. Les événements de modification peuvent être enrichis pour inclure toujours des ID d'enregistrement externes ou d'autres données de l'objet (telles que la région) nécessaires à l'intégration. Les flux d'événements de modification de plusieurs objets peuvent être combinés dans _des canaux_ pour simplifier le traitement des abonnements et des flux (vous pouvez ainsi vous abonner à et traiter un seul flux au lieu de plusieurs). **Services externes** Si vous avez un service Web qui prend en charge la spécification OpenAPI 2.0 ou 3.0, vous pouvez exposer les opérations et les services en tant que Service externe dans Salesforce. Les opérations d'API (par exemple créer un ordre) peuvent être appelées en tant qu'Action invocable dans un flux élaboré avec Flow Builder lorsque l'étape de l'opportunité change en « Gagné ». **Heroku Connect** Heroku Connect est généralement utilisé pour synchroniser une base de données Heroku Postgres et Salesforce. Si le client utilise Heroku Postgres comme magasin transactionnel source de vérité, vous pouvez synchroniser les enregistrements et les modifications depuis Salesforce vers Heroku Postgres en utilisant Heroku Connect. Vous pouvez ensuite utiliser les connecteurs Heroku Streaming pour publier ces modifications dans Apache Kafka et les envoyer sous forme d'événements à des applications en aval, notamment le système ERP ou de gestion des commandes. **Procédure d'intégration** OmniStudio Lorsqu'une commande est soumise, l'Omniscript orchestrant le processus peut publier les détails de la commande dans un connecteur ERP ou MuleSoft. La publication peut être exécutée directement par l'Omniscript (côté client) ou indirectement via une Procédure d'intégration (côté serveur). Si le système ERP renvoie une erreur de validation, l'interface utilisateur Omniscript doit notifier l'utilisateur et, si nécessaire, traduire et contextualiser l'erreur pour l'utilisateur. **Salesforce Connect/Objets externes** Vous pouvez créer dans Salesforce un flux déclenché par un enregistrement qui insère un enregistrement dans le ou les objets externes associés lorsque l'étape de l'opportunité change en "Gagné". Comme il s'agit d'une [transaction mixte](https://help.salesforce.com/articleView?id=000328873&type=1&mode=1), pour éviter les erreurs, ajoutez un élément Interrompre pendant zéro seconde entre la mise à jour de l'opportunité et l'insertion d'objets externes associés afin de fermer un contexte de transaction avant d'en démarrer un autre. ### Outils hybrides pour les intégrations sortantes depuis Salesforce
Guide Licence Calendrier Volume et échelle Livraison et maintenance Confidentialité et sécurité
Quand utiliser Licence supplémentaire Synchronisation (demande/réponse) ou asynchrone (incendie/oubli) Support multi-objets LDV/En masse Test et déploiement** Débogage Comportement intégré de traitement des erreurs/réessayer Peut être utilisé avec des données cryptées au repos Protocole d'authentification
Actions Apex Lorsque vous souhaitez automatiser les appels externes vers un autre système via Salesforce Flow. Un développeur peut écrire une classe Apex qu'un flux peut invoquer, ou vous pouvez télécharger depuis AppExchange une solution prédéfinie. Non requis Les deux Oui Non Oui Avec des outils pro-code Non Oui Multiple
Relais d'événements Lorsque vous devez envoyer des événements de plate-forme et des événements de capture des données de modification à Amazon EventBridge depuis Salesforce. Les relais d'événements se connectent uniquement à AWS Eventbridge Non Asynchrone Oui Non Oui Oui Oui Oui HTTP/1.1 avec TLS
Messagerie sortante Lorsque vous devez envoyer des messages SOAP sur HTTP(S) à un point de terminaison désigné avec une réception garantie lorsqu'il est déclenché par une règle de workflow. Non requis Asynchrone Non Non Oui Appui déclaratif Oui Oui TLS bidirectionnel
Événements de plate-forme Lorsque vous avez besoin d'une charge de travail structurée et définie sur mesure pour des modifications en temps quasi réel dans Salesforce ou un système externe. Non requis* Asynchrone Oui Non Oui Avec des outils pro-code Oui Oui OAuth
Salesforce Connect/Objets externes (avec adaptateurs Apex personnalisés) Lorsque vous souhaitez afficher des données dans l'interface utilisateur de Salesforce, mais que vous souhaitez que les données soient stockées dans un système externe qui ne peut pas utiliser des protocoles standard comme Odata ou GraphQL. Obligatoire Les deux Oui Oui Oui Avec des outils pro-code Non S.O. Multiple
Data 360 Lorsque vous souhaitez harmoniser les données de différentes sources dans un magasin de données, ou répliquer vos données dans d'autres organisations Salesforce ou dans d'autres systèmes externes. Obligatoire Les deux Oui Oui Oui Oui Oui Oui Multiple
[\* Complément](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_event_limits.htm) requis pour les cas d'utilisation à haut volume. \*\* Test et déploiement désigne la possibilité d'élaborer dans un environnement inférieur et de déployer via l'[API de métadonnées](https://developer.salesforce.com/docs/metadata-coverage/), des packages ou des ensembles de modifications en production. ### Cas d'utilisation : Intégration sortante en utilisant des outils hybrides > Lorsque des opportunités sont gagnées, une commande pour les produits associés doit être créée dans le système ERP ou de gestion des commandes de l'entreprise. **Actions Apex** Un flux déclenché par un enregistrement basé sur l'état de l'opportunité peut être automatiquement déclenché lorsqu'une opportunité est gagnée. Le flux exécute une action invocable qui utilise un appel externe pour soumettre la commande au système de gestion des commandes ou à la solution ERP. Les soumissions à haut volume et les commandes multisites sont gérées par des mécanismes par lot et file d'attente Apex. **Messagerie sortante** Après avoir [configuré la messagerie sortante](https://developer.salesforce.com/docs/atlas.en-us.api.meta/api/sforce_api_om_outboundmessaging_setting_up.htm), vous pouvez définir une règle de workflow déclenchée par la mise à jour de l'opportunité pour envoyer un message SOAP sur HTTP(S) à une URL de point de terminaison spécifiée qui héberge l'écouteur. Le message contiendra les champs spécifiés lors de la création du message sortant. Si les informations de l'objet changent après la mise en file d'attente de la notification, mais avant son envoi, seules les informations mises à jour sont livrées et les messages restent dans la file d'attente jusqu'à ce qu'ils soient envoyés avec succès ou jusqu'à ce qu'ils aient 24 heures. Après 24 heures, les messages sont retirés de la file d'attente. Si le système ERP nécessite des données supplémentaires, vous pouvez transmettre le sessionId dans des messages sortants afin que le système externe puisse effectuer une requête de rappel. **Événements de plate-forme** Vous pouvez définir un événement de plate-forme qui inclut la charge de travail personnalisée avec les données requises pour créer les enregistrements dans le système externe. Les événements de plate-forme ne sont pas automatiquement publiés lors d'un changement d'enregistrement. Par conséquent, vous devez publier l'événement via Apex, Salesforce Flow ou Process Builder lorsque l'étape de l'opportunité change en « Gagné ». Un service externe écoute le canal d'événement de plate-forme en utilisant CometD (ou un connecteur MuleSoft) et crée les enregistrements appropriés dans le système externe. **Salesforce Connect/External Objects (avec adaptateurs Apex personnalisés)** Une solution basée sur Salesforce Connect/External Objects n'est pas parfaitement adaptée à un cas d'utilisation qui nécessite uniquement la synchronisation des données. Cependant, cette solution peut s'appliquer lorsque les utilisateurs de Salesforce doivent afficher et potentiellement interagir avec des données du système externe, et que les données ne peuvent pas être répliquées dans Salesforce. Si le système ERP ou de gestion des commandes ne prend pas en charge les protocoles Odata ou GraphQL, l'équipe de développement peut utiliser l'[infrastructure du connecteur Apex](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_connector_start.htm) pour écrire des classes Apex qui gèrent la communication avec le système externe via un protocole pris en charge. **Data 360** Une solution basée sur Data 360 est parfaitement adaptée aux cas d'utilisation où nous avons besoin de données harmonisées provenant de différentes sources dans un seul magasin de données. Il peut également être utilisé lorsque nous devons répliquer des données d'une organisation Salesforce à plusieurs organisations Salesforce ou à d'autres systèmes externes en utilisant Data 360 comme plate-forme de données. Lorsqu'une opportunité est gagnée et mise à jour dans l'organisation source, les données de l'opportunité sont synchronisées vers Data 360, où elles peuvent être répliquées dans d'autres systèmes, y compris dans des organisations Salesforce, en utilisant différents mécanismes tels que des actions, des activations et des API. De la même façon, une opportunité peut être référencée sans répliquer les données dans d'autres organisations Salesforce en utilisant Data Cloud One. Cependant, Data Cloud One ne prend pas en charge les plates-formes non-Salesforce. ### Outils pro-code pour les intégrations sortantes depuis Salesforce
Guide Licence Calendrier Volume et échelle Livraison et maintenance Confidentialité et sécurité
Quand utiliser Licence supplémentaire Synchronisation (demande/réponse) ou asynchrone (incendie/oubli) Support multi-objets LDV/En masse Test et déploiement** Débogage Comportement intégré de traitement des erreurs/réessayer Peut être utilisé avec des données cryptées au repos Protocole d'authentification
Custom Apex Lorsque vous avez besoin de fonctionnalités supérieures à celles disponibles dans les outils à faible code. Non requis Les deux Oui Oui Oui Avec des outils pro-code Non Oui* Multiple
Services externes L'intégration à partir de code avec des API système externes est décrite en utilisant les spécifications OpenAPI. Non requis Synchronisation Oui Non Oui Avec des outils pro-code Non S.O. Multiple
MuleSoft Anypoint Lorsque vous avez besoin d'une solution unique unifiée de niveau entreprise pour élaborer, orchestrer et gérer vos intégrations, lorsque vous devez remplacer une architecture point à point héritée ou lorsque vous avez besoin d'un support de gestion d'API. Obligatoire Les deux Oui Oui Oui Avec des outils pro-code Non Oui* Multiple
\*L'activation Shield Platform Encryption modifie certains comportements, voir [General Shield Platform Encryption Considérations](https://help.salesforce.com/articleView?id=sf.security_pe_considerations_general.htm&type=5) pour plus de détails. \*\* Test et déploiement désigne la possibilité d'élaborer dans un environnement inférieur et de déployer via l'[API de métadonnées](https://developer.salesforce.com/docs/metadata-coverage/), des packages ou des ensembles de modifications en production. ### Cas d'utilisation : Intégration sortante en utilisant les outils Pro-Code > Lorsque des opportunités sont gagnées, une commande pour les produits associés doit être créée dans le système ERP ou de gestion des commandes de l'entreprise. **Apex personnalisé** Vous pouvez créer un déclencheur Apex et un ou plusieurs gestionnaires de déclencheur dans l'opportunité qui passent un appel au système ERP ou de gestion des commandes lorsque l'étape de l'opportunité change en «Gagné». Notez que si vous passez des appels externes à partir d'un déclencheur ou après avoir exécuté une opération DML, vous devez utiliser une méthode annotée comme future ou pouvant être mise en file d'attente. Un appel externe dans un déclencheur maintient la connexion à la base de données ouverte pendant la durée de vie de l'appel externe. Tout code Apex est soumis aux [limites Apex Governor et](https://developer.salesforce.com/docs/atlas.en-us.salesforce_app_limits_cheatsheet.meta/salesforce_app_limits_cheatsheet/salesforce_app_limits_overview.htm) API, qui sont régulièrement révisées. **Services externes** Si le système ERP externe ou de gestion des commandes de l'entreprise est défini via une spécification OpenAPI, les appels externes aux services exécutés dans la future méthode ou tâche en file d'attente peuvent être simplifiés. Les services externes enregistrés peuvent être appelés directement depuis Apex sans avoir besoin d'écrire un code standard. Dans l'exemple, l'appel externe pour créer la commande peut être géré par le service externe. **MuleSoft Anypoint** MuleSoft Anypoint fournit une gestion d'API de niveau entreprise. MuleSoft Anypoint peut créer des API pour activer l'accès en lecture (et/ou en écriture) aux données pour Salesforce et de nombreux autres systèmes d'entreprise. De [nombreux connecteurs prédéfinis](https://www.mulesoft.com/platform/cloud-connectors) simplifient l'implémentation, et les entreprises peuvent également créer et publier leurs propres connecteurs. Ces API peuvent être déployées dans Anypoint avec des stratégies de sécurité flexibles, qui prennent en charge la gestion et la gouvernance centralisées. Le volume de transactions n'est soumis à aucune restriction, à condition que l'API ait été correctement dimensionnée pour son utilisation maximale (mesurée en vCores). ## Données système externes vers Salesforce (intégration entrante) Pour les intégrations entrantes à Salesforce, vous pouvez envisager différents types d'outils : low-code, pro-code ou hybride. Les sections suivantes fournissent des conseils pour chaque type d'outil et offrent des exemples de solutions. - [Outils à faible code pour les intégrations entrantes](#outils-à-faible-code-pour-les-intégrations-entrantes-à-salesforce) - [Outils hybrides pour les intégrations entrantes](#outils-hybrides-pour-les-intégrations-entrantes-à-salesforce) - [Outils Pro-Code pour les intégrations entrantes](#outils-pro-code-pour-les-intégrations-entrantes-à-salesforce) ### Outils à faible code pour les intégrations entrantes à Salesforce
Guide Licence Calendrier Volume et échelle Livraison et maintenance Confidentialité et sécurité
Quand utiliser Licence supplémentaire Synchronisation (demande/réponse) ou asynchrone (incendie/oubli) Prise en charge multi-objets LDV/En masse Test et déploiement* Débogage Comportement de traitement des erreurs/réessayer intégré Peut être utilisé avec des données cryptées au repos Protocole d'authentification
Heroku Connect Lorsque vous souhaitez étendre vos données avec la synchronisation bidirectionnelle pour activer les applications mobiles et autres dans Heroku, et que vous souhaitez également répliquer les données dans Salesforce. Obligatoire Asynchrone Oui Oui Non Avec des outils pro-code Oui Oui, via Shield Connect OAuth
Procédure d'intégration OmniStudio Lorsque vous devez importer et transformer des données à partir de sources tierces sans interaction de l'utilisateur. Obligatoire Les deux Oui Oui Oui Appui déclaratif Non Oui Identifiants nommés
Salesforce Connect/Objets externes Lorsque vous souhaitez afficher des données dans l'interface utilisateur de Salesforce, mais que vous souhaitez que les données soient stockées dans un système externe qui peut utiliser des protocoles standard comme Odata ou GraphQL. Obligatoire Synchronisation Oui Oui Oui Avec des outils pro-code Non S.O. Multiple
\* Test et déploiement désigne la possibilité d'élaborer dans un environnement inférieur et de déployer via l'[API de métadonnées](https://developer.salesforce.com/docs/metadata-coverage/), des packages ou des ensembles de modifications en production. ### Cas d'utilisation : Intégration entrante en utilisant des outils à faible code > Un contact est mis à jour dans le système ERP de l'organisation. Ces coordonnées doivent être mises à jour dans Salesforce. **Heroku Connect** Heroku Connect est généralement utilisé pour synchroniser une base de données Heroku Postgres et Salesforce. Si le système ERP n'utilise pas Heroku Postgres comme magasin de transactions, ce cas d'utilisation n'est pas possible. S'il utilise Heroku Postgres, les modifications apportées aux tableaux Postgres peuvent être synchronisées avec des objets Salesforce en utilisant Heroku Connect. **Procédure d'intégration** OmniStudio Lorsque le système ERP a mis à jour l'enregistrement du contact, une procédure d'intégration OmniStudio avec une action de chargement de Data Mapper et une action de réponse peut être appelée via l'API REST générée par Data Mapper. Pour commencer, une action Chargement du mappeur de données envoie une charge utile JSON ou XML, qui est utilisée pour mettre à jour/insérer les enregistrements de contact en fonction d'un champ ID externe ou via une [clé Mettre à](https://trailhead.salesforce.com/content/learn/modules/omnistudio-data-tools-and-internal-data/build-an-integration-procedure-with-conditional-dataraptor-loads?trail_id=build-guided-experiences-with-omnistudio) jour/insérer. Si une simple réponse en JSON suffit, une Action de réponse peut renvoyer toutes les informations pertinentes des actions précédentes pour indiquer la réussite ou l'échec. Si le système ERP attend une réponse spécifique, une Transformation Data Mapper ou une Action d'extraction peut être utilisée pour générer une réponse JSON ou XML avec des fonctionnalités supplémentaires pour inclure par déclaration les données générées dans les déclencheurs par la mise à jour de l'enregistrement de contact. Le principal défi de ce scénario est la concurrence : Plusieurs appels pour mettre à jour simultanément le même enregistrement de contact entraînent des problèmes, car l'API existe directement dans Salesforce. **Salesforce Connect / Objets externes** Salesforce Connect et les objets externes ne sont pas recommandés pour ce cas d'utilisation, car le scénario nécessite spécifiquement la réplication des données dans Salesforce. Si vous avez une intégration Salesforce Connect préexistante élaborée à l'ERP, vous pouvez configurer le connecteur OData 4.0 pour prendre en charge la capture des données de modification externes si l'ERP peut prendre en charge la capture des données de modification. De plus, vous devez configurer dans Salesforce pour vous abonner au flux de modification depuis l'ERP, en utilisant l'API Pub/Sub. ### Outils hybrides pour les intégrations entrantes à Salesforce
Guide Licence Calendrier Volume et échelle Livraison et maintenance Confidentialité et sécurité
Quand utiliser Licence supplémentaire Synchronisation (demande/réponse) ou asynchrone (incendie/oubli) Prise en charge multi-objets LDV/En masse Test et déploiement** Débogage Comportement de traitement des erreurs/réessayer intégré Peut être utilisé avec des données cryptées au repos Protocole d'authentification
Événements de plate-forme Lorsque vous avez besoin d'une charge de travail structurée et définie sur mesure pour des modifications en temps quasi réel dans Salesforce ou un système externe. Non requis* Asynchrone Oui Non Oui Avec des outils pro-code Oui Oui OAuth
Salesforce Connect/Objets externes (avec adaptateurs Apex personnalisés) Lorsque vous souhaitez afficher des données dans l'interface utilisateur de Salesforce, mais que les données sont stockées dans un système externe qui ne peut pas utiliser les protocoles Odata 2.0/4.0. Obligatoire Les deux Oui Oui Oui Avec des outils pro-code Non S.O. Multiple
Data 360 Lorsque vous souhaitez harmoniser les données de différentes sources dans un magasin de données, ou répliquer vos données d'autres organisations Salesforce ou d'autres systèmes externes. Data 360 prend également en charge la virtualisation pour certaines plates-formes. Obligatoire Les deux Oui Oui Oui Non Oui Oui Multiple
\*[Complément](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_event_limits.htm) requis pour les cas d'utilisation à haut volume. \*\* Test et déploiement désigne la possibilité d'élaborer dans un environnement inférieur et de déployer via l'[API de métadonnées](https://developer.salesforce.com/docs/metadata-coverage/), des packages ou des ensembles de modifications en production. ### Cas d'utilisation : Intégration entrante en utilisant des outils hybrides > Un contact est mis à jour dans le système ERP de l'organisation. Ces coordonnées doivent être mises à jour dans Salesforce. **Événements de plate-forme** Un code personnalisé dans un système externe publie un Événement de plate-forme lorsque l'enregistrement du contact est mis à jour dans le système ERP. Un déclencheur, un processus ou un flux dans Salesforce peut s'abonner à l'événement de plate-forme et mettre à jour le ou les objets Salesforce correspondants lorsqu'un événement est traité. L'événement de plate-forme peut fonctionner simplement comme un signal indiquant qu'une modification s'est produite dans le système ERP du client sans contenir de données, ou contenir les données réelles nécessaires pour mettre à jour l'objet Salesforce. **Salesforce Connect/Objets externes (avec adaptateurs Apex personnalisés)** Cette solution n'est pas applicable dans un cas d'utilisation qui nécessite une réplication des données. Cette solution est applicable si vous avez besoin d'utilisateurs dans Salesforce pour afficher les informations d'un système externe qui ne doit pas ou ne peut pas être répliqué dans Salesforce, et le système externe ne peut pas prendre en charge les protocoles standard comme Odata ou GraphQL. Consultez [Cas d'utilisation : Intégration sortante en utilisant des outils hybrides](#cas-dutilisation--intégration-sortante-en-utilisant-des-outils-hybrides) comme exemple de cas d'utilisation d'un adaptateur personnalisé Apex **Data 360** Lorsqu'un contact est mis à jour dans des systèmes externes tels que ERP, les mises à jour de contact peuvent être synchronisées vers Data 360 en utilisant des connecteurs prêts à l'emploi ou en utilisant des API et des outils pro-code tels que MuleSoft. Le contact peut également être référencé dans Data 360 en utilisant le mécanisme de copie zéro (disponible sur certaines plates-formes). Une fois les données disponibles dans Data 360, différents mécanismes d'intégration prêts à l'emploi peuvent être utilisés pour synchroniser les données avec d'autres organisations Salesforce. Les données sont accessibles par référence en utilisant Data Cloud One. Les données peuvent également être répliquées en utilisant des activations et d'autres API en utilisant des connecteurs prêts à l'emploi ou avec l'aide d'outils pro-code tels que MuleSoft Anypoint Platform. ### Outils pro-code pour les intégrations entrantes à Salesforce
Guide Licence Calendrier Volume et échelle Livraison et maintenance Confidentialité et sécurité
Quand utiliser Licence supplémentaire Synchronisation (demande/réponse) ou asynchrone (incendie/oubli) Prise en charge multi-objets LDV/En masse Test et déploiement**** Débogage Comportement de traitement des erreurs/réessayer intégré Peut être utilisé avec des données cryptées au repos Protocole d'authentification
Services Web Apex REST & SOAP personnalisés Lorsque vous avez besoin de fonctionnalités supplémentaires que celles fournies par les points de terminaison d'API natifs, par exemple le traitement inter-objets ou d'autres logiques complexes. Non requis Les deux Oui Oui Oui Avec des outils pro-code Non Oui*** Multiple
MuleSoft Anypoint Lorsque vous avez besoin d'une solution unique unifiée de niveau entreprise pour élaborer, orchestrer et gérer vos intégrations, lorsque vous devez remplacer une architecture point à point héritée ou lorsque vous avez besoin d'un support de gestion d'API. Obligatoire Les deux Oui Oui Oui Avec des outils pro-code Non Oui*** Multiple
API Salesforce natives Lorsque vous avez besoin de davantage de contrôle ou si vous avez un ensemble de compétences pro-code pour élaborer des intégrations via l'API REST, l'API SOAP, l'API de transfert en masse, ou les API GraphQL, ou gRPC. Non requis* Les deux Oui***** Oui Oui Avec des outils pro-code Oui** Oui*** Multiple
\* Des [limites et allocations](https://developer.salesforce.com/docs/atlas.en-us.salesforce_app_limits_cheatsheet.meta/salesforce_app_limits_cheatsheet/salesforce_app_limits_platform_api.htm) en requêtes d'API s'appliquent. \*\*Les API de transfert en masse ont des aspects de comportement de nouvelle tentative et un certain nombre d'API offrent une protection _contre l'annulation_ via le paramètre allOrNone (par exemple, consultez [Paramètres allOrNone dans Requêtes](https://developer.salesforce.com/docs/atlas.en-us.api_rest.meta/api_rest/resources_composite_allornone.htm) composées et Collections) \*\*\*L'activation Shield Platform Encryption modifie certains comportements, voir [General Shield Platform Encryption Considérations](https://help.salesforce.com/articleView?id=sf.security_pe_considerations_general.htm&type=5) pour plus de détails. \*\*\*\*Test et déploiement désigne la possibilité d'élaborer dans un environnement inférieur et de déployer via l'[API de métadonnées](https://developer.salesforce.com/docs/metadata-coverage/), des packages ou des ensembles de modifications en production. \*\*\*\*\*Les API composées ont la prise en charge des objets multiples. ### Cas d'utilisation : Intégration entrante en utilisant les outils Pro-Code > Un contact est mis à jour dans le système ERP de l'organisation. Ces coordonnées doivent être mises à jour dans Salesforce. **Services Web Apex REST et SOAP** personnalisés Vous pouvez créer un service Web en utilisant un code Apex qui pourrait exécuter des opérations CRUD (créer, lire, mettre à jour, supprimer) sur l'objet Contact. Ce service sera invoqué via SOAP ou REST depuis le système externe (l'ERP). **MuleSoft Anypoint** L'intention de MuleSoft Anypoint est de fournir une gestion d'API de niveau entreprise. MuleSoft Anypoint offre un [grand nombre de connecteurs](https://www.mulesoft.com/platform/cloud-connectors) prédéfinis que vous pouvez utiliser pour intégrer à de nombreux systèmes ERP, notamment SAP, Oracle EBS, Oracle ERP et NetSuite. Vous pouvez créer un flux pour écouter les événements dans ces systèmes ERP (dans le cas présent, lors de la création d'un contact). Lorsque le flux est démarré, il utilise le connecteur Salesforce pour créer un enregistrement Contact (ou le mettre à jour si le contact existe déjà). En outre, il est possible d'intégrer à d'autres systèmes si la transaction de réplication implique la syndication du contact dans d'autres systèmes. Si nécessaire, vous pouvez utiliser le langage de mappage et de transformation (DataWeave) pour exécuter une logique et des calculs complexes sous forme de flux d'informations à travers plusieurs systèmes disparates. L'authentification à ces systèmes peut être effectuée via de nombreux mécanismes d'authentification différents tels que l'authentification de base et OAuth, entre autres. Le volume de transactions n'est soumis à aucune restriction tant que le flux a été correctement dimensionné pour son utilisation maximale (mesurée en vCores). **API Salesforce natives** Une fois la transaction de mise à jour terminée dans le système ERP, vous pouvez effectuer une opération de mise à jour/insertion sur l'objet Contact via l'API SOAP ou effectuer un [PATCH](https://developer.salesforce.com/docs/atlas.en-us.api_rest.meta/api_rest/dome_update_fields.htm) sur l'API REST Contact sObjects dans l'organisation Salesforce. ## Intégrations Salesforce à Salesforce Le produit Salesforce to Salesforce est arrivé en fin de vie. Salesforce to Salesforce a facilité la vente et le support de clients communs pour les partenaires qui travaillent ensemble, mais Salesforce investira dans l'innovation d'autres outils. À l'avenir, les approches suivantes sont recommandées pour le partage de données entre les organisations Salesforce. ### Outils d'intégration de données entre les organisations Salesforce
Guide Coût Calendrier Volume et échelle Livraison et maintenance Confidentialité et sécurité Outils à implémenter
Quand utiliser Licence supplémentaire Synchronisation (demande/réponse) ou asynchrone (incendie/oubli) Support multi-objets LDV/En masse Test et déploiement* Débogage Comportement intégré de traitement des erreurs/réessayer Peut être utilisé avec des données cryptées au repos Protocole d'authentification Code bas → Code pro
Heroku Connect Lorsque vous souhaitez étendre vos données avec la synchronisation bidirectionnelle entre les organisations Salesforce et également activer l'accès aux données à partir d'applications mobiles et autres exécutées sur Heroku Obligatoire Asynchrone Oui Oui Non Avec des outils pro-code Oui Oui, via Shield Connect OAuth Code faible
MuleSoft Anypoint Lorsque vous avez besoin d'une solution unique unifiée de niveau entreprise pour élaborer, orchestrer et gérer vos intégrations, lorsque vous devez remplacer une architecture point à point héritée ou lorsque vous avez besoin d'un support de gestion d'API Obligatoire Les deux Oui Oui Oui Avec des outils pro-code Non Oui** Multiple Code Pro
API Salesforce natives Lorsque Salesforce ou Heroku Connect ne sont pas une option ou si vous avez besoin d'un traitement plus complexe Non requis Les deux Non Oui Oui Avec des outils pro-code Non Oui** Multiple Code Pro
Capture des données Lorsque vous devez publier des modifications au niveau de l'enregistrement effectuées dans Salesforce sur un système externe et que vous n'avez pas besoin d'une charge de travail personnalisée. Obligatoire Asynchrone Non Non Oui Avec des outils pro-code Oui Oui OAuth
Salesforce Connect avec un adaptateur inter-organisations Lorsque vous souhaitez que les utilisateurs d'une organisation puissent afficher ou modifier des enregistrements dans une autre organisation sans réplication des données Obligatoire Asynchrone Oui Oui Oui Avec des outils pro-code S.O. S.O. Multiple Code faible
Data 360 Lorsque vous souhaitez que les utilisateurs d'une organisation affichent ou modifient des enregistrements dans une autre organisation avec des données répliquées dans Data 360. Obligatoire Les deux Oui Oui Oui Avec des outils pro-code Oui Oui Multiple Hybride
\* Test et déploiement désigne la possibilité d'élaborer dans un environnement inférieur et de déployer via l'[API de métadonnées](https://developer.salesforce.com/docs/metadata-coverage/), des packages ou des ensembles de modifications en production \*\*L'activation Shield Platform Encryption modifie certains comportements, voir [General Shield Platform Encryption Considérations](https://help.salesforce.com/articleView?id=sf.security_pe_considerations_general.htm&type=5) pour plus de détails. Les événements _de plate-forme ne sont pas optimaux pour intégrer des données d'une organisation Salesforce à une autre, car ils ne peuvent pas « écouter » entre les organisations pour le même événement. Apex personnalisé n'est pas non plus une approche recommandée pour ce type d'intégration._ ### Cas d'utilisation : Connexion de plusieurs organisations Salesforce > Une grande entreprise opère à travers plusieurs unités commerciales (BU). Chaque unité commerciale a sa propre organisation Salesforce. Un seul client traite avec plusieurs unités commerciales de l'entreprise et dispose ainsi de données de compte et d'opportunité dans plusieurs organisations. L'entreprise doit accéder à une vue agrégée de toutes les données Compte et Opportunité dans toutes les unités commerciales d'une seule organisation. _Note : Toutes les solutions ci-dessous sont conçues pour réduire au maximum la réplication des données, conformément à [la recommandation n° 1](#points-à-retenir)._ **Data 360** Les données de comptes et d'opportunités de différentes organisations Salesforce peuvent être ingérées dans Data 360 en utilisant des connecteurs Salesforce prêts à l'emploi. Ils peuvent également être agrégés et harmonisés (si nécessaire). Une fois les données agrégées dans Data 360, elles sont accessibles dans d'autres organisations Salesforce en utilisant Data Cloud One sans réplication des données. **Heroku Connect** Pour chaque organisation commerciale, vous pouvez utiliser Heroku Connect afin de synchroniser les modifications depuis Salesforce vers une base de données Heroku Postgres unique. Dans ce scénario, la synchronisation bidirectionnelle n'est pas activée, mais uniquement depuis Salesforce vers Postgres. Ensuite, dans Heroku Connect, vous pouvez activer le fournisseur OData et sélectionner les tableaux que vous souhaitez exposer en tant qu'objets externes dans l'organisation Salesforce où vous souhaitez une vue agrégée. Depuis Salesforce, vous définissez une source de données externe pointant vers le fournisseur Odata dans Heroku. **MuleSoft Anypoint** MuleSoft Anypoint fournit une gestion d'API de niveau entreprise. Une API MuleSoft Anypoint peut être configurée pour lire les informations de plusieurs organisations Salesforce associées en utilisant le connecteur Salesforce avec plusieurs connexions aux organisations. Le flux MuleSoft peut interroger les différentes organisations Salesforce et renvoyer une structure spécifique améliorée ou enrichie avec d'autres informations tierces si nécessaire. Lorsque l'API est invoquée, elle effectue tous les appels externes appropriés à l'organisation Salesforce (dans cet exemple, elle interroge les informations sur les comptes et les opportunités) afin de permettre au consommateur de traiter les données (probablement une interface utilisateur). L'authentification à ces systèmes peut être effectuée via divers mécanismes d'authentification, notamment l'authentification de base et OAuth. Le volume de transactions n'est soumis à aucune restriction, à condition que le flux ait été correctement dimensionné pour son utilisation maximale (mesurée en vCores ou Cores). **API Salesforce natives** Des opérations de requête peuvent être émises pour chaque organisation d'intérêt, notamment via l'API de transfert en masse Salesforce 2.0, qui est bien adaptée pour extraire efficacement des milliers d'enregistrements. Vous pouvez récupérer les résultats de requête de chaque organisation individuellement et les agréger avec une application personnalisée ou un middleware selon les besoins du client. **Salesforce Connect avec adaptateur inter-organisations** L'adaptateur inter-organisations Salesforce Connect ne convient pas très bien dans ce scénario, car les comptes ou les opportunités d'organisations distantes apparaîtront tous dans l'organisation centrale sous forme d'objets _différents_. Par exemple, il n'est pas possible d'additionner le total général des montants de toutes les opportunités dans toutes les organisations. **Scénario inter-organisations Mises à jour sélectives :** Un commercial qui utilise l'organisation Salesforce A doit afficher et mettre à jour les données des requêtes de l'organisation Salesforce B et ajouter des commentaires à la requête parente dans l'organisation Salesforce B en travaillant dans l'organisation A. Les données ne doivent pas être répliquées à l'organisation A. **Heroku Connect** Vous pouvez utiliser la même approche décrite dans le _scénario d'agrégation_ de données ci-dessus. Vous devez toutefois activer CRUD sur l'objet externe via le connecteur Odata et réécrire les modifications dans Heroku Postgres. **MuleSoft Anypoint** MuleSoft Anypoint fournit une gestion d'API de niveau entreprise. Vous pouvez utiliser la même approche décrite dans le _scénario d'agrégation_ de données ci-dessus. Les **API Salesforce natives** utilisent des identifiants nommés et invoquent les API Salesforce natives pour lire et mettre à jour les données dans l'organisation Salesforce associée. Un composant doit être conçu pour afficher les données. **Salesforce Connect with Cross-Org Adapter** L ' [adaptateur Salesforce cross-Org](https://help.salesforce.com/articleView?id=sf.xorg_adapter_about.htm&type=5) permet d ' afficher les données d ' un objet externe (et de les modifier si CRUD est activé dans l ' objet externe). Les relations sont également prises en charge entre les objets externes. Par conséquent, vous pouvez lier à la requête parente dans l'objet externe. Cependant, la création de relations est aujourd'hui un processus manuel dans lequel vous convertissez un type de données existant en type de données de relation. De plus, les optimisations effectuées dans Service Cloud pour travailler plus efficacement avec les requêtes ne sont pas transmises en cascade à l'organisation distante. Salesforce recommande vivement de tester l'adaptateur inter-organisations et d'évaluer les compromis entre l'utilisation d'objets externes et d'objets standard pour votre cas d'utilisation. **Organisation croisée de synchronisation des données**: Lorsqu'un compte d'un client est mis à jour dans l'une des organisations Salesforce de l'unité commerciale de l'organisation, les autres objets Compte de l'organisation Salesforce doivent être mis à jour pour conserver des informations cohérentes sur le compte. **Data 360** Data 360 peut être utilisé pour la réplication de données d'une organisation à une autre Salesforce. Les données de compte d'une organisation Salesforce peuvent être ingérées dans Data 360 en utilisant des connecteurs Salesforce prêts à l'emploi. Nous pouvons également utiliser des mécanismes d'activation de données tels que l'activation par lot, des actions de données en temps quasi réel ou des activations basées sur l'API pour déplacer les données depuis Data 360 vers l'organisation Salesforce. **Heroku Connect** Vous pouvez utiliser la même approche décrite dans le _scénario d'agrégation_ de données ci-dessus. Cependant, vous devez activer la synchronisation bidirectionnelle, et il n'est plus nécessaire d'activer Salesforce Connect car la synchronisation bidirectionnelle tiendra toutes les organisations à jour lorsque des modifications seront apportées au tableau Postgres. **MuleSoft Anypoint** MuleSoft Anypoint fournit une gestion d'API de niveau entreprise. Vous pouvez [configurer une application](https://docs.mulesoft.com/design-center/about-designing-a-mule-application) Mule avec Flow Designer dans MuleSoft Anypoint afin d'écouter les événements d'objet standard et personnalisé qui déclenchent un flux lancé automatiquement dans Salesforce. Lorsque l'application Mule est déclenchée, elle peut invoquer le connecteur Anypoint pour Salesforce afin de communiquer avec n'importe quelle organisation Salesforce. Dans ce cas d'utilisation, lorsqu'un enregistrement Compte est mis à jour dans une organisation Salesforce, l'application Mule peut mettre à jour les enregistrements Compte dans les organisations Salesforce associées. Chaque organisation Salesforce associée aurait une étape de mise à jour unique intégrée au flux d'application global dans MuleSoft. L'authentification à ces systèmes peut être effectuée via divers mécanismes d'authentification, notamment l'authentification de base et OAuth. Le volume de transactions n'est soumis à aucune restriction tant que le flux a été correctement dimensionné pour son utilisation maximale (mesurée en vCores ou Cores). **API Salesforce natives** L'[API Replication](https://developer.salesforce.com/docs/atlas.en-us.api.meta/api/sforce_api_guidelines_datareplication.htm) (opérations getUpdated, getDeleted) peut être utilisée pour synchroniser les données entre les organisations, mais cette approche n'est pas recommandée. **Salesforce Connect avec adaptateur inter-organisations** Vous pouvez utiliser des flux déclenchés par un enregistrement et des objets externes pour garder certaines données synchronisées entre les organisations Salesforce. Par exemple, la mise à jour d'un enregistrement de compte dans l'organisation A déclenche un flux qui met ensuite à jour l'enregistrement correspondant dans l'objet externe Compte, ce qui écrit ces mises à jour dans l'enregistrement de compte dans l'organisation B. Cela nécessite l'utilisation correcte de la sémantique de flux pour éviter les [transactions DML mixtes](https://help.salesforce.com/articleView?id=000328873&type=1&mode=1). Notez également que les règles de validation et les flux dans l'organisation B sont déclenchés de la même façon que lorsque des modifications sont effectuées par nos API REST/SOAP. ## Mot de la fin Tenez compte de ce guide et consultez-le lorsque vous planifiez une nouvelle intégration de données impliquant Salesforce. Il est toujours recommandé de comprendre l'éventail complet des options qui s'offrent à vous et leur adéquation à votre cas d'utilisation spécifique. ### Dites-nous ce que vous pensez Aidez-nous à publier les informations les plus pertinentes pour vous. [Répondez à notre sondage](https://sfdc.co/J0cWb) pour nous faire part de vos commentaires sur ce contenu et nous dire ce que vous aimeriez voir ensuite. ## Vue d'ensemble Les entreprises stockent souvent des données dans Salesforce et dans d'autres lacs de données externes tels que Snowflake, Google BigQuery, Databricks, Redshift ou dans un stockage cloud tel que Amazon S3. Ce cloisonnement des données dans différents systèmes sources pose un défi aux entreprises qui souhaitent exploiter toute la puissance de leurs données. Les architectes qui travaillent pour regrouper des données à travers plusieurs lacs de données doivent prendre des décisions architecturales importantes sur la meilleure façon d'intégrer ces données. Data 360 offre plusieurs options d'intégration de données, chacune offrant des avantages et des inconvénients différents. Ce guide fournit un cadre qui permet d'évaluer le modèle le plus adapté à vos exigences en matière de latence, de coût, d'évolutivité, de gouvernance et de complexité lors de l'intégration de données, en vous aidant à choisir quand utiliser l'ingestion de données, la fédération de données Zero Copy ou une approche hybride. Le guide vous aidera également à sélectionner entre différentes méthodes d'ingestion de données et de fédération de données, chacune répondant à un besoin différent. L'intégration de lacs de données externes à Data 360 nécessite un examen attentif des compromis entre l'actualisation des données, la gouvernance et l'efficacité du pipeline. Par exemple, l'utilisation de requêtes live de fédération de données Zero Copy optimise l'actualisation des données, mais peut réduire l'efficacité du pipeline en déplaçant davantage de données sur le réseau. Par conséquent, pour la plupart des implémentations réelles, une combinaison d'ingestion et de fédération dans un écosystème Lakehouse multicloud est la voie optimale. Cette approche hybride garantit une architecture évolutive, régie et interopérable qui prend en charge de façon transparente à la fois les charges de travail opérationnelles à faible latence telles que la personnalisation en temps réel et la détection des fraudes, et les charges de travail analytiques telles que les rapports réglementaires et l'analyse des tendances historiques. Ce guide de décision vous aidera à comprendre comment parcourir ces compromis et sélectionner la stratégie appropriée. ## Points à retenir - **Ingestion de données :** Copie les données dans Salesforce Data 360, créant des modèles de données gouvernés et canoniques. Idéal lorsque vous devez : - **Élaborer un Customer 360 complet :** Unifiez et transformez des sources différentes en un profil unique et de confiance. - **Satisfaire à la stricte conformité réglementaire :** Créez une copie auditable et centralisée dans laquelle l'accès aux données et le lignage peuvent être étroitement contrôlés. - **Zero Copy Federation :** Interroge les sources externes en temps réel sans duplication, ce qui permet une personnalisation en temps réel, des tableaux de bord live et une intégration rapide des sources. Deux options principales avec des compromis que vous devez équilibrer : - **Live et mise en cache (requête accélérée) :** Idéal pour l'analyse interactive et les tableaux de bord en temps réel sur les données qui vivent sur des plates-formes de données externes telles que Snowflake, Google BigQuery, Redshift ou Databricks. Évite les duplications de données lentes et coûteuses en orientant le traitement vers le système source. - **Fédération de fichiers :** Idéal pour le traitement par lot à grande échelle et la formation au modèle IA sur les données de votre lac de données Cloud (S3, ADLS). Évite l'ingestion coûteuse et lente en interrogeant directement des fichiers sous des formats de tableau ouvert, ce qui déverrouille des jeux de données massifs pour les charges de travail ETL et de science des données. - **Modèle hybride:** Combinez l'ingestion pour Profils unifiés avec la fédération pour la fraîcheur, en prenant en charge l'engagement omni-canal, les actions pilotées par Agentforce et la formation IA/ML. ### Considérations importantes - **Architecture hybride :** La combinaison de l'ingestion de données et de la fédération de données est souvent nécessaire. - Utilisez Ingestion de données sur des données critiques pour des modèles de données canoniques et la gouvernance de base. - Fédérez toutes les autres données via Zero Copy afin de limiter les coûts opérationnels liés à l'élaboration et à la maintenance des pipelines de données d'ingestion. - **La fréquence d'ingestion des données est importante :** Choisissez la fréquence en fonction de la valeur métier, des besoins en latence et de la complexité opérationnelle. - Utilisez le temps réel pour des workflows temporels (personnalisation, tableaux de bord live, actions Agentforce). - Temps quasi réel pour des processus modérément urgents (campagnes, rapports opérationnels). - Lot de jeux de données historiques ou à faible vitesse. - **Mappez le schéma de fédération avec Latence et performance :** Choisissez celui qui correspond le mieux à vos modèles d'accès et aux exigences de fraîcheur, de performance et de coût. - Utilisez Live Query pour les tableaux de bord opérationnels et la personnalisation en temps réel lorsque la faible latence est critique. - Utilisez la mise en cache (requête accélérée) lorsque les requêtes sont fréquentes, mais que les résultats légèrement périmés sont acceptables, ce qui équilibre les performances et le coût. - Utilisez Fédération de fichiers pour des analytiques ou des charges de travail par lot à grande échelle et lourdes en débit, idéales pour des jeux de données historiques ou moins temporels. - **Alignement de la gouvernance avec les exigences de résidence des données :** - Utilisez l'ingestion lorsque la gouvernance centralisée est essentielle. - Utilisez la fédération lorsque la gouvernance décentralisée est acceptable, tout en appliquant une gouvernance stricte à la source externe. Zero Copy respecte les stratégies au niveau source telles que la sécurité au niveau de la ligne (RLS) et le masquage des données. - **Priorité à l'ingestion pour les workflows à valeur élevée :** Appliquez l'ingestion de façon sélective à des processus critiques tels que la résolution de l'identité, les rapports réglementaires et l'activation opérationnelle. - **Les coûts et la complexité déterminent la décision :** L'ingestion en temps réel peut être coûteuse et complexe. Les architectes doivent évaluer le coût de l'intégration, du stockage et de la transformation des données par rapport au coût de leur interrogation directe via Zero Copy. Le choix du modèle d'intégration approprié (Ingestion de données, Zéro copie ou approche hybride) impacte directement la latence, la gouvernance, l'efficacité opérationnelle et le coût sur les plates-formes multicloud. Cette décision détermine comment les connaissances en temps réel, l'activation pilotée par l'IA et l'engagement personnalisé peuvent être fournis de façon fiable et à grande échelle. ## Comparaison des produits Le tableau ci-dessous présente une comparaison technique des modèles Ingestion de données et Zéro copie dans Salesforce Data 360, en se concentrant sur les capacités, les compromis et les avantages, ainsi que sur les cas d'utilisation et les résultats de l'entreprise. Les architectes peuvent s'en servir comme référence pour concevoir des plates-formes de données hybrides et multicloud qui concilient performance, coût et conformité.
Type de modèle Mode / Outil Avantages Considérations Résultats
Ingestion de données En temps réel : Ingestion de latence subseconde via des API Ingestion avec la prise en charge du CDC. Pipelines en continu. - Connaissances immédiates
- Idéal pour les cas d'utilisation opérationnels et de personnalisation à faible latence
- Prend en charge les workflows pilotés par l'événement
- Coût élevé
- Architecture complexe
- Nécessite des systèmes sources à faible latence
- Les sources à haut volume peuvent entraîner une diffusion excessive conduisant à des pipelines saturés
- E/S intensives
- Prendre en compte les champs sélectifs et le filtrage pour réduire les frais généraux
Agentforce :
- Alertes anti-fraude en temps réel, personnalisation de la vente au détail, alertes opérationnelles
Analytics :
- Tableaux de bord sub-seconde, suivi des indicateurs de performance clés
Conformité :
- Mises à jour continues des enregistrements clients pour les workflows réglementés
Streaming : Ingestion par microbatch toutes les 1 à 3 minutes via des connecteurs natifs - Coût équilibré vs fraîcheur
- Une architecture plus simple que le temps réel
- Prend en charge les mises à jour incrémentielles
- Légère latence
- Peut ne pas convenir à des décisions critiques de deuxième seconde
- La taille du lot impacte la mémoire/calcul
- E/S est modéré
- Idéal pour les modèles de mise à jour prévisibles et répétés
- Envisager l'agrégation fenêtrée pour réduire la charge de traitement
Agentforce :
- Déclencheurs de campagne au moment opportun, engagement en direct
Analytics :
- Moteurs de recommandation, tableaux de bord en quasi direct
Conformité :
- Mises à jour fréquentes avec auditabilité
Batch : Chargements planifiés à grand volume via des connecteurs ou des API. Prend en charge le stockage d'objets et les pipelines ETL/ELT. - Rentable pour des jeux de données massifs
- Facile à mettre en oeuvre
- Fiable pour les analytiques historiques
- Latence des données
- Inadapté aux opérations temporelles
- E/S intensives pendant les fenêtres de chargement
- Le débit réseau peut devenir un goulot d'étranglement pour les fichiers volumineux
- Idéal pour les workflows d'agrégation historique ou de rapports réglementés
Agentforce :
- tickets de support informatique (Jira/ServiceNow), workflows agrégés
Analytics :
- Analyse historique, évaluation des tendances
Plainte :
- Rapports réglementaires, agrégation des données patients/réclamations
Zéro copie Live Query : Requêtes directes sur des systèmes externes ; schéma en lecture seule ; pas de duplication des données - Maximum de fraîcheur
- Réduction des surcharges de stockage; prend en charge les connaissances opérationnelles en temps réel
- Selon les performances de la source
- Un volume de requête élevé peut affecter la latence
- Idéal pour les requêtes avec pushdown et agrégation de prédicat afin de minimiser les entrées/sorties
- Éviter les requêtes non filtrées dans les jeux de données massifs
Agentforce :
- Workflows dynamiques s'adaptant à l'activité live
Analytics :
- Tableaux de bord opérationnels, reporting live
Conformité :
- Respecte la sécurité au niveau de la ligne et le masquage à la source
Requête accélérée (mise en cache) : copies locales mises en cache pour les requêtes fédérées. Configurable de 15 min à 7 jours. Exécution de requête optimisée - Réduit la latence
- Coût inférieur aux requêtes live répétées
- Améliore les performances des modèles d'accès fréquents
- Gestion du cache requise
- L'absence dépend de l'intervalle de cache
- Idéal pour les requêtes à haute fréquence
- Ne convient pas à la prise de décision en sous-seconde
Agentforce :
- Métriques d'engagement préagrégées pour accélérer la prise de décision
Analytics :
- Tableaux de bord BI, segmentation, reporting analytique
Conformité :
- Tableaux de bord réglementés cohérents avec des journaux d'audit
Fédération de fichiers: accès direct aux jeux de données historiques volumineux dans les magasins d'objets ou les lacs (S3, Iceberg, Google BigQuery, Redshift). - Gère les jeux de données à grande échelle
- Stockage minimal dans Data 360
- Prend en charge les charges de travail IA/ML
- Lecture seule
- Les performances des requêtes dépendent du débit système externe
- Optimisé pour les tâches lourdes en lots et gourmandes en débit
- Ne convient pas aux tableaux de bord en temps réel
Agentforce :
- (pas typique — lourd en lots)
Analytics :
- Entraînement ML/IA, analytiques historiques, rapports à l'échelle pétaoctets
Conformité :
- Accès régi aux jeux de données externes sans duplication
## Modèles d'intégration Data 360 ### Ingestion de données Avec l'ingestion de données, les données sont physiquement copiées dans Data 360 et entièrement régies, contrairement à Zero Copy où les données restent à la source. Le calcul des transformations est effectué dans Data 360, ce qui permet une gouvernance et un audit centralisés. #### Cas d'utilisation d'ingestion de données Utilisez l'ingestion de données pour stocker des jeux de données canoniques et gouvernés dans Salesforce Data 360 à des fins de conformité et de contrôle opérationnel. Utilisez l'ingestion lorsqu'un contrôle total, un audit et une traçabilité sont requis. Idéal pour les workflows réglementés ou à valeur élevée dans lesquels le calcul centralisé et la gouvernance sont essentiels. L'ingestion est la meilleure méthode pour établir une base de confiance pour la résolution de l'identité, les rapports réglementaires, et les workflows critiques pilotés par l'IA et l'engagement des clients. Vue d'ensemble de l'ingestion de données #### Méthodes d'ingestion de données Les méthodes d'ingestion de données varient selon le connecteur que vous utilisez pour ingérer vos données. Certains connecteurs offrent diverses méthodes d'ingestion, tandis que d'autres fonctionnent uniquement en mode par lot ou streaming. Consultez [Data 360 : Intégrations et connecteurs](https://help.salesforce.com/s/articleView?id=data.c360_a_sources_targets.htm&type=5) pour une liste complète des connecteurs Data 360 et leurs méthodes disponibles. - **En temps réel** - Ingestion d'une seconde en utilisant des pipelines en continu ou Capture des données de modification (CDC). - Idéal pour les workflows temporels (détection des fraudes, personnalisation, tableaux de bord opérationnels). - Transformations push et agrégations dans Data 360 pour réduire les entrées/sorties en aval et optimiser l'utilisation des calculs. Utilisez le CDC incrémentiel pour limiter le mélange de données. - **Streaming** - Ingestion toutes les 1 à 3 minutes par petits incréments. - Équilibre fraîcheur et coût, adapté à l'orchestration de campagnes, à l'engagement en direct et aux rapports opérationnels. - Utilisez des micro-batchs pour contrôler les pics d'E/S. Agrégez les données à la source si possible pour réduire les volumes de transfert et optimiser le stockage. - **Lot (chargements planifiés)** - Ingestion périodique de jeux de données volumineux (horaire, quotidien, hebdomadaire). - Rentable et fiable pour les jeux de données historiques, les rapports réglementaires et les cas d'utilisation de conformité. - Garantissez la localisation du calcul dans la même région que le stockage source pour optimiser les performances et les coûts. #### Architect Playbook - **Cas d'utilisation pour l'ingestion de données** - **Générer des profils Customer 360 unifiés :** Élaboration d'une source de vérité unique pour l'identité et les attributs des clients. - **Gérer les jeux de données de conformité réglementaire :** Application de la gouvernance, de la lignage et de l'auditabilité pour les données confidentielles. - **Centraliser l'orchestration des campagnes :** Le marketing, les ventes et le service fonctionnent à partir de jeux de données cohérents et de confiance. - **Pratiques de conception** - Privilégiez l'ingestion par lot pour les besoins historiques ou tolérants à faible latence, par exemple les rapports d'archives ou les clichés instantanés périodiques. - Utilisez des API CDC ou streaming pour actualiser les workflows opérationnels et de personnalisation, en garantissant des mises à jour en temps quasi réel. - Contrôlez le stockage et calculez la croissance en appliquant des charges incrémentielles, au lieu de recharger des jeux de données complets, afin d'optimiser le coût et l'efficacité. - Alignez les pipelines d'ingestion avec la localisation du calcul et le traitement incrémentiel afin de réduire les entrées/sorties réseau. Appliquez des transformations dans Data 360 pour éviter de déplacer inutilement des données brutes. - **Considérations relatives aux coûts** - **Ingestion en temps réel :** Coûts de calcul et de pipeline les plus élevés ; justifiés pour des workflows à forte valeur ajoutée et urgents tels que la personnalisation, des tableaux de bord opérationnels ou des actions pilotées par Agentforce. - **Ingestion en continu :** Modérer les coûts de calcul et de stockage. Convient aux mises à jour fréquentes qui peuvent tolérer de légers retards, par exemple l'orchestration de campagnes ou la génération de rapports opérationnels. - **Ingestion par lot :** Réduction des coûts de calcul, stockage prévisible, idéal pour les jeux de données historiques ou les mises à jour à basse fréquence. L'ingestion de données par lot à partir d'organisations Salesforce en utilisant certains connecteurs est gratuite. - **Mode d'actualisation :** La sélection du mode Actualisation incrémentielle réduit les coûts totaux d'ingestion et de calcul. Nous recommandons d'utiliser l'actualisation incrémentielle dans la mesure du possible afin d'optimiser l'efficacité dans tous les types d'ingestion. - Le coût est également impacté par le volume d'E/S depuis la source vers Data 360. L'optimisation de la taille des lots, des partitions et de l'alignement régional réduit les coûts de transfert et améliore les performances. - **Scénarios de secteur d'activité** - **Finances :** Ingérez les jeux de données requis pour connaître vos clients (KYC), Anti Money Laundering (AML) et la détection des fraudes, où l'auditabilité et la conformité ne sont pas négociables. - **Soins de santé :** Utilisez l'ingestion pour la résolution de l'identité des patients et les enregistrements conformes HIPAA, ce qui permet des vues sécurisées et unifiées. - **Détail :** Consolider les données des points de vente (POS), du commerce électronique et du programme de fidélité dans des profils unifiés pour la segmentation et la personnalisation - **Télécom :** Prenez en charge la prévention des résiliations et les analytiques d'utilisation avec des données d'abonné gouvernées canoniques. #### Critères de décision de la méthode d'ingestion de données
Fonctionnalité Ingestion en temps réel Ingestion en continu Ingestion par lot
Latence et fraîcheur Ingestion de latence en une seconde via les API Ingestion avec prise en charge de la Capture des données de modification (CDC). Fournit des pipelines en continu. Idéal pour les cas d'utilisation opérationnels à faible latence. Ingestion par microbatch toutes les 1 à 3 minutes via des connecteurs natifs. Prend en charge les mises à jour incrémentielles. Une légère latence est attendue. Une latence des données est attendue. Chargements planifiés à grand volume. Ingestion périodique (horaire, quotidienne, hebdomadaire). Inadapté aux opérations temporelles.
Cas d'utilisation principaux Idéal pour les cas d'utilisation opérationnels et de personnalisation à faible latence. Utilisé pour les workflows temporels. Prend en charge les workflows pilotés par l'événement. Utilisé pour les alertes de fraude et les alertes opérationnelles en temps réel. Convient aux processus modérément urgents. Utilisé pour l'orchestration de campagnes, l'engagement en direct et les rapports opérationnels. Utilisé pour les déclencheurs de campagne opportuns. Rentable pour des jeux de données massifs. Fiable pour les analytiques historiques. Utilisé pour les workflows d'agrégation historique ou de rapports réglementés. Idéal pour les jeux de données historiques ou à faible vitesse.
Complexité architecturale et E/S Coût élevé et architecture complexe. Nécessite des systèmes sources à faible latence. E/S intensives. Les sources à haut volume peuvent entraîner la saturation des pipelines. Une architecture plus simple que le temps réel. Les entrées/sorties sont modérées. Idéal pour les modèles de mise à jour prévisibles et répétés. La taille du lot impacte la mémoire/calcul. Facile à implémenter. E/S intensives pendant les fenêtres de chargement. Le débit réseau peut devenir un goulot d'étranglement pour les lots volumineux.
Considérations relatives aux coûts Coûts de calcul et de pipeline les plus élevés. Justifié uniquement pour les workflows de grande valeur et urgents. Modérer les coûts de calcul et de stockage. Fournit une approche coût/fraîcheur équilibrée. Convient pour les mises à jour fréquentes qui peuvent tolérer de légers retards. Réduction des coûts de calcul et stockage prévisible. Recommandé pour les jeux de données historiques ou les mises à jour à basse fréquence. L'ingestion via des pipelines internes Salesforce est gratuite.
Pratiques de conception Utilisez le CDC incrémentiel pour limiter le mélange de données. Filtrez et utilisez des champs sélectifs pour réduire les frais généraux. Utilisez des micro-batchs pour contrôler les pics d'E/S. Envisagez l'agrégation fenêtrée pour réduire la charge de traitement. Favorisez cette option pour les rapports d'archives ou les clichés instantanés périodiques. Assurez-vous de calculer la localisation dans la même région que le stockage source pour optimiser les coûts.
### Fédération de données Zero Copy #### Cas d'utilisation sans copie Utilisez Zero Copy pour l'interrogation en temps réel de systèmes externes sans duplication des données, ce qui permet l'agilité, la fraîcheur et l'accès évolutif à des jeux de données volumineux ou temporaires. Il est idéal pour les tableaux de bord live, les analytiques exploratoires, l'entraînement au modèle IA/ML et l'engagement client en temps réel directement via Salesforce Data 360. Vue d'ensemble de la fédération de données Zero Copy #### Méthodes de copie zéro Lors de l'utilisation de Zero Copy, les architectes doivent choisir entre trois méthodes de fédération de données disponibles, chacune offrant ses propres compromis entre fraîcheur, performance et coût. - **Requête live** - Exécute des requêtes directement sur des systèmes externes (Snowflake, Google BigQuery, Redshift, Databricks, etc.) sans duplication de données. - Optimal lorsque les prédicats et les agrégations peuvent être poussés vers le bas, ce qui réduit les mouvements de données sur le réseau et réduit les entrées/sorties dans le calcul Salesforce Data 360. - Idéal pour les connaissances en temps réel et les tableaux de bord opérationnels à faible latence. Selon les performances du système externe. - **Mise en cache (requête accélérée)** - Stocke temporairement des copies mises en cache de données fédérées dans Salesforce Data 360. - Réduit les coûts des requêtes répétées et la latence des jeux de données fréquemment accédés, avec une durée configurable (minutes à jours). - Les données ne sont pas copiées de façon permanente ni entièrement régies. La fraîcheur est gérée par des actualisations planifiées à partir de la source. - **Fédération de fichiers** - Fournit un accès direct en lecture seule aux jeux de données à grande échelle dans les magasins d'objets (par exemple, S3, GCS avec Iceberg). - Idéal pour les charges de travail IA/ML, les analytiques historiques et les rapports à l'échelle du pétaoctet sans déplacer les données. - Les performances des requêtes dépendent fortement du format des objets, du partitionnement et des entrées/sorties réseau. Les analyses volumineuses peuvent générer des entrées/sorties importantes si elles ne sont pas optimisées. #### Architect Playbook - **Cas d'utilisation** - **Personnalisation en temps réel et workflows adaptatifs :** Proposez des offres dynamiques, des recommandations et des actions Next Best lorsque le comportement des clients change. - **Tableaux de bord live et analytiques opérationnelles :** Pilotez des tableaux de bord et des indicateurs de performance clés critiques pour l'entreprise directement depuis des entrepôts externes. - **Entraînement au modèle IA/ML avec de grands jeux de données externes :** Exploitez les données à l'échelle du pétaoctet des lacs de données et des entrepôts en utilisant la fédération de fichiers sans les déplacer. - **Scénarios de secteur d'activité** - **Retail/Media:** Activez des recommandations personnalisées et l'engagement client en temps réel en fédérant les données de flux de clics ou d'interaction de contenus. - **Finances :** Exécutez la détection des fraudes et le score de risque en temps quasi réel en interrogeant des entrepôts externes sans dupliquer les données confidentielles. - **Tech/Entreprise :** Prenez en charge les rapports inter-clouds, les tableaux de bord de service TI et les analytiques opérationnelles lorsque les jeux de données résident dans plusieurs systèmes. - **Pratiques de conception** - **Requête live** - Utilisé pour les requêtes à QPS élevé et à faible latence lorsque la fraîcheur est critique. - Envoyez automatiquement des prédicats et des agrégations au système externe afin de réduire le transfert de données sur le réseau. - Évitez les requêtes qui analysent inutilement des volumes de données massifs. Pensez à l'élagage des partitions et aux filtres. - **Fédération de fichiers** - Accédez aux jeux de données à l'échelle du pétaoctet dans les magasins d'objets sans ingestion. - Gardez le stockage d'objets dans la même zone cloud que Salesforce compute afin de limiter les coûts de latence et de sortie. - Utilisez des formats partitionnés et colonnaires (Parquet/ORC) et des filtres pushdown pour réduire les entrées/sorties et le transfert réseau. - Exploitez les requêtes et les prédicats pushdown pour filtrer et agréger les données à la source, réduisant ainsi le mouvement des données. - Évitez l'accès aux données entre les régions, sauf si nécessaire, car cela augmente les entrées/sorties, la latence et les coûts. - **Mise en cache (requête accélérée)** - Mettez en cache les jeux de données fréquemment accédés pour équilibrer les coûts et les performances. - Configurez des intervalles d'actualisation pour équilibrer la fraîcheur et le coût des requêtes. - **Conformité :** Appliquez la gouvernance à la source en exploitant la sécurité au niveau de la ligne (RLS) et en masquant les stratégies directement dans les systèmes fédérés. Voici les meilleures pratiques pour uniformiser le RLS et le masquage entre les plates-formes. - **Utiliser un ID d'entreprise centralisé :** Mappez des utilisateurs et des entités dans Salesforce Data 360 avec un identifiant d'entreprise unique et centralisé qui correspond aux identités dans des systèmes externes. - **Aligner les stratégies de sécurité :** Assurez-vous que les stratégies de sécurité et de masquage au niveau de la ligne dans les systèmes fédérés sont appliquées en fonction de l'identité mappée. Cela préserve la conformité lors de l'interrogation de données externes. - **Schémas d'identité normalisés :** Maintenez des attributs d'identité cohérents (e-mail, ID d'utilisateur, ID de client, etc.) entre toutes les sources de données afin d'éviter les incohérences et les violations d'accès. - **Considérations relatives aux coûts** - **Live Query :** Modèle de paiement par requête : les coûts s'accumulent dans le calcul externe de Lakehouse et peuvent augmenter avec un QPS élevé. Idéal pour les cas d'utilisation critiques pour la fraîcheur où la valeur est supérieure à la variabilité du coût. - **Requête accélérée (mise en cache) :** Réduit le coût des requêtes par rapport à Live Query en réduisant les accès au système source, mais augmente les coûts d'ingestion de données par lot pour remplir et actualiser le cache. Idéal pour les jeux de données fréquemment accédés. - **Fédération de fichiers :** L'option de stockage la moins chère en tant que données dans Object Store, mais les coûts de requête dépendent de la taille du fichier, du partitionnement et de l'élagage. Idéal pour les données historiques ou en masse à l'échelle du pétaoctet. #### Critères de décision de la méthode de copie zéro
Point de décision Live Query Mise en cache (requête accélérée) Fédération de fichiers
Emplacement de la source de données Lakehouses de données externes (Snowflake, Google BigQuery, Redshift, Databricks). Lakehouses de données externes (Snowflake, Google BigQuery, Redshift, Databricks) Stocks d'objets ou lacs de données cloud (S3, ADLS, GCS), souvent en utilisant des formats de tableau ouverts tels que Iceberg.
Objectif/cas d'utilisation Idéal pour l'analyse interactive et les tableaux de bord en temps réel. Idéal pour la personnalisation en temps réel et les workflows dynamiques. Idéal lorsque les requêtes sont fréquentes, mais que les résultats légèrement périmés sont acceptables. Convient pour les tableaux de bord BI et la segmentation. Idéal pour le traitement par lot à grande échelle et l'entraînement au modèle IA/ML. Idéal pour les analytiques historiques et les rapports à l'échelle du pétaoctet.
Fraîcheur/Latence Une fraîcheur maximale ; les requêtes sont exécutées directement en temps réel. Prend en charge la prise de décision sub-seconde. Les résultats légèrement périmés sont acceptables. La fraîcheur dépend de l'intervalle de cache, configurable de 15 minutes à 7 jours. Optimisé pour les tâches lourdes en lots et exigeantes en débit. Ne convient pas aux tableaux de bord en temps réel.
Modèle d'accès Idéal pour les requêtes peu fréquentes ou ponctuelles. Utilisé pour les requêtes à QPS élevé (requête par seconde) et à faible latence dans lesquelles la fraîcheur est critique. Idéal pour les scénarios de lecture à haute fréquence. Améliore les performances des modèles d'accès fréquents. Accès en lecture seule. Convient aux jeux de données à l'échelle du pétaoctet sans ingestion.
Performance Drivers Très dépendant des performances du système source externe. Optimisé lorsque les prédicats et les agrégations peuvent être automatiquement dirigés vers la source. Réduit la latence par rapport aux requêtes live répétées. Les performances dépendent de la gestion du cache et de l'intervalle. Les performances dépendent fortement du format de l'objet, du partitionnement et du débit système externe. Utilisez des formats partitionnés et colonnaires (Parquet/ORC).
Incidences sur les coûts Modèle de paiement par requête. Les coûts s'accumulent dans le calcul externe Lakehouse. Rentable pour les requêtes peu fréquentes, mais les dépenses peuvent augmenter avec un volume de requêtes par seconde (QPS) élevé. Coût inférieur aux requêtes live répétées. Réduit la nécessité d'interroger régulièrement la source externe. Ajoute le stockage en cache et l'actualisation. Option de stockage la moins chère. Les coûts de requête dépendent de la taille du fichier et du partitionnement.
Considérations clés Évitez les requêtes non filtrées qui analysent inutilement des volumes de données importants. Nécessite la gestion du cache. Ne convient pas à la prise de décision sub-seconde. Les performances des requêtes dépendent fortement de l'optimisation via le partitionnement et la pushdown des prédicats.
### Approche hybride Les architectures hybrides permettent aux architectes d'ancrer des jeux de données critiques dans Data 360 pour une gouvernance centralisée tout en exploitant les requêtes fédérées pour plus d'actualité, réduire les duplications et un accès évolutif aux jeux de données externes volumineux. Cette approche concilie les exigences d'E/S, de localisation du calcul, de coût et de conformité. #### Cas d'utilisation hybrides Utilisez une approche hybride pour une gouvernance équilibrée, la fraîcheur et l'efficacité opérationnelle en combinant l'ingestion de données et la copie zéro pour fournir des connaissances en temps réel et actionnables. Utilisez l'ingestion pour des jeux de données réglementés de grande valeur où la traçabilité, le RLS et le masquage sont requis, et la fédération pour des jeux de données éphémères ou à haut volume où la fraîcheur et les performances sont essentielles. Vue d'ensemble de l'approche hybride #### Architect Playbook - **Cas d'utilisation** - **Engagement Omni-channel :** Combinez les données clients historiques avec un comportement en temps réel pour offrir des expériences cohérentes et sensibles au contexte. - **Encours IA/ML :** Entraînez les modèles sur des jeux de données organisés et canoniques tout en les enrichissant avec des signaux bruts ou en temps réel provenant de sources externes. - **Besoins mixtes de conformité et d'agilité :** Appliquez une gouvernance stricte pour les données confidentielles, mais fédérez pour plus d'agilité opérationnelle. - **Scénarios de secteur d'activité** - **Détail :** Utilisez l'ingestion pour la résolution de l'identité et l'unification des profils, fédérez pour les offres en temps réel et la personnalisation. - **Soins de santé :** Gérez les enregistrements de patient dorés via l'ingestion tout en fédérant les flux d'appareils Internet des objets et les données des capteurs pour un contexte immédiat. - **Services financiers :** Ingérez des données réglementées dans un lac régi par la conformité tout en fédérant des requêtes externes pour la détection des fraudes et la surveillance des risques. - **Pratiques de conception** - **Ancrage de la gouvernance avec l'ingestion :** Ingérez des données de grande valeur ou réglementées dans des modèles canoniques pour garantir Trust et conformité. - **Utilisez Federation for Freshness :** Laissez les maisons de lac externes fournir un accès aux données en temps réel ou à grande échelle sans duplication. - **Coût d'équilibre vs. Performance :** Profilez les charges de travail pour décider ce que vous ingérez par rapport à fédérer, en réduisant les coûts inutiles de stockage ou de requête. - **Appliquer la gouvernance en couches :** Appliquer la gouvernance centralisée pour les données ingérées, tout en tirant parti des propres contrôles de sécurité des systèmes fédérés (par exemple, RLS, masquage). - Lors de la conception de pipelines hybrides, assurez l'ingestion incrémentielle de jeux de données historiques et envoyez automatiquement des agrégations ou des filtres à des sources fédérées afin d'optimiser les entrées/sorties et l'utilisation des calculs. - **Considérations relatives aux coûts** - Optimisez le coût total par rapport aux performances en combinant l'ingestion pour la conformité ou des données critiques avec la fédération lorsque la fraîcheur est nécessaire. - Tenez compte des entrées/sorties et calculez la distribution en mélangeant l'ingestion et la fédération. Pour réduire les coûts de calcul dans les systèmes sources de requêtes répétées, utilisez la mise en cache (requête accélérée) pour les jeux de données fédérés fréquemment accédés et lus. ## Guide de décision de cas d'utilisation Voici des archétypes courants qui illustrent comment appliquer cette logique. 1. **L'archétype « Source unique de vérité » : Centraliser et gouverner** - **Scénario :** Vous devez élaborer des profils Customer 360 conformes et unifiés pour l'ensemble de votre entreprise mondiale. Les données proviennent d’une douzaine de systèmes différents, doivent respecter les réglementations strictes du GDPR et de la CCPA, et serviront de source de confiance pour toutes les interactions marketing et de service. - **Modèle recommandé :** **Ingestion de données.** La priorité est gouvernance, Trust et contrôle. L'ingestion des données dans Data 360 est le seul moyen de créer un profil canonique entièrement auditable, isolé des systèmes sources. 2. **L'archétype « Connaissances en temps réel » : Analyser sans bouger** - **Scénario :** Votre équipe de science des données doit exécuter des requêtes exploratoires sur un tableau de transactions massif et constamment mis à jour dans Snowflake. En même temps, votre équipe de direction souhaite un tableau de bord live BI piloté par ces mêmes données. Le déplacement quotidien de pétaoctets de données est trop lent et coûteux. - **Modèle recommandé :** **Zero Copy Federation.** La priorité est la rapidité, l'agilité et la rentabilité à l'échelle. Zero Copy vous permet de tirer parti de l'immense puissance de votre entrepôt de données existant pour les requêtes en temps réel sans les surcharges et la latence de la duplication des données. 3. **L'archétype « Intelligence hybride » : Gouvernance du cœur, fédération de l’avantage** - **Scénario :** Vous souhaitez enrichir vos profils clients gouvernés et ingérés avec des signaux comportementaux en temps réel (par exemple des clics sur un site Web) à partir d'un lac de données. Vous avez besoin de la stabilité du profil principal, mais de l'immédiateté des données live pour piloter la personnalisation instantanée. - **Modèle recommandé :** **A Hybrid Approach.** Utilisez Ingestion de données pour créer le noyau stable et gouverné de vos données clients. Utilisez ensuite Zero Copy pour fédérer les données « edge » volatiles en temps réel, en les joignant au moment de la requête pour une vue complète et actualisée. ## La voie à suivre La stratégie de données d'entreprise ne consiste plus à choisir un modèle d'intégration unique, mais à concevoir une flexibilité contrôlée dans un écosystème de données interopérable. La sélection de la méthode d'intégration de données appropriée pour chaque système de données source en fonction des besoins métiers conduit souvent à une approche hybride qui combine les forces de l'ingestion de données et de la fédération de données. - Ingérez des jeux de données gouvernés critiques dans Salesforce Data 360 pour la conformité, la résolution de l'identité et les workflows opérationnels. - Fédérez des données via Zero Copy pour des analytiques live, exploratoires et pilotées par l'IA sans dupliquer le stockage. Salesforce Data 360 sur Hyperforce offre une résilience et une évolutivité multi-régions. s open lakehouse avec des tableaux Iceberg permet la séparation des calculs et l'interopérabilité avec des plates-formes telles que Snowflake, Databricks et S3 Iceberg, formant l'épine dorsale d'un écosystème de données multicloud véritablement interopérable. À mesure que les écosystèmes de données évoluent, conciliez en permanence fraîcheur, coût, performance et conformité pour préserver l'agilité architecturale. Préservez votre plate-forme en unifiant les données ingérées et régies avec un accès fédéré. Cela permet l'intelligence en temps réel, l'activation de l'IA et la personnalisation à l'échelle de l'entreprise à travers les clouds, les régions et les domaines métiers. Les solutions universelles ne conviennent pas à la plupart des entreprises. La stratégie optimale mappe le modèle approprié avec le moteur métier approprié. ## À propos des auteurs Yugandhar Bora est architecte en génie logiciel chez Salesforce, spécialisé dans l'architecture de données au sein de la plate-forme Data & Intelligence Applications. Il dirige les initiatives du comité d'examen de l'architecture d'entreprise (EARB) axées sur la gouvernance des données et les modèles de données unifiés, tout en contribuant aux solutions de provisionnement de plate-forme automatisé. Jan Fernando est architecte principal au bureau de l'architecte en chef chez Salesforce. Il a rejoint Salesforce en 2012, apportant une riche expérience de son passage dans l’écosystème des startups. Avant de se joindre au Bureau de l'architecte en chef, il a passé plus d'une décennie au sein de l'organisation Platform, où il a dirigé plusieurs transformations technologiques clés. # Premiers pas avec les guides de décision d'intégration Cette section fournit des conseils pratiques pour choisir les outils et les approches d'intégration de données appropriés pour Salesforce. Il couvre les intégrations sortantes, les intégrations entrantes et les scénarios inter-organisations, aidant les architectes à concevoir et à implémenter des intégrations de couche de données qui équilibrent performances, maintenabilité et coût. --- ## Intégration de données à Salesforce L'[intégration de données](/docs/architect/fr-fr/decision-guides/guide/data-integration) à Salesforce présente une vue d'ensemble complète des outils et des meilleures pratiques d'intégration de données Salesforce : - **Paysage de l'outil d'intégration**: Vue d'ensemble des outils d'intégration de données Salesforce, notamment les options low-code, hybrides et pro-code, avec des conseils pour sélectionner l'outil approprié à des cas d'utilisation spécifiques. - **Intégrations sortantes**: Méthodes d'envoi de données depuis Salesforce vers des systèmes externes, notamment Capture des données de modification, Services externes, Heroku Connect, Procédures d'intégration OmniStudio, Salesforce Connect, MuleSoft Anypoint et solutions Apex personnalisées. - **Intégrations entrantes**: Approches d'intégration de données externes dans Salesforce, avec des conseils sur la réplication des données par rapport à la virtualisation et quand utiliser chaque outil. - **Intégrations inter-organisations**: Méthodes recommandées pour le partage de données entre les organisations Salesforce, notamment MuleSoft Anypoint, Heroku Connect, les API Salesforce natives, Capture des données de modification et Salesforce Connect avec l'adaptateur inter-organisations, y compris un guide pour remplacer les implémentations Salesforce vers Salesforce héritées. - **Cadre de décision**: Considérations clés relatives à la sélection d'outils d'intégration, notamment les outils et le paysage existants, les exigences en flux de données (calendrier, directionnalité, expérience utilisateur attendue), la complexité de l'implémentation, la maintenabilité, le volume de données et les limites de la plate-forme. Permet aux architectes de choisir les outils et les modèles d'intégration appropriés pour chaque scénario, en réduisant les réplications de données inutiles, en exploitant les solutions ESB/ETL existantes et en garantissant des intégrations évolutives et maintenables qui respectent les principes de l'architecture d'entreprise. # Premiers pas avec les guides de décision Data 360 Cette section fournit des conseils pratiques pour prendre des décisions architecturales critiques concernant Salesforce Data 360, notamment des stratégies de provisionnement, la connectivité multi-organisations et des modèles d'intégration. Utilisez ces guides pour concevoir et implémenter des architectures de données efficaces qui unifient les données des clients et activent des fonctionnalités pilotées par l’IA. --- ## Provisionnement de Data 360 [Le provisionnement Data 360](/docs/architect/fr-fr/decision-guides/guide/data-360-provisioning) couvre les décisions fondamentales lors du provisionnement de Salesforce Data 360 : - **Sélection de l'organisation d'accueil**: Déterminez si Data 360 est provisionnée dans une organisation de production existante ou si vous créez une organisation dédiée, en tenant compte de la gouvernance, de la conformité et de la valeur temps. - **Stratégie multi-organisations**: Choisissez entre plusieurs instances Data 360 indépendantes ou utilisez Data Cloud One pour unifier plusieurs organisations Salesforce, en équilibrant autonomie, conformité et coût. - **Architecture Data Cloud One**: Activez plusieurs organisations compagnes pour partager une instance Data 360 unique avec la gouvernance centralisée, le partage de métadonnées et la parité des fonctionnalités entre les organisations. - **Partage de données entre des organisations Data 360**: Utilisez le partage de données sans copie entre des instances indépendantes pour la conformité régionale, la collaboration des unités commerciales ou des tableaux de bord exécutifs fédérés. - **Considérations relatives au provisionnement**: Tenez compte de la résidence des données, des modèles de gouvernance, de la latence, de la complexité de l'intégration, du coût et de la préparation de l'IA aux déploiements à l'échelle de l'entreprise. Aide les architectes à concevoir des stratégies de provisionnement qui garantissent la simplicité, la cohérence de l'entreprise, la conformité et l'évolutivité pour Customer 360, l'IA et l'innovation multi-plate-forme. --- ## Interopérabilité de Data 360 [L'interopérabilité Data 360](/docs/architect/fr-fr/decision-guides/guide/data-360-interoperability) fournit un cadre pour l'intégration de Data 360 à des plates-formes externes et des lacs de données : - **Modèles d'ingestion de données**: Ingestion en temps réel, en continu et par lot pour créer des jeux de données canoniques régis idéaux pour Customer 360, la conformité et la gouvernance centralisée. - **Zero-Copy Data Federation**: Méthodes de requête live, de requête accélérée (mise en cache) et de fédération de fichiers pour accéder en temps réel à des systèmes externes sans duplication, ce qui permet la personnalisation, les tableaux de bord et les charges de travail IA/ML. - **Approche hybride**: Combinez l'ingestion régie pour les jeux de données de base à la fédération zéro copie pour la fraîcheur et l'évolutivité, en prenant en charge l'engagement omni-canal, les actions pilotées par Agentforce et les analytiques d'entreprise. - **Cadre de décision**: Évaluez les compromis en termes de latence, de coût, d'évolutivité, de gouvernance et de complexité afin de sélectionner le modèle d'intégration approprié par source de données. - **Architect Playbooks**: Guides spécifiques au secteur d'activité, pratiques de conception et considérations sur les coûts pour les scénarios de finance, de santé, de vente au détail et de télécommunications. Guide les architectes dans l'équilibre entre l'actualisation des données, la gouvernance et l'efficacité du pipeline pour élaborer des architectures de données évolutives, interopérables et prêtes pour l'IA qui prennent en charge les charges de travail opérationnelles et analytiques. # Premiers pas avec les guides de décision de plate-forme Cette section fournit des conseils pratiques pour prendre des décisions architecturales critiques sur les capacités de Salesforce Platform. Il couvre le traitement asynchrone, les événements déclenchés par un enregistrement, l'élaboration de formulaires, l'architecture pilotée par l'événement et les infrastructures asynchrones basées sur des étapes afin d'aider les architectes à concevoir des solutions de plate-forme évolutives, maintenables et performantes. --- ## Traitement asynchrone [Traitement asynchrone](/docs/architect/fr-fr/decision-guides/guide/async-processing) fournit des conseils sur les outils et les approches pour les opérations asynchrones dans Salesforce : - **Outils de traitement asynchrone**: Comparaison entre Apex Queueable, Apex planifié, Déclencheurs d'événements de plate-forme, Capture des données de modification, Parcours planifié (après validation des flux) et Parcours asynchrone (flux déclenchés par un enregistrement), avec des conseils sur les cas d'utilisation appropriés. - **Traitement asynchrone côté serveur**: Modèles pour les opérations de base de données de longue durée, les appels externes et le traitement d'enregistrements volumineux. - **Traitement asynchrone côté client**: Des techniques comme les Appels externes de continuation Apex et le traitement asynchrone côté client qui peuvent être exécutés dans des navigateurs ou des applications mobiles. - **Cadre de décision**: Tenez compte de la validation des cas d'utilisation, de l'évolutivité, de la compréhension des transactions réellement asynchrones, de la surveillance et de la gestion des événements de charge extrêmes. - **Meilleures pratiques et anti-modèles**: Guide de bonne utilisation, y compris les intégrations sortantes, la surveillance et éviter les pièges courants. Permet aux architectes d'implémenter des modèles asynchrones évolutifs, fiables et maintenables, en évitant les pièges qui compromettent les performances. --- ## Élaboration de formulaires [Building Forms](/docs/architect/fr-fr/decision-guides/guide/build-forms) guide les architectes sur les options de création de formulaire Salesforce : - **Outils de création de formulaire**: Comparaison des formulaires dynamiques, du flux d'écran, d'OmniStudio, du flux d'écran avec les composants Web Lightning (LWC) et des composants Web Lightning, y compris les compétences et les considérations relatives aux licences. - **Cadre de décision**: Tenez compte de l'impact des objets, de l'étendue du formulaire, de la navigation, de la localisation (application, mobile, Web), de l'expérience utilisateur et de l'automatisation des tests. - **Guide de sélection**: Recommandations depuis de simples présentations d'enregistrement jusqu'à des assistants multipages et des formulaires de marque destinés aux clients. - **Modèles de combinaison**: Guide pour combiner des outils, par exemple la navigation dans les flux d'écran avec le style Composant Web Lightning. - **Fonctionnalités avancées**: Exploration approfondie des capacités et des limitations pour éclairer le choix de l'outil. Aide les architectes à sélectionner l'approche de création de formulaire adaptée à leurs exigences spécifiques en matière d'utilisation, de fonctionnement et d'intégration. --- ## Architecture pilotée par l'événement L'[architecture pilotée par](/docs/architect/fr-fr/decision-guides/guide/event-driven) les événements fournit un guide complet sur les outils et les modèles d'événement Salesforce : - **Outils d'événement**: Vue d'ensemble des événements de plate-forme, Capture des données de modification, API Pub/Sub, MuleSoft Anypoint, API Streaming, et considérations relatives à l'intégration. - **Schémas pilotés par l'événement**: Inclut des modèles de publication/inscription, fanout, messages transmis, streaming et mise en file d'attente pour divers cas d'utilisation pilotés par l'événement. - **Intégration à MuleSoft**: Utilisation des connecteurs Anypoint (Pub/Sub, JMS, Kafka, Solace, MQ, MQTT, AMQP) pour les architectures d'entreprise. - **Événements de plate-forme et capture des données modifiées**: Guide sur les mécanismes préférés de publication des modifications des enregistrements et des champs, avec la migration depuis PushTopic/Generic Events. - **Schémas d'implémentation**: Meilleures pratiques pour l'évolutivité, la cohérence, le traitement des erreurs et la surveillance. Permet aux architectes de concevoir des systèmes pilotés par des événements évolutifs en temps quasi réel qui connectent efficacement plusieurs systèmes. --- ## Infrastructure asynchrone basée sur une étape [Step-Based Async Framework](/docs/architect/fr-fr/decision-guides/guide/step-based-async-framework) fournit une infrastructure pour le traitement modulaire et évolutif des tâches asynchrones : - **Architecture du cadre**: Les composants comprennent Apex Queueable, Finalizers, Scheduled Flow, Apex Cursors, Actions invocables et intégrations Slack. - **Traitement basé sur l'étape**: Brise le travail en étapes indépendantes qui peuvent être exécutées, réessayées et redémarrées avec une gouvernance partagée et une visibilité opérationnelle. - **Instruction de mise**: en œuvre Modèles pour l'interface Étape, le processeur Étape, la couche Invocable Apex, le traitement des délais et les notifications. - **Meilleures pratiques**: Recommandé lorsque la plupart des informations existent dans CRM, pour les charges de travail à haut volume et le traitement hiérarchique ou arborescent des enregistrements. - **Fonctionnalités Enterprise-Grade**: Gouvernance, conformité, état distribué, suivi de la progression, surveillance des accords de niveau de service, diagnostics d'échec et consignation au niveau de l'audit. Fournit aux architectes une alternative évolutive aux tâches par lot monolithiques et aux appels asynchrones enchaînés, prenant en charge les charges de travail Salesforce à haut volume avec une transparence opérationnelle totale. --- ## Automatisation déclenchée par un enregistrement L'[automatisation déclenchée par](/docs/architect/fr-fr/decision-guides/guide/record-triggered) un enregistrement fournit le cadre de conception de l'automatisation déclenchée par un enregistrement sur Salesforce Platform : - **Sélection d'outils**: Quand utiliser les déclencheurs Flux déclenché par un enregistrement par rapport aux déclencheurs Apex, guidés par la densité d'automatisation (faible, moyenne, élevée) et la matrice de sélection de densité. - **Densité d'automatisation**: Comment évaluer la quantité d'automatisation, le volume d'enregistrements et l'étalement des dépendances pour choisir des déclencheurs Flux, hybrides (Flux avec Apex invocable) ou Apex. - **Points d'entrée et gouvernance**: Un point d'entrée par objet Salesforce ; guide sur les conditions d'entrée, le contrôle de la récursivité et l'exécution ordonnée. - **Invocation asynchrone**: Quand et comment invoquer des processus asynchrones à partir de flux déclenchés par un enregistrement ou Apex, avec précaution quant au traitement des erreurs et aux limites du gouverneur. - **Meilleures pratiques**: Modèles de traitement en masse, conception hybride Flow–Apex et évitez les pièges courants dans l'automatisation des déclencheurs. Permet aux architectes de concevoir une automatisation déclenchée par un enregistrement évolutive, maintenable et performante, conforme aux normes de la plate-forme. ## Vue d'ensemble Salesforce Data 360 est une plate-forme de données basée sur Hyperforce qui unifie Salesforce et les données externes dans une vue complète, claire et fiable de chaque client ou compte. Les entreprises exploitent souvent plusieurs organisations Salesforce en raison de fusions et d'acquisitions, d'opérations régionales, d'une séparation fonctionnelle ou pour des raisons historiques. Les architectes doivent choisir non seulement entre une configuration Home Org unique et une configuration multi-organisations, mais également entre provisionner plusieurs instances Data 360 indépendantes, utiliser Data Cloud One pour unifier les organisations sous une instance unique ou collaborer entre des instances Data 360 indépendantes en utilisant le partage de données entre Data 360 (partage de données Data 360-to-Data 360). Ces choix impactent la gouvernance, la conformité, le coût, la latence et la capacité de l'organisation à adapter les fonctionnalités d'IA et de plate-forme inter-organisations. Data 360 est automatiquement provisionnée dans toute organisation de production qui reçoit une licence Data 360. Data Cloud One est l'architecture de connectivité multi-organisations de Salesforce qui permet à une seule organisation d'accueil d'héberger l'instance Data 360, tandis que d'autres organisations Salesforce se connectent en tant qu'organisations compagnes. Le choix de l'organisation détentrice de la licence Data 360, qui devient ainsi une organisation domestique Data 360, est une décision architecturale critique avec des conséquences à long terme. Le provisionnement de Salesforce Data 360 est une décision architecturale fondamentale, car il détermine comment l'entreprise unifie les données des clients, applique la gouvernance et active les fonctionnalités critiques de la plate-forme, en particulier l'IA, Agentforce et les analytiques, dans l'ensemble de l'organisation. L'ancrage d'un cluster d'organisations à une Data 360 unique fournit un modèle de données unifié, une gouvernance centralisée et une préparation à l'IA à l'échelle de l'entreprise, tout en permettant aux organisations compagnes d'accéder aux métadonnées et fonctionnalités partagées comme si les données étaient locales. Par contre, plusieurs instances Data 360 indépendantes sont appropriées lorsque les exigences réglementaires, de conformité ou d'autonomie empêchent la centralisation, le Partage de données entre les organisations Data 360 permettant une collaboration sélective et sans copie entre ces instances. Pour les architectes, cette décision est critique. Il définit qui contrôle la gouvernance des données, où résident les données, comment les fonctionnalités de la plate-forme sont activées et comment les futures intégrations et initiatives IA peuvent évoluer en douceur. Même pour les organisations qui n'ont pas Data 360 actuellement, il peut être important de pérenniser votre architecture en développant une stratégie pour ajouter l'accès Data 360 à l'avenir. Les fonctionnalités de Salesforce dans Sales, Service, Marketing, Commerce, Industries et Agentforce sont de plus en plus élaborées sur Data 360. Les organisations qui souhaitent utiliser ces fonctionnalités de plate-forme doivent provisionner leur propre Data 360 ou se connecter à une Data 360 partagée en tant qu'organisations partenaires. Ce guide aide les architectes à concevoir une stratégie de provisionnement qui concilie simplicité, cohérence à l'échelle de l'entreprise, conformité et évolutivité, afin de s'assurer que l'organisation peut exploiter en toute confiance Data 360 pour Customer 360, l'IA et l'innovation multi-plate-forme. Il vous aidera à choisir les organisations sur lesquelles vous provisionnez Data 360 et comment choisir entre Data Cloud One et Partage de données entre les organisations Data 360, ce qui vous aidera à jeter les bases solides qui feront avancer votre entreprise vers un avenir centré sur Data 360. --- ## Considérations relatives au provisionnement Chaque choix de provisionnement, qu'il s'agisse de choisir entre Data Cloud One et le partage de données entre des organisations Data 360, ou l'organisation à désigner en tant qu'organisation d'origine, doit être évalué par rapport aux considérations transversales suivantes :
Considérations Pourquoi c'est important Exemples de scénarios
Résidence et conformité des données Détermine où les données sont stockées et traitées. Les règles réglementaires peuvent exiger des régions spécifiques ou plusieurs instances. Une banque mondiale provisionne un locataire Data 360 dans une organisation Salesforce géolocalisée à Francfort pour la conformité au RGPD et un autre dans une organisation en Virginie pour sa division aux États-Unis.
Gouvernance et sécurité Qui est propriétaire et administrateur de Data 360 ? Les politiques doivent-elles être gérées de façon centralisée ou déléguées par unité commerciale ? Une multinationale dotée d'une solide informatique centrale crée une organisation à domicile dédiée gérée par un centre d'excellence.
Autonomie vs. Centralisation Différents dirigeants peuvent souhaiter une propriété séparée des données. L'autonomie favorise plusieurs Data 360; la centralisation favorise Data Cloud One . Une holding avec des filiales indépendantes permet à chaque unité commerciale de gérer sa propre Data 360.
Latence et performance Influe sur la vitesse et l'expérience des requêtes, en particulier pour les organisations compagnes connectées à un locataire Data 360 dans toutes les régions. Une équipe commerciale à Londres qui interroge les données d'un locataire Data 360 aux États-Unis peut afficher une latence plus élevée.
Complexité de l'intégration Plus de locataires Data 360 = plus de pipelines, d'API et de middleware. La consolidation simplifie l'intégration. Un détaillant évite d’élaborer 10 pipelines ETL en les regroupant dans une configuration Data Cloud One.
Zone source de données Zéro copie Les connecteurs Zero Copy peuvent avoir des exigences d'accès inter-régions qui limitent les régions dans lesquelles votre Data 360 peut se trouver. Une entreprise a une instance Snowflake dans la région AWS eu-west-1. Ils peuvent utiliser Zero Copy pour fédérer des données dans une Data 360 de leur région, mais ne peuvent pas utiliser Zero Copy pour fédérer dans une Data 360 aux États-Unis.
Compatibilité inter-régions Private Connect Dans certains cas, la prise en charge de Private Connect dépend de la localisation de la source de données dans la même région que le locataire Data 360. Une entreprise a une instance Snowflake dans la région aws-east-1 à laquelle elle souhaite se connecter via zéro copie. Ils peuvent établir une connexion réseau Private Connect uniquement si l'organisation d'accueil Data 360 réside dans la même région.
Coût et licence Chaque locataire Data 360 ajoute un coût. La consolidation en moins d'instances optimise les dépenses. Un prestataire de soins réduit les coûts de licence en adoptant Data Cloud One au lieu de plusieurs instances Data 360 indépendantes.
Évolutivité future Les choix de provisionnement posent aujourd'hui les bases de la croissance. Une entreprise SaaS commence avec une instance Data 360 unique, mais envisage de se développer vers Data Cloud One en acquérant des filiales avec des organisations Salesforce.
Préparation à l’IA de l’entreprise Les fonctionnalités IA et Agentforce nécessitent un locataire Data 360 connecté dans chaque organisation. Les décisions de provisionnement affectent l'entraînement et l'activation des modèles IA dans l'entreprise. Une société de services financiers unifie les données dans Data Cloud One afin que ses modèles IA Einstein aient accès aux données clients de l'entreprise.
### Considérations importantes
  • Le provisionnement est lié à la licence : Data 360 est provisionnée dans l'organisation où la licence Data 360 est achetée, et la région est déterminée par l'emplacement de cette organisation au moment du provisionnement.
  • Gardez vos options ouvertes en planifiant Data 360 même si vous n'en avez pas besoin maintenant. Les décisions que vous prenez maintenant peuvent faciliter votre parcours si vous implémentez Data 360 pour piloter ultérieurement des fonctionnalités de plate-forme telles que Agentforce.
  • Clients mono-organisation : Provisionnez Data 360 dans votre organisation de production existante pour accélérer la mise en valeur.
  • Clients multi-organisations : Réduisez la complexité en créant le moins d'instances Data 360 possible, idéalement en utilisant la configuration Data Cloud One.
  • Plusieurs instances Data 360 doivent être utilisées uniquement lorsque la conformité, la résidence ou l'autonomie organisationnelle l'exige. Dans ce cas, utilisez le partage de données entre les organisations Data 360 pour activer la collaboration sécurisée.
  • Sources de données zéro copie : Faites très attention aux régions prises en charge pour divers clouds publics et sources de données Zero Copy. Déterminez également si Private Connect est requis pour votre dispositif de sécurité afin de vous connecter à ces sources de données et si les connexions dans la région ou entre les régions sont prises en charge.
  • La gouvernance et l'autonomie sont des concepts centraux: déterminez si Data 360 doit être gérée de façon centralisée (modèle Centre d'excellence) ou si des secteurs d'activité individuels ont besoin d'instances Data 360 gérées séparément.
--- ## Section 1 : Provisionnement de Data 360 – Choix de l'organisation d'origine ### 1.1 Qu'est-ce qu'une organisation domestique Data 360 ? Lorsque vous achetez une licence Data 360, l'instance Data 360 est provisionnée dans l'organisation Salesforce associée à cette licence. Cette organisation est appelée Organisation d'accueil Data 360. Diagramme de décision montrant l'organisation d'accueil Data 360 L'organisation d'accueil est l'ancrage de votre instance Data 360. Il est où : - Le stockage et le calcul Data 360 sont gérés (dans la région sélectionnée lors du provisionnement). - Des stratégies d'administration, de gouvernance et de sécurité sont appliquées. - Ingestion, harmonisation, résolution de l'identité, segmentation et activation des données sont effectuées. Dans les scénarios multi-organisations, l'organisation d'accueil gère l'instance centrale Data 360 pour les autres organisations Salesforce « Companion ». Pourquoi l'organisation d'origine est importante : - Il détermine l'emplacement géographique de votre instance Data 360. - Il détermine qui est propriétaire et administrateur de votre instance Data 360. Les administrateurs de votre organisation d'accueil Data 360 peuvent accéder à toutes les données ingérées dans Data 360. - Il contrôle les connexions d'organisations compagnes dans une configuration Data Cloud One. - Elle pose les bases de votre stratégie de données d'entreprise. La modifier ultérieurement est difficile et perturbateur. ### 1.2 Décision : Organisation existante ou Nouvelle organisation en tant qu'organisation d'accueil ? La première décision importante est de provisionner Data 360 dans une organisation de production existante ou de créer une organisation dédiée pour agir en tant qu'organisation d'origine. Diagramme de décision montrant l'organisation existante par rapport à la nouvelle organisation en tant qu'organisation d'accueil #### Option A : Provisionnement de Data 360 dans une organisation existante **Convient mieux pour :** Les clients d'une seule organisation Salesforce ou les clients de plusieurs organisations qui ont déjà une organisation centralisée majeure où la plupart des affaires sont gérées. Diagramme montrant le provisionnement Data 360 dans une organisation existante - **Pros**: - Chemin le plus simple : Data 360 est provisionnée là où vivent déjà vos données CRM. - Accès immédiat aux données commerciales, de service et marketing locales. - Aucune intégration supplémentaire requise. - Moins de licences et d'environnements à gérer. - Accélére l'adoption précoce, les pilotes et les cas d'utilisation en production. - **Inconvénients**: - Peut hériter de la gouvernance ou de la dette technique d'une organisation existante. - Si aucune « organisation principale » n'existe, sa sélection peut entraîner des débats sur la propriété. - Performances liées à l'emplacement de l'organisation, peut ne pas correspondre aux besoins de résidence de l'entreprise. - Si plusieurs unités commerciales utilisent différentes organisations, le provisionnement local peut entraîner une fragmentation s'il n'est pas associé à Data Cloud One. **Exemple :** Une entreprise SaaS avec une organisation Salesforce provisionne Data 360 dans cette organisation pour unifier les données d'abonnement et de support des clients. #### Option B : Provisionnement de Data 360 dans une nouvelle organisation dédiée **Convient mieux pour :** Les clients de plusieurs organisations Salesforce qui ne peuvent pas s'aligner sur une seule organisation majeure, ou les entreprises qui ont un modèle Centre d'excellence (CoE) solide. Diagramme montrant le provisionnement de Data 360 dans une nouvelle organisation dédiée - **Pros**: - Faire table rase pour la gouvernance, sans complexité d'organisation héritée. - Contrôle centralisé dans plusieurs secteurs d'activité. - Flexibilité pour choisir une région en fonction des besoins de conformité. - Agit en tant qu'organisation neutre de « service partagé », pas liée à une seule unité commerciale. - Configurez pour la future architecture Data Cloud One (organisation d'accueil avec plusieurs organisations compagnes). - **Inconvénients**: - Les clients doivent licencier une nouvelle organisation Salesforce sur laquelle provisionner Data 360. - Intégration supplémentaire requise pour connecter l'organisation à Data 360 via une connexion complémentaire Data Cloud One. - Peut ajouter des frais administratifs (gestion des utilisateurs, sécurité, identité). - Temps de mise en valeur plus lent que le provisionnement dans une organisation de production existante. **Exemple :** Une multinationale de services financiers crée une organisation d'accueil dédiée pour provisionner Data 360. Toutes les organisations d'unité commerciale (Retail, Wealth, Commercial Banking) se connectent en tant qu'organisations complémentaires via Data Cloud One. #### Critères de décision
Considérations Organisation existante en tant qu'organisation d'accueil (préféré par défaut) Nouvelle organisation en tant qu'organisation d'accueil (alternative)
Simplicité S'appuie sur l'utilisateur existant et la structure de données pour accélérer la configuration. Data 360 est intégrée par défaut à l'organisation d'accueil. Nécessite une licence et la configuration d'une nouvelle organisation Salesforce, ainsi que des frais administratifs supplémentaires pour la gérer.
Délai de mise en valeur Utilisation immédiate des données CRM locales. Rampe plus lente; intégration requise.
Gouvernance Hérite du modèle de gouvernance de base de l'organisation existante, c'est-à-dire des utilisateurs et des ensembles d'autorisations existants. Cela peut convenir si l'organisation est déjà centrale. Faire table rase pour la gouvernance; idéal pour les modèles pilotés par le Conseil de l'Europe.
Conformité Résidence liée à la région de l'organisation existante. Flexibilité de sélection d'une région indépendante des organisations existantes.
Performance Meilleures performances pour les requêtes CRM locales. Dépend de la connectivité de l'organisation compagnon, qu'elle soit de même région ou inter-régions avec les autres organisations.
Évolutivité future Fonctionne bien s'il est associé à Data Cloud One. Il est plus difficile de basculer ultérieurement si l'organisation est incorrecte. Évolue aisément avec Data Cloud One ; conçu pour la neutralité.
Coût Réduction du coût incrémentiel. Augmentation des frais généraux liés à des environnements supplémentaires.
### 1.3 Recommandations En règle générale, privilégiez l'utilisation d'une organisation majeure existante en tant qu'organisation d'origine afin de réduire les efforts initiaux et d'accélérer l'adoption. Créez une organisation d'accueil dédiée uniquement si votre stratégie de gouvernance ou de conformité à long terme l'exige. La création d'une organisation à domicile dédiée est un choix courant pour les grandes entreprises qui ont un Centre d'excellence (COE). **Environnement d'organisation unique** Provisionnez Data 360 dans votre organisation de production existante. Cela optimise la simplicité et la valeur immédiate. Il évite les coûts d'intégration inutiles. **Environnement d'organisation multiple** Préférez sélectionner l'une de vos principales organisations, généralement celle où la plupart de vos activités sont gérées, ou l'organisation qui sert déjà de CRM centralisé, pour agir en tant qu'organisation d'origine. Cela réduit la complexité, réduit les tâches de configuration et permet de prendre rapidement conscience de la valeur de Data 360. L'utilisation d'une organisation majeure existante évite également les coûts et les efforts d'intégration liés à la gestion d'un nouvel environnement. **Quand envisager une nouvelle organisation d'accueil dédiée** Si votre organisation a un solide Centre d'excellence (CoE) et souhaite une gouvernance séparée des organisations d'unité commerciale. Si aucune organisation existante ne convient en raison de contraintes de conformité ou d'organisation. Dans ce cas, la création d'une organisation d'accueil offre flexibilité et neutralité, mais avec un délai de valorisation plus lent. --- ## Section 2 : Stratégie multi-organisations et Data Cloud One ### 2.1 Le défi des organisations multiples Les entreprises exploitent souvent plusieurs organisations Salesforce, et ce n'est pas un cas exceptionnel, mais la norme. En février 2024, environ 19 000 clients Salesforce exécutaient déjà plusieurs organisations Salesforce. Pourquoi ça arrive ? - **Acquisitions et fusions :** Les nouvelles sociétés acquises apportent leurs propres instances Salesforce. - **Opérations régionales :** Organisations distinctes pour l'UE, l'Amérique du Nord, l'Asie-Pacifique, etc., souvent pour satisfaire aux lois sur la résidence des données. - **Séparation fonctionnelle :** Différentes unités commerciales (p. ex. Retail Banking, Wealth Management, Insurance) maintiennent leur propre organisation pour l'autonomie. - **Isolement réglementaire ou de sécurité :** Certains secteurs d'activité exigent des organisations logiquement distinctes pour des raisons de conformité. - **Raisons historiques/techniques :** Au fil du temps, les clients accumulent organiquement plusieurs organisations. Chaque raison est logique individuellement, mais ensemble, elles créent une fragmentation des données. Sans couche unificatrice, chaque organisation n'a qu'une vue partielle du client. Le défi architectural : Comment unifier les données entre les organisations en une seule source de vérité tout en respectant les exigences de conformité, de gouvernance et d'autonomie ? --- ### 2.2 Qu'est-ce que Data Cloud One ? Data Cloud One est l'architecture de connectivité multi-organisations de Salesforce qui permet à plusieurs organisations Salesforce de partager une seule instance Data 360. Il correspond au modèle recommandé pour les entreprises qui ont plusieurs organisations Salesforce. Dans n'importe quel cluster Data Cloud One, une organisation Salesforce est désignée Organisation d'accueil, qui héberge l'instance Data 360. D'autres organisations Salesforce se connectent en tant qu'organisations compagnes, consommant les données et les métadonnées unifiées de Data 360 de l'organisation d'origine. Diagramme montrant l'architecture Data Cloud One #### Fonctionnement de Data Cloud One
  1. Ingestion et unification des données (organisation d'origine)
    • Toutes les configurations d'ingestion de données (Salesforce CRM, sources externes, streaming, batch) sont effectuées uniquement depuis l'organisation d'origine.
    • Le locataire Data 360 lié à l'organisation d'origine effectue la résolution de l'identité, harmonisation, modélisation et unification dans des profils Customer 360 de confiance.
    • L'administration de Data 360, les politiques de gouvernance, le balisage et le masquage sont appliqués de façon centralisée depuis l'organisation d'origine.
  2. Architecture d'espace de données
    • Depuis l'organisation d'accueil, les données sont organisées en espaces de données, qui agissent comme des conteneurs logiques pour les données, les métadonnées et les processus.
    • Les entreprises peuvent créer des espaces de données pour des marques, des régions ou des secteurs d'activité.
    • Partage d'espace de données : Depuis l'organisation d'accueil, des espaces de données spécifiques sont partagés de façon sélective avec des organisations compagnes. Ainsi, seules les données pertinentes (et les métadonnées associées) sont transmises aux organisations appropriées.
  3. Partage de métadonnées
    Les organisations compagnes reçoivent des définitions de métadonnées de l'organisation d'accueil, notamment des objets modèle de données (DMO), un schéma de profil unifié, des connaissances calculées, des segments et davantage. Ceux-ci apparaissent nativement dans l'Organisation Compagnon comme s'il s'agissait d'actifs locaux, mais ils sont en fait liés à l'Organisation d'origine.
  4. Tâches à réaliser dans l'organisation d'origine par rapport à Organisations compagnes
  5. L'accès aux fonctionnalités diffère entre les organisations d'accueil et d'accompagnement. Les organisations compagnes ne peuvent pas ingérer ni unifier des données, et s'appuient sur l'organisation d'origine pour l'ingestion, la modélisation et l'unification. Les organisations compagnes peuvent accéder aux données Data 360 pour piloter les fonctionnalités de plate-forme pilotées par Data 360, et créer des connaissances, des segments et des flux locaux en plus des données partagées et approuvées. Dans la vision future, ils peuvent également accéder aux fonctionnalités d'activation.
    Capacité Organisation d'accueil Organisation compagne
    Connecter Configurer des connecteurs, créer des flux de données, ingérer ou fédérer des données ✅ ❌
    Harmoniser et unifier Élaborer et exécuter des transformations de données et la résolution de l'identité ✅ ❌
    Gouvernement Sécuriser les données avec un espace de données et des autorisations ✅ ✅
    Segmenter et prédire Élaborer des segments, des connaissances et des modèles Einstein Studio ✅ ✅
    Activer partout Activations, actions de données ✅ ✅
    Générateur de répliques, flux, rapports, enrichissement, et plus encore, fonctionnalités de plate-forme ✅ ✅
    Centre de prospection des fonctionnalités pilotées par Data 360, fonctionnalités Sales et Service Cloud, Agentforce, et plus encore ✅ ✅
  6. Parité des fonctionnalités de plate-forme
    Du point de vue des utilisateurs et des concepteurs, une fois les métadonnées partagées, il existe quelques différences fonctionnelles entre les organisations d'accueil et les organisations d'accompagnement en ce qui concerne l'utilisation des fonctionnalités de Salesforce Platform. La liste des fonctionnalités prises en charge est disponible dans Data 360 Features on Companion Orgs.
    • Les fonctionnalités de la plate-forme Salesforce, telles que les flux, les rapports, le Générateur de répliques, les tableaux de bord et d'autres outils natifs de la plate-forme, fonctionnent dans les organisations d'accueil et d'accompagnement une fois les métadonnées disponibles.
    • Les fonctionnalités pilotées par Data 360, telles que Agentforce, Prospecting Center, Sales Cloud Einstein et Service Cloud AI, fonctionnent également de façon transparente dans les organisations d'accueil et d'accompagnement. Certaines fonctionnalités sont peut-être sur la voie de la compatibilité complète, mais l'objectif global est d'obtenir une parité de fonctionnalités entre les organisations d'accueil et d'accompagnement pour toutes les fonctionnalités Cross-Cloud qui dépendent de Data 360.
  7. Modèle de consommation
    Toute l'activité de l'Organisation Compagnon (requêtes, exécutions de segments, flux déclenchés par Data 360, utilisation de l'IA, consignation Einstein Trust Layer, etc.) consomme les crédits Data 360 de l'Organisation d'origine. Les flux de consommation sont unidirectionnels : les crédits sont centralisés, facturés et suivis par rapport à l'allocation de crédit de l'organisation d'origine. Vous pouvez toutefois explorer le nombre de crédits utilisés dans Digital Wallet par chaque organisation.
  8. Principe de conception : Construction horizontale
    Data Cloud One est conçu comme une construction horizontale de la plate-forme Salesforce, un peu comme les sandbox. L'objectif est que chaque nouvelle fonctionnalité publiée par Salesforce fonctionne dans les organisations d'accueil et les organisations d'accompagnement sans configuration supplémentaire. Cela garantit que Data Cloud One n'est pas seulement un choix d'architecture de données, mais un élément fondamental de la plate-forme Salesforce à l'avenir.
--- ### 2.3 Décision : Données indépendantes multiples 360s vs. One Shared Data 360 (Data Cloud One) Les entreprises qui ont plusieurs organisations doivent choisir comment et où localiser Data 360 dans leur écosystème. Vous souhaitez provisionner des Data 360 indépendantes dans chaque organisation ou utiliser Data Cloud One pour unifier les organisations sous une seule organisation d'accueil ? #### Option A : 360 de données indépendantes multiples Chaque organisation Salesforce provisionne sa propre instance Data 360. **Pros**: - **Autonomie**: Chaque unité commerciale ou région contrôle sa propre Data 360. - **Simplicité** dans chaque organisation : La gouvernance, la sécurité et les personnalisations sont localisées. - **Conformité réglementaire**: Utile lorsqu'une séparation réglementaire stricte est requise (p. ex., les données ne doivent pas traverser les frontières). **Inconvénients**: - **Silos de données :** Customer 360 ne peut pas être atteint entre les organisations. - **Coût plus élevé**: Chaque instance nécessite une licence, une administration et une intégration. Les clients finissent par ingérer plusieurs fois les mêmes données sources pour obtenir une vue C360 complète dans plusieurs organisations différentes. - **Travail en double :** La résolution, la segmentation et l'enrichissement de l'identité doivent être répétés dans chaque Data 360. #### Option B : One Shared Data 360 (Data Cloud One Cluster) Une Data 360 unique est provisionnée dans une organisation domestique, avec d'autres organisations Salesforce connectées en tant qu'organisations complémentaires. **Pros**: - **Source unique de vérité (SSOT) :** Toutes les organisations partagent le même modèle de données unifié. - **Rentabilité :** Une seule licence Data 360 et infrastructure à gérer. - **Gouvernance unifiée :** Les politiques, la sécurité et les contrôles de conformité sont appliqués de façon centralisée. - **Enrichissement inter-organisations :** Les organisations compagnes peuvent accéder à des profils, des connaissances et des segments harmonisés. - **Préparation IA :** Le jeu de données d'entreprise permet d'améliorer l'entraînement et l'activation des modèles d'IA. - **Épreuve future :** L'ajout de nouvelles organisations compagnes est simple, pas besoin de nouvelles Data 360. **Inconvénients**: - **Préparation supplémentaire :** Nécessite de planifier la connectivité de l'organisation à domicile. - **Considérations relatives à la latence :** Les organisations compagnes de différentes régions peuvent afficher des requêtes plus lentes. - **Gouvernance complexe :** Si chaque organisation a des besoins de personnalisation très différents, une gouvernance fine peut s'avérer complexe. #### Option C : Clusters uniques Data Cloud multiples Dans certains cas, la gouvernance, la conformité ou d'autres exigences métiers peuvent rendre difficile le regroupement de chaque organisation. Cela peut entraîner la nécessité d'implémenter une solution hybride dans laquelle l'entreprise exploite plusieurs Data 360, chacune étant l'organisation d'accueil d'un cluster d'organisations d'accompagnement différent. #### Exemple : Une multinationale a des organisations Salesforce dans diverses régions, notamment en Europe, aux États-Unis et en Asie. Pour respecter les réglementations régionales sur la résidence des données, ils provisionnent une Data 360 pour chaque région séparée. #### Critères de décision
Considérations 360 de données indépendantes multiples One Shared Data 360 (Data Cloud One )
Autonomie Grande autonomie pour chaque organisation ou unité commerciale. Gouvernance centralisée, moins d'autonomie par organisation.
Conformité Utile lorsqu'une séparation stricte est requise (p. ex. lois régionales). Fonctionne mieux lorsque la résidence permet la centralisation.
Coût Augmentation des coûts de licence et d'administration. Plus économique, une licence pour de nombreuses organisations.
Gouvernance Fragmenté ; les politiques diffèrent selon l'organisation. Stratégies centralisées et cohérentes entre les organisations.
Silos de données Chaque organisation a sa propre vue, pas d'entreprise 360. Jeu de données unifié, pas de duplication.
IA/Analytics Limité aux données de chaque organisation. Modèles d'entreprise avec une meilleure précision.
Complexité Plus d'instances à gérer, plus d'intégrations. Architecture plus simple, moins de pièces mobiles.
Performance Idéal pour les cas d'utilisation dans l'organisation. L'accès à l'organisation complémentaire peut introduire une latence.
--- ### 2.4 Recommandations **Modèle préféré :** **Data Cloud One** Par défaut, une organisation domestique unique avec des organisations compagnes connectées pour les entreprises multi-organisations. Cela crée un Customer 360 à l'échelle de l'entreprise, simplifie la gouvernance et optimise les coûts. **Quand utiliser plusieurs Data 360 :** Uniquement si la conformité, la résidence ou l'autonomie organisationnelle l'exige strictement. Par exemple, si les opérations européennes doivent rester totalement séparées des opérations américaines en raison de la réglementation. **Comment choisir l'organisation d'accueil dans Data Cloud One :** Commencez par prendre en compte l'une de vos principales organisations, généralement l'endroit où la plupart des activités sont exécutées. Le provisionnement de Data 360 peut réduire la complexité et optimiser la valeur initiale. Seulement si aucune organisation existante ne convient, vous pouvez créer une organisation d'accueil dédiée gérée par une équipe du Centre d'excellence. **Principe général :** Dans les environnements multi-organisations, limitez le nombre de Data 360. Favorisez Data Cloud One comme modèle par défaut pour réduire les doublons, activer la préparation à l’IA et simplifier la gouvernance. --- ## Section 3 : Données 360 multiples et partage de données entre des organisations Data 360 ### 3.1 Qu'est-ce que le partage de données entre les organisations Data 360 ? Bien que Data Cloud One soit l'approche recommandée pour la plupart des entreprises, il existe des scénarios dans lesquels les clients doivent provisionner plusieurs instances Data 360. Lorsque plusieurs Data 360 existent, l'unification n'est pas automatique. Le partage de données Data 360 vers Data 360 permet aux clients de partager des objets spécifiques entre des instances Data 360 sans duplication ni pipeline personnalisé. Il s'agit d'un mécanisme de partage de métadonnées sans copie conçu pour la collaboration entre les Data 360. #### Fonctionnement - Chaque Data 360 est provisionnée dans sa propre organisation d'accueil. - Les administrateurs peuvent créer un partage de données, un regroupement d'objets spécifiques qu'ils souhaitent partager. - L'accès aux données sélectionnées est partagé avec Data 360 d'une organisation cible, où les objets apparaissent comme définis localement. Les données sous-jacentes restent dans la source Data 360 ; seul l'accès est partagé. - Les balises ne sont pas partagées. Seuls les objets bruts sont disponibles. L'organisation cible doit réappliquer les balises de gouvernance, opérationnelles ou IA si nécessaire. #### Différence clé par rapport à Data Cloud One - Dans Data Cloud One, plusieurs organisations compagnes partagent une seule instance Data 360. Les fonctionnalités de la plate-forme (Agentforce, Centre de prospection, Tableau Next, etc.) sont toutes exécutées sur les mêmes données sous-jacentes, ce qui garantit une cohérence. - Lors de l'utilisation du partage de données entre des organisations Data 360, chaque organisation possède sa propre Data 360. Des fonctionnalités telles que Agentforce dans l'organisation A et l'organisation B fonctionnent chacune indépendamment dans leur instance locale. Aucun partage n'est automatiquement effectué. Des partages de données délibérés doivent être créés pour collaborer uniquement sur des objets spécifiques. --- ### 3.2 Cas d'utilisation du partage de données entre des organisations Data 360 **Conformité régionale :** Un distributeur multinational provisionne un Data 360 dans l’UE et un autre aux États-Unis. Le partage de données Data 360-to-Data 360 permet à l'entreprise d'agréger des connaissances (p. ex. des indicateurs de performance clés de fidélité) à partager avec le siège social américain, alors que les données brutes restent locales. **Collaboration avec les unités commerciales :** Un conglomérat gère des Data 360 distincts pour Retail et Insurance. Le partage de données entre Data 360 permet aux utilisateurs d'accéder à une source de données unique et faisant autorité sans déplacer ni copier. Avec le partage de données entre les organisations Data 360, l'organisation Insurance reçoit le segment « High Value Customer » de Retail pour des campagnes de vente croisée ciblées. **Fusions et acquisitions :** Une société mère acquiert une filiale avec sa propre Data 360. Avec deux instances à gérer, la conservation des silos de données à court terme préserve la sécurité des données et l'intégrité SSOT. Simultanément, le partage de données entre deux instances Data 360 permet une collaboration nécessaire pendant la transition. **Tableaux de bord exécutifs fédérés :** Une multinationale répartie sur plusieurs continents provisionne des Data 360 individuels par région. Les dirigeants souhaitent une vue de performance trimestrielle fédérée. Chaque Data 360 régionale partage des connaissances calculées agrégées avec une « organisation exécutive », qui permet la génération de rapports à l'échelle de l'entreprise. #### Avantages et inconvénients du partage de données entre des organisations Data 360
Facteur Avantages Points négatifs
Data Residency Prend en charge la séparation régionale tout en permettant la collaboration. Ne supprime pas la nécessité de gérer plusieurs Data 360.
Duplication des données Zéro copie; pas de duplication d'objets. Nécessite une sélection délibérée d'objets à inclure dans chaque partage de données.
Gouvernance Le partage est explicite et délibéré (au niveau de l'objet). Aucun flux de balises ou de stratégies. L'organisation cible doit réappliquer la gouvernance.
Complexité Active la collaboration sélective sans centralisation. Nécessite la gestion de plusieurs Data 360 et partages de données.
IA/Analytics IA/analytiques régionales possibles ; les connaissances peuvent être partagées entre les organisations. Aucune IA d'entreprise, sauf si les données sont délibérément partagées.
Caractéristiques de la plate-forme Les fonctionnalités pilotées par Data 360 de chaque organisation sont exécutées indépendamment. Pas de partage automatique — risque de duplication s'il n'est pas soigneusement conçu.
Coût Peut réduire le besoin de pipelines ETL. Encourt toujours le coût de plusieurs Data 360. Consomme des crédits pour les requêtes de données et le partage de données.
#### Critères de décision
Considérations Data Cloud One (préféré pour les organisations multiples) Partage de données entre des organisations Data 360
Source unique de vérité ✅ Oui : toutes les organisations partagent le même DC. ❌ Non : chaque Data 360 a son propre modèle de données.
Conformité Fonctionne uniquement lorsque la résidence permet la centralisation. Nécessaire lorsque les lois sur la résidence empêchent la centralisation.
Gouvernance Centralisé, cohérent. Fédérés; partages délibérés au niveau de l'objet.
Complexité Moins de pièces mobiles, plus simple. ore complex : nécessite des partages de données de configuration et plusieurs Data 360.
IA/Analytics Modèles IA d'entreprise. IA régionale ; les connaissances peuvent être partagées de façon sélective.
Caractéristiques de la plate-forme Shared Data 360 signifie que toutes les fonctionnalités fonctionnent de façon cohérente entre Home + Companions. Les fonctionnalités sont exécutées indépendamment dans chaque Data 360. Le partage doit être explicite.
### 3.3 Meilleures pratiques **Si votre entreprise a plusieurs Data 360 :** - Utilisez le partage de données entre les organisations Data 360 pour collaborer entre elles plutôt que d'élaborer des pipelines personnalisés ou de dupliquer des données. - Partagez des objets spécifiques (DMO, Connaissances calculées, Segments) en créant des Partages de données et en les accordant à des organisations cibles. - Notez que les balises ne sont pas partagées : l'organisation destinataire doit réappliquer les balises (par exemple, gouvernance, classification, enrichissement IA). **Quand utiliser le partage de données entre des organisations Data 360 :** - Pour satisfaire aux exigences réglementaires qui empêchent la centralisation. - Maintenir l'autonomie des unités commerciales tout en permettant une collaboration sélective. - Fournir des tableaux de bord exécutifs fédérés à travers plusieurs régions. - Pour rapprocher les scénarios de fusions-acquisitions dans lesquels la consolidation n'est pas immédiatement possible. **Concevoir avec soin** Le partage doit être délibéré et spécifique à un objet. Évitez le « partage excessif » : alignez les partages de données sur les besoins métiers et de conformité. Traitez le partage de données Data 360 vers Data 360 comme une stratégie de fédération, pas comme un remplacement de Data Cloud One . --- ## Résumé
  1. Chaque organisation doit planifier l'accès à Data 360
    • À l'avenir, toutes les fonctionnalités de la plate-forme Salesforce, depuis Sales Cloud et Service Cloud jusqu'à Agentforce, nécessitent une connectivité Data 360. Chaque organisation doit héberger une organisation d'accueil Data 360 ou être une organisation d'accompagnement connectée via Data Cloud One.
  2. Pensez à l'échelle de l'entreprise, pas organisation par organisation
    • Évitez les décisions unilatérales et sectorielles prises isolément.
    • Le provisionnement doit être décidé collectivement, idéalement par une architecture d'entreprise ou un conseil de gouvernance des données. Anticipez toujours les besoins futurs en IA et en analytiques, qui dépendent de jeux de données larges et unifiés.
  3. Réduction des silos de données
    • Favorisez le provisionnement de Data 360 dans une organisation majeure existante pour plus de simplicité et de rapidité.
    • Dans les environnements multi-organisations, Data Cloud One est le modèle par défaut pour unifier les organisations sous une seule Data 360.
    • Provisionnez plusieurs Data 360 uniquement si elles sont strictement requises pour la conformité, la résidence ou l'autonomie organisationnelle.
  4. Concevez délibérément si vous devez exécuter plusieurs Data 360
    • Configurez le partage de données entre les organisations Data 360 pour la collaboration, pas les pipelines ETL personnalisés.
    • Partagez des objets spécifiques (DMO, Connaissances calculées, Segments) via des partages de données.
    • Rappelez-vous : les balises ne sont pas partagées et la consommation est facturée à l'organisation source.
  5. Gouvernance et appropriation anticipées du plan
    • Déterminez si Data 360 sera gérée de façon centralisée (modèle Centre d'excellence) ou déléguée à des secteurs d'activité. Définissez les rôles des administrateurs, des équipes de sécurité et des pistes de conformité.
    • Évitez toute ambiguïté : le manque de clarté dans la propriété est une source fréquente de friction.
  6. Éviter les raccourcis à court terme
    • Ne faites pas tourner plusieurs Data 360 pour des POC sans plan à long terme, ce qui entraînera ultérieurement un travail de consolidation perturbateur.
    • Alignez à la place les pilotes et les déploiements anticipés sur votre stratégie de provisionnement à l'échelle de l'entreprise.
Ces choix de provisionnement sont essentiels, car la plate-forme Salesforce évolue vers un modèle Data 360-first, où chaque fonctionnalité, de la segmentation des clients à l'ancrage des agents IA, en dépendra. Les décisions que vous prenez aujourd'hui jetteront les bases de l'efficacité avec laquelle votre entreprise unifie les données des clients, de la rapidité avec laquelle vous pouvez adopter de nouvelles fonctionnalités Salesforce et de la confiance avec laquelle vous pouvez adapter l'IA à l'ensemble de votre activité. Pour réussir, vous devez provisionner avec précaution, réduire les doublons, vous conformer aux exigences de conformité, gouverner délibérément et penser à long terme. En définitive, le provisionnement de Data 360 est la première étape pour que les données, l’IA et le CRM fonctionnent ensemble en tant que plate-forme cohérente. # ## À propos des auteurs Kunal Goyal est directeur de la gestion des produits chez Salesforce. Il s'attache à faire progresser l'architecture multi-organisations et l'évolutivité dans Data 360. Depuis 2017, il dirige de multiples initiatives et produits axés sur la collaboration inter-organisations et la conception de systèmes multi-locataires. Kunal est l'une des pistes de l'architecture des meilleures pratiques Data 360 et le propriétaire du produit pour les expériences de configuration, de provisionnement et d'administration de Data Cloud One. Erin Wagner Tidwell est un rédacteur technique principal et concepteur de contenu pour Data 360. Elle travaille chez Salesforce depuis 2013. Elle s'attache à faciliter la compréhension et l'utilisation de Data 360 grâce à une documentation technique claire, cohérente et précise et à une communication dans l'application. Yugandhar Bora est architecte en génie logiciel chez Salesforce, spécialisé dans l'architecture de données au sein de la plate-forme Data & Intelligence Applications. Il dirige les initiatives du comité d'examen de l'architecture d'entreprise (EARB) axées sur la gouvernance des données et les modèles de données unifiés, tout en contribuant aux solutions de provisionnement de plate-forme automatisé. Samarpan Jain est architecte principal chez Salesforce spécialisé dans Commerce Cloud, l'intégration de plate-forme et l'architecture inter-organisations. L'un des employés les plus anciens de Salesforce, il dirige des initiatives clés, notamment la conformité de la résidence des données pour les clients gouvernementaux et les systèmes d'attribution d'utilisation Data 360. ## Présentation du guide Ce guide vous aidera à évaluer l'approche adaptée à vos besoins en traitement asynchrone sur Salesforce Platform. Il explique chaque approche, en détaillant les forces et les limitations de chacune. La plupart des approches sont alignées sur une fonctionnalité produit, mais certaines utilisent plusieurs fonctionnalités en coordination. Le guide inclut des cas d'utilisation pour souligner quand utiliser chaque approche. Le traitement asynchrone offre deux avantages majeurs pour votre architecture. Premièrement, il augmente l'évolutivité, car les processus asynchrones ont des limites en gouverneur plus élevées. Deuxièmement, les requêtes asynchrones sont exécutées dans leurs propres threads afin de permettre aux utilisateurs d'effectuer d'autres tâches pendant que les tâches asynchrones sont exécutées en arrière-plan. Notez que ce guide se concentre exclusivement sur le choix d'une technologie de traitement asynchrone dans Salesforce Platform. La [section Ressources](#ressources) répertorie d'autres ressources qui facilitent votre processus de décision. ## Produits visés par ce guide
Salesforce Platform Salesforce Lightning Platform est une plate-forme complète pilotée par l'IA qui unifie les employés, les agents IA autonomes, les données de l'entreprise et les applications dans un système unique et de confiance afin d'améliorer la productivité et l'expérience client. Il permet la création d'une "entreprise agentique" en connectant les applications Customer 360, Data Cloud, et Slack pour une automatisation de bout en bout.
Ce document ne couvre pas les technologies d'autres écosystèmes tels que MuleSoft, Informatica, Commerce Cloud, Tableau et Marketing Cloud. ## Points à retenir - **Avant d'utiliser le traitement asynchrone, assurez-vous que vos cas d'utilisation correspondent au modèle.** Les modèles asynchrones n'ont pas de contrat de niveau de service, sont soumis à plusieurs mécanismes de gouverneur, peuvent avoir des limites de capacité définies en fonction de la licence et peuvent entraîner des retards de traitement en raison de la nature limitée des ressources allouées à l'infrastructure asynchrone dans Salesforce Platform. Tenez compte des limitations ci-dessous lors de l'utilisation d'un traitement asynchrone dans des scénarios où un utilisateur demande une réponse du système avant de pouvoir poursuivre son travail. - **Le traitement asynchrone avec Salesforce n'est pas une solution pour des besoins d'évolutivité illimités.** Salesforce Platform n'évolue pas à l'infini et les modèles asynchrones sont soumis à des limitations. Le traitement asynchrone utilise des threads, qui contiennent les informations contextuelles dont un processeur a besoin pour exécuter un flux d'instructions. Les threads peuvent être exécutés en parallèle. Le nombre de threads disponibles dans un processeur est limité. Par conséquent, la plate-forme a mis en place des mécanismes pour utiliser ses threads disponibles aussi efficacement que possible. Le [mécanisme de contrôle](/docs/architect/fr-fr/fundamentals/guide/async-fundamentals#contrôle-de-flux) de flux de la plate-forme empêche les organisations de consommer trop de threads et d'affecter négativement les autres organisations. L'[algorithme d'utilisation équitable](/docs/architect/fr-fr/fundamentals/guide/async-fundamentals#utilisation-équitable) de la plate-forme contrôle également le nombre de threads disponibles pour chaque type de message. - **Compte tenu des événements qui peuvent entraîner des charges extrêmes.** Lorsque vous concevez des processus asynchrones, assurez-vous qu'ils peuvent gérer de façon prévisible les pics de charge de travail et les accalmies. Examinez comment votre implémentation gère les événements inattendus, tels que les pannes de courant, et concevez des mesures de protection qui atténuent la perte de données ou la perte de fonctionnalité. ## Comparaison des produits Le tableau ci-dessous présente les outils disponibles pour le traitement asynchrone avec Salesforce. Consultez ce tableau pour examiner les principales caractéristiques de chaque outil pendant votre processus de prise de décision. Consultez [Cas d'utilisation](#cas-dutilisation) et [Points de décision](#points-de-décision) pour choisir les outils adaptés à votre architecture.
Approche Description Compétences requises Licences et limites
Apex Queueable Utilisé pour les processus qui impliquent de longues opérations de base de données ou des appels externes de service Web. Apex Queueable offre des fonctionnalités telles que les ID de tâche, la prise en charge des types non primitifs et l'enchaînement des tâches. Pro-code Le nombre de licences peut augmenter les limitations.
Batch Apex Élaborez des processus complexes et longs qui impliquent des millions d'enregistrements en divisant votre ensemble d'enregistrements et en le traitant en segments gérables. Pro-code Le nombre de licences peut augmenter les limitations.
Apex planifié Exécutez Apex à une heure planifiée définie par une expression cron. Bien que l'action de planifier Apex via l'expression cron soit un processus asynchrone, le code sous-jacent est exécuté de façon synchrone au démarrage de la tâche. Pro-code Le nombre de licences peut augmenter les limitations.
Appels externes de continuation Apex Exécutez des appels externes à partir de méthodes Apex exécutées dans un contexte de transaction synchrone. Pro-code Non
Trajet asynchrone (flux déclenchés par un enregistrement) Exécutez une opération que vous souhaitez exécuter sur son propre temps. Évitez les erreurs DML mixtes qui se produisent lorsque vous mettez à jour une valeur dans un enregistrement associé qui ne fait pas partie de l'enregistrement ayant déclenché un flux. Code faible Le nombre et le type de licences peuvent augmenter les limitations.
Parcours planifié (après validation des flux) Exécutez à une heure planifiée dynamiquement après un événement déclenchant, par exemple lors de la création, de la mise à jour ou de la suppression d'un enregistrement. Code faible Le nombre et le type de licences peuvent augmenter les limitations.
Flux planifiés Exécutez un flux en arrière-plan à une heure spécifiée et à une fréquence répétée (quotidienne, hebdomadaire ou unique) pour exécuter des actions sur un lot d'enregistrements. Code faible Le nombre et le type de licences peuvent augmenter les limitations.
Déclencheurs d'événements de plate-forme Couplez librement Salesforce à des systèmes externes et communiquez entre des composants asynchrones dans Salesforce Platform. Code bas + code pro Une licence complémentaire est requise pour les cas d'utilisation d'événements de plate-forme à haut volume
Capture des données Capturez et traitez les événements de modification de façon asynchrone une fois la transaction de base de données engagée. Pro-code Une licence complémentaire est requise pour dépasser l'allocation de référence.
API de transfert en masse Insérez, mettez à jour, mettez à jour/insérez, interrogez ou supprimez de nombreux enregistrements de façon asynchrone, puis traitez les résultats ultérieurement. Pro-code Il y a des limites.
Actions Lightning Autorisez les pages Lightning à interagir avec le serveur sans forcer les utilisateurs à actualiser entièrement la page. Code faible Non
## Points de décision Le tableau ci-dessous présente une vue d'ensemble des points à prendre en compte lorsque vous choisissez l'outil asynchrone à utiliser.
Compétences requises Certains outils décrits dans ce guide nécessitent un code, tandis que d'autres peuvent être configurés par déclaration. En examinant vos options, tenez compte des compétences des membres de votre équipe. Notez que même si des développeurs sont disponibles pour votre implémentation initiale (par l'intermédiaire d'un partenaire d'implémentation, par exemple), il peut être nécessaire de modifier vos solutions à l'avenir. Si votre équipe de maintenance n'a pas de développeur, une option à faible code peut être plus adaptée.
Type de limites de plate-forme appliquées Déterminez le type de limite qui s'applique à l'exécution. En concevant vos solutions, réfléchissez attentivement à la façon dont le volume et la fréquence des transactions seront pris en compte dans les limites du gouverneur pour l'approche choisie chaque jour. Calculez le nombre d'exécutions qui auront lieu chaque jour. Assurez-vous que les valeurs calculées respectent les limites associées aux outils que vous avez sélectionnés.
Latence Déterminez la vitesse à laquelle les résultats du traitement seront disponibles sur la plate-forme. Pour certaines approches, les changements seront presque immédiats, alors que pour d'autres, ils peuvent prendre quelques minutes ou quelques heures.
## Cas d'utilisation Lorsque vous sélectionnez un outil pour le traitement asynchrone, commencez par évaluer les besoins de votre organisation et les ressources disponibles. Votre objectif est de sélectionner le ou les outils qui réduisent les coûts d'implémentation et de maintenance, tout en garantissant l'évolutivité et en limitant la probabilité d'infractions aux limites. Cet objectif dépend des considérations techniques exposées précédemment, ainsi que de la composition de votre équipe. Prenons l'exemple d'un processus de commande asynchrone dans Salesforce. Lorsqu'une commande est enregistrée, elle déclenche un message à un système de gestion d'entrepôt externe avec des instructions spéciales pour emballer et expédier un article. L'utilisateur qui passe la commande n'a pas besoin d'une réponse immédiate du système de gestion de l'entrepôt. Par conséquent, la demande peut être envoyée de façon asynchrone. Le traitement asynchrone permet à l'utilisateur de poursuivre son travail sans attendre une réponse. Pour ce cas d'utilisation, vous pouvez envisager d'implémenter avec Apex . Cette approche ne fonctionnera que si vous avez dans votre équipe des développeurs Apex capables de maintenir votre solution pro-code. Sinon, une approche déclarative est plus logique. Notez également que différents ensembles de [limites](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_gov_limits.htm) s'appliquent à différents outils. Le tableau ci-dessous répertorie les cas d'utilisation courants dans la colonne la plus à gauche, suivis d'une description. La colonne _Premier choix_ fournit l'approche la plus typique utilisée pour satisfaire un tel cas d'utilisation, ainsi que la justification de l'approche Premier choix. Utilisez-le comme point de départ de votre analyse. L'approche Premier choix peut avoir des limitations qui ne fonctionneront pas pour votre cas d'utilisation.
Cas d'utilisation Description Approche de premier choix Justification
Traitement par lot hautement performant Toute automatisation qui doit traiter efficacement des milliers ou des millions d'enregistrements Batch Apex Apex par lot fournit des API riches pour l'interface avec la plate-forme et pour la vitesse brute.
Tâche de nettoyage des données Une tâche exécutée régulièrement, ou à la demande, qui nettoie les données. Par exemple, la déduplication, la vérification de l'adresse ou la consolidation des données. Batch Apex Apex par lot fournit des API riches pour l'interface avec la plate-forme et pour la vitesse brute.
Tâche de cumul nocturne Tâche qui calcule les données de cumul à la fin d'un jour ouvrable. Batch Apex Apex par lot fournit des API riches pour l'interface avec la plate-forme et pour la vitesse brute.
Logique déclenchée par un enregistrement Exécutez une logique en réponse à une mise à jour d'enregistrement. Varie Consultez notre guide de décision complémentaire, Automatisation des événements déclenchés par un enregistrement. Il inclut un arbre de décision pour les cas d'utilisation asynchrones, notamment Apex Queueable, Apex par lot, Apex planifié, Flux planifié, Flux de chemin asynchrone et Capture des données de modification.
Mises à jour en cascade via un graphique d'objet Permet d'exécuter rapidement l'action d'enregistrement d'un utilisateur, en reportant l'exécution asynchrone des mises à jour en cascade d'autres objets. Queueable Apex Apex Queueable dispose de puissantes fonctionnalités d'enchaînement qui permettent à la logique de diviser une chaîne de mises à jour en une série de transactions asynchrones.
Traitement planifié spécifique à l'enregistrement Automatisation à une date future et dynamique spécifique à l'enregistrement (par exemple, 3 jours avant une date de fermeture). Flux avec un parcours planifié Les parcours planifiés offrent une force unique à Flux, car la plate-forme gère automatiquement la planification, l'annulation et la replanification de ces parcours si les données de l'enregistrement changent.
Invocation parallèle de plusieurs services externes lents Lors d'une exécution synchrone, plusieurs services externes sont invoqués en parallèle pour optimiser le temps d'exécution global. Appels externes de continuation Apex L'autorisation d'exécution simultanée de plusieurs appels externes lents réduit le temps total nécessaire pour réaliser le travail.
Migration des données d'enregistrements à partir d'un système externe Déplacez de grandes quantités d'enregistrements vers Salesforce Platform à partir d'un système externe. Un processus unique ou planifié régulièrement. API de transfert en masse Il s'agit de l'approche la plus efficace et la plus conviviale pour la migration des données.
Exécution d'une logique supplémentaire sur un système externe Modèle de notification par oubli d'un système externe d'un événement sur la plate-forme, puis permettant à ce système de traiter l'événement de façon asynchrone. Événements de plate-forme ou Capture des données modifiées Un modèle pub-sub fonctionne mieux ici et permet au système externe de traiter l'événement lorsqu'il est prêt. Pour plus d'informations sur ce schéma, consultez Architecture pilotée par les événements.
Le tableau Cas d'utilisation indique l'approche la plus adaptée à chaque cas d'utilisation. Cependant, vous devez vérifier si la technologie First Choice répond aux besoins spécifiques de votre cas d'utilisation. Déterminez notamment si l'approche choisie peut respecter les limites du gouverneur de votre organisation. Lorsque vous avez identifié une approche candidate pour votre cas d'utilisation, le [guide Asynchronous Processing Basics Guide](/docs/architect/fr-fr/fundamentals/guide/async-fundamentals) peut vous aider à vérifier entièrement la solution. ## Ressources Les ressources supplémentaires suivantes peuvent vous aider à prendre des décisions : - Explorez en profondeur chacune des technologies asynchrones de la plate-forme : [Notions fondamentales du traitement asynchrone](/docs/architect/fr-fr/fundamentals/guide/async-fundamentals) - Choisir entre Apex et Flux pour les déclencheurs d'enregistrement: [Automatisation des événements déclenchés par un enregistrement](/docs/architect/fr-fr/decision-guides/guide/record-triggered) - Informations sur les modèles d'intégration asynchrone : [Architecture pilotée par les événements](/docs/architect/fr-fr/decision-guides/guide/event-driven)