---
schema_version: "1"
id: 9c30548d8605e14ae788845762069ef4c613c97d1a3513e2f8f7c71edd82bf69
title: Infrastructure asynchrone basée sur une étape
collection: architect
version: next
locale: fr-fr
portal_url: https://docs.salesforce.com/architect/next/fr-fr/decision-guides/guides/step-based-async-framework.md
canonical_url: https://staging.architect.salesforce.com/docs/architect/fr-fr/decision-guides/guide/step-based-async-framework.html
source_site: staging.architect.salesforce.com
content_type: documentation
content_hash: daf0efac3ce22860b3aec9b43a784784b7445f2ec7977ad14768ea87cf1ad856
products:
- Guides de décision
- Architect Site Content Repo
updated_at: 2025-11-01T00:00:00Z
---
## Vue d'ensemble
Les architectures Salesforce modernes sont de plus en plus pilotées par le traitement asynchrone, non pas comme une commodité, mais comme une exigence stratégique d'échelle. Ces dernières années, nous avons vu de plus en plus d'entreprises faire face à des volumes de données en augmentation, à des intégrations complexes impliquant plusieurs points de contact et à l'essor des systèmes autonomes fonctionnant 24/7/365. Toutes ces choses poussent les architectes à concevoir des systèmes qui sont d'abord asynchrones.
Le traitement asynchrone dans Salesforce implique souvent de concevoir en fonction des limites et de la complexité du gouverneur. Ces limites agissent comme des garde-fous et des contraintes architecturales qui aident à produire des systèmes évolutifs et sûrs en masse. Bien qu'aucune limite de plate-forme ne serve directement à gérer la complexité, les [modèles de conception](https://refactoring.guru/design-patterns) peuvent aider à atténuer les risques sur ce front. En interne, Salesforce repousse souvent les limites de la plate-forme pour tester de nouvelles fonctionnalités et automatiser des processus métiers complexes. Nous avons élaboré une infrastructure de traitement asynchrone basée sur une étape pour exécuter des tâches asynchrones avec un nombre arbitraire d'étapes. Chaque étape peut être exécutée, réessayée et redémarrée indépendamment avec des contrôles de gouvernance partagés et une visibilité opérationnelle totale via la consignation centralisée. Le présent document décrit ses principaux éléments architecturaux : Apex et finaliseurs Queueable, flux planifié, curseurs Apex, actions invocables et intégrations à Slack. Ensemble, ces composants offrent une architecture modulaire, évolutive et observable adaptée à l'évolution des besoins de l'entreprise.
## Principaux points à retenir
- Les architectures Salesforce modernes doivent adopter une approche asynchrone avant tout pour atteindre l'échelle, la résilience et la transparence opérationnelle.
- La division d'un travail complexe en étapes exécutables indépendantes permet d'obtenir des performances prévisibles, des tentatives plus sûres, un pointage, une restauration et une évolution modulaire sans reconcevoir les workflows de base.
- L'infrastructure offre une alternative évolutive aux tâches par lot monolithiques et vieillissantes, aux appels asynchrones enchaînés et aux flux profondément imbriqués, et est conçue pour les charges de travail à haut volume qui doivent évoluer horizontalement dans Salesforce sans orchestration hors plate-forme.
- Une exécution déterministe et observable garantit le suivi des progrès, la surveillance des accords de niveau de service, les diagnostics d'échec et la transparence au niveau de l'audit grâce à une consignation et une gouvernance centralisées.
- Conçu pour la rigueur de l'entreprise, notamment la gouvernance unifiée, la conformité et le contrôle de l'État distribué à travers des processus métiers à long terme.
## Meilleures pratiques de la plate-forme
Avant de passer en revue les exigences, voici quelques recommandations à ne pas faire pour utiliser une infrastructure de ce type. Réfléchissez surtout au système qui est la source unique de vérité. Si votre organisation Salesforce s'appuie peu sur des données externes, mais doit passer de centaines à des millions d'enregistrements, envisagez une infrastructure asynchrone basée sur une étape.
**N'**utilisez cette infrastructure que si :
- La plupart (ou toutes) les informations sur lesquelles agir existent déjà dans votre CRM.
- Le coût initial ou permanent de la maintenance d'une tâche ETL (Extract Transform Load) pour harmoniser les données externes est trop élevé.
- Vous devez reporter le traitement d'un grand nombre d'enregistrements Salesforce selon une planification définie.
- Vous pouvez décomposer le traitement en étapes discrètes. Par exemple, vous pouvez créer un ensemble d'enregistrements hiérarchiques ou arborescents, en particulier si le volume de données s'étend à la hiérarchie ou à l'arborescence.
**N'**utilisez pas cette infrastructure si :
- La création ou la mise à jour d'enregistrements nécessite un recalcul immédiat.
- L'intégration est difficile, car les systèmes externes hébergent les données principales pour les mises à jour d'enregistrements. (vous pouvez envoyer automatiquement des données mises à jour à Salesforce avec l'API de transfert en masse).
Avec ces pratiques à l'esprit, révisons nos exigences et commençons à élaborer.
## Répartition des exigences
Tenez compte de l'énoncé du problème :
> Avec une tâche qui doit être exécutée quotidiennement, vérifiez si certains enregistrements remplissent des critères préétablis pour un traitement ultérieur. S'ils le font, lancez ces tâches de traitement. Le traitement d'enregistrements peut impliquer l'extraction de données de plusieurs systèmes externes pour effectuer des calculs. Les étapes des tâches doivent notifier les personnes via Slack que les enregistrements traités sont prêts à être révisés. Les étapes doivent également escalader les notifications aux responsables et aux échelons supérieurs de la hiérarchie des rôles en fonction d'un délai configurable après la première série de notifications.
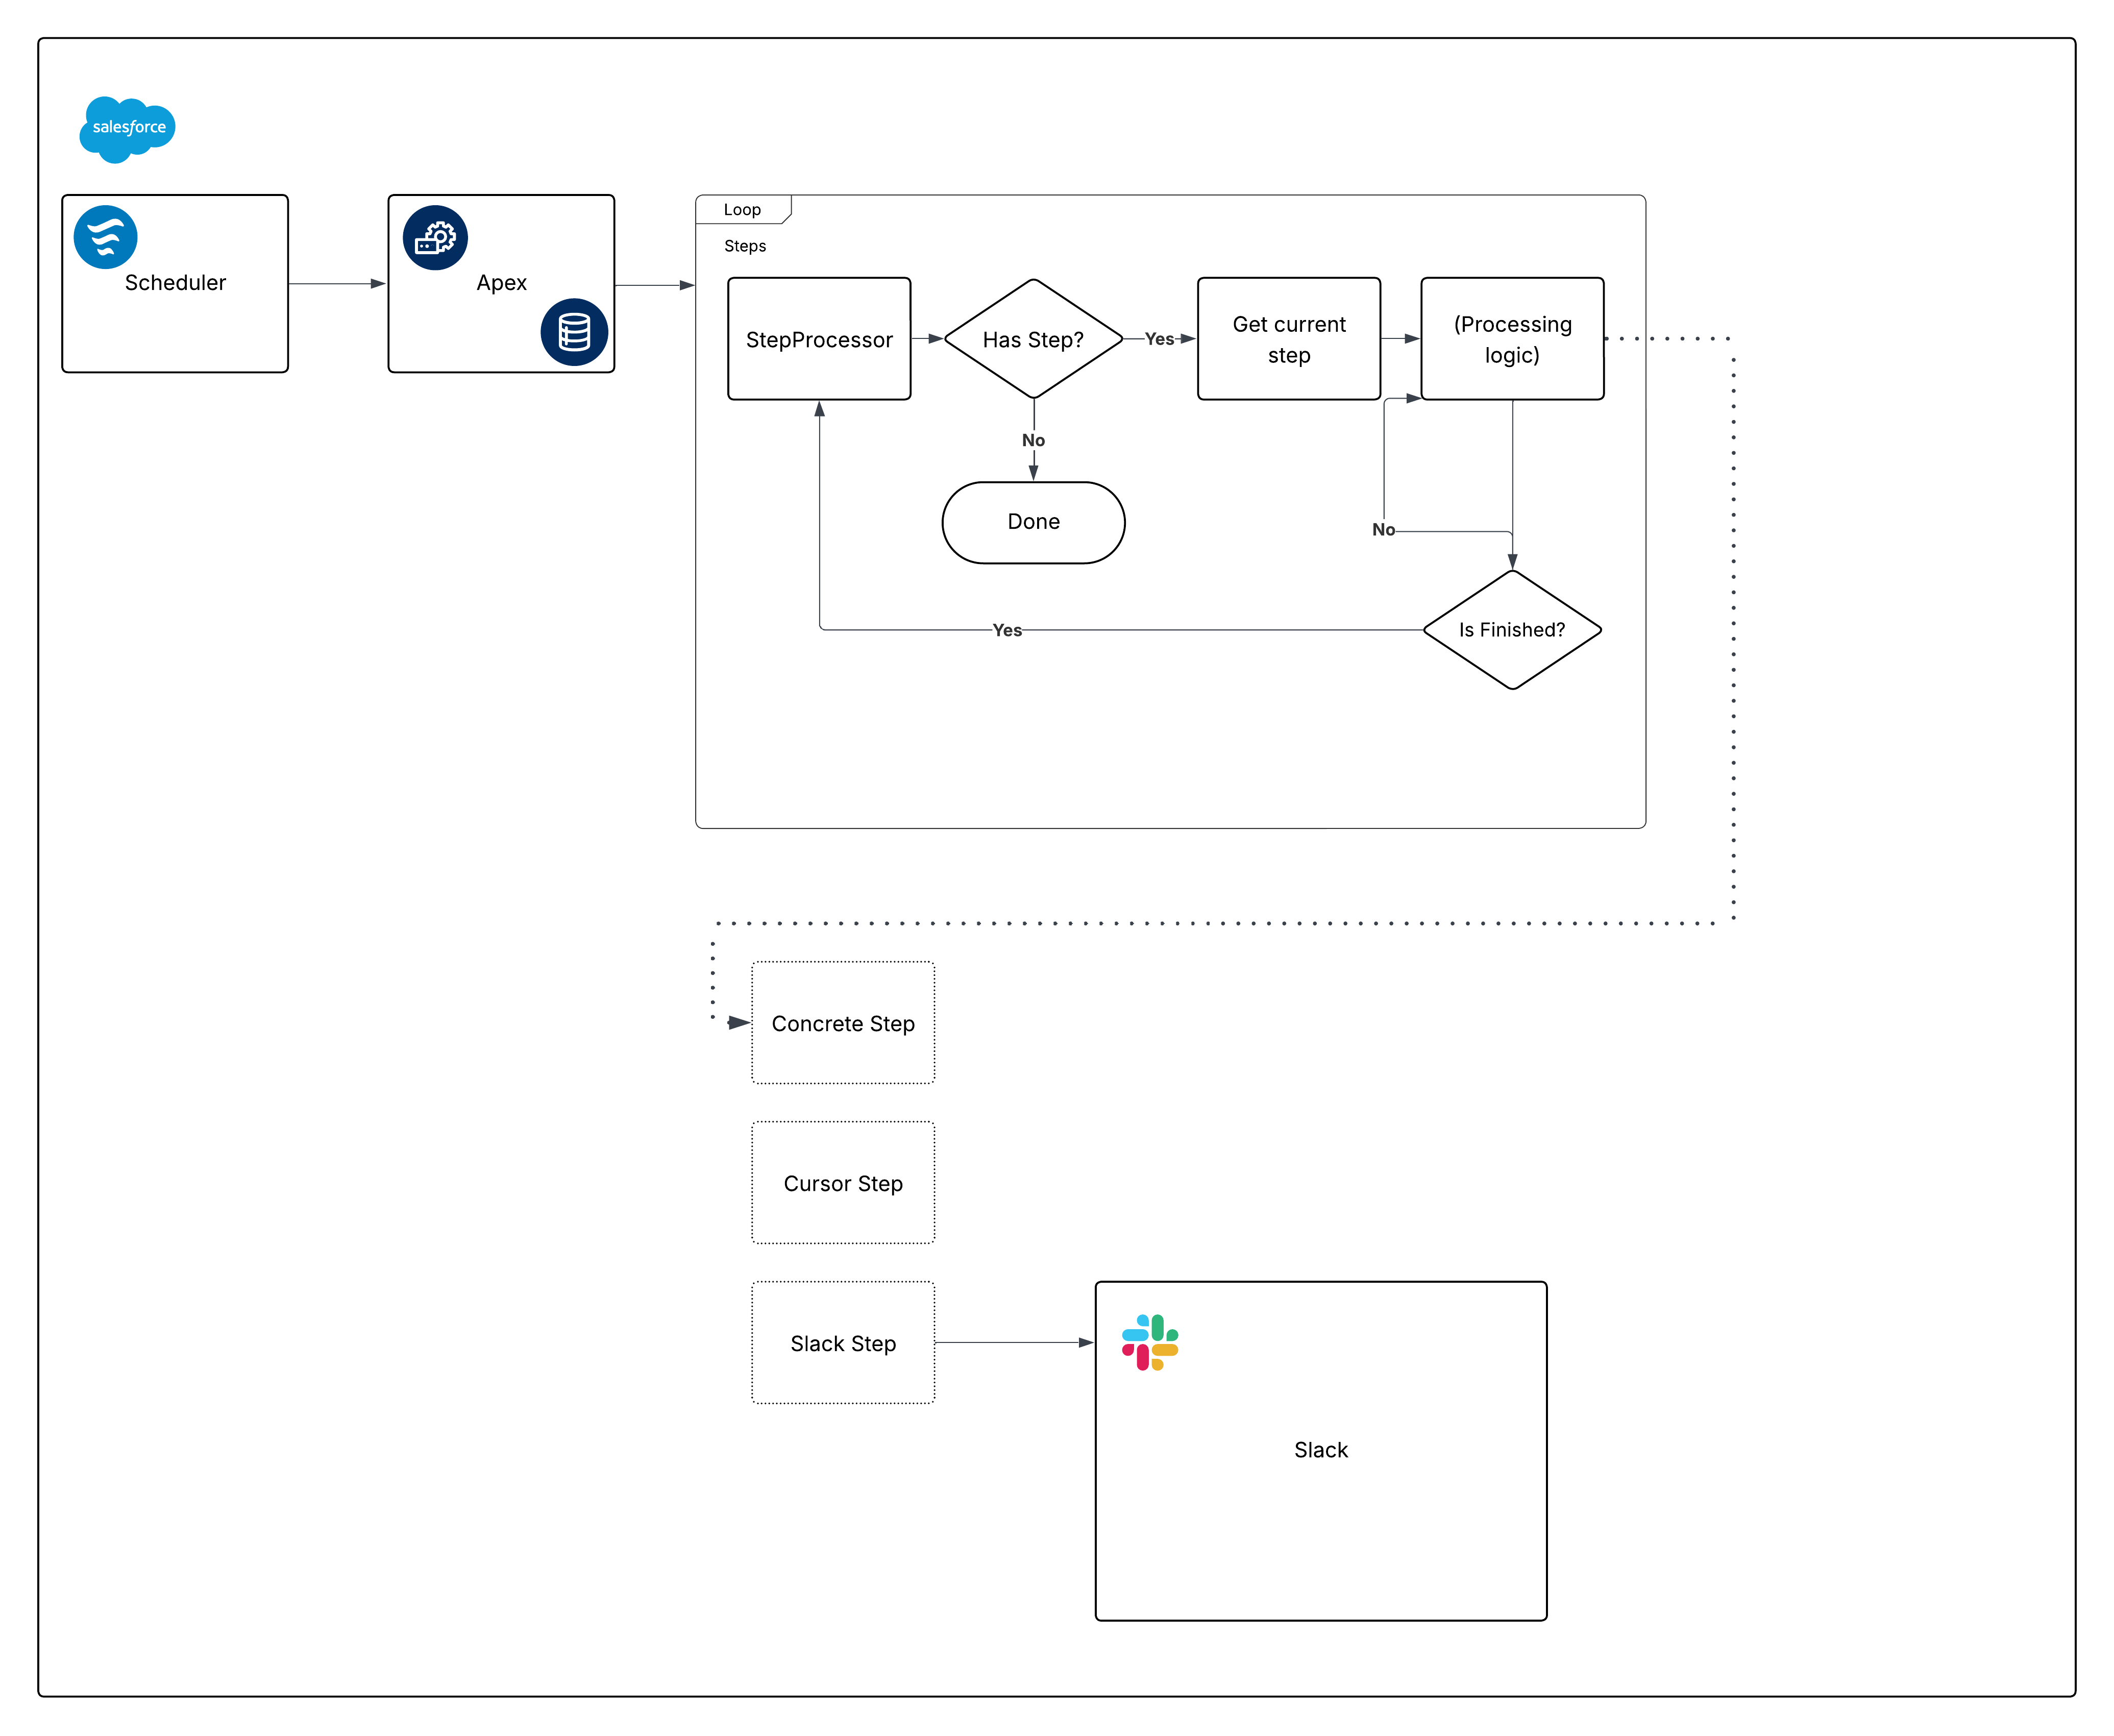
Ce problème implique plusieurs étapes différentes, dont certaines peuvent se produire indépendamment les unes des autres. Il existe de nombreuses façons de répartir le travail. Voici un regroupement :
- Le planificateur.
- L'interface de l'étape et les implémentations concrètes qui traitent les enregistrements (quel que soit le type de traitement).
- Le processeur qui organise les étapes.
- L'Apex Invocable appelé par le planificateur.
- L'élément de notification. On utilise le [SDK Apex Slack](https://developer.salesforce.com/docs/platform/salesforce-slack-sdk/guide/overview.html).
- L'expression « délai configurable » cache une certaine complexité. Nous allons examiner cette complexité plus loin dans cet article.
Voici un diagramme de l'infrastructure élaborée :
Maintenant, décomposez ce diagramme et commencez à construire les pièces.
## Planification avec un flux planifié
Le flux planifié offre plusieurs avantages en tant que mécanisme de planification :
- Les flux planifiés peuvent être empaquetés et déployés en tant que métadonnées. Ce n'est pas vrai pour les tâches planifiées via Apex (ou via la page Tâches planifiées).
- L'élément Attente est essentiel pour les infrastructures qui nécessitent une légende. En l'utilisant dans Flux, les appels externes ne sont pas nécessaires dans la partie Invocable de l'infrastructure.
- La granularité de la planification remplit les exigences : l'intervalle minimal pour les flux planifiés est quotidien. Si vous avez besoin d'une fréquence plus élevée (par exemple, toutes les heures), reconsidérez Flux planifié pour cette exigence.
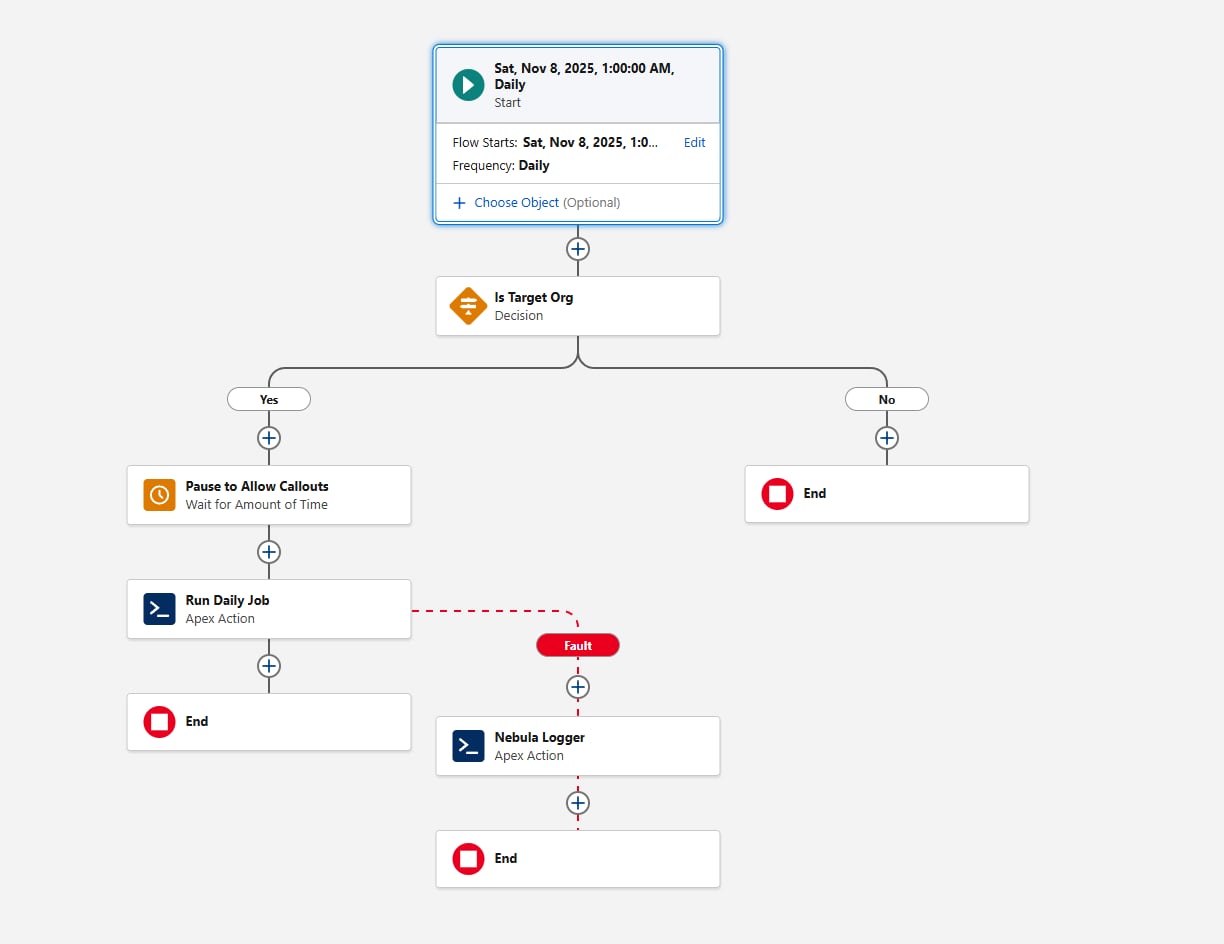
Une autre considération lors de la configuration du flux planifié est le portage de l'environnement. Avant d'invoquer l'action Apex, ajoutez un élément Décision qui évalue la variable `{!$Api.Enterprise_Server_URL_100}`. Cela garantit que la tâche est exécutée uniquement dans les environnements prévus, tels que UAT et Production. Ce schéma est important, car les sandbox sont fréquemment actualisées ou créées pendant le développement de l'infrastructure, et sans vérification explicite de l'environnement, un flux planifié peut involontairement être exécuté dans des environnements où l'infrastructure n'est pas conçue pour être exécutée. L'utilisation de l'opérateur `contains` dans l'élément Décision rend la configuration résiliente aux futures créations de sandbox ou aux changements d'URL.
Enfin, déterminez comment l'infrastructure doit capturer les échecs. Ajoutez toujours un chemin de défaut lorsque Flux appelle n'importe quelle action. Vous pouvez par exemple câbler les défauts à l'action « Ajouter une entrée au journal » [de Nebula Logger](https://www.nebulalogger.com/). Nebula Logger écrit des journaux dans des objets personnalisés. Par conséquent, les clients doivent savoir que les données des journaux consomment du stockage dans l'organisation. Par défaut, les journaux sont stockés pendant 14 jours dans une organisation, puis nettoyés. Cette période de rétention est configurable. Nebula Logger utilise également les événements de plate-forme pour publier des journaux. Par conséquent, les entrées dans les journaux sont enregistrées indépendamment de la transaction de traitement des données principale. Cela garantit la capture des échecs, même si l'action principale Flux ou Apex est annulée. Les clients doivent évaluer le volume de consignation attendu et les exigences de rétention en envisageant l'ajout d'une infrastructure de consignation.
Le flux se présente comme suit :
Passons aux premiers bouts de code Apex avec l'exigence de planification désormais satisfaite.
## Création d'une interface d'étape
Définissez une interface de `Step` :
```java
public interface Step {
void execute();
void finalize();
String getName();
Boolean shouldRestart();
}
```
Pour cet article, l'interface de `step` est affichée en tant que classe externe pour plus de clarté. L'infrastructure elle-même est flexible. Les équipes peuvent organiser l'interface et ses implémentations en utilisant n'importe quel modèle d'empaquetage Apex de leur choix, à condition que toutes les classes Étape référencent la même interface.
Voici quelques points à noter concernant les méthodes définies dans notre interface :
- La `execute`, bien que sans argument pour le moment, s'améliore lorsque nous passons une classe (ou interface) de `State` pour orchestrer les données entre les étapes lorsque l'ordre importe.
- `getName` peut renvoyer une valeur de `System.Type` au lieu d'une `String`. L'objectif est de fournir à la couche d'orchestration un moyen de consigner les noms d'étape sans exposer d'autres propriétés.
Voici la première mise en œuvre concrète qui montre comment ces pièces s’agencent. À une exception près plus loin, nous recommandons d'utiliser Apex Queueable pour implémenter le traitement asynchrone dans Apex; Apex par lot est généralement inutile (et les méthodes de `@future` sont déconseillées). Apex Queueable démarre rapidement et présente, avec les curseurs Apex, de nombreux avantages par rapport aux Apex batch.
### Une implémentation Apex semblable à un curseur
Les [curseurs Apex](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_cursors.htm) offrent une alternative moderne au modèle Apex traditionnel par lot. De la même façon qu'un traitement par lot, une implémentation de curseur peut récupérer des enregistrements par segments (jusqu'à 2000 par lot). Cependant, les curseurs autorisent plusieurs récupérations dans une seule transaction, ce qui augmente considérablement le débit pour les opérations à grand volume.
Lors de l'adoption des curseurs dans ce cadre, les équipes doivent être conscientes des limitations actuelles en matière de test et de moquabilité. Le comportement du curseur dans les tests peut différer de celui de la production. Par conséquent, il est important de concevoir des stratégies de test qui évitent de dépendre des internes du curseur et valident à la place la logique d'orchestration aux frontières. À mesure que la plate-forme évoluera, ces domaines continueront de s'améliorer, mais les orientations principales demeurent les suivantes : Les curseurs offrent des performances supérieures et réduisent les surcharges d'orchestration par rapport à Apex par lot pour de nombreux cas d'utilisation.
Pour définir une frontière claire entre le curseur fourni par le système et votre propre code, nous recommandons de créer une représentation de type curseur lors de l'implémentation de l'interface de `Step`. Tenez compte du code suivant :
```java
public inherited sharing abstract class CursorStep implements Step {
private static final Integer MAX_CHUNK_SIZE = 2000;
protected Cursor cursor;
private Integer chunkSize = System.Limits.getLimitDMLRows();
private Integer position = 0;
protected abstract Cursor getCursor();
protected abstract void innerExecute(List records);
public abstract String getName();
public virtual CursorStep withChunkSize(Integer chunkSize) {
this.chunkSize = chunkSize;
return this;
}
public void execute() {
this.cursor = this.cursor ?? this.getCursor();
this.cursor.setFetchesPerTransaction(this.getFetchesPerTransaction());
List records = new List();
if (this.shouldAdvance()) {
records = this.cursor.fetch(this.position, this.chunkSize);
this.position += this.chunkSize;
}
this.innerExecute(records);
}
public virtual void finalize() {
Logger.info('finished cursor step for ' + this.getName());
}
public virtual Boolean shouldRestart() {
return this.position < this.cursor.getNumRecords();
}
protected virtual Integer getFetchesPerTransaction() {
Integer maxRecordsPerFetchCall = 2000;
if (this.chunkSize < maxRecordsPerFetchCall) {
return this.chunkSize;
}
// Integer division rounds down
// which is perfect for our use-case
return this.chunkSize / maxRecordsPerFetchCall;
}
protected virtual Boolean shouldAdvance() {
return true;
}
}
```
Notez la classe `Cursor`. Les curseurs Apex sont des instances de `Database.Cursor`, mais notre implémentation `Cursor` nous donne la flexibilité nécessaire pour contourner les lacunes des curseurs. Voici l'implémentation :
```java
public virtual without sharing class Cursor {
private static final Integer MAX_FETCHES_PER_TRANSACTION = Limits.getLimitFetchCallsOnApexCursor();
@TestVisible
private static Integer maxRecordsPerFetchCall = 2000;
private Integer cursorNumRecords;
private Integer fetchesPerTransaction = MAX_FETCHES_PER_TRANSACTION;
private final Database.Cursor cursor;
public Cursor(
String finalQuery,
Map bindVars,
System.AccessLevel accessLevel
) {
try {
this.cursor = Database.getCursorWithBinds(finalQuery, bindVars, accessLevel);
} catch (FatalCursorException e) {
Logger.newEntry(
System.LoggingLevel.WARN,
'Error creating cursor. This can happen if there' +
' are no records returned by the query: ' + e.getMessage()
);
}
}
public Cursor setFetchesPerTransaction(Integer possibleFetchesPerTransaction) {
// Handle accidental round downs from Integer division
if (possibleFetchesPerTransaction == 0) {
return this;
}
if (possibleFetchesPerTransaction > MAX_FETCHES_PER_TRANSACTION) {
Logger.newEntry(
System.LoggingLevel.DEBUG,
'Fetches per transaction: ' +
possibleFetchesPerTransaction +
' exceeded platform max fetches per transaction: ' +
MAX_FETCHES_PER_TRANSACTION +
', defaulting to platform max'
);
possibleFetchesPerTransaction = MAX_FETCHES_PER_TRANSACTION;
}
this.fetchesPerTransaction = possibleFetchesPerTransaction;
return this;
}
@SuppressWarnings('PMD.EmptyStatementBlock')
protected Cursor() {
}
public virtual List fetch(Integer start, Integer advanceBy) {
if (this.getNumRecords() == 0) {
Logger.newEntry(
System.LoggingLevel.DEBUG,
'Bypassing fetch call, no records to fetch'
);
return new List();
}
Integer localStart = start;
List results = new List();
while (
Limits.getFetchCallsOnApexCursor() < this.fetchesPerTransaction &&
results.size() < this.getNumRecords() &&
localStart < start + advanceBy
) {
Integer actualAdvanceBy = this.getAdvanceBy(localStart, advanceBy);
results.addAll(this.cursor?.fetch(localStart, actualAdvanceBy) ?? new List());
localStart += actualAdvanceBy;
}
return results;
}
public virtual Integer getNumRecords() {
this.cursorNumRecords = this.cursorNumRecords ?? this.cursor?.getNumRecords() ?? 0;
return this.cursorNumRecords;
}
protected Integer getAdvanceBy(Integer start, Integer advanceBy) {
Integer possibleFetchSize = Math.min(advanceBy, this.getNumRecords() - start);
if (possibleFetchSize > maxRecordsPerFetchCall) {
Logger.newEntry(
System.LoggingLevel.DEBUG,
'Fetch size: ' +
possibleFetchSize +
' exceeded platform max fetch size of ' +
maxRecordsPerFetchCall +
', defaulting to max fetch size'
);
possibleFetchSize = maxRecordsPerFetchCall;
} else if (possibleFetchSize < 0) {
possibleFetchSize = 0;
}
return possibleFetchSize;
}
}
```
Pour la suite de cet article, nous omettons les déclarations de `sharing` en faisant référence à des classes Apex. En pratique, assurez-vous que les classes de niveau supérieur sont explicitement utilisées avec ou sans partage pour être conformes à votre modèle d'objet et à vos autorisations.
Notez également que notre implémentation `Cursor` délègue à la `Database.Cursor` de plate-forme, avec des avantages supplémentaires discutés ci-dessous.
Pour commencer, voici les tests correspondants :
```java
@IsTest
private class CursorTest {
@IsTest
static void itCapsAdvanceByArgument() {
String accountName = 'helloWorld!';
insert new Account(Name = accountName);
String query = 'SELECT Name FROM Account WHERE Name = :bindVar0';
Map bindVars = new Map{ 'bindVar0' => accountName };
Cursor instance = new Cursor(query, bindVars, System.AccessLevel.SYSTEM_MODE);
Assert.areEqual(1, instance.getNumRecords());
Assert.areEqual(accountName, instance.fetch(0, 1000).get(0).get('Name'));
Assert.areEqual(1, System.Limits.getApexCursorRows());
}
@IsTest
static void itCapsMaxRecordsPerFetchCall() {
Cursor.maxRecordsPerFetchCall = 20;
Integer oneMoreThanMaxFetch = Cursor.maxRecordsPerFetchCall + 1;
List accounts = new List();
for (Integer i = 0; i < oneMoreThanMaxFetch; i++) {
accounts.add(new Account(Name = 'Fetch ' + i));
}
insert accounts;
Exception ex;
List results;
Cursor instance = new Cursor(
'SELECT Id FROM Account',
new Map(),
System.AccessLevel.SYSTEM_MODE
);
try {
results = instance.fetch(0, oneMoreThanMaxFetch);
} catch (System.InvalidParameterValueException e) {
ex = e;
}
Assert.areEqual(null, ex?.getMessage());
Assert.areEqual(2, Limits.getFetchCallsOnApexCursor());
Assert.areEqual(oneMoreThanMaxFetch, results.size());
}
@IsTest
static void itFetchesMultipleTimesPerTransactionWhenMoreThanMaxFetch() {
Cursor.maxRecordsPerFetchCall = 20;
List accounts = new List();
Set expectedFetchNames = new Set();
for (Integer i = 0; i < Cursor.maxRecordsPerFetchCall + 1; i++) {
String accountName = 'Fetch' + i;
expectedFetchNames.add(accountName);
accounts.add(new Account(Name = accountName));
}
insert accounts;
Integer oneMoreThanMaxFetch = Cursor.maxRecordsPerFetchCall + 1;
Cursor instance = new Cursor(
'SELECT Name FROM Account',
new Map(),
System.AccessLevel.SYSTEM_MODE
);
List results = instance.setFetchesPerTransaction(2).fetch(0, oneMoreThanMaxFetch);
Assert.areEqual(Cursor.maxRecordsPerFetchCall + 1, results.size());
Assert.areEqual(2, Limits.getFetchCallsOnApexCursor());
Set actuallyFetchedNames = new Set();
for (Account account : (List) results) {
actuallyFetchedNames.add(account.Name);
}
Assert.areEqual(expectedFetchNames, actuallyFetchedNames);
}
@IsTest
static void itFetchesMultipleTimesPerTransaction() {
Cursor.maxRecordsPerFetchCall = 1;
insert new List{ new Account(Name = 'One'), new Account(Name = 'Two') };
Cursor instance = new Cursor(
'SELECT Id FROM Account',
new Map(),
System.AccessLevel.SYSTEM_MODE
)
.setFetchesPerTransaction(2);
List results = instance.fetch(0, 2);
Assert.areEqual(2, instance.getNumRecords());
Assert.areEqual(2, results.size());
results = instance.fetch(2, 1);
Assert.areEqual(0, results.size());
}
@IsTest
static void fetchesCorrectAmountOfRecords() {
List accounts = new List();
for (Integer i = 0; i < 10; i++) {
accounts.add(new Account(Name = 'Fetch ' + i));
}
insert accounts;
Cursor instance = new Cursor(
'SELECT Id FROM Account',
new Map(),
System.AccessLevel.SYSTEM_MODE
)
.setFetchesPerTransaction(10);
List results = instance.fetch(0, 2);
Assert.areEqual(2, results.size(), '' + results);
Assert.areEqual(1, Limits.getFetchCallsOnApexCursor());
}
@IsTest
static void doesNotExceedPlatformMaxFetch() {
List accounts = new List();
for (Integer i = 0; i < 101; i++) {
accounts.add(new Account(Name = 'Fetch ' + i));
}
insert accounts;
Test.startTest();
Cursor instance = new Cursor(
'SELECT Id FROM Account',
new Map(),
System.AccessLevel.SYSTEM_MODE
)
.setFetchesPerTransaction(100);
Integer counter = 0;
List results;
while (counter <= 100) {
results = instance.fetch(counter, counter + 1);
counter++;
}
Test.stopTest();
Assert.areEqual(101, counter);
Assert.areEqual(0, results.size());
}
}
```
En rendant les `Cursor` virtuelles, les implémentations `CursorStep` concrètes peuvent fonctionner sans `Database.Cursor` lorsqu’elles n’ont pas besoin d’itérer un ensemble d’enregistrements volumineux, de la même façon qu’en renvoyant un `System.Iterable` au lieu d’un `Database.QueryLocator` dans Apex batch. Voici un exemple :
```java
public abstract class CursorLikeImplementation extends CursorStep {
private final Cursor cursorLike;
public CursorLikeImplementation(List previouslyRetrievedRecords) {
this.cursorLike = new CursorLike(previouslyRetrievedRecords);
}
public override String getName() {
return CursorLikeImplementation.class.getName();
}
public override Cursor getCursor() {
return this.cursorLike;
}
private class CursorLike extends Cursor {
private final List records;
public CursorLike(List records) {
super();
this.records = records;
}
public override List fetch(Integer position, Integer chunkSize) {
// clone, to keep the underlying list type
List clonedRecords = this.records.clone();
clonedRecords.clear();
for (Integer i = position; i < this.getAdvanceBy(position, chunkSize); i++) {
clonedRecords.add(this.records[i]);
}
return clonedRecords;
}
public override Integer getNumRecords() {
return this.records.size();
}
}
}
```
Notez que cette classe est également abstraite, elle laisse l'implémentation concrète de `innerExecute` à des sous-classes.
Il existe également une alternative à la sous-classe interne `CursorLike`. Si vous savez que les versions concrètes d'une étape comme celle-ci ne brûleront pas à travers les autres limites du gouverneur, vous pouvez renvoyer `this.records` depuis `CursorLike.fetch` et remplacer le `CursorStep.shouldRestart()` parent pour renvoyer false. Cela permet d'itérer sur une liste limitée uniquement par la limite en heap Apex de 12 Mo par transaction asynchrone.
### Autres implémentations basées sur une étape possibles
Notre implémentation basée sur le curseur nous offre beaucoup de flexibilité lors de la pagination sur de grandes quantités de données. L'interface de `Step`, quant à elle, nous offre la flexibilité nécessaire pour décrire et encapsuler toutes sortes d'étapes.
Prenons une étape basée sur un flux :
```java
public virtual class FlowStep implements Step {
private final Invocable.Action specificFlow;
private Boolean shouldRestart = false;
public FlowStep(String specificFlowName, Map inputs) {
this.specificFlow = Invocable.Action.createCustomAction('flow', specificFlowName);
this.specificFlow.setInvocations(new List>{ inputs });
}
public void execute() {
List results = this.specificFlow.invoke();
for (Invocable.Action.Result result : results) {
if (result.isSuccess()) {
Map outputParams = result.getOutputParameters();
Object potentialShouldRestartValue = outputParams.get('shouldRestart');
// Flow does not enforce Booleans being initialized
// so a null check is sadly necessary here
if (potentialShouldRestartValue != null) {
this.shouldRestart = this.shouldRestart ||
Boolean.valueOf(potentialShouldRestartValue);
}
} else {
List errorMessages = new List();
for (Invocable.Action.Error error : result.getErrors()) {
errorMessages.add(
'Error code: ' + error.getCode() +
', error message: ' + error.getMessage()
);
}
Logger.error(
'An error occurred within your auto-launched flow:\n' +
String.join(errorMessages, '\n\t')
);
}
}
}
public virtual void finalize() {
Logger.info(this.getName() + ' finished processing');
}
public String getName() {
return FlowStep.class.getName() + ':' + this.specificFlow.getName();
}
public Boolean shouldRestart() {
return this.shouldRestart;
}
}
```
Les flux ne peuvent pas renvoyer des paramètres de sortie conformes à un type défini par Apex. Par conséquent, nous vérifions la présence d'un paramètre de sortie `shouldRestart` avant de l'utiliser.
Certaines étapes peuvent être signalées par une fonctionnalité. Vous pouvez implémenter une logique pour décider des étapes à inclure ou utiliser une étape sans option pour une fonctionnalité désactivée. Le [modèle Objet nul](https://refactoring.guru/introduce-null-object) est un moyen courant de réduire la complexité dans la couche d'orchestration :
```java
@SuppressWarnings('PMD.EmptyStatementBlock')
public class NoOpStep implements Step {
// The null object pattern is commonly implemented
// as a singleton to reduce memory consumption
public static final NoOpStep SELF {
get {
SELF = SELF ?? new NoOpStep();
}
private set;
}
public void execute() {
}
public void finalize() {
}
String getName() {
return NoOpStep.class.getName();
}
Boolean shouldRestart() {
return false;
}
}
```
Nous avons maintenant plusieurs blocs de construction à travailler. Examinons la couche d'orchestration responsable de l'itération des étapes.
## Création d'un processeur d'étape
Le processeur est un point d'inflexion dans l'architecture. Nous devons décider qui définit les étapes à initialiser et où. Les options comprennent :
- Demandez au processeur de définir les étapes à mapper avec une logique métier. Cette option est simple, mais son échelle est faible pour la lisibilité.
- Définissez le mappage avec des métadonnées personnalisées (CMDT). Les champs Relation des métadonnées ne prennent pas en charge les `ApexClass`, qui couplent vaguement l'orthographe du nom de classe dans la configuration de vos processus métiers. Vous pouvez réduire le risque administrateur en définissant le champ en tant que liste de sélection et en validant l'existence du type (`Type.forName()` ou en interrogeant des `ApexClass`), mais comme les enregistrements CMDT ne prennent pas en charge les déclencheurs, la validation est effectuée à l'exécution. Cet itinéraire peut être testé, mais les administrateurs peuvent créer des enregistrements CMDT uniquement en production.
- Définissez le mappage avec des enregistrements. Les non-administrateurs peuvent configurer des étapes, mais les déploiements deviennent plus difficiles et les environnements peuvent dériver. Procédez avec précaution.
Il y a une citation célèbre de [Clean Code](https://www.oreilly.com/library/view/clean-code-a/9780136083238/) sur la façon de gérer cette partie particulière de complexité :
> La solution à ce problème est d'enterrer l'instruction `switch` [pour fabriquer des objets] dans le sous-sol d'une usine abstraite, et de ne jamais laisser personne la voir.
Avec cela à l'esprit, et parce que notre nombre actuel d'étapes est bien défini et qu'il est peu probable qu'il augmente trop, il est correct que le processeur d'étape soit également l'usine pour les étapes. Cela peut utiliser une énumération pour piloter l'instruction switch :
```java
public enum StepType {
TYPE_ONE,
TYPE_TWO,
TYPE_THREE,
TYPE_FOUR
// etc ...
}
```
Et puis pour notre `StepProcessor`:
```java
public StepProcessor implements System.Queueable, System.Finalizer,
Database.AllowsCallouts {
private final List steps = new List();
private Step currentStep;
public StepProcessor setSteps(List stepTypes) {
for (StepType type : stepTypes) {
switch on type {
WHEN TYPE_ONE {
this.addTypeOneSteps();
}
WHEN TYPE_TWO {
this.addTypeTwoSteps();
}
// ... etc
}
}
this.cleanSteps();
return this;
}
public void execute(System.QueueableContext context) {
this.currentStep = this.currentStep ?? this.steps.remove(0);
if (context != null) {
System.attachFinalizer(this);
Logger.setAsyncContext(context);
}
Logger.info('Executing step ' + this.currentStep.getName());
try {
this.currentStep.execute();
} catch (Exception e) {
Logger.exception('Unexpected exception', e);
}
Logger.info('Finished executing step ' + this.currentStep.getName());
Logger.saveLog();
}
public void execute(System.FinalizerContext context) {
Logger.info('Executing finalizer for step ' + this.currentStep.getName());
Logger.setAsyncContext(context);
switch on context?.getResult() {
when UNHANDLED_EXCEPTION {
// see the note below about this logging paradigm
Logger.warn(
'Failed to run on step' + this.currentStep,
context?.getException()
);
}
when else {
this.currentStep.finalize();
if (this.currentStep.shouldRestart()) {
this.kickoff();
} else if (this.steps.isEmpty() == false) {
this.currentStep = this.steps.remove(0);
this.kickoff();
} else {
Logger.info('Finished executing steps');
}
}
}
Logger.info(
'Finished executing finalizer for step ' +
this.currentStep.getName()
);
Logger.saveLog();
}
public String kickoff() {
return this.steps.isEmpty() ? null : System.enqueueJob(this);
}
private void cleanSteps() {
for (Integer reverseIndex = this.steps.size() - 1;
reverseIndex >= 0; reverseIndex--) {
if (this.steps[reverseIndex] instanceof NoOpStep) {
this.steps.remove(reverseIndex);
}
}
}
private void addTypeOneSteps() {
this.steps.addAll(
new List {
new ExampleCursorStepOne(),
new ExampleCursorStepTwo()
}
);
}
private void addTypeTwoSteps() {
this.steps.addAll(
new List {
new FlowStep('
ExampleInvocableName',
new Map( 'exampleParameter' => true)
),
new ExampleCursorStepThree()
}
);
}
}
```
Les méthodes d'usine affichées, par exemple `addTypeOneSteps()`, peuvent déléguer des problèmes tels que le marquage des fonctionnalités. `cleanSteps()` effectue un contrôle unique des étapes rassemblées pour s'assurer qu'il n'y a pas d'étapes « vides » avant la synchronisation. Ça pourrait ressembler à ça :
```java
private Step getStepOrDefault(String customPermissionName, Step defaultStep) {
if (System.FeatureManagement.checkPermission(customPermissionName)) {
return defaultStep;
}
return NoOpStep.SELF;
}
```
Nous n'avons pas abordé le traitement des erreurs depuis que nous avons mentionné Nebula Logger dans la section Flux planifié. En effet, `System.Finalizer` nous permet de couvrir la consignation de toutes les conditions d'erreur sans ajouter de traitement spécifique des erreurs à chaque étape. Chaque `Step` se concentre sur la course à pied, tandis que nous consignons et renversons tous les chemins malheureux afin qu'ils soient exposés dans des tests unitaires. Cela prend en charge l'itération sécurisée et les alertes au niveau de la production (en utilisant le [plug-in Slack Logger pour Nebula](https://github.com/jongpie/NebulaLogger/tree/main/nebula-logger/plugins/slack) pour tous les journaux WARN et ERROR).
Une remarque concernant la consignation des erreurs: transmettre l'instance de l'étape dans des messages de consignation suppose un niveau de Trust dans ce qui devient visible dans les journaux. La `toString()` par défaut des classes Apex inclut dans le message toutes les propriétés statiques et au niveau de l'instance. Cela peut être souhaitable — ou cela peut divulguer des informations confidentielles. Bien que la consignation et la sécurité ne soient pas au centre des préoccupations ici, notez que pour certains systèmes, l'adhésion à une interface telle que `Step` peut également impliquer de forcer un remplacement pour `toString()`.
```java
public interface Step {
void execute();
void finalize();
String getName();
Boolean shouldRestart();
String toString();
}
```
Une telle méthode impose à chaque créateur d'objet de décider ce qui est autorisé à imprimer, ce qui peut être souhaitable.
Au niveau de la consignation : au niveau `StepProcessor`, nous utilisons `INFO`, le niveau sans erreur le plus élevé. À mesure que vous gagnez en précision dans l'application, les niveaux de consignation devraient diminuer en conséquence. Les étapes individuelles peuvent utiliser des `DEBUG` pour des informations générales, les `FINE`, `FINER` et `FINEST` étant réservés à des produits de plus en plus détaillés. La consignation est autant un art qu'une science, mais suivre ces principes permet de garder les journaux cohérents et utiles.
### Traitement de complexité supplémentaire dans le processeur de l'étape
Avant de passer à autre chose, réfléchissons brièvement à la décision de laisser notre processeur d'étape héberger la logique pour laquelle les étapes sont utilisées. Dans une vaste base de codes, vous pouvez définir des `StepProcessor` virtuelles ou abstraites, et demander aux sous-classes d'identifier des étapes spécifiques pour établir une séparation appropriée des préoccupations.
## La couche invocable Apex
Le planificateur finit par invoquer Apex . Une fois le reste de la configuration terminée, la section Apex invocable peut décider quelles étapes doivent être exécutées et transmettre le `List` au processeur :
```java
public class DailyJobExecutor {
@InvocableMethod(label='Execute Daily Job')
public static void executeJob() {
Logger.info('Executing daily Job');
List correspondingTypes = new List();
// based on [business logic], determine which step types
// should be included for any daily invocation
if (correspondingTypes.isEmpty() == false) {
try {
new StepProcessor().setSteps(correspondingTypes).kickoff();
} catch (Exception ex) {
Logger.exception('Error starting job', ex);
}
}
}
Logger.saveLog();
}
```
Il s'agit d'une partie simple de l'équation, qui utilise des enregistrements, des données ou une logique pour déterminer les types d'étape à exécuter. L'action invocable est simple, car nous avons encapsulé la complexité ailleurs. Nous avons également protégé contre les exceptions inattendues et facilité le test de chaque pièce isolée.
## Traitement des délais avant d'appeler Slack
Le [Kit de développement Apex Slack](https://developer.salesforce.com/docs/platform/salesforce-slack-sdk/guide/overview.html) dépasse le cadre de cet article, mais il convient de revenir sur l ' un des problèmes potentiels liés aux exigences : notifier les personnes de rang supérieur dans la hiérarchie des rôles en fonction d ' un délai configurable. Sur le papier, c'est simple, et vous pourriez (correctement) considérer la `System.enqueueJob(this)` dans le `StepProcessor`. Avec [System.AsyncOptions](https://developer.salesforce.com/docs/atlas.en-us.apexref.meta/apexref/apex_class_System_AsyncOptions.htm), notre penchant initial était d'utiliser la surcharge de `enqueueJob` pour satisfaire cette exigence.
Pour le moment, cependant, le délai maximal via `System.AsyncOptions.MinimumQueueableDelayInMinutes` est de 10 minutes. Comme l'exigence est de 120 minutes, il reste quelques options. Une approche naïve pourrait ressembler à ceci :
```java
public class ExampleDelayedNotifier implements Step {
private final List notifications = new List();
private final Slack.BotClient botClient = Slack.App
.getAppByKey('some-slack-app-key')
.getBotClientForTeam('slack team id');
// account for the initial delay,
// so 120 - 10 = 110
private Integer delayMinutes = 110;
public void execute() {
if ( this.delayInMinutes > 0) {
return;
}
Integer maximumAllowedCallouts = 100;
while (this.notifications.isEmpty() == false && maximumAllowedCallouts > 0) {
this.botClient.chatPostMessage(this.notifications.remove(0));
maximumAllowedCallouts--;
}
}
public void finalize() {
this.delayInMinutes -= 10;
}
public String getName() {
return ExampleDelayedNotifier.class.getName();
}
public Boolean shouldRestart() {
return this.delayInMinutes > 0 || this.notifications.isEmpty() == false;
}
}
```
En pratique, le délai serait transmis dans cette classe, car il est piloté par la configuration.
Nous recommandons cette approche, sauf si vous êtes certain qu'il n'y aura jamais qu'un seul type de notification retardée. Il brûle 11 tâches asynchrones supplémentaires avant de démarrer (ou plus, si le délai augmente). Ce coût peut convenir pour un seul travail, pas pour beaucoup. Vous devez également ajouter une méthode à l'interface de `Step` afin que chaque étape indique au processeur le temps d'attente avant le redémarrage, ce qui ajoute du bruit.
Cela nous laisse deux possibilités intéressantes :
- Vous pouvez insérer l'étape retardée dans votre infrastructure de travail existante si vous avez déjà planifié une tâche d'interrogation à un intervalle approprié. Vous devriez également être d'accord avec le délai spécifié frappant jusqu'à 15 minutes plus tard (15 minutes est l'intervalle d'actualisation minimum pour une expression CRON planifiée Apex). Cela correspond à peu près à l'exemple Apex invocable; la planification est effectuée à la place via Apex. En d'autres termes, vous pouvez réutiliser la même architecture basée sur l'`Step` pour traiter les enregistrements basés sur un horodatage « Commencer après » et choisir les étapes à utiliser en fonction d'un mappage de liste de sélection ou de liste à sélection multiple avec les valeurs d'énumération `StepType` précédemment affichées.
- Alternativement, si vous êtes à l’aise pour définir une classe Apex externe supplémentaire, rabattez-vous sur Apex par lot (contrairement à Apex Queueable, qui prend en charge les classes internes, les classes Apex par lot doivent être des classes externes) en utilisant `System.scheduleBatch()`.
Prenons l'exemple Apex par lot. Bien que nous recommandons généralement Apex Queueable pour la flexibilité et le contrôle, c'est un cas où Apex Batch règne toujours en maître:
```java
public class DelayedNotifier implements Database.Batchable
 Maintenant, décomposez ce diagramme et commencez à construire les pièces.
## Planification avec un flux planifié
Le flux planifié offre plusieurs avantages en tant que mécanisme de planification :
- Les flux planifiés peuvent être empaquetés et déployés en tant que métadonnées. Ce n'est pas vrai pour les tâches planifiées via Apex (ou via la page Tâches planifiées).
- L'élément Attente est essentiel pour les infrastructures qui nécessitent une légende. En l'utilisant dans Flux, les appels externes ne sont pas nécessaires dans la partie Invocable de l'infrastructure.
- La granularité de la planification remplit les exigences : l'intervalle minimal pour les flux planifiés est quotidien. Si vous avez besoin d'une fréquence plus élevée (par exemple, toutes les heures), reconsidérez Flux planifié pour cette exigence.
Une autre considération lors de la configuration du flux planifié est le portage de l'environnement. Avant d'invoquer l'action Apex, ajoutez un élément Décision qui évalue la variable `{!$Api.Enterprise_Server_URL_100}`. Cela garantit que la tâche est exécutée uniquement dans les environnements prévus, tels que UAT et Production. Ce schéma est important, car les sandbox sont fréquemment actualisées ou créées pendant le développement de l'infrastructure, et sans vérification explicite de l'environnement, un flux planifié peut involontairement être exécuté dans des environnements où l'infrastructure n'est pas conçue pour être exécutée. L'utilisation de l'opérateur `contains` dans l'élément Décision rend la configuration résiliente aux futures créations de sandbox ou aux changements d'URL.
Enfin, déterminez comment l'infrastructure doit capturer les échecs. Ajoutez toujours un chemin de défaut lorsque Flux appelle n'importe quelle action. Vous pouvez par exemple câbler les défauts à l'action « Ajouter une entrée au journal » [de Nebula Logger](https://www.nebulalogger.com/). Nebula Logger écrit des journaux dans des objets personnalisés. Par conséquent, les clients doivent savoir que les données des journaux consomment du stockage dans l'organisation. Par défaut, les journaux sont stockés pendant 14 jours dans une organisation, puis nettoyés. Cette période de rétention est configurable. Nebula Logger utilise également les événements de plate-forme pour publier des journaux. Par conséquent, les entrées dans les journaux sont enregistrées indépendamment de la transaction de traitement des données principale. Cela garantit la capture des échecs, même si l'action principale Flux ou Apex est annulée. Les clients doivent évaluer le volume de consignation attendu et les exigences de rétention en envisageant l'ajout d'une infrastructure de consignation.
Le flux se présente comme suit :
 Passons aux premiers bouts de code Apex avec l'exigence de planification désormais satisfaite.
## Création d'une interface d'étape
Définissez une interface de `Step` :
```java
public interface Step {
void execute();
void finalize();
String getName();
Boolean shouldRestart();
}
```
Pour cet article, l'interface de `step` est affichée en tant que classe externe pour plus de clarté. L'infrastructure elle-même est flexible. Les équipes peuvent organiser l'interface et ses implémentations en utilisant n'importe quel modèle d'empaquetage Apex de leur choix, à condition que toutes les classes Étape référencent la même interface.
Voici quelques points à noter concernant les méthodes définies dans notre interface :
- La `execute`, bien que sans argument pour le moment, s'améliore lorsque nous passons une classe (ou interface) de `State` pour orchestrer les données entre les étapes lorsque l'ordre importe.
- `getName` peut renvoyer une valeur de `System.Type` au lieu d'une `String`. L'objectif est de fournir à la couche d'orchestration un moyen de consigner les noms d'étape sans exposer d'autres propriétés.
Voici la première mise en œuvre concrète qui montre comment ces pièces s’agencent. À une exception près plus loin, nous recommandons d'utiliser Apex Queueable pour implémenter le traitement asynchrone dans Apex; Apex par lot est généralement inutile (et les méthodes de `@future` sont déconseillées). Apex Queueable démarre rapidement et présente, avec les curseurs Apex, de nombreux avantages par rapport aux Apex batch.
### Une implémentation Apex semblable à un curseur
Les [curseurs Apex](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_cursors.htm) offrent une alternative moderne au modèle Apex traditionnel par lot. De la même façon qu'un traitement par lot, une implémentation de curseur peut récupérer des enregistrements par segments (jusqu'à 2000 par lot). Cependant, les curseurs autorisent plusieurs récupérations dans une seule transaction, ce qui augmente considérablement le débit pour les opérations à grand volume.
Lors de l'adoption des curseurs dans ce cadre, les équipes doivent être conscientes des limitations actuelles en matière de test et de moquabilité. Le comportement du curseur dans les tests peut différer de celui de la production. Par conséquent, il est important de concevoir des stratégies de test qui évitent de dépendre des internes du curseur et valident à la place la logique d'orchestration aux frontières. À mesure que la plate-forme évoluera, ces domaines continueront de s'améliorer, mais les orientations principales demeurent les suivantes : Les curseurs offrent des performances supérieures et réduisent les surcharges d'orchestration par rapport à Apex par lot pour de nombreux cas d'utilisation.
Pour définir une frontière claire entre le curseur fourni par le système et votre propre code, nous recommandons de créer une représentation de type curseur lors de l'implémentation de l'interface de `Step`. Tenez compte du code suivant :
```java
public inherited sharing abstract class CursorStep implements Step {
private static final Integer MAX_CHUNK_SIZE = 2000;
protected Cursor cursor;
private Integer chunkSize = System.Limits.getLimitDMLRows();
private Integer position = 0;
protected abstract Cursor getCursor();
protected abstract void innerExecute(List