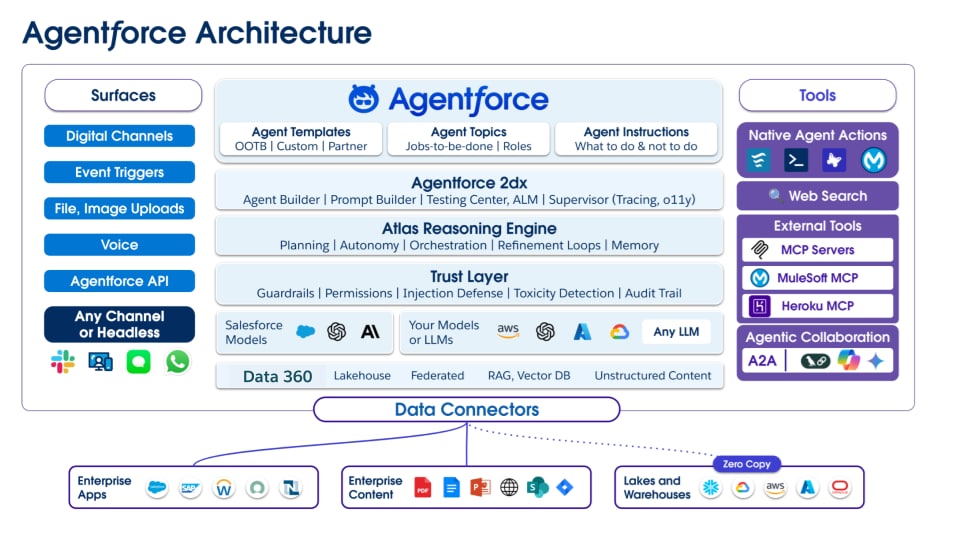
 ## 2\. Principios arquitectónicos principales
La racionalización de una arquitectura de múltiples agentes comienza con la proyección de principios arquitectónicos principales en las funciones y la estructura de los agentes. Las arquitecturas de múltiples agentes resultantes son entonces una manifestación del diseño del sistema principal y los principios de arquitectura del sistema que están alineados con el “grano” exclusivo de las tecnologías de IA.
Los principios clave que dirigen esta arquitectura incluyen:
- Gestionar la complejidad a través de la descomposición
- Mejorar la resiliencia y reducir la fragilidad a través del desacoplamiento
- Mejorar la fiabilidad y la eficiencia a través de la reutilización de código
- Mejore la fiabilidad de los agentes limitando el ámbito de preocupación de cualquier agente
- Mejorar el mantenimiento y la evolución del sistema a través de la modularidad y la capacidad de ampliación
- Simplificar la gestión y la responsabilidad de los agentes a través de la especialización
A diferencia de las arquitecturas de agentes más primitivas (por ejemplo, las que se centran en los LLM como la estructura arquitectónica principal), _Agentforce se concibió para la orquestación de múltiples agentes desde su creación_. La orquestación de múltiples agentes subyace en el motor de razonamiento de Atlas y el razonamiento de agentes para crear rutas de programación dinámicas y efectivas en una respuesta de agente para ampliar drásticamente la capacidad de entregar un aumento de agente amplio y profundo a la experiencia de usuario (UX).
En Agentforce este tipo de coordinación está activada por estos protocolos abiertos e interoperables clave y Productos de Salesforce:
- **Agentforce** proporciona un subsistema Agent para encapsular todos los elementos clave de un agente: temas, instrucciones, acciones, barandillas, contexto, invocaciones, salidas, detalles de ejecución, registros, etc.
- **Acciones**: proporcione ganchos para acceder a datos, flujos de llamadas, invocar sistemas externos y llamar a otros agentes.
- **Data 360**: proporciona una capa de virtualización de datos para aportar contexto específico e individualizado al agente (aprovechando el perfil unificado y la cadena clave de Data 360 para extraer información específica de toda la compañía).
Además, para agentes de toda la compañía o para acceder a agentes o recursos, admitimos:
- **Model Context Protocol (MCP)**: es una capa de comunicación segura que conecta agentes con herramientas de negocio, datos y Knowledge para garantizar la precisión del contexto.
- **Protocolo de agente a agente (A2A)**: es un enlace estandarizado para la delegación entre agentes que permite la coordinación segura y gobernada entre sistemas, organizaciones y proveedores.
Estos principios proporcionan la base para construir un sistema ampliable y gobernable de inteligencia orquestada.
### Consideraciones adicionales
Las soluciones sólidas de agentes requieren enfoques claros para los requisitos no funcionales que sustentan la entrega de tecnología efectiva:
- Seguridad y gobernanza (Gestión de identidad y acceso, Privacidad de datos, Seguridad de datos y Modelado de amenazas).
- Observabilidad y monitoreo (Rastreo distribuido, Registro centralizado, Mediciones y Tableros).
- Operacionalización y gestión del ciclo de vida (Especificación, Generación de casos de prueba, Pruebas, Comentarios, Aprendizaje continuo, Desuso).
Estas son consideraciones arquitectónicas clave para la creación de soluciones de Enterprise Agentic que no se tratan en este documento técnico; sin embargo, se abordarán en publicaciones futuras.
## 3\. Taxonomía de agente de compañía
Para gestionar un panorama de agentes de toda la compañía, los arquitectos deben clasificar a los agentes a través de dos lentes complementarias: función técnica e impacto de negocio.
### 3.1 Clasificación de funciones funcionales
Esta taxonomía categoriza las funciones funcionales que los agentes pueden asumir en una arquitectura.
- **Funciones de canal/UX**: Defina la modalidad de interacción (por ejemplo, Sin encabezado, Solicitud, Chats y mensajes o Espacios de trabajo gestionados por IA).
- **Funciones de especialistas**: Encapsule Knowledge de dominio profundo (por ejemplo, Experto de dominio, Knowledge Minion, Asistente o Planificador).
- **Funciones de servicio**: público Realice tareas transaccionales discretas (por ejemplo, Generación, Resumen, Transformación o Configuración).
- **Funciones de mantenimiento y servicio proactivo**: Céntrese en el estado y la calidad de los datos (por ejemplo, Depuración, Conformación, Calidad de datos o Enriquecimiento de datos).
- **Funciones de larga duración**: Gestione procesos durante periodos de tiempo prolongados (por ejemplo, Concierge, Gerente de proyecto, Nutridor o Vigilante/Alterador).
## 4\. La plantilla Mapa agente
Para facilitar un diseño y una comunicación claros, el **Mapa de agentes** es la plantilla estándar para describir soluciones de agentes. Define entidades clave, sistemas e interacciones dentro de un patrón de diseño específico.
Estos son los componentes de plantilla de mapa agente:
- Las **capas de usuario** definen los actores humanos en el sistema (por ejemplo, clientes, empleados autenticados (SF-Users) y empleados no autenticados).
- Las **capas de agentes** describen agentes requeridos, patrones exhibidos, relaciones entre sí e instrucciones que se utilizan para actualizar patrones específicos.
- **Contexto/Acciones** son los recursos, las funciones o las acciones que gestiona o accede el agente.
- Los **orígenes** son los datos, las aplicaciones, las bases de Knowledge y otros sistemas subyacentes a los que se conectan los agentes.
Los apéndices A y B ilustran patrones de agentes a nivel del sistema demostrando su composición dentro de los swimlanes de la plantilla de mapa de agentes.
## 5\. Marcos de trabajo de patrones agentes
En Salesforce, utilizamos una biblioteca de patrones de agentes para organizar y entregar soluciones de agentes fiables y predecibles. Estos patrones son nuestros planes para resolver problemas arquitectónicos comunes.
Se agrupan en cuatro categorías principales:
- **Patrones de interacción**: Céntrese en la implicación de agentes y la experiencia de usuario (UX).
- **Patrones de especialista/trabajador**: Encapsule Knowledge profundo o habilidades específicas en un dominio concreto.
- **Patrones de utilidades y gestión de datos**: Realice tareas específicas, a menudo repetibles, que admiten otros agentes o procesos.
- **Patrones de larga ejecución**: Gestione procesos y flujos de trabajo que se producen durante periodos prolongados, que implican múltiples pasos.
Las siguientes secciones detallan patrones clave de cada categoría. Cada descripción de patrón proporciona una **Descripción general**, **Tipo de salida**, **Orientación de uso** de patrón, **Casos de uso** representativos y un **Diagrama de solución**, así como asignación a la **Rúbrica de madurez** de Salesforce Agentic.
## 6\. Patrones de interacción
Los _patrones de interacción_ son diseños fundamentales que se centran en la implicación de agentes y la experiencia de usuario.
### Patrón Greeter
- **Descripción general**: El _patrón Greeter_ es un patrón sencillo y fácil de implementar que utiliza lenguaje natural para determinar la intención del usuario. A continuación, dirige al usuario al agente humano apropiado.
- **Tipo de salida**: Traspaso/Distribución al siguiente recurso.
- **Valor de negocio**: Facilite un primer contacto transparente y eficiente para los clientes mientras maximiza la resolución de intenciones y la recopilación de contexto para los proveedores de servicio.
- **Orientación de uso**: de patrones Configure el agente como el recurso de implicación principal para canales de marca. Proporcione instrucciones sobre la marca, los productos y los servicios que se emparejan con instrucciones de enrutamiento basadas en la intención del usuario. El agente recopila y resume la intención de entregar una transferencia cálida.
- **Caso de uso representativo**: Imagine una página web que utiliza un bot de chat para presentar un menú de opciones donde los usuarios deben hacer clic en todas las opciones antes de que se les enrute a un humano. Para mejorar la productividad y la eficiencia de back-office, los chatbots a menudo utilizan interacciones y rutas de trabajo complejas y complicadas. Esto lleva a un escenario de fatiga de “llenar, elegir y hacer clic” para clientes que a menudo da como resultado frustración si su contexto se encuentra fuera de las opciones de menú disponibles. Al sustituir los chatbots tradicionales por la _Puerta principal auténtica_, que utiliza interacciones de lenguaje natural, alivia la carga y proporciona una interacción similar a la humana.
- **Receta Agentforce**:
- Agente de servicio Agentforce: [Crear un Agente de servicio](https://trailhead.salesforce.com/content/learn/projects/quick-start-build-your-first-agent-with-agentforce)
- El Agente de servicio empaquetado tiene funciones de transferencia configurables que admiten la transferencia:
- A agentes humanos
- A agentes de IA
- A agentes externos
- Patrones específicos de la industria que contienen ejemplos de código
- **Diagrama**:
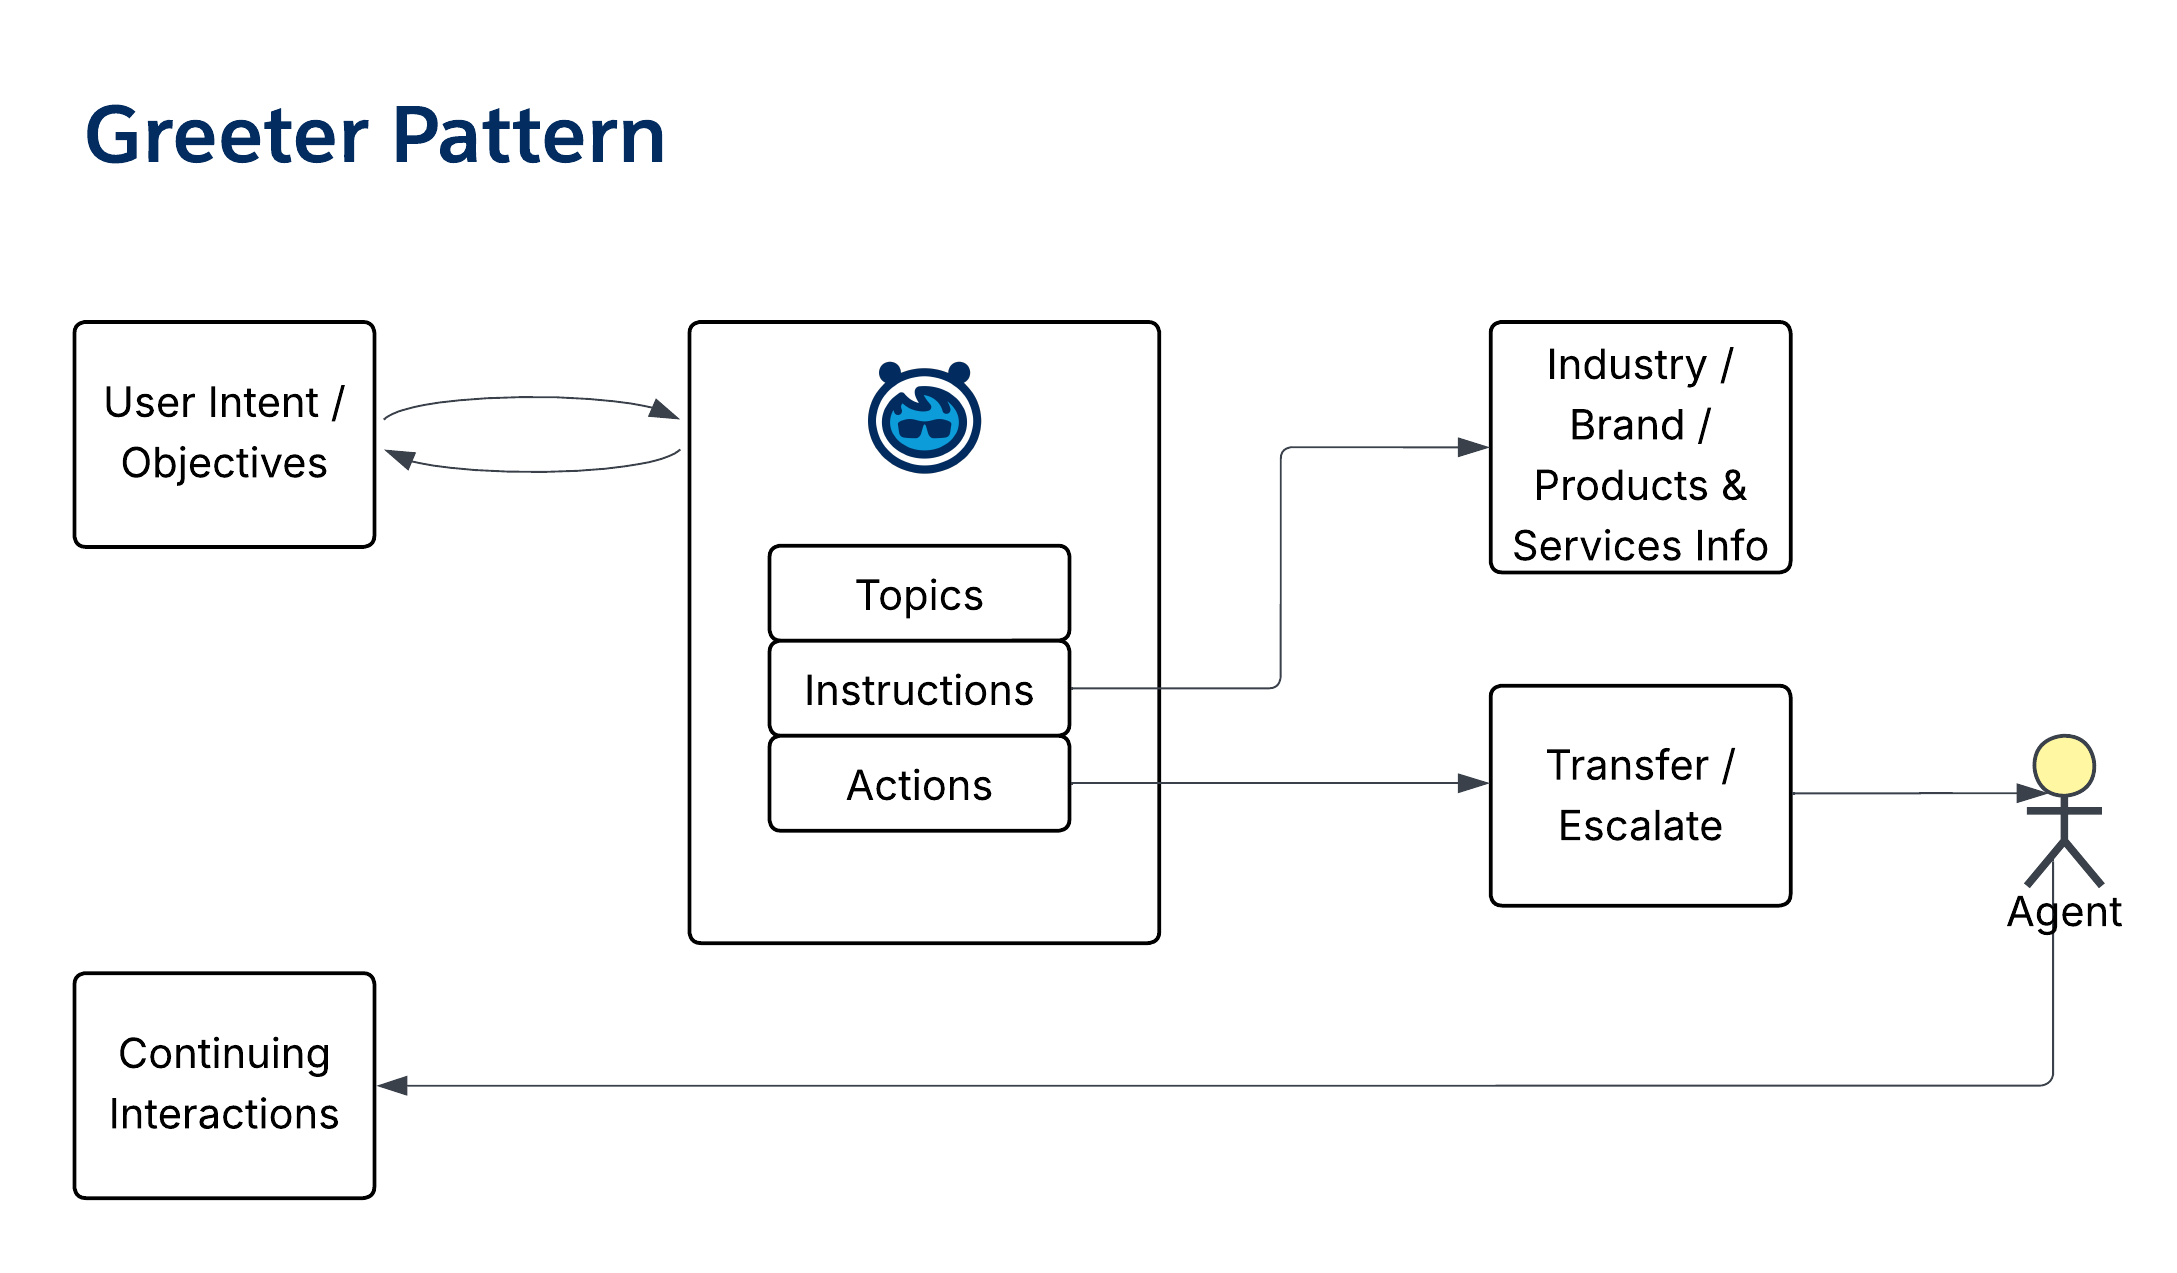 - **Madurez de Salesforce Agentic**: Nivel 1 (o Nivel 0 si utiliza el Agente de servicio listo para su uso con transferencia y distribución integradas)
### Patrón de operador
- **Descripción general**: El _patrón Operador_ se basa en el _patrón Mayor_ enrutando solicitudes al agente especializado o humano apropiado e intención de negociación (si es necesario).
- **Tipo de salida**: Traspaso/Transferencia al siguiente recurso.
- **Orientación de uso**: de patrones Combine instrucciones específicas de marca y servicio con instrucciones sobre dónde enviar al usuario basándose en la intención. Defina recursos de distribución, que pueden ser humanos u otros agentes.
- **Caso de uso representativo**: Utilice la _Puerta de entrada_ para escenarios donde hay un alto grado de especialización entre representantes humanos o de IA.
- **Diagrama**:
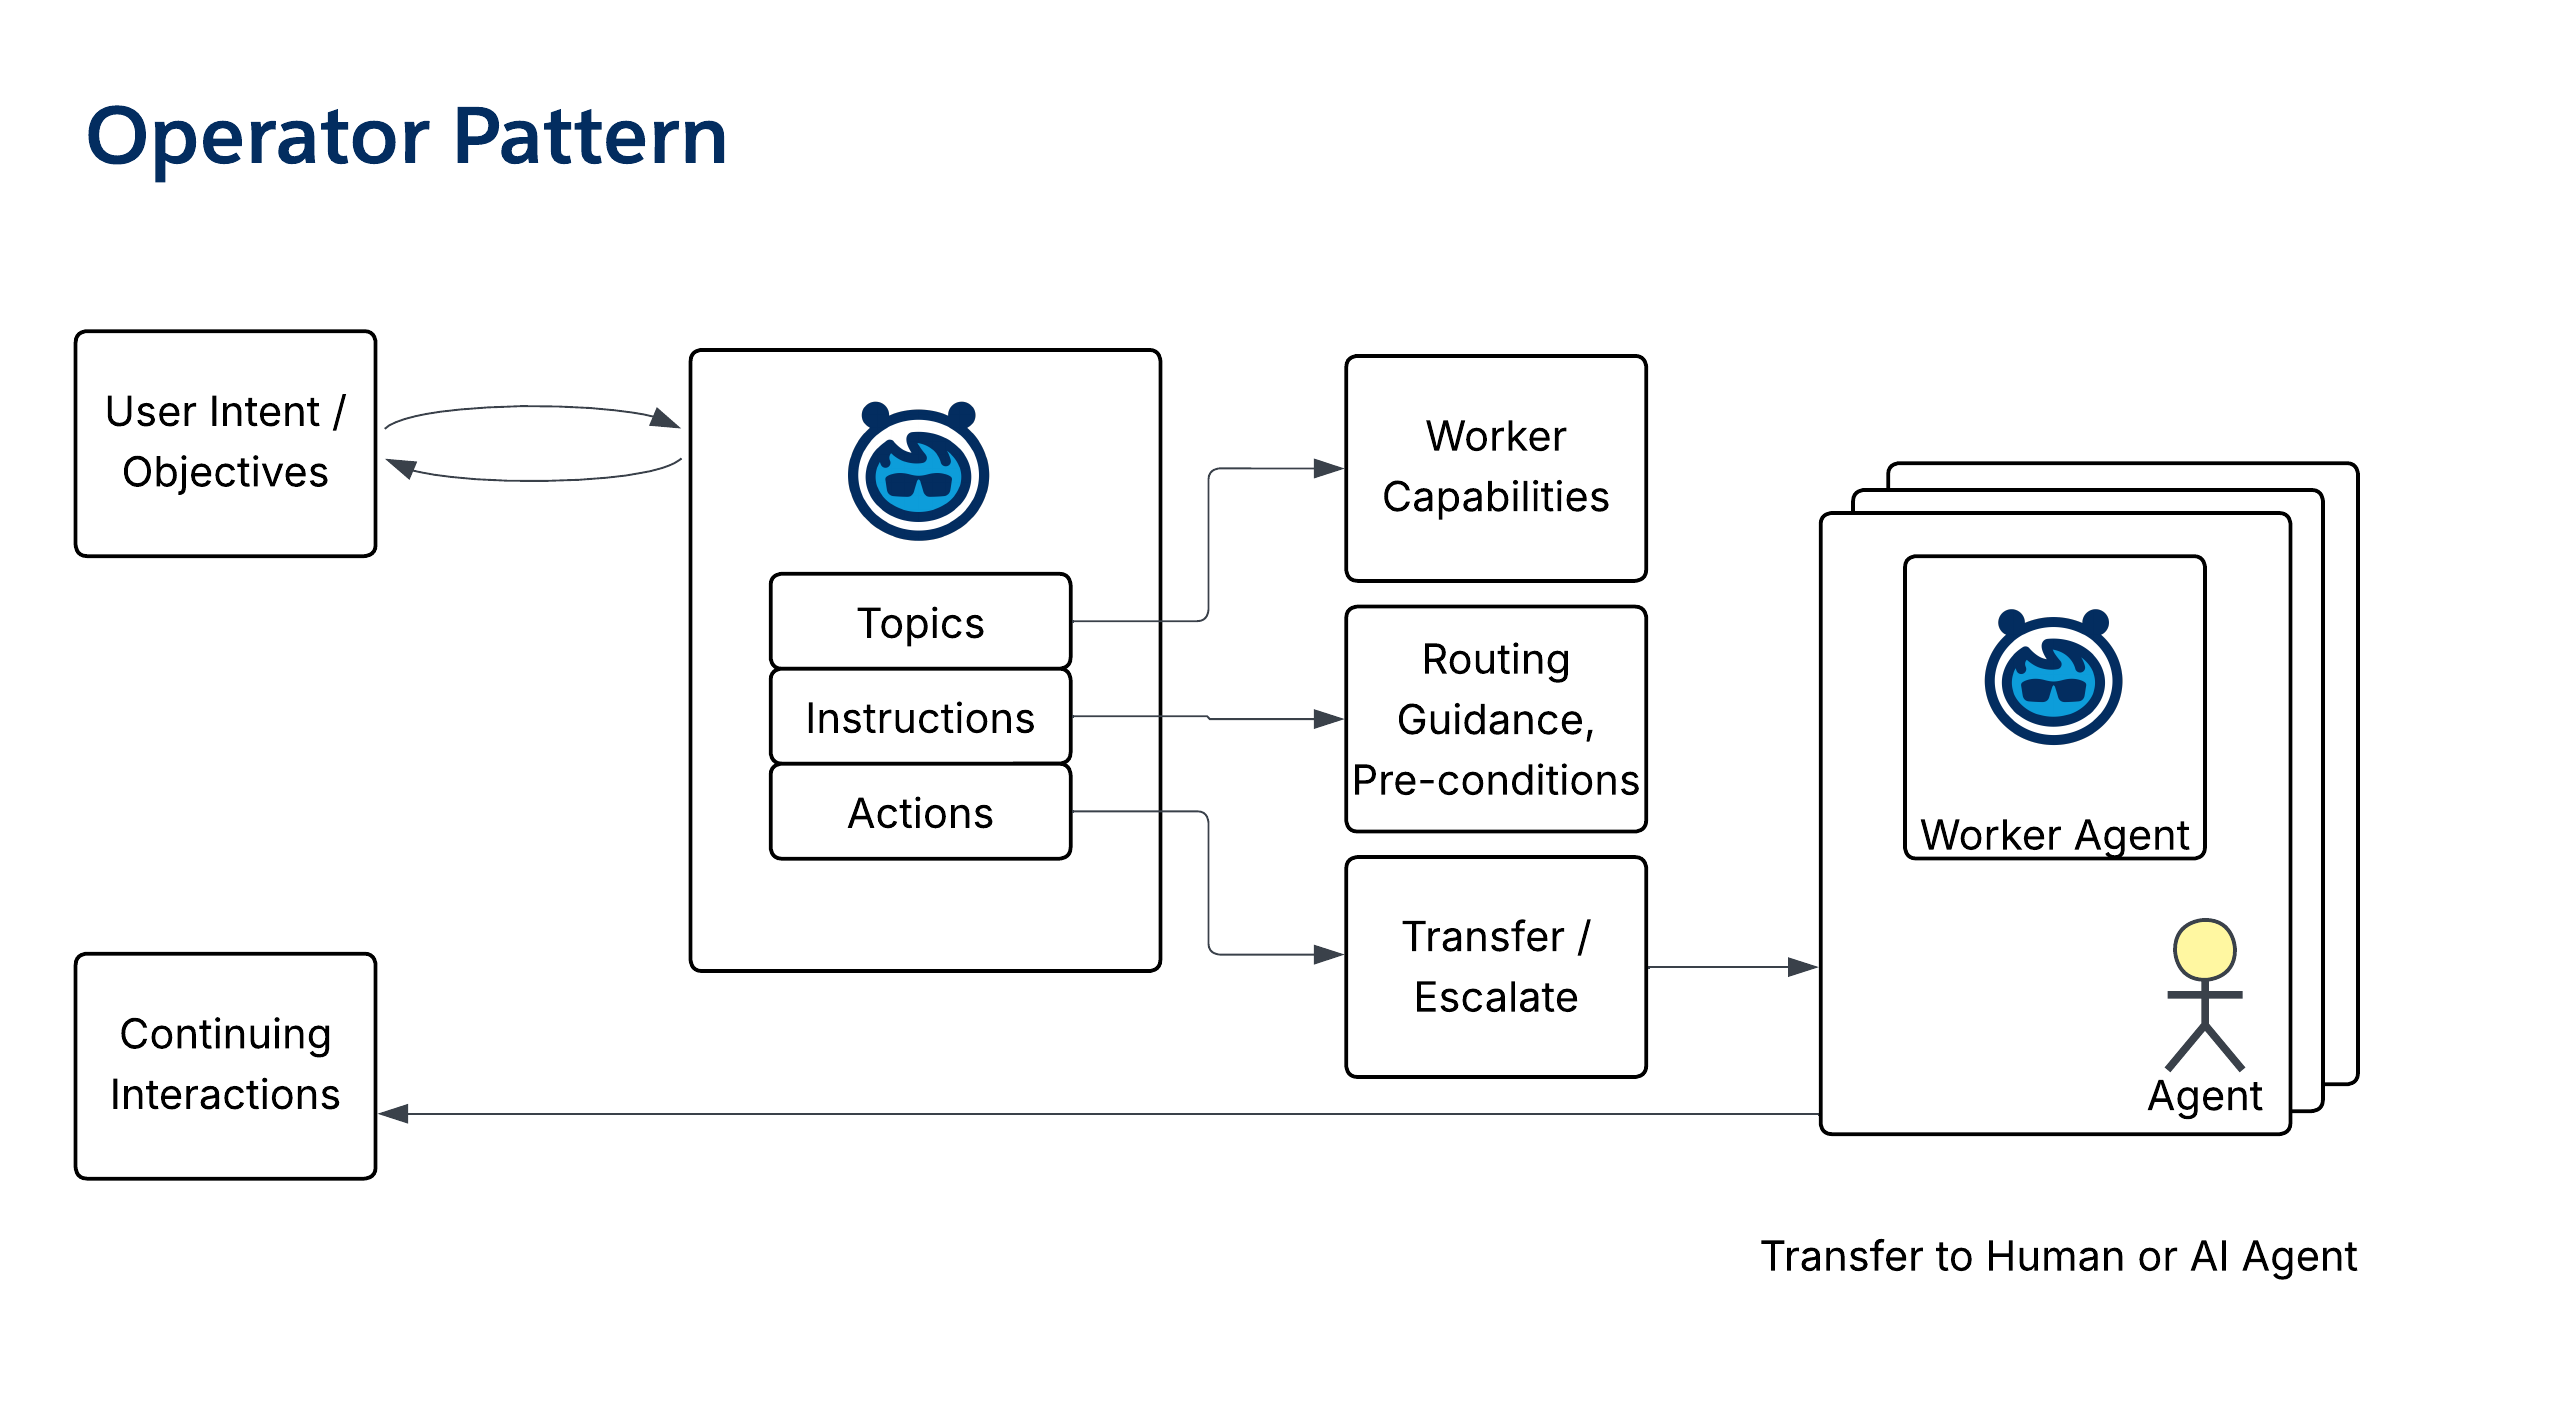 - **Madurez de Salesforce Agentic**: Nivel 2
### Patrón de orquestador
- **Descripción general**: El _patrón Orquestador_ gestiona un "Enjambre" de agente de IA. Cuando recibe una solicitud de usuario, pasa la expresión a uno o más agentes especializados y luego agrega las respuestas para el usuario. A diferencia del _patrón Operador_, sigue siendo el primer punto de contacto (POC).
- **Tipo de salida**: Coteje y prepare respuestas de agentes de trabajadores.
- **Orientación de uso**: de patrones Configurado como el implicador principal. Proporcione instrucciones para cada agente de trabajo de asistencia (por ejemplo, un Priorizador o una SME de dominio) que permite al orquestador transmitirles expresiones.
- **Caso de uso representativo**: Utilice el _Patrón de orquestador_ como la puerta principal de agente para asistir a clientes que podrían necesitar debatir múltiples temas por plática, lo que requiere soluciones de múltiples agentes e interacciones coherentes. En una arquitectura multisistema, considere el _Patrón de orquestador_ para coordinar respuestas entre sistemas y con la colaboración de agentes externos.
- **Diagrama**:
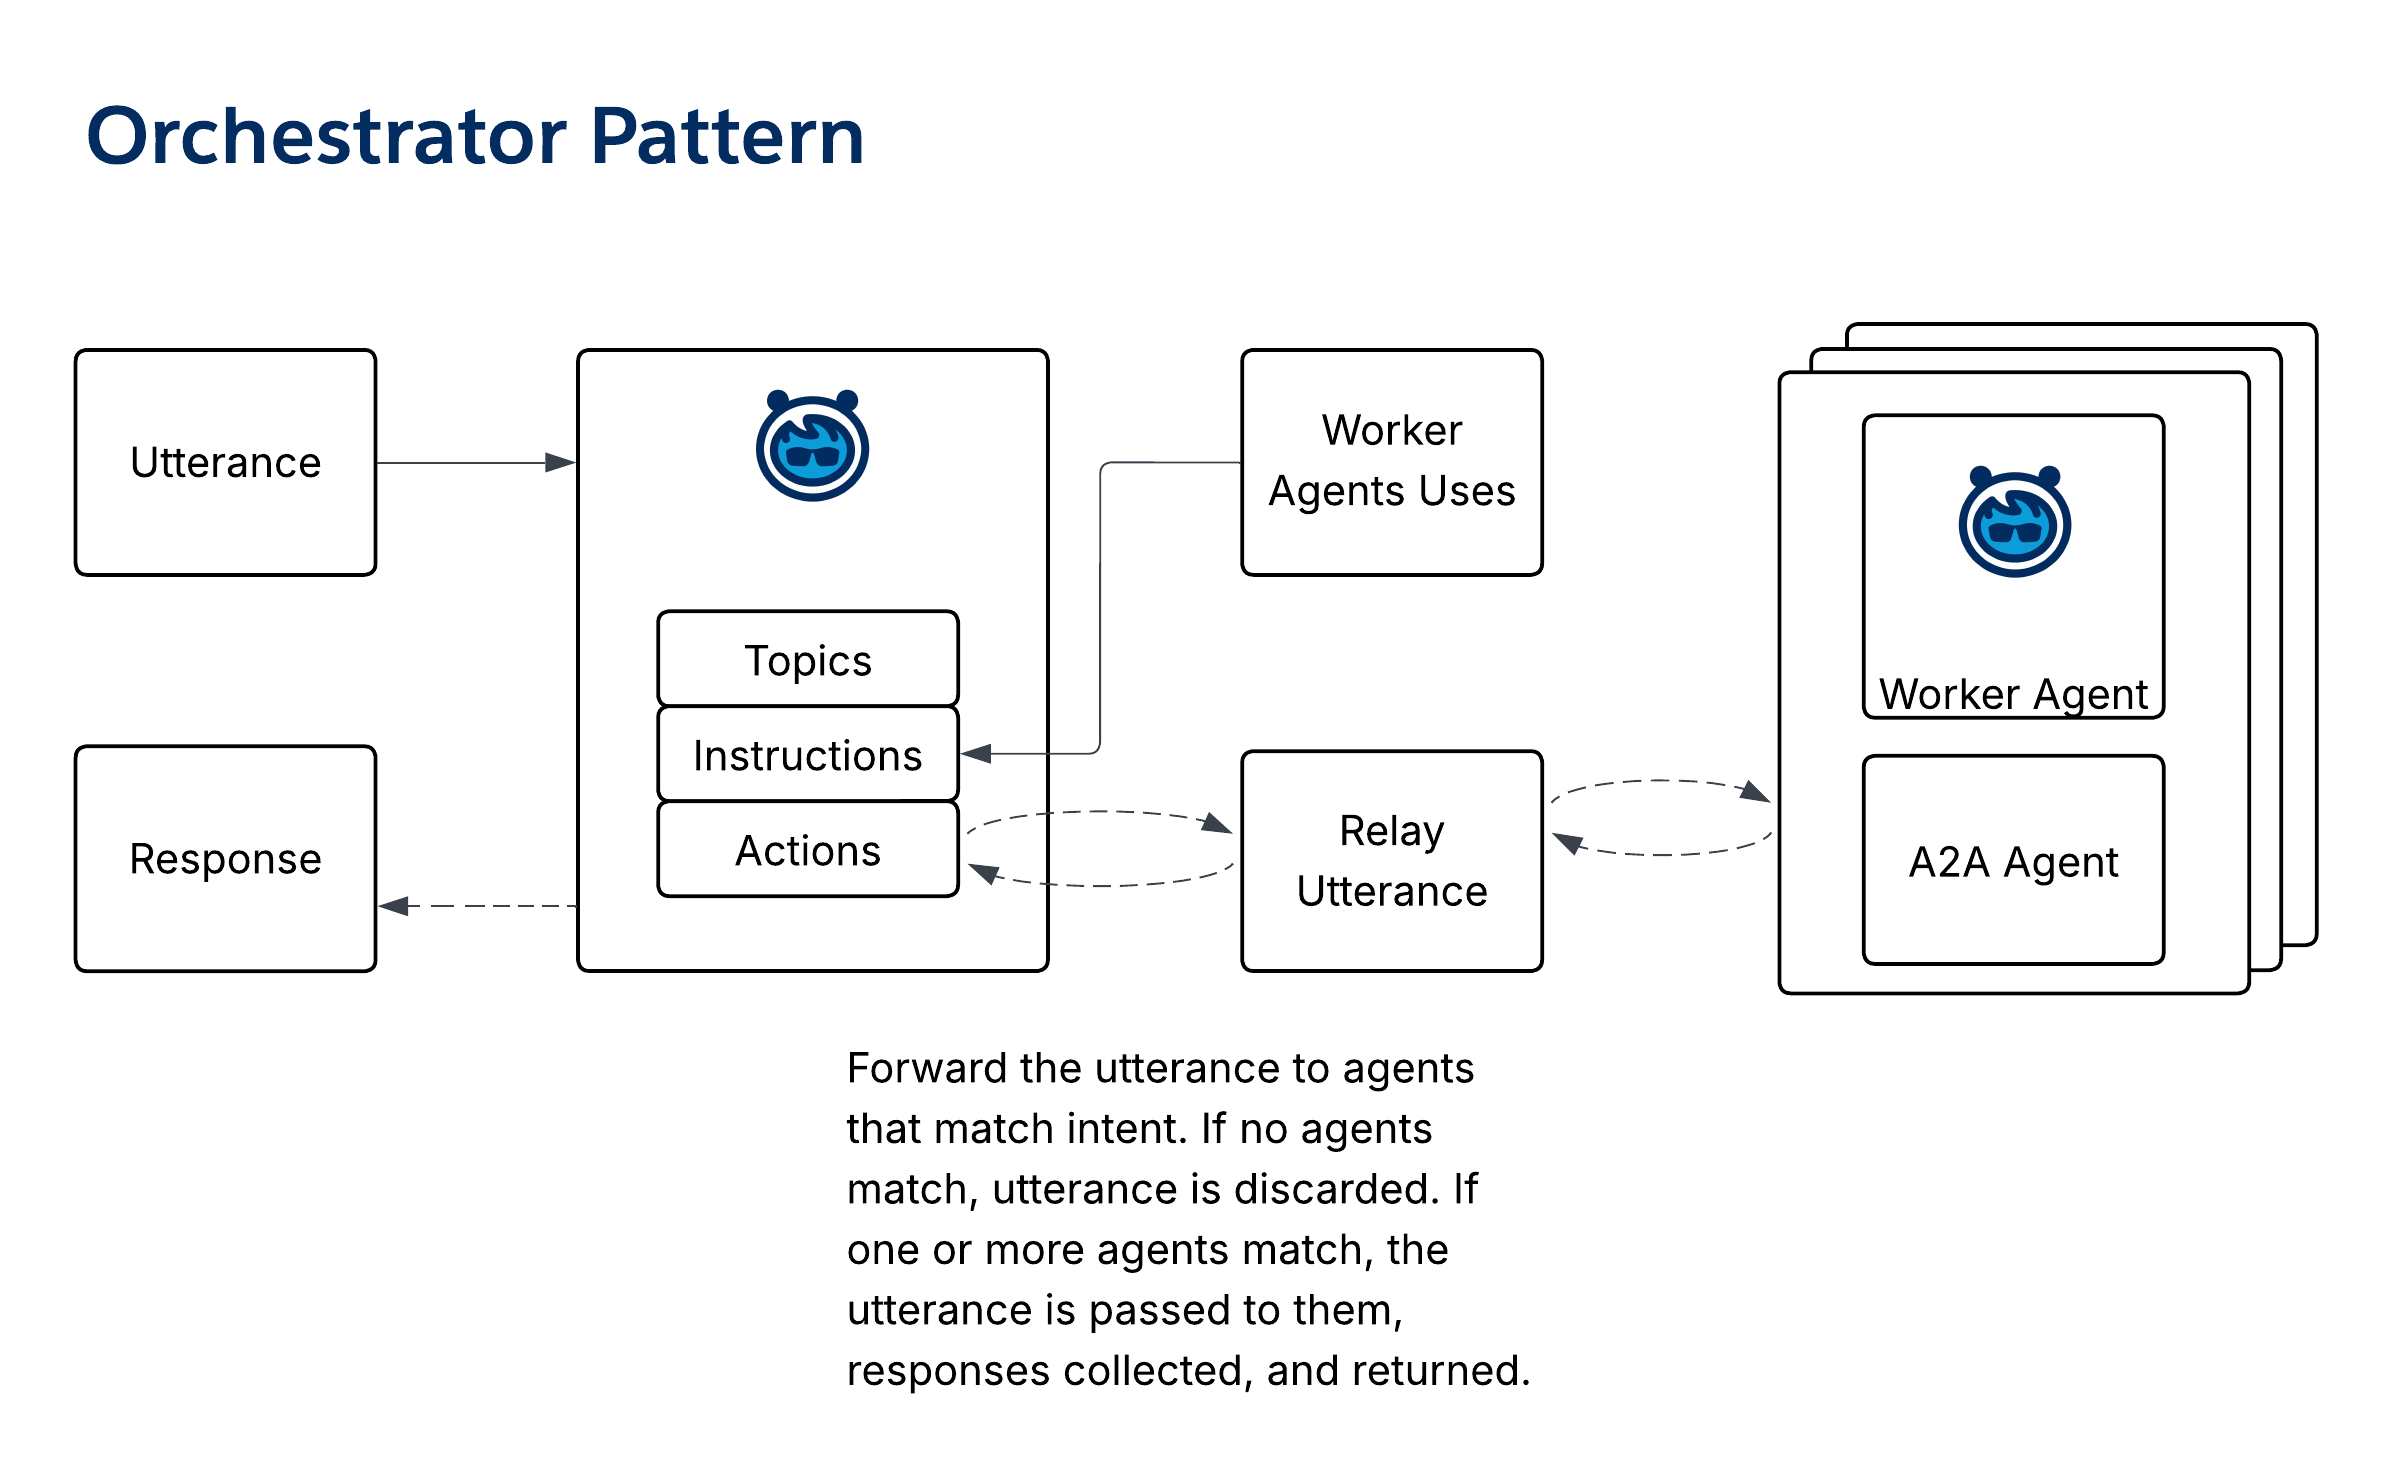 - **Madurez de Salesforce Agentic**: Nivel 3
### Patrón de escucha/noticias
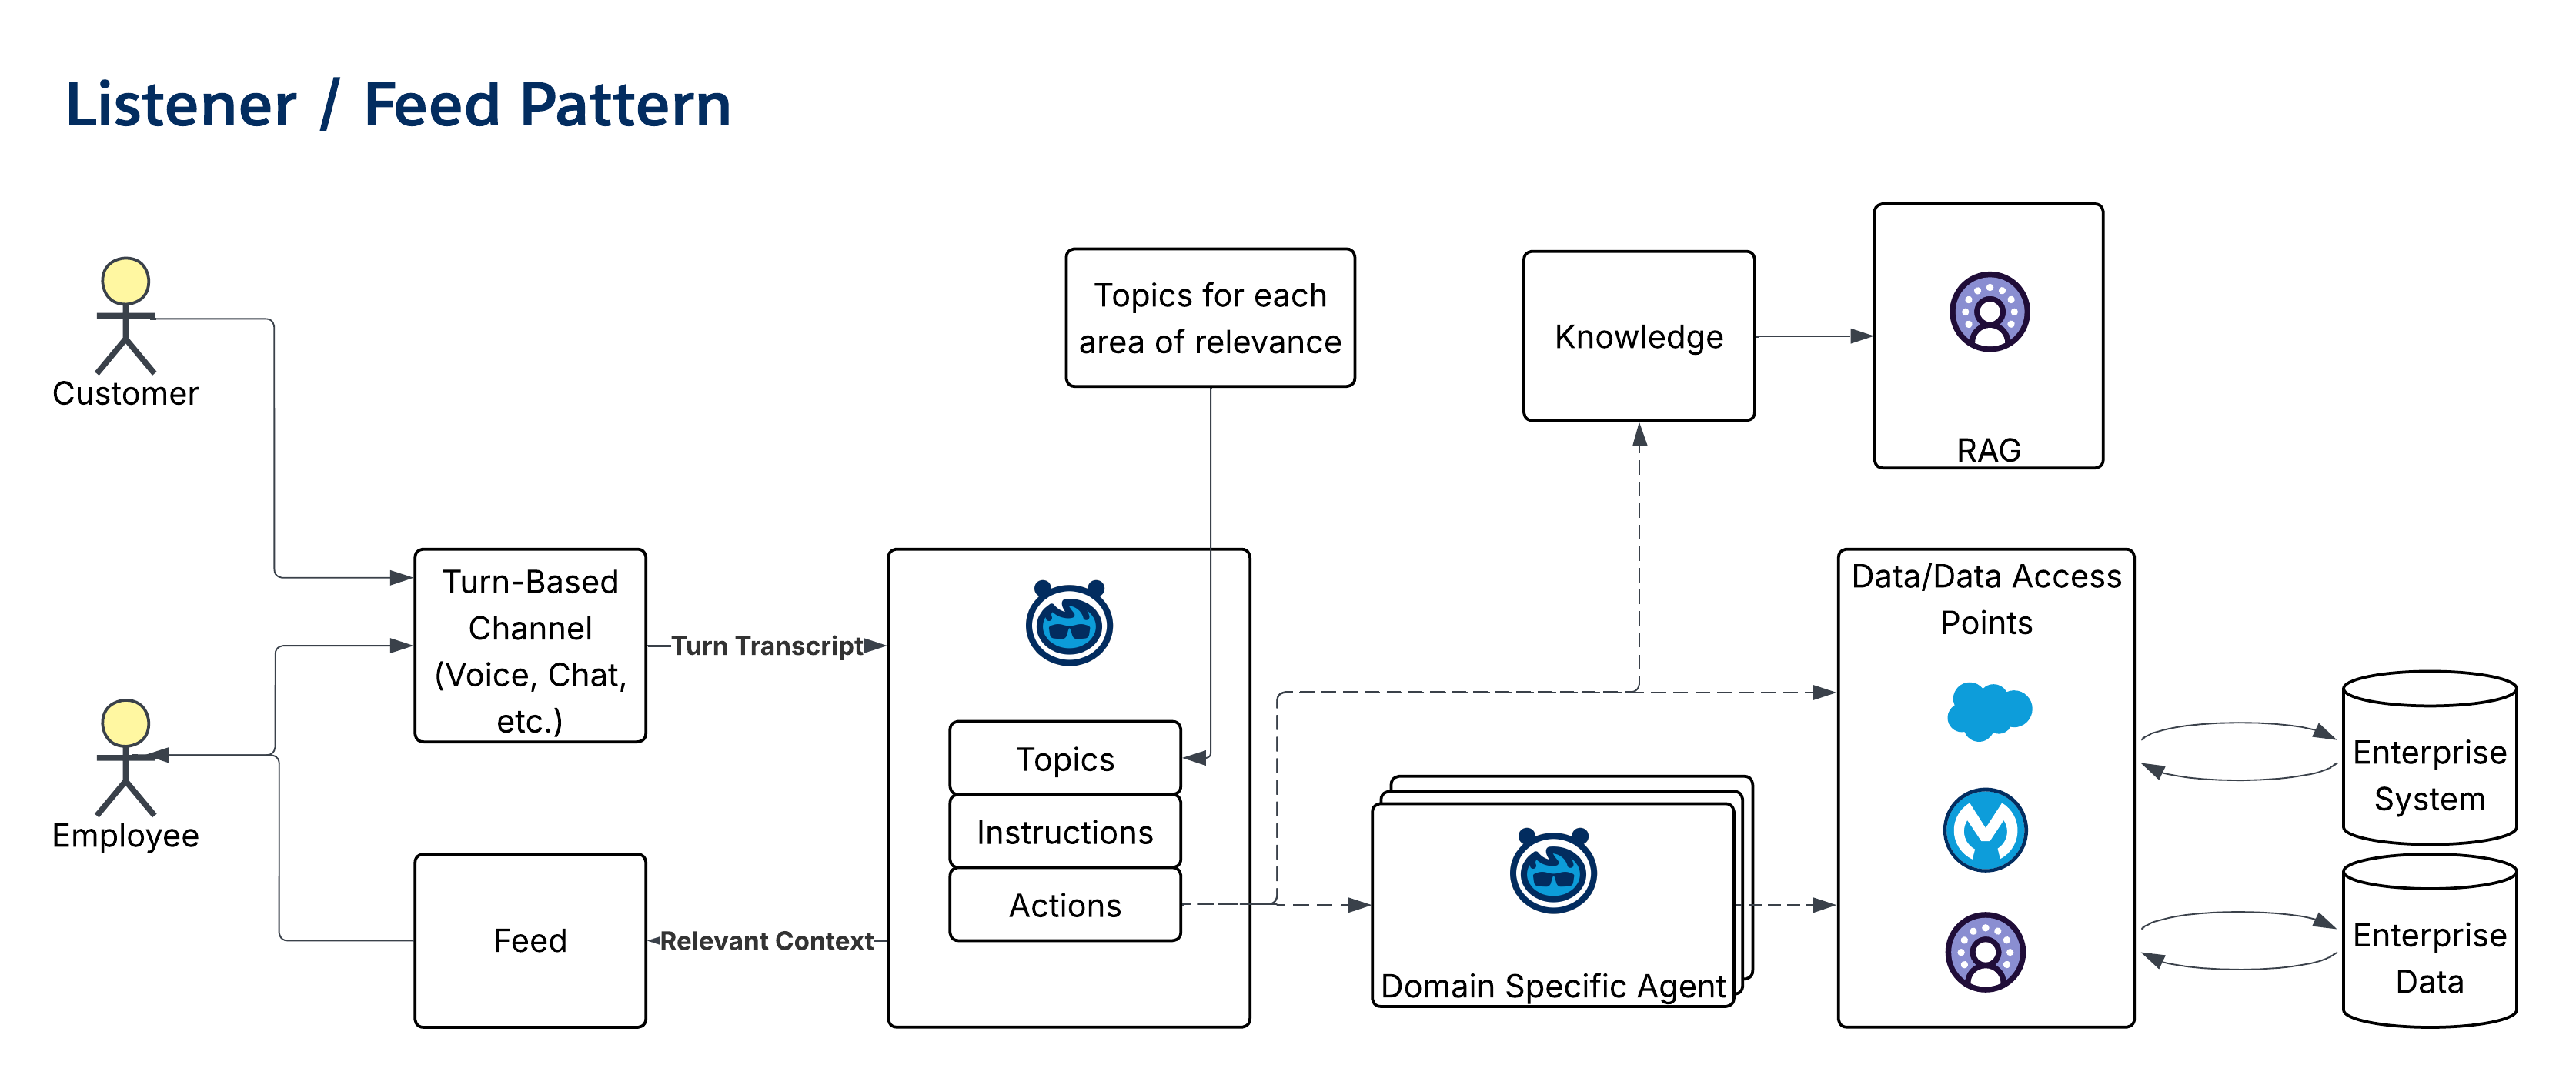
- **Descripción general**: El _patrón Escucha/Noticias_ aflora contexto y perspectivas durante el flujo de una plática. El _oyente_ se desencadena durante cada turno conversacional para buscar y mostrar información relevante para un empleado.
- **Tipo de salida**: Proporcione contexto relevante basándose en plática, que puede tener formato para efectos (por ejemplo, realizando comparaciones o resaltando puntos clave).
- **Orientación de uso**: de patrones Adjunte el oyente a un canal por turnos (por ejemplo, chat, voz o SMS). Defina temas para cada área de asunto. El agente consume la transcripción, identifica temas e invoca acciones para buscar y publicar contenido relevante en noticias en tiempo real en ejecución para el empleado.
- **Caso de uso representativo**: Utilice el _Asistente universal_ para ayudar a los representantes de Servicio al cliente o Ventas.
- **Diagrama**:
 - **Madurez de Salesforce Agentic**: Nivel 3
### Patrón Espacio de trabajo (Radar O'Reilly)
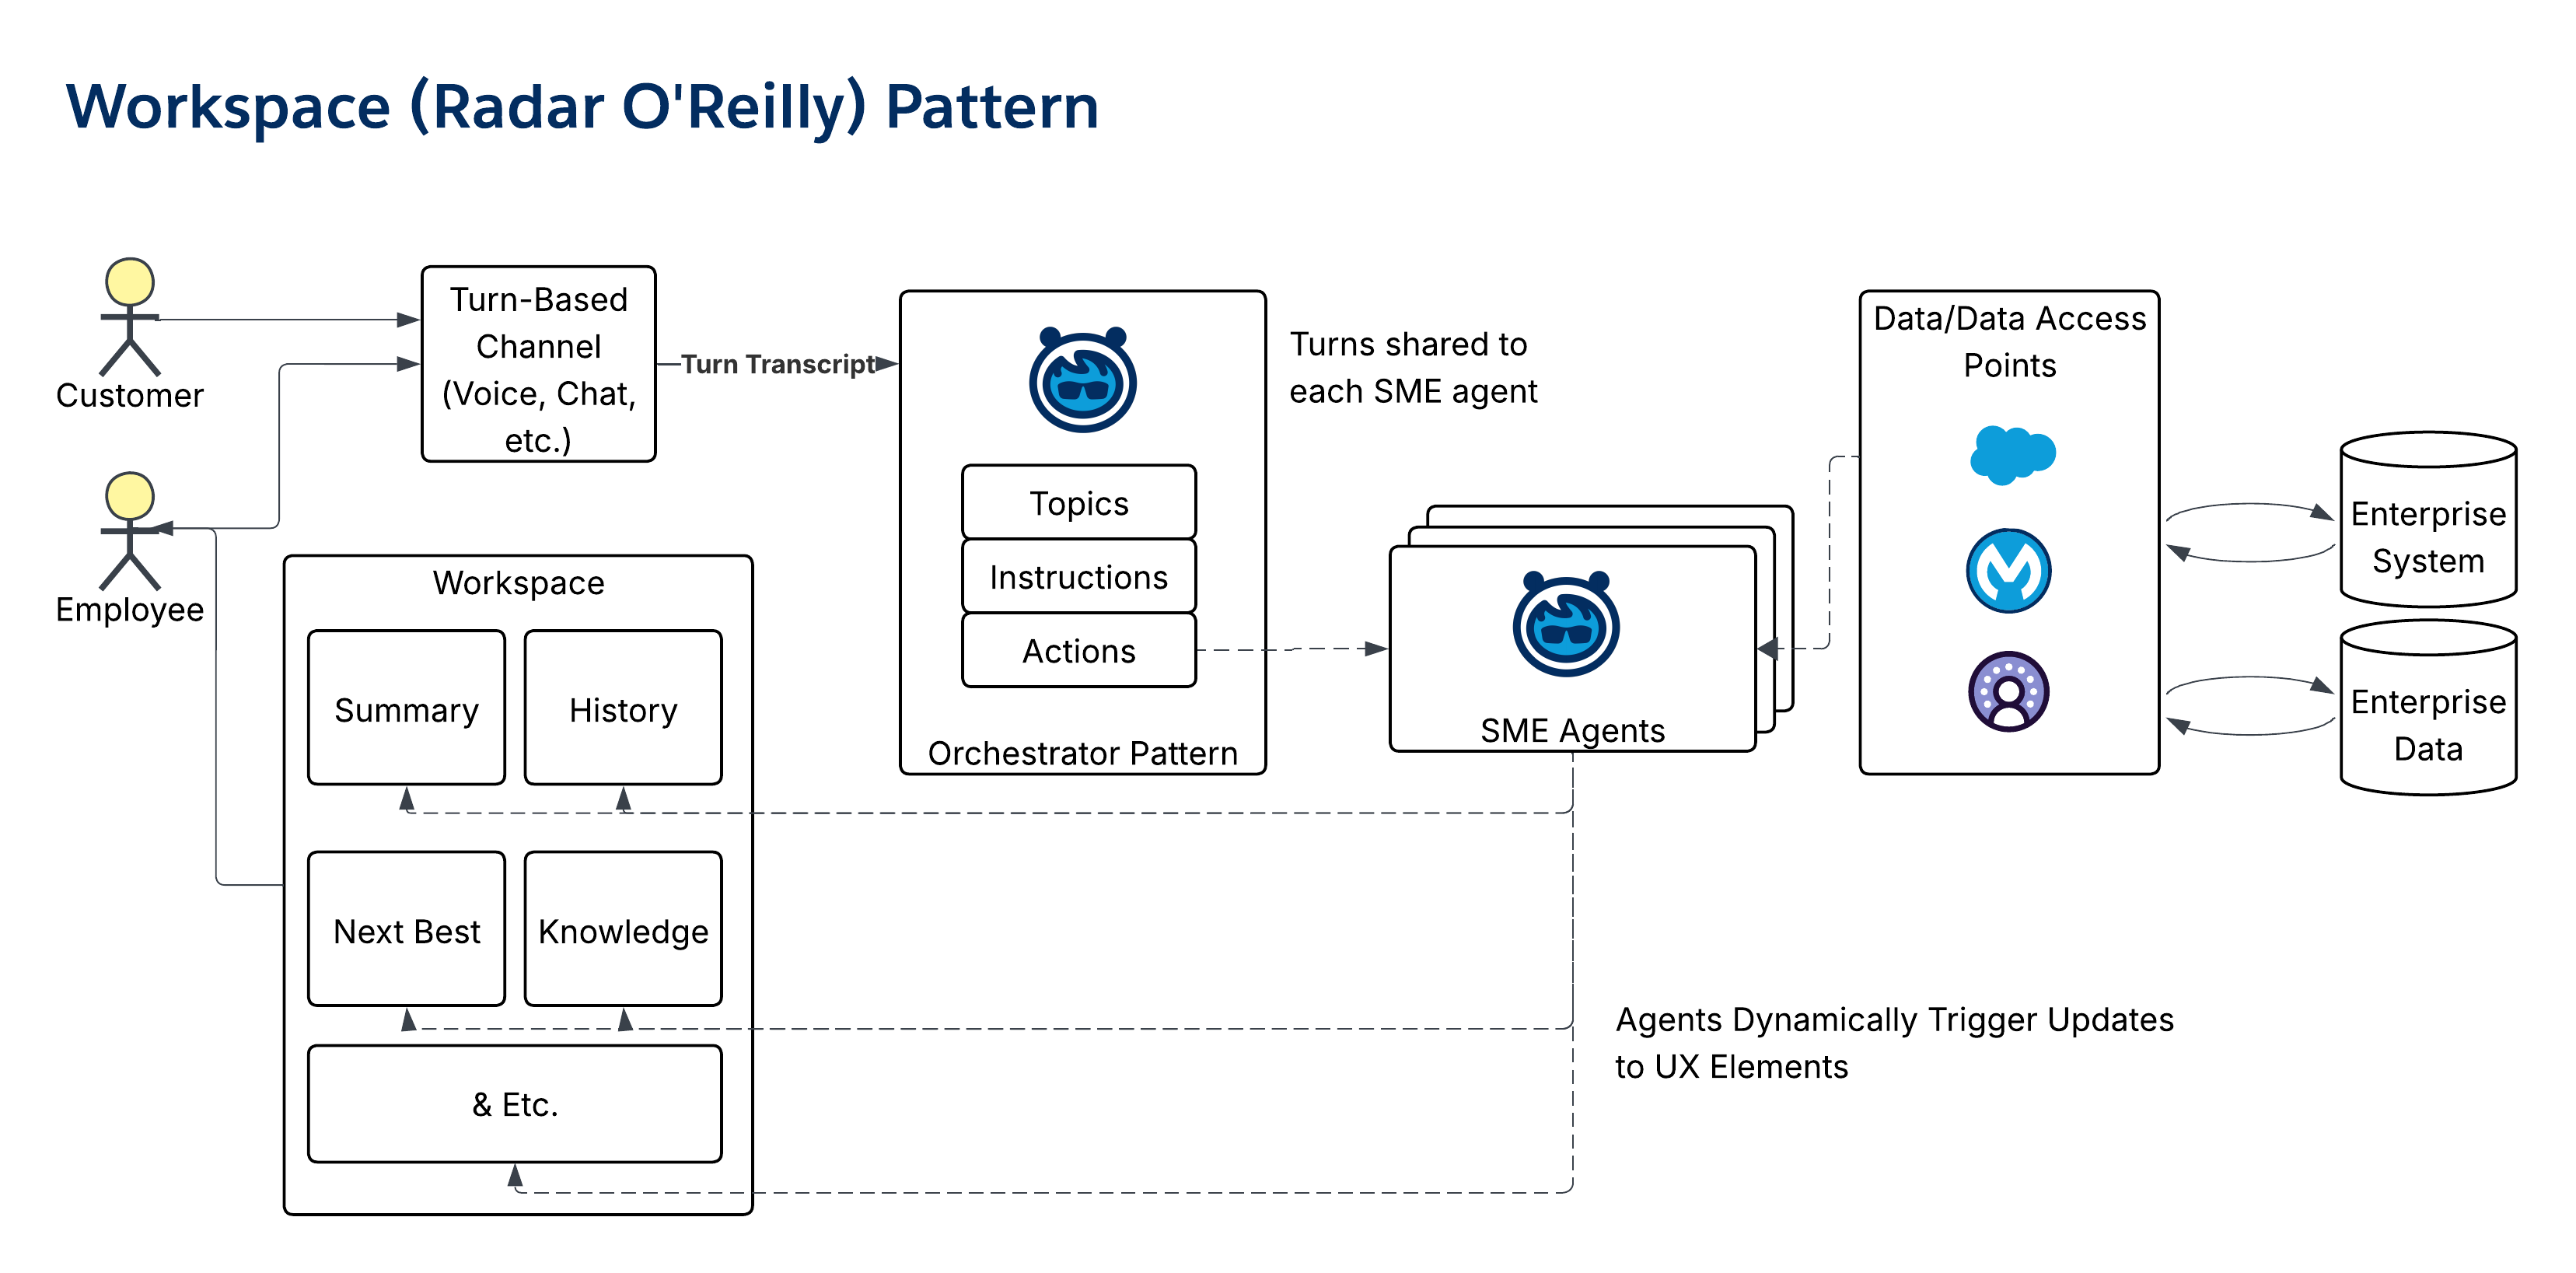
- **Descripción general**: El _patrón Espacio de trabajo (Radar O’Reilly)_ gestiona un UX con capacidad de respuesta de un solo panel de vidrio en el flujo de una plática. Procesa cada expresión para actualizar partes de la UX con contenido relevante.
- **Tipo de salida**: Proporcione contexto relevante ubicado en un portlet en una vista de un solo panel de vidrio más grande.
- **Orientación de uso**: de patrones Un agente de _Orquestador_ pasa expresiones a un conjunto de agentes de _Temas_. Cada agente Tema evalúa la declaración para determinar si es necesaria una actualización de UX. Si es así, envía actualizaciones dinámicas al LWC correspondiente.
- **Caso de uso representativo**: Esto funciona como una puerta principal de agente avanzado.
- **Diagrama**:
 - **Madurez de Salesforce Agentic**: Nivel 3
## 7\. Patrones de especialistas
Los _patrones especializados_ encapsulan Knowledge profundo o habilidades en un dominio concreto, y normalmente están orquestados por _patrones de interacción_.
### Patrón de respuesta
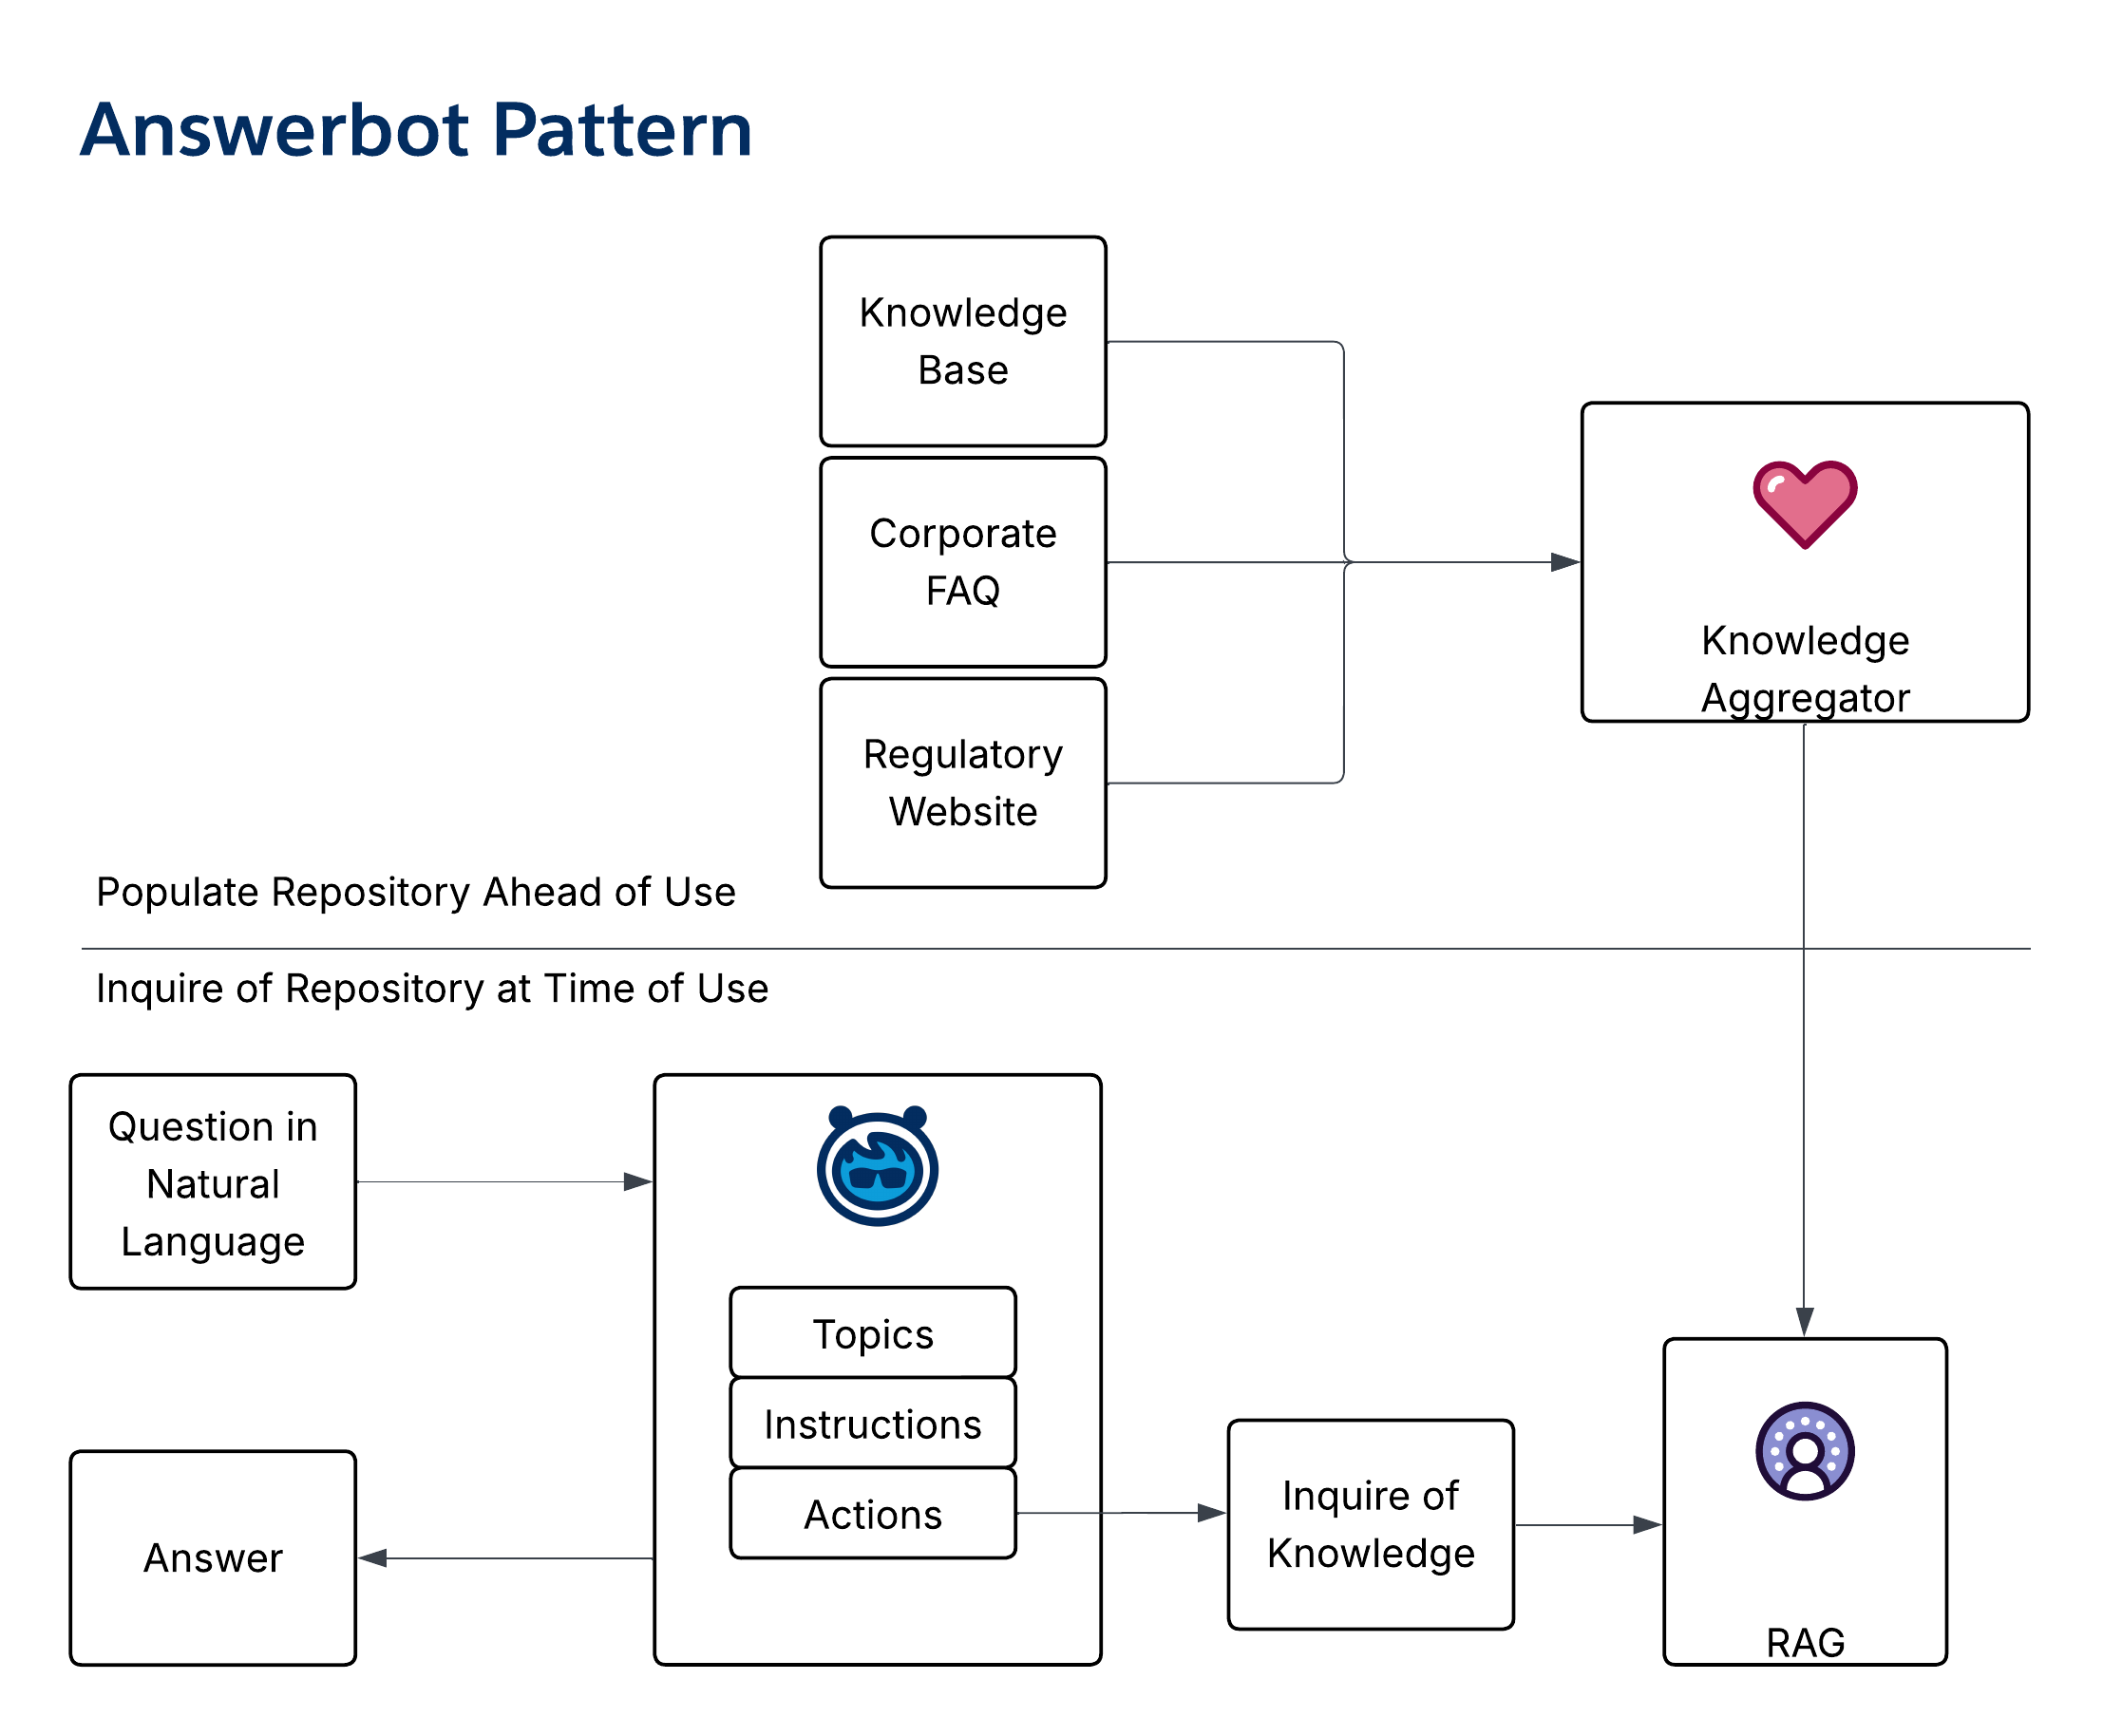
- **Descripción general**: El _patrón Respondedor_ es un patrón efectivo para el autoservicio que utiliza GenAI para determinar el lenguaje natural para la recuperación de Knowledge, no solo palabras clave.
- **Tipo de salida**: Knowledge resumido y referencias/citas a materiales de apoyo.
- **Orientación de uso**: de patrones Organice e ingrese materiales de origen fiables (por ejemplo, Knowledge Stores o Preguntas más frecuentes) para configurar el agente. Posicione al agente en sitios web corporativos o en portales internos. Monitoree preguntas para identificar y solucionar brechas Knowledge.
- **Caso de uso representativo**: Facilitar las búsquedas de lenguaje natural en un sitio web corporativo, interactuar con un bot de beneficios de RRHH y proporcionar componentes de autoservicio para todos los integrantes.
- **Diagrama**:
 - **Madurez de Salesforce Agentic**: Nivel 1
### Patrón de PYME de dominio
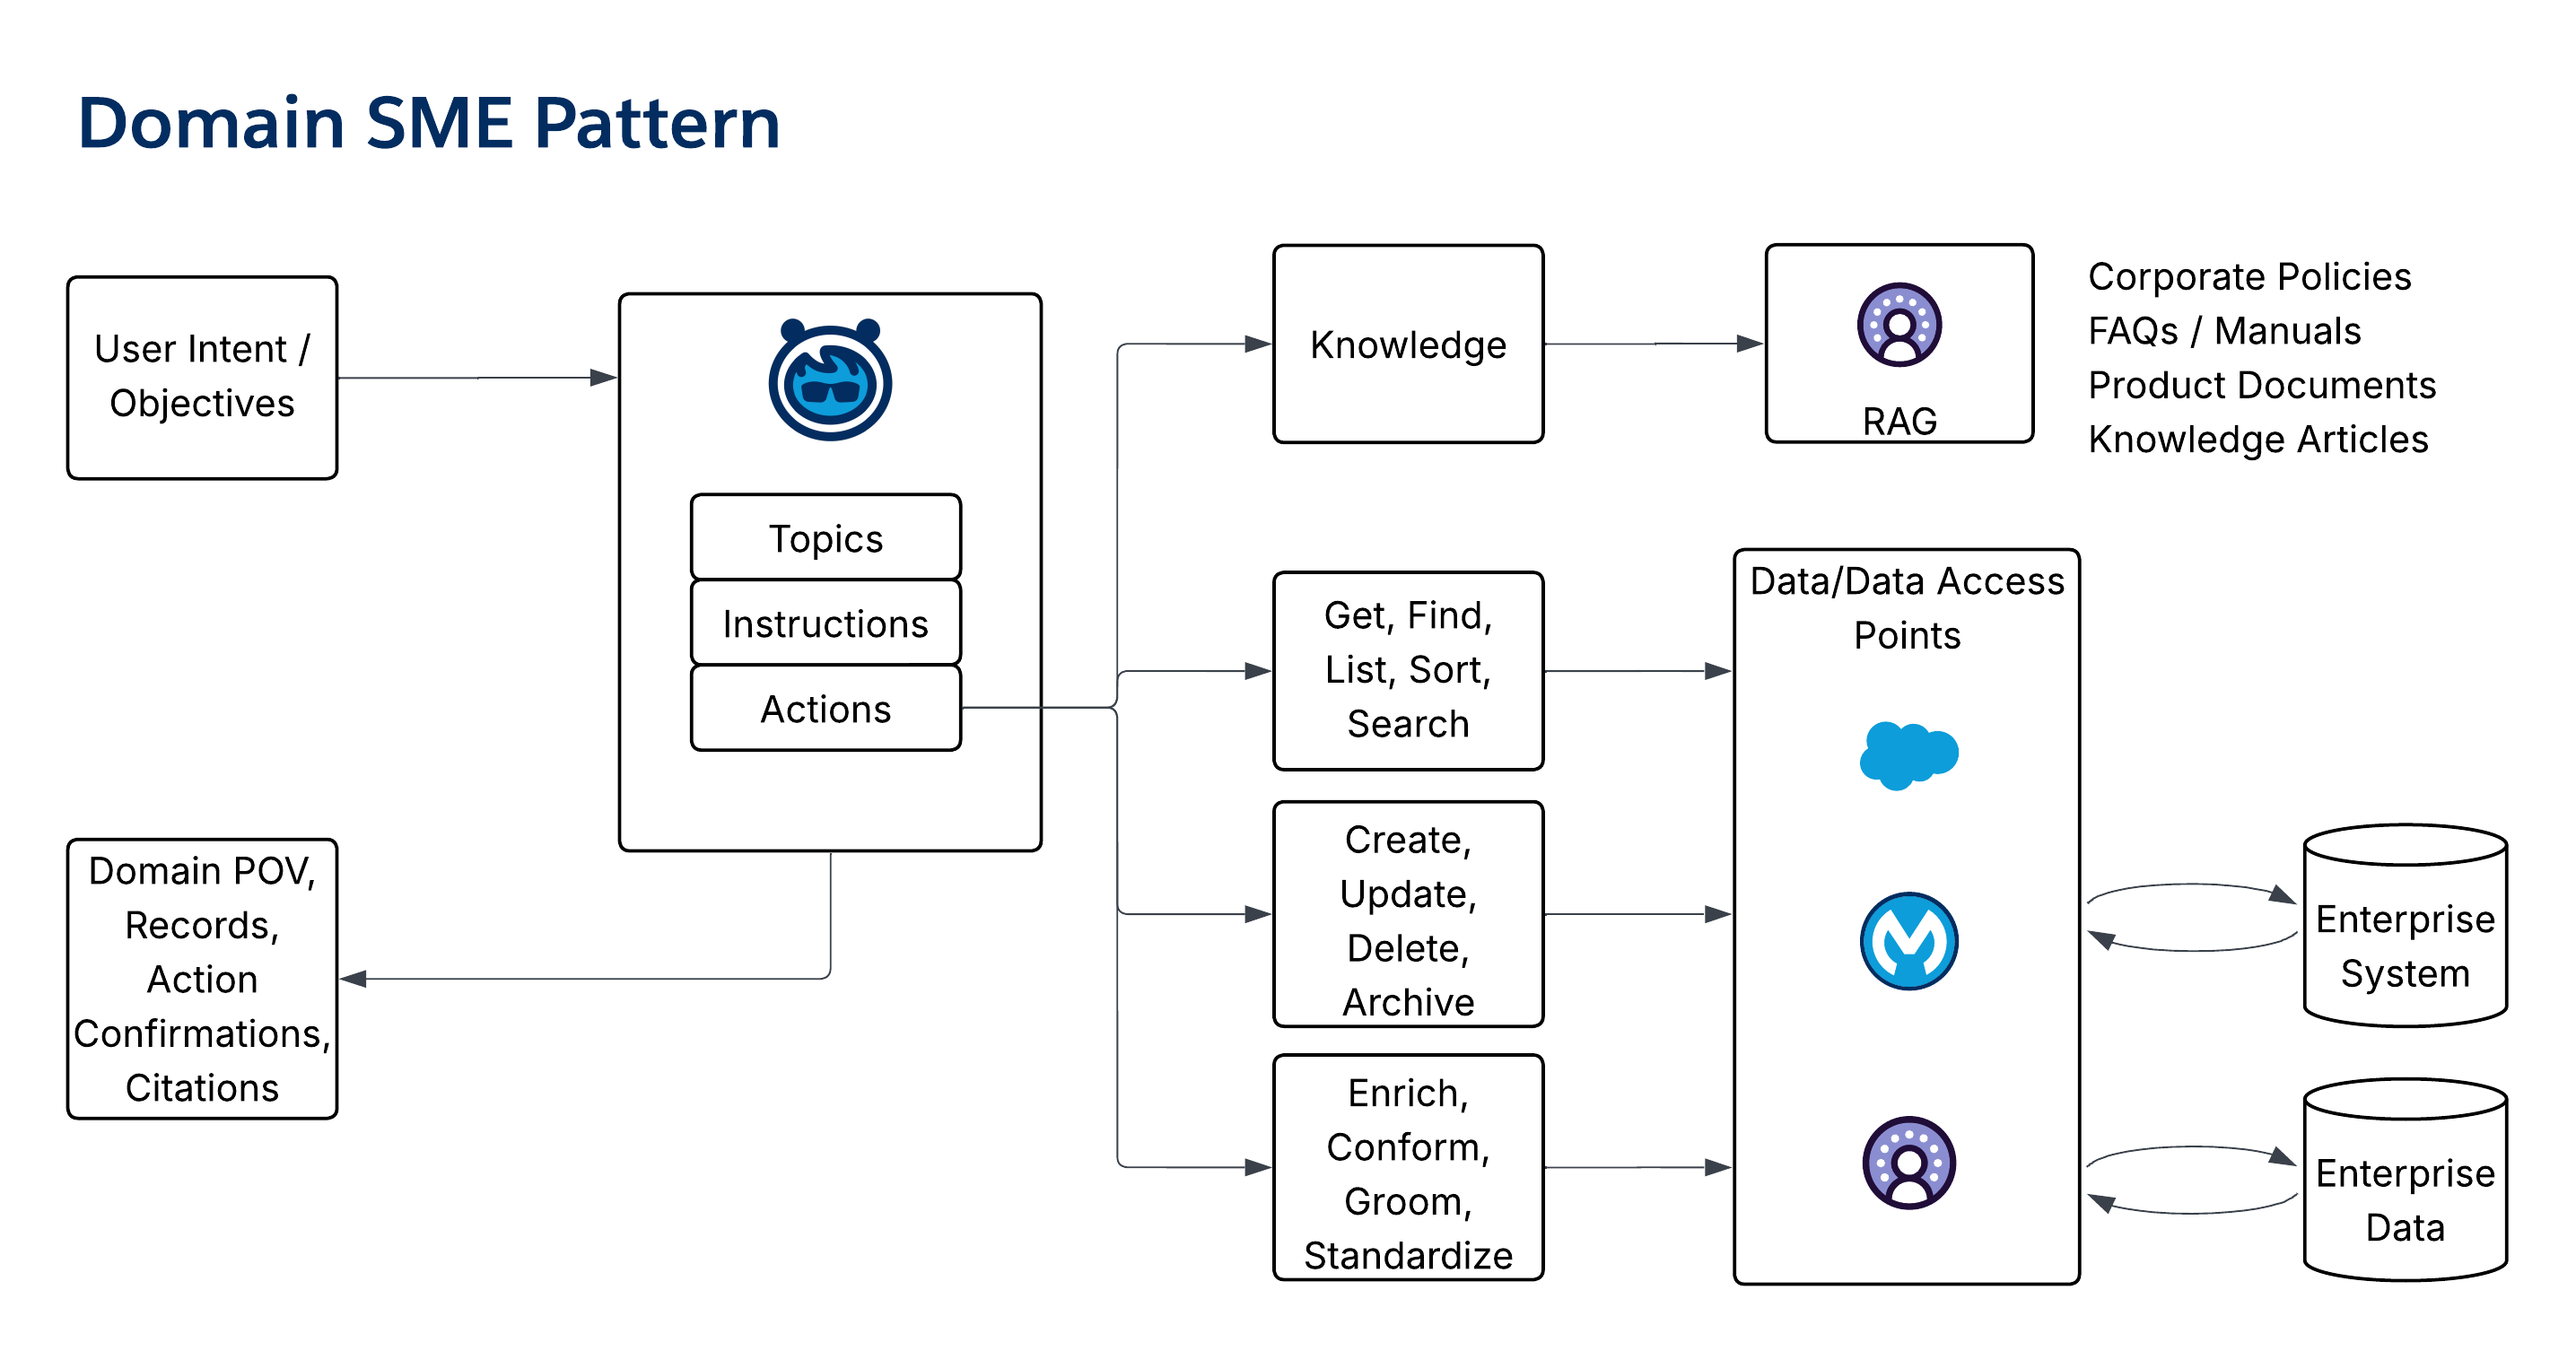
- **Descripción general**: El _patrón Pyme de dominio_ es un patrón fundamental que proporciona un front-end de lenguaje natural para un dominio de negocio (por ejemplo, Pedidos o Reclamaciones).
- **Tipo de salida**: Proporcione contenido relevante, temas, datos e información con formato acerca del dominio.
- **Orientación de uso**: de patrones Utilice este patrón para encapsular un asunto o dominio de negocio. Configure el agente con la capacidad de realizar operaciones CRUD apropiadas. Haga que estos agentes estén disponibles a través de [_patrones de interacción_](/docs/architect/es-mx/fundamentals/guide/enterprise-agentic-architecture#6-patrones-de-interacción) (por ejemplo, - Orchestrator u Listener).
- **Caso de uso representativo**: Mantener un dominio de datos de negocio, proporcionar un "Agente de pedidos" o "Agente de inventario" y proporcionar una interfaz de agente para un dominio de negocio.
- **Diagrama**:
 - **Madurez de Salesforce Agentic**: Nivel 2
### Patrón de interrogador
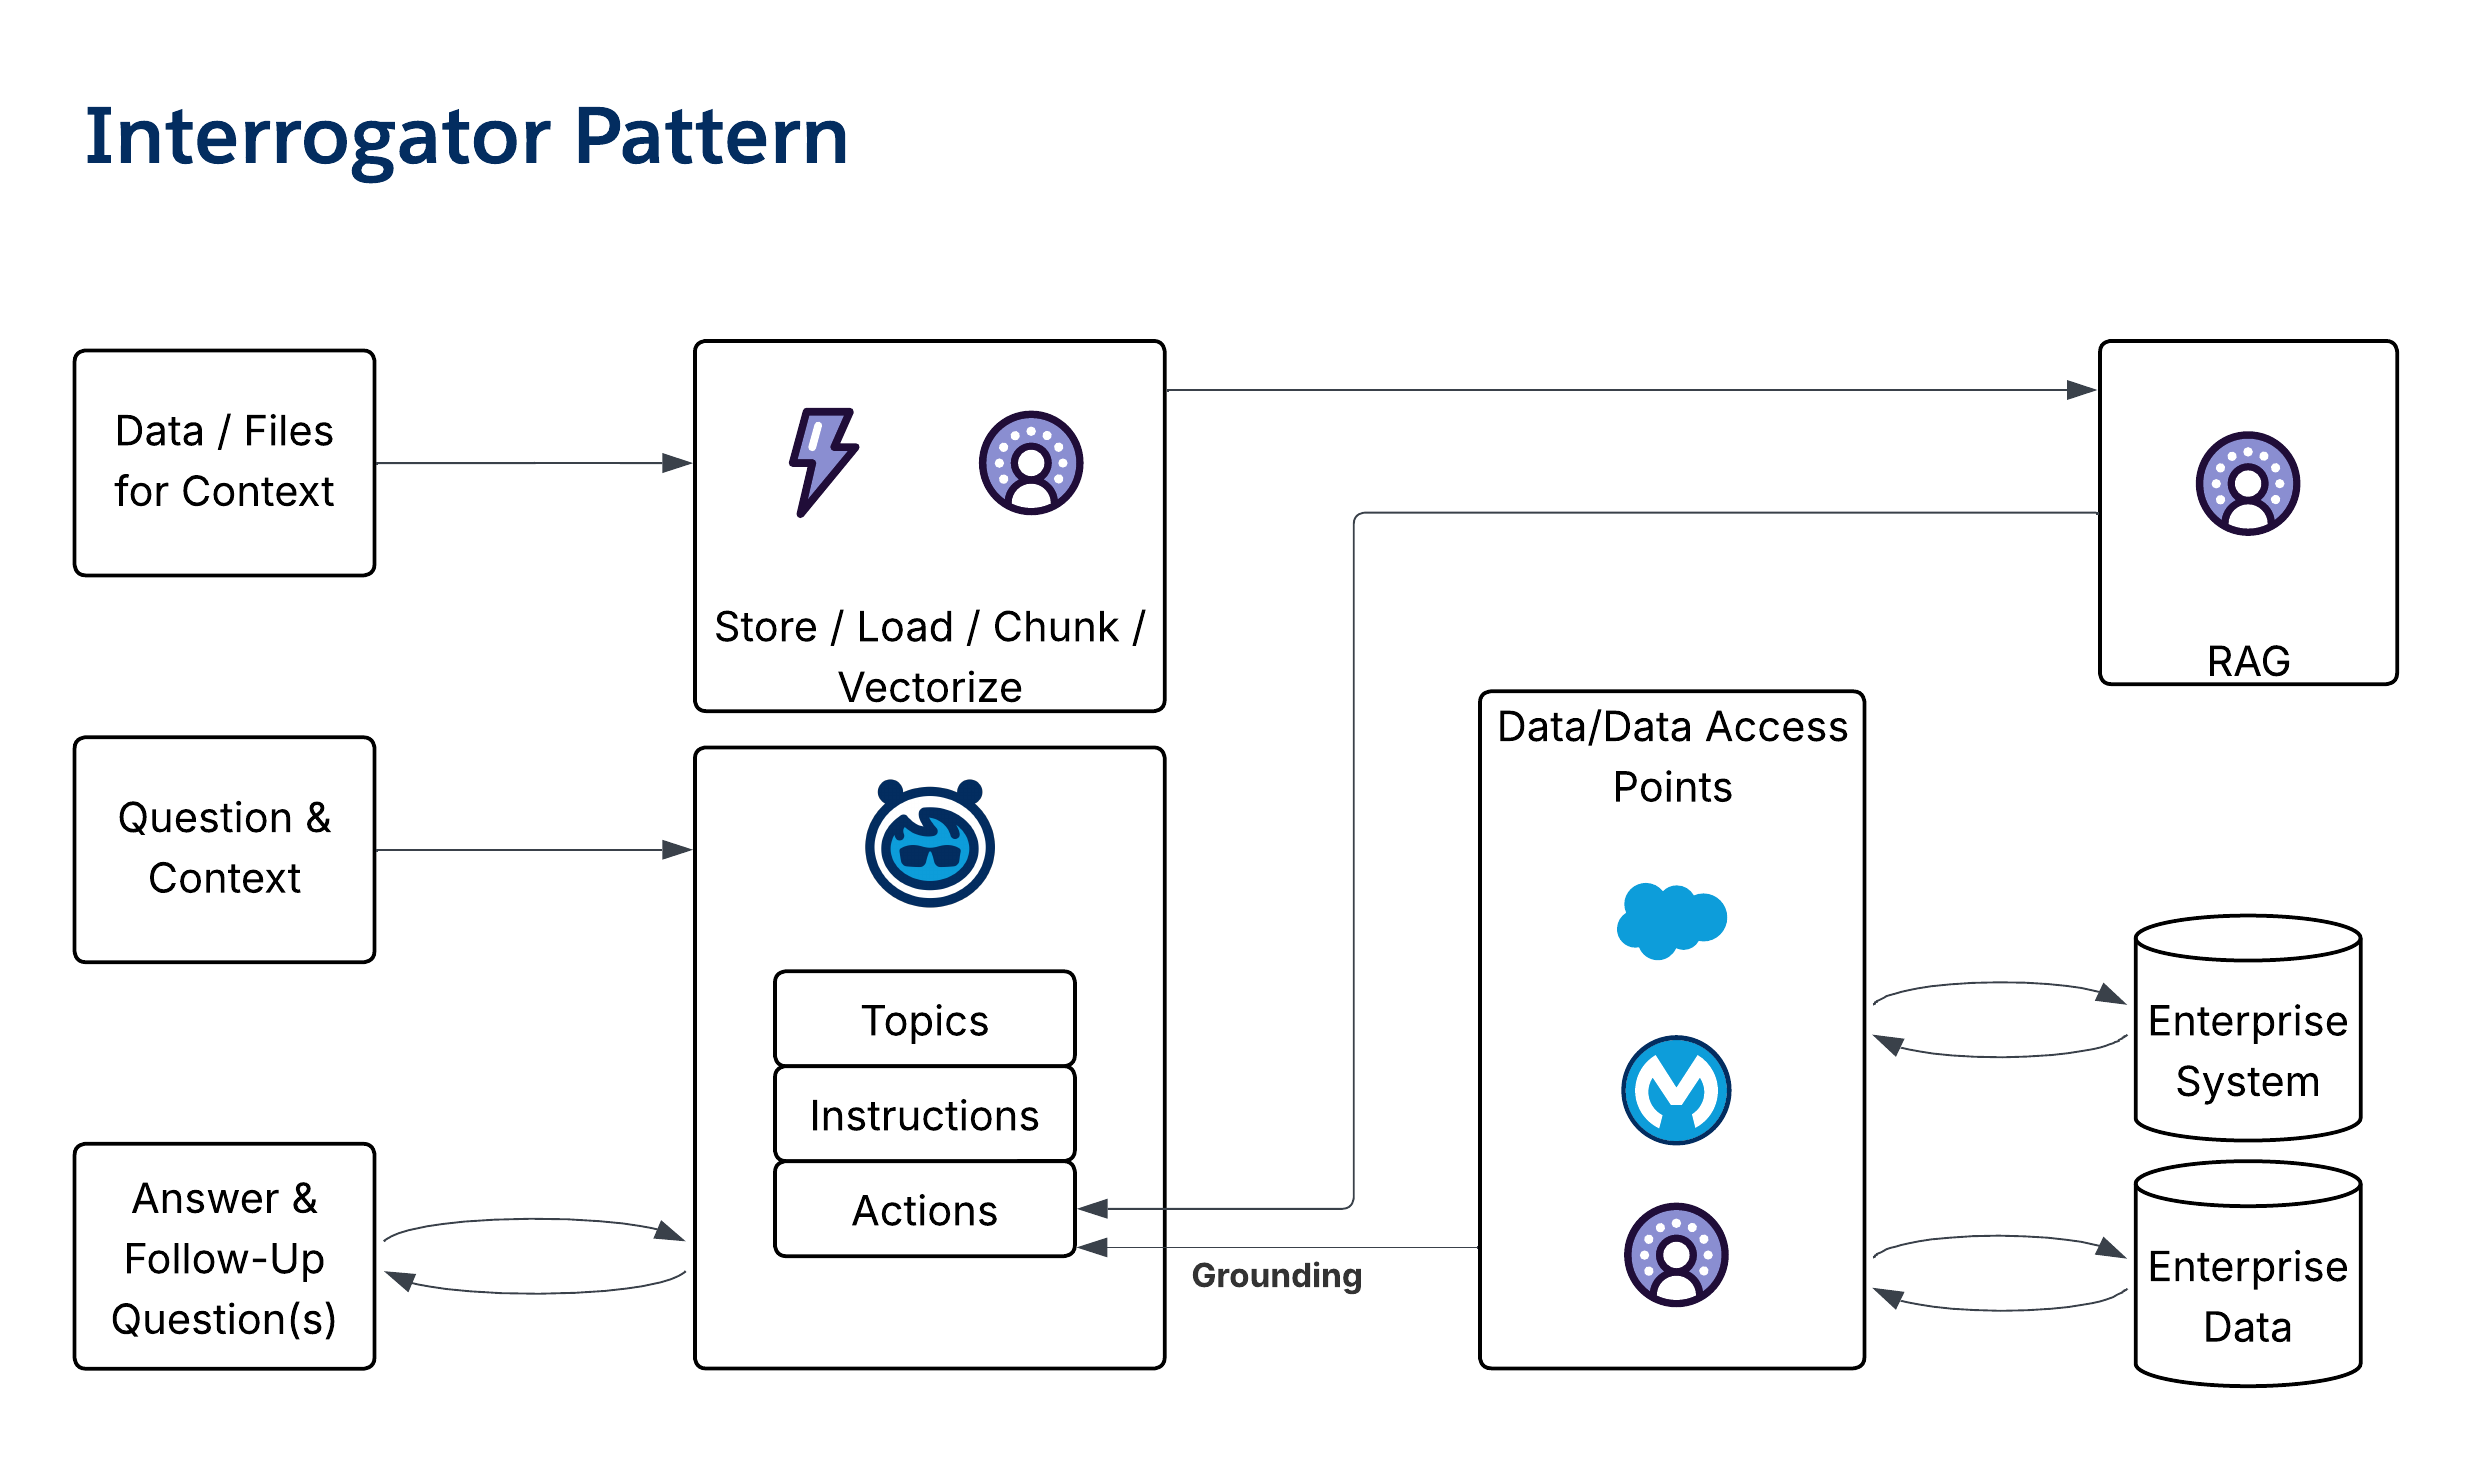
- **Descripción general**: El _patrón Interrogador_ es un agente de SME que se puede interrogar sobre un tema para reunir contexto desde múltiples orígenes para responder a preguntas. La función de agente clave aprovechada es la capacidad de extraer contexto y conectar conceptos en un cuerpo de contenido, del modo en que lo haría un humano después de leer e internalizar el contenido. Este patrón mitiga la necesidad de "integración de silla giratoria".
- **Tipo de salida**: Proporcione respuestas a preguntas.
- **Orientación de uso**: de patrones A menudo se configura como un widget de consola conectado al contexto actual del usuario de modo que pueda formular preguntas directamente. También se utiliza junto con recursos Knowledge como Preguntas más frecuentes, Políticas y Catálogos de productos. Emparejar el _patrón Interrogador_ con solicitudes estándar para ampliar respuestas comunes a preguntas comunes.
- **Caso de uso representativo**: Utilizar como agente asistente de contratos; Asistente de consultas de beneficios o agente trabajador especializado en patrones de múltiples agentes (por ejemplo, Escucha o Espacio de trabajo).
- **Diagrama**:
 - **Madurez de Salesforce Agentic**: Nivel 2
### Patrón de priorizador
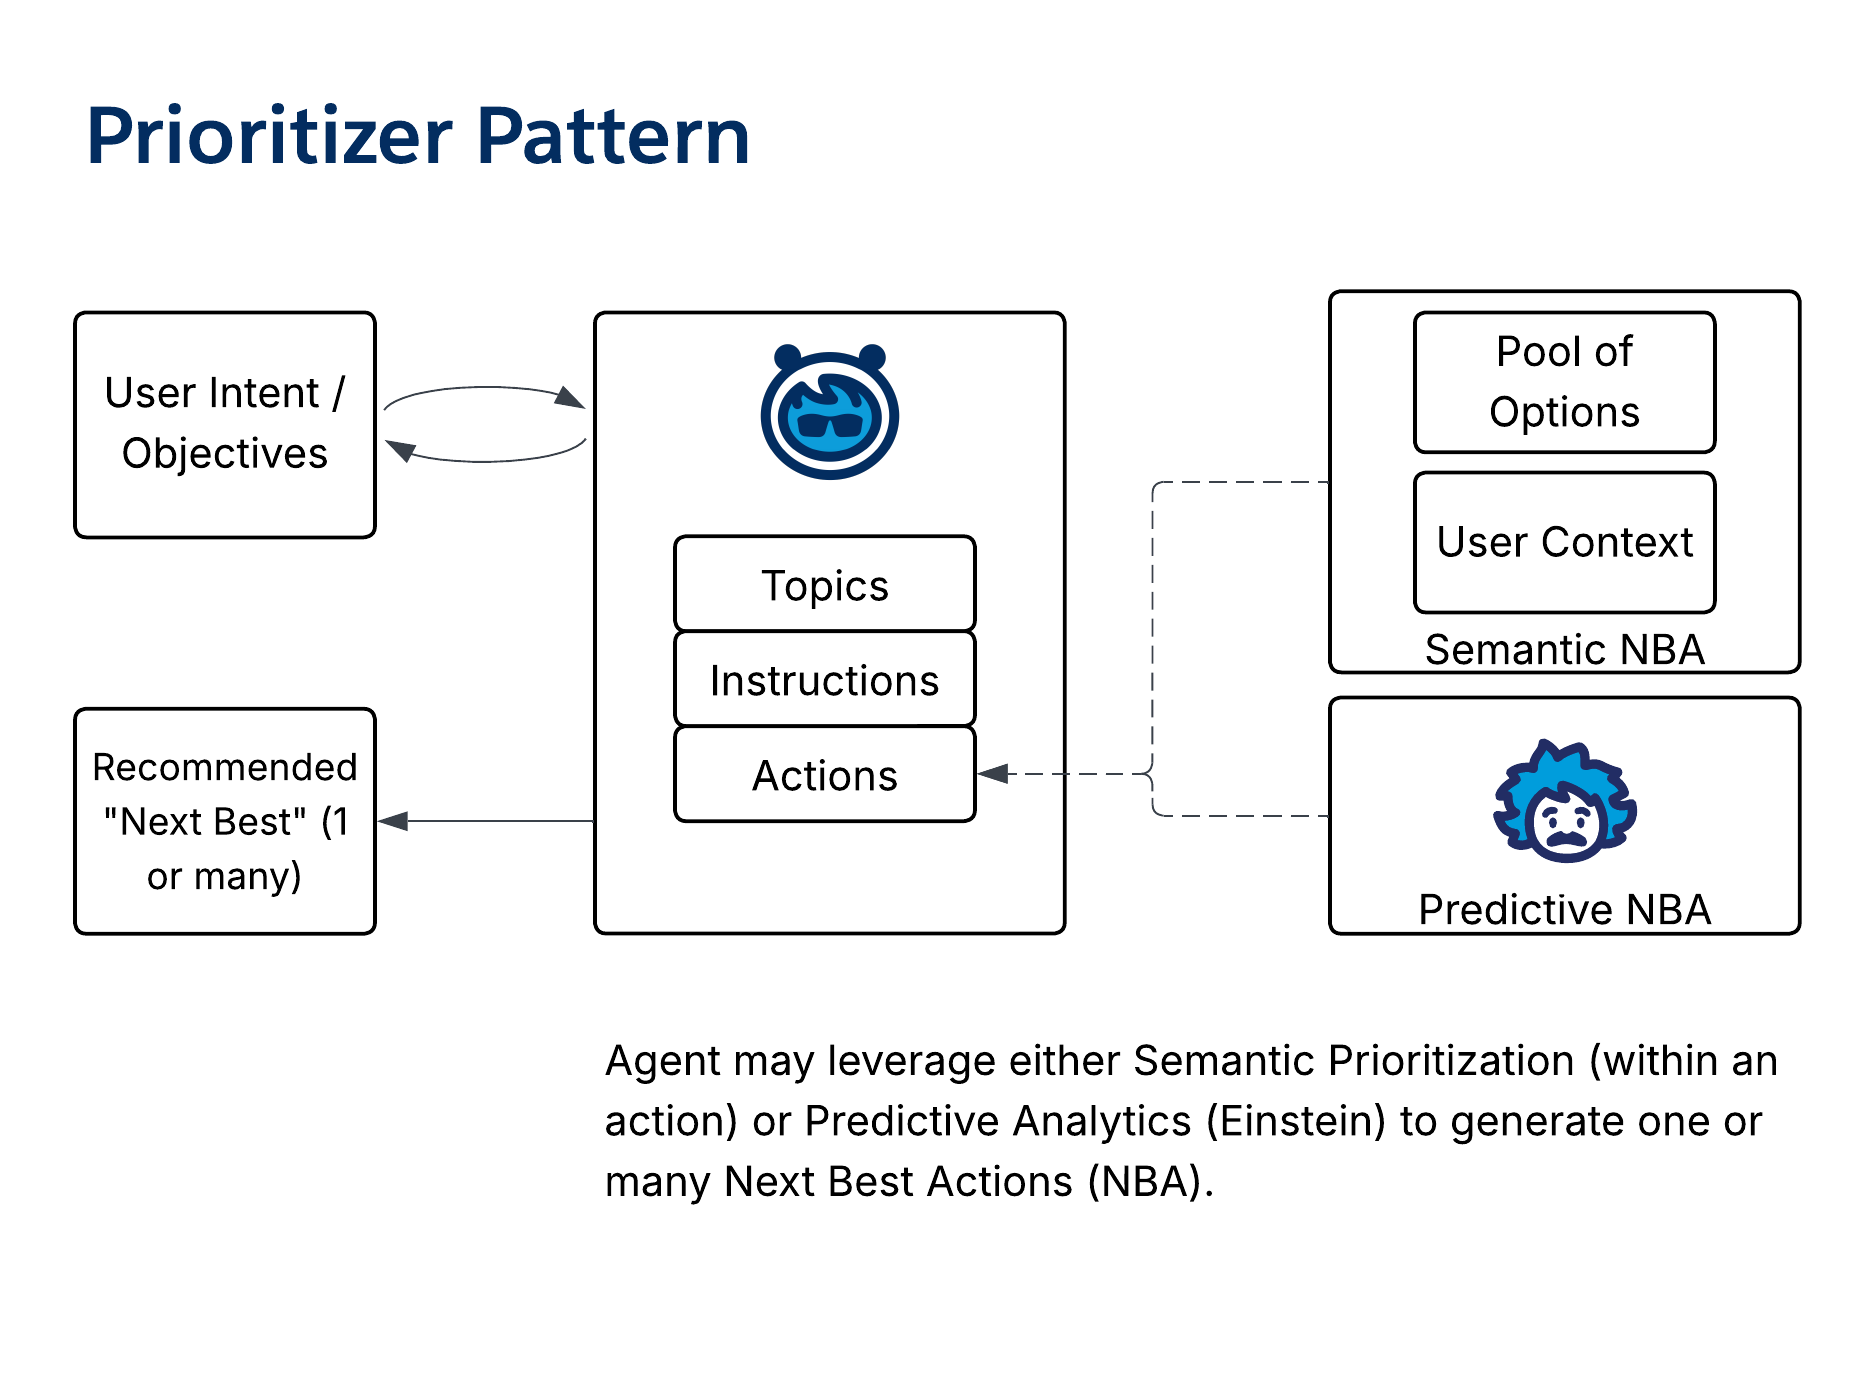
- **Descripción general**: El _patrón Priorizador_ se utiliza para ordenar un conjunto de tareas u objetos de trabajo basándose en un objetivo definido. Aprovecha la IAgen para análisis cualitativos, análisis de datos no estructurados o análisis integrador entre múltiples dominios de datos.
- **Tipo de salida**: Proporcione perspectivas generativas.
- **Orientación de uso**: de patrones Utilice lenguaje natural para describir las cualidades deseadas para la priorización. Fundamente el agente utilizando un conjunto de opciones seleccionables. Combine con el patrón Oyente para crear una "Siguiente mejor acción" con capacidad de respuesta en el flujo de trabajo.
- **Caso de uso representativo**: Utilice como generador de _Next Best Action_ o agente de trabajo especializado en patrones de múltiples agentes o de larga ejecución.
- **Diagrama**:
 - **Madurez de Salesforce Agentic**: Nivel 2
## 8\. Patrones de utilidades y datos
Los _patrones de utilidades_ realizan tareas repetibles específicas que admiten otros agentes o procesos.
### Patrón de generador
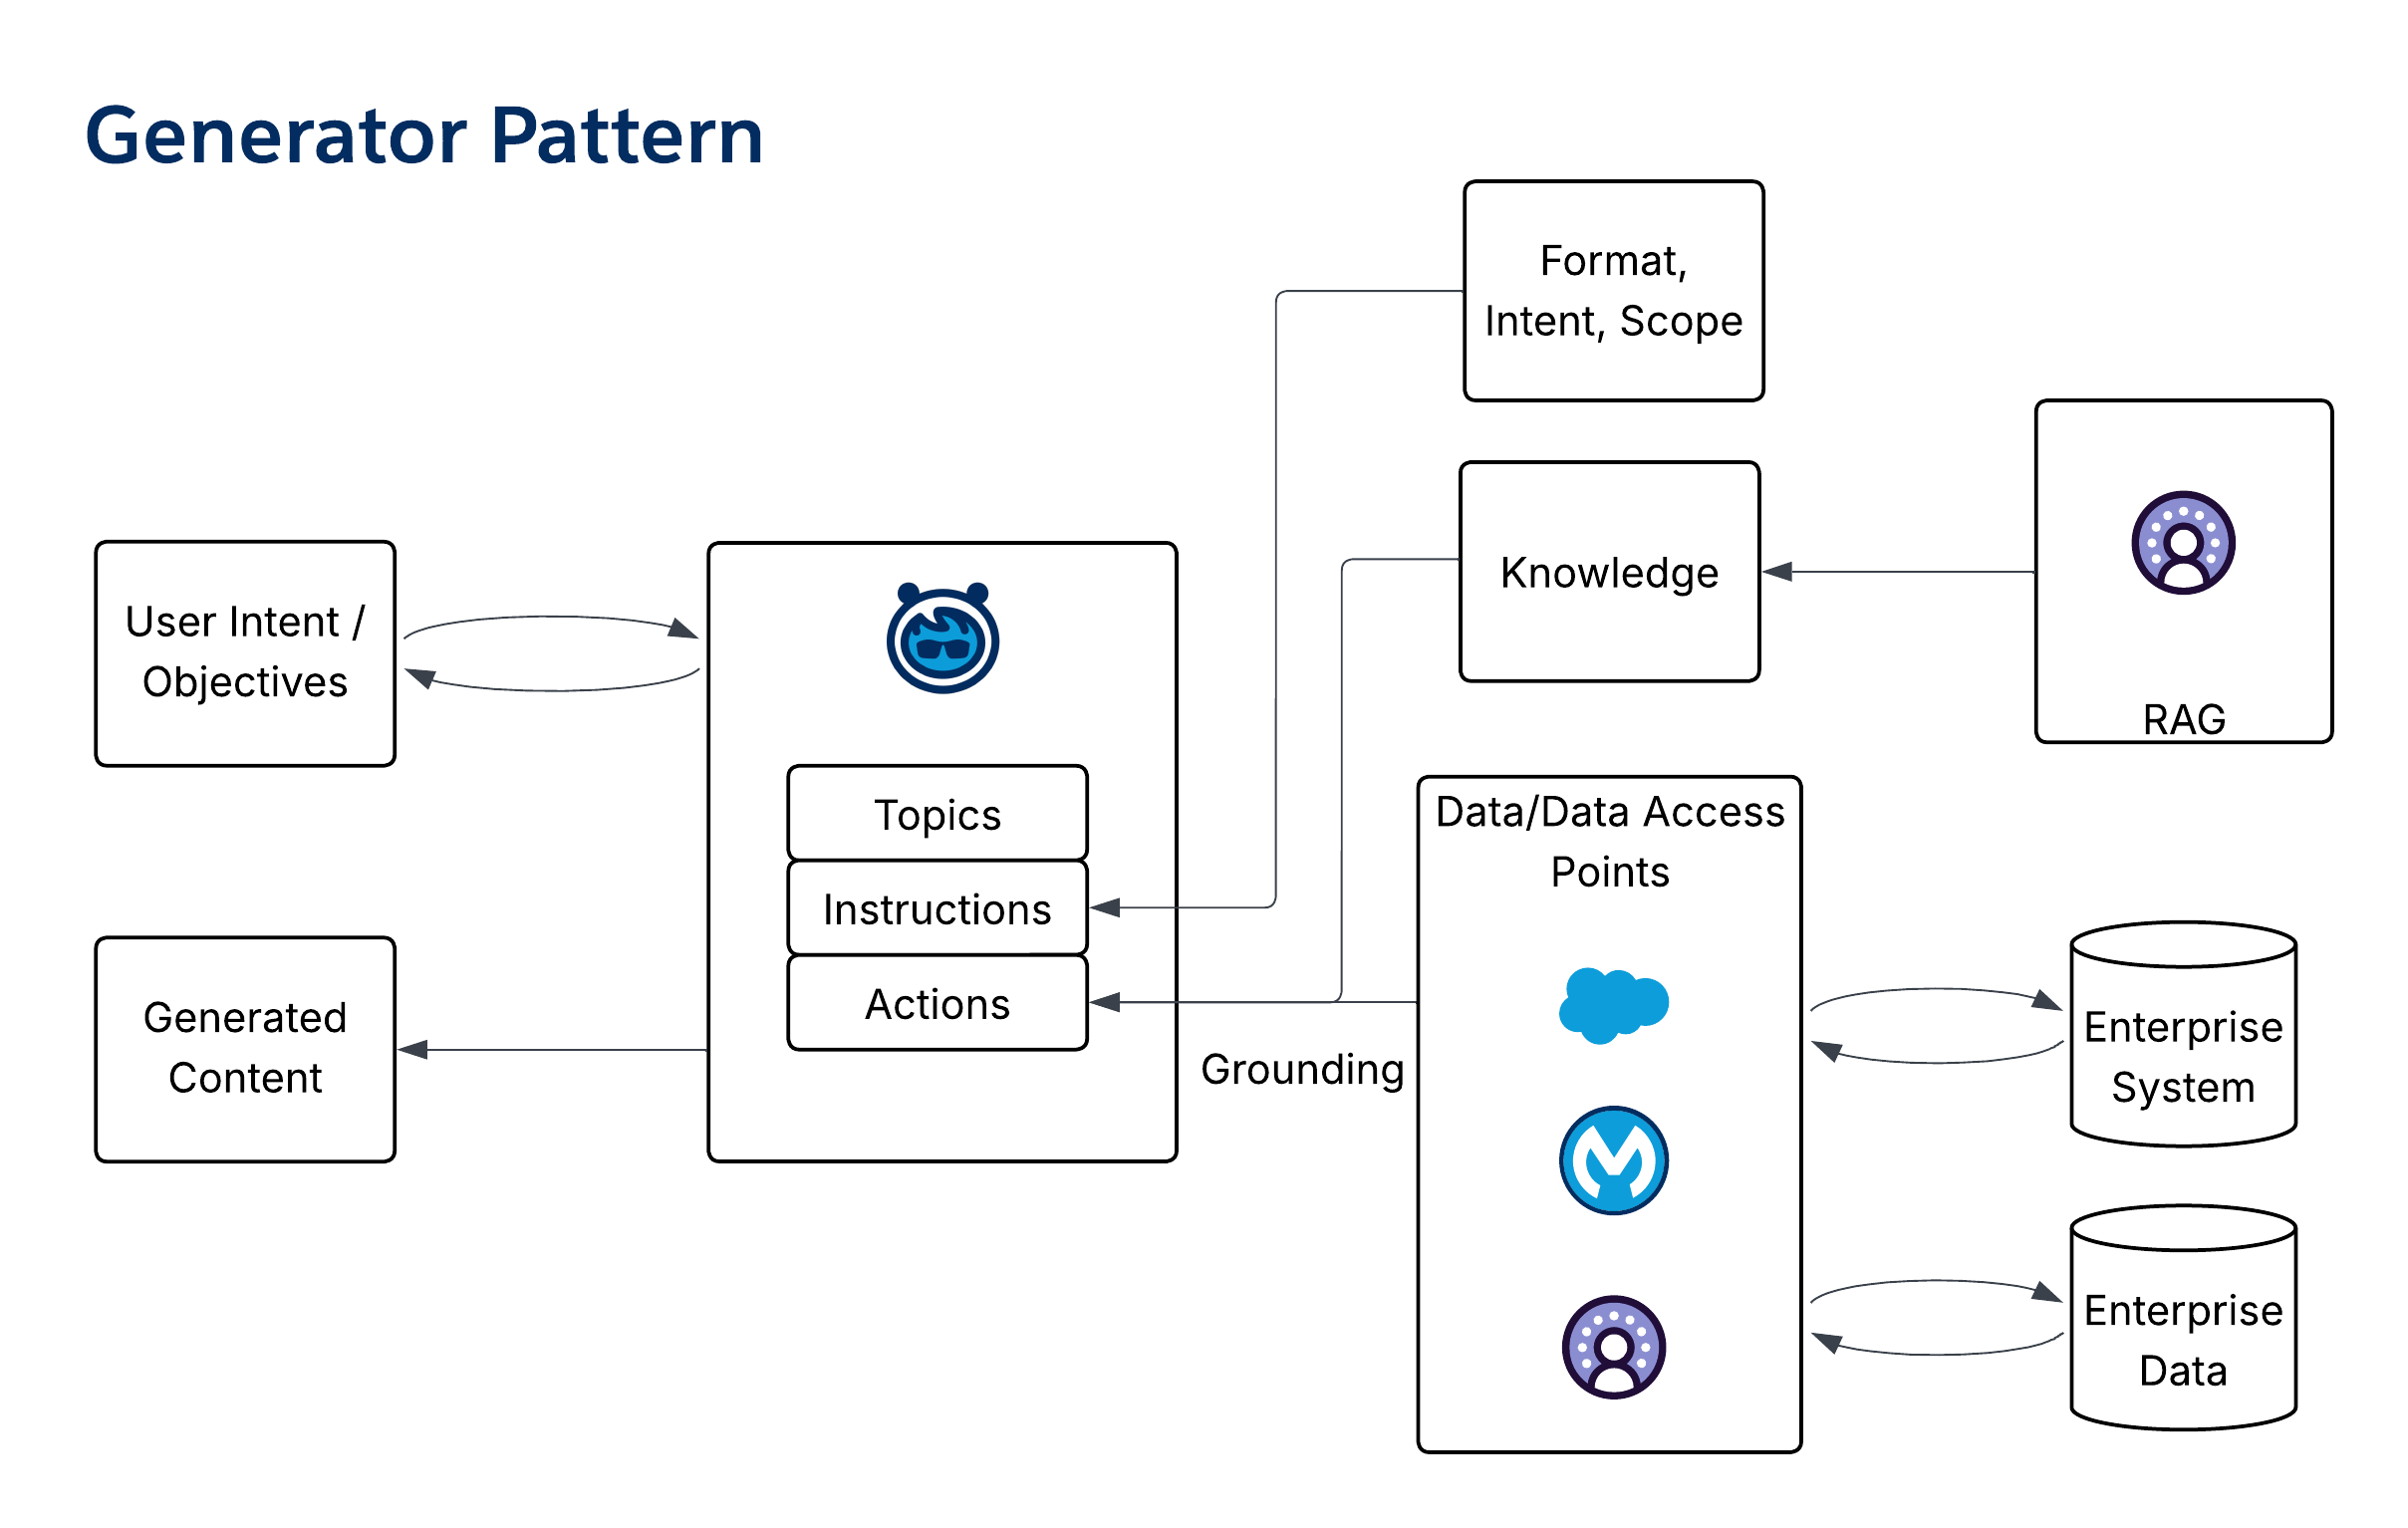
- **Descripción general**: El _patrón Generador_ es un patrón básico para crear nuevo contenido (por ejemplo, resúmenes de casos o borradores de email) a partir de entradas y estándares existentes. A menudo se implementa como una solicitud y puede incrustarse en otros agentes.
- **Tipo de salida**: Proporcione contenido generado que se ajuste al formato y la intención solicitados.
- **Orientación de uso**: de patrones El _patrón Generador_ se puede utilizar en la mayoría de los otros patrones o como un patrón independiente. El contexto se puede proporcionar a través de la solicitud, la hidratación durante la ejecución o pasos de enriquecimiento adicionales.
- **Caso de uso representativo**: Proporcione resúmenes de casos, borradores de email, artículos Knowledge o propuestas/respuestas a los QBR.
- **Diagrama**:
 - **Madurez de Salesforce Agentic**: Nivel 1
### Patrón de administrador de datos
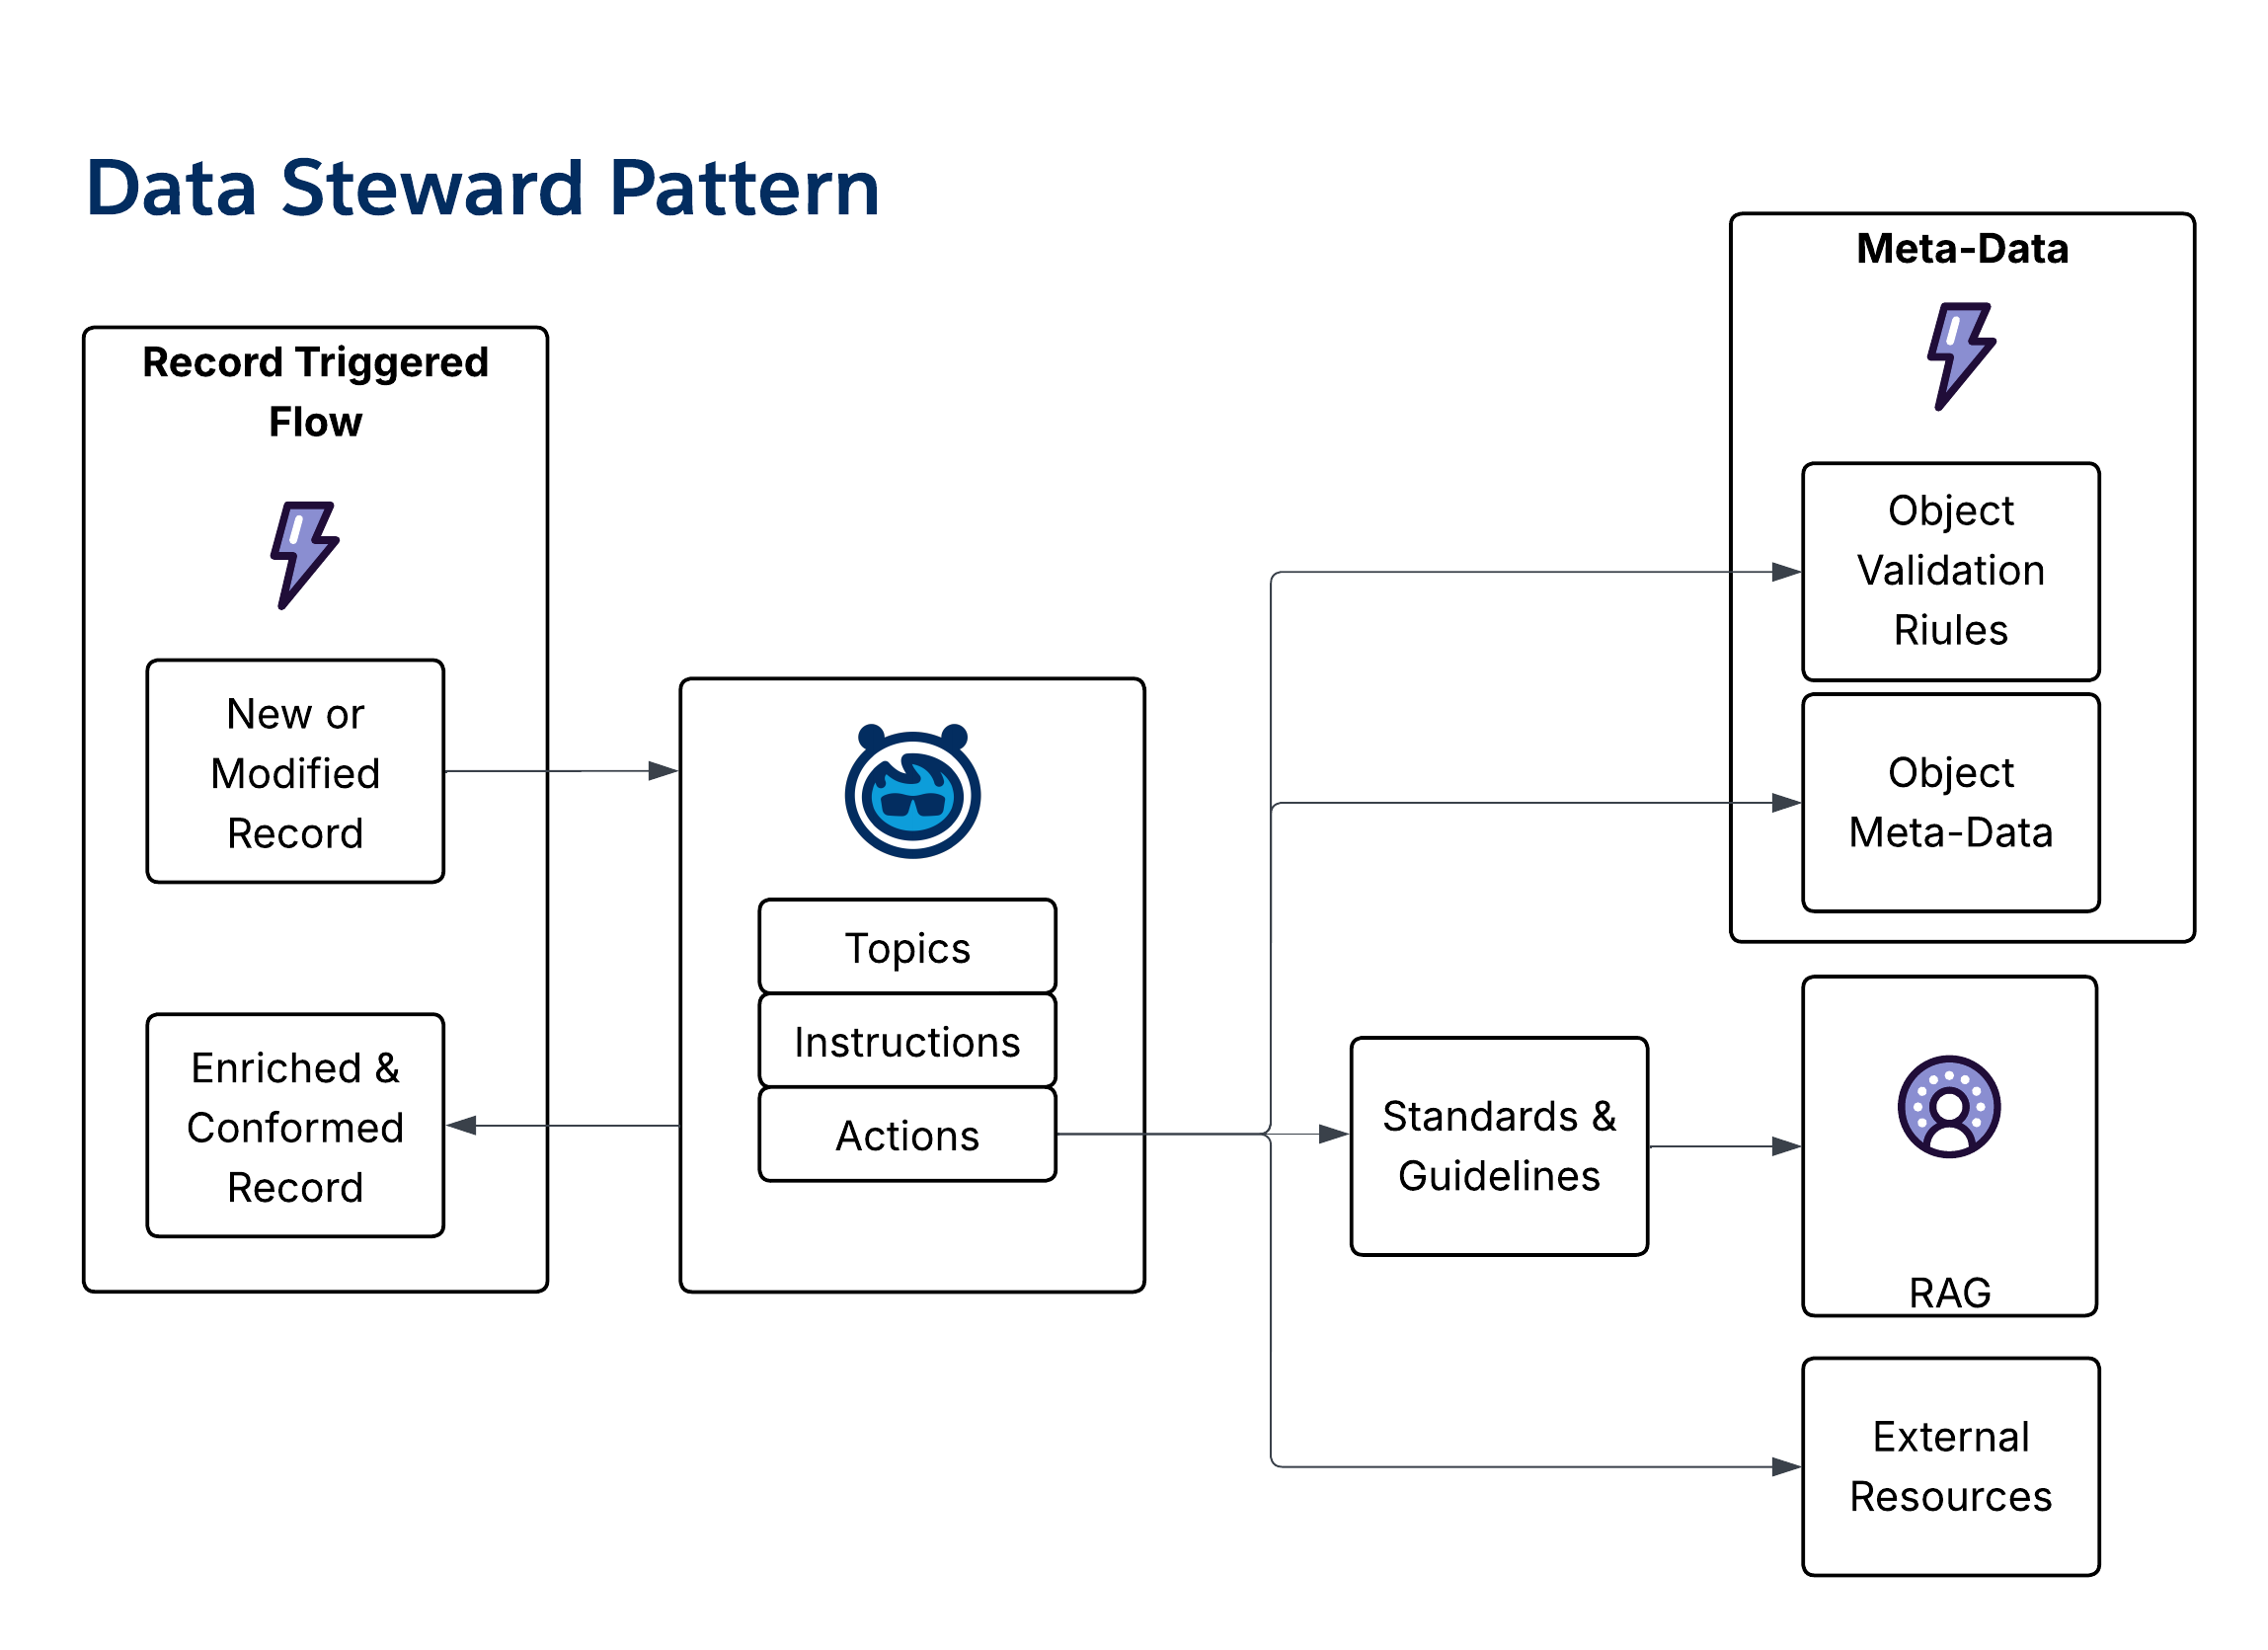
- **Descripción general**: El _patrón Administrador de datos_ es un patrón autónomo en segundo plano que introduce un paso de agente en operaciones de datos para garantizar una calidad, conformidad y enriquecimiento coherentes de los datos.
- **Tipo de salida**: Proporcione campos de datos y registro actualizados antes de guardar.
- **Orientación de uso**: de patrones Incruste la calidad de los datos en el punto de creación de datos agregando administradores de datos que registran flujos desencadenadores antes de guardar datos. Ayuda a garantizar la aplicación coherente de datos de categorización, resumen y estado.
- **Caso de uso representativo**: Garantizar actualizaciones de estilo "Pizza-Tracker" coherentes, enriqueciendo datos de cuentas y eliminando direcciones y códigos postales no coincidentes.
- **Diagrama**:
 - **Madurez de Salesforce Agentic**: Nivel 2
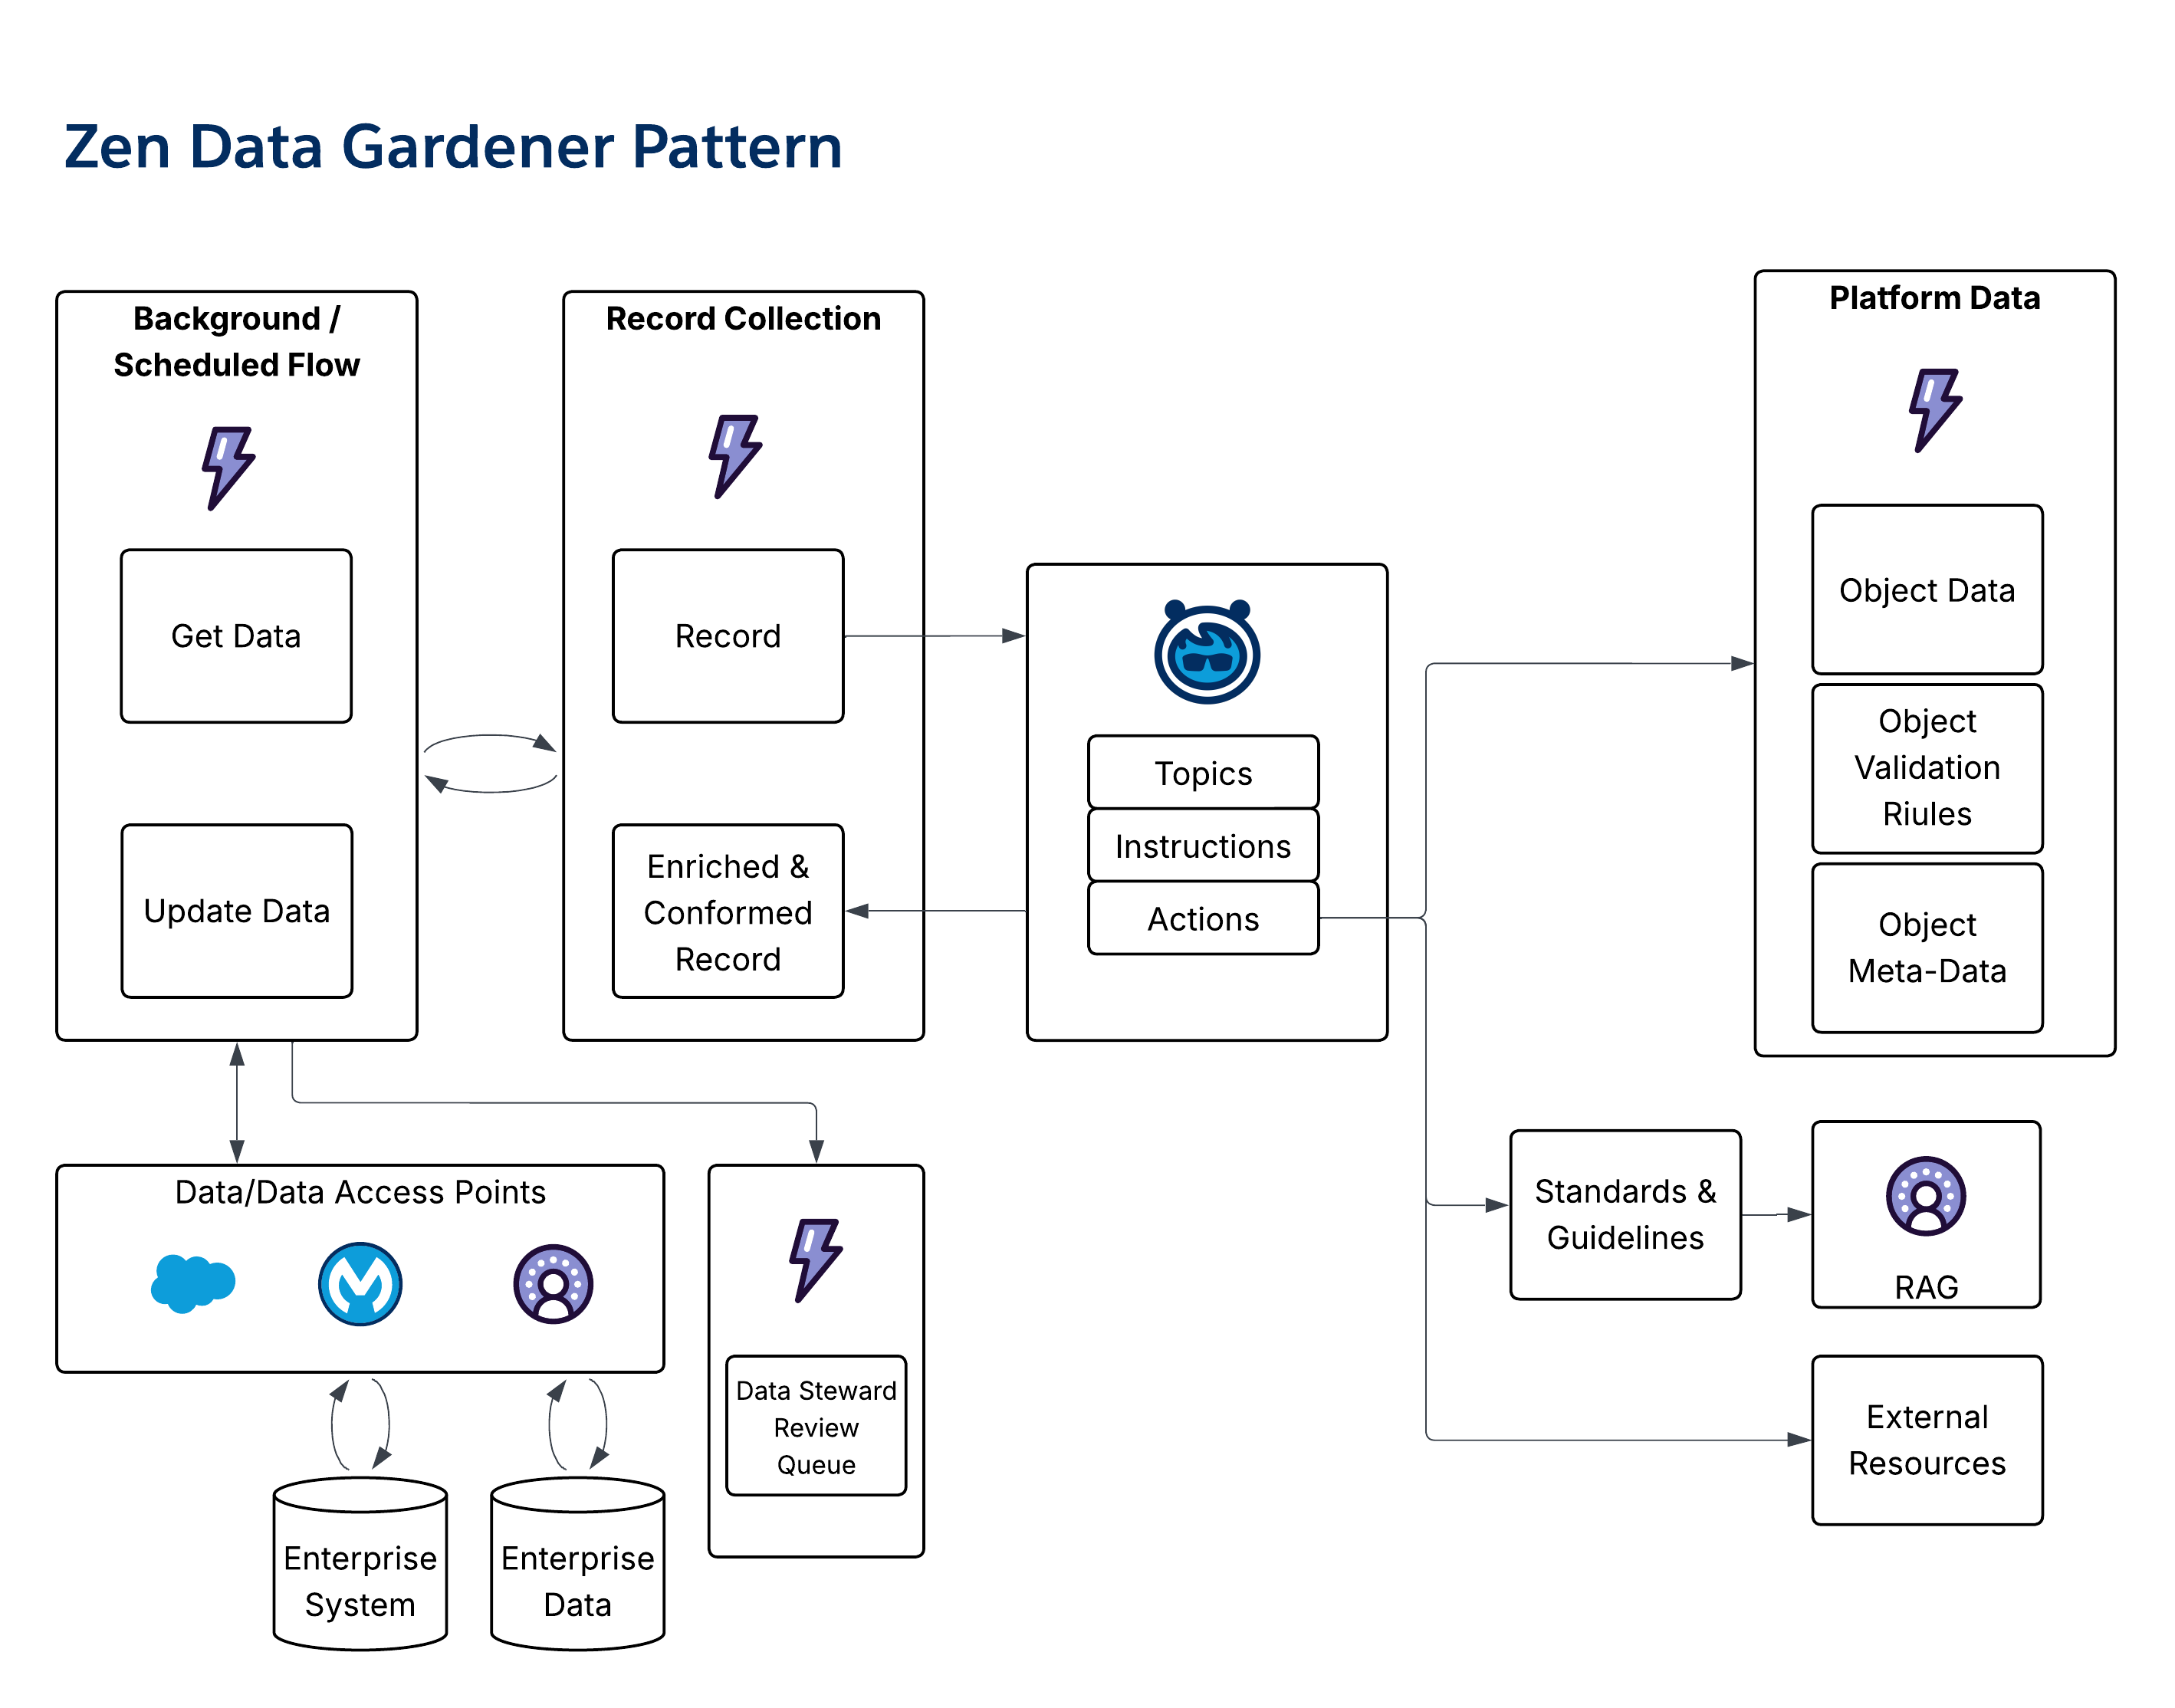
### Patrón de jardinero de datos Zen
- **Descripción general**: El _patrón Zen Data Gardener_ es un patrón en segundo plano programado que se utiliza para preparar y estandarizar datos, aprovechando el razonamiento de bajo costo para validar, enriquecer y conformar datos entre dominios de datos no conectados.
- **Tipo de salida**: Proporcione registros actualizados y/o tareas de gestión de datos.
- **Orientación de uso**: de patrones Utilice el patrón para activar la validación y revisión periódica de datos. Para datos que cambian lentamente, programe el agente en una cadencia lenta (por ejemplo, mensualmente). Combine con el [patrón Administrador de datos](/docs/architect/es-mx/fundamentals/guide/enterprise-agentic-architecture#patrón-de-administrador-de-datos) para proporcionar operaciones de calidad de datos prospectivas y retrospectivas.
- **Caso de uso representativo**: Garantizar la alineación entre los beneficios vendidos y el sistema de reclamaciones, así como la validación periódica de licencias de corredor con registros nacionales.
- **Diagrama**:
 - **Madurez de Salesforce Agentic**: Nivel 4
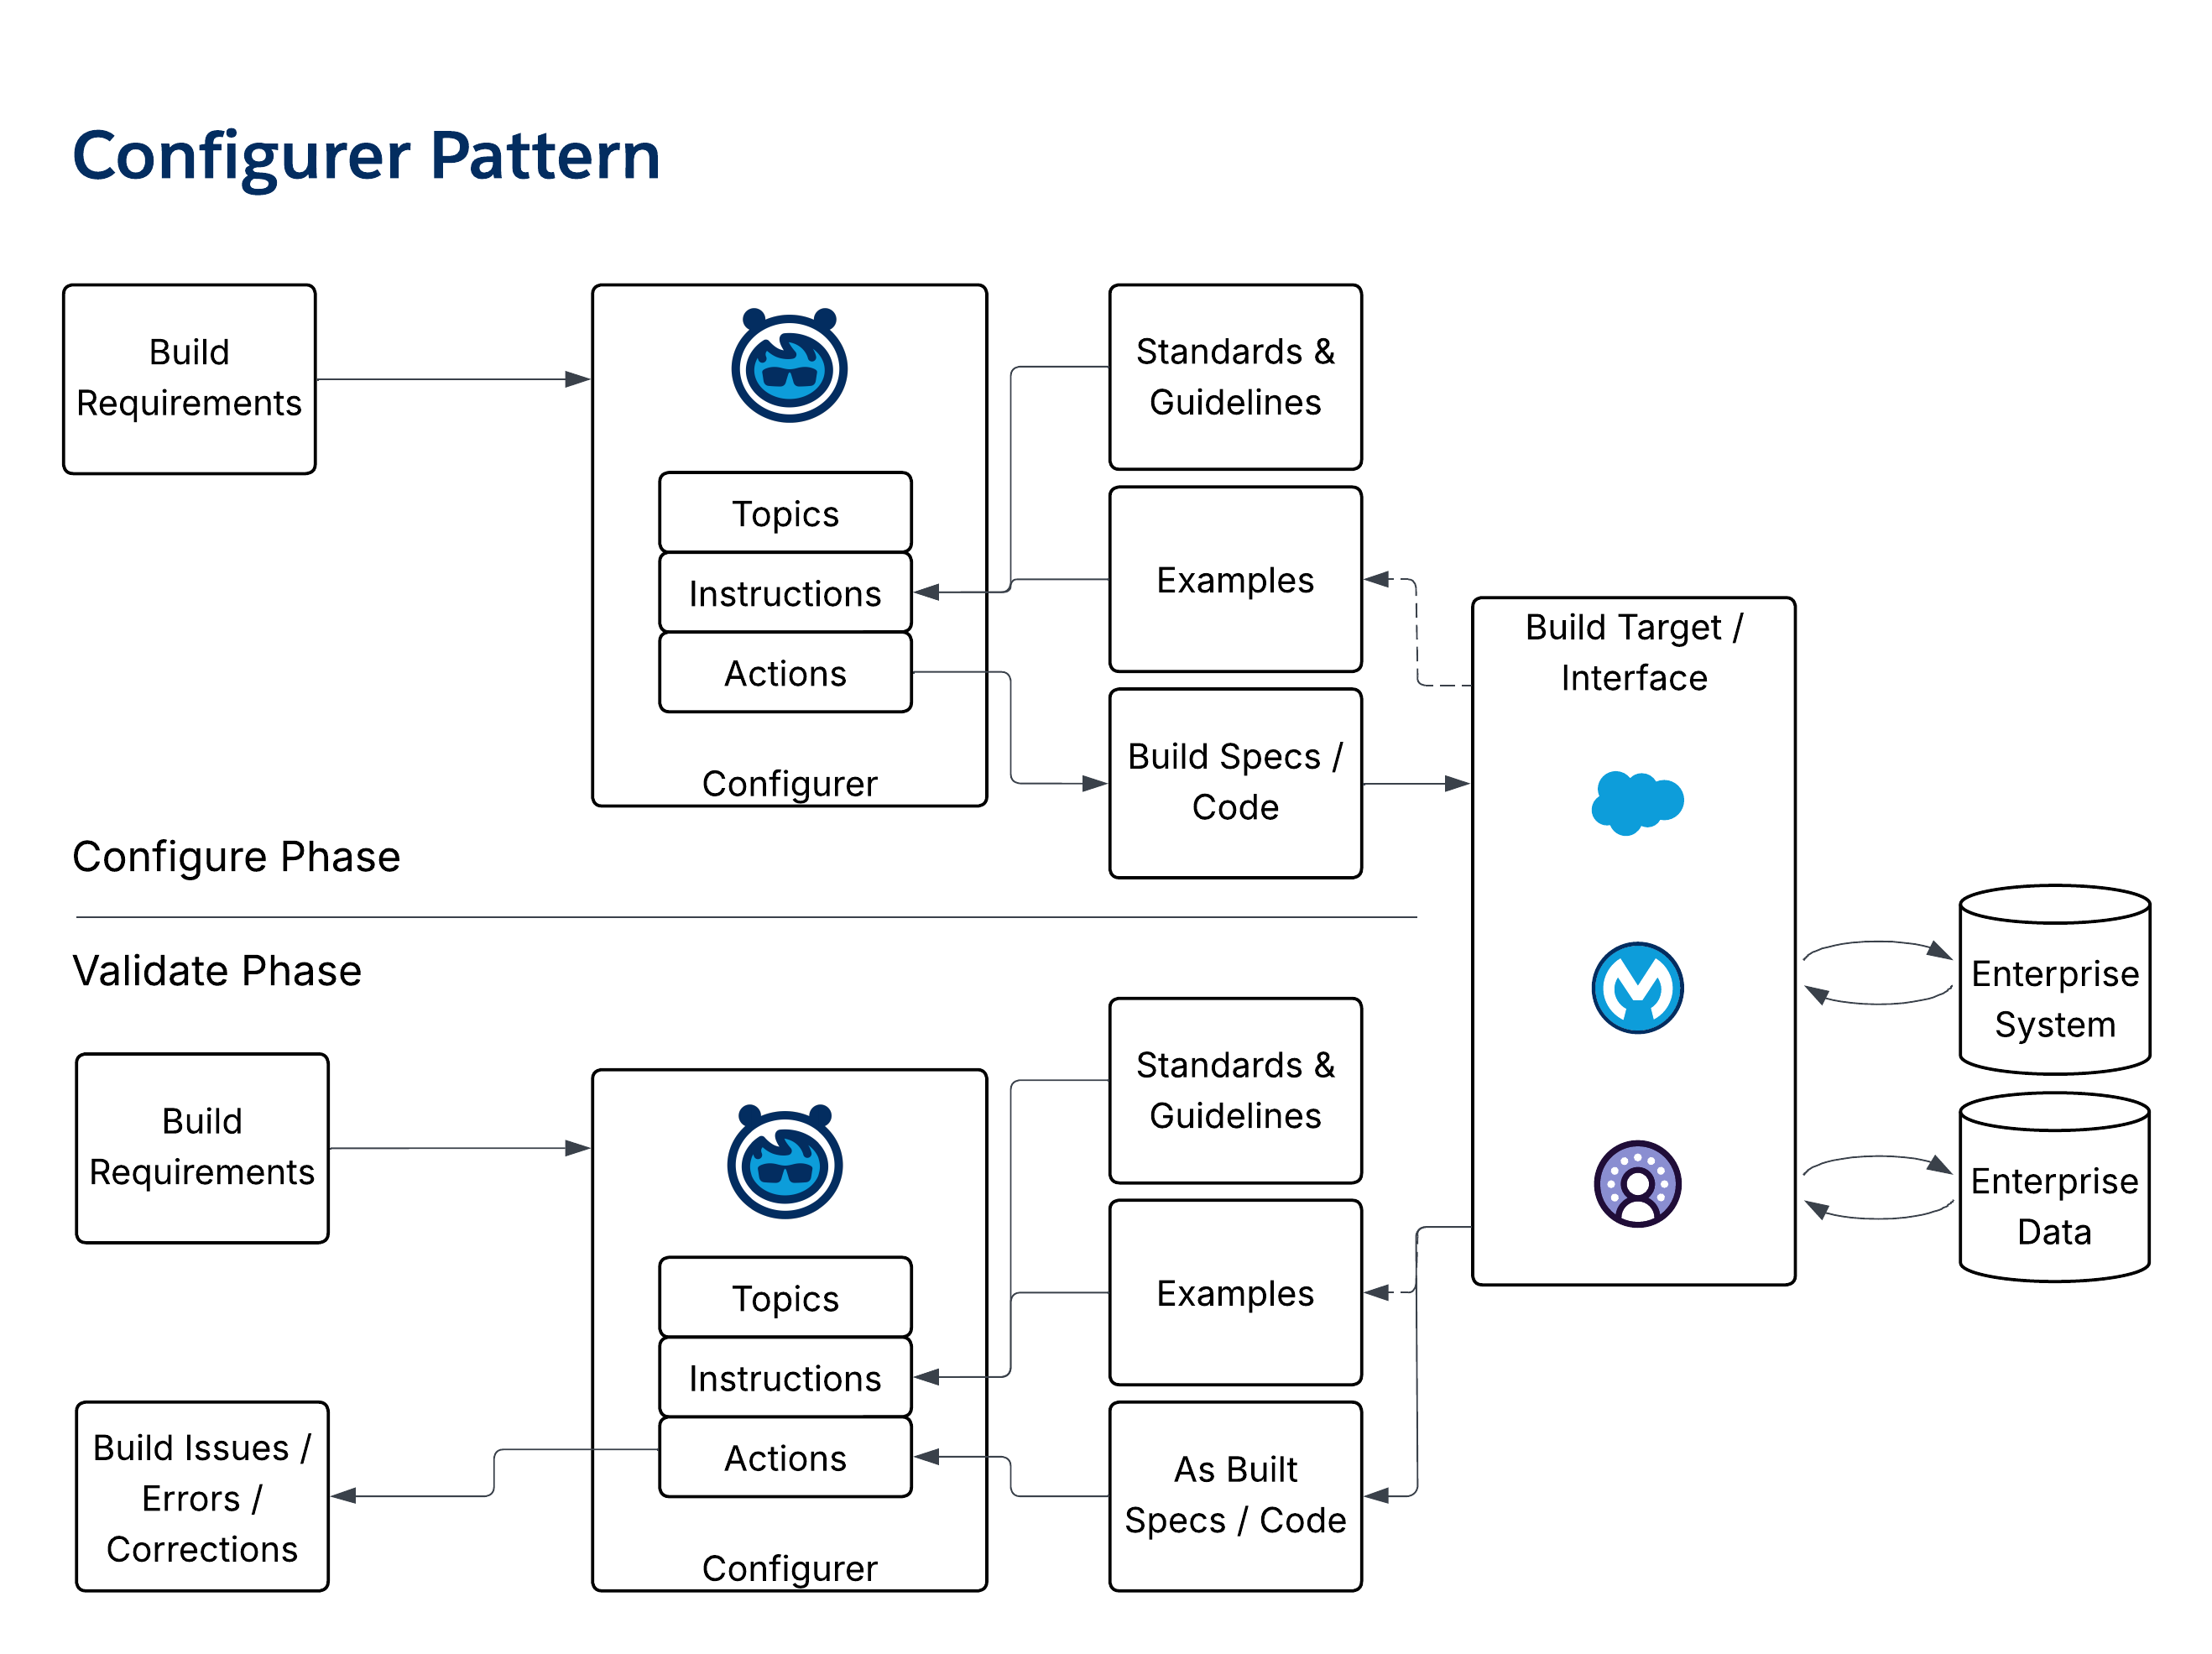
### Patrón de configurador
- **Descripción general**: El _patrón Configurador_ genera artefactos de configuración (por ejemplo, SQL/SOQL, JSON y CSV) desde requisitos de lenguaje natural. También puede ejecutarse de forma inversa para validar una configuración existente frente a requisitos.
- **Tipo de salida**: Proporcione registros actualizados, tareas de gestión de datos o cree problemas/errores para correcciones.
- **Orientación de uso**: de patrones Fundamente el agente utilizando estándares, directrices o ejemplos específicos. Configure requisitos de construcción utilizando orígenes como contratos o especificaciones de productos. Conecte el _patrón Configurador_ al sistema de destino para enviar la configuración generada.
- **Caso de uso representativo**: Generación de registros de configuración de productos para productos de seguro médico y validación de condiciones de pago/contrato para proveedores de salud.
- **Diagrama**:
 - **Madurez de Salesforce Agentic**: Nivel 4
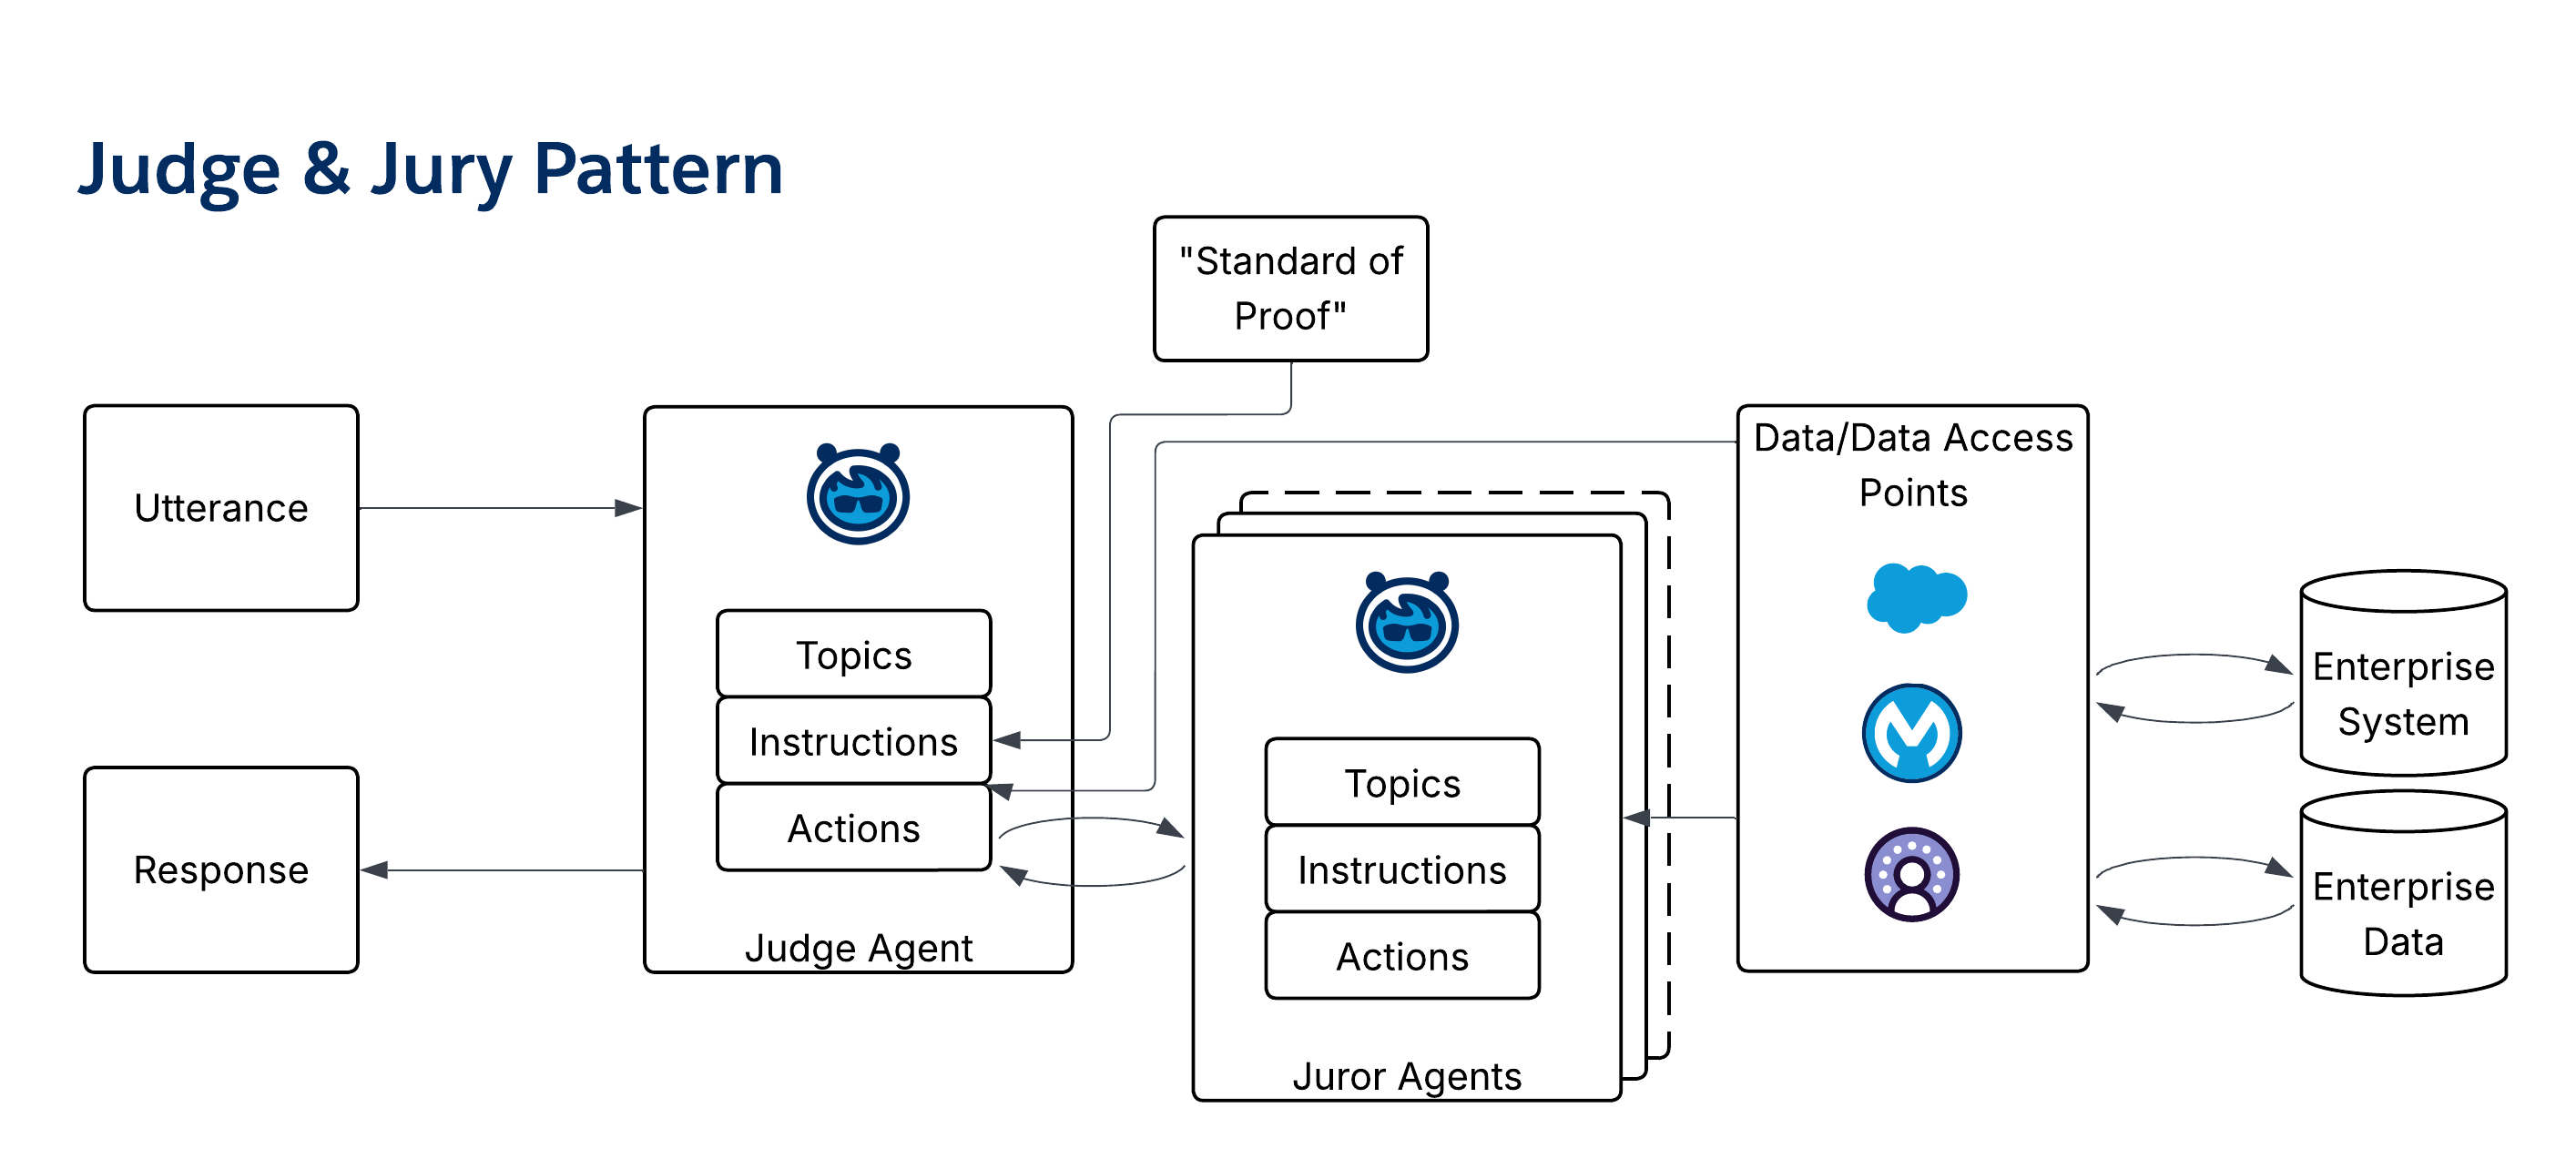
### Patrón de juez y jurado
- **Descripción general**: El _patrón Juez y jurado_ está diseñado para minimizar las alucinaciones utilizando un conjunto de agentes "jurados" y un agente "juez" que evalúa la congruencia de las respuestas para garantizar que son coherentes y fundamentadas materialmente.
- El _Enfoque de conjunto_ está integrado en Agentforce y el motor de razonamiento de Atlas para abordar la pertinencia y la veracidad de las respuestas. El _patrón Jurado y Jurado_ se basa en esta función cuando son esenciales altos niveles de precisión.
- La combinación de Fundamentación de _datos_ (por ejemplo, “encuentre su respuesta en estos registros/documentos”) y _Ingeniería de solicitudes_ (por ejemplo, “solo devuelva una respuesta si se encuentra en estos registros” o “valide su respuesta en esta fuente externa”) también son formas efectivas de minimizar las alucinaciones.
- **Tipo de salida**: Proporcione perspectivas generativas.
- **Orientación de uso**: de patrones Utilizar cuando hay una gran necesidad de resultados generativos coherentes y fundamentados. Un _agente Juez_ compila una solicitud fundamentada y la pasa a dos o más _agentes Jurados_, y luego el Juez evalúa las respuestas. Para obtener mejores resultados, utilice diferentes modelos (por ejemplo, uno de OpenAI y otro de Anthropic) para cada agente del jurado.
- **Caso de uso representativo**: Proporcione respuestas de alta fidelidad y fundamentadas en hechos para minimizar las alucinaciones.
- **Diagrama**:
 - **Madurez de Salesforce Agentic**: Nivel 2
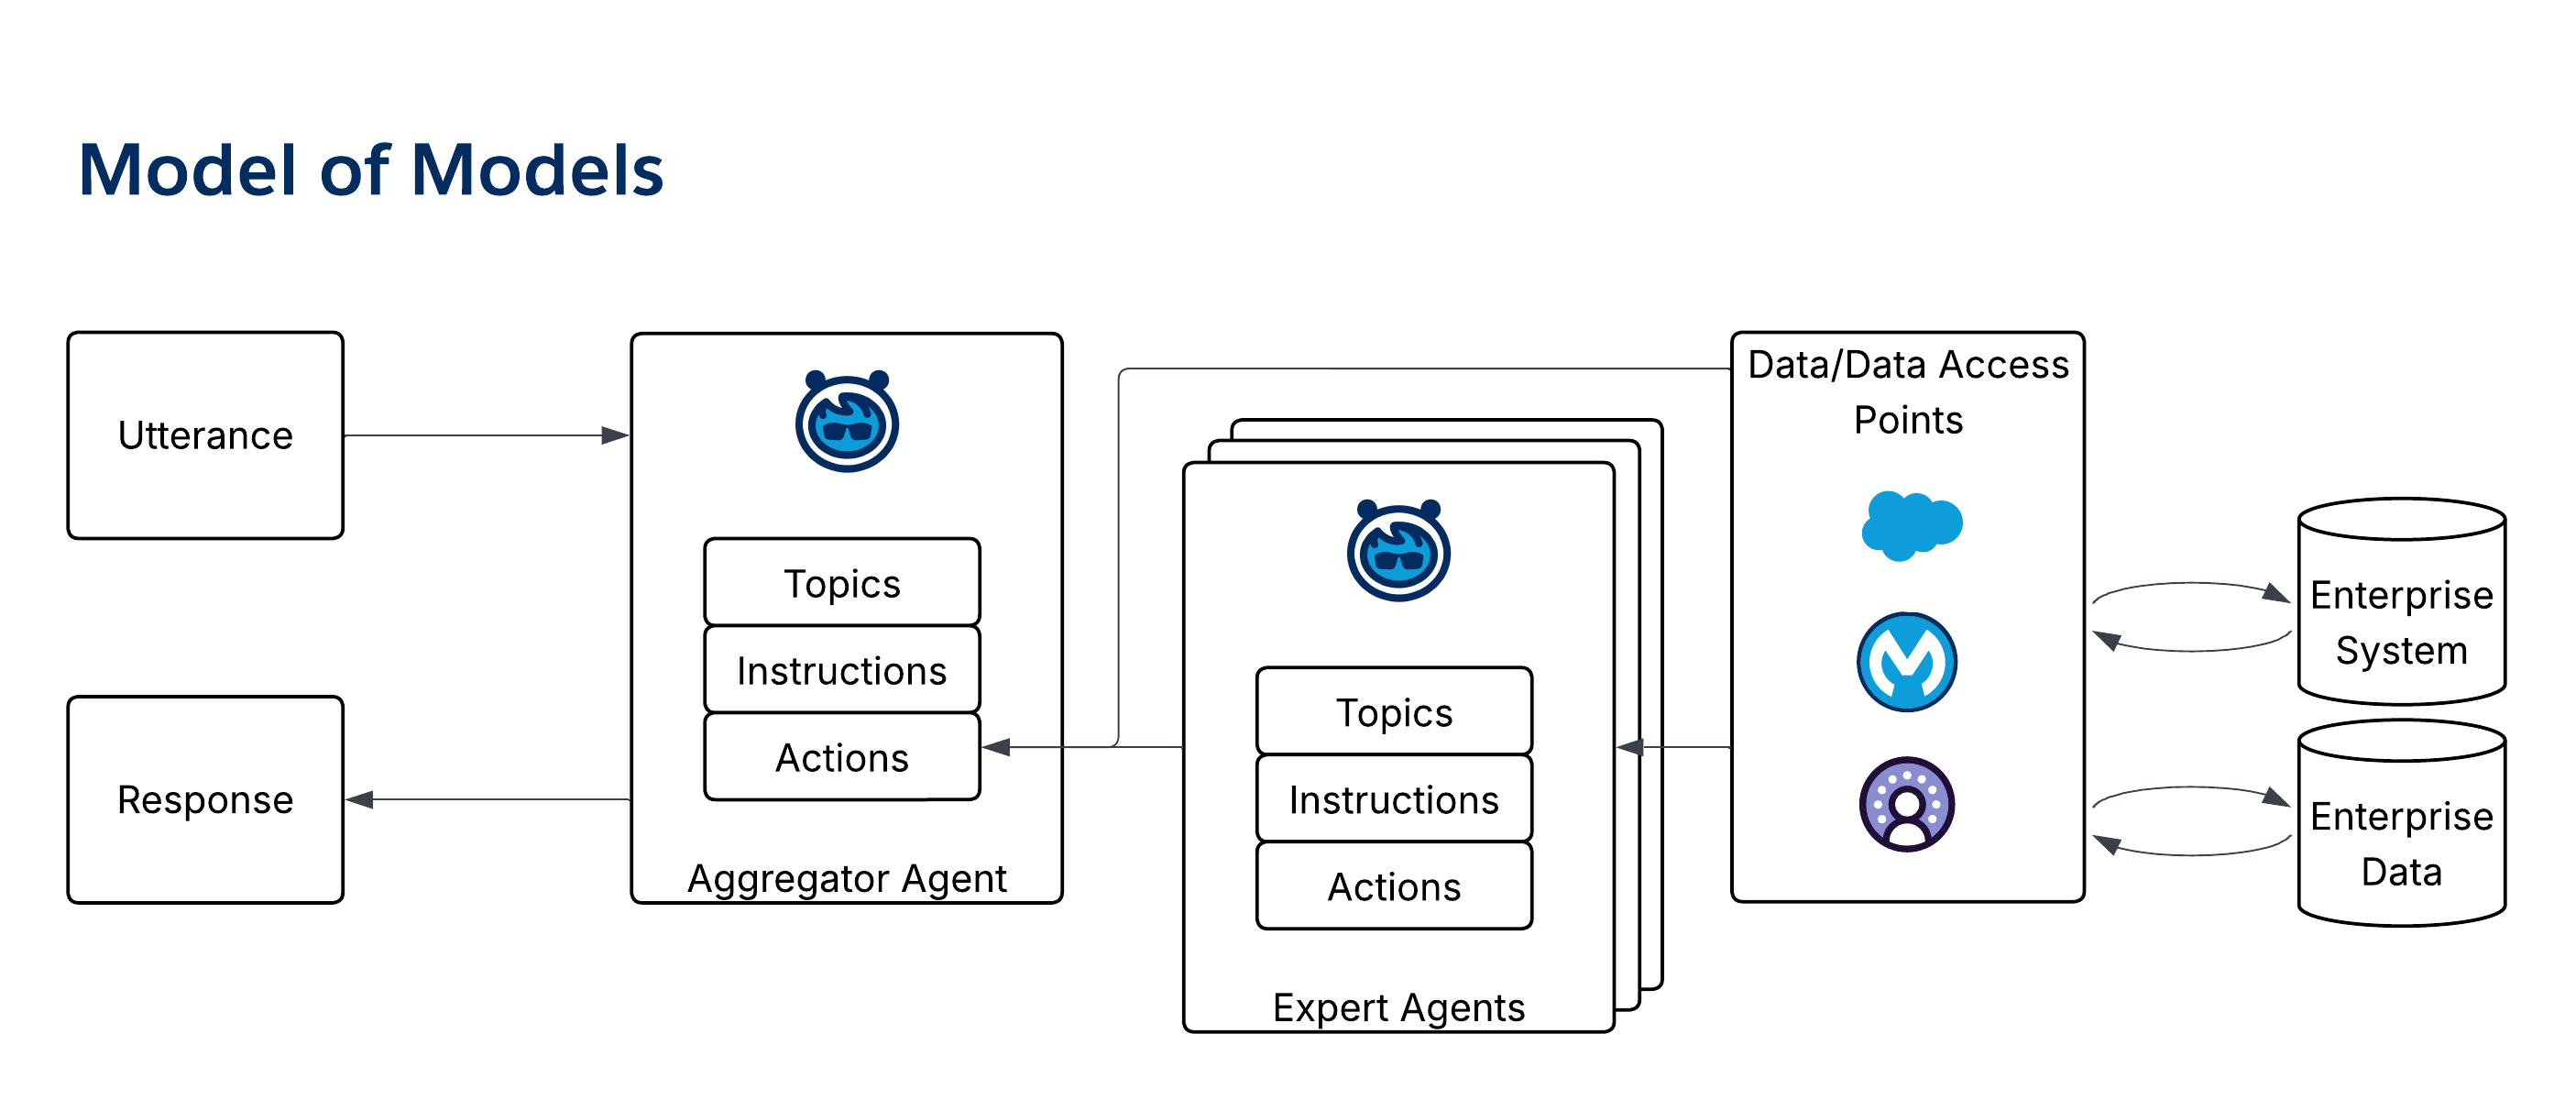
### Modelo de patrón de modelos
- **Descripción general**: El _patrón Modelo de modelos_ aprovecha múltiples agentes expertos para generar una amplia gama de perspectivas, y luego extrae el consenso. A diferencia del [patrón Juez y jurado](/docs/architect/es-mx/fundamentals/guide/enterprise-agentic-architecture#patrón-de-juez-y-jurado), este patrón abarca múltiples puntos de vista para mejorar la riqueza.
- Este patrón también puede denominarse patrón Panel de expertos cuando existen modelos expertos con diferentes puntos de vista (POV) que puede ser útil tocar.
- A diferencia del patrón Juez y Jurado, donde la intención es garantizar que la respuesta agente converge en una “verdad” accesible comúnmente, el _patrón Modelo de modelos_ amplía el ámbito de la respuesta aprovechando la diversidad en el entorno agente.
- Este patrón asume que hay agentes adicionales que tienen un POV distinto. Por ejemplo, en un entorno de múltiples organizaciones y múltiples agentes o un entorno con múltiples agentes proporcionados por proveedores entre pilas de tecnología, el _patrón Modelo de modelos_ proporciona una estructura para integrar múltiples POV.
- Al considerar este patrón, también considere otros enfoques, a menudo más ligeros:
- En vez de definir múltiples agentes expertos, especifique múltiples solicitudes y haga que el sistema trabaje como un conjunto de solicitudes.
- Aproveche la “fundamentación” a través de acciones que acceden a datos apropiados en contexto.
- **Tipo de salida**: Proporcione perspectivas generativas.
- **Orientación de uso**: de patrones La función de un agente _Agregador_ es formar y devolver un POV enriquecido basándose en los conceptos clave que devolvieron los agentes Modelo. Los Agentes de modelo determinan una respuesta basándose en su POV exclusivo.
- **Caso de uso representativo**: Utilice en situaciones que pueden beneficiarse de la combinación de puntos de vista dispares para aumentar la calidad de las respuestas.
Por ejemplo, un entorno agente multisistema donde los agentes privilegiados (por ejemplo, un _agente ERP_) pueden tener un POV valioso y de otro modo inaccesible.
- **Diagrama**:
 - **Madurez de Salesforce Agentic**: Nivel 2
## 9\. Patrones de procesos de larga ejecución
Los _patrones Proceso de larga_ ejecución gestionan procesos que se producen durante periodos prolongados e implican múltiples pasos y actores.
### Patrón de gestor de proyectos
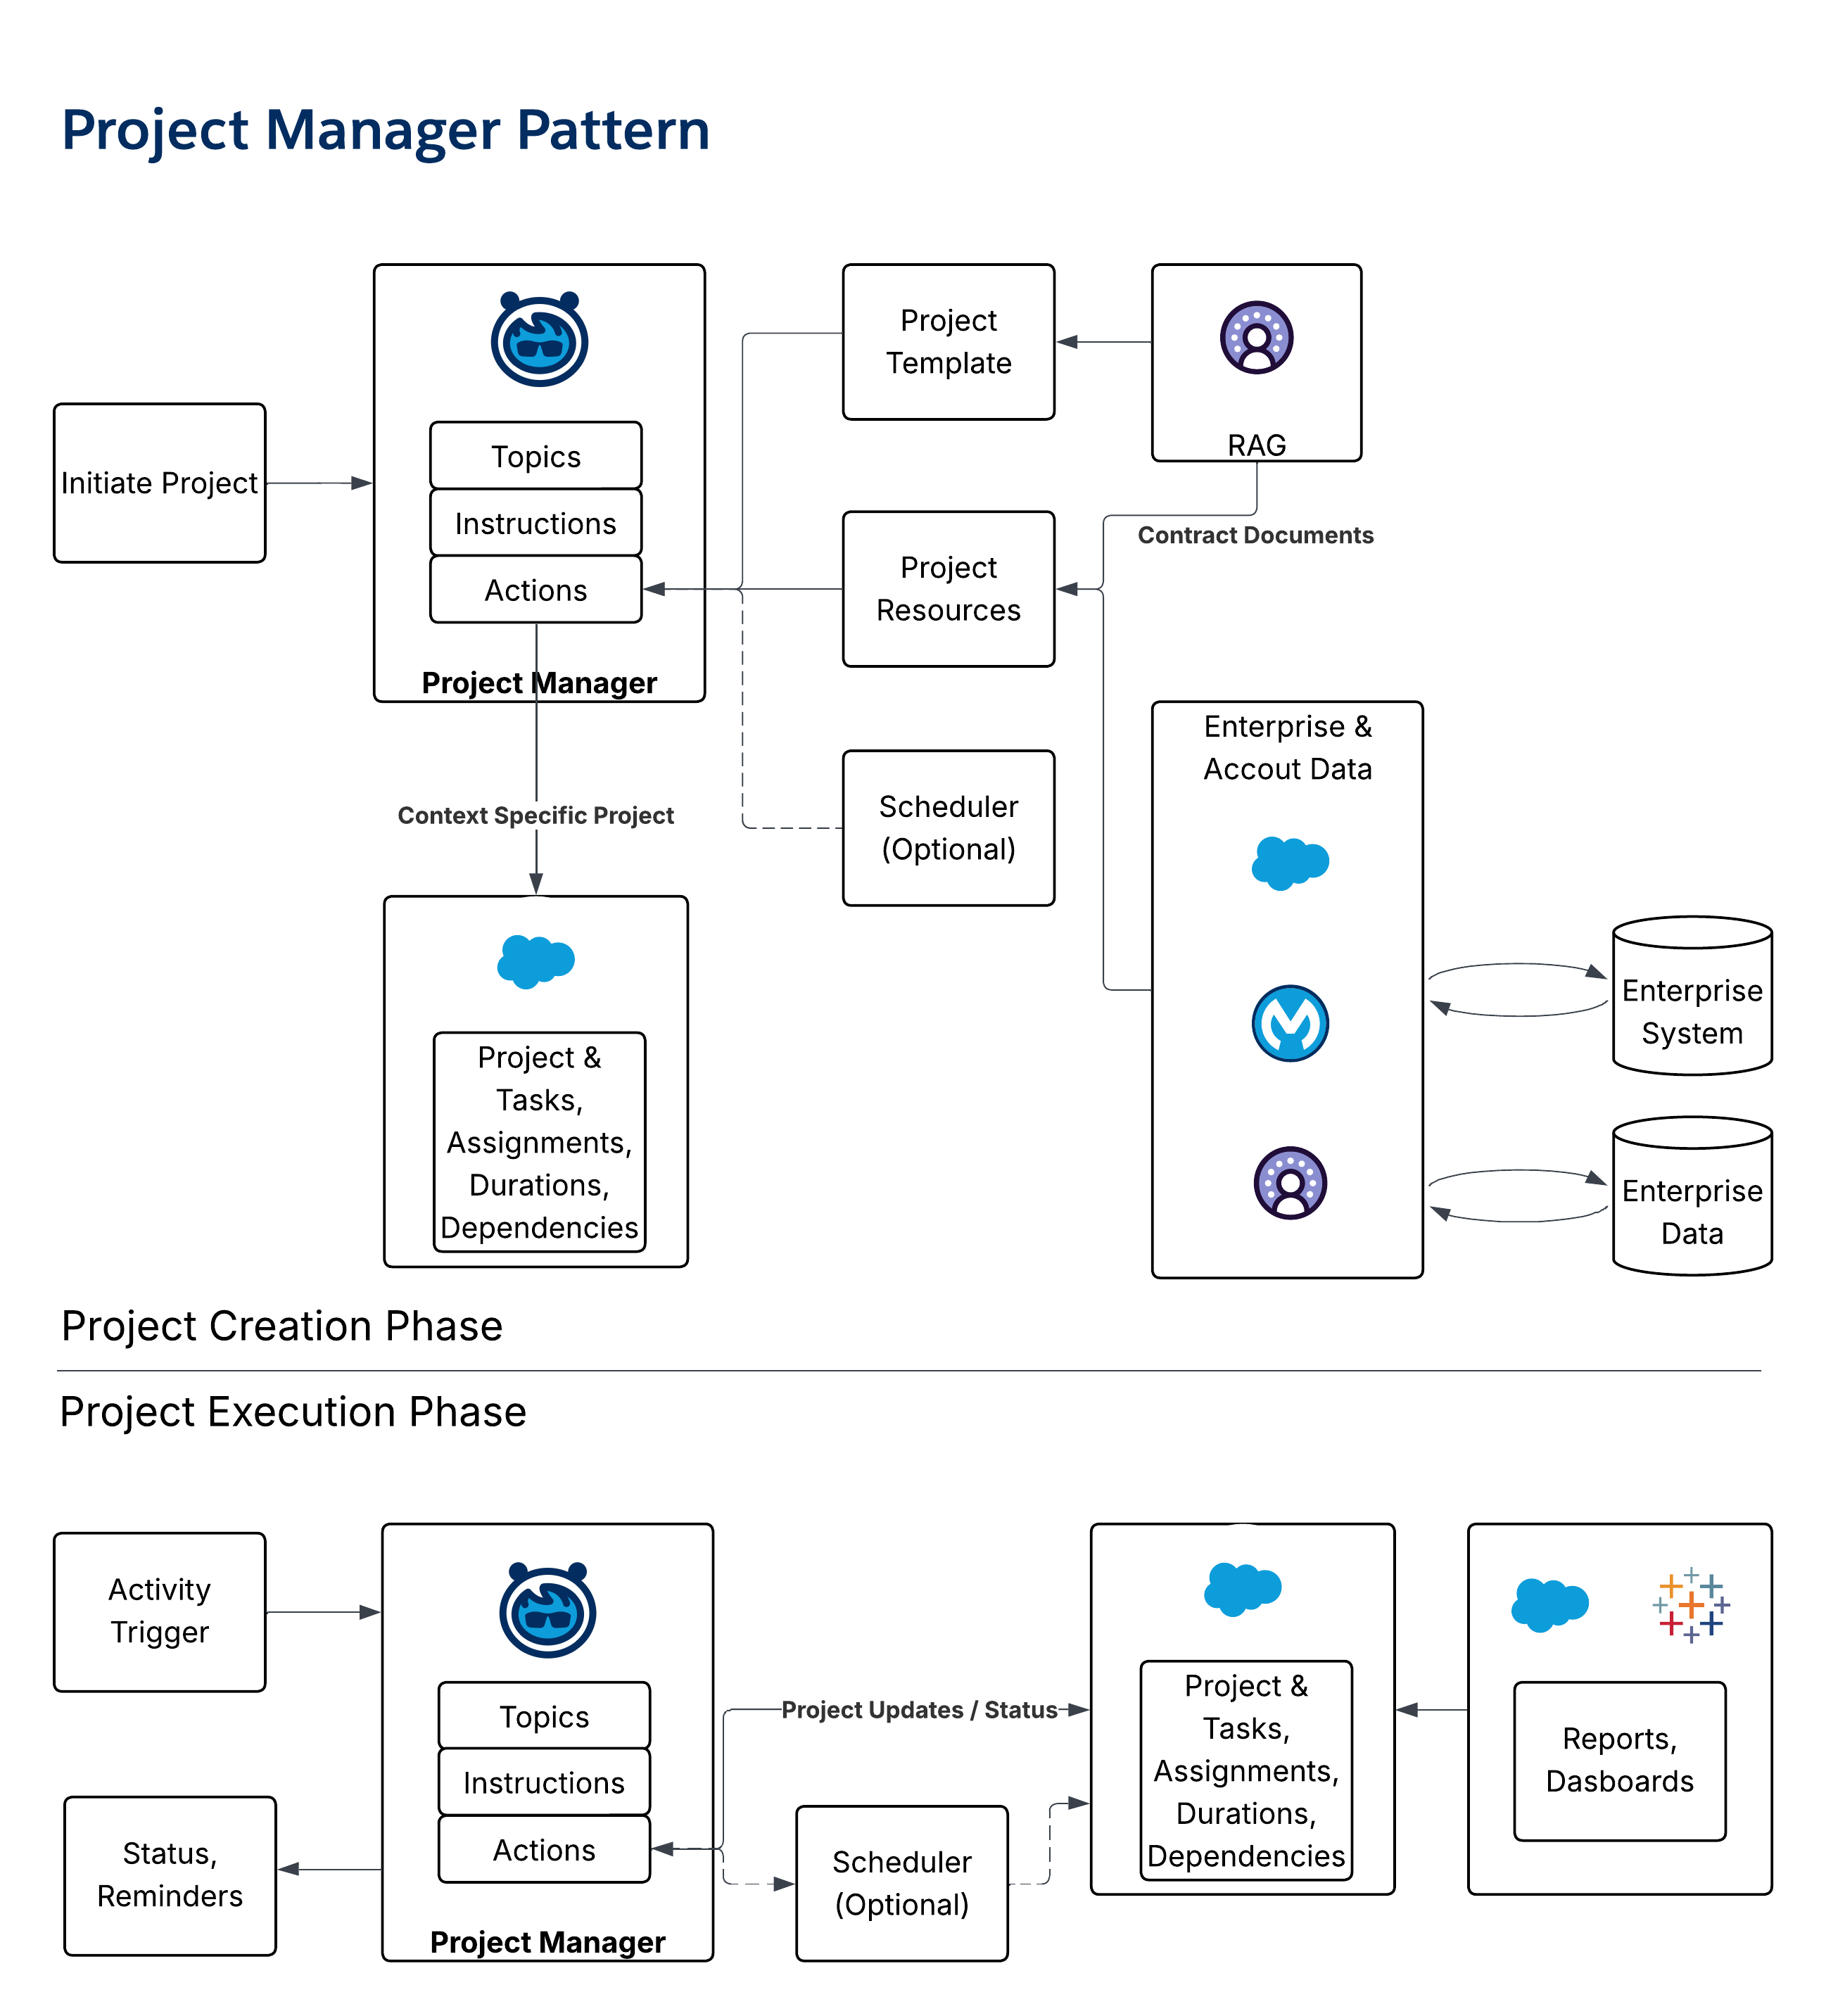
- **Descripción general**: El _patrón Gestor de proyectos_ es un patrón complejo que supervisa un proyecto de larga duración. Coordina actividades, realiza un seguimiento de la finalización, notifica a los usuarios y representa el estado del proyecto a las partes interesadas.
- **Tipo de salida**: Existen múltiples resultados (por ejemplo, casos, tareas, actualizaciones de estado y notificaciones).
- **Orientación de uso**: de patrones Utilice como patrón de paraguas para admitir actividades regulares, repetidas y de múltiples pasos. El _patrón Gestor de proyectos_ toma una plantilla/esquema de entrada de un proyecto (incluyendo tareas, funciones y dependencias), luego crea una instancia de casos y actividades y los asigna a usuarios.
- **Caso de uso representativo**: Utilizar para la gestión de la instalación de cuentas y la implicación de ventas de negocio.
- **Diagrama**:
 - **Madurez de Salesforce Agentic**: Nivel 4
## 10\. Arquetipos de orquestación de compañía
Aunque los patrones describen funciones de agentes, los _arquetipos de orquestación_ definen los planes a nivel del sistema para el modo en que colabora una flota de agentes. Estos arquetipos aclaran las funciones de _Agentforce_ como cerebro de orquestación y _MuleSoft_ como conector y adaptador universal.
**Arquetipo 1: SOMA (organización única, múltiples agentes)**
- **Definición**: Múltiples agentes colaboran en una organización de Salesforce que utiliza datos y gobernanza compartidos.
- **Flujo arquitectónico**: En Agentforce, un _agente Supervisor_ actúa como una única puerta principal, enrutando solicitudes a _agentes Especialistas_ dentro de la organización. Para funciones externas, los agentes utilizan el _cliente Agentforce MCP_ con MuleSoft actuando como contenedor de MCP para API no activadas por MCP.
- **Consideraciones clave**: Este patrón centraliza la lógica de orquestación en Salesforce (similar al contexto de CRM y Data 360) para preservar la gobernanza, la identidad, los permisos y la observabilidad unificados.
**Arquetipo 2: MOMA (organización múltiple, múltiples agentes)**
- **Definición**: Los agentes colaboran entre múltiples organizaciones de Salesforce, lo que requiere una coordinación segura entre datos y límites de permisos.
- **Flujo arquitectónico**: Un _agente Supervisor_ en una organización delega una tarea a un agente en otra organización a través del protocolo estandarizado _agente a agente (A2A)_. Este apretón de manos garantiza Trust a nivel de organización, flujo de identidad de usuario y contexto de plática compartido.
- **Consideraciones clave**: Este patrón mantiene la autonomía de la organización mientras activa flujos de trabajo de toda la compañía, lo que proporciona una base para operaciones de agentes coherentes en estados complejos de múltiples organizaciones.
**Arquetipo 3: Proveedores múltiples A2A (orquestación dirigida por Salesforce)**
- **Definición**: Un _agente Supervisor_ en Salesforce coordina el trabajo entre una mezcla de agentes nativos de Salesforce y agentes de otros proveedores (por ejemplo, Google/Vertex o LangGraph) a través del protocolo A2A.
- **Flujo arquitectónico**: El _agente Supervisor_ procesa la solicitud y orquesta un plan, invocando agentes de proveedores internos y externos a través del protocolo A2A. Para sistemas externos que no tienen capacidad A2A, _MuleSoft_ puede exponer una "fachada de agente ligera" que encierra la herramienta existente y se comunica con A2A.
- **Consideraciones clave**: Este arquetipo mantiene el cerebro de la orquestación cerca de CRM y Data 360 utilizando A2A para producir una composición limpia y gobernable sin un nivel de orquestación separado.
**Arquetipo 4: Proveedores múltiples A2A (Orquestación dirigida por MuleSoft)**
- **Definición**: La orquestación se inicia desde un punto de entrada que no sea Salesforce, que requiere un orquestador externo neutro para realizar el razonamiento y el enrutamiento.
- **Flujo arquitectónico**: Un _agente de interfaz_ de usuario en un sistema externo reenvía la solicitud a un servicio de orquestación (conceptualizado como _MuleSoft Conductor_), que interpreta la intención y planifica la tarea. El conductor utiliza a continuación el A2A para enrutar llamadas a agentes de proveedores, incluyendo agentes Agentforce para CRM o acciones de servicio.
- **Consideraciones clave**: Este patrón es para puntos de entrada que no son de Salesforce donde un orquestador neutro es arquitectónicamente preferible. Mantiene la UX en el sistema de dominios mientras centraliza el razonamiento, la gobernanza, la política y la observabilidad en MuleSoft.
## 11\. Conjunto de soluciones: Redacción de patrones
Estos patrones individuales y arquetipos de orquestación son elementos constructivos arquitectónicos diseñados para componerse en soluciones integrales. El Mapa de soluciones de agente se utiliza para visualizar cómo se conectan estos componentes.
- Una _Solución de servicios_ para miembros para un proveedor de cuidados sanitarios es una implementación estándar del arquetipo SOMA. Utiliza un Answerbot para usuarios anónimos, un _Orquestador_ para miembros autenticados y múltiples _agentes Pymes de dominio_ (por ejemplo, Caso, Reclamaciones y Beneficios) para gestionar solicitudes específicas.
- Un _portal de corredor_ B2C es una composición compleja que utiliza un agente _Orquestador de_ portal para invocar un _agente Gestor de proyectos_ de larga ejecución para un proceso RFP, que a su vez utiliza _agentes Desatendida_, _Administradora de datos_ e _Interrogadora_ para operaciones de datos de back-office.
## 12\. Conclusión
Una metodología de patrón de diseño agente proporciona la disciplina arquitectónica requerida para crear sistemas de IA de negocio sólidos, ampliables y mantenibles. Al desglosar la complejidad y promover la modularidad, estos patrones permiten a los arquitectos ofrecer soluciones agentes fiables y predecibles.
La elección del arquetipo de orquestación es una decisión estratégica basada en dónde trabajan los usuarios, dónde reside el contexto y cómo rige la compañía la interacción entre humanos, agentes y sistemas. Comprendiendo la distinción entre agentes de creación y orquestándolos, y aprovechando protocolos abiertos como _MCP_ y _A2A_, los arquitectos pueden ir más allá de la creación de bots aislados para diseñar un sistema de razonamiento de negocio cohesionado, gobernado y distribuido. Este enfoque proporciona un lenguaje compartido y un conjunto de planes reutilizables para construir una arquitectura de agentes sostenible.
## Apéndice: Mapas de soluciones y arquitecturas del sistema
Este apéndice proporciona ejemplos concretos de cómo se componen los patrones de agentes en soluciones a nivel del sistema.
### Apéndice A: Ejemplo de composición de patrón básico
Este diagrama ilustra cómo se pueden conectar cinco patrones fundamentales entre sí para crear un flujo de trabajo de servicio al cliente común.
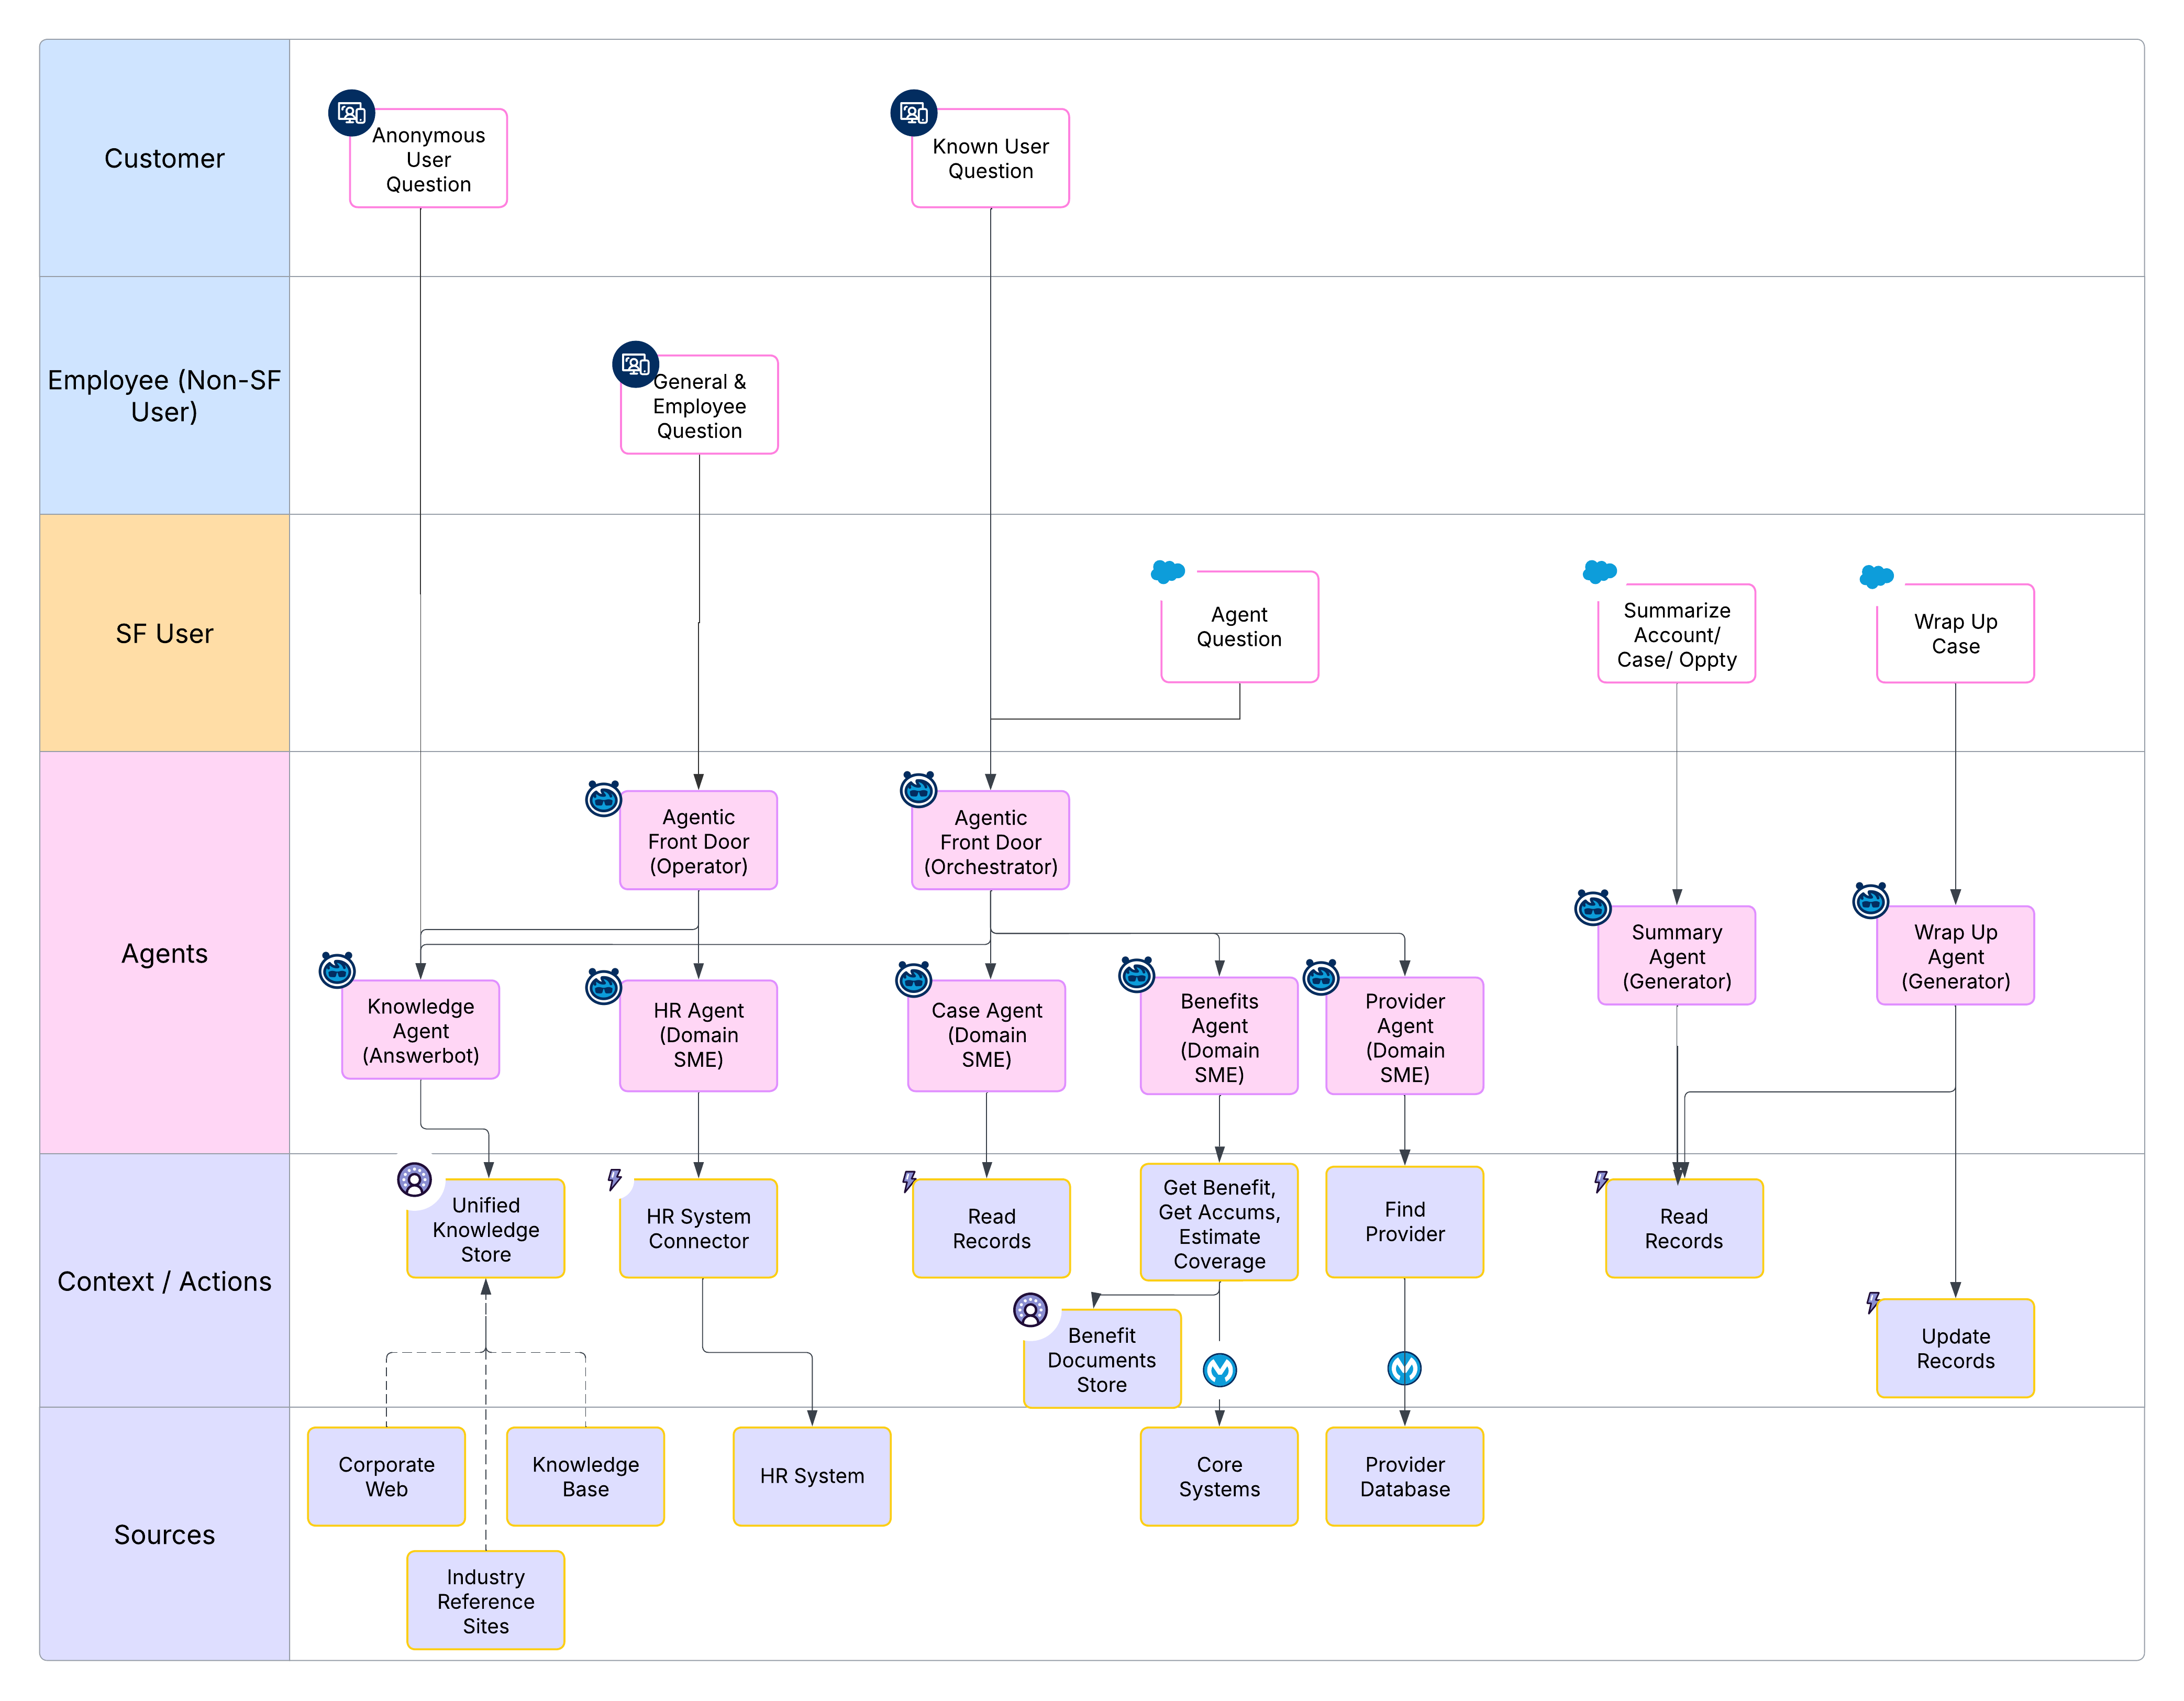 1. **Answerbot**: Un usuario anónimo formula una pregunta, gestionada por un agente basado en Knowledge.
2. **Operador**: La pregunta de un empleado es clasificada por un Operador, que asigna un campo a la plática y la pasa a un agente más especializado.
3. **Orquestador**: Un usuario autenticado (SF User) se implica con un Orchestrator que coordina múltiples agentes para gestionar una consulta potencialmente multifacética.
4. **PYME de dominio**: Los agentes especializados (por ejemplo, Agentes de RRHH o Agentes de beneficios) son invocados por el orquestador para realizar actualizaciones de materia y recuperar datos específicos.
5. **Generador**: Los agentes de utilidades se utilizan para resumir detalles de cuenta o cerrar un caso después de que se complete la interacción.
### Apéndice B: Mapa de soluciones de agente - Servicios de miembros
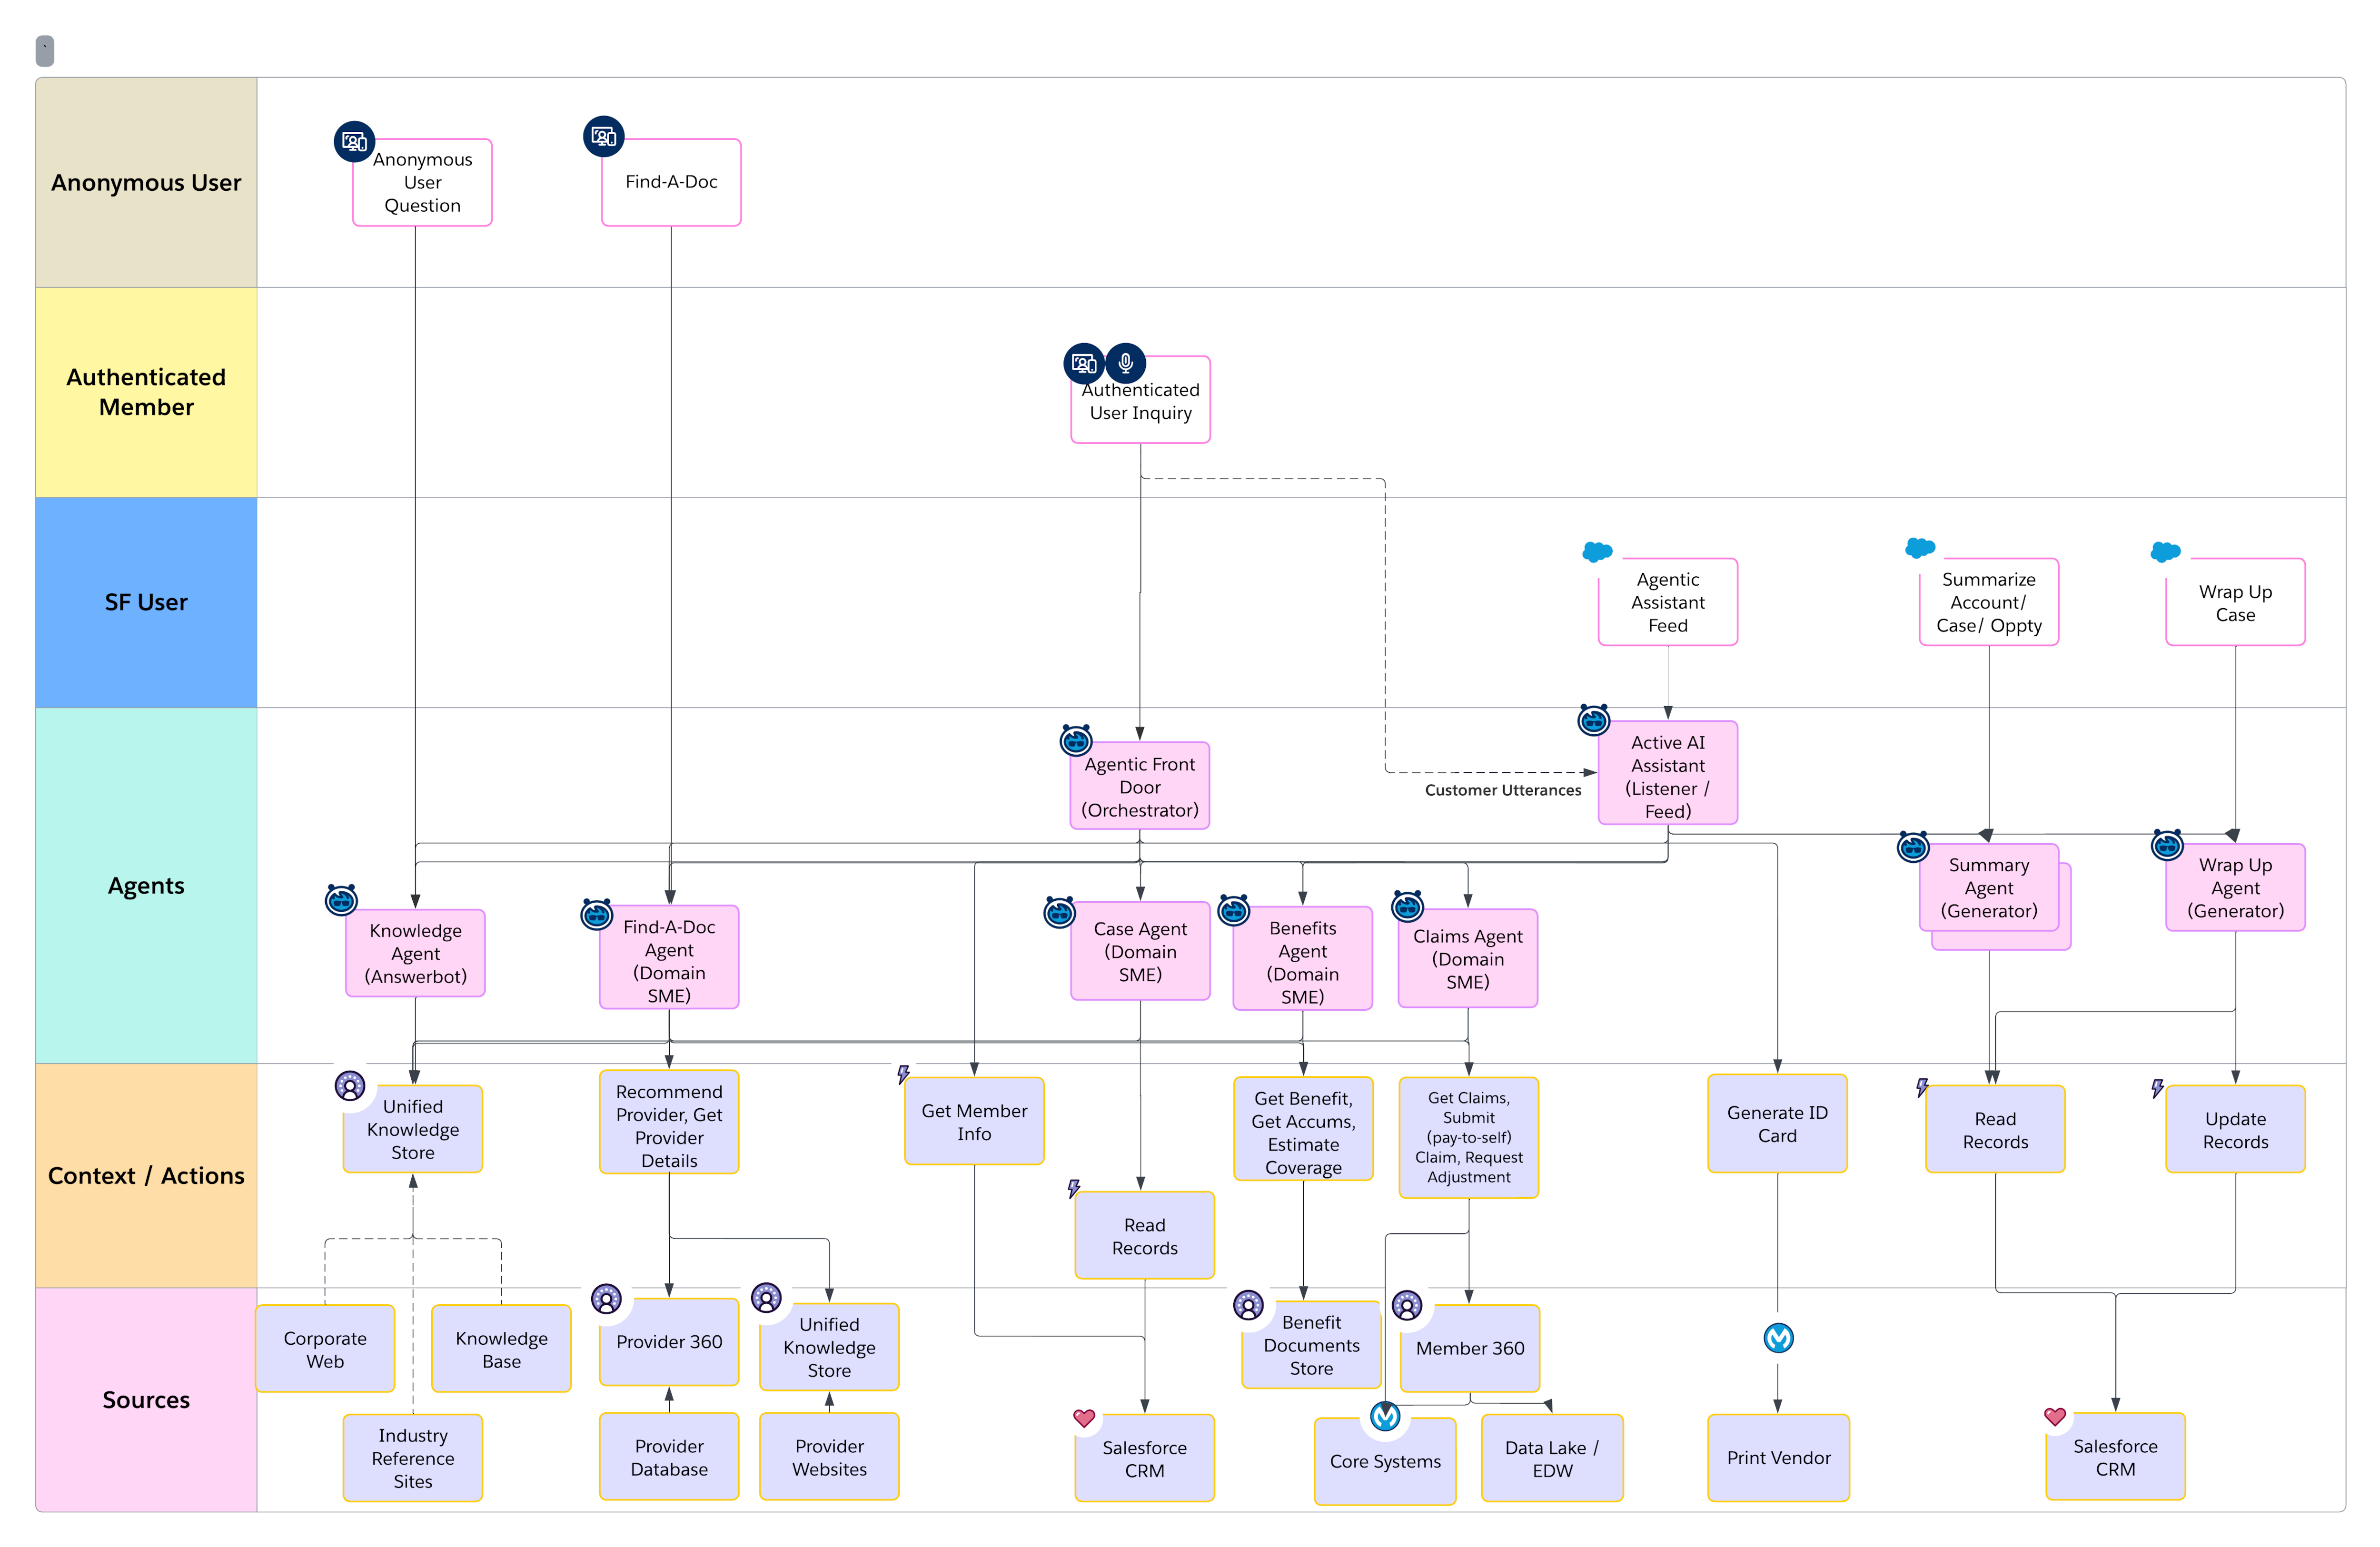
Este mapa de soluciones detalla una arquitectura agente para un caso de uso de Servicios de miembros, demostrando la composición de múltiples patrones.
- **Perfiles de usuario**: La solución sirve para tres tipos de usuario distintos: Usuario anónimo, Miembro autenticado y Usuario de SF (por ejemplo, un CSR humano).
- **Patrones de interacción**: Un _bot de respuesta_ gestiona consultas anónimas de "Buscar un documento", mientras que un orquestador (Puerta principal de agencia) gestiona consultas de usuarios autenticados. Un _patrón Escucha/Noticias_ asiste al usuario de SF.
- **Reutilización de agente de dominio**: Los _agentes PYME de dominio_ especializado (por ejemplo, Agente de casos, Agente de reclamaciones o Agente de beneficios) se reutilizan entre diferentes flujos de interacción.
- **Autonomía y asistencia**: El sistema combina _agentes autónomos_ (para dirigir la interacción del usuario) y _agentes de asistencia_ (para aumentar las CSR humanas).
- **Orígenes de datos**: La arquitectura integra una mezcla de orígenes de datos públicos y de compañía, con un amplio uso de _Data 360_ y _MuleSoft_ para la conectividad.
 ### Apéndice C: Arquitectura del sistema - Centro de contacto
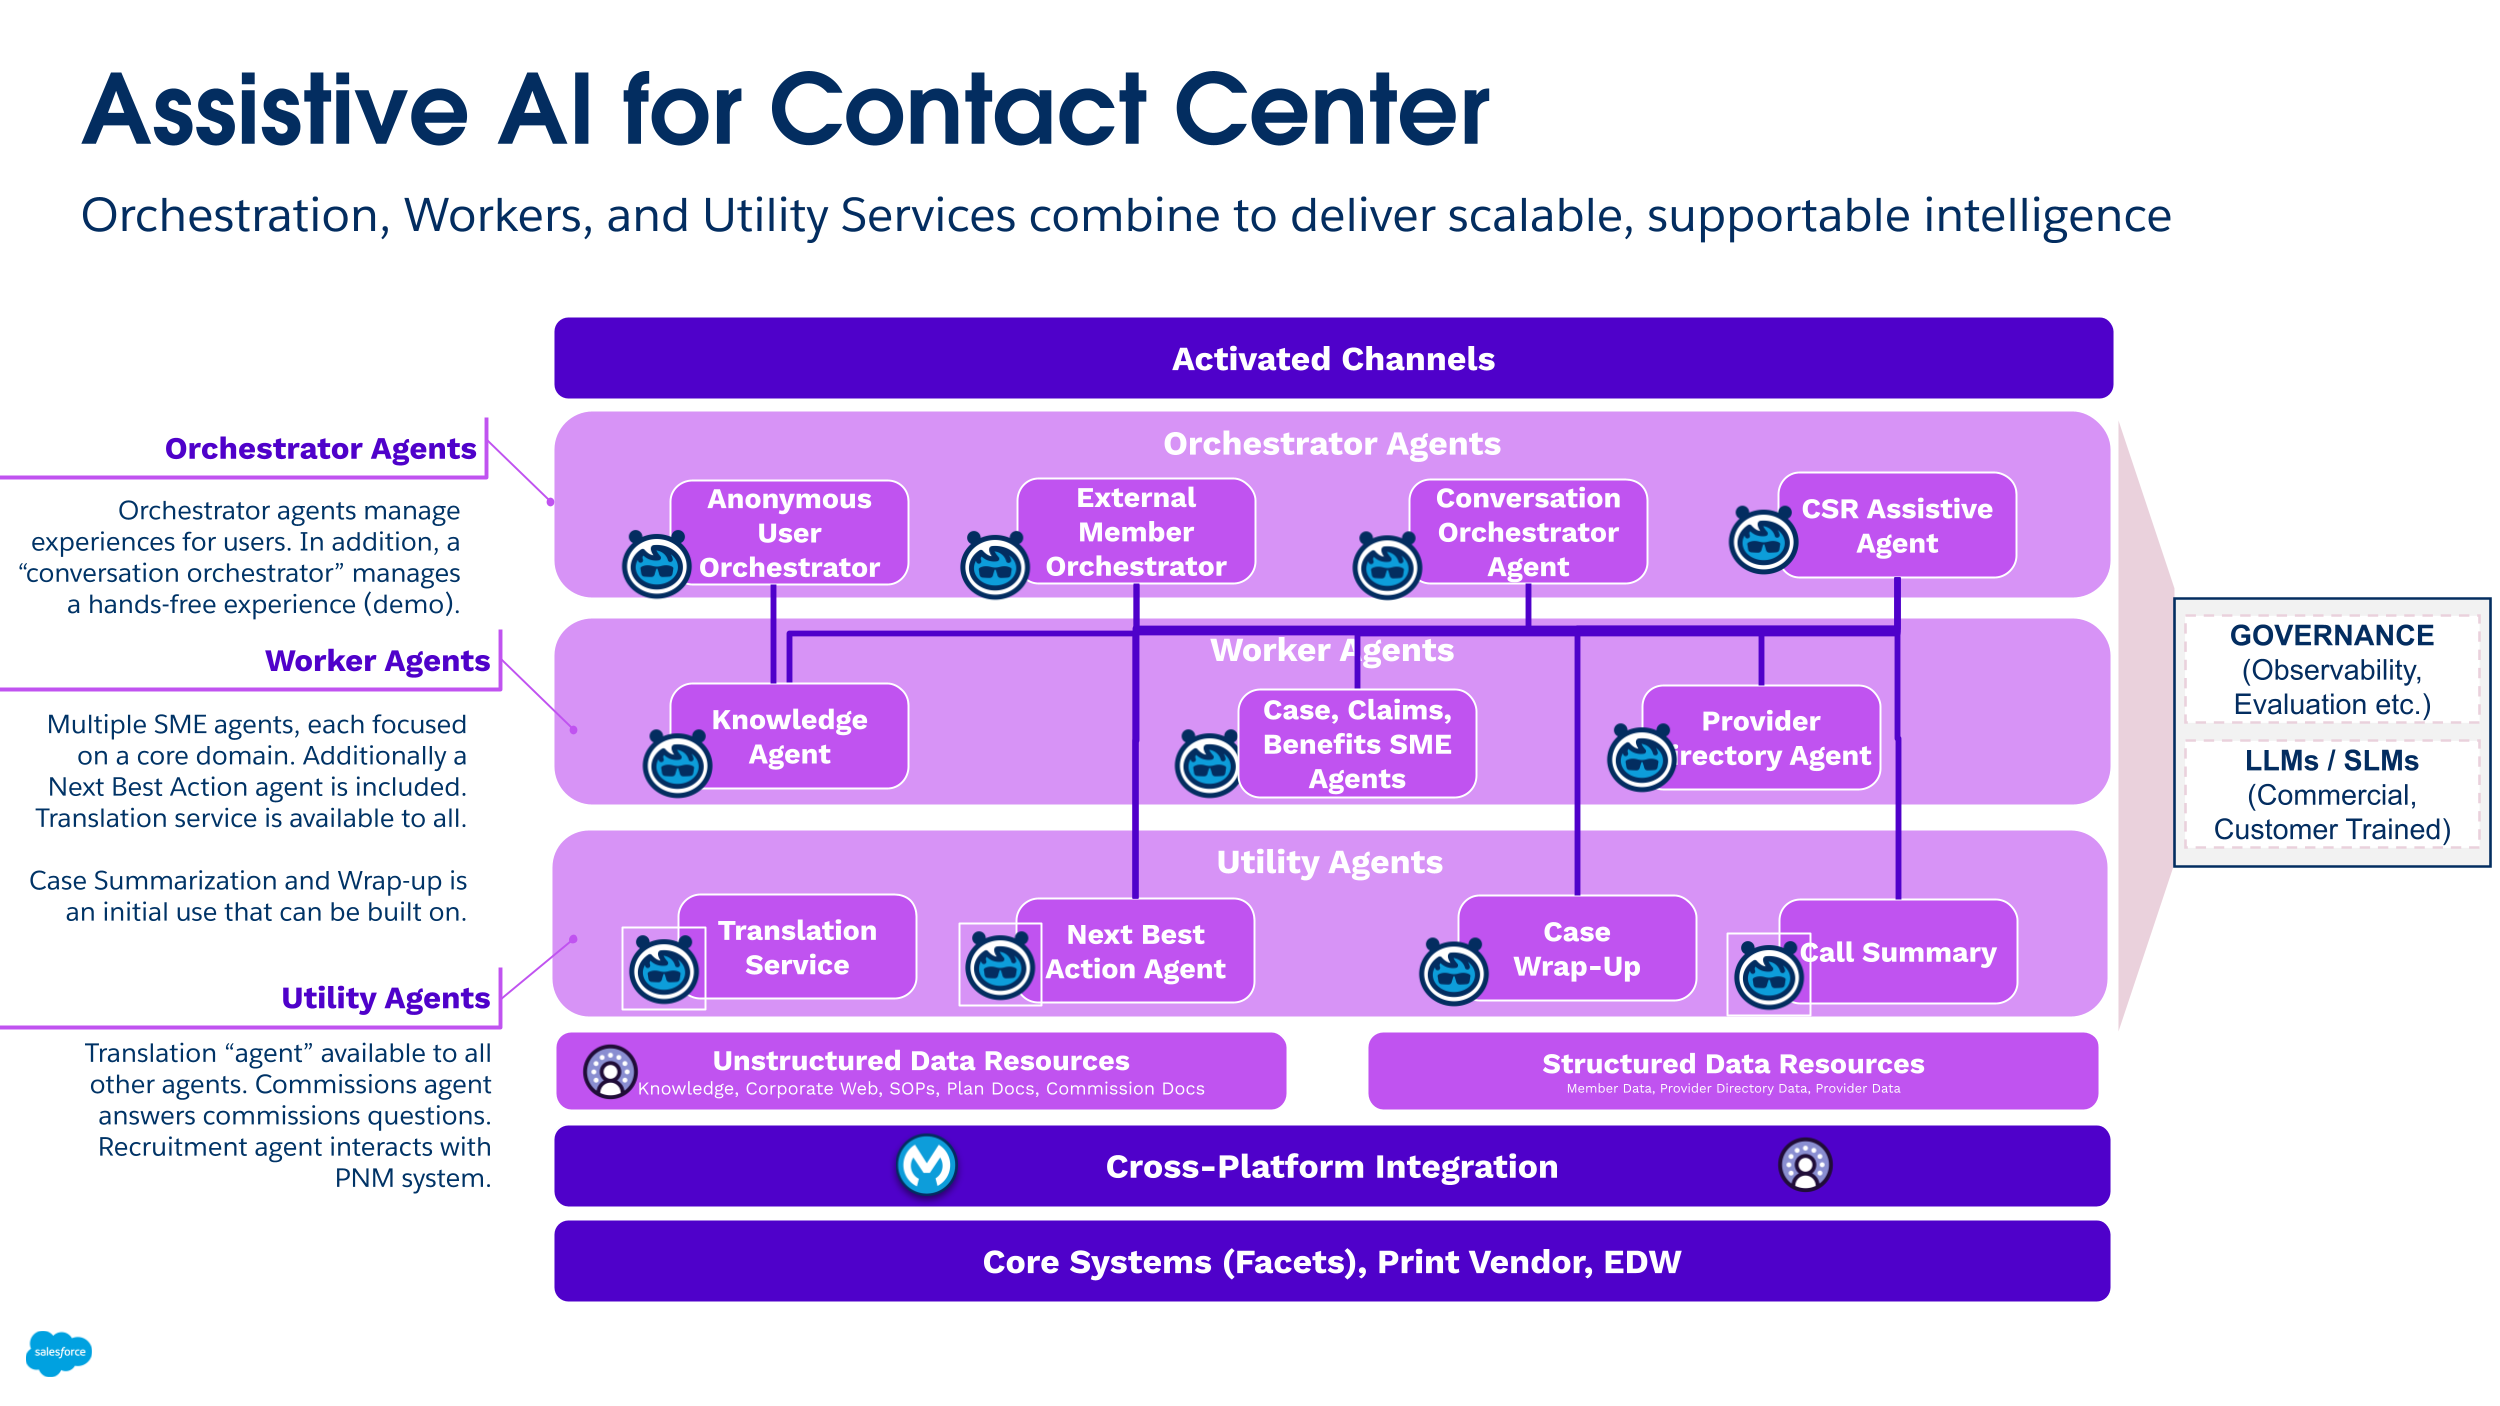
Este diagrama ilustra una arquitectura lógica para una solución de IA de asistencia en un Centro de contacto, organizada en capas funcionales.
- **Agentes orquestadores**: Gestione experiencias de usuario para diferentes personas (por ejemplo, Anónimo, Miembro externo o CSR) y orqueste el flujo de interacción general.
- **Agentes de trabajo**: _Múltiples agentes Pymes_ se centran en dominios de negocio principales como Knowledge, Caso/Reclamaciones/Beneficios y Directorio de proveedores. También se incluye un agente de _Next Best Action_.
- **Agentes de utilidades**: Realice tareas específicas reutilizables como Traducción, Cierre de casos y Resumen de llamadas.
Integración y sistemas principales: Todo el sistema agente está conectado a través de una capa de integración entre plataformas a recursos de datos no estructurados, recursos de datos estructurados y sistemas de negocio principales.
- **Gobernanza**: Una capa de gobernanza proporciona observabilidad, evaluación y gestión para los LLM/SLM utilizados por los agentes.
Arquitectura del sistema del centro de contacto
 ### Apéndice D: Mapa de soluciones de agente - Portal de corredores
Este mapa de soluciones detalla una interacción compleja y de larga duración para un portal de corredores de seguros médicos B2B. El modelo incluye un _agente de portal_ (_Orquestador_) que facilita la trayectoria del corredor por múltiples pasos (por ejemplo, enviar una RFP y recibir una propuesta). Este orquestador invoca a un agente _Gestor de proyectos_, que a su vez coordina varios agentes desatendidos para transformaciones y calidad de datos de back-office, como Extractor de RFP, Transformación de censo y Administrador de datos.
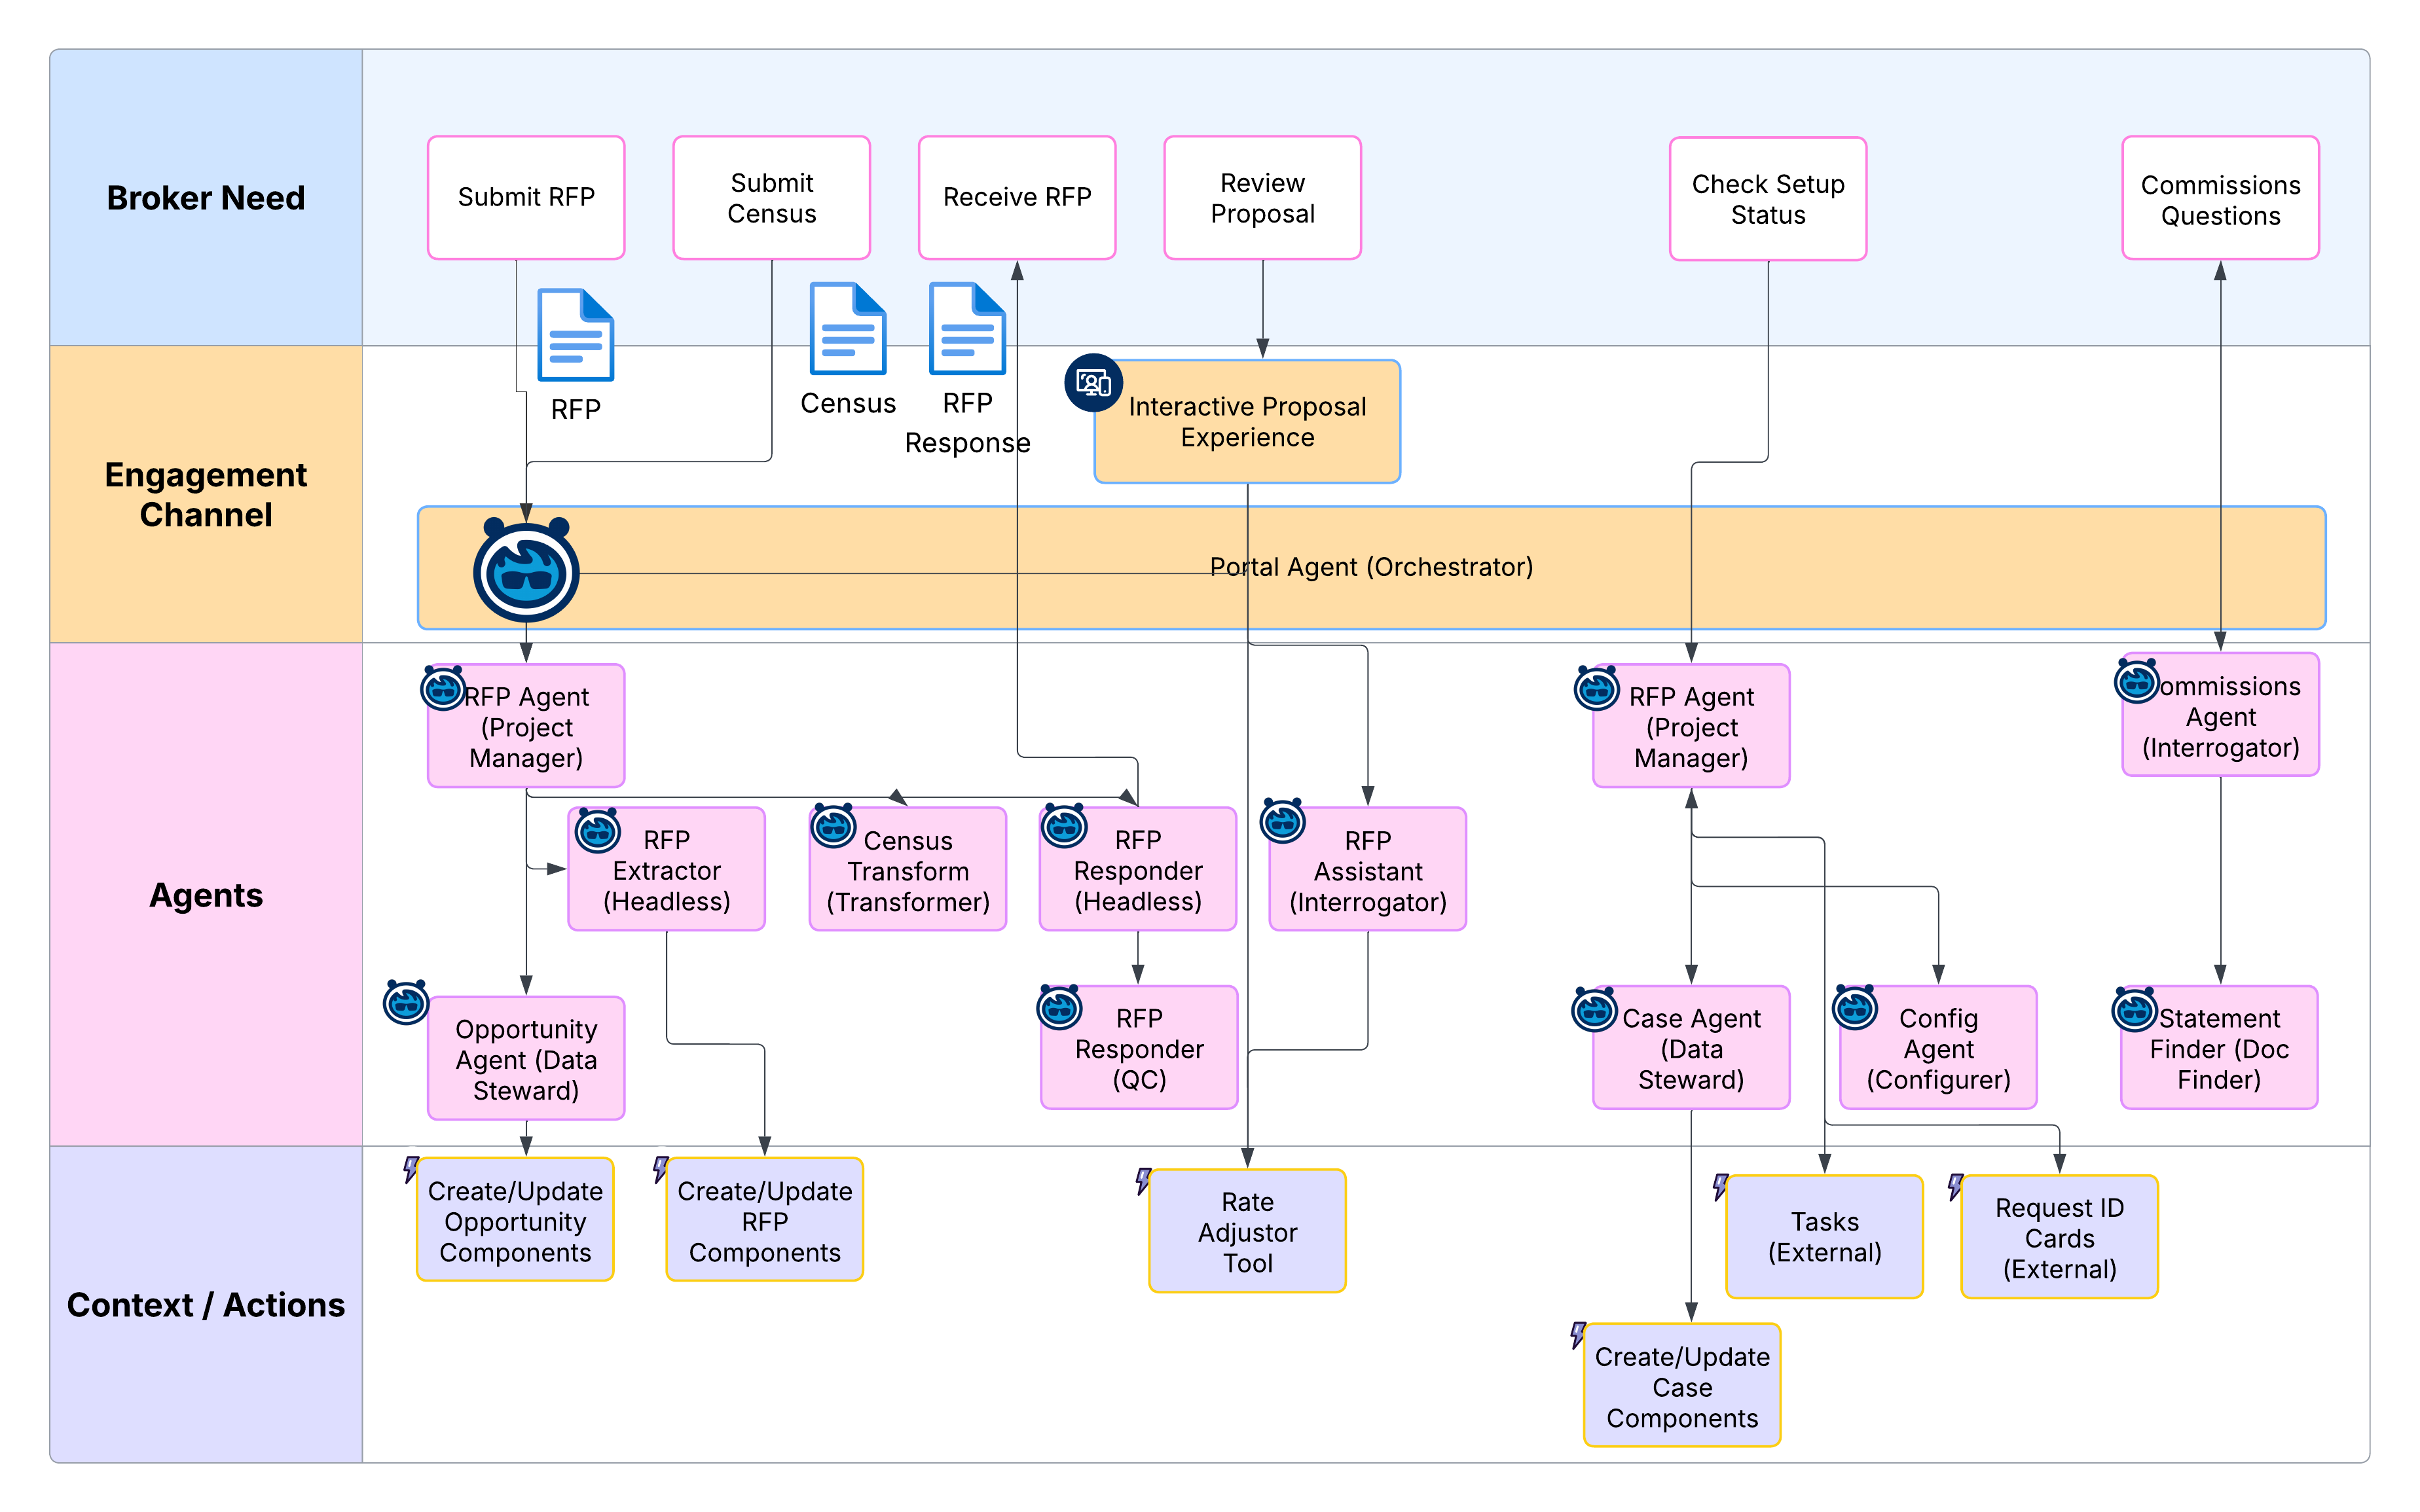 ### Apéndice E: Arquitectura del sistema - Agentes de B2C Broker
Este diagrama muestra una arquitectura lógica para una solución de B2C Broker, que demuestra un enfoque por capas similar al Centro de contacto. Incluye _agentes de orquestador_ para diferentes personas de usuario, _agentes de trabajador_ reutilizables para dominios clave (por ejemplo, Knowledge, Servicios de miembros o Comisiones) y _agentes de utilidades_ para funciones específicas como traducción y resumen.
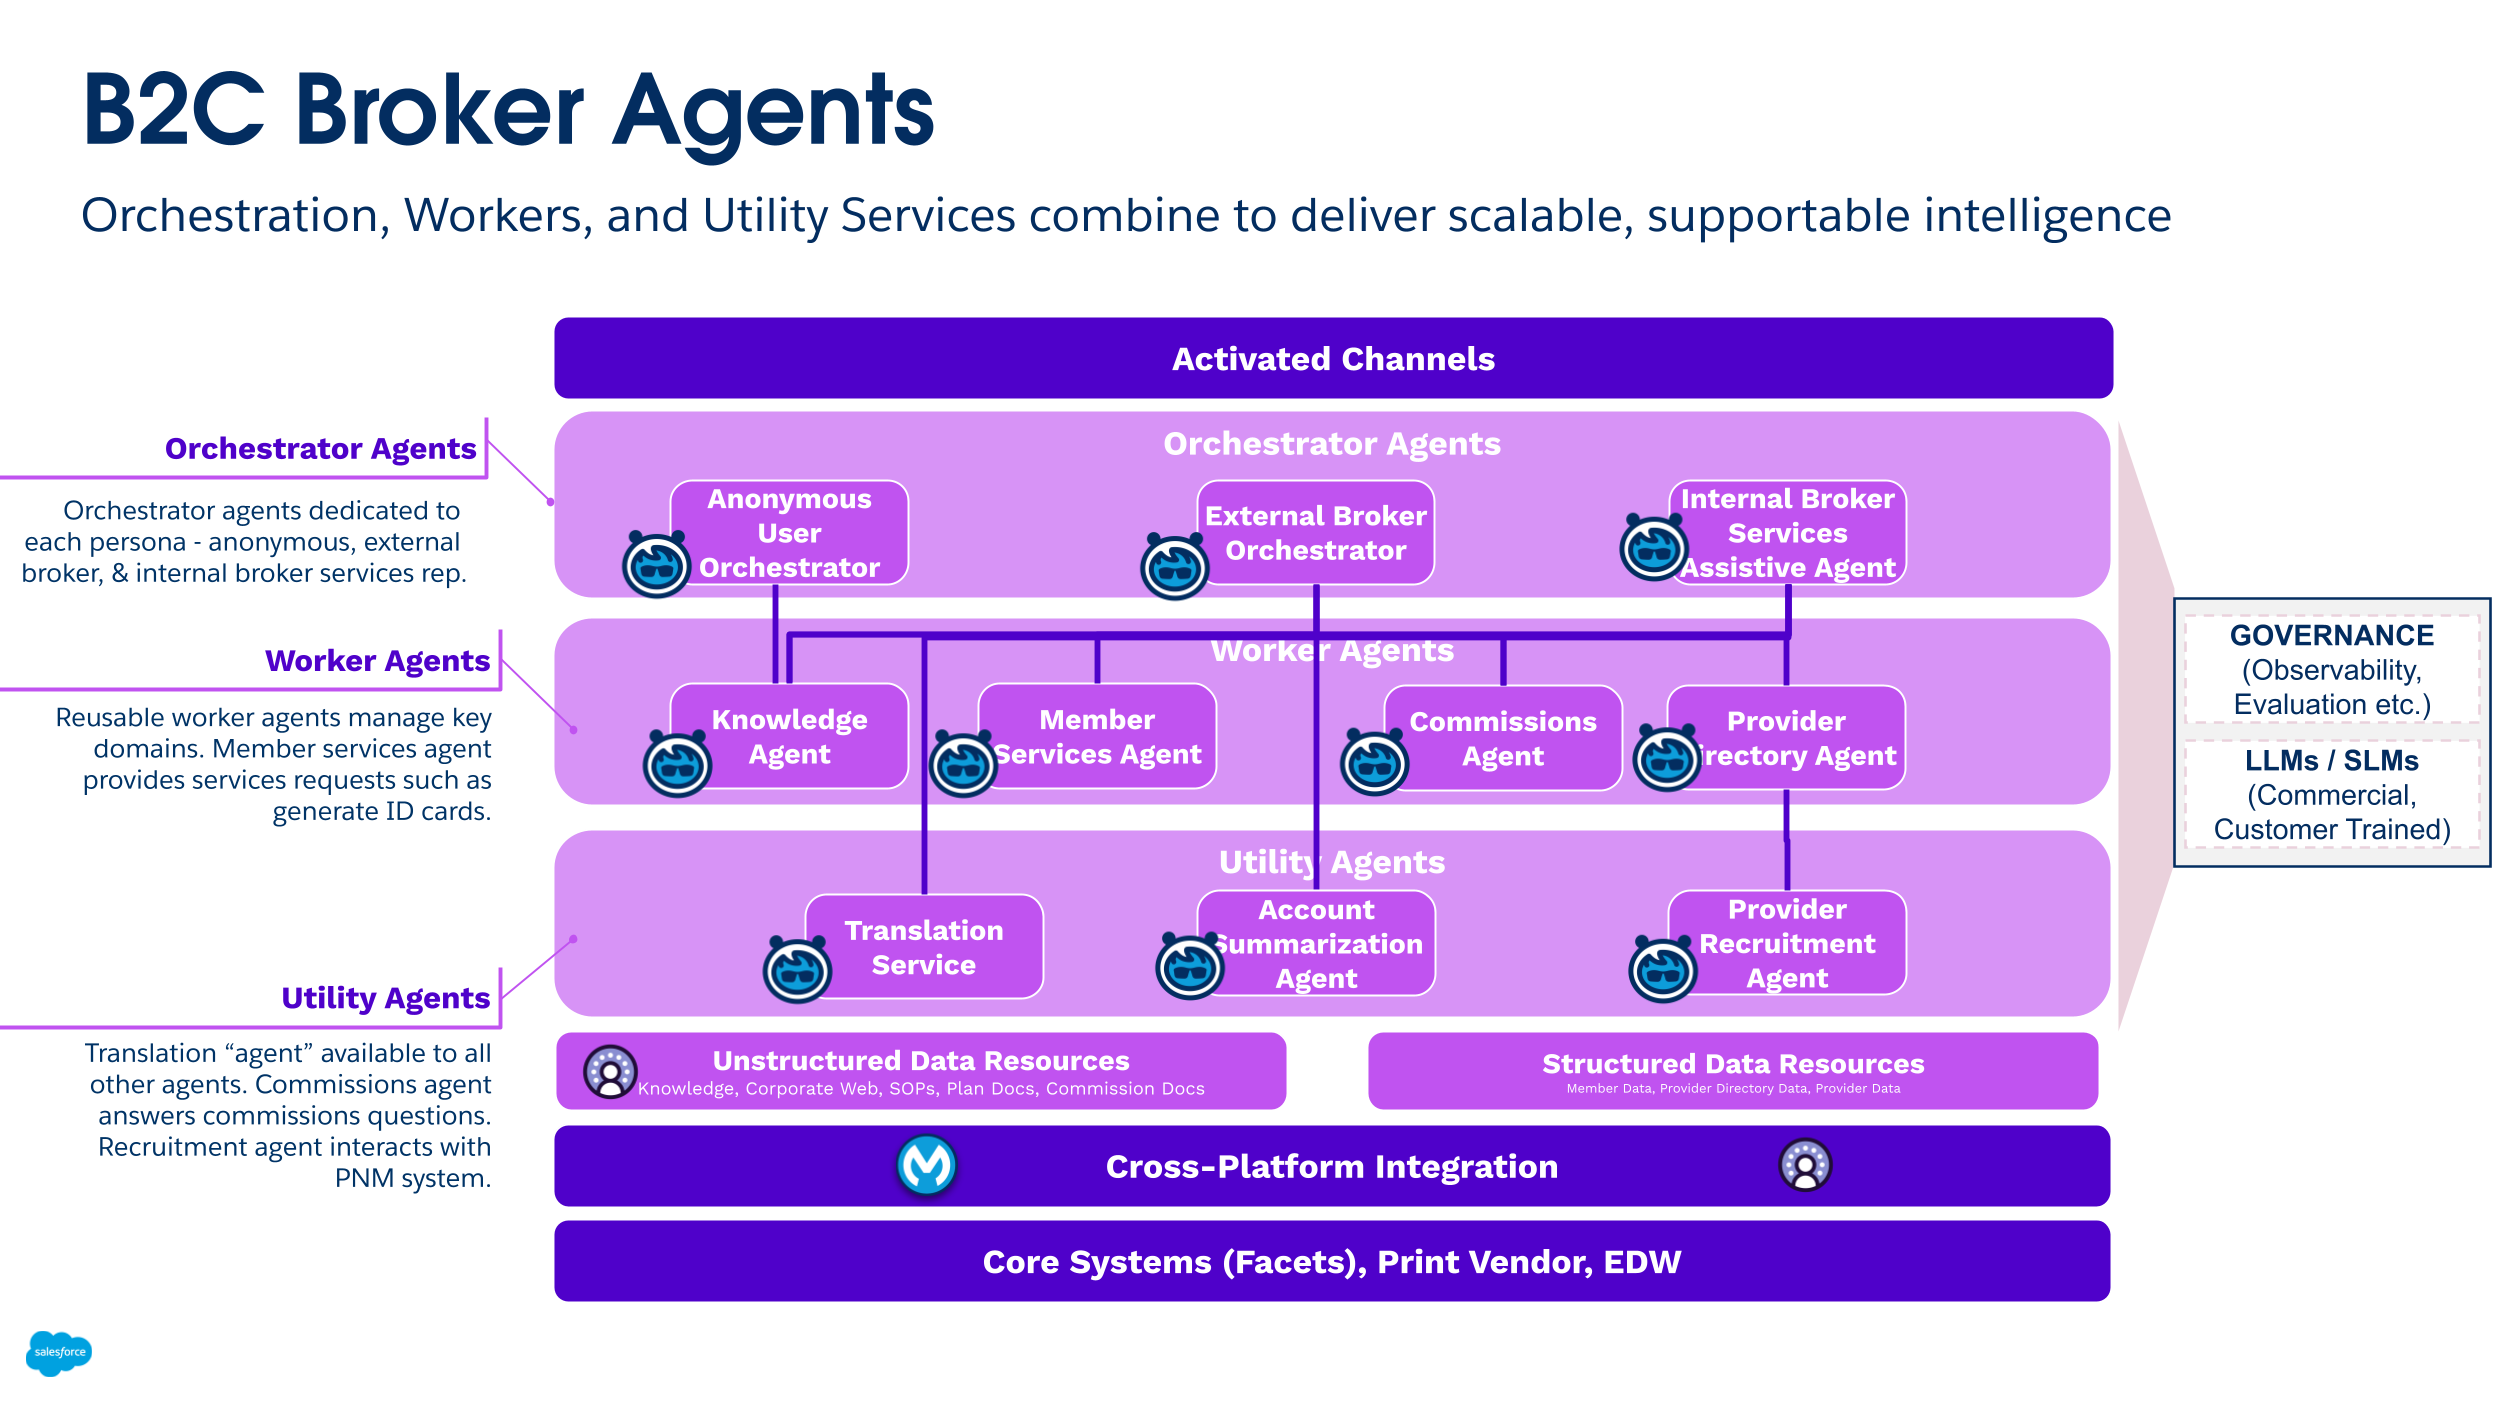 ### Apéndice F: Arquitectura del sistema - Contratación de proveedores
Este diagrama muestra una arquitectura lógica para una solución Contratación de proveedores. Los agentes _de orquestadores_ gestionan interacciones completas, los _agentes de trabajadores_ gestionan intenciones específicas dentro de un dominio (por ejemplo, un agente de PYME de contratación) y los agentes de _utilidades_ realizan tareas discretas como comparar contratos o generar perspectivas.
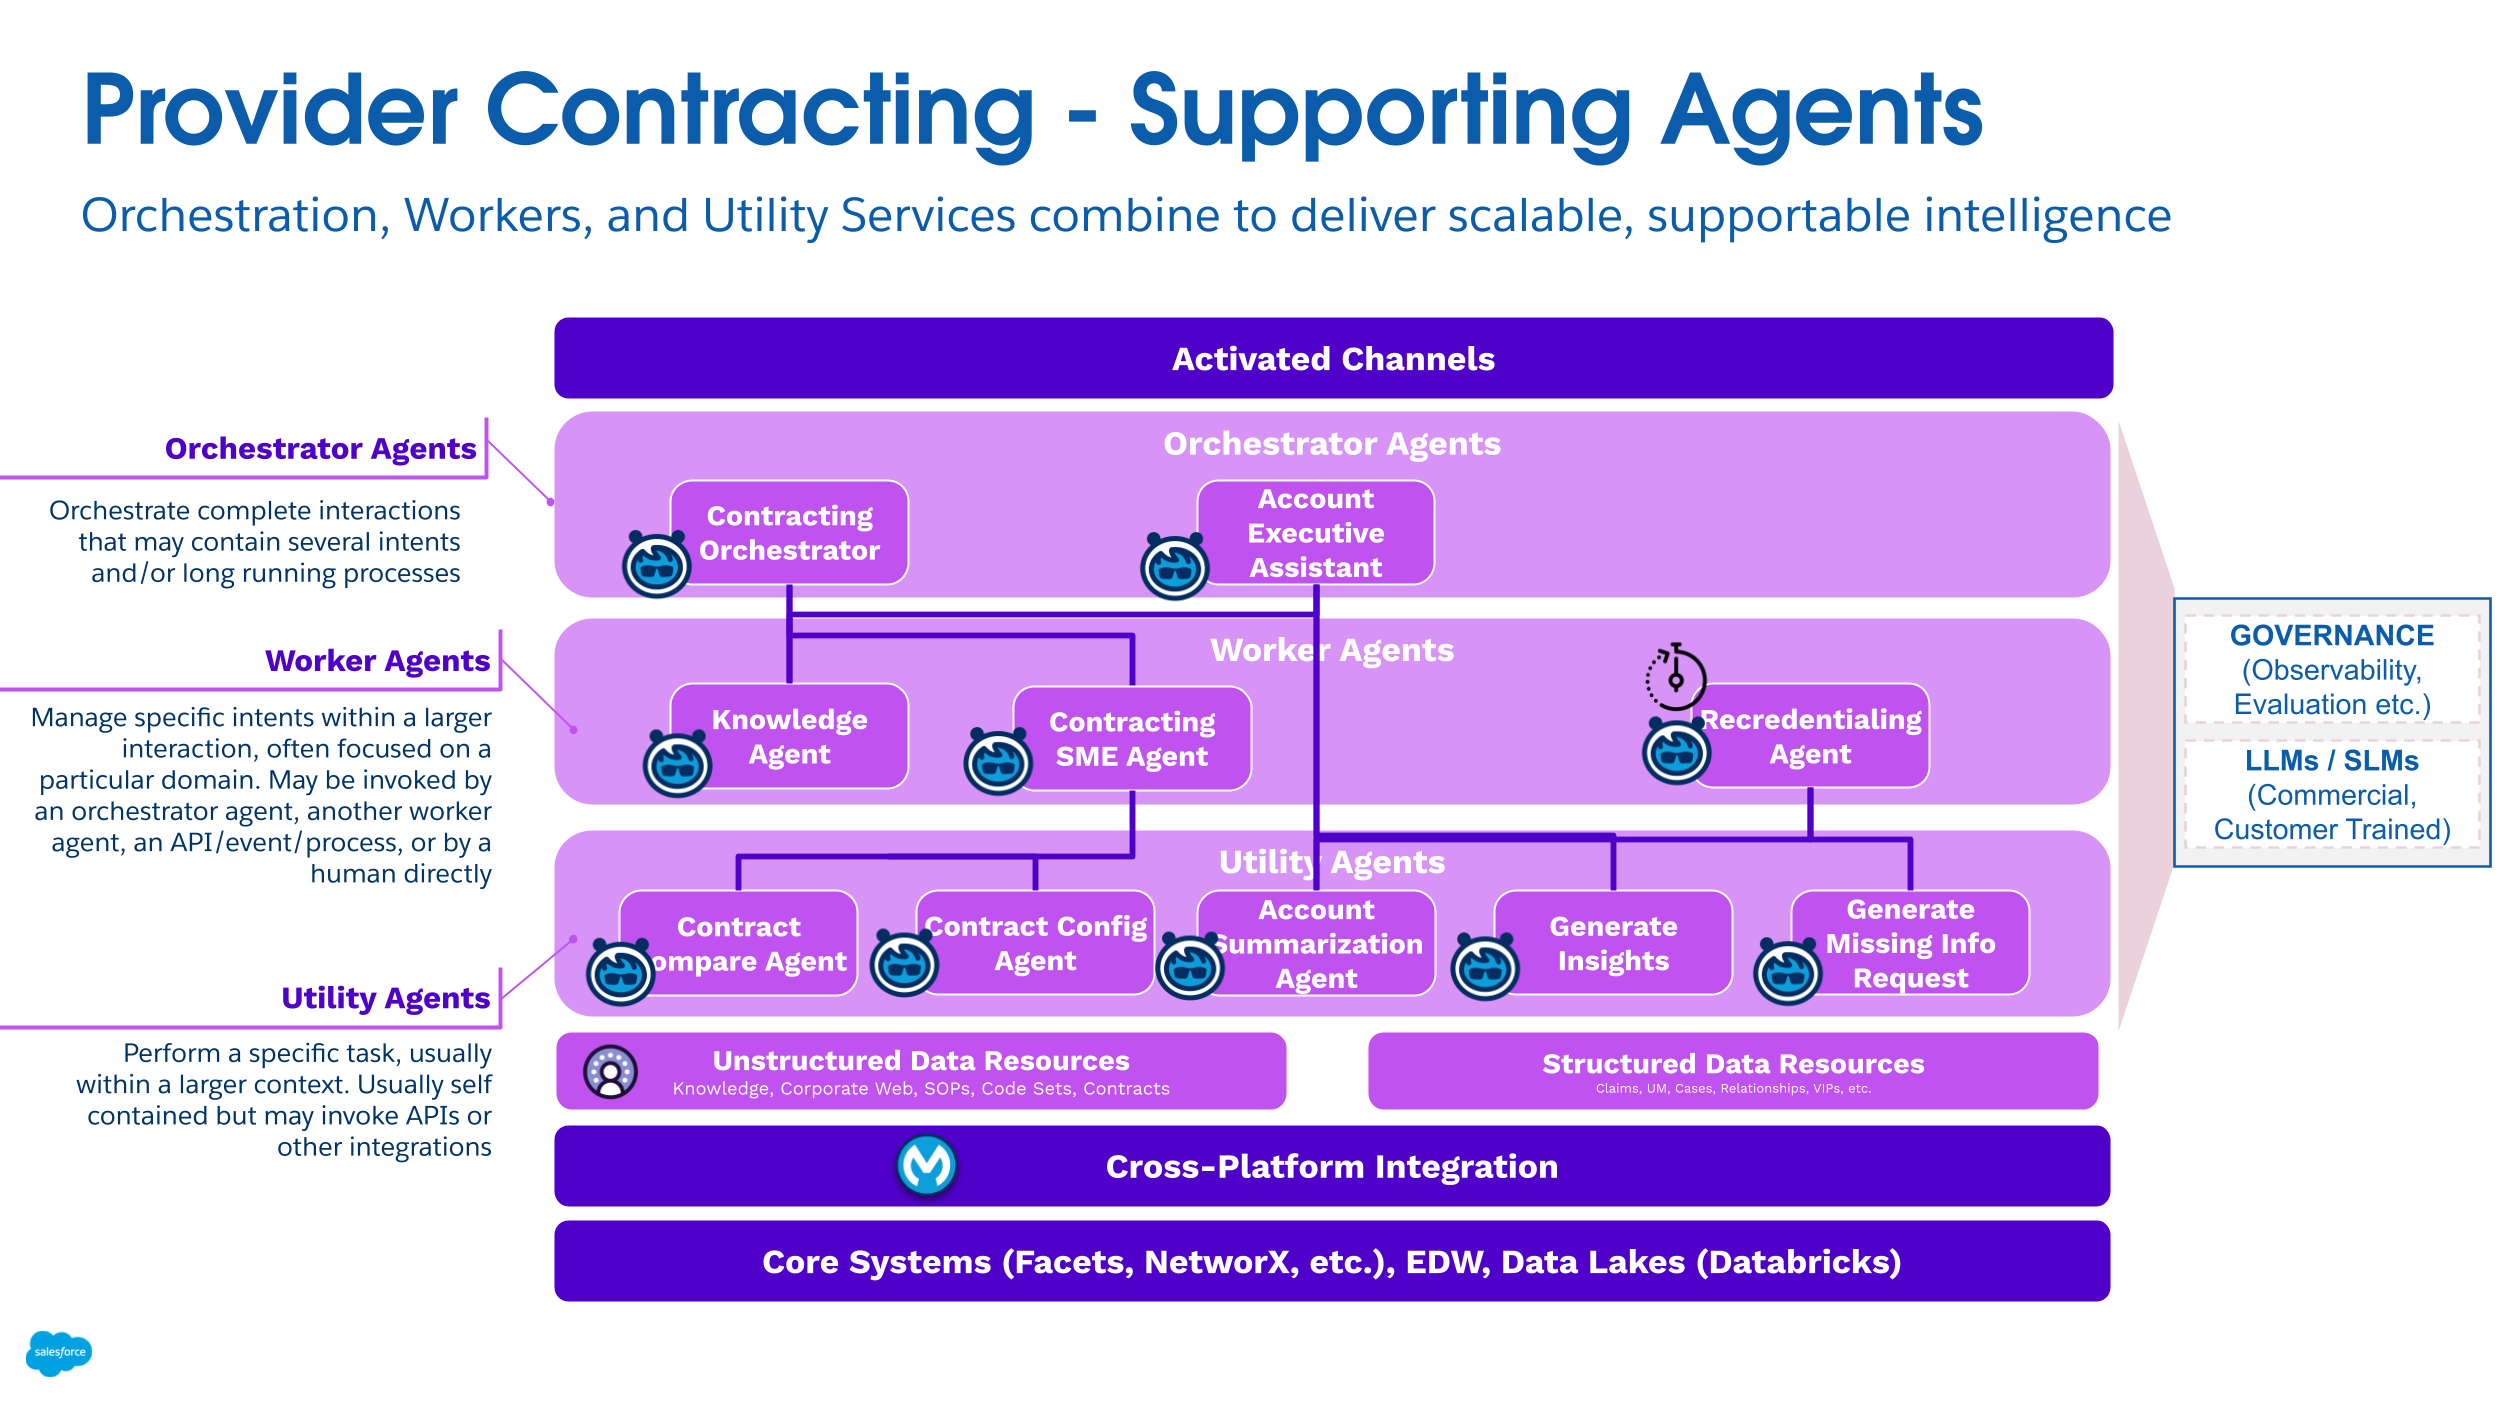 ### Apéndice G: Tabla de resumen de patrones de interacción
La siguiente tabla resume varios patrones de interacción clave, experiencias de usuario habituales y fines arquitectónicos principales.
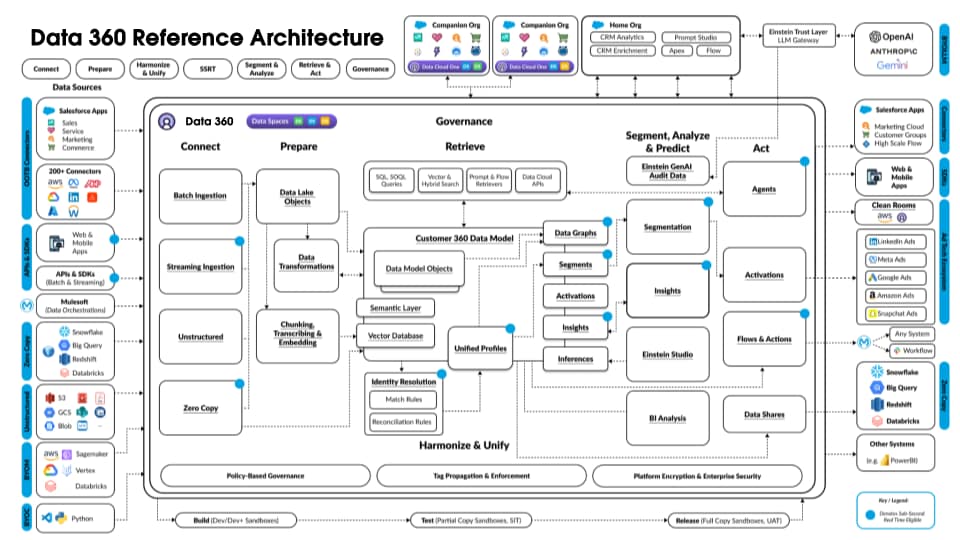 Consideremos un hipotético Agentforce Loan Agent en capas sobre Data 360 para describir un flujo de arquitectura de ejemplo. Supongamos que el Agente de préstamos es un agente de cara al cliente donde los clientes (consumidores) solicitan préstamos y obtienen aprobaciones de préstamos instantáneas.
Data 360 realiza estos pasos según lo programado, preparando datos para su uso por el Agente de préstamos.
- Data 360 ingresa datos de Cuenta de cliente estructurados desde CRM y los almacena en el lago de datos.
- Data 360 procesa datos de política financiera y préstamo de compañía no estructurados.
- Data 360 federa datos personales desde una fuente de datos externa como Snowflake.
- Data 360 transforma y modela datos ingresados y federados.
- Data 360 crea y mantiene el gráfico de datos de perfil.
Cada vez que un cliente solicita un préstamo, se realizan estas acciones.
- Un cliente inicia sesión en el Agente de préstamos, que inicia una sesión de cliente en la capa en tiempo real. El perfil unificado del cliente se extrae en la capa en tiempo real.
- El cliente completa una solicitud de préstamo proporcionando la información requerida.
- El cliente carga documentos financieros (como devoluciones de impuestos, inversiones, extractos bancarios) en Data 360 para el procesamiento de datos no estructurado.
- Los datos cargados se fragmentan y vectorizan (generación de incrustación) y se crean índices (palabra clave y vector).
- A continuación, el cliente rellena el documento de solicitud de préstamo y lo carga. Data 360 extrae el importe y la duración del préstamo en tiempo real.
- El Agente de préstamos recupera datos financieros relevantes utilizando la consulta Data 360 y la búsqueda híbrida sobre el perfil y otros índices precreados.
- El Agente de préstamos activa un Agente de aprobación con datos de préstamos y otros datos de perfil financiero para tomar la decisión de aprobación de préstamos.
- El Agente de préstamos responde al cliente con una decisión.
- Esta interacción completa entre el cliente y el Agente de préstamos también se captura y se almacena en Data 360.
El ejemplo anterior proporciona una descripción general de componentes de arquitectura de Data 360 utilizados para crear una aplicación Agente como un Agente de préstamos. En la siguiente sección describimos los componentes y las capas de arquitectura de Data 360.
## Arquitectura de Data 360
En esta sección, profundizaremos en los elementos constructivos fundamentales de Salesforce Data 360, comenzando con su sólido modelo de almacenamiento y explorando posteriormente los mecanismos para conectar, ingresar y preparar datos. Luego examinaremos cómo se almacenan, modelan y procesan los datos estructurados y no estructurados, lo que culmina en una comprensión de sus funciones de Armonización, Unificación, Recuperación y Activación inteligente.
### Almacenamiento de Data 360
Salesforce Data 360 se basa en un modelo de almacenamiento por niveles pero integrado que combina los puntos fuertes de un lago con almacenamiento en tiempo real. La capa de lago proporciona almacenamiento escalable y rentable para grandes volúmenes de datos históricos y por lotes, permitiendo análisis avanzados y casos de uso de aprendizaje automático. El almacenamiento en tiempo real, por otro lado, está optimizado para el acceso de baja latencia y actualizaciones de alta frecuencia, garantizando que las interacciones, los perfiles y las señales de implicación de los clientes estén siempre actualizados. Juntos, estos niveles funcionan a la perfección, permitiendo que los datos se muevan de forma fluida entre contextos históricos y en tiempo real, proporcionando profundidad e inmediatez en una base de datos unificada para la personalización, la IA y la activación.
#### Lakehouse
Data 360 cuenta con una arquitectura de lago nativa basada en Iceberg/Parquet, diseñada para gestionar la gestión y el procesamiento de datos a gran escala para escenarios por lotes, de transmisión y en tiempo real que admiten datos estructurados y no estructurados, cruciales para aplicaciones de IA y análisis.
En lagos de datos basados en la nube como Azure, AWS o GCP, la unidad de almacenamiento fundamental es un archivo, normalmente organizado en carpetas y jerarquías. Lakehouse mejora esta estructura introduciendo abstracciones estructurales y semánticas de nivel superior para facilitar operaciones como consultas y procesamiento de IA/ML. La abstracción principal es una tabla con metadatos que define su estructura y semántica, incorporando elementos de proyectos de código abierto como Iceberg o Delta Lake, con capas semánticas adicionales agregadas por Data 360.
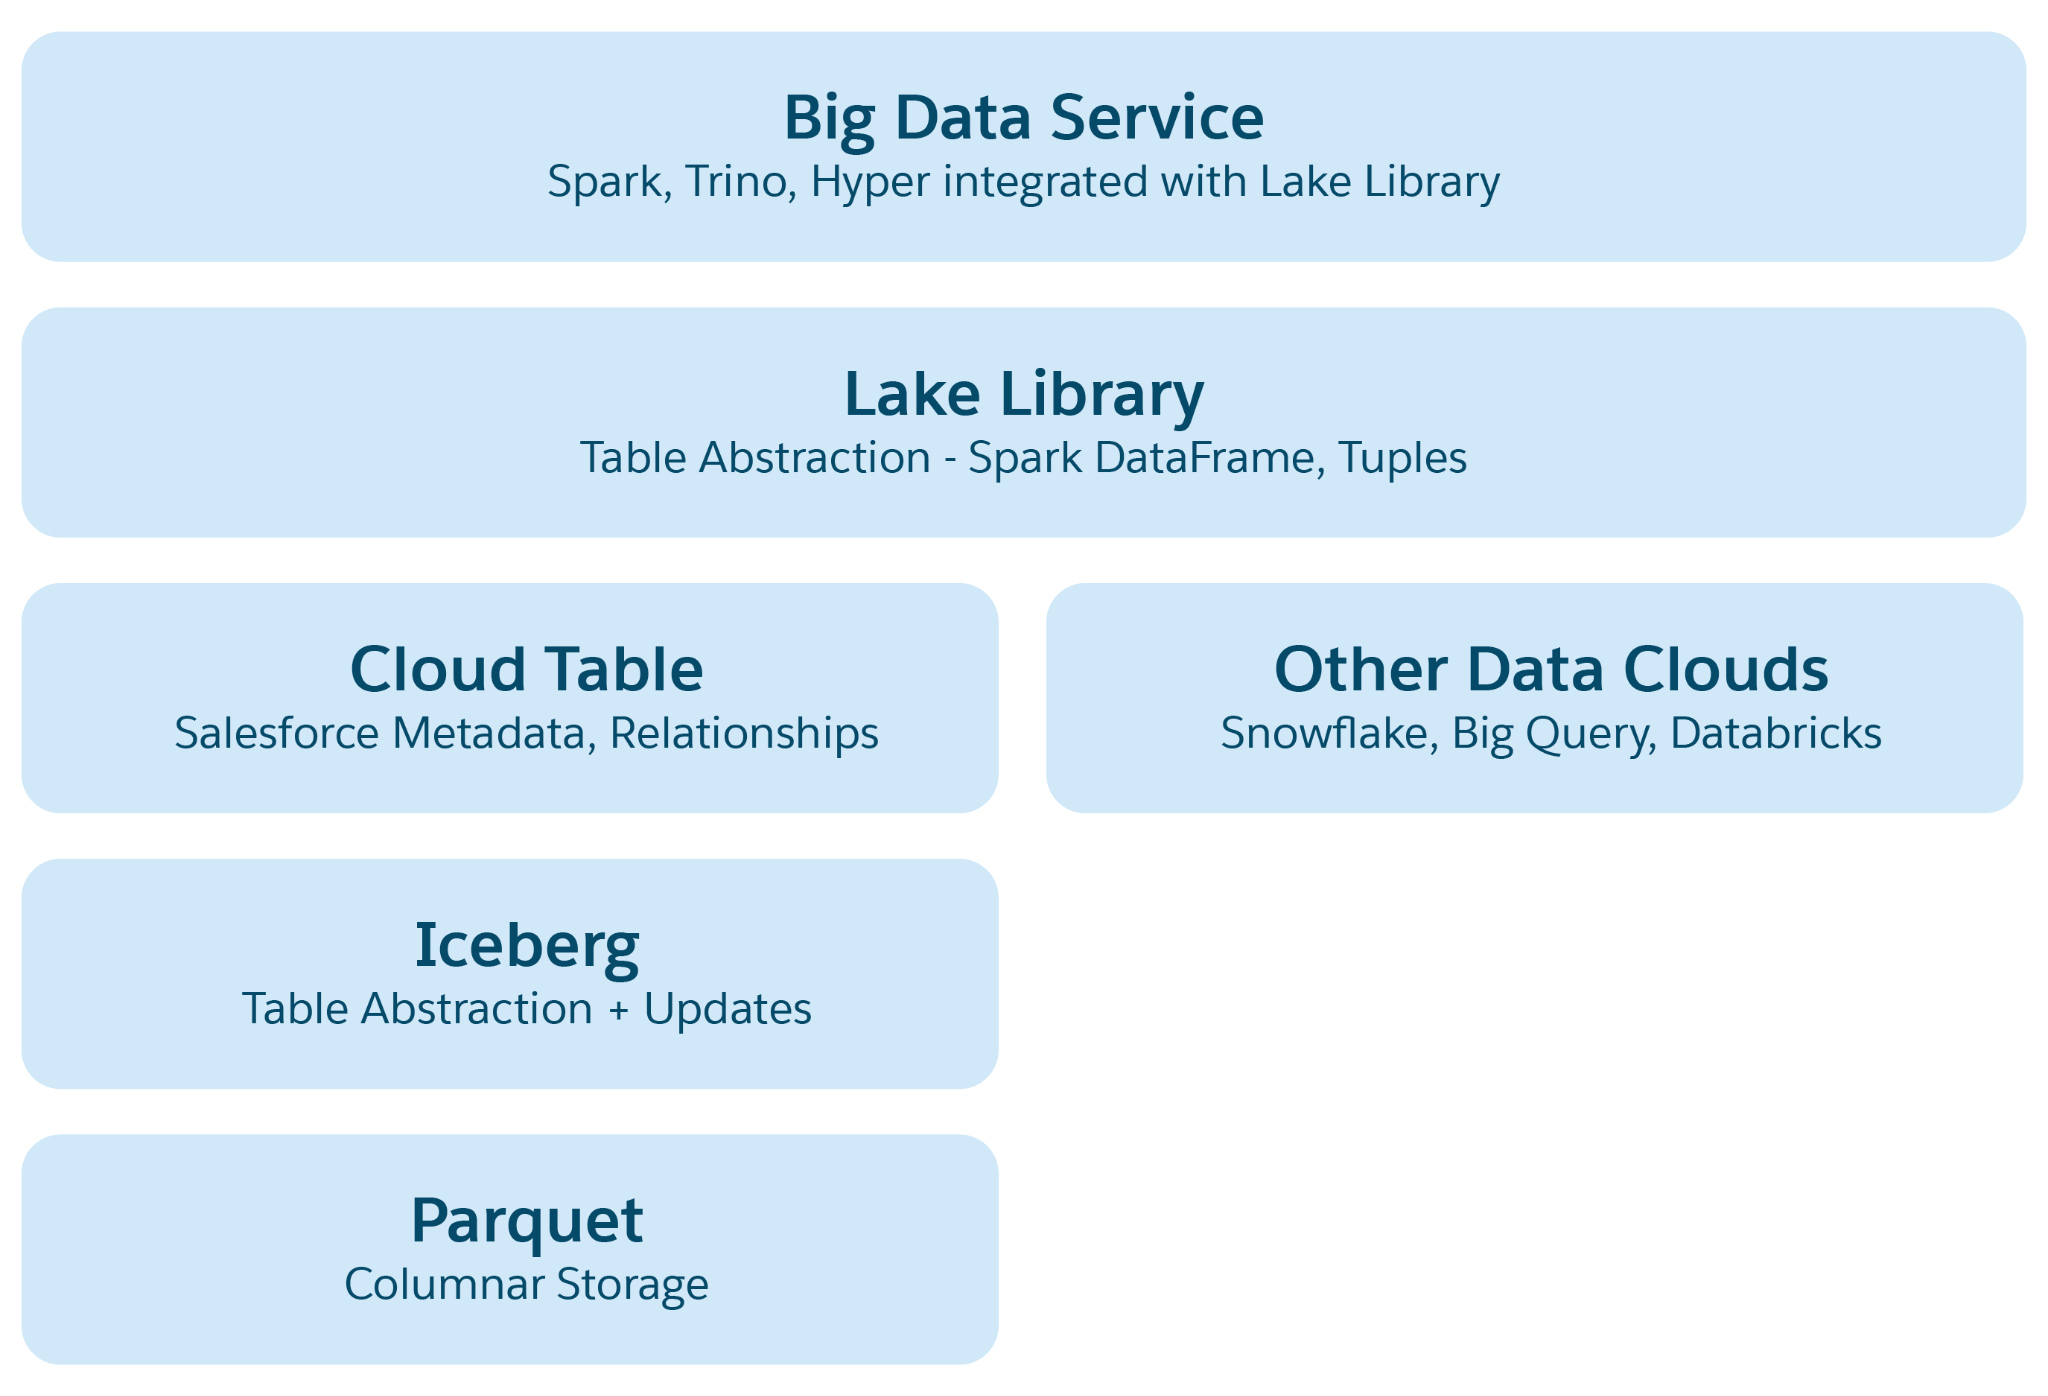 Capas de abstracción en Lakehouse:
1. **Abstracción de archivos Parquet**: En la base, el almacenamiento consta de archivos de lago de datos (por ejemplo, S3 en AWS o Blob en Azure) en formato Parquet. Los datos para una tabla de origen se almacenan entre múltiples particiones como archivos Parquet, siendo cada tabla una recopilación de estos archivos.
2. **Abstracción de tabla Iceberg**: Las tablas están organizadas como carpetas, con particiones de datos almacenadas como archivos Parquet en estas carpetas. Las modificaciones en una partición dan como resultado nuevos archivos Parquet como instantáneas. Iceberg gestiona un archivo de metadatos para cada tabla, detallando esquemas, especificaciones de particiones e instantáneas.
3. **Abstracción de tablas de Salesforce Cloud**: Basándose en Iceberg, esta capa agrega metadatos semánticos como nombres de columna y relaciones, junto con configuraciones como tamaño de archivo de destino y compresión. Abstrae tablas entre varias plataformas como Snowflake y Databricks, protegiendo aplicaciones de Data 360 de especificaciones de plataforma de almacenamiento subyacentes.
4. **Biblioteca de acceso**: a lago Esta biblioteca proporciona acceso a la Tabla de Salesforce Cloud, gestionando datos y metadatos, y resume los mecanismos de almacenamiento subyacentes para desarrolladores de aplicaciones.
5. **Extracción de Big Data Service**: Esto incluye marcos de trabajo de procesamiento como Hyper para consultas y Spark para el procesamiento en cualquier plataforma de tabla de nube.
#### Almacenamiento en tiempo real
Para dar cobertura a aplicaciones de análisis y agentes en tiempo real, Data 360 aumenta el almacenamiento de Big Data de Lakehouse con Establecimiento de baja latencia. Capa en tiempo real de Data 360 procesa señales en tiempo real y datos de implicación en memoria. Sin embargo, dado que la capacidad de almacenamiento basado en memoria es limitada, todos los datos no pueden ajustarse y el procesamiento podría no realizarse en tiempo real. Data 360 agrega un establecimiento de baja latencia (LLS) para eliminar dichas limitaciones, permitiendo el procesamiento en tiempo real ampliable.
El establecimiento de baja latencia es una capa de almacenamiento NVMe (SSD) a escala de petabytes en Lakehouse. No todos los datos deben mantenerse en el establecimiento de baja latencia. Es una caché duradera. La mayoría de los datos llegan finalmente a Lakehouse para la persistencia a largo plazo. Los datos en sesión en la capa en tiempo real se pueden enjuagar al establecimiento de baja latencia para un acceso rápido posterior. Por ejemplo, en una plática de agente, los mensajes recientes se pueden procesar en memoria; los mensajes antiguos se pueden enjuagar en el establecimiento de baja latencia. Si se requiere una plática anterior, se puede acceder a ella en unos milisegundos desde el establecimiento de baja latencia. El almacenamiento basado en NVMe permite almacenar grandes cantidades de datos y acceder a ellos en latencias de milisegundos. Los datos pueden llegar al almacenamiento de Lakehouse Cloud para la persistencia a largo plazo. Además, los datos de Lakehouse requeridos para el procesamiento en tiempo real o para aumentar experiencias en tiempo real se obtienen y se mantienen en el almacén de baja latencia. Por ejemplo, Contexto de perfil de cliente se obtiene previamente o se trae desde Lakehouse y se almacena en caché en el establecimiento de baja latencia. Del mismo modo, cualquier objeto de lago y otros objetos requeridos para el procesamiento en tiempo real durante el procesamiento en sesión también se pueden almacenar en caché en el establecimiento de baja latencia.
Almacén de baja latencia de Data 360 activa la capa Temporizador real en una verdadera jerarquía de almacenamiento con capas de almacenamiento Lakehouse de memoria (SSD), con datos que migran sin problemas entre estas capas. Tratamos la capa Tiempo real de Data 360 más adelante en este documento.
### Organización de datos
Salesforce Data 360 está diseñado para estandarizar, armonizar y activar todos los datos de clientes (estructurados y no estructurados) siguiendo un ciclo de vida riguroso que transforma la entrada sin procesar en un modelo de datos actual unificado.
#### Ciclo de vida de datos y tipos de objetos
El ciclo de vida se centra en tomar varias entradas de datos externos y estructurarlas en objetos modelados persistentes. Los datos modelados se pueden armonizar en perfiles unificados Customer 360.
**Datos ingresados sin procesar y transformaciones iniciales**
El proceso comienza con datos sin procesar ingresados tal cual desde sistemas de origen (CRM, Marketing, archivos, etc.). Esto incluye cargas de datos completas y eventos de cambio continuo (deltas), que se gestionan y combinan con datos persistentes para mantener un estado actual.
Las **transformaciones en línea** (por ejemplo, recortar, normalizar, concatenar) se aplican inmediatamente durante el ingreso para garantizar la calidad y limpieza preliminar de los datos.
##### Objetos de lago de datos (DLO): La capa persistente
**Los DLO** (Objetos de lago de datos) forman la capa de almacenamiento persistente principal en Data 360. Almacenan los datos limpios y transformados y sirven como el repositorio organizado a largo plazo para toda la información del cliente.
Las **transformaciones de datos** avanzadas (por ejemplo, uniones, agregaciones, perspectivas calculadas) se aplican a los DLO de origen para producir nuevos DLO derivados altamente depurados.
Los datos que están disponibles a través de Federación de datos de copia cero se representan directamente como DLO.
**Organización de metadatos y datos no estructurados**
Para contenido no estructurado (como texto, medios, documentos), Data 360 incorpora los datos extrayendo y manteniendo sus metadatos estructurados en DLO específicos denominados Objetos de lago de datos no estructurados (UDLO).
Estos DLO especializados funcionan como tablas de directorios, proporcionando un mapa a la ubicación física y el contexto de los activos no estructurados. Esta función permite a los arquitectos relacionar de forma transparente los metadatos de datos no estructurados con el resto de los datos de clientes estructurados, lo que permite la consulta y Armonización unificadas.
##### Objetos de modelo de datos (DMO): La capa armonizada
**Los DMO** (Objetos de modelo de datos) representan la capa de datos final, armonizada y estructurada.
Se crean asignando campos de DLO (desde DLO de metadatos de origen, derivados y no estructurados) al modelo de datos estándar Customer 360.
La capa de DMO actúa como la única fuente de confianza para todos los datos de clientes, permitiendo la creación, segmentación y activación de perfiles unificados en el ecosistema más amplio.
#### Espacio de datos: El contenedor lógico
Un espacio de datos es el contenedor lógico fundamental para organizar todos los datos y metadatos en Data 360, incluyendo todos los DLO (estructurados y no estructurados) y DMO. Los espacios de datos ofrecen un entorno seguro y aislado para el procesamiento y modelado de datos.
Los espacios de datos actúan como límites lógicos y de gobernanza, permitiendo el multiarrendamiento interno separando datos para distintas entidades como unidades de negocio, regiones o marcas, manteniendo al mismo tiempo la visibilidad, el linaje y el cumplimiento de toda la compañía, sirviendo como la base para definir el control de acceso de grano grueso.
El aislamiento en espacios de datos se aplica en múltiples capas de la plataforma:
- **Aislamiento a nivel de datos**: Cada DLO/DMO pertenece a un único espacio de datos, garantizando que las consultas, transformaciones y asignaciones de objetos no puedan cruzar los límites del espacio de datos a menos que se autoricen explícitamente.
- **Integración de control de acceso**: Los conjuntos de permisos están vinculados de forma nativa a espacios de datos, permitiendo el control sobre operaciones de lectura, escritura y administrativas. Esto garantiza que solo los usuarios y servicios autorizados puedan acceder a objetos, perspectivas y activaciones en un espacio de datos.
- **Gobernanza y auditoría**: Todas las operaciones en un espacio de datos se registran con seguimientos de auditoría de nivel de compañía, lo que permite la trazabilidad para el cumplimiento, la administración y la creación de reportes normativos.
El acceso y los permisos se gestionan a través de Conjuntos de permisos, garantizando visibilidad granular, actualizaciones controladas y prevención de fugas de datos entre dominios. Integrando límites de espacio de datos con la arquitectura de seguridad y gobernanza de Data 360, los arquitectos pueden implementar con confianza estrategias de gobernanza centralizadas y descentralizadas manteniendo la coherencia entre múltiples nubes y dominios de negocio.
#### Calcular tela
La estructura de computación de Data 360 proporciona una capa unificada para gestionar y ejecutar todas las cargas de trabajo de Big Data, simplificando las complejidades de infraestructura subyacentes. Su componente principal es el controlador de procesamiento de datos (DPC).
DPC es un servicio de orquestación de procesamiento de datos integral y con múltiples cargas de trabajo que proporciona funciones de trabajo como servicio (JaaS) entre diversos entornos de computación en nube. Abstrae la complejidad de la infraestructura y unifica la ejecución de trabajos para marcos de trabajo como Spark (EMR en EC2 y EMR en EKS) y cargas de trabajo de Controlador de recursos de Kubernetes (KRC). Al servir como una pasarela de plano de control centralizada, DPC orquesta, programa y monitorea trabajos entre múltiples planos de datos, garantizando fiabilidad, capacidad de ampliación, eficiencia de costos y una experiencia de desarrollador coherente.
La necesidad de DPC proviene de las limitaciones de interactuar directamente con sistemas de gestión de clústeres nativos como EMR.
##### Abstracción de infraestructura y nube
Aunque EMR ofrece API para clústeres, tareas y pasos, aún carga a los equipos de clientes con tareas de gestión de infraestructura críticas como aprovisionamiento, ampliación, ajuste de desempeño y optimización de costos. DPC soluciona esto ofreciendo una API simplificada a nivel de plataforma para el envío de trabajos. Admite la gestión de fallos automática, reintentos y equilibrio de carga dinámico. Proporciona eficiencia de costos a través de nodos basados en binpacking, spot y graviton. Proporciona seguridad sólida con aislamiento TLS, PKI, IAM y parches automatizados. Gestiona actualizaciones de versión de tiempo de ejecución de Spark y EMR para entregar mejoras de desempeño, parches de seguridad y mejoras de funciones.
Además, DPC proporciona una interfaz unificada que distingue entre la nube para enviar y gestionar trabajos de datos, abstrayendo las complejidades y las API propias del sustrato de nube subyacente (AWS, futuros proveedores). Esto garantiza que los equipos de clientes interactúen únicamente con una interfaz de envío de trabajos basada en API de Data 360 común que abstrae las complejidades de gestores de recursos subyacentes como Kubernetes e HILO. Esto permite a los equipos de clientes enviar trabajos de Spark a través de una API sencilla y unificada sin necesidad de gestionar módulos, conjuntos de nodos o configuraciones de clústeres de Spark directamente.
El ajuste manual de parámetros de Spark requiere habilidades especializadas, y configuraciones incorrectas pueden ralentizar la ejecución del trabajo. El equipo de DPC centraliza esta experiencia, proporcionando configuraciones optimizadas para evitar problemas de desempeño comunes. Este equipo especializado integra continuamente Knowledge desde la comunidad de código abierto para garantizar un desempeño óptimo entre todas las cargas de trabajo gestionadas por el controlador.
DPC no está limitado a Spark; admite una amplia gama de cargas de trabajo. Estos incluyen:
- Cargas de trabajo de procesamiento en tiempo real
- Función Entrega de eventos para acciones de datos
- Gestión de Milvus (la base de datos vectorial para el indexado de datos no estructurados)
- Infraestructura de almacenamiento de baja latencia
DPC también aprovecha el marco de trabajo **Kubernetes Resource Controller (KRC)**, que admite cargas de trabajo como Trino para consulta, Entrega de eventos para acciones de datos, Trabajos de extracción de datos para conectores y Procesamiento en tiempo real. Para todas las cargas de trabajo de KRC, DPC proporciona funciones de trabajo como servicio centrales, gestionando el aprovisionamiento, la implementación y la gestión de computación en una abstracción de trabajos de alto nivel.
##### Arquitectura y beneficios de JaaS
El modelo Trabajo como servicio, proporcionado por DPC, garantiza una canalización de procesamiento de trabajos rentable y resistente.
Los usuarios proporcionan especificaciones de clúster sencillas, centrándose en CPU, memoria, almacenamiento, conteos de instancias y conteos y etiquetas de clúster mínimo/máximo requeridos para la coincidencia de clústeres. DPC luego gestiona automáticamente detalles de infraestructura abstractos, incluyendo la selección de SKU de máquinas virtuales óptimas, la gestión de flotas de instancias, la determinación del índice de Core frente a. Nodos de tareas y gestión On-Demand frente a Detecte instancias basándose en entradas. También gestiona la gestión de versiones de componentes y EMR y las actualizaciones sin tiempo de inactividad.
De forma crucial, DPC admite de forma inherente el arrendamiento múltiple, diseñado para comprender y aplicar límites de arrendamiento de Data 360 y separación de recursos. También garantiza la seguridad y el cumplimiento aplicando imágenes de máquinas certificadas por Salesforce, gestionando funciones de IAM específicas de servicio y garantizando el cifrado tanto en tránsito como en periodos de inactividad. Para el enrutamiento y el control de capacidad, la coincidencia de trabajo a clúster se gestiona utilizando Etiquetas de clúster, y el enrutamiento basado en capacidad utiliza una configuración de concurrencia de trabajo máxima para controlar de forma efectiva la utilización de recursos.
Cloud Agnostic Client Experience es un beneficio principal, ya que la complejidad de los entornos de nube subyacentes está oculta a los servicios de cliente, permitiéndoles centrarse exclusivamente en la lógica de negocio. Esto logra el objetivo de Abstracción de proveedor de nube. Por último, DPC permite un uso sencillo y un seguimiento de costos, lo que permite segmentar la utilización de clústeres y los costos por servicio para una contabilidad precisa. En general, DPC sigue una arquitectura conectable que permite integrar nuevos motores de ejecución (por ejemplo, Flink, Ray) y sustratos de nube (GKE/Dataproc) de forma transparente sin exponer detalles de infraestructura subyacentes a usuarios. Este diseño desvincula el plano de control de la capa de ejecución, garantizando una API coherente y una experiencia operativa independientemente del backend.
### Procesamiento de datos en Data 360: De sin procesar a con capacidad de acción
Data 360 afina y enriquece los datos sin procesar, salvando la brecha entre la información sin procesar y el consumo de negocio con capacidad de acción. Complementa el ciclo de vida del objeto de datos preparando datos complejos para una activación y análisis sofisticados. Data 360 admite varios tipos de procesamiento, incluyendo Transformaciones de datos por lotes y transmisión, Perspectivas calculadas por lotes y transmisión, Procesamiento de datos no estructurado y Resolución de identidad. Para activar estas diversas operaciones de forma eficiente, especialmente en tiempo real y entre conjuntos de datos masivos, se requiere un mecanismo sofisticado para gestionar los cambios de datos de forma efectiva.
#### Potenciación del procesamiento incremental
Para lograr un procesamiento de datos eficiente casi en tiempo real, especialmente con tablas de tamaño de terabytes y millones de actualizaciones potenciales, Data 360 necesitaba un avance. Requería una forma de notificar a los sistemas con precisión cuando cambian los datos y luego identificar de forma eficiente qué datos cambiaron de modo que solo se procesen actualizaciones relevantes y solo cuando se actualizan. Este reto dio lugar a dos innovaciones complementarias: Eventos de cambio nativos de almacenamiento (SNCE) para notificar cuando cambia algo y Noticias en tiempo real de datos de cambios (CDF) para identificar qué cambió.
##### Eventos de cambio nativos de almacenamiento (SNCE)
SNCE cambió fundamentalmente Data 360 en una plataforma de datos reactiva e incremental. Este cambio implica pasar de sondear activamente el lago de datos a monitorear de forma pasiva eventos de confirmación atómica, utilizando un formato de evento estandarizado y un sistema de entrega de mensajes de alto rendimiento.
Cada operación de escritura correcta (INSERT, UPDATE, DELETE) en una tabla de Iceberg culmina en un intercambio atómico del puntero del archivo de metadatos actual de la tabla en el catálogo. La capa de almacenamiento de objetos subyacente (digamos S3) está configurada para emitir un evento de notificación nativo (como un evento S3) siempre que se redacte una nueva instantánea de metadatos en el directorio de la tabla.
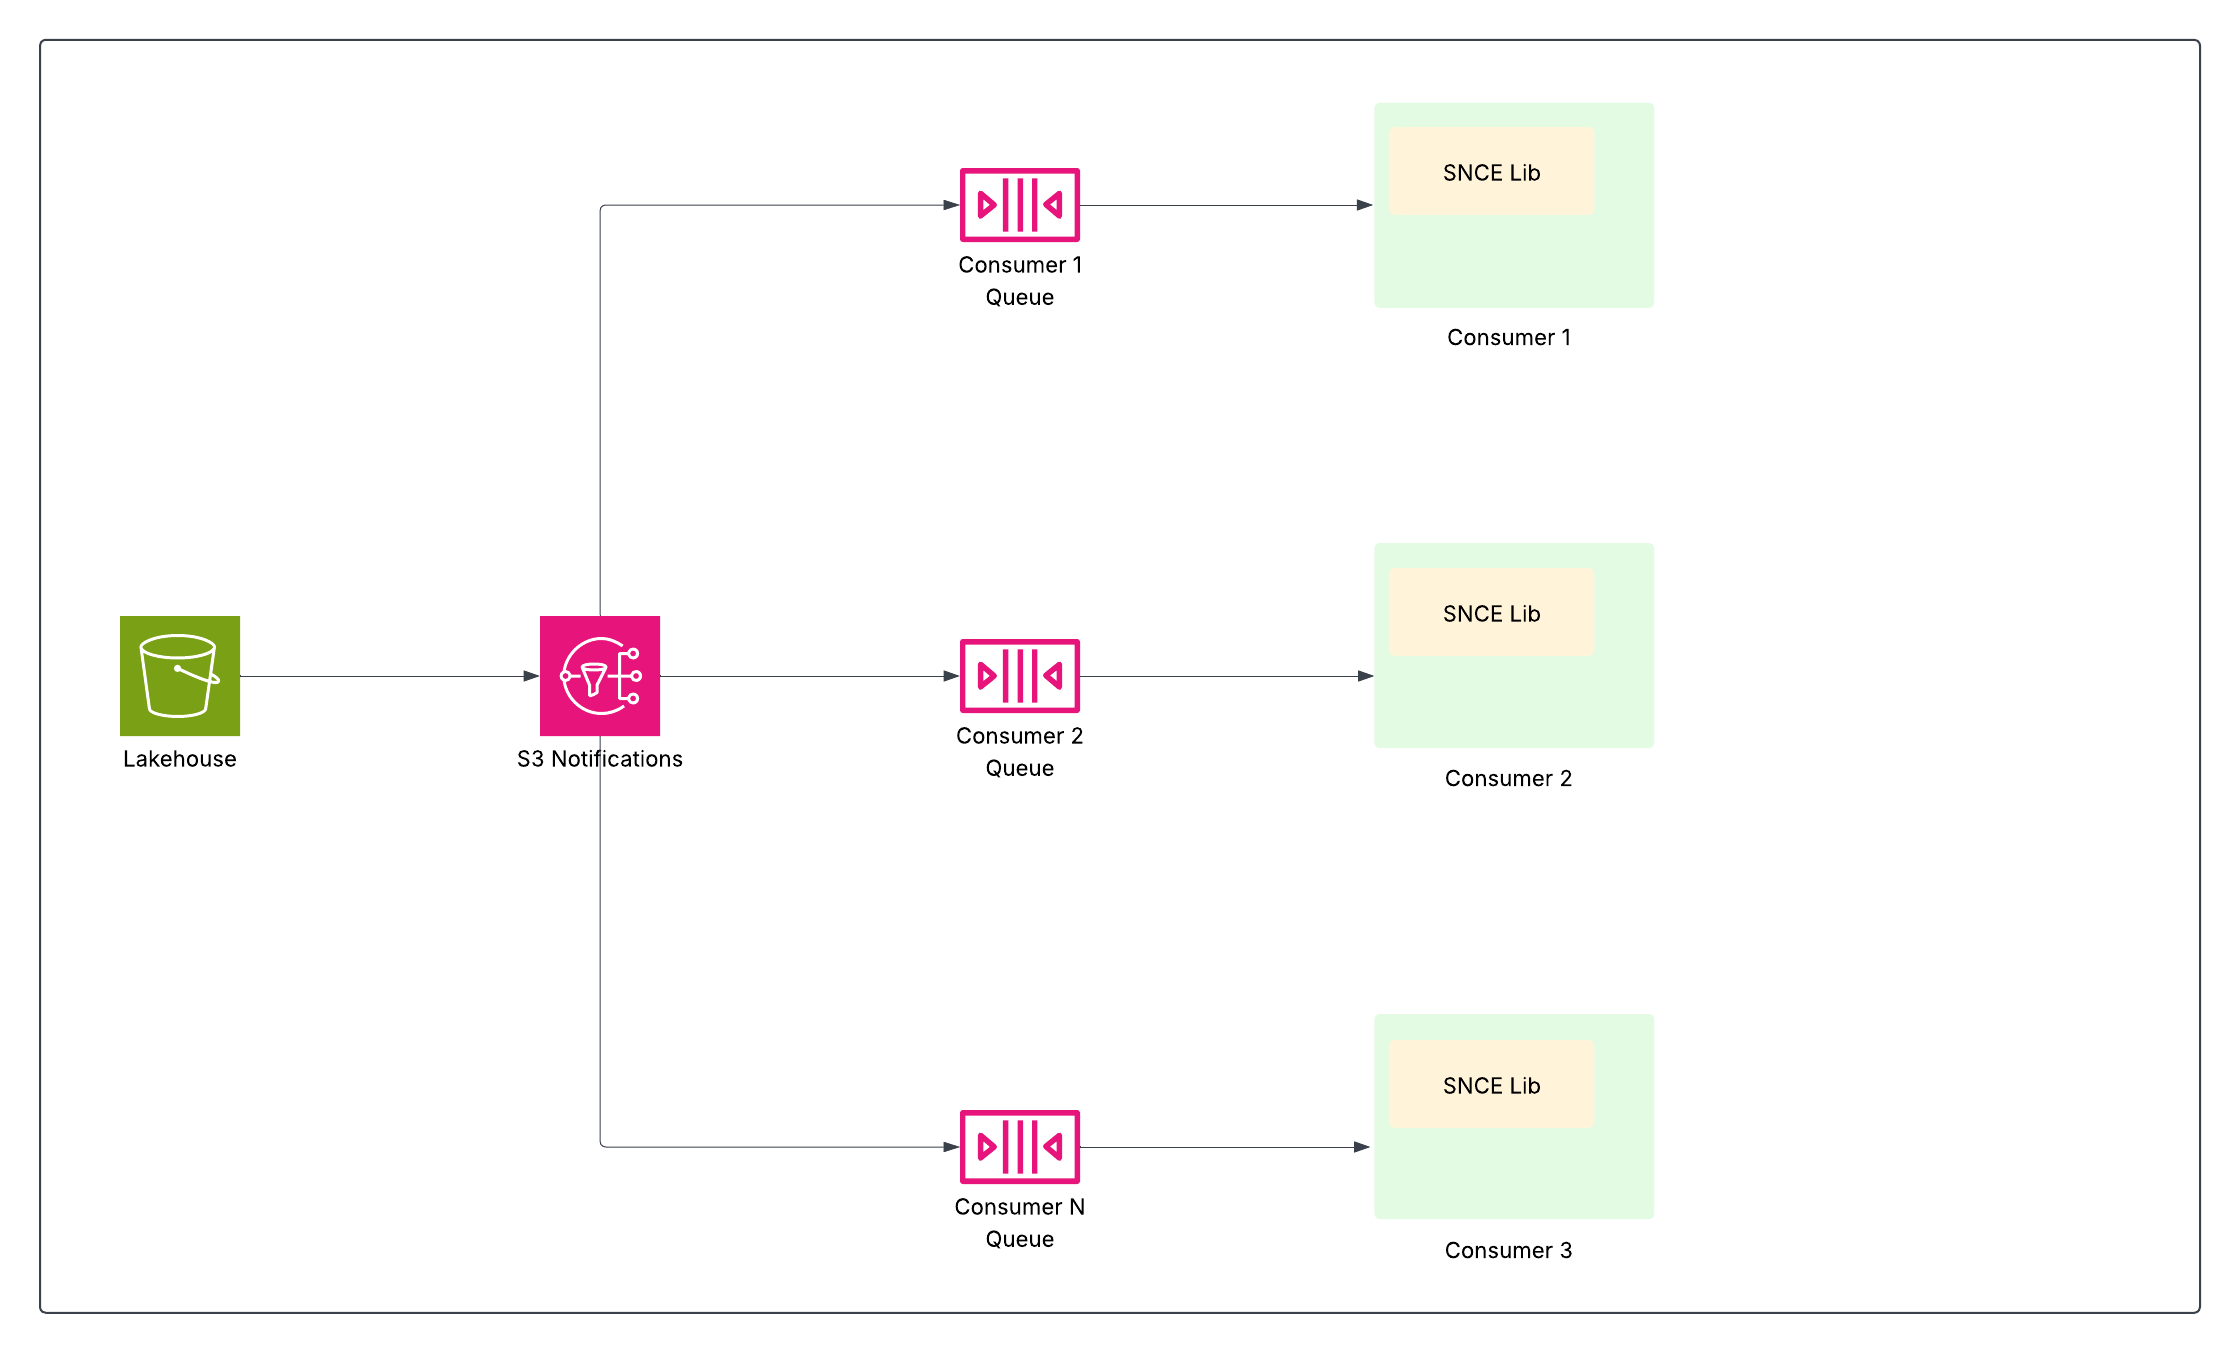 La biblioteca SNCE ofrece un método estandarizado para consumir estos eventos, y también puede enriquecerlos con metadatos de instantáneas bajo solicitud.
Esto permite que las oportunidades en curso de datos descendentes (como perspectivas calculadas de transmisión, resolución de identidad y segmentación) se suscriban y actúen solo cuando cambien los datos, potenciando significativamente la eficiencia evitando costosas exploraciones de tablas completas.
##### Cambiar noticias en tiempo real de datos (CDF)
Basándose en SNCE, las Noticias en tiempo real de datos de cambios (CDF) proporcionan un mecanismo simplificado para consumir y procesar los cambios de forma incremental.
CDF aprovecha instantáneas de Iceberg para generar de forma eficiente la transmisión de cambios. De forma crítica, el redactor Iceberg optimizado de Data 360 calcula y mantiene los cambios como parte de la operación de escritura en sí, haciendo que la generación de CDF sea altamente eficiente y minimizando la carga adicional. Esto permite procesar trabajos (como transformaciones de transmisión o perspectivas calculadas de transmisión) para procesar selectivamente solo los registros alterados evitando el costoso cálculo de diferencias de instantáneas.
Esta estrategia incremental proporciona varios beneficios para grandes conjuntos de datos, incluyendo ahorros de costos, latencia reducida y eficiencia mejorada. Activa funciones como transformaciones de transmisión y resolución de identidad incremental, que a su vez llevan a perspectivas más rápidas, cargas del sistema más predecibles, desempeño mejorado y gastos operativos más bajos.
### Conectar, ingresar y preparar
Data 360 ofrece funciones de ingreso sólidas con compatibilidad nativa para productos de Salesforce, garantizando un flujo de datos transparente. Para fuentes externas, proporciona conectividad amplia a través de más de 270 conectores, API, SDK y MuleSoft. Además, Data 360 cuenta con federación de copia cero, lo que permite la BI y los análisis sin duplicación de datos.
#### Marco del conector de Data 360
El marco de trabajo del conector de Data 360 (DCF) es la base para la mayor parte de la conectividad de Data 360. Permite la entrada, federación y salida a través de una arquitectura unificada. DCF define los estándares para la creación y gestión de conectores, desde la interfaz de usuario para la configuración y la administración hasta la persistencia de metadatos, la extracción de datos y la entrega en Lakehouse o a través de consultas en vivo en orígenes externos. También admite opciones de conectividad privada (como vínculos privados, VPN y túneles seguros) para garantizar la seguridad y el cumplimiento de los datos de nivel de compañía al conectar con entornos de clientes o socios. Proporcionando un enfoque coherente entre todos los conectores, DCF potencia Data 360 para conectar de forma transparente en el ecosistema más amplio garantizando la capacidad de ampliación, la fiabilidad y la integración segura.
#### Conectores de Data 360
Data 360 proporciona conectividad sólida a un vasto ecosistema de orígenes de datos, admitiendo tanto productos nativos de Salesforce como numerosos sistemas externos. Esta amplia conectividad es crucial para unificar datos de compañía en silos y activar aplicaciones de IA/ML y Agentes.
Data 360 ofrece más de 270 conectores de forma nativa o a través de MuleSoft, API y SDK para dar cobertura a sus funciones de canalización de datos de extremo a extremo con ingreso por lotes, transmisión o en tiempo real. Estos conectores se pueden categorizar ampliamente por el tipo de sistema de origen que integran.
**Conectores nativos de Salesforce**
Estos conectores garantizan un flujo de datos sencillo y nativo desde productos de Salesforce.
Algunos ejemplos incluyen conectores para Salesforce CRM, Data Cloud One , Marketing Cloud Engagement, Marketing Cloud Account Engagement y B2C Commerce.
**Aplicaciones externas y SaaS**
Los conectores para varias aplicaciones de negocio y servicios en la nube permiten el ingreso de datos desde plataformas de software externas.
Algunos ejemplos incluyen Adobe Marketo Engage, Microsoft Dynamics 365, Mailchimp y Airtable.
**Bases de datos y almacenes de datos**
Data 360 se conecta a una variedad de plataformas de almacenamiento de datos relacionales y basadas en la nube.
Algunos ejemplos incluyen Amazon Redshift, Amazon DynamoDB, Amazon RDS (MySQL, PostgreSQL, Oracle), Google BigQuery y Microsoft SQL Server.
**Almacenamiento de objetos de nube y sistemas de archivos**
Estos conectores se integran con soluciones de almacenamiento de hiperescala para datos estructurados y no estructurados.
Algunos ejemplos incluyen Amazon S3, Google Cloud Storage (GCS) y Azure Blob Storage.
**Servicios de transmisión y mensajería**
Los conectores que gestionan transmisiones de datos continuas en tiempo real son críticos para escenarios dirigidos por eventos y procesamiento en tiempo real.
Un ejemplo es el Conector de Amazon Kinesis.
**Plataformas de integración**
El conector MuleSoft Anypoint amplía el alcance de Data 360 integrándolo con una gama más amplia de aplicaciones y bases de datos a través de Anypoint Exchange.
**Conectores de almacenamiento de datos y objetos de nube no estructurados**
Estos conectores son críticos para ingresar y hacer referencia a datos no estructurados (datos que carecen de un modelo predefinido) a funciones de IA generativa de energía.
Todos estos conectores están construidos sobre el marco de trabajo del conector de Data 360 proporcionando una experiencia coherente.
#### Transformaciones de datos
La transformación de datos es un componente arquitectónico fundamental en Data 360, diseñado para limpiar, enriquecer y dar forma a datos ingresados sin procesar en activos de datos normalizados con capacidad de acción alineados con el modelo de datos Customer 360. Este proceso es esencial para Armonización, mejora de la calidad y garantizar que los datos están listos para casos de uso descendentes como unificación, segmentación y activación de perfiles. Las transformaciones aprovechan los objetos de lago de datos de origen (DLO) y los objetos de modelo de datos (DMO) como entrada, produciendo los resultados en nuevos DLO o DMO respectivamente.
Data 360 proporciona dos paradigmas de transformación principales para tratar diferentes requisitos de velocidad de datos: transformaciones de datos por lotes y transformaciones de datos de transmisión.
##### Transformaciones de datos por lotes
Las transformaciones de datos por lotes están diseñadas para el procesamiento de gran volumen basándose en una programación definida o un desencadenador on demand. Este motor está optimizado para gestionar operaciones de reestructuración complejas que requieren muchos recursos.
El proceso Transformación por lotes se configura utilizando un lienzo de oportunidades en curso visual de código bajo que permite a los usuarios definir lógica de transformación de múltiples etapas. Este motor admite de forma exclusiva operaciones de reestructuración complejas vitales para la alineación de modelos de datos canónicos: estructuración y normalización de datos. Esto incluye el giro (descomposición de registros desnormalizados en múltiples registros normalizados) y el aplanamiento (reestructuración de datos jerárquicos, como JSON, en tablas estructuradas). El modo de ejecución del sistema admite la sincronización completa (procesando todos los registros) y un modo de procesamiento incremental altamente eficiente. El modo incremental reduce significativamente el tiempo de procesamiento y el consumo de recursos solo procesando registros que cambiaron desde la última ejecución correcta. Las transformaciones por lotes son ideales para tareas donde las actualizaciones en tiempo real no son esenciales, como agregaciones periódicas y reestructuración de datos compleja.
##### Transformaciones de datos de transmisión
Los datos de transmisión transforman los datos del proceso de forma continua e incremental casi en tiempo real a medida que fluyen al sistema, lo que los hace esenciales para casos de uso de baja latencia.
La interfaz principal es un enfoque SQL-first, donde las transformaciones se definen como una consulta SQL SELECT que se ejecuta continuamente en la transmisión entrante de cambios de registro. Este motor admite funciones de transformación principales, incluyendo la limpieza y estandarización de datos (por ejemplo, validación de PII y estandarización de formatos de datos) y el enriquecimiento y la combinación de datos (utilizando Uniones y Uniones). De forma crítica, admite uniones de búsqueda de transmisión para permitir el enriquecimiento de datos en tiempo real y búsquedas con datos de referencia estáticos o que cambian lentamente, garantizando actualizaciones de perfil instantáneas. Para optimizar el costo de servicio, la arquitectura emplea un diseño de trabajo de alta densidad (HD), que empaqueta múltiples definiciones de transformación de transmisión para un único arrendatario en un único trabajo de computación subyacente, maximizando la utilización de recursos. Las transformaciones de transmisión son esenciales para casos de uso como monitoreo de eventos, personalización inmediata y actualizaciones de perfil en tiempo real.
### Federación de datos de copia cero y colaboración de datos
Data 360 revoluciona la gestión de datos al admitir la federación de copia cero y el uso compartido de datos, lo que elimina la necesidad de mover o duplicar datos. Esta función permite a los usuarios acceder de forma transparente y directa a datos desde diversos orígenes externos y compartir datos con entornos externos, reduciendo significativamente la complejidad, reduciendo los costos de almacenamiento y garantizando que todas las decisiones se basan en la información más actualizada y fiable.
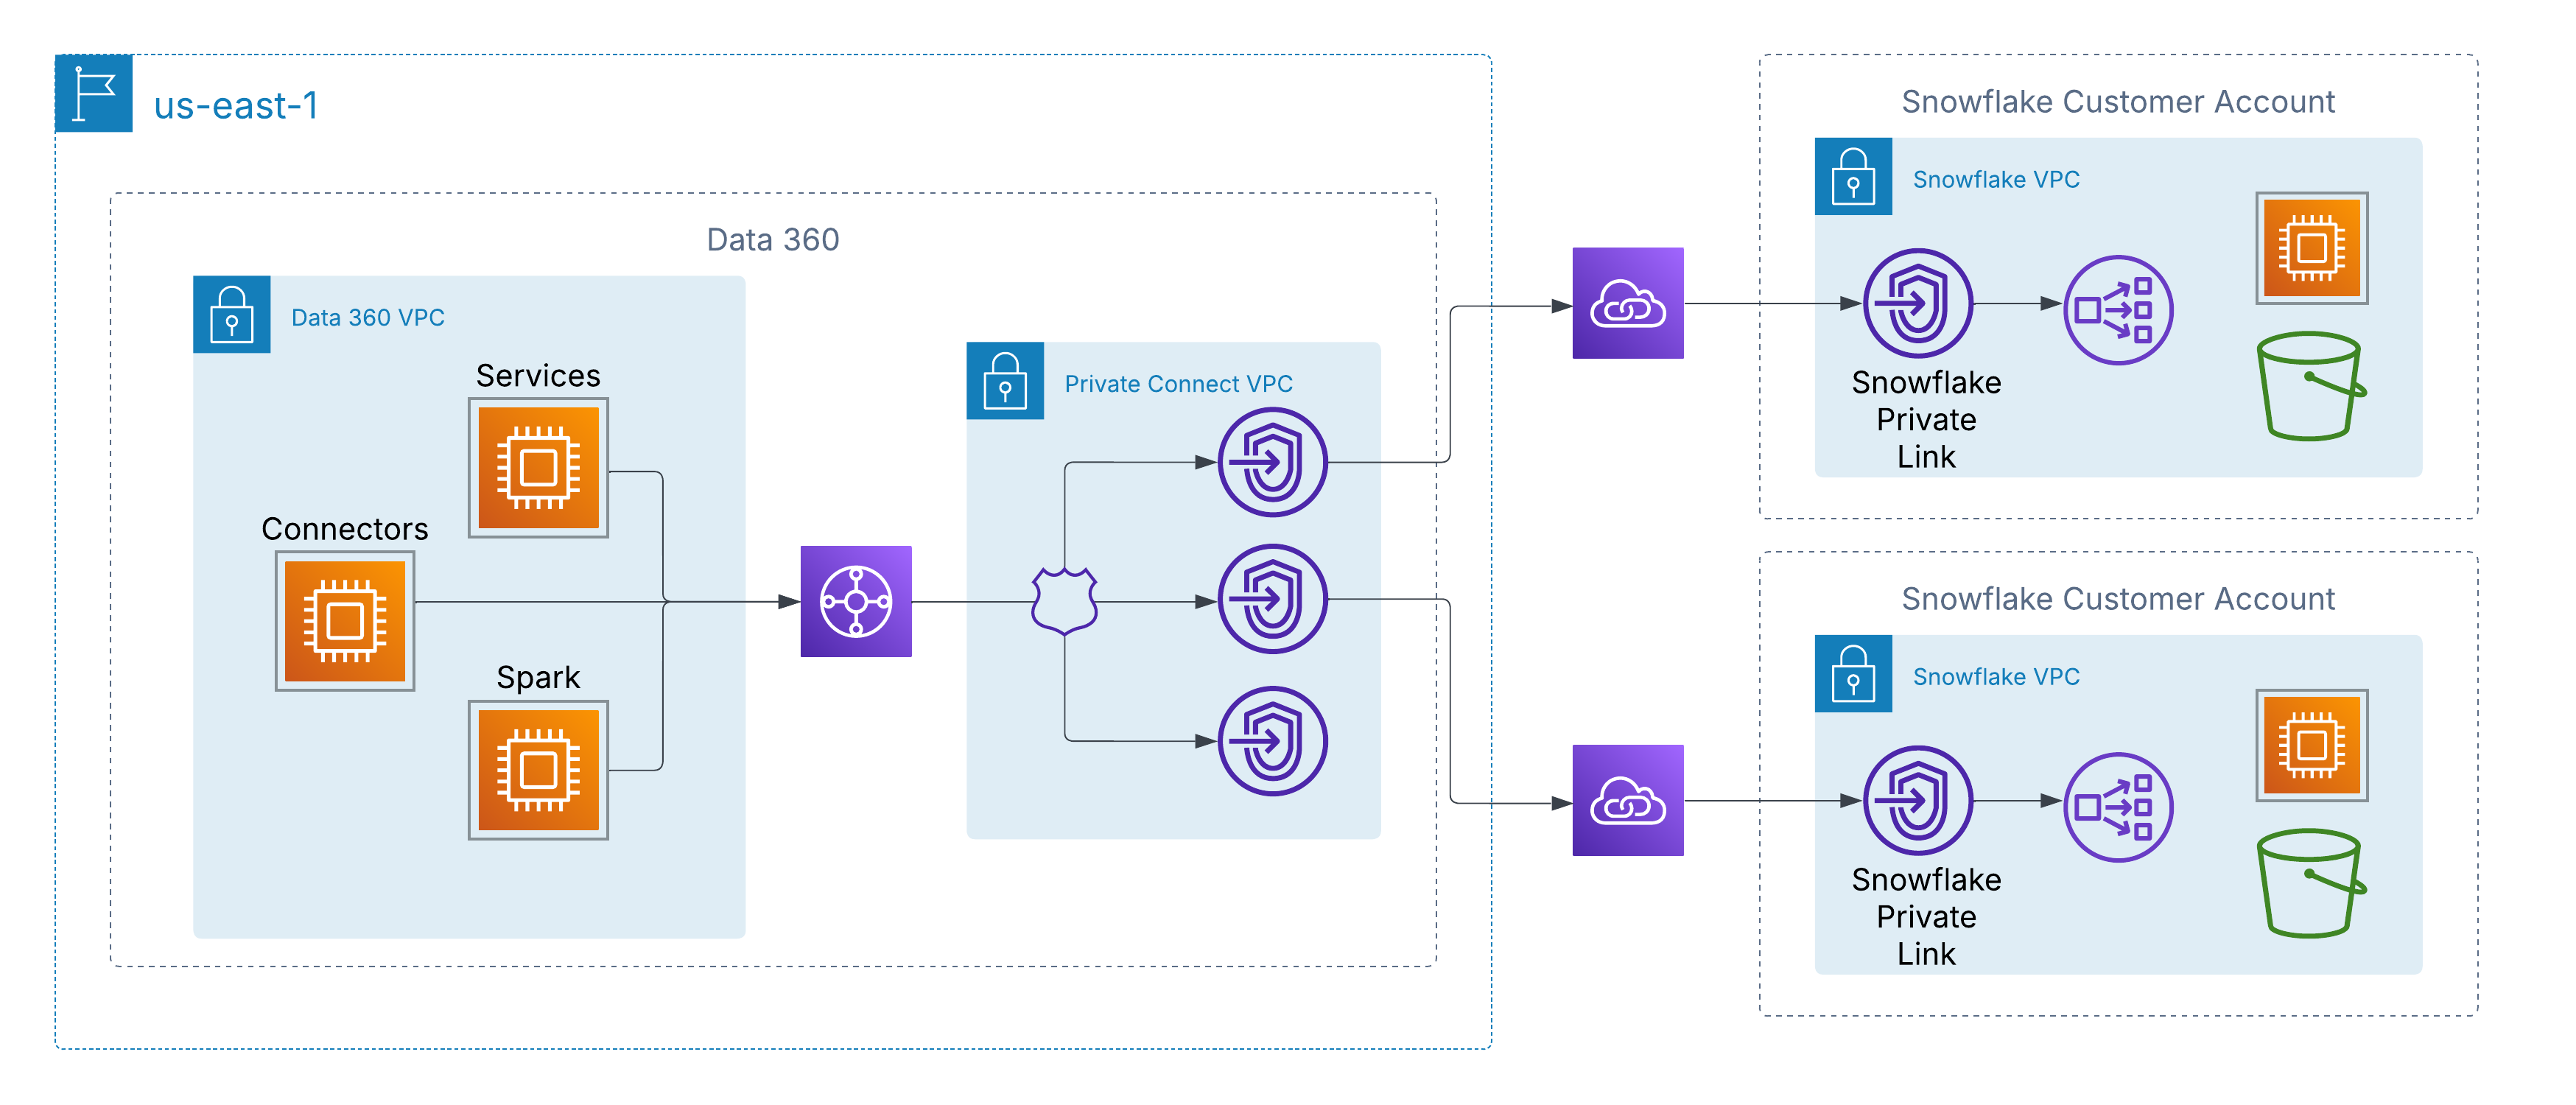 Para solucionar esto, Data 360 admite conectividad privada a nivel de red con orígenes de datos gestionados por clientes entre nubes. En AWS, esto se activa a través de AWS PrivateLink, que permite a Data 360 conectarse directamente a extremos aprovisionados por el cliente, ya sea dentro de sus propias cuentas o en entornos de lago de datos externos (por ejemplo, Snowflake), sin atravesar la Internet pública.
Esta arquitectura garantiza que todo el tráfico permanezca completamente en la red principal de AWS, utilizando direcciones IP privadas y rutas de red no enrutables, satisfaciendo así estrictos requisitos de seguridad y cumplimiento al tiempo que permite un acceso sencillo a los datos de los clientes.
#### Interconexión privada
Para clientes con arquitecturas de múltiples nubes, Data 360 está ampliando la conectividad privada más allá de AWS a través de la compatibilidad de interconexión entre nubes. Esto permite rutas de red seguras y solo troncales desde Data 360 a lagos de datos y servicios alojados en Azure o Google Cloud, manteniendo los mismos principios que AWS PrivateLink: dirección IP privada, enrutamiento no público y cero exposición a Internet.
Los clientes pueden elegir entre dos modelos de implementación:
- **Interconexión gestionada por clientes**: Integre circuitos privados existentes como Azure ExpressRoute, Google Cloud Interconnect o Equinix Fabric directamente con los VPC de Data 360.
- **Interconexión gestionada por Salesforce**: Utilice una conexión llave en mano completamente gestionada donde Salesforce aprovisiona y opera el vínculo entre nubes, exponiendo extremos privados en la nube de destino.
En ambos modelos, la experiencia es coherente: Los servicios de Data 360 se conectan a fuentes de datos externas entre hiperescaladores como si fueran locales, permitiendo el ingreso, la activación y las consultas seguros sin atravesar la Internet pública.
### Gobernanza de datos en Data 360: Una base de Trust y control
Para arquitectos de compañía, una gobernanza de datos sólida no es solo una casilla de verificación de cumplimiento, sino un pilar fundamental para crear Inteligencia de clientes confiable, ampliable y con capacidad de acción. Salesforce Data 360 está diseñado con un marco de trabajo de gobernanza integral que garantiza la calidad, la seguridad y el cumplimiento de los mandatos normativos en todo su ciclo de vida de los datos.
Data 360 funciona como un núcleo de gobernanza centralizado, garantizando que todos los datos, desde el ingreso sin procesar hasta las perspectivas activadas, se gestionan con integridad y control.
 #### Control de acceso avanzado: Por qué Control de acceso basado en atributos (ABAC)
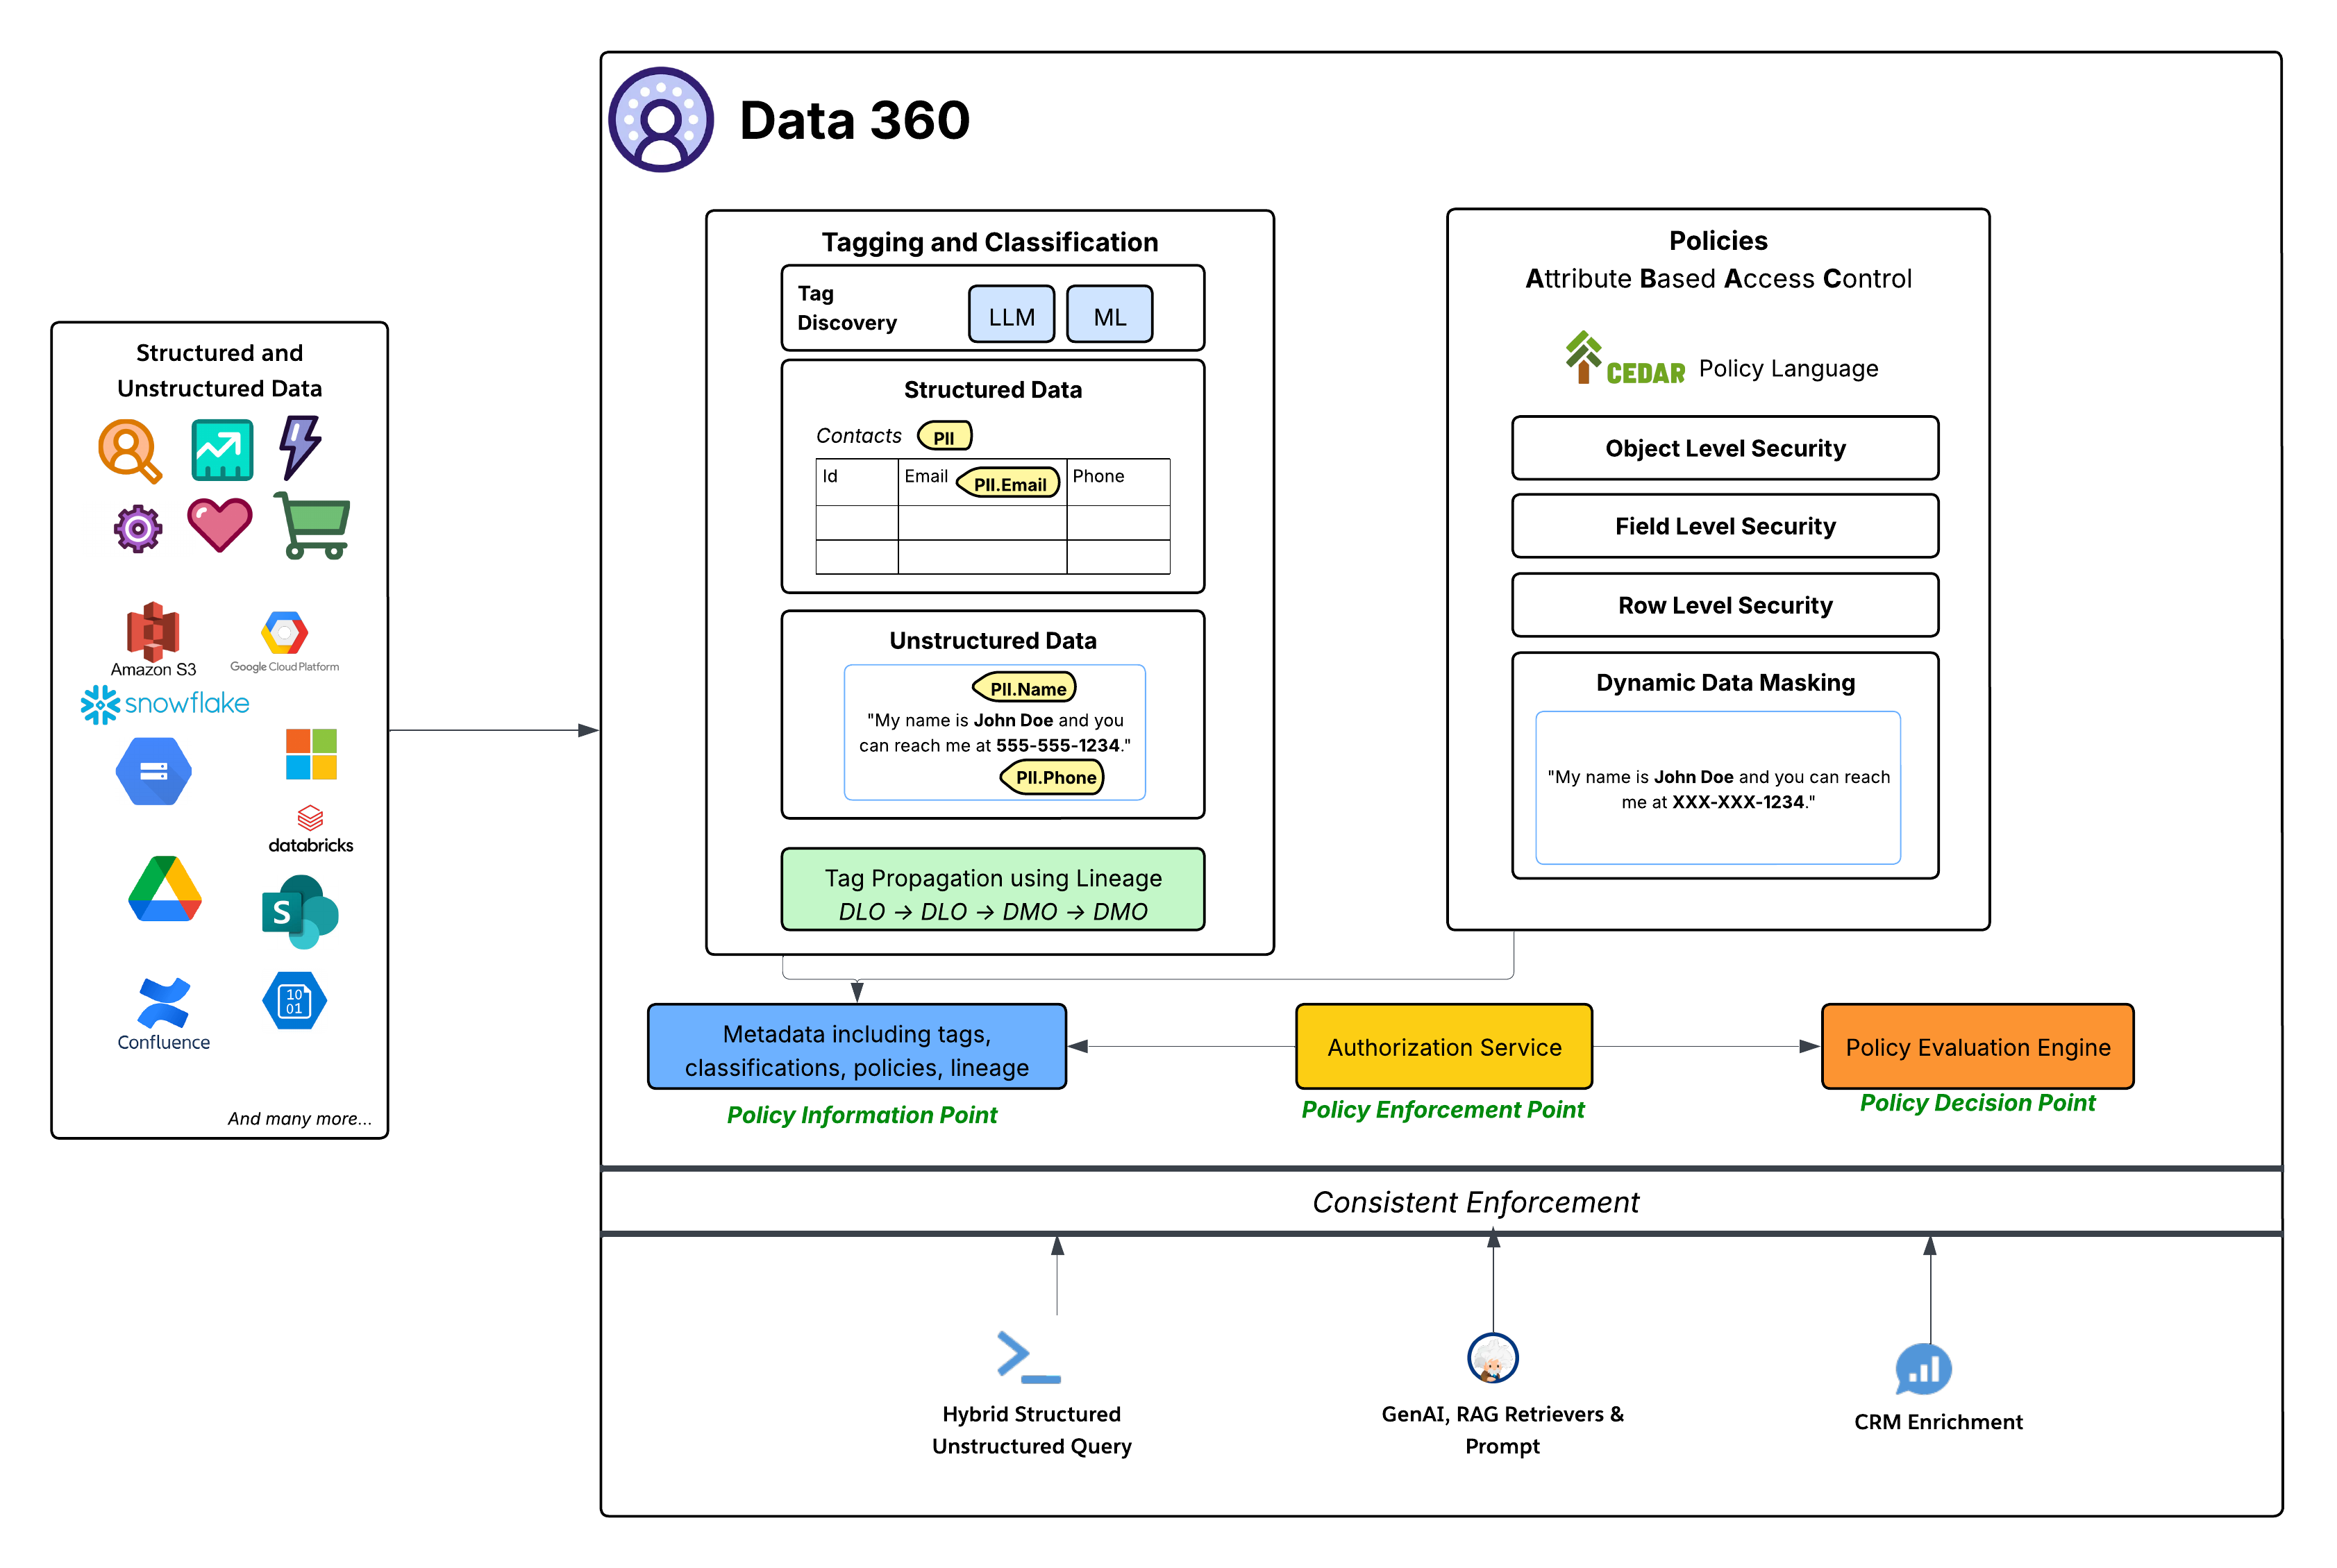
Aunque el espacio de datos proporciona control de acceso de grano grueso para determinar el acceso a todos los objetos en un espacio de datos, las políticas basadas en ABAC proporcionan control de acceso de grano fino a objetos, campos y filas individuales en un espacio de datos. Data 360 adoptó el Control de acceso basado en atributos (ABAC) como su modelo de autorización principal para el control de acceso de grano fino. Esta opción estratégica proporciona flexibilidad y capacidad de ampliación superiores en comparación con el Control de acceso basado en funciones (RBAC) tradicional, particularmente crucial para entornos de negocio complejos y dinámicos con grandes cantidades de datos y necesidades de acceso variadas. ABAC permite que las decisiones de acceso se basen en atributos del usuario (por ejemplo, departamento, función, ubicación), los datos (por ejemplo, PII, sensibilidad, espacio de datos) y el entorno (por ejemplo, hora del día), en vez de solo funciones predefinidas. Esto permite políticas de acceso altamente granulares y contextuales que se adaptan a medida que cambian los datos y los atributos de usuario.
- **Idioma de política de CEDAR**: En el centro de la implementación de ABAC de Data 360 está el uso del lenguaje de políticas CEDAR. Este lenguaje de políticas formal creado específicamente proporciona una forma precisa y verificable de definir reglas de autorización complejas, garantizando que las políticas son inequívocas y se pueden evaluar coherentemente a escala.
#### Arquitectura de gobernanza: Información de póliza, Aplicación y Puntos de decisión
El sistema de gobernanza en Data 360 se adhiere a una arquitectura ABAC sólida y estándar:
- **Etiquetado, clasificación y creación de políticas (Punto de información de políticas - PIP)**:
- Data 360 proporciona mecanismos automatizados de Etiquetado y Clasificación, aprovechando LLM (Modelo de lenguaje grande) y ML (Aprendizaje automático) para identificar categorías de datos confidenciales (por ejemplo, PII.Email, PII.Phone, PII.Name) y otras taxonomías creadas específicamente (PHI, FinancialData) en Datos estructurados (por ejemplo, tabla Contactos) y Datos no estructurados (para ex desde Google Drive).
- De manera crucial, la propagación de etiquetas se produce a lo largo del linaje de datos (DLO -> DLO -> DMO), garantizando que las clasificaciones sigan automáticamente las transformaciones y derivaciones de datos, desde los datos ingresados sin procesar a la capa de DMO armonizada y a través de datos derivados creados desde definiciones de procesos.
- Finalmente, el panel de creación de políticas proporciona una experiencia sencilla para aprovechar los datos y los atributos de usuario para definir reglas de acceso dinámicas para una organización.
- Estos metadatos enriquecidos (incluyendo etiquetas, clasificaciones, políticas y linaje) se alimentan al Punto de información de políticas (PIP).
- **Servicio de autorización (Punto de aplicación de políticas - PEP)**:
- El Servicio de autorización actúa como el Punto de aplicación de políticas (PEP). Intercepta todas las solicitudes de acceso a datos desde varias capas de consumo (Consulta estructurada/no estructurada híbrida, Solicitud y recuperadores de RAG de GenAI, Enriquecimiento de CRM) y consulta el Punto de decisión de política para determinar si el acceso está permitido.
- **Motor de evaluación de políticas (Punto de decisión de política - PDP)**:
- Este motor sirve como el Punto de decisión de política (PDP). Toma el contexto de solicitud de acceso desde el PEP, junto con definiciones de políticas (en CEDAR) y atributos desde el PIP, para tomar una decisión de acceso autorizada.
#### Aplicación e integración de políticas clave
- **Políticas de seguridad granulares**: Las políticas definidas en CEDAR aplican varios niveles de seguridad, incluyendo:
- **Seguridad a nivel**: de objeto Control del acceso a DLO o DMO completos basándose en etiquetas asociadas con estos objetos.
- **Seguridad a nivel de campo**: Restringir el acceso a campos confidenciales específicos en un objeto basándose en etiquetas.
- **Seguridad a nivel**: de filas Filtrado de datos en objetos específicos para mostrar solo filas relevantes basándose en atributos de usuario.
- **Enmascaramiento de datos dinámico**: Enmascare dinámicamente ciertos datos (basándose en etiquetas) en el punto de acceso, sin alterar los datos subyacentes. Esto garantiza que la información confidencial está protegida mientras permite una amplia utilidad. Esto se aplica al enmascaramiento de campos en datos estructurados así como contenido en datos no estructurados.
- **Aplicación coherente**: Todo el marco de trabajo de ABAC garantiza la aplicación coherente de políticas en todos los patrones de consumo de Data 360, ya sea consulta de datos directa, recuperación para aplicaciones de IA generativa (RAG) o enriquecimiento de experiencias de Salesforce CRM a través de Listas relacionadas, por ejemplo.
- **Integración profunda con Salesforce Platform**: Las funciones de regulación de Data 360 se definen y se administran directamente en la plataforma principal de Salesforce. Esta integración permite a los administradores gestionar políticas de acceso, identidades de usuario y gestión de atributos utilizando herramientas de Salesforce familiares, garantizando una capa de gobernanza unificada y coherente en todo el ecosistema de Salesforce.
Al crear este sofisticado marco de trabajo de ABAC con políticas de CEDAR, Data 360 proporciona a los arquitectos un nivel de control y flexibilidad sin igual, garantizando que los datos de los clientes no solo sean sobre los que se pueden realizar acciones, sino que también sean seguros, compatibles y fiables en toda la compañía.
### Cifrado de Data 360: Aportar su propia clave
En todas las industrias, las organizaciones están haciendo mayor hincapié en la seguridad de los datos de extremo a extremo para garantizar la protección contra la fuga de datos, el acceso no autorizado, la manipulación o la destrucción. La mayoría de las plataformas de datos, incluyendo Data 360 hoy en día, proporcionan cifrado en periodos de inactividad utilizando una clave de cifrado gestionada por proveedores. Sin embargo, las empresas (especialmente las de sectores regulados) exigen cada vez más funciones de cifrado gestionado por clientes para datos en periodos de inactividad y en tránsito.
Este modelo permite a las compañías controlar sus propias claves de cifrado, garantizando que incluso en el caso altamente improbable de una brecha a nivel de plataforma o acceso no autorizado, los datos permanecen protegidos criptográficamente. Sin la clave de propiedad del cliente, ninguna entidad (incluyendo el proveedor de plataforma) puede descifrar o reconstruir los datos, manteniendo así la confidencialidad y el control completos.
### Almacenamiento y procesamiento de datos no estructurados
Data 360 admite el almacenamiento y la gestión de datos estructurados (tablas), semiestructurados (JSON) y no estructurados de forma transparente entre mecanismos de ingreso, procesamiento, indexado y consulta de datos. Data 360 admite varios tipos de datos no estructurados más allá del texto, incluyendo audio, video e imágenes, ampliando el ámbito de la gestión y el análisis de datos. La figura siguiente ilustra los dos lados de la fundamentación (ingesta y recuperación).
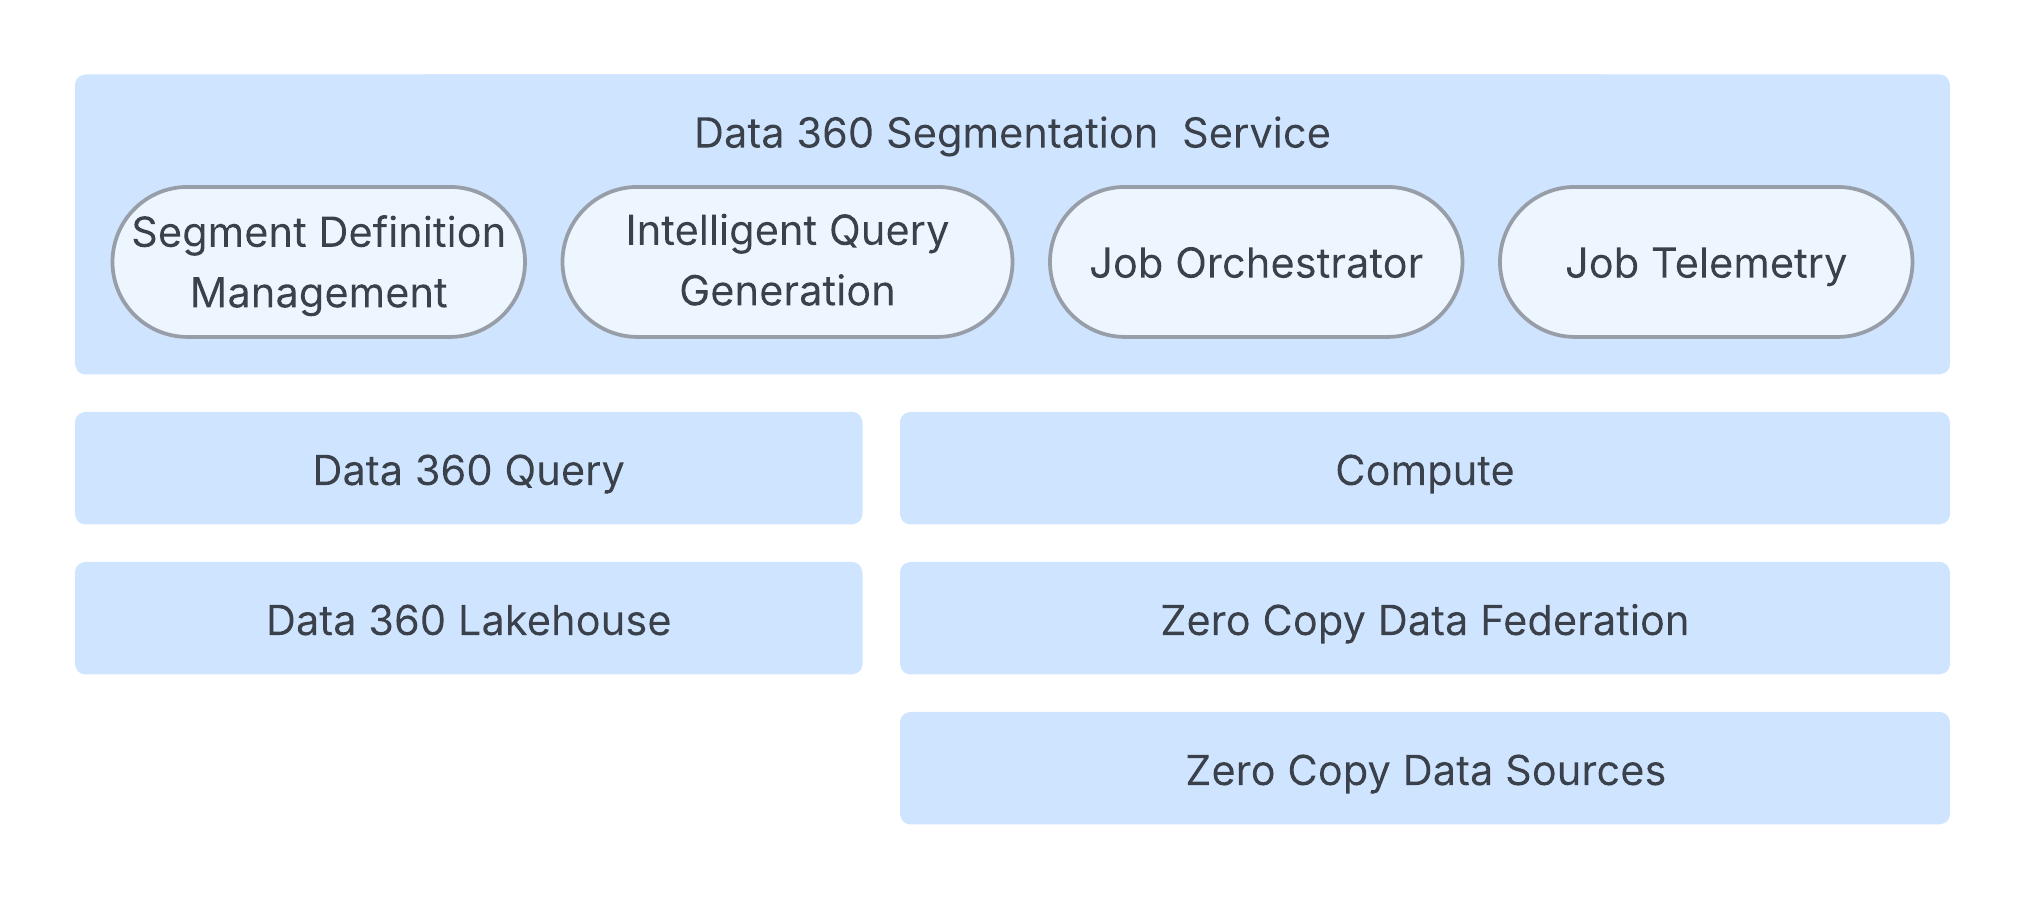 El proceso principal está gestionado por un servicio de orquestación de trabajos que controla el ciclo de vida del segmento, generando la configuración de trabajo necesaria y desencadenando la ejecución. Esta capa de orquestación mantiene el estado y los metadatos en una base de datos dividida para su capacidad de ampliación.
Aunque la Consulta de Data 360 gestiona cálculos de conteo de segmentación, la capa de cálculo de Spark es responsable de calcular la pertenencia real a Segmentos. La aplicación Spark ejecuta consultas Spark SQL en datos de clientes extensos. Estos datos pueden residir en Data 360 Lakehouse, sistemas externos a través de la federación de datos Cero copia o una combinación de ambos.
El sistema está altamente optimizado a través de la generación de consultas inteligentes, que afina la consulta Spark SQL subyacente. Esto incluye técnicas como la poda de particiones inteligente para minimizar el escaneo de datos y la eliminación de subexpresiones redundantes. Para garantizar la fiabilidad del servicio, la arquitectura cuenta con una gestión de recursos adaptativa que ajusta dinámicamente los recursos de computación en base al tamaño y la complejidad de la carga de trabajo. Además, la Adhesión de SLO se gestiona de forma proactiva con duraciones adaptativas y lógica de reintento. Para una experiencia de usuario rápida, los conteos de segmentos acelerados utilizan un enfoque basado en muestreo para proporcionar estimaciones de tamaño rápidas durante la creación de segmentos, evitando una ejecución de consultas completa.
Finalmente, se mantiene un enfoque profundo en la observabilidad y la atribución de causas raíz a través de mediciones de ejecución integrales de Spark y clasificación automatizada de errores (por ejemplo, problemas del lado del cliente frente al sistema), reduciendo significativamente el tiempo de diagnóstico y garantizando una plataforma de datos altamente resiliente.
### Activación
La activación es el paso final crítico en el ciclo de vida de Data 360. Su función principal es transformar perfiles de clientes estáticos, segmentados y unificados en datos con capacidad de acción y enriquecidos y entregar estos datos a extremos internos y externos (como Marketing Cloud, Commerce Cloud y plataformas Adtech). Este proceso está diseñado para desencadenar trayectorias de clientes personalizadas e interacciones casi en tiempo real. Admite funciones avanzadas como atributos relacionados, filtrado de suscripción de activación, filtrado de consentimiento, limitación y clasificación.
La activación ofrece tres métodos distintos para la entrega externa y el cumplimiento de canal:
- **Activación por lotes**: Diseñado para operaciones programadas de gran volumen, como campañas de email a gran escala y actualizaciones de audiencia de publicidad. Los datos se entregan mediante su organización en Depósitos internos seguros (Almacenamiento de objetos de nube) o a través de Transferencia de archivos segura, seguido de un proceso de ingreso de API iniciado por el sistema de destino. Las activaciones por lotes pueden utilizar el modo de actualización especial (incremental) para reducir los volúmenes enviados y procesados por socios de Salesforce.
- **Activación de transmisión**: Optimizado para casos de uso casi en tiempo real que requieren automatización dirigida por eventos. La entrega se logra a través de llamadas de API directas enviadas al extremo de destino.
- **Flujos desencadenados por activación**: Este canal altamente plataformado proporciona un enfoque sin código/bajo código para integrar Datos de audiencia con cientos de plataformas de implicación activadas por API de clientes. Tras la finalización de la activación, Data 360 rellena un DMO de audiencia, que luego desencadena un flujo de alta escala. El motor de flujos consume posteriormente los datos de audiencia y utiliza funciones de plataforma como Servicios externos y Mule Outbound destinations para realizar llamadas al destino basado en API final. Este método reduce significativamente el tiempo necesario para incorporar nuevos destinos de activación.
La activación utiliza los mismos patrones que la segmentación para la gestión de trabajos, la ejecución distribuida y el monitoreo. Esto incluye los principios del servicio de orquestación de trabajos para la gestión del ciclo de vida y la capa de cálculo (Spark) para el procesamiento, y se basa en la telemetría de trabajos para la observabilidad del desempeño y el cumplimiento del objetivo de nivel de servicio (SLO).
Además de eso, la activación tiene:
**Activation Target Management** supervisa las conexiones, credenciales y configuraciones seguras para todos los extremos de destino. Garantiza que los formatos de datos y los protocolos de seguridad están estandarizados, garantizando una entrega saliente fiable en varias plataformas, incluyendo Marketing Cloud, socios de Adtech y otras aplicaciones externas.
La activación adapta la carga útil para objetivos específicos. Para Salesforce Marketing Cloud, esto incluye Filtrado consciente de unidad de negocio (BU), compatibilidad con múltiples EID y controles de polinización cruzada.
**Gobernanza de comunicación** actúa como controlador, garantizando que el uso de datos y la comunicación cumplen con las preferencias y los requisitos legales de los clientes. El modelo de consentimiento centralizado unifica todas las preferencias de los clientes, desde las anulaciones de suscripción globales hasta el consentimiento específico de canal y propósito, y se almacenan en el Perfil de particular unificado. Durante la ejecución, la plataforma aplica estrictamente estas políticas utilizando filtrado de exclusión para eliminar automáticamente individuos no consentidos de la carga final. Además, el sistema aplica reglas de selección de punto de contacto para garantizar que utiliza el punto de contacto único, más compatible y preferido para el canal previsto antes de transmitir cualquier dato. Este mecanismo de aplicación está protegido por el marco de trabajo de gobernanza subyacente, que emplea medidas de protección como el enmascaramiento de datos dinámico y controles de acceso para proteger campos de datos confidenciales durante el proceso de activación.
### Consulta unificada: Acceso sencillo a todos los datos del cliente
El verdadero valor de una plataforma de datos unificada radica en su capacidad de proporcionar acceso coherente y sin esfuerzo a todos sus activos de datos, independientemente de su origen o estructura. La función Consulta unificada de Salesforce Data 360 está diseñada con precisión para entregar esto, abstrayendo las complejidades subyacentes de diversos establecimientos de datos para proporcionar una única y potente interfaz de consulta.
La capa Consulta unificada ofrece acceso sofisticado para diversos patrones de consumo:
- **Consulta estructurada y no estructurada híbrida**: Proporciona una amplia cobertura de SQL para consultar de forma transparente tanto datos estructurados como los metadatos estructurados de datos no estructurados. Esto se mejora por la capacidad de ampliación del operador a través de funciones de tabla, permitiendo la búsqueda especializada entre texto, imagen y tipos espaciales.
- **Desempeño acelerado con Hyper**: Aprovechando Hyper, un motor de alto desempeño en memoria, Data 360 acelera las consultas analíticas complejas y los tableros interactivos, proporcionando respuestas casi instantáneas sobre conjuntos de datos masivos.
- **Enfoque unificado para IA y personalización**: Este acceso unificado es crucial para generar resultados dirigidos y personalizados, facilitando directamente respuestas LLM más precisas utilizando Generación aumentada de recuperación (RAG) basando modelos de IA en datos de compañía enriquecidos.
- **Integración con consumo descendente**: Sirve como la capa de acceso de datos fundamental para experiencias dirigidas por la interfaz de usuario, API sólidas, flujos de trabajo de IA generativa y enriquecimiento de CRM, conectando datos de forma transparente con la activación.
Al proporcionar una interfaz de consulta única, inteligente y de alto desempeño, la consulta unificada de Data 360 permite a los arquitectos crear aplicaciones ágiles dirigidas por datos que aprovechan al máximo su espectro completo de información de clientes.
### Acciones de datos
Data 360 es una plataforma activa que admite la activación de oportunidades en curso en respuesta a eventos de datos. Por ejemplo, un evento significativo, como una caída en el saldo de cuenta de un cliente, puede desencadenar un flujo de Salesforce para orquestar una acción correspondiente. Del mismo modo, las actualizaciones en mediciones clave, como el gasto de toda la vida, se pueden propagar automáticamente a aplicaciones relevantes.
Las acciones de datos monitorean continuamente datos incrementales para cambios utilizando eventos de cambio nativos de almacenamiento (SNCE) y noticias en tiempo real de datos de cambios (CDF). Estos datos se evalúan con respecto a reglas de acción configuradas por el cliente, como monitoreo de umbral o cambios de estado. Cuando se cumplen estas reglas, se genera un evento de acción de datos. Este evento se enriquece con información adicional (por ejemplo, estado de fidelidad del cliente) y se envía inmediatamente a su destino configurado, como Salesforce Flow o una aplicación externa, para desencadenar orquestaciones de negocio.
#### Plataforma de datos de clientes
Data 360 admite funciones nativas de CDP (Customer Data Platform), incluyendo funciones avanzadas de resolución de identidad y creando perfiles e identificadores individuales unificados junto con historiales de implicación integrales. Esta plataforma es experta en la gestión de marcos de trabajo de negocio a negocio (B2B) y de negocio a consumidor (B2C) admitiendo la resolución de identidad y gráficos de identidad que utilizan reglas de coincidencia exactas y parciales, como se describió anteriormente. Estos gráficos de identidad están enriquecidos con datos de implicación de varios canales, lo que ayuda a crear gráficos de perfil detallados con perspectivas analíticas y segmentos valiosos.
Un concepto clave que admite el perfil de cliente es el gráfico de datos. Data 360 ofrece un gráfico de datos de compañía en formato JSON, que es un objeto desnormalizado derivado de varias tablas de Lakehouse y sus interrelaciones. Esto incluye un gráfico de datos de "Perfil" creado por CDP que abarca el historial de compras y exploración de una persona, el historial de casos, el uso de productos y otras perspectivas calculadas, y es ampliable por clientes y socios. Estos Gráficos de datos están adaptados a aplicaciones específicas y mejoran la precisión de solicitudes de IA generativa proporcionando contexto de cliente o usuario relevante. La capa en tiempo real de Data 360 utiliza el gráfico Perfil para la personalización y segmentación en tiempo real. Prevemos modelar Contexto Agentforce que abarca Pláticas, Sesiones y memoria Agente como Gráficos de datos.
Además, el CDP permite la segmentación y activación efectivas entre diferentes plataformas como Marketing Cloud, Facebook y Google de Salesforce. Procesa perfiles de clientes por lotes, casi en tiempo real y en tiempo real, lo que permite la personalización y la toma de decisiones inmediatas. Esta función mejora las interacciones en escenarios B2C y B2B, garantizando que los negocios puedan responder de forma rápida y precisa a las necesidades y comportamientos de los clientes.
### Capa en tiempo real
La capa en tiempo real de Data 360 está respaldada por Data 360 CDP y amplía sus conceptos para casos de uso en tiempo real. La capa en tiempo real de Data 360 está diseñada para procesar eventos como transmisiones de clics web y móviles, visitas, datos de carritos y pasos por caja en latencias de milisegundos, mejorando la personalización de la experiencia del cliente. Monitorea continuamente la implicación de los clientes y actualiza el perfil de clientes desde Customer 360 con datos de implicación en tiempo real, segmentos y cálculos para una personalización inmediata.
Por ejemplo, cuando un consumidor adquiere un artículo en un sitio web de compras, la capa en tiempo real detecta e ingresa rápidamente este evento, identifica al consumidor y enriquece su perfil con información de gasto de toda la vida actualizada. Esto permite la personalización de su experiencia en el sitio en subsegundos. Además, esta capa incluye funciones para desencadenar y responder en tiempo real, lo que permite acciones inmediatas basadas en interacciones de clientes.
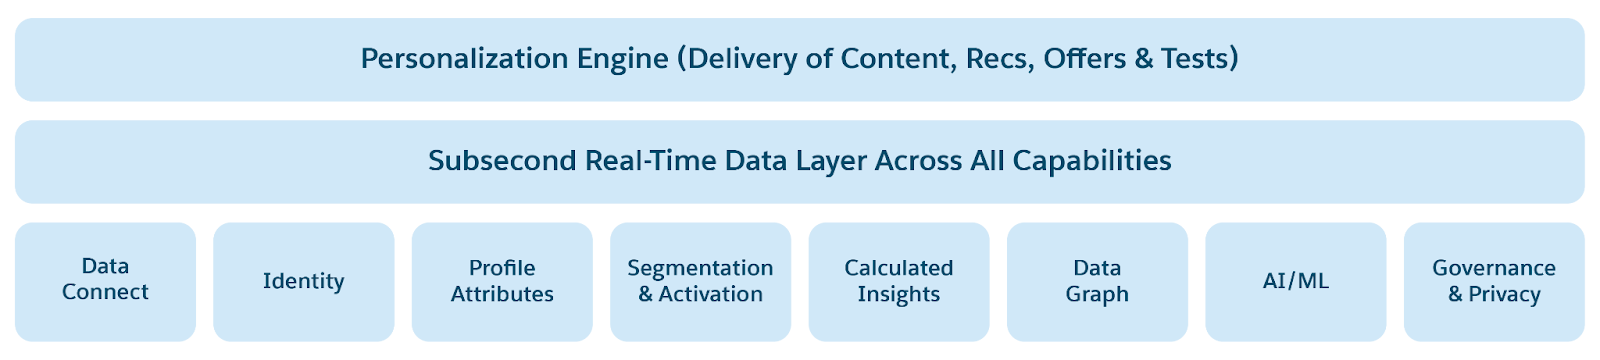 La plataforma Subsegunda en tiempo real impulsa esta transformación a través de varias funciones clave:
1. **Gráficos de datos en tiempo real**: Un perfil Customer 360 se crea utilizando un gráfico desnormalizado que incluye objetos clave y campos más relevantes para las marcas. Estos Gráficos de datos permiten el procesamiento de datos en tiempo real y entregan contenido con capacidad de acción y perspectivas en milisegundos
2. **Ingreso y transformación en tiempo real**: Ingrese eventos y perfiles de usuario en milisegundos desde orígenes web y móviles.
3. **Resolución de identidad en tiempo real**: Combine perfiles de clientes entre dispositivos, unificando usuarios desconocidos y conocidos al instante.
4. **Perspectivas calculadas en tiempo real**: Calcule mediciones como el valor de vida útil (LTV) o el historial de visitas de usuarios en milisegundos para activar Personalización u Ofertas para web, ChatBot o Agente de servicio.
5. **Segmentación en tiempo real**: Segmente audiencias sobre la marcha, personalizando mensajes e interacciones en tiempo real.
6. **Acciones en tiempo real**: Permita a las marcas evaluar cada implicación de usuario y realizar acciones a través de Salesforce Flow u otros canales de comunicación relevantes.
En Data 360, creamos una nueva plataforma en tiempo real con oportunidades en curso en tiempo real, almacenamiento de baja latencia y una capa de procesamiento de datos de subsegundos. A medida que se ingresan datos interactivos rápidamente desde canales Web y móviles, pasan por una serie de procesos rápidos.
Nuestros SDK web y móviles y las API en tiempo real recopilan datos de aplicaciones web/móviles (en futuras interacciones de Agentic) y los envían a nuestro servidor de baliza. Estos datos se enrutan a continuación a la Capa en tiempo real para el procesamiento de milisegundos y la Capa Lakehouse para la integración con datos por lotes/transmisión. La capa Tiempo real procesa los datos en tiempo real entrantes en el contexto de un perfil de usuario (anónimo o que inició sesión) como la actualización del valor de gasto total o de vida útil del usuario, etc. para la personalización en tiempo real en sesión. La Capa en tiempo real está respaldada por memoria principal y almacenamiento NVme (SSD) para almacenar datos en tiempo real y perfiles de clientes. Una vez que los datos están en la Capa en tiempo real, pasan por los siguientes procesos antes de actualizarse en Gráfico de datos en tiempo real:
- **Ingreso sencillo y transformaciones**: Los datos se ingresan y se transforman para su posterior procesamiento.
- **Resolución de identidad**: Las reglas de coincidencia exactas se aplican para unificar perfiles con todos los conjuntos de reglas de coincidencia existentes, de modo que los especialistas en datos no tienen que crear nuevos conjuntos de reglas de resolución de identidad específicamente para tiempo real.
- **Perspectivas computadas**: Se evalúa cada implicación, se ejecutan cálculos sencillos como la suma y el conteo en milisegundos y los datos se actualizan en el Gráfico de datos en tiempo real.
- **Segmentos en tiempo real**: Cada dato de implicación se evalúa para determinar si cumple los criterios para segmentos en tiempo real definidos, y los usuarios se agregan a segmentos aptos en milisegundos.
- **Acciones y desencadenadores en tiempo real**: Cada implicación se evalúa con reglas definidas para desencadenar acciones en un intervalo de objetivos en tiempo real cuando se cumplen las reglas en milisegundos.
- **API y gráfico de datos en tiempo real**: El gráfico de datos en tiempo real, que también incluye una API en tiempo real, permite a las marcas recuperar datos en formato JSON actualizados para cada usuario, garantizando que todas las interacciones de clientes estén informadas por los datos más actualizados.
#### Personalización
La personalización se basa en saber a quién dirigirse, cuándo y dónde entregar contenido y recomendaciones relevantes, qué decir y con qué frecuencia. La plataforma de servicios de personalización es el orquestador de las decisiones que se toman para optimizar el logro de objetivos a través de experiencias personalizadas.
Los **Servicios de personalización** ofrecen las siguientes funciones:
- Conjunto coherente de modelos y formas de interpretar datos de perfil, actividad y activo en Data 360
- Experimentación integrada de plataforma (A/B/n, Bandido de múltiples brazos)
- Integración de objetivos en tiempo de diseño (configuración), tiempo de entrenamiento de ML y tiempo de ejecución (inferencia de ML)
- Compatibilidad de interacción en tiempo real y por lotes a escala B2C (usuarios anónimos, alto volumen externo interactivo/en tiempo real, alto volumen de lotes internos)
- Analytics dirigido por Data 360
- Patrones para integrar el modelo de IA y el servicio de otras partes (internas y externas)
- Integración en el ecosistema de metadatos principal (características PLACA)
- Implementaciones de OOTB de casos de uso dirigidos por IA de alto valor (Recomendaciones/decisiones con varios algoritmos de ML incluyendo bandas contextuales para la selección de promoción/contenido, recomendaciones de productos, decisiones de precios, etc.)
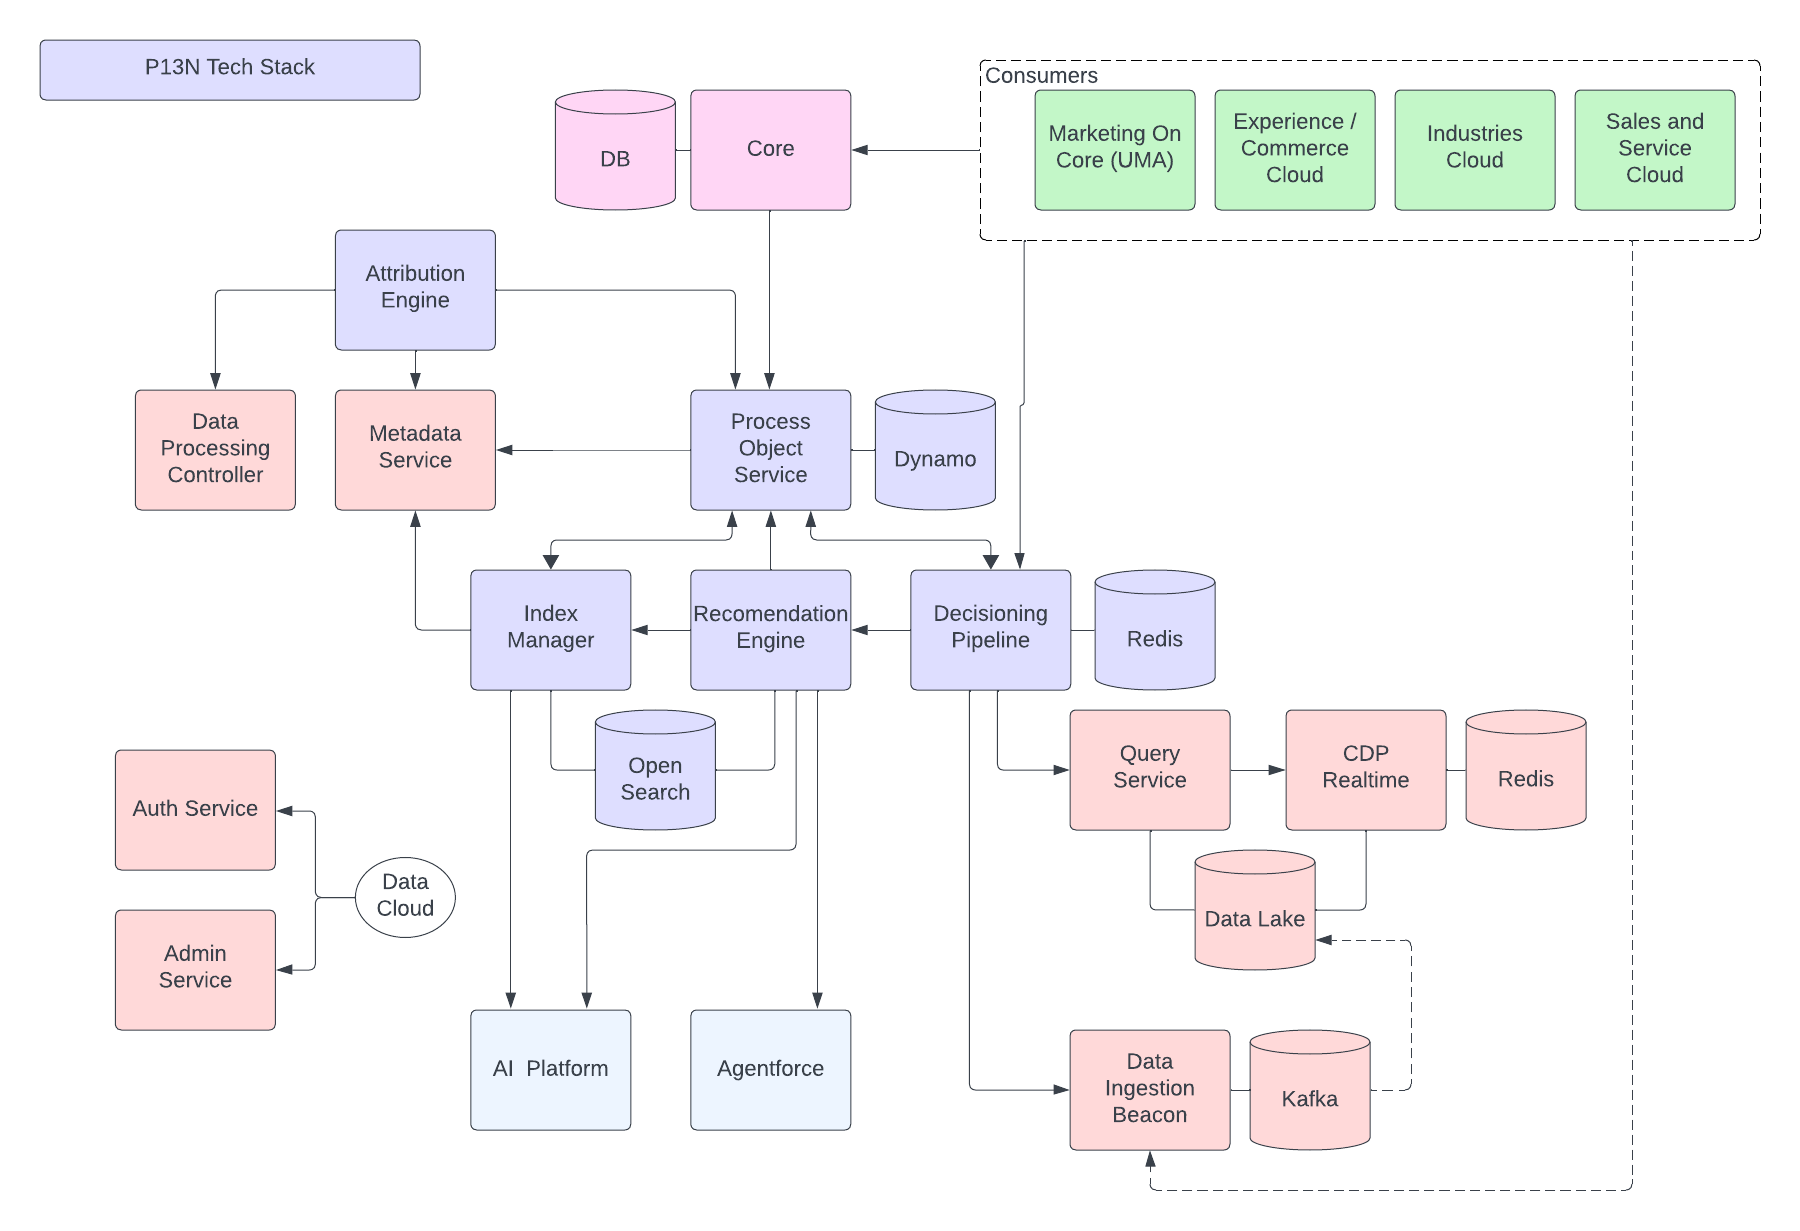 - **Oportunidades en curso de decisiones**
- Servir solicitudes externas para decisiones de personalización incluyendo aumento de perfil, experimentación y recomendaciones.
- **Motor de recomendaciones**
- Servicio en tiempo de ejecución de recomendaciones basadas en reglas o ML.
- **Gestor de índices**
- Gestiona/Orquesta flujos de trabajo para procesos asíncronos incluyendo entrenamientos de ML para modelos de recomendación
- **Servicio de objetos de proceso**
- Responsable de sincronizar metadatos de personalización entre principales y externos
- **Motor de atribución y experimentación**
- Atribución de Analytics y experimentación de recomendaciones de personalización
### Búsqueda de compañía agente
Data 360 está diseñado como una plataforma sólida y enriquecida específicamente para dar cobertura a las experiencias de agentes emergentes. Alcanzamos estas funciones construyendo sobre varios servicios de Data 360 existentes y a través de una integración profunda con Agentforce.
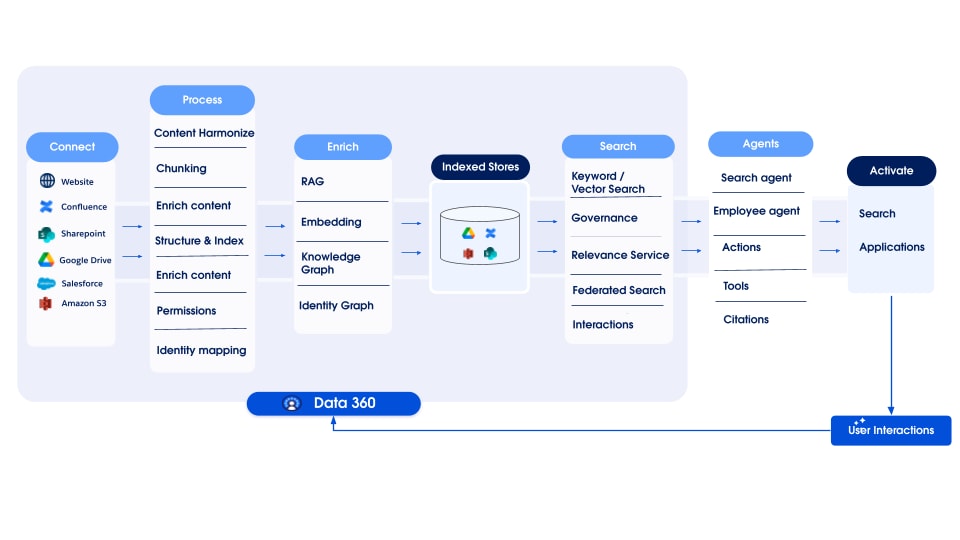 #### Aprovechamiento de los puntos fuertes principales de Data 360
Nuestro enfoque de Búsqueda de compañía de agentes se basa en los siguientes principios:
- Los datos de compañía se mantienen en establecimientos o servicios aislados, con los permisos seguros necesarios para el acceso. La capacidad de acceder a estos datos y procesarlos mientras mantiene los permisos de origen es vital para garantizar Trust.
- La clasificación cruzada y la relevancia entre el conjunto completo de datos permiten mejores resultados, lo que a su vez puede proporcionar un mejor contexto para experiencias de agentes.
Para entregar estas experiencias, Búsqueda de compañía de agente está construida sobre estos componentes arquitectónicos clave:
- **Conectores**: El amplio conjunto de conectores disponibles en Data 360 permite a uno acceder e ingresar datos desde una amplia variedad de orígenes.
- **Procesamiento de datos no estructurado**: Esto es fundamental para gestionar contenido no tabular, permitiendo al sistema derivar significado y contexto desde diversos datos.
- **Gobernanza**: Garantizar la seguridad de nivel de compañía, el cumplimiento y los controles de acceso para todos los datos consumidos por la búsqueda. La compatibilidad con permisos de visibilidad de origen garantiza que los datos sean accesibles solo para usuarios autorizados, tanto para experiencias de búsqueda sencilla como de agentes. Para garantizar una recuperación rápida, los permisos de seguridad se evalúan y aplican de forma nativa por los backends de búsqueda en la etapa más temprana del acceso a los datos.
- **Capa de recuperación unificada**: Para abordar el reto de los datos en silos, los conectores se alimentan a una capa de recuperación unificada integral. Esta capa proporciona un único punto de acceso a todos los datos, independientemente de que permanezcan en sistemas externos a los que se accede a través de Búsqueda federada o se gestionen de forma nativa a través de índices avanzados para la copia cero y los datos ingresados.
- **Comprensión de consulta inteligente**: Antes de la recuperación, el sistema utiliza mecanismos con tecnología de IA para interpretar la intención del usuario. Además de integrar representaciones de la consulta para la coincidencia de vectores semánticos, puede reescribir y ampliar búsquedas basadas en palabras clave para mejorar la precisión.
- **Búsqueda híbrida y consulta avanzada**: Para encontrar la información más relevante, la plataforma utiliza múltiples estrategias en paralelo. La búsqueda híbrida proporciona coincidencia de palabras clave precisa con la búsqueda de vectores semánticos en fragmentos de datos optimizados, mientras que la búsqueda de registro completo recupera simultáneamente documentos completos. Ambas se combinan para garantizar la relevancia semántica y la cobertura de contenido completa.
- **Clasificación jerárquica**: Después de recuperar los datos, una arquitectura de clasificación jerárquica de múltiples etapas puntúa, combina y vuelve a clasificar los resultados desde cada origen y método. Este proceso crea una lista única y unificada que aflora la información más pertinente para el usuario o agente.
#### Aplicaciones de búsqueda de agentes
La IA generativa está cambiando el consumidor principal de la búsqueda de compañía de usuarios humanos a modelos de lenguaje grande (LLM). Búsqueda de Data 360 está diseñada desde cero para servir a ambos. Está optimizado para gestionar las consultas más largas y complejas de los agentes y devolver los resultados contextuales enriquecidos necesarios para el consumo programático y los bucles de razonamiento. Al mismo tiempo, el sistema puede gestionar las consultas más cortas y a menudo ambiguas típicas de usuarios humanos, proporcionando funciones como miniprogramas y resaltando para una evaluación rápida en una interfaz de usuario.
La entrega definitiva de experiencias de búsqueda de agentes combina ambos enfoques:
1. **Resultados de búsqueda** directa: la aplicación puede mostrar una lista tradicional de resultados clasificados utilizando una API dirigida por metadatos construida sobre la base de búsqueda unificada de Data 360.
2. **Respuestas conversacionales auténticas** de múltiples turnos: las respuestas de agentes se aplican mediante la integración nativa con Agentforce. Esta experiencia conversacional está dirigida por un agente principal que orquesta acciones y consultas, delegando todas las tareas de recuperación de información a un agente de búsqueda interno especializado.
Este Agente de búsqueda especializado está optimizado para la recuperación de información de compañía. Utiliza un bucle de razonamiento para formular y ejecutar búsquedas paralelas para explorar diferentes aspectos de la solicitud de un usuario. Utiliza un potente conjunto de herramientas, incluyendo la búsqueda unificada de Data 360 para todos los tipos de datos y lenguajes de consulta estructurados para recuperar datos precisos desde tablas y entidades.
A través de esta síntesis arquitectónica, Data 360 potencia la creación de experiencias de búsqueda de negocio de agentes altamente inteligentes, conscientes del contexto y con capacidad de acción.
### Ampliación de Data 360 con código personalizado
La capacidad de ampliación es una función clave en Salesforce Platform. La extensión de código proporciona capacidad de ampliación en Data 360, permitiendo a los usuarios pro-código ejecutar lógica Python personalizada directamente dentro del entorno de Data 360, complementando sus funciones declarativas enriquecidas y de código bajo. Utilizando Extensión de código, los usuarios pueden ampliar de forma segura funciones principales de Data 360 como Transformaciones y Canalizaciones de datos no estructuradas (troceado personalizado).
Nuestro diseño para Extensión de código prioriza la flexibilidad, la seguridad, la eficiencia y una experiencia de desarrollador simplificada. Admite dos modelos de ejecución principales, cada uno adaptado a necesidades arquitectónicas específicas:
- **Modelo de secuencias**: de comandos
- **Objetivo**: Para una lógica personalizada integral que requiere interacción directa con Data 360 Lakehouse.
- **Funciones**: Los clientes redactan secuencias de comandos Python completas utilizando el SDK de extensión de código, lo que permite el acceso de lectura y escritura a Lakehouse a través de las API de SDK. Ideal para la preparación de datos personalizados/complejos o la manipulación de datos a medida.
- **Aislamiento y seguridad**: Aunque las secuencias de comandos acceden a Lakehouse, su ejecución está confinada a un entorno seguro y aislado dentro del tiempo de ejecución de Data 360, evitando la interferencia con otros procesos o el acceso no autorizado al sistema.
- **Modelo de funciones**:
- **Objetivo**: Análogo a una función sin servidor, para cálculos modulares sin estado invocados desde oportunidades en curso de Data 360 existentes (por ejemplo, fragmentación personalizada en una oportunidad en curso no estructurada).
- **Funciones**: Las funciones proporcionadas por el cliente toman entrada, computan y devuelven salida.
- **Aislamiento y seguridad**: Estas funciones están diseñadas para un aislamiento estricto; no tienen acceso directo a Lakehouse. Su ejecución es sandbox, sin estado y con recursos limitados, lo que las hace adecuadas para pasos de procesamiento centrados y sin estado, garantizando la seguridad, la ejecución predecible y minimizando el radio de explosión.
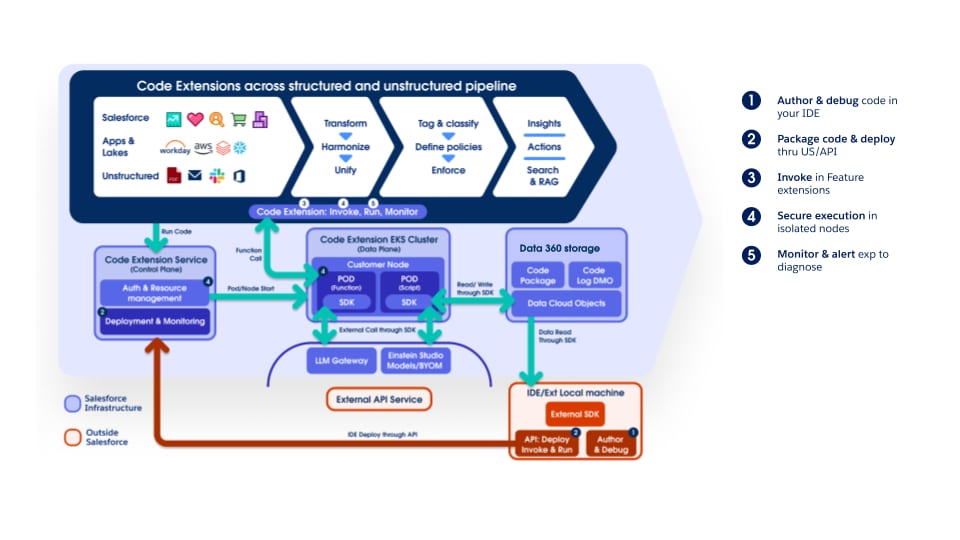 Tanto el modelo de secuencia de comandos como el de función tienen como objetivo ejecutar código de cliente de forma segura, evitando que el código de un arrendatario afecte a otros u obtenga acceso no autorizado a los datos de otros arrendatarios, recursos de Salesforce o recursos externos. Esta seguridad se logra a través de una arquitectura por capas (defensa en profundidad). Esta arquitectura proporciona un entorno de ejecución aislado para el código personalizado de cada arrendatario, incorporando varias barandillas. Estos incluyen el aislamiento lógico a nivel de Kubernetes (K8s), el aislamiento de red, el sandbox en tiempo de ejecución y los permisos de menor privilegio, todo ello complementado con monitoreo operativo y preparación de la respuesta ante incidentes para la detección y la respuesta.
#### Experiencia de desarrollador y visibilidad operativa
Para dar cobertura a un ciclo de vida de desarrollo sólido, Extensión de código ofrece:
- **Escritoría y depuración externas**: Los desarrolladores pueden crear y depurar código Python en entornos familiares como VSCode, aprovechando el SDK.
- **Implementación flexible**: El código personalizado se puede empaquetar e implementar utilizando utilidades de SDK, la interfaz de usuario de Data 360 o la API, lo que permite la integración en CI/CD.
**Registros operativos**: El acceso a registros de ejecución detallados proporciona transparencia y ayuda a solucionar problemas en producción.
Ofreciendo estas funciones de extensión de código seguras y flexibles, Data 360 permite a los arquitectos adaptar la plataforma a sus requisitos de procesamiento de datos más exclusivos y complejos, consolidando realmente su función como un tejido de datos de compañía ampliable.
### Ampliación de Data 360 aportando sus propios modelos de IA
A medida que las empresas aceleran la adopción de la IA, la mayoría mantiene ecosistemas de ML heterogéneos, incluyendo Amazon SageMaker, la IA de Google Vertex y entornos basados en Python personalizados, alojando modelos que dirigen predicciones críticas para la misión, como el puntuaje de riesgo de crédito, la propensión a abandonos, recomendaciones de productos y decisiones de la siguiente mejor acción.
Tradicionalmente, la integración de estos modelos externos en Salesforce requería capas de API a medida, oportunidades en curso de ETL u orquestación de middleware, introduciendo duplicación de datos, gastos generales de gobernanza, latencia y complejidad operativa: retos que entran en conflicto con una visión de Customer Data Platform (CDP) unificada, compatible y en tiempo real.
**Aportar su propio modelo (BYOM)**: Entregado a través de Einstein Studio en Data 360, soluciona estos desafíos activando la invocación directa de modelos entrenados externamente en flujos de trabajo de Salesforce, lógica Apex y herramientas de automatización, sin mover o replicar datos. A través de la federación de copia cero, Data 360 actúa como la única fuente de verdad gobernada, exponiendo datos Customer 360 armonizados para inferencia en extremos externos. Las salidas de predicción vuelven a fluir en tiempo real, potenciando procesos de negocio con inteligencia ampliable.
BYOM cierra de forma efectiva la brecha entre la ciencia de datos y la ejecución operativa desvinculando el desarrollo de modelos, los datos gobernados y las capas de consumo. Preserva la independencia de la plataforma, reduce la complejidad de la integración, acelera la implementación de la IA y mantiene la gobernanza sobre datos confidenciales.
La arquitectura funciona del siguiente modo: Data 360 proporciona una base de datos Customer 360 unificada, mientras Einstein Studio orquesta conexiones a plataformas ML externas (SageMaker, IA de Vertex o extremos personalizados). Los modelos externos ejecutan inferencias en tiempo real, por lotes o modos de transmisión. Las capas de Salesforce (Flow, Apex y las API de consulta) consumen resultados para entregar perspectivas personalizadas, automatizadas y analíticas entre Sales, Service, Marketing e Industry Cloud.
Desde el punto de vista de la compañía, BYOM ofrece:
- **Integridad y gobernanza de datos**: Elimina copias de datos no controladas y aplica el cumplimiento de políticas.
- **Democratización de IA**: Hace que los modelos complejos sean accesibles para usuarios no técnicos a través de herramientas de Salesforce.
- **Aceleración de tiempo a valor**: Los modelos externos se activan inmediatamente en procesos de Salesforce.
- **Escalabilidad y compatibilidad de arquitectura híbrida**: Activa la implementación de múltiples nubes de cargas de trabajo de IA.
- **Arquitectura de IA preparada para el futuro**: Admite estrategias de IA componibles, desvinculando datos, modelo y capas de consumo para agilidad operativa.
**Aportar su propio LLM (BYO-LLM)**: Ofrece el mismo mecanismo de capacidad de ampliación pero para modelos generativos. Activando la invocación directa de LLM externos, permitimos a los clientes utilizarlos en Agentforce Platform en lugar de modelos proporcionados por Salesforce. Para empresas BYO-LLM permite:
- Acceso a modelos ajustados
- Integración de modelos no proporcionados actualmente por Salesforce
- Uso de modelos en cuentas proporcionadas por el cliente
### Colaboración de datos
Las empresas modernas operan en un panorama de datos complejo caracterizado por dos retos arquitectónicos principales:
1. **Fragmentación intraempresarial**: Las organizaciones de gran tamaño utilizan con frecuencia múltiples organizaciones de Salesforce (a menudo segmentadas por región, unidad de negocio o adquisición histórica) y numerosos otros sistemas de datos. Esta fragmentación crea silos de datos internos, lo que hace imposible establecer una vista única, de confianza y unificada del cliente para la implicación en tiempo real en todo el negocio. El reto es unificar estos datos sin consolidarlos físicamente o duplicarlos en todos los sistemas, garantizando que la gobernanza permanece intacta.
2. **Colaboración entre empresas**: Las compañías a menudo necesitan compartir datos con socios y proveedores para marketing conjunto, medición e inteligencia de negocio. El reto es activar esta colaboración mientras protege datos confidenciales y patentados y cumple con leyes de privacidad como el RGPD y CCPA, así como barreras competitivas.
Salesforce Data 360 aborda estos retos con un marco de trabajo Trust by Design de copia cero creado sobre el principio de compartir el acceso y las perspectivas en vez de mover o duplicar datos.
#### Mecanismos de colaboración de Data 360
Salesforce Data 360 soluciona los retos de colaboración y fragmentación de datos con Data Cloud One, Colaboración de datos entre Data 360 y Salas limpias de datos de privacidad. Estas soluciones unifican datos de clientes, permiten el intercambio de datos seguro y proporcionan perspectivas que preservan la privacidad. Con un enfoque de copia cero, Trust by Design, las organizaciones pueden liberar el potencial de datos para la implicación en tiempo real, las asociaciones mejoradas y la toma de decisiones inteligente. Cada una de estas opciones de colaboración de datos tiene diferentes propósitos.
##### Habilitación de compañía interna con Data Cloud One
Data Cloud One es la solución arquitectónica fundamental para empresas que operan con múltiples organizaciones de Salesforce. Su propósito va más allá del simple uso compartido de datos; está diseñado para establecer una vista de cliente única y de confianza y activar funciones de plataforma Data 360 completas en toda la organización.
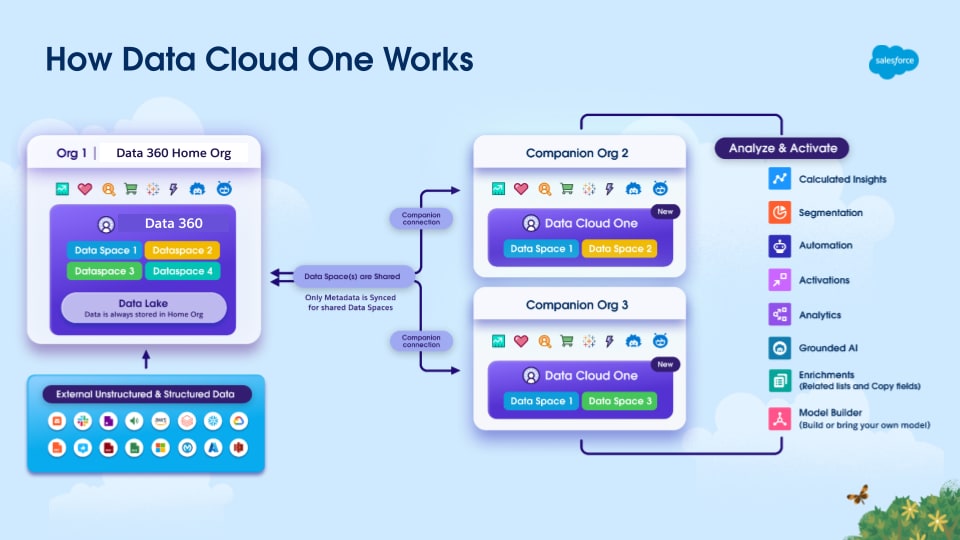 Este mecanismo se centra en una instancia designada de Home Org Data 360, que sirve como la autoridad central para la gestión de datos y la creación del perfil de cliente unificado. La organización de inicio es la organización en la que se aprovisiona Data 360. Se establece una conexión de Data Cloud One entre Data 360 y otras organizaciones de Salesforce, denominadas Organizaciones complementarias. Como parte de la conexión de Data Cloud One, Data 360 comparte uno o más de sus espacios de datos con cada organización complementaria, proporcionando acceso a datos y metadatos en cada espacio de datos compartido. Esto se logra a través de un modelo de federación de copia cero y sincronización de metadatos entre organizaciones.
Data Cloud One también permite a las organizaciones de compañía aprovechar la instancia Data 360 de la organización de inicio para sus propias necesidades de activación, personalización e inteligencia. Esta estrategia es esencial para eliminar la fragmentación de datos interna y garantizar que todas las unidades de negocio se activen en el mismo perfil de cliente, gobernado y unificado, maximizando el desempeño de las inversiones de la implementación principal de Data 360.
##### Colaboración de datos entre organizaciones de Data 360
Para entornos internos distribuidos (donde la centralización completa no es factible) y para la colaboración con socios externos de confianza, la colaboración de datos de Data 360 a Data 360 conecta instancias independientes de Data 360.
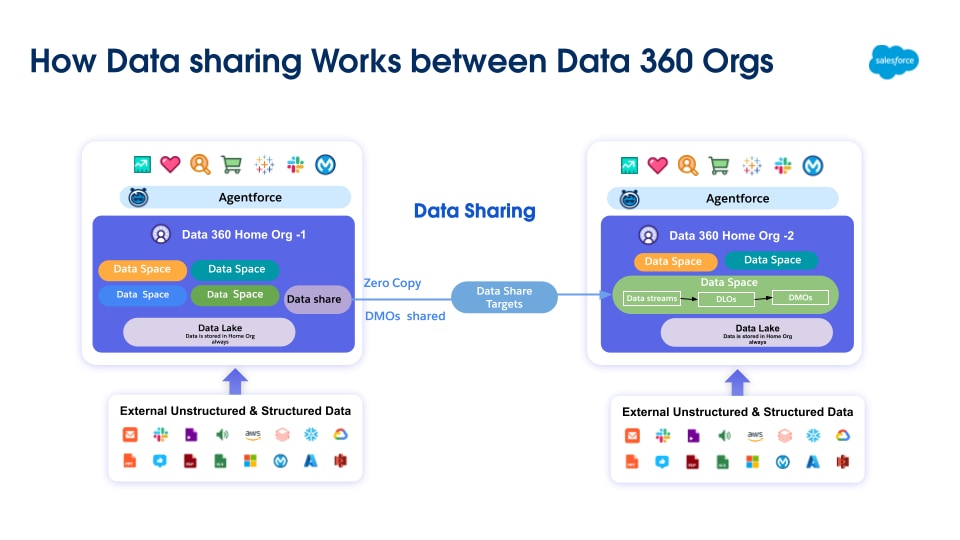 Este modelo de colaboración de copia cero establece una conexión entre arrendatarios de Data 360 separados aprovisionados en diferentes organizaciones de Salesforce con el fin de un intercambio seguro de objetos de datos (DLO, DMO y CIO). Una vez conectado, todo el objeto de datos se vuelve accesible en el destinatario Data 360. El administrador de Data 360 del destinatario puede establecer reglas de gobernanza para gestionar el acceso de los usuarios a estos datos.
##### Privacidad-Primera colaboración con la colaboración de salas blancas de Data 360
Cuando la colaboración requiere los niveles más altos de privacidad y cumplimiento, o cuando las preocupaciones de la competencia prohíben el uso compartido de datos sin procesar, Data 360 Clean Rooms tiene un mandato arquitectónico.
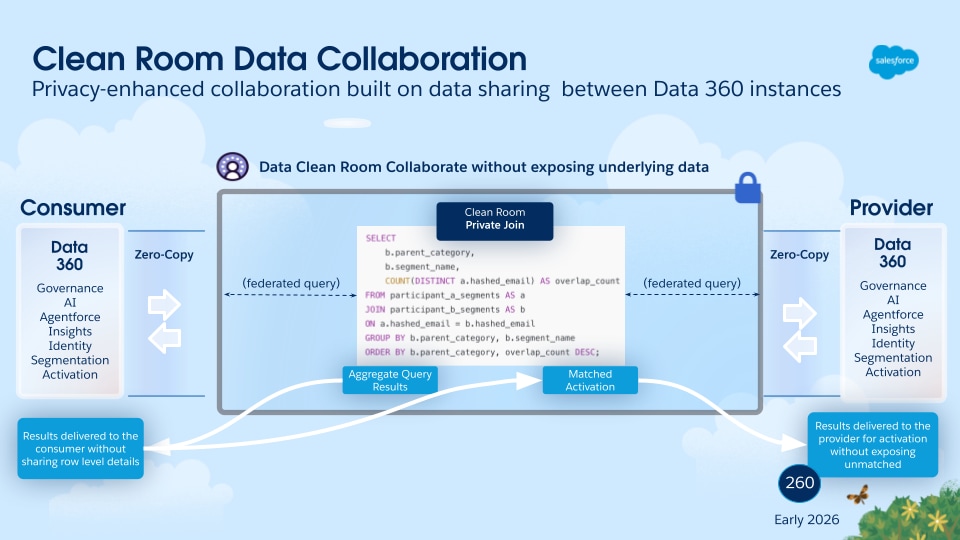 Arquitectónicamente, la colaboración de salas blancas de Data 360 está construida sobre el marco de trabajo Colaboración de copia cero utilizado por la colaboración de datos de Data 360 a Data 360, pero con capas adicionales de regulación y restricciones computacionales aplicadas. La Sala blanca de Data 360 proporciona un entorno informático seguro y controlado donde las partes pueden unir sus conjuntos de datos basándose en claves anónimas. Su propósito principal es permitir el análisis conjunto y la generación de perspectivas sin exponer los datos patentados subyacentes. El entorno aplica reglas programables estrictas como umbrales de agregación mínimos e identificadores no exportables. Estas reglas garantizan que solo se deriven y compartan perspectivas aprobadas, de mejora de la privacidad y agregadas. Esto hace que Salas limpias sea esencial para casos de uso como la medición de campañas entre plataformas y el análisis de solapamiento de audiencia confidencial.
## Conclusión: Salesforce Data 360: La columna vertebral de datos indispensable para Agentic Enterprise
Data 360 está diseñado como una estructura de datos inteligente, ampliable y de confianza necesaria para impulsar la IA de próxima generación. Su diseño arquitectónico soluciona el problema de los datos fragmentados, permitiendo a las organizaciones unificar, procesar y activar todos los datos de clientes a escala, utilizando la federación de datos de copia cero para garantizar la eficiencia.
Su sólida Organización de datos establece una vista armonizada desde los DLO (incluyendo datos no estructurados) a los DMO, todo ello protegido dentro de espacios de datos particionados. Las versátiles funciones de procesamiento de datos de Data 360, incluyendo transformaciones por lotes y transmisión, perspectivas calculadas, procesamiento de datos no estructurado y resolución de identidad, están impulsadas por la arquitectura incremental de SNCE y CDF, garantizando un procesamiento eficiente casi en tiempo real y ahorros de costos significativos.
La capacidad de ampliación se proporciona por la arquitectura Extensión de código, activando de forma segura la lógica Python personalizada a través de secuencias de comandos o Funciones aisladas para requisitos exclusivos. Además, un marco de trabajo de gobernanza de datos integral, construido sobre el control de acceso basado en atributos (ABAC) con políticas de CEDAR, garantiza seguridad granular, enmascaramiento de datos dinámico y aplicación coherente en todo el consumo de datos. Esto culmina en funciones de segmentación y activación sofisticadas, traduciendo perfiles de clientes unificados en estrategias de implicación dinámicas de múltiples canales con capacidad de respuesta en tiempo real.
De manera crucial, la capacidad de Data 360 para unificar datos vastos y diversos, proporcionar contexto en tiempo real a través de su consulta unificada (incluyendo búsqueda estructurada/no estructurada híbrida y aceleración Hyper) y aplicar una regulación estricta es primordial para potenciar agentes de IA inteligentes. Proporciona los datos de confianza, actualizados y relevantes necesarios para fundamentar flujos de trabajo de IA generativa (RAG) y alimentar las funciones de múltiples turnos orientadas a la acción de agentes con tecnología Agentforce, garantizando que operan con precisión y precisión.
Proporcionando una plataforma preparada para el futuro donde los datos de origen se transforman en perspectivas con capacidad de acción, Data 360 sirve como una base arquitectónica indispensable para organizaciones que crean experiencias de clientes de Agentic. Es la columna vertebral vital que convierte los datos de los clientes en experiencias de clientes sofisticadas y personalizadas que impulsan el éxito para las organizaciones modernas de hoy.
## De integración componible a una compañía de agentes gobernada
La transición a Agentic Enterprise representa el cambio arquitectónico más significativo desde el amanecer de la nube. Promete niveles de productividad y automatización sin precedentes, pero también presenta retos profundos relacionados con la gobernanza, la seguridad y la complejidad operativa. El uso de un enfoque fragmentario (despliegue de agentes en silos sin una estrategia unificadora) es un camino directo hacia la deuda técnica y el caos organizativo.
La implementación de agentes sin un plano de gestión central crea un riesgo operativo significativo, incluyendo vulnerabilidades de seguridad procedentes del acceso directo al sistema, la falta de observabilidad en interacciones y acciones de agentes y altos costos debido a integraciones redundantes de punto a punto. Esta estrategia de implementación en silos da como resultado un entorno frágil difícil de gestionar a escala. Un modelo sostenible requiere una plataforma unificada para la integración y la gobernanza de agentes.
_MuleSoft_ proporciona una plataforma integral, unificada y abierta para guiar con confianza a las empresas en su trayectoria. Aprovecha el panorama de API existente de la compañía como la base para acciones de agentes y acelera la creación de nuevos activos listos para agentes a través de un ciclo de vida de desarrollo de confianza con tecnología de IA. A través de la compatibilidad de nivel de compañía para estándares abiertos como los protocolos Model Context Protocol (MCP) y Agent2Agent (A2A), hace que estos activos tengan capacidad de acción para comandos sencillos y colaboración compleja de múltiples agentes, independientemente de cómo evolucione el panorama de la IA. [_MuleSoft Agent Fabric_](https://docs.mulesoft.com/agent-fabric/) proporciona una solución para descubrir, orquestar, gobernar y observar todo el ecosistema de agentes. A través de este enfoque integrado, _MuleSoft Agent Fabric_ proporciona una base probada para ampliar una red de agentes IA de confianza, que transforma la promesa de la IA en resultados de negocio tangibles y automatizados y realiza todo el potencial de la empresa inteligente.
## **La base componible para la IA con capacidad de acción**
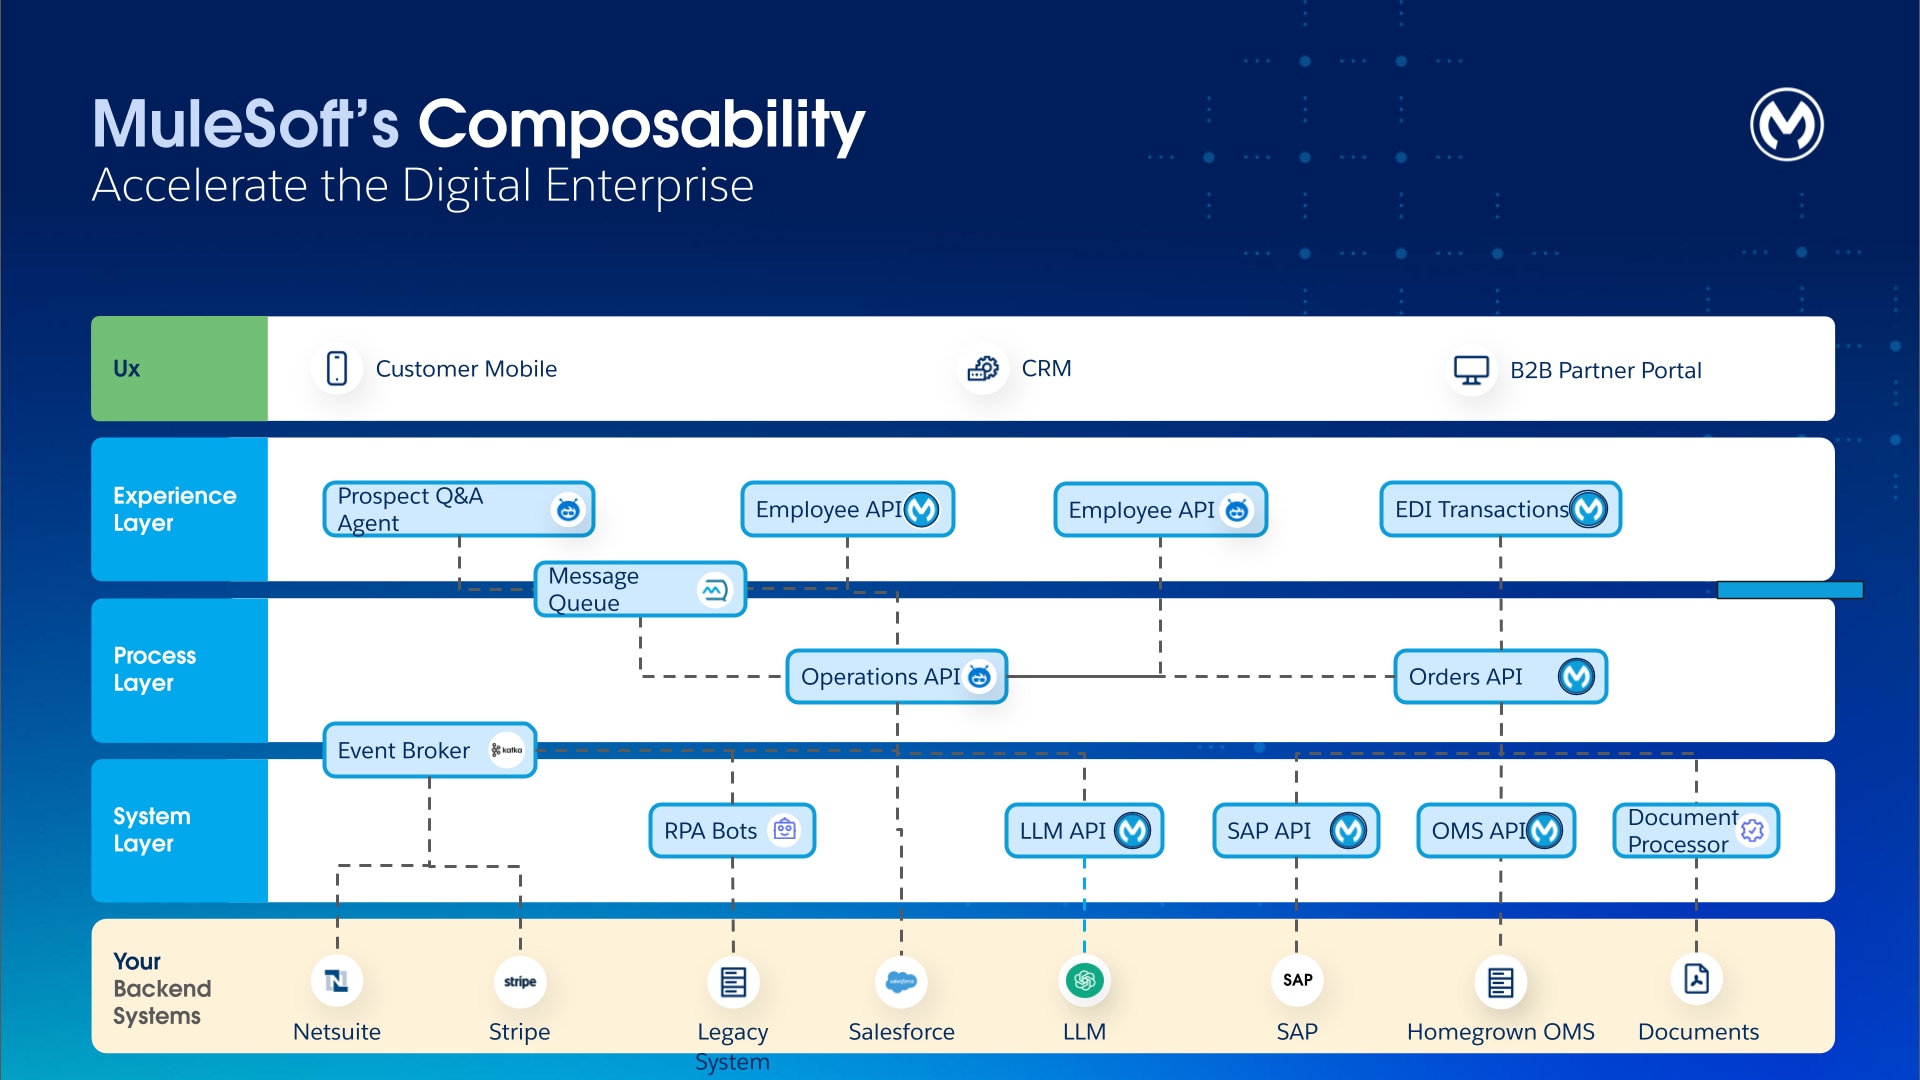 El enfoque de tres capas establecido de conectividad dirigida por API - API de sistema, proceso y experiencia - proporciona un potente marco de trabajo para estructurar la capacidad de acción de los agentes.
- Las **API del sistema** ofrecen una interfaz coherente, segura y abstracta con los sistemas de registro subyacentes. Desvinculan los agentes de la complejidad de los protocolos backend y los modelos de datos, lo que garantiza que todas las acciones de agentes se realicen en extremos gobernados y fiables.
- Las **API de procesos** encapsulan lógica de negocio compleja de múltiples pasos. Los agentes no necesitan comprender la compleja orquestación detrás de la creación de pedidos de ventas, la comprobación de inventario o el inicio de envíos. Pueden utilizar las API de procesos (por ejemplo, "Procesar pedido") sin tener que gestionar las complejidades subyacentes. Las API de procesos proporcionan un mecanismo seguro, transaccional y auditable para que los agentes ejecuten procesos de negocio, lo que reduce drásticamente el razonamiento de los agentes requerido y garantiza que las reglas de negocio se apliquen de forma coherente.
- Las **API de Experience** se diseñaron tradicionalmente para servir aplicaciones de interfaz de usuario específicas (por ejemplo, Aplicación de gestión de pedidos); sin embargo, también se pueden reutilizar como acciones enriquecidas en contexto para agentes. Esto proporciona a los agentes información esencial para realizar una tarea concreta sin requerir múltiples llamadas a sistemas descendentes.
## **1\. Creación generativa: Acelerar el desarrollo de activos** listos para agentes
Para satisfacer la creciente demanda de herramientas y funciones listas para agentes, las compañías deben acelerar el desarrollo de las API e integraciones que forman la base componible. _MuleSoft_ aborda este reto integrando la IA generativa directamente en el ciclo de vida del desarrollo, lo que crea un círculo virtuoso que utiliza la IA para crear los activos de alta calidad que otros agentes consumen.
### **1.1 MuleSoft Vibes**
Para desarrolladores, [MuleSoft Vibes](https://www.mulesoft.com/platform/api/anypoint-code-builder/announcing-mulesoft-vibes) actúa como un socio inteligente automatizando los aspectos más repetitivos del desarrollo de integración y proporcionando una interfaz unificada y agente para todo el ciclo de vida del desarrollo de software. A través de MuleSoft Vibes en [Anypoint Code Builder](https://docs.mulesoft.com/anypoint-code-builder/), los desarrolladores interactúan con funciones generativas con tecnología de las [confianzas _Einstein AI Pipelines_](https://blogs.mulesoft.com/automation/how-mulesoft-turns-generative-output-into-value/), lo que hace que el proceso de desarrollo asistido por IA sea fluido y eficiente. Esta canalización, el _Servicio de ejecución_ de gráficos de conferencias (IGES), es un proceso de múltiples etapas que se utiliza para alcanzar resultados de alta calidad. Consta de fundamentación, validación, corrección de errores y evaluación rigurosa.
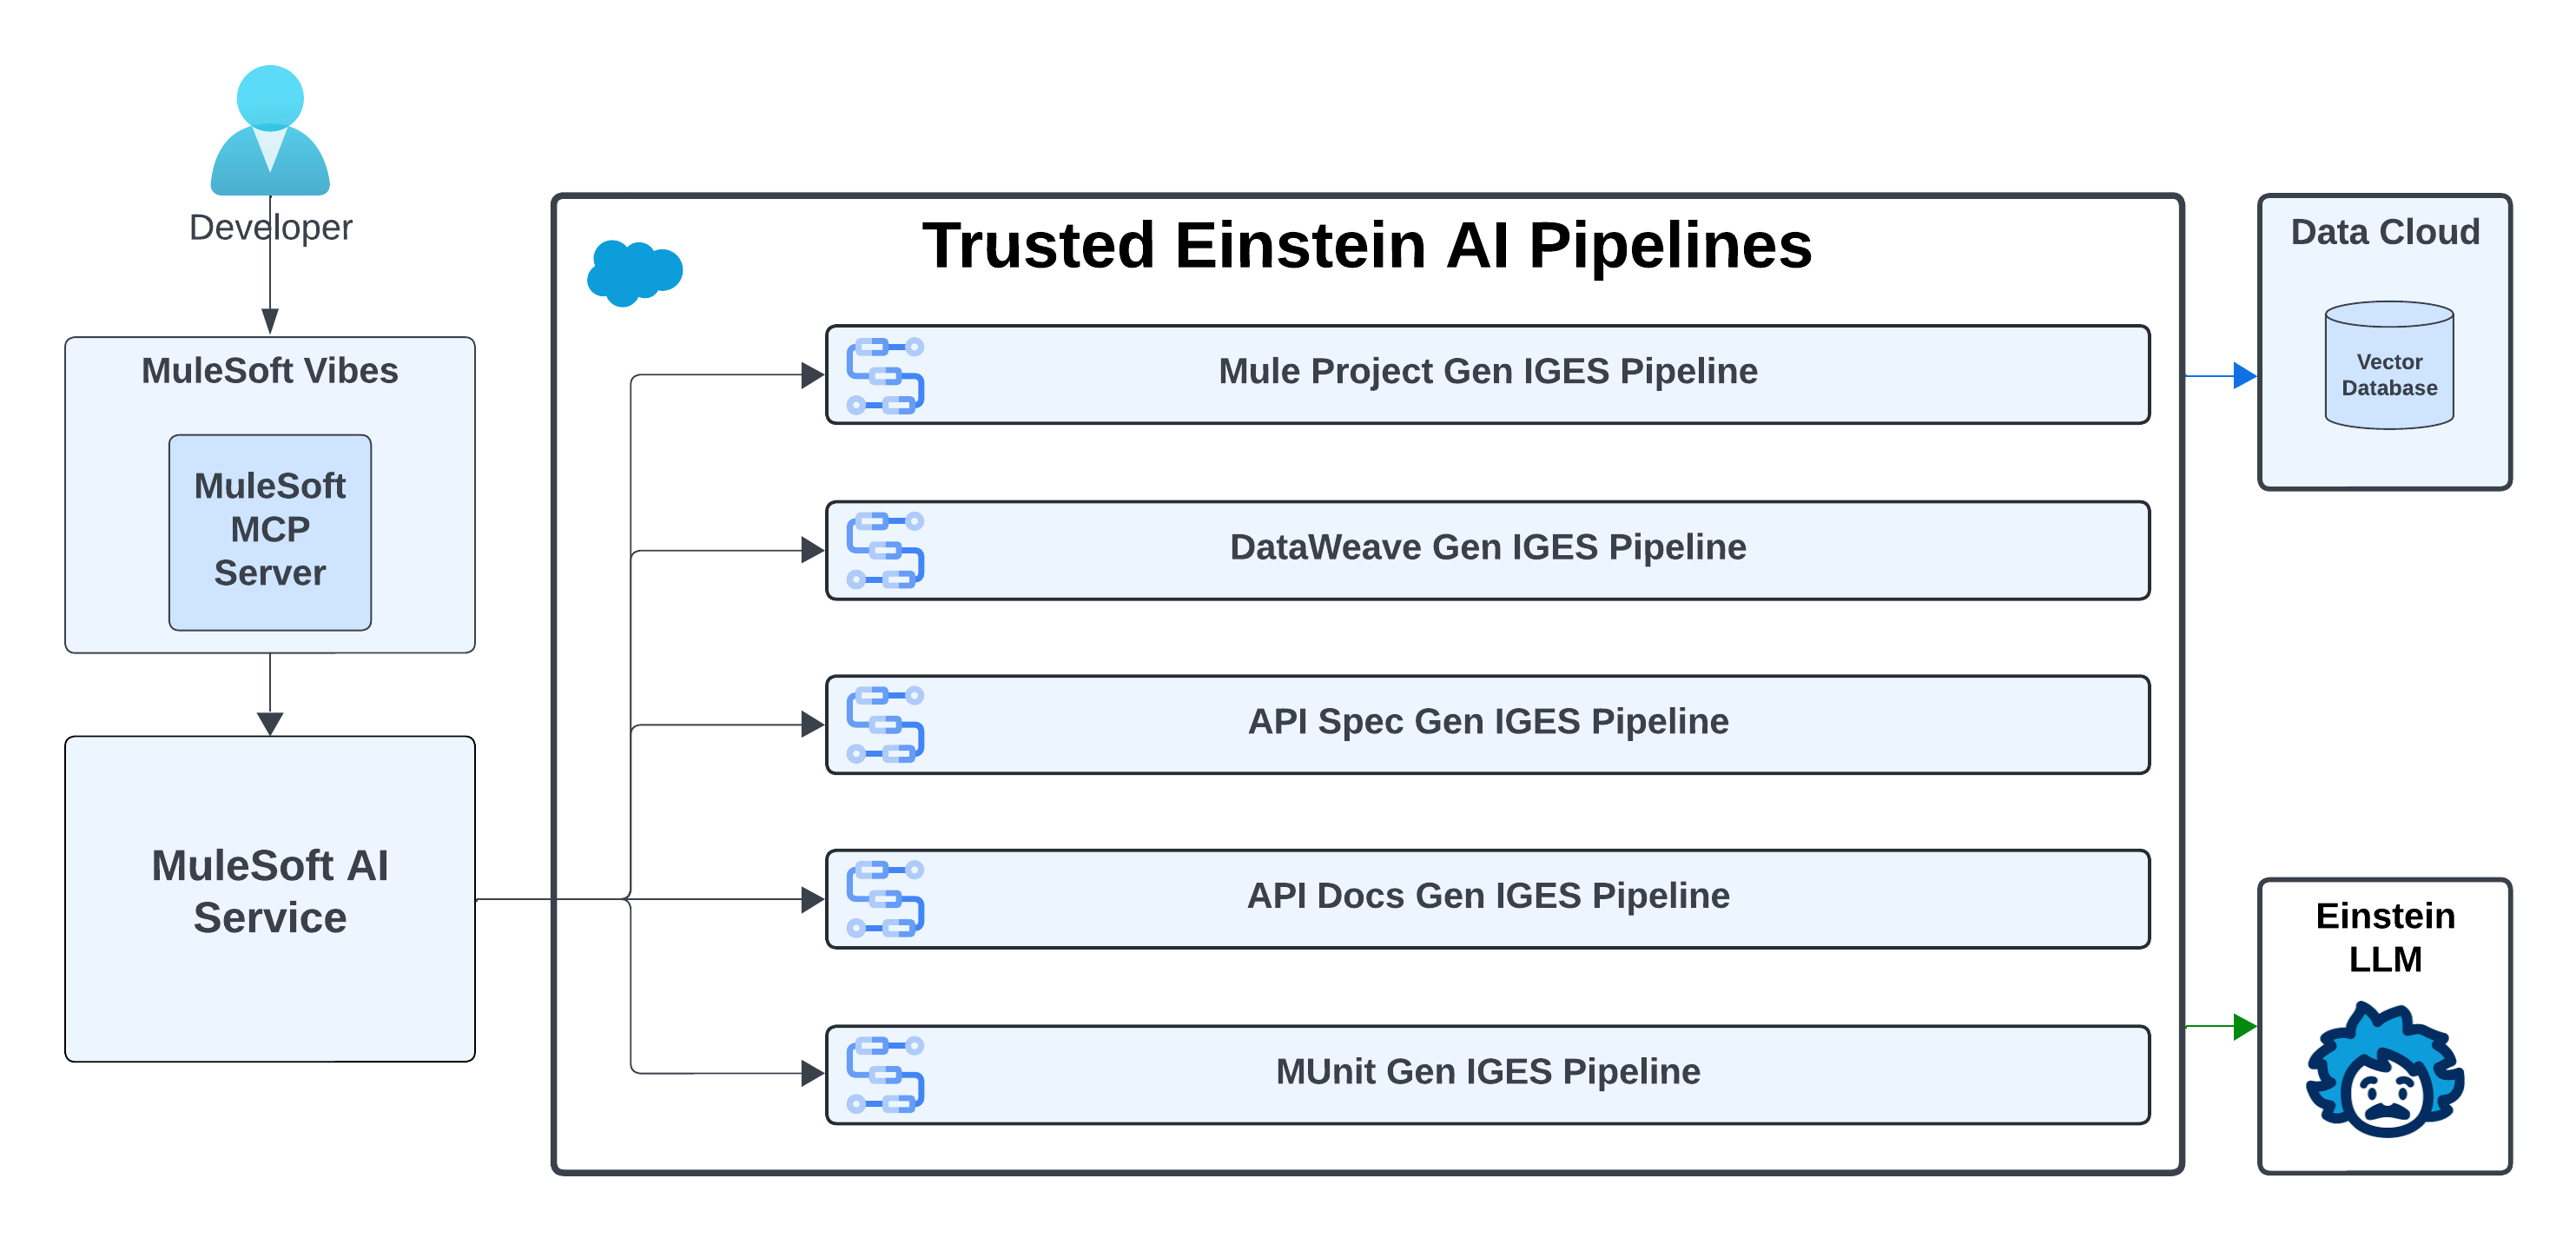 - La función [**Flujos generativos**](https://blogs.mulesoft.com/dev-guides/einstein-for-acb/) en _MuleSoft Vibes_ está construida sobre el marco de trabajo de _IA Agentforce_. Transforma la lógica de negocio del lenguaje natural (Solicitudes de usuario) en aplicaciones Mule funcionales. _IGES Pipeline_ consta de los siguientes pasos:
- **Resumen del historial de pláticas:** El LLM analiza la solicitud actual y los mensajes anteriores del usuario para crear una solicitud resumida que captura la intención del usuario y el historial de pláticas. Esta solicitud consolidada mejora la precisión de los pasos de generación y recuperación de datos posteriores.
- **Recuperación semántica de flujos desde una base de datos de vectores:** El sistema toma la solicitud resumida del paso anterior y realiza una búsqueda semántica en una base de datos vectorial que contiene más de 200 conectores, más de 7.000 operaciones de conector y más de 7.000 miniprogramas de código de muestra. Recupera los conectores, las operaciones y los ejemplos de código más relevantes para fundamentar el proceso de generación utilizando datos precisos y garantiza que los resultados están alineados con el ecosistema de conectores extenso de MuleSoft. Puesto que MuleSoft es el estándar de la industria para conectores y operaciones, esta fundamentación proporciona al modelo contexto enriquecido y precisión de dominio de la que carecen los LLM genéricos.
- **Aumento:** El contenido recuperado y los mensajes de historial de pláticas se combinan a continuación con la solicitud resumida. Esta solicitud aumentada guía el LLM para reducir las alucinaciones. También incluye instrucciones para evitar la generación de contenido tóxico.
- **Generación de flujos:** Este paso aprovecha el modelo _Einstein AI LLM_ para generar código XML sin procesar basado en el contexto y los ejemplos proporcionados. Este es el paso principal de las oportunidades en curso de generación.
- **Posprocesamiento y validación:** El postprocesador y el validador comprueban el código para garantizar la sintaxis correcta y el uso de operaciones de conector válidas mientras que una comprobación de toxicidad separada marca contenido dañino.
- **Corrección de errores de múltiples pasos:** Si todas las generaciones iniciales no son válidas, el mecanismo de corrección de errores automatizado analiza los mensajes de error para detectar patrones. A continuación, vuelve a enviar la solicitud al LLM junto con mensajes de error enriquecidos y metadatos correctivos.
- **Configurar generación de archivos:** Este paso extrae metadatos de conector relevantes, aumenta la solicitud y la envía al LLM para generar configuraciones de conector precisas. Por último, todos los espacios de nombres POM y XML se generan de forma determinista utilizando la versión más reciente de cada dependencia, lo que elimina alucinaciones y garantiza la coherencia.
- [**Generación de transformación**](https://blogs.mulesoft.com/dev-guides/dataweave-generative-transformation/)**:** DataWeave La transformación de datos es a menudo la parte que más tiempo consume del desarrollo de la integración. _MuleSoft Vibes_ aborda este proceso utilizando el enfoque de múltiples pasos que es similar a la generación _XML de Mule Flow_.
- **Razonamiento de intención:** El LLM analiza muestras de datos de entrada y salida de usuarios para inferir y articular lógica de transformación de alto nivel en lenguaje natural. Este paso separa el objetivo del usuario de los valores de datos literales que se proporcionaron en la solicitud.
- **Recuperación semántica de DataWeave:** Para encontrar la documentación de función DataWeave más relevante semánticamente y ejemplos de transformación completos, el sistema utiliza la solicitud generada desde el paso anterior como una consulta a la base de datos de vectores. Esto fundamenta el proceso de generación en información verificada de alta calidad.
- **Aumento:** Las funciones y los ejemplos recuperados se combinan con la solicitud de usuario original para crear un conjunto de instrucciones conscientes del contexto para la llamada LLM posterior, que influye en el comportamiento del LLM para reducir las alucinaciones.
- **Generación de DataWeave:** Este paso aprovecha el modelo LLM para generar una secuencia de comandos de transformación de DataWeave y una explicación adjunta que se basa en el contexto y los ejemplos proporcionados. Este es el paso principal de las oportunidades en curso de generación.
- **Posprocesamiento y validación** La secuencia de comandos generada se evalúa con dos mediciones específicas: validez y corrección. La secuencia de comandos debe compilarse sin errores de sintaxis (validez) y producir el resultado esperado cuando se ejecuta utilizando la entrada de muestra (corrección).
- **Corrección de errores de múltiples pasos:** Si la validación inicial falla, este complemento identifica las categorías de error y corrige los problemas en la secuencia de comandos generada. Este ajuste ayuda a mejorar el índice de éxito general y la precisión del sistema.
- **Posprocesamiento y validación** finales La secuencia de comandos corregida desde el módulo de corrección de errores se somete a un proceso de revalidación para garantizar que es sintácticamente válida y funcionalmente correcta. Esta puerta de calidad final garantiza que el resultado sea preciso y fiable antes de enviarlo de vuelta al usuario.
- [**Especificación de API**](https://docs.mulesoft.com/anypoint-code-builder/api-ai-create-spec) **y [Generación de documentación](https://docs.mulesoft.com/exchange/generating-documentation-with-ai):** Los desarrolladores pueden generar especificaciones de _OpenAPI (OAS)_ o _RAML_ completamente validadas describiendo la API deseada en lenguaje natural. _MuleSoft Vibes_ ingresa la solicitud (que incluye detalles sobre recursos, métodos, esquemas de seguridad y parámetros) y produce una definición de API válida y sintácticamente correcta. Tras la generación, puede crear documentación para la API en _Anypoint Exchange_, que cubre todo desde la autenticación hasta los detalles de extremos y la gestión de errores, liberando a los desarrolladores de este tipo de tareas tediosas.
- **Generación de MUnit asistida por IA:** La garantía de calidad es primordial para activos consumidos por agentes autónomos. _MuleSoft Vibes_ ayuda a generar casos de prueba MUnit directamente desde el Código de flujo de Mule. Esto ayuda a simular dependencias externas y afirmaciones, e identificar brechas de prueba comunes, lo que reduce drásticamente el esfuerzo manual requerido para alcanzar una alta cobertura de prueba y garantizar la fiabilidad de la lógica de integración.
### **1.2 MuleSoft a su manera**
Los desarrolladores prosperan en sus entornos preferidos. Es por eso que _MuleSoft_ se reúne con desarrolladores donde están, lo que les permite crear integraciones en su IDE de IA de su elección. [Servidor de protocolo de contexto de modelo (MCP)](https://www.npmjs.com/package/@mulesoft/mcp-server) de MuleSoft expone funciones de desarrollo, implementación y gestión como herramientas de MCP que cualquier IDE nativo de IA basado en VS Code (por ejemplo, Cursor, Windsurf o Trace) puede consumir para interactuar con la _Plataforma Anypoint_ utilizando lenguaje natural.
Al empaquetar su función de IDE principal en una [extensión VS Code estándar](https://marketplace.visualstudio.com/items?itemName=salesforce.mule-dx-extension-pack), _MuleSoft_ desvincula sus herramientas de un shell de IDE con marca, lo que permite que las herramientas de desarrollo tengan en cuenta el IDE. En vez de competir con la rápida evolución de los IDE, esta opción de arquitectura permite a las herramientas de desarrollo de MuleSoft permanecer compatibles y accesibles en el creciente ecosistema de IDE modernos con tecnología de IA.
## **2\. Activar capacidad de acción: Transformar las API en herramientas para agentes**
En una compañía agente, tener una base sólida de API componibles es necesario, pero insuficiente. El siguiente paso crítico es garantizar que estos activos son detectables, comprensibles e invocables por agentes de IA. Esto requiere una "capa con capacidad de acción" que esté construida sobre estándares abiertos diseñados específicamente para la comunicación de agentes. _MuleSoft_ proporciona herramientas de nivel de compañía para los dos protocolos emergentes dominantes:
- **MCP** para interacciones de agente a sistema
- **A2A** para interacciones de agente a agente
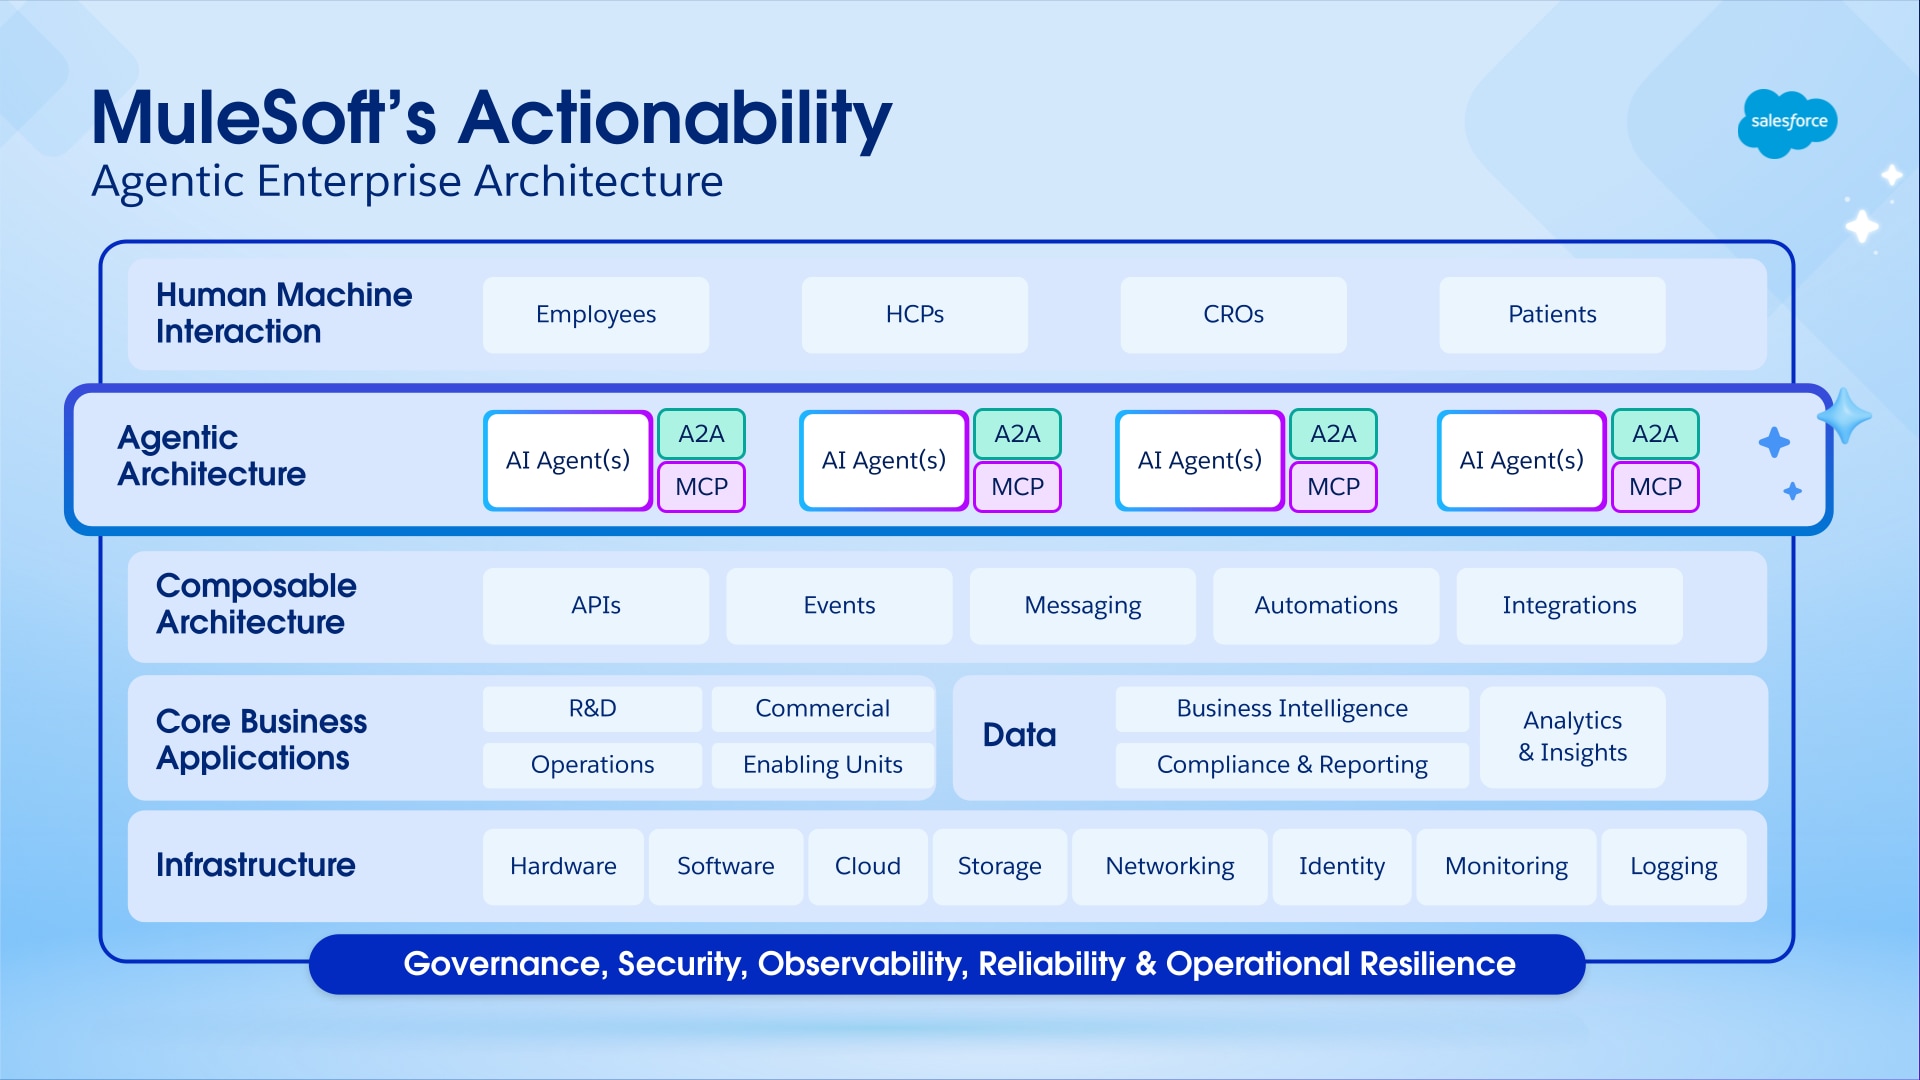 ### **2.1 Protocolo de contexto de modelo (MCP)**
_MCP_ ha surgido rápidamente como el estándar de la industria para la comunicación de agente a herramienta, que es análogo a lo que se convirtió _REST_ para servicios web. _MCP_ permite a los agentes de IA descubrir dinámicamente las funciones de un sistema, comprender sus entradas y salidas e invocarlo para realizar una acción, todo ello sin requerir lógica preprogramada o codificada.
El [Conector MCP MuleSoft](https://docs.mulesoft.com/mcp-connector/latest/) permite que cualquier API implementada como una aplicación Mule se publique como un servidor MCP. Puesto que _MuleSoft_ proporciona cientos de conectores preintegrados a prácticamente todos los sistemas de negocio principales (por ejemplo, SaaS, heredados y bases de datos), esto transforma instantáneamente las API y aplicaciones de una organización en un conjunto de herramientas listas para agentes. Una API diseñada para comprobar el inventario en SAP, un flujo que procesa un nuevo prospecto en Salesforce o una aplicación personalizada conectada a través de _MuleSoft_ pueden ponerse a disposición de los agentes de IA como herramientas atómicas gobernadas utilizando el _Conector MCP_.
### **2.2 Protocolo de agente a agente (A2A)**
Aunque el _MCP_ destaca en interacciones jerárquicas de herramienta de invocación de agentes, los procesos de negocio complejos a menudo requieren colaboración entre múltiples agentes especializados. El protocolo de _agente a agente (A2A)_ es el estándar abierto emergente diseñado para facilitar la comunicación de punto a punto que permite flujos de trabajo sofisticados de múltiples agentes.
La compatibilidad de MuleSoft con A2A permite a las compañías diseñar y crear sistemas avanzados con el mismo nivel de gobernanza y fiabilidad que esperan para sus API. El [Conector A2A MuleSoft](https://docs.mulesoft.com/a2a-connector/latest/) permite a los desarrolladores exponer fácilmente cualquier agente como un servidor A2A, o invocar cualquier agente compatible con A2A desde una aplicación Mule. Por ejemplo, un proceso de solicitud de hipoteca puede orquestarse entre un "Agente de comprobación de crédito", un "Agente de firma de documentos" y un "Agente de cumplimiento normativo", con cada agente descubriendo e invocando las funciones de los demás (según sea necesario) para hacer avanzar la solicitud.
Al proporcionar herramientas sólidas de nivel de compañía para MCP y A2A, MuleSoft admite la creación de un ecosistema flexible que consta de interacciones directas de agente a sistema (a través de herramientas de MCP) e interacciones de agente a agente (A2A). Independientemente de cómo evolucione el panorama de la IA, este enfoque posiciona _MuleSoft_ como la base subyacente que conecta todas las formas de comunicación de agentes.
## **3\. Tela de agente de MuleSoft: El sistema nervioso central de la compañía** de agentes
A medida que las empresas adoptan la IA de agentes, inevitablemente se enfrentan al reto de la expansión de los agentes. Para evitar que esto se convierta en caos, se requiere una capa de orquestación dedicada. [MuleSoft Agent Fabric](https://docs.mulesoft.com/agent-fabric/) ([demostración](https://www.youtube.com/watch?v=GAqwPie16ic)) es una solución arquitectónica integral diseñada para abordar este reto de frente. Proporciona un plano de gestión central para descubrir, gobernar, orquestar y observar toda la red de agentes de IA, independientemente de dónde se construyen o cómo operan. Funcionando como el "controlador de tráfico aéreo" para la plantilla digital de la compañía, _MuleSoft Agent Fabric_ transforma una colección de agentes fragmentados en una red de inteligencia cohesionada, segura y de alto desempeño.
_MuleSoft Agent Fabric_ se basa en cuatro pilares integrados que cubren la gestión del ciclo de vida completo para agentes como activos de compañía de primera clase.
### **3.1 Registro de agentes (Descubrir)**
La base de cualquier ecosistema gestionado es la capacidad de descubrimiento. El _Registro de agentes_ sirve como el catálogo universal y centralizado para cada activo de agente en la compañía. Esto incluye agentes creados a medida, agentes incrustados en aplicaciones SaaS, servidores MCP que exponen sistemas heredados y extremos A2A para la colaboración entre agentes. Al proporcionar una única fuente de verdad, el _Registro de agentes_ resuelve el problema de descubrimiento crítico evitando que los equipos creen funciones redundantes y permitiendo a los desarrolladores humanos y otros agentes de IA encontrar y reutilizar dinámicamente activos existentes a escala.
 El _Registro de agentes_ está construido sobre _Anypoint Exchange_ y agrega tres nuevos tipos de activos: Agentes, servidores MCP y LLM. Captura información acerca de estos activos, incluyendo herramientas de MCP, protocolos de transporte y tarjetas de agentes, así como las dependencias entre agentes y los servidores de MCP y las herramientas que consumen. Los desarrolladores pueden crear y gestionar activos directamente en el registro. También pueden descubrir y reutilizar programáticamente activos existentes en MuleSoft Vibes (a través de la herramienta search*asset del \_servidor MuleSoft MCP*) al crear nuevas orquestaciones. Esto equipa a los desarrolladores con toda la información que necesitan para comprender y consumir estos activos.
### **3.2 Corredor de agentes (Orquesta)**
Una vez que los activos son detectables, deben orquestarse para realizar un trabajo útil. _Agent Broker_ es un servicio de orquestación que ejecuta procesos de negocio de múltiples pasos. Utiliza un LLM configurable para interpretar tareas de alto nivel y generar flujos de trabajo correspondientes. El _intermediario de agentes_ descubre, secuencia e invoca dinámicamente los agentes y herramientas requeridos para completar estos procesos.
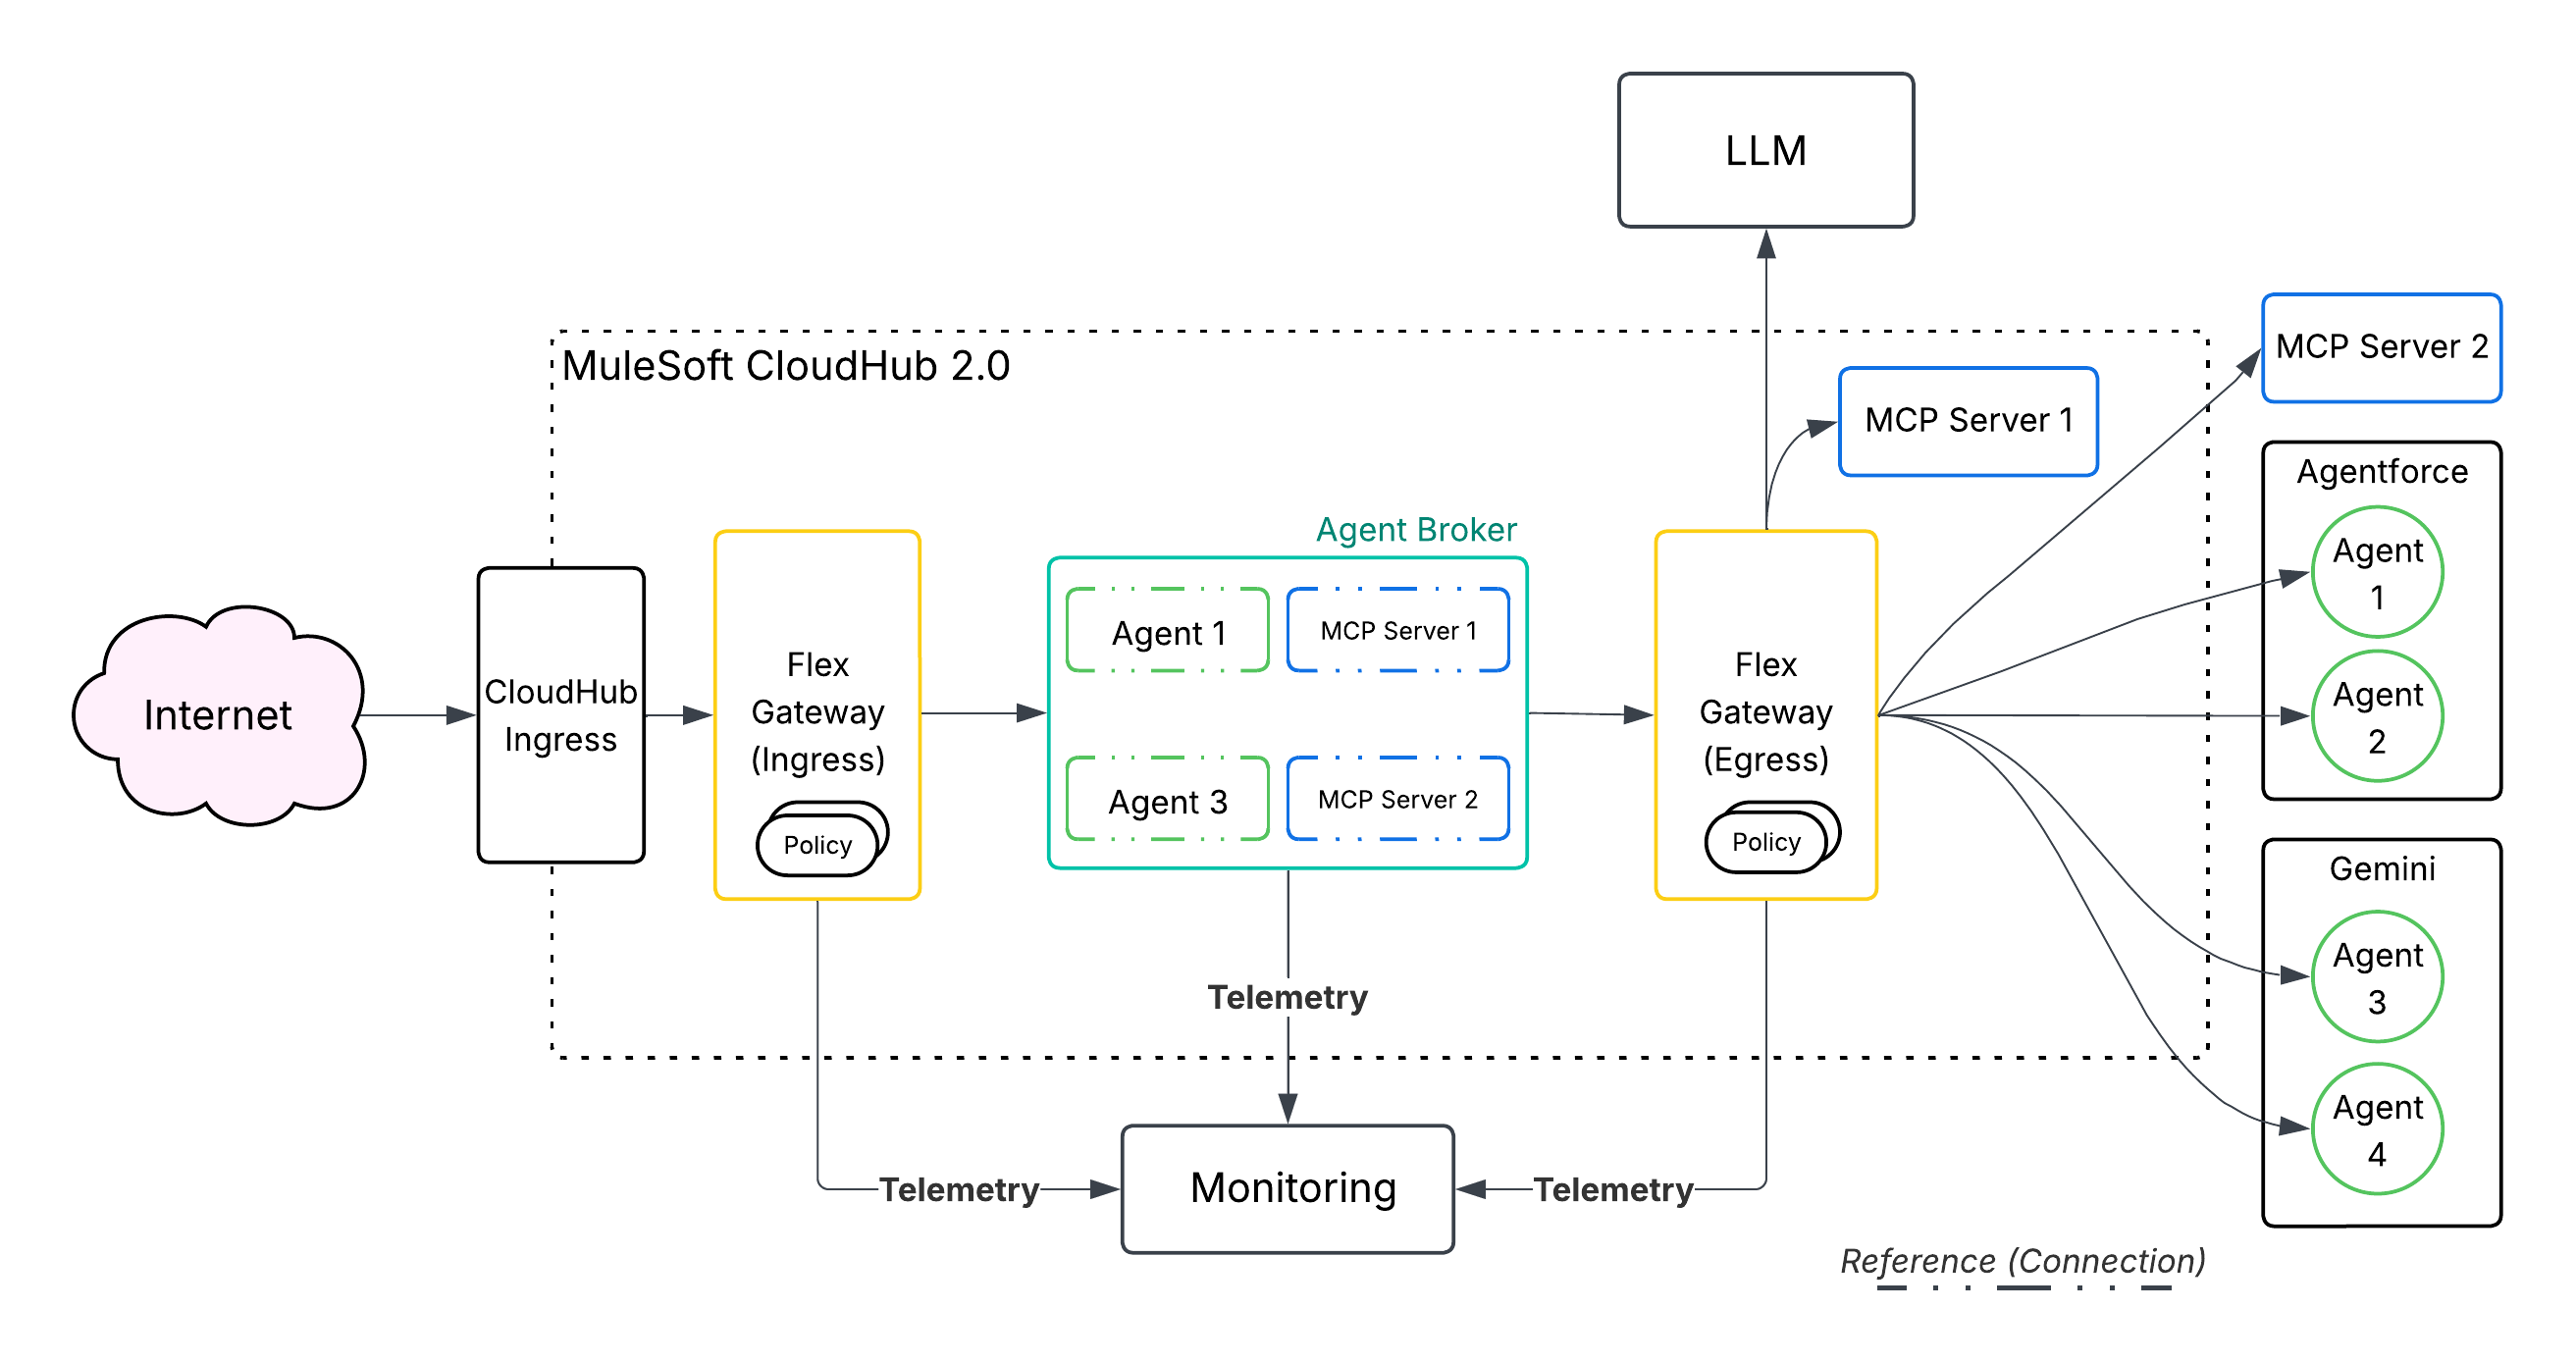 La conectividad se gestiona a través de la _MCP_ para herramientas y un protocolo _A2A_ para agentes. Esto permite al sistema organizar agentes en dominios específicos de negocio (por ejemplo, Cadena de suministro o Finanzas) y enrutar tareas entre todos ellos. Una solicitud de lenguaje natural única (por ejemplo, “Incorporar un empleado”) se descompone en una secuencia de acciones discretas que ejecutan diferentes agentes o herramientas entre múltiples sistemas backend. Orquestación de corredor de agentes incluye:
- **Patrón de orquestación dinámica:** Este es un patrón de bucle de agente que determina las subtareas y las orquesta entre los agentes y herramientas más adecuados para alcanzar el objetivo general. Aprovechando este patrón, se pueden crear [agentes de colaboración](/docs/architect/es-mx/fundamentals/guide/agentic-patterns#15-agentes-de-colaboración-enjambres-de-agentes) para resolver casos de uso complejos (por ejemplo, [gestionando una distribución](/docs/architect/es-mx/fundamentals/guide/agentic-patterns#35-caso-de-uso-de-agente-de-colaboración-distribución-de-servicios-compleja) de servicios compleja).
- **Razonamiento con tecnología LLM:** Utiliza un LLM para interpretar objetivos de lenguaje natural y generar planes de ejecución, lo que elimina la necesidad de lógica de flujo de trabajo rígida y codificada.
- **Modelo LLM configurable:** Permite a los desarrolladores especificar qué modelo LLM utilizar, lo que proporciona control sobre el costo, el desempeño y las funciones.
- **Desarrollo del lenguaje natural:** La lógica _de Agent Broker_ se puede definir utilizando lenguaje natural a través de _MuleSoft Vibes_.
- **Observabilidad:** _Anypoint Monitoring_ proporciona registro y rastreo tras la implementación para ayudar los usuarios a comprender y depurar el razonamiento y las interacciones de Agent Broker con herramientas _de MCP_ y Agentes _A2A_.
- **Implementación gestionada:** _Agent Broker_ es una aplicación en contenedores respaldada por _Mule Runtime_, que gestiona la disponibilidad y la capacidad de ampliación de la implementación.
### **3.3 Pasarela flexible para MCP y A2A (Gobierno)**
_Anypoint Flex Gateway_ es el mecanismo a través del cual se aplican ciertas políticas técnicamente. _MuleSoft Agent Fabric_ aprovecha la _Anypoint Flex Gateway_ para [asegurar, inspeccionar y gestionar cada interacción](https://docs.mulesoft.com/gateway/latest/flex-agent-secure) de agentes que se produce a través de protocolos _MCP_ y _A2A_. Esto permite a las organizaciones aplicar un amplio [conjunto de políticas](https://docs.mulesoft.com/gateway/latest/flex-agent-policies) de nivel de compañía a todo el tráfico de agentes para garantizar que cada acción es segura, compatible y auditable antes de su ejecución. Para ampliar la adopción de la IA de forma segura y responsable, estas barandillas son fundamentales.
| Nombre de póliza | Protocolo(s) | Descripción |
| :------------------------------------------------------------------------- | :----------- | :--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Política de validación de JWT/Política de aplicación de Id. de cliente** | A2A, MCP | La **Política de validación JWT/Política de aplicación de Id. de cliente** protege agentes _A2A_ y servidores _MCP_ restringiendo el acceso a llamantes autenticados únicamente. |
| **Schema Validation** | A2A, MCP | La **validación de esquemas** garantiza que las solicitudes de agentes entrantes se ajustan a la especificación _A2A_ o _MCP_, lo que evita el tráfico defectuoso. |
| **Detector de PII A2A** | A2A | El **Detector de PII A2A** identifica _Información de identificación personal_ (PII) en solicitudes y respuestas, y activa el registro o el bloqueo para cumplir los requisitos de cumplimiento. |
| **Decorador de solicitudes A2A** | A2A | **A2A Prompt Decorator** inyecta contexto personalizado o instrucciones en solicitudes que se envían a agentes para guiar su comportamiento y aplicar barandillas. |
| **Control de acceso basado en atributos de MCP** | MCP | El **Control de acceso** basado en atributos de MCP regula el acceso a herramientas y recursos específicos expuestos por un servidor de _MCP_ basándose en atributos de usuario (por ejemplo, reclamaciones de Niveles, IP o JWT). |
| **Registro de ESS** | A2A, MCP | **El registro SSE** registra el contenido de transmisiones de _eventos enviados por_ servidor (SSE) que utilizan los protocolos de agentes para una auditoría y trazabilidad integrales. |
| **Limitación de frecuencia y Control de picos** | A2A, MCP | **Limitación de índices y Control** de picos protege a los agentes y sistemas backend de aumentos de tráfico y ataques de denegación de servicio aplicando límites de solicitudes. |
| **Tarjeta de agente A2A** | A2A | La **Tarjeta de agente** A2A reescribe la URL de la Tarjeta de agente para garantizar que todo el tráfico se proxise correctamente a través de la instancia de Flex Gateway gobernada. |
**Políticas de gobernanza de compañía para protocolos de agentes**
Además de regir las solicitudes entrantes, la _Puerta de enlace flexible Anypoint_ también gestiona todas las conexiones y solicitudes salientes desde un agente a servicios externos (por ejemplo, Servidores y herramientas _de MCP_ u otros agentes). Esto incluye:
- **Registro:** Proporciona un punto de observabilidad centralizado para monitorear y registrar todas las solicitudes de agentes salientes para la auditoría y la solución de problemas.
- **Seguridad:** Evita la fuga de datos confidenciales inspeccionando el tráfico saliente.
- **Autenticación:** Gestiona credenciales para sistemas externos aplicando mecanismos de autenticación salientes, incluyendo Claves de API, OAuth y ClientId/ClientSecret desde un único punto.
El [**Kit de desarrollo de políticas de _pasarela Anypoint Flex_ (PDK**)](https://docs.mulesoft.com/pdk/latest/policies-pdk-overview) permite a los usuarios crear políticas personalizadas cuando las políticas listas para su uso no cumplen requisitos específicos. Al utilizar el _PDK_, los desarrolladores pueden redactar lógica de políticas en el lenguaje de programación _Rust_ y compilarla en un módulo _WebAssembly (WASM)_. El módulo autónomo se carga a continuación en la _Puerta flexible Anypoint_ para aplicar reglas de seguridad exclusivas, transformaciones de datos personalizadas o lógica de integración especializada directamente en el borde de la API. Esto proporciona una forma potente y de alto desempeño de ampliar la funcionalidad de la pasarela para casos de uso exclusivos o complejos.
Estos son los cuatro componentes clave del _PDK_:
- **Complemento PDK de Anypoint CLI:** Este complemento crea el proyecto _PDK_ y carga la política compilada en _Exchange_. También genera un _Makefile_ que simplifica el proceso de desarrollo proporcionando un conjunto claro de comandos para crear y gestionar la política.
- **Plantilla de política:** Cuando se crea un nuevo proyecto, el _PDK_ genera un andamio o plantilla básica. Esta estructura incluye todos los archivos y la configuración necesarios para compilar correctamente la política, lo que proporciona a los desarrolladores un punto de partida para la lógica personalizada.
- **Herramientas de creación de SDK:** Estas herramientas abstraen la arquitectura compleja dirigida por eventos del proxy _Enviado_ subyacente. Al utilizar patrones de reactor y ejecutor, el _SDK_ proporciona un método de codificación lineal sencillo. Esto ayuda a reducir la complejidad, mejorar la depuración y reducir la curva de aprendizaje para desarrolladores.
- **Gestión de políticas:** El [Servidor MCP de MuleSoft](https://docs.mulesoft.com/mulesoft-mcp-server/reference-mcp-tools) proporciona herramientas de _MCP_ para ayudar los usuarios a gestionar el ciclo de vida de pólizas personalizadas. Ejemplos de estas herramientas incluyen:
- get_flex_gateway_policy_example
- manage_api_instance_policy
- manage_flex_gateway_policy_project
### **3.4 Visualizador de agentes (observar)**
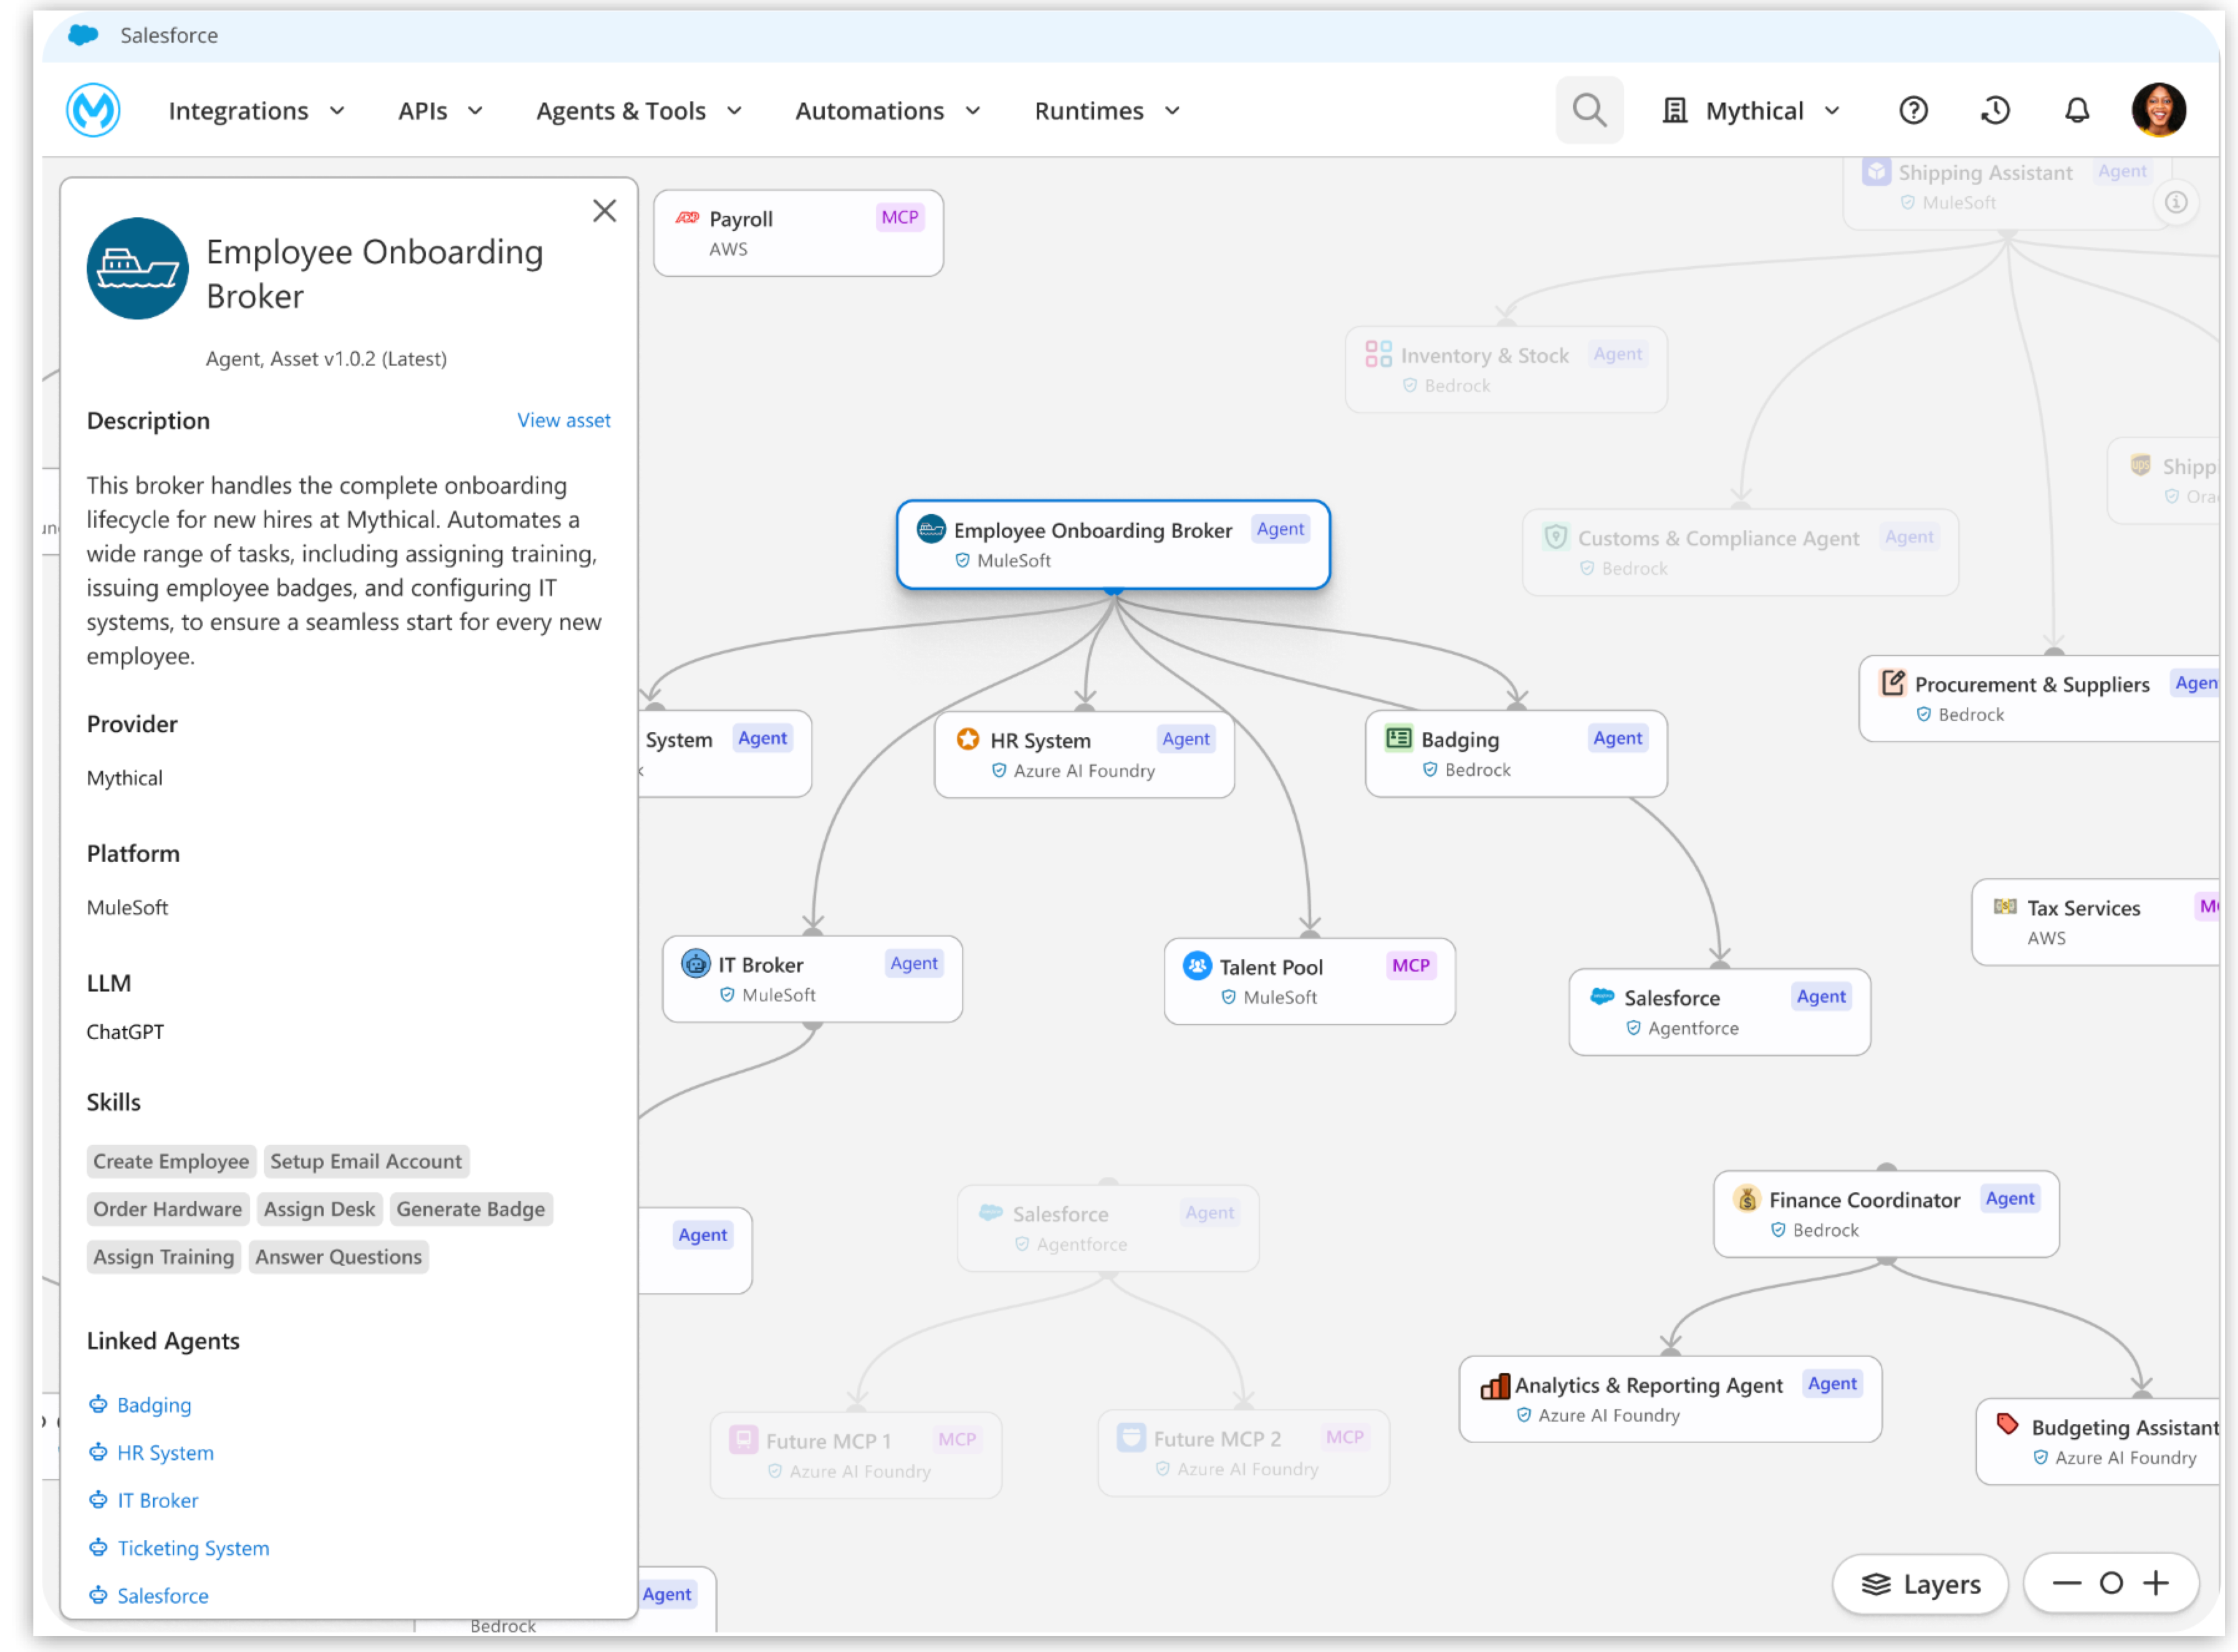 El _Visualizador de agentes_ proporciona un mapa dinámico en tiempo real de toda la red de agentes, convirtiendo lo que podría ser una "caja negra" de interacciones de IA en un sistema completamente observable. Los arquitectos y equipos de operaciones pueden utilizar el _Visualizador de agentes_ para revisar cómo están conectados los agentes, realizar un seguimiento de sus flujos de decisiones, monitorear su estado y desempeño e identificar dependencias. Este nivel de visibilidad es crucial para optimizar el desempeño, solucionar fallos de forma eficiente, detectar cuellos de botella y fomentar la confianza en los agentes implementados.
## **4\. Unificación** de Salesforce Platform
### **4.1 Catálogo de API y Centro de temas**
El _Catálogo de API_ y el _Centro de temas_ de MuleSoft están diseñados para mejorar el modo en que se descubren, se utilizan y se gestionan las API, en particular junto con _Agentforce_.
Todas las API de _MuleSoft_ diseñadas y publicadas pueden hacerse detectables y consumibles a través del [Catálogo de API](https://help.salesforce.com/s/articleView?id=platform.api_catalog.htm&type=5) en _Salesforce Platform_. El _Catálogo de API_ sirve como el repositorio centralizado y unifica todas las API de una organización desde _MuleSoft_, _Salesforce_, _Heroku_ y otras nubes en una sola vista. Esto facilita a los desarrolladores y administradores la tarea de descubrir, comprender y reutilizar API existentes permitiéndoles utilizarse en automatizaciones (por ejemplo, _Agentforce_, _Flow_ y _Apex_).
El [MuleSoft para Agentforce: Centro de](https://blogs.mulesoft.com/news/mulesoft-for-agentforce-topic-center/) temas permite a los desarrolladores estructurar sus API en base a casos de uso de negocio específicos definiendo metadatos de **acciones** y **temas de** Agentforce en el momento del diseño. Esto incluye:
- **Acciones**, que son las tareas que un agente puede realizar
- **Instrucciones**, que guían al agente sobre cómo aplicar ciertas acciones
Al [agregar esta capa semántica](https://docs.mulesoft.com/anypoint-code-builder/ai-enabling-api-project-topic-center), el _Centro de temas_ hace que las API sean comprensibles y consumibles por _Agenteforce_, lo que garantiza que pueda interactuar con sistemas de negocio de forma efectiva.
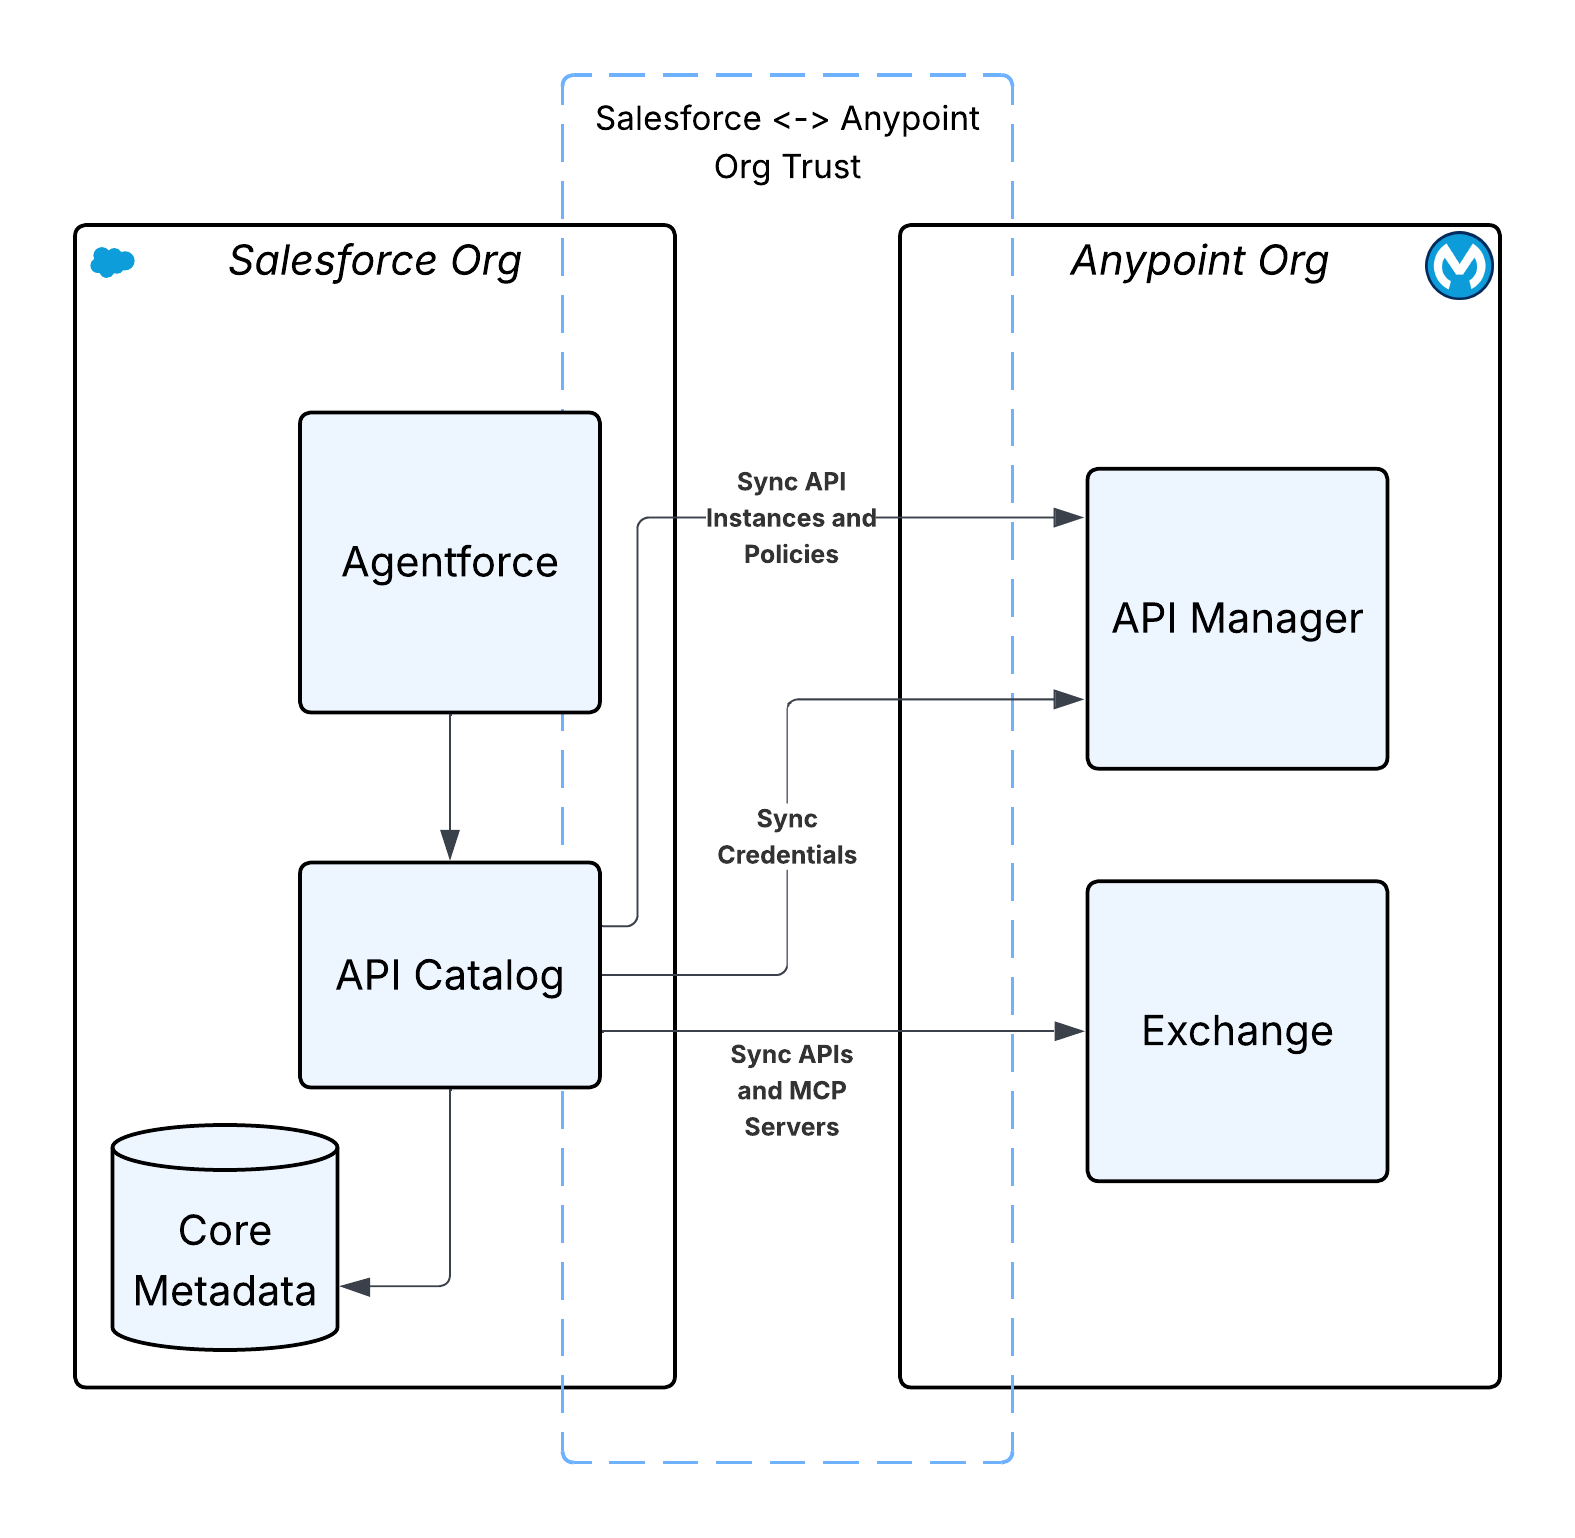 ### **4.2 Agentforce Gateway**
_Agentforce Gateway_ es una capa de gobernanza centralizada diseñada para gestionar y proteger interacciones dentro del ecosistema _Agentforce_ en expansión. Como _Agentforce_ integra con herramientas y API externas adicionales a través de protocolos como _MCP_, la función principal de la _Agentforce Gateway_ es aplicar políticas (por ejemplo, límites de velocidad y restricciones de herramientas) en todo el tráfico saliente iniciado por _Agentforce_, y auditar todas las solicitudes salientes.
La _Puerta de_ enlace Agentforce aprovecha el motor de políticas de gobernanza de API _de MuleSoft_ existente, que está integrado de forma nativa en la _Plataforma Salesforce_. Este motor de políticas basado en _enviados_ intercepta el tráfico de agentes, aplica políticas configuradas (por ejemplo, control de acceso basado en atributos y límites de cuota) y gestiona la autenticación y la autorización, todo ello sin requerir a los clientes instalar infraestructura de pasarela adicional.
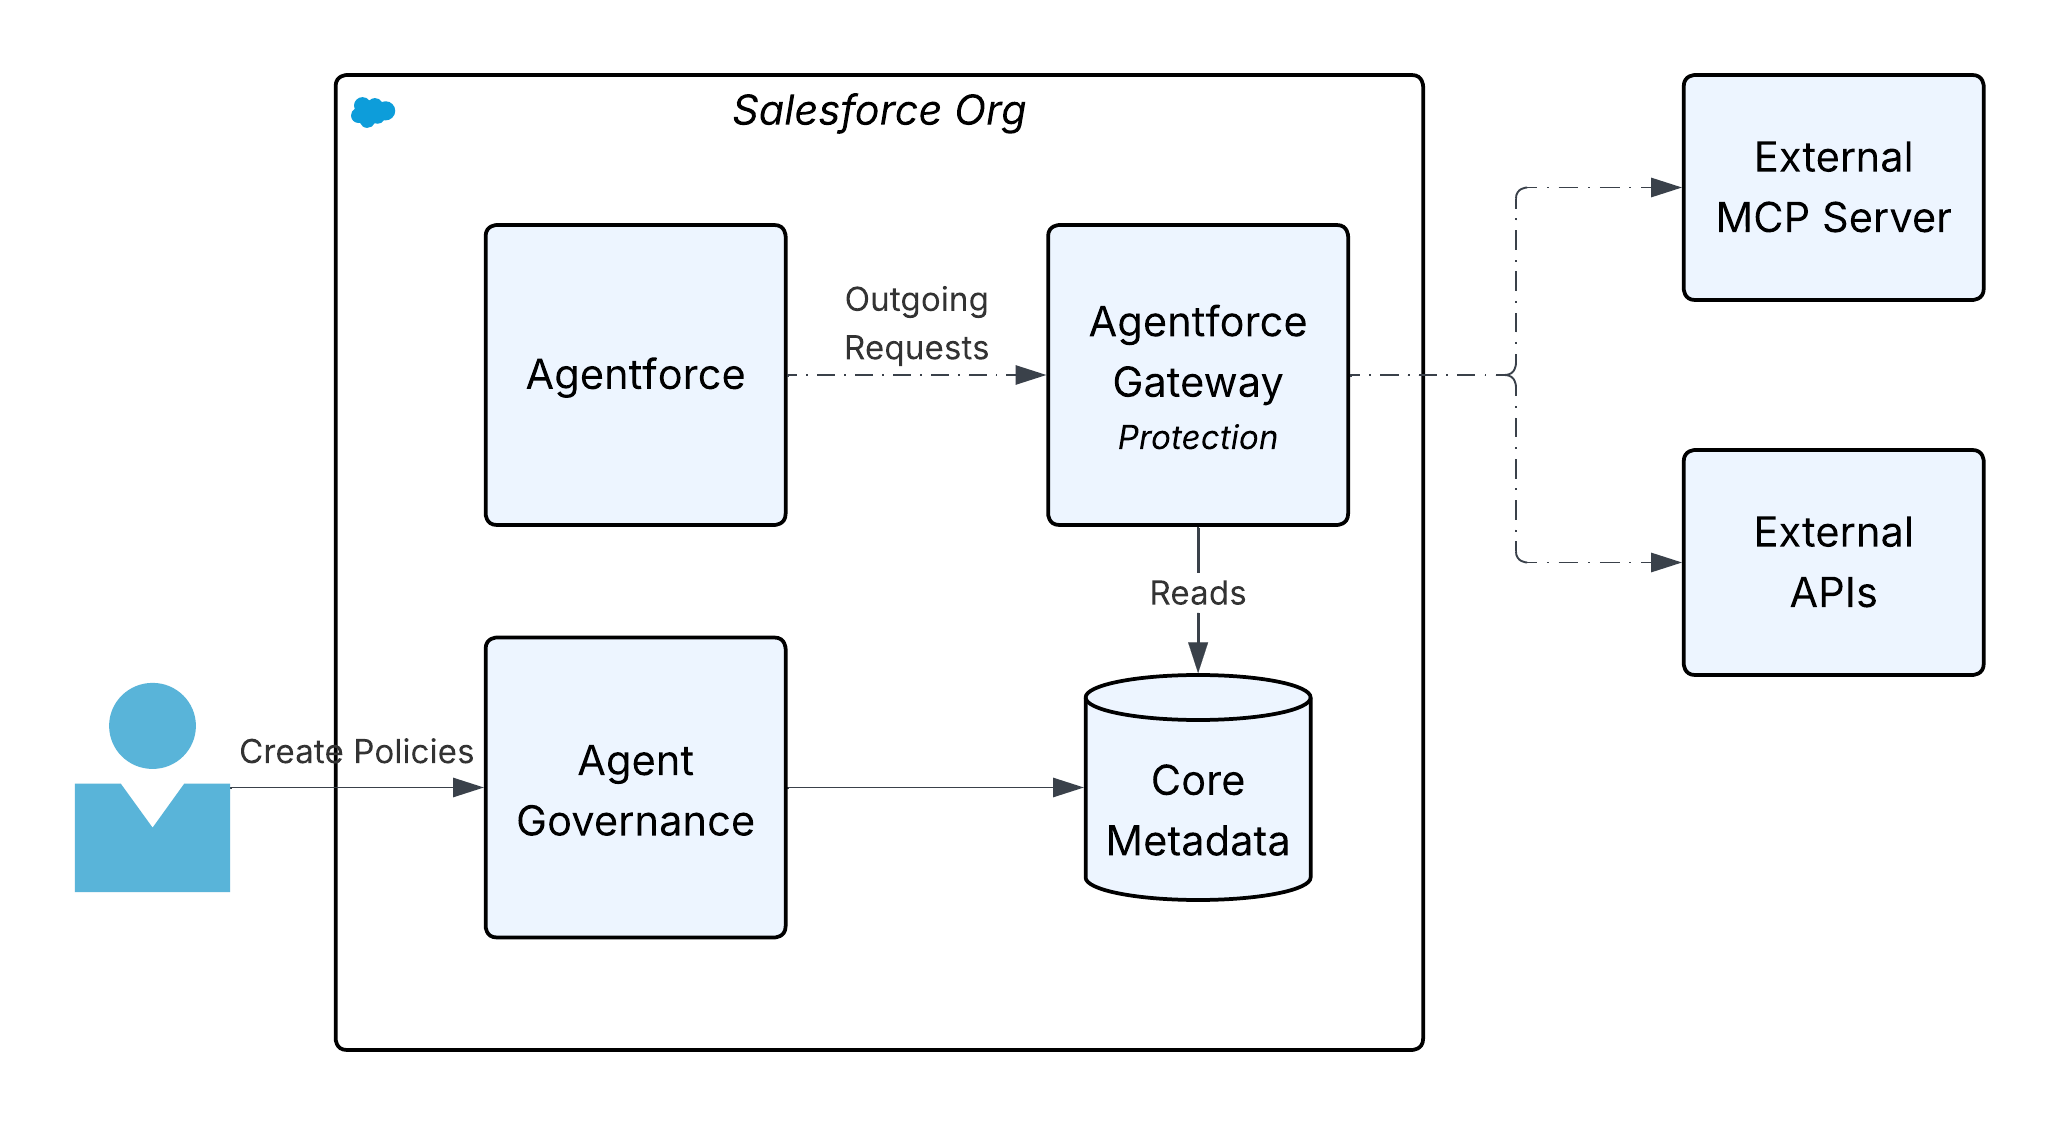 ### **4.3 Inteligencia de integración**
La implementación de una red gobernada de agentes es un logro clave. Sin embargo, presenta nuevos retos operativos del "Día 2". Requiere un nivel mejorado de inteligencia operativa para monitorear, medir y solucionar problemas de un sistema dinámico y distribuido de actores autónomos. La visión arquitectónica definitiva es un sistema donde la IA no solo se utiliza para ejecutar procesos de negocio, sino también para monitorear, gestionar y sanar la infraestructura en la que se ejecuta.
_La_ visión de inteligencia de integración de MuleSoft aprovecha el poder del ecosistema de _Salesforce_ más amplio para proporcionar perspectivas profundas y personalizables sobre el desempeño del tejido de integración y la red de agentes. Capturando y almacenando datos que [cumplen OpenTelemetry (OTEL)](https://opentelemetry.io/) \- el estándar emergente para la observabilidad - en **Salesforce Data 360**, las organizaciones pueden crear un repositorio unificado para registros, mediciones y rastreos en todo su panorama. Estos datos se pueden ver en **Tableau** a través de tableros preconstruidos y visualizaciones personalizadas para obtener perspectivas detalladas sobre el desempeño de la API, los patrones de interacción de agentes y el estado general del sistema.
 Este sistema tiene tres componentes clave:
1. **Ingestión:** El servicio de ingreso es el punto de entrada centralizado para recopilar y procesar datos de telemetría desde varias aplicaciones _Mule_, _agentes_ y _pasarelas Flex_. Realiza la validación de esquemas, la normalización de datos y el filtrado para mantener la calidad y la coherencia de los datos entre varias aplicaciones. Además, aplica controles (por ejemplo, autenticación, cifrado, equidad de arrendatario y limitación de frecuencia) en las oportunidades en curso de ingreso.
2. **Almacenamiento:** Un trabajo de transmisión de alto rendimiento se ejecuta en _Data 360_ que lee datos de temas de _Kafka_ de múltiples arrendatarios y los transforma en el formato _OTEL_. Los datos de OTEL se confirman a continuación con _Data 360_ del arrendatario en los _DMO TelemetryTraceSpan_, _TelemetryLogs_ y _TelemetryMetrics_ en _Lakehouse_.
3. **Visualización/Consumo:** Con los datos de telemetría disponibles en _Data 360_, los clientes pueden revisar el estado del sistema y obtener perspectivas utilizando tableros preconstruidos o personalizados a través de _Tableau Next_. Los clientes también pueden aprovechar [Tableau Concierge](https://help.salesforce.com/s/articleView?id=analytics.tua_metric_questions.htm&type=5), que es una habilidad de análisis de agentes preconstruida en _Tableau Next_, que permite a los usuarios formular preguntas sobre datos de telemetría en lenguaje natural y recibir respuestas de confianza con capacidad de acción con visualizaciones. Los clientes también pueden exportar los datos a sistemas de Gestión del desempeño de _aplicaciones (APM)_ existentes (por ejemplo, _DynaTrace_, _Datadog_, _Splunk_, etc.).
## **Conclusión**
La transición a Agentic Enterprise no es solo una actualización de TI; es un punto de inflexión arquitectónico fundamental. Una implementación fragmentada y aislada de agentes de IA es un camino directo al caos operativo, la TI en la sombra y la deuda técnica inmanejable. El único camino sostenible hacia delante es a través de una arquitectura unificada y componible. Construyendo sobre la base probada de la conectividad dirigida por API, el _MuleSoft Agent Fabric_ entrega el “sistema nervioso central” requerido para gestionar esta nueva plantilla de trabajo digital. Proporciona las funciones críticas para el descubrimiento, la orquestación, la gobernanza de nivel de compañía y la observabilidad de extremo a extremo. Así es como avanzamos más allá de la experimentación de IA y comenzamos a diseñar una empresa verdaderamente inteligente, automatizada y segura, transformando el potencial autónomo en resultados de negocio gobernados tangibles.
## **Guías técnicas y referencias**
- [Primeros pasos con Anypoint Code Builder](https://docs.mulesoft.com/anypoint-code-builder/start-acb)
- [Guía técnica de Einstein for Anypoint Code Builder: Flujos generativos](https://blogs.mulesoft.com/dev-guides/einstein-for-acb/)
- [DataWeave Transformación generativa Deep Dive: Innovación de IA para una transformación](https://blogs.mulesoft.com/dev-guides/dataweave-generative-transformation/) rápida de datos
- [Creación de especificaciones de API con MuleSoft Dev Agent](https://docs.mulesoft.com/anypoint-code-builder/api-ai-create-spec)
- [Generación de documentación de API con IA generativa de Einstein](https://docs.mulesoft.com/exchange/generating-documentation-with-ai)
- [Descripción general del servidor MCP de MuleSoft](https://docs.mulesoft.com/mulesoft-mcp-server/)
- [Herramientas de servidor MCP de MuleSoft](https://docs.mulesoft.com/mulesoft-mcp-server/reference-mcp-tools)
- [Conector MCP](https://docs.mulesoft.com/mcp-connector/latest/)
- [Conector A2A](https://docs.mulesoft.com/a2a-connector/latest/)
- [Primeros pasos con Agent Fabric](https://docs.mulesoft.com/agent-fabric/learning-map-agent-fabric)
- [Proteger interacciones de agentes con pasarela Flex](https://docs.mulesoft.com/gateway/latest/flex-agent-secure)
- [Políticas de agente de pasarela Flex](https://docs.mulesoft.com/gateway/latest/flex-agent-policies)
- [Descripción general del kit de desarrollo de políticas de pasarela Flex (PDK)](https://docs.mulesoft.com/pdk/latest/policies-pdk-overview)
- [Catálogo de API de MuleSoft para Salesforce](https://help.salesforce.com/s/articleView?id=platform.api_catalog.htm&type=5)
- [Activación de un proyecto de API para temas y acciones de agentes](https://docs.mulesoft.com/anypoint-code-builder/ai-enabling-api-project-topic-center)
- [Trabajar con Tableau Next](https://help.salesforce.com/s/articleView?id=analytics.tua_consume.htm&type=5)
- [OpenTelemetry](https://opentelemetry.io/)
- [Protocolo de contexto de modelo](https://modelcontextprotocol.io/docs/getting-started/intro)
- [Protocolo Agent2Agent (A2A)](https://a2a-protocol.org/latest/)
## Acerca del autor
Nikhil Aggarwal es Arquitecto principal en Salesforce, donde lidera la arquitectura para MuleSoft y Salesforce Automation Cloud. Nikhil aporta más de 18 años de experiencia entregando productos a gran escala y es un apasionado de la arquitectura ampliable, las experiencias de desarrollador intuitivas y la creación de equipos de alto desempeño. Antes de Salesforce, dirigió múltiples iniciativas en Microsoft Power Platform, Dataverse y Office 365 desde el concepto hasta el lanzamiento. Su trabajo continúa dando forma a cómo las empresas modernas conectan sistemas, automatizan flujos de trabajo y desbloquean valor de negocio en la primera era de la IA.
Cada día, [cientos de miles de empresas y millones de usuarios](https://www.salesforce.com/customer-stories/) operan su negocio en la nube utilizando aplicaciones con tecnología de Salesforce Platform. ¿Por qué la plataforma tiene tanto éxito? ¿Por qué puede Trust it para apoyar su negocio? ¿Qué beneficios exclusivos proporciona la plataforma para negocios como el suyo?
Este resumen técnico explica cómo Salesforce Platform ofrece experiencias de usuario final fiables, ampliables y fáciles de personalizar utilizando su arquitectura de software exclusiva para computación en nube. Tras leer este resumen, comprenderá mejor la tecnología subyacente que hace de Salesforce Platform una opción convincente para sus aplicaciones de negocio.
## Descripción general de plataforma
Salesforce Platform es el ejemplo preeminente de una plataforma de computación en nube exitosa y un ecosistema relacionado de aplicaciones. Desde el cambio de milenio, la plataforma ha sido la base para:
- Muchas [aplicaciones de negocio](http://www.salesforce.com/products/) populares para casos de uso comunes como ventas y servicio al cliente
- [Aplicaciones específicas de](https://www.salesforce.com/solutions/industries/) la industria para casos de uso más especializados como finanzas y cuidados sanitarios
- Millones de [aplicaciones personalizadas y extensiones](https://www.salesforce.com/products/platform/overview/) para casos de uso exclusivos
En gran parte, Salesforce Platform es tan exitosa y popular porque su arquitectura de software exclusiva admite aplicaciones fáciles de crear, utilizar, personalizar y ampliar con un [desempeño y fiabilidad](http://trust.salesforce.com/trust/) excepcionales. El corazón de la arquitectura de software de la plataforma es su diseño dirigido por metadatos de múltiples arrendatarios.
| Medición de selectividad previa a la consulta | Escribir consulta de acceso de base de datos final, forzando... | |
| Usuario | Filtro | |
| Bajo | Bajo | ... bucles anidados se unen, conducen utilizando la vista de filas que el usuario puede ver |
| Bajo | Alto | ... uso de índice relacionado con filtro |
| Alto | Bajo | ... unión de hash ordenado, conducir utilizando MT_DATA |
| Alto | Alto | ... uso de filtro relacionado con índice |
 #### Salesforce: Seguridad de la nube
Salesforce es responsable de proteger y mantener la integridad de la plataforma Data 360 y su infraestructura global. Esto incluye:
- **Seguridad física y medioambiental:** Hyperforce está alojado en infraestructura de AWS y Amazon tiene la responsabilidad delegada de la protección de sus centros de datos globales a través de controles de acceso, vigilancia y salvaguardas medioambientales.
- **Defensa de red y perímetro:** Mitigación de denegación de servicio distribuida (DDoS), detección de intrusos y cifrado para todo el tráfico en tránsito (TLS 1.2 y superior) y en periodos de inactividad (AES-256).
- **Endurecimiento de plataforma y gestión de parches:** Gestión de vulnerabilidades continua, implementación de parches y línea base de seguridad a nivel de sistema operativo.
- **Cumplimiento y certificación:** Auditorías continuas con estándares como SOC 1/2/3, ISO 27001, ISO 27017, ISO 27018, y preparación para marcos como GDPR.
Estos controles garantizan que la plataforma Data 360 sigue siendo segura, fiable y compatible, permitiendo a los clientes centrarse en la lógica de negocio y la gestión de datos en vez de la defensa de la infraestructura.
#### Cliente: Seguridad en la nube
Los clientes son responsables de proteger sus datos, configuraciones y procesos operativos en sus organizaciones de Salesforce Data 360. Las áreas clave de rendición de cuentas incluyen:
- **Gestión de identidad y acceso (IAM):** Defina funciones, aplique la autenticación de múltiples factores (MFA) y el inicio de sesión único (SSO) y aplique el principio de menor privilegio.
- **Gobernanza de datos:** Clasifique datos confidenciales, aplique enmascaramiento donde sea necesario y aplique controles de acceso a nivel de objeto, campo y registro.
- **Seguridad de integración:** Gestione el acceso de API a través de OAuth 2.0, JSON Web Token JWT y otros estándares de autenticación utilizando credenciales nombradas y credenciales externas.
- **Monitoreo y respuesta:** Utilice monitoreo de eventos y seguimientos de auditoría, y reenvíe registros a un sistema de Gestión de eventos e información de seguridad (SIEM) para la detección avanzada de amenazas.
Salesforce proporciona la base segura, pero los clientes determinan su postura de seguridad real a través de sus configuraciones, controles y vigilancia.
#### Responsabilidad centrada en las personas
La seguridad no es solo una construcción técnica, es una disciplina organizativa. La protección de datos en Salesforce Data 360 se logra a través de la colaboración entre equipos de arquitectura, operaciones y gobernanza.
**Las empresas deben:**
- Revise y retire continuamente cuentas sin utilizar o con privilegios excesivos.
- Automatice la aplicación utilizando políticas como oportunidades en curso de CI/CD y código.
- Realice ejercicios de sobremesa simulando incidentes como activación o exfiltración de datos no autorizada para reforzar la preparación para la respuesta.
La efectividad de Data 360 no se amplía solo por funciones, sino por la responsabilidad con la que los clientes las implementan.
#### Seguro de forma predeterminada: Una postura de seguridad proactiva
Salesforce Data 360 adopta una filosofía segura de forma predeterminada, que es un cambio del control reactivo al diseño preventivo. En vez de comenzar a abrir y ajustar más tarde, cada nueva organización de Data 360 ahora comienza en un estado “Denegar todo”, aplicando principios de Trust cero desde la primera implementación.
#### Del control reactivo al diseño preventivo
En entornos antiguos, los clientes heredaban un modelo permisivo “Permitir todo” para una incorporación más rápida. Aunque conveniente, esto creaba riesgo de sobreexposición accidental y configuración incorrecta.
La nueva arquitectura segura de forma predeterminada invierte este enfoque:
- Ningún usuario o sistema tiene acceso implícito.
- Todos los permisos deben otorgarse de forma explícita.
- Los controles de acceso, integración y gobernanza de datos se aplican desde el día 0.
Esto aplica el menor privilegio por diseño, reduciendo drásticamente el riesgo de exposición accidental o distribución de privilegios.
#### Repercusión operativa y de gobernanza
Este modelo tiene implicaciones técnicas y de comportamiento:
- Los equipos deben planificar modelos de acceso deliberadamente, alineando permisos con el cumplimiento y los límites de negocio.
- La gobernanza se convierte en un requisito de diseño integrado, no en un pensamiento posterior.
- La propiedad y la responsabilidad de los datos se definen desde el principio.
Para organizaciones de Data 360 heredadas que aún operan bajo “Permitir todo”, los administradores deben restringir manualmente las configuraciones para alinearse con la nueva línea base, un paso crítico en cualquier modernización de seguridad o programa de madurez de Data 360.
#### Trust por diseño
Al tomar como valor predeterminado cero acceso y requerir definiciones de políticas explícitas, Salesforce Data 360 establece Trust by Design, una evolución fundamental en la seguridad de datos de compañía.
Este enfoque garantiza que:
- El acceso no autorizado y los riesgos de fuga de datos se minimizan.
- Los marcos de gobernanza se aplican de manera estructural, no opcional.
- Las compañías obtienen una postura de seguridad más predecible, auditable y resiliente entre entornos.
En esencia, la seguridad ya no es una función que agregue. Es la base con la que comienza.
## Gestión de identidad y acceso: La pasarela a sus datos
Gestión de identidad y acceso (IAM) en **Salesforce Data 360** es la primera y más crítica capa de defensa. Gobierna **quién** puede acceder a la plataforma y **qué** acciones pueden realizar una vez dentro. Un marco de trabajo de IAM bien implementado es el único control más sólido que tiene una compañía para proteger sus datos de clientes y garantizar la integridad operativa.
### Autenticación: Verificación de "Quién es"
La autenticación establece **digital Trust,** confirmando que cada usuario, servicio o sistema externo que accede a Salesforce Data 360 es legítimo.
### Gestión de identidad federada
Data 360 admite la **autenticación federada** con proveedores de identidad de nivel de compañía (IdP) como [**Microsoft Entra ID (Azure AD)**](https://learn.microsoft.com/en-us/entra/identity/saas-apps/salesforce-tutorial), [**Okta**](https://help.okta.com/en-us/content/topics/provisioning/salesforce/sfdc-provision.htm) o [**Ping Identity**](https://docs.pingidentity.com/configuration_guides/salesforce/config_saml_salesforce_pf.html) utilizando [**SAML 2.0**](https://help.salesforce.com/s/articleView?id=xcloud.sso_saml.htm&type=5), OpenID Connect ([**OIDC**](https://help.salesforce.com/s/articleView?id=xcloud.sso_provider_openid_connect.htm&type=5)) o sistema para la gestión de identidad entre dominios ([**SCIM**](https://help.salesforce.com/s/articleView?id=xcloud.identity_scim_overview.htm&type=5)).
Esta federación amplía su ciclo de vida de identidad corporativa directamente en Salesforce. Cuando un empleado se une, transfiere o deja la compañía, su acceso se ajusta automáticamente, reduciendo las cuentas huérfanas y mejorando la preparación para el cumplimiento.
### Inicio de sesión único (SSO)
Con el inicio de [**sesión único (SSO)**](https://help.salesforce.com/s/articleView?id=xcloud.sso_about.htm&type=5), los usuarios se autentican una vez utilizando sus credenciales corporativas y obtienen acceso seguro a aplicaciones de Salesforce sin contraseñas separadas. Esto reduce la fatiga de las credenciales y minimiza los riesgos de reutilización de contraseñas o phishing.
### Acceso adaptativo y condicional
El Proveedor de identidad (IdP) se convierte en la autoridad única para las decisiones de autenticación, aplicando la autenticación de múltiples factores (MFA), el acceso condicional y los controles basados en riesgo. La autenticación evoluciona de un único evento a una evaluación continua de Trust, con capacidad de respuesta al comportamiento y contexto del usuario.
La autenticación federada proporciona:
- **Aplicación de políticas centralizada:** Los estándares de autenticación se gestionan en un solo lugar en todos los entornos de Salesforce.
- **Trazabilidad de extremo a extremo:** Los seguimientos de auditoría unificados vinculan cada acción de vuelta a una identidad verificada.
- **Experiencia centrada en humanos:** Un proceso de inicio de sesión seguro y sin fricciones permite a los equipos centrarse en perspectivas, no credenciales.
### Autorización: Definición de "Lo que puede hacer"
Una vez verificado un usuario, la autorización define a qué puede acceder, ver o modificar. Establece los límites operativos que protegen datos confidenciales y aplican el menor privilegio.
**Principio de menor privilegio (PoLP):** Cada usuario y sistema solo tiene los permisos necesarios para su función de trabajo, nada más. Este principio limita drásticamente el daño potencial de credenciales comprometidas o configuraciones incorrectas.
**Control de acceso basado en funciones (RBAC):** Salesforce Data 360 utiliza conjuntos de permisos y grupos de conjuntos de permisos para asignar funciones granulares alineadas con funciones de negocio. Por ejemplo:
- Un ingeniero de datos puede gestionar oportunidades en curso y transformaciones de ingreso con la ayuda del conjunto de permisos Arquitecto de Data 360.
- Un analista de marketing puede consultar datos armonizados pero no puede alterar modelos con la ayuda del conjunto de permisos Gestor de activación de Data 360.
- Un Gestor de activación puede ejecutar campañas salientes pero no puede acceder a datos de origen con la ayuda del conjunto de permisos Gestor de activación de Data 360
El acceso es gestionado de forma centralizada y auditable, garantizando la rendición de cuentas a lo largo del ciclo de vida de los datos. Cuando se integran con IdP como Id. de entrada, Okta o Ping Identity, las políticas de acceso se amplían sin problemas en toda la compañía a través del aprovisionamiento SCIM y la federación SAML/SSO.
### Comprender funciones y permisos estándar en Data 360
Salesforce proporciona conjuntos de permisos predefinidos que encapsulan mejores prácticas para la separación de funciones y el cumplimiento de estándares de la industria como ISO 27001.
| Función | Responsabilidad principal | Principio de diseño de acceso |
|---|---|---|
| Administrador del sistema | Configuración, aprovisionamiento y configuración de entornos | Sin acceso a conjuntos de datos subyacentes: garantiza la separación entre el sistema y el control de datos |
| Data 360 Architect | Ingreso, transformación, resolución de identidad y modelado de datos | No se puede realizar la activación de datos para mantener los límites de exposición de datos |
| Gestor de activación de Data 360 | Creación de segmentos, gestión de canales y activación | Acceso de solo visualización a modelos de datos; sin privilegios de modificación |
| Usuario de Data 360 | Consume análisis y perspectivas | Solo lectura; cero privilegios de modificación |
| Data 360 Un usuario | Acceso entre organizaciones a través de la organización de compañía | Regido por permisos de espacio compartido y políticas de acceso con ámbito |
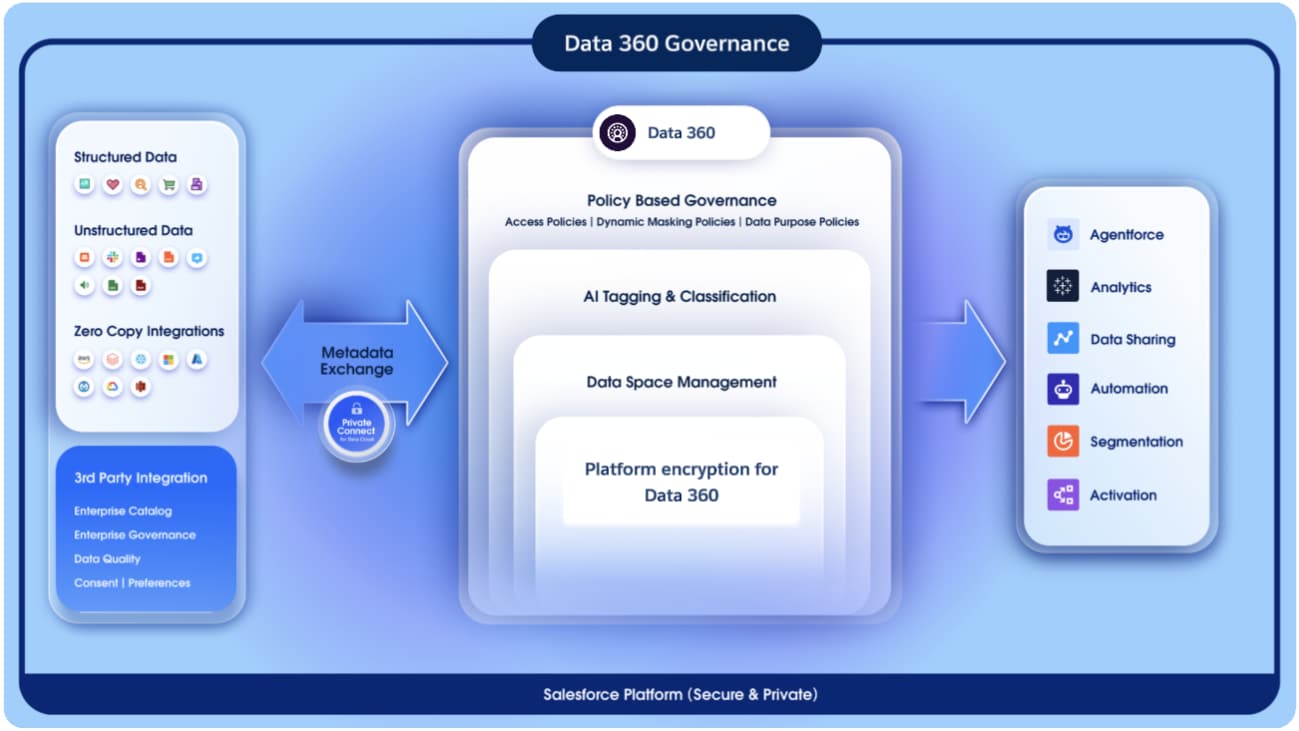 ### Gobernanza como plano de control
Data 360 está diseñado en torno a un modelo de gobernanza primero, garantizando que cada interacción de datos, desde el ingreso hasta la activación de perspectivas, sea consciente de las políticas, auditable y compatible. La gobernanza funciona como el plano de control central, gestionando cómo se descubren, clasifican y protegen los datos en su ciclo de vida.
Este plano de control unificado garantiza que:
- El **acceso a datos está autorizado**: solo los usuarios correctos, bajo las políticas correctas, pueden actuar sobre los datos correctos.
- La **gobernanza está integrada en las capas semántica y operativa**, garantizando la coherencia entre cómo se modelan los datos y cómo se protegen.
- Se aplican los principios de **cero Trust y** privilegios mínimos: se evalúan la identidad, el contexto y la política en tiempo real antes de conceder acceso.
A través de esta arquitectura, Salesforce Data 360 transforma la gobernanza de la gestión de permisos estática en una capa de orquestación dinámica dirigida por políticas. Una que se adapta continuamente al contexto, aplica el cumplimiento por diseño y mantiene Trust a escala de la compañía.
### Segregación de datos lógica con espacios de datos
A nivel de macro, Espacios de datos proporciona segregación lógica y aislamiento de dominios de datos de compañía, permitiendo a las organizaciones con modelos operativos de múltiples marcas, múltiples regiones o múltiples arrendatarios gestionar datos en una única plataforma unificada. Los espacios de datos pueden alinearse con dominios de negocio (como Ventas, Marketing o Customer Success) o con límites normativos y geográficos (como UE, AMER o APAC), lo que permite que los controles de gobernanza y acceso reflejen la estructura operativa y de cumplimiento de la organización sin fragmentar la plataforma de datos subyacente.
- Cada espacio de datos actúa como un límite virtual, definiendo qué recopilaciones de datos puede ver o interactuar un usuario o equipo.
- El acceso dentro de un espacio de datos se otorga de forma explícita, garantizando que no hay permisos implícitos o contaminación cruzada de la visibilidad de los datos.
- Esto permite la propiedad federada: cada unidad de negocio puede gobernar su dominio de forma independiente mientras mantiene la supervisión y el cumplimiento centralizados.
Por diseño, los espacios de datos proporcionan la primera capa de gobernanza, estableciendo claridad estructural y responsabilidad entre los conjuntos de datos de la compañía.
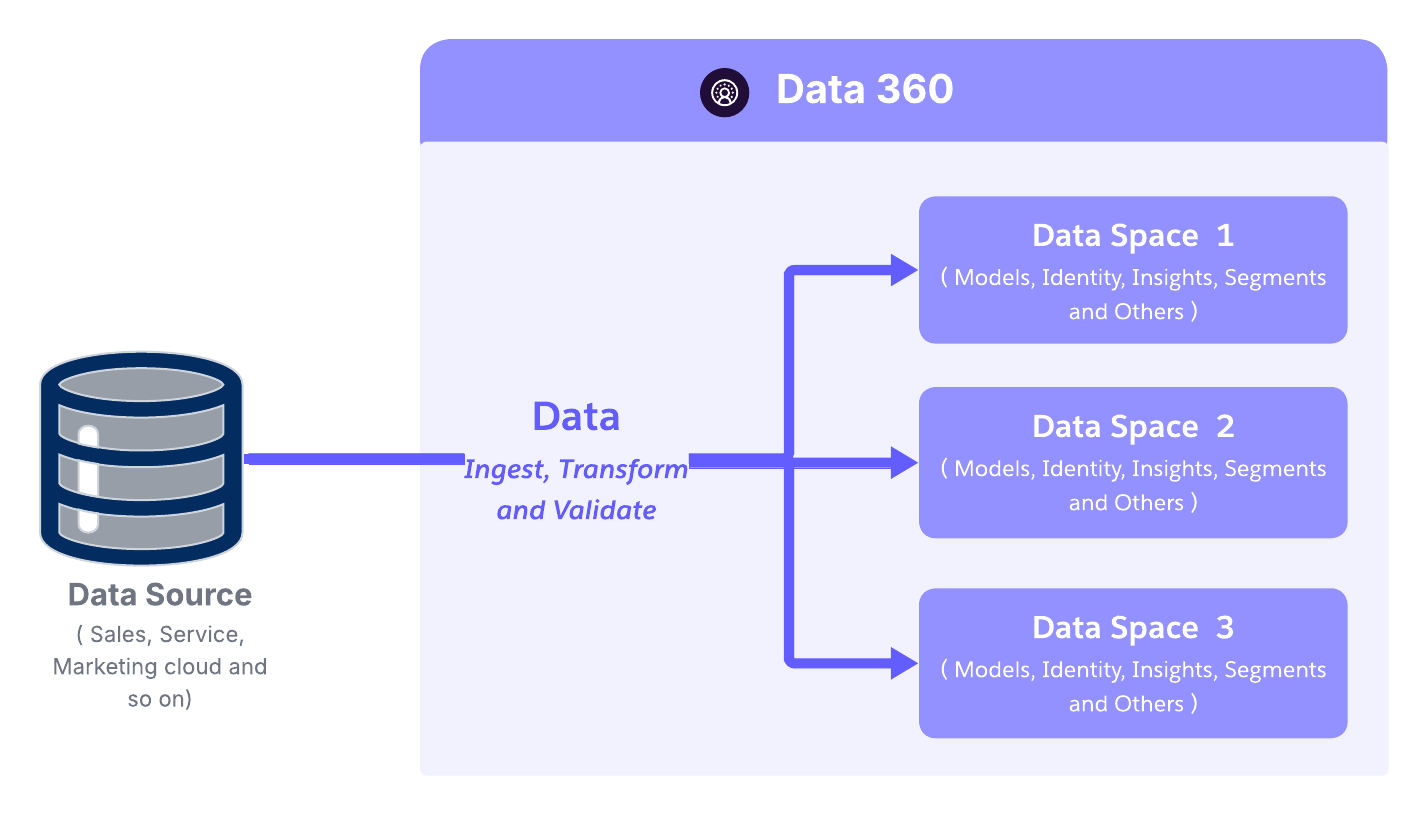 ### De RBAC a ABAC: Hacia la autorización contextual
En Salesforce Data 360, RBAC y ABAC sirven para fines distintos pero complementarios y se aplican en diferentes capas de la plataforma.
RBAC se utiliza principalmente para el acceso de plataforma y capacidad. Gobierna quién puede acceder a funciones y construcciones de Data 360 como Espacios de datos, creación de procesos, funciones administrativas y acceso a herramientas. RBAC se implementa a través de permisos y conjuntos de permisos, por ejemplo, asignando a los usuarios acceso a un Espacio de datos con funciones activadas específicas.
ABAC se utiliza para la aplicación forzosa del acceso a los datos. Las políticas de ABAC son completamente responsables de determinar quién puede acceder a qué objetos y atributos de datos, incluyendo Seguridad a nivel de objeto (OLS), acceso a nivel de campo y restricciones a nivel de fila. Estas decisiones se toman de forma dinámica evaluando la acción, los atributos de usuario y los atributos de recurso en tiempo de ejecución.
En ABAC, los permisos siguen siendo parte del modelo, pero la política en sí determina el acceso, no la función únicamente. Las políticas evalúan contextos como unidad de negocio, región, confidencialidad de datos, propósito de uso o restricciones regulatorias para permitir o denegar el acceso.
Por ejemplo:
- RBAC permite a un usuario acceder a un Espacio de datos de Data 360 y funciones de análisis.
- ABAC determina si ese mismo usuario puede leer un conjunto de datos de clientes específico, qué filas puede ver y qué atributos están enmascarados o restringidos.
Esta clara separación permite a Data 360 ampliar de forma segura:
- RBAC proporciona acceso controlado a funciones y flujos de trabajo de plataforma.
- ABAC ofrece un acceso a datos preciso y dirigido por políticas alineado con los requisitos de cumplimiento, residencia y protección de datos.
Juntos, activan la democratización de datos gobernada sin combinar permisos de plataforma con lógica de autorización de datos.
En esencia, RBAC aplica el acceso basándose en la asignación de permisos, mientras que ABAC evalúa los permisos en contexto: combinando atributos de acción, usuario y recurso para entregar un control de acceso preciso y adaptativo entre Salesforce Data 360
### ABAC: Una jerarquía de seguridad de múltiples capas
En el centro del control de acceso detallado de Salesforce Data 360 está el control de acceso basado en atributos (ABAC, con tecnología del lenguaje de políticas CEDAR.
A diferencia de los permisos estáticos basados en funciones, ABAC evalúa dinámicamente _quién_ está solicitando acceso, _a qué_ está intentando acceder y _bajo qué condiciones_, garantizando que cada interacción de datos se alinea con las políticas de la compañía y los límites Trust.
#### Evaluación dinámica de políticas
El motor ABAC de Data 360 evalúa las decisiones de acceso en base a una combinación de tres tipos de atributos principales:
- **Atributos de usuario:** departamento, ubicación, nivel de autorización
- **Atributos de datos:** clasificación, confidencialidad (PII, PHI, Datos financieros), espacio de datos
Este modelo flexible dirigido por políticas permite que la aplicación se adapte automáticamente a medida que evolucionan las funciones de usuario, las clasificaciones de datos o las condiciones de funcionamiento, lo que es esencial para grandes empresas, distribuidas y reguladas.
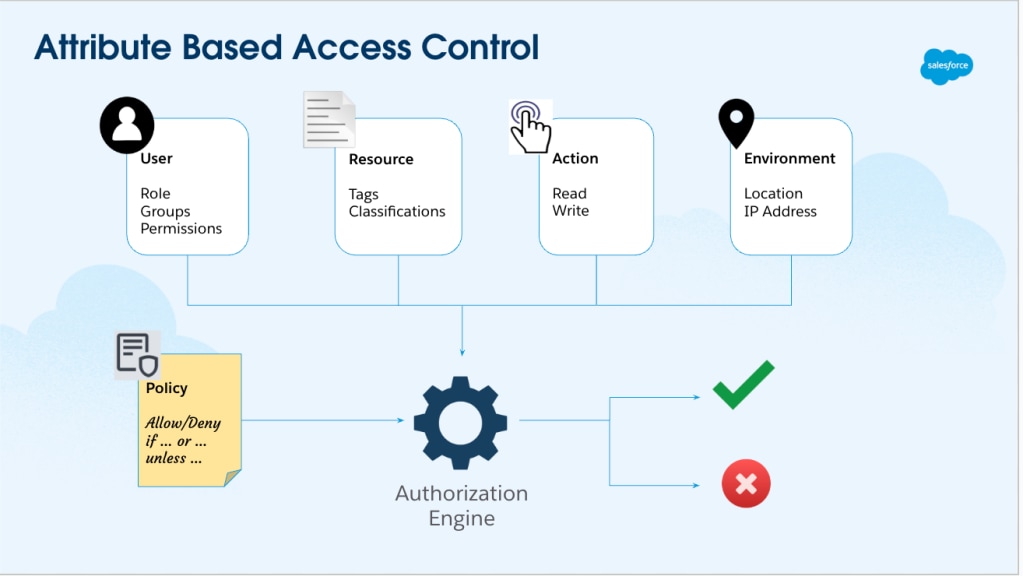 #### Componentes de arquitectura ABAC en Salesforce Data 360
Salesforce Data 360 implementa una arquitectura de Control de acceso basado en atributos (ABAC) basada en estándares alineada con las mejores prácticas de la industria para la gobernanza de datos dirigida por políticas. Se compone de tres componentes funcionales principales:
- **Punto de información de políticas (PIP): Políticas, metadatos enriquecidos y clasificación:**
- Alberga definiciones de políticas en sí, incluyendo acceso a datos, clasificación, enmascaramiento, retención y políticas de uso que rigen los datos de la compañía.
- Mantiene metadatos enriquecidos como etiquetas, clasificaciones, contexto de negocio y linaje de extremo a extremo.
- Utiliza la clasificación dirigida por LLM y ML para etiquetar automáticamente datos confidenciales (por ejemplo, PII.Email, PII.Phone, PHI).
- La propagación de etiquetas garantiza que las clasificaciones fluyan automáticamente a lo largo del linaje de datos (DLO → DLO → DMO).
- Conservación de la confidencialidad y el cumplimiento entre transformaciones.
- **Punto de decisión de política (PDP)**: El PDP es el motor de decisiones que interpreta las políticas de CEDAR.
- Ingresa entradas contextuales desde el PEP (identidad de usuario, metadatos de solicitud) y atributos de referencia desde el PIP.
- Evalúa políticas de forma determinante para entregar decisiones de acceso coherentes, explicables y ampliables.
- Admite evaluaciones en tiempo real y por lotes, garantizando desempeño y precisión incluso en entornos de gran volumen.
- **Punto de aplicación de políticas (PEP)**: El PEP es donde se aplican las decisiones de autorización en tiempo de ejecución.
- Intercepta solicitudes de acceso a datos entre todos los canales de interacción como API, consultas de interfaz de usuario, enriquecimiento de CRM o oportunidades en curso de generación aumentada de recuperación de GenAI (RAG).
- Aplica resultados de PDP al instante, garantizando que cada consulta y recuperación cumple con las políticas de acceso de compañía.
Juntos, la tríada PIP-PDP-PEP forma una estructura de gobernanza distribuida, que aplica un control coherente basado en políticas en todos los servicios y modos de acceso de Data 360.
Es importante destacar que [ABAC](https://help.salesforce.com/s/articleView?id=data.c360_a_policy_based_governance_dg.htm&type=5) en Data 360 está configurado, no construido. Los arquitectos no ensamblan planos de control personalizados o lógica de aplicación. En su lugar, rellenan y conectan tres componentes arquitectónicos nativos que funcionan juntos como una estructura de gobernanza unificada.
A nivel práctico, la implementación sigue una progresión sencilla: clasificar los datos, definir las políticas y permitir que la plataforma las aplique automáticamente. Una vez configurado, el control de acceso se convierte en un comportamiento del sistema en vez de un proceso manual o procedimental.
Esta estructura de gobernanza distribuida garantiza la aplicación **coherente de políticas** en todos los canales de acceso, creando un límite Trust unificado en Data 360.
#### Aplicación de políticas de múltiples niveles
El marco de trabajo ABAC de Data 360 admite límites de acceso en capas, garantizando que los datos están protegidos no solo en el nivel del objeto, sino también en campos y registros específicos.
- **Seguridad a nivel de objeto (OLS)**: El límite más externo del control de acceso.
Gobierna el acceso a estructuras de datos completas como objetos de lago de datos (DLO) u objetos de modelo de datos (DMO).
Ejemplo: Otorgar acceso al objeto _Cliente_, pero no a _Transacciones_.
- **Seguridad a nivel de campo (FLS)**: Controla el acceso a campos específicos en un objeto.
Ejemplo: Un usuario de marketing puede ver nombres de clientes pero tiene restringido ver números de tarjeta de crédito o identificadores nacionales.
- **Seguridad a nivel de registro (RLS)**: La capa de control más granular.
Determina qué registros individuales en un conjunto de datos puede ver o modificar un usuario.
Ejemplo: Un gestor regional solo puede acceder a datos de clientes vinculados a su región asignada.
- **Enmascaramiento dinámico de datos (DDM):** Activa la protección de datos en tiempo real. Complementando ABAC, DDM aplica la ofuscación dirigida por políticas de información confidencial sin alterar el conjunto de datos subyacente. En el momento de la consulta, DDM enmascara automáticamente campos como PII o datos financieros basándose en la función del usuario, el contexto o las reglas de cumplimiento.
- Los datos confidenciales permanecen protegidos entre vistas de la interfaz de usuario, API y flujos de trabajo de IA.
- Reduce los riesgos de fuga de datos garantizando un enmascaramiento coherente entre todas las capas de consumo.
- Mantiene la capacidad de auditoría. Cada consulta enmascarada se registra y se puede rastrear dentro del marco de trabajo de gobernanza de Data 360.
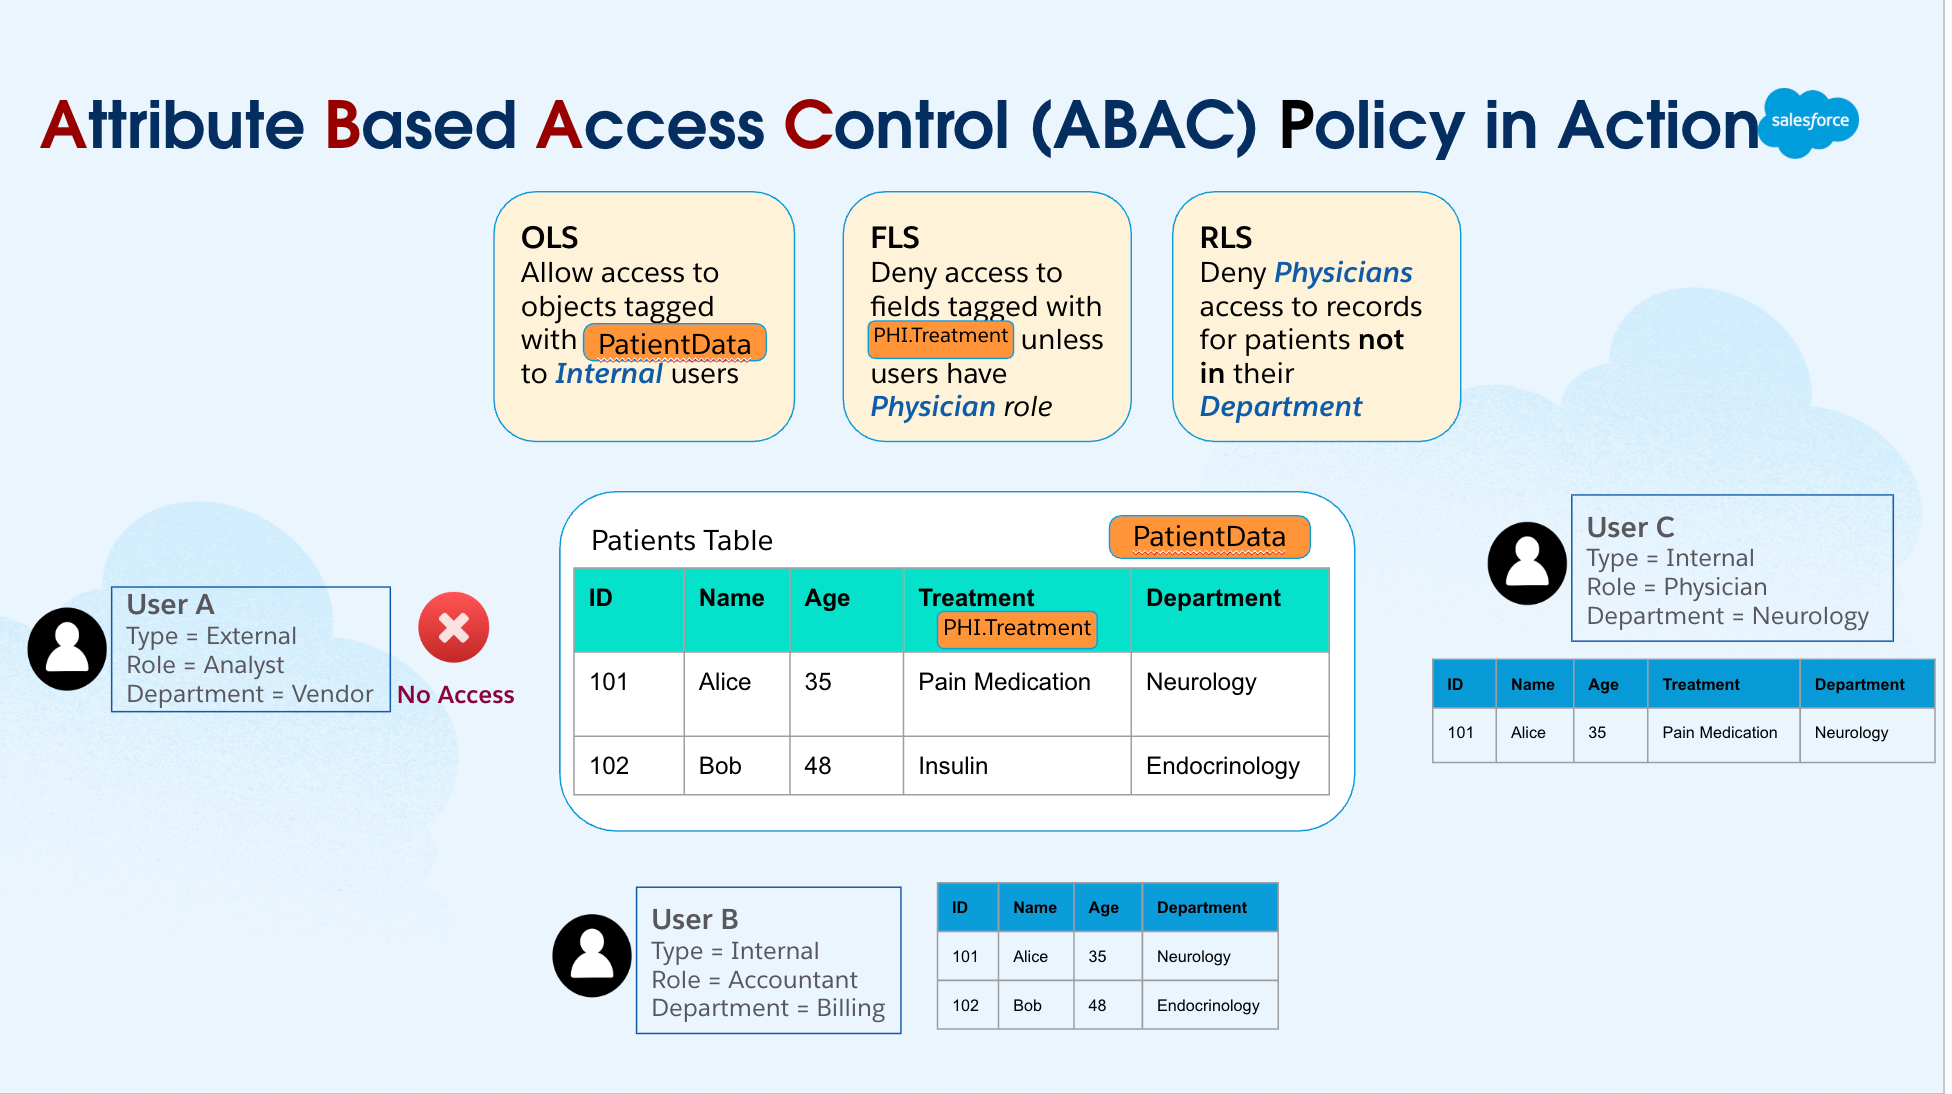 Esta arquitectura transforma el control de acceso de un modelo de permisos estático en una estructura de políticas dinámica y contextual. Combinando la simplicidad estructurada de RBAC con la profundidad contextual de ABAC, Salesforce Data 360 logra:
- Aplicación coherente de políticas en ingreso, Armonización y Activación.
- Gobernanza adaptativa que evoluciona con datos, funciones y necesidades de cumplimiento.
- Límites de Trust unificados en todo el ciclo de vida de los datos, desde el ingreso hasta la activación de la IA.
#### Integración profunda con Salesforce Platform
El modelo de gobernanza de Salesforce Data 360 está incrustado de forma nativa en Salesforce Platform, lo que permite la seguridad, el cumplimiento y el control de acceso unificados entre datos operativos y analíticos. Heredando las funciones de gestión de identidad y acceso principales de Salesforce (como federación de identidad, conjuntos de permisos, creación de políticas centralizadas y cifrado de plataforma), Data 360 aplica políticas Trust coherentes entre nubes sin introducir pilas de gobernanza paralelas. En vez de tratar el aislamiento, la autorización y el linaje como preocupaciones separadas, la plataforma los integra en un único Trust de ejecución que abarca todo el ciclo de vida de los datos.
A nivel estructural, este tejido de gobernanza está formado por tres capas complementarias que trabajan de forma concertada:
- **Espacios de datos**, que establecen límites lógicos claros para el aislamiento de datos y la segmentación regulatoria
- **Control de acceso basado en atributos (ABAC)**, que permite decisiones de autorización detalladas y conscientes del contexto basadas en atributos de identidad, propósito y datos
- **Linaje semántico**, que mantiene el significado de negocio, la confidencialidad y la trazabilidad a medida que los datos pasan de la introducción a la perspectiva y la activación
Juntos, crean un modelo de gobernanza donde las decisiones de acceso son explicables, la aplicación es automática y el cumplimiento es continuo en vez de retrospectivo. El resultado es una plataforma en la que la gobernanza ya no es un factor limitante o una idea posterior. En su lugar, se convierte en una capa de activación, lo que permite a los arquitectos diseñar productos de datos y flujos de trabajo dirigidos por IA con la confianza de que Trust, privacidad y requisitos normativos están siendo aplicados por el propio sistema.
Este enfoque de composición garantiza que los datos de la compañía no solo se puedan utilizar, sino que también se puedan realizar acciones de forma responsable, lo que admite perspectivas, activación y automatización a escala sin comprometer la transparencia, la seguridad o el control.
## Protección del ciclo de vida de los datos: De ingreso a activación
En la era de las empresas dirigidas por IA, la protección de datos no es un evento puntual, sino un proceso continuo que protege la información desde el momento en que ingresa en el ecosistema hasta que se activa para su uso de negocio o IA.
Salesforce Data 360 integra controles de seguridad y gobernanza en cada fase del ciclo de vida de los datos, garantizando que la integridad, confidencialidad y Trust de los datos se mantienen desde el ingreso hasta la activación de la perspectiva.
### Fundamento de protección: Cifrado en reposo y en tránsito
En el núcleo del modelo de protección de Salesforce Data 360 se encuentra Cifrado de plataforma para datos 360, un marco de trabajo de cifrado transparente y de alto desempeño que protege los datos tanto en tiempo de inactividad como en tránsito, sin comprometer la capacidad de uso o la escalabilidad.
#### Cifrado en reposo: Seguridad de capa de almacenamiento
Los datos que persisten en el lago de datos de Data 360 se **cifran automáticamente en el nivel de almacenamiento**, garantizando que los datos permanecen ilegibles incluso si se produce un acceso físico o no autorizado. Las funciones clave incluyen:
- **Cifrado de lago de datos transparente:** Todos los datos que persisten en el Lago de datos se cifran en el nivel de almacenamiento utilizando claves gestionadas por el cliente (CMK). Esto garantiza que incluso si se produce un acceso no autorizado al almacenamiento físico, los datos permanecen ilegibles e indescifrables.
- **Claves gestionadas por el cliente (CMK):** Los clientes mantienen el control completo sobre claves de cifrado, una función crucial para industrias reguladas como servicios financieros, cuidados sanitarios y gobierno. CMK permite la auditoría granular, el control y la prueba de la soberanía de los datos, alineándose directamente con mandatos normativos como el RGPD, la HIPAA y la ISO 27001.
- **Gestión de claves externas (EKM):** Con Gestión de claves externas, una función de Cifrado de plataforma para Data 360, los clientes podrán cifrar datos en Data 360 utilizando claves almacenadas en las cuentas de AWS KMS de los clientes. Esto proporciona a los clientes más flexibilidad mientras mantienen sus datos en Data 360 protegidos y protegidos.
- **Traiga su propia clave (BYOK):** Basándose en CMK y EKM, Data 360 ahora permite a los clientes cargar su propio material clave directamente en Salesforce para cifrar datos en periodos de inactividad e índices de búsqueda. Esta mejora proporciona una capa adicional de protección para datos PII, confidenciales, confidenciales y de propiedad, sin requerir a los clientes crear o gestionar claves en AWS KMS.
- **Rotación de claves y gestión del ciclo de vida:** La rotación de claves se gestiona correctamente. Los nuevos datos se cifran con la nueva clave mientras que los datos antiguos permanecen cifrados con su clave original, evitando tiempos de inactividad o degradación del desempeño. Este mecanismo de rotación refuerza el cumplimiento sin interrupciones operativas.
#### Cifrado en tránsito: Seguridad a nivel de red
Cada parte de los datos transmitidos entre servicios, API y conectores de Data 360 está protegida utilizando Seguridad de capa de transporte (TLS) 1.2 o superior, proporcionando cifrado de extremo a extremo en movimiento.
Esto garantiza que:
- Los datos no se pueden interceptar o alterar durante la transferencia.
- Las comunicaciones entre servicios de Salesforce, conectores de confianza y extremos de clientes permanecen privadas y verificables.
- La seguridad se extiende de forma coherente entre Canalizaciones de ingreso, Procesos de Armonización, Flujos de trabajo de activación e integraciones de API externas.
Combinando el cifrado gestionado por el cliente en periodos de inactividad con el cifrado continuo en tránsito, Salesforce Data 360 crea una arquitectura de defensa en profundidad que protege los datos del cliente de ataques externos y amenazas de infraestructura interna.
### Proteger la integración de sistema a sistema (integración de datos) en Data 360
Aunque el cifrado y los controles de acceso salvaguardan los datos en Salesforce Data 360, la protección del movimiento de datos entre sistemas es igualmente importante. Las empresas modernas operan en entornos híbridos y de múltiples nubes, donde los datos confidenciales fluyen entre Salesforce, plataformas de análisis, API externas y lagos de datos.
Para solucionar esto, Salesforce diseñó un marco de trabajo de integración seguro centrado en credenciales nombradas (NC) y credenciales externas (EC), entregando una base dirigida por políticas y alineada con zero Trust para una conectividad segura.
#### Marco de trabajo de integración seguro de Salesforce
Salesforce ha diseñado un sólido **[marco de integración](https://developer.salesforce.com/docs/platform/named-credentials/guide/get-started.html)**, centrado en credenciales nombradas (NC) y credenciales externas (EC). Juntos, eliminan la complejidad de las credenciales, aplican el acceso con menos privilegios y permiten una gestión de autenticación coherente en todas las integraciones, sin exponer secretos en código o configuración.
Este marco de trabajo abstrae complejidades de seguridad, aplica mejores prácticas y establece un **plano de control** dirigido por políticas para todas las conexiones externas, en sintonía con los principios de **Cero Trust** y **seguridad por diseño** de Salesforce.
##### Credenciales nombradas
Las credenciales nombradas (NC) son la piedra angular de la arquitectura de integración segura de Salesforce. Proporcionan un mecanismo declarativo y centralizado para definir extremos externos y sus parámetros de autenticación, eliminando la necesidad de codificar credenciales confidenciales como nombres de usuario, contraseñas o tokens en archivos de configuración o código Apex. En su lugar, los desarrolladores y administradores simplemente hacen referencia a un alias de credencial nombrado (por ejemplo, SnowflakeConnector_NC), y Salesforce gestiona automáticamente la autenticación subyacente y la gestión de conexiones.
**Ventajas arquitectónicas y de seguridad:**
- **Mantenimiento simplificado:** Los CN consolidan las direcciones URL de extremos externos y los parámetros de autenticación en un único registro gestionado. Cualquier actualización, como el cambio de un extremo o la rotación de credenciales, requiere cambios solo en el registro NC, evitando la reimplementación de código o flujos entre entornos.
- **Seguridad mejorada:** Las credenciales se almacenan de forma segura en el almacén de secretos cifrado de Salesforce, evitando la exposición en repositorios de código, archivos de configuración o registros. El proceso de autenticación en sí se gestiona automáticamente en tiempo de ejecución, reduciendo los errores humanos y el riesgo de fugas.
**Cumplimiento:** La separación de credenciales de la lógica de negocio simplifica el cumplimiento de leyes de protección de datos como **RGPD, HIPAA y PCI DSS**. Los auditores pueden verificar fácilmente que el acceso a datos externos se ajusta a las políticas de gobernanza y seguridad de la compañía.
- **Omite la configuración del sitio remoto:** Las NC eliminan el requisito heredado de configuración de sitio remoto, simplificando la configuración y la implementación, particularmente para implementaciones de negocio a gran escala o de múltiples entornos.
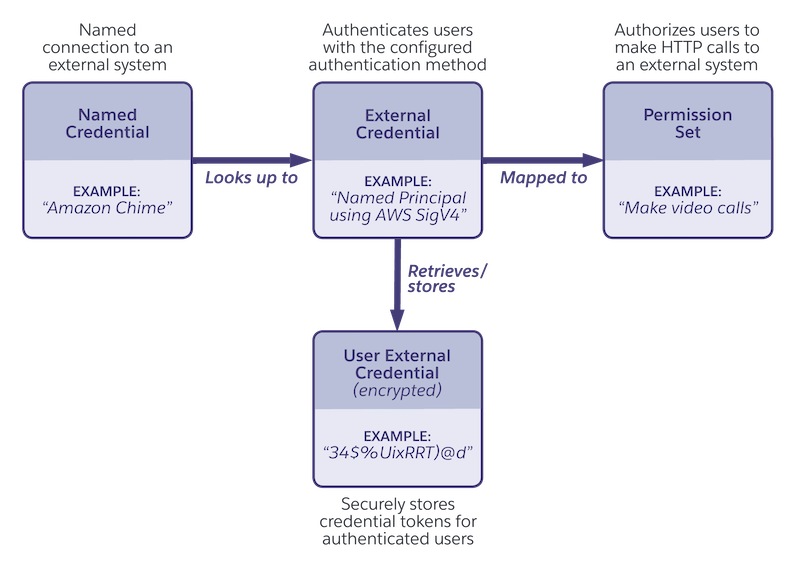 #### Credenciales externas
Las credenciales externas (EC) definen el protocolo de autenticación y el flujo que Salesforce utiliza al conectar con un servicio externo, respondiendo de forma efectiva a “cómo autenticarse”. Se puede reutilizar una única EC entre múltiples NC que comparten el mismo tipo de autenticación, promoviendo la reutilización de la configuración y la aplicación de seguridad coherente.
**Protocolos de autenticación admitidos:**
- OAuth 2.0 (se admiten todas las variantes)
- JWT (Token web JSON)
- Autenticación básica
- AWS Signature v4
- Autenticación personalizada
- Sin autenticación (para API abiertas o extremos públicos)
Las credenciales externas y las credenciales nombradas están diseñadas en torno a una clara separación de funciones. Una credencial externa define cómo autenticarse, especificando el protocolo de autenticación, el tipo de token y el comportamiento de actualización para conectar con sistemas externos. Una credencial nombrada, por otro lado, define dónde conectarse: la URL del extremo y qué credencial externa utilizar para esa conexión. Este diseño garantiza que la lógica de autenticación y la configuración de extremos permanecen desvinculadas, permitiendo a Salesforce admitir diversos protocolos de integración de forma segura mientras mantiene una gestión de credenciales centralizada y coherente en toda la compañía.
### Cómo los conectores de Data 360 aprovechan este marco de trabajo
Aunque la interfaz de usuario de Data 360 abstrae gran parte de la configuración subyacente, el marco de trabajo Credencial nombrada y Credencial externa se utiliza frecuentemente en segundo plano por sus conectores nativos y transmisiones de datos. Esto significa que, incluso cuando los administradores simplemente están “agregando una conexión de datos” a través de una interfaz de usuario guiada, Data 360 aún está aplicando este modelo de seguridad estandarizado en segundo plano.
Implicaciones arquitectónicas:
- **Modelo de seguridad unificado:** Cada conector (ya sea en una base de datos externa, AWS S3 o una API de compañía) se beneficia de los mismos estándares de cifrado, autenticación y gestión de claves aplicados por credenciales nombradas y externas.
- **Abstracción de desarrollador:** Los desarrolladores y administradores no necesitan gestionar manualmente flujos de autenticación o rotación de credenciales. Salesforce gestiona el ciclo de vida, la caducidad y la actualización de tokens automáticamente.
- **Aplicación coherente de políticas:** Este marco de trabajo garantiza que todos los conectores se adhieran a políticas de autenticación, auditoría y registro coherentes, clave para el ingreso a gran escala de múltiples orígenes en industrias reguladas.
- **Extensibilidad a prueba de futuro:** A medida que Salesforce mejora su pila de autenticación (por ejemplo, para admitir nuevos flujos de OAuth o estándares FIDO2), estas mejoras se propagan automáticamente entre todos los conectores sin requerir refactorización o reimplementación.
### Seguridad y gobernanza del conector de Data 360
Salesforce Data 360 ofrece un gran conjunto de conectores listos para su uso que simplifican la integración de datos desde varios orígenes. Esto permite a las empresas consolidar y utilizar sus datos de forma eficiente. Salesforce proporciona múltiples tipos de conectores incluyendo conectores nativos de Salesforce, conectores de almacenamiento en la nube, conectores de base de datos y conectores de API y aplicación. Además de los conectores ofrecidos, también se admiten herramientas ETL cero. Los conectores de Salesforce permiten una integración sencilla entre productos de Salesforce, como Sales Cloud, Service Cloud y Marketing Cloud, con Data 360. Además, se ofrece una gama de conectores a proveedores de almacenamiento en la nube, incluyendo Amazon S3, Google Cloud Storage y Azure Data Lake. Los conectores preintegrados para bases de datos como Snowflake, Redshift y BigQuery permiten a las empresas vincular sus almacenes de datos existentes con Data 360. Además, Data 360 proporciona conectores para varias aplicaciones y API externas, como anuncios de Google, anuncios de Facebook y otras plataformas de marketing. Para mejorar la flexibilidad, Data 360 se integra con herramientas de ETL como MuleSoft e Informatica.
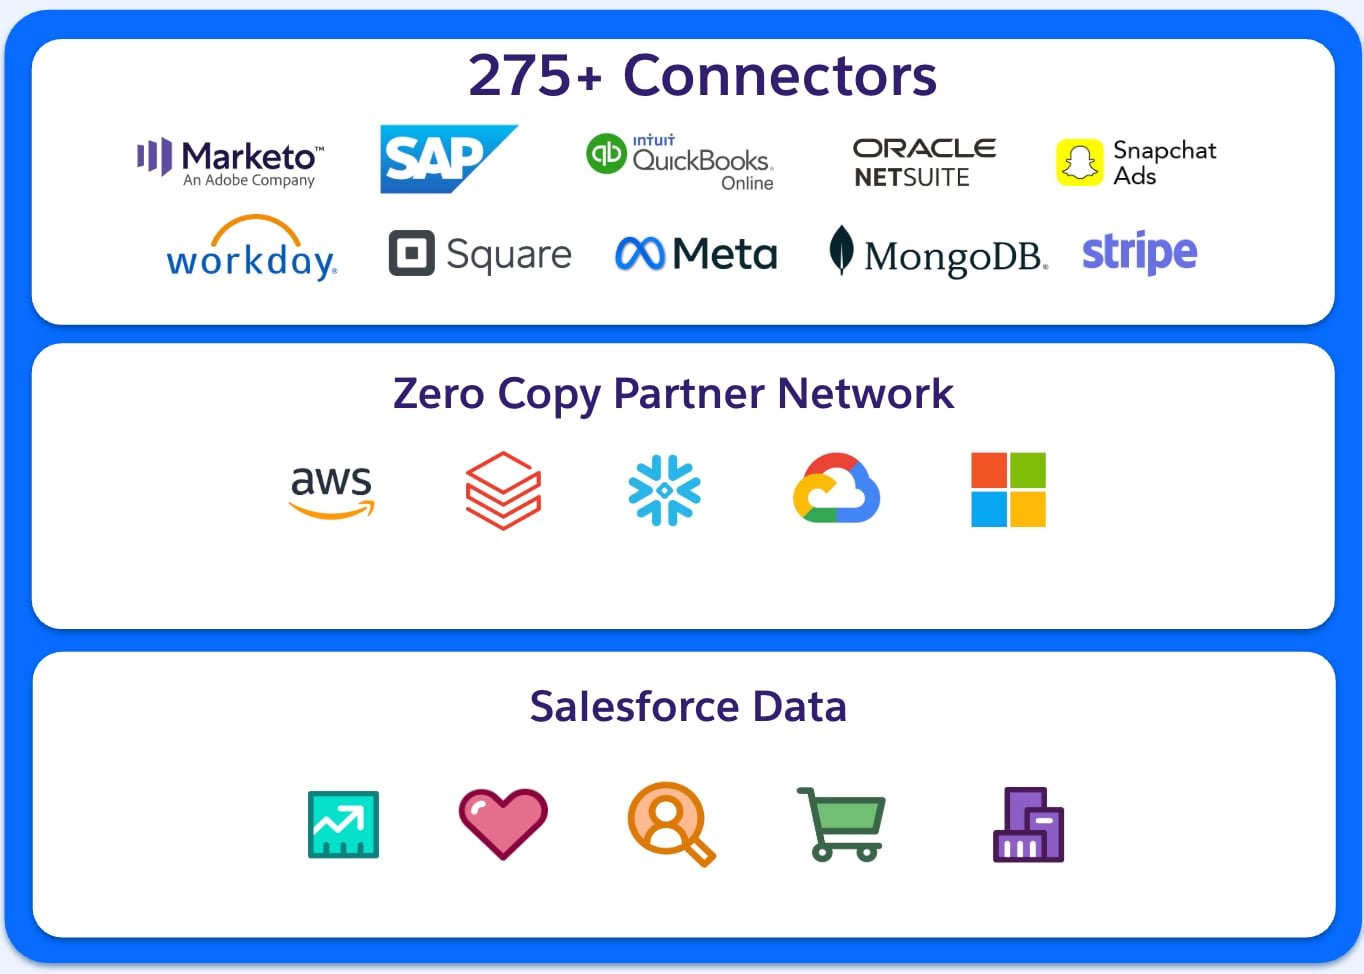 #### Seguridad de datos y conectores de Salesforce Data 360
La seguridad de los datos almacenados en Salesforce Data 360 ha estado a la vanguardia de muchas pláticas relacionadas con Data 360. Como parte del compromiso de Salesforce con un enfoque de seguridad de defensa en profundidad, se asigna la misma importancia a la seguridad de cómo se ingresan los datos en el entorno de Data 360.
Salesforce reconoce que los negocios operan en diversos ecosistemas de datos, a menudo abarcando múltiples plataformas de nube, soluciones de almacenamiento y herramientas de análisis. Nuestros conectores de Data 360 sirven como puente entre estos entornos. El conector permite una integración de datos segura, ampliable y eficiente manteniendo al mismo tiempo los altos estándares de seguridad de Salesforce. Estos conectores facilitan un flujo de datos transparente sin comprometer la integridad o la privacidad.
Los tres componentes esenciales de la seguridad del conector de Data 360 son:
- **Asignación de autenticación/autorización**: La gestión de acceso seguro es fundamental para la seguridad de los datos. Diferentes conectores de nube emplean mecanismos de autenticación y autorización variables para validar y controlar el acceso de los usuarios. La autenticación garantiza que los usuarios o sistemas son entidades legítimas, mientras que la autorización define el nivel de acceso otorgado. Salesforce garantiza que, siempre que sea posible, sus conectores sean estándares de la industria de aprovechamiento.
- **Interoperabilidad de funciones de copia cero (ZETL)**: La duplicación de datos presenta retos operativos y de seguridad. Esto también conlleva costos de almacenamiento innecesarios, incoherencias de datos y una mayor exposición al riesgo. El enfoque Extracción, transformación y carga cero (ZETL) de Salesforce garantiza que el uso compartido de datos en tiempo real entre plataformas pueda producirse sin requerir replicación física de datos. Esto significa que los datos pueden permanecer dentro de su entorno original mientras siguen siendo accesibles para procesamiento, creación de reportes y análisis. Además, esto también reduce significativamente la superficie de ataque y mejora el posible cumplimiento de las leyes de residencia de datos.
- **Compatibilidad de federación**: de datos En los entornos multinube actuales, las organizaciones necesitan acceso a datos integral sin movimientos de datos innecesarios. El modelo de datos federados del conector Data 360 admite la federación de datos basada en archivos y consultas, lo que permite a las compañías aprovechar orígenes de datos externos en tiempo real. Ya sea accediendo a bases de datos estructuradas, registros semiestructurados o archivos no estructurados, los conectores de Salesforce garantizan que los datos permanecen seguros durante todo su ciclo de vida.
Salesforce tiene como objetivo proporcionar a sus clientes la transparencia necesaria para ayudar a navegar por las complejidades de la seguridad y el cumplimiento de los datos, incluso con nuestras integraciones. Independientemente de que se integren con AWS S3, Google Cloud Storage, Snowflake u otras plataformas, nuestros conectores Data 360 están diseñados para garantizar Trust, transparencia y control sobre datos de negocio críticos.
##### Asignación de autenticación y seguridad del conector de Salesforce Data 360
| Tipo de conector | Compatibilidad de tipo de conexión | Tipos de autenticación principales | Notas y aspectos clave de seguridad |
|---|---|---|---|
| Salesforce CRM | N/D (Interno) | Basado en sesión (Interno) | Utiliza el sólido modelo de gestión de identidad y acceso interno (IAM) de Salesforce. Todos los datos están cifrados en tránsito y en periodos de inactividad en la infraestructura de Salesforce. |
| Implicación de Marketing Cloud | Solo Internet público | OAuth 2.0, Nombre de usuario/Contraseña | Los protocolos estándar de OAuth 2.0 se utilizan para la autenticación segura. Los datos se cifran en tránsito (TLS) a través de Internet pública. |
| B2C Commerce | Solo Internet público | OAuth 2.0 | OAuth 2.0 estándar. Se basa en protocolos de Internet públicos seguros (TLS) para la transferencia de datos. |
| Aplicación web y móvil | Solo Internet público | Claves de API, OAuth 2.0 | Datos ingresados a través de las API (API de ingreso, API de transmisión). Seguridad gestionada a través de la gestión de claves de API y protocolos web estándar. |
| Amazon S3 | Conexión privada y pública | Funciones de IAM, credenciales externas | Admite AWS PrivateLink para una conexión privada segura. La conexión pública utiliza credenciales seguras. Los datos se cifran en tránsito y en reposo (claves gestionadas por el cliente en S3 opcional). |
| Snowflake | Conexión privada y pública | OAuth 2.0, autenticación de clave privada, nombre de usuario/contraseña | Admite la conexión privada de VPC (AWS PrivateLink). Conexión pública disponible con métodos de autenticación seguros. Los datos se pueden cifrar con claves de clientes en Snowflake. |
| Amazon Redshift | Conexión privada y pública | Nombre de usuario/contraseña, Autenticación IAM | Admite conexión privada (AWS PrivateLink). La conexión pública utiliza mejores prácticas de seguridad estándar. |
| Microsoft Azure (Almacenamiento/SQL) | Solo Internet público | Tokens SAS, OAuth 2.0, Nombre de usuario/contraseña | Las conexiones se basan en tokens SAS u OAuth seguros para la autenticación. Los datos atraviesan Internet pública a través de canales cifrados (TLS). |
| Google Cloud Storage (GCS) | Solo Internet público | OAuth 2.0, Cuentas de servicio | Las conexiones se basan en OAuth 2.0 seguro. Los datos atraviesan Internet pública a través de canales cifrados (TLS). |
| MuleSoft (API) | Solo Internet público | OAuth 2.0, Clave de API | Se conecta a través de las API. La seguridad se gestiona a través de autenticación de API estándar y políticas de gobernanza sólidas implementadas a través de MuleSoft Anypoint Platform. |
| Etapa | Mecanismo | Controles de seguridad / gobernanza |
|---|---|---|
| Configuración de activación | Definido en la configuración de activación de Data 360 | Protegido a través de credenciales nombradas y credenciales externas |
| Preparación de datos | Filtrado y unido desde DMO | Metadatos de consentimiento y privacidad aplicados |
| Transferencia saliente | Cifrado a través de TLS / Conexión privada | Aplicación de políticas y abstracción de credenciales |
| Entrega externa | SFTP / Almacenamiento en la nube / API | Acceso controlado y entrega auditable |
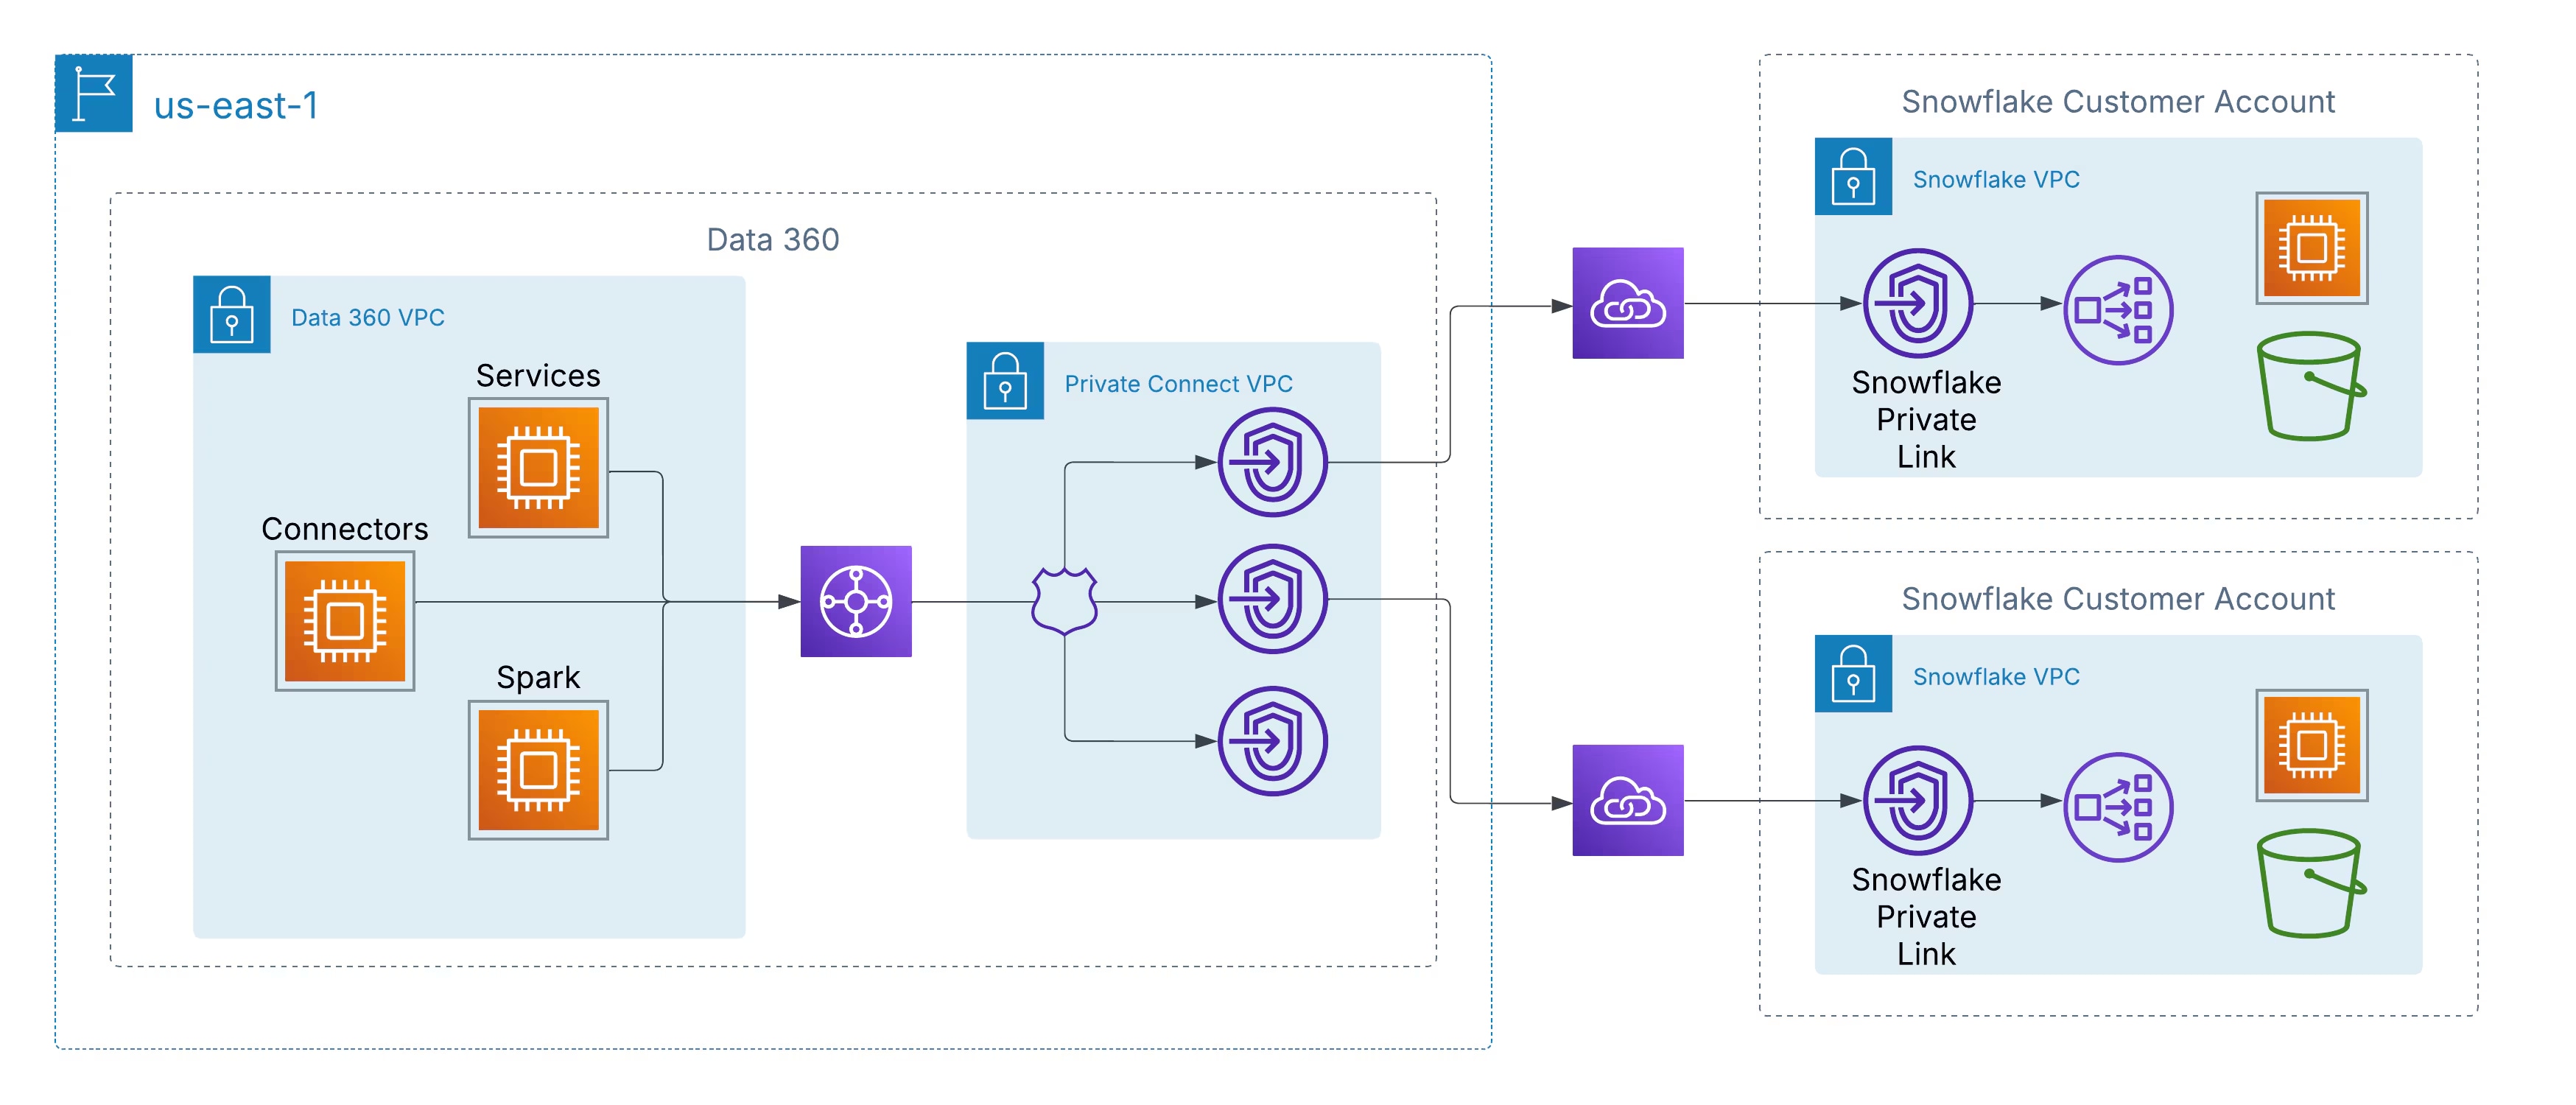 Toda la comunicación permanece dentro de la columna vertebral de AWS, utilizando direcciones IP privadas y rutas de red no enrutables, eliminando así el riesgo de interceptación de datos en tránsito y cumpliendo estrictos requisitos de seguridad regulatorios y de compañía.
Esta arquitectura garantiza:
- **Exposición cero a Internet:** Los datos nunca salen de la red privada de AWS.
- **Comunicación IP privada:** El tráfico permanece aislado e inabordable de forma externa.
- **Alineación de cumplimiento:** Satisface estándares de seguridad como ISO 27001, SOC 2 y FedRAMP.
#### Interconexión privada: Ampliación de la seguridad entre nubes
Para dar cobertura a clientes que operan en entornos de múltiples nubes, Salesforce está ampliando los mismos principios de seguridad más allá de AWS a través de Interconexión privada. Esta función permite la conectividad privada entre nubes entre Data 360 y lagos de datos alojados en Azure o Google Cloud, manteniendo las mismas garantías de enrutamiento privado, cero recorrido por Internet y tráfico cifrado solo de red troncal.
Hay dos modelos de implementación arquitectónicos disponibles:
- **Interconexión gestionada por el cliente:** Los clientes integran sus circuitos de red privados existentes, como Azure ExpressRoute, Google Cloud Interconnect o Equinix Fabric, directamente con VPC de Data 360.
- **Interconexión gestionada por Salesforce:** Salesforce aprovisiona y gestiona el vínculo entre nubes, exponiendo extremos de servicio privados en el entorno de nube de destino del cliente para una configuración llave en mano.
### Protección de las puertas: Funciones de seguridad de API en Salesforce Data 360
Salesforce Data 360, una potente plataforma para unificar datos de compañía, está construida con controles de seguridad robustos y de múltiples capas. Para los clientes, la gestión de la seguridad de API es una parte clave de una estrategia de protección de datos integral, permitiéndoles controlar el acceso, gestionar integraciones y monitorear el uso de forma efectiva.
Estas son las funciones clave disponibles para que los clientes configuren, controlen y gestionen la seguridad de API en Salesforce Data 360.
#### Funciones y capacidades clave de seguridad de API
Los clientes pueden aprovechar varias funciones integradas de Salesforce para garantizar el acceso seguro de API a sus instancias de Data 360:
##### 1\. Autenticación y autorización sólidas (OAuth 2.0)
Salesforce exige una autenticación estricta para sus API de Data 360, siendo OAuth 2.0 el protocolo estándar y recomendado.
- **Aplicaciones conectadas**: Los clientes crean y configuran aplicaciones conectadas para gestionar el acceso a aplicaciones externas. Este es el mecanismo principal para autenticar y otorgar acceso a las API de consulta e ingreso de Data 360.
- **Ámbitos de OAuth**: Los administradores pueden definir ámbitos de OAuth específicos (por ejemplo, cdp_ingest_api, api) para solicitar los permisos mínimos requeridos, respetando el principio de menor privilegio.
- **Autenticación de múltiples factores (MFA)**: Salesforce Authenticator y otras soluciones de MFA se pueden aplicar, agregando una capa vital de seguridad y garantizando que solo los usuarios verificados puedan acceder al sistema, incluyendo a través de inicios de sesión de API.
##### 2\. Control de acceso granular y permisos
Los clientes tienen un control preciso sobre qué usuarios y aplicaciones pueden acceder a datos y qué acciones pueden realizar.
- **Control de acceso de API (Función)**: Una vez activada por el Servicio de asistencia de Salesforce, esta función permite a los administradores aprobar explícitamente qué aplicaciones conectadas se pueden utilizar para acceder a las API. Todas las aplicaciones no aprobadas se bloquean automáticamente, reduciendo significativamente el riesgo de extracción de datos no autorizada.
- **Conjuntos de permisos y perfiles**: Los administradores gestionan el acceso de API asignando el permiso "API activada" a través de perfiles de usuario o conjuntos de permisos exclusivos. Esto garantiza que los usuarios solo tengan acceso relevante a sus funciones de trabajo.
- **Control de acceso basado en funciones (RBAC)**: Dentro de Data 360, los clientes pueden crear y gestionar políticas de control de acceso basadas en funciones para definir niveles de acceso a datos (seguridad de nivel de registro, campo y objeto), garantizando la coherencia y el control en toda la plataforma.
- **Usuarios de integración exclusivos**: Las mejores prácticas recomiendan crear usuarios específicos de "Solo API" para integraciones, limitando sus permisos a solo lo necesario para la llamada de API, en vez de utilizar una cuenta de administrador del sistema.
##### 3\. Controles de seguridad de red
- **Intervalos de IP de lista blanca/IP**: Los clientes pueden restringir el acceso de API a un intervalo definido de direcciones IP de confianza. Cualquier intento de inicio de sesión desde un intervalo de direcciones IP no aprobado puede denegarse o impugnarse para su verificación.
- **Conexión privada**: Construida sobre AWS PrivateLink, esta función permite a los administradores gestionar datos confidenciales sin exponer extremos a Internet pública, eliminando el riesgo de ataques a extremos visibles públicamente.
- **Cifrado en tránsito y en reposo**: Todos los datos se cifran en tránsito (utilizando TLS) y en reposo, protegiendo la información confidencial del acceso no autorizado incluso si se intercepta.
##### 4\. Monitoreo, auditoría y gobernanza
La visibilidad es clave para la seguridad. Salesforce proporciona amplias herramientas para monitorear y auditar la actividad de API.
- **Monitoreo de eventos**: Proporciona un seguimiento casi en tiempo real de varios eventos, incluyendo llamadas de API e intentos de inicio de sesión. Los clientes pueden utilizar estos datos para auditar y crear políticas de seguridad de transacciones.
- **Centro de seguridad**: Esta función ofrece una vista única y consolidada de las mediciones de estado, cumplimiento y gobernanza de seguridad en todas las organizaciones de Salesforce, simplificando el monitoreo y la gestión.
- **Seguimiento de auditoría**: de campo Ayuda a los clientes a realizar un seguimiento del historial de inicios de sesión y campos, monitorear cambios de configuración y tratar obligaciones de auditoría y cumplimiento de retención de datos.
- **Funciones de gobernanza de datos**: Incluye etiquetado y clasificación de datos, aplicación de políticas y enmascaramiento de datos dinámico para garantizar que se aplican políticas de gobernanza coherentes en todos los puntos de contacto de datos, incluyendo aquellos a los que se accede a través de API.
#### Configuración y gestión de la seguridad de API: Una trayectoria de cliente
1. Activar controles principales: Comience activando valores predeterminados de toda la organización como restricciones de MFA e IP.
2. Control de acceso de API de solicitud: Registre un caso con el Servicio de asistencia de Salesforce para activar la función "Control de acceso de API" en su organización.
3. Configurar aplicaciones conectadas: Cree aplicaciones conectadas específicas para cada integración, definiendo los ámbitos de OAuth requeridos y asignándolos a perfiles/conjuntos de permisos autorizados.
4. Implementar menor privilegio: Asegúrese de que todos los usuarios de integración tienen permisos "Solo API" y acceso mínimo a los datos.
5. Monitorear y auditar: Utilice regularmente Event Monitoring and Security Center para revisar el uso de API, detectar anomalías y realizar evaluaciones de vulnerabilidad.
6. Aplicar mejores prácticas: Aplique siempre TLS, almacene de forma segura tokens de actualización, rote los Id. de sesión y valide entradas de datos.
Aprovechando estas funciones robustas y configurables por el cliente, los negocios pueden mantener un entorno seguro y compatible para todas las interacciones de API en Salesforce Data 360.
### Cumplimiento, auditoría y monitoreo continuo
#### Disponibilidad de servicio y residencia de datos
Salesforce Data 360 está diseñado para cumplir los requisitos de soberanía y residencia de datos globales a través de su modelo de implementación distribuido geográficamente. El servicio está disponible actualmente en múltiples regiones reguladas, incluyendo Estados Unidos, Canadá, Brasil, Alemania, India, Australia y Japón.
La residencia de datos se determina asignando la instancia de la organización principal de cada cliente a la instancia regional de Data 360 correspondiente más cercana. Por ejemplo, las organizaciones principales ubicadas en Estados Unidos o Canadá se emparejan con una instancia de Data 360 en la región de Estados Unidos, mientras que las organizaciones principales en la Unión Europea se asignan a una instancia alojada en Alemania. Del mismo modo, las organizaciones principales en India, Australia, Nueva Zelanda o Singapur están asociadas con una instancia de Data 360 alojada en India.
La infraestructura Hyperforce de Salesforce sustenta este modelo, proporcionando la base para el control de datos geográficos, el aislamiento de seguridad y el cumplimiento normativo. Hyperforce garantiza que los datos de clientes, incluyendo metadatos, copias de seguridad y conjuntos de datos derivados, permanecen dentro de límites regionales definidos. Esta arquitectura permite a las empresas cumplir con los mandatos de cumplimiento y residencia de datos locales como GDPR, FFIEC, HIPAA y leyes de privacidad regionales en APAC y EMEA.
Salesforce continúa ampliando la disponibilidad de Data 360 a regiones Hyperforce adicionales para alinearse con estándares de privacidad globales en evolución, requisitos de cumplimiento regional y expectativas de los clientes para el control de datos soberano.
#### Habilitación de cumplimiento normativo
Salesforce Data 360 está diseñado para ayudar a las empresas a cumplir estrictos requisitos legales y de privacidad globales como el RGPD y CCPA. La plataforma proporciona funciones nativas para gestionar los Derechos de titular de datos (DSR), incluyendo el acceso, la exportación y la eliminación de datos (“Derecho al olvido”), garantizando el tratamiento de datos personales conforme a lo largo de su ciclo de vida.
Aunque el cliente mantiene la responsabilidad final del cumplimiento, Salesforce opera como un “proveedor de servicio” certificado bajo leyes como la CCPA, entregando los controles a nivel de plataforma, garantías de seguridad y mecanismos contractuales que permiten a las organizaciones implementar sus marcos de trabajo de cumplimiento de forma eficiente y a escala.
#### Foundational Trust: Certificaciones y certificados
Trust es la piedra angular de la plataforma de Salesforce, y esa Trust se obtiene a través de la validación independiente. Salesforce mantiene una amplia cartera de certificados y certificaciones de seguridad global que demuestran su compromiso continuo con la protección de datos de clientes y el mantenimiento de los estándares más altos de seguridad en la nube.
Estas certificaciones no son solo casillas de verificación: representan auditorías rigurosas y recurrentes que verifican la solidez y la coherencia de los controles de seguridad, los procesos y la infraestructura de Salesforce. Juntos, forman la columna vertebral del modelo Trust fundacional de Salesforce.
**Las certificaciones y certificados clave incluyen:**
- **ISO/IEC 27001:** Valida el sistema de gestión de seguridad de la información integral de Salesforce.
- **ISO/IEC 27017:** Establece mejores prácticas para controles de seguridad específicos de la nube.
- **ISO/IEC 27018:** Se centra en la protección de la información de identificación personal (PII) en la nube.
- **SOC 1, SOC 2 y SOC 3:** Reportes independientes que confirman el diseño y la eficacia operativa de los controles de seguridad y privacidad de Salesforce.
- **PCI DSS:** Garantiza el procesamiento y almacenamiento seguro de la información de la tarjeta de pago.
- **FedRAMP High & DoD Impact Nivel 4:** Certifica Salesforce Government Cloud para su uso por agencias federales de Estados Unidos que gestionan cargas de trabajo confidenciales.
Al mantener este conjunto integral de certificaciones, Salesforce proporciona a los clientes la confianza de que sus datos se gestionan dentro de una plataforma que cumple (y a menudo supera) las expectativas de cumplimiento y seguridad globales.
### Maximización de la visibilidad: Registro, monitoreo y observabilidad en Salesforce Data 360
En el trepidante panorama digital actual, tener una vista de 360 grados de sus datos de clientes es crucial, pero igualmente importante es tener una vista de 360 grados de la plataforma que gestiona esos datos. Salesforce Data 360 proporciona funciones de registro, monitoreo y observabilidad sólidas e integradas que permiten a los clientes garantizar la calidad, la seguridad y el desempeño de los datos.
Estas herramientas le ayudan a pasar de la solución de problemas reactiva a la gestión proactiva, garantizando que su implementación de Data 360 se ejecute de forma fluida y eficiente.
#### Detección y respuesta proactiva ante amenazas
La seguridad no termina con la prevención, sino que evoluciona con la vigilancia. En un panorama de amenazas en constante cambio, Salesforce combina funciones de monitoreo de plataforma avanzado con procesos de revisión gestionados por clientes para garantizar una protección continua y proactiva.
Salesforce proporciona potentes herramientas nativas para la visibilidad y la detección de amenazas:
- **Configurar seguimiento de** auditoría captura un historial completo de cambios administrativos, ayudando los equipos a realizar un seguimiento de actualizaciones de políticas o configuración.
- **Monitoreo de eventos** ofrece perspectivas profundas sobre el comportamiento de los usuarios, la actividad de API y los patrones de acceso a los datos. Esta telemetría se puede integrar fácilmente con una solución de Gestión de eventos e **información de seguridad** para el análisis y la correlación centralizados.
#### 1\. Monitoreo de eventos: El pulso de su organización
Monitoreo de eventos, parte de la oferta Salesforce Shield, es el núcleo central para el seguimiento de datos detallados de actividad de usuario y desempeño del sistema en su organización de Salesforce, incluyendo acciones específicas de Data 360. Captura una amplia gama de "eventos" en archivos de registro y objetos para su análisis.
- **Archivos de registro de eventos (ELF):** Estos proporcionan detalles granulares de la actividad del usuario y los eventos del sistema, disponibles para descargar después de un breve retraso (cada hora o diariamente). Puede acceder a hasta 30 días de datos a través de la API o el navegador Archivo de registro de eventos, con la opción de exportar para almacenamiento a largo plazo.
- **Monitoreo de eventos en tiempo real:** Para obtener perspectivas inmediatas, los eventos en tiempo real se transmiten como eventos de plataforma, lo que le permite monitorear y detectar actividad casi en tiempo real. Esto es vital para la seguridad y el desempeño, permitiéndole realizar acciones inmediatas si es necesario.
- **Eventos específicos de Data 360:** Monitoreo de eventos incluye tipos de eventos específicos del uso de Data 360, como Vista de página Lightning, Lightning Interaction y Evento de reporte relacionados con páginas y datos de Data 360.
- **Integración con herramientas externas:** Salesforce facilita la integración sencilla con soluciones de monitoreo externas populares como Splunk, Datadog, New Relic y Sumo Logic. Puede transmitir o exportar datos de Event Monitoring a estas plataformas para una observabilidad consolidada en toda su pila de tecnología.
#### 2\. Optimización y monitoreo de desempeño
Comprender el desempeño de su implementación de Data 360 es clave para una excelente experiencia de usuario.
- **Aplicación de uso Lightning:** Esta aplicación integrada proporciona una vista agregada de mediciones de desempeño, como tiempos de carga de página (Tiempo de página experimentado o EPT) y desempeño de navegador, para páginas de Data 360 en Lightning Experience.
- **Reportes y tableros personalizados:** Puede crear reportes y tableros personalizados utilizando objetos de Data 360 y datos de Event Monitoring, incluyendo el uso de una aplicación con plantilla gratuita de CRM Analytics denominada Event Monitoring Plus. Estas visualizaciones le ayudan a detectar tendencias e identificar cuellos de botella de desempeño rápidamente.
Pero la tecnología por sí sola no es suficiente. La verdadera resiliencia requiere una asociación disciplinada entre la detección automatizada y la revisión humana. Las alertas automatizadas pueden aflorar anomalías en tiempo real, pero las amenazas sutiles o a largo plazo, como la exfiltración de datos lenta y no autorizada por un usuario válido, a menudo se identifican mejor a través de auditorías periódicas y análisis de tendencias.
Salesforce proporciona los ganchos de telemetría, registros de auditoría e integración; los clientes aportan el rigor del proceso, la cadencia operativa y la inteligencia específica del contexto. Juntos, forman un **modelo de defensa**: combinando automatización, análisis y supervisión humana para detectar, investigar y responder a amenazas antes de que se conviertan en incidentes.
### Impulsar decisiones fundamentadas: Reportes, tableros, mediciones y notificaciones en Salesforce Data 360
Salesforce Data 360 no se trata solo de unificar sus datos de clientes; se trata de hacer que esos datos sean inteligentes y con capacidad de acción. Una parte principal de esta propuesta de valor es proporcionar reportes sólidos, tableros potentes, mediciones con perspectivas y funciones de notificación en tiempo real. Estas herramientas permiten a los clientes monitorear el estado de los datos, realizar un seguimiento del desempeño y automatizar acciones basándose en datos unificados, todo ello en el entorno familiar de Salesforce.
#### Reportes y tableros: Su núcleo de visualización de datos
Las funciones de tablero y creación de reportes nativas de Salesforce se amplían sin problemas a Data 360, permitiéndole visualizar y analizar sus datos unificados sin salir de la plataforma.
#### Creación de reportes sobre datos unificados
Puede crear reportes estándar y personalizados sobre datos almacenados en Data 360, incluyendo datos unificados de varios orígenes y perspectivas calculadas.
- **Tipos de reporte estándar y personalizados:** Data 360 presenta nuevos tipos de reportes específicamente para objetos de Data 360, como Transmisiones de datos, Segmentos, Activaciones, Resolución de identidad y Perspectivas calculadas. Esto le permite consultar sus datos unificados con generadores de reportes estándar de Salesforce.
- **Análisis granular:** Los reportes admiten hasta 10 agrupaciones de filas, lo que permite una segmentación más precisa y un análisis detallado de las tendencias y los atributos de los clientes.
- **Fórmulas y resúmenes:** Puede aprovechar fórmulas de resumen y a nivel de filas para evaluar cada registro o grupo de registros, ayudándole a realizar un seguimiento de mediciones detalladas y resúmenes agregados de alto nivel en un solo reporte.
#### Tableros dinámicos para vistas holísticas
Los tableros proporcionan una visualización de tendencias y mediciones clave en su implementación de Data 360.
- **Vista unificada:** Combine datos desde múltiples reportes de Data 360, o incluso mezcle reportes de Data 360 con reportes estándar de CRM, en un único tablero para una vista holística de sus operaciones y perspectivas de clientes.
- **Widgets personalizables:** Utilice varios tipos de gráficos (barra, línea, circular, indicador, etc.) y tablas para mostrar datos de reportes de forma efectiva.
- **Perspectivas en tiempo real:** Los tableros se pueden actualizar para proporcionar información actualizada, ayudando en la toma de decisiones rápida y dirigida por datos.
#### Mediciones y KPI: Medición del éxito
Data 360 le permite definir y realizar un seguimiento de indicadores clave de desempeño (KPI) relevantes para sus objetivos de negocio. Estos se pueden generar a través de:
- **Perspectivas calculadas:** Cree potentes mediciones utilizando datos procesados en lotes de gran volumen. Por ejemplo, calcule mediciones como "Valor medio de vida del cliente" o "Total de ingresos de contratos activos" y utilícelas como dimensiones o mediciones en sus reportes y tableros.
- **Perspectivas de transmisión:** Procese datos desde orígenes de transmisión casi en tiempo real para crear agregaciones de series temporales, como datos de implicación móvil o sitio web. Estas mediciones pueden dirigir orquestaciones inmediatas y acciones de datos.
#### Notificaciones y alertas: Mantenerse informado y proactivo
Salesforce ofrece potentes funciones de automatización y notificación para garantizar que está al tanto de eventos críticos o cambios de datos en Data 360.
- **Notificaciones basadas en flujos:** Puede configurar Flujos de proceso para desencadenar acciones y enviar notificaciones basándose en eventos en objetos de Data 360 como Transmisiones de datos, Segmentos y Activaciones.
- **Alertas personalizadas:** Cree notificaciones personalizadas que desencadenan un email o aparecen en la campana de notificaciones de Salesforce cuando se cumplen condiciones específicas. Por ejemplo, puede recibir una alerta si una transmisión de datos falla, una regla de resolución de identidad encuentra un error o una medición clave cruza un umbral concreto.
- **Servicio de notificación de eventos (ENS):** Para desarrolladores, el Servicio de notificación de eventos de API first permite a los sistemas externos recibir notificaciones cuando se producen ciertos eventos, permitiendo una integración sencilla y reacciones en tiempo real en su pila de tecnología.
- **Acciones de datos:** Basándose en perspectivas de transmisión, puede desencadenar acciones de datos, que se pueden configurar para enviar alertas, invocar eventos de plataforma o integrar con otras aplicaciones SaaS a través de webhooks.
Aprovechando estas funciones integrales, los clientes de Salesforce Data 360 pueden monitorear de forma efectiva sus ecosistemas de datos, visualizar mediciones clave y recibir alertas oportunas para dirigir la implicación proactiva y la excelencia operativa.
### Recomendaciones estratégicas para la adopción de compañías
La adopción de Salesforce Data 360 a escala de la compañía requiere más que la activación técnica: requiere una arquitectura deliberada y de seguridad en primer lugar. Las siguientes recomendaciones estratégicas proporcionan a los CTO y arquitectos de negocio una hoja de ruta para fomentar Trust, Resiliencia y cumplimiento en cada capa de su implementación de Data 360.
- **Implementar un enfoque “Secure-by-Design” :** La seguridad no debe actualizarse, debe ser fundamental. Comience con la política predeterminada _“Denegar todo”_ de Salesforce y otorgue acceso de forma explícita según sea necesario. Defina la gobernanza, las políticas y los marcos de trabajo de acceso antes de ingresar o activar datos. La creación de seguridad desde el primer día elimina el riesgo de exposiciones ocultas y simplifica el cumplimiento a largo plazo.
- **Aplicar una estrategia sólida de gestión de identidad y acceso (IAM):** Centralice la identidad a través de SSO federado y aplique la autenticación de múltiples factores (MFA) para mitigar el compromiso de credenciales. Restrinja el acceso por Intervalos de direcciones IP de inicio de sesión y utilice las funciones Proveedor de identidad (IdP) de Salesforce para establecer la responsabilidad de extremo a extremo entre usuarios e integraciones. Una capa IAM unificada reduce la complejidad operativa y endurece su superficie de autenticación.
- **Aplicar el principio de menor privilegio:** Diseñe funciones por precisión, no por comodidad. Utilice los conjuntos de permisos estándar de Salesforce como base para la separación de funciones, garantizando que los usuarios solo accedan a lo necesario. Evite la personalización excesiva de permisos: cada desviación aumenta los gastos generales de mantenimiento y el riesgo de acceso no intencionado.
- **Establecer un marco de trabajo de gobernanza de datos de múltiples capas:** Separe datos por unidad de negocio o marca utilizando Espacios de datos y aplique el Control de acceso basado en atributos (ABAC) con Seguridad a nivel de objeto, campo y registro (OLS, FLS, RLS). Utilice Enmascaramiento de datos dinámico para proteger información confidencial en tiempo real sin obstaculizar el análisis o la capacidad de uso. Este modelo por capas garantiza que la gobernanza se mantiene coherente a medida que los datos se amplían entre dominios.
- **Aprovechar estratégicamente el cifrado y asegurar integraciones:** Para cargas de trabajo confidenciales, implemente Cifrado de plataforma con claves gestionadas por el cliente (CMK) para mantener la soberanía sobre su ciclo de vida de cifrado. Utilice Credenciales nombradas y Conexión privada para proteger todas las integraciones de sistema a sistema, eliminando secretos codificados y garantizando que todo el tráfico permanece privado, cumpliendo y auditable.
- **Cree un programa de operaciones de seguridad continua:** La seguridad no termina con la configuración, sino que prospera en la disciplina operativa. Complemente el monitoreo automatizado con revisiones de auditoría regulares de registros de eventos y rutas de acceso. Establezca una función Operaciones de seguridad (SecOps) exclusiva para identificar anomalías, investigar amenazas y validar el cumplimiento. El objetivo: detectar temprano, responder rápido y mejorar continuamente la postura.
### Ruta a seguir: Construcción de un Data 360 resiliente y de confianza
La trayectoria hacia una empresa segura e inteligente no finaliza con la implementación, sino que evoluciona a través de la disciplina, el diseño y Trust. Salesforce Data 360 proporciona la base arquitectónica, pero el verdadero valor emerge cuando las organizaciones operacionalizan la seguridad, la gobernanza y la inteligencia como un movimiento unificado.
Las compañías deben enfocar Data 360 no como otra plataforma de datos, sino como una capa Trust segura y componible que conecta datos, IA e implicación de clientes bajo un marco de trabajo de gobernanza único. Adoptando una filosofía _segura por diseño_, aplicando el menor privilegio en cada capa y ampliando la conectividad privada a todos los flujos de datos, las organizaciones transforman el cumplimiento de una casilla de verificación en una ventaja competitiva.
El siguiente paso es la modernización continua: la integración de la automatización de auditoría, la aplicación de políticas y la gestión del ciclo de vida del cifrado en las operaciones diarias. A medida que las compañías evolucionan hacia arquitecturas dirigidas por IA y agentes, los mismos principios que protegen los datos hoy formarán la columna vertebral de la gobernanza de la IA mañana, garantizando que cada modelo, agente y decisión sea explicable, tenga en cuenta las políticas y cumpla con el diseño.
En última instancia, Trust se convierte en la nueva divisa de la transformación digital. Con Salesforce Data 360, las compañías pueden ampliar con confianza sus ecosistemas de datos, sabiendo que cada byte, cada conexión y cada perspectiva está protegida, gobernada y activada con integridad.
## Acerca de los autores
**Krishna Chalamasandra** es una experta en ciberseguridad con más de 25 años de experiencia en tecnología de seguridad de la información y cumplimiento. En Salesforce, se desempeña como asesor de confianza para clientes y líder clave en la función Customer Trust Security and Compliance dentro de la organización de CISO. Anteriormente, Krishna pasó 10 años en Cisco, liderando la arquitectura de seguridad en IAM, seguridad de red y PKI, y conduciendo certificaciones clave incluyendo ISO 27001, SOC 1-3, PCI, FedRAMP y FIPS 140-2. También pasó más de 8 años en Novell implementando controles a nivel de infraestructura y dando cobertura a revisiones de seguridad complejas para clientes globales regulados.
**Yugandhar Bora** es Arquitecto de Ingeniería de Software en Salesforce, especializado en arquitectura de datos dentro de la plataforma Aplicaciones de inteligencia y datos. Lidera iniciativas de la junta de revisión de arquitectura de negocio (EARB) centradas en la gobernanza de datos y modelos de datos unificados, mientras contribuye a soluciones de aprovisionamiento de plataforma automatizadas.
## Descripción general
Este documento describe las opciones actuales para implementar aplicaciones en CloudHub 2.0 para cumplir los requisitos de alta disponibilidad y recuperación de desastres. Utiliza la región de EE.UU. como ejemplo y se puede aplicar a otras regiones.
CloudHub 2.0 es una plataforma de integración nativa de la nube completamente gestionada que elimina los gastos generales de infraestructura automatizando la implementación, la ampliación y la gestión de las API de MuleSoft y las integraciones en la nube. Es la plataforma de implementación en la nube moderna de MuleSoft, que se ejecuta en la infraestructura de Amazon AWS.
## Requisitos de recuperación de desastres
En la mayoría de los casos, la Alta disponibilidad (HA) y la Recuperación de desastres (DR) predeterminadas proporcionadas por CloudHub 2.0 son suficientes. CloudHub 2.0 proporciona HA y DR a nivel regional (para obtener más detalles, consulte [Escenarios de cortes](#escenarios-de-interrupciones-de-cloudhub-20) de CloudHub 2.0). [La sección Consideraciones clave](#consideraciones-clave-de-cloudhub-20) de CloudHub 2.0 proporciona más detalles acerca de HA y DR compatibles con CloudHub-2.0.
Las condiciones que exigen un diseño más allá de la disponibilidad predeterminada de CloudHub 2.0 incluyen:
- Una aplicación necesita garantizar que no se produzca ninguna pérdida de datos en un escenario de desastre (por ejemplo, una región de Amazon fallida).
- Una aplicación depende del Almacén de objetos y necesita garantizar la continuidad si la región de implementación falla.
## Supuestos
- Los sistemas backend están configurados para una disponibilidad equivalente. CloudHub 2.0 puede a veces proporcionar fiabilidad a través de colas o mecanismos similares, pero si la integración es en tiempo real o asíncrona, los sistemas backend deben admitir un nivel comparable de HA y DR.
- Cuando una interrupción a nivel de región de AWS afecta a sistemas backend, se supone que su recuperación se ejecuta en paralelo con la recuperación de CloudHub 2.0.
- La configuración del espacio privado está completa en múltiples regiones.
## Fuera del ámbito
Las opciones de diseño en esta guía se centran en soluciones para la disponibilidad de aplicaciones en CloudHub 2.0 cuando una zona o región de disponibilidad de AWS completa deja de estar disponible.
Esta guía **no** aborda estos escenarios de recuperación, aunque sí señala implicaciones cuando procede:
- Recuperación de sistemas backend, aplicaciones, bases de datos, componentes de red y centros de datos gestionados y aprovisionados fuera de Anypoint CloudHub, ya sea en las instalaciones o en la nube.
- Recuperación de vínculos VPN entre CloudHub 2.0 y el centro de datos privado del cliente (por ejemplo, túneles IPsec y pasarelas VPN). Algunas opciones de DR en esta guía podrían solucionar parcialmente estos escenarios.
- Los cambios en MuleSoft generan direcciones IP durante la recuperación de desastres cuando se utiliza la lista de admisión de direcciones IP para integraciones. Algunas opciones de DR en esta guía podrían solucionar parcialmente estos escenarios.
- Sistemas de mensajería externos utilizados en soluciones de clientes, ya sean proporcionados por MuleSoft (como Anypoint MQ) u otros proveedores (como AWS MSK o Heroku Kafka).
## Consideraciones clave de CloudHub 2.0
Al evaluar CloudHub 2.0 para [requisitos de recuperación](#requisitos-de-recuperación-de-desastres) de desastres, piense en estas consideraciones clave.
**Dependencia de CloudHub 2.0 de la disponibilidad regional de AWS**
- CloudHub 2.0 se ejecuta en AWS; su disponibilidad está vinculada a regiones de AWS.
- Las implementaciones y la disponibilidad de aplicaciones están organizadas por región. Estas regiones corresponden a regiones de AWS.
Si una región de AWS completa falla, las aplicaciones en esa región no están disponibles y no se replican automáticamente en otro lugar.
**Alta disponibilidad de aplicaciones (HA) y Gestión de réplicas**
- CloudHub 2.0 vuelve a implementar automáticamente aplicaciones en la misma región cuando falla el hardware, pero una aplicación con una única réplica puede experimentar tiempo de inactividad.
- Las aplicaciones con múltiples réplicas se implementan entre zonas de disponibilidad separadas de forma predeterminada, proporcionando HA entre zonas.
- Si la zona de disponibilidad para una aplicación de una sola réplica falla, la aplicación aparece automáticamente en otra zona de disponibilidad en la misma región.
**Repercusión específica de la región este de EE.UU.**
- En caso de un fallo de funcionamiento de la región Este de EE.UU.:
- La interfaz de usuario de gestión de CloudHub 2.0 y los servicios de REST de implementación no están disponibles y no se pueden implementar nuevas aplicaciones.
- Las solicitudes en otras regiones no se ven afectadas en la mayoría de los escenarios de fallo. Estas aplicaciones siguen funcionando normalmente; sin embargo, las funciones de monitoreo y gestión a través del plano de control no estarán disponibles durante el fallo.
- Los módulos Core CloudHub 2.0 (como la configuración de la aplicación) se mantienen en el Este de EE.UU., de modo que no se pueden modificar los parámetros durante el fallo.
**Monitoreo y alerta**
- Configure alertas para fallos de zona de disponibilidad o nivel de región a través de [status.mulesoft.com](http://status.mulesoft.com).
- Utilice un mecanismo de alerta y comprobación de estado separado fuera de CloudHub 2.0 de modo que se notifique a los equipos si las réplicas fallan o las aplicaciones dejan de responder.
**Persistencia de datos (almacén de objetos V2)**
- Establecimiento de objetos V2 está vinculado a la región donde se implementó la aplicación por _primera vez_.
- Si mueve la aplicación a otra región, Object Store V2 permanece en la región original para evitar la pérdida de datos.
- Si la región donde Almacén de objetos V2 está implementada falla, el almacén de objetos no está disponible.
**Controladores de ingreso y espacios privados**
- Los controladores de ingreso de CloudHub 2.0 están altamente disponibles a nivel de región.
- En un espacio compartido, si una región falla, un controlador de ingreso en otra región permanece disponible pero solo puede servir aplicaciones implementadas en esa región.
- En un espacio privado, si una región falla, los controladores de ingreso en otras regiones no están disponibles a menos que se configuraran allí con antelación.
- La configuración del espacio privado es regional; si una región falla, el espacio privado no estará disponible a menos que se haya configurado otra región.
## Escenarios de interrupciones de CloudHub 2.0
### Réplica / Zona de disponibilidad / Apagones de región
#### Responsabilidad de Salesforce
| Estado de componente | Responsabilidad de Salesforce |
| -------------------------------- | :----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Réplica hacia abajo** | **Acción**: CloudHub 2.0 reinicia automáticamente la réplica en una zona de disponibilidad diferente si hay un error con la zona de disponibilidad actual. Pero la aplicación estará sin conexión hasta que se inicie completamente la nueva réplica. **Condición**: Configuración predeterminada. **Tiempo empleado**: Aproximadamente 2-15 minutos dependiendo de la complejidad de la aplicación y el tamaño de la réplica. |
| **Zona de disponibilidad abajo** | **Acción**: Igual que la réplica. **Condición**: Configuración predeterminada. **Tiempo empleado**: Igual que la réplica. **Notificación**: Igual que la réplica. |
| **Región hacia abajo** | **Acción**: Sin recuperación automática. Debe existir un diseño de conmutación por error. |
#### Responsabilidad del cliente
| Estado de componente | Responsabilidad del cliente |
| -------------------------------- | :------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------ |
| **Réplica hacia abajo** | **Notificación**: Realice comprobaciones de estado periódicas utilizando un mecanismo de latidos integrado en las API. **Mitigación**: Implemente la aplicación en múltiples réplicas en la misma región. **Prueba / Simulación:** Eleve un ticket con la asistencia de MuleSoft y admitirán una prueba de conmutación por error para comprobar si una nueva réplica aparece en una AZ diferente en 1 a 15 minutos. |
| **Zona de disponibilidad abajo** | **Notificación**: Igual que la réplica. **Mitigación**: Implemente la aplicación en múltiples réplicas en la misma región o en regiones diferentes. **Prueba / Simulación:** El escenario AZ Down es difícil de simular. Requiere la participación de MuleSoft Engineering para dar cobertura a posibles escenarios de prueba. |
| **Región hacia abajo** | **Notificación**: Igual que la réplica. Compruebe también las actualizaciones de estado en [https://status.aws.amazon.com](https://status.aws.amazon.com). **Mitigación**: Igual que AZ Down. Plan de contingencia de recuperación de desastres: 2 espacios privados con la misma configuración en diferentes regiones. **Prueba / Simulación:** Igual que AZ Down. |
### Apagones del controlador de entrada y pasarela VPN
#### Responsabilidad de Salesforce
| Estado de componente | Responsabilidad de Salesforce |
| :---------------------------------------------------- | :----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Pasarela VPN caída** | **Estado de réplica**: Ejecución pero no se puede conectar a ningún recurso alojado en las instalaciones y accesible a través del túnel VPN. **Acción**: Sin recuperación automática. Debe existir un diseño de conmutación por error. |
| **Controlador de ingreso (Espacio compartido) Abajo** | **Estado de réplica**: El controlador de ingreso es una configuración en clúster con múltiples instancias, similar a las réplicas de aplicaciones. Si una réplica de aplicación falla, se crea una nueva y se inicia automáticamente. Si una instancia del controlador de ingreso falla, las solicitudes permanecen disponibles a través de la otra instancia. Si todo el controlador de ingreso está inactivo, la región se considera inactiva. |
| **Controlador de ingreso (Espacio privado) Abajo** | **Estado de réplica:** Igual que Controlador de ingreso en espacio compartido hacia abajo. |
#### Responsabilidad del cliente
| Estado de componente | Responsabilidad del cliente |
| :------------------------------------------------------ | :------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Pasarela VPN caída | **Notificación**: Realice comprobaciones de estado periódicas utilizando un mecanismo de latidos integrado en las API. **Mitigación**: Las pasarelas VPN CloudHub 2.0 admiten alta disponibilidad a través de una arquitectura de doble túnel con conmutación por error automática entre túneles; un cliente debe configurar este patrón. **Prueba / Simulación:** El escenario de VPN Gateway Down es difícil de simular. Requiere la participación de MuleSoft Engineering para dar cobertura a posibles escenarios de prueba. |
| Controlador de ingreso (Espacio compartido) hacia abajo | **Notificación**: Igual que VPN Gateway Down. **Mitigación**: Igual que Región hacia abajo. Migre aplicaciones a un espacio de espera o activo en otra región. **Prueba / Simulación:** Igual que VPN Gateway Down. |
| Controlador de ingreso (Espacio privado) Abajo | **Notificación**: Igual que VPN Gateway Down. **Mitigación**: Igual que Región hacia abajo. Migre aplicaciones a un espacio privado activo o en espera en otra región, en coordinación con la configuración de AWS Route 53 (o equivalente). **Prueba / Simulación:** Igual que VPN Gateway Down. |
### Almacenes de objetos y colas persistentes
**Escenario descendente de Servicios de plataforma – Establecimiento de objetos**
| Almacén de objetos en memoria | Almacén de objetos persistente v2 | |
|---|---|---|
| Ubicación de datos | Local solo para la aplicación. | En la misma región donde se implementó por primera vez la aplicación MuleSoft. |
| ¿Compartido entre réplicas? | No | Sí |
| Recuperación de establecimiento de objetos en aplicaciones | Los datos se pierden; todos los datos en memoria se pierden en el reinicio de la aplicación, la nueva implementación o el fallo de la réplica. | Los datos no se pierden a menos que se elimine la aplicación. |
| Recuperación de establecimiento de objetos en región | Los datos se pierden (igual que anteriormente). | Los datos no se pierden (igual que anteriormente). |
| Recuperación regional | Igual que antes. | Los datos no están disponibles. Incluso con una configuración de DR activa-activa, Establecimiento de objetos solo está disponible en la región de implementación original. |
| Mitigación | Externalice datos para la recuperación regional. | Los datos permanecen disponibles mientras la región de implementación original está disponible. Para HA o DR entre regiones, externalice datos fuera del establecimiento de objetos. |
 Los componentes básicos de la arquitectura de red CloudHub 2.0 son:
- Un equilibrador de carga HTTP
- Registros DNS de réplica de mula
- Espacios privados
- Servicios regionales
Para obtener más detalles, consulte [Arquitectura de redes CloudHub 2.0](https://docs.mulesoft.com/cloudhub-2/ch2-networking-guide).
**Dominios de tocador**
Cuando se crea un Espacio privado, recibe un nombre de destino DNS en el formato: \
 CloudHub 2.0 también admite dominios personalizados, o de tocador, configurándolos en un Espacio privado utilizando contextos TLS y registros DNS. Para crear un contexto TLS en Gestor de tiempo de ejecución para un espacio privado, cargue el certificado público y la clave privada, luego agregue un extremo personalizado en la configuración de su aplicación para utilizar ese dominio. Cree un registro DNS (como un CNAME) que apunte su dominio de tocador al nombre de host predeterminado de su espacio privado.
Por ejemplo, una aplicación denominada test-api implementada en us-west-2 con DNS predeterminado 42y52r.usa-w2.cloudhub.io tiene un extremo de API de:
https://test-api-mwsklu-42y52r.usa-w2.cloudhub.io
Esta URL no utiliza un dominio vanidoso o personalizado. Para utilizar [acme.com de](https://acme.com) modo que las URL de API aparezcan como [https://test-api.acme.com](https://test-api.acme.com), siga estos pasos.
1. Cree contexto TLS en Gestor de tiempo de ejecución con claves públicas y privadas.
2. Agregue un dominio de tocador en la configuración de la aplicación para utilizar ese dominio.
3. Cree un registro DNS en AWS Route 53 y configure una política de enrutamiento sencilla (por ejemplo, CNAME) de modo que el dominio de tocador se resuelva con el nombre de host predeterminado del espacio privado.
Para dominios personalizados, puede utilizar AWS Route 53 o cualquier otro servicio de CDN global con políticas de enrutamiento. En el siguiente diagrama, la Ruta 53 de AWS se utiliza con una política de enrutamiento “simple”. Cuando un consumidor de una red pública (externa) solicita acme.com, la Ruta 53 de AWS enruta la solicitud al controlador de entrada de espacio privado MuleSoft.
 ## Estrategia de conmutación por error
Utilice esta opción cuando las aplicaciones requieren conmutación por error: implemente una instancia en la región principal (por ejemplo, us-west-2) y otra en una región secundaria (por ejemplo, us-east-1).
Utilice un entorno existente en la región secundaria cuando sea posible; la creación de un nuevo entorno requiere esfuerzo adicional.
**Ejemplo de aplicaciones implementadas en una región (EE.UU. Oeste 2) con una conmutación por error a otra región (EE.UU. Este 1)**
 | Nombre de registro | Valor/Enrutar tráfico a | Política de enrutamiento | Id. de Comprobación de estado |
| :----------------: | :-----------------------: | :----------------------: | :---------------------------: |
| acme.com | 42y52r.usa-w2.cloudhub.io | Conmutación por error | 31s3wseq121 |
| acme.com | 31e51s.usa-e1.cloudhub.io | Conmutación por error | 43e131s131sq |
En esta configuración, AWS Route 53 enruta el tráfico a los controladores de entrada para los espacios privados en US West 2 y US East 1. Una política de enrutamiento por error está configurada con una comprobación de estado.
## Alta disponibilidad y baja latencia
Para una latencia más baja junto con una alta disponibilidad, utilice la estrategia de implementación descrita en el diagrama. Con esta estrategia, las aplicaciones se pueden implementar en dos regiones (us-west-2 y us-east-1 en este ejemplo).
Utilice la política de enrutamiento de latencia en Ruta 53 de AWS para enrutar solicitudes a la región que ofrece la latencia más baja manteniendo al mismo tiempo la alta disponibilidad. Política de enrutamiento de “latencia” en Ruta 53 de AWS para enrutar la solicitud de latencia más baja que aún tiene alta disponibilidad.
**Aplicaciones implementadas en ambas regiones (EE.UU. Oeste 2 y EE.UU. Este 1) para una latencia más baja y alta disponibilidad**
 | Nombre de registro | Valor/ Enrutar tráfico a | Política de enrutamiento | Id. de Comprobación de estado |
| :----------------: | :-----------------------: | :----------------------: | :---------------------------: |
| acme.com | 42y52r.usa-w2.cloudhub.io | Latencia | 31s3wseq121 |
| acme.com | 31e51s.usa-e1.cloudhub.io | Latencia | 43e131s131sq |
## Conclusión
MuleSoft CloudHub 2.0 proporciona una base sólida para la resiliencia intrarregional, aprovechando principalmente la redundancia de réplicas automatizada y el equilibrio de carga inteligente. Dentro de una sola región de nube, la implementación de aplicaciones con múltiples réplicas garantiza que si una instancia falla, otras puedan asumir inmediatamente la carga de trabajo. El equilibrador de carga integrado distribuye de forma eficiente el tráfico entrante entre estas réplicas saludables, minimizando el tiempo de inactividad y garantizando la disponibilidad de servicio continua en condiciones de funcionamiento normales.
Sin embargo, depender exclusivamente de esta arquitectura de una sola región, incluso una con alta redundancia, presenta un riesgo significativo de un fallo generalizado y catastrófico en la región. La historia ha demostrado que incluso los proveedores de nube más fiables y tecnológicamente avanzados son susceptibles a incidentes perturbadores que pueden afectar a toda una región geográfica. Estos puntos únicos de fallo, aunque raros, pueden surgir de varios eventos, incluyendo:
- Incidentes de infraestructura a gran escala
- Fallos de energía importantes
- Interrupciones generalizadas de la red
Por lo tanto, para lograr una verdadera alta disponibilidad (HA) y recuperación de desastres (DR), una arquitectura debe diseñarse para trascender las limitaciones de un modelo de una sola región. La estrategia recomendada es la implementación entre múltiples regiones geográficamente distintas. Esta resistencia interregional garantiza que si una región de nube completa deja de estar disponible debido a un desastre inesperado, el tráfico puede fallar sin problemas en una instancia de aplicación que se ejecuta en una región separada y no afectada, garantizando una interrupción mínima del servicio y alcanzando objetivos de tiempo de disponibilidad máximo.
## Referencias
[Arquitectura de redes CloudHub 2.0](https://docs.mulesoft.com/cloudhub-2/ch2-networking-guide)
[Configuración de la conmutación por error entre regiones para colas estándar](https://docs.mulesoft.com/mq/mq-failover)
[Regiones de implementación de Object Store V2](https://docs.mulesoft.com/object-store/osv2-faq#osv2-regions)
[Su región de implementación de establecimiento de objetos](https://docs.mulesoft.com/object-store/osv2-faq#is-object-store-v2-persistent-in-the-same-region-as-the-worker)
## Acerca de los autores
Gulal Kumar es Arquitecto de Ingeniería de Software en Salesforce, con un enfoque en datos y arquitectura de integración. Con más de 20 años de experiencia en integración y API, programas de modernización, seguridad e iniciativas AIML, aporta una gran experiencia. Gulal se ha comprometido a avanzar en iniciativas de transformación de negocio, mejorando la seguridad y la resiliencia, promoviendo la excelencia de la arquitectura y liderando iniciativas de AIML entre varios dominios.
Ajay Nagaraju es Arquitecto de compañía y Director Senior de MuleSoft con más de 28 años de experiencia en arquitectura de compañía, integración de sistemas y transformación digital a gran escala. Ha liderado la arquitectura y la entrega de programas complejos y multimillonarios entre organizaciones Fortune 100 y Fortune 500, con una profunda experiencia en conectividad dirigida por API, SOA, tecnologías de nube y patrones de integración de negocio. Ajay se asoció estrechamente con el liderazgo ejecutivo para modernizar procesos de negocio, plataformas de datos y ecosistemas de integración, y es apasionado de la creación de arquitecturas ampliables, equipos de mentores e impulsar resultados de negocio mensurables a través de la tecnología.
## Introducción
En el desarrollo de software tradicional, el Ciclo de vida de desarrollo de software (SDLC) proporciona un enfoque estructurado y por fases para la creación de aplicaciones. Establece la calidad, reduce el riesgo y proporciona una hoja de ruta clara desde la idea hasta la versión. El Ciclo de vida de desarrollo de agentes (ADLC) es una metodología similar que está claramente adaptada para abordar las complejidades exclusivas de la creación de agentes autónomos.
Los agentes no son aplicaciones pasivas; son sistemas que razonan, actúan y aprenden en entornos de ejecución dinámicos. Su comportamiento no determinista hace que la evaluación cualitativa tradicional sea insuficiente. El Ciclo de vida de desarrollo de agentes (ADLC), liderado por plataformas como Agentforce, aborda esto en cinco fases: Ideación y diseño, Desarrollo (el “bucle interno”), Pruebas y validación, Implementación y Monitoreo y ajuste continuos (el “bucle externo”).
Este documento sirve como una guía integral para desarrolladores y Arquitectos de compañía que ya están familiarizados con las complejidades del Ciclo de vida de desarrollo de software (SDLC) y están buscando ampliar su experiencia en sistemas basados en agentes. Nuestro objetivo principal es facilitar una comprensión rápida del Ciclo de vida de desarrollo de agentes (ADLC) resaltando sus distinciones clave de las metodologías de SDLC tradicionales y proporcionando un marco estructurado para conceptualizar todo el proceso de creación, implementación y gestión de agentes inteligentes.
El documento está organizado en tres capítulos diferentes, cada uno diseñado para desarrollar progresivamente su Knowledge y habilidades prácticas:
- **Capítulo 1: El Marco de trabajo de ADLC.** Este capítulo presenta el Ciclo de vida de desarrollo de agentes (ADLC), detallando su divergencia con el SDLC debido a los desafíos exclusivos del desarrollo de agentes autónomos. Establece un marco para el diseño, el desarrollo, las pruebas y la implementación de agentes.
- **Capítulo 2: The Agentforce Platform.** Este capítulo explora Agentforce, una plataforma unificada que simplifica y acelera todo el ciclo de vida de desarrollo de agentes. Agentforce ofrece herramientas para el diseño de agentes, el procesamiento de datos, la capacitación de modelos, la implementación y el monitoreo continuo, simplificando tareas complejas y mejorando la eficiencia.
- **Capítulo 3: Implementación de procódigo.** Esta guía utiliza las herramientas de código pro de Agentforce para proporcionar instrucciones prácticas paso a paso y ejemplos reales para el desarrollo de agentes. Cubre todo el ciclo de vida de desarrollo de agentes, desde la creación de prototipos y la ingeniería de funciones hasta la implementación de modelos, el ajuste del desempeño y el mantenimiento, equipando a los desarrolladores con las habilidades para crear agentes listos para producción.
Este documento tiene como objetivo proporcionarle los Knowledge teóricos y prácticos de las herramientas de pro-código de Agentforce. Aprenderá a construir, implementar y monitorear agentes de forma eficiente, segura y confiable, obteniendo una comprensión integral del ADLC y maximizando el potencial Agentforce en el desarrollo de agentes inteligentes.
## Capítulo 1: Presentación del ciclo de vida de desarrollo de agentes
La naturaleza no determinista de los agentes de IA requiere un marco de desarrollo especializado. Este capítulo describe ese marco introduciendo el Ciclo de vida de desarrollo de agentes (ADLC). Este capítulo proporciona una descripción general integral de las cinco fases principales del ADLC, desde la Ideación y el diseño iniciales hasta el Monitoreo y ajuste continuos. Este capítulo establece el Knowledge fundamental requerido para construir agentes sólidos y confiables.
Esta sección asigna conceptos de SDLC a las cinco fases del ADLC.
#### Fase 1: Ideación y diseño
Esta es la fase fundamental donde se definen el propósito estratégico y los límites operativos de un agente. Una fase de diseño bien estructurada es el paso más crítico para el éxito, ya que traduce una necesidad de negocio en un plan técnico. El proceso de diseño garantiza que el agente no solo sea funcional, sino también responsable y alineado con las expectativas del usuario. Es donde se establecen el "qué" y el "por qué" antes de redactar cualquier código.
1. **Definir objetivos y funciones de agentes**: En primer lugar, debe articular claramente el objetivo principal del agente y las tareas específicas y mensurables que realizará. Esto implica definir su función (por ejemplo, "asistente de servicio al cliente"), sus funciones principales (por ejemplo, "reservar citas", "responder a preguntas de productos") y las mediciones de éxito para cada una.
2. **Establecer barandillas personales y éticas**: Este paso implica el diseño de la personalidad del agente y la definición de sus límites éticos para garantizar su fiabilidad y seguridad. Establece el tono del agente (por ejemplo, "formal", "amistoso") e implementa reglas estrictas para evitar respuestas dañinas, sesgadas o inapropiadas.
3. **Contexto y comprensión de mapas**: Debe determinar qué información necesita comprender y recordar el agente para ser efectivo. Esto incluye definir el ámbito de su base Knowledge y su memoria conversacional, lo que le permite tener pláticas coherentes y de múltiples turnos.
4. **Identificar herramientas e integraciones del sistema**: Esto implica el inventario de los sistemas externos, las API y los orígenes de datos con los que el agente debe conectarse para ejecutar tareas. Cada herramienta (por ejemplo, una API de reserva, una base de datos de clientes) está identificada y su función está asignada a una capacidad de agente específica.
5. **Plan para la distribución humana en bucle**: Es fundamental definir las condiciones bajo las cuales un agente se distribuye a un humano. Esto implica revisar posibles puntos de fallo y "calles sin salida" conversacionales para determinar cuándo un agente debe distribuirse a un operador humano. El diseño debe describir cómo se realizará esta transferencia para garantizar que se transfiere suficiente contexto, de modo que se pueda consumir rápidamente para garantizar una experiencia de cliente transparente.
#### Fase 2: Desarrollo
Esta es la fase de construcción práctica donde el plan de diseño se convierte en un agente funcional. Los desarrolladores crean el agente, lo conectan a sus herramientas y lo potencian con los datos que necesita para realizar sus tareas. Este "bucle interno" iterativo de construcción y refinamiento es donde el agente realmente cobra vida.
1. **Configurar la lógica y la toma de decisiones del agente**: Este paso implica dar forma al razonamiento del agente conectando su marco de trabajo de toma de decisiones con contexto, herramientas y orígenes de datos. La función del desarrollador es definir el comportamiento del agente creando API o reutilizando API existentes, estableciendo barandillas operativas y especificando cómo el agente selecciona y utiliza herramientas disponibles para completar tareas complejas de múltiples pasos.
2. **Solicitudes de ingeniero y modelos afinados**: La persona, las instrucciones y las restricciones del agente se codifican a través de una ingeniería de solicitudes meticulosa. Este proceso implica la elaboración de la solicitud principal que guía el modelo de lenguaje grande (LLM) y, para casos de uso más avanzados, ajustar el modelo en datos específicos de dominio para mejorar su desempeño.
3. **Integrar y proteger herramientas de IA**: Las funciones y las API identificadas durante la fase de diseño están conectadas al agente. Utilizando un SDK, los desarrolladores encierran funciones existentes o crean nuevas, haciéndolas llamables de forma segura por el agente y asegurándose de que tienen la autenticación y el tratamiento de errores apropiados.
4. **Crear datos y oportunidades en curso RAG**: Para potenciar al agente con Knowledge externo, los desarrolladores crean las oportunidades en curso de datos para Recuperación-Generación aumentada (RAG). Esto implica conectar e indexar datos desde orígenes como establecimientos vectoriales, bases de datos relacionales, bases de datos de gráficos o documentos internos, haciendo que esa información sea accesible para el agente para proporcionar respuestas precisas y contextuales.
#### Fase 3: Pruebas y validación
La prueba de agentes de IA presenta un cambio de paradigma desde la validación determinista del software tradicional. Aunque se prueba la corrección de una aplicación convencional (una entrada específica debe producir una salida única y esperada), la naturaleza no determinista de un agente requiere un enfoque más sofisticado. El objetivo no es validar una única respuesta correcta, sino garantizar que el comportamiento del agente está alineado con su propósito previsto, es sólido frente a entradas inesperadas y permanece fiable en un espectro de resultados aceptables.
1. **Pruebas de unidades**: Esta capa se centra en los componentes deterministas no de IA del agente. Implica pruebas de unidad tradicionales para validar que cada herramienta y función individual funciona correctamente de forma aislada, garantizando una base fiable antes de que se aplique el razonamiento complejo del agente.
2. **Pruebas de extremo a extremo (E2E)**: Esta etapa evalúa la capacidad del agente para alcanzar objetivos en escenarios realistas, lo que es crítico dada su naturaleza no determinista. En vez de comprobar un resultado exacto, estas pruebas integrales verifican que el agente completa tareas correctamente y que su desempeño no se degrada a medida que se realizan cambios.
3. **Pruebas adversariales y de robustez**: Esta es la práctica de intentar intencionadamente romper el agente para descubrir de forma proactiva sus debilidades. Los probadores utilizan solicitudes ambiguas, solicitudes maliciosas y otros casos extremos para exponer vulnerabilidades y garantizar que el agente permanece resistente y seguro bajo presión.
4. **Evaluación humana en bucle (HITL)**: Como las pruebas automatizadas no pueden medir cualidades matizadas como el tono o el flujo conversacional, esta etapa se basa en comentarios humanos. Los probadores interactúan con el agente para puntuar sus respuestas para mayor utilidad y experiencia de usuario general, proporcionando datos esenciales para ajustar su comportamiento.
5. **Pruebas de desempeño y escala**: Este es un paso crítico para evitar cuellos de botella de desempeño antes de que afecten a los usuarios. Este proceso simula escenarios de uso máximo realistas para garantizar que los agentes y las aplicaciones puedan gestionar altos volúmenes de forma fluida y predecible. Valida que la solución no solo sea correcta, sino también ampliable.
#### Fase 4: Implementación y versión
La implementación de un agente de IA es un proceso gestionado centrado en garantizar que el agente validado es con el que interactúan los usuarios de forma fiable y repetible. Esto requiere un enfoque estructurado que mueva al agente de un activo controlado por versión a un servicio monitoreado en vivo.
1. **Control de paquetes y versiones**: Toda la definición del agente, incluyendo sus solicitudes y herramientas, se captura como metadatos en un archivo y se almacena en un sistema de control de origen como Git. Esto crea una única fuente de verdad y un historial auditable de todos los cambios.
2. **Oportunidades en curso CI/CD**: La ruta a la producción está automatizada para eliminar errores humanos y garantizar la coherencia. Estas oportunidades en curso promocionan automáticamente al agente a través de entornos de desarrollo, pruebas y producción, ejecutando pruebas de extremo a extremo en cada etapa para actuar como una puerta de calidad.
3. **Estrategias de implantación por fases**: Para minimizar el riesgo, las nuevas versiones de agentes se publican para un pequeño subconjunto de usuarios primero utilizando estrategias como Canary Releases. Esto permite el monitoreo del desempeño real antes de una implementación completa, con la capacidad de revertir rápidamente si se encuentra cualquier problema.
4. **Activación y gobernanza**: El paso crítico en la implementación de un agente implica activar el agente de forma segura con los permisos correctos y garantizar que está conectado a herramientas de monitoreo. Esto proporciona visibilidad inmediata sobre el estado y el desempeño del agente recién implementado desde el momento en que se pone en marcha.
#### Fase 5: Monitoreo y ajuste
La implementación no es el final del ciclo de vida de desarrollo de agentes; es el comienzo de su "bucle externo" continuo. Los agentes son sistemas dinámicos que operan en entornos reales impredecibles. Esta fase está dedicada a observar el desempeño en vivo del agente, recopilar perspectivas de sus interacciones y utilizar esos datos para ajustar y mejorar sistemáticamente su efectividad, seguridad y eficiencia con el tiempo.
1. **Monitoreo de desempeño en tiempo real**: Esta es la práctica de realizar un seguimiento de las mediciones operativas clave del agente cuando interactúa con usuarios. Los tableros se utilizan para monitorear la latencia, el consumo de tokens (costo) y los índices de error de API, proporcionando una vista inmediata de alto nivel del estado y la eficiencia del agente.
2. **Comportamiento y análisis de éxito**: Esto implica el análisis de registros conversacionales para comprender cómo el agente está realizando _actualmente_ sus funciones. Se centra en el seguimiento de los índices de realización de tareas, la identificación de puntos de fallo comunes o callejones sin salida conversacionales y la medición de la satisfacción del usuario para determinar si el agente está alcanzando sus objetivos con éxito. Como ejemplo para agentes de Servicio, podría proporcionar mediciones sobre la frecuencia y el motivo por el que un agente se distribuye a un humano.
3. **Ajuste y refinamiento inteligente**: Este es el proceso activo de utilizar perspectivas de monitoreo para mejorar el agente. Esto puede ir desde la ingeniería de solicitudes a la optimización de herramientas.
4. **Mejora de RAG dirigida por datos**: La calidad de la base de Knowledge del agente se mejora continuamente basándose en consultas del mundo real. El monitoreo puede revelar que el agente tiene problemas con ciertos temas, lo que lleva a un ajuste de los orígenes de datos o el proceso de recuperación (RAG Refinement) para mejorar la precisión de sus respuestas.
5. **Aprendizaje y adaptación continuos**: Esto implica la creación de un bucle de comentarios donde los datos de producción se utilizan para hacer que el agente sea más inteligente. Al etiquetar registros de interacciones (ya sea con supervisión humana o etiquetado basado en LLM), se crea un conjunto de datos depurado, que se puede utilizar para ajustar el modelo subyacente y recomendar mejoras adicionales
## Capítulo 2: Ciclo de vida de desarrollo de agentes _de Agentforce_
Agentforce admite cada fase de ADLC con herramientas integradas para el diseño, el desarrollo, las pruebas, la implementación, el monitoreo y los análisis, todo ello dentro de una única plataforma unificada para crear y probar rápidamente agentes sólidos.
Agentforce ADLC se basa en los siguientes principios rectores:
- **Creado para códigos bajos y procódigo**: Compatibilidad con la implementación basada en configuración (código bajo) y la capacidad de ampliación programática (código pro).
- **Bucles continuos de asistencia y comentarios dirigidos por IA**: Captura y analiza datos conversacionales para informar al agente sobre el ajuste para una mejora continua dirigida por la IA.
- **Desarrollo dirigido por pruebas en todos los niveles**: Pruebas rigurosas en todas las etapas, validando componentes deterministas a través de pruebas de unidades tradicionales y proporcionando nuevos enfoques para probar el razonamiento de agentes y el comportamiento no determinista.
- **Observabilidad ejecutiva y de LOB**: Proporcionando mediciones de costo, uso y desempeño para partes interesadas operativas y ejecutivas.
 Este capítulo muestra cómo Agentforce apoya cada fase del ADLC **en una única plataforma unificada.**
#### Fase 1: Ideación y diseño
##### Ideación
La fase de ideación es la etapa fundamental del ADLC, donde se formulan la visión inicial y los requisitos para los agentes. Implica profundizar en la comprensión del problema, identificar posibles soluciones y describir las funciones principales del agente.
Inicie el proceso de ideación de su agente definiendo sus atributos clave:
1. **Propósito/Objetivo**: Defina claramente el objetivo principal del agente. ¿Qué problema específico está diseñado para resolver, o qué tarea se pretende realizar? ¿A quién debe servir el agente? Esta debe ser una declaración concisa y mensurable que guíe todo el proceso de desarrollo.
2. **Persona**: Desarrolle una persona detallada para el agente. Esto incluye definir su identidad, estilo de comunicación y la función que desempeñará en la interacción con usuarios u otros sistemas. Considere su tono, nivel de formalidad y cualquier característica específica que lo hará efectivo en su contexto previsto.
3. **Patrón**: Identifique y vincule a patrones de agentes relevantes y estrategias de implementación. Esto implica diseños arquitectónicos o mejores prácticas que pueden informar la estructura y el comportamiento del agente. "[Patrones e implementación de agencia en Salesforce Agentforce: Un documento técnico](/docs/architect/es-mx/fundamentals/guide/agentic-patterns)" sirve como un recurso valioso para este paso, ofreciendo perspectivas sobre el diseño de agentes efectivo en Salesforce Platform y Agentforce.
##### Diseño
La fase de diseño traduce los conceptos desde la ideación a un plan detallado para la construcción del agente. Esto implica definir la arquitectura del agente, los flujos de usuario, los modelos de interacción y las especificaciones técnicas como temas, herramientas y salvaguardas.
Durante la fase de diseño, creará un plan detallado para la construcción de su agente que incluye:
- **Diseño de agentes**: Describa la estructura interna del agente, incluyendo sus componentes, módulos y cómo interactúan. Esto podría implicar definir la base de Knowledge, la configuración y la lógica para controlar el comportamiento de los agentes, los componentes de procesamiento de lenguaje natural (NLP) y los puntos de integración con otros sistemas.
- **Flujos de usuario/Diseño de interacciones**: Asigne la trayectoria de usuario completa y las interacciones del agente. Defina flujos de plática, árboles de decisiones, gestión de errores y mecanismos de comentarios para crear experiencias intuitivas y efectivas.
- **Especificaciones técnicas**: Documente los requisitos técnicos no funcionales para el agente, como mediciones de desempeño, consideraciones de escalabilidad, protocolos de seguridad y especificaciones de integración.
- **Prototipado y maquetas**: Cree representaciones visuales o prototipos interactivos de la interfaz y las interacciones del agente. Esto permite pruebas tempranas y comentarios, ayudando a refinar el diseño antes de que comience el desarrollo a gran escala.
- **Datos**: Cuando determine el tipo y los orígenes de datos que requiere un agente, identifique conjuntos de datos, API, bases de datos y repositorios a los que debe acceder el agente. Para Agentforce, céntrese en qué datos se proporcionan como contexto, si están estructurados o no y si son en tiempo real o por lotes. La plataforma Agentforce está construida con una integración profunda con Data 360, lo que le permite utilizar datos estructurados y no estructurados desde Salesforce CRM y otros orígenes. El contenido no estructurado se puede segmentar e indexar de forma nativa para RAG. MuleSoft le permite conectarse a sistemas externos.
- **Herramientas**: Identifique las acciones que el agente debe realizar. Utilice Acciones Agentforce para exponer herramientas que alcanzan objetivos de negocio. Estas acciones aprovechan activos de Salesforce existentes como Solicitudes a través del Generador de solicitudes, MuleSoft, Apex, Flujos y API con especificaciones de OpenAPI. Cualquier acción invocable se puede integrar en Agentforce y utilizar por el agente, haciendo que todas las herramientas de desarrollo de Salesforce familiares estén disponibles como Acciones Agentforce.
- **Datos de entrada para agentes**: En SDLC tradicional, las entradas se especifican con precisión. En el ADLC, las entradas son a menudo expresiones naturales, no deterministas y de forma libre. Recopile un corpus representativo de expresiones que se espera que produzcan respuestas apropiadas.
#### Fase 2: Desarrollo
La fase de desarrollo se centra en traducir el propósito, las funciones y el ámbito operativo del agente definidos determinados en la fase Ideación y diseño en un nuevo agente Agentforce.
Para ayudar a los desarrolladores a crear agentes, Agentforce proporciona **Agent Builder** y **Agentforce Developer Experience (AFDX).** Estas herramientas fundamentales sirven como los entornos principales para construir y configurar el agente.
- **Agent Builder** proporciona una experiencia de interfaz de usuario para definir las funciones principales del agente.
- **AFDX** proporciona una interfaz programática para la personalización e integración con otros sistemas.
El desarrollo y la creación de un agente implica estos pasos que se pueden realizar utilizando Agent Builder o AFDX:
1. **Definición de la persona**: Un aspecto crucial del diseño de agentes es establecer una persona distinta. Esto implica la configuración de:
- **Descripción de agente**: Una descripción detallada de la función del agente, los objetivos y las tareas de servicio al cliente específicas para las que está diseñado.
- **Tono**: El estilo de comunicación del agente, el nivel de empatía y cualquier directriz de marca específica que necesita cumplir.
2. **Definición de temas y acciones de agentes**: Para hacer que un agente sea sofisticado y capaz de gestionar una amplia gama de tareas, es esencial desglosar sus funciones en distintos temas con las acciones correspondientes.
- **Temas**: Cada tema puede conceptualizarse como su propio agente especializado con un conjunto exclusivo de instrucciones y herramientas.
- **Arquitectura modular.** El enfoque modular de los temas permite una mayor organización y capacidad de ampliación. Al definir múltiples temas, el agente puede gestionar una gama más amplia de escenarios complejos. Por ejemplo, un agente podría tener temas separados para "Gestión de pedidos", "Preguntas más frecuentes", "Asistencia técnica" y "Consultas de facturación".
- **Instrucciones de tema (barandillas)**: Cada tema incluye instrucciones específicas que actúan como salvaguardas, definiendo el ámbito de lo que el agente puede debatir o hacer dentro de ese tema. Estas instrucciones evitan que el agente se desvíe del tema o proporcione información irrelevante. También ayudan a mantener la coherencia y la precisión en las respuestas.
- **Acciones**: Los temas también están equipados con "herramientas", que representan las acciones que el agente puede realizar. Estas herramientas pueden ser:
- **Acciones informativas**: Recuperación de datos desde una base Knowledge o un sistema externo para responder a una consulta.
- **Acciones transaccionales**: Realizar acciones en nombre del usuario, como realizar un pedido, actualizar un registro de cliente o iniciar un proceso de reembolso. Estas acciones a menudo se integran con otros sistemas (por ejemplo, CRM, ERP).
#### Fase 3: Pruebas y validación
Al evaluar el desempeño y la fiabilidad de los agentes de IA, los probadores a menudo se encuentran con una serie de retos que pueden degradar la experiencia del usuario. Estos problemas van desde una mala interpretación de la intención del usuario hasta el fallo en la ejecución de tareas correctamente.
##### Escenarios de fallo de agentes comunes
Crear un agente sólido requiere comprender cómo y dónde puede fallar. La siguiente tabla categoriza los problemas comunes encontrados durante el ciclo de vida de los agentes, desde un razonamiento defectuoso hasta una mala recuperación Knowledge. Utilice esto como una guía estratégica durante el desarrollo y una lista de comprobación durante las pruebas para garantizar que su agente no solo es funcional, sino también confiable e intuitivo para el usuario final. Estos escenarios de fallo deben ayudarle a definir casos de prueba.
| Categoría | Descripción | Ejemplos de fallos |
|---|---|---|
| Clasificación de temas | El agente no identifica correctamente la intención o el objetivo del usuario. |
|
| Calidad de respuesta | Fallos en el contenido, la precisión y el formato de las respuestas del agente. |
|
| Ejecución de acciones | El agente falla al intentar realizar una función o tarea específica. |
|
| Barandillas e instrucciones | El agente infringe reglas, restricciones o límites conversacionales predefinidos. |
|
| Recuperación de Knowledge | El agente tiene problemas para obtener y presentar información desde su base Knowledge. |
|
| Directrices estructuradas | El agente tiene dificultades para guiar a los usuarios por procesos de múltiples pasos. |
|
| Objeto de lago de datos/Objeto de modelo de datos | Descripción |
|---|---|
| AIAgentSession | Un contenedor global que captura interacciones contiguas con uno o más agentes de IA. |
| AIAgentSessionParticipant | Entidad (humana o de IA) que participa en una AIAgentSession. |
| AIAgentInteraction | Un segmento dentro de una sesión. Normalmente comienza con la solicitud de un usuario y finaliza cuando el agente de IA proporciona una respuesta a esa solicitud. |
| AIAgentInteractionStep | Una acción u operación discreta realizada durante una interacción para satisfacer la solicitud del usuario. |
| AIAgentInteractionMessage | Comunicación única proporcionada por el usuario o generada por el agente de IA durante una sesión. |
 ##### Análisis de expresiones
Análisis de expresiones muestra cómo los usuarios Agentforce (Predeterminado) están utilizando agentes, qué están solicitando y si el agente pudo gestionar estas solicitudes. Estos reportes personalizables pueden ayudarle a restringir sus temas y acciones de modo que sus agentes respondan de forma más efectiva y precisa.
 ##### SDK de Python Agentforce: Monitoreo con integraciones de Data 360
La implementación del SDK de agente utiliza análisis y monitoreo avanzados con Conector Python de Data 360, estableciendo la conexión con Salesforce Data 360, consultando mediciones de desempeño de agentes y creando tableros de monitoreo integrales.
El sistema realiza un seguimiento de los tiempos de respuesta, los índices de éxito, la satisfacción del usuario y las mediciones de costos para proporcionar perspectivas sobre las que se pueden realizar acciones para la optimización de agentes.
```py
# Data 360 Python Connector Integration
from salesforce_cdp_connector import SalesforceCDPConnector
# Initialize Data 360 Connector
cdp_connector = SalesforceCDPConnector(
client_id='your_client_id',
client_secret='your_client_secret',
username='your_username@example.com',
password='your_password'
)
# Query agent performance data
performance_data = cdp_connector.query("""
SELECT timestamp, response_time_ms, success_rate, user_satisfaction
FROM AgentPerformanceMetrics
WHERE agent_id = 'Coral_Cloud_Resorts_Resort_Manager'
""")
# Create monitoring dashboard
def create_monitoring_dashboard(performance_data):
fig = go.Figure()
fig.add_trace(go.Scatter(
x=performance_data['timestamp'],
y=performance_data['response_time_ms'],
mode='lines+markers'
))
return fig
```
##### Agentforce DX: Monitoreo de agentes
La implementación utiliza comandos de AFDX estándar con gestión de agentes basada en CLI, manteniendo al agente al día con los cambios de plataforma e incorporando comentarios de usuarios para una mejora continua.
```zsh
# List all agents and their status
sf agent list --target-org "production-org"
# Get detailed agent information
sf agent get \
--api-name "Resort_Manager" --target-org "production-org"
# Activate agent if needed
sf agent activate --api-name "Resort_Manager" --target-org "production-org"
# Query agent performance data
sf data query \
--query "SELECT Id, Name, Status, LastModifiedDate FROM BotDefinition WHERE DeveloperName = 'Resort_Manager'" \
--target-org "production-org"
```
```python
# AgentforceDX Dashboard Creation (Similar to Agent SDK)
import pandas as pd
import plotly.graph_objects as go
from salesforce_cdp_connector import SalesforceCDPConnector
# Initialize Data 360 Connector for AgentforceDX
cdp_connector = SalesforceCDPConnector(
client_id='your_client_id',
client_secret='your_client_secret',
username='your_username@example.com',
password='your_password'
)
# Query agent performance data from Data 360
performance_data = cdp_connector.query("""
SELECT timestamp, agent_id, response_time_ms, success_rate, user_satisfaction
FROM AgentPerformanceMetrics
WHERE agent_id = 'Resort_Manager'
AND timestamp >= CURRENT_DATE - 30
ORDER BY timestamp DESC
""")
```
Consulte el repositorio de GitHub [aquí](https://github.com/akshatasawant9699/ADLC_Whitepaper) para la implementación de ADLC utilizando Agent SDK y AFDX.
## Mejores prácticas
Dominar el ciclo de vida de desarrollo de agentes requiere adherirse a un conjunto de principios principales que garantizan la eficiencia, la fiabilidad y la alineación estratégica. Las siguientes directrices sintetizan las lecciones clave de cada fase del ADLC en un marco estratégico para arquitectos y desarrolladores.
**1\. Planificación e ideación**
Esta fase inicial se centra en alinear el propósito del agente con los objetivos de negocio y garantizar que se construye sobre una base sólida.
- **Priorizar para repercusión de negocio**: Comience asignando casos de uso potenciales directamente a objetivos de negocio estratégicos. Utilice una matriz de priorización para puntuar su posible repercusión y comenzar con un caso de uso único y centrado con KPI claros.
- **Implicar a las partes interesadas pronto**: Recopile perspectivas sobre puntos débiles y garantice la alineación.
- **Aprovechar perspectivas de datos**: Un agente solo es tan bueno como sus datos. Utilice Data 360 para explorar datos estructurados y no estructurados disponibles para informar el contexto y las funciones del agente. Revise tableros y reportes existentes para identificar tendencias actuales que pueden informar su selección de casos de uso.
- **Utilizar marcos de trabajo para Ideación**: Aplique métodos de ideación estructurados para realizar una lluvia de ideas y refinar posibles aplicaciones, como pensamiento de diseño o análisis DAFO.
**2\. Agentes** de construcción
Esta fase cubre las mejores prácticas para construir un agente de alto desempeño y eficiente.
- **Evitar demasiados temas**: Limite el número de temas para reducir el riesgo de crear temas similares o solapados que podrían confundir al agente.
- **Mantener instrucciones y solicitudes concisas**: Utilice un lenguaje directo y sencillo y proporcione expresiones de ejemplo para guiar al agente de forma efectiva.
- **Variables de apalancamiento y acciones deterministas**: Utilice estas herramientas para guiar el comportamiento del agente y optimizar su desempeño para resultados más predecibles.
- **Mantener los resultados de acciones pequeños y concisos**: Asegúrese de que las respuestas del agente son breves y precisas. Las salidas más largas utilizan más contexto y su generación es más lenta.
- **Optimizar acciones para la velocidad**: Diseñe flujos y clases Apex para devolver datos mínimos requeridos. Procure tener menos acciones necesarias para generar una respuesta mediante el procesamiento previo donde sea posible.
- **Definir un ámbito claro**: Redacte descripciones, instrucciones y ámbito apropiados para acciones para evitar que el agente llame a RAG (Generación de recuperación aumentada) para preguntas fuera del ámbito.
- **Utilizar búsqueda híbrida con moderación**: Solo utilice la búsqueda híbrida si es absolutamente necesario, ya que puede afectar negativamente a la latencia.
**3\. Pruebas, monitoreo y ajuste**
Esta fase iterativa es crucial para refinar la precisión y el desempeño del agente.
- **Establecer un flujo de pruebas**: Siga un ciclo de pruebas coherente:
1. **Ejecutar prueba por lotes**: Ejecute un conjunto completo de pruebas.
2. **Ver puntuajes/errores**: Analice las mediciones de desempeño e identifique fallos.
3. **Inspeccionar fallos**: Examine cada fila de fallo para comprender la discrepancia.
4. **Actualizar agente**: Realice los ajustes necesarios en el agente o sus datos de evaluación.
- **Revisar información de rastreo de sesiones**: Utilice el Modelo de datos de rastreo de sesiones y Agentforce Interaction Explorer para realizar análisis de causa raíz cuando se identifican problemas o comportamientos inesperados. Ajuste su agente basándose en la información y continúe iterando su agente.
## Conclusión
El _Ciclo de vida_ de los agentes representa una evolución crítica de los principios de desarrollo de software tradicionales, diseñados para la era de los sistemas inteligentes y autónomos.
- **Evolución, no sustitución**: Ciclo de vida de desarrollo de agentes amplía y mejora la Gestión del ciclo de vida de aplicaciones tradicional sin sustituirla.
- **Datos como ciudadano de primera clase**: Los datos desempeñan un papel mucho más dinámico y central en el desarrollo de agentes.
- **Herramientas y habilidades especializadas**: Requiere nuevas herramientas y un conjunto más amplio de habilidades especializadas en ciencia de datos, ingeniería de ML y desarrollo de agentes.
- **Aprendizaje continuo**: El desarrollo de agentes agrega _aprendizaje_ continuo y _adaptación_ del sistema en sí.
- **Repercusión futura**: La IA agente promete automatizar y optimizar aún más operaciones de TI complejas y flujos de trabajo de desarrollo de software.
## Introducción
Salesforce Customer 360 Platform proporciona una potente [arquitectura dirigida por](/docs/architect/es-mx/fundamentals/guide/platform-multitenant-architecture) metadatos para cada instancia de arrendatario de Salesforce individual (también conocida como “organización”). Este documento de fundamentos de arquitectura proporciona una descripción general de áreas donde la arquitectura subyacente de Salesforce Platform crea una consideración clave para las arquitecturas de soluciones construidas en la plataforma.
Existen tres áreas esenciales a comprender al diseñar arquitecturas en Salesforce Platform:
- [Transacciones](/docs/architect/es-mx/fundamentals/guide/architecture-basics#transacciones)
- [Metadata Versus Data](/docs/architect/es-mx/fundamentals/guide/architecture-basics#metadatos-frente-a-datos)
- [API de plataforma](/docs/architect/es-mx/fundamentals/guide/architecture-basics#api-de-plataforma)
## Transacciones
En Salesforce Platform, una transacción puede instanciarse mediante la ejecución de código y/o una operación de base de datos. Una competencia fundamental para la arquitectura en Salesforce es comprender cómo la plataforma define y controla transacciones para arrendatarios. Para mantener los recursos para todos los arrendatarios, Salesforce impone límites a cada arrendatario, calculados por transacción y por organización.
A nivel de transacciones, Salesforce establece [límites reguladores y](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_gov_limits.htm) de ejecución para garantizar que las instancias individuales de ejecución de código y transacciones de base de datos no monopolicen recursos de computación compartidos. A nivel de toda la organización, Salesforce establece límites basados en [edición y tipo](https://help.salesforce.com/s/articleView?id=sf.overview_limits_general.htm&type=5) de función. Los límites de toda la organización también incluyen un cálculo continuo del uso de API entre todas las transacciones en la organización, que están sujetas a [límites de API](https://developer.salesforce.com/docs/atlas.en-us.salesforce_app_limits_cheatsheet.meta/salesforce_app_limits_cheatsheet/salesforce_app_limits_platform_api.htm).
Echemos un vistazo con más detalle a dos partes clave de las transacciones en Salesforce Platform: el contexto de ejecución y la manipulación de la base de datos.
### Contexto de ejecución
Salesforce calcula los límites de transacciones basándose en un concepto de [contexto de ejecución](https://trailhead.salesforce.com/content/learn/modules/apex_basics_dotnet/execution_context). Es importante comprender que para aplicaciones de Salesforce, esto no es exclusivo de ejecuciones de código personalizado en una única organización de Salesforce. El contexto de ejecución se basa en el motor de tiempo de ejecución de plataforma y todo el código disponible para el motor de tiempo de ejecución para un arrendatario concreto. Esto significa que el código personalizado definido en la organización de un arrendatario, el código de paquetes instalados con esa organización, así como el código contenido en los servicios de la plataforma Salesforce pueden crear instancias de una transacción. La plataforma distingue entre diferentes tipos de código Apex y calcula límites reguladores basándose en esas distinciones.
Consulte la guía del desarrollador de Apex para obtener más información sobre los [límites de transacciones Apex](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_gov_limits.htm).
### Manipulación de base de datos
Cuando una transacción implica manipulación de la base de datos, un [orden de ejecución](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_triggers_order_of_execution.htm) integrado prescribe cómo se comportarán las diferentes partes de la configuración y el código de su organización. Una clave para comprender cómo utilizar correctamente el orden de ejecución en sus aplicaciones de Salesforce es comprender la integridad de datos sólida que proporciona este comportamiento para sus aplicaciones de Salesforce.
| Comportamiento | Data | Metadata |
|---|---|---|
| Copiado desde producción en entornos sandbox | No* | Sí |
| API de migración por metadatos | No | Sí** |
| Migrar por carga de datos | Sí | No |
| Se puede incluir en paquetes | No | Sí** |
| Cuenta en límites de almacenamiento de datos | Sí | No |
| *Los entornos sandbox de copia completa y copia parcial permiten la replicación de datos desde producción. **Algunos tipos de metadatos no están disponibles para su uso con la API de metadatos y/o paquetes. Puede encontrar excepciones en el Reporte de cobertura de metadatos. |
||
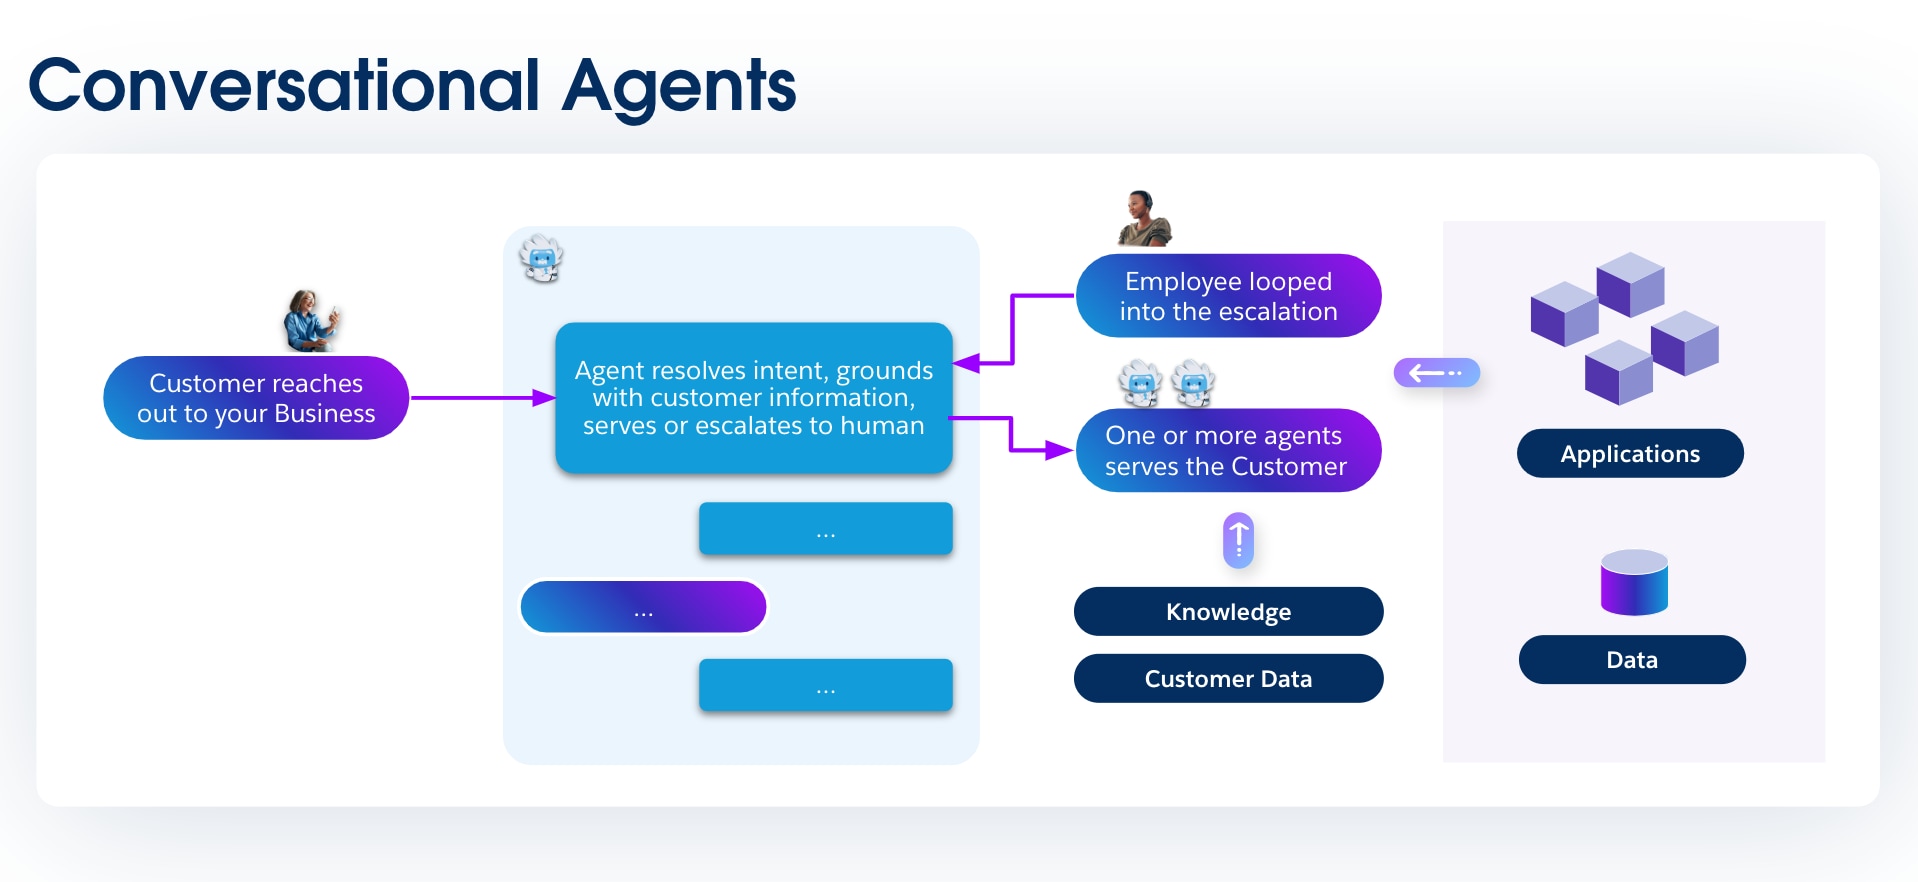 ### 1.2 Agentes proactivos
**Definición:** A diferencia de los agentes conversacionales que esperan una solicitud, los agentes proactivos actúan como observadores vigilantes. Se desencadenan por eventos específicos, cambios de datos o condiciones predefinidas en un sistema. Cuando se desencadenan, ejecutan una tarea o inician un flujo de trabajo sin requerir la interacción directa del usuario.
**Importancia:** Los agentes proactivos transforman un sistema de un repositorio pasivo de datos en un participante activo en procesos de negocio. Identifican oportunidades y riesgos a medida que emergen, permitiendo a los negocios actuar sobre señales críticas en tiempo real.
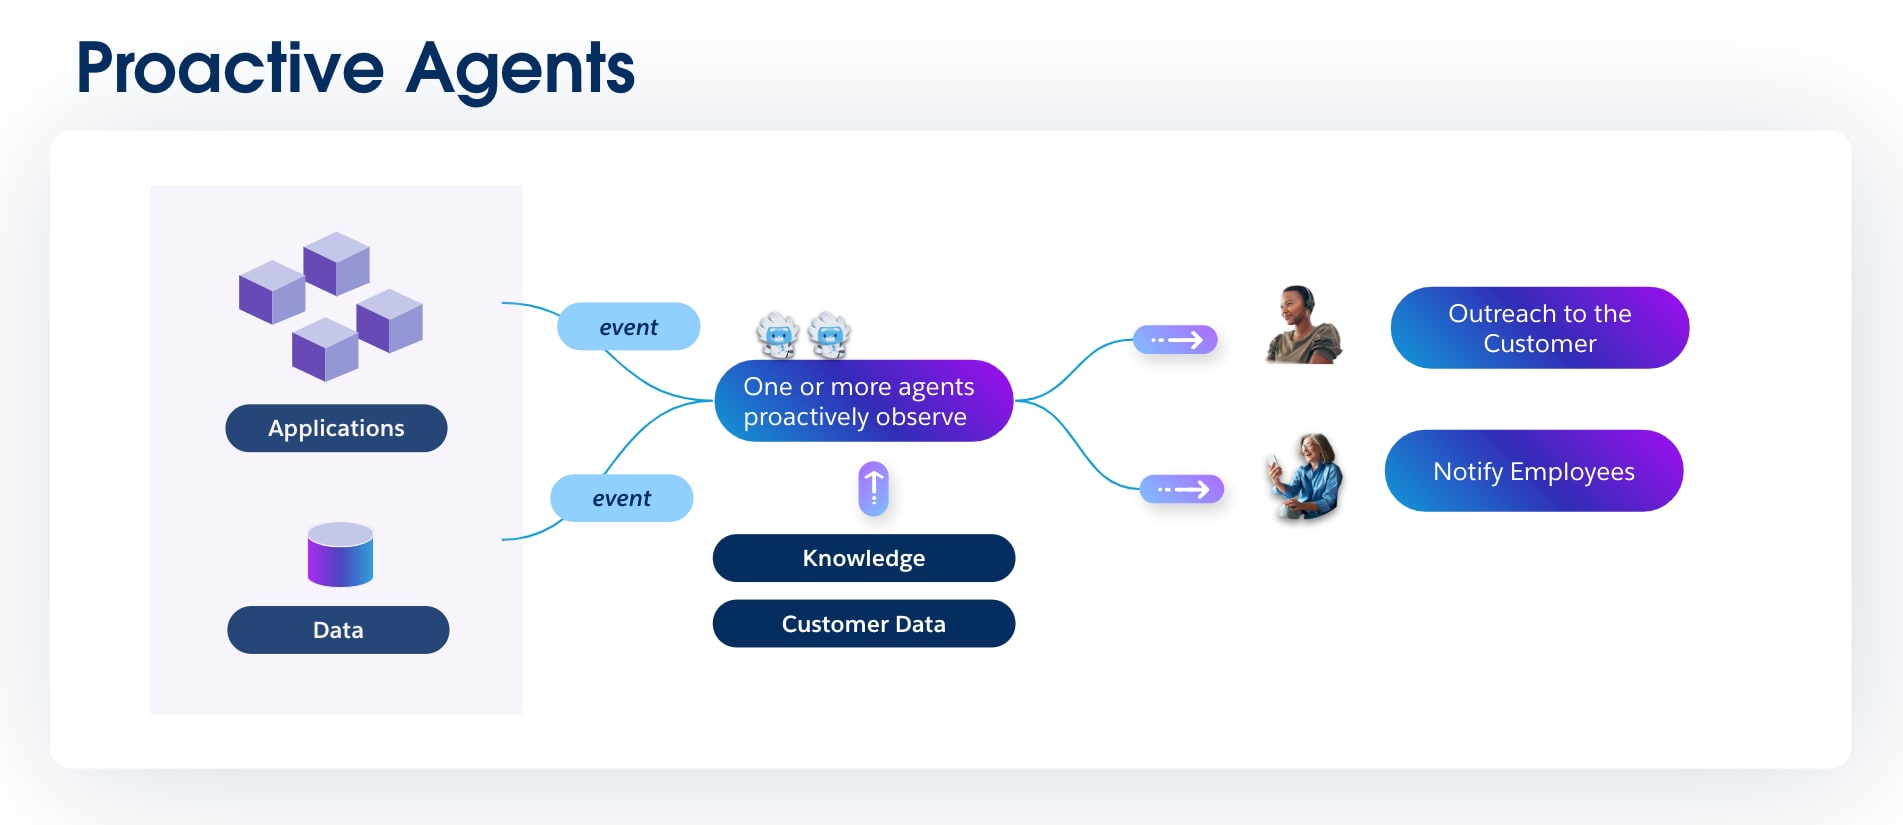 ### 1.3 Agentes ambientales
**Definición:** Los agentes ambientales son un tipo específico de agentes proactivos que operan continuamente en segundo plano del flujo de trabajo de un usuario sin requerir comandos explícitos. Los usuarios a menudo se benefician de sus acciones sin ser conscientes de su funcionamiento, porque están diseñados para aumentar las capacidades humanas mientras mantienen un perfil bajo.
**Importancia:** El objetivo de un agente ambiental es reducir la carga cognitiva sobre los usuarios automatizando el mundano "trabajo sobre trabajo". Hacen que los procesos sean más eficientes integrándose a la perfección en las herramientas que los empleados utilizan a diario, capturando y estructurando información automáticamente.
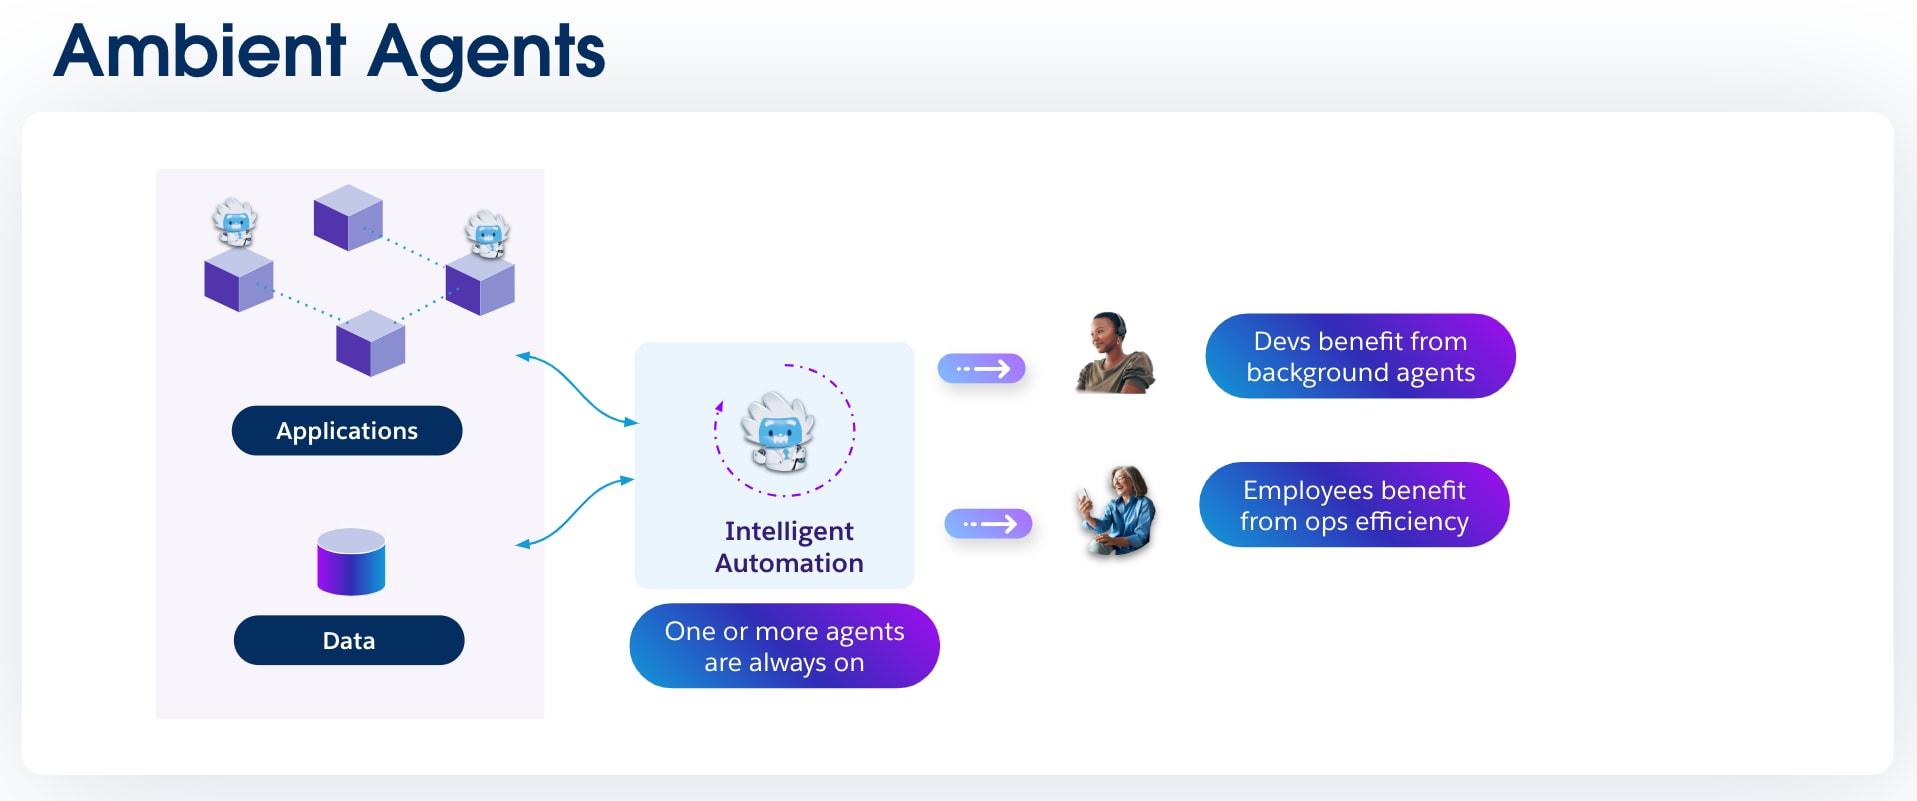 ### 1.4 Agentes autónomos
**Definición:** Los agentes autónomos representan un salto significativo en la complejidad. Se les asigna un objetivo de alto nivel y son capaces de planificar y ejecutar de forma independiente una secuencia de pasos para alcanzar ese objetivo. Pueden razonar, tomar decisiones e incluso aprender de sus acciones para mejorar el desempeño con el tiempo.
**Importancia:** Esto es lo más cerca que estamos de un verdadero empleado digital. Se puede delegar en los agentes autónomos un objetivo complejo de varios pasos, como "Generar 50 nuevos prospectos cualificados en el sector manufacturero este trimestre", y se puede confiar en formular y ejecutar un plan para alcanzarlo.
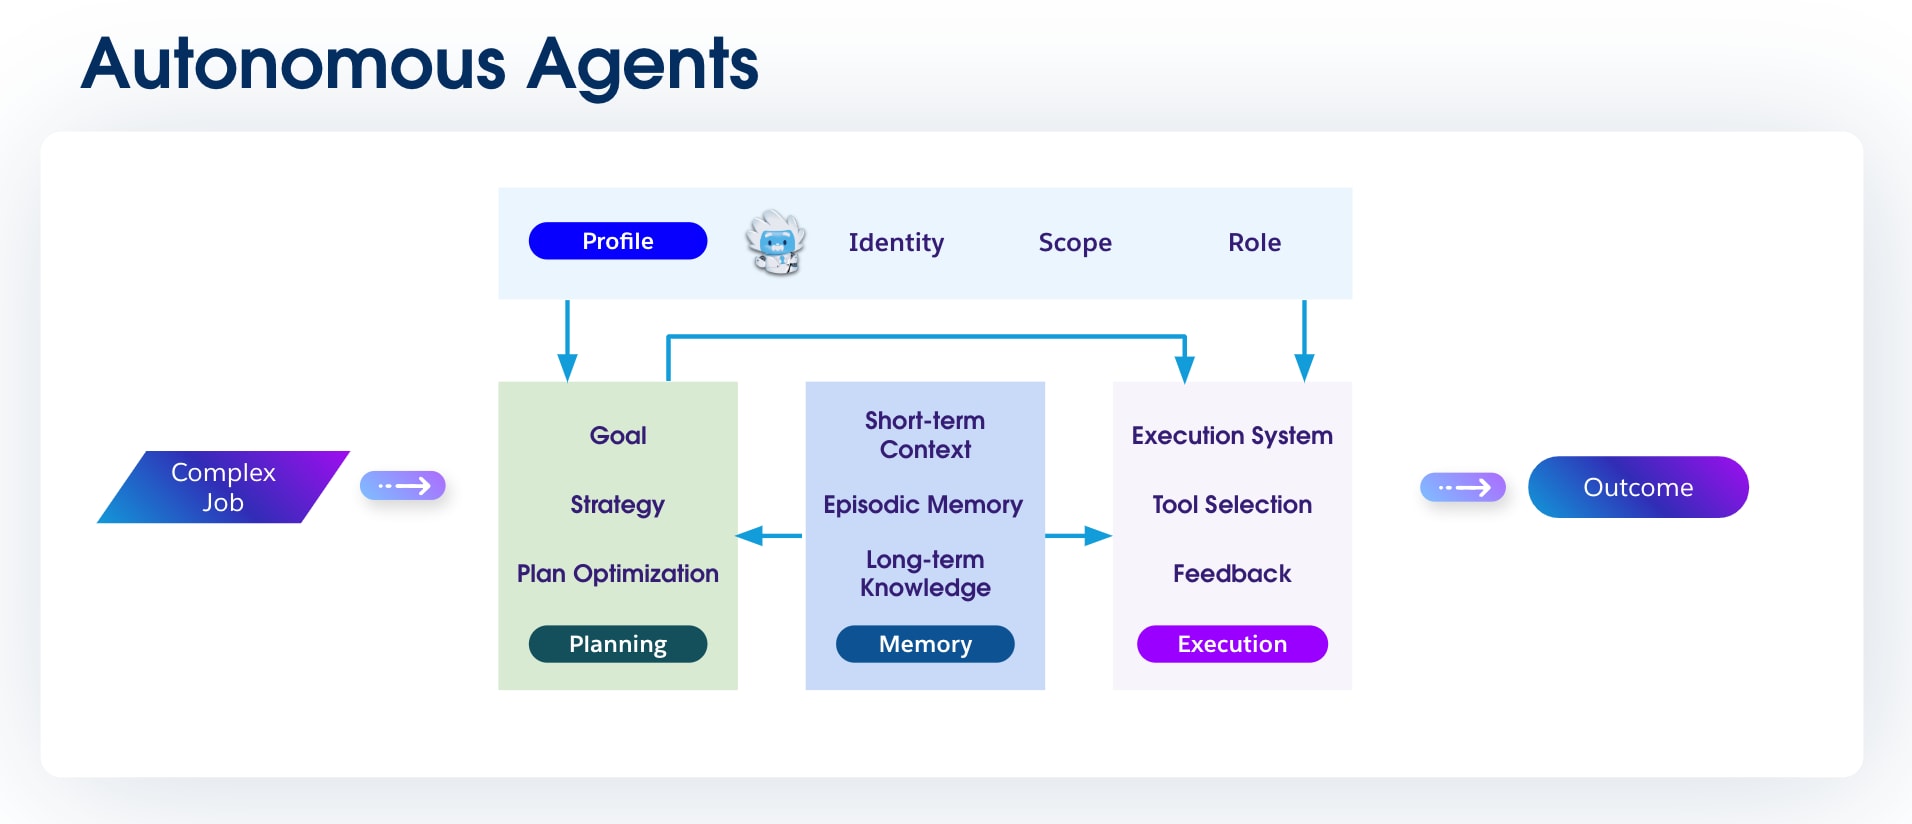 ### 1.5 Agentes de colaboración (enjambres de agentes)
**Definición:** Los agentes de colaboración, a menudo denominados "enjambres de agentes", son un conjunto de agentes especializados que trabajan juntos para resolver un problema que es demasiado complejo para que lo gestione un único agente. Un "orquestador" o agente "principal" a menudo descompone una tarea grande, delega subtareas a los agentes especializados apropiados y luego sintetiza sus resultados. Un protocolo de comunicación Agent2Agent (A2A) robusto lo logra.
**Importancia:** Este enfoque refleja un equipo humano. Al desglosar un problema complejo, cada agente especializado puede aportar sus habilidades exclusivas: uno se especializa en análisis de datos, otro en comunicación con el cliente y un tercero en integración del sistema, lo que lleva a una solución más sólida y completa.
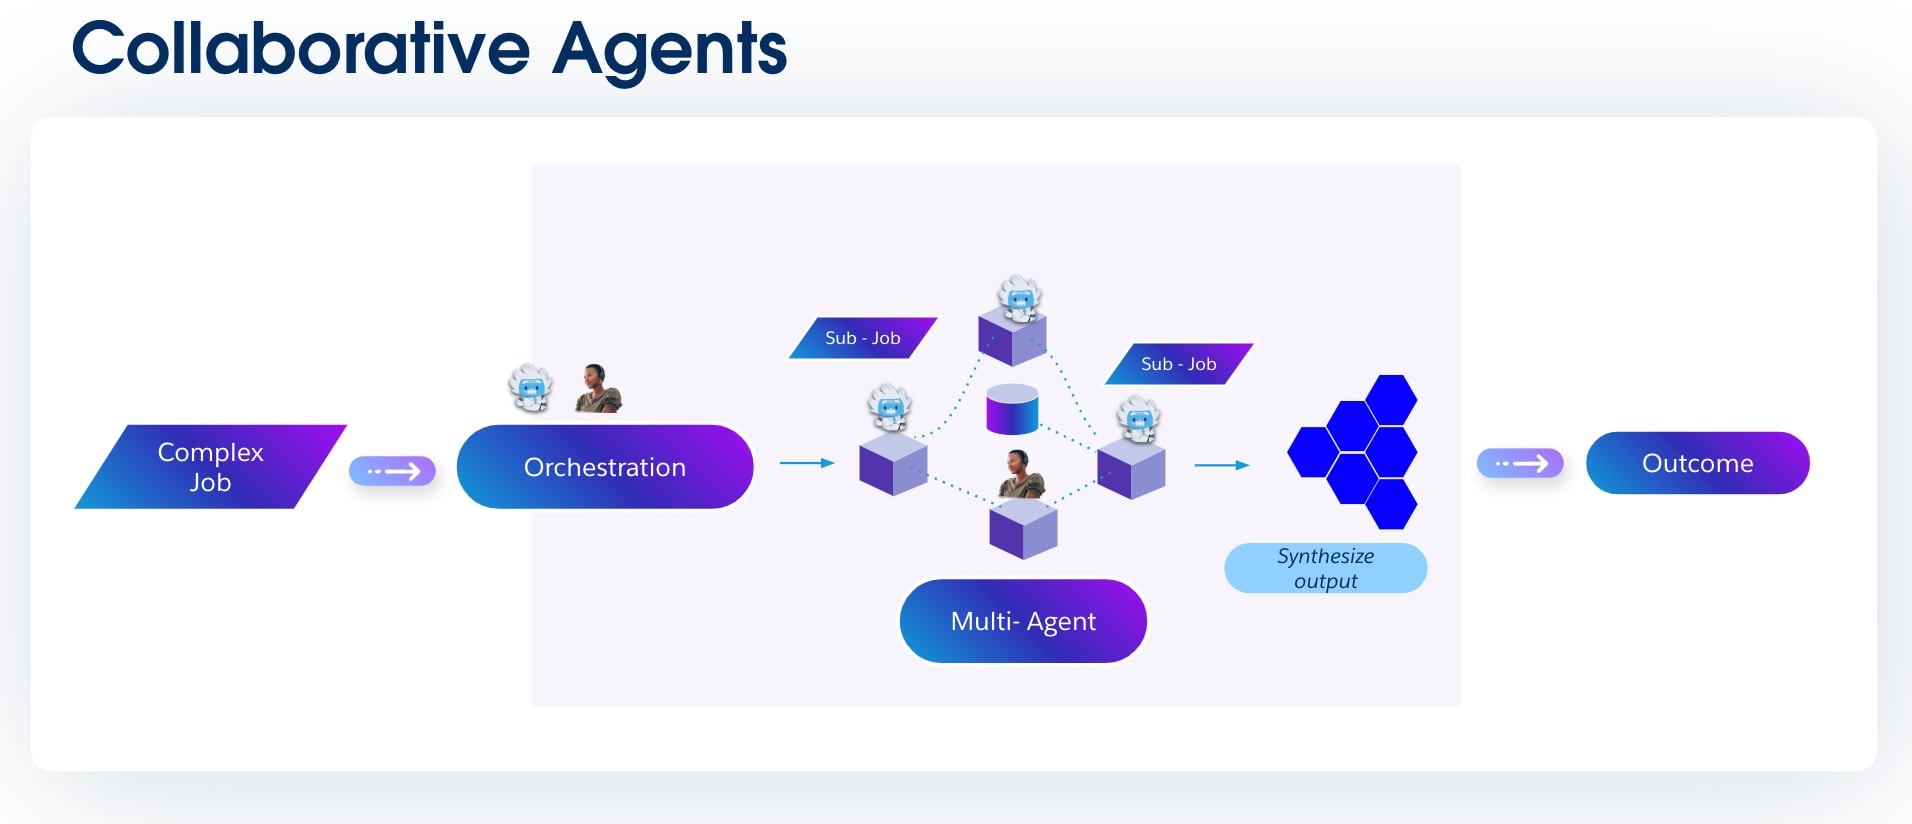 ## Capítulo 2: Patrones de arquitectura Agentforce
Tras explorar la taxonomía de los agentes de IA, queda una pregunta crucial: ¿cómo combinamos estos elementos para resolver problemas de negocio reales de forma eficiente y fiable? Este capítulo responde a esa pregunta proporcionando un repositorio de patrones de diseño de agentes comunes. Cada patrón es una solución probada para un reto recurrente, ofreciendo un plan para todo, desde agentes sencillos y de un solo propósito hasta enjambres de agentes complejos y colaborativos.
### 2.1 Patrones de agentes conversacionales
Los agentes conversacionales son a menudo la puerta de entrada a las funciones de IA de una organización. Se definen por su capacidad de participar en un diálogo de múltiples turnos con estado, actuando como la interfaz principal a través de la cual los usuarios realizan tareas y recuperan información utilizando lenguaje natural. Esta sección presenta dos recetas esenciales para la creación de agentes conversacionales, cada una adaptada a un canal específico: una para los intercambios rápidos e interactivos de clientes de mensajería y otra para la naturaleza estructurada y asíncrona del email.
La inteligencia de un agente conversacional se deriva de su capacidad de acceder y razonar sobre los datos correctos en el momento correcto. Este patrón se basa en una base de datos sofisticada que conecta con registros de clientes, artículos Knowledge y análisis de negocio. Las recetas completas y reutilizables para estas integraciones están disponibles en el [Capítulo 4: Patrones de integración](#capítulo-4-patrones-de-integración-para-agentes).
#### 2.1.a Agente conversacional: Patrón de cliente de mensajería interactiva
**Problema**
Los clientes se implican en muchos canales digitales y esperan **respuestas instantáneas, contextuales e inteligentes.** Los chatbots tradicionales tienen **secuencias de comandos** o **datos ciegos,** lo que lleva a una personalización deficiente, distribuciones tempranas en humanos y altos costos de servicio.
**Context**
- Su organización tiene implicación digital de múltiples canales (WhatsApp, SMS, Slack y Salesforce Experience Cloud).
- Los clientes de su organización interactúan con su organización en [varios idiomas](https://help.salesforce.com/s/articleView?id=ai.service_agent_considerations.htm&type=5).
- Su organización necesita aumentar los flujos de trabajo de servicio y ventas con agentes que:
- Extraer datos de clientes de confianza en tiempo real
- Respetar barandillas y requisitos de cumplimiento
- Distribuir a agentes humanos solo cuando sea necesario
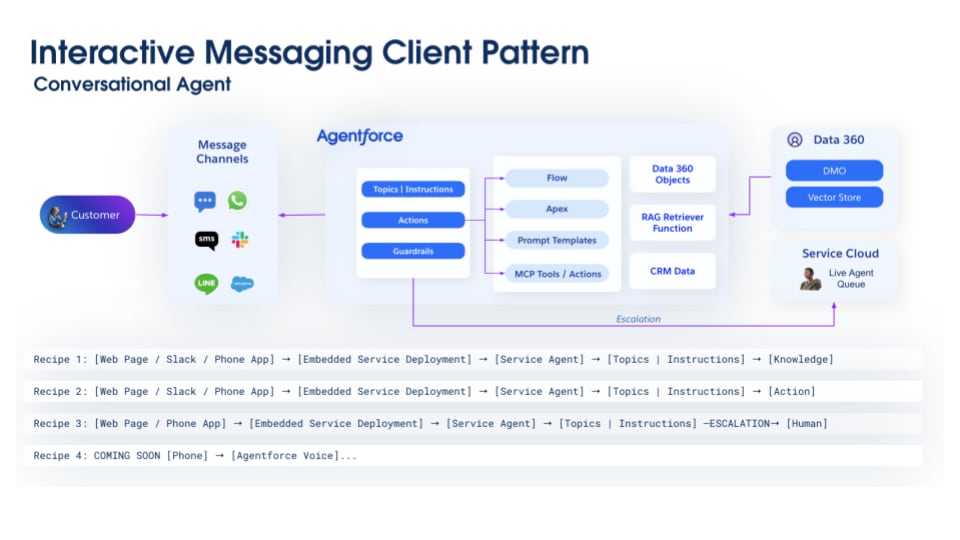 **Componentes clave**
- **Abstracción de canal:** Chat mejorado de Service Cloud (anteriormente Mensajería para web y en aplicación) permite al agente comunicarse entre múltiples canales a través de una única experiencia.
- **Agente de servicio Agentforce:** El comportamiento y el propósito del agente se definen por los siguientes componentes.
- **Temas e instrucciones:** Define la persona del agente y el propósito conversacional para la interacción directa con el usuario. Esto incluye su misión principal (por ejemplo, "Es un experto en la solución de problemas de asistencia al cliente"), instrucciones sobre el mantenimiento de un tono profesional y empático y barandillas claras sobre el ámbito de consultas que está autorizado a gestionar.
- **Acciones:** Acciones orientadas al servicio que son herramientas que el agente utiliza para diagnosticar y resolver problemas de clientes en tiempo real. Estas herramientas están diseñadas para ejecutar tareas como comprobar el estado de un pedido, buscar soluciones en una base de Knowledge o crear un nuevo caso de asistencia directamente desde la interfaz conversacional.
- **Barandillas:** Las barandillas actúan como un conjunto de reglas configurables y comprobaciones de tiempo de ejecución que restringen el comportamiento del agente. Actúa como una capa de seguridad que puede interceptar solicitudes, validar las acciones propuestas del agente y filtrar su respuesta final para evitar contenido dañino, aplicar reglas de negocio y garantizar que el agente opera dentro de su ámbito designado.
- **Plantillas de solicitudes:** Plantillas reutilizables que se rellenan dinámicamente con datos de CRM en vivo a través de campos de combinación o datos semánticos desde Recuperadores de RAG de Data 360. Estas plantillas permiten a los agentes generar contenido contextual dentro de la marca mientras que Einstein Trust Layer enmascara de forma segura información confidencial antes de que se envíen las instrucciones al LLM.
- **Data 360**
- Los componentes de Data 360, incluyendo DLO, DMO, almacenamiento vectorial y recuperadores de RAG, proporcionan al agente una vista unificada de todos los datos de compañía relevantes, desde registros de clientes estructurados a artículos Knowledge no estructurados, garantizando que las respuestas sean precisas y fundamentadas en contexto.
- **Service Cloud**
- **Datos CRM:** Conecta el agente con el historial de casos completo, proporcionando contexto crucial en detalles de cuenta, registros de contacto y asignaciones
- **Cola de Live Agent:** Compatibilidad para distribución y enrutamiento a un representante de servicio humano con el contexto de plática completo inyectado
**Interacciones**
1. El cliente de su organización inicia la plática a través de un canal.
2. El mensaje enruta a **Agentforce,** que determina el ámbito (temas) y aplica barandillas.
3. La IA redacta respuestas utilizando **plantillas de solicitud** mientras que Flujo o Apex pueden desencadenar lógica backend.
4. El contexto se recupera de **objetos Data 360, establecimiento vectorial y CRM** a través de RAG retriever.
5. La IA devuelve una respuesta contextual.
6. Si la IA no puede resolverse, la plática se distribuye al **Service Cloud Live Agent.**
**Trade-offs**
| Aspecto | Ganancia | Costo |
|---|---|---|
| Velocidad de respuesta | Respuestas instantáneas siempre activadas | Latencia de más de 2 segundos para consultas complejas |
| Precisión | Fundamentado en datos reales a través de RAG | Requiere almacenamiento de vectores actualizado y depurado |
| Escalabilidad | Pláticas simultáneas casi infinitas | Los costos deben optimizarse a través del almacenamiento en caché, cualificación y filtrado |
| Flexibilidad | Gestiona consultas abiertas | Requiere ingeniería de solicitudes sofisticada |
| Toque humano | Los representantes de servicio humano solo tratan casos complejos | Frustración del cliente si los umbrales de distribución son erróneos |
| Diversidad de pláticas | Gran número de intenciones que requiere diferentes Knowledge, habilidades y herramientas | Requiere ajuste continuo de temas e instrucciones para optimizar la precisión y la latencia |
 **Componentes clave**
- **Canal de email:** Gestiona la captura de mensajes entrantes, el análisis de su contenido y archivos adjuntos y el mantenimiento de la continuidad de hilos para permitir pláticas asíncronas.
- **Agente de DEG Agentforce:** El comportamiento y el propósito del agente se definen por los siguientes componentes.
- **Temas e instrucciones:** Define la misión del agente para implicar y cualificar prospectos entrantes a través de la plática. Esto incluye instrucciones para comprender las necesidades de clientes potenciales, recopilar datos de cualificación clave (por ejemplo, presupuesto, autoridad y cronología) y guiar la plática hacia un siguiente paso claro, como programar una reunión con un ejecutivo de cuenta.
- **Acciones:** Acciones de ventas especializadas que permiten al agente gestionar el ciclo de vida de prospectos. Estas herramientas están diseñadas para ejecutar tareas de DEG principales, como enriquecer datos de prospectos, enviar emails de seguimiento con plantilla o integrar con sistemas de calendario para reservar llamadas de descubrimiento.
- **Barandillas:** Las barandillas actúan como un conjunto de reglas configurables y comprobaciones de tiempo de ejecución que restringen el comportamiento del agente. Actúa como una capa de seguridad que puede interceptar solicitudes, validar las acciones propuestas del agente y filtrar su respuesta final para evitar contenido dañino, aplicar reglas de negocio y garantizar que el agente opera dentro de su ámbito designado.
- **Plantillas de solicitudes:** Plantillas reutilizables que se rellenan dinámicamente con datos de CRM en vivo a través de campos de combinación o datos semánticos desde Recuperadores de RAG de Data 360. Estas plantillas permiten a los agentes generar contenido contextual dentro de la marca mientras que Einstein Trust Layer enmascara de forma segura información confidencial antes de que se envíen las instrucciones al LLM.
- **Data 360**
- Los componentes de Data 360, incluyendo DLO, DMO, almacenamiento vectorial y recuperadores de RAG, proporcionan al agente una vista unificada de todos los datos de compañía relevantes, desde registros de clientes estructurados a artículos Knowledge no estructurados, garantizando que las respuestas sean precisas y fundamentadas en contexto.
- **Sales Cloud**
- **Datos CRM:** Conecta el agente con el historial de casos completo, proporcionando contexto crucial en detalles de cuenta, registros de contacto y asignaciones
- **Programar una reunión entre el cliente y DEG:** La transferencia de SDR Live Agent se puede configurar para configurar una reunión en vivo utilizando Tarea y Programación de reuniones (Próximas acciones).
- **Registro de actividad:** Capture eventos, tareas y actividades de email, y relacione esto con prospectos, cuentas y oportunidades como resultado de interacciones de agentes de DEG.
**Interacciones**
1. El cliente envía y recibe email a través del canal, que enruta a Agentforce.
2. Agentforce aplica temas, acciones y salvaguardas para analizar la intención.
3. Agentforce elabora respuestas contextuales utilizando plantillas de solicitudes enriquecidas con contexto de CRM y Data 360.
4. Una plática de email de varios turnos continúa hasta la resolución o las directrices de política.
5. Para prospectos cualificados, Agentforce programa una reunión y actualiza CRM.
6. Si la intención supera el ámbito de IA, Agentforce escala a Sales Cloud SDR para una respuesta de representante de servicio humano.
**Trade-offs**
| Aspecto | Ganancia | Costo |
|---|---|---|
| Velocidad de respuesta | <5 min primera respuesta (vs. 8 a 24 horas) | Alcance inicial menos personalizado en comparación con el teléfono |
| Capacidad de DEG | Aumento de 2 a 5 veces en la cobertura de prospectos | Pérdida de puntos de contacto de creación de relaciones temprana |
| Coherencia de cualificación | Adquirir de forma asíncrona cobertura de presupuesto, autoridad, necesidad y cronología (BANT) | Puede perder señales matizadas |
| Precisión de contenido | RAG garantiza información actualizada | Requiere producto de ventas depurado y biblioteca de habilitación. Las vueltas múltiples pueden ser extenuantes |
| Conversión de reuniones | Conversión significativamente superior | Algunas reuniones con prospectos de menor calidad si hay brechas de BANT |
| Eficiencia de costos | Más rentable que los DEG humanos | Costes de desarrollo y mantenimiento |
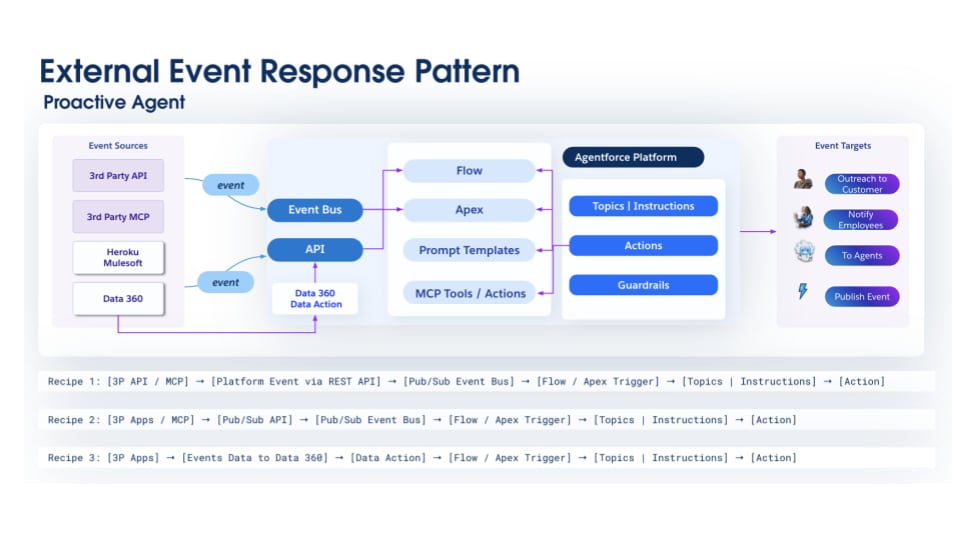 **Componentes clave**
- **Origen del evento**
- Eventos desencadenados por acciones de datos después de ingresar datos externos en Data 360
- Servidores MCP externos o de Salesforce Heroku capaces de enviar eventos a Salesforce a través de la API Pub/Sub de Salesforce
- Aplicación externa capaz de enviar notificaciones de eventos a través de la API Pub/Sub de Salesforce
- **Middleware opcional:** MuleSoft o Data 360 para transformaciones
- **Agente Agentforce:** El comportamiento y el propósito del agente se definen por los siguientes componentes.
- **Temas e instrucciones:** Especifica la misión principal del agente y sus desencadenadores, incluyendo la definición de su objetivo principal (por ejemplo, "Monitorear todos los casos de alta prioridad y evitar infracciones de SLA"). Contiene los eventos específicos o condiciones de datos que el agente debe escuchar para iniciar sus tareas
- **Acciones:** Acciones programadas y desencadenadas por eventos diseñadas para responder a eventos externos. Aunque estas acciones funcionan de forma autónoma para tareas rutinarias, a menudo incluyen la capacidad de orquestar flujos de trabajo que implican intervención humana, distribuyendo a usuarios para su revisión, aprobación o gestión de escenarios que requieren juicio humano.
- **Barandillas:** Las barandillas actúan como un conjunto de reglas configurables y comprobaciones de tiempo de ejecución que restringen el comportamiento del agente. Actúa como una capa de seguridad que puede interceptar solicitudes, validar las acciones propuestas del agente y filtrar su respuesta final para evitar contenido dañino, aplicar reglas de negocio y garantizar que el agente opera dentro de su ámbito designado.
- **Plantillas de solicitudes:** Plantillas reutilizables que se rellenan dinámicamente con datos de CRM en vivo a través de campos de combinación o datos semánticos desde Recuperadores de RAG de Data 360. Estas plantillas permiten a los agentes generar contenido contextual dentro de la marca mientras que Einstein Trust Layer enmascara de forma segura información confidencial antes de que se envíen las instrucciones al LLM.
- **Data 360**
- Componentes de Data 360, incluyendo **DLO y DMO,** que almacenan datos de eventos [generados por sistemas externos y enviados a salesforce](https://developer.salesforce.com/docs/data/data-cloud-int/guide/c360-a-create-eventbusconnector-data-stream.html), transformando y creando perspectivas de transmisión o en tiempo real
- Las **perspectivas calculadas, de transmisión y en tiempo real** proporcionan a los agentes datos inmediatos y pertinentes sobre los clientes. Esto permite la resolución preventiva de problemas, mitigando la distribución. **Gráficos de datos** afloran de forma proactiva relaciones y perspectivas desde orígenes de datos dispares, permitiendo la detección temprana de patrones o anomalías relevantes para la implicación, actividad y perfil del cliente.
- El almacenamiento vectorial de **Data 360 y** los recuperadores de RAG proporcionan al agente una vista unificada de todos los datos de negocio y artículos Knowledge no estructurados pertinentes, garantizando que las respuestas sean precisas y basadas en el contexto.
- **Objetivos de eventos**
- Notificar proactivamente a los empleados o hacer contacto con los clientes
- Ampliable a agentes (consulte Patrones de [agente ambiental](#23-patrones-de-agentes-ambientales) y [agente autónomo](#25-patrones-de-agentes-autónomos))
**Interacciones**
1. Se produce un cambio notable en el sistema externo.
2. El sistema externo emite un evento y lo publica en Salesforce Event Bus a través de la API (crea un evento de plataforma) o la API Pub/Sub, o los datos de Eventos se transmiten a Data 360.
3. Los suscriptores del evento se desencadenan. Se desencadena un flujo.
4. El flujo llama [Acción de agente](https://help.salesforce.com/s/articleView?id=platform.automate_flow_ref_elements_actions_generate_ai_agent_response.htm&type=5) con los datos del evento. El agente determina el curso de acción correcto y lo ejecuta.
5. El resultado es una notificación o un flujo de trabajo que se está desencadenando. Las notificaciones se entregan a un usuario en una herramienta de colaboración (como Slack). También se generan tareas o eventos. Además, las acciones pueden llamar a sistemas externos. Los eventos, por lo tanto, no se pierden, pero se ejecutan, se señalan y se realizan acciones de forma proactiva, eliminando la sobrecarga humana o la automatización compleja para descubrirlos.
**Trade-offs**
| Aspecto | Ganancia | Costo |
|---|---|---|
| Integración en tiempo real | Los eventos desencadenan acciones en cuestión de segundos. | Complejidad de ingreso de API (variabilidad de SLA de socio) |
| Respuesta inteligente | Decisiones con tecnología de IA con CRM y contexto externo | El enriquecimiento agrega latencia y datos obsoletos (como eventos fuera de orden). |
| Acoplamiento suelto | Sistemas externos independientes de la lógica de Salesforce | El procesamiento asíncrono lleva a una posible coherencia. |
| Escalabilidad | Gestiona eventos de ráfaga | Límites de API, costos de almacenamiento de eventos |
| Bidirectional | Salesforce puede responder a sistemas externos. | Dependencias de API externas, escenarios de fallo |
| Seguridad | Eventos verificados firmados, acceso de privilegio mínimo (o cero) por sistemas externos | Protección contra reproducción, rotación de claves y sobrecarga operativa |
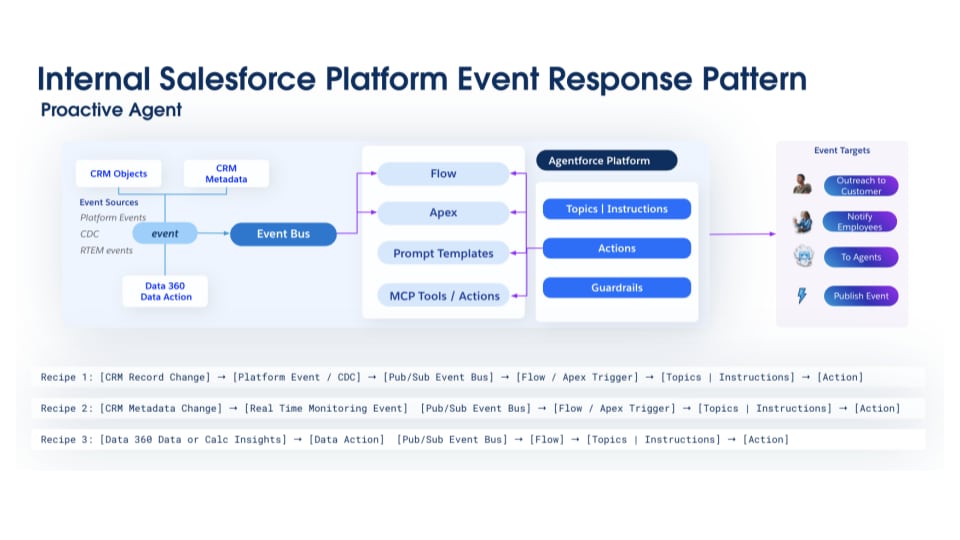 **Componentes clave**
- **Capa de origen** de evento
- Datos de CRM, Eventos de plataforma, Captura de datos de cambios (CDC) y Monitoreo de eventos en tiempo real (RTEM) desde actividad de plataforma de bajo nivel
- **Data 360**
- Componentes de Data 360, incluyendo **DLO y DMO,** que almacenan datos de eventos [generados por CRM o eventos de plataforma](https://developer.salesforce.com/docs/data/data-cloud-int/guide/c360-a-create-eventbusconnector-data-stream.html), transformando y creando perspectivas de transmisión o en tiempo real
- Las **perspectivas calculadas, de transmisión y en tiempo real** proporcionan a los agentes datos inmediatos y pertinentes acerca de los cambios de clientes, actividad de empleados o metadatos en el sistema. Esto permite la resolución preventiva de problemas, mitigando la distribución. Este conocimiento de la situación en tiempo real capacita a los agentes para entregar intervenciones oportunas para el desempeño operativo de gobernanza y cumplimiento.
- **Gráficos de datos** afloran de forma proactiva relaciones y perspectivas procedentes de orígenes de datos dispares, permitiendo la detección temprana de patrones o anomalías relevantes para la implicación, actividad y perfil del cliente.
- El almacenamiento vectorial de **Data 360 y** los recuperadores de RAG proporcionan al agente una vista unificada de todos los datos de negocio y artículos Knowledge no estructurados pertinentes, garantizando que las respuestas sean precisas y basadas en el contexto.
- **Agente Agentforce:** El comportamiento y el propósito del agente se definen por los siguientes componentes.
- **Temas e instrucciones:** Especifica la misión del agente para aplicar reglas de negocio y automatizar procesos basándose en cambios de datos en Salesforce. Define el objetivo del agente (por ejemplo, "Asegurarse de que todas las oportunidades se actualizan con un contacto principal antes de alcanzar la etapa de negociación") y las creaciones de registros específicas, actualizaciones de campos, etc. que desencadenan el agente.
- **Acciones:** Acciones programadas y desencadenadas por eventos diseñadas para responder a eventos internos de Salesforce. Aunque estas acciones funcionan de forma autónoma para tareas rutinarias, a menudo incluyen la capacidad de orquestar flujos de trabajo que implican intervención humana, distribuyendo a usuarios para su revisión, aprobación o gestión de escenarios que requieren juicio humano.
- **Barandillas:** Las barandillas actúan como un conjunto de reglas configurables y comprobaciones de tiempo de ejecución que restringen el comportamiento del agente. Actúa como una capa de seguridad que puede interceptar solicitudes, validar las acciones propuestas del agente y filtrar su respuesta final para evitar contenido dañino, aplicar reglas de negocio y garantizar que el agente opera dentro de su ámbito designado.
- **Plantillas de solicitudes:** Plantillas reutilizables que se rellenan dinámicamente con datos de CRM en vivo a través de campos de combinación o datos semánticos desde Recuperadores de RAG de Data 360. Estas plantillas permiten a los agentes generar contenido contextual dentro de la marca mientras que Einstein Trust Layer enmascara de forma segura información confidencial antes de que se envíen las instrucciones al LLM.
- **Objetivos de eventos**
- Notifique proactivamente a los empleados o haga contacto con los clientes.
- Ampliable para llamar a otros agentes (consulte Patrones de [IA ambiental](#23-patrones-de-agentes-ambientales) e [IA autónoma](#25-patrones-de-agentes-autónomos))
**Interacciones**
1. Se produce un cambio notable en el sistema interno, como una actualización en un registro de CRM, una modificación de metadatos o una acción de datos desencadenada desde Data 360.
2. El sistema interno emite un evento y lo publica en Salesforce Event Bus a través de la API (crea un evento de plataforma) o la API Pub/Sub, o los datos del evento se transmiten a Data 360.
3. Los suscriptores del evento se desencadenan y activan un flujo o Apex.
4. El flujo o Apex activado llama [Acción de agente](https://help.salesforce.com/s/articleView?id=platform.automate_flow_ref_elements_actions_generate_ai_agent_response.htm&type=5).
5. El resultado es una notificación o un flujo de trabajo que se está desencadenando. Las notificaciones se entregan a un usuario en una herramienta de colaboración (como Slack). También se generan tareas o eventos. Además, las acciones pueden llamar a sistemas externos.
6. Los eventos, por lo tanto, no se pierden, pero se ejecutan, se señalan y se realizan acciones de forma proactiva, eliminando la sobrecarga humana o la automatización compleja para descubrirlos.
**Trade-offs**
| Aspecto | Ganancia | Costo |
|---|---|---|
| Integración en tiempo real | Los eventos desencadenan acciones en cuestión de segundos. | Más capas pueden causar latencia para una gestión de eventos sencilla. |
| Respuesta inteligente | Decisiones con tecnología de IA con CRM y contexto externo | El enriquecimiento agrega latencia y datos obsoletos (por ejemplo, eventos fuera de orden). |
| Acoplamiento suelto | Desplegable (más suscriptores) y ampliable | El procesamiento asíncrono lleva a una posible coherencia entre suscriptores. |
| Escalabilidad | Gestionar eventos de ráfaga | Límites de API |
| Seguridad | Capa Trust proporcionada por plataforma | Gastos generales operacionales no negociables |
| Aspecto | Ganancia | Costo |
|---|---|---|
| Tamaño de ventana | Ventana pequeña: latencia más baja, apoyo más rápido | También tiene menos contexto, menor precisión |
| Modo de procesamiento | El tiempo real presenta una oportunidad de asistente inmediata. | Uso intensivo de recursos |
| Resolución de transmisión | El audio y el video de alta calidad pueden tener mejor precisión pero aumentar la latencia. | Más almacenamiento y computación |
| Periodo de retención | Se pueden utilizar grandes cantidades de datos para la capacitación y el cumplimiento. | Más costos de almacenamiento, puede llevar a ruido |
| Multi-Modal | Contexto más enriquecido, comprensión holística | Complejidad de sincronización |
| Ambiente | Puede proporcionar asistencia coherente al usuario humano | Privacidad/aplicación de políticas |
| Aspecto | Ganancia | Costo |
|---|---|---|
| Ámbito | Amplio conjunto de coberturas de actividad, el agente puede compartir el contexto en diferentes modos (email, calendarios, páginas de aplicación) | Costo de cálculo |
| Automatización inteligente | Puede ser un módulo y ampliarse a IA completamente autónoma y puede eliminar a los humanos del bucle donde la política es clara | Más evaluación de agentes. Riesgo de falsos positivos o errores, puede pasar desapercibido en un plazo de tiempo razonable |
| Complejidad de interceptación | Puede beneficiarse de análisis en tiempo real. Por ejemplo, puede detectar fraudes o amenazas y evitar que se produzcan transacciones | Necesita flujos de trabajo de agentes y humanos sincronizados |
| Profundidad de contexto | Un contexto más profundo lleva a decisiones inteligentes | Necesita ser completo en contexto |
| Autonomía de agente | Los agentes desatendidos trabajan en segundo plano sin solicitudes de usuario, por lo que reduce la fricción | Menos transparencia en la toma de decisiones de los agentes, más seguimientos de auditoría |
| Multiagente | Los agentes desatendidos pueden trabajar juntos para formar agentes especializados | Orquestación desatendida y complejidad adicional |
| Aspecto | Ganancia | Costo |
|---|---|---|
| Superficies de colaboración nativas | Los agentes pueden participar y contribuir inmediatamente al flujo humano de trabajo | La adopción de usuarios requiere capacitación y activación adicionales |
| Colaboración de contexto bidireccional | Los agentes pueden aflorar y compartir contexto con todas las partes, haciendo que la información esté disponible para todos. | La información confidencial asimétrica intencionada requiere salvaguardas adicionales. |
| Colaboración | Los agentes activan la colaboración en tiempo real, entregando comentarios inmediatos y un tiempo de resolución más rápido. | Resoluciones más rápidas significan un trabajo más activo en la cola para los seres humanos que puede provocar fatiga |
| Especialización | Los agentes específicos de dominio ofrecen asistencia de alto valor. | Mayores necesidades de contexto limitado y especificidad de dominio. Complejidad para adaptarse a los cambios |
| Observabilidad | Proporcionar razonamientos, seguimientos de auditoría, Evaluaciones de agentes build Trust | Costes de telemetría aumentados |
| Aspecto | Ganancia | Costo |
|---|---|---|
| Velocidad | Los agentes completan las tareas en horas a días en vez de semanas a meses | Requiere activación para operación agente autónoma |
| Autonomía | Los agentes logran la ejecución completa sin intervención humana | La intervención es limitada y costosa durante la ejecución |
| Escalabilidad | Los agentes se amplían fácilmente | Deben establecerse límites de frecuencia para evitar el bloqueo de recursos. |
| Coherencia | Los agentes se adhieren a políticas a través de barandillas | La gestión de nuevos escenarios requiere inspección para garantizar el resultado correcto. |
| Costo | Los agentes evitan a los humanos en el bucle | El proceso es costoso de crear |
| Recursos humanos | Los agentes liberan recursos críticos y expertos | Los expertos carecen de visibilidad experiencial a través de la práctica, reduciendo la capacidad de identificar mejoras en los procesos |
| Control de calidad | Puede monitorear y revisar | Los costos de reparación son altos si no se detectan errores de agentes de inmediato |
| Precisión | Los agentes pueden utilizar contexto y políticas para tomar la decisión correcta. | El contexto y los datos deben depurarse y mantenerse para eliminar cualquier ambigüedad o obsolescencia. |
-
Configure un agente conversacional.
Configurar Chat mejorado → Crear Agente de servicio → Definir tema Pedidos de asistencia → Acción Crear Obtener pedido ↓ Agregar flujo de OmniCanal de distribución saliente ← Crear tema Distribuir ← Agregar acciones a temas ← Acción Crear Obtener estado ↓ Publicar el agente - Configure Chat mejorado como el punto de entrada de chat de Jane de modo que pueda abrir la ventana Agentforce en la página web.
- Active Agentforce y cree un Agente de servicio en Agentforce Builder para gestionar pláticas y desencadenar acciones personalizadas.
-
Defina un tema Pedidos de asistencia con una descripción y instrucciones de modo que el agente reconozca de forma natural "¿Dónde está mi último pedido?".
-
Crear acciones personalizadas:
- Acción Obtener pedido más reciente para contacto para recuperar el pedido más reciente de Jane
- Obtener estado de envío por acción Id. de pedido para obtener información de seguimiento a través de MuleSoft
- Opcionalmente orqueste ambas acciones en Flow (obtener el pedido más reciente y llamar a MuleSoft) utilizando acciones de servicio externo.
- Agregue ambas acciones al Agente de servicio en el generador, vincúlelas al tema Pedidos y seguimiento y publique.
-
Crear acciones personalizadas:
-
Defina un tema Distribución con una descripción para distribuir a un representante de servicio.
- Cree y active un flujo de OmniCanal saliente.
- Agréguelo a la ficha Conexiones en el generador para distribución con un mensaje de distribución.
-
Configure OmniCanal.
Configurar OmniCanal → Definir reglas de distribución en instrucciones → Establecer prioridades y capacidad → Probar y validar - Active la distribución sencilla a agentes de servicio humano cuando el agente de IA no pueda resolver la consulta. Configure el enrutamiento de OmniCanal para asignar sesiones de chat a representantes de servicio y transferir la transcripción completa para contexto.
- Integre la lógica de distribución en las instrucciones Agentforce y una acción de distribución de modo que el agente sepa cuándo transferir casos complejos. Gestione las prioridades y capacidad de enrutamiento a través del Supervisor de Omni.
- Pruebe la experiencia completa: Jane abre el chat y el agente la saluda, identifica su pedido, recupera datos de envío y se distribuye sin problemas cuando se requiere intervención humana (consulte también Activar registros de eventos mejorados).
-
Configure la integración de datos.
Asignar datos de contexto → Crear credenciales de API de MuleSoft → Registrar servicio externo de MuleSoft - Fundamente al agente con el contexto de Salesforce de Jane asignando sus registros de pedidos y contactos a través de formularios de chat o previos al chat autenticados.
- Conecte Salesforce de forma segura con la API de envío de MuleSoft utilizando credenciales externas y credenciales nombradas para la autenticación.
- Si MuleSoft expone una especificación de OpenAPI, regístrela como un servicio externo de modo que Flujo y el agente puedan llamarla declarativamente.
-
Configure la integración de datos no estructurados.
- Cree una nueva biblioteca de datos desde Configuración. Asígnele el nombre "Política de pedidos y envíos".
- Agregue los PDF de documentos de política que contienen las excepciones de política de envío.
- En segundo plano, los documentos se segmentan, indexan y preparan para su uso automáticamente.
-
Configure un evento de carrito abandonado para que se desencadene cuando John, un cliente VIP, deje el carrito abandonado.
Campo Crear contacto personalizado → Definir nuevo evento de plataforma - Cree un evento de plataforma
Cart_Abandoned__e con los campos Id. de contacto, Valor de carrito, Fecha y hora de última actualización de carrito y Detalles de carrito. - Configure el evento de abandono: Utilizando Commerce Cloud, cree un evento de plataforma para notificaciones de eventos Checkout. El abandono se detecta cuando el estado de la sesión de Checkout del carrito está en un estado intermedio y el tiempo de espera de la sesión se agota después de un umbral. De manera alternativa, si su comercio electrónico es un sistema externo, publique el evento en Salesforce utilizando cualquiera de estos métodos: Flujos, Apex, API de Salesforce o API Pub/Sub.
- En el objeto Contacto, cree un nuevo campo,
Customer_Tier__c , con los valores de lista de selecciónEstándar ,Premium yVIP .
- Cree un evento de plataforma
-
Configure el ingreso de datos no estructurados en Data 360: Agregue un documento de política de descuentos originado desde un repositorio de documentos a Data 360 a través de Amazon S3.
Crear credenciales de AWS S3 → Crear nueva transmisión de datos de S3 → Configurar e implementar transmisión → Crear índice de búsqueda ↓ Función de recuperación de prueba ← Configurar e implementar índice - Cree credenciales externas para acceder a S3: Cree un nuevo conjunto de claves y secretos de acceso para un usuario de IAM o Nombre de recurso de Amazon (ARN) de IAM para un IdP.
- Cree una nueva transmisión de datos de S3: En la ficha Transmisiones de datos, cree la transmisión de documentos de política de transmisión de datos, seleccione el origen de S3, seleccione el tipo de archivo PDF, establezca la frecuencia de actualización, asigne los campos de metadatos (nombre y tamaño del archivo) y luego implemente.
- Tras completar la transmisión de datos, cree un índice de búsqueda: Utilice la extracción de pasajes para la fragmentación, el modelo integrado E5-large-v2 y el tipo de búsqueda híbrida, y luego implemente el índice.
- Pruebe la función de recuperación creada.
-
Configure el agente Recuperación de carrito VIP.
Crear agente desde plantilla → Agregar tema Recuperar carrito VIP → Agregar instrucciones de tema → Acción Crear alerta de Slack ↓ Agregar acciones al tema ← Acción Crear inscripción de trayectoria ← Acción Crear oferta de descuento ← Tarea Crear recuperación de carrito - Cree un agente desde la plantilla Agentforce Employee Agent.
- Agregue un nuevo tema, Recuperar carrito VIP, con la descripción de que este agente gestiona el abandono de carrito de alto valor para clientes VIP.
- Agregue instrucciones de tema para validar el estado VIP, cualificar el carrito, notificar al gestor de cuentas en Slack, recomendar una oferta de descuento e inscribir al cliente en la trayectoria de email de recuperación del carrito.
- Cree acciones y una tarea.
- Acción Alertar al gestor de cuentas: Envía una notificación proactiva de Slack
- Tarea Recuperar carrito abandonado, asignada al gestor con detalles de carrito
- Acción Obtener oferta de descuento: Analiza la política y el historial de compras anteriores. Cree una plantilla de solicitud con fundamentación, haga referencia a la función de recuperación en la plantilla de solicitud y utilice los datos.
- Inscribirse en la acción Trayectoria de recuperación: Se inscribe en la trayectoria de recuperación de Marketing Cloud a través de la API y toma todos los datos de suscriptor y el mensaje de email de oferta con descuento generado desde el agente.
- Agregue las acciones al tema.
- Cree una trayectoria de recuperación de carrito de clientes VIP utilizando plantillas en Marketing Cloud, o cree una nueva trayectoria.
-
Conecte un evento de plataforma para llamar al agente.
Crear flujo desencadenado por evento → Suscribirse al evento de plataforma → Agregar acción invocable de agente → Pasar datos de eventos a agentes - Cree un nuevo flujo desencadenado por evento de plataforma, Recuperación de abandono de carrito VIP.
- Seleccione el evento Carrito abandonado al que debe suscribirse el flujo.
- Configure una acción invocable de agente personalizada en Flow Builder y seleccione el agente Recuperación de carrito VIP. Envíe la solicitud para iniciar una recuperación de carrito abandonado VIP para el cliente y enviar la carga de evento de plataforma.
| El cliente abandona el carrito | → | Evento de publicación de Commerce Cloud | → | Flujo de desencadenadores de eventos de plataforma | → | Flujo invoca Agente de empleado |
| ↓ | ||||||
| Analiza la oferta de descuentos | ← | Crea una tarea para el gestor | ← | Gerente de alertas en Slack | ← | El agente ejecuta el tema Recuperación |
| ↓ | ||||||
| Inscribe al cliente en la trayectoria | → | El cliente canjea la oferta | → | Agente analiza resultados para comentarios |
-
Configure un agente de Respuesta en tiempo real de llamada de ventas.
Crear agente desde plantilla → Agregar tema de llamada de asistencia → Agregar instrucciones de tema → Acción Crear análisis de transcripción ↓ Agregar acciones al tema ← Acción Crear perspectivas de Slack ← Acción Crear especificación de producto - Cree un agente desde la plantilla Agentforce Employee Agent.
- Agregue un nuevo tema, Asistir llamada, con la descripción de que este agente escucha transcripciones en vivo, comprende la intención y ayuda con datos de productos.
- Agregue instrucciones de tema para analizar transcripciones, recuperar especificaciones de productos y enviar mensajes de Slack.
- Cree acciones.
- Acción Analizar transcripción de llamada: Analiza los datos de transcripción de llamadas recibidos en tiempo real y extrae preguntas o acciones clave
- Acción Obtener especificación de producto: Consultas artículos de product Knowledge
- Enviar perspectivas de Slack al usuario "interno"
- Agregue las acciones al tema.
-
Configure una biblioteca de datos de Product Knowledge.
Crear nueva biblioteca de datos → Agregar artículos Knowledge → Índices y partes del sistema → Biblioteca terrestre en acción - Cree una nueva biblioteca de datos desde Configuración. Asígnele el nombre "Product Knowledge".
- Agregue los artículos Knowledge que contienen la información del producto.
- En segundo plano, los documentos se segmentan, indexan y preparan para su uso automáticamente.
- Utilice la fundamentación en la acción Obtener especificación de producto.
-
Publique la transcripción en tiempo real en Salesforce a través de la API Pub/Sub.
El servidor recibe la transcripción de audio → Evento de plataforma de publicación de servidor - Cree un evento de plataforma,
Transcript_Segment__e , con los camposId. de llamada ,Secuencia ,Altavoces ,Hora de inicio de segmento,Hora de finalización de segmento,Duración yDatos de transcripción . - En su servidor de señalización (consulte la sección de requisitos previos), una vez reciba el texto transcrito desde audio, publique inmediatamente los datos a través del evento
Transcript_Segment__e . Puede publicar el evento en Salesforce utilizando cualquiera de estos métodos: Flujos, Apex, API de Salesforce o API Pub/Sub.
- Cree un evento de plataforma,
-
Flujo de red para suscribirse al evento
Transcript_Segment__e publicado.Crear flujo desencadenado por evento → Suscribirse al evento Transcripción → Agregar acción invocable de agente → Enviar carga a agente ↓ El agente envía Slack DM - Cree un nuevo flujo desencadenado por eventos de plataforma, Perspectivas de llamadas de descubrimiento.
- Seleccione el evento
Transcript_Segment__e al que debe suscribirse el flujo. - Configure una acción invocable de agente personalizada en Flow Builder y seleccione el agente Respuesta en tiempo real de llamada de ventas. Envíe la carga del evento para enrutar al tema Llamada de asistencia. Después de derivar la pregunta del tema, la pregunta se envía a la acción Obtener especificación de producto para obtener una respuesta.
- La respuesta final se compila y se envía inmediatamente al usuario a través de un DM de Slack.
| Usuario inicia llamada de zoom | → | El servidor transcribe y publica | → | El flujo invoca al agente Respuesta | → | Base de Knowledge consultas de agentes |
| ↓ | ||||||
| Analytics afina el desempeño de los agentes | ← | El agente compila un resumen de llamada | ← | El agente sigue escuchando | ← | El agente envía Slack DM |
-
Configure la arquitectura de múltiples agentes.
Agente de investigación recopila inteligencia → Prospecto de puntuajes de agentes de cualificación → Agente de DEG inicia alcance - Agente de investigación: Consulta Data 360 y orígenes externos a través de MuleSoft
- Agente de cualificación: Prioriza, puntúa y enriquece prospectos
- Agente de DEG: Obtiene asignaciones de prospectos, ejecuta alcance, realiza un seguimiento y programa reuniones. Monitoree la actividad y el progreso de los agentes de DEG con Agentforce Analytics para agentes de DEG.
-
Descubra e ingrese nuevos datos de la compañía.
Crear nuevo espacio de datos → Ingresar datos de Salesforce CRM → Ingresar datos de ZoomInfo → Ingresar datos de base de datos de proveedores - Configure un nuevo Espacio de datos denominado Ventas y marketing. Este nuevo espacio de datos contendrá todos los datos necesarios para agentes autónomos.
- Utilice conectores de Salesforce para hacer fluir los datos de CRM de prospectos, cuentas, contactos y oportunidades al espacio de datos.
- Configure un conector de Data 360 para ZoomInfo. Fluya los datos en el Espacio de datos de ventas y marketing de Data 360.
- Configure el conector Anypoint Salesforce Data 360 para conectar con la base de datos de proveedores e ingresar los datos en Data 360.
-
Configure un evento de plataforma para iniciar el agente Investigación y cualificación desatendido.
Crear nuevo evento de plataforma - Cree un nuevo evento de plataforma
AgentGoal__e con elobjetivo de campo que captura el objetivo de alto nivel del usuario humano.
- Cree un nuevo evento de plataforma
-
Configure un agente Orquestador de objetivos, un agente de IA conversacional que recibe el objetivo del usuario y lo orquesta a otros agentes.
Crear agente desde plantilla → Agregar tema Objetivo de análisis → Agregar instrucciones de tema → Acción Crear evento de objetivo ↓ Agregar acción al tema - Cree un agente desde la plantilla Agentforce Employee Agent.
- Agregue un nuevo tema, Analizar objetivo, con la descripción de que este agente comprende la intención del objetivo y puede llamar a agentes adicionales según sea necesario.
- Agregue instrucciones de tema para analizar el objetivo y desencadenar eventos para otros agentes.
- Cree un evento Objetivo,
AgentGoal__e .
-
Configure un agente de Investigación y cualificación de prospectos, que se desencadena por un agente orquestador.
Crear tema de investigación → Acción Crear deduplicación → Acción Crear enriquecimiento de prospectos → Acción Crear puntuaje de prospectos ↓ Agregar acciones al tema ← Acción Crear cualificación de prospectos - Cree un tema Investigación de clientes potenciales con la descripción "Investigación de nuevos prospectos en una región o estado".
- Cree acciones.
- Acción de Apex Deduplicar prospecto: Comprobar y validar nuevos prospectos con clientes existentes
- Acción de Apex Enriquecer prospecto, que utiliza una plantilla de solicitud: Busca en la perspectiva de marketing no estructurada y datos de base de datos de proveedores para enriquecer datos de prospectos
- Acción Puntuaje de prospecto: Puntuar un prospecto de forma proactiva con datos de prospectos actualizados
- Acción Cualificar prospecto para agente: Basándose en el puntuaje, asigne parámetros que cualifican el prospecto para un agente de DEG
-
Configure un agente de DEG de Agentforce para realizar actividades de alcance, fomento de prospectos y programación de reuniones.
Crear agente de DEG desde plantilla → Configurar base de datos de Knowledge de agentes → Configurar ajustes de email de agentes → Establecer reglas de asignación de prospectos ↓ Definir criterios de prospectos aptos - Cree un nuevo agente de DEG desde la página Configuración utilizando la plantilla Agente de prospectos preconfigurada. Configure los parámetros de email y las reglas de asignación de prospectos, seleccionando el objeto Prospecto o el objeto Contacto y definiendo los criterios de aptitud (puntuaje de prospecto de umbral y nuevo prospecto) para las reglas de asignación.
- Configure Agentforce Lead Nurturing configurando el agente, asignando permisos y configurando las reglas de asignación y cadencia.
- Configure Knowledge necesario para que el agente de DEG responda a preguntas.
-
Configure un nuevo flujo para suscribirse al evento
AgentGoal__e publicado.Crear flujo desencadenado por evento → Suscribirse al evento Objetivo de agente → Agregar acción invocable de agente - Cree un nuevo flujo desencadenado por eventos de plataforma denominado Enrutar objetivos a agentes.
- Seleccione el evento Objetivo de agente al que debe suscribirse el flujo.
- Configure una acción invocable de agente personalizado en Flow Builder y seleccione el agente Investigación y cualificación de prospectos.
| Usuario asigna objetivo de alto nivel | → | El agente Orchestrator crea un evento | → | Objetivo de ruta de flujo a agente | → | Agente de investigación califica prospecto |
| ↓ | ||||||
| Monitorear agentes con análisis | ← | Agente de DEG programa reunión | ← | Agente de DEG inicia alcance |
- Configure Chat mejorado como el punto de entrada de chat del cliente de modo que pueda abrir la ventana Agentforce en la página web.
-
Configure un Agentforce Billing Agent, un agente especializado desatendido que puede tomar un pedido o factura y realizar una consulta de facturación.
Crear agente desde plantilla → Definir tema de consulta de facturación → Acción Crear flujo personalizado → Agregar acción al tema - Active Agentforce y cree un Agente de empleados desde la plantilla Agentforce Employee Agent.
- Defina un tema, Consulta de facturación, con la descripción "Investigar discrepancias de facturas, problemas de pago y errores de facturación".
- Agregue una acción de flujo personalizada, Comprobar discrepancia de factura, con una entrada de
Número de factura ,Id. de cliente eIntervalo de fechas , y una salida deImporte de discrepancia ,Causa raíz yTransacciones afectadas .
- Agregue una acción de flujo personalizada, Comprobar discrepancia de factura, con una entrada de
-
Configure un Agentforce Logistics Agent, un agente especializado desatendido que puede verificar envíos, realizar un seguimiento del envío y comprobar el inventario.
Crear agente desde plantilla → Definir tema Verificación de envío → Acción Crear flujo personalizado → Agregar acción al tema - Active Agentforce y cree un Agente de empleados desde la plantilla Agentforce Employee Agent.
- Defina un tema: Verificación de envío, con una descripción para verificar el envío para factura.
- Agregue una acción Flujo personalizada, Verificar detalles de envío, con una entrada de
Número de factura ,Id. de cliente eIntervalo de fechas , y una salida dePieza enviada ,Fecha yEstado de inventario .
- Agregue una acción Flujo personalizada, Verificar detalles de envío, con una entrada de
-
Configure un Agentforce Provisioning Agent, un agente especializado desatendido que puede verificar el aprovisionamiento y el estado del servicio.
Crear agente desde plantilla → Definir tema de Comprobación de servicio → Acción Crear flujo personalizado → Agregar acción al tema - Active Agentforce y cree un Agente de empleados desde la plantilla Agentforce Employee Agent.
- Defina un tema, Comprobación de servicio, con una descripción para verificar la conectividad del servicio y el estado de la cuenta.
- Agregue una acción de flujo personalizada, Verificar servicio, con una entrada de
Id. de cliente eId. de activo y una salida deEstado de servicio yMotivo de excepción de servicio.
- Agregue una acción de flujo personalizada, Verificar servicio, con una entrada de
-
Exponga los agentes de facturación, logística y aprovisionamiento como servidores A2A y regístrelos en Registro de agentes.
Exponer agentes a través de MuleSoft → Registrar agentes en registro - En ausencia de compatibilidad A2A directa en Agentforce Agents, los conectores MuleSoft pueden utilizarse para exponer las API de agentes como servidores A2A.
- Registre estos servidores A2A en Registro de agente.
- Utilice Anypoint Agent Fabric para la orquestación de agentes.
- MuleSoft Agent Broker puede ayudar a orquestar cualquier agente entre plataformas basándose en funciones de agente mencionadas en las tarjetas de agente.
-
Configure un Agente de ayuda de Agentforce, agente de IA conversacional que interactúa con clientes, evalúa la complejidad y se coordina con múltiples agentes especializados para resolver el problema.
Crear Agente de servicio → Definir tema de investigación → Acción Crear notificación → Definir tema de orquestación ↓ Definir tema de distribución ← Acción Crear crear caso ← Acción Crear agente de llamadas ← Crear flujo de orquestación de agentes ↓ Crear flujo de OmniCanal → Flujo Conectar para distribución - Active Agentforce y cree un Agente de servicio en Agentforce Builder para gestionar pláticas y desencadenar acciones personalizadas.
- Defina un tema, Investigación de servicio, con una descripción e instrucciones de modo que el agente reconozca de forma natural un tema complejo con, normalmente, múltiples problemas simultáneos.
- Cree acciones personalizadas.
- Acción Notificación de estado para reconocer el problema y proporcionar actualizaciones de progreso
- Cree acciones personalizadas.
- Defina un tema de orquestación que pueda llamar a otros agentes a través de acciones.
- Cree una acción Agente de llamadas que llame a una acción Flujo. La acción Flujo tiene varias acciones de agente y puede iniciar cada uno de los agentes desatendidos: el Agente de facturación, el Agente logístico y el Agente de aprovisionamiento.
- Cree una acción Crear caso que cree un caso, agregue detalles y establezca el estado.
- Defina un tema Distribución con una descripción para distribuir a un representante de servicio.
- Cree y active un flujo de OmniCanal saliente.
- Agréguelo a la ficha Conexiones en el Agente para distribución con un mensaje de distribución.
| Agente de ayuda de Agentforce | → | Broker de agente de MuleSoft | → | Agente de facturación como servidor A2A | → | Agente logístico como servidor A2A |
| ↓ | ||||||
| Ayuda Agente obtiene respuesta | ← | Respuesta de agregados de corredor | ← | Agente de adquisiciones como servidor A2A |
| Cliente inicia chat | → | El cliente establece múltiples problemas | → | Agente investiga detalles de pedidos | → | Orchestrator llama a agentes especializados |
| ↓ | ||||||
| Orchestrator sintetiza plan de resolución | ← | Agente de aprovisionamiento encuentra un problema | ← | Agente logístico confirma error | ← | Agente de facturación encuentra discrepancia |
| ↓ | ||||||
| El agente se distribuye a representante de servicio | → | Representante de servicio ofrece resolución | → | El agente del sistema ejecuta tareas | → | El agente actualiza y cierra el caso |
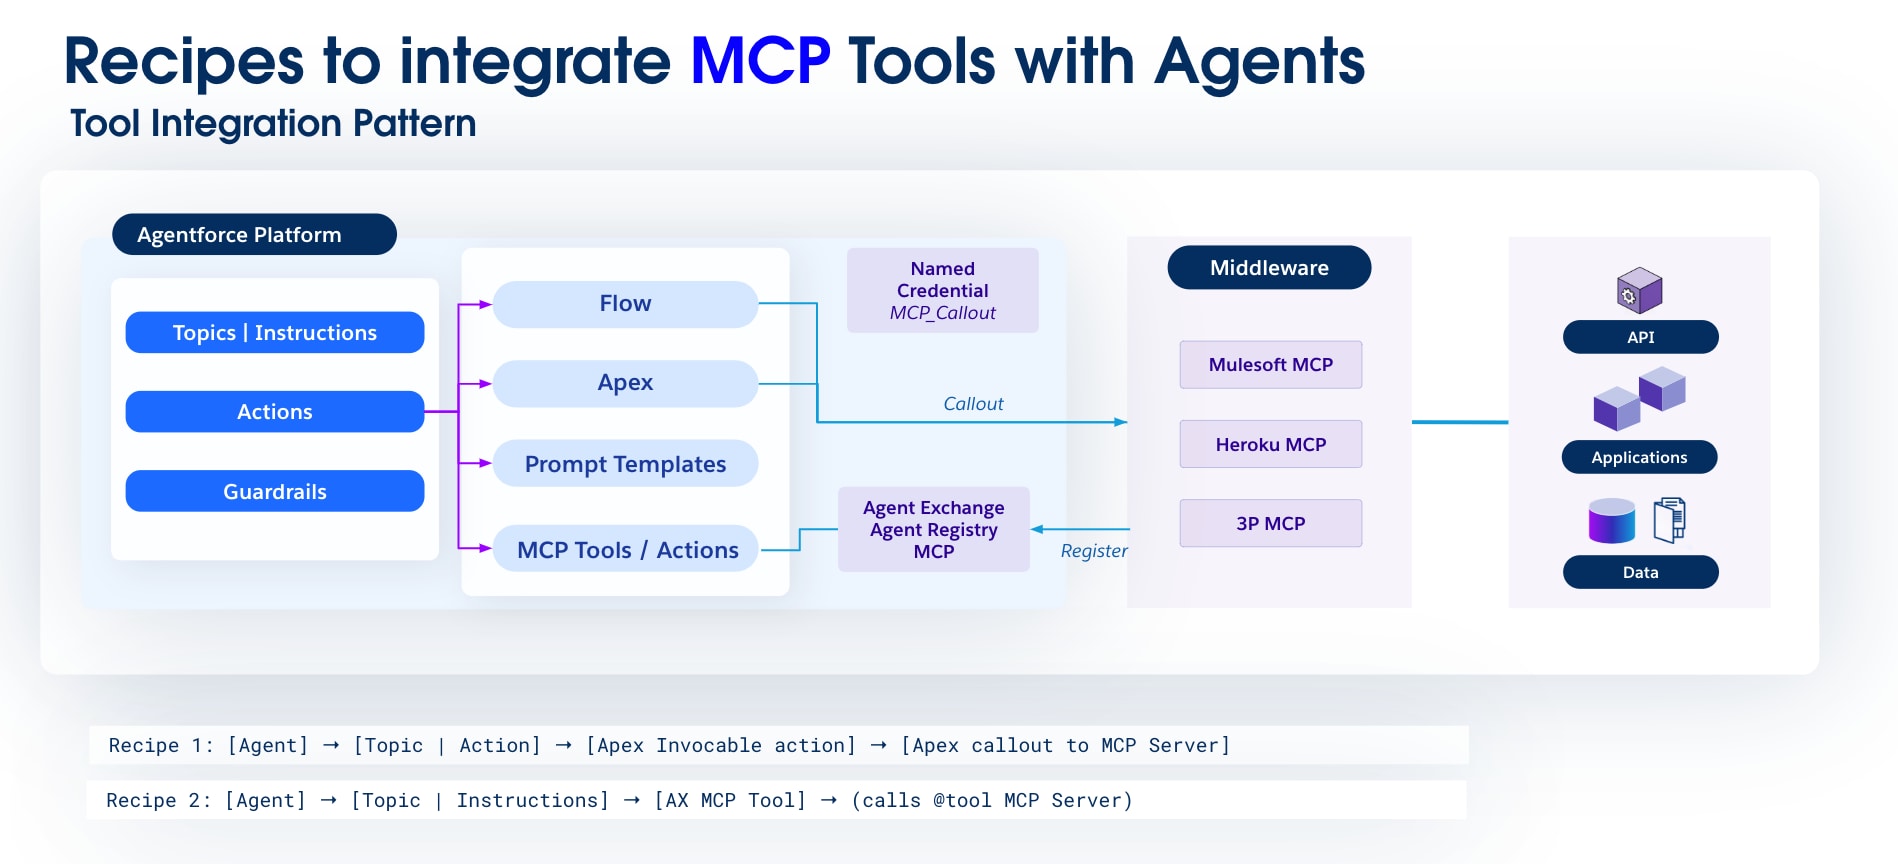 **Receta 1:** **Activación de herramientas externas con MCP**
**Problema**
Las organizaciones se ejecutan en una mezcla de sistemas ERP heredados y SaaS modernos, pero integrarlos con un agente es difícil porque no hay un protocolo común: cada herramienta tiene sus propias API, autenticación y modelo de datos. Los desarrolladores terminan creando y manteniendo conectores punto a punto personalizados para cada herramienta, produciendo integraciones frágiles, inescalables y costosas.
**Patrón**
El agente invoca una herramienta externa (expuesta a través de MCP) a través de una acción estructurada, permitiéndole utilizar herramientas especializadas más allá de la plataforma Salesforce.
**Context**
- El agente actúa como proxy para un conjunto de herramientas que existen fuera de Salesforce Platform.
- Estas herramientas externas pueden tener diversas API, mecanismos de autenticación y formatos de datos.
- Se requiere un protocolo de comunicación estandarizado para permitir una interacción sencilla entre el agente y estas herramientas externas.
- La reutilización es una preocupación clave, ya que las mismas herramientas externas pueden ser utilizadas por múltiples agentes para diferentes fines.
**Interacciones**
1. **Desencadenador:** Una solicitud de usuario o un evento interno en Agentforce requiere el uso de una herramienta externa.
2. **Intención de actuar:** Agentforce Agent identifica la intención y determina que se requiere una herramienta basada en MCP externa.
3. **Planificador (interno):** El planificador de Agentforce Agent selecciona la herramienta o acción MCP apropiada basándose en sus instrucciones configuradas y herramientas disponibles.
4. **Ejecución:** El Agentforce Agent envía una solicitud compatible con MCP al servidor MCP externo (por ejemplo, a través de una llamada Apex a un extremo MuleSoft, que luego enruta al servidor MCP externo).
5. **Procesamiento externo:** El servidor MCP externo procesa la solicitud, interactúa con la aplicación externa subyacente y prepara una respuesta compatible con MCP.
6. **Resultado**: El servidor MCP externo devuelve la respuesta al agente de Agentforce.
7. **Seguimiento:** Agentforce Agent procesa la respuesta, actualiza su estado interno y continúa su tarea o proporciona comentarios al usuario.
**Trade-offs**
| Aspecto | Ganancia | Costo |
|---|---|---|
| Flexibilidad | Acceso a diversas funciones externas | Desarrollo inicial para servidor MCP/capa de integración |
| Modularidad | Las funciones de agentes están desvinculadas de herramientas externas | Requiere un diseño y versionado cuidadosos de la API |
| Escalabilidad | Utiliza la capacidad de ampliación del sistema externo | El desempeño del sistema externo se convierte en una dependencia |
| Estandarización | Protocolo estandarizado (MCP) | Adopción y/o envoltorio |
| Seguridad | Seguridad centralizada para acceso externo | Gestión de credenciales y políticas de acceso para sistemas externos |
| Mantenibilidad | Las actualizaciones en herramientas externas no requieren cambios de agentes. MCP puede señalar cambios | Costo de cambios frecuentes |
| Aspecto | Ganancia | Costo |
|---|---|---|
| Velocidad | Una llamada de herramienta | Más gastos generales de gobernanza |
| Idempotencia y seguridad | Reintentos seguros | Implementación para dar cobertura a la deduplicación y la idempotencia |
| Escalabilidad | Puede ampliarse fácilmente | Gastos generales de conexión |
| Coherencia | Claro y explícito | Atómica |
| Seguridad | Se pueden implementar barandillas y políticas. | Gastos generales de operaciones para cambios de políticas en cascada |
| Observabilidad | La correlación y la auditoría están disponibles para su funcionamiento. | Costes de telemetría aumentados |
| Aspecto | Ganancia | Costo |
|---|---|---|
| Velocidad | Una llamada para múltiples operaciones distribuidas | Desarrollo y gastos generales operacionales |
| Idempotencia y seguridad | Reintentos seguros/compatibilidad con SAGA | Complejidad |
| Escalabilidad | Puede ampliarse fácilmente, puede ser asíncrono | Coherencia eventual para asíncrono |
| Seguridad | Políticas en capa de API | Gastos generales de operaciones para cambios de políticas en cascada |
| Observabilidad | Correlación y auditoría disponibles para el rastreo | Costes de telemetría aumentados |
| Aspecto | Ganancia | Costo |
|---|---|---|
| Movimiento de datos | Ninguna; copia cero | Calcular costo |
| Latencia | De días o semanas a tiempo casi real | SLA |
| Escalabilidad | Volumen de datos ilimitado | Calcular costo |
| Aspecto | Ganancia | Costo |
|---|---|---|
| Latencia | Disponible en segundos | Costo de computación e implementación |
| Acoplamiento | Los productores son independientes de los consumidores. | Más difícil de depurar y rastrear |
| Escalabilidad | Puede escalar | Límites |
| Pedido | Construcción de contexto incremental | Llegada fuera de pedido |
| Valor | Perspectiva casi en tiempo real | Gastos generales de gobernanza y cumplimiento |
| Aspecto | Ganancia | Costo |
|---|---|---|
| Precisión | Higher Trust (respuestas fundamentadas con cita) | Depuración e higiene de documentos |
| Retrieval | Gestiona lenguaje natural y palabras clave | Más almacenamiento, esfuerzo de ajuste |
| Seguridad | Puede aplicar acceso privilegiado | Gastos generales de tiempo de ejecución, complejidad de caché |
| Trozos | Mejor relevancia | Más preprocesamiento y ajuste |
| Versionado | Filtra Knowledge desfasado | Costos de mantenimiento y gobernanza |
| Aspecto | Ganancia | Costo |
|---|---|---|
| Precisión | Higher Trust (respuestas fundamentadas con relaciones verificables) | Armonización de datos y esfuerzo de modelado de gráficos |
| Retrieval | Gestiona consultas relacionales complejas | El desplazamiento de gráficos puede ser computacionalmente costoso para gráficos muy grandes |
| Seguridad | Puede aplicar acceso privilegiado basándose en relaciones | Gastos generales de tiempo de ejecución, control de acceso complejo |
| Profundidad de contexto | Comprensión holística y enriquecida de entidades y sus conexiones | Más preprocesamiento y ajuste para la optimización de gráficos |
| Mantenibilidad | Modelo de datos centralizado para relaciones | Alineación continua de DMO con necesidades de negocio en evolución |
| Patrones | Escenario |
|---|---|
| Invocación de proceso remoto: Solicitud y respuesta | Salesforce invoca un proceso en un sistema remoto, espera la finalización de ese proceso y luego realiza un seguimiento del estado basándose en la respuesta del sistema remoto. |
| Invocación de procesos remotos: Disparar y olvidar | Salesforce invoca un proceso en un sistema remoto pero no espera a la finalización del proceso. En su lugar, el proceso remoto recibe y confirma la solicitud y luego devuelve el control a Salesforce. |
| Sincronización de datos por lotes | Los datos almacenados en Lightning Platform se crean o actualizan para reflejar actualizaciones desde un sistema externo, y cuando se envían cambios desde Lightning Platform a un sistema externo. Las actualizaciones en cualquier dirección se realizan de forma por lotes. |
| Llamada remota | Los datos almacenados en Salesforce Platform se crean, recuperan, actualizan o eliminan por un sistema remoto. |
| Actualización de interfaz de usuario basada en cambios de datos | La interfaz de usuario de Salesforce debe actualizarse automáticamente como resultado de cambios en datos de Salesforce. |
| Virtualización de datos | Salesforce accede a datos externos en tiempo real. Esto elimina la necesidad de mantener los datos en Salesforce y luego conciliar los datos entre Salesforce y el sistema externo. |
| Aspecto | Descripción |
|---|---|
| Tipo | Especifica el estilo de integración: Proceso, Datos o Virtual.
|
| Cronología | Especifica el estilo de integración: Proceso, Datos o Virtual.
|
| Tipo | Cronología | Patrón clave a tener en cuenta |
|---|---|---|
| Integración de procesos | Síncrono | Invocación de proceso remoto: Solicitud y respuesta |
| Integración de procesos | Asíncrono | Invocación de procesos remotos: Disparar y olvidar |
| Integración de datos | Síncrono | Invocación de proceso remoto: Solicitud y respuesta |
| Integración de datos | Asíncrono | Actualización de interfaz de usuario basada en cambios de datos |
| Integración virtual | Síncrono | Virtualización de datos |
| Tipo | Cronología | Patrón clave a tener en cuenta |
|---|---|---|
| Integración de procesos | Síncrono | Llamada remota |
| Integración de procesos | Asíncrono | Llamada remota |
| Integración de datos | Síncrono | Llamada remota |
| Integración de datos | Asíncrono | Sincronización de datos por lotes |
| Plazo | Definición |
|---|---|
| Gestión de eventos | La gestión de eventos es la recepción de una incidencia identificable en un receptor designado (“controlador”). Los procesos clave implicados en la gestión de eventos incluyen:
Recuerde que el controlador de eventos puede en última instancia reenviar el evento a un consumidor de eventos. Los usos comunes de esta función con middleware pueden ampliarse para incluir la popular función “publish/subscribe” o “pub/sub”. En un escenario de publicación/suscripción, el middleware enruta solicitudes o mensajes a suscriptores de eventos de datos activos desde publicadores de eventos de datos activos. Estos consumidores con oyentes activos pueden recuperar los eventos a medida que se publican. En integraciones de Salesforce que utilizan middleware, la capa de middleware asume el control de la gestión de eventos. Recopila todos los eventos relevantes, síncronos o asíncronos, y gestiona la distribución a todos los extremos, incluyendo Salesforce. De manera alternativa, esta función se puede lograr con la plataforma de mensajería de compañía Salesforce utilizando el bus de eventos con eventos de plataforma. |
| Conversión de protocolo | La conversión de protocolos es normalmente una aplicación de software que convierte el protocolo estándar o propietario de un dispositivo en el protocolo adecuado para que otro dispositivo alcance la interoperabilidad. En el contexto del middleware, la conectividad a un sistema de destino concreto puede estar restringida por el protocolo. En estos casos, el formato del mensaje debe convertirse o encapsularse en el formato del sistema de destino, donde se puede extraer la carga. Esto también se conoce como tunelización. Salesforce no admite la conversión de protocolos nativos, por lo que se supone que la capa de middleware o el extremo cumplen cualquiera de estos requisitos. |
| Traducción y transformación | La transformación es la capacidad de asignar un formato de datos a otro para garantizar la interoperabilidad entre los diversos sistemas que se están integrando. Habitualmente, el proceso implica dar nuevo formato a mensajes en ruta para coincidir con los requisitos del remitente o destinatario. En casos más complejos, una aplicación puede enviar un mensaje en su propio formato nativo, y otras dos o más aplicaciones pueden recibir una copia del mensaje en su propio formato nativo. Las herramientas de transformación y traducción de middleware a menudo incluyen la capacidad de crear fachadas de servicio para extremos heredados u otros no estándar. Estas fachadas de servicio permiten que esos extremos aparezcan como direccionables por servicio. Con integraciones de Salesforce, se asume que cualquiera de estos requisitos se cumple por la capa de middleware o el extremo. La transformación de datos se puede codificar en Apex, pero no se recomienda debido a consideraciones de mantenimiento y desempeño. |
| Colocación en cola y almacenamiento intermedio | La colocación en cola y el almacenamiento en búfer generalmente se basan en el paso de mensajes asíncronos, en contraposición a una arquitectura de solicitud-respuesta. En sistemas asíncronos, las colas de mensajes proporcionan almacenamiento temporal cuando el programa de destino está ocupado o la conectividad está comprometida. Además, la mayoría de los sistemas de middleware asíncronos proporcionan almacenamiento persistente para realizar una copia de seguridad de la cola de mensajes. El beneficio clave de un proceso de mensajes asíncronos es que si la aplicación del receptor falla por cualquier motivo, los remitentes pueden continuar sin verse afectados. Los mensajes enviados simplemente se acumulan en la cola de mensajes para su posterior procesamiento cuando se reinicia el receptor. Salesforce solo proporciona capacidad de colocación en cola explícita en forma de mensajería saliente basada en flujo de trabajo. Para proporcionar colas de mensajes verdaderas para otros escenarios de integración, incluyendo orquestación, coreografía de procesos y calidad de servicio, se requiere una solución de middleware. |
| Protocolos de transporte síncronos | Los protocolos de transporte síncronos hacen referencia a protocolos que admiten actividades en las que un “único hilo en el llamante envía el mensaje de solicitud, bloquea la espera del mensaje de respuesta y luego procesa la respuesta....El hilo de solicitud que espera la respuesta implica que solo hay una solicitud pendiente o que el canal de respuesta para esta solicitud es privado para este hilo”. |
| Protocolos de transporte asíncronos | Los protocolos de transporte asíncronos hacen referencia a protocolos que admiten actividades en las que “un hilo de la persona que llama envía el mensaje de solicitud y configura una devolución de llamada para la respuesta. Un hilo separado escucha los mensajes de respuesta. Cuando llega un mensaje de respuesta, el hilo de respuesta invoca la devolución de llamada apropiada, que restablece el contexto de la persona que llama y procesa la respuesta. Este enfoque permite múltiples solicitudes pendientes para compartir un único hilo de respuesta.” |
| Enrutamiento de mediación | El enrutamiento de mediación es la especificación de un “flujo” complejo de mensajes de componente a componente. Por ejemplo, muchas soluciones basadas en middleware dependen de un sistema de colas de mensajes. Aunque algunas implementaciones permiten proporcionar lógica de enrutamiento por la propia capa de mensajería, otras dependen de aplicaciones cliente para proporcionar información de enrutamiento o permitir una mezcla de ambos paradigmas. En casos tan complejos, la mediación por parte del middleware simplifica el desarrollo, la integración y la validación. coordinador [Mediador] podría asegurarse de que el mensaje correcto llega al consumidor correcto”. |
| Coreografía de procesos y orquestación de servicios | La coreografía de procesos y la orquestación de servicios son formas de “composición de servicio” donde se están coordinando cualquier número de extremos y funciones.
La diferencia entre coreografía y orquestación de servicio es:
Partes de las coreografías de procesos de negocio se pueden crear en flujos de trabajo de Salesforce o utilizando Apex. Recomendamos que todas las orquestaciones complejas se implementen en la capa de middleware debido a los valores de tiempo de espera de Salesforce y los límites reguladores, especialmente en soluciones que requieren una verdadera gestión de transacciones. |
| Transaccionalidad (cifrado, firma, entrega fiable, gestión de transacciones) | La transaccionalidad se puede definir como la capacidad de admitir transacciones globales que abarcan todas las operaciones necesarias en cada recurso requerido. La transaccionalidad implica el soporte de las cuatro propiedades ACID, atomicidad, consistencia, aislamiento, durabilidad, donde la atomicidad garantiza resultados de todo o nada para la unidad de trabajo (transacción).
Aunque Salesforce es transaccional dentro de sí mismo, no puede participar en transacciones distribuidas o transacciones iniciadas fuera de Salesforce. Por lo tanto, se asume que para soluciones que requieren transacciones complejas y multisistema, la transaccionalidad y los mecanismos de reversión/compensación asociados se implementan en la capa de middleware. |
| Enrutamiento | El enrutamiento se puede definir como la especificación del flujo complejo de mensajes de componente a componente. En soluciones basadas en servicios modernas, dichos flujos de mensajes pueden basarse en una serie de criterios, incluyendo encabezado, tipo de contenido, regla y prioridad.
Con integraciones de Salesforce, se asume que cualquiera de estos requisitos se cumple por la capa de middleware o el extremo. El enrutamiento de mensajes puede codificarse en Apex, pero no lo recomendamos debido a consideraciones de mantenimiento y desempeño. |
| Extraer, transformar y cargar | Extraer, transformar y cargar (ETL) hace referencia a un proceso que implica:
Salesforce ahora también admite Captura de datos de cambios, que es la publicación de eventos de cambio que representan cambios en registros de Salesforce. Con Captura de datos de cambios, el sistema cliente o externo recibe cambios casi en tiempo real de registros de Salesforce. Con esta información, el cliente o el sistema externo puede sincronizar registros correspondientes en un almacén de datos externo. |
| Sondeo largo | Sondeo largo, también denominado programación Comet, emula un envío de información desde un servidor a un cliente. Al igual que un sondeo normal, el cliente conecta y solicita información al servidor. Sin embargo, en vez de enviar una respuesta vacía si la información no está disponible, el servidor mantiene la solicitud y espera hasta que la información esté disponible (se produce un evento). El servidor envía a continuación una respuesta completa al cliente. El cliente vuelve a solicitar información inmediatamente. El cliente mantiene continuamente una conexión con el servidor, de modo que siempre está esperando recibir una respuesta. Si se agota el tiempo de espera del servidor, el cliente se conecta de nuevo y comienza de nuevo. La API de transmisión de Salesforce utiliza el protocolo Bayeux y CometD para sondeos largos.
|
| Solución | Ajuste | Comentarios |
|---|---|---|
| Servicios externos invoca una llamada de API de REST | Mejor | Servicios externos le permite invocar un servicio alojado de forma externa de forma declarativa (no se requiere código). Esta función se utiliza mejor cuando se cumplen las siguientes condiciones:
|
| Salesforce Lightning: El componente o la página Lightning inicia una llamada de REST o SOAP de Apex síncrona.</ Si el extremo remoto supone un riesgo de respuesta de alta latencia (consulte la documentación de límites más recientes para los límites aplicables aquí), se recomienda una llamada asíncrona, también llamada continuación, para evitar alcanzar límites reguladores de transacciones Apex síncronos. |
Mejor | Salesforce le permite consumir un WSDL y generar una clase Apex proxy resultante. Esta clase proporciona la lógica necesaria para llamar al servicio remoto. Salesforce también le permite invocar servicios HTTP (REST) utilizando métodos GET, POST, PUT y DELETE estándar. Una acción iniciada por el usuario en una página Lightning luego llama a una acción del controlador Apex que luego ejecuta esta clase Apex proxy para realizar la llamada remota. Las páginas Lightning requieren la personalización de la aplicación Salesforce. |
| Un desencadenador síncrono invocado desde cambios de datos de Salesforce realiza una llamada asíncrona de SOAP Apex o HTTP. | Suboptimal | Puede utilizar desencadenadores Apex para realizar la automatización basándose en cambios de datos de registro. Se puede ejecutar una clase de proxy Apex como resultado de una operación DML utilizando un desencadenador Apex. Sin embargo, todas las llamadas realizadas desde el contexto del desencadenador deben ejecutarse de forma asíncrona desde el evento que inicia. Por lo tanto, no se recomienda esta solución para este problema de integración. Esta solución se adapta mejor al patrón Invocación de proceso remoto: Disparar y olvidar. |
| Un trabajo Apex por lotes realiza una llamada síncrona SOAP o HTTP de Apex. | Suboptimal | Puede realizar llamadas a un sistema remoto desde un trabajo por lotes. Esta solución permite la ejecución de procesos remotos por lotes y el procesamiento de la respuesta desde el sistema remoto en Salesforce. Sin embargo, un lote concreto tiene límites en el número de llamadas. Para obtener más información, consulte Límites reguladores. Una ejecución por lotes determinada puede ejecutar múltiples contextos de transacciones (normalmente en intervalos de 200 registros). Los límites reguladores se restablecen por contexto de transacción. |
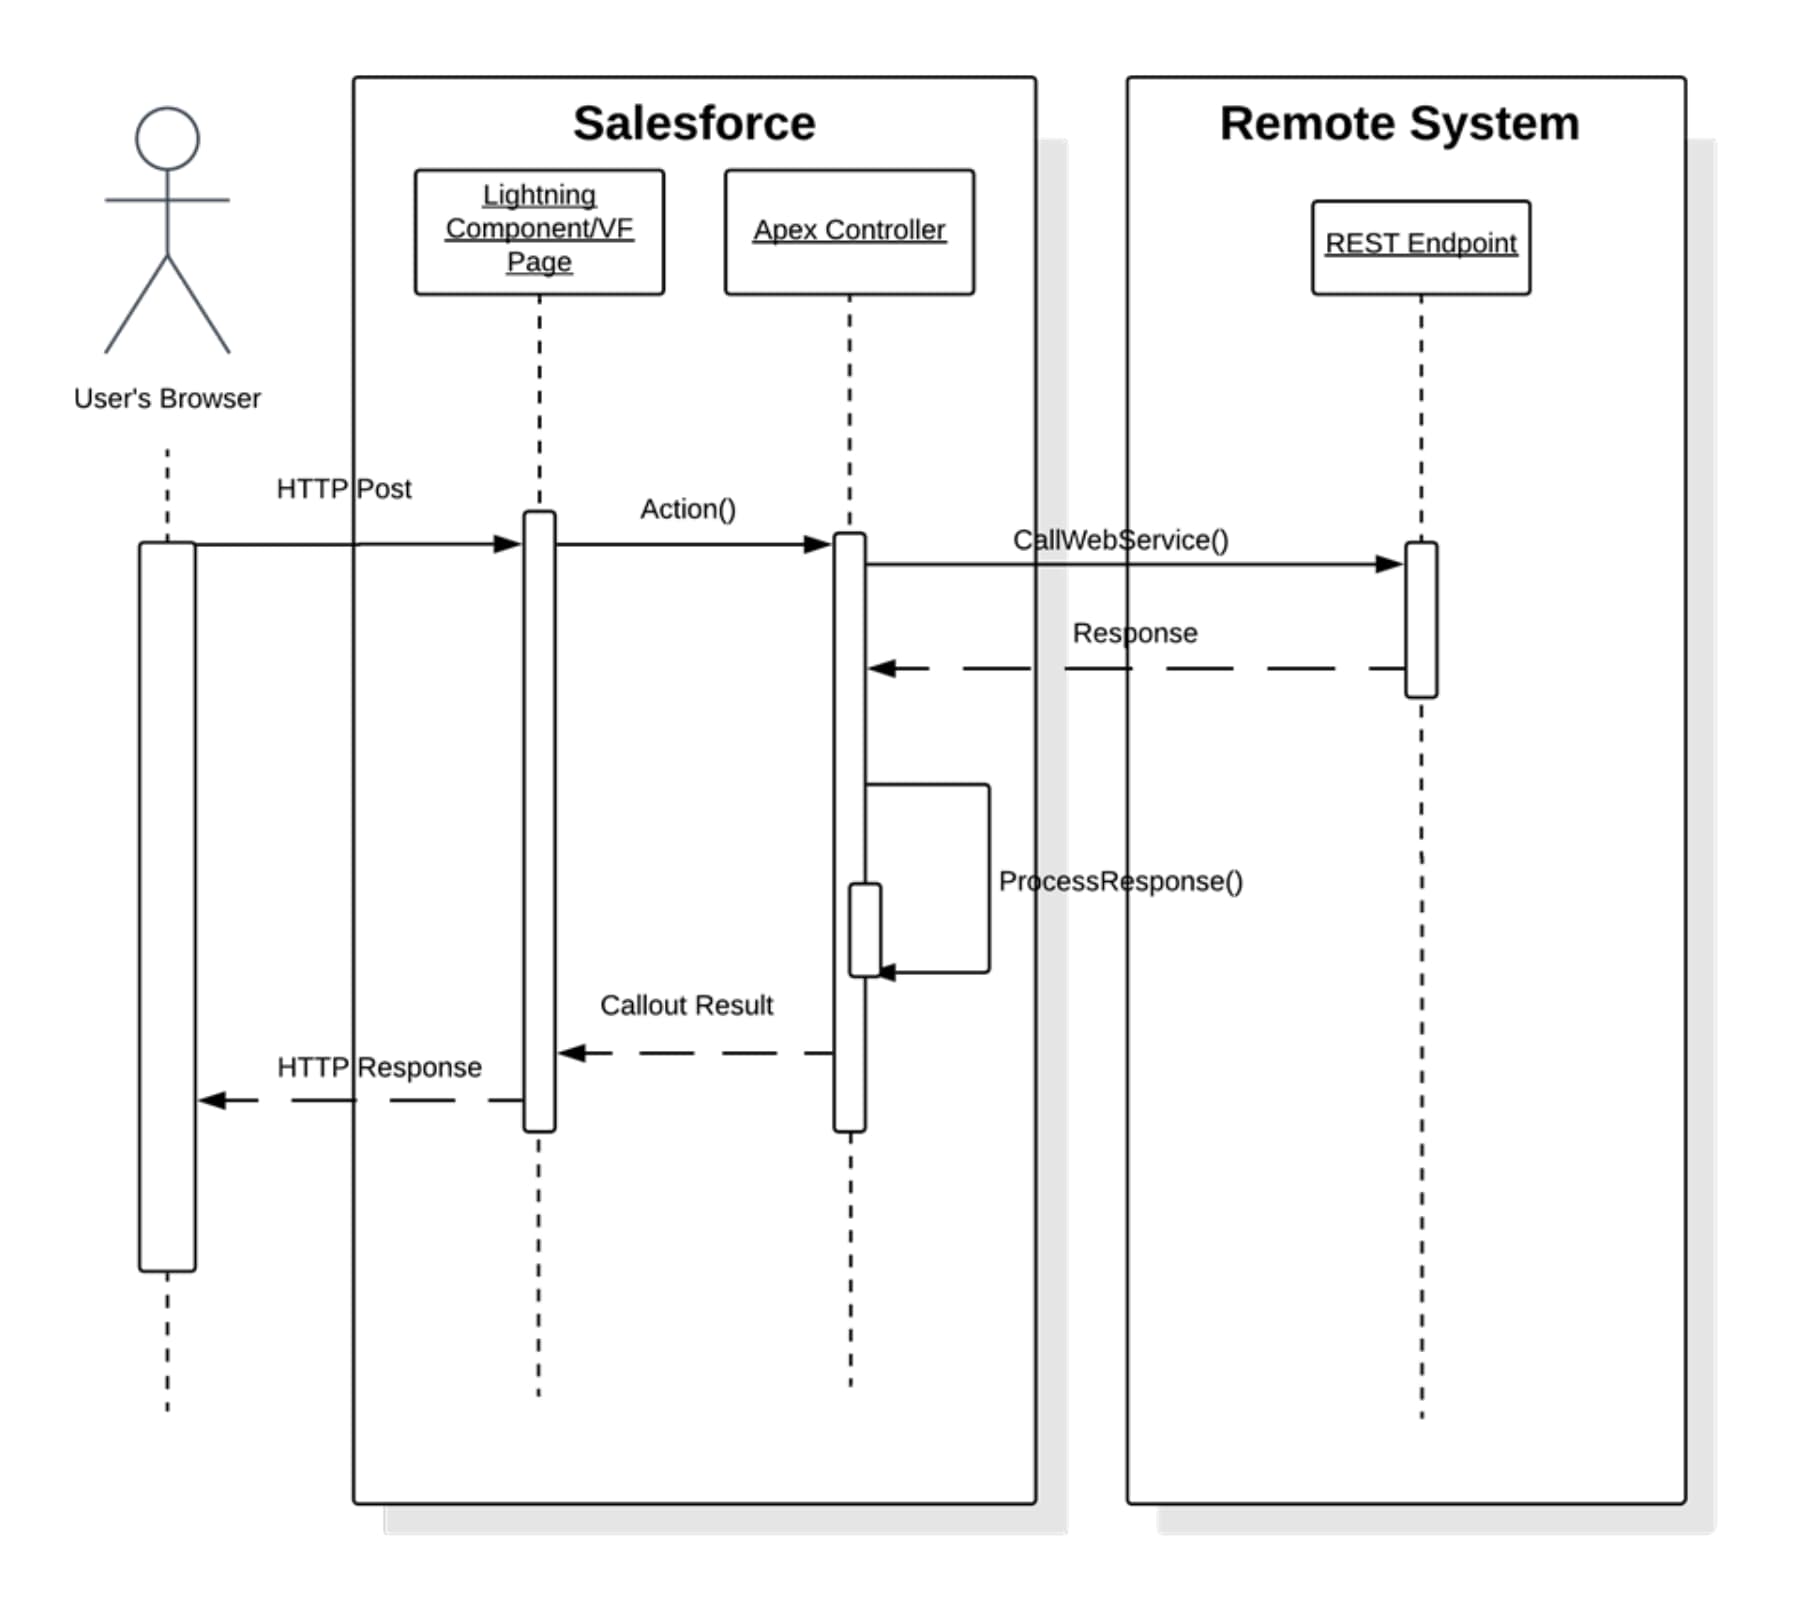 Diagrama de descarga
En este escenario: - Se inicia una acción en la página Lightning (por ejemplo, un clic de botón). - El navegador (a través de un controlador del lado del cliente en el caso de un componente Lightning) realiza una POST HTTP que a su vez realiza una acción en el controlador Apex correspondiente. - El controlador invoca la llamada real al servicio web remoto. - La respuesta del sistema remoto se devuelve al controlador de Apex. El controlador procesa la respuesta, actualiza los datos en Salesforce según sea necesario y vuelve a representar la página. En casos donde se debe realizar un seguimiento del estado posterior, el sistema remoto devuelve un identificador exclusivo almacenado en el registro de Salesforce. **Resultados** La aplicación de las soluciones relacionadas con este patrón permite invocaciones de procesos remotos iniciados por eventos en los que Salesforce gestiona el procesamiento. **Mecanismos de llamadas** El mecanismo de llamada depende de la solución elegida para implementar este patrón.
| Mecanismo de llamada | Descripción |
|---|---|
| Servicio externo mejorado integrado en un flujo o Componente Lightning o Controladores Apex |
Se utiliza cuando el proceso remoto se desencadena como parte de un proceso de extremo a extremo que implica la interfaz de usuario, y el resultado debe mostrarse o actualizarse en un registro de Salesforce. Por ejemplo, el envío de un pago con tarjeta de crédito a una pasarela de pago externa y los resultados del pago se devuelven inmediatamente y se muestran al usuario. |
| Desencadenadores Apex | Se utiliza principalmente para la invocación de procesos remotos utilizando llamadas Apex desde eventos iniciados por DML. Para obtener más información acerca de este mecanismo de llamada, consulte patrón Invocación de proceso remoto: Disparar y olvidar. |
| Clases por lotes Apex | Se utiliza para la invocación de procesos remotos por lotes. Para obtener más información acerca de este mecanismo de llamada, consulte patrón Invocación de proceso remoto: Disparar y olvidar. |
| Solución | Consideraciones sobre los extremos |
|---|---|
| Llamadas HTTP Apex | El extremo debe poder recibir llamadas HTTP. Salesforce debe poder acceder al extremo a través de Internet pública. Para comunicaciones privadas y seguras, Salesforce ahora también ha comenzado a admitir Salesforce Private connect a través de Hyperforce Platform de forma segura. Consulte Salesforce Private Connect para obtener más detalles.
Puede utilizar llamadas HTTP Apex para llamar a servicios de REST utilizando los métodos GET, POST, PUT, DELETE y PATCH estándar. |
| Llamadas de SOAP Apex | El extremo debe poder recibir llamadas HTTP. Salesforce debe poder acceder al extremo a través de Internet pública. Para comunicaciones privadas y seguras, Salesforce ahora también ha comenzado a admitir Salesforce Private connect a través de Hyperforce Platform de forma segura. Consulte Salesforce Private Connect para obtener más detalles.
Esta solución requiere que el sistema remoto sea compatible con los estándares admitidos por Salesforce. En el momento de redactar este artículo, los estándares de servicio web admitidos por llamadas de SOAP de Salesforce for Apex son:
|
- Salesforce almacena la clave de sustitución principal o exclusiva del sistema remoto para el registro remoto.
- El sistema remoto almacena el Id. de registro exclusivo de Salesforce o alguna otra clave sustitutiva exclusiva.
| Principal | Sistema Descripción |
|---|---|
| Salesforce | El sistema remoto almacena el RecordId de Salesforce o alguna otra clave sustitutiva exclusiva del registro. |
| Sistema remoto | La llamada al proceso remoto devuelve la clave exclusiva de la aplicación, y Salesforce almacena ese valor de clave en un campo de registro exclusivo. |
- Orquestación de procesos de negocio y reglas que implican lógica de flujo compleja
- Agregación de llamadas y sus resultados entre llamadas a múltiples sistemas
- Transformación de mensajes entrantes y salientes
- Mantenimiento de la integridad de las transacciones entre llamadas a múltiples sistemas
| Propiedad | Obligatorio | Deseable | No se requiere |
|---|---|---|---|
| Gestión de eventos | X | ||
| Conversión de protocolo | X | ||
| Traducción y transformación | X | ||
| Colocación en cola y almacenamiento intermedio | X | ||
| Protocolos de transporte síncronos | X | ||
| Protocolos de transporte asíncronos | X | ||
| Enrutamiento de mediación | X | ||
| Coreografía de procesos y orquestación de servicios | X | ||
| Transaccionalidad (cifrado, firma, entrega fiable, gestión de transacciones) | X | ||
| Enrutamiento | X | ||
| Extraer, transformar y cargar | X | ||
| sondeo largo | X |
- Salesforce consume el servicio de cuenta de facturación WSDL desde una clase proxy Apex.
- Ejecute la clase de proxy Apex con la información del cliente pasada al servicio web externo desde un controlador Apex personalizado o servicio externo.
- A continuación, el controlador personalizado analiza los valores de devolución de la llamada de Apex y almacena esa información en el objeto de salesforce.
- Se realiza un seguimiento del estado del cliente con un número de cuenta almacenado en el objeto de cuenta de Salesforce.
- Procesamiento posterior del mensaje de respuesta por el llamante
- ¿Requiere la llamada al sistema remoto que Salesforce espere una respuesta antes de continuar el procesamiento? ¿La llamada al sistema remoto es síncrona o asíncrona?
- Si la llamada al sistema remoto es síncrona, ¿necesita Salesforce procesar la respuesta como parte de la misma transacción que la llamada?
- ¿El tamaño del mensaje es pequeño?
- ¿Se basa la integración en la aparición de un evento específico, como un clic de botón en la interfaz de usuario de Salesforce o eventos basados en DML?
- ¿Es un requisito la entrega de mensajes garantizada desde Salesforce al sistema remoto?
- ¿Puede el sistema remoto participar en una integración de contrato primero en la que Salesforce especifica el contrato? En algunas variantes de solución (por ejemplo, mensajería saliente), Salesforce especifica un contrato que implementa el extremo del sistema remoto.
- ¿El extremo o el Bus de servicio de compañía (ESB) admiten sondeos largos?
- ¿Se prefieren los métodos de configuración declarativa al desarrollo Apex personalizado? En este caso, se prefieren soluciones como eventos de plataforma a llamadas Apex.
| Solución | Ajuste | Comentarios |
|---|---|---|
| Eventos de plataforma dirigidos por flujos | Mejor | Cree flujos de forma declarativa para implementar eventos de plataforma. La solución recomendada es cuando se invoca el proceso remoto desde un evento de inserción o actualización. Los eventos de plataforma son los mensajes de eventos (o notificaciones) que sus aplicaciones envían y reciben para realizar más acciones. Los eventos de plataforma simplifican el proceso de comunicar cambios y responder a ellos sin redactar lógica compleja. Uno o más suscriptores pueden escuchar el mismo evento y realizar acciones. Por ejemplo, un sistema de software puede enviar eventos que contienen información acerca de cartuchos de tinta de impresora. Los suscriptores pueden suscribirse a los eventos para monitorear los niveles de tinta de la impresora y realizar pedidos para sustituir cartuchos con niveles de tinta bajos. Las aplicaciones externas pueden escuchar mensajes de eventos suscribiéndose a un canal a través de CometD. Las aplicaciones de plataforma, como componentes Lightning, también pueden suscribirse a mensajes de eventos con CometD. La API de PubSub de Salesforce que se basa en gRPC y HTTP/2 también se puede utilizar aquí. Salesforce también admite Flujos desencadenados por eventos de plataforma, lo que permite de forma efectiva crear un oyente utilizando la interfaz de Flow Builder. Este tipo de flujo se inicia automáticamente cuando se publica un mensaje de evento de plataforma específico en el Bus de eventos de Salesforce. |
| API Pub/Sub | Mejor | La API Pub/Sub es la forma recomendada para que los consumidores externos consuman los eventos en el Bus de eventos. La API Pub/Sub basada en gRPC :
Una vez definido un evento de plataforma en Salesforce, queda disponible para consumidores internos y externos. |
| Captura de datos de cambios | Mejor | Captura de datos de cambios (CDC) publica eventos para cambios en registros de Salesforce correspondientes a operaciones de creación, actualización, eliminación y anulación de eliminación. Activar Captura de datos de cambios (CDC) en Salesforce es un proceso puramente declarativo, que no requiere código Apex. Los mensajes de notificación se envían al bus de eventos al que los clientes pueden suscribirse utilizando desencadenadores de Apex o API Pub/Sub. Los sistemas dirigidos por eventos simplifican la comunicación entre sistemas de compañía distribuidos, aumentan la capacidad de ampliación y entregan datos en tiempo real. Por ejemplo, si la información de pedidos reside en su sistema ERP y Salesforce, puede transmitir eventos de cambio de pedidos desde Salesforce a una aplicación de integración. La aplicación sincroniza a continuación los cambios en el sistema ERP |
| Procedimientos de integración de OmniStudio | Bien | Utilice procedimientos de integración de OmniStudio para automatizar de forma declarativa interacciones de datos entre Salesforce y aplicaciones externas externas. Los procedimientos de integración gestionan transformaciones de datos complejas, llamadas de API y automatización dirigida por eventos, y pueden ejecutar múltiples acciones en una sola llamada de servidor. Utilice Procedimientos de integración cuando no se requiere interacción de usuario durante la ejecución y desea:
Consulte más detalles sobre Procedimientos de integración aquí. |
| Eventos de plataforma dirigidos por personalización | Bien | Similar a eventos de plataforma dirigidos por flujo, pero los eventos se crean por desencadenadores o clases Apex. Puede publicar y consumir eventos de plataforma utilizando Apex o una API. Los eventos de plataforma se integran con la plataforma Salesforce a través de desencadenadores Apex. Los desencadenadores son los consumidores de eventos en Salesforce Platform que escuchan mensajes de eventos. Cuando una aplicación externa utiliza la API o una aplicación nativa de Salesforce utiliza Apex para publicar el mensaje del evento, se desencadena un desencadenador en ese evento. Los desencadenadores ejecutan las acciones en respuesta a las notificaciones de eventos. |
| Mensajería saliente dirigida por flujo | Ajuste | La solución recomendada para este tipo de integración es cuando se invoca el proceso remoto desde un evento de inserción o actualización. Salesforce proporciona una función de mensajería saliente dirigida por flujo que permite enviar mensajes SOAP a sistemas remotos desencadenados por una operación de inserción o actualización en Salesforce. Estos mensajes se envían de forma asíncrona y son independientes de la interfaz de usuario de Salesforce. El mensaje saliente se envía a un extremo remoto específico. El servicio remoto debe poder participar en una integración de contrato primero donde Salesforce proporciona el contrato. Al recibir el mensaje, si el servicio remoto no responde con un acuse de recibo positivo, Salesforce reintenta enviar el mensaje, proporcionando una forma de entrega garantizada. |
| Componente Lightning personalizado que inicia una llamada asíncrona HTTP o SOAP de Apex | Suboptimal | Esta solución se utiliza habitualmente en escenarios basados en la interfaz de usuario, pero requiere personalización. Además, la solución debe gestionar la entrega garantizada del mensaje en el código. Similar a la solución para la solución de patrón Remote Process Invocation: Request and Reply que especifica el uso de un componente Lightning, junto con una llamada Apex. La diferencia es que en este patrón, Salesforce no espera a que se complete la solicitud antes de traspasar el control al usuario. Tras recibir el mensaje, el sistema remoto responde e indica la recepción del mensaje, luego procesa el mensaje de forma asíncrona. El sistema remoto devuelve el control a Salesforce antes de que comience a procesar el mensaje; por lo tanto, Salesforce no tiene que esperar a que se complete el procesamiento. |
| Apex desencadena la llamada asíncrona SOAP o HTTP de Apex | Suboptimal | Puede utilizar desencadenadores Apex para realizar la automatización basándose en cambios de datos de registro. Se puede ejecutar una clase de proxy Apex como resultado de una operación DML utilizando un desencadenador Apex. Sin embargo, todas las llamadas realizadas desde el contexto del desencadenador deben ejecutarse de forma asíncrona. |
| Apex desencadena la llamada asíncrona SOAP o HTTP de Apex | Suboptimal | Las llamadas a un sistema remoto se pueden realizar desde un trabajo por lotes. Esta solución permite la ejecución de procesos remotos por lotes y el procesamiento de la respuesta desde el sistema remoto en Salesforce. Sin embargo, existen límites en el número de llamadas para un contexto por lotes concreto. Para obtener más información, consulte la Referencia rápida Límites y asignaciones de desarrollador de Salesforce.
|
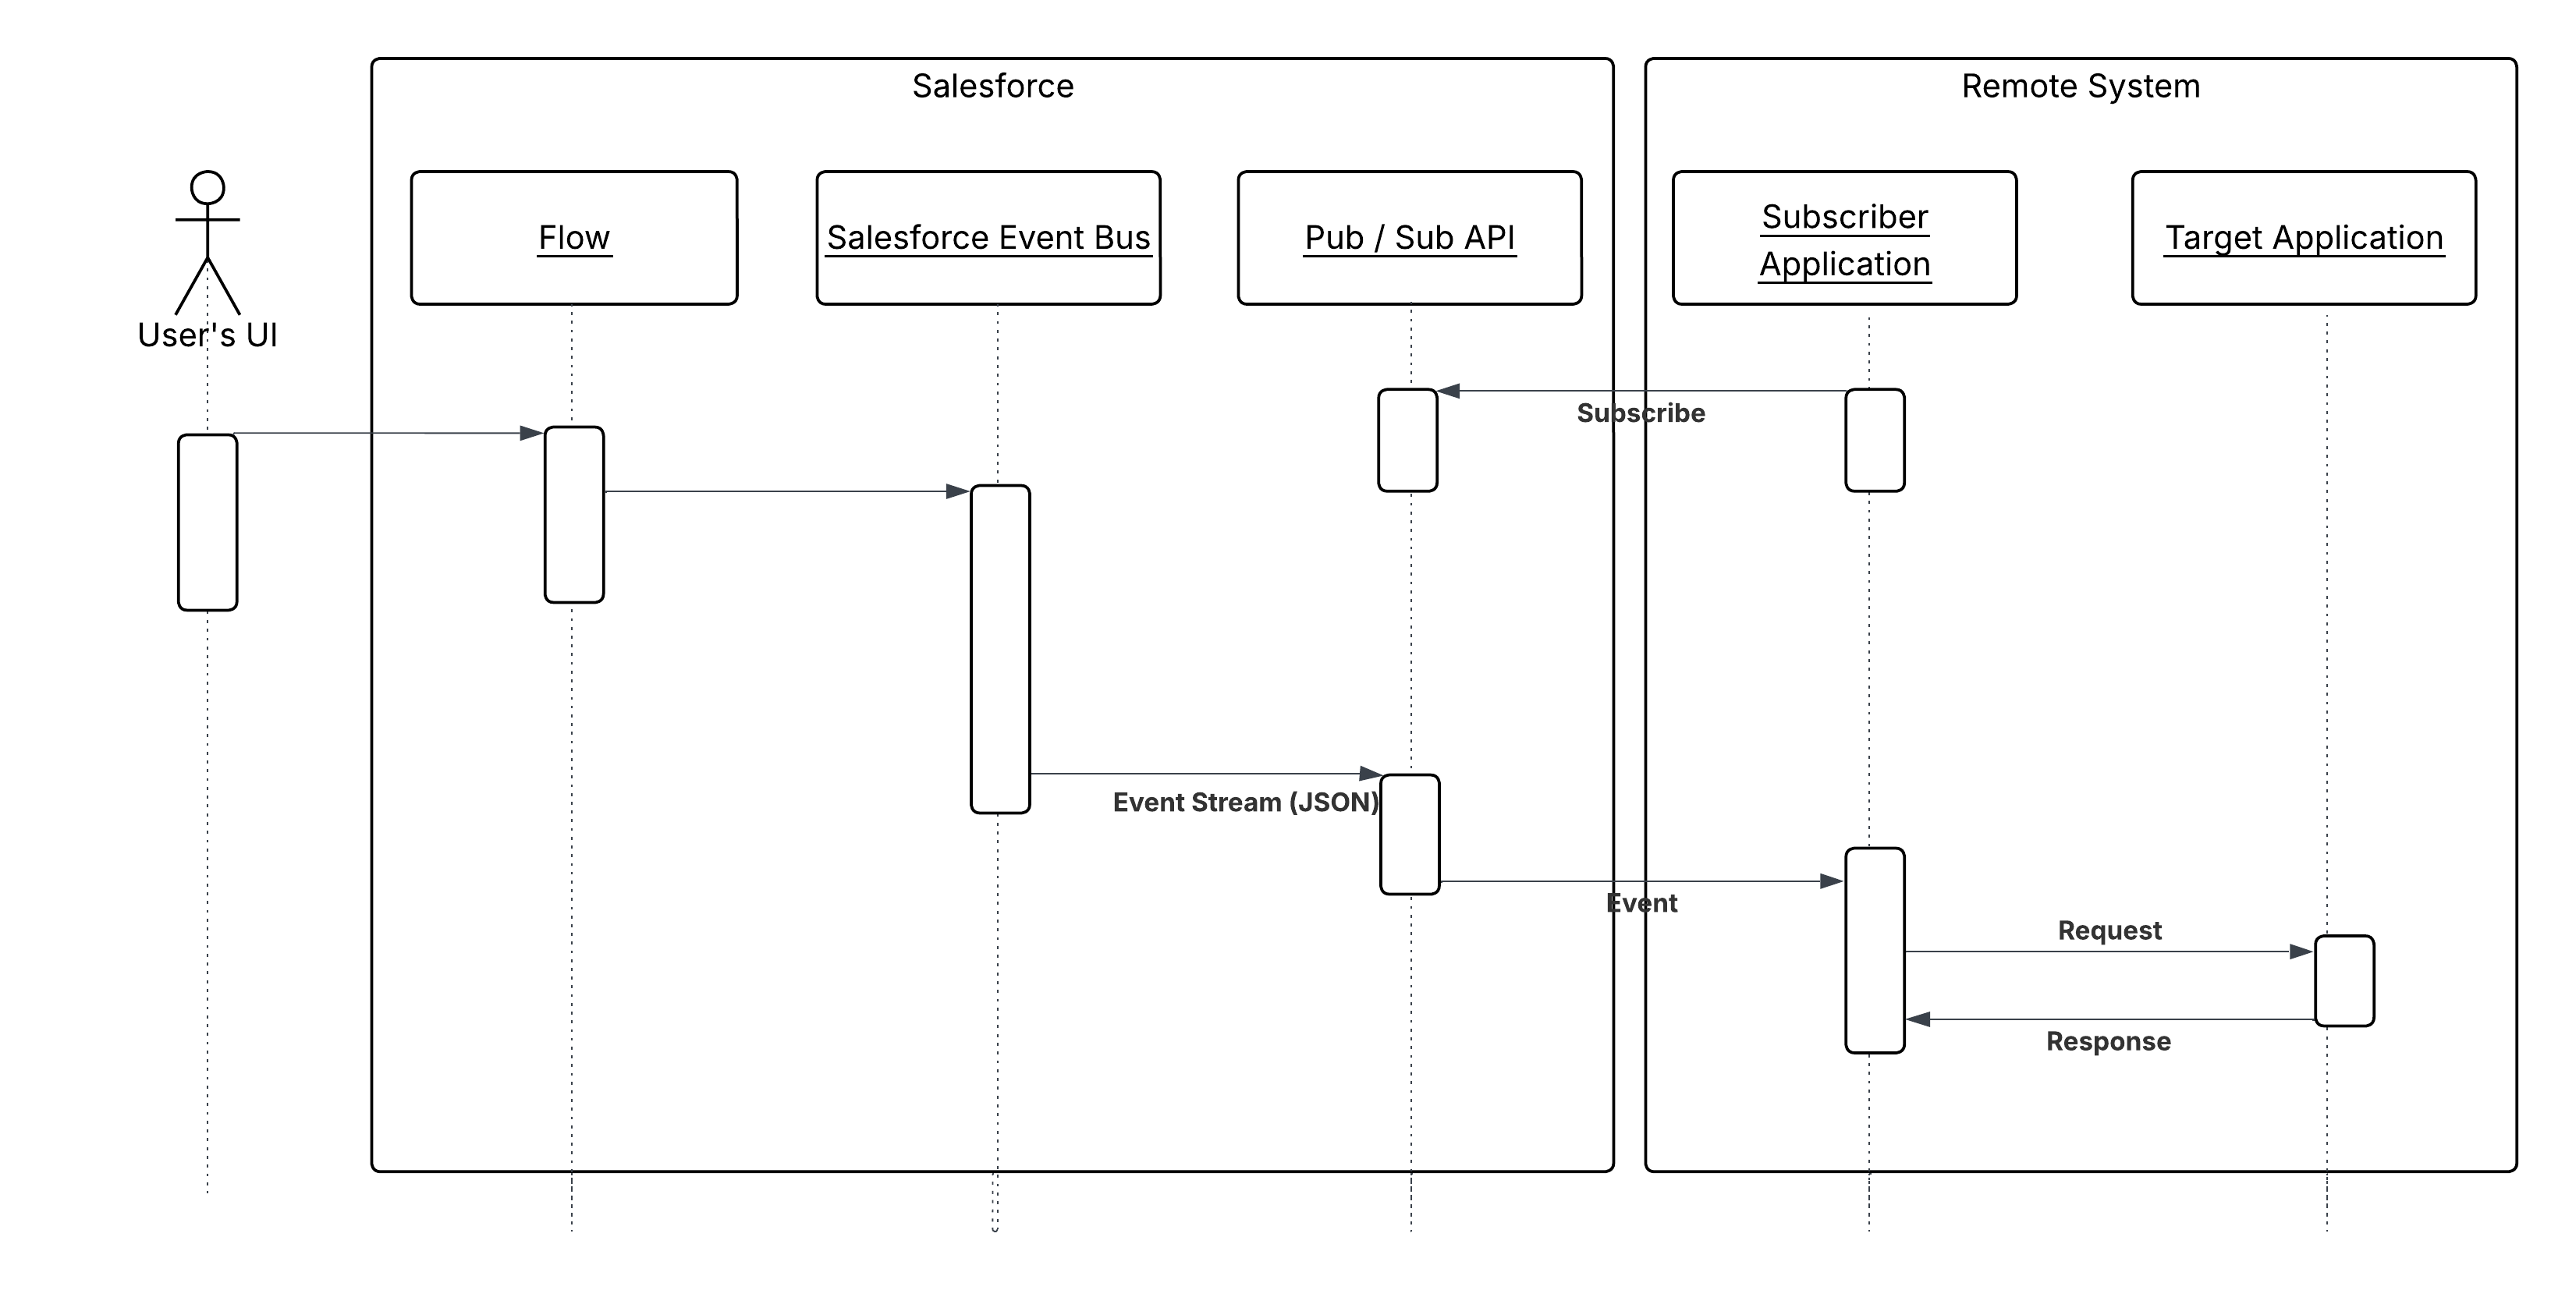 Diagrama de descarga
En este escenario:
- Un sistema remoto se suscribe al evento de plataforma.
- Se produce una actualización o inserción en un conjunto concreto de registros en Salesforce.
- Un flujo de Salesforce se desencadena cuando se cumple un conjunto de condiciones.
- Este flujo crea un evento de plataforma.
- El oyente remoto recibe el mensaje del evento y coloca el mensaje en una cola local.
- La aplicación en cola reenvía el mensaje a la aplicación remota para su procesamiento.
- Invocaciones de procesos remotos iniciadas por la interfaz de usuario en las que el resultado de la transacción puede mostrarse al usuario final
- Invocaciones de procesos remotos iniciados por eventos DML en las que el resultado de la transacción puede procesarse por el proceso de llamada
| Mecanismo de llamada | Descripción |
|---|---|
| Flujo | Utilizado por las soluciones dirigidas por procesos y por personalización. Los eventos desencadenan el proceso de Salesforce, que luego puede publicar un evento de plataforma para su suscripción por un sistema remoto. |
| API Pub / Sub | API Pub/Sub proporciona una única interfaz para publicar y suscribirse a eventos de plataforma, incluyendo eventos de monitoreo de eventos en tiempo real y eventos Captura de datos de cambios. Basándose en gRPC y HTTP/2, la API Pub/Sub publica y entrega de forma eficiente mensajes de eventos binarios en el formato Apache Avro. |
| Captura de datos de cambios | Captura de datos Cambio de Salesforce publica eventos de cambio, que representan cambios en registros de Salesforce. Los cambios incluyen la creación de un nuevo registro, actualizaciones en un registro existente, la eliminación de un registro y la anulación de la eliminación de un registro. |
| Componente Lightning y controladores Apex | Se utiliza para invocar un proceso remoto de forma asíncrona utilizando una llamada Apex. |
| Mensajería saliente dirigida por flujo | Solo se utiliza para la solución de mensajería saliente. Los eventos DML de creación y actualización desencadenan las reglas de flujo de trabajo de Salesforce, que pueden enviar un mensaje a un sistema remoto. |
| Desencadenadores Apex | Se utiliza para eventos de plataforma dirigidos por desencadenadores e invocación de procesos remotos, utilizando llamadas Apex desde eventos iniciados por DML. |
| Clases por lotes Apex | Se utiliza para la invocación de procesos remotos en modo por lotes. |
| Solución | Estrategia de gestión y recuperación de errores |
|---|---|
| Flujo |
|
| Llamadas Apex |
|
| Captura de datos de cambios (CDC) / Eventos de plataforma |
|
| Solución | Consideraciones de seguridad |
|---|---|
| Llamadas Apex | Una llamada a un sistema remoto debe mantener la confidencialidad, integridad y disponibilidad de la solicitud. Las siguientes son consideraciones de seguridad específicas para utilizar llamadas SOAP y HTTP Apex en este patrón.
|
| Captura de datos de cambios (CDC) / Eventos de plataforma | Para eventos de plataforma, el sistema externo suscriptor debe poder autenticarse en la API de transmisión de Salesforce. Los eventos de plataforma se ajustan al modelo de seguridad existente configurado en la organización de Salesforce. Para suscribirse a un evento, el usuario necesita acceso de lectura a la entidad del evento. Para publicar un evento, el usuario necesita el permiso “crear” en la entidad del evento. |
| Solución | Consideraciones sobre los extremos |
|---|---|
| Llamadas de SOAP Apex | El extremo debe poder procesar una llamada de servicio web a través de HTTP. Salesforce debe poder acceder al extremo a través de Internet pública. Esta solución requiere que el sistema remoto sea compatible con los estándares admitidos por Salesforce. En el momento de redactar este artículo, los estándares de servicio web admitidos por llamadas de SOAP de Salesforce for Apex son:
|
| Llamadas HTTP Apex | El extremo debe poder recibir llamadas HTTP y ser accesible a través de Internet pública por Salesforce. Las llamadas HTTP Apex se pueden utilizar para llamar a servicios RESTful utilizando los métodos GET, POST, PUT y DELETE estándar. |
| Captura de datos de cambios (CDC) / Eventos de plataforma |
|
- Salesforce almacena la clave de sustitución principal o exclusiva del sistema remoto para el registro remoto.
- El sistema remoto almacena el Id. de registro exclusivo de Salesforce o alguna otra clave sustitutiva exclusiva.
| Principal | Sistema Descripción |
|---|---|
| Salesforce | El sistema remoto debe almacenar el RecordId de Salesforce o alguna otra clave sustitutiva exclusiva en el registro de Salesforce. |
| Sistema remoto | Salesforce debe almacenar una referencia al identificador exclusivo en el sistema remoto. Como el proceso es asíncrono, el almacenamiento de este identificador exclusivo no puede formar parte de la transacción original. Salesforce debe proporcionar un Id. exclusivo en la llamada al proceso remoto. El sistema remoto debe volver a llamar a Salesforce para actualizar el registro en Salesforce con el identificador exclusivo del sistema remoto, utilizando el Id. exclusivo de Salesforce. La devolución de llamada implica la gestión de estado específico en la aplicación remota para almacenar el identificador exclusivo de Salesforce para que esa transacción se utilice para la devolución de llamada cuando se complete el procesamiento, o el identificador exclusivo de Salesforce se almacena en el registro del sistema remoto. |
| Solución | Consideraciones |
|---|---|
| Llamadas Apex | En ciertos casos, las soluciones prescritas por este patrón requieren la implementación de varios escenarios de integración complejos mejor servidos utilizando middleware o haciendo que Salesforce llame a un servicio compuesto. Estos escenarios incluyen:
|
| Captura de datos de cambios (CDC) / Eventos de plataforma | Dada la naturaleza declarativa y estática de los eventos, no se pueden realizar escenarios de integración complejos, como agregación, orquestación o transformación en Salesforce. El sistema remoto o middleware debe gestionar estos tipos de operaciones. |
| Procedimientos de integración de OmniStudio | Procedimientos de integración (OmniStudio) proporciona orquestación sin estado del lado del servidor para coordinar múltiples servicios backend mientras realiza transformaciones de datos declarativas complejas. Pasos de cadena de Procedimientos de integración como Acciones HTTP, Extracción/Transformación/Carga de DataRaptor, Establecer valores, Bucle/Si y búsquedas matriciales para normalizar, enriquecer, agregar y asignar cargas entre contratos de la interfaz de usuario y API dispares. Admiten sólidos controles de tiempo de ejecución como la bifurcación condicional, la paginación, los tiempos de espera, los reintentos, la gestión de fallos parciales y la continuación de errores, así como optimizaciones de desempeño como el almacenamiento en caché del lado del servidor y la configuración de respuestas. Las direcciones IP se pueden invocar de forma síncrona desde OmniScripts o de forma desatendida a través de REST, lo que permite “fachadas de integración” versionadas reutilizables que ocultan la complejidad del backend a los canales. |
| Solución | Consideraciones de mensajería fiable |
|---|---|
| Llamadas Apex | Salesforce no proporciona asistencia explícita para protocolos de mensajería fiables (por ejemplo, WS-ReliableMessaging). Recomendamos que el extremo remoto que recibe el mensaje de Salesforce implemente un sistema de mensajería fiable, como JMS o MQ. Este sistema garantiza la entrega completa garantizada de extremo a extremo al sistema remoto que procesa el mensaje en última instancia. Sin embargo, este sistema no garantiza la entrega garantizada desde Salesforce al extremo remoto al que llama. La entrega garantizada debe gestionarse a través de personalizaciones en Salesforce. Se deben implementar técnicas específicas, como el procesamiento de un reconocimiento positivo desde el extremo remoto además de la lógica de reintento personalizada. |
| Captura de datos de cambios (CDC) / Eventos de plataforma | Eventos de plataforma intenta proporcionar mensajería fiable manteniendo temporalmente mensajes de eventos en el bus de eventos. Los suscriptores pueden ponerse al día con mensajes de eventos perdidos reproduciendo mensajes desde el bus de eventos utilizando el Id. de reproducción de mensajes de eventos. El bus de eventos es un sistema distribuido y no tiene las mismas garantías que una base de datos de transacciones. Como resultado, Salesforce no puede proporcionar una respuesta síncrona para una solicitud de publicación de evento. Los eventos se colocan en cola y en la memoria intermedia, y Salesforce intenta publicar los eventos de forma asíncrona. En raras ocasiones, es posible que el mensaje de evento no persista en el sistema distribuido durante el intento inicial o posteriores. Esto significa que los eventos no se entregan a suscriptores y no son recuperables. |
| Propiedad | Obligatorio | Deseable | No se requiere |
|---|---|---|---|
| Gestión de eventos | X | ||
| Conversión de protocolo | X | ||
| Traducción y transformación | X | ||
| Colocación en cola y almacenamiento intermedio | X | ||
| Protocolos de transporte síncronos | X | ||
| Protocolos de transporte asíncronos | X | ||
| Enrutamiento de mediación | X | ||
| Coreografía de procesos y orquestación de servicios | X | ||
| Transaccionalidad (cifrado, firma, entrega fiable, gestión de transacciones) | X | ||
| Enrutamiento | X | ||
| Extraer, transformar y cargar | X | ||
| sondeo largo | X (obligatorio para eventos de plataforma) |
- Publicar después de confirmar para que el mensaje del evento se publique solo después de que una transacción se confirme correctamente. Seleccione esta opción si los suscriptores se basan en datos que confirma la transacción de publicación. Por ejemplo, un proceso publica un mensaje de evento y crea un registro de tarea. Un segundo proceso suscrito al evento se desencadena y espera encontrar el registro de tarea. Otra razón para elegir este comportamiento es cuando no desea que se publique el mensaje del evento si la transacción falla.
- Publicar inmediatamente para que el mensaje del evento se publique cuando se ejecute la llamada de publicación. Seleccione esta opción si desea que se publique el mensaje del evento independientemente de si la transacción se realiza correctamente. Seleccione también esta opción si el publicador y los suscriptores son independientes y los suscriptores no se basan en datos confirmados por el publicador. Por ejemplo, el comportamiento de publicación inmediato es adecuado para un evento utilizado para fines de registro. Con esta opción, un suscriptor podría recibir el mensaje del evento antes de que la transacción del publicador confirme los datos.
- Solo se puede implementar el desarrollo declarativo.
- No requiere notificación inmediata del número de pedido después de que la oportunidad se convierta en un pedido.
- La organización tiene un ESB que admite el protocolo CometD y puede suscribirse a eventos de plataforma.
- Cree un flujo para iniciar el evento de plataforma (por ejemplo, cuando el estado de la oportunidad cambia a Cerrada ganada).
- Cree un nuevo evento de plataforma que publique los detalles de la oportunidad.
- El ESB se suscribe al evento de plataforma Salesforce utilizando el protocolo CometD.
- El ESB recibe una o más notificaciones indicando que la oportunidad se va a convertir en un pedido.
- El ESB reenvía el mensaje al sistema ERP back-end de modo que se pueda crear el pedido.
- Después de crear el pedido en el sistema ERP, un hilo separado vuelve a llamar a Salesforce utilizando SessionId como token de autenticación. La devolución de llamada actualiza la oportunidad con el número de pedido y el estado. Puede realizar esta devolución de llamada utilizando soluciones de patrón documentadas, como eventos de plataforma Salesforce, API de SOAP de Salesforce, API de REST o un servicio web Apex.
- Implementación de un proceso remoto invocado de forma asíncrona
- Entrega garantizada de extremo a extremo
- Devolución de llamada posterior a Salesforce para actualizar el estado del registro
- Extraiga y transforme cuentas, contactos y oportunidades del sistema CRM actual y cargue los datos en Salesforce (importación de datos inicial).
- Extraiga, transforme y cargue datos de facturación de clientes en Salesforce desde un sistema remoto de forma semanal (continua).
- Extraiga información de actividad de clientes de Salesforce e impórtela en un almacén de datos local semanalmente (de forma continua).
- ¿Deberían almacenarse los datos en Salesforce? Si no, existen otras opciones de integración que un arquitecto puede y debe considerar (mashups, por ejemplo).
- Si los datos se deben almacenar en Salesforce, ¿se deben actualizar los datos en respuesta a un evento en el sistema remoto?
- ¿Se deben actualizar los datos de forma programada?
- ¿Los datos admiten procesos de negocio principales?
- ¿Existen requisitos de análisis (creación de reportes) afectados por la disponibilidad de estos datos en Salesforce?
| Solución | Ajuste | Maestro de datos | Comentarios |
|---|---|---|---|
| Replicación a través de una herramienta ETL externa | Mejor | Sistema remoto | Donde un sistema externo necesita enviar una gran cantidad de datos a Salesforce, aproveche una herramienta ETL externa que le permite ejecutar Captura de datos de cambios en datos de origen. La herramienta reacciona a cambios en el conjunto de datos de origen, transforma los datos y luego llama a la API masiva de Salesforce para emitir declaraciones DML. Esto también se puede implementar utilizando las API de REST de Salesforce si el número de registros es inferior. |
| Replicación a través de una herramienta ETL externa | Bien | Salesforce | Aproveche una herramienta ETL externa que le permite ejecutar Captura de datos de cambios en conjuntos de datos de ERP y Salesforce. En esta solución, Salesforce es el origen de datos y puede utilizar información de tiempo/estado en filas individuales para consultar los datos y filtrar el conjunto de resultados de destino. Esto se puede implementar utilizando la API masiva 2.0 o las API de REST estándar (si el número de registros es inferior a ). |
| Asistente de importación de datos y Cargador de datos | Ajuste | Salesforce / Sistema externo | El Asistente de importación de datos y el Cargador de datos se pueden utilizar para importar, exportar y migrar datos. Aunque los comandos del Cargador de datos también se pueden programar para automatizar la importación y exportación de datos, la interfaz de línea de comandos es solo para Windows. Ninguna de estas herramientas es una base recomendada para una estrategia de integración de datos. En su lugar, deben complementar su estrategia de mantenimiento y administración de datos. Para obtener más información sobre el Cargador de datos, consulte aquí. |
| Llamada remota | Suboptimal | Sistema remoto | Es posible que un sistema remoto llame a Salesforce utilizando una de las API y realice actualizaciones en datos a medida que se producen. Sin embargo, esto provoca un tráfico considerable entre los dos sistemas. Se debe hacer mayor hincapié en la gestión y el bloqueo de errores. Este patrón tiene el potencial de provocar actualizaciones continuas, lo que tiene el potencial de afectar al desempeño para usuarios finales. |
| Invocación de proceso remoto | Suboptimal | Salesforce | Es posible que Salesforce llame a un sistema remoto y realice actualizaciones en datos a medida que se producen. Sin embargo, esto provoca un tráfico considerable entre los dos sistemas. Se debe hacer mayor hincapié en la gestión y el bloqueo de errores. Este patrón tiene el potencial de provocar actualizaciones continuas, lo que tiene el potencial de afectar al desempeño para usuarios finales. |
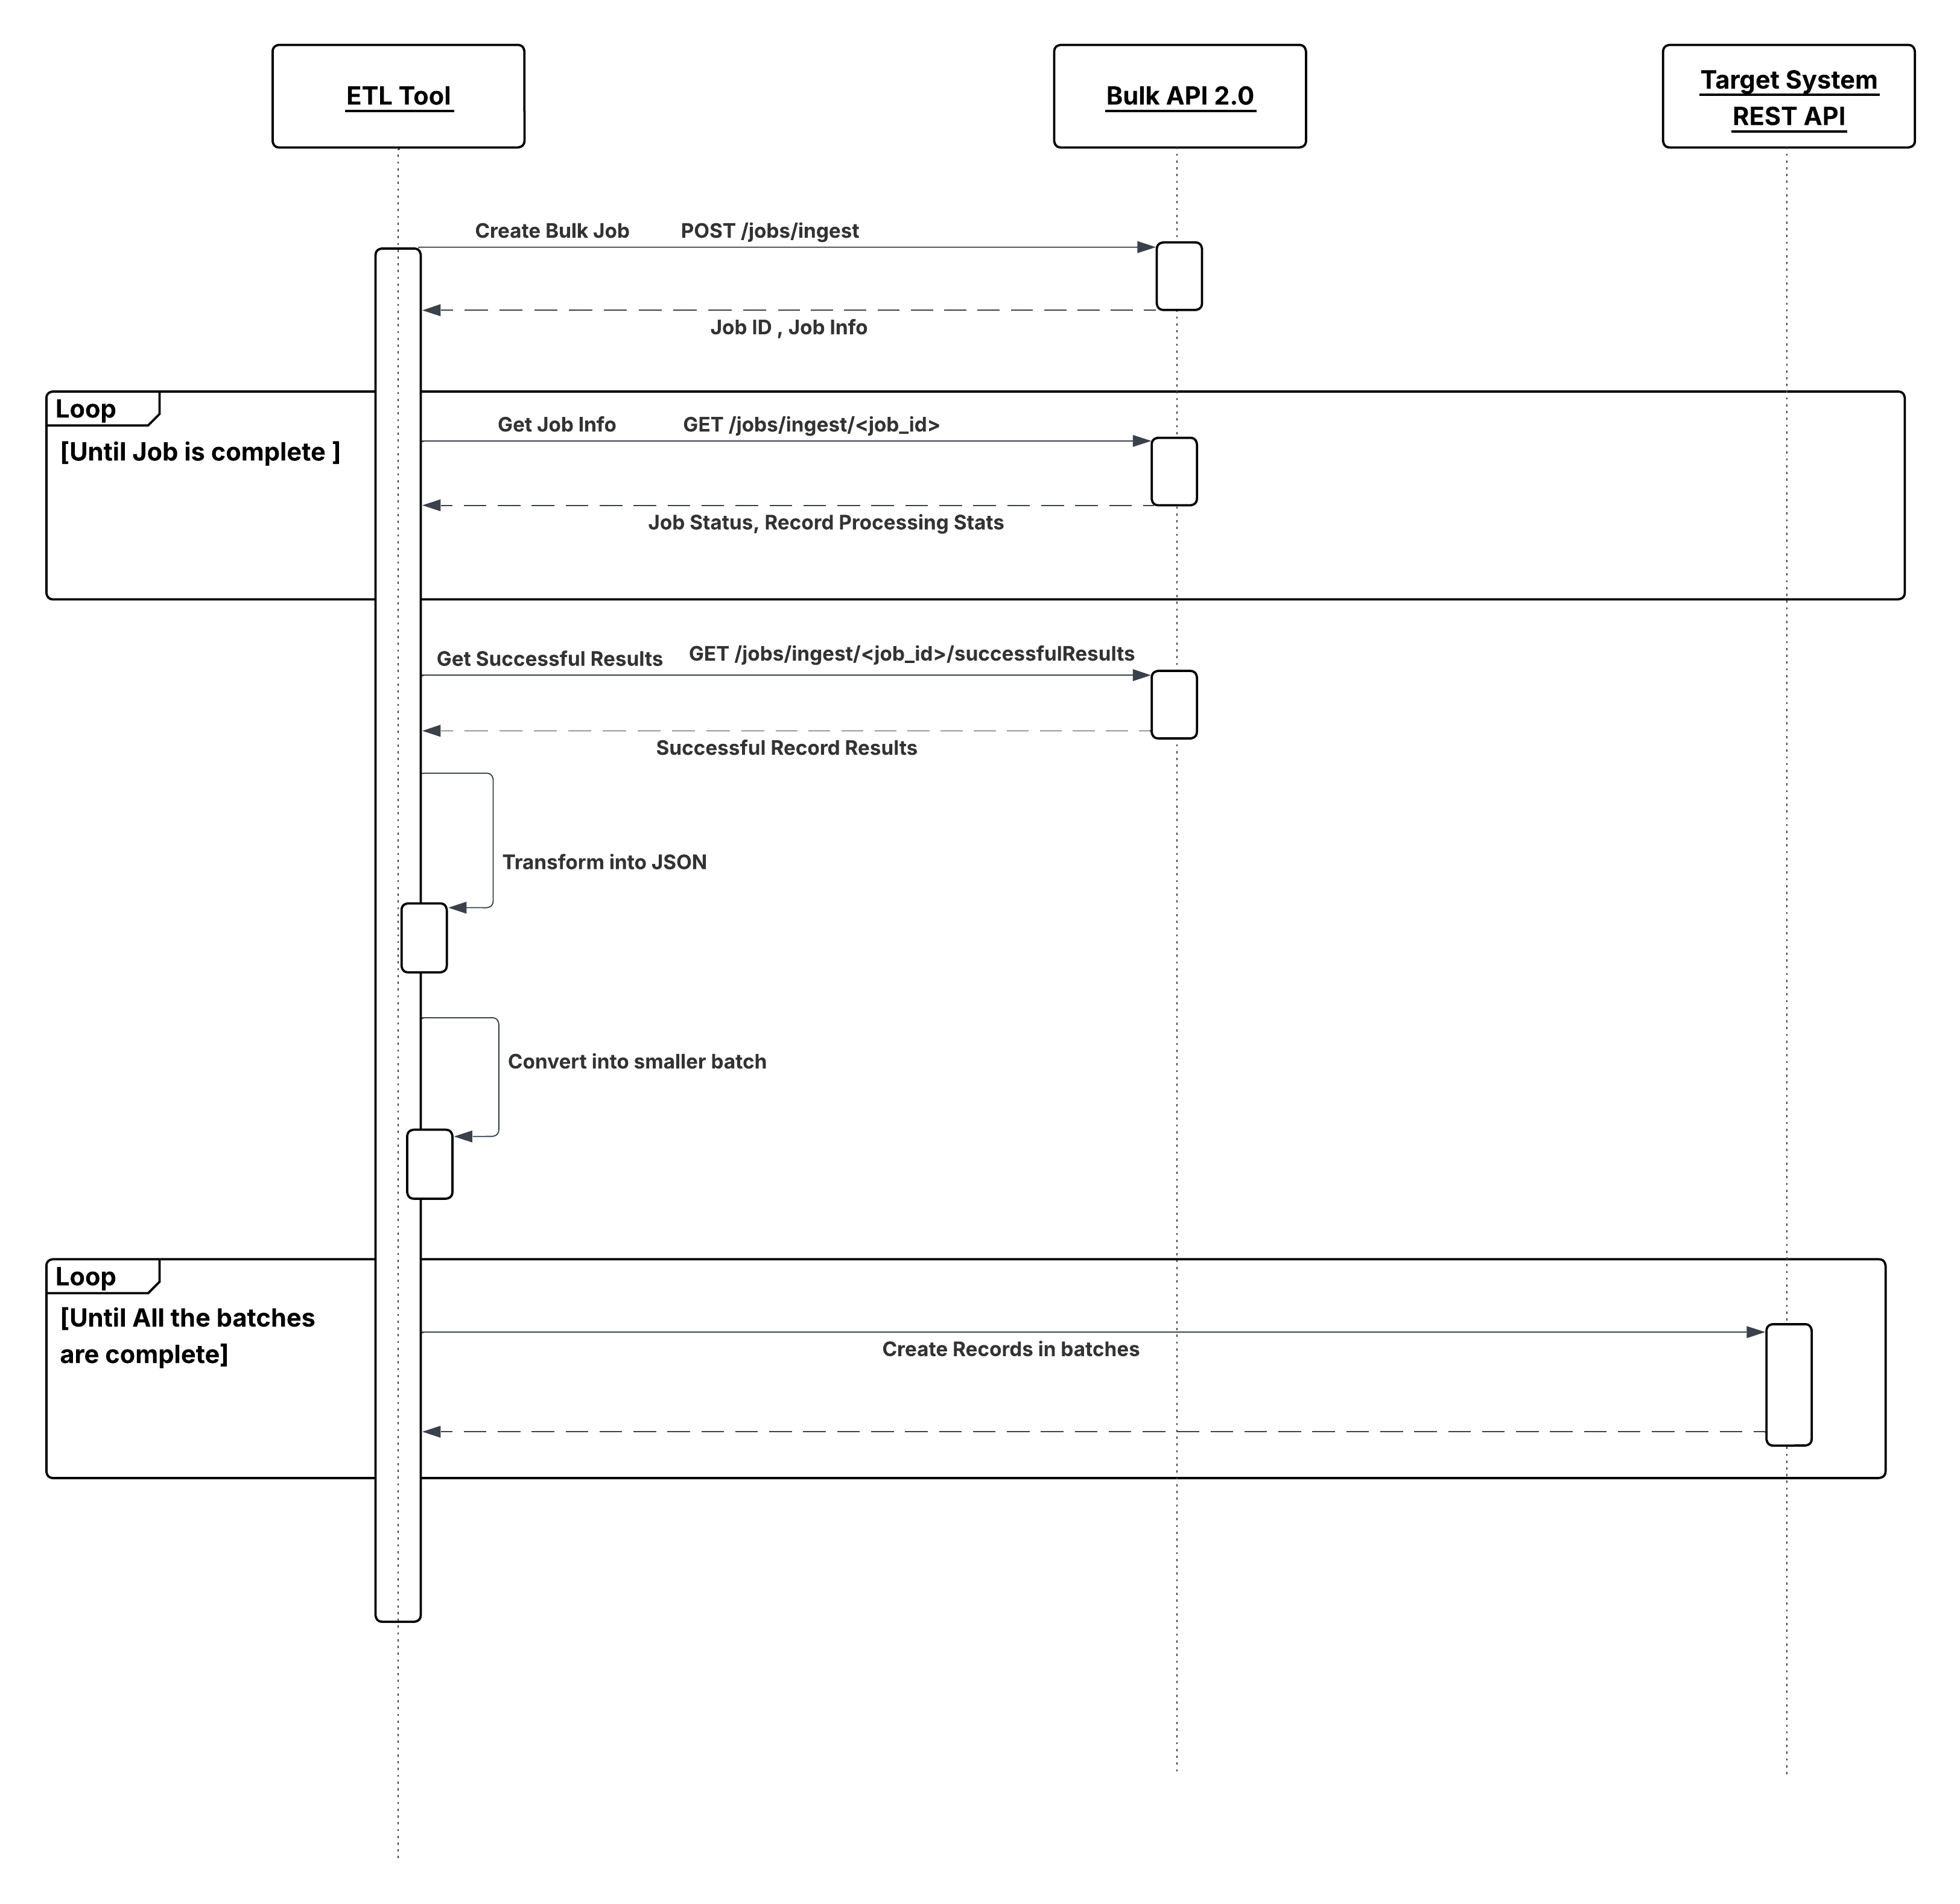 Diagrama de descarga
El siguiente diagrama ilustra la sincronización posterior de eventos casi en tiempo real, donde Salesforce es el principal de datos.
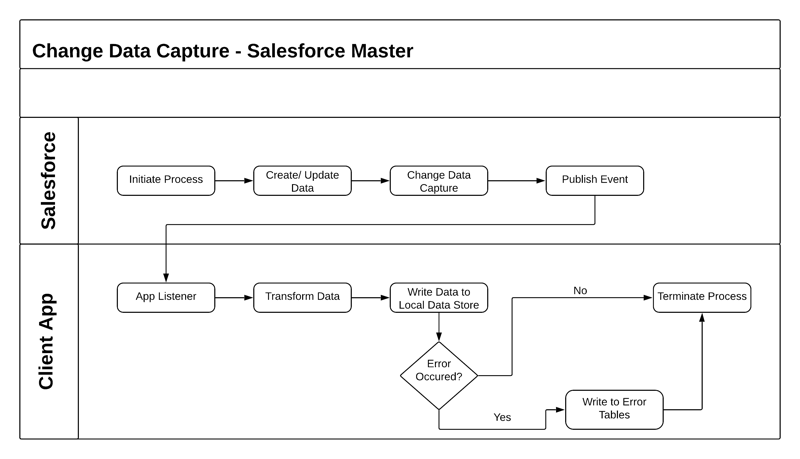 **Resultados**
Puede integrar datos originados de forma externa con Salesforce bajo los siguientes escenarios:
- Sistema externo es el principal de datos: Salesforce es consumidor de datos proporcionados por un único sistema de origen o múltiples sistemas. En este escenario, es común tener un almacén de datos o mercado de datos que agrega los datos antes de importar los datos en Salesforce.
- Salesforce es el principal de datos: Salesforce es el sistema de registro para ciertas entidades y las aplicaciones cliente de Captura de datos Salesforce Change pueden ser informadas de cambios en datos de Salesforce.
- Implemente Captura de datos de cambios en el conjunto de datos de origen.
- Implemente un conjunto de estructuras de base de datos compatibles, conocidas como tablas de control, en una base de datos local intermedia.
- Lea una tabla de control para determinar el último tiempo de ejecución del trabajo y extraer cualquier otro valor de control necesario.
- Utilice los valores de control anteriores como filtros y consulte el conjunto de datos de origen.
- Aplique reglas de procesamiento predefinidas, incluyendo validación, enriquecimiento, etc.
- Utilice conectores/funciones de transformación disponibles de la herramienta ETL para crear el conjunto de datos de destino.
- Redacte el conjunto de datos en objetos de Salesforce.
- Si el procesamiento se realiza correctamente, actualice los valores de control en la tabla de control.
- Si el procesamiento falla, actualice las tablas de control con valores que activan un reinicio y una salida.
- Encadene y ordene los trabajos de ETL para proporcionar un proceso coherente.
- Utilice claves principales de ambos sistemas para comparar datos entrantes.
- Utilice métodos de API específicos para extraer solo datos actualizados.
- Si importa registros secundarios en una relación principal-detalle o de búsqueda, agrupe los datos importados utilizando su clave principal en el origen para evitar el bloqueo. Por ejemplo, si está importando datos de contacto, asegúrese de agrupar los datos de contacto por la clave de cuenta principal de modo que se pueda cargar el número máximo de contactos para una sola cuenta en una llamada de API. La no agrupación de los datos importados suele dar como resultado la carga del primer registro de contacto y el fallo de los registros de contacto posteriores para esa cuenta en el contexto de la llamada de API.
- Cualquier procesamiento posterior a la importación, como desencadenadores, solo debe procesar datos de forma selectiva.
- Si su escenario implica grandes volúmenes de datos, siga las mejores prácticas de este módulo Trailhead Mejores prácticas para implementaciones con grandes volúmenes de datos .
| Ubicación del error | Estrategia de gestión y recuperación de errores |
|---|---|
| Leer desde Salesforce utilizando Captura de datos de cambios |
|
| Leer desde Salesforce utilizando un sistema ETL externo |
|
| Redactar en Salesforce |
|
| Sistema principal externo | Los errores deben tratarse de acuerdo con las mejores prácticas del sistema general. |
- Se requiere una licencia de Lightning Platform con al menos permisos de usuario “Solo API” para permitir el acceso de API autenticado a la API de Salesforce.
- Recomendamos que se utilice el cifrado estándar para mantener el acceso de contraseña seguro.
- Utilice el protocolo HTTPS cuando realice llamadas a las API de Salesforce. También puede asignar tráfico a las API de Salesforce a través de una solución de seguridad local, si es necesario.
- Salesforce no mantiene el estado de un registro que está siendo modificado por un usuario específico.
- Al leer, registra la hora en la que se extrajeron los datos.
- Si el usuario actualiza el registro y lo guarda, Salesforce comprueba si otro usuario actualizó el registro mientras tanto.
- Si el registro se actualizó, el sistema notifica al usuario que se realizó una actualización y el usuario debe recuperar la versión más reciente del registro antes de continuar con sus actualizaciones.
| Propiedad | Obligatorio | Deseable | No se requiere |
|---|---|---|---|
| Gestión de eventos | X | ||
| Conversión de protocolo | X | ||
| Traducción y transformación | X | ||
| Colocación en cola y almacenamiento intermedio | X | ||
| Protocolos de transporte síncronos | X | ||
| Protocolos de transporte asíncronos | X | ||
| Enrutamiento de mediación | X | ||
| Coreografía de procesos y orquestación de servicios | X | ||
| Transaccionalidad (cifrado, firma, entrega fiable, gestión de transacciones) | X | ||
| Enrutamiento | X | ||
| Extraer, transformar y cargar | X | ||
| Sondeo largo | X (obligatorio para Captura de datos Salesforce Change) |
- Un programador similar a un cronólogo ejecuta un trabajo por lotes que asigna clientes potenciales a usuarios y equipos.
- Después de que el trabajo por lotes ejecute y actualice los datos, la herramienta ETL reconoce estos cambios utilizando Captura de datos de cambios. La herramienta ETL recopila los cambios desde el almacén de datos.
- El conector ETL utiliza la API de REST de Salesforce para cargar los cambios en Salesforce.
- ¿El propósito de la llamada remota a Salesforce es notificar a Salesforce de un evento que se produjo de forma externa utilizando una arquitectura dirigida por eventos? ¿O el propósito es realizar operaciones CRUD en registros específicos? Si utiliza una arquitectura dirigida por eventos, el productor del evento (el proceso remoto) se desvincula del consumidor del evento de Salesforce.
- ¿Requiere la llamada a Salesforce que el proceso remoto espere una respuesta antes de continuar el procesamiento? Las llamadas remotas a Salesforce siempre son síncronas, aunque el proceso remoto puede descartar la respuesta si no es necesario para simular una llamada asíncrona.
- ¿Opera cada transacción en un único objeto de Salesforce o múltiples objetos relacionados?
- ¿Cuál es el formato del mensaje (por ejemplo, SOAP o REST, o ambos a través de HTTP)?
- ¿El tamaño del mensaje es relativamente pequeño o grande?
- Si el sistema remoto tiene capacidad para SOAP, ¿puede el sistema remoto participar en un enfoque de contrato primero, donde Salesforce dicta el contrato? Esto es obligatorio donde se utiliza nuestra API de SOAP, para la que se proporciona un WSDL predefinido.
- ¿Se requiere procesamiento de transacciones?
- ¿Cuál es la medida en que es tolerante a la personalización en Salesforce?
| Solución | Ajuste | Comentarios |
|---|---|---|
| API compuesta | Mejor | Salesforce proporciona una API compuesta que es básicamente una API de REST y admite solicitudes compuestas. Esto puede ser utilizado por sistemas remotos para:
API síncrona: Después de realizar la llamada de API, la aplicación cliente remota espera hasta que recibe una respuesta del servicio. Comportamiento de transacción/confirmación: de forma predeterminada, la API compuesta no permite el éxito parcial si algunos registros están marcados con errores. Esto se puede cambiar marcando “todo o nada” como falso, lo que permitirá un éxito parcial. Tratamiento de errores: La gestión de errores apropiada debe examinar el cuerpo de la respuesta, no solo los códigos de estado HTTP. Un extremo compuesto responde con código de estado HTTP 200 incluso si dentro del cuerpo de respuesta muestra que una de las subsolicitudes falló y la transacción tuvo que revertirse. |
| API DE REST | Mejor | Accesibilidad: Salesforce proporciona una API de REST que los sistemas remotos pueden utilizar para:
API síncrona: Después de realizar la llamada de API, la aplicación cliente remota espera hasta que recibe una respuesta del servicio. La API de REST respeta la seguridad a nivel de objeto y de campo configurada en Salesforce basándose en el perfil del usuario que inició sesión. REST expone recursos (entidades/objetos) como URI y utiliza verbos HTTP para definir operaciones CRUD en estos recursos. A diferencia de SOAP, la API de REST no requiere ningún contrato predefinido, utiliza XML y JSON para respuestas y tiene escritura suelta. API de REST es ligera y proporciona un método sencillo para interactuar con Salesforce. Sus ventajas incluyen la facilidad de integración y desarrollo, y es una excelente opción para su uso con aplicaciones móviles y aplicaciones web. Comportamiento de transacción/confirmación: de forma predeterminada, cada registro se trata como una transacción separada y se confirma por separado. El fallo de un cambio de registro no causa la reversión de otros cambios de registro. Este comportamiento puede alterarse a un comportamiento “todo o nada”. Utilice los recursos compuestos de API de REST para realizar una serie de actualizaciones en una llamada de API. Datos masivos: Cualquier operación de datos que incluya más de 2.000 registros es un buen candidato para que la API masiva 2.0 prepare, ejecute y gestione con éxito un flujo de trabajo asíncrono que utilice el marco de trabajo masivo. |
| API masiva 2.0 | Ideal para operaciones masivas | API masiva 2.0 es la API moderna y simplificada de Salesforce para gestionar operaciones de datos a gran escala. La API masiva basada en REST 2.0 proporciona una opción programática para insertar, alterar, consultar o eliminar de forma asíncrona grandes conjuntos de datos en su organización de Salesforce. Está diseñado para la eficiencia cuando necesita cargar grandes cantidades de datos en Salesforce o realizar consultas masivas en los datos de su organización. A diferencia de la API masiva 1.0, la API masiva 2.0 siempre procesa lotes en paralelo y no admite el modo serie. Esto significa que:
Cada lote en API masiva 2.0 se procesa como su propia transacción. Esto significa:
Aunque la API de SOAP también se puede utilizar para procesar grandes números de registros, se vuelve menos óptima cuando los conjuntos de datos contienen cientos de miles a millones de registros. Esto se debe a su sobrecarga relativamente alta y características de desempeño más bajas.
|
| API Pub/Sub | Mejor |
La API Pub/Sub es la forma recomendada para que los publicadores externos publiquen eventos en el Bus de eventos. API Pub/Sub es una API basada en gRPC que permite a los sistemas externos publicar eventos de plataforma. API Pub/Sub:
Una vez definido un evento de plataforma en Salesforce, queda disponible para consumidores internos y externos. |
| Eventos de plataforma | Mejor |
Los eventos de plataforma se definen del mismo modo que define los objetos de Salesforce. Los eventos de plataforma se pueden publicar utilizando diferentes mecanismos como las API de REST, la API masiva y las API de SOAP.
Publicar un evento a través de la API de REST es lo mismo que crear un registro de Salesforce. Formato de extremo: POST /services/data/vXX.X/sobjects/NombreEvento__e/
Con la API masiva, solo se admiten las operaciones de creación e inserción. Los eventos dentro de un lote se publican en el bus de eventos de Salesforce de forma asíncrona a medida que se procesa el trabajo por lotes. Puesto que los eventos de plataforma son SObjects, se admiten las operaciones de API de SOAP estándar. |
| API DE SOAP | Ajuste |
Accesibilidad: Salesforce proporciona una API de SOAP que los sistemas remotos pueden utilizar para:
API síncrona: Después de realizar la llamada de API, la aplicación cliente remota espera hasta que recibe una respuesta del servicio. No se admiten las llamadas asíncronas a Salesforce. WSDL generado: Salesforce proporciona dos WSDL para sistemas remotos:
Seguridad: El cliente que ejecuta la API de SOAP debe tener un inicio de sesión válido y obtener una sesión para realizar cualquier llamada de API. La API respeta la seguridad a nivel de objeto y de campo configurada en Salesforce basándose en el perfil del usuario que inició sesión. Comportamiento de transacción/confirmación: de forma predeterminada, cada llamada de API permite el éxito parcial si algunos registros están marcados con errores. Esto se puede cambiar a un comportamiento de “todo o nada” donde todos los resultados se revierten si se produce cualquier error. No es posible abarcar una transacción entre múltiples llamadas de API. Para superar esta limitación, es posible que una sola llamada de API afecte a múltiples objetos. |
| Servicios web Apex | Suboptimal |
Los métodos de clase Apex pueden exponerse como métodos de servicio web a aplicaciones externas. Este método es una alternativa a la API de SOAP y se utiliza habitualmente solo donde se deben cumplir los siguientes requisitos adicionales.
El beneficio de utilizar un servicio web Apex debe sopesarse con el código adicional que se debe mantener en Salesforce. No aplicable para eventos de plataforma porque la lógica de inserción previa de transacciones en el consumidor no se aplica en un arquitectura dirigida por eventos. Para notificar a una organización de Salesforce que se produjo un evento, utilice API de SOAP, API de REST o API masiva 2.0. |
| Servicios REST Apex | Suboptimal |
Una clase Apex puede exponerse como recursos REST asignados a URI específicos con un verbo HTTP definido (por ejemplo, POST o GET).
Puede utilizar recursos compuestos de API de REST para realizar múltiples actualizaciones en una sola transacción. A diferencia de SOAP, no es necesario que el cliente consuma una definición/contrato de servicio (WSDL) y genere código auxiliar de cliente. El sistema remoto solo requiere la capacidad de formar una solicitud HTTP y procesar los resultados devueltos (XML o JSON). No aplicable para eventos de plataforma porque la lógica de inserción previa de transacciones en el consumidor no se aplica en un arquitectura dirigida por eventos. Para notificar a una organización de Salesforce que se produjo un evento, utilice API de SOAP, API de REST o API masiva 2.0. |
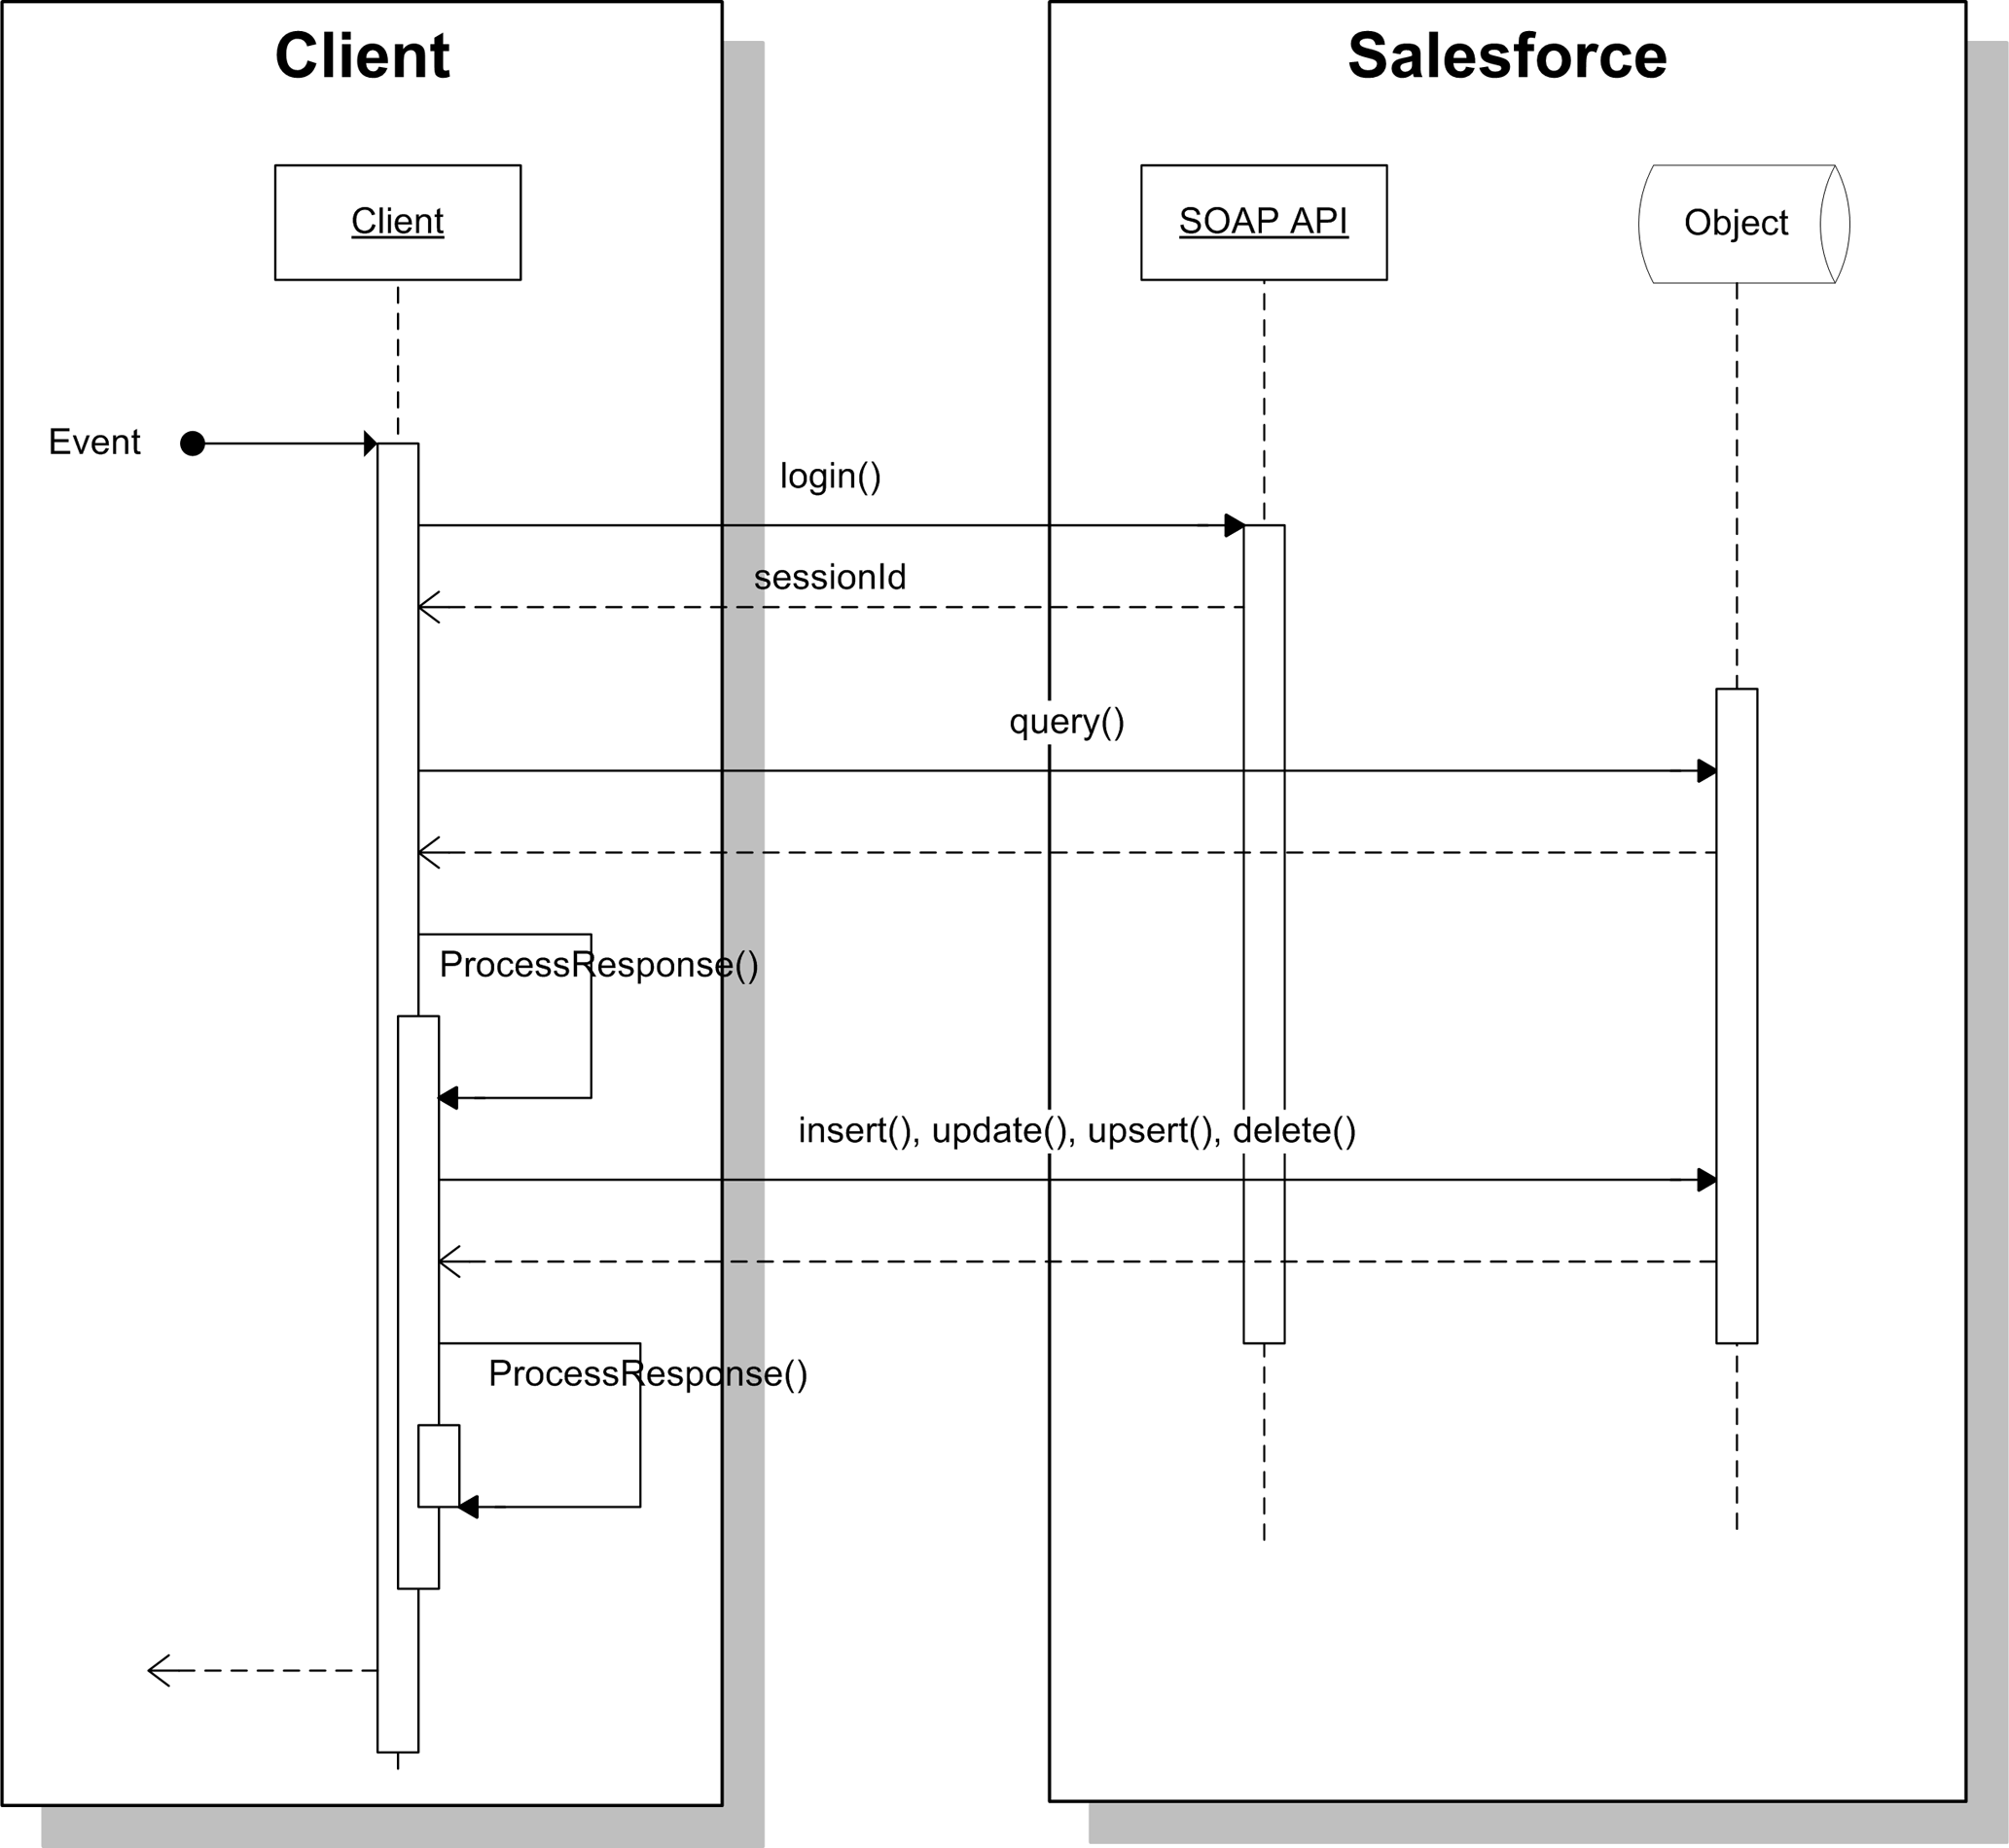 _Sistema remoto que notifica a Salesforce con eventos a través de la API de REST_
 **Resultados**
En una arquitectura dirigida por eventos, el sistema remoto llama a Salesforce utilizando API de SOAP, API de REST o API masiva 2.0 para publicar un evento en el bus de eventos de Salesforce. La publicación de un evento notifica a todos los suscriptores. Los suscriptores de eventos pueden estar en Salesforce Platform como Flujos o Componentes Lightning, desencadenadores Apex. Los suscriptores de eventos también pueden ser externos a Salesforce Platform como suscriptores de CometD.
Al trabajar directamente con objetos de Salesforce, las soluciones relacionadas con este patrón permiten:
- El sistema remoto llama a las API de Salesforce para consultar la base de datos y ejecutar operaciones de un solo objeto (crear, actualizar, eliminar, etc.).
- El sistema remoto para llamar a los recursos compuestos de API de REST de Salesforce para realizar una serie de operaciones de objetos.
- Sistema remoto para llamar a API (servicios) de Salesforce creadas a medida que pueden admitir operaciones de transacciones de múltiples objetos y lógica de procesamiento previo/posterior personalizada.
| Mecanismo de llamada | Descripción |
|---|---|
| API DE SOAP | El sistema remoto utiliza Salesforce Enterprise o Partner WSDL para generar código auxiliar de cliente que se utilizan a su vez para invocar la API de SOAP estándar. |
| API DE REST | El sistema remoto tiene que autenticarse antes de acceder a cualquier servicio REST Apex. El sistema remoto puede utilizar OAuth 2.0 o autenticación de nombre de usuario y contraseña. En cualquier caso, el cliente debe establecer el encabezado HTTP de autorización con el valor apropiado (se puede adquirir un token de acceso de OAuth o un Id. de sesión a través de una llamada de inicio de sesión a la API de SOAP). El sistema remoto genera a continuación invocaciones de REST (solicitudes HTTP) con los verbos apropiados y procesa los resultados devueltos (se admiten formatos de datos JSON y XML). |
| Servicio web Apex | El sistema remoto consume el servicio web Apex personalizado WSDL para generar código auxiliar de cliente que se utilizan a su vez para invocar el servicio web Apex personalizado. |
| Servicio REST Apex | Según la API de REST, el URI del recurso y los verbos aplicables se definen utilizando las anotaciones @RestResource, @HttpGet y @HttpPost. |
| API masiva 2.0 | API masiva 2.0 es una API basada en REST, por lo que se aplican los mismos mecanismos de llamada que la API de REST. |
| API de REST para invocar Flujo | Utilice la API de REST para llamar a un extremo de acciones invocables personalizadas para invocar un flujo iniciado automáticamente. |
- Gestión de errores: Todos los métodos de llamadas remotas, las API estándar o personalizadas, requieren que el sistema remoto gestione cualquier error posterior, como los tiempos de espera y la gestión de reintentos. El middleware se puede utilizar para proporcionar la lógica para la gestión y recuperación de errores.
- Recuperación: Se necesita crear un mecanismo de reintento personalizado si los requisitos de calidad de servicio lo dictan. En este caso, es importante garantizar características de diseño idempotentes. El evento de plataforma permite a los suscriptores utilizar el Id. de reproducción para obtener mensajes en un periodo de tiempo específico después de la publicación de esos mensajes.
| Solución | Consideraciones de seguridad |
|---|---|
| API DE SOAP | alesforce admite los protocolos Secure Sockets Layer v3 (SSL) y Transport Layer Security (TLS). Los cifrados deben tener una longitud de clave de al menos 128 bits. El sistema remoto debe iniciar sesión utilizando credenciales válidas para obtener un Id. de sesión. Si el sistema remoto ya tiene un Id. de sesión válido, puede llamar a la API sin un inicio de sesión explícito. Esto se utiliza en patrones de devolución de llamadas tratados anteriormente en este documento, donde un mensaje saliente de Salesforce anterior contenía un Id. de sesión y un Id. de registro para su uso posterior. Recomendamos que los clientes que llaman a la caché de API de SOAP y reutilicen el Id. de sesión para maximizar el desempeño, en vez de obtener un nuevo Id. de sesión para cada llamada. |
| API DE REST | Recomendamos que el sistema remoto establezca un Trust OAuth para la autorización. Las llamadas de REST se pueden realizar en recursos específicos utilizando verbos HTTP. También es posible realizar llamadas de REST con un Id. de sesión válido que podría haberse obtenido por otros medios (por ejemplo, recuperado llamando a la API de SOAP o proporcionado a través de un mensaje saliente). Recomendamos que los clientes que llaman a la caché de API de REST y reutilicen el Id. de sesión para maximizar el desempeño, en vez de obtener un nuevo Id. de sesión para cada llamada. |
| Servicio web Apex | Recomendamos que el sistema remoto establezca un Trust OAuth para la autorización. |
| Servicio REST Apex | Recomendamos que el sistema remoto establezca un Trust OAuth para la autorización. |
| API masiva 2.0 | Recomendamos que el sistema remoto establezca un Trust OAuth para la autorización. |
- Tiempo de espera de sesión: La sesión se agota si no hay actividad basada en la configuración de tiempo de espera de sesión de la organización de Salesforce.
- Tiempo de espera de consulta: Cada consulta SOQL tiene un límite de tiempo de espera individual de 120 segundos.
| Solución | Tipo de comunicación | Límites |
|---|---|---|
| API de SOAP o API de REST | Síncrono |
|
| API masiva 2.0 | Asíncrono | API masiva 2.0 está optimizada para importar y exportar grandes conjuntos de datos de forma asíncrona. Cualquier operación de datos que incluya más de 2.000 registros es un buen candidato para la API masiva 2.0 para preparar, ejecutar y gestionar con éxito un flujo de trabajo asíncrono que utiliza el marco de trabajo masivo. Los trabajos con menos de 2.000 registros deben implicar llamadas síncronas “masificadas” en REST (por ejemplo, Compuesto) o SOAP. La API masiva 2.0 es síncrona al enviar la solicitud por lotes y los datos asociados. El procesamiento real de los datos se produce de forma asíncrona. Para obtener más información acerca de los límites de API y procesamiento por lotes, consulte Límites. |
| Solución | Consideraciones sobre los extremos |
|---|---|
| API DE SOAP | El sistema remoto debe poder implementar un cliente que pueda llamar a la API de SOAP de Salesforce, basándose en un formato de mensaje predefinido por Salesforce. El sistema remoto (cliente) debe participar en una implementación de contrato primero donde el contrato se proporciona por Salesforce (por ejemplo, Enterprise o Partner WSDL). |
| API DE REST | El sistema remoto debe poder implementar un cliente de REST que invoque servicios de REST definidos por Salesforce y procese los resultados XML o JSON. |
| Servicio web Apex | El sistema remoto debe ser capaz de implementar un cliente que pueda invocar mensajes SOAP de un formato predefinido, como lo define Salesforce. El sistema remoto debe participar en una implementación de código primero, donde el contrato lo proporciona Salesforce después de implementar el servicio web Apex. Cada servicio web Apex tiene su propio WSDL. |
| Servicio REST Apex | Se aplican las mismas consideraciones de extremo que la API de REST. |
- Salesforce almacena la clave de sustitución principal o exclusiva del sistema remoto para el registro remoto.
- El sistema remoto almacena el Id. de registro exclusivo de Salesforce o alguna otra clave sustitutiva exclusiva. Existen consideraciones específicas para la gestión de claves de integración en este patrón síncrono.
| Principal | sistema Descripción |
|---|---|
| Salesforce | En este escenario, el sistema remoto almacena el RecordId de Salesforce o alguna otra clave sustitutiva exclusiva desde el registro. |
| Sistema remoto | En este escenario, Salesforce almacena una referencia al identificador exclusivo en el sistema remoto. Como el proceso es síncrono, la clave se puede proporcionar como parte de la misma transacción utilizando campos de Id. externo. |
| Solución | Consideraciones |
|---|---|
| API de SOAP o API de REST | API de SOAP y API de REST proporcionan transacciones sencillas en objetos. Los escenarios de integración complejos, como agregación, orquestación y transformación, no se pueden realizar en Salesforce. Estos escenarios deben ser gestionados por el sistema remoto o middleware, con middleware como el método preferido. |
| Servicio web Apex o servicio REST Apex | Los servicios web personalizados pueden proporcionar funciones de objetos cruzados, lógica personalizada y compatibilidad de transacciones más compleja. Esta solución debe utilizarse con cuidado y siempre debe tener en cuenta la idoneidad del middleware para cualquier transformación, orquestación y lógica de gestión de errores. |
| Solución | Límites |
|---|---|
| API de SOAP, API de REST y API de Apex personalizadas |
|
| API masiva 2.0 | Consulte la barra lateral Volúmenes de datos para obtener más información. |
| Eventos de plataforma |
|
| Propiedad | Obligatorio | Deseable | No se requiere |
|---|---|---|---|
| Gestión de eventos | X | ||
| Conversión de protocolo | X | ||
| Traducción y transformación | X | ||
| Colocación en cola y almacenamiento intermedio | X | ||
| Protocolos de transporte síncronos | X | ||
| Protocolos de transporte asíncronos | X | ||
| Enrutamiento de mediación | X | ||
| Coreografía de procesos y orquestación de servicios | X | ||
| Transaccionalidad (cifrado, firma, entrega fiable, gestión de transacciones) | X | ||
| Enrutamiento | X | ||
| Extraer, transformar y cargar | X (para granel/lotes) |
- El PMS puede participar en una integración de contrato primero, donde Salesforce proporciona el contrato y el PMS actúa como un cliente (consumidor) del servicio de Salesforce (definido a través de la WSDL de compañía o socio).
- No debe haber desarrollo personalizado en Salesforce.
- Defina un evento de plataforma en Salesforce para incluir los datos de notificación procedentes del PMS.
- Cree un flujo desencadenado por la notificación de evento de impresora. El proceso actualiza el activo de impresora y crea un pedido (utilizando un flujo iniciado automáticamente).
- Descargue el WSDL de compañía o socio y proporciónelo al sistema remoto.
- Cree un código auxiliar de cliente desde el WSDL de compañía o socio.
- Autentique en Salesforce (a través del flujo de token de soporte o servidor web de OAuth) utilizando las credenciales del usuario de integración.
- Tras el evento de estado de impresora, el PMS llama a la API para crear el evento de plataforma de estado de impresora (con estadísticas de uso de impresora). El bus de eventos de Salesforce notifica al suscriptor de Flow y a todos los demás suscriptores.
- Implementación de un cliente de API síncrona de Salesforce (consumidor).
- Una devolución de llamada a Salesforce para publicar un evento de plataforma (alineado con patrones de eventos de plataforma de solicitud/respuesta cubiertos anteriormente).
 **Resultados**
**Beneficios**
La aplicación de la solución relacionada con este patrón tiene los siguientes beneficios:
- Elimina la necesidad de redactar mecanismos de sondeo personalizados
- Elimina la necesidad de un bucle de comentarios iniciado por el usuario
- No se garantiza la entrega de notificaciones.
- No se garantiza el orden de las notificaciones.
- Las notificaciones no se generan desde cambios de registro realizados por la API masiva.
- Cree un PushTopic desencadenado por Apex que envíe un evento de plataforma cuando se guarde un caso con un estado de “Cerrado” y una resolución de “Exitoso”.
- Cree una interfaz de usuario personalizada disponible para gestores de servicio al cliente. Esta interfaz de usuario se suscribe al bus de eventos para consumir eventos de plataforma.
- Implemente lógica en la interfaz de usuario personalizada que muestra alertas generadas por los representantes de servicio al cliente de ese gestor.
- ¿Desea crear una integración saliente declarativa/de apuntar y hacer clic o una interfaz de usuario en Salesforce?
- ¿Tiene una gran cantidad de datos que no desea copiar en su organización de Salesforce?
- ¿Necesita acceder a pequeñas cantidades de datos del sistema remoto en cualquier momento?
- ¿Necesita acceso en tiempo real a los datos más recientes?
- ¿Almacena sus datos en la nube o en un sistema de back-office, pero desea mostrar o procesar esos datos en su organización de Salesforce?
- ¿Tiene problemas de residencia de datos para almacenar ciertos tipos de datos en Salesforce?
| Solución | Ajuste | Comentarios |
|---|---|---|
| Salesforce Connect | Mejor | Utilice Salesforce Connect para acceder a datos de fuentes externas, junto con sus datos de Salesforce. Extraiga datos de sistemas como SAP, Microsoft, Oracle y otros sistemas basados en la nube como Snowflake en tiempo real sin realizar una copia de los datos en Salesforce. Salesforce Connect asigna tablas de datos en sistemas externos a objetos externos en su organización. Los objetos externos son similares a los objetos personalizados, excepto que se asignan a datos ubicados fuera de su organización de Salesforce. Salesforce Connect utiliza una conexión en vivo con datos externos para mantener siempre actualizados los objetos externos. El acceso a un objeto externo obtiene los datos del sistema externo en tiempo real. Salesforce Connect le permite:
|
| Solicitud y respuesta | Suboptimal |
Utilice las API de servicios web de Salesforce para realizar solicitudes de datos ad-hoc para acceder y actualizar datos del sistema externo. Esta solución incluye los siguientes enfoques:
Utilice la API de SOAP de Salesforce. Una página o botón personalizado inicia una llamada REST/SOAP de Apex de forma síncrona. En Salesforce, puede consumir un WSDL y generar una clase Apex proxy resultante. Esta clase proporciona la lógica necesaria para llamar al servicio remoto. Una acción iniciada por el usuario en una página luego llama a una acción del controlador Apex que ejecuta esta clase Apex proxy para realizar la llamada remota. Las páginas requieren la personalización de la aplicación Salesforce. Utilice la API de REST de Salesforce. Una página o botón personalizado inicia una llamada HTTP Apex (servicio REST) de forma síncrona. En Salesforce, puede invocar servicios HTTP utilizando métodos GET, POST, PUT y DELETE estándar. Para obtener más información acerca de esta solución, consulte Invocación de procesos remotos: Solicitud y respuesta. |
 En este escenario:
- El navegador realiza una llamada AJAX que a su vez realiza una acción en el adaptador de objeto externo correspondiente.
- El adaptador traduce la acción en una solicitud Odata y realiza una solicitud GET HTTP al sistema remoto a través de las capas Integración y Servicios.
- El sistema remoto devuelve una respuesta JSON a Salesforce a través de las capas Integración y Servicios.
- La respuesta se traduce de Odata a un objeto externo y se presenta de nuevo al navegador.
| Mecanismo de llamada | Descripción |
|---|---|
| Objetos externos | Salesforce Connect asigna objetos externos de Salesforce a tablas de datos en sistemas externos. En vez de copiar los datos en su organización, Salesforce Connect accede a los datos on demand y en tiempo real. Aunque los datos se almacenan fuera de su organización, Salesforce Connect proporciona una integración sencilla con Lightning Platform. Los objetos externos están disponibles para herramientas de Salesforce, como la búsqueda global, las relaciones de búsqueda, las noticias en tiempo real de registros y la aplicación móvil Salesforce. Los objetos externos también están disponibles para consultas Apex, SOSL, SOQL, API de Salesforce e implementación a través de la API de metadatos, conjuntos de cambios y paquetes. |
| Componentes de iluminación | Se utiliza cuando el proceso remoto se desencadena como parte de un proceso de extremo a extremo que implica la interfaz de usuario, y el resultado debe mostrarse o actualizarse en un registro de Salesforce. Por ejemplo, un proceso que envía pagos con tarjeta de crédito a una pasarela de pago externa y devuelve inmediatamente resultados de pago que se muestran al usuario. La integración desencadenada desde eventos de interfaz de usuario requiere habitualmente la creación de componentes Lightning personalizados. |
- Esta solución no consume almacenamiento de datos en Salesforce.
- Los usuarios no tienen que preocuparse por la sincronización regular de datos entre el sistema externo y Salesforce.
- Una configuración declarativa que se puede lograr rápidamente con Odata, o un adaptador entre organizaciones, o utilizando código mínimo con un adaptador Apex personalizado.
- Los usuarios pueden acceder a datos externos con muchas de las mismas funciones que los objetos personalizados en forma de objetos externos.
- Capacidad de realizar una búsqueda federada en el sistema externo conectado utilizando la búsqueda global.
- Capacidad de ejecutar reportes que acceden a datos externos desde la nube y fuentes locales. Consulte las consideraciones de creación de reportes a continuación.
- Los objetos externos se comportan como objetos personalizados, pero algunas funciones no están disponibles para objetos externos. Para obtener más información, consulte Consideraciones de compatibilidad Salesforce para Salesforce Connect.
- Los objetos externos pueden afectar al desempeño del reporte. Para obtener más información, consulte Consideraciones sobre Salesforce Connect.
- Para obtener consideraciones adicionales sobre el uso de adaptadores Salesforce Connect, consulte Consideraciones sobre Salesforce Connect: Todos los adaptadores.
- Si está considerando utilizar un adaptador entre organizaciones, consulte Consideraciones para Salesforce Connect: Adaptador entre organizaciones.
- Si está considerando utilizar un adaptador Odata, consulte Consideraciones para Salesforce Connect: Adaptadores Odata 2.0 y 4.0.
- Si está considerando utilizar un adaptador Apex personalizado, consulte Consideraciones para Salesforce Connect: Adaptador personalizado.
- La solicitud se invoca habitualmente desde la interfaz de usuario, de modo que el proceso no debe hacer esperar al usuario.
- Dependiendo de la disponibilidad y la conexión con el sistema externo, puede tardar mucho tiempo en recuperar datos externos. Salesforce tiene un valor de tiempo de espera máximo de 120 segundos configurable para esperar una respuesta del sistema externo.
- La finalización del proceso remoto debe ejecutarse de forma oportuna y completa dentro del límite de tiempo de espera de Salesforce y dentro de las expectativas del usuario.
| Solución | Consideraciones sobre los extremos |
|---|---|
| Salesforce Connect | API Odata: Utilice el Protocolo de datos abiertos para acceder a datos almacenados fuera de Salesforce. Los datos externos deben exponerse a través de productores Odata. Otras API: Utilice el Marco de trabajo del conector Apex para desarrollar su propio adaptador personalizado cuando los otros adaptadores disponibles no son adecuados para sus necesidades. Un adaptador personalizado puede obtener datos de cualquier origen. Por ejemplo, algunos datos pueden recuperarse de Internet a través de llamadas, mientras que otros datos pueden manipularse o incluso generarse de forma programática. Conectar con Salesforce: Utiliza la API de REST de Lightning Platform para acceder a datos almacenados en otras organizaciones de Salesforce. Conectar a través de Middleware Connect a través de Middleware: El ecosistema de socios Salesforce Connect ha trabajado estrechamente con Salesforce para asegurarse de que sus pasarelas de middleware exponen extremos Odata de su servicio de modo que Salesforce pueda conectar con ellos sin redactar código adicional. |
| Solicitud y respuesta | Llamadas de SOAP Apex: El extremo debe poder recibir una llamada de servicio web a través de HTTP. Llamadas HTTP Apex - El extremo debe poder recibir llamadas HTTP. Puede utilizar llamadas HTTP Apex para llamar a servicios RESTful utilizando los métodos GET, POST, PUT y DELETE estándar |
- Salesforce almacena la clave de sustitución principal o exclusiva para el registro remoto.
- El sistema remoto almacena el Id. de registro exclusivo de Salesforce o alguna otra clave sustitutiva exclusiva. Existen consideraciones específicas para la gestión de claves de integración en este patrón síncrono.
| Sistema principal | Descripción |
|---|---|
| Salesforce | El sistema remoto almacena el Id. de registro de Salesforce o alguna otra clave sustitutiva exclusiva del registro. |
| Sistema remoto | La llamada al proceso remoto devuelve la clave exclusiva de la aplicación, y Salesforce almacena ese valor de clave en un campo de registro exclusivo. |
- Agregación de llamadas y sus resultados entre llamadas a múltiples sistemas
- Transformación de mensajes entrantes y salientes
- Mantenimiento de la integridad de las transacciones entre llamadas a múltiples sistemas
- Otras actividades de orquestación de procesos entre Salesforce y el sistema externo
| Propiedad | Obligatorio | Deseable | No se requiere |
|---|---|---|---|
| Gestión de eventos | X | ||
| Conversión de protocolo | X | ||
| Traducción y transformación | X | ||
| Colocación en cola y almacenamiento intermedio | X | ||
| Protocolos de transporte síncronos | X | ||
| Protocolos de transporte asíncronos | X | ||
| Enrutamiento de mediación | X | ||
| Coreografía de procesos y orquestación de servicios | X | ||
| Transaccionalidad (cifrado, firma, entrega fiable, gestión de transacciones) | X | ||
| Enrutamiento | X | ||
| Extraer, transformar y cargar | X | ||
| Sondeo largo | X |
| Relación | Objetos secundarios permitidos | Objetos principales permitidos | Campo principal para coincidencia de registros |
|---|---|---|---|
| Búsqueda | Estándar, Personalizado, Externo | Estándar, personalizado | El Id. de registro de Salesforce de 18 caracteres |
| Búsqueda externa | Estándar, Personalizado, Externo | Externo | El campo estándar Id. externo |
| Búsqueda indirecta | Externo | Estándar, personalizado | Seleccionar un campo personalizado con los atributos Id. externo y Exclusivo |
- Configure su origen de datos externo con un extremo Odata. Su aplicación remota puede incluir compatibilidad nativa con Odata. Para otras aplicaciones, los principales proveedores de integración como Dell Boomi, Informatica, Jitterbit, MuleSoft y Progress Software se asociaron con Salesforce en Salesforce Connect para crear adaptadores.
- Apunte Salesforce Connect al extremo de Odata, ya sea directamente o a través de una solución de middleware.
- Sincronice sus tablas de base de datos externas con objetos externos en Salesforce. Cuando un usuario accede a una página con datos de estos objetos externos, Salesforce Connect realiza llamadas en tiempo real a sus aplicaciones de back-end.
| Nivel de patrón1 | Nivel de patrón2 | Patrón | Escenario |
|---|---|---|---|
| Patrones de ingreso de datos: Datos entrantes | Patrones de ingreso por lotes | Ingreso masivo de datos desde Cloud Storage | Los datos se ingresan desde un origen de almacenamiento de Enterprise Cloud como Amazon S3, Azure Blob o Google Cloud Storage en Data 360 en forma de grandes lotes de datos sin procesar (por ejemplo, transacciones o registros de productos). |
| Ingreso masivo de datos desde Salesforce Cloud | Data 360 recibe datos de CRM de forma masiva desde múltiples organizaciones de Salesforce (por ejemplo, Sales Cloud, Service Cloud) para crear perfiles de clientes unificados. | ||
| Patrones de transmisión e ingreso en tiempo real | Ingreso dirigido por eventos a través de API de ingreso: Transmisión | Data 360 se suscribe a extremos de ingreso de transmisión que reciben cargas de eventos continuas (por ejemplo, eventos de compra, telemetría de IoT) desde sistemas de compañía para actualizaciones de perfil en tiempo real. | |
| Ingreso de comportamiento web y móvil en tiempo real | Data 360 recopila y procesa datos de comportamiento de sitios web y aplicaciones móviles en tiempo real a través de SDK para enriquecer mediciones de implicación y modelos de personalización. | ||
| Sincronización de CRM casi en tiempo real a través de transmisión | Data 360 recibe actualizaciones de datos de CRM (por ejemplo, cambios de contacto, caso u oportunidad) casi en tiempo real a través de transmisiones de eventos para mantener una vista Customer 360 sincronizada continuamente. | ||
| Ingreso de transmisiones de eventos desde plataformas de mensajería de nube: Kinesis y MSK | Data 360 consume datos de transmisión directamente desde plataformas de eventos en la nube como AWS Kinesis o Kafka (MSK) para procesar eventos operativos o de IoT de alta frecuencia. | ||
| Cero patrones de copia: entrante y saliente | Copia de cero entrante: Plataformas externas en Data 360 | Data 360 consulta conjuntos de datos externos (por ejemplo, Snowflake, BigQuery) on demand a través de Cero ingreso de copia, sin mover físicamente datos en Salesforce. | |
| Copia cero saliente: Data 360 en plataformas externas | Los sistemas externos como Databricks o Tableau acceden a segmentos enriquecidos y perspectivas en Data 360 a través de conexiones salientes de copia cero sin replicación de datos. | ||
| Plataforma de datos de múltiples organizaciones unificada con Data Cloud One | Data Cloud One unifica múltiples organizaciones de Salesforce y orígenes de datos externos bajo un modelo semántico y de metadatos compartidos, proporcionando un Customer 360 coherente sin duplicación de datos. | ||
| Patrones de activación de datos: Datos salientes | Patrones de activación por lotes | Activación de segmentos en plataformas de marketing y publicidad | Data 360 activa segmentos de clientes depurados directamente en Marketing Cloud, Meta, Google Ads u otras plataformas de anuncios para la entrega de campañas personalizadas |
| Exportación de datos a Cloud Storage | Data 360 exporta conjuntos de datos unificados o filtrados (por ejemplo, registros de clientes consentidos) como archivos CSV o Parquet a almacenamiento de Enterprise Cloud para análisis o archivado de cumplimiento. | ||
| Activación basada en API On Demand | Integración de aplicaciones personalizadas a través de la API de Connect | Las aplicaciones externas invocan la API de Data 360 Connect en tiempo real para recuperar o desencadenar acciones personalizadas (por ejemplo, comprobación de balance de fidelidad o generación de ofertas de IA) basándose en datos de clientes actuales.Las aplicaciones web o móviles creadas a medida recuperan perspectivas de Data 360 armonizadas de forma segura a través de la API de REST de Connect para mostrar en las interfaces de usuario de compañías o socios. | |
| Recuperación de perfil de cliente completa a través de API de gráficos de datos | Un sistema recupera el perfil unificado de un cliente utilizando la API de gráfico de datos, devolviendo una representación JSON en tiempo real unida previamente de la vista completa de 360° para la decisión o la personalización. | ||
| Acciones de datos en tiempo real | Acción de datos en tiempo real Conversión de señales de clientes en acciones instantáneas | Data 360 detecta y procesa un evento en vivo (por ejemplo, actualización de consentimiento, desencadenador de compra) e invoca inmediatamente un sistema conectado o Salesforce Flow para una acción descendente.Una señal de actividad de cliente (por ejemplo, riesgo de abandono detectado) en Data 360 desencadena una acción instantánea en tiempo real, como la actualización de CRM, la invocación de puntuaje Einstein o el inicio de una trayectoria de retención. |
| Tipo | Cronología | Consideraciones de salida |
|---|---|---|
| Integración de datos | Asíncrono | Activación de segmentos en plataformas de marketing y publicidad |
| Integración de procesos/datos | Síncrono | Integración de aplicaciones personalizadas a través de la API de Connect Recuperación de perfil de cliente completa a través de API de gráficos de datos |
| Integración de datos | Síncrono | Acción de datos en tiempo real Conversión de señales de clientes en acciones instantáneas |
| Integración virtual (utilizando copia cero) | Asíncrono | Copia cero saliente: Data 360 en plataformas externas |
| Integración virtual | Asíncrono | Plataforma de datos de múltiples organizaciones unificada con Data Cloud One |
| Tipo | Cronología | Consideraciones sobre el ingreso |
|---|---|---|
| Integración de datos | Asíncrono | Ingreso masivo de datos desde Cloud Storage Ingreso masivo de datos desde Salesforce Cloud |
| Integración de datos | Asíncrono | Ingreso de transmisiones de eventos desde plataformas de mensajería de nube: Kinesis y MSK Sincronización de CRM casi en tiempo real a través de transmisión |
| Integración de procesos | Síncrono | Ingreso dirigido por eventos a través de API de ingreso: Transmisión Ingreso de comportamiento web y móvil en tiempo real |
| Integración virtual | Asíncrono | Copia de cero entrante: Plataformas externas en Data 360 |
| Plazo | Definición |
|---|---|
| Gestión de eventos | La gestión de eventos hace referencia a la recepción, el enrutamiento y la respuesta a incidencias identificables desde un sistema o una aplicación de origen. El middleware gestiona eventos identificando el extremo de destino, reenviando el evento y desencadenando la acción de negocio requerida (por ejemplo, registro, reintentos o activación de servicios descendentes). En arquitecturas de Data 360, la gestión de eventos es clave para el ingreso de datos en tiempo real, desencadenadores de activación y patrones de publicación/suscripción. Los eventos pueden originarse desde sistemas externos (Kafka, AWS Kinesis) o Eventos de Salesforce Platform y se enrutan por middleware o el bus de eventos de Data 360 para su procesamiento inmediato. |
| Conversión de protocolo | La conversión de protocolos permite la comunicación entre sistemas utilizando diferentes estándares de transporte de datos. El middleware traduce protocolos propios o heredados (como AMQP, MQTT, FTP) en protocolos de Data 360 compatibles (REST, gRPC o HTTPS). Esto garantiza la interoperabilidad entre sistemas heterogéneos. Como Data 360 no gestiona de forma nativa la conversión de protocolos, el middleware proporciona la capa de adaptación, encapsulando o transformando mensajes en un formato que las API y conectores de Data 360 pueden interpretar. |
| Traducción y transformación | La traducción y la transformación garantizan la interoperabilidad asignando un formato de datos o esquema a otro. Middleware realiza estas transformaciones para alinear diversas cargas de datos (CSV, XML, JSON) con objetos de modelo de datos (DMO) y objetos de capa de datos unificados (UDLO) de Data 360. Esto incluye la limpieza, el enriquecimiento y la aplicación de asignaciones semánticas u ontológicas antes de la ingesta. Aunque Salesforce ofrece herramientas de transformación como Recetas de Preparación de datos, las transformaciones complejas (especialmente para Armonización semántica) se gestionan mejor en middleware. |
| Cola y almacenamiento en memoria intermedia | Las colas y el almacenamiento en memoria intermedia dependen del paso de mensajes asíncronos para garantizar una comunicación resiliente y desvinculada. Las plataformas de middleware (por ejemplo, MuleSoft, Kafka o Azure Event Hub) proporcionan colas persistentes que almacenan temporalmente datos cuando Data 360 o sistemas descendentes están ocupados o no se puede acceder a ellos. Esto evita la pérdida de datos y admite reintentos de ingreso o activación casi en tiempo real. Data 360 admite el ingreso de transmisiones y la mensajería saliente basada en flujos, pero el middleware suele gestionar las colas duraderas y la entrega garantizada. |
| Protocolos de transporte síncronos | Los protocolos de transporte síncronos implican operaciones de bloqueo de solicitudes/respuestas en tiempo real. El remitente espera una respuesta antes de continuar. En Data 360, estos se utilizan para activaciones basadas en API on-demand, enriquecimiento en tiempo real o búsquedas de perfil, donde se requieren respuestas de inmediato. El middleware garantiza la fiabilidad de la conexión y gestiona reintentos o gestión de reserva para llamadas de API de Data 360 síncronas. |
| Protocolos de transporte asíncronos | Los protocolos de transporte asíncronos admiten la comunicación desvinculada no bloqueada donde el remitente continúa procesando sin esperar una respuesta. El middleware gestiona flujos asíncronos para activaciones por lotes, ingreso de transmisiones y activación dirigida por eventos. Esto permite un alto rendimiento y capacidad de recuperación, clave para la transmisión de eventos y patrones de ingreso de datos casi en tiempo real en Data 360. |
| Enrutamiento de mediación | El enrutamiento de mediación define un flujo de mensajes complejo entre sistemas, garantizando que los datos o eventos correctos llegan al consumidor correcto. El middleware actúa como mediador, gestionando la lógica de enrutamiento basándose en reglas, encabezados, contenido o tipo de evento. En integraciones de Data 360, la mediación garantiza que los eventos y las actualizaciones de perfil desde múltiples sistemas se enruten correctamente a las API de ingreso de datos, los extremos de activación o los consumidores externos. Esto simplifica la orquestación y admite la sincronización de datos de múltiples sistemas. |
| Coreografía de proceso y Orquestación de servicio | La coreografía de procesos y la orquestación coordinan procesos de múltiples sistemas. Coreografía admite flujos autónomos dirigidos por eventos asíncronos, donde los sistemas actúan basándose en reglas compartidas sin un controlador central. Orquestación es un flujo gestionado de forma centralizada que dirige la ejecución del servicio. En arquitecturas de Data 360, el middleware gestiona la orquestación para el ingreso y la activación entre sistemas, mientras que los flujos de trabajo o flujos de Salesforce gestionan coreografías ligeras dentro de la plataforma. La orquestación compleja, que requiere coordinación de transacciones o gestión de estados, se recomienda en la capa de middleware. |
| Transacción (Cifrado, Firma, Entrega fiable, Gestión de transacciones) | La transaccionalidad garantiza operaciones atómicas, coherentes, aisladas y duraderas (ACID) entre sistemas. Salesforce y Data 360 son transaccionales dentro de sus límites pero no admiten transacciones distribuidas entre sistemas externos. El middleware gestiona el control de transacciones globales, incluyendo cifrado, firma de mensajes, reversión, compensación y entrega fiable. Para flujos de datos de misión crítica (por ejemplo, actualizaciones financieras o de consentimiento), el middleware garantiza la integridad y la recuperación de extremo a extremo entre Data 360 y sistemas externos. |
| Enrutamiento | El enrutamiento especifica el flujo controlado de mensajes o datos entre componentes. Puede basarse en encabezados, tipo de contenido, prioridad o reglas. El middleware gestiona la lógica de enrutamiento para eventos y activaciones que implican Data 360, como dirigir segmentos de audiencia enriquecidos a diferentes sistemas descendentes (plataformas de anuncios, almacenes, aplicaciones CRM). Aunque el enrutamiento se puede implementar dentro de Salesforce (Apex, Flows), el enrutamiento middleware se prefiere por su capacidad de ampliación, flexibilidad y gobernanza. |
| Extracción, transformación y carga (ETL) | ETL implica extraer datos de sistemas de origen, transformarlos en un esquema coherente y cargarlos en un destino (como Data 360). Las herramientas de middleware o ETL gestionan estas operaciones antes del ingreso de datos. Data 360 puede recibir salidas de ETL a través de API, conectores o oportunidades en curso de ingreso masivo, y también admite Captura de datos de cambios (CDC) para la sincronización casi en tiempo real. Los procesos ETL de middleware son esenciales para integrar sistemas heredados y garantizar la calidad de los datos antes de la unificación en Data 360. |
| Votación larga | Sondeo largo (Programación de cometas) es un método para mantener la comunicación abierta entre sistemas para actualizaciones en tiempo real. El cliente envía una solicitud y el servidor la mantiene hasta que se produzca un evento, luego responde y reabre una nueva conexión. Salesforce utiliza esto en la API de transmisión y los protocolos CometD/Bayeux para la sincronización de datos dirigida por eventos. El middleware puede suscribirse a estos eventos y reenviarlos a Data 360 para desencadenadores de ingreso o activación en tiempo real, garantizando una latencia mínima entre sistemas de compañía. |
| Solución | Ajuste | Comentarios |
|---|---|---|
| Utilizar conectores de almacenamiento de nube nativos (Amazon S3, Google Cloud Storage, Azure Blob Storage) | Mejor | Este es el patrón recomendado y más fiable para el ingreso recurrente a gran escala basado en archivos en Data 360\. Los conectores nativos proporcionan autenticación gestionada, asignación de esquemas y movimiento de datos seguro directamente en los objetos de lago de datos (DLO) de Data 360. Ideal para cargas por lotes programadas donde la latencia no es crítica (por ejemplo, programación cada hora o diariamente). |
| Gestión de grandes conjuntos de datos (más allá de los límites del conector) | Mejor con preprocesamiento | Cada conector aplica límites de admisión (por ejemplo, S3: 100M filas o 50 GB por objeto). Para conjuntos de datos más grandes, implemente un paso de preprocesamiento de ETL para particionar datos en archivos/carpetas más pequeños que se encuentren por debajo de estos umbrales. A continuación, configure múltiples transmisiones de datos para ingresar cada partición en paralelo, y utilice el nodo adjunto en transformaciones de datos por lotes) dentro de Data 360 para recombinar las particiones en un conjunto de datos unificado. |
| Seguridad y gobernanza | Mejor | Todos los conectores admiten la autenticación segura a través de métodos nativos de la nube (funciones IAM, cuentas de servicio o claves de acceso). Para mayor control, restrinja el acceso a intervalos de IP de Data 360 a través de la lista de admisión del proveedor de nube. La transferencia de datos se produce en canales cifrados, con archivos almacenados en una capa de organización temporal y segura durante el ingreso. |
| Cuándo no utilizar | Suboptimal | Este patrón no es óptimo para:
|
 En este escenario:
- El administrador configura una conexión al almacenamiento en la nube a través de la interfaz Configuración de Data 360 (especificando autenticación, detalles de depósito, funciones de IAM y listas blancas).
- La interfaz de configuración de Data Cloud se autentica con Cloud Storage Platform, verificando credenciales y acceso.
- El administrador crea una transmisión de datos en Data 360, vinculando la transmisión de datos al objeto/carpeta en Cloud Storage y definiendo la programación de ingreso.
- En el desencadenador de programación, la transmisión de datos solicita archivos de origen (por ejemplo, CSV, Parquet) desde Cloud Storage Platform.
- Cloud Storage Platform entrega archivos, incluyendo el schema_sample.csv válido requerido y otros archivos de datos que cumplen con convenciones de nomenclatura.
- Transmisión de datos transfiere archivos al entorno de organización interno en Data 360.
- Canalizaciones de Data 360 procesa los archivos: Utiliza la definición de esquema de schema_sample.csv Valida la estructura, los nombres de campo y divide la carga si está por encima de los umbrales de ingreso (100 millones de filas/50 GB por archivo). Si se detectan archivos de gran tamaño, se realiza un paso de partición de preprocesamiento (notificado al administrador para la siguiente ejecución) de forma externa.
- Los registros se importan desde la organización en un objeto de lago de datos (DLO).
- Si es necesario y los datos están particionados, utilice el nodo de anexado en una Trasformación de datos por lotes para combinar múltiples DLO.
- Data 360 registra el éxito/fallo, actualiza el estado para el monitoreo y señala que los datos están listos para la asignación, Armonización y Unificación.
##### Resultados
La aplicación de este patrón permite el ingreso seguro, programado y a gran escala de archivos estructurados o no estructurados desde plataformas de almacenamiento de Enterprise Cloud en Data 360. El proceso es automatizado, ampliable y resistente, entregando datos sin procesar en objetos de lago de datos (DLO) que sirven como la base para Armonización y asignación al modelo de datos Customer 360.
###### Mecanismos de admisión
El mecanismo de ingreso depende del conector y la estrategia de programación definidos en Data 360.
| Mecanismo de admisión | Descripción |
|---|---|
| Conector de almacenamiento de nube nativo (Amazon S3, GCS, Azure) | Recomendado para el ingreso directo de archivos en formato CSV o Parquet desde el lago de datos de nube de la compañía. Estos conectores admiten programaciones de actualización incrementales y completas. Por ejemplo, un banco puede configurar una sincronización diaria de archivos de transacciones de clientes desde un depósito de S3 a un DLO. |
| Estrategia de archivo particionado | Para conjuntos de datos muy grandes (más de 100 millones de filas o 50 GB por objeto), los datos se dividen en conjuntos lógicos más pequeños (por ejemplo, por mes o región). Cada partición se gestiona como una Transmisión de datos separada y se recombina más adelante utilizando una Trasformación de datos por lotes con un nodo Anexado. |
| Sincronización programada automatizada | Data 360 proporciona un programador declarativo (cadencia horaria, diaria o personalizada) que desencadena trabajos de ingreso automáticamente, garantizando la actualización de los datos sin intervención manual. |
| Tipo de conector | Requisitos de extremo |
|---|---|
| Conector de Amazon S3 | Depósito de S3 con política de IAM apropiada y archivo schema\_sample.csv que define el esquema. |
| Conector de Google Cloud Storage | Credenciales de cuentas de servicio y acceso a depósitos con convenciones de nomenclatura uniforme. |
| Conector de almacenamiento de Azure | Clave de acceso o autenticación basada en tokens de SAS; la estructura de carpetas o blob debe seguir las convenciones de Data 360. |
| Área de solución | Ajuste | Comentarios / Detalles de implementación |
|---|---|---|
| Ajuste de solución | Mejor | Utilice el conector nativo de Salesforce CRM y el conector de Marketing Cloud Engagement en Data 360\. Comience con Paquetes de datos de inicio para casos de uso estándar y acelere la incorporación. Utilice la personalización de transmisiones manual para modelos de datos a medida o específicos de dominio. |
| Gestión de instancias de CRM altamente personalizadas | Mejor con taller de asignación | Trate los paquetes de inicio como una línea base y realice un taller de asignación para identificar: Relaciones y objetos personalizados. Fórmula o campos calculados. Extensiones de paquetes gestionados. Para campos de fórmula pesados, calcule valores en un ETL previo a la etapa o dentro de Transformaciones de Data 360 para minimizar la carga de API en organizaciones de origen. |
| Cuándo no utilizar | Escenarios subóptimos | Evite este patrón si: Necesita ingreso de eventos de alta frecuencia o en tiempo real (en su lugar, utilice Conectores de transmisión, Eventos de plataforma o Federación de copia cero). La organización de origen tiene una capacidad de API limitada y no puede mantener las extracciones programadas sin demoras de estrangulación o cola. |
| Seguridad y gobernanza | Controles obligatorios | Principio de menor privilegio: utilice un usuario de integración exclusivo con acceso de lectura mínimo. Nunca utilice administradores de toda la organización. Autenticación: Utilice OAuth 2.0 y aplicaciones conectadas; rote secretos de cliente regularmente y monitoree el uso de tokens de actualización. Auditoría y trazabilidad: registre todas las ejecuciones de ingreso, cambios de esquema y eventos de conector. Reenvíe registros a SIEM o sistemas de cumplimiento para la preparación de auditorías. Clasificación de datos: Aplique el etiquetado PII/PHI y el Control de acceso basado en atributos (ABAC) utilizando políticas de CEDAR inmediatamente después del ingreso para aplicar el enmascaramiento, el consentimiento y el cumplimiento descendente. |
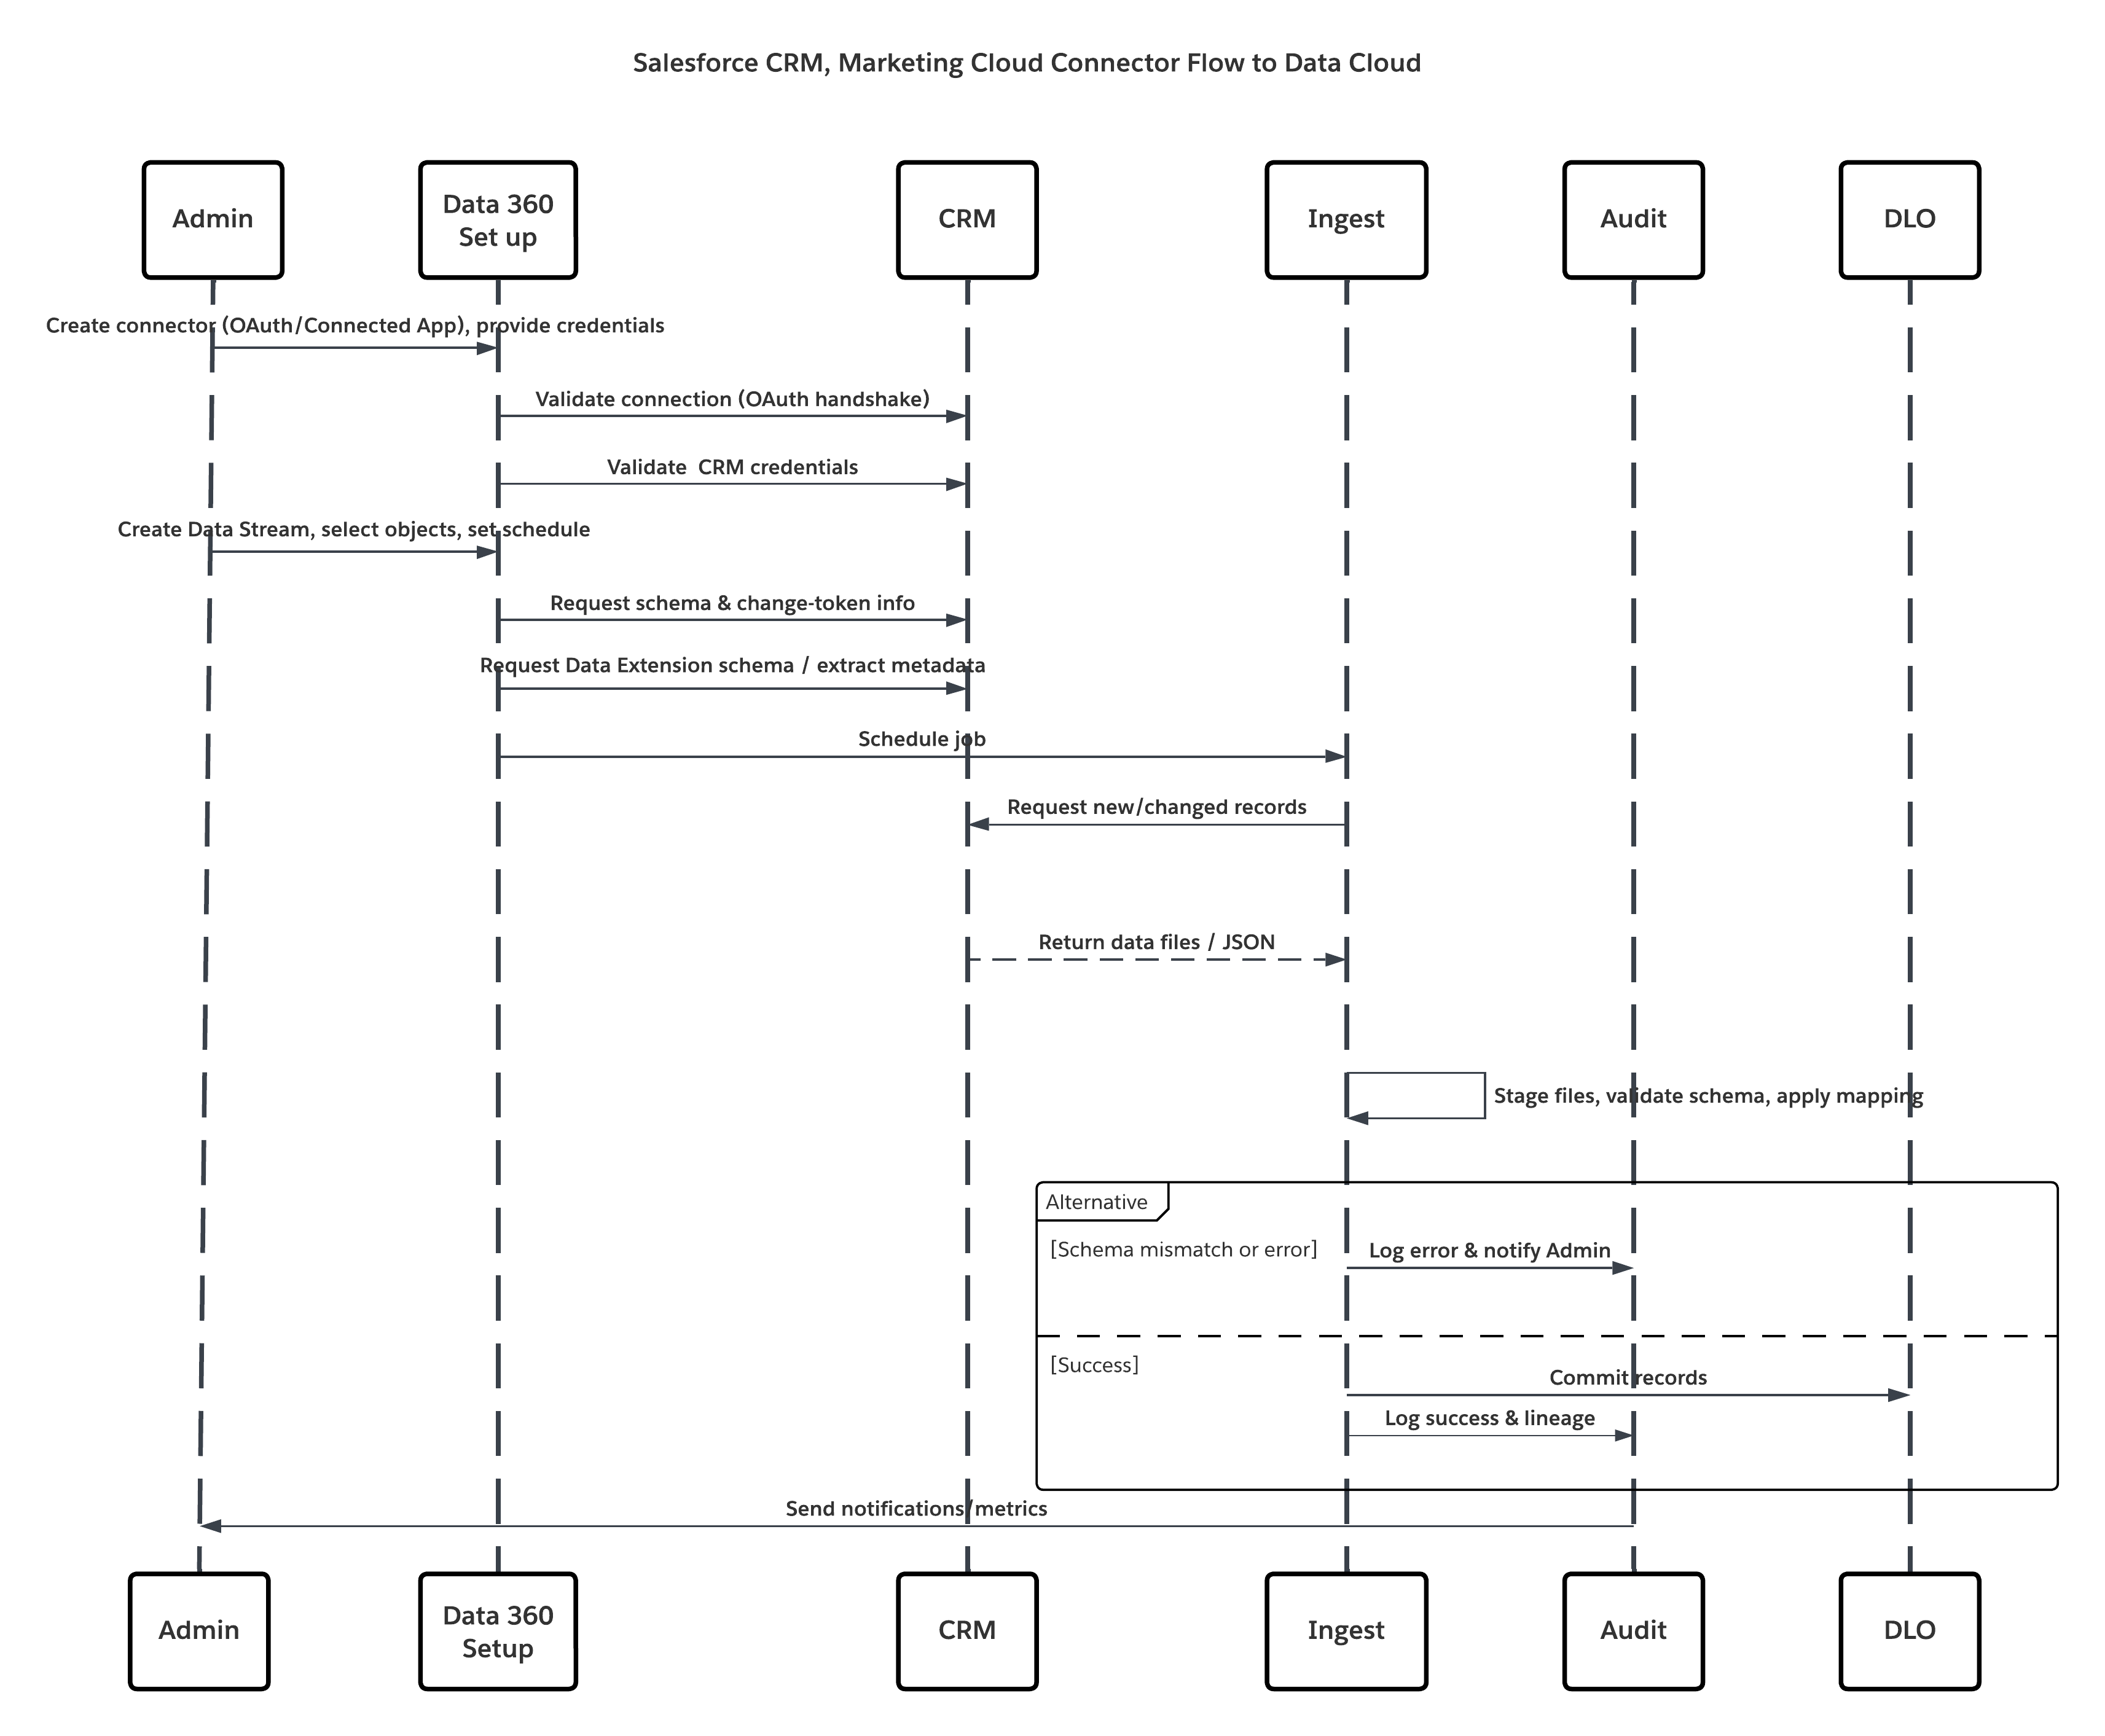 En este escenario:
- El **administrador proporciona usuarios** de integración y asigna conjuntos de permisos de conector en organizaciones de origen.
- El **administrador configura conectores** en Configuración de Data 360 (se conecta a Salesforce CRM y Marketing Cloud a través de OAuth/aplicación conectada).
- El **administrador crea Transmisiones** de datos seleccionando objetos y Extensiones de datos, selecciona la actualización completa o delta y establece programaciones.
- **En la ejecución programada**, Data 360 solicita tokens de esquema y delta desde la(s) fuente(s).
- Los **sistemas de origen devuelven registros** (delta o carga completa). Marketing Cloud puede entregar extractos; CRM puede devolver resultados de JSON/Consulta.
- **Data 360 organiza archivos** en su área de organización segura interna y valida con el esquema asignado.
- **Si falla la validación**, el error de registro de ingreso, el administrador de alertas y la confirmación se detiene. Si la validación se realiza correctamente, Data 360 confirma registros atómicamente en el DLO de destino.
- Los **registros de monitoreo** y auditoría se actualizan con el linaje, la duración de la ejecución, los conteos de filas y el uso de credenciales. Alertas emitidas a administradores si se desencadenan umbrales o errores.
##### Resultados
Los datos principales de relaciones con los clientes e implicación de marketing se ingresan en Data 360 como Objetos de lago de datos (DLO). Esto proporciona:
- **Conjunto de datos unificado** que contiene perfiles, casos, oportunidades y mediciones de email/implicación.
- **Fundamento para resolución** de identidad y construcción de perfiles de particulares unificados.
- **Preparación operativa** para Armonización descendente, enriquecimiento, modelado de IA y activación preservando al mismo tiempo la gobernanza y la capacidad de auditoría.
###### Mecanismos de admisión
El mecanismo de ingreso depende del conector y la estrategia de programación definidos en Data 360.
| Mecanismo | Cuándo utilizar |
|---|---|
| Conector de Salesforce CRM (nativo) | Lo mejor para objetos CRM estándar/personalizados; admite la actualización completa y delta. |
| Conector de implicación de Marketing Cloud (nativo) | Lo mejor para extensiones de datos, envíos y seguimiento de extractos; admite modos completo/delta. |
| Paquetes de datos de inicio | Acelere la incorporación para objetos comunes de Ventas/Servicio/Marketing. |
| Transmisiones personalizadas + preprocesamiento | Se utiliza cuando se requieren transformaciones complejas o normalización de esquemas intensa. |
| Conector | Requisitos de extremo |
|---|---|
| Conector de Salesforce CRM | La organización de origen debe permitir una aplicación conectada, tokens de OAuth y un usuario de integración exclusivo con permisos de lectura. |
| Conector de Marketing Cloud | Credenciales de API de Marketing Cloud o paquete instalado; las extensiones de datos deben exponer datos a través de Extractos/API. |
| Área de solución | Ajuste | Comentarios / Detalles de implementación |
|---|---|---|
| Ajuste de solución | Mejor para captura de eventos de baja latencia | Utilice la API de ingreso de Data 360 (JSON de transmisión) para enviar eventos únicos o microlotes. Configure el conector de API de ingreso con un esquema estricto de OAS 3.0 (.yaml). Utilice el ingreso masivo de CSV para sincronizaciones más grandes y menos frecuentes. |
| Gestión de cambios de esquema | Estricto / Gestionado | Los cambios de esquemas se están interrumpiendo: actualice .yaml de OAS, versione el conector y realice pruebas de contratos. Implemente la migración de esquemas progresiva si los productores no pueden cambiar simultáneamente. |
| Cuándo no utilizar | Suboptimal | No es ideal si se necesita preprocesamiento (ej: deduplicación, pedido garantizado, etc.) o para cargas masivas extremadamente grandes (utilice conectores masivos nativos o ETL por lotes). Si el origen no puede producir cargas válidas para esquemas o no puede autenticarse de forma segura, utilice métodos de ingreso alternativos. |
| Seguridad y gobernanza | Obligatorio | Utilice OAuth 2.0 con ámbitos de menor privilegio, rotar claves, registrar uso de tokens. Aplique TLS 1.2+, valide direcciones IP de clientes si es necesario y garantice el etiquetado de PII de carga. Todos los eventos deben incluir metadatos de procedencia (origen, marca de tiempo, versión de esquema, clave de idempotencia). |
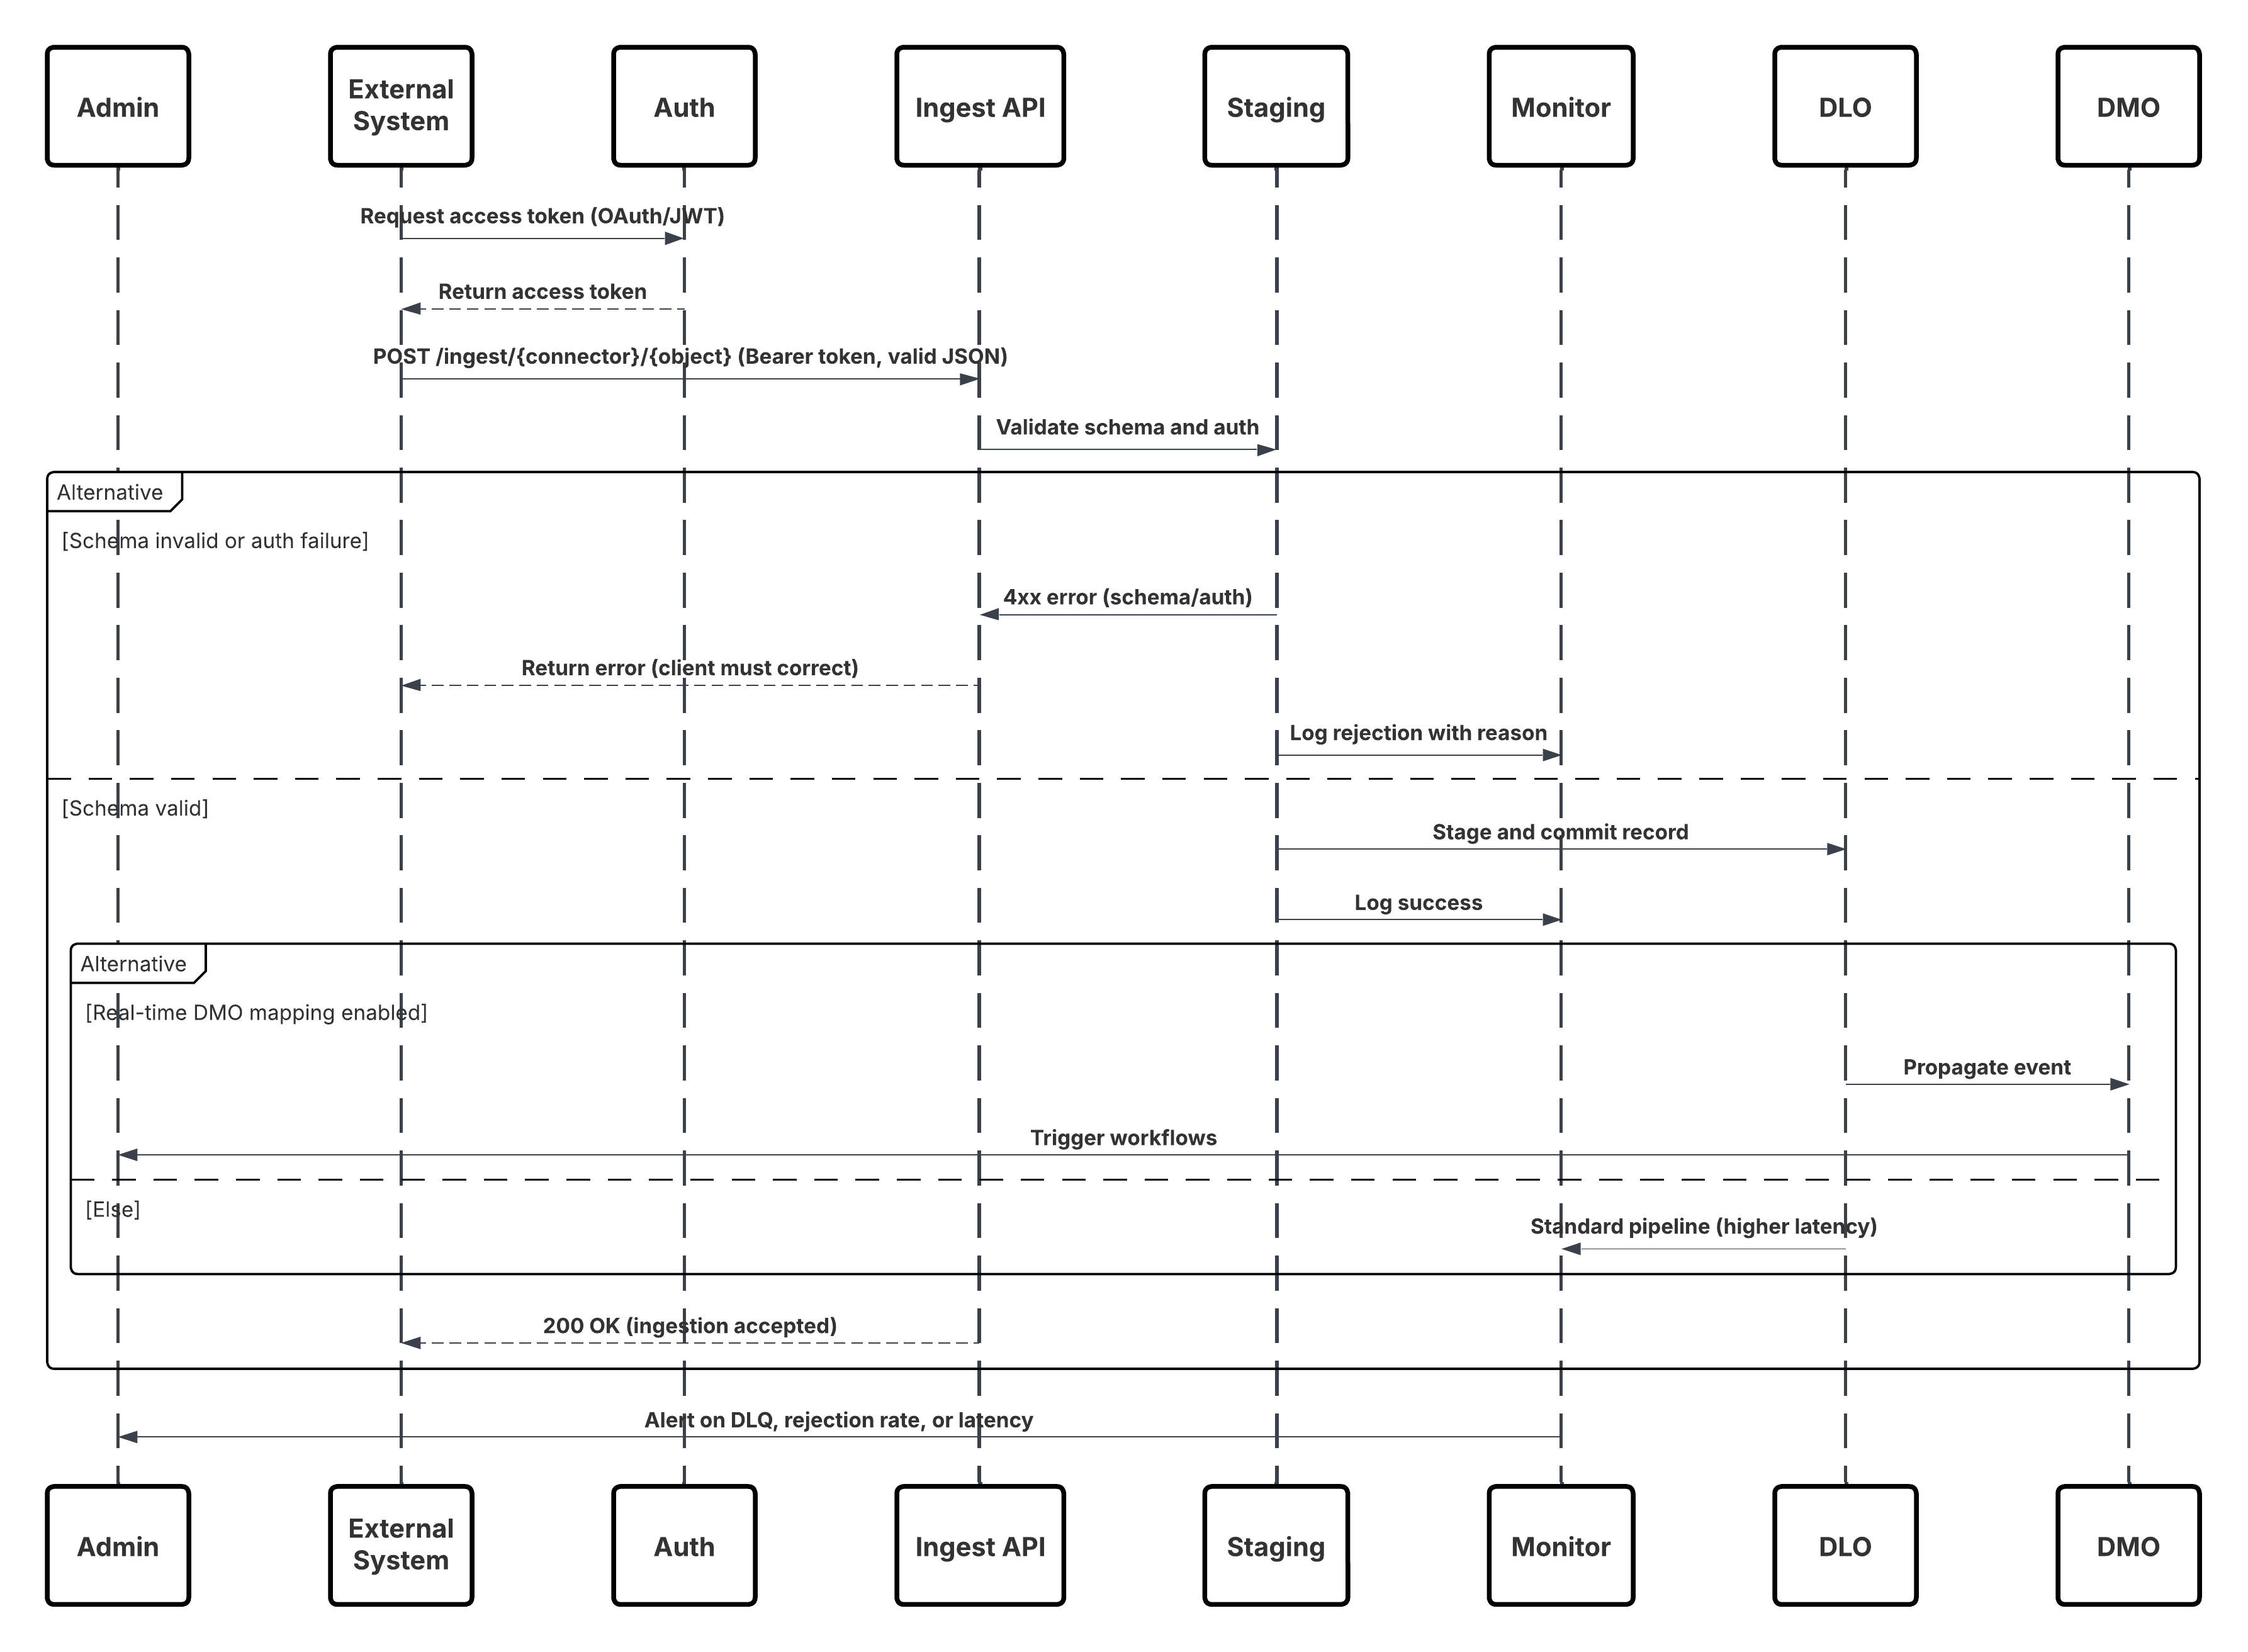 **En este escenario:**
- El sistema externo solicita autenticación a través de OAuth/JWT desde el servidor de autenticación.
- Servidor de autenticación devuelve el token de acceso a Sistema externo.
- El sistema externo envía la solicitud POST de ingreso de datos a la API de ingreso de Data 360 con autorización y carga JSON.
- La API de ingreso valida el esquema de solicitud y la autenticación a través del módulo Etapa y validación.
- En caso de fallo de esquema/autenticación:
- Error devuelto a Sistema externo.
- Rechazo registrado para monitoreo y alerta.
- En validación correcta:
- Registros organizados y confirmados en Objeto de lago de datos (DLO).
- Éxito registrado para el monitoreo.
- Si se activa, los datos se propagan a Gráfico de datos en tiempo real (DMO) desencadenando flujos de trabajo descendentes.
- De lo contrario, los datos procesados a través de lotes estándar o oportunidades en curso de latencia superior.
- API de ingreso confirma el éxito en Sistema externo.
- Los componentes de monitoreo alertan al administrador sobre colas de letra muerta, índices de rechazo o problemas de latencia.
##### Resultados
Los datos de eventos externos se ingresan en los DLO de Data 360 con baja latencia. Cuando el DMO de destino forma parte del gráfico en tiempo real, los datos están disponibles para segmentación instantánea, flujos de trabajo de agentes, modelos de IA y activación operativa. Esto permite respuestas de negocio rápidas a eventos originados desde cualquier sistema conectado.
###### Mecanismos de admisión
El mecanismo de ingreso depende del conector y la estrategia de programación definidos en Data 360.
| Mecanismo | Cuándo utilizar |
|---|---|
| JSON de transmisión (API de ingreso) | Eventos únicos, microlotes, eventos de comportamiento, transmisiones de clics, telemetría de IoT: cuando se requiere baja latencia. |
| CSV masivo (modo masivo de API de ingreso) | Cargas periódicas más grandes donde los requisitos de latencia se relajan. |
| Perfil / Middleware | Utilice cuando necesite validación, transformación, enriquecimiento o limitación de velocidad antes de enviar a la API de ingreso. |
| Área de solución | Ajuste | Comentarios / Detalles de implementación |
|---|---|---|
| Captura de eventos basada en SDK | Mejor | Implemente el SDK de interacciones de Salesforce (web) o el SDK nativo (móvil). Estas bibliotecas ligeras capturan y serializan interacciones de usuarios en tiempo real, adjuntando metadatos (Id. de sesión, marca de tiempo, contexto). |
| Oportunidades en curso de transmisión de eventos | Mejor | Los eventos se envían al servicio de transmisión de eventos de Marketing Cloud Personalization a través de HTTPS seguro. Esta capa es ampliable horizontalmente y está optimizada para la transmisión de baja latencia (<2s). |
| Integración de Data 360 | Mejor | El Conector de personalización de Data 360 se suscribe a las noticias en tiempo real de transmisión, ingresando cada evento en un Objeto de lago de datos (DLO) casi en tiempo real. |
| Asignación de modelo de datos | Mejor práctica | El DLO ingresado se asigna a Objetos de modelo de datos (DMO) Customer 360. Esto permite vincular usuarios anónimos y conocidos a través de Resolución de identidad. |
| Activación de gráficos en tiempo real | Opcional / Recomendado | Incluya DMO asignados en el gráfico en tiempo real para segmentación instantánea, desencadenando acciones personalizadas a través de flujos de trabajo Einstein o Agentforce. |
| Cuándo no utilizar | Suboptimal | Este patrón no es ideal cuando: Los datos de origen son cliente web y eventos (utilice la API de ingreso en su lugar). La organización carece de control sobre clientes web/móviles. No se requiere el seguimiento del comportamiento en tiempo real (utilice el ingreso por lotes). |
| Gestionar los cambios de esquema | Evolución gestionada | Los esquemas de eventos evolucionan a medida que se agregan nuevas interacciones. Los SDK deben versionar definiciones de eventos. Los cambios compatibles con versiones anteriores (agregar campos opcionales) son seguros; la interrupción de los cambios requiere la reconfiguración del conector y pruebas de contratos. |
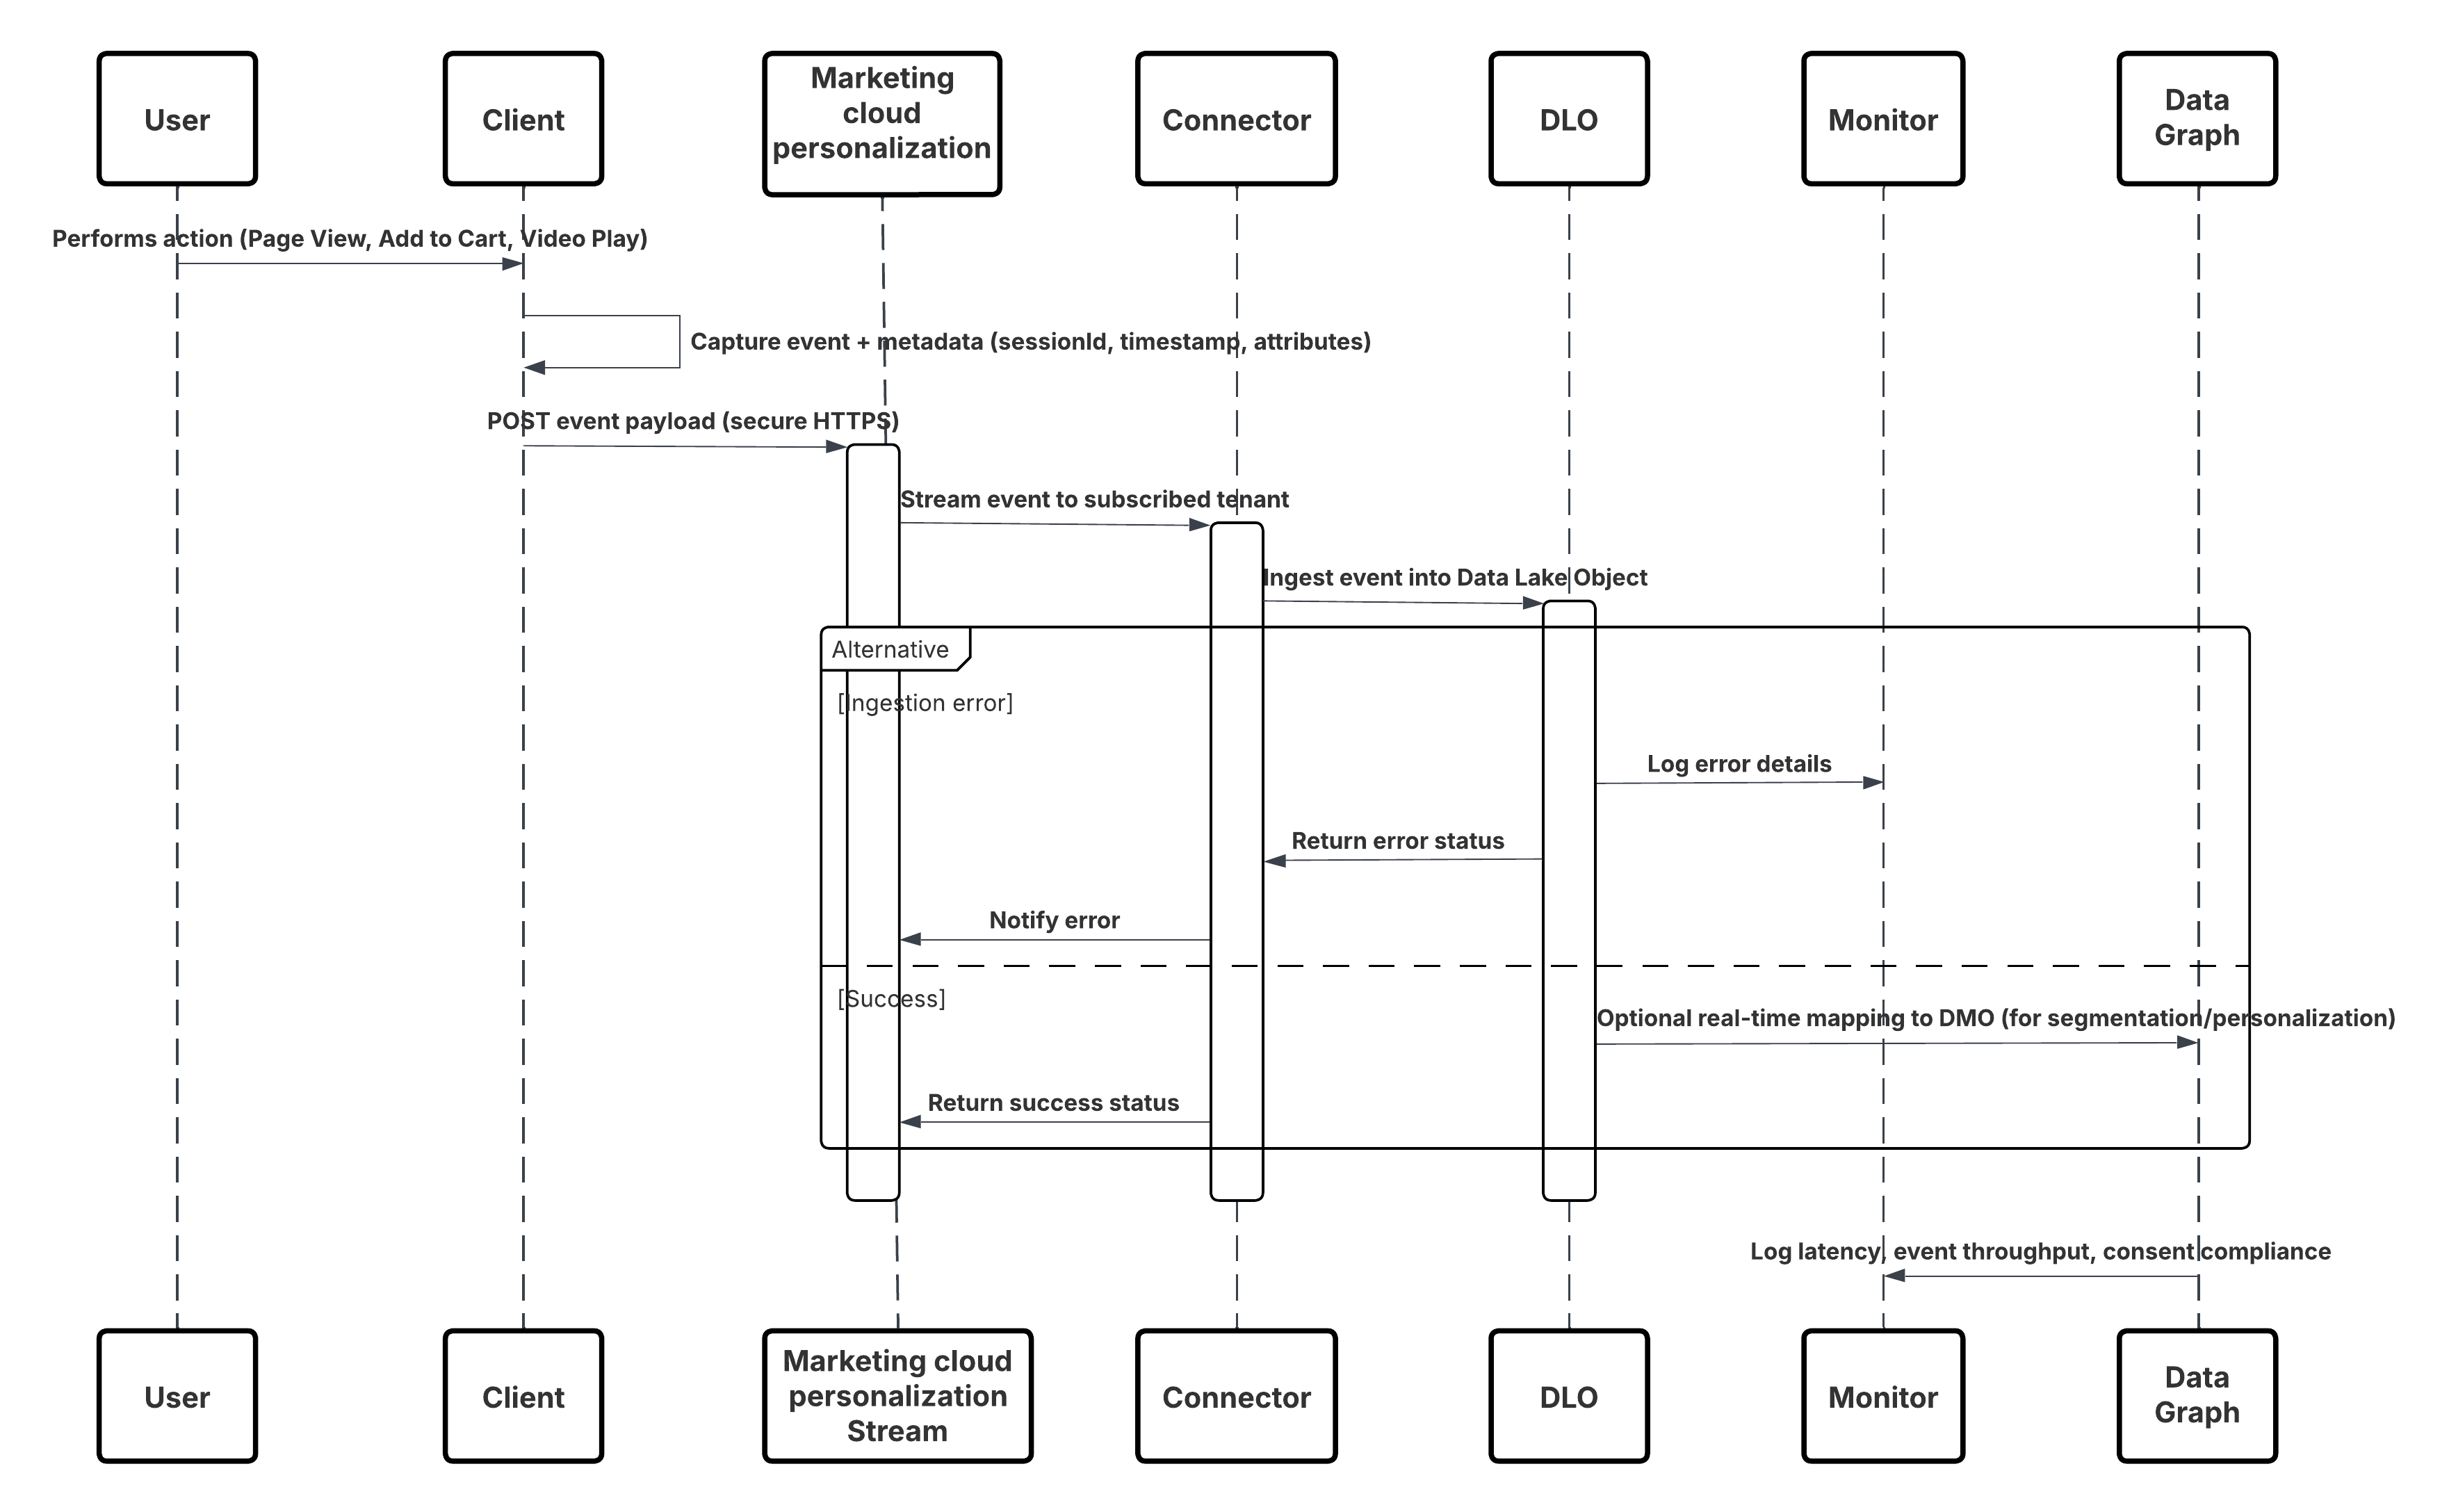 **En este escenario:**
- Implemente el SDK en canales web o móviles (captura de interacción de usuario).
- Configure SDK con controles de Id. de arrendatario, entorno y consentimiento.
- Transmita eventos JSON capturados (metadatos + atributos) al extremo de transmisión de Marketing Cloud.
- En Configuración de Data 360, cree y configure el Conector de personalización para el arrendatario.
- Ingrese eventos en un DLO y asigne el DLO → DMO dentro de Data 360.
- Active el DMO en el gráfico en tiempo real para una activación inmediata.
- Monitoree la latencia, la conformidad de esquemas, los indicadores de consentimiento, el rendimiento y los índices de error.
- Implemente en producción y monitoree continuamente.
##### Resultados
Una transmisión continua y de baja latencia de eventos de comportamiento fluye desde canales digitales a Data 360. En cuestión de segundos, cada acción de usuario queda disponible para segmentación en tiempo real, modelado predictivo o personalización desencadenada, permitiendo experiencias de cliente verdaderamente adaptativas.
###### Mecanismos de admisión
El mecanismo de ingreso depende del conector y la estrategia de programación definidos en Data 360.
| Mecanismo | Cuándo utilizar |
|---|---|
| SDK de interacciones (Web) | Captura en tiempo real desde navegadores web y SPA. |
| SDK móvil | Captura en tiempo real desde aplicaciones móviles nativas. |
| Conector de personalización | Suscripción gestionada entre Marketing Cloud y Data 360\. |
| Asignación de gráficos en tiempo real | Activa la activación inmediata en Segmentación, Einstein y Trayectorias. |
| Área de solución | Ajuste | Comentarios / Detalles de implementación |
|---|---|---|
| Conector de transmisión basado en CDC | Mejor | Mecanismo nativo de Salesforce; completamente gestionado e integrado con la infraestructura de eventos de plataforma. |
| Suscripción y entrega de eventos | Mejor | El conector se suscribe a canales ChangeEvent (por ejemplo, /data/ContactChangeEvent) a través de identificadores de reproducción duraderos. |
| Asignación de datos y evolución de esquemas | Mejores prácticas | Asigne cargas transmitidas al DLO correspondiente; gestione la versión de esquemas en metadatos para evitar interrupciones de ingreso. |
| Reproducción y recuperación de fallos | Recomendado | Utilice los Id. de reproducción y las claves de idempotencia para evitar duplicaciones y recuperarse de errores transitorios. |
| Modo híbrido (Transmisión + Lote) | Opcional | Para objetos no admitidos o carga masiva inicial, utilice el ingreso por lotes en combinación con la transmisión de CDC. |
| Cuándo no utilizar | Suboptimal | Este patrón puede ser subóptimo cuando: El objeto de origen no está activado por CDC. El caso de uso no requiere actualizaciones en tiempo real (lote es suficiente). La salida de red de la organización de origen está restringida o se superan los límites de eventos. |
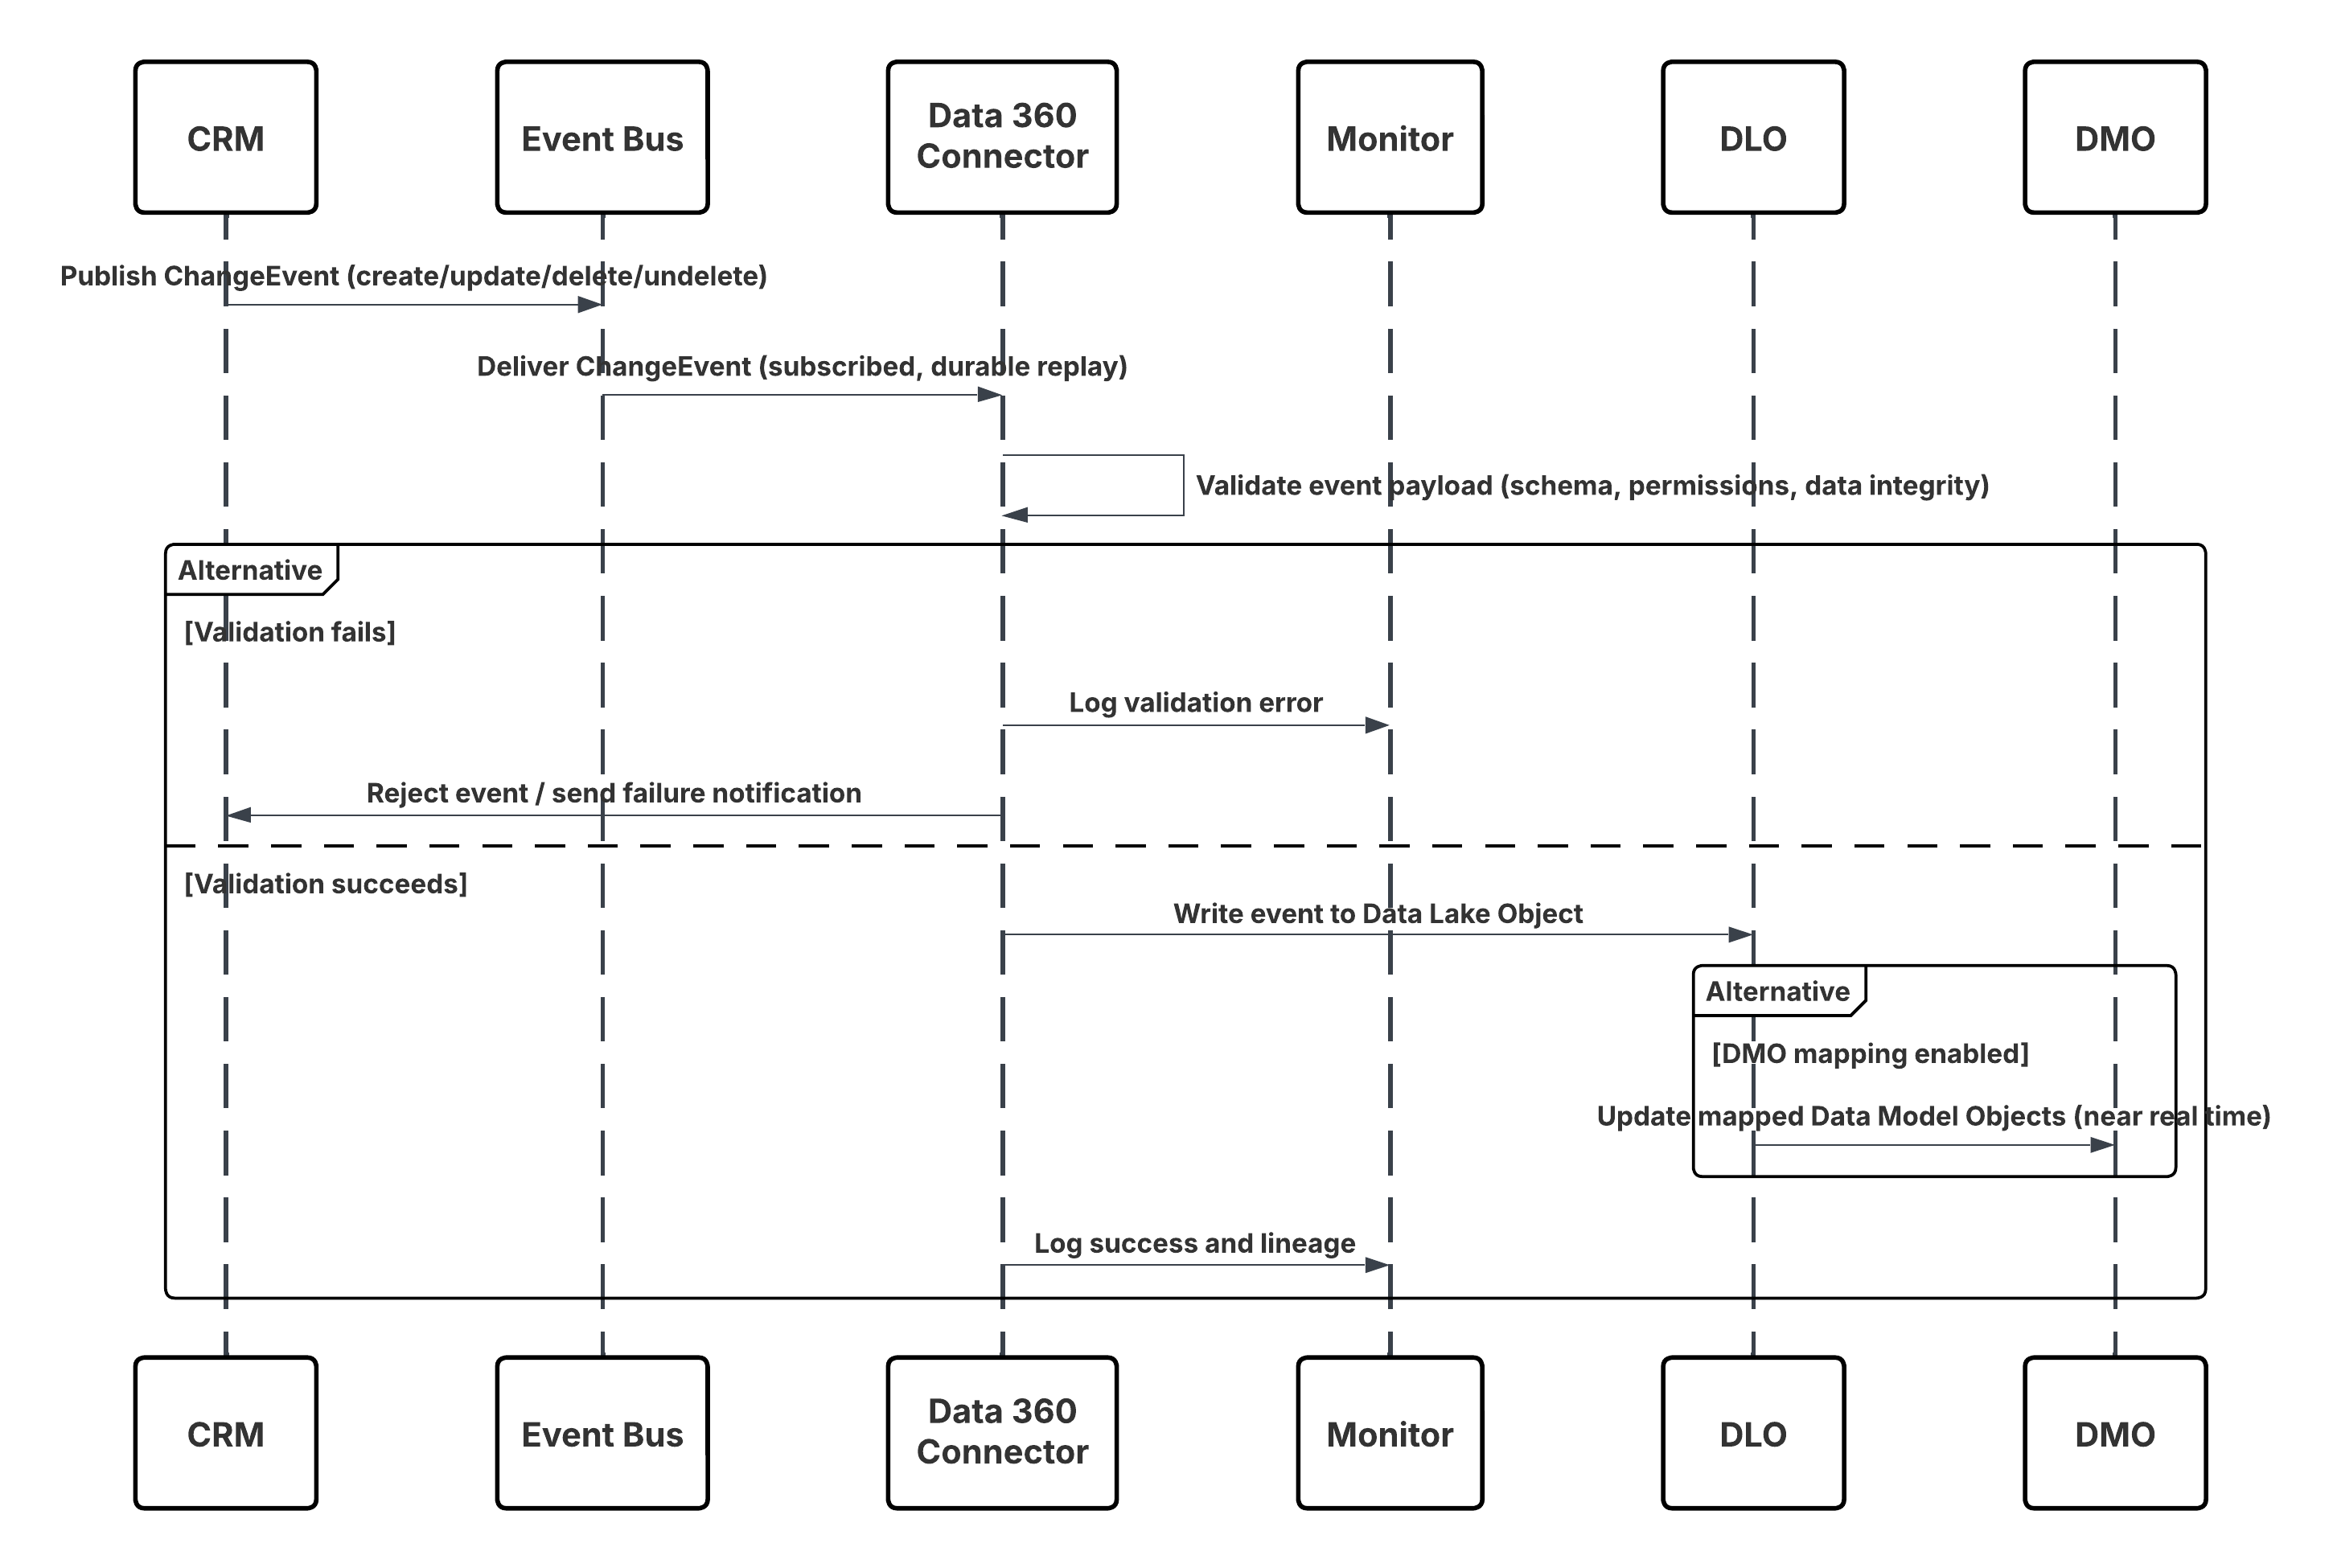 **En este escenario:**
- El cambio se produce en Salesforce CRM (create/update/delete/undelete).
- Los CDC publican un ChangeEvent en el Bus de eventos de Salesforce interno.
- Conector de CRM de Data 360 se suscribe al Bus de eventos utilizando un cursor de reproducción duradero.
- La carga de evento se valida para esquema, permisos e integridad de datos.
- Data 360 escribe el evento validado en el **Objeto de lago de datos (DLO)** asignado.
- Si está activado, los **Objetos de modelo** de datos (DMO) asignados se actualizan casi en tiempo real, potenciando la segmentación y la activación.
##### Resultados
Data 360 mantiene un espejo sincronizado continuamente de datos de CRM clave.
Esto activa:
- Desencadenadores en tiempo real (por ejemplo, la trayectoria se inicia cuando se crea un caso).
- Segmentación actualizada (por ejemplo, mover clientes al segmento “Oro” tras el cambio de estado de Cuenta).
- Análisis y personalización más precisos basados en contexto de CRM en vivo.
###### Mecanismos de admisión
El mecanismo de ingreso para este patrón se gestiona de forma nativa a través del Conector de Salesforce CRM con Captura de datos de cambios (CDC) activada. Data 360 actúa como un suscriptor de la transmisión de eventos de CDC, garantizando una sincronización fiable y de baja latencia entre la organización de CRM de origen y Data 360.
| Mecanismo | Cuándo utilizar |
|---|---|
| Transmisión a través de CDC (Preferido) | Para todos los objetos estándar y personalizados de Salesforce admitidos donde se requiere sincronización casi en tiempo real. |
| Modo híbrido (CDC + Lote) | Para objetos aún no activados por CDC o donde se requiere carga histórica inicial. |
| Modo de suscripción de reproducción | Para la resincronización después del tiempo de inactividad o la implementación. |
| Modo de aislamiento de error | Para entornos de prueba y validación. |
| Área de solución | Ajuste | Comentarios / Detalles de implementación |
|---|---|---|
| Conector nativo de Kinesis | Mejor | Integración de primera parte con AWS Kinesis; admite el ingreso continuo de alto rendimiento. |
| Conector nativo MSK | Mejor | Ingreso de Kafka gestionado con OIDC y compatibilidad de autenticación basada en claves. |
| Validación y asignación de esquemas | Mejores prácticas | Cargue el esquema (.json/.avro) que define la estructura del evento; aplica la coherencia durante el ingreso. |
| Configuración de IAM | Recomendado | Asigne la función IAM de menor privilegio con acceso de solo lectura a la transmisión de Kinesis de destino o el tema MSK. |
| Enrutamiento de red privado | Opcional | Configure extremos PrivateLink/VPC para un enrutamiento interno seguro. |
| Patrón híbrido (Transmisión + Lote) | Opcional | Utilice la transmisión para deltas y el ingreso por lotes para rellenos o cargas históricas. |
| Modo de aislamiento de error | Recomendado | Enrutar rechazos de esquemas y errores transitorios a DLQ para su reproducción |
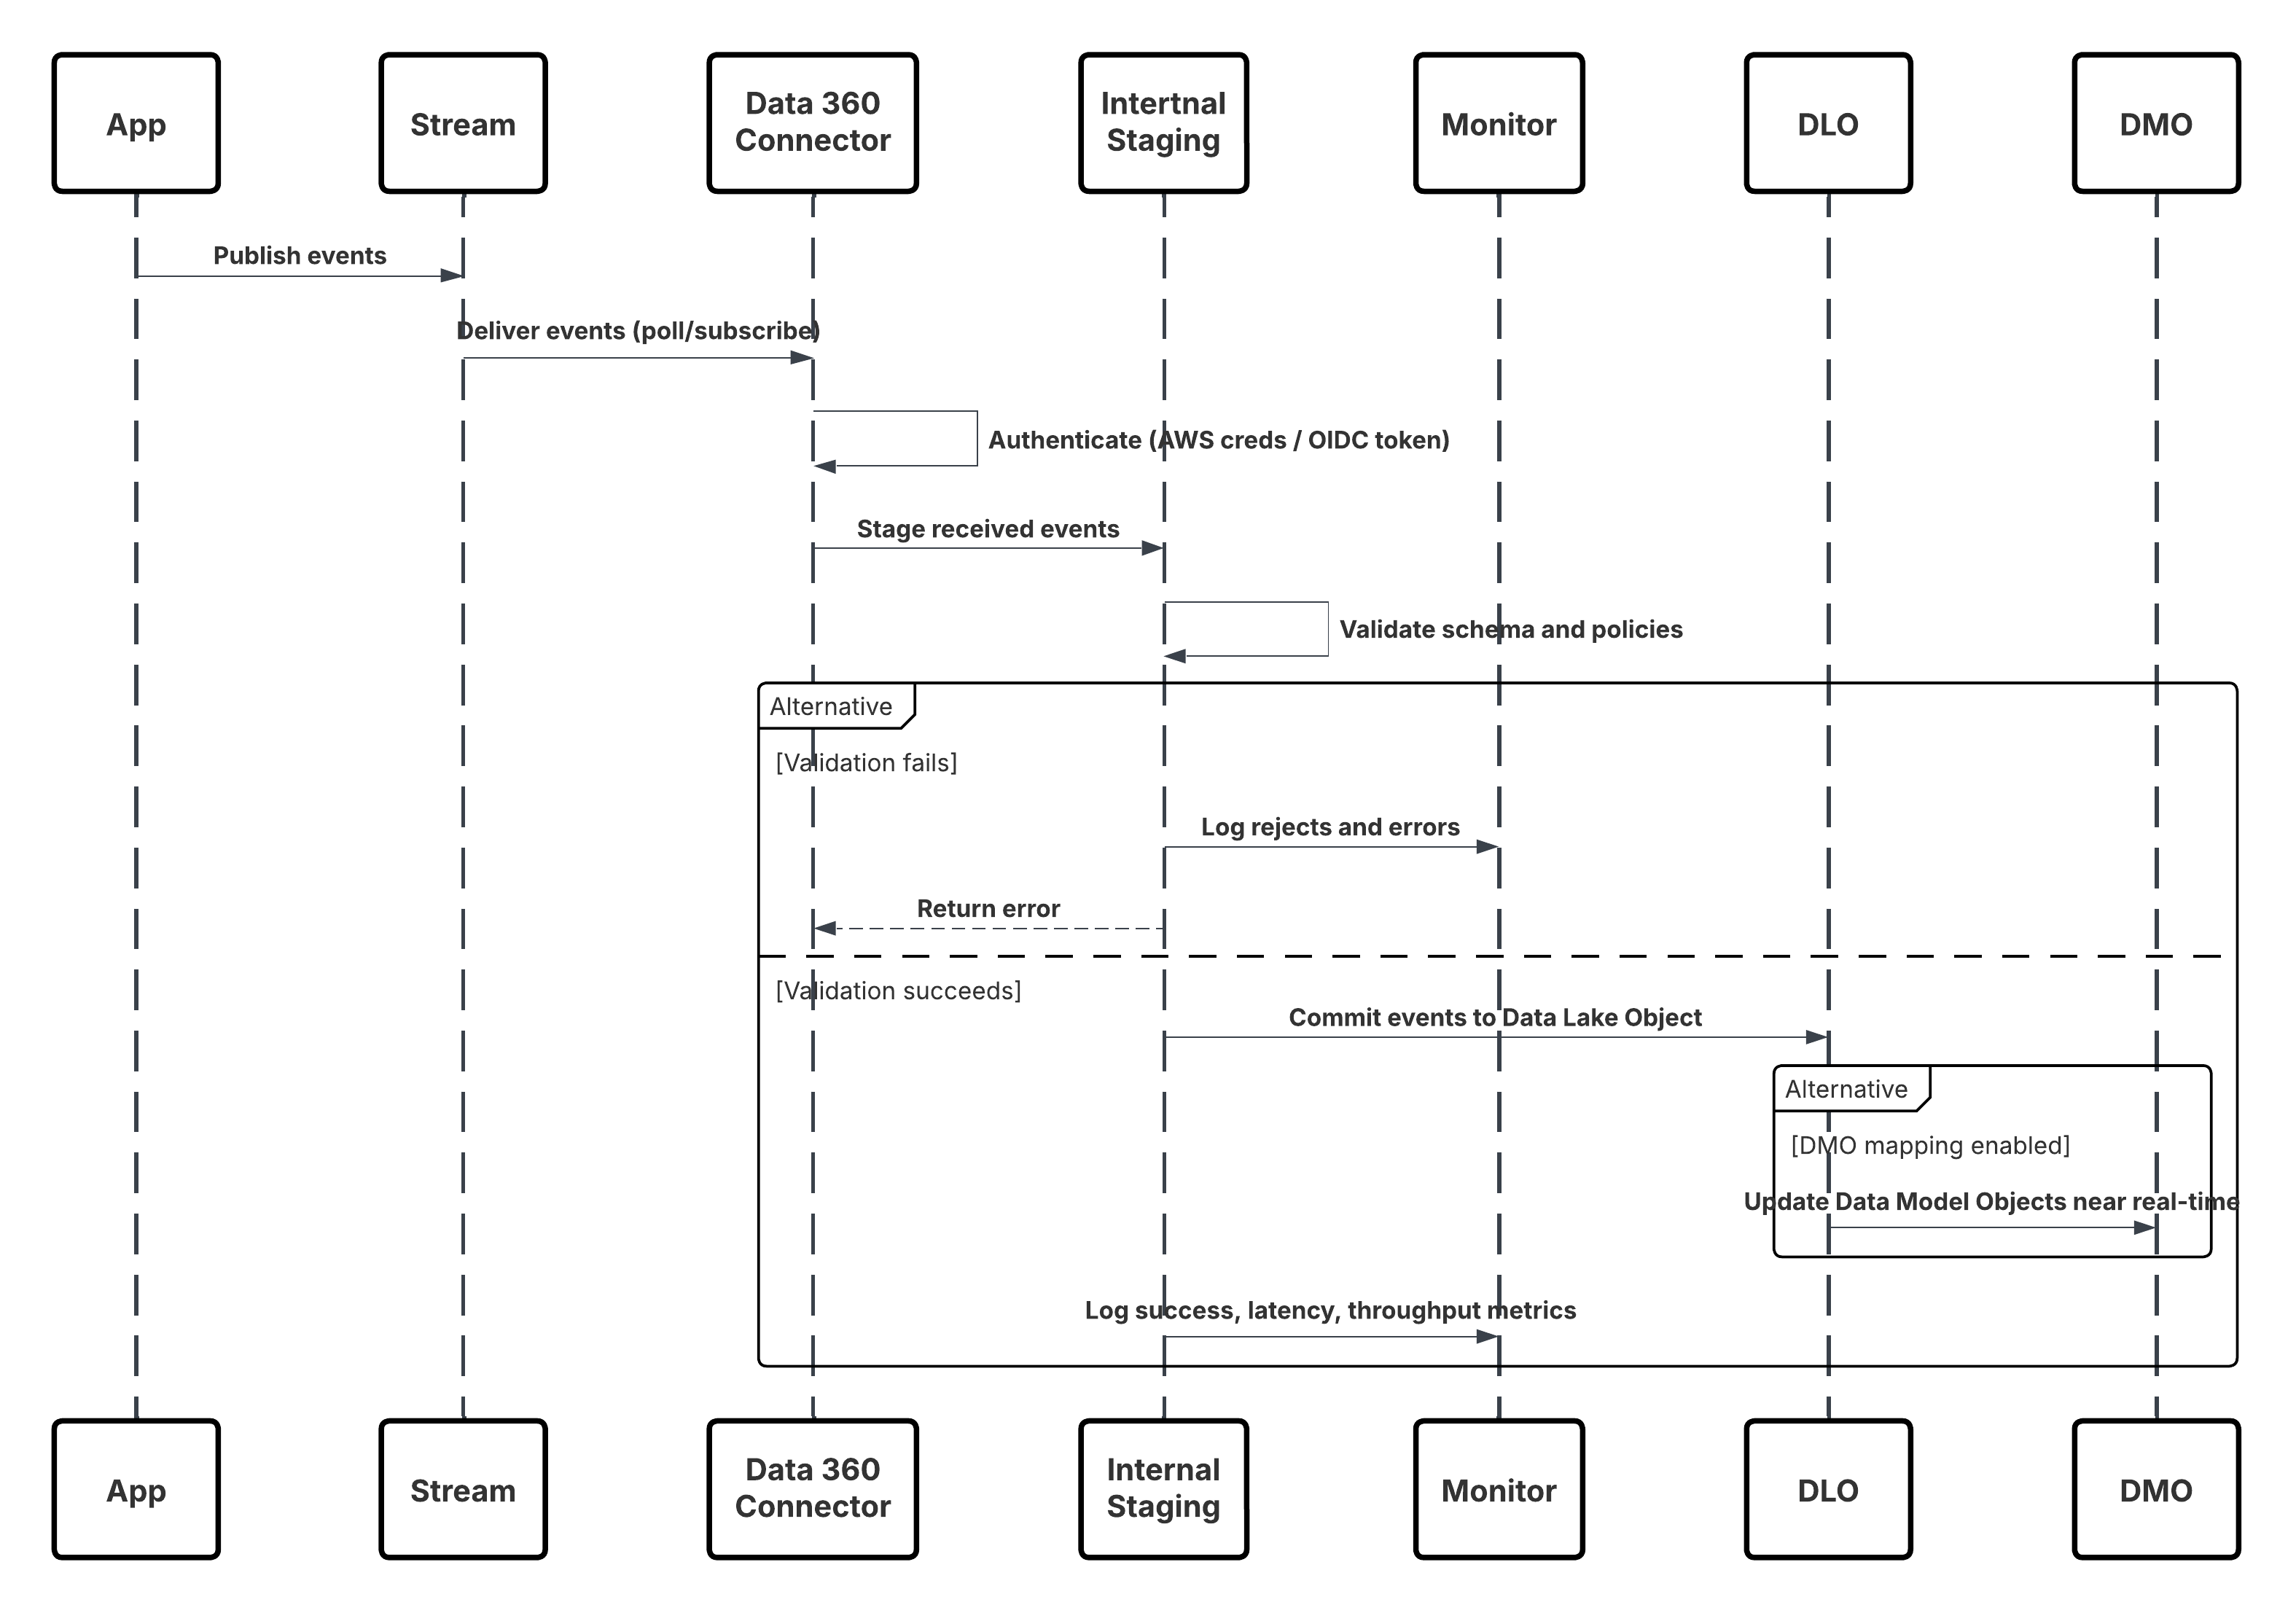 **En este escenario:**
- Las aplicaciones o dispositivos publican eventos en Transmisión de Kinesis o Tema MSK.
- Conector de Data 360 se autentica utilizando credenciales de AWS o token de OIDC.
- El conector sondea o se suscribe continuamente a la transmisión.
- Los eventos se organizan, se validan para esquemas y políticas, luego se confirman en Objeto de lago de datos (DLO).
- Si se asignan, los objetos de modelo de datos (DMO) se actualizan casi en tiempo real para su activación.
- Capa de monitoreo realiza un seguimiento de mediciones, rechazos de esquemas y latencia.
##### Resultados
Ingreso continuo y de baja latencia de datos estructurados directamente desde AWS Kinesis o MSK en Data 360. Los datos están disponibles de inmediato para:
- Resolución de identidad
- Segmentación en tiempo real
- Activación de IA Einstein
- Desencadenadores dirigidos por Agentforce
Elimina la dependencia de ETL por lotes, permitiendo arquitecturas basadas en transmisiones alineadas con diseños dirigidos por eventos de negocio.
###### Mecanismos de admisión
| Mecanismo | Cuándo utilizar |
|---|---|
| Conector Kinesis (Preferido) | Para orígenes de transmisión nativos de AWS que requieren el ingreso continuo de datos estructurados de gran volumen. |
| Conector MSK | Para organizaciones que ejecutan oportunidades en curso de eventos en plataformas compatibles con Kafka. |
| Híbrido (Transmisión + Lote) | Para el ingreso de eventos incremental combinado con cargas masivas periódicas. |
| Área de solución | Ajuste | Comentarios / Detalles de implementación |
|---|---|---|
| Conector de copia de Snowflake Zero | Mejor | Integración nativa de primera parte; establece la federación de consultas en vivo a través de las API de colaboración de datos o tabla externa de Snowflake. |
| Conector de copia cero de Databricks | Mejor | Admite acceso directo en vivo a tablas/vistas en Delta Lake; las consultas distribuidas se ejecutan en tiempo de ejecución de Databricks. |
| Federación de archivos (Apache Iceberg / Delta / Parquet) | Mejor práctica emergente | Data 360 lee directamente formatos de tabla abiertos desde el almacenamiento de objetos sin dependencia de computación externa. Ideal para conjuntos de datos masivos. |
| Configuración de red privada | Recomendado | Utilice Salesforce Private Connect o VPC peering para una federación segura a nivel de red. |
| Autenticación y gestión de claves | Mejor práctica | Implemente la autenticación segura basada en claves o basada en OAuth con rotación periódica y gestión de bóveda. |
| Registro de esquema | Obligatorio | Data 360 recupera el esquema externo y lo asigna a un objeto de lago de datos externo (DLO externo). |
| Metadatos gubernamentales | Recomendado | Todos los DLO externos heredan metadatos de clasificación, consentimiento y linaje para la visibilidad del cumplimiento. |
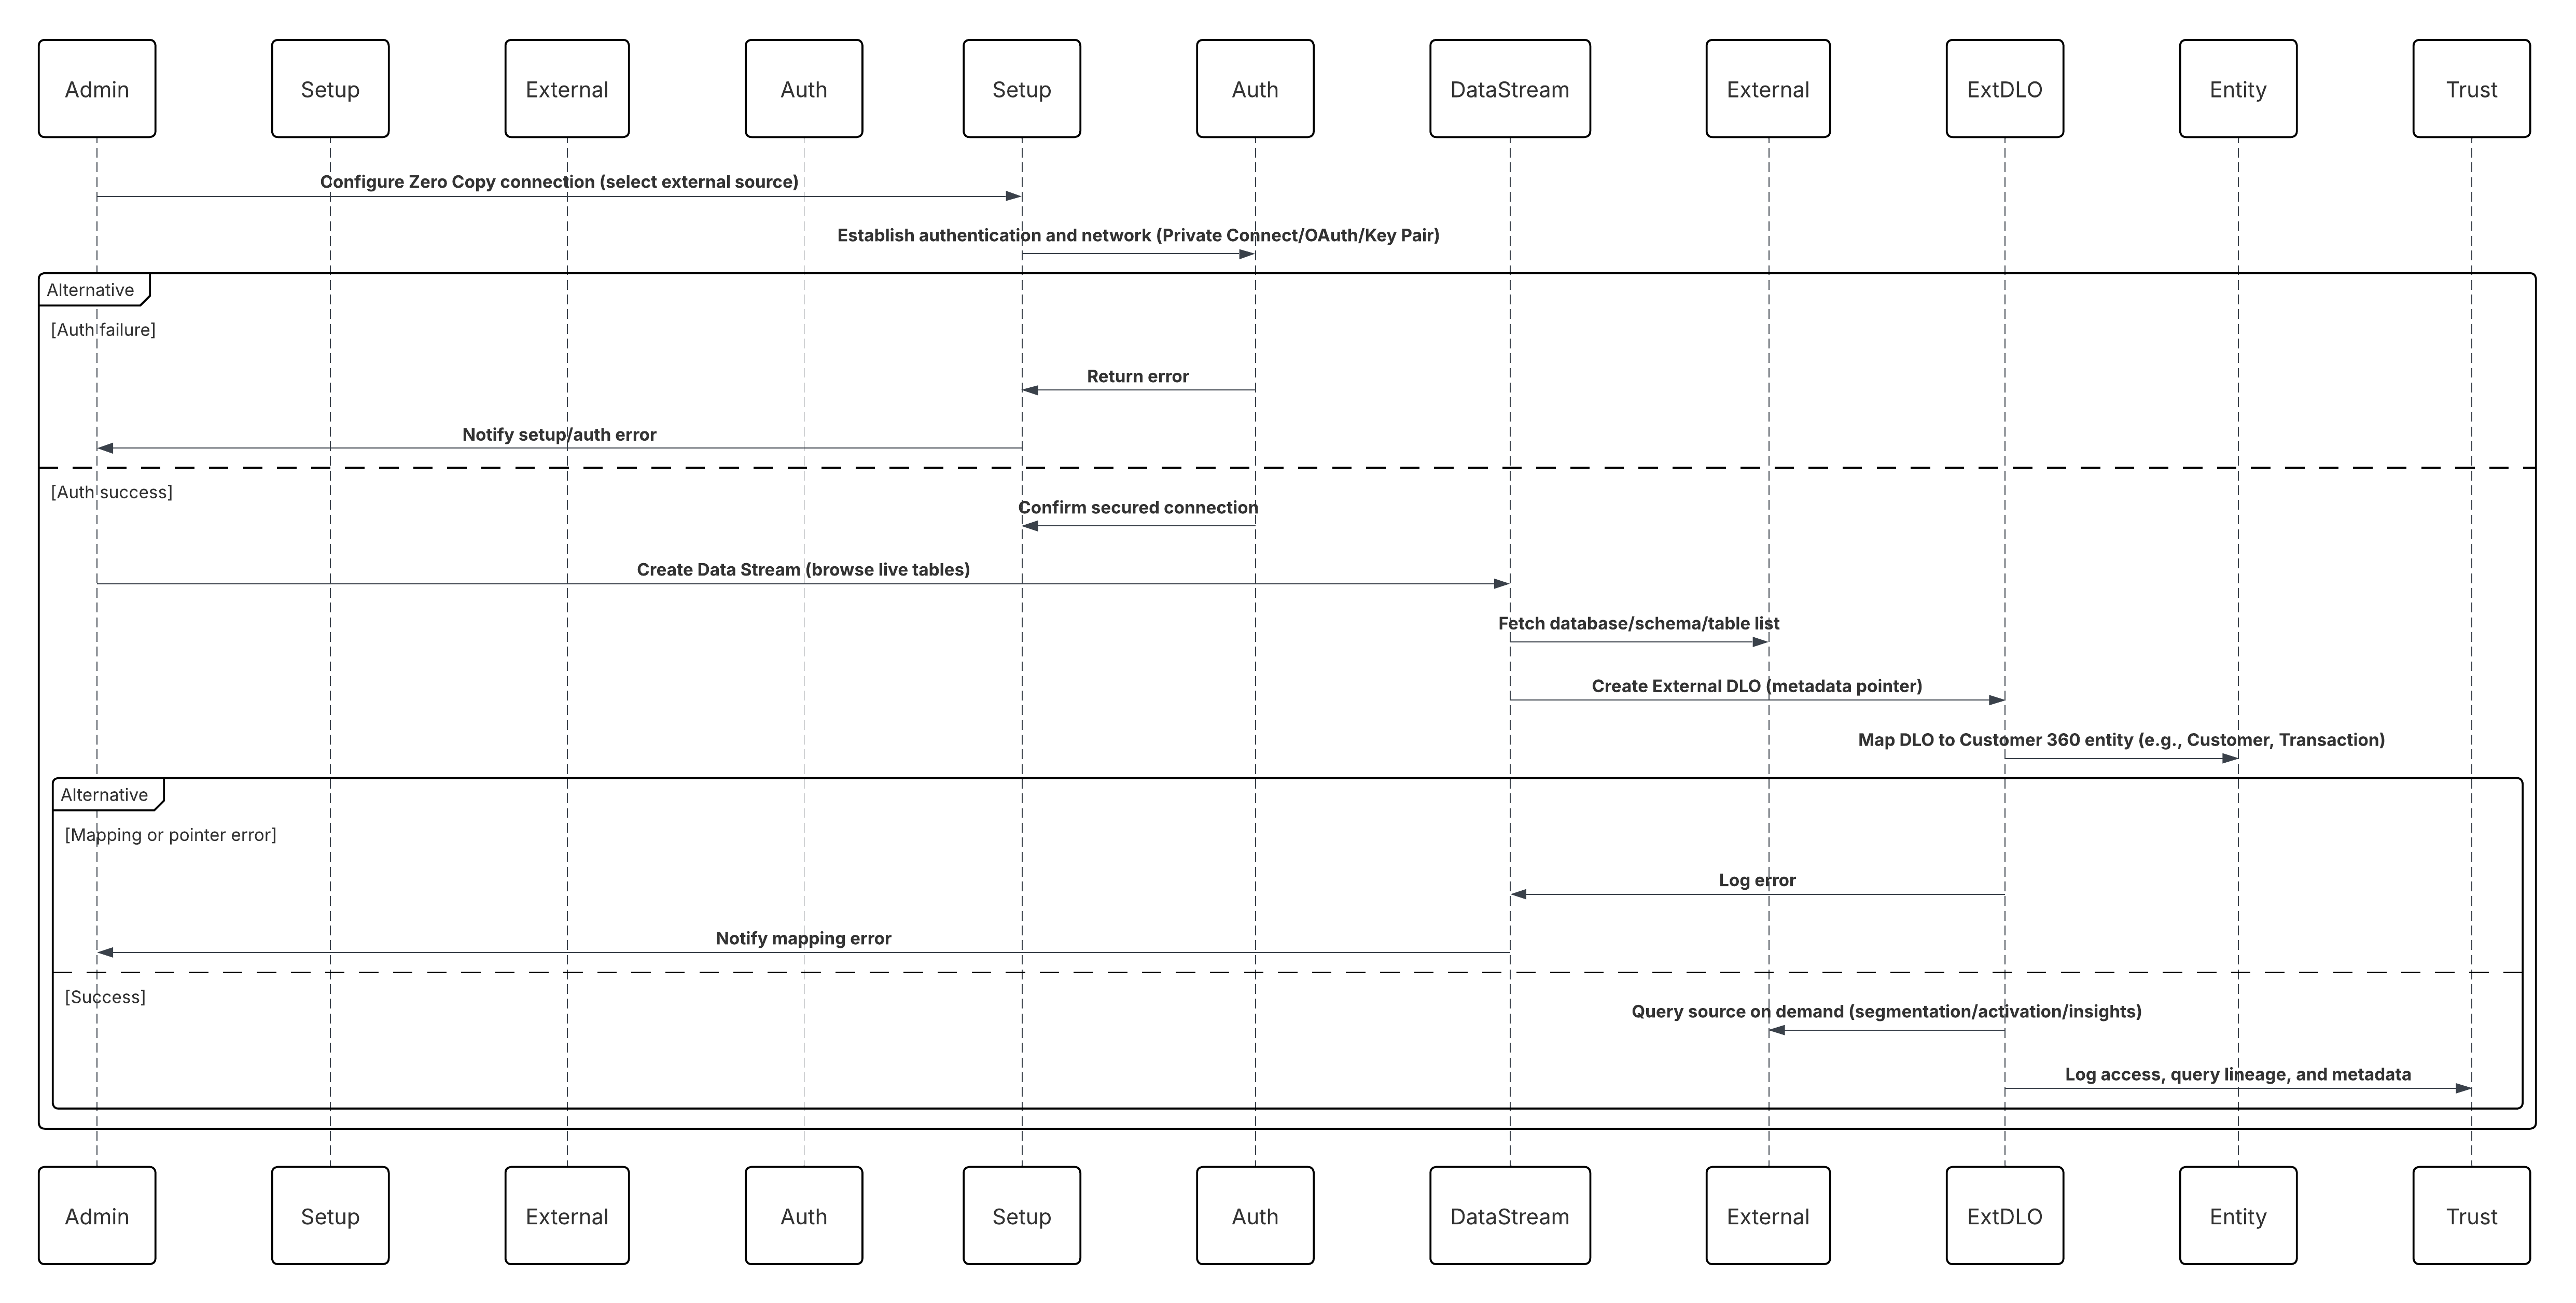 En este escenario:
- El administrador configura una conexión Cero copia en Configuración de Data 360 (Snowflake, Databricks o Federación de archivos).
- La autenticación segura y el enrutamiento de red están establecidos (Conexión privada / OAuth / Par de claves).
- El administrador crea una Transmisión de datos seleccionando el origen externo: exploración de bases de datos en vivo, esquemas y tablas.
- En vez de copiar datos, Data 360 crea un DLO externo (Objeto de lago de datos): un puntero de metadatos que hace referencia a la tabla en vivo o el archivo Iceberg.
- Los DLO externos se asignan a entidades Customer 360 (por ejemplo, Cliente, Transacción, Producto).
- Data 360 consulta el origen durante la segmentación, la activación o el cálculo de perspectivas.
- Todo el acceso, el linaje de la consulta y los metadatos se auditan en Data 360 Trust Layer.
##### Resultados
- Los datos externos permanecen en Snowflake, Databricks o S3: sin ETL, sin duplicación ni almacenamiento adicional.
- Data 360 obtiene acceso en tiempo real y en tiempo de lectura a datos a escala de compañía para la resolución de identidad, perspectivas calculadas y activación.
- Las organizaciones mantienen el control completo bajo sus marcos de trabajo de gobernanza, cifrado y cumplimiento existentes.
- Este patrón activa una verdadera arquitectura Cero copia: combinando el desempeño del acceso local con la regulación del almacenamiento federado.
###### Mecanismos de llamada
El mecanismo de llamada depende de la solución elegida para implementar este patrón.
| Mecanismo | Cuándo utilizar |
|---|---|
| Federación de Snowflake (Preferido) | Para una federación de consultas en vivo y de alto desempeño con almacenes de datos de compañía gobernados. |
| Federación de Databricks | Para análisis unificados y entornos de lago con conjuntos de datos respaldados por Delta o Parquet. |
| Federación de archivos (Apache Iceberg / Delta Lake) | Para conjuntos de datos a gran escala en almacenamiento de objetos donde la separación de cálculos y la optimización de costos son clave. |
| Modo híbrido (Copia cero + ingreso) | Cuando los datos históricos necesitan un ingreso puntual pero se accede a los datos en vivo a través de Cero copia. |
| Área de solución | Ajuste | Comentarios / Detalles de implementación |
|---|---|---|
| Creación de colaboración de datos | Mejor | El administrador crea una colaboración de datos en Data 360, agregando DMO y CIO seleccionados (por ejemplo, Particular unificado, Puntuaje de salud del cliente). |
| Configuración de destino | Mejor | Cree un Objetivo de colaboración de datos especificando parámetros de autenticación e identificadores de cuentas de Snowflake o Databricks. |
| Compartir publicación | Mejor práctica | Vincule la colaboración de datos al objetivo de colaboración de datos para publicar de forma segura. |
| Aceptación de almacén | Obligatorio | El administrador externo acepta la colaboración, materializando objetos compartidos como vistas/tablas de solo lectura en el almacén. |
| Control de acceso granular | Recomendado | Aplique permisos basados en objetos y funciones en Data 360; alinee con el control de acceso basado en funciones a nivel de almacén. |
| Acceso a consultas federadas | Mejor | Los analistas consultan datos compartidos en vivo a través de SQL estándar; se une con datos de almacén nativos para análisis descendentes y ML. |
| Opción Federación de archivos | Optional | Para conjuntos de datos de gran tamaño, aproveche la federación basada en Apache Iceberg para lecturas directas de S3 o Delta Lake sin calcular la dependencia. |
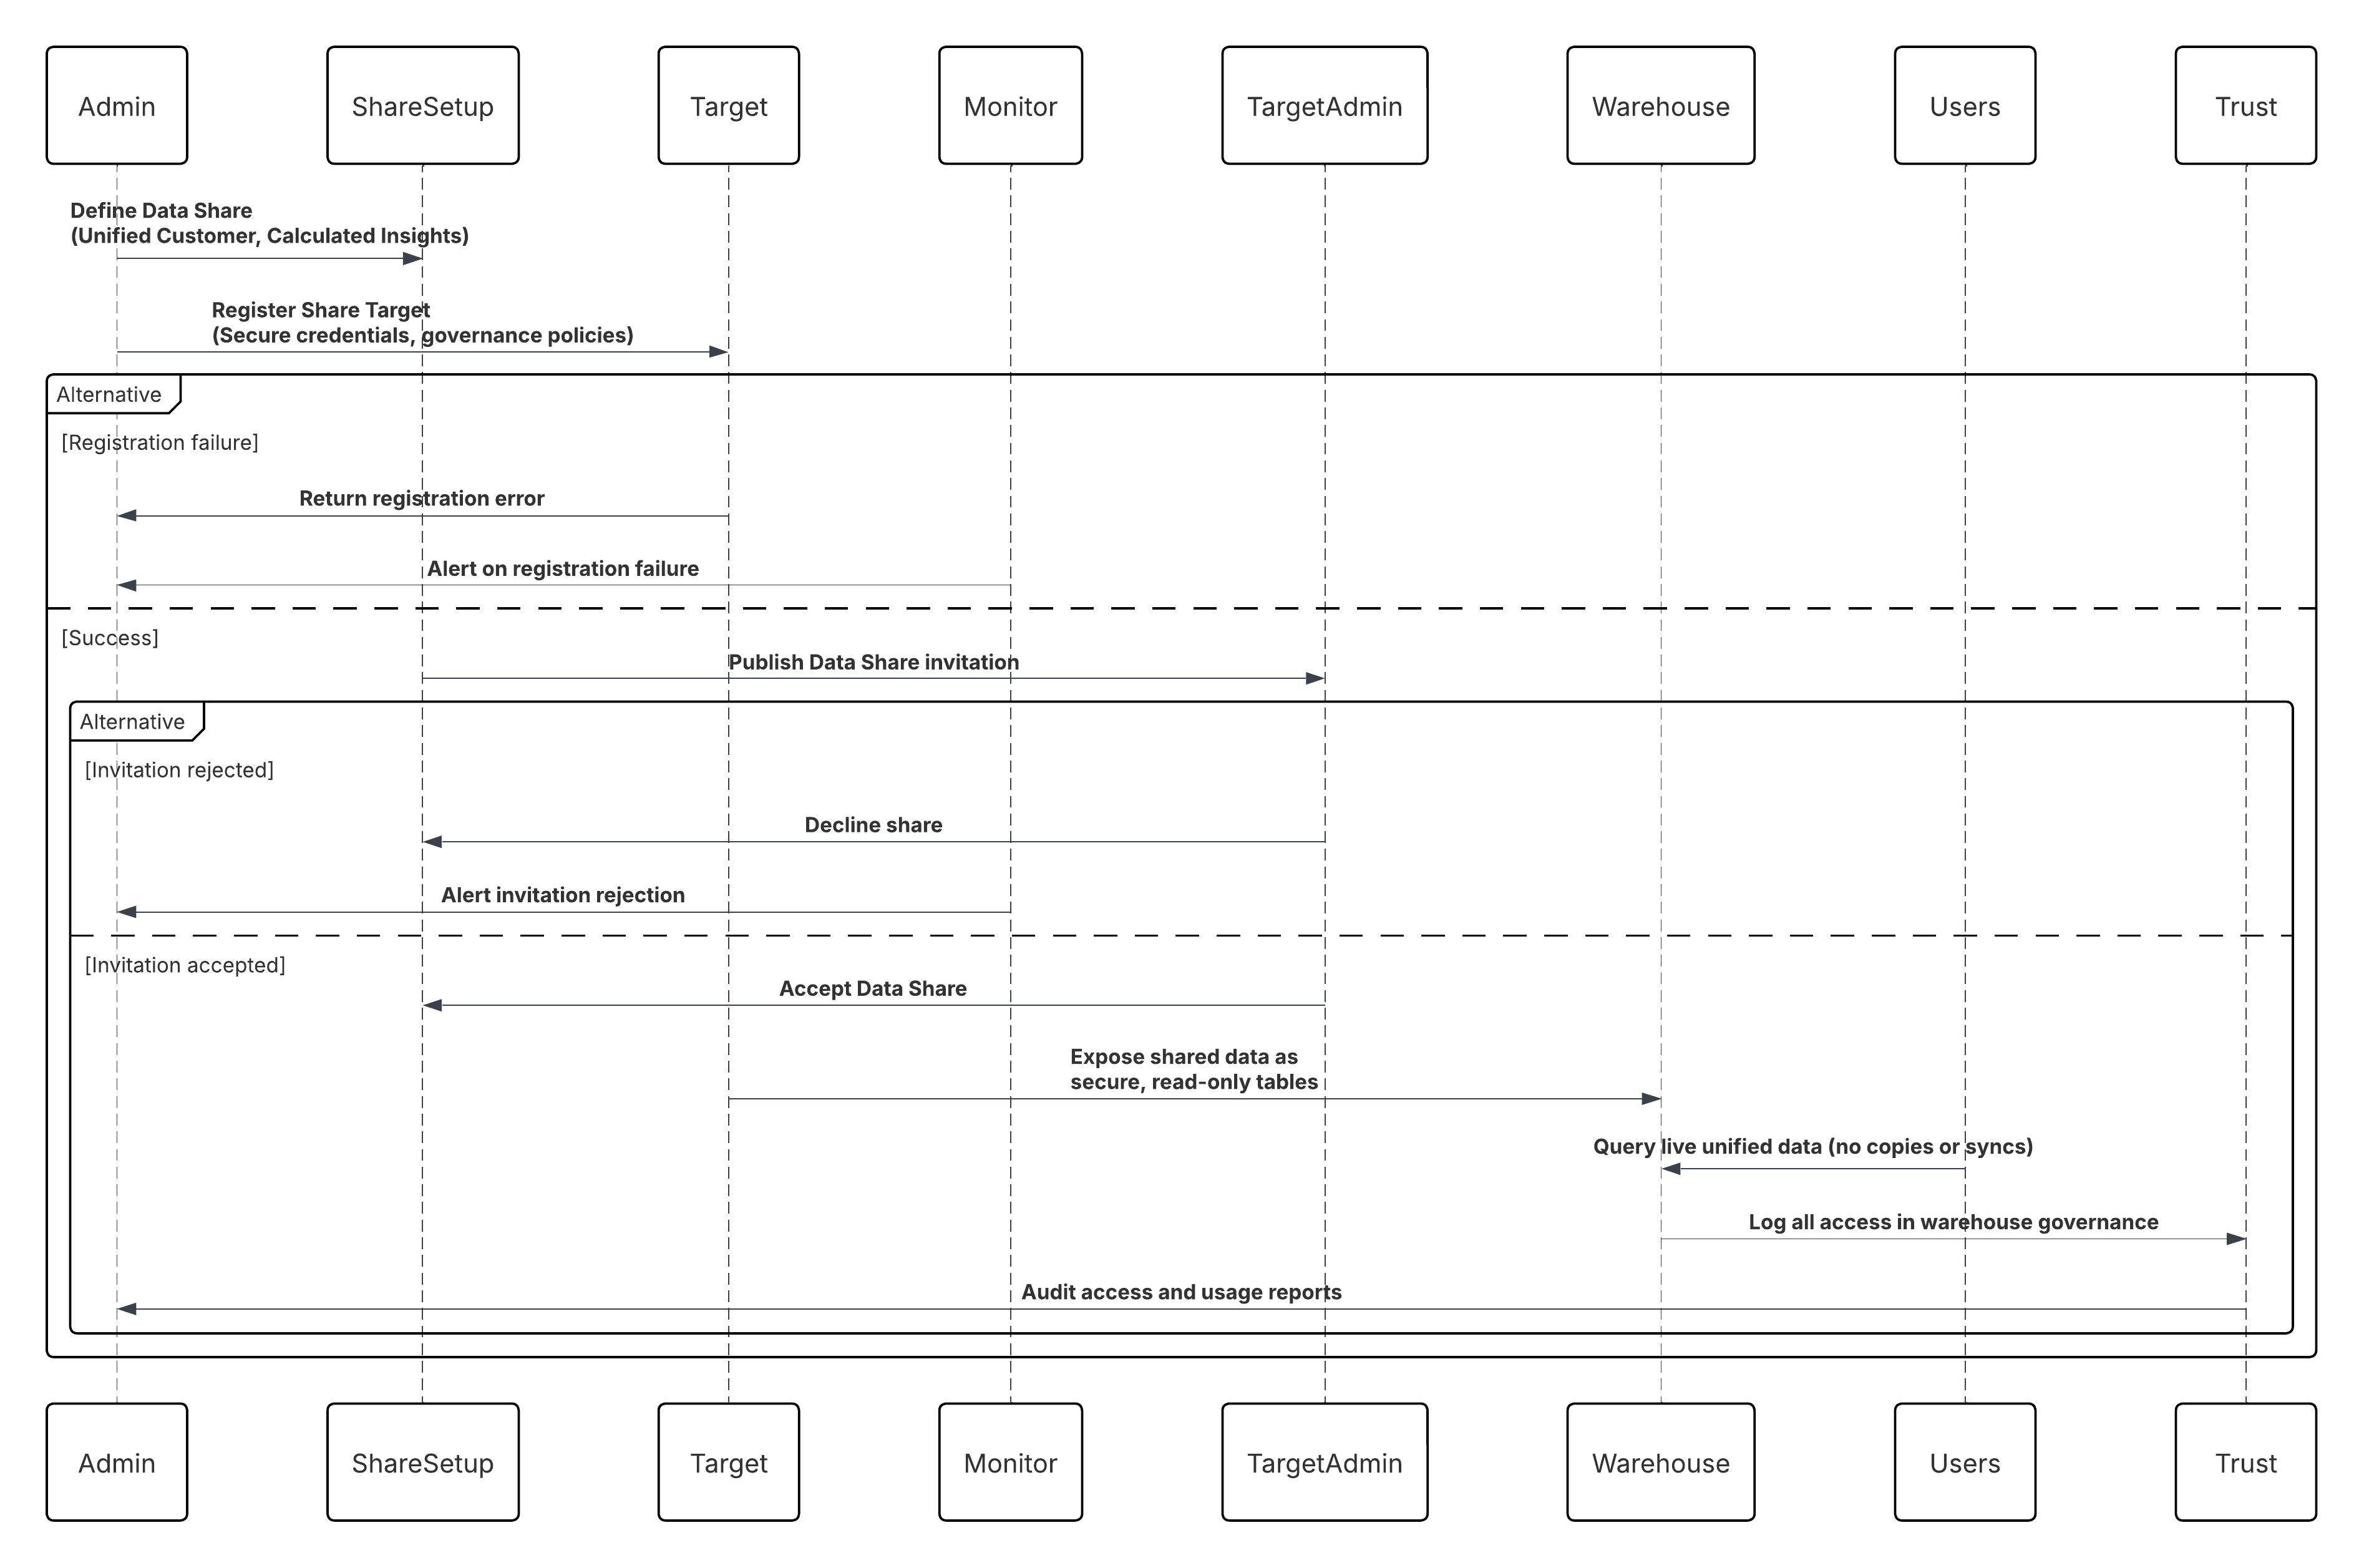 **En este escenario:**
- Administrador de Data 360 define una colaboración de datos incluyendo objetos Cliente unificado y Perspectiva calculada.
- Un Objetivo de colaboración de datos (cuenta de Snowflake o Databricks) está registrado con credenciales seguras y políticas de gobernanza.
- Data 360 publica la colaboración; los administradores de Snowflake/Databricks la aceptan.
- Los datos compartidos aparecen como tablas de solo lectura seguras en el almacén.
- Analistas, herramientas de BI o oportunidades en curso de ML consultan los datos de clientes unificados en vivo sin copiar o sincronizar.
- Todo el acceso se audita en los registros de Data 360 Trust Layer y de gobernanza de almacén.
##### Resultados
- Los almacenes externos obtienen acceso consultable en tiempo real a datos armonizados de Data 360.
- Elimina las oportunidades en curso de ETL inversas, reduciendo la carga operativa y la latencia.
- Activa el entrenamiento de IA/ML, el modelado predictivo y la BI avanzada directamente en datos unificados.
- Mantiene cero duplicaciones, una gobernanza sólida y un control de acceso seguro por diseño.
- Completa el bucle Cero copia bidireccional, donde la federación entrante y la colaboración saliente coexisten bajo un único modelo de gobernanza.
###### Mecanismos de llamada
El mecanismo de llamada depende de la solución elegida para implementar este patrón.
| Mecanismo | Cuándo utilizar |
|---|---|
| Compartir datos seguros de Snowflake (Preferido) | Utilice cuando su almacén de negocio es Snowflake y necesita acceso en vivo y controlado a conjuntos de datos de Data 360 armonizados sin movimiento de datos o duplicación. Ideal para análisis, IA y cargas de trabajo dirigidas por cumplimiento que requieren colaboración de latencia cero y aplicación forzosa de linajes nativos. |
| Databricks Delta Compartir | Se utiliza cuando los consumidores descendentes operan en entornos Databricks o Delta Lake y requieren acceso de solo lectura en tiempo real a conjuntos de datos unificados o activados a través del protocolo Delta Sharing abierto. |
| Cuota de tabla externa (Apache Iceberg / Parquet) | Utilice esta función cuando mantenga arquitecturas de formato abierto en almacenamiento de objetos (S3, ADLS o GCS) y necesite colaboración interoperable y de bajo costo entre motores analíticos como Athena, BigQuery o Snowflake-on-Iceberg. |
| API de colaboración de datos (acceso programático) | Utilice cuando aplicaciones personalizadas o middleware (por ejemplo, MuleSoft) deben descubrir, suscribirse o consumir conjuntos de datos compartidos de forma segura a través de API, con notificaciones de actualización basadas en eventos y un control de acceso preciso. |
| Cuota híbrida (Copia cero + Cuota saliente) | Utilice cuando implemente patrones de intercambio bidireccionales: aprovechando Cero copia para datos entrantes y Compartir datos salientes para publicar perspectivas, garantizando la coherencia semántica y de gobernanza entre planos de datos de compañía. |
| Área de solución | Ajuste | Comentarios / Detalles de implementación |
|---|---|---|
| Aprovisionamiento de organización principal | Mejor | Designe una organización de Salesforce como la organización de inicio donde se aprovisiona Data 360; esta se convierte en el repositorio de datos central y el núcleo de gobernanza. |
| Conexión de organización de compañía | Mejor | Configure conexiones de compañía desde la organización de inicio a una o más organizaciones de compañía a través de la aplicación Data Cloud One: no se requiere código personalizado. |
| Definición de espacio de datos | Mejor práctica | Defina Espacios de datos en la organización de inicio para segmentar lógicamente datos (por ejemplo, Retail, Servicio, Marketing) y aislar límites de acceso. |
| Compartir espacio de datos | Mejor | Comparta explícitamente espacios de datos seleccionados desde la organización de inicio a organizaciones complementarias, garantizando la visibilidad gobernada basada en funciones de datos unificados. |
| Configuración de acceso | Obligatorio | En Organizaciones de compañía, active la aplicación Data Cloud One y asigne permisos de usuario para el acceso a perfiles, perspectivas y segmentos. |
| Control de políticas y gobernanza | Recomendado | Centralice todas las configuraciones de ingreso, resolución de identidad y Trust en la organización doméstica, manteniendo la gobernanza de extremo a extremo. |
| Sincronización de múltiples organizaciones | Mejor | Los cambios de datos y las perspectivas calculadas en la organización de inicio se reflejan en tiempo real entre organizaciones de compañía a través de oportunidades en curso de sincronización gestionadas. |
| Opción de implementación híbrida | Optional | Para grandes empresas, múltiples organizaciones de compañía pueden conectarse a una única organización de inicio manteniendo al mismo tiempo el contexto local y los límites de cumplimiento. |
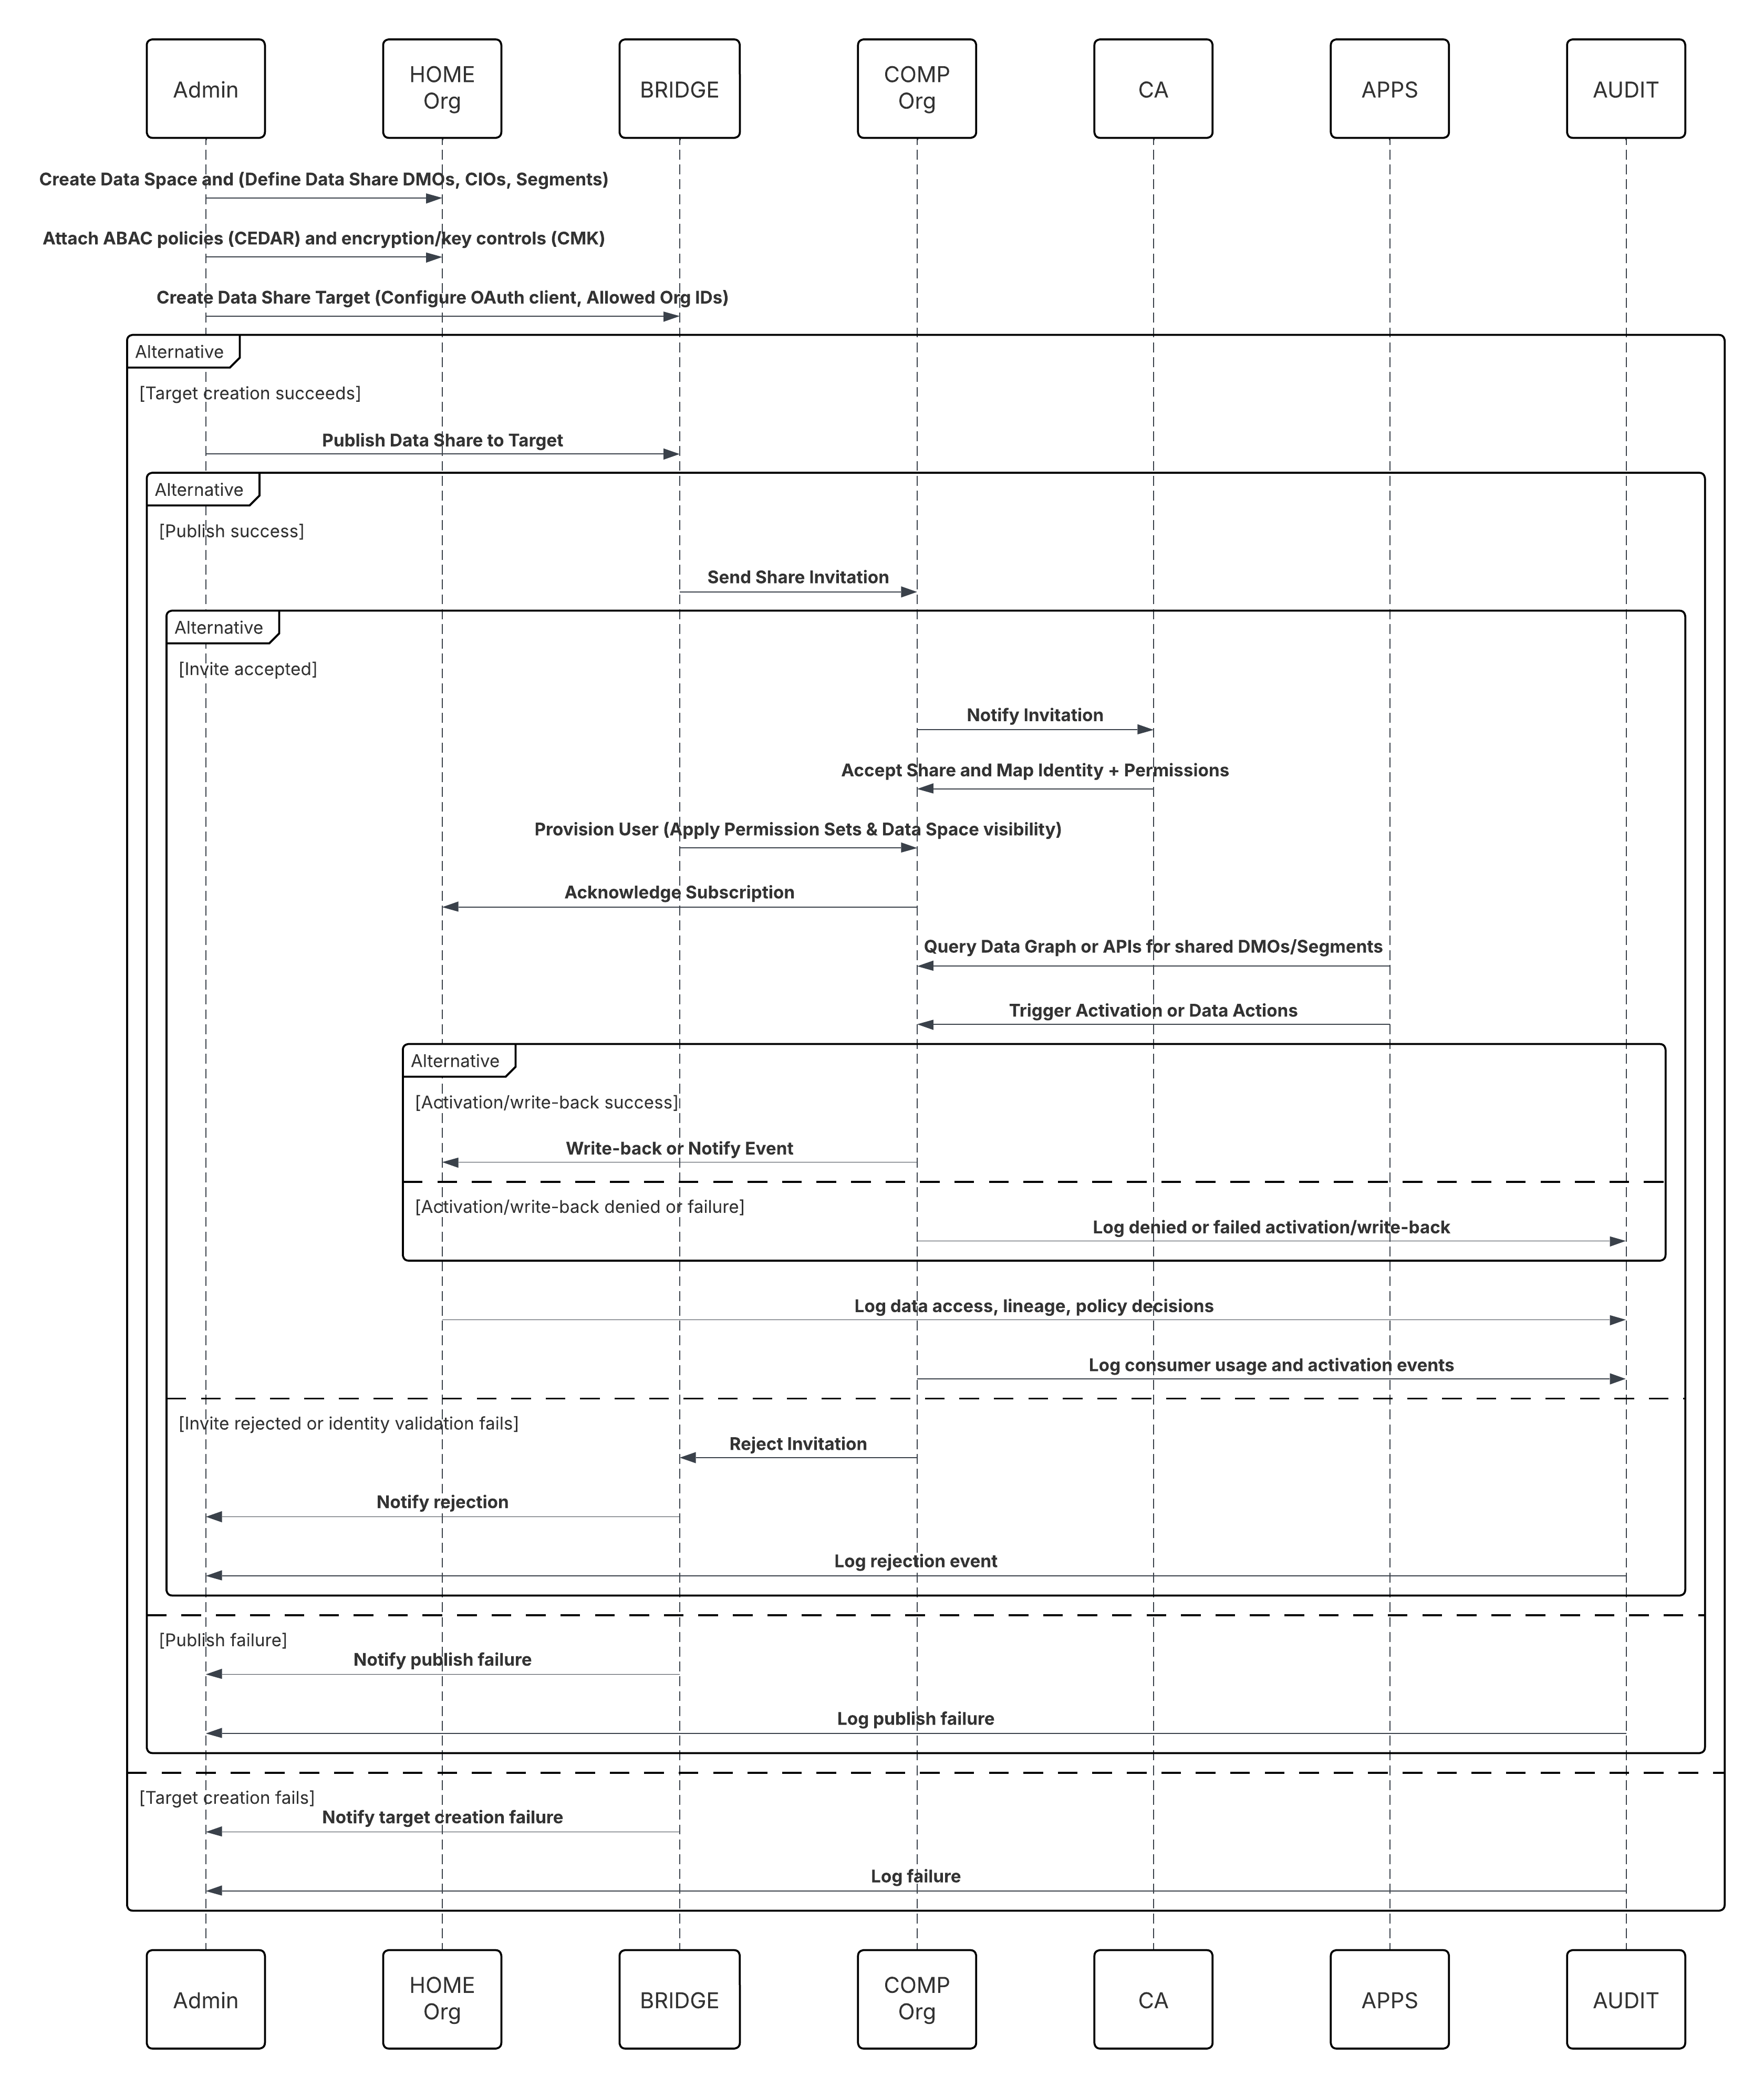 **En este escenario:**
- **Administrador principal**: cree Espacio de datos y defina Colaboración de datos (seleccione DMO/CIO, segmentos).
- **Administrador de inicio**: cree Objetivo de colaboración de datos para organizaciones de compañía y configure Trust (cliente de OAuth, Id. de organización permitidos).
- **Administrador principal**: publique Compartir datos en destino; adjunte políticas de ABAC (CEDAR) y controles de cifrado/clave (CMK si es necesario).
- **Administrador de organización** de compañía: recibe invitación, valida asignación de identidad y acepta colaboración.
- **Organización de compañía**: Puente de Data Cloud One aprovisiona un usuario de Data Cloud One y aplica Conjuntos de permisos y visibilidad de Espacio de datos.
- **Aplicaciones de organización de compañía (Flujos / Einstein / Apex)**: Consulte un gráfico de datos o llame a las API de Data Cloud One para leer segmentos o DMO compartidos.
- **Activación**: La organización de compañía desencadena la activación o escribe a través de acciones de datos (si se permite).
##### Resultados
- Una **única fuente de verdad** para datos de clientes (Customer 360) en todas las organizaciones conectadas: sin instancias de Data 360 redundantes.
- **Un tiempo más** rápido para valorar. Las organizaciones complementarias pueden acceder a datos unificados y funciones con tecnología Data 360 en minutos, no semanas de codificación personalizada.
- **Compartición de datos controlada.** Solo se comparten los espacios de datos autorizados, lo que mantiene la seguridad y la gobernanza al tiempo que permite la agilidad de negocio.
- Las funciones de negocio (ventas, servicio, marketing) funcionan sobre la misma base de datos unificada, lo que permite mediciones, activaciones y perspectivas coherentes en toda la compañía.
###### Mecanismos de llamada
El mecanismo de llamada depende de la solución elegida para implementar este patrón.
| Mecanismo | Cuándo utilizar |
|---|---|
| Compartición nativa de Data Cloud One (Preferido) | Utilice cuando múltiples organizaciones de Salesforce (Ventas, Servicio o Industry Cloud) necesitan acceso en tiempo real a datos de clientes unificados directamente desde Data 360\. Esto elimina la replicación y permite el acceso de latencia cero a registros dorados, segmentos y perspectivas calculadas. |
| Compartición de organización a organización a través de Data Cloud One Bridge | Se utiliza cuando múltiples unidades de negocio o filiales operan en organizaciones de Salesforce separadas pero necesitan acceso compartido a datos y segmentos de clientes comunes desde una instancia central de Data 360. Ideal para empresas de múltiples organizaciones que mantienen sistemas operativos independientes. |
| API de consulta de plataforma Einstein 1 | Se utiliza cuando las aplicaciones Salesforce, Flow o Einstein Copilot deben consultar o activar datos de Data 360 de forma programática. Activa la recuperación en tiempo real de perfiles unificados, mediciones o resultados de activación en otras aplicaciones de Salesforce sin exportaciones por lotes. |
| Activación en canales de Salesforce | Utilice cuando los datos de Data 360 (segmentos, perspectivas o atributos) deben activarse en Marketing Cloud, Service Cloud o Commerce Cloud para la personalización, la ejecución de campañas o experiencias de asistencia de agentes. |
| Acceso a gráficos de datos (Capa de consulta semántica) | Utilice esta función cuando necesite acceso a nivel semántico al modelo de datos unificado a través del gráfico de datos de Salesforce, que admite flujos de trabajo de Copilot, IA y análisis entre nubes en tiempo real, sin uniones o transformaciones manuales. |
| Área de solución | Ajuste | Comentarios / Detalles de implementación |
|---|---|---|
| Creación de segmentos | Mejor | Un especialista en marketing o analista crea un segmento en el lienzo de segmentación visual aplicando filtros entre cualquier objeto de modelo de datos (DMO) u Objeto de perspectiva calculada (CIO). Esto define la audiencia de destino para la activación. |
| Configuración de activación | Mejor | El usuario crea una activación y selecciona el segmento que acaba de crear como el origen. Esto define qué audiencia exportará Data 360 a sistemas descendentes. |
| Selección de destino de activación | Mejor práctica | El especialista en marketing selecciona un destino de activación preconfigurado (por ejemplo, Marketing Cloud, Google Ads, LinkedIn Ads). Cada destino se registra en Data 360 con credenciales de autenticación y asignaciones de campos. |
| Definición de carga | Obligatorio | El especialista en marketing define la carga seleccionando identificadores de contacto (por ejemplo, email, móvil, Id. de hash) y seleccionando atributos de perfil adicionales (por ejemplo, nombre, nivel de fidelidad o CLV) para enriquecer en el sistema de destino. |
| Programación y frecuencia | Recomendado | Las activaciones pueden programarse para ejecutarse una vez o de forma recurrente (por ejemplo, diariamente o semanalmente). La programación garantiza que las audiencias descendentes permanecen sincronizadas y actualizadas. |
| Ejecución y exportación | Mejor | Cuando se ejecuta el trabajo de activación, Data 360 consulta el segmento, recopila los atributos seleccionados, aplica filtros de consentimiento y exporta los datos a la plataforma de destino. Para Marketing Cloud, esto suele dar como resultado la creación o actualización de una extensión de datos compartida. |
| Gobernanza y cumplimiento | Obligatorio | Trust Layer aplica la validación de esquemas, los metadatos de consentimiento y los controles de políticas para garantizar el cumplimiento de las leyes de marketing y protección de datos (por ejemplo, RGPD, CCPA). |
| Monitoreo y capacidad de auditoría | Mejor práctica | Se realiza un seguimiento de cada ejecución de activación con mediciones de éxito/fallo, registros de ejecución y visibilidad de linaje en el tablero Trust Layer Monitoring, lo que permite la transparencia operativa y la garantía de SLA. |
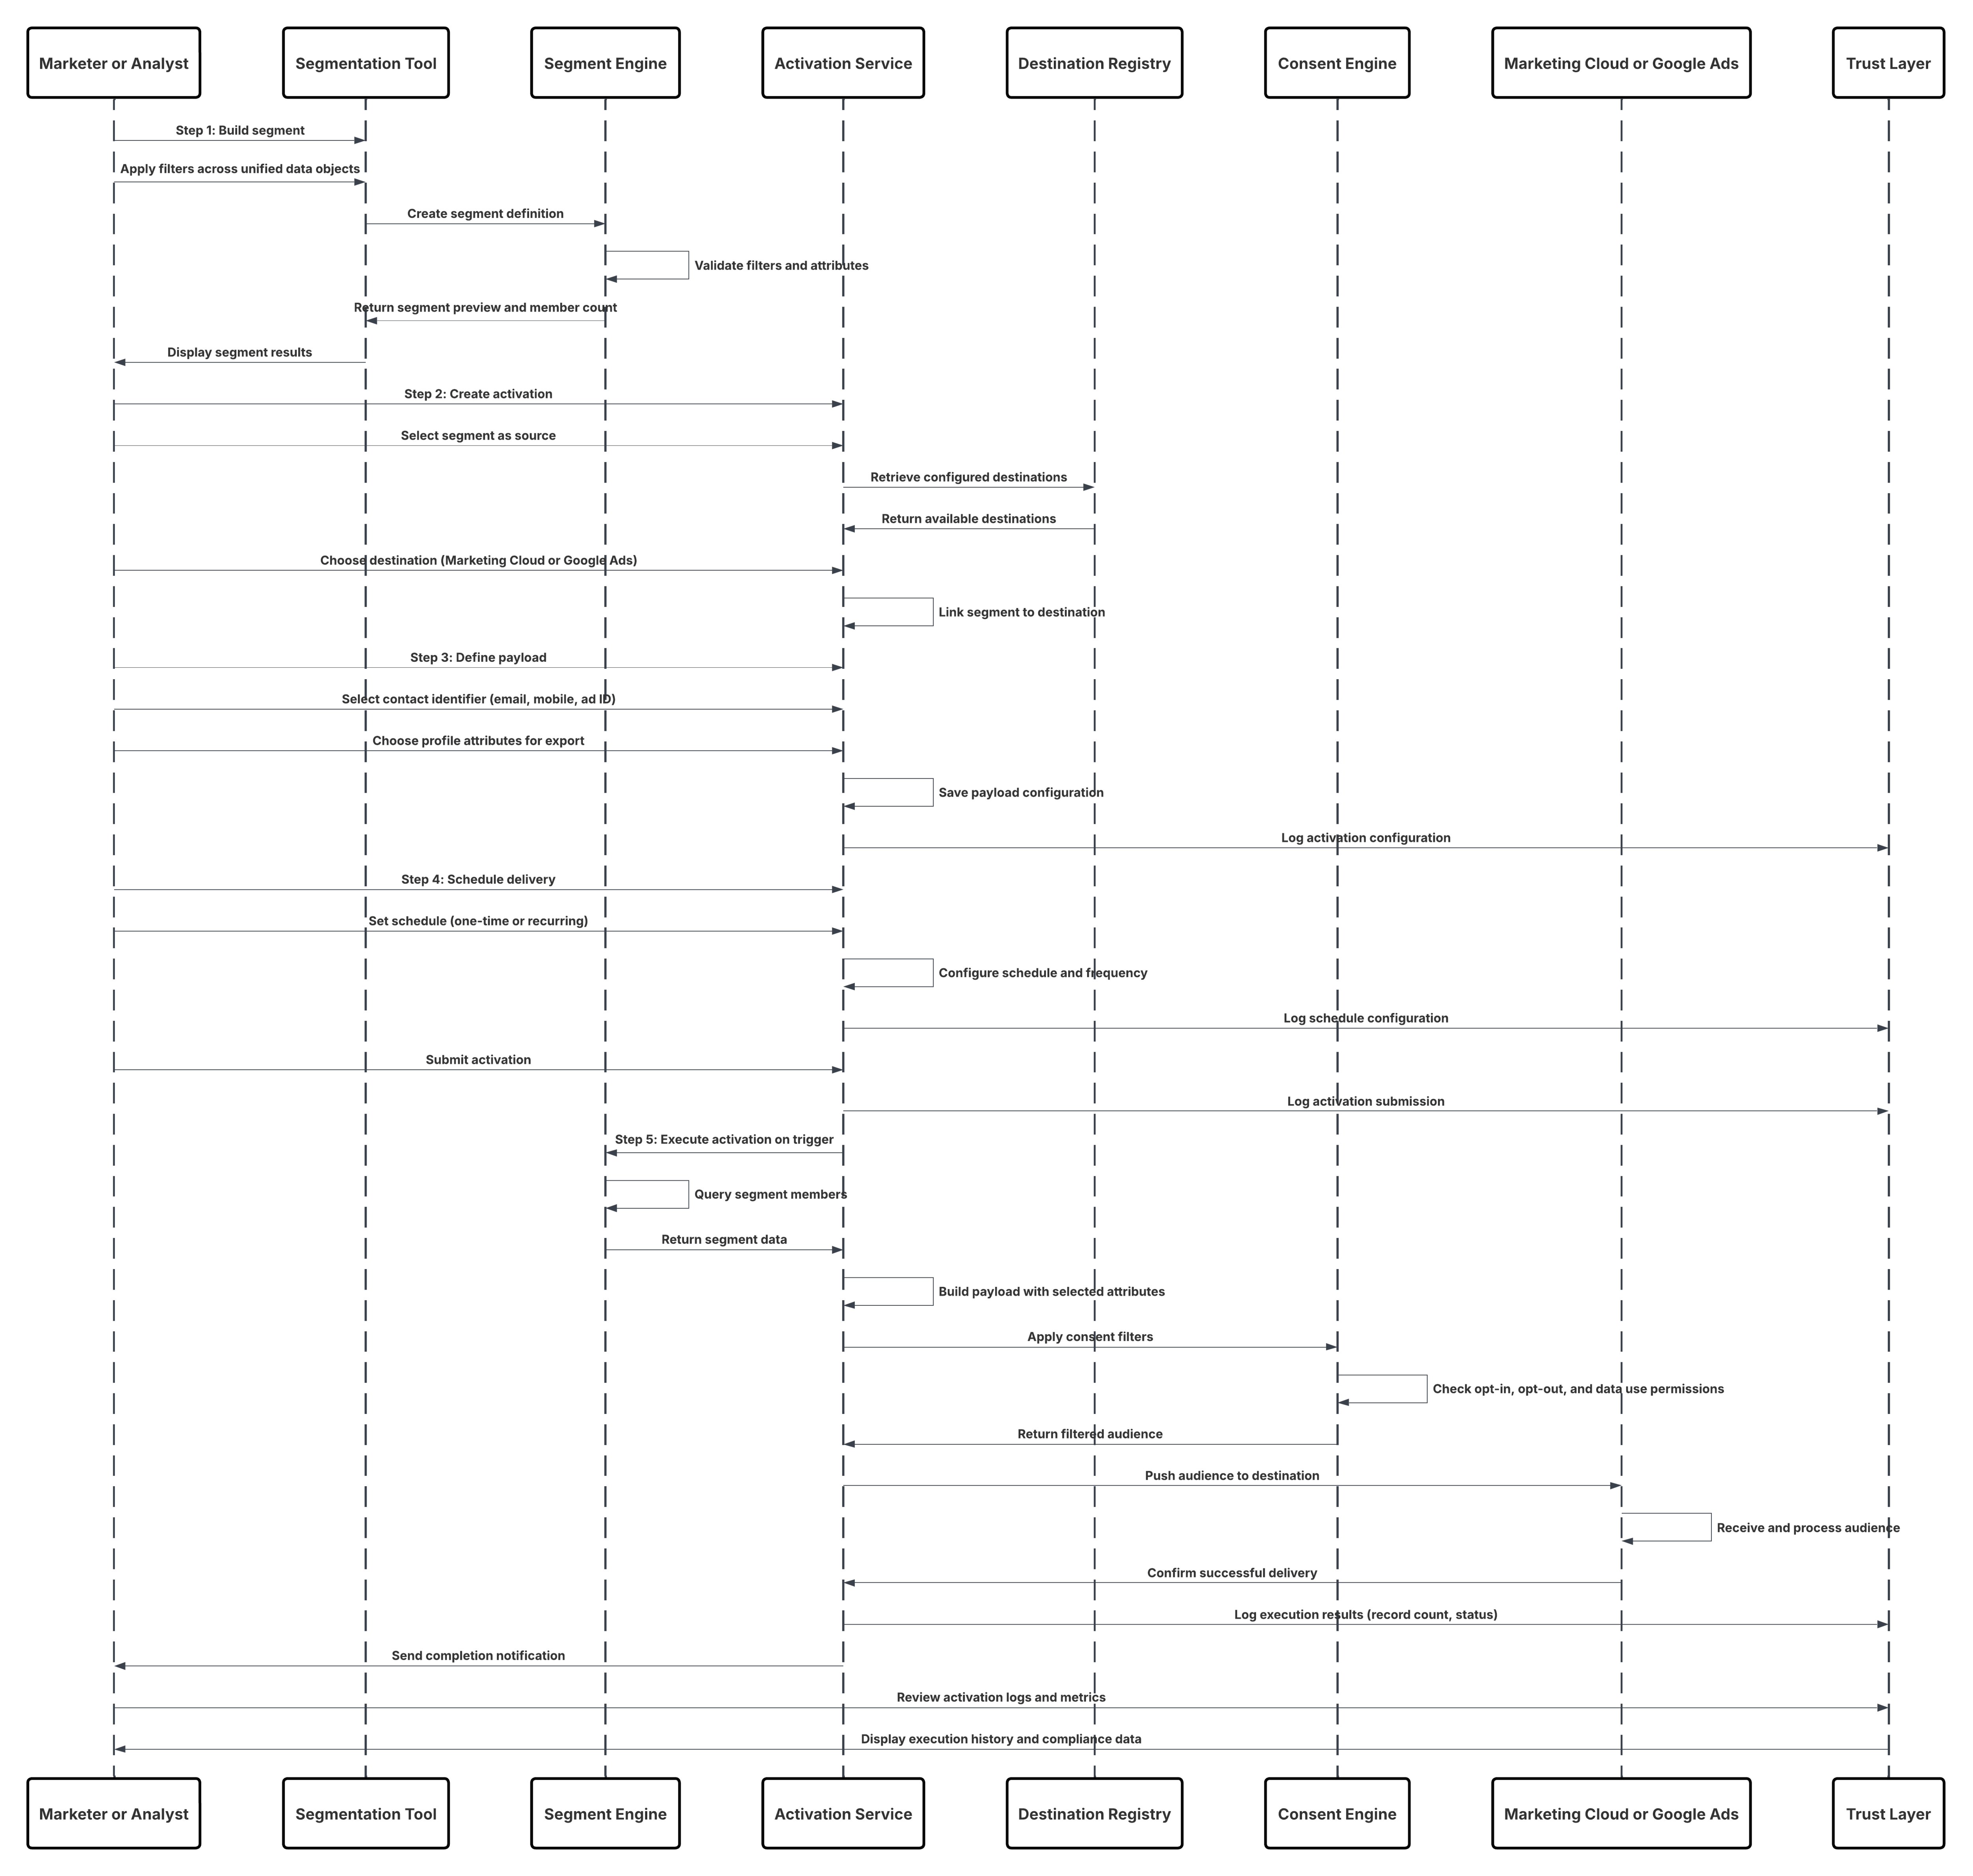 ##### Resultados
- Los segmentos de audiencia enriquecidos dirigidos desde Data 360 están disponibles directamente en plataformas de marketing y publicidad descendentes.
- Las audiencias se actualizan y sincronizan automáticamente con los datos de clientes unificados más recientes, manteniendo la relevancia de la campaña en tiempo real.
- Los especialistas en marketing pueden utilizar estas audiencias activadas como orígenes de entrada para trayectorias de Marketing Cloud, campañas de email o audiencias personalizadas en plataformas de anuncios digitales como Google Ads, Meta o LinkedIn Ads.
- Cada ejecución de activación mantiene un linaje de extremo a extremo, garantizando el cumplimiento, la trazabilidad y la coherencia entre Data 360 y sistemas externos.
- Los usuarios de negocio pueden entregar experiencias altamente personalizadas dirigidas por datos con tecnología de una vista Customer 360 completa y de confianza.
###### Mecanismos de llamada
El mecanismo de llamada depende de la plataforma de destino y la configuración de destino de activación.
| Mecanismo | Cuándo utilizar |
|---|---|
| Activación de Marketing Cloud Engagement (Preferido) | Utilice esta función cuando ejecute trayectorias de email o canales cruzados que requieran segmentos dinámicos, atributos personalizados y actualizaciones en tiempo real en Marketing Cloud. Data 360 exporta directamente a Extensiones de datos compartidas para la activación de campañas. |
| Activación de plataforma de anuncios (Google Ads, LinkedIn Ads, Meta Ads) | Utilice al activar segmentos de Data 360 como audiencias personalizadas en plataformas de publicidad para modelado de redirección o parecido. Admite identificadores de hash y entrega consciente del consentimiento. |
| Activación de CRM (Ventas o Service Cloud) | Utilice cuando comparta datos de clientes enriquecidos, perspectivas o puntuajes de propensión a usuarios de CRM para interacciones de servicio o implicación de ventas personalizadas. Los datos están disponibles como registros o perspectivas enriquecidos a través de Acciones de datos o Componentes de perfil unificado. |
| Activación externa a través de MuleSoft o API | Utilizar cuando la activación necesita llegar a sistemas que no son de Salesforce como la fidelidad, el comercio electrónico o almacenes de datos externos. MuleSoft o la API de activación de Data 360 garantiza una entrega segura y gobernada por políticas con opciones de actualización basadas en eventos. |
| Activación híbrida (por lotes + desencadenada por evento) | Utilice esta opción cuando combine activaciones por lotes programadas con desencadenadores basados en eventos, lo que permite la personalización “siempre activada” para campañas urgentes como alertas de riesgo de abandono o abandono de carritos. |
| Área de solución | Ajuste | Comentarios / Detalles de implementación |
|---|---|---|
| Selección de segmentos | Mejor | Los analistas seleccionan una definición de Segmento o Consulta existente en Data 360\. El segmento determina qué registros y atributos se exportan. |
| Configuración de activación | Mejor | Los usuarios crean una nueva Activación, seleccionando el Segmento como el origen y el Destino de almacenamiento en nube (por ejemplo, S3) como el destino. |
| Configuración de destino de activación | Obligatorio | Los administradores preconfiguran el destino con credenciales, funciones de IAM y ruta de salida. Los formatos compatibles incluyen CSV, Parquet y JSON. |
| Definición de carga | Mejor práctica | Defina el esquema de exportación seleccionando los atributos requeridos (por ejemplo, Id., Nombre, Email, Región, Indicador de consentimiento). El sistema aplica la regulación a nivel de atributos. |
| Programación y frecuencia | Recomendado | Las exportaciones pueden programarse para ejecutarse en una cadencia definida (diaria, semanal, mensual) o desencadenarse manualmente según sea necesario. |
| Ejecución y entrega | Mejor | En la ejecución, Data 360 consulta el segmento, compila el archivo de exportación, lo cifra y lo escribe en el depósito/carpeta configurado utilizando la API del proveedor de nube. |
| Gobernanza y cumplimiento | Obligatorio | Trust Layer de Data 360 garantiza que todas las exportaciones se adhieren a políticas de consentimiento, validación de esquemas y filtros de cumplimiento. |
| Monitoreo y capacidad de auditoría | Mejor práctica | Cada exportación se sigue en el tablero Trust Layer Monitoring con el estado, los registros de ejecución y los metadatos de linaje. |
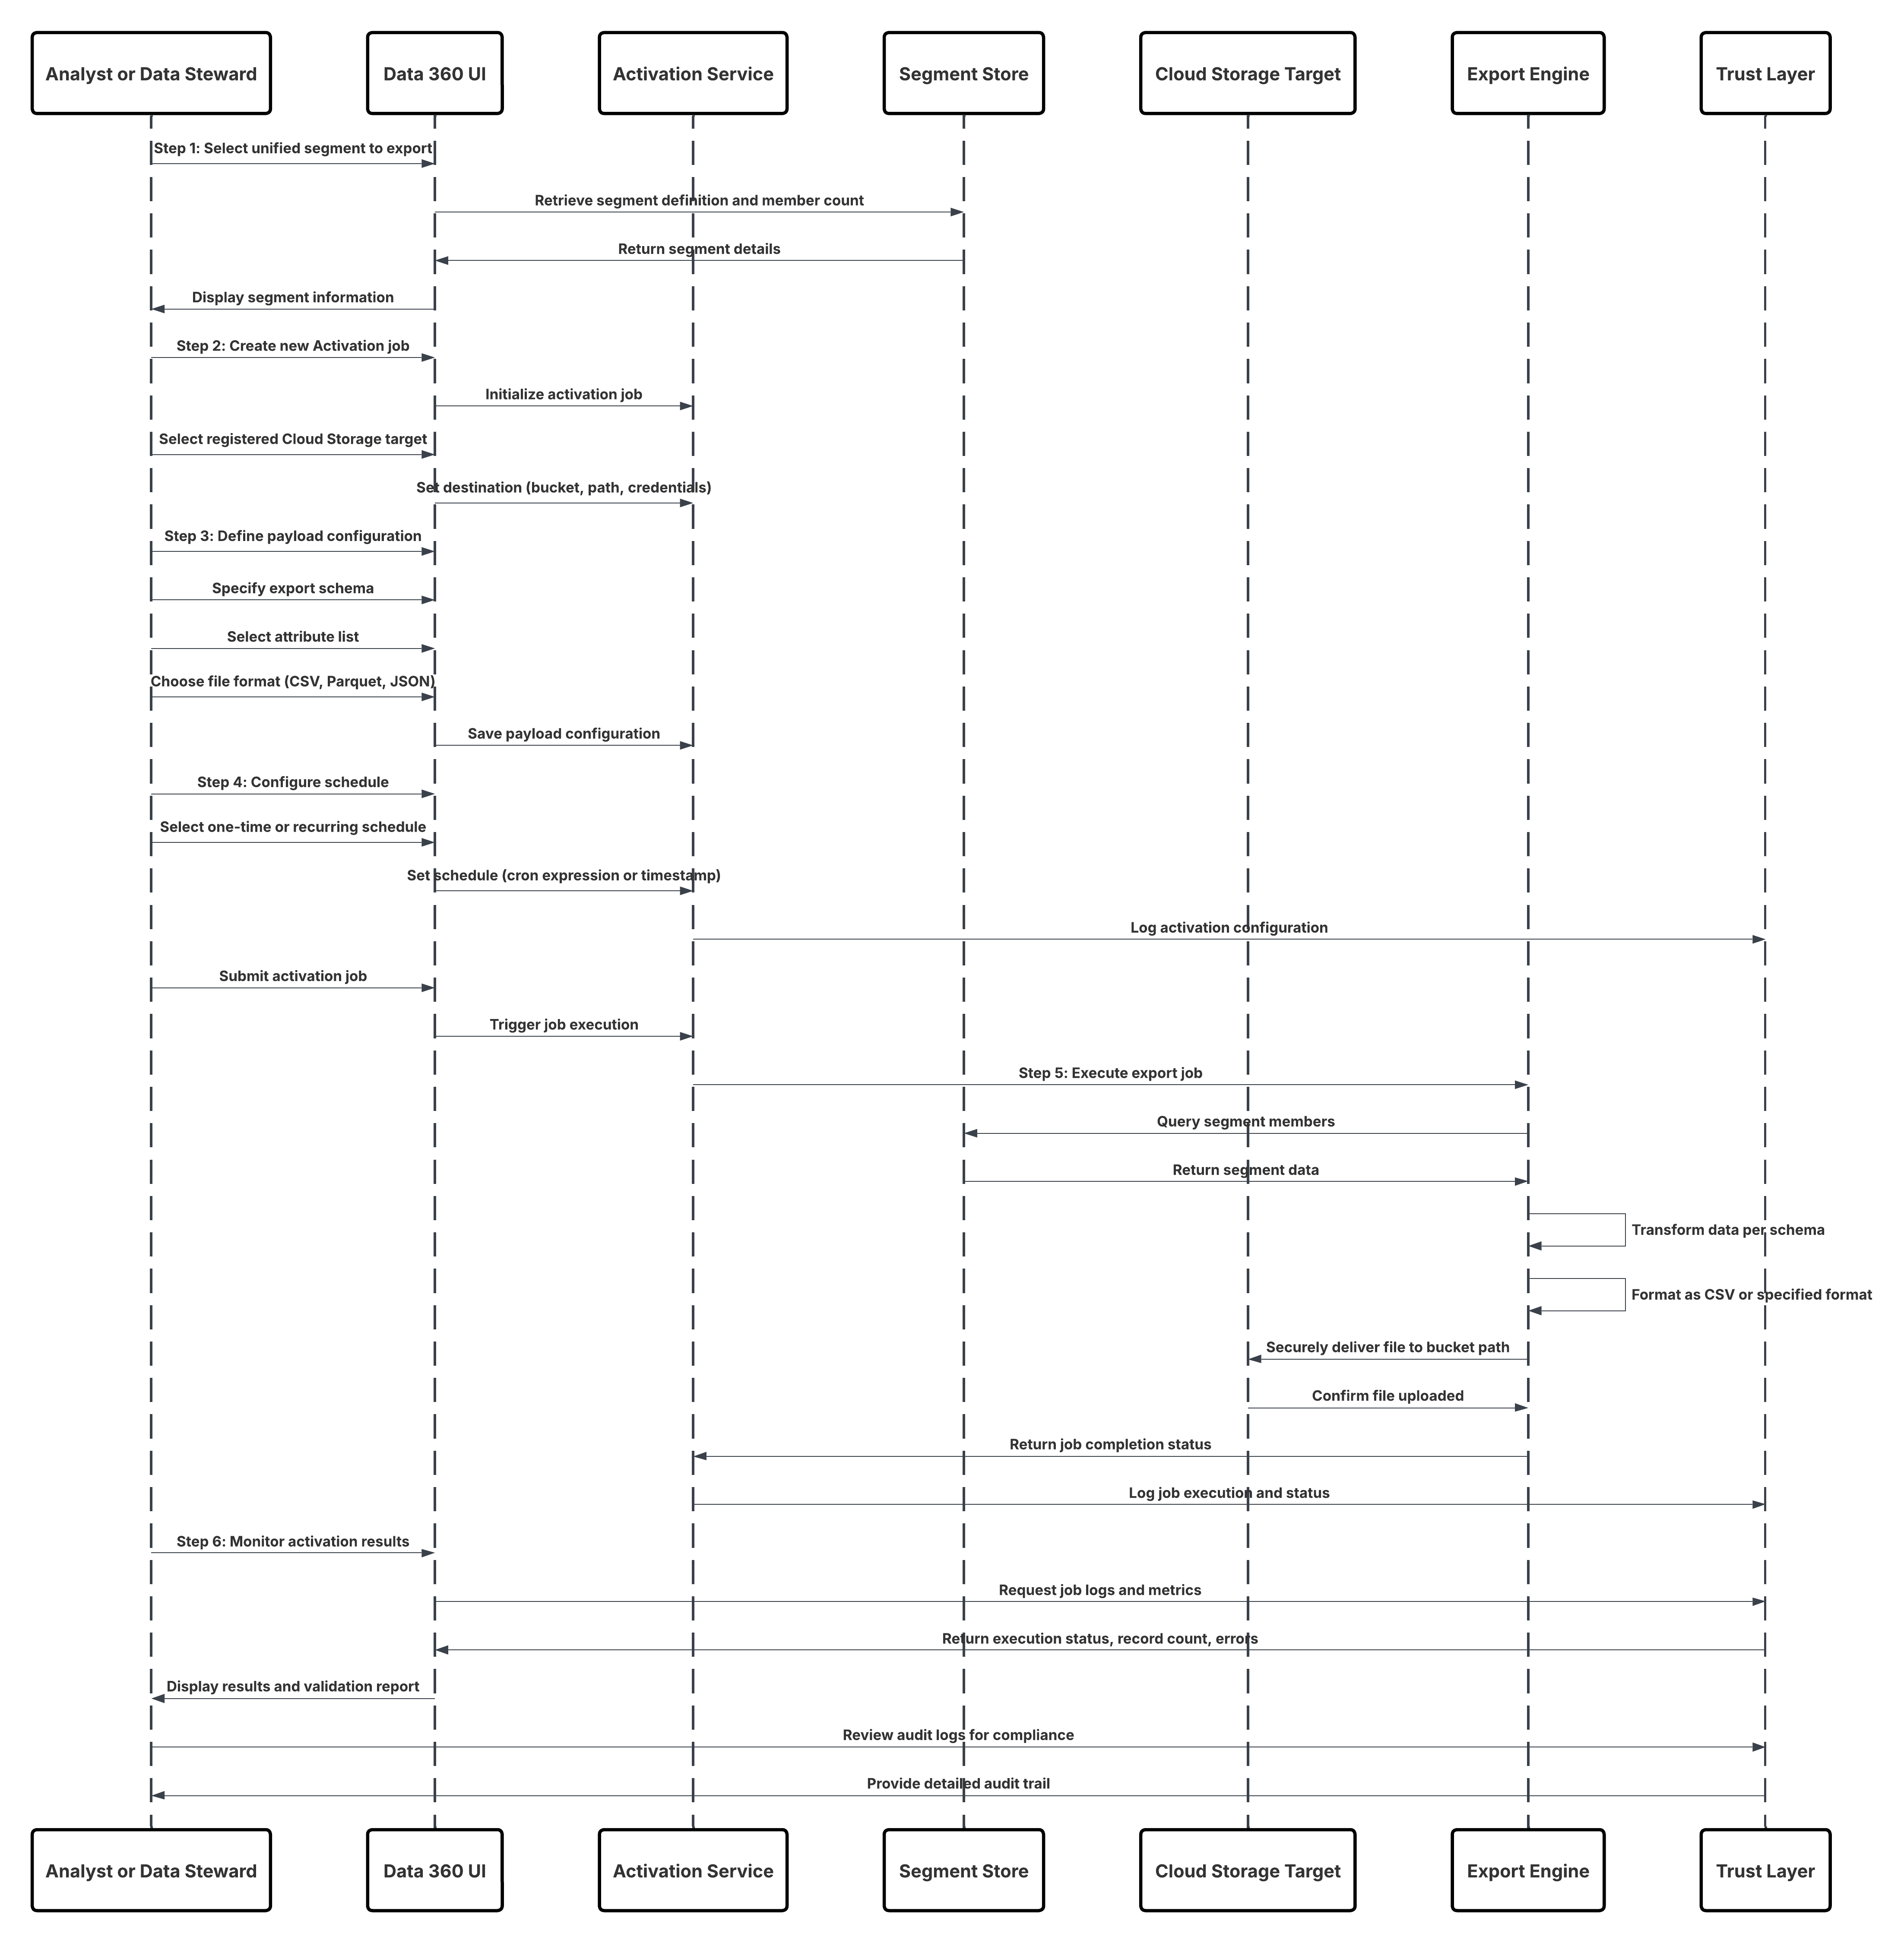 ##### Resultados
- Los segmentos de audiencia enriquecidos dirigidos desde Data 360 están disponibles directamente en plataformas de marketing y publicidad descendentes.
- Las audiencias se actualizan y sincronizan automáticamente con los datos de clientes unificados más recientes, manteniendo la relevancia de la campaña en tiempo real.
- Los especialistas en marketing pueden utilizar estas audiencias activadas como orígenes de entrada para trayectorias de Marketing Cloud, campañas de email o audiencias personalizadas en plataformas de anuncios digitales como Google Ads, Meta o LinkedIn Ads.
- Cada ejecución de activación mantiene un linaje de extremo a extremo, garantizando el cumplimiento, la trazabilidad y la coherencia entre Data 360 y sistemas externos.
- Los usuarios de negocio pueden entregar experiencias altamente personalizadas dirigidas por datos con tecnología de una vista Customer 360 completa y de confianza.
###### Mecanismos de llamada
El mecanismo de llamada depende de la plataforma de almacenamiento en la nube de destino y la configuración de activación.
| Mecanismo | Cuándo utilizar |
|---|---|
| Activación de Amazon S3 | Utilice cuando su lago de datos de compañía esté alojado en AWS. Data 360 escribe directamente en un depósito de S3 utilizando funciones de IAM o credenciales temporales, garantizando una exportación segura y ampliable. |
| Activación de almacenamiento de Azure Blob | Se utiliza cuando su organización opera en Microsoft Azure. Data 360 utiliza tokens de SAS o principales de servicio para redactar archivos cifrados en contenedores Blob. |
| Activación de Google Cloud Storage (GCS) | Utilice cuando sus cargas de trabajo de análisis o ciencia de datos se ejecutan en GCP. Data 360 utiliza credenciales de OAuth para exportar archivos a depósitos de GCS en formato CSV o Parquet. |
| SFTP o pasarela de archivos externos | Se utiliza cuando los sistemas reguladores o heredados requieren una entrega de archivos segura a través de extremos SFTP o plataformas de transferencia de archivos gestionadas por la compañía. |
| Exportación híbrida (Archivo + API) | Se utiliza cuando una aplicación descendente necesita exportación basada en archivos para análisis y un desencadenador de API para orquestación de flujos de trabajo (por ejemplo, flujo de MuleSoft). |
| Área de solución | Ajuste | Comentarios / Detalles de implementación |
|---|---|---|
| Registro de autenticación y aplicación | Requerido | Cree una aplicación conectada en Salesforce para la autenticación basada en OAuth 2.0. Configure ámbitos para el acceso de API de Data 360. |
| Acceso a datos (perfiles, segmentos, perspectivas) | Mejor | Utilice extremos de API de Connect (/services/data/vXX.X/connect) para consultar datos de Data 360 armonizados, perfiles unificados y perspectivas calculadas. |
| Integración de interfaz de usuario | Mejor | Las aplicaciones front-end (React, Angular, iOS, Android) llaman a la API de Connect para representar datos de Data 360 en tableros, portales o interfaces móviles. |
| Consulta de gráfico de datos | Recomendado | Combine la API de Connect con la API de gráficos de datos para consultas de nivel semántico que simplifican uniones y relaciones complejas. |
| Actualización en tiempo real | Opcional | Utilice la API de Connect con extensiones WebSocket o de transmisión para actualizaciones de datos en vivo. |
| Seguridad y gobernanza | Requerido | Aplique la visibilidad de datos utilizando ámbitos de OAuth, políticas de Data 360 y el marco de trabajo de auditoría Trust Layer. |
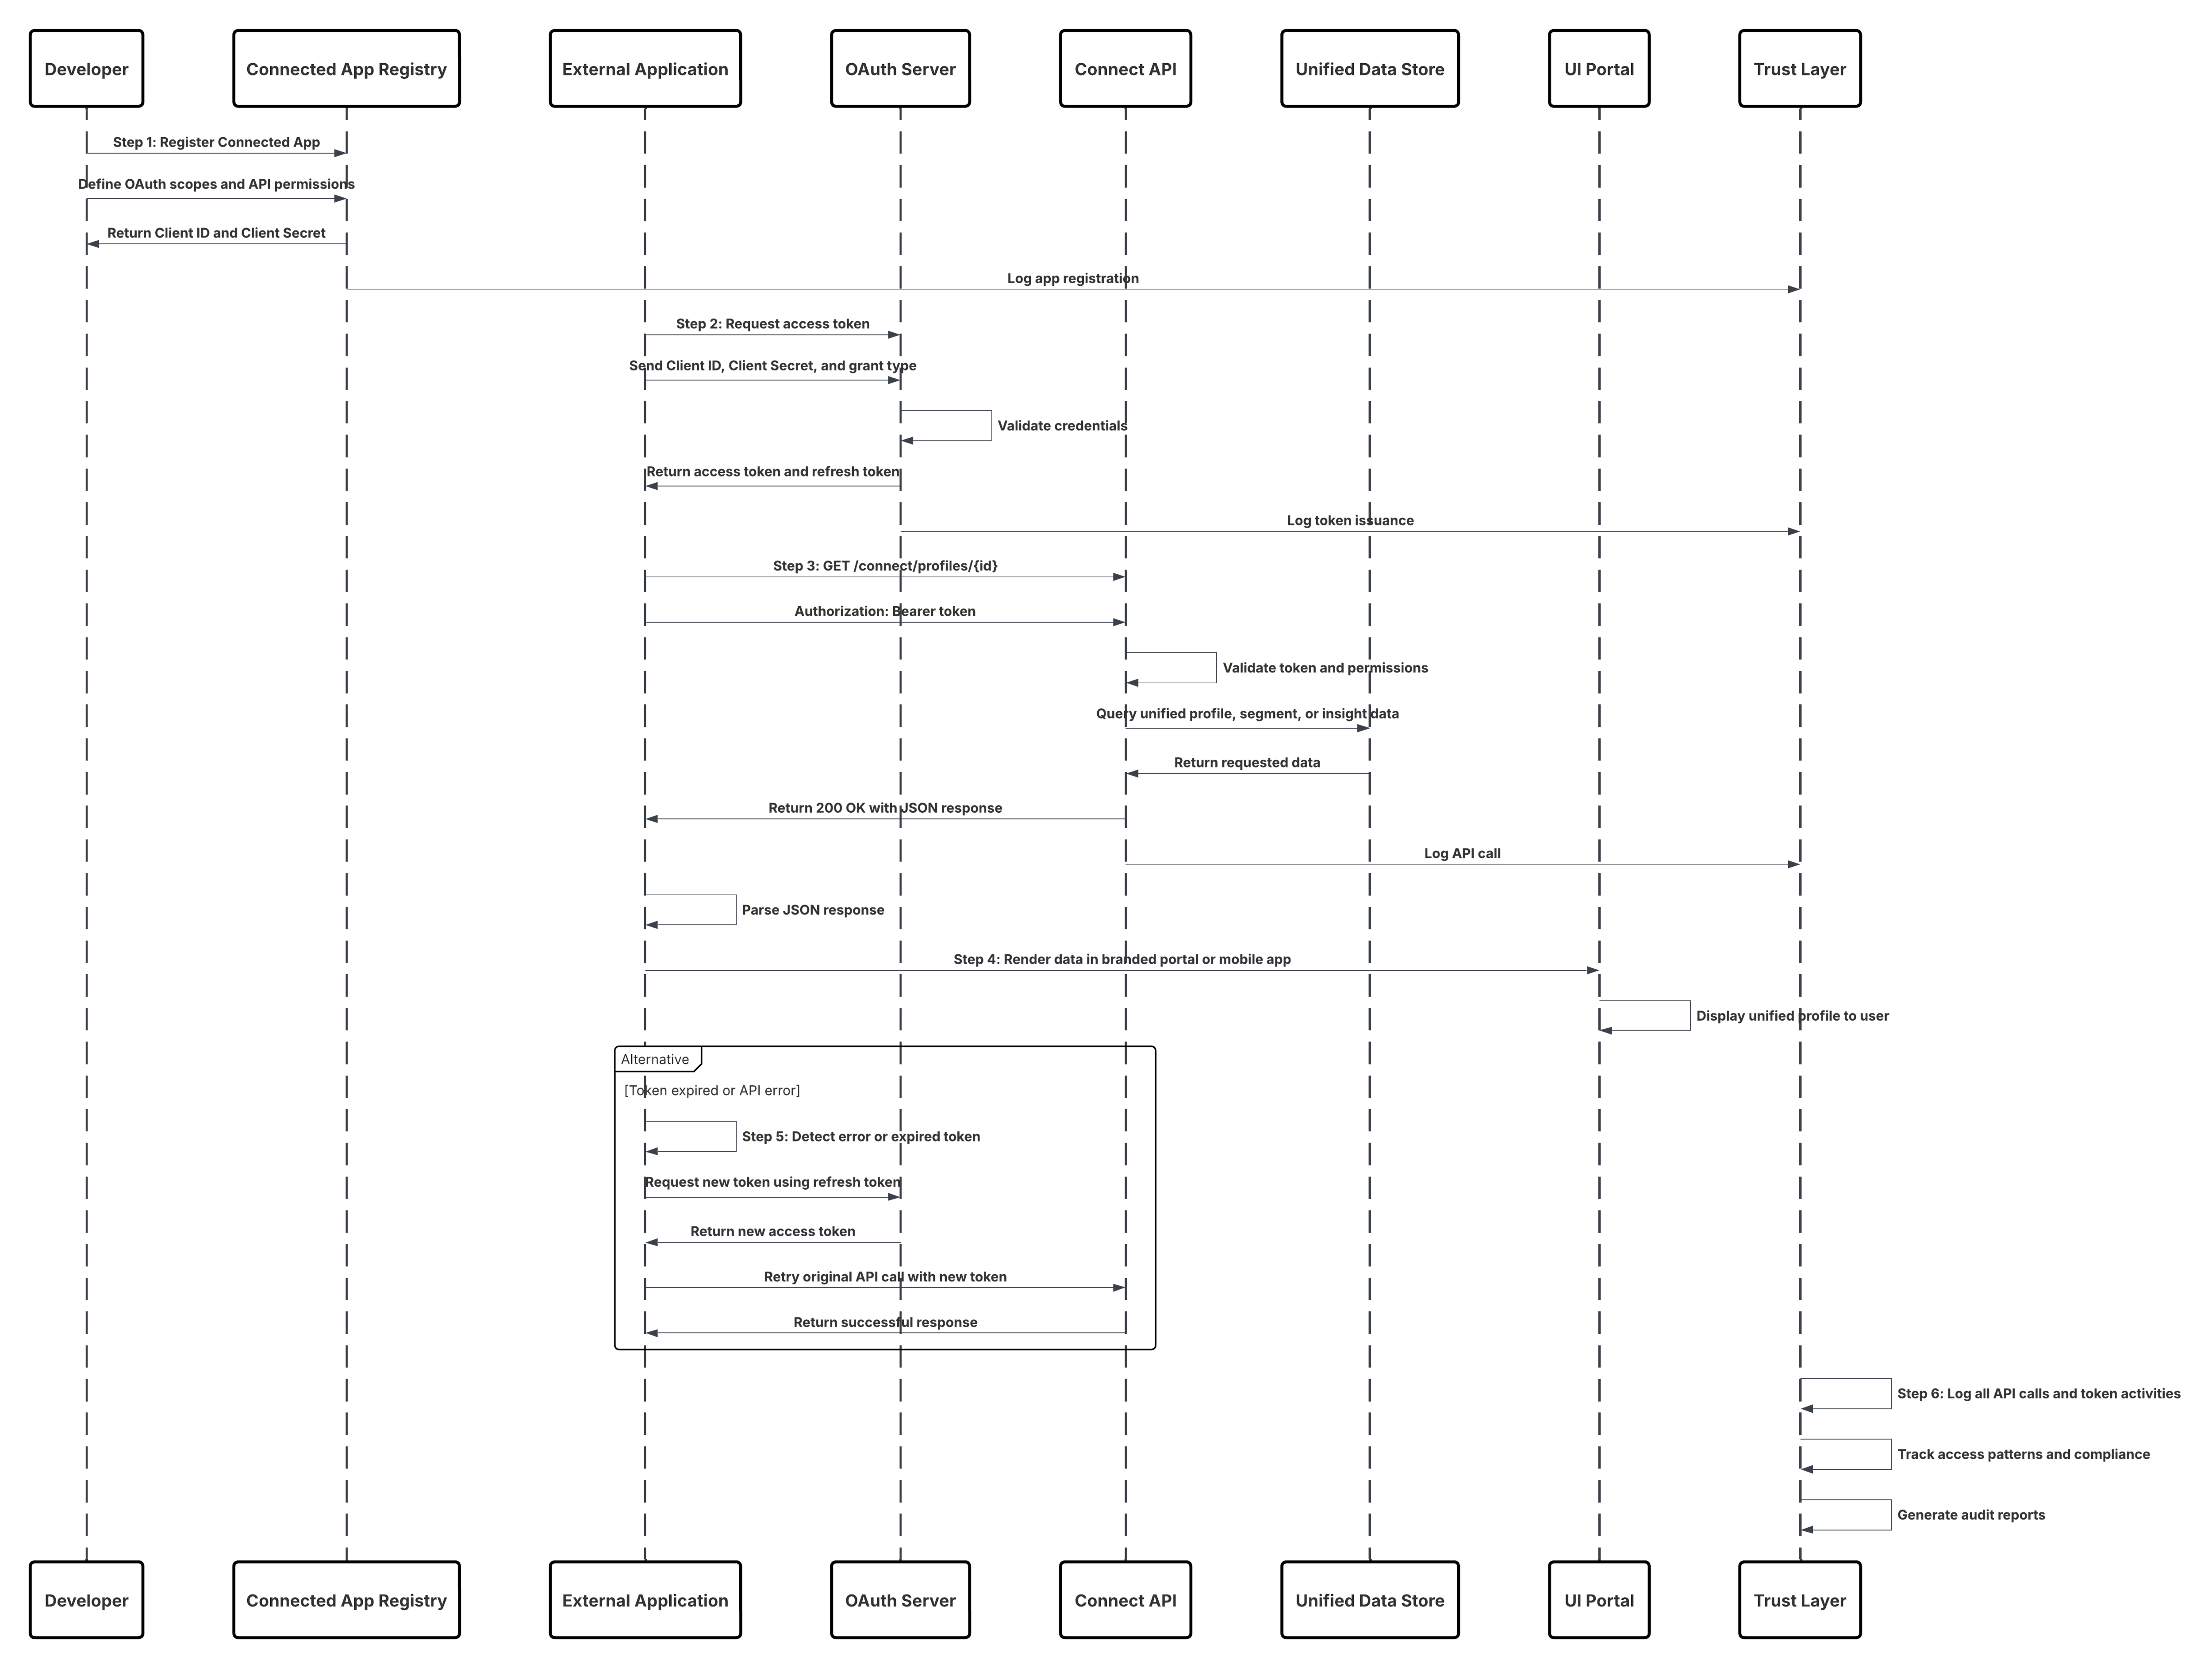 ##### Resultados
Los desarrolladores pueden crear aplicaciones seguras con marca personalizada estrechamente integradas con Data 360. Estas aplicaciones pueden:
- Aflore perspectivas y perfiles de clientes armonizados en tiempo real.
- Muestre datos de Data 360 junto con CRM u objetos personalizados a través de API unificadas.
- Aproveche los controles de autenticación, autorización y auditoría coherentes a través de Trust Layer.
- Proporcione a los usuarios de negocio o socios un acceso sencillo y controlado a Inteligencia de clientes de confianza entre experiencias.
##### Mecanismos de llamada
El mecanismo de llamada depende de la plataforma de almacenamiento en la nube de destino y la configuración de activación.
| Mecanismo | Cuándo utilizar |
|---|---|
| API de REST de Connect (Preferido) | Se utiliza al crear aplicaciones web, móviles o de terceros que requieren acceso en tiempo real a datos de Data 360 en un formato JSON dirigido a la interfaz de usuario. |
| API de gráfico de datos | Se utiliza cuando la aplicación necesita realizar consultas a nivel semántico entre múltiples objetos (por ejemplo, Cliente → Transacciones → Campañas). |
| API de consulta | Utilice cuando ejecute consultas similares a SOQL para recuperar conjuntos de datos armonizados con alta precisión. |
| API de plataforma Einstein 1 | Utilizar al integrar perspectivas dirigidas por IA o recomendaciones generadas por copiloto en interfaces de usuario personalizadas. |
| MuleSoft o Apex Gateway Wrappers | Se utiliza cuando se requiere orquestación adicional, almacenamiento en caché o aplicación de políticas entre la aplicación y la API de Connect. |
| Área de solución | Ajuste | Comentarios / Detalles de implementación |
|---|---|---|
| Definición de gráfico de datos | Requerido | Los arquitectos definen un Gráfico de datos que combina múltiples DMO en una única entidad semántica (por ejemplo, UnifiedCustomerProfile). |
| Recuperación de búsqueda de perfil | Mejor | Las aplicaciones llaman GET /api/v1/dataGraph/{entity}/{id} para recuperar perfiles completos y desnormalizados por Id. o clave exclusivos. |
| Uso de parámetros en vivo | Opcional | Anexe ?live=true para forzar el cálculo actualizado en vez de la recuperación en caché; adecuado para decisiones de alto valor. |
| Autenticación | Requerido | Utilice OAuth 2.0 a través de aplicaciones conectadas para autenticar llamadas de API de forma segura. |
| Análisis de respuestas | Mejores prácticas | Las aplicaciones analizan la respuesta JSON directamente en su interfaz de usuario o motor de decisiones; no se requieren más uniones. |
| Estrategia de caché | Recomendado | Implemente caché local a corto plazo (por ejemplo, en memoria o CDN) para búsquedas de perfil repetidas. |
| Monitoreo y observabilidad | Requerido | Utilice tableros Trust Layer para monitorear el desempeño de consultas, los tiempos de respuesta y la adhesión a políticas. |
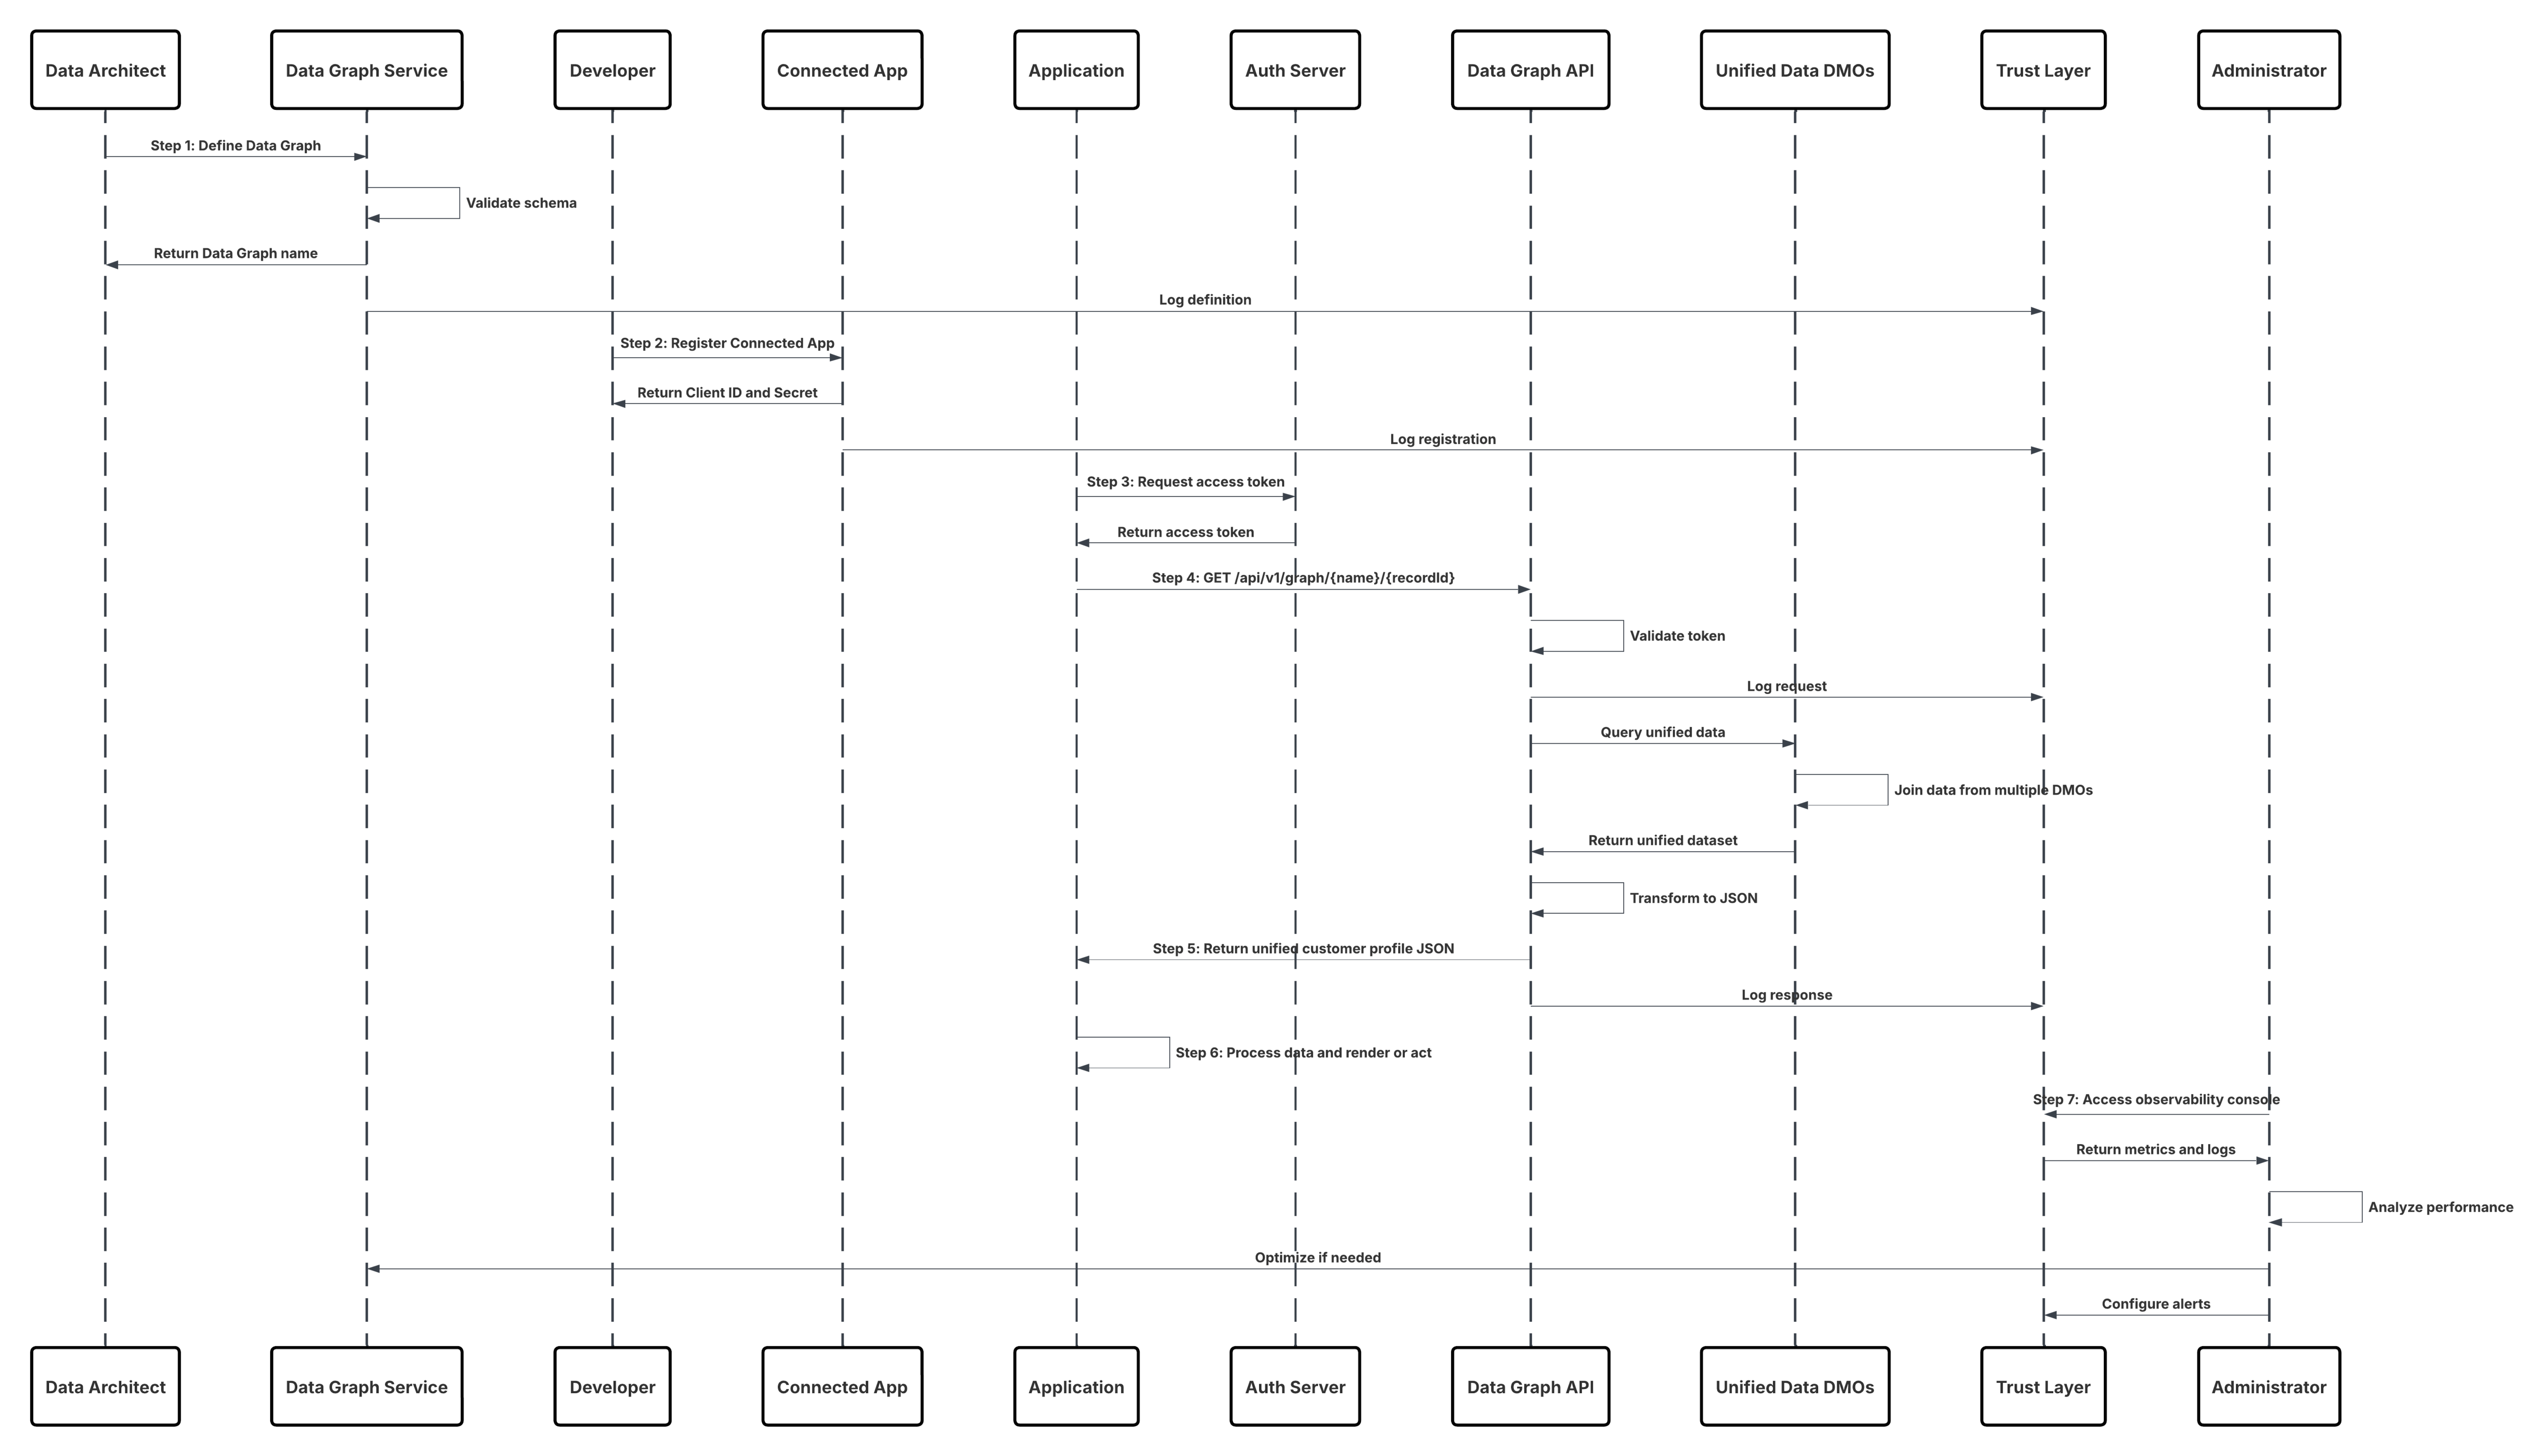 ##### Resultados
Las aplicaciones ahora pueden recuperar un perfil de cliente completo unido previamente al instante, potenciando interacciones en tiempo real como la personalización, el servicio y la automatización de decisiones.
Este patrón garantiza:
- Tiempos de respuesta por debajo del segundo para la decisión en el momento.
- Recuperación de datos gobernada coherente alineada con el modelo semántico de Data 360.
- Lógica de aplicación simplificada: sin uniones, sin reconciliación de esquemas.
- Acceso rastreable y compatible a través de Trust Layer para auditoría y observabilidad.
###### Mecanismos de llamada
El mecanismo de llamada depende de la plataforma de almacenamiento en la nube de destino y la configuración de activación.
| Mecanismo | Cuándo utilizar |
|---|---|
| API de gráficos de datos (Preferido) | Utilizar para recuperar perfiles completos prematerializados al instante por Id. o clave. |
| API de gráfico de datos con live=true | Utilice para casos de uso de alto valor (por ejemplo, detección de fraude, ofertas en vivo) donde se necesitan los datos más actuales, aceptando una latencia ligeramente superior. |
| API de conexión (Respaldo) | Utilizar para escenarios de aplicaciones compuestas que combinan recuperaciones de gráficos de datos con otros datos de Salesforce. |
| API de consulta | Se utiliza al construir consultas ad hoc o lecturas analíticas en vez de la recuperación instantánea de perfiles. |
| Proxy de API de MuleSoft | Se utiliza al enrutar llamadas de Gráfico de datos a través de pasarelas de compañía o cuando se requiere orquestación/aplicación de políticas adicional. |
| Área de solución | Ajuste | Comentarios / Detalles de implementación |
|---|---|---|
| Acción de datos en tiempo real | Mejor | Exponga el extremo para desencadenadores de lectura/escritura y acción de un solo registro. Autentique a través de OAuth/JWT. |
| Resolución de identidad | Obligatorio | Resuelva identificadores entrantes (email, externalId, cookie) en Id. de Particular unificado en línea. Utilice una resolución determinista con caché. |
| Aplicación de políticas (CEDAR) | Mejor práctica | Evalúe las políticas de consentimiento, ABAC y enmascaramiento en el momento de la solicitud; deniegue o enmascare campos por decisiones de política. |
| Capa de borde/caché | Recomendado | Utilice caché de TTL corto para fragmentos de perfil y perspectivas calculadas para reducir la latencia; invalide en eventos de cambio. |
| Transformaciones ligeras | Recomendado | Aplique enriquecimientos sencillos o campos calculados en la ruta de acción; las transformaciones pesadas deben calcularse previamente. |
| Orquestación de acciones | Mejor | Admita acciones de un solo paso síncronas (por ejemplo, token de oferta de devolución) y orquestaciones asíncronas (cola \+ webhook) para flujos complejos. |
| Observabilidad y rastreo | Obligatorio | Registre la solicitud/respuesta, las decisiones de política y el linaje en Trust Layer/SIEM para auditoría y depuración. |
| Limitación y aceleración de índices | Obligatorio | Aplique cuotas de clientes y estrategias de degradación elegantes para momentos de alto tráfico. |
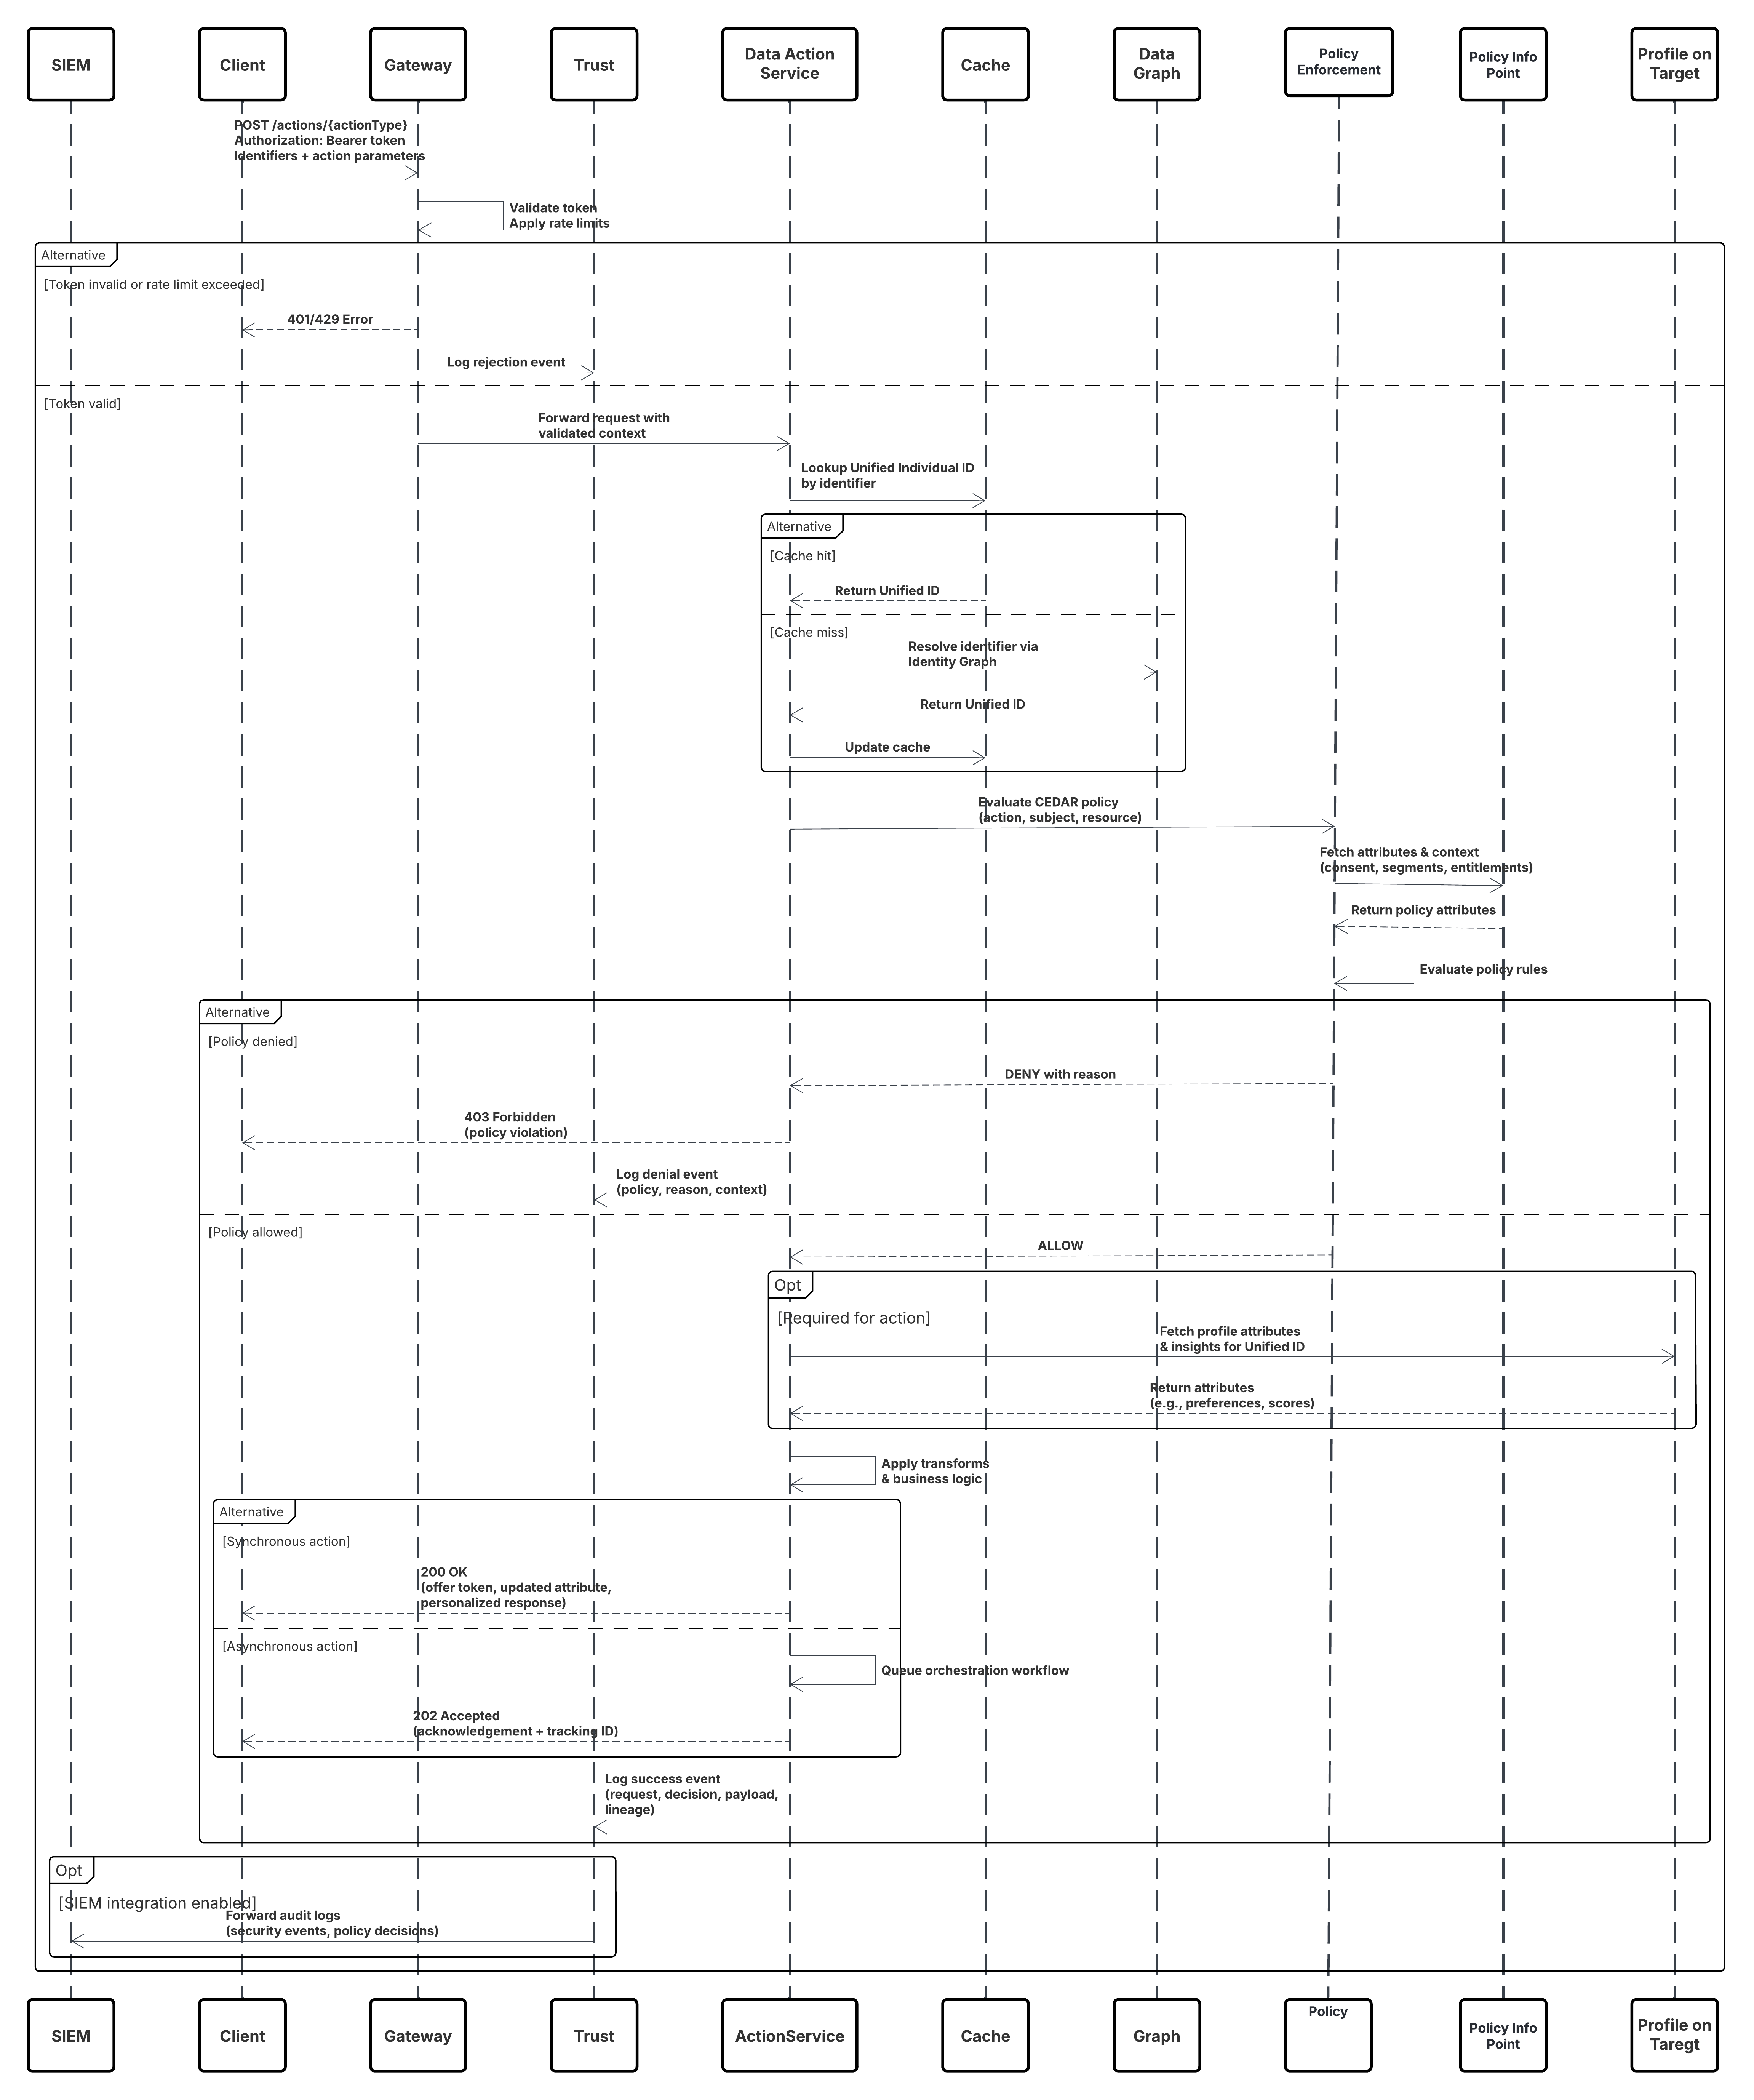 ##### Resultados
- Las aplicaciones reciben acceso inmediato y regulado por políticas a lecturas/escrituras de perfiles unificados y desencadenadores de acciones con latencia de subsegundo a segundo.
- La personalización en tiempo real, la toma de decisiones y los flujos de trabajo operativos (por ejemplo, ofertas, asistencia de agentes, actualizaciones de inventario) se activan sin demoras por lotes.
- Todas las acciones son auditables, conscientes del consentimiento y aplican el enmascaramiento a nivel de atributos para mantener la privacidad y el cumplimiento.
###### Mecanismos de llamada
El mecanismo de llamada depende de la plataforma de destino y la configuración de destino de activación.
| Mecanismo | Cuándo utilizar |
|---|---|
| API de acciones de datos RESTANTES | Preferido para aplicaciones web/móviles y middleware que necesitan lecturas de perfil síncronas o respuestas de acción. |
| gRPC / RPC binario | Utilizar para servicios de negocio de latencia ultra baja o microservicios internos con conexiones persistentes. |
| Consultas de registro único de GraphQL | Se utiliza cuando los clientes necesitan una selección de campos flexible y desean minimizar las cargas. |
| Webhooks desencadenados por eventos | Utilice para flujos de trabajo asíncronos donde la acción desencadena procesos descendentes (por ejemplo, iniciar una trayectoria). |
| Eventos de plataforma / PubSub | Utilice para escenarios de abanico donde múltiples sistemas deben reaccionar a un único evento de acción. |
| Edge SDK (libertades de clientes) | Utilizar para clientes de baja latencia que almacenan en caché fragmentos de perfil y llaman a la API de acciones de datos solo cuando es necesario. |
 |
Salesforce Lightning Platform es una plataforma integral dirigida por IA que unifica empleados, agentes de IA autónomos, datos de la compañía y aplicaciones en un único sistema de confianza para mejorar la productividad y la experiencia del cliente. Permite la creación de una "compañía agencia" conectando aplicaciones Customer 360, Data Cloud y Slack para la automatización de extremo a extremo. |
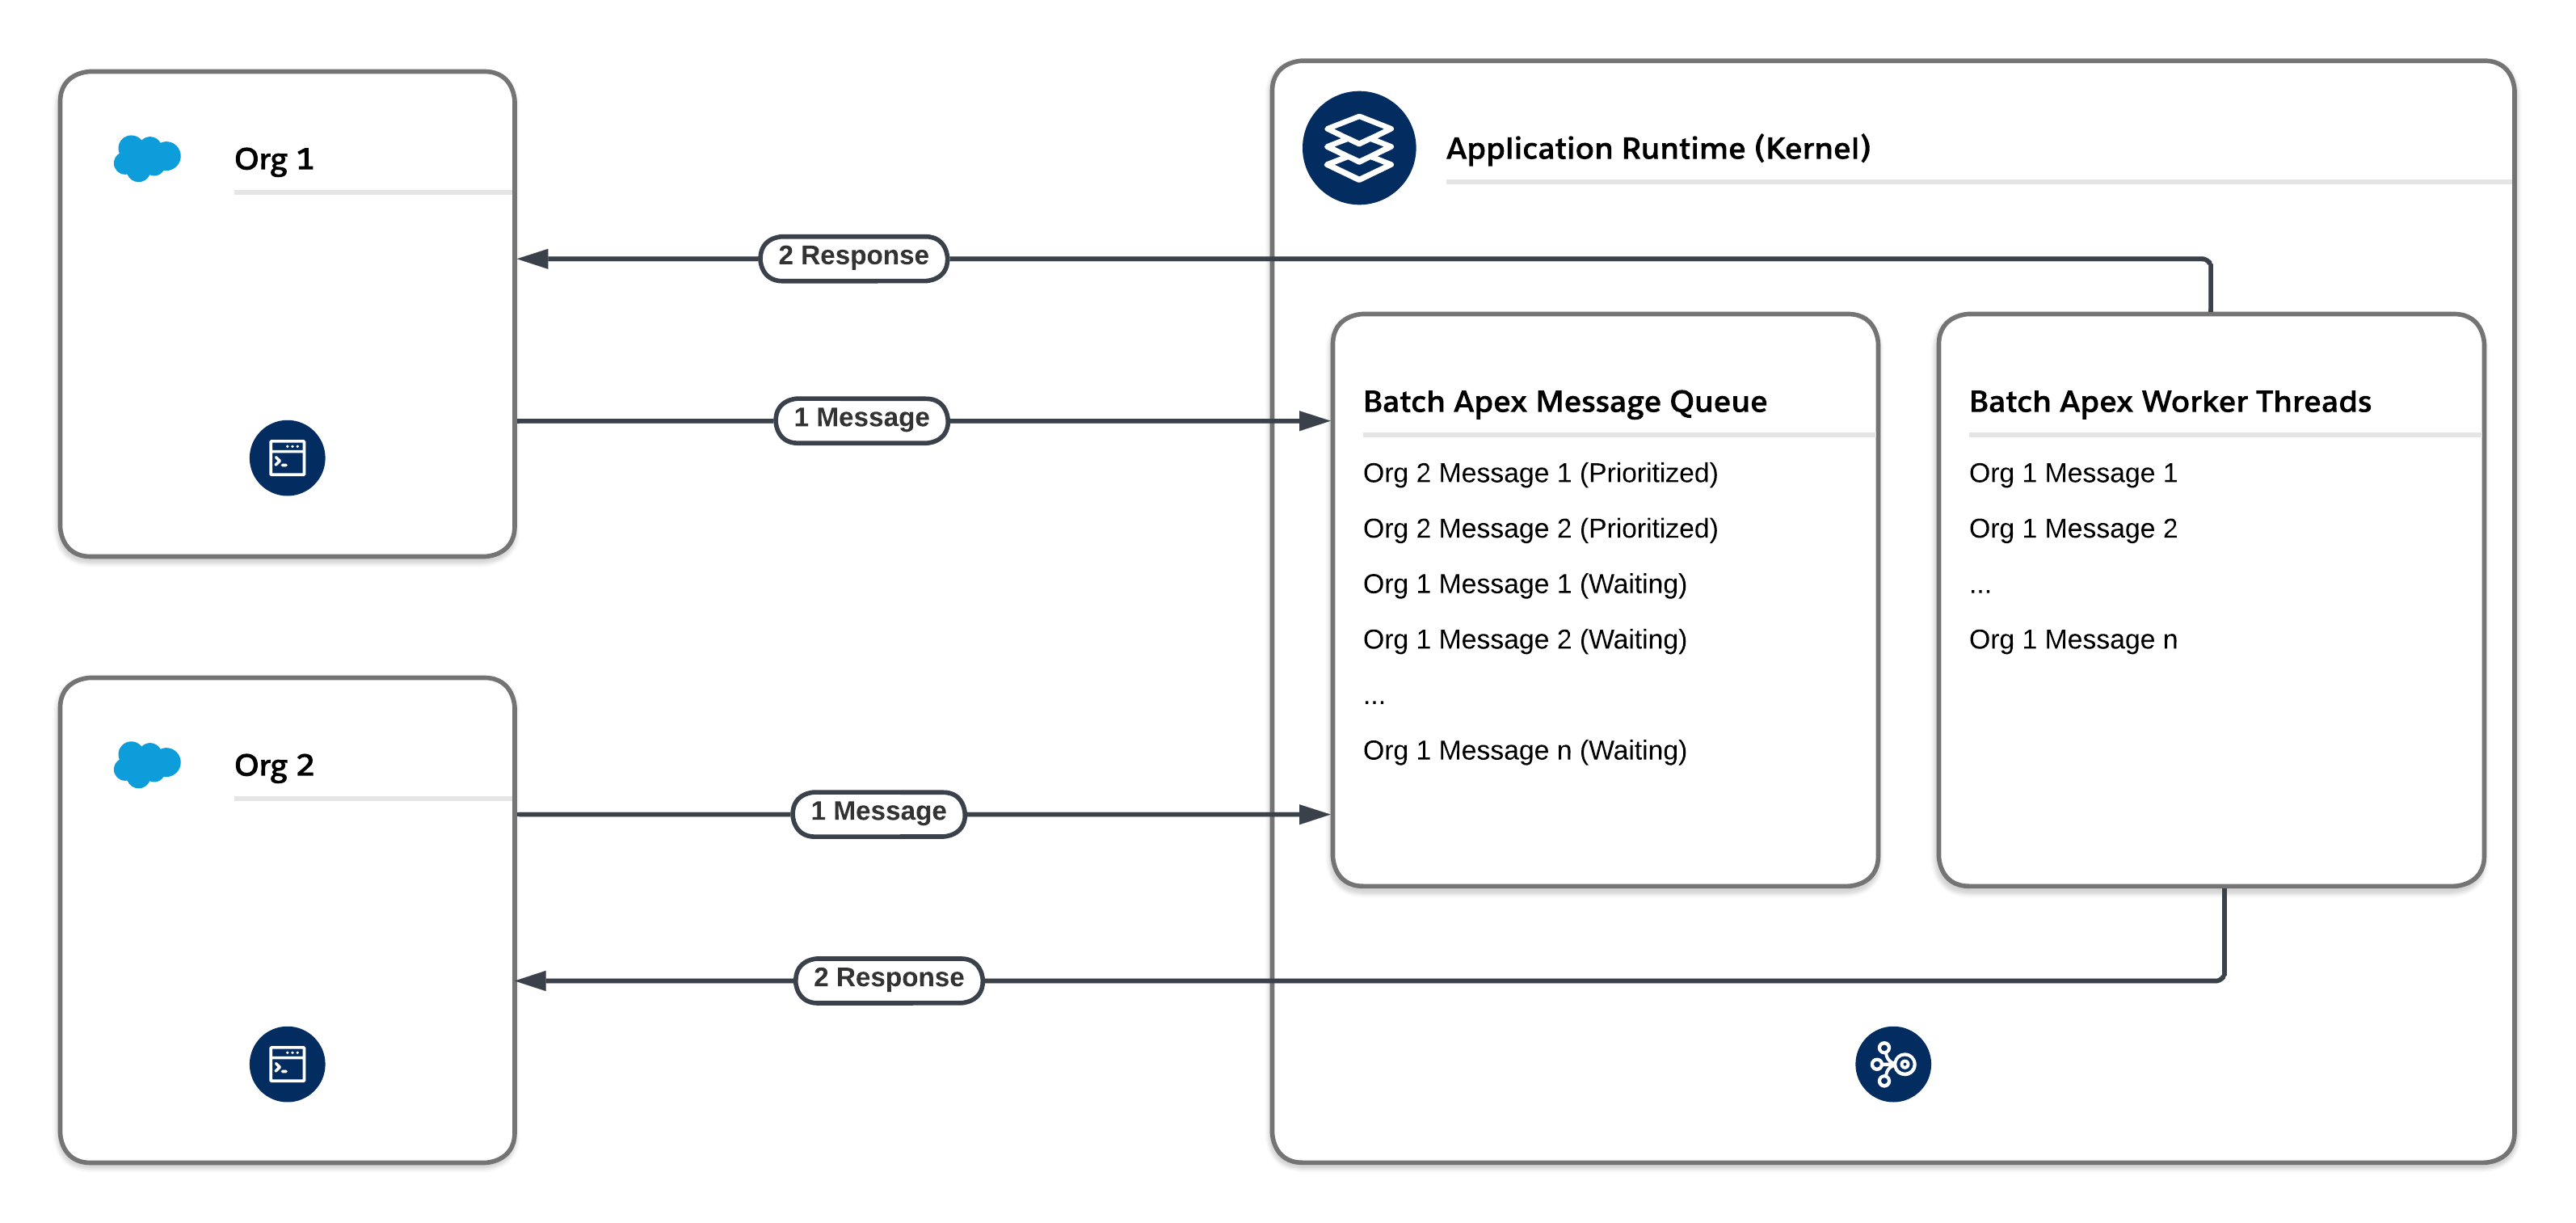 #### Uso justo
El mecanismo de uso justo de la plataforma implementa un sistema basado en niveles. El sistema garantiza que cada organización en Salesforce Platform obtiene una parte justa del tiempo de procesamiento para un tipo de mensaje concreto, incluyendo tipos de mensajes Futuro, Colocable en cola y Por lotes. Si una organización domina un tipo de mensaje concreto durante el mismo tiempo que otras organizaciones están esperando para realizar trabajo en el mismo tipo de mensaje, el algoritmo de uso justo reduce el número de hilos que la organización tiene disponibles para ese tipo de mensaje concreto.
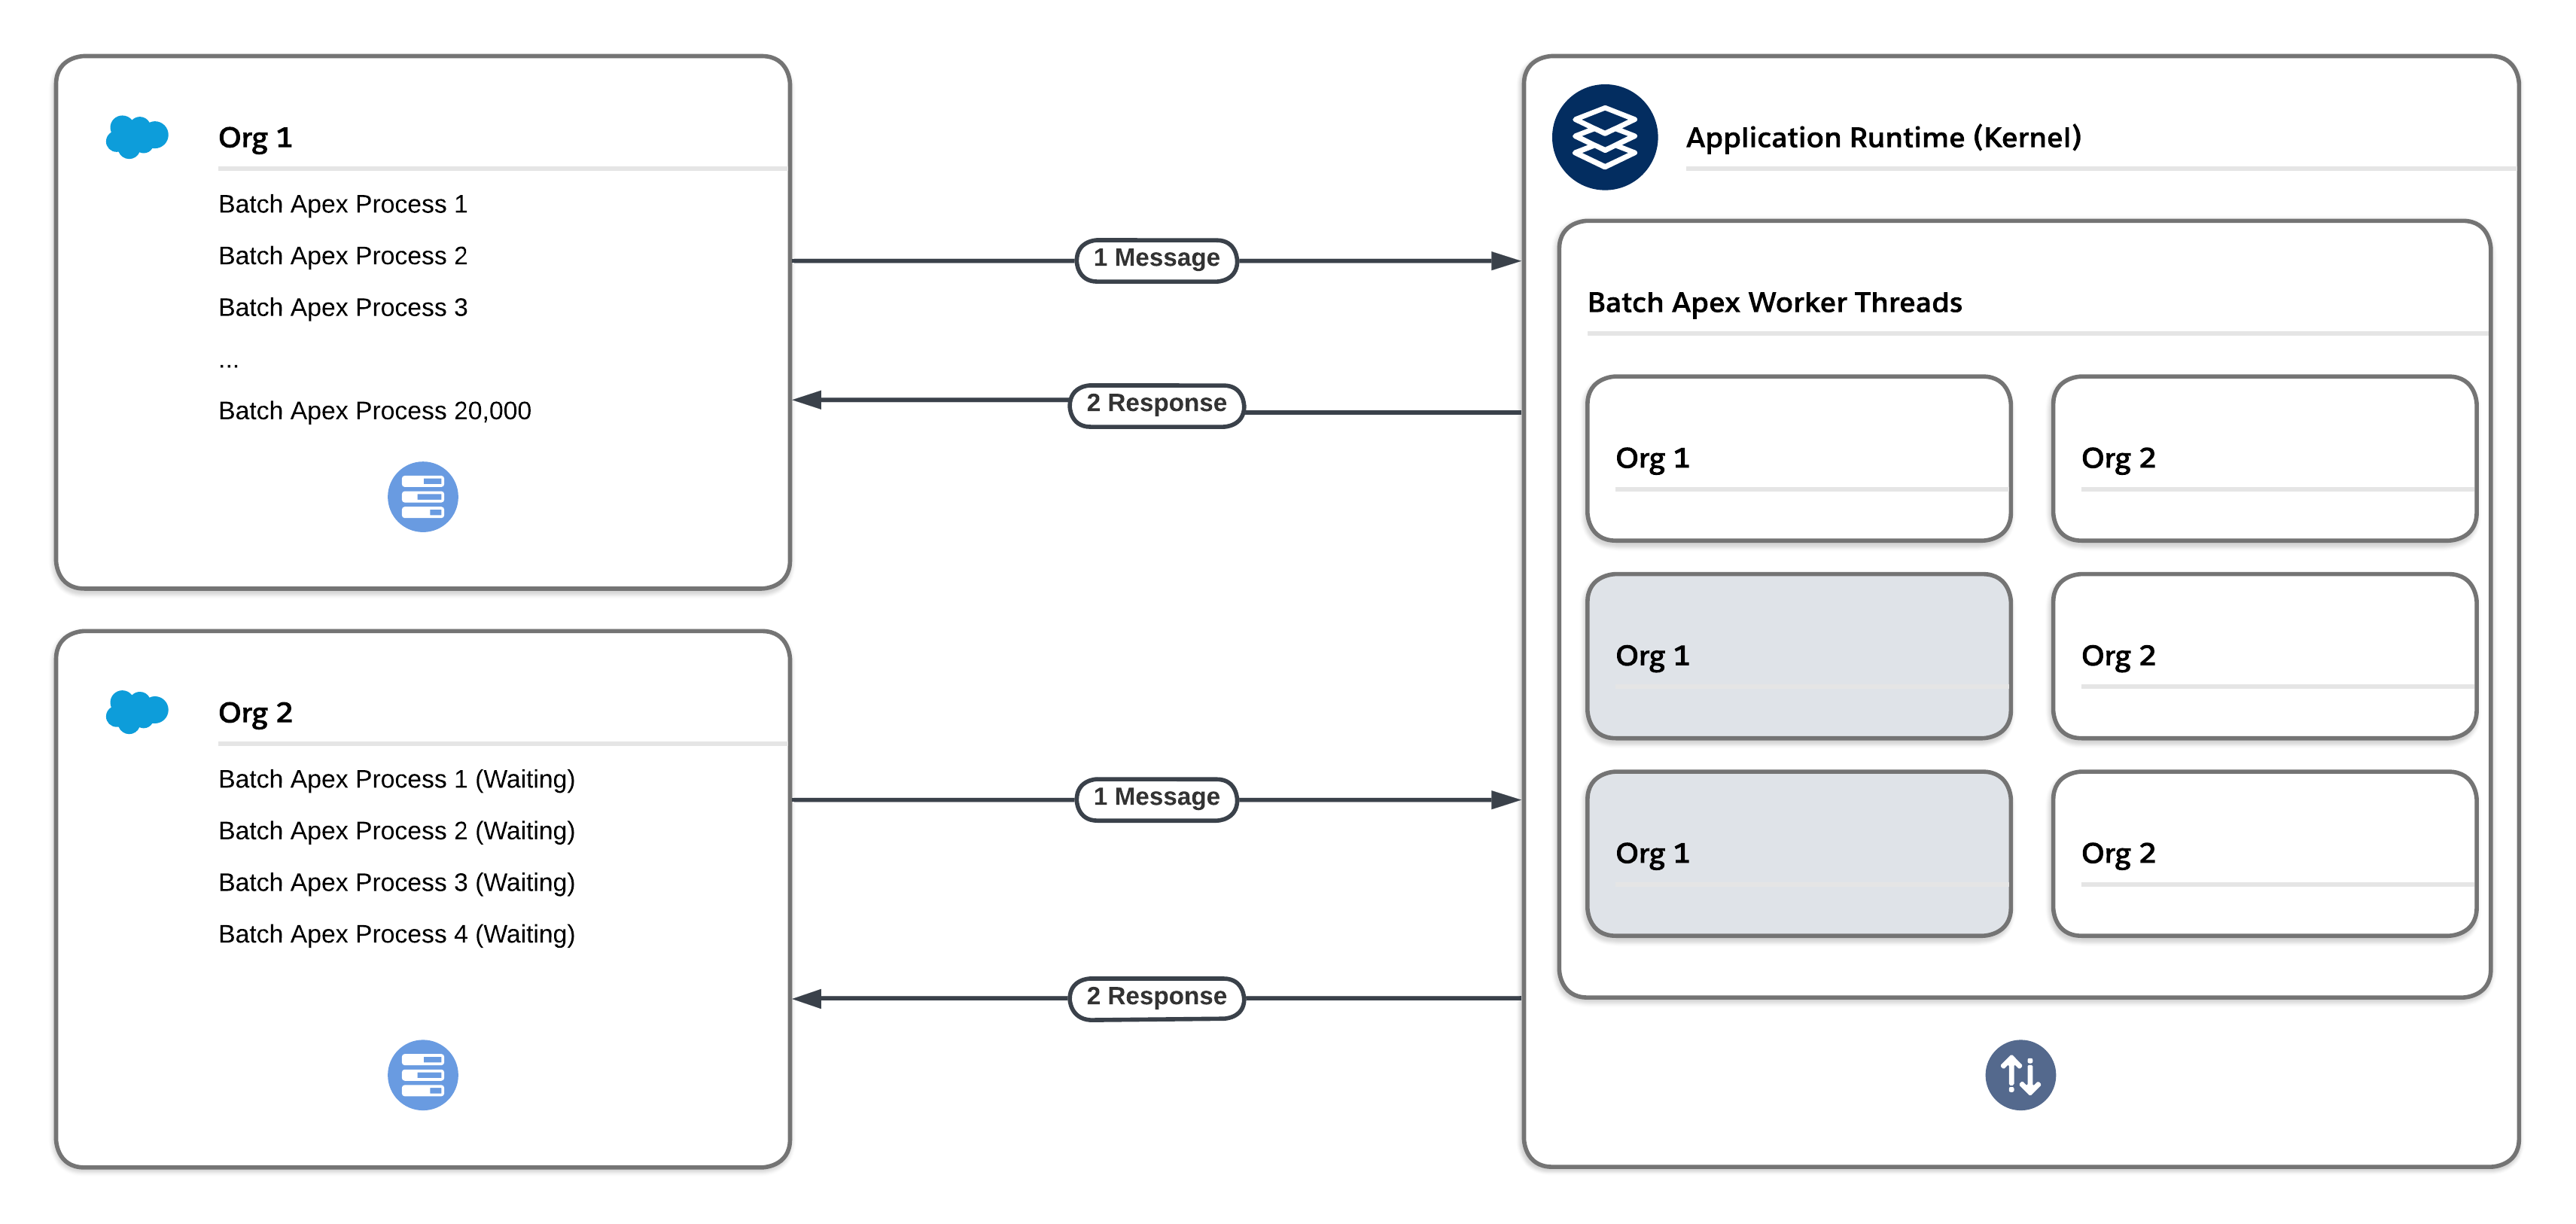 Un beneficio de utilizar métodos Apex asíncronos es que algunos límites reguladores, como los límites de consulta SOQL y los límites de tamaño de pila, son más altos. Sin embargo, no se base demasiado en estos métodos. Debido a los recursos finitos asignados a la infraestructura asíncrona, el uso intensivo de Apex futuro, colocable en cola y por lotes puede causar retrasos de procesamiento derivados de limitaciones basadas en el uso justo y el control de flujos.
#### Consideraciones especiales para llamadas salientes mediante Apex asíncrono
Las llamadas salientes que utilizan Apex asíncrono cuentan en el límite de Apex asíncrono. El límite diario es actualmente 250.000 o 200 veces el número de licencias de usuario aplicables, cualquiera que sea superior. Este límite puede ser un problema para casos de uso de gran volumen. Si supera el límite, sus trabajos de Apex asíncronos y sus llamadas salientes asociadas fallarán.
Además, debido a que la plataforma tiene un número finito de hilos asíncronos disponibles, las integraciones salientes a través de Apex asíncrono tienen una capacidad de ampliación limitada. Cualquier integración saliente de gran volumen que supere el número de hilos disponibles puede tener largos tiempos de procesamiento y provocar retrasos.
Para casos de uso de gran volumen, considere estos enfoques alternativos. Las llamadas de API con estos enfoques cuentan en el límite de solicitudes de API diarias, que es significativamente superior al límite de Apex asíncrono diario. Por lo tanto, estos enfoques son más ampliables. Tenga en cuenta, sin embargo, que aún existen limitaciones físicas en el número de solicitudes simultáneas que cualquier CPU puede procesar.
- **Extracción programada de middleware.** Evite retrasos asociados con trabajos de integración salientes de gran volumen utilizando middleware para extraer los datos de forma programada en vez de enviarlos mediante Apex asíncrono. El middleware, como MuleSoft Anypoint Platform, puede utilizar la API de SOAP nativa o la API de REST de forma síncrona de modo que se introduzcan pocos retrasos, si los hubiera. El middleware también puede utilizar la API masiva nativa para grandes volúmenes de datos.
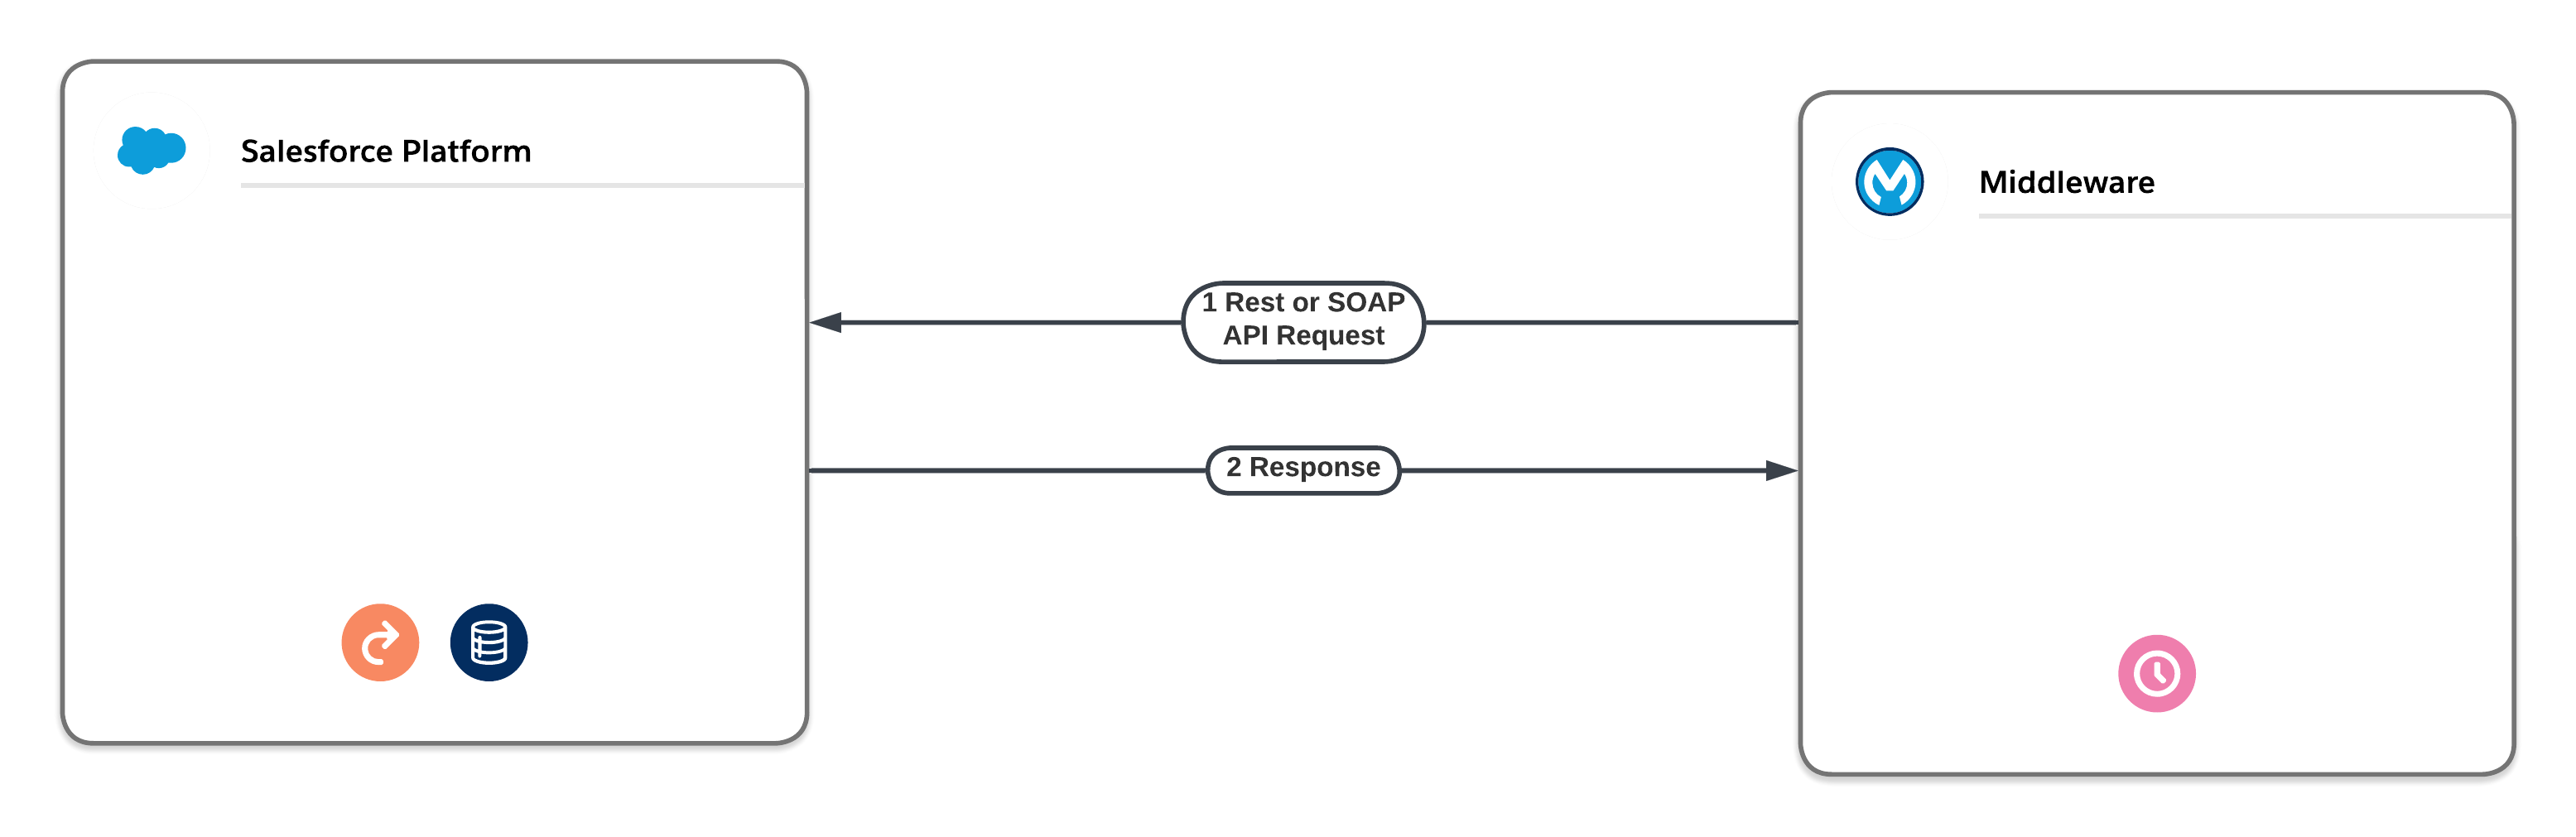 - **Extracción de middleware a través de Notificación de evento de plataforma.** En vez de poner en cola Apex asíncrono Futuro, Colocable en cola o Por lotes para realizar integraciones salientes, puede utilizar eventos de plataforma. El evento de plataforma puede entregar la información saliente en sí o indicar a una herramienta de middleware que extraiga la información requerida a través de una API nativa y la entregue a su destino final. Ninguno de estos enfoques está sujeto a los retrasos a los que está sujeto Apex asíncrono. Sin embargo, los [límites de eventos](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_events_limits_default.htm) de plataforma aún se aplican.
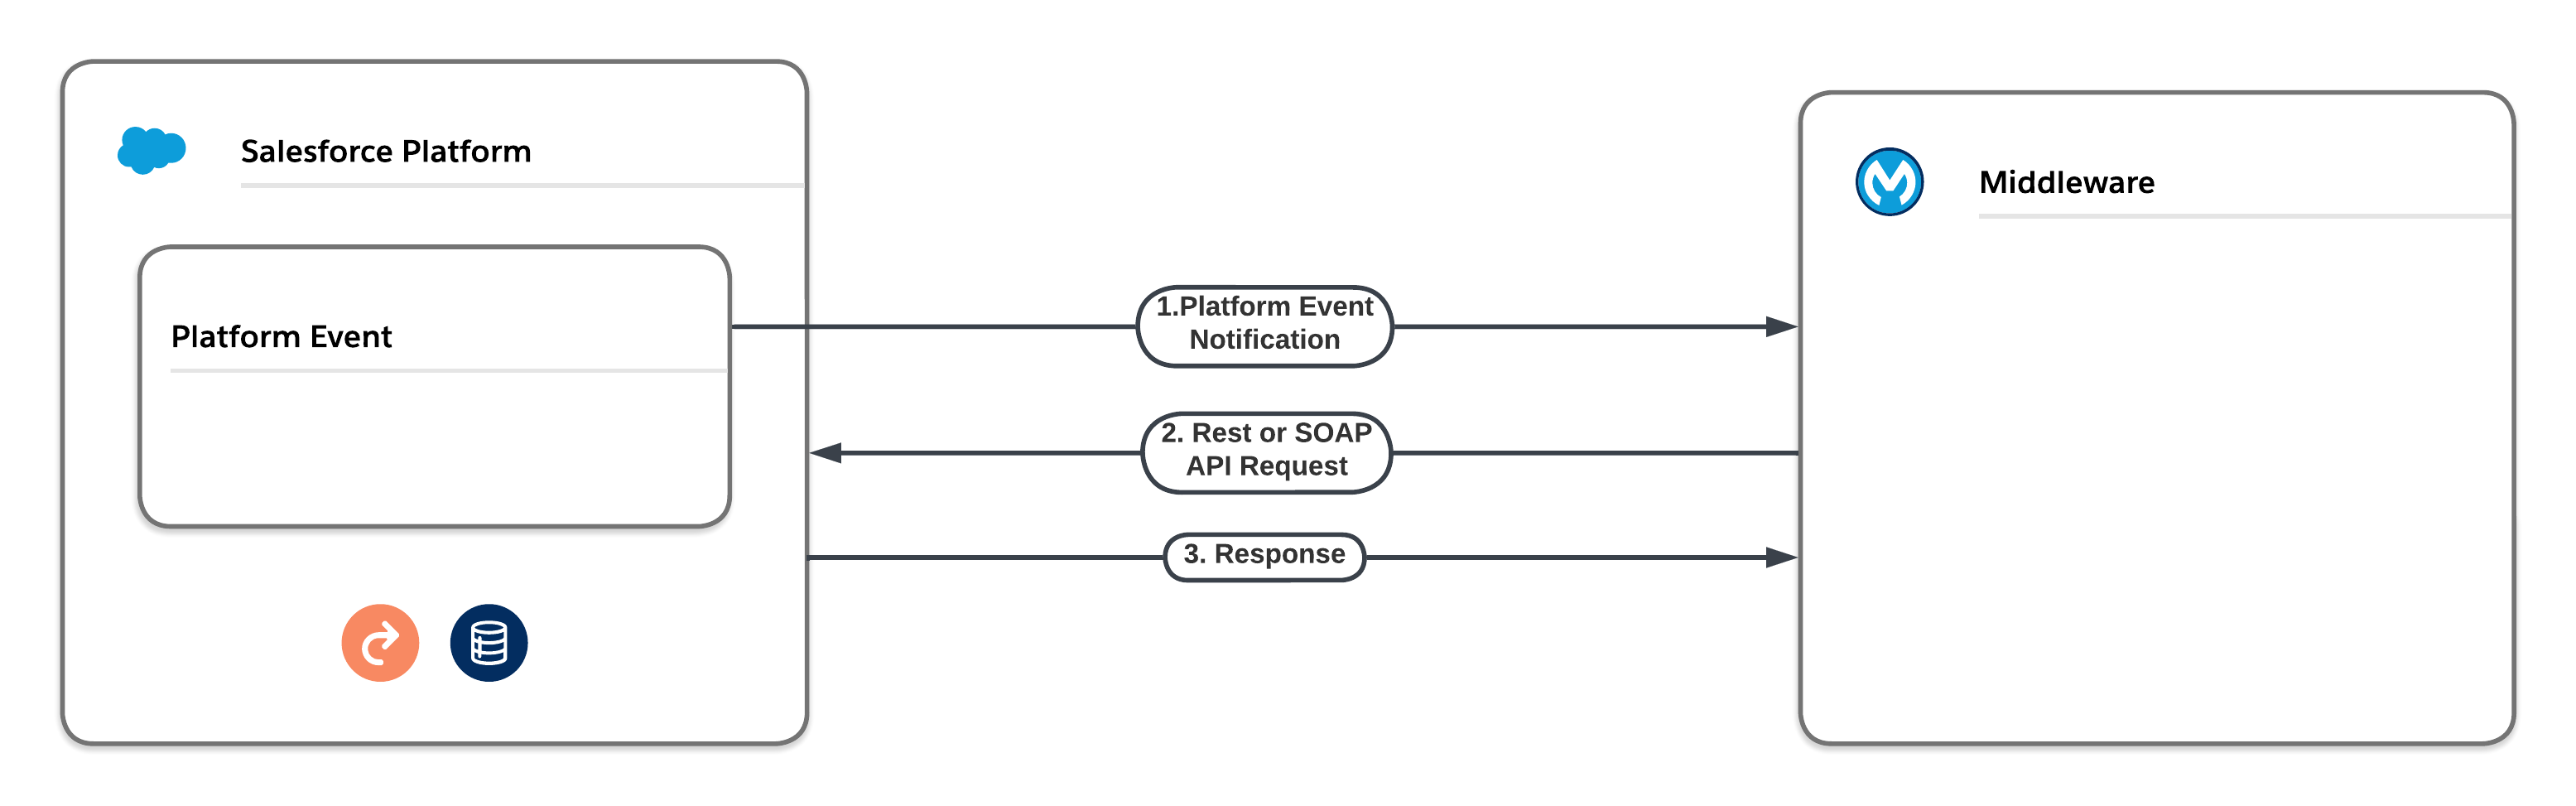 #### Compensaciones asíncronas de Apex
| Producto / Enfoque | Casos de uso | Habilidades requeridas | Asíncrono con respecto al cliente | Asíncrono con respecto al servidor | Tipo de límites de plataforma aplicados |
|---|---|---|---|---|---|
| Métodos futuros Apex | Recomendamos que utilice Apex colocable en cola en vez de métodos futuros de Apex. Los colocables en cola tienen los mismos casos de uso que los métodos futuros pero ofrecen beneficios adicionales. | Código pro | Sí | Sí | Asíncrono |
| Apex colocable en cola | Preferimos este enfoque a métodos futuros. Utilizar para procesos que implican operaciones de base de datos de larga ejecución o llamadas de servicio web externo. Apex colocable en cola ofrece beneficios adicionales sobre métodos futuros, incluyendo Id. de trabajo, compatibilidad para tipos no primitivos y encadenamiento de trabajos. | Código pro | Sí | Sí | Asíncrono |
| Apex programado | Ejecute Apex a una hora programada definida por una expresión cron. Aunque el acto de programar Apex mediante la expresión cron es un proceso asíncrono, el código subyacente se ejecuta de forma síncrona cuando se inicia el trabajo. | Código pro | Sí | Sí | Síncrono |
| Llamadas de continuación Apex | Llamadas desde métodos Apex ejecutándose en un contexto de transacción síncrono. | Código pro | Sí | Sí | Síncrono |
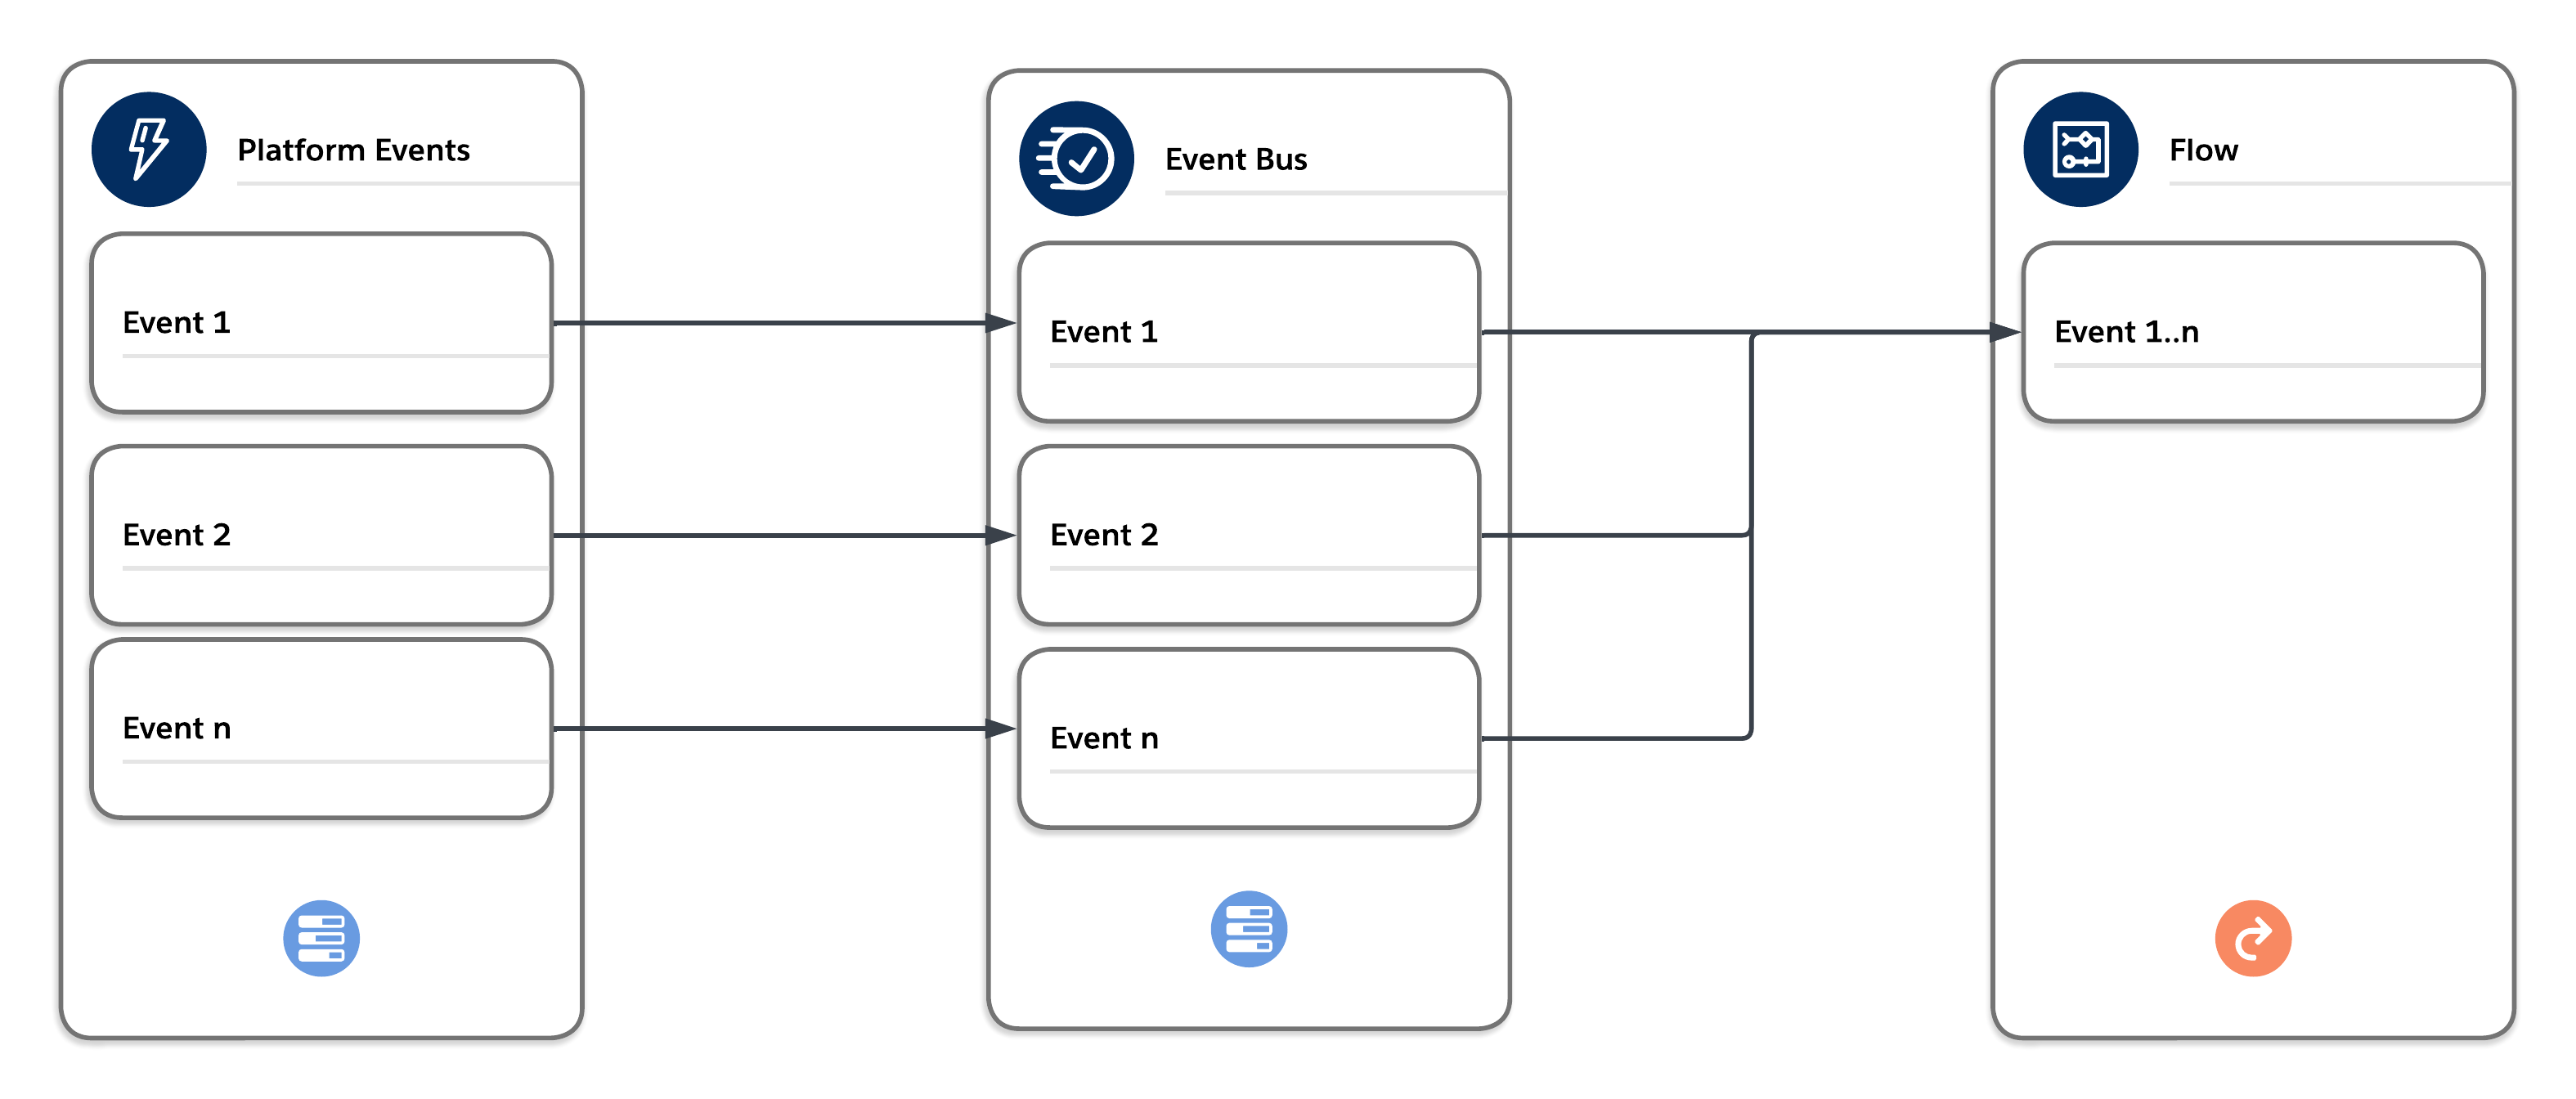 Los eventos publicados en el bus a través de [publicación después de](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_events_intro.htm) confirmación se entregan en orden y pueden procesarse de forma masiva por el desencadenador o el flujo en un contexto síncrono separado. El contexto es síncrono y aplica todos los límites reguladores síncronos. Seleccione el desencadenador de evento de plataforma/tamaño de lote de flujo cuidadosamente para evitar alcanzar límites.
| Producto / Enfoque | Casos de uso | Habilidades requeridas | Asíncrono con respecto al cliente | Asíncrono con respecto al servidor | Tipo de límites de plataforma aplicados |
|---|---|---|---|---|---|
| Desencadenadores de eventos de plataforma | Acople Salesforce libremente con sistemas externos y comuníquese entre componentes de plataforma asíncronos. | Código bajo + código profesional | Sí | Sí | Síncrono |
| Producto / Enfoque | Casos de uso | Habilidades requeridas | Asíncrono con respecto al cliente | Asíncrono con respecto al servidor | Tipo de límites de plataforma aplicados |
|---|---|---|---|---|---|
| Ruta programada (Flujos después de confirmar) | Ejecute a horas programadas dinámicamente después de desencadenar eventos. | Código bajo | Sí | Sí | Asíncrono |
| Ruta asíncrona (Flujos desencadenados por registro) | Ejecute una operación que desea ejecutar en su propio tiempo y para evitar errores DML mixtos. | Código bajo | Sí | Sí | Asíncrono |
| Producto / Enfoque | Casos de uso | Habilidades requeridas | Asíncrono con respecto al cliente | Asíncrono con respecto al servidor | Tipo de límites de plataforma aplicados |
|---|---|---|---|---|---|
| Mensajes salientes | Compartir datos con sistemas externos casi en tiempo real a través del protocolo SOAP | Código bajo | N/A | Sí | N/A |
| Producto / Enfoque | Casos de uso | Habilidades requeridas | Asíncrono con respecto al cliente | Asíncrono con respecto al servidor | Tipo de límites de plataforma aplicados |
|---|---|---|---|---|---|
| Email para registro de casos | Cree casos automáticamente y rellene campos de casos basándose en valores en emails entrantes. | Código bajo | Sí | Sí* | Síncrono |
| * Email para registro de casos se gestiona como sincronizado y asíncrono, pero con límites Apex síncronos | |||||
| Producto / Enfoque | Casos de uso | Habilidades requeridas | Asíncrono con respecto al cliente | Asíncrono con respecto al servidor | Tipo de límites de plataforma aplicados |
|---|---|---|---|---|---|
| Apex por lotes | Procesos complejos y de larga ejecución que implican miles de registros | Código pro | Sí | Sí | Asíncrono |
| Flujos desencadenados por programación | Realice acciones en un lote de registros en segundo plano a una hora especificada y con una frecuencia repetida a través de un flujo. | Código bajo | Sí | Sí | Síncrono |
| API masiva | Inserte, actualice, altere, consulte o elimine muchos registros de forma asíncrona. | Código pro | Sí | Sí | Asíncrono |
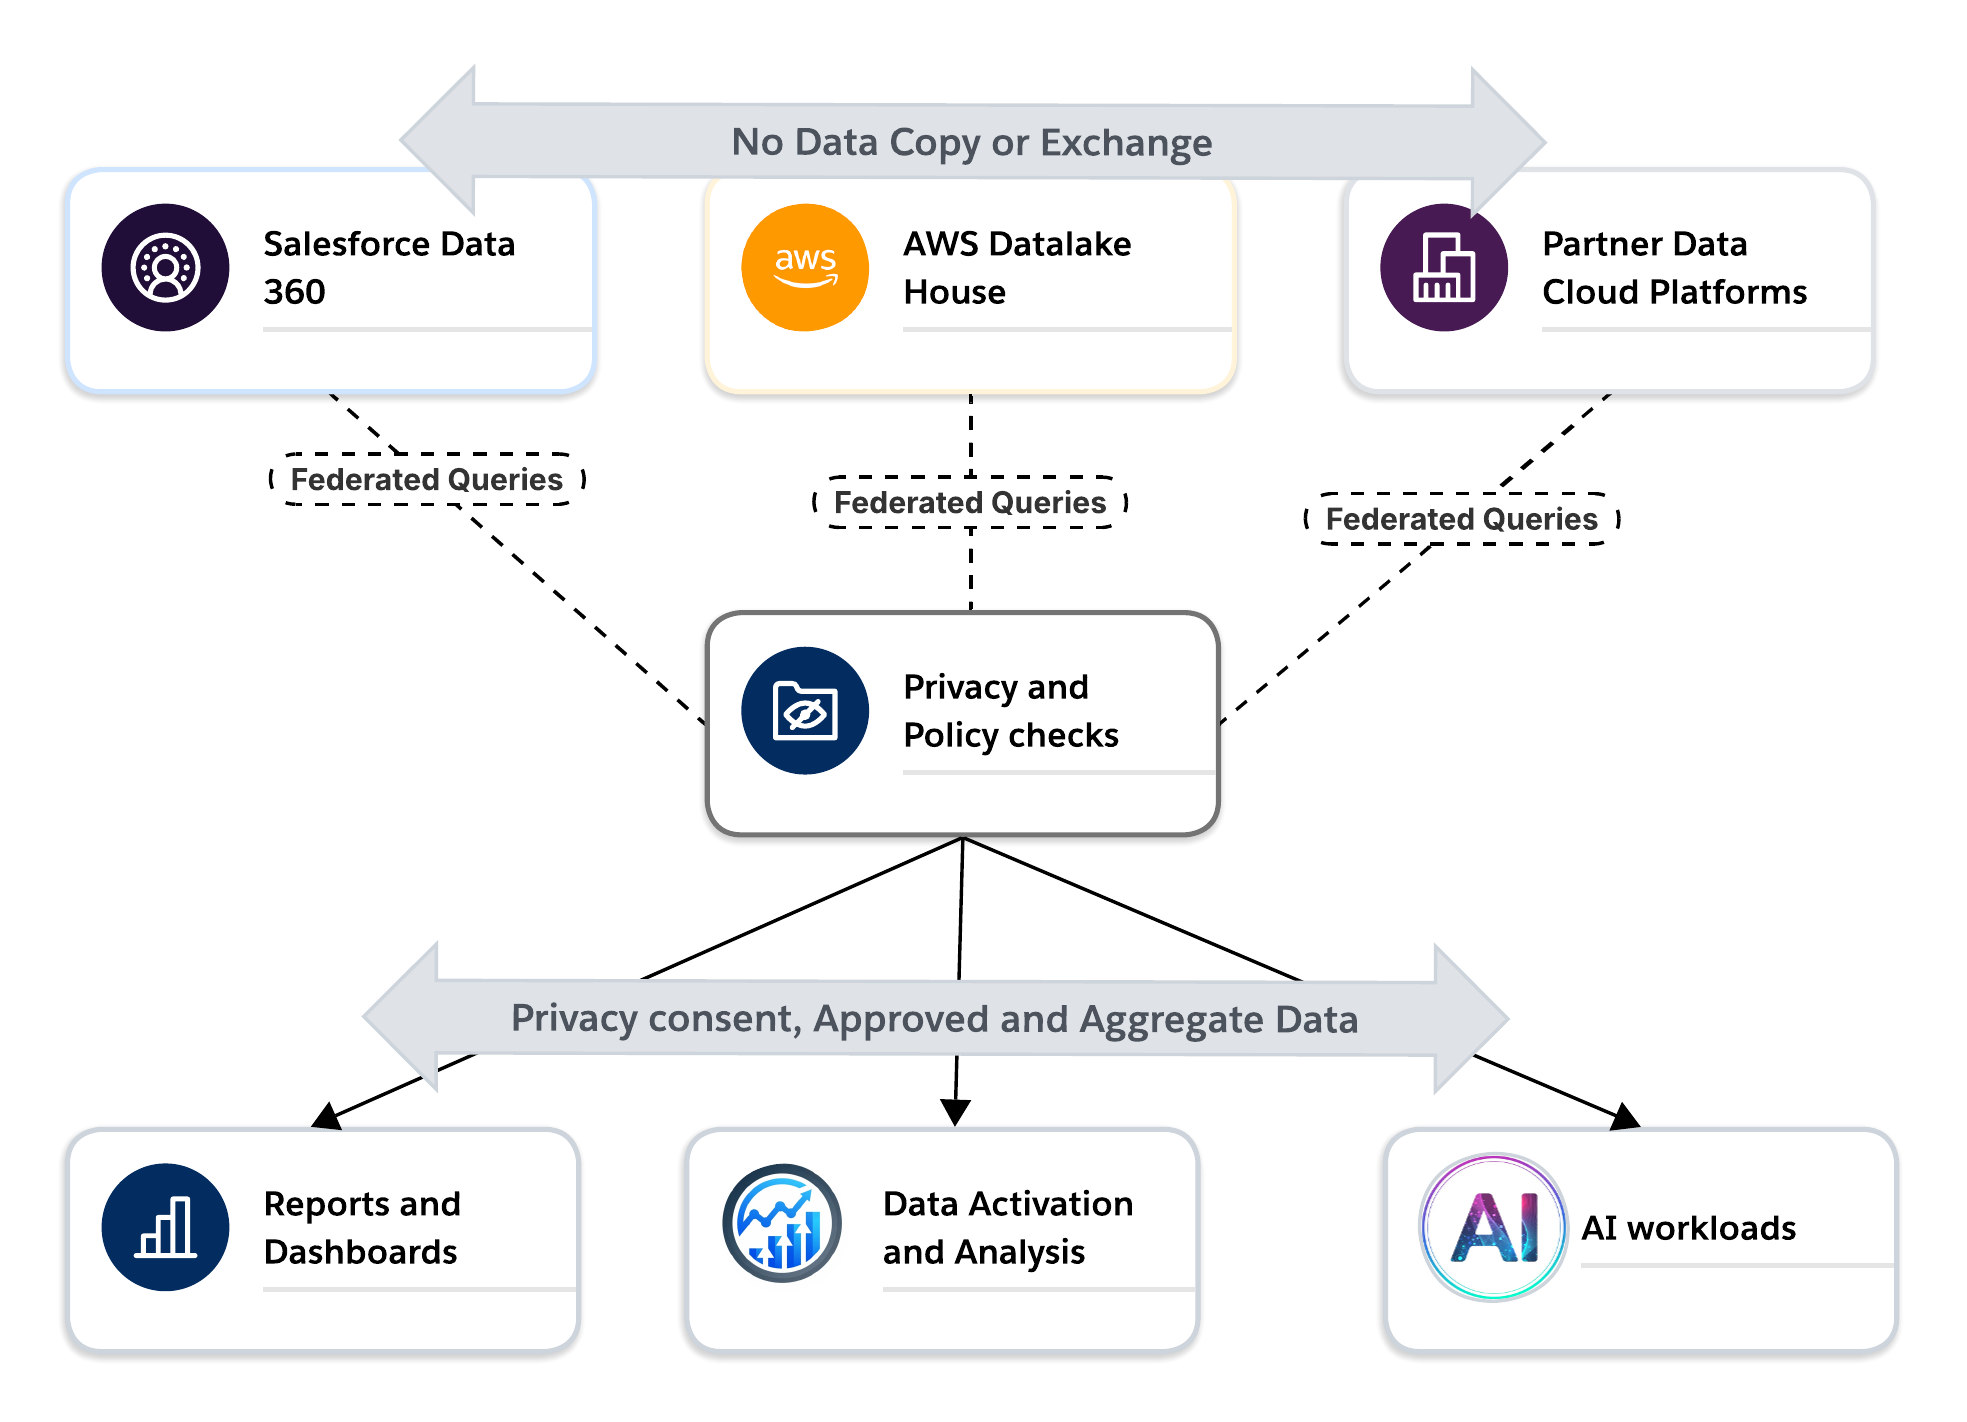 En este modelo, las salas limpias de datos actúan como el Trust Border de las arquitecturas de datos modernas. Permiten a las organizaciones trabajar con socios y filiales sin perder el control de sus datos, aplicar la privacidad y el consentimiento a través de controles del sistema en vez de políticas únicamente, y operar entre nubes respetando la residencia de datos y los límites contractuales.
Para casos de uso de activación, análisis e IA, las salas blancas proporcionan una forma segura de generar perspectivas desde datos externos sin exponer información confidencial. Permiten un cambio de colaboración de datos a colaboración de confianza. Para casos de uso de Activación, las salas blancas proporcionan una forma segura de generar audiencias que se pueden activar directamente a un destino permitido. Todo esto se consigue sin exponer ninguna información de identificación personal (PII) a ninguna de las partes. Esto marca un punto de inflexión en la arquitectura de datos de la compañía. Las salas limpias de datos ya no son herramientas de nicho. Se están convirtiendo en infraestructura principal para plataformas de datos federadas, que preservan la privacidad y están listas para la IA.
## Personas interesadas y barandillas técnicas
Una arquitectura de sala blanca de datos exitosa es un sistema de múltiples interfaces diseñado para resolver las presiones competidoras de utilidad, seguridad y velocidad de los datos. Existen tres personas principales cuyos puntos de fricción distintos deben abordarse en el diseño técnico subyacente.
### El responsable de privacidad y cumplimiento (El Mitigador de riesgos)
Los responsables de privacidad y cumplimiento utilizan la sala blanca de datos como una herramienta de gobernanza. Su principal preocupación es la desviación del cumplimiento, el riesgo de que los entornos de colaboración externos no apliquen los mismos estándares rigurosos que los sistemas internos.
- **Puntos de fricción:** Exposición regulatoria (GDPR, CCPA, DMA) y ataques de "phishing" donde un socio intenta triangular la identidad de un usuario a través de consultas granulares repetidas.
### El científico de datos y analista (El Optimizador de utilidades)
Los científicos de datos ven la sala blanca de datos como un refugio seguro para el modelado avanzado. Su principal preocupación es la conservación de la utilidad, garantizando que las medidas de privacidad no inutilicen los datos estadísticamente.
- **Puntos de fricción:** Alta latencia y acceso restringido a atributos granulares necesarios para aprendizaje automático (ML), modelado de parecidos y predicción de abandono.
### El usuario de marketing y negocio (El realizador de valores)
Esta persona se centra exclusivamente en el tiempo para valorar (TTV). Su preocupación es que los proyectos de salas blancas de datos a menudo se convierten en cuellos de botella técnicos que requieren semanas de asistencia de ingeniería de datos.
- **Puntos de fricción:** Procesos de configuración complejos, limpieza manual de datos y el problema de la "página en blanco" de tener que escribir código para obtener resultados de solapamiento sencillos.
### El modelo personal “Empresa primero”
Aunque las arquitecturas tradicionales se centran en la creación de la capa de datos antes de la capa de usuario, nuestro enfoque estratégico, alineado con la metodología "Business First", invierte este modelo. Priorizamos un enfoque sin código a pocos clics que permite a los usuarios de negocio generar perspectivas y realizar acciones inmediatas.
**Flujo de trabajo "Perspectiva a acción":** La arquitectura está diseñada como un espacio de trabajo activo en vez de como un repositorio pasivo. Proporcionando plantillas de casos de uso (por ejemplo, solapamiento de segmentos, activación y desempeño de campañas), permitimos a los usuarios de negocio servir perspectivas propias. Esto garantiza que una perspectiva, como un segmento de parecidos optimizado, esté disponible de inmediato para su activación en el ecosistema de marketing sin necesidad de que un ingeniero de datos mueva archivos manualmente.
**Federación de copia cero como activo estratégico:** Para maximizar TTV, la arquitectura adopta una lógica de copia cero. En vez del proceso ETL tradicional, que introduce riesgos de latencia y seguridad, nuestra arquitectura federa consultas directamente a donde residen los datos (por ejemplo, Snowflake, BigQuery o Amazon S3). Esto convierte la inversión de datos existente de la organización en un activo estratégico, permitiendo a los usuarios de negocio actuar sobre los datos más actuales en tiempo real mientras mantienen una gobernanza estricta y eliminan el costo de la redundancia de datos.
## Casos de uso de sala de limpieza de datos clave
Las salas blancas de datos surgieron en la publicidad como una respuesta al desuso de las cookies y la regulación de la privacidad, pero evolucionaron más allá de la medición en análisis de clientes, segmentación de audiencias y casos de uso de activación entre industrias. Según el reporte Estado de los medios minoristas de 2025, el 66% de las organizaciones ahora utilizan salas blancas en cierta capacidad, impulsado por la necesidad de una colaboración segura para la privacidad que ofrezca resultados de negocio mensurables.
El patrón es coherente entre sectores: los datos permanecen con su propietario, el cálculo se rige y solo se comparten perspectivas seguras para la privacidad.
### Marketing y publicidad: Medición sin cookies externas
**El reto:** Los especialistas en marketing necesitan medir la efectividad de las campañas, evitar impresiones de anuncios duplicadas y optimizar el alcance/la frecuencia, pero ya no pueden depender de cookies externas o identificadores de dispositivos.
**Solución Sala blanca:**
- Los anunciantes contribuyen con datos de exposición de clientes o campañas de hash
- Los publicadores contribuyen con señales de impresión e implicación
- Sala limpia calcula el alcance, la frecuencia, la atribución y la elevación
- La activación se produce a través de plataformas aprobadas sin exportaciones de datos sin procesar
**Resultado de negocio:** Las salas blancas proporcionan atribución de bucle cerrado que vincula impresiones de anuncios a transacciones reales, análisis de incrementos que aíslan la elevación real de campañas y mediciones unificadas entre canales, funciones que la publicidad digital tradicional no puede ofrecer.
**Evidencia de la industria:** La medición es el caso de uso de salas blancas más establecido en la actualidad, con las principales redes de medios como Pinterest, Disney y Paramount creando sus propias salas blancas.
### Medios minoristas y Bienes empaquetados de consumo (CPG): Monetización de datos de primera parte sin compartirlos
**El reto:** Las marcas de CPG gastan mucho en medios minoristas pero carecen de visibilidad sobre los resultados de compra. Los minoristas poseen datos de punto de venta enriquecidos pero no pueden exponerlos sin violar los compromisos de privacidad.
**Solución Sala blanca:**
- Los minoristas y las compañías de CPG combinan datos de punto de venta desde ubicaciones minoristas con datos de marketing para optimizar actividades promocionales
- Las marcas contribuyen con identificadores de fidelidad o CRM hash
- Sala limpia vincula la exposición de anuncios a compras en establecimiento/online
- La activación permanece dentro del ecosistema multimedia del minorista
**Resultado de negocio:**
- Los minoristas monetizan datos de primera parte sin vender información de clientes sin procesar
- Las marcas obtienen atribución de bucle cerrado mostrando qué campañas impulsaron las compras
- Las redes de medios minoristas se amplían sin riesgo de privacidad
**Evidencia de la industria:** Redes de medios minoristas como Luminate de Walmart y Kroger Precision Marketing ofrecen salas blancas que ayudan a las marcas de CPG a analizar el comportamiento de los clientes y optimizar estrategias de marketing utilizando datos de minoristas.
### Servicios financieros: Detección de fraude de colaboración
**El reto:** Las redes de fraude operan entre instituciones, pero los bancos no pueden compartir abiertamente datos de clientes o transacciones debido a leyes como GLBA y leyes de privacidad emergentes.
**Solución Sala blanca:**
- Múltiples bancos agrupan datos anónimos para identificar patrones indicativos de fraude, como actividad interbancaria inusual
- Los modelos o análisis federados se ejecutan en señales de fraude compartidas
- Ninguna institución ve los datos a nivel de cliente de otra
**Resultado de negocio:**
- Detección temprana de patrones de fraude entre instituciones
- Menos falsos positivos a través de conjuntos de señales enriquecidos
- Cumplimiento normativo sin centralizar datos confidenciales
**Evidencia de la industria:** Las soluciones de servicios financieros de Experian y TransUnion ofrecen tecnologías de salas blancas que permiten a los bancos y las aseguradoras colaborar en la detección de fraudes y la evaluación de riesgos mientras mantienen estrictos controles de privacidad de datos.
### Cuidados sanitarios y ciencias de la vida: Investigación sin exposición a datos de pacientes
**El reto:** Las compañías farmacéuticas necesitan resultados de pacientes reales para el desarrollo de fármacos, pero los datos residen en sistemas de HCE hospitalarios protegidos por HIPAA y leyes similares.
**Solución Sala blanca:**
- Los médicos e investigadores farmacéuticos comparten datos en una sala blanca para obtener información acerca de cómo reaccionan los pacientes a los tratamientos.
- Los datos de pacientes permanecen en entornos de proveedor.
- Los investigadores ejecutan análisis estadísticos aprobados a través de una sala blanca.
- La privacidad diferencial evita la reidentificación.
**Resultado de negocio:**
- Evidencia real estadísticamente válida a escala
- Simplificó el reclutamiento de pacientes para ensayos clínicos comparando datos de pacientes anónimos con criterios de ensayo, encontrando candidatos aptos sin violar las leyes de privacidad sanitaria
- Dependencia reducida de poblaciones de ensayos clínicos limitadas
**Evidencia de la industria:** Las salas blancas centradas en cuidados sanitarios como Datavant proporcionan entornos que cumplen con HIPAA para investigadores y organizaciones sanitarias para analizar de forma segura datos de pacientes para ensayos clínicos y desarrollo de fármacos.
### Patrones entre industrias: El imperativo de colaboración
Más allá de estos casos de uso principales, las salas blancas activan:
- **Optimización de cadena de suministro:** Los fabricantes y proveedores colaboran para compartir detalles de inventario, programaciones de producción y pronósticos de demanda, permitiendo una mejor coordinación mientras protegen la información patentada.
- **M&A Due Diligence:** Cuando una compañía adquiere otra, la diligencia debida requiere examinar proyecciones financieras y bases de datos de clientes sin compartir información confidencial directamente; las salas blancas revelan perspectivas como la alineación de segmentos de clientes y los riesgos de cumplimiento.
- **Medios y entretenimiento:** Los publicadores prueban el valor de la audiencia para los anunciantes mientras protegen las identidades de los suscriptores, permitiendo CPM premium respaldados por mediciones de confianza en vez de objetivos probabilistas
En AdTech, minorista, servicios financieros, cuidados sanitarios y medios de comunicación, Salas de limpieza de datos se han convertido en una infraestructura Trust fundamental. Permiten la colaboración de alto valor que antes estaba bloqueada por restricciones de privacidad, normativas o competitivas. Las salas blancas son **componentes arquitectónicos principales** que permiten una colaboración segura y controlada: desbloquear perspectivas y monetización sin renunciar al control o cumplimiento de los datos.
## Salas de limpieza de datos: La base de la colaboración de datos de confianza
Una sala blanca de datos es un entorno seguro y regulado que permite a múltiples partes generar perspectivas conjuntas sin exponer o intercambiar datos sin procesar. En vez de replicar conjuntos de datos, los análisis aprobados, la IA y las cargas de trabajo de activación se ejecutan y solo se devuelven resultados que cumplen las políticas. Donde la activación requiere registros de nivel individual, los datos se entregan directamente en el destino previsto sin exponerse a partes colaboradoras.
De forma arquitectónica, las salas blancas cambian la colaboración del uso compartido de datos al cálculo controlado. Cada participante conserva la custodia de sus datos, mientras que la aplicación forzosa en tiempo de ejecución rige el comportamiento de las consultas, las restricciones de salida, el consentimiento y las políticas de uso.
La colaboración se activa aún más a través de mecanismos de alineación de identificadores que preservan la privacidad, permitiendo que los conjuntos de datos de diferentes partes se correlacionen sin exponer los identificadores subyacentes, una función explicada con más detalle más adelante en este documento.
Como resultado, las salas blancas de datos sirven como infraestructura fundamental para empresas dirigidas por IA, multinube y reguladas por privacidad que operan en estrategias de datos federadas de copia cero.
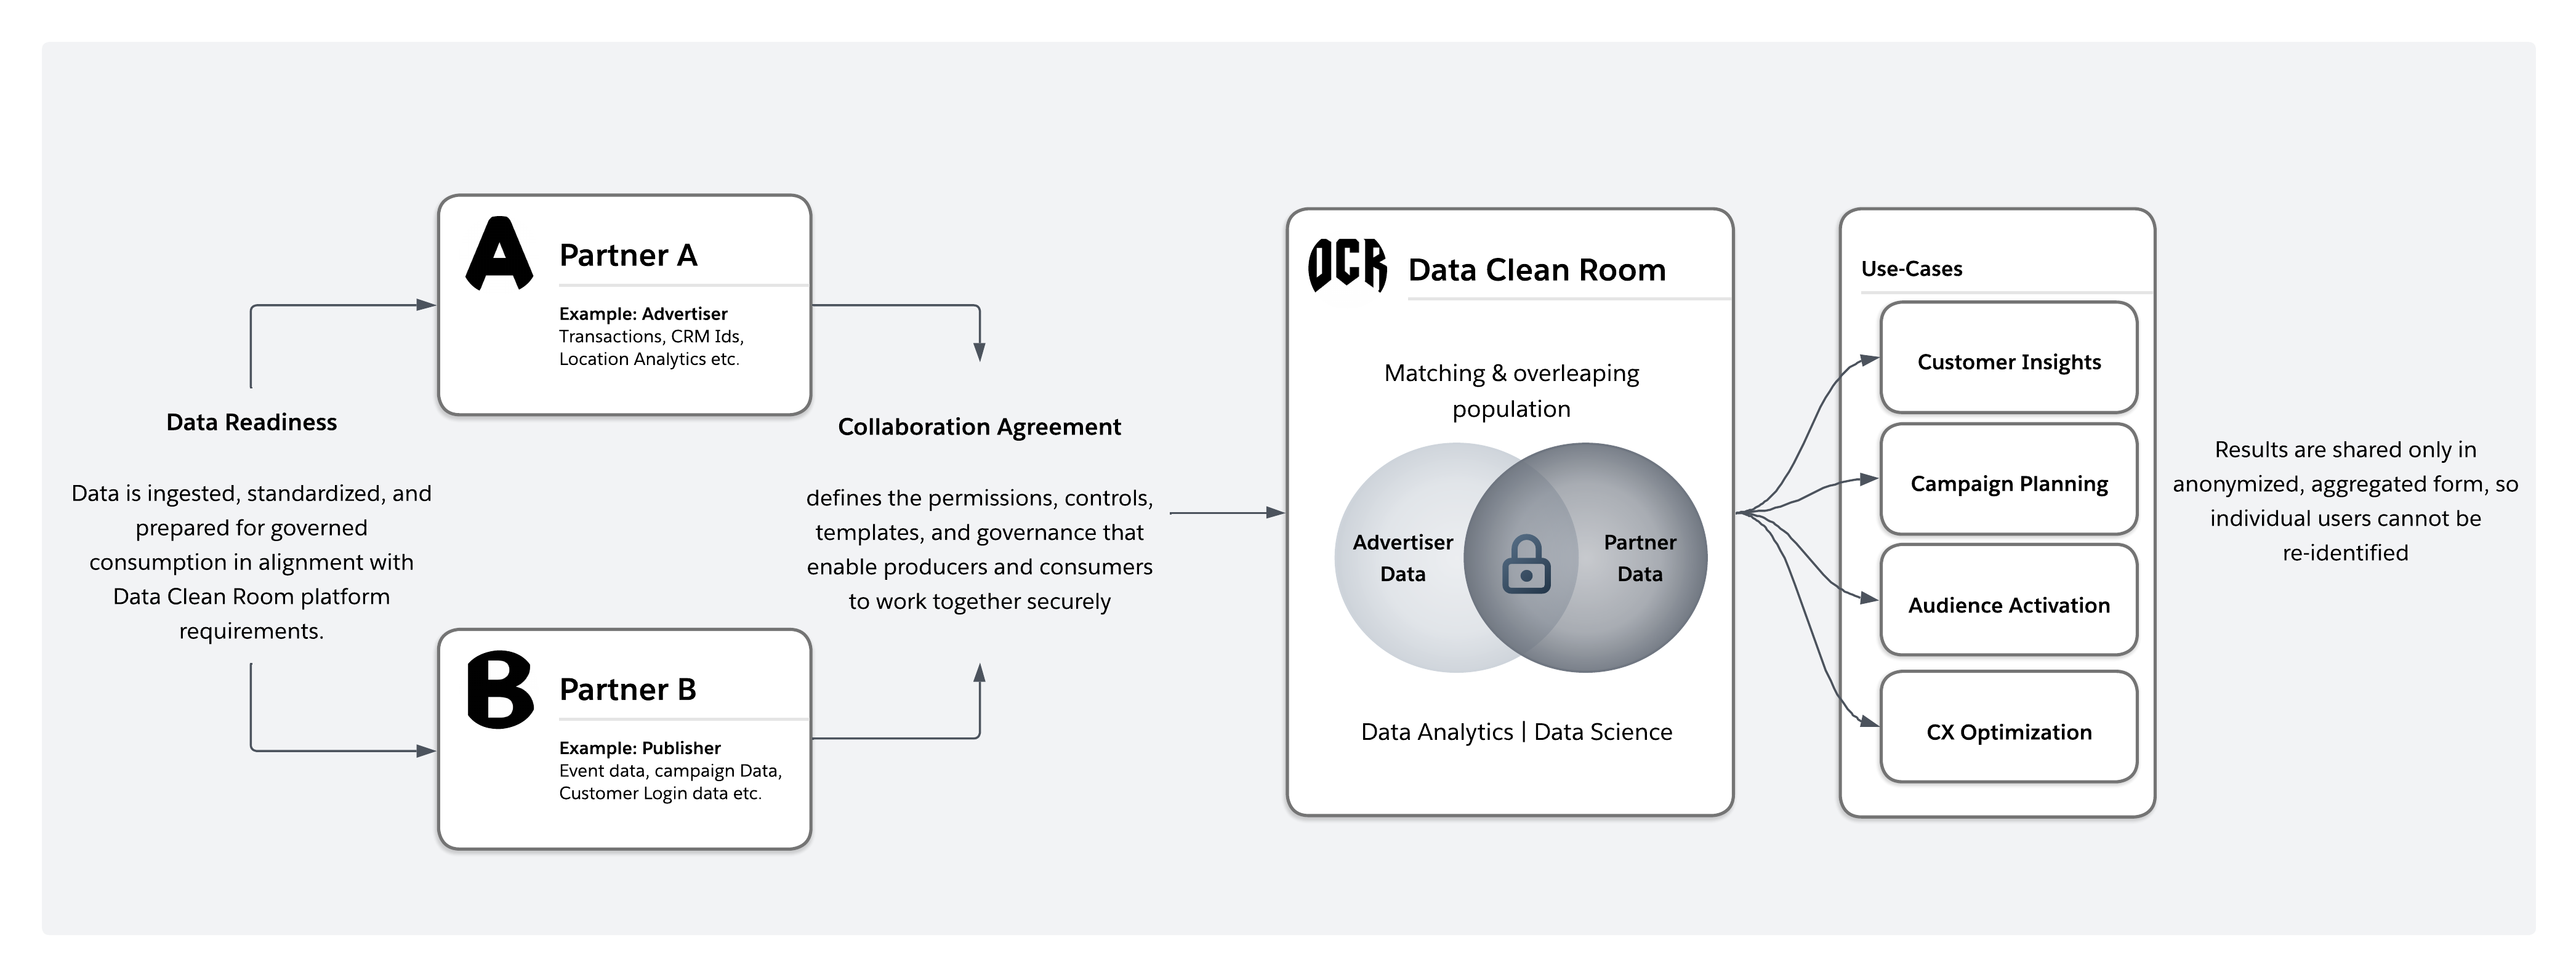 Las salas limpias de datos tempranas seguían un modelo de “búnker” centralizado. Todos los participantes tenían que copiar datos en un entorno externo neutro para su análisis. Si bien el concepto era sencillo, este enfoque introducía importantes fricciones. El movimiento de datos aumentó la latencia y el costo, complicó los acuerdos legales y de cumplimiento y obligó a las organizaciones a renunciar al control directo de datos confidenciales. En las industrias reguladas, estas compensaciones a menudo hacían que la colaboración no fuera práctica.
Las salas limpias de datos modernas evolucionaron hacia un modelo distribuido y federado. Los datos permanecen en el entorno del propietario y los análisis se ejecutan a través de consultas federadas. La sala blanca en sí funciona como una capa de regulación que intercepta cada consulta, aplica controles de privacidad y políticas en el tiempo de ejecución y devuelve solo resultados agregados aprobados.
| Dimensión | Habitación limpia tradicional (modelo "Búnker") | Sala limpia moderna (modelo distribuido/federado) |
|---|---|---|
| Ubicación de datos | Los datos se copian en un entorno externo centralizado | Los datos permanecen en el entorno del propietario |
| Movimiento de datos | Requiere transferencia física y duplicación de conjuntos de datos | Sin movimiento de datos sin procesar, las consultas se ejecutan en su lugar |
| Control y custodia | Custodia parcialmente cedida a plataforma externa | Propiedad y custodia de datos sin procesar retenidas por cada parte |
| Modelo de arquitectura | Agregación centralizada | Cálculo distribuido y federado |
| Aplicación de gobernanza | Políticas aplicadas después de mover los datos | Políticas aplicadas en tiempo de ejecución de consultas |
| Modelo de privacidad | Se basa en gran medida en controles contractuales y de procedimiento | Aplicado técnicamente a través de controles de tiempo de ejecución y umbrales de agregación |
| Latencia | Mayor latencia debido al ingreso y la sincronización | Menor latencia, consultas federadas casi en tiempo real |
| Estructura de costos | Mayores costos de almacenamiento, transferencia y duplicación | Duplicación reducida, la computación se produce donde residen los datos |
| Complejidad de cumplimiento | Acuerdos legales complejos debido al movimiento de datos transfronterizo | Cumplimiento simplificado ya que los datos no salen del límite de origen |
| Escalabilidad | La ampliación requiere más almacenamiento y replicación de datos | Escala a través del cálculo distribuido sin duplicar datos |
| Ajuste de industria regulado | A menudo no es práctico debido a problemas de custodia y residencia | Mejor alineado con la soberanía, el consentimiento y las restricciones regulatorias |
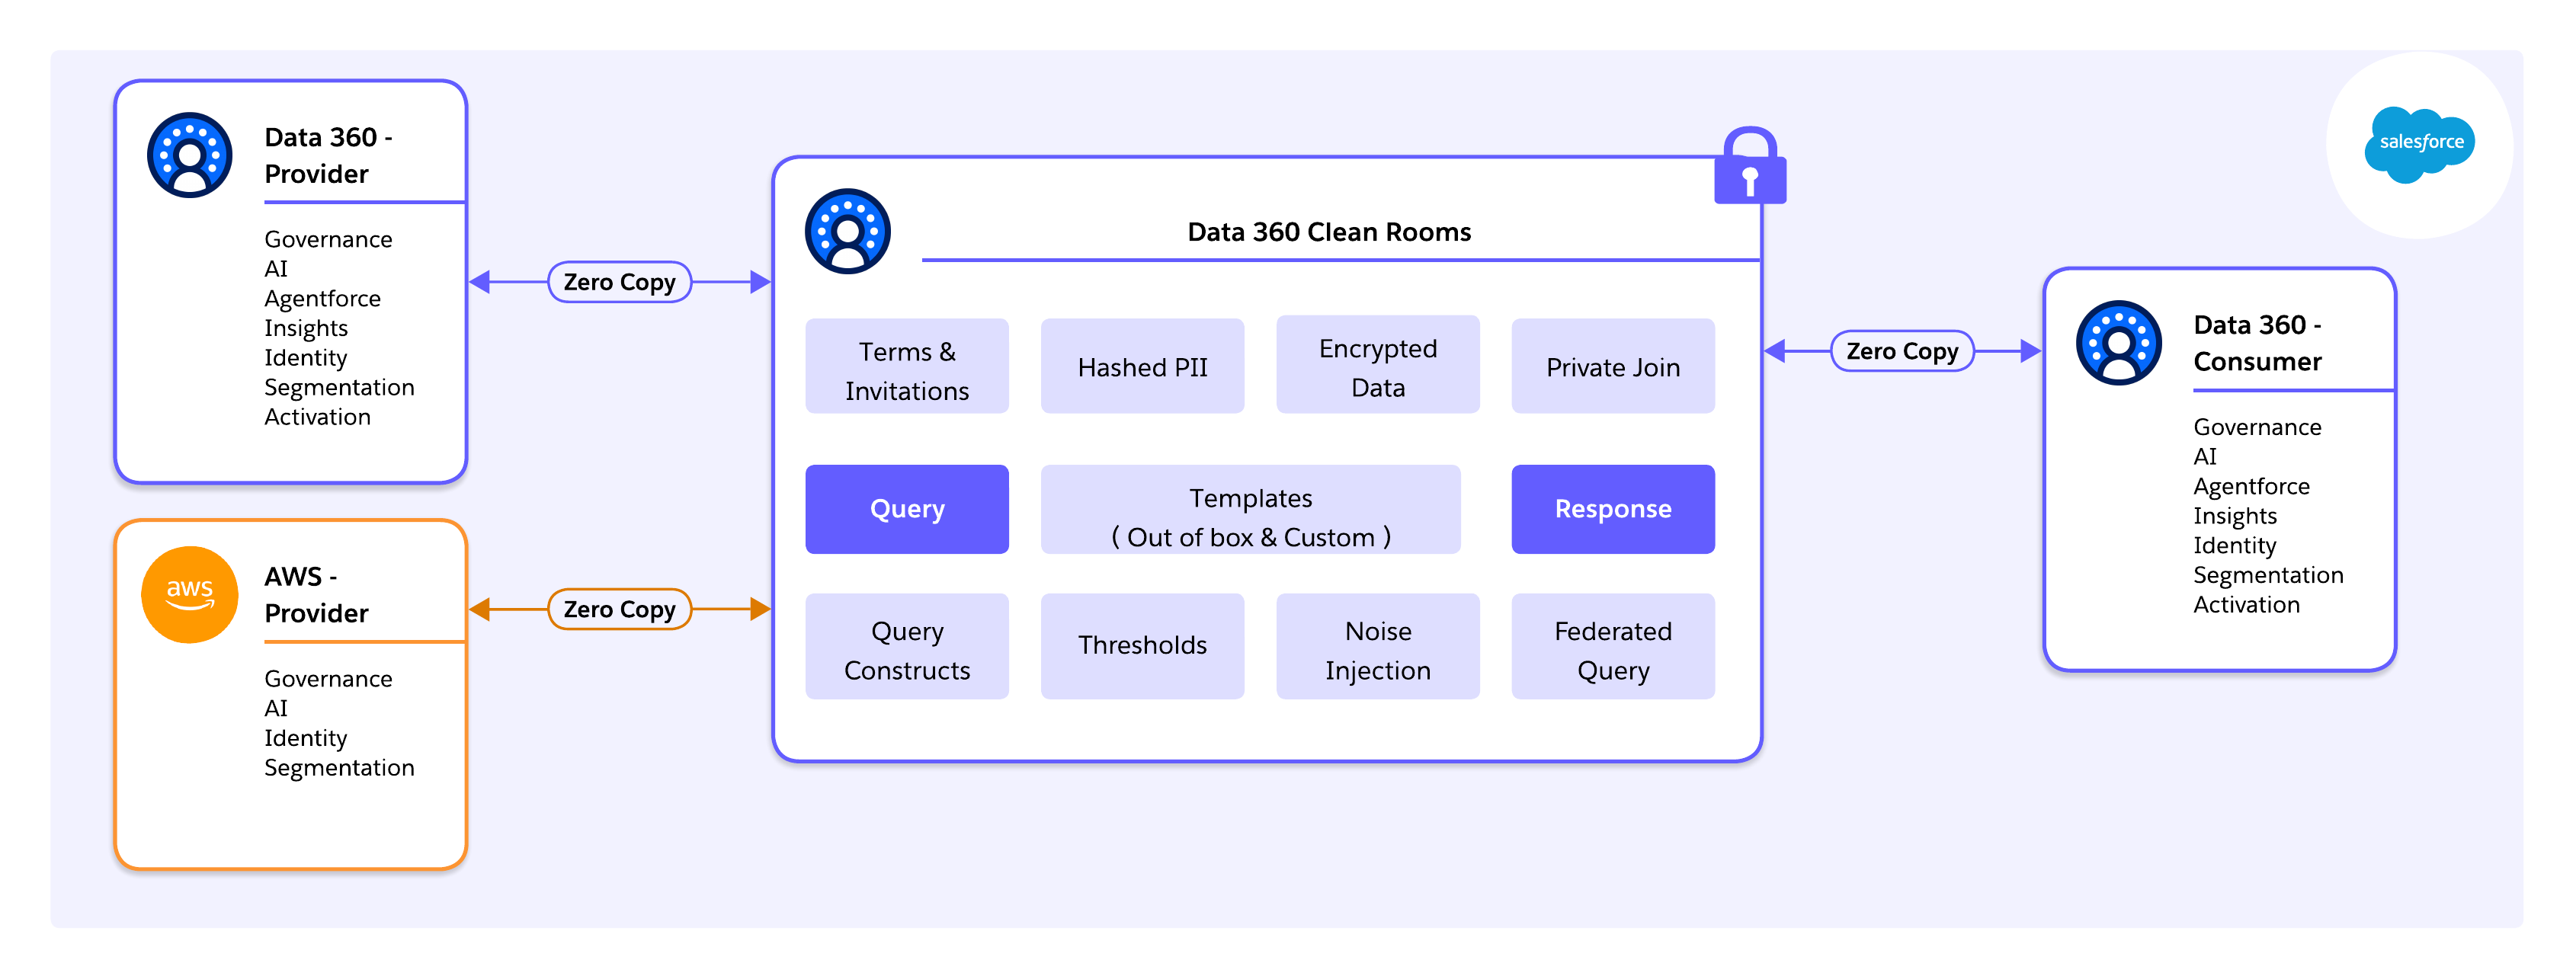 ### Bases de plataforma para salas limpias de datos ampliables
En la capa de infraestructura, Salesforce Data 360 se ejecuta en Hyperforce, el tiempo de ejecución nativo de la nube de Salesforce que abstrae recursos de hiperescala (AWS, Azure, GCP) detrás de un plano de control unificado. Esta arquitectura permite que los datos permanezcan en la región para satisfacer los requisitos de soberanía y residencia, al tiempo que permite operaciones de salas blancas gobernadas de forma global.
De forma crítica, esta base permite la colaboración de salas limpias entre nubes, incluyendo la interoperabilidad nativa con Salas limpias de AWS. Utilizando Data 360 como la capa de orquestación y gobernanza, las compañías pueden colaborar con socios que operan directamente en AWS sin forzar la migración de datos al almacenamiento gestionado por Salesforce. Las consultas se envían al origen, las reglas de privacidad se aplican de forma coherente y solo se intercambian resultados agregados que cumplen entre plataformas.
El cumplimiento y Trust se aplican en el límite de la infraestructura y la ejecución, en vez de actualizarse en la capa de aplicación, proporcionando una base duradera para la colaboración entre múltiples nubes y partes a escala.
### Canalizaciones de Data 360 desde el ingreso hasta la activación
Data 360 implementa una canalización de datos rastreable de extremo a extremo, garantizando que las operaciones de sala blanca se ejecutan sobre datos armonizados, gobernados y conscientes de la identidad en vez de extractos sin procesar.
Las etapas clave incluyen:
- **Conectar**: Ingreso de datos y virtualización a través de conectores listos para su uso, API, SDK, MuleSoft o conectores de copia cero
- **Persistir**: Almacenamiento de datos sin procesar en formatos nativos (Parquet / Iceberg)
- **Armonizar**: Asignación a objetos de modelo de datos canónicos (DMO) para uniones coherentes
- **Unificar**: La resolución de identidad crea registros dorados
- **Perspectivas de derivaciones**: Las perspectivas calculadas calculan mediciones agregadas dentro del límite regulado
- **Ley**: Flujo de salidas gobernadas a organizaciones de Salesforce, plataformas de marketing, redes de anuncios, plataformas de datos externas **u otras salas limpias**, cerrando el bucle de perspectiva a acción
Esta canalización garantiza que las salas blancas funcionan con datos de nivel de compañía, no con extractos ad hoc.
### Integración nativa y “Clics-Not-Code”
A diferencia de las plataformas de salas blancas de datos individuales que requieren aprovisionamiento separado y desarrollo de SQL, las salas blancas de Salesforce están incrustadas de forma nativa en Data 360. Esto permite la reutilización de DMO, reglas de identidad, modelos de consentimiento y políticas de gobernanza, eliminando capas de seguridad duplicadas.
El modelo de sala blanca dirigido por plantillas de Salesforce es un acelerador clave, que utiliza:
- **Plantillas listas para** su uso para admitir patrones de colaboración comunes como la superposición de audiencias, la supresión, el alcance y la medición de elevación.
- **Plantillas personalizadas** que permiten a arquitectos y usuarios avanzados definir lógica analítica reutilizable adaptada a necesidades específicas de la industria o socios, sin exponer datos sin procesar o complejidad de políticas.
Este enfoque estandariza la colaboración permitiendo al mismo tiempo la flexibilidad, permitiendo que las salas blancas se amplíen como una capacidad de negocio repetible, no un proyecto de análisis puntual.
### El “camino de oro”: cierre del bucle Perspectiva a acción
Data 360 soluciona un modo de fallo común de las salas blancas tradicionales: el Déficit de activación. Su marco de trabajo Ruta de oro garantiza que las perspectivas generadas dentro de una sala limpia puedan actuarse de inmediato, sin exportar datos sin procesar.
- **Configuración y descubrimiento**: Los socios comparten metadatos de esquemas y aprovechan plantillas para evaluar la viabilidad antes de que finalicen los contratos.
- **Análisis**: Las plantillas preconstruidas y personalizadas dirigen el análisis de solapamiento, la supresión, el modelado de parecidos y la medición de elevación, todo ello ejecutado dentro del límite regulado.
- **Activación**: Los segmentos aprobados se envían directamente a Marketing Cloud, plataformas de anuncios o sistemas de socios, con solo resultados agregados que cumplen las normas compartidas.
Las plantillas se convierten en rutas de ejecución con opiniones, garantizando que la colaboración se mueva de forma predecible desde el análisis a la activación.
## Libro de jugadas para salas blancas de Salesforce Data 360
La implementación de una Sala blanca de Salesforce Data 360 no es solo un ejercicio de configuración, es un flujo de trabajo arquitectónico disciplinado que abarca la preparación de datos, el diseño de gobernanza, la conectividad segura y el monitoreo operativo.
### Paso 1: Definir el caso de uso de colaboración (comenzar con intención)
Antes de tocar datos o configuración, los arquitectos deben definir claramente:
- ¿Qué pregunta estamos intentando responder?
- ¿Qué resultado se espera? (por ejemplo, análisis de solapamiento, medición de elevación, supresión, detección de fraude)
- ¿Qué nivel de agregación se requiere?
- ¿Qué restricciones legales o contractuales se aplican?
- ¿Qué ruta de activación consumirá los resultados?
Comprender el objetivo del colaborador da forma a todo lo que sigue: unir claves, reglas de identidad, umbrales de gobernanza y modelado de costos. Las salas blancas son entornos creados específicamente. deben diseñarse en torno a un objetivo analítico definido, no exposición de datos genérica.
### Paso 2: Preparación de los datos para la colaboración de salas blancas
Antes de que pueda comenzar la colaboración, los datos de la compañía deben prepararse de forma estructural y semántica. Las salas blancas amplifican los puntos fuertes y débiles de los datos subyacentes. Basura dentro, basura fuera es tanto más cierto aquí.
**Ingestión:** Conecte sistemas de origen como Salesforce CRM, Marketing Cloud, AWS S3 y Google Cloud Storage con Data 360. Siempre que sea posible, utilice conectores de copia cero (por ejemplo, Snowflake) para evitar movimientos innecesarios o duplicaciones de datos.
**Asignación semántica:** Asigne transmisiones de datos al modelo de datos Customer 360. Estandarice campos clave como números de teléfono (formato E.16), códigos de país/estado (estándares ISO) y direcciones de email. La desalineación (por ejemplo, una parte que utiliza “CA” y otra “California”) puede fallar silenciosamente las uniones y reducir los índices de coincidencia.
**Resolución de identidad:** Configure reglas deterministas (coincidencia exacta) y probabilistas (coincidencia parcial) para crear un Particular unificado (Registro de oro). Esta entidad unificada es la superficie para la coincidencia de salas blancas.
La calidad de la resolución de identidad afecta directamente al valor de colaboración. Una precisión de coincidencia superior aumenta los índices de solapamiento, la confianza analítica y reduce los falsos negativos.
### Paso 3: Aprovisionamiento de la sala blanca
Una vez que se armonizan los datos, se debe aprovisionar la propia sala blanca para definir límites de colaboración.
**Validación de licencia:** Confirme que todas las organizaciones participantes tienen las asignaciones de Data 360 y salas blancas necesarias.
**Ámbito de espacio de datos:** Los objetos de sala blanca deben tener el ámbito de un espacio de datos específico. Solo los objetos asignados a ese espacio de datos son visibles para la sala blanca. Esto garantiza que la colaboración esté lógicamente aislada sin requerir la creación de un nuevo espacio de datos únicamente para salas blancas.
**Definir reglas de gobernanza:** Establezca políticas de forma declarativa antes de ejecutar consultas:
- **Umbrales de agregación:** por ejemplo, un mínimo de 100 registros por salida
- **Unir claves:** por ejemplo, Email_Hash_SHA256
- **Operaciones permitidas:** solo agrega funciones como COUNT, SUM, AVG
- **Restricciones explícitas:** bloquear exportaciones a nivel de fila (SELECT \*)
Las reglas de gobernanza se aplican en el momento de la ejecución, lo que convierte las propiedades a nivel del sistema de privacidad y cumplimiento en directrices de procedimiento.
### Paso 4: Establecimiento de una conectividad segura entre múltiples partes
Las habitaciones limpias a menudo abarcan límites organizativos y de plataforma. La conectividad debe ser explícita y estar estrictamente controlada.
**Vinculación de cuentas:**
- **Salesforce a Salesforce:** Utilice Data Cloud One o mecanismos de colaboración entre organizaciones aprobados.
- **Escenarios de múltiples nubes:** Valide la alineación y la residencia de la región antes de activar las consultas.
**Autenticación y autorización:** Configure el acceso basado en OAuth para usuarios de integración exclusivos con el principio de menor privilegio: limite el acceso estrictamente a los espacios de datos necesarios y evite permisos administrativos.
Los fallos de seguridad a menudo se deben a usuarios de integración con permisos excesivos en vez debilidades en criptografía o controles de plataforma.
### Paso 5: Ejecución, monitoreo y control de cargas de trabajo de salas limpias
Una vez en vivo, el enfoque cambia a la supervisión operativa, la calidad de las consultas y la gestión de costos.
**Ejecución de consulta:** Los analistas o flujos de trabajo realizan análisis de solapamiento y agregaciones a través de Perspectivas calculadas o interfaces SQL aprobadas. Todas las consultas aplican automáticamente umbrales de agregación y controles de privacidad.
**Auditoría y trazabilidad:** Las salas blancas de Salesforce Data 360 proporcionan seguimientos de auditoría en forma de un objeto de modelo de datos de auditoría (DMO). Esto captura metadatos acerca de la actividad de la consulta, incluyendo quién ejecutó la consulta, cuándo se ejecutó y qué políticas se aplicaron. El DMO de auditoría permite la creación de reportes de cumplimiento, la validación de gobernanza y la trazabilidad forense, garantizando que la colaboración sea segura para la privacidad y revisable.
**Monitoreo de consumo:** Data Cloud utiliza un modelo de crédito basado en consumo. Los controladores clave incluyen:
- Filas procesadas (por ejemplo, 1M filas = unidad de crédito de línea base)
- Complejidad de consulta
- Operaciones de resolución de identidad (multiplicador superior)
- Admisión por lotes (multiplicador inferior)
**Digital Wallet y alertas:** Utilice Digital Wallet para realizar un seguimiento del consumo en tiempo real y configurar alertas en umbrales del 50%, 75% y 90%. Correlacione picos con cargas de trabajo específicas para evitar costos inesperados.
Tenga en cuenta que la copia cero no elimina los costos de computación. Mientras se elimina la duplicación física, la ejecución se produce en el sistema de origen. Los arquitectos deben gestionar patrones de consulta, unir selectividad y frecuencia de ejecución para controlar el costo y el desempeño.
## Gobernanza, seguridad y cumplimiento
### Arquitectura de salas blancas para Trust a escala
En las empresas modernas, Trust no está atornillado en una sala limpia de datos. Es un resultado arquitectónico. Salesforce Data 360 aplica la gobernanza, la seguridad y el cumplimiento de forma continua y automática, cambiando salas blancas de entornos dirigidos por políticas a sistemas gobernados por plataforma.
Los controles de tiempo de ejecución (identidades bloqueadas, seguimientos de auditoría y privacidad diferencial) se aplican de forma coherente tanto si la colaboración se produce dentro de Salesforce, entre socios o entre nubes.
### Trust y gobernanza en tiempo de ejecución
El cambio más importante para los arquitectos es que Trust se aplica durante la ejecución, no se asume de antemano. Salesforce Data 360 logra esto a través de una serie de controles de plataforma principales:
- **Locked Identity:** El acceso de socios está vinculado criptográficamente a identidades de organizaciones de Salesforce verificadas, evitando la suplantación o la participación no autorizada.
- **Seguimientos de auditoría:** Cada consulta, unión, solapamiento de segmentos y activación se registra para una capacidad de auditoría completa y cumplimiento normativo.
- **Privacidad diferencial:** La inspección a nivel de filas es estructuralmente imposible. Los resultados se agregan y se limitan estadísticamente. Los colaboradores solo ven resultados seguros para la privacidad, como mediciones de alcance o porcentajes de elevación, nunca transacciones o identidades individuales.
Estos controles sustituyen Contractual Trust por garantías matemáticas y aplicación a nivel de plataforma, reduciendo el riesgo operativo y legal.
### Gobernanza de la IA a través de la capa Einstein Trust
A medida que los agentes de IA interactúan cada vez más con datos de Salas blancas, Salesforce presenta Einstein Trust Layer. Actúa como una esclusa de aire arquitectónica entre datos de compañía confidenciales y LLM externos. Esto garantiza que las perspectivas de salas blancas puedan potenciar de forma segura las decisiones dirigidas por la IA sin exponer datos subyacentes.
**Funciones clave:**
- **Retención de datos cero:** Los datos enviados a los LLM son efímeros. Los proveedores de modelos no pueden almacenar solicitudes o respuestas para capacitación.
- **Detección de lenguaje tóxico y enmascaramiento de PII:** Las entradas y salidas se exploran automáticamente, y la PII se enmascara según Políticas de enmascaramiento de datos configuradas en Data 360.
### Aislamiento lógico a través de espacios de datos y conjuntos de permisos
Los **espacios de datos** proporcionan aislamiento lógico en una organización y deben alinearse con límites reguladores, geográficos y de asociación como:
- Espacio de datos de la UE
- Espacio de datos de Norteamérica
Solo los conjuntos de datos asignados a un espacio de datos son visibles en sus salas blancas, evitando la exposición transfronteriza accidental.
Los conjuntos de permisos ofrecen un control preciso sobre quién puede crear o gestionar salas blancas, ejecutar consultas o activar segmentos. Los permisos conscientes de los datos aplican restricciones a nivel de campo en objetos de modelo de datos; por ejemplo, los especialistas de marketing pueden ver nombres de segmentos y tamaño de audiencia pero no indicadores de ingresos o salud.
La seguridad se aplica en la capa semántica, permitiendo un autoservicio seguro para usuarios de negocio sin supervisión constante de TI.
### Cumplimiento y consentimiento por diseño
Las señales de consentimiento se propagan automáticamente a través de Data 360 en la ejecución de salas blancas. Los usuarios que revocan el consentimiento se excluyen del análisis y la activación de forma predeterminada, garantizando que el cumplimiento se aplique de forma forzosa por el sistema, no manualmente.
Salesforce Data 360 trata la gobernanza, la seguridad y el cumplimiento como elementos arquitectónicos primitivos de primera clase, no como complementos opcionales. Combinando la capacidad de auditoría en tiempo de ejecución, identidades bloqueadas, privacidad diferencial, espacios de datos, resolución de identidad consciente del consentimiento y Einstein Trust Layer, las empresas pueden ampliar la colaboración de salas blancas entre socios, sistemas de múltiples nubes y cargas de trabajo dirigidas por IA, todo ello sin comprometer Trust, privacidad o cumplimiento normativo.
## Conclusión y ruta a seguir
### Un camino práctico para los arquitectos
Para capturar el valor completo de las salas limpias de datos, los arquitectos deben tratarlas como infraestructura arquitectónica principal, no como herramientas de análisis aisladas. Las siguientes prioridades definen un camino pragmático y ampliable:
**Hacer de la colaboración una preocupación arquitectónica de primera clase:** La colaboración de datos externos debe diseñarse con el mismo rigor que la integración interna. Las salas blancas deben integrarse en arquitecturas de referencia de negocio junto con plataformas de datos, capas de integración y sistemas de IA, no implementarse como extensiones ad hoc. A medida que se amplía la interoperabilidad (por ejemplo, la integración de salas blancas de Data 360 con salas blancas de AWS y la futura compatibilidad entre salas blancas), los arquitectos deben diseñar patrones de colaboración que anticipen ecosistemas de múltiples plataformas en vez de silos de un solo proveedor.
**Diseño para privacidad de forma predeterminada en origen**
**Diseño para Fluidez de datos: En **lugar de tomar como valor predeterminado ETL pesado y replicación central, los arquitectos deben considerar primero el acceso de federación y copia cero. Mover el cálculo a datos (cuando sea apropiado) reduce la duplicación innecesaria, reduce el costo y mantiene la integridad de la fuente de la verdad. “Conectar frente a copiar” debe ser una decisión arquitectónica consciente, no un hábito heredado.
**Cerrar la brecha de Perspectiva a Acción:** Las habitaciones limpias que se detienen en el análisis no entregan valor de negocio. Las arquitecturas deben conectar de forma nativa salidas de salas blancas con sistemas de activación y flujos de trabajo de IA. Los bucles de comentarios, la medición del desempeño y la ejecución descendente deben diseñarse desde el principio.
**Prepararse para la compañía agente:** A medida que los agentes de IA utilizan cada vez más datos de compañía, las salas blancas servirán como entornos de ejecución controlada donde los agentes pueden operar sin exponer datos sin procesar. Los arquitectos que alinean la estrategia de salas blancas con marcos de trabajo de gobernanza y Trust de IA estarán mejor posicionados para esta siguiente fase.
### Conclusión
Las salas limpias de datos modernas representan un cambio fundamental en la arquitectura de datos de negocio. Resuelven la tensión de larga data entre la utilidad de datos y la privacidad activando la colaboración sin exposición de datos.
Arquitecturas como Salesforce Data 360 demuestran que esta compensación no es una consideración “o ambas”. Desvinculando el almacenamiento de datos de la activación a través de patrones de copia cero e integrando tecnologías de mejora de la privacidad directamente en la ejecución, las compañías pueden colaborar en análisis de alto valor sin renunciar al control de sus datos. La privacidad pasa de la obligación contractual a la garantía arquitectónica.
Lo que es más importante, las salas blancas transforman los datos de un activo estático en un recurso gobernado con capacidad de acción. Cuando se conecta de forma nativa a capas de activación e IA, las perspectivas ya no se estancan en tableros. Fluyen directamente en decisiones, campañas y sistemas autónomos, cerrando el círculo entre datos, acciones y resultados a escala de la compañía.
## Acerca de los autores
**Yugandhar Bora** es Arquitecto de Ingeniería de Software en Salesforce, especializado en arquitectura de datos dentro de la plataforma Aplicaciones de datos e inteligencia. Lidera iniciativas de la junta de revisión de arquitectura de negocio (EARB) centradas en la gobernanza de datos y modelos de datos unificados, mientras contribuye a soluciones de aprovisionamiento de plataforma automatizadas.
**Birendra Kumar Singh** es miembro principal del personal técnico, especializada en arquitectura de datos y plataforma dentro de Data 360 en Salesforce. Es un miembro principal de la Plataforma de activación y lidera la iniciativa Salas blancas centrada en proporcionar infraestructura de salas blancas de datos a clientes de Data 360.
**Priyanka Kshirsagar** es Gerente de productos sénior de Salesforce, liderando Salas blancas de Data 360, una función que creó desde cero para permitir a los clientes de la compañía colaborar en datos de primera parte en un entorno de protección de la privacidad. Dirige la visión para casos de uso con tecnología de IA de agentes y ML, incluyendo modelado de parecidos y enriquecimiento de identidad en salas blancas, y ha llevado el producto a través de Disponibilidad general y un lanzamiento de Dreamforce de nivel 1.
## 1\. Introducción
Hace más de dos décadas, Salesforce fue pionera en la primera plataforma en la nube de múltiples arrendatarios, sentando un precedente en la industria. Desde entonces, Salesforce ha evolucionado hasta convertirse en una plataforma de negocio integral, capaz de encapsular y automatizar aspectos clave de un negocio, y que sirve a cientos de miles de negocios y millones de usuarios en varias industrias y regiones. Salesforce también mejoró su conjunto de productos Customer360 a través de adquisiciones estratégicas.
Durante los últimos años, los cambios en el mercado, la industria y el panorama tecnológico nos han llevado a una serie de transformaciones profundas en Salesforce Platform fundamental. Estos incluyen:
- La aparición de proveedores de nube pública que invierten mucho en infraestructura.
- Avances rápidos en IA, incluyendo aprendizaje automático, IA generativa y experiencias de agentes.
- Mayor residencia de datos y requisitos reguladores entre industrias y países.
- La necesidad de gestionar datos y transacciones en tiempo real a una escala en rápido aumento.
- Aumento del enfoque en requisitos de ciberseguridad, disponibilidad del sistema, desempeño y resiliencia.
- Demanda del cliente de un conjunto integrado que ofrezca una arquitectura altamente resiliente, acoplada de forma flexible y fuertemente coherente.
En respuesta a estos cambios, en particular el cambio sísmico de la IA y su impacto en los negocios, Salesforce ha transformado completamente su plataforma desde cero, sentando las bases para la próxima generación de aplicaciones y casos de uso de clientes, todo ello manteniendo nuestros objetivos Trust.
El lanzamiento de Agentforce en Dreamforce 2024 y el siguiente diagrama representan la culminación de este esfuerzo extensivo, que involucra a miles de miembros del equipo de la organización de Tecnología y productos de Salesforce. Actualmente, más del 95% de nuestros clientes han realizado la transición a esta nueva plataforma. La migración exitosa de la mayoría de nuestros clientes, incluyendo aquellos con las cargas de trabajo más exigentes, subraya el ingenio de nuestros ingenieros y reafirma los valores fundamentales de Salesforce de Trust, Customer Success e Innovación.
Desde el lanzamiento de Agentforce, Salesforce ha seguido siendo pionera en el uso de la IA en aplicaciones de negocio y ha sido líder del mercado en el desarrollo de experiencias de agentes que proporcionan experiencias conversacionales en tiempo real para funciones de negocio nuevas y existentes.
En este documento técnico, elaborado en colaboración con los mejores ingenieros, se proporciona una exploración detallada para constructores que aprecian las complejidades detrás de las principales transformaciones tecnológicas. El documento profundiza en las mejoras arquitectónicas esenciales que mantienen la plataforma ampliable, segura y lista para gestionar futuras aplicaciones mientras satisface las necesidades cambiantes de nuestros clientes. Se recomienda que comience con el capítulo Descripción general de arquitectura para comprender la imagen completa. Desde allí, los lectores pueden continuar en secuencia o explorar los capítulos que más les interesan.
_Emin Gerba_
_Arquitecto jefe de Salesforce_
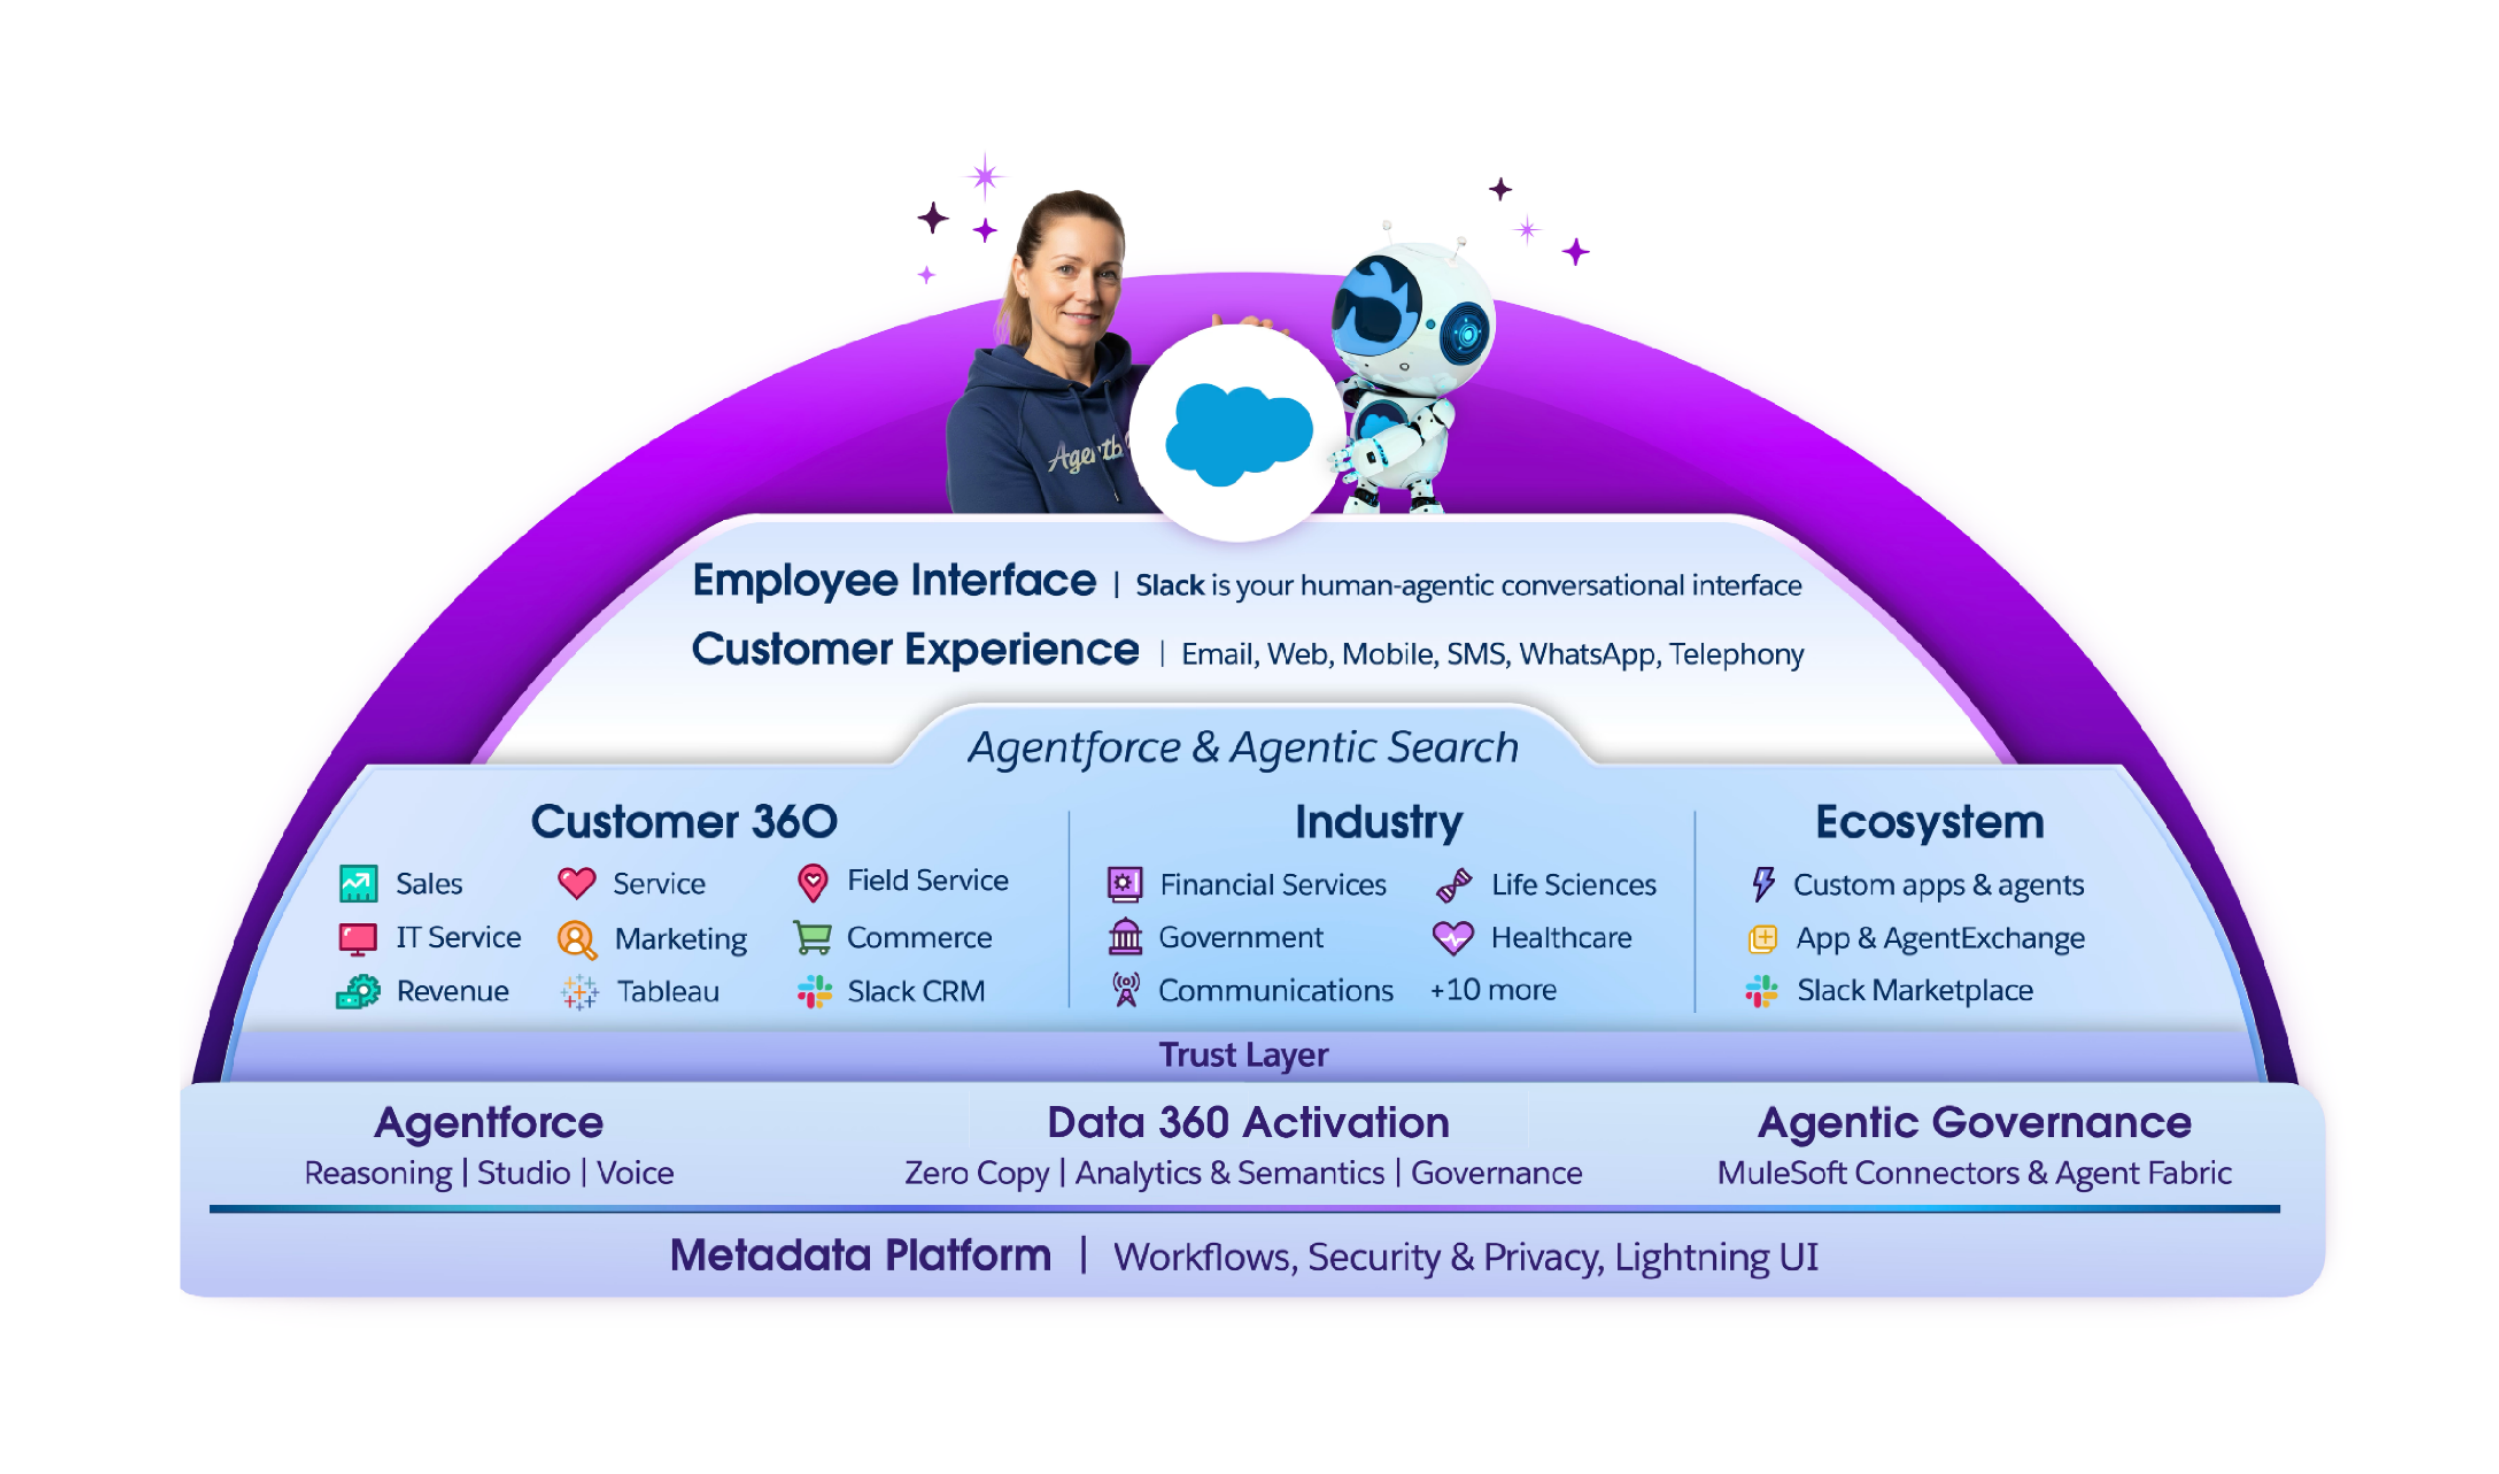 ## 2\. Descripción general de arquitectura
Los principios arquitectónicos de Salesforce Platform a continuación capturan la base y la diferenciación de cómo diseñamos funciones y capacidades:
- **Enterprise-Grade Trust**: Trust es el valor número 1 de Salesforce, y damos prioridad no solo a la disponibilidad y la seguridad de nuestros servicios, sino también a la creación de funciones de control de acceso, cumplimiento y seguridad de modo que nuestros clientes puedan cumplir sus estándares de cumplimiento y seguridad con Salesforce Platform.
- **Multiarrendatario**: Todos los servicios e infraestructura están creados para alojar múltiples clientes. Esto proporciona un patrón estratégico para la ampliación con el uso, así como la estandarización en una barra alta común de disponibilidad y seguridad independientemente del tamaño de nuestros clientes.
- **Dirigido por metadatos**: Los metadatos están en el centro de cómo nuestros servicios de múltiples arrendatarios son personalizables. Nuestros metadatos son ampliables de modo que los administradores y desarrolladores puedan aprovechar el trabajo existente, así como beneficiarse de actualizaciones de productos futuras de Salesforce y socios de ecosistemas.
- **API First:** Salesforce Platform da prioridad a una cartera de API enriquecida y coherente que cubre todo lo que se puede hacer a través de interfaces de usuario nativas de Salesforce. Esto permite a los desarrolladores y socios aprovechar y recomponer las funciones de la plataforma para integrar sistemas o crear nuevas experiencias de usuario.
- **Abierto e interoperable**: Salesforce Platform se puede integrar en cualquiera de las arquitecturas de negocio de nuestros clientes. Diseñamos Salesforce Platform para funcionar con otros sistemas basados en la nube y on-prem, así como para proporcionar API, herramientas y estándares de integración para que los sistemas externos se integren con Salesforce Platform.
- **Agente:** Salesforce Platform está evolucionando rápidamente para ser el agente primero en todo el conjunto de aplicaciones. Queremos que los usuarios puedan implicarse con Salesforce a través de experiencias conversacionales con agentes profundas que les permitan realizar el trabajo e interactuar con sus datos de formas cada vez más naturales.
La plataforma Salesforce actual representa la etapa más reciente en la evolución de las funciones de Salesforce desde el debut en 2008 de Force.com Platform. Las transformaciones clave recientes incluyen:
- Adopción de Hyperforce y un cambio a arquitecturas basadas en la nube.
- Evolución de una arquitectura monolítica a una estructura con servicios independientes.
- Introducción de tecnologías Data 360 y Lakehouse junto con establecimientos de datos relacionales tradicionales.
- Integración profunda de tecnologías de IA, aprendizaje generativo y automático y una evolución a experiencias de agentes en la plataforma.
Estos cambios han ampliado y refinado las funciones de la plataforma sin interrupciones significativas, gracias a abstracciones sólidas que permiten a los ingenieros de Salesforce avanzar en nuestras tecnologías de forma transparente con interrupciones mínimas para los clientes. La sólida abstracción también sigue siendo clave para el valor de Salesforce Platform de simplificar las complejidades técnicas del software de nivel empresarial, como la seguridad, la disponibilidad y las convenciones tecnológicas, de modo que los desarrolladores de aplicaciones puedan centrarse en resolver sus retos exclusivos. Las funciones de Salesforce Platform se destacan a continuación:
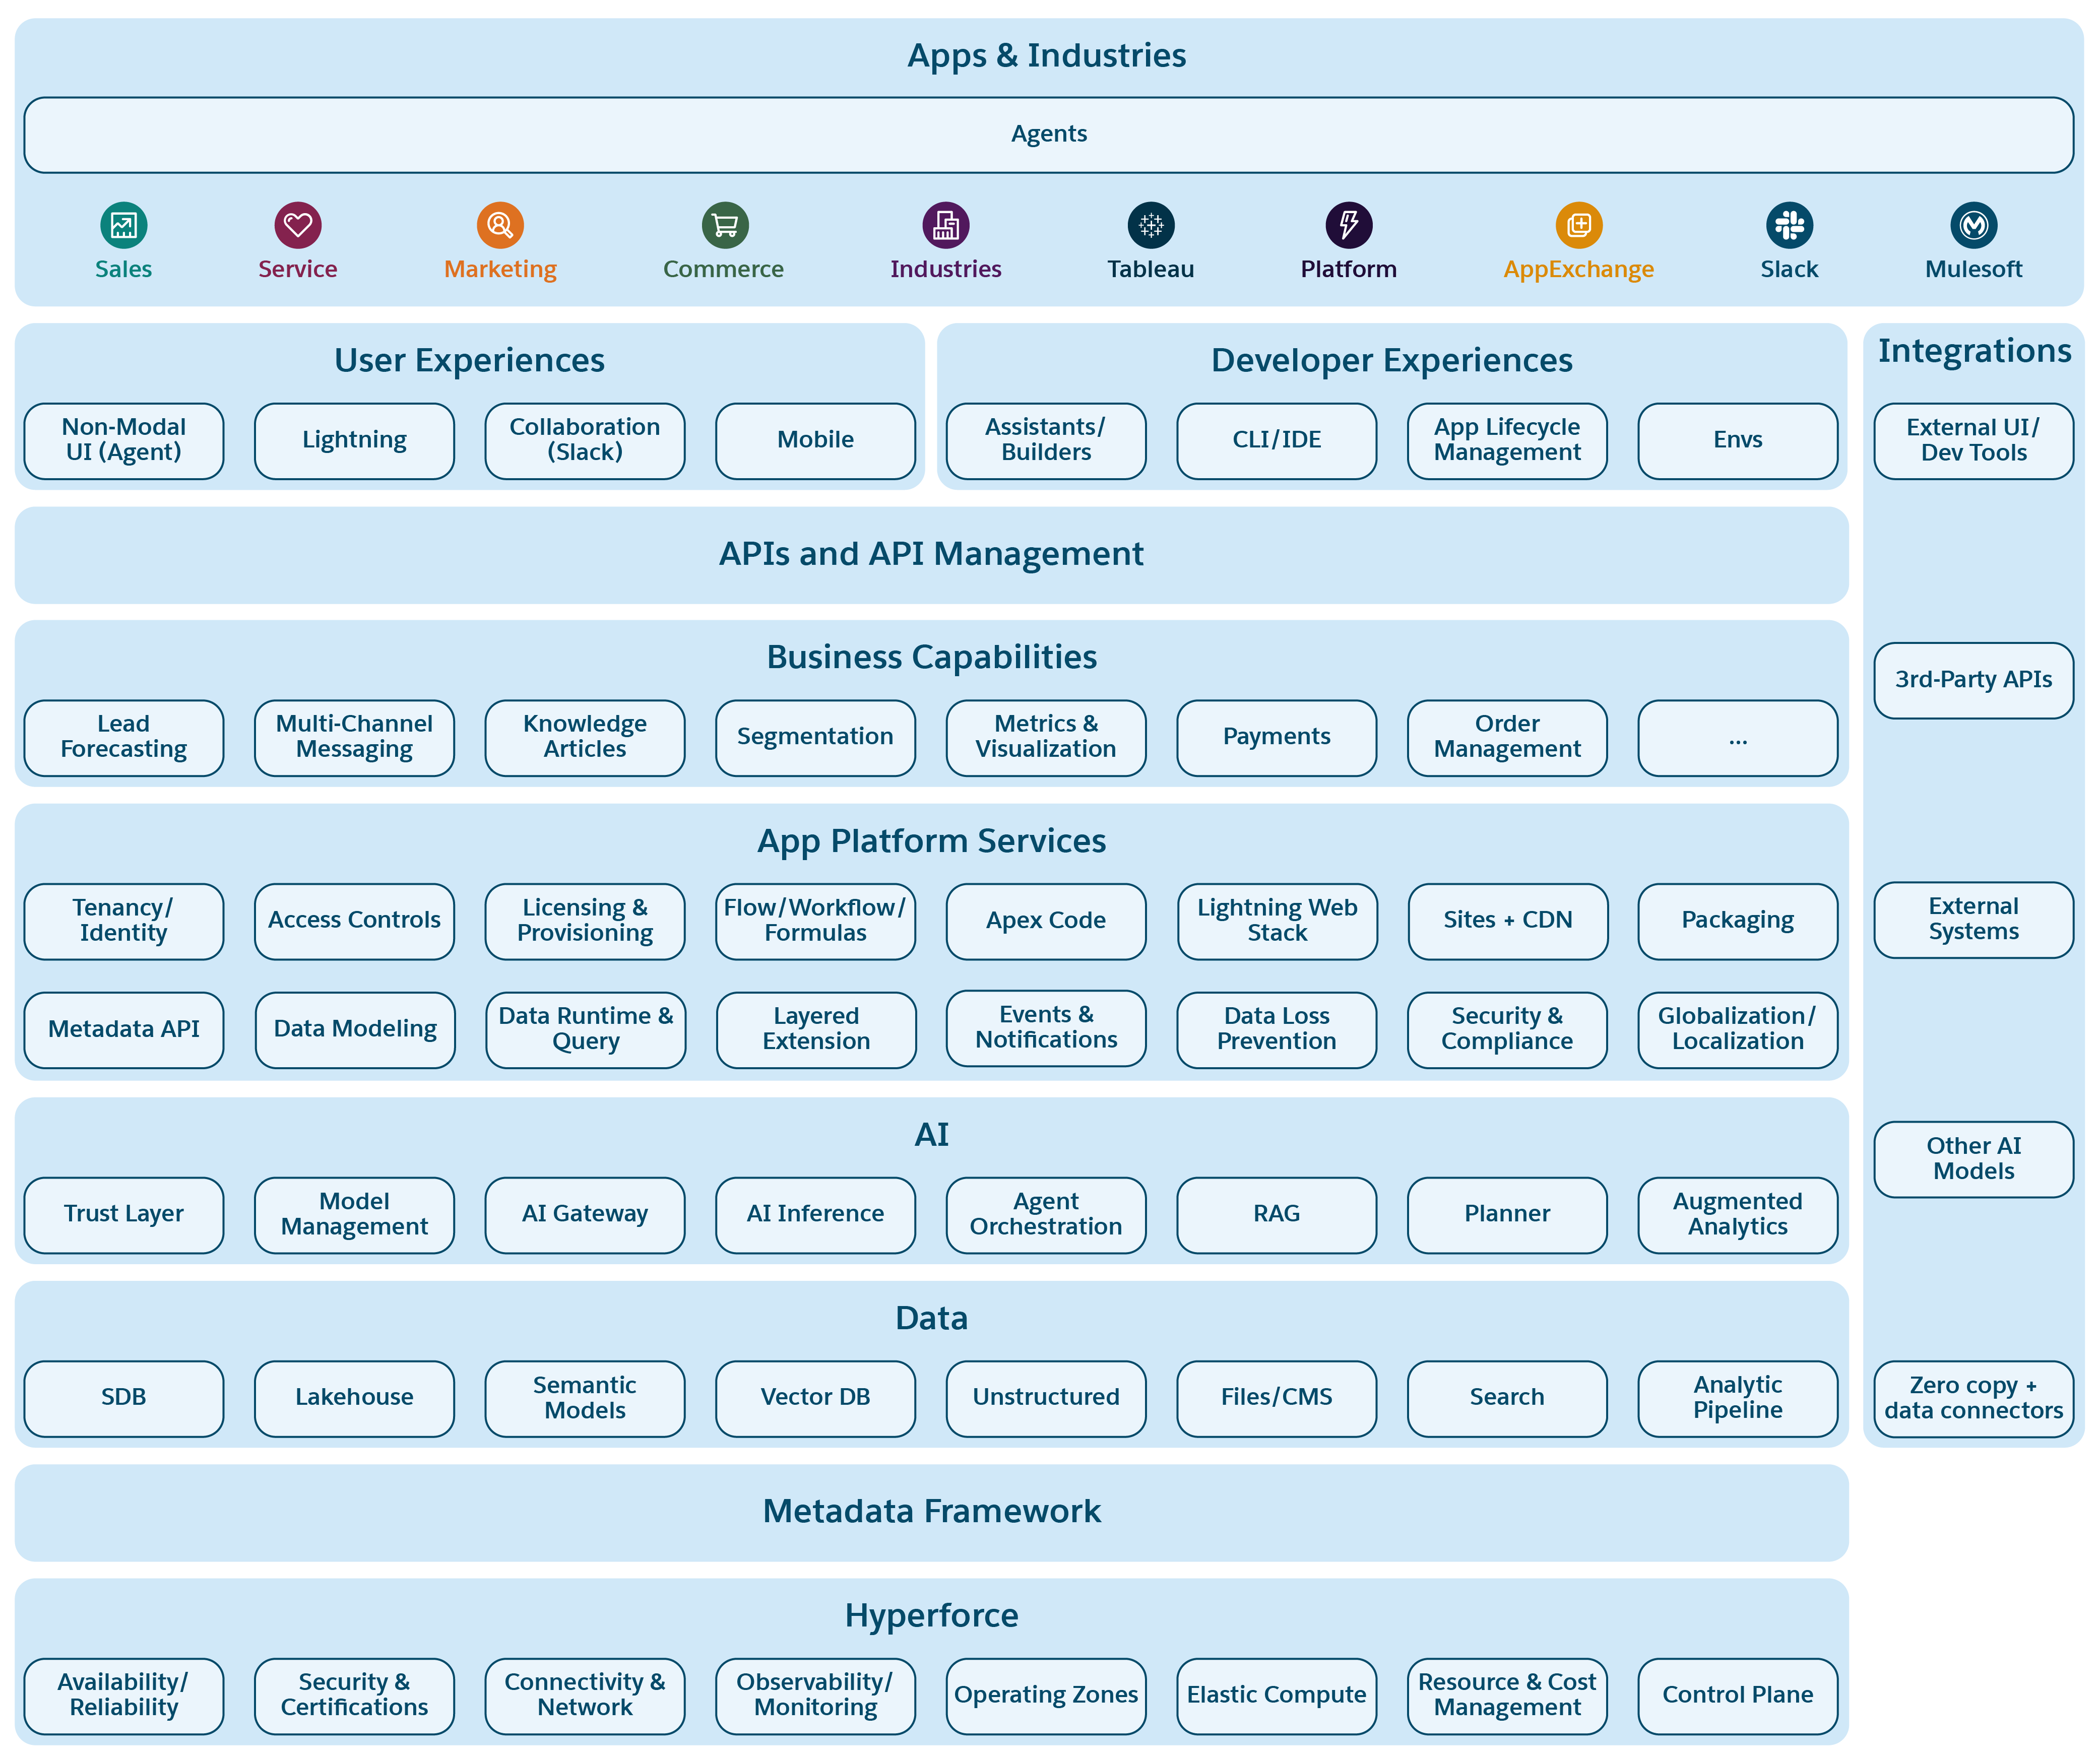 Salesforce Platform se muestra como un conjunto de capas que componen el sistema. Cada capa representa un grupo de funciones relacionadas importantes para aplicaciones creadas en la plataforma. Las subcajas de cada capa proporcionan ejemplos ilustrativos de estas funciones. Las funciones de cada capa inferior están integradas en todas las capas anteriores, garantizando una experiencia coherente en todo el conjunto de aplicaciones de Salesforce.
Salesforce Platform incorpora transformaciones de ingeniería extensivas en todas las capas de una plataforma tecnológica madura desarrollada en los últimos 20 años. Dirigidos por la evolución de las demandas de los clientes y las nuevas tecnologías, estos cambios permiten la compatibilidad con nuevos tipos y soluciones de aplicación. Las transformaciones están interconectadas, con cambios en capas inferiores que influyen en la evolución de todas las capas posteriores anteriores.
Salesforce Platform está estructurada en varias capas, cada una contribuyendo a sus funciones integrales:
- **Hyperforce**: La infraestructura fundacional ha evolucionado desde centros de datos de primera parte a proveedores de nube pública, mejorados con tecnologías de Salesforce para un alojamiento seguro, compatible, altamente disponible y rentable.
- **Marco de metadatos**: Proporciona una abstracción estable para aplicaciones sobre las que construir, incluso cuando las tecnologías que tenemos y utilizamos evolucionan. Incluye un asignador relacional de objetos, orden de ejecución prescriptivo y un tiempo de ejecución “principal” que acorta las definiciones de metadatos con los tiempos de ejecución dirigidos por metadatos.
- **Datos**: Incluye una base de datos relacional de múltiples arrendatarios y un Lakehouse a escala de petabytes para gestionar datos de Salesforce y no de Salesforce, lo que admite la gestión de datos y contenido no estructurados, la búsqueda avanzada, la gobernanza y las funciones de procesamiento analítico.
- **AI**: Se basa en la capa de datos con tecnologías de IA de confianza fundamentales que aprovechan la IA predictiva y generativa para potenciar experiencias de agentes.
- **Servicios de plataforma de aplicaciones:** Proporciona herramientas para administradores de TI, desarrolladores y proveedores para crear y personalizar aplicaciones, ofreciendo una abstracción con opiniones para simplificar tareas comunes y complejas.
- **Capacidades de negocio**: Ofrece una gama de funciones para satisfacer diversas necesidades de negocio, lo que permite a los desarrolladores confeccionar aplicaciones según sea necesario.
- **API y Gestión de API**: Garantiza que todas las funciones de plataforma son accesibles a través de API bien formadas, facilitando las interdependencias de servicio y capa.
- **Experiencia de usuario y desarrollador**: Cuenta con interfaces fáciles de usar para usuarios finales y una gama de herramientas de desarrollo desde código bajo a código profesional para el desarrollo y la personalización de aplicaciones, con compatibilidad para el desarrollo moderno dirigido por IA.
- **Integración**: Se integra con cualquier arquitectura de compañía, permitiendo la compatibilidad con sistemas de Salesforce y no de Salesforce a través de conectores de datos, integración de datos de copia cero y otras herramientas.
- **Aplicaciones e industrias**: Proporciona un conjunto de aplicaciones personalizables y soluciones específicas de la industria construidas sobre las funciones integradas de la plataforma, aprovechando la gama completa de funciones de capa inferior y con agentes de IA profundamente integrados.
## 3\. Hyperforce
Salesforce ha estado desarrollando infraestructura de centro de datos global durante casi 25 años, siendo anterior a muchos hiperescaladores y proveedores de IaaS actuales. Hyperforce, la generación actual de la evolución de la infraestructura de Salesforce, está diseñada para operar entre múltiples proveedores de nube pública en todo el mundo.
Está diseñado para satisfacer las necesidades de los clientes en cuanto a escala B2C elástica, residencia de datos global, disponibilidad mejorada, seguridad de nivel superior y cumplimiento normativo. Hyperforce estandariza la infraestructura en todos los productos de Salesforce, facilitando la integración rápida de nuevas adquisiciones.
Hyperforce garantiza la entrega de Salesforce Platform, permitiendo una implementación rápida de nuevas funciones y aplicaciones, cumpliendo los requisitos de residencia de datos y cumplimiento normativo en más de 20 regiones de todo el mundo.
### 3.1 Principios arquitectónicos
Durante la transición de Salesforce a Hyperforce, se identificaron diferencias significativas en servicios, interfaces y niveles de cumplimiento entre hiperescaladores. Para crear una base sólida y portátil para Salesforce Platform, se adoptaron estos principios arquitectónicos:
- **Infraestructura como código**: Utilizando una arquitectura dirigida por dominios, este principio implica la codificación declarativa para infraestructura, la creación de artefactos inmutables y la automatización de infraestructura on demand utilizando estándares como Kubernetes y Service Mesh.
- **Zero Trust Security**: Implementación de un modelo de seguridad zero Trust con estrategias de defensa integrales incluyendo gestión de identidad, autenticación, autorización, aislamiento de red, políticas de seguridad de privilegios mínimos y cifrado de datos tanto en tránsito como en periodos de inactividad.
- **Servicios gestionados**: Haciendo hincapié en el uso de servicios de múltiples arrendatarios y múltiples nubes, este principio mejora la portabilidad entre diferentes infraestructuras y entornos como sistemas comerciales, gubernamentales y con espacios aéreos.
- **Resistencia incorporada**: Los servicios de misión crítica están diseminados entre múltiples Zonas de disponibilidad para garantizar una alta disponibilidad. Los datos se replican entre regiones de disponibilidad. Los servicios también están etiquetados con niveles de disponibilidad para gestionar objetivos de nivel de servicio y planificación de resiliencia.
- **Plenamente observable**: Integración de todos los servicios en una plataforma de observabilidad estándar para un monitoreo eficiente, que incluye recopilación de registros, recopilación de mediciones, alertas, rastreo distribuido y seguimiento de operaciones de servicio como volumen de tráfico, índices de error y utilización de recursos.
- **Operaciones automatizadas**: Esto incluye la gestión automatizada del ciclo de vida de la infraestructura y los AIOp predictivos (IA para operaciones) para mantener la calidad del servicio, detectar y solucionar degradaciones del servicio y detección de fallos.
- **Escala automatizada**: Centrándose en la escalabilidad y la rentabilidad, este principio permite flexibilidad operativa entre diferentes escalas sin aumentar los riesgos operativos, abstrayendo límites de cuentas específicos relacionados con el proveedor de nube.
- **FinOps consciente**: La nube pública aporta agilidad a la infraestructura, pero con el riesgo de costos elevados. Adoptamos una cultura de ingeniería dirigida por la eficiencia a lo largo del ciclo de vida del servicio, sin comprometer la disponibilidad, la seguridad y Customer Trust.
Estos principios guían el desarrollo y el funcionamiento de la plataforma Hyperforce Salesforce, garantizando que se mantenga adaptable, segura y eficiente en varios entornos.
### 3.2 Conceptos de infraestructura
Salesforce Platform y sus servicios de asistencia se ejecutan en Hyperforce Foundation, que incluye múltiples Hyperforce Instances. Estas instancias están distribuidas estratégicamente entre varios países para alinearse con las preferencias de los clientes por geografía y disponibilidad. Para cumplir los estrictos requisitos operativos y de residencia de datos, una o más Instancias Hyperforce se pueden agrupar y designar opcionalmente como una Zona operativa. Cada instancia se actualiza regularmente para garantizar la seguridad, la capacidad de ampliación y el cumplimiento de los estándares legales y locales.
Hyperforce Instances se compone de varias instancias de dominio funcional Hyperforce, que son clústeres de servicios que entregan funciones específicas. Los dominios funcionales fundamentales proporcionan servicios críticos como seguridad, autenticación, registro y monitoreo, todos los cuales son esenciales para otros servicios Hyperforce. Los dominios funcionales de negocio admiten varios productos de Salesforce como Sales Cloud, Service Cloud y otros, facilitando su funcionalidad de producto.
Los servicios dentro de un dominio funcional pueden organizarse en celdas, que son unidades de entrega de servicios ampliables y repetibles. Hyperforce Cell corresponde a lo que tradicionalmente se conoce como una "instancia de Salesforce" en la que residen una o más organizaciones de Salesforce (organización). Una celda es una unidad de escala así como un fuerte límite de radio de explosión. Las superceldas proporcionan una agrupación lógica de múltiples celdas para demarcar un radio de explosión mayor debido a los servicios compartidos entre celdas. Pueden estar presentes múltiples Superceldas en un dominio funcional. Las celdas y las superceldas permiten a Hyperforce ampliar horizontalmente dentro de un dominio funcional mientras también mantienen un fuerte control sobre el tamaño del radio de explosión.
Cada Hyperforce Instance está asignada a una Región de disponibilidad, un concepto que se encuentra en todas las infraestructuras de nube pública, y es capaz de operar independientemente de todas las demás Hyperforce Instances. Todos los datos y los servicios de misión crítica en Hyperforce Instance se distribuyen y replican en al menos tres Zonas de disponibilidad, para lograr la tolerancia y la estabilidad ante fallos. Además, las copias de seguridad de datos se copian en otras instancias de Hyperforce adecuadas para la continuidad del negocio y el cumplimiento normativo.
La infraestructura Hyperforce evoluciona continuamente, ya que se crean o se actualizan nuevas instancias y celdas Hyperforce. Los clientes están aislados de los cambios en los detalles físicos de Hyperforce. Se accede a todos los extremos de clientes visibles de forma externa a través de Mis dominios de Salesforce estables y seguros (por ejemplo, acme.my.salesforce.com) que enrutan el tráfico de forma segura a los datos actuales y la ubicación de servicio. El tráfico saliente (por ejemplo, correo, llamadas web) se implementa mejor utilizando mecanismos seguros como Correo identificado de claves de dominio (DKIM) y mTLS, para garantizar que la infraestructura local de los clientes no codifica los detalles físicos de la infraestructura de Salesforce, como direcciones IP que pueden cambiar con el tiempo.
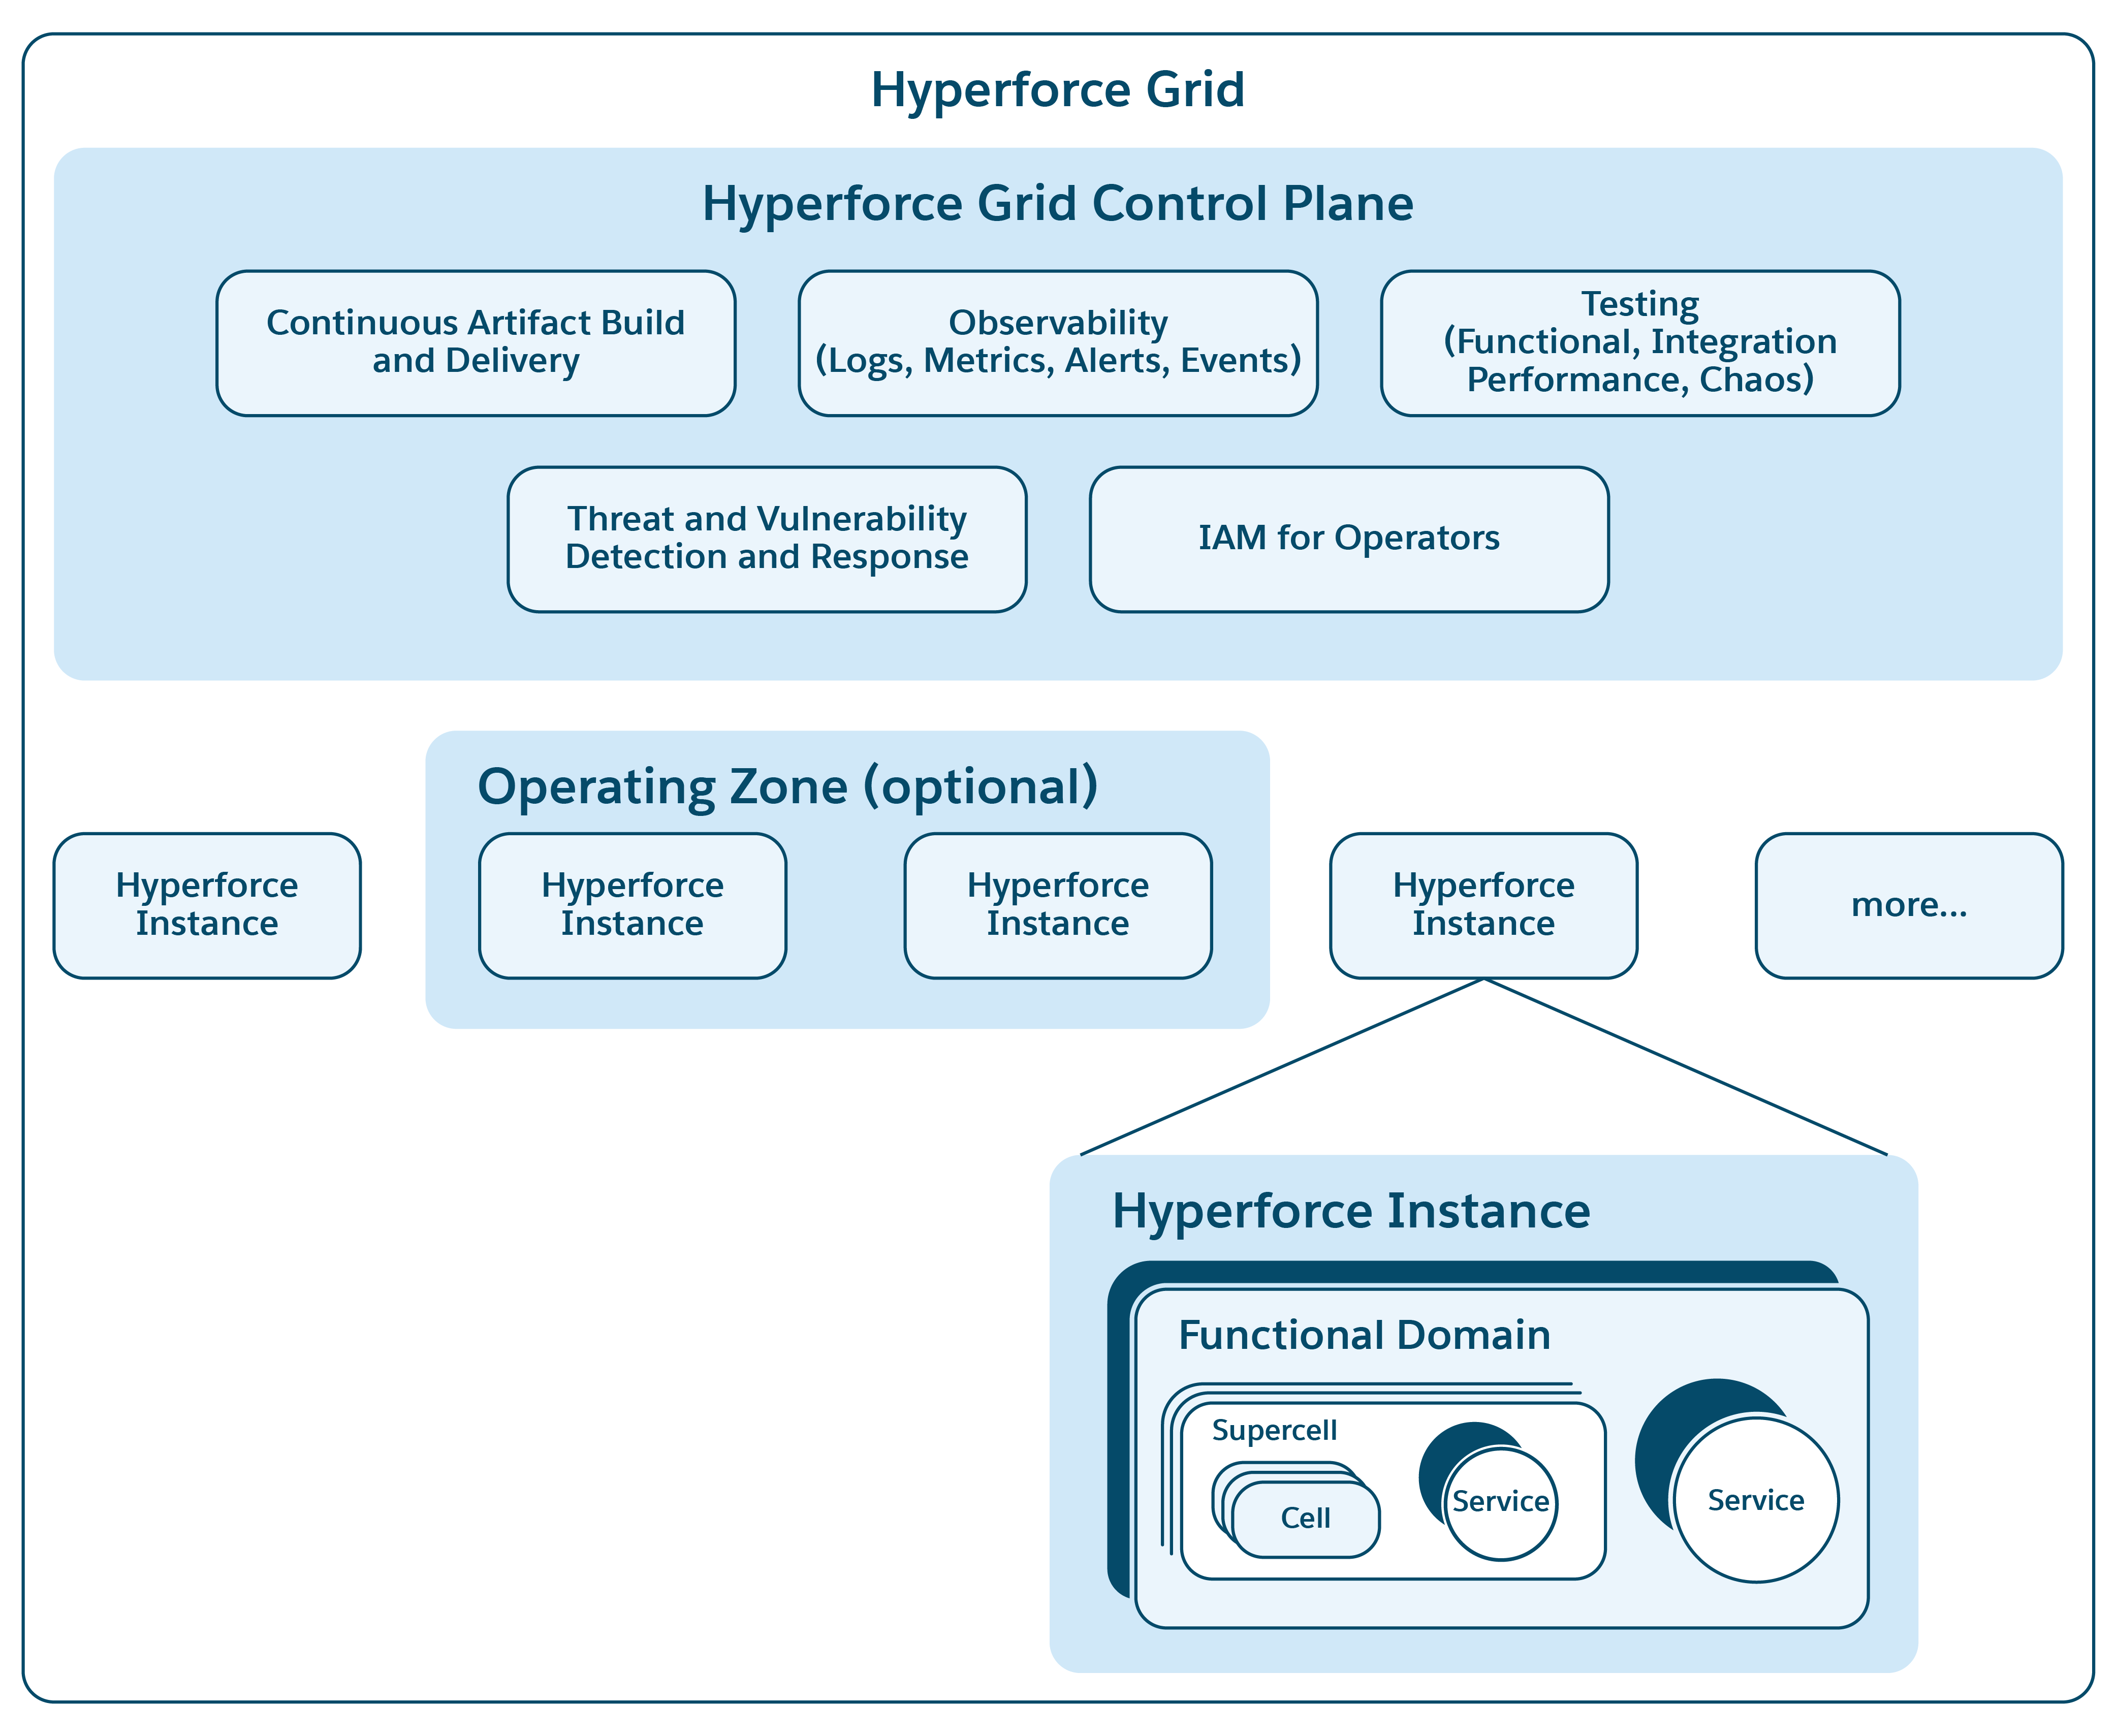 ### 3.3 Seguridad de red
Los dominios funcionales Hyperforce están diseñados con medidas de seguridad sólidas. Cada dominio está protegido en el perímetro y aislado, con servicios dentro de un dominio separados en cuentas dedicadas para mayor seguridad. La comunicación entre servicios se facilita de forma segura a través de Service Mesh o protocolos similares. La gestión del tráfico se gestiona por pasarelas de entrada y salida que inspeccionan, enrutan y aplican los controles necesarios como disyuntores o límites de frecuencia a todo el tráfico entrante y saliente.
Los servicios dentro de un dominio funcional Hyperforce se agrupan en grupos de seguridad, con solo aquellos en el grupo periférico expuestos a Internet pública. Las políticas de seguridad en tiempo de ejecución aplican reglas de comunicación entre diferentes grupos de seguridad, respetando el principio de menor privilegio para garantizar que los servicios solo tienen el acceso necesario.
Cada región geográfica tiene un dominio Hyperforce Edge Functional Domain que termina la seguridad de la capa de transporte y emplea políticas de cortafuegos de aplicaciones web programables para abordar de forma preventiva amenazas. Esto garantiza que solo el tráfico legítimo alcance los extremos Hyperforce mientras mantiene una experiencia de cliente segura y eficiente. Además, los vínculos de red internos entre Hyperforce Instances están estrictamente controlados y todos los datos de registro que contienen información de identificación personal se anonimizan para cumplir con los estándares del RGPD.
### 3.4 Plano de control de cuadrícula Hyperforce
Una cuadrícula Hyperforce incluye múltiples instancias Hyperforce compartiendo el mismo plano de control, que está diseñado para aislar cargas de trabajo confidenciales donde sea apropiado. Garantiza cero fugas de datos de clientes o sistemas, metadatos de plataforma o datos de monitoreo entre cuadrículas. El Plano de control consta de instancias Hyperforce redundantes que alojan servicios esenciales para crear, gestionar y monitorear instancias Hyperforce de cara al cliente.
El código de servicio e infraestructura para todos los servicios Hyperforce está desarrollado de forma segura dentro de un dominio funcional de plano de control exclusivo, utilizando servicios de gestión de código fuente, integración continua, pruebas y construcción de artefactos. El código generado se explora en busca de amenazas y vulnerabilidades antes de empaquetarse en contenedores estandarizados firmados digitalmente y almacenarse en registros de imágenes. La implementación de código se gestiona por oportunidades en curso autorizadas en el sistema de entrega continua Hyperforce, con privilegios de implementación restringidos a equipos y operadores autorizados. Un avión de control con brechas de aire gestiona salvaguardas adicionales necesarias en dichos entornos.
Los servicios de Gestión de identidad y acceso (IAM) aplican la aprobación justo a tiempo para limitar la duración y las acciones de acceso, mientras que los seguimientos de auditoría monitorean toda la actividad, alimentando los sistemas de detección en tiempo real para identificar y alertar sobre cualquier actividad sospechosa.
### 3.5 Gestión de costos de Hyperforce
A medida que Salesforce realiza la transición de sus servicios a Hyperforce en nubes públicas desde sus centros de datos de primera parte, es crucial renovar nuestras estrategias de creación de presupuestos, visualización de costos y optimización de recursos.
Nuestro enfoque de gestión de costos no se trata solo de reducir costos; es un proceso estratégico que diferencia entre productos dirigidos al crecimiento frente a aquellos que son estables. Planifica precios basados en consumo y márgenes que mantienen la disponibilidad de productos, en sintonía con nuestro valor principal de Trust. Las cuentas de nube pública están organizadas de forma jerárquica y vinculadas a productos y ejecutivos específicos. El etiquetado de recursos a nivel de servicio detallado, enriquecido con metadatos organizativos, ayuda a precisar los costos de microservicios individuales. Herramientas como Tableau y Slack, junto con herramientas de pronósticos avanzados, se emplean para proporcionar a ejecutivos y equipos datos en tiempo real sobre costos, pronósticos y análisis de presupuestos, infundiendo confianza en la planificación financiera futura.
Para garantizar una gestión de costos óptima, Salesforce emplea una combinación de Computar planes de ahorro, Capacidad de punto y Reservas de capacidad on-demand (ODCR), garantizando la capacidad necesaria. Estas reservas se gestionan a través de pronósticos de series temporales avanzados y tableros personalizados, lo que permite la supervisión humana y la toma de decisiones. Establecer objetivos alcanzables en reducciones de costos de transacción unitarios (el costo para procesar un volumen definido de transacciones de negocio) es una estrategia efectiva para impulsar mejoras. La herramienta Hyperforce Unit Cost Explorer permite a los equipos analizar y gestionar tendencias de costos unitarios, atribuyendo costos a servicios específicos e identificando nuevas oportunidades de mejora. El Índice de optimización de Salesforce Cloud, o puntuaje “COIN”, evalúa los servicios con una lista dinámica de oportunidades de ahorro, motivando a los equipos de servicio a mantener una eficiencia óptima de los recursos.
En nuestro compromiso inquebrantable con la Sostenibilidad, perseguimos activamente la reducción de nuestra huella de carbono, estableciendo objetivos específicos para reducir nuestra unidad Carbono para servir, una medición de emisiones relativas al trabajo realizado.
## 4\. Trust de nivel de compañía
La seguridad y la disponibilidad son aspectos fundamentales cruciales de nuestra plataforma de nivel empresarial, esenciales para mantener Customer Trust. En Salesforce, estos controles son integrales con Salesforce Platform, aplicados automáticamente a través de servicios compartidos y marcos de trabajo de software. Este enfoque integrado garantiza que los sistemas individuales se beneficien sin requerir esfuerzo adicional.
La gestión y mejora continua de esta amplia gama de controles de seguridad y disponibilidad entre miles de servicios y cientos de equipos presenta un desafío significativo. Sin embargo, es crucial, ya que pasar por alto incluso un detalle menor puede dar como resultado una brecha de seguridad o un fallo del sistema.
### 4.1 Seguridad
Hyperforce es una plataforma de infraestructura segura y compatible que admite el desarrollo y la implementación de servicios con funciones de seguridad avanzadas. Ofrece un fuerte control de acceso, cifrado de datos y cumplimiento de estándares de seguridad. Salesforce cumple con más de 40 estándares de seguridad y cumplimiento como PCI/DSS, GDPR, HIPAA, FedRamp y mucho más.
Los principios de seguridad clave incluyen Zero Trust Architecture (ZTA) y cifrado de extremo a extremo, garantizando la protección de los datos de los clientes en todas las etapas de procesamiento. Salesforce se adhiere a los estándares de seguridad y las mejores prácticas desde el ciclo de vida de desarrollo de software seguro hasta las operaciones de producción, así como prácticas de seguridad sólidas a nivel de aplicación para mitigar posibles amenazas.
#### Arquitectura de Trust cero (ZTA)
El paradigma de ciberseguridad de ZTA garantiza que todos los usuarios, dispositivos y conexiones de servicio se sometan a autenticación, autorización y validación continua, independientemente de la ubicación. ZTA e Infraestructura de clave pública (PKI) son esenciales para la ciberseguridad moderna, estableciendo límites Trust y comunicación segura sin depender de la seguridad perimetral.
Sin embargo, las implementaciones de PKI a menudo pasan por alto la importancia de la revocación de certificados y la gobernanza sobre las autoridades de certificados raíz. La implementación de Salesforce de la revocación de certificados es sólida y ampliable, lo que admite la seguridad PKI de extremo a extremo.
Además, Hyperforce aplica ZTA a través de la seguridad de capa de transporte mutua entre servicios, utilizando claves privadas de corta duración y acceso justo a tiempo para usuarios con control de acceso basado en funciones.
#### Cifrado de extremo a extremo
Salesforce Platform garantiza la protección de los datos en tránsito utilizando TLS con conjuntos de cifrado de secreto directo perfectos, que protege los datos a medida que se desplazan por la red entre dispositivos de usuario y servicios de Salesforce, así como dentro de los dominios de infraestructura de Salesforce.
Para datos en periodos de inactividad, Salesforce Platform emplea un sistema de gestión de claves compatible con módulos de seguridad de hardware. En su plataforma de múltiples arrendatarios, cada arrendatario tiene asignada una clave de cifrado exclusiva, evitando cualquier cruce de claves entre arrendatarios.
La seguridad de la comunicación y el cifrado depende en gran medida de la entropía para generar claves o datos aleatorios. Reconociendo la vulnerabilidad de los protocolos criptográficos a ataques debido a la generación de claves predecible, Salesforce Platform mitiga este riesgo obteniendo entropía desde múltiples orígenes para todos los procesos de generación de claves. Aprovechamos la función de cifrado de memoria disponible en varios procesadores, activada por un proveedor de servicio en la nube, para mejorar la protección contra ataques de arranque en frío.
#### Ciclo de vida de desarrollo de software seguro
Salesforce tiene un JDK personalizado para cumplir muchos estándares de cumplimiento, como Estándar Federal de Procesamiento de Información (FIPS), simplificando el proceso para desarrolladores y operadores eliminando la necesidad de que realicen trabajo de cumplimiento por sí mismos. Esta personalización no solo ayuda a evitar riesgos como la inyección de entidades externas XML (XXE), sino que también mejora la agilidad y la capacidad de criptografía de Salesforce para intercambiar estrategias de criptografía según sea necesario. Permite la transformación de código no compatible, ya sea desarrollado de forma interna o procedente de repositorios abiertos, en código compatible con FIPS sin necesidad de una reescritura completa, reduciendo así la carga de trabajo en equipos de desarrollo y manteniendo la adhesión a principios de diseño seguros de forma predeterminada.
Además, Salesforce ha incorporado marcos de trabajo para contrarrestar vulnerabilidades como secuencias de comandos de sitio cruzadas (XSS), falsificación de solicitudes (CSRF) e inyección de SQL integrando medidas de protección en el Ciclo de vida de desarrollo de software seguro (SSDL).
Se implementa un sistema de gestión de secretos centralizado, reforzado por controles de acceso basados en funciones (RBAC), para proteger tanto los servicios como el acceso de los usuarios. Además, se emplean herramientas de escaneo de códigos para evitar la exposición accidental de secretos en entornos de producción a través de sistemas de gestión de código fuente.
#### Funciones de seguridad operativa Hyperforce
El phishing sigue siendo una amenaza significativa para las organizaciones, lo que lleva a Salesforce a implementar la autenticación de múltiples factores (MFA) resistente al phishing de acuerdo con una serie de mejores prácticas de la industria, incluyendo los principios CISA (Cybersecurity and Infrastructure Security Agency) Zero Trust. Esto incluye claves respaldadas por hardware para empleados con acceso de producción y un núcleo seguro para acceso controlado a cuentas de proveedor de servicio de nube.
Para mantener una postura de seguridad sólida, Salesforce ha estandarizado los controles de seguridad e integrado servicios de seguridad nativos de la nube en Hyperforce, proporcionando visibilidad mejorada, detección de amenazas y aplicación de políticas. Existe un sistema de gestión de eventos e información de seguridad integral para el monitoreo, la alerta y la creación de reportes en tiempo real, que se admite con un programa de gestión de vulnerabilidades exhaustivo y herramientas de gestión de posturas de seguridad en la nube para identificar, evaluar y remediar vulnerabilidades de forma continua.
Además, un cortafuegos de aplicación web filtra y monitorea el tráfico HTTP para protegerse contra varios ataques, y se utiliza una gama de herramientas de seguridad de red incluyendo cortafuegos, sistemas de prevención y detección de intrusos, redes privadas virtuales y agentes de respuesta y detección de extremos para proporcionar monitoreo continuo y detección de amenazas. La segmentación de red y la microsegmentación están implementadas para minimizar la superficie de ataque y contener posibles brechas.
Salesforce también ha desarrollado e implementado un sólido plan de respuesta ante incidentes adaptado a los desafíos exclusivos de Hyperforce, que incluye procedimientos predefinidos para identificar, contener y mitigar incidentes de seguridad, garantizando una respuesta rápida y efectiva ante posibles amenazas de seguridad.
### 4.2 Disponibilidad
Salesforce gestiona cargas de trabajo de clientes de misión crítica que demandan alta disponibilidad. Nuestra estrategia para la alta disponibilidad incluye varias facetas organizativas como nuestro modelo de propiedad de servicio, gestión de incidentes y revisiones operativas. Los elementos técnicos clave de nuestra estrategia incluyen nuestra arquitectura de monitoreo, automatización de operaciones dirigidas por IA y mecanismos de seguridad automatizados para cambios de producción.
#### Estándares de arquitectura de disponibilidad
Para lograr una alta disponibilidad de forma coherente entre miles de servicios, un enfoque de tres pasos gestiona los riesgos técnicos a escala.
En primer lugar, se establecen estándares de arquitectura de disponibilidad, definiendo mejores prácticas como:
- **Redundancia con conmutación por error automatizada**. Para gestionar los fallos constantes que encuentra un sistema basado en la nube de gran tamaño, Salesforce crea sus servicios con un alto nivel de redundancia, detección de fallos completamente automatizada y recuperación automatizada transparente para fallos completos y parciales.
- **Limite el radio** de explosión. Se _producirán_ fallos, por lo que el equipo diseña todos sus servicios con máximos de radio de explosión intencionados para limitar la repercusión de los fallos. El ejemplo más clásico y visible es el de Hyperforce Cell (fka Pod).
- **Compartimente fallos**. Evita que los fallos se propaguen y se compongan entre unidades independientes del sistema. Las llamadas de API tolerantes a fallos entre servicios son un patrón clave que evita una cascada de fallos en el sistema distribuido. En el camino, el equipo equilibra cuidadosamente la compartimentación con la redundancia.
- **Escala automáticamente**. Para servir cargas impredecibles sin degradación del desempeño, amplíe automáticamente de forma rápida y lenta sin depender de operadores humanos lentos y falibles, desencadenados por puntos de saturación de recursos como CPU, memoria o profundidades de cola.
- **Rápidas reversiones**. Establecemos objetivos de reversión en minutos para todos los servicios, y probamos automáticamente reversiones en entornos de preproducción haciendo que la reversión, el retroceso y el avance de nuevo sean una operación predeterminada. El equipo hace un amplio uso de indicadores de funciones para implementaciones e interruptores de emergencia aún más rápidos y granulares.
- **Proteja todos los servicios que reciben llamadas de API**. El desprendimiento de carga, los límites justos de arrendatarios, los cortafuegos de aplicaciones web y las sofisticadas protecciones de capa siete se implementan en todos los niveles del sistema, desde nuestros servicios perimetrales más externos expuestos directamente a Internet hasta los servicios internos más profundos del equipo que pueden ser atacados accidentalmente por fallos en servicios de llamadas de nivel superior.
- **Suavice dependencias**. Las dependencias entre servicios están diseñadas para ser flexibles siempre que sea posible para permitirles fallar o tener éxito de forma independiente. El almacenamiento en caché es uno de los patrones más comunes aquí: a menudo un resultado obsoleto de una dependencia descendente es adecuado para una función continuada.
- **Favorezca la comunicación asíncrona**. La comunicación asíncrona y negociada entre servicios desvincula esos servicios entre sí y los buffers cargan picos entre ellos.
- **Realice llamadas de API tolerantes a** fallos. Para ser tolerantes a fallos parciales y problemas de red transitorios, utilizamos varios patrones: tiempos de espera y plazos, interrupción del circuito y reintentos con retroceso. Preferimos llamadas no bloqueadas cuando sea posible para limitar el consumo y el bloqueo de recursos. La compatibilidad hacia atrás y hacia delante se aplica con la inclinación a nivel de esquema en tiempo de construcción y pruebas de integración.
- **Gestione restricciones y cuotas** de servicio. El equipo establece cuotas y restricciones en su flota de servicio, como direcciones IP, IOps de disco o la capacidad de un clúster de Kubernetes concreto. El equipo agrega, monitorea y alerta sobre el uso de estas cuotas y restricciones de forma centralizada para evitar que un límite próximo afecte al sistema en tiempo de ejecución.
En segundo lugar, un modelo de inspección de múltiples capas garantiza que los servicios cumplen estos estándares. Esto incluye pruebas de caos automatizadas, análisis y análisis de antipatrones, así como revisiones de arquitectura con arquitectos senior para detectar problemas no solucionados por la automatización.
En tercer lugar, las soluciones están integradas en Hyperforce para facilitar la adhesión a estos estándares. Esto incluye la recopilación de telemetría automática, la redundancia predeterminada y los mecanismos de conmutación por error, así como protecciones integradas como el desprendimiento de carga y la defensa DDoS, todo ello activado de forma predeterminada para servicios individuales.
#### Monitoreo y observabilidad
Salesforce gestiona un inmenso volumen de datos de telemetría, incluyendo mediciones, registros, eventos y rastreos, que las soluciones de monitoreo tradicionales no siempre pueden gestionar de forma efectiva.
Para solucionar esto, Salesforce desarrolló un sistema de observabilidad integral que se integra con su ciclo de vida de desarrollo de software, operaciones y funciones de asistencia. Este sistema proporciona una experiencia unificada para los equipos de ingeniería y asistencia al cliente, al tiempo que satisface las necesidades de escala y reduce los costos de licencias para software externo.
La infraestructura de mediciones en Salesforce, construida sobre OpenTSDB y HBase, admite la recopilación a gran escala, el almacenamiento y la consulta en tiempo real de datos de series temporales. Los casos de uso no en tiempo real utilizan Trino e Iceberg, gestionando más de 2.000 millones de mediciones por minuto para proporcionar perspectivas sobre la utilización de CPU, el uso de memoria y los índices de solicitudes. Para la gestión de registros, Salesforce utiliza Splunk por sus potentes funciones de indexación y búsqueda. Apache Druid admite el ingreso en tiempo real y el análisis de datos de eventos a gran escala, cruciales para comprender interacciones de usuarios y eventos del sistema. El rastreo distribuido entre microservicios se gestiona con OpenTelemetry y ElasticSearch, lo que ayuda a identificar puntos de latencia y fallo específicos.
Salesforce también implementó una infraestructura de Monitoreo de desempeño de aplicaciones (APM) que se integra con sus pilas de tecnología para la recopilación de datos y establecimientos de telemetría. Esta instrumentación automática de aplicaciones simplifica la recopilación de datos y garantiza una telemetría coherente entre servicios. El tablero unificado de APM correlaciona varios tipos de datos, mejorando la capacidad de los ingenieros para monitorear el desempeño, diagnosticar problemas y optimizar sistemas a través de una interfaz coherente.
Estandarizando herramientas de observabilidad, Salesforce vincula tipos de telemetría dispares entre servicios utilizando rastreo distribuido. Esto crea un gráfico de dependencia de servicio integral, visualizando el ecosistema de servicio completo y rastreando solicitudes con granularidad fina. Esta función es crucial para determinar problemas, identificar cuellos de botella y admitir funciones dirigidas por IA como detección de anomalías, análisis predictivo y remediación automatizada.
#### Agente de AIOps
Para aumentar los tiempos de resolución de incidentes, desarrollamos un agente de operaciones de IA (AIOps) que detecta, triagea y remedia automáticamente incidentes en nombre de operadores humanos, con intervención solo en una minoría de casos. El Agente de AIOps es un kit de herramientas ampliable con capacidad de reacción de múltiples agentes diseñado para facilitar el desarrollo de sistemas complejos basados en agentes reactivos. Es altamente modular y se puede mejorar con varias herramientas para ampliar su funcionalidad. Está diseñado para ampliarse de forma eficiente con un número creciente de agentes. Las funciones clave incluyen una arquitectura reactiva, que permite a los agentes reaccionar de forma dinámica a los cambios en su entorno; la mejora de herramientas, que permite una integración sencilla de herramientas para ampliar las funciones de los agentes; y un módulo de planificación conectable, que permite la personalización de las estrategias de planificación de los agentes conectando diferentes módulos de planificación.
La detección proactiva rápida se realiza para el 91% (en el momento de redactar este artículo) de nuestros incidentes de productos CRM principales con modelos de aprendizaje automático avanzados desde nuestra biblioteca Merlion, una biblioteca de código abierto disponible públicamente desarrollada por nuestro equipo de investigación de IA. Merlion es un conjunto de modelos de aprendizaje automático como Bosques de aislamiento, Estadísticas, Bosques aleatorios y redes neuronales de memoria a corto plazo (LSTM) que procesan los datos de telemetría extensos generados por nuestros sistemas casi en tiempo real.
El 79% de los incidentes (en el momento de redactar este artículo) se resuelven automáticamente por las acciones del agente. Nuestro agente de AIOps puede procesar y clasificar vectores de datos como registros, perfiles, diagnósticos, series temporales y artefactos específicos de servicio para recomendar acciones de corrección. El controlador y planificador de AIOps Agent selecciona un agente con habilidades específicas para realizar acciones en producción.
Para los incidentes restantes que requieren participación humana, el Agente de AIOps triagea de forma eficiente problemas no resueltos a los equipos de servicio apropiados. Para ello, comprende de forma inteligente la naturaleza y el contexto de cada incidente utilizando el modelo interno XGenOps, que está capacitado en conjuntos de datos operativos como registros de problemas, incidentes, JFR y registros, garantizando que se dirige al equipo con la experiencia necesaria. Esto da como resultado más de 2800 horas de tiempo de ingeniería ahorradas por semana, mitigando la necesidad de que los ingenieros triajeen problemas no resueltos.
#### Implementación continua
Para gestionar el riesgo de interrupciones por casi 250 000 cambios de producción realizados semanalmente, se utilizan sistemas de implementación completamente automatizados para aplicar prácticas de cambio seguras, eliminando errores humanos. Los sistemas estándar no eran lo suficientemente personalizables o ampliables, lo que provocó el desarrollo de soluciones más personalizadas.
El sistema de implementación continua personalizado garantiza la seguridad a través de múltiples capas, siguiendo estrategias de implementación azul/verde estándar de la industria:
- Prueba obligatoria para cada cambio.
- Pruebas canarias iniciales de cambios.
- Implementación escalonada con radio de explosión controlado.
- Comprobaciones de remojo y estado entre etapas de implementación.
- Mitigación de conflictos con moratorias e incidentes existentes.
Además, los sistemas de integración continua se optimizaron para ejecutar millones de pruebas seleccionadas por IA, permitiendo versiones rápidas mientras se minimizan los riesgos de regresión.
## 5\. Marco de metadatos
El principio arquitectónico principal de Salesforce Platform es su diseño dirigido por metadatos. Los ingenieros de Salesforce crean establecimientos de datos y servicios para múltiples arrendatarios. Cada aplicación en la plataforma es esencialmente una recopilación de metadatos que adapta cómo se utilizan estos servicios de múltiples arrendatarios por clientes individuales. Es por eso que una frase de marketing común para Salesforce Platform es que “se accede a todo con metadatos”.
La plataforma hace hincapié en metadatos estructurados y tipificados con firmeza. Estos metadatos sirven como una capa de abstracción entre la experiencia del cliente y la infraestructura e implementaciones subyacentes de Salesforce. Este enfoque mejora la capacidad de uso y la calidad de las aplicaciones. Por ejemplo, en vez de utilizar consultas y definiciones de esquemas SQL, los clientes interactúan con metadatos estructurados como entidades, campos y registros a través de las API de objetos de Salesforce (sObject). Este diseño permite a la plataforma integrar nuevas tecnologías de almacenamiento de datos o modificar las existentes sin necesidad de reescrituras de aplicaciones, admitiendo así mejores prácticas de desarrollo continuo.
 La arquitectura de Salesforce Platform presenta un enfoque de “extensión por capas” que admite cuatro personas clave en la creación y ampliación de aplicaciones:
- **Salesforce Engineering:** Los equipos desarrollan aplicaciones nativas como Sales Cloud y Service Cloud, que se implementan en todos los servicios y tiempos de ejecución a través de un amplio proceso de versión. Estas aplicaciones están disponibles para todos los arrendatarios a través de mecanismos de licencia y aprovisionamiento.
- **Socios externos**: Los proveedores de software independientes (ISV) y otros socios pueden ampliar los metadatos creados por Salesforce para crear soluciones de valor añadido, como extensiones de esquemas en modelos de datos de Sales Cloud o reglas de validación adicionales para registros de casos de Service Cloud. Pueden empaquetar estas soluciones para su distribución a múltiples clientes.
- **Administradores y desarrolladores de TI específicos de la organización**: Pueden personalizar sus aplicaciones más allá de lo que ofrecen los ISV, confeccionando soluciones para cumplir retos de negocio exclusivos como procesos propios o específicos de la región.
- **Usuarios finales individuales**: Los usuarios finales pueden personalizar su experiencia de aplicación, como cambiar el orden de columnas en una vista de lista o establecer una ficha predeterminada.
Cada persona puede iterar de forma independiente en la misma aplicación garantizando que las capas inferiores no dependen de cambios de personas en las capas superiores y manteniendo contratos de versiones sólidas y retrocompatibilidad.
Una función que destaca el concepto de “extensión en capas” es el Orden de ejecución de guardado de registros, que garantiza que la lógica de negocio de las cuatro capas se aplica en una secuencia predecible. Esto permite que una lógica de negocio de capa superior más específica determinada por el administrador de la organización o el desarrollador de TI sustituya apropiadamente la lógica de capa inferior durante el guardado de registros que podría proporcionar Salesforce o un socio externo.
Además, los marcos de trabajo de metadatos de la plataforma utilizan un tiempo de ejecución “Núcleo” y un Asignador relacional de objetos (ORM) propietario con múltiples arrendamientos integrados, conectado a una base de datos relacional. Este tiempo de ejecución principal activa el estado de memoria compartida, las validaciones de integridad referencial y las confirmaciones de transacciones, lo que da prioridad a la estabilidad de la aplicación y mejora la fiabilidad de las implementaciones de aplicaciones. La arquitectura ha evolucionado continuamente para dar cobertura a la creciente escala de complejidad de las aplicaciones. Por ejemplo, en octubre de 2025, hay más de 85.000 entidades definidas por Salesforce y más de 300 millones de entidades personalizadas definidas por nuestros clientes.
Históricamente, el tiempo de ejecución principal alojaba la mayoría de las funciones de plataforma y aplicación. La arquitectura actual de Salesforce Platform ahora incluye cientos de servicios independientes dirigidos por metadatos. El tiempo de ejecución principal sigue siendo el único sistema de registro para metadatos de aplicaciones, aprovechando los beneficios exclusivos de una arquitectura monolítica para la gestión de metadatos. Los metadatos relevantes se sincronizan con cachés locales en servicios independientes, impulsando la variedad de servicios ampliables para tiempos de ejecución de aplicaciones.
## 6\. Data
Los datos son un activo esencial para las organizaciones, e Hyperforce proporciona una base fiable para su almacenamiento en Salesforce. El reto clave es almacenar datos de una forma que optimice su utilidad para aplicaciones. Salesforce Platform transformó la capa de datos al acomodar varios requisitos de almacenamiento y acceso. Equilibra de forma efectiva costos, velocidades de lectura/escritura, capacidad de almacenamiento y tipos de datos para satisfacer diversas necesidades.
A medida que la IA y los análisis moldean cada vez más las aplicaciones de negocio, los datos han surgido como un elemento clave. Su importancia radica en su capacidad para permitir a la IA y los análisis aprender, analizar, tomar decisiones y automatizar procesos.
Los datos se originan en bases de datos del Sistema de registro (SOR), cumpliendo los requisitos operativos de los negocios. A continuación, realiza la transición a través de varias transformaciones en plataformas de Big Data, que son esenciales para potenciar la IA y las aplicaciones dirigidas por análisis.
La gestión efectiva de los datos, desde la información de transacciones hasta las perspectivas analíticas, es crucial para extraer valor y dar cobertura a aplicaciones sofisticadas. Salesforce Database (SalesforceDB) destaca como una base de datos de transacciones de primer nivel para la gestión de datos de SOR, mientras que Data 360 sirve como una sólida plataforma de Big Data que mejora las funciones de IA y análisis.
### 6.1 Base de datos de transacciones
Los datos y metadatos de transacciones son esenciales para Salesforce Platform. SalesforceDB es una base de datos relacional moderna nativa de la nube diseñada específicamente para las cargas de trabajo de múltiples arrendatarios de Salesforce, similar a otras bases de datos de nube de proveedores principales pero con funciones personalizadas para la arquitectura de Salesforce. Amplía PostgreSQL, separa computación y almacenamiento y aprovecha Kubernetes y almacenamiento en la nube, mejorando las operaciones con funciones específicas del arrendatario como cifrado y sandboxes.
SalesforceDB gestiona todos los datos de CRM transaccionales, más de 1,1 billones de transacciones al mes, así como metadatos para Data 360 y servicios relacionados. Sus objetivos principales son garantizar Trust a través de durabilidad, disponibilidad, desempeño y seguridad; ampliar para grandes clientes y facilitar operaciones en la nube fiables y simplificadas. Alcanza estos objetivos con un diseño que separa las capas de computación y almacenamiento, un sistema de almacenamiento distribuido inmutable y acceso a datos de árbol de combinación estructurado por registros. Esto permite funciones avanzadas como el cifrado por arrendatario de datos en almacenamiento y migraciones y sandboxes eficientes.
#### Descripción general de la arquitectura
La arquitectura de servicio de SalesforceDB se ejecuta en tres zonas de disponibilidad, con computación y almacenamiento replicados en estas zonas para garantizar que el sistema permanece disponible incluso si se pierde cualquier nodo o toda la zona. Todos los servicios se ejecutan en Kubernetes para permitir la recuperación de fallos automatizada y las implementaciones de servicio.
Para proporcionar altos niveles de durabilidad y disponibilidad, el sistema de registro definitivo para SalesforceDB es el almacenamiento en la nube como S3 de AWS. Las operaciones como el archivado y la replicación entre regiones se gestionan en este nivel de almacenamiento en la nube. Los objetos de almacenamiento son inmutables, mejorando la distribución y replicación de datos para una alta disponibilidad.
Debido a la alta latencia en el almacenamiento en la nube, SalesforceDB utiliza caché de almacenamiento para acceder a datos. Estos cachés son sistemas de almacenamiento distribuido que mantienen copias temporales de objetos de almacenamiento en un clúster de nodos, garantizando la replicación y la durabilidad según necesite la base de datos. Se utilizan cachés separados para el almacenamiento del registro de transacciones y el almacenamiento de archivos de datos.
El nivel de computación de SQL consta de un clúster de base de datos principal y dos clústeres de espera en tres zonas de disponibilidad diferentes. El clúster principal gestiona todas las modificaciones de la base de datos, mientras que los clústeres de espera solo gestionan operaciones de consulta.
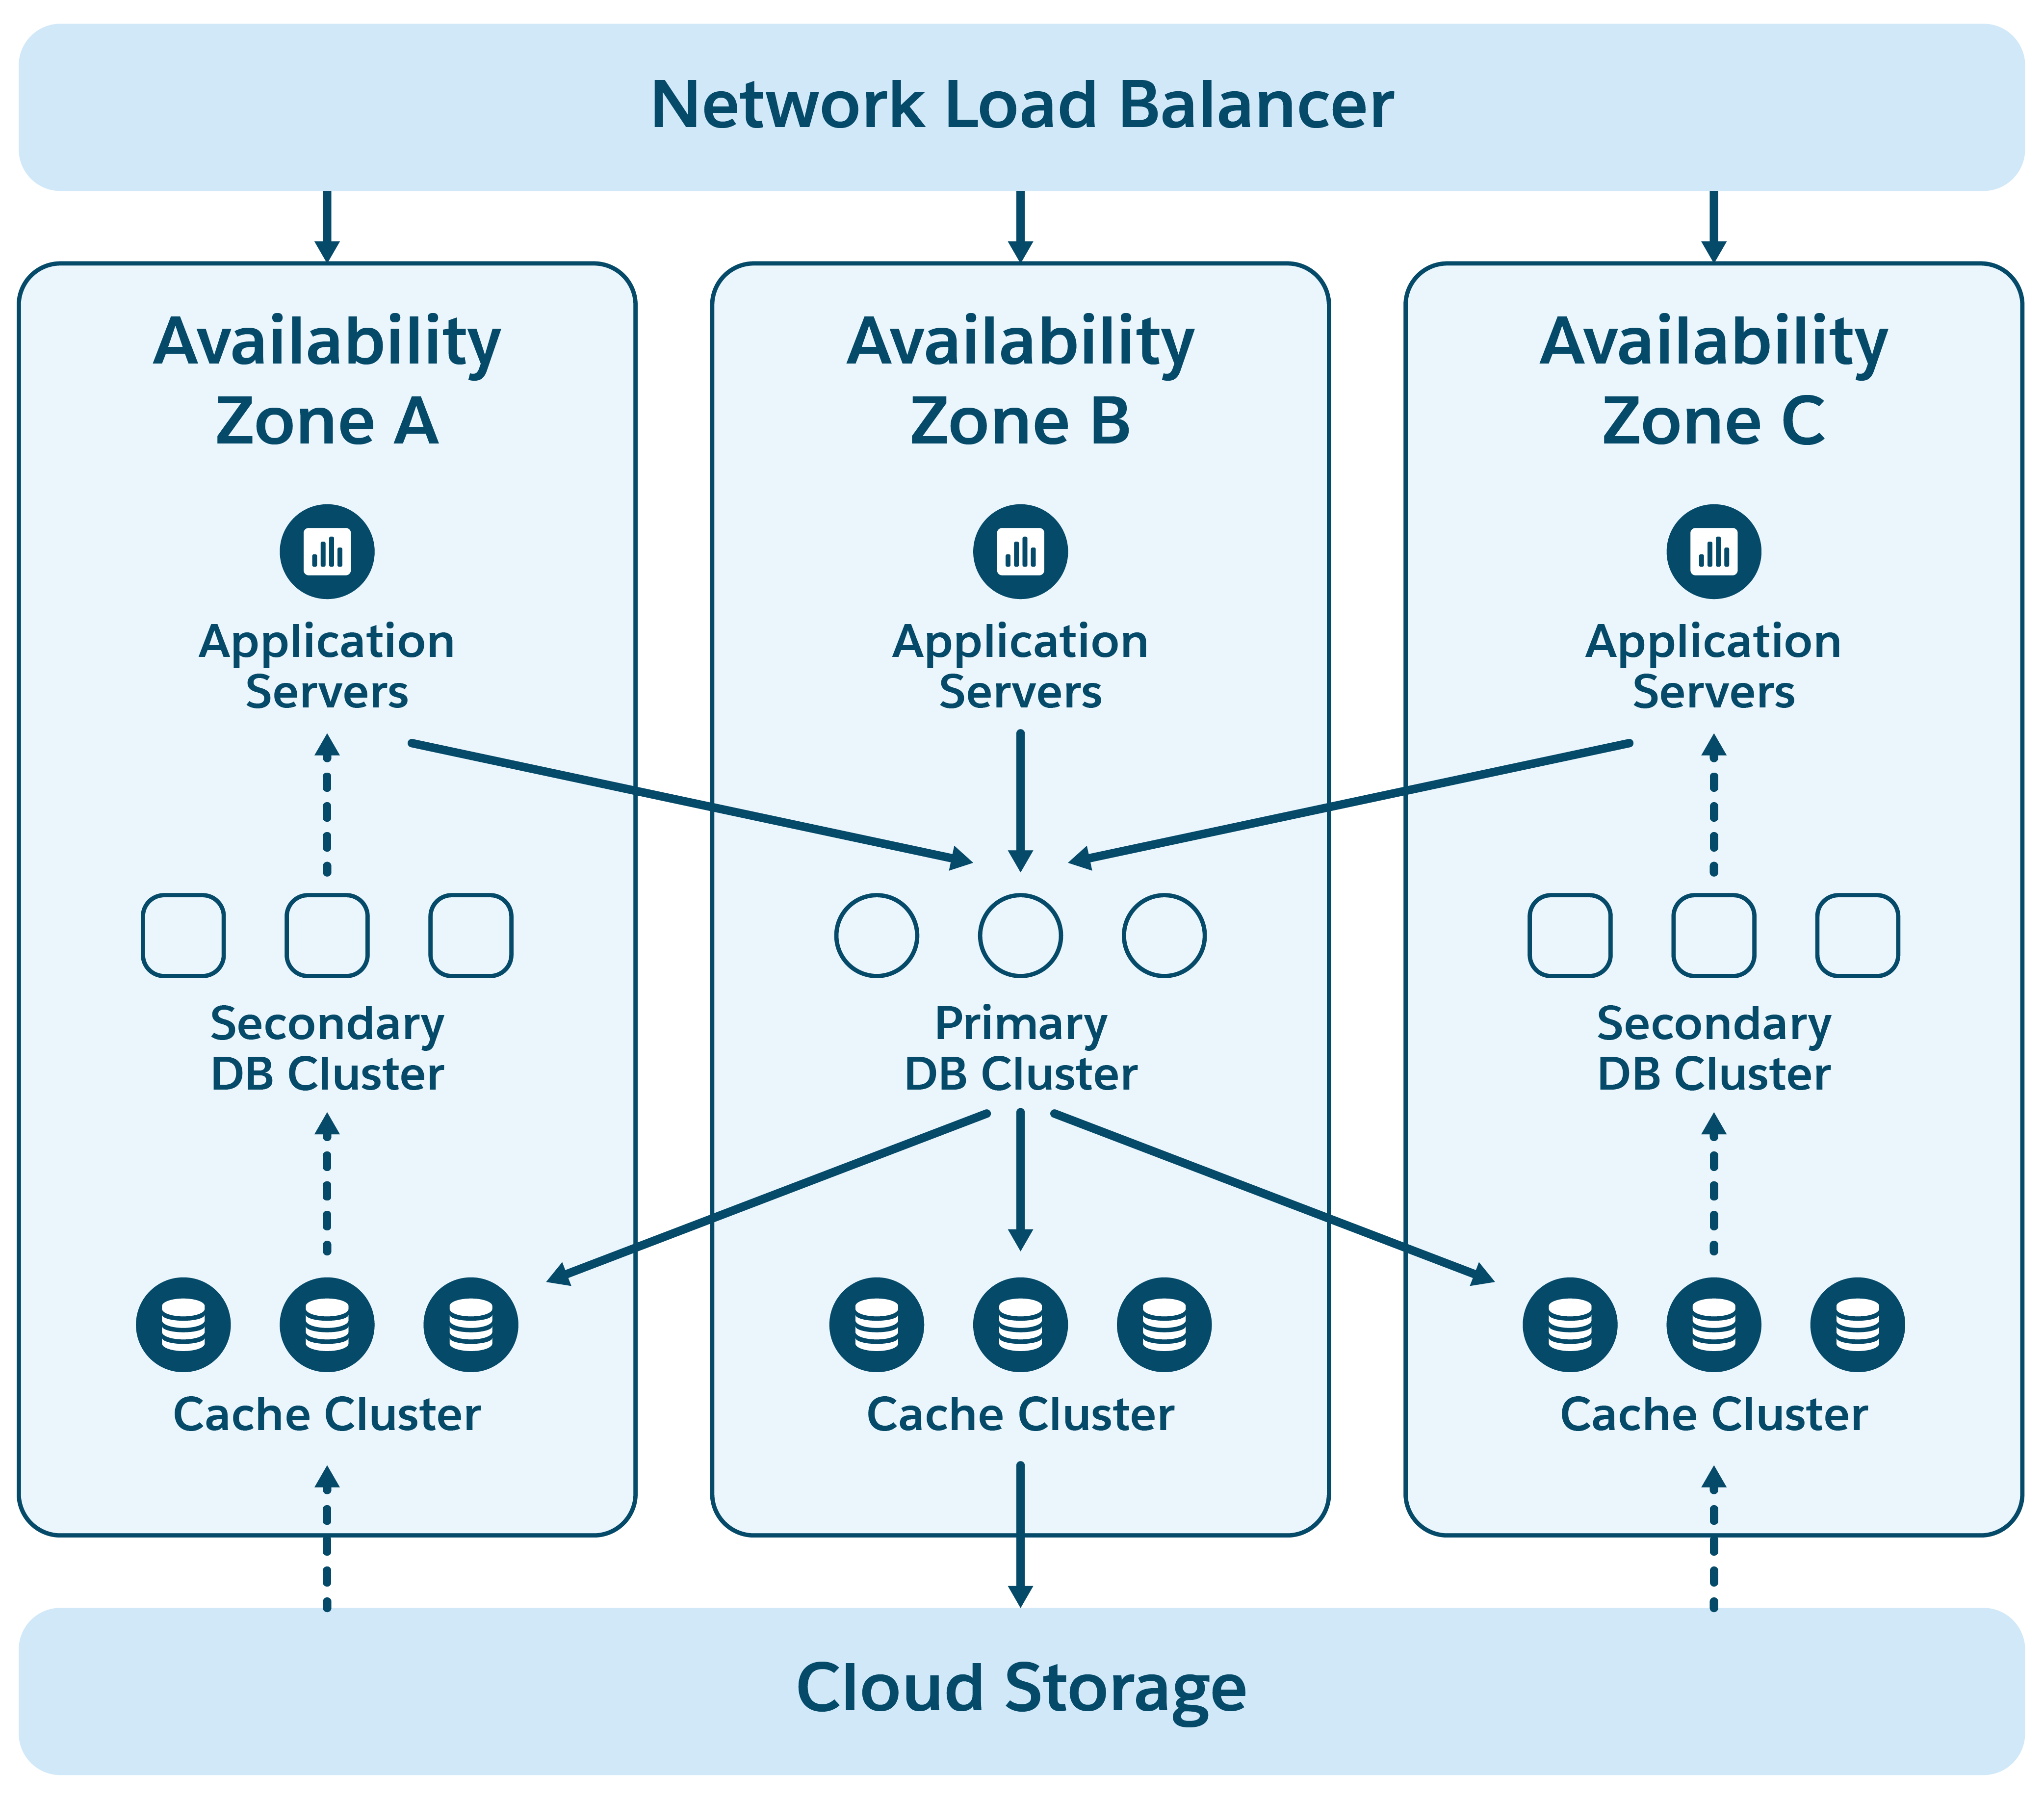 #### Acceso y almacenamiento LSM
SalesforceDB utiliza una estructura de datos de árbol de combinación estructurado por registro (LSM), donde los cambios se registran inicialmente en un registro de transacciones y se acumulan en memoria. Los cambios confirmados se redactan a continuación de forma colectiva en archivos de datos ordenados por clave, que se combinan y compactan periódicamente para optimizar la eficiencia del almacenamiento.
Esta estructura elimina de forma efectiva problemas de actualización simultánea comunes en bases de datos que actualizan el almacenamiento directamente. Al utilizar el enfoque LSM, SalesforceDB admite funciones críticas como almacenamiento inmutable, lo que la convierte en una solución sólida para gestionar cargas de trabajo de Salesforce.
#### Almacenamiento inmutable
Los datos en almacenamiento son inmutables; una vez que los archivos de datos están escritos y visibles, no cambian. Los registros de transacciones son de solo anexado, lo que simplifica los patrones de acceso a los datos y mejora la fiabilidad. Esta estructura admite lecturas descoordinadas, simplifica las copias de seguridad, potencia la capacidad de ampliación y facilita la virtualización del almacenamiento, lo que la hace adecuada para entornos de nube.
#### Disponibilidad y durabilidad
Las transacciones en SalesforceDB se confirman entre múltiples zonas de disponibilidad, lo que garantiza que no haya pérdida de datos incluso si falla un nodo o una zona. Si se produce un fallo, las transacciones en vuelo se cancelan y las transacciones confirmadas se recuperan correctamente. Como los fallos no pierden datos confirmados, la conmutación por error a nuevos nodos se automatiza.
El software de gestión de clústeres gestiona automáticamente las conmutaciones por error monitoreando los quórumes y gestionando las transferencias de propiedad. Este proceso no solo se utiliza en emergencias, sino también de forma rutinaria durante el parcheo regular, mejorando la fiabilidad del sistema a través de un uso constante. Los reinicios de base de datos cortos suelen pasar desapercibidos para los usuarios finales, lo que mantiene una experiencia de usuario sencilla.
Salesforce realiza tres actualizaciones de esquema principales al año, con actualizaciones de esquema más pequeñas semanalmente. SalesforceDB proporciona operaciones de esquema de tiempo de inactividad cero que permiten realizar estas actualizaciones sin repercusión sobre el cliente.
#### Sistema de registro
Nuestra base de datos de transacciones sirve como el repositorio principal para datos de clientes, que se almacenan en caché entre múltiples zonas de disponibilidad y en la nube. Cada bloque de datos está protegido con una suma de comprobación inmutable, verificada por la capa de almacenamiento y el motor de base de datos. La base de datos realiza un seguimiento del linaje para detectar cualquier cambio fuera de orden o versión perdida y ejecuta comprobaciones de coherencia continuas entre índices y tablas base.
Para la protección contra ransomware, las bases de datos se archivan en almacenamiento separado bajo una cuenta diferente, incluyendo copias de seguridad de registro de transacciones completas e incrementales. Estas copias de seguridad se validan regularmente a través de un proceso de pruebas de restauración. Además, la infraestructura de nube está preconfigurada pero no activada, lista para gestionar solicitudes de restauración de datos según sea necesario.
#### Escala
Cada organización de Salesforce está alojada en una celda Hyperforce, que incluye el servicio SalesforceDB. Esta configuración permite una rápida ampliación global a través de la creación de nuevas celdas a través de la arquitectura Hyperforce, y el tráfico puede cambiarse fácilmente entre celdas para gestionar la carga. Sin embargo, a medida que aumentan las cargas de trabajo y las demandas de negocio de los clientes, la capacidad de una única instancia de base de datos puede ser insuficiente.
Para solucionar esto, SalesforceDB emplea una arquitectura de escala horizontal para sus niveles de almacenamiento y computación. El almacenamiento en la nube es prácticamente ilimitado y las capas de caché se amplían automáticamente para satisfacer la demanda. Además, el nivel de computación puede ampliarse agregando más nodos de computación de base de datos, que leen de forma eficiente desde almacenamiento inmutable compartido sin necesidad de coordinación. Este enfoque permite a SalesforceDB alcanzar una capacidad de ampliación que coincide o supera la de las arquitecturas de base de datos de clústeres comerciales líderes, sin requerir hardware o redes especiales.
#### Multiarrendamiento
Salesforce es una aplicación de múltiples arrendatarios donde una única base de datos aloja múltiples arrendatarios. Cada registro de tabla incluye un Id. de arrendatario para distinguir su propiedad, y el aislamiento del arrendatario se mantiene a través de predicados de consulta automáticos agregados por la capa de aplicación de Salesforce.
SalesforceDB está adaptado a este modelo, admitiendo procesos de DDL, metadatos y tiempo de ejecución específicos del arrendatario, mejorando la fiabilidad, el desempeño y la seguridad. Combina los bajos gastos generales de un modelo arrendatario por fila con la eficiencia de un esquema arrendatario por base de datos.
En SalesforceDB, los Id. de arrendatario forman parte de la clave principal en tablas de múltiples arrendatarios, que agrupan datos por arrendatario en la estructura de datos LSM, mejorando la eficiencia de acceso. Esta configuración no solo facilita el acceso eficiente a los datos y el cifrado por arrendatario, sino que también simplifica la gestión de los datos del arrendatario. Los arrendatarios se pueden copiar o mover fácilmente con ajustes de metadatos mínimos debido a la estructura de metadatos compacta.
### 6.2 Data 360 y Lago de datos
Las funciones de IA, análisis y datos son esenciales en las compañías modernas. Las compañías ya invierten en plataformas de Big Data maduras como Snowflake, Databricks, BigQuery y Redshift. Sin embargo, muchos
los clientes no están derivando valor de negocio de sus datos debido a silos de datos, falta de procesamiento de IA, datos obsoletos o inacción en un proceso de negocio existente. La centralización de datos de clientes en una única fuente de verdad, con una única vista de la implicación de los clientes, es crucial para un negocio y un reto debido a la fragmentación de datos y la complejidad de la gestión del sistema. Salesforce lidera la facilitación de una vista holística de un cliente integrando datos, IA y CRM en un círculo virtuoso, impulsado por perspectivas de IA generativa y aprendizaje automático y con tecnología de datos.
SalesforceDB está optimizado para cargas de trabajo transaccionales de alto desempeño en datos estructurados, mientras que las cargas de trabajo de IA y análisis requieren gestionar grandes volúmenes de datos no estructurados desde varios orígenes y realizar consultas complejas y procesamiento por lotes. Para abordar estas necesidades, Salesforce ha desarrollado Data 360, una plataforma diseñada para desglosar silos de datos, unificar, almacenar y procesar datos de forma segura y eficiente, admitiendo demandas de IA y análisis y permitiendo operaciones de negocio en tiempo real.
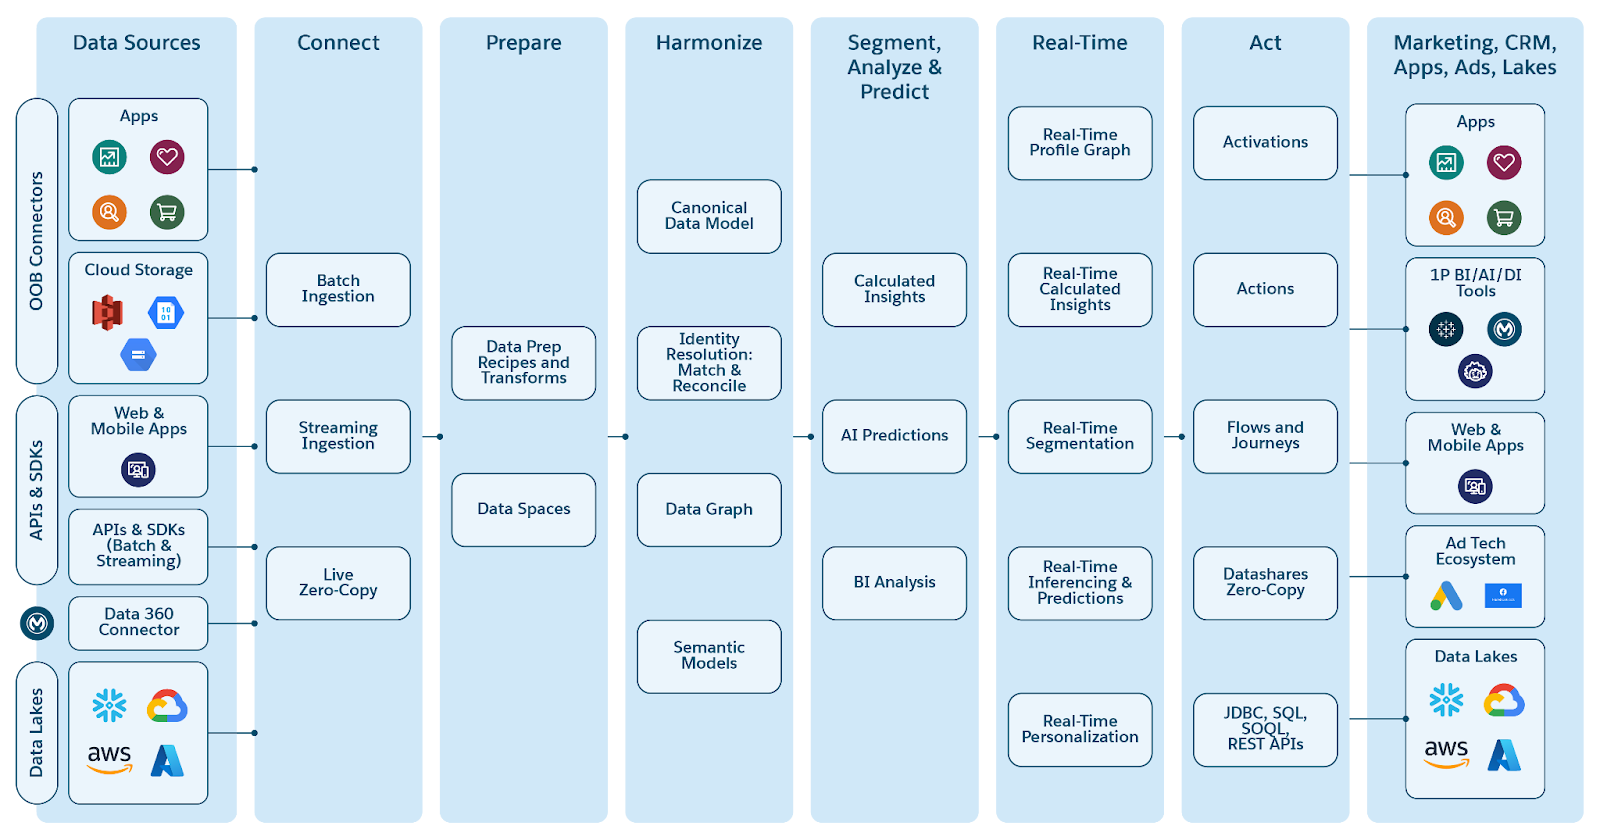 Data 360, construida sobre Hyperforce, sirve como la plataforma fundamental para IA y Analytics, ofreciendo:
- Infraestructura integrada y una plataforma sin código para consolidar silos de datos a través de conexiones
- Ingreso de datos real y casi en tiempo real
- Federación de copia cero
- Limpieza, preparación y modelado de datos para el procesamiento
- Servicio de consulta unificado sobre datos estructurados y no estructurados
- Desarrollo de modelos analíticos y de IA/ML para la generación de perspectivas
- Acciones y activaciones desencadenadas por datos
- Compatibilidad con la generación aumentada (RAG) de recuperación de IA generativa
- Gobernanza basada en políticas integrales
Arquitectura de Data 360 admite una serie de componentes y funciones, que se describen a continuación.
#### Conectividad, Transformación y Armonización
Data 360 admite oportunidades en curso de ingreso eficientes desde varios orígenes de datos estructurados y no estructurados, para procesamiento de datos por lotes, casi en tiempo real y en tiempo real. El servicio de ingreso de Data 360 funciona en un patrón Extracción-Carga-Transformación (ELT), diseñado para baja latencia y adecuado para escala B2C. El ingreso en tiempo real incluye API y transmisiones interactivas, mientras que las fuentes casi en tiempo real cubren el uso detallado de productos. Una vez ingresados, los datos se transforman ampliamente para preparar, armonizar (por ejemplo, unificar varios tipos de contacto) y modelarlos para aplicaciones de consulta, análisis e IA efectivas. La plataforma también incluye una amplia gama de modelos de datos armonizados listos para su uso.
Data 360 se integra perfectamente con aplicaciones de Salesforce como Sales Cloud, Service Cloud, Marketing Cloud y Commerce Cloud. Además, ofrece cientos de conectores para fuentes de datos externas, garantizando una integración de datos fluida.
#### Lakehouse para Big Data
Data 360 cuenta con una arquitectura de lago nativa basada en Iceberg/Parquet, diseñada para gestionar la gestión y el procesamiento de datos a gran escala para escenarios por lotes, de transmisión y en tiempo real. Esta arquitectura admite datos estructurados y no estructurados, cruciales para aplicaciones de IA y análisis.
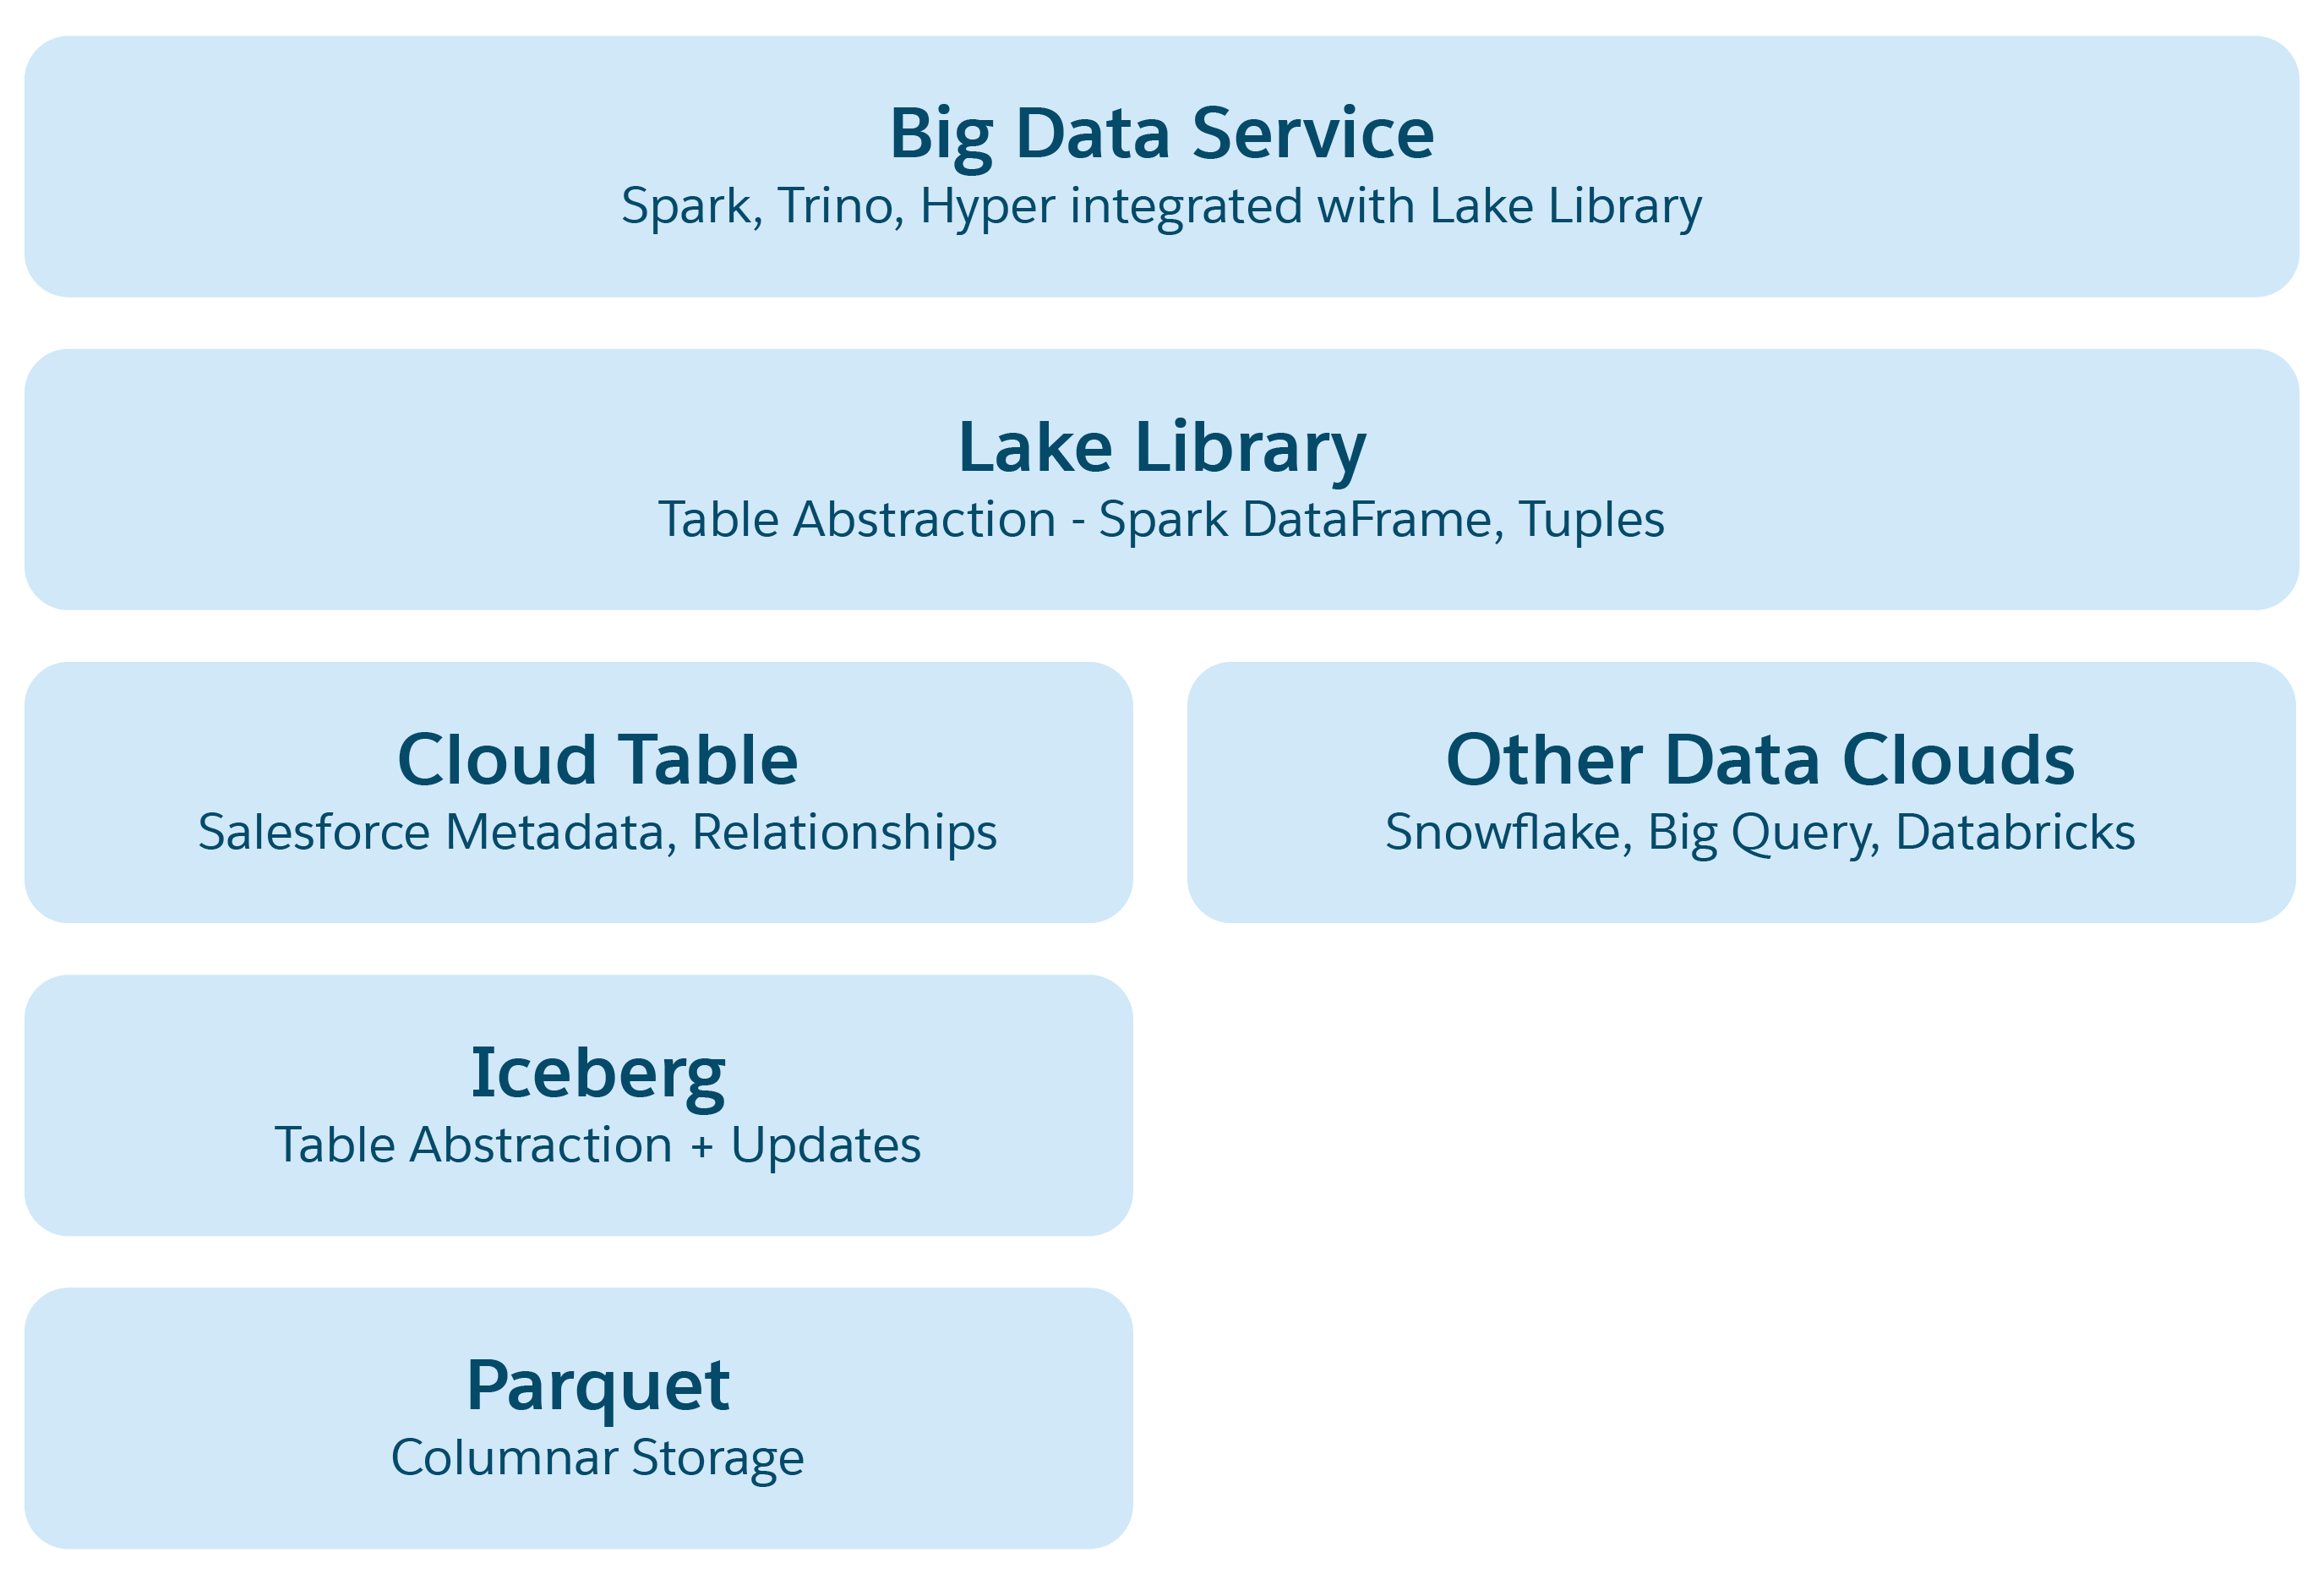 En lagos de datos basados en la nube como Azure, AWS o GCP, la unidad de almacenamiento fundamental es un archivo, normalmente organizado en carpetas y jerarquías. Este lago mejora esta estructura introduciendo abstracciones estructurales y semánticas de nivel superior para facilitar operaciones como consultas y procesamiento de IA/ML. La abstracción principal es una tabla con metadatos que define su estructura y semántica, incorporando elementos de proyectos de código abierto como Iceberg o Delta Lake, con capas semánticas adicionales agregadas por Data 360.
Capas de abstracción en el lago:
- **Abstracción de archivos Parquet**: En la base, el almacenamiento consta de archivos de lago de datos (por ejemplo, S3 en AWS o Blob en Azure) en formato Parquet. Los datos para una tabla de origen se almacenan entre múltiples particiones como archivos Parquet, siendo cada tabla una recopilación de estos archivos.
- **Abstracción de tabla Iceberg**: Las tablas están organizadas como carpetas, con particiones de datos almacenadas como archivos Parquet en estas carpetas. Las modificaciones en una partición dan como resultado nuevos archivos Parquet como instantáneas. Iceberg gestiona un archivo de metadatos para cada tabla, detallando esquemas, especificaciones de particiones e instantáneas.
- **Abstracción de tablas de Salesforce Cloud**: Basándose en Iceberg, esta capa agrega metadatos semánticos como nombres de columna y relaciones, junto con configuraciones como tamaño de archivo de destino y compresión. Abstrae tablas entre varias plataformas como Snowflake y Databricks, protegiendo aplicaciones de Data 360 de especificaciones de plataforma de almacenamiento subyacentes.
- **Biblioteca de acceso**: a lago Esta biblioteca proporciona acceso a la Tabla de Salesforce Cloud, gestionando datos y metadatos, y resume los mecanismos de almacenamiento subyacentes para desarrolladores de aplicaciones.
- **Extracción de Big Data Service**: Esto incluye marcos de trabajo de procesamiento como Trino e Hyper para consultas, y Spark para el procesamiento en cualquier plataforma de tabla en la nube.
Lakehouse de Data 360 admite escala B2C, ingreso en tiempo real, procesamiento, aplicación y evolución de esquemas, instantáneas y utiliza formatos de almacenamiento abiertos.
#### Almacenamiento en tiempo real
Para dar cobertura a aplicaciones de análisis y agentes en tiempo real, Data 360 aumenta el almacenamiento de Big Data de un lago con un Almacén de baja latencia (LLS) adicional. La capa de procesamiento en tiempo real de Data 360 analiza señales en tiempo real y datos de implicación en memoria. Como la capacidad de almacenamiento basado en memoria es limitada, no se pueden procesar todos los datos a la vez. Data 360 agrega este LLS para eliminar dichas limitaciones, permitiendo el procesamiento en tiempo real ampliable.
El Establecimiento de baja latencia es una capa de almacenamiento NVMe (SSD) a escala de petabytes en el lago. Es una caché duradera: la mayoría de los datos llegan finalmente al lago para la persistencia a largo plazo. Los datos en sesión en la capa en tiempo real se pueden enjuagar al establecimiento de baja latencia para un acceso rápido posterior. Por ejemplo, en una plática de agente, los mensajes recientes pueden procesarse en memoria; los mensajes antiguos pueden enjuagarse en el LLS. Si se requiere una plática anterior, se puede acceder a ella en unos milisegundos desde el LLS. El almacenamiento basado en NVMe permite almacenar grandes cantidades de datos y acceder a ellos en latencias de milisegundos. Los datos pueden llegar al lago para la persistencia a largo plazo.
Además, los datos del lago necesarios para el procesamiento en tiempo real o para aumentar las experiencias en tiempo real se recuperan y se mantienen en el LLS. Por ejemplo, el contexto de perfil de cliente se obtiene previamente o se trae desde el lago y se almacena en caché en el LLS. Del mismo modo, cualquier objeto de lago y otros objetos requeridos para el procesamiento en tiempo real durante el procesamiento en sesión también se pueden almacenar en caché en la LLS. El LLS activa una capa en tiempo real en una verdadera jerarquía de almacenamiento con capas de almacenamiento de memoria, SSD y Lakehouse, con datos que migran sin problemas entre cada una.
Data 360 también ofrece una sólida cobertura para la seguridad, incluyendo Cifrado a nivel de arrendatario (TLE) con claves gestionadas por clientes, así como privacidad y cumplimiento a través de sus tecnologías de gobernanza. En el núcleo está la compatibilidad con el control de acceso basado en atributos (ABAC), que evalúa dinámicamente el acceso basándose en atributos relacionados con entidades, operaciones y factores medioambientales. Este sistema admite controles de acceso discrecionales y obligatorios.
Complementando ABAC, un sistema de clasificación de datos detallado categoriza los datos por confidencialidad y propósito, mejorando el cumplimiento, la gestión de riesgos y la respuesta ante incidentes. Juntos, ABAC y este sistema de clasificación proporcionan una regulación de datos integral, garantizando que los datos en Data 360 se gestionan de forma segura y eficiente.
#### Metadata-driven
Data 360 se integra profundamente con Salesforce Platform para metadatos, empaquetado, capacidad de ampliación, experiencia de usuario y distribución de aplicaciones mediante AppExchange. Los clientes pueden definir y gestionar los metadatos para tablas y transmisiones de Lakehouse, justo como otros metadatos de Salesforce. Cada objeto de datos (incluyendo tablas federadas o externas) se representa como un objeto de Salesforce y se modela como entidades virtuales respaldadas por almacenamiento de datos en Data 360. Los desarrolladores pueden utilizarlos para crear aplicaciones en Salesforce Platform.
#### Federación de copia cero y capacidad de ampliación
Data 360 ofrece una amplia cobertura para la federación de copia cero, permitiendo a los usuarios integrar con almacenes de datos externos como Snowflake y Redshift, lagos como Google BigQuery, Databricks y Azure Fabric, así como bases de datos SQL y varios tipos de archivos incluyendo Excel. Data 360 admite la federación basada en archivos y consultas, con consulta en vivo y aceleración de acceso como se muestra en la figura. Las etiquetas (1) y (2) ilustran la consulta de Data 360 (incluyendo envíos de consultas en vivo) y la federación basada en archivos para acceder a datos desde lagos de datos/almacenes/orígenes de datos externos; y la etiqueta (3) resalta la aceleración del acceso federado desde lagos de datos/orígenes de datos externos. Las etiquetas (4) y (5) ilustran la colaboración basada en consultas y archivos de datos desde Data 360 con lagos/almacenes de datos externos. La capacidad también se amplía a orígenes de datos no estructurados como Slack y Google Drive, a los que pueden acceder las oportunidades en curso de procesamiento no estructurado de Data 360. Además, Data 360 facilita la extracción de objetos de Salesforce y el acceso a datos para datos federados desde orígenes externos, permitiendo el acceso a dichos datos en la plataforma y las aplicaciones Salesforce.
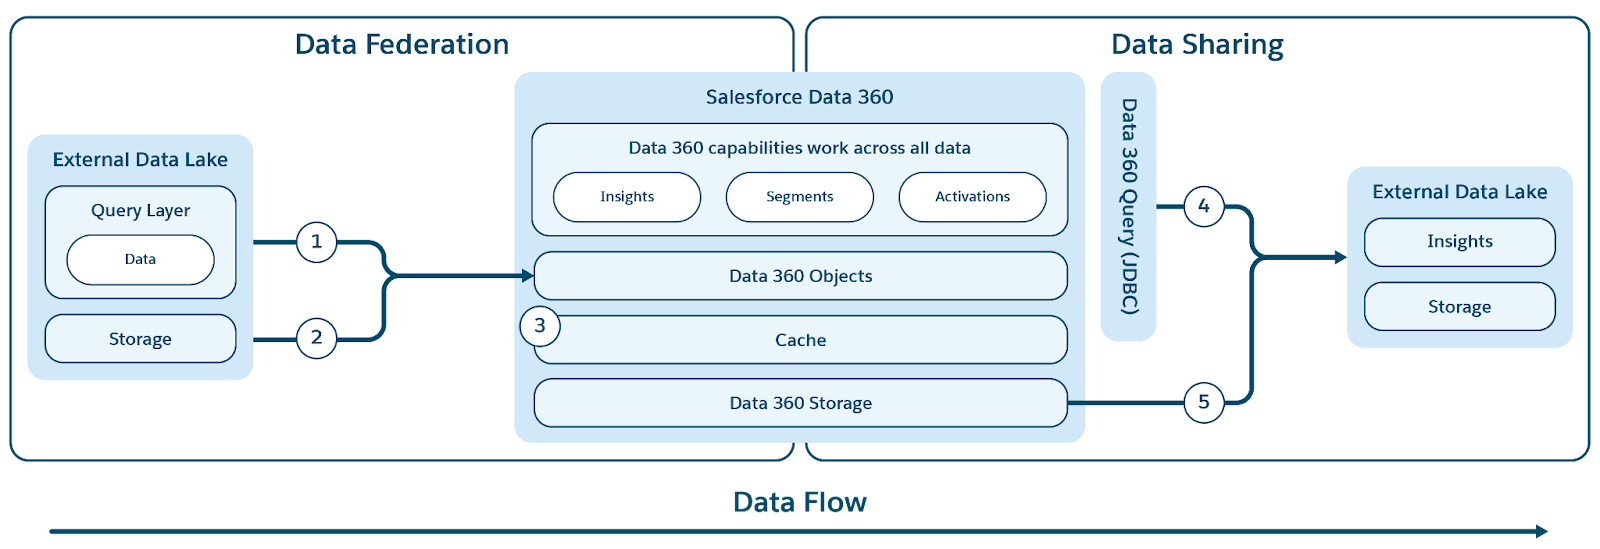 #### Customer Data Platform (CDP)
Data 360 integra un CDP que cuenta con funciones avanzadas de resolución de identidad, creando perfiles e identificadores individuales unificados junto con historiales de implicación integrales. Esta plataforma es experta en la gestión de marcos de trabajo de negocio a negocio (B2B) y de negocio a consumidor (B2C) admitiendo gráficos de identidad que utilizan reglas de coincidencia exactas y parciales. Estos gráficos de identidad están enriquecidos con datos de implicación de varios canales, lo que ayuda a crear gráficos de perfil detallados con perspectivas analíticas y segmentos valiosos.
Además, el CDP permite la segmentación y activación efectivas entre diferentes plataformas como Marketing Cloud, Facebook y Google de Salesforce. Procesa perfiles de clientes por lotes, casi en tiempo real y en tiempo real, lo que permite la personalización y la toma de decisiones inmediatas. Esta función mejora las interacciones en escenarios B2C y B2B, garantizando que los negocios puedan responder de forma rápida y precisa a las necesidades y comportamientos de los clientes.
#### Gráficos de datos
Data 360 ofrece un gráfico de datos de compañía en formato JSON, que es un objeto desnormalizado derivado de varias tablas de Lakehouse y sus interrelaciones. Esto incluye un gráfico de datos de "Perfil" creado por CDP que abarca el historial de compras y exploración de una persona, el historial de casos, el uso de productos y otras perspectivas calculadas, y es ampliable por clientes y socios. Estos Gráficos de datos están adaptados a aplicaciones específicas y mejoran la precisión de solicitudes de IA generativa proporcionando contexto de cliente o usuario relevante.
Además, existen planes para ampliar estos Gráficos de datos para incluir Gráficos Knowledge que capturan y modelan Knowledge derivado, como entidades extraídas y relaciones desde datos no estructurados. La capa en tiempo real de Data 360 utiliza el gráfico Perfil para la personalización y segmentación en tiempo real.
#### Capa en tiempo real
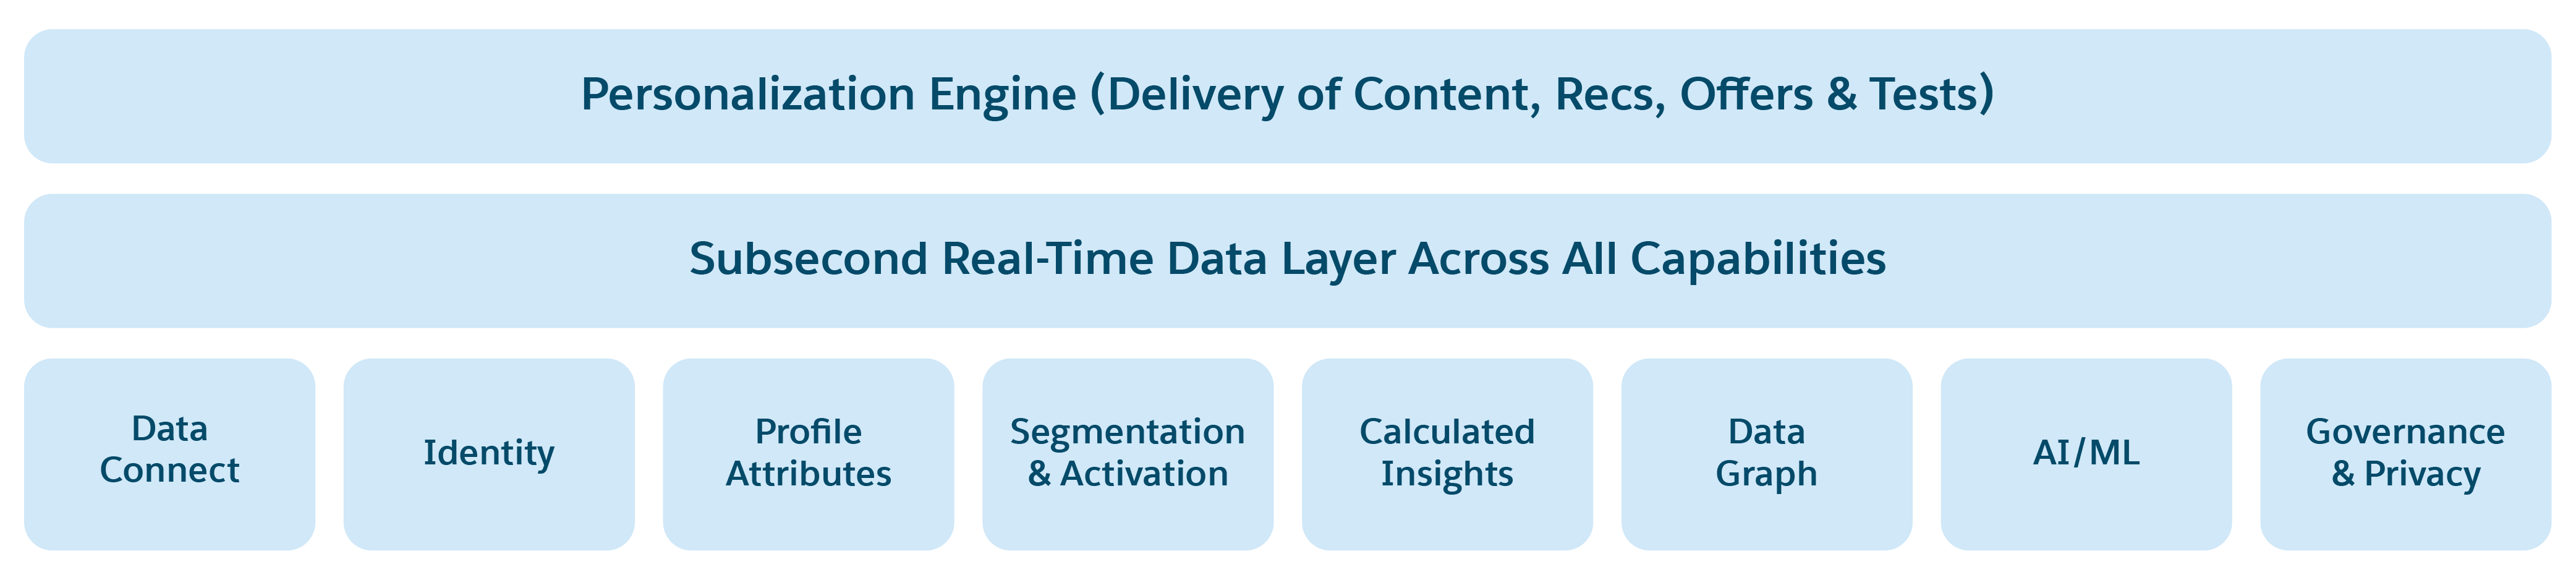 La capa en tiempo real de Data 360 está diseñada para procesar eventos como transmisiones de clics web y móviles, visitas, datos de carritos y pasos por caja en latencias de milisegundos, mejorando la personalización de la experiencia del cliente. Monitorea continuamente la implicación de clientes y actualiza el perfil de clientes desde CDP con datos de implicación en tiempo real, segmentos y cálculos para una personalización inmediata.
Por ejemplo, cuando un consumidor adquiere un artículo en un sitio web de compras, la capa en tiempo real detecta e ingresa rápidamente este evento, identifica al consumidor y enriquece su perfil con información de gasto de toda la vida actualizada. Esto permite la personalización de su experiencia en el sitio en subsegundos. Además, esta capa incluye funciones para desencadenar y responder en tiempo real, lo que permite acciones inmediatas basadas en interacciones de clientes.
#### Personalización
La personalización es saber a qué persona dirigirse, cuándo y dónde entregar contenido y recomendaciones relevantes, qué decir y con qué frecuencia. La función Plataforma de servicios de personalización de Data 360 es el orquestador del que se toman decisiones para optimizar el logro de objetivos a través de experiencias personalizadas. Esta plataforma proporciona las siguientes funciones:
- Conjunto coherente de modelos y formas de interpretar datos de perfil, actividad y activo en Data 360.
- Experimentación integrada en plataforma (por ejemplo, A/B/n o toma de decisiones de bandidos de múltiples brazos).
- Integración de objetivos en tiempo de diseño a través de configuración, tiempo de entrenamiento de ML y tiempo de ejecución (inferencia de ML).
- Compatibilidad con escala B2C, tiempo real e interacción por lotes (usuarios anónimos, externo interactivo/en tiempo real de gran volumen, lote interno de gran volumen).
- Analytics dirigido por Data 360.
- Patrones para integrar modelos de IA y servicio de otras partes (tanto internas como externas).
- Implementaciones de OOTB de casos de uso dirigidos por IA de alto valor (recomendaciones y decisiones con varios algoritmos de ML, incluyendo bandas contextuales para la selección de promociones/contenidos, recomendaciones de productos y decisiones de precios).
#### Acciones de datos
Data 360 es una plataforma activa que admite la activación de oportunidades en curso en respuesta a eventos de datos. Por ejemplo, un evento significativo, como una caída en el saldo de cuenta de un cliente, puede desencadenar un flujo de Salesforce para orquestar una acción correspondiente. Del mismo modo, las actualizaciones en mediciones clave, como el gasto de toda la vida, se pueden propagar automáticamente a aplicaciones relevantes.
#### Tela de cálculo de datos
Data 360 cuenta con clústeres de cálculo de escala elásticos que gestionan de forma eficiente tareas de procesamiento. Ofrece una gestión sólida tanto para entornos informáticos de múltiples arrendatarios como dedicados. Además, proporciona asistencia gestionada para Spark y SQL. Las funciones BYOC (Bring Your Own Compute/Code) admiten múltiples lenguajes de programación, incluyendo Java, Python y Spark, permitiendo la integración de transformaciones personalizadas, modelos (incluyendo LLM) y funciones, mejorando la capacidad de ampliación.
Data 360 Compute Fabric proporciona una capa unificada conocida como Controlador de procesamiento de datos (DPC) para gestionar y ejecutar todas las cargas de trabajo de Big Data. DPC es un servicio de orquestación de procesamiento de datos integral y con múltiples cargas de trabajo que proporciona funciones de trabajo como servicio (JaaS) entre diversos entornos de computación en nube. Abstrae la complejidad de la infraestructura y unifica la ejecución de trabajos para marcos de trabajo como Spark (EMR en EC2 y EMR en EKS) y cargas de trabajo de Controlador de recursos de Kubernetes (KRC). Al servir como una pasarela de plano de control centralizada, DPC orquesta, programa y monitorea trabajos entre múltiples planos de datos, garantizando fiabilidad, capacidad de ampliación, eficiencia de costos y una experiencia de desarrollador coherente.
#### Consultas unificadas
El Servicio de consultas de Data 360 proporciona funciones de consulta avanzadas, con amplia cobertura de SQL para datos estructurados y no estructurados a través de Trino e Hyper. Mejora la funcionalidad con capacidad de ampliación de operadores a través de Funciones de tabla, permitiendo diversas operaciones de búsqueda entre texto, imagen, espacio y otros tipos de datos no estructurados. Estas funciones se integran perfectamente con operaciones relacionales, como la selección de registros de clientes. Este enfoque unificado permite la generación de resultados dirigidos y personalizados, facilitando respuestas LLM más precisas utilizando RAG.
#### Procesamiento de datos no estructurado
Data 360 admite el almacenamiento y la gestión de datos estructurados (tablas), semiestructurados (JSON) y no estructurados de forma transparente entre mecanismos de ingreso, procesamiento, indexado y consulta de datos. Data 360 admite varios tipos de datos no estructurados más allá del texto, incluyendo audio, video e imágenes, ampliando el ámbito de la gestión y el análisis de datos. La figura siguiente ilustra los dos lados de la fundamentación (ingesta y recuperación).
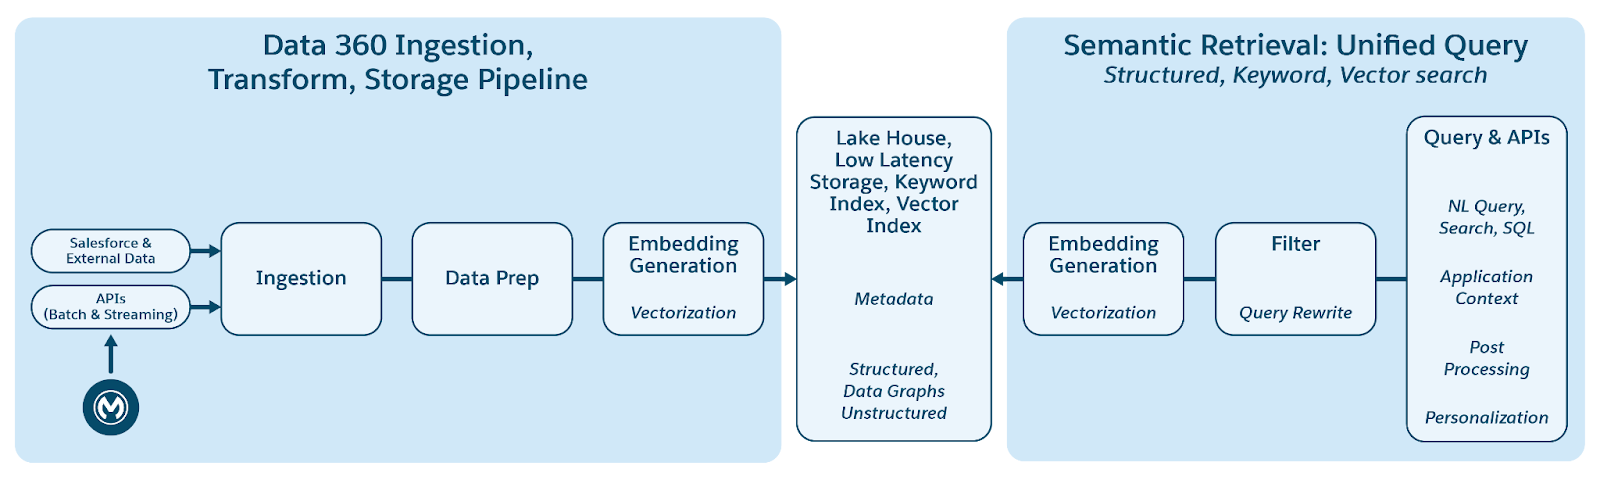 Data 360 gestiona datos no estructurados almacenándolos en columnas como texto o en archivos para conjuntos de datos más grandes. Admite la federación de datos para contenido no estructurado, lo que permite la integración y gestión de datos desde múltiples orígenes.
Las oportunidades en curso de indexación de datos no estructuradas de Data 360 están diseñadas como una arquitectura modular ampliable que comprende cinco etapas principales: Análisis, preprocesamiento, fragmentación, postprocesamiento e integración. A continuación, estas etapas van seguidas de indexación de palabras clave y vectores. Algunos ejemplos de procesamiento previo incluyen operaciones como la eliminación de ruido, la normalización de idiomas y la comprensión de imágenes (Reconocimiento óptico de caracteres), mientras que las etapas de procesamiento posterior pueden incluir enriquecimiento de metadatos, agrupación semántica o técnicas avanzadas como fragmentación.
Data 360 proporciona múltiples modelos listos para su uso y conectables para la generación de fragmentos e incrustaciones. Las oportunidades en curso de datos en Data 360 admiten completamente extensiones de código, permitiendo a los clientes y equipos internos conectar lógica personalizada en cualquier etapa. Estas etapas también admiten el procesamiento basado en LLM, que permite a los clientes definir sus propias solicitudes según sea necesario.
Para el indexado, Data 360 admite el indexado de palabras clave utilizando servicios de búsqueda y el indexado vectorial utilizando Milvus; un índice vectorial nativo de código abierto. Para la configuración de RAG con procesamiento no estructurado, Data 360 aprovecha el indexado de contexto para permitir una iteración rápida y una validación rápida utilizando consultas de prueba de muestra, con contenido específico de la persona configurado para adaptarse a la persona o usuario que consume.
La función IA de documentos de Data 360 admite la lectura e importación de datos no estructurados o semiestructurados desde documentos como facturas, currículums, reportes de laboratorio y pedidos de compra. Esta función admite procesamiento interactivo ad-hoc, así como procesamiento por lotes masivo. Esta es una función clave que permite la automatización de procesos de negocio para nuestros clientes.
#### Capa semántica
Data 360 cuenta con una Capa semántica desatendida con API diseñadas para mejorar la semántica de negocio y los análisis dirigidos por IA/ML, similares a Tableau Next. Esta capa incluye un servicio de modelado de datos semántico que enriquece los modelos analíticos tradicionales con taxonomía de negocio como mediciones y mediciones.
Su servicio de consultas semánticas utiliza un lenguaje declarativo para interactuar con estos modelos, traduciendo consultas a SQL para acceder a datos desde orígenes de datos nativos y federados en Data 360.
Esta integración facilita exploraciones analíticas, reportes y tableros escalables e interactivos, compatibles con herramientas de visualización externas.
#### Gobernanza de datos
Data 360 funciona como un núcleo de gobernanza centralizado, garantizando que todos los datos, desde el ingreso sin procesar a las perspectivas activadas, se gestionan con integridad y control. Data 360 adoptó Control de acceso basado en atributos como su modelo de autorización principal. ABAC permite que las decisiones de acceso se basen en atributos del usuario (departamento, función, ubicación), datos (información personal, confidencialidad, espacio de datos) y entorno (por ejemplo, hora del día), en vez de funciones predefinidas. Esto permite políticas de acceso altamente granulares y contextuales que se adaptan a medida que cambian los datos y los atributos de usuario. En el centro de la implementación de ABAC de Data 360 está el uso del lenguaje de políticas CEDAR. Este lenguaje de políticas formal de código abierto creado específicamente proporciona una forma precisa y verificable de definir reglas de autorización complejas, garantizando que las políticas son inequívocas y se pueden evaluar coherentemente a escala.
El ciclo de vida de la gobernanza incluye funciones clave relativas a la información de políticas, la aplicación y los puntos de decisión:
- **Etiquetado y clasificación (Punto de información de política):** Los datos se identifican y enriquecen con atributos críticos. Data 360 proporciona mecanismos de etiquetado y clasificación automatizados, aprovechando el descubrimiento, los LLM y el aprendizaje automático para identificar categorías de datos confidenciales (por ejemplo, información de identificación personal como email, teléfono, nombre) en datos estructurados y no estructurados.
- **Servicio de autorización (Punto de aplicación de políticas):** Este servicio intercepta todas las solicitudes de acceso a datos desde varias capas de consumo (consultas estructuradas/no estructuradas híbridas, solicitudes y recuperadores de RAG y enriquecimiento de CRM) y consulta el Punto de decisión de política para determinar si el acceso está permitido.
- **Motor de evaluación de políticas (Punto de decisión de política):** Este motor toma el contexto de solicitud de acceso desde el Punto de aplicación de políticas, junto con definiciones de políticas (en CEDAR) y atributos desde el Punto de información de políticas, para tomar una decisión de acceso autorizada.
El marco de trabajo de ABAC con políticas de CEDAR proporciona control y flexibilidad, garantizando que los datos de los clientes no solo sean sobre los que se pueden realizar acciones, sino que también sean seguros, compatibles y fiables en toda la compañía.
### 6.3 Almacenamiento en caché de datos
Los cachés son esenciales para un acceso rápido a datos utilizados frecuentemente. Salesforce utiliza muchas caché en Salesforce Platform, incluyendo en Servidores de aplicaciones principales, SalesforceDB y Edge. Salesforce Platform y las aplicaciones necesitan una solución de caché ampliable y consciente del arrendatario con baja latencia y alto rendimiento. Esta solución debe permitir a los ingenieros de Salesforce controlar qué se almacena en caché y durante cuánto tiempo, garantizando que sus datos no se desalojen por ruido del sistema u otros datos de clientes. Vegacache, un servicio de caché gestionado por Salesforce basado en Redis, está diseñado para un entorno políglota, multiarrendatario y de nube pública. Es ampliamente utilizado por servicios de Salesforce y accesible para desarrolladores de plataforma a través de API de lenguaje de programación Apex. Operando a escala en Hyperforce, a fecha de redacción, Vegacache gestiona más de 2 billones de solicitudes diariamente con tiempos de respuesta de menos de milisegundos.
Las instancias de Vegacache, que se ejecutan en contenedores Kubernetes a los que se accede a través de Service Mesh, se implementan entre múltiples Zonas de disponibilidad para equilibrar la disponibilidad y la latencia de los datos. Se amplía automáticamente basándose en la carga del sistema, garantizando la disponibilidad de datos y la conservación de pedidos de divisiones. Vegacache proporciona un tamaño de caché garantizado por cliente y ofrece protección contra vecinos ruidosos, con resiliencia contra fallos de infraestructura a través del almacenamiento de datos replicado.
Para los desarrolladores de Salesforce Platform, Vegacache hace posible que los desarrolladores almacenen en caché los resultados de consultas de la base de datos de objetos Apex y SOQL, reduciendo el uso y la latencia de CPU eliminando las recuperaciones de datos innecesarias desde SalesforceDB. Admite operaciones Put(), Get() y Delete(), manteniendo los objetos utilizados frecuentemente accesibles.
### 6.4 Procesamiento de datos asíncrono
Salesforce admite de forma nativa arquitecturas y procesos de datos asíncronos para una flexibilidad, resiliencia y escalabilidad mejoradas del flujo de trabajo.
Los ingenieros de Salesforce primero aprovecharon las colas de mensajes para desvincular procesos de datos masivos y de gran tamaño, así como coordinar procesos entre sistemas independientes. Estas colas de mensajes se extrajeron del desarrollador externo a través de funciones de plataforma, como consultas de API masiva o Apex asíncrono. Salesforce Platform presentó a continuación transmisiones de eventos organizados por registro construidas sobre una sólida infraestructura de mensajería de clústeres de Apache Kafka gestionados internamente. Esto activó una arquitectura basada en eventos con un modelo de interacción publicar/suscribir y se produjo para desarrolladores externos como Eventos de plataforma.
Tanto las colas de mensajes como las transmisiones de eventos continúan siendo tecnologías altamente aprovechadas de aplicaciones y soluciones construidas en la plataforma, especialmente porque aprovechan más funciones, nubes y sistemas externos alojados en tiempos de ejecución independientes. La comunicación a través de esquemas de eventos versionados permite ciclos de vida de desarrollo de software independientes para los diferentes tiempos de ejecución. El desacoplamiento de sistemas a través de eventos también ayuda a gestionar picos de carga y elasticidad/escala de tiempos de ejecución individuales para admitir una mayor resiliencia y disponibilidad general de una aplicación.
### 6.5 Búsqueda de compañía
Las funciones de búsqueda en Salesforce, cruciales para aplicaciones que van desde la búsqueda global a la IA generativa, se enfrentan a retos exclusivos que dan forma a nuestro enfoque arquitectónico:
- **Escala**: Con cientos de miles de clientes y millones de arrendatarios, nuestra solución de búsqueda nativa de nube está diseñada para una escala masiva sin dejar de ser rentable.
- **Diversidad de clientes**: La diversa base de clientes de Salesforce entre varias industrias tiene requisitos de búsqueda exclusivos y complejos debido a la amplia personalización de la plataforma, que implica numerosos tipos de objetos y campos.
- **Funcionamiento**: La solución de búsqueda debe ser resistente y altamente disponible, compatible con la residencia de datos, operaciones del ciclo de vida de arrendatarios como migraciones regionales y sandboxing, y mantener una latencia de indexación baja con equidad entre arrendatarios.
- **Relevancia a escala**: Mejorar la relevancia de los resultados de búsqueda para cumplir diversas consultas de usuarios es fundamental, especialmente cuando ampliamos algoritmos de relevancia para acomodar varios arrendatarios, tipos de datos y escenarios de búsqueda.
- **AI y funciones semánticas**: La búsqueda admite el aprendizaje automático y la IA generativa, en particular para Recuperación de generación aumentada (RAG) y Búsqueda de agentes.
- **Integración sencilla**: Para garantizar una experiencia de usuario cohesionada, la tecnología de búsqueda de Salesforce se integra profundamente con Salesforce Platform más amplia, incluyendo modelos de metadatos y servicios de IA/datos.
La solución nativa de la nube de Salesforce, SeaS (Búsqueda como servicio), está construida sobre Solr, un motor de búsqueda distribuido de código abierto. Salesforce amplió y optimizó significativamente Solr para responder a nuestros desafíos exclusivos y la integró profundamente con aplicaciones y plataforma de Salesforce, incorporando tecnologías semánticas para mejorar las aplicaciones de IA y la relevancia de las búsquedas.
SeaS emplea una arquitectura de separación de computación/almacenamiento, permitiendo una distribución ampliable de índices entre nodos y reequilibrando cargas y disponibilidad entre zonas durante fallos. Cuenta con fragmentación automática y cambio de tamaño de fragmentos, actualizaciones de tiempo de inactividad cero y optimizaciones como carga perezosa de réplica y archivado para atender a índices utilizados rara vez.
La arquitectura también incluye una implementación de índice de bajo nivel optimizada para un gran número de campos, relleno automático, corrección ortográfica y cifrado de traer su propia clave. Gestionando alrededor de 6.000 nodos solares en todo el mundo, la infraestructura de búsqueda Hyperforce utiliza múltiples clústeres independientes (células Hyperforce) en cada región para equilibrar el costo y el control, colocando automáticamente índices de clientes basándose en carga, dominio y tipo.
Las oportunidades en curso de relevancia de búsqueda de Salesforce emplean técnicas de aprendizaje para clasificar, adaptándose a las diversas necesidades de nuestros clientes y funciones de asistencia como la clasificación de resultados. También incluye predicciones de entidades desde consultas de usuario e interacciones pasadas. Los modelos de relevancia se perfeccionan continuamente aprendiendo de interacciones de usuarios y se evalúan a través de pruebas A/B, mejorando la precisión de los resultados de búsqueda. Este proceso también admite modelos de arranque para aplicaciones de IA mediante transferencia Knowledge.
La pila incorpora un motor de búsqueda vectorial para aplicaciones de búsqueda semántica e IA, integrado con Data 360 para funciones de IA generativa. Esto incluye una canalización integral para la transformación de datos, compatibilidad de búsqueda híbrida, un catálogo de clasificadores configurables, como Deep Fusion Ranker y Suelte automático para filtrar resultados de búsqueda de baja relevancia.
Como la IA generativa está desplazando el consumidor principal de servicios de búsqueda de usuarios humanos a utilizar LLM, la pila de búsqueda de Salesforce se está adaptando para buscar y devolver resultados optimizados para este consumo programático, tratando con consultas más largas y complejas y devolviendo resultados más descriptivos como fragmentos. Esto admite nuevas funciones de Búsqueda de agentes, donde los agentes Agentforce aprovechan la búsqueda con un bucle de razonamiento para realizar tareas complejas.
Las funciones de búsqueda de Salesforce abarcan varios contextos, incluyendo búsqueda global, búsquedas, Búsqueda de respuestas, búsqueda de comunidad, listas relacionadas, configuración, aplicaciones móviles y de IA generativa. Esta amplia funcionalidad se logra a través de una estrecha integración de la pila Búsqueda con el sistema de metadatos de Salesforce y el ecosistema de la interfaz de usuario, lo que permite una compatibilidad sencilla con objetos estándar y personalizados.
Además, la integración con Data 360 mejora las funciones de búsqueda en objetos de datos a través de configuraciones sin código y permite la composición de funciones de búsqueda en oportunidades en curso de datos, como la inclusión de declaraciones de búsqueda en consultas SQL. La pila Búsqueda aprovecha el ecosistema de conectores enriquecidos de Data 360, como el conector con permiso de Google Drive, para proporcionar una capacidad de búsqueda de compañía completa. La integración se amplía a la plataforma de IA, permitiendo que las consultas de búsqueda se utilicen como recuperadores en Generador de solicitudes para fundamentación y en Búsqueda de agentes.
## 7\. IA y Agentforce
La IA ha remodelado el panorama tecnológico y Salesforce Platform, con su capa de datos integrada y enriquecida, posiciona Salesforce para entregar experiencias de IA impactantes a los clientes. Salesforce comenzó su transformación de IA hace casi una década y ha liderado el campo desde 2013, centrándose en la investigación, la ética y el desarrollo de productos para capacitar a los negocios para resolver problemas complejos e impulsar el crecimiento.
Aprovechando el valor principal de Innovación, Salesforce presentó IA predictiva Einstein, permitiendo a los negocios analizar datos, automatizar procesos, comprender clientes y optimizar operaciones con un conjunto integral de herramientas con tecnología de IA como Generador de predicciones Einstein y bots de IA. Con el auge de la IA generativa, Salesforce lanzó Agentforce, una plataforma que combina modelos predictivos y generativos para ofrecer funciones de IA avanzadas mientras prioriza la privacidad de los datos.
Con el lanzamiento más reciente de Agentforce 3.0, construido en Python con un marco de trabajo dirigido por eventos, Salesforce presenta flexibilidad mejorada a través de funciones como historial de pláticas integrado, rastreo de sesiones de extremo a extremo, asistencia de voz y funciones del motor de razonamiento personalizado (Aportar su propio planificador), permitiendo sistemas de múltiples agentes más ampliables, personalizables e inteligentes.
### 7.1 Principios básicos de IA
Agentforce sigue estos principios principales:
- **Seguridad y ética**: de los datos Da prioridad a la protección de datos, el cumplimiento y los principios éticos de la IA.
- **Transparencia y capacidad de explicación**: Ofrece una comprensión y validación claras de resultados generados por IA.
- **Flexibilidad y personalización**: Adapta aplicaciones de IA a necesidades e industrias específicas.
- **Integración sencilla**: Se integra con Salesforce CRM y otros sistemas.
- **Escalabilidad**: Gestiona implementaciones a gran escala y entrega experiencias de IA en tiempo real.
- **Experiencias inteligentes y coherentes**: Proporciona experiencias personalizadas, aumentadas y automatizadas a través de datos conectados y comprensión contextual.
- **Observabilidad integral:** Proporciona visibilidad profunda y monitoreo de interacciones de agentes de IA para permitir la optimización proactiva y el ajuste de agentes utilizando Agentforce Interaction Explorer.
### 7.2 Descripción general de la arquitectura
 La pila de IA consta de varios componentes clave:
- **AI Platform**: Esta capa de plataforma es responsable de gestionar, entrenar y ajustar modelos de IA utilizados en aplicaciones predictivas y generativas. Ofrece servicios listos para su uso (OOTB), Trust Services y modelos fundacionales para entrenamiento, pruebas y realización de inferencias en modelos. Adicionalmente, admite la integración de sus propios modelos predictivos y generativos, permitiéndole aportar modelos personalizados dentro de la plataforma.
- **Servicios fundacionales de IA**: Esto incluye los servicios Pasarela de IA, Marco de trabajo de comentarios, RAG, Orquestación de agentes, Evaluación de agentes y Razonamiento, que facilitan la integración de aplicaciones de negocio con la pila de IA.
- **Experiencias de usuario y agente con tecnología de IA**: Salesforce entrega aplicaciones especializadas con tecnología de IA a través de sus servicios en la nube. Los clientes también pueden crear experiencias personalizadas aprovechando cualquier componente de la plataforma (como Flow, Apex o incluso Componentes web Lightning (LWC)) para crear experiencias con tecnología de IA integradas a la perfección en sus flujos de trabajo y procesos de negocio.
- **Agenteforce Studio**: Este componente cuenta con herramientas como Generador de agentes, Generador de solicitudes, Centro de pruebas y Generador de modelos, diseñadas para crear experiencias de IA generativa y predictiva. Ofrece asistencia integral para el desarrollo/entrenamiento, pruebas y ajuste de modelos de IA. Next Gen Authoring mejora estas funciones, diseñadas para simplificar y acelerar la creación de agentes de IA con UX mejorado y compatibilidad con SFDX.
### 7.3 Componentes fundamentales
#### Capa Agentforce Trust
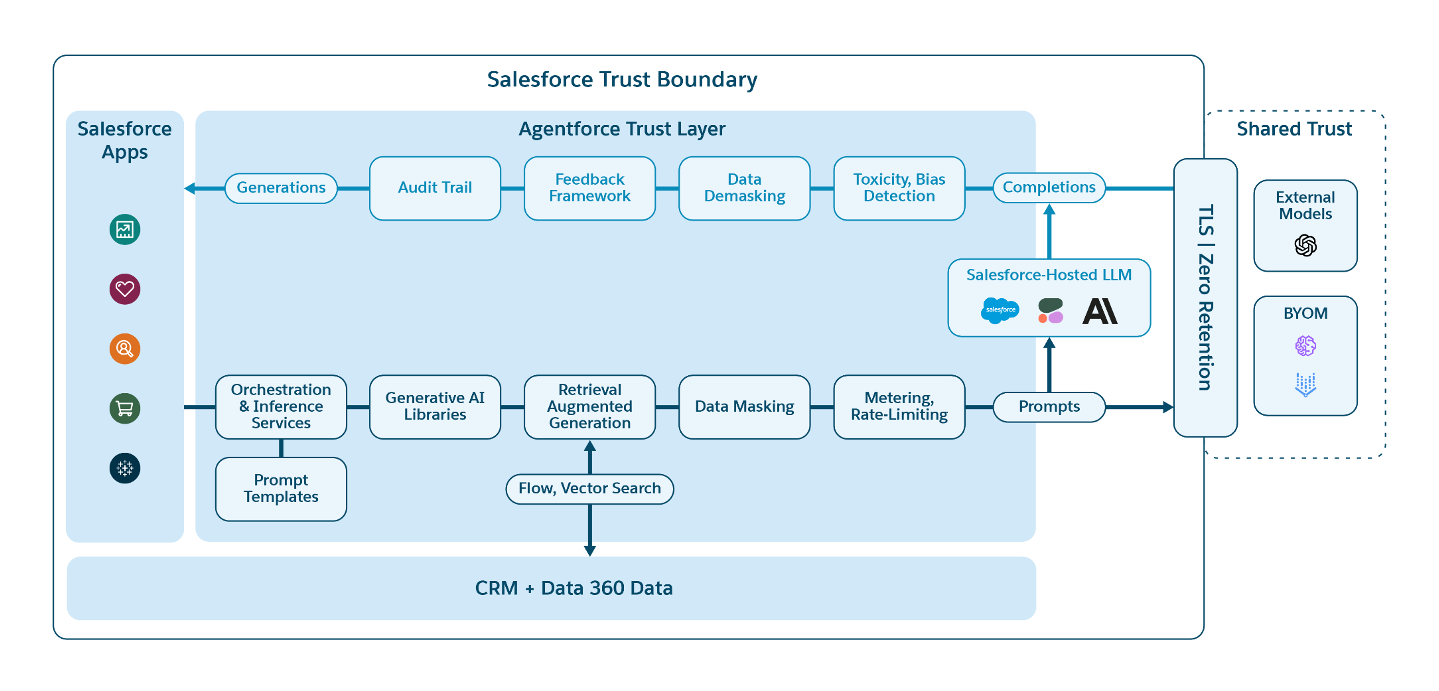 Agentforce Trust Layer está disponible en casos de uso seleccionados para ayudar a salvaguardar datos de clientes en aplicaciones de IA generativa ofreciendo funciones sólidas:
- **Privacidad de datos**: Los sólidos controles de privacidad y enmascaramiento protegen la información confidencial del acceso a modelos de IA externos.
- **Seguridad**: Garantiza un entorno de procesamiento de datos seguro y evita el acceso no autorizado.
- **Confianza**: Mantiene el control del cliente sobre los datos, sin almacenamiento o uso de IA externa.
- **Barandillas:** Aplique estándares de comportamiento de agentes y mitigue el no determinismo inherente de los LLM, los agentes verificadores siguen de forma coherente instrucciones y flujos de trabajo predefinidos.
- **Precisión**: Mejora las salidas de IA utilizando datos relevantes de Salesforce para fundamentar solicitudes.
- **Moderación de contenido**: Ofrece moderación previa y posterior al contenido, enmascaramiento de datos personalizable para información confidencial (PII/PCI/PHI) y clasificación de toxicidad para respuestas de modelo de lenguaje grande (LLM).
#### Pasarela de IA Agentforce
La pasarela de IA proporciona una interfaz unificada para acceder y gestionar varios modelos predictivos y LLM. Actúa como un puente entre Salesforce y el mundo de los LLM, abstrayendo las complejidades de diferentes proveedores de LLM y los modelos de IA predictiva de los propios clientes, ofreciendo una forma coherente de interactuar con ellos. La pasarela de IA Agentforce se integra con múltiples proveedores de LLM, permitiendo a los clientes elegir el mejor modelo para sus necesidades, e incorpora sólidas medidas de seguridad de datos para ayudar a gestionar los costos asociados con el uso de diferentes LLM.
Servicio de comentarios es un componente que recopila, analiza, mide y utiliza comentarios de usuarios para volver a entrenar y refinar modelos de IA. Desempeña un papel crucial en la mejora continua de funciones y funciones dirigidas por IA en Salesforce Platform.
#### Recuperación de generación aumentada (RAG)
RAG es una técnica vital que mejora las funciones de búsqueda con IA generativa, lo que lleva a respuestas más informativas y precisas. Utilizando la amplia Salesforce Data 360 y la base de datos de vectores integrada, la plataforma Agentforce recupera rápidamente datos relevantes para la consulta de un usuario. Estos datos se utilizan a continuación como base para que los LLM generen respuestas óptimas.
Además, este método potencia la velocidad de respuesta y la Trust del usuario incluyendo datos de origen en respuestas. RAG se emplea ampliamente en la plataforma Agentforce, particularmente para aplicaciones como Agentforce para Servicio y Agentforce para ventas, resaltando cómo aflora información relevante para estos casos de uso.
### 7.4 Plataforma Agentforce
A medida que avanzan los modelos de IA, el siguiente paso es el desarrollo de agentes para automatizar tareas que requieren razonamiento. Estos agentes sirven como asistentes inteligentes, capaces de comprender y responder a consultas en lenguaje natural, permitiendo a los usuarios diseñarlas, probarlas e implementarlas para varias tareas. Un componente crucial de este sistema es el Servicio de planificación, que funciona del siguiente modo:
- **Solicitud de usuario de intérpretes**: Analiza la entrada del usuario para determinar la intención.
- **Cree un plan**: Formula un plan estructurado para tratar las necesidades del usuario.
- **Inicia acciones**: Ejecuta el plan iniciando acciones directamente o a través de otros servicios.
El Servicio de planificación orquesta el proceso, garantizando que el agente cumple de forma eficiente las solicitudes de los usuarios gestionando y ejecutando los pasos necesarios.
#### Agentforce
Agentforce representa una plataforma para la creación de agentes, permitiendo a los clientes e ISV crear agentes de IA automatizados para aplicaciones como Agentes de servicio y Agentes de ventas. Estos agentes pueden procesar y responder a consultas de clientes de una manera natural y humana, gestionando un amplio espectro de tareas de negocio y entregando beneficios significativos tanto a los negocios como a sus clientes.
El flujo de trabajo de un agente incluye:
- **Activación**: El agente se desencadena por criterios predefinidos como la solicitud de un cliente entre varios canales.
- **Comprender y responder**: Emplea Procesamiento de lenguaje natural (NLP) para captar la consulta, la intención y la opinión del cliente, luego consulta la base de Knowledge u otras fuentes de datos de Salesforce para elaborar una respuesta apropiada.
- **Tratamiento de complejidades**: Si se enfrenta a un problema complejo o necesita supervisión humana, el agente puede transferir sin problemas la interacción a un agente humano.
- **Aprendizaje continuo**: El agente aprende de cada interacción, mejorando continuamente sus respuestas y desempeño general.
#### Agentforce Studio
Agentforce Studio proporciona una plataforma de código bajo que permite a los clientes integrar la IA en sus aplicaciones y flujos de trabajo de Salesforce, haciendo que la tecnología de IA sea accesible más allá de los científicos de datos.
Las funciones clave del estudio incluyen:
- **Generador de modelos**: Permite crear o importar modelos de IA adaptados a necesidades de negocio específicas.
- **Generador de solicitudes**: Una herramienta sin código/con código bajo que facilita la creación y gestión de solicitudes de IA generativa, mejorando la experiencia del usuario con una interfaz sencilla para crear, probar e implementar solicitudes.
- **Generador de agentes**: Permite a clientes e ISV desarrollar agentes conversacionales y autónomos personalizados.
- **Centro de pruebas**: Admite pruebas de modelos, solicitudes y agentes, cruciales para garantizar aplicaciones de IA de alta calidad y optimizar el desempeño y la rentabilidad, mientras mejora las respuestas deterministas y la calidad de la experiencia del usuario.
Agentforce combina IA predictiva y generativa, aprovechando el marco de trabajo de metadatos unificado de Salesforce Platform y Data 360 para entregar soluciones de negocio inteligentes, personalizadas y efectivas.
### 7.5 La siguiente evolución: Agentforce 3.0
Para satisfacer las demandas cada vez mayores del mercado de IA generativa, incluyendo los rápidos avances en el razonamiento, la necesidad de sistemas de múltiples agentes ampliables y el cambio hacia interfaces multimodales, Salesforce está evolucionando su arquitectura con Agentforce 3.0. Esta plataforma de próxima generación se basa en varios avances clave:
- **Arquitectura asíncrona dirigida por eventos:** Agentforce 3.0 está construida sobre una base Python con un marco de trabajo dirigido por eventos mejorado. Esto permite la implementación de agentes asíncrona y altamente ampliable, mejorando el desempeño y sentando las bases para casos de uso complejos de múltiples agentes donde los agentes pueden comunicarse a través de eventos.
- **Funciones de voz de múltiples:** Más allá de las interacciones basadas en texto, Agentforce 3.0 presenta la compatibilidad para voz como una modalidad principal. La arquitectura se integra con proveedores de telefonía y pasarelas WebRTC para gestionar la transmisión de audio en tiempo real. Los nuevos servicios gestionan la conversión de audio a texto (ASR) y de texto de vuelta a audio (TTS), permitiendo experiencias de voz conversacionales naturales para casos de uso como centros de contacto automatizados.
- **Script y determinación de Agentforce:** Un mecanismo de interceptación basado en estado-máquina que restringe el comportamiento de los agentes dentro de una estructura definida explícitamente, garantizando rutas de ejecución coherentes. Esto activa gráficos deterministas, proporciona una gestión de estado sólida para evitar la pérdida de memoria y facilita transferencias condicionales y determinadas por LLM, garantizando así acciones de agentes predecibles y coherentes para procesos de negocio críticos.
## 8\. Servicios de plataforma de aplicaciones
El ecosistema de aplicaciones de Salesforce Platform se distingue por su integración de funciones entre las capas Servicios de plataforma de aplicaciones, API, Experiencia de usuario y Experiencia de desarrollador. Los Servicios de plataforma de aplicaciones son funciones comunes que se utilizan para crear y personalizar la mayoría de las aplicaciones en Salesforce Platform, mientras que las funciones de negocio son generalmente más específicas de la solución.
### 8.1 Funciones clave
El ecosistema de aplicaciones se basa en cinco funciones clave, que guían el proceso de desarrollo de aplicaciones.
- **Arrendatario**: Esto implica la separación lógica de datos y metadatos en un servicio de múltiples arrendatarios, permitiendo a los usuarios autenticados acceder a funciones y datos específicos. Esto es más visible para los clientes cuando reciben una organización de Salesforce tras el registro.
- **Entidades**: Representando tablas de base de datos, las entidades constan de campos similares a columnas de tabla. Los metadatos de Entidad y Campo incluyen atributos para el modelado de datos como tipos de datos y nombres de API, así como atributos funcionales, como si la entidad tiene capacidad de consulta o escritura. Esta abstracción, en vez de la manipulación directa del establecimiento de datos en sí, permite a Salesforce introducir y cambiar tecnologías de almacenamiento sin problemas sin requerir actualizaciones de desarrolladores de TI, garantizando funciones de aplicación continuas.
- **Controles de acceso**: Estos controles regulan el acceso de los usuarios a datos y funciones, principalmente basándose en la identidad de los usuarios y políticas específicas. Las políticas se componen de reglas y conmutadores de funciones, y rigen las entidades, los campos y las funciones a las que se puede acceder. Las políticas y los permisos se capturan en “conjuntos de permisos”, y el acceso se otorga asignando conjuntos de permisos a identidades de usuario.
- **Extensión por capas**: Como se comentó anteriormente, esto admite el desarrollo independiente de metadatos y aplicaciones por diferentes funciones incluyendo ingenieros de Salesforce, socios externos, administradores de TI y usuarios finales, facilitado por pedidos de guardado estructurados y espacios de nombres de metadatos.
- **Embalaje**: Esta función permite el empaquetado y la distribución de metadatos entre arrendatarios de Salesforce, simplificando el proceso de actualización y distribución de aplicaciones sin necesidad de volver a construir.
Más allá de estas funciones clave, App Platform Services también incluye:
- Tiempo de ejecución y consulta de **datos**: Admite operaciones como la creación, actualización, eliminación y consulta de datos entre varios establecimientos de datos especializados. Un espectro de escala y desempeño de datos es compatible con una arquitectura que permite ejecutar operaciones de datos directamente en el almacén de datos, a través de una abstracción interna para que los ingenieros de Salesforce utilicen o a través del “Objeto de Salesforce” de cara al cliente o convención de sObject.
- **Flujo / Flujo de trabajo / Fórmulas**: Definición y ejecución de reglas de validación y lógica de negocio utilizando herramientas de código bajo.
- **Código Apex**: Lenguaje de pro-código para lógica de aplicación, integrado de forma nativa con API y tiempos de ejecución de datos de plataforma.
- **Servicios de infraestructura nativos de la nube:** Heroku proporciona un entorno sólido para desarrolladores que utilizan marcos de trabajo y lenguajes de programación de la industria para crear, implementar y gestionar aplicaciones que se integran con datos y eventos de plataforma.
- **Eventos y notificaciones**: Gestiona desencadenadores y orquestación basada en eventos.
- **Globalización**: Proporciona asistencia para aplicaciones multilingüe y multinacionales.
- **Licencias y aprovisionamiento**: Gestiona la compra y la gestión del acceso a funciones y aplicaciones de plataforma.
- **Pila web Lightning**: Permite la personalización de interfaces visuales utilizando metadatos estructurados, como formatos y tecnologías web estándar.
- **Sitios + CDN**: Garantiza experiencias web de baja latencia y alto tráfico, incluso para usuarios no autenticados.
- **Seguridad y cumplimiento**: Ofrece herramientas y controles para cumplir requisitos de cumplimiento y seguridad organizativos específicos.
- **Prevención de pérdida**: de datos Incluye funciones para copia de seguridad, restauración y archivado de datos.
### 8.2 Plataforma de aplicaciones Cloud
Salesforce Platform proporciona un conjunto de herramientas y funciones a través de Heroku que permiten a los desarrolladores crear, ejecutar y gestionar aplicaciones en la nube utilizando los marcos de trabajo y lenguajes de programación de su elección. La plataforma de aplicación gestionada Cloud de Heroku proporciona tiempos de ejecución de aplicaciones, almacenes de datos, colas de mensajería y sistemas de eventos como servicios ampliables para crear extensiones en aplicaciones de Salesforce.
Las aplicaciones que se ejecutan en Heroku tienen acceso al conjunto completo de funciones de Salesforce, datos de clientes y lógica de negocio, así como la capacidad de conectar con servicios y sistemas externos. Con Heroku, los desarrolladores pueden centrarse en ofrecer valor sin verse sobrecargados por problemas de infraestructura subyacentes.
## 9\. Automatización
La automatización es lo que hace que una aplicación sea dinámica y es crucial para la transformación digital de procesos de negocio esenciales.
Automatización de procesos de Salesforce se creó para abordar retos clave a los que se enfrentan los clientes, incluyendo la necesidad de procesos de negocio simplificados y eficientes a medida que se amplían las organizaciones. Estos desafíos a menudo implican flujos de trabajo que requieren un esfuerzo manual excesivo, lo que lleva a ineficiencias y costos operativos más altos. Los clientes buscan una solución que pueda automatizar estos procesos, minimizar el trabajo manual y mantener la coherencia y la precisión.
Un problema importante era la falta de un instrumento fácil de utilizar que permitiera a los usuarios no técnicos diseñar e implementar procesos institucionales sin conocimientos amplios de codificación. Además, era necesaria una solución que pudiera integrarse de forma segura, ampliable y sencilla con tareas automatizadas existentes de Salesforce como el ingreso de datos, las aprobaciones, las notificaciones y los procesos complejos de múltiples pasos.
Salesforce Process Automation satisface estas necesidades ofreciendo una plataforma sólida pero intuitiva para la creación de flujos de trabajo automatizados. Permite a los usuarios crear y personalizar flujos a través de una interfaz visual, accesible para usuarios técnicos y no técnicos, automatizando así tareas repetitivas, aplicando reglas de negocio y simplificando procesos dentro del ecosistema de Salesforce.
Para la automatización que requiere una orquestación compleja que interactúe con datos de transacciones, Salesforce ofrece Apex como un lenguaje de procódigo para redactar lógica de negocio.
### 9.1 Arquitectura y funciones de automatización de procesos
**Generador de lógica visual**: Los clientes e ISV utilizan Flow Builder, una interfaz de arrastrar y soltar, para crear flujos de automatización de procesos sin codificación. Esta herramienta visual es fácil de usar para todos los niveles técnicos, permitiendo a los analistas de negocio y administradores diseñar automatizaciones complejas fácilmente.
Flow Builder permite a los clientes crear flujos versátiles que funcionan en varios contextos, compatibles con el Motor de flujos principal:
- **Desencadenadores de registros**: Los flujos se activan tras actualizaciones de registros o envíos de formularios, lo que permite modificaciones de datos, validaciones e iniciaciones de flujos de trabajo basándose en acciones de clientes.
- **Flujos programados o dirigidos por eventos**: Estos flujos pueden operar en una programación predeterminada o desencadenarse después de eventos específicos, y pueden realizar llamadas a servicios externos.
- **Flujos de pantalla**: Proporcione una interfaz de usuario para procesos guiados paso a paso con formularios, pantallas y otros elementos interactivos, útiles para tareas como el ingreso de datos, la solución de problemas o la incorporación.
- **Flujos de orquestador**: Gestione e integre procesos de múltiples pasos, facilitando la gestión de operaciones complejas.
El Motor de flujos sin conexión puede ejecutarse sin una conexión al servidor de aplicaciones de Salesforce. Flujo sin conexión potencia la automatización para casos de uso de Field Service Mobile. El Motor de flujos de alta escala potencia los flujos de marketing. Ofrece una escala B2C para procesar un alto volumen de flujos de larga duración de forma simultánea.
Todos los casos de uso y entornos están mejorados por un modelo de metadatos unificado en Flow Builder, que admite una variedad de potentes elementos de lógica aplicables en todos los flujos de automatización de procesos:
- **Lógica avanzada y condiciones**: Los usuarios pueden integrar lógica compleja como elementos de decisiones, bucles y condiciones de espera en sus flujos de trabajo, permitiendo la gestión de escenarios de negocio complejos.
- Gestión y transformación de **datos**: Flow Builder permite el ingreso, la transformación y la gestión de datos desde varios orígenes, incluyendo servicios web, organizaciones de Salesforce y Data 360. Admite operaciones de datos integrales como la creación, actualización, eliminación y consulta de registros.
### 9.2 Automatización en Salesforce Platform
Automatización de procesos de Salesforce ofrece una integración sencilla con otros productos de Salesforce y sistemas externos, garantizando un flujo de datos fluido entre aplicaciones para una vista unificada de procesos de negocio e interacciones de clientes. Admite varios métodos de integración como API, llamadas web y conectores MuleSoft.
Servicios externos y conectividad de MuleSoft dentro de Salesforce permite conexiones a API externas y la utilización de sus datos en Automatización de procesos de Salesforce. El registro del esquema de API permite la creación de acciones invocables que se integran a la perfección en flujos, facilitando la automatización de procesos con orígenes de datos externos. Las sólidas funciones de integración de MuleSoft garantizan un flujo de datos sencillo entre Salesforce y otras aplicaciones, eliminando los silos de datos y proporcionando una vista unificada de los procesos de negocio.
**Integración Agentforce**: Salesforce Process Automation aprovecha Agentforce para mejorar los flujos de trabajo con la toma de decisiones inteligente. Utiliza perspectivas de IA para dirigir automáticamente prospectos a representantes de ventas adecuados o iniciar campañas de marketing personalizadas basadas en el comportamiento de los clientes, potenciando así la eficacia de la automatización con inteligencia adicional.
**Sinergia de plataforma**: La automatización de procesos de Salesforce se integra perfectamente con otros productos de Salesforce como Sales Cloud, Service Cloud, Commerce Cloud y Marketing Cloud. Esta integración permite a las organizaciones automatizar procesos entre varios departamentos, mejorando la eficiencia operativa. Por ejemplo, un flujo de trabajo puede generar automáticamente un caso de asistencia en Service Cloud cuando se envía una queja de cliente a través de un formulario de Marketing Cloud.
### 9.3 Automatización de código pro con Apex
Apex es un potente lenguaje de programación orientado a objetos que permite a los desarrolladores redactar lógica de negocio personalizada y realizar operaciones complejas en Salesforce Platform. Ha sido un pilar de nuestra plataforma, y actualmente la plataforma gestiona más de 350 mil millones de transacciones Apex al mes (a octubre de 2025).
Apex se utiliza para desarrollar una amplia gama de funciones personalizadas e integraciones profundas en Salesforce Platform, incluyendo:
- **Automatización basada en desencadenadores**: Implemente una automatización compleja que se ejecuta antes o después de insertar, actualizar o eliminar registros. Esto permite la validación de datos complejos, actualizaciones de registros relacionados y la invocación de otros procesos basándose en cambios de datos específicos.
- **Servicios web:** Cree integraciones personalizadas con sistemas externos y llame a las API de REST o SOAP desde Apex.
- **Interfaces de usuario personalizadas**: Cree interfaces de usuario y experiencias altamente personalizadas utilizando Visualforce y Componentes web Lightning (LWC), donde Apex sirve como controlador backend para gestionar la manipulación de datos y la lógica de negocio.
- **API personalizadas:** Los desarrolladores pueden exponer lógica personalizada como API utilizando Apex REST y Apex SOAP, permitiendo a los sistemas externos interactuar con datos y procesos de Salesforce de forma programática.
- **Procesamiento asíncrono**: Ejecute tareas de larga ejecución o intensivas en recursos de forma asíncrona a través de métodos futuros, Apex colocable en cola y Apex programado. Esto permite descargar y procesar operaciones de larga ejecución en segundo plano, mejorando la experiencia del usuario y el desempeño del sistema.
- **Apex programado:** Los desarrolladores pueden programar clases Apex para ejecutarse a horas específicas utilizando Apex Scheduler para tareas periódicas como sincronización de datos nocturna, generación de reportes y actividades de mantenimiento.
## 10\. Experiencias de usuario
Las funciones Experiencias de usuario en Salesforce Platform permiten a los usuarios finales interactuar con aplicaciones a través de varias opciones de implementación entre aplicaciones Lightning basadas en navegador, sitios de Experience, UX nativas de dispositivos móviles, orientadas a IA, colaborativas o componentes integrados utilizando Lightning Out.
### 10.1 Sistema de diseño Lightning
Salesforce Lightning Design System (SLDS) es un marco de trabajo de diseño integral que fomenta la creación de interfaces de usuario coherentes y accesibles con los principios de diseño de Salesforce para una experiencia de usuario cohesionada entre todos los productos. Permite a los ingenieros, clientes y socios de Salesforce crear aplicaciones que se sienten nativas en todo el ecosistema de Salesforce.
Las funciones clave del sistema de diseño incluyen:
- **Patrones de diseño**: Soluciones probadas para retos de diseño comunes, proporcionando directrices para el formato, la presentación de datos y las interacciones de usuario para garantizar una experiencia de usuario coherente.
- **Ganchos de estilo**: Variables CSS que representan decisiones de diseño, como colores, tipografía, espaciado y tamaños, garantizando la coherencia entre aplicaciones.
- **Biblioteca de componentes Lightning Base**: Un conjunto de componentes de la interfaz de usuario reutilizables, como botones, elementos de formulario y elementos de navegación, que se adhieren a los principios de diseño de Salesforce, facilitando un desarrollo rápido y eficiente.
- **Accesibilidad**: Directrices y funciones de accesibilidad integradas para garantizar que todos los componentes son utilizables por personas con discapacidades y se adhieren a estándares, como Directrices de accesibilidad de contenido web (WCAG).
- **Formatos con capacidad de respuesta**: Un sistema de cuadrícula flexible y directrices de formato que permiten a las aplicaciones adaptarse sin problemas entre diferentes dispositivos y tamaños de pantalla.
- **Herramientas**: Un conjunto de herramientas, recursos y tecnologías que admiten la higiene de componentes, la reducción de antipatrones y la regulación del sistema de diseño.
El marco de trabajo SLDS sigue evolucionando para admitir ganchos de estilo enriquecidos y funciones de personalización más profundas de modo que los componentes puedan reutilizarse sin dejar de personalizarse para cumplir requisitos de marca y tema exclusivos. Nuestra aspiración del sistema de diseño es hacer que Salesforce sea rápido, fácil y atractivo de utilizar con IA.
### 10.2 Pila web Lightning
La interfaz basada en navegador de Salesforce, conocida como Lightning, ofrece un contenedor de interfaz de usuario coherente y un marco de trabajo de interfaz de usuario dirigido por metadatos y una recopilación de tecnologías para ingenieros de Salesforce, administradores de TI, desarrolladores y socios para desarrollar rápidamente la interfaz de usuario con una estética coherente de Salesforce, así como puntos de extensión para un control completo para cambiar el estilo y la marca. Lightning Web Stack incluye varias tecnologías:
- **Componentes web Lightning**: Componentes web personalizados construidos con HTML y JavaScript, cumpliendo con los estándares web de W3C.
- **Seguridad web Lightning**: Un motor de virtualización que gestiona código JavaScript en el navegador, garantizando el cumplimiento de los estándares de seguridad de Salesforce para código externo.
- **Servicios de datos Lightning**: Un marco de trabajo diseñado para una interacción eficiente con datos del lado del servidor.
- **Lightning Web Runtime**: Garantiza una representación de la interfaz de usuario coherente y con desempeño entre varios clientes.
Ingeniería de Salesforce ha incorporado lecciones de tecnologías anteriores de la interfaz de usuario y contribuido a cuerpos de estándares web, influyendo en el desarrollo de implementaciones de componentes basados en estándares. Por ejemplo, Salesforce sigue siendo miembro de aproximadamente 20 grupos de trabajo del W3C. Los componentes web Lightning y la pila web Lightning se alinean con estos estándares de la industria, reduciendo la complejidad para los desarrolladores.
### 10.3 Móvil
Mobile sigue siendo una interfaz creciente y crítica para que los usuarios interactúen con aplicaciones de Salesforce.
Salesforce proporciona una aplicación móvil nativa de modo que todas las aplicaciones Lightning basadas en navegador pueden convertirse en aplicaciones móviles sin necesidad de redactar nuevo código. Salesforce también ofrece un espectro de herramientas, SDK y funciones para crear aplicaciones nativas completamente personalizadas optimizadas para dispositivos. Estos incluyen:
- **SDK: móvil** Interfaz de código profesional para desarrolladores entre sistemas operativos móviles que simplifica la integración con autenticación, gestión de sesión/token, API de Salesforce y mucho más.
- **Tiempo de ejecución nativo móvil**: Permite a los desarrolladores crear experiencias nativas dirigidas por metadatos representadas de forma dinámica en tiempo de ejecución utilizando tecnologías iOS y Android que también aprovechan las funciones en dispositivos.
- **Marca**: Permite la personalización de la estética de aplicaciones móviles a través de Mobile Publisher Pipeline para convertir aplicaciones móviles Salesforce en aplicaciones de marca de cliente.
- **Capacidades sin conexión**: Garantiza una funcionalidad de aplicación sencilla con conectividad a Internet incoherente o nula.
El Marco de trabajo de personalización móvil (MCF) mejora significativamente el desarrollo de aplicaciones móviles nativas de Salesforce ofreciendo facilidad de uso y amplias opciones de personalización. Las ventajas clave incluyen:
- **Enfoque dirigido por metadatos**: MCF utiliza metadatos, que se pueden originar desde generadores visuales, repositorios comunes y recursos alojados en Salesforce, para crear experiencias de usuario dinámicas y adaptables adaptadas a necesidades específicas.
- **Experimentación y optimización**: El marco de trabajo admite la experimentación en tiempo de ejecución con diferentes formatos, facilitando la optimización de implicación continua y el refinamiento de la experiencia del usuario.
- **Extensibilidad**: Diseñado para la flexibilidad, MCF permite la integración de componentes personalizados en el marco de trabajo de metadatos principal, mejorando la funcionalidad y la versatilidad.
- **Experiencias de usuario componibles**: Utilizando las últimas tecnologías iOS y Android, MCF admite el ensamblaje de componentes reutilizables como botones, listas y tarjetas para crear interfaces de usuario sofisticadas.
- **Personalización en tiempo de ejecución**: MCF permite la experimentación y la personalización de la interfaz de usuario en tiempo real, fomentando una experiencia de usuario más personalizada y atractiva.
Los escenarios sin conexión y de baja conectividad son una preocupación aumentada al utilizar aplicaciones en dispositivos móviles. La pila de tecnología móvil prioriza la creación de aplicaciones que pueden estar sin conexión en primer lugar. Las funciones clave incluyen:
- **Primera experiencia en caché**: Se centra en el almacenamiento en caché de datos para su uso sin conexión, garantizando un alto desempeño y seguridad. La interacción de usuario también está diseñada teniendo en cuenta los principios de representación sin conexión.
- **Gestión de caché**: Mantiene la caché relevante y actualizada, incluso sin conexión.
- **Caché compartida**: Utiliza una única caché para pantallas nativas e híbridas, facilitando experiencias sin conexión transparentes.
Nimbus es la solución lista para la producción de la plataforma que simplifica el proceso de acceso a funciones de dispositivos para desarrolladores de aplicaciones híbridas. Tradicionalmente, salvar la brecha entre JavaScript y el código nativo móvil era una tarea compleja. Sin embargo, con Nimbus, los desarrolladores ahora pueden aprovechar todo el potencial de los dispositivos móviles sin profundizar en la codificación de bajo nivel. Las funciones clave incluyen:
- **Acceso amplio**: Proporciona una integración sencilla con una variedad de funciones de dispositivo como cámara, micrófono, geolocalización y LiDAR.
- **Interfaz estandarizada**: Ofrece un método uniforme para acceder a funciones de dispositivos.
- **Integración de aplicaciones híbridas**: Activa aplicaciones híbridas para utilizar completamente funciones de dispositivo.
- **Desarrollo eficiente**: Simplifica el proceso de desarrollo de aplicaciones, reduciendo la complejidad.
A medida que la IA continúa transformando lo que es posible con aplicaciones de Salesforce, Salesforce también proporciona una experiencia de usuario diferenciada aprovechando modelos de IA específicos de tareas en dispositivos junto con soluciones basadas en la nube:
- **Modelos de lenguaje pequeño (SLM):** Estos pueden ejecutarse en dispositivos móviles de forma eficiente y a un costo inferior.
- **Privacidad y seguridad:** Garantiza la privacidad del usuario y mantiene Trust y seguridad en niveles comparables a los modelos basados en servidor.
- **Funcionalidad sin conexión:** Opera de forma efectiva en entornos de baja conectividad, lo que permite casos de uso sin conexión.
- **Voz:** Los modelos de voz a texto de última generación, texto a voz natural y diarización de interlocutores ahora se ejecutan de forma nativa en dispositivos, entregando interacciones de voz de alta fidelidad con privacidad completa y latencia cero.
### 10.4 IA y colaboración
La interfaz de usuario no de modelo para lenguaje natural e interacciones de múltiples turnos con nuestra aplicación seguirán creciendo en prevalencia. Se espera que los desarrollos futuros mejoren la integración entre modelos, funciones de dispositivos y aplicaciones, mejorando las interacciones de usuarios a través de interfaces de voz y texto más intuitivas. La recopilación de mediciones en dispositivo también permitirá ajustes personalizados basándose en preferencias de usuario.
La colaboración es esencial entre todos los usuarios, incluidos los humanos y los agentes, para aprovechar las ventajas combinadas de la automatización y la supervisión humana. Esta colaboración es particularmente crucial para interacciones de negocio complejas que implican a los empleados de una organización y sus clientes. Slack sirve como una herramienta principal dentro de Salesforce Platform, facilitando esta interacción a través de mensajería directa y canales de múltiples usuarios adaptados a temas de debate específicos. Estos debates pueden variar desde pláticas espontáneas creadas por el usuario a diálogos más estructurados centrados en datos específicos dentro del flujo de trabajo de un usuario, como un hilo de mensajes de Slack detallado que trata un problema significativo del cliente.
De cara al futuro, Salesforce Platform tiene previsto mejorar la experiencia de colaboración que proporciona actualmente Slack. Esta ampliación tendrá como objetivo utilizar al máximo las amplias funciones de la plataforma, enriqueciendo la forma en que los usuarios interactúan y colaboran dentro del espacio de trabajo digital.
## 11\. Experiencia de desarrollador
Las funciones de Developer Experience en la plataforma proporcionan herramientas para la creación, personalización, prueba e implementación de aplicaciones, centrándose en el espectro del código bajo a través de enfoques pro-código, garantizando la igualdad de oportunidades para desarrolladores de todos los niveles de habilidades.
- **Herramientas de código bajo**: Estos incluyen Schema Builder para modelos de datos, Flow para reglas de negocio y AppBuilder para personalización de la interfaz de usuario, todos diseñados para simplificar el proceso de desarrollo manipulando metadatos estructurados y trabajo en el lenguaje de la solución de negocio, en vez de conceptos técnicos y jerga.
- **Herramientas Pro-Código**: Para desarrolladores que necesitan una personalización más enriquecida y compleja, la plataforma ofrece herramientas como Salesforce Code Builder, un IDE basado en la nube, junto con una interfaz de línea de comandos (CLI) y API para la codificación avanzada y la creación de componentes. Los desarrolladores pueden programar en el idioma de su elección aprovechando soluciones para implementar, gestionar y optimizar aplicaciones con Heroku.
- **Entorno de desarrollo integrado**: El ecosistema de Salesforce admite la integración sencilla entre herramientas de código bajo y pro-código, así como el desarrollo coherente en la nube y localmente con herramientas estándar de la industria.
- **Gestión del ciclo de vida de aplicaciones (ALM)**: Cuenta con una gama de organizaciones Sandbox para el desarrollo separadas del entorno de producción, incluyendo organizaciones borrador para el desarrollo inicial y organizaciones Sandbox completas para pruebas con datos y escala similares a los de producción.
### 11.1 IA para desarrolladores
La IA y los “Asistentes de desarrollador” están revolucionando la experiencia del desarrollador simplificando y acelerando la creación de aplicaciones eficientes y de alta calidad. En Salesforce, nuestros equipos de Investigación de IA y Experiencia de desarrollador están continuamente iterando y explorando cómo la IA predictiva y generativa con razonamiento agente puede transformarse en potentes agentes desarrolladores. Estos agentes desarrolladores están integrados de forma nativa con herramientas que los desarrolladores ya utilizan, como VS Code, Code Builder, línea de comandos, DevOps Center y Code Analyzer, lo que los hace más relevantes e impactantes.
Realizamos avances significativos en el análisis de código para identificar antipatrones y puntos críticos en código Apex, y luego proporcionamos recomendaciones críticas para mejorar su implementación. Los problemas identificados suelen malgastar recursos informáticos y a menudo dan lugar a incidentes a gran escala. Se lanzó como Perspectivas de ApexGuru en enero de 2024.
En el primer año tras su lanzamiento, más de 2.800 organizaciones de Salesforce utilizaron ApexGuru para analizar y mejorar su implementación de Salesforce. Se implementaron con éxito más de 22.000 recomendaciones, lo que supone un ahorro de 28.000 horas de CPU cada semana. Esta mejora no solo potencia el desempeño, sino que también contribuye a la sostenibilidad medioambiental reduciendo las emisiones de CO2 en 135 kg semanales, en sintonía con nuestro valor fundamental de Sostenibilidad y compromiso con la reducción de emisiones de carbono.
También estamos integrando la IA en herramientas y funciones de desarrollador pro-código para mejorar Developer Productivity. Producto como “Agentforce para desarrolladores” en 2024, los desarrolladores pueden acceder a estas nuevas funciones dentro de los paquetes Extensión de Salesforce en Visual Studio Code Builder y Visual Studio Code Builder. Estas extensiones activan:
- Sugerencias de código en línea a medida que el desarrollador escribe y generación de código para Apex y Componentes web Lightning (JavaScript, CSS, HTML).
- Explicación de código y generación de documentación para componentes web Apex y Lightning.
- Generación de código de prueba de unidad Apex.
- Una experiencia de chat de múltiples turnos distinta en el IDE que puede funcionar en múltiples respuestas para la generación de código, la explicación y la documentación.
- Optimizaciones de componentes web Lightning.
- Generación de agentes con metadatos YAML legibles por humanos, incluyendo funciones de prueba y depuración de agentes.
A octubre de 2025, más de 42.000 desarrolladores están utilizando activamente esta tecnología mensualmente, con 17,6 millones de líneas de código aceptadas. Este conjunto integral garantiza un entorno de desarrollo flexible, integrado y eficiente, que satisface una amplia gama de necesidades de desarrollo en Salesforce Platform. Las herramientas de desarrollador de IA también están mejoradas con una arquitectura que funciona entre múltiples modelos externos y creados por Salesforce para elegir el modelo más efectivo y eficiente para un caso de uso concreto.
### 11.2 Compatibilidad con MCP y codificación asistida por IA
El Protocolo de contexto de modelo (MCP) es un estándar abierto emergente diseñado para permitir a los agentes de IA interactuar de forma segura y coherente con cualquier herramienta u origen de datos. Salesforce está integrando de forma nativa la compatibilidad de MCP en el kit de herramientas de desarrollador de Salesforce para ayudar a los agentes de desarrolladores que pueden acceder a funciones y herramientas en su compañía. Esto incluye:
- **Servidor MCP local:** Un servidor MCP local permite a los desarrolladores crear, probar y depurar fácilmente sus integraciones de agentes dentro de su IDE local antes de implementar en producción, mejorando drásticamente la productividad. El servidor MCP local ofrece herramientas especializadas para interacciones de organización y flujos de trabajo de desarrollo, como desarrollo móvil, pruebas de accesibilidad, migración de Aura a LWC y DevOps agente. El servidor MCP local también incluye integración con razonamientos de agentes y LLM para potenciar mejor a los desarrolladores para “codificar” su aplicación de forma iterativa y en lenguaje natural.
- **Servidor MCP personalizado para las API de Salesforce:** Los desarrolladores ahora pueden exponer de forma segura las API de Salesforce, los objetos de Data 360 y los flujos de automatización como "herramientas" de MCP. Esto convierte toda Salesforce Platform en un conjunto enriquecido, de confianza y detectable de funciones para cualquier agente o aplicación de IA externa, completo con control de acceso granular y la posibilidad de nuevos modelos de monetización basados en consumo.
- **Conectividad MCP externa nativa:** Los desarrolladores también pueden gestionar de forma segura la conectividad con servidores externos que cumplen con el estándar MCP. Esto permite a los desarrolladores crear agentes que pueden trabajar en su compañía.
## 12\. Conjunto de aplicaciones
Nuestras nubes de aplicaciones, incluyendo Sales Cloud, Service Cloud, Marketing Cloud, Revenue Cloud y Commerce Cloud, están construidas sobre Salesforce Platform, ofreciendo funciones de negocio líderes y componiendo nuestro conjunto de aplicaciones para dirigir el éxito del cliente. Las funciones clave incluyen:
- **Integración sencilla**: Profundamente integrado y diseñado para trabajar de forma cohesionada en la trayectoria del cliente y garantizar un flujo de datos y procesos fluido entre puntos de contacto del cliente, mejorando la experiencia del cliente.
- **Personalización de extremo a extremo**: Construidas sobre nuestra plataforma, nuestras aplicaciones ofrecen amplias opciones de personalización desde sin código a procódigo, permitiendo una adaptación precisa a las necesidades del cliente.
- **Capacidades de IA avanzadas**: Entregue flujos de trabajo basados en canales interactivos asistidos por agentes y autónomos de agentes con nuestros Agentforce Agents. Incorpora IA predictiva y generativa para potenciar la eficiencia a través de automatización, análisis predictivos y experiencias de usuario personalizadas, proporcionando perspectivas y recomendaciones sobre las que se pueden realizar acciones.
- **Procesamiento de datos en tiempo real**: Utiliza Data 360 para el acceso y análisis de datos en tiempo real, lo que da cobertura a la toma de decisiones oportuna e informada basándose en la información más actualizada. Esto mejora la capacidad de respuesta y la agilidad en entornos acelerados.
- **Datos y análisis unificados**: Integra varios orígenes de datos en una plataforma centralizada para vistas de datos coherentes y completas, entregando análisis precisos y mejorando la toma de decisiones.
- **Seguridad y cumplimiento mejorados**: Cuenta con sólidas herramientas de seguridad y cumplimiento para proteger datos confidenciales y cumplir con estándares reguladores.
- **Experiencia de usuario de nivel de consumidor**: Ofrece interfaces intuitivas y fáciles de usar que hacen que las aplicaciones sean accesibles y efectivas entre dispositivos, canales y modalidades.
- **Fiabilidad**: Garantiza un tiempo de inactividad mínimo y capacidad de ampliación para dar cobertura a operaciones vitales y de misión, incluyendo servicios de emergencia y sistemas de transporte críticos.
- **Escalabilidad elástica**: Construido sobre Hyperforce que admite el aumento de los volúmenes de interacción de datos y usuarios sin sacrificar el desempeño o el costo de servir.
- **Mejora continua**: Integra regularmente innovaciones para mejorar funciones sin interrumpir operaciones existentes.
Salesforce se dedica a hacer avanzar sus aplicaciones unificando funciones en su plataforma, basándose en las tecnologías fundamentales descritas en este documento técnico. Esta transformación se guía por un conjunto de prioridades clave que dan forma al diseño y el desarrollo del conjunto de aplicaciones de Salesforce.
### 12.1 Escala y desempeño
Nuestros equipos de aplicación se especializan en desempeño y capacidad de ampliación, utilizando laboratorios de desempeño avanzado para crear réplicas exactas de nuestros entornos de producción con datos sintéticos. Esta configuración permite una simulación exhaustiva de trayectorias de usuarios paralelas para garantizar que cada nueva función se prueba a fondo y se evalúa su repercusión. Cuando se identifican cuellos de botella en tiempo de ejecución, ajustamos dinámicamente los límites de frecuencia y otras medidas para proteger el estado del sistema mientras recopilamos datos para dirigir la resolución.
Nuestros sistemas están diseñados para la ampliación horizontal para utilizar la flexibilidad de la nube pública de forma efectiva. Las comprobaciones automatizadas garantizan que las actualizaciones o mejoras no afecten negativamente al desempeño. Empleamos escaladores automáticos predictivos que gestionan la carga del sistema de forma proactiva, no solo reaccionando ante el aumento de la demanda, sino anticipando y ajustando de antemano.
El escalado automático es crucial para minimizar el costo para servir reduciendo la capacidad no utilizada. Monitoreamos los costos de ejecución del sistema de cerca, identificando y solucionando cualquier ineficiencia en el escalado automático o el uso de recursos. Aunque la eficiencia de costos es importante, damos prioridad a la entrega de aplicaciones confiables, optando por escaladores automáticos que se amplían rápidamente y se reducen lentamente para mantener Customer Trust, incluso si genera costos más altos.
### 12.2 Integración sencilla
#### Modelo de datos común
Los modelos de datos son fundamentales para todas las operaciones de negocio en Salesforce, influyendo en las funciones de negocio, las API, la navegación, las visualizaciones de la interfaz de usuario y los reportes que se pueden crear. Forman parte integral de las funciones de la plataforma.
Nuestro conjunto de aplicaciones comparte un modelo de datos común entre Sales Cloud, Service Cloud, Revenue Cloud, Commerce Cloud, Marketing Cloud e Industries Cloud. Esto contribuye a nuestro conjunto integrado, proporcionando un comportamiento coherente e interoperabilidad, y rutas claras para actualizaciones y extensiones.
Por ejemplo, la colaboración de entidades Cuenta y Producto entre todas las nubes permite a los usuarios de Marketing Cloud y Sales Cloud intercambiar datos, metadatos, componentes de la interfaz de usuario y lógica de negocio. Esta integración ayuda a descomponer los silos y fomenta la colaboración entre funciones.
#### Plataforma de datos virtual
Un modelo de datos común entre todas las Salesforce Cloud mejora significativamente la integración pero puede no satisfacer todas las necesidades de integración de socios complejas. El modelo de datos común de Data 360 amplía este aspecto ampliando los beneficios del modelo de datos compartido más allá de los límites de datos típicos de Salesforce, dando cabida a escenarios de integración más amplios.
#### Ampliabilidad por capas
El Marco de trabajo de metadatos de Salesforce permite a varios grupos como equipos de ingeniería, ISV, socios, administradores y usuarios finales personalizar y ampliar sus aplicaciones en distintas capas de capacidad de ampliación sin interferir entre sí. Esta estructura admite un entorno ampliable donde las modificaciones por un grupo no interrumpen a otros, manteniendo la integridad del sistema.
Un excelente ejemplo del Marco de trabajo en acción es el producto Conocimiento unificado, que integra todas las fuentes Knowledge en un lago de datos. Esta configuración incluye una capa semántica y recuperadores, mejorando las funciones de IA predictiva y generativa en Sales Cloud, Service Cloud, Revenue Cloud, Marketing Cloud y Commerce Cloud. Incorpora un modelo de datos para Knowledge no estructurado y semiestructurado vinculado al modelo de Knowledge estructurado existente.
Además, el Marco de trabajo utiliza metadatos para definir relaciones personalizadas entre tipos de datos, facilitando la generación de consultas avanzadas. Esto permite a los equipos de aplicación crear aplicaciones personalizables que aprovechan esta base de Knowledge integral, mientras que los ISV, socios y clientes pueden mejorar aún más las funciones de la aplicación modificando relaciones de metadatos o desarrollando recuperadores personalizados para casos de uso de negocio específicos.
#### Mejorar la plataforma de datos común
Los datos de clientes se almacenan de forma segura en varias plataformas como SalesforceDB y Data 360, y se estandarizan y normalizan independientemente de su formato estructurado o no estructurado. Esto garantiza la gestión coherente de los datos a través de un formato unificado conocido como sObject, que admite una plataforma de datos cohesionada entre todos los datos del cliente.
Esta estandarización activa una API única para todas las operaciones de datos, una interfaz unificada para desencadenadores en Apex y la creación de flujos de trabajo personalizados con Flow. También admite Tableau Next, lo que permite la integración y vistas de datos personalizadas con herramientas de IA generativa como Generador de solicitudes para la generación de respuestas inteligentes basadas en datos de clientes.
Además, las aplicaciones de Salesforce se integran con varios establecimientos de datos para mejorar la flexibilidad de los procesos de negocio en los productos. Por ejemplo, en Marketing Cloud, Flow se utiliza para gestionar experiencias de clientes multitáctiles, con opciones para utilizar plantillas prediseñadas o crear flujos personalizados que integran marketing con otros procesos de negocio, todo ello basado en datos de clientes subyacentes.
### 12.3 Funciones de negocio compartidas
Las aplicaciones aprovechan y mejoran los servicios compartidos como la resolución de identidad, la orquestación de contenido, la personalización, los análisis, la pasarela LLM y los servicios de razonamiento, lo que permite una rápida innovación y entrega. Estos servicios admiten el procesamiento de datos en tiempo real, perspectivas dirigidas por IA y experiencias de usuario enriquecidas, proporcionando una vista integral de 360 grados del cliente.
Los beneficios incluyen eficiencia mejorada a través de automatización inteligente y análisis predictivos, capacidad de ampliación para aumentar las interacciones de datos y usuarios, y seguridad y cumplimiento sólidos. Las funciones de personalización de la plataforma permiten a las organizaciones adaptarse rápidamente a necesidades cambiantes, fomentando el crecimiento y la excelencia operativa.
La innovación en el nivel de aplicación se impulsa por Salesforce Platform y aplicaciones individuales, mejorando el ecosistema de Salesforce y estableciendo aplicaciones como líderes de la industria.
### 12.4 Optimizado para canales múltiples y canales
Las aplicaciones de Salesforce están diseñadas para reunirse con usuarios en una variedad de plataformas, incluyendo web, móvil, email, SMS, WhatsApp y otros canales. Optimizan las funciones nativas de cada canal para mejorar la experiencia y la eficiencia de los usuarios.
Las funciones incluyen funciones sin conexión de varios meses para usuarios de Salesforce Field Service, notificaciones distribuidas de navegador y formatos de pantalla ancha para agentes de servicio en Lightning Service Console, así como escaparates de alto desempeño y copilotos para compradores de Commerce.
La plataforma de metadatos garantiza que Salesforce, sus socios y clientes puedan beneficiarse inmediatamente de estas funciones desde el principio.
### 12.5 Entrega rápida de innovación
Servicios de Foundation, Plataforma y Funciones de negocio compartidas de Salesforce permiten a las aplicaciones adaptarse rápidamente a los cambios del mercado y las tendencias tecnológicas, permitiendo una entrega rápida de innovaciones. Por ejemplo, con la llegada de la IA generativa, Salesforce utilizó rápidamente servicios de IA existentes como NLP Trust Layer y Detección de intenciones para incorporar plantillas de solicitudes en Universal Communications Platform. Esta integración mejora las funciones de mensajería y teléfono entre productos, facilitando conexiones de clientes más personales.
Siguiendo la tendencia hacia la IA autónoma, Salesforce lanzó Agentforce, una solución que capitaliza estas inversiones existentes para automatizar casos de uso de negocio con agentes de forma eficiente, sin necesidad de construir desde cero.
### 12.6 Ruta al conjunto de aplicaciones
Reconstruimos Marketing Cloud, Revenue Cloud y Commerce Cloud en Salesforce Platform, lo que permite a estas nubes compartir la misma infraestructura, plataforma, metadatos, datos, IA, componentes de la interfaz de usuario y lógica de negocio, mientras se benefician de la potencia completa de Salesforce Platform. Por ejemplo, tomamos funciones de Revenue Cloud y funciones principales integradas como el configurador basado en restricciones, los motores de precios y la gestión de catálogos, convirtiéndolos en servicios básicos disponibles en el conjunto. Esto también nos permite tener una integración sencilla entre todas nuestras nubes, y las funciones que Commerce Cloud y Marketing Cloud ofrecen se convierten en parte de las funciones de negocio compartidas que pueden aprovechar las otras aplicaciones. Esta es nuestra visión de conjunto de aplicaciones integradas entregada.
La trayectoria de Salesforce Platform ha llevado al desarrollo de un conjunto de aplicaciones integrado que combina Sales Cloud, Service Cloud, Marketing Cloud, Revenue Cloud y Commerce Cloud en una solución unificada. Disponible desde Salesforce Starter Edition en adelante, este conjunto ofrece alcance de múltiples canales, gestión de relaciones con los clientes y perspectivas de negocio en un paquete cohesionado. Independientemente de la edición elegida, los usuarios pueden acceder a las funciones principales de Sales Cloud, Service Cloud, Marketing Cloud y Commerce Cloud, garantizando una experiencia coherente en todos los niveles.
## 13\. Soluciones específicas de la industria
Los productos de Salesforce Industries para Financial Services, Health, Life Sciences, Media, Energy and Utilities, Manufacturing, Auto, Consumer Goods, Retail, Net Zero, Public Sector, Education y Nonprofit amplían nuestros productos de aplicación y plataforma para proporcionar soluciones personalizadas que abordan los retos exclusivos de las industrias. Simplifican las operaciones y mejoran la productividad incorporando flujos de trabajo específicos de la industria, mediciones de cumplimiento y modelos de datos.
La cartera Industries se ha vuelto a crear en Salesforce Platform para permitir la compostabilidad entre verticales. Los clientes ahora pueden reunir una o más funciones de la industria en soluciones adaptadas, aprovechando metadatos compartidos, API y servicios de negocio. Este enfoque equilibra la diferenciación vertical con la coherencia de la plataforma, garantizando la adaptabilidad y la escala entre diversos contextos regulatorios y de negocio.
### 13.1 Enfoque de arquitectura por capas
Nuestros productos utilizan una arquitectura en capas. En la base está Salesforce Platform y aplicaciones horizontales como Sales Cloud y Service Cloud, que sirven como la base para todas las soluciones de la industria. A esto, Salesforce agregó servicios comunes de valor agregado que mejoran los componentes reutilizables incrustados en la mayoría de las industrias. Ejemplos de estos incluyen funciones para Automatización digital, Cronologías, Planes de acción y mucho más. Por encima de esta capa, hay una capa de lógica de negocio reutilizable que encapsula funciones horizontales como gestión de comentarios, CPQ (configuración, precio, presupuesto) y gestión de servicios.
La capa superior cuenta con personalizaciones específicas del dominio adaptadas para cumplir requisitos específicos de la industria, aprovechando la plataforma subyacente para una escalabilidad y eficiencia mejoradas. Por ejemplo, en la vertical de fabricación, esta configuración optimiza la planificación de producción a través de pronósticos precisos. En el sector de las ciencias de la vida, proporciona a los equipos de ventas de farmacia soluciones móviles sin conexión que gestionan de forma eficiente los flujos de trabajo y la gestión de muestras cumpliendo al mismo tiempo con varios requisitos normativos geográficos.
### 13.2 Funciones específicas de la industria
**IA de confianza Excellence**: Nuestras soluciones de IA generativa de confianza proporcionan funciones de IA específicas de la industria. Estos incluyen agentes e ingeniería de solicitudes, que facilitan la automatización y la digitalización de códigos bajos/sin códigos en sectores como la atención sanitaria, las ciencias de la vida y los servicios financieros. Además, funciones como la minería de documentos/texto y el resumen atienden a industrias que gestionan grandes volúmenes de datos, ayudando en la extracción de información y la recopilación de perspectivas.
Los agentes personalizados mejoran la comunicación tridireccional entre agentes y clientes, lo que lleva a resoluciones más rápidas. La capa Trust de Salesforce Platform facilita la adhesión a todos los estándares de cumplimiento y regulación entre industrias.
**Datos, perspectivas e inteligencia con cumplimiento normativo y seguridad**: Salesforce Industries ofrece una vista integral de 360o con estrictas medidas de privacidad, colaboración y seguridad de los datos adaptadas a leyes de la industria específicas como GDPR, HIPAA y FedRamp. Salesforce integra datos de varios orígenes, permitiendo el cumplimiento y la seguridad, y mejora estas soluciones con funciones adicionales como Cifrado Shield BYOK (Aportar sus propias claves) para el cifrado de datos de arrendatarios.
**Experiencia de usuario elevada**: Salesforce Industries hace hincapié en una experiencia de usuario transparente adaptada a las necesidades específicas de la industria para mejorar la trayectoria del usuario. Esto incluye herramientas como el Centro de recursos con capacidad de acción, plantillas de Experience Cloud y soluciones basadas en OmniStudio.
**Digitalización, integración e incorporación**: Salesforce Industries proporciona digitalización, integración e incorporación a través de soluciones de código bajo a sin código, aprovechando herramientas como Flows y OmniStudio para nuevos clientes y ofreciendo soluciones de migración para sistemas CRM existentes. La integración con datos y sistemas externos se simplifica a través de los conectores ofrecidos por MuleSoft. Salesforce también incluye procesos de servicio específicos de la industria, como la gestión de conflictos para Retail Banking.
**Móvil y offline**: Salesforce Industries proporciona una sólida cobertura específica de dominio para la aplicación móvil Salesforce y la aplicación móvil Field Service. Para dominios altamente especializados que requieren asistencia sin conexión avanzada, Industries proporciona aplicaciones móviles a medida creadas sobre SDK móviles de Salesforce.
**Funciones de negocio comunes**: Salesforce Industries se basa en una base de funciones de negocio comunes, lo que permite la coherencia y la productividad mientras adapta soluciones a necesidades exclusivas de la industria, como diferentes sistemas de reserva de citas para bancos y hospitales. Integrado con el ecosistema de Salesforce más amplio, Salesforce proporciona una vista holística Customer 360, lo que lo convierte en una parte vital del conjunto de productos de Salesforce.
## 14\. Analytics
Durante años, el mercado de la plataforma Analytics and Business Intelligence (BI) ha promovido el autoservicio visual y perspectivas automatizadas dirigidas por IA para usuarios finales para ayudarles a tomar decisiones más rápidas y dirigidas por datos. Sin embargo, sabemos que no todo el mundo ha visto esto realizarse debido a varios desafíos:
- **Perspectivas desconectadas**: Las perspectivas no están integradas en los flujos de trabajo de los usuarios, lo que dificulta la acción sobre las perspectivas, a pesar de su potencial para informar la toma de decisiones.
- **Silos y sobrecarga de datos**: Los datos siguen creciendo rápidamente y permanecen compartimentados, lo que lleva a riesgos de desorganización y seguridad. Las organizaciones se enfrentan a un dilema entre un entorno de datos caótico y de autoservicio y un entorno de datos restrictivo y bien gobernado.
- **Desconfianza en datos**: La expansión y fragmentación de datos ha erosionado Trust de los usuarios en las perspectivas derivadas de datos de la compañía.
- **Falta de componibilidad**: Existe una ausencia significativa de capacidad de compostaje y reutilización en procesos de trabajo, obligando a los usuarios a repetir tareas y sin vías claras para la monetización.
Tableau Next está diseñado para ampliar el ciclo de análisis visual reuniendo usuarios de negocio y profesionales de datos de formas nuevas y colaborativas; todo ello aumentado con la IA. Proporciona mediciones y perspectivas oportunas y de confianza a través de Salesforce Platform, facilitando el acceso ubicuo a perspectivas con capacidad de acción.
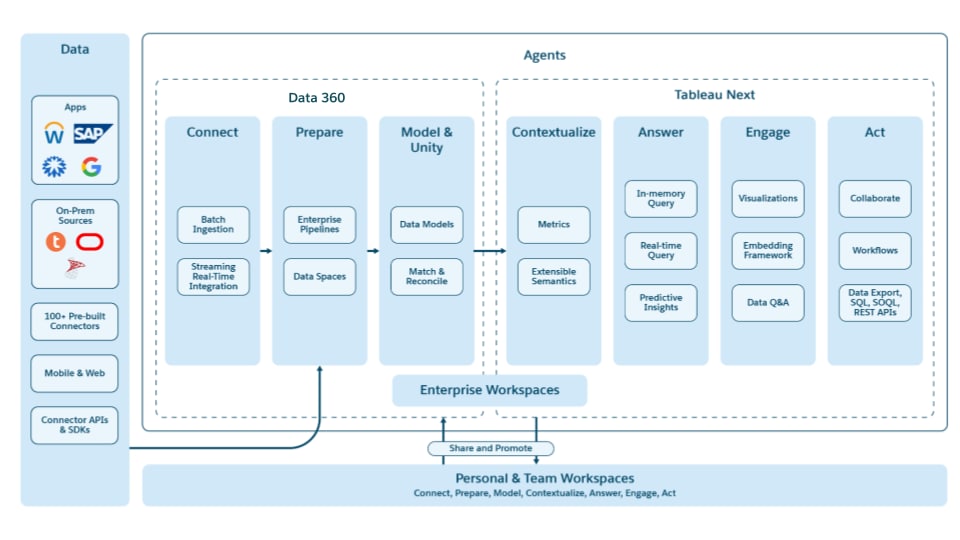 Tableau Next aborda estos retos:
- Creación de una plataforma abierta, componible y con capacidad de primera API para experiencias conectadas desde la conexión de datos a la acción. Proporcionando herramientas para el desarrollo, componentes componibles para aplicaciones analíticas enriquecidas y funciones para gestionar su empaquetado y distribución.
- Construyendo con la IA en el centro, y capaz de proporcionar perspectivas contextuales y relevantes, con herramientas para que los profesionales de datos revisen y validen de forma eficiente para garantizar Trust.
- Basándose en Tableau Semantics como una capa semántica universal para análisis de datos rápidos, de autoservicio y gobernados dentro de un ecosistema controlado pero flexible.
- Ofreciendo funciones de datos a escala de nube en tiempo real a través de Data 360 para acceso a datos de confianza, ampliables y regulados.
- Proporcionar un entorno enriquecido y mercado para que los desarrolladores construyan y moneticen aplicaciones.
- Integración de inteligencia en su núcleo, aportando el poder de la semántica y Knowledge de su organización a los agentes que le empoderan.
- Priorizando Trust, de modo que pueda tener confianza en sus datos, análisis y cargas de trabajo e implementación de agentes, a través del control directo y la visibilidad de sus actividades y eficacia.
- Aprovechar la colaboración como un principio de diseño de primera clase, con integraciones profundas y enriquecidas con Slack, así como cualquier otra herramienta de colaboración para su organización.
### 14.1 Mejores experiencias de Analytics de su clase
Tableau Next se basa en el liderazgo de Tableau en herramientas de análisis de datos ofreciendo una plataforma abierta que mejora las funciones e integra experiencias. Las funciones clave incluyen:
- **Visualización de datos enriquecidos**: Utiliza la tecnología VizQL de Tableau para análisis visual expansivo.
- **Espacios de trabajo colaborativos y regulados**: Ofrece una interfaz unificada para tareas de análisis, se integra con Slack para la colaboración en tiempo real.
- **Datos gobernados de confianza**: Admite análisis de autoservicio con rutas de promoción estructuradas para la gestión global en un entorno seguro.
- **Escritoría de mediciones avanzada**: Permite a los analistas crear y reutilizar indicadores clave de desempeño de forma eficiente en toda su organización, facilitando la coherencia y la fiabilidad.
### 14.2 Agentic Analytics
Tableau Next está construido fundamentalmente con Agentforce como una construcción arquitectónica fundamental, mejorando la capacidad de Tableau Next para entregar herramientas de datos altamente conectadas, de confianza y colaborativas con tecnología de IA.
- **Herramientas de BI**: Mejora la eficiencia en el análisis de autoservicio para trabajadores de datos, centrándose en la preparación de datos y la depuración de metadatos visuales y semánticos.
- **Experiencias contextuales**: Aporta perspectivas de datos, experiencias e IA transparente en el contexto de donde trabaja la mayor parte de una organización (por ejemplo, Slack).
- **Agenteforce Architecture**: Construido sobre la pila Agentforce, proporcionando a Tableau Next un contexto enriquecido sobre una arquitectura agente avanzada.
- **Catálogo semántico**: Ofrece un sistema centralizado para gestionar metadatos, linaje y búsqueda, lo que permite experiencias compartidas entre usuarios de Tableau Next.
- **Metadatos compartidos y generados**: Facilita flujos de trabajo transparentes entre análisis de autoservicio y contenido regulado en un ecosistema integral.
- **Marco de acción**: Lleva la perspectiva a la acción a través de flujos de trabajo preempaquetados, depurados o generados.
- **Perspectivas personalizadas**. Aprende sus preferencias de datos, su función y mucho más (en la medida en que lo permita), para aportarle perspectivas de datos altamente contextualizadas y personalizadas de inmediato.
- **Perspectivas proactivas**. Explore de forma inteligente su ecosistema de datos, buscando lugares de interés estadístico para usted; mientras comprende de forma proactiva los impulsores del cambio, qué hacer al respecto y recomienda acciones a realizar como siguientes pasos.
- **Agentes de datos** de confianza. Le devuelve el poder, como el controlador de sus agentes de datos, de crear y ajustar la aplicación a través de experiencias integradas. También le proporciona herramientas de prueba para evaluar previamente sus cambios de datos y su repercusión en la precisión y eficacia de sus agentes.
### 14.3 Experiencias de usuario de negocio dirigidas por soluciones integradas
Tableau Next mejora las experiencias de usuario de negocio entre varias plataformas como Slack y Salesforce, y a través de nuevas funciones de análisis como Tableau Pulse, todas accesibles a través de experiencias de agentes para simplificar la implicación de análisis. Los aspectos clave incluyen:
- **Colaboración**: Central en análisis de confianza, facilita la interacción entre diferentes componentes analíticos e integra herramientas de validación en el flujo de trabajo de los usuarios.
- **Métricas de pulso**: Ofrece perspectivas depuradas y automatizadas de forma más eficiente que los tableros creados por analistas tradicionales.
- **Experiencias dirigidas por IA**: Emplea IA para reducir la necesidad de experiencia técnica en análisis avanzado, ayudando a garantizar la fiabilidad con metadatos deterministas y datos gobernados.
- **Entrega de perspectivas para múltiples jugadores**: Permitir a los usuarios de negocio trabajar en colaboración con analistas para obtener Knowledge y Trust en las perspectivas que entrega el sistema.
- **Integración profunda**: Construido sobre una plataforma de metadatos y datos compartida, proporcionando capacidad de creación de compostura entre diferentes sistemas y experiencias para permitir la creación de compostura para promoción, flujo de datos y para diferentes personas ayudándose entre sí a revisar y completar el trabajo.
### 14.4 Semántica de Tableau
La Capa semántica de Tableau sirve como un puente crucial entre los datos sin procesar y la interpretación del usuario, simplificando el análisis de datos, la toma de decisiones y el desarrollo de aplicaciones, y mejorando el contexto y la recuperación dirigidos por la IA. Las funciones clave incluyen:
- **Gestión integrada de metadatos**: Admite tanto metadatos de autoservicio como gobernados, facilitando el análisis ad-hoc con rutas estructuradas para convertirse en la única fuente de verdad organizativa.
- **Capacidades mejores de Tableau**: Incluyendo compatibilidad con objetos multilógicos, capacidad de creación de compostura de modelos, dimensiones compartidas, jerarquía geoespacial compleja y modelado temporal.
- **Datos y análisis diversos**: Ayuda a vincular datos no estructurados y estructurados, como correlacionar categorías de productos basados en imágenes con datos de ventas estructurados e incorporar análisis de opiniones desde reseñas de productos semiestructurados.
- **Integración de Salesforce Platform**: Establece una fuente de verdad unificada, facilitando una semántica de negocio coherente y una integración sencilla entre aplicaciones y un modelo de metadatos coherente que admite varias experiencias de usuario y casos de uso.
- **Inteligencia genética**: La capa semántica es una de las áreas clave donde los agentes obtienen inteligencia comprendiendo no solo los datos y metadatos que impulsan su negocio, sino también la semántica que lo define, incluyendo descripciones más profundas y preferencias que se dirigen a su organización.
### 14.5 Flujos de trabajo integrados y perspectivas con capacidad de acción
Tableau Next ofrece soluciones integradas que mejoran la toma de decisiones dirigida por datos y la automatización de confianza, con acciones sencillas, flujos predefinidos, programación e integraciones de API. Los componentes clave incluyen:
- **Acciones de negocio inteligentes estandarizadas**: Facilita comunicaciones urgentes y específicas del contexto dentro de los negocios, que son esenciales pero complejas.
- **Programaciones de flujos predefinidas y generadas**: Activa acciones ad-hoc y programadas a través de flujos estáticos y generados de forma dinámica que son confiables pero verificables.
- **Agentforce**: Admite pláticas e interacciones de datos dirigidas por IA, permitiendo a los usuarios implicarse con perspectivas y realizar acciones similares a las de una interfaz de usuario tradicional, tanto dentro como fuera de sus aplicaciones de negocio, y simplificadas a través de pláticas.
### 14.6 Plataforma de desarrollador componible
Tableau Next ofrece una plataforma de desarrollador componible con opciones sin código, de código bajo y procódigo para el desarrollo de aplicaciones, todo ello utilizando Tableau Semantics en Data 360. Las ofertas clave incluyen:
- **Industria/Aplicaciones inteligentes preempaquetadas**: Proporciona aplicaciones analíticas con plantilla y personalizables adaptadas a necesidades específicas de la industria.
- **Aplicaciones externas e ISV**: Admite la creación de aplicaciones dinámicas e interactivas para fines analíticos, específicos de la industria y personalizados.
- **Mercado y cambio**: Permite a los ISV y desarrolladores empaquetar y distribuir sus aplicaciones dentro del ecosistema de desarrollo de aplicaciones de negocio más grande y confiable.
### 14.7 Colaboración profunda
Tableau Next está diseñado para usuarios de negocio y profesionales de datos, fomentando un enfoque colaborativo para la comprensión de datos. Ya sea técnico o no técnico, todos los miembros del equipo, desde usuarios de negocio a expertos en datos, pueden revisar las perspectivas de datos de los demás. Además, estas perspectivas no están limitadas a una ficha de navegador en una plataforma de BI.
Como plataforma de BI, Tableau Next es:
- **Componible entre plataformas**. Las perspectivas se representan del mismo modo, independientemente de la plataforma en la que las visualice. Esta coherencia es un principio de diseño de pilares cuando se trabaja con datos visualmente.
- **Profundamente integrado con Slack**. El desarrollo de integración con Slack ha garantizado una de las experiencias de datos colaborativos más intuitivas e inmersivas del mercado actual.
- **Abierto para cualquier herramienta**. La aplicación de nuestro principio API-first, en nuestra plataforma profundamente unificada, garantiza que la integración pueda extenderse a otras herramientas de colaboración y externas, manteniendo la riqueza en todo.
## 15\. Integración
Aunque Salesforce Platform ofrece un conjunto completo de funciones de integración para abordar una amplia gama de retos digitales, muchos clientes operan dentro de arquitecturas de negocio que se han desarrollado a lo largo del tiempo a través del uso de varios proveedores y tecnologías.
Las empresas modernas enfrentan retos con la integración del sistema y la automatización de procesos de negocio, lo que a menudo da como resultado silos de datos e ineficiencias. Salesforce Integration Platform, aprovechando la potencia de MuleSoft, aborda estos problemas facilitando el desarrollo rápido y la mejora de procesos automatizados. Garantiza una conectividad del sistema transparente, mejora el flujo de información y apoya la toma de decisiones entre diferentes plataformas, reduciendo así los costos de mano de obra y los gastos de automatización. Esta capa es crucial para crear, gestionar, gobernar y monitorear integraciones entre servicios de Salesforce y otros servicios personalizados o externos.
Los sistemas se definen a través de las API, que sirven para:
- Acceda a datos desde sistemas esenciales como sistemas ERP, sistemas de clientes y facturación y bases de datos propias.
- Facilite la interacción e integración de datos, ayudando a eliminar los silos de datos.
- Agregue contexto de negocio a los datos y procesos gestionados por las API de sistema y proceso.
Para una comunicación efectiva, las API se describen utilizando:
- Especificación de OpenAPI (OAS) para intercambios síncronos inmediatos
- AsyncAPI para comunicaciones asíncronas dirigidas por eventos
- Protocolo de contexto de modelo (MCP) para interacciones de contexto de modelo estructuradas
- Protocolo de agente a agente (A2A) para integraciones directas de agente a agente.
La Capa de integración de Salesforce proporciona funciones sólidas para integrar y gestionar cualquier sistema, mejorando la conectividad con las funciones de datos, IA y aplicación de Salesforce, independientemente de si los sistemas son nativos de Salesforce o de otros proveedores.
Las integraciones complejas requieren transformaciones avanzadas y necesitan herramientas sólidas, incluyendo conectividad universal; gobernanza y gestión de API; un entorno de desarrollo integrado (IDE) para crear cargas de trabajo de integración; una plataforma de tiempo de ejecución para implementar, gestionar y supervisar estas integraciones; y una plataforma de observabilidad para proporcionar visibilidad de extremo a extremo en estas integraciones.
Para acelerar aún más el proceso de integración, ofrecemos aceleradores y plantillas específicas de la industria que codifican patrones y necesidades de integración comunes.
### 15.1 Patrones de integración con Salesforce
Dos patrones de integración principales tratan el flujo de datos y procesos entre Salesforce y el ecosistema más amplio: integración saliente e integración entrante.
**Conexión de Salesforce a sistemas externos (saliente):** Este patrón implica procesos originados desde Salesforce que acceden a datos o desencadenan acciones en sistemas externos.
- **Secure Endpoint Management (Credenciales nombradas):** Las credenciales nombradas proporcionan una ubicación segura y centralizada para almacenar detalles de autenticación y extremo. Las aplicaciones y automatizaciones hacen referencia a un nombre lógico, mientras que la plataforma gestiona las complejidades del ciclo de vida de autenticación.
- **Integración declarativa (Servicios externos):** Para sistemas externos que ofrecen una especificación OpenAPI estándar, un administrador puede utilizar Servicios externos para registrar la API de forma declarativa. A continuación, la plataforma procesa la especificación, haciendo que las operaciones del servicio estén disponibles automáticamente como acciones nativas en herramientas como Flow o como objetos nativos en Apex.
- **Integración de sistemas complejos (MuleSoft)**: Para sistemas que carecen de interfaces modernas, MuleSoft crea una capa de API estándar reutilizable. Esto elimina la complejidad heredada y aporta datos y procesos locales al ecosistema de Salesforce.
- **Acceso a datos en tiempo real (Objetos externos):** Representa tablas de sistemas externos como objetos virtuales en el modelo de datos de Salesforce, haciendo que los datos externos sean accesibles a través de consultas estándar y componentes de la interfaz de usuario sin replicación.
- **Central Capability Management (Catálogo de API unificado):** El Catálogo de API unificado es un repositorio centralizado y la única fuente de la verdad para todas las especificaciones de API y sus metadatos asociados, como su ubicación y protocolos de seguridad. Garantiza que, independientemente de dónde resida un dato o una lógica de negocio, se pueda descubrir, conectar de forma segura y componer en nuevas aplicaciones y automatizaciones potentes en todo el ecosistema de Salesforce.
- **Lógica de procódigo personalizado (APex REST):** Los desarrolladores pueden exponer lógica de negocio personalizada escrita en Apex como una acción y API de REST. La acción está disponible como un paso en un flujo o una herramienta para un agente de IA.
**Conexión de sistemas externos a Salesforce (Entrante):** Este patrón permite a los sistemas y aplicaciones externos conectarse a Salesforce Platform para acceder a datos, desencadenar lógica de negocio y orquestar procesos. Esta función está construida sobre una base de API de nivel de compañía probadas que funcionan a gran escala. A octubre de 2025:
- La API de consulta (SOQL) gestiona más de 50.000 millones de solicitudes diariamente.
- La API de REST sirve casi 5.000 millones de llamadas al día desde sistemas externos, con un uso que crece un 30% año tras año.
- La API masiva procesa cientos de miles de millones de registros para operaciones de datos a gran escala diariamente.
Esta fiabilidad y escala comprobadas respaldan las siguientes funciones:
- **Una experiencia de API unificada:** El acceso a todas las funciones de Salesforce se está unificando a través de una estructura de extremo coherente (api.salesforce.com), eliminando la necesidad de que los desarrolladores aprendan diferentes patrones o flujos de autenticación para cada producto.
- **Una cartera de API integral creada específicamente:** La plataforma proporciona una recopilación diversa de API adaptadas a necesidades específicas, incluyendo las API de REST y SOAP para operaciones transaccionales, la API masiva para procesamiento de datos de gran volumen, la API Pub/Sub para aplicaciones dirigidas por eventos y las API de Apex personalizadas o de productos especializados.
- **Preparación futura para la integración de agentes:** A través de estándares como MCP, los clientes pueden exponer de forma segura sus datos y acciones de Salesforce como "herramientas" para agentes de IA externos, convirtiendo una instancia de Salesforce en un conjunto ampliable de habilidades para una plantilla digital.
### 15.2 Integración de agentes con MCP
Más allá de los patrones entrantes y salientes establecidos para la integración de datos y procesos, está surgiendo un nuevo patrón para la era de los agentes. Salesforce Platform está implementando una estrategia integral de MCP, posicionándola como consumidora y proveedora de servicios con tecnología de IA. Este enfoque bidireccional permite la interoperabilidad de agentes, permitiendo a las compañías integrar datos y funciones de Salesforce sin problemas con el ecosistema en evolución de agentes y herramientas de IA mientras mantienen la seguridad y la gobernanza de nivel de compañía.
**Salesforce como cliente de MCP:** Los agentes pueden actuar como un cliente de MCP aprovechando de forma inteligente y dinámica las API y los sistemas externos. Esta función permite a las organizaciones ampliar el alcance de Agentforce más allá de los límites de Salesforce, orquestando acciones entre cualquier sistema, ya tenga una API moderna o requiera conexión a través de MuleSoft a sistemas heredados o bots RPA. La configuración se gestiona a través de una experiencia de configuración declarativa basada en temas familiar, permitiendo una integración rápida sin desarrollo personalizado. Un mecanismo de descubrimiento simplificado para servidores MCP proporcionados por socios simplifica aún más la integración de funciones externas. Abstrayendo las complejidades de la conectividad externa a través de una pila de alta escala, las compañías pueden integrar rápidamente Agentforce con su panorama tecnológico más amplio.
**Salesforce como servidor MCP:** Como un servidor MCP, la plataforma expone su lógica y activos, incluyendo API de REST estándar, extremos personalizados, Acciones invocables y Flujos, como "herramientas" detectables para agentes externos. A través de una interfaz declarativa, los clientes e ISV pueden crear y configurar sus propios servidores MCP personalizados, depurando funciones en conjuntos de herramientas adaptadas para procesos de negocio exclusivos. Esto se amplía a Solicitudes de MCP, creando sinergias naturales con las funciones Plantilla de solicitud de la plataforma y permitiendo a las organizaciones hacer que su inversión en ingeniería de solicitudes sea accesible para cualquier sistema de IA externo.
Esta función se rige por un modelo de seguridad de múltiples capas:
- **Control de aplicación:** La construcción Aplicación cliente externa proporciona a los administradores un control sólido sobre qué aplicaciones de agentes externos pueden acceder a su organización de Salesforce.
- **Permisos con ámbito:** La autenticación se aumenta con el ámbito granular de OAuth, lo que permite un seguimiento preciso y la aplicación forzosa de acciones que un agente autenticado puede realizar.
- **Autorización de plataforma principal:** Estos nuevos controles están construidos sobre el sólido modelo de autorización de Salesforce, incluyendo controles de acceso a registros, permisos a nivel de entidad y campo y otros permisos definidos en Perfiles y Conjuntos de permisos.
Los ISV y socios también pueden empaquetar y distribuir configuraciones de servidor MCP, permitiendo la implementación rápida de integraciones listas para IA en el ecosistema de Salesforce.
### 15.3 Conectividad universal
El enfoque moderno de Salesforce para la conectividad universal es la _conectividad interpretada_, un enfoque centrado en metadatos para desarrollar conectores que se pueden ejecutar en cualquier plataforma (MuleSoft, Flow o Data 360) para cualquier caso de uso sin programación. Los modelos de metadatos comprenden cómo conectarse a servicios remotos para autenticar una solicitud, modelar los datos devueltos, crear consultas, pasar por la página de resultados y recibir eventos (desencadenadores) para automatizar un proceso.
Para sistemas que no utilizan API basadas en HTTP, Salesforce ofrece cientos de conectores preintegrados y un SDK completo para la creación de conectores personalizados. Para sistemas sin ningún acceso de API, Salesforce ofrece Automatización de procesos robótica (RPA) que utiliza agentes para automatizar tareas repetitivas basadas en reglas que normalmente realizan los humanos. Estas tareas pueden incluir el ingreso de datos, el procesamiento de transacciones y la respuesta a consultas de servicio al cliente sencillas. Para extraer información de documentos, Salesforce ofrece nuestro Procesamiento inteligente de documentos (IDP) que aprovecha la IA para extraer, clasificar y procesar automáticamente datos desde varios tipos de documentos, como facturas, contratos y formularios. Sea cual sea la información existente, Salesforce ofrece una forma automatizada de recuperarla y manipularla.
Con los avances recientes en IA, Salesforce proporciona elementos constructivos para activar rápidamente funciones de agentes en la organización:
- El **Conector de protocolo de contexto de modelo (MCP)** permite a las organizaciones exponer rápidamente su API como herramientas de MCP y facilitar el descubrimiento de API y recursos para el consumo por agentes.
- **Conector de agente a agente (A2A)** permite a las organizaciones estandarizar la comunicación de agente a agente proporcionando cobertura de protocolo A2A para agentes. Cada agente (un experto funcional en el dominio) puede descubrir y delegar la consulta de un cliente en el agente más adecuado para el dominio.
- **Conector de conferencia** proporciona elementos constructivos para crear un agente desde cero proporcionando llamadas LLM, incrustaciones vectoriales y búsqueda, recuperación de RAG y compatibilidad con herramientas MCP.
### 15.4 Gestión de API
Gestión de API de MuleSoft, entregada a través de Anypoint API Manager, proporciona una plataforma integral para diseñar, proteger, gobernar, monitorear y ampliar API y microservicios en cualquier entorno de implementación. Las organizaciones pueden gestionar sus API y microservicios con perspectivas y controles coherentes de nivel de compañía desde un único panel de cristal, independientemente de la plataforma, con gestión centralizada desde la implementación hasta la versión. Las funciones clave incluyen:
- **Anypoint Flex Gateway** es una pasarela de API de capa de aplicación para gestionar y proteger las API, aplicando políticas para limitación de velocidad, almacenamiento en caché, autenticación, autorización, protección contra amenazas, monitoreo y registro a nivel HTTP/S. Es una pasarela ligera, de alto desempeño y basada en enviados diseñada para entornos distribuidos basados en microservicios y está construida para integrarse perfectamente con flujos de trabajo de DevOps y CI/CD, proporcionando al mismo tiempo seguridad y capacidad de gestión de negocio en cualquier entorno mientras admite políticas entrantes y salientes.
- Las **Alertas de API** permiten a las organizaciones definir y monitorear umbrales o condiciones específicos para sus API para detectar comportamientos inusuales o no deseados. Los ejemplos incluyen alertas cuando el tiempo de respuesta supera un límite (por ejemplo, 60 segundos), cuando el número de solicitudes en un plazo de tiempo es demasiado alto, cuando se devuelven ciertos códigos de respuesta HTTP o cuando se producen infracciones de políticas.
- **API Analytics** proporciona visibilidad sobre cómo se están utilizando las API y su desempeño. El tablero Analytics permite a las organizaciones realizar un seguimiento y ver mediciones de alto nivel, desglosar gráficos, crear y personalizar tableros y reportes para comprender tendencias de uso, infracciones de políticas, tiempos de respuesta, códigos de solicitud/respuesta y mucho más.
### 15.5 Entorno de desarrollo de integración de próxima generación
MuleSoft Anypoint Code Builder (ACB) es nuestro IDE de próxima generación diseñado para el desarrollo de API e integración, con una experiencia moderna y unificada con VS Code como backend.
- **Entorno de desarrollo unificado:** Consolida la API completa y el proceso de desarrollo de integración en una sola herramienta, admitiendo las API de AsyncAPI, OAS y RAML, conjuntos de reglas de gobernanza, un lienzo de flujo de código bajo, conectores preintegrados y opciones de prueba e implementación integradas. Además, ACB admite la depuración, la solución de problemas y el mantenimiento continuo con sugerencias contextuales inteligentes.
- **Experiencia de desarrollo de agencias:** Entrega experiencias de agentes en todo el ciclo de vida de desarrollo de aplicaciones. En el núcleo está el servidor MuleSoft MCP, que activa Desarrollo de integración de agentes. MuleSoft MCP Server proporciona potentes herramientas para generar especificaciones de API e integraciones desde lenguaje natural, crear transformaciones de datos, gestionar activos en MuleSoft Exchange y administrar aplicaciones y políticas de API. Las herramientas del servidor MuleSoft MCP potencian al máximo la especificación de API de los usuarios y el desarrollo de la integración en cualquier editor de código de IA basado en VS Code, incluyendo Cursor, Windsurf y muchos más.
- **Integraciones de IA:** MuleSoft mejora el desarrollo de la integración con funciones de agentes utilizando MuleSoft Topic Center, que convierte llamadas de API en Acciones Agentforce para acceso al sistema de la compañía. Agentforce Connector integra la automatización del lenguaje natural en integraciones. El Conector de inferencia integra de forma segura proveedores LLM externos, activando la lógica dirigida por IA en aplicaciones MuleSoft. Las organizaciones pueden utilizar estas funciones combinadas para crear integraciones inteligentes y adaptativas.
### Plataforma de tiempo de ejecución 15.6
La plataforma Tiempo de ejecución de MuleSoft proporciona opciones de implementación flexibles para la ejecución de aplicaciones, API e integraciones de MuleSoft entre entornos. Las organizaciones pueden elegir el modelo de tiempo de ejecución que mejor se ajuste a sus necesidades operativas, de cumplimiento y de capacidad de ampliación mientras mantienen una gestión y gobernanza coherentes a través de Anypoint Platform. Esta flexibilidad garantiza que las aplicaciones puedan ejecutarse cerca de orígenes de datos, cumplir con leyes regionales y ampliarse sin problemas basándose en la demanda.
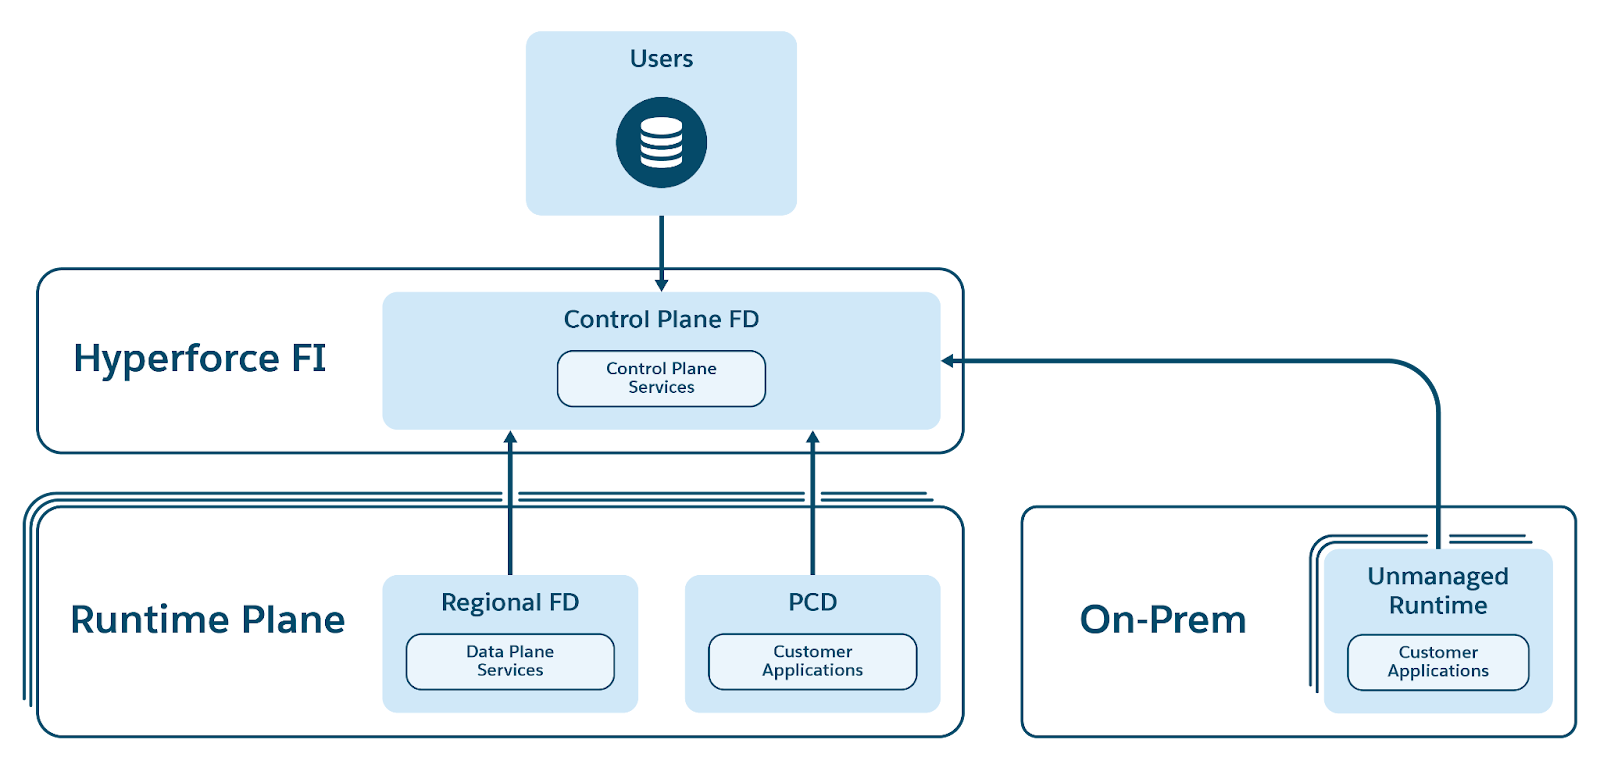 Las opciones de alojamiento clave incluyen:
- **Nube:** Plataforma como servicio (iPaaS) de integración de múltiples arrendatarios completamente gestionada de MuleSoft que elimina los gastos generales de gestión de infraestructura. CloudHub 2.0 proporciona ampliaciones elásticas, alta disponibilidad y actualizaciones/implementaciones de tiempo de inactividad cero, con necesidades de observabilidad integradas y certificaciones de cumplimiento. Los desarrolladores pueden centrarse en la creación de API e integraciones mientras MuleSoft gestiona la infraestructura de tiempo de ejecución, garantizando seguridad de nivel de compañía, fiabilidad y alta disponibilidad.
- **Híbrido:** Para organizaciones que necesitan alojar sus aplicaciones por sí mismas para tener más control, MuleSoft ofrece Runtime Fabric, un servicio de contenedor que automatiza la implementación y orquestación de tiempos de ejecución de MuleSoft entre Kubernetes o máquinas virtuales. Admite ampliación horizontal, implementaciones de tiempo de inactividad cero, controles de seguridad integrados y gestión de clúster simplificada.
- **Private Cloud Edition (PCE):** Private Cloud Edition de MuleSoft proporciona una versión local completamente autogestionada de Anypoint Platform (incluyendo Planos de control y tiempo de ejecución), permitiendo a las organizaciones cumplir estrictos requisitos de regulación, residencia de datos y seguridad. Permite a las grandes empresas mantener el control completo sobre la infraestructura mientras se benefician de las funciones de gestión de API e integración unificada de Anypoint Platform.
### 15.7 Observabilidad
MuleSoft entrega soluciones de observabilidad integrales que proporcionan visibilidad de extremo a extremo en API, integraciones y aplicaciones en cualquier modelo de implementación. Las funciones de observabilidad son coherentes independientemente de dónde se ejecuten las cargas de trabajo, proporcionando una vista unificada de los entornos. Al capturar datos de telemetría históricos y en tiempo real, MuleSoft permite a las organizaciones detectar, analizar y resolver problemas de producción con mayor rapidez en toda la red de aplicaciones. Los datos de observabilidad se pueden ver de forma nativa en Anypoint Platform o se pueden exportar a través de OpenTelemetry en el APM preferido de un cliente, permitiendo una integración sencilla con ecosistemas de monitoreo existentes. Esto permite a las organizaciones reforzar de forma proactiva la resiliencia de la infraestructura y mejorar la fiabilidad de las aplicaciones críticas para las misiones.
MuleSoft proporciona observabilidad a través de dos ofertas principales:
- **Anypoint Monitoring** es la solución de observabilidad en el mercado actual integrada en Anypoint Platform. Ofrece tableros personalizables y listos para su uso para monitorear el estado de la aplicación, búsqueda avanzada de registros para la gestión de registros y funciones de alerta que notifican a los equipos cuando se producen umbrales o anomalías definidos.
- **Inteligencia de integración** es la plataforma de observabilidad de primera IA de próxima generación para MuleSoft rediseñada y construida de forma nativa en Salesforce Platform. Esta oferta utiliza Data 360 como una capa de datos unificada para los datos de telemetría; Tableau Semantics como una capa semántica de confianza para permitir perspectivas inteligentes con capacidad de acción; Tableau Concierge para lograr la solución de problemas asistida por IA; y Tableau Next Dashboards para entregar interfaces visuales interactivas que reúnen múltiples visualizaciones de datos enriquecidos en una única vista cohesiva. Tableau Next también ofrece a los clientes la capacidad de crear tableros personalizados sobre el modelo de datos semánticos enviado con funciones de observabilidad.
Esta pila también potencia el rastreo centrado en agentes que proporciona a los clientes una transparencia completa en la ruta de invocación de agentes de extremo a extremo no determinista, permitiéndoles observar al agente trabajando en cada paso intermedio, permitiendo a los usuarios llegar a la causa raíz de los fallos con mayor rapidez e identificar cualquier cuello de botella de desempeño.
## 16\. Ecosistema y AppExchange
El ecosistema de Salesforce ejemplifica la potencia de la plataforma. Los Integradores de sistemas (SI) y los socios consultores ayudan a los clientes desarrollando, configurando y optimizando soluciones complejas de Salesforce. Los proveedores de software independientes (ISV) crean aplicaciones y soluciones innovadoras en la plataforma, que los clientes pueden instalar en sus organizaciones de Salesforce. Estas aplicaciones ISV están disponibles en AppExchange, la tienda de aplicaciones de Salesforce lanzada en 2006, que ahora cuenta con más de 10.000 aplicaciones con más de 14,3 millones de instalaciones a octubre de 2025.
Para ayudar a los clientes a navegar por el amplio mercado y descubrir aplicaciones relevantes, la experiencia de búsqueda AppExchange se volvió a diseñar en 2025 para aprovechar Data 360. Las funciones de búsqueda vectorial de Salesforce Data 360 funcionan conjuntamente con la coincidencia de palabras clave tradicional para entregar resultados más relevantes semánticamente comprendiendo la intención de un usuario a través del lenguaje natural. La visión final es hacer evolucionar esta base integrándola con la plataforma Agentforce, permitiendo una interfaz completamente agente, “preguntar cualquier cosa” donde los clientes pueden describir conversacionalmente sus retos de negocio para recibir recomendaciones de soluciones altamente personalizadas.
AppExchange garantiza soluciones de alta calidad a través de un riguroso proceso de revisión que implica analizadores de código, escáneres de seguridad y guías de implementación de referencia, todo ello en estrecha colaboración con Salesforce. Esta plataforma también proporciona a los ISV herramientas de gestión de licencias para adaptar la monetización y las licencias de aplicaciones, admitiendo varios modelos de precios incluyendo opciones basadas en el usuario y en el consumo.
Los principios de "plataforma dirigida por metadatos" permiten a los ISV ampliar las aplicaciones y los metadatos nativos de Salesforce, facilitando el desarrollo de modelos de datos, lógica de negocio e interfaces de usuario. Salesforce Platform admite una amplia gama de soluciones, desde aplicaciones específicas de la industria a aplicaciones con marca altamente personalizadas que utilizan tecnologías como Componentes web Lightning para la interfaz de usuario y Código Apex para la lógica de negocio.
El concepto de "empaquetado" es crucial para la distribución de estas aplicaciones entre varias organizaciones de Salesforce. El empaquetado implica la serialización de metadatos en un artefacto que puede instalar cualquier cliente de Salesforce, utilizando tecnologías subyacentes diseñadas para la gestión de metadatos en varios entornos. Un aspecto único del empaquetado es que permite instalaciones en entornos desconocidos para el desarrollador.
Para mejorar el control y la seguridad, las funciones de “manejabilidad” dentro del empaquetado permiten a los ISV actualizar partes de una aplicación de forma segura porque otros no pueden depender de estas partes, permitiendo al mismo tiempo a los clientes poseer y gestionar otras partes. Por ejemplo, los ISV pueden establecer ciertos metadatos, como la configuración personalizada, en “gestionados”, haciéndolos invisibles y no modificables por el cliente, evitando así interrupciones en el entorno del cliente. Los paquetes gestionados incluyen estos controles de capacidad de gestión, mientras que los paquetes no gestionados tratan los metadatos implementados como creados por el cliente, que no se pueden actualizar después de la implementación.
Desde el inicio de AppExchange y Salesforce Platform, ha habido un aumento notable en el número y la complejidad de los paquetes que se crean e instalan. En respuesta a estas demandas, la plataforma presentó la Arquitectura de empaquetado de segunda generación en 2020. Esta nueva arquitectura mejora la modularidad de paquetes gestionados, mejora la flexibilidad de versión, permite la colaboración de espacios de nombres y admite dependencias declarativas, entre otros avances en el ciclo de vida de desarrollo de software. La arquitectura de implementación de paquetes también tenía varias mejoras significativas para una mayor eficiencia y escala, como determinar qué metadatos cambiaron y solo implementar los deltas.
Una medida crítica para el desarrollo de nuevos productos y funciones es su compatibilidad con el empaquetado y preparación para el uso de ISV. La plataforma hace hincapié en la rápida disponibilidad de sus funciones para socios, permitiendo al Ecosistema de Salesforce aprovechar el potencial innovador de Salesforce Platform de forma efectiva y más allá de las ofertas de uso inmediato de Salesforce. Sin embargo, esta es un área de inversión continua para garantizar que todas las funciones descritas en este documento que están disponibles para desarrolladores internos de Salesforce también están disponibles para nuestros desarrolladores ISV.
Además, Heroku Marketplace y Slack Marketplace ofrecen una amplia gama de integraciones y complementos externos que pueden mejorar las funciones de las aplicaciones de Salesforce. Heroku Marketplace proporciona herramientas y servicios para funciones de aplicación adicionales, así como mejorar el modo en que los desarrolladores crean, implementan y gestionan aplicaciones. Slack Marketplace ofrece integraciones que pueden simplificar los flujos de trabajo y mejorar la colaboración en entornos de Salesforce.
## 17\. Salesforce en Salesforce
En el espíritu de nuestro valor principal, Customer Success, Salesforce actúa como “Customer Zero” para todas las aplicaciones y servicios en Salesforce Platform, aprovechando los productos de cara al cliente de forma interna siempre que sea posible. Esto proporciona ventajas significativas:
- **Pruebas de productos rigurosas**: Al utilizar el conjunto de productos a diario, los empleados de Salesforce exponen la plataforma a retos reales, mejorando la calidad de los productos e identificando áreas de mejora.
- **Productos refinados**: Los comentarios inmediatos del uso interno permiten un refinamiento rápido de las funciones y la capacidad de uso, así como una identificación y resolución rápidas de cualquier fallo, dando como resultado productos que cumplen mejor las necesidades del cliente tras el lanzamiento.
- **Experiencia industrial profunda**: El uso interno entre varias funciones proporciona a Salesforce perspectivas valiosas sobre retos específicos de productos e industrias, particularmente en sectores de alta tecnología.
- **Empatía de clientes mejorada**: La experiencia de primera mano con la plataforma permite a los empleados comprender y tratar mejor los puntos débiles de los clientes.
- **Perspectivas de marketing y ventas**: El uso diario de productos informa las estrategias de ventas y marketing, ayudando a adaptar la plataforma a las necesidades de los clientes.
- **Estrategia de salida al mercado más potente**: La implementación interna correcta permite a Salesforce comercializar con confianza el conjunto como una solución probada.
Además, todas las actualizaciones de software destinadas a producción se implementan inicialmente en una instancia de Hyperforce "Salesforce on Salesforce" dedicada como parte de un proceso de implementación escalonado. Desde agosto de 2020, esta instancia ha alojado con éxito GUS, la organización de Salesforce para equipos de ingeniería, así como las operaciones de CRM de Salesforce, mostrando la solidez y preparación de Hyperforce para cualquier cliente. Esta estrategia permite a los equipos internos probar y aflorar cualquier problema mucho antes de las implementaciones de producción en clientes externos.
La organización de Tecnología Salesforce ha adoptado completamente Agentforce como la plataforma interna para una productividad y calidad aumentadas en el SDLC. Esto nos ha permitido no solo mejorar la calidad del código que enviamos a nuestros clientes detectando y mitigando fallos de forma temprana, sino que también nos ha permitido iterar rápidamente en experiencias de agentes basándose en comentarios internos de primera mano.
## 18\. Entrega de transformación a escala
Desde su fundación en 1999, Salesforce ha experimentado múltiples transformaciones tecnológicas. Sin embargo, la transformación de Salesforce Platform fue especialmente significativa debido a su escala y al rápido ritmo al que se implementaron los cambios. Esta transformación requería una evolución simultánea de todos los componentes arquitectónicos principales para lograr una plataforma integrada. Para garantizar que esta transformación fuera iterativa y mínimamente perturbadora para las partes interesadas y los pioneros, la organización de Salesforce Technology también tuvo que evolucionar sus prácticas de ingeniería y entrega de productos.
La organización de Salesforce Technology es un equipo grande y diverso, que comprende más de 2500 equipos ubicados en más de 20 sitios en 14 países diferentes. Este grupo opera a gran escala, entregando más de 200 versiones de productos e implementando 250 000 cambios del sistema cada semana. En línea con el espíritu más amplio de la compañía, el grupo Tecnología se guía por cinco valores fundamentales: Trust, Customer Success, Innovación, Igualdad y Sostenibilidad. Estos valores son integrales para dar forma a la estrategia del grupo, guiar su ejecución e influir en las decisiones diarias.
Siguiendo nuestros valores principales, el marco de trabajo de Salesforce Engineering 360 equipa a los equipos de ingeniería con tableros orientados a la acción y perspectivas integrales sobre sus operaciones, estableciendo expectativas claras para estándares y mejores prácticas dentro de la organización. Esta vista holística abarca varias áreas críticas incluyendo disponibilidad, seguridad, cumplimiento, calidad, accesibilidad, Developer Productivity, desarrollo de productos ágil y eficiencia de costos. Para proporcionar estas perspectivas, el marco de trabajo procesa miles de millones de registros desde cientos de sistemas de ingeniería internos, como sistemas de seguridad, registros de estado de producción, repositorios de código, entornos de desarrollo, CI/CD y sistemas de planificación y seguimiento de versiones/trabajo, todos construidos sobre Salesforce Platform utilizando las innovaciones más recientes de Agentforce, Data 360, Tableau y Slack.
Raíces en estos y otros datos, la organización de Tecnología de Salesforce aprovecha la IA y las tecnologías de agentes para acelerar la productividad. Tenemos más de 10.000 usuarios activos diarios de herramientas de IA internas y hemos creado más de 100 agentes de IA que forman parte de nuestro programa AgentExchange interno, impulsando mejoras de productividad en toda la organización.
Gracias a nuestro valor superior de Trust, la propiedad de servicios está profundamente arraigada en nuestra cultura de ingeniería. Cada servicio y producto está diseñado para no solo cumplir sino superar sus Objetivos de nivel de servicio (SLO) relacionados con mediciones de disponibilidad y gestión de incidentes como Tiempo para detectar (TTD) y Tiempo para restaurar (TTR). Nuestro enfoque para la gestión de cambios, la preparación para la versión y la gestión de problemas se adhiere a altos estándares. La seguridad está integrada en cada fase de nuestro ciclo de vida de desarrollo seguro, respetando el principio de seguridad predeterminada. Se da prioridad a la calidad y el desempeño a través de la metodología de pruebas ágiles, que incluye millones de pruebas automatizadas entre pruebas de unidad, funcionales, de integración y de carga/escala en nuestras oportunidades en curso de CI/CD.
Arquitectónicamente, nos centramos en el desarrollo de funciones compartidas para mejorar el apalancamiento y la eficiencia, mejorando así la calidad. Por ejemplo, desarrollamos servicios gestionados en Hyperforce para satisfacer diversas necesidades como la gestión de datos y computación, permitiendo a los equipos de productos centrarse en la innovación de productos mientras que los equipos centrales mejoran estos servicios en términos de seguridad, disponibilidad y rentabilidad.
Nuestras operaciones son ágiles, fomentando la entrega de innovación a los clientes. Cada uno de los más de 3000 equipos tiene la autonomía de cómo implementar el marco de trabajo ágil, utilizando Scrum o Kanban. La planificación del desarrollo de productos en toda la organización está estructurada con varios plazos, incluyendo un plan de largo plazo de 3 años para la dirección estratégica, seguido de planes de ejecución anuales, y desglosado en planes de lanzamiento de productos de 4 meses, que informan los planes de sprint quincenales. Los productos, las funciones y las soluciones de fallos se implementan a través de múltiples vehículos de versión para satisfacer las diversas necesidades de los clientes, incluyendo tres versiones anuales principales, versiones quincenales y versiones diarias.
La productividad es de vital importancia dada nuestra escala. Utilizamos el marco de trabajo SPACE para medir la productividad de forma efectiva, respaldado por un conjunto integral de mediciones proporcionadas por el sistema Engineering 360. También nos centramos en mejorar herramientas y experiencias para nuestros desarrolladores internos para simplificar el ciclo de vida del desarrollo, con inversiones en experiencias de agentes e IA, flujo de trabajo, herramientas de construcción, configuraciones de desarrollo, versiones más seguras y servicios de seguridad que proporcionan beneficios significativos.
## 19\. Conclusión
En conclusión, Salesforce Platform ha experimentado una transformación notable en los últimos cinco años, evolucionando desde la plataforma pionera de nube de múltiples arrendatarios a una plataforma de confianza, integrada, con capacidad de agentes y datos que impulsa un conjunto de aplicaciones y servicios en su región de elección. Esta evolución fue impulsada por la necesidad de abordar retos emergentes como el aumento de proveedores de nube pública, las crecientes demandas regulatorias y los avances en la IA generativa y el aprendizaje automático.
La introducción de Hyperforce, Data 360 y Agentforce ha mejorado significativamente las funciones de la plataforma, garantizando que permanece a la vanguardia de la innovación mientras mantiene Trust y fiabilidad. La migración exitosa de la mayoría de nuestros clientes a esta nueva plataforma subraya el ingenio y la dedicación de nuestros ingenieros.
A medida que continuamos innovando y adaptándonos a las cambiantes demandas del mercado, Salesforce Platform está bien posicionada para dar cobertura a la próxima generación de aplicaciones y casos de uso de clientes, reafirmando nuestro compromiso con el éxito de los clientes y la excelencia tecnológica.
## Introducción
En el panorama de múltiples agentes en evolución, los agentes son más efectivos cuando se les asignan tareas granulares específicas. Esto requiere una red diversa de agentes especializados y reutilizables. Sin embargo, el reto principal es coordinar estos numerosos agentes heterogéneos, que pueden proceder de diversas fuentes, para colaborar eficazmente en la consecución de objetivos de negocio comunes. Sin una plataforma unificada, esta complejidad lleva a la expansión de los agentes y una falta crítica de gobernanza.
Estos Agentes de IA se están multiplicando rápidamente, integrados en plataformas SaaS, desarrollados internamente o empaquetados con LLM populares. Esta multiplicación da como resultado silos organizativos desconectados. Aunque un agente optimiza tareas en sus aplicaciones nativas, a menudo carece de una vista de compañía holística. Esta falta de visibilidad impide que los agentes orquesten, protejan y rijan de forma efectiva acciones entre diferentes dominios y sistemas.
MuleSoft Agent Fabric aborda el reto de gestionar la "extensión de agentes" y permitir la orquestación transparente de diversos agentes, independientemente de su origen. Establece mejores prácticas arquitectónicas y proporciona las herramientas necesarias para crear la Red de agentes. Una Red de agentes hace referencia a una recopilación coordinada de agentes de IA, herramientas y recursos que trabajan conjuntamente para ejecutar procesos de negocio complejos de múltiples pasos.
## Componentes
MuleSoft Agent Fabric es una plataforma unificada que proporciona a cada compañía una forma sencilla de descubrir, orquestar, gobernar y observar a cualquier agente independientemente de su ubicación.
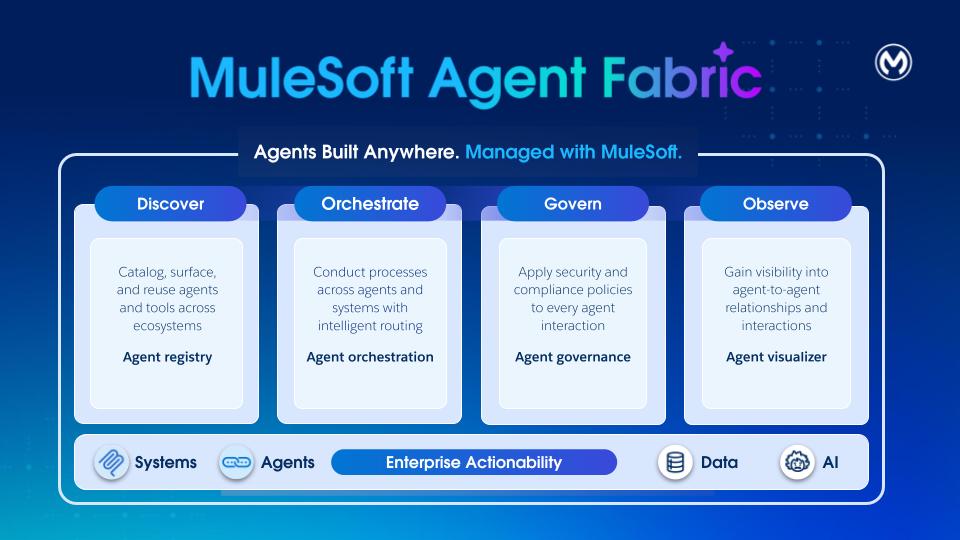 **Descubra:** Registro de agentes proporciona un catálogo centralizado de todos los agentes y herramientas de IA en toda la organización. Permite el descubrimiento y la reutilización de activos internos, integrados en SaaS y externos. Al proporcionar una única fuente de verdad para todos los activos de agentes, Registro de agentes elimina la redundancia y garantiza que los desarrolladores puedan aprovechar las funciones existentes a escala.
**Orquestar:** MuleSoft Agent Broker es una solución de enrutamiento inteligente que compara dinámicamente tareas con el agente o la herramienta que mejor se ajuste. Con tecnología de un LLM de su elección, se coordina entre agentes y herramientas para garantizar que las solicitudes de múltiples pasos complejas y los procesos de negocio se ejecutan con alta fiabilidad y resultados rastreables.
**Gobierno:** [MuleSoft Agent Governance](https://www.mulesoft.com/platform/ai/ai-agent-governance) utiliza Flex Gateway y su compatibilidad con [Model Context Protocol (MCP)](https://www.mulesoft.com/platform/ai/model-context-protocol) y el [protocolo Agent2Agent (A2A)](https://www.mulesoft.com/platform/ai/a2a-support). Con Flex Gateway, las compañías pueden aplicar políticas de seguridad y cumplimiento a cada interacción agente-agente y agente-herramienta.
**Observar:** Visualizador de agentes proporciona observabilidad en tiempo real a través de un mapa interactivo dinámico de interacciones de agentes. Realiza un seguimiento de decisiones, monitorea el estado del sistema, permitiendo así la optimización continua y la supervisión fiable de todo el ecosistema de agentes.
Agent Fabric defiende un enfoque de especificación primero (YAML) donde los usuarios definen redes de agentes a través de un descriptor de metadatos (el "archivo YAML"). Este archivo YAML es agnóstico para MuleSoft y desvincula la definición de la red de agentes de su ejecución.
## Especificación de red de agente (Descriptor de metadatos)
Cada red de agentes (YAML) define un área funcional específica con sus activos de agente, incluyendo sus reglas y políticas operativas. El YAML se utiliza para activar los cuatro pilares Tela de agente:
1. Descubrir: Rellene el Registro de agentes con Activos de agente existentes como:
1. Agentes implementados entre varias plataformas (MuleSoft u otras)
2. Servidores MCP
3. Proveedores de LLM
2. Orquestar: Crear corredores de agentes para orquestación
3. Gobernar: Aplicar políticas en los activos para la seguridad y la gobernanza
4. Observe: Defina y reutilice conexiones con los activos definidos. Del mismo modo, las funciones de observabilidad y monitoreo están disponibles para redes de agentes.
### Creación
La trayectoria del usuario comienza en Anypoint Code Builder. Utilice el nuevo comando disponible a través de la paleta de comandos denominada “MuleSoft: Crear un proyecto de red de agentes” para crear un nuevo proyecto. Este comando crea un nuevo proyecto (la ‘Red de agentes’) que contiene dos archivos.
- **agent-network.yaml:** Este archivo define la configuración para el sistema de múltiples agentes, permitiendo la orquestación de agentes de IA con herramientas externas (a través de MCP) y agentes (a través del protocolo A2A). Este formato proporciona una forma declarativa de definir funciones, dependencias e integraciones de agentes.
- **exchange.json:** Todos los proyectos de red de agentes también tienen un archivo exchange.json. Este archivo contiene metadatos de activos disponibles en Anypoint Exchange tras la publicación de sus activos de red de agente.
El desarrollo de su Red de agentes sigue un ciclo de vida de desarrollo de software (SDLC) estándar que incluye cuatro etapas principales:
1. **Configuración de entorno:** Configurar pasarelas y entornos de tiempo de ejecución
2. **Creación y diseño de proyectos**: Especificación de proyecto Crear red de agentes
3. **Edificio y publicación:** Crear y publicar activos en el Registro de agentes
4. **Implementación:** Implementar o promocionar la red de agentes en un entorno concreto
Después de crear el proyecto y generar la aplicación y los activos de MuleSoft requeridos, déjelos disponibles en Exchange. Dentro del Generador de códigos Anypoint, desencadene el proceso de creación y publicación utilizando **_“MuleSoft: Comando Publicar proyecto de agente corredor en Exchange”_** disponible a través de la paleta de comandos.
El paso de publicación transforma cada activo agente en el archivo YAML en una especificación A2A, MCP o LLM y lo publica en Exchange.
Además, el sistema **publica** el YAML en Exchange utilizando un nuevo tipo de activo agente-red. Puede **ver** este activo en la interfaz de usuario del Registro de agentes y **buscarlo** a través de la API de Exchange.
### Ejemplo
Consulte un [archivo Red de agentes](https://docs.mulesoft.com/anypoint-code-builder/af-project-files) que define una red de agentes para una compañía. Esta red de agentes activa la red para la realización de pedidos en Salesforce, Stripe, otro agente de realización de pedidos y servidor MCP de inventario con una única experiencia gobernada por políticas.
- **Descubrir**
Publique agentes y herramientas existentes (como Salesforce, Stripe, Realización de pedidos e Inventario) como activos de Exchange para su reutilización. También la definición de realización de pedidos (YAML) que está versionada y se puede compartir, permitiendo una adaptación rápida para funciones, regiones o filiales sin volver a construir flujos.
- **Orquestar**
Un corredor de agentes utiliza un LLM para descomponer el proceso de realización de pedidos en una secuencia de tareas, como la verificación de detalles de clientes, la asignación de inventario y el cálculo de costos de envío. A continuación, ejecuta este flujo de trabajo llamando a agentes de MCP y A2A, garantizando que se solicitan aprobaciones actualizadas siempre que sea necesario.
- **Gobierno**
Anypoint Flex Gateway aplica la autenticación, el acceso con menos privilegios y las barandillas. Las políticas del Gestor de API garantizan controles coherentes entre todas las llamadas e intercambios de datos.
- **Observar**
El monitoreo y los rastreos proporcionan visibilidad integral del progreso, los fallos y la latencia. La visualización muestra qué agentes interactuaron y dónde se produjeron cuellos de botella.
- **Confianza y cumplimiento**
Las credenciales centralizadas, los seguimientos de auditoría y la herencia de pólizas admiten la seguridad, la privacidad y los requisitos normativos (gestión de PII, aprobaciones y separación de funciones).
El diagrama muestra los diferentes nodos de la Red de agentes (metadatos) definidos en YAML.
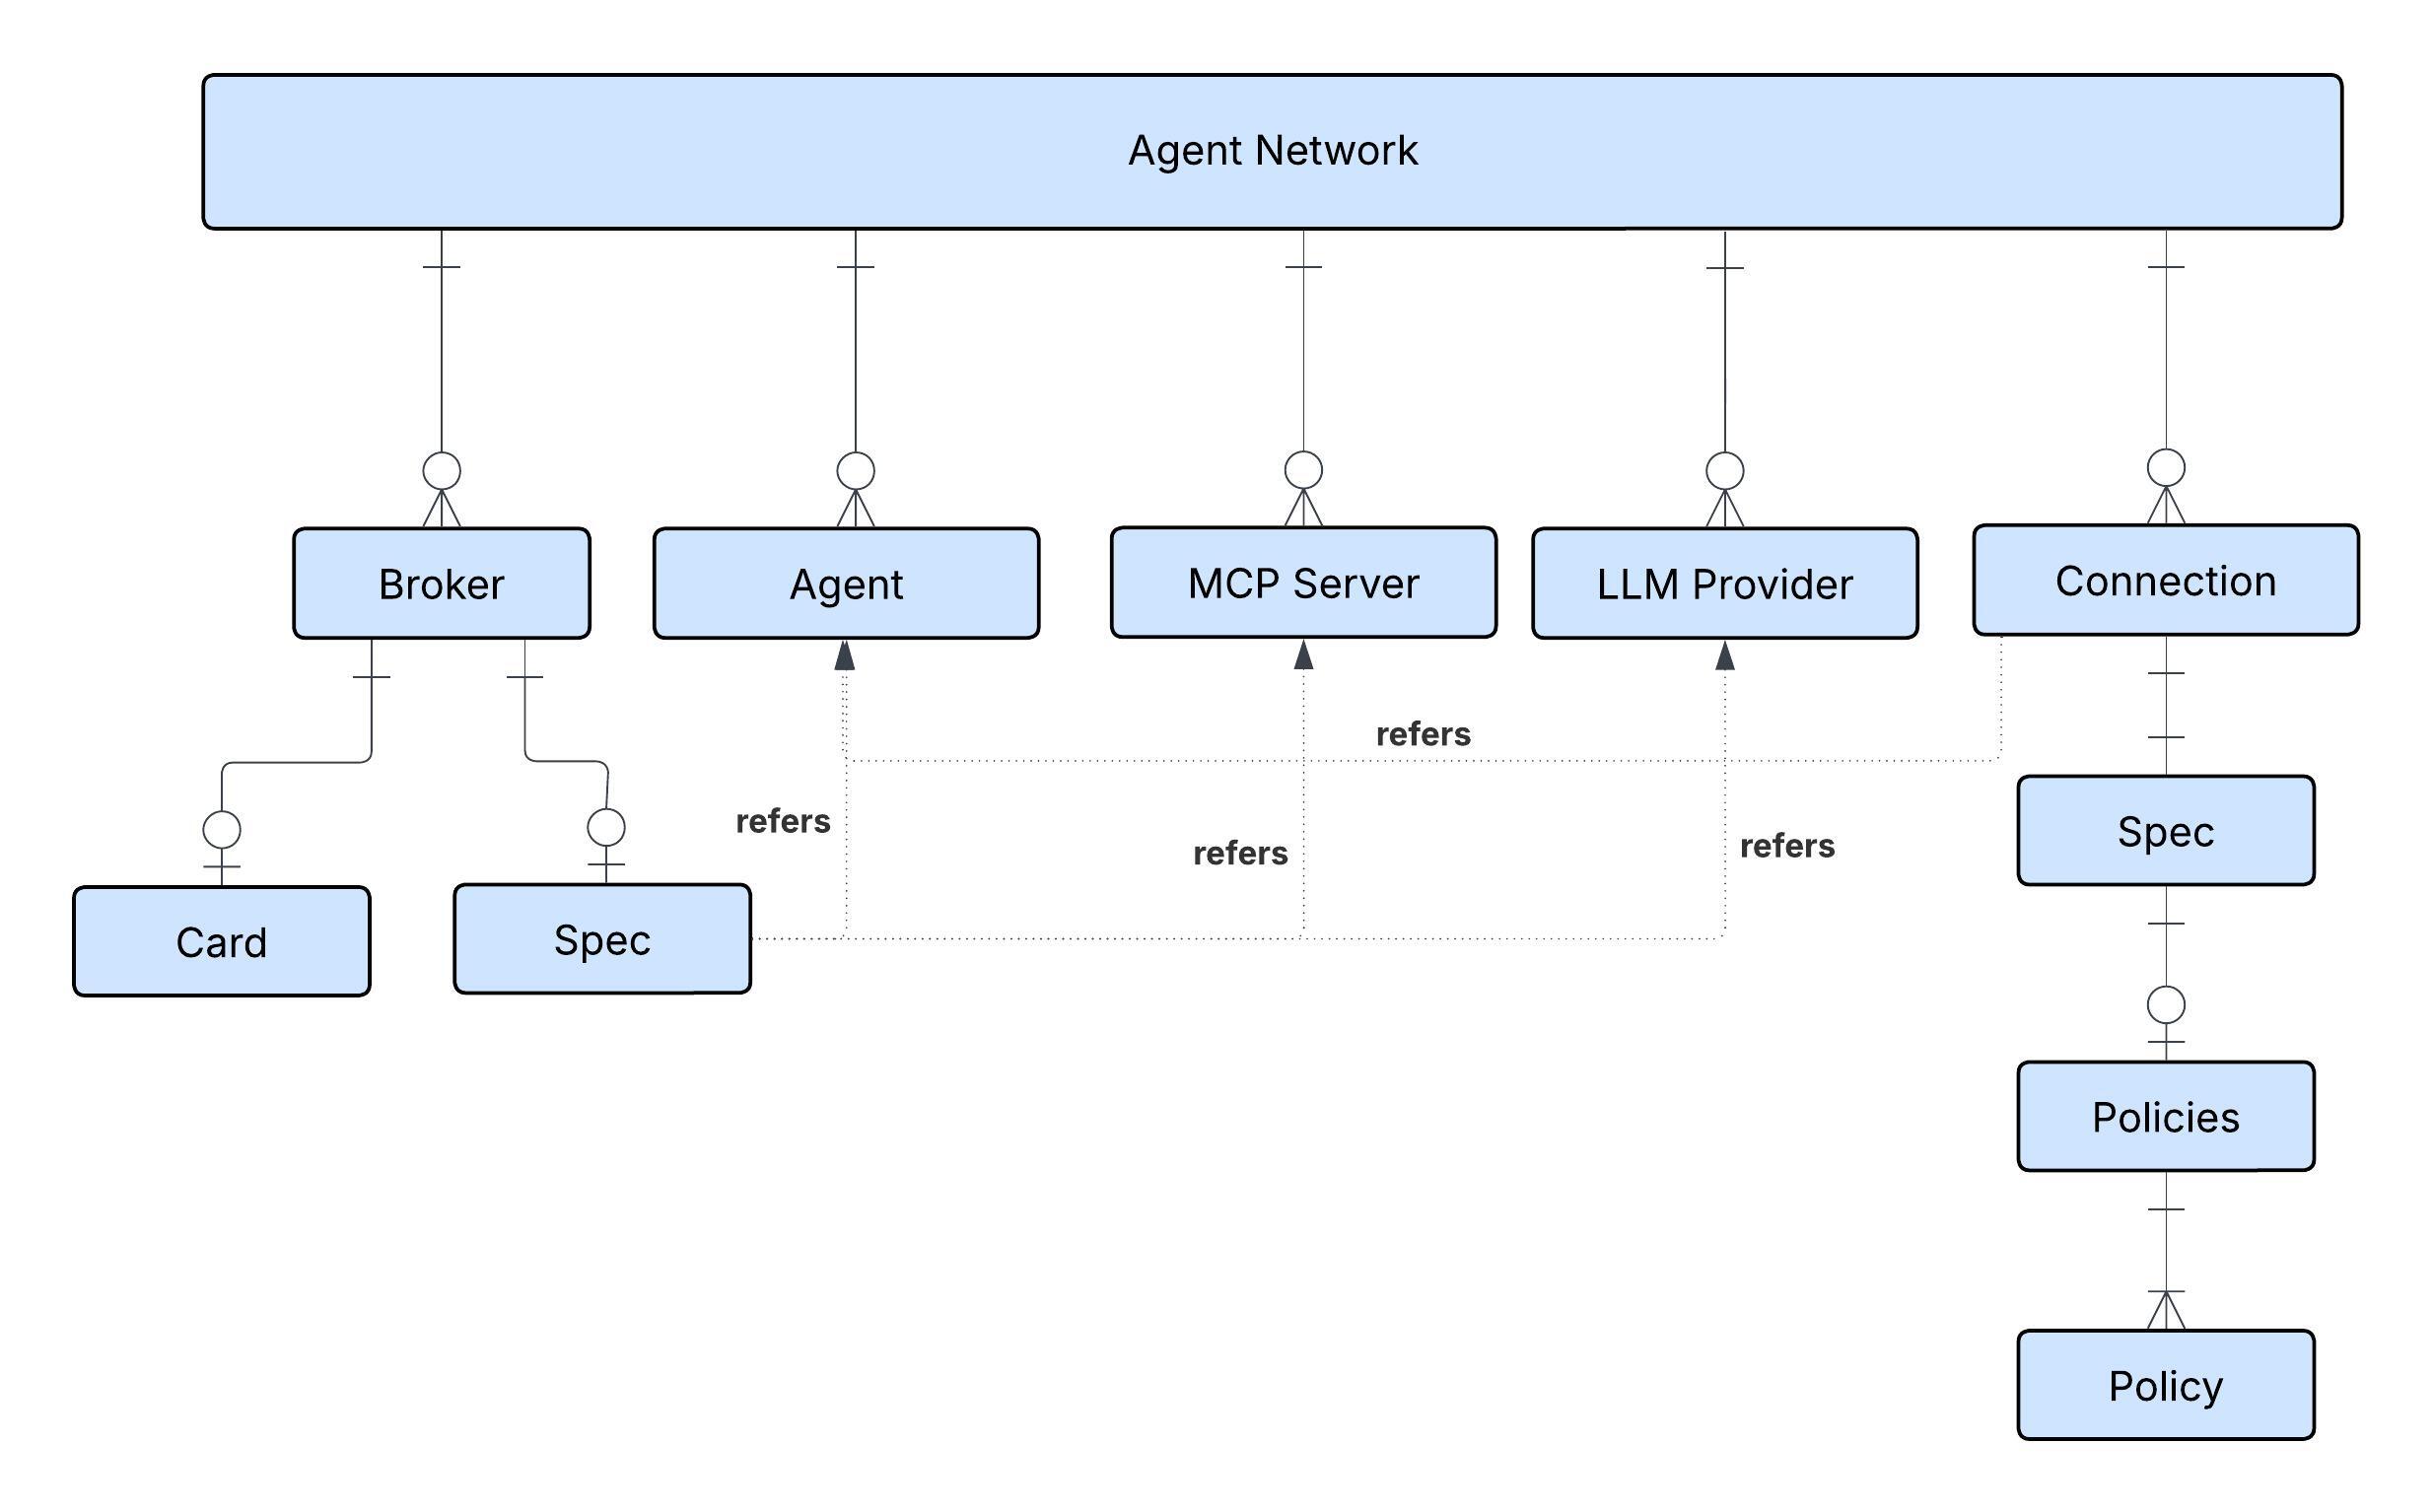 ## Registro de agentes (Descubrir)
 - **Objetivo**: Exchange es el catálogo de agentes, herramientas y otros activos. Su objetivo principal es resolver la "extensión de agentes" proporcionando un catálogo único gobernado para el descubrimiento, la depuración y la gestión del ciclo de vida de agentes heterogéneos. Permite a los desarrolladores encontrar y reutilizar agentes, propietarios de plataforma para mantener la visibilidad y orquestadores para descubrir funciones.
- **Heterogéneo por diseño**: Anypoint Exchange ahora admite tres nuevos activos: Agentes, MCP y LLM. Exchange está diseñado para ser un catálogo universal, para registrar y gestionar cualquier tipo de agente. Admite Agentes que cumplen con A2A, Servidores MCP y proveedores LLM de cualquier origen, incluyendo agentes externos, Agentforce y MuleSoft personalizados.
- **Metadatos principales**: Cada activo registrado tiene un conjunto de línea base de metadatos inmutables, incluyendo un Nombre y una Versión exclusivos, Propiedad y Publicador. También se realiza un seguimiento de los estados del ciclo de vida (desarrollo, organización, producción, desusado).
- **Detección**:
- **Tiempo de diseño**: Los desarrolladores pueden descubrir agentes registrados a través de la interfaz de usuario de Exchange existente o a través de la búsqueda de lenguaje natural con Vibes en Anypoint Code Builder.
- **Etiquetado y clasificación**: Los activos se pueden clasificar por tipo (agente, MCP, LLM, corredor) y dominio (por ejemplo, RRHH, clima) utilizando un sistema de etiquetado de valores clave básico, lo que permite políticas de vinculación, búsqueda y selección dinámicas.
- **Catálogo**: El repositorio admite modelos de catálogo privados e internos para compartir agentes en una organización.
- **Visualización**: Proporciona una herramienta visual para admitir vistas de red, mostrando conexiones para activos únicos o el mapa completo de nodos y vínculos en toda la organización, con funciones de filtrado.
Los corredores en una red de agentes pueden hacer referencia a agentes registrados, servidores MCP y proveedores LLM almacenados en Anypoint Exchange. Pero si aún no están registrados, se pueden declarar en los metadatos de Red de agentes (YAML) y se registran automáticamente. En el ejemplo, múltiples agentes, servidores MCP y proveedores LLM se declaran y se registran en Anypoint Exchange.
```
agents:
orders-agent:
label: Order Fulfilment Agent
metadata:
protocol: a2a
platform: OpenAI
salesforce-agent:
label: Salesforce Agent
metadata:
protocol: a2a
platform: OpenAI
stripe-agent:
label: Stripe Payment Agent
metadata:
protocol: a2a
platform: OpenAI
mcpServers:
inventory:
label: Inventory MCP
metadata:
transport:
kind: streamableHttp
path: /mcp
llmProviders:
open-ai:
label: OpenAI
description: OpenAI LLM Provider
metadata:
platform: OpenAI
```
## Corredor de agentes (Orquesta)
 Un corredor de agentes es un agente de enrutamiento inteligente que coordina la delegación de tareas entre agentes especializados en una compañía. Está definido por los agentes y servidores MCP que utiliza para realizar tareas.
Un corredor es un agente especializado que aparece en Anypoint Exchange después de publicar un activo de red de agente y reutilizarlo por otros corredores.
Los corredores se definen en la sección _de corredores_ del YAML. Los brokers definidos se “compilan” de forma transparente en una aplicación, sin requerir ningún Knowledge previo sobre Mule. Esta aplicación generada se implementa en CloudHub 2.0 (CH2) y aprovecha la sólida infraestructura de CH2.
Esto significa que los Agent Brokers se benefician de las características de desempeño establecidas de CloudHub 2.0, incluyendo sus funciones de registro y mediciones. Los aspectos operativos, como "Costo para operar" y "Monitoreo/Alerta/Herramientas", son los mismos que cualquier otra carga de trabajo.
Para escenarios que requieren intervención humana (Human-in-the-Loop), el estado de cada interacción se mantiene utilizando MuleSoft Object Store, una solución distribuida diseñada para una gestión de estado efectiva en entornos altamente simultáneos.
Una definición de broker se compone de dos secciones: tarjeta y especificación.
### Tarjeta
La sección de tarjeta sigue la [especificación Agente a Agente (A2A)](https://a2a-protocol.org/v0.2.5/specification/). Entre otras cosas, describe el contrato, las habilidades y las funciones del agente de corretaje. La URL de la tarjeta se rellena automáticamente con el valor ${ingressgw.url}/nombre-corredor. Tras la implementación, el marcador de posición ${ingressgw.url} se sustituye automáticamente por la URL de la pasarela Anypoint Flex que está frente a las solicitudes de ingreso de agentes.
### Especificación
La sección de especificación configura el “código fuente” del broker. Aquí, el desarrollador puede especificar el LLM a utilizar, las instrucciones, las herramientas disponibles, la gestión de errores y, lo que es más importante, los diversos agentes y herramientas MCP disponibles para este broker.
**Proveedores de LLM**
Esta sección forma parte de la especificación en cada corredor. Esta es una referencia a uno de los LLM definidos en la sección de servicios. Podemos elegir si compartir un LLM entre todos los brokers, o si es necesario hacer que diferentes brokers utilicen el LLM que mejor se ajuste a sus tareas.
Los corredores pueden apuntar a proveedores de LLM. Podemos elegir modelos de estos proveedores dependiendo de nuestras necesidades.
```
llmProviders:
open-ai:
label: OpenAI
description: OpenAI LLM Provider
metadata:
platform: OpenAI
```
**Instrucciones**
Esta sección es opcional y puede utilizarla para especificar instrucciones específicas para este agente de broker. Estas instrucciones a menudo se centran en problemas específicos orientados a la actividad empresarial. Por ejemplo, imagine un Agente de servicio al cliente que coordina la gestión para incidentes reportados a clientes:
```
instructions:
- |
You are an Incident Management Orchestrator Agent. Your primary responsibility is to coordinate the resolution of incidents reported by customers.
The process for incident management is:
1. Fetch Salesforce Case Details: Retrieve the latest critical case details for the given customer.
2. Fetch Entitlement Details: Obtain the customer's entitlement information.
3. Fetch On-Call Engineer: Identify the current on-call engineer for the incident.
4. Create Slack War Room and invite on-call engineer: Set up a Slack war room channel and invite the on-call engineer.
5. Summarize Actions: Provide a clear, human-readable summary of the steps performed, including information about the created slack channel and the on-call engineer assigned
```
Tenga en cuenta que no es necesario proporcionar instrucciones explícitas, como **"dividir la solicitud en tareas" o "seleccionar la mejor herramienta"**, ya que el corredor gestiona eso por sí mismo. Estas instrucciones solo son necesarias al describir procesos de negocio específicos.
**Configuración de herramientas**
Las herramientas proporcionan a los agentes funciones externas. Siempre que un broker necesita acceder a un sistema externo (que no sea otro agente, por ejemplo, una API existente o un servicio SaaS), hace contacto con un servidor MCP (Protocolo de contexto de modelo):
```
tools:
- mcp:
server: collaboration-mcp # MCP server reference
allowed: # Allowlist specific tools
- create_channel
- invite_user
```
Se hace referencia al servidor MCP con el nombre del activo de intercambio. Los detalles de conectividad para él se especifican en la sección de servicios.
De forma predeterminada, el corredor tiene acceso a todas las herramientas disponibles en el servidor MCP. Según nuestra observación, los LLM más modernos solo pueden gestionar entre 20 y 25 herramientas por contexto antes de empezar a generar imprecisiones (o perder contexto). Por este motivo, es generalmente una buena práctica limitar las herramientas disponibles al mínimo necesario. Puede aplicar ese filtrado a través de las listas permitidas.
**Vínculos de agente**
Esta sección es la parte más importante de toda la definición. La sección de vínculos activa la comunicación y orquestación entre agentes. Eso significa que este corredor se apoya en los agentes vinculados aquí para ejecutar las acciones apropiadas para completar el objetivo del usuario.
```
links:
- agent:
ref:
name: orders-agent
- agent:
ref:
name: salesforce-agent
- agent:
ref:
name: stripe-agent
```
En efecto, esta sección define una red de agentes para la colaboración.
## Pasarela Flex (Gobierno)
 La gobernanza de agentes es un pilar crítico para el tejido de agentes, fundamental para crear una red de agentes de confianza y garantizar la seguridad y el cumplimiento.
Para la gobernanza, se requiere un total de dos pasarelas Flex (1 entrada y 1 salida) en su espacio privado.
La gobernanza establece las estructuras, los controles y la evidencia necesarios para ampliar de forma segura todo el ciclo de vida de desarrollo de agentes (ADLC). Específicamente, la gobernanza implementa procesos clave como la certificación de agentes, la catalogación, las decisiones del ciclo de vida y la aplicación de políticas de tiempo de ejecución.
- **Catálogo:**
- Intercambio: Admite el registro de fines de agentes, propietarios, entornos y límites de clasificación y datos. También registra funciones, herramientas, recursos, solicitudes y dependencias externas con versiones.
- **Versión y ciclo de vida:**
- Documente y gestione versiones semánticas de agentes, herramientas y activos durante el ciclo de vida de desarrollo de agentes completo.
- El versionado ayuda a gestionar las cronologías de desuso de agentes y admite la doble ejecución (donde sea posible) garantizando migraciones sin problemas.
- **Aplicación de políticas**:
- La arquitectura de IA agente amplía la superficie de ataque (interfaz de pláticas, solicitudes y nuevos protocolos como MCP). Cualquier compromiso en cualquier componente puede llevar a efectos en cascada en múltiples sistemas que proporcionan componentes como protocolo, solicitud, API o herramienta.
- Asegurar implementaciones de IA de agentes de compañía requiere un enfoque especializado, ya que estos entornos autónomos e impredecibles amplían de forma inherente la superficie de ataque a través de interacciones de agente a agente. Aunque las herramientas de seguridad existentes para sistemas estáticos son esenciales, ya no son suficientes por sí solas. Las compañías deben planificar e implementar de forma proactiva cuatro soluciones de seguridad específicas, cada una directamente abordando un riesgo de negocio crítico asociado con la IA de agentes.
- Flex Gateway: Todo el tráfico A2A y MCP se enruta a través de Flex Gateway, incluso si el sistema de destino no es seguro, para garantizar que las políticas se aplican en cada extremo. Este enrutamiento es crucial para proteger las comunicaciones de los agentes e integrar con los servidores de autorización.
- Paquetes de pólizas: Los usuarios pueden definir y aplicar paquetes de políticas predefinidas a flujos de trabajo antes de la ejecución, aplicando un conjunto coherente de políticas operativas y de seguridad.
- Tipos de pólizas: La plataforma admite varias políticas entrantes y salientes, incluyendo:
- Políticas de A2A: Tarjeta de agente, Detector de PII, Decorador de solicitud, Validación de esquema.
- Políticas de MCP: Control de acceso basado en atributos, Validación de esquema, Compatibilidad con MCP.
- Políticas de LLM/IA: Decorador de solicitudes de IA, Protección de solicitudes de IA (filtrado de contenido dañino), Plantilla de solicitud de IA (aplicación de plantillas predefinidas), Limitación de frecuencia de tokens básicos de IA.
- Políticas de telemetría: Telemetría A2A y MCP para ampliar las soluciones de telemetría abierta para la recopilación y exportación de datos de registro.
- **Registro**: Gracias al rastreo automático, los registros en la Red de agentes están disponibles para realizar un seguimiento de cada interacción de agentes, explicar comportamientos y fomentar Trust.
El ejemplo representa una política para el registro de mensajes, que se configura utilizando los metadatos de red de agentes. El corredor de Orderfullfillment hace referencia a un agente existente denominado agente de Salesforce y la política para la mensajería se configura utilizando los metadatos. Tenga en cuenta que Tela de agente configura automáticamente todas las políticas mencionadas bajo la sección “especificaciones” en Pasarela Flex. No requiere pasos adicionales.
```
salesforce-agent-connection:
kind: agent
ref:
name: salesforce-agent
spec:
url: ${salesforce-agent.cardUrl}
policies:
- ref:
name: message-logging
namespace: 68ef9520-24e9-4cf2-b2f5-620025690913
configuration:
loggingConfiguration:
- itemName: "Payload"
itemData:
message: "#[payload]"
firstSection: true
secondSection: true
level: "INFO"
- itemName: "Headers"
itemData:
message: "#[attributes.headers]"
firstSection: true
secondSection: true
level: "INFO"
```
## Visualizador de agentes (Observar)
 Dada la naturaleza no determinista y la complejidad de los agentes de LLM y las implementaciones de múltiples agentes, la observabilidad y el monitoreo son fundamentales.
- **Registros y trazas básicos**: El razonamiento y el rastreo de ejecución de herramientas se proporcionan a través de registros. Los registros y rastreos de ejecuciones de flujos de trabajo son visibles después de la ejecución en Gestor de tiempo de ejecución.
- **Métricas**: En la fase inicial, la plataforma publica a2a_total_calls y mcp_total_calls como contadores con etiquetas (como, ruta, estado, método, herramienta) para determinar el total, el éxito y el error de las llamadas. Estas mediciones se publican desde código de póliza utilizando la interfaz de estadísticas nativa de Envoy (Puerta de enlace Flex), preferiblemente a través de políticas existentes como mcp_support_policy y a2a_agent_card_policy.
- **Observabilidad mejorada (futura)**: Los planes incluyen el uso de Open Telemetry para el rastreo distribuido en versiones futuras. La observabilidad más avanzada incluye:
- **Rastreo de solicitudes detallado**: Obtener visibilidad integral de solicitudes, incluyendo solicitudes, procesos de planificación, acciones invocadas e interacciones con subagentes.
- **Monitoreo de salud**: de agentes Monitoreo del tiempo de disponibilidad de los agentes, la latencia de la respuesta, el rendimiento, los índices de error y la utilización de recursos subyacente (CPU, memoria, red, GPU).
- **Monitoreo de coordinación de múltiples agentes**: Captura de índices de éxito y fallo de interacciones de agente a agente, detección de patrones de invocación circulares (bucles) y seguimiento de mediciones por agente como la realización de tareas y el conteo de invocaciones.
- **Seguimiento de costos**: Seguimiento del uso de tokens y los costos asociados para cada llamada LLM, idealmente por agente, con tableros y alertas.
- **Rastreo cognitivo**: Captura y visualización de un seguimiento detallado de la sesión de un agente, incluyendo procesos de pensamiento internos y todas las llamadas de herramientas, que sirve como un seguimiento de auditoría inmutable.
- **Reproducción de sesión de agente**: Una interfaz de usuario que permite "reproducir" visualmente el rastreo cognitivo de un agente paso a paso para una depuración profunda.
- **Visualización de DAG**: Proporcionar una visualización de Gráfico acíclico dirigido (DAG) de la ejecución del flujo de trabajo de agentes para interacciones complejas de múltiples agentes.
Visualizador de agentes se utiliza para identificar las partes de su red de agentes y ver cómo funcionan juntas.
- Distinga los tipos de nodos (agentes y servidores MCP).
- Vea los bordes para ver interacciones declaradas y en tiempo de ejecución.
- Utilizar capas para centrar vistas en entornos específicos
- Tarjetas de detalles abiertas para inspeccionar metadatos y mediciones para nodos y registros y rastreos de acceso
- Revise indicadores de gobernanza como protección de pasarela flexible y políticas aplicadas.
Encuentre detalles sobre los componentes de Visualizador de agentes [aquí](https://docs.mulesoft.com/agent-visualizer/agent-visualizer-components).
## Tela de agente: Cuatro pilares juntos
Con estos cuatro pilares juntos, MuleSoft Agent Fabric amplía la seguridad y el control a cualquier agente con gobernanza integrada. Permite a los agentes actuar en cualquier parte aprovechando nuevos protocolos como A2A (Agente a Agente) y MCP (Protocolo de contexto de modelo) para crear y ampliar los procesos de negocio. Conectamos todo (aplicaciones, datos y sistemas) para potenciar y gobernar a los agentes cuando actúan en todo el negocio. Las herramientas inteligentes admiten la creación y ampliación de procesos de negocio o API utilizando IA de forma nativa o aportando herramientas de IA externas.
No se requiere el uso de los cuatro pilares juntos, pero se recomienda. Puede elegir pilares de forma independiente según sea necesario. Por ejemplo, puede aprovechar Tela de agente para el registro y la gobernanza, sin utilizar la capa de orquestación. Del mismo modo, puede utilizar el broker para orquestar agentes gobernados a través de otra plataforma.
El diagrama muestra cómo interactúan los cuatro componentes entre sí:
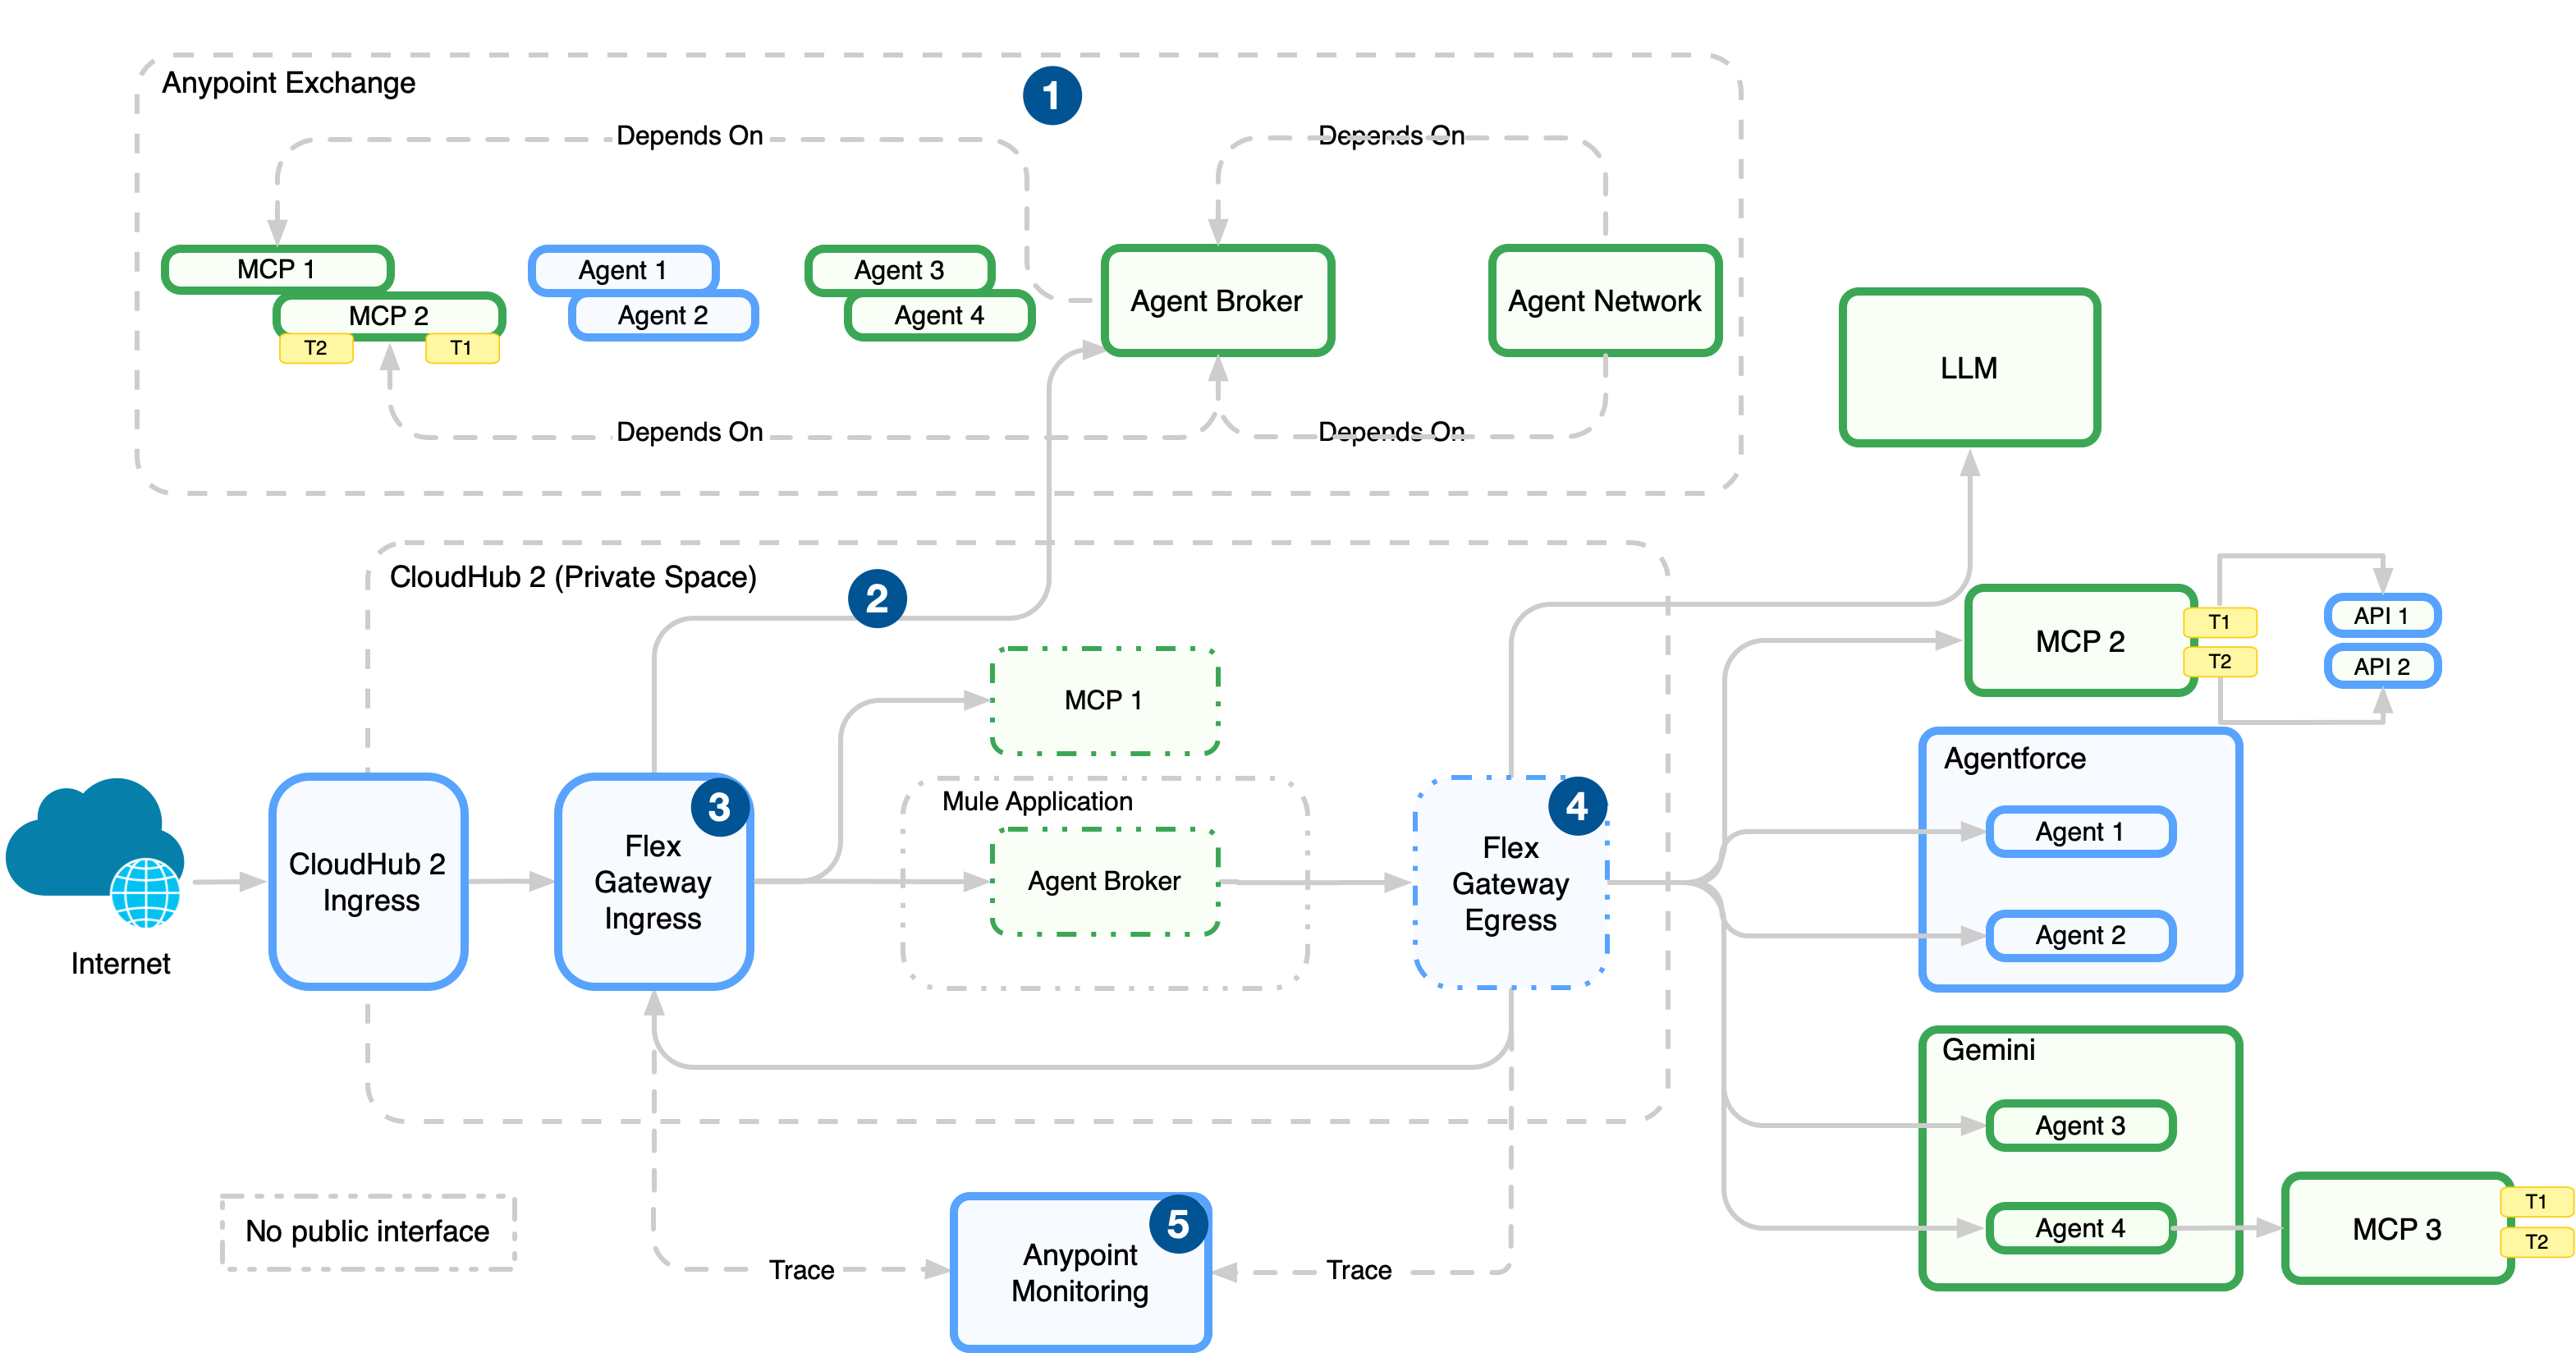 1. Publique los activos de agentes en Anypoint Exchange para su descubrimiento y reutilización después de definir la red de agentes (corredores, agentes, servidores MCP) en la red de agentes YAML en Anypoint Code Builder.
2. Implemente los activos de agente en CloudHub 2.0 (gestionado en Gestor de tiempo de ejecución).
3. Aplique políticas sobre el tráfico entrante a la red con una pasarela Flex de entrada, que se encuentra frente a los extremos de broker y API.
4. Aplique políticas, gestione conexiones y emita datos de telemetría con una pasarela Flex de salida. Esta pasarela se encuentra en rutas salientes desde corredores y agentes a servicios externos.
5. Recopile registros, mediciones y rastreos desde Flex Gateway y tiempos de ejecución en Anypoint Monitoring.
## Patrones de diseño de orquestación de agentes
Es tentador hacer que cada agente especializado sea accesible de inmediato en una arquitectura plana y sin restricciones, con un único orquestador capaz de abordar cualquier tarea teniendo acceso a cada activo de IA disponible. Sin embargo, este enfoque resulta rápidamente perjudicial para la eficiencia y fiabilidad generales del sistema. Al igual que el principio aplicado a un exceso de herramientas individuales, muchas opciones de agentes introducen ruido y complejidad significativos para el **agente de corredor** central (u orquestador). Esta complejidad aumentada conduce directamente a una caída notable tanto en la precisión de la toma de decisiones del corredor (seleccionando el agente correcto para el trabajo) como en el determinismo de la respuesta del sistema (resultados predecibles y coherentes para consultas similares). El agente de broker sufre efectivamente de parálisis de opciones, lo que lleva a un enrutamiento más lento y menos fiable.
En vez de una estructura plana, abogamos firmemente por un **enfoque jerárquico multinivel** para estructurar la Red de agentes. Este principio organizativo ofrece numerosas ventajas críticas. En primer lugar, favorece inherentemente la **trazabilidad y gestión**. Una estructura jerárquica refleja las mejores prácticas organizativas establecidas, facilitando la auditoría del flujo de una solicitud, la depuración de problemas precisando la capa de fallo y la gestión de la implementación y retirada de agentes o subredes específicos.
En segundo lugar, y de forma crucial en el contexto de modelos de lenguaje grandes (LLM) que impulsan estos agentes, una jerarquía ayuda de forma espectacular a **mantener los tamaños** del contexto bajo control. Al segmentar el panorama de agentes, el agente de corredor en cualquier capa determinada solo tiene en cuenta el conjunto limitado de agentes o subcorredores directamente debajo de él. Esta estructura evita que el orquestador principal cargue la descripción, las funciones y el contexto histórico de _cada agente_ en su memoria de trabajo, **evitando** el riesgo de **superar** rápidamente los límites de plazo de contexto del LLM y **suponiendo** costos y latencia prohibitivos.
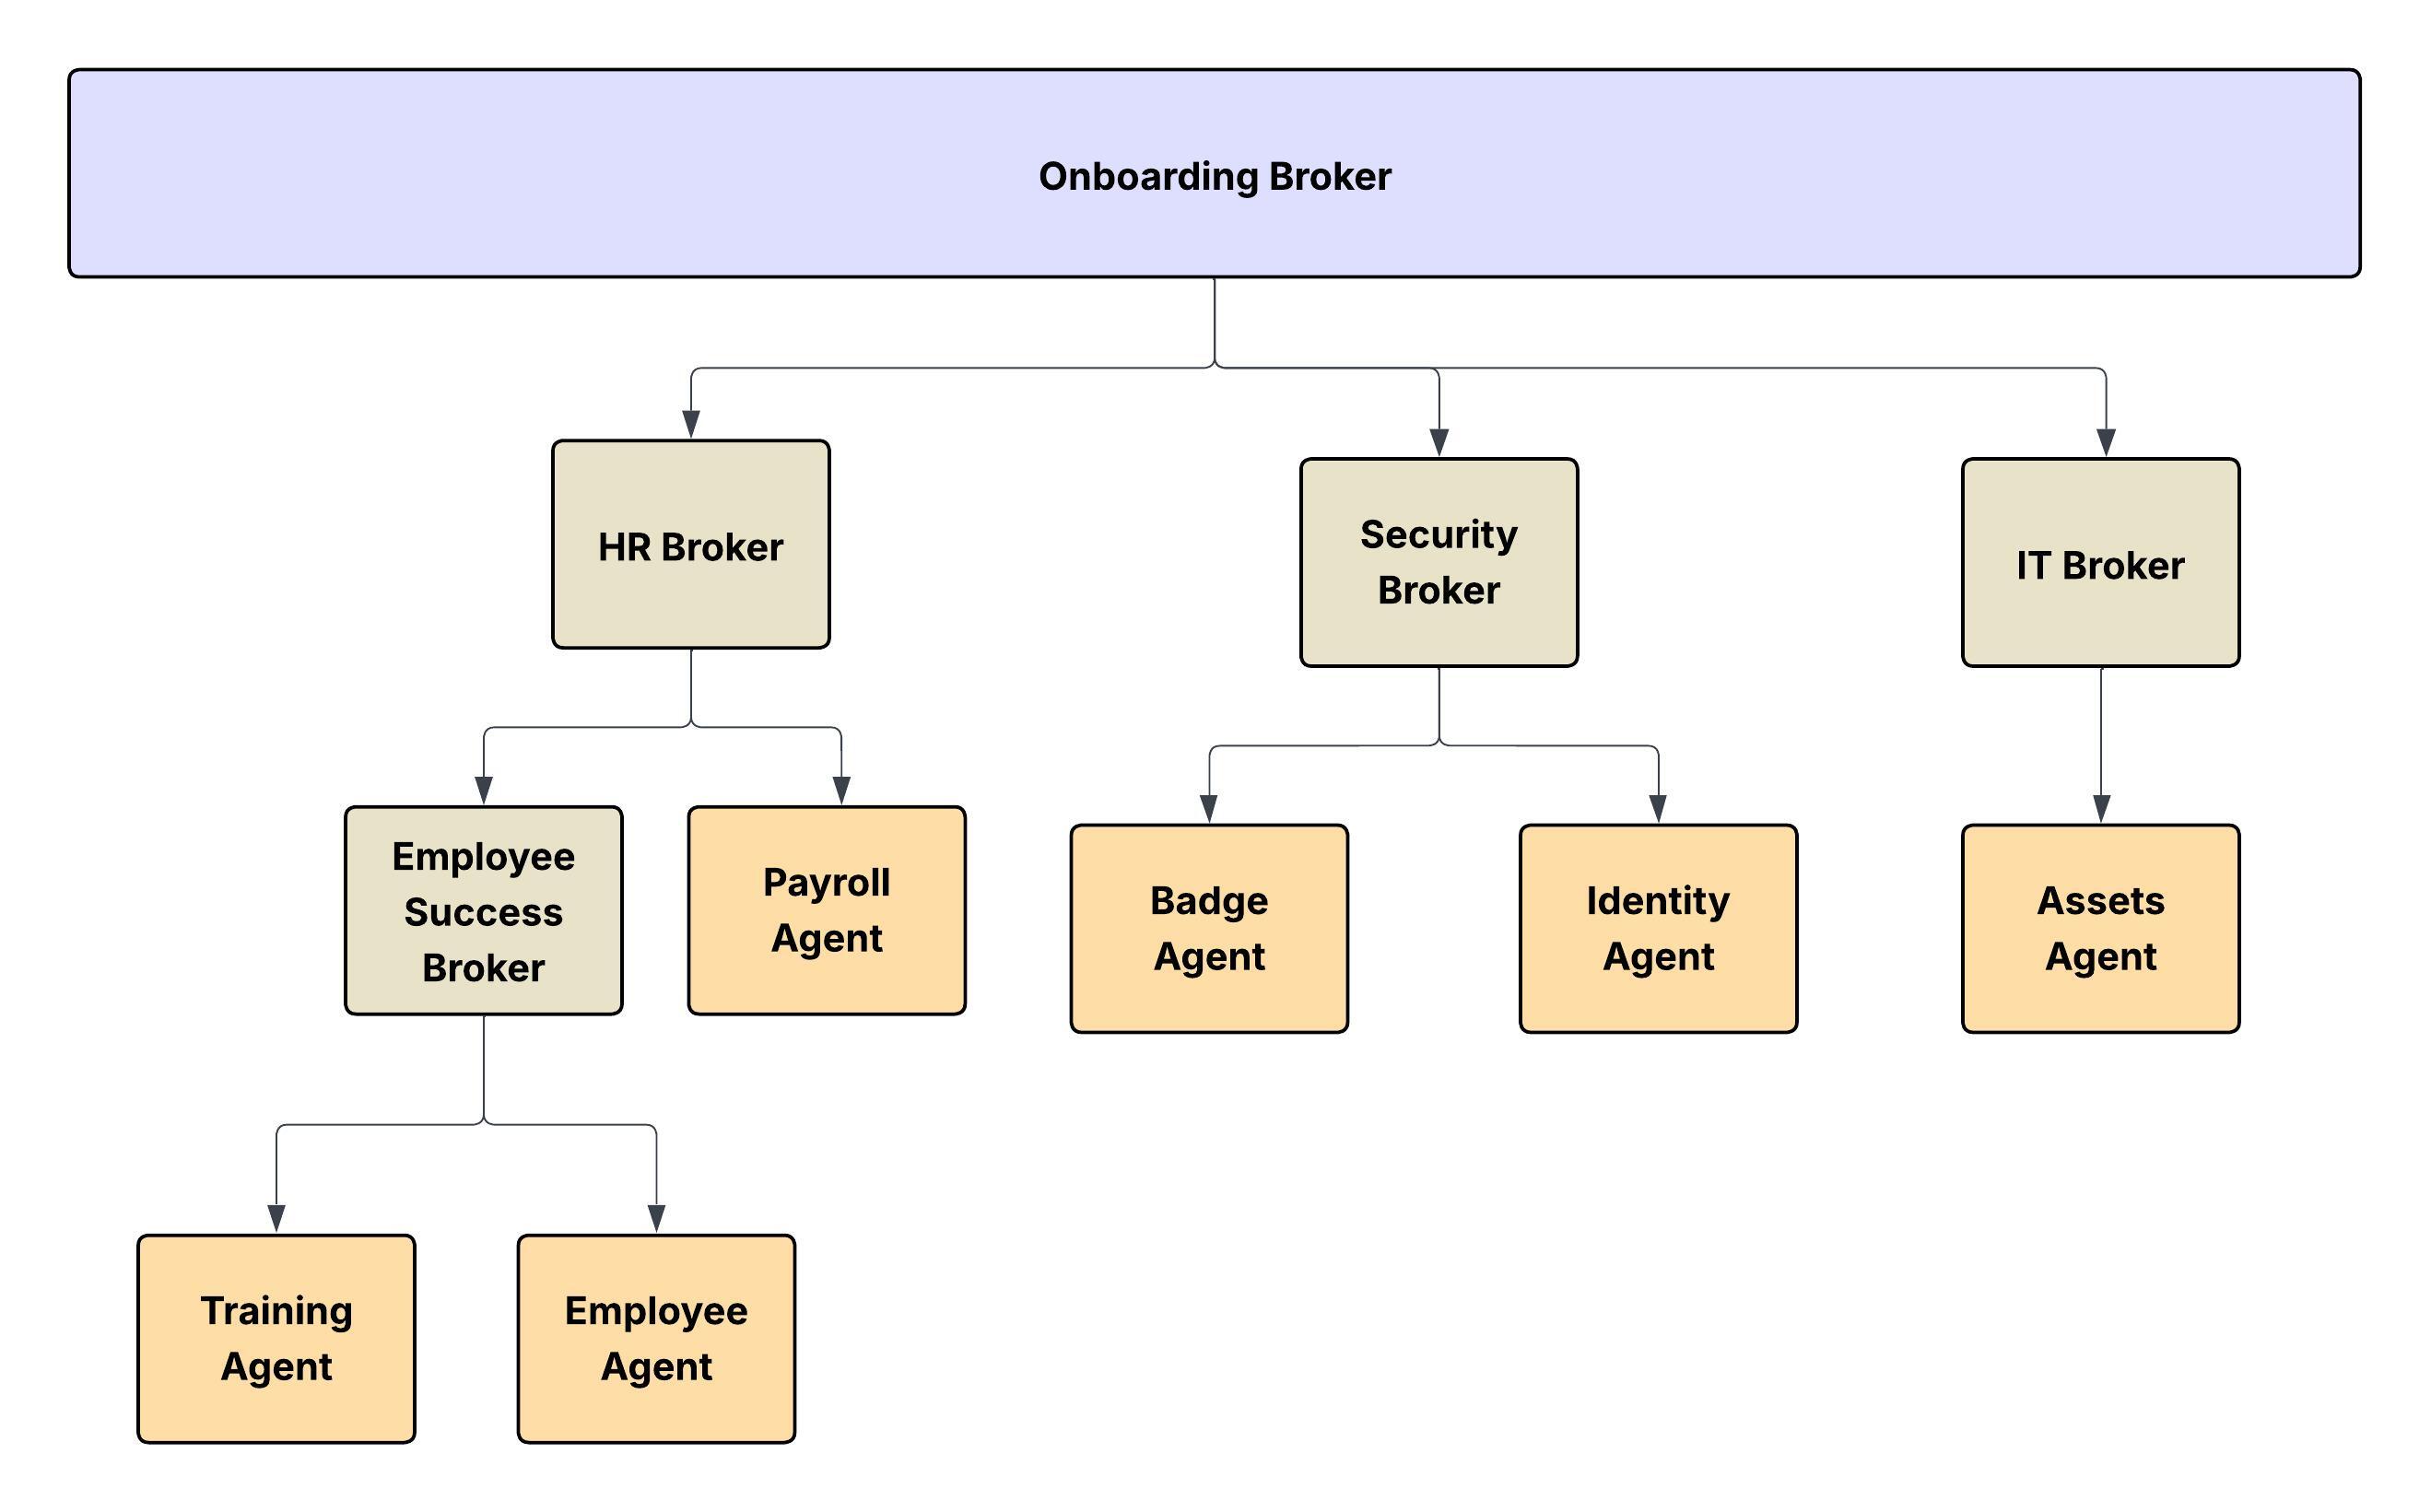 La red de agentes puede implementarse de múltiples formas. Dos de ellos son:
1. Ley de Conway: forma intuitiva de asignarla a la estructura jerárquica del mundo real.
2. Diseño dirigido por dominios - Más centrado en dominios de negocio
# Opción 1: Asignación con estructura jerárquica del mundo real
En una organización jerárquica, la comunicación fluye verticalmente (de los gerentes a los subordinados) y las decisiones a menudo están centralizadas. Según la ley de Conway:
- Los sistemas o las arquitecturas de software creados por dichas organizaciones tienden a tener capas y jerarquías también.
- Cada equipo tiende a diseñar subsistemas que reflejan sus propios límites y autoridades.
- Las interfaces entre sistemas reflejan los canales de comunicación entre los departamentos.
La Red de agentes también se puede asignar de forma intuitiva a la **estructura jerárquica real de una gran empresa** siguiendo la Ley de Conway.
- **El modelo conceptual:** Del mismo modo que una corporación tiene divisiones, departamentos y capas de gestión diferentes (por ejemplo, C-suite, Vicepresidentes, Directores, Gerentes), una red de agentes que opera en un dominio específico puede modelarse como un organigrama paralelo.
- **Los nodos y las hojas:** En esta jerarquía:
- **Las hojas** de la estructura del árbol son los **agentes especializados** o **MCP**. Son las unidades funcionales que realizan el trabajo real (por ejemplo, un "Agente de consulta de base de datos", un "Agente de autenticación de clientes", un "Agente de análisis de sentimientos"). Representan los colaboradores individuales o las unidades de trabajo de la organización.
- **Todos los demás nodos** de la jerarquía, incluidas las capas raíz e intermedia, son **agentes corredores** (o suborquestadores). Estos agentes no realizan la tarea final pero son responsables del enrutamiento, la delegación, la agregación y la resolución de conflictos en su dominio o capa específicos. Un broker de alto nivel delega una tarea a un "Sales Domain Broker", que a su vez delega a un "Opportunity Management Broker", que realiza la tarea a través de un "Opportunity Status Update Agent" (la hoja).
Esta estructura garantiza que la complejidad se gestione localmente, que el contexto esté contenido y que el sistema se amplíe de forma predecible y fiable. Puede presentar nuevos agentes especializados en ramas específicas y apropiadas del árbol organizativo.
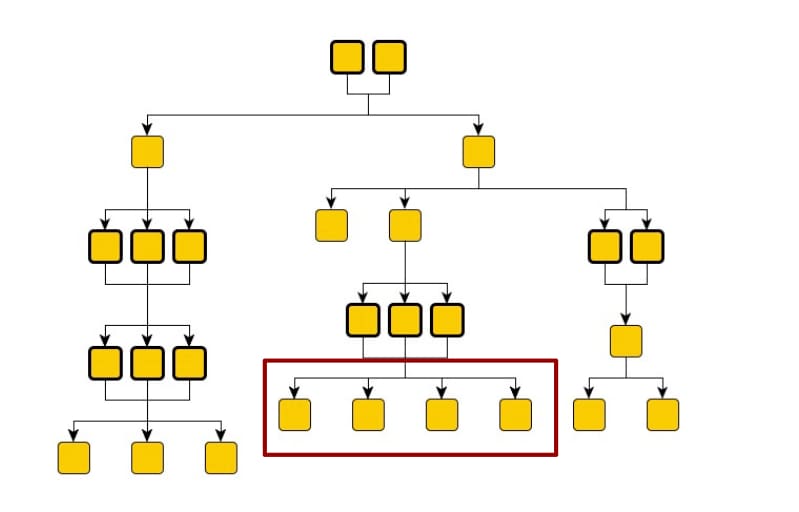 Considere la analogía de un gráfico de organización para trabajo digital. Cada archivo YAML representa cada una de las organizaciones internas (Éxito de empleados, Seguridad, Finanzas, etc.). Dentro de cada organización (agente-red) puede tener una estructura jerárquica a través de la cual los actores colaboran, los trabajos se dividen en tareas y se asignan. En el diagrama anterior, la comunicación fluye de arriba a abajo. Además, las hojas no están restringidas para el consumo solo por un conjunto de agentes de broker.
## Opción 2: Diseño dirigido por dominio e implementación de IA agente
El modelado de redes de agentes basadas en el organigrama humano conlleva el riesgo de requerir una re-arquitectura frecuente, particularmente en compañías que experimentan reorganizaciones frecuentes. Un enfoque alternativo es organizar agentes por dominio funcional. Esta agrupación puede requerir cruzar los límites organizativos humanos tradicionales. Por ejemplo, la incorporación de nuevos empleados implica operaciones de TI para el aprovisionamiento de hardware y usuarios, mientras que una moción de ventas requiere operaciones y marketing.
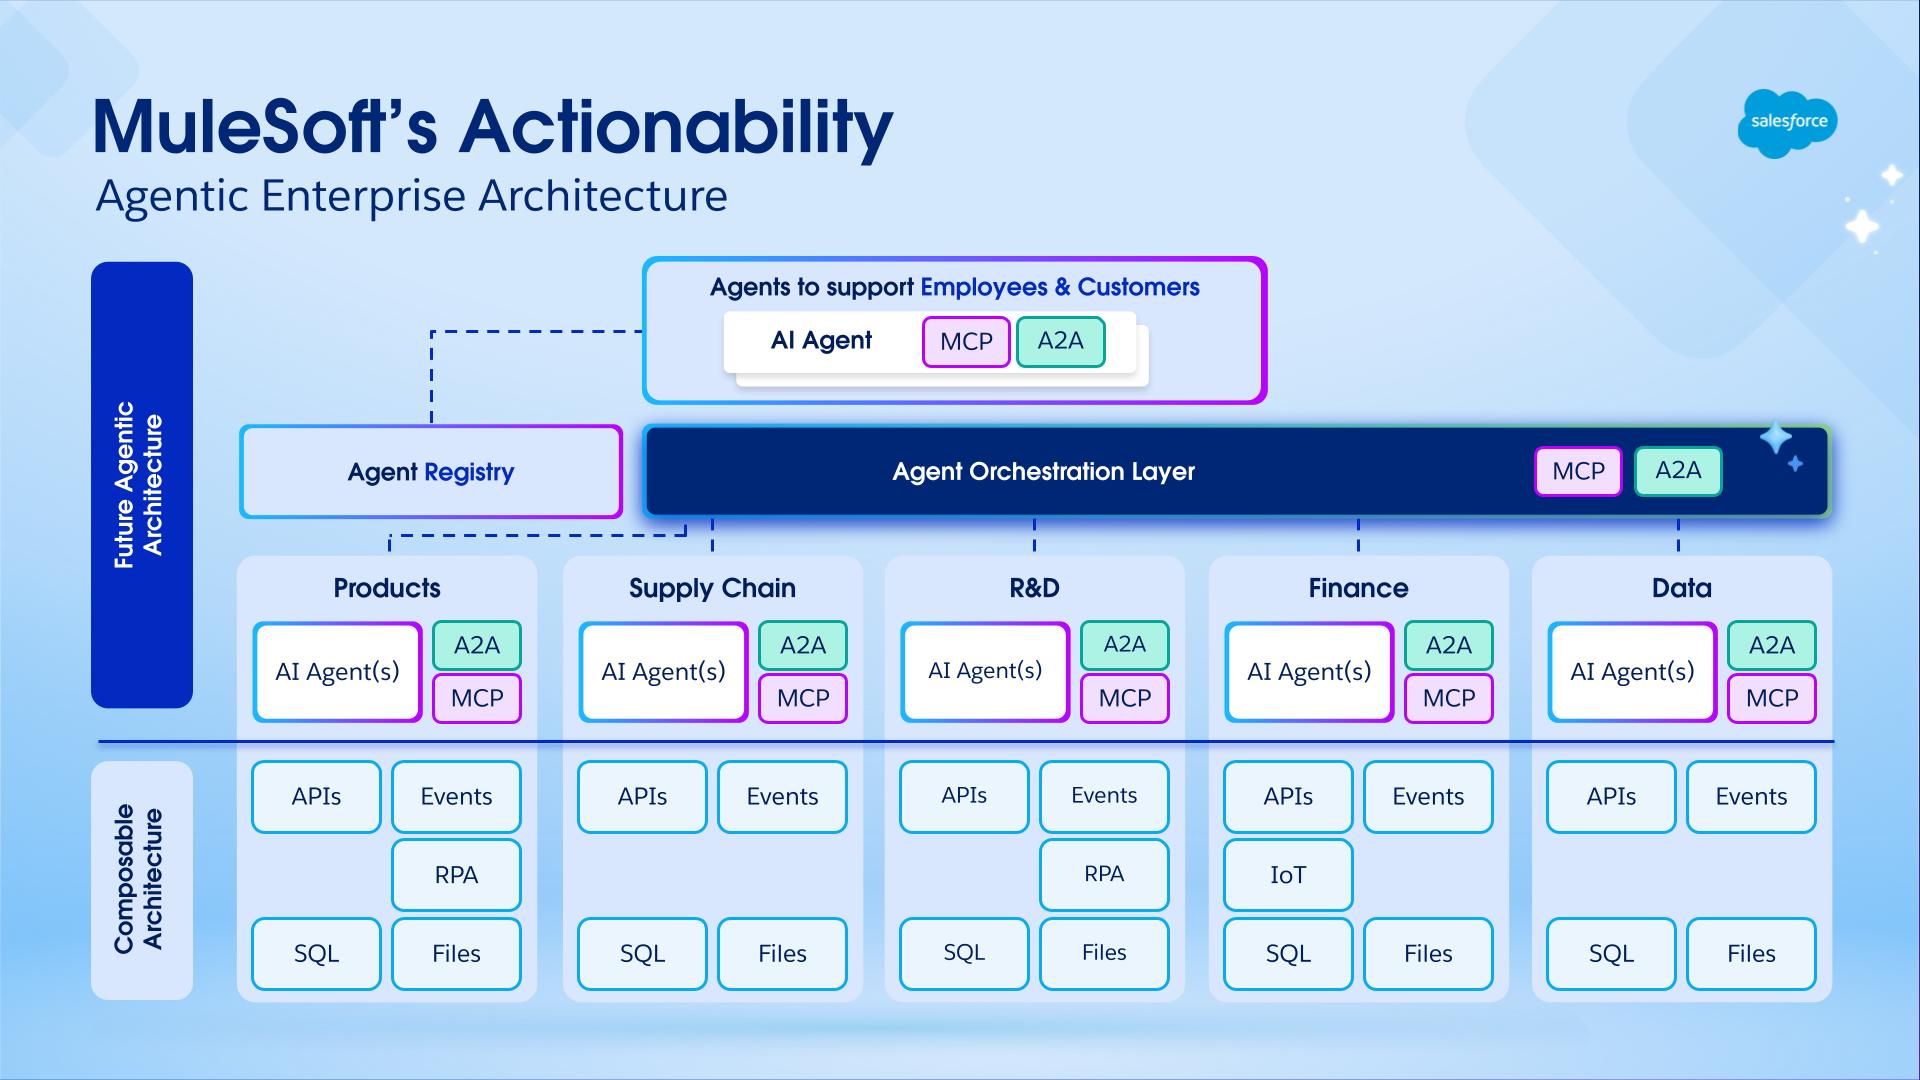 ## Acerca de los autores
Nikhil Aggarwal es Arquitecto principal en Salesforce, donde lidera la arquitectura para MuleSoft y Salesforce Automation Cloud. Nikhil aporta más de 18 años de experiencia entregando productos a gran escala y es un apasionado de la arquitectura ampliable, las experiencias de desarrollador intuitivas y la creación de equipos de alto desempeño. Antes de Salesforce, dirigió múltiples iniciativas en Microsoft Power Platform, Dataverse y Office 365 desde el concepto hasta el lanzamiento. Su trabajo continúa dando forma a cómo las empresas modernas conectan sistemas, automatizan flujos de trabajo y desbloquean valor de negocio en la primera era de la IA.
Mariano González se unió a MuleSoft en sus primeros días en 2011, especializándose en sistemas distribuidos de misión crítica, integración, PaaS y computación en nube. Hoy, Mariano se centra en el avance de las plataformas de IA, con especial atención a la gobernanza, la orquestación, el descubrimiento y la observabilidad. Con más de 20 años en la industria de TI, Mariano se ha desempeñado como arquitecto de software y líder de equipo, diseñando y entregando soluciones de BPM, ERP e integración en los sectores de agricultura, energía, gobierno, TI, telecomunicaciones y gestión de contenidos.
Pedro Colunga es Arquitecto ingeniero de software en Salesforce, especializado en API y arquitectura de metadatos. Con un enfoque en el ciclo de vida completo de la plataforma, Pedro desempeña un papel clave en la configuración de cómo interactúan las organizaciones con la inteligencia del sistema, la semántica y las soluciones dirigidas por metadatos. La carrera de 20 años de Pedro, que incluye experiencia empresarial, abarca compañías como Fuego, BEA Systems, Oracle y TekGenesis, una compañía adquirida más tarde por MuleSoft, donde ha impulsado constantemente la arquitectura basada en plataforma, proporcionando una profunda experiencia en áreas como BPM, RAD e Integraciones.
Gulal Kumar es Arquitecto de Ingeniería de Software en Salesforce, con un enfoque en datos y arquitectura de integración. Con más de 20 años de experiencia en integración y API, programas de modernización, seguridad e iniciativas AIML, aporta una gran experiencia. Gulal se ha comprometido a avanzar en iniciativas de transformación de negocio, mejorando la seguridad y la resiliencia, promoviendo la excelencia de la arquitectura y liderando iniciativas de AIML entre varios dominios.
## Introducción
Este documento presenta un punto de vista que describe la arquitectura de TI que las empresas necesitarán en los próximos 3-5 años para capturar completamente el valor de una plantilla de agentes; describe la transformación de TI requerida para dar cobertura a la implementación a gran escala de agentes de IA. El objetivo es proporcionar una guía estratégica y una arquitectura de referencia para ayudar a los CIO, los CDO y los líderes de TI a planificar su trayectoria para convertirse en una compañía agente.
Los potentes modelos de IA están permitiendo la creación de una plantilla de agentes capaz de detectar el entorno, razonar sobre datos, tomar decisiones autónomas, realizar tareas y colaborar de forma efectiva con trabajadores humanos. Esta nueva plantilla promete un cambio radical en innovación, productividad y agilidad, creando valor para accionistas y clientes. Para realizar esta visión, las organizaciones deben someterse a una transformación de negocio y TI para convertirse en Agentic Enterprises.
## Funciones de negocio de Agentic Enterprise
Hoy en día, la empresa tradicional enfrenta ineficiencias operativas derivadas de silos de información, empleados enterrados en trabajo manual, incentivos desalineados en estructuras organizativas y bucles de comentarios inconexos entre estrategias y resultados. Estos problemas conducen a experiencias de cliente subóptimas, procesos ineficientes y oportunidades perdidas de crecimiento.
Agentic Enterprise supera estas limitaciones integrando una plantilla digital de agentes de IA inteligentes con trabajadores humanos. Con esta nueva plantilla de trabajo aumentada por IA, una organización puede fomentar la innovación para el crecimiento, impulsar la excelencia operativa y crear resiliencia empresarial con varios tipos de nuevas funciones de negocio.
**Nuevas funciones de negocio para fomentar la innovación:**
- Productividad humana aumentada: La velocidad, la escala y la naturaleza siempre activa de los agentes de IA permite a las empresas automatizar el trabajo repetitivo y liberar trabajadores humanos para centrarse en tareas de mayor valor y más creativas.
- Mejora de la capacidad de adaptación: Debido a que se puede observar el razonamiento de los agentes de IA, pueden aprender e implementar nuevas habilidades de forma dinámica, permitiendo a la compañía mejorar continuamente el desempeño para cumplir objetivos de negocio y adaptarse rápidamente a nuevas oportunidades de mercado.
_Ejemplo en acción: Innovación de la experiencia del cliente en servicios financieros:_ Una firma de gestión de patrimonio puede utilizar un agente de IA para reinventar su modelo de implicación de clientes. El agente monitorea de forma autónoma carteras, identifica momentos clave para una revisión de cliente y prepara el plan previo a la llamada para el asesor, ajustando el plan a medida que surgen noticias. Esto permite al asesor humano ofrecer una experiencia de cliente proactiva y personalizada a escala, fortaleciendo las relaciones y descubriendo nuevas oportunidades.
**Nuevas funciones de negocio para proteger y garantizar la resiliencia organizativa:**
- Capacidad de plantilla de trabajo elástica: Las compañías pueden ampliar rápidamente su capacidad para hacer frente a aumentos en la carga de trabajo a partir de condiciones de negocio cambiantes, sin los costos y retrasos de aumentar una plantilla laboral completamente humana.
- Resiliencia operativa predictiva: La naturaleza ininterrumpida de los agentes de IA les permite anticipar, modelar y mitigar de forma autónoma los riesgos operativos, de cumplimiento y de seguridad en tiempo real, garantizando que la compañía mantiene la Trust de sus clientes y partes interesadas.
_Ejemplo en acción: Protección de datos de clientes:_ Una gran compañía puede implementar un agente de gobernanza de datos de IA para explorar el entorno normativo en busca de cambios en las leyes de privacidad de datos, descubrir y clasificar información confidencial en conjuntos de datos de compañía y luego aplicar la política de gobernanza apropiada. El agente puede revisar solicitudes de acceso a datos y enrutar excepciones a un analista humano para su revisión, reduciendo el riesgo de cumplimiento al mismo tiempo que permite que los datos se utilicen de una manera confiable.
**Nuevas funciones de negocio que optimizan la excelencia operativa:**
- Ejecución de procesos autónoma: Una plantilla de trabajo digital puede ejecutar tareas complejas de múltiples pasos las 24 horas del día, los 7 días de la semana a velocidad de máquina (con los humanos al tanto), reduciendo costos y ampliando procesos de forma eficiente.
- Orquestación transfronteriza: Los agentes de IA pueden trabajar en los silos de información e incentivos que normalmente restringen a los trabajadores humanos, fomentando la agilidad para procesos interfuncionales.
_Ejemplo en acción: Optimización del embudo de marketing en minorista:_ Un equipo de marketing minorista puede implementar un agente de IA para acelerar su proceso de campaña en respuesta a las nuevas tendencias de los consumidores. El agente puede generar planes de marketing, colaborar con equipos de marketing, productos y ventas para su revisión, y luego crear automáticamente garantías digitales y ejecutar entre múltiples canales, ajustando dinámicamente la campaña basándose en comentarios en tiempo real.
## Arquitectura de TI de Agentic Enterprise
### Los límites de la arquitectura de TI tradicional
La arquitectura de TI de la compañía se puede representar utilizando una construcción de capa. Las capas agrupan lógicamente funciones técnicas relacionadas y facilitan el razonamiento estructurado, pero no implican necesariamente implementaciones específicas o el grado en que una capa debe diseñarse de forma monolítica o de una manera más heterogénea. En esta vista de capa (Figura 1), la arquitectura de TI tradicional consta de cinco capas principales: Infraestructura, Datos, Integración, Aplicación y Experiencia. Dos capas cruzadas, Seguridad y Operaciones de TI, abarcan estas capas para garantizar la gobernanza, el monitoreo y la protección.
La arquitectura de TI tradicional se diseñó para un paradigma donde la inteligencia de la compañía residía en trabajadores humanos que realizaban acciones en aplicaciones para acceder a datos, aplicar lógica de negocio, facilitar la colaboración y ejecutar flujos de trabajo. No está diseñado para un paradigma donde los agentes de IA pueden razonar y realizar acciones para ciertos casos de uso realizados anteriormente por humanos (o no realizados en absoluto) mientras los humanos supervisan a los agentes de IA y se centran en tareas más creativas y ambiguas.
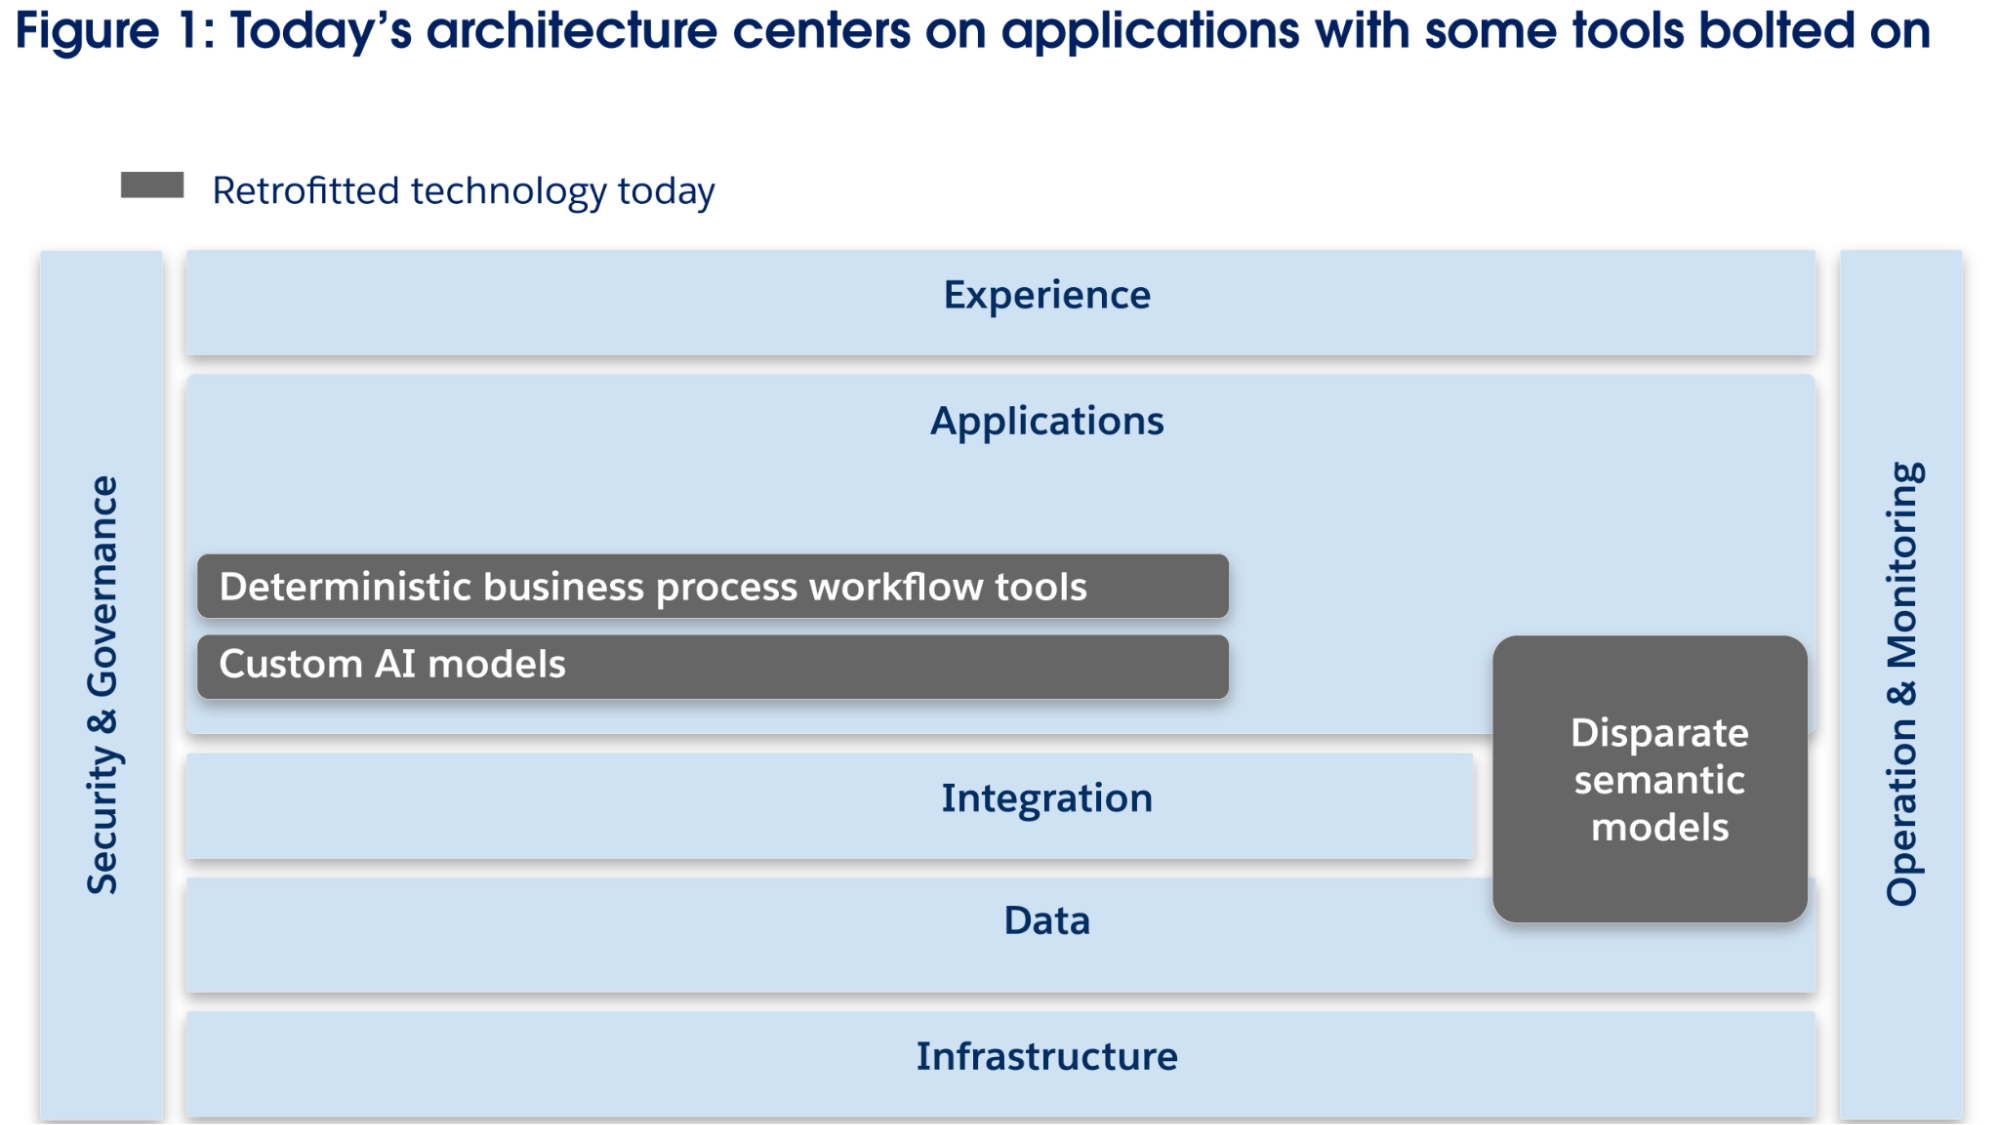 Aunque la arquitectura tradicional puede admitir implementaciones a subescala de agentes de IA hoy en día, no puede entregar completamente las funciones de negocio de Agentic Enterprise descritas anteriormente. La realización de estas funciones requiere una arquitectura de TI diseñada para una implementación generalizada de potentes agentes de IA que puedan tratar casos de uso amplios en vez de restringirse a implementaciones limitadas dirigidas a casos de uso estrechos.
Los agentes de IA seguirán mejorando en los próximos 5 años, y la arquitectura de TI tendrá que evolucionar para darse cuenta del valor de agentes de IA más potentes e inteligentes, para convertirse en pruebas futuras. En primer lugar, los agentes serán más inteligentes a medida que evolucionen los modelos de IA subyacentes (como los LLM multimodales) y las arquitecturas cognitivas de los agentes (por ejemplo, planificación de múltiples pasos, descomposición de tareas, etc.). En segundo lugar, los agentes de IA tendrán habilidades de aprendizaje y adaptación mejoradas con mejoras de memoria, funciones de autorreflexión y la capacidad de aprender de comentarios. En tercer lugar, los agentes de IA tendrán una mayor capacidad de interactuar con otros agentes, herramientas y datos, como lo demuestra la rápida evolución del ecosistema de estándares de tecnología abierta (por ejemplo, Protocolo de contexto de modelo, Agent2Agent, etc.). Aunque estas tres tendencias tecnológicas permitirán a los agentes de IA ser más potentes a medida que ejecutan tareas más abstractas y complejas, también presentará numerosos desafíos para la arquitectura de TI actual.
En primer lugar, los agentes de IA se basan fundamentalmente en modelos de IA, tanto desarrollados internamente como de origen externo, que evolucionan rápidamente y demandan una gestión de modelos de IA/ML sofisticada, compartida y estandarizada. Hoy en día, los modelos de IA están atornillados para casos de uso específicos en una aplicación, no como funciones compartidas para su reutilización con herramientas comunes para la capacitación, implementación, gobernanza y gestión de riesgos. En adelante, las compañías tendrán que poder utilizar diferentes modelos de IA para varios casos de uso de agentes que requieren herramientas que permitan a los agentes intercambiar modelos subyacentes (por ejemplo, modelo de base frente a modelo más pequeño específico de dominio) basándose en contexto de negocio. Esto requiere gestionar modelos de IA internamente desarrollados u alojados con herramientas de ciclo de vida unificadas para garantizar la coherencia, la reutilización, la escalabilidad y la eficiencia. Del mismo modo, el acceso a modelos de IA alojados de forma externa requiere un marco de trabajo de control de toda la compañía para garantizar un desempeño, seguridad, cumplimiento, disponibilidad y fiabilidad óptimos.
En segundo lugar, los agentes de IA tienen distintos patrones de escala y requisitos operativos como alojamiento, desarrollo, razonamiento, aprendizaje, gestión de memoria y operaciones, que requieren un límite arquitectónico separado y exclusivo para los agentes. La integración de esta función directamente en la arquitectura de aplicaciones estática y determinista actual introduciría riesgos y complejidad arquitectónica innecesarios. Además, los agentes de IA deben interoperar con aplicaciones existentes a través de interfaces estandarizadas o sistemas de mensajería para la interacción en tiempo real.
En tercer lugar, los agentes de IA necesitan poder razonar sobre conjuntos de datos dispares y colaborar entre sí, a menudo entre pilas de aplicaciones en silos, pero en la arquitectura actual, no hay funciones semánticas comunes para proporcionar un entendimiento compartido para que estos agentes razonen sobre diferentes conjuntos de datos. Como resultado, aunque los agentes de un solo propósito pueden implementarse con éxito, su ampliación para operar en gran número en tareas complejas entre sí sigue siendo difícil y arriesgada.
Por último, la arquitectura de TI de negocio actual carece de una forma efectiva de orquestar, optimizar y gobernar procesos de negocio de extremo a extremo que incluyan los flujos de trabajo dinámicos realizados por agentes más potentes, que aumentarán y en algunos casos sustituirán la función realizada por los trabajadores humanos en ese proceso. Hoy en día, las herramientas de automatización se aprovechan para gestionar flujos de trabajo lineales y deterministas que normalmente siguen una secuencia predefinida, documentada en lenguajes específicos de procesos y se basan en lógica estática que rara vez cambia. Las tecnologías de IA pueden mejorar algunos de estos procesos lineales (por ejemplo, el uso de modelos ML en vez de reglas de negocio codificadas para calcular umbrales de aprobación de préstamos), pero los aspectos estratégicos y de ejecución de la mayoría de los procesos de negocio críticos siguen siendo inherentemente dinámicos y flexibles. Tareas como el desarrollo de estrategias de marketing, la resolución de problemas complejos de clientes o la prospección de clientes tienen objetivos claros (satisfacción del cliente, velocidad de resolución de casos, etc.) pero no siguen una secuencia de ejecución fija y predefinida.
Actualmente, las empresas tradicionales dependen principalmente de los humanos para coordinar y realizar estos procesos de negocio complejos (como la configuración de estrategias y la gestión de programas complejos). A medida que los agentes de IA continúen evolucionando (mayores capacidades de inteligencia, aprendizaje e interacción) durante los próximos 3-5 años, su capacidad de ejecutar dichos procesos dinámicos de forma autónoma se ampliará significativamente, introduciendo complejidades y desafíos de integración que superan con creces las capacidades de las herramientas de integración y automatización existentes. La naturaleza adaptativa y dinámica de los agentes de IA crea una gran necesidad de nuevas funciones de orquestación para garantizar el control a nivel de compañía, la visibilidad integral y la alineación coherente con los objetivos estratégicos de toda la compañía, particularmente en la gestión de flujos de trabajo complejos, largos y de múltiples pasos que abarcan agentes de IA, seres humanos, herramientas de automatización y otros sistemas deterministas.
La arquitectura de TI de Agentic Enterprise establece una plataforma para acciones inteligentes integrando a la perfección trabajadores humanos, agentes de IA y sistemas deterministas. Esta arquitectura permite a los agentes humanos y de IA acceder de forma dinámica y aprovechar Knowledge empresarial unificado desde diversos orígenes de datos, enriquecido con contexto semántico para ejecutar de forma eficiente flujos de trabajo complejos y procesos alineados con objetivos de negocio estratégicos. La arquitectura de TI existente de un conjunto de plataformas en silos y soluciones puntuales evolucionará hacia un conjunto de servicios de aplicación componibles, herramientas semánticas y de datos y redes de agentes de IA supervisadas y gobernadas por nuevas herramientas de orquestación de procesos de negocio inteligentes.
Esta arquitectura permite a los agentes detectar, razonar y actuar dentro de sus ámbitos respectivos, trabajar dentro y entre dominios de negocio y aprender, mejorar y adaptarse continuamente. Esto requiere un diseño centrado en mecanismos sólidos para acceder a datos y Knowledge (comprensión semántica), protocolos e interfaces de comunicación flexibles y estandarizados (como agentes a agentes, agentes a sistemas deterministas y agentes a humanos) y, de forma crítica, orquestar flujos de trabajo y procesos entre agentes, humanos y herramientas de automatización y sistemas deterministas.
### Principios de arquitectura
Para realizar la visión arquitectónica de una plataforma para acciones inteligentes, se recomiendan estos principios de diseño como mejores prácticas:
- **Componibilidad y modularidad:** Diseñe elementos arquitectónicos como componentes modulares con interfaces estandarizadas para permitir el ensamblaje rápido y dinámico de funciones de agentes, flujos de trabajo y superficies orientadas hacia las personas. Dé prioridad a la abstracción y los contratos de interfaz claros para permitir la mayor flexibilidad para que los agentes de IA redacten flujos de trabajo.
- **Datos y semántica primero:** Garantice un acceso integral, preciso, rápido, seguro y rentable a los datos, con comprensión semántica compartida para que los agentes razonen de forma efectiva entre sistemas en silos. Esto requiere tratar los datos (y metadatos) como un producto, con herramientas para garantizar la calidad, el linaje, la gobernanza y el acceso, así como una forma de proporcionar comprensión semántica compartida entre agentes y seres humanos.
- **IT y observabilidad de negocio integrados:** Integre funciones de monitoreo, rastreo, evaluación y capacidad de explicación integrales en toda la arquitectura para obtener perspectivas sobre el razonamiento, los comportamientos, las interacciones del sistema y el impacto de los agentes en los indicadores clave de desempeño de negocio para permitir la optimización continua del desempeño de los agentes. Esto incluye optimización de costos (FinOps), mediciones de sostenibilidad y telemetría operativa manteniendo Trust, cumplimiento y consumo de recursos responsable. Dado que los agentes de IA son inherentemente no deterministas, la observabilidad es primordial para garantizar que los agentes de IA puedan operar de una manera confiable, compatible y auditable con la supervisión humana.
- **Confianza durante:** Aplique permisos granulares y dinámicos basándose en la intención de las tareas del agente (acceso a datos, acciones, etc.) e implemente prácticas de seguridad integrales incluyendo la creación de equipos rojos, la exploración CVE automatizada, la detección de vulnerabilidades y los controles de validación basados en riesgos. Se necesitan controles más granulares y dinámicos dado el riesgo de que los agentes provoquen riesgos en cascada debido a su capacidad para operar a velocidades de máquina. Asegúrese de que todos los resultados generados por IA (desde agentes o modelos) se validan rigurosamente con políticas definidas de cumplimiento, seguridad, toxicidad y sesgo antes de su uso o entrega, lo que requiere mecanismos de registro y capacidad de explicación con seguimientos de auditoría verificables para decisiones, acciones, contenido y predicciones de IA.
- **Agente primero con supervisión humana:** Active los agentes de IA para que sean la herramienta predeterminada para resolver casos de uso de negocio, excluyendo otras consideraciones (por ejemplo, costo, ajuste técnico) y diseñe sistemas de TI para que sean accesibles para flujos de trabajo de agentes. Esto incluye la capacidad de los humanos de monitorear, intervenir y sustituir cualquier paso del proceso de un agente. Los agentes requieren funciones de autorreflexión para buscar orientación humana de forma proactiva si su confianza sobre la toma de decisiones cae por debajo de umbrales preprogramados.
- **Interacción reactiva y multimodal:** Active la arquitectura para admitir mecanismos de respuesta e invocación de agentes integrales entre todos los tipos de interacciones incluyendo protocolos de agente a agente, entradas multimodales humanas (voz, texto, visual), eventos de negocio, señales del sistema y datos de transmisión. Active funciones de procesamiento dirigidas por eventos y en tiempo real para garantizar que los agentes pueden reaccionar a cualquier señal oportuna desde cualquier origen o formato.
- **Infraestructura preparada para la IA:** Asegúrese de que la infraestructura puede ampliarse elásticamente con redundancia incorporada para gestionar cargas de trabajo de IA fluctuantes e integrar oportunidades en curso ML/LLM en la arquitectura de datos y aplicaciones, mientras mantiene el cumplimiento de los requisitos de residencia de datos.
- **Ecosistema abierto:** Dé prioridad a la interoperabilidad y evite el bloqueo tecnológico favoreciendo estándares abiertos, protocolos e interfaces bien definidas (API, eventos) para beneficiarse del ecosistema tecnológico.
## Capas de arquitectura
Para activar y ampliar con éxito la transformación de agentes, las empresas deben ir más allá de la mera mejora de las capas actuales; deben considerar la introducción explícita de cuatro capas arquitectónicas adicionales (Figura 2) diseñadas específicamente para satisfacer las necesidades de los agentes de IA.
La **Capa genética** está dedicada al desarrollo y la gestión de agentes de IA, abarcando funciones cognitivas como planificación, razonamiento, memoria, utilización de herramientas, gestión de estados y control del ciclo de vida. Esta capa aborda los requisitos técnicos y operativos exclusivos de los agentes de IA, garantiza la interoperabilidad entre aplicaciones y almacenes de datos a través de protocolos estandarizados y facilita la colaboración de agente a agente. La capa de aplicación existente evolucionará a servicios de aplicación para estar compuesta de forma dinámica para flujos de trabajo de agentes.
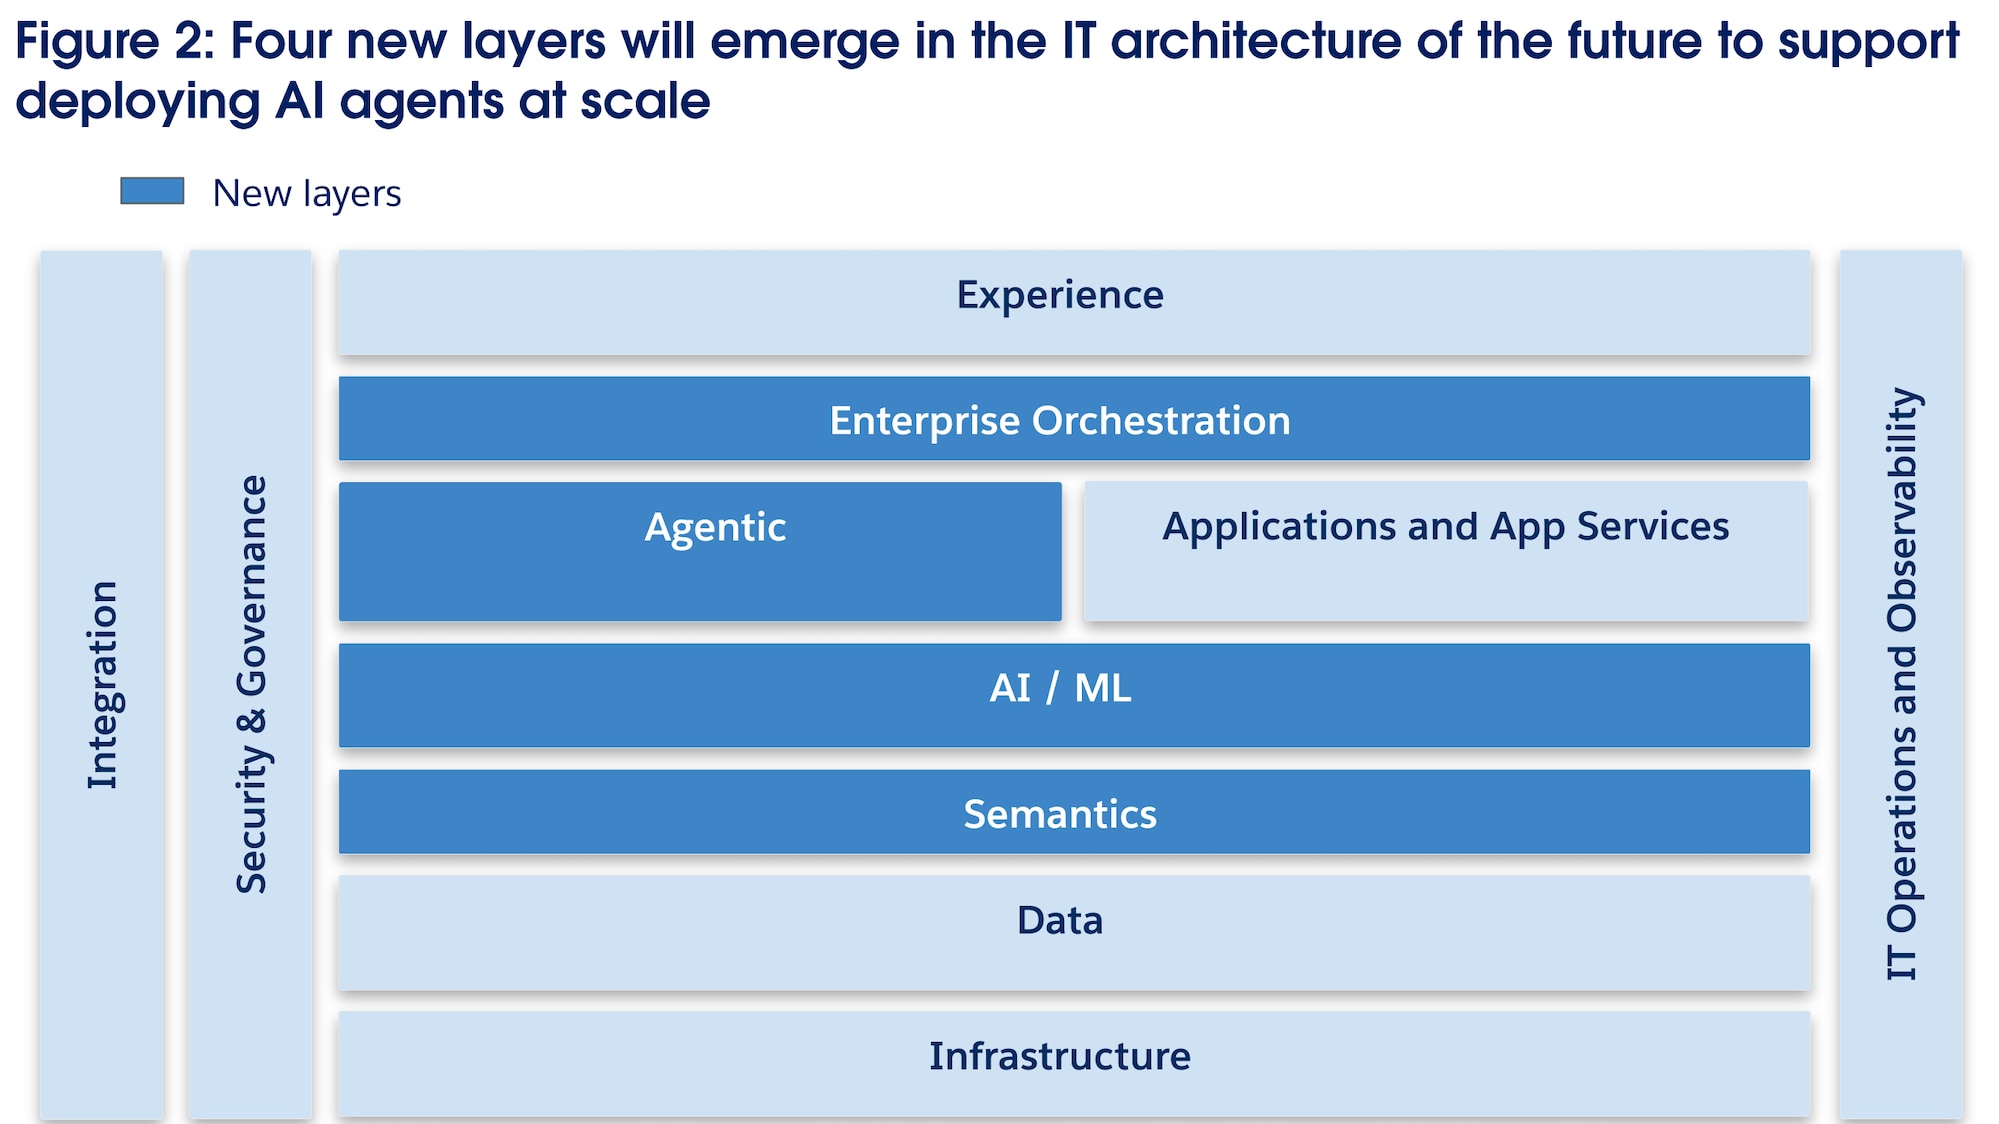 La **Capa semántica** se presenta para resolver la desconexión entre datos de compañía sin procesar y la comprensión semántica que necesitan los agentes de IA. Codifica y gestiona explícitamente entidades de negocio, conceptos, definiciones e interrelaciones, creando una ontología de negocio y una representación de Knowledge de negocio para permitir la comprensión semántica compartida que impulsa flujos de trabajo de múltiples agentes más complejos realizando tareas de nivel superior. Más allá de un catálogo de datos, Capa semántica traduce una consulta de lenguaje natural en consultas precisas en establecimientos de datos específicos, armoniza los resultados y devuelve una respuesta contextual y más enriquecida para el agente. La Capa de datos existente mientras tanto unifica a través de la adopción de lagos centralizados al tiempo que amplía el acceso a los datos a través de un entramado de datos listo para IA para admitir principios de modelo operativo de malla de datos.
La **Capa de IA/ML** centraliza la gestión de funciones de IA de compañía, incluyendo modelos de lenguaje grandes, modelos de acción grandes y modelos de ML específicos de dominio, gestionando modelos de IA desarrollados internamente a lo largo de su ciclo de vida y el acceso/uso controlado a servicios de IA externos. A diferencia de las arquitecturas tradicionales donde los modelos de IA están integrados en aplicaciones, esta capa establece modelos de IA como componentes de primera clase y servicios compartidos en la compañía. Se centra en funciones de IA controladas por la compañía (no funciones de IA proporcionadas por proveedores externos). Esta capa proporciona la inteligencia para varios agentes y otras cargas de trabajo de IA en la compañía con mecanismos estandarizados para Trust, seguridad, cumplimiento e implementación.
La **Capa de orquestación** de compañía es la abstracción funcional para coordinar, gobernar y optimizar flujos de trabajo complejos de múltiples pasos y procesos de negocio que abarcan agentes de IA, seres humanos, herramientas de automatización y sistemas deterministas. Esta capa aprovecha un modelo de orquestación combinado que permite a los agentes y sistemas individuales gestionar de forma autónoma tareas coreográficas locales utilizando protocolos abiertos como MCP y A2A proporcionando al mismo tiempo supervisión y coordinación centralizadas de extremo a extremo de todo el proceso. Para implementar el modelo de orquestación combinado, esta capa representa procesos de negocio críticos en formatos semánticamente enriquecidos legibles por máquina que definen los pasos deterministas (modelados durante el tiempo de diseño) y los pasos dinámicos (decididos por agentes durante el tiempo de ejecución) de un proceso de negocio, creando la base del modelo de proceso para la gobernanza y la optimización.
Tradicionalmente, partes significativas de los procesos de negocio dirigidos por humanos permanecen indocumentados o inaccesibles en formas legibles por máquina. Sin embargo, la observabilidad detallada de las actividades de los agentes de IA, incluyendo datos enriquecidos y metadatos acerca de sus tareas y acciones, permite capturar, documentar e integrar trabajo dinámico no estructurado anteriormente con flujos de trabajo lineales deterministas para crear modelos de procesos integrales. La documentación detallada del proceso captura interdependencias de tareas y rutas de ejecución invisibles anteriormente, permitiendo a la compañía optimizar continuamente la eficiencia operativa, solucionar de forma efectiva cuellos de botella y codificar sistemáticamente mejores prácticas identificadas por agentes en libros de jugadas reutilizables de toda la compañía. Esto da como resultado un gemelo digital holístico de procesos individuales, y cuando se amplía, toda la compañía.
Por ejemplo, los procesos complejos como la ejecución de estrategias de ventas integrales o la incorporación de nuevos empleados implican numerosos pasos interdependientes donde la capa de orquestación puede garantizar niveles apropiados de implicación humana (por ejemplo, gestión de excepciones), autonomía limitada para agentes de IA y cumplimiento obligatorio. A lo largo de estos procesos, la capa de orquestación descendente agrega previsibilidad y gobernanza, realiza un seguimiento y una evaluación continuos de indicadores clave de desempeño (KPI), garantiza la integridad transaccional de los flujos de trabajo y la lógica de reversión, y mantiene la visibilidad en cada etapa del flujo de trabajo para garantizar la alineación con objetivos de negocio generales. Para implementar esta función, esta capa consume políticas, reglas y salvaguardas de la capa de seguridad y gobernanza (a través de política como código) y objetivos de negocio e indicadores clave de desempeño almacenados en la Capa semántica. Dada la naturaleza autónoma y rápida de las interacciones dirigidas por la IA, el hecho de depender únicamente de una coreografía descentralizada conlleva el riesgo de errores de alineación estratégica o infracciones de cumplimiento, especialmente en flujos de trabajo de múltiples pasos de larga duración. El enfoque de orquestación combinada mitiga estos riesgos integrando reglas de negocio de toda la compañía, comprobaciones de cumplimiento y aplicación de políticas directamente en flujos de trabajo complejos e integra la supervisión humana en coyunturas críticas.
Cada una de estas 11 capas contribuye con funciones específicas a la implementación de agentes de IA a escala de una forma segura, de confianza y efectiva que libera todo el potencial de la IA de agentes para transformar el modo en que se realiza el trabajo en una compañía. La sección siguiente describe la función de la capa, los cambios novedosos debidos al aumento de agentes de IA y sus funciones de tecnología clave.
### Capa de experiencia
**Función:** La Capa de experiencia sirve como la interfaz principal para usuarios humanos, permitiendo la interacción multimodal capturando entradas (texto, voz, visual) y entregando respuestas relevantes en contexto entre múltiples dispositivos. Transfiere sin problemas las intenciones de los usuarios a la Capa de agente para la acción, proporcionando al mismo tiempo la interfaz de usuario dinámica y visualizaciones que facilitan las distribuciones y aprobaciones humanas en flujos de trabajo de agentes.
**Qué es diferente frente a hoy:** La IA aumentará las interfaces tradicionales basadas en la interfaz de usuario con procesamiento de lenguaje natural, conciencia contextual y compatibilidad de decisiones proactiva. Los agentes de IA podrán iniciar interacciones de forma proactiva, entregando recomendaciones personalizadas en tiempo real entre todos los canales y modalidades.
**Funciones de tecnología clave:**
- **Asistentes digitales y de IA conversacional:** Active la UX de forma predeterminada para ofrecer asistencia de IA para usuarios humanos.
- **Interfaz de usuario de Atribución y transparencia:** Haga que las respuestas sean explicables en la interfaz de usuario, como mostrando citas, orígenes de archivos/sistemas y el enfoque/la justificación de las decisiones.
- **Servicio de notificación ambiental y proactivo:** Permite a los agentes enviar de forma proactiva perspectivas o alertas a usuarios en el canal y el factor de forma más apropiados, basándose en el contexto actual del usuario.
- **Experiencias de OmniCanal:** Proporciona una experiencia transparente, coherente y unificada entre todos los canales con continuidad de trayectoria, donde las pláticas y tareas siguen a la persona en vez de la aplicación.
- **Capacidades multimodales:** Permite a las personas interactuar con agentes y aplicaciones a través de texto, voz, imagen, tacto, video y AR/VR de modo que los agentes puedan comprender y presentar información en la modalidad más eficiente.
- **Personalización consciente del contexto e interfaz de usuario dinámica:** Activa experiencias de usuario en tiempo real (tiempo, ubicación, acciones de usuario) contextuales para activar la personalización, incluyendo la generación de interfaz de usuario sobre la marcha.
### Capa agente
**Función:** La Capa agente actúa como el entorno de tiempo de ejecución predeterminado para realizar trabajo en la compañía donde los agentes de IA descomponen tareas desde la capa de experiencia y ejecutan tareas reuniendo flujos de trabajo de forma dinámica utilizando herramientas desde la capa de aplicaciones y servicios de aplicación y la capa de datos. El estado de configuración de los agentes de IA se almacena y gestiona en esta capa. Los agentes se instancian para tareas específicas y las instancias de agentes específicas se retiran posteriormente. Esta implementación permite invocar siempre a los agentes desde el estado de configuración más reciente basándose en optimizaciones sin conexión (utilizando funciones desde capas de IA/ML, observabilidad y orquestación). Esta capa es responsable de la gestión, coordinación y gobernanza integrales del ciclo de vida de los agentes de IA.
**Qué es diferente frente a hoy:** Esta capa emergerá del conjunto dispar de pilotos actual y las implementaciones de agentes limitadas. Aunque existen bots basados en reglas, existen pocos programas de software adaptativos, no deterministas y orientados a objetivos implementados a escala.
**Funciones de tecnología clave:**
- **Entorno de tiempo de ejecución de agentes:** Gestiona el ciclo de vida, la ejecución y la asignación de recursos para agentes de IA.
- **Suite de gestión del ciclo de vida de agentes:** Incluye marcos de trabajo de desarrollo, herramientas de desarrollo y prueba y sistemas de gestión para actividades de agentes y control de versiones.
- **Motor de razonamiento de agentes:** Un marco cognitivo para que los agentes descompongan objetivos, planifiquen y decidan qué herramientas utilizar para resolver problemas complejos.
- **Almacén de memoria y contexto de agente:** Permite a las instancias de agentes recuperar y mantener contexto sobre interacciones anteriores, garantizando la coherencia y la personalización.
- **Protocolos de interoperabilidad de agentes:** Interfaces estandarizadas para la comunicación de agente a agente (A2A) y para que los agentes interactúen con sistemas externos (como a través del Protocolo de contexto de modelo).
- **Registro de herramientas:** Un conjunto depurado de herramientas admitidas interna y externamente para que los agentes las invoquen para realizar una tarea concreta.
- **Registro de agentes:** Un ecosistema depurado de soluciones y agentes de IA preconstruidos que admite el descubrimiento y la coincidencia de funciones.
- **Aplicación de políticas de agentes distribuidos:** Activa la gobernanza de toda la compañía permitiendo a los agentes autocomprobar el cumplimiento antes de realizar acciones.
- **Marco de trabajo de autorreflexión y adaptación de agentes:** Proporciona un mecanismo para que un agente analice su propio desempeño y, con la aprobación humana, desencadene mejoras o sugiera modificaciones a sí mismo.
### Capa de IA/ML
**Función:** Esta capa funciona como un núcleo de inteligencia centralizado, ofreciendo modelos de IA como un conjunto de servicios compartidos para ser consumidos por la Capa de agente (y aplicaciones) para potenciar sus funciones de razonamiento y toma de decisiones con marcos de trabajo de seguridad y monitoreo integrados.
**Qué es diferente frente a hoy:** Tradicionalmente, los modelos de IA se incrustaban en aplicaciones específicas. En la arquitectura de TI de Agentic Enterprise, la capa de IA/ML será un conjunto de servicios centralizado de primera clase que potenciará muchas aplicaciones y agentes, admitiendo el ciclo de vida completo del modelo desde el desarrollo hasta el servicio en tiempo real a escala.
**Funciones de tecnología clave:**
- **Modelos de Foundation preintegrados:** Modelos ML de gran tamaño entrenados en un amplio espectro de datos, capaces de realizar una amplia variedad de tareas generales.
- **Generación aumentada de recuperación (RAG):** Oportunidades en curso centradas en la IA que fundamentan modelos de base en datos específicos de la compañía para mejorar la precisión y reducir las alucinaciones.
- **Núcleo de confianza, seguridad y gobernanza de IA:** Un conjunto de herramientas integradas en el ciclo de vida del modelo para aplicar principios de IA responsables como detección de sesgos, capacidad de explicación y monitoreo de seguridad.
- **Pasarela de modelo:** Un motor de enrutamiento que actúa como un punto de entrada único para todas las solicitudes de inferencia de modelo, gestionando llamadas a varios modelos internos y externos para optimizar el costo, el desempeño y el cumplimiento.
- **Sobremesa de trabajo de desarrollo de modelos:** Un entorno de desarrollo integrado para científicos de datos con herramientas para el preprocesamiento de datos, la capacitación de modelos y la experimentación.
- **Oportunidades en curso de MLOps y automatización del ciclo de vida:** El motor de CI/CD para el aprendizaje automático, automatizando el ciclo de vida de extremo a extremo de modelos desde la capacitación hasta la implementación y la retirada.
- **Tiempo de ejecución de servicio de modelo e inferencia:** Un entorno ampliable y de baja latencia para implementar modelos entrenados como extremos de API seguros para el consumo en tiempo real.
- **Registro de modelos y activos:** Un repositorio centralizado y controlado por versión para todos los activos de IA/ML, incluyendo modelos, conjuntos de datos y código fuente, garantizando la reproducibilidad y la capacidad de auditoría.
- **Generación y gestión de datos sintéticos:** Herramientas para generar y gestionar datos sintéticos que mantienen las propiedades estadísticas de datos reales sin exponer información confidencial.
### Capa de orquestación de compañía
**Función:** La Capa de orquestación de compañía es el plano de control para el trabajo de extremo a extremo en una compañía de agentes. Garantiza que los flujos de trabajo y las interacciones de agentes se adhieren a los objetivos de la compañía y las políticas de gobernanza. Consume telemetría de observabilidad desde otras capas para construir modelos de procesos de negocio integrales, permitiendo la optimización frente a KPI extraídos desde la Capa semántica. Esta capa proporciona el contexto compartido y la memoria de larga duración a cada nueva instancia de un agente de IA para flujos de trabajo críticos.
**Qué es diferente frente a hoy:** Esta capa proporciona visibilidad unificada en procesos de negocio creando modelos legibles por máquina que capturan pasos estructurados y deterministas y el trabajo dinámico no estructurado realizado por humanos y agentes. Va más allá de los modelos de gobernanza y colaboración centrados en las personas actuales codificando programáticamente objetivos de negocio y reglas de cumplimiento como restricciones en flujos de trabajo de agentes para gobernar la plantilla de agentes.
**Funciones de tecnología clave:**
- **Motor de ejecución de flujo de trabajo híbrido:** El tiempo de ejecución principal que ejecuta el "modelo de orquestación combinado", proporcionando supervisión centralizada mientras permite la coreografía de agentes locales.
- **Motor de restricción y gobernanza de procesos:** Un servicio de gobernanza en tiempo real que consume y aplica reglas de negocio declarativas, políticas y restricciones a todos los procesos en vuelo.
- **Memoria compartida y gestión de contexto:** Una capa de memoria compartida accesible para todos los actores en un flujo de trabajo para mantener la continuidad y la coherencia entre múltiples pasos.
- **Process Modeling Studio:** Un entorno de tiempo de diseño para crear y gestionar modelos de procesos legibles por máquina y enriquecidos semánticamente que definen pasos deterministas y dinámicos orientados a objetivos.
- **Optimización y simulación de procesos:** Una función que construye simulaciones digitales de procesos de negocio para análisis avanzados, simulaciones de caso y optimización predictiva.
- **Descubrimiento de procesos y monitoreo de estado:** Ingresa modelos de procesos y datos en tiempo real para crear reportes sobre mediciones de negocio del estado de procesos.
- **Modelado de procesos dobles digitales:** Un espejo en tiempo real de flujos de trabajo en vivo para probar, simular cambios y optimizar sin afectar a la producción.
### Capa de servicios de aplicación y aplicación
**Función:** Esta capa expone las funciones de aplicaciones de negocio existentes como herramientas y servicios modulares y componibles para que los utilicen los agentes. También sirve como tiempo de ejecución de presentación para integrar funciones de agentes en la experiencia de usuario. Las aplicaciones continúan siendo el sistema de registro, pero están rediseñadas para ser funciones "desatendido" para agentes.
**Qué es diferente frente a hoy:** Las aplicaciones evolucionarán de interfaces de usuario monolíticas a "servicios back-end" que los agentes pueden llamar dinámicamente a través de API y eventos. Esta capa se integrará de forma nativa con modelos y agentes de IA, y la proliferación de LLM de generación de código llevará a un aumento en el número de microaplicaciones personalizadas creadas por agentes.
**Funciones de tecnología clave:**
- **Servicios de aplicación modular:** Lógica de negocio descompuesta desde aplicaciones tradicionales, publicadas como acciones legibles por máquina para que las llamen los agentes.
- **SDK de integración de agentes:** Kits de herramientas y bibliotecas que permiten a los desarrolladores integrar agentes de forma segura directamente en las interfaces de usuario de aplicaciones.
- **Servicios de generación de interfaz de usuario dinámica:** Servicios que permiten a un agente de IA generar o modificar componentes de la interfaz de usuario en tiempo real basándose en contexto de usuario.
- **Marcos de trabajo nativos de la interfaz de usuario de IA:** Marcos de trabajo frontales diseñados con compatibilidad integrada para la gestión de interfaces de usuario dirigidas por IA, como la gestión de datos probabilistas y respuestas de texto de transmisión.
- **Sistemas de implicación infundidos por agentes:** Aplicaciones de colaboración y productividad de negocio que incorporan funciones de agentes de IA a través de componentes visuales.
- **Desarrollo de aplicaciones de código bajo/sin código mejorado por IA:** Herramientas que permiten a los usuarios y agentes crear aplicaciones y servicios personalizados utilizando lenguaje natural y solicitudes.
- **Barandillas de aplicación para uso de agentes:** Controles del lado de la aplicación para el uso de agentes, como limitación de velocidad, permisos con ámbito y telemetría.
### Capa semántica
**Función:** La Capa semántica proporciona una comprensión unificada de datos y Knowledge en toda la compañía, permitiendo tanto a los humanos como a los agentes de IA interpretar y actuar sobre la información de forma coherente. Utiliza herramientas de representación Knowledge como ontologías y gráficos Knowledge para traducir consultas de lenguaje natural en consultas de datos precisas y contextuales.
**Qué es diferente frente a hoy:** Aunque las empresas actuales tienen establecimientos de metadatos dispares, la arquitectura de TI de Agentic Enterprise requiere un Enterprise Knowledge Graph (EKG) centralizado que vincula datos entre dominios con relaciones semánticas definidas explícitamente. Esto proporciona el contexto enriquecido que los agentes de IA pueden atravesar para realizar razonamientos complejos, creando requisitos para un conjunto de funciones técnicas para impulsar gráficos Knowledge que abarcan múltiples dominios funcionales.
**Funciones de tecnología clave:**
- **Servicio de metadatos:** Proporciona metadatos descriptivos, incluyendo linaje de datos, propiedad y clasificaciones.
- **Glosario de negocio y gestión de taxonomía:** Una herramienta para usuarios de negocio para definir y acordar condiciones de negocio estándar.
- **Gestión de modelos semánticos:** Un sistema de trabajo para ingenieros de Knowledge para crear, gestionar y gobernar modelos semánticos y ontologías.
- **Enterprise Knowledge Graph (EKG):** Una instanciación en tiempo de ejecución de la ontología de la compañía que almacena y asigna las relaciones entre entidades de negocio.
- **Motor de Admisión y Armonización de Metadatos:** Canalizaciones automatizadas que rellenan y mantienen Enterprise Knowledge Graph desde varios sistemas de origen.
- **Motor de consultas semánticas**: Interpreta consultas de lenguaje natural y construye consultas estructuradas basándose en el ECG para recuperar datos de diversos orígenes.
- **Motor de razonamiento semántico:** Analiza y deriva Knowledge implícito y relaciones ocultas del ECG.
### Capa de datos
**Función:** La Capa de datos es la fuente fundamental de la verdad, que gestiona y proporciona acceso seguro y regulado a todos los datos de la compañía para que la Capa semántica los interprete, la Capa de IA/ML los utilice para la capacitación, las aplicaciones para las transacciones y los agentes para el razonamiento.
**Qué es diferente frente a hoy:** La Capa de datos evoluciona para ser más unificada, en tiempo real y centrada en la gobernanza, a menudo centrada en un lago de datos a escala de nube. Debe gestionar un mayor volumen y variedad de datos y cambiar del procesamiento orientado por lotes a la transmisión en tiempo real para dar cobertura a agentes reactivos. La gobernanza y la calidad de los datos adquieren una importancia aún mayor para evitar que los datos deficientes creen resultados de IA defectuosos.
**Funciones de tecnología clave:**
- **VectorDB:** Una base de datos especializada optimizada para almacenar y consultar incrustaciones de vectores de alta dimensión, clave para RAG.
- **Oportunidades en curso de datos de análisis inteligente:** Un servicio automatizado dirigido por metadatos para el ingreso, la transformación y la carga de datos (ETL/ELT) en la Capa de datos.
- **Enterprise Data Lakehouse:** Un repositorio central para datos estructurados, semiestructurados y no estructurados, optimizado para cargas de trabajo de análisis e IA.
- **Búsqueda y federación de datos de copia cero:** Técnicas para acceder, consultar y buscar datos entre múltiples establecimientos sin movimiento de datos físico.
- **Lenguaje natural a SQL:** Una técnica para convertir consultas de lenguaje natural en SQL.
- **Servicio de descubrimiento y catálogo de datos de compañía:** Un inventario centralizado con capacidad de búsqueda de todos los activos de datos en la compañía.
- **Gestión de datos principal y de referencia (MDM):** Gestiona el "registro de oro" para entidades de negocio críticas como Cliente y Producto.
- **Servicio de calidad de datos adaptativo:** Un servicio de monitoreo continuo que utiliza la IA para detectar y remediar automáticamente Problemas de calidad de datos en tiempo real.
- **Contratos de datos:** Acuerdos legibles por máquina entre productores de datos y consumidores que especifican el esquema, la semántica y los SLA del intercambio de datos.
- **Almacenes de datos especializados en IA:** Bases de datos diseñadas para casos de uso de IA específicos, como bases de datos de gráficos o series temporales.
- **Tela de datos preparada para IA:** Una capa de abstracción de datos lógica que proporciona una vista unificada y virtualizada de datos entre sistemas físicos dispares.
- **Procesamiento de datos en tiempo real:** Funciones para procesar y analizar transmisiones de datos multimodales de forma continua a velocidades de máquina.
### Capa de infraestructura
**Función:** La Capa de infraestructura sustenta el resto de capas, proporcionando las funciones de computación, almacenamiento, red y nube requeridas para ejecutar cargas de trabajo de IA y agentes a escala de una manera resiliente y rentable.
**Qué es diferente frente a hoy:** Las cargas de trabajo de IA requieren mayor escalabilidad y elasticidad para controlar la naturaleza probabilista de los sistemas de agentes. La infraestructura debe admitir el aprovisionamiento rápido, hardware especializado como GPU y tráfico de red de alta latencia y bajo rendimiento para la comunicación entre agentes.
**Funciones de tecnología clave:**
- **Infraestructura como código:** Aprovisionamiento y gestión automatizados de infraestructura con oportunidades en curso de implementación de CI/CD.
- **Infraestructura de IA híbrida y de múltiples nubes:** Aprovecha la elasticidad de la nube pública y la infraestructura especializada para cargas de trabajo de IA generativa.
- **Computación, almacenamiento y red optimizados para IA:** Asigna y amplía dinámicamente recursos de infraestructura basándose en demanda variable desde cargas de trabajo de IA.
- **Infraestructura de IA periférica:** Permite implementar modelos y agentes de IA en el borde de la red para casos de uso con requisitos de privacidad o latencia exclusivos.
- **Infraestructura de autocuración:** Utiliza la IA para gestionar la recuperación del sistema sin entrada manual, garantizando una alta disponibilidad.
- **Computación de IA sostenible:** Enfoques de eficiencia energética para mitigar el impacto medioambiental de las cargas de trabajo de IA.
- **Escalado automático consciente del costo y el carbono:** Utiliza FinOps y señales de sostenibilidad para dirigir la ampliación y la colocación de capacidad.
### Capa de integración
**Función:** La Capa de integración sirve como la estructura de comunicación universal para todos los sistemas (heredados y nuevos) a través de API, eventos, protocolos y middleware para garantizar que los agentes puedan descubrir e interactuar con servicios, datos y herramientas de forma transparente.
**Qué es diferente frente a hoy:** La integración debe evolucionar para dar cobertura a los patrones de comunicación dinámicos de varios a varios agentes de IA, en vez de solo gestionar interacciones estáticas predeterminadas entre algunos sistemas conocidos. Requiere procesamiento de datos en tiempo real y debe acomodar el descubrimiento ad-hoc y la colaboración entre agentes.
**Funciones de tecnología clave:**
- **Oportunidades en curso de conectividad de datos operativos:** Herramientas asistidas por IA para la asignación de esquemas automática, la transformación de datos y la generación de flujos de trabajo, incluyendo funciones de ETL inversas, dirigidas por API y dirigidas por eventos.
- **Gestión de API adaptativa y malla de servicio:** Pasarelas de API y tecnología de malla de servicio que pueden registrar, descubrir y gobernar servicios de forma dinámica con aplicación de políticas adaptativa para agentes.
- **Adaptadores de Semantic Knowledge:** Un componente de integración que proporciona un vocabulario compartido y un modelo de datos entre agentes y aplicaciones para una interpretación de datos coherente.
- **Tela de integración dirigida por eventos:** Una cadena principal de transmisión y mensajería de alto rendimiento y baja latencia que permite la comunicación asíncrona desvinculada.
- **Puerta de enlace de protocolo de agente:** Una pasarela para servicios de MCP que permite a los agentes descubrir herramientas y desencadenar acciones de forma segura, uniendo MCP a API y eventos internos.
- **Catálogo de funciones componibles y Mercado:** Un catálogo centralizado y regulado para todas las funciones de la compañía (API, servicios, habilidades de agentes, modelos y conjuntos de datos) anotado con metadatos semánticos para la composición on-demand.
### Capa de operaciones y observabilidad de TI
**Función:** Esta capa monitorea y gestiona el estado y el desempeño operativo de los agentes y todo el sistema (principio integrado de observabilidad), proporcionando transparencia y control generando perspectivas para permitir la auditoría, la depuración, la capacidad de explicación, el costo y la optimización de recursos de la plantilla de agentes de la compañía.
**Qué es diferente frente a hoy**: Esta capa se vuelve aún más crucial dado el riesgo de que los agentes de IA creen errores a velocidad de máquina. Debe ampliarse más allá del monitoreo de infraestructura para incluir el comportamiento impredecible de agentes autónomos, requiriendo nuevos tipos de telemetría y la capacidad de comprender la corrección semántica, no solo el desempeño técnico.
**Funciones de tecnología clave:**
- **Plataforma de monitoreo y observabilidad en tiempo real:** Recopila continuamente registros, mediciones y rastreos en todo el entorno de TI, con extensiones para mediciones de ML y comportamiento de agentes.
- **FinOps y Gestión de costos de nube:** Responsable de monitorear, analizar y optimizar los costos de infraestructura asociados con la IA y las cargas de trabajo de agentes.
- **Monitoreo específico de agente y ML:** Registra cada paso de la ejecución de un agente en un seguimiento de auditoría inmutable y perfila continuamente comportamientos de agentes para detectar desviaciones de las normas establecidas.
- **AIOps, Gestión de incidentes y cambios:** Utiliza IA/ML para predecir posibles problemas de TI, identificar causas raíz y crear flujos de trabajo de corrección.
- **Bucle de comentarios de aprendizaje cerrado:** Integra la telemetría de observabilidad de los agentes de vuelta en las oportunidades en curso de MLOps, permitiendo el reentrenamiento de modelos automatizado o el ajuste de solicitudes.
- **Motor de observabilidad semántica:** Integra la observabilidad con la capa semántica para la contextualización para permitir la detección de anomalías semánticas en el comportamiento de agentes.
### Capa de seguridad y gobernanza
**Objetivo:** Esta capa integra Trust y seguridad en toda la arquitectura protegiendo los activos de la compañía de amenazas, gestionando riesgos y garantizando el cumplimiento de los requisitos normativos. Abarca la gestión de identidad, la detección de amenazas, el GRC y las medidas de seguridad específicas de la IA.
**Qué es diferente frente a hoy:** La capa de seguridad debe evolucionar para solucionar nuevas superficies de ataque presentadas por agentes y modelos de IA, como inyección rápida y envenenamiento de modelo. La gestión de identidad y acceso debe cambiar de controles estáticos basados en funciones a permisos dinámicos basados en intenciones que se otorgan justo a tiempo y se revocan inmediatamente después de su uso.
**Funciones de tecnología clave:**
- **Seguridad de entrada/salida de LLM y barandillas:** Barandillas de compañía aplicadas en tiempo de solicitud y respuesta para bloquear contenido inseguro, fugas de PII y fugas de cárcel.
- **Cero Trust Architecture con Verificación de IA:** Autenticación continua mejorada por análisis de comportamiento basado en IA, con acceso granular justo a tiempo para agentes basándose en su tarea específica.
- **Marco de trabajo de seguridad de agentes:** Modelos de permisos detallados, monitoreo de comportamientos nocivos y mecanismos de contención para interrumpir de forma segura actividades de agentes.
- **Seguridad de modelo de IA:** Una estrategia de defensa en profundidad con controles en cada etapa del ciclo de vida del modelo para proteger contra intoxicaciones, extracciones y ataques adversarios.
- **IA que preserva la privacidad:** Técnicas como el aprendizaje federado y la privacidad diferencial para proteger datos confidenciales.
- **GRC mejorado por IA:** Uso de agentes de IA para monitorear continuamente el cumplimiento de la arquitectura de TI con los controles.
- **Motor de políticas como código:** Una fuente única de verdad para definir reglas de negocio y restricciones de cumplimiento en un formato declarativo legible por máquina para establecer barandillas para el comportamiento de agentes.
- **Equipo rojo continuo:** Pruebas adversarias continuas automatizadas de agentes y modelos de IA para identificar vulnerabilidades antes de que los atacantes las exploten.
## Una hoja de ruta arquitectónica de referencia para la compañía agente
La transformación en Agentic Enterprise requiere seguir una trayectoria de múltiples etapas estableciendo las bases tecnológicas mientras crea valor de negocio tangible (consulte la Figura 3 a continuación). Aunque la hoja de ruta precisa depende de la estrategia, la cultura, el modelo de gobernanza de IA y el punto de partida de la arquitectura de TI de la compañía, la mayoría de las organizaciones deben adoptar un enfoque por fases como agentes de potencia de inversiones de TI continuadas con un ámbito, una complejidad y una creación de valor crecientes. El [Modelo de madurez](https://www.salesforce.com/news/stories/agentic-maturity-model/) de Salesforce ofrece un marco de trabajo útil de niveles de madurez para que las compañías formulen estrategias para su transformación, describiendo cómo las funciones de agentes pueden crecer desde la recuperación de información básica (nivel 1) a la orquestación de flujos de trabajo de múltiples dominios (nivel 2 y 3) y múltiples agentes (nivel 4). Para avanzar con éxito por estas etapas, la arquitectura de TI debe evolucionar de forma concertada, con inversiones dirigidas en diferentes capas de la arquitectura en cada fase para satisfacer las necesidades de las implementaciones más complejas y de mayor valor de los agentes de IA. Para cada nivel de madurez, las funciones de tecnología específicas requeridas en las 11 capas arquitectónicas se identifican con una justificación para la inversión.
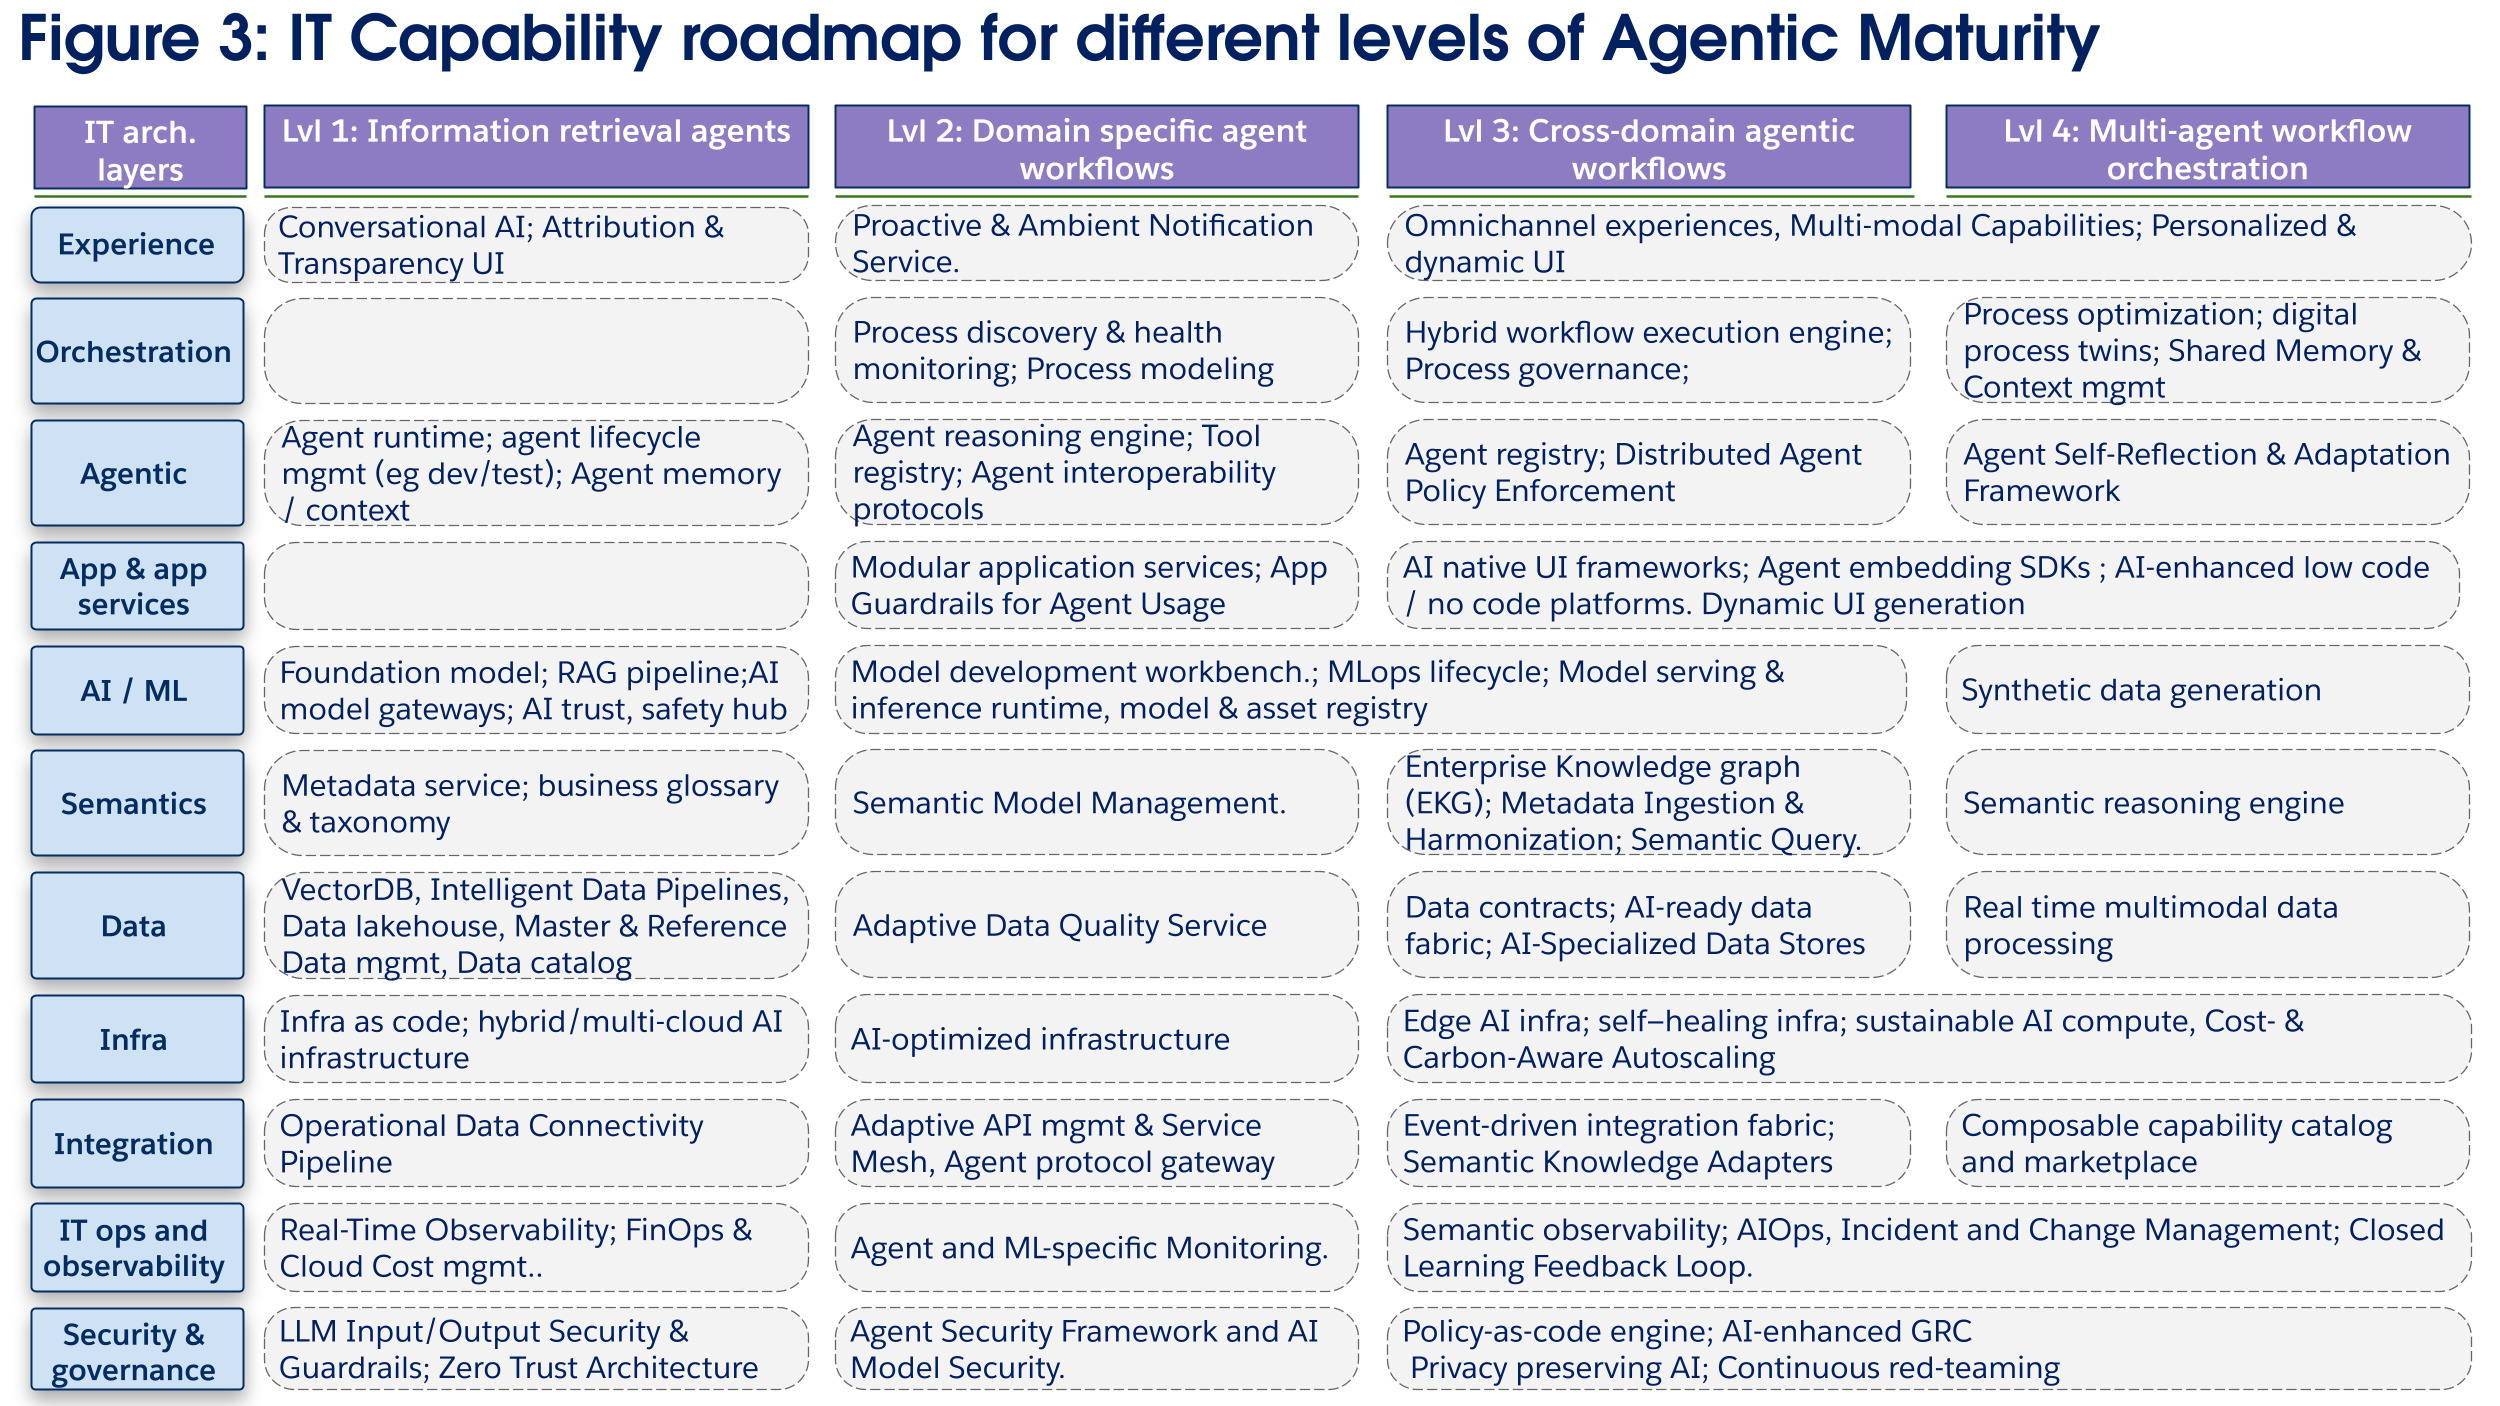 **Nivel de madurez 1: Agentes de** recuperación de información
Valor y objetivo de **negocio: Mejore la productividad de los trabajadores humanos proporcionando una interfaz conversacional de confianza para consultar Knowledge empresarial.** El valor principal está en aumentar las capacidades humanas, no en sustituirlas. Estos agentes ayudan a los seres humanos recuperando información y recomendando acciones.
**Enfoque arquitectónico:** El enfoque está en establecer una base de datos segura y confiable y los componentes de IA básicos necesarios para la recuperación de información. La gobernanza y la observabilidad son fundamentales desde el primer día para fomentar la Trust y controlar los costos.
**Inversiones tecnológicas clave (figura 4):**
En esta etapa, la TI debe centrarse en la creación de oportunidades en curso de datos a agentes fiables y otras funciones de base. Las tecnologías en la **Capa de datos**, como una **VectorDB**, son esenciales para activar las técnicas de generación aumentada (RAG) de recuperación que impulsan agentes de recuperación de información. Esto va unido a una **capa de IA/ML** centralizada que incluye una **pasarela de modelo** para un acceso seguro y controlado a los modelos de base y un **núcleo de IA** Trust, Safety & Governance para supervisar los resultados inseguros y garantizar su cumplimiento. La **gestión de datos principal** y los **glosarios de negocio** en la **Capa** **semántica** son fundamentales para que los agentes recuperen información precisa. Se requieren funciones de ciclo de vida y tiempo de ejecución de agentes para garantizar que los agentes creados en esta etapa se pueden modificar y ampliar para casos de uso futuros. Para entregar valor y generar confianza en los usuarios, la **Capa de experiencia** debe incorporar una **Interfaz de usuario** de Atribución y transparencia, que hace que las respuestas de los agentes sean explicables mostrando citas y los orígenes de su información. Las inversiones fundamentales en observabilidad y seguridad (por ejemplo, **zero** **Fideicomiso**) deben comenzar a ejecutarse para sentar las bases para futuros despliegues de agentes.
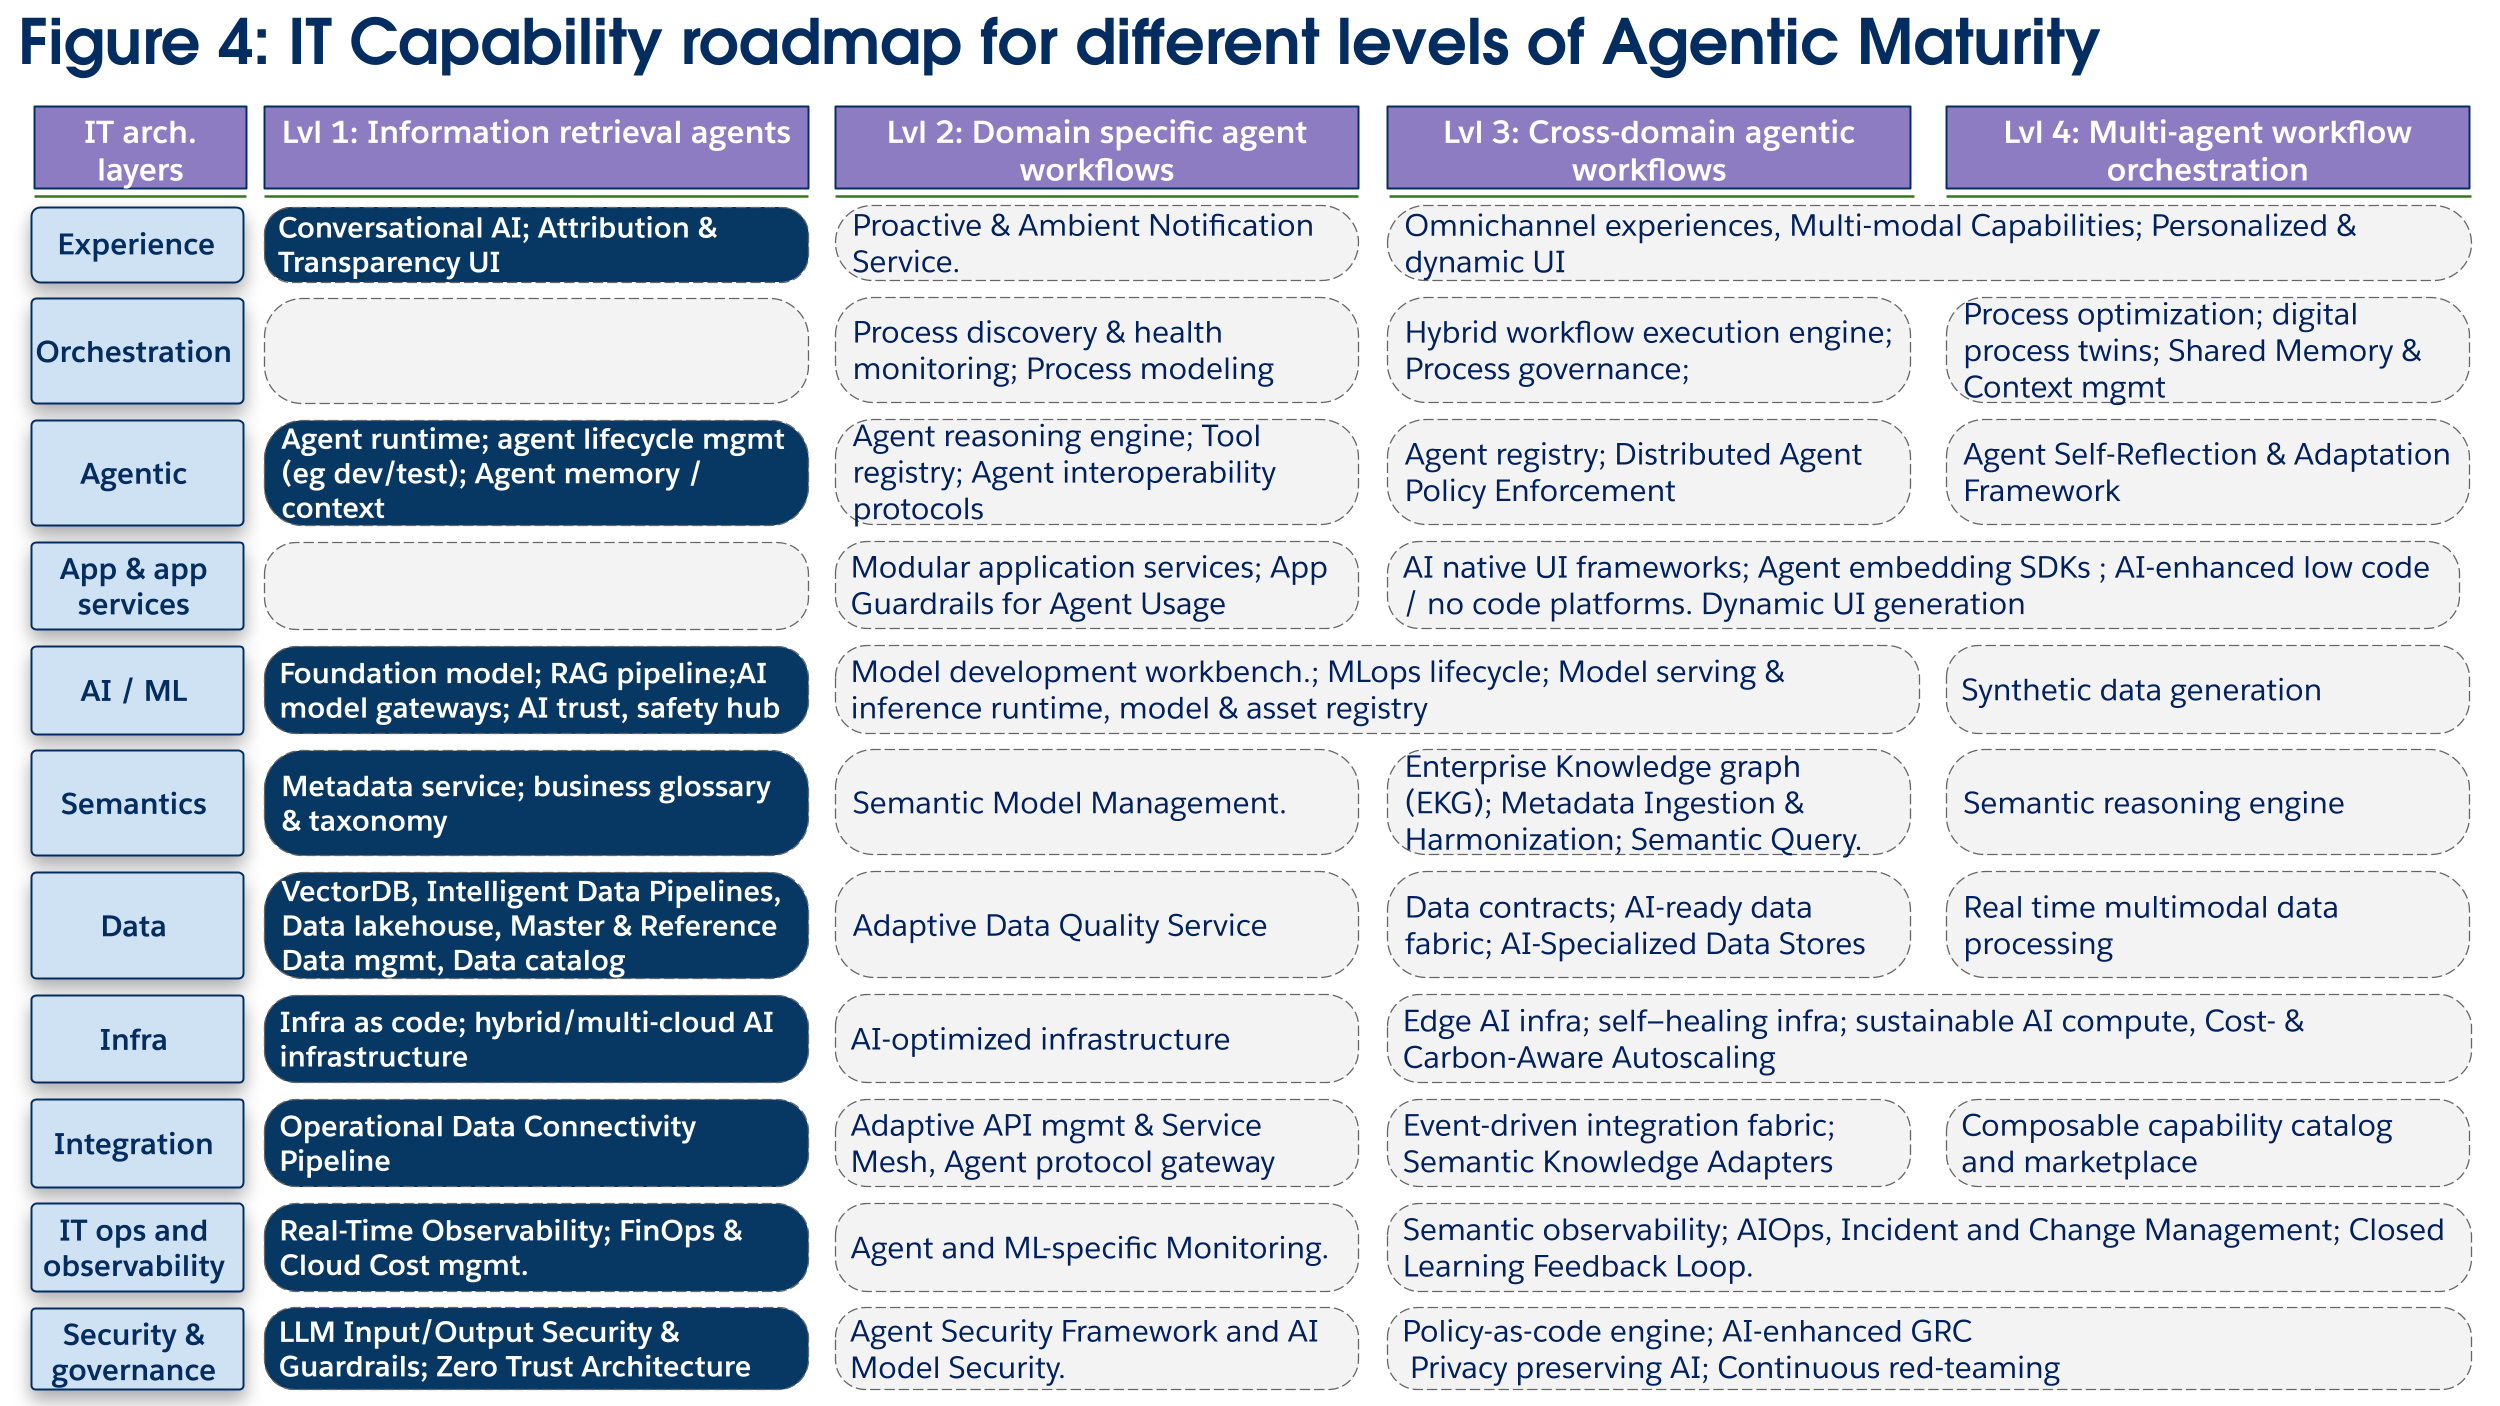 **Nivel de madurez 2: Orquestación sencilla, Agentes** de dominio único
Valor y objetivo de **negocio: Automatice tareas rutinarias y orqueste flujos de trabajo de baja complejidad en un único dominio de negocio.** Esto mejora la eficiencia operativa y reduce el trabajo manual, permitiendo a los trabajadores humanos centrarse en actividades de mayor valor.
**Enfoque arquitectónico:** El cambio arquitectónico clave es de la recuperación de datos de solo lectura a la ejecución de acciones. Esto requiere comenzar una trayectoria más larga para modularizar las funciones de la aplicación (a menudo expuestas como API) para que los agentes accedan, implementar una seguridad sólida para las acciones de los agentes y crear funciones de desarrollo semántico y de IA para promover la inteligencia de los agentes de IA.
**Inversiones tecnológicas clave (figura 5):**
Las inversiones se centran temáticamente en permitir a los agentes de IA realizar acciones con una gobernanza adecuada. La **Capa Aplicaciones y** Servicios de aplicación experimenta un cambio crítico, ya que la lógica de negocio monolítica se descompone en **servicios de aplicación** (API) modulares para que los agentes llamen. Estos están protegidos por **Barandillas de aplicación** para evitar que los agentes abrumen los sistemas, con integraciones en herramientas de observabilidad. Para potenciar estos agentes, es necesario realizar inversiones en razonamiento de agentes, protocolos de herramientas (como MCP) y **registros**. Esto introduce nuevos riesgos, lo que hace que un **Marco de trabajo** de seguridad de agentes y un modelo de IA exclusivos y funciones de monitoreo de agentes sean esenciales para la gobernanza y la seguridad. Por último, las compañías pueden comenzar a ampliar sus funciones de IA/ML para modelos personalizados para potenciar estos agentes que abordan tareas específicas de dominio.
 **Nivel de madurez 3: Agentes** de orquestación de múltiples dominios
**Objetivo y valor de negocio:** **Automatice procesos de negocio complejos de extremo a extremo que abarcan límites organizativos y funcionales** (como "presupuesto a efectivo", "prospecto a pedido"). El valor está en descomponer silos, acelerar los tiempos de ciclo de procesos y optimizar cadenas de valor completas dentro del negocio. Es posible que se produzcan cambios escalonados más altos en la productividad de los trabajadores humanos a medida que las barreras organizativas comiencen a romperse y que los humanos comiencen a centrarse más en la supervisión de los agentes de IA.
**Enfoque arquitectónico:** La arquitectura debe admitir ahora problemas técnicos transversales. Un entendimiento semántico compartido en toda la compañía, un motor de orquestación centralizado para la gobernanza y un tejido de integración dirigido por eventos desvinculado se convierten en los habilitadores críticos.
 **Inversiones tecnológicas clave (figura 6):**
Las inversiones en tecnología se centran temáticamente en la orquestación de procesos a escala de compañía entre humanos, agentes y sistemas deterministas. La **Capa de orquestación** de compañía se convierte en un foco de inversión, requiriendo un **Motor de ejecución** de flujos de trabajo híbridos para coordinar actividades, y un **Motor de restricción** y gobernanza de procesos para aplicar reglas de negocio y políticas de cumplimiento en procesos en vuelo ya que los agentes están trabajando entre dominios, a menudo con diferentes políticas y definiciones semánticas. Esta coordinación entre dominios solo es posible con una **capa semántica** madura que incluya un **Enterprise Knowledge Graph (EKG)**, que crea una comprensión compartida de cómo se relacionan las entidades de negocio entre dominios. La **Capa de integración** debe evolucionar para incluir un **Tela de integración** dirigida por eventos, que utiliza una columna vertebral de transmisión para desvincular sistemas y permitir la comunicación resiliente y asíncrona típica de procesos de negocio de larga ejecución. Dado el mayor valor de estos flujos de trabajo y los riesgos asociados, las inversiones adicionales en seguridad y supervisión son primordiales (por ejemplo**, AIOps, política como código**). Por último, se debe seguir invirtiendo en la Capa de aplicaciones y servicios (como el LCNC activado **por IA,** experiencias de usuario más dinámicas y multimodales) a medida que los usuarios humanos comienzan a monitorear y colaborar con agentes de IA más capaces.
**Nivel de madurez 4: Orquestación de múltiples agentes y dominios**
Valor y objetivo de **negocio: Rediseñe y optimice operaciones de negocio entre dominios para dirigir cambios de paso en productividad y eficiencia.** Esta etapa avanza hacia la creación de una simulación digital holística (gemelo digital) de la compañía para la mejora continua y la planificación estratégica entre los principales procesos de negocio y flujos de trabajo.
**Enfoque arquitectónico:** La etapa final se centra en la activación de la colaboración dinámica y emergente entre agentes. Esto requiere protocolos de comunicación avanzados de agente a agente (A2A), funciones de autoaprendizaje de agentes, más inversión en la maduración de las capas Orquestación, Datos y Semántica, e infraestructura completamente dinámica y de autocuración para dar cobertura a las crecientes necesidades de cargas de trabajo de IA dinámicas a medida que los agentes se amplían en la compañía.
 **Inversiones tecnológicas clave (figura 7):**
Las inversiones temáticas se centran en la creación de un sistema autónomo y automejorable. En la **Capa de agente**, un **Marco de trabajo** de autorreflexión y adaptación de agentes proporciona el mecanismo para que un agente analice sus propios registros de desempeño y desencadene mejoras. Este aprendizaje es compatible con la **Capa Operaciones TI** y Observabilidad, que implementa un **Bucle de comentarios** de aprendizaje cerrado para realimentar automáticamente datos de observabilidad en oportunidades en curso de MLOps para el reciclaje de modelos que también puede aprovechar la generación de datos sintéticos para optimizar aún más el desempeño del modelo. Con la implementación de redes de agentes entre departamentos junto con los esfuerzos de modularización de aplicaciones en curso, se hacen necesarias más inversiones en seguridad y, de forma crucial, un **catálogo de funciones** para que los agentes compongan de forma dinámica funciones para resolver tareas más abstractas y de mayor valor. Todos estos procesos están orquestados y optimizados a través de una nueva **función Digital Twin Process Modeling** que utiliza datos en tiempo real para crear simulaciones para el análisis "qué pasa si" y la optimización predictiva, permitiendo a la compañía probar e implementar nuevas implementaciones de agentes de forma segura.
**Conclusión**
La hoja de ruta hacia una compañía agente se ejecuta a través de una evolución arquitectónica de TI. Los arquitectos de compañía serán los impulsores cruciales de esta transformación, impulsando las decisiones de inversión críticas, junto con otros socios en el negocio y las TI, necesarias para que la organización obtenga el valor de las nuevas funciones de negocio de Agentic Enterprise.