
| Consideración | Por qué importa | Escenarios de ejemplo |
|---|---|---|
| Residencia y cumplimiento de datos | Determina dónde se almacenan y procesan los datos. Las reglas reguladoras pueden requerir regiones específicas o múltiples instancias. | Un banco global aprovisiona un arrendatario de Data 360 en una organización de Salesforce geolocalizada en Frankfurt para el cumplimiento del RGPD y otro en una organización en Virginia para su división de EE.UU. |
| Gobernanza y seguridad | ¿Quién es el propietario y el administrador de Data 360? ¿Deben gestionarse las políticas de forma centralizada o delegarse por unidad de negocio? | Una multinacional con una sólida TI central crea una organización doméstica dedicada gestionada por un Centro de excelencia. |
| Autonomía vs. Centralización | Es posible que diferentes líderes deseen la propiedad separada de los datos. La autonomía favorece múltiples Data 360; la centralización favorece Data Cloud One . | Un holding con filiales independientes permite a cada unidad de negocio ejecutar su propio Data 360. |
| Latencia y desempeño | Afecta a la velocidad y la experiencia de las consultas, especialmente para organizaciones de compañía conectadas a un arrendatario de Data 360 entre regiones. | Un equipo de ventas en Londres que consulta datos de un arrendatario de Data 360 en EE.UU. puede ver una latencia más alta. |
| Complejidad de integración | Más arrendatarios de Data 360 = más oportunidades en curso, API y middleware. La consolidación simplifica la integración. | Un minorista evita crear 10 oportunidades en curso de ETL consolidándolas en una configuración de Data Cloud One. |
| Región de origen de datos de copia cero | Los conectores de copia cero pueden tener requisitos de acceso entre regiones que limitan en qué regiones se puede ubicar su Data 360. | Una compañía tiene una instancia de Snowflake en la región eu-west-1 de AWS. Pueden utilizar Cero copia para federar datos a Data 360 en su región, pero no pueden utilizar Cero copia para federar a Data 360 en la región de EE.UU. |
| Compatibilidad entre regiones de Connect privada | En algunos casos, la compatibilidad de Conexión privada depende de si el origen de datos está en la misma región que el arrendatario de Data 360. | Una compañía tiene una instancia de Snowflake en la región aws-east-1 a la que desea conectarse a través de copia cero. Solo pueden establecer una conexión de red de Conexión privada si la organización de inicio de Data 360 está en la misma región. |
| Costo y licencias | Cada arrendatario de Data 360 agrega costo. La consolidación en menos instancias optimiza el gasto. | Un proveedor de cuidados sanitarios reduce los costos de licencias adoptando Data Cloud One en vez de múltiples instancias independientes de Data 360. |
| Escalabilidad futura | Las opciones de aprovisionamiento establecen hoy las bases para el crecimiento. | Una compañía de SaaS comienza con una única instancia de Data 360 pero planea ampliar a Data Cloud One a medida que adquiere filiales con organizaciones de Salesforce. |
| Preparación de IA de toda la compañía | Las funciones de IA y Agentforce requieren un arrendatario de Data 360 conectado en cada organización. Las decisiones de aprovisionamiento afectan al modo en que los modelos de IA se entrenan y activan en toda la compañía. | Una compañía de servicios financieros unifica datos en Data Cloud One de modo que sus modelos de IA de Einstein tengan acceso a datos de clientes de toda la compañía. |
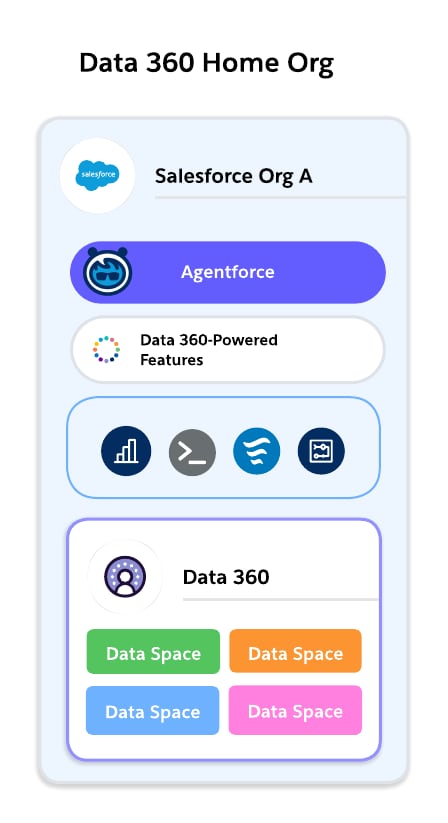 La organización de inicio es el anclaje para su instancia de Data 360. Es donde:
- El almacenamiento y la computación de Data 360 están gestionados (en la región seleccionada en el aprovisionamiento).
- Se aplican políticas de administración, gobernanza y seguridad.
- Se realiza el ingreso, Armonización, Resolución de identidad, Segmentación y Activación de datos.
En escenarios de múltiples organizaciones, la organización de inicio gestiona la instancia central de Data 360 para otras organizaciones "compañeras" de Salesforce.
Por qué importa la organización de inicio:
- Determina la ubicación geográfica de su instancia de Data 360.
- Determina quién es el propietario y el administrador de su instancia de Data 360. Los administradores de su organización de inicio de Data 360 pueden acceder a todos los datos ingresados en Data 360.
- Controla las conexiones de la organización de compañía en una configuración de Data Cloud One.
- Establece las bases para su estrategia de datos de compañía: cambiarla más adelante es difícil e interrumpe.
### 1.2 Decisión: ¿Organización existente o Nueva organización como la organización de inicio?
La primera decisión importante es si aprovisionar Data 360 en una organización de producción existente o crear una nueva organización dedicada para actuar como la organización de inicio.
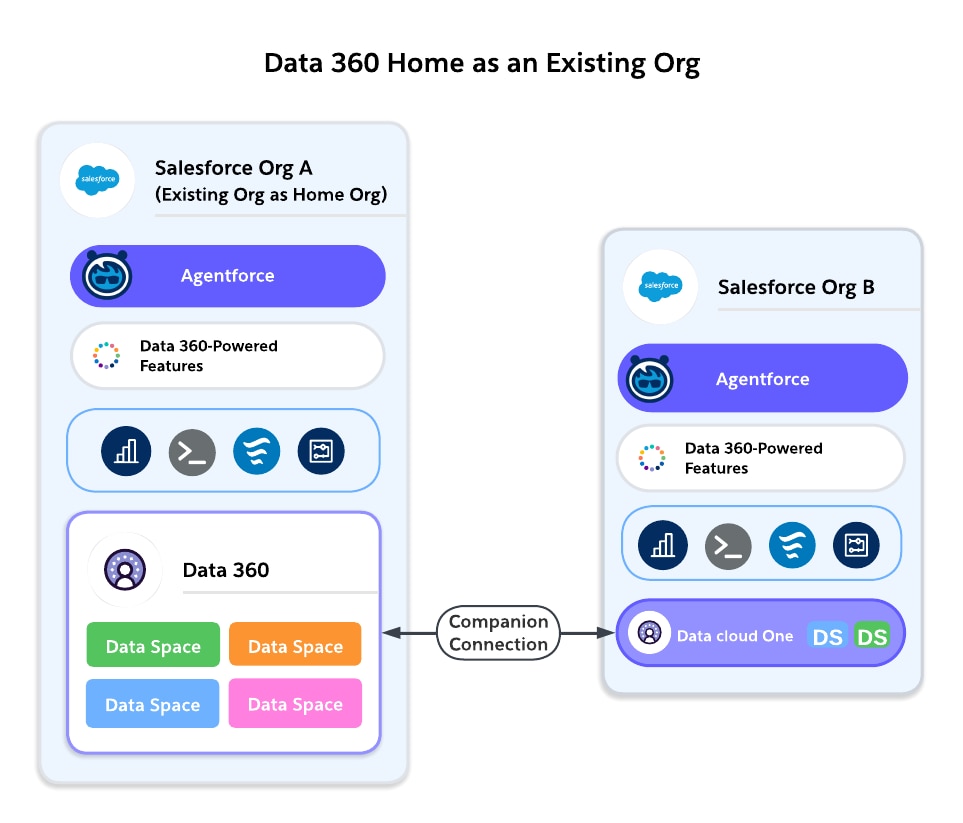
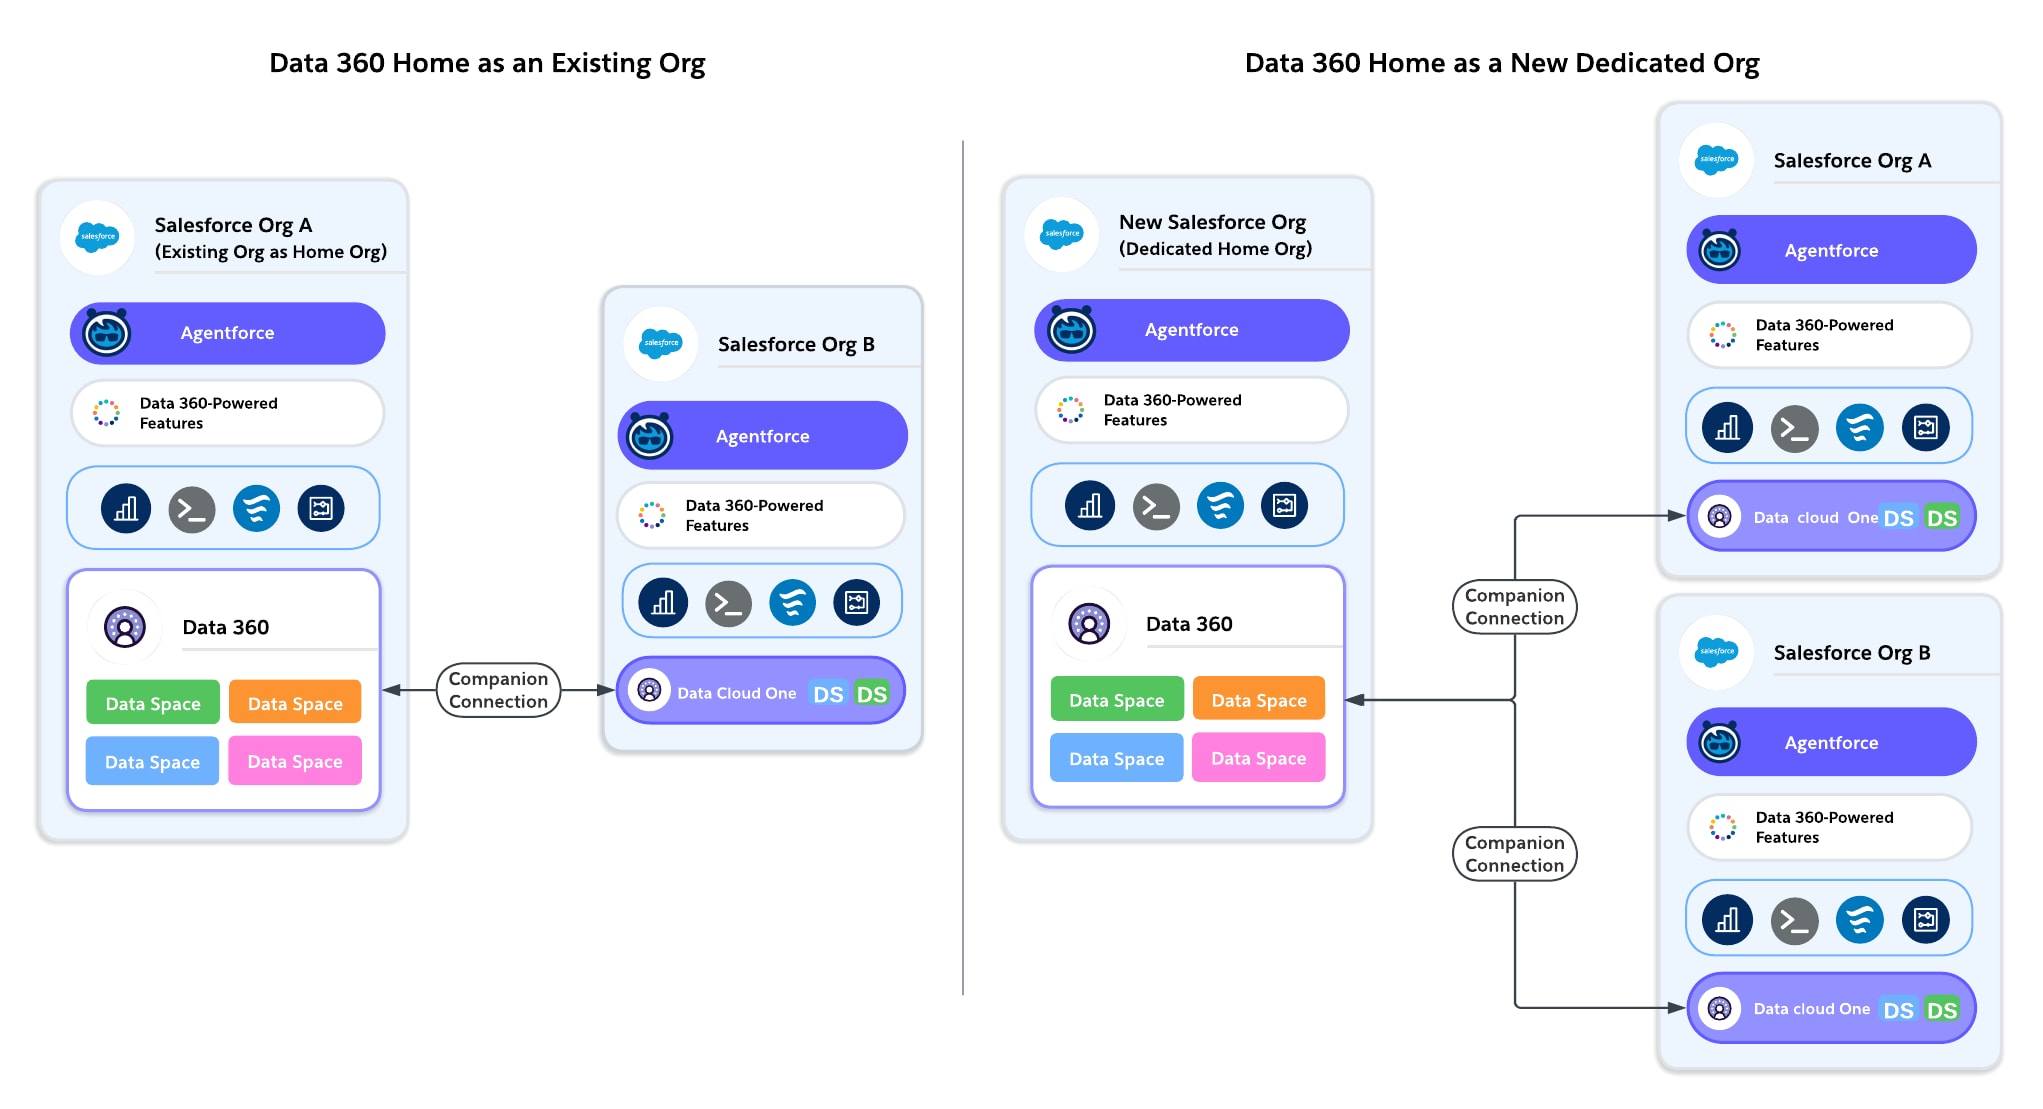 #### Opción A: Aprovisionar datos 360 en una organización existente
**Funciona mejor para:** Clientes con una única organización de Salesforce o clientes de múltiples organizaciones que ya tienen una organización centralizada principal donde se ejecuta la mayoría de los negocios.
 - **Pros**:
- Ruta más sencilla: Data 360 se aprovisiona donde ya se encuentran sus datos de CRM.
- Acceso inmediato a datos locales de Ventas, Servicio y Marketing.
- No se requiere integración adicional.
- Menos licencias y entornos para gestionar.
- Acelera la adopción temprana, los pilotos y los casos de uso de producción.
- **Cons**:
- Puede heredar la deuda técnica o de gobernanza de la organización existente.
- Si no existe ninguna “organización principal” única, la selección de una puede crear debates sobre la propiedad.
- Desempeño vinculado a la ubicación de la organización; puede no estar en sintonía con las necesidades de residencia de toda la compañía.
- Si varias unidades de negocio utilizan organizaciones diferentes, el aprovisionamiento local puede llevar a la fragmentación si no se empareja con Data Cloud One.
**Ejemplo:**
Una compañía SaaS con una organización de Salesforce aprovisiona Data 360 en esa organización para unificar los datos de asistencia y suscripción de clientes.
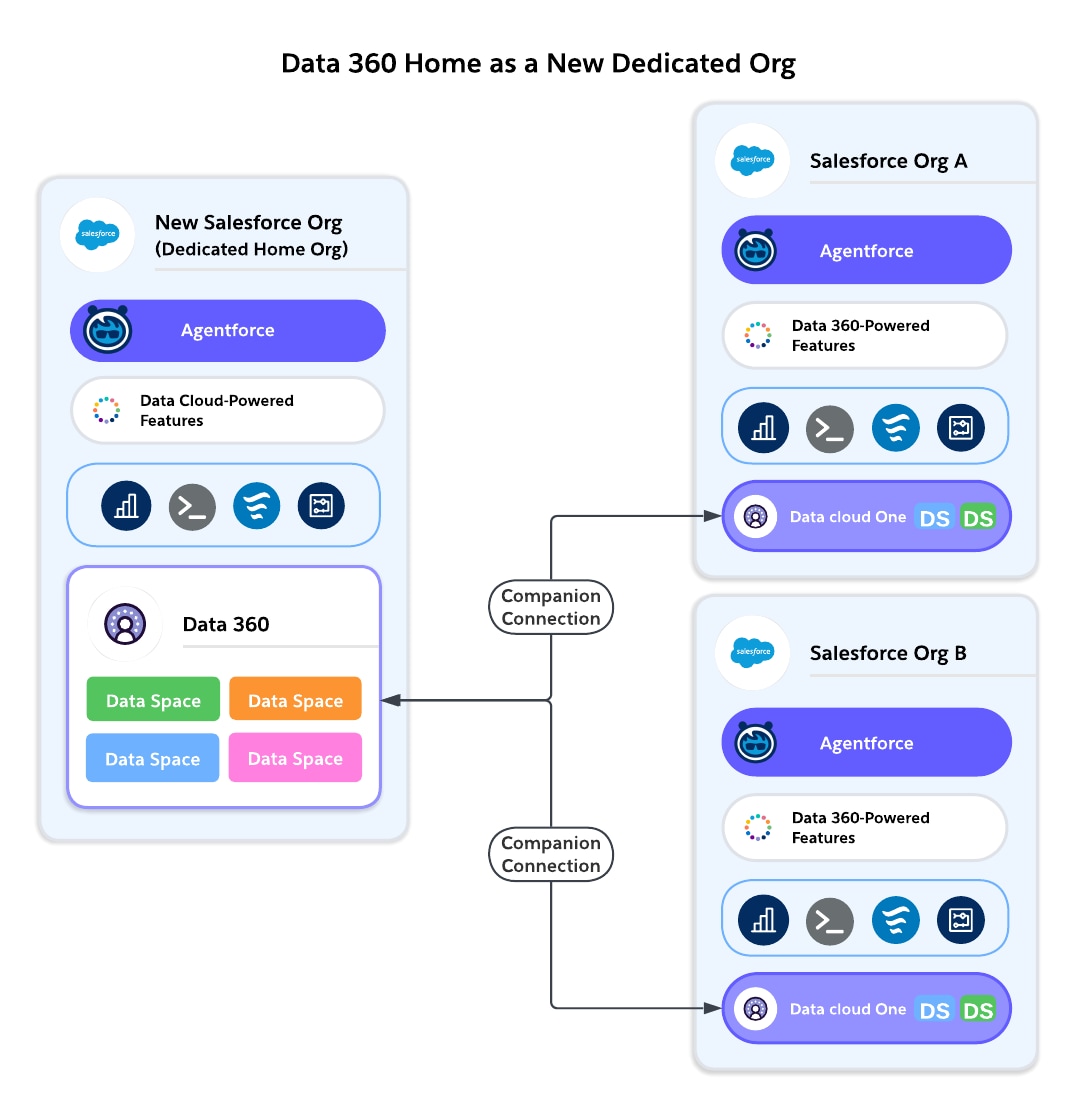
#### Opción B: Aprovisionar Data 360 en una organización nueva y exclusiva
**Funciona mejor para:** Clientes con múltiples organizaciones de Salesforce que no pueden alinearse en una única organización principal, o empresas con un modelo de Centro de excelencia (CoE) sólido.
 - **Pros**:
- Borrón y cuenta nueva para la gobernanza, sin complejidades de organización heredadas.
- Control centralizado entre múltiples líneas de negocio.
- Flexibilidad para elegir una región basándose en necesidades de cumplimiento.
- Actúa como una organización de “servicio compartido” neutral, no vinculada a una unidad de negocio.
- Configure la futura arquitectura de Data Cloud One (Organización de inicio con múltiples organizaciones de compañía).
- **Cons**:
- Los clientes deben otorgar licencias a una nueva organización de Salesforce para aprovisionar Data 360.
- Integración adicional requerida para conectar la organización con Data 360 a través de una conexión complementaria de Data Cloud One.
- Puede agregar gastos administrativos (gestión de usuarios, seguridad, identidad).
- Tiempo de valor más lento en comparación con el aprovisionamiento en una organización de producción existente.
**Ejemplo:**
Una compañía multinacional de servicios financieros crea una organización de inicio exclusiva para aprovisionar Data 360. Todas las organizaciones de unidades de negocio (Retail, Wealth, Commercial Banking) se conectan como organizaciones complementarias a través de Data Cloud One.
#### Criterios de decisión
| Consideración | Organización existente como organización de inicio (Predeterminado preferido) | Nueva organización como organización de inicio (alternativa) |
|---|---|---|
| Simplicidad | Se basa en la estructura de datos y usuarios existentes para una configuración más rápida; Data 360 está integrado de forma predeterminada con la organización de inicio. | Requiere licencias y configuración de nueva organización de Salesforce, así como gastos administrativos adicionales para gestionarla. |
| Tiempo hasta valor | Uso inmediato de datos de CRM locales. | Rampa más lenta; se requiere integración. |
| Gobernanza | Hereda el modelo de gobernanza básico de la organización existente: usuarios y conjuntos de permisos existentes. Esto puede estar bien si la organización ya es central. | Borrón y cuenta nueva para la gobernanza; ideal para modelos dirigidos por centros de excelencia. |
| Cumplimiento | Residencia vinculada a la región de la organización existente. | Flexibilidad para seleccionar una región independiente de organizaciones existentes. |
| Desempeño | El mejor desempeño para consultas de CRM locales. | Dependiendo de la conectividad de la organización de compañía, ya sea en la misma región o entre regiones a las otras organizaciones. |
| Escalabilidad futura | Funciona bien si se empareja con Data Cloud One; es más difícil cambiar más adelante si se selecciona la organización incorrecta. | Se amplía fácilmente con Data Cloud One ; diseñado para la neutralidad. |
| Costo | Costo incremental inferior. | Mayor sobrecarga desde entornos adicionales. |
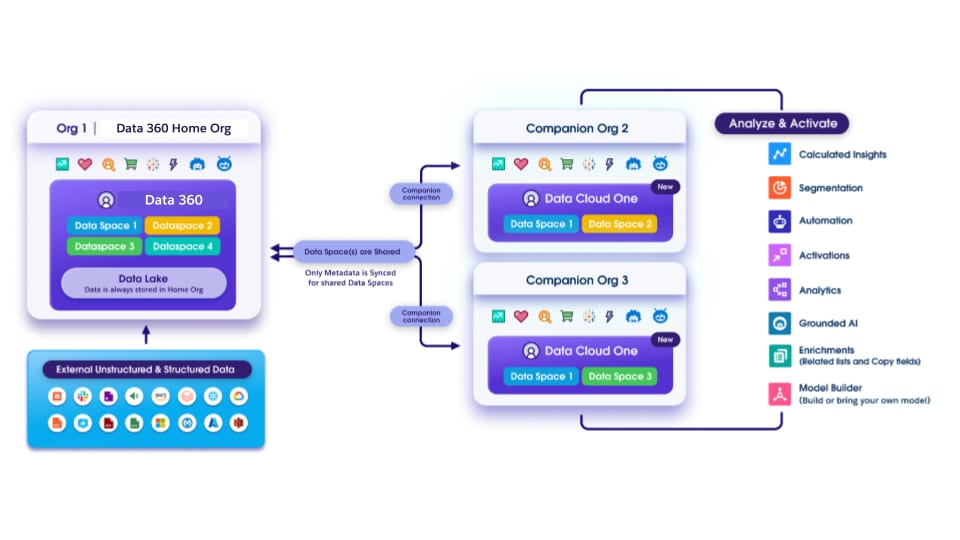 #### Cómo funciona Data Cloud One
| Capacidad | Organización de inicio | Organización complementaria |
|---|---|---|
| Conectar Configurar conectores, crear transmisiones de datos, ingresar o federar datos | ✅ | ❌ |
| Armonizar y unificar Construir y ejecutar transformaciones de datos y resolución de identidad | ✅ | ❌ |
| Gebernar datos seguros con espacio de datos y permisos | ✅ | ✅ |
| Construir segmentos, perspectivas y modelos de Einstein Studio para segmentar y predecir | ✅ | ✅ |
| Activaciones de Activate Everywhere, acciones de datos | ✅ | ✅ |
| Funciones de plataforma Generador de solicitudes, flujos, reportes, enriquecimiento y mucho más | ✅ | ✅ |
| Funciones con tecnología de Data 360 Centro de prospección, funciones de Sales y Service Cloud, Agentforce y mucho más | ✅ | ✅ |
| Consideración | Múltiples 360 de datos independientes | One Shared Data 360 (Data Cloud One ) |
|---|---|---|
| Autonomía | Alta autonomía para cada organización o unidad de negocio. | Gobernanza centralizada, menos autonomía por organización. |
| Cumplimiento | Es útil cuando se requiere una separación estricta (por ejemplo, leyes regionales). | Funciona mejor cuando la residencia permite la centralización. |
| Costo | Mayores costos de licencia y administración. | Más rentable; una licencia para muchas organizaciones. |
| Gobernanza | Fragmentado; las políticas varían por organización. | Políticas coherentes y centralizadas entre organizaciones. |
| Silos de datos | Cada organización tiene su propia vista; no hay Enterprise 360. | Conjunto de datos unificado, sin duplicaciones. |
| IA/Analytics | Limitado a los datos de cada organización. | Modelos de toda la compañía con mejor precisión. |
| Complejidad | Más instancias para gestionar, más integraciones. | Arquitectura más sencilla, menos piezas móviles. |
| Desempeño | Ideal para casos de uso dentro de la organización. | El acceso de la organización de compañía puede introducir latencia. |
| Factor | Ventajas | Contras |
|---|---|---|
| Residencia de datos | Admite la separación regional mientras activa la colaboración. | No elimina la necesidad de gestionar múltiples Data 360. |
| Duplicación de datos | Cero copia; sin duplicación de objetos. | Requiere la selección deliberada de objetos para su inclusión en cada colaboración de datos. |
| Gobernanza | La colaboración es explícita y deliberada (a nivel de objeto). | No fluyen etiquetas ni políticas; la organización de destino debe volver a aplicar la gobernanza. |
| Complejidad | Activa la colaboración selectiva sin centralización. | Requiere la gestión de múltiples Data 360 y colaboraciones de datos. |
| IA/Analytics | Es posible realizar análisis/IA regionales; las perspectivas se pueden compartir entre organizaciones. | Ninguna IA de toda la compañía a menos que se compartan datos deliberadamente. |
| Funciones de plataforma | Las funciones con tecnología de Data 360 de cada organización se ejecutan de forma independiente. | Sin colaboración automática: riesgo de duplicación si no se diseña cuidadosamente. |
| Costo | Puede reducir la necesidad de oportunidades en curso de ETL. | Sigue teniendo el costo de múltiples Data 360. Consume créditos para consultas de datos y colaboración de datos. |
| Consideración | Data Cloud One (Preferido para múltiples organizaciones) | Colaboración de datos entre organizaciones de Data 360 |
|---|---|---|
| Una única fuente de verdad | ✅ Sí: todas las organizaciones comparten el mismo DC. | ❌ No: cada Data 360 tiene su propio modelo de datos. |
| Cumplimiento | Solo funciona cuando la residencia permite la centralización. | Se necesita cuando las leyes de residencia impiden la centralización. |
| Gobernanza | Centralizado, coherente. | Colaboraciones a nivel de objeto federadas y deliberadas. |
| Complejidad | Menos piezas móviles, más sencillo. | mineral complejo: requiere colaboraciones de datos de configuración y múltiples Data 360. |
| IA/Analytics | Modelos de IA de toda la compañía. | IA regional; las perspectivas se pueden compartir de forma selectiva. |
| Funciones de plataforma | Datos compartidos 360 significa que todas las funciones funcionan de forma coherente en Inicio + Acompañantes. | Las funciones se ejecutan de forma independiente en cada Data 360; la colaboración debe ser explícita. |
|
Salesforce Platform es una plataforma integral dirigida por IA que unifica empleados, agentes de IA autónomos, datos de compañía y aplicaciones en un único sistema de confianza para mejorar la productividad y la experiencia del cliente. Permite la creación de una "compañía agencia" conectando aplicaciones Customer 360, Data Cloud y Slack para la automatización de extremo a extremo. |
|
MuleSoft es la plataforma de integración líder de Salesforce que permite a las organizaciones conectar aplicaciones, datos y dispositivos en entornos locales y de nube. MuleSoft es una plataforma que proporciona a TI las plataformas para desbloquear datos entre sistemas, desarrollar marcos de trabajo de automatización e integración ampliables y crear experiencias conectadas diferenciadas rápidamente. |
| Punto de decisión | Directrices |
|---|---|
| Notificaciones casi en tiempo real | Los patrones de arquitectura dirigidos por eventos como publicación/suscripción, fanout y transmisión tienden a funcionar bien en escenarios donde múltiples aplicaciones necesitan ser notificadas de cambios de estado o actualizaciones de registros casi en tiempo real. |
| Procesamiento paralelo | Patrones como publicar/suscribir tienden a funcionar bien en escenarios donde grandes volúmenes de datos o mensajes altamente complejos requieren distribuir la carga de procesamiento entre múltiples sistemas. |
| Lecturas de gran volumen | Los patrones Mensajes pasados y Colocación en cola se utilizan habitualmente en escenarios donde las organizaciones experimentan aumentos y el volumen de mensajes que se están produciendo puede superar la capacidad de los suscriptores para procesarlos inmediatamente. |
| Escrituras de gran volumen | Los patrones de Transmisión y Colas funcionan bien en muchos escenarios donde las organizaciones experimentan aumentos en el número de mensajes producidos. |
| Envío de los mismos datos a diferentes sistemas | Aunque la publicación/suscripción tiende a ser una solución bastante común para organizaciones que necesitan enviar los mismos datos a múltiples sistemas, la mayoría de los patrones cubiertos aquí pueden solucionarla. Asegúrese de revisarlos en detalle para encontrar el mejor ajuste. |
| Introducción frecuente de nuevos sistemas o dispositivos | Los patrones de publicación/suscripción, Transmisión y Colocación en cola tienden a funcionar bien para escenarios donde el panorama general tiende a estar en flujo, con nuevos sistemas y dispositivos agregados regularmente. En este escenario, un nuevo sistema o dispositivo simplemente necesita convertirse en un suscriptor del bus de eventos o asociado con una cola, para comenzar a recibir mensajes en vez de requerir una integración de punto a punto personalizada. |
| Dispositivos IoT | Debido a que los dispositivos de IoT normalmente entregan actualizaciones frecuentes y también pueden generar una oleada de mensajes en algunos escenarios, los patrones de Transmisión y Colocación en cola tienden a funcionar bien al integrarlos en un entorno de TI. |
| Dispositivos y sistemas móviles sin conexión | Los dispositivos móviles que necesitan trabajar en áreas con acceso a Internet de baja calidad o inexistente o sistemas que podrían estar sin conexión en el momento de la entrega de los mensajes se beneficiarán del patrón Colas, que les permite conectarse a sus colas y recuperar cualquier mensaje relevante una vez que vuelvan a estar conectados. |
| Punto de decisión | Directrices/Preguntas para formular |
|---|---|
| Requisitos de negocio | ¿Existe una necesidad de negocio genuina para cualquiera de las funciones descritas en la sección [Cuándo utilizar una arquitectura dirigida por eventos](#cuándo utilizar una arquitectura dirigida por eventos)? |
| Requisitos técnicos | ¿La integración que está diseñando se ajusta de forma obvia a un patrón diferente, como la virtualización de datos, los lotes o las solicitudes/respuestas? En otras palabras, ¿está intentando encajar una clavija cuadrada en un agujero redondo? |
| Procesos que requieren que los humanos esperen respuestas | Cualquier integración que implique un humano esperando una respuesta del sistema de destino no es una buena opción para arquitecturas dirigidas por eventos, ya que están diseñadas para la ejecución asíncrona y no pueden garantizar un tiempo de respuesta. Considere si procesos como este son óptimos para su organización antes de implementar soluciones técnicas. Consulte [Well-Architected - Process Design](/docs/architect/es-mx/well-architected/guide/automated#diseño-de-procesos) para obtener más información. |
| Cambiar datos de origen con poca frecuencia | Si los datos en su sistema de origen cambian con tan poca frecuencia que las actualizaciones periódicas son suficientes, es probable que pueda simplificar su arquitectura utilizando [patrones por lotes] (https://developer.salesforce.com/docs/atlas.en-us.integration_patterns_and_practices.meta/integration_patterns_and_practices/integ_pat_batch_data_sync.htm) en vez de patrones dirigidos por eventos. |
| Requisitos de implementación | ¿La mayoría de los sistemas implicados en su solución admiten arquitecturas dirigidas por eventos? ¿Qué se requeriría para utilizar arquitecturas dirigidas por eventos con los sistemas que no las admiten (por ejemplo, actualizaciones, personalizaciones o middleware)? ¿Qué nivel de esfuerzo sería necesario para cumplir estos requisitos? |
| Estabilidad de estructura de mensajes | ¿Con qué frecuencia tendrán que cambiar sus estructuras de mensajes? ¿Qué sistemas se verán afectados por dicho cambio y cuál será el proceso de rehabilitación? |
| Gobernanza organizativa | ¿Tiene una estructura de gobernanza establecida para garantizar que todas las partes interesadas estén informadas y puedan ponderar los cambios en las estructuras de mensajes, desencadenadores y otras decisiones relacionadas con la arquitectura y los procesos? |
| Conjuntos de habilidades requeridos | ¿Tiene su personal experiencia con arquitecturas dirigidas por eventos y sabrán cómo brindarles asistencia? |
| Patrón | Casi en tiempo real | Copiar mensaje exclusivo | Entrega de garantía | Reducir el tamaño de mensajes | Transformar datos |
|---|---|---|---|---|---|
| Publicar / Suscribir | ✓ | ✓ | ✓ | ||
| Fanout | ✓ | ✓ | ✓ | ||
| Mensajes pasados | ✓ | ✓ | ✓ | ✓ | |
| Transmisión | ✓ | ✓ | ✓ | ||
| Colocación en cola | ✓ | ✓ | ✓ |
| Herramienta | Descripción | Habilidades requeridas | |
|---|---|---|---|
| MuleSoft | Plataforma Anypoint | Plataforma que activa la integración de datos utilizando capas de API. | Código pro |
| Conector Salesforce Pub/Sub | API de Connector para Pub/Sub, que proporciona una única interfaz para publicar y suscribirse a eventos de plataforma, eventos de monitoreo de eventos en tiempo real y eventos Captura de datos de cambios. | Código pro | |
| MuleSoft Anypoint JMS Connector | Conector que permite enviar y recibir mensajes a colas y temas para cualquier servicio de mensajes que implemente la especificación Servicio de mensajes Java (JMS). | Código pro | |
| MuleSoft Anypoint Apache Kafka Connector | Conector para mover datos entre Apache Kafka y aplicaciones y servicios de negocio. | Código pro | |
| Conector de consola Anypoint de MuleSoft | Un conector para corredores de eventos PubSub+ de Solace con integración de API nativa utilizando el SDK de Java JCSMP | Código pro | |
| MuleSoft Anypoint MQ Connector | Un servicio de mensajería en la nube de múltiples arrendatarios que permite a los clientes realizar mensajería asíncrona avanzada entre sus aplicaciones. | Código pro | |
| MuleSoft Anypoint MQTT Connector | Una extensión MuleSoft que cumple el protocolo MQTT (Message Queing Telemetry Transport). | Código pro | |
| Conector AMQP de Mulsoft Anypoint | Un conector que permite a su aplicación publicar y consumir mensajes utilizando un broker compatible con AMQP 0.9.1. | Código pro | |
| API dirigida por eventos de MuleSoft Anypoint (ASync) | Lenguaje que distingue entre la industria y que admite la publicación de API dirigidas por eventos separándolas en capas de evento, canal y transporte. | Código pro | |
| MuleSoft Anypoint MQ | Servicio de mensajería en la nube de múltiples arrendatarios que permite a los clientes realizar mensajería asíncrona avanzada entre sus aplicaciones. | Código pro | |
| Transmisiones de datos de MuleSoft Anypoint | Marco de trabajo disponible en MuleSoft Anypoint para publicar y suscribirse a datos de transmisión. | Código pro | |
| Plataforma Salesforce | Apache Kafka on Heroku | Complemento de Heroku que proporciona Apache Kafka como un servicio con integración de plataforma completa en la plataforma Heroku. | Código pro |
| Captura de datos | Registro de eventos de cambio, que publica los cambios en registros de Salesforce. Los cambios incluyen la creación de un nuevo registro, actualizaciones en un registro existente, la eliminación de un registro y la anulación de la eliminación de un registro. | Código bajo a código profesional | |
| Mensajes salientes | Acciones que envían mensajes XML a extremos externos cuando se actualizan valores de campo en Salesforce. | Código bajo | |
| Eventos de plataforma | Mensajes seguros y ampliables que contienen datos de eventos personalizados. | Código bajo a código profesional | |
| API Pub/Sub | API que activa suscripciones a eventos de plataforma, eventos de Captura de datos de cambios y/o eventos de Monitoreo de eventos en tiempo real. | Código pro | |
| Retransmisiones de eventos | Activa eventos de plataforma y Captura de datos de cambios para enviar desde Salesforce a Amazon EventBridge. Tenga en cuenta que las retransmisiones de eventos solo se conectan a AWS Eventbridge. | Código bajo | |
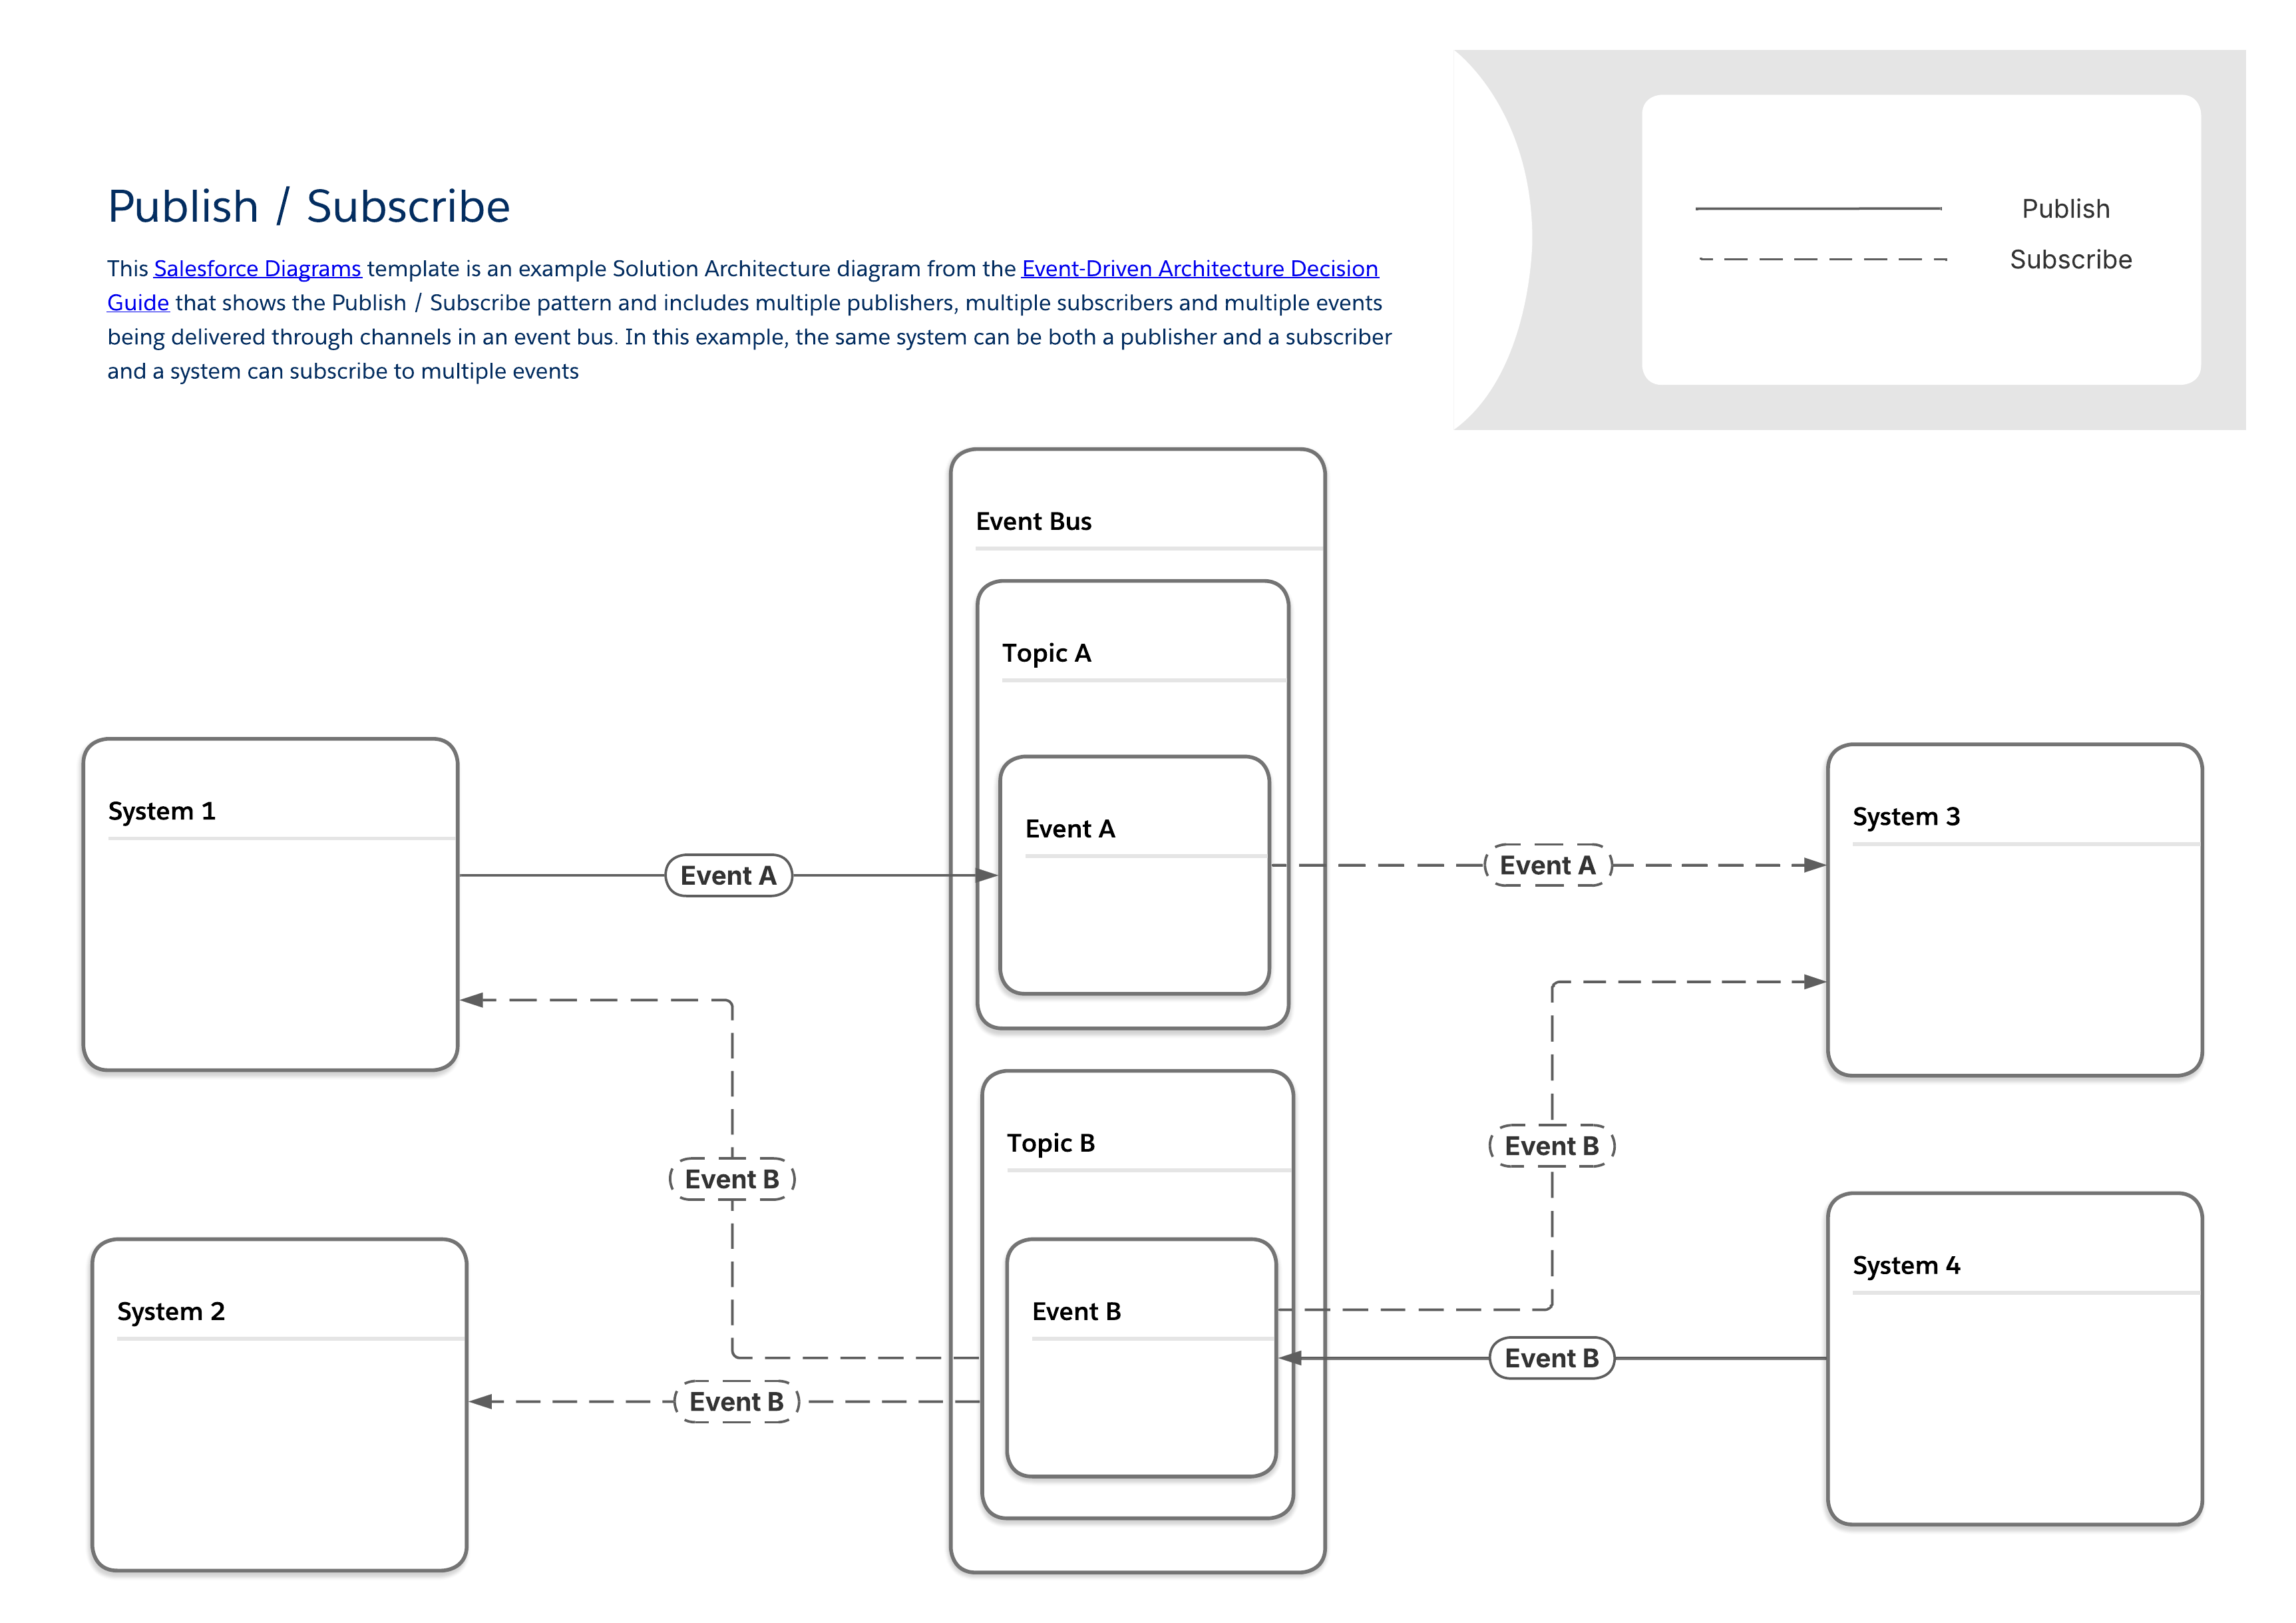 #### Herramientas relevantes para el patrón Publicar/Suscribir
| Comportamiento y flujo de eventos | Consideraciones sobre la carga | ||||||
|---|---|---|---|---|---|---|---|
| Herramientas disponibles | Habilidades requeridas | Publicar vía | Suscribirse a través | Periodo de reproducción | Estructura de carga | Límites de carga | |
| MuleSoft | Plataforma Anypoint | Código pro | API | API | Como está configurado | Usuario definido | Ninguna |
| Conector Salesforce Pub/Sub | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| MuleSoft Anypoint JMS Connector | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| MuleSoft Anypoint Apache Kafka Connector | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| Conector de consola Anypoint de MuleSoft | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| MuleSoft Anypoint MQ Connector | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| MuleSoft Anypoint MQTT Connector | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| Conector AMQP de Mulsoft Anypoint | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| API dirigida por eventos de MuleSoft Anypoint (ASync) | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| MuleSoft Anypoint MQ | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| Plataforma Salesforce | Apache Kafka on Heroku | Código pro | API, registrar cambios en Postgres de Heroku | N/A | 1-6 semanas | Usuario definido | Usuario definido |
| Captura de datos | Código bajo a código profesional | Cambios de registro | Apex, API, componentes web Lightning (LWC) | 3 días | Predefinido | 1 MB | |
| Mensajes salientes* | Código bajo | Reglas de flujo y flujo de trabajo | N/A | 24 horas | Usuario definido | 100 notificaciones por mensaje | |
| Eventos de plataforma | Código bajo a código profesional | API, Apex, Flujo | Apex, API, Flow, LWC | 3 días | Usuario definido | 1 MB | |
| API Pub/Sub | Código pro | API o API Pub/Sub, Apex, Flujo | API Pub/Sub | 3 días | Usuario definido | 1 MB | |
| Retransmisiones de eventos** | Código bajo | Eventos de plataforma, Captura de datos de cambios | API | 3 días | Usuario definido | 1 MB | |
| *Salesforce seguirá admitiendo mensajes salientes dentro de las funciones actuales, pero no tiene intención de realizar más inversiones en esta tecnología. **Las retransmisiones de eventos solo se conectan a AWS Eventbridge | |||||||
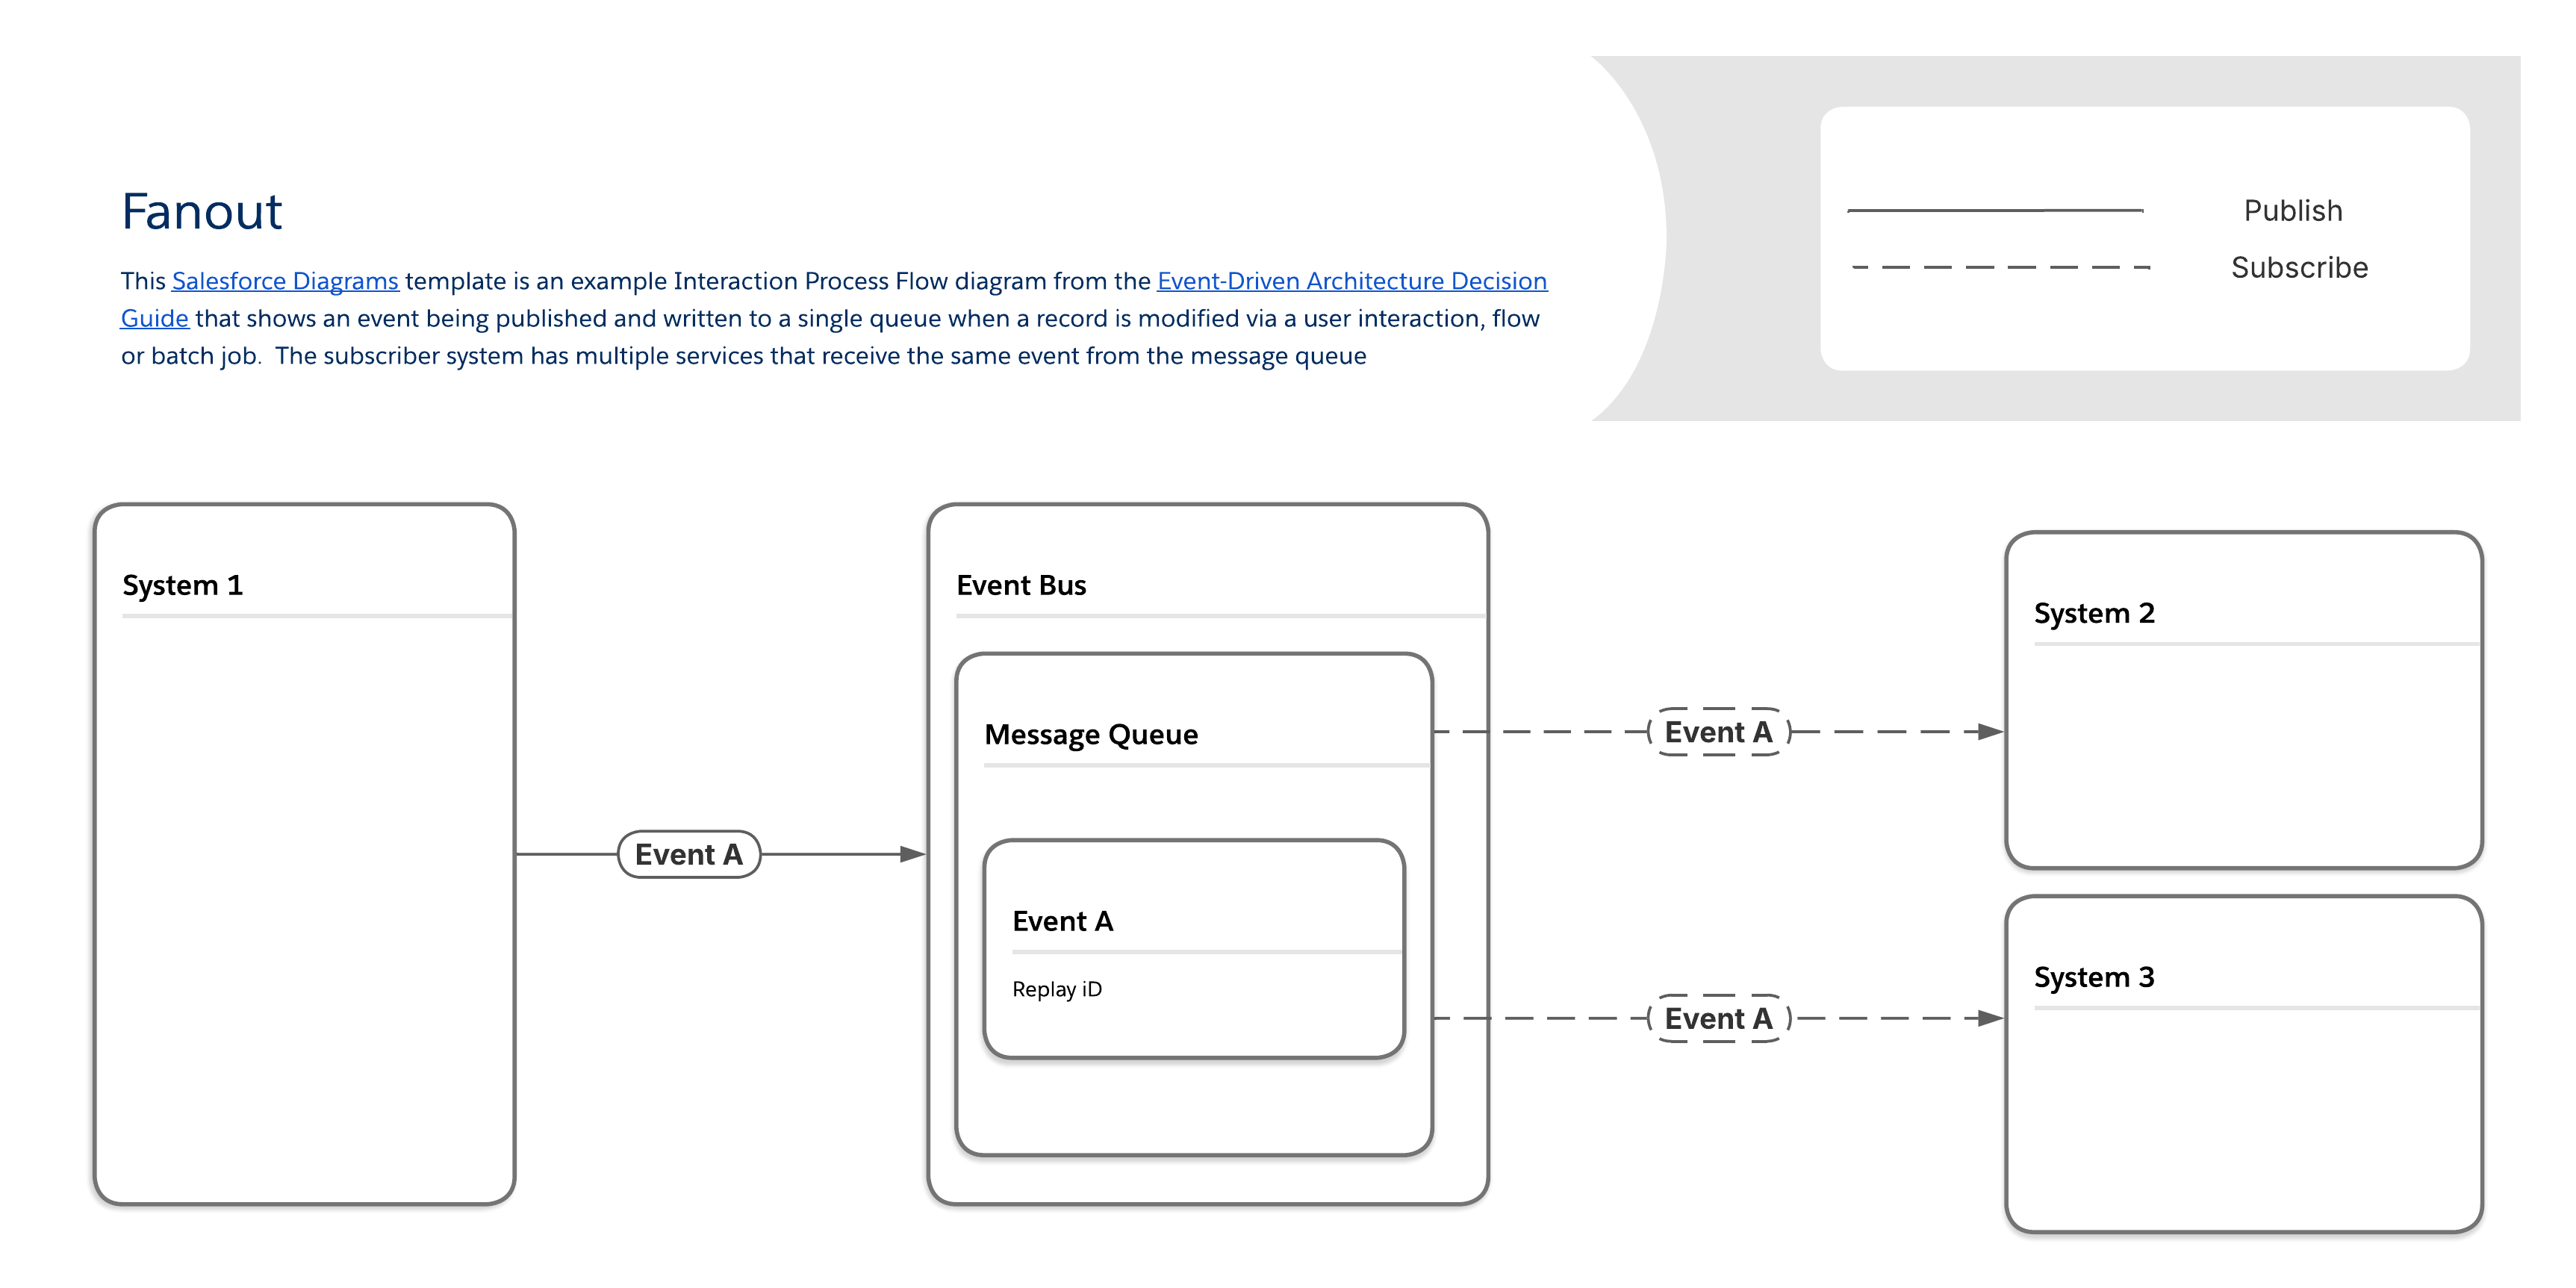 #### Herramientas relevantes para el patrón Fanout
| Comportamiento y flujo de eventos | Consideraciones sobre la carga | ||||||
|---|---|---|---|---|---|---|---|
| Herramientas disponibles | Habilidades requeridas | Publicar vía | Suscribirse a través | Periodo de reproducción | Estructura de carga | Límites de carga | |
| MuleSoft | MuleSoft Anypoint JMS Connector | Código pro | API | API | Como está configurado | Usuario definido | Ninguna |
| Conector Salesforce Pub/Sub | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| MuleSoft Anypoint Apache Kafka Connector | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| Conector de consola Anypoint de MuleSoft | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| MuleSoft Anypoint MQ Connector | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| MuleSoft Anypoint MQTT Connector | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| Conector AMQP de Mulsoft Anypoint | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| MuleSoft Anypoint MQ | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| Plataforma Salesforce | Apache Kafka on Heroku | Código pro | API, registrar cambios en Postgres de Heroku | N/A | 1-6 semanas | Usuario definido | Usuario definido |
| Captura de datos | Código bajo a código profesional | Cambios de registro | Apex, API, componentes web Lightning (LWC) | 3 días | Predefinido | 1 MB | |
| Eventos de plataforma | Código bajo a código profesional | API, Apex, Flujo | Apex, API, Flow, LWC | 3 días | Usuario definido | 1 MB | |
| API Pub/Sub | Código pro | API Pub/Sub o Apex, API, Flujo | API Pub/Sub | 3 días | Usuario definido | 1 MB | |
| Retransmisiones de eventos* | Código bajo | Eventos de plataforma, Captura de datos de cambios | API | 3 días | Usuario definido | 1 MB | |
| *Las retransmisiones de eventos solo envían datos a AWS Eventbridge | |||||||
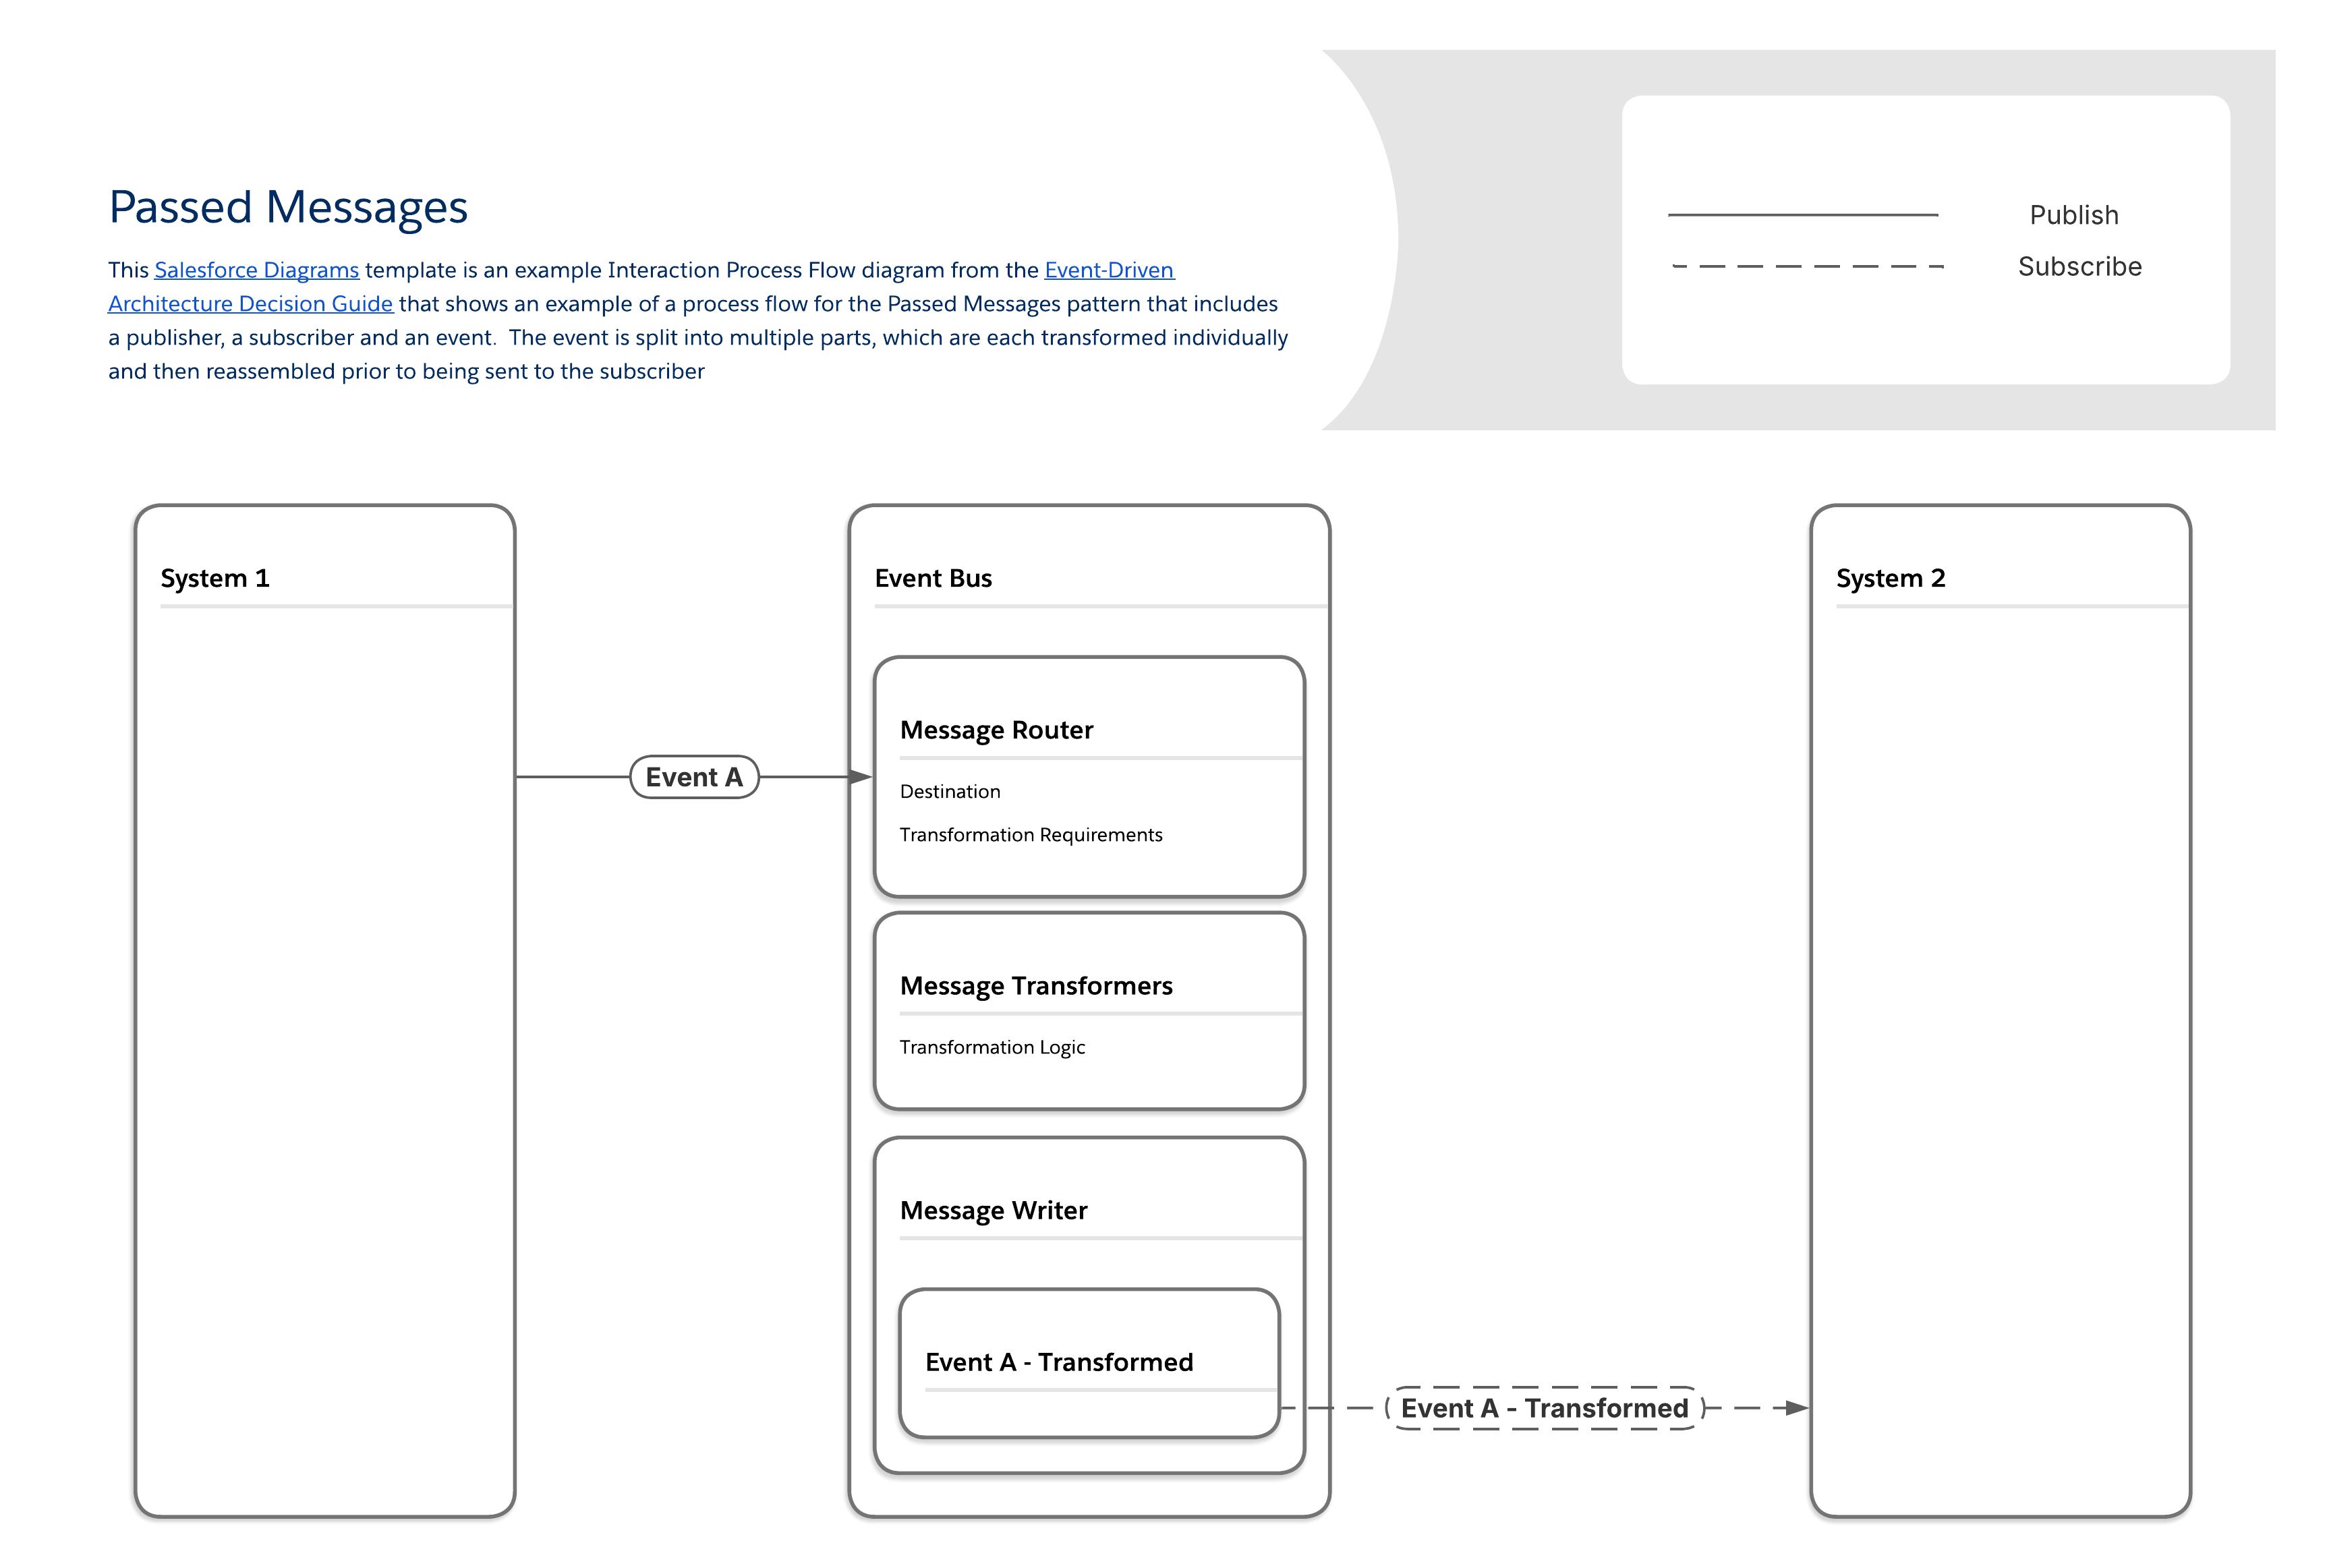 #### Herramientas relevantes para el patrón de mensajes pasados
| Comportamiento y flujo de eventos | Consideraciones sobre la carga | ||||||
|---|---|---|---|---|---|---|---|
| Herramientas disponibles | Habilidades requeridas | Publicar vía | Suscribirse a través | Periodo de reproducción | Estructura de carga | Límites de carga | |
| MuleSoft | MuleSoft Anypoint Apache Kafka Connector | Código pro | API | API | Como está configurado | Usuario definido | Ninguna |
| Conector Salesforce Pub/Sub | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| Plataforma Salesforce | Apache Kafka on Heroku | Código pro | API, registrar cambios en Postgres de Heroku | N/A | 1-6 semanas | Usuario definido | Usuario definido |
| Captura de datos | Código bajo a código profesional | Cambios de registro | Apex, API, componentes web Lightning (LWC) | 3 días | Predefinido | 1 MB | |
| Eventos de plataforma | Código bajo a código profesional | API, Apex, Flujo | Apex, API, Flow, LWC | 3 días | Usuario definido | 1 MB | |
| API Pub/Sub | Código pro | API o API Pub/Sub, flujo Apex | API Pub/Sub | 3 días | Usuario definido | 1 MB | |
| Retransmisiones de eventos* | Código bajo | Eventos de plataforma, Captura de datos de cambios | API | 3 días | Usuario definido | 1 MB | |
| *Las retransmisiones de eventos solo envían datos a AWS Eventbridge | |||||||
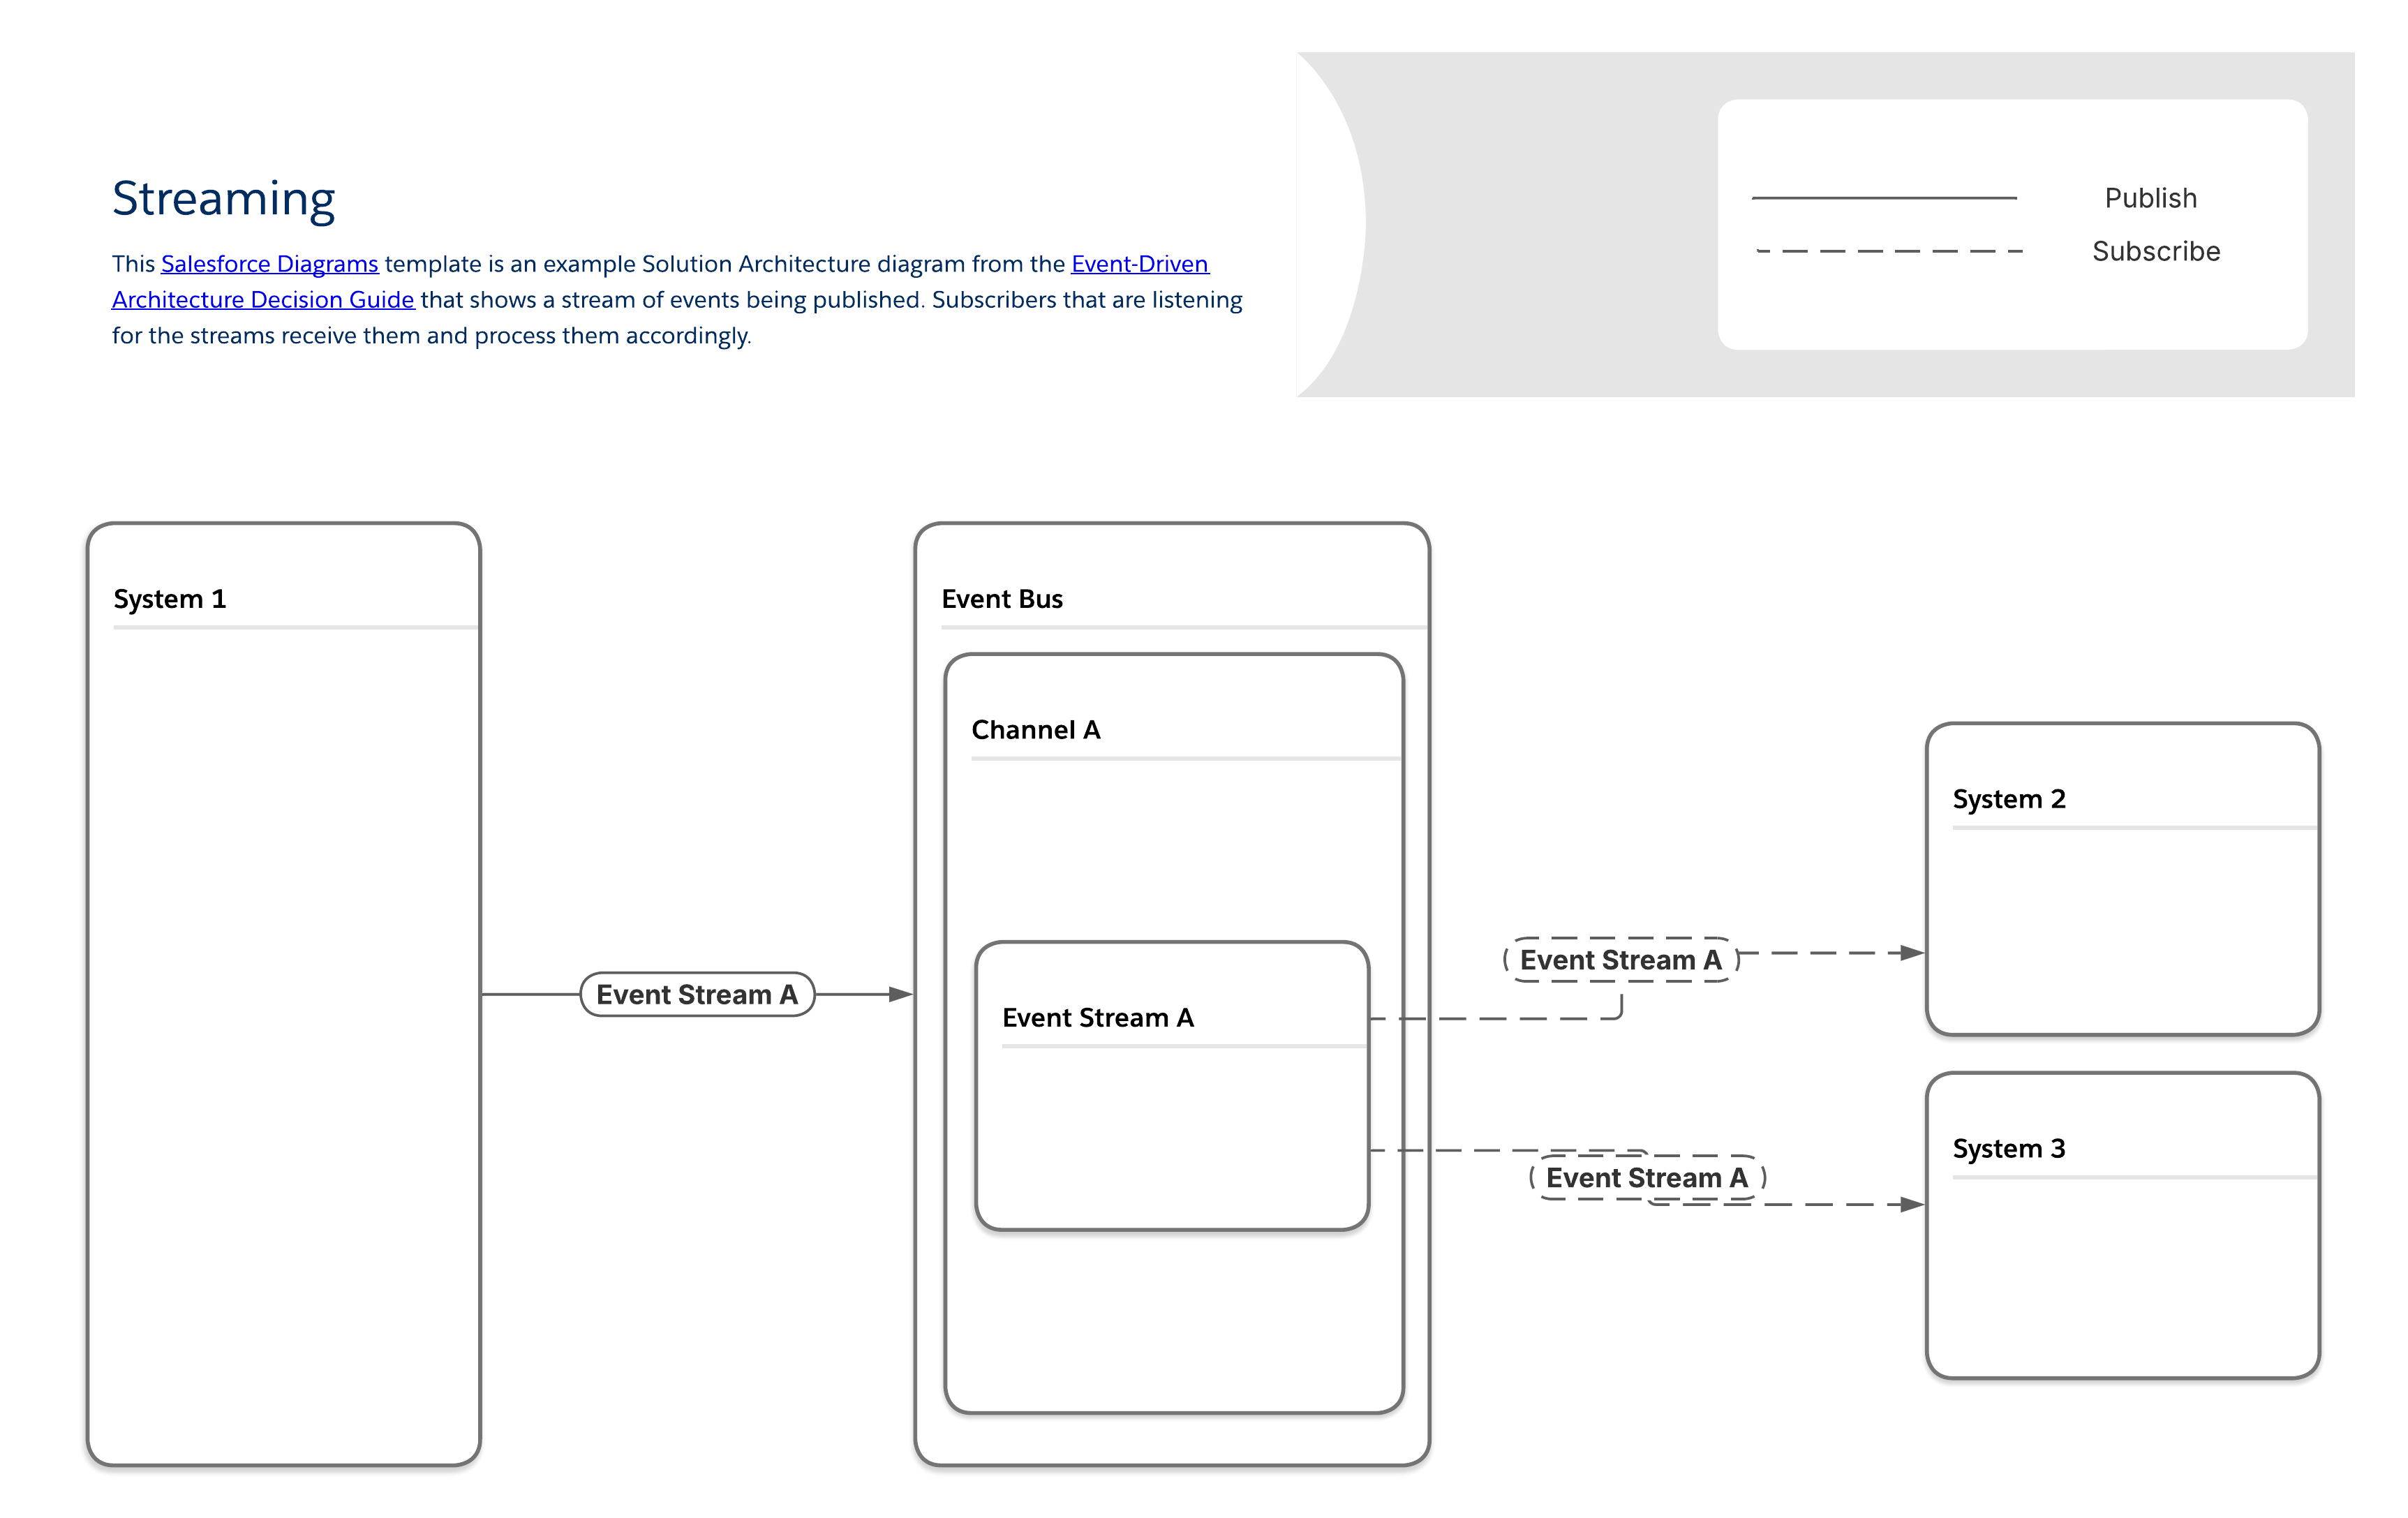 #### Herramientas relevantes para el patrón de transmisión
| Comportamiento y flujo de eventos | Consideraciones sobre la carga | ||||||
|---|---|---|---|---|---|---|---|
| Herramientas disponibles | Habilidades requeridas | Publicar vía | Suscribirse a través | Periodo de reproducción | Estructura de carga | Límites de carga | |
| MuleSoft | Transmisiones de datos de MuleSoft Anypoint | Código pro | API | API | Como está configurado | Usuario definido | Ninguna |
| Conector Salesforce Pub/Sub | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| MuleSoft Anypoint Apache Kafka Connector | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| Plataforma Salesforce | Apache Kafka on Heroku | Código pro | API, registrar cambios en Postgres de Heroku | N/A | 1-6 semanas | Usuario definido | Usuario definido |
| API Pub/Sub | Código pro | API o API Pub/Sub, flujo Apex | API Pub/Sub | 3 días | Usuario definido | 1 MB | |
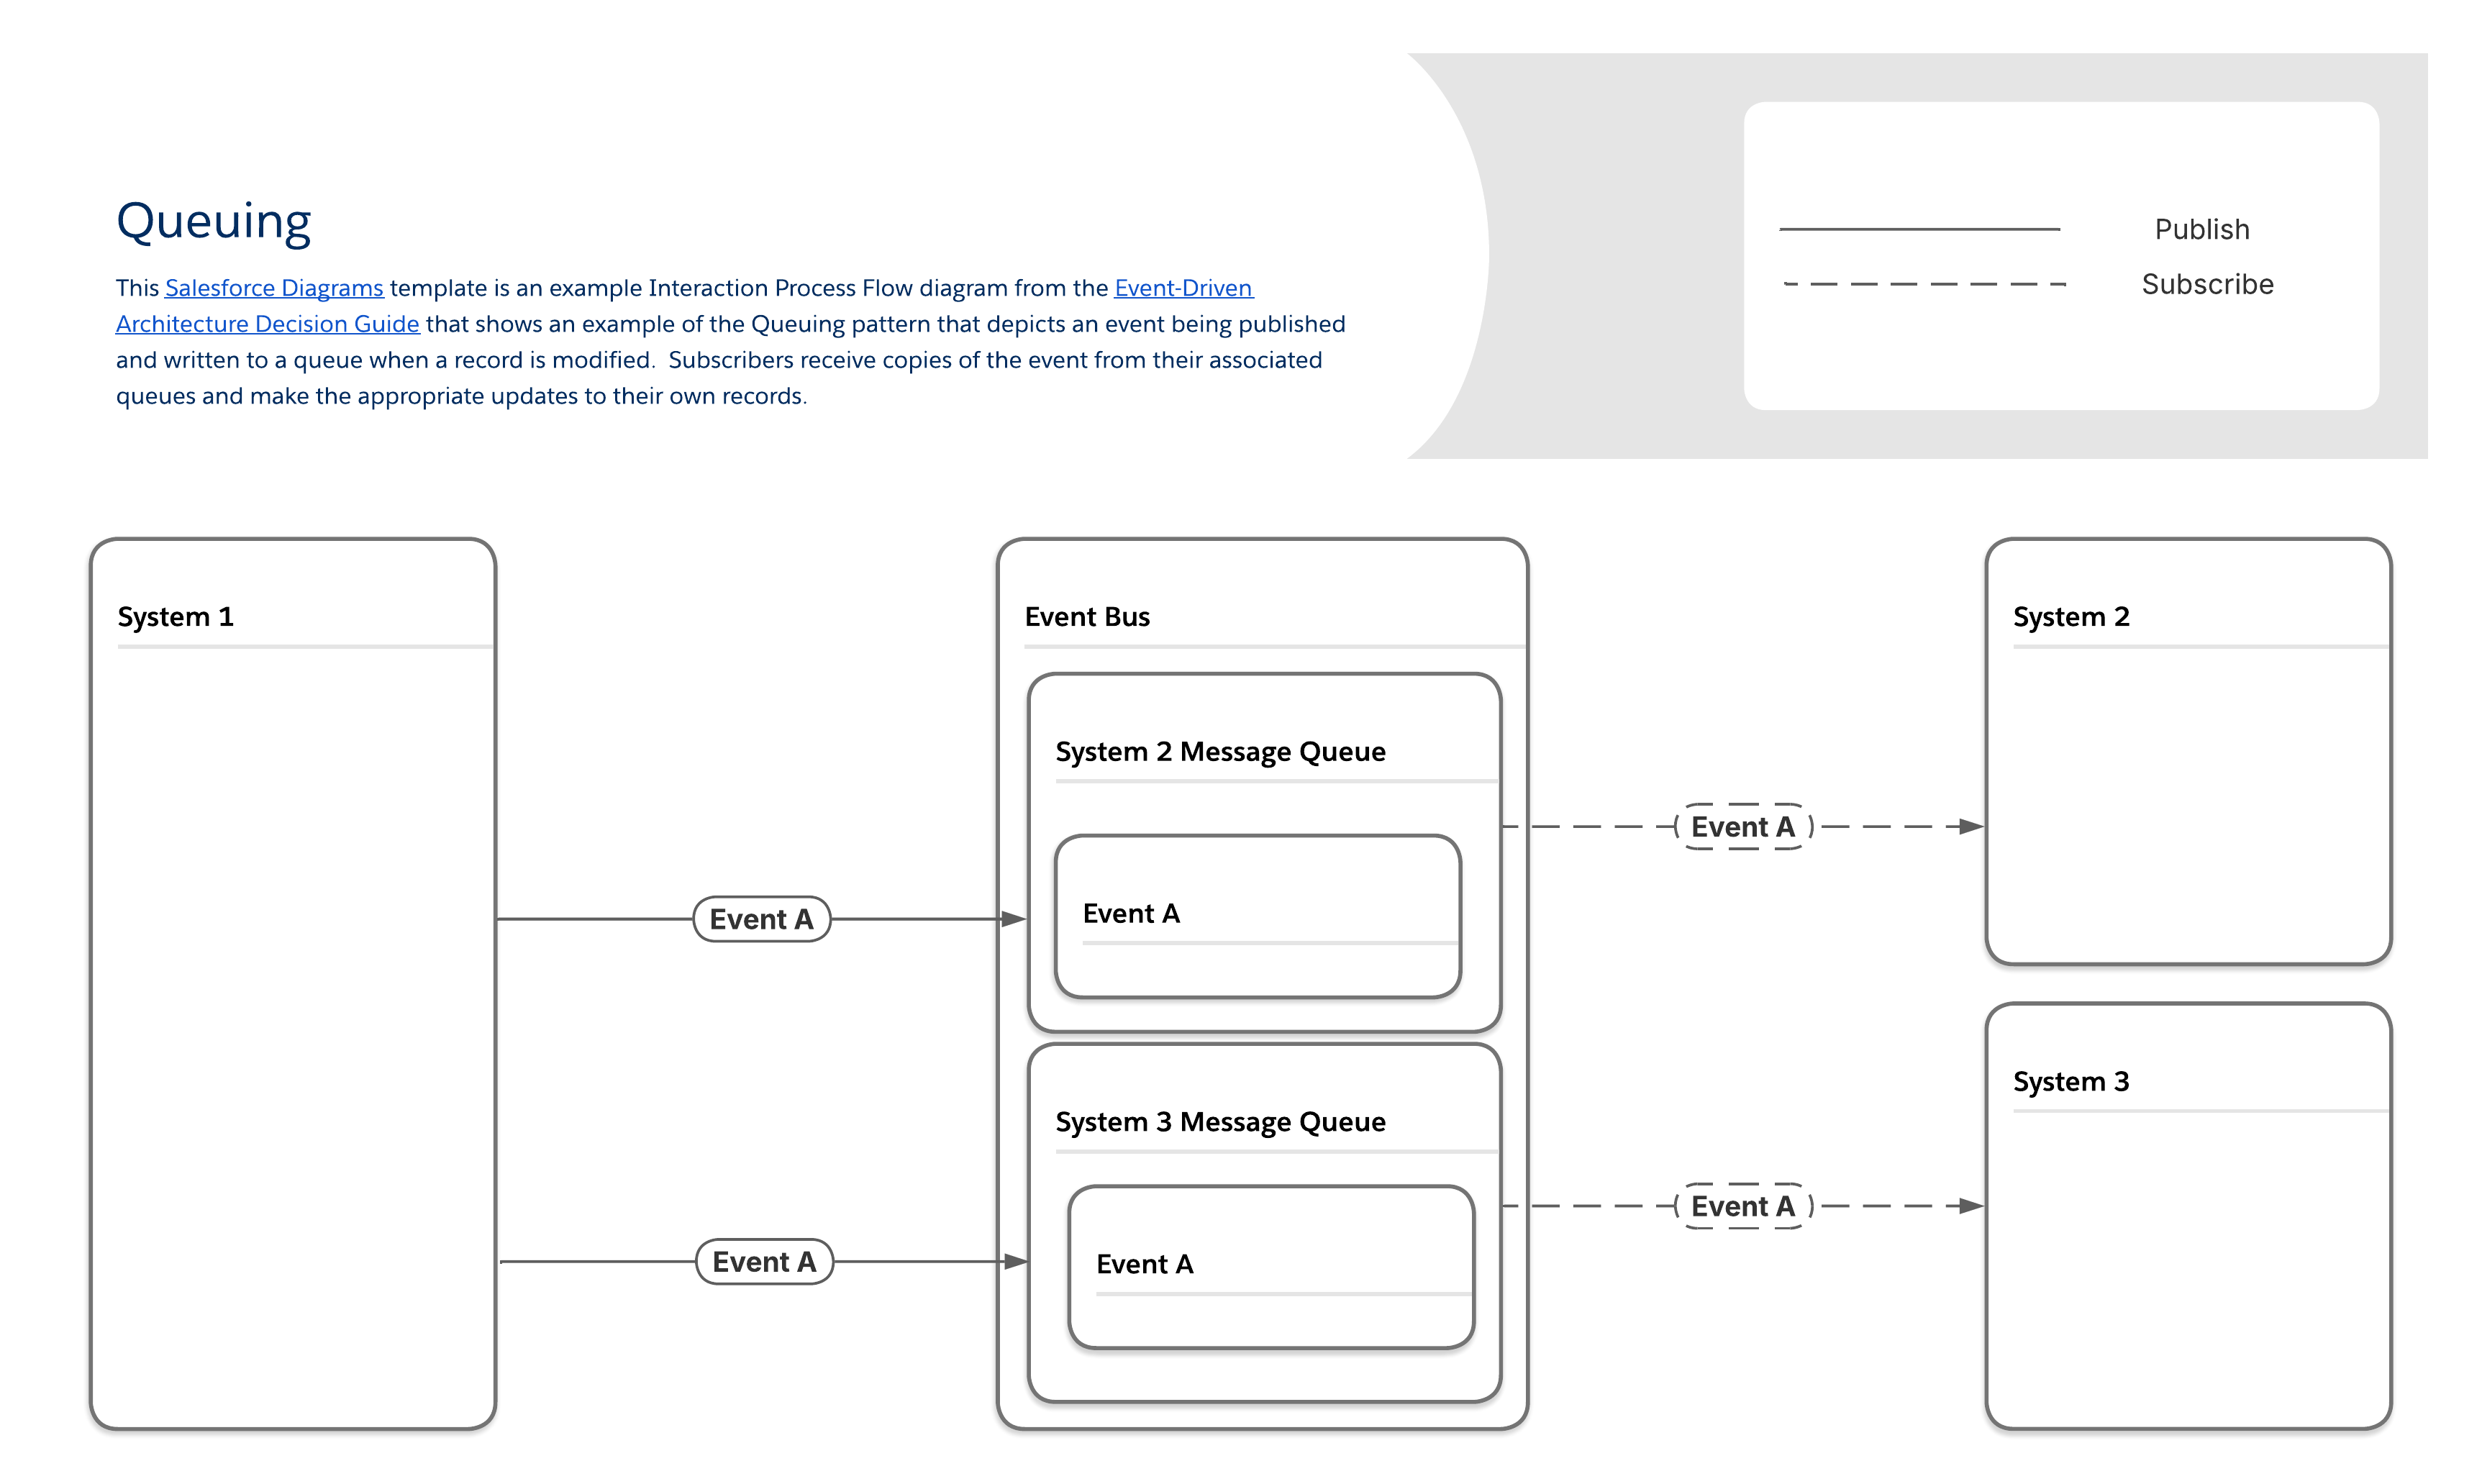 #### Herramientas relevantes para el patrón de cola
| Comportamiento y flujo de eventos | Consideraciones sobre la carga | ||||||
|---|---|---|---|---|---|---|---|
| Herramientas disponibles | Habilidades requeridas | Publicar vía | Suscribirse a través | Periodo de reproducción | Estructura de carga | Límites de carga | |
| MuleSoft | MuleSoft Anypoint MQ | Código pro | API | API | Como está configurado | Usuario definido | Ninguna |
| Conector Salesforce Pub/Sub | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| MuleSoft Anypoint Apache Kafka Connector | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| MuleSoft Anypoint MQ Connector | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| MuleSoft Anypoint MQTT Connector | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| Conector AMQP de Mulsoft Anypoint | Código pro | API | API | Como está configurado | Usuario definido | Ninguna | |
| Plataforma Salesforce | Apache Kafka on Heroku | Código pro | API, registrar cambios en Postgres de Heroku | N/A | 1-6 semanas | Usuario definido | Usuario definido |
| Captura de datos | Código bajo a código profesional | Cambios de registro | Apex, API, componentes web Lightning (LWC) | 3 días | Predefinido | 1 MB | |
| Eventos de plataforma | Código bajo a código profesional | API, Apex, Flujo | Apex, API, Flow, LWC | 3 días | Usuario definido | 1 MB | |
| API Pub/Sub | Código pro | API o API Pub/Sub, Apex, Flujo | API Pub/Sub | 3 días | Usuario definido | 1 MB | |
| Retransmisiones de eventos* | Código bajo | Eventos de plataforma, Captura de datos de cambios | API | 3 días | Usuario definido | 1 MB | |
| *Las retransmisiones de eventos solo envían datos a AWS Eventbridge | |||||||
| Flujo | Salesforce Flow es una potente herramienta de automatización de apuntar y hacer clic que permite a los usuarios crear procesos de negocio complejos, pantallas y lógica visualmente utilizando Flow Builder, sin redactar código. Automatiza tareas como actualizaciones de datos, envío de emails y orientación de usuarios, ofreciendo flexibilidad a través de tipos como Flujos de pantalla (interacción de usuario) y Flujos desencadenados (eventos de registro/programados). |
| Apex | Salesforce Apex es un lenguaje de programación patentado y orientado a objetos para la plataforma Salesforce, similar a Java, que se utiliza para crear lógica de negocio personalizada, automatizar procesos y ampliar las funciones principales de CRM más allá de las herramientas declarativas. |
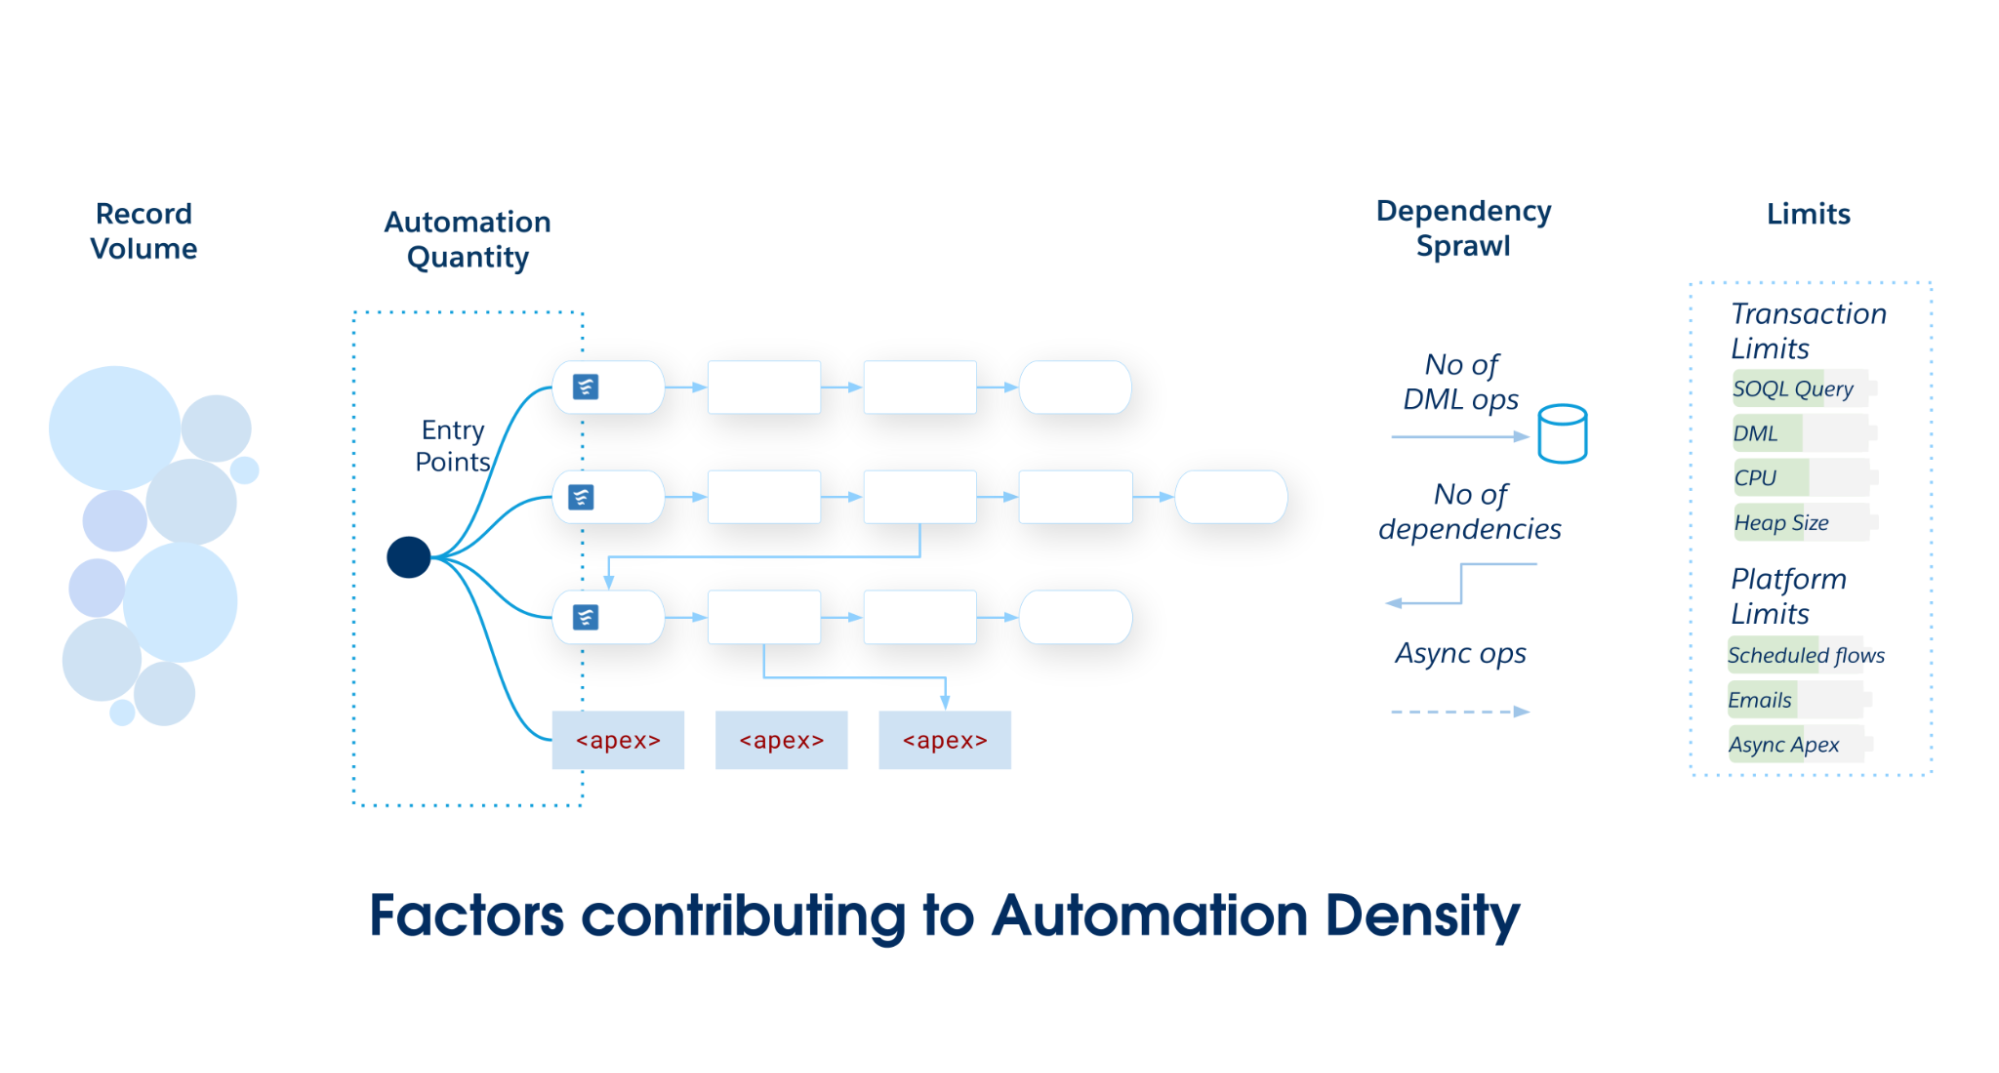 A medida que crece el ámbito y la complejidad de su aplicación de Salesforce, confirme un único punto de entrada principal: Flujo desencadenado por registro o Desencadenadores de Apex. Evite particionar automatizaciones entre múltiples mecanismos en un único objeto de Salesforce, ya que lleva a una mala capacidad de mantenimiento y una gobernanza fragmentada.
### Matriz de selección de densidad
Utilice esta matriz para determinar el estándar arquitectónico requerido para su objeto de Salesforce.
- **Flujo desencadenado por registro** es la solución preferida para baja densidad de automatización. Ofrece un equilibrio de potencia y accesibilidad ideal para automatizaciones sencillas e independientes entre sí.
- **El patrón híbrido (Flujo desencadenado por registro con Apex invocable)** es una opción potente y mantenible para automatizaciones de densidad media con complejidad creciente. Este patrón permite a los equipos mantener la coreografía ordenada en Flujo declarativo mientras delegan operaciones con gran volumen de computación en Apex, equilibrando la accesibilidad con el desempeño.
- Los **desencadenadores Apex** proporcionan los elementos constructivos necesarios para una base arquitectónica sólida que admita automatizaciones de alta densidad. El desempeño, el control granular y la abstracción y el polimorfismo orientados a objetos de Apex son más adecuados para gestionar la complejidad y la escala de estos escenarios.
| Nivel de densidad | Cantidad de automatización | Volumen de datos (Tamaño de lote) | Extensión de dependencia | Estándar arquitectónico |
|---|---|---|---|---|
| Bajo | < 15 Automatizaciones |
Estándar Interacciones de la interfaz de usuario dirigidas por el usuario o pequeñas cargas de API (1 a 200 registros) |
Discreta Lógica autónoma. 0-1 operaciones DML descendentes en el mismo objeto o un objeto relacionado. |
Flujo desencadenado por registro |
| Medio | 15–30 Automatizaciones |
Moderado Procesamiento por lotes estándar (con lógica que requiere una masificación cuidadosa) |
Acoplado Principal/Secundario actualiza de 2 a 4 operaciones DML descendentes. Riesgo de recurrencia |
Patrón híbrido Flujo + Apex invocable |
| Alto | > 30 Automatizaciones |
Alto Grandes volúmenes de datos con cargas de API masivas (2.000 a 10.000+ registros) |
Complejo y recursivo Gráfico de dependencia profunda (5+ operaciones DML descendentes). Riesgo de bucles de recursión triangulares |
Marco de metadatos desencadenado por Apex |
| Capacidad | Flujo desencadenado por registro | Desencadenador Apex |
|---|---|---|
| Rápida entrega y mantenimiento | Recomendado La interfaz de usuario visual de Flow Builder permite a los administradores y otros generadores declarativos crear y modificar automatizaciones con mayor rapidez que redactar, probar e implementar código Apex. Esta interfaz potencia una gama más amplia de miembros del equipo para entregar valor de negocio y reduce la dependencia de recursos de desarrollador especializados para tareas sencillas. |
Requiere experiencia Apex requiere desarrolladores de software debidamente cualificados para implementar, probar y mantener el código. |
| Modularidad | Disponible Los flujos desencadenados por registros son modulares de forma predeterminada. En vez de lógica monolítica, los equipos crean flujos discretos para requisitos específicos y los coreografíen juntos utilizando el Explorador de desencadenadores de flujos. Esta modularidad permite una modificación aislada y una ampliación sencilla, reduciendo enormemente el costo de propiedad a largo plazo. |
Disponible Apex está dividido en módulos funcionales por diseño. Cada clase Apex está pensada para implementar un único módulo de funciones. |
| Visibilidad y gobernanza | Recomendado La naturaleza visual de Flujo proporciona una representación intuitiva de la lógica de negocio. El Explorador de desencadenadores de flujos proporciona una vista consolidada de todos los flujos en un objeto, facilitando a los arquitectos y administradores la tarea de comprender, gobernar y solucionar problemas sin leer código. |
Requiere experiencia El uso de un marco de trabajo de metadatos para organizar desencadenadores es ventajoso, pero Apex requiere un equipo de desarrollo disciplinado para mantener el código organizado y mantenible. |
| Procesamiento masivo de datos de alto desempeño | No recomendado Existe un riesgo elevado de alcanzar límites reguladores cuando se trata de lógica compleja o grandes volúmenes de datos. |
Recomendado El código Apex se ejecuta más cerca de los servicios principales de la plataforma y ofrece a los desarrolladores un control mejorado sobre la optimización de consultas, el tratamiento de datos y la eficiencia algorítmica. Esto da como resultado un mejor desempeño y escala, especialmente en escenarios complejos que implican grandes volúmenes de datos. |
| Lógica robusta y estructuras de datos | Disponible El elemento Transformación de flujo puede ayudar con algunas tareas de procesamiento complejas. Sin embargo, Flow carece de estructuras de datos de asignación y conjunto nativas, lo que hace que el procesamiento de datos complejo sea engorroso e ineficiente desde el punto de vista computacional. |
Recomendado Apex proporciona acceso completo a Map, Set y bucles programáticos para una manipulación de datos altamente eficiente y segura. Como un lenguaje de programación completo, Apex también proporciona acceso a construcciones lógicas complejas, estructuras de datos y patrones de diseño que pueden ayudar a resolver problemas de negocio complejos de una manera mantenible y eficiente. Apex incluye una biblioteca estándar enriquecida de funciones avanzadas (por ejemplo, BusinessHours, Crypto) no disponible actualmente en herramientas declarativas. |
| Control de transacciones | No disponible Flow no proporciona acceso a `Database.savepoint`, `Database.rollback` u operaciones DML parcialmente satisfactorias para confirmaciones o reversiones de transacciones parciales. |
Disponible Apex proporciona un control completo y granular sobre la integridad de las transacciones y escenarios de recuperación de errores complejos. |
| Distribución de email | Recomendado El envío de alertas de email preconfiguradas desde un flujo desencadenado por registro es sencillo y ampliable. Las alertas de email personalizadas se pueden crear y distribuir en tiempo de ejecución. Los emails personalizados están sujetos a límites de envío diarios. |
Disponible Apex puede generar y enviar mensajes de email personalizados. Todos los emails enviados desde Apex están sujetos a los límites de envío diarios. |
| Aplicación de salvaguardias de plataforma | Recomendado El flujo incluye protecciones integradas, como la masificación automática y los reintentos automáticos. Estas salvaguardas aumentan la velocidad de valorización y evitan riesgos de desempeño que requieren codificación manual compleja. |
Se requiere implementación manual Las salvaguardias como el masificado deben codificarse de forma explícita (por ejemplo, gestionando recopilaciones y evitando SOQL dentro de bucles). Los reintentos automáticos no son nativos de desencadenadores y requieren lógica personalizada compleja para implementarse. |
| Procesamiento asíncrono | Disponible Flow ofrece mecanismos sencillos para automatizaciones que requieren una transacción separada en una ruta asíncrona. Estas automatizaciones están sujetas a límites diarios. |
Disponible Apex permite el control completo mediante Captura de datos de cambios y eventos colocables en cola gestionados por un suscriptor de desencadenador desvinculado. |
| Procesamiento programado | Recomendado Las rutas programadas del flujo proporcionan una capacidad de programación única y potente (por ejemplo, "disparo 3 días antes de la fecha de cierre"). Esta función incluye la cancelación automática y la reprogramación si cambian los datos del registro. Estas automatizaciones están sujetas a límites diarios. |
No disponible Un desencadenador Apex no puede programar de forma nativa un evento específico de registro temporal con cancelación automática. Aunque Apex programado existe, es un mecanismo fundamentalmente diferente que se ejecuta a una hora específica y no se programa durante el procesamiento de un registro individual como parte de un desencadenador. |
| Ordenación y coreografía | Disponible El Explorador de desencadenadores de flujos permite a los administradores definir un orden de ejecución relativo para múltiples flujos en el mismo objeto. |
Disponible Un marco de trabajo de desencadenador proporciona control granular sobre el orden exacto de las automatizaciones. |
| Actualizaciones de campos del mismo registro | Disponible (antes de guardar) Flujo desencadenado por registro es la opción declarativa de mayor desempeño para actualizar el registro desencadenante antes de la confirmación DML inicial. |
Disponible (antes de guardar) Apex proporciona la oferta de mayor desempeño con un gasto general mínimo. |
| Crudo de objeto cruzado | Disponible (después de guardar) Flujo es adecuado para operaciones DML de objetos cruzados sencillas y de baja complejidad. |
Disponible (después de guardar) Apex proporciona un control superior sobre la deduplicación, la gestión de errores y el desempeño para operaciones DML de objetos cruzados. |
| Deduplicación de cálculos costosos | Disponible Flujo destaca en la eliminación de consultas redundantes y declaraciones DML a través de masificación automática. Sin embargo, el estado no se puede almacenar en caché o compartir entre diferentes desencadenadores de flujo o entre múltiples invocaciones del mismo flujo en una transacción. Esta limitación puede volverse importante en escenarios de desempeño extremo. |
Recomendado Apex proporciona mecanismos para deduplicar operaciones costosas. Los desarrolladores pueden aprovechar el almacenamiento en caché de transacciones utilizando variables y propiedades estáticas, y el almacenamiento en caché a nivel de plataforma utilizando Caché de plataforma, para almacenar y reutilizar datos. Estas técnicas son importantes para reducir el consumo de límites reguladores de transacciones, como consultas SOQL, y garantizar un alto desempeño y capacidad de ampliación. |
| Gestión de errores personalizados | Disponible El elemento CustomError puede bloquear una operación de guardado y mostrar un mensaje al usuario. |
Recomendado El método addError() proporciona mensajería de error condicional y a nivel de campo flexible. |
| Caso de uso | Descripción | Mejor ajuste | Justificación |
|---|---|---|---|
| Procesamiento por lotes de alto desempeño | Cualquier automatización que debe procesar miles de registros de forma eficiente | Apex | Apex proporciona API enriquecidas para la interfaz con la plataforma y para la velocidad sin procesar. |
| Procesamiento de datos complejo | Escenarios que requieren manipulación de datos avanzada | Apex | Apex proporciona estructuras de datos, como Map y Set, que no están disponibles de forma nativa en Flow, y pueden ser críticas para redactar código de desempeño seguro y masivo. |
| Control de transacciones | Mecanismos de control como puntos de guardado, reversiones y confirmaciones parciales | Apex | Apex proporciona acceso a mecanismos como Database.savepoint y Database.rollback, y tiene la capacidad de procesar operaciones DML parcialmente satisfactorias. |
| Sofisticada validación personalizada | Validación de datos entre múltiples campos en un registro | Apex | Aunque Flujo puede evitar un guardado con el elemento `CustomError`, no está disponible en todos los tipos de flujo, incluyendo subflujos. El método Apex addError() proporciona múltiples mensajes de error específicos de campo que se pueden agregar a un registro en cualquier momento durante el procesamiento del desencadenador. |
| Lógica moderadamente compleja en un proceso sencillo | Manipulación de lógica y datos de complejidad moderada, simplificada por una biblioteca estándar de funciones avanzadas, que se produce como parte de un proceso sin complicaciones | Flujo + Apex | Flujo desencadenado por registro actúa como la capa de orquestación, mientras que las operaciones de alta complejidad están encapsuladas en Apex invocable. |
| Lógica simple a moderadamente compleja | Manipulación de datos de complejidad baja a moderada, con actualizaciones de desencadenador en los objetos de datos principales y relacionados | Flujo | Flujo es normalmente la opción a la que dirigirse, ya que se basa en un modelo declarativo que lo hace accesible tanto para administradores como desarrolladores. |
| Notificaciones y mensajes salientes | Envío de emails y mensajes salientes | Flujo | Flujo hace que el envío de alertas de email y mensajes salientes en cambios de registro sea sencillo y altamente escalable. |
| Procesamiento programado | Automatización en una fecha futura dinámica (por ejemplo, 3 días antes de una fecha de cierre) | Flujo | Las rutas programadas proporcionan una solidez única a Flujo, ya que la plataforma gestiona automáticamente la programación, cancelación y reprogramación de estas rutas si cambian los datos del registro. |
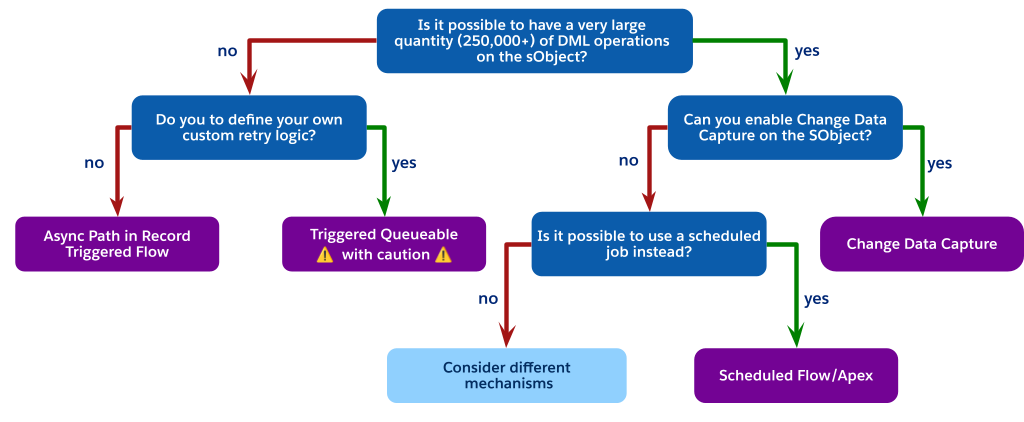 ### La alternativa de trabajo programado
Como indica el gráfico de flujo, cuando se enfrenta a operaciones DML de gran volumen pero no puede utilizar Captura de datos de cambios (quizás debido a límites de objetos), la mejor opción arquitectónica es a menudo evitar un proceso invocado por desencadenador completamente.
En su lugar, considere utilizar un proceso programado. Este puede ser un Flujo programado o Apex programado. Los pasos requeridos son:
1. Realice una actualización sencilla y de bajo costo en el desencadenador síncrono. Por ejemplo, establezca un campo de `Status__c` en "procesamiento pendiente" o inserte un registro relacionado de bajo costo, como una publicación de Chatter, para indicar que el registro necesita procesamiento.
2. Cree un trabajo programado, ya sea un flujo programado o Apex programado, que se ejecuta periódicamente, como cada 15 minutos o cada hora.
3. Tenga la consulta de trabajo programada para todos los registros en el estado pendiente, ejecute la lógica compleja en un contexto controlado de gran volumen y luego actualice los registros como procesados.
Este patrón desvincula completamente el procesamiento pesado del guardado síncrono del usuario, no está sujeto al límite de un trabajo por transacción de un lote desencadenado y proporciona una solución altamente ampliable y gobernable para requisitos que no son en tiempo real.
Si la latencia de un trabajo programado no es aceptable para los requisitos de negocio y aún está restringido a utilizar CDC o una cola desencadenada, esto indica un desajuste arquitectónico significativo. En este punto, deben considerarse diferentes mecanismos. La reevaluación del diseño de la aplicación principal puede llevar a ciertas conclusiones, como:
- Adquisición del complemento para eliminar límites de objetos de CDC.
- Fundamentalmente, desafiar el requisito de negocio para determinar si el procesamiento casi en tiempo real es realmente una necesidad o si la latencia de un trabajo programado es una ventaja aceptable para la estabilidad de la plataforma.
## Consideraciones no funcionales
### Complejidad
El nivel de complejidad en una implementación forma parte del costo total de propiedad de una solución, así como su capacidad de adaptarse a los requisitos de negocio cambiantes. La complejidad puede afectar a cualquier implementación si no se siguen las mejores prácticas. En la sección _Mejores prácticas relacionadas_ de este documento, existen recomendaciones para reducir la cantidad de complejidad en su solución, incluyendo estos patrones:
- Patrón híbrido: Apex invocable para lógica compleja en flujo
- Uso de un marco de trabajo de metadatos para desencadenadores Apex
- Megaflujos frente a Flujos múltiples
### Procesos y estándares
La documentación es tan importante como la automatización en sí. No solo garantiza la capacidad de mantenimiento, también es clave para la IA y las herramientas basadas en agentes. La documentación le ayuda a comprender y gestionar sus procesos de negocio.
**En flujo**
- Establezca una convención de nomenclatura coherente para todos los elementos y variables.
- Utilice el campo Descripción para el flujo para explicar su propósito general, criterios de desencadenador y resultado previsto.
- Utilice el campo Descripción en cada elemento individual (por ejemplo, `Get Records`, `Action`, `Transform`). Esta práctica es la mejor forma de transmitir la intención. Es especialmente importante para acciones y subflujos invocables, donde la descripción es el lugar principal para explicar la lógica compleja realizada por la acción.
**En Apex**
- Comente su código claramente para explicar el _por qué_ detrás de su lógica, no solo el _qué_.
- Si utiliza un marco de trabajo dirigido por metadatos, asegúrese de que sus registros de metadatos incluyen y rellenan un campo Descripción legible para explicar qué hace cada clase de controlador y cuándo debe ejecutarse.
DevOps y el control de origen forman parte de un ciclo de vida de desarrollo maduro. Utilice siempre una herramienta de control de origen como Git para proyectos de Salesforce. Tanto las clases Apex como Salesforce Flows son metadatos que definen su lógica de negocio, y deben versionarse y gestionarse.
En el contexto de la gestión de automatizaciones desencadenadas por registros, una canalización de DevOps moderna proporciona beneficios esenciales.
- **Comprobaciones de calidad automatizadas:** Herramientas como [Salesforce Code Analyzer](https://developer.salesforce.com/docs/platform/salesforce-code-analyzer/overview) se pueden configurar para ejecutarse automáticamente en sus oportunidades en curso. El análisis estático puede detectar patrones problemáticos en ambas herramientas de automatización antes de promocionarse, marcando problemas como elementos de `Get Records` ineficientes dentro de un bucle de flujo o consultas de `SOQL` dentro de un bucle de Apex for, que son causas comunes de degradación del desempeño.
- **Prevención de regresión:** A medida que crece su densidad de automatización, un cambio en una clase de Flujo o Apex puede tener consecuencias no deseadas para otras automatizaciones en el mismo objeto. Una estrategia de pruebas de DevOps sólida, donde las pruebas de Apex automatizadas se ejecutan contra cualquier cambio propuesto, es la forma más fiable de garantizar que una nueva versión de Flow no rompe la lógica Apex existente (y viceversa).
- **Colaboración y visibilidad:** El control de origen es la "fuente única de verdad". Permite a los administradores y desarrolladores trabajar en la automatización para el mismo objeto en paralelo. También proporciona un seguimiento de auditoría inestimable: cuando se interrumpe un proceso de producción, puede ver al instante _quién_ cambió la automatización, _cuándo_ la cambió y, a través de mensajes de confirmación, _por qué_ la cambió.
Para equipos con una combinación de administradores y desarrolladores, [DevOps Center](https://help.salesforce.com/s/articleView?id=platform.devops_center_overview.htm&type=5) proporciona una interfaz unificada para ayudar a coreografiar todos estos pasos, haciendo accesible un proceso de desarrollo escalable basado en el control de origen para todos los miembros del equipo.
Esta disciplina combinada de documentación y DevOps garantiza el estado y la capacidad de mantenimiento a largo plazo de su organización, lo que beneficiará a cada arquitecto y administrador que le siga.
## Mejores prácticas relacionadas
La guía de decisiones anterior se utiliza mejor antes de planificar su implementación. Está dirigido a ayudarle a elegir el mejor producto para sus casos de uso. Tras la selección del producto, es importante comprender las mejores prácticas existentes para su implementación.
### Explotar el patrón híbrido: Apex invocable para lógica compleja en flujo
El principio _Una herramienta por objeto_ es crítico para gestionar la automatización de alta densidad, pero no lo interprete como una opción binaria entre una pila puramente declarativa o programática. Un patrón arquitectónico más efectivo y mantenible aprovecha un modelo Híbrido: posicione Flujo desencadenado por registro como la capa de orquestación, mientras encapsula operaciones de alta complejidad en Apex invocable.
 #### La capa de orquestación: Flujo
Flujo desencadenado por registro sirve como la capa de orquestación para el proceso de negocio. Posee los criterios de entrada y el contexto de ejecución (el _qué_ y _el cuándo_). Al mantener la lógica de decisiones y el enrutamiento en esta capa, la topología de procesos de la arquitectura permanece transparente y gestionable a través del Explorador de desencadenadores de flujos, evitando que la lógica de negocio crítica se oculte en el código.
#### El componente Complejo: Apex invocable
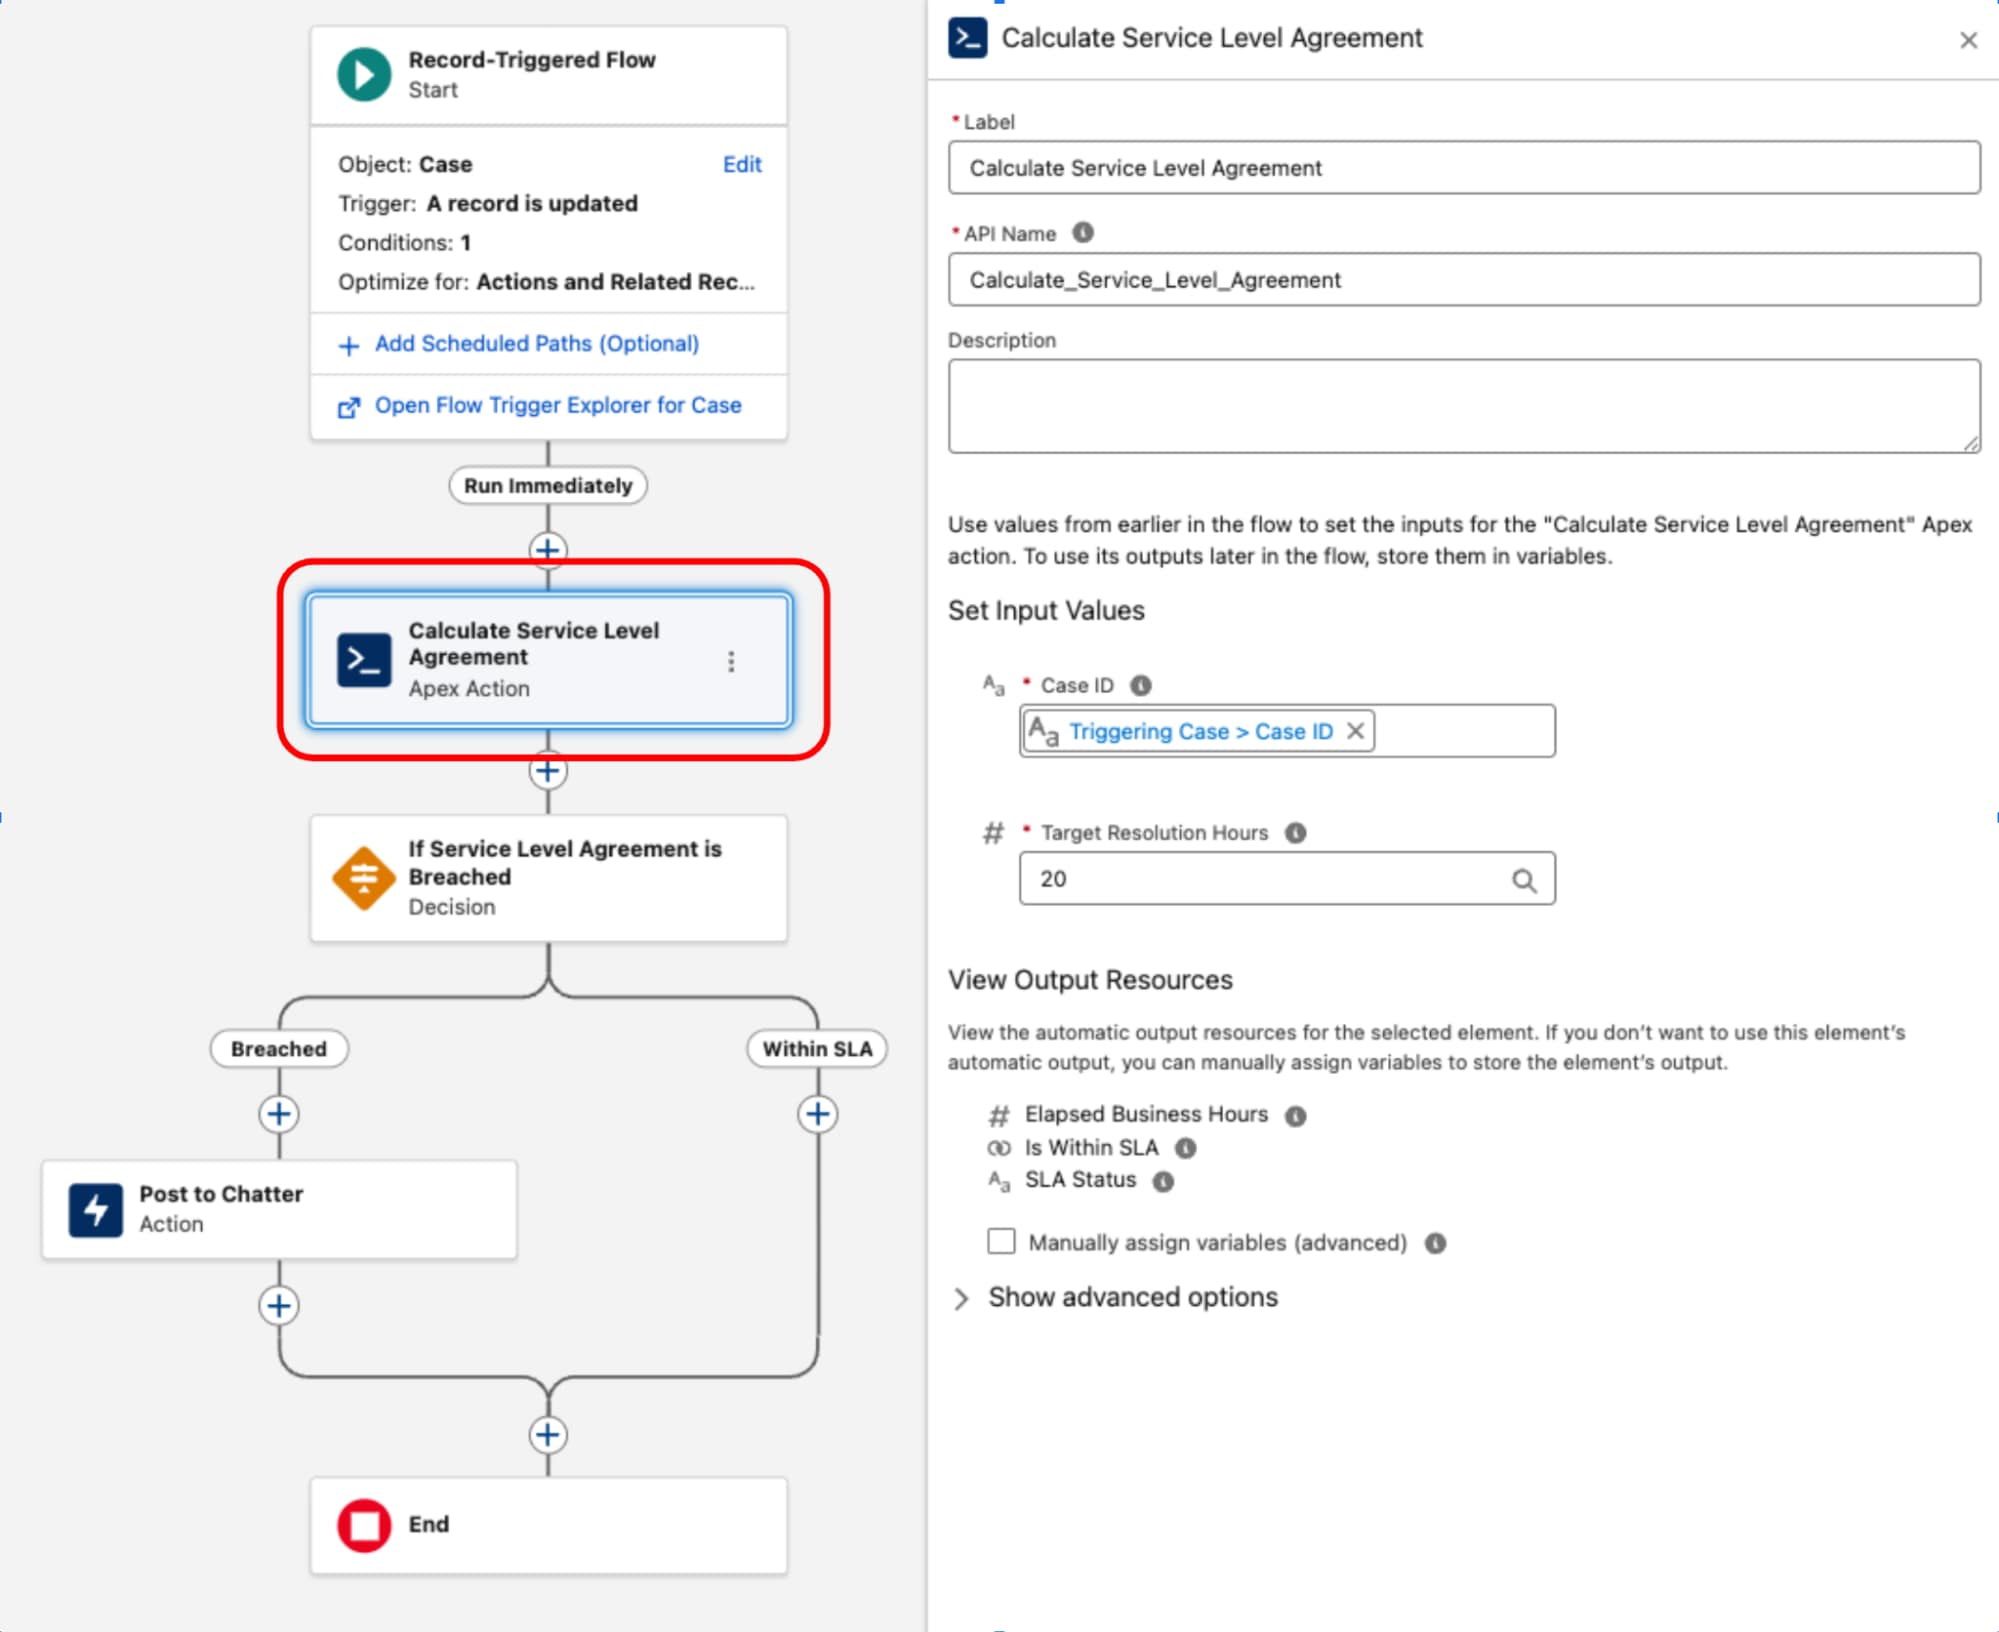
Un ejemplo común de un componente complejo es la implementación de cálculos de Acuerdo de nivel de servicio (SLA) para registros Caso. Puesto que el objeto BusinessHours y su lógica relacionada (crítica para cálculos precisos que excluyen horarios no laborales y festivos) no es accesible de forma nativa en Flow, se utiliza una clase de Apex dedicada. Esta clase, a menudo denominada algo así como `ServiceLevelAgreementCalculator`, está diseñada con un único método estático, anotado con `@InvocableMethod`, para calcular el horario laboral transcurrido, determinar si el SLA está "Dentro del objetivo" o "Incumplido" y devolver un resultado estructurado. Este enfoque encapsula la lógica compleja y de alto desempeño en Apex permitiendo al mismo tiempo su ejecución e integración transparentes en la capa de orquestación declarativa de un flujo desencadenado por registro.
Una vez definida la clase de `ServiceLevelAgreementCalculator` Apex, está disponible para su uso en un flujo desencadenado por registro:
Este patrón demuestra una estricta separación de preocupaciones. La capa declarativa se utiliza para gestionar el ciclo de vida y la orquestación de transacciones mientras que el código se utiliza para la ejecución de alta complejidad. Al tratar el código como una utilidad funcional en vez de la base, equilibramos el desempeño y la capacidad de mantenimiento.
#### Ganancias clave con el patrón híbrido
**Modularidad**: La decisión se aleja de la singularidad de utilizar Apex o Flow para todo el proceso. En su lugar, la arquitectura encapsula lógica compleja en unidades discretas, seguras de forma masiva y comprobables de forma independiente. Estas unidades funcionan como componentes reutilizables consumidos por la capa declarativa, garantizando las escalas de automatización sin complicar el diseño arquitectónico.
**Reutilización**: La lógica está desvinculada del evento desencadenador. Una unidad de código bien diseñada (como un `InvocableMethod`) se escribe una vez pero se aprovecha en múltiples puntos de entrada: Flujos desencadenados por registro, flujos de pantalla o integraciones externas. Esta reutilización de código elimina el desarrollo redundante.
**Mantenibilidad**: La lógica de flujo de proceso permanece visible y gestionable en el Flujo declarativo. Esta centralización reduce drásticamente los gastos generales de depuración y garantiza que el orden de ejecución del sistema sea determinista y transparente.
#### Limitaciones y ventajas del patrón híbrido
Aunque el modelo híbrido de utilizar Apex invocable desde Flow es potente, no es un enfoque de talla única. Los arquitectos deben ser conscientes de las limitaciones y las ventajas específicas antes de comprometerse con una solución híbrida.
- **Sin asistencia antes de guardar**: Esta es la limitación más crítica. Las acciones invocables solo están disponibles en el contexto después del guardado (flujos para acciones y registros relacionados). No se pueden utilizar en el contexto de alto desempeño antes del guardado (flujos para actualizaciones de campo rápidas). Por lo tanto, este patrón no se puede utilizar para delegar actualizaciones de campos del mismo registro. Realice ese trabajo de alto desempeño utilizando elementos Flujo nativos en un flujo antes de guardar o dentro de un desencadenador Apex antes de contexto.
- **Sin compatibilidad después de la eliminación:** Flujo desencadenado por registro actualmente no admite el contexto posterior a la eliminación. Si un objeto de Salesforce tiene un requisito de negocio para ejecutar la automatización cuando se restaura un registro desde la papelera, un desencadenador Apex es la única solución.
- **Carga de desempeño en escenarios de gran volumen:** La transición del tiempo de ejecución de Flujo al tiempo de ejecución de Apex no es una operación de costo cero. Aunque generalmente es rápido, el acto de soltar en una acción invocable desde el tiempo de ejecución de Flow no es tan rápido como la ejecución nativa que permanece completamente dentro de un desencadenador Apex. Para la mayoría de las automatizaciones de densidad media, esta microcarga es una ventaja insignificante y valiosa para la accesibilidad aumentada. Sin embargo, para escenarios de alto desempeño y gran volumen extremos, un marco de trabajo solo de Apex puro tendrá una ventaja de velocidad de cálculo sin procesar.
### Estrategias para la automatización heredada
Aunque la heurística de densidad de automatización proporciona directrices definitivas para una arquitectura de campo nuevo más reciente, la realidad de los entornos de Salesforce de negocio suele ser más matizada. En organizaciones maduras, es común encontrar flujos desencadenados por registros y desencadenadores Apex operando en el mismo objeto de Salesforce. Este escenario es distinto del patrón híbrido explicado anteriormente: aquí, los flujos y desencadenadores Apex no están acoplados ni diseñados para funcionar juntos.
Esta coexistencia es a menudo el resultado de la evolución de las funciones de la plataforma o de deudas técnicas heredadas. Aunque este es un estado operativo tolerado, los arquitectos deben tratarlo como una compensación calculada en vez de un estado final.
La orquestación fragmentada causa una carga de trabajo de mantenimiento y regulación significativa, haciendo que las actividades de desarrollo, pruebas y gestión de incidentes sean inconexas y engorrosas. Esto lleva a un aumento del Tiempo de resolución (TTR) y la complejidad operativa.
- Para nuevos objetos de Salesforce, respete el principio de densidad de automatización como la guía principal.
- Para Objetos de Salesforce existentes con una huella híbrida y un desencadenador Apex dual y puntos de entrada de flujo desencadenados por registro, evalúe la densidad y luego cree arquitectos para refactorizar a un estado híbrido mantenible.
- Para baja densidad, vuelva a factorizar desencadenadores Apex en flujos desencadenados por registros y especifique el orden de ejecución, llevándolos a un único punto de entrada de automatización.
- Para densidad media, vuelva a factorizar megaflujos complejos en un subconjunto de flujos, con el orden de ejecución correcto. Introduzca desencadenadores Apex solo cuando sea absolutamente necesario, por ejemplo para dar cobertura después de cancelar la eliminación de contexto.
- Para alta densidad, favor de implementar desencadenadores Apex.
### Uso de un marco de trabajo de metadatos para desencadenadores Apex
A medida que maduran los procesos de negocio de una organización en Salesforce Platform, el volumen y la complejidad de la automatización desencadenada por registros aumentan inevitablemente. Una mejor práctica fundamental es mantener _un desencadenador Apex por objeto de Salesforce_. Esta regla es crítica porque la plataforma no garantiza el orden de ejecución de múltiples desencadenadores en el mismo objeto para el mismo evento. Esta limitación puede llevar a comportamientos no deterministas, condiciones de raza y problemas difíciles de depurar.
Sin embargo, la adhesión al principio _de desencadenador único_ presenta un reto arquitectónico: cómo gestionar y orquestar toda la lógica de negocio invocada desde ese punto de entrada único de una forma ampliable y mantenible.
#### Las limitaciones de los controladores de desencadenadores Classic
La primera evolución de esta arquitectura fue el patrón Classic Trigger Handler. En este enfoque, el desencadenador Apex único delega toda su lógica a una clase de controlador correspondiente (por ejemplo, `OpportunityTriggerHandler`). Este método separa la lógica del archivo desencadenador y proporciona a los desarrolladores un control determinista sobre el orden de ejecución dentro de los métodos de la clase de controlador (por ejemplo, `afterInsert()`).
Aunque es una mejora, este patrón a menudo lleva a clases de controlador monolítico. Con el tiempo, a medida que se agregan más requisitos de negocio, la clase se vuelve grande, difícil de gestionar y difícil de probar de forma aislada. El orden de ejecución de todos los procesos individuales está codificado en un único método, lo que hace que la clase sea propensa a combinar conflictos, lo que aumenta drásticamente la regulación y los gastos generales de mantenimiento en un entorno de grandes compañías.
#### La solución: Un marco de trabajo de desencadenador dirigido por metadatos
Para resolver los problemas principales de modularidad y orquestación, los arquitectos cambian a un **Marco de trabajo** de desencadenador dirigido por metadatos. Este es un salto arquitectónico significativo que desvincula la lógica de automatización en sí de la configuración de _cómo_ y _cuándo_ se ejecuta.
Este marco se basa en tres ventajas clave:
- **Partición:** En vez de una única clase de gestor, la lógica de negocio principal se divide en clases de Apex atómicas pequeñas (por ejemplo, una clase de `RecalculateAccountValues` o una clase de `NotifySalesLeads`), respetando cada clase el _principio de responsabilidad_ única. Esta modularidad facilita la tarea de probar, depurar y comprender la lógica de forma aislada.
- **Orden y coreografía:** La orden de ejecución ya no está codificada en Apex. En su lugar, se define declarativamente por registros de configuración, normalmente almacenados en un tipo de metadatos personalizados (por ejemplo, `TriggerAction__mdt`). Esto permite a los administradores reordenar, agregar o eliminar acciones de automatización simplemente modificando un registro de metadatos, que no requiere una implementación o cambio de código.
- **Omitir funciones:** El marco de trabajo proporciona funciones de omisión granulares estandarizadas. Cada acción de automatización puede configurarse a través de su registro de metadatos para desactivarse de forma global o omitirse para usuarios administrativos específicos haciendo referencia a un permiso personalizado.
El desencadenador de Apex único para el objeto sirve solo como un despachador dinámico. No contiene lógica de negocio, pero en su lugar crea una instancia de una clase de `MetadataTriggerHandler` central. Este controlador consulta los registros de metadatos personalizados para determinar dinámicamente la secuencia de ejecución e invocar las clases Apex atómicas correctas en el orden prescrito. La automatización está unificada bajo una capa única, transparente y gobernable.
### Desduplicación de operaciones costosas en la transacción
Un beneficio importante de utilizar Apex en un marco de trabajo sólido es la capacidad de gestionar el estado de las transacciones y optimizar el desempeño eliminando el trabajo redundante. A medida que se acumula la lógica, es común que diferentes automatizaciones en la orden de guardado ejecuten de forma independiente las mismas operaciones costosas, consumiendo límites reguladores valiosos y aumentando el tiempo de operación DML.
El marco está diseñado para abordar esto con dos estrategias principales:
- **Gestión de estado compartido:** Dentro del ámbito de una única transacción Apex, las propiedades estáticas y las variables se aprovechan para almacenar en caché datos. Esto garantiza que una operación costosa, como una consulta de `SOQL` para un parámetro de configuración, solo se ejecute una vez, incluso si la lógica de automatización se invoca varias veces entre diferentes registros o fases del desencadenador. El consumo de límites de transacciones se reduce significativamente.
- **Utilización de caché de plataforma:** Para ir más allá del simple almacenamiento en caché intratransacción, utilice la caché de plataforma para evitar consultar la base de datos completa para ciertos datos. Esta caché en memoria gestionada es ideal para recuperar datos que no son primitivos, leídos frecuentemente en la base de códigos e inmutables en el transcurso de una transacción (por ejemplo, perfiles, funciones, horarios laborales). Utilizando la interfaz de `Cache.CacheBuilder`, el sistema comprueba la caché primero y solo realiza la consulta de la base de datos si los datos no están presentes, maximizando el desempeño y la capacidad de ampliación.
### Utilizar antes del guardado para actualizaciones del mismo registro
Utilice siempre una actualización antes del guardado cuando su automatización solo necesite cambiar valores de campo en el registro que inicia la transacción. Esto se aplica a actualizaciones de campo rápido en Flujo (que se ejecutan antes de guardar) y lógica antes de contexto en Desencadenadores Apex (antes de insertar, antes de actualizar).
Este patrón es de desempeño, independientemente de la herramienta que se utilice, porque evita una segunda operación DML y un ciclo de guardado recursivo. Los cambios se realizan en el registro en memoria _antes_ de que se confirme en la base de datos y se guardan como parte de la transacción original. Se elimina la sobrecarga de un segundo guardado, que de lo contrario volvería a ejecutar la orden de guardado completa e iniciaría toda la automatización de nuevo.
### Evitar la repetición no controlada
La recursión no controlada es un problema común en desencadenadores posteriores a la actualización, donde la lógica de un desencadenador realiza una actualización DML que a su vez provoca que el mismo desencadenador se active de nuevo. Esto crea un bucle infinito que termina finalmente con una excepción de límite regulador. Aunque históricamente se han utilizado indicadores booleanos estáticos o recopilaciones de Id. de registros procesados para evitar dicha repetición, un patrón más preciso y sólido es portar la lógica comparando valores de campo entre las versiones nueva y antigua del registro en sí.
Ejecute la lógica solo si un campo de interés específico cambió realmente. Esto evita que el desencadenador ejecute su lógica en operaciones DML posteriores en la misma transacción donde los datos críticos permanecen sin cambios.
#### Control de la recurrencia en flujos desencadenados por registros
En un flujo desencadenado por registro, evite la repetición no controlada estableciendo el flujo para ejecutarse solo cuando se actualiza el registro para cumplir los requisitos de condición:
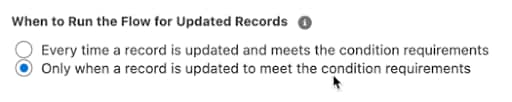 Si elige utilizar una fórmula de criterios de entrada en su flujo, puede evitar la repetición desbocada comparando la variable global de `$Record` (representando los nuevos valores) con la variable global de `$RecordPrior` (representando los valores originales antes del guardado). Por ejemplo, para asegurarse de que un flujo solo se ejecuta si el campo Importe en una oportunidad cambió, utilice esto en los criterios de entrada:
```
$Record.Amount != $Record__Prior.Amount
```
#### Control de la recurrencia en Apex
Compare valores de campo de la nueva versión del registro, `Trigger.new`, con los valores de campo de la versión antigua del registro, `Trigger.oldMap`, para ver si se produjo el cambio específico que está buscando. Este enfoque garantiza que la automatización sea idempotente y solo se ejecute cuando sea necesario, haciendo que el sistema sea más eficiente y evitando bucles recursivos catastróficos.
### Omitir la automatización
Una organización de Salesforce bien diseñada requiere un mecanismo coherente y fiable para omitir la automatización. Esta no es una función opcional, sino un requisito operativo principal para mantener la integridad de los datos y activar tareas administrativas.
Un marco de trabajo de omisión es esencial para algunos escenarios:
- Cuando se cargan grandes volúmenes de datos, la activación de desencadenadores para cada registro puede ralentizar drásticamente el proceso, provocar excepciones de límite y crear notificaciones y registros relacionados erróneos. Una omisión permite insertar los datos de forma limpia y eficiente.
- Un usuario de integración puede necesitar sincronizar datos desde un sistema de registro externo. La automatización que normalmente se desencadena para un cambio iniciado por el usuario (por ejemplo, el envío de un email, la creación de una tarea) puede ser indeseable o redundante cuando el cambio se origina desde otro sistema.
- Es posible que los administradores o el personal de asistencia necesiten realizar actualizaciones correctivas en registros. Un mecanismo de omisión les permite realizar estos cambios sin desencadenar la automatización de negocio estándar, lo que podría tener consecuencias no deseadas.
**Permisos personalizados**: El estándar moderno y ampliable para la implementación de la lógica de omisión son los permisos personalizados. Estos métodos son superiores a los antiguos por varias razones:
- **Flexibilidad:** Los permisos personalizados se pueden asignar a usuarios a través de conjuntos de permisos. Esta práctica se alinea con el modelo moderno de acceso y seguridad de Salesforce, permitiendo una asignación granular y flexible. Se puede otorgar una omisión a un usuario específico, o incluso temporalmente con una fecha/hora de caducidad específica.
- **Mantenibilidad:** El uso de permisos personalizados evita codificar perfiles o usuarios en lógica de automatización. Si la función de un usuario cambia o un nuevo perfil necesita omitir el acceso, el cambio es una asignación de Conjunto de permisos sencilla, no una modificación de flujo o código que requiere una implementación.
- **Escalabilidad:** Los permisos personalizados proporcionan un marco de trabajo ampliable para gestionar excepciones en una base de usuarios compleja. Se pueden asignar a usuarios a través de conjuntos de permisos, grupos de conjuntos de permisos o perfiles. Su asociación a un conjunto de permisos o perfil también es representable en metadatos de origen.
**Patrones de implementación**: Aplique un patrón de omisión coherente a todas las automatizaciones desencadenadas por registros en la organización.
**Omitir un flujo desencadenado por registro**: La forma más eficiente de omitir un flujo es evitar que se ejecute. Esto se logra agregando una condición a los criterios de entrada del flujo.
- En el elemento Inicio del flujo desencadenado por registro, establezca los Requisitos de condición en La fórmula se evalúa como Verdadero.
- En el generador de fórmulas, incorpore una comprobación para el permiso personalizado utilizando la variable global `$Permission`. Combine la comprobación con sus criterios de entrada existentes.
- Patrón de fórmula:
```
( ) && NOT($Permission.Bypass_This_Flow)
```
- Este patrón garantiza que el flujo solo se ejecute si el usuario _no_ tiene el permiso personalizado especificado asignado. Esta comprobación se realiza incluso antes de que se cree la entrevista de flujo, lo que la convierte en el enfoque con mayor desempeño.
**Omitir un marco de trabajo desencadenador Apex**: En Apex, integre la lógica de omisión directamente en el marco de desencadenador dirigido por metadatos, permitiendo un control granular.
- El tipo de metadatos personalizados de `TriggerAction__mdt` debe incluir un campo de texto, por ejemplo, `BypassPermission__c`.
- En la clase `MetadataTriggerHandler`, antes de ejecutar una acción de forma dinámica, el código debe leer el valor de este campo.
- Si el campo se rellena, el controlador utiliza el método `FeatureManagement.checkPermission()` para determinar si el usuario que ejecuta actualmente tiene el permiso personalizado especificado.
- Si `checkPermission()` devuelve true, el controlador omite esa acción específica y continúa con la siguiente en la secuencia.
- Este patrón es potente porque permite una omisión global (si todos los registros de `TriggerAction__mdt` hacen referencia al mismo permiso) y una omisión granular por acción (si diferentes registros hacen referencia a diferentes permisos, o algunos no tienen ningún permiso de omisión).
### Megaflujos frente a Flujos múltiples
Es un antipatrón para consolidar toda la automatización de un objeto en un único flujo masivo. La consolidación en un flujo frente a la división de la lógica en múltiples flujos bien acondicionados no tiene un impacto importante en el desempeño. Las ganancias de desempeño más significativas provienen de:
- Uso de flujos antes de guardar para actualizaciones de campos del mismo registro.
- Redactar condiciones de entrada precisas para garantizar que los flujos no se ejecutan en cambios que no afectan a su caso de uso específico.
[Flow Trigger Explorer](https://trailhead.salesforce.com/content/learn/modules/record-triggered-flows/meet-flow-trigger-explorer) le permite asignar un valor de pedido a cada flujo en un objeto, garantizando un orden de ejecución secuencial.
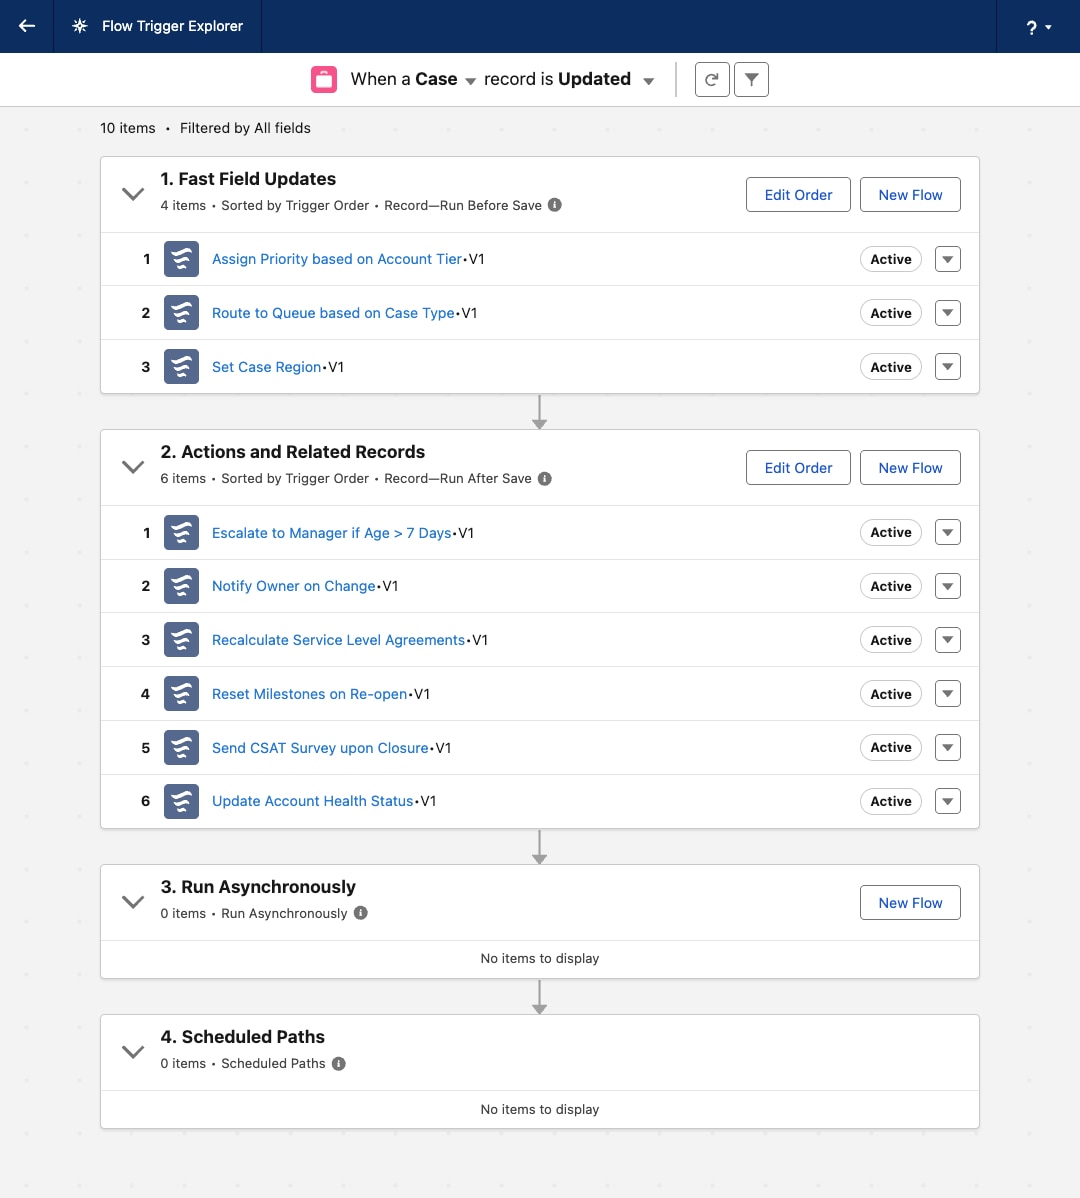 ## Recursos
| Apex | Flujo | Operaciones |
|---|---|---|
| Habilidades requeridas | Requisitos de licencia adicionales | |
|---|---|---|
| Formularios dinámicos | Código bajo | No |
| Flujo de pantalla | Código bajo | No |
| OmniStudio | Código bajo + Código profesional | Requiere paquete Industries |
| Flujo de pantalla + Componentes web Lightning | Código bajo + Código profesional | No |
| Componentes web Lightning | Código Pro | No |
| Repercusión de objeto | Determine si su formulario operará contra un único objeto o necesita operar contra múltiples objetos. |
| Ámbito de formulario y navegación | Determine si todos los campos de su formulario se ajustarán lógicamente a una única pantalla o si los usuarios deben poder navegar entre múltiples pantallas. |
| Ubicación | Identifique la(s) ubicación(es) donde desea incrustar el formulario, que puede ir desde algún lugar dentro de una aplicación de Salesforce a una aplicación móvil o incluso un sitio web externo. |
| Controlador | Identifique las acciones o la lógica que se deben realizar en segundo plano mientras los usuarios interactúan con su formulario, incluyendo transformaciones de datos e integraciones con sistemas externos. |
| Validation | Determine si tiene o no requisitos de validación de entrada adicionales que vayan más allá de la validación a nivel del sistema estándar proporcionada por Salesforce. |
| Seguridad | Determine si su formulario debe comprobar el acceso del usuario antes de realizar ciertas operaciones, si desea controlar quién puede acceder al formulario y si desea controlar dónde se puede incrustar el formulario. |
| Diseño de interacciones | Identifique los tipos de interacciones o condiciones que deben desencadenar respuestas dinámicas en su formulario. |
| Estilo | Determine el nivel de sofisticación para su estilo y CSS deseados. |
| Formato | Identifique los requisitos de formato de su formulario en términos del número requerido de columnas, fichas, acordeones y la capacidad de mostrar bloques de datos repetitivos. |
| Traducción | Determine si su formulario tendrá que traducirse a otros idiomas. |
| Automatización de pruebas de interfaz de usuario | Determine si sus procesos de DevOps requerirán que su formulario se someta a pruebas de unidad automatizadas o pruebas de extremo a extremo automatizadas |
| Métricas | Identifique las formas en que le gustaría realizar un seguimiento del uso de su formulario, incluyendo vistas de página, cantidad de tiempo empleado en el formulario, índices de realización y índices de éxito |
| Empaquetado e implementación | Determine cómo desea distribuir o implementar su formulario después de su creación. |
| Objeto único | Objeto cruzado | Agnóstico de objetos | |
|---|---|---|---|
| Formularios dinámicos | Disponible | Disponible | No disponible |
| Flujo de pantalla | Disponible | Disponible | Disponible |
| OmniStudio | Disponible | Disponible | Disponible |
| Flujo de pantalla + LWC | Disponible | Disponible | Disponible |
| LWC | Disponible | Disponible | Disponible |
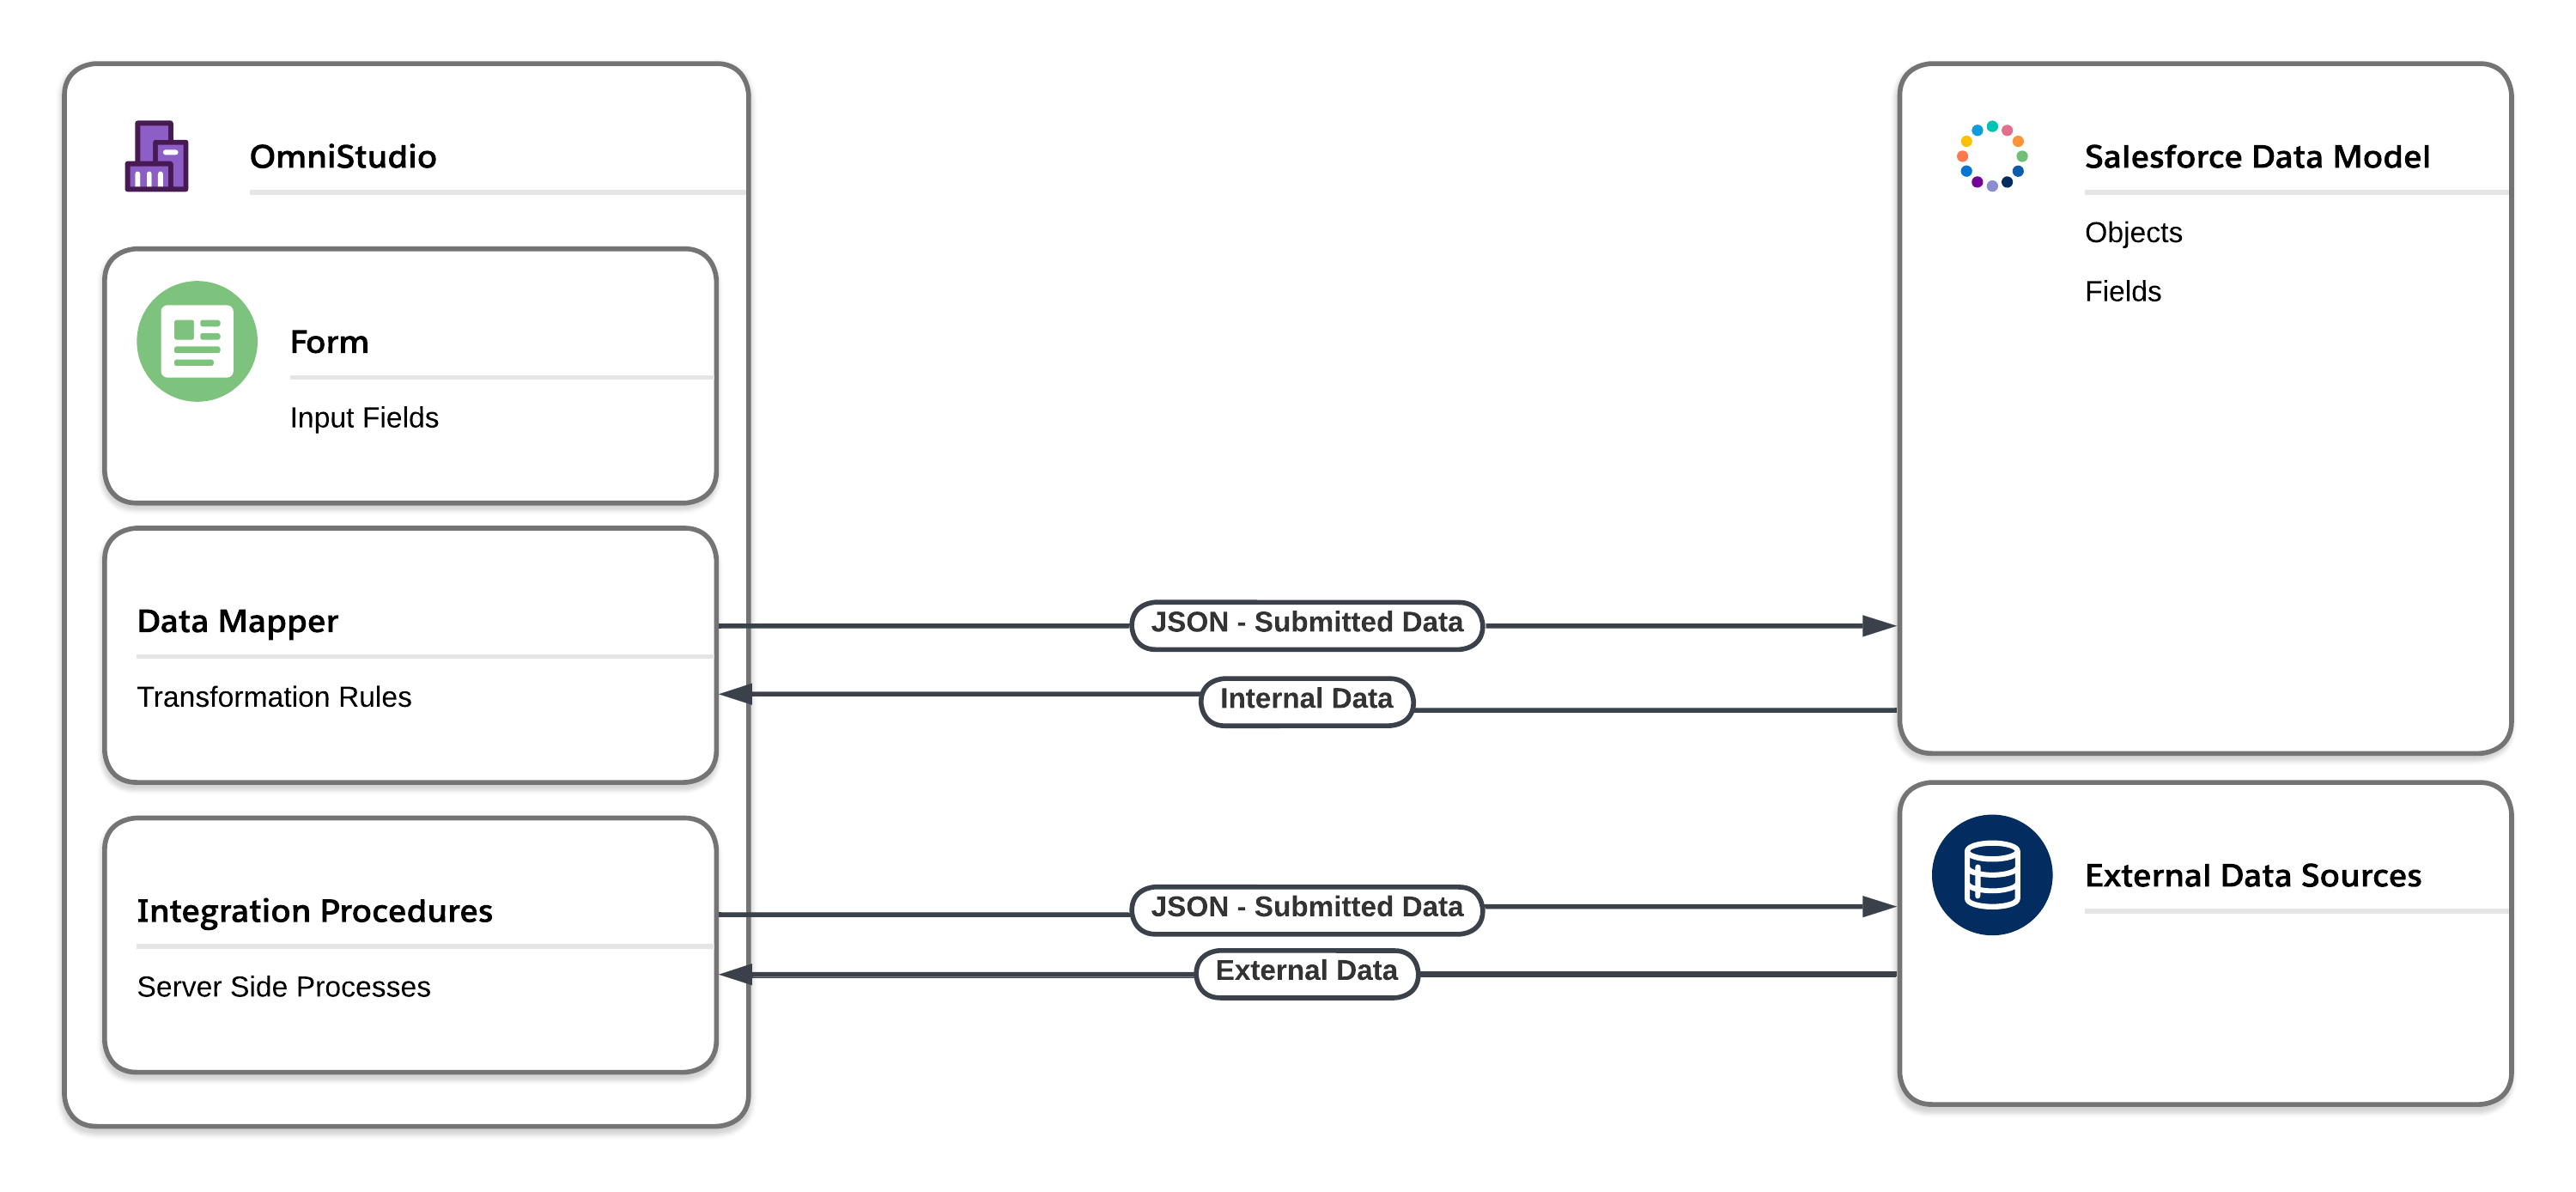 _Integraciones de OmniStudio_](/docs/architect/es-mx/reference-diagrams/guide/omnistudio-integrations)
### Ámbito y navegación de formularios
Si puede obtener todas sus entradas de usuario desde un formulario de pantalla única, comience con Formularios dinámicos. Sin embargo, aunque Formularios dinámicos en páginas de registro puede utilizar la función Ruta para representar libremente las diversas etapas en su proceso de negocio, es posible que no se ajuste a la mayoría de sus casos de uso.
#### Preguntas para formular:
- ¿Necesita una sola pantalla o el usuario tendrá que navegar entre múltiples pantallas para completar una tarea?
- ¿Desea que sus usuarios vean una representación visual de lo avanzado que están en el proceso de rellenar su formulario?
- ¿Se requerirá a sus usuarios rellenar la información en cada pantalla en un orden específico o deben poder moverse de un lado a otro entre pantallas según sea necesario?
| Pantalla única | Formulario de múltiples pantallas | Indicadores de progreso | Saltar la navegación entre pasos / pantallas | |
|---|---|---|---|---|
| Formularios dinámicos | Disponible | No disponible | Disponible | No disponible |
| Flujo de pantalla | Disponible | Disponible | Disponible | No disponible |
| OmniStudio | Disponible | Disponible | Disponible | Disponible |
| Flujo de pantalla + LWC | Disponible | Disponible | Disponible | Disponible |
| LWC | Disponible | No es ideal | No es ideal | No es ideal |
| Página de registro Lightning | Página de inicio o página de aplicación Lightning | Sitios de Aura Experience Cloud | Sitios de LWR Experience Cloud | Snap integrados | Barra de utilidades | Acción específica de objeto | Acción global | Aplicación móvil Salesforce** | Field Service Mobile | SDK móvil | Sitios y aplicaciones externos | LWC personalizado | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Formularios dinámicos | Disponible | No disponible | No disponible | No disponible | No disponible | No disponible | No disponible | No disponible | Disponible | No disponible | No disponible | No disponible | No disponible |
| Flujo de pantalla | Disponible | Disponible | Disponible | Disponible | Disponible | Disponible | Disponible | Roadmap | Disponible | Disponible*** | No disponible | Roadmap | Disponible |
| OmniStudio | Disponible | Disponible | Disponible | No disponible | No disponible | Disponible | No disponible | No disponible | Disponible | No disponible | No disponible | Disponible | Disponible |
| Flujo de pantalla + LWC | Disponible | Disponible | Disponible | Disponible | Disponible | Disponible | Disponible | Roadmap | Disponible | No disponible | No disponible | No es ideal | Disponible |
| LWC | Disponible | Disponible | Disponible | Disponible | Disponible | Disponible | Roadmap | Roadmap | Disponible | Roadmap | Roadmap | Disponible | Disponible |
| *Los flujos se pueden integrar en sitios de Experience Cloud LWR pero tienen consideraciones que debe tener en cuenta. **Los flujos y los LWC son compatibles con la aplicación móvil Salesforce, pero la aplicación móvil Salesforce no es compatible con todas las formas en que puede incrustar flujos y LWC. Por ejemplo, las acciones específicas de objetos son compatibles en dispositivos móviles, pero los elementos de la barra de utilidades no. ***La aplicación Field Service Mobile no admite muchas de las funciones de flujo más recientes, ya que está diseñada desde un Motor de flujos antiguo y Tiempo de ejecución de flujo de pantalla: tiene modificaciones especiales para que funcione sin conexión. |
|||||||||||||
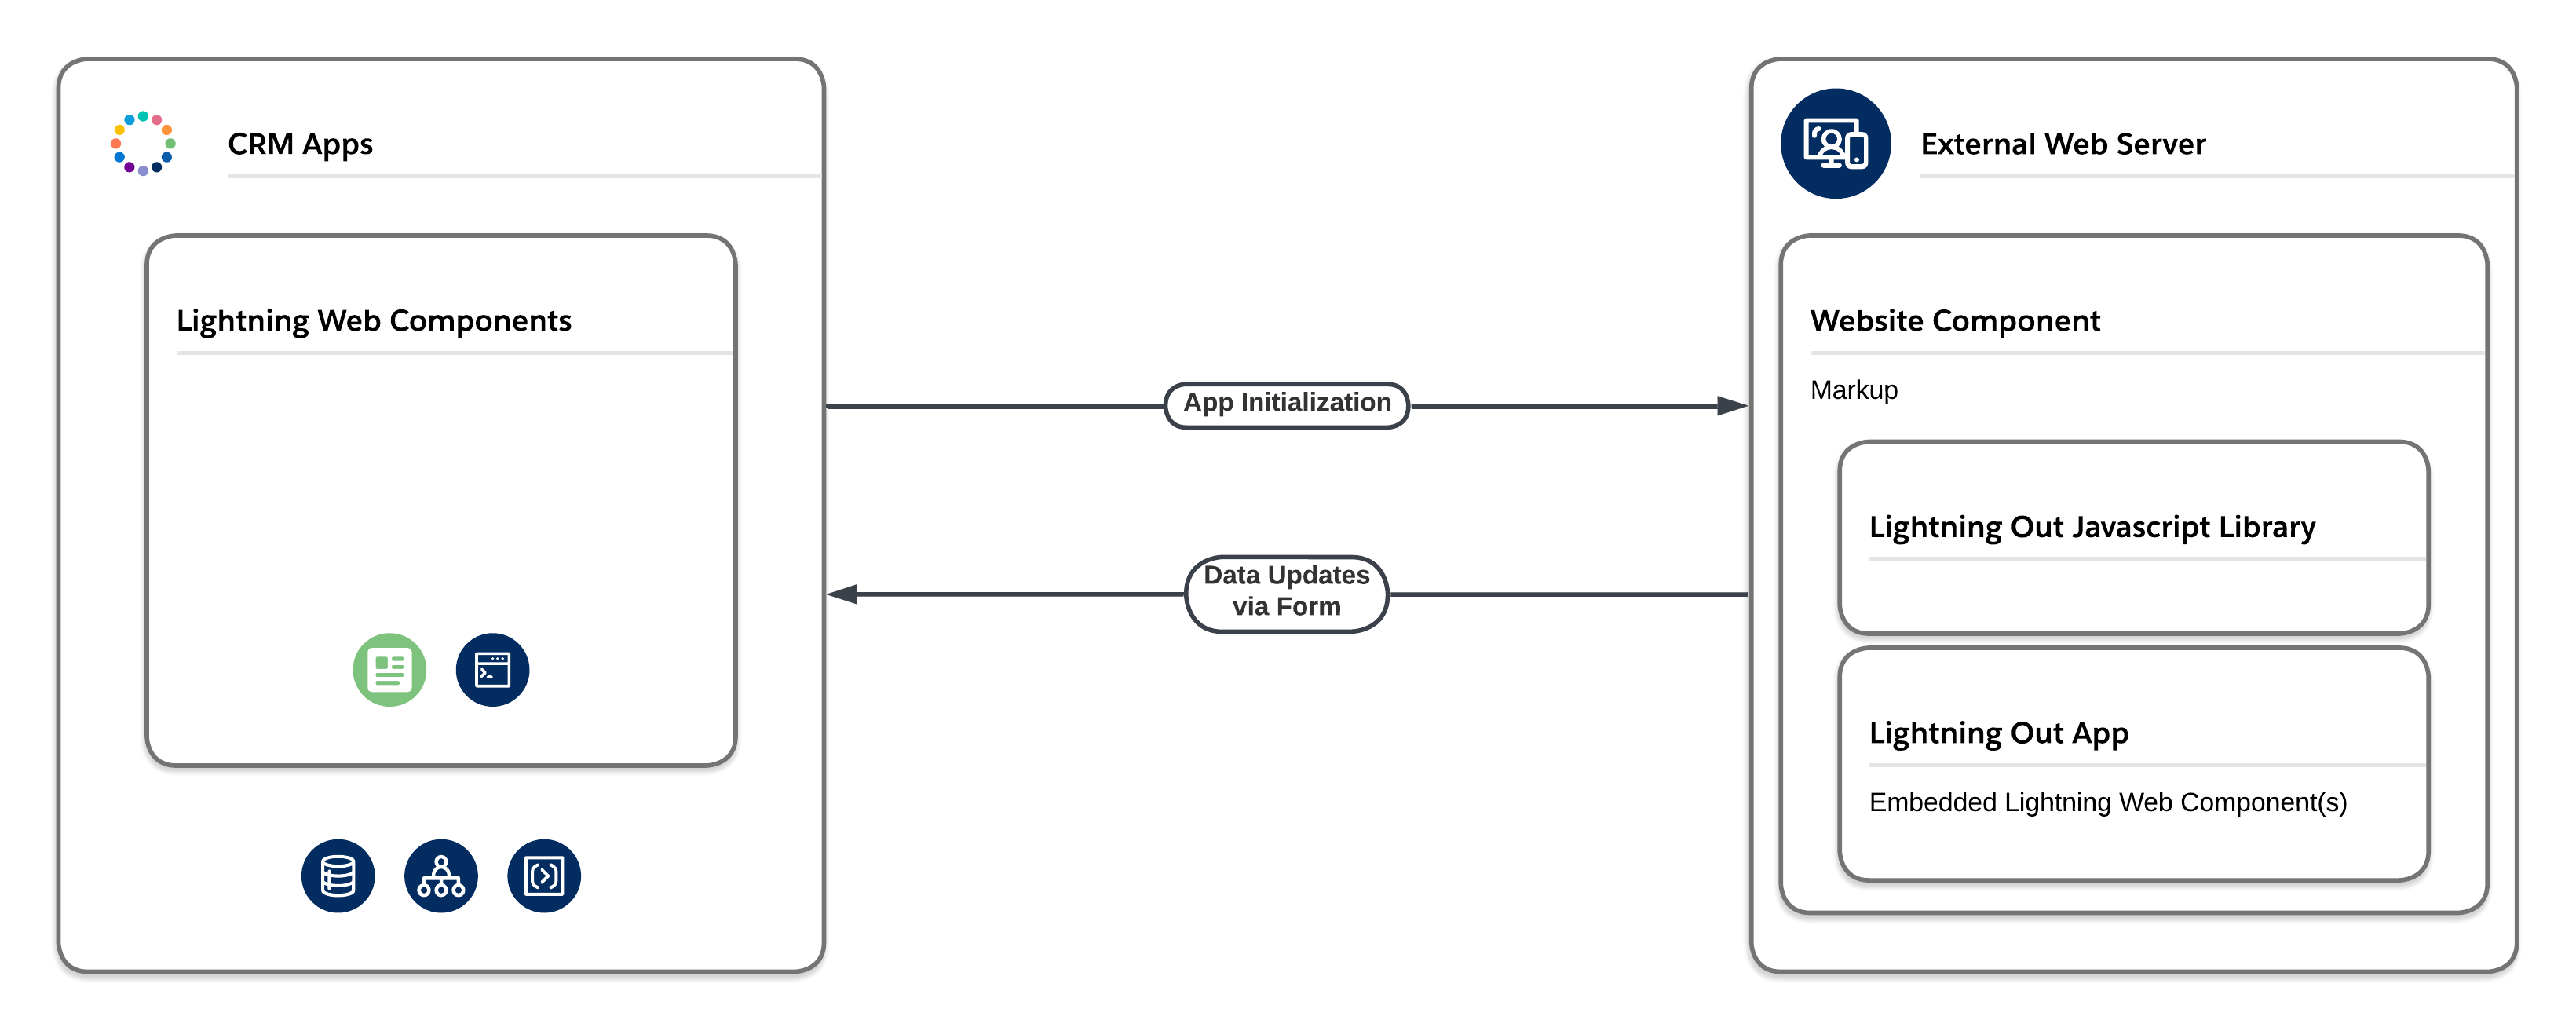 _ Lightning Out en sitios externos_](/docs/architect/es-mx/reference-diagrams/guide/lightning-out-on-external-sites)
Los componentes web Lightning no se admiten actualmente como acciones rápidas (específicas de objetos o globales), pero como solución puede incluir un LWC en un componente Aura (como puede hacer con flujos). Los componentes LWC también pueden iniciar flujos con el componente [Lightning](https://developer.salesforce.com/docs/component-library/bundle/lightning-flow/documentation).
OmniStudio destaca en la exposición de contenido a sus sitios externos a través de la función OmniOut. Con OmniStudio y OmniOut, puede compilar sus formularios de OmniScript y componentes FlexCard en componentes estándar y ejecutarlos fuera de la plataforma en sitios o aplicaciones externos.
Ninguna de las tecnologías de formularios cubiertas en esta guía se admite oficialmente en plantillas de Mobile SDK hoy. Si el SDK móvil es esencial para su caso de uso, es mejor que cree su formulario de forma nativa en su aplicación móvil o cree una página Visualforce, teniendo en cuenta las directrices de [factores de forma](/docs/architect/es-mx/well-architected/guide/engaging#factor-de-forma) bien arquitectadas de Salesforce.
**Nota de hoja de ruta:** El equipo de Mobile SDK está trabajando activamente en la asistencia a LWC en páginas Visualforce.
### Controlador
Formularios dinámicos es perfecto si necesita utilizar los valores de su formulario para crear o actualizar un registro. Para cualquier función más allá de eso, deberá aprovechar Flow, OmniStudio o LWC. Esas funciones podrían incluir una capa de decisiones o iteraciones, o la generación de publicaciones o mensajes de email de Slack utilizando las entradas del formulario.
#### Preguntas para formular:
- ¿Qué acciones o lógica desea que se realicen en segundo plano?
- ¿Contiene su modelo de datos datos datos jerárquicos?
- ¿Necesitará su formulario completar sus operaciones en una sola transacción o entre múltiples transacciones?
- ¿Necesita integrar con sistemas externos?
- ¿Cuáles son sus requisitos de reutilización y modularidad?
| Registro y acciones | Gestión de datos jerárquica | Operar en una sola transacción | Operar entre múltiples transacciones | Integración | Diseño modular y reutilización | Empaquetado | |
|---|---|---|---|---|---|---|---|
| Formularios dinámicos | No disponible | No disponible | No disponible | No disponible | No disponible | No disponible | Disponible |
| Flujo de pantalla | Disponible | Roadmap | Disponible | Disponible | Disponible | Disponible | Disponible |
| OmniStudio | Disponible | Disponible | Disponible | Disponible | Disponible | Disponible | No disponible |
| Flujo de pantalla + LWC | Disponible | Disponible | Disponible | Disponible | Disponible | Disponible | Disponible |
| LWC | Disponible | Disponible | Disponible | Disponible | Disponible | Disponible | Disponible |
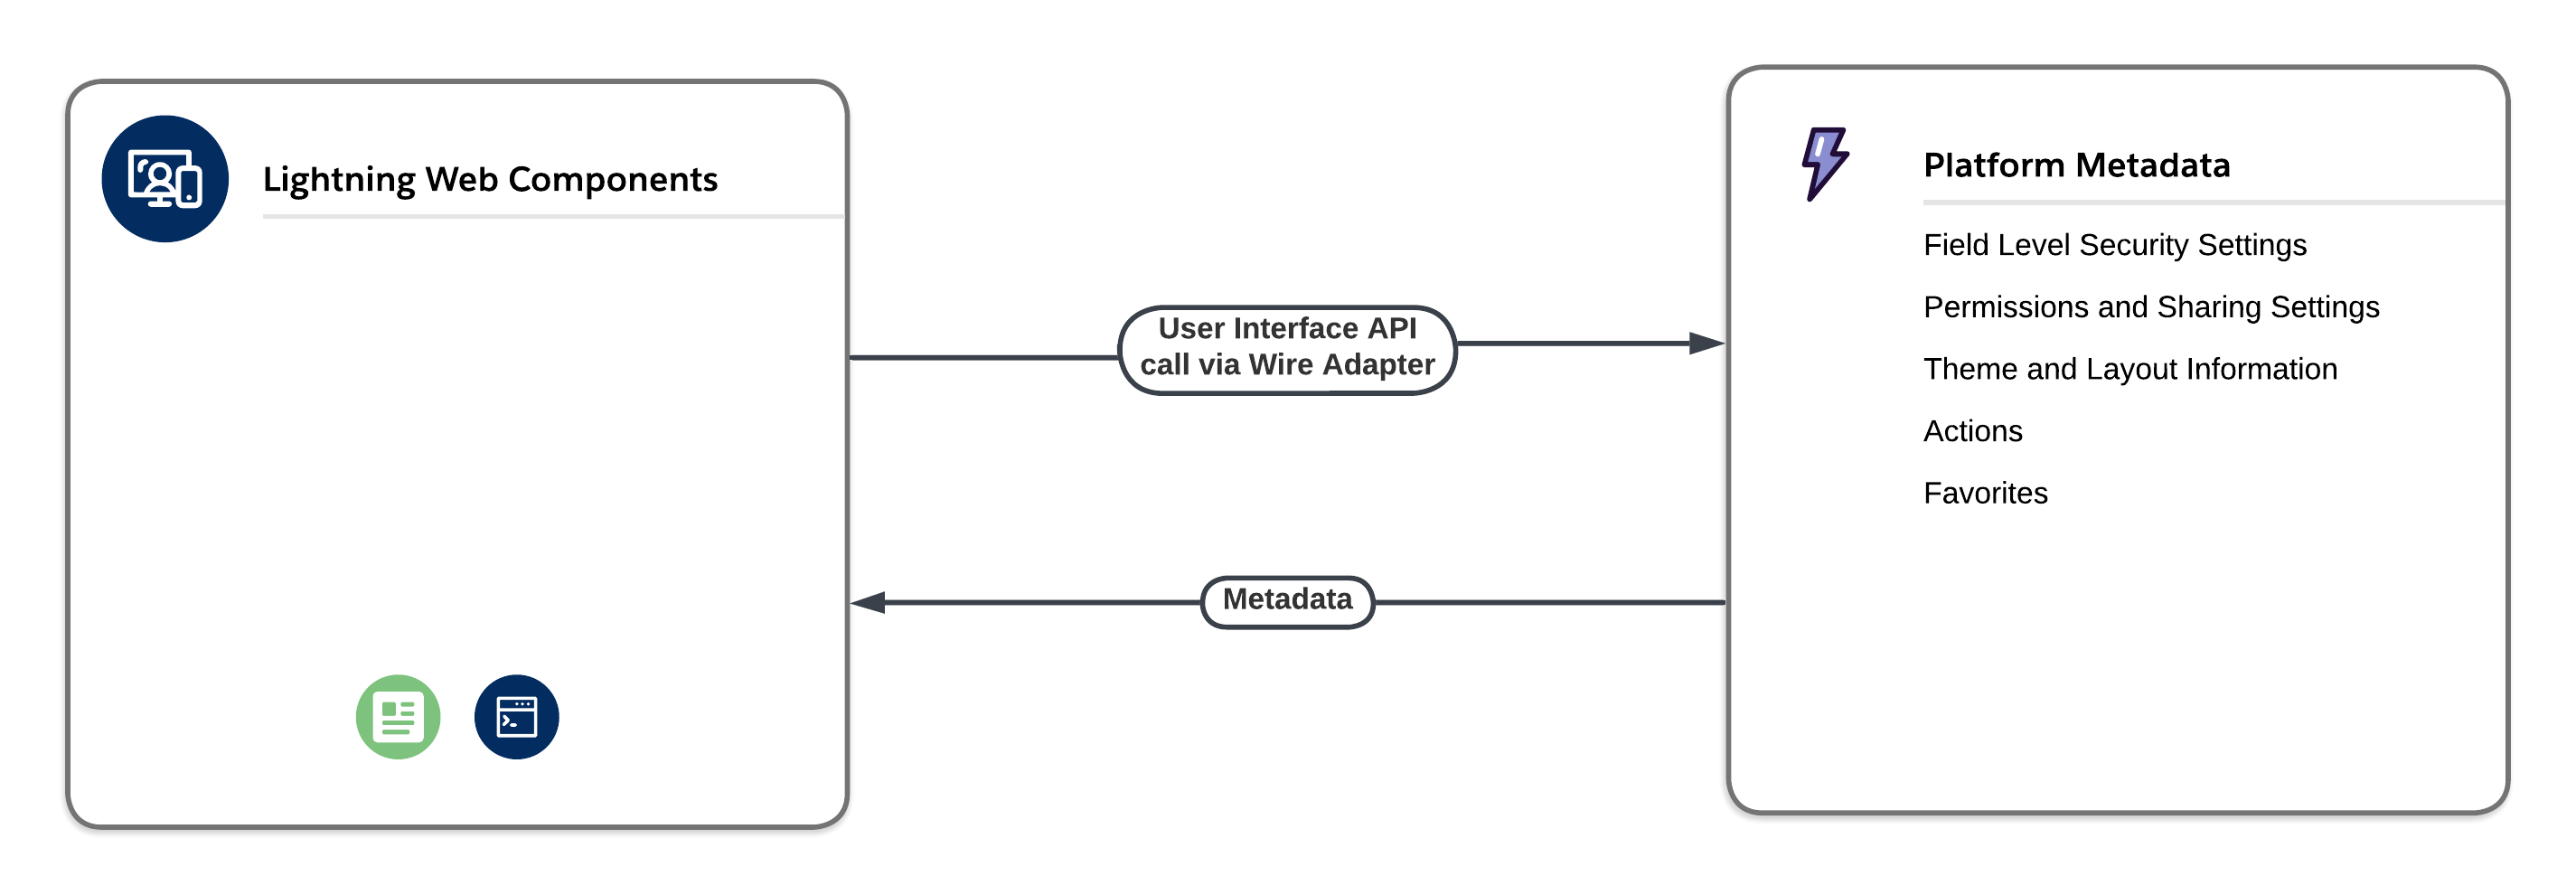 Interacción de _componentes web Lightning a través de adaptadores de red_](/docs/architect/es-mx/reference-diagrams/guide/lightning-web-components-interaction-via-wire-adapters)
Como se mencionó anteriormente, OmniStudio utiliza Procedimientos de integración y Asignador de datos para capturar y transformar fácilmente datos externos e internos en Salesforce. Brilla en aplanar y ampliar conjuntos de datos con varios niveles de relaciones gracias a numerosas funciones libres de código que puede utilizar.
**Nota de hoja de ruta:** Flow pronto admitirá la capacidad de alterar recopilaciones de registros, así como gestionar datos jerárquicos.
Flow, OmniStudio y LWC se integran con Apex, de modo que puede cerrar fácilmente cualquier brecha en la solución que elija. Por ejemplo, si requiere filtrar registros desde un LWC, siempre puede utilizar el adaptador de red para Apex para crear consultas SOQL complejas. Si se deja influir por la historia basada en clics, considere Flow u OmniStudio como alternativas viables a un controlador Apex para sus necesidades del lado del servidor.
Una pregunta secundaria aquí es si desea confirmar acciones inmediatamente o aplazarlas a una parte concreta de su formulario. Esto es especialmente relevante si está en un formulario de varias páginas. Flujo facilita combinar entradas desde múltiples formularios (pantallas de flujo) y utilizarlas mucho más adelante en el asistente (flujo) para realizar algunas operaciones. De hecho, recomendamos diseñar flujos justo de esa forma (realizar acciones al final) en caso de que el usuario se desplace entre pantallas, cambiando sus respuestas.
#### Control de operaciones
Las transacciones y los [límites reguladores](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_gov_limits.htm) son una forma de vida en Salesforce Platform. Si su caso de uso es bastante sencillo, es posible que no sea tan importante controlar en qué transacción se produce una operación concreta. Sin embargo, existen algunos casos de uso en los que es posible que desee combinar múltiples operaciones en una sola [transacción en](/docs/architect/es-mx/fundamentals/guide/architecture-basics#transacciones) vez de realizarlas en múltiples transacciones. Algunos ejemplos:
- **Para revertir o no revertir**: Esa es la cuestión. Supongamos que su formulario crea múltiples registros en segundo plano. Si no se crea el tercer registro, ¿se deben revertir los dos primeros registros? Si cada una de sus acciones son independientes entre sí, no dude en ejecutarlas en transacciones separadas. Sin embargo, si son dependientes y desea que el fallo de uno también revierta los otros, impleméntelos en una sola transacción. Si su formulario está en Flujo, puede utilizar el elemento Reversión en una ruta Fallo para revertir su transacción y garantizar la integridad de los datos.
- **Repercusión descendente en límites reguladores**: Especialmente cuando su formulario crea o actualiza un registro, considere cuáles son las implicaciones descendentes de esa operación. ¿Qué procesos, reglas de flujo de trabajo, desencadenadores de flujo, desencadenadores Apex u otros elementos en el orden de guardado se van a desencadenar basándose en este cambio de registro? ¿Y cómo afectan esos cambios colectivos a los límites reguladores que se consumen en esa transacción? Si un cambio de registro concreto dará como resultado muchos cambios descendentes que afectarán a sus límites, considere aislar ese cambio de registro en su propia transacción.
- **Procesamiento por lotes**: Incluso en un contexto de interfaz de usuario, es posible que necesite realizar múltiples actualizaciones por lotes juntas. Supongamos que su formulario de múltiples pantallas itera sobre un gran grupo de registros. En vez de confirmar una actualización de registro después de cada pantalla, espere a que haya recopilado las actualizaciones para todos los registros y luego envíe una solicitud para actualizar todos los registros.
Cuando utiliza Formularios dinámicos para crear o modificar un registro, solo siempre está realizando una operación, y esa operación es siempre el inicio de una transacción nueva neta.
Al crear un flujo de pantalla, tiene un control significativo sobre lo que sucede en una transacción concreta. Las pantallas y las acciones locales actúan como límites entre transacciones. Este es un resumen de alto nivel de cómo se gestionan las transacciones en la arquitectura de flujo de pantalla.
1. El usuario final interactúa con una pantalla y luego hace clic en **Siguiente**.
2. El cliente publica una solicitud en la API con las entradas.
3. La API recibe la solicitud y se abre una transacción y una conexión de base de datos. A continuación, la API llama al motor de flujos para invocar la solicitud.
4. El motor de flujos toma el relevo y sigue la ruta apropiada en la definición de flujo, hasta que alcanza un nodo Pantalla o Acción local. A continuación, el motor devuelve información sobre ese nodo a la API.
5. La API crea un objeto de respuesta que contiene los detalles de la siguiente pantalla para representar y devuelve ese objeto al cliente. En este punto, se confirman los cambios de la base de datos (por ejemplo, la [ejecución del pedido](/docs/architect/es-mx/fundamentals/guide/architecture-basics#manipulación-de-base-de-datos) de guardado) y se cierran la conexión y la transacción de la base de datos.
6. El cliente utiliza la respuesta de API para representar la siguiente pantalla con la que el usuario debe interactuar.
7. Repita el paso 1.
En otras palabras, las pantallas “rompen” transacciones. Cuando eso sucede, se confirma cualquier acción pendiente o DML, se cierra la transacción anterior y se inicia una nueva transacción.
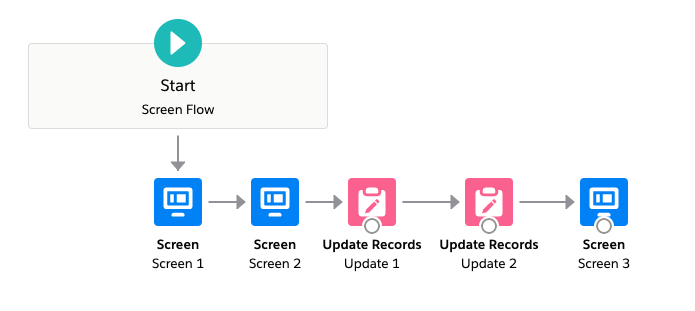 El diseño correcto, qué operaciones agrupa en una transacción concreta, es su llamada. Veamos algunos ejemplos.
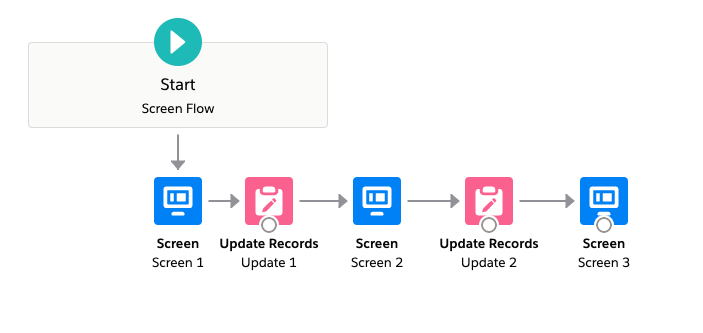
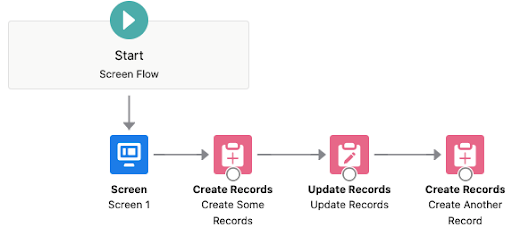
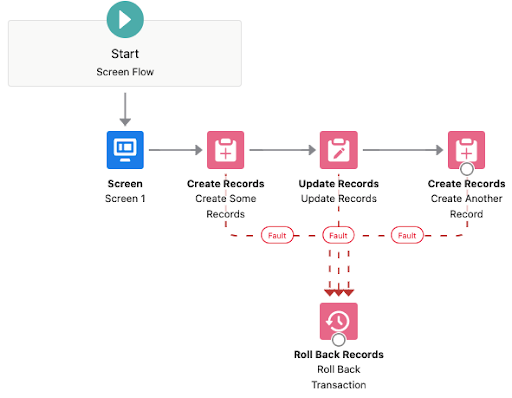
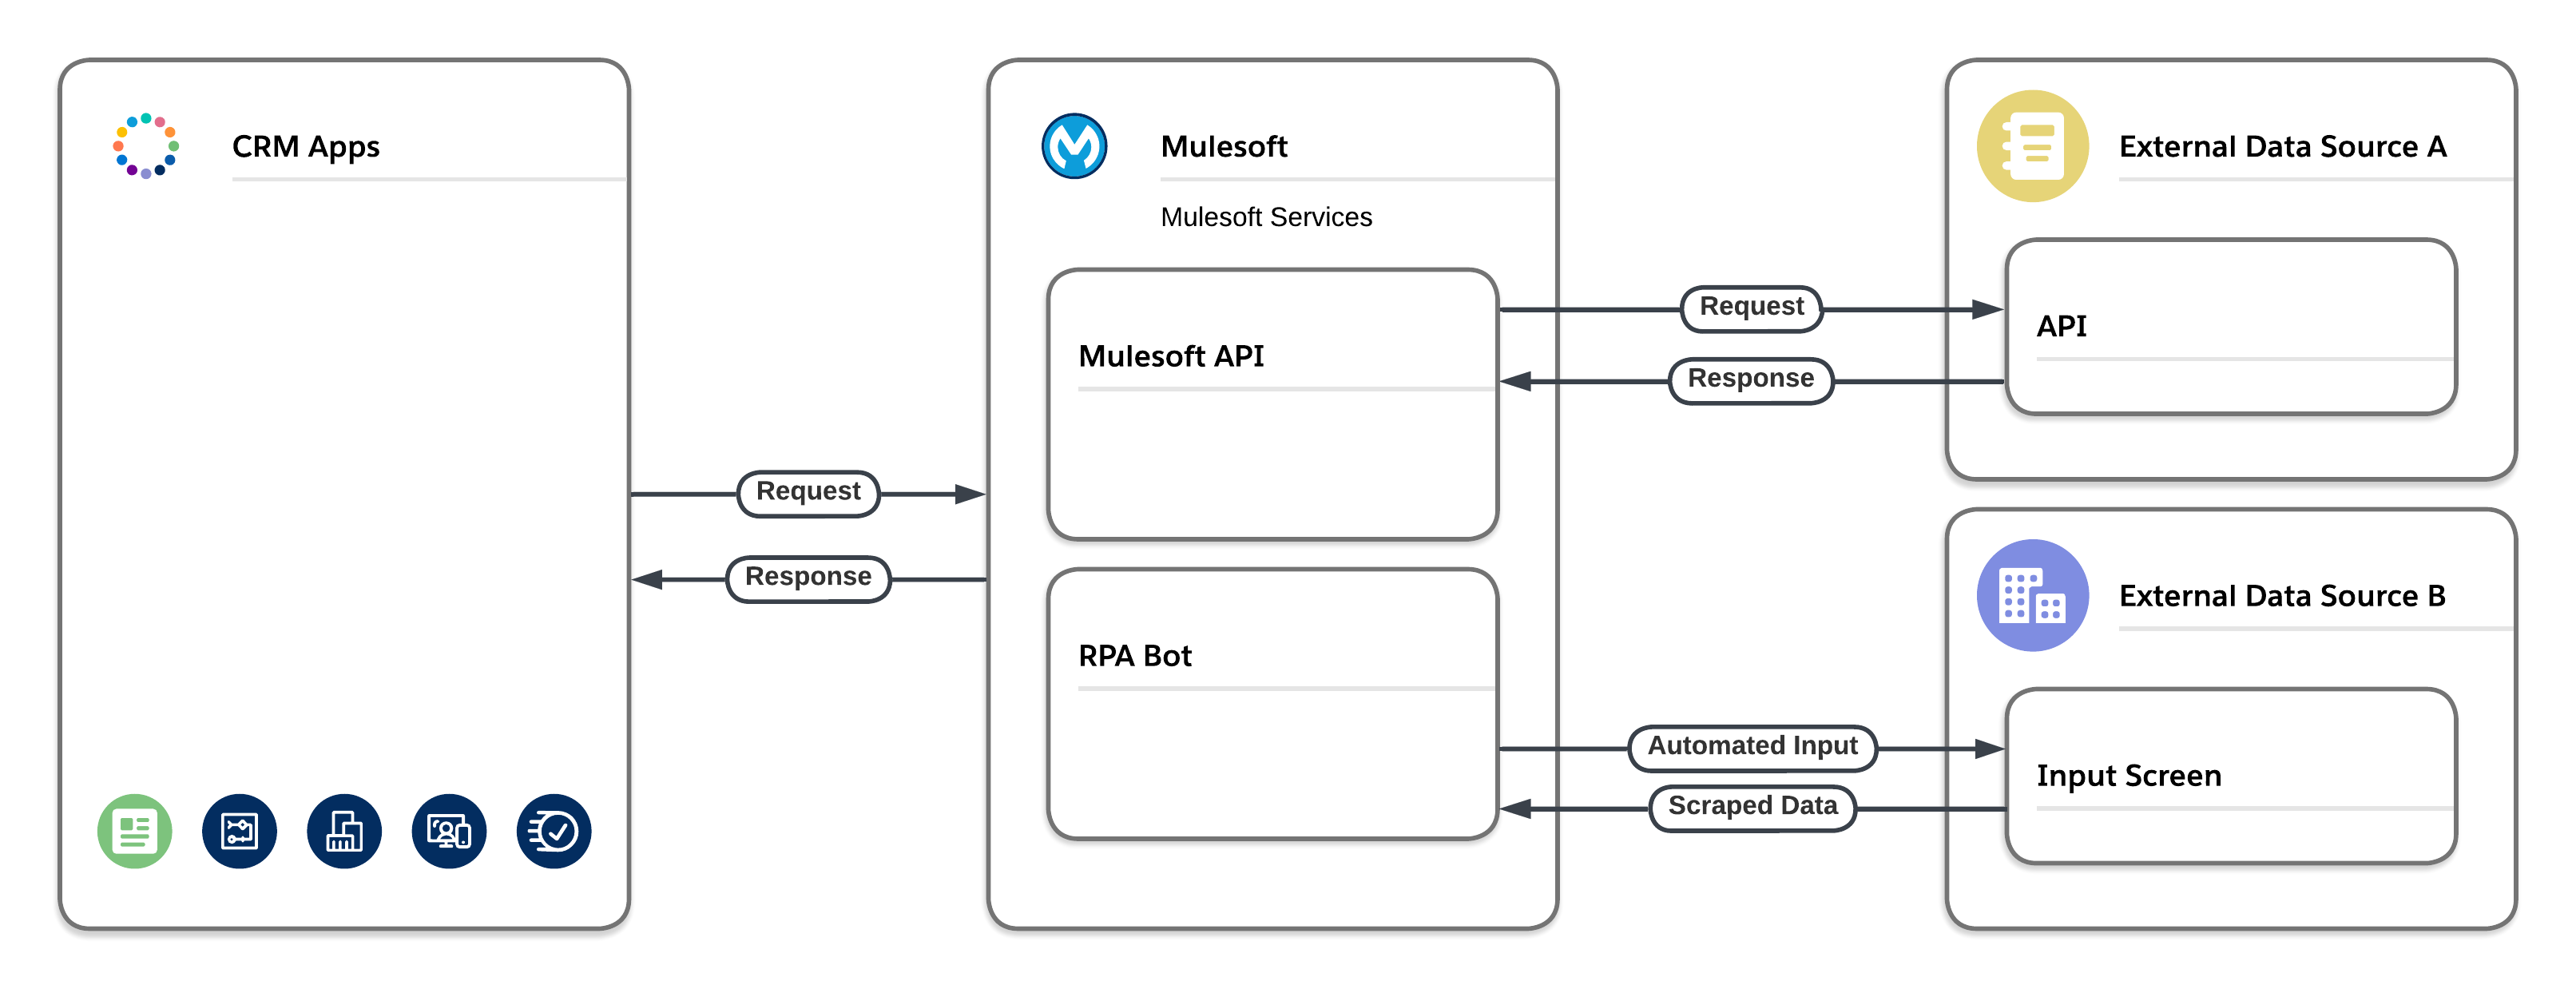 _Integraciones externas a través de API de MuleSoft y Bots RPA_](/docs/architect/es-mx/reference-diagrams/guide/external-integrations-via-mulesoft-apis-and-rpa-bots)
Si la API tiene un esquema de OpenAPI, cree un Servicio externo.
[
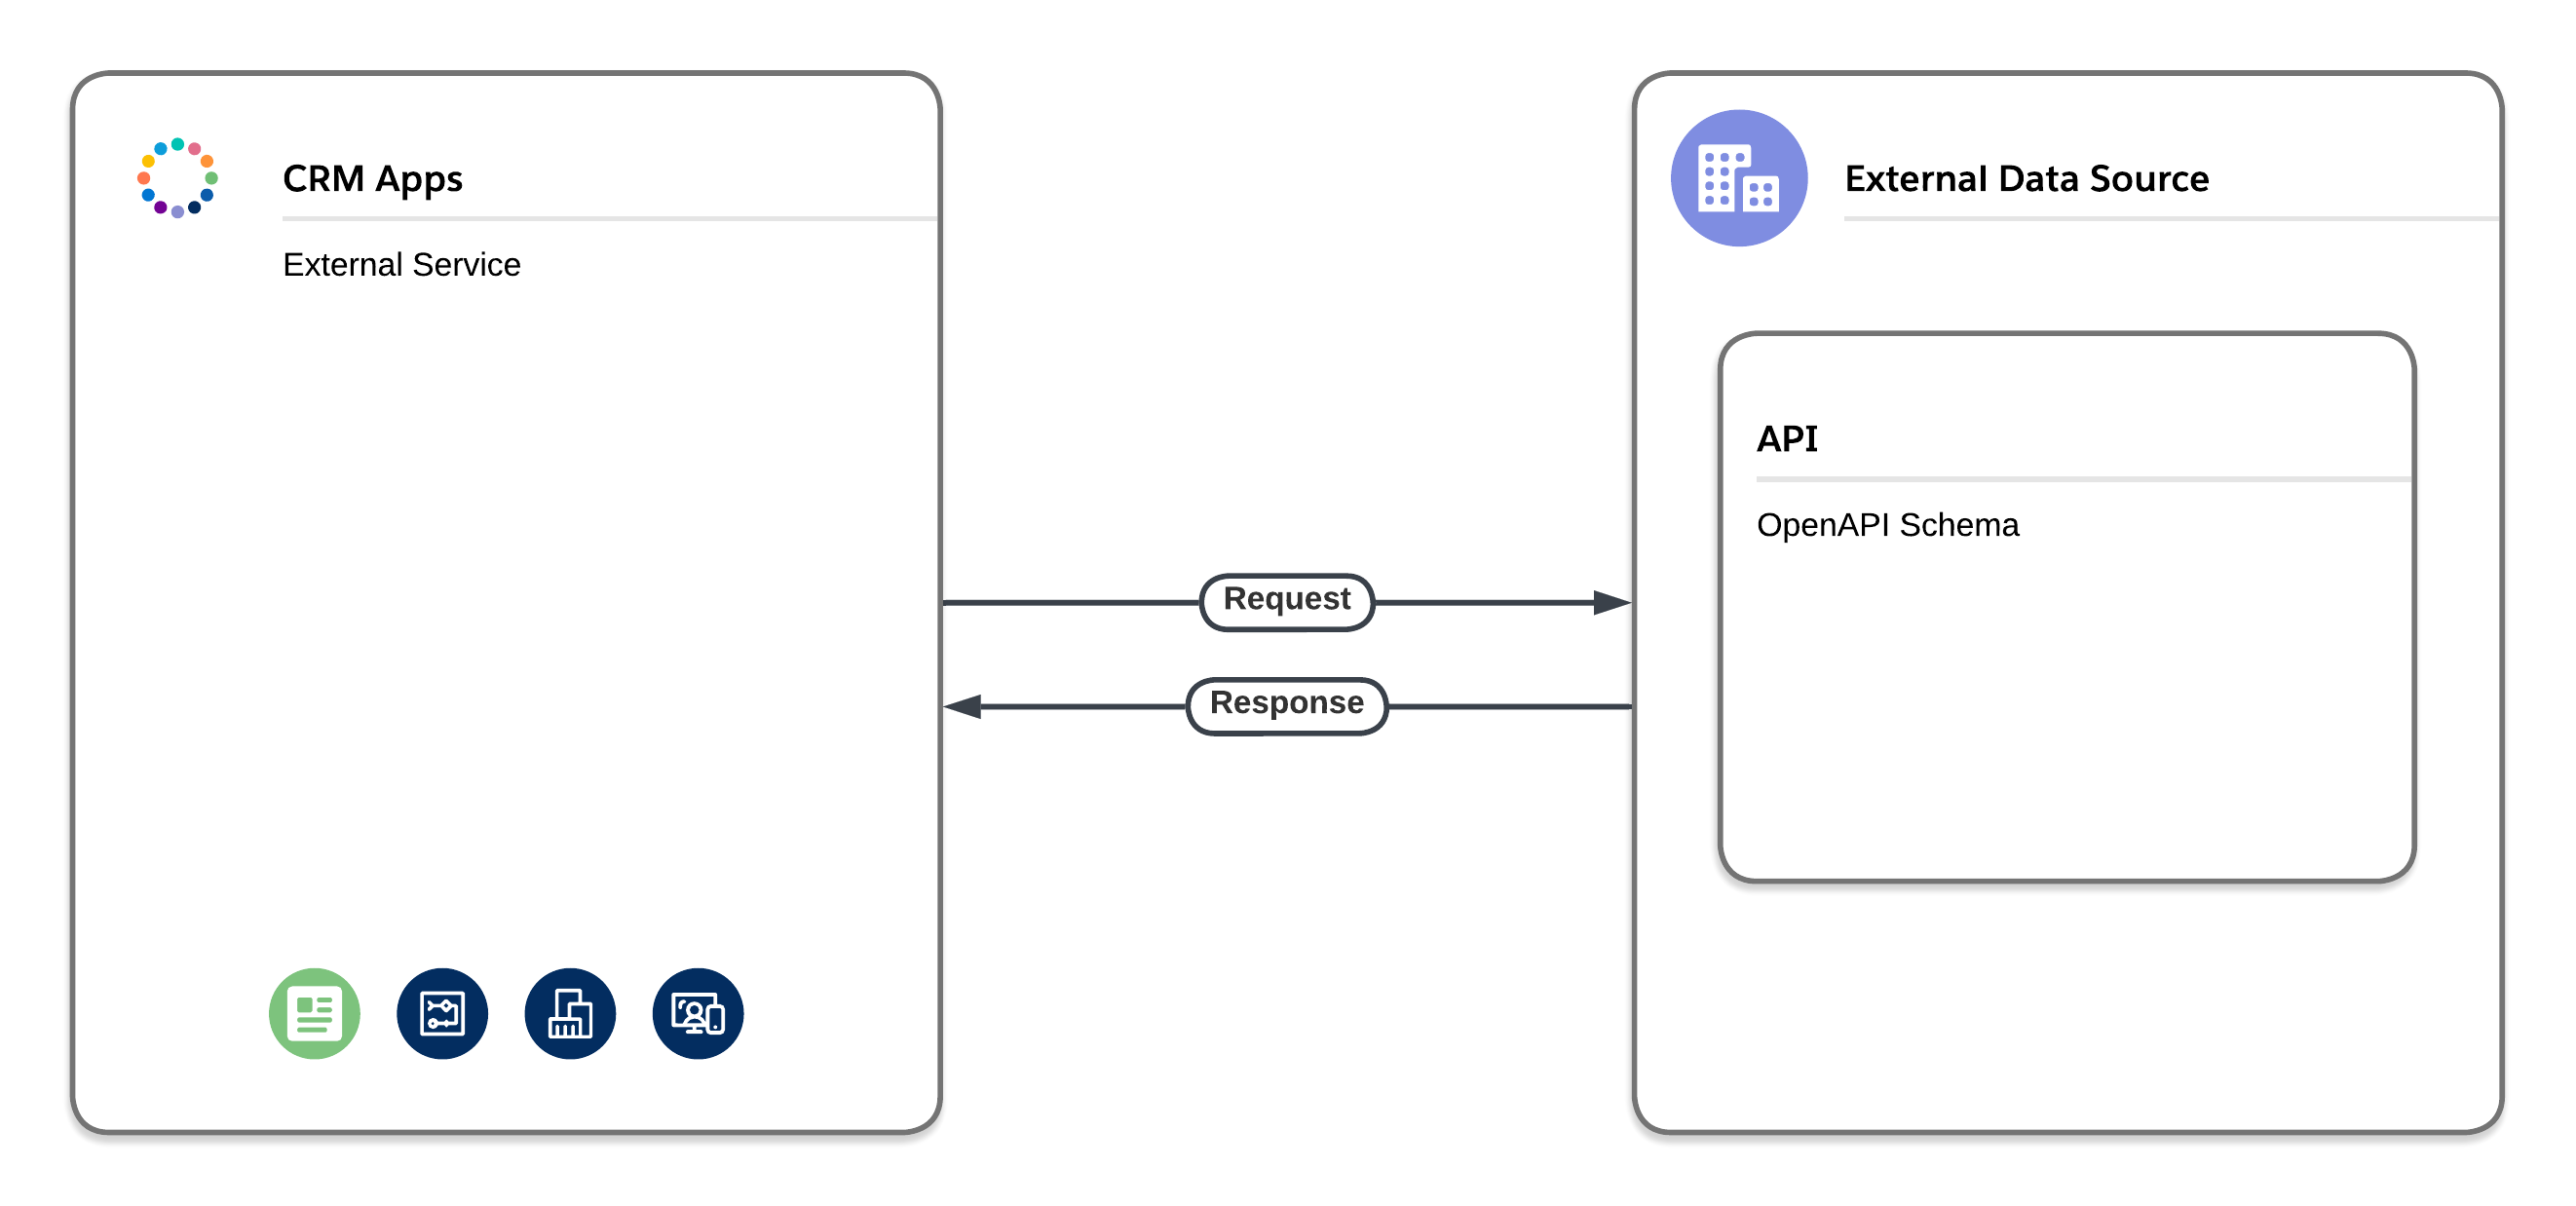 _Integraciones externas en API con esquemas de OpenAPI_](/docs/architect/es-mx/reference-diagrams/guide/external-integrations-to-apis-with-openapi-schemas)
De lo contrario, utilice la función Llamada HTTP en Flujo o Acción HTTP en OmniStudio. La llamada HTTP de Flow tiene tecnología de Servicios externos.
[
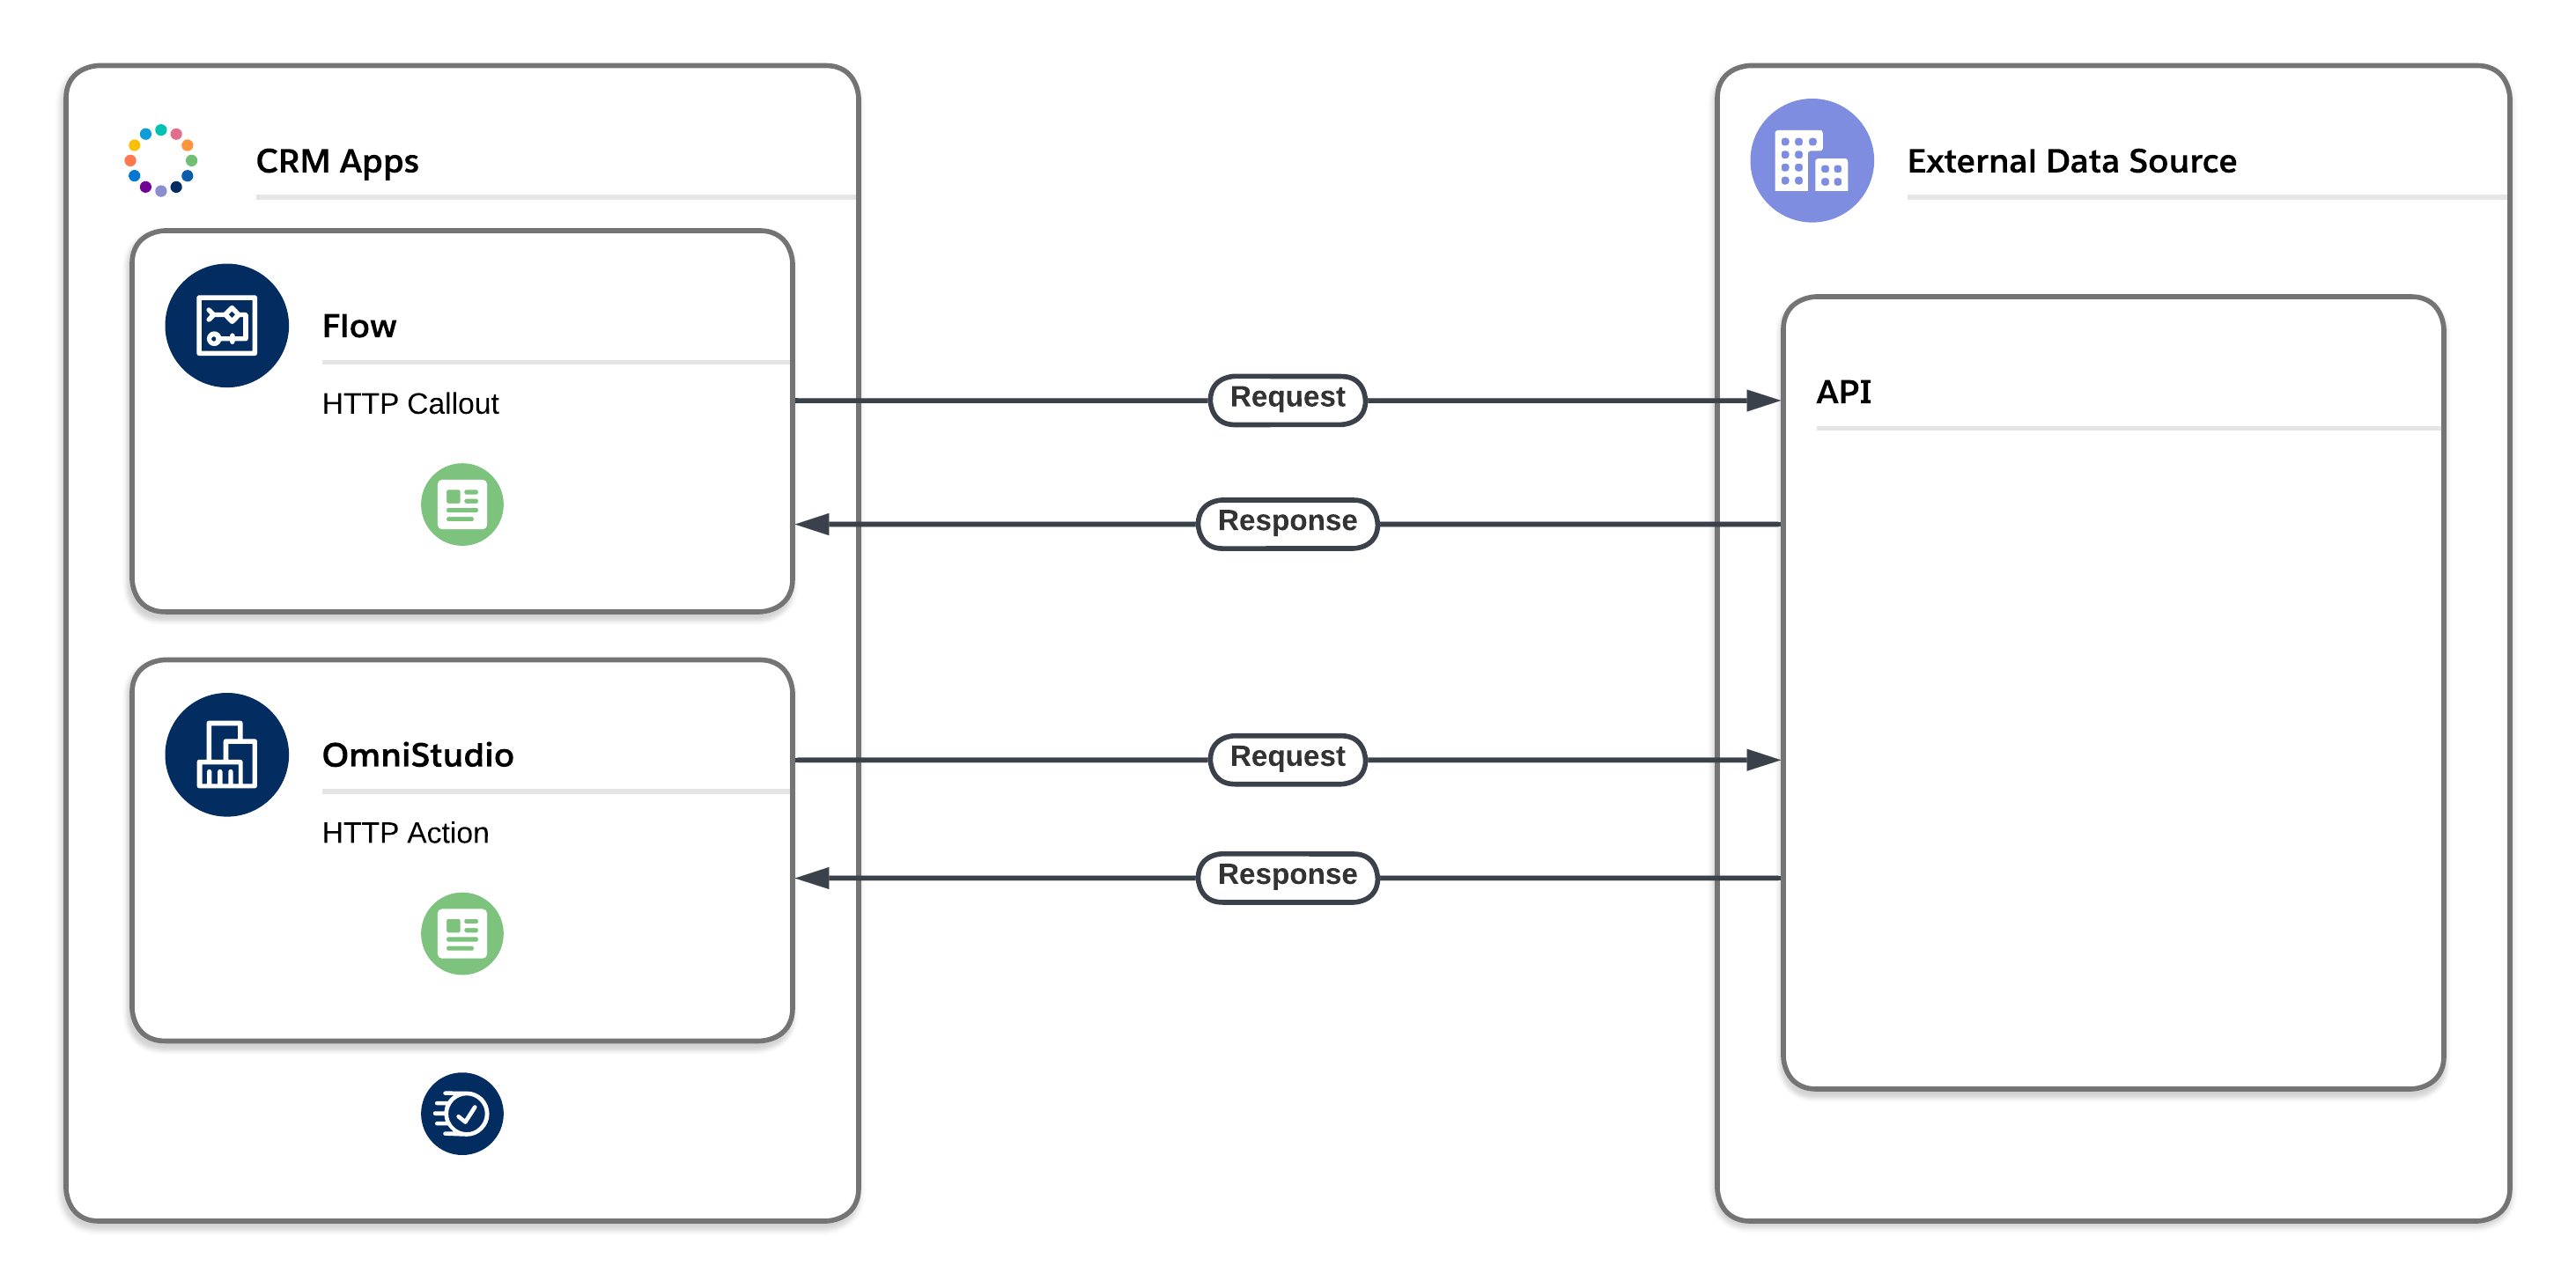 _. Integraciones externas mediante HTTP_](/docs/architect/es-mx/reference-diagrams/guide/external-integrations-via-http)
OmniStudio cuenta con un conjunto enriquecido de funciones de integración que pueden llamar a sistemas externos con Procedimientos de integración y transformar los datos con Asignador de datos. (Consulte [Repercusión de objeto](#impacto-de-objeto) para obtener más información)
Independientemente de si lo implementa con Apex personalizado o un servicio externo, una llamada es una llamada. Esto es lo que necesita saber.
1. Una llamada puede tardar mucho tiempo.
2. Cuando una llamada se ejecuta de forma síncrona, se realiza mientras una transacción de base de datos está abierta.
3. Salesforce no le permite mantener una transacción de base de datos abierta si tiene operaciones de base de datos pendientes.
La principal limitación a tener en cuenta es el peligro de las llamadas **_transacciones sucias_**, donde realiza una operación de creación, actualización o eliminación y luego, en la misma transacción, ejecuta una llamada. Este patrón no está permitido debido a la consideración #3 anterior, que por supuesto existe debido a las consideraciones #1 y #2.
En Flujo, puede solucionar esta limitación rompiendo la transacción. Recuerde que las pantallas y las acciones locales reintroducen el contexto del navegador, lo que interrumpe la transacción. Aunque puede utilizar pantallas y acciones locales cuando trabaje con llamadas externas, recomendamos activar Control de transacciones en configuración avanzada invocable. Control de transacciones es una función de acciones invocables que le permite finalizar automáticamente la transacción antes de que se realice una llamada. Puede activar Control de transacciones seleccionando Iniciar siempre una nueva transacción en la sección Avanzado de una acción invocada.
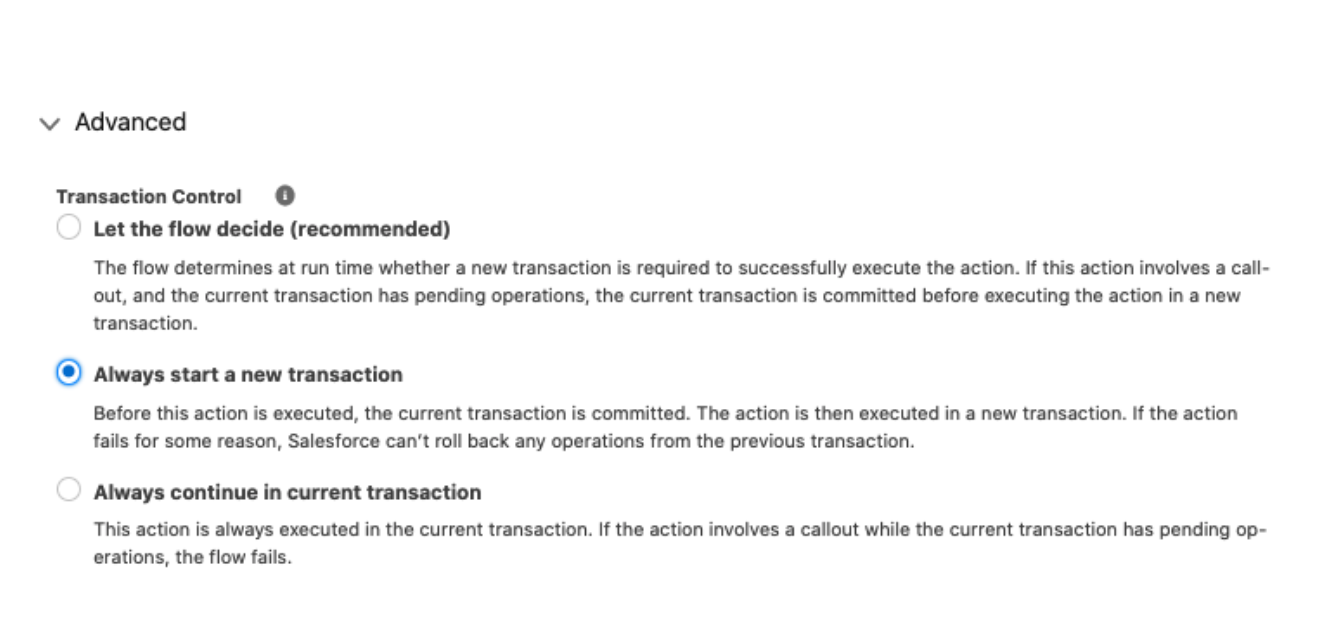 La repercusión de las llamadas en la transacción es menos complicada con LWC. En términos generales, realizará sus operaciones de datos utilizando Lightning Data Service (LDS) y luego utilizará un controlador Apex para realizar la llamada externa. Este diseño le protege de transacciones sucias, ya que la llamada LDS está aislada en su propia transacción separada de la llamada Apex.
_Para obtener directrices más detalladas sobre llamadas Apex, servicios externos y funciones de integración de datos en general, consulte la [Guía del arquitecto para la integración de datos con Salesforce](/docs/architect/es-mx/decision-guides/guide/data-integration)._
#### Reutilización y modularidad
Formularios dinámicos no admite la reutilización. Cada Formulario dinámico está vinculado a una página de registro Lightning específica para un objeto específico (aunque puede asignar esa página de registro Lightning a múltiples aplicaciones, perfiles, etc.).
Del mismo modo que puede redactar bibliotecas, utilidades y componentes pensados para su uso en múltiples otros componentes, puede aplicar patrones de diseño similares al crear flujos con la potencia de **_subflujos_**. Guarde sus flujos en depósitos más pequeños y modulares, y luego llámelos desde otros flujos utilizando el elemento Flujo secundario. Si su diseño lo requiere, puede crear un flujo que sea independiente y útil como subflujo de otro.
OmniStudio está construido de forma inherente para la modularidad. Asignadores de datos, OmniScripts, FlexCards y Procedimientos de integración se crean de forma independiente y pueden funcionar indistintamente. Además, las FlexCards se pueden crear como componentes LWC que se pueden integrar en otros LWC, OmniScripts, páginas de registro y sitios de Experience Cloud.
Los flujos de pantalla, los OmniScripts y los LWC se pueden crear para su reutilización e integrar en una variedad de ubicaciones, incluyendo sitios externos y aplicaciones Lightning Out. Cuando diseña sus soluciones para que sean [componibles](/docs/architect/es-mx/well-architected/guide/composable), obtiene beneficios adicionales como adaptabilidad y estabilidad.
### Validación
Todas las tecnologías que se utilizan para crear o actualizar un registro se adhieren a la validación a nivel del sistema, ya sean reglas de validación clásicas o validación personalizada integrada en un desencadenador Apex. Independientemente de la tecnología que utilice para realizar un cambio de registro, cada cambio pasa por la orden de guardado. Eso significa que además de las reglas de validación, el cambio de registro se procesa por cualquier número de flujos antes o después de guardar, antes o después de desencadenadores, reglas de distribución, reglas de asignación y mucho más. Si aún no lo hizo, asegúrese de marcar y familiarizarse con el [orden de ejecución](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_triggers_order_of_execution.htm) de Apex.
#### Preguntas para formular:
- ¿Tiene su formulario requisitos adicionales más allá de la validación a nivel del sistema?
- ¿Necesitará establecer campos obligatorios o de solo lectura de forma dinámica en el formulario?
| Respetar validación a nivel del sistema | Validación a nivel de campo personalizada específica de este formulario | Validación a nivel de campo personalizada | |
|---|---|---|---|
| Formularios dinámicos | Disponible | No disponible | No disponible |
| Flujo de pantalla | Disponible | No disponible | Roadmap |
| OmniStudio | Disponible | Disponible | Disponible |
| Flujo de pantalla + LWC | Disponible | Disponible | Disponible |
| LWC | Disponible | Disponible | Disponible |
| Elevar permisos de usuario | Controlar quién tiene acceso | Restringir ubicaciones permitidas | |
|---|---|---|---|
| Formularios dinámicos | No disponible | Disponible | No disponible |
| Flujo de pantalla | Disponible | Disponible | No disponible |
| OmniStudio | No disponible | Disponible | No disponible** |
| Flujo de pantalla + LWC | Disponible | Disponible | No disponible |
| LWC | Disponible* | Disponible | Disponible |
| *Requiere Apex **Aunque los OmniScripts no pueden tener un conjunto especificado de ubicaciones de destino, las FlexCards sí. |
|||
| Ejecutar operaciones de datos fuera de pantalla | Valores condicionales y cálculos | Visibilidad condicional | Requisito condicional | Formato condicional | Estado de solo lectura condicional | Estado desactivado condicional | |
|---|---|---|---|---|---|---|---|
| Formularios dinámicos | No disponible | No disponible | Disponible | No disponible | Roadmap | No disponible | No disponible |
| Flujo de pantalla | Disponible | Disponible** | Disponible | Disponible* | No disponible | Disponible** | Disponible** |
| OmniStudio | Disponible | Disponible | Disponible | Disponible | Disponible | Disponible | Disponible |
| Flujo de pantalla + LWC | Disponible | Disponible | Disponible | Disponible | Disponible | Disponible | Disponible |
| LWC | Disponible | Disponible | Disponible | Disponible | Disponible | Disponible | Disponible |
| *Limitado a componentes que utilizan un selector de recursos y no una casilla de verificación estática **Beta limitada |
|||||||
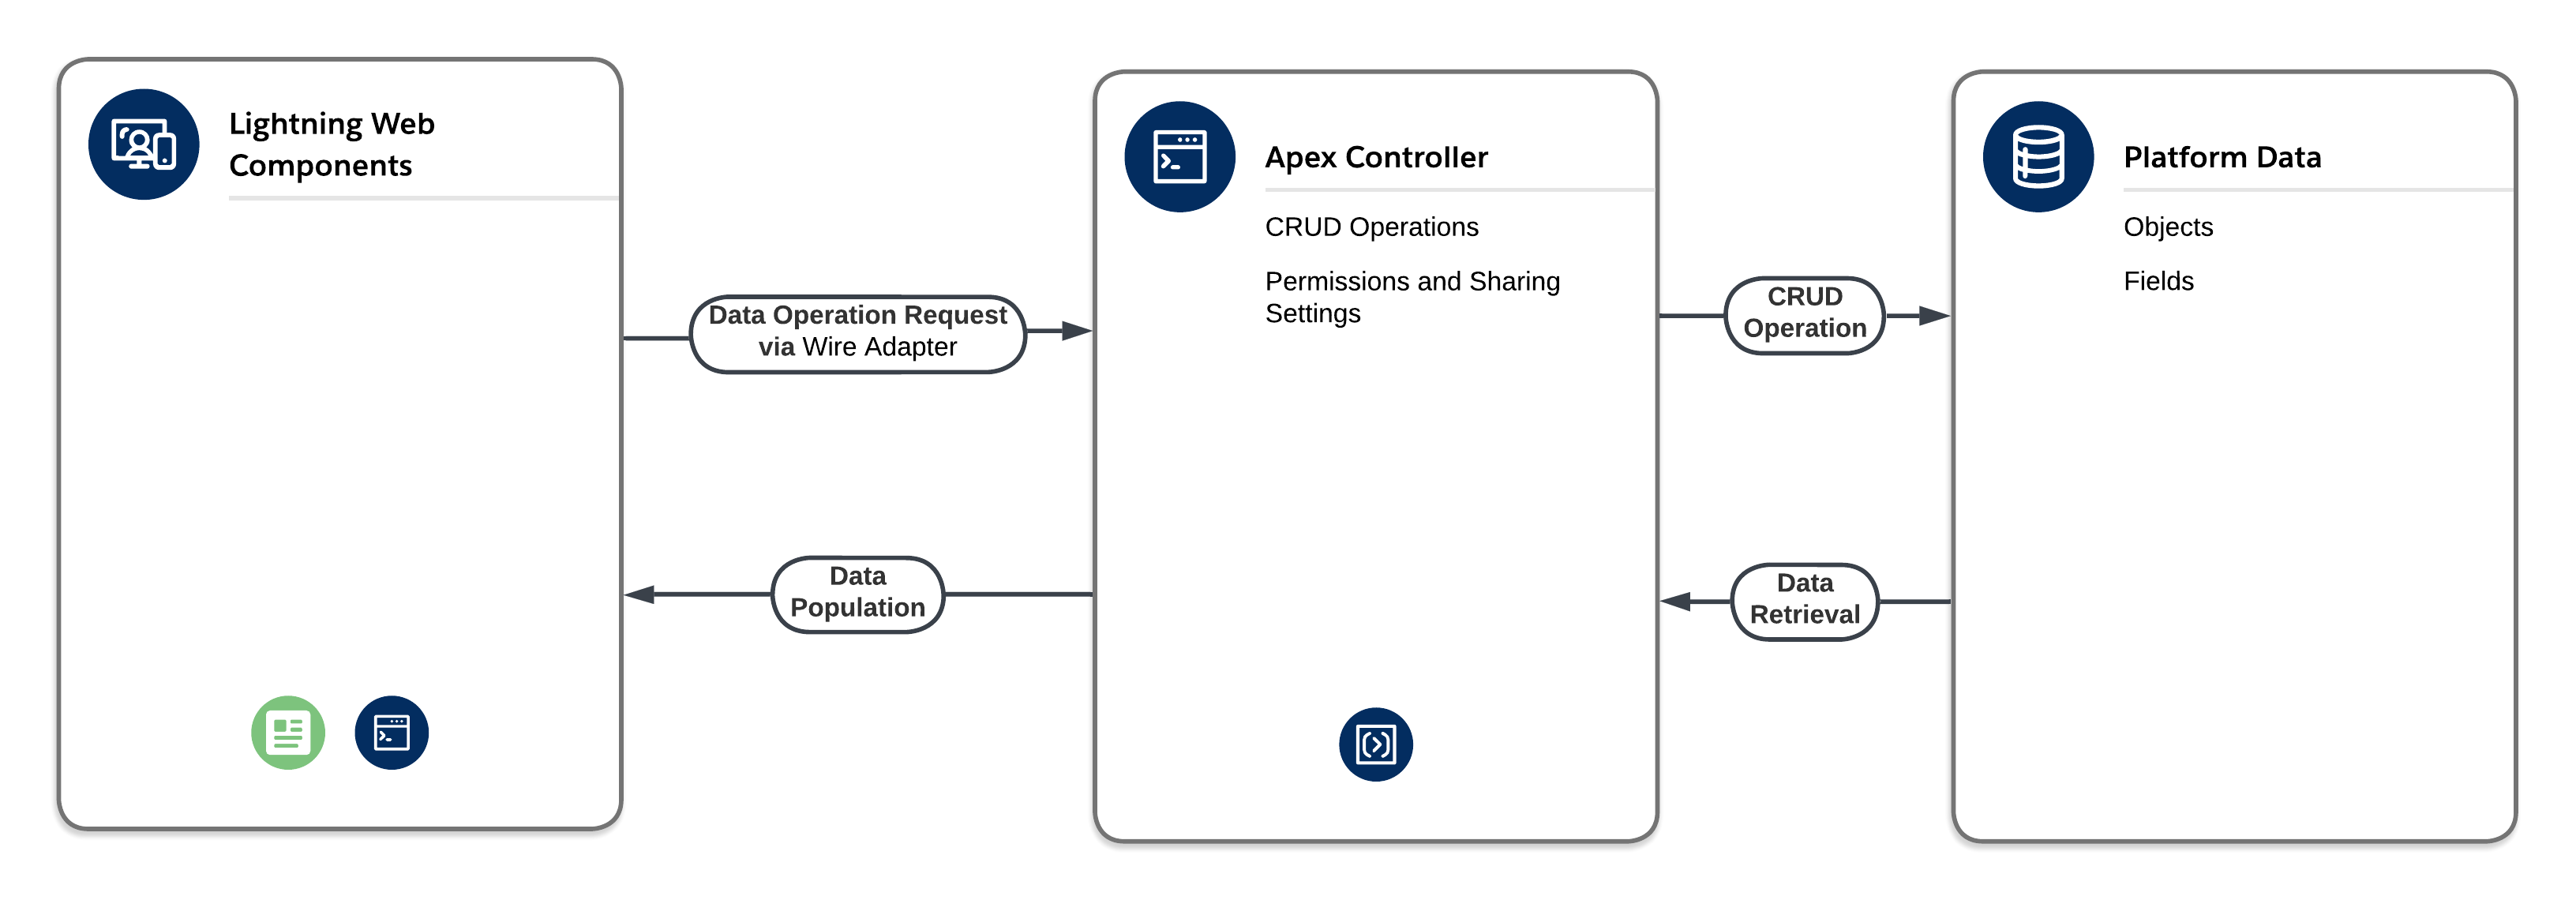 Operaciones de _datos fuera de pantalla_](/docs/architect/es-mx/reference-diagrams/guide/lightning-web-components-off-screen-data-operations)
**Visibilidad:** La visibilidad se puede controlar de forma dinámica en todas las herramientas de creación de formularios. Formularios dinámicos, Flow Builder y OmniStudio solucionan esto con funciones de visibilidad de componentes. Con esto, puede mostrar u ocultar campos de forma declarativa basándose en otros valores en el formulario o si el usuario está en un dispositivo móvil o no.
- Con Formularios dinámicos, la visibilidad se puede controlar basándose en valores de campo de registro, registros relacionados a través de campos de búsqueda y factor de forma.
- Con Flujo, puede basar una regla de visibilidad en otras entradas en la pantalla, así como otros recursos rellenados anteriormente en el flujo como fórmulas o valores de otros registros.
- **Reglas basadas en dispositivos:** No es obvio desde el principio, pero puede utilizar una fórmula para mostrar u ocultar un campo concreto cuando el usuario está en un dispositivo móvil. Escriba una fórmula de flujo que compruebe el valor de la variable global \$User.UIThemeDisplayed. Si el valor es Theme4t, el usuario está en la aplicación móvil Salesforce.
- **Evaluación de otros recursos:** Las referencias manuales de variables y fórmulas solo se evalúan en el servidor. Por lo tanto, cualquier valor que tenga ese recurso cuando se represente la pantalla por primera vez es el valor que tendrá hasta que navegue a otra pantalla. En la navegación, el tiempo de ejecución del flujo envía una solicitud al motor de flujos (el servidor) y obtiene los valores más recientes de las variables y fórmulas manuales. Si espera que su regla de visibilidad se actualice a medida que el usuario pasa por una única pantalla (por ejemplo, desenfoque), asegúrese de hacer referencia únicamente a valores de los otros componentes de la pantalla.
- Con OmniStudio, puede mostrar u ocultar componentes condicionalmente configurando una Propiedad de vista condicional. Sin embargo, no puede agregar más de una propiedad de vista condicional para una entrada.
**Estados de entrada condicionales:** Si necesita controlar dinámicamente cualquier otra propiedad, como si un campo es obligatorio, está desactivado o es de solo lectura, tiene algunas opciones. Como se espera, LWC le proporciona un control reactivo completo sobre su estado de entrada. Con componentes Flujo de pantalla reactivos, puede controlar dinámicamente atributos de componentes como Solo lectura, Desactivado y Obligatorio para componentes estándar que lo admiten, mientras que OmniStudio admite el espectro completo de atributos específicos de componentes. Si sus requisitos dictan que necesita Flujo y el componente no admite un estado de atributo específico, puede crear un LWC incrustable para alcanzar un estado de entrada dinámico.
Si necesita controlar dinámicamente cualquier otra propiedad, como si un campo es obligatorio o de solo lectura, su mejor apuesta a corto plazo es LWC, donde tiene el control completo. Eso es especialmente cierto si tiene requisitos personalizados sobre cómo gestionar el desenfoque o el onclick.
LWC reactivos en flujos de pantalla: Al crear LWC que pueden reaccionar y cambiar otros componentes en un flujo de pantalla, consulte esta guía [Mejores prácticas LWC para flujos](https://developer.salesforce.com/blogs/2023/02/lwc-best-practices-for-screen-flows) de pantalla para garantizar que sus componentes se integran bien en el motor de tiempo de ejecución de flujos y funcionan como se espera en el futuro.
| Gestión de eventos estándar (desenfoque, enfoque) | Gestión de eventos personalizados | |
|---|---|---|
| Formularios dinámicos | No disponible | No disponible |
| Flujo de pantalla | No disponible | No disponible |
| OmniStudio | No disponible | Disponible* |
| Flujo de pantalla + LWC | Disponible | Disponible |
| LWC | Disponible | Disponible |
| *El Tiempo de ejecución estándar de OmniStudio no admite Pub/Sub, pero admite Windows postMessage | ||
| Estilo directo | Temas de organización y Experience Builder | Estilo perfecto para píxeles | |
|---|---|---|---|
| Formularios dinámicos | No disponible | Disponible | No disponible |
| Flujo de pantalla | No disponible | Disponible | Roadmap |
| OmniStudio | Disponible* | No disponible | Disponible |
| Flujo de pantalla + LWC | No disponible | Disponible | Disponible |
| LWC | No disponible | Disponible | Disponible |
| *Solo tarjetas Flex | |||
| 2 columnas | 4 columnas | Más allá de 4 columnas | Bloques de datos repetitivos | Ficha Contenedores | Contenedores de acordeón | |
|---|---|---|---|---|---|---|
| Formularios dinámicos | Disponible | No disponible | No disponible | No disponible | Disponible | Disponible |
| Flujo de pantalla | Disponible | Disponible | No disponible | Disponible | No disponible | Disponible |
| OmniStudio | Disponible | Disponible | Disponible | Disponible | Disponible* | Disponible |
| Flujo de pantalla + LWC | Disponible | Disponible | Disponible | Disponible | Disponible | Disponible |
| LWC | Disponible | Disponible | Disponible | Disponible | Disponible | Disponible |
| *Las fichas se pueden utilizar si se incrustan datos en una FlexCard en un OmniScript | ||||||
| Etiquetas ingresadas en el generador | Etiquetas en el código | |
|---|---|---|
| Formularios dinámicos | Disponible* | No disponible |
| Flujo de pantalla | Disponible | Disponible |
| OmniStudio | Disponible | Disponible |
| Flujo de pantalla + LWC | Disponible | Disponible |
| LWC | No disponible | Disponible |
| *Solo encabezados de sección de campo | ||
| Pruebas de unidad | Automatización de extremo a extremo | |
|---|---|---|
| Formularios dinámicos | No disponible | Disponible* |
| Flujo de pantalla | No disponible | Disponible* |
| OmniStudio | Disponible* | Disponible* |
| Flujo de pantalla + LWC | Disponible* | Disponible* |
| LWC | Disponible | Disponible |
| *Requiere código | ||
| Vistas de página | Tiempo empleado en el formulario | Realizar seguimiento de la cumplimentación de formularios | Realizar un seguimiento del índice de éxito | |
|---|---|---|---|---|
| Formularios dinámicos | Disponible** | No disponible | No disponible | No disponible |
| Flujo de pantalla | Disponible | Disponible* | Disponible | Disponible |
| OmniStudio | Disponible | Disponible* | Disponible | Disponible |
| Flujo de pantalla + LWC | Disponible | Disponible* | Disponible | Disponible |
| LWC | Disponible** | Disponible* | Disponible | Disponible |
| *Disponible cuando Tiempo de ejecución de OmniStudio basado en paquetes está activado ** Disponible realizando un seguimiento del uso de la página Lightning principal |
||||
| Paquetes gestionados de primera generación (1GP) | Paquetes gestionados de segunda generación (2GP) | Paquetes desbloqueados | Conjuntos de cambios | DevOps Center | |
|---|---|---|---|---|---|
| Formularios dinámicos | Disponible | Disponible | Disponible | Disponible | Disponible |
| Flujo de pantalla | Disponible | Disponible | Disponible | Disponible | Disponible |
| OmniStudio | No disponible | No disponible | No disponible | No disponible* | No disponible* |
| Flujo de pantalla + LWC | Disponible | Disponible | Disponible | Disponible | Disponible |
| LWC | Disponible | Disponible | Disponible | Disponible | Disponible |
| *Utilice IDX Workbench para implementar Soluciones de OmniStudio en otras organizaciones. | |||||
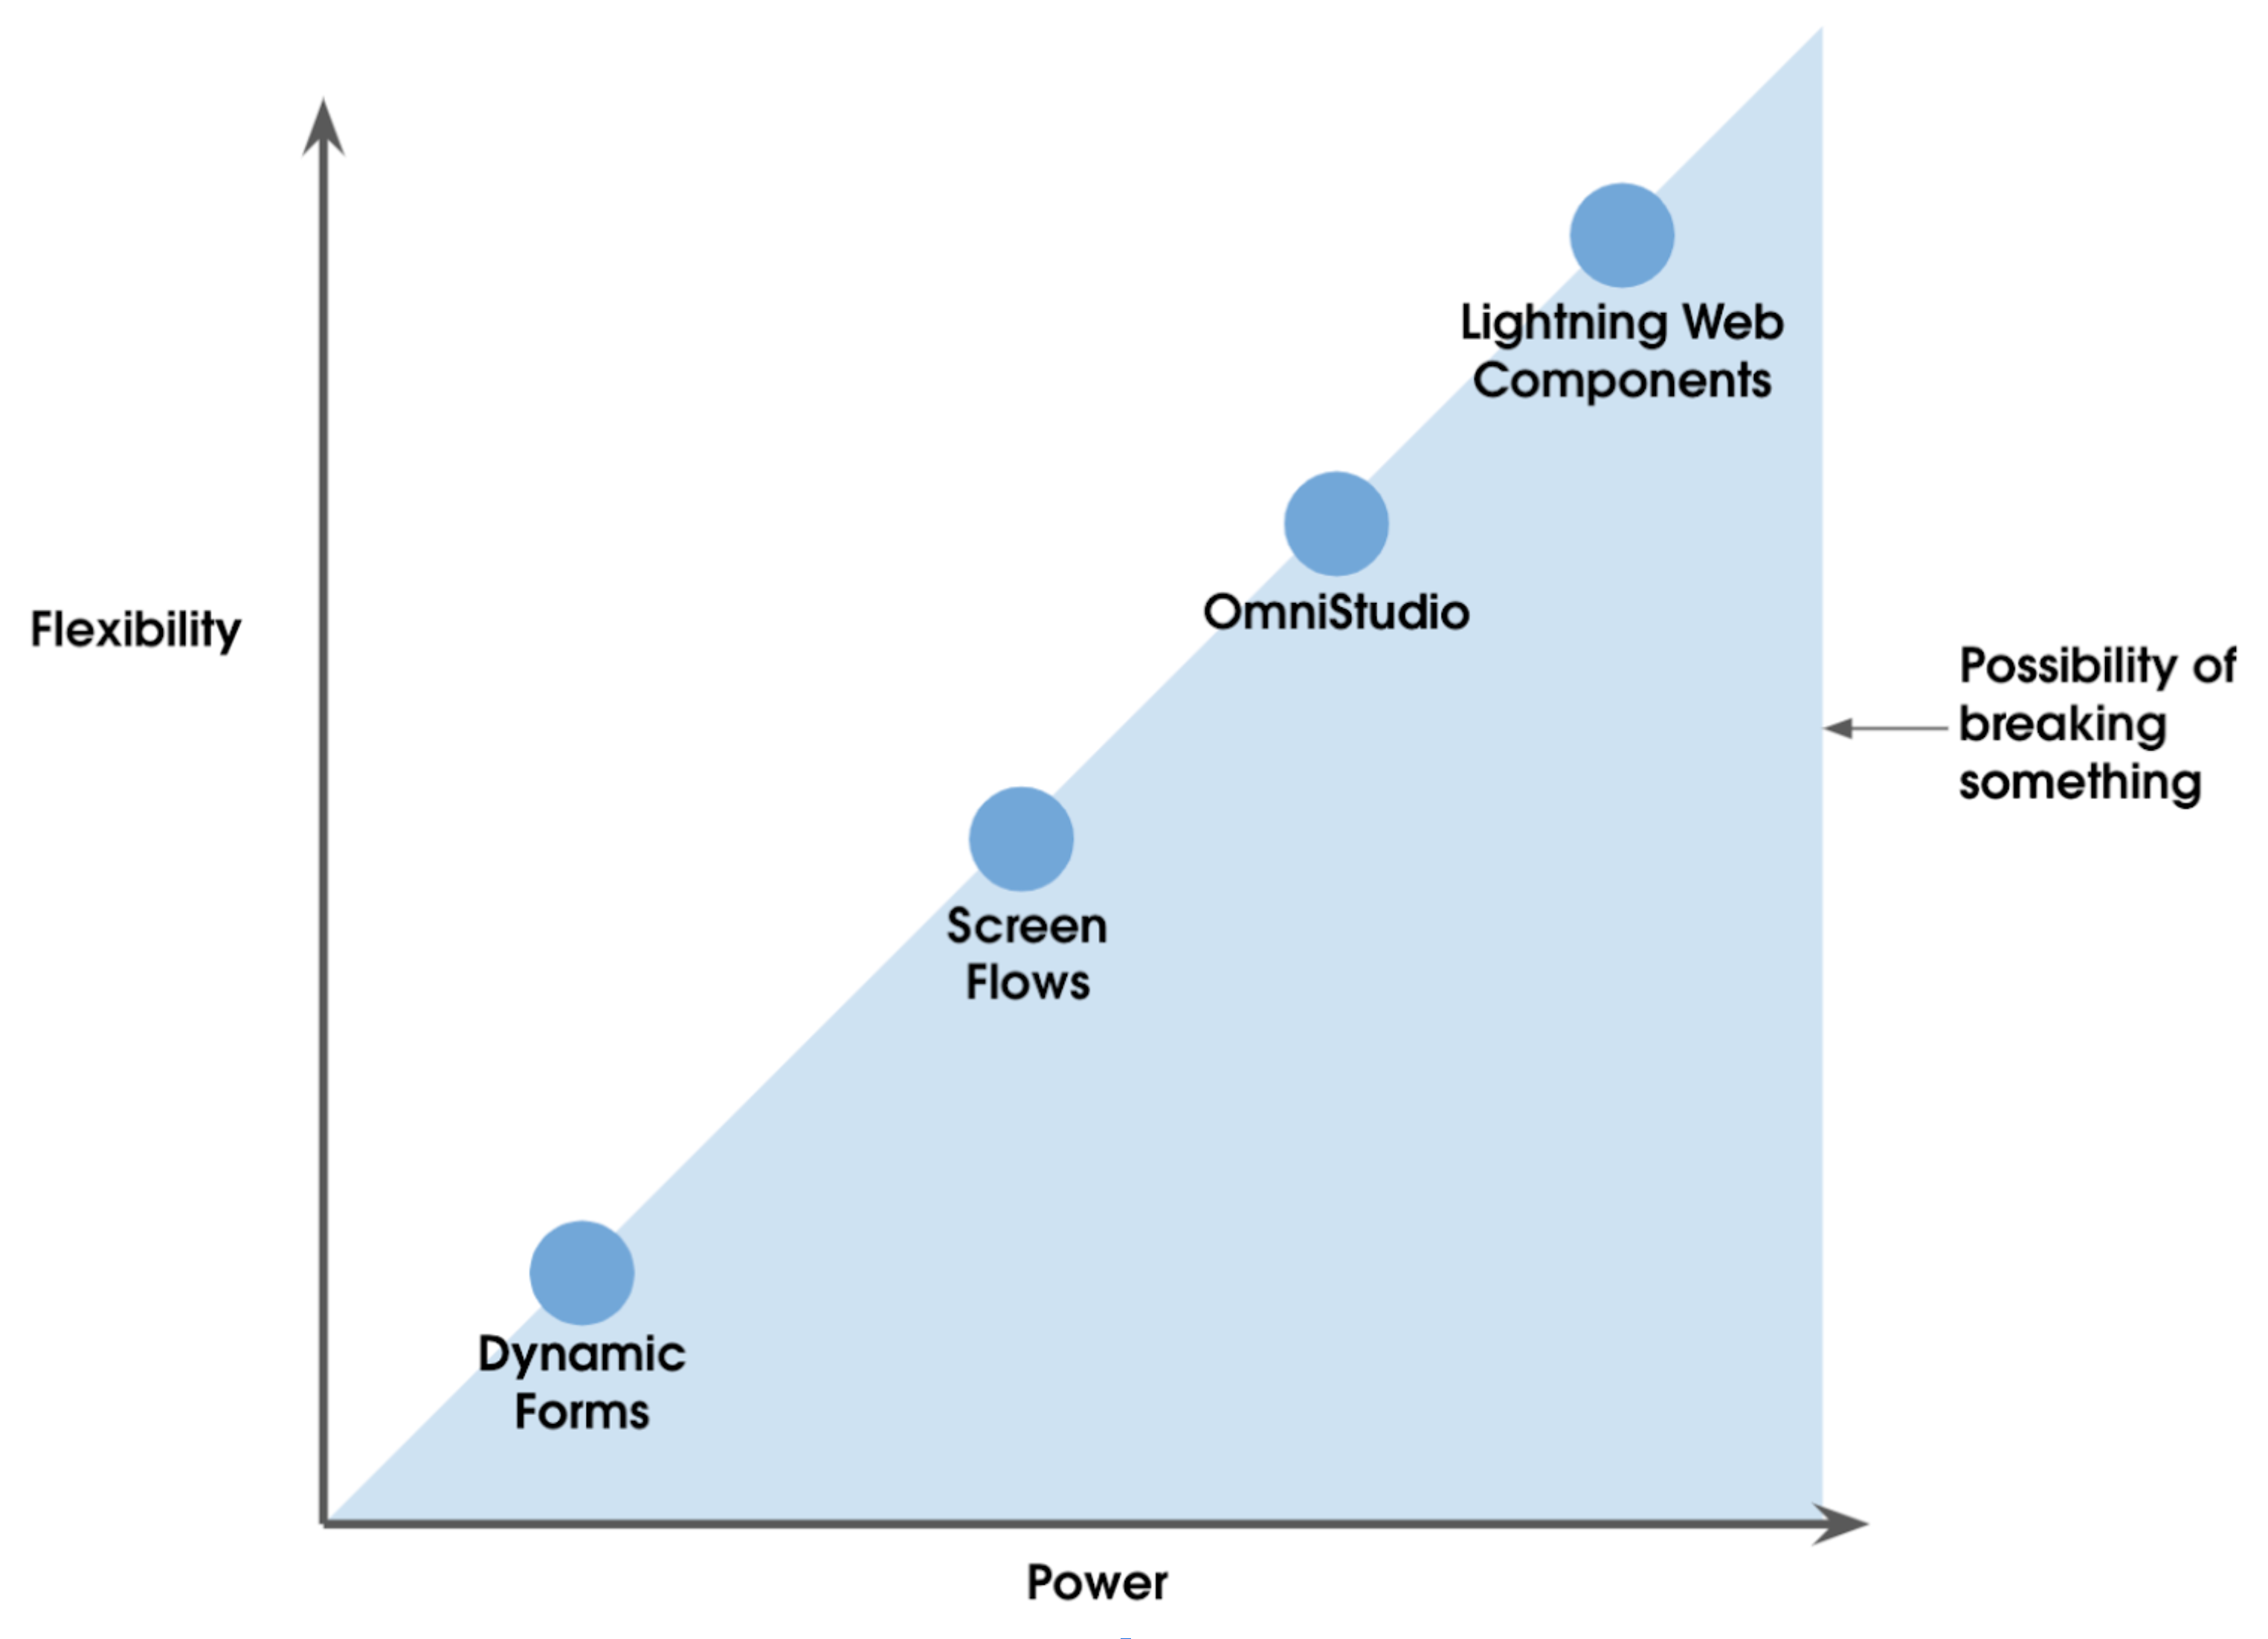
| Área a tener en cuenta | Preguntas comunes |
|---|---|
| Herramientas y panorama existentes | ¿Existe una solución ESB o ETL existente? ¿Tienen los datos implicados requisitos normativos o de cumplimiento? ¿Dónde están ubicados los sistemas que está intentando integrar (en la nube o in situ)? |
| Flujo de datos (Cronología, Experiencia de usuario prevista, Dirección) | ¿Necesitan los datos moverse de forma síncrona, asíncrona o pueden ser por lotes/programados? ¿Se requiere replicación de datos? ¿Qué sistema debe ser la fuente de la verdad? ¿Cuál es el origen de datos? ¿Cuál es el destino de destino? ¿Se requiere la interacción del usuario? ¿Necesita el usuario ver el resultado de la integración? ¿Cuáles son las necesidades sobre la gestión de excepciones (reintentar, notificar, fallar)? ¿Qué grado de acoplamiento deben tener los sistemas? |
| Implementación | ¿Cuál es el nivel de esfuerzo para sistemas que no son de Salesforce? ¿Qué equipos son responsables de entregar integraciones? ¿Qué herramientas prefieren utilizar? |
| Mantenibilidad | ¿Qué equipos se espera que mantengan la integración? ¿Qué habilidades tienen actualmente? ¿Qué habilidades necesitarán en el futuro? ¿Cuál es el costo total de propiedad a lo largo del tiempo? ¿Qué importancia tiene la capacidad de probar, depurar y solucionar problemas con herramientas de código bajo o profesional? |
| Volumen de datos | ¿Cuántos datos están implicados en la integración? ¿Trabajará con grandes volúmenes de datos (LDV)? ¿Con qué frecuencia se producirán cambios de forma masiva? ¿Qué tipo de repercusión tendrán las actualizaciones singleton? ¿Con qué frecuencia se producirán? |
| Límites | ¿Necesitarán los datos someterse a una transformación compleja? ¿Necesitan combinarse los datos desde varios sistemas de origen? ¿Con qué frecuencia se realizará una integración por usuario? ¿Cuántos usuarios en total? ¿Planificó con antelación cargas de datos masivas (ejemplo: carga de datos inicial para una nueva instancia)? |
| De Salesforce a Sistema externo | Del sistema externo a Salesforce | Ejecución | Se requiere licencia adicional | |
|---|---|---|---|---|
| Acciones Apex | Disponible | Disponible | Del lado del servidor | No |
| Captura de datos | Disponible | No disponible | Del lado del servidor | No* |
| Apex personalizado (servicios web REST y SOAP) | Disponible | Disponible | Del lado del servidor | No |
| Servicios externos | Disponible | No disponible | Del lado del servidor | No |
| Heroku Connect | Disponible | Disponible | Del lado del servidor | Sí |
| Data 360 | Disponible | Disponible | Del lado del servidor | Sí |
| MuleSoft Anypoint | Disponible | Disponible | Del lado del servidor | Sí |
| API nativas de Salesforce | No disponible | Disponible | Del lado del servidor | No |
| OmniScript | Disponible | Disponible | Del lado del cliente*** | Sí |
| Procedimiento de integración de OmniStudio | Disponible | Disponible | Del lado del servidor | Sí |
| Mensajería saliente | No es ideal | No disponible | Del lado del servidor | No |
| Eventos de plataforma | Disponible | Disponible | Del lado del servidor | No** |
| Salesforce Connect / Objetos externos | Disponible | Disponible | Del lado del servidor | Sí |
| Directrices | Licencia | Cronología | Volumen y escala | Entrega y mantenimiento | Privacidad y seguridad | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Cuándo utilizar | Licencia adicional | Sincronizar (Solicitud/Respuesta) o Asíncronizar (Fuego/Olvido) | Compatibilidad con múltiples objetos | LDV/masa | Pruebas e implementación** | Depuración | Comportamiento de reintento/gestión de errores integrado | Puede utilizar con datos cifrados en periodos de inactividad | Protocolo de autenticación | |
| Captura de datos | Cuando necesita publicar cambios a nivel de registro realizados en Salesforce en un sistema externo y no necesita una carga personalizada. | Requerido | Async | No | No | Sí | Con herramientas de procódigo | Sí | Sí | OAuth |
| Servicios externos | Cuando está orquestando un proceso utilizando Flow, Apex, Einstein Bots u OmniStudio y las API del sistema externo se describen utilizando especificaciones de OpenAPI. | No se requiere | Sync | Sí | No | Sí | Con herramientas de procódigo | No | N/A | Credenciales nombradas |
| Heroku Connect | Cuando desea ampliar sus datos con sincronización bidireccional para activar aplicaciones móviles y otras en Heroku, y desea que los datos también se repliquen en Salesforce. | Requerido | Async | Sí | Sí | No | Con herramientas de código profesional | Sí | Sí, a través de Shield Connect | OAuth |
| Procedimiento de integración de OmniStudio | Cuando necesita transformar datos sin interacción del usuario y mejorar el desempeño procesando en el servidor en vez del navegador. | Requerido | Ambos | Sí | Sí | Sí | Compatibilidad declarativa | Sí | Sí | Credenciales nombradas |
| Salesforce Connect / Objetos externos | Cuando desea que los datos aparezcan en la interfaz de usuario de Salesforce, pero desea que los datos se almacenen en un sistema externo. Los datos no se replican en Salesforce. | Requerido | Sync | No | Sí* | Sí | Con herramientas de procódigo y un trazador declarativo | No | N/A | Credenciales nombradas |
| *Los adaptadores Odata anteriores a la versión 4.01 están sujetos a límites de llamadas. Consulte Consideraciones sobre límites de frecuencia de llamadas Odata para obtener más detalles. ** Pruebas e implementación hace referencia a la capacidad de crear en un entorno inferior e implementar a través de la API de metadatos, paquetes o conjuntos de cambios en producción. | ||||||||||
| Directrices | Licencia | Cronología | Volumen y escala | Entrega y mantenimiento | Privacidad y seguridad | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Cuándo utilizar | Licencia adicional | Sincronizar (Solicitud/Respuesta) o Asíncronizar (Fuego/Olvido) | Compatibilidad con múltiples objetos | LDV/masa | Pruebas e implementación** | Depuración | Comportamiento de reintento/gestión de errores integrado | Puede utilizar con datos cifrados en periodos de inactividad | Protocolo de autenticación | |
| Acciones Apex | Cuando desea automatizar llamadas a otro sistema a través de Salesforce Flow. Un desarrollador puede redactar una clase Apex que un flujo puede invocar, o puede descargar una solución preconstruida desde AppExchange. | No se requiere | Ambos | Sí | No | Sí | Con herramientas de procódigo | No | Sí | Múltiples |
| Retransmisiones de eventos | Cuando necesite enviar eventos de plataforma y eventos de Captura de datos de cambios a Amazon EventBridge desde Salesforce. Las retransmisiones de eventos solo se conectan a AWS Eventbridge | No | Async | Sí | No | Sí | Sí | Sí | Sí | HTTP/1.1 con TLS |
| Mensajería saliente | Cuando necesita enviar mensajes SOAP a través de HTTP(S) a un extremo designado con recepción garantizada cuando se desencadena por una regla de flujo de trabajo. | No se requiere | Async | No | No | Sí | Compatibilidad declarativa | Sí | Sí | TLS bidireccional |
| Eventos de plataforma | Cuando necesita una carga estructurada definida personalizada para cambios casi en tiempo real en Salesforce o un sistema externo. | No requerido* | Async | Sí | No | Sí | Con herramientas de procódigo | Sí | Sí | OAuth |
| Salesforce Connect / Objetos externos (con adaptadores Apex personalizados) | Cuando desea que los datos aparezcan en la interfaz de usuario de Salesforce, pero desea que los datos se almacenen en un sistema externo que no puede utilizar protocolos estándar como Odata o GraphQL. | Requerido | Ambos | Sí | Sí | Sí | Con herramientas de procódigo | No | N/A | Múltiples |
| Data 360 | Cuando desea datos armonizados desde diferentes orígenes en un solo establecimiento de datos, o desea replicar sus datos en otras organizaciones de Salesforce o en otros sistemas externos. | Requerido | Ambos | Sí | Sí | Sí | Sí | Sí | Sí | Múltiples |
| Directrices | Licencia | Cronología | Volumen y escala | Entrega y mantenimiento | Privacidad y seguridad | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Cuándo utilizar | Licencia adicional | Sincronizar (Solicitud/Respuesta) o Asíncronizar (Fuego/Olvido) | Compatibilidad con múltiples objetos | LDV/masa | Pruebas e implementación** | Depuración | Comportamiento de reintento/gestión de errores integrado | Puede utilizar con datos cifrados en periodos de inactividad | Protocolo de autenticación | |
| Apex personalizado | Cuando necesita más funciones de las disponibles en herramientas de código bajo. | No se requiere | Ambos | Sí | Sí | Sí | Con herramientas de procódigo | No | Sí* | Múltiples |
| Servicios externos | La integración desde código con API del sistema externas se describe utilizando especificaciones de OpenAPI. | No se requiere | Sync | Sí | No | Sí | Con herramientas de procódigo | No | N/A | Múltiples |
| MuleSoft Anypoint | Cuando necesita una única solución unificada de nivel de compañía para crear, orquestar y gestionar sus integraciones; cuando necesita sustituir una arquitectura de punto a punto heredada; o cuando necesita asistencia de gestión de API. | Requerido | Ambos | Sí | Sí | Sí | Con herramientas de procódigo | No | Sí* | Múltiples |
| Directrices | Licencia | Cronología | Volumen y escala | Entrega y mantenimiento | Privacidad y seguridad | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Cuándo utilizar | Licencia adicional | Sincronizar (Solicitud/Respuesta) o Asíncronizar (Fuego/Olvido) | Compatibilidad con múltiples objetos | LDV/masa | Pruebas e implementación* | Depuración | Comportamiento de reintento/gestión de errores integrado | Puede utilizar con datos cifrados en periodos de inactividad | Protocolo de autenticación | |
| Heroku Connect | Cuando desea ampliar sus datos con sincronización bidireccional para activar aplicaciones móviles y otras en Heroku, y desea que los datos también se repliquen en Salesforce. | Requerido | Async | Sí | Sí | No | Con herramientas de procódigo | Sí | Sí, a través de Shield Connect | OAuth |
| Procedimiento de integración de OmniStudio | Cuando necesita importar y transformar datos desde fuentes externas sin interacción del usuario. | Requerido | Ambos | Sí | Sí | Sí | Compatibilidad declarativa | No | Sí | Credenciales nombradas |
| Salesforce Connect / Objetos externos | Cuando desea que los datos aparezcan en la interfaz de usuario de Salesforce, pero desea que los datos se almacenen en un sistema externo que pueda utilizar protocolos estándar como Odata o GraphQL. | Requerido | Sync | Sí | Sí | Sí | Con herramientas de procódigo | No | N/A | Múltiples |
| Directrices | Licencia | Cronología | Volumen y escala | Entrega y mantenimiento | Privacidad y seguridad | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Cuándo utilizar | Licencia adicional | Sincronizar (Solicitud/Respuesta) o Asíncronizar (Fuego/Olvido) | Compatibilidad con múltiples objetos | LDV/masa | Pruebas e implementación** | Depuración | Comportamiento de reintento/gestión de errores integrado | Puede utilizar con datos cifrados en periodos de inactividad | Protocolo de autenticación | |
| Eventos de plataforma | Cuando necesita una carga estructurada definida personalizada para cambios casi en tiempo real en Salesforce o un sistema externo. | No requerido* | Async | Sí | No | Sí | Con herramientas de procódigo | Sí | Sí | OAuth |
| Salesforce Connect / Objetos externos (con adaptadores Apex personalizados) | Cuando necesita que los datos aparezcan en la interfaz de usuario de Salesforce, pero desea que los datos se almacenen en un sistema externo que no puede utilizar protocolos Odata 2.0/4.0. | Requerido | Ambos | Sí | Sí | Sí | Con herramientas de procódigo | No | N/A | Múltiples |
| Data 360 | Cuando desea datos armonizados desde diferentes orígenes en un solo establecimiento de datos, o desea replicar sus datos desde otras organizaciones de Salesforce o en otros sistemas externos. Data 360 también admite la virtualización para algunas plataformas. | Requerido | Ambos | Sí | Sí | Sí | No | Sí | Sí | Múltiples |
| Directrices | Licencia | Cronología | Volumen y escala | Entrega y mantenimiento | Privacidad y seguridad | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Cuándo utilizar | Licencia adicional | Sincronizar (Solicitud/Respuesta) o Asíncronizar (Fuego/Olvido) | Compatibilidad con múltiples objetos | LDV/masa | Pruebas e implementación**** | Depuración | Comportamiento de reintento/gestión de errores integrado | Puede utilizar con datos cifrados en periodos de inactividad | Protocolo de autenticación | |
| Servicios web REST y SOAP de Apex personalizados | Cuando necesita más funciones que las proporcionadas por los extremos de API nativos como procesamiento de objetos cruzados u otra lógica compleja. | No se requiere | Ambos | Sí | Sí | Sí | Con herramientas de procódigo | No | Sí*** | Múltiples |
| MuleSoft Anypoint | Cuando necesita una única solución unificada de nivel de compañía para crear, orquestar y gestionar sus integraciones; cuando necesita sustituir una arquitectura de punto a punto heredada; o cuando necesita asistencia de gestión de API. | Requerido | Ambos | Sí | Sí | Sí | Con herramientas de procódigo | No | Sí*** | Múltiples |
| API nativas de Salesforce | Cuando necesita más control o tiene un conjunto de habilidades de procódigo para crear integraciones a través de API de REST, API de SOAP, API masiva o API de GraphQL o gRPC. | No requerido* | Ambos | Sí***** | Sí | Sí | Con herramientas de procódigo | Sí** | Sí*** | Múltiples |
| Directrices | Costo | Cronología | Volumen y escala | Entrega y mantenimiento | Privacidad y seguridad | Herramientas para implementar | |||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| Cuándo utilizar | Licencia adicional | Sincronizar (Solicitud/Respuesta) o Asíncronizar (Fuego/Olvido) | Compatibilidad con múltiples objetos | LDV/masa | Pruebas e implementación* | Depuración | Comportamiento de reintento/gestión de errores integrado | Puede utilizar con datos cifrados en periodos de inactividad | Protocolo de autenticación | Código bajo → Código profesional | |
| Heroku Connect | Cuando desea ampliar sus datos con sincronización bidireccional entre organizaciones de Salesforce y también activar el acceso a los datos desde aplicaciones móviles y otras que se ejecutan en Heroku | Requerido | Async | Sí | Sí | No | Con herramientas de procódigo | Sí | Sí, a través de Shield Connect | OAuth | Código bajo |
| MuleSoft Anypoint | Cuando necesita una única solución unificada de nivel de compañía para crear, orquestar y gestionar sus integraciones; cuando necesita sustituir una arquitectura de punto a punto heredada; o cuando necesita asistencia de gestión de API | Requerido | Ambos | Sí | Sí | Sí | Con herramientas de procódigo | No | Sí** | Múltiples | Código Pro |
| API nativas de Salesforce | Cuando Salesforce o Heroku Connect no son una opción o necesita un procesamiento más complejo | No se requiere | Ambos | No | Sí | Sí | Con herramientas de procódigo | No | Sí** | Múltiples | Código Pro |
| Captura de datos | Cuando necesita publicar cambios a nivel de registro realizados en Salesforce en un sistema externo y no necesita una carga personalizada. | Requerido | Async | No | No | Sí | Con herramientas de procódigo | Sí | Sí | OAuth | |
| Salesforce Connect con adaptador entre organizaciones | Cuando desea que los usuarios en una organización vean o modifiquen registros en una organización diferente sin replicación de datos | Requerido | Async | Sí | Sí | Sí | Con herramientas de procódigo | N/A | N/A | Múltiples | Código bajo |
| Data 360 | Cuando desea que los usuarios de una organización vean o modifiquen registros en una organización diferente con datos replicados en Data 360. | Requerido | Ambos | Sí | Sí | Sí | Con herramientas de procódigo | Sí | Sí | Múltiples | Híbrido |
| Tipo de patrón | Modo / Herramienta | Beneficios | Consideraciones | Resultados |
|---|---|---|---|---|
| Ingreso de datos | Tiempo real: Ingreso de latencia por debajo del segundo a través de las API de ingreso con compatibilidad de CDC. Canalizaciones de transmisión continua. | - Perspectivas inmediatas - Ideal para casos de uso operativos y de personalización de baja latencia - Admite flujos de trabajo dirigidos por eventos |
- Alto costo - Arquitectura compleja - Requiere sistemas de origen de baja latencia - Las fuentes de gran volumen pueden causar una transmisión excesiva que conduce a oportunidades en curso saturadas - E/S intensiva - Considerar campos selectivos y filtrado para reducir los gastos generales |
Agentforce: - Alertas de fraude en tiempo real, personalización minorista, alertas operativas Analytics: - Tableros de subsegundos, monitoreo de KPI Cumplimiento: - Actualizaciones continuas de registros de clientes para flujos de trabajo regulados |
| Transmisión:Ingreso de microlotes cada 1 a 3 minutos a través de conectores nativos | Costo equilibrado frente a frescura - Arquitectura más sencilla que en tiempo real - Admite actualizaciones incrementales |
- Latencia ligera - Puede no ser adecuado para decisiones críticas de subsegundos - El tamaño de lote afecta a la memoria/cómputo - E/S es moderada - Lo mejor para patrones de actualización predecibles y repetidos - Considere la agregación con ventanas para reducir la carga de procesamiento |
Agentforce: - Desencadenadores de campaña oportunos, implicación casi en vivo Analytics: - Motores de recomendaciones, tableros casi en vivo Cumplimiento: - Actualizaciones frecuentes con capacidad de auditoría |
|
| Lote: Cargas de gran volumen programadas a través de conectores o API. Admite almacenamiento de objetos y oportunidades en curso de ETL/ELT. | - Costo-eficiente para conjuntos de datos masivos - Fácil de implementar - Fiable para análisis históricos |
- Latencia de datos - Inadecuado para operaciones urgentes - E/S intensiva durante los plazos de carga - El rendimiento de red puede convertirse en un cuello de botella para archivos de gran tamaño - Ideal para flujos de trabajo de agregación histórica o creación de reportes regulados |
Agentforce: - Tickets de asistencia de TI (Jira/ServiceNow), flujos de trabajo agregados Analytics: - Análisis histórico, evaluación de tendencias Queja: - Creación de reportes reguladores, agregación de datos de pacientes/reclamaciones |
|
| Zero Copy | Consulta en vivo: Consultas directas en sistemas externos; esquema en lectura; sin duplicación de datos | - Máxima frescura - Gastos generales de almacenamiento mínimos; admite perspectivas operativas en tiempo real |
-Dependiendo del desempeño de origen - El alto volumen de consultas puede afectar a la latencia - Ideal para consultas con distribución y agregación de predicados para minimizar las E/S - Evitar consultas sin filtrar en conjuntos de datos masivos |
Agentforce: - Flujos de trabajo dinámicos adaptándose a la actividad en vivo Analytics: - Tableros operativos, creación de reportes en vivo Cumplimiento: - Respeta la seguridad a nivel de filas y el enmascaramiento en origen |
| Consulta acelerada (almacenamiento en caché): Copias locales en caché para consultas federadas. Configurable de 15 min a 7 días. Ejecución de consultas optimizada | - Reduce la latencia - Menor costo que las consultas en vivo repetidas - Mejora el desempeño para patrones de acceso frecuente |
- Gestión de caché requerida - El estado depende del intervalo de caché - Ideal para consultas de alta frecuencia - No apto para la decisión de subsegundos |
Agentforce: - Mediciones de implicación preagregadas para una decisión rápida Analytics: - Tableros de BI, segmentación, creación de reportes analíticos Cumplimiento: - Tableros regulados coherentes con registros de auditoría |
|
| Federación de archivos: Acceso directo a grandes conjuntos de datos históricos en establecimientos de objetos o lagos (S3, Iceberg, Google BigQuery, Redshift). | - Gestiona conjuntos de datos a gran escala Almacenamiento mínimo en Data 360 - Admite cargas de trabajo de IA/ML |
-Solo lectura - El desempeño de las consultas depende del rendimiento del sistema externo - Optimizado para trabajos intensivos de rendimiento y por lotes - No apto para tablero en tiempo real |
Agentforce: - (No es típico — pesado por lotes) Analytics: - Entrenamiento de ML/IA, análisis histórico, creación de reportes a escala de petabytes Cumplimiento: Acceso regulado a conjuntos de datos externos sin duplicación |
 #### Métodos de ingreso de datos
Los métodos de ingreso de datos varían dependiendo del conector que utilice para ingresar sus datos. Algunos conectores ofrecen una variedad de métodos de ingreso, mientras que otros solo funcionan en modo por lotes o transmisión. Consulte [Datos 360: Integraciones y conectores](https://help.salesforce.com/s/articleView?id=data.c360_a_sources_targets.htm&type=5) para una lista completa de conectores de Data 360 y sus métodos disponibles.
- **En tiempo real**
- Ingreso de subsegundos utilizando oportunidades en curso de transmisión o Captura de datos de cambios (CDC).
- Ideal para flujos de trabajo urgentes (detección de fraude, personalización, tableros operativos).
- Distribuya transformaciones y agregaciones en Data 360 para reducir las E/S descendentes y optimizar el uso de computación. Utilice CDC incrementales para minimizar la reorganización de datos.
- **Transmisión**
- Ingesta cada 1-3 minutos en pequeños incrementos.
- Equilibra la frescura y el costo, adecuados para la orquestación de campañas, la implicación casi en vivo y los reportes operativos.
- Utilice microlotes para controlar picos de E/S. Agregue datos en origen si es posible para reducir los volúmenes de transferencia y optimizar el almacenamiento.
- **Lote (Cargas programadas)**
- Ingreso periódico de grandes conjuntos de datos (por hora, diariamente, semanalmente).
- Rentable y fiable para conjuntos de datos históricos, creación de reportes regulatorios y casos de uso de cumplimiento.
- Asegúrese de calcular la localidad en la misma región que el almacenamiento de origen para la optimización de desempeño y costos.
#### Libro de jugadas de arquitecto
- **Casos de uso para ingreso de datos**
- **Generar perfiles unificados Customer 360:** Creación de una fuente de verdad única para la identidad y los atributos del cliente.
- **Mantener conjuntos de datos de cumplimiento normativo:** Aplicación de la gobernanza, el linaje y la capacidad de auditoría para datos confidenciales.
- **Centralice la orquestación de campañas:** Garantizar que marketing, ventas y servicio funcionan desde conjuntos de datos coherentes y de confianza.
- **Prácticas de diseño**
- Favorezca el ingreso por lotes para necesidades históricas o tolerantes a baja latencia, como creación de reportes de archivo o instantáneas periódicas.
- Utilice las API de transmisión o CDC para mantener la actualización para flujos de trabajo operativos y de personalización, garantizando actualizaciones casi en tiempo real.
- Controle el almacenamiento y calcule el crecimiento aplicando cargas incrementales, en vez de volver a cargar conjuntos de datos completos, para optimizar el costo y la eficiencia.
- Alinee las oportunidades en curso de ingreso con la localidad de cálculo y el procesamiento incremental para reducir la E/S de red. Aplique transformaciones dentro de Data 360 para evitar mover datos sin procesar innecesariamente.
- **Consideraciones de costos**
- **Ingreso en tiempo real:** Costos de computación y oportunidades en curso más altos; justificados para flujos de trabajo de alto valor y urgentes como personalización, tableros operativos o acciones dirigidas por Agentforce.
- **Ingreso de transmisión:** Modere los costos de computación y almacenamiento; adecuado para actualizaciones frecuentes que pueden tolerar ligeros retrasos, como orquestación de campañas o creación de reportes operativos.
- **Ingestión por lotes:** Costos de computación más bajos, almacenamiento predecible; lo mejor para conjuntos de datos históricos o actualizaciones de baja frecuencia. El ingreso de datos por lotes desde organizaciones de Salesforce utilizando ciertos conectores es gratuito.
- **Modo de actualización:** La selección del modo Actualización incremental reduce el ingreso total y calcula los costos. Recomendamos utilizar la actualización incremental siempre que sea posible para optimizar la eficiencia entre todos los tipos de ingreso.
- El costo también se ve afectado por el volumen de E/S desde el origen a Data 360. La optimización de tamaños de lote, particiones y alineación regional reduce los costos de transferencia y mejora el desempeño.
- **Escenarios industriales**
- **Finanzas:** Ingrese los conjuntos de datos requeridos para conocer a su cliente (KYC), Antilavado de dinero (AML) y detección de fraude, donde la capacidad de auditoría y el cumplimiento no son negociables.
- **Cuidados sanitarios:** Utilice el ingreso para la resolución de identidad de pacientes y registros compatibles con HIPAA, permitiendo vistas seguras y unificadas.
- **Retail:** Consolidar datos de punto de venta (POS), comercio electrónico y programa de fidelidad en perfiles unificados para segmentación y personalización
- **Telecom:** Apoye la prevención de abandonos y los análisis de uso con datos de suscriptor gobernados canónicos.
#### Criterios de decisión de método de ingreso de datos
| Función | Ingreso en tiempo real | Ingreso de transmisión | Ingestión por lotes |
|---|---|---|---|
| Latencia y frescura | Ingreso de latencia por debajo del segundo a través de las API de ingreso con compatibilidad con Captura de datos de cambios (CDC). Proporciona oportunidades en curso de transmisión continua. Ideal para casos de uso operativos de baja latencia. | Ingreso de microlotes cada 1 a 3 minutos a través de conectores nativos. Admite actualizaciones incrementales. Se espera una ligera latencia. | Se espera latencia de datos. Cargas de gran volumen programadas. Ingestión periódica (por hora, diariamente, semanalmente). Inadecuado para operaciones urgentes. |
| Casos de uso principales | Ideal para casos de uso operativos y de personalización de baja latencia. Se utiliza para flujos de trabajo urgentes. Admite flujos de trabajo dirigidos por eventos. Se utiliza para alertas de fraude en tiempo real y alertas operativas. | Adecuado para procesos de urgencia moderada. Se utiliza para orquestación de campañas, implicación casi en vivo y creación de reportes operativos. Se utiliza para desencadenadores de campaña oportunos. | Rentable para conjuntos de datos masivos. Fiable para análisis históricos. Se utiliza para flujos de trabajo de agregación histórica o creación de reportes regulados. Ideal para conjuntos de datos históricos o de baja velocidad. |
| Complejidad arquitectónica y E/S | Arquitectura compleja y de alto costo. Requiere sistemas de origen de baja latencia. E/S intensiva. Los orígenes de gran volumen pueden causar oportunidades en curso saturadas. | Arquitectura más sencilla que en tiempo real. E/S es moderada. Lo mejor para patrones de actualización repetidos y predecibles. El tamaño de lote afecta a la memoria/cómputo. | Fácil de implementar. intensivo de E/S durante los plazos de carga. El rendimiento de red puede convertirse en un cuello de botella para lotes grandes. |
| Consideraciones de costos | Costos de computación y oportunidades en curso más altos. Solo se justifica para flujos de trabajo de alto valor y urgentes. | Modere los costos de computación y almacenamiento. Proporciona un enfoque de costo frente a frescura equilibrado. Adecuado para actualizaciones frecuentes que pueden tolerar ligeros retrasos. | Reduzca los costos de computación y el almacenamiento predecible. Recomendado para conjuntos de datos históricos o actualizaciones de baja frecuencia. El ingreso a través de oportunidades en curso internas de Salesforce es gratuito. |
| Prácticas de diseño | Utilice CDC incrementales para minimizar la reorganización de datos. Filtre y utilice campos selectivos para reducir los gastos generales. | Utilice microlotes para controlar picos de E/S. Considere la agregación con ventanas para reducir la carga de procesamiento. | Favorezca esto para reportes de archivo o instantáneas periódicas. Asegúrese de calcular la localidad en la misma región que el almacenamiento de origen para la optimización de costos. |
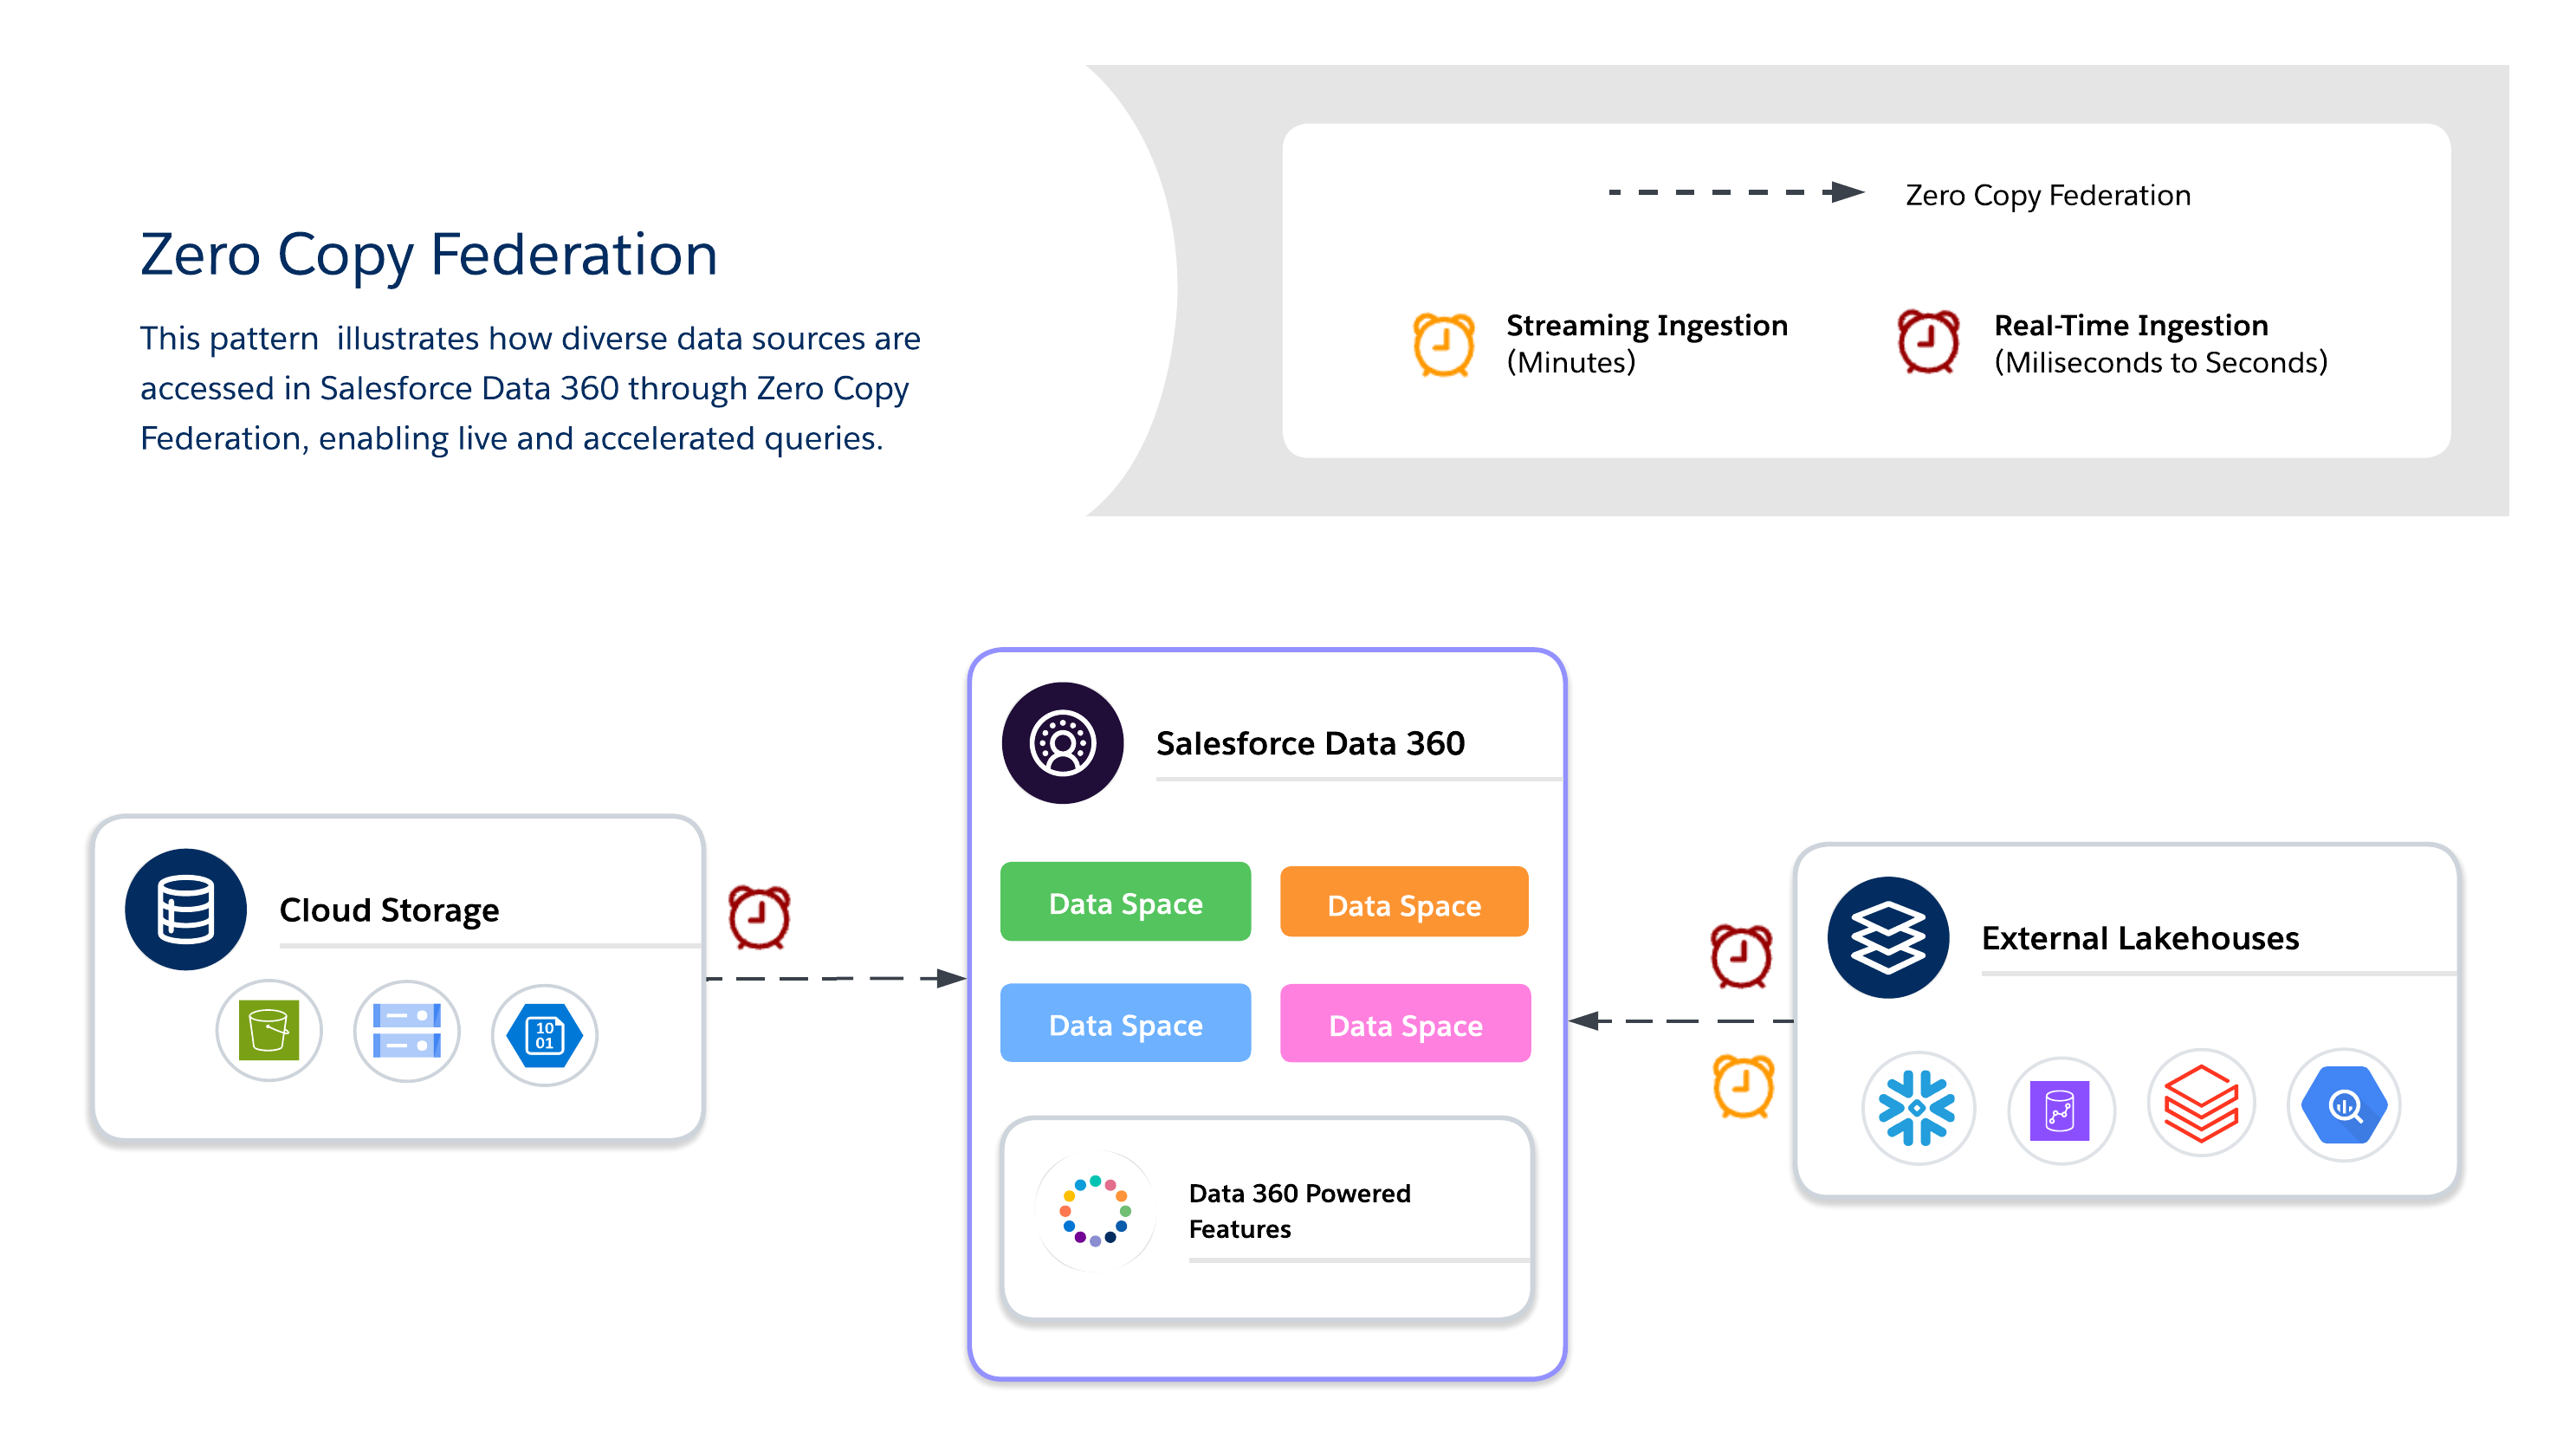 #### Métodos de copia cero
Al utilizar Cero copia, los arquitectos deben decidir además entre tres métodos de federación de datos disponibles, cada uno de los cuales ofrece sus propias ventajas entre frescura, desempeño y costo.
- **Consulta en vivo**
- Ejecuta consultas directamente en sistemas externos (Snowflake, Google BigQuery, Redshift, Databricks, etc.) sin duplicación de datos.
- Óptimo cuando los predicados y las agregaciones se pueden empujar hacia abajo, minimizando el movimiento de datos en la red y reduciendo la E/S en el cálculo de Salesforce Data 360.
- Lo mejor para perspectivas en tiempo real y tableros operativos de baja latencia. Dependiendo del desempeño del sistema externo.
- **Almacenamiento en caché (Consulta acelerada)**
- Almacena temporalmente copias en caché de datos federados en Salesforce Data 360.
- Reduce los costos y la latencia de consultas repetidas para conjuntos de datos a los que se accede con frecuencia, con duración configurable (minutos a días).
- Los datos no se copian de forma permanente ni se rigen completamente; la actualización se gestiona a través de actualizaciones programadas desde el origen.
- **Federación de archivos**
- Proporciona acceso directo de solo lectura a conjuntos de datos a gran escala en establecimientos de objetos (por ejemplo, S3, GCS con Iceberg).
- Ideal para cargas de trabajo de IA/ML, análisis históricos y creación de reportes a escala de petabytes sin mover datos.
- El desempeño de las consultas depende en gran medida del formato del objeto, la partición y la E/S de red. Las exploraciones de gran tamaño pueden generar E/S sustanciales si no están optimizadas.
#### Libro de jugadas de arquitecto
- **Casos de uso**
- **Personalización en tiempo real y flujos de trabajo adaptativos:** Entregue ofertas dinámicas, recomendaciones y las mejores acciones siguientes a medida que cambia el comportamiento de los clientes.
- **Tableros en vivo y análisis operativos:** Potencie tableros clave de negocio y KPI directamente desde almacenes externos.
- **Entrenamiento de modelo de IA/ML con grandes conjuntos de datos externos:** Aproveche datos a escala de petabytes desde lagos de datos y almacenes utilizando Federación de archivos sin moverlos.
- **Escenarios industriales**
- **Retail/Media:** Active recomendaciones personalizadas e implicación de clientes en tiempo real federando datos de interacciones de contenido o transmisiones de clics.
- **Finanzas:** Ejecute la detección de fraudes y el puntuaje de riesgos casi en tiempo real consultando almacenes externos sin duplicar datos confidenciales.
- **Tech/Enterprise:** Admita la creación de reportes entre nubes, tableros de servicio de TI y análisis operativos donde los conjuntos de datos residen en múltiples sistemas.
- **Prácticas de diseño**
- **Consulta en vivo**
- Utilizar para consultas de alta QPS y baja latencia cuando la actualización es crítica.
- Envíe predicados y agregaciones al sistema externo para reducir la reorganización de datos en la red.
- Evite consultas que exploran volúmenes de datos masivos innecesariamente; considere filtros y poda de particiones.
- **Federación de archivos**
- Acceda a conjuntos de datos a escala de petabytes en establecimientos de objetos sin ingreso.
- Mantenga el almacenamiento de objetos en la misma región de nube que Salesforce computa para minimizar la latencia y los costos de salida.
- Utilice formatos particionados y columnares (Parquet/ORC) y filtros de distribución para reducir la transferencia de E/S y red.
- Aproveche la distribución de consultas y predicados para filtrar y agregar datos en el origen, reduciendo el movimiento de datos.
- Evite el acceso a datos entre regiones a menos que sea necesario, ya que aumenta la E/S, la latencia y los costos.
- **Almacenamiento en caché (Consulta acelerada)**
- Almacenar en caché conjuntos de datos a los que se accede frecuentemente para equilibrar el costo y el desempeño.
- Configure intervalos de actualización para equilibrar la actualización frente al costo de consulta.
- **Cumplimiento:** Aplique la regulación en el origen aprovechando la seguridad a nivel de filas (RLS) y enmascarando políticas directamente en sistemas federados. A continuación se muestran mejores prácticas para RLS uniforme y enmascaramiento entre plataformas.
- **Utilice un Id. de compañía centralizado:** Asigne usuarios y entidades en Salesforce Data 360 a un identificador de compañía único y centralizado que se corresponda con identidades en sistemas externos.
- **Alinear políticas de seguridad:** Garantice que las políticas de enmascaramiento y seguridad a nivel de filas en sistemas federados se aplican basándose en la identidad asignada. Esto mantiene el cumplimiento al consultar datos externos.
- **Estandarizar esquemas de identidad:** Mantenga atributos de identidad coherentes (email, Id. de usuario, Id. de cliente, etc.) entre todos los orígenes de datos para evitar desajustes e infracciones de acceso.
- **Consideraciones de costos**
- **Consulta en vivo:** Modelo de pago por consulta: los costos se acumulan en computación externa de Lakehouse y pueden aumentar con un alto QPS. Lo mejor para casos de uso críticos de frescura donde el valor es superior a la variabilidad de costos.
- **Consulta acelerada (almacenamiento en caché):** Reduce el costo de la consulta en comparación con Consulta en vivo reduciendo las coincidencias en el sistema de origen, pero agrega costos de ingreso de datos por lotes para rellenar y actualizar la caché. Ideal para conjuntos de datos a los que se accede con frecuencia.
- **Federación de archivos:** Opción de almacenamiento más barata como datos en Almacén de objetos, pero los costos de consulta dependen del tamaño del archivo, la partición y la poda. Ideal para datos históricos o masivos a escala de petabytes.
#### Criterios de decisión de método de copia cero
| Punto de decisión | Consulta en vivo | Almacenamiento en caché (Consulta acelerada) | Federación de archivos |
|---|---|---|---|
| Ubicación de origen de datos | Lagos de datos externos (Snowflake, Google BigQuery, Redshift, Databricks). | Lagos de datos externos (Snowflake, Google BigQuery, Redshift, Databricks) | Almacenamientos de objetos o lagos de datos en la nube (S3, ADLS, GCS), a menudo utilizando formatos de tabla abiertos como Iceberg. |
| Propósito/Caso de uso | Ideal para análisis interactivos y tableros en tiempo real. Lo mejor para la personalización en tiempo real y flujos de trabajo dinámicos. | Lo mejor para cuando las consultas son frecuentes pero los resultados ligeramente obsoletos son aceptables. Adecuado para tableros de BI y segmentación. | Ideal para el procesamiento por lotes a gran escala y el entrenamiento de modelos de IA/ML. Ideal para análisis históricos y creación de reportes a escala de petabytes. |
| Frescura/Latencia | Máxima actualización; las consultas se ejecutan directamente en tiempo real. Admite decisiones por debajo del segundo. | Los resultados ligeramente obsoletos son aceptables. La actualización depende del intervalo de caché, configurable de 15 minutos a 7 días. | Optimizado para trabajos intensivos de rendimiento y por lotes. No es adecuado para tableros en tiempo real. |
| Patrón de acceso | Ideal para consultas poco frecuentes o ad hoc. Utilizar para consultas de alta QPS (consulta por segundo) y baja latencia donde la actualización es crítica. | Ideal para escenarios de lectura de alta frecuencia. Mejora el desempeño para patrones de acceso frecuentes. | Acceso de solo lectura. Adecuado para conjuntos de datos a escala de petabytes sin ingreso. |
| Controladores de desempeño | Muy dependiente del desempeño del sistema de origen externo. Optimizado cuando los predicados y las agregaciones pueden enviarse hacia abajo al origen. | Reduce la latencia en comparación con consultas en vivo repetidas. El desempeño depende de la gestión y el intervalo de caché. | El desempeño depende en gran medida del formato del objeto, la partición y el rendimiento del sistema externo. Utilice formatos particionados y de columnas (Parquet/ORC). |
| Consecuencias de costos | Modelo de pago por consulta. Los costos se acumulan en computación de Lakehouse externa. Rentable para consultas poco frecuentes, pero los gastos pueden aumentar con un alto volumen de consultas por segundo (QPS). | Costo inferior al de las consultas en vivo repetidas. Reduce la necesidad de consultar repetidamente el origen externo. Agrega almacenamiento en caché y gastos generales de actualización. | Opción de almacenamiento más barata. Los costos de consulta dependen del tamaño del archivo y la partición. |
| Consideración clave | Evite consultas sin filtrar que exploran volúmenes de datos masivos innecesariamente. | Requiere gestión de caché. No es adecuado para la decisión de subsegundos. | El desempeño de las consultas se basa en gran medida en la optimización a través de particiones y distribución de predicados. |
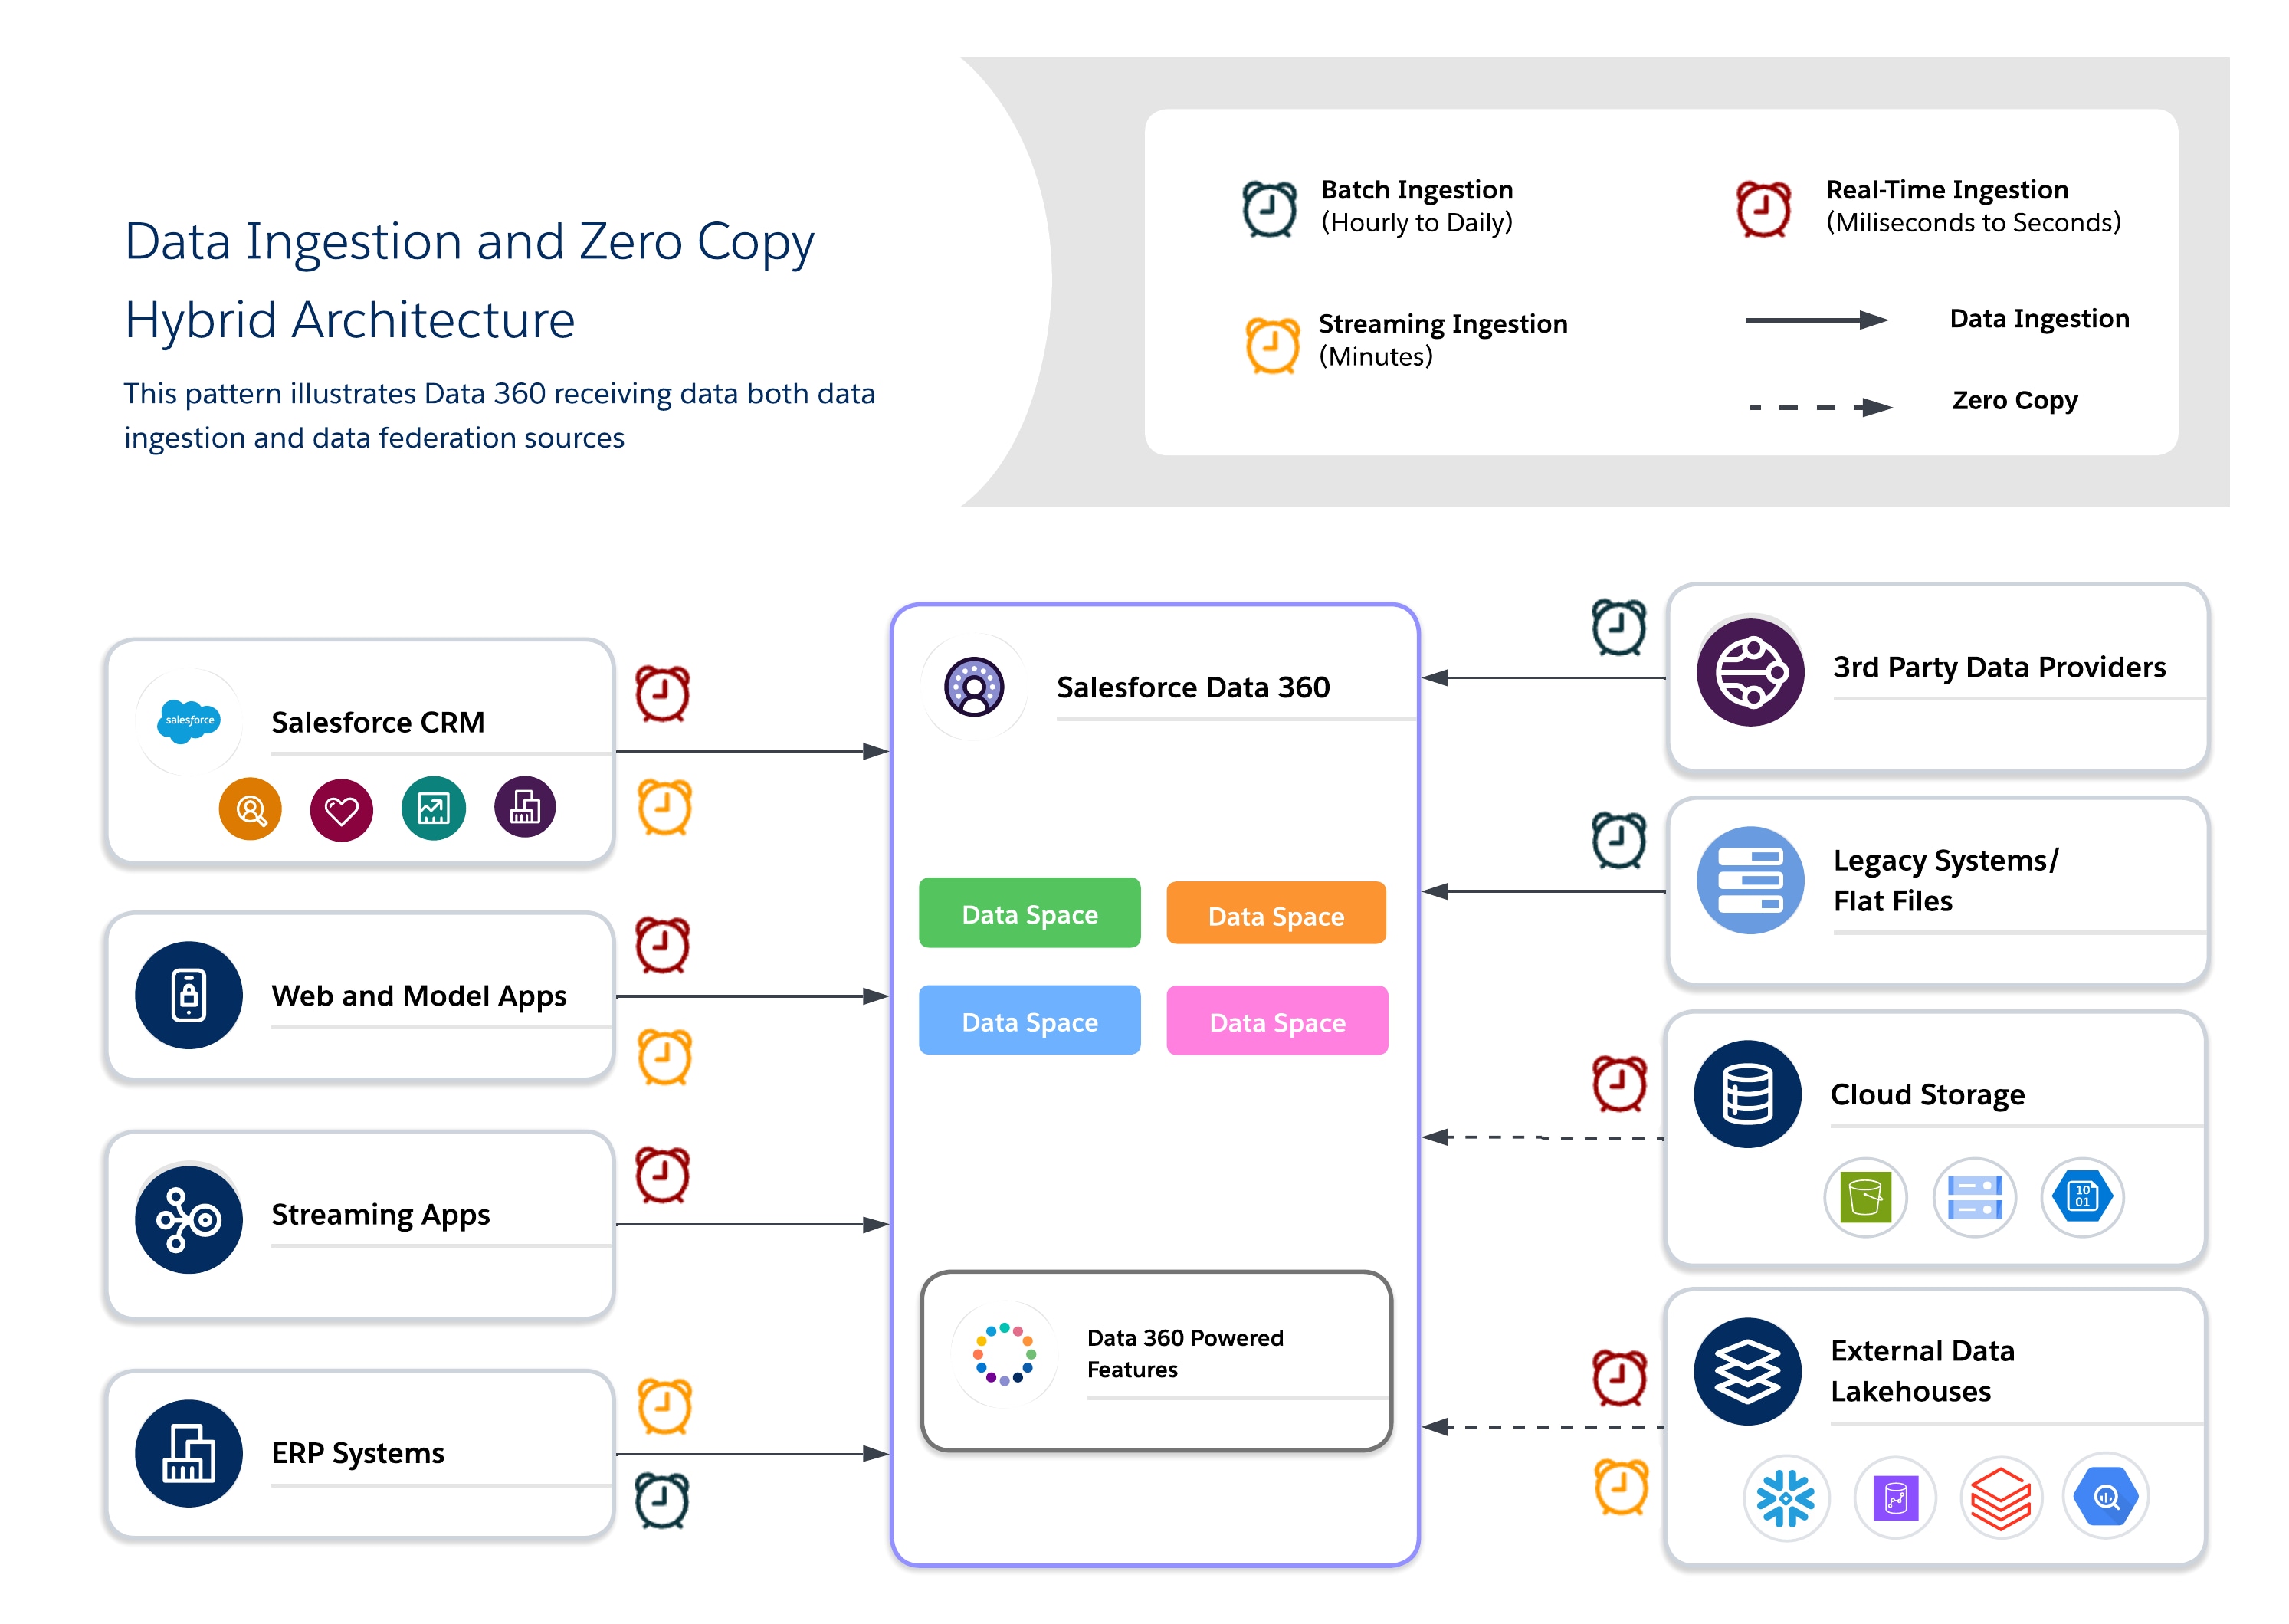 #### Libro de jugadas de arquitecto
- **Casos de uso**
- **Participación de OmniCanal:** Combine datos históricos de clientes con comportamiento en tiempo real para entregar experiencias coherentes y contextuales.
- **Oportunidades en curso de IA/ML:** Entrene modelos en conjuntos de datos canónicos depurados mientras los enriquece con señales sin procesar o en tiempo real procedentes de fuentes externas.
- **Necesita cumplimiento y agilidad mixtos:** Aplique una regulación estricta para datos confidenciales pero federe para agilidad operativa.
- **Escenarios industriales**
- **Retail:** Utilice el ingreso para la resolución de identidad y la unificación de perfiles; federe para ofertas en tiempo real y personalización.
- **Cuidados sanitarios:** Mantenga registros de pacientes dorados a través del ingreso mientras federa transmisiones de dispositivos IoT y datos de sensores para contexto inmediato.
- **Servicios financieros:** Ingrese datos regulados en un lago regulado por el cumplimiento mientras federa consultas externas para la detección de fraude y el monitoreo de riesgos.
- **Prácticas de diseño**
- **Ancle la gobernanza con el ingreso:** Ingrese datos de alto valor o regulados en modelos canónicos para garantizar Trust y cumplimiento.
- **Utilizar Federation for Freshness:** Permita a los lagos externos proporcionar acceso a datos en tiempo real o a gran escala sin duplicación.
- **Equilibrar costo frente a Desempeño:** Perfil de cargas de trabajo para decidir qué ingresar frente a federar, minimizando los costos de almacenamiento o consulta innecesarios.
- **Aplicar gobernanza por capas:** Aplique la regulación centralizada para datos ingresados, mientras aprovecha los propios controles de seguridad de sistemas federados (por ejemplo, RLS, enmascaramiento).
- Cuando diseñe oportunidades en curso híbridas, garantice el ingreso incremental para conjuntos de datos históricos y envíe agregaciones o filtros a orígenes federados para optimizar la E/S y calcular el uso.
- **Consideraciones de costos**
- Optimice el costo total frente al desempeño combinando el ingreso para el cumplimiento o los datos críticos con la federación cuando sea necesaria la actualización.
- Tenga en cuenta las E/S y calcule la distribución al mezclar el ingreso y la federación. Para reducir el costo de computación en sistemas de origen de consultas repetidas, utilice el almacenamiento en caché (Consulta acelerada) para conjuntos de datos federados de alta lectura y acceso frecuente.
## Guía de decisiones de casos de uso
A continuación se muestran arquetipos comunes que ilustran cómo aplicar esta lógica.
1. **El arquetipo "Fuente única de la verdad": Centralizar y gobernar**
- **Escenario:** Necesita crear perfiles Customer 360 unificados que cumplan los requisitos para toda su compañía global. Los datos proceden de una docena de sistemas diferentes, deben cumplir con las estrictas leyes de RGPD y CCPA y servirán como la fuente de confianza para todas las interacciones de marketing y servicio.
- **Patrón recomendado:** **Ingreso de datos.** La prioridad es la gobernanza, Trust y Control. El ingreso de los datos en Data 360 es la única forma de crear un perfil canónico completamente auditable que esté aislado de los sistemas de origen.
2. **El arquetipo "Perspectivas en tiempo real": Analizar sin moverse**
- **Escenario:** Su equipo de ciencia de datos necesita ejecutar consultas exploratorias en una tabla de transacciones masiva y en constante actualización en Snowflake. Al mismo tiempo, su equipo ejecutivo desea un tablero de BI en vivo con esos mismos datos. Mover petabytes de datos diariamente es demasiado lento y costoso.
- **Patrón recomendado:** **Zero Copy Federation.** La prioridad es la velocidad, la agilidad y la rentabilidad a escala. Cero copia le permite aprovechar el inmenso poder de su almacén de datos existente para consultas en tiempo real sin la sobrecarga y la latencia de la duplicación de datos.
3. **El arquetipo "Inteligencia híbrida": Gobernar el núcleo, federar el borde**
- **Escenario:** Desea enriquecer sus perfiles de clientes gobernados e ingresados con señales de comportamiento en tiempo real (como clics de sitios web) desde un lago de datos. Necesita la estabilidad del perfil principal pero la inmediatez de los datos en vivo para potenciar la personalización en el momento.
- **Patrón recomendado:** **Un enfoque híbrido.** Utilice el ingreso de datos para crear el núcleo estable y regulado de sus datos de clientes. Luego utilice Cero copia para federar los datos volátiles en tiempo real, uniéndolos en el momento de la consulta para una vista completa al segundo.
## El camino a seguir
La estrategia de datos de compañía ya no se trata de elegir un patrón de integración único: se trata de diseñar flexibilidad controlada dentro de un ecosistema de datos interoperable. La selección del método de integración de datos correcto para cada sistema de datos de origen en base a las necesidades de negocio a menudo lleva a un enfoque híbrido que combina los puntos fuertes del ingreso de datos y la federación de datos.
- Ingrese conjuntos de datos gobernados de misión crítica en Salesforce Data 360 para el cumplimiento, la resolución de identidad y los flujos de trabajo operativos.
- Genere datos a través de Cero copia para análisis en vivo, exploratorios y dirigidos por IA sin duplicar el almacenamiento.
Salesforce Data 360 en Hyperforce ofrece resiliencia y capacidad de ampliación de múltiples regiones. ts open lakehouse with Iceberg tables permite calcular la separación y la interoperabilidad con plataformas como Snowflake, Databricks y S3 Iceberg, formando la columna vertebral de un ecosistema de datos multinube verdaderamente interoperable.
A medida que evolucionan los ecosistemas de datos, equilibre continuamente la frescura, el costo, el desempeño y el cumplimiento para mantener la agilidad arquitectónica. Prepare su plataforma para el futuro unificando datos ingresados y gobernados con acceso federado. Esto permite la inteligencia en tiempo real, la activación de IA y la personalización a escala de compañía entre nubes, regiones y dominios de negocio.
Las soluciones únicas no se adaptan a la mayoría de los negocios. La estrategia óptima asigna el patrón correcto al controlador de negocio correcto.
## Acerca de los autores
Yugandhar Bora es Arquitecto de Ingeniería de Software en Salesforce, especializado en arquitectura de datos dentro de la plataforma Aplicaciones de inteligencia y datos. Lidera iniciativas de la junta de revisión de arquitectura de negocio (EARB) centradas en la gobernanza de datos y modelos de datos unificados, mientras contribuye a soluciones de aprovisionamiento de plataforma automatizadas.
Jan Fernando es Arquitecto principal en la Oficina del Arquitecto jefe de Salesforce. Se unió a Salesforce en 2012, aportando una gran experiencia desde su época en el ecosistema de startups. Antes de incorporarse a la Oficina del Arquitecto Jefe, pasó más de una década en la organización Platform, donde dirigió varias transformaciones tecnológicas clave.
## Descripción general
Las arquitecturas modernas de Salesforce están cada vez más impulsadas por el procesamiento asíncrono; no como una comodidad, sino como un requisito estratégico para la escala. En los últimos años, hemos visto a más y más compañías lidiar con volúmenes de datos crecientes, integraciones complejas que implican múltiples puntos de contacto y el auge de sistemas autónomos que se ejecutan 24/7/365. Todo esto empuja a los arquitectos hacia el diseño de sistemas que son asíncronos en primer lugar.
El procesamiento asíncrono en Salesforce a menudo significa diseñar alrededor de límites reguladores y complejidad. Esos límites actúan como barandillas y restricciones arquitectónicas que ayudan a producir sistemas escalables y seguros en masa. Aunque ningún límite de plataforma sirve directamente para gestionar la complejidad, los [patrones de diseño](https://refactoring.guru/design-patterns) pueden ayudar a mitigar el riesgo en ese frente. Internamente, Salesforce a menudo amplía los límites de la plataforma para probar nuevas funciones y automatizar procesos de negocio complejos. Construimos un Marco de trabajo de procesamiento asíncrono basado en pasos para ejecutar trabajos asíncronos con un número arbitrario de pasos. Cada paso puede ejecutarse, reintentarse y reiniciarse de forma independiente con controles de gobernanza compartidos y visibilidad operativa completa a través del registro centralizado. Este documento describe sus componentes arquitectónicos clave: Apex y finalizadores colocables en cola, Flujo programado, Cursores Apex, Acciones invocables e integraciones con Slack. Juntos, estos componentes proporcionan una arquitectura modular, ampliable y observable adecuada para necesidades de negocio en evolución.
## Conclusiones clave
- Las arquitecturas modernas de Salesforce deben adoptar un enfoque asíncrono primero para alcanzar la escala, la resiliencia y la transparencia operativa.
- Dividir el trabajo complejo en pasos ejecutables de forma independiente permite un desempeño predecible, reintentos más seguros, puntos de control, reversión y evolución modular sin volver a diseñar flujos de trabajo principales.
- El marco de trabajo proporciona una alternativa ampliable a trabajos por lotes monolíticos y antiguos, llamadas asíncronas encadenadas y flujos profundamente anidados, y está construido para cargas de trabajo de gran volumen que deben ampliarse horizontalmente dentro de Salesforce sin orquestación fuera de la plataforma.
- La ejecución determinista y observable garantiza el seguimiento del progreso, el monitoreo de SLA, el diagnóstico de fallos y la transparencia a nivel de auditoría a través del registro y la gobernanza centralizados.
- Diseñado para el rigor de nivel de compañía, incluyendo la gobernanza unificada, el cumplimiento y el control de estado distribuido entre procesos de negocio de larga duración.
## Mejores prácticas de plataforma
Antes de revisar los requisitos, estos son algunos de los aspectos que se deben y no se deben tener en cuenta para cuándo utilizar un marco como este. Sobre todo, considere qué sistema es la única fuente de verdad. Si su organización de Salesforce depende mínimamente de datos externos pero necesita ampliarse de cientos a millones de registros, considere un marco de trabajo asíncrono basado en pasos.
**Sí** utilice este marco de trabajo si:
- La mayoría (o toda) la información sobre la que actuar ya existe en su CRM.
- El costo inicial o continuo de mantener un trabajo Extraer carga de transformación (ETL) para armonizar datos externos es demasiado alto.
- Debe aplazar el procesamiento de un gran número de registros de Salesforce en una programación establecida.
- Puede desglosar el procesamiento en pasos discretos. Por ejemplo, puede crear un conjunto de registros jerárquicos o basados en árboles, especialmente si el volumen de datos se desvía de la jerarquía o el árbol.
**No** utilice este marco de trabajo si:
- La creación o actualización de registros requiere un nuevo cálculo inmediato.
- La integración es un reto porque los sistemas externos alojan datos principales para actualizaciones de registros. (Considere el envío de datos actualizados a Salesforce con la API masiva.)
Con esas prácticas en mente, revisemos nuestros requisitos y comencemos a construir.
## Desglose de los requisitos
Considere la declaración de problema:
> Dado un trabajo que necesita ejecutarse diariamente, compruebe si ciertos registros cumplen criterios preestablecidos para un procesamiento posterior. Si lo hacen, inicie esos trabajos de procesamiento. Procesar registros podría significar extraer datos de múltiples sistemas externos para realizar cálculos. Los pasos en trabajos deben notificar a las personas a través de Slack que los registros procesados están listos para su revisión. Los pasos también deben distribuir notificaciones a gestores y superiores en la jerarquía de funciones basándose en un retraso configurable después de la primera ronda de notificaciones.
Este problema implica varios pasos diferentes, algunos de los cuales pueden producirse independientemente entre sí. Existen muchas formas de dividir el trabajo. Esta es una agrupación:
- El programador.
- La interfaz de pasos e implementaciones concretas que procesan registros (independientemente del tipo de procesamiento).
- El procesador que organiza los pasos.
- El Apex Invocable llamado por el programador.
- La pieza de notificación. Utilizamos el [SDK Apex Slack](https://developer.salesforce.com/docs/platform/salesforce-slack-sdk/guide/overview.html).
- Existe cierta complejidad oculta en la frase “retraso configurable”. Revisaremos esta complejidad más adelante en este artículo.
Este es un diagrama con opiniones para el marco de trabajo construido:
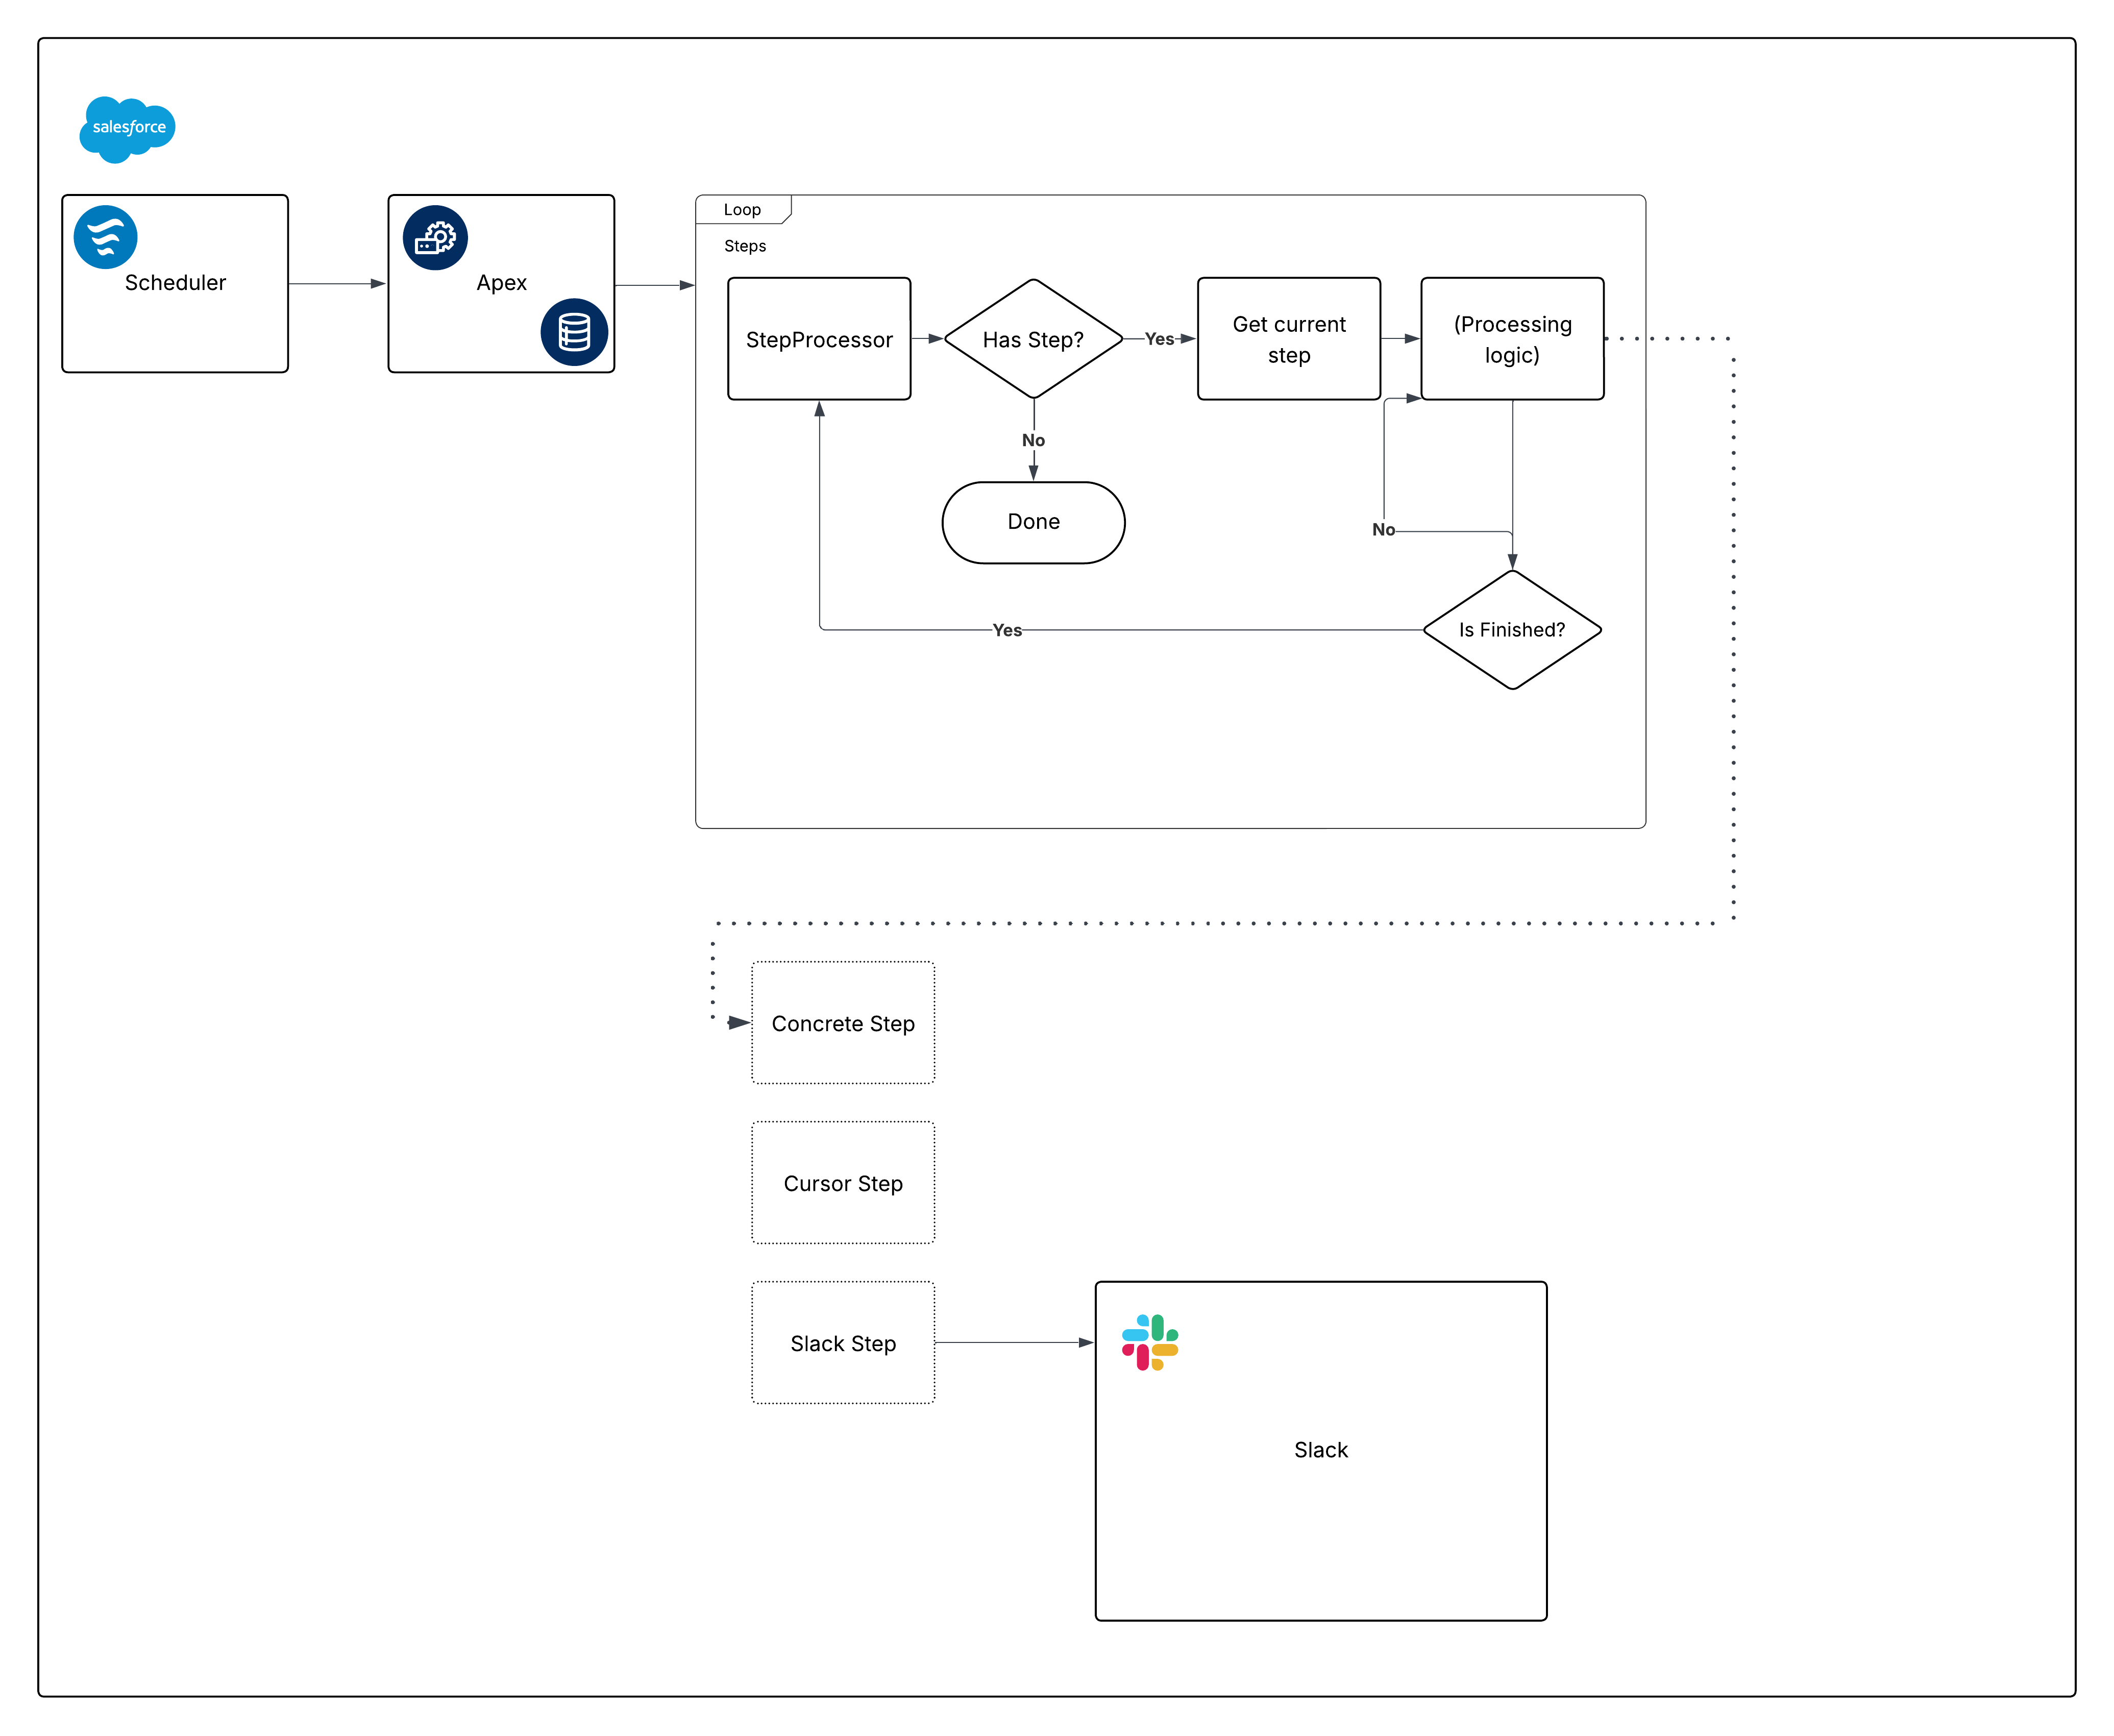 Ahora, desglose ese diagrama y comience a construir las piezas.
## Programación con flujo programado
Flujo programado ofrece varias ventajas como mecanismo de programación:
- Los flujos programados se pueden empaquetar e implementar como metadatos. Esto no es cierto para trabajos programados mediante Apex (o a través de la página Trabajos programados).
- El elemento Espera es crítico para marcos de trabajo que requieren llamadas. Al utilizarlo en Flujo, las llamadas no son necesarias en la parte invocable del marco de trabajo.
- La granularidad de la programación cumple los requisitos: el intervalo mínimo para Flujos programados es diario. Si necesita una frecuencia más alta (por ejemplo, cada hora), reconsidere Flujo programado para este requisito.
Otra consideración al configurar el Flujo programado es la apertura de puertas de entorno. Antes de invocar la acción Apex, agregue un elemento Decisión que evalúe la variable `{!$Api.Enterprise_Server_URL_100}`. Esto garantiza que el trabajo se ejecute solo en los entornos previstos, como UAT y Producción. Este patrón es importante porque los entornos sandbox se actualizan con frecuencia o se crean recientemente durante el SDLC, y sin una comprobación de entorno explícita, un Flujo programado podría ejecutarse de forma no intencionada en entornos donde el marco no está destinado a ejecutarse. El uso del operador `contains` en el elemento Decisión hace que la configuración sea resistente a futuras creaciones de sandbox o cambios de URL.
Finalmente, considere cómo debe capturar el marco los fallos. Agregue siempre una ruta de fallo cuando Flow llame a cualquier acción; por ejemplo, puede transferir fallos a la acción "Agregar entrada de registro" de [Nebula Logger](https://www.nebulalogger.com/). Nebula Logger escribe registros en objetos personalizados, de modo que los clientes deben saber que los datos de registro consumen almacenamiento de la organización; de forma predeterminada, los registros se almacenan durante 14 días en una organización y luego se limpian; este periodo de retención es configurable. Nebula Logger también utiliza Eventos de plataforma para publicar registros, de modo que las entradas de registro se guardan independientemente de la transacción de procesamiento de datos principal; esto garantiza la captura de fallos incluso si la acción principal Flujo o Apex se revierte. Los clientes deben evaluar el volumen de registro esperado y los requisitos de retención cuando consideren la incorporación de un marco de trabajo de registro.
Este es el aspecto del flujo:
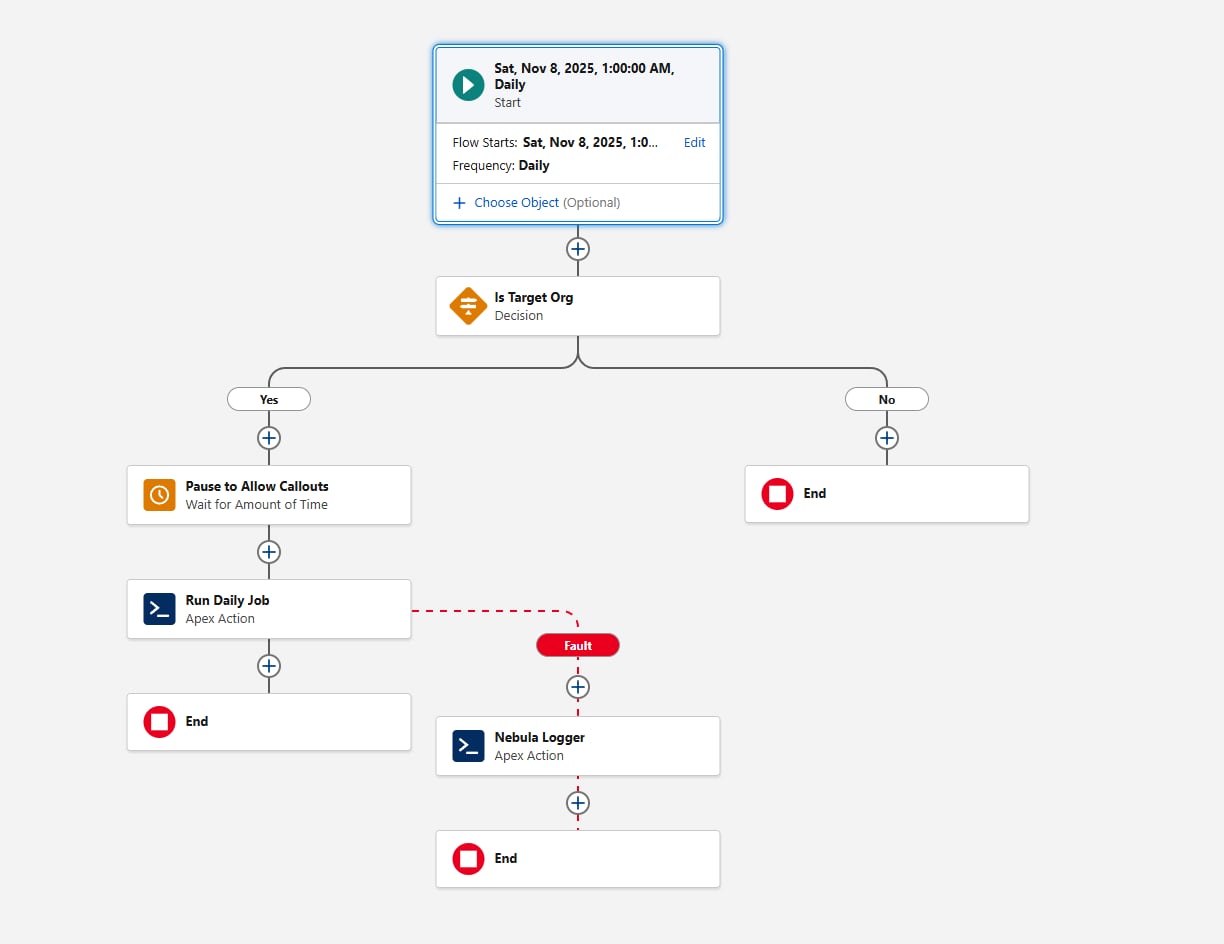 Pasemos a los primeros fragmentos de código Apex con el requisito de programación ahora satisfecho.
## Creación de una interfaz de pasos
Definir una interfaz de `Step`:
```java
public interface Step {
void execute();
void finalize();
String getName();
Boolean shouldRestart();
}
```
Para este artículo, la interfaz de `step` se muestra como una clase externa para mayor claridad. El marco en sí es flexible: los equipos pueden organizar la interfaz y sus implementaciones utilizando cualquier patrón de empaquetado Apex que prefieran, siempre que todas las clases Paso hagan referencia a la misma interfaz.
Existen algunas cosas a tener en cuenta acerca de los métodos definidos en nuestra interfaz:
- `execute`, aunque sin argumentos por el momento, mejora cuando pasamos una clase de `State` (o interfaz) para orquestar datos entre pasos cuando el pedido importa.
- Los `getName` podrían devolver un valor de `System.Type` en vez de un `String`. El objetivo es proporcionar a la capa de orquestación una forma de registrar nombres de pasos sin exponer otras propiedades.
Esta es la primera implementación concreta que muestra cómo se ajustan estas piezas. Con una excepción más adelante, recomendamos utilizar Apex colocable en cola para implementar el procesamiento asíncrono en Apex; Apex por lotes es normalmente innecesario (y se desaconsejan los métodos de `@future`). Apex colocable en cola se inicia rápidamente y, con Apex Cursors, tiene muchas ventajas sobre Apex por lotes.
### Una implementación similar a un cursor de Apex
Los [cursores Apex](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_cursors.htm) ofrecen una alternativa moderna al modelo Apex por lotes tradicional. Al igual que el procesamiento por lotes, una implementación de Cursor puede obtener registros en partes (hasta 2.000 por lote). Sin embargo, los Cursores permiten múltiples recuperaciones en una sola transacción, lo que permite un rendimiento significativamente superior para operaciones de gran volumen.
Al adoptar Cursores como parte de este marco de trabajo, los equipos deben tener en cuenta las limitaciones de prueba y simulabilidad actuales. El comportamiento del cursor en las pruebas puede diferir del comportamiento de producción, por lo que es importante diseñar estrategias de prueba que eviten depender de los elementos internos del cursor y que validen la lógica de orquestación en los límites. A medida que evolucione la plataforma, estas áreas seguirán mejorando, pero la orientación principal sigue siendo: Los cursores proporcionan un desempeño superior y una carga de orquestación reducida en comparación con Apex por lotes para muchos casos de uso.
Para definir un límite claro entre el Cursor proporcionado por el sistema y su propio código, recomendamos crear una representación similar a Cursor al implementar la interfaz de `Step`. Considere este código:
```java
public inherited sharing abstract class CursorStep implements Step {
private static final Integer MAX_CHUNK_SIZE = 2000;
protected Cursor cursor;
private Integer chunkSize = System.Limits.getLimitDMLRows();
private Integer position = 0;
protected abstract Cursor getCursor();
protected abstract void innerExecute(List