---
schema_version: "1"
id: 9faa667b62a6b4ad4dae75caf0e0350f782a57d40ffe866797cc4dbb30b3d601
title: Data 360 互通性
collection: architect
version: current
locale: zh-tw
portal_url: https://docs.salesforce.com/architect/current/zh-tw/decision-guides/guides/data-360-interoperability.md
canonical_url: https://architect.salesforce.com/docs/architect/zh-tw/decision-guides/guide/data-360-interoperability.html
source_site: architect.salesforce.com
content_type: documentation
content_hash: ad2a1046749b979b0e9539475820d5ca21059e292b63772500e1c09ebb7b8ca1
products:
  - 決策指南
  - Architect Site Content Repo
updated_at: 2026-07-01T00:00:00Z
---
# Data 360 互通性

企業通常會將資料儲存在 Salesforce 和其他外部資料湖中 (例如,_Snowflake_、_Google BigQuery_、_Databricks_、_Redshift_ 或物件儲存空間,例如 _Amazon S3_)。在多個系統之間隔離資料會對想要充分運用其資料價值的公司造成挑戰,以強化 AI 驅動的體驗。Salesforce _Data 360_ 是每個 Agentforce AI 工作人員在正確時間存取正確內容的基礎情報層。

努力將多個資料湖之間的資料整合在一起的結構設計師會面臨關於如何最佳整合該資料的重要結構決策。_Data 360_ 提供資料整合的多個選項,每個選項都有不同的優點與缺點。

## 指南概觀

本指南提供一個架構來評估哪些模式最適合整合資料時的延遲、成本、可擴展性、管治和複雜性需求,協助您選擇何時使用資料提取、零複製資料聯合或混合式方法。此指南也會協助您在不同方法之間進行選取,這些方法皆滿足不同的需求。

將外部資料湖首頁與 _Data 360_ 整合需要仔細考量資料新鮮度、管治和管道效率之間的權衡。例如,使用「零複製」資料聯合即時查詢可將資料的最新度最大化,但隨著更多資料在網路上移動,可能會降低銷售管道效率。針對大多數的實作,在多重雲端湖家生態系統中結合取用與聯合是最佳的路徑。此混合式方法可確保可調整、受管理、可互通的結構,支援低延遲的作業工作負載 (例如,即時個人化和詐騙偵測) 和分析工作負載 (例如,法規報告和歷程記錄趨勢分析)。本指南可協助您決定如何使用適當的策略來瀏覽這些權衡。

## 重要道具

- **Data Capture** 會將資料複製到 Salesforce _Data 360,_ 並建立受管理的標準資料模型。這是您需要進行下列動作時的理想選擇:
  - **建立全方位的 Customer 360**,可讓您將不同的來源統一並轉換為一個信任的設定檔。
  - **符合嚴格的法規合規性。**這可讓您建立可稽核的集中複本,以便密切控制資料存取與歷程。
- **Zero Copy Federation** 會即時查詢外部來源,而不會重複,以啟用即時個人化、即時顯示面板和快速來源上線。此方法提供兩個主要選項,但有必須平衡的權衡:
  - **即時查詢:**請將其用於位於外部資料平台中的互動式分析和即時資料顯示面板 (例如,_Snowflake_、_BigQuery_、_Redshift_ 或 _Databricks_)。這有助於透過將查詢處理推送至來源系統,並僅傳回必要的結果,以避免慢速且高成本的資料重複。此方法針對不常見或臨時的查詢最佳化,其中重新整理十分重要。適用於低 _每秒查詢 (QPS)_ 的工作負載 (查詢成本在高 QPS 時可能大幅高)。
  - **快取 (加速查詢):**將此用於不常變更的頻繁資料查詢。加速查詢會維持以可設定的間隔時間 (15 分鐘到 7 天) 更新的本機快取,進而減少重複的來源點擊。此方法會平衡顯示面板效能與成本、區隔和 BI 工作負載,其中略有延遲的結果是可接受的。這不適用於次要決策。
  - **檔案聯合:**針對雲端資料湖中的資料 (例如,_S3_ 或 _ADLS_) 進行大規模批次處理和 AI 模型訓練。此方法可透過直接以開放式表格格式查詢檔案,以避免慢速且高成本的採取,進而解鎖大量 ETL 資料集和資料科學工作量。
- **混合式模型**結合了針對 _統一設定檔_採取的注意事項,同時也結合了關聯性,其支援 Omni-Channel 參與、Agentforce 驅動的動作和 AI/ML 訓練。

### 重要考量事項

- **使用混合結構。**經常需要混合資料取用與聯合。
  - 針對標準資料模型和核心控管,在重要資料上使用「_資料取用_」。
  - 針對所有其他資料聯合使用「_零複製」,_以保持最新狀態,並將建立和維護資料取用管道的作業負擔降到最低。
- **資料取用頻率很重要**根據業務價值、延遲需求和營運複雜度選擇頻率。
  - 將 _即時_用於具有時效性的工作流程 (例如個人化、即時顯示面板和 Agentforce 動作)。
  - 針對中度緊急的流程 (例如行銷活動和作業報告) 使用 _近乎即時_。
  - 針對歷程記錄或低速資料集使用批次。
- **將聯合模式與延遲和效能比對。**選擇最符合您存取模式與更新性、效能與成本需求的選項。
  - 將「_即時查詢」_用於在低延遲十分重要的作業顯示面板和即時個人化。
  - 當查詢頻繁且略有延遲的結果可接受時,請使用 _快取 (加速查詢)_,這有助於平衡效能與成本。
  - 將 _檔案聯合_用於大規模、輸送量繁多的分析或批次工作負載,這是歷史或較不敏感時間的資料集的理想選擇。
- **將管治與資料落地需求保持一致。**
  - 當集中化治理十分重要時,請使用 _耗用_。
  - 當去中心化治理可接受時,請使用_聯邦_,同時在外部來源強制執行嚴格的監管。
  - 針對來源層級原則使用「_零複製」(_例如,_列層級安全性 (RLS)_ 和資料遮蔽)。
- **為高價值工作流程排定採取優先順序。**選擇性地套用至重要流程 (例如身分解析、監管報告和作業啟用)。
- **成本與複雜性驅動決策。**即時採取可能高成本且複雜。這就是為什麼結構設計師必須將上線、儲存和轉換資料的成本對照直接透過 _零複製_查詢資料的成本進行加權。

選擇正確的整合模式 (包括_資料取用_、_零複製_或_混合式_方法) 會直接影響多重雲端平台的延遲、管治、營運效率和成本。此決策會決定如何可靠且大規模地提供即時洞察、AI 驅動的啟用和個人化參與。

## 產品比較

此表格比較 Salesforce _Data 360_ 中的「_資料取用_」和「_零複製_」模式,專注於功能、權衡和優點,以及企業使用個案和成果。使用此作為設計混合式多雲端資料平台的參考,以平衡效能、成本和合規性。

<table>
  <thead>
    <tr>
      <th align="left" valign="top"><strong>模式類型</strong></th>
      <th align="left" valign="top"><strong>模式/工具</strong></th>
      <th align="left" valign="top"><strong>福利</strong></th>
      <th align="left" valign="top"><strong>考量事項</strong></th>
      <th align="left" valign="top"><strong>成果</strong></th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td align="left" valign="top"><strong>資料取用</strong></td>
      <td align="left" valign="top">
        <strong>即時:</strong>
        <ul>
          <li>透過具有 CDC 支援的「取用 API」來進行子秒延遲。</li>
          <li>連續串流銷售管道。</li>
        </ul>
      </td>
      <td align="left" valign="top">
        <ul>
          <li>提供立即洞察</li>
          <li>包含低延遲作業與個人化使用個案</li>
          <li>支援以事件為導向的工作流程</li>
        </ul>
      </td>
      <td align="left" valign="top">
        <ul>
          <li>高成本</li>
          <li>複雜結構</li>
          <li>低延遲來源系統需求</li>
          <li>大量來源可能會造成過多的串流,這會導致飽和的銷售管道</li>
          <li>I/O 密集</li>
          <li>選擇性欄位與篩選可能有助於減少超額</li>
        </ul>
      </td>
      <td align="left" valign="top">
        <strong>Agentforce:</strong>
        <ul>
          <li>即時詐騙警示、零售個人化和作業警示</li>
        </ul>
        <strong>Analytics:</strong>
        <ul>
          <li>子秒顯示面板與 KPI 監視</li>
        </ul>
        <strong>合規性:</strong>
        <ul>
          <li>監管工作流程的連續客戶記錄更新</li>
        </ul>
      </td>
    </tr>
    <tr>
      <td align="left" valign="top"></td>
      <td align="left" valign="top">
        <strong>串流:</strong>
        <ul>
          <li>每 1–3 分鐘透過原生連接器進行每個 1–3 個批次採取</li>
        </ul>
      </td>
      <td align="left" valign="top">
        <ul>
          <li>平衡成本與新鮮度</li>
          <li>具有比即時更簡單的結構</li>
          <li>支援增量更新</li>
        </ul>
      </td>
      <td align="left" valign="top">
        <ul>
          <li>輕微延遲</li>
          <li>可能不適用於重要子秒決策</li>
          <li>批次大小會影響記憶體/計算</li>
          <li>仲裁 I/O</li>
          <li>適用於可預測的重複更新模式</li>
          <li>視窗彙總可能有助於減少處理負載</li>
        </ul>
      </td>
      <td align="left" valign="top">
        <strong>Agentforce:</strong>
        <ul>
          <li>及時的行銷活動觸發和即時參與</li>
        </ul>
        <strong>Analytics:</strong>
        <ul>
          <li>建議引擎與近乎即時的顯示面板</li>
        </ul>
        <strong>合規性:</strong>
        <ul>
          <li>含稽核性的頻繁更新</li>
        </ul>
      </td>
    </tr>
    <tr>
      <td align="left" valign="top"></td>
      <td align="left" valign="top">
        <strong>批次:</strong>
        <ul>
          <li>透過連接器或 API 提供排程的大量負載。</li>
          <li>支援物件儲存和 ETL/ELT 銷售管道。</li>
        </ul>
      </td>
      <td align="left" valign="top">
        <ul>
          <li>支援高成本效益的大量資料集</li>
          <li>功能簡易實作</li>
          <li>提供歷程記錄分析的可靠性</li>
        </ul>
      </td>
      <td align="left" valign="top">
        <ul>
          <li>資料延遲</li>
          <li>不適用於具有時效性的作業</li>
          <li>載入期間的 I/O 密集</li>
          <li>網路輸送量可能會成為大型檔案的瓶頸</li>
          <li>適用於歷程記錄彙總或監管報告工作流程</li>
        </ul>
      </td>
      <td align="left" valign="top">
        <strong>Agentforce:</strong>
        <ul>
          <li>IT 支援票證 (Jira/ServiceNow) 和彙總工作流程</li>
        </ul>
        <strong>Analytics:</strong>
        <ul>
          <li>歷程記錄分析與趨勢評估</li>
        </ul>
        <strong>合規性:</strong>
        <ul>
          <li>法規報告和病患/索賠資料彙總</li>
        </ul>
      </td>
    </tr>
    <tr>
      <td align="left" valign="top"><strong>零複製</strong></td>
      <td align="left" valign="top">
        <strong>即時查詢:</strong>
        <ul>
          <li>提供外部系統的直接查詢和結構描述讀取,而不需要資料重複</li>
        </ul>
      </td>
      <td align="left" valign="top">
        <ul>
          <li>提供最大的新鮮度</li>
          <li>功能最低儲存空間負擔</li>
          <li>支援即時作業洞察</li>
        </ul>
      </td>
      <td align="left" valign="top">
        <ul>
          <li>取決於來源效能</li>
          <li>高查詢量可能會影響延遲</li>
          <li>適用於含述詞推送和彙總以將 I/O 最小化的查詢</li>
          <li>避免在大量資料集中使用未篩選的查詢</li>
        </ul>
      </td>
      <td align="left" valign="top">
        <strong>Agentforce:</strong>
        <ul>
          <li>適用於即時活動的動態工作流程</li>
        </ul>
        <strong>Analytics:</strong>
        <ul>
          <li>作業顯示面板與即時報告</li>
        </ul>
        <strong>合規性:</strong>
        <ul>
          <li>遵循來源的列層級安全性和遮蔽</li>
        </ul>
      </td>
    </tr>
    <tr>
      <td align="left" valign="top"></td>
      <td align="left" valign="top">
        <strong>加速查詢 (快取):</strong>
        <ul>
          <li>針對可設定為 15 分鐘到 7 天的聯合查詢,提供快取的本機複本。</li>
          <li>提供最佳化查詢執行</li>
        </ul>
      </td>
      <td align="left" valign="top">
        <ul>
          <li>減少延遲</li>
          <li>功能比重複即時查詢更低的成本</li>
          <li>改善頻繁存取模式的效能</li>
        </ul>
      </td>
      <td align="left" valign="top">
        <ul>
          <li>需要快取管理</li>
          <li>延遲時間取決於快取間隔</li>
          <li>適用於高頻率查詢</li>
          <li>不適用於次要決策</li>
          <li>增量重新整理僅支援更新插入;刪除的記錄不會從快取中移除。</li>
          <li>定期需要手動完整重新整理,以使快取與來源保持同步</li>
        </ul>
      </td>
      <td align="left" valign="top">
        <strong>Agentforce:</strong>
        <ul>
          <li>用於快速決策的預先彙總參與度量</li>
        </ul>
        <strong>Analytics:</strong>
        <ul>
          <li>BI 顯示面板、區隔和分析報告</li>
        </ul>
        <strong>合規性:</strong>
        <ul>
          <li>使用稽核記錄持續調控的顯示面板</li>
        </ul>
      </td>
    </tr>
    <tr>
      <td align="left" valign="top"></td>
      <td align="left" valign="top">
        <strong>檔案聯合:</strong>
        <ul>
          <li>提供物件商店或湖中大型歷史資料集的直接存取權 (例如,<em>S3</em>、<em>Iceberg</em>、<em>Google BigQuery</em> 和 <em>Redshift</em>)。</li>
        </ul>
      </td>
      <td align="left" valign="top">
        <ul>
          <li>處理大規模資料集</li>
          <li>在 <em>Data 360 中</em>需要最少的儲存空間</li>
          <li>支援 AI/ML 工作量</li>
        </ul>
      </td>
      <td align="left" valign="top">
        <ul>
          <li>唯讀</li>
          <li>查詢效能取決於外部系統輸送量</li>
          <li>適用於批次繁重、輸送量密集型工作</li>
          <li>不適用於即時顯示面板</li>
        </ul>
      </td>
      <td align="left" valign="top">
        <strong>Agentforce:</strong>
        <ul>
          <li>非典型 (批次繁重)</li>
        </ul>
        <strong>Analytics:</strong>
        <ul>
          <li>ML/AI 訓練、歷程記錄分析和 petabyte 級報告</li>
        </ul>
        <strong>合規性:</strong>
        <ul>
          <li>管理無重複的外部資料集存取權</li>
        </ul>
      </td>
    </tr>
  </tbody>
</table>

## Data 360 整合模式

Data 360 有三個主要的整合模式:資料提取、零複製資料聯合,以及混合式方法。

### 資料匯入

透過「_Data Capture_」,資料會實際複製到 _Data 360_ 並完全受管理,而「_零複製」_則是資料保留在來源處。換句話說,轉換的運算是在 _Data 360_ 內部進行的,其提供集中管理與稽核。

#### 資料取用個案

在 Salesforce _Data 360 中_使用「_資料取用」_來儲存標準、受管理的資料集,以達成合規性和作業控制。當需要完整控制、稽核和可追溯性時,請使用採取。Data Capture 非常適用於受監管或高價值的工作流程,其中集中運算與管治十分重要。

其適用於建立身分解析、法規報告、任務關鍵 AI 驅動工作流程和客戶參與的信任基礎。

<img src="https://a.sfdcstatic.com/developer-website/prod/images/architect/df25_dc_images/Data Ingestion and Zero Copy - Data 360  Ingestion.png" alt="資料取用概觀" />

#### 資料取用方法

根據您使用哪個連接器來取用資料,可能會有不同的 _資料取用_方法。某些連接器提供各式各樣的方法,而其他連接器僅在批次或串流模式中運作。如需 _Data 360_ 連接器和可用方法的完整清單,請查看 [Data 360: 整合和連接器](https://help.salesforce.com/s/articleView?id=data.c360_a_sources_targets.htm&type=5)。

- **即時:**
  - 使用「_變更資料匯取」(CDC)_ 提供子秒匯取
  - 適用於具有時效性的工作流程 (例如詐騙偵測、個人化和作業顯示面板)
  - 功能在 _Data 360_ 內推送轉換和彙總,這有助於減少下游 I/O 並最佳化運算用量
  - 支援使用增量 CDC 將資料混亂降到最低
- **串流:**
  - 每 1–3 分鐘提供每 1–3 分鐘以小量增量為單位。
  - 平衡更新與成本
  - 適用於行銷活動協調流程、近乎即時的參與和作業報告
  - 支援使用微批次控制 I/O 峰值
  - 彙總來源的資料 (如果可以的話) 以減少傳輸量並最佳化儲存空間
- **批次 (已排程載入):**
  - 提供大型資料集的定期取用 (例如每小時、每日和每週)
  - 為歷程記錄資料集、法規報告和合規性使用個案提供成本效益與可靠性
  - 確保計算地區設定位於與來源儲存空間相同的區域,以提升效能並最佳化成本

#### 結構設計師手冊

- **資料取用個案:**
  - **產生 Customer 360 統一設定檔。**建立客戶身分與屬性的單一事實來源。
  - **維護法規合規性資料集。**強制管理敏感資料、歷程和稽核能力。
  - **集中行銷活動協調流程。**確保行銷、銷售和服務皆從一致且信任的資料集中作業。
- **設計作法:**
  - 針對歷程記錄或低延遲容忍需求 (例如,歸檔報告或定期快照) 容納批次取用。
  - 使用 CDC 或串流 API 來維持作業與個人化工作流程的最新狀態,以確保近乎即時更新。
  - 透過套用增量負載來最佳化成本和效率來控制儲存和運算成長 (而不是重新載入整個資料集)。
  - 透過運算本地性和增量處理來讓取用管道保持一致,以減少網路 I/O。
  - 在 _Data 360_ 內套用轉換,以避免不必要地移動原始資料。
- **成本考量事項:**
  - 針對高價值且具時間敏感性的工作流程 (例如個人化、作業顯示面板或 Agentforce 驅動的動作),**即時接收**的運算與管道成本最高。
  - **串流吸收**具有中度的運算和儲存成本,適用於可能容忍輕微延遲的頻繁更新 (例如行銷活動協調流程或營運報告)。
  - **批次入院**的計算成本和可預測的儲存空間較低,適用於歷程記錄資料集或低頻率更新。使用特定連接器可免費從 Salesforce 組織中取用批次資料。
  - **重新整理模式** 可讓您選取「_增量重新整理」_模式,進而減少整體耗用和計算成本。在 Salesforce,我們建議盡可能使用「_增量重新整理」,_以最佳化所有採取類型的效率。
  - **成本**也會受到來源到 _Data 360_ 的 I/O 量影響。最佳化批次大小、分割和區域對齊方式可降低傳輸成本並改善效能。
- **行業案例:**
  - **財務:**_瞭解客戶 (KYC)_、_反洗錢 (AML)_ 和詐騙偵測 (若可稽核性與合規性為不可協商) 所需的資料集。
  - **醫療照護:**針對病患身分解析和 HIPAA 規範的記錄,請針對這些記錄使用採取,以啟用安全且統一的檢視。
  - **零售:**將 _銷售點 (POS)_、電子商務和忠誠度計畫資料合併至統一設定檔,以進行區隔和個人化。
  - **電信:**使用標準、受管理的訂閱者資料支援流失預防和使用量分析。

#### 資料取用方法決策條件

| 功能                              | 即時快取                                                                                                                                                                         | 串流捕取                                                                                                                                           | 批次提取                                                                                                                                                                            |
| :----------------------------------- | :------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------ | :------------------------------------------------------------------------------------------------------------------------------------------------------------ | :----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **延遲與新鮮度**            | 使用支援的「_變更資料摘取」(CDC)_,可透過「取用 API」來進行次秒延遲。提供連續串流管道。適用於低延遲作業使用個案。 | 可透過原生連接器每 1–3 分鐘進行一次微批次採取。支援增量更新。預期略有延遲。                             | 預期資料延遲。允許排程大量載入。提供定期取用 (每小時、每日和每週)。不適用於具有時效性的作業。                        |
| **主要使用個案**                | 適用於低延遲作業和個人化使用個案的理想選擇。用於具有時效性的工作流程。支援以事件為導向的工作流程。用於即時詐騙警示和作業警示。  | 適用於中度緊急的程序。用於行銷活動協調流程、近乎即時的參與和作業報告。用於及時的行銷活動觸發。  | 針對大量資料集具有成本效益。可靠以進行歷程記錄分析。用於歷程記錄彙總或監管報告工作流程。適用於歷程記錄或低速資料集。 |
| **結構複雜性和 I/O** | 包含高成本與複雜結構。需要低延遲來源系統。I/O 密集。大量來源會造成飽和的銷售管道。                                         | 具有比即時更簡單的結構。I/O 為中。適用於可預測的重複更新模式。批次大小會影響記憶體與計算。 | 實作簡單。載入期間的 I/O 密集。網路輸送量可能會成為大型批次的瓶頸。                                                                        |
| **成本考量事項**              | 包含最高的計算和管道成本。僅適用於高價值且具有時效性的工作流程。                                                                                 | 包含仲裁運算和儲存成本。提供平衡成本與新鮮性的方法。適用於可承受輕微延遲的頻繁更新。   | 可降低計算成本和可預測的儲存空間。建議用於歷程記錄資料集或低頻率更新。透過 Salesforce 內部銷售管道可免費使用。                   |
| **設計作法**                 | 使用增量 CDC 將資料混亂降到最低。篩選並使用選擇性欄位來減少超額。                                                                                         | 使用微批次控制 I/O 峰值。請考慮使用視窗彙總來減少處理量。                                                             | 用於歸檔報告或定期快照。確定計算地區設定與來源儲存空間所在的區域相同,以進行成本最佳化。                                              |

### 零複製資料聯合

#### 零複製使用個案

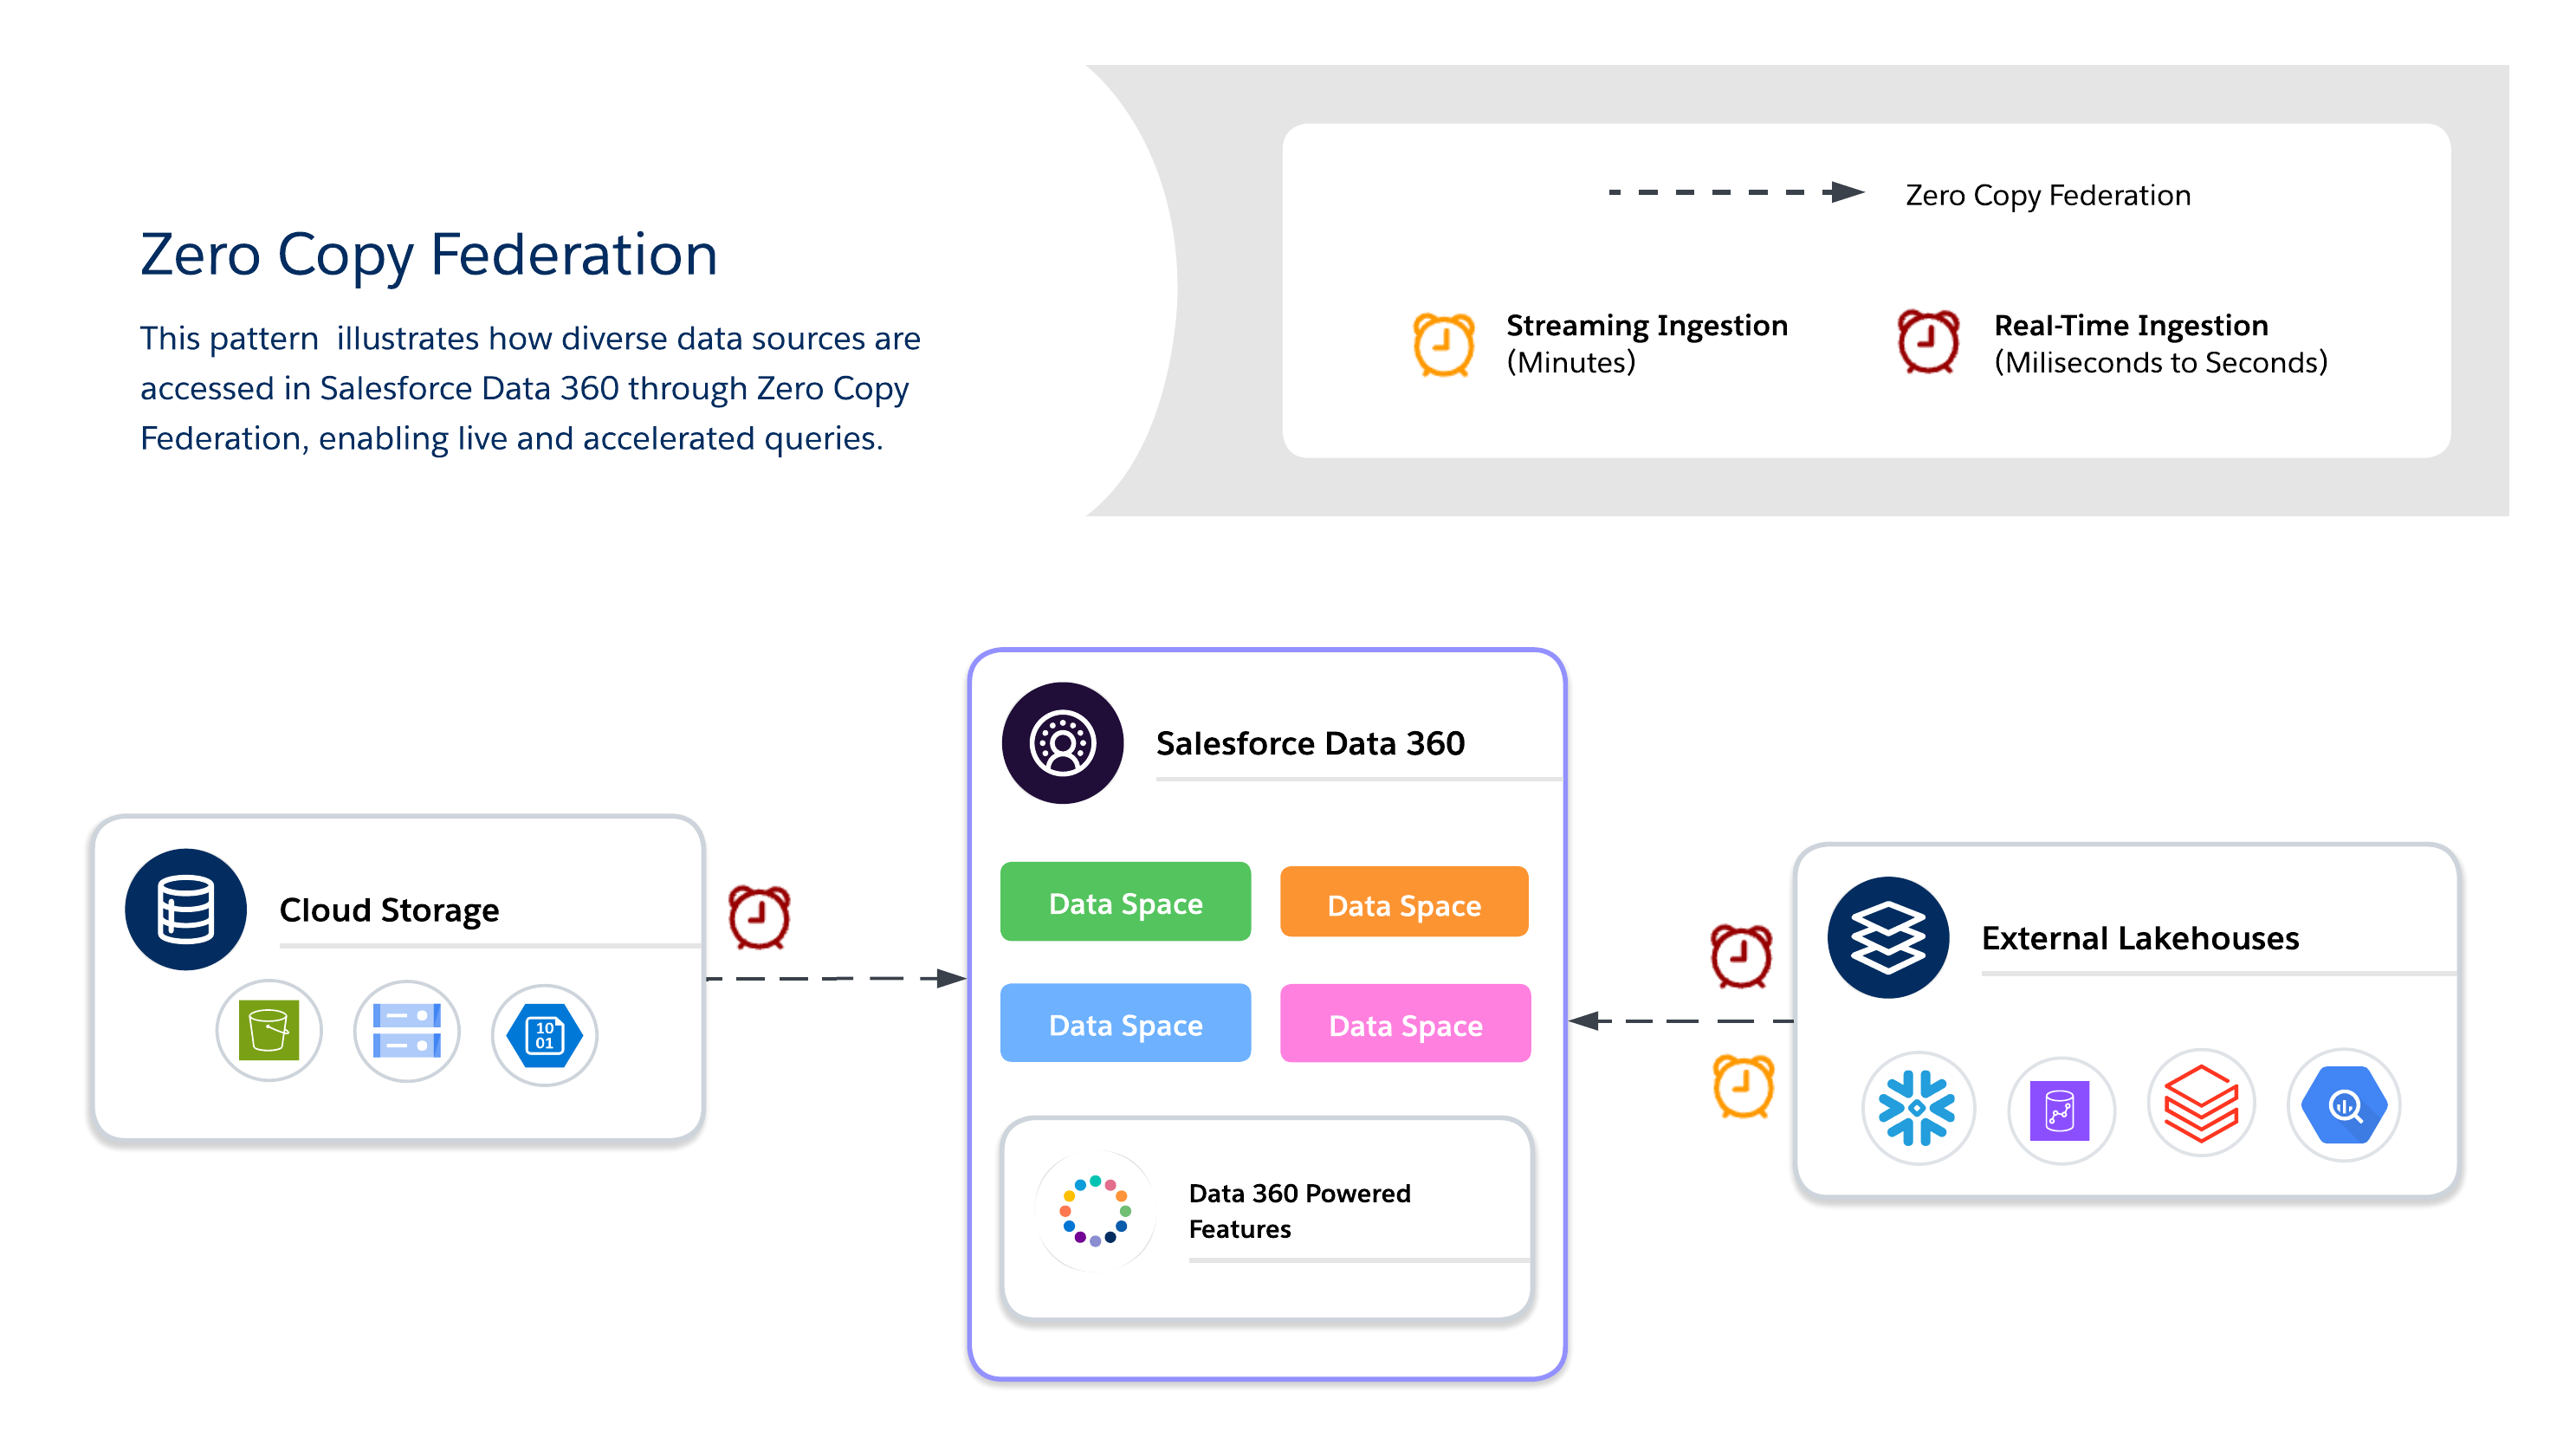
使用「_零複製」_來即時查詢外部系統,而無須資料重複,以啟用對大型或暫時資料集的靈活性、新鮮性和可調整存取權。適用於即時顯示面板、探索分析、AI/ML 模型訓練,以及直接透過 Salesforce _Data 360_ 進行即時客戶參與。

<img src="https://a.sfdcstatic.com/developer-website/prod/images/architect/df25_dc_images/Data Ingestion and Zero Copy - Data 360 Zero Copy.png" alt="零複製資料聯合概觀" />

#### 零複製方法

使用「_零複製」時_,結構設計師必須在三個可用的資料聯合方法之間選擇,每個方法都會在更新性、效能和成本之間提供自己的權衡。

- **即時查詢**
  - 直接針對外部系統 (例如,_Snowflake_、_Google BigQuery_、_Redshift_、_Databricks_ 等) 執行查詢,而不會重複資料。
  - 最小化網路上的資料移動,並減少 Salesforce _Data 360_ 計算的 I/O,這在可向下推送述詞和彙總時為最佳。
  - 適用於即時洞察和低延遲作業顯示面板。
  - 取決於外部系統效能。
- **快取 (加速查詢)**
  - 暫時將同盟資料的快取複本儲存在 Salesforce _Data 360 中_。
  - 透過可設定的持續時間 (分鐘到天) 來減少經常存取資料集的重複查詢成本和延遲。
  - 資料不會永久複製或完全管理,因此系統會透過來源的排程重新整理來管理重新整理。
  - _增量重新整理_僅支援更新插入。刪除的記錄不會從快取中移除。
  - 定期執行完整重新整理,以確保快取與來源保持同步。
  - **備註:**_Snowflake_ 連接器支援「_卸載」_功能,其使用 Snowflake 初始的暫存分類來增強加速率。此為預設啟用狀態,但可透過編輯連線來停用。
- **檔案聯合**
  - 提供物件存放區中大規模資料集的直接唯讀存取權 (例如,_S3_ 和具有 _Iceberg_ 的 _GCS_)。
  - 適用於 AI/ML 工作負載、歷程記錄分析和 petabyte 規模報告,無須移動資料。
  - 查詢效能取決於物件格式、分割和網路 I/O。如果未最佳化大型掃描,則可能會產生大量 I/O。

#### 結構設計師手冊

- **使用個案**
  - 隨著客戶行為變更,**即時個人化和自訂工作流程**會提供動態優惠、建議和 Next Best 動作。
  - **即時顯示面板和作業分析**會直接從外部倉庫支援業務關鍵顯示面板和 KPI。
  - **具有大型外部資料集的 AI/ML 模型訓練**可利用來自資料湖和倉庫的 petabyte 規模資料,而無須透過檔案聯合移動。
- **行業案例**
  - **零售/媒體:**透過聯合點閱串流或內容互動資料來啟用個人化建議和即時客戶參與。
  - **財務:**透過查詢外部倉庫,而不重複敏感資料,以近乎即時執行詐騙偵測和風險評分。
  - **技術/企業:**當資料集位於多個系統中時,支援跨雲端報告、IT 服務顯示面板和作業分析。
- **設計作法**
  - **即時查詢**
    - 當新鮮度十分重要時,用於高 QPS、低延遲的查詢。
    - 將述詞和彙總推送至外部系統,以減少網路上的資料混亂。
    - 避免進行不必要掃描大量資料的查詢。
    - 請考慮改為裁切分割和篩選。
  - **檔案聯合**
    - 在物件存放區中存取 petabyte 級資料集,而無須取用。
    - 將物件儲存空間與 Salesforce 計算保持在相同的雲端區域中,以將延遲和匯出成本降到最低。
    - 使用分割的資料欄格式 (Parquet/ORC) 和推送式篩選條件來減少 I/O 和網路傳輸。
    - 利用查詢和述詞推送功能來篩選和彙總來源的資料,進而減少資料移動。
    - 除非完全必要,否則請避免跨區域資料存取,因為這會增加 I/O、延遲和成本。
  - **快取 (加速查詢)**
    - 快取經常存取的資料集以平衡成本與效能。
    - 設定重新整理間隔以平衡更新與查詢成本。
  - **合規性:**透過利用 _列層級安全性 (RLS)_ 並直接在聯邦系統內遮蔽原則,強制執行來源的管治。
    - 以下是統一 RLS 和跨平台遮蔽的一些最佳作法:
      - **使用集中化企業識別碼。**將 Salesforce _Data 360_ 中的使用者與實體對應至與外部系統中身分對應的唯一集中企業識別碼。
      - **符合安全性原則。**確保聯合系統中的 RLS 和遮蔽原則會根據對應的身分套用。這可在查詢外部資料時保留合規性。
      - **標準化身分結構描述。**在所有資料來源之間維護一致的身分屬性 (電子郵件、使用者識別碼、客戶識別碼等),以避免不相符和存取權違規。
- **成本考量事項**
  - **即時查詢:**在每查詢付款模型中,會產生外部湖家計算的成本,這可能會造成高 QPS 的峰值。這適用於值大於成本變異性的關鍵性使用個案。
  - **加速查詢 (快取):**此方法透過減少對來源系統的點擊來降低查詢成本 (相較於 _即時查詢),_不過,這會增加填入和重新整理快取的批次資料取用成本。這適用於頻繁存取的資料集。
  - **檔案聯合:**這是「物件商店」中資料的最便宜儲存選項,但查詢成本取決於檔案大小、分割和裁切。這適用於 Petabyte 級的歷程記錄或大量資料。

#### 零複製方法決策條件

| 決策點           | 即時查詢                                                                                                                                                                                                                    | 快取 (加速查詢)                                                                                                                                | 檔案聯合                                                                                                                                                                                                                                                                                                                                                                                                                                                                  |
| :----------------------- | :---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | :--------------------------------------------------------------------------------------------------------------------------------------------------------- | :------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **資料來源位置** | 外部資料湖首頁 (例如,_Snowflake_、_Google BigQuery_、_Redshift_ 和 _Databricks_)                                                                                                                         | 外部資料湖首頁 (例如,_Snowflake_、_Google BigQuery_、_Redshift_ 和 _Databricks_)                                                      | 物件存放區或雲端資料湖 (例如,_S3_、_ADLS_ 和 _GCS_),通常使用如 _Iceberg_ 等開放式表格式。                                                                                                                                                                                                                                                                                                                                                     |
| **用途/使用個案**     | 適用於互動式分析與即時顯示面板。適用於即時個人化和動態工作流程。                                                                                                     | 適用於查詢頻繁,但可接受略過時的結果時。適用於 BI 顯示面板與區段。                            | 適用於大規模批次處理和 AI/ML 模型訓練。適用於歷程記錄分析和 petabyte 級報告。                                                                                                                                                                                                                                                                                                                                              |
| **新鮮度/延遲性**    | 提供最新的方式 直接即時執行查詢。透過有效的述詞推送功能表,針對低延遲查詢最佳化來源系統時,支援次要決策。                                 | 當略過時的結果可接受時使用。更新程度取決於快取間隔,可設定為 15 分鐘到 7 天。                  | 適用於批次繁重、輸送量密集型工作。不適用於即時顯示面板。                                                                                                                                                                                                                                                                                                                                                                                    |
| **存取模式**       | 適用於不常見或臨時的查詢,其中清新性十分重要且查詢量較少。成本在高 QPS 時大幅高,因此在查詢頻率高時評估快取 (加速查詢) 很重要。 | 適用於高頻率讀取情況。改善頻繁存取模式的效能。                                                             | 提供 r *ead-only* 存取權。適用於不需要採取的 petabyte 級資料集。                                                                                                                                                                                                                                                                                                                                                                                             |
| **效能驅動因素**  | 高度依賴外部來源系統效能。適用於可將述詞和彙總向下推送至來源時。                                                                                     | 與重複的即時查詢相比,減少延遲。效能取決於快取管理與間隔。                                             | 效能取決於物件格式、分割和外部系統輸送量。使用分割的資料欄格式 (Parquet/ORC)。                                                                                                                                                                                                                                                                                                                                     |
| **成本影響**    | 這是每個查詢的付款模式,因此系統會在外部湖家計算上收取成本。對於不常見的查詢而言,這符合成本效益,但費用可能會因高 QPS 量而高峰。                                                  | 成本低於重複的即時查詢。這會減少重複查詢外部來源的需求,但會增加快取儲存空間和重新整理額外負擔。 | 這是最便宜的儲存空間選項。針對相同區域的相同雲端 AWS 設定 (例如,在 US-East-1 的 _S3_ 與同時在 US-East-1 的 _Data Cloud_ 租戶),系統不會為存取的資料列耗用信用額。跨區域或跨雲端組態 (例如,_Azure_、_GCS_ 或不同的 _AWS_ 區域) 會為存取的資料列產生信用額度耗用。查詢成本也取決於檔案大小、分割和述詞下拉式最佳化。 |
| **重要考量事項**    | 避免未經篩選的查詢不必要地掃描大量資料。                                                                                                                                                        | 此方法需要快取管理。不適用於次要決策。                                                                          | 查詢效能主要依賴透過分割和述詞推送功能表進行最佳化。                                                                                                                                                                                                                                                                                                                                                                                        |

### 混合式方法

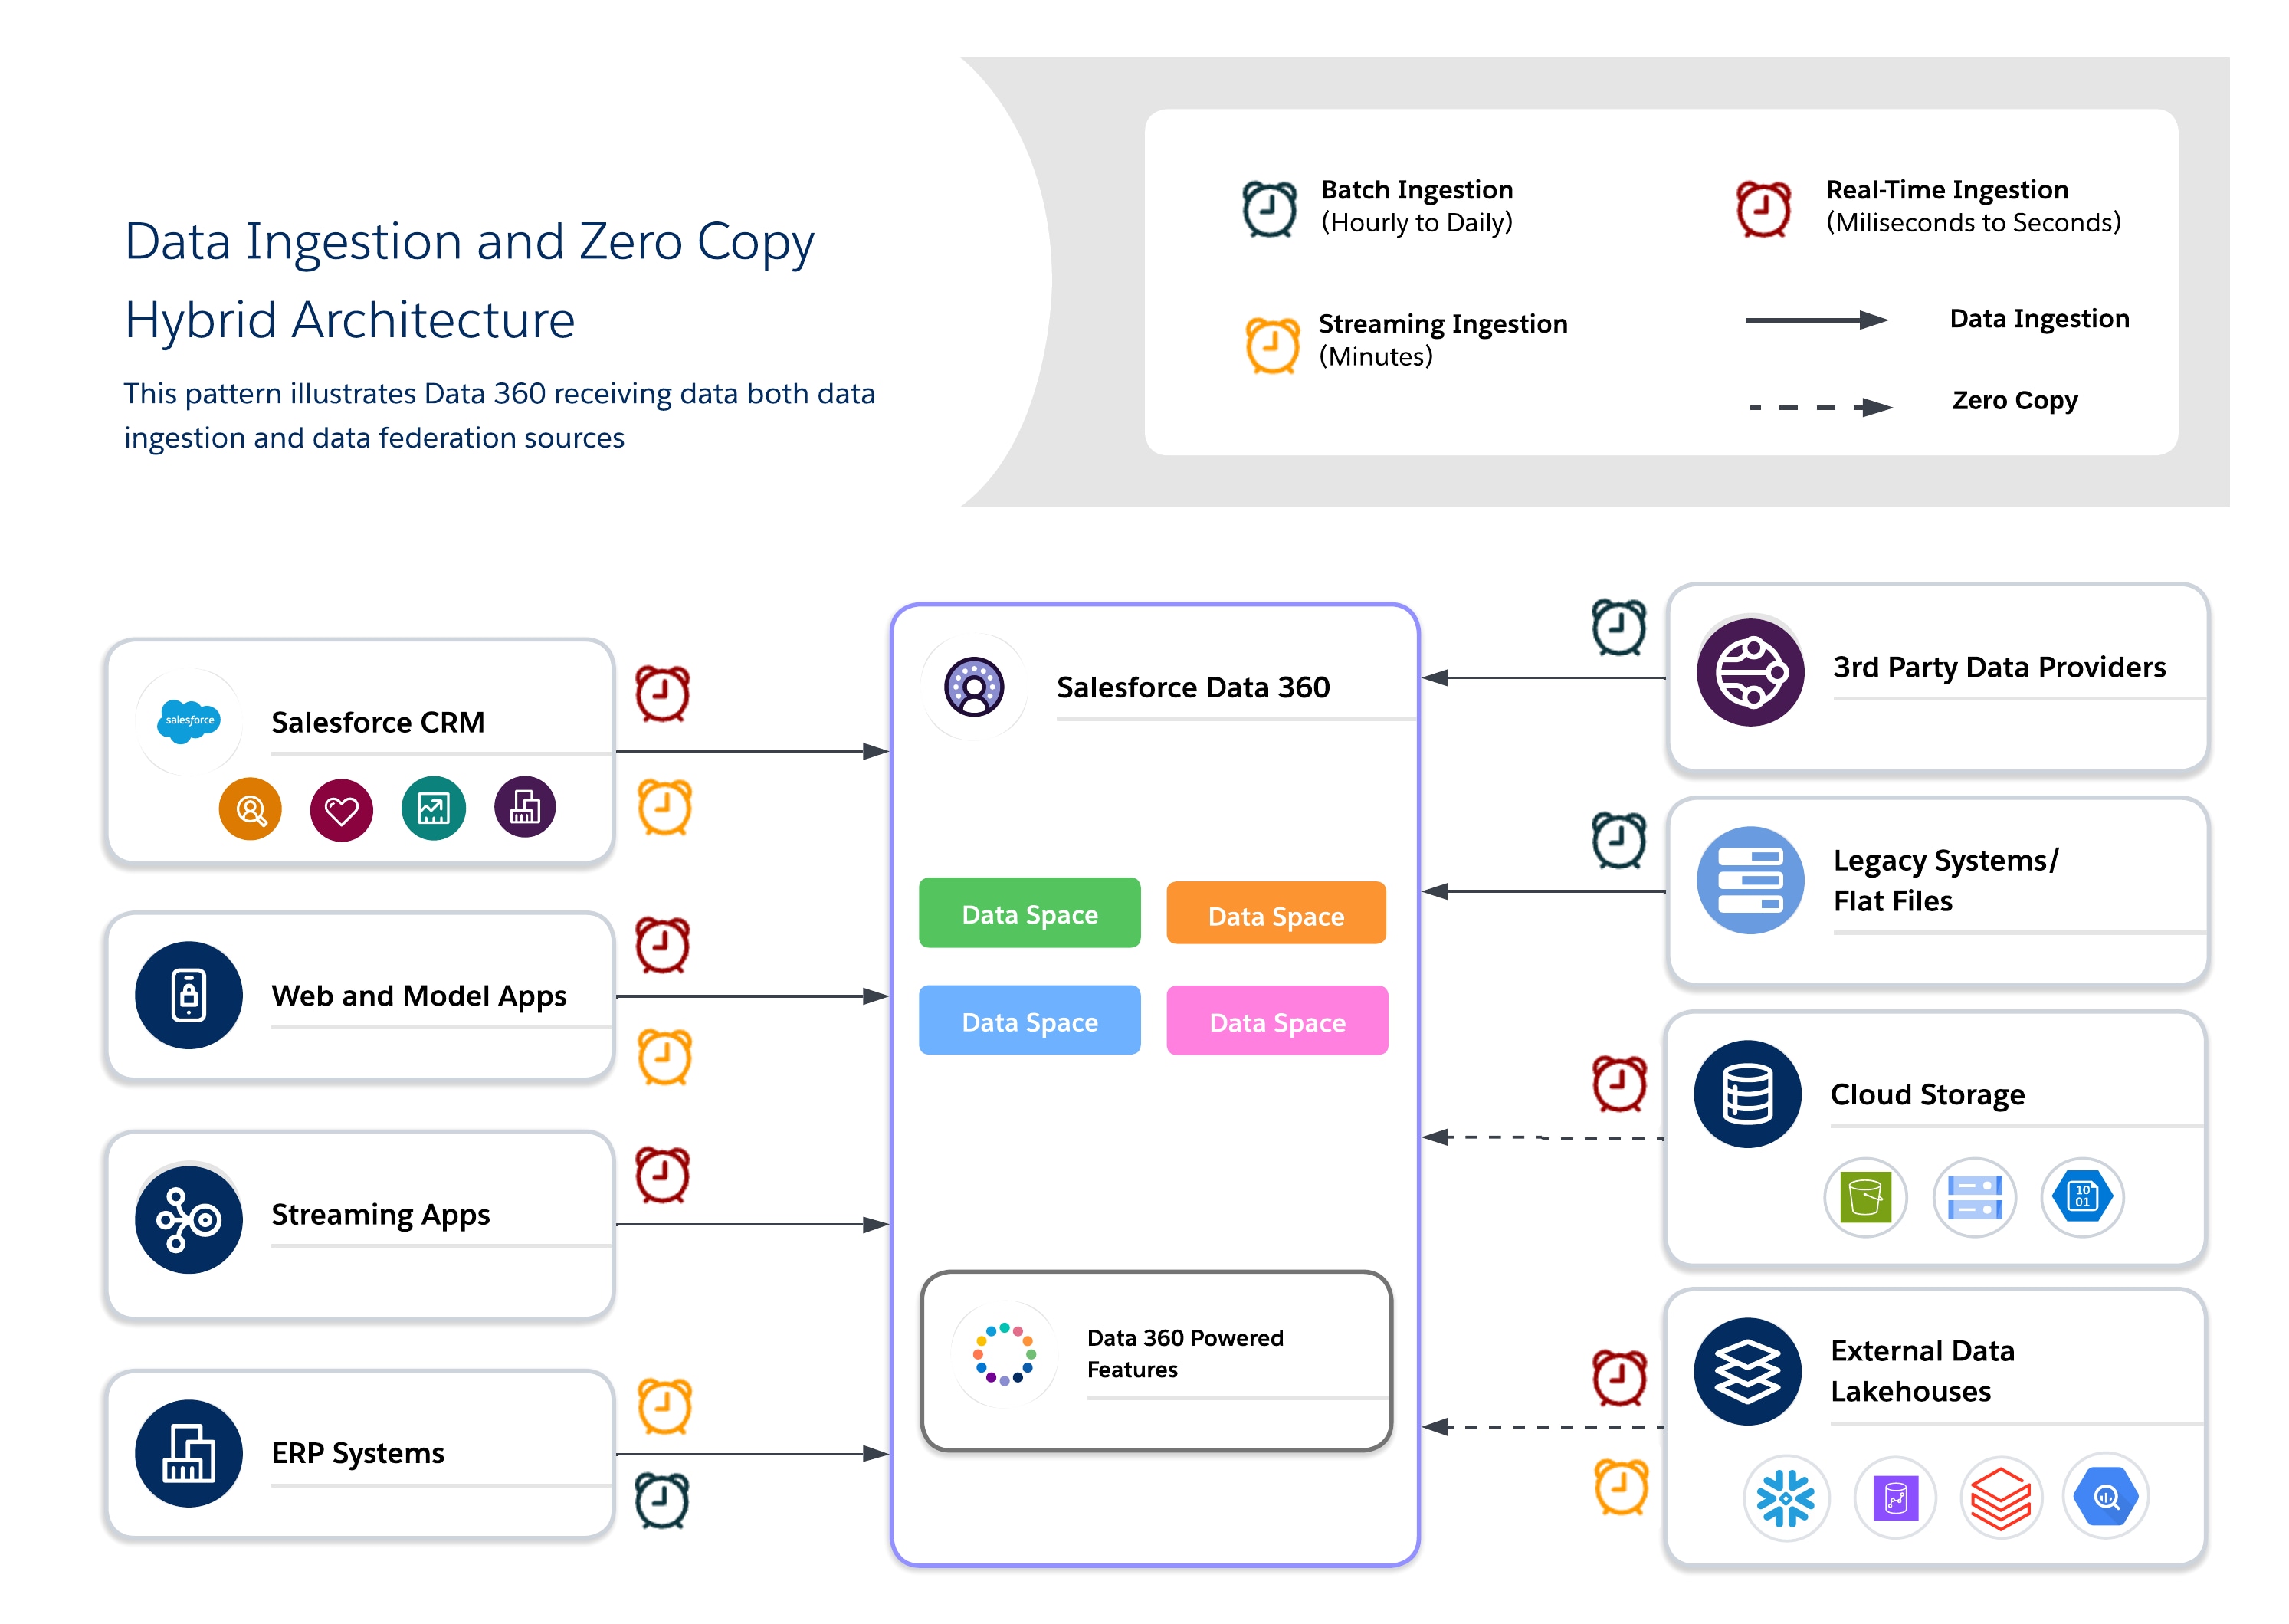
混合式結構可讓結構設計師將重要資料集固定在 _Data 360 中_,以進行集中管理,同時運用聯合查詢以獲得最新狀態、減少重複,並可擴充存取大型外部資料集。此方法會平衡 I/O、計算地區設定、成本和合規性需求。

#### 混合式使用個案

使用混合式方法來結合資料取用和零複製,以提供即時且可採取動作的洞察,以達到平衡的管治、新鮮性和營運效率。針對需要可追蹤性、RLS 和遮蔽的高價值、受監管的資料集,並針對最新性和效能為關鍵的暫時或大量資料集使用同盟。

<img src="https://a.sfdcstatic.com/developer-website/prod/images/architect/df25_dc_images/Data Ingestion and Zero Copy - Copy of Hybrid.png" alt="混合式方法概觀" />

#### 結構設計師手冊

- **使用個案**
  - **Omni-Channel 參與:**將歷程記錄客戶資料與即時行為混合在一起,以提供一致且感知內容的體驗。
  - **AI/ML 銷售管道:**針對精密設計的標準資料集訓練模型,同時使用來自外部來源的原始或即時訊號來增強模型。
  - **混合合規性和靈活性需求:**針對敏感資料套用嚴格的監管,並針對營運靈活性套用聯合。
- **行業案例**
  - **零售:**針對身分解析和設定檔統一使用 _摘要_,針對即時優惠和個人化使用 _同盟_。
  - **醫療照護:**透過使用 IoT 裝置串流和感應器資料的即時內容使用_同盟,以_透過 _摘要_來維護金級病患記錄。
  - **金融服務:**使用 _聯邦_ 來進行外部詐騙偵測和風險監視查詢,將受監管的監管資料匯入合規性管理湖。
- **設計作法**
  - ** 含採取的節點管理:**將高價值或受監管的資料匯入標準模型,以確保 Trust 與合規性。
  - **使用聯合提升新鮮度:**允許外部湖家提供即時或大規模的資料存取,而不會重複。
  - **平衡成本與績效:**設定工作量以判斷何時使用 _摘要_與_聯邦_,以將不必要的儲存和查詢成本降到最低。
  - **套用階層管理:**在利用聯邦系統安全性控制 (例如,RLS 和遮蔽) 時,強制執行已收取資料的集中管理。
  - **備註:**設計混合式銷售管道時,務必確保歷程記錄資料集及將彙總或篩選條件推送至聯合來源的漸進式採取,以最佳化 I/O 和運算用量。
- **成本考量事項**
  - 將合規性或重要資料與必要時的 _同盟_ 結合,以加權總成本與效能。__
  - 當混合_取用_和_聯邦_時,請考量 I/O 和運算散佈。若要降低針對來源系統重複查詢的計算成本,請針對高讀取率且經常存取的聯合資料集使用快取 (加速查詢)。
  - 使用此規則來引導採取與聯合決策:當資料頻繁存取但變更不頻繁時,_加速查詢_通常更具成本效益。不過,當資料經常變更時 (相對於存取頻率),更適當的是「_即時查詢」_或「_取用_」。以下是一些成本範例:
    - **加速成交:**從 1 百萬筆記錄建立並每天更新為 ~10,000 次的顯示面板,每天會檢視 20 次。_加速_成本等於大約 ~600 credits/month,相較於 _Live Queries_ 的 ~4,200 credits/month。
    - **即時查詢成交:**使用每 30 分鐘變更一次資料,每天發佈 20 次的區段。_即時查詢_的成本約為 ~4,200 credits/month,相較於此重新整理頻率的_加速_成本約為 ~28,800 credits/month。

## 使用個案決策指南

讓我們進一步瞭解一些常見的原型,說明如何套用此邏輯。

- **「單一事實來源」架構類型:集中與控管**
  - **案例:**您需要為整個全球企業建立符合、統一的 _Customer 360_ 設定檔。資料來自十幾個不同的系統,必須遵循嚴格的 _GDPR_ 和 _CCPA_ 法規,並且會作為所有行銷和服務互動的事實來源。
  - **建議模式:****Data Capture.**此處的優先順序為監管、 Trust 和控制。在「_Data 360_」中將資料提取是建立可完全稽核且與來源系統隔離的標準設定檔的唯一方法。
- **「即時洞察」架構類型:不移動分析**
  - **案例:**您的資料科學小組需要對 _Snowflake_ 中大量且不斷更新的交易表執行探索查詢。同時,您的管理小組想要由相同資料提供的即時 _BI_ 顯示面板。每天移動 petabyte 的資料速度緩慢且高成本。
  - **建議模式:****零複製聯邦.**此處的優先順序是速度、靈活性和大規模成本效益。_「零複製」_ 可讓您利用現有資料倉庫的強大功能進行即時查詢,而不會造成資料重複的負擔和延遲。
- **「混合智慧」架構類型:管理核心、聯合邊緣**
  - **案例:**您想要使用來自資料湖的即時行為訊號 (例如,點擊網站) 來增強受管理且已採取的客戶設定檔。您需要核心設定檔的穩定性,但需要即時資料的立即性才能提供即時個人化功能。
  - **建議模式:****混合式方法。**使用「_Data Capture_」為您的客戶資料建立穩定的受管理核心。使用「_零複製」_ 聯合浮動的即時「邊緣」資料,然後在查詢時間將其聯結在一起,以取得完整且即時的檢視。

## 前進路徑

企業資料策略不再專注於選擇單一整合模式,而是關於在可互通資料生態系統內架構受控制的彈性。正確的方法會將每個來源系統對應至最適合其更新性、管治、成本和存取需求的模式:

- 將關鍵任務且受監管的資料集匯入 Salesforce _Data Cloud_,以達成合規性、身分解析和作業工作流程。
- 透過「_零複製」_聯合資料,以進行即時、探索性和 AI 驅動的分析,而不需要重複儲存空間。
- 當查詢頻率高且資料變更頻率低時,套用 _快取 (加速查詢)_ 可減少來源系統負載和信用額度耗用

_Hyperforce_ 上的 Salesforce _Data 360_ 提供多區域彈性與延展性。其含有 _Iceberg_ 表格的開放式湖頭,可與如 _Snowflake_、_Databricks_ 和 _S3 Iceberg 等平台進行計算分隔和互通,這_ 是真正可互通的多雲資料生態系統的支柱。

隨著資料生態系統的演變,我們必須持續平衡新鮮度、成本、效能和合規性,以維持結構靈活性。這就是為什麼透過使用聯合存取權統一已採取的受管理資料來進一步驗證您的平台十分重要。這可在雲端、區域和業務網域之間啟用即時情報、AI 啟用和企業規模個人化。

請記住,一體適用的解決方案不適合大多數企業。最佳策略會將正確的模式對應至正確的業務驅動因素。

## 關於作者

**Yugandhar Bora** 是 Salesforce 的軟體工程結構設計師,專門在「資料和情報應用程式」平台內進行資料結構。他負責領導專注於資料管理和統一資料模型的_企業結構審查委員會 (EARB)_ 計畫,同時為自動平台佈建解決方案做出貢獻。

**Jan Fernando** 是 Salesforce _首席結構設計師辦公室 (OCA)_ 的首席結構設計師,他於 2012 年加入 Salesforce。他從入門生態系統中獲得豐富的經驗。在加入 OCA 之前,他曾在 _平台_ 組織工作十多年,在該組織領導了數項關鍵技術轉型。
