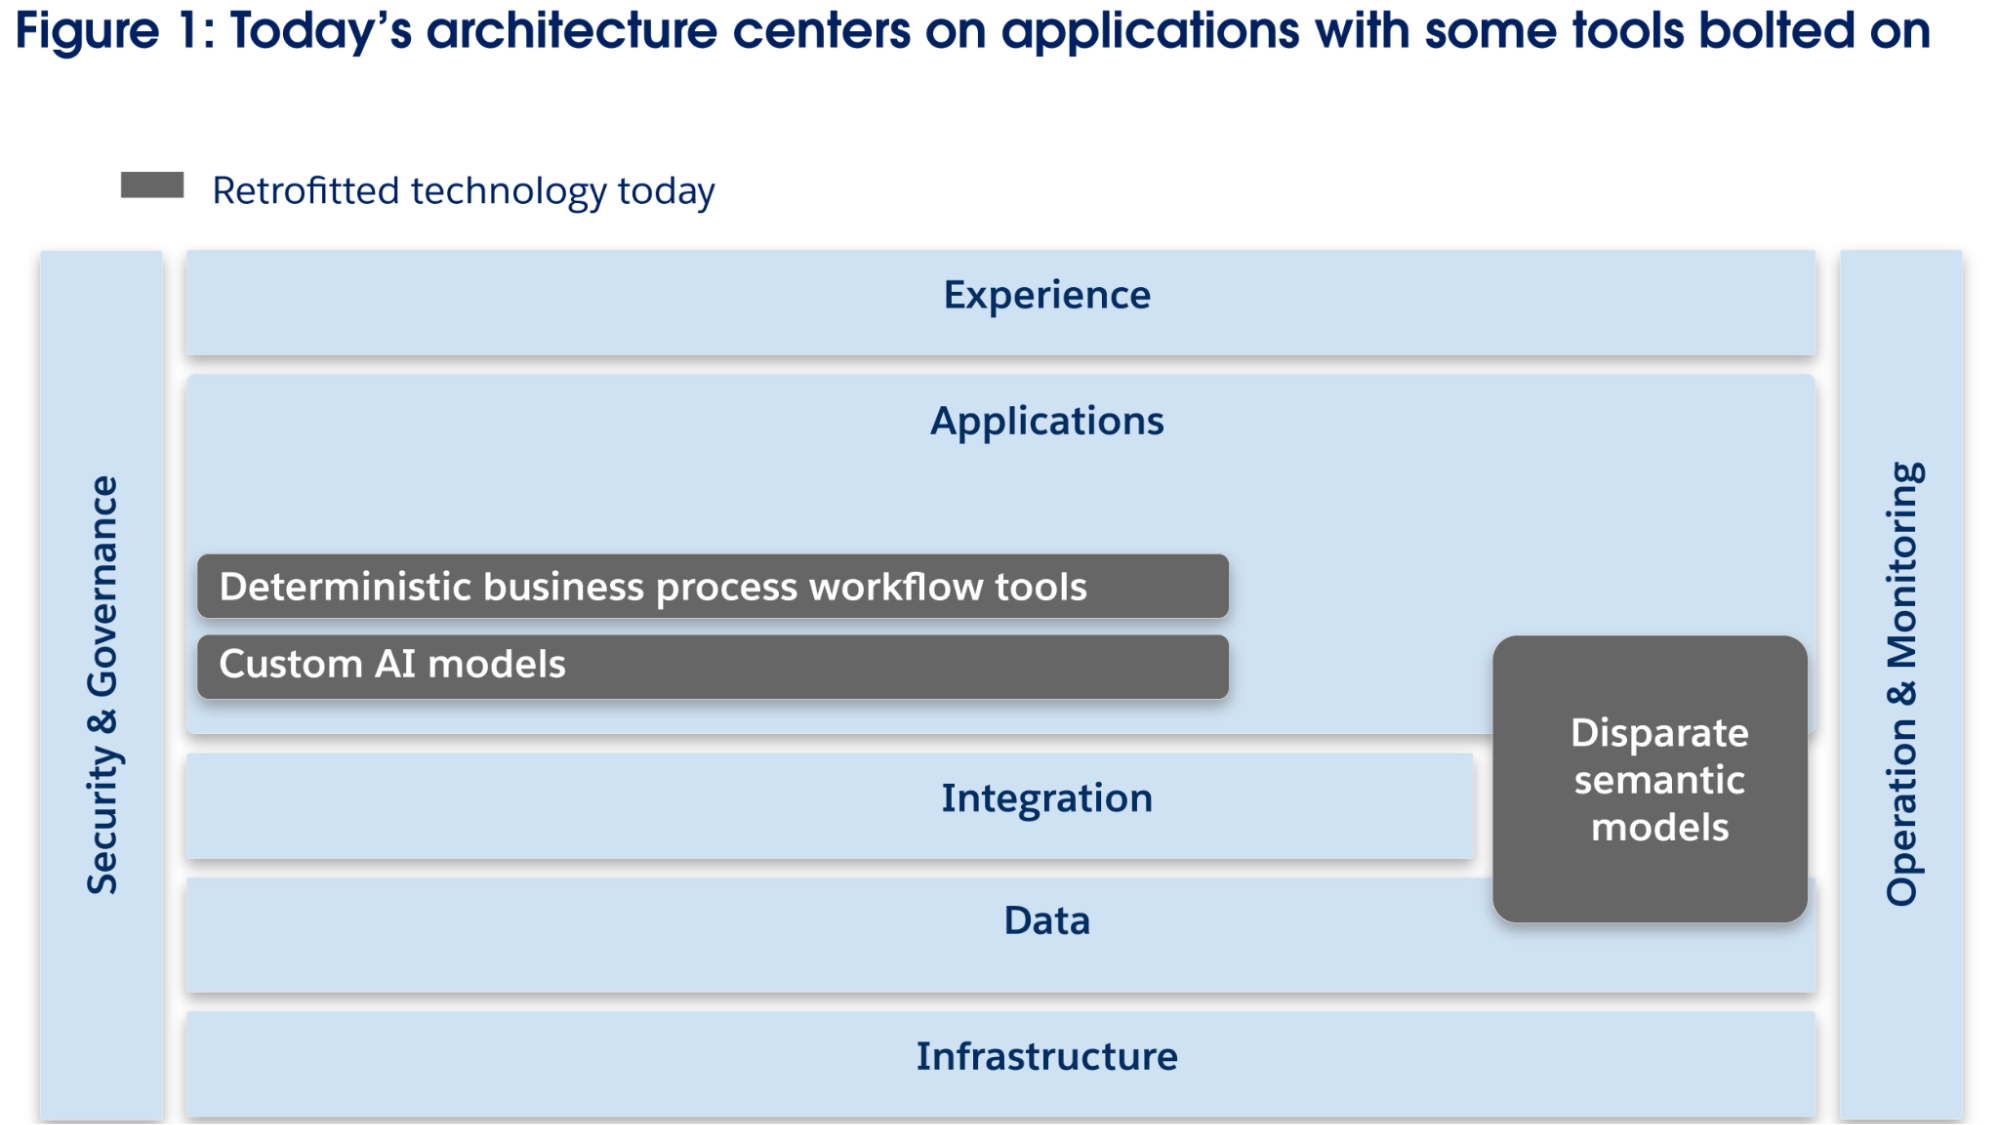
 Embora a arquitetura tradicional possa dar suporte a implantações de subescala de agentes de IA hoje, ela não pode fornecer totalmente os recursos de negócios da Enterprise do agente descritos acima. A realização desses recursos requer uma arquitetura de TI projetada para implantação ampla de agentes de IA poderosos que podem lidar com casos de uso amplos, em vez de serem restritos a implantações limitadas direcionadas a casos de uso estreitos.
Os agentes de IA continuarão melhorando nos próximos cinco anos, e a arquitetura de TI precisará evoluir para perceber o valor de agentes de IA mais poderosos e inteligentes, para se tornar uma prova futura. Primeiro, os agentes se tornarão mais inteligentes à medida que os modelos de IA subjacentes (como LLMs multimodais) e as arquiteturas cognitivas dos agentes evoluírem (por exemplo, planejamento de várias etapas, decomposição de tarefas e assim por diante). Segundo, os agentes de IA terão habilidades aprimoradas de aprendizagem e adaptação com melhorias de memória, recursos de auto-reflexão e a capacidade de aprender com feedback. Em terceiro lugar, os agentes de IA terão uma maior capacidade de interagir com outros agentes, ferramentas e dados, conforme evidenciado pelo ecossistema em rápida evolução de padrões de tecnologia aberta (por exemplo, Protocolo de contexto do modelo, Agent2Agent e assim por diante). Embora essas três tendências de tecnologia permitam que os agentes de IA sejam mais poderosos à medida que executam tarefas mais abstratas e complexas, elas também apresentarão vários desafios para a arquitetura de TI de hoje.
Primeiro, os agentes de IA dependem fundamentalmente de modelos de IA, desenvolvidos internamente e adquiridos externamente, que evoluem rapidamente e exigem gerenciamento de modelo de IA/ML sofisticado, compartilhado e padronizado. Hoje, os modelos de IA são desenvolvidos para casos de uso específicos em um aplicativo, não como recursos compartilhados para reutilização com ferramentas comuns para treinamento, implantação, governança e gerenciamento de risco. No futuro, as empresas precisarão poder usar diferentes modelos de IA para vários casos de uso de agentes que exigem ferramentas que permitam que os agentes troquem modelos subjacentes (por exemplo, modelo de base vs. modelo menor específico do domínio) com base no contexto de negócios. Isso exige o gerenciamento de modelos de IA desenvolvidos internamente ou hospedados com ferramentas de ciclo de vida unificadas para garantir consistência, reutilizabilidade, escalabilidade e eficiência. Da mesma forma, acessar modelos de IA hospedados externamente exige uma estrutura de controle corporativa para garantir o desempenho ideal, a segurança, a conformidade, a disponibilidade e a confiabilidade.
Em segundo lugar, os agentes de IA têm padrões de escala e requisitos operacionais distintos, como hospedagem, desenvolvimento, raciocínio, aprendizado, gerenciamento de memória e operações, que exigem um limite arquitetônico separado e dedicado para os agentes. Integrar essa funcionalidade diretamente à arquitetura de aplicativos estática e determinística de hoje introduziria complexidade e risco arquitetônicos desnecessários. Além disso, os agentes de IA devem interoperar com aplicativos existentes por meio de interfaces padronizadas ou sistemas de mensagens para interação em tempo real.
Em terceiro lugar, os agentes de IA precisam ser capazes de pensar sobre conjuntos de dados diferentes e colaborar entre si, geralmente em pilhas de aplicativos isoladas, mas na arquitetura atual, não há nenhuma funcionalidade semântica comum para fornecer uma compreensão compartilhada para esses agentes raciocinarem sobre conjuntos de dados diferentes. Como resultado, embora os agentes de uso único possam ser implementados com sucesso, escalar para operar em grandes números em tarefas complexas e entre silos continua sendo difícil e arriscado.
Por fim, a arquitetura de TI corporativa atual não tem uma maneira eficaz de orquestrar, otimizar e controlar processos de negócios de ponta a ponta que incluem os fluxos de trabalho dinâmicos realizados por agentes mais poderosos, o que aumentará e, em alguns casos, substituirá o papel desempenhado pelos trabalhadores humanos nesse processo. Hoje, as ferramentas de automação são aproveitadas para gerenciar fluxos de trabalho lineares determinísticos que geralmente seguem uma sequência predefinida, documentados em idiomas específicos do processo e dependem de lógica estática que raramente muda. As tecnologias de IA podem aprimorar alguns desses processos lineares (por exemplo, usar modelos de ML em vez de regras de negócios embutidas em código para calcular limites de aprovação de empréstimo), mas os aspectos estratégicos e de execução da maioria dos processos de negócios críticos permanecem inerentemente dinâmicos e flexíveis. Tarefas como desenvolver estratégias de marketing, resolver problemas complexos do cliente ou prospectar clientes têm objetivos claros (satisfação do cliente, velocidade de resolução de caso etc.), mas não seguem uma sequência de execução fixa e predefinida.
Atualmente, as empresas tradicionais dependem principalmente de humanos para coordenar e realizar esses processos de negócios complexos (como definir a estratégia e gerenciar programas complexos). Conforme os agentes de IA continuam evoluindo (maior inteligência, aprendizagem e recursos de interação) nos próximos 3-5 anos, sua capacidade de executar esses processos dinâmicos de modo autônomo aumentará significativamente, introduzindo complexidades e desafios de integração que vão muito além das capacidades das ferramentas de integração e automação existentes. A natureza adaptativa e dinâmica dos agentes de IA cria uma forte necessidade de novos recursos de orquestração para garantir controle em nível corporativo, visibilidade abrangente e alinhamento consistente com objetivos estratégicos em toda a empresa, particularmente no gerenciamento de fluxos de trabalho complexos, longos e de várias etapas que abrangem agentes de IA, humanos, ferramentas de automação e outros sistemas determinísticos.
A arquitetura de TI da Enterprise do agente estabelece uma plataforma para ações inteligentes integrando perfeitamente trabalhadores humanos, agentes de IA e sistemas determinísticos. Essa arquitetura permite que agentes humanos e de IA acessem e aproveitem dinamicamente o Knowledge corporativo unificado de diversas fontes de dados, enriquecido com contexto semântico para executar de modo eficiente fluxos de trabalho e processos complexos alinhados a objetivos estratégicos de negócios. A arquitetura de TI existente de um conjunto de plataformas isoladas e soluções de ponto evoluirá para um conjunto de serviços de aplicativo composíveis, ferramentas de semântica e dados e redes de agentes de IA supervisionadas e governadas por novas ferramentas de orquestração de processos de negócios inteligentes.
Essa arquitetura permite que os agentes sentem, justifiquem e realizem ações dentro de seus respectivos escopos, trabalhem dentro e entre domínios de negócios e aprendam, melhorem e adaptem-se continuamente. Isso exige um projeto focado em mecanismos robustos para acessar dados e Knowledge (compreensão semântica), protocolos e interfaces de comunicação flexíveis e padronizados (como agente a agente, agente a sistemas determinísticos e agente a humano) e, de forma crítica, orquestrar fluxos de trabalho e processos entre agentes, humanos e ferramentas de automação e sistemas determinísticos.
### Princípios de arquitetura
Para realizar a visão arquitetônica de uma plataforma para ações inteligentes, estes princípios de design são recomendados como prática recomendada:
- **Composibilidade e modularidade:** Projete elementos arquitetônicos como componentes modulares com interfaces padronizadas para permitir a montagem rápida e dinâmica de funcionalidades do agente, fluxos de trabalho e superfícies voltadas para humanos. Priorize contratos de interface claros e abstração para permitir a maior flexibilidade para os agentes de IA comporem fluxos de trabalho.
- **Dados e semântica primeiro:** Garanta acesso abrangente, preciso, rápido, seguro e econômico aos dados com compreensão semântica compartilhada para que os agentes justifiquem de modo eficaz em sistemas isolados. Isso exige o tratamento de dados (e metadados) como um produto, com ferramentas para garantir a qualidade, a linhagem, a governança e o acesso, bem como um modo de fornecer uma compreensão semântica compartilhada entre agentes e humanos.
- **Observabilidade de TI e negócios integrada:** Integre funcionalidades de monitoramento, rastreamento, avaliação e capacidade de explicação de ponta a ponta em toda a arquitetura para obter percepções sobre o raciocínio, os comportamentos, as interações do sistema e o impacto nos KPIs de negócios dos agentes para permitir a otimização contínua do desempenho dos agentes. Isso inclui otimização de custos (FinOps), métricas de sustentabilidade e telemetria operacional, mantendo o Trust, a conformidade e o consumo responsável de recursos. Como os agentes de IA são inerentemente não deterministas, a capacidade de observação é essencial para garantir que os agentes de IA possam operar de maneira confiável, em conformidade e auditável com supervisão humana.
- **Total Trust:** Imponha permissões dinâmicas e granulares com base na intenção das tarefas do agente (acesso a dados, ações etc.) e implemente práticas de segurança abrangentes, incluindo equipe vermelha, verificação de CVE automatizada, detecção de vulnerabilidade e controles de validação baseados em risco. Controles mais granulares e dinâmicos são necessários, considerando o risco de agentes causarem riscos em cascata devido à sua capacidade de operar a velocidades de máquina. Garanta que todas as saídas geradas por IA (de agentes ou modelos) sejam rigorosamente validadas em relação a políticas definidas de conformidade, segurança, toxicidade e viés antes do uso ou da entrega, exigindo mecanismos de registro e explicabilidade com trilhas de auditoria verificáveis para decisões, ações, conteúdo e previsões de IA.
- **Agente em primeiro lugar com supervisão humana:** Permita que os agentes de IA sejam a ferramenta padrão para resolver casos de uso de negócios, excluindo outras considerações (por exemplo, custo, adequação técnica) e projetem sistemas de TI para serem acessíveis para fluxos de trabalho agentes. Isso inclui a capacidade dos humanos de monitorar, intervir e substituir qualquer etapa do processo de um agente. Os agentes precisam de recursos de auto-reflexão para buscar orientação humana proativamente se sua confiança na tomada de decisão ficar abaixo dos limites pré-programados.
- **Interação reativa e multimodal:** Habilite a arquitetura para dar suporte a mecanismos abrangentes de invocação e resposta do agente em todos os tipos de interação, incluindo protocolos de agente para agente, entradas multimodais humanas (voz, texto, visual), eventos de negócios, sinais do sistema e dados de streaming. Habilite os recursos de processamento acionado por evento e em tempo real para garantir que os agentes possam reagir a qualquer sinal oportuno de qualquer origem ou formato.
- **Infraestrutura pronta para IA:** Garanta que a infraestrutura possa ser dimensionada de modo elástico com a redundância integrada para lidar com cargas de trabalho de IA flutuantes e integrar pipelines de ML/LLM à arquitetura de dados e aplicativos, mantendo a conformidade com os requisitos de residência de dados.
- **Ecosistema aberto:** Priorize a interoperabilidade e evite o bloqueio de tecnologia favorecendo padrões abertos, protocolos e interfaces bem definidas (APIs, eventos) para se beneficiar do ecossistema de tecnologia.
## Camadas de arquitetura
Para habilitar e dimensionar com sucesso a transformação agente, as empresas devem ir além de simplesmente aprimorar as camadas atuais; elas precisam considerar introduzir explicitamente quatro camadas arquitetônicas adicionais (Figura 2) projetadas especificamente para atender às necessidades dos agentes de IA.
A **Caixa Agente** é dedicada ao desenvolvimento e gestão de agentes de IA, abrangendo capacidades cognitivas como planejamento, raciocínio, memória, utilização de ferramentas, gerenciamento de estado e controle de ciclo de vida. Essa camada lida com os requisitos técnicos e operacionais exclusivos dos agentes de IA, garante a interoperabilidade entre aplicativos e repositórios de dados por meio de protocolos padronizados e facilita a colaboração entre agentes. A camada de aplicativo existente evoluirá para serviços de aplicativo para ser criada dinamicamente para fluxos de trabalho agentes.
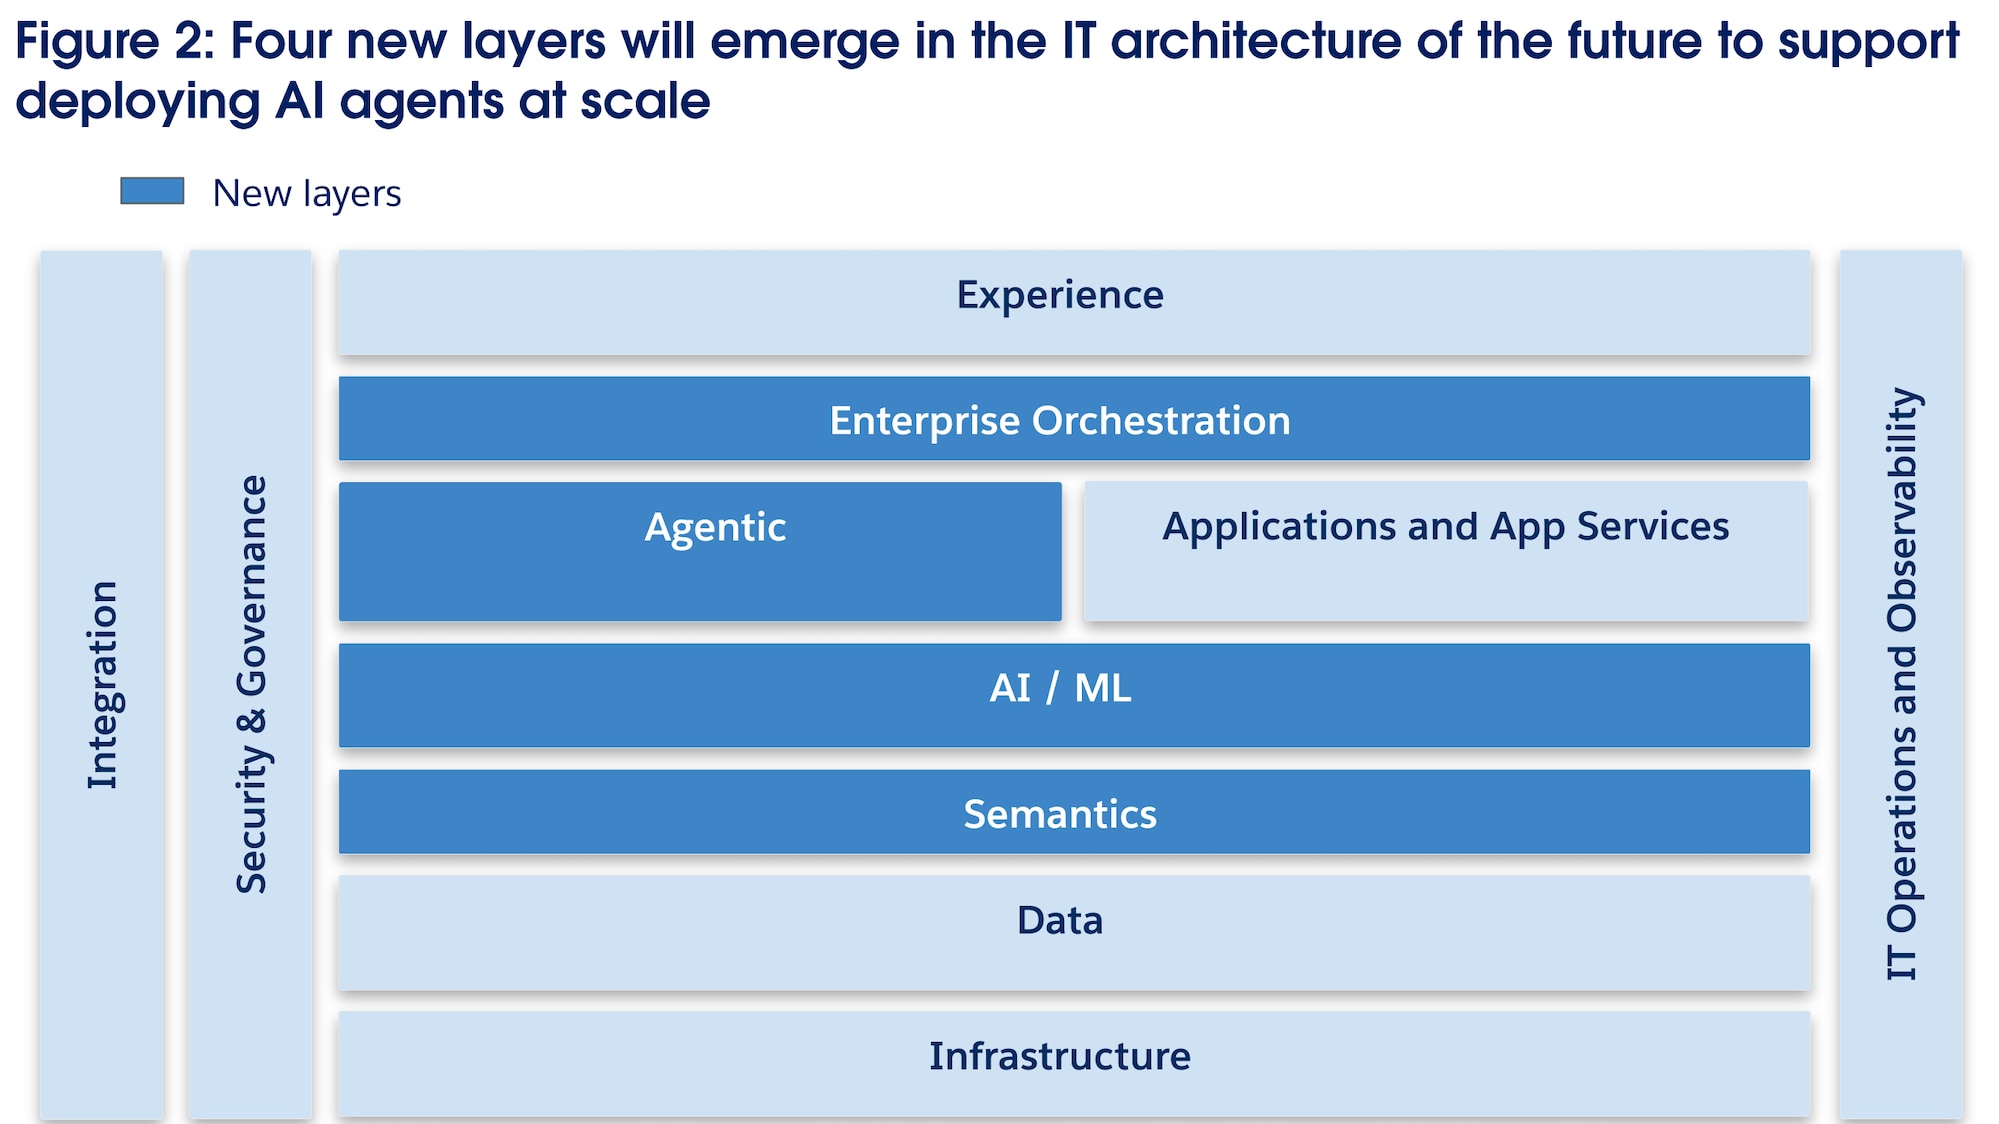 A **camada semântica** é introduzida para resolver a desconexão entre dados corporativos brutos e a compreensão semântica de que os agentes de IA precisam. Ele codifica e gerencia explicitamente entidades de negócios, conceitos, definições e interrelações, criando uma ontologia corporativa e representação do Knowledge de negócios para permitir a compreensão semântica compartilhada que capacita fluxos de trabalho de vários agentes mais complexos realizando tarefas de nível superior. Além de um catálogo de dados, a Camada semântica traduz uma consulta de linguagem natural em consultas precisas em relação a repositórios de dados específicos, harmoniza os resultados e retorna uma resposta contextual e mais avançada para o agente. Enquanto isso, a Camada de dados existente se unifica por meio da adoção de lagoas centralizadas enquanto amplia o acesso a dados por meio de um tecido de dados pronto para IA para dar suporte a princípios de modelo de operação de malha de dados.
A **Laixa de IA/ML** centraliza o gerenciamento de recursos de IA empresarial, incluindo grandes modelos de linguagem, grandes modelos de ação e modelos de ML específicos de domínio, lidando com ambos os modelos de IA desenvolvidos internamente ao longo de seu ciclo de vida e o acesso/uso controlado a serviços de IA externos. Diferentemente das arquiteturas tradicionais em que os modelos de IA são integrados a aplicativos, essa camada estabelece modelos de IA como componentes de primeira classe e serviços compartilhados na empresa. Ele se concentra em recursos de IA controlados pela empresa (não recursos de IA fornecidos por fornecedores externos). Essa camada fornece a inteligência para vários agentes e outras cargas de trabalho de IA na empresa com mecanismos padronizados para Trust, segurança, conformidade e implantação.
A camada de **orquestração corporativa** é a abstração funcional para coordenar, governar e otimizar fluxos de trabalho complexos e de várias etapas e processos de negócios que abrangem agentes de IA, humanos, ferramentas de automação e sistemas determinísticos. Essa camada aproveita um modelo de orquestração combinada que permite que agentes e sistemas individuais lidem de modo autônomo com tarefas coreografadas localmente usando protocolos abertos, como MCP e A2A, ao mesmo tempo que fornecem supervisão centralizada de ponta a ponta e coordenação de todo o processo. Para implementar o modelo de orquestração combinada, essa camada representa processos de negócios críticos em formatos semânticamente avançados legíveis por máquina que definem as etapas deterministas (modeladas durante o tempo de design) e as etapas dinâmicas (determinadas pelos agentes durante o tempo de execução) de um processo de negócios, criando a base do modelo de processo para governança e otimização.
Tradicionalmente, partes significativas dos processos de negócios conduzidos por humanos permanecem não documentados ou inacessíveis em formulários legíveis por máquina. No entanto, a observabilidade detalhada das atividades dos agentes de IA, incluindo dados avançados e metadados sobre suas tarefas e ações, permite capturar, documentar e integrar trabalho dinâmico anteriormente não estruturado a fluxos de trabalho lineares determinísticos para criar modelos de processo abrangentes. A documentação de processo detalhada captura interdependências de tarefa e caminhos de execução anteriormente invisíveis, permitindo que a empresa otimize continuamente a eficiência operacional, corrija de modo eficaz gargalos e codifique sistematicamente as práticas recomendadas identificadas pelo agente em manuais reutilizáveis para toda a empresa. Isso resulta em um gêmeo digital holístico de processos individuais e, quando dimensionado, de toda a empresa.
Por exemplo, processos complexos, como a execução de estratégias de vendas abrangentes ou a integração de novos funcionários, envolvem várias etapas interdependentes em que a camada de orquestração pode garantir níveis adequados de envolvimento humano (por exemplo, tratamento de exceções), autonomia limitada para agentes de IA e imposição de conformidade. Ao longo desses processos, a camada de orquestração de cima para baixo adiciona previsibilidade e governança, acompanha e avalia continuamente os indicadores-chave de desempenho (KPIs), garante a integridade transacional dos fluxos de trabalho e a lógica de reversão e mantém a visibilidade de cada estágio do fluxo de trabalho para garantir o alinhamento com objetivos de negócios gerais. Para implementar essa funcionalidade, essa camada consome políticas, regras e proteções da camada de segurança e governança (por meio de policy-as-code) e metas de negócios e KPIs armazenados na Camada semântica. Dada a natureza autônoma e rápida das interações conduzidas por IA, confiar apenas em uma coreografia descentralizada corre o risco de desalinhamento estratégico ou violações de conformidade, especialmente em fluxos de trabalho de várias etapas de longa duração. A abordagem de orquestração combinada mitiga esses riscos integrando regras de negócios corporativas, verificações de conformidade e imposição de políticas diretamente em fluxos de trabalho complexos e integra a supervisão humana em junções críticas.
Cada uma dessas 11 camadas contribui com funcionalidades específicas para implantar agentes de IA em escala de maneira segura, confiável e eficaz que desbloqueia todo o potencial da IA agente para transformar como o trabalho é feito em uma empresa. A seção abaixo descreve a função da camada, novas alterações devido ao aumento dos agentes de IA e seus principais recursos tecnológicos.
### Camada da experiência
**Função:** A Camada da experiência serve como a interface principal para usuários humanos, habilitando a interação multimodal capturando entradas (texto, voz, visual) e fornecendo respostas contextualmente relevantes em vários dispositivos. Ele distribui perfeitamente as intenções do usuário para a Camada do agente para ação enquanto também fornece a interface de usuário dinâmica e visualizações que facilitam escalonamentos humanos e aprovações em fluxos de trabalho agentes.
**O que é diferente de hoje:** A IA aumentará as interfaces tradicionais baseadas em GUI com processamento de linguagem natural, consciência contextual e suporte proativo à decisão. Os agentes de IA poderão iniciar interações proativamente, fornecendo recomendações personalizadas em tempo real em todos os canais e modalidades.
**Principais funcionalidades tecnológicas:**
- **IA conversacional e assistentes digitais:** Habilite a UX por padrão para incluir a assistência de IA para dar suporte a usuários humanos.
- **Interface do usuário de Atribuição e Transparência:** Torne as respostas explicáveis na interface do usuário, como mostrar citações, origens de arquivos/sistemas e a abordagem/racionalização das decisões.
- **Serviço de notificação proativo e ambiental:** Permite que os agentes enviem por push percepções ou alertas proativamente aos usuários no canal e no formato mais adequados com base no contexto atual do usuário.
- **Experiências do Omnichannel:** Fornece uma experiência contínua, consistente e unificada em todos os canais com continuidade da jornada, em que conversas e tarefas seguem a pessoa, em vez do aplicativo.
- **Capacidades multimodais:** Permite que os humanos interajam com agentes e aplicativos por meio de texto, voz, imagem, toque, vídeo e AR/VR para que os agentes possam entender e apresentar informações na modalidade mais eficiente.
- **Personalização sensível ao contexto e UI dinâmica:** Habilita experiências de usuário sensíveis ao contexto em tempo real (hora, local, ações do usuário) para habilitar a personalização, incluindo a geração de UI rapidamente.
### Camada agente
**Função:** A Camada agente atua como o ambiente de tempo de execução padrão para fazer trabalho na empresa em que os agentes de IA descomponem tarefas da camada de experiência e executam tarefas montando dinamicamente fluxos de trabalho usando ferramentas da camada de serviços de aplicativos e aplicativos e da camada de dados. O estado de configuração dos agentes de IA é armazenado e gerenciado nessa camada. Os agentes são instanciados para tarefas específicas e as instâncias específicas do agente são desativadas posteriormente. Essa implementação permite que os agentes sempre sejam chamados do estado de configuração mais recente com base em otimizações offline (usando funcionalidades de IA/ML, capacidade de observação e camadas de orquestração). Essa camada é responsável pelo gerenciamento de ciclo de vida abrangente, coordenação e governança dos agentes de IA.
**O que é diferente de hoje:** Essa camada emergirá do conjunto distinto atual de pilotos e implantações agentes limitadas. Embora existam bots baseados em regras, há poucos programas de software adaptativos, não determinísticos e orientados a metas implantados em escala.
**Principais funcionalidades tecnológicas:**
- **Entorno de tempo de execução do agente:** Gerencia o ciclo de vida, a execução e a alocação de recursos para agentes de IA.
- **Suíte de gerenciamento de ciclo de vida do agente:** Inclui estruturas de desenvolvimento, ferramentas de desenvolvimento e teste e sistemas de gerenciamento para atividades do agente e controle de versão.
- **Mecanismo de raciocínio do agente:** Uma estrutura cognitiva para que os agentes decomponham metas, planejem e decidam quais ferramentas usar para resolver problemas complexos.
- **Memória do agente e Armazenamento de contexto:** Permite que as instâncias do agente se lembrem e mantenham o contexto sobre interações anteriores, garantindo consistência e personalização.
- **Protocolos de interoperabilidade do agente:** Interfaces padronizadas para comunicação entre agentes (A2A) e para que os agentes interajam com sistemas externos (por exemplo, por meio do Protocolo de contexto do modelo).
- **Registro de ferramentas:** Um conjunto selecionado de ferramentas com suporte interno e externo para os agentes invocarem para realizar uma determinada tarefa.
- **Registro do agente:** Um ecossistema selecionado de soluções de IA predefinidas e agentes que dão suporte à descoberta e à correspondência de recursos.
- **Imposição da política do agente distribuído:** Habilita a governança corporativa permitindo que os agentes façam verificação automática da conformidade antes de realizarem ações.
- **Quadro de auto-reflexão e adaptação do agente:** Fornece um mecanismo para um agente analisar seu próprio desempenho e, com aprovação humana, acionar melhorias ou sugerir modificações a si mesmo.
### Camada de IA/ML
**Função:** Essa camada funciona como um hub de inteligência centralizado, oferecendo modelos de IA como um conjunto de serviços compartilhados para serem consumidos pela Camada do agente (e aplicativos) para aprimorar seus recursos de raciocínio e tomada de decisão com estruturas de segurança e monitoramento integradas.
**O que é diferente de hoje:** Tradicionalmente, os modelos de IA eram integrados a aplicativos específicos. Na arquitetura de TI da Agential Enterprise, a camada de IA/ML será um conjunto centralizado de primeira classe que habilita muitos aplicativos e agentes, oferecendo suporte a todo o ciclo de vida do modelo, do desenvolvimento ao fornecimento em tempo real em escala.
**Principais funcionalidades tecnológicas:**
- **Modelos de base pré-construídos:** Modelos de ML grandes treinados em um amplo espectro de dados, capazes de realizar uma ampla variedade de tarefas gerais.
- **Geração de recuperação ampliada (RAG):** Um pipeline centrado em IA que baseia modelos de base em dados específicos da empresa para melhorar a precisão e reduzir alucinações.
- **Hub de Trust, Segurança e Governança de IA:** Um conjunto de ferramentas integrado ao ciclo de vida do modelo para aplicar princípios de IA responsável, como detecção de viés, capacidade de explicação e monitoramento de segurança.
- **Gateway do modelo:** Um mecanismo de roteamento que atua como um único ponto de entrada para todas as solicitações de inferência de modelo, gerenciando chamadas a vários modelos internos e externos para otimizar quanto a custo, desempenho e conformidade.
- **Desenvolvimento de modelo Workbench:** Um ambiente de desenvolvimento integrado para cientistas de dados com ferramentas para pré-processamento de dados, treinamento de modelo e experimentação.
- **MLOps e pipeline de automação de ciclo de vida:** O mecanismo CI/CD para aprendizado de máquina, automatizando o ciclo de vida de ponta a ponta dos modelos, do treinamento à implantação e à descontinuação.
- **Model Serving & Inference Runtime:** Um ambiente dimensionável e de baixa latência para implantar modelos treinados como pontos de extremidade de API seguros para consumo em tempo real.
- **Modelo e registro de ativos:** Um repositório centralizado controlado por versão para todos os ativos de IA/ML, incluindo modelos, conjuntos de dados e código-fonte, garantindo a reprodutibilidade e a capacidade de auditoria.
- **Geração e gerenciamento de dados sintéticos:** Ferramenta para gerar e gerenciar dados sintéticos que mantêm as propriedades estatísticas de dados reais sem expor informações confidenciais.
### Camada de orquestração corporativa
**Função:** A Camada de orquestração corporativa é o plano de controle para trabalho de ponta a ponta em uma empresa agente. Ele garante que fluxos de trabalho e interações agentes cumpram os objetivos corporativos e as políticas de governança. Ele consome a telemetria de observabilidade de outras camadas para criar modelos de processo de negócios abrangentes, habilitando a otimização em relação a KPIs obtidos da Camada semântica. Essa camada fornece o contexto compartilhado e a memória de execução longa a cada nova instância de um agente de IA para fluxos de trabalho críticos.
**O que é diferente de hoje:** Essa camada fornece visibilidade unificada dos processos de negócios criando modelos legíveis por máquina que capturam etapas deterministas estruturadas e trabalho dinâmico não estruturado realizado por humanos e agentes. Ela vai além dos modelos de colaboração e governança centrados em humanos de hoje, codificando programaticamente os objetivos de negócios e as regras de conformidade como restrições em fluxos de trabalho agentes para governar a equipe agente.
**Principais funcionalidades tecnológicas:**
- **Mecanismo de execução de fluxo de trabalho híbrido:** O tempo de execução principal que executa o "modelo de orquestração combinada", fornecendo supervisão centralizada enquanto permite a coreografia local do agente.
- **Governança de processo e mecanismo de restrição:** Um serviço de governança em tempo real que consome e aplica regras comerciais declarativas, políticas e restrições a todos os processos em andamento.
- **Gerenciamento de memória compartilhada e contexto:** Uma camada de memória compartilhada acessível a todos os agentes em um fluxo de trabalho para manter a continuidade e a coerência entre várias etapas.
- **Process Modeling Studio:** Um ambiente de tempo de design para criar e gerenciar modelos de processo semânticamente avançados legíveis por máquina que definem etapas deterministas e dinâmicas orientadas a metas.
- **Otimização e simulação de processos:** Uma funcionalidade que cria simulações digitais de processos de negócios para análise avançada, simulações What-If e otimização preditiva.
- **Descoberta de processos e monitoramento de saúde:** Ingere modelos de processo e dados em tempo real para relatar métricas de negócios da integridade do processo.
- **Modelação de processo gêmeo digital:** Um espelho em tempo real de fluxos de trabalho ativos para teste, simulação de alterações e otimização sem afetar a produção.
### Camada de aplicativo e serviços de aplicativo
**Função:** Essa camada expõe a funcionalidade de aplicativo de negócios existente como ferramentas e serviços compostos e modulares para os agentes usarem. Ele também serve como o tempo de execução de apresentação para integrar recursos agentes à experiência do usuário. Os aplicativos continuam sendo o sistema de registro, mas são remodelados para serem recursos "autônomos" para agentes.
**O que é diferente de hoje:** Os aplicativos evoluirão de UIs monolíticos para "serviços de back-end" que os agentes podem chamar dinamicamente por meio de APIs e eventos. Essa camada será integrada nativamente a agentes e modelos de IA, e a proliferação de LLMs de geração de código levará a um aumento no número de microaplicativos personalizados criados por agentes.
**Principais funcionalidades tecnológicas:**
- **Serviços de aplicação modular:** Lógica de negócios descomposta de aplicativos tradicionais, publicadas como ações legíveis por máquina para os agentes chamarem.
- **SDKs de integração do agente:** Kits de ferramentas e bibliotecas que permitem aos desenvolvedores integrar com segurança os agentes diretamente às UIs do aplicativo.
- **Serviços de geração de UI dinâmica:** Serviços que permitem que um agente de IA gere ou modifique componentes da IU em tempo real com base no contexto do usuário.
- **Estruturas de IU nativas de IA:** Estruturas de front-end projetadas com suporte integrado para lidar com UIs conduzidas por IA, como gerenciar dados probabilísticos e respostas de texto de streaming.
- **Sistemas de engajamento infundidos por agente:** Aplicativos de produtividade e colaboração corporativos que incorporam recursos de agente de IA por meio de componentes visuais.
- **Desenvolvimento de aplicativos de baixo código/sem código aprimorado por IA:** Ferramentas que permitem que usuários e agentes criem aplicativos e serviços personalizados usando linguagem natural e avisos.
- **App Guardrails para uso do agente:** Controles no lado do aplicativo para uso do agente, como limitação de taxa, permissões com escopo e telemetria.
### Camada semântica
**Função:** A Camada Semântica fornece uma compreensão unificada dos dados e Knowledge em toda a empresa, permitindo que os seres humanos e os agentes de IA interpretem e atuem com base em informações de maneira consistente. Ele usa ferramentas de representação do Knowledge como ontologias e gráficos do Knowledge para traduzir consultas de linguagem natural em consultas de dados precisas e sensíveis ao contexto.
**O que é diferente de hoje:** Embora as empresas de hoje tenham repositórios de metadados diferentes, a arquitetura de TI da Agentic Enterprise requer um Enterprise Knowledge Graph (EKG) centralizado que vincula dados entre domínios com relacionamentos semânticos explicitamente definidos. Isso fornece o contexto rico que os agentes de IA podem percorrer para realizar raciocínio complexo, criando requisitos para um conjunto de recursos técnicos para capacitar gráficos do Knowledge que abrangem vários domínios funcionais.
**Principais funcionalidades tecnológicas:**
- **Serviço de metadados:** Fornece metadados descritivos, incluindo linhagem de dados, propriedade e classificações.
- **Glossário de negócios e gerenciamento de taxonomia:** Uma ferramenta para que usuários de negócios definam e concordem com termos comerciais padrão.
- **Gerenciamento de modelo semântico:** Um workbench para engenheiros do Knowledge criar, gerenciar e gerenciar modelos e ontologias semânticas.
- **Enterprise Knowledge Graph (EKG):** Uma instanciação de tempo de execução da ontologia corporativa que armazena e mapeia os relacionamentos entre entidades de negócios.
- **Motores de ingestão e harmonização de metadados:** Um pipeline automatizado que preenche e mantém o Enterprise Knowledge Graph de vários sistemas de origem.
- **Mecanismo de consulta semântica**: Interpreta consultas de linguagem natural e cria consultas estruturadas com base no EKG para recuperar dados de várias fontes.
- **Engenharia de raciocínio semântico:** Analisa e deriva Knowledge implícito e relacionamentos ocultos do ECG.
### Camada de dados
**Função:** A Camada de dados é a fonte fundamental da verdade, gerenciando e fornecendo acesso seguro e controlado a todos os dados corporativos para a Camada semântica interpretar, a Camada de IA/ML para usar para treinamento, aplicativos para usar para transações e agentes para raciocínio.
**O que é diferente de hoje:** A Camada de dados evolui para ser mais unificada, em tempo real e focada em governança, muitas vezes centralizada em um data lakehouse em escala de nuvem. Ele deve lidar com um maior volume e variedade de dados e mudar de processamento orientado em lote para streaming em tempo real para dar suporte a agentes reativos. A governança e a qualidade dos dados assumem uma importância ainda maior para evitar que dados ruins criem saídas de IA com defeito.
**Principais funcionalidades tecnológicas:**
- **VectorDB:** Um banco de dados especializado otimizado para armazenar e consultar integrações de vetores de alta dimensão, essenciais para RAG.
- **Pipelines de dados analíticos inteligentes:** Um serviço automatizado conduzido por metadados para ingestão, transformação e carregamento de dados (ETL/ELT) na Camada de dados.
- **Enterprise Data Lakehouse:** Um repositório central para dados estruturados, semistruturados e não estruturados, otimizado para cargas de trabalho de análise e IA.
- **Federação de dados de cópia zero e pesquisa:** Técnicas para acessar, consultar e pesquisar dados em várias lojas sem movimento de dados físico.
- **Linguagem natural para SQL:** Uma técnica para converter consultas de linguagem natural em SQL.
- **Serviço de descoberta e catálogo de dados corporativo:** Um inventário centralizado pesquisável de todos os ativos de dados na empresa.
- **Mestre e Gerenciamento de Dados de Referência (MDM):** Gerencia o "registro ouro" para entidades de negócios críticas, como Cliente e Produto.
- **Serviço de qualidade de dados adaptável:** Um serviço de monitoramento contínuo que usa IA para detectar e corrigir Problemas de qualidade dos dados automaticamente em tempo real.
- **Contratos de dados:** Acordos legíveis por máquina entre produtores de dados e consumidores que especificam o esquema, a semântica e os SLAs de troca de dados.
- **Armazenamentos de dados especializados em IA:** Bancos de dados projetados para casos de uso de IA específicos, como bases de dados de série temporal ou de gráfico.
- **Tela de dados pronta para IA:** Uma camada de abstração de dados lógica que fornece uma visualização unificada e virtualizada dos dados em sistemas físicos distintos.
- **Processamento de dados em tempo real:** Capacidades para processar e analisar fluxos de dados multimodais continuamente a velocidades de máquina.
### Camada de infraestrutura
**Função:** A Camada de infraestrutura é a base de todas as outras camadas, fornecendo os recursos de computação, armazenamento, rede e nuvem necessários para executar IA e cargas de trabalho agentes em escala de maneira resiliente e econômica.
**O que é diferente de hoje:** As cargas de trabalho de IA exigem maior escalabilidade e elasticidade para lidar com a natureza probabilística de sistemas agentes. A infraestrutura deve dar suporte a provisionamento rápido, hardware especializado como GPUs e tráfego de rede de baixa latência e alta taxa de transferência para comunicação entre agentes.
**Principais funcionalidades tecnológicas:**
- **Infra-estrutura como código:** Provisionamento automatizado e gerenciamento de infraestrutura com pipelines de implantação de CI/CD.
- **Infraestrutura de IA híbrida e multi-nuvem:** Aproveita a elasticidade da nuvem pública e a infraestrutura especializada para cargas de trabalho de IA generativa.
- **Computador, armazenamento e rede otimizados por IA:** Aloca e escala dinamicamente recursos de infraestrutura com base na demanda variável de cargas de trabalho de IA.
- **Infraestrutura de IA de ponta:** Permite que modelos e agentes de IA sejam implantados na borda da rede para casos de uso com requisitos exclusivos de latência ou privacidade.
- **Infra-estrutura de autolimpeza:** Usa IA para gerenciar a recuperação do sistema sem entrada manual, garantindo alta disponibilidade.
- **Computando IA Sustentável:** Abordagens de eficiência energética para mitigar o impacto ambiental de cargas de trabalho de IA.
- **Autoscaling sensível ao custo e carbono:** Usa FinOps e sinais de sustentabilidade para promover a escala e o posicionamento da capacidade.
### Camada de integração
**Função:** A Camada de integração serve como o tecido de comunicação universal para todos os sistemas (legados e novos) por meio de APIs, eventos, protocolos e middleware para garantir que os agentes possam descobrir e interagir com serviços, dados e ferramentas sem problemas.
**O que é diferente de hoje:** A integração deve evoluir para dar suporte aos padrões dinâmicos de comunicação do tipo muitos para muitos dos agentes de IA, em vez de apenas lidar com interações estáticas predeterminadas entre alguns sistemas conhecidos. Ele requer processamento de dados em tempo real e deve acomodar a descoberta e a colaboração ad-hoc entre agentes.
**Principais funcionalidades tecnológicas:**
- **Pipeline de conectividade de dados operacionais:** Ferramentas com suporte de IA para mapeamento automático de esquema, transformação de dados e geração de fluxo de trabalho, incluindo recursos de API conduzido, conduzido por evento e ETL reverso.
- **Gerenciamento de API adaptável e Rede de serviço:** Gateways de API e tecnologia de rede de serviços que podem registrar, descobrir e gerenciar dinamicamente serviços com aplicação de política adaptativa para agentes.
- **Adaptadores semânticos do Knowledge:** Um componente de integração que fornece um vocabulário compartilhado e um modelo de dados entre agentes e aplicativos para interpretação de dados consistente.
- **Tela de integração conduzida por evento:** Uma base de mensagens e streaming de alta taxa de transferência e baixa latência que habilita comunicação assíncrona e desacoplada.
- **Gateway de protocolo do agente:** Um gateway para serviços de MCP que permite aos agentes descobrir com segurança ferramentas e acionar ações, conectando o MCP a APIs e eventos internos.
- **Catálogo e mercado de capacidade composta:** Um catálogo centralizado e governado para todas as funcionalidades corporativas (APIs, serviços, habilidades do agente, modelos e conjuntos de dados) anotado com metadados semânticos para composição sob demanda.
### Camada de capacidade de observação e operações de TI
**Função:** Essa camada monitora e gerencia o desempenho operacional e de integridade dos agentes e de todo o sistema (princípio integrado de observabilidade), fornecendo transparência e controle gerando percepções para habilitar a auditoria, depuração, capacidade de explicação, custo e otimização de recursos da equipe agente da empresa.
**O que é diferente versus hoje**: Essa camada se torna ainda mais crucial, considerando o risco de agentes de IA criarem erros na velocidade da máquina. Ele deve se expandir além do monitoramento de infraestrutura para incluir o comportamento imprevisível de agentes autônomos, exigindo novos tipos de telemetria e a capacidade de entender a correção semântica, não apenas o desempenho técnico.
**Principais funcionalidades tecnológicas:**
- **Plataforma de monitoramento e observabilidade em tempo real:** Coleta continuamente registros, métricas e rastreamentos em todo o ambiente de TI, com extensões para métricas de ML e comportamento do agente.
- **FinOps e gerenciamento de custos na nuvem:** Responsável por monitorar, analisar e otimizar os custos de infraestrutura associados a IA e cargas de trabalho agentes.
- **Monitoramento específico do agente e do ML:** Registra cada etapa da execução de um agente em uma trilha de auditoria imutável e faz o perfil contínuo dos comportamentos do agente para detectar desvios das normas estabelecidas.
- **AIOps, Gerenciamento de incidentes e mudanças:** Usa IA/ML para prever possíveis problemas de TI, identificar causas-raiz e criar fluxos de trabalho de remediação.
- **Loop de feedback de aprendizado fechado:** Integra a telemetria de observabilidade dos agentes de volta aos pipelines de MLOps, habilitando o treinamento automatizado de modelo ou o ajuste de prompt.
- **Mecanismo de observabilidade semântica:** Integra a capacidade de observação à camada semântica para contextualização para permitir a detecção de anomalias semânticas no comportamento do agente.
### Camada de segurança e governança
**Objetivo:** Essa camada incorpora Trust e segurança em toda a arquitetura, protegendo os ativos da empresa contra ameaças, gerenciando o risco e garantindo a conformidade com os requisitos regulatórios. Ele abrange gerenciamento de identidade, detecção de ameaças, GRC e medidas de segurança específicas da IA.
**O que é diferente de hoje:** A camada de segurança deve evoluir para lidar com novas surpresas de ataque apresentadas por agentes e modelos de IA, como injeção imediata e envenenamento de modelo. O gerenciamento de identidade e acesso deve mudar de controles estáticos baseados em papel para permissões dinâmicas baseadas em intenção que são concedidas imediatamente e revogadas imediatamente após o uso.
**Principais funcionalidades tecnológicas:**
- **Segurança de entrada/saída de LLM e proteções:** Proteções corporativas aplicadas no tempo de solicitação e resposta para bloquear conteúdo inseguro, vazamentos de PII e jailbreaks.
- **Arquitetura Zero Trust com verificação de IA:** Autenticação contínua aprimorada pela análise comportamental baseada em IA, com acesso preciso granular para agentes com base em sua tarefa específica.
- **Quadro de segurança do agente:** Modelos de permissão detalhados, monitoramento de comportamentos prejudiciais e mecanismos de contenção para interromper com segurança as atividades do agente.
- **Segurança do modelo de IA:** Uma estratégia de defesa em profundidade com controles em cada estágio do ciclo de vida do modelo para proteger contra envenenamento, extração e ataques adversários.
- **IA de preservação de privacidade:** Técnicas como aprendizado federado e privacidade diferencial para proteger dados confidenciais.
- **GRC aprimorado por IA:** Uso de agentes de IA para monitorar continuamente a conformidade da arquitetura de TI com controles.
- **Policy-as-Code Engine:** Uma única fonte da verdade para definir regras de negócios e restrições de conformidade em um formato declarativo e legível por máquina para definir proteções para o comportamento do agente.
- **Red-Teaming contínuo:** Teste adversário automatizado e contínuo de modelos de IA e agentes para identificar vulnerabilidades antes que os invasores as explorem.
## Um roteiro arquitetônico de referência para a Enterprise do agente
Transformar-se em uma empresa agente exige seguir uma jornada de vários estágios definindo as noções básicas da tecnologia enquanto cria valor comercial tangível (consulte Figura 3 abaixo). Embora o roteiro preciso dependa da estratégia, da cultura, do modelo de governança de IA e do ponto de partida da arquitetura de TI da empresa, a maioria das organizações deve adotar uma abordagem em fases como a continuação dos investimentos de TI impulsiona os agentes com escopo, complexidade e criação de valor crescentes. O [Modelo de maturidade agente](https://www.salesforce.com/news/stories/agentic-maturity-model/) da Salesforce oferece uma estrutura útil de níveis de maturidade para que as empresas possam estruturar sua transformação, descrevendo como as capacidades dos agentes podem crescer da recuperação de informações básicas (nível 1) à orquestração de fluxos de trabalho de vários domínios mais complexos (níveis 2 e 3) e de vários agentes (nível 4). Para avançar com sucesso nesses estágios, a arquitetura de TI deve evoluir de maneira concertada, com investimentos direcionados em diferentes camadas da arquitetura em cada fase para atender às necessidades das implementações mais complexas e de maior valor dos agentes de IA. Para cada nível de maturidade, os recursos de tecnologia específicos necessários nas 11 camadas arquitetônicas são identificados com uma fundamentação para o investimento.
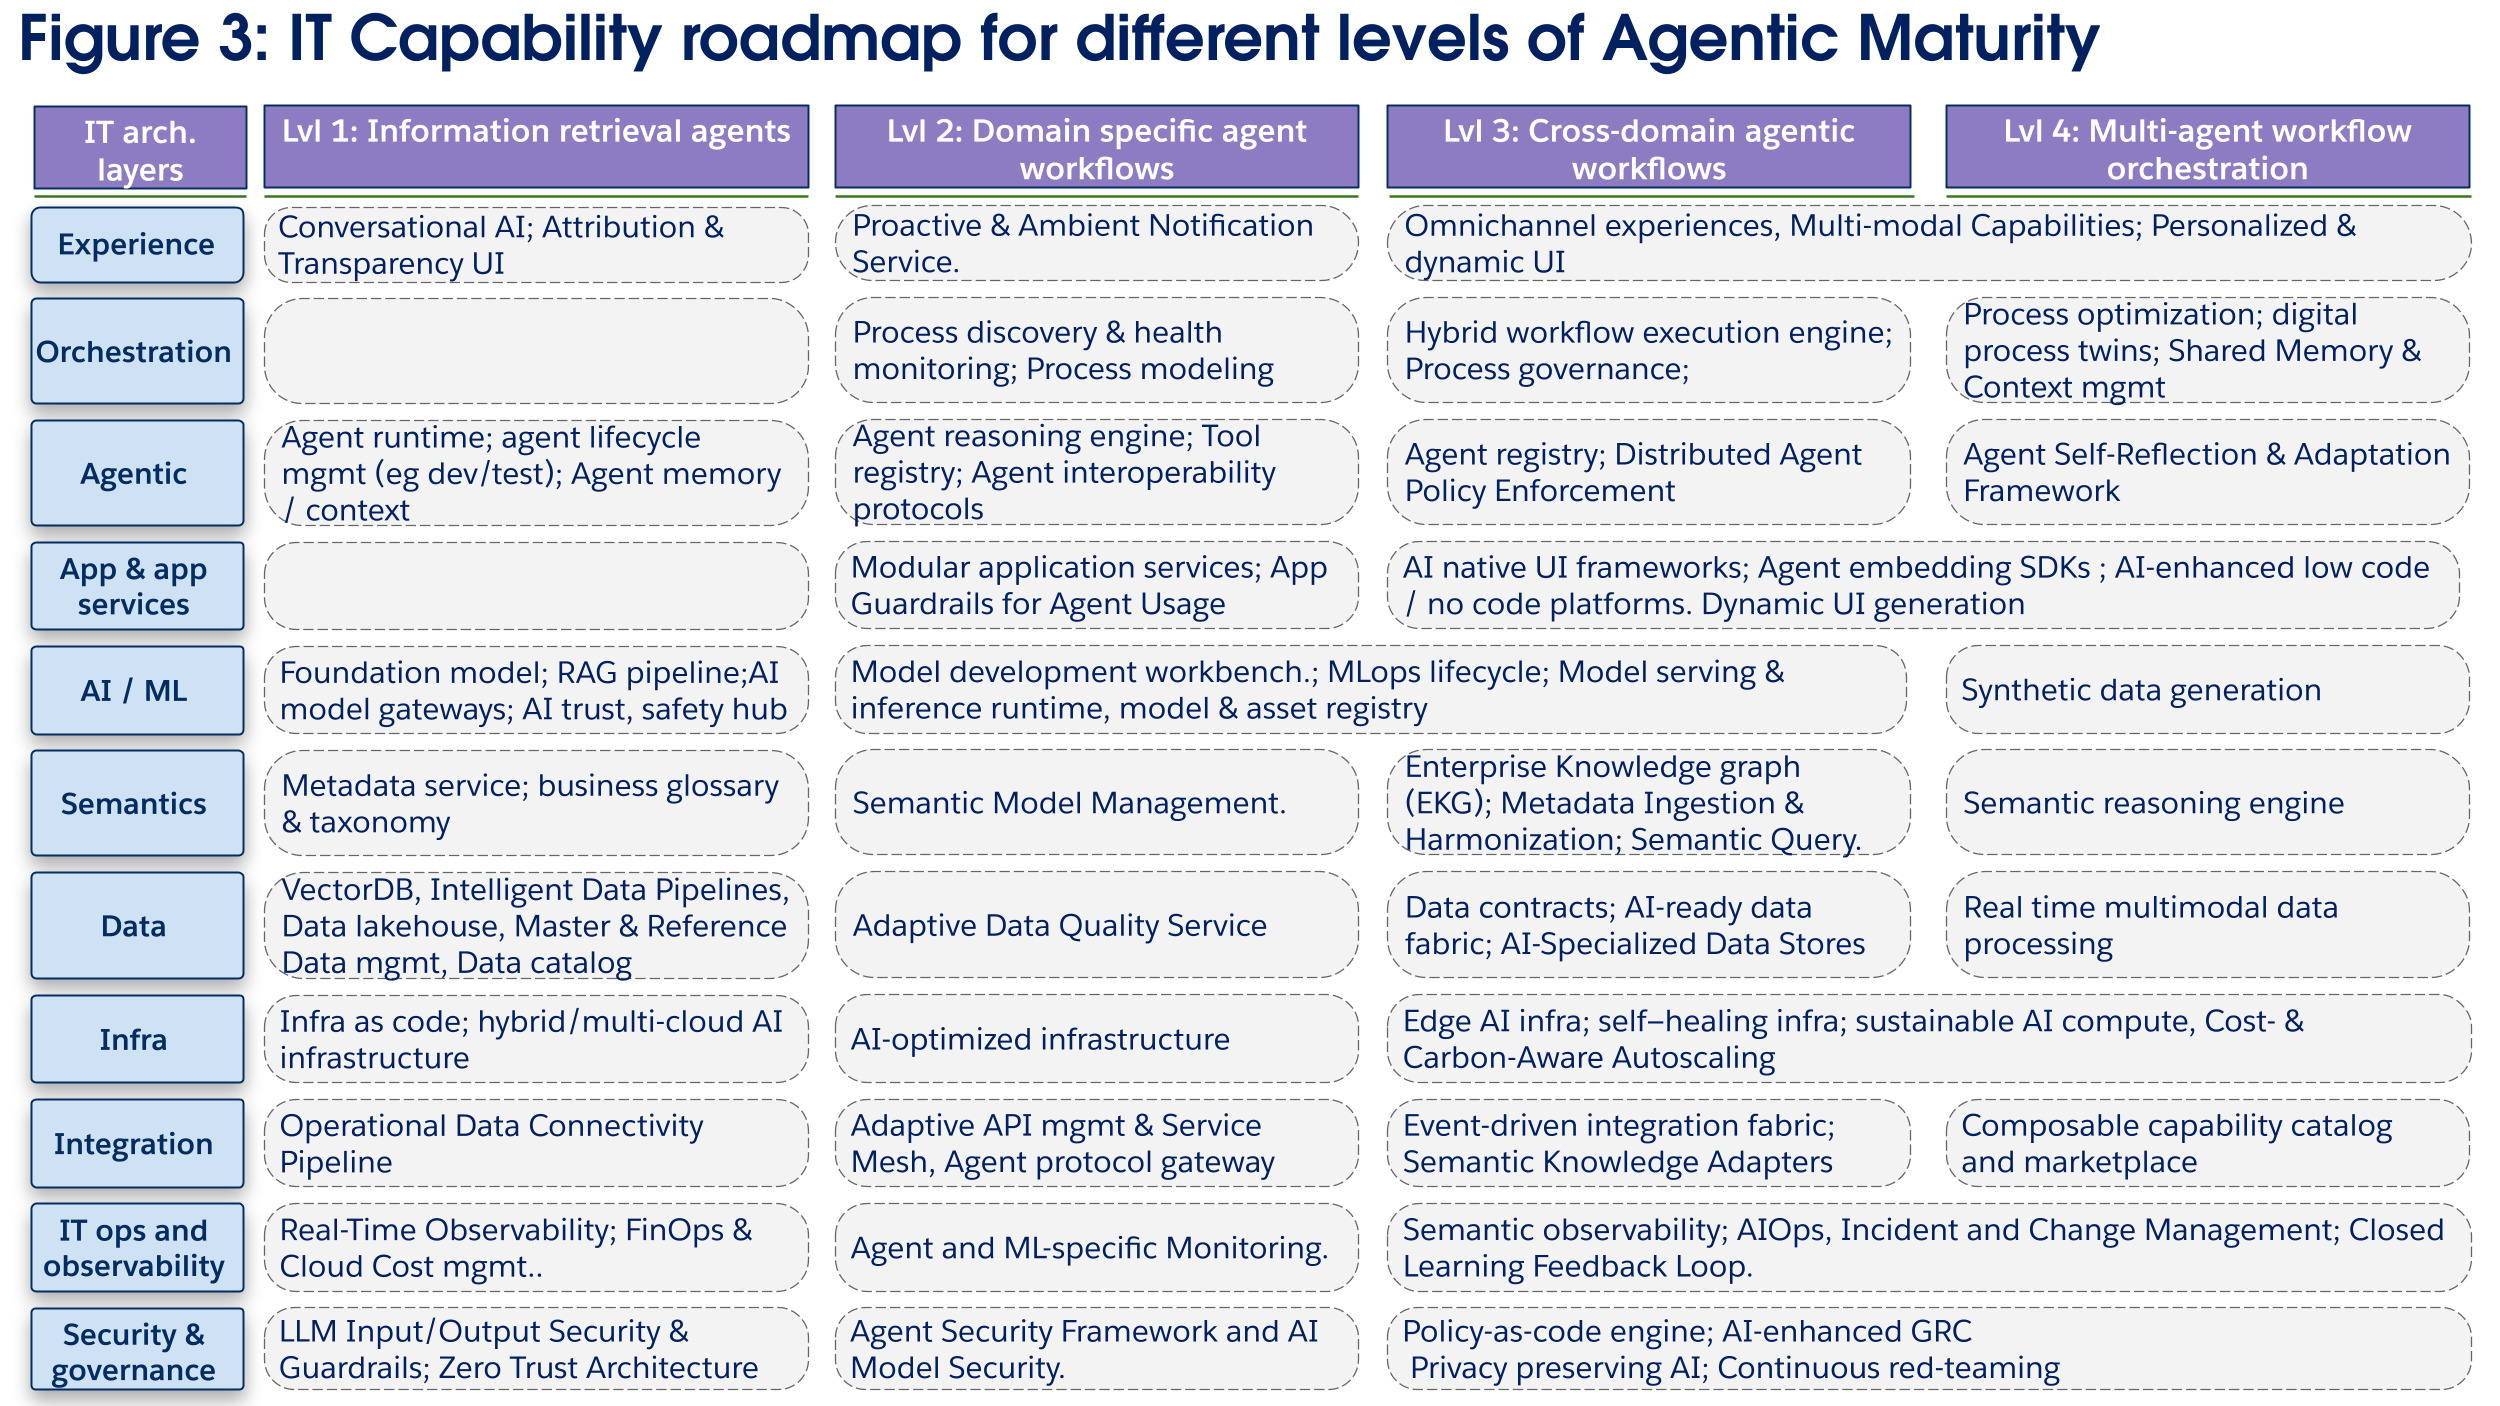 **Nível de maturidade 1: Agentes de recuperação de informação**
Objetivo & Valor **de Negócios: Aumente a produtividade dos trabalhadores humanos fornecendo uma interface confiável e conversacional para consultar o Knowledge empresarial.** O valor primário é aumentar as capacidades humanas, não substituí-las. Esses agentes ajudam os humanos recuperando informações e recomendando ações.
**Foco arquitetônico:** O foco é estabelecer uma base de dados segura e confiável e os componentes básicos de IA necessários para recuperação de informações. A governança e a observabilidade são essenciais desde o primeiro dia para criar o Trust do usuário e controlar os custos.
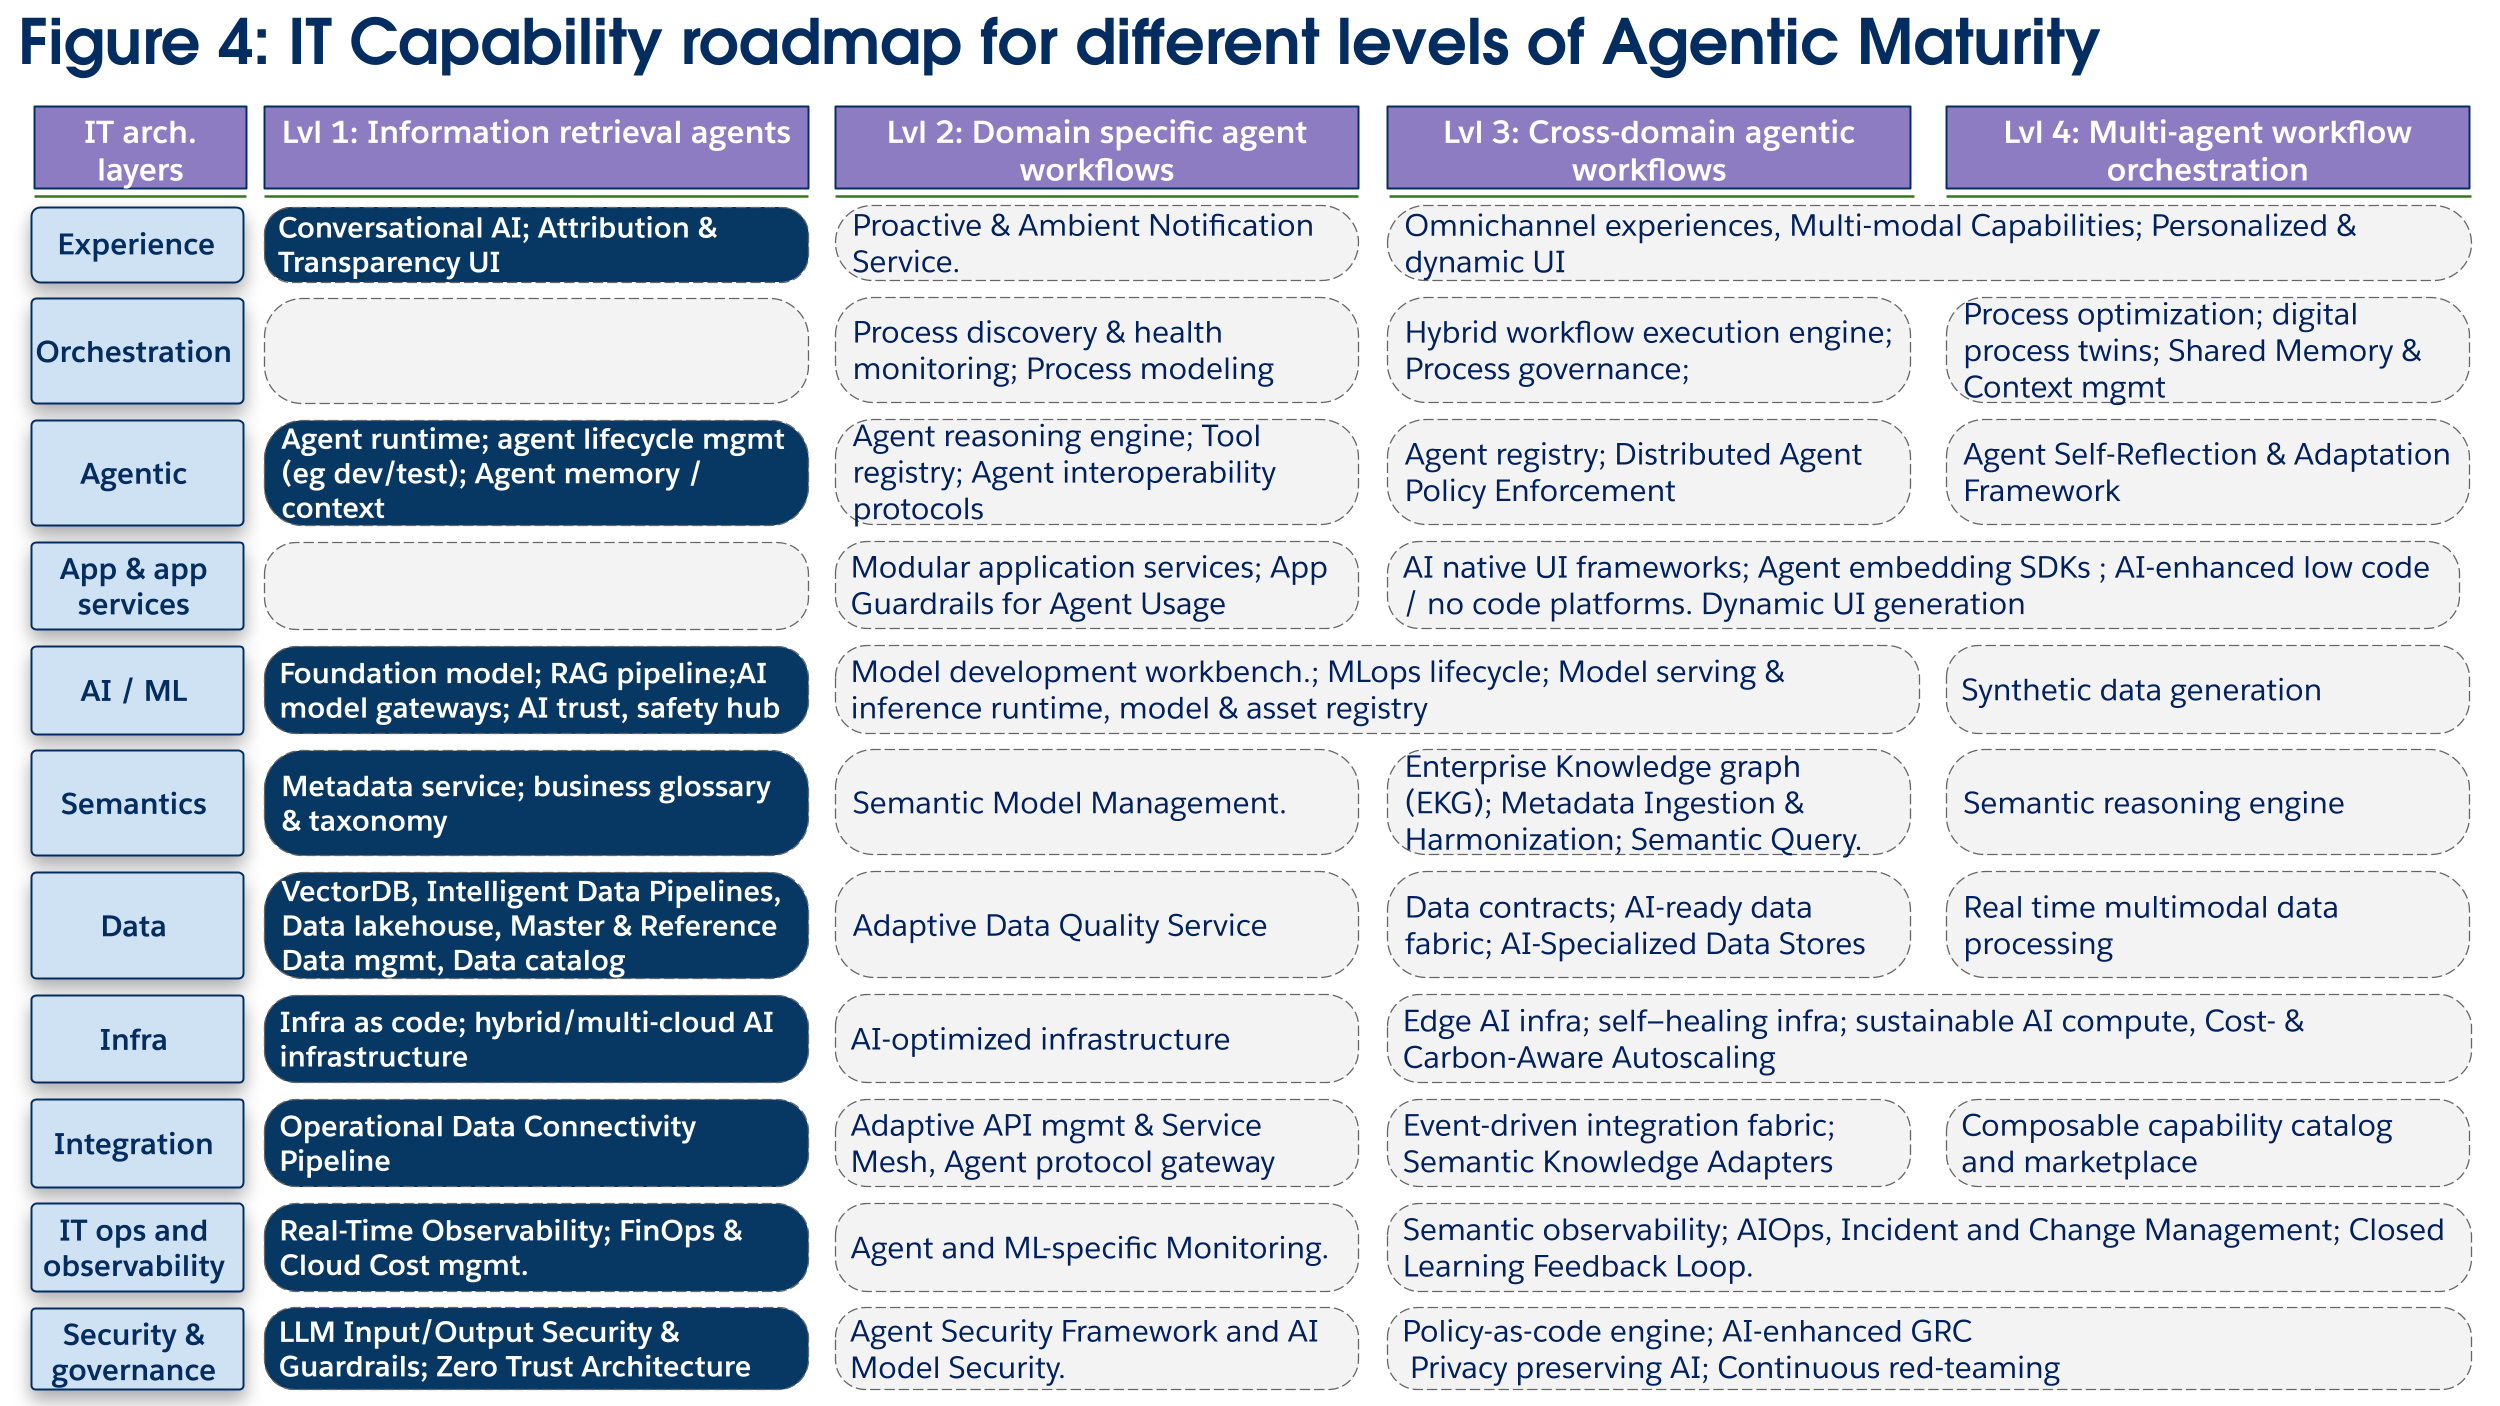
**Principais investimentos em tecnologia (Figura 4):**
Nesse estágio, a TI deve se concentrar em criar um pipeline de dados para agente confiável e outros recursos de base. As tecnologias na **camada de dados**, como um **VectorDB**, são essenciais para habilitar as técnicas de geração aumentada de recuperação (RAG) que alimentam os agentes de recuperação de informações. Isso é combinado com uma camada centralizada de **IA/ML** que inclui um **Gateway de modelo** para acesso seguro e controlado por custo aos modelos de base e um **AI Trust, Safety & Governance Hub** para monitorar saídas inseguras e garantir a conformidade. **Gerenciamento de dados mestre** e **glossários de negócios** na **Camada** **semântica** são fundamentais para que os agentes recuperem informações precisas. Os recursos de tempo de execução e ciclo de vida do agente são necessários para garantir que os agentes criados nesse estágio possam ser modificados e estendidos para casos de uso futuros. Para oferecer valor e aumentar a confiança do usuário, a **Caixa de experiência** deve incorporar uma IU de **Atribuição e Transparência**, que torna as respostas dos agentes explicáveis mostrando as citações e as fontes de suas informações. Investimentos fundamentais de observabilidade e segurança (por exemplo, **trust** **zero**) devem começar a ser implementados para estabelecer a base para futuras implantações por agências.
 **Nível de maturidade 2: Orquestração simples, Agentes de domínio único**
Objetivo & Valor **de Negócios: Automatize tarefas de rotina e orquestre fluxos de trabalho de baixa complexidade em um único domínio de negócios.** Isso melhora a eficiência operacional e reduz o trabalho manual, permitindo que os trabalhadores humanos se concentrem em atividades de maior valor.
**Foco arquitetônico:** A principal mudança arquitetônica é da recuperação de dados somente leitura para executar ações. Isso exige iniciar uma jornada mais longa para modularizar a funcionalidade do aplicativo (frequentemente exposta como APIs) para os agentes acessarem, implementar segurança robusta para ações do agente e criar funcionalidades de desenvolvimento de IA e semântica para melhorar a inteligência dos agentes de IA.
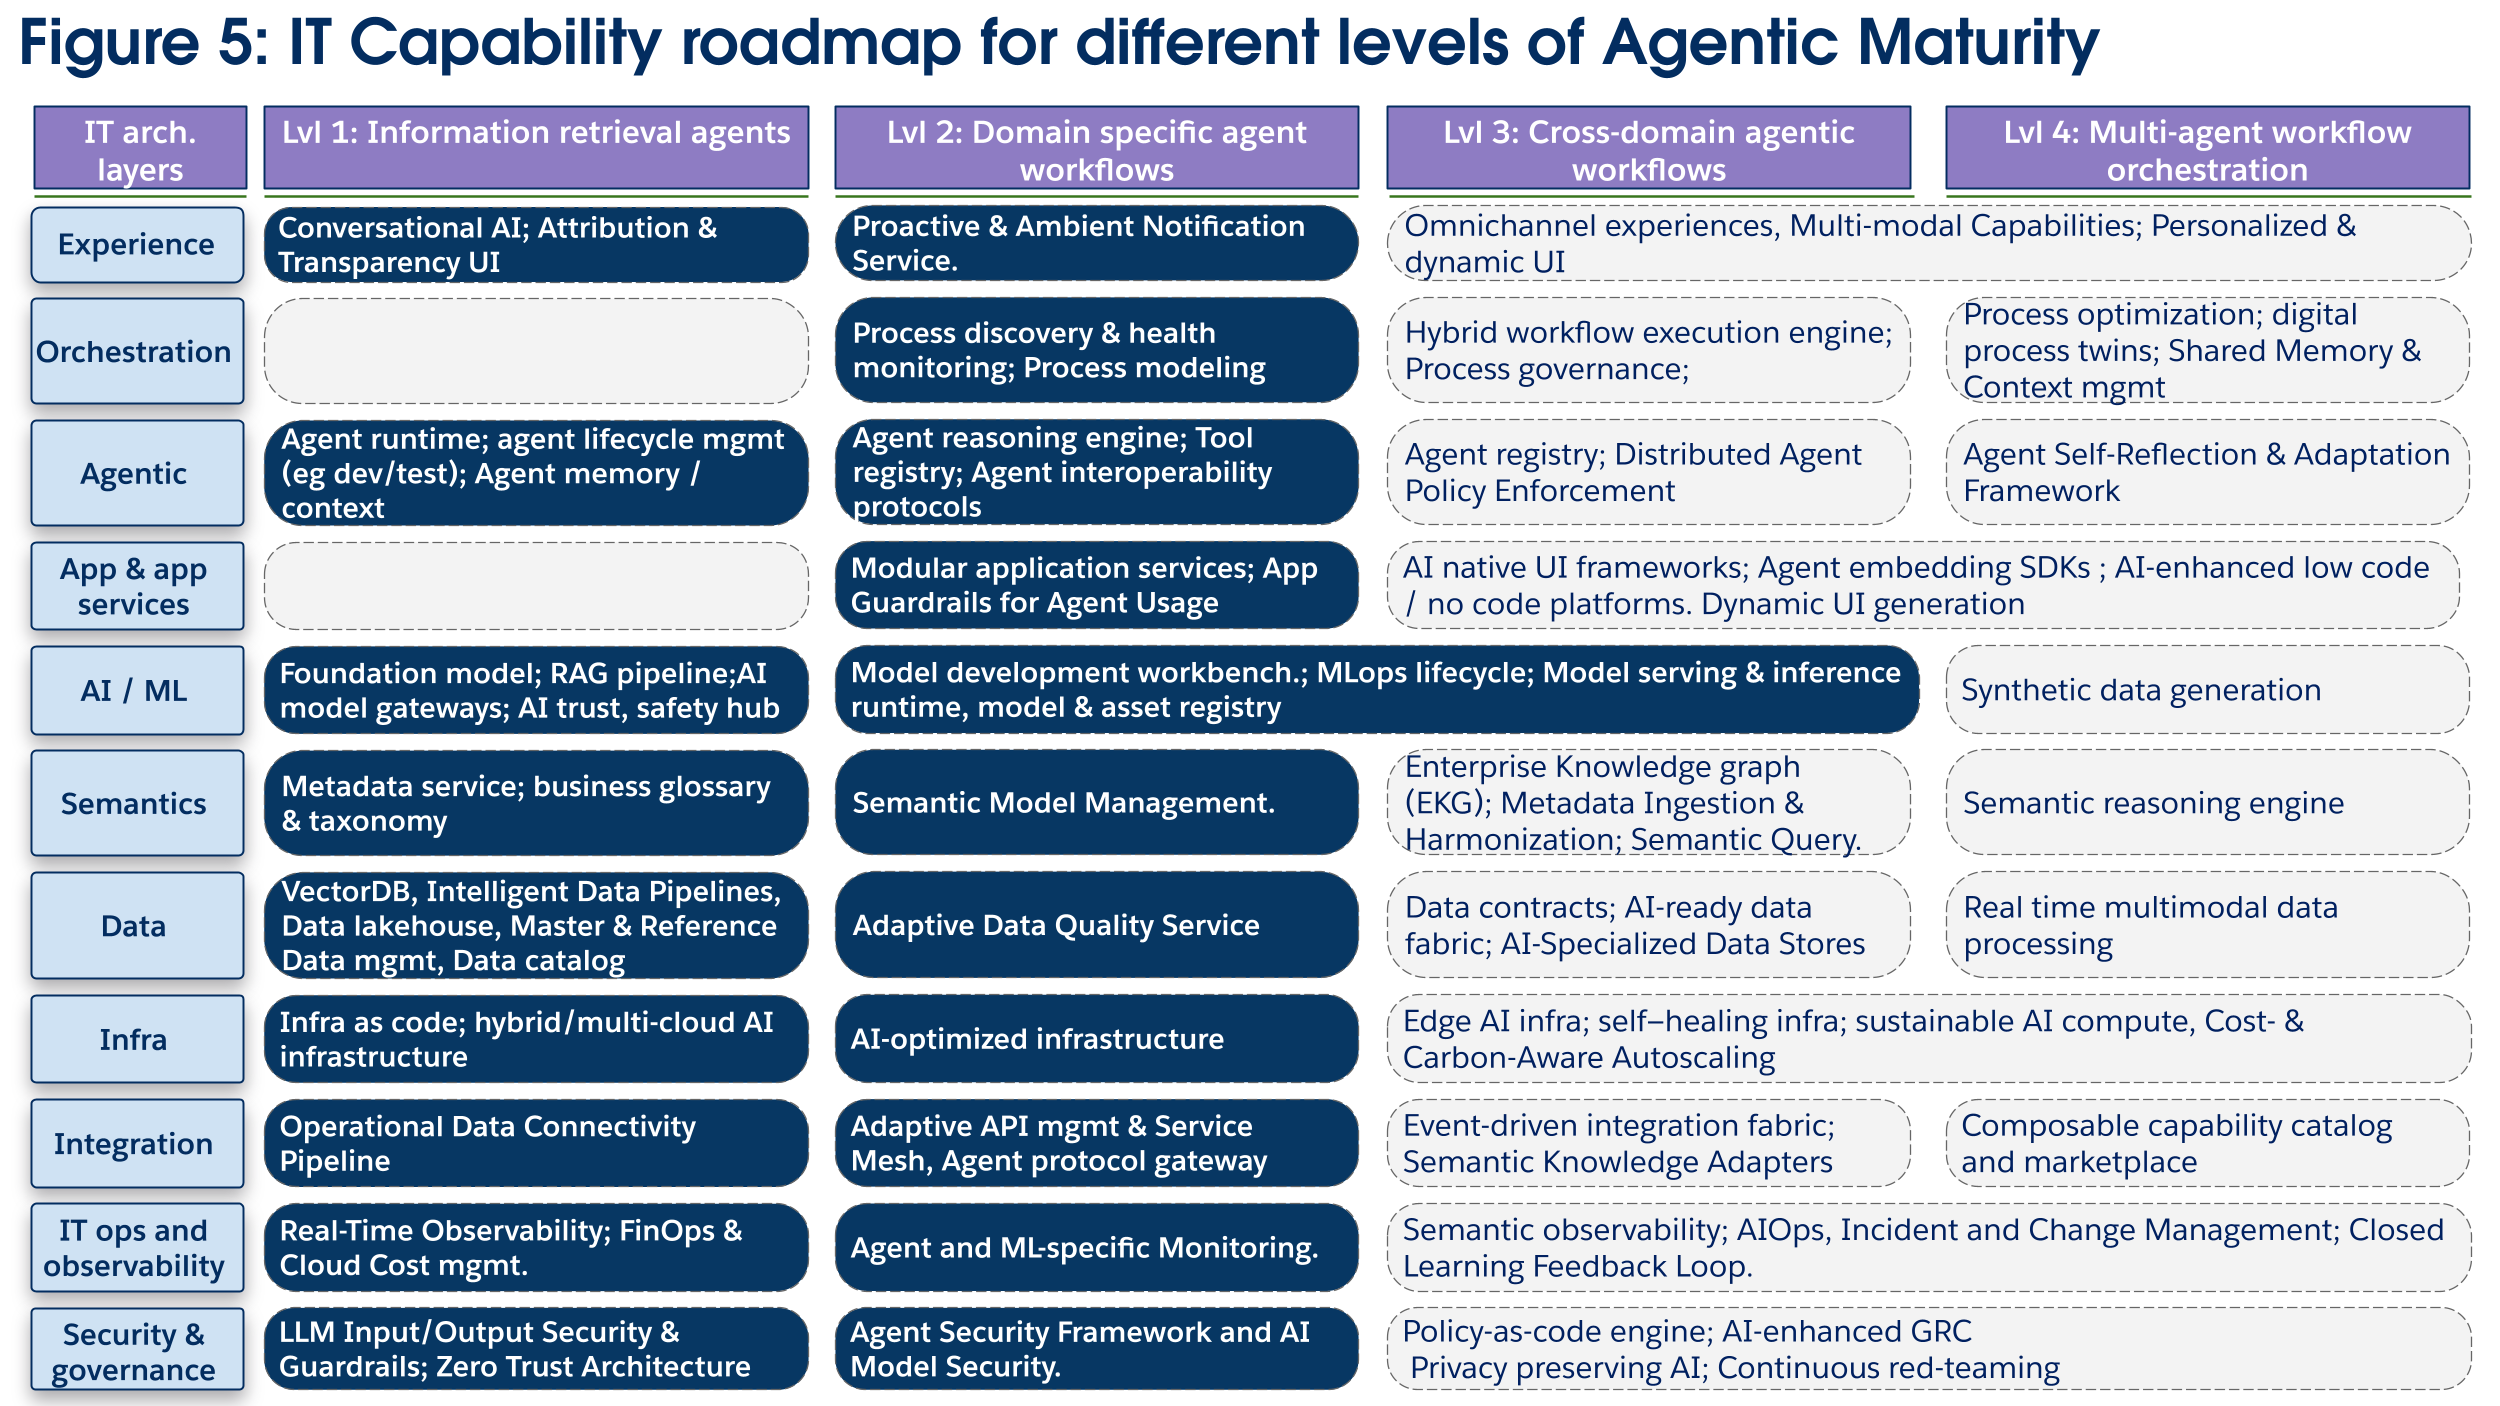
**Principais investimentos em tecnologia (Figura 5):**
Os investimentos se concentram tematicamente em capacitar os agentes de IA a agir com a governança adequada. A camada de **aplicativos e serviços de aplicativos** está passando por uma mudança crítica, à medida que a lógica de negócios monolítica é decomposta em **serviços de aplicativos modulares** (APIs) para os agentes ligarem. Estes são protegidos por **App Guardrails** para evitar que os agentes sobrecarreguem os sistemas, com integrações em ferramentas de observabilidade. Para capacitar esses agentes, é necessário investir em raciocínio do agente, protocolos de ferramentas (como MCP) e **registros**. Isso introduz novos riscos, tornando um dedicado **Quadro de Segurança do Agente e modelo de IA e recursos de monitoramento do agente** essenciais para a governança e a segurança. Por fim, as empresas podem começar a dimensionar seus recursos de IA/ML para modelos personalizados para capacitar esses agentes a lidar com tarefas específicas do domínio.
 **Nível de maturidade 3: Agentes de orquestração de vários domínios**
**Objetivo & Valor de Negócios:** **Automate processos de negócios complexos e completos que abrangem limites organizacionais e funcionais** (como "cotação em dinheiro", "lead to order"). O valor está em quebrar silos, acelerar tempos de ciclo do processo e otimizar cadeias de valor inteiras dentro do negócio. Alterações mais altas na produtividade do trabalhador humano são possíveis à medida que as barreiras organizacionais começam a quebrar e os humanos começam a se concentrar mais em supervisionar agentes de IA.
**Foco arquitetônico:** A arquitetura agora deve dar suporte a problemas técnicos intersetoriais. Uma compreensão semântica compartilhada em toda a empresa, um mecanismo de orquestração centralizado para governança e um tecido de integração desacoplado conduzido por evento se tornam os habilitadores críticos.
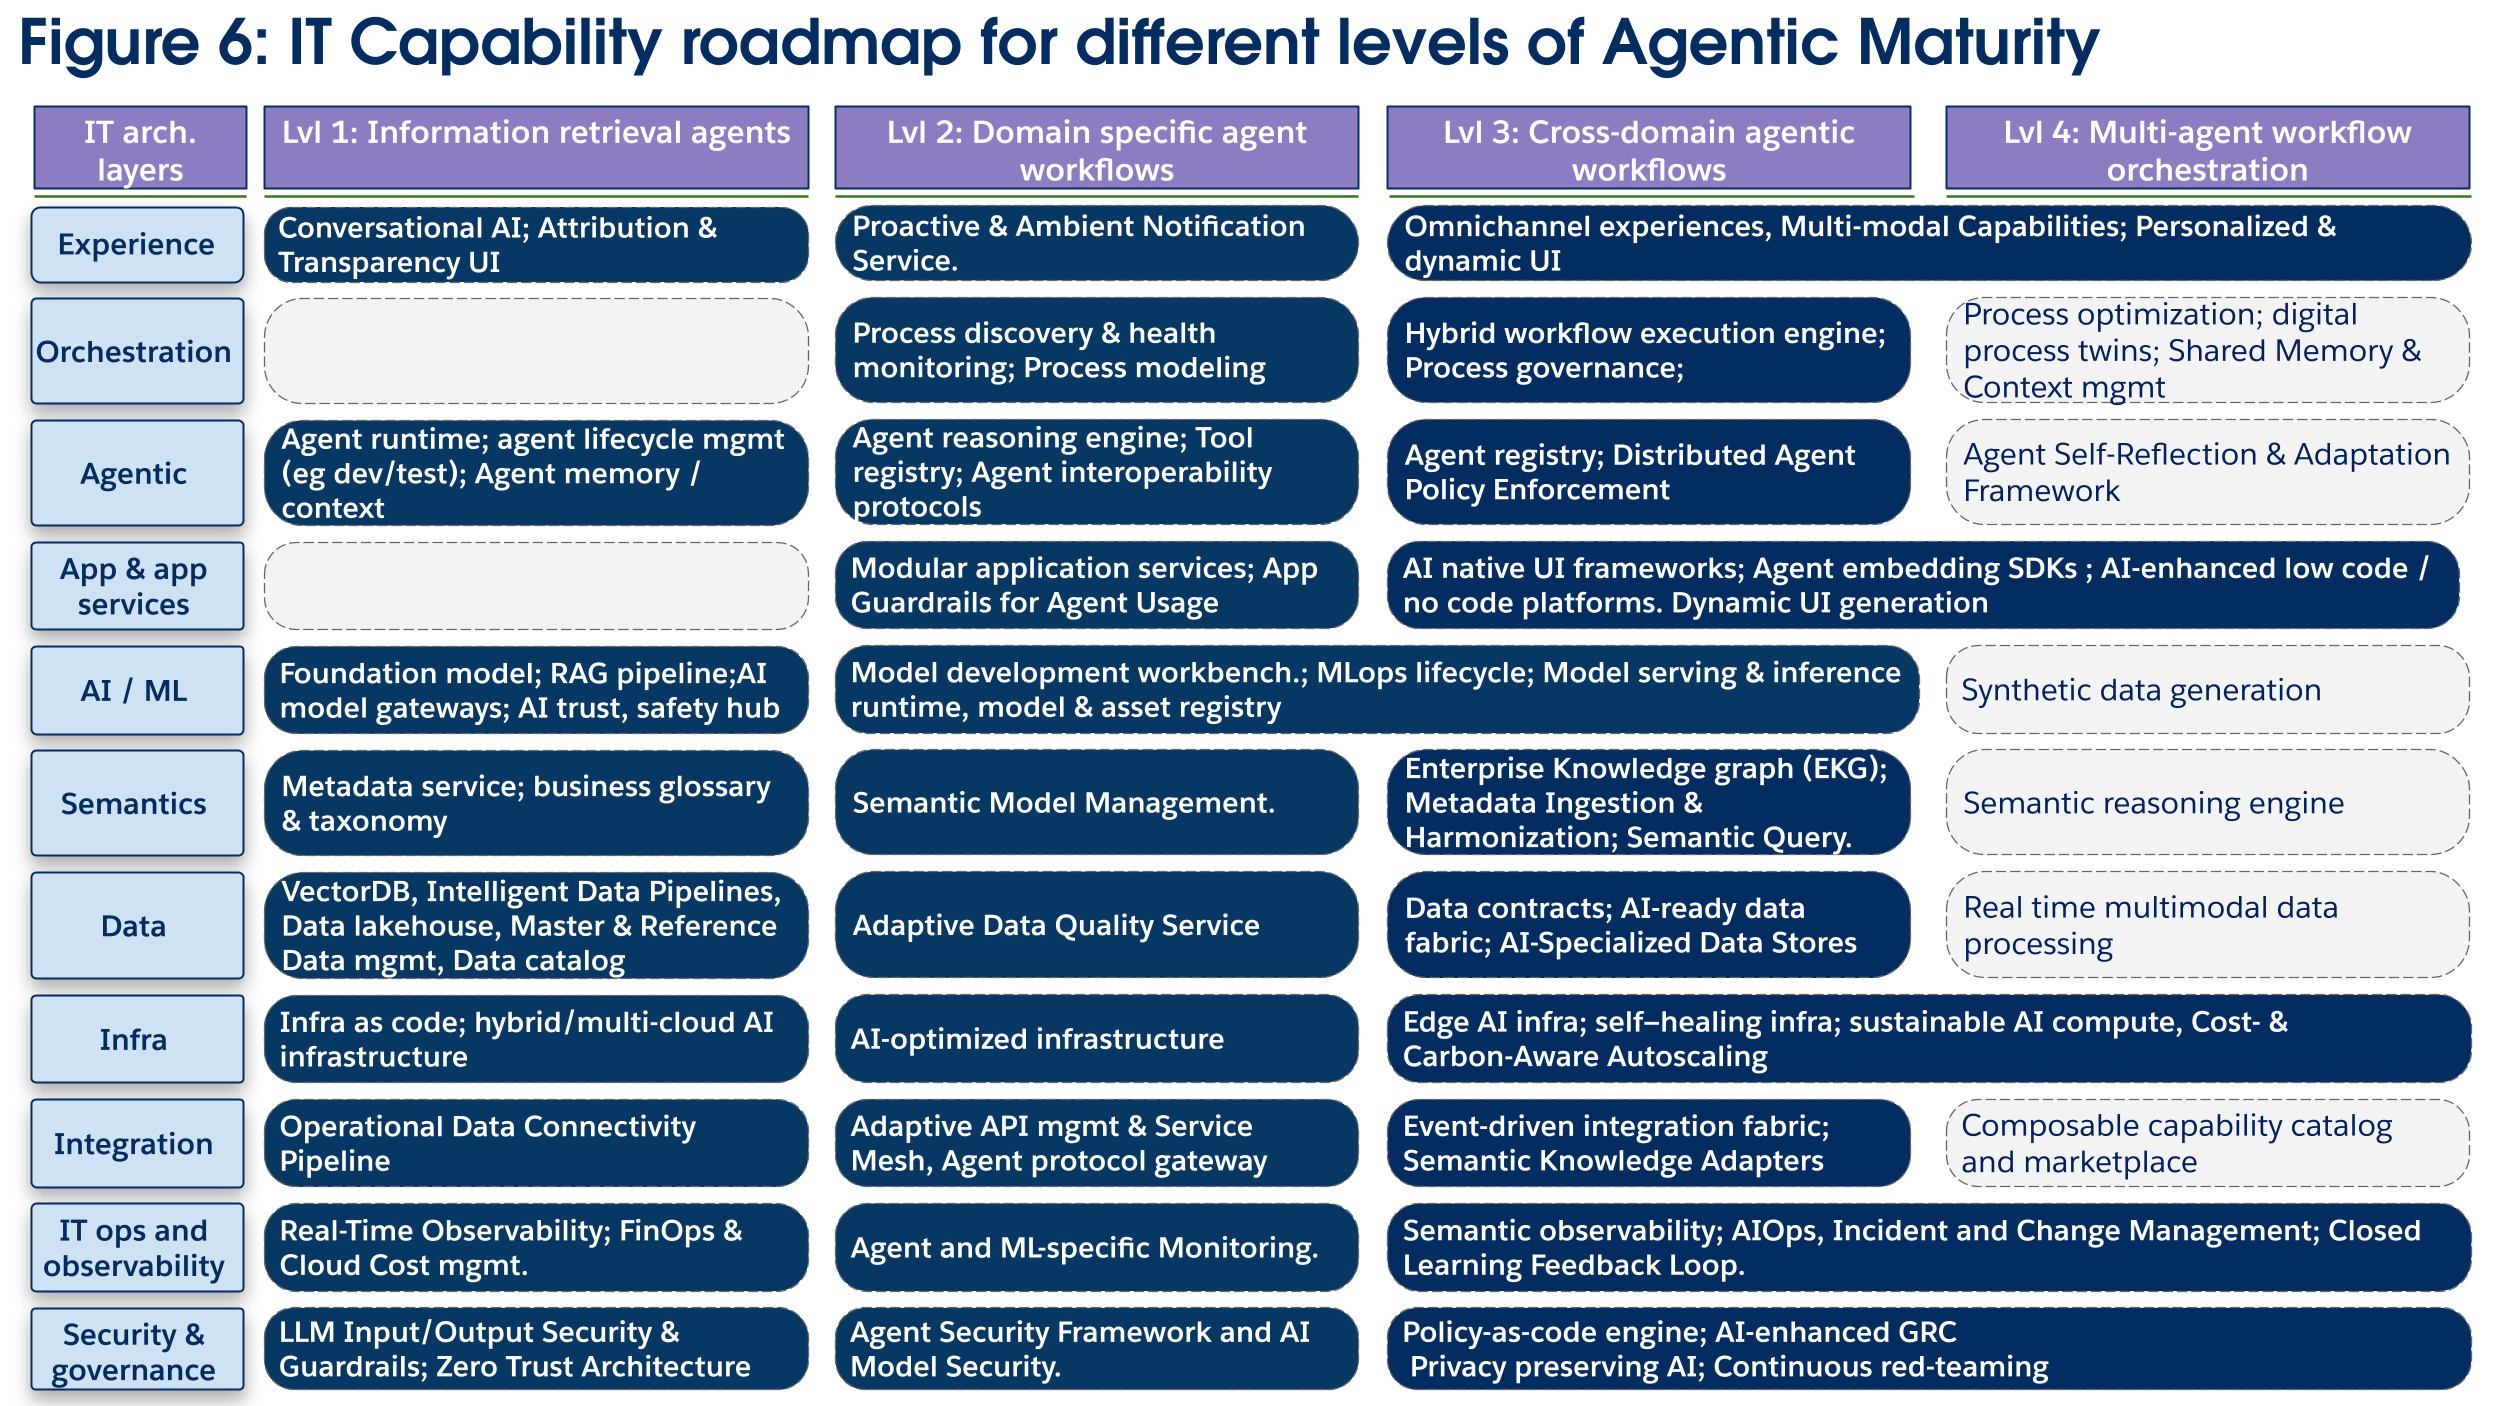 **Principais investimentos em tecnologia (Figura 6):**
Os investimentos em tecnologia são tematicamente focados na orquestração de processos em escala corporativa entre humanos, agentes e sistemas determinísticos. A camada de **orquestração corporativa** se torna um foco de investimento, exigindo um **mecanismo de execução de fluxo de trabalho híbrido** para coordenar atividades e um **mecanismo de governança e restrição de processos** para aplicar regras de negócios e políticas de conformidade em processos em voo, uma vez que os agentes trabalham entre domínios, muitas vezes com diferentes políticas e definições semânticas. Essa coordenação entre domínios só é possível com uma **camada semântica** madura com um **Enterprise Knowledge Graph (EKG)**, que cria uma compreensão compartilhada de como as entidades de negócios se relacionam entre domínios. A **camada de integração** deve evoluir para incluir um tecido de **integração conduzido por evento**, que usa uma estrutura de streaming para desacoplar sistemas e permitir a comunicação resiliente e assíncrona típica de processos empresariais de longa duração. Dado o maior valor desses fluxos de trabalho e os riscos associados, os investimentos adicionais em segurança e monitoramento tornam-se primordiais (por exemplo, **AIOps, policy-as-code**). Por fim, é necessário investir ainda mais na Camada de Aplicações e Serviços (como LCNC habilitado por **IA, experiências de usuário mais dinâmicas e multimodais**) à medida que os usuários humanos começam a monitorar e colaborar com agentes de IA mais capazes.
**Nível de maturidade 4: orquestração de vários agentes e domínios**
Objetivo & Valor **de Negócios: Redesenhe e otimize as operações de negócios entre domínios para impulsionar mudanças graduais em produtividade e eficiência.** Esse estágio avança para a criação de uma simulação digital holística (twin digital) da empresa para melhoria contínua e planejamento estratégico entre os principais processos de negócios e fluxos de trabalho.
**Foco arquitetônico:** O estágio final se concentra em habilitar a colaboração dinâmica entre agentes. Isso requer protocolos de comunicação avançados de agente a agente (A2A), recursos de autoaprendizagem do agente, investimento adicional na maturação das camadas Orquestração, Dados e Semântica e infraestrutura totalmente dinâmica e de auto-cura para dar suporte às crescentes necessidades de cargas de trabalho de IA dinâmica conforme os agentes foram expandidos em toda a empresa.
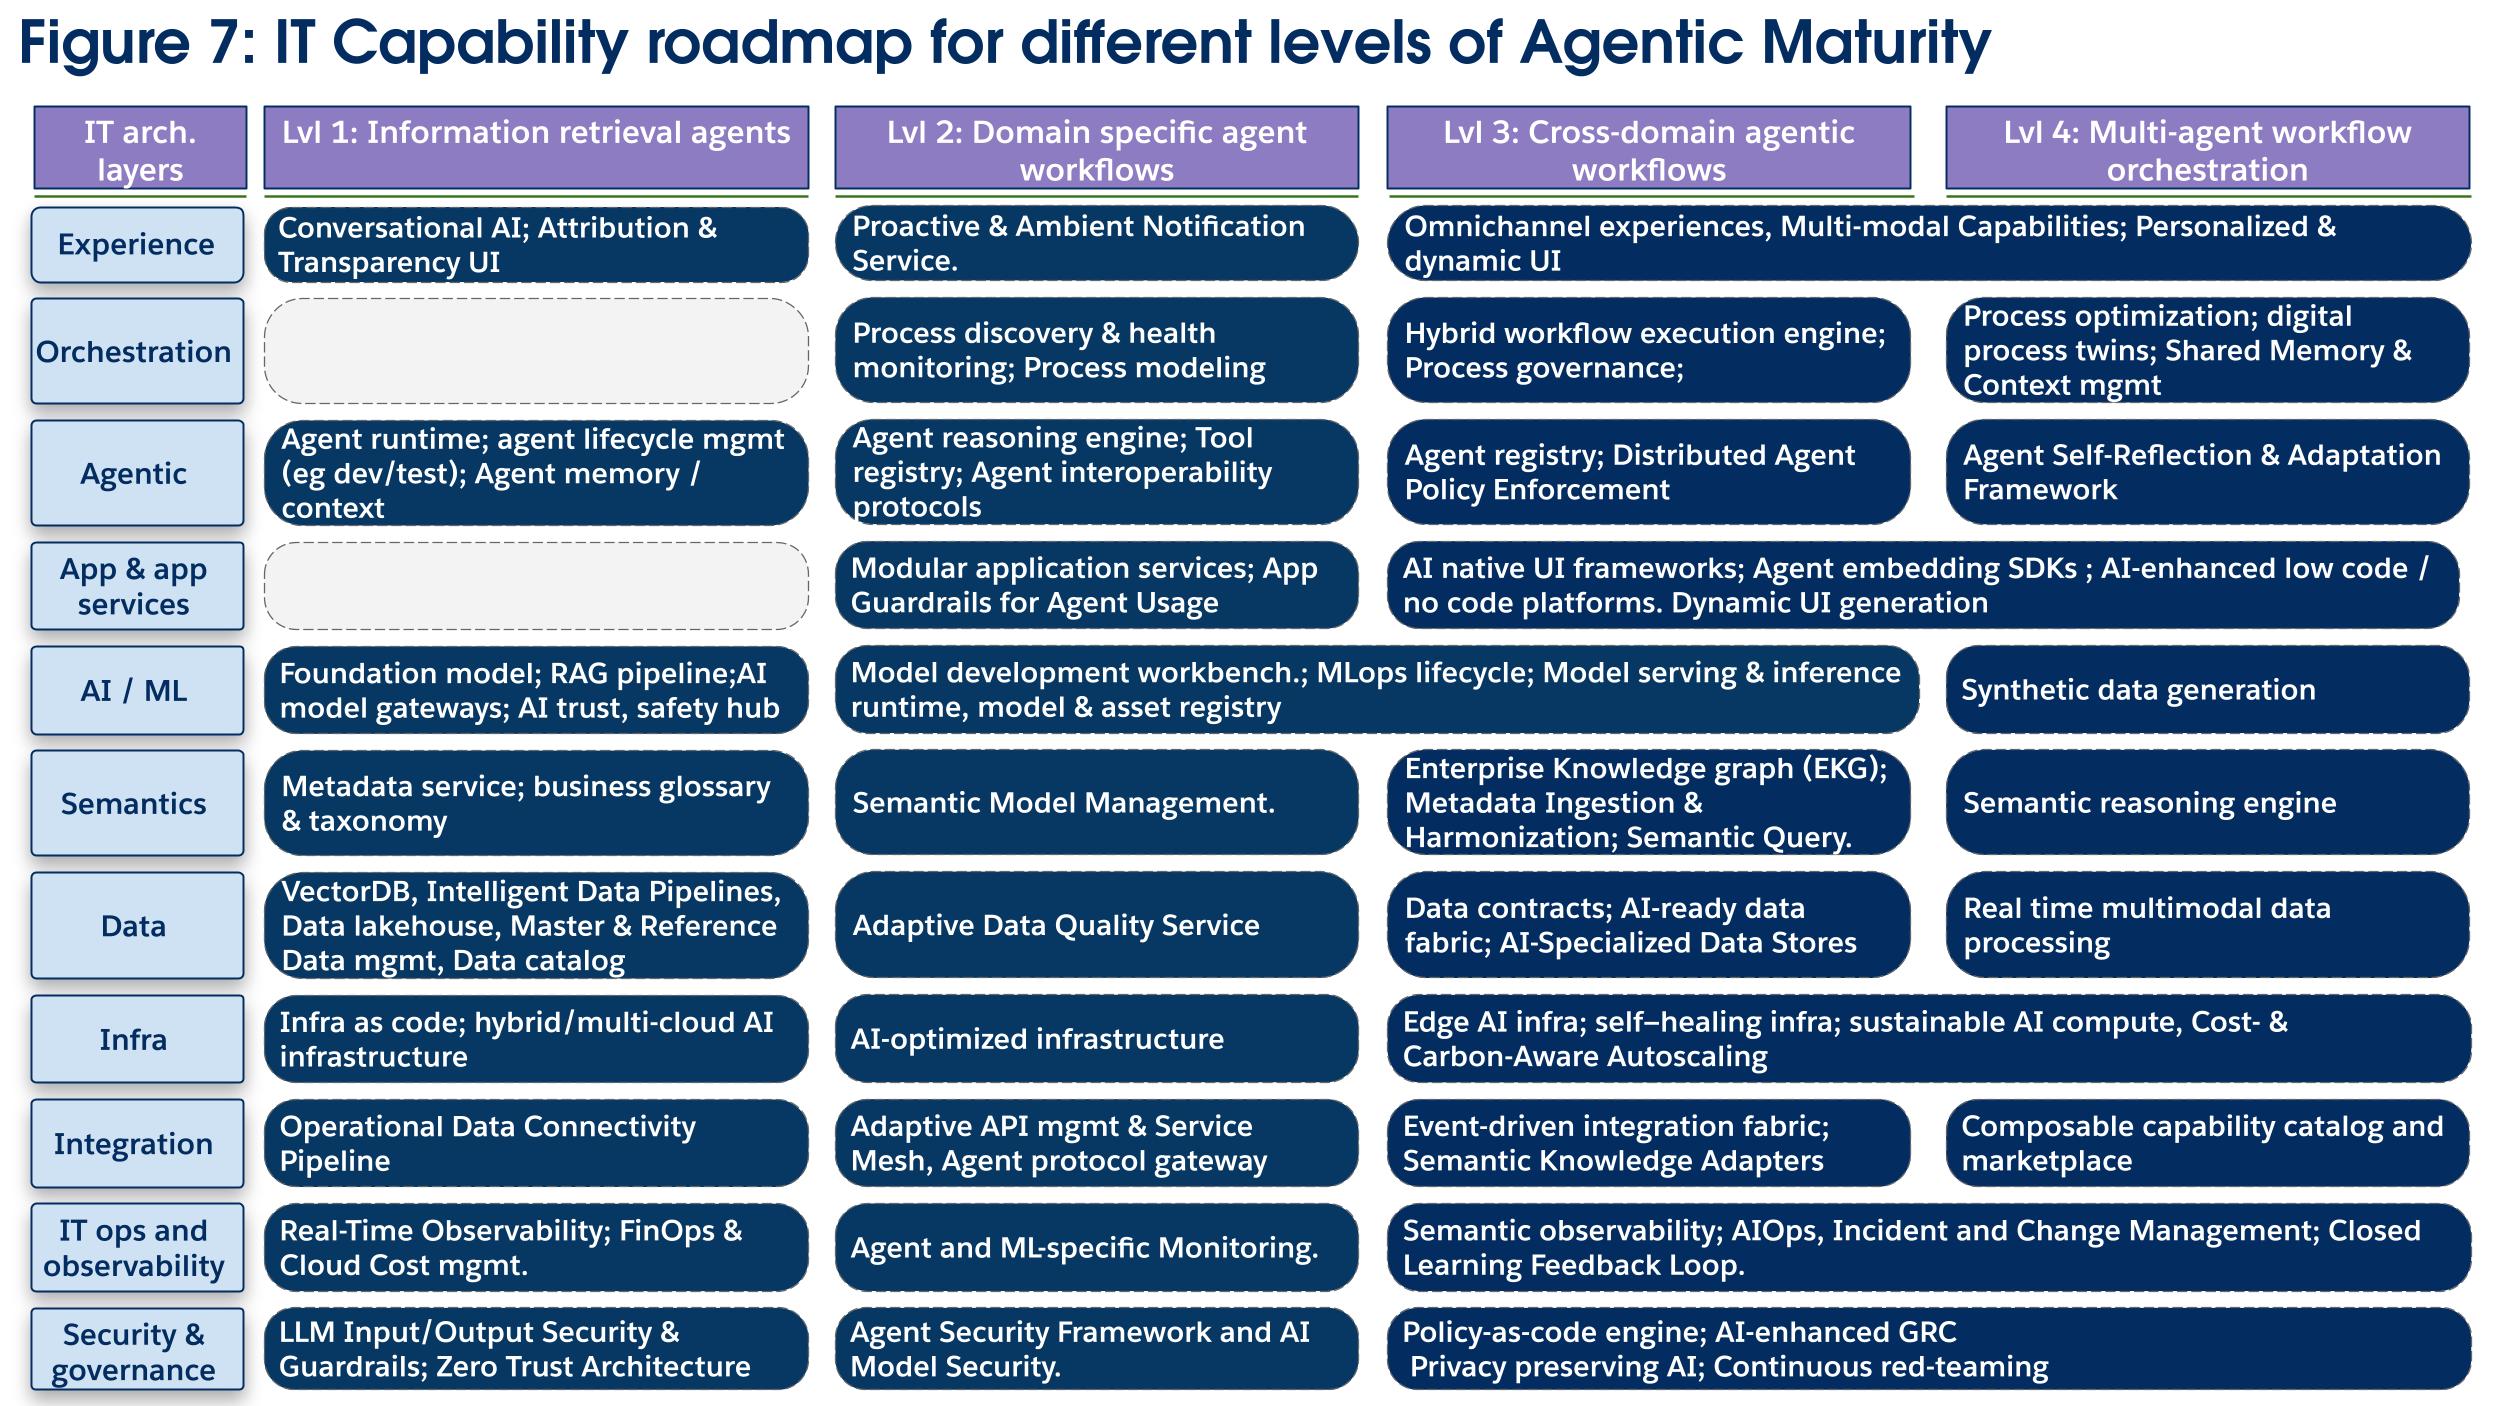 **Principais investimentos em tecnologia (Figura 7):**
Os investimentos temáticos focam a criação de um sistema autônomo para auto-melhoria. Na **camada agente**, um **Quadro de auto-reflexão e adaptação do agente** fornece o mecanismo para que um agente analise seus próprios registros de desempenho e acione melhorias. Esse aprendizado é suportado pela **Caixa de operações e observabilidade de TI**, que implementa um **Closed Learning Feedback Loop** para automaticamente alimentar dados de observabilidade de volta aos pipelines MLOps para retrabalho de modelo, que também pode aproveitar a geração de dados sintéticos para otimizar ainda mais o desempenho do modelo. Com as redes de agentes sendo implantadas em todos os departamentos, juntamente com os esforços de modularização de aplicativos em andamento, novos investimentos em segurança e, essencialmente, um **catálogo de recursos** compostos tornam-se necessários para que os agentes comprem dinamicamente recursos para resolver tarefas mais abstratas e de maior valor. Esses processos são todos orquestrados e otimizados por meio de uma nova funcionalidade **Digital Twin Process Modeling,** que usa dados em tempo real para criar simulações para análise "o que é" e otimização preditiva, permitindo que a empresa teste e implante com segurança novas implementações agentes.
**Conclusão**
O roteiro para uma Enterprise agendada percorre uma evolução arquitetônica de TI. Os arquitetos empresariais serão os principais impulsionadores dessa transformação, conduzindo as decisões de investimento críticas, junto com outros parceiros nos negócios e TI, necessárias para a organização perceber o valor dos novos recursos de negócios da Enterprise do agente.
# Introdução
Há mais de duas décadas, a Salesforce iniciou a primeira plataforma de nuvem multilocatário, estabelecendo um precedente no setor. Desde então, o Salesforce evoluiu para uma plataforma corporativa abrangente, capaz de encapsular e automatizar os principais aspectos de um negócio e atender centenas de milhares de empresas e milhões de usuários em vários setores e regiões. A Salesforce também aprimorou seu pacote de produtos Customer360 por meio de aquisições estratégicas.
Ao longo dos últimos anos, mudanças no mercado, no setor e no panorama tecnológico nos levaram a várias transformações profundas na base da Salesforce Platform. Essas incluem:
- O surgimento de provedores de nuvem pública que investem muito em infraestrutura.
- Avanços rápidos na IA, incluindo aprendizado de máquina, IA generativa e experiências agentes.
- Maior residência de dados e requisitos regulatórios em indústrias e países.
- A necessidade de lidar com dados e transações em tempo real em uma escala crescente.
- Maior foco nos requisitos de segurança cibernética, disponibilidade do sistema, desempenho e resiliência.
- A demanda do cliente por um pacote integrado que ofereça uma arquitetura altamente resiliente, solta e altamente coesa.
Em resposta a essas mudanças, particularmente a mudança sísmica da IA e seu impacto nas empresas, a Salesforce transformou completamente sua plataforma desde o início, estabelecendo as bases para a próxima geração de aplicativos e casos de uso do cliente, ao mesmo tempo em que defende nossos objetivos de Trust.
O lançamento do Agentforce no Dreamforce 2024 e o diagrama abaixo representam o culminar desse extenso esforço, envolvendo milhares de membros da equipe da organização de Tecnologia e Produtos do Salesforce. No momento, mais de 95% de nossos clientes mudaram para essa nova plataforma. A migração bem-sucedida da maioria dos nossos clientes, incluindo aqueles com as cargas de trabalho mais exigentes, sublinha a ingenuidade dos nossos engenheiros e reafirma os valores centrais da Salesforce de Trust, Customer Success e Inovação.
Desde o lançamento da Agentforce, a Salesforce continuou a pioneirizar o uso de IA em aplicativos empresariais e tem sido líder de mercado no desenvolvimento de experiências agenciais que fornecem experiências em tempo real, conversacionais para funcionalidades de negócios existentes e novas.
Neste artigo, elaborado em colaboração com os principais engenheiros, uma exploração detalhada é fornecida para criadores que apreciam as complexidades por trás das principais transformações tecnológicas. O artigo aprofunde-se nos aprimoramentos arquitetônicos essenciais que mantêm a plataforma escalonável, segura e pronta para lidar com aplicativos futuros enquanto atende às mudanças nas necessidades de nossos clientes. Recomendamos que você comece com o capítulo Visão geral da arquitetura para entender o panorama completo. De lá, os leitores podem continuar em sequência ou explorar os capítulos que mais capturam seu interesse.
_Emin Gerba_
 ## 2\. Visão geral da arquitetura
Os princípios arquitetônicos da Salesforce Platform abaixo capturam a base e a diferenciação para como engenhar recursos e recursos:
- **Enterprise-Grade Trust**: O Trust é o maior valor da Salesforce, e priorizamos não apenas a disponibilidade e a segurança dos nossos serviços, mas também criamos os recursos de controle de acesso, conformidade e segurança para que nossos clientes possam cumprir os padrões de conformidade e segurança com a Salesforce Platform.
- **Tenente**: Todos os serviços e infraestrutura são criados para hospedar vários clientes. Isso fornece um padrão estratégico para escalonamento com uso, bem como padronização em uma barra alta comum de disponibilidade e segurança independentemente do tamanho de nossos clientes.
- **Acionada por metadados**: Os metadados estão no centro de como nossos serviços multilocatários são personalizáveis. Nossos metadados são extensíveis para que administradores e desenvolvedores possam se basear no trabalho existente, além de se beneficiar de futuras atualizações de produto do Salesforce e de parceiros do ecossistema.
- **API em primeiro lugar:** A Salesforce Platform prioriza um portfólio de API avançado e consistente que cobre tudo o que pode ser feito por meio de interfaces de usuário nativas do Salesforce. Isso permite que desenvolvedores e parceiros aproveitem e recomponham a funcionalidade da plataforma para integrar sistemas ou criar novas experiências de usuário.
- **Aberto e interoperável**: A Salesforce Platform pode ser integrada a qualquer arquitetura corporativa de nossos clientes. Projetamos a Salesforce Platform para funcionar com outros sistemas baseados em nuvem e locais, além de fornecer APIs, ferramentas e padrões de integração para sistemas externos para integração com a Salesforce Platform.
- **Agente:** A Salesforce Platform está evoluindo rapidamente para ser o primeiro agente em todo o pacote de aplicativos. Queremos que os usuários possam interagir com o Salesforce por meio de experiências de conversa agenciais profundas que lhes permitam realizar o trabalho e interagir com seus dados de maneiras cada vez mais naturais.
A atual Plataforma Salesforce representa o último estágio na evolução das capacidades do Salesforce desde o lançamento da Plataforma Force.com em 2008. As principais transformações recentes incluem:
- Adoção do Hyperforce e uma mudança para arquiteturas baseadas em nuvem.
- Evolução de uma arquitetura monolítica para uma estrutura com serviços independentes.
- Apresentação das tecnologias Data 360 e Lakehouse junto com os repositórios de dados relacionais tradicionais.
- Integração profunda de tecnologias de IA, aprendizado generativo e de máquina e uma evolução para experiências agentes em toda a plataforma.
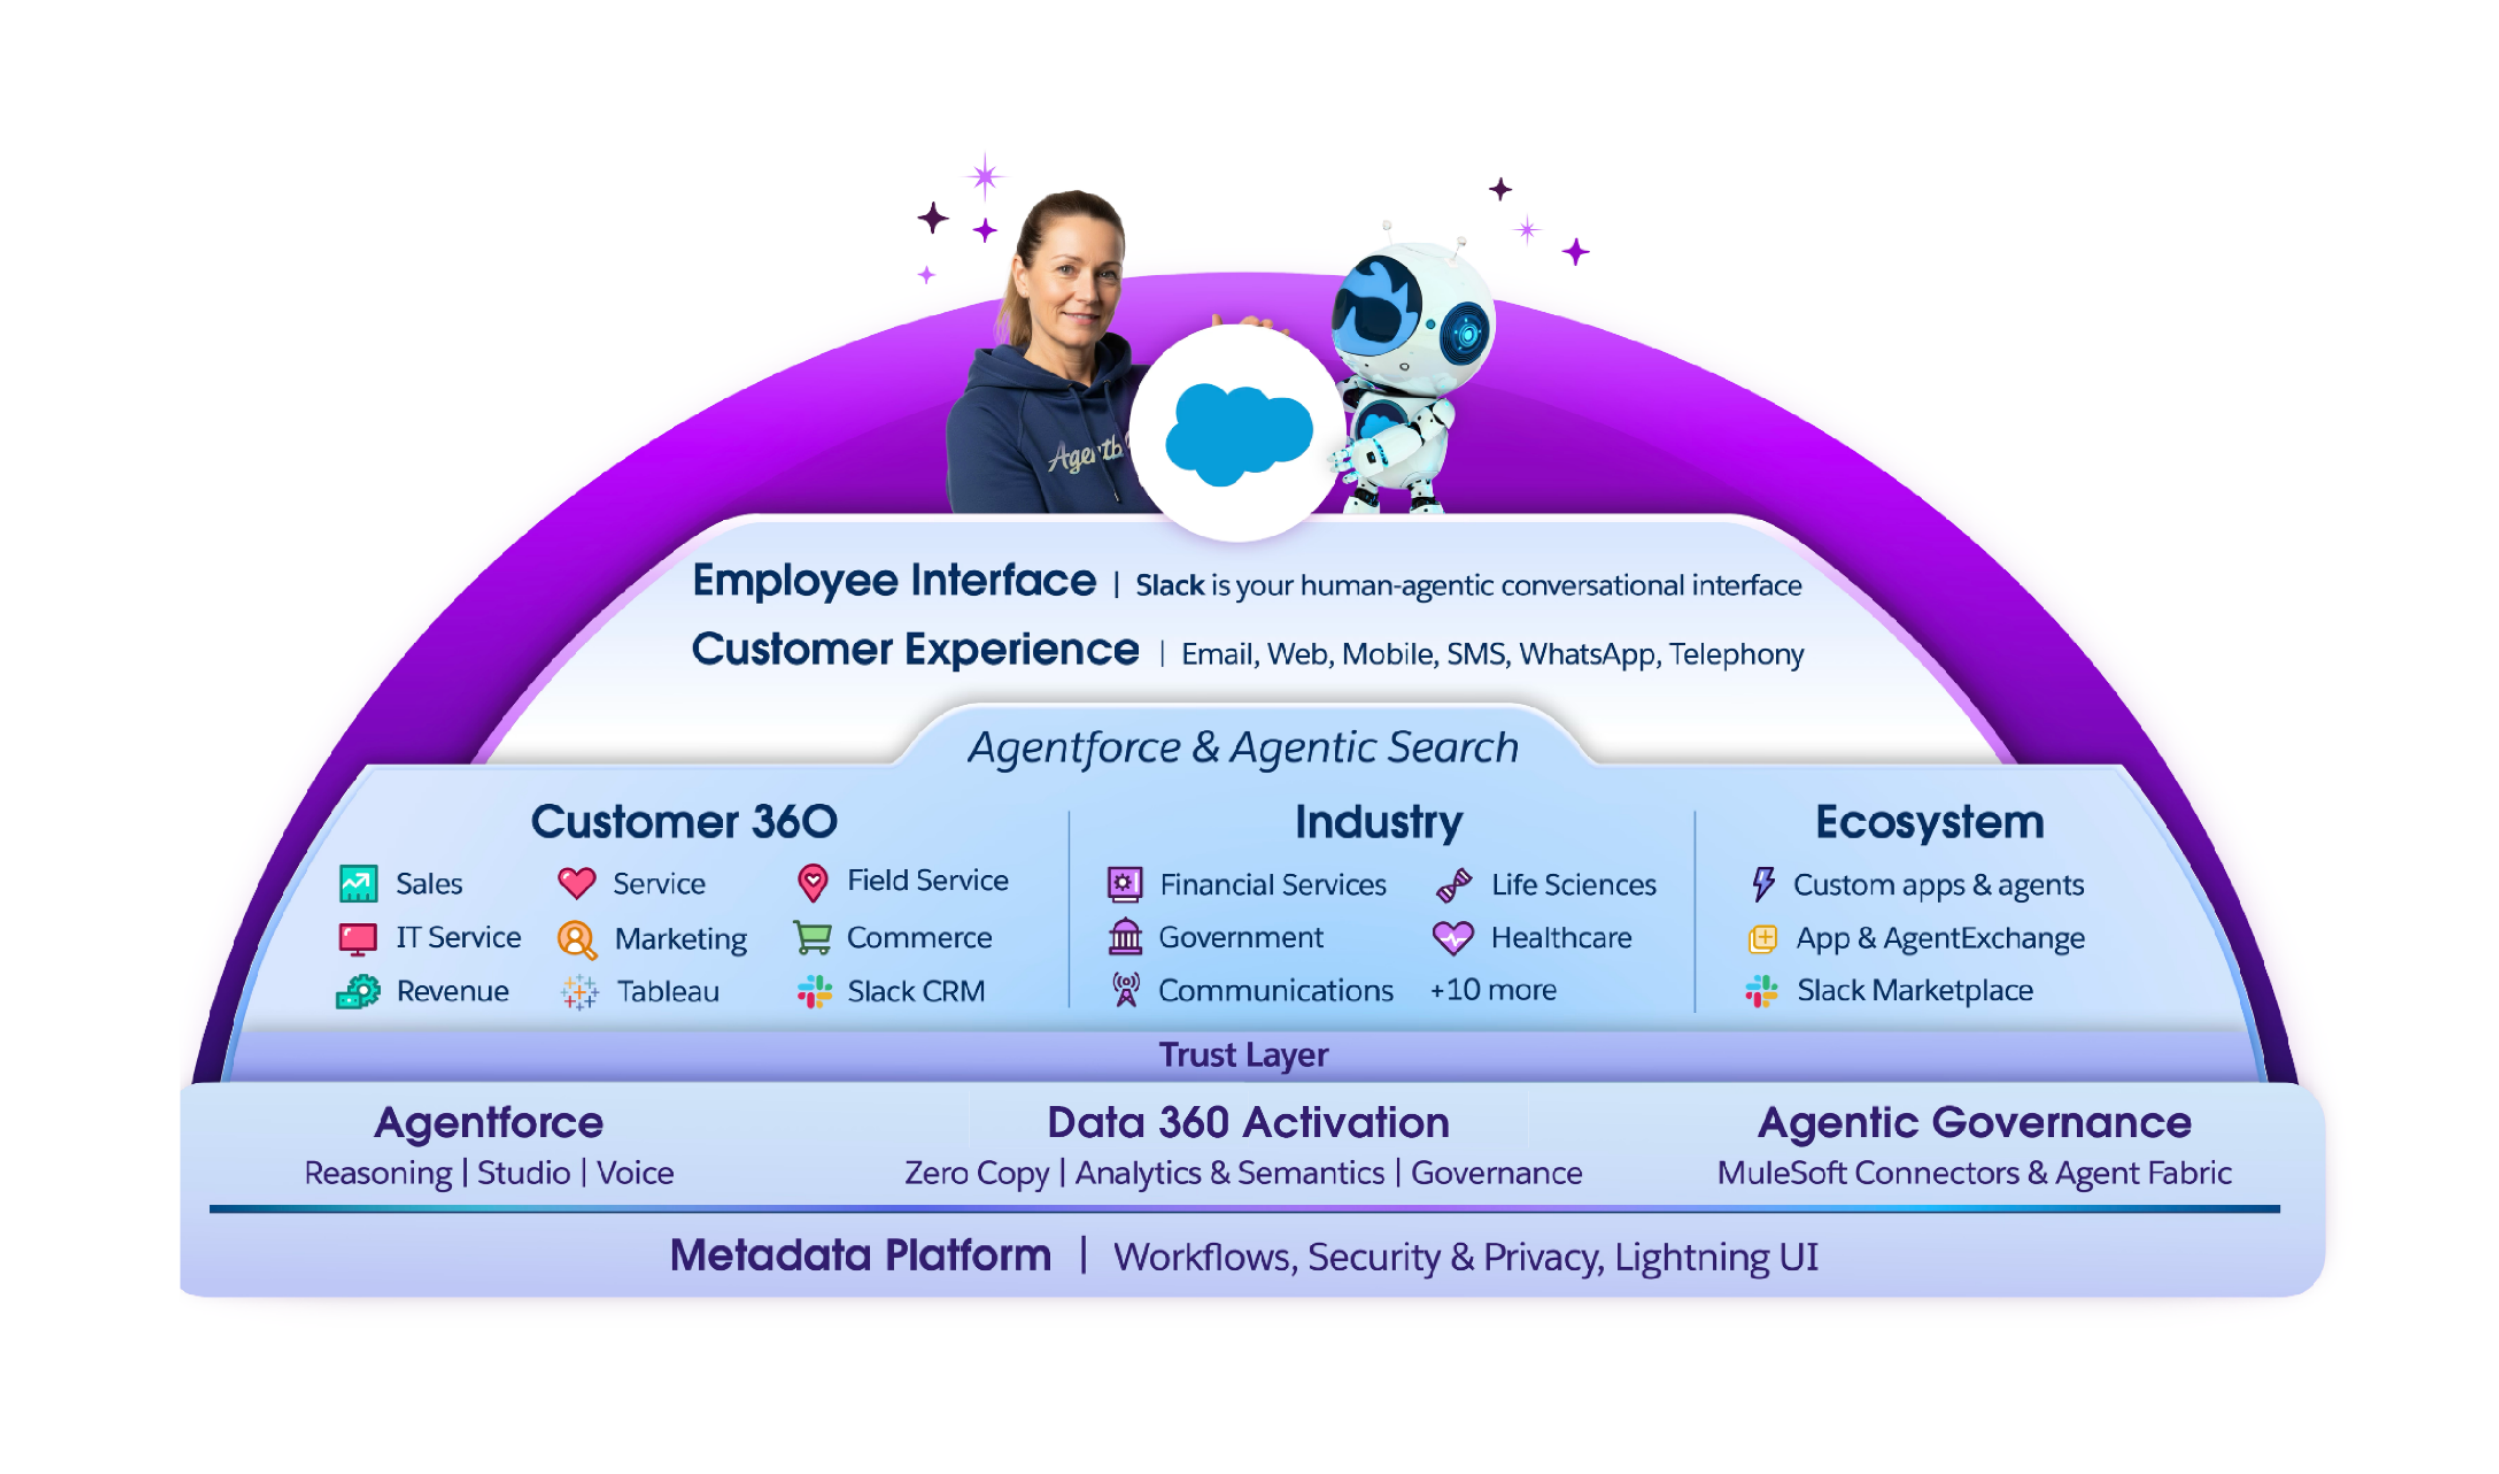
Essas alterações expandiram e refinaram os recursos da plataforma sem interrupções significativas, graças a abstrações robustas que permitem aos engenheiros do Salesforce avançar nossas tecnologias sem problemas com interrupções mínimas do cliente. A abstração robusta também continua sendo fundamental para o valor da Salesforce Platform de simplificar as complexidades técnicas de software de nível corporativo, como convenções de segurança, disponibilidade e tecnologia, para que os desenvolvedores de aplicativos possam se concentrar em resolver seus desafios exclusivos. Os recursos da Salesforce Platform são destacados abaixo:
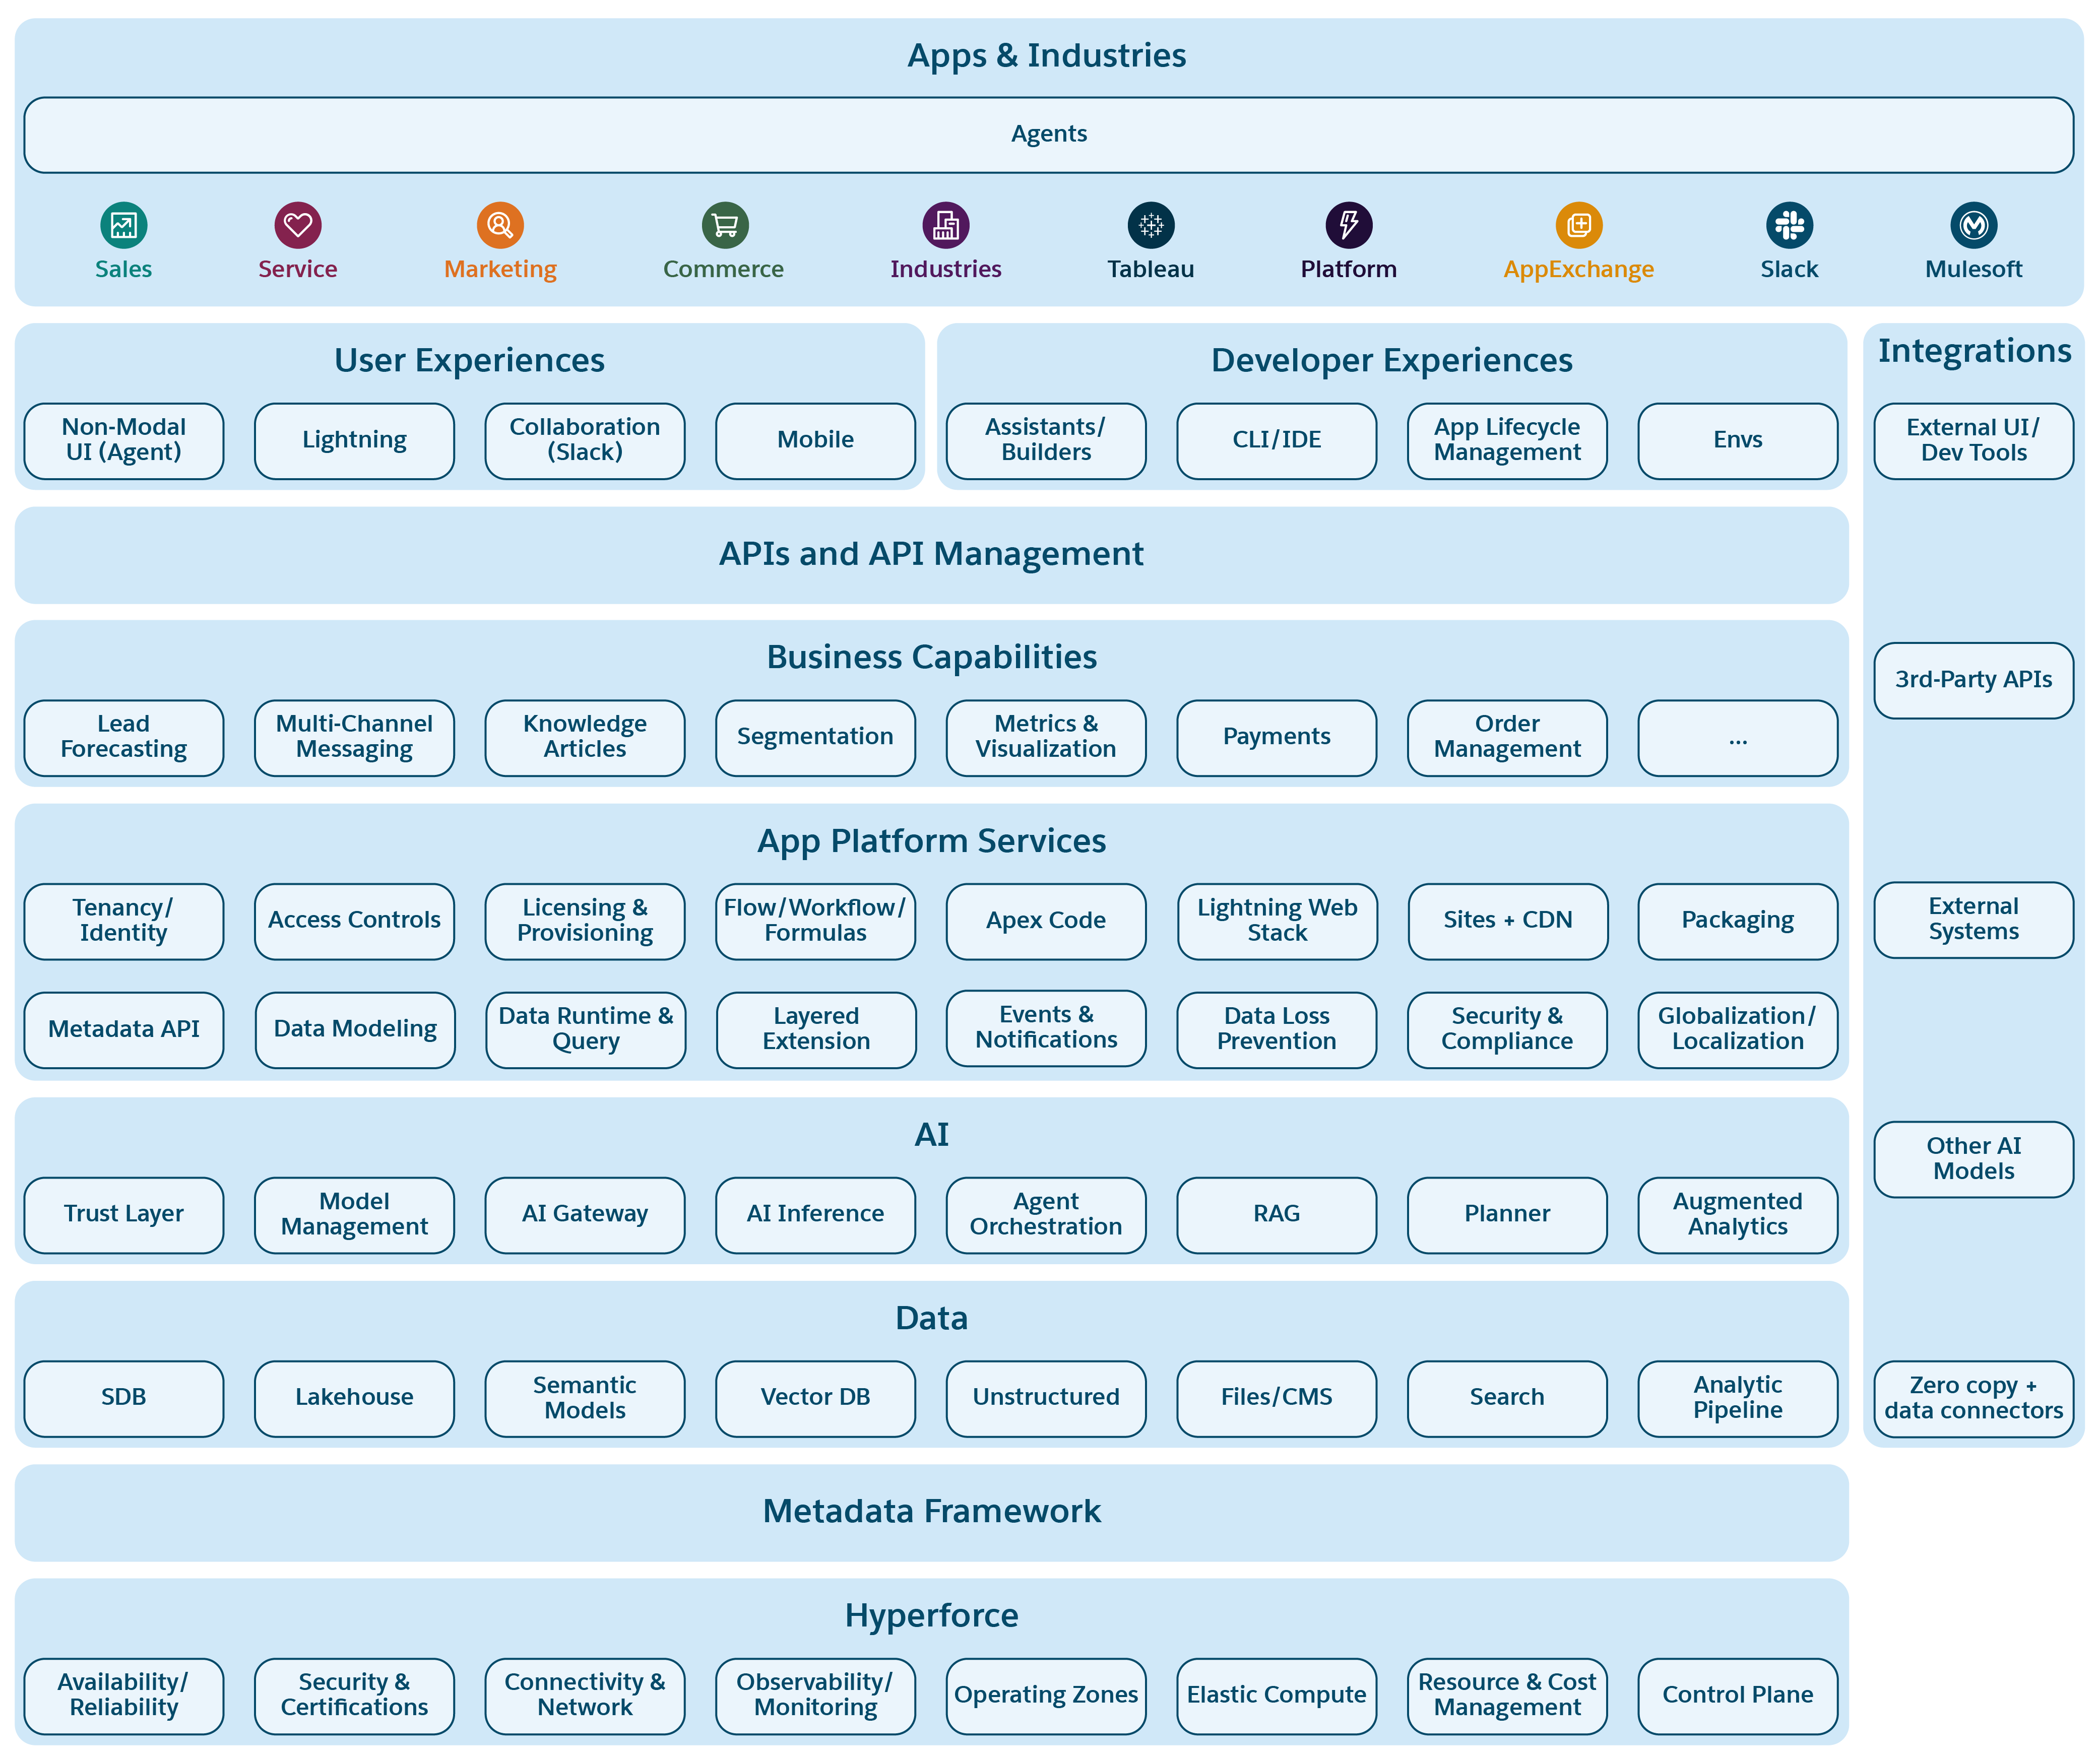 A Salesforce Platform é mostrada como um conjunto de camadas que compõem o sistema. Cada camada representa um grupo de recursos relacionados que são importantes para aplicativos criados na plataforma. As subcaixas em cada camada fornecem exemplos ilustrativos desses recursos. Os recursos de cada camada inferior são integrados a todas as camadas acima, garantindo uma experiência consistente e coesa em todo o pacote de aplicativos do Salesforce.
A Salesforce Platform incorpora transformações de engenharia extensas em todas as camadas de uma plataforma de tecnologia madura desenvolvida nos últimos 20 anos. Impulsionadas pela evolução das demandas dos clientes e novas tecnologias, essas alterações habilitam o suporte para novos tipos de aplicativo e soluções. As transformações são interconectadas, com alterações nas camadas inferiores influenciando a evolução de todas as camadas subsequentes acima.
A Salesforce Platform é estruturada em várias camadas, cada uma contribuindo para seus recursos abrangentes:
- **Hyperforce**: A infraestrutura fundamental evoluiu de data centers de primeira parte para provedores de nuvem pública, aprimorada com tecnologias do Salesforce para hospedagem segura, em conformidade, altamente disponível e econômica.
- **Framework de metadados**: Fornece uma abstração estável para os aplicativos serem criados, mesmo à medida que as tecnologias que temos e usamos evoluem. Inclui um mapeador relacionado a objeto, uma ordem prescritiva de execução e um tempo de execução "principal" que faz a ponte entre as definições de metadados e os tempos de execução orientados por metadados.
- **Dados**: Inclui um banco de dados relacional multitenant e um Lakehouse em escala de petabytes para gerenciar dados do Salesforce e não do Salesforce, oferecendo suporte a dados não estruturados e gerenciamento de conteúdo, pesquisa avançada, governança e recursos de processamento analítico.
- **AI**: Baseia-se na camada de dados com tecnologias fundamentais e IA confiáveis que aproveitam a IA preditiva e generativa para impulsionar experiências agentes.
- **Serviços da plataforma de aplicativos:** Fornece ferramentas para administradores, desenvolvedores e fornecedores de TI criarem e personalizarem aplicativos, oferecendo uma abstração fundamentada para simplificar tarefas comuns e complexas.
- **Capacidades de negócios**: Oferece uma gama de recursos para atender a diversas necessidades de negócios, permitindo que os desenvolvedores personalizem aplicativos conforme necessário.
- **APIs e Gerenciamento de API**: Garante que todos os recursos da plataforma estejam acessíveis por meio de APIs bem formadas, facilitando as interdependências de serviço e camada.
- **Experiência de usuário e desenvolvedor**: Apresenta interfaces fáceis de usar para usuários finais e uma gama de ferramentas de desenvolvimento de baixa codificação a pro-código para desenvolvimento e personalização de aplicativos, com suporte para desenvolvimento baseado em IA moderno.
- **Integração**: Integra-se a qualquer arquitetura corporativa, habilitando a compatibilidade com sistemas do Salesforce e não Salesforce por meio de conectores de dados, integração de dados de cópia zero e outras ferramentas.
- **Aplicativos e Indústrias**: Fornece um conjunto de aplicativos personalizáveis e soluções específicas do setor criadas com base nos recursos integrados da plataforma, aproveitando toda a gama de funcionalidades de camada inferior e com agentes de IA profundamente integrados.
## 3\. Hyperforce
A Salesforce está desenvolvendo a infraestrutura de data center global há quase 25 anos, antecedendo muitos fornecedores de IaaS e hiperescalers atuais. O Hyperforce, a geração atual da evolução da infraestrutura do Salesforce, foi projetado para operar em vários provedores de nuvem pública em todo o mundo.
Ele é personalizado para atender às necessidades dos clientes de escala B2C elástica, residência de dados globais, disponibilidade aprimorada, segurança de nível superior e conformidade regulatória. O Hyperforce padroniza a infraestrutura em todos os produtos do Salesforce, facilitando a rápida integração de novas aquisições.
A Hyperforce garante a entrega da Salesforce Platform, permitindo a rápida implantação de novos recursos e aplicativos, cumprindo os requisitos de residência de dados e conformidade regulatória em mais de 20 regiões em todo o mundo.
### 3.1 Princípios arquitetônicos
Durante a transição do Salesforce para o Hyperforce, foram identificadas diferenças significativas em serviços, interfaces e níveis de conformidade entre os hiperescaladores. Para criar uma base robusta e portátil para a Salesforce Platform, estes princípios de arquitetura foram adotados:
- **Infra-estrutura como código**: Usando uma arquitetura conduzida por domínio, esse princípio envolve a codificação declarativa para a infraestrutura, a criação de artefatos imutáveis e a automação da infraestrutura sob demanda usando padrões como Kubernetes e Service Mesh.
- **Security Zero-Trust**: Implementar um modelo de segurança zero Trust com estratégias de defesa abrangentes, incluindo gerenciamento de identidade, autenticação, autorização, isolamento de rede, políticas de segurança de privilégios mínimos e criptografia de dados tanto em trânsito quanto em repouso.
- **Serviços gerenciados**: Enfatizando o uso de serviços multitenant e multi-cloud, esse princípio aprimora a portabilidade em diferentes infraestruturas e ambientes, como sistemas comerciais, governamentais e com lacunas de ar.
- **Resiliência integrada**: Os serviços essenciais para a missão são distribuídos entre várias Zonas de disponibilidade para garantir a alta disponibilidade. Os dados são replicados entre regiões de Disponibilidade. Os serviços também são rotulados com níveis de disponibilidade para gerenciar objetivos de nível de serviço e planejamento de resiliência.
- **Completamente observável**: Integração de todos os serviços a uma plataforma de observabilidade padrão para monitoramento eficiente, que inclui coleta de registros, coleta de métricas, alerta, rastreamento distribuído e rastreamento de operações de serviço, como volume de tráfego, taxas de erro e utilização de recursos.
- **Operações automatizadas**: Isso inclui o gerenciamento automatizado do ciclo de vida da infraestrutura e AIOps preditivos (IA para operações) para manter a qualidade do serviço, detectar e lidar com degradações de serviço e detectar falhas.
- **Escala automatizada**: Focando a escalabilidade e o custo-benefício, esse princípio permite flexibilidade operacional em diferentes escalas sem aumentar os riscos operacionais, abstraindo limites de conta específicos relacionados ao provedor de nuvem.
- **FinOps Aware**: A nuvem pública traz agilidade de infraestrutura, mas com o risco de custos elevados. Adotamos uma cultura de engenharia orientada para a eficiência ao longo do ciclo de vida do serviço, sem comprometer a disponibilidade, a segurança e o Trust do cliente.
Esses princípios orientam o desenvolvimento e a operação da plataforma Hyperforce da Salesforce, garantindo que ela permaneça adaptável, segura e eficiente em vários ambientes.
### 3.2 Conceitos de infraestrutura
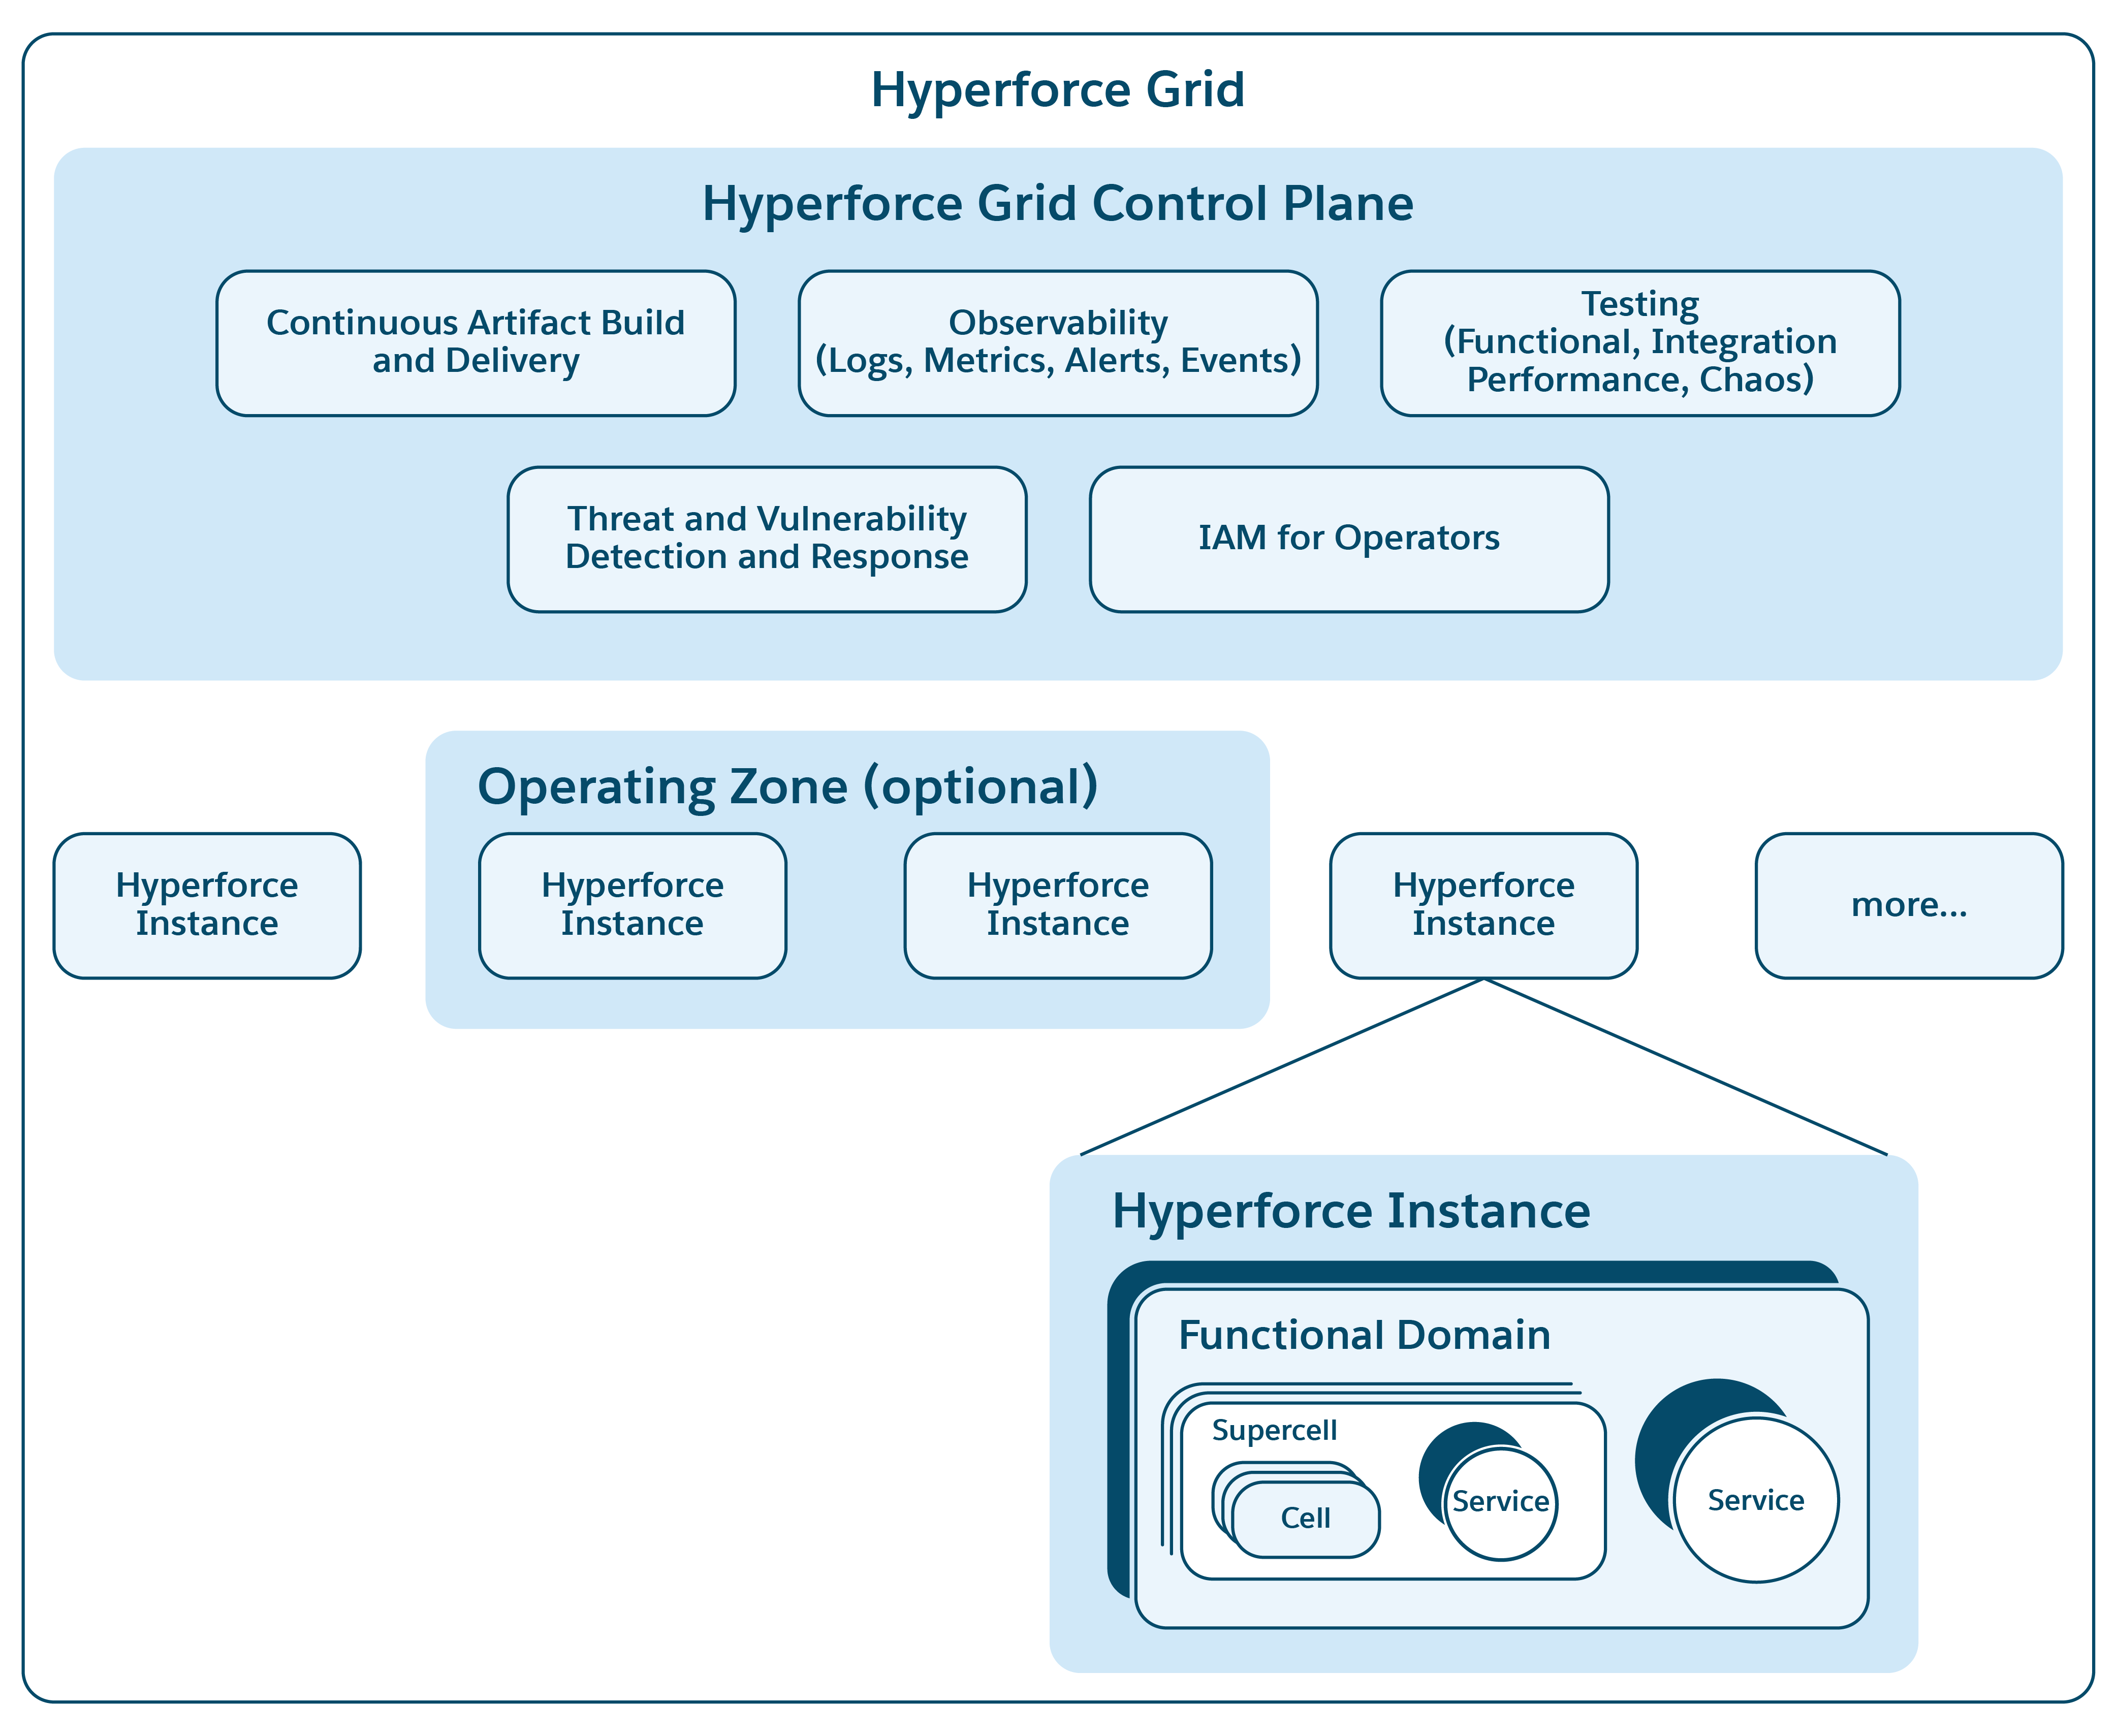
A Salesforce Platform e seus serviços de suporte são executados na Hyperforce Foundation, que consiste em várias instâncias do Hyperforce. Essas instâncias são distribuídas estrategicamente em vários países para se alinharem às preferências do cliente em termos de geografia e disponibilidade. Para atender aos requisitos operacionais e de residência de dados rigorosos, uma ou mais Instâncias do Hyperforce podem ser agrupadas e designadas como uma Zona de operação. Cada instância é atualizada regularmente para garantir a segurança, a escalabilidade e a conformidade com os padrões locais e legais.
As Instâncias do Hyperforce são compostas por várias instâncias do Domínio funcional do Hyperforce, que são grupos de serviços que fornecem funcionalidades específicas. Os domínios funcionais fundamentais fornecem serviços essenciais, como segurança, autenticação, registro e monitoramento, todos eles essenciais para outros serviços do Hyperforce. Domínios funcionais de negócios oferecem suporte a vários produtos do Salesforce, como Sales Cloud, Service Cloud e outros, facilitando a funcionalidade do produto.
Os serviços em um domínio funcional podem ser organizados em células, que são unidades escalonáveis e repetíveis de entrega de serviço. A célula Hyperforce corresponde ao que é tradicionalmente conhecido como uma "instância do Salesforce" em que uma ou mais organizações do Salesforce (org) residem. Uma célula é uma unidade de escala e um limite de raio de explosão forte. As supercelulas fornecem um agrupamento lógico de várias células para delimitar um raio de explosão maior devido a serviços compartilhados entre as células. Várias supercelulas podem estar presentes em um domínio funcional. As células e as supercélulas permitem que o Hyperforce escale horizontalmente dentro de um domínio funcional, mantendo um forte controle sobre o tamanho do raio de explosão.
Cada instância do Hyperforce é mapeada para uma Região de disponibilidade, um conceito encontrado em todas as infraestruturas de nuvem pública, e é capaz de operar de forma independente de todas as outras instâncias do Hyperforce. Todos os serviços e dados críticos para a missão na Instância do Hyperforce são distribuídos e replicados em pelo menos três Zonas de Disponibilidade, para obter tolerância a falhas e estabilidade. Além disso, os backups de dados são copiados para outras instâncias adequadas do Hyperforce para continuidade de negócios e conformidade regulatória.
A infraestrutura do Hyperforce está em constante evolução à medida que novas instâncias e células do Hyperforce são criadas ou atualizadas. Os clientes estão isolados de alterações nos detalhes físicos do Hyperforce. Todos os pontos de extremidade do cliente visíveis externamente são acessados por meio de Meus domínios do Salesforce estáveis e seguros (por exemplo, acme.my.salesforce.com) que roteiam com segurança o tráfego para os dados e o local de serviço atuais. O tráfego de saída (por exemplo, correio, chamadas da Web) é melhor implementado usando mecanismos seguros, como Correio identificado de chaves de domínio (DKIM) e mTLS, para garantir que a infraestrutura local dos clientes não esteja codificando os detalhes físicos da infraestrutura do Salesforce, como endereços IP que podem mudar ao longo do tempo.
 ### 3.3 Segurança de rede
Domínios funcionais do Hyperforce são projetados com medidas de segurança robustas. Cada domínio é protegido no perímetro e isolado, com serviços dentro de um domínio separados em contas dedicadas para maior segurança. A comunicação entre serviços é facilitada com segurança por meio da Service Mesh ou protocolos semelhantes. O gerenciamento de tráfego é tratado por gateways de entrada e saída que inspecionam, roteiam e aplicam os controles necessários, como quebradores de circuito ou limites de frequência, a todo o tráfego de entrada e saída.
Os serviços dentro de um domínio funcional do Hyperforce são agrupados em Grupos de segurança, com apenas os do grupo de extremidade expostos à Internet pública. As políticas de segurança de tempo de execução aplicam regras de comunicação entre diferentes grupos de segurança, seguindo o princípio de privilégio mínimo para garantir que os serviços tenham apenas o acesso necessário.
Cada região geográfica tem um Domínio funcional do Hyperforce Edge que encerra a segurança da camada de transporte e usa políticas de firewall de aplicativo da Web programáveis para lidar com ameaças preventivas. Isso garante que apenas o tráfego legítimo chegue aos pontos de extremidade do Hyperforce enquanto mantém uma experiência do cliente segura e eficiente. Além disso, as ligações de rede internas entre as Instâncias do Hyperforce são rigorosamente controladas e todos os dados de log contendo informações de identificação pessoal são anonimizados para cumprir as normas do GDPR.
### 3.4 Plano de controle de grade do Hyperforce
Uma grade do Hyperforce consiste em várias instâncias do Hyperforce compartilhando o mesmo plano de controle, que é projetado para isolar cargas de trabalho sensíveis quando apropriado. Ele garante zero vazamento de dados do cliente ou do sistema, metadados da plataforma ou dados de monitoramento entre grades. O Plano de controle consiste em instâncias redundantes do Hyperforce que hospedem serviços essenciais para criar, gerenciar e monitorar instâncias do Hyperforce voltadas para o cliente.
O código de serviço e infraestrutura para todos os serviços do Hyperforce é desenvolvido com segurança dentro de um domínio funcional de plano de controle dedicado, utilizando serviços de gerenciamento de código-fonte, integração contínua, testes e criação de artefatos. O código gerado é verificado quanto a ameaças e vulnerabilidades antes de ser empacotado em contêineres padronizados assinados digitalmente e armazenado em registros de imagem. A implantação de código é processada por pipelines autorizados no sistema de Entrega contínua do Hyperforce, com privilégios de implantação restritos a equipes e operadores autorizados. Um Plano de controle com lacuna aérea lida com proteções adicionais necessárias nesses ambientes.
Os serviços de Gerenciamento de acesso e identidade (IAM) aplicam a aprovação preciso para limitar a duração e as ações de acesso, enquanto as trilhas de auditoria monitoram toda a atividade, alimentando sistemas de detecção em tempo real para identificar e alertar sobre atividades suspeitas.
### 3.5 Gerenciamento de custo do Hyperforce
À medida que a Salesforce muda seus serviços para o Hyperforce em nuvens públicas de seus data centers de primeira parte, é crucial reformular nossas estratégias de criação de orçamento, visualização de custo e otimização de recursos.
Nossa abordagem de gerenciamento de custo não é apenas sobre cortar custos; é um processo estratégico que diferencia produtos voltados para crescimento e produtos estáveis. Ele planeja uma precificação baseada em consumo e margens que sustentem a disponibilidade dos produtos, alinhando-se ao nosso valor central de Trust. As contas de nuvem pública são organizadas de modo hierárquico e vinculadas a produtos e executivos específicos. A marcação detalhada do recurso em nível de serviço, aprimorada com metadados organizacionais, ajuda a detectar custos para microsserviços individuais. Ferramentas como o Tableau e o Slack, junto com ferramentas avançadas de previsão, são empregadas para fornecer a executivos e equipes dados em tempo real sobre custos, previsões e análises de orçamento, gerando confiança no planejamento financeiro futuro.
Para garantir um gerenciamento de custo ideal, o Salesforce usa uma combinação de Computar planos de economia, Capacidade de local e Reservas de capacidade sob demanda (ODCR), garantindo a capacidade necessária. Essas reservas são gerenciadas por meio de previsões de série temporal avançada e painéis personalizados, permitindo supervisão humana e tomada de decisão. Definir metas alcançáveis em reduções de custo transacional unitário (o custo para processar um volume definido de transações comerciais) é uma estratégia eficaz para promover melhorias. A ferramenta Explorador de custo da unidade do Hyperforce permite que as equipes analisem e gerenciem tendências de custo unitário, atribuam custos a serviços específicos e identifiquem novas oportunidades de melhoria. O Índice de otimização do Salesforce Cloud, ou pontuação "COIN", avalia os serviços em relação a uma lista dinâmica de oportunidades de economia, motivando as equipes de serviço a manter a eficiência ideal dos recursos.
Em nosso compromisso inabalável com a sustentabilidade, procuramos ativamente reduzir nossa pegada de carbono, definindo metas específicas para reduzir nossa unidade de carbono a servir, uma medida das emissões em relação ao trabalho realizado.
## 4\. Enterprise-Grade Trust
Segurança e disponibilidade são aspectos fundamentais cruciais da nossa plataforma corporativa, essenciais para manter o Trust do cliente. No Salesforce, esses controles são integrais à Salesforce Platform, aplicados automaticamente por meio de serviços compartilhados e estruturas de software. Essa abordagem integrada garante que os sistemas individuais se beneficiem sem exigir esforço adicional.
Gerenciar e aprimorar continuamente esse amplo conjunto de controles de segurança e disponibilidade em milhares de serviços e centenas de equipes apresenta um desafio significativo. No entanto, isso é crucial, pois ignorar até mesmo pequenos detalhes pode resultar em uma falha de segurança ou falha do sistema.
### 4.1 Segurança
O Hyperforce é uma plataforma de infraestrutura segura e compatível que suporta o desenvolvimento e a implantação de serviços com recursos de segurança avançados. Ele oferece controle de acesso forte, criptografia de dados e conformidade com os padrões de segurança. O Salesforce adere a mais de 40 padrões de segurança e conformidade, como PCI/DSS, GDPR, HIPAA, FedRamp e muito mais.
Principais princípios de segurança incluem Zero Trust Architecture (ZTA) e criptografia completa, garantindo a proteção dos dados do cliente em todas as fases do processamento. O Salesforce adere a padrões de segurança e práticas recomendadas do ciclo de vida de desenvolvimento de software seguro às operações de produção, bem como práticas de segurança em nível de aplicativo robustas para mitigar possíveis ameaças.
#### Arquitetura Zero Trust (ZTA)
O paradigma de cibersegurança da ZTA garante que todos os usuários, dispositivos e conexões de serviço passem por autenticação, autorização e validação contínua, independentemente do local. A ZTA e a Infraestrutura de Chave Pública (PKI) são essenciais para a cibersegurança moderna, estabelecendo limites de Trust e comunicação segura sem depender da segurança do perímetro.
No entanto, as implantações de PKI geralmente ignoram a importância da revogação e da governança de certificados em relação às autoridades de certificação raiz. A implementação da revogação de certificado pela Salesforce é robusta e escalonável, oferecendo suporte à segurança de PKI completa.
Além disso, o Hyperforce aplica a ZTA por meio da segurança de camada de transporte mútua entre serviços, usando chaves privadas de curta duração e acesso just-in-time para usuários com controle de acesso baseado em papel.
#### Criptografia de ponta a ponta
A Salesforce Platform garante a proteção de dados em trânsito usando o TLS com pacotes de criptografia de segredo avançado perfeitos, que protegem os dados enquanto eles se deslocam pela rede entre dispositivos do usuário e serviços do Salesforce, bem como dentro dos domínios da infraestrutura do Salesforce.
Para dados em repouso, a Salesforce Platform usa um sistema de gerenciamento de chaves compatível com módulos de segurança de hardware. Em sua plataforma multitenant, cada locatário recebe uma chave de criptografia exclusiva, impedindo qualquer cruzamento de chaves entre locatários.
A segurança da comunicação e da criptografia depende fortemente da entropia para gerar chaves ou dados aleatórios. Reconhecendo a vulnerabilidade dos protocolos criptográficos a ataques devido à geração de chave previsível, a Salesforce Platform mitiga esse risco adquirindo entropia de várias origens para todos os processos de geração de chave. Utilizamos o recurso de criptografia de memória disponível em vários processadores, habilitados por um provedor de serviços de nuvem, para aprimorar a proteção contra ataques de inicialização fria.
#### Ciclo de vida de desenvolvimento de software seguro
O Salesforce tem um JDK personalizado para atender a muitos padrões de conformidade, como o Padrão Federal de Processamento de Informações (FIPS), simplificando o processo para desenvolvedores e operadores eliminando a necessidade de eles mesmos realizarem o trabalho de conformidade. Essa personalização não apenas ajuda a prevenir riscos como a injeção de entidade externa XML (XXE), mas também aprimora a agilidade de criptografia do Salesforce e a capacidade de trocar estratégias de criptografia conforme necessário. Permite a transformação de código fora de conformidade, seja desenvolvido internamente ou adquirido de repositórios abertos, em código em conformidade com FIPS sem exigir uma reescrita completa, reduzindo assim a carga de trabalho nas equipes de desenvolvimento e mantendo a adesão aos princípios de design de segurança padrão.
Além disso, o Salesforce incorporou estruturas para combater vulnerabilidades como script entre sites (XSS), falsificação de solicitação (CSRF) e injeção de SQL integrando medidas de proteção ao ciclo de vida de desenvolvimento de software seguro (SSDL).
Um sistema de gerenciamento de segredos centralizado, reforçado por controles de acesso baseados em papel (RBAC), é implementado para proteger os serviços e o acesso do usuário. Além disso, as ferramentas de leitura de código são empregadas para evitar a exposição acidental de segredos em ambientes de produção por meio de sistemas de gerenciamento de código-fonte.
#### Recursos de segurança operacional do Hyperforce
O phishing continua sendo uma ameaça significativa para as organizações, levando a Salesforce a implementar a autenticação multifator (MFA) resistente ao phishing de acordo com várias práticas recomendadas do setor, incluindo os princípios Zero Trust da CISA (CyberSecurity and Infrastructure Security Agency). Isso inclui chaves com suporte em hardware para funcionários com acesso de produção e um kernel seguro para acesso controlado a contas de provedor de serviços de nuvem.
Para manter uma postura de segurança robusta, a Salesforce padronizou os controles de segurança e integrou serviços de segurança nativos da nuvem no Hyperforce, proporcionando maior visibilidade, detecção de ameaças e imposição de políticas. Há um sistema abrangente de gerenciamento de eventos e informações de segurança para monitoramento, alerta e relatório em tempo real, que é suportado por um programa de gerenciamento de vulnerabilidade completo e ferramentas de gerenciamento de postura de segurança na nuvem para identificar, avaliar e corrigir continuamente vulnerabilidades.
Além disso, um firewall de aplicativo da Web filtra e monitora o tráfego HTTP para proteger contra vários ataques, e uma variedade de ferramentas de segurança de rede, incluindo firewalls, sistemas de detecção e prevenção de intrusão, redes privadas virtuais e agentes de detecção e resposta de ponto final, são usadas para fornecer monitoramento contínuo e detecção de ameaças. A segmentação de rede e a microsegmentação são implementadas para minimizar a superfície de ataque e conter possíveis violações.
A Salesforce também desenvolveu e implementou um plano robusto de resposta a incidentes adaptado aos desafios exclusivos do Hyperforce, com procedimentos predefinidos para identificar, conter e mitigar incidentes de segurança, garantindo uma resposta rápida e eficaz a possíveis ameaças à segurança.
### 4.2 Disponibilidade
O Salesforce gerencia cargas de trabalho do cliente essenciais para a missão que exigem alta disponibilidade. Nossa estratégia para alta disponibilidade inclui várias facetas organizacionais, como nosso modelo de propriedade de serviço, gerenciamento de incidentes e análises operacionais. Os principais elementos técnicos de nossa estratégia incluem nossa arquitetura de monitoramento, automação de operações conduzidas por IA e mecanismos de segurança automatizados para alterações de produção.
#### Padrões de arquitetura de disponibilidade
Para alcançar consistentemente a alta disponibilidade em milhares de serviços, uma abordagem em três etapas gerencia riscos técnicos em escala.
Primeiro, os padrões de arquitetura de disponibilidade são estabelecidos, definindo práticas recomendadas, como:
- **Redundância com failover automatizado**. Para lidar com as falhas constantes que um grande sistema baseado em nuvem encontra, o Salesforce cria seus serviços com um alto nível de redundância, detecção de falha totalmente automatizada e recuperação automatizada contínua para falhas completas e parciais.
- **Limite o raio da explosão**. Falhas _serão_ ocorridas, e assim a equipe projeta todos os seus serviços com máximos intencionais de raio de explosão para limitar o impacto de falhas. O exemplo mais clássico e visível é o da célula Hyperforce (fka Pod).
- **Compartilhar falhas**. Evita a disseminação e a composição de falhas em unidades independentes do sistema. Chamadas à API tolerantes a falhas entre serviços são um padrão essencial que evita uma cascata de falhas no sistema distribuído. Ao longo do caminho, a equipe equilibra cuidadosamente a compartimentalização com a redundância.
- **Escala automaticamente**. Para apresentar uma carga imprevisível sem degradação de desempenho, ajuste a escala automaticamente rapidamente e reduza-a lentamente sem depender de operadores humanos lentos e com falha, acionados por pontos de saturação de recursos, como CPU, memória ou profundidades de fila.
- **Rápidos recuos**. Definimos metas de reversão em minutos para todos os serviços e testamos automaticamente reversões em ambientes pré-produção tornando progressão, retorno e avanço novamente uma operação padrão. A equipe utiliza amplamente sinalizadores de recurso para alternâncias e distribuições de emergência ainda mais rápidas e granulares.
- **Proteger todos os serviços que recebem chamadas à API**. A transferência de carga, os limites justos do locatário, os firewalls de aplicativo da Web e as proteções sofisticadas da camada sete são implementadas em todos os níveis do sistema, desde nossos serviços de perímetro mais externos expostos diretamente à Internet até os serviços internos mais profundos da equipe que podem ser atacados acidentalmente por bugs em serviços de chamada de nível superior.
- **Dependências suaves**. As dependências entre serviços são projetadas para ser suaves sempre que possível para permitir que falhem ou tenham sucesso de forma independente. O armazenamento em cache é um dos padrões mais comuns aqui. Muitas vezes, um resultado obsoleto de uma dependência a jusante é adequado para a função contínua.
- **Favorecer a comunicação assíncrona**. A comunicação assíncrona e intermedia entre serviços desconecta esses serviços uns dos outros e evita picos de carregamento entre eles.
- **Fazer chamadas de API tolerantes a falhas**. Para ser tolerantes a falhas parciais e problemas de rede temporários, usamos vários padrões: tempos limite e prazos, interrupção de circuito e novas tentativas com pendências. Preferimos chamadas que não sejam de bloqueio quando possível para limitar o consumo e o bloqueio de recursos. A compatibilidade com versões anteriores e anteriores é imposta com o lint no nível do esquema no tempo de criação e nos testes de integração.
- **Gerenciar cotas e restrições de serviço**. A equipe define cotas e restrições em sua frota de serviços, como endereços IP, IOps de disco ou a capacidade de um determinado cluster do Kubernetes. A equipe agrega, monitora e alerta contra o uso dessas cotas e restrições centralmente para evitar que um limite se aproximando afete o sistema no tempo de execução.
Segundo, um modelo de inspeção de várias camadas garante que os serviços atendam a esses padrões. Isso inclui teste de caos automatizado, leitura e lint para antipadrões e revisões de arquitetura com arquitetos seniores para detectar problemas não resolvidos pela automação.
Em terceiro lugar, soluções são integradas no Hyperforce para facilitar a adesão a essas normas. Isso inclui coleta de telemetria automática, redundância padrão e mecanismos de failover e proteções integradas, como descarte de carga e proteção DDoS, ativadas por padrão para serviços individuais.
#### Monitoramento e capacidade de observação
O Salesforce lida com um enorme volume de dados de telemetria, incluindo métricas, logs, eventos e rastreamentos, que as soluções de monitoramento tradicionais nem sempre podem gerenciar de modo eficaz.
Para lidar com isso, o Salesforce desenvolveu um sistema abrangente de observabilidade que se integra ao seu ciclo de vida de desenvolvimento de software, operações e funções de suporte. Esse sistema oferece uma experiência unificada para equipes de engenharia e suporte ao cliente, enquanto atende a necessidades de escala e reduz os custos de licenciamento de software de terceiros.
A infraestrutura de métricas no Salesforce, criada com base no OpenTSDB e no HBase, oferece suporte à coleta em grande escala, ao armazenamento e à consulta em tempo real de dados de série temporal. Os casos de uso não em tempo real usam Trino e Iceberg, que processam mais de 2 bilhões de métricas por minuto para fornecer percepções sobre a utilização de CPU, o uso de memória e as taxas de solicitação. Para gerenciamento de log, o Salesforce usa o Splunk por seus eficientes recursos de indexação e pesquisa. O Druid do Apache dá suporte à ingestão e à análise em tempo real de dados de evento em grande escala, cruciais para entender interações do usuário e eventos do sistema. O rastreamento distribuído entre microsserviços é gerenciado com OpenTelemetry e ElasticSearch, ajudando a identificar pontos de latência e falha específicos.
A Salesforce também implementou uma infraestrutura de Monitoramento de desempenho de aplicativo (APM) que se integra às pilhas de tecnologia para coleta de dados e lojas de telemetria. Essa instrumentação automática de aplicativos simplifica a coleta de dados e garante a telemetria consistente entre os serviços. O painel unificado do APM correlaciona vários tipos de dados, aprimorando a capacidade dos engenheiros de monitorar o desempenho, diagnosticar problemas e otimizar os sistemas por meio de uma interface coesa.
Ao padronizar as ferramentas de observabilidade, o Salesforce vincula diferentes tipos de telemetria entre serviços usando o rastreamento distribuído. Isso cria um gráfico de dependência de serviço abrangente, visualizando todo o ecossistema de serviço e rastreando solicitações com granularidade fina. Essa funcionalidade é crucial para identificar problemas, identificar gargalos e dar suporte a recursos conduzidos por IA, como detecção de anomalia, análise preditiva e remediação automatizada.
#### Agente AIOps
Para aumentar os tempos de resolução de incidentes, desenvolvemos um agente de operações de IA (AIOps) que detecta, triagem e remedia automaticamente incidentes em nome de operadores humanos, com intervenção apenas em uma minoria de casos. O Agente AIOps é um kit de ferramentas multiagente reativo dimensionável projetado para facilitar o desenvolvimento de sistemas complexos e reativos baseados em agente. É altamente modular e pode ser aprimorado com várias ferramentas para estender sua funcionalidade. Ele é projetado para ser dimensionado com eficiência com um número crescente de agentes. Os principais recursos incluem uma arquitetura reativa, que permite que os agentes respondam dinamicamente a mudanças em seu ambiente; aprimoramento de ferramentas, permitindo uma fácil integração de ferramentas para estender os recursos do agente; e um módulo de pluggable planning, que habilita a personalização das estratégias de planejamento dos agentes conectando diferentes módulos de planejamento.
A detecção proativa rápida é realizada para 91% (no momento da redação) de nossos incidentes de produto de CRM principais com modelos de aprendizado de máquina avançados de nossa biblioteca Merlion, uma biblioteca de código aberto disponível ao público desenvolvida pela nossa equipe de pesquisa de IA. Merlion é um conjunto de modelos de aprendizado de máquina, como Florestas de isolamento, Estatísticas, Florestas aleatórias e Redes neurais de memória de curto prazo (LSTM) que processam os dados extensos de telemetria gerados por nossos sistemas quase em tempo real.
79% dos incidentes (no momento da redação) são resolvidos automaticamente pelas ações do agente. Nosso agente de AIOps pode processar e triar vetores de dados, como logs, perfil, diagnóstico, série temporal e artefatos específicos do serviço, para recomendar ações de remediação. O planejador e o controlador do Agente de AIOps escolhem um agente com habilidades específicas para realizar ações em produção.
Para os incidentes restantes que exigem envolvimento humano, o agente de AIOps realiza uma triagem eficiente de problemas não resolvidos para as equipes de serviço adequadas. Ele faz isso compreendendo de modo inteligente a natureza e o contexto de cada incidente usando o modelo ajustado internamente XGenOps, que é treinado em conjuntos de dados operacionais, como registros problemáticos, incidentes, JFRs e logs, garantindo que seja direcionado à equipe com o conhecimento necessário. Isso resulta em mais de 2.800 horas de tempo de engenharia economizadas por semana, minimizando a necessidade de os engenheiros fazerem triagem de problemas não resolvidos.
#### Implantação contínua
Para gerenciar o risco de interrupções de quase 250 mil alterações de produção feitas semanalmente, sistemas de implantação totalmente automatizados são usados para impor práticas de alteração seguras, eliminando o erro humano. Os sistemas prontos para uso não eram escalonáveis nem personalizáveis o suficiente, levando ao desenvolvimento de soluções mais personalizadas.
O sistema de implantação contínua personalizado garante a segurança por meio de várias camadas, seguindo estratégias de implantação azul/verde padrão do setor:
- Prova de teste obrigatória para cada alteração.
- Teste canário inicial das alterações.
- Implantação preparada com raio de explosão controlado.
- Verificações de enchimento e integridade entre os estágios da implementação.
- Mitigação de conflitos com moratórios e incidentes existentes.
Além disso, os sistemas de integração contínua foram otimizados para executar milhões de testes selecionados por IA, permitindo versões rápidas e minimizando os riscos de regressão.
## 5\. Estrutura de metadados
O princípio arquitetônico central da Salesforce Platform é seu design conduzido por metadados. Os engenheiros do Salesforce criam serviços multilocatários e repositórios de dados. Cada aplicativo na plataforma é essencialmente uma coleção de metadados que ajusta como esses serviços multilocatários são utilizados por clientes individuais. É por isso que uma frase de marketing comum para a Salesforce Platform é que "tudo é acessado com metadados".
A plataforma enfatiza metadados estruturados e com tipos altos. Esses metadados servem como uma camada de abstração entre a experiência do cliente e a infraestrutura e as implementações subjacentes do Salesforce. Essa abordagem melhora a usabilidade e a qualidade dos aplicativos. Por exemplo, em vez de usar definições e consultas de esquema SQL, os clientes interagem com metadados estruturados, como entidades, campos e registros, por meio de APIs do Salesforce Object (sObject). Esse design permite que a plataforma integre novas tecnologias de armazenamento de dados ou modifique as existentes sem exigir reescrituras de aplicativos, oferecendo suporte às práticas recomendadas de desenvolvimento contínuo.
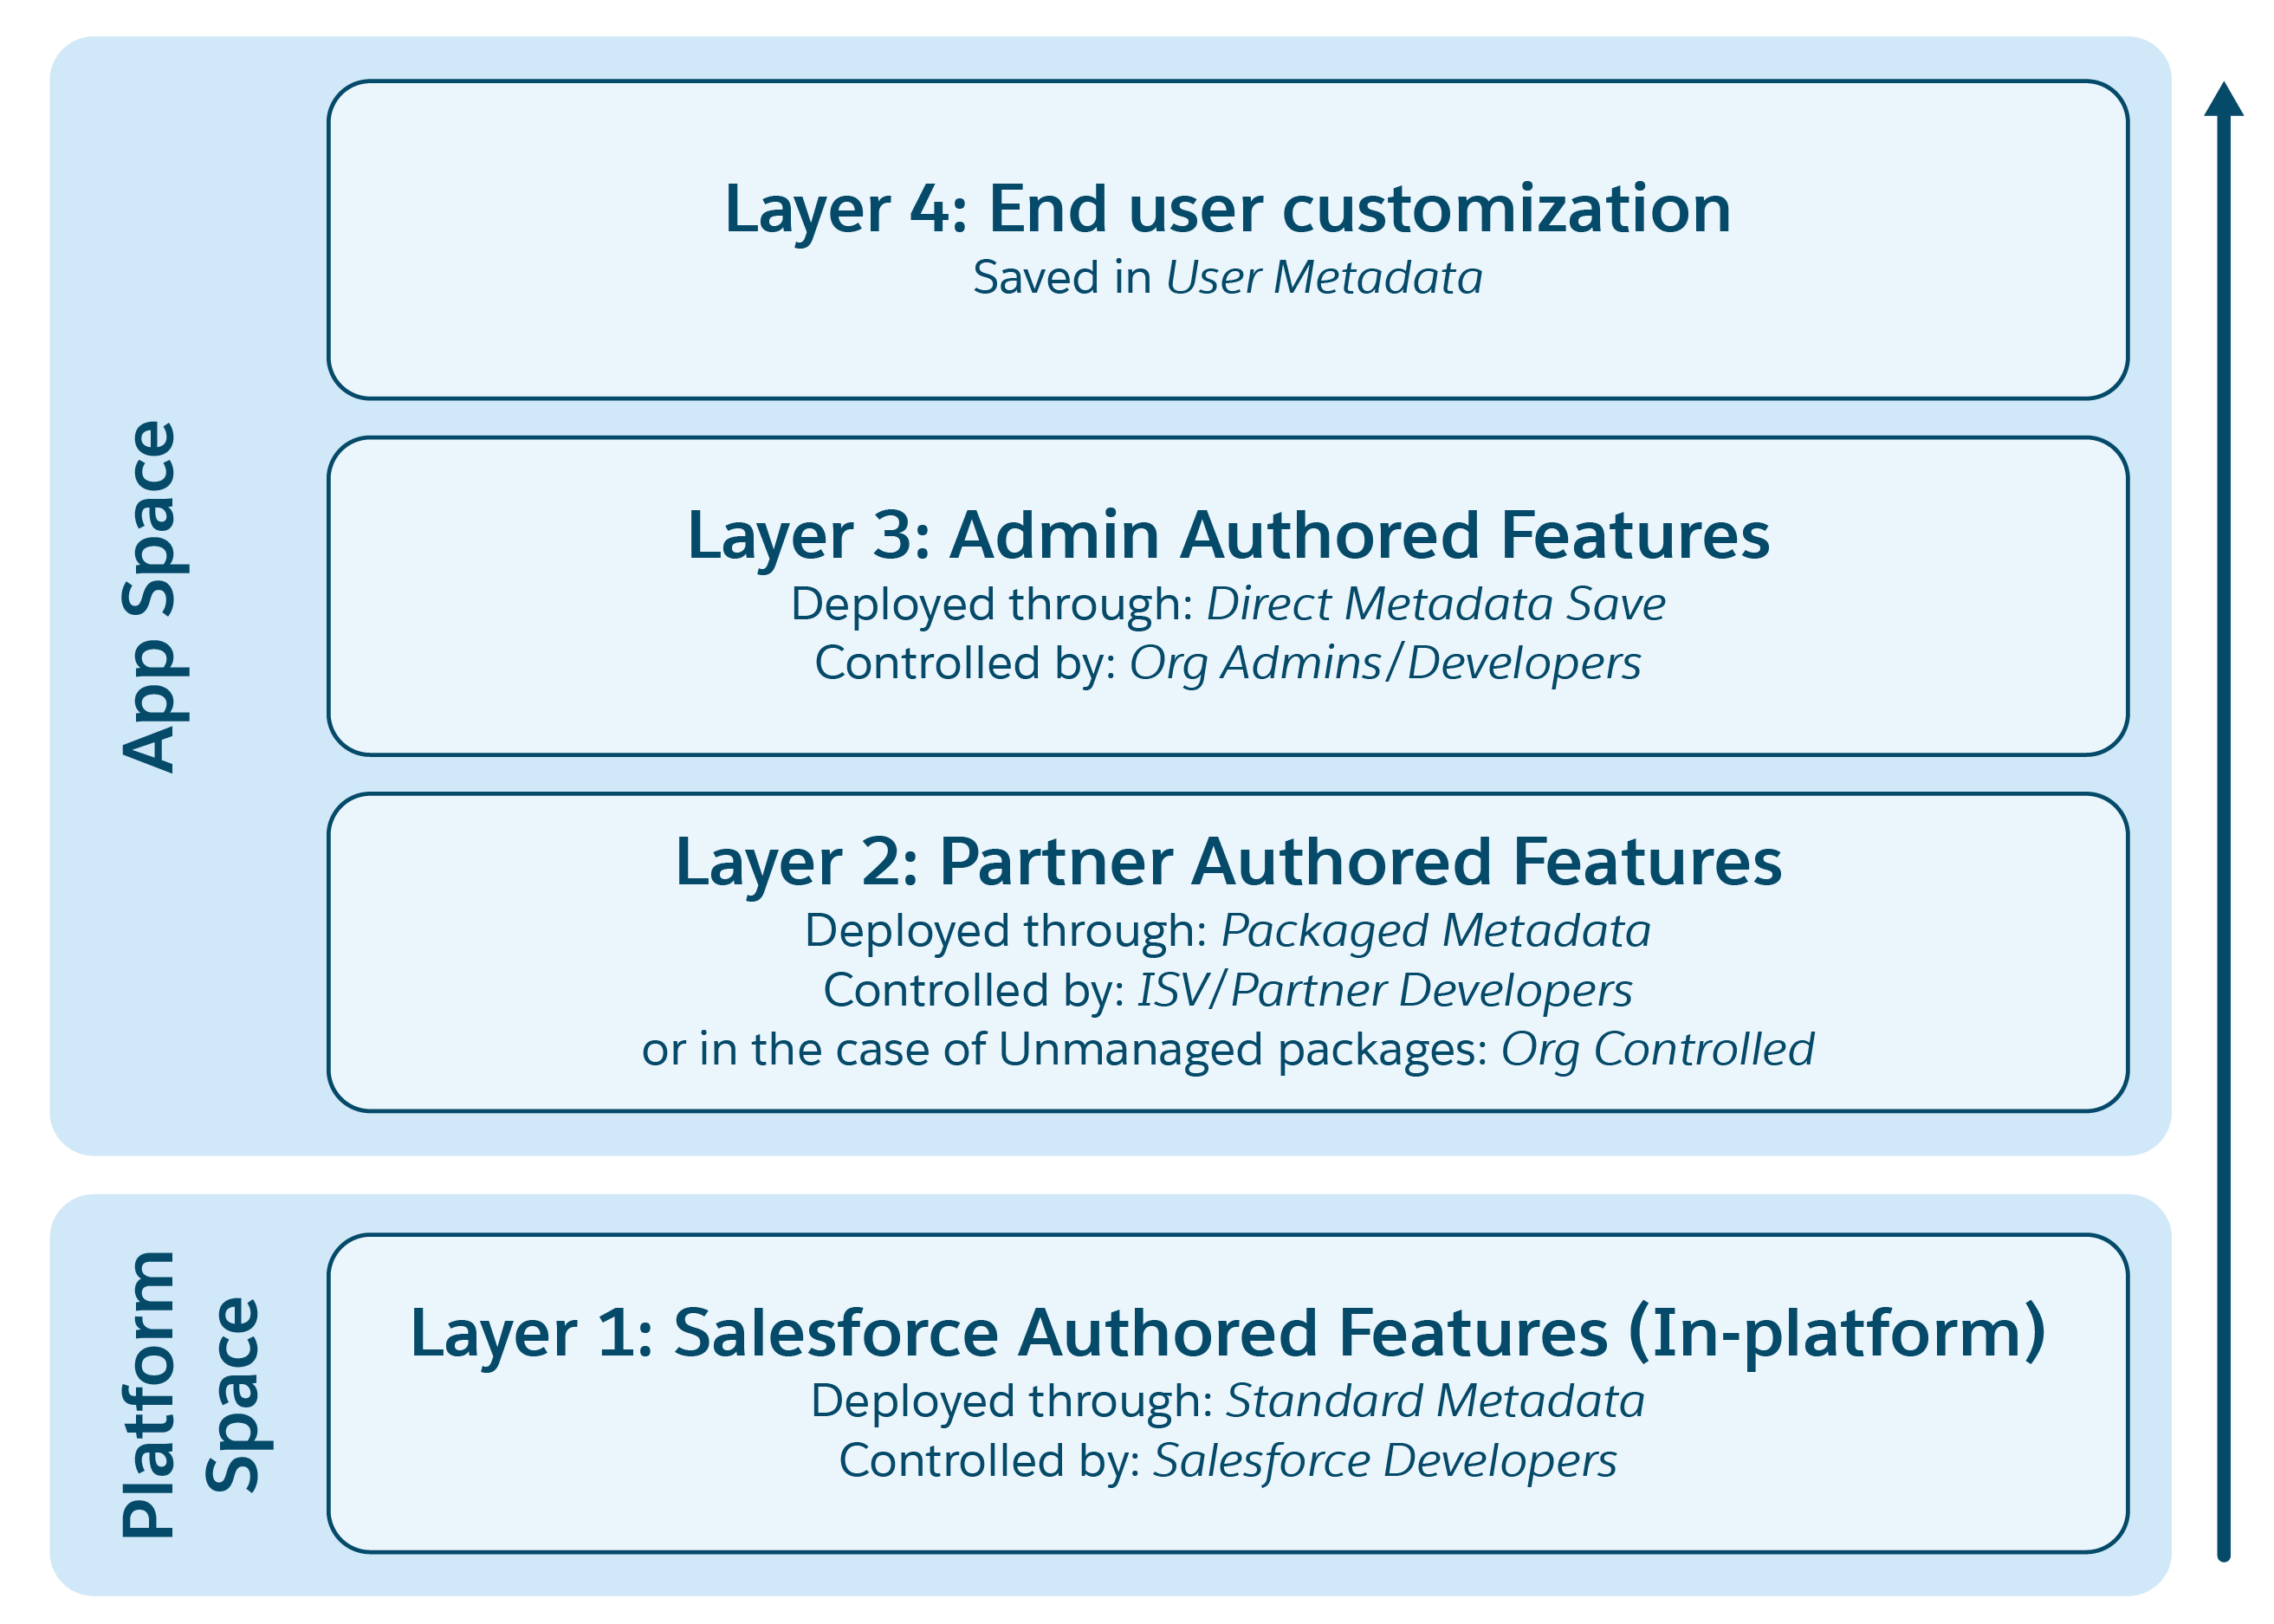 A arquitetura da Salesforce Platform apresenta uma abordagem de "extensão em camadas" que dá suporte a quatro personalidades principais na criação e na extensão de aplicativos:
- **Engenharia do Salesforce:** As equipes desenvolvem aplicativos nativos, como o Sales Cloud e o Service Cloud, que são implementados em todos os serviços e tempos de execução por meio de um amplo processo de versão. Esses aplicativos são disponibilizados a todos os locatários por meio de mecanismos de licenciamento e provisionamento.
- **Parceiros externos**: Fornecedores de software independentes (ISVs) e outros parceiros podem estender os metadados criados pelo Salesforce para criar soluções com valor agregado, como extensões de esquema em modelos de dados do Sales Cloud ou regras de validação adicionais para registros de caso do Service Cloud. Eles podem empacotar essas soluções para distribuição a vários clientes.
- **Administradores e desenvolvedores de TI específicos da organização**: Eles podem personalizar seus aplicativos além do que os ISVs oferecem, personalizando soluções para atender a desafios de negócios exclusivos, como processos proprietários ou específicos da região.
- **Usuários finais individuais**: Os usuários finais podem personalizar a experiência do aplicativo, como alterar a ordem das colunas em um modo de exibição de lista ou configurar uma guia padrão.
Cada personalidade pode iterar de modo independente no mesmo aplicativo garantindo que as camadas inferiores não dependam de alterações de personalidades nas camadas superiores e mantendo contratos de compatibilidade com versões e versões fortes.
Um recurso que destaca o conceito de "extensão em camadas" é a Ordem de execução de salvamento de registro, que garante que a lógica de negócios de todas as quatro camadas seja aplicada em uma sequência previsível. Isso permite que a lógica de negócios de camada superior mais específica determinada pelo administrador da organização ou o desenvolvedor de TI substitua adequadamente a lógica de camada inferior durante o salvamento de registros que pode ser fornecida pelo Salesforce ou por um parceiro externo.
Além disso, as estruturas de metadados da plataforma utilizam um tempo de execução "Núcleo" e um Mapeador proprietário de objeto-relacional (ORM) com vários contratados integrados conectados a um banco de dados relacional. Esse tempo de execução principal habilita o estado de memória compartilhado, as validações de integridade referencial e as confirmações transacionais, o que prioriza a estabilidade do aplicativo e aumenta a confiabilidade das implementações do aplicativo. A arquitetura está em constante evolução para dar suporte à escala crescente da complexidade do aplicativo. Por exemplo, em outubro de 2025, há mais de 85.000 entidades definidas pelo Salesforce e mais de 300 milhões de entidades personalizadas definidas por nossos clientes.
Historicamente, o tempo de execução principal hospedava a maioria das funcionalidades de plataforma e aplicativo. A arquitetura atual da Salesforce Platform agora inclui centenas de serviços independentes orientados por metadados. O tempo de execução principal continua sendo o único sistema de registro para metadados de aplicativo, aproveitando os benefícios exclusivos de uma arquitetura monolítica para gerenciamento de metadados. Os metadados relevantes são sincronizados com cache locais em serviços independentes, alimentando a variedade de serviços escalonáveis para tempos de execução de aplicativos.
## 6\. Dados
Os dados são um ativo essencial para as organizações, e o Hyperforce fornece uma base confiável para seu armazenamento no Salesforce. O principal desafio é armazenar dados de uma maneira que otimize seu utilitário para aplicativos. A Salesforce Platform transformou a camada de dados acomodando vários requisitos de armazenamento e acesso. Ele equilibra de modo eficaz os custos, as velocidades de leitura/gravação, a capacidade de armazenamento e os tipos de dados para atender a diversas necessidades.
Conforme a IA e a análise moldam cada vez mais os aplicativos corporativos, os dados emergiram como um elemento essencial. Sua importância reside na capacidade de habilitar a IA e a análise para aprender, analisar, tomar decisões e automatizar processos.
Os dados são originados em bancos de dados do Sistema de registro (SOR), cumprindo os requisitos operacionais das empresas. Ele então faz a transição por várias transformações para plataformas de big data, que são essenciais para habilitar aplicativos orientados por IA e análise.
O gerenciamento eficaz de dados, das informações transacionais às percepções analíticas, é crucial para extrair valor e dar suporte a aplicativos sofisticados. O Salesforce Database (SalesforceDB) se destaca como um primeiro banco de dados transacional para gerenciar dados SOR, enquanto o Data 360 serve como uma plataforma de big data robusta que aprimora as funcionalidades de IA e análise.
### 6.1 Banco de dados transacional
Dados transacionais e metadados são essenciais para a Salesforce Platform. O SalesforceDB é um banco de dados relacional moderno nativo de nuvem projetado especificamente para as cargas de trabalho de vários locatários do Salesforce, semelhante a outros bancos de dados de nuvem de provedores principais, mas com recursos personalizados para a arquitetura do Salesforce. Ele estende o PostgreSQL, separa computação e armazenamento e aproveita o Kubernetes e o armazenamento na nuvem, aprimorando as operações com funcionalidades específicas do locatário, como criptografia e sandboxes.
O SalesforceDB lida com todos os dados de CRM transacionais, com mais de 1,1 trilhão de transações por mês, bem como metadados para o Data 360 e serviços relacionados. Seus principais objetivos são garantir a Trust por meio de durabilidade, disponibilidade, desempenho e segurança; escala para grandes clientes; e facilitar operações de nuvem simplificadas e confiáveis. Ele atinge essas metas com um design que separa camadas de computação e armazenamento, um sistema de armazenamento distribuído imutável e acesso a dados de árvore de mesclagem estruturada em log. Isso habilita recursos avançados, como criptografia por locatário de dados no armazenamento e sandboxes e migrações eficientes.
#### Visão geral arquitetônica
A arquitetura de serviço do SalesforceDB é executada em três zonas de disponibilidade, com computação e armazenamento replicados entre essas zonas para garantir que o sistema permaneça disponível mesmo que qualquer nó ou zona inteira seja perdida. Todos os serviços são executados no Kubernetes para habilitar implantações de serviço e recuperação de falha automatizadas.
Para fornecer altos níveis de durabilidade e disponibilidade, o sistema de registro final para o SalesforceDB é o armazenamento em nuvem, como o S3 da AWS. Operações como arquivamento e replicação entre regiões são gerenciadas nesse nível de armazenamento em nuvem. Os objetos de armazenamento são imutáveis, aprimorando a distribuição de dados e a replicação para alta disponibilidade.
Devido à alta latência no armazenamento na nuvem, o SalesforceDB usa cache de armazenamento para acessar dados. Esses cache são sistemas de armazenamento distribuídos que mantêm cópias temporárias de objetos de armazenamento em um cluster de nós, garantindo a replicação e a durabilidade conforme necessário pelo banco de dados. Armazéns de cache separados são usados para armazenamento de registro de transação e armazenamento de arquivo de dados.
O nível de computação SQL consiste em um cluster de banco de dados primário e dois clusters de espera em três zonas de disponibilidade diferentes. O cluster principal lida com todas as modificações do banco de dados, enquanto os clusters de espera tratam apenas de operações de consulta.
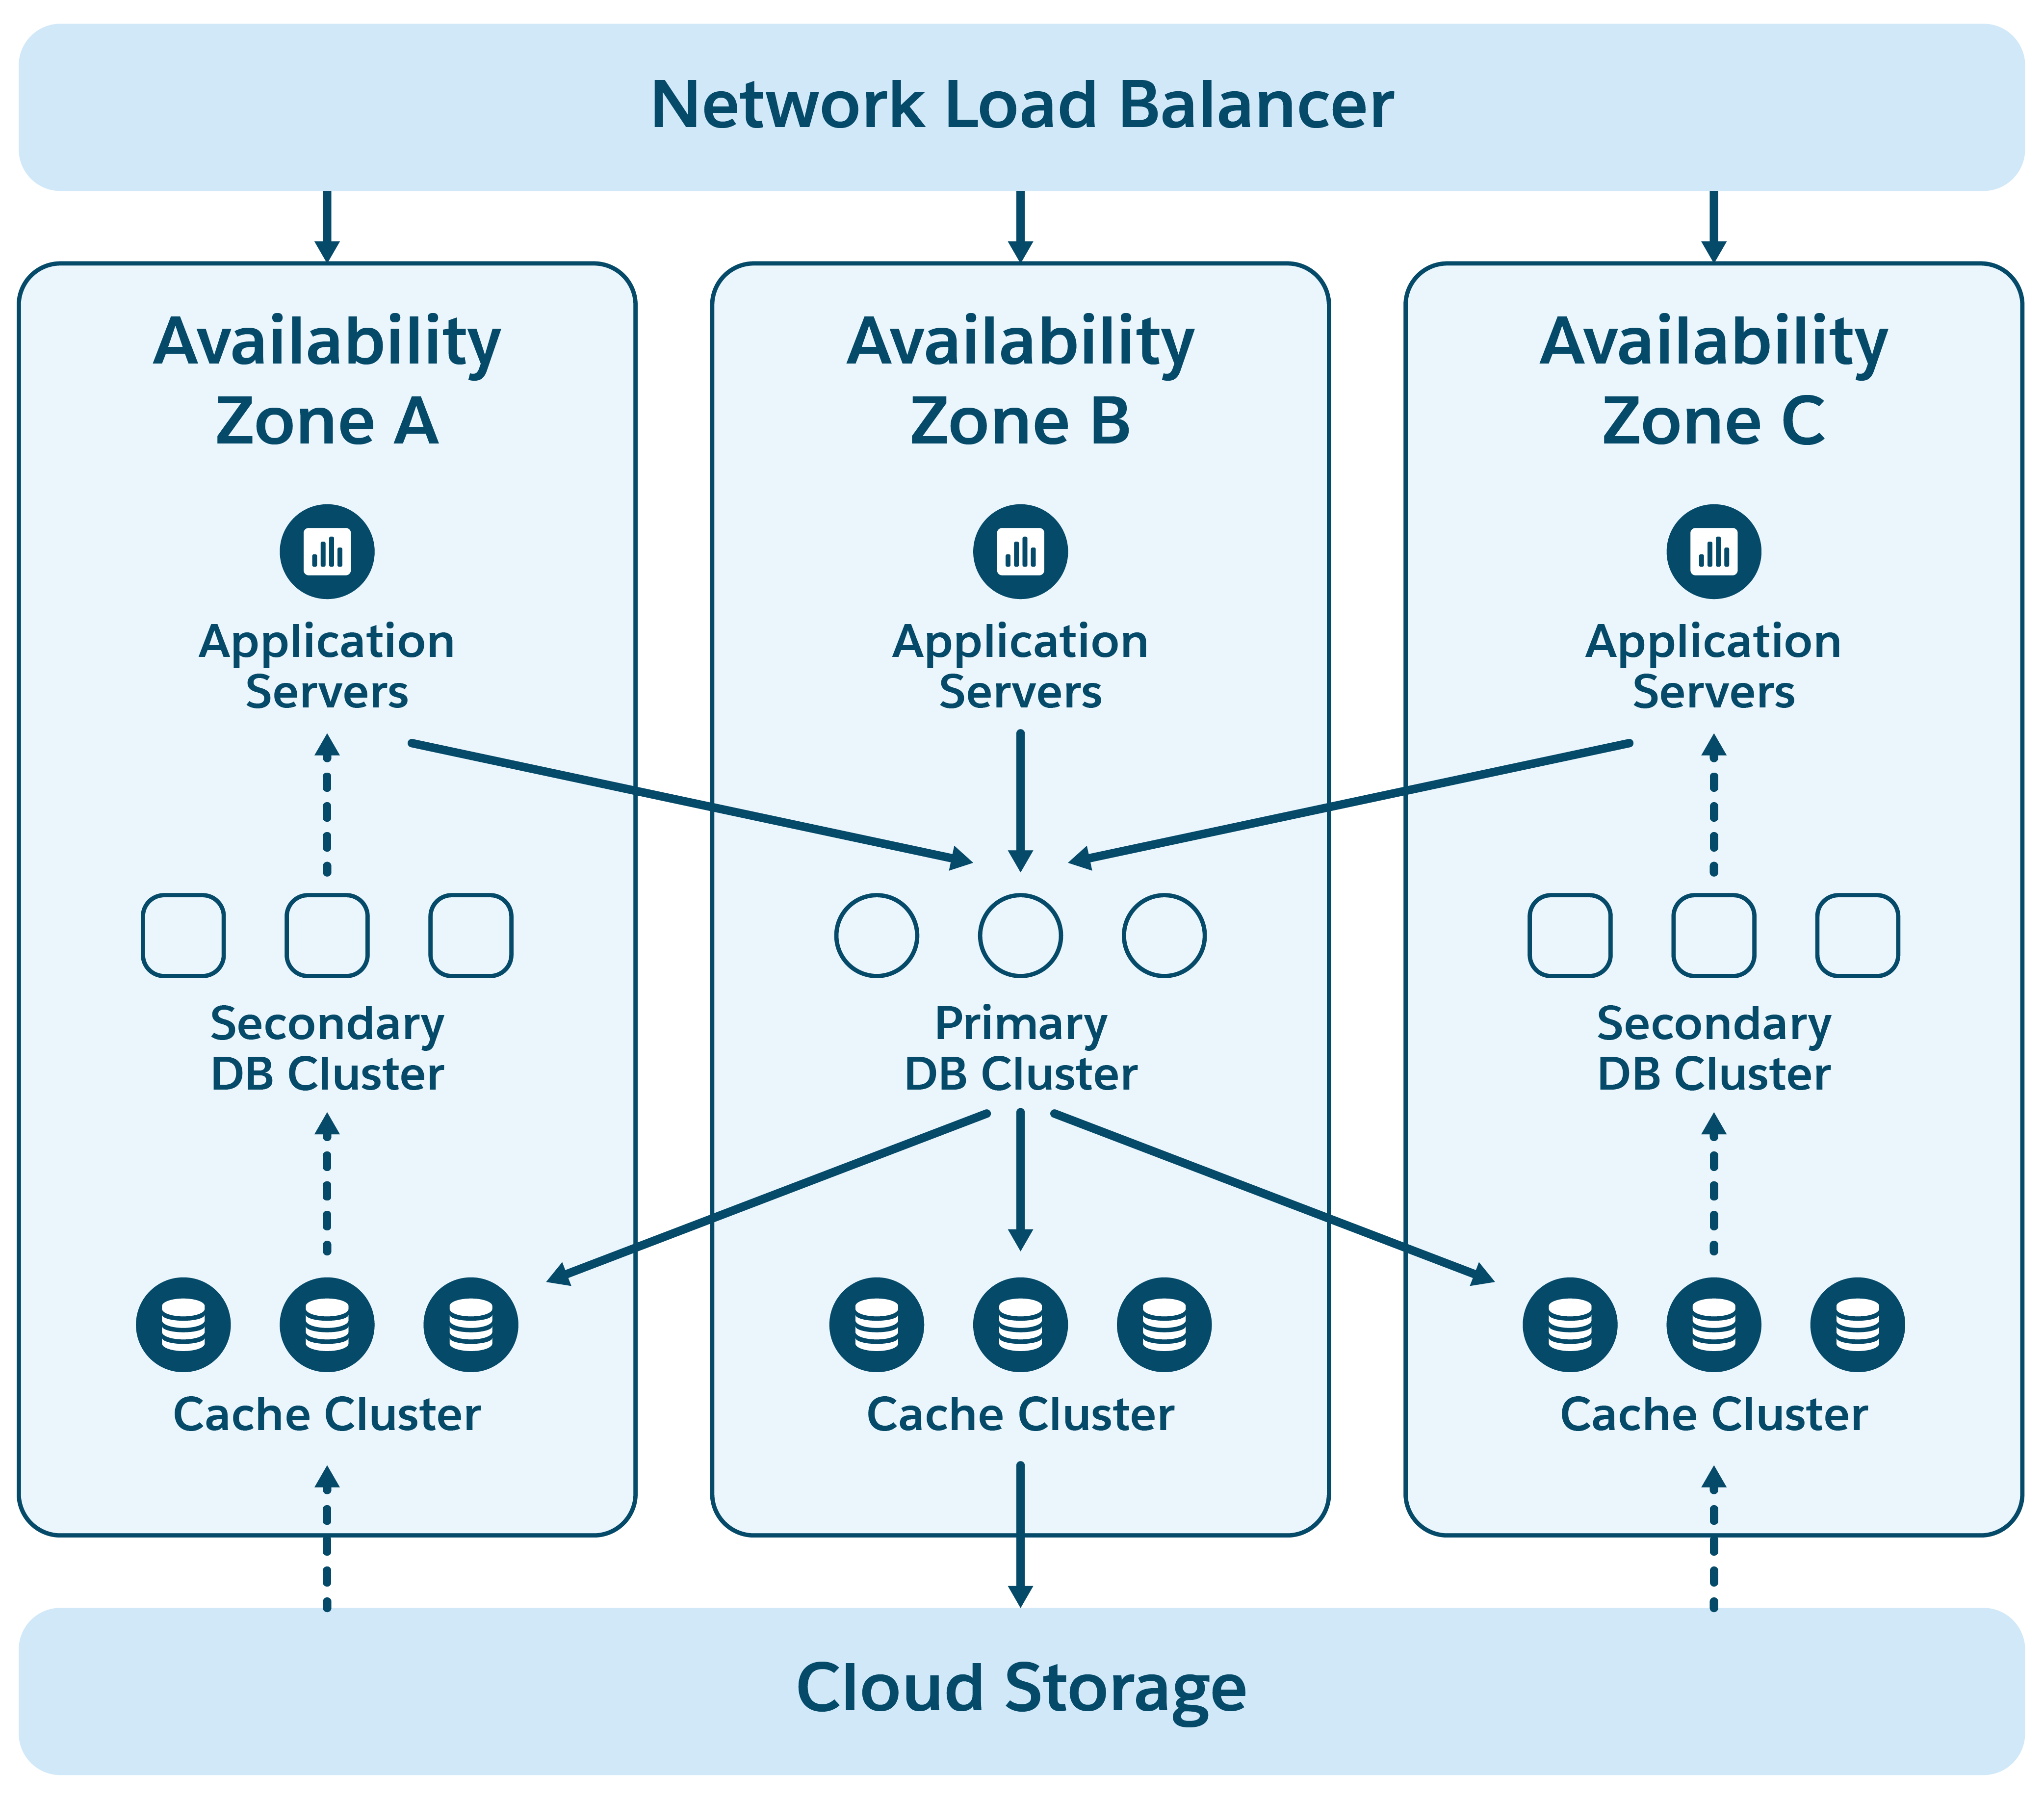 #### Armazenamento e acesso do LSM
O SalesforceDB usa uma estrutura de dados de árvore de mesclagem estruturada por log (LSM), em que as alterações são registradas inicialmente em um registro de transação e acumuladas na memória. As alterações confirmadas então são gravadas de modo coletivo em arquivos de dados ordenados por chave, que são mesclados periodicamente e compactados para otimizar a eficiência do armazenamento.
Essa estrutura elimina de modo eficaz problemas de atualização simultânea que são comuns em bancos de dados que atualizam o armazenamento diretamente. Ao usar a abordagem LSM, o SalesforceDB oferece suporte a recursos críticos, como armazenamento imutável, tornando-o uma solução robusta para gerenciar cargas de trabalho do Salesforce.
#### Armazenamento imutável
Os dados no armazenamento são imutáveis; depois que os arquivos de dados são gravados e tornados visíveis, eles não mudam. Os registros de transação são somente acréscimos, simplificando padrões de acesso a dados e aprimorando a confiabilidade. Essa estrutura oferece suporte a leituras não coordenadas, simplifica backups, aumenta a escalabilidade e facilita a virtualização de armazenamento, tornando-a perfeita para ambientes de nuvem.
#### Disponibilidade e durabilidade
As transações no SalesforceDB são confirmadas em várias zonas de disponibilidade, o que garante que não haja perda de dados mesmo que um nó ou zona falhe. Se ocorrer uma falha, as transações no voo serão canceladas e as transações confirmadas serão recuperadas com sucesso. Como falhas não perdem dados confirmados, a migração de falha para novos nós é automatizada.
O software de gerenciamento de cluster lida automaticamente com failovers monitorando quorum e gerenciando transferências de propriedade. Esse processo não é usado apenas em emergências, mas também rotineiramente durante o patch regular, aumentando a confiabilidade do sistema por meio do uso constante. Reinicializações curtas de banco de dados geralmente não são percebidas pelos usuários finais, mantendo uma experiência de usuário contínua.
O Salesforce faz três principais atualizações de esquema por ano, com atualizações de esquema menores a cada semana. O SalesforceDB fornece operações de esquema de tempo de inatividade zero que permitem que essas atualizações sejam feitas sem impacto sobre o cliente.
#### Sistema de registro
Nosso banco de dados transacional serve como o repositório principal para dados do cliente, que é armazenado em cache em várias zonas de disponibilidade e armazenado na nuvem. Cada bloco de dados é protegido com uma soma de verificação imutável, verificada pela camada de armazenamento e pelo mecanismo de banco de dados. O banco de dados realiza o rastreamento de linha para detectar quaisquer alterações fora de ordem ou versões perdidas e executa verificações de consistência contínuas entre índices e tabelas de base.
Para proteção contra ransomware, os bancos de dados são arquivados em armazenamento separado sob uma conta diferente, incluindo backups de log de transações completos e incrementais. Esses backups são validados regularmente por meio de um processo de teste de restauração. Além disso, a infraestrutura de nuvem é pré-configurada, mas não ativada, pronta para gerenciar solicitações de restauração de dados conforme necessário.
#### Escala
Cada organização do Salesforce está hospedada em uma célula do Hyperforce, que inclui o serviço SalesforceDB. Essa configuração permite uma rápida escala global através da criação de novas células por meio da arquitetura Hyperforce, e o tráfego pode ser facilmente deslocado entre as células para gerenciar a carga. No entanto, à medida que as cargas de trabalho e as demandas de negócios do cliente aumentam, a capacidade de uma única instância do banco de dados pode ser insuficiente.
Para lidar com isso, o SalesforceDB usa uma arquitetura de escala horizontal para seus níveis de armazenamento e computação. O armazenamento na nuvem é virtualmente ilimitado e as camadas de cache são escaladas automaticamente para atender à demanda. Além disso, o nível de computação pode ser expandido adicionando mais nós de computação do banco de dados, que leem de modo eficiente do armazenamento imutável compartilhado sem precisar de coordenação. Essa abordagem permite que o SalesforceDB obtenha escalabilidade que corresponda ou supere a dos principais arquiteturas de banco de dados de cluster comercial sem exigir rede ou hardware especial.
#### Multijugador
O Salesforce é um aplicativo multitenant em que um único banco de dados hospeda vários locatários. Cada registro de tabela inclui um ID do locatário para distinguir sua propriedade, e o isolamento do locatário é mantido por meio de predicados de consulta automáticos adicionados pela camada de aplicativo do Salesforce.
O SalesforceDB é personalizado para esse modelo, oferecendo suporte a DDL, metadados e processos de tempo de execução específicos do locatário, aprimorando a confiabilidade, o desempenho e a segurança. Ele combina a baixa sobrecarga de um modelo de locatário por linha com a eficiência de um esquema de locatário por banco de dados.
No SalesforceDB, os IDs de locatário fazem parte da chave primária em tabelas de vários locatários, que agrupam dados por locatário na estrutura de dados do LSM, aprimorando a eficiência de acesso. Essa configuração não apenas facilita o acesso a dados eficiente e a criptografia por locatário, mas também simplifica o gerenciamento de dados do locatário. Os locatários podem ser copiados ou movidos facilmente com ajustes mínimos de metadados devido à estrutura de metadados compacta.
### 6.2 Data 360 e Data Lake
Recursos de IA, análise e dados são essenciais em empresas modernas. As empresas já investem em plataformas de big data maduras, como Snowflake, Databricks, BigQuery e Redshift. No entanto, muitos
os clientes não estão derivando valor comercial de seus dados devido a silos de dados, falta de processamento de IA, dados obsoletos ou inatividade em um processo de negócios existente. Centralizar dados do cliente em uma única fonte de verdade, com uma única visão do engajamento do cliente, é crucial para um negócio e desafiador devido à fragmentação de dados e à complexidade do gerenciamento do sistema. A Salesforce é líder na facilitação de uma visão holística de um cliente integrando dados, IA e CRM em um círculo virtuoso, conduzido por percepções de aprendizado de máquina e IA generativas e alimentado por dados.
O SalesforceDB é otimizado para cargas de trabalho transacionais de alto desempenho em dados estruturados, enquanto as cargas de trabalho de IA e análise exigem lidar com grandes volumes de dados não estruturados de várias origens e realizar consultas complexas e processamento em lote. Para atender a essas necessidades, a Salesforce desenvolveu o Data 360, uma plataforma projetada para dividir silos de dados, unificar, armazenar e processar dados de modo seguro e eficiente, dar suporte a demandas de IA e análise e habilitar operações empresariais em tempo real.
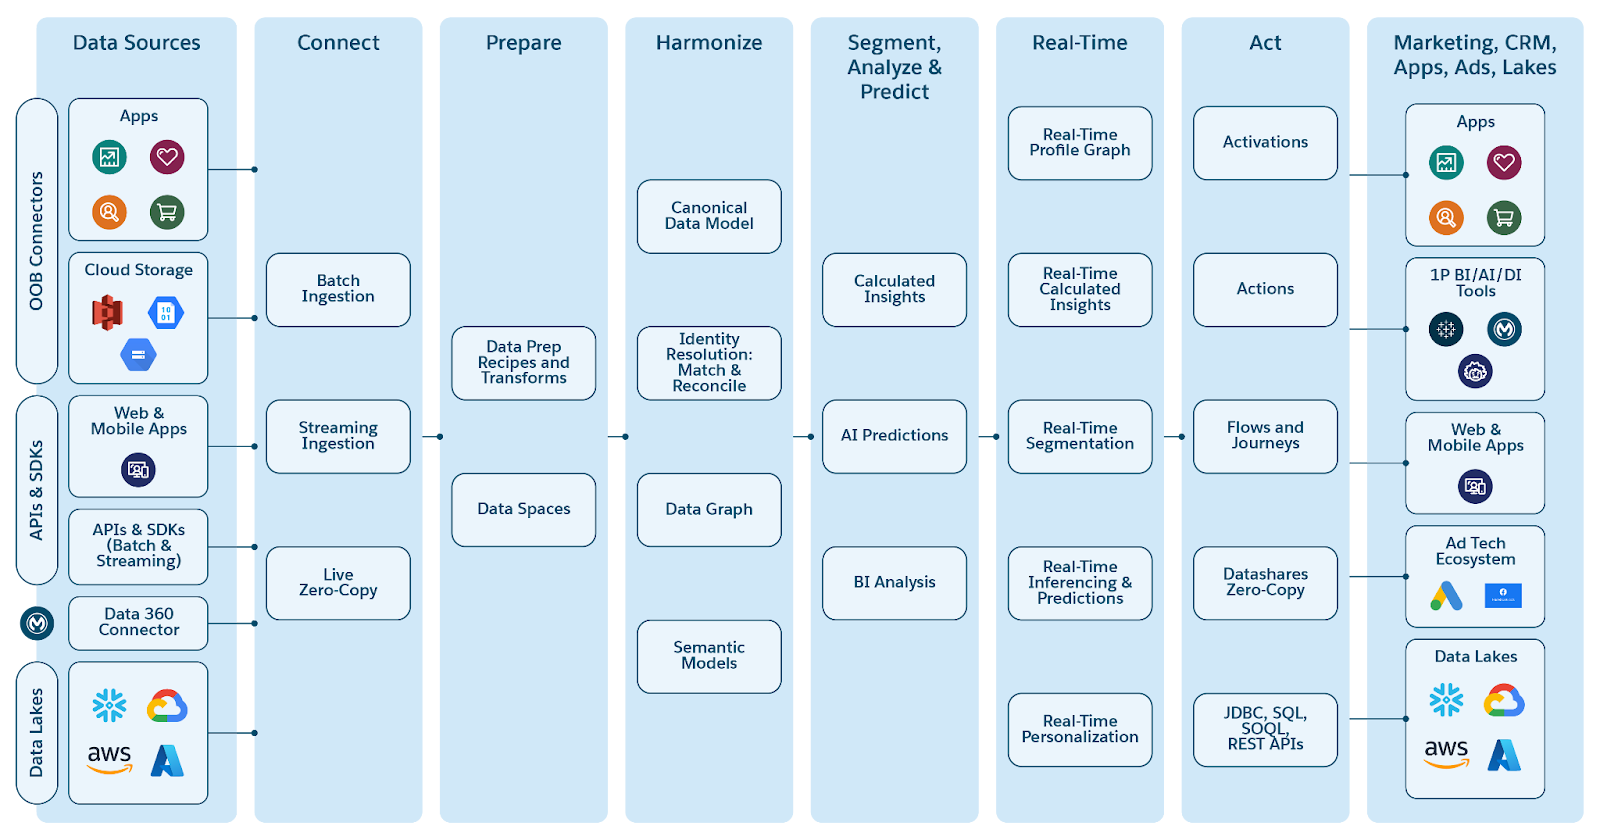 O Data 360, baseado no Hyperforce, serve como a plataforma fundamental para a IA e o Analytics, oferecendo:
- Infraestrutura integrada e uma plataforma sem código para consolidar silos de dados por meio de conexões
- Ingestão de dados em tempo real e quase em tempo real
- Federação de cópia zero
- Limpeza, preparação e formatação de dados para processamento
- Serviço de consulta unificado sobre dados estruturados e não estruturados
- Desenvolvimento de modelos analíticos e de IA/ML para geração de percepções
- Ações e ativações acionadas por dados
- Suporte para geração aumentada de recuperação de IA generativa (RAG)
- Governança baseada em política abrangente
A Arquitetura do Data 360 oferece suporte a vários componentes e recursos, que são descritos abaixo.
#### Conectividade, Transformação e Harmonização
O Data 360 oferece suporte a pipelines de ingestão eficientes de várias fontes de dados estruturadas e não estruturadas para processamento de dados em lote, quase em tempo real e em tempo real. O serviço de ingestão do Data 360 opera em um padrão de extração-carga-transformação (ELT), projetado para baixa latência e adequado para escala B2C. A ingestão em tempo real inclui APIs e fluxos interativos, enquanto fontes quase em tempo real abrangem o uso detalhado do produto. Depois de ingeridos, os dados são amplamente transformados para preparar, harmonizar (por exemplo, unificar vários tipos de contato) e modelá-los para consultas, análises e aplicativos de IA eficientes. A plataforma também inclui uma ampla gama de modelos de dados harmonizados prontos para uso.
O Data 360 se integra perfeitamente a aplicativos Salesforce, como Sales Cloud, Service Cloud, Marketing Cloud e Commerce Cloud. Além disso, ele oferece centenas de conectores para origens de dados externas, garantindo uma integração tranquila de dados.
#### Lakehouse para Big Data
O Data 360 apresenta uma arquitetura nativa de lakehouse baseada em IceBerg/Parquet, projetada para lidar com gerenciamento e processamento de dados em grande escala para cenários em lote, streaming e em tempo real. Essa arquitetura dá suporte a dados estruturados e não estruturados, cruciais para aplicativos de IA e análise.
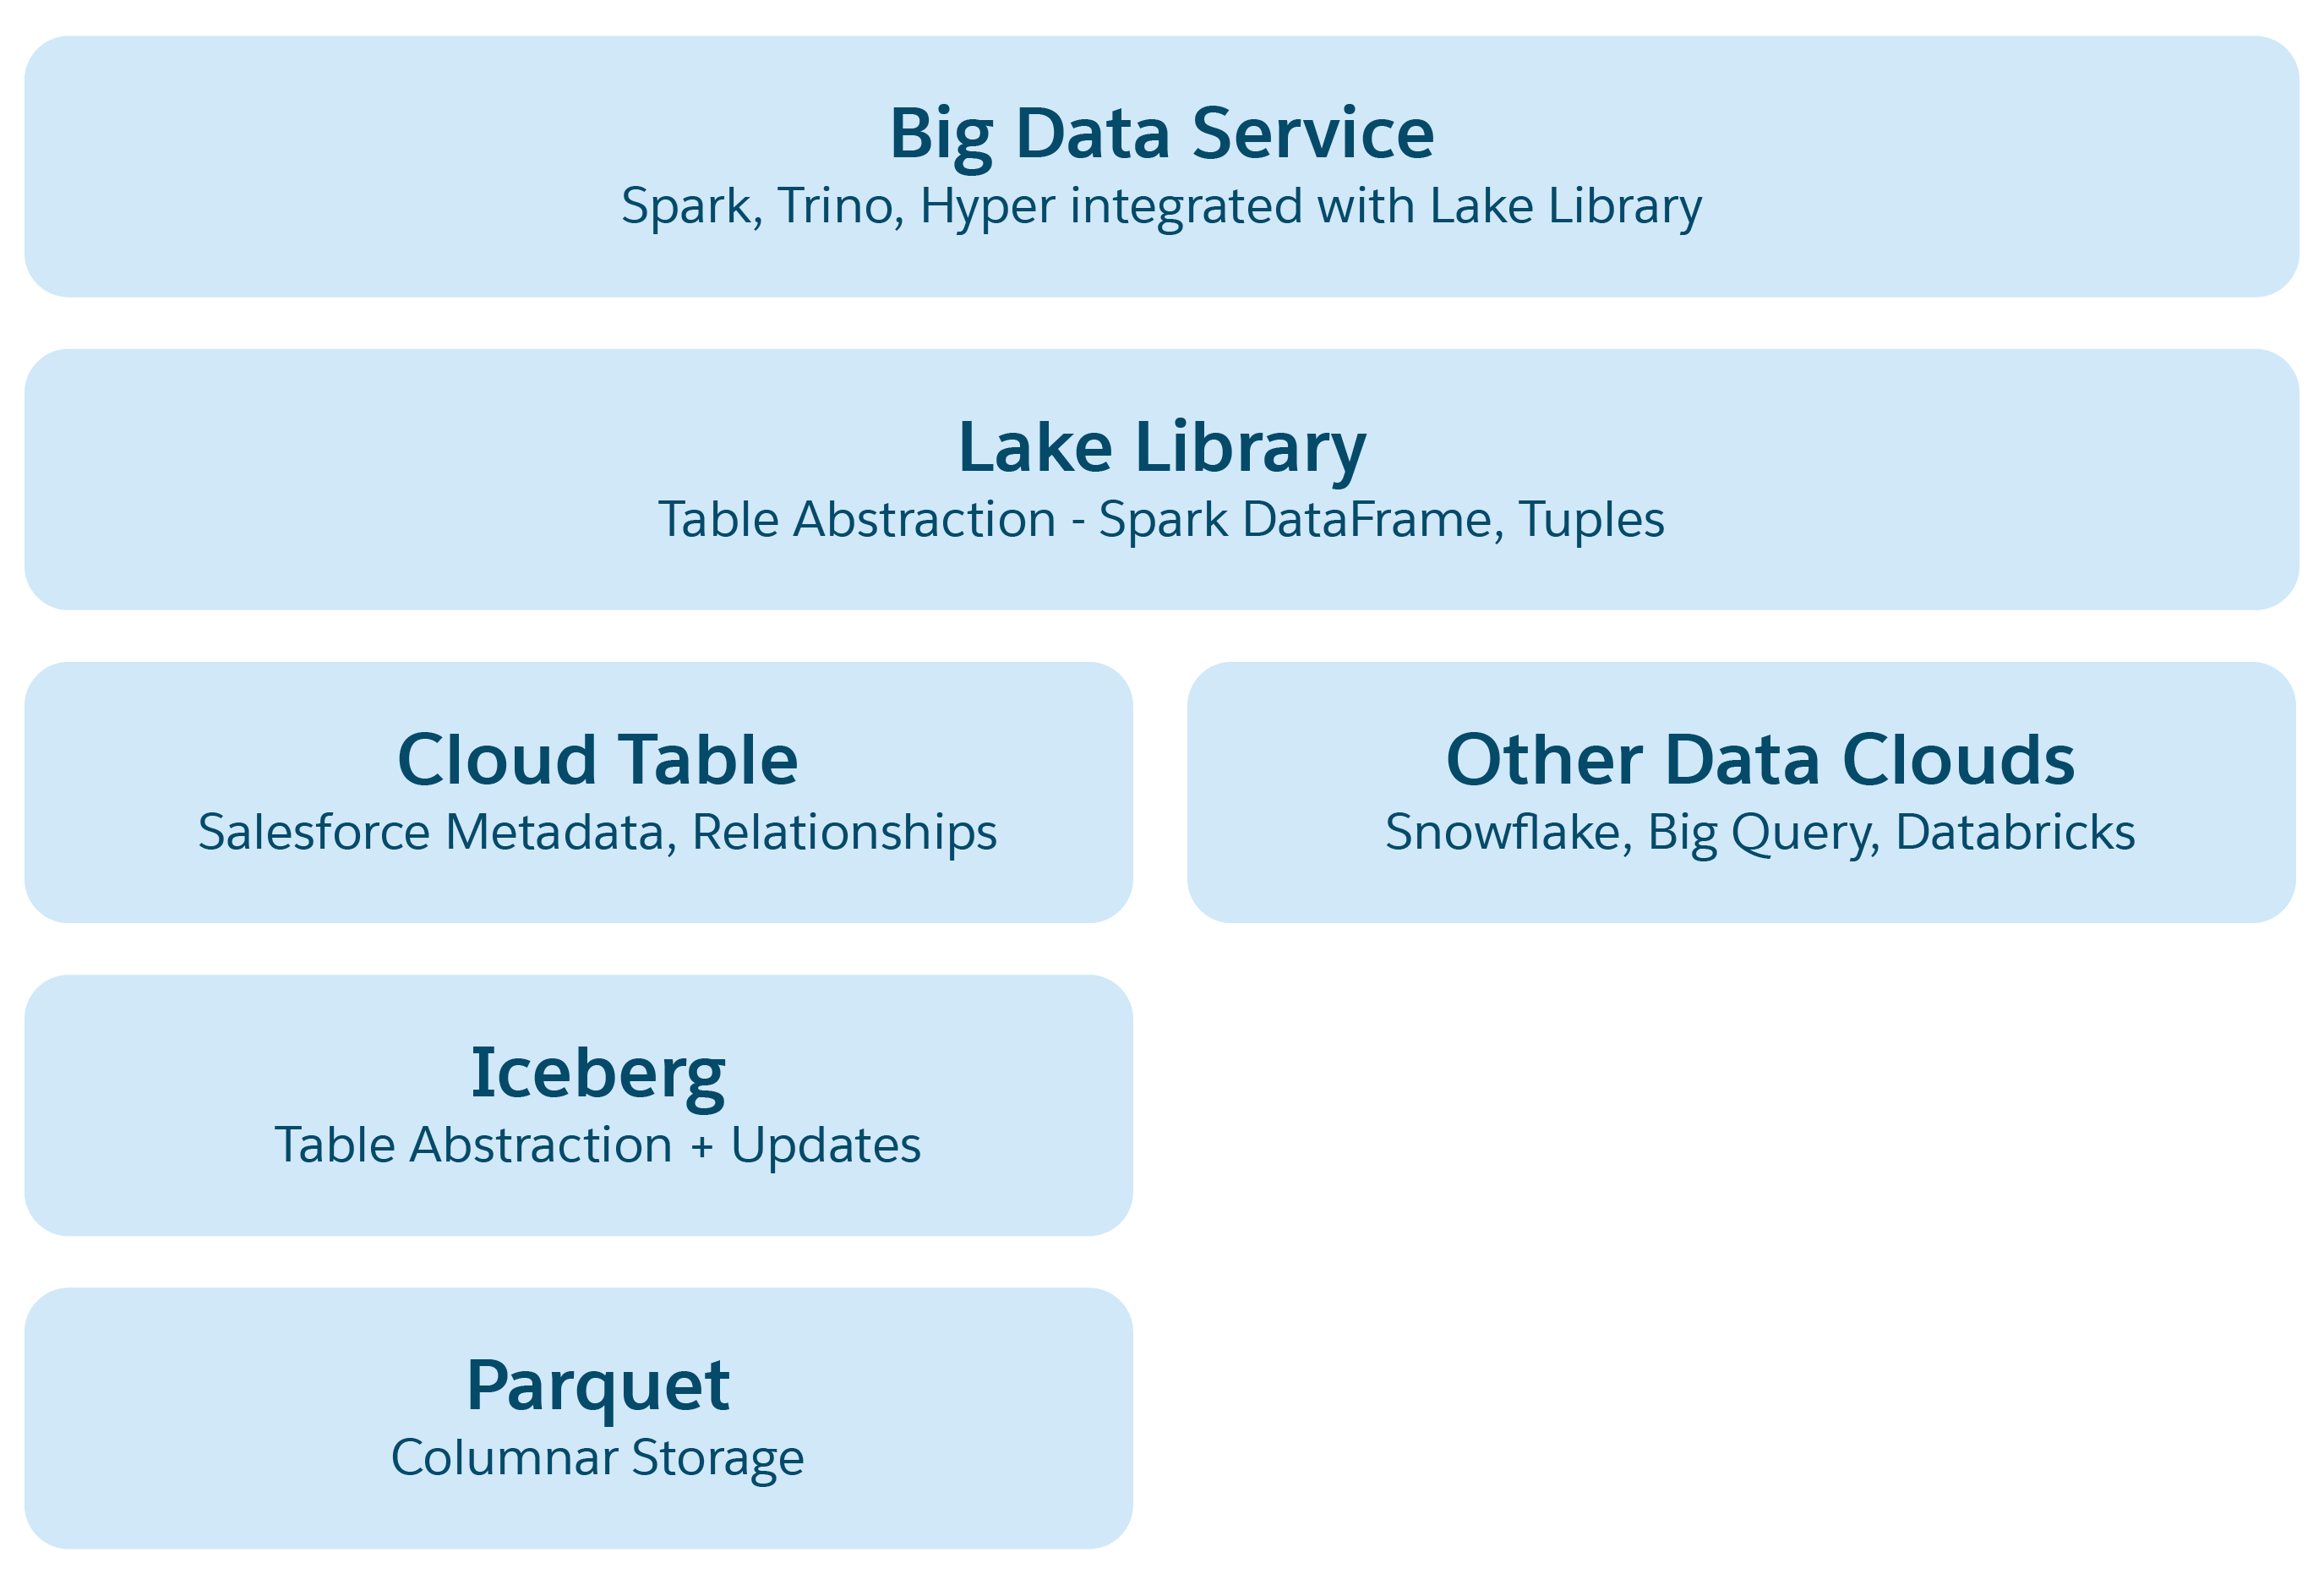 Em data lakes baseados em nuvem, como Azure, AWS ou GCP, a unidade de armazenamento fundamental é um arquivo, normalmente organizado em pastas e hierarquias. Esse lakehouse aprimora essa estrutura introduzindo abstrações estruturais e semânticas de nível superior para facilitar operações como consulta e processamento de IA/ML. A abstração primária é uma tabela com metadados que define sua estrutura e semântica, incorporando elementos de projetos de código aberto, como Iceberg ou Delta Lake, com camadas semânticas adicionais adicionadas pelo Data 360.
Camadas de abstração no lakehouse:
- **Abstração de arquivo Parquet**: Na base, o armazenamento consiste em arquivos de data lake (por exemplo, S3 na AWS ou Blob no Azure) no formato Parquet. Os dados de uma tabela de origem são armazenados entre várias partições como arquivos Parquet, sendo que cada tabela é uma coleção desses arquivos.
- **Abstração de tabela de gelo**: As tabelas são organizadas como pastas, com partições de dados armazenadas como arquivos Parquet nessas pastas. As modificações em uma partição resultam em novos arquivos Parquet como instantâneos. O IceBerg gerencia um arquivo de metadados para cada tabela, detalhando esquemas, especificações de partição e instantâneos.
- **Abstração de tabela do Salesforce Cloud**: Com base no iceberg, essa camada adiciona metadados semânticos, como nomes de coluna e relacionamentos, junto com configurações como tamanho de arquivo de destino e compactação. Ele abstrai tabelas em várias plataformas, como o Snowflake e o Databricks, protegendo aplicativos do Data 360 dos detalhes subjacentes da plataforma de armazenamento.
- **Lake Access Library**: Essa biblioteca fornece acesso à Tabela do Salesforce Cloud, que lida com dados e metadados e abstrai os mecanismos de armazenamento subjacentes para desenvolvedores de aplicativos.
- **Abstração de serviço de big data**: Isso inclui estruturas de processamento como Trino e Hyper para consulta e Spark para processamento em qualquer plataforma de tabela de nuvem.
O Data 360 Lakehouse oferece suporte a escala B2C, ingestão em tempo real, processamento, imposição e evolução de esquema, instantâneos e usa formatos de armazenamento abertos.
#### Armazenamento em tempo real
Para dar suporte a análises em tempo real e aplicativos agentes, o Data 360 aumenta o armazenamento de big data de um lakehouse com uma Loja de baixa latência (LLS) adicional. A camada de processamento em tempo real do Data 360 analisa sinais em tempo real e dados de engajamento na memória. Como a capacidade de armazenamento baseado em memória é limitada, não é possível processar todos os dados de uma só vez. O Data 360 adiciona esse LLS para remover essas limitações, habilitando o processamento escalonável em tempo real.
A Loja de baixa latência é uma camada de armazenamento NVMe (SSD) em escala de petabytes no lakehouse. É um cache durável – a maioria dos dados finalmente chega ao lakehouse para a manutenção a longo prazo. Os dados na sessão na camada em tempo real podem ser transferidos para o armazenamento de baixa latência para acesso rápido subsequente. Por exemplo, em uma conversa agente, as mensagens recentes podem ser processadas na memória; mensagens mais antigas podem ser enviadas para o LLS. Se uma conversa anterior for necessária, ela poderá ser acessada em poucos milissegundos a partir do LLS. O armazenamento baseado em NVMe permite que grandes quantidades de dados sejam armazenadas e acessadas em latências de milissegundos. Os dados podem entrar no lakehouse para persistência de longo prazo.
Além disso, os dados do lakehouse necessários para processamento em tempo real ou para aumentar experiências em tempo real são recuperados e mantidos no LLS. Por exemplo, o contexto do perfil do cliente é pré-coletado ou trazido do lakehouse e armazenado em cache no LLS. Além disso, todos os objetos do lakehouse e outros objetos necessários para processamento em tempo real durante o processamento na sessão também podem ser armazenados em cache no LLS. O LLS habilita uma camada em tempo real em uma hierarquia de armazenamento verdadeira com camadas de armazenamento de memoria, SSD e lakehouse, com dados migrando perfeitamente entre cada uma.
O Data 360 também oferece suporte robusto para segurança, incluindo Criptografia de nível de locatário (TLE) com chaves gerenciadas pelo cliente, bem como privacidade e conformidade por meio de suas tecnologias de governança. No centro está o suporte ao controle de acesso baseado em atributo (ABAC), que avalia dinamicamente o acesso com base em atributos relacionados a entidades, operações e fatores ambientais. Esse sistema oferece suporte a controles de acesso opcionais e obrigatórios.
Complementando o ABAC, um sistema de classificação de dados detalhado categoriza dados por confidencialidade e finalidade, aprimorando a conformidade, o gerenciamento de risco e a resposta a incidentes. Juntos, o ABAC e esse sistema de classificação fornecem uma governança de dados abrangente, garantindo que os dados no Data 360 sejam gerenciados com segurança e eficiência.
#### Acionado por metadados
O Data 360 integra-se profundamente com a Salesforce Platform para metadados, empacotamento, extensibilidade, experiência do usuário e distribuição de aplicativos por meio do AppExchange. Os clientes podem definir e gerenciar os metadados para fluxos e tabelas do Lakehouse, assim como outros metadados do Salesforce. Cada objeto de dados (incluindo tabelas federadas ou externas) é representado como um objeto do Salesforce e modelado como entidades virtuais com suporte no armazenamento de dados no Data 360\. Eles podem ser usados por desenvolvedores para criar aplicativos na Salesforce Platform.
#### Extensibilidade e federação de cópia zero
O Data 360 oferece amplo suporte para federação de cópia zero, permitindo que os usuários se integram a armazéns de dados externos, como Snowflake e Redshift, lagoas, como Google BigQuery, Databricks e Azure Fabric, bem como bancos de dados SQL e vários tipos de arquivo, incluindo o Excel. O Data 360 oferece suporte à federação baseada em consulta e arquivo, com a aceleração de acesso e consulta ativa, conforme mostrado na figura. Os rótulos (1) e (2) ilustram a consulta do Data 360 (incluindo push-downs de consulta ativa) e a federação baseada em arquivo para acessar dados de data lakes / warehouses / origens de dados externas; e o rótulo (3) destaca a aceleração do acesso federado de data lakes / origens de dados externas. Os rótulos (4) e (5) ilustram a consulta e o compartilhamento baseado em arquivo de dados do Data 360 com data lakes/armazéns externos. a funcionalidade também se estende a fontes de dados não estruturadas, como Slack e Google Drive, que podem ser acessadas pelos pipelines de processamento não estruturados do Data 360. Além disso, o Data 360 facilita a extração de objetos do Salesforce e o acesso a dados para dados federados de origens externas, permitindo o acesso a esses dados em toda a plataforma e aplicativos do Salesforce.
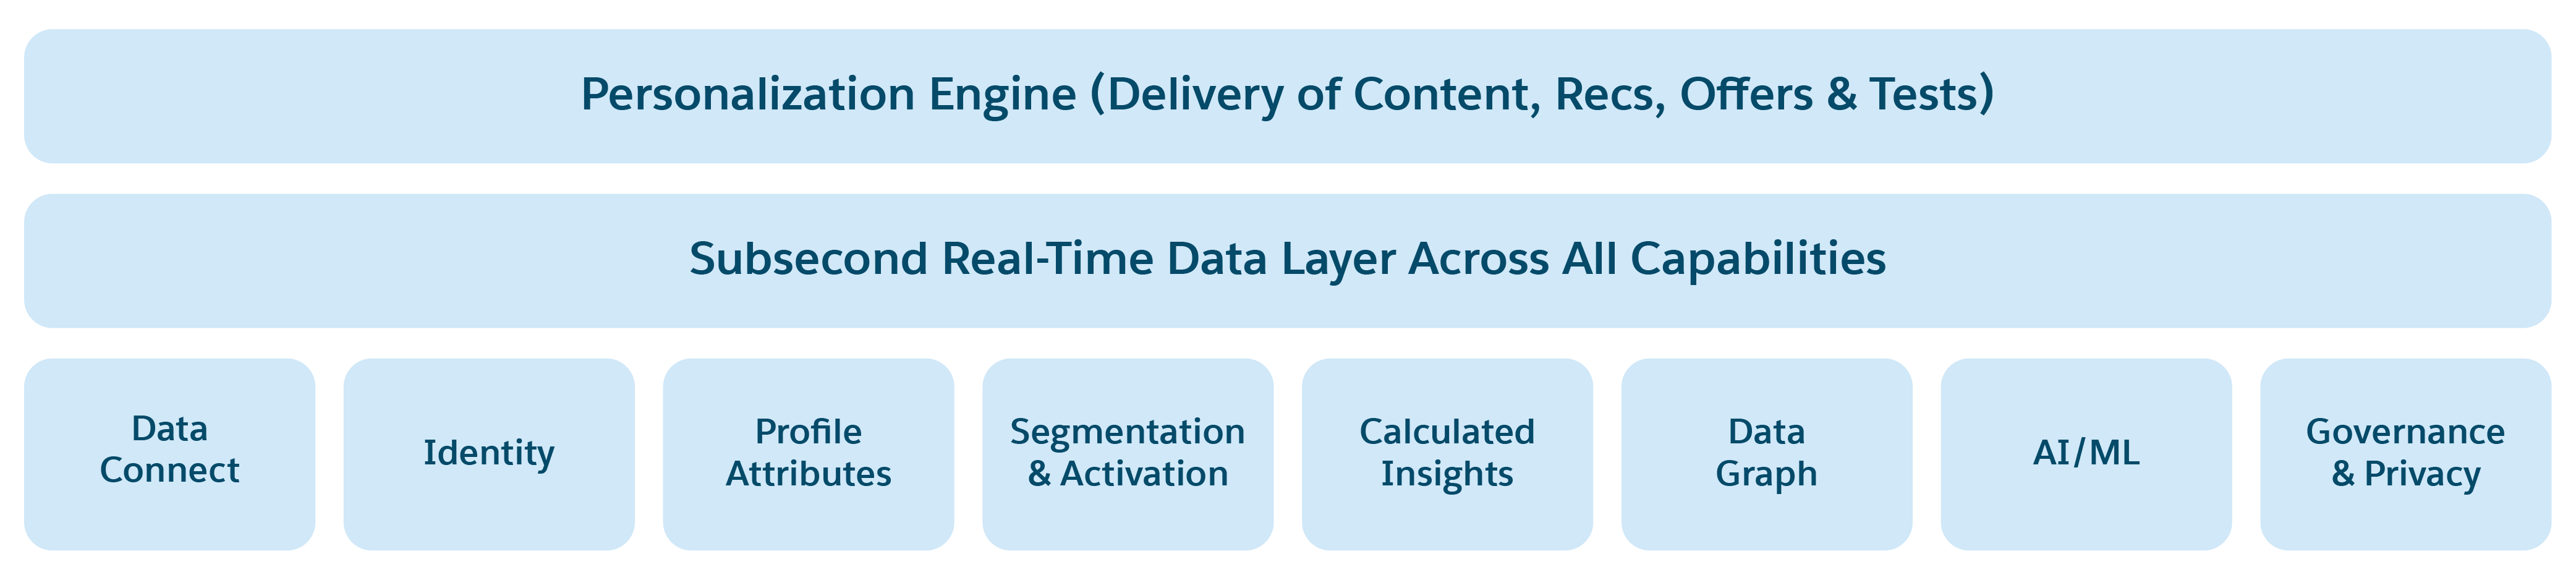 A camada em tempo real do Data 360 é projetada para processar eventos como fluxos de cliques da Web e móveis, visitas, dados do carrinho e checkouts em latências de milissegundos, aprimorando a personalização da experiência do cliente. Ele monitora continuamente o engajamento do cliente e atualiza o perfil do cliente da CDP com dados de engajamento em tempo real, segmentos e cálculos para personalização imediata.
Por exemplo, quando um consumidor compra um item em um site de compras, a camada em tempo real rapidamente detecta e ingere esse evento, identifica o consumidor e aprimora seu perfil com informações atualizadas sobre o gasto na vida útil. Isso permite a personalização da experiência deles no site em menos de segundos. Além disso, essa camada inclui recursos para acionamento e respostas em tempo real, habilitando ações imediatas com base nas interações com o cliente.
#### Personalização
Personalização é saber que personalidade direcionar, quando e onde entregar conteúdo e recomendações relevantes, o que dizer e com que frequência. O recurso Plataforma de serviços de personalização do Data 360 é o orquestrador do qual as decisões são tomadas para otimizar a realização da meta por meio de experiências personalizadas. Essa plataforma oferece os seguintes recursos:
- Conjunto consistente de modelos e maneiras de interpretar dados de perfil, atividade e ativo no Data 360.
- Experimentação integrada à plataforma (por exemplo, A/B/n ou tomada de decisão de bandido de vários braços).
- Integração de metas no momento do design por meio de ajustes, tempo de treinamento de ML e tempo de execução (inferência de ML).
- Suporte para interação em escala B2C, em tempo real e em lote (usuários anônimos, lote externo interativo em tempo real de alto volume e lote interno de alto volume).
- Analytics conduzido pelo Data 360.
- Padrões para integrar modelos de IA e serviço de outras partes (internos e externos).
- Implementações OOTB de casos de uso conduzidos por IA de alto valor (recomendações e decisões com vários algoritmos de ML, incluindo bandidos contextuais para promoção/seleção de conteúdo, recomendações de produto e decisões de precificação).
#### Ações de dados
O Data 360 é uma plataforma ativa que dá suporte à ativação de pipelines em resposta a eventos de dados. Por exemplo, um evento significativo, como uma queda no saldo da conta de um cliente, pode acionar um Salesforce Flow para orquestrar uma ação correspondente. Da mesma forma, as atualizações nas principais métricas, como o gasto da vida útil, podem ser propagadas automaticamente para aplicativos relevantes.
#### Computar tecido de dados
O Data 360 oferece clusters de computação de escala elástica que lidam com tarefas de processamento de modo eficiente. Ele oferece gerenciamento robusto para ambientes de computação dedicados e multilocatários. Além disso, ele fornece suporte gerenciado para Spark e SQL. Os recursos de BYOC (Traga o seu próprio computador/código) oferecem suporte a várias linguagens de programação, incluindo Java, Python e Spark, permitindo a integração de transformações personalizadas, modelos (incluindo LLMs) e funções, aprimorando a extensibilidade.
O Compute Fabric do Data 360 fornece uma camada unificada conhecida como Controlador de processamento de dados (DPC) para gerenciar e executar todas as cargas de trabalho de dados grandes. O DPC é um serviço abrangente de orquestração de processamento de dados de várias cargas de trabalho que fornece funcionalidades de Trabalho como serviço (JaaS) em vários ambientes de computação em nuvem. Ele abstrai a complexidade da infraestrutura e unifica a execução de trabalhos para estruturas como Spark (EMR em EC2 e EMR em EKS) e cargas de trabalho do Controlador de recurso Kubernetes (KRC). Ao servir como um gateway de plano de controle centralizado, o DPC orquestra, agenda e monitora trabalhos em vários planos de dados, garantindo confiabilidade, escalabilidade, custo-benefício e uma experiência de desenvolvedor consistente.
#### Consultas unificadas
O Serviço de consulta do Data 360 oferece recursos avançados de consulta, com amplo suporte de SQL para dados estruturados e não estruturados por meio do Trino e do Hyper. Ele aprimora a funcionalidade com extensibilidade do operador por meio de Funções de tabela, permitindo diversas operações de pesquisa em texto, imagem, espacial e outros tipos de dados não estruturados. Esses recursos são integrados perfeitamente a operações relacionais, como selecionar registros do cliente. Essa abordagem unificada habilita a geração de resultados direcionados e personalizados, facilitando respostas de LLM mais precisas usando RAG.
#### Processamento de dados não estruturado
O Data 360 oferece suporte ao armazenamento e ao gerenciamento de dados estruturados (tabelas), semiestruturados (JSON) e não estruturados de modo contínuo em todos os mecanismos de ingestão, processamento, indexação e consulta de dados. O Data 360 oferece suporte a vários tipos de dados não estruturados além do texto, incluindo áudio, vídeo e imagens, ampliando o escopo do tratamento e da análise de dados. A figura abaixo ilustra os dois lados da fundamentação (ingestão e recuperação).
 A pilha de IA consiste em vários componentes principais:
- **Plataforma de IA**: Essa camada de plataforma é responsável por gerenciar, treinar e ajustar modelos de IA usados em aplicativos preditivos e generativos. Oferece serviços prontos para uso (OOTB), serviços Trust e modelos básicos para treinamento, testes e inferência de modelos. Além disso, ele dá suporte à integração de seus próprios modelos preditivos e generativos, permitindo que você traga modelos personalizados dentro da plataforma.
- **Serviços fundamentais de IA**: Isso inclui os serviços Gateway de IA, Estrutura de feedback, RAG, Orquestração do agente, Avaliação do agente e Mocionamento, que facilitam a integração de aplicativos de negócios com a pilha de IA.
- **Experiências de usuário e agente habilitadas por IA**: O Salesforce oferece aplicativos avançados com IA especializados por meio de seus serviços de nuvem. Os clientes também podem criar experiências personalizadas aproveitando qualquer componente da plataforma – como Fluxo, Apex ou até Componentes da Web Lightning (LWC) – para criar experiências desenvolvidas com IA integradas perfeitamente aos seus fluxos de trabalho e processos de negócios.
- **Agentforce Studio**: Este componente possui ferramentas como o Criador de agentes, Criador de prompts, Centro de testes e Criador de modelo, projetadas para criar experiências de IA generativa e preditiva. Ele oferece suporte completo para desenvolver/treinar, testar e ajustar modelos de IA. O Next Gen Authoring aprimora esses recursos, projetados para simplificar e acelerar a criação de agentes de IA com a UX aprimorada e a compatibilidade com SFDX.
### 7.3 Componentes fundamentais
#### Camada Agentforce Trust
Camada
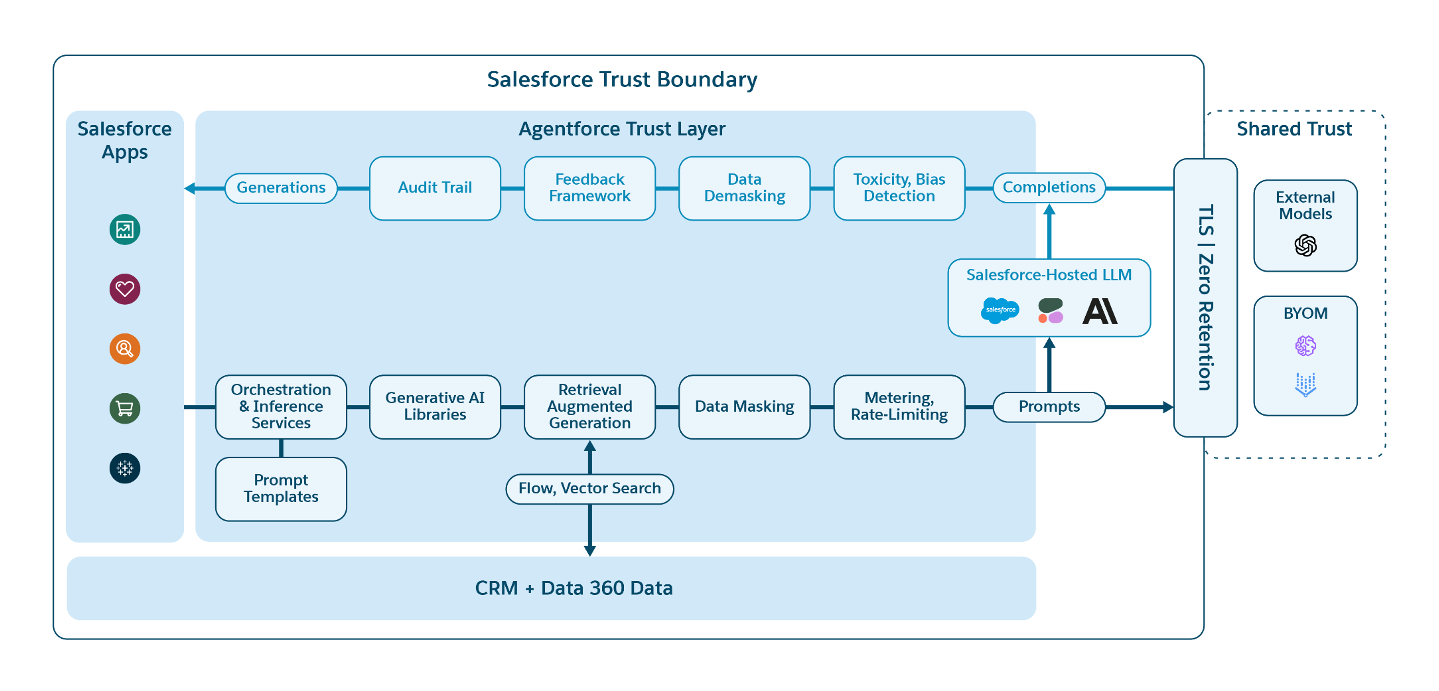 A Camada Agentforce Trust está disponível em casos de uso selecionados para ajudar a proteger os dados do cliente em aplicativos de IA generativa, oferecendo recursos robustos:
- **Privacidade dos dados**: Controles de mascaramento e privacidade fortes protegem informações confidenciais contra o acesso por modelos de IA externos.
- **Segurança**: Garante um ambiente de processamento de dados seguro e impede acesso não autorizado.
- **Trust**: Mantenha o controle do cliente sobre os dados, sem armazenamento ou uso de IA de terceiros.
- **Guardrails:** Imponha padrões de comportamento do agente e mitigar o não determinismo inerente de LLMs, verificando que os agentes seguem de modo consistente instruções predefinidas e fluxos de trabalho.
- **Precisão**: Aprimora as saídas de IA usando dados relevantes do Salesforce para apresentar avisos.
- **Moderação de conteúdo**: Oferece moderação pré e pós-conteúdo, mascaramento de dados personalizável para informações confidenciais (PII/PCI/PHI) e classificação de toxicidade para respostas de modelo de linguagem grande (LLM).
#### Gateway de IA do Agentforce
O Gateway de IA fornece uma interface unificada para acessar e gerenciar vários LLMs e modelos preditivos. Ele atua como uma ponte entre o Salesforce e o mundo dos LLMs, abstraindo as complexidades de diferentes provedores de LLM e os próprios modelos de IA preditiva dos clientes, oferecendo uma maneira consistente de interagir com eles. O Gateway de IA do Agentforce se integra a vários provedores de LLM, permitindo que os clientes escolham o melhor modelo para suas necessidades e incorpora medidas de segurança de dados robustas para ajudar a gerenciar os custos associados ao uso de diferentes LLMs.
O Serviço de feedback é um componente que coleta, analisa, mede e utiliza feedback do usuário para treinar e refinar modelos de IA. Ele desempenha um papel crucial na melhoria contínua de recursos e funcionalidades conduzidos por IA na Salesforce Platform.
#### Geração aumentada de recuperação (RAG)
RAG é uma técnica vital que aprimora os recursos de pesquisa com IA generativa, levando a respostas mais informativas e precisas. Utilizando o extenso Salesforce Data 360 e o Vector Database integrado, a plataforma Agentforce recupera rapidamente dados relevantes para a consulta de um usuário. Esses dados então são usados como base para LLMs para gerar respostas ideais.
Além disso, esse método aumenta a velocidade de resposta e a Trust do usuário incluindo dados de origem em respostas. O RAG é amplamente empregado na plataforma Agentforce, particularmente para aplicativos como Agentforce para serviço e Agentforce para vendas, destacando como ele apresenta informações relevantes para esses casos de uso.
### 7.4 Plataforma Agentforce
Conforme os modelos de IA avançam, o desenvolvimento de agentes para automatizar tarefas que exigem raciocínio é a próxima etapa. Esses agentes servem como assistentes inteligentes, capazes de entender e responder a consultas em linguagem natural, permitindo que os usuários os projetem, testem e implementem para várias tarefas. Um componente crucial desse sistema é o Serviço do planejador, que funciona da seguinte maneira:
- **Interpreta a solicitação do usuário**: Ele analisa a entrada do usuário para determinar a intenção.
- **Criar um plano**: Ele formula um plano estruturado para atender às necessidades do usuário.
- **Iniciar ações**: Ele executa o plano iniciando ações diretamente ou por meio de outros serviços.
O Serviço do planejador orquestra o processo, garantindo que o agente atenda de modo eficiente às solicitações do usuário gerenciando e executando as etapas necessárias.
#### Agentforce
Agentforce representa uma plataforma para criar agentes, permitindo que clientes e ISVs criem agentes de IA automatizados para aplicativos como Agentes de serviço e Agentes de vendas. Esses agentes podem processar e responder a consultas do cliente de maneira natural e humana, lidar com um amplo espectro de tarefas de negócios e fornecer benefícios significativos para as empresas e seus clientes.
O fluxo de trabalho de um agente inclui:
- **Ativação**: O agente é acionado por critérios predefinidos, como a solicitação de um cliente em vários canais.
- **Entendendo e respondendo**: Ele utiliza o Processamento de linguagem natural (NLP) para entender a consulta, a intenção e o sentimento do cliente, então consulta a base de Knowledge do Salesforce ou outras fontes de dados para criar uma resposta adequada.
- **Lidar com complexidades**: Se enfrentar um problema complexo ou precisar de supervisão humana, o agente poderá transferir sem problemas a interação para um agente humano.
- **Aprendizagem contínua**: O agente aprende com cada interação, aprimorando continuamente suas respostas e o desempenho geral.
#### Agentforce Studio
O Agentforce Studio fornece uma plataforma de baixo código que permite aos clientes integrar a IA em seus aplicativos e fluxos de trabalho do Salesforce, tornando a tecnologia de IA acessível além dos cientistas de dados.
Os principais recursos do estúdio incluem:
- **Criador de modelo**: Permite criar ou importar modelos de IA adaptados a necessidades de negócios específicas.
- **Criador de prompts**: Uma ferramenta sem código/baixo código que facilita a criação e o gerenciamento de avisos de IA generativa, aprimorando a experiência do usuário com uma interface simples para criar, testar e implementar avisos.
- Criador de **agentes**: Permite que clientes e ISVs desenvolvam agentes conversacionais e autônomos personalizados.
- **Centro de teste**: Suporta testes de modelos, avisos e agentes, cruciais para garantir aplicativos de IA de alta qualidade e otimizar o desempenho e o custo-benefício, ao mesmo tempo que aprimora as respostas determinísticas e a qualidade da experiência do usuário.
A Agentforce combina IA preditiva e generativa, aproveitando a estrutura unificada de metadados da Salesforce Platform e do Data 360 para oferecer soluções de negócios inteligentes, personalizadas e eficientes.
### 7.5 A próxima evolução: Agentforce 3.0
Para atender às demandas aceleradas do mercado de IA generativa, incluindo os rápidos avanços no raciocínio, a necessidade de sistemas multiagentes escalonáveis e a mudança para interfaces multimodais, a Salesforce está evoluindo sua arquitetura com a Agentforce 3.0.
- **Arquitetura assíncrona orientada por evento:** O Agentforce 3.0 é baseado em uma base do Python com uma estrutura de evento aprimorada. Isso habilita a implementação de agente assíncrona e altamente escalonável, melhorando o desempenho e estabelecendo a base para casos de uso complexos de vários agentes em que os agentes podem se comunicar por meio de eventos.
- **Capacidades de voz multimodal:** Passando para além das interações baseadas em texto, o Agentforce 3.0 introduz o suporte para voz como uma modalidade primária. A arquitetura se integra a provedores de telefonia e gateways WebRTC para lidar com transmissão de áudio em tempo real. Novos serviços gerenciam a conversão de áudio em texto (ASR) e texto de volta em áudio (TTS), habilitando experiências de voz conversacionais naturais para casos de uso, como centrais de contato automatizadas.
- **Agentforce Script e determinismo:** Um mecanismo de interceptação baseado em estado-máquinas que restringe o comportamento do agente em uma estrutura explicitamente definida, garantindo caminhos de execução consistentes. Isso habilita gráficos determinísticos, fornece gerenciamento de estado robusto para evitar perda de memória e facilita transferências condicionais e determinadas por LLM, garantindo assim ações do agente previsíveis e consistentes para processos de negócios críticos.
## 8\. Serviços da plataforma de aplicativo
O ecossistema de aplicativo da Salesforce Platform é distinguido por sua integração de recursos entre as camadas de Serviços da plataforma de aplicativo, API, Experiência do usuário e Experiência do desenvolvedor. Os serviços da plataforma de aplicativos são recursos comuns usados para criar e personalizar a maioria dos aplicativos na Salesforce Platform, enquanto os recursos de negócios geralmente são mais específicos da solução.
### 8.1 Principais recursos
O ecossistema do aplicativo é baseado em cinco recursos-chave, que orientam o processo de desenvolvimento do aplicativo.
- **Tenancy**: Isso envolve a separação lógica de dados e metadados em um serviço multilocatário, permitindo que usuários autenticados acessem dados e funcionalidades específicos. Isso fica mais visível para os clientes quando eles recebem uma organização do Salesforce no registro.
- **Entidades**: Representando tabelas de banco de dados, as entidades consistem em campos semelhantes a colunas de tabela. Metadados de entidade e campo incluem atributos para modelagem de dados, como tipos de dados e nomes de API, bem como atributos funcionais, como se a entidade é consultável ou gravável. Essa abstração, em vez de manipulação direta do próprio repositório de dados, permite que o Salesforce introduza e alterne perfeitamente tecnologias de armazenamento sem exigir atualizações de desenvolvedores de TI, garantindo a funcionalidade contínua do aplicativo.
- **Controlo de acesso**: Esses controles regulam o acesso do usuário a dados e recursos, principalmente com base na identidade do usuário e nas políticas específicas. As políticas são compostas por regras e alternâncias de recurso e regem as entidades, os campos e os recursos que podem ser acessados. As políticas e permissões são capturadas em "conjuntos de permissões" e o acesso é concedido atribuindo conjuntos de permissões a identidades de usuário.
- **Extensão em camadas**: Conforme discutido anteriormente, isso dá suporte ao desenvolvimento independente de metadados e aplicativos por diferentes papéis, incluindo engenheiros do Salesforce, parceiros externos, administradores de TI e usuários finais, facilitado por pedidos de salvamento estruturados e namespaces de metadados.
- **Embalagem**: Esse recurso permite o empacotamento e a distribuição de metadados entre locatários do Salesforce, simplificando o processo de atualização e distribuição de aplicativos sem a necessidade de recriação.
Além desses recursos-chave, os Serviços da plataforma de aplicativo também incluem:
- **Tempo de execução de dados e consulta**: Dá suporte a operações como criar, atualizar, excluir e consultar dados em vários repositórios de dados especializados. Um espectro de escala e desempenho de dados é suportado por uma arquitetura que permite executar operações de dados diretamente no repositório de dados, por meio de uma abstração interna para os engenheiros do Salesforce usarem, ou por meio da convenção "Salesforce Object" ou sObject voltada para o cliente.
- **Fluxo / Fluxo de trabalho / Fórmulas**: Definição e execução de regras de validação e lógica de negócios usando ferramentas de baixa codificação.
- **Código do Apex**: Idioma de código profissional para lógica de aplicativo, integrado nativamente a APIs e tempos de execução de dados da plataforma.
- **Serviços de infraestrutura nativos de nuvem:** O Heroku oferece um ambiente robusto para desenvolvedores que usam estruturas e linguagens de programação do setor para criar, implementar e gerenciar aplicativos que se integram a dados e eventos da plataforma.
- **Eventos e Notificações**: Gerencia acionadores e orquestração baseada em evento.
- **Globalização**: Fornece suporte para aplicativos multilíngues e multinacionais.
- **Licenciamento e provisionamento**: Lida com a compra e o gerenciamento do acesso a recursos e aplicativos da plataforma.
- **Lightning Web Stack**: Permite a personalização de interfaces visuais usando metadados estruturados, como layouts, e tecnologias da Web padrão.
- **Sites + CDN**: Garante experiências da Web com baixa latência e alto tráfego, inclusive para usuários não autenticados.
- **Segurança e conformidade**: Oferece ferramentas e controles para cumprir requisitos de conformidade e segurança organizacionais específicos.
- **Prevenção de perda de dados**: Inclui recursos para backup, restauração e arquivamento de dados.
### Plataforma de aplicativos de nuvem 8.2
A Salesforce Platform fornece um conjunto de ferramentas e recursos por meio do Heroku que permite que os desenvolvedores criem, executem e gerenciem aplicativos na nuvem usando as linguagens de programação e estruturas de sua escolha. A Plataforma de aplicativos de nuvem gerenciada do Heroku fornece tempos de execução de aplicativos, armazéns de dados, filas de mensagens e sistemas de eventing como serviços escalonáveis para criar extensões para aplicativos Salesforce.
Os aplicativos que são executados no Heroku têm acesso ao pacote completo de funcionalidades do Salesforce, dados do cliente e lógica de negócios e a capacidade de se conectar a sistemas e serviços de terceiros. Com o Heroku, os desenvolvedores podem se concentrar em entregar valor sem ser sobrecarregados com preocupações de infraestrutura subjacentes.
## 9\. Automação
A automação é o que torna um aplicativo dinâmico e é crucial para a transformação digital de processos comerciais essenciais.
A Automação de processos do Salesforce foi criada para lidar com os principais desafios enfrentados pelos clientes, incluindo a necessidade de processos comerciais simplificados e eficientes conforme a escala das organizações. Esses desafios geralmente envolvem fluxos de trabalho que exigem esforço manual excessivo, levando a ineficiências e custos operacionais maiores. Os clientes buscam uma solução que possa automatizar esses processos, minimizar o trabalho manual e manter a consistência e a precisão.
Um problema significativo foi a ausência de uma ferramenta fácil de usar que permitiu que usuários não técnicos projetassem e implementassem processos de negócios sem habilidades extensas de codificação. Além disso, havia a necessidade de uma solução que possa ser integrada de forma segura, escalonável e perfeita com tarefas do Salesforce automatizadas existentes, como entrada de dados, aprovações, notificações e processos complexos de várias etapas.
A Automação de processos do Salesforce atende a essas necessidades oferecendo uma plataforma robusta, mas intuitiva, para criar fluxos de trabalho automatizados. Permite que os usuários criem e personalizem fluxos por meio de uma interface visual, acessível a usuários técnicos e não técnicos, automatizando tarefas repetitivas, aplicando regras de negócios e simplificando processos no ecossistema do Salesforce.
Para automação que exige orquestração complexa interagindo com dados transacionais, o Salesforce oferece Apex como uma linguagem pro-código para escrever lógica de negócios.
### 9.1 Arquitetura e funcionalidades de automação de processos
**Criador de lógica visual**: Clientes e ISVs usam o Flow Builder, uma interface de arrastar e soltar, para criar fluxos de automação de processo sem codificação. Essa ferramenta visual é fácil de usar para todos os níveis técnicos, permitindo que analistas de negócios e administradores projetem facilmente automações complexas.
O Flow Builder permite que os clientes criem fluxos versáteis que operam em vários contextos, com suporte no Mecanismo de fluxo principal:
- **Acionadores de registro**: Os fluxos são ativados após atualizações de registro ou envios de formulário, habilitando modificações de dados, validações e início de fluxo de trabalho com base nas ações do cliente.
- **Fluxos agendados ou conduzidos por evento**: Esses fluxos podem operar em uma agenda predeterminada ou acionar após eventos específicos e fazer chamadas a serviços externos.
- **Fluxos de tela**: Forneça uma interface do usuário para processos guiados passo a passo com formulários, telas e outros elementos interativos, úteis para tarefas como entrada de dados, solução de problemas ou integração.
- **Fluxos de orquestração**: Gerencie e integre processos de várias etapas, facilitando o tratamento de operações complexas.
O Mecanismo de fluxo offline pode ser executado sem uma conexão com o servidor de aplicativo Salesforce. O Fluxo offline habilita a automação para casos de uso do Field Service Mobile. O Mecanismo de fluxo de alta escala habilita os fluxos de marketing. Ele oferece uma escala B2C para processar um alto volume de fluxos de execução longa simultaneamente.
Todos os casos de uso e ambientes são aprimorados por um modelo de metadados unificado no Flow Builder, que oferece suporte a uma variedade de elementos de lógica eficientes aplicáveis a todos os fluxos de Automação de processos:
- **Lógica e condições avançadas**: Os usuários podem integrar lógica complexa, como elementos de decisão, loops e condições de espera, em seus fluxos de trabalho, permitindo o tratamento de cenários de negócios complexos.
- **Gerenciamento e transformação de dados**: O Flow Builder habilita a ingestão, a transformação e o gerenciamento de dados de várias origens, incluindo serviços da Web, organizações do Salesforce e Data 360\. Ele dá suporte a operações de dados abrangentes, como criação, atualização, exclusão e consulta de registros.
### 9.2 Automação em toda a Salesforce Platform
A Automação de processos do Salesforce oferece uma integração perfeita com outros produtos Salesforce e sistemas de terceiros, garantindo um fluxo de dados tranquilo entre aplicativos para uma visualização unificada de processos de negócios e interações com o cliente. Ele oferece suporte a vários métodos de integração, como APIs, chamadas da Web e conectores do MuleSoft.
A conectividade de Serviços externos e MuleSoft no Salesforce habilita conexões a APIs externas e a utilização de seus dados na Automação de processos do Salesforce. Registrar o esquema de API permite a criação de ações invocáveis que se integram perfeitamente a fluxos, facilitando a automação de processos com origens de dados externas. Os recursos de integração robustos da MuleSoft garantem um fluxo de dados contínuo entre o Salesforce e outros aplicativos, eliminando silos de dados e fornecendo uma visualização unificada dos processos de negócios.
**Agentforce Integration**: A Automação de processos do Salesforce utiliza o Agentforce para aprimorar os fluxos de trabalho com tomada de decisão inteligente. Ele usa percepções de IA para direcionar automaticamente leads a representantes de vendas adequados ou iniciar campanhas de marketing personalizadas com base no comportamento do cliente, aumentando assim a eficácia da automação com inteligência adicional.
**Sinergia de plataforma**: A Automação de processos do Salesforce se integra perfeitamente a outros produtos do Salesforce, como Sales Cloud, Service Cloud, Commerce Cloud e Marketing Cloud. Essa integração permite que as organizações automatizem processos em vários departamentos, aprimorando a eficiência operacional. Por exemplo, um fluxo de trabalho pode gerar automaticamente um caso de suporte no Service Cloud quando uma reclamação do cliente é enviada por meio de um formulário do Marketing Cloud.
### 9.3 Automação de código profissional com Apex
O Apex é uma poderosa linguagem de programação orientada a objetos que permite aos desenvolvedores escrever lógica de negócios personalizada e realizar operações complexas na plataforma Salesforce. Ele tem sido um pilar da nossa plataforma, e atualmente a plataforma lida com mais de 350 bilhões de transações do Apex por mês (em outubro de 2025).
O Apex é usado para desenvolver uma ampla gama de funcionalidades personalizadas e integrações profundas na plataforma Salesforce, incluindo:
- **Automação baseada em acionador**: Implemente automação complexa que seja executada antes ou depois de os registros serem inseridos, atualizados ou excluídos. Isso permite validação de dados complexa, atualizações de registro relacionadas e a invocação de outros processos com base em alterações de dados específicas.
- **Serviços da Web:** Crie integrações personalizadas com sistemas externos e chame APIs REST ou SOAP do Apex.
- **Interfaces de usuário personalizadas**: Crie interfaces e experiências de usuário altamente personalizadas usando o Visualforce e os Componentes da Web Lightning (LWC), em que o Apex serve como o controlador de back-end para lidar com manipulação de dados e lógica de negócios.
- **APIs personalizadas:** Os desenvolvedores podem expor lógica personalizada como APIs usando Apex REST e Apex SOAP, permitindo que sistemas externos interajam com dados e processos do Salesforce de forma programática.
- **Processamento assíncrono**: Execute tarefas de execução longa ou de uso intensivo de recursos de forma assíncrona por meio de métodos futuros, Apex enfileirável e Apex agendado. Isso permite que operações de execução longa sejam descarregadas e processadas em segundo plano, melhorando a experiência do usuário e o desempenho do sistema.
- **Apex agendado:** Os desenvolvedores podem agendar classes do Apex para execução em horários específicos usando o Agendador do Apex para tarefas periódicas, como sincronização de dados noturna, geração de relatórios e atividades de manutenção.
## 10\. Experiências do usuário
Os recursos Experiências do usuário na Salesforce Platform permitem que os usuários finais interajam com aplicativos por meio de várias opções de implantação em aplicativos do Lightning baseados em navegador, sites do Experience, componentes nativos para dispositivos móveis, orientados para IA, UX colaborativa ou integrados usando o Lightning Out.
### 10.1 Sistema de design do Lightning
O Salesforce Lightning Design System (SLDS) é uma estrutura de design abrangente que promove a criação de interfaces de usuário consistentes e acessíveis com os princípios de design da Salesforce para uma experiência de usuário coesa em todos os produtos. Ele permite que engenheiros, clientes e parceiros do Salesforce criem aplicativos que parecem nativos em todo o ecossistema do Salesforce.
Os principais recursos do sistema de design incluem:
- **Padrões de design**: Soluções comprovadas para desafios de design comuns, fornecendo diretrizes para layout, apresentação de dados e interações com o usuário para garantir uma experiência de usuário consistente.
- **Cacos de estilo**: Variáveis CSS que representam decisões de design, como cores, tipografia, espaçamento e tamanhos, garantindo a consistência entre os aplicativos.
- **Biblioteca de componentes do Lightning Base**: Uma coleção de componentes reutilizáveis da IU, como botões, elementos de formulário e elementos de navegação, que seguem os princípios de design do Salesforce, facilitando o desenvolvimento rápido e eficiente.
- **Acessibilidade**: Recursos e diretrizes de acessibilidade integrados para garantir que todos os componentes sejam utilizáveis por indivíduos com deficiência e cumpram padrões, como Diretrizes de acessibilidade de conteúdo da Web (WCAG).
- Layouts **responsivos**: Um sistema de grade flexível e diretrizes de layout que permitem que os aplicativos se adaptem perfeitamente em diferentes dispositivos e tamanhos de tela.
- **Tooling**: Uma coleção de ferramentas, recursos e tecnologias que dão suporte à higiene do componente, à redução antipadrão e à governança do sistema de design.
A estrutura SLDS continua a evoluir para dar suporte a ganchos de estilo mais avançados e capacidades de personalização mais profundas, de modo que os componentes possam ser reutilizados enquanto ainda são personalizados para atender aos requisitos exclusivos de identidade visual e tema. Nossa aspiração do sistema de design é tornar o Salesforce rápido, fácil e atraente para usar com IA.
### 10.2 Lightning Web Stack
A interface baseada em navegador do Salesforce, conhecida como Lightning, oferece um contêiner de interface do usuário consistente e uma estrutura de interface do usuário orientada por metadados e uma coleção de tecnologias para engenheiros, administradores de TI, desenvolvedores e parceiros do Salesforce desenvolver rapidamente a interface do usuário com uma estética consistente do Salesforce, bem como pontos de extensão para controle completo para reformular o estilo e redefinir a marca. O Lightning Web Stack inclui várias tecnologias:
- **Componentes da Web Lightning**: Componentes da Web personalizados criados com HTML e JavaScript, seguindo os padrões da Web W3C.
- **Lightning Web Security**: Um mecanismo de virtualização que gerencia o código JavaScript no navegador, garantindo a conformidade com os padrões de segurança do Salesforce para código de terceiros.
- **Lightning Data Services**: Uma estrutura projetada para interação eficiente com dados do lado do servidor.
- **Lightning Web Runtime**: Garante uma renderização eficiente e consistente da IU em vários clientes.
A engenharia do Salesforce incorporou lições de tecnologias anteriores da IU e contribuiu para os corpos de padrões da Web, influenciando o desenvolvimento de implementações de componentes baseadas em padrões. Por exemplo, o Salesforce continua a ser membro de aproximadamente 20 grupos de trabalho do W3C. Os Componentes da Web Lightning e o Lightning Web Stack estão alinhados a esses padrões da indústria, reduzindo a complexidade para os desenvolvedores.
### 10.3 Dispositivo móvel
O aplicativo móvel continua sendo uma interface crescente e crítica para os usuários interagirem com os aplicativos Salesforce.
O Salesforce fornece um aplicativo móvel nativo para que todos os aplicativos do Lightning baseados em navegador possam se tornar aplicativos móveis sem precisar escrever novo código. O Salesforce também oferece uma gama de ferramentas, SDKs e recursos para criar aplicativos nativos totalmente personalizados otimizados para dispositivos. Essas incluem:
- **SDK: móvel** Interface de código profissional para desenvolvedores em sistemas operacionais móveis que simplifica a integração com autenticação, gerenciamento de sessão/token, APIs do Salesforce e muito mais.
- **Tempo de execução nativo móvel**: Permite que os desenvolvedores criem experiências nativas conduzidas por metadados renderizadas dinamicamente em tempo de execução usando tecnologias iOS e Android que também aproveitam os recursos no dispositivo.
- **Branding**: Permite a personalização da estética do aplicativo móvel por meio do Mobile Publisher Pipeline para converter aplicativos móveis do Salesforce em aplicativos com a marca do cliente.
- **Capacidades offline**: Garante a funcionalidade perfeita do aplicativo com conectividade à Internet inconsistente ou nenhuma.
A Estrutura de personalização móvel (MCF) aprimora significativamente o desenvolvimento de aplicativos móveis nativos do Salesforce oferecendo facilidade de uso e amplas opções de personalização. As principais vantagens incluem:
- **Abordagem baseada em metadados**: O MCF utiliza metadados, que podem ser adquiridos de criadores visuais, repositórios comuns e recursos hospedados no Salesforce, para criar experiências de usuário dinâmicas e adaptáveis personalizadas para necessidades específicas.
- **Experimentação e otimização**: A estrutura dá suporte à experimentação de tempo de execução com diferentes layouts, facilitando a otimização de engajamento contínua e o refinamento da experiência do usuário.
- **Extensibilidade**: Projetado para flexibilidade, o MCF permite a integração de componentes personalizados à estrutura de metadados essenciais, aprimorando a funcionalidade e a versatilidade.
- **Experiências do usuário compostas**: Usando as tecnologias mais recentes para iOS e Android, o MCF oferece suporte à montagem de componentes reutilizáveis, como botões, listas e cartões, para criar interfaces de usuário sofisticadas.
- **Personalizar tempo de execução**: O MCF habilita a personalização e a experimentação da IU em tempo real, promovendo uma experiência de usuário mais personalizada e envolvente.
Cenários offline e de baixa conectividade são uma preocupação crescente ao usar aplicativos em dispositivos móveis. A pilha de tecnologia móvel prioriza a criação de aplicativos que podem ser offline primeiro. Os principais recursos incluem:
- **Cache Primeira experiência**: Concentra-se no armazenamento em cache de dados para uso offline, garantindo alto desempenho e segurança. A interação do usuário também é projetada considerando os princípios de renderização offline.
- **Gerenciamento de cache**: Mantenha o cache relevante e atualizado mesmo quando offline.
- **Cache compartilhado**: Usa um único cache para telas nativas e híbridas, facilitando experiências offline perfeitas.
O Nimbus é a solução pronta para produção da plataforma que simplifica o processo de acessar os recursos do dispositivo para desenvolvedores de aplicativos híbridos. Tradicionalmente, a ponte entre o JavaScript e o código nativo móvel era uma tarefa complexa. No entanto, com o Nimbus, os desenvolvedores agora podem aproveitar todo o potencial de dispositivos móveis sem se aprofundar na codificação de baixo nível. Os principais recursos incluem:
- **Acesso amplo**: Fornece integração perfeita com uma variedade de recursos de dispositivo, como câmera, microfone, geolocalização e LiDAR.
- **Interface padronizada**: Oferece um método uniforme para acessar os recursos do dispositivo.
- **Integração de aplicativo híbrido**: Permite que aplicativos híbridos utilizem totalmente as funções do dispositivo.
- **Desenvolvimento eficiente**: Simplifica o processo de desenvolvimento do aplicativo, reduzindo a complexidade.
Conforme a IA continua a transformar o que é possível com aplicativos Salesforce, o Salesforce também proporciona uma experiência de usuário diferenciada aproveitando modelos de IA específicos de tarefas no dispositivo junto com soluções baseadas na nuvem:
- **Modelos de pequena linguagem (SLM):** Eles podem ser executados em dispositivos móveis de modo eficiente e a um custo menor.
- **Privacidade e Segurança:** Garante a privacidade do usuário e mantém Trust e segurança em níveis comparáveis aos modelos baseados em servidor.
- **Funcionalidade offline:** Opera de modo eficaz em ambientes com pouca conectividade, habilitando casos de uso offline.
- **Voice:** Os modelos state-of-the-art de discagem de texto para texto, texto para voz natural e discagem de locutor agora são executados nativamente em dispositivos, oferecendo interações de voz de alta fidelidade com privacidade total e zero latência.
### 10.4 IA e colaboração
Interface do usuário não modelo para interações de múltiplos turnos e linguagem natural com nosso aplicativo continuará aumentando a prevalência. Os desenvolvimentos futuros devem aprimorar a integração entre modelos, recursos do dispositivo e aplicativos, melhorando as interações do usuário por meio de interfaces de texto e voz mais intuitivas. A coleção de métricas no dispositivo também permitirá ajustes personalizados com base nas preferências do usuário.
A colaboração é essencial entre todos os usuários, incluindo humanos e agentes, para aproveitar os pontos fortes combinados de automação e supervisão humana. Essa colaboração é particularmente crucial para interações de negócios complexas envolvendo os funcionários de uma organização e seus clientes. O Slack serve como uma ferramenta principal na Salesforce Platform, facilitando essa interação por meio de mensagens diretas e canais de vários usuários personalizados para tópicos de discussão específicos. Essas discussões podem variar de conversas espontâneas criadas pelo usuário a diálogos mais estruturados centrados em dados específicos no fluxo de trabalho de um usuário, como um segmento de mensagem do Slack detalhado que lida com um problema significativo do cliente.
No futuro, a Salesforce Platform planeja aprimorar a experiência colaborativa fornecida atualmente pelo Slack. Essa expansão terá como objetivo utilizar totalmente os amplos recursos da plataforma, aprimorando a maneira como os usuários interagem e colaboram no espaço de trabalho digital.
## 11\. Experiência do desenvolvedor
Os recursos da Experiência do desenvolvedor na plataforma fornecem ferramentas para criar, personalizar, testar e implementar aplicativos, focando o espectro de baixo código por meio de abordagens de código profissional, garantindo oportunidades iguais para desenvolvedores de todos os níveis de habilidade.
- **Ferramentas de baixo código**: Eles incluem o Criador de esquemas para modelos de dados, o Fluxo para regras de negócios e a personalização do AppBuilder para interface do usuário, todos projetados para simplificar o processo de desenvolvimento manipulando metadados estruturados e trabalhando no idioma da solução de negócios, em vez de conceitos técnicos e jargão.
- **Ferramentas pro-código**: Para desenvolvedores que precisam de uma personalização mais avançada e complexa, a plataforma oferece ferramentas como o Criador de código do Salesforce, um IDE baseado em nuvem, junto com uma interface de linha de comando (CLI) e APIs para codificação avançada e criação de componentes. Os desenvolvedores podem codificar no idioma de sua escolha aproveitando soluções para implantar, gerenciar e otimizar aplicativos com o Heroku.
- **Entorno de desenvolvimento integrado**: O ecossistema do Salesforce oferece suporte à integração perfeita entre ferramentas de código baixo e de código profissional, bem como ao desenvolvimento coerente na nuvem e localmente com ferramentas padrão do setor.
- **Gerenciamento de ciclo de vida do aplicativo (ALM)**: Possui uma variedade de organizações de sandbox para desenvolvimento separadas do ambiente de produção, incluindo organizações teste para desenvolvimento inicial e organizações de sandbox completas para testes com base em dados e escala semelhantes à produção.
### IA 11.1 para desenvolvedores
A IA e os "Assistentes do desenvolvedor" estão revolucionando a experiência do desenvolvedor simplificando e acelerando a criação de aplicativos eficientes e de alta qualidade. No Salesforce, nossas equipes de pesquisa de IA e experiência do desenvolvedor estão continuamente iterando e explorando como a IA preditiva e generativa com raciocínio agencial pode ser transformada em agentes avançados do desenvolvedor. Esses agentes de desenvolvedor são nativamente integrados às ferramentas que os desenvolvedores já usam, como VS Code, Code Builder, linha de comando, DevOps Center e Code Analyzer, tornando-os mais relevantes e impactantes.
Fizemos avanços significativos na análise de código para identificar antipadrões e pontos críticos no Apex code e, em seguida, fornecer recomendações críticas para melhorar sua implementação. Os problemas identificados geralmente desperdiçam recursos de computação e geralmente levam a incidentes em grande escala. Foi iniciado como Insights do ApexGuru em janeiro de 2024.
No primeiro ano após o lançamento, mais de 2.800 organizações do Salesforce usaram o ApexGuru para analisar e melhorar a implementação do Salesforce. Mais de 22.000 recomendações foram implementadas com sucesso, levando a uma economia de 28.000 horas de CPU por semana. Esse aprimoramento não só aumenta o desempenho, como também contribui para a sustentabilidade ambiental, reduzindo as emissões de CO2 em 135 kg por semana, alinhando-se ao nosso principal valor de Sustentabilidade e compromisso de reduzir as emissões de carbono.
Também estamos integrando a IA em ferramentas e recursos de desenvolvedor pro-código para melhorar a Developer Productivity. Produzido como "Agentforce para desenvolvedores" em 2024, os desenvolvedores podem acessar esses novos recursos nos pacotes de Extensão do Salesforce no Visual Studio code e no Criador de código. Essas extensões habilitam:
- Sugestões de código em linha conforme o desenvolvedor escreve e gera código para componentes da Web do Apex e do Lightning (JavaScript, CSS, HTML).
- Geração de explicações de código e documentação para componentes da Web do Apex e do Lightning.
- Geração de código de teste da unidade do Apex.
- Uma experiência de chat de vários turnos distinta no IDE que pode trabalhar em várias respostas para geração, explicação e documentação de código.
- Otimizações de Componentes da Web do Lightning.
- Geração do agente com metadados YAML legíveis por humanos, incluindo funcionalidades de depuração e teste do agente.
A partir de outubro de 2025, mais de 42.000 desenvolvedores estão usando ativamente essa tecnologia mensalmente, com 17,6 milhões de linhas de código aceitas. Esse pacote abrangente garante um ambiente de desenvolvimento flexível, integrado e eficiente, atendendo a um amplo espectro de necessidades de desenvolvimento dentro da Salesforce Platform. As ferramentas de desenvolvedor de IA também são aprimoradas com uma arquitetura que funciona em vários modelos externos e criados pelo Salesforce para escolher o modelo mais eficaz e eficiente para um determinado caso de uso.
### 11.2 Suporte a MCP e codificação assistida por IA
O Protocolo de contexto de modelo (MCP) é um padrão aberto emergente projetado para permitir que os agentes de IA interajam de modo seguro e consistente com qualquer ferramenta ou fonte de dados. A Salesforce está integrando nativamente o suporte para MCP ao kit de ferramentas do desenvolvedor do Salesforce para ajudar os agentes de desenvolvedores que podem acessar recursos e ferramentas em toda a empresa. Isso inclui:
- **Servidor MCP local:** Um servidor MCP local permite que os desenvolvedores criem, testem e depurem facilmente suas integrações agentes em seu IDE local antes de implementar em produção, melhorando dramaticamente a produtividade. O servidor MCP local oferece ferramentas especializadas para interações da organização e fluxos de trabalho de desenvolvimento, como desenvolvimento móvel, testes de acessibilidade, migração do Aura para LWC e DevOps agentes. O servidor de MCP local também inclui integração com o raciocínio agente e LLMs para capacitar melhor os desenvolvedores a "codificar" seu aplicativo de modo iterativo e em linguagem natural.
- **Servidor MCP personalizado para APIs do Salesforce:** Os desenvolvedores agora podem expor com segurança APIs do Salesforce, objetos do Data 360 e fluxos de automação como "ferramentas" de MCP. Isso transforma toda a Salesforce Platform em um conjunto de recursos avançado, confiável e descobrível para qualquer aplicativo ou agente de IA externo, completo com controle de acesso granular e o potencial para novos modelos de monetização baseados em consumo.
- **Conexão de MCP externo nativo:** Os desenvolvedores também podem gerenciar com segurança a conectividade com servidores externos em conformidade com o padrão MCP. Isso permite que os desenvolvedores criem agentes que podem trabalhar em toda a empresa.
## 12\. Pacote de aplicativos
Nossas nuvens de aplicativos, incluindo o Sales Cloud, o Service Cloud, o Marketing Cloud, o Revenue Cloud e o Commerce Cloud, são criadas com base na Salesforce Platform, oferecendo recursos de negócios líderes e compondo nosso aplicativo Suite para promover o sucesso do cliente. Os principais recursos incluem:
- **Integração perfeita**: Profundamente integrado e projetado para trabalhar de modo coeso em toda a jornada do cliente e garantir um fluxo tranquilo de dados e processos em pontos de contato do cliente, aprimorando a experiência do cliente.
- **Personalizabilidade completa**: Criados em nossa plataforma, nossos aplicativos oferecem amplas opções de personalização, de sem código a pro-código, permitindo a personalização precisa de acordo com as necessidades do cliente.
- **Capacidades avançadas de IA**: Forneça fluxos de trabalho baseados em canal interativos com assistência do agente e autônomos do agente com nossos Agentes Agentforce. Incorpora IA preditiva e generativa para aumentar a eficiência por meio de automação, análise preditiva e experiências de usuário personalizadas, fornecendo percepções e recomendações acionáveis.
- **Processamento de dados em tempo real**: Usa o Data 360 para acesso e análise de dados em tempo real, oferecendo suporte à tomada de decisão oportuna e informada com base nas informações mais atuais. Isso aumenta a responsividade e a agilidade em ambientes de ritmo acelerado.
- **Dados unificados e análise**: Integra várias fontes de dados a uma plataforma centralizada para visualizações de dados consistentes e abrangentes, fornecendo análises precisas e aprimorando a tomada de decisão.
- **Segurança e conformidade aprimoradas**: Dispõe de ferramentas robustas de segurança e conformidade para proteger dados confidenciais e cumprir padrões regulatórios.
- **Experiência do usuário de nível de consumidor**: Oferece interfaces intuitivas e fáceis de usar que tornam os aplicativos acessíveis e eficientes em dispositivos, canais e modalidades.
- **Confiabilidade**: Garante tempo de inatividade mínimo e escalabilidade para dar suporte a operações essenciais para a vida e a missão, incluindo serviços de emergência e sistemas de transporte críticos.
- **Elastic Scalability**: Criado com base no Hyperforce que suporta o aumento dos volumes de dados e interação do usuário sem sacrificar o desempenho ou o custo de servir.
- **Melhoramento contínuo**: Integra regularmente inovações para aprimorar os recursos sem interromper as operações existentes.
A Salesforce está dedicada ao avanço de seus aplicativos unificando recursos em toda a plataforma, com base nas tecnologias fundamentais descritas neste artigo. Essa transformação é guiada por um conjunto de prioridades-chave que moldam o design e o desenvolvimento do pacote de aplicativos do Salesforce.
### 12.1 Escala e desempenho
Nossas equipes de aplicativos se especializam em desempenho e escalabilidade, usando laboratórios de desempenho avançados para criar réplicas exatas de nossos ambientes de produção com dados sintéticos. Essa configuração permite uma ampla simulação de jornadas de usuário paralelas para garantir que cada novo recurso seja totalmente testado e seu impacto avaliado. Quando gargalos de tempo de execução são identificados, ajustamos dinamicamente os limites de taxa e outras medidas para proteger a integridade do sistema enquanto também coletamos dados para promover a resolução.
Nossos sistemas são projetados para escala horizontal para utilizar a flexibilidade da nuvem pública de modo eficaz. As verificações automatizadas garantem que atualizações ou aprimoramentos não afetem negativamente o desempenho. Empregamos escaladores automáticos preditivos que gerenciam proativamente a carga do sistema, não apenas reagindo a um aumento da demanda, mas prevendo e ajustando com antecedência.
A escala automática é crucial para minimizar o custo de atendimento reduzindo a capacidade não utilizada. Monitoramos os custos de execução do sistema de perto, identificando e resolvendo quaisquer ineficiências na escala automática ou no uso de recursos. Embora a rentabilidade seja importante, priorizamos a entrega confiável de aplicativos, optando por escaladores automáticos que aumentam rapidamente e diminuem lentamente para manter a Trust do cliente, mesmo que incida em custos maiores.
### 12.2 Integração aprimorada
#### Modelo de dados comum
Os modelos de dados são fundamentais para todas as operações de negócios no Salesforce, influenciando as funcionalidades de negócios, as APIs, a navegação, as exibições da IU e os relatórios que podem ser criados. Eles são integrais à funcionalidade da plataforma.
Nosso pacote de aplicativos compartilha um modelo de dados comum entre o Sales Cloud, o Service Cloud, o Revenue Cloud, o Commerce Cloud, o Marketing Cloud e o Industries Cloud. Isso contribui para nosso pacote integrado, fornecendo comportamento e interoperabilidade consistentes e caminhos claros para atualizações e extensões.
Por exemplo, o compartilhamento de entidades de Conta e Produto em todas as nuvens permite que os usuários no Marketing Cloud e no Sales Cloud troquem dados, metadados, componentes da IU e lógica de negócios. Essa integração ajuda a dividir silos e promove a colaboração interfuncional.
#### Plataforma de dados virtual
Um modelo de dados comum em todos os Salesforce Clouds aprimora significativamente a integração, mas pode não atender a todas as necessidades complexas de integração do parceiro. O Modelo de dados comuns do Data 360 expande isso estendendo os benefícios do modelo de dados compartilhado além dos limites de dados típicos do Salesforce, acomodando cenários de integração mais extensos.
#### Extensibilidade em camadas
A Estrutura de metadados do Salesforce permite que vários grupos, como equipes de engenharia, ISVs, parceiros, administradores e usuários finais, personalizem e expandam seus aplicativos dentro de camadas distintas de extensibilidade sem interferir entre si. Essa estrutura oferece suporte a um ambiente escalonável em que modificações de um grupo não interrompem outras, mantendo a integridade do sistema.
Um excelente exemplo do quadro em vigor é o produto Conhecimento unificado, que integra todas as fontes de Knowledge em um data lake. Essa configuração inclui uma camada semântica e recuperadores, aprimorando os recursos de IA preditiva e generativa no Sales Cloud, no Service Cloud, no Revenue Cloud, no Marketing Cloud e no Commerce Cloud. Incorpora um modelo de dados para Knowledge não estruturado e semiestruturado vinculado ao modelo de Knowledge estruturado existente.
Além disso, a Estrutura usa metadados para definir relacionamentos personalizados entre tipos de dados, facilitando a geração de consultas avançadas. Isso permite que as equipes de aplicativos criem aplicativos personalizáveis que aproveitem essa ampla base de Knowledge, enquanto ISVs, parceiros e clientes podem aprimorar ainda mais as capacidades de aplicativos modificando relacionamentos de metadados ou desenvolvendo recuperadores personalizados para casos de uso de negócios específicos.
#### Aprimorar a plataforma de dados comum
Os dados do cliente são armazenados com segurança em várias plataformas, como o SalesforceDB e o Data 360, e são padronizados e normalizados independentemente de seu formato estruturado ou não estruturado. Isso garante o tratamento de dados consistente por meio de um formato unificado conhecido como sObject, que oferece suporte a uma plataforma de dados coesa em todos os dados do cliente.
Essa padronização permite uma API única para todas as operações de dados, uma interface unificada para acionadores no Apex e a criação de fluxos de trabalho personalizados com o Fluxo. Ele também oferece suporte ao Tableau Next, permitindo visualizações de dados personalizadas e integração com ferramentas de IA generativa, como Criador de prompts, para geração de resposta inteligente com base em dados do cliente.
Além disso, os aplicativos do Salesforce se integram a vários repositórios de dados para aprimorar a flexibilidade do processo de negócios nos produtos. Por exemplo, no Marketing Cloud, o Fluxo é usado para gerenciar experiências do cliente com múltiplos contatos, com opções para usar modelos pré-projetados ou criar fluxos personalizados que integram o marketing a outros processos de negócios, tudo com base nos dados subjacentes do cliente.
### 12.3 Funcionalidades comerciais compartilhadas
Os aplicativos aproveitam e aprimoram serviços compartilhados, como resolução de identidade, orquestração de conteúdo, personalização, análise, Gateway de LLM e Serviços de raciocínio, permitindo a rápida inovação e entrega. Esses serviços oferecem suporte ao processamento de dados em tempo real, percepções conduzidas por IA e experiências de usuário aprimoradas, proporcionando uma visão abrangente de 360 graus do cliente.
Os benefícios incluem maior eficiência por meio de automação inteligente e análise preditiva, escalabilidade para aumentar as interações de dados e usuários e segurança e conformidade robustas. Os recursos de personalização da plataforma permitem que as organizações adaptem-se rapidamente às necessidades em mudança, promovendo o crescimento e a excelência operacional.
A inovação no Nível de aplicativo é impulsionada pela Salesforce Platform e por aplicativos individuais, aprimorando o ecossistema do Salesforce e estabelecendo aplicativos como líderes do setor.
### 12.4 Multicanal e otimizado para canal
Os aplicativos do Salesforce são projetados para atender usuários em uma variedade de plataformas, incluindo Web, dispositivos móveis, email, SMS, WhatsApp e outros canais. Eles otimizam os recursos nativos de cada canal para aprimorar a experiência e a eficiência do usuário.
Os recursos incluem funcionalidades offline de vários meses para usuários do Salesforce Field Service, notificações por push do navegador e layouts de tela larga para agentes de serviço no Console de serviço do Lightning e lojas de alto desempenho e co-pilotos para compradores do Commerce.
A plataforma de metadados garante que a Salesforce, seus parceiros e clientes possam aproveitar imediatamente esses recursos prontos para uso.
### 12.5 Entrega rápida da inovação
Os serviços básicos, a plataforma e as funcionalidades de negócios compartilhados da Salesforce permitem que os aplicativos se adaptem rapidamente a mudanças de mercado e tendências tecnológicas, permitindo uma rápida entrega de inovação. Por exemplo, com o advento da IA generativa, a Salesforce rapidamente utilizou serviços de IA existentes, como a Camada de Trust do NLP e a Detecção de intenção, para incorporar modelos de prompt na Universal Communications Platform. Essa integração aprimora a funcionalidade de mensagens e telefone entre produtos, facilitando conexões mais pessoais com clientes.
Seguindo a tendência para a IA autônoma, a Salesforce lançou Agentforce, uma solução que aproveita esses investimentos existentes para automatizar casos de uso de negócios com agentes de forma eficiente, sem a necessidade de criar do zero.
### 12.6 Caminho para o pacote de aplicativos
Recriamos o Marketing Cloud, o Revenue Cloud e o Commerce Cloud na Salesforce Platform, permitindo que essas nuvens compartilhem a mesma infraestrutura, plataforma, metadados, dados, IA, componentes da IU e lógica de negócios, ao mesmo tempo que se beneficiam do poder total da Salesforce Platform. Por exemplo, pegamos recursos do Revenue Cloud e recursos principais integrados, como o configurador baseado em restrições, os mecanismos de precificação e o gerenciamento de catálogos, tornando-os serviços básicos disponíveis em todo o pacote. Isso também nos permite ter uma integração perfeita em todas as nossas nuvens, e os recursos que o Commerce Cloud e o Marketing Cloud fornecem se tornam parte dos recursos de negócios compartilhados que podem ser aproveitados pelos outros aplicativos. Esta é nossa visão do pacote de aplicativos integrado entregue.
A jornada da Salesforce Platform levou ao desenvolvimento de um pacote de aplicativos integrado que combina o Sales Cloud, o Service Cloud, o Marketing Cloud, o Revenue Cloud e o Commerce Cloud em uma solução unificada. Disponível da edição Salesforce Starter em diante, esse pacote oferece alcance de vários canais, gerenciamento de relacionamento com o cliente e percepções de negócios em um pacote coeso. Independentemente da edição escolhida, os usuários podem acessar os recursos principais do Sales Cloud, do Service Cloud, do Marketing Cloud e do Commerce Cloud, garantindo uma experiência consistente em todos os níveis.
## 13\. Soluções específicas do setor
Os produtos do Salesforce Industries para Serviços financeiros, Saúde, Ciências da Vida, Mídia, Energia e Utilitários, Manufatura, Automotivo, Bens de consumo, varejo, Net Zero, Setor público, Educação e Organizações sem fins lucrativos estendem nossos produtos e plataforma de aplicativos para fornecer soluções personalizadas que atendem aos desafios exclusivos das indústrias. Eles simplificam as operações e aumentam a produtividade incorporando fluxos de trabalho, medidas de conformidade e modelos de dados específicos do setor.
O portfólio de Indústrias foi recriado na Salesforce Platform para habilitar a capacidade de composição entre verticais. Os clientes agora podem montar um ou mais recursos do setor em soluções personalizadas, aproveitando metadados compartilhados, APIs e serviços de negócios. Essa abordagem balanceia a diferenciação vertical com a consistência da plataforma, garantindo adaptabilidade e escala em diversos contextos regulatórios e de negócios.
### 13.1 Abordagem da arquitetura em camadas
Nossos produtos usam uma arquitetura em camadas. Na base estão a Salesforce Platform e aplicativos horizontais, como o Sales Cloud e o Service Cloud, que servem como a base para todas as soluções do setor. Para isso, o Salesforce adicionou serviços comuns de valor agregado que aprimoram componentes reutilizáveis integrados na maioria das indústrias. Exemplos disso incluem funcionalidades para Automação digital, Linhas do tempo, Planos de ação e muito mais. Acima dessa camada, há uma camada de lógica de negócios reutilizável que encapsula recursos horizontais, como gerenciamento de feedback, CPQ (config, price, cotação) e gerenciamento de serviço.
A camada superior apresenta personalizações específicas do domínio personalizadas para atender a requisitos específicos do setor, aproveitando a plataforma subjacente para maior escalabilidade e eficiência. Por exemplo, na vertical de manufatura, essa configuração otimiza o planejamento de produção por meio de previsões precisas. No setor de biociências, ele fornece às equipes de vendas farmacêuticas soluções offline móveis que gerenciam de modo eficiente fluxos de trabalho e tratamento de amostras enquanto cumprem vários requisitos regulatórios geográficos.
### 13.2 Recursos específicos do setor
Excelência **IA confiável**: Nossas soluções de IA generativa confiáveis fornecem recursos de IA específicos do setor. Eles incluem agentes e engenharia de prompt, que facilitam a automação e a digitalização de código baixo/sem em setores como saúde, biociências e serviços financeiros. Além disso, recursos como mineração de documentos/texto e resumo atendem a setores que lidam com grandes volumes de dados, ajudando na extração de informações e na coleta de percepções.
Agentes personalizados aprimoram a comunicação de três vias entre agentes e clientes, levando a resoluções mais rápidas. A camada Trust da Salesforce Platform facilita a adesão a todos os padrões de conformidade e regulatórios em todas as indústrias.
**Dados, percepções e inteligência com conformidade regulatória e segurança**: O Salesforce Industries oferece uma visão completa abrangente com medidas de privacidade, compartilhamento e segurança de dados rígidas adaptadas a normas específicas do setor, como GDPR, HIPAA e FedRamp. O Salesforce integra dados de várias origens, habilitando a conformidade e a segurança, e aprimora essas soluções com recursos adicionais, como Shield Encryption BYOK (Traga suas próprias chaves) para criptografia de dados do locatário.
**Experiência de usuário aprimorada**: O Salesforce Industries enfatiza uma experiência de usuário aprimorada, adaptada às necessidades específicas do setor, para aprimorar a jornada do usuário. Isso inclui ferramentas como o Centro de recursos acionável, modelos do Experience Cloud e soluções baseadas em OmniStudio.
**Digitização, integração e integração**: O Salesforce Industries fornece digitalização, integração e integração por meio de soluções sem código e sem código, aproveitando ferramentas como Fluxos e OmniStudio para novos clientes e oferecendo soluções de migração para sistemas de CRM existentes. A integração com sistemas e dados externos é simplificada por meio dos conectores oferecidos pela MuleSoft. O Salesforce também inclui processos de serviço específicos do setor, como gerenciamento de litígios para Retail Banking.
**Móvel e Offline**: O Salesforce Industries fornece suporte robusto específico de domínio para o aplicativo Salesforce móvel e o aplicativo Field Service Mobile. Para domínios altamente especializados que exigem suporte offline avançado, as Indústrias fornecem aplicativos móveis personalizados criados com SDKs móveis do Salesforce.
**Capacidades de negócios comuns**: As Indústrias do Salesforce se baseiam em funcionalidades de negócios comuns, permitindo consistência e produtividade enquanto personalizam soluções para necessidades específicas do setor, como diferentes sistemas de agendamento de consultas para bancos e hospitais. Integrado ao ecossistema mais amplo do Salesforce, o Salesforce oferece uma visualização holística do Customer 360, tornando-o uma parte vital do pacote de produtos do Salesforce.
## 14\. Análise
Por anos, o mercado da plataforma Analytics e Inteligência de negócios (BI) promove percepções automatizadas conduzidas por IA e autoatendimento visual para os usuários finais para ajudá-los a tomar decisões mais rápidas e orientadas por dados. No entanto, sabemos que nem todos viram isso funcionar devido a vários desafios:
- **Insights desconectados**: As percepções não são integradas aos fluxos de trabalho dos usuários, tornando difícil agir quanto às percepções, apesar de seu potencial para informar a tomada de decisão.
- **Sobrecarga de dados e silos**: Os dados continuam crescendo rapidamente e permanecem compartilhados, levando a riscos de desorganização e segurança. As organizações enfrentam um dilema entre um ambiente de dados de autoatendimento caótico e um ambiente de dados restritivo e bem gerenciado.
- **Confiança nos dados**: A expansão e fragmentação dos dados tem erodido o Trust dos usuários nas percepções derivadas dos dados da empresa.
- **Falta de capacidade de composição**: Há uma ausência significativa de capacidade de composição e reutilização em processos de trabalho, forçando os usuários a repetir tarefas e sem caminhos claros para a monetização.
O Tableau Next é projetado para ampliar o ciclo da análise visual unindo usuários de negócios e profissionais de dados de novas maneiras colaborativas, tudo ampliado com IA. Ele fornece métricas e percepções oportunas e confiáveis por meio da Salesforce Platform, facilitando o acesso onipresente a percepções acionáveis.
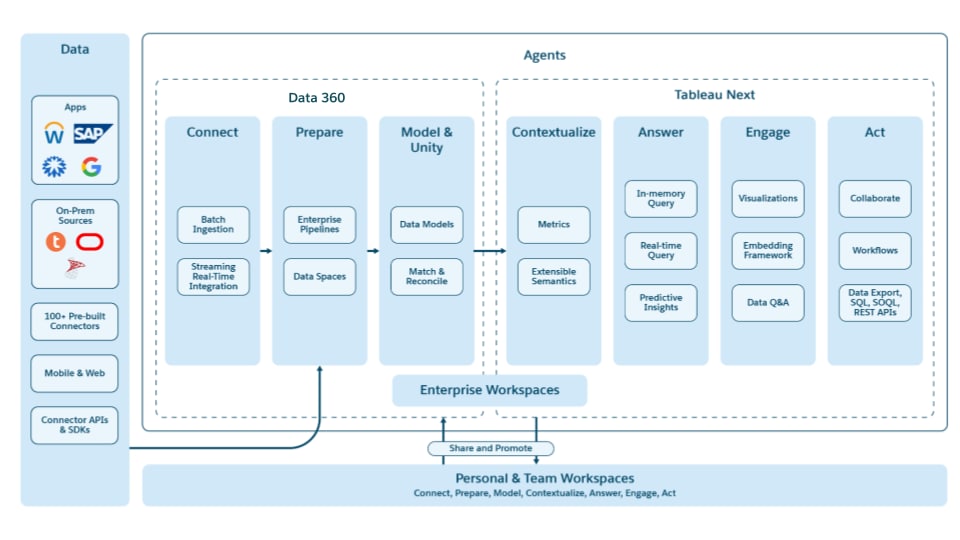 O Tableau Next lida com estes desafios:
- Criar uma plataforma aberta, composível e de primeira API para experiências conectadas da conexão de dados à ação. Fornecer ferramentas para desenvolvimento, componentes composíveis para aplicativos analíticos avançados e funcionalidades para gerenciar o empacotamento e a distribuição.
- Criar com IA no centro, e capaz de fornecer percepções contextuais e relevantes, com ferramentas para profissionais de dados revisarem e validar de modo eficiente para garantir a Trust.
- Criar no Tableau Semantics como uma camada semântica universal para análise de dados rápida, com autosserviço e governada em um ecossistema controlado, mas flexível.
- Oferecer recursos de dados em escala de nuvem em tempo real por meio do Data 360 para acesso a dados confiável, dimensionável e governado.
- Fornecer um ambiente e um mercado avançados para desenvolvedores criarem e monetizarem aplicativos.
- Integrar inteligência em seu núcleo, levando o poder da semântica e Knowledge da sua organização para os agentes que o capacitam.
- Priorizar Trust para que você possa ter confiança em seus dados, análises e cargas de trabalho e implantação agenciais, através de controle direto e visibilidade de suas atividades e eficácia.
- Aproveite a colaboração como um princípio de design de primeira classe, com integrações profundas e avançadas com o Slack, bem como qualquer outra ferramenta colaborativa para sua organização.
### 14.1 Experiências do Analytics de melhor qualidade
O Tableau Next baseia-se na liderança do Tableau em ferramentas de análise de dados oferecendo uma plataforma aberta que aprimora funcionalidades e integra experiências. Os principais recursos incluem:
- Visualização de **rich data**: Usa a tecnologia VizQL do Tableau para análise visual expansiva.
- **Espaços de trabalho colaborativos e governados**: Oferece uma interface unificada para tarefas de análise, integra ao Slack para colaboração em tempo real.
- **Dados confiáveis e governados**: Dá suporte à análise de autoatendimento com caminhos de promoção estruturados para gerenciamento global em um ambiente seguro.
- **Autoria avançada de métricas**: Permite que os analistas criem e reutilizem KPIs de modo eficiente em toda a organização, facilitando a consistência e a confiabilidade.
### 14.2 Análise de agência
O Tableau Next é fundamentalmente construído com o Agentforce como uma construção arquitetônica fundamental, aprimorando a capacidade do Tableau Next de fornecer ferramentas de dados desenvolvidas com IA altamente conectadas, confiáveis e colaborativas.
- **BI Tools**: Melhora a eficiência na análise de autoatendimento para trabalhadores de dados, com foco na preparação de dados e na criação de metadados visuais e semânticos.
- **Experiências contextuais**: Leva percepções de dados, experiências e IA transparente no contexto de onde a maioria das organizações trabalha (por exemplo, Slack).
- **Agentforce Architecture**: Criado com base na pilha Agentforce, fornecendo ao Tableau Next contexto avançado com uma arquitetura agente avançada.
- **Catálogo semântico**: Oferece um sistema centralizado para gerenciar metadados, lineagem e pesquisa, habilitando experiências compartilhadas entre usuários do Tableau Next.
- **Metadados compartilhados e gerados**: Facilita fluxos de trabalho perfeitos entre análise por autoatendimento e conteúdo gerenciado em um ecossistema abrangente.
- **Quadro de Acção**: Leva percepções para ação por meio de fluxos de trabalho pré-empacotados, selecionados por humanos ou gerados.
- **Insights personalizados**. Aprende suas preferências de dados, seu papel e muito mais (no grau em que você permite isso) para fornecer percepções de dados altamente contextualizadas e personalizadas imediatamente.
- **Insights proativos**. Explora de modo inteligente seu ecossistema de dados, procurando locais de interesse estatístico para você, enquanto compreende proativamente os fatores da mudança, o que fazer com isso e recomenda ações a serem tomadas como próximas etapas.
- **Agentes de dados confiáveis**. Dá a você, como o motor de seus agentes de dados, o poder de criar e ajustar o aplicativo por meio de experiências integradas. Também oferece ferramentas de teste para pré-avaliar suas alterações de dados e seu impacto sobre a precisão e a eficácia de seus agentes.
### 14.3 Experiências de usuário de negócios conduzidas por soluções integradas
O Tableau Next aprimora as experiências do usuário de negócios em várias plataformas, como o Slack e o Salesforce, e por meio de novos recursos de análise, como o Tableau Pulse, acessíveis por meio de experiências de agente para simplificar o engajamento de análise. Os principais aspectos incluem:
- **Colaboração**: Análise central para confiável, facilita a interação entre diferentes componentes analíticos e integra ferramentas de validação no fluxo de trabalho dos usuários.
- Métricas de **impulsos**: Entrega percepções selecionadas e automatizadas com mais eficiência do que painéis tradicionais criados por analistas.
- **Experiências conduzidas por IA**: Usa IA para reduzir a necessidade de conhecimento técnico em análise avançada, ajudando a garantir a confiabilidade com metadados determinísticos e dados governados.
- **Entrega de Insights de vários jogadores**: Permitir que usuários de negócios trabalhem em colaboração com analistas para ganhar Knowledge e Trust nas percepções que o sistema fornece.
- **Integração profunda**: Criado em uma plataforma de metadados e dados compartilhados, fornecendo capacidade de composição em diferentes sistemas e experiências para permitir a capacidade de composição para promoção, fluxo de dados e diferentes personalidades ajudando umas às outras a revisar e concluir o trabalho.
### 14.4 Semântica do Tableau
A Camada semântica do Tableau serve como uma ponte crucial entre dados brutos e interpretação do usuário, simplificando a análise de dados, a tomada de decisão e o desenvolvimento de aplicativos e aprimorando o contexto e a recuperação orientados por IA. Os principais recursos incluem:
- **Gerenciamento integrado de metadados**: Suporta tanto o autoatendimento quanto os metadados governados, facilitando a análise ad-hoc com caminhos estruturados para se tornar a única fonte da verdade da organização.
- **As melhores capacidades de tabelau**: Incluindo suporte a objetos multilógicos, capacidade de composição do modelo, dimensões compartilhadas, hierarquia geoespacial complexa e modelagem temporal.
- **Dados e análise diversificados**: Ajuda a vincular dados não estruturados e estruturados, como correlacionar categorias de produto baseadas em imagem com dados de vendas estruturados e incorporar análise de sentimento de análises de produto semistruturadas.
- **Integração da Salesforce Platform**: Estabelece uma origem unificada da verdade, facilitando a semântica de negócios consistente e a integração perfeita entre aplicativos e um modelo de metadados coeso que dá suporte a várias experiências de usuário e casos de uso.
- **Agent Intelligence**: A camada semântica é uma das principais áreas em que os agentes obtêm inteligência compreendendo não apenas os dados e metadados que alimentam seus negócios, mas também a semântica que a define, incluindo descrições e preferências mais profundas personalizadas para sua organização.
### 14.5 Fluxos de trabalho integrados e Insights acionáveis
O Tableau Next oferece soluções integradas que aprimoram a tomada de decisão orientada por dados e a automação confiável, com ações simples, fluxos predefinidos, agendamento e integrações de API. Os principais componentes incluem:
- **Ações de negócios padronizadas e inteligentes**: Facilita comunicações urgentes e contextuais dentro das empresas, que são essenciais, mas complexas.
- **Agendamentos de fluxo predefinidos e gerados**: Habilita ações ad-hoc e agendadas por meio de fluxos estáticos e gerados dinamicamente que são confiáveis, mas verificáveis.
- **Agentforce**: Dá suporte a conversas e interações de dados conduzidas por IA, permitindo que os usuários interajam com percepções e realizem ações semelhantes às de uma IU tradicional, tanto dentro quanto fora de seus aplicativos de negócios, e simplificado por meio da conversa.
### 14.6 Plataforma do desenvolvedor composível
O Tableau Next oferece uma plataforma de desenvolvedor composível com opções sem código, de código baixo e de código profissional para desenvolvimento de aplicativos, tudo usando a Semântica do Tableau no Data 360\. As principais ofertas incluem:
- **Indústria pré-empacotada/Aplicativos inteligentes**: Fornece aplicativos analíticos modelados e personalizáveis adaptados a necessidades específicas do setor.
- **Aplicativos de terceiros e ISV**: Dá suporte à criação de aplicativos dinâmicos e interativos para fins analíticos, específicos do setor e personalizados.
- **Market and Exchange**: Permite que ISVs e desenvolvedores empacotem e distribuam seus aplicativos dentro do maior e mais confiável ecossistema de desenvolvimento de aplicativo de negócios.
### 14.7 Profundamente colaborativa
O Tableau Next é projetado para usuários de negócios e profissionais de dados, promovendo uma abordagem colaborativa para a compreensão de dados. Seja técnico ou não, todos os membros da equipe, de usuários de negócios a especialistas em dados, podem revisar as percepções de dados uns dos outros. Além disso, essas percepções não estão limitadas a uma guia do navegador em uma plataforma de BI.
Como uma plataforma de BI, o Tableau Next é:
- **Composto entre plataformas**. As percepções são renderizadas da mesma maneira, independentemente da plataforma em que são visualizadas. Essa consistência é um princípio de design essencial ao trabalhar com dados visualmente.
- **Integração profunda com o Slack**. O desenvolvimento de integração com o Slack garantiu uma das experiências de dados colaborativas mais intuitivas e imersivas do mercado de hoje.
- **Aberta para qualquer ferramenta**. A aplicação do princípio de API em primeiro lugar em nossa plataforma profundamente unificada garante que a integração possa ser estendida a outras ferramentas de colaboração e de terceiros, mantendo a riqueza ao longo do processo.
## 15\. Integração
Embora a Salesforce Platform ofereça um conjunto abrangente de recursos de integração para lidar com uma ampla gama de desafios digitais, muitos clientes operam em arquiteturas empresariais que se desenvolveram ao longo do tempo por meio do uso de vários fornecedores e tecnologias.
As empresas modernas enfrentam desafios com a integração do sistema e a automação de processos de negócios, geralmente resultando em silos de dados e ineficiências. A Plataforma de integração do Salesforce, aproveitando o poder do MuleSoft, lida com esses problemas facilitando o rápido desenvolvimento e o aprimoramento de processos automatizados. Ele garante a conectividade perfeita do sistema, aprimora o fluxo de informações e dá suporte à tomada de decisão em diferentes plataformas, reduzindo os custos de mão de obra e as despesas de automação. Essa camada é crucial para criar, gerenciar, regular e monitorar integrações entre serviços do Salesforce e outros serviços personalizados ou de terceiros.
Os sistemas são definidos por meio de APIs, que servem para:
- Acesse dados de sistemas essenciais, como ERP, sistemas de faturamento e cliente e bancos de dados proprietários.
- Facilite a interação e a integração de dados, ajudando a eliminar silos de dados.
- Adicione contexto de negócios aos dados e processos gerenciados por APIs de sistema e processo.
Para comunicação eficaz, as APIs são descritas usando:
- Especificação OpenAPI (OAS) para trocas síncronas imediatas
- API assíncrona para comunicações assíncronas conduzidas por evento
- Protocolo de contexto de modelo (MCP) para interações estruturadas de modelo-contexto
- Protocolo de Agente para agente (A2A) para integrações diretas de agente para agente.
A Camada de integração do Salesforce oferece recursos robustos para integrar e gerenciar qualquer sistema, aprimorando a conectividade com os dados, a IA e as funcionalidades de aplicativo do Salesforce, independentemente de os sistemas serem nativos do Salesforce ou de outros provedores.
Integrações complexas exigem transformações avançadas e precisam de ferramentas robustas, incluindo conectividade universal; gerenciamento e governança de API; um ambiente de desenvolvimento integrado (IDE) para criar cargas de trabalho de integração; uma plataforma de tempo de execução para implementar, gerenciar e supervisionar essas integrações; e uma plataforma de capacidade de observação para fornecer visibilidade de ponta a ponta dessas integrações.
Para acelerar ainda mais o processo de integração, oferecemos aceleradores e modelos específicos do setor que codificam padrões e necessidades comuns de integração.
### 15.1 Padrões de integração com o Salesforce
Dois padrões de integração principais tratam do fluxo de dados e processos entre o Salesforce e o ecossistema geral: integração de saída e integração de entrada.
**Conectar o Salesforce a sistemas externos (saída):** Esse padrão envolve processos originários do Salesforce que acessam dados ou acionam ações em sistemas externos.
- **Gerenciamento seguro de endpoint (credenciais nomeadas):** As Credenciais nomeadas fornecem um local seguro e centralizado para armazenar detalhes de ponto de extremidade e autenticação. Aplicativos e automações fazem referência a um nome lógico, enquanto a plataforma lida com as complexidades do ciclo de vida da autenticação.
- **Integração declarativa (Serviços externos):** Para sistemas externos que oferecem uma especificação OpenAPI padrão, um administrador pode usar os Serviços externos para registrar a API de modo declarativo. A plataforma então processa a especificação, tornando as operações do serviço automaticamente disponíveis como ações nativas em ferramentas como o Fluxo ou como objetos nativos no Apex.
- **Integração de sistema complexo (MuleSoft)**: Para sistemas sem interfaces modernas, o MuleSoft cria uma camada de API padrão reutilizável. Isso abstrai a complexidade legada e traz dados e processos locais para o ecossistema do Salesforce.
- **Acesso a dados em tempo real (objetos externos):** Representa tabelas de sistemas externos como objetos virtuais no modelo de dados do Salesforce, tornando os dados externos acessíveis por meio de consultas padrão e componentes da IU sem replicação.
- **Gerenciamento central de recursos (catálogo de API unificado):** O Catálogo de API unificado é um repositório centralizado e a única fonte da verdade para todas as especificações da API e seus metadados associados, como seus protocolos de local e segurança. Ela garante que, não importa onde um dado ou lógica de negócios resida, ele possa ser descoberto, conectado com segurança e composto em novos aplicativos e automações eficientes em todo o ecossistema do Salesforce.
- **Lógica de código profissional personalizada (Apex REST):** Os desenvolvedores podem expor lógica de negócios personalizada escrita no Apex como uma API e ação REST. A ação então fica disponível como uma etapa em um Fluxo ou uma ferramenta para um agente de IA.
**Conectar sistemas externos ao Salesforce (entrada):** Esse padrão permite que sistemas e aplicativos externos se conectem à Salesforce Platform para acessar dados, acionar lógica de negócios e orquestrar processos. Essa funcionalidade é baseada em APIs de nível corporativo comprovadas que operam em escala enorme. A partir de outubro de 2025:
- A API de consulta (SOQL) processa mais de 50 bilhões de solicitações por dia.
- A API REST atende quase 5 bilhões de chamadas por dia de sistemas externos, com uso crescendo 30% ano a ano.
- A API em massa processa centenas de bilhões de registros para operações de dados em grande escala diariamente.
Essa confiabilidade e escala comprovadas baseiam-se nos seguintes recursos:
- **Uma experiência de API unificada:** O acesso a todos os recursos do Salesforce está sendo unificado por meio de uma estrutura de ponto de extremidade consistente (api.salesforce.com), eliminando a necessidade de os desenvolvedores aprenderem diferentes padrões ou fluxos de autenticação para cada produto.
- **Um portfólio de API abrangente e personalizado:** A plataforma oferece uma coleção diversificada de APIs adaptadas a necessidades específicas, incluindo APIs REST e SOAP para operações transacionais, a API em massa para processamento de dados de grande volume, a API Pub/Sub para aplicativos conduzidos por evento e APIs do Apex especializadas ou personalizadas.
- **Pronto para o futuro para a integração agente:** Por meio de padrões como MCP, os clientes podem expor com segurança seus dados e ações do Salesforce como "ferramentas" para agentes de IA externos, transformando uma instância do Salesforce em um conjunto extensível de habilidades para uma equipe digital.
### 15.2 Integração agente com MCP
Além dos padrões de entrada e saída estabelecidos para integração de dados e processos, um novo padrão está surgindo para a era agente. A Salesforce Platform está implementando uma estratégia abrangente de MCP, posicionando-a como um consumidor e um provedor de serviços desenvolvidos com IA. Essa abordagem bidirecional habilita a interoperabilidade agente, permitindo que as empresas integram perfeitamente dados e recursos do Salesforce com o ecossistema em evolução de agentes e ferramentas de IA enquanto mantêm a segurança e a governança em nível corporativo.
**Salesforce como cliente de MCP:** Os agentes podem agir como um cliente de MCP aproveitando de modo inteligente e dinâmico sistemas e APIs externos. Essa funcionalidade permite que as organizações estendam o alcance do Agentforce além dos limites do Salesforce, orquestrando ações em qualquer sistema, quer tenha uma API moderna ou exija conexão via MuleSoft a sistemas legados ou bots de RPA. A configuração é tratada por meio de uma experiência de configuração declarativa familiar baseada em tópico, permitindo uma integração rápida sem desenvolvimento personalizado. Um mecanismo de descoberta simplificado para servidores MCP fornecidos pelo parceiro simplifica ainda mais a integração de recursos externos. Ao abstrair as complexidades da conectividade externa por meio de uma pilha em grande escala, as empresas podem integrar rapidamente o Agentforce ao seu panorama tecnológico mais amplo.
**Salesforce como um servidor MCP:** Como um servidor MCP, a plataforma expõe sua lógica e seus ativos, incluindo APIs REST padrão, pontos de extremidade personalizados, Ações invocáveis e Fluxos, como "ferramentas" descobríveis para agentes externos. Por meio de uma interface declarativa, clientes e ISVs podem criar e configurar seus próprios servidores MCP personalizados, organizando recursos em coleções de ferramentas personalizadas para processos de negócios exclusivos. Isso se estende a avisos de MCP, criando sinergias naturais com os recursos do Modelo de prompts da plataforma e permitindo que as organizações tornem seu investimento em engenharia de prompts acessível a qualquer sistema de IA externo.
Esse recurso é controlado por um modelo de segurança de várias camadas:
- **Controle de aplicação:** A estrutura do aplicativo cliente externo fornece aos administradores um controle robusto sobre quais aplicativos de agente externo podem acessar a organização do Salesforce.
- **Permissões de escopo:** A autenticação é aprimorada pelo escopo granular do OAuth, habilitando o rastreamento e a imposição precisos de ações que um agente autenticado tem permissão para realizar.
- **Autorização da plataforma principal:** Esses novos controles são criados com base no modelo de autorização robusto do Salesforce, incluindo controles de acesso ao registro, permissões no nível de entidade e campo e outras permissões definidas em Perfis e Conjuntos de permissões.
Os ISVs e parceiros também podem empacotar e distribuir configurações de servidor MCP, permitindo a implantação rápida de integrações prontas para IA em todo o ecossistema do Salesforce.
### 15.3 Conectividade universal
A abordagem moderna da Salesforce para a conectividade universal é a _conectividade interpretada_, uma abordagem centrada em metadados para desenvolver conectores que podem ser executados em qualquer plataforma (MuleSoft, Flow ou Data 360) para qualquer caso de uso sem programação. Os modelos de metadados compreendem como se conectar a serviços remotos para autenticar uma solicitação, modelar os dados retornados, criar consultas, percorrer os resultados e receber eventos (acionadores) para automatizar um processo.
Para sistemas que não usam APIs baseadas em HTTP, o Salesforce oferece centenas de conectores predefinidos e um SDK completo para criar conectores personalizados. Para sistemas sem acesso à API, o Salesforce oferece Automação de processo robótico (RPA) que usa agentes para automatizar tarefas repetitivas baseadas em regras que normalmente são realizadas por humanos. Essas tarefas podem incluir entrada de dados, processamento de transações e resposta a consultas simples de atendimento ao cliente. Para extrair informações de documentos, o Salesforce oferece nosso Processamento inteligente de documentos (IDP) que aproveita a IA para extrair, classificar e processar automaticamente dados de vários tipos de documentos, como faturas, contratos e formulários. Por mais que haja informações, o Salesforce oferece uma maneira automatizada de recuperá-las e manipulá-las.
Com os avanços recentes na IA, o Salesforce fornece blocos de criação para habilitar rapidamente a funcionalidade agente na organização:
- O **Model Context Protocol (MCP) Connector** permite que as organizações exponham rapidamente sua API como ferramentas MCP e facilitem a descoberta de APIs e recursos para o consumo dos agentes.
- O **Conector de agente para agente (A2A)** permite que as organizações padronizem a comunicação entre agentes fornecendo suporte a protocolos A2A para agentes. Cada agente (um especialista funcional no domínio) pode descobrir e delegar a consulta de um cliente ao agente mais adequado para o domínio.
- O **Inference Connector** fornece blocos de construção para criar um agente do zero, fornecendo chamada LLM, integração de vetores e pesquisa, recuperação RAG e suporte de ferramentas MCP.
### 15.4 Gerenciamento de API
O Gerenciamento de API da MuleSoft, fornecido por meio do Gerenciador de API do Anypoint, fornece uma plataforma abrangente para projetar, proteger, governar, monitorar e dimensionar APIs e microsserviços em qualquer ambiente de implementação. As organizações podem gerenciar suas APIs e microsserviços com controles e percepções de nível corporativo consistentes de um único painel de vidro, independentemente da plataforma, com gerenciamento centralizado da implementação até o controle de versões. Os principais recursos incluem:
- O **Anypoint Flex Gateway** é um gateway de API de camada de aplicativo para gerenciar e proteger APIs, aplicando políticas para limitação de taxa, armazenamento em cache, autenticação, autorização, proteção contra ameaças, monitoramento e registro no nível HTTP/S. É um gateway leve e de alto desempenho baseado em Envoy projetado para ambientes distribuídos baseados em microsserviços e criado para integrar-se perfeitamente a fluxos de trabalho DevOps e CI/CD, ao mesmo tempo que fornece segurança e gerenciamento corporativos em qualquer ambiente e oferece suporte a políticas de entrada e saída.
- Os **alertas de API** permitem que as organizações definam e monitorem limites ou condições específicas para suas APIs detectarem comportamento incomum ou indesejado. Os exemplos incluem alertas quando o tempo de resposta excede um limite (por exemplo, 60 segundos), quando o número de solicitações em uma janela de tempo é muito alto, quando determinados códigos de resposta HTTP são retornados ou quando ocorrem violações de política.
- O **API Analytics** dá visibilidade de como as APIs estão sendo usadas e do desempenho delas. O painel do Analytics permite que as organizações rastreiem e visualizem métricas de alto nível, detalhem gráficos, criem e personalizem painéis e relatórios para entender tendências de uso, violações de políticas, tempos de resposta, códigos de solicitação/resposta e muito mais.
### 15.5 Ambiente de desenvolvimento de integração de próxima geração
O MuleSoft Anypoint Code Builder (ACB) é nosso IDE de próxima geração projetado para desenvolvimento de API e integração, com uma experiência moderna e unificada com VS Code como back-end.
- **Entorno de desenvolvimento unificado:** Consolida todo o processo de desenvolvimento de API e integração em uma única ferramenta, com suporte para APIs assíncronas, OAS e RAML, conjuntos de regras de governança, uma tela de Fluxo com pouco código, conectores predefinidos e opções de teste e implantação integradas. Além disso, o ACB dá suporte para depuração, solução de problemas e manutenção contínua com sugestões contextuais inteligentes.
- **Experiência de desenvolvimento do agente:** Proporciona experiências agentes em todo o ciclo de vida de desenvolvimento do aplicativo. No centro está o MCP Server da MuleSoft, que habilita o Desenvolvimento de integração agente. O MCP Server do MuleSoft fornece ferramentas eficientes para gerar especificações e integrações de API usando linguagem natural, criar transformações de dados, gerenciar ativos no MuleSoft Exchange e administrar aplicativos e políticas de API. As ferramentas do MCP Server da MuleSoft turbinam o desenvolvimento de especificação de API e integração dos usuários em qualquer Editor de código de IA baseado no VS Code, incluindo o Cursor, o Windsurf e muitos outros.
- **Integrações de IA:** A MuleSoft aprimora o desenvolvimento de integração com recursos de agência usando o MuleSoft Topic Center, que converte chamadas de API em Ações do Agentforce para acesso do sistema corporativo. O Conector Agentforce incorpora a automação de linguagem natural em integrações. O Conector de inferência integra com segurança provedores de LLM externos, habilitando a lógica conduzida por IA em aplicativos do MuleSoft. As organizações podem usar esses recursos combinados para criar integrações inteligentes e adaptáveis.
### Plataforma de tempo de execução 15.6
A Plataforma de tempo de execução da MuleSoft oferece opções de implantação flexíveis para executar aplicativos, APIs e integrações do MuleSoft em ambientes diferentes. As organizações podem escolher o modelo de tempo de execução mais adequado às suas necessidades operacionais, de conformidade e de escalabilidade enquanto mantêm o gerenciamento e a governança consistentes por meio da Anypoint Platform. Essa flexibilidade garante que os aplicativos possam ser executados perto de fontes de dados, estar em conformidade com os regulamentos regionais e ser dimensionados de modo contínuo conforme a demanda.
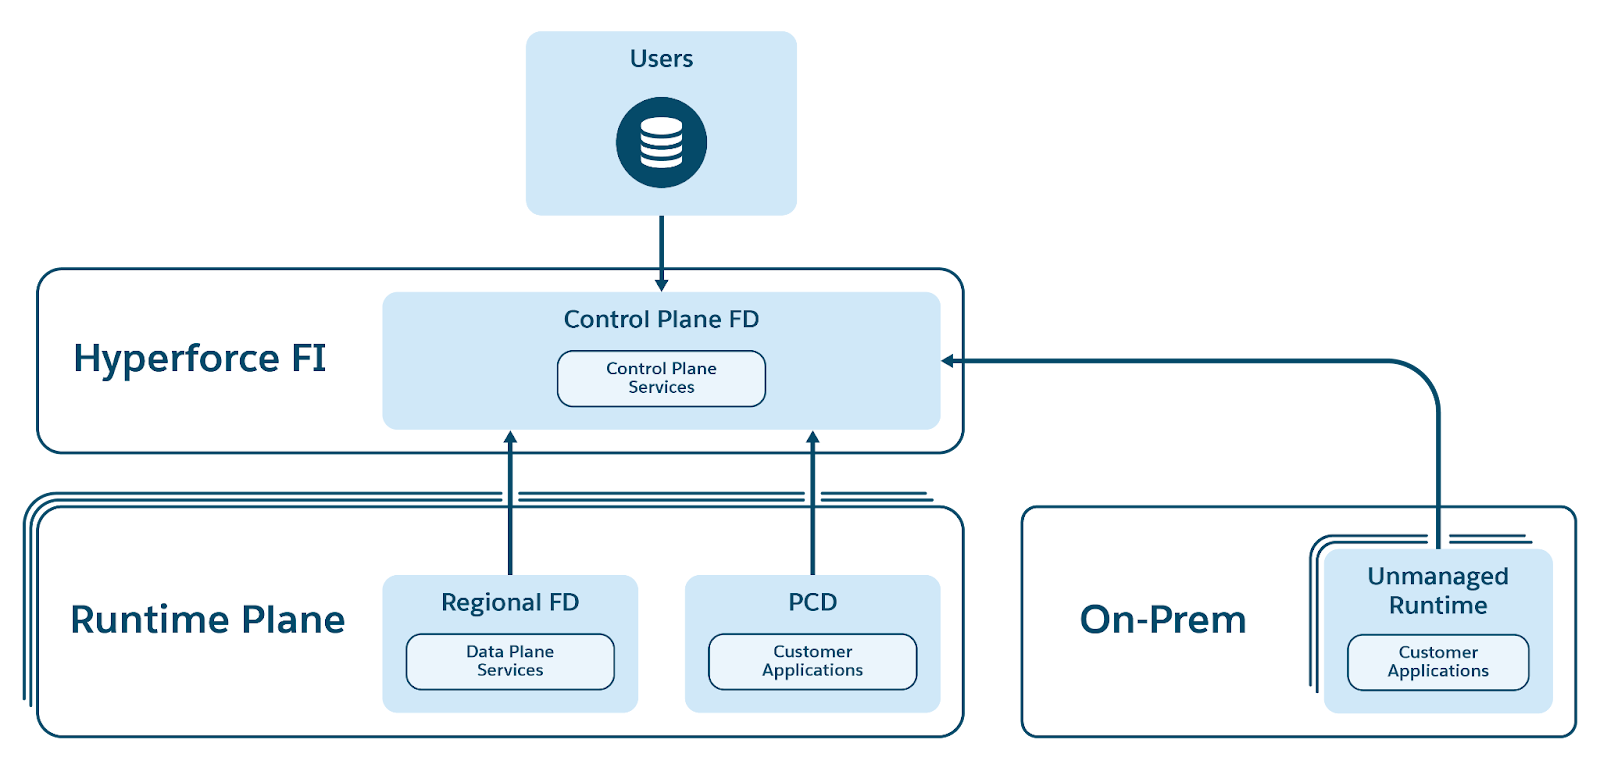 As principais opções de hospedagem incluem:
- **Nuvem:** Plataforma como um serviço (iPaaS) de integração multilocatário totalmente gerenciada da MuleSoft que elimina a sobrecarga de gerenciamento de infraestrutura. O CloudHub 2.0 fornece escala elástica, alta disponibilidade e implantações/atualizações com tempo de inatividade zero, com necessidades de observabilidade integradas e certificações de conformidade. Os desenvolvedores podem se concentrar na criação de APIs e integrações enquanto o MuleSoft gerencia a infraestrutura de tempo de execução, garantindo segurança, confiabilidade e alta disponibilidade em nível corporativo.
- **Híbrido:** Para organizações que precisam hospedar automaticamente seus aplicativos para obter mais controle, o MuleSoft oferece o Runtime Fabric, um serviço de contêiner que automatiza a implantação e a orquestração de tempos de execução do MuleSoft em Kubernetes ou máquinas virtuais. Ele oferece suporte a escala horizontal, implantações com tempo de inatividade zero, controles de segurança integrados e gerenciamento de cluster simplificado.
- **Private Cloud Edition (PCE):** A Private Cloud Edition da MuleSoft fornece uma versão no local totalmente autogerenciada da Anypoint Platform (incluindo Control e Runtime Plans), permitindo que as organizações atendam a requisitos rigorosos de regulamentação, residência de dados e segurança. Ele permite que grandes empresas mantenham o controle completo da infraestrutura enquanto ainda se beneficiam dos recursos unificados de integração e gerenciamento de API da Anypoint Platform.
### 15.7 Capacidade de observação
O MuleSoft oferece soluções abrangentes de capacidade de observação que fornecem visibilidade completa de APIs, integrações e aplicativos em qualquer modelo de implementação. Os recursos de observabilidade são consistentes independentemente de onde as cargas de trabalho são executadas, fornecendo uma visualização unificada dos ambientes. Ao capturar dados de telemetria em tempo real e históricos, o MuleSoft permite que as organizações detectem, analisem e resolvam problemas de produção mais rapidamente em toda a rede de aplicativos. Os dados de capacidade de observação podem ser visualizados nativamente na Anypoint Platform ou podem ser exportados por meio de OpenTelemetry para o APM preferencial de um cliente, permitindo uma integração perfeita com os ecossistemas de monitoramento existentes. Isso capacita as organizações a reforçar proativamente a resiliência da infraestrutura e melhorar a confiabilidade de aplicativos críticos para a missão.
O MuleSoft fornece capacidade de observação por meio de duas ofertas principais:
- **Anypoint Monitoring** é a solução atual de observabilidade no mercado integrada à Anypoint Platform. Ele oferece painéis prontos para uso e personalizáveis para monitorar a integridade do aplicativo, pesquisa avançada de log para gerenciamento de log e recursos de alerta que notificam as equipes quando ocorrem limites ou anomalias definidos.
- A **Inteligência de Integração** é a plataforma de observação de IA de primeira geração para a MuleSoft reimaginada e criada nativamente na Salesforce Platform. Essa oferta usa o Data 360 como uma camada de dados unificada para os dados de telemetria; o Tableau Semantics como uma camada semântica confiável para habilitar percepções inteligentes e acionáveis; o Tableau Concierge para realizar a solução de problemas assistida por IA; e os Tableau Next Painéis para fornecer interativas interfaces visuais que unem várias visualizações de dados avançadas em uma única visualização coesa. O Tableau Next também oferece aos clientes a capacidade de criar painéis personalizados com base no modelo de dados semântico enviado com recursos de capacidade de observação.
Essa pilha também habilita o rastreamento centrado no agente que fornece aos clientes transparência total sobre o caminho de invocação agente de ponta a ponta não determinista, permitindo que eles observem o agente trabalhando em cada etapa intermediária, permitindo que os usuários acessem a causa-raiz das falhas mais rapidamente e identifiquem quaisquer gargalos de desempenho.
## 16\. Ecossistema e AppExchange
O ecossistema do Salesforce exemplifica o poder da plataforma. Os integradores de sistemas (SIs) e os parceiros de consultoria dão suporte aos clientes desenvolvendo, configurando e otimizando soluções complexas do Salesforce. Fornecedores de software independentes (ISVs) criam aplicativos e soluções inovadores na plataforma, que os clientes podem então instalar em suas organizações do Salesforce. Esses aplicativos ISV estão disponíveis no AppExchange, a loja de aplicativos da Salesforce lançada em 2006, que agora apresenta mais de 10.000 aplicativos com mais de 14,3 milhões de instalações a partir de outubro de 2025.
Para ajudar os clientes a navegar pelo vasto mercado e descobrir aplicativos relevantes, a experiência de pesquisa do AppExchange foi reformulada em 2025 para aproveitar o Data 360.As funcionalidades de pesquisa vetorial do Salesforce Data 360 trabalham em conjunto com a correspondência de palavras-chave tradicional para fornecer resultados mais relevantes semanticamente, compreendendo a intenção do usuário por meio de linguagem natural. A visão final é evoluir essa base integrando-a com a plataforma Agentforce, possibilitando uma interface totalmente agente, "perguntar qualquer coisa", onde os clientes podem descrever conversativamente seus desafios de negócios para receber recomendações de soluções altamente personalizadas.
O AppExchange garante soluções de alta qualidade por meio de um processo de análise rigoroso envolvendo analisadores de código, scanners de segurança e guias de implementação de referência, tudo em estreita colaboração com a Salesforce. Essa plataforma também fornece aos ISVs ferramentas de gerenciamento de licenças para personalizar o licenciamento e a monetização de aplicativos, oferecendo suporte a vários modelos de precificação, incluindo opções baseadas em consumidor e baseadas em usuário.
Os princípios da "plataforma conduzida por metadados" permitem que os ISVs estendam os aplicativos e metadados nativos do Salesforce, facilitando o desenvolvimento de modelos de dados, lógica de negócios e interfaces de usuário. A Salesforce Platform oferece suporte a uma ampla gama de soluções, desde aplicações específicas do setor até aplicativos de marca altamente personalizados que utilizam tecnologias como Componentes da Web Lightning para UI e Apex code para lógica de negócios.
O conceito de "empacotamento" é crucial para a distribuição desses aplicativos em várias organizações do Salesforce. O empacotamento envolve a serialização de metadados em um artefato que pode ser instalado por qualquer cliente do Salesforce, usando tecnologias subjacentes projetadas para gerenciamento de metadados em vários ambientes. Um aspecto exclusivo do empacotamento é que ele permite instalações em ambientes desconhecidos para o desenvolvedor.
Para aprimorar o controle e a segurança, os recursos de "gerenciabilidade" no empacotamento permitem que os ISVs atualizem com segurança partes de um aplicativo, pois outros não podem depender dessas peças, ao mesmo tempo que permitem que os clientes sejam proprietários e gerenciem outras peças. Por exemplo, os ISVs podem definir determinados metadados, como configurações personalizadas, como "gerenciados", tornando-os invisíveis e não editáveis pelo cliente, impedindo interrupções no ambiente do cliente. Os pacotes gerenciados incluem esses controles de gerenciamento, enquanto os pacotes não gerenciados tratam os metadados implantados como criados pelo cliente, que não podem ser atualizados após a implementação.
Desde a criação do AppExchange e da Salesforce Platform, houve um aumento notável no número e na complexidade dos pacotes criados e instalados. Em resposta a essas demandas, a plataforma lançou a Arquitetura de empacotamento de segunda geração em 2020\. Essa nova arquitetura aprimora a modularidade de pacotes gerenciados, melhora a flexibilidade de controle de versão, permite o compartilhamento de namespace e dá suporte a dependências declarativas, entre outros avanços no ciclo de vida do desenvolvimento de software. A arquitetura de implementação do pacote também teve vários aprimoramentos significativos para maior eficiência e escala, como determinar quais metadados foram alterados e implementar apenas os deltas.
Uma medida crítica para o desenvolvimento de novos produtos e recursos é sua compatibilidade com o empacotamento e prontidão para uso de ISV. A plataforma enfatiza a rápida disponibilidade de seus recursos para parceiros, permitindo que o ecossistema do Salesforce aproveite o potencial inovador da Salesforce Platform de modo eficaz e além das ofertas prontas para uso da Salesforce. No entanto, essa é uma área de investimento contínuo para garantir que todos os recursos descritos neste documento que estão disponíveis para desenvolvedores internos do Salesforce também estejam disponíveis para nossos desenvolvedores de ISV.
Além disso, o Heroku Marketplace e o Slack Marketplace oferecem uma ampla gama de integrações e complementos de terceiros que podem aprimorar a funcionalidade dos aplicativos Salesforce. O Heroku Marketplace fornece ferramentas e serviços para funcionalidades adicionais do aplicativo, bem como para melhorar a maneira como os desenvolvedores criam, implementam e gerenciam aplicativos. O Slack Marketplace oferece integrações que podem simplificar os fluxos de trabalho e melhorar a colaboração em ambientes do Salesforce.
## 17\. Salesforce no Salesforce
No espírito de nosso valor principal, Customer Success, o Salesforce atua como "Customer Zero" para todos os aplicativos e serviços na Salesforce Platform, aproveitando produtos voltados para o cliente internamente sempre que possível. Isso oferece vantagens significativas:
- **Teste de produto rigoroso**: Ao usar o pacote de produtos diariamente, os funcionários do Salesforce expõem a plataforma a desafios do mundo real, aprimorando a qualidade do produto e identificando áreas de melhoria.
- **Produtos refinados**: O feedback imediato do uso interno permite o refinamento rápido de recursos e usabilidade, bem como a identificação e resolução rápida de quaisquer bugs, resultando em produtos que atendem melhor às necessidades do cliente após a liberação.
- **Expertise profunda na indústria**: O uso interno em várias funções dá ao Salesforce percepções valiosas sobre desafios específicos do produto e do setor, especialmente em setores de alta tecnologia.
- **Melhora a empatia do cliente**: A experiência em primeira mão com a plataforma permite que os funcionários entendam melhor e lidem com os problemas do cliente.
- **Marketing e Insights de vendas**: O uso diário do produto informa as estratégias de vendas e marketing, ajudando a personalizar a plataforma de acordo com as necessidades do cliente.
- **Estratégia de entrada no mercado mais forte**: Uma implementação interna bem-sucedida permite que o Salesforce comercialize com confiança o pacote como uma solução comprovada.
Além disso, todas as atualizações de software destinadas à produção são implementadas inicialmente em uma instância dedicada do Hyperforce "Salesforce no Salesforce" como parte de um processo de implantação escalonado. Desde agosto de 2020, esta instância hospeda com sucesso o GUS, a organização da Salesforce para equipes de engenharia, bem como as operações de CRM da Salesforce, demonstrando a robustez e a prontidão do Hyperforce para qualquer cliente. Essa estratégia permite que as equipes internas testem e detectem quaisquer problemas bem antes de implantações de produção para clientes externos.
A organização Salesforce Technology adotou totalmente o Agentforce como a plataforma interna para aumentar a produtividade e a qualidade em todo o SDLC. Isso nos permitiu não apenas melhorar a qualidade do código que enviamos aos nossos clientes detectando e mitigando bugs cedo, mas também nos permitiu iterar rapidamente em experiências agentes com base em feedback interno de primeira mão.
## 18\. Entrega da transformação em escala
Desde a sua fundação em 1999, o Salesforce passou por várias transformações tecnológicas. No entanto, a transformação envolvendo a Salesforce Platform foi particularmente significativa devido à sua escala e ao ritmo rápido com que as alterações foram implementadas. Essa transformação exigiu uma evolução simultânea de todos os principais componentes arquitetônicos para obter uma plataforma integrada. Para garantir que essa transformação seja iterativa e minimamente disruptiva para as partes interessadas e os líderes, a organização de Tecnologia do Salesforce também precisou evoluir suas práticas de entrega de produto e engenharia.
A organização de Tecnologia do Salesforce é uma equipe grande e diversificada, com mais de 2.500 equipes localizadas em mais de 20 sites em 14 países diferentes. Esse grupo opera em grande escala, entregando mais de 200 versões de produto e implementando 250 mil alterações do sistema a cada semana. De acordo com o etos da empresa mais amplo, o grupo de Tecnologia é guiado por cinco valores centrais: Trust, Sucesso do Cliente, Inovação, Igualdade e Sustentabilidade. Esses valores são essenciais para moldar a estratégia do grupo, orientar sua execução e influenciar decisões diárias.
Seguindo nossos valores centrais, a estrutura do Salesforce Engineering 360 fornece às equipes de engenharia painéis orientados para ação e percepções abrangentes sobre suas operações, definindo expectativas claras para padrões e práticas recomendadas na organização. Essa visão holística abrange várias áreas críticas, incluindo disponibilidade, segurança, conformidade, qualidade, acessibilidade, Developer Productivity, desenvolvimento de produto ágil e economia. Para fornecer essas percepções, a estrutura processa bilhões de registros de centenas de sistemas de engenharia interna, como sistemas de segurança, registros de saúde da produção, repositórios de código, ambientes de desenvolvimento, CI/CD e sistemas de planejamento e rastreamento de lançamento/trabalho, todos criados com base na Salesforce Platform usando as últimas inovações do Agentforce, Data 360, Tableau e Slack.
Enraizada nestes e outros dados, a organização de Tecnologia do Salesforce utiliza IA e tecnologias agentes para acelerar a produtividade. Temos mais de 10.000 usuários ativos diários de ferramentas de IA internas e criamos mais de 100 agentes de IA que fazem parte de nosso programa interno do AgentExchange, promovendo melhorias de produtividade em toda a organização.
Graças ao nosso valor superior de Trust, a propriedade do serviço está profundamente enraizada na nossa cultura de engenharia. Cada serviço e produto é projetado para não apenas atender, mas exceder seus Objetivos de nível de serviço (SLOs) relacionados a métricas de gerenciamento de incidentes e disponibilidade, como Tempo para detectar (TTD) e Tempo para restaurar (TTR). Nossa abordagem para gerenciamento de mudanças, prontidão para a versão e gerenciamento de problemas adere a altos padrões. A segurança é integrada a cada fase do ciclo de vida de desenvolvimento seguro, seguindo o princípio de proteção por padrão. A qualidade e o desempenho são priorizados por meio da Metodologia de teste ágil, que inclui milhões de testes automatizados em testes de unidade, funcionais, de integração e de carga/escala em nossos pipelines de CI/CD.
Em termos arquitetônicos, focamos o desenvolvimento de recursos compartilhados para aprimorar a alavancagem e a eficiência, melhorando a qualidade. Por exemplo, desenvolvemos serviços gerenciados no Hyperforce para atender a diversas necessidades, como computação e gerenciamento de dados, permitindo que as equipes de produto se concentrem na inovação de produtos, enquanto as equipes centrais aprimoram esses serviços em termos de segurança, disponibilidade e economia.
Nossas operações são ágeis, promovendo a entrega de inovação aos clientes. Cada uma das mais de 3.000 equipes tem a autonomia de implementar a estrutura ágil usando Scrum ou Kanban. O planejamento de desenvolvimento de produto em toda a organização é estruturado com várias linhas do tempo, incluindo um plano de longo prazo de três anos para direção estratégica, seguido por planos de execução anuais e ainda dividido em planos de lançamento de produto de quatro meses, que informam planos de sprint de duas semanas. Produtos, recursos e correções de bug são implementados por meio de vários veículos de versão para atender a diversas necessidades do cliente, incluindo três versões anuais principais, versões de duas semanas e versões diárias.
A produtividade é essencial devido à nossa escala. Utilizamos a estrutura SPACE para medir a produtividade de modo eficaz, com suporte a um conjunto abrangente de métricas fornecidas pelo sistema Engineering 360. Também nos concentramos em melhorar ferramentas e experiências para nossos desenvolvedores internos simplificarem o ciclo de vida do desenvolvimento, com investimentos em experiências de agência e IA, fluxo de trabalho, ferramentas de criação, configurações de desenvolvimento, versões mais seguras e serviços de segurança gerando benefícios significativos.
## 19\. Conclusão
Em conclusão, a Salesforce Platform passou por uma transformação notável nos últimos cinco anos, evoluindo da plataforma de nuvem multilocatário pioneira para uma plataforma confiável, integrada, agente e habilitada para dados que habilita um conjunto de aplicativos e serviços na região de sua escolha. Essa evolução foi conduzida pela necessidade de lidar com desafios emergentes, como o surgimento de provedores de nuvem pública, crescentes demandas regulatórias e avanços em IA generativa e aprendizado de máquina.
A introdução do Hyperforce, Data 360 e Agentforce aumentou significativamente as capacidades da plataforma, garantindo que ela permaneça na vanguarda da inovação, mantendo a Trust e a confiabilidade. A migração bem-sucedida da maioria de nossos clientes para essa nova plataforma sublinha a ingenuidade e a dedicação de nossos engenheiros.
À medida que continuamos inovando e adaptando-nos às mudanças nas demandas do mercado, a Salesforce Platform está bem posicionada para dar suporte à próxima geração de aplicativos e casos de uso do cliente, reafirmando nosso compromisso com o sucesso do cliente e a excelência tecnológica.
# Visão geral
Este documento descreve as opções atuais para implantar aplicativos no CloudHub 2.0 para atender aos requisitos de alta disponibilidade e recuperação de desastres. Ela usa a região dos EUA como exemplo e pode ser aplicada a outras regiões.
O CloudHub 2.0 é uma plataforma de integração nativa de nuvem totalmente gerenciada que elimina a sobrecarga de infraestrutura automatizando a implantação, a escala e o gerenciamento de APIs e integrações do MuleSoft na nuvem. É a moderna plataforma de implementação de nuvem da MuleSoft, executada na infraestrutura da Amazon AWS.
## Requisitos de recuperação de desastres
Na maioria dos casos, a Alta disponibilidade (HA) e a Recuperação de desastres (DR) padrão fornecidas pelo CloudHub 2.0 são suficientes. O CloudHub 2.0 fornece HA e DR a nível regional (para mais detalhes, consulte [Cenários de fora do CloudHub 2.0](#cenários-de-fora-do-cloudhub-20)). [A seção Considerações-chave do CloudHub 2.0](#principais-considerações-sobre-o-cloudhub-20) fornece mais detalhes sobre HA e DR compatíveis com o CloudHub 2.0.
As condições que exigem um design além da disponibilidade padrão do CloudHub 2.0 incluem:
- Um aplicativo precisa garantir que não ocorra perda de dados em um cenário de desastre (por exemplo, uma região da Amazon em queda).
- Um aplicativo depende da Loja de objetos e precisa garantir a continuidade se a região de implementação ficar inativa.
## Premissas
- Os sistemas de back-end são configurados para disponibilidade equivalente. O CloudHub 2.0 às vezes pode fornecer confiabilidade por meio de filas ou mecanismos semelhantes, mas, independentemente de a integração ser em tempo real ou assíncrona, os sistemas de back-end devem dar suporte a um nível comparável de HA e DR.
- Quando uma interrupção no nível da região da AWS afeta sistemas de back-end, a recuperação é presumida ser executada em paralelo com a recuperação do CloudHub 2.0.
- A configuração de espaço privado está concluída em várias regiões.
## Fora do escopo
As opções de design neste guia focam soluções para disponibilidade de aplicativo no CloudHub 2.0 quando uma zona ou região de disponibilidade da AWS ficar indisponível.
Este guia **não** aborda estes cenários de recuperação, embora observe implicações quando relevante:
- Recuperação de sistemas de back-end, aplicativos, bancos de dados, componentes de rede e data centers gerenciados e provisionados fora do Anypoint CloudHub, seja no local ou na nuvem.
- Recuperação de links de VPN entre o CloudHub 2.0 e o data center privado do cliente (por exemplo, túneis IPsec e gateways de VPN). Algumas opções de DR neste guia podem lidar parcialmente com esses cenários.
- Alterações no MuleSoft enviam IPs durante a recuperação de desastres quando a lista de permissões de IP é usada para integrações. Algumas opções de DR neste guia podem lidar parcialmente com esses cenários.
- Sistemas de mensagens externos usados em soluções do cliente, seja fornecidos pela MuleSoft (como Anypoint MQ) ou outros fornecedores (como AWS MSK ou Heroku Kafka).
## Principais considerações sobre o CloudHub 2.0
Ao avaliar o CloudHub 2.0 para os [requisitos de recuperação de desastres](#requisitos-de-recuperação-de-desastres), pense nestas considerações importantes.
**Dependência do CloudHub 2.0 da disponibilidade regional da AWS**
- O CloudHub 2.0 é executado na AWS; sua disponibilidade está vinculada a regiões da AWS.
- As implantações e a disponibilidade do aplicativo são organizadas por região. Essas regiões correspondem às regiões da AWS.
Se toda uma região da AWS falhar, os aplicativos nessa região ficarão indisponíveis e não serão replicados automaticamente em outro lugar.
**Aplicativo de alta disponibilidade (HA) e gerenciamento de réplica**
- O CloudHub 2.0 reimplanta automaticamente os aplicativos na mesma região quando o hardware falha, mas um aplicativo com uma só réplica pode passar por tempo de inatividade.
- Aplicativos com várias réplicas são implementados em zonas de disponibilidade separadas por padrão, fornecendo HA entre as zonas.
- Se a zona de disponibilidade para um aplicativo de réplica única falhar, o aplicativo será automaticamente gerado em outra zona de disponibilidade dentro da mesma região.
**Impacto específico da região leste dos EUA**
- No caso de uma falha na região leste dos EUA:
- A IU de gerenciamento do CloudHub 2.0 e os serviços REST de implementação estão indisponíveis e não é possível implementar novos aplicativos.
- Aplicativos em outras regiões não são afetados na maioria dos cenários de falha. Esses aplicativos continuam operando normalmente; no entanto, os recursos de monitoramento e gerenciamento por meio do plano de controle estarão indisponíveis durante a interrupção.
- Os módulos do Core CloudHub 2.0 (como as configurações do aplicativo) são mantidos no Leste dos EUA, portanto, as configurações não podem ser editadas durante a interrupção.
**Monitoramento e alerta**
- Configure o alerta para falhas no nível da região ou da zona de disponibilidade em [status.mulesoft.com](http://status.mulesoft.com).
- Use um mecanismo de verificação de integridade e alerta separado fora do CloudHub 2.0 para que as equipes sejam notificadas se as réplicas falharem ou se os aplicativos pararem de responder.
**Persistência de dados (Armazenamento de objetos V2)**
- A Loja de objetos V2 está vinculada à região em que o aplicativo é implementado _primeiro_.
- Se você mover o aplicativo para outra região, a Loja de objetos V2 permanecerá na região original para evitar a perda de dados.
- Se a região em que a Loja de objetos V2 está implantada falhar, a loja de objetos estará indisponível.
**Controladores de entrada e espaços privados**
- Os controladores de entrada do CloudHub 2.0 estão altamente disponíveis no nível da região.
- Em um espaço compartilhado, se uma região falhar, um controlador de entrada em outra região permanecerá disponível, mas poderá atender apenas aplicativos implantados nessa região.
- Em um espaço privado, se uma região falhar, os controladores de entrada em outras regiões estarão indisponíveis, a menos que tenham sido configurados lá com antecedência.
- A configuração de espaço privado é regional; se uma região falhar, o espaço privado ficará indisponível, a menos que outra região tenha sido configurada.
## Cenários de fora do CloudHub 2.0
O CloudHub 2.0 oferece resiliência em vários níveis: réplica, zona de disponibilidade e região. Esta seção descreve as responsabilidades do Salesforce e as opções do cliente para cada cenário de interrupção.
### Réplica / Fuso de disponibilidade / Descontinuidades da região
#### Responsabilidade do Salesforce
| Status do componente | Responsabilidade do Salesforce |
| -------------------------- | :------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Replica para baixo** | **Ação**: O CloudHub 2.0 reinicia automaticamente a réplica em uma zona de disponibilidade diferente se houver algum problema com a zona de disponibilidade atual. Porém, o aplicativo estará offline até que a nova réplica seja totalmente iniciada. **Condição**: Configuração padrão. **Tempo necessário**: Aproximadamente 2 a 15 minutos, dependendo da complexidade do aplicativo e do tamanho da réplica. |
| **Zona de disponibilidade para baixo** | **Ação**: Igual à réplica abaixo. **Condição**: Configuração padrão. **Tempo necessário**: Igual à réplica abaixo. **Notificação**: Igual à réplica abaixo. |
| **Região abaixo** | **Ação**: Nenhuma recuperação automática. Um design de failover deve estar em vigor. |
#### Responsabilidade do cliente
| Status do componente | Responsabilidade do cliente |
| -------------------------- | :----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Replica para baixo** | **Notificação**: Realize verificações periódicas de integridade usando um mecanismo de pulso integrado às APIs. **Migração**: Implemente o aplicativo em várias réplicas na mesma região. **Teste / Simulação:** Gere um pedido com o suporte da MuleSoft e eles oferecerão suporte a um teste de fallover para verificar se uma nova réplica é ativada em um AZ diferente em 1 a 15 minutos. |
| **Zona de disponibilidade para baixo** | **Notificação**: Igual à réplica abaixo. **Migração**: Implemente o aplicativo para várias réplicas na mesma região ou em diferentes regiões. **Teste / Simulação:** O cenário AZ Down é difícil de simular. Ele exige o envolvimento da Engenharia do MuleSoft para dar suporte a possíveis cenários de teste. |
| **Região abaixo** | **Notificação**: Igual à réplica abaixo. Verifique também as atualizações de status em [https://status.aws.amazon.com](https://status.aws.amazon.com). **Migração**: Igual a AZ Down. Plano de emergência de recuperação de desastres: Dois espaços privados com a mesma configuração em diferentes regiões. **Teste / Simulação:** Igual a AZ Down. |
### Passeios do controlador de entrada e do gateway de VPN
#### Responsabilidade do Salesforce
| Status do componente | Responsabilidade do Salesforce |
| :------------------------------------------ | :-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **VPN Gateway seta para baixo** | **Status da réplica**: Em execução, mas sem poder se conectar a nenhum recurso hospedado no local e acessível por meio do túnel de VPN. **Ação**: Nenhuma recuperação automática. Um design de failover deve estar em vigor. |
| **Controlador de entrada (espaço compartilhado) para baixo** | **Status da réplica**: O controlador de entrada é uma configuração agrupada com várias instâncias, semelhante a réplicas de aplicativo. Se uma réplica de aplicativo falhar, uma nova será criada e iniciada automaticamente. Se uma instância do controlador de entrada falhar, os aplicativos permanecerão disponíveis por meio da outra instância. Se todo o controlador de entrada estiver inativo, a região será considerada inativa. |
| **Controlador de entrada (espaço privado) para baixo** | **Status da réplica:** Igual ao Controlador de entrada no espaço compartilhado abaixo. |
#### Responsabilidade do cliente
| Status do componente | Responsabilidade do cliente |
| :-------------------------------------- | :-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Gateway de VPN seta para baixo | **Notificação**: Realize verificações periódicas de integridade usando um mecanismo de pulso integrado às APIs. **Migração**: Os gateways de VPN do CloudHub 2.0 oferecem suporte à alta disponibilidade por meio de uma arquitetura de duplo túnel com failover automático entre túneis; um cliente deve configurar esse padrão. **Teste / Simulação:** O cenário de Gateway de VPN seta para baixo é difícil de simular. Requer o envolvimento da Engenharia do MuleSoft para dar suporte a possíveis cenários de teste. |
| Controlador de entrada (espaço compartilhado) seta para baixo | **Notificação**: Igual ao Gateway de VPN seta para baixo. **Migração**: Igual a Região abaixo. Migre solicitações para um espaço de espera ou ativo em outra região. **Teste / Simulação:** Igual ao Gateway de VPN seta para baixo. |
| Controlador de entrada (espaço privado) seta para baixo | **Notificação**: Igual ao Gateway de VPN seta para baixo. **Migração**: Igual a Região abaixo. Migre aplicativos para um espaço reservado ou privado ativo em outra região, em coordenação com a configuração da Rota 53 da AWS (ou equivalente). **Teste / Simulação:** Igual ao Gateway de VPN seta para baixo. |
### Armazéns de objetos e filas persistentes
**Scenário de desvio de serviços de plataforma – Loja de objetos**
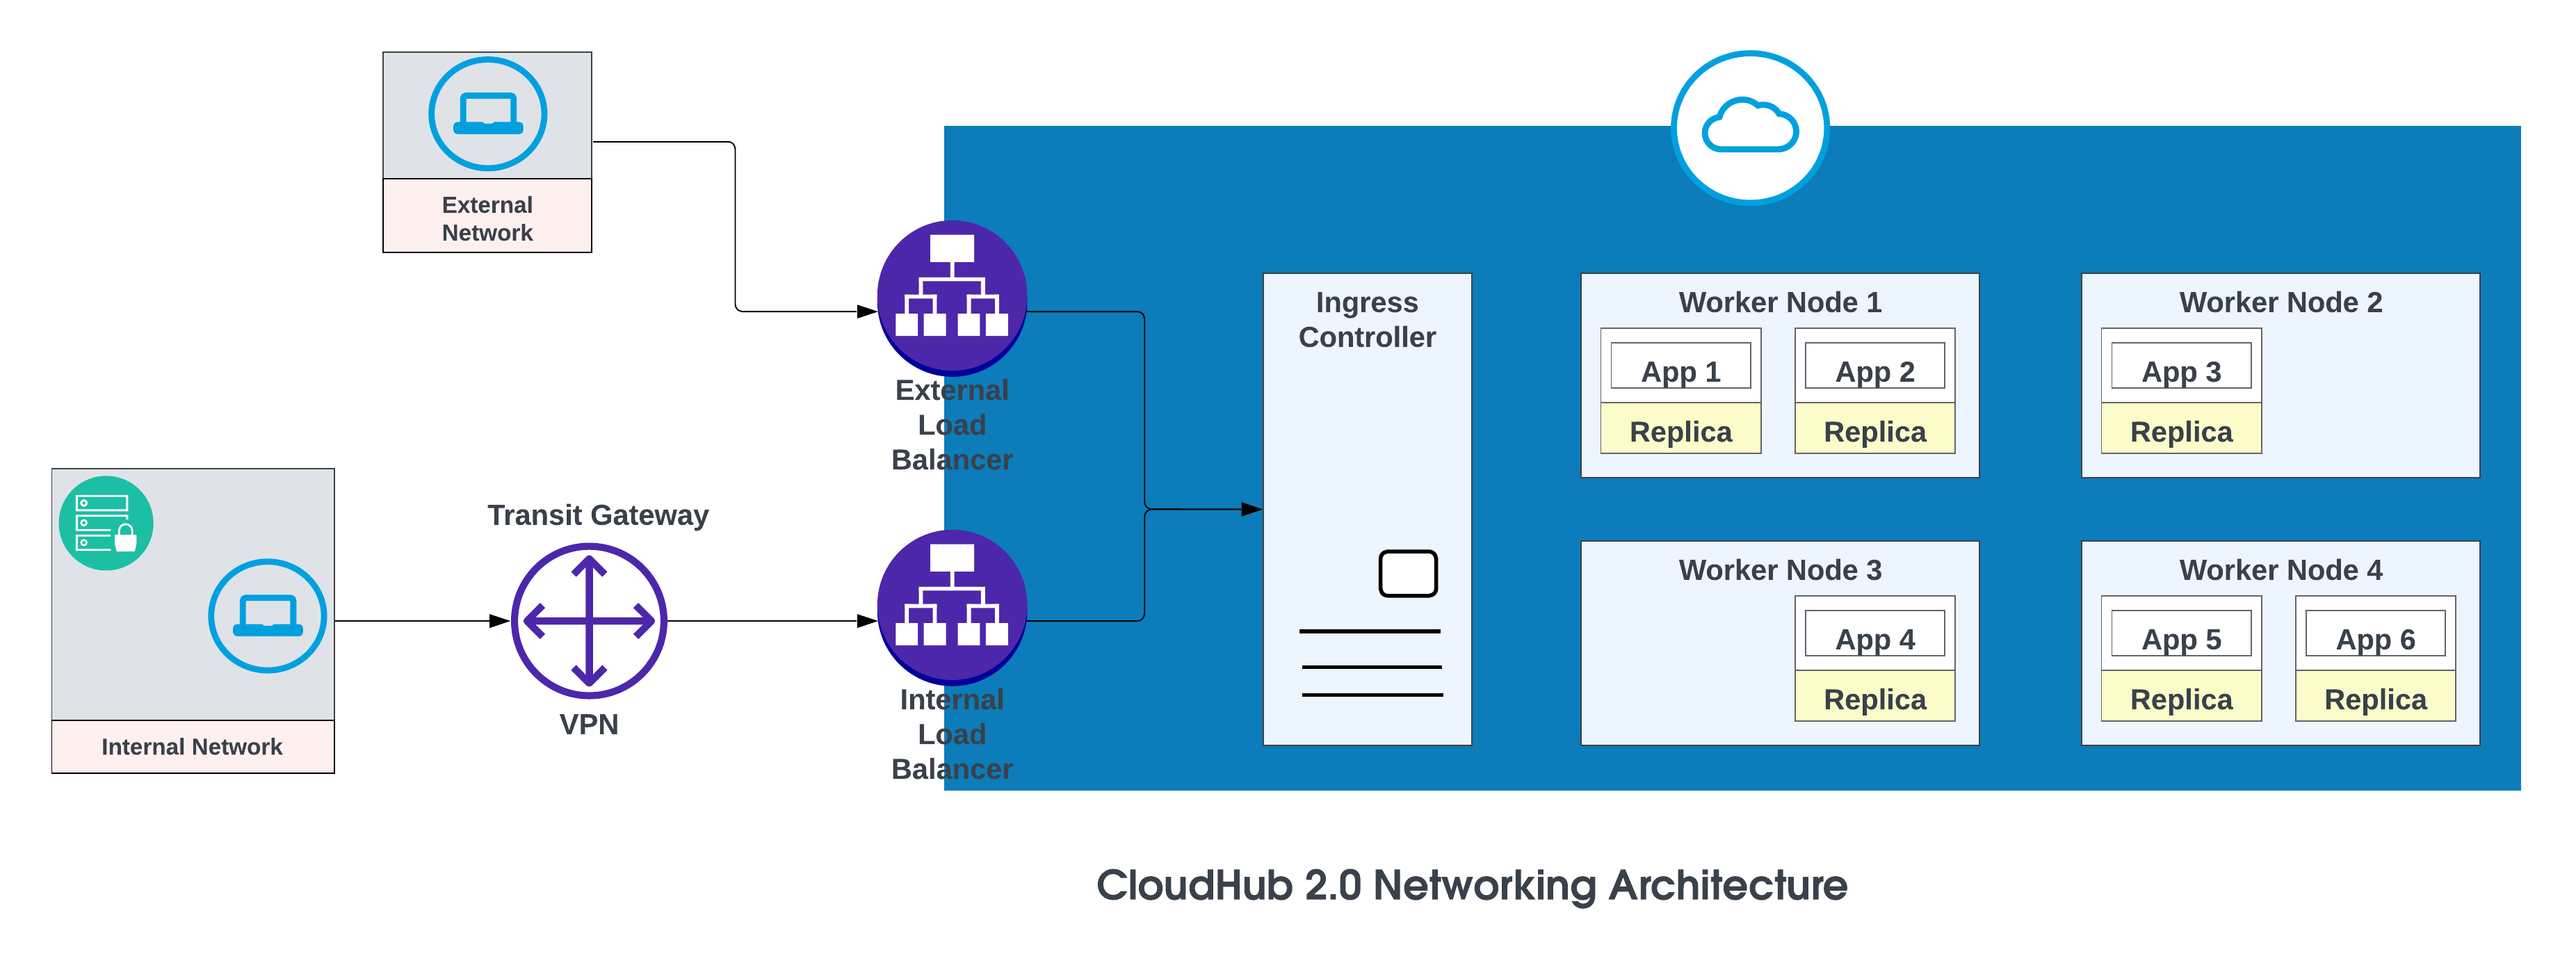 Os componentes básicos da arquitetura de rede do CloudHub 2.0 são:
- Um balanceador de carga HTTP
- Mule registros de DNS de réplica
- Espaços privados
- Serviços regionais
Para obter mais detalhes, consulte [Arquitetura de rede do CloudHub 2.0](https://docs.mulesoft.com/cloudhub-2/ch2-networking-guide).
Domínios **vanity**
Quando um Espaço privado é criado, ele recebe um nome de destino DNS no formato: \
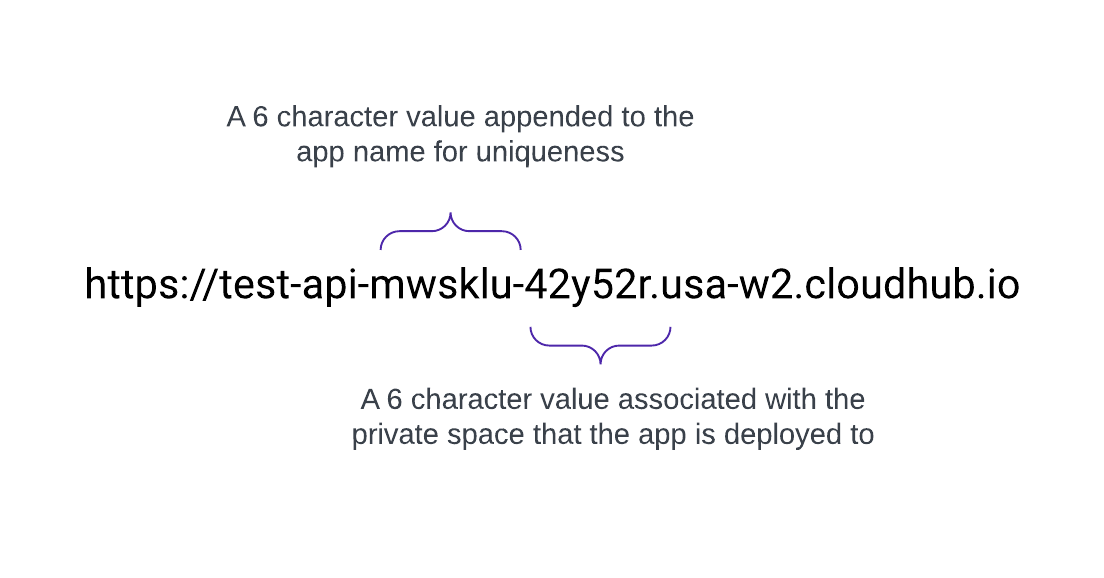 O CloudHub 2.0 também oferece suporte a domínios personalizados ou intuitivos configurando-os em um Espaço privado usando contextos TLS e registros DNS. Para criar um contexto de TLS no Gerenciador de tempo de execução para um espaço privado, carregue o certificado público e a chave privada e adicione um ponto de extremidade personalizado nas configurações do seu aplicativo para usar esse domínio. Crie um registro de DNS (como CNAME) que aponte seu domínio intuitivo para o nome de host padrão do espaço privado.
Por exemplo, um aplicativo chamado test-api implantado em us-west-2 com o DNS padrão 42y52r.usa-w2.cloudhub.io tem um ponto de extremidade de API de:
https://test-api-mwsklu-42y52r.usa-w2.cloudhub.io
Esse URL não usa um domínio intuitivo ou personalizado. Para usar `acme.com` para que os URLs da API apareçam como `https://test-api.acme.com`, siga estas etapas.
1. Crie um contexto de TLS no Gerenciador de tempo de execução com chaves públicas e privadas.
2. Adicione um domínio intuitivo nas configurações do aplicativo para usar esse domínio.
3. Crie um registro de DNS na Rota 53 da AWS e configure uma política de roteamento simples (por exemplo, CNAME) para que o domínio intuitivo seja resolvido para o nome de host padrão do espaço privado.
Para domínios personalizados, você pode usar a AWS Route 53 ou qualquer outro serviço de CDN global com políticas de roteamento. No diagrama abaixo, a Rota 53 do AWS é usada com uma política de roteamento "simples". Quando um consumidor de uma rede pública (externa) solicita acme.com, a Rota 53 da AWS encaminha a solicitação para o controlador de entrada de espaço privado do MuleSoft.
 ## Estratégia de fallover
Use essa opção quando os aplicativos precisarem de uma alteração de falha: implantar uma instância na região primária (por exemplo, us-west-2) e outra em uma região secundária (por exemplo, us-east-1).
Use um ambiente existente na região secundária quando possível; criar um novo ambiente requer esforço adicional.
**Exemplo de aplicativos implantados em uma região (Oeste dos EUA 2) com uma migração de falha para outra região (Leste dos EUA 1)**
 | Nome do registro | Valor/Tráfego de rota para | Política de roteamento | ID da verificação de integridade |
| :---------: | :-----------------------: | :------------: | :-------------: |
| acme.com | 42y52r.usa-w2.cloudhub.io | Failover | 31s3wseq121 |
| acme.com | 31e51s.usa-e1.cloudhub.io | Failover | 43e131s131sq |
Nessa configuração, a Rota 53 da AWS roteia o tráfego para os controladores de entrada para os espaços privados no oeste dos EUA 2 e no leste dos EUA 1\. Uma política de roteamento de fallover é configurada com uma verificação de integridade.
## Disponibilidade alta e latência baixa
Para menor latência e alta disponibilidade, use a estratégia de implantação descrita no diagrama. Com essa estratégia, os aplicativos podem ser implementados em duas regiões (neste exemplo, us-west-2 e us-east-1).
Use a política de roteamento de latência na Rota 53 da AWS para encaminhar solicitações para a região que oferece a menor latência enquanto mantém a alta disponibilidade. política de roteamento de "latência" na Rota 53 da AWS para rotear a solicitação de menor latência ainda com alta disponibilidade.
**Aplicativos implantados nas duas regiões (Oeste dos EUA 2 e Leste dos EUA 1) para menor latência e alta disponibilidade**
 | Nome do registro | Valor/Rotear tráfego para | Política de roteamento | ID da verificação de integridade |
| :---------: | :-----------------------: | :------------: | :-------------: |
| acme.com | 42y52r.usa-w2.cloudhub.io | Latência | 31s3wseq121 |
| acme.com | 31e51s.usa-e1.cloudhub.io | Latência | 43e131s131sq |
## Conclusão
O MuleSoft CloudHub 2.0 fornece uma base robusta para a resiliência intra-regional, aproveitando principalmente a redundância de réplica automatizada e o balanceamento de carga inteligente. Em uma única região de nuvem, implantar aplicativos com várias réplicas garante que, se uma instância falhar, outras possam assumir imediatamente a carga de trabalho. O balanceador de carga integrado distribui de modo eficiente o tráfego recebido entre essas réplicas saudáveis, minimizando o tempo de inatividade e garantindo a disponibilidade contínua de serviço sob condições de operação normais.
No entanto, contar exclusivamente com essa arquitetura de região única, mesmo com alta redundância, apresenta um risco significativo de uma falha regional generalizada e catastrófica. A história mostrou que até mesmo os provedores de nuvem mais confiáveis e tecnologicamente avançados são suscetíveis a incidentes de interrupção que podem afetar toda uma região geográfica. Esses pontos únicos de falha, embora raros, podem surgir de vários eventos, incluindo:
- Incidentes de infraestrutura em grande escala
- Principais falhas de energia
- Interrupções de rede amplas
Portanto, para alcançar a alta disponibilidade (HA) e a recuperação de desastres (DR), uma arquitetura deve ser projetada para superar as limitações de um modelo de região única. A estratégia recomendada é a implantação em várias regiões geograficamente distintas. Essa resiliência inter-região garante que, se uma região inteira da nuvem ficar indisponível devido a um desastre inesperado, o tráfego possa ser transferido sem problemas para uma instância de aplicativo em execução em uma região separada e não afetada, garantindo interrupções mínimas de serviço e atingindo metas de tempo de atividade máximo.
## Referências
[Arquitetura de rede CloudHub 2.0](https://docs.mulesoft.com/cloudhub-2/ch2-networking-guide)
[Configurando a alteração de falha entre regiões para filas padrão](https://docs.mulesoft.com/mq/mq-failover)
[Regiões de implementação da Loja de objetos V2](https://docs.mulesoft.com/object-store/osv2-faq#osv2-regions)
[Sua região de implementação da loja de objetos](https://docs.mulesoft.com/object-store/osv2-faq#is-object-store-v2-persistent-in-the-same-region-as-the-worker)
## Sobre os autores
Gulal Kumar é um arquiteto de engenharia de software na Salesforce, com foco em arquitetura de integração e dados. Com mais de 20 anos de experiência em integração e APIs, programas de modernização, segurança e iniciativas AIML, ele traz uma grande quantidade de conhecimento. O Gulal está empenhado em promover iniciativas de transformação de negócios, aprimorar a segurança e a resiliência, promover a excelência de arquitetura e liderar iniciativas de AIML em vários domínios.
Ajay Nagaraju é um arquiteto corporativo e diretor sênior na MuleSoft com mais de 28 anos de experiência em arquitetura corporativa, integração de sistemas e transformação digital em grande escala. Ele liderou a arquitetura e a entrega de programas complexos de vários milhões de dólares em organizações Fortune 100 e Fortune 500, com profundo conhecimento em conectividade conduzida por API, SOA, tecnologias de nuvem e padrões de integração corporativa. Ajay tem uma parceria estreita com a liderança executiva para modernizar processos de negócios, plataformas de dados e ecossistemas de integração e é apaixonada por criar arquiteturas dimensionáveis, equipes de mentoria e impulsionar resultados de negócios mensuráveis por meio da tecnologia.
# Aproveitando o MuleSoft e o Informatica: "Melhor juntos"
Este documento fornece uma estrutura para conectividade de aplicativo em tempo real e gerenciamento de dados usando o MuleSoft e o Informatica.
## Uma estrutura para conectividade de aplicativo em tempo real e gerenciamento de dados
## Visão geral
A MuleSoft e a Informatica fornecem os pilares fundamentais para uma estratégia de integração moderna e de alto desempenho. Embora ambos residam no mesmo ecossistema, eles resolvem desafios arquitetônicos distintos. As principais empresas implementam essas plataformas em conjunto para criar uma estrutura abrangente "Melhor juntos" que atenda a todo o espectro de dados e necessidades de aplicativos.
As organizações mais ágeis têm sucesso ao desacoplar o gerenciamento de dados da conectividade do aplicativo. A MuleSoft e a Informatica atuam como parceiros especializados. O MuleSoft oferece experiências de aplicativo interativas seguras e de alto desempenho por meio de uma arquitetura baseada em serviço, enquanto o Informatica garante a integridade, a qualidade e a governança de dados em escala maciça. Os arquitetos aproveitam ambos para aplicar o mecanismo certo ao padrão de integração certo, otimizando para desempenho e escalabilidade de longo prazo.
## Produtos no escopo
 |
A MuleSoft é a plataforma de integração líder da Salesforce. Permite que as organizações conectem aplicativos, dados e dispositivos em ambientes locais e de nuvem. O MuleSoft fornece a TI as ferramentas para desbloquear dados entre sistemas, desenvolver estruturas de integração e automação escalonáveis e criar experiências diferenciadas e conectadas rapidamente. |
 |
A Informatica é uma plataforma líder de gerenciamento e integração de dados corporativos. Ela ajuda as organizações a coletar, gerenciar, integrar e analisar dados de várias fontes. Ele usa processos ETL (extrair, transformar, carregar) para fornecer os dados conectados e confiáveis necessários para capacitar agentes de IA autônomos e análise moderna. |
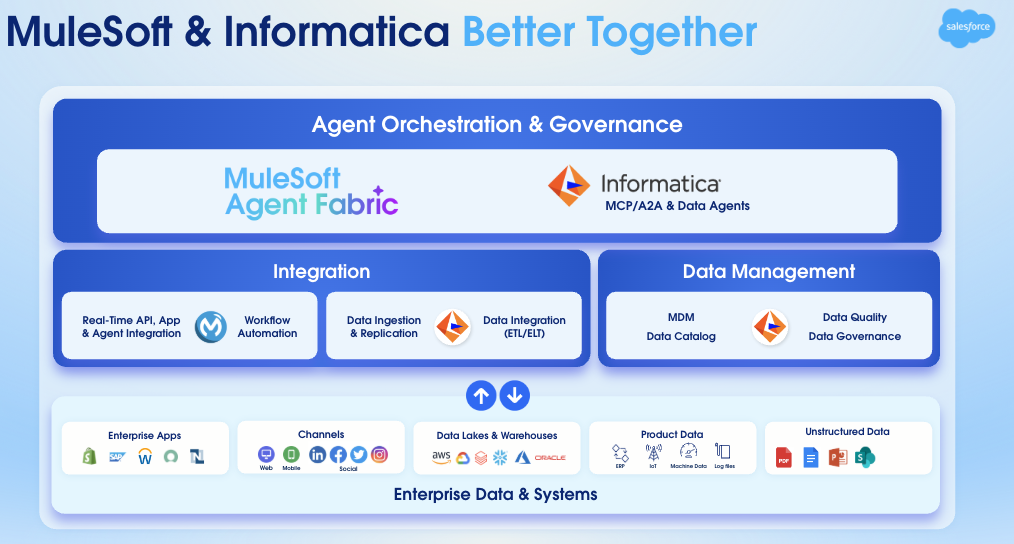 As seções a seguir demonstram como a MuleSoft e a Informatica trabalham juntas nos principais pilares fundamentais: Integração, Gerenciamento de dados e Orquestração e governança do agente.
### Integração: Fazer a ponte entre silos de dados e aplicativo
Para cada empresa moderna, operações bem-sucedidas dependem da integração de aplicativos e planos de dados. As plataformas de integração de aplicativo e de integração de dados são complementares, não intercambiáveis. A tentativa de aproveitar um sem o outro cria pontos cegos operacionais e gargalos.
As falhas das abordagens de integração em silos estão claras.
**1\. Integração de aplicativos sem robusta governança de dados**
Conectar aplicativos, ou integração de aplicativos, permite que a empresa mova processos e transações rapidamente entre sistemas. No entanto, se essa camada de execução não tiver uma visualização unificada, governada e confiável dos dados subjacentes, as ações resultantes, não importa quão rápida, serão baseadas em informações fragmentadas, inconsistentes ou obsoletas.
As organizações podem orquestrar processos rapidamente, mas sem dados confiáveis, as decisões permanecem de alto risco. Interações inconsistentes com o cliente, gerenciamento de inventário e relatórios financeiros se originam de uma falta de "única fonte da verdade", levando a ineficiências e exposição regulatória.
A MuleSoft mitiga esse risco fornecendo a conformidade pronta para uso para setores altamente regulamentados, com certificações ativas, incluindo FedRAMP, ISMAP, HITRUST, SOC 1/2/3 e ISO 27001\. No entanto, mesmo quando a camada de aplicativo se comunica com segurança, ela ainda pode compartilhar dados incoerentes.
**2\. Integração de dados e gerenciamento sem integração de aplicativo ágil**
Priorizar plataformas de gerenciamento e integração de dados, especialmente por meio de um poderoso armazém de dados ou sistema de gerenciamento de dados mestre (MDM), é essencial para limpar, padronizar e unificar dados. Estas plataformas criam uma única fonte da verdade: uma visualização confiável e holística de entidades como clientes, produtos ou fornecedores.
Embora os dados sejam limpos, consolidados e confiáveis, os mecanismos para injetar sua inteligência derivada de volta em processos de negócios ativos e aplicativos voltados para o cliente são lentos ou inexistentes. Sem a integração do aplicativo, a empresa não pode traduzir uma única fonte da verdade em ação em tempo real. Dados de alta qualidade ficam em segundo plano, não conseguindo influenciar uma decisão de vendas no momento, uma interação de serviço personalizada ou um ajuste crítico da cadeia de abastecimento. A inteligência existe, mas o pipeline operacional permanece bloqueado.
**A Solução Holística: MuleSoft e Informatica juntos**
A MuleSoft e a Informatica fornecem uma estrutura unificada líder do setor para operações de negócios orientadas por dados.
Esse alinhamento arquitetônico garante que:
* **Ação em tempo real**: O MuleSoft fornece o mecanismo ágil para expor esses dados confiáveis por meio de APIs seguras. Por meio da conectividade conduzida por API, ela integra a única fonte da verdade da Informatica diretamente a aplicativos e processos de negócios essenciais. Isso permite que a empresa aja em tempo real com base na fonte única da verdade fornecida pela Informatica.
* **Contexto confiável**: A Informatica, como a líder em gerenciamento de dados na nuvem, garante que os dados que fluem pela empresa sejam limpos, consistentes, regulados e em conformidade. Ele cria um contexto confiável dominando dados, habilitando a garantia de qualidade e facilitando a governança de dados corporativos.
##### O momento "Dados para agente"
Essa integração permite que os clientes controlem o momento de dados para agente. Esta é a meta final: quando um funcionário (agente) ou um sistema automatizado precisar agir, o sistema fornecerá instantaneamente o contexto completo, confiável e em tempo real necessário para o sucesso. Essa poderosa sinergia transforma dados de um mero ativo histórico em um fluxo de inteligência dinâmico e acionável, gerando resultados de negócios superiores e vantagem competitiva.
#### MuleSoft para integração de aplicativo
O MuleSoft fornece um ciclo de vida completo de integração desenvolvido com IA. Com o MuleSoft Vibes, os desenvolvedores podem usar avisos de linguagem natural para projetar APIs, criar integrações e gerar testes de unidade. A plataforma oferece suporte ao desenvolvimento em qualquer IDE, incluindo cursor ou VSCode, usando servidores MCP locais para acelerar a entrega.
A arquitetura se concentra na conectividade extensível: uma ponte universal que conecta agentes de IA, aplicativos SaaS, sistemas legados e parceiros. Essa única plataforma garante que qualquer ativo possa dar suporte ao negócio em tempo real, independentemente de onde o ativo está.
Conectividade sem supervisão cria risco. É por isso que permitimos que as equipes registrem, protejam e observem cada ativo e aplicativo. Ao fornecer um conjunto de ferramentas abrangente de IA, fornecemos a TI a visibilidade e as proteções para gerenciar o ciclo de vida do aplicativo com total confiança.
O MuleSoft também oferece suporte ao ecossistema mais amplo com B2B e EDI corporativos. Essa integração simplifica o gerenciamento de parceiros enquanto mantém a conformidade de ponta a ponta.
Por fim, a MuleSoft garante que todas as partes da empresa não sejam apenas conectadas, mas governadas e prontas para agir em tempo real.
#### Informatica para integração de dados
Velocidade de negócios exige uma base de Trust. A Informatica garante que a empresa aja com base em dados confiáveis e de alta qualidade, evitando a responsabilidade por percepções rápidas, mas não confiáveis.
A plataforma Informatica pode transformar dados brutos em ativos prontos para a empresa. Seu ambiente com pouco código facilita a escala instantânea sem aumentar o número de funcionários. Com mais de 300 conectores pré-criados compatíveis com todos os estilos de integração, incluindo ETL, ELT e ETL reverso, ele pode integrar, controlar e preparar praticamente qualquer dado existente para iniciativas conduzidas por IA.
### A base confiável de gerenciamento de dados para IA
O Informatica é a potência de gerenciamento de dados, essencial para o sucesso da IA. Ele fornece um conjunto completo de recursos, do catálogo à governança, que transforma as organizações de avançadas em dados para orientadas por percepções.
A IA é tão eficaz quanto os dados que a alimentam, e, para a maioria das organizações, esses dados são isolados, duplicados e inconsistentes. Isso representa um risco significativo, pois dados "sujos" levam a uma saída de IA não confiável.
É nisso que o MDM do Informatica se destaca. Em vez de apenas conectar dados, nós os unificamos. Ele divide silos desconectados para criar uma visão completa de clientes, produtos e fornecedores, estabelecendo uma única fonte confiável da verdade. Essa visualização unificada permite que as equipes tomem decisões conduzidas por IA com confiança sem debater a precisão dos dados.
A Informatica é crucial para iniciar a IA e expandir uma base de IA confiável em toda a empresa.
O melhor de tudo é que a Informatica automatizou o trabalho de trabalho pesado. Com o CLAIRE GPT, a plataforma simplifica os processos de correspondência, mesclagem e governança. Isso fornece uma única fonte de verdade aos clientes a velocidade do Lightning, ao mesmo tempo que elimina o esforço manual.
Alcançar uma única fonte da verdade é a primeira etapa. Conforme os dados fluem para análise, aplicativos e IA, uma preocupação crítica surge para CDOs e CIOs: "Podemos realmente Trust esses dados onde quer que sejam consumidos?"
Na era da IA, a governança e a qualidade dos dados são essenciais. Eles devem ser automatizados e integrados intrinsecamente, uma funcionalidade que o Informatica foi projetado para oferecer. A Informatica incorpora uma camada de Trust, garantindo que os dados sejam precisos e compatíveis antes de chegarem a um painel ou modelo de IA.
O Informatica rastreia não apenas os dados, mas sua linhagem, mostrando com precisão sua origem e histórico de acesso para estabelecer a confiança em sua confiabilidade. Essa certeza é necessária para operar em escala.
Por fim, o Informatica conecta metadados ao contexto de negócios. Quando um cliente inicia um projeto de IA, ele não está apenas se movendo rapidamente, ele está se movendo com certeza absoluta.
### Desbloquear a Enterprise agência
O MuleSoft e o Informatica oferecem funcionalidades de agente complementares. O MuleSoft Agent Fabric serve como o plano de controle unificado, fornecendo governança completa, orquestração e capacidade de observação. Os agentes de dados e servidores MCP da Informatica se conectam a esse tecido, fornecendo acesso a dados confiáveis e ações de dados governadas, como alimentar dados MDM ou metadados do catálogo ao ecossistema.
Juntos, eles permitem que os clientes dimensionem seus investimentos perfeitamente. Para operar esse ecossistema integrado em escala corporativa, o MuleSoft Agent Fabric fornece uma estrutura sistemática de quatro pilares:
1. **Descobrir:** Obtenha visibilidade completa do ecossistema de seus agentes. O Registro do agente e os scanners integrados sincronizam e catalogam automaticamente cada agente A2A e servidor MCP, incluindo ativos Informatica e agentes externos da Amazon Bedrock ou do Google Vertex, garantindo descoberta e reutilização instantâneas.
2. **Orquestra:** Coordene agentes e APIs para executar fluxos de trabalho complexos. O agente de agentes roteia dinamicamente tarefas para o agente ou ferramenta correto, eliminando transferências manuais e transformando agentes individuais dispersos em uma equipe confiável e coordenada.
3. **Governador:** Aplique controle seguro orientado por política a todas as interações. O Trusted Agent Identity e o Flex Gateway aplicam os controles de conformidade e acesso em três níveis: interações de ponta a ponta, solicitações de LLM de camada de modelo e ações de camada de execução.
4. **Observe:** Acompanhe o raciocínio, o desempenho e a colaboração dos agentes em tempo real. O Visualizador do agente e o monitoramento centralizado fornecem transparência completa, permitindo que as equipes de TI validem decisões, detectem anomalias e otimizem os resultados do agente.
A integração do plano de controle da MuleSoft e dos agentes de dados da Informatica fornece uma estrutura unificada para ação governada em tempo real. Essa sinergia capacita a empresa agente ancorando a orquestração ágil em uma base de contexto confiável.
## Saiba mais sobre o MuleSoft e o Informatica
Para criar uma empresa agente resiliente, as organizações devem ir além do tratamento da integração de dados e da integração de aplicativos como esforços isolados. Ao aproveitar o Informatica para gerenciar ativos de dados de alto volume e o MuleSoft para orquestrar fluxos de trabalho de agente e aplicativo em tempo real, as empresas estabelecem uma base segura e escalonável.
Explore os recursos dedicados para cada plataforma para aprofundar sua compreensão. Para saber mais sobre conectividade de aplicativos em tempo real, integração conduzida por API e orquestração do MuleSoft Agent Fabric para IA, explore a página de produto oficial da [MuleSoft](https://www.salesforce.com/mulesoft/). Para obter detalhes abrangentes sobre os recursos de gerenciamento de dados, governança e MDM de Gerenciamento de dados mestre, visite o centro de recursos [Informatica](https://www.informatica.com/salesforce.html). Você encontrará especificações detalhadas sobre os recursos de cada plataforma, o que o ajudará a mapear a arquitetura certa para seu ambiente específico.
# Da integração composta para uma empresa governada por agentes
A transição para a Enterprise do agente representa a mudança arquitetônica mais significativa desde o nascimento da nuvem. Ela promete níveis sem precedentes de produtividade e automação, mas também apresenta desafios profundos relacionados à governança, à segurança e à complexidade operacional. Usar uma abordagem fragmentar – implantar agentes em silos sem uma estratégia unificadora – é um caminho direto para dívida técnica e caos organizacional.
Implantar agentes sem um plano de gerenciamento central cria um risco operacional significativo, incluindo vulnerabilidades de segurança de acesso direto ao sistema, falta de observabilidade nas interações e ações do agente e altos custos devido a integrações redundantes de ponto a ponto. Essa estratégia de implementação isolada resulta em um ambiente vulnerável que é difícil de gerenciar em escala. Um modelo sustentável requer uma plataforma unificada para integração e governança de agentes.
A _MuleSoft_ fornece uma plataforma aberta, unificada e abrangente para orientar com confiança as empresas em toda a sua jornada. Ele aproveita o panorama de API existente da empresa como a base para ações de agentes e acelera a criação de novos ativos prontos para agentes por meio de um ciclo de vida de desenvolvimento baseado em IA confiável. Por meio do suporte de nível corporativo para padrões abertos, como protocolos de Protocolo de contexto de modelo (MCP) e Agent2Agent (A2A), ele torna esses ativos acionáveis para comandos simples e colaboração complexa de vários agentes, independentemente de como o panorama da IA evolui. O [_MuleSoft Agent Fabric_](https://docs.mulesoft.com/agent-fabric/) fornece uma solução para descobrir, orquestrar, controlar e observar todo o ecossistema do agente. Através dessa abordagem integrada, a _MuleSoft Agent Fabric_ fornece uma base comprovada para escalar uma rede de agentes de IA confiáveis, que transforma a promessa da IA em resultados de negócios tangíveis e automatizados e realiza todo o potencial da empresa inteligente.
## **A base composta para IA acionável**
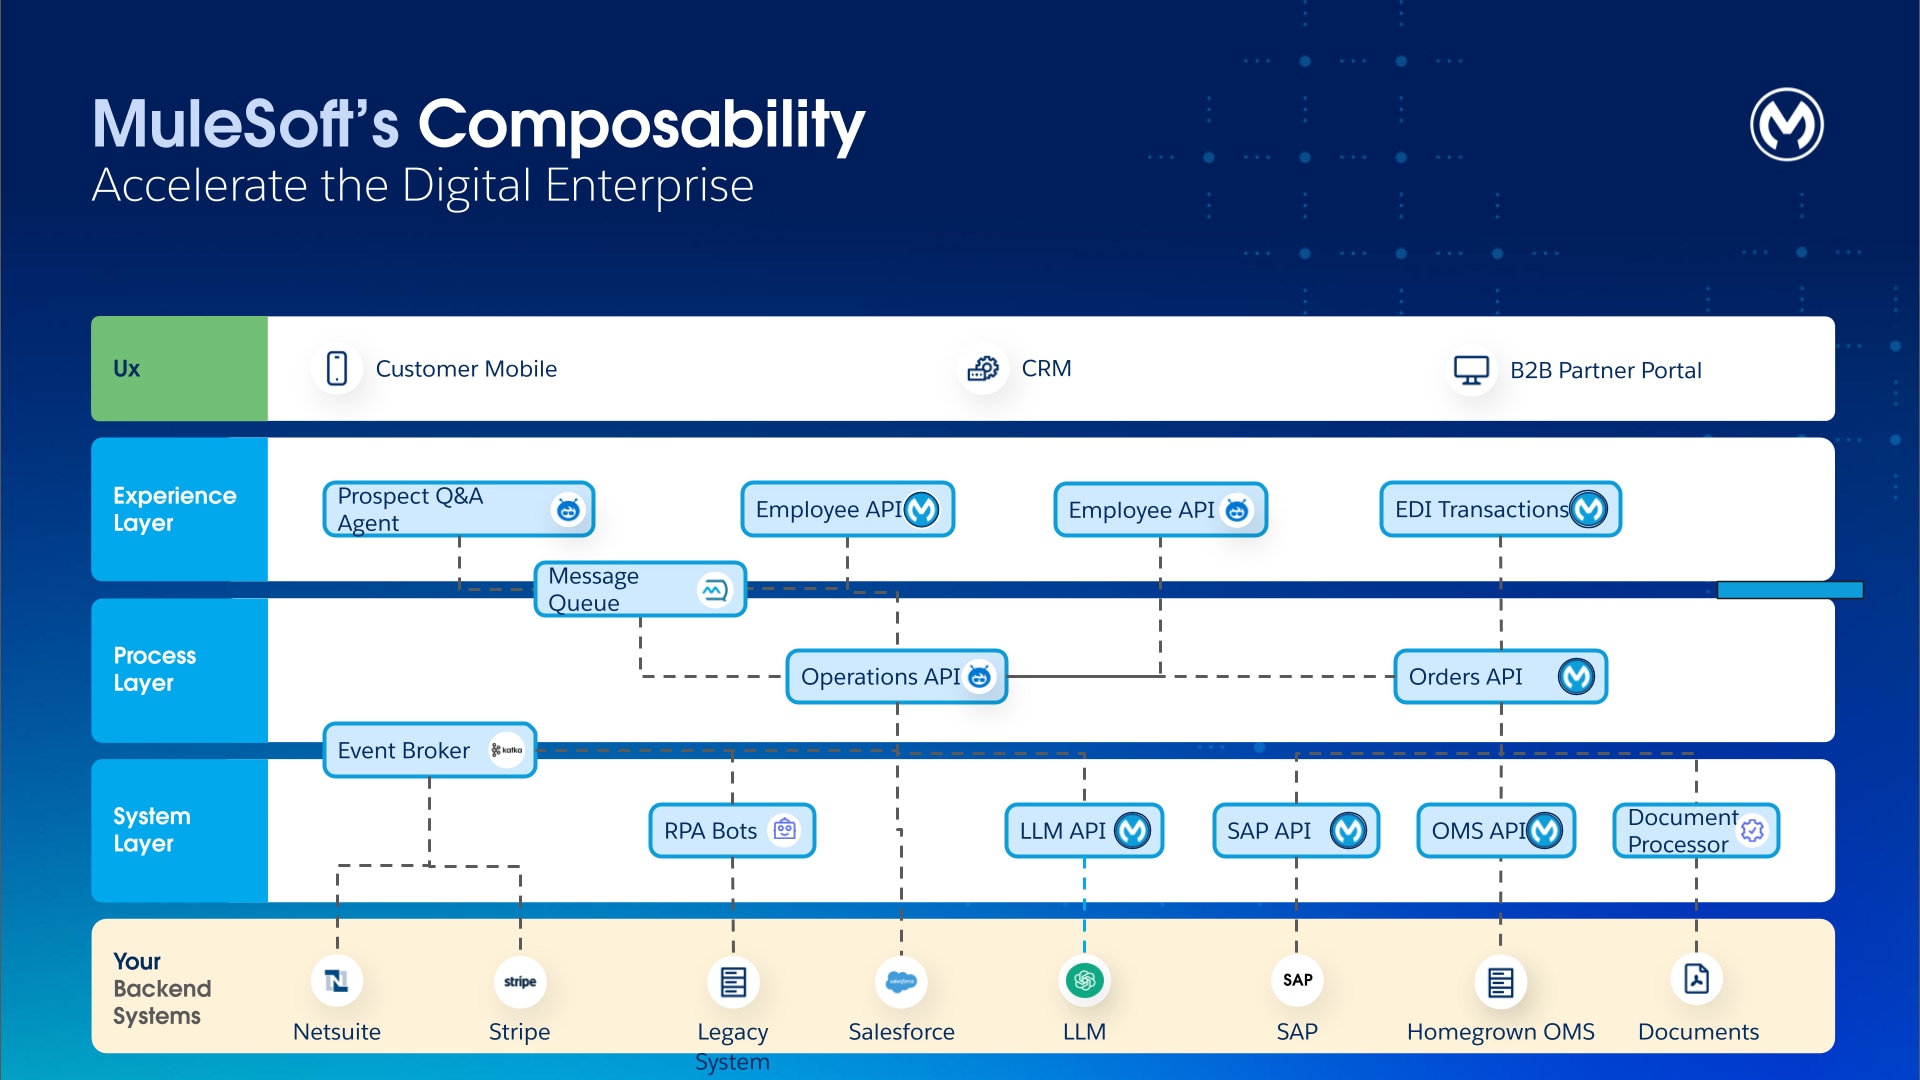 A abordagem de três camadas estabelecida da conectividade conduzida por API (APIs de sistema, processo e experiência) fornece uma estrutura eficiente para estruturar a capacidade de ação do agente.
- As **APIs do sistema** oferecem uma interface consistente, segura e abstrata para os sistemas de registro subjacentes. Eles desconectam os agentes da complexidade de protocolos de back-end e modelos de dados, o que garante que todas as ações do agente sejam realizadas em pontos de extremidade governados e confiáveis.
- As **APIs de processo** encapsulam lógica de negócios complexa e de várias etapas. Os agentes não precisam entender a orquestração complexa por trás da criação de pedidos de vendas, da verificação de inventário ou do início de envios. Eles podem usar as APIs de processo (por exemplo, "Ordem do processo") sem precisar lidar com as complexidades subjacentes. As APIs de processo fornecem um mecanismo seguro, transacional e auditável para os agentes executarem processos de negócios, o que reduz drasticamente o raciocínio necessário do agente e garante que as regras de negócios sejam aplicadas de maneira consistente.
- **As APIs de experiência** foram tradicionalmente projetadas para servir aplicativos específicos da IU (por exemplo, o Aplicativo de gerenciamento de pedidos); no entanto, elas também podem ser reutilizadas como ações repletas de contexto para agentes. Isso fornece aos agentes informações essenciais para realizar uma determinada tarefa sem exigir várias chamadas a sistemas downstream.
## 1\. Criação generativa: Acelerar o desenvolvimento de ativos prontos para o agente
Para atender à crescente demanda por ferramentas e recursos prontos para agentes, as empresas devem acelerar o desenvolvimento das APIs e integrações que formam a base composta. A _MuleSoft_ lida com esse desafio integrando a IA generativa diretamente no ciclo de vida do desenvolvimento, o que cria um ciclo virtuoso que usa a IA para criar os ativos de alta qualidade que outros agentes consomem.
### **1.1 MuleSoft Vibes**
Para os desenvolvedores, a [MuleSoft Vibes](https://www.mulesoft.com/platform/api/anypoint-code-builder/announcing-mulesoft-vibes) atua como um parceiro inteligente automatizando os aspectos mais repetitivos do desenvolvimento de integração e fornecendo uma interface unificada e agente para todo o ciclo de vida do desenvolvimento de software. Por meio do MuleSoft Vibes no [Anypoint Code Builder](https://docs.mulesoft.com/anypoint-code-builder/), os desenvolvedores interagem com recursos generativos que são alimentados pelos [confiáveis Pipelines _Einstein AI_](https://blogs.mulesoft.com/automation/how-mulesoft-turns-generative-output-into-value/), o que torna o processo de desenvolvimento assistido por IA suave e eficiente. Este pipeline - o _Service de Execução de Gráfico de Inferência (IGES)_ \- é um processo de várias etapas usado para obter resultados de alta qualidade. Ele consiste em fundamentação, validação, correção de erros e avaliação rigorosa.
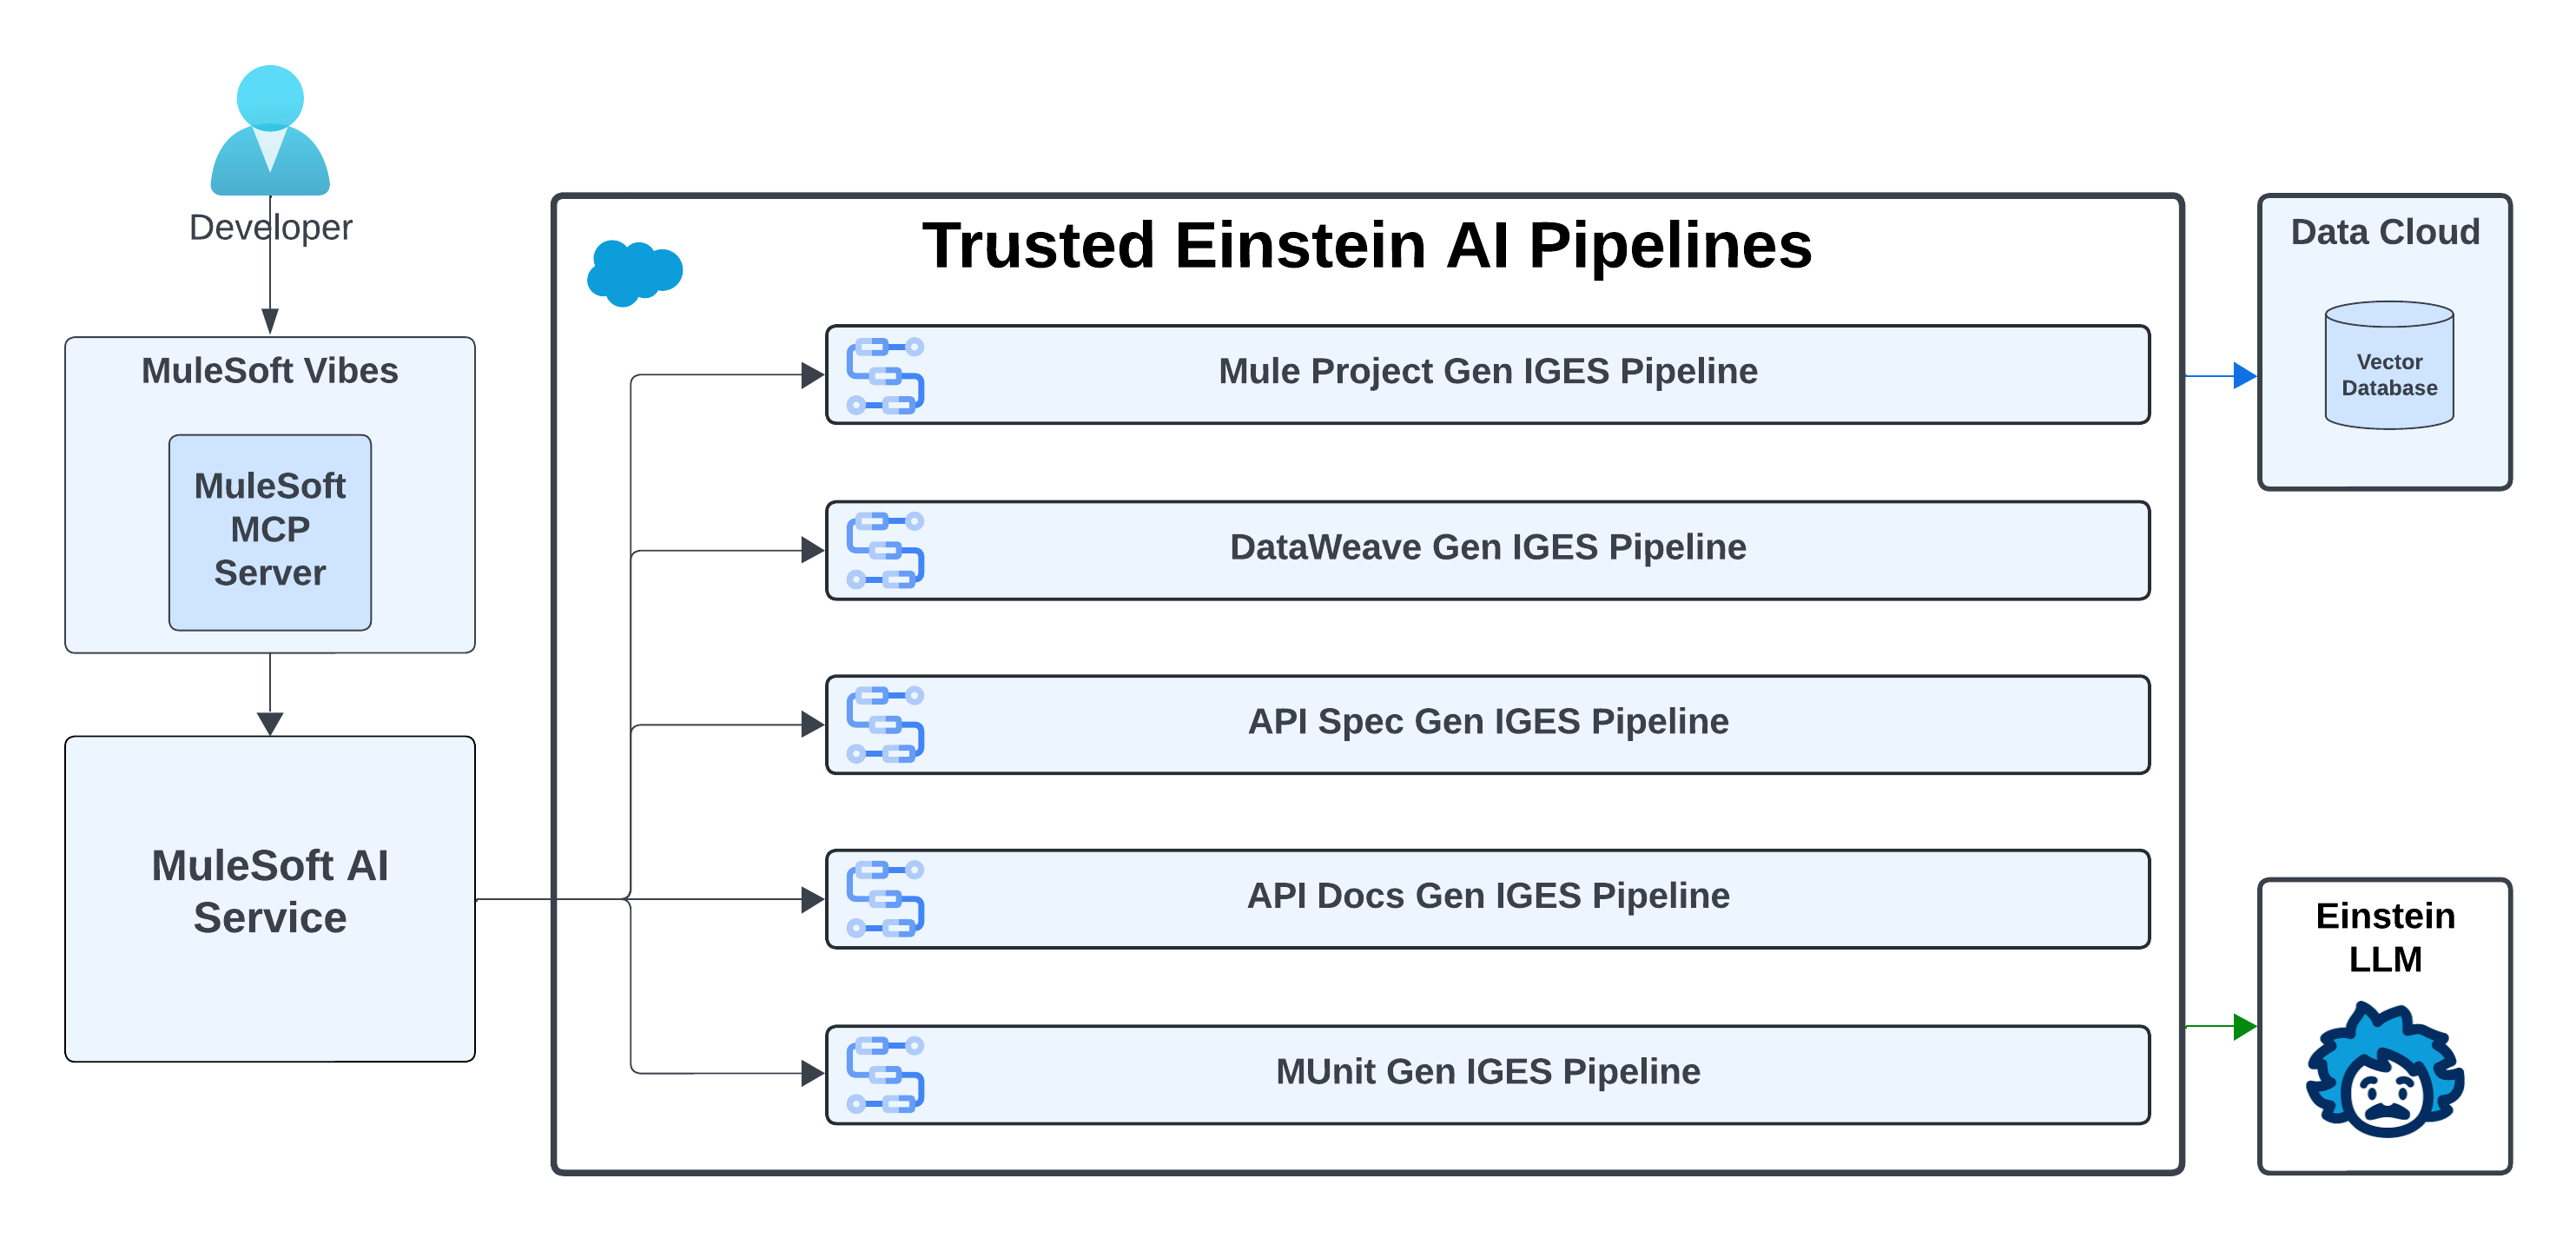 - A funcionalidade de Fluxos [**gerativos**](https://blogs.mulesoft.com/dev-guides/einstein-for-acb/) no _MuleSoft Vibes_ é baseada na estrutura de IA _Agentforce_. Ele transforma a lógica de negócios de linguagem natural (Avisos do usuário) em aplicativos do Mule funcionais. O _Pipeline IGES_ consiste nas seguintes etapas:
- **Resumo do histórico da conversa:** O LLM analisa o aviso atual e as mensagens anteriores do usuário para criar um aviso resumido que captura a intenção do usuário e o histórico da conversa. Esse aviso consolidado melhora a precisão das etapas subsequentes de recuperação e geração de dados.
- **Recuperação semântica do fluxo de um banco de dados vetorial:** O sistema pega o aviso resumido da etapa anterior e realiza uma pesquisa semântica em um banco de dados vetorial que contém mais de 200 conectores, mais de 7.000 operações de conector e mais de 7.000 snippets de código de amostra. Ele recupera os conectores, operações e exemplos de código mais relevantes para fundamentar o processo de geração usando dados precisos e garante que as saídas estejam alinhadas ao extenso ecossistema do conector da MuleSoft. Como o MuleSoft é o padrão do setor para conectores e operações, essa fundamentação fornece ao modelo uma rigorosa precisão de contexto e domínio que os LLMs genéricos não têm.
- **Aumento:** O conteúdo recuperado e as mensagens do histórico da conversa então são combinadas com o aviso resumido. Esse aviso aumentado conduz o LLM para reduzir alucinações. Ele também inclui instruções para evitar a geração de conteúdo tóxico.
- **Geração de fluxo:** Esta etapa utiliza o modelo _Einstein AI LLM_ para gerar código XML bruto baseado no contexto e exemplos fornecidos. Esta é a etapa principal do pipeline de geração.
- **Pós-processamento e validação:** O pós-processador e o validador verificam o código para garantir a sintaxe correta e o uso de operações válidas do conector enquanto uma verificação de toxicidade separada sinaliza conteúdo prejudicial.
- **Corrigência de erro de várias etapas:** Se todas as gerações iniciais forem inválidas, o mecanismo de correção de erro automatizado analisará as mensagens de erro para detectar padrões. Em seguida, ele reenvia o aviso para o LLM junto com mensagens de erro aprimoradas e metadados corretivos.
- **Geração de arquivo de configuração:** Esta etapa extrai metadados do conector relevantes, aumenta o aviso e os envia ao LLM para gerar configurações de conector precisas. Por fim, todos os namespaces POM e XML são gerados de modo determinístico usando a versão mais recente de cada dependência, o que elimina alucinações e garante consistência.
- A geração de transformação [**DataWeave**](https://blogs.mulesoft.com/dev-guides/dataweave-generative-transformation/)**:** A transformação de dados é frequentemente a parte mais demorada do desenvolvimento de integração. A _MuleSoft Vibes_ lida com esse processo usando a abordagem de várias etapas semelhante à geração do _Mule Flow XML_.
- **Reasoning of Intention:** O LLM analisa amostras de dados de entrada e saída do usuário para inferir e articular a lógica de transformação de alto nível em linguagem natural. Essa etapa separa a meta do usuário dos valores de dados literais que podem ter sido fornecidos no aviso.
- **Recuperação semântica do DataWeave:** Para localizar a documentação da função DataWeave mais relevante semanticamente e os exemplos de transformação concluídos, o sistema usa o aviso gerado da etapa anterior como uma consulta para o banco de dados do vetor. Isso baseia o processo de geração em informações verificadas de alta qualidade.
- **Aumento:** As funções e exemplos recuperados são combinados com o aviso do usuário original para criar um conjunto de instruções sensível ao contexto para a chamada de LLM subsequente, o que influencia o comportamento do LLM para reduzir alucinações.
- **Geração de DataWeave:** Esta etapa utiliza o modelo de LLM para gerar um script de transformação do DataWeave e uma explicação que acompanha baseada no contexto e nos exemplos fornecidos. Esta é a etapa principal do pipeline de geração.
- **Pós-processamento e validação** O script gerado é avaliado com base em duas métricas específicas: validade e correção. O script deve ser compilado sem erros de sintaxe (validade) e produzir a saída esperada quando for executado usando a entrada de amostra (correcção).
- **Corrigência de erro de várias etapas:** Se a validação inicial falhar, esse plugin identificará as categorias de erro e corrigirá os problemas no script gerado. Esse refinamento ajuda a melhorar a taxa de sucesso geral e a precisão do sistema.
- **Processamento e validação finais** O script corrigido do módulo de correção de erros passa por um processo de nova validação para garantir que seja sintaxicamente válido e funcionalmente correto. Esse gate de qualidade final garante que a saída seja precisa e confiável antes de enviá-la de volta ao usuário.
- Os desenvolvedores de [**especificação de API**](https://docs.mulesoft.com/anypoint-code-builder/api-ai-create-spec) **e geração de [documentação](https://docs.mulesoft.com/exchange/generating-documentation-with-ai):** podem gerar especificações _OpenAPI (OAS)_ ou _RAML_ totalmente validadas descrevendo a API desejada em linguagem natural. O _MuleSoft Vibes_ ingere o aviso (que inclui detalhes sobre recursos, métodos, esquemas de segurança e parâmetros) e produz uma definição de API válida e sintaxicamente correta. Após a geração, ele pode criar documentação para a API no _Anypoint Exchange_, que cobre tudo, desde autenticação até detalhes do ponto de extremidade e tratamento de erros, liberando os desenvolvedores desses tipos de tarefas tediosas.
- **Geração de MUnit assistida por IA:** A garantia de qualidade é fundamental para ativos consumidos por agentes autônomos. A _MuleSoft Vibes_ ajuda a gerar casos de teste do MUnit diretamente do Código de fluxo do Mule. Isso ajuda a simular dependências e declarações externas e identificar lacunas de teste comuns, o que reduz drasticamente o esforço manual necessário para alcançar uma alta cobertura de teste e garantir a confiabilidade da lógica de integração.
### **1.2 MuleSoft do seu jeito**
Os desenvolvedores prosperam em seus ambientes preferidos. É por isso que a _MuleSoft_ encontra desenvolvedores onde estão, o que lhes permite criar integrações em seu IDE de IA preferido. O [Model Context Protocol (MCP) Server da MuleSoft](https://www.npmjs.com/package/@mulesoft/mcp-server) expõe recursos de desenvolvimento, implantação e gerenciamento como ferramentas MCP que qualquer IDE nativa de IA baseada em VS Code (por exemplo, Cursor, Windsurf ou Trae) pode consumir para interagir com a _Plataforma Anypoint_ usando linguagem natural.
Ao empacotar sua funcionalidade IDE principal em uma [extensão padrão do VS Code](https://marketplace.visualstudio.com/items?itemName=salesforce.mule-dx-extension-pack), a _MuleSoft_ desacopla suas ferramentas de um shell IDE de marca, o que permite que as ferramentas de desenvolvimento sejam agnósticas ao IDE. Em vez de competir com a rápida evolução dos IDEs, essa escolha de arquitetura permite que as ferramentas de desenvolvimento da MuleSoft permaneçam compatíveis e acessíveis em todo o ecossistema crescente de IDEs modernos baseados em IA.
## 2\. Habilitar capacidade de ação: Transformar APIs em ferramentas para agentes
Em uma empresa agente, ter uma base robusta de APIs composíveis é necessário, mas insuficiente. A próxima etapa crítica é garantir que esses ativos sejam descobríveis, compreensíveis e invocáveis pelos agentes de IA. Isso exige uma "camada de capacidade de ação" criada com base em padrões abertos projetados especificamente para comunicação agente. A _MuleSoft_ fornece ferramentas de nível empresarial para os dois protocolos emergentes dominantes:
- **MCP** para interações entre agentes
- **A2A** para interações entre agentes
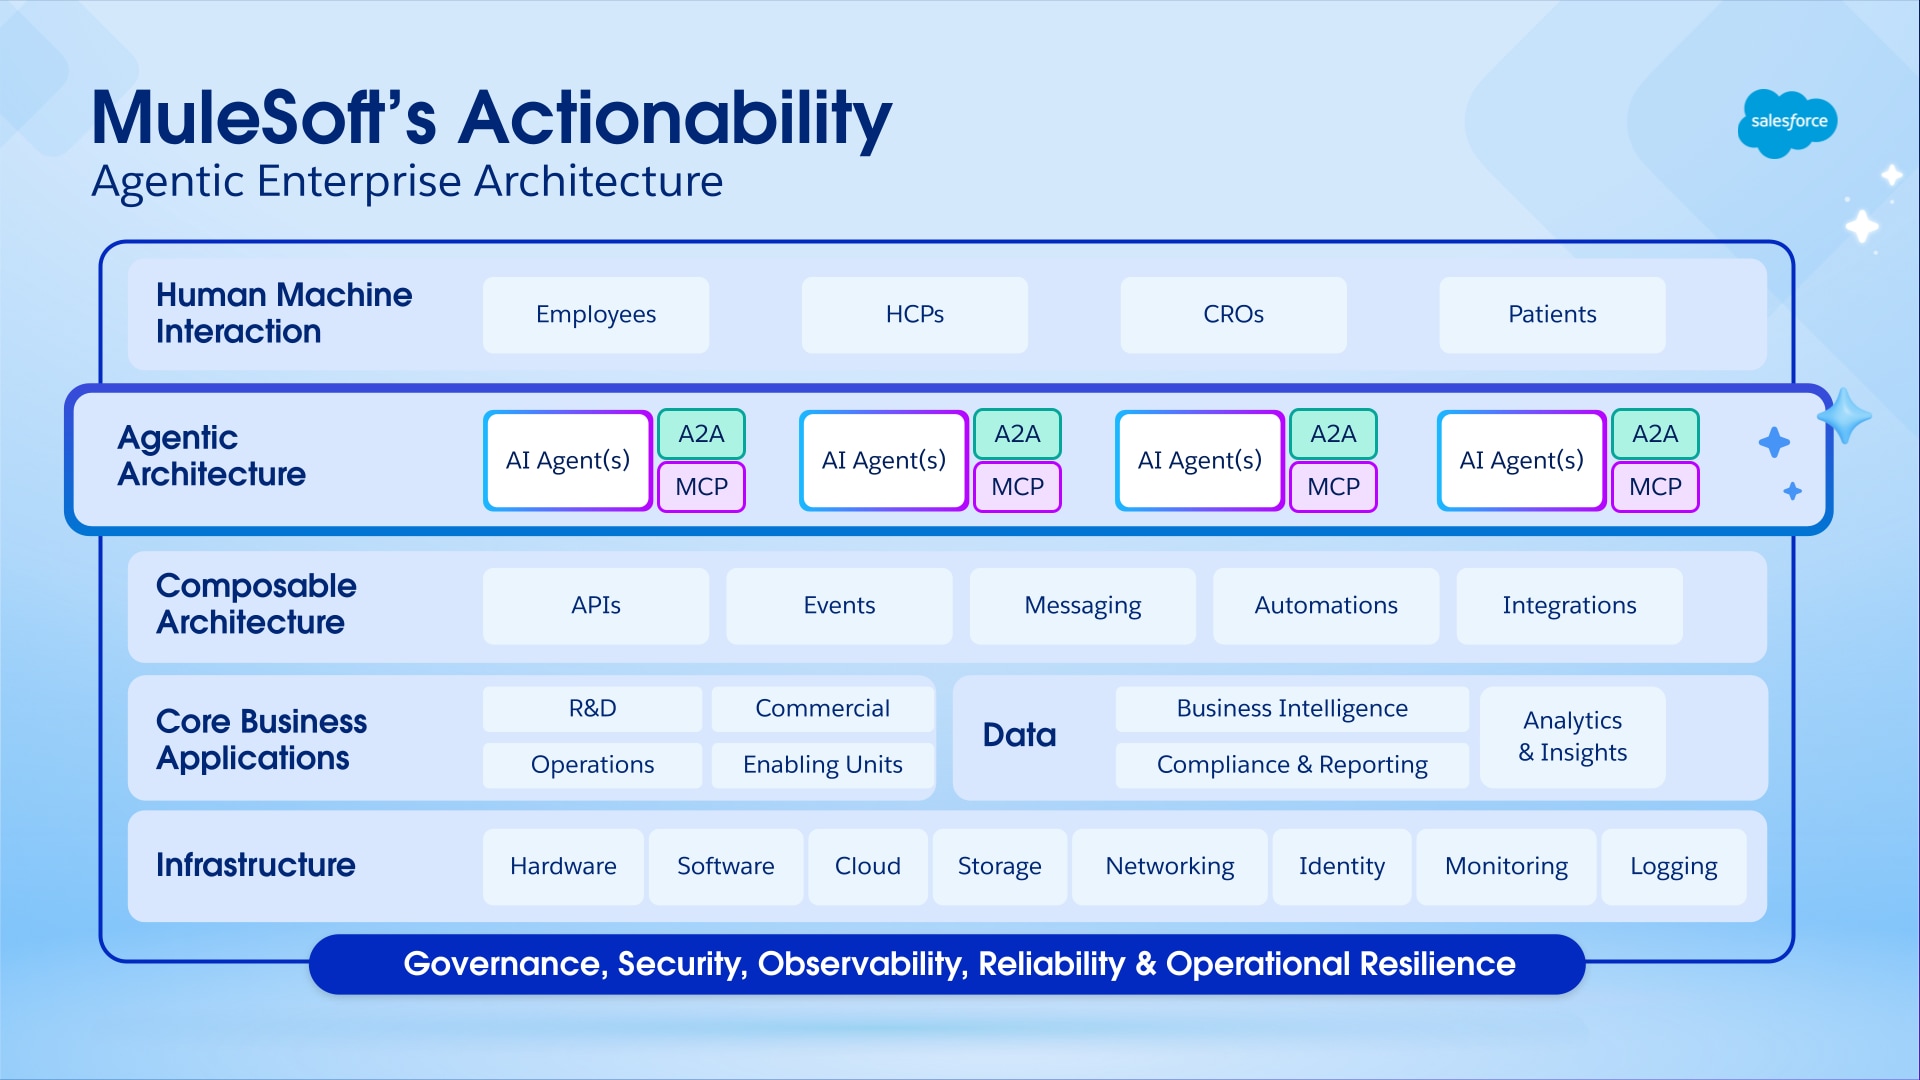 ### **2.1 Protocolo de contexto modelo (MCP)**
O _MCP_ rapidamente surgiu como o padrão da indústria para comunicação entre agentes, o que é análogo ao que o _REST_ se tornou para serviços da Web. O _MCP_ permite que os agentes de IA descubram dinamicamente as capacidades de um sistema, entendam suas entradas e saídas e o invocem para executar uma ação, tudo sem exigir lógica pré-programada ou codificada.
O [MuleSoft MCP Connector](https://docs.mulesoft.com/mcp-connector/latest/) permite que qualquer API implementada como um aplicativo Mule seja publicada como um servidor MCP. Como a _MuleSoft_ fornece centenas de conectores predefinidos para praticamente todos os principais sistemas empresariais (por exemplo, SaaS, legados e bancos de dados), isso transforma instantaneamente as APIs e aplicativos de uma organização em um conjunto de ferramentas prontas para agentes. Uma API projetada para verificar o inventário no SAP, um fluxo que processa um novo lead no Salesforce ou um aplicativo personalizado conectado por meio do _MuleSoft_ podem ser disponibilizados aos agentes de IA como ferramentas gerenciadas atômicas usando o _Conector MCP_.
### **2.2 Protocolo entre agentes (A2A)**
Embora o _MCP_ seja excelente em interações hierárquicas entre agentes e ferramentas, processos de negócios complexos geralmente exigem a colaboração entre vários agentes especializados. O protocolo _agente a agente (A2A)_ é o padrão aberto emergente projetado para facilitar a comunicação entre pares que permite fluxos de trabalho sofisticados de vários agentes.
O suporte da MuleSoft para A2A permite que as empresas projetem e criem sistemas avançados com o mesmo nível de governança e confiabilidade que esperam para suas APIs. O [MuleSoft A2A Connector](https://docs.mulesoft.com/a2a-connector/latest/) permite que os desenvolvedores exponham facilmente qualquer agente como um servidor A2A ou invoquem qualquer agente em conformidade com A2A de um aplicativo Mule. Por exemplo, um processo de solicitação de hipoteca pode ser orquestrado em um "Agente de verificação de crédito", um "Agente de assinatura de documento" e um "Agente de conformidade regulatória", com cada agente a descobrir e invocar as capacidades dos outros (conforme necessário) para promover o progresso da solicitação.
Ao fornecer ferramentas robustas de nível corporativo para MCP e A2A, o MuleSoft dá suporte à criação de um ecossistema flexível que consiste em interações diretas entre agentes (por meio de ferramentas de MCP) e interações entre agentes (A2A). Independentemente de como a paisagem da IA evolui, essa abordagem coloca a _MuleSoft_ como a base subjacente que conecta todas as formas de comunicação agente.
## 3\. Tecido do agente do MuleSoft: O sistema nervoso central da empresa agente
Conforme as empresas adotam a IA agente, elas inevitavelmente enfrentam o desafio da disseminação de agentes. Para evitar que isso devolva em caos, é necessária uma camada de orquestração dedicada. O [MuleSoft Agent Fabric](https://docs.mulesoft.com/agent-fabric/) ([demo](https://www.youtube.com/watch?v=GAqwPie16ic)) é uma solução de arquitetura abrangente concebida para enfrentar este desafio. Ele fornece um plano de gerenciamento central para descobrir, governar, orquestrar e observar toda a rede de agentes de IA, independentemente de onde eles são criados ou como operam. Funcionando como o "controle de tráfego aéreo" para a força de trabalho digital da empresa, o _MuleSoft Agent Fabric_ transforma uma coleção de agentes fragmentados e isolados em uma rede de inteligência coesa, segura e de alto desempenho.
O _MuleSoft Agent Fabric_ é baseado em quatro pilares integrados que abrangem o gerenciamento completo do ciclo de vida dos agentes como ativos empresariais de primeira classe.
### **3.1 Registro do agente (descobrir)**
A base de qualquer ecossistema gerenciado é a capacidade de descoberta. O _registro de agentes_ serve como o catálogo universal e centralizado para cada ativo agente dentro da empresa. Isso inclui agentes criados personalizados, agentes integrados a aplicativos SaaS, servidores MCP que expõem sistemas legados e pontos de extremidade A2A para colaboração entre agentes. Ao fornecer uma única fonte de verdade, o _Registro do agente_ resolve o problema de descoberta crítica impedindo que as equipes criem recursos redundantes e permitindo que desenvolvedores humanos e outros agentes de IA encontrem e reutilizem ativos existentes dinamicamente em escala.
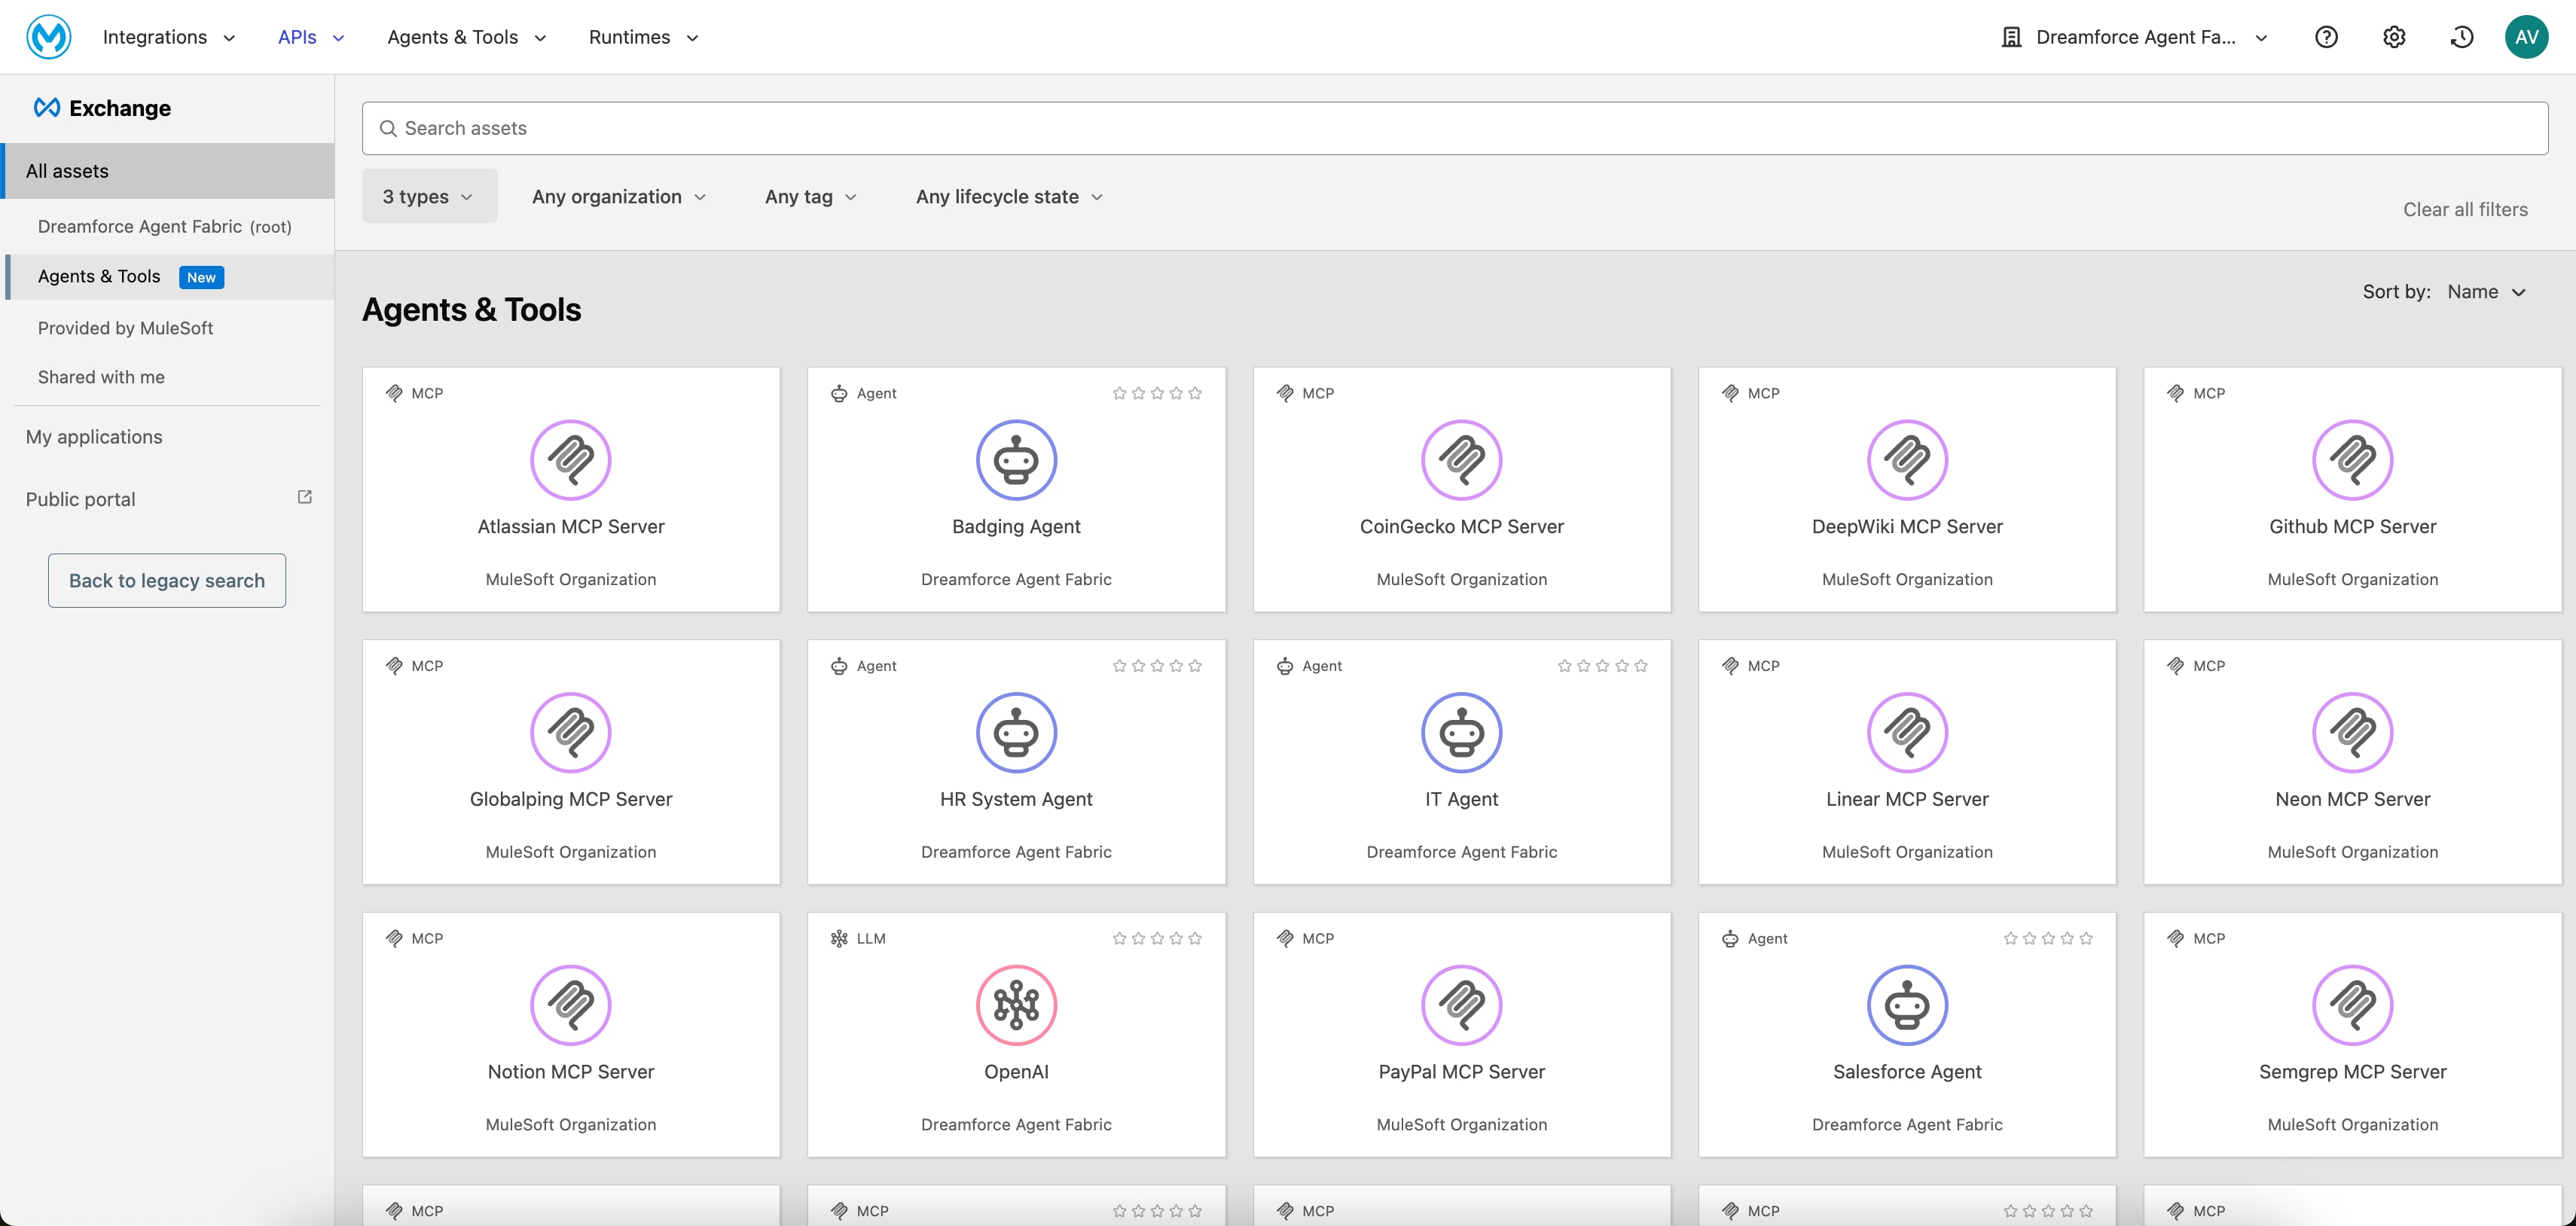 O _Registro de agentes_ é criado com base em _Anypoint Exchange,_ e adiciona três novos tipos de ativos: Agentes, servidores MCP e LLMs. Ele captura informações sobre esses ativos, incluindo ferramentas de MCP, protocolos de transporte e cartões do agente, bem como as dependências entre os agentes e os servidores e ferramentas de MCP que eles consomem. Os desenvolvedores podem criar e gerenciar ativos diretamente no registro. Eles também podem programaticamente descobrir e reutilizar ativos existentes no MuleSoft Vibes (por meio da ferramenta search_asset do _MuleSoft MCP Server_) ao criar novas orquestrações. Isso fornece aos desenvolvedores todas as informações necessárias para entender e consumir esses ativos.
### **3.2 Agente Broker (Orquestração)**
Quando os ativos são descobríveis, eles devem ser orquestrados para realizar um trabalho útil. O _Agent Broker_ é um serviço de orquestração que executa processos de negócios em várias etapas. Ele usa um LLM configurável para interpretar tarefas de alto nível e gerar fluxos de trabalho correspondentes. O _Agent Broker_ descobre, sequencia e chama dinamicamente os agentes e ferramentas necessários para concluir esses processos.
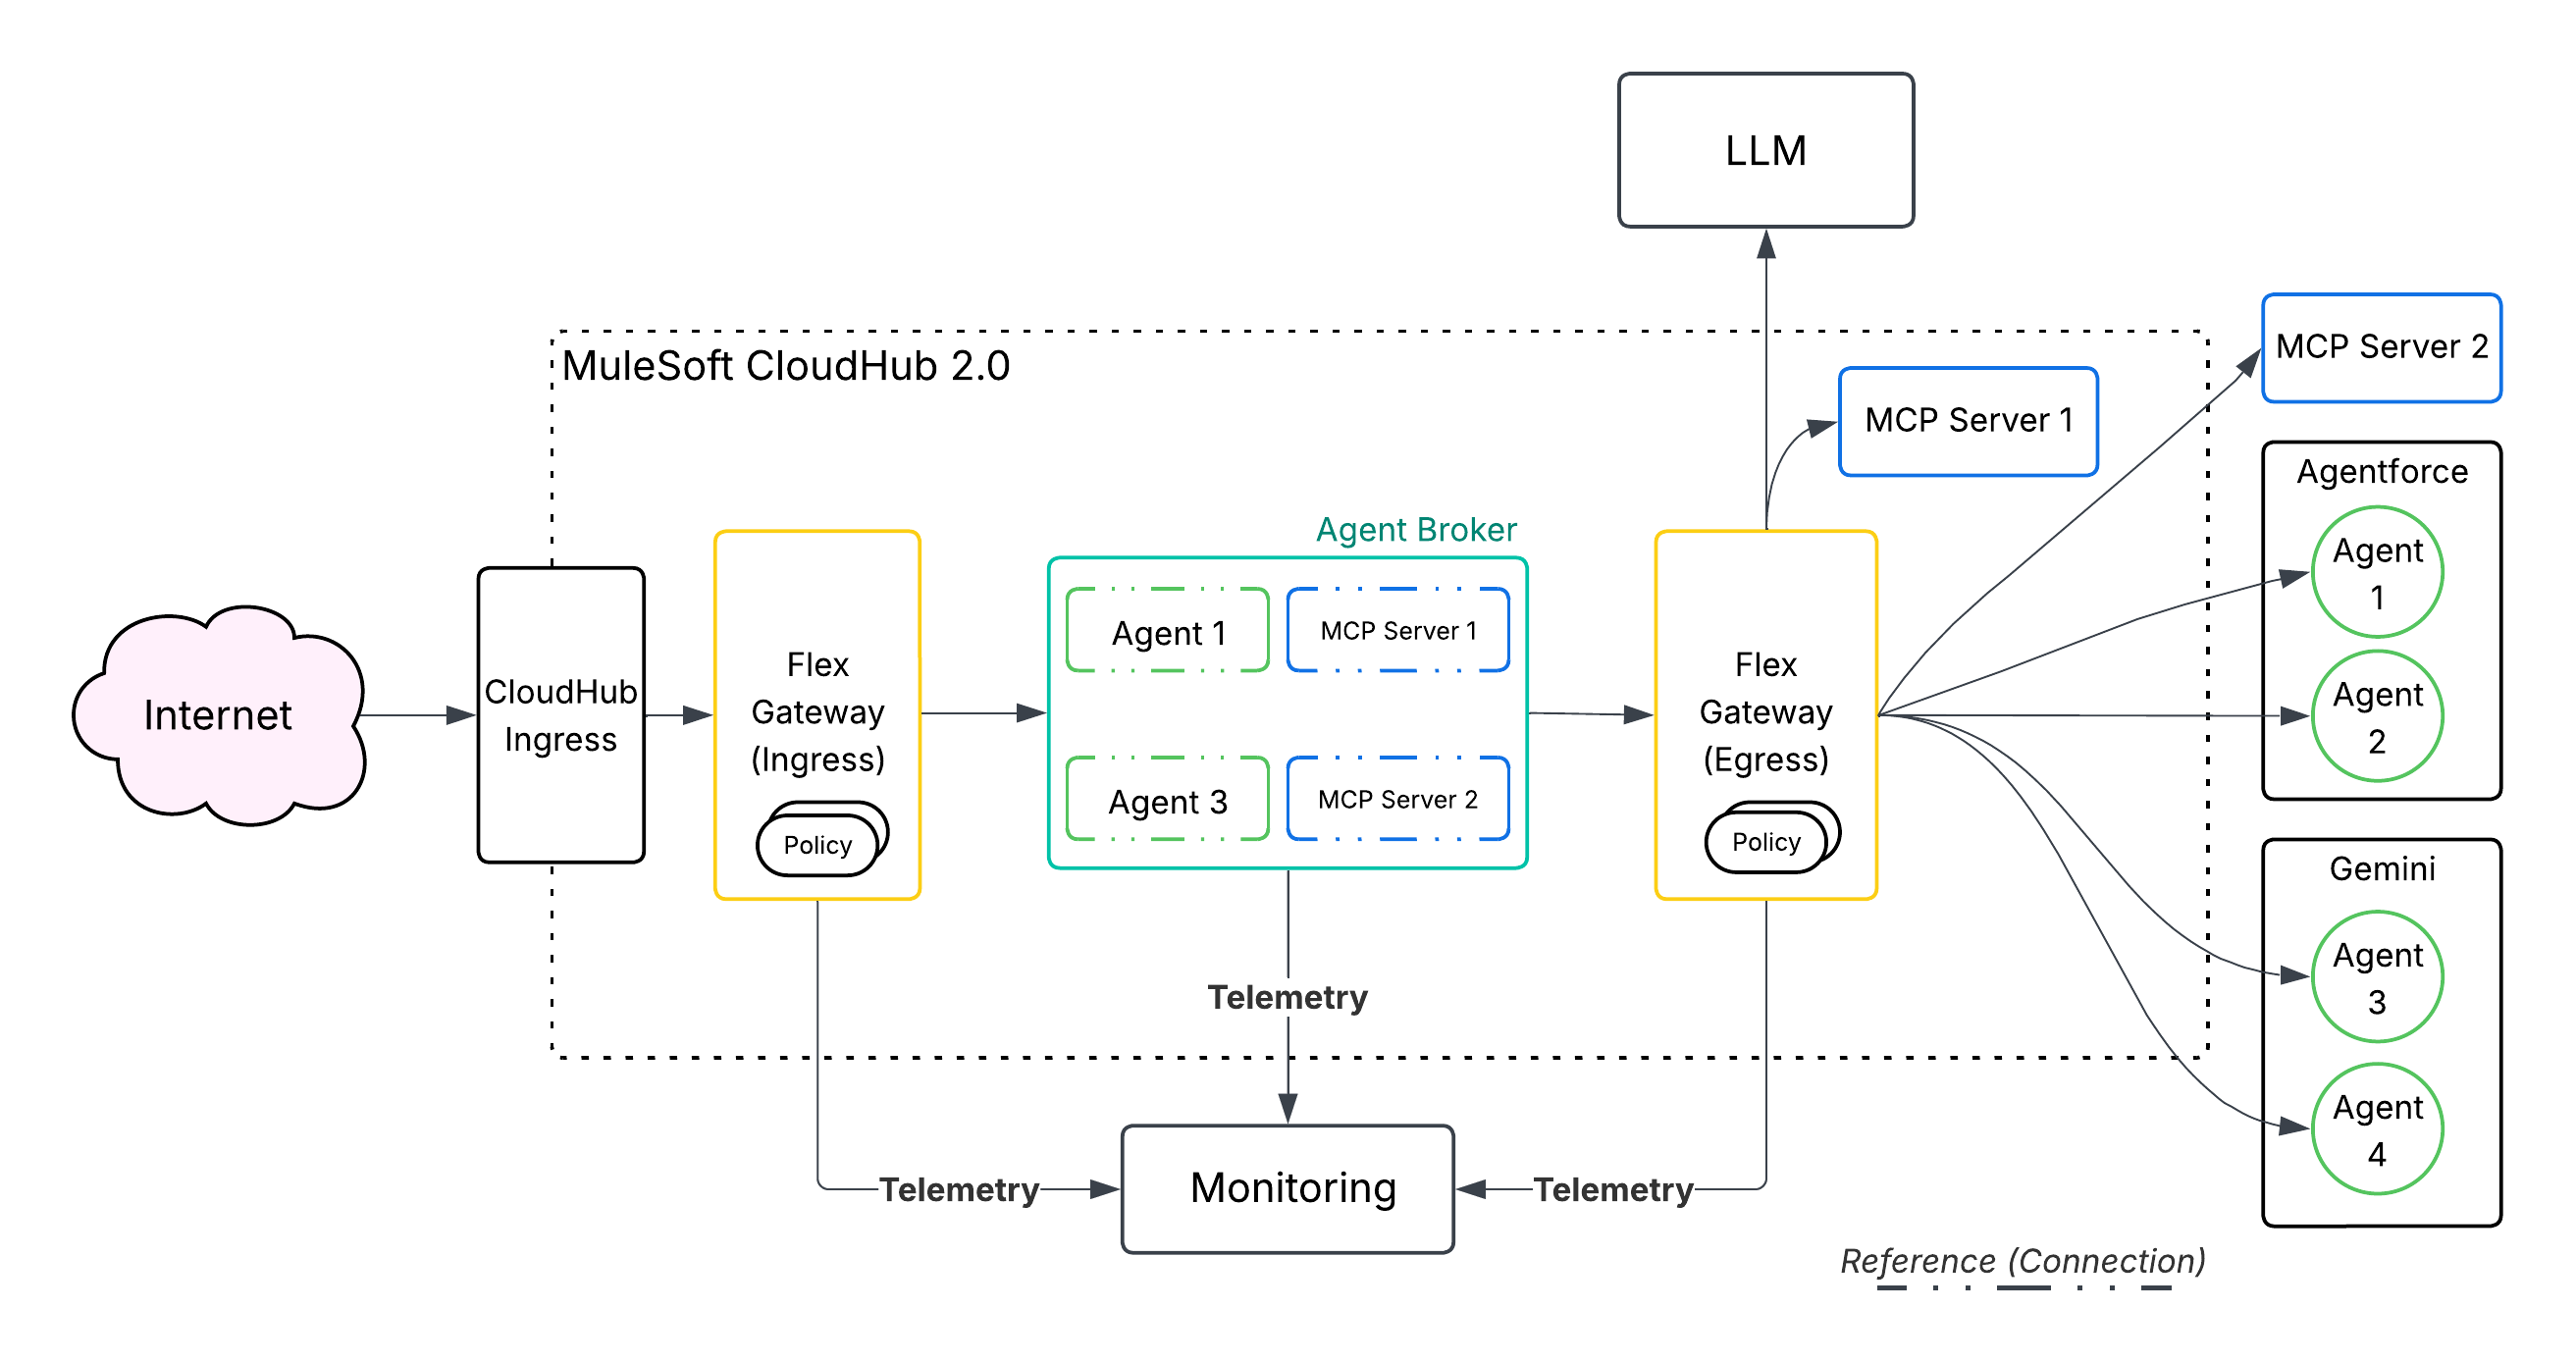 A conectividade é gerenciada por meio do _MCP_ para ferramentas e um protocolo _A2A_ para agentes. Isso permite que o sistema organize os agentes em domínios específicos da empresa (por exemplo, Cadeia de abastecimento ou Finanças) e encaminhe tarefas em todos eles. Um único aviso em linguagem natural (por exemplo, "Integrar um funcionário") é dividido em uma sequência de ações distintas executadas por diferentes agentes ou ferramentas em vários sistemas de back-end. A Orquestração do agente de corretagem inclui:
- **Padrão de orquestração dinâmica:** Esse é um padrão de Agente-Loop que determina as subtarefas e as orquestra nos agentes e ferramentas mais adequados para atingir a meta geral. Ao aproveitar esse padrão, podem ser criados [agentes colaborativos](/docs/architect/pt-br/fundamentals/guide/agentic-patterns#15-agentes-colaborativos-mutirões-de-agentes) para resolver casos de uso complexos (por exemplo, [tratamento de escalonamento de serviço complexo](/docs/architect/pt-br/fundamentals/guide/agentic-patterns#35-caso-de-uso-do-agente-colaborativo-escalonamento-de-serviço-complexo)).
- **Reasoning desenvolvido com LLM:** Usa um LLM para interpretar metas de linguagem natural e gerar planos de execução, o que elimina a necessidade de lógica de fluxo de trabalho rígida embutida em código.
- **Modelo de LLM configurável:** Permite que os desenvolvedores especifiquem qual modelo de LLM usar, o que fornece controle sobre custo, desempenho e recursos.
- **Desenvolvimento da Língua Natural:** A lógica do _Agent Broker_ pode ser definida usando linguagem natural por meio de _MuleSoft Vibes_.
- **Observabilidade:** O _Monitoramento de qualquer ponto_ fornece registro e rastreamento após a implantação para ajudar os usuários a entender e depurar o raciocínio e as interações do agente corretor com ferramentas _MCP_ e agentes _A2A_.
- **Implantação gerenciada:** O _Agent Broker_ é um aplicativo containerizado que é suportado pelo _Mule Runtime_, que gerencia a disponibilidade e a escalabilidade da implantação.
### **3.3 Gateway flexível para MCP e A2A (Govern)**
O _Anypoint Flex Gateway_ é o mecanismo através do qual determinadas políticas são tecnicamente aplicadas. A _MuleSoft Agent Fabric_ utiliza o _Anypoint Flex Gateway_ para [segurar, inspecionar e gerenciar todas as interações agentes](https://docs.mulesoft.com/gateway/latest/flex-agent-secure) que ocorrem por meio dos protocolos _MCP_ e _A2A_. Isso permite que as organizações apliquem um rico [conjunto de políticas de nível corporativo](https://docs.mulesoft.com/gateway/latest/flex-agent-policies) a todo o tráfego de agentes para garantir que cada ação seja segura, em conformidade e auditável antes de sua execução. Para escalar a adoção de IA de modo seguro e responsável, essas proteções são essenciais.
| Nome da política | Protocolo(s) | Descrição |
| :----------------------------------------------------- | :---------- | :-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Política de validação do JWT/Política de imposição do ID do cliente** | A2A, MCP | A **Política de validação/Política de imposição de ID do cliente** protege agentes _A2A_ e servidores _MCP_ restringindo o acesso apenas a chamadores autenticados. |
| **Validação de esquema** | A2A, MCP | A **validação de esquema** garante que as solicitações de agente recebidas estejam de acordo com a especificação _A2A_ ou _MCP_, o que evita o tráfego malformado. |
| **Detector de PII A2A** | A2A | O **detector de PII A2A** identifica _informações de identificação pessoal (PII)_ em solicitações e respostas e habilita o registro ou o bloqueio para atender aos requisitos de conformidade. |
| **Decorador de prompts A2A** | A2A | O **A2A Prompt Decorator** insere contexto personalizado ou instruções em avisos enviados aos agentes para orientar seu comportamento e impor proteções. |
| **Controle de acesso baseado em atributo do MCP** | MCP | **O Controle de acesso baseado em atributo do MCP** regula o acesso a ferramentas e recursos específicos expostos por um servidor _MCP_ com base em atributos do usuário (por exemplo, reivindicações de Níveis, IP ou JWT). |
| **Registro de SSE** | A2A, MCP | O registro **SSE** registra o conteúdo dos fluxos de _eventos enviados pelo servidor (SSE)_ que são usados por protocolos de agência para auditoria abrangente e rastreabilidade. |
| **Limitação de taxa e controle de spike** | A2A, MCP | A **Limitação de taxa e o Spike Control** protegem agentes e sistemas de back-end contra surtos de tráfego e ataques de denegação de serviço aplicando limites de solicitação. |
| **Cartão do agente A2A** | A2A | O **Cartão do agente A2A** reescreve o URL do cartão do agente para garantir que todo o tráfego seja provisionado corretamente por meio da instância de Gateway flexível gerenciada. |
**Políticas de governança corporativa para protocolos agentes**
Além de reger solicitações de entrada, o _Anypoint Flex Gateway_ também gerencia todas as conexões de saída e solicitações de um agente para serviços externos (por exemplo, Servidores e ferramentas _MCP_ ou outros agentes). Isso inclui:
- **Registro:** Fornece um ponto de observabilidade centralizado para monitorar e registrar todas as solicitações de agente de saída para auditoria e solução de problemas.
- **Segurança:** Evita vazamento de dados confidenciais inspecionando o tráfego de saída.
- **Autenticação:** Gerencia as credenciais para sistemas externos aplicando mecanismos de autenticação de saída, incluindo Chaves de API, OAuth e ClientId/ClientSecret de um único ponto.
O [**Kit de desenvolvimento de políticas (PDK**)](https://docs.mulesoft.com/pdk/latest/policies-pdk-overview) do _Anypoint Flex Gateway_ permite que os usuários criem políticas personalizadas quando as políticas prontas para uso não atendem a requisitos específicos. Usando o _PDK_, os desenvolvedores podem escrever lógica de política na linguagem de programação _Rust_ e compilá-la em um módulo _WebAssembly (WASM)_. O módulo independente é carregado no _Anypoint Flex Gateway_ para aplicar regras de segurança exclusivas, transformações de dados personalizadas ou lógica de integração especializada diretamente na borda da API. Isso fornece uma maneira eficiente e de alto desempenho de estender a funcionalidade do gateway para casos de uso exclusivos ou complexos.
Estes são os quatro componentes-chave do _PDK_:
- **Anypoint CLI PDK Plugin:** Esse plugin cria o projeto _PDK_ e carrega a política compilada para o _Exchange_. Ele também gera um _Makefile_ que simplifica o processo de desenvolvimento fornecendo um conjunto claro de comandos para criar e gerenciar a política.
- **Modelo de política:** Quando um novo projeto é criado, o _PDK_ gera um quadro ou modelo básico. Essa estrutura inclui todos os arquivos e ajustes necessários para compilar com sucesso a política, o que dá aos desenvolvedores um ponto de partida para a lógica personalizada.
- **Estruturas de construção de SDK:** Essas ferramentas resumem a arquitetura complexa e orientada por evento do proxy _Envoy_ subjacente. Usando padrões de reator e executor, o _SDK_ fornece um método de codificação linear e simples. Isso ajuda a reduzir a complexidade, melhorar a depuração e diminuir a curva de aprendizado para desenvolvedores.
- **Gestão de políticas:** O [Servidor MCP MuleSoft](https://docs.mulesoft.com/mulesoft-mcp-server/reference-mcp-tools) fornece ferramentas de _MCP_ para ajudar os usuários a gerenciar o ciclo de vida da política personalizada. Exemplos dessas ferramentas incluem:
- get_flex_gateway_policy_example
- manage_api_instance_policy
- manage_flex_gateway_policy_project
### **3.4 Visualizador do agente (Observe)**
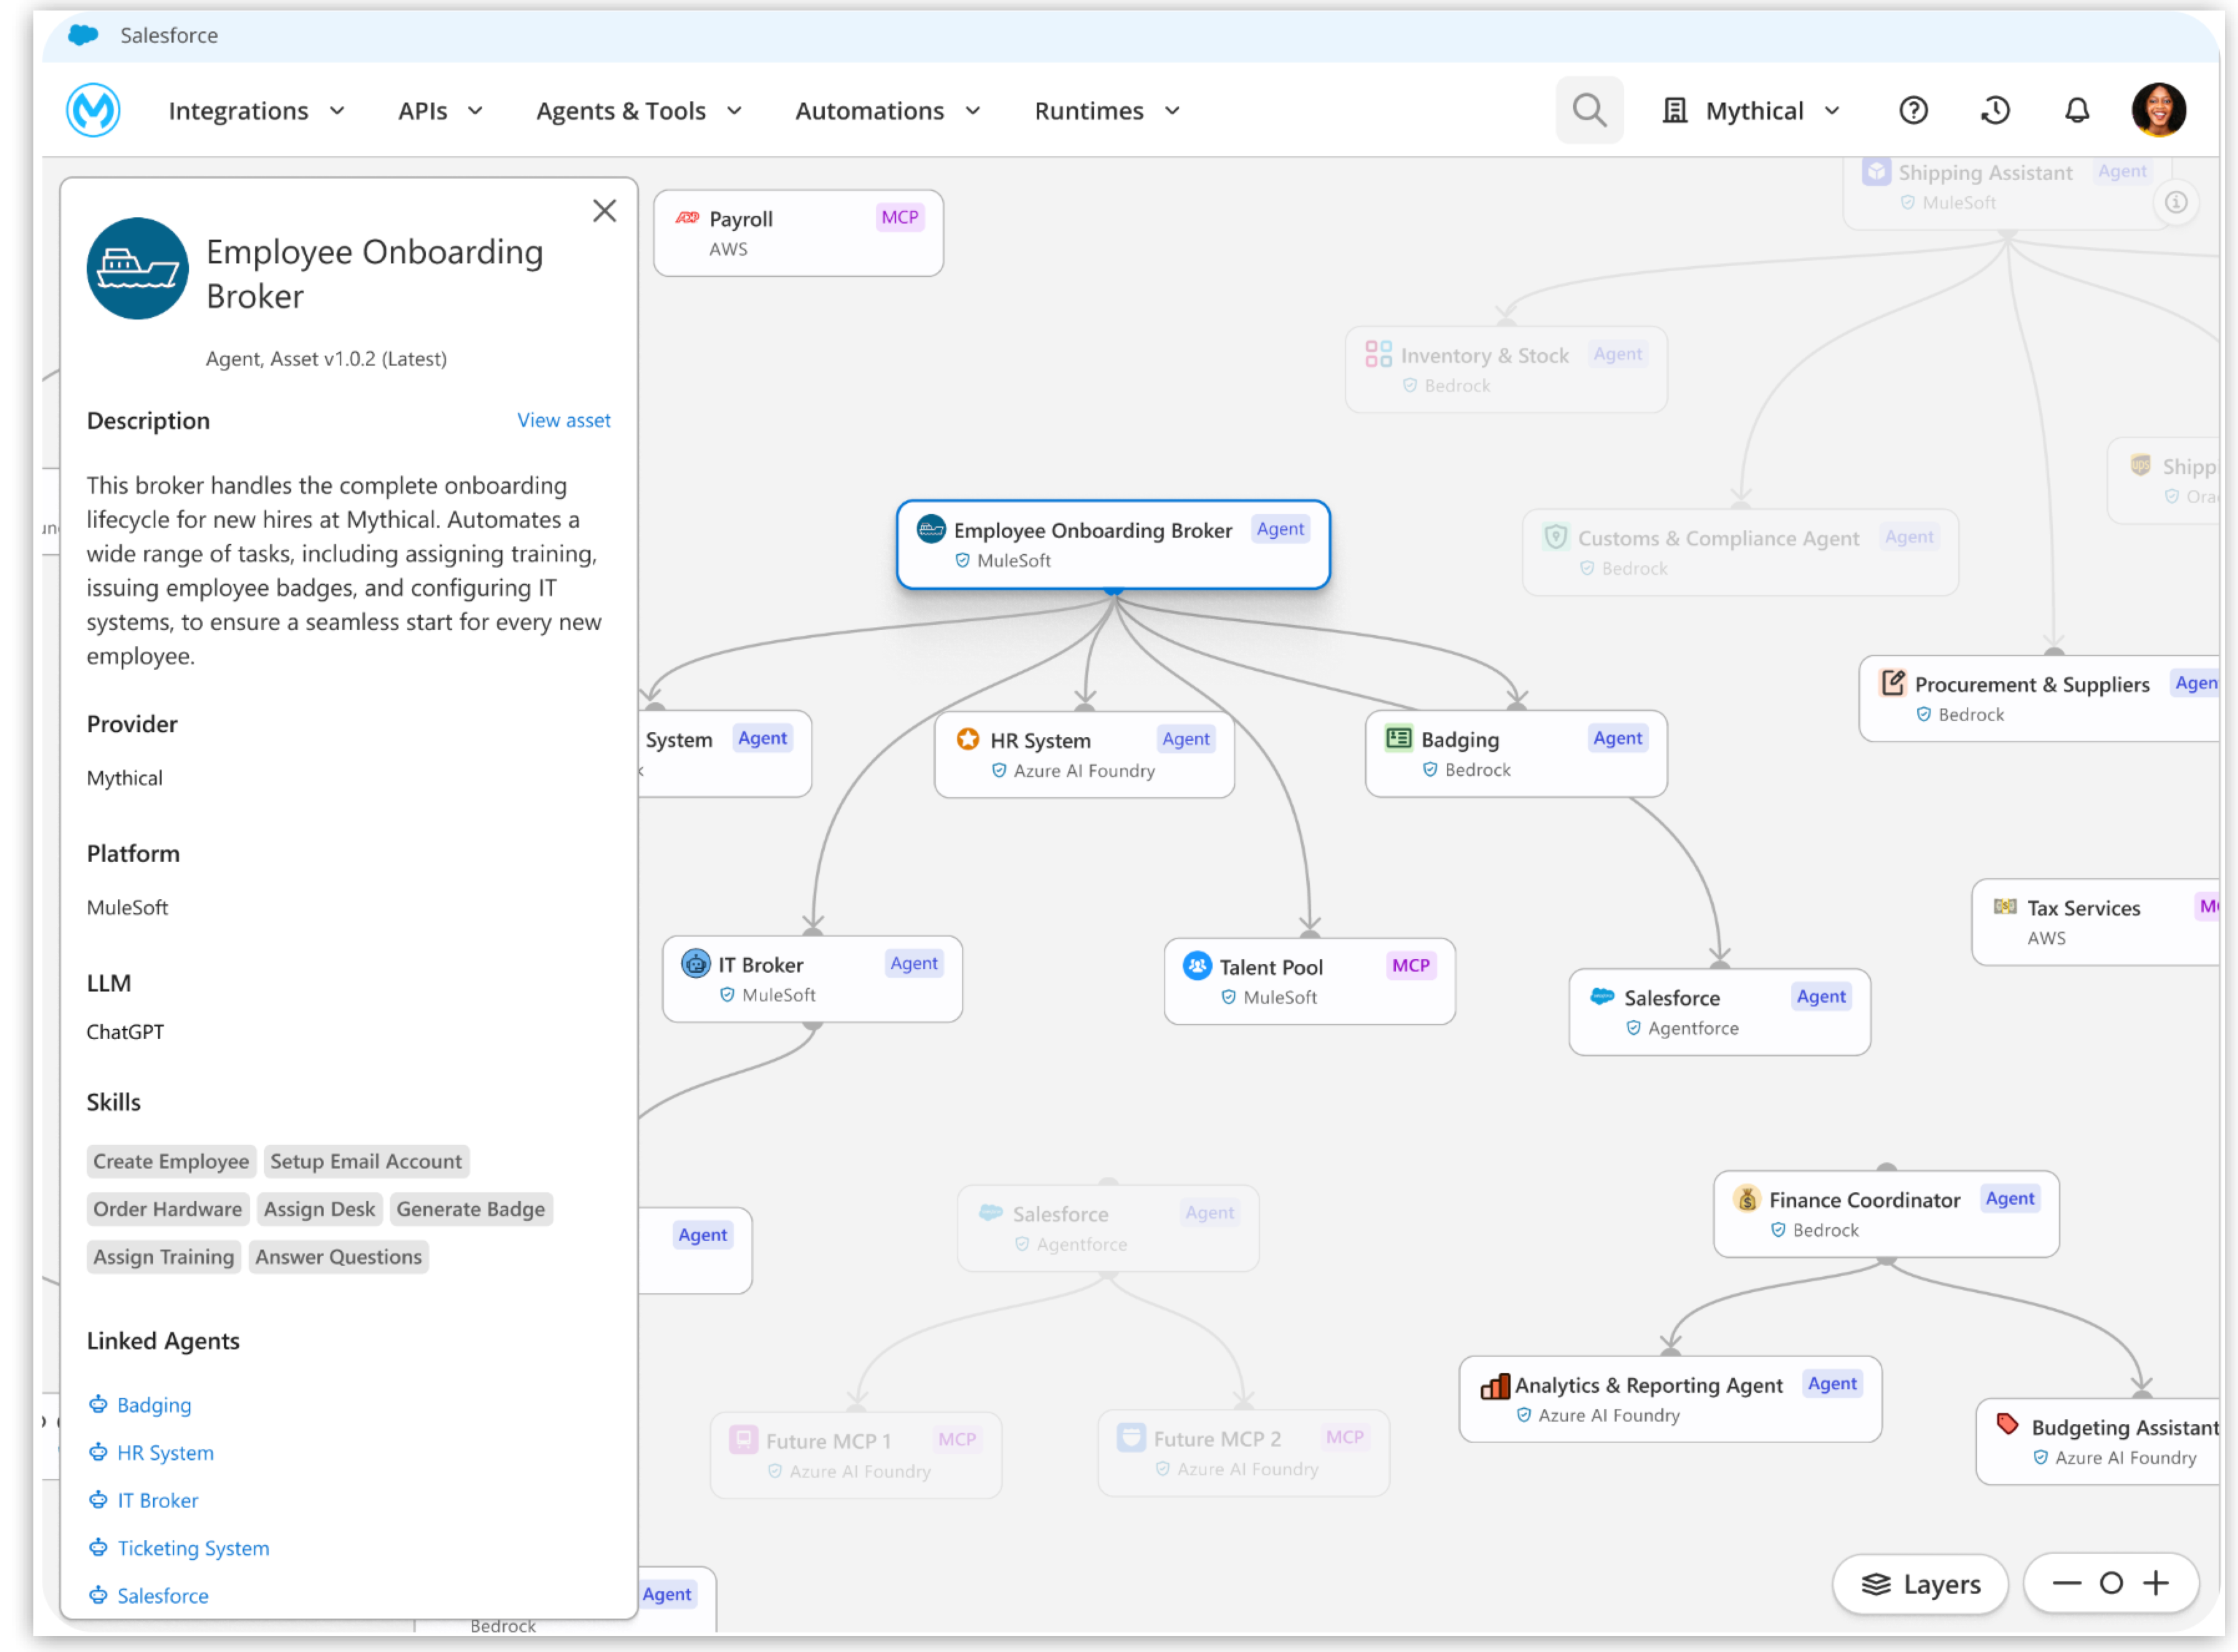 O _Agent Visualizer_ fornece um mapa dinâmico em tempo real de toda a rede de agentes, transformando o que poderia ser uma "caixa negra" de interações de IA em um sistema totalmente observável. Os arquitetos e as equipes de operações podem usar o _Visualizador do agente_ para revisar como os agentes estão conectados, rastrear seus fluxos de decisão, monitorar sua saúde e desempenho e identificar dependências. Esse nível de visibilidade é crucial para otimizar o desempenho, solucionar falhas de modo eficiente, detectar gargalos e aumentar a confiança nos agentes implantados.
## **4\. Unificação da Salesforce Platform**
### **4.1 Catálogo da API e Centro de tópicos**
O _Catálogo da API MuleSoft_ e o _Tema Center_ são projetados para melhorar a forma como as APIs são descobertas, usadas e gerenciadas, particularmente em conjunto com a _Agentforce_.
Todas as APIs da _MuleSoft_ projetadas e publicadas podem ser descobertas e consumidas por meio do [Catálogo de APIs](https://help.salesforce.com/s/articleView?id=platform.api_catalog.htm&type=5) na _Plataforma Salesforce_. O _Catálogo de API_ serve como o repositório centralizado e unifica todas as APIs de uma organização, desde _MuleSoft_, _Salesforce_, _Heroku_ e outras nuvens, em uma única visualização. Isso facilita a descoberta, a compreensão e a reutilização de APIs existentes para desenvolvedores e administradores, permitindo que elas sejam usadas em automações (por exemplo, _Agentforce_, _Flow_ e _Apex_).
O [MuleSoft para Agentforce: O Centro de tópicos](https://blogs.mulesoft.com/news/mulesoft-for-agentforce-topic-center/) permite que os desenvolvedores estruturem suas APIs em torno de casos de uso de negócios específicos definindo os metadados Agentforce **Tópicos** e **Ações** no momento do projeto. Isso inclui:
- **Ações**, que são as tarefas que um agente pode realizar
- **Instruções**, que orientam o agente sobre como aplicar determinadas ações
Ao [adicionar essa camada semântica](https://docs.mulesoft.com/anypoint-code-builder/ai-enabling-api-project-topic-center), o _Topic Center_ torna as APIs compreensíveis e consumíveis pela _Agentforce_, o que garante que ela possa interagir com sistemas empresariais de maneira eficaz.
 ### **4.2 Agentforce Gateway**
O _Agentforce Gateway_ é uma camada de governança centralizada projetada para gerenciar e proteger interações dentro do ecossistema em expansão _Agentforce_. À medida que a _Agentforce_ se integra a APIs e ferramentas adicionais de terceiros por meio de protocolos como o _MCP_, a principal função do _Agentforce Gateway_ é aplicar políticas (por exemplo, limites de taxa e restrições de ferramentas) a todo o tráfego de saída iniciado pela _Agentforce_ e auditar todas as solicitações de saída.
O _Agentforce Gateway_ utiliza o mecanismo de políticas de governança da API _MuleSoft_ existente, que é integrado nativamente à _Plataforma Salesforce_. Esse mecanismo de política baseado em _Envoy_ intercepta o tráfego do agente, aplica políticas configuradas (por exemplo, controle de acesso baseado em atributo e limites de cotação) e gerencia a autenticação e autorização, tudo sem exigir que os clientes instalem infraestrutura de gateway adicional.
 ### **4.3 Inteligência de integração**
Implantar uma rede governada de agentes é uma realização marcante. No entanto, ele introduz novos desafios operacionais "dia 2". É necessário um nível aprimorado de inteligência operacional para monitorar, medir e solucionar problemas de um sistema dinâmico distribuído de atores autônomos. A visão arquitetônica final é um sistema em que a IA não é usada apenas para executar processos de negócios, mas também para monitorar, gerenciar e curar a própria infraestrutura em que ela é executada.
A visão de integração da _MuleSoft_ aproveita o poder do ecossistema mais amplo da _Salesforce_ para fornecer percepções profundas e personalizáveis sobre o desempenho do tecido de integração e da rede de agentes. Ao capturar e armazenar dados em conformidade com a [OpenTelemetry (OTEL)](https://opentelemetry.io/) \- o padrão emergente de observabilidade - no **Salesforce Data 360**, as organizações podem criar um repositório unificado para logs, métricas e rastreamentos em todo o seu panorama. Esses dados podem ser visualizados no **Tableau** por meio de painéis predefinidos e visualizações personalizadas para obter percepções detalhadas sobre o desempenho da API, os padrões de interação do agente e a integridade geral do sistema.
 Esse sistema tem três componentes principais:
1. **Ingestão:** O serviço de ingestão é o ponto de entrada centralizado para coletar e processar dados de telemetria de vários aplicativos _Mule_, _Agent Brokers_ e _Flex Gateways_. Ele realiza validação de esquema, normalização de dados e filtragem para manter a qualidade e a consistência dos dados em vários aplicativos. Além disso, ele impõe controles (por exemplo, autenticação, criptografia, equidade do locatário e limitação de taxa) no pipeline de ingestão.
2. **Armazenamento:** Um trabalho de streaming de alto rendimento é executado no _Data 360_ que lê dados de tópicos de vários locatários _Kafka_ e os transforma no formato _OTEL_. Os dados OTEL então são vinculados ao _Data 360_ do locatário nos DMOs _TelemetryTraceSpan_, _TelemetryLogs_ e _TelemetryMetrics_ no _Lakehouse_.
3. **Visualização/Consumo:** Com os dados de telemetria disponíveis no _Data 360_, os clientes podem revisar a integridade do sistema e obter percepções usando painéis predefinidos ou personalizados por meio do _Tableau Next_. Os clientes também podem aproveitar o [Tableau Concierge](https://help.salesforce.com/s/articleView?id=analytics.tua_metric_questions.htm&type=5), uma habilidade de análise agente pré-construída no _Tableau Next_, que permite aos usuários fazer perguntas sobre dados de telemetria em linguagem natural e receber respostas confiáveis e acionáveis com visualizações. Os clientes também podem exportar os dados para sistemas existentes de _Gerenciamento de desempenho de aplicativo (APM)_ (por exemplo, _DynaTrace_, _Datadog_, _Splunk_ e assim por diante).
## **Conclusão**
A transição para uma Enterprise do agente não é apenas uma atualização de TI; é um ponto de inflexão arquitetônica fundamental. Uma implantação fragmentada e isolada de agentes de IA é um caminho direto para caos operacional, TI sombra e débito técnico não gerenciável. O único caminho sustentável é por uma arquitetura unificada e composível. Com base na base comprovada de conectividade conduzida por API, o _MuleSoft Agent Fabric_ fornece o "sistema nervoso central" necessário para gerenciar esta nova força de trabalho digital. Ele fornece os recursos essenciais para descoberta, orquestração, governança de nível corporativo e observabilidade completa. É assim que ultrapassamos a experimentação de IA e começamos a arquitetar uma empresa verdadeiramente inteligente, automatizada e segura, transformando potencial autônomo em resultados de negócios controlados e tangíveis.
## **Guia Técnico e Referências**
- [Introdução ao Anypoint Code Builder](https://docs.mulesoft.com/anypoint-code-builder/start-acb)
- Guia [técnico do Einstein para Anypoint Code Builder: Fluxos generativos](https://blogs.mulesoft.com/dev-guides/einstein-for-acb/)
- Mergulho profundo de transformação generativa [DataWeave: Inovação de IA para transformação rápida de dados](https://blogs.mulesoft.com/dev-guides/dataweave-generative-transformation/)
- [Criando especificações de API com o MuleSoft Dev Agent](https://docs.mulesoft.com/anypoint-code-builder/api-ai-create-spec)
- [Gerar documentação da API com a IA generativa do Einstein](https://docs.mulesoft.com/exchange/generating-documentation-with-ai)
- [Visão geral do servidor MCP da MuleSoft](https://docs.mulesoft.com/mulesoft-mcp-server/)
- [MuleSoft Ferramentas do servidor MCP](https://docs.mulesoft.com/mulesoft-mcp-server/reference-mcp-tools)
- [Conector MCP](https://docs.mulesoft.com/mcp-connector/latest/)
- [Conector A2A](https://docs.mulesoft.com/a2a-connector/latest/)
- [Introdução ao Agent Fabric](https://docs.mulesoft.com/agent-fabric/learning-map-agent-fabric)
- [Protegendo interações do agente com o Flex Gateway](https://docs.mulesoft.com/gateway/latest/flex-agent-secure)
- [Políticas de agente de gateway flexível](https://docs.mulesoft.com/gateway/latest/flex-agent-policies)
- [Kit de desenvolvimento de política de gateway flexível (PDK) Visão geral](https://docs.mulesoft.com/pdk/latest/policies-pdk-overview)
- [Catálogo da API do MuleSoft para Salesforce](https://help.salesforce.com/s/articleView?id=platform.api_catalog.htm&type=5)
- [Habilitar um projeto de API para tópicos e ações do agente](https://docs.mulesoft.com/anypoint-code-builder/ai-enabling-api-project-topic-center)
- [Trabalhar com o Tableau Next](https://help.salesforce.com/s/articleView?id=analytics.tua_consume.htm&type=5)
- [OpenTelemetry](https://opentelemetry.io/)
- [Protocolo de contexto do modelo](https://modelcontextprotocol.io/docs/getting-started/intro)
- [Protocolo Agent2Agent (A2A)](https://a2a-protocol.org/latest/)
## Sobre o autor
Nikhil Aggarwal é um arquiteto principal na Salesforce, onde ele lidera a arquitetura para MuleSoft e Salesforce Automation Clouds. Nikhil traz mais de 18 anos de experiência em entregar produtos em grande escala e tem paixão pela arquitetura escalonável, experiências intuitivas do desenvolvedor e a criação de equipes de alto desempenho. Antes da Salesforce, ele liderava várias iniciativas no Microsoft Power Platform, no Dataverse e no Office 365 do conceito ao lançamento. Seu trabalho continua a moldar como as empresas modernas conectam sistemas, automatizam fluxos de trabalho e liberam valor comercial na era da IA.
# Introdução
O modelo de compartilhamento do Salesforce é um elemento essencial na capacidade da sua organização de fornecer acesso seguro aos dados do aplicativo. Portanto, é crucial arquitetar seu modelo de compartilhamento corretamente para atender aos seus requisitos de acesso a dados atuais e futuros. Neste documento, revisaremos componentes de acessibilidade de dados, casos de uso de modelo de compartilhamento e soluções reais de compartilhamento de clientes e forneceremos algumas diretrizes de solução de problemas.
## Público pretendido e pré-requisitos
Este documento é destinado a administradores e arquitetos avançados do sistema. Para entender os conceitos, você deve ter um Knowledge prático do modelo de compartilhamento e segurança do Salesforce. Os pré-requisitos para esse guia são:
- Ajuda do [Salesforce: Configurações de compartilhamento](https://help.salesforce.com/s/articleView?id=sf.managing_the_sharing_model.htm)
- Módulo [Trailhead: Segurança de dados](https://trailhead.salesforce.com/en/content/learn/modules/data_security)
- [Construindo o acesso ao registro em escala corporativa](https://developer.salesforce.com/docs/atlas.en-us.draes.meta/draes/draes_preface.htm)
- [Salesforce bem-construído - Trust](/docs/architect/pt-br/well-architected/guide/trust.html)
### Acesso a dados não coberto
Este guia se concentra nos principais recursos usados para controlar o acesso em nível de registro a objetos padrão e personalizados. Os tópicos não abordados neste guia incluem:
- Acesso à pasta
- Acesso ao conteúdo
- Acesso ao Chatter
- Acesso à base de Knowledge
- Ideias, Perguntas/Acesso a respostas
- Acessibilidade de dados móveis
## Tipos de acesso a dados
A segurança em nível de registro permite que você dê aos usuários acesso a alguns registros de objeto, mas não a outros. Como acontece com a maioria dos aplicativos, o acesso aos dados começa com um usuário. O aplicativo deve saber quem é o usuário antes de dar acesso. Para o Salesforce, há diferentes tipos de usuários e, às vezes, o nível de acesso é diferente por tipo. Em vez de revisar cada atributo de cada tipo de licença, vamos focar aqui os atributos interessantes que têm impacto significativo no acesso aos dados. A propriedade do registro e o acesso total são sinônimos e intercambiáveis e fornecem ao usuário o nível mais alto de acesso a um registro.
### Usuários e licenças
**_Usuários de alto volume_**
Usuários de alto volume (incluindo usuários com os tipos de licença Comunidade de clientes, Portal de clientes de alto volume e Site autenticado) não utilizam o modelo de compartilhamento, pois seus tipos de licença não oferecem suporte a papéis. Essas licenças têm seu próprio modelo de compartilhamento que funciona por correspondência de chave estrangeira entre o usuário (que contém a licença) e os dados nas pesquisas de Conta e Contato. Os administradores podem criar conjuntos de compartilhamento ou compartilhar grupos para conceder aos usuários de alto volume acesso a registros.
**_Licenças externas do Chatter Free e Chatter_**
As licenças Chatter Free e Chatter External não seguem o modelo de compartilhamento padrão. Essas licenças não têm acesso a registros do CRM (objetos padrão ou personalizados) e funcionalidades de Conteúdo e não oferecem suporte a papéis, portanto, não há compartilhamento.
Para o restante deste documento, estamos presumindo um tipo de usuário do Salesforce usando um modelo de compartilhamento completo. Consulte [Licenças de usuário](https://help.salesforce.com/apex/HTViewHelpDoc?id=users_understanding_license_types.htm) para obter mais informações sobre cada tipo de licença disponível.
### Componentes
**_Perfis e conjuntos de permissões_**
Perfis e conjuntos de permissões fornecem segurança em nível de objeto determinando quais tipos de dados os usuários veem e se eles podem editar, criar ou excluir registros. Para cada objeto, as permissões "Visualizar tudo" e "Modificar tudo" ignoram regras e configurações de compartilhamento, permitindo que os administradores concedam acesso rapidamente a registros associados a um determinado objeto em toda a organização. Essas permissões costumam ser alternativas preferidas às permissões administrativas "Visualizar todos os dados" e "Modificar todos os dados", que permitem aos usuários visualizar ou modificar todos os aplicativos e dados.
Os perfis e os conjuntos de permissões também controlam a segurança em nível de campo, que determina os campos em cada objeto que os usuários podem acessar. Por exemplo, um objeto pode ter 20 campos, mas a segurança em nível de campo pode ser configurada para impedir que os usuários vejam cinco dos 20 campos.
Recomendamos enfaticamente que você use conjuntos de permissões e grupos de conjuntos de permissões em vez de perfis para gerenciar as permissões de objeto de seus usuários. Como você pode reutilizar blocos de criação de conjuntos de permissões menores, pode evitar a criação de dezenas ou mesmo centenas de perfis para cada usuário e função de trabalho.
**_Propriedade do registro e filas_**
Cada registro deve ser de propriedade de um único usuário ou uma fila. O proprietário tem acesso ao registro com base nas Configurações de objeto do perfil do proprietário. Por exemplo, se o perfil do proprietário tiver a permissão Criar e Ler em um objeto, mas não a permissão Editar ou Excluir, o proprietário poderá criar um registro para o objeto e ver o novo registro. No entanto, o proprietário não poderá editar nem excluir o registro. Usuários superiores em uma hierarquia (papel ou território) herdam o mesmo acesso a dados que seus subordinados para objetos padrão. Se o subordinado tiver acesso somente leitura, os usuários acima dele na hierarquia de papéis também terão. Esse acesso se aplica a registros de propriedade dos usuários, bem como a registros compartilhados com eles.
As filas ajudam você a priorizar, distribuir e atribuir registros a equipes que compartilham cargas de trabalho. Membros da fila e usuários acima na hierarquia de papéis podem acessar filas de modos de exibição de lista e assumir a propriedade de registros em uma fila.
Se um único usuário tiver mais de 10 mil registros, como prática recomendada:
- O registro de usuário do proprietário não deve conter um papel na hierarquia de papéis.
- Se o registro do usuário do proprietário precisar conter um papel, coloque o papel no topo da hierarquia em sua própria ramificação da hierarquia de papéis.
Consulte [Consulte Salesforce Well-Architected – Confiabilidade](/docs/architect/pt-br/well-architected/guide/reliability.html) para obter mais informações.
**_Padrões para toda a organização_**
As configurações de compartilhamento para toda a organização especificam o nível padrão de acesso que os usuários têm aos registros uns dos outros. Você usa as configurações de compartilhamento de toda a organização para bloquear seus dados no nível mais restritivo. Use as outras ferramentas de compartilhamento e segurança em nível de registro para dar acesso seletivamente a outros usuários. Por exemplo, os usuários têm permissões no nível do objeto para ler e editar oportunidades, e a configuração de compartilhamento para toda a organização é Somente leitura. Por padrão, esses usuários podem ler todos os registros de oportunidade, mas não podem editar nenhum, a menos que sejam proprietários do registro ou recebam outras permissões.
As configurações padrão para toda a organização podem ser alteradas de uma configuração para outra (Privado para Controlado pelo pai, então de volta para Privado). No entanto, essas alterações exigem recálculo de compartilhamento e, dependendo do volume, podem resultar em longos tempos de processamento.
Somente para objetos personalizados, você pode configurar a configuração Conceder acesso usando hierarquias. Se desmarcada (o padrão está marcado), os usuários acima na hierarquia de papéis serão impedidos de herdar o acesso. Essa configuração é encontrada nas configurações padrão de toda a organização.
**_Hierarquia de papéis_**
Uma hierarquia de papéis representa um nível de acesso a dados de que um usuário ou grupo de usuários precisa. A hierarquia de papéis garante que os gerentes sempre tenham acesso aos mesmos dados que seus funcionários, independentemente das configurações padrão de toda a organização. As hierarquias de papéis não precisam corresponder exatamente ao seu organograma. Em vez disso, cada papel na hierarquia deve representar um nível de acesso a dados de que um usuário ou grupo de usuários precisa.
Em organizações do Salesforce criadas na versão Spring '21 ou posterior, você pode criar até 5 mil papéis. Em organizações criadas antes da versão Spring '21, você pode criar até 500 papéis e entrar em contato com o Suporte ao cliente da Salesforce para aumentar esse limite. Como prática recomendada, mantenha o número de papéis internos para 25 mil e o número de papéis externos para 100 mil.
Como prática recomendada, mantenha a hierarquia de papéis para não mais de 10 níveis de ramificações na hierarquia.
Quando o papel de um usuário muda, todas as regras de compartilhamento relevantes são avaliadas para corrigir o acesso conforme necessário. Os colegas no mesmo papel não garantem acesso aos dados uns dos outros.
A modelagem da hierarquia de papéis começa com a compreensão de como a organização é estruturada. Isso geralmente é criado com base na compreensão do escopo de um gerente, começando do topo. O CEO supervisiona toda a empresa. O CEO normalmente tem subordinados diretos que podem ser segmentados por unidade de negócios (Vendas ou Suporte) ou região geográfica (EMEA, APAC). Essa pessoa então tem subordinados diretos que podem ser segmentados ainda mais, e assim por diante. Embora pareça muito como um gráfico organizacional de RH, ao modelar o acesso a dados, concentre-se na acessibilidade de dados com uma consideração para os relatórios de RH.
Sobreposições sempre são a parte complicada da hierarquia. Se eles estiverem em sua própria agência, precisarão de regras de compartilhamento, equipes ou gerenciamento de território para obter o acesso necessário. Se eles forem dobrados na hierarquia, talvez haja implicações de relatórios.
É importante passar o tempo configurando a hierarquia de papéis, pois é um dos aspectos fundamentais do modelo de compartilhamento.
| Casos de uso de hierarquia de papéis |
| --------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Acesso de gerenciamento: a capacidade dos gerentes de ver e fazer o que seus subordinados podem ver e fazer. |
| Relatórios de gerenciamento – a capacidade de os relatórios serem totalizados de modo hierárquico para que qualquer pessoa acima da hierarquia veja mais dados do que aqueles abaixo deles. |
| Segregação entre ramificações organizacionais: diferentes unidades de negócios não precisam ver os dados umas das outras; ter uma hierarquia na qual você pode definir ramificações separadas permite que você segregue a visibilidade dentro de unidades de negócios, ao mesmo tempo que distribui a visibilidade até os níveis executivos acima dessas unidades. |
| Segregação dentro de um papel – em muitas organizações/aplicativos, as pessoas que desempenham todos o mesmo papel não devem necessariamente ver os dados umas das outras. Ter papéis hierárquicos permite que você defina um nó de "folha" em que todos os dados são essencialmente privados e ainda totalize esses dados para um papel pai que possa ver tudo. |
**_Grupos públicos_**
Um grupo público é uma coleção de usuários individuais, papéis, territórios e assim por diante, que todos têm uma função em comum. Grupos públicos podem consistir em:
- Usuários
- Usuários do portal de clientes
- Usuários parceiros
- Papéis
- Papéis e subordinados internos
- Papéis, subordinados internos e do portal
- Papéis do portal
- Papéis e subordinados do portal
- Territórios
- Territórios e subordinados
- Outros grupos públicos (aninhamento)
Os grupos podem ser aninhados (Grupo A aninhado no Grupo B), mas não aninhe mais de cinco níveis. Aninhar tem impacto sobre a manutenção e o desempenho do grupo devido ao cálculo de associação ao grupo. Como prática recomendada, mantenha o número total de grupos públicos para uma organização para 100 mil.
| Casos de uso de grupo público |
| --------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Quando você precisa fornecer acesso a um grupo arbitrário de pessoas, cria um grupo público para coletá-las e, em seguida, use outras ferramentas de compartilhamento para dar ao grupo o acesso necessário. Somente a associação ao grupo não fornece acesso a dados. |
| Os grupos também podem ser aninhados entre si, portanto, permitindo que um grupo aninhado obtenha o mesmo acesso que o grupo em que ele está contido. Isso permite a criação de hierarquias ad-hoc menores que não interagem necessariamente com as hierarquias de papel ou território. Se o Grupo A for membro do Grupo B, os membros do Grupo A terão acesso aos dados compartilhados com o Grupo B no mesmo nível de acesso que os membros do Grupo B. |
| Os grupos também podem proteger os dados compartilhados no grupo contra que sejam acessados por pessoas na hierarquia de papéis acima dos membros do grupo. Isso (e lidar com o acesso dos proprietários de registro e sua hierarquia de gerenciamento) permite a criação de grupos em que informações altamente confidenciais podem ser compartilhadas – os dados estarão acessíveis Apenas aos membros do grupo e ninguém mais na organização. Isso é feito usando a configuração Conceder acesso usando hierarquias. |
**_Regras de compartilhamento baseadas em proprietário_**
As regras de compartilhamento baseadas em proprietário permitem exceções às configurações padrão de toda a organização e à hierarquia de papéis que dão aos usuários acesso a registros que eles não possuem. As regras de compartilhamento baseadas em proprietário são baseadas apenas no proprietário do registro.
As regras de compartilhamento baseadas em proprietário do contato não se aplicam a contatos privados ou contatos que não estão associados a uma conta.
O limite total de regras de compartilhamento por objeto é de 300.
| Casos de uso de regra de compartilhamento baseado em proprietário |
| ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Gerenciamento de matriz baseado em papel ou situações de sobreposição: uma pessoa em Serviço deve poder ver alguns dados de Vendas, mas ela mora em ramificações diferentes da hierarquia, de modo que você pode criar uma regra que compartilhe dados entre papéis em ramificações diferentes. |
| Para fornecer acesso a dados a colegas que têm o mesmo papel ou território. |
| Para fornecer acesso a dados a outros agrupamentos de usuários (grupos públicos, portal. papéis, territórios). Os membros dos agrupamentos que são proprietários dos registros podem ser compartilhados com os membros de outros agrupamentos. |
**_Regras de compartilhamento baseadas em critérios_**
As regras de compartilhamento baseadas em critérios dão acesso a registros com base nos valores de campo (critérios) do registro. Se os critérios forem atendidos (um ou muitos valores de campo), um registro de compartilhamento será criado para a regra. A propriedade do registro não é uma consideração.
O limite de regras de compartilhamento de usuário convidado e baseado em critérios por objeto é 50.
| Caso de uso de regra de compartilhamento baseado em critérios |
| -------------------------------------------------------------------------------------- |
| Para fornecer acesso a dados a usuários ou grupos com base no valor de um campo no registro. |
**_Regras de compartilhamento de usuário convidado_**
Uma regra de compartilhamento de usuário convidado é um tipo especial de regra de compartilhamento baseada em critérios usada para conceder acesso de registro a usuários convidados não autenticados. O limite de regras de compartilhamento de usuário convidado e baseado em critérios por objeto é 50.
> **Aviso:** O tipo de regra de compartilhamento de usuário convidado concede acesso a usuários convidados sem credenciais de login. Ao criar uma regra de compartilhamento de usuário convidado, você está permitindo acesso imediato e ilimitado a todos os registros que correspondem aos critérios da regra de compartilhamento a qualquer pessoa. Para proteger seus dados do Salesforce e dar aos usuários convidados acesso ao que eles precisam, considere todos os casos de uso e as implicações de criar esse tipo de regra de compartilhamento. Implemente os controles de segurança que você considera adequados para a confidencialidade dos seus dados. A Salesforce não é responsável por qualquer exposição de seus dados a usuários não autenticados com base nessa alteração em relação às configurações padrão.
| Caso de uso de regra de compartilhamento do usuário convidado |
| ------------------------------------------------------ |
| Para fornecer acesso a dados a usuários convidados não autenticados. |
**_Compartilhamento manual_**
Às vezes, é impossível definir um grupo consistente de usuários que precisam de acesso a um determinado conjunto de registros. Proprietários de registro ou outros usuários com privilégios adequados, como administradores do sistema, podem usar o compartilhamento manual para conceder permissões de leitura e edição a usuários que não têm acesso de outra forma. O compartilhamento manual não é automatizado, como configurações de compartilhamento de toda a organização, hierarquias de papéis ou regras de compartilhamento. Porém, oferece aos proprietários de registro a flexibilidade de compartilhar registros com os usuários que precisam vê-los.
O compartilhamento manual é removido quando o proprietário do registro muda ou quando o acesso de compartilhamento concedido não concede acesso adicional além do nível de acesso padrão de compartilhamento para toda a organização do objeto. Isso também se aplica a compartilhamentos manuais criados programaticamente.
Registros de compartilhamento manual são definidos como registros de compartilhamento com a causa da linha definida como compartilhamento manual.
Todos os registros de compartilhamento (objetos padrão e personalizados) com uma causa de linha definida como _compartilhamento manual_ podem ser editados e excluídos pelo botão **_Compartilhar_** no layout de página do objeto, mesmo que o registro de compartilhamento tenha sido criado programaticamente.
| Caso de uso de compartilhamento manual |
| ------------------------------------------------------------------------------------------------------------------------------------- |
| Para fornecer ao usuário a capacidade de conceder acesso (somente leitura ou leitura/gravação) ao registro atual a outros usuários, grupos ou papéis. |
**_Equipes_**
Uma equipe é um grupo de usuários que trabalham juntos em uma conta, oportunidade de vendas ou caso. Os proprietários de registro podem criar uma equipe para cada registro de sua propriedade. O proprietário do registro adiciona membros da equipe e especifica o nível de acesso que cada membro da equipe tem ao registro. Alguns membros da equipe podem ter acesso somente leitura, enquanto outros têm leitura/gravação.
Somente proprietários, pessoas superiores na hierarquia e administradores podem adicionar membros da equipe e dar mais acesso ao membro. Um membro da equipe com acesso de leitura/gravação pode adicionar outro membro que já tenha acesso ao registro ao qual a equipe está associada. O membro da equipe não pode dar a ele acesso adicional.
Criar um membro da equipe no aplicativo cria dois registros: um registro de equipe e um registro de compartilhamento associado. Se você criar membros da equipe programaticamente, terá que gerenciar o registro da equipe e o registro de compartilhamento associado. Há apenas uma equipe por registro (Conta, Oportunidade ou Caso). Se várias equipes forem necessárias, dependendo de suas necessidades específicas, considere o gerenciamento de território ou o compartilhamento programático
| Casos de uso da equipe |
| ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Para fornecer ao usuário a capacidade de conceder acesso (somente leitura ou leitura/gravação) a um único grupo de usuários (a equipe). |
| Se as equipes forem gerenciadas externamente, por exemplo, por meio de uma comissão externa ou sistema de gerenciamento de território, a integração poderá ser usada para gerenciar a equipe da conta. Há casos em que o gerenciamento de território em um sistema externo pode se alinhar a uma solução de equipe no Salesforce. |
| Vários proprietários de uma conta podem ser gerenciados pela equipe da conta. |
| Um único grupo de usuários (equipe) requer acesso somente leitura ou leitura/gravação a um registro de oportunidade. (Equipe de oportunidades) |
**_Hierarquia territorial_**
Ao usar o Gerenciamento de território Enterprise, você configura uma hierarquia de territórios que mostra a estrutura de território de um modelo e serve como seu principal ponto de interação. Se o Gerenciamento de território Enterprise estiver habilitado, você deverá gerenciar a hierarquia de papéis e a hierarquia de territórios. Para obter mais informações, consulte [Gerenciamento de Território Enterprise](https://help.salesforce.com/articleView?id=sf.tm2_intro.htm) na Ajuda do Salesforce.
**_Compartilhamento gerenciado do Apex_**
O compartilhamento gerenciado do Apex (também conhecido como compartilhamento programático) permite que você use código para criar configurações de compartilhamento sofisticadas e dinâmicas quando um requisito de acesso a dados não puder ser atendido por nenhum outro meio.
Se você criar um registro de compartilhamento programaticamente e a causa de linha pronta para uso (_compartilhamento manual_) for usada, poderá manter esse registro de compartilhamento com o botão **_Compartilhar_** no aplicativo. O registro de compartilhamento está sujeito a todas as regras com a causa da linha de compartilhamento manual, como exclusão após a transferência do proprietário.
Você também pode criar seus próprios motivos de compartilhamento do Apex para objetos personalizados para rastrear por que um registro com um usuário ou grupo de usuários e simplificar a codificação necessária para fazer atualizações e exclusões de registros de compartilhamento.
Para obter mais informações, revise [Compartilhar um registro usando o Apex](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_bulk_sharing_creating_with_apex.htm) antes de considerar o uso de compartilhamento programático.
| Casos de uso de compartilhamento gerenciado do Apex |
| ------------------------------------------------------------------------------------------------------------------------------------------------- |
| Nenhum outro método de compartilhamento (declarativo) atende às necessidades de acesso aos dados. |
| Há um sistema externo de verdade para atribuições de acesso do usuário que continuará a promover o acesso e a ser integrado ao Salesforce. |
| Desempenho ruim usando componentes de compartilhamento nativos. (Geralmente se aplica a volumes de dados muito grandes) |
| Funcionalidade da equipe em objetos personalizados. |
**_Regras de restrição_**
Em sua configuração de acesso a dados, talvez você queira impedir que os usuários vejam registros que podem conter dados confidenciais ou simplesmente não sejam essenciais para o trabalho deles. Você pode usar regras de restrição para permitir que os usuários acessem apenas registros que atendam aos critérios especificados. Quando uma regra de restrição é aplicada a um usuário, os registros aos quais o usuário recebe acesso por meio de padrões organizacionais, regras de compartilhamento e outros mecanismos de compartilhamento são filtrados por critérios que você especificar. As regras de restrição funcionam da maneira oposta aos componentes de compartilhamento discutidos neste tópico; em vez de abrir o acesso aos usuários, elas o restringem ainda mais.
As regras de restrição estão disponíveis para objetos personalizados, objetos externos, contratos, eventos, tarefas, quadros de horários e entradas de quadros de horários. Você pode criar até duas regras de restrição ativas por objeto nas edições Enterprise e Developer e até cinco regras de restrição ativas por objeto nas edições Performance e Unlimited. As regras de restrição são aplicadas aos seguintes recursos do Salesforce:
- Modos de exibição de lista
- Pesquisas
- Listas relacionadas
- Relatórios
- Pesquisar
- SOQL
- SOSL
| Casos de uso de regra de restrição |
| ---------------------------------------------------------------------------------------------------------------------------------- |
| Você deseja que determinados usuários vejam apenas um conjunto específico de registros. |
| Para simplificar o controle do acesso a registros com informações confidenciais ou confidenciais. |
| Para tornar o acesso a contratos, tarefas e eventos verdadeiramente privado, pois isso pode ser difícil de alcançar usando padrões para toda a organização. |
**_Compartilhamento implícito_**
O compartilhamento implícito é automático. Você não pode desativá-lo nem ativá-lo, ele é nativo do aplicativo. Em outras palavras, o compartilhamento implícito não é uma configuração configurável; no entanto, é importante para qualquer arquiteto entender. O compartilhamento implícito pai está fornecendo acesso a registros pai (somente conta) quando um usuário tem acesso a oportunidades filho, casos ou contatos para essa conta. O Salesforce tem uma política de acesso a dados que determina se um usuário pode ver um contato (ou oportunidade, caso ou pedido), então o usuário vê implicitamente a conta associada. O compartilhamento implícito filho está fornecendo acesso aos registros filhos de uma conta ao proprietário da conta. Esse acesso é definido no papel do proprietário na hierarquia de papéis. O compartilhamento implícito filho se aplica apenas a objetos de contato, oportunidade e caso (filhos da conta). Os níveis de acesso que podem ser fornecidos são Visualizar, Editar e Sem acesso para cada um dos objetos filhos quando o papel é criado. Ao configurar para Visualizar, o proprietário da conta pode ver implicitamente os registros de objeto associados (contato, oportunidade ou caso). Ao definir Editar, o proprietário da conta pode modificar implicitamente o objeto associado (contato, oportunidade ou caso).
O compartilhamento implícito não se aplica a objetos personalizados.
## Cenários de implementação do cliente
Não há um modelo de compartilhamento adequado a todas as organizações do Salesforce. Cada organização tem diferentes requisitos e desafios ao tentar arquivar o melhor modelo de compartilhamento. É crucial usar os componentes de acesso a dados mais adequados para atender aos requisitos de compartilhamento da organização. Os cenários a seguir são desafios comuns ao tentar arquitetar um modelo de compartilhamento.
### Atribuição de equipe gerenciada externamente por meio do Sistema mestre do cliente
| **Requisitos ou desafios** | **Solução** |
| ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Dois em uma caixa: um gerente de vendas de uma área de cobertura geográfica também deseja ter acesso a outra área de cobertura geográfica para auxiliar. | Regra de compartilhamento baseada em proprietário: Uma regra de compartilhamento baseada em proprietário funciona aqui porque esses são casos de ponta e não a norma. Também é aceitável se a regra de compartilhamento baseada em proprietário fornecer mais acesso do que realmente necessário, pois esse é um gerente, um indivíduo confiável. |
| Os usuários de operações baseadas em país precisam de acesso a todos os dados de vendas do país. | Regra de compartilhamento baseada em proprietário: Um uso muito comum de uma regra de compartilhamento é quando um departamento diferente (além de vendas) precisa de acesso aos dados de vendas. |
| Pelo menos 80% das vezes, há uma equipe "núcleo 4" em uma conta (Executivo de conta, Representante de vendas interno, Consultor de vendas, Representante de vendas técnico). O sistema de registro para a atribuição da equipe da conta é externo. Sempre há apenas uma equipe para uma conta. | Equipes: Como sempre há apenas uma equipe por conta, mesmo que haja muitos membros diferentes com papéis diferentes, a funcionalidade da equipe da conta atende a esse requisito. |
| Os gerentes da equipe devem ter o mesmo acesso que seus subordinados. | Hierarquia de papéis: A hierarquia de papéis resolve esse requisito permitindo que os gerentes tenham acesso aos dados de seus subordinados. |
| A equipe da conta atribuída não deve ser modificável. | Equipes: Esse requisito não é realmente cumprido com a funcionalidade da equipe da conta. No entanto, isso também não deve impedir que você ainda use equipes da conta. No entanto, há várias maneiras de bloquear as equipes. Nesse caso, a remoção do layout de página da equipe da conta é usada. |
| Deve haver uma funcionalidade "amigável" para que, quando alguém estiver doente ou em férias, alguém sem acesso padrão a uma conta ou oportunidade possa ser acessado e coberto durante o tempo livre. | Equipes: Um "colega" pode simplesmente ser um papel na equipe que atende a esse requisito. No entanto, o desafio vem do requisito anterior em que o Teams não deve ser modificável. A única solução é ter um grupo definido de pessoas que possam modificar as equipes para criar o papel de colega quando necessário. |
| Quando um negócio exige uma solução personalizada, pessoas adicionais (que não estão necessariamente na organização de vendas) devem ter acesso ao negócio. | Equipes: Um uso bastante padrão da Equipe de oportunidades realizado adicionando manualmente um novo membro à Equipe de oportunidades (por meio da lista relacionada). Também pode ser realizada por meio de um acionador se você sempre souber quem deve ser adicionado. Neste caso, é oportunidade por oportunidade. |
### Gerenciamento de território pronto para uso
| **Requisitos ou desafios** | **Solução** |
| ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Duas equipes de oportunidade diferentes de duas unidades de negócios distintas (Vendas de varejo e Remarketing) precisam de acesso ao mesmo registro de conta. Eles devem compartilhar contatos e estar ciente de todas as atividades na conta. Essas duas unidades de negócios têm sua própria hierarquia e totalizações. | Gerenciamento de território: A melhor maneira de pensar sobre esse requisito é ter duas ramificações de uma hierarquia que podem ser estruturadas de maneira diferente. O que justifica o gerenciamento de território é que há dois níveis dessas duas ramificações diferentes (ambos níveis com membros = a equipe de oportunidade para essa unidade de negócios) que precisam de acesso à conta. Embora você pudesse cumprir esse requisito com um conceito de Teaming, isso era muito granular. A segmentação de vendas não estava em um nível de conta, mas em uma hierarquia. |
| Há um grupo separado de desenvolvedores de negócios que são atribuídos e precisam de acesso a contas específicas para uma equipe de oportunidade específica (um território). Os desenvolvedores de negócios são recursos compartilhados para as equipes de oportunidade, o que significa que cada desenvolvedor de negócios pode ser atribuído a uma ou mais contas para uma ou mais equipes de oportunidade. | Gerenciamento de território: Como esse é um grupo de usuários (ou uma equipe) e cada equipe de desenvolvimento de negócios pode ser diferente por conta, e como o gerenciamento de território era necessário por outro motivo, a melhor abordagem provavelmente é criar subterritórios ou ramificações separadas que representem essas equipes de desenvolvimento de negócios. |
| Há papéis de suporte de vendas não baseados em comissão que precisam de acesso a contas de modo único. | Equipes: A parte principal do requisito é "base única". Isso significa que é feito em uma conta por conta, de modo que as equipes da conta fornecem isso nativamente. |
| O departamento de crédito precisa de acesso a todas as contas de uma determinada unidade de negócios. | Regra de compartilhamento baseada em proprietário: Esta é uma situação em que, em geral, para uma determinada unidade de negócios, um grupo de usuários deve ver tudo. Esse requisito pode ser cumprido com uma regra de compartilhamento para um papel ao qual o grupo pertence, uma ramificação da hierarquia de papéis à qual o grupo pertence (papel e subordinados) ou até mesmo um grupo público.Gerenciamento de território: Você também pode realizar esse requisito modelando o departamento de crédito como um território com a mesma lógica para a unidade de negócios fornecida. |
| Os gerentes devem ter o mesmo acesso que seus subordinados. | Hierarquia de papéis: A hierarquia de papéis resolve esse requisito permitindo que os gerentes tenham acesso aos dados de seus subordinados. |
## Considerações
### Considerações sobre implementação do Gerenciamento de território Enterprise
- O que acontece com a hierarquia de papéis?
- Nada acontece com a hierarquia de papéis se você também estiver usando uma hierarquia de territórios. No entanto, se você estiver usando previsões baseadas em território e previsões baseadas em papel juntas, deverá gerenciar duas hierarquias. Nesse caso, recomendamos usar a hierarquia de papéis para modelar a estrutura de relatórios de RH e, em seguida, usar a hierarquia de territórios para modelar a hierarquia de vendas real. A hierarquia de territórios é melhor para modelar uma estrutura de relatórios de matriz, em que alguém pode gerar relatórios a vários gerentes.
Se você não estiver usando previsões baseadas em território e previsões baseadas em papel juntas, é possível usar apenas a hierarquia de territórios como a hierarquia de vendas. Nesse cenário, é melhor simplificar ou nivelar a hierarquia o máximo possível.
Não recomendamos tornar a hierarquia de papéis e a hierarquia de territórios idênticas porque isso causa atividade de compartilhamento desnecessária.
- Você ainda pode usar equipes?
- Sim. No entanto, se você puder cumprir seus requisitos de acesso dentro da hierarquia de territórios (como sobreposições), é melhor fazer isso lá do que usar equipes. Você já está mantendo várias hierarquias (papel e território), portanto, ao tentar manter tudo o mais simples possível, implemente equipes apenas se nenhum outro componente de compartilhamento atender ao requisito.
### Outras considerações
- Realinhamento e reatribuição
- Há dois tipos de alterações que ocorrem: a associação de papéis, equipes ou territórios e a estrutura da hierarquia. As alterações de associação normalmente podem ocorrer diariamente, mesmo a cada hora. Alterações estruturais da hierarquia (realinhamentos) geralmente ocorrem com menos frequência (trimestral, semestral ou anual) e podem ser dispendiosas. O que deve ser considerado é o volume de alterações e o número de alterações em cascata que cada alteração vai causar. Como regra geral, as alterações estruturais não devem ocorrer mais do que trimestralmente e todas as alterações de alto volume (alterações em massa ou em massa) devem ser bem planejadas, testadas e coordenadas.
- Grandes volumes de dados
- Não importa se você está modelando para a distribuição inicial ou planejando uma alteração de realinhamento, você deve considerar seriamente o volume de dados. Há limites em que o desempenho pode se tornar um fator, portanto, é altamente recomendável testar suas alterações em um sandbox antes da produção. Esse teste também fornecerá uma linha de base para quanto tempo a alteração levará.
Se você tiver mais de dois milhões de contas e tiver equipes implementadas ou Gerenciamento de Território Enterprise, você deverá prestar atenção especialmente ao desempenho. Esses são componentes de modelo de compartilhamento complexos que podem criar um grande volume de registros de compartilhamento e, portanto, transações de longa duração.
- Adiar cálculos de compartilhamento
- Se você tiver um objeto que utiliza compartilhamento e tem um grande volume de registros (como mais de dois milhões de contas) e precisar fazer uma alteração em massa (como um realinhamento trimestral que exija uma alteração de hierarquia), há um recurso que o Suporte ao cliente da Salesforce pode habilitar para adiar os cálculos de compartilhamento automáticos. Nativamente, cada alteração individual na hierarquia de papéis, hierarquia de territórios, grupos, regras de compartilhamento, papéis de usuário, associação à equipe ou propriedade de registros pode iniciar cálculos de compartilhamento automáticos. Quando uma alteração em massa é feita, vários recálculos de compartilhamento automáticos começam. Ao suspender esses recálculos temporariamente, você pode fazer a alteração e fazer com que os cálculos de compartilhamento aconteçam de uma só vez. Esse método geralmente é mais eficiente e tem um melhor desempenho para alterações em massa.
- Skews de dados e propriedade
- Os desvios de dados são definidos como alguns registros pai com muitos registros filhos. Esses desvios podem realmente magoar você quando algumas contas têm muitos contatos, oportunidades ou casos. A proporção em que começamos a ver a degradação do desempenho é de 1:10 mil. Como prática recomendada, mantenha a proporção o mais próxima possível (preferencialmente menor).
Desvios de propriedade são semelhantes a desvios de dados, exceto que estamos se referindo a um único usuário, papel ou grupo que possui muitos registros para um objeto. Como acontece com distorções de dados, elas também podem causar transações em execução longa, causando uma degradação do desempenho quando ocorre uma alteração. A proporção recomendada de proprietário para número de registros também é de 1:10.000.
Se um único usuário tiver mais de 10 mil registros, como prática recomendada:
- O registro de usuário do proprietário não deve conter um papel na hierarquia de papéis.
- Se o registro do usuário do proprietário precisar conter um papel, coloque o papel no topo da hierarquia em sua própria ramificação da hierarquia de papéis.
- Impacto das hierarquias de contas no acesso a dados
- Muitas pessoas fazem uma pressuposição ruim quando implementam uma hierarquia de contas. Eles presumem que os usuários que podem acessar uma conta pai também podem acessar as contas filho. O fato simples de ter apenas um relacionamento pai/filho entre dois registros não gera acesso. Embora a hierarquia de papéis e a hierarquia de territórios funcionem dessa maneira, a hierarquia de contas não.
## Solução de problemas
Depois de concluir sua arquitetura de modelo de compartilhamento, você provavelmente será questionado sobre por que um usuário pode ou não pode ver um registro. Geralmente, você não ouvirá quando os usuários poderão ver algo que não deveriam ver, mas, se necessário, há uma maneira de ver cada usuário que tem acesso a um registro e por quê.
O desafio mais difícil, e provavelmente mais comum, é por que um usuário não pode ver um registro. As camadas de segurança que você arquitetou determinam onde você começa. Se você conhece bem o modelo de compartilhamento, provavelmente saberá qual componente deveria ter fornecido o acesso e pode começar por aí. Porém, se você estiver menos familiarizado com o modelo de compartilhamento, comece com a hierarquia de papéis e despeje cada camada para determinar qual deve fornecer o acesso. Aqui está um fluxo de solução de problemas.
1. Verifique se o usuário tem permissões para acessar o objeto.
2. Identifique o papel do usuário que não pode ver o registro e anote-o.
3. Identifique o proprietário do papel do registro e anote-o.
4. Revise a hierarquia de papéis e verifique se esses dois papéis estão em duas ramificações diferentes (elas devem estar).
5. Agora você deve revisar as regras de compartilhamento do objeto e garantir que não haja nenhuma regra que conceda acesso do usuário. Se necessário, procure em grupos públicos também. Talvez o usuário tenha sido excluído de um grupo em que há uma regra de compartilhamento ou faz sentido criar uma nova regra de compartilhamento para conceder acesso ao usuário? Essa opção depende da arquitetura que você está tentando manter e se aplica a regras de compartilhamento baseadas em proprietário e regras de compartilhamento baseadas em critérios.
6. Se você estiver usando equipes, esse usuário deve estar na equipe para esse registro? Como as equipes são mantidas e como a falta ocorreu?
7. Se o compartilhamento manual for usado, o usuário poderá ter perdido o acesso porque o proprietário do registro mudou. Os compartilhamentos manuais são descartados quando a propriedade muda. O compartilhamento manual também poderia ter sido removido usando o botão **Compartilhar**.
8. Se você estiver usando o Gerenciamento de Território Enterprise, o usuário estará ausente em um dos territórios? Onde a associação de territórios é mantida e como a ausência ocorreu? Ou talvez o registro não tenha sido atribuído ao território em que o usuário é membro.
9. Se você estiver criando compartilhamentos programáticos e houver critérios para criar o compartilhamento em código, revise o código para entender por que esse usuário foi omitido.
Todos os dias, [centenas de milhares de empresas e milhões de usuários](https://www.salesforce.com/customer-stories/) operam seus negócios na nuvem usando aplicativos habilitados pela Salesforce Platform. Por que a plataforma é tão bem-sucedida? Por que você pode Trust para apoiar seu negócio? Quais benefícios exclusivos a plataforma oferece para empresas como a sua?
Este resumo técnico explica como a Salesforce Platform oferece experiências de usuário final confiáveis, escalonáveis e fáceis de personalizar usando sua arquitetura de software exclusiva para computação em nuvem. Depois de ler este resumo, você entenderá melhor a tecnologia subjacente que torna a Salesforce Platform uma escolha atraente para seus aplicativos comerciais.
# Visão geral da plataforma
A Salesforce Platform é o exemplo proeminente de uma plataforma de computação em nuvem bem-sucedida e um ecossistema relacionado de aplicativos. Desde o início do milénio, a plataforma tem sido a base ativa para:
- Muitos [aplicativos de negócios](http://www.salesforce.com/products/) populares para casos de uso comuns, como vendas e atendimento ao cliente
- [Aplicativos específicos do setor](https://www.salesforce.com/solutions/industries/) para casos de uso mais especializados, como finanças e saúde
- Milhões de [aplicativos personalizados e extensões de aplicativo](https://www.salesforce.com/products/platform/overview/) para casos de uso únicos
Em grande parte, a Salesforce Platform é tão bem-sucedida e popular porque sua arquitetura de software exclusiva suporta aplicativos fáceis de criar, usar, personalizar e estender com [desempenho e confiabilidade](http://trust.salesforce.com/trust/) excepcionais. O coração da arquitetura de software da plataforma é seu design baseado em metadados de vários locatários.
| Medidas de seleção pré-consulta | Escrever consulta de acesso ao banco de dados final, forçando... | |
| Usuário | Filtro | |
| Baixo | Baixo | ... junção de loops aninhados, acionando usando a visualização das linhas que o usuário pode ver |
| Baixo | Alto | ... uso do índice relacionado ao filtro |
| Alto | Baixo | ... junção de hash ordenada, drive usando MT_DATA |
| Alto | Alto | ... uso do filtro relacionado ao índice |
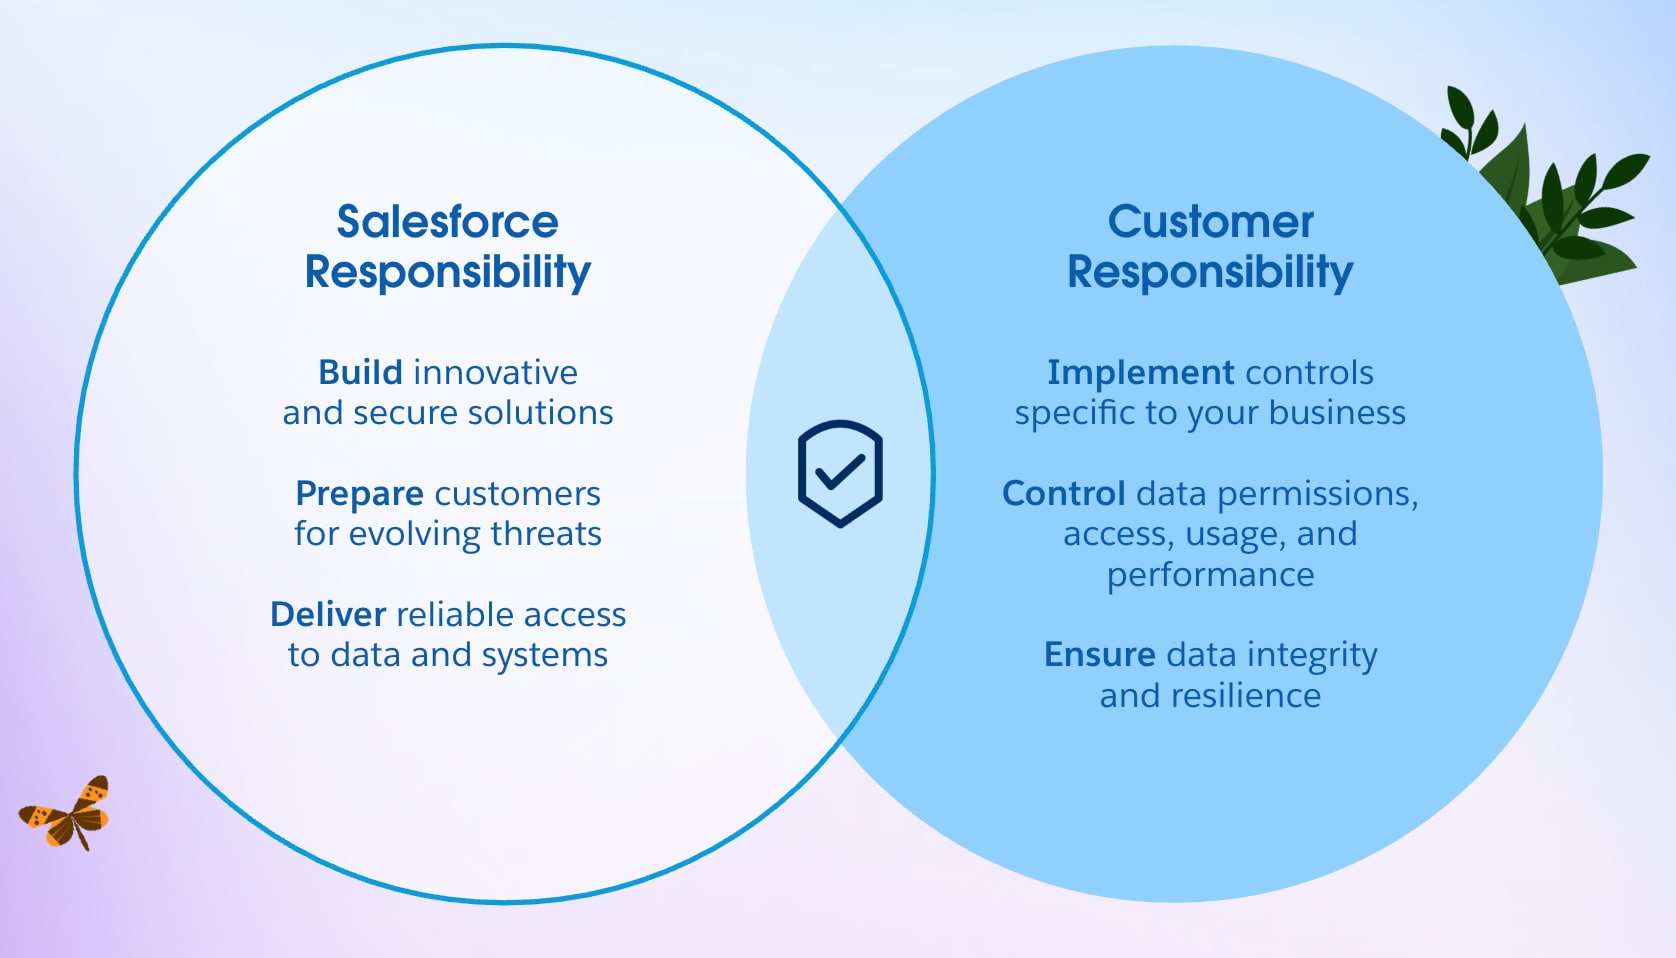 #### Salesforce: Segurança da nuvem
A Salesforce é responsável por proteger e manter a integridade da plataforma Data 360 e sua infraestrutura global. Isso inclui:
* **Segurança física e ambiental:** O Hyperforce está hospedado na infraestrutura da AWS e a Amazon tem a responsabilidade delegada pela proteção dos seus data centers globais por meio de controles de acesso, vigilância e salvaguardas ambientais.
* **Defesa de rede e perímetro:** Mitigação de denegação de serviço distribuída (DDoS), detecção de intrusão e criptografia para todo o tráfego em trânsito (TLS 1.2 e superior) e em repouso (AES-256).
* **Hardening de plataforma e gerenciamento de patches:** Gerenciamento de vulnerabilidade contínuo, implantação de patch e linha de base de segurança no nível do SO.
* **Conformidade e certificação:** Auditorias contínuas em relação a padrões como SOC 1/2/3, ISO 27001, ISO 27017, ISO 27018 e prontidão para estruturas como GDPR.
Esses controles garantem que a plataforma Data 360 permaneça segura, confiável e em conformidade, permitindo que os clientes se concentrem na lógica de negócios e no gerenciamento de dados em vez de na defesa da infraestrutura.
#### Cliente: Segurança na nuvem
Os clientes são responsáveis por proteger seus dados, configurações e processos operacionais em suas organizações do Salesforce Data 360. As principais áreas de responsabilidade incluem:
* **Gerenciamento de identidade e acesso (IAM):** Defina papéis, aplique autenticação multifator (MFA) e Single Sign On (SSO) e aplique o princípio de privilégio mínimo.
* **Governança de dados:** Classifique dados confidenciais, aplique mascaramento quando necessário e aplique controles de acesso em nível de objeto, campo e registro.
* **Segurança de integração:** Gerencie o acesso à API por meio de OAuth 2.0, JWT de token da Web JSON e outros padrões de autenticação usando credenciais nomeadas e credenciais externas.
* **Monitoramento e resposta:** Use as trilhas de monitoramento e auditoria de evento e encaminhe os registros para um sistema de Gerenciamento de eventos e informações de segurança (SIEM) para detecção avançada de ameaças.
O Salesforce fornece a base segura, mas os clientes determinam sua posição de segurança real por meio de suas configurações, controles e vigilância.
#### Responsabilidade humana
A segurança não é apenas uma construção técnica, é uma disciplina organizacional. A proteção de dados no Salesforce Data 360 é alcançada por meio da colaboração entre equipes de arquitetura, operações e governança.
**As empresas devem:**
* Revise e descontinue contas não usadas ou com privilégios excedentes continuamente.
* Automatize a imposição usando políticas como pipelines de CI/CD e código.
* Realize exercícios de mesa simulando incidentes como ativação de dados não autorizada ou exfiltração para reforçar a prontidão de resposta.
A eficácia do Data 360 não é dimensionada apenas pelos recursos, mas por como os clientes os implementam de modo responsável.
#### Secure-by-Padrão: Uma postura proativa de segurança
O Salesforce Data 360 adota uma filosofia de segurança por padrão, que é uma mudança do controle reativo para o design preventivo. Em vez de abrir e apertar mais tarde, cada nova organização do Data 360 agora começa no estado "Negar tudo", aplicando princípios de zero Trust desde a primeira implantação.
#### Do controle reativo ao design preventivo
Em ambientes mais antigos, os clientes herdaram um modelo permissivo "Permitir tudo" para uma integração mais rápida. Embora seja conveniente, isso criou o risco de sobreexposição acidental e configuração incorreta.
A nova arquitetura segura por padrão inverte esta abordagem:
* Nenhum usuário ou sistema tem acesso implícito.
* Todas as permissões devem ser concedidas explicitamente.
* Controles de acesso, integração e governança de dados são impostos a partir do dia 0.
Isso impõe o privilégio mínimo por design, reduzindo drasticamente o risco de exposição acidental ou escalonamento de privilégio.
#### Impacto operacional e de governança
Esse modelo tem implicações técnicas e comportamentais:
* As equipes devem planejar o acesso a modelos deliberadamente, alinhando as permissões com a conformidade e os limites de negócios.
* A governança se torna um requisito de design integrado, não uma reflexão posterior.
* A propriedade e a responsabilidade pelos dados são definidas desde o início.
Para organizações legadas do Data 360 que ainda operam sob "Permitir tudo", os administradores devem apertar manualmente as configurações para se alinharem com a nova linha de base, uma etapa crítica em qualquer modernização de segurança ou programa de maturidade do Data 360.
#### Trust por design
Ao usar como padrão o acesso zero e exigir definições de política explícitas, o Salesforce Data 360 estabelece a Trust por design, uma evolução fundamental na segurança de dados corporativos.
Essa abordagem garante que:
* Os riscos de vazamento de dados e acesso não autorizado são minimizados.
* As estruturas de governança são aplicadas estruturalmente, não opcionalmente.
* As empresas obtêm uma postura de segurança mais previsível, auditável e resiliente entre ambientes.
Na essência, a segurança não é mais um recurso que você adiciona. É a base com a qual você começa.
## Gerenciamento de identidade e acesso: O gateway para seus dados
O Gerenciamento de identidade e acesso (IAM) no **Salesforce Data 360** é a primeira e mais crítica camada de defesa. Ele determina **quem** pode acessar a plataforma e **quelas** ações que eles podem executar uma vez dentro. Uma estrutura de IAM bem implementada é o controle mais forte que uma empresa tem para proteger os dados do cliente e garantir a integridade operacional.
### Autenticação: Verificar "Quem você é"
A autenticação estabelece o **digital Trust,** confirmando que cada usuário, serviço ou sistema externo que acessa o Salesforce Data 360 é legítimo.
### Gerenciamento de identidade federado
O Data 360 oferece suporte à **autenticação federada** com provedores de identidade (IdPs) de nível corporativo, como [**Microsoft Entra ID (Azure AD)**](https://learn.microsoft.com/en-us/entra/identity/saas-apps/salesforce-tutorial), [**Okta**](https://help.okta.com/en-us/content/topics/provisioning/salesforce/sfdc-provision.htm) ou [**Ping Identity**](https://docs.pingidentity.com/configuration_guides/salesforce/config_saml_salesforce_pf.html) usando [**SAML 2.0**](https://help.salesforce.com/s/articleView?id=xcloud.sso_saml.htm&type=5), OpenID Connect ([**OIDC**](https://help.salesforce.com/s/articleView?id=xcloud.sso_provider_openid_connect.htm&type=5)) ou sistema para gerenciamento de identidade entre domínios ([**SCIM**](https://help.salesforce.com/s/articleView?id=xcloud.identity_scim_overview.htm&type=5)).
Essa federação estende seu ciclo de vida de identidade corporativa diretamente para o Salesforce. Quando um funcionário entra, transfere ou sai da empresa, seu acesso é ajustado automaticamente, reduzindo as contas órfãs e melhorando a prontidão para conformidade.
### Login único (SSO)
Com o [**login único (SSO)**](https://help.salesforce.com/s/articleView?id=xcloud.sso_about.htm&type=5), os usuários se autenticam uma vez usando suas credenciais corporativas e obtêm acesso seguro a aplicativos do Salesforce sem senhas separadas. Isso reduz a fadiga da credencial e minimiza os riscos de reutilização de senha ou phishing.
### Acesso adaptativo e condicional
O Provedor de identidade (IdP) se torna a autoridade única para decisões de autenticação, aplicando autenticação multifator (MFA), acesso condicional e controles baseados em risco. A autenticação evolui de um único evento para uma avaliação contínua de Trust, respondendo ao comportamento e contexto do usuário.
A autenticação federada fornece:
* **Imposição centralizada de políticas:** Os padrões de autenticação são gerenciados em um só lugar em todos os ambientes do Salesforce.
* **Rastreabilidade de ponta a ponta:** As trilhas de auditoria unificadas vinculam cada ação de volta a uma identidade verificada.
* **Experiência humana:** Um processo de login seguro e sem atrito permite que as equipes se concentrem em percepções, não em credenciais.
### Autorização: Definindo "O que você pode fazer"
Depois que um usuário é verificado, a autorização define o que ele pode acessar, visualizar ou modificar. Ela define os limites operacionais que protegem dados confidenciais e impõem privilégio mínimo.
**Princípio de privilégio mínimo (PoLP):** Cada usuário e sistema recebe apenas as permissões necessárias para sua função de trabalho, nada mais. Esse princípio limita dramaticamente o possível dano de credenciais comprometidas ou configurações incorretas.
**Controle de acesso baseado em papel (RBAC):** O Salesforce Data 360 usa conjuntos de permissões e grupos de conjuntos de permissões para atribuir recursos granulares alinhados a papéis de negócios. Por exemplo:
* Um Engenheiro de dados pode gerenciar pipelines e transformações de ingestão com a ajuda do conjunto de permissões do Data 360 Architect.
* Um Analista de marketing pode consultar dados harmonizados, mas não pode alterar modelos com a ajuda do conjunto de permissões Gerenciador de ativação do Data 360.
* Um Gerenciador de ativação pode executar campanhas de saída, mas não pode acessar dados de origem com a ajuda do conjunto de permissões Gerente de ativação do Data 360
O acesso é gerenciado centralmente e auditável, garantindo a responsabilidade em todo o ciclo de vida dos dados. Quando integrados a IdPs como Entra ID, Okta ou Ping Identity, as políticas de acesso se estendem perfeitamente em toda a empresa por meio do provisionamento SCIM e da federação SAML/SSO.
### Entendendo papéis e permissões padrão no Data 360
O Salesforce fornece conjuntos de permissões predefinidos que encapsulam as práticas recomendadas para segregação de tarefas e conformidade com os padrões do setor, como ISO 27001.
| Papel | Responsabilidade principal | Acessar princípio de design |
|---|---|---|
| Administrador do sistema | Configuração, provisionamento e configuração de ambiente | Sem acesso aos conjuntos de dados subjacentes – garante a separação entre o sistema e o controle de dados |
| Arquiteto do Data 360 | Ingestão de dados, transformação, resolução de identidade e modelagem | Não é possível realizar ativação de dados para manter limites de exposição de dados |
| Gerenciador de ativação do Data 360 | Criação de segmento, gerenciamento de canal e ativação | Acesso somente visualização a modelos de dados; nenhum privilégio de modificação |
| Usuário do Data 360 | Consome análises e percepções | Somente leitura; nenhum privilégio de modificação |
| Usuário único do Data 360 | Acesso entre organizações por meio da organização de companheiro | Governado por permissões de espaço compartilhadas e políticas de acesso com escopo |
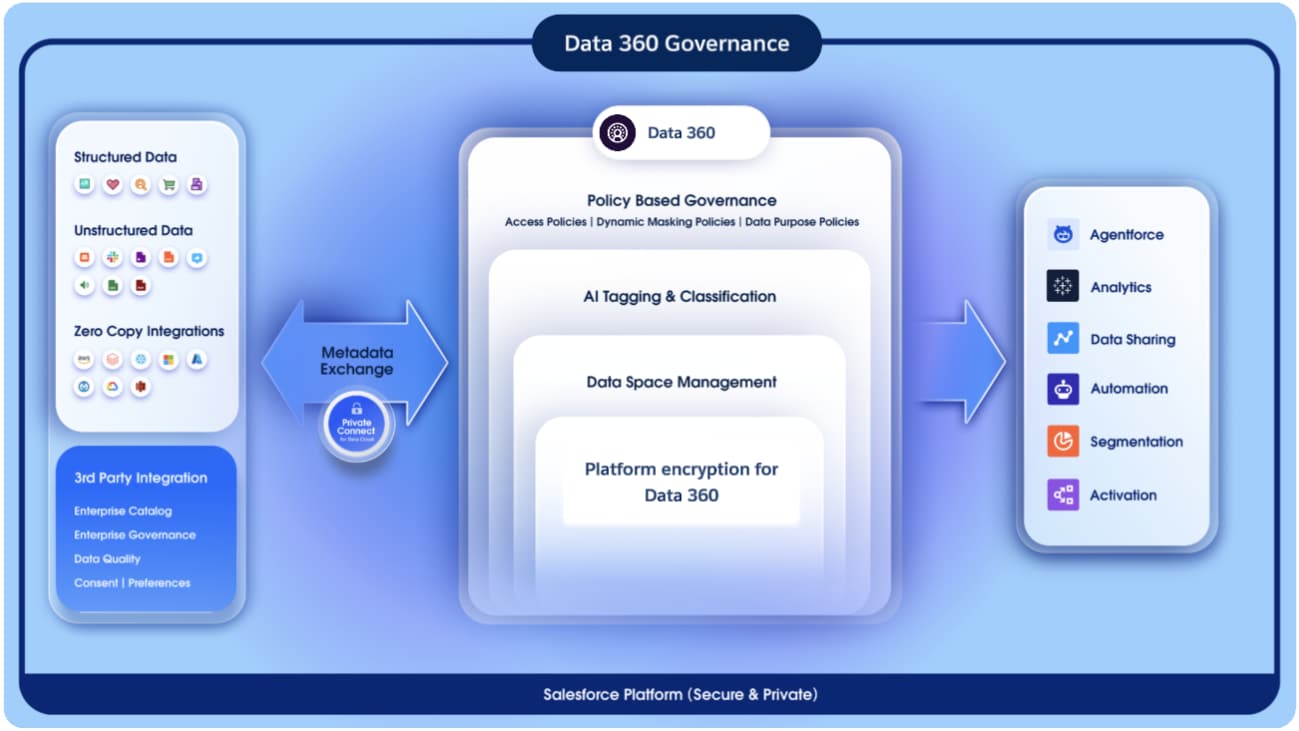 ### Governança como um plano de controle
O Data 360 é arquitetado em torno de um modelo de governança em primeiro lugar, garantindo que cada interação de dados, da ingestão à ativação de percepções, seja sensível à política, auditável e em conformidade. A governança funciona como o plano de controle central, gerenciando como os dados são descobertos, classificados e protegidos em seu ciclo de vida.
Esse plano de controle unificado garante que:
* **O acesso aos dados é contextualmente autorizado**: apenas os usuários certos, sob as políticas certas, podem agir com base nos dados certos.
* **A governança está integrada nas camadas semântica e operacional**, garantindo a consistência entre como os dados são modelados e como eles são protegidos.
* Os princípios **Zero Trust e Minimum Privilege** são aplicados: em que identidade, contexto e política são avaliados em tempo real antes de conceder acesso.
Por meio dessa arquitetura, o Salesforce Data 360 transforma a governança do gerenciamento de permissões estáticas em uma camada dinâmica de orquestração orientada por política. Uma que se adapta continuamente ao contexto, impõe conformidade por design e mantém a Trust em escala corporativa.
### Segregação de dados lógica com espaços de dados
No nível de macro, os Espaços de dados fornecem a segregação lógica e o isolamento de domínios de dados corporativos, permitindo que organizações com modelos operacionais de várias marcas, várias regiões ou vários locatários gerenciem dados em uma única plataforma unificada. Os Espaços de dados podem ser alinhados a domínios de negócios (como Vendas, Marketing ou Customer Success) ou a limites regulatórios e geográficos (como UE, AMER ou APAC), permitindo que os controles de governança e acesso reflitam a estrutura operacional e de conformidade da organização sem fragmentar a plataforma de dados subjacente.
* Cada espaço de dados atua como um limite virtual, definindo quais coleções de dados um usuário ou equipe pode ver ou interagir com.
* O acesso em um espaço de dados é concedido explicitamente, garantindo nenhuma permissão implícita ou contaminação cruzada da visibilidade dos dados.
* Isso habilita a propriedade federada: cada unidade de negócios pode controlar seu domínio de modo independente enquanto mantém a supervisão e a conformidade centralizadas.
Por meio do design, os espaços de dados fornecem a primeira camada de governança, estabelecendo clareza estrutural e responsabilidade em todos os conjuntos de dados corporativos.
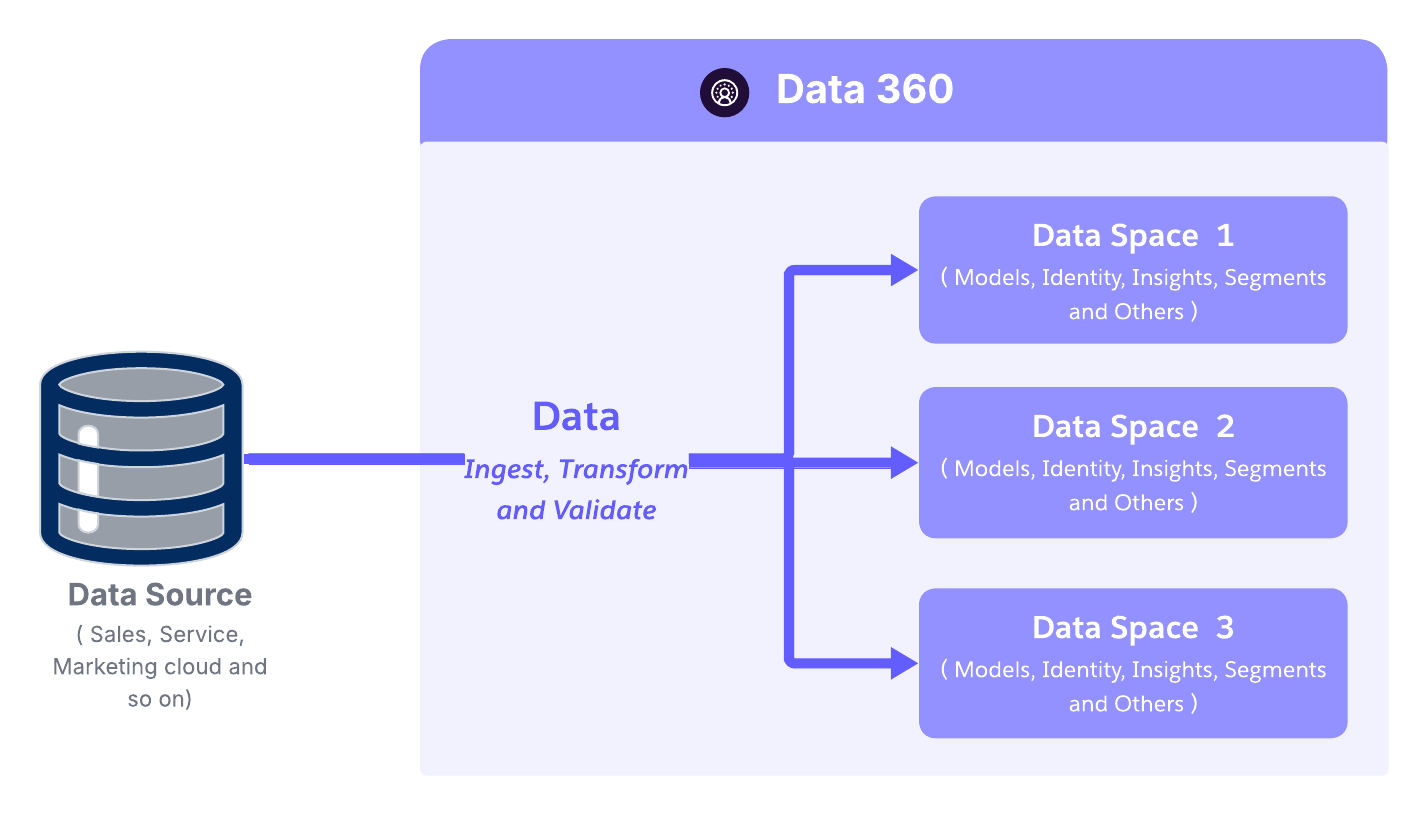 ### De RBAC para ABAC: Avançar para autorização contextual
No Salesforce Data 360, o RBAC e o ABAC atendem a fins distintos, mas complementares, e são aplicados a camadas diferentes da plataforma.
O RBAC é usado principalmente para acesso a plataforma e recursos. Ele controla quem pode acessar as construções e recursos do Data 360, como Espaços de dados, criação de processos, recursos administrativos e acesso a ferramentas. O RBAC é implementado por meio de conjuntos de permissões e permissões, por exemplo, atribuindo aos usuários acesso a um Espaço de dados com recursos específicos habilitados.
ABAC é usado para imposição de acesso a dados. As políticas ABAC são totalmente responsáveis por determinar quem pode acessar quais objetos e atributos de dados, incluindo segurança em nível de objeto (OLS), acesso em nível de campo e restrições em nível de linha. Essas decisões são tomadas dinamicamente avaliando a ação, os atributos de usuário e os atributos de recurso no tempo de execução.
No ABAC, as permissões continuam fazendo parte do modelo, mas a própria política determina o acesso, não apenas o papel. As políticas avaliam o contexto, como unidade de negócios, região, confidencialidade de dados, finalidade de uso ou restrições regulatórias para permitir ou negar acesso.
Por exemplo:
* O RBAC permite que um usuário acesse um recurso de análise e espaço de dados do Data 360.
* A ABAC determina se o mesmo usuário pode ler um conjunto de dados do cliente específico, quais linhas ele pode ver e quais atributos são mascarados ou restritos.
Essa separação clara permite que o Data 360 escale com segurança:
* O RBAC fornece acesso controlado a recursos e fluxos de trabalho da plataforma.
* A ABAC fornece acesso a dados detalhado e orientado por política alinhado aos requisitos de conformidade, residência e proteção de dados.
Juntos, eles permitem a democratização de dados governados sem confundir permissões de plataforma com lógica de autorização de dados.
Em essência, o RBAC aplica o acesso com base na atribuição de permissões, enquanto o ABAC avalia as permissões no contexto, combinando atributos de ação, usuário e recurso para fornecer controle de acesso adaptativo e detalhado no Salesforce Data 360
### ABAC: Uma hierarquia de segurança de várias camadas
No centro do controle de acesso detalhado do Salesforce Data 360 está o controle de acesso baseado em atributo (ABAC), habilitado pela linguagem de política CEDAR.
Diferentemente das permissões estáticas baseadas em papel, a ABAC avalia dinamicamente *quem* está solicitando acesso, *o que* está tentando acessar e *em que condições* – garantindo que cada interação de dados esteja alinhada às políticas e limites de Trust da empresa.
#### Avaliação de política dinâmica
O mecanismo ABAC do Data 360 avalia as decisões de acesso com base em uma combinação de três tipos de atributo essenciais:
* **Atributos do usuário:** departamento, local, nível de limpeza
* **Atributos de dados:** classificação, confidencialidade (PII, PHI, dados financeiros), espaço de dados
Esse modelo flexível conduzido por políticas permite que a imposição se adapte automaticamente à medida que papéis de usuário, classificações de dados ou condições operacionais evoluem, o que é essencial para empresas grandes, distribuídas e regulamentadas.
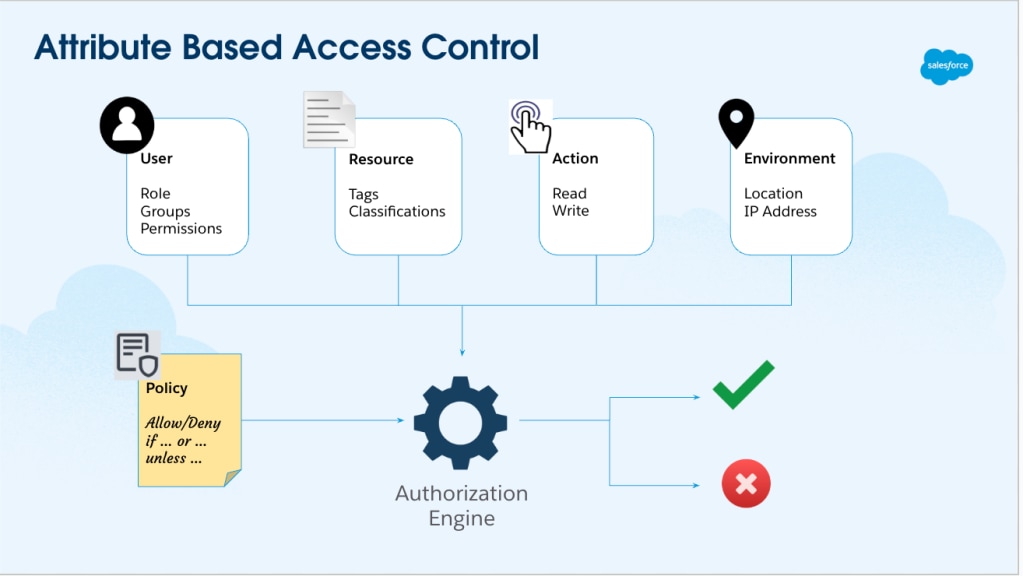 #### Componentes de arquitetura ABAC no Salesforce Data 360
O Salesforce Data 360 implementa uma arquitetura de Controle de acesso baseado em atributo (ABAC) baseada em padrões alinhada às melhores práticas do setor para governança de dados orientada por política. Ele é composto por três componentes funcionais principais:
* **Ponto de Informação da Política (PIP) - Políticas, Metadados e Classificação enriquecidos:**
* Apresenta as próprias definições de política, incluindo acesso a dados, classificação, mascaramento, retenção e políticas de uso que regem os dados corporativos.
* Mantenha metadados aprimorados, como marcas, classificações, contexto de negócios e linhagem de ponta a ponta.
* Usa classificação conduzida por LLM e ML para marcar automaticamente dados confidenciais (por exemplo, PII.Email, PII.Phone, PHI).
* A propagação de marcas garante que as classificações fluam automaticamente ao longo da linhagem de dados (DLO → DLO → DMO).
* Preservar a confidencialidade e a conformidade entre as transformações.
* **Ponto de decisão política (PDP)**: O PDP é o mecanismo de decisão que interpreta as políticas do CEDAR.
* Ingere entradas contextuais do PEP (identidade do usuário, metadados da solicitação) e atributos de referência do PIP.
* Avalia as políticas de modo determinístico para fornecer decisões de acesso consistentes, explicáveis e escalonáveis.
* Dá suporte a avaliações em tempo real e em lote, garantindo desempenho e precisão mesmo em ambientes de alto volume.
* **Ponto de Aplicação de Políticas (PEP)**: É no PEP que as decisões de autorização são aplicadas no tempo de execução.
* Intercepta solicitações de acesso a dados em todos os canais de interação, como APIs, consultas da IU, aprimoramento de CRM ou pipelines de Geração de recuperação aumentada GenAI (RAG).
* Aplica resultados do PDP instantaneamente, garantindo que cada consulta e recuperação estejam em conformidade com as políticas de acesso Enterprise.
Juntos, a triada PIP–PDP–PEP forma um tecido de governança distribuída, aplicando um controle consistente baseado em política em todos os serviços e modos de acesso do Data 360.
Importante, o [ABAC](https://help.salesforce.com/s/articleView?id=data.c360_a_policy_based_governance_dg.htm&type=5) no Data 360 está configurado, não criado. Os arquitetos não montam planos de controle ou lógica de imposição personalizados. Em vez disso, eles preenchem e conectam três componentes arquitetônicos nativos que funcionam juntos como um tecido de governança unificado.
Em um nível prático, a implementação segue uma progressão simples: classificar os dados, definir as políticas e permitir que a plataforma os aplique automaticamente. Depois de configurado, o controle de acesso se torna um comportamento do sistema, em vez de um processo manual ou procedural.
Esse tecido de governança distribuída garante a aplicação **de políticas consistente em todos os canais de acesso**, criando um limite de Trust unificado em todo o Data 360.
#### Aplicação de políticas de vários níveis
A estrutura ABAC do Data 360 oferece suporte a limites de acesso em camadas, garantindo que os dados sejam protegidos não apenas no nível do objeto, mas também em campos e registros específicos.
* **Segurança em nível de objeto (OLS)**: O limite mais externo do controle de acesso.
Controla o acesso a estruturas de dados inteiras, como objetos de data lake (DLOs) ou objetos de modelo de dados (DMOs).
Exemplo: Conceder acesso ao objeto *Cliente*, mas não às * Transações*.
* **Segurança em nível de campo (FLS)**: Controla o acesso a campos específicos em um objeto.
Exemplo: Um usuário de marketing pode ver os nomes dos clientes, mas é impedido de visualizar números de cartão de crédito ou identificadores nacionais.
* **Segurança de nível de registro (RLS)** : A camada de controle mais granular.
Determina quais registros individuais em um conjunto de dados um usuário pode visualizar ou modificar.
Exemplo: Um gerente regional pode acessar apenas dados do cliente vinculados à região atribuída.
* **Mascaramento dinâmico de dados (DDM):** Ativa a proteção de dados em tempo real. Complementando o ABAC, o DDM impõe o ofuscar por política de informações confidenciais sem alterar o conjunto de dados subjacente. No momento da consulta, o DDM mascara automaticamente campos como PII ou dados financeiros com base no papel do usuário, no contexto ou nas regras de conformidade.
* Dados confidenciais permanecem protegidos em visualizações de UI, APIs e fluxos de trabalho de IA.
* Reduz os riscos de vazamento de dados garantindo um mascaramento consistente em todas as camadas de consumo.
* Mantenha a capacidade de auditoria. Todas as consultas mascaradas são registradas e rastreáveis dentro da estrutura de governança do Data 360.
 Essa arquitetura transforma o controle de acesso de um modelo de permissão estático em um tecido de política dinâmico sensível ao contexto. Ao combinar a simplicidade estruturada do RBAC com a profundidade contextual do ABAC, o Salesforce Data 360 alcança:
* Aplicação consistente da política em toda a ingestão, harmonização e ativação.
* Governança adaptativa que evolui com dados, papéis e necessidades de conformidade.
* Limites unificados do Trust em todo o ciclo de vida dos dados, da ingestão à ativação de IA.
#### Integração profunda com a Salesforce Platform
O modelo de governança do Salesforce Data 360 é integrado nativamente à Salesforce Platform, permitindo a segurança unificada, a conformidade e o controle de acesso em dados operacionais e analíticos. Ao herdar os recursos de gerenciamento de acesso e identidade principais do Salesforce, como federação de identidade, conjuntos de permissões, criação centralizada de políticas e criptografia de plataforma, o Data 360 aplica políticas de Trust consistentes em todas as nuvens sem introduzir pilhas de governança paralelas. Em vez de tratar isolamento, autorização e linhagem como preocupações separadas, a plataforma os integra em um único tecido de Trust sensível à execução que abrange todo o ciclo de vida dos dados.
Em um nível estrutural, esse tecido de governança é formado por três camadas complementares que trabalham em conjunto:
* **Espaços de dados**, que estabelecem limites lógicos claros para o isolamento de dados e a segmentação regulatória
* Controle de acesso baseado em **atributo (ABAC)**, que permite decisões de autorização detalhadas e sensíveis ao contexto com base em atributos de identidade, finalidade e dados
* **Linhaxe semântica**, que preserva o significado comercial, a sensibilidade e a rastreabilidade à medida que os dados passam da ingestão para a percepção e ativação
Juntos, eles criam um modelo de governança em que as decisões de acesso são explicáveis, a imposição é automática e a conformidade é contínua em vez de retrospectiva. O resultado é uma plataforma em que a governança não é mais um fator limitante ou uma reflexão posterior. Em vez disso, ele se torna uma camada de habilitação, permitindo que os arquitetos projetem produtos de dados e fluxos de trabalho conduzidos por IA com confiança de que os requisitos de Trust, privacidade e regulamentação estão sendo aplicados pelo próprio sistema.
Essa abordagem composta garante que os dados corporativos permaneçam não apenas utilizáveis, mas acionáveis de maneira responsável, oferecendo suporte a percepções, ativações e automação em escala sem comprometer a transparência, a segurança ou o controle.
## Proteger o ciclo de vida de dados: Da ingestão à ativação
Na era das empresas conduzidas por IA, proteger dados não é um evento único, mas um processo contínuo que protege as informações do momento em que elas entram no ecossistema até que sejam ativadas para uso comercial ou de IA.
O Salesforce Data 360 incorpora controles de segurança e governança em todas as fases do ciclo de vida dos dados, garantindo que a integridade, a confidencialidade e o Trust dos dados sejam preservados desde a ingestão até a ativação de percepções.
### Base da proteção: Criptografia em repouso e em trânsito
No centro do modelo de proteção do Salesforce Data 360 está a Criptografia de plataforma para Data 360, uma estrutura de criptografia de alto desempenho transparente que protege dados em repouso e em trânsito, sem comprometer a usabilidade ou a escalabilidade.
#### Criptografia em repouso: Segurança da camada de armazenamento
Os dados persistidos no Data 360 Data Lake são **criptografados automaticamente no nível de armazenamento**, garantindo que os dados permaneçam ilegíveis mesmo que ocorra acesso físico ou não autorizado. Os principais recursos incluem:
* **Criptografia transparente do Data Lake:** Todos os dados persistidos no Data Lake são criptografados no nível de armazenamento usando chaves gerenciadas pelo cliente (CMK). Isso garante que, mesmo que ocorra acesso não autorizado ao armazenamento físico, os dados permaneçam ilegíveis e indecifráveis.
* **Chases gerenciadas pelo cliente (CMK):** Os clientes mantêm o controle total sobre as chaves de criptografia, uma funcionalidade crucial para setores regulamentados, como serviços financeiros, saúde e governo. O CMK habilita a auditoria, o controle e a comprovação granulares da soberania de dados, alinhando-os diretamente a mandatos regulatórios, como GDPR, HIPAA e ISO 27001.
* **Gerenciamento de chaves externas (EKM):** Com o Gerenciamento de chave externa, um recurso da Criptografia de plataforma para Data 360, os clientes poderão criptografar dados no Data 360 usando chaves armazenadas nas contas do AWS KMS dos clientes. Isso dá aos clientes mais flexibilidade enquanto mantêm seus dados no Data 360 seguros e protegidos.
* **Traga sua própria chave (BYOK):** Com base no CMK e no EKM, o Data 360 agora permite que os clientes carreguem seu próprio material de chave diretamente no Salesforce para criptografar dados em repouso e índices de pesquisa. Esse aprimoramento fornece uma camada adicional de proteção para dados PII, confidenciais, confidenciais e proprietários sem exigir que os clientes criem ou gerenciem chaves no AWS KMS.
* **Rotação chave e gerenciamento de ciclo de vida:** A rotação de chave é tratada com facilidade. Novos dados são criptografados com a nova chave, enquanto os dados mais antigos permanecem criptografados com a chave original, evitando tempo de inatividade ou degradação do desempenho. Esse mecanismo de rotação reforça a conformidade sem interrupção operacional.
#### Criptografia em trânsito: Segurança em nível de rede
Cada dado transmitido entre serviços, APIs e conectores do Data 360 é protegido usando a Segurança de camada de transporte (TLS) 1.2 ou superior, fornecendo criptografia completa em movimento.
Isso garante que:
* Os dados não podem ser interceptados nem alterados durante a transferência.
* As comunicações entre serviços do Salesforce, conectores confiáveis e pontos de extremidade do cliente continuam privadas e verificáveis.
* A segurança se estende de forma consistente em pipelines de ingestão, processos de harmonização, fluxos de trabalho de ativação e integrações de API externas.
Ao combinar criptografia gerenciada pelo cliente em repouso com criptografia contínua em trânsito, o Salesforce Data 360 cria uma arquitetura de defesa em profundidade que protege os dados do cliente contra ataques externos e ameaças à infraestrutura interna.
### Integração segura entre sistemas (Integração de dados) no Data 360
Embora os controles de criptografia e acesso protejam dados no Salesforce Data 360, proteger a movimentação de dados entre sistemas é igualmente crucial. As empresas modernas operam em ambientes de várias nuvens e híbridos, em que dados confidenciais fluem entre o Salesforce, plataformas de análise, APIs externas e data lakes.
Para solucionar isso, a Salesforce criou uma estrutura de integração segura centrada em credenciais nomeadas (NCs) e credenciais externas (ECs), proporcionando uma base orientada por políticas e alinhada a zero Trust para conectividade segura.
#### Estrutura de integração segura do Salesforce
A Salesforce criou uma robusta **[estrutura de integração segura](https://developer.salesforce.com/docs/platform/named-credentials/guide/get-started.html)**, centrada em credenciais nomeadas (NCs) e credenciais externas (ECs). Juntos, eles eliminam a complexidade da credencial, impõem o acesso de privilégio mínimo e habilitam o gerenciamento de autenticação consistente em todas as integrações sem expor segredos em código ou configuração.
Essa estrutura abstrai complexidades de segurança, aplica práticas recomendadas e estabelece um **plano de controle baseado em políticas** para todas as conexões externas, alinhando-se aos princípios de **Zero Trust** e **segurança por design** da Salesforce.
##### Credenciais nomeadas
As credenciais nomeadas (NCs) são a pedra angular da arquitetura de integração segura do Salesforce. Eles fornecem um mecanismo declarativo e centralizado para definir pontos de extremidade externos e seus parâmetros de autenticação, eliminando a necessidade de codificar credenciais confidenciais, como nomes de usuário, senhas ou tokens no Apex code ou arquivos de configuração. Em vez disso, desenvolvedores e administradores simplesmente fazem referência a um alias de credencial nomeada (por exemplo, SnowflakeConnector_NC) e o Salesforce gerencia automaticamente a autenticação e o gerenciamento de conexão subjacentes.
**Vantagens arquitetônicas e de segurança:**
* **Manutenção simplificada:** Os NCs consolidam URLs de ponto de extremidade externos e parâmetros de autenticação em um único registro gerenciado. Qualquer atualização, como alterar um ponto de extremidade ou girar as credenciais, requer alterações apenas no registro NC, evitando a reimplantação de código ou fluxos entre ambientes.
* **Segurança aprimorada:** As credenciais são armazenadas com segurança no repositório de segredo criptografado do Salesforce, evitando a exposição em repositórios de código, arquivos de configuração ou registros. O processo de autenticação em si é gerenciado automaticamente no tempo de execução, reduzindo o erro humano e o risco de vazamento.
**Conformidade de adesão:** A separação de credenciais da lógica de negócios simplifica a conformidade com regulamentos de proteção de dados, como **GDPR, HIPAA e PCI DSS**. Os auditores podem verificar facilmente se o acesso a dados externos cumpre as políticas de governança e segurança corporativas.
* **Bypassas Configurações do site remoto:** Os NCs eliminam o requisito legado para configurações de site remoto, simplificando a configuração e a implantação, particularmente para implementações corporativas em grande escala ou em vários ambientes.
 #### Credenciais externas
As credenciais externas (ECs) definem o protocolo de autenticação e o fluxo que o Salesforce usa ao se conectar a um serviço externo, respondendo de modo eficaz a "como autenticar". Um único EC pode ser reutilizado em várias NCs que compartilham o mesmo tipo de autenticação, promovendo a reutilização de ajustes e a imposição de segurança consistente.
**Protocolos de autenticação com suporte:**
* OAuth 2.0 (todas as variantes suportadas)
* JWT (token da Web JSON)
* Autenticação básica
* AWS Signature v4
* Autenticação personalizada
* Sem autenticação (para APIs abertas ou pontos de extremidade públicos)
Credenciais externas e credenciais nomeadas são projetadas em torno de uma separação clara de tarefas. Uma Credencial externa define como autenticar, especificando o protocolo de autenticação, o tipo de token e o comportamento de atualização para conexão a sistemas externos. Uma Credencial nomeada, por outro lado, define onde conectar, o URL do ponto de extremidade e qual Credencial externa usar para essa conexão. Esse design garante que a lógica de autenticação e a configuração do ponto de extremidade permaneçam desconectadas, permitindo que o Salesforce ofereça suporte a vários protocolos de integração com segurança enquanto mantém o gerenciamento de credenciais centralizado e consistente em toda a empresa.
### Como os conectores do Data 360 aproveitam essa estrutura
Embora a interface do usuário do Data 360 abstraia grande parte da configuração subjacente, a estrutura Credencial nomeada e Credencial externa é usada com frequência sob o capô por seus conectores nativos e fluxos de dados.Isso significa que, mesmo quando os administradores estão simplesmente "adicionando uma conexão de dados" por meio de uma IU guiada, o Data 360 ainda está aplicando esse modelo de segurança padronizado nos bastidores.
Implicações arquitetônicas:
* **Modelo de segurança unificado:** Cada conector, seja para um Banco de Dados externo , AWS S3 ou uma API corporativa, se beneficia dos mesmos padrões de criptografia, autenticação e gerenciamento de chave impostos por Credenciais nomeadas e externas.
* **Abstração do desenvolvedor:** Desenvolvedores e administradores não precisam lidar manualmente com fluxos de autenticação ou rotação de credenciais. O Salesforce gerencia o ciclo de vida, a expiração e a atualização do token automaticamente.
* **Imposição consistente das políticas:** Essa estrutura garante que todos os conectores cumpram políticas de autenticação, auditoria e registro consistentes, essenciais para ingestão de múltiplas fontes em grande escala em setores regulados.
* **Extensibilidade à prova de futuro:** Conforme o Salesforce aprimora sua pilha de autenticação (por exemplo, para dar suporte a novos fluxos OAuth ou padrões FIDO2), essas melhorias se propagam automaticamente em todos os conectores sem exigir refatoramento ou reimplantação.
### Segurança e governança do conector do Data 360
O Salesforce Data 360 oferece um grande conjunto de conectores prontos para uso que simplificam a integração de dados de várias origens. Isso permite que as empresas consolidem e utilizem seus dados com eficiência. O Salesforce fornece vários tipos de conectores, incluindo conectores nativos do Salesforce, conectores de armazenamento em nuvem, conectores de banco de dados e conectores de API e aplicativo. Além dos conectores oferecidos, também há suporte para zero ferramentas ETL. Os conectores do Salesforce permitem uma integração perfeita entre produtos do Salesforce, como Sales Cloud, Service Cloud e Marketing Cloud, com o Data 360\. Além disso, uma variedade de conectores para provedores de armazenamento de nuvem, incluindo Amazon S3, Google Cloud Storage e Azure Data Lake, são oferecidos. Os conectores predefinidos para bancos de dados, como Snowflake, Redshift e BigQuery, permitem que as empresas vinculem seus armazéns de dados existentes ao Data 360\. Além disso, o Data 360 fornece conectores para vários aplicativos e APIs de terceiros, como anúncios do Google, anúncios do Facebook e outras plataformas de marketing. Para aprimorar a flexibilidade, o Data 360 se integra a ferramentas ETL, como MuleSoft e Informatica.
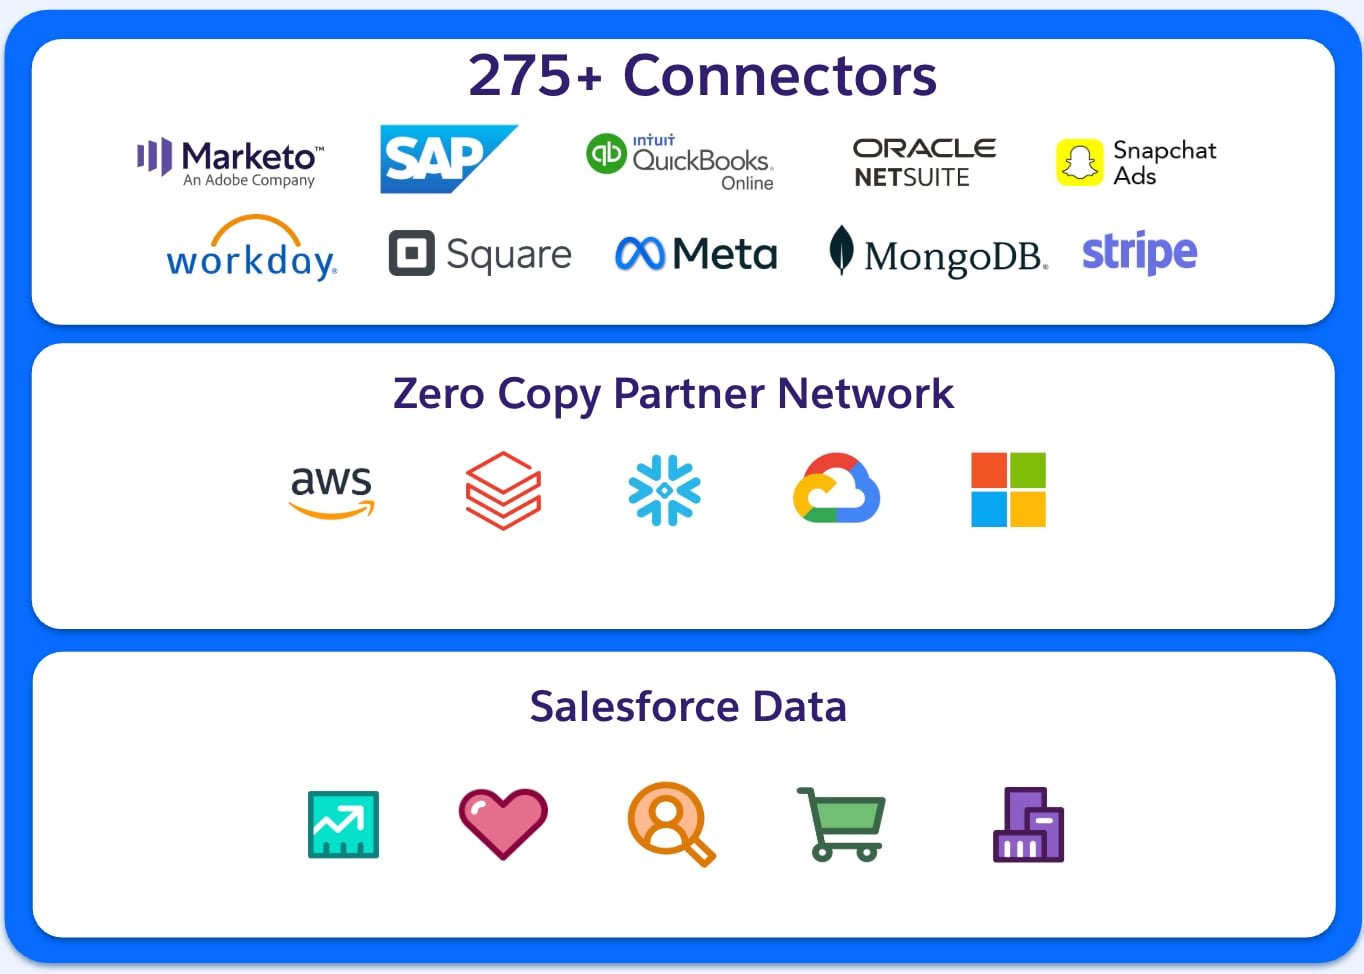 #### Segurança de dados e conectores do Salesforce Data 360
A segurança dos dados armazenados no Salesforce Data 360 está na vanguarda de muitas conversas relacionadas ao Data 360. Como parte do compromisso da Salesforce com uma abordagem de segurança de defesa em profundidade, a mesma importância é dada à segurança de como os dados são ingeridos no ambiente do Data 360.
O Salesforce reconhece que as empresas operam em diversos ecossistemas de dados, geralmente abrangendo várias plataformas de nuvem, soluções de armazenamento e ferramentas de análise. Nossos conectores do Data 360 servem como a ponte entre esses ambientes. O conector permite uma integração de dados segura, escalonável e eficiente enquanto mantém os altos padrões de segurança do Salesforce. Esses conectores facilitam o fluxo de dados contínuo sem comprometer a integridade ou a privacidade.
Os três componentes essenciais da segurança do conector do Data 360 são:
* **Mapeamento de autenticação/autorização**: O gerenciamento de acesso seguro é fundamental para a segurança dos dados. Diferentes conectores de nuvem usam diferentes mecanismos de autenticação e autorização para validar e controlar o acesso do usuário. A autenticação garante que os usuários ou os sistemas sejam entidades legítimas, enquanto a autorização define o nível de acesso concedido. A Salesforce garante que, sempre que possível, seus conectores atendam aos padrões do setor.
* **Interoperabilidade de recursos de cópia zero (ZETL)**: A duplicação de dados apresenta desafios operacionais e de segurança. Isso também vem com custos de armazenamento desnecessários, inconsistências de dados e maior exposição a risco. A abordagem de Extração, transformação e carregamento zero (ZETL) do Salesforce garante que o compartilhamento de dados em tempo real entre plataformas possa ocorrer sem exigir replicação de dados físicos. Isso significa que os dados podem permanecer em seu ambiente original enquanto ainda estão acessíveis para processamento, relatórios e análise. Além disso, isso também reduz significativamente a superfície de ataque e aprimora a conformidade potencial com as leis de residência de dados.
* **Suporte de federação de dados**: Nos ambientes de várias nuvens de hoje, as organizações precisam de acesso abrangente a dados sem movimentação desnecessária de dados. O modelo de dados federado do conector do Data 360 oferece suporte à federação de dados baseada em arquivo e baseada em consulta, permitindo que as empresas aproveitem origens de dados externas em tempo real. Quer estejam acessando bancos de dados estruturados, registros semiestruturados ou arquivos não estruturados, os conectores do Salesforce garantem que os dados permaneçam seguros durante todo o ciclo de vida.
A Salesforce tem como objetivo fornecer aos seus clientes a transparência necessária para ajudar a navegar pelas complexidades de segurança e conformidade de dados, mesmo com nossas integrações. Quer se integre ao AWS S3, ao Google Cloud Storage, ao Snowflake ou a outras plataformas, nossos Conectores do Data 360 são projetados para garantir a Trust, a transparência e o controle de dados essenciais para os negócios.
##### Segurança e mapeamento de autenticação do conector do Salesforce Data 360
| Tipo de conector | Suporte de tipo de conexão | Tipos de autenticação primários | Principais aspectos e notas de segurança |
|---|---|---|---|
| Salesforce CRM | N/A (interno) | Baseado em sessão (interno) | Usa o modelo robusto de gerenciamento de acesso e identidade interna (IAM) do Salesforce. Todos os dados são criptografados em trânsito e em repouso dentro da infraestrutura do Salesforce. |
| Engajamento do Marketing Cloud | Somente Internet pública | OAuth 2.0, nome de usuário/senha | Os protocolos padrão do OAuth 2.0 são usados para autenticação segura. Os dados são criptografados em trânsito (TLS) pela Internet pública. |
| B2C Commerce | Somente Internet pública | OAuth 2.0 | OAuth 2.0. Conta com protocolos públicos seguros da Internet (TLS) para transferência de dados. |
| Aplicativo Web e móvel | Somente Internet pública | Chaves de API, OAuth 2.0 | Dados ingeridos por meio de APIs (API de ingestão, API de streaming). Segurança gerenciada por meio de gerenciamento de chave de API e protocolos da Web padrão. |
| Amazon S3 | Conexão privada e pública | Papéis de IAM, credenciais externas | Dá suporte ao AWS PrivateLink para conexão segura e privada. A conexão pública usa credenciais seguras. Os dados são criptografados em trânsito e em repouso (chaves gerenciadas pelo cliente no S3 opcional). |
| Snowflake | Conexão privada e pública | OAuth 2.0, autenticação de chave privada, nome de usuário/senha | Dá suporte à conexão privada da VPC (AWS PrivateLink). Conexão pública disponível com métodos de autenticação seguros. Os dados podem ser criptografados com chaves de cliente no Snowflake. |
| Amazon Redshift | Conexão privada e pública | Nome de usuário/senha, autenticação IAM | Suporta conexão privada (AWS PrivateLink). A conexão pública usa as melhores práticas de segurança padrão. |
| Microsoft Azure (armazenamento/SQL) | Somente Internet pública | Tokens SAS, OAuth 2.0, Nome de usuário/senha | As conexões dependem de tokens SAS seguros ou OAuth para autenticação. Os dados passam pela Internet pública por meio de canais criptografados (TLS). |
| Armazenamento do Google Cloud (GCS) | Somente Internet pública | OAuth 2.0, Contas de serviço | As conexões dependem de OAuth 2.0. Os dados passam pela Internet pública por meio de canais criptografados (TLS). |
| MuleSoft (API) | Somente Internet pública | OAuth 2.0, chave de API | Conecta por meio de APIs. A segurança é gerenciada por meio da autenticação de API padrão e políticas de governança robustas implementadas por meio da MuleSoft Anypoint Platform. |
| Estágio | Mecanismo | Controles de segurança/governança |
|---|---|---|
| Configuração de ativação | Definido na configuração da ativação do Data 360 | Protege por meio de credenciais nomeadas e credenciais externas |
| Preparação de dados | Filtrado e unido de DMOs | Metadados de consentimento e privacidade aplicados |
| Transferência de saída | Criptografado via TLS/Conexão privada | Aplicação de apólice e abstração de credenciais |
| Envio externo | SFTP/Armazenamento na nuvem/API | Entrega controlada de acesso e auditável |
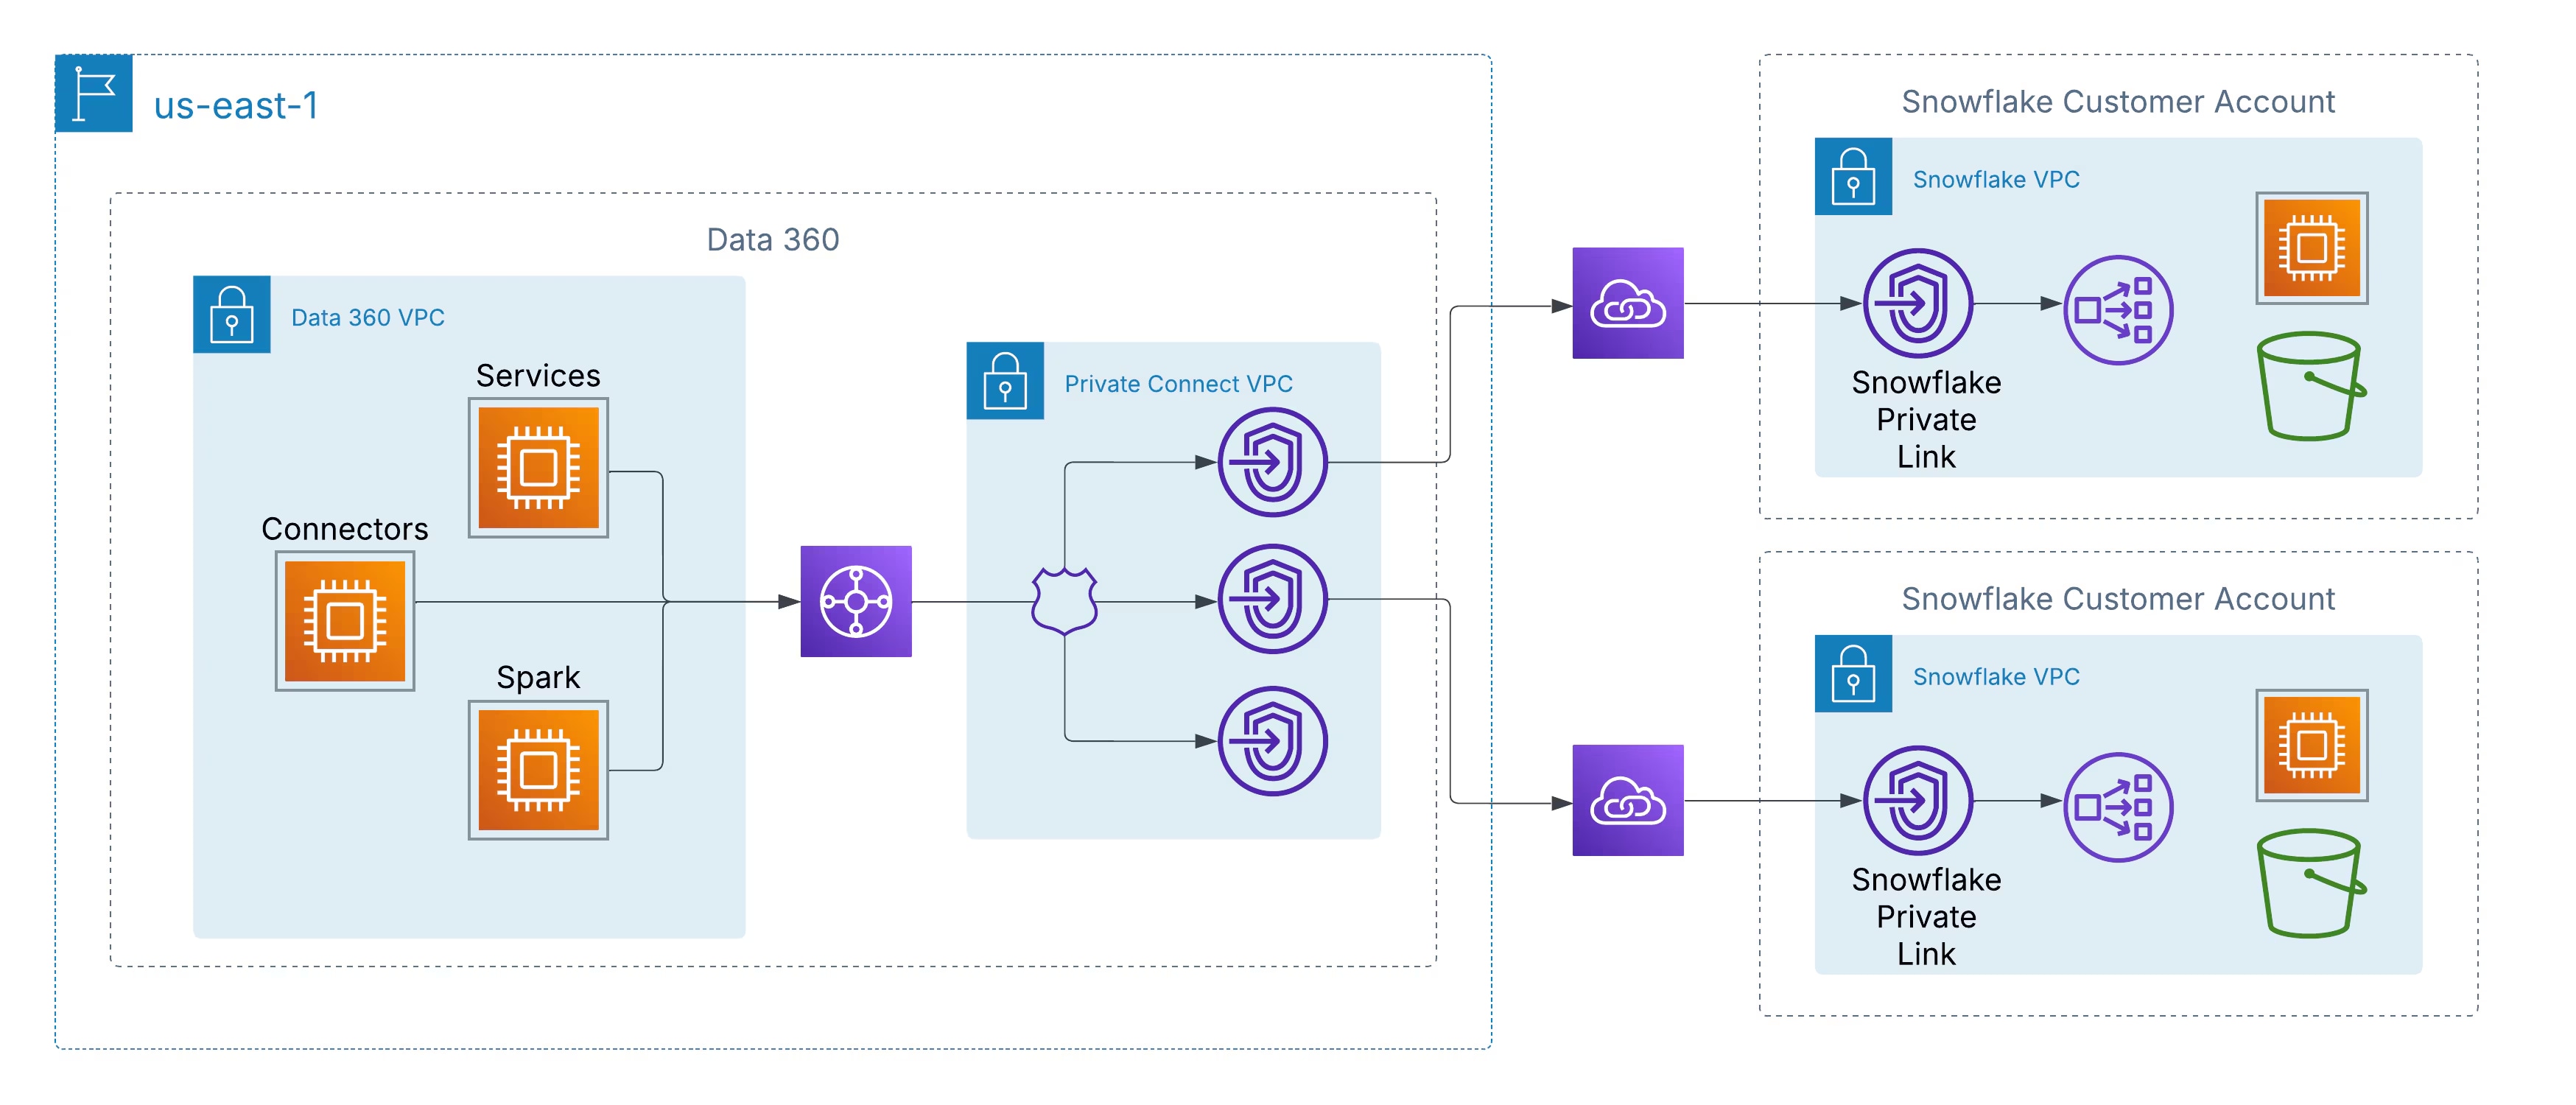 Todas as comunicações permanecem dentro do backbone da AWS, usando endereço IP privado e caminhos de rede não roteáveis, eliminando assim o risco de interceptação de dados em trânsito e cumprindo requisitos de segurança corporativos e regulatórios rígidos.
Essa arquitetura garante que:
* **Exposição zero à Internet:** Os dados nunca saem da rede privada da AWS.
* **Comunicação de IP privado:** O tráfego permanece isolado e não pode ser endereçado externamente.
* **Alinhamento de conformidade:** Cumpra padrões de segurança como ISO 27001, SOC 2 e FedRAMP.
#### Interconexão privada: Estender a segurança entre nuvens
Para dar suporte a clientes que operam em ambientes de várias nuvens, a Salesforce está estendendo os mesmos princípios de segurança além da AWS por meio da Interconexão privada. Essa funcionalidade habilita a conectividade privada entre nuvens entre o Data 360 e data lakes hospedados no Azure ou no Google Cloud, mantendo as mesmas garantias de roteamento privado, navegação sem Internet e tráfego somente base criptografado.
Dois modelos de implementação arquitetônica estão disponíveis:
* **Interconexão gerenciada pelo cliente:** Os clientes integram seus circuitos de rede privada existentes, como Azure ExpressRoute, Google Cloud Interconnect ou Equinix Fabric, diretamente com VPCs do Data 360.
* **Interconexão gerenciada pelo Salesforce:** O Salesforce provisiona e gerencia o link entre nuvens, expondo pontos de extremidade de serviço privados no ambiente de nuvem de destino do cliente para uma configuração pronta para uso.
### Proteger os portões: Funcionalidades de segurança de API no Salesforce Data 360
O Salesforce Data 360, uma plataforma eficiente para unificar dados corporativos, é criado com controles de segurança robustos e de várias camadas. Para os clientes, gerenciar a segurança da API é uma parte essencial de uma estratégia abrangente de proteção de dados, permitindo que eles controlem o acesso, gerenciem integrações e monitorem o uso de modo eficaz.
Aqui estão os principais recursos e funcionalidades disponíveis para que os clientes configurem, controlem e gerenciem a segurança da API no Salesforce Data 360.
#### Principais recursos e funcionalidades de segurança da API
Os clientes podem aproveitar vários recursos integrados do Salesforce para garantir acesso à API seguro às instâncias do Data 360:
##### 1\. Autenticação e autorização robustas (OAuth 2.0)
O Salesforce exige autenticação rígida para suas APIs do Data 360, sendo OAuth 2.0 o protocolo padrão e recomendado.
* **Aplicativos conectados**: Os clientes criam e configuram aplicativos conectados para gerenciar o acesso a aplicativos externos. Esse é o mecanismo principal para autenticar e conceder acesso às APIs de ingestão e consulta do Data 360.
* **Escopos de OAuth**: Os administradores podem definir escopos específicos do OAuth (por exemplo, cdp_ingest_api, api) para solicitar as permissões mínimas necessárias, seguindo o princípio de privilégio mínimo.
* **Autenticação multifator (MFA)**: O Salesforce Authenticator e outras soluções de MFA podem ser aplicadas, adicionando uma camada vital de segurança e garantindo que apenas usuários verificados possam acessar o sistema, inclusive por meio de logins de API.
##### 2\. Controle de acesso granular e permissões
Os clientes têm controle detalhado sobre quais usuários e aplicativos podem acessar dados e quais ações eles podem realizar.
* **Controle de acesso da API (recurso)**: Depois de habilitado pelo Suporte do Salesforce, esse recurso permite que os administradores aprovem explicitamente quais aplicativos conectados podem ser usados para acessar as APIs. Todos os aplicativos não aprovados são bloqueados automaticamente, reduzindo significativamente o risco de extração de dados não autorizada.
* **Conjuntos de permissões e perfis**: Os administradores gerenciam o acesso à API atribuindo a permissão "API habilitada" por meio de perfis de usuário ou conjuntos de permissões dedicados. Isso garante que os usuários tenham acesso apenas relevante às funções de trabalho.
* **Controle de acesso baseado em papel (RBAC)**: No Data 360, os clientes podem criar e gerenciar políticas de controle de acesso baseadas em papel para definir níveis de acesso a dados (segurança em nível de objeto, campo e registro), garantindo consistência e controle em toda a plataforma.
* **Usuários de integração dedicados**: As práticas recomendadas recomendam criar usuários específicos "apenas API" para integrações, limitando suas permissões apenas ao que é necessário para a chamada de API, em vez de usar uma conta de administrador do sistema.
##### 3\. Controles de segurança de rede
* **Intervalos de IP de lista de permissões/login**: Os clientes podem restringir o acesso à API a um intervalo definido de endereços IP confiáveis. Qualquer tentativa de login de um intervalo de IP não aprovado pode ser negada ou contestada para verificação.
* **Conexão privada**: Criado no AWS PrivateLink, esse recurso permite que os administradores gerenciem dados confidenciais sem expor pontos de extremidade à Internet pública, eliminando o risco de ataques em pontos de extremidade publicamente visíveis.
* **Criptografia em trânsito e em repouso**: Todos os dados são criptografados em trânsito (usando TLS) e em repouso, protegendo informações confidenciais de acesso não autorizado mesmo que sejam interceptadas.
##### 4\. Monitoramento, auditoria e governança
A visibilidade é fundamental para a segurança. O Salesforce fornece ferramentas extensas para monitorar e auditar a atividade da API.
* **Monitoramento de evento**: Fornece rastreamento quase em tempo real de vários eventos, incluindo chamadas à API e tentativas de login. Os clientes podem usar esses dados para auditoria e para criar políticas de segurança da transação.
* **Security Center**: Esse recurso oferece uma visualização única e consolidada das métricas de integridade, conformidade e governança de segurança em todas as organizações do Salesforce, simplificando o monitoramento e o gerenciamento.
* **Pista de auditoria de campo**: Ajuda os clientes a rastrear o histórico de login e campo, monitorar alterações de configuração e lidar com obrigações de conformidade de auditoria e retenção de dados.
* **Recursos de governança de dados**: Inclui marcação e classificação de dados, imposição de políticas e mascaramento de dados dinâmico para garantir que políticas de governança consistentes sejam aplicadas a todos os pontos de contato de dados, incluindo aqueles acessados por meio de APIs.
#### Configurar e gerenciar a segurança da API: Uma jornada do cliente
1. Habilitar controles principais: Comece habilitando padrões para toda a organização, como restrições de MFA e IP.
2. Solicitar controle de acesso à API: Registre um caso com o Suporte do Salesforce para habilitar o recurso "Controle de acesso à API" em sua organização.
3. Configurar aplicativos conectados: Crie aplicativos conectados específicos para cada integração, definindo os escopos de OAuth necessários e atribuindo-os a perfis/conjuntos de permissões autorizados.
4. Implementar privilégio mínimo: Garanta que todos os usuários de integração tenham permissões "apenas API" e acesso mínimo a dados.
5. Monitorar e auditar: Use regularmente o Monitoramento de evento e a Central de segurança para revisar o uso da API, detectar anomalias e realizar avaliações de vulnerabilidade.
6. Impor melhores práticas: Sempre aplique o TLS, armazene com segurança tokens de atualização, faça a rotação de IDs de sessão e valide entradas de dados.
Ao aproveitar esses recursos robustos configuráveis pelo cliente, as empresas podem manter um ambiente seguro e em conformidade com todas as interações de API no Salesforce Data 360.
### Conformidade, auditoria e monitoramento contínuo
#### Disponibilidade de serviço e residência de dados
O Salesforce Data 360 é projetado para atender aos requisitos de residência e soberania de dados globais por meio de seu modelo de implantação distribuído geograficamente. O serviço está disponível atualmente em várias regiões regulamentadas, incluindo Estados Unidos, Canadá, Brasil, Alemanha, Índia, Austrália e Japão.
A residência de dados é determinada mapeando a instância da organização principal de cada cliente para a instância regional correspondente mais próxima do Data 360. Por exemplo, organizações principais localizadas nos Estados Unidos ou no Canadá são emparelhadas com uma instância do Data 360 na região dos EUA, enquanto organizações principais dentro da União Europeia são mapeadas para uma instância hospedada na Alemanha. Da mesma forma, organizações principais na Índia, Austrália, Nova Zelândia ou Cingapura estão associadas a uma instância do Data 360 hospedada na Índia.
A infraestrutura Hyperforce da Salesforce é a base desse modelo, fornecendo a base para o controle de dados geográficos, o isolamento de segurança e a conformidade regulatória. O Hyperforce garante que os dados do cliente, incluindo metadados, backups e conjuntos de dados derivados, permaneçam dentro dos limites regionais definidos. Essa arquitetura permite que as empresas cumpram os mandatos de residência e conformidade de dados locais, como GDPR, FFIEC, HIPAA e leis de privacidade regionais em APAC e EMEA.
A Salesforce continua expandindo a disponibilidade do Data 360 para regiões adicionais do Hyperforce para se alinhar com os padrões de privacidade globais em evolução, os requisitos de conformidade regionais e as expectativas dos clientes em relação ao controle de dados soberanos.
#### Habilitação de conformidade regulatória
O Salesforce Data 360 é projetado para ajudar as empresas a cumprir requisitos regulatórios e de privacidade globais rígidos, como GDPR e CCPA. A plataforma oferece recursos nativos para gerenciar direitos de sujeito de dados (DSRs), incluindo acesso a dados, exportação e exclusão ("Direito de ser esquecido"), garantindo o tratamento em conformidade de dados pessoais em todo o ciclo de vida.
Embora o cliente mantenha a responsabilidade final pela conformidade, o Salesforce opera como um "provedor de serviços" certificado sob normas como a CCPA, fornecendo os controles no nível da plataforma, garantias de segurança e mecanismos contratuais que permitem que as organizações implementem suas estruturas de conformidade de forma eficiente e em escala.
#### Foundational Trust: Certificações e atestados
Trust é a pedra angular da plataforma do Salesforce, e esse Trust é ganho através de validação independente. A Salesforce mantém um amplo portfólio de certificações e atestados de segurança globais que demonstram seu compromisso contínuo com a proteção de dados do cliente e a manutenção dos mais altos padrões de segurança na nuvem.
Essas certificações não são apenas caixas de seleção, elas representam auditorias rigorosas e recorrentes que verificam a força e a consistência dos controles, processos e infraestrutura de segurança do Salesforce. Juntos, eles formam a espinha dorsal do modelo Fundamental Trust da Salesforce.
**As principais certificações e atestados incluem:**
* **ISO/IEC 27001:** Valida o sistema abrangente de gerenciamento de segurança de informações do Salesforce.
* **ISO/IEC 27017:** Estabelece as melhores práticas para controles de segurança específicos da nuvem.
* **ISO/IEC 27018:** Foco na proteção de informações de identificação pessoal (PII) na nuvem.
* **SOC 1, SOC 2 e SOC 3:** Relatórios independentes que confirmam o design e a eficácia operacional dos controles de segurança e privacidade da Salesforce.
* **PCI DSS:** Garante o processamento e o armazenamento seguros de informações de cartão de pagamento.
* **FedRAMP High & DoD Impact Level 4:** Certifica o Salesforce Government Cloud para uso por agências federais dos EUA que gerenciam cargas de trabalho confidenciais.
Ao manter esse conjunto abrangente de certificações, o Salesforce dá aos clientes a confiança de que seus dados são gerenciados em uma plataforma que atende, e muitas vezes ultrapassa, as expectativas globais de conformidade e segurança.
### Maximizando a visibilidade: Registro, monitoramento e capacidade de observação no Salesforce Data 360
No panorama digital de ritmo rápido de hoje, ter uma visão completa dos dados do cliente é crucial, mas igualmente importante é ter uma visão completa da plataforma que gerencia esses dados. O Salesforce Data 360 fornece recursos robustos de registro, monitoramento e observabilidade integrados que capacitam os clientes a garantir a qualidade, a segurança e o desempenho dos dados.
Essas ferramentas ajudam você a passar da solução de problemas reativa para o gerenciamento proativo, garantindo que sua implementação do Data 360 seja executada sem problemas e com eficiência.
#### Detecção e resposta proativas a ameaças
A segurança não termina com a prevenção, ela evolui com a vigilância. Em um panorama de ameaças em constante mudança, o Salesforce combina recursos avançados de monitoramento de plataforma com processos de análise gerenciados pelo cliente para garantir uma proteção proativa e contínua.
O Salesforce fornece ferramentas nativas eficientes para visibilidade e detecção de ameaças:
* A **Trilha de auditoria de configuração** captura um histórico completo de alterações administrativas, ajudando as equipes a rastrear configurações ou atualizações de política.
* O **Monitoramento de evento** fornece percepções profundas sobre o comportamento do usuário, a atividade da API e os padrões de acesso aos dados. Esta telemetria pode ser perfeitamente integrada a uma solução de **Gerenciamento de Informações e Eventos de Segurança (SIEM)** para análise e correlação centralizada.
#### 1\. Monitoramento de evento: O pulso da sua organização
O Monitoramento de evento, parte da oferta Salesforce Shield, é o centro central para rastrear dados detalhados de atividade do usuário e desempenho do sistema em sua organização do Salesforce, incluindo ações específicas do Data 360. Ele captura uma ampla gama de "eventos" em arquivos de log e objetos para sua análise.
* **Arquivos de log de evento (ELFs):** Eles fornecem detalhes granulares de atividades do usuário e eventos do sistema, disponíveis para download após um breve atraso (dia ou hora). Você pode acessar até 30 dias de dados por meio da API ou do navegador Arquivo de registro de evento, com a opção de exportar para armazenamento de longo prazo.
* **Monitoramento de evento em tempo real:** Para percepções imediatas, os eventos em tempo real são transmitidos como eventos de plataforma, permitindo monitorar e detectar a atividade quase em tempo real. Isso é vital para segurança e desempenho, permitindo que você tome medidas imediatas se necessário.
* **Eventos específicos do Data 360:** O Monitoramento de evento inclui tipos de evento específicos para o uso do Data 360, como Visualização de página do Lightning, Interação do Lightning e Evento de relatório relacionados a páginas e dados do Data 360.
* **Integração com ferramentas externas:** O Salesforce facilita a integração perfeita com soluções de monitoramento de terceiros populares, como Splunk, Datadog, New Relic e Sumo Logic. Você pode transmitir ou exportar dados de Monitoramento de evento para essas plataformas para capacidade de observação consolidada em toda a sua pilha de tecnologia.
#### 2\. Monitoramento e otimização de desempenho
Entender o desempenho de sua implementação do Data 360 é fundamental para uma ótima experiência do usuário.
* **Aplicativo de uso do Lightning:** Esse aplicativo integrado fornece uma visualização agregada de métricas de desempenho, como tempos de carregamento de página (tempo de página experimentado ou EPT) e desempenho do navegador, para páginas do Data 360 no Lightning Experience.
* **Relatórios e painéis personalizados:** Você pode criar relatórios e painéis personalizados usando objetos do Data 360 e dados de Monitoramento de evento, incluindo o uso de um aplicativo baseado em modelo do CRM Analytics gratuito chamado Monitoramento de evento Plus. Essas visualizações ajudam a identificar tendências e identificar gargalos de desempenho rapidamente.
Porém, tecnologia sozinha não é suficiente. A verdadeira resiliência requer uma parceria disciplinada entre detecção automatizada e revisão humana. Alertas automatizados podem detectar anomalias em tempo real, mas ameaças subtis ou de longo prazo, como exfiltração de dados lenta e não autorizada por um usuário válido, geralmente são melhor identificadas por meio de auditorias periódicas e análise de tendência.
O Salesforce fornece telemetria, registros de auditoria e ganchos de integração; os clientes trazem rigor do processo, ritmo operacional e inteligência específica do contexto. Juntos, eles formam um **modelo de defesa em profundidade**, combinando automação, análise e supervisão humana para detectar, investigar e responder a ameaças antes que elas se tornem incidentes.
### Conduzindo decisões informadas: Relatórios, painéis, métricas e notificações no Salesforce Data 360
O Salesforce Data 360 não é apenas sobre unificar os dados do cliente; é sobre tornar esses dados inteligentes e acionáveis. Uma parte essencial dessa proposta de valor é fornecer relatórios robustos, painéis eficientes, métricas inteligentes e recursos de notificação em tempo real. Essas ferramentas permitem que os clientes monitorem a integridade dos dados, acompanhem o desempenho e automatizem ações com base em dados unificados, tudo dentro do ambiente familiar do Salesforce.
#### Relatórios e painéis: Hub de visualização de dados
Os recursos nativos de relatórios e painéis do Salesforce se estendem perfeitamente para o Data 360, permitindo que você visualize e analise seus dados unificados sem sair da plataforma.
#### Criar relatórios sobre dados unificados
Você pode criar relatórios padrão e personalizados sobre dados armazenados no Data 360, incluindo dados unificados de várias fontes e insights calculados.
* **Tipo de relatório padrão e personalizado:** O Data 360 introduz novos tipos de relatório especificamente para objetos do Data 360, como Fluxos de dados, Segmentos, Ativações, Resolução de identidade e Insights calculados. Isso permite consultar seus dados unificados com criadores de relatórios padrão do Salesforce.
* **Análise granular:** Os relatórios oferecem suporte a até 10 agrupamentos de linhas, permitindo uma segmentação mais precisa e uma análise detalhada dos atributos e tendências do cliente.
* **Fórmulas e resumos:** Você pode aproveitar fórmulas de resumo e nível de linha para avaliar cada registro ou grupo de registros, ajudando a rastrear métricas detalhadas e resumos agregados de alto nível em um único relatório.
#### Painéis dinâmicos para visualizações holísticas
Os painéis fornecem uma exibição visual das principais métricas e tendências em toda a sua implementação do Data 360.
* **Visualização unificada:** Combine dados de vários relatórios do Data 360 ou até mesmo misture relatórios do Data 360 com relatórios padrão do CRM em um único painel para uma visualização holística de suas operações e percepções do cliente.
* **Widgets personalizáveis:** Use vários tipos de gráfico (barras, linhas, pizza, medidor etc.) e tabelas para exibir dados de relatório de modo eficaz.
* **Insights em tempo real:** Os painéis podem ser atualizados para fornecer informações atualizadas, ajudando na tomada de decisão rápida orientada por dados.
#### Métricas e KPIs: Medindo o sucesso
O Data 360 permite que você defina e rastreie os indicadores-chave de desempenho (KPIs) relevantes para suas metas de negócios. Eles podem ser gerados por meio de:
* **Insights calculados:** Crie métricas eficientes usando dados processados em lotes de alto volume. Por exemplo, calcule métricas como "Valor médio da vida útil do cliente" ou "Receita total do contrato ativo" e use-as como dimensões ou medidas em seus relatórios e painéis.
* **Insights de streaming:** Processe dados de origens de streaming quase em tempo real para criar agregações de série temporal, como dados de engajamento móvel ou de site. Essas métricas podem promover orquestrações imediatas e ações de dados.
#### Notificações e alertas: Manter-se informado e proativo
O Salesforce oferece recursos eficientes de automação e notificação para garantir que você esteja ciente de eventos críticos ou alterações de dados no Data 360.
* **Notificações baseadas em fluxo:** Você pode configurar Fluxos de processo para acionar ações e enviar notificações com base em eventos em objetos do Data 360, como Fluxos de dados, Segmentos e Ativações.
* **Alertas personalizados:** Crie notificações personalizadas que acionam um email ou aparecem no Salesforce Notification Bell quando condições específicas forem atendidas. Por exemplo, você poderá receber um alerta se um fluxo de dados falhar, uma regra de resolução de identidade encontrar um erro ou uma métrica-chave ultrapassar um determinado limite.
* **Serviço de Notificação de Eventos (ENS):** Para desenvolvedores, o Serviço de notificação de evento de primeira API permite que os sistemas externos recebam notificações quando determinados eventos ocorrem, permitindo uma integração perfeita e reações em tempo real em sua pilha de tecnologia.
* **Ações de dados:** Com base nas percepções de streaming, você pode acionar ações de dados, que podem ser configuradas para enviar alertas, chamar eventos de plataforma ou integrar-se a outros aplicativos SaaS por meio de webhooks.
Ao aproveitar esses recursos abrangentes, os clientes do Salesforce Data 360 podem monitorar de modo eficaz o ecossistema de dados, visualizar as principais métricas e receber alertas oportunos para promover o engajamento proativo e a excelência operacional.
### Recomendações estratégicas para adoção corporativa
A adoção do Salesforce Data 360 em escala corporativa exige mais do que habilitação técnica, exigindo uma arquitetura deliberada e priorizada em segurança. As recomendações estratégicas a seguir fornecem aos CTOs e aos arquitetos empresariais um roteiro para criar Trust, resiliência e conformidade em cada camada da implantação do Data 360.
* **Implementar uma abordagem "Secure-by-Design":** A segurança não deve ser adaptada; ela deve ser fundamental. Comece com a política padrão *"Negar tudo"* do Salesforce e conceda acesso explicitamente conforme necessário. Defina estruturas de governança, políticas e acesso antes de ingerir ou ativar dados. A segurança do prédio desde o primeiro dia elimina o risco de exposições ocultas e simplifica a conformidade de longo prazo.
* **Impor uma estratégia robusta de gerenciamento de identidade e acesso (IAM):** Centralize a identidade por meio de SSO federado e aplique a autenticação multifator (MFA) para mitigar o comprometimento de credenciais. Restrinja o acesso por Intervalos de IP de login e use os recursos do Provedor de identidade (IdP) do Salesforce para estabelecer a responsabilidade de ponta a ponta entre usuários e integrações. Uma camada de IAM unificada reduz a complexidade operacional e endurece sua superfície de autenticação.
* **Aplicar o princípio do privilégio mínimo :** Projete papéis para precisão, não conveniência. Use os conjuntos de permissões padrão do Salesforce como a base para a separação de tarefas, garantindo que os usuários acessem apenas o necessário. Evite a personalização excessiva de permissões: cada desvio aumenta a sobrecarga de manutenção e o risco de acesso indesejado.
* **Estabelecer uma estrutura de governança de dados em várias camadas:** Separe dados por unidade de negócios ou marca usando Espaços de dados e aplique o Controle de acesso baseado em atributo (ABAC) com Segurança em nível de objeto, campo e registro (OLS, FLS, RLS). Use o mascaramento dinâmico de dados para proteger informações confidenciais em tempo real sem prejudicar a análise ou a usabilidade. Esse modelo em camadas garante que a governança permaneça consistente à medida que os dados são escalados entre domínios.
* **Avalie estrategicamente a criptografia e as integrações seguras:** Para cargas de trabalho confidenciais, implemente a Criptografia de plataforma com chaves gerenciadas pelo cliente (CMK) para manter a soberania em seu ciclo de vida de criptografia. Use as Credenciais nomeadas e a Conexão privada para proteger todas as integrações entre sistemas, eliminando segredos embutidos em código e garantindo que todo o tráfego permaneça privado, em conformidade e auditável.
* **Criar um programa de operações de segurança contínuas :** A segurança não termina com a configuração, ela prospera com a disciplina operacional. Complemente o monitoramento automatizado com revisões de auditoria regular de registros de evento e trilhas de acesso. Estabeleça uma função de Operações de segurança (SecOps) dedicada para identificar anomalias, investigar ameaças e validar a conformidade. A meta: detectar antecipadamente, responder rapidamente e melhorar continuamente a postura.
### Caminho para frente: Criar um Data 360 resiliente e confiável
A jornada para uma empresa segura e inteligente não termina com a implantação – ela evolui através da disciplina, do design e do Trust. O Salesforce Data 360 fornece a base arquitetônica, mas o verdadeiro valor emerge quando as organizações operacionalizam segurança, governança e inteligência como um movimento unificado.
As empresas não devem abordar o Data 360 como outra plataforma de dados, mas como uma camada de Trust segura e integrável que conecta dados, IA e engajamento do cliente sob uma única estrutura de governança. Ao adotar uma filosofia *segura por design*, impor privilégios mínimos em cada camada e estender a conectividade privada a todos os fluxos de dados, as organizações transformam a conformidade de uma caixa de seleção em uma vantagem competitiva.
A próxima etapa é a modernização contínua, incorporando automação de auditoria, imposição de políticas e gerenciamento de ciclo de vida de criptografia em operações diárias. Conforme as empresas evoluem em direção a arquiteturas orientadas por IA, os mesmos princípios que protegem dados hoje formarão a base da governança de IA de amanhã, garantindo que cada modelo, agente e decisão seja explicável, consciente da política e em conformidade com o projeto.
Em última análise, o Trust se torna a nova moeda da transformação digital. Com o Salesforce Data 360, as empresas podem dimensionar com confiança o ecossistema de dados, sabendo que cada byte, cada conexão e cada percepção são protegidos, controlados e ativados com integridade.
## Sobre os autores
**Krishna Chalamasandra** é uma especialista em cibersegurança experiente com mais de 25 anos de experiência em tecnologia de segurança da informação e conformidade. Na Salesforce, ele atua como um consultor confiável para os clientes e um líder chave na função Security and Compliance Customer Trust dentro da organização CISO. Antes, Krishna passou 10 anos na Cisco, liderando a arquitetura de segurança em IAM, segurança de rede e PKI e conduzindo as principais certificações, incluindo ISO 27001, SOC 1–3, PCI, FedRAMP e FIPS 140-2\. Ele também passou mais de 8 anos na Novell implementando controles em nível de infraestrutura e oferecendo suporte a revisões de segurança complexas para clientes globais e regulamentados.
**Yugandhar Bora** é um arquiteto de engenharia de software na Salesforce, especializado em arquitetura de dados na plataforma de aplicativos de dados e inteligência. Ele lidera iniciativas do Conselho de revisão de arquitetura corporativa (EARB) focadas na governança de dados e modelos de dados unificados, ao mesmo tempo que contribui para soluções de provisionamento de plataforma automatizadas.
# Contexto
As plataformas de dados estão evoluindo há mais de três décadas. Inicialmente, o setor era dominado por bancos de dados operacionais/OLTP locais, centralizados e estruturados (principalmente relacionais). Isso se expandiu para incluir plataformas OLAP/Big Data de armazéns de dados que eram usadas principalmente para processamento analítico e permaneciam relacionais e centralizadas. O armazenamento em nuvem impulsionava arquiteturas distribuídas, como armazéns de dados, lagos e armazenamento desagregado. No entanto, plataformas de operações e plataformas analíticas permaneceram separadas. Hoje, a computação em nuvem e a revolução da IA estão mudando fundamentalmente a arquitetura da plataforma de dados.
As empresas já investem em plataformas de Big Data maduras, como Snowflake, Databricks, BigQuery e Redshift. Porém, essas plataformas servem como silos de dados. Os clientes não estão derivando valor comercial de seus dados porque os dados não podem ser usados diretamente dentro dos fluxos de negócios e aplicativos. Essas soluções não têm processamento de IA agente generativa e não podem fornecer acesso a dados em tempo real, portanto, não podem fornecer personalização conduzida por IA no momento do engajamento do cliente e outros recursos líderes do setor.
O futuro das plataformas de dados é caracterizado por uma infraestrutura de dados unificada, flexível, acessível e aberta. Essa nova arquitetura é criada com base em tendências de computação e armazenamento modernas (GPUs, memória grande, SSDs NVMe e armazenamento em nuvem) para integração com computação em nuvem e IA. Eles podem fornecer percepções em tempo real, aprimorar a tomada de decisão autônoma e promover solicitações em tempo real. Isso inclui o surgimento de IA agente, IA preditiva, análise, bancos de dados OLTP em alta escala em tempo real, data lakes e lakehouses. Essas plataformas de dados modernas são projetadas para simplicidade, escalabilidade, agilidade, desempenho, segurança, disponibilidade e economia.
## Principais tendências na arquitetura da plataforma de dados de próxima geração
As seguintes tendências de dados conduzem a arquitetura da plataforma de dados de próxima geração.
- **IA, aprendizado de máquina e análise no centro**: O surgimento da IA agente mudará fundamentalmente o desenvolvimento, a implantação e o uso/acesso da plataforma de dados. A IA agente entenderá a intenção de conversa/consulta, planejará, gerará fluxos de trabalho e automatizará a tomada de decisão. A memória agente (de curto e longo prazo) é criada com base no histórico de conversas para personalizar o planejamento e as decisões do agente, a modelagem de conversas em tempo real e o suporte de personalização são essenciais em plataformas de dados. Os agentes ajudarão na automação de “capacidades” operacionais, como governança de dados (ou seja, segurança, conformidade, Trust), desempenho (ou seja, escalação automática para simultaneidade, taxa de transferência e latência), failover e disponibilidade, e observabilidade e manutenção. Análise habilitada por IA, previsão, processamento de linguagem natural (NLP) para perguntas/resposta de análise e análise em dados não estruturados (texto como PDFs, imagens, áudio, vídeo) serão padrão, permitindo que as empresas derivem percepções mais profundas de diversas fontes de dados.
- **Descentralização dos dados, mas acesso unificado aos dados**: Os agentes precisam de dados corporativos para derivar percepções e tomar decisões e automatizar atividades de negócios. Os dados são inerentemente descentralizados em empresas, em aplicativos e plataformas de dados diferentes. Porém, não é fácil unificar perfeitamente os silos entre diferentes unidades de negócios dentro da empresa e com parceiros fora dela. Unificar dados envolve compartilhamento de dados, seja por meio de ingestão de fontes ou federação com fontes de dados; dados brutos da preparação de dados, harmonização e modelagem para processamento analítico e de IA; armazenamento e gerenciamento de dados em escala para acesso eficiente com baixo CTS; e acesso a dados por meio de vários mecanismos e ferramentas de consulta e análise, profundamente integrados com as plataformas de armazenamento e acesso de dados subjacentes
- **Lacos abertos baseados em nuvem**: As plataformas de Big Data (OLAP) baseadas em nuvem estão se convergindo para adotar formatos de arquivo abertos (Parquet) e formatos de tabela (Iceberg) habilitando a federação de dados (entrada de dados) e o compartilhamento (saída de dados).
- **Processamento de dados não estruturados**: Com o surgimento, o avanço e a adoção da IA generativa, as empresas estão começando a derivar percepções valiosas e valor comercial do corpus corporativo de dados que constituem grandes volumes de documentos de texto, transcrições de áudio, gravações de vídeo e outras mídias. Processamento de dados não estruturados, incluindo agrupamento, vetorização, pesquisa semântica e gráficos do Knowledge, tornam essas percepções possíveis. Técnicas como RAG (gerência aumentada de recuperação) e CAG (gerência aumentada de cache) estão se tornando os principais acionadores de pesquisa rápida e agente em todo o corpus de dados.
- ** Knowledge Management**: Knowledge vai além do conteúdo bruto em si (documentos, artigos, vídeos). Ele representa o aumento desse conteúdo derivando significado, selecionando metadados e colocando-os no contexto para desenvolver uma compreensão compartilhada do conteúdo em uma organização ou empresa. O Knowledge em si é geralmente estruturado. O Knowledge Management envolve gerenciamento de conteúdo, extração do Knowledge, representação por meio de modelos como gráficos e navegação.
- **Acesso a ricos dados**: O acesso a dados avançados significa que dados, análises e ferramentas de IA devem estar acessíveis a uma variedade de personalidades, incluindo usuários finais, usuários de negócios, administradores e analistas. A acessibilidade é alcançada por meio de mecanismos como consulta de conjunto (com consulta relacional, palavra-chave e consulta semântica), consulta de linguagem natural para SQL (NL2SQL), acesso em tempo real e assim por diante.
- **Processamento em tempo real**: Os aplicativos agentes tomam decisões em tempo real com base no estado atual e em novos eventos, respostas personalizadas e ações, que exigem acessar, processar e agir com base em dados em tempo real. O processamento em tempo real requer dados atualizados (latência de dados) e acesso interativo (latência de acesso). Esses dados e a latência de acesso exigem que a plataforma de dados subjacente dê suporte a acesso a dados atualizado de lojas operacionais e analíticas, acesso de baixa latência (pesquisas de pontos e consulta), processamento de alta escala de dados e alta taxa de transferência.
- **Segurança de dados, governança e residência**: A IA agente e conversacional simplifica a IU do aplicativo, permitindo que qualquer pessoa, de consumidores a funcionários a outros agentes de IA, interaja com aplicativos de modo conversacional usando linguagem natural falada ou escrita. Os dados valiosos do cliente e pessoais que devem ser armazenados e modelados para aplicativos do agente devem ser protegidos e controlados com políticas de acesso e compartilhamento bem definidas. Cada vez mais, muitos clientes devem cumprir regulamentos que exigem residência de dados em seu próprio país ou região, especialmente aqueles no governo ou trabalhando com governos.
O Salesforce Data 360 é arquitetado para o futuro para lidar com essas tendências de dados. O Data 360 é uma plataforma de dados orientada por metadados nativa da nuvem que unifica dados isolados em toda a empresa, permitindo que as organizações armazenem, modelem e processem seus dados para habilitar aplicativos de análise, IA, aprendizado de máquina e Agência.
Este documento é um guia essencial para arquitetos empresariais e CTOs. Ele detalha a arquitetura, os recursos, os princípios de design e os casos de uso do Data 360\. Ele apresenta os fundamentos da arquitetura do Data 360 como um primer, seguido por uma série de aprofundamentos em seus principais diferenciais, como interoperabilidade com plataformas de dados existentes, incluindo estratégia de várias organizações, segurança, governança e privacidade, ativação em tempo real e Data Clean Rooms.
## Princípios de design
O Salesforce Data 360 é projetado em torno de um conjunto essencial de princípios que tornam os dados corporativos operacionais, confiáveis e em tempo real.
- **Abrilidade e interoperabilidade**: Criado para ecossistemas de várias nuvens. Federa com plataformas de dados como Snowflake, Databricks, BigQuery e Redshift sem duplicação, estendendo o Customer 360 enquanto preserva os investimentos existentes.
- **Storage-Computer Separation**: Dimensiona o armazenamento e o processamento (lote, streaming e interativo) de modo independente. Proporciona elasticidade e eficiência para cargas de trabalho de alto volume e alto desempenho.
- **Armazenamento e processamento de vários modelos**: Dá suporte a tipos de dados estruturados e diversos tipos de dados não estruturados, como texto, áudio de imagem e vídeo. Fornece armazenamento eficiente, processamento em tempo real e em lote, indexação extensível, pesquisa unificada, consulta e análise.
- **Design conduzido por metadados**: Os aplicativos são definidos por metadados em vez de código. Os metadados são tratados como um ativo de primeira classe, permitindo a governança unificada, a flexibilidade e a integração profunda na Salesforce Platform.
- **Processamento híbrido em tempo real**: Dá suporte a consultas de baixa latência e tomada de decisão instantânea, junto com processamento em lote e cargas de trabalho analíticas.
- **Dados inteligentes e ativos**: Ingere, analisa e envia percepções continuamente diretamente para fluxos de trabalho de negócios. Aprimora a automação sem código, com baixa codificação, de código profissional e conduzida por IA com o contexto mais atual.
- **Governança e privacidade por design**: Linha, controle de acesso, residência, criptografia de dados e conformidade são integrados. Trust e confiança regulatória são reforçadas em cada camada.
- **Um para muitos locatários**: Uma organização centralizada do Data 360 serve como a única Fonte da verdade para Customer 360, oferecendo suporte integrado a ambientes do Salesforce de várias organizações amplamente usados pelos clientes do Salesforce.
Esses princípios garantem que o Data 360 torne os dados abertos, inteligentes e acionáveis em tempo real.
### De princípios a recursos
O Salesforce Data 360 é uma moderna plataforma de dados criada com base em princípios de design que lidam com as tendências de dados atuais. Seus recursos de arquitetura garantem que os dados corporativos sejam confiáveis, unificados e acionáveis em tempo real, de acordo com seus princípios diretos.
- **Cloud-Native Foundation**: Executa no Hyperforce, implementado em Hypercalers (como AWS), com infraestrutura baseada em microsserviços imutável. Oferece escala elástica, segurança zero Trust, entrega contínua e conformidade global.
- **Salesforce (núcleo) baseado em metadados**: Os metadados são projetados, modelados e armazenados como metadados do Salesforce, permitindo o uso imediato por TODOS os aplicativos Salesforce. Esses metadados são armazenados em um RDBMS totalmente compatível com ACID. Garante governança, consistência do ciclo de vida e integração profunda com a Salesforce Lightning Platform.
- **Lakehouse Storage**: Criado com base no Apache Iceberg e Parquet, combinando a escala do data lake com a governança de armazém com suporte para evolução de esquema, viagem de tempo e atualizações de alto volume. O Data 360 armazena, modeliza e processa dados estruturados e não estruturados com armazenamento em escala extrema com padrões abertos modernos e com recursos avançados de transformação e processamento de dados para cargas de trabalho conduzidas por evento e lote.
- **Pipeline de dados completo com ingestão flexível**: Cobre todo o ciclo de vida (ingerir, preparar, modelar, unificar, analisar e ativar), reduzindo a dependência de soluções de ponto fragmentadas. Suporta lote, quase em tempo real e streaming com mais de 270 conectores e MuleSoft. A abordagem ELT First permite a disponibilidade rápida de dados com flexibilidade de transformação a jusante.
- **Interoperabilidade de dados corporativos com estruturas abertas e Federação**: Unifica dados de silo em toda a empresa com federação bidirecional do Zero Copy com Snowflake, Databricks, BigQuery e Redshift evitando migração ou duplicação de dados.
- **Classificação, modelagem e organização de dados**: O Data 360 organiza dados como dados brutos ingeridos, dados limpos e armazenados e dados modelados de acordo com o esquema de informações comuns conhecido como SSOT (Fonte única da verdade). Esses objetos SSOT formam a base para definir Modelos de dados semânticos (SDM) e outros modelos selecionados e específicos do aplicativo.
- **Modelação de dados semânticos integrada** para análise extensível com APIs de consulta semântica aberta, acionando o Tableau Next e habilitando a análise específica do aplicativo.
- **Motor de consulta SQL de alto desempenho** que suporta uma consulta unificada do Data 360 SQL em dados estruturados, não estruturados e de gráfico.
- **Armazéns de dados de baixa latência**: Armazenamento de valor-chave para dados quentes com tempos de resposta de milissegundos. Ativa a personalização e cenários conduzidos por evento em tempo real. Coleta e processa dados de engajamento do cliente em tempo real. Unifica identidades, interações e conversas em um único gráfico de perfil e contexto do Customer 360 confiável.
- **Pipelines de processamento de dados não estruturados** para suporte flexível e extensível para armazenamento de dados não estruturados, particionamento, geração de integração (vectorização), extração de metadados (aumento), resumo, indexação, extração de Knowledge, processamento inteligente de documentos, criação de memória de curto e longo prazo (conversa) e assim por diante.
- **Palavra-chave nativa, vetor e indexação híbrida** para acesso a dados não estruturados preciso e eficiente, como pesquisa rápida e agente, RAG, extração de Knowledge, derivação de memória agente, etc.
- **Serviços de perfil, personalização, contexto** para habilitar aplicativos de IA/ML e agência.
- **Governança integrada e segurança** em cada camada para rastreamento de linha, mascaramento de dados, residência de dados e segurança de zero Trust garantindo conformidade e Trust.
- **Tela Elástica Computar**: Tecido computacional nativo de Kubernetes com vários locatários. Executa o Spark para processamento distribuído e cargas de trabalho do Hyper para SQL. Escala elasticamente em diversos trabalhos e dá suporte ao isolamento para executar código não confiável.
Tudo isso é executado no Hyperforce, a base de nuvem do Salesforce. O Hyperforce fornece:
- **Security Trust Zero** com criptografia, isolamento e políticas de privilégio mínimo.
- **Resiliência** por meio de implantações de várias regiões. Embora o Salesforce Data 360 beneficie da resiliência multi-região do Hyperforce e da tolerância a falhas no nível da plataforma, a verdadeira recuperação de desastres de nível empresarial (DR) exige uma arquitetura mais ampla semelhante a qualquer plataforma de dados com as principais funcionalidades: pipelines de ingestão repetíveis, replicação e reidratação conduzida por metadados em todos os ecossistemas dependentes.
- **Observabilidade** com monitoramento, métricas e rastreamento integrados.
- **Escala automatizada e consciência de FinOps** para eficiência sem sobrecarga de custos.
O Data 360 não substitui investimentos empresariais existentes. Em vez disso, o Data 360 torna os dados já confiáveis, controlados e acionáveis, proporcionando engajamento conduzido por IA em tempo real onde mais importa. Em suma, o Salesforce transforma todos os dados corporativos, incluindo dados externos, como objetos conduzidos por metadados (Salesforce) e habilita aplicativos Agentes para descoberta, tomada de decisão e tomada de ações.
A figura a seguir ilustra a Arquitetura de referência do Data 360:
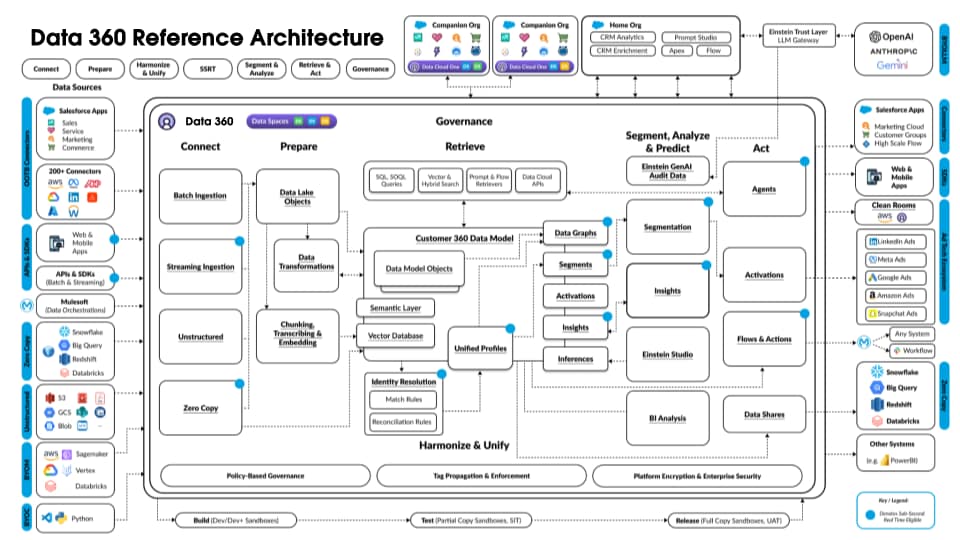 Vamos considerar um Agentforce Loan Agent hipotético estratificado no Data 360 para descrever um exemplo de fluxo de arquitetura. Digamos que o Agente de empréstimo seja um agente voltado para o cliente em que os clientes (consumidores) solicitam empréstimos e recebem aprovações de empréstimo instantâneas.
O Data 360 realiza essas etapas conforme agendado, preparando dados para uso pelo agente de empréstimo.
- O Data 360 ingere dados de Conta do cliente estruturados do CRM e os armazena no data lake.
- O Data 360 processa dados de política financeira e empréstimo da empresa não estruturados.
- O Data 360 federa dados pessoais de uma origem de dados externa, como o Snowflake.
- O Data 360 transforma e modeliza dados ingeridos e federados.
- O Data 360 cria e mantém o gráfico de dados do perfil.
Sempre que um cliente solicita um empréstimo, estas ações são realizadas.
- Um cliente faz login no Agente de empréstimo, que inicia uma sessão do cliente na camada em tempo real. O perfil unificado do cliente é capturado para a camada em tempo real.
- O cliente conclui uma solicitação de empréstimo fornecendo as informações necessárias.
- O cliente carrega documentos financeiros (como devoluções de impostos, investimentos, extratos bancários) para o Data 360 para processamento de dados não estruturado.
- Os dados carregados são divididos em blocos e vetorizados (geração de integração) e os índices (palavra-chave e vetor) são criados.
- Em seguida, o cliente preenche o documento de solicitação de empréstimo e o carrega. O Data 360 extrai o valor e a duração do empréstimo em tempo real.
- O Agente de empréstimo recupera dados financeiros relevantes usando a consulta do Data 360 e a pesquisa híbrida em perfis e outros índices pré-criados.
- O agente de empréstimo ativa um agente de aprovação com dados de empréstimo e outros dados de perfil financeiro para tomar a decisão de aprovação do empréstimo.
- O agente de empréstimo responde ao cliente com uma decisão.
- Toda essa interação entre o cliente e o Agente de empréstimo também é capturada e armazenada no Data 360.
O exemplo acima apresenta uma visão geral dos componentes da arquitetura do Data 360 usados para criar um aplicativo Agente como um Agente de empréstimo. Na próxima seção, descrevemos as camadas e os componentes da arquitetura do Data 360.
## Arquitetura do Data 360
Nesta seção, aprofundaremos-nos nos blocos de construção fundamentais do Salesforce Data 360, começando com seu modelo de armazenamento robusto e depois explorando os mecanismos para conexão, ingestão e preparação de dados. Vamos então examinar como dados estruturados e não estruturados são armazenados, modelados e processados, culminando em uma compreensão de suas capacidades de harmonização, unificação, recuperação e ativação inteligente.
### Armazenamento do Data 360
O Salesforce Data 360 é baseado em um modelo de armazenamento em níveis, mas integrado, que combina os pontos fortes de um lakehouse com armazenamento em tempo real. A camada do lakehouse fornece armazenamento dimensionável e econômico para grandes volumes de dados históricos e em lote, habilitando análises avançadas e casos de uso de aprendizado de máquina. O armazenamento em tempo real, por outro lado, é otimizado para acesso de baixa latência e atualizações de alta frequência, garantindo que as interações, os perfis e os sinais de engajamento do cliente estejam sempre atualizados. Juntos, esses níveis funcionam perfeitamente, permitindo que os dados se movam fluidamente entre contextos históricos e em tempo real, proporcionando profundidade e imediato em uma base de dados unificada para personalização, IA e ativação.
#### Lakehouse
O Data 360 apresenta uma arquitetura nativa do lakehouse baseada em Iceberg/Parquet, projetada para lidar com o gerenciamento e o processamento de dados em grande escala para cenários em lote, streaming e em tempo real que dão suporte a dados estruturados e não estruturados, cruciais para aplicativos de IA e análise.
Em data lakes baseados em nuvem, como Azure, AWS ou GCP, a unidade de armazenamento fundamental é um arquivo, normalmente organizado em pastas e hierarquias. O Lakehouse aprimora essa estrutura introduzindo abstrações estruturais e semânticas de nível superior para facilitar operações como consulta e processamento de IA/ML. A abstração primária é uma tabela com metadados que define sua estrutura e semântica, incorporando elementos de projetos de código aberto, como Iceberg ou Delta Lake, com camadas semânticas adicionais adicionadas pelo Data 360.
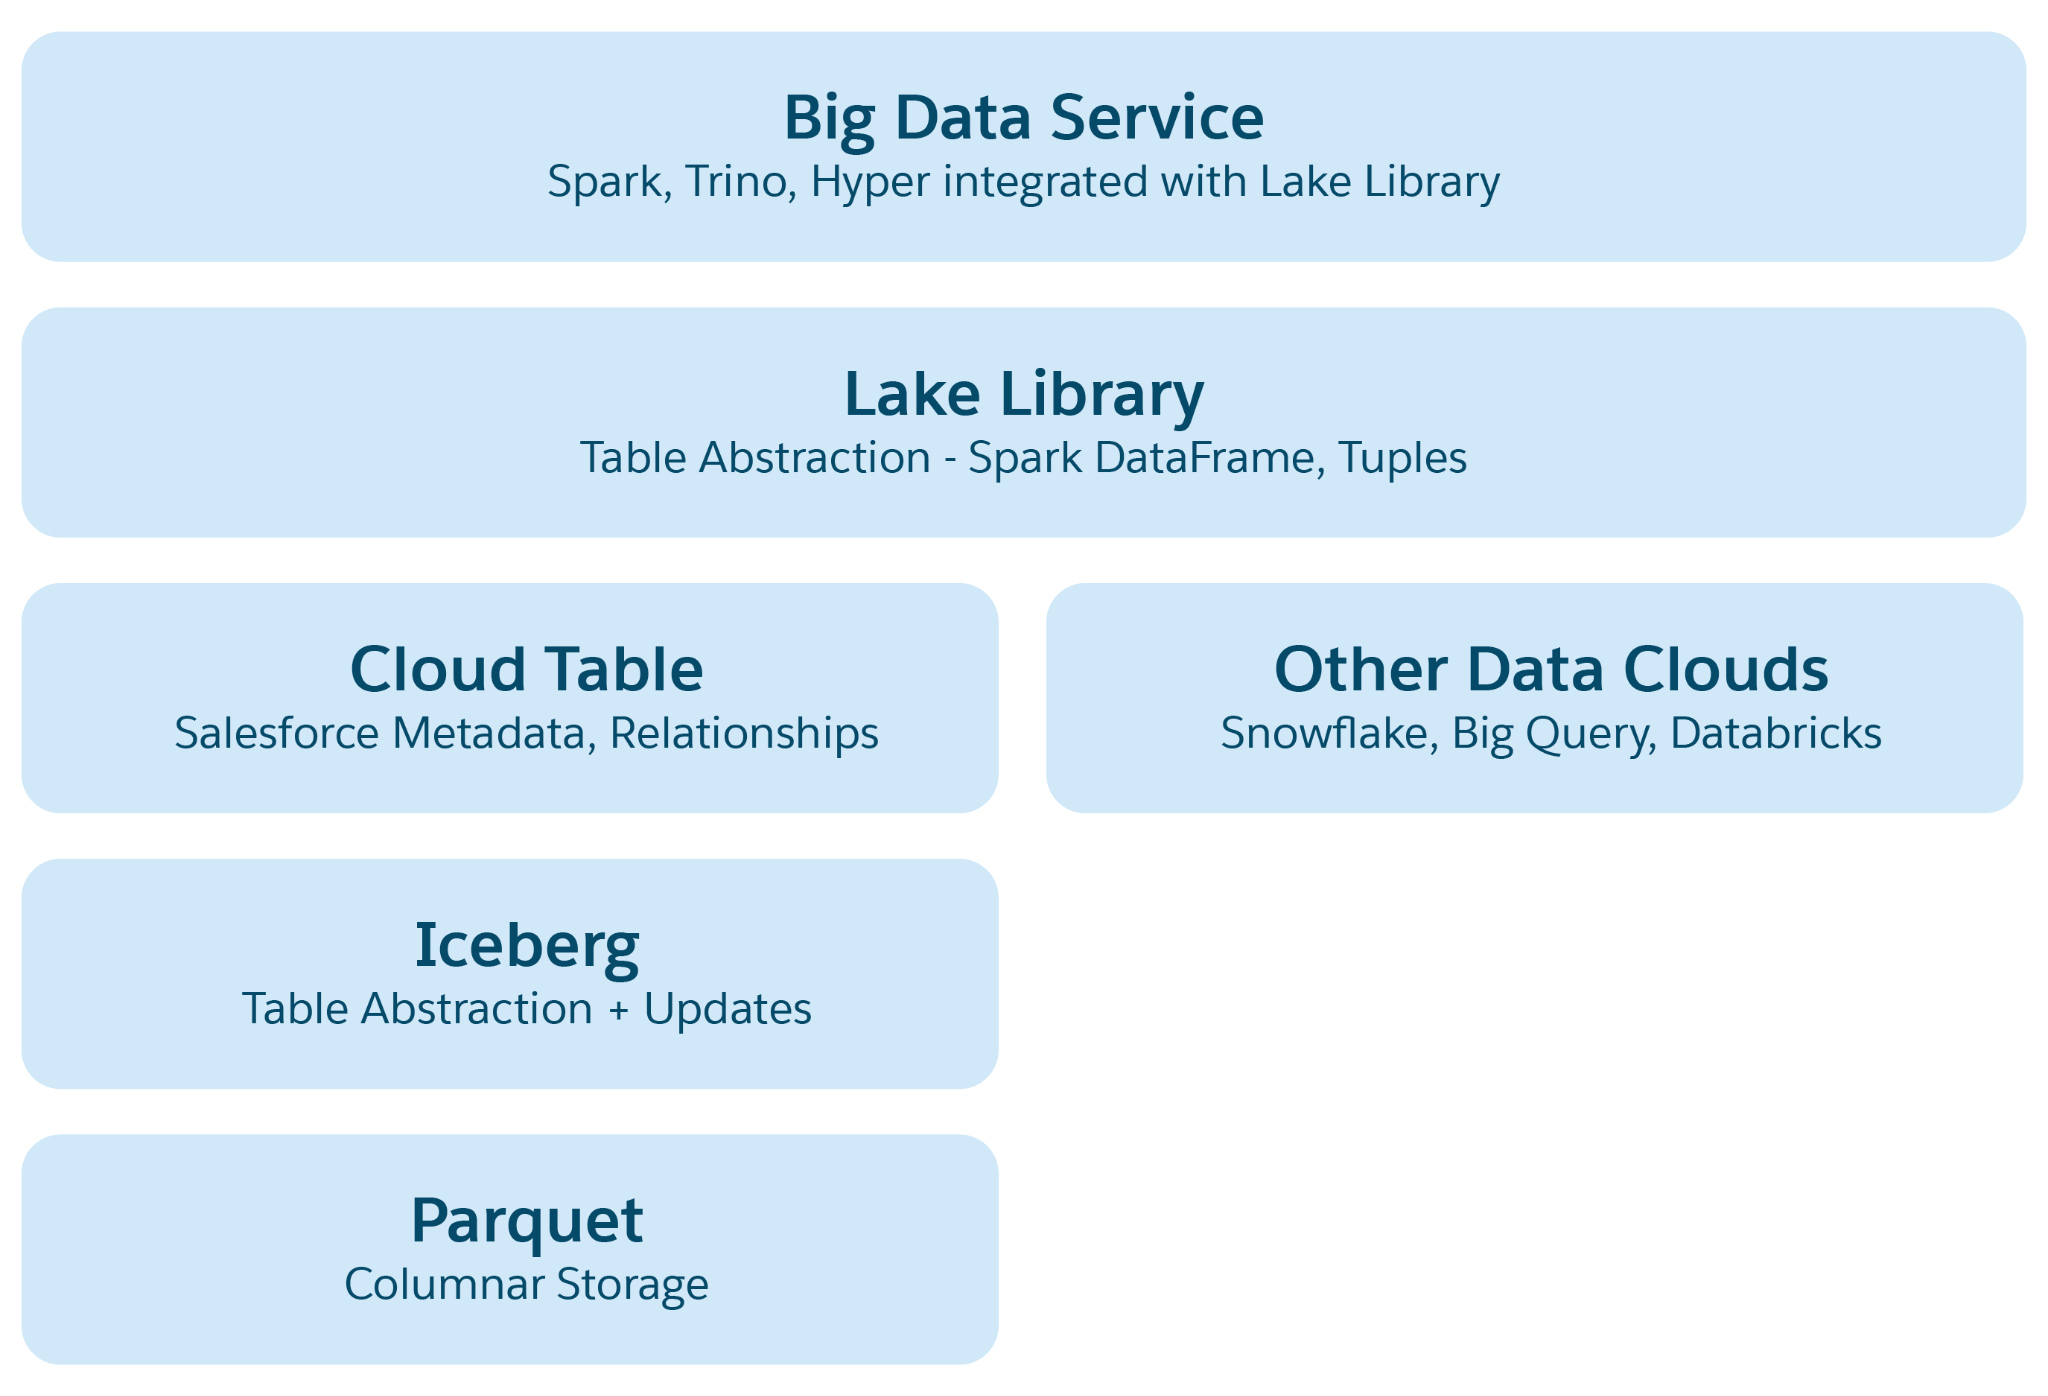 Camadas de abstração no Lakehouse:
1. **Abstração de arquivo Parquet**: Na base, o armazenamento consiste em arquivos de data lake (por exemplo, S3 na AWS ou Blob no Azure) no formato Parquet. Os dados de uma tabela de origem são armazenados entre várias partições como arquivos Parquet, sendo que cada tabela é uma coleção desses arquivos.
2. **Abstração de tabela de gelo**: As tabelas são organizadas como pastas, com partições de dados armazenadas como arquivos Parquet nessas pastas. As modificações em uma partição resultam em novos arquivos Parquet como instantâneos. O IceBerg gerencia um arquivo de metadados para cada tabela, detalhando esquemas, especificações de partição e instantâneos.
3. **Abstração de tabela do Salesforce Cloud**: Com base no iceberg, essa camada adiciona metadados semânticos, como nomes de coluna e relacionamentos, junto com configurações como tamanho de arquivo de destino e compactação. Ele abstrai tabelas em várias plataformas, como o Snowflake e o Databricks, protegendo aplicativos do Data 360 dos detalhes subjacentes da plataforma de armazenamento.
4. **Lake Access Library**: Essa biblioteca fornece acesso à Tabela do Salesforce Cloud, que lida com dados e metadados e abstrai os mecanismos de armazenamento subjacentes para desenvolvedores de aplicativos.
5. **Abstração de serviço de big data**: Isso inclui estruturas de processamento como Hyper para consulta e Spark para processamento em qualquer plataforma de tabela de nuvem.
#### Armazenamento em tempo real
Para oferecer suporte a análises em tempo real e aplicativos agentes, o Data 360 aumenta o armazenamento de big data do Lakehouse com a Loja de baixa latência. A Camada em tempo real do Data 360 processa sinais em tempo real e dados de engajamento na memória. No entanto, como a capacidade de armazenamento baseado em memória é limitada, todos os dados não podem caber e o processamento pode não ser feito em tempo real. O Data 360 adiciona um armazenamento de baixa latência (LLS) para remover essas limitações, habilitando o processamento escalonável em tempo real.
O repositório de baixa latência é uma camada de armazenamento NVMe (SSD) em escala de petabytes no Lakehouse. Nem todos os dados precisam ser mantidos no repositório de baixa latência. É um cache durável. A maioria dos dados acaba chegando ao Lakehouse para persistência de longo prazo. Os dados na sessão na camada de tempo real podem ser transferidos para o armazenamento de baixa latência para acesso rápido subsequente. Por exemplo, em uma conversa agente, as mensagens recentes podem ser processadas na memória; mensagens mais antigas podem ser enviadas para o repositório de baixa latência. Se uma conversa anterior for necessária, ela poderá ser acessada em poucos milissegundos do repositório de baixa latência. O armazenamento baseado em NVMe permite que grandes quantidades de dados sejam armazenadas e acessadas em latências de milissegundos. Os dados podem entrar no armazenamento do Lakehouse Cloud para a manutenção de longo prazo. Além disso, os dados do Lakehouse necessários para processamento em tempo real ou para aumentar experiências em tempo real são buscados e mantidos no repositório de baixa latência. Por exemplo, o Contexto do perfil do cliente é pré-coletado ou trazido do Lakehouse e armazenado em cache na loja de baixa latência. Além disso, todos os objetos do Lakehouse e outros objetos necessários para processamento em tempo real durante o processamento na sessão também podem ser armazenados em cache no repositório de baixa latência.
O armazenamento de baixa latência do Data 360 habilita a camada de Tempo real em uma hierarquia de armazenamento verdadeira com camadas de armazenamento do Lakehouse de memória (SSD), com dados migrando perfeitamente entre essas camadas. Vamos discutir a camada do Data 360 em tempo real mais adiante neste documento.
### Organização de dados
O Salesforce Data 360 é projetado para padronizar, harmonizar e ativar todos os dados do cliente, estruturados e não estruturados, seguindo um ciclo de vida rigoroso que transforma a entrada bruta em um modelo de dados unificado e atual.
#### Ciclo de vida de dados e tipos de objeto
O ciclo de vida se concentra em obter várias entradas de dados externos e estruturá-las em objetos persistentes modelados. Os dados modelados podem ser harmonizados em perfis unificados do Customer 360.
**Dados brutos ingeridos e transformações iniciais**
O processo começa com dados brutos ingeridos como estão de sistemas de origem (CRM, Marketing, arquivos etc.). Isso inclui carregamentos de dados completos e eventos de alteração contínua (deltas), que são gerenciados e mesclados com dados persistentes para manter um estado atual.
As **transformações inline** (por exemplo, recorte, normalização, concatenação) são aplicadas imediatamente durante a ingestão para garantir a qualidade preliminar dos dados e a limpeza.
##### Objetos do Data Lake (DLOs): A camada persistente
Os **DLOs** (Objetos do Data Lake) formam a camada de armazenamento persistente central no Data 360.Eles armazenam os dados limpos e transformados e servem como o repositório organizado e de longo prazo para todas as informações do cliente.
As **transformações de dados avançadas** (por exemplo, junções, agregações, insights calculados) são aplicadas aos DLOs de origem para produzir novos DLOs derivados altamente selecionados.
Os dados disponibilizados por meio da Federação de dados de cópia zero são representados diretamente como DLOs.
**Organização de metadados e dados não estruturados**
Para conteúdo não estruturado (como texto, mídia, documentos), o Data 360 incorpora os dados extraindo e mantendo seus metadados estruturados dentro de DLOs específicos chamados de objetos de data lake não estruturados (UDLOs).
Esses DLOs especializados funcionam como tabelas de diretório, fornecendo um mapa para a localização física e o contexto dos ativos não estruturados. Essa funcionalidade permite aos arquitetos relacionar perfeitamente os metadados de dados não estruturados com o restante dos dados do cliente estruturado, permitindo consulta unificada e harmonização.
##### Objetos de modelo de dados (DMOs): A camada harmonizada
Os **DMOs** (Objetos de modelo de dados) representam a camada de dados final, harmonizada e estruturada.
Eles são criados mapeando campos de DLO (de DLOs de metadados de origem, derivados e não estruturados) para o Modelo de dados Customer 360 padrão.
A camada de DMO atua como a única fonte da verdade para todos os dados do cliente, habilitando a criação, segmentação e ativação de perfil unificados em todo o ecossistema.
#### Espaço de dados: O contêiner lógico
Um espaço de dados é o contêiner lógico fundamental para organizar todos os dados e metadados no Data 360, incluindo todos os DLOs (estruturados e não estruturados) e DMOs. Os espaços de dados oferecem um ambiente seguro e isolado para processamento e modelagem de dados.
Os espaços de dados atuam como limites lógicos e de governança, habilitando multitarefa interna separando dados para entidades distintas, como unidades de negócios, regiões ou marcas, enquanto mantêm a visibilidade, a linhagem e a conformidade em toda a empresa, servindo como a base para definir o controle de acesso granular.
O isolamento dentro de espaços de dados é imposto em várias camadas da plataforma:
- **Isolamento em nível de dados**: Cada DLO/DMO pertence a um único espaço de dados, garantindo que consultas, transformações e mapeamentos de objeto não possam cruzar limites de espaço de dados, a menos que autorizados explicitamente.
- **Integração de controle de acesso**: Os conjuntos de permissões são vinculados nativamente a espaços de dados, permitindo o controle de operações administrativas, de leitura e gravação. Isso garante que apenas usuários e serviços autorizados possam acessar objetos, percepções e ativações em um espaço de dados.
- **Governance and audit**: Todas as operações em um espaço de dados são registradas com trilhas de auditoria de nível corporativo, habilitando a rastreabilidade para conformidade, orientação e relatórios regulatórios.
O acesso e as permissões são gerenciados por meio de Conjuntos de permissões, garantindo visibilidade granular, atualizações controladas e prevenção de vazamento de dados entre domínios. Ao integrar limites de espaço de dados à arquitetura de segurança e governança do Data 360, os arquitetos podem implementar com confiança estratégias de governança centralizada e descentralizada enquanto mantêm a consistência em várias nuvens e domínios de negócios.
#### Computar tecido
O tecido de computação do Data 360 fornece uma camada unificada para gerenciar e executar todas as cargas de trabalho de big data, simplificando as complexidades de infraestrutura subjacentes. Seu componente principal é o controlador de processamento de dados (DPC).
O DPC é um serviço abrangente de orquestração de processamento de dados de várias cargas de trabalho que fornece funcionalidades de Trabalho como serviço (JaaS) em vários ambientes de computação em nuvem. Ele abstrai a complexidade da infraestrutura e unifica a execução de trabalhos para estruturas como Spark (EMR em EC2 e EMR em EKS) e cargas de trabalho do Controlador de recurso Kubernetes (KRC). Ao servir como um gateway de plano de controle centralizado, o DPC orquestra, agenda e monitora trabalhos em vários planos de dados, garantindo confiabilidade, escalabilidade, custo-benefício e uma experiência de desenvolvedor consistente.
A necessidade de DPC deriva das limitações de interagir diretamente com sistemas de gerenciamento de cluster nativos, como EMR.
##### Infraestrutura e abstração de nuvem
Embora o EMR ofereça APIs para clusters, tarefas e etapas, ele ainda carrega as equipes do cliente com tarefas críticas de gerenciamento de infraestrutura, como provisionamento, escalação, ajuste de desempenho e otimização de custo. A DPC lida com isso oferecendo uma API simplificada no nível da plataforma para envio de trabalhos. Ele oferece suporte a manuseio automático de falhas, novas tentativas e balanceamento de carga dinâmico. Fornece eficiência de custo por meio de nós com base em empacotamento, spot e graviton. Fornece segurança forte com TLS, PKI, isolamento IAM e correção automatizada. Gerencia upgrades de versão do tempo de execução do Spark e do EMR para proporcionar melhorias de desempenho, correções de segurança e aprimoramentos de recursos.
Além disso, o DPC fornece uma interface unificada agnóstica à nuvem para enviar e gerenciar trabalhos de dados, abstraindo as complexidades e as APIs proprietárias do substrato de nuvem subjacente (AWS, provedores futuros). Isso garante que as equipes do cliente interajam apenas com uma interface de envio de trabalho comum baseada na API do Data 360 que abstrai as complexidades dos gerentes de recursos subjacentes, como Kubernetes e YARN. Isso permite que as equipes do cliente enviem trabalhos do Spark por meio de uma API simples e unificada sem precisar gerenciar pods, grupos de nós ou configurações de cluster do Spark diretamente.
O ajuste manual dos parâmetros do Spark requer habilidades especializadas, e configurações incorretas podem levar à execução lenta do trabalho. A equipe de DPC centraliza esse conhecimento, fornecendo configurações otimizadas para evitar problemas comuns de desempenho. Essa equipe especializada integra continuamente o Knowledge da comunidade de código aberto para garantir um desempenho ideal em todas as cargas de trabalho gerenciadas pelo controlador.
O DPC não está limitado ao Spark; ele oferece suporte a uma ampla gama de cargas de trabalho. Essas incluem:
- Cargas de trabalho de processamento em tempo real
- Entrega de evento para recurso Ações de dados
- Gerenciamento do Milvus (o banco de dados vetorial para indexação de dados não estruturados)
- Infraestrutura de armazenamento de baixa latência
A DPC também utiliza a estrutura **Kubernetes Resource Controller (KRC)**, que dá suporte a cargas de trabalho como Trino para consulta, Entrega de evento para ações de dados, Trabalhos de extração de dados para conectores e processamento em tempo real. Para todas as cargas de trabalho do KRC, o DPC fornece funcionalidades centrais de Trabalho como um serviço, lidando com provisionamento de computação, implantação e gerenciamento em uma abstração de trabalho de alto nível.
##### Benefícios e arquitetura de JaaS
O modelo de Trabalho como um serviço, fornecido pela DPC, garante um pipeline de processamento de trabalho rentável e resiliente.
Os usuários fornecem especificações de cluster simples, focando a CPU necessária, a memória, o armazenamento, as contagens de instância e as contagens mín/máx. de cluster e as marcas para correspondência de cluster. O DPC então gerencia automaticamente detalhes da infraestrutura abstrata, incluindo seleção de SKUs de VM ideais, gerenciamento de frotas de instância, determinação da proporção de nós Core vs. Tarefa e gerenciamento de instâncias On-Demand vs. Spot com base em entradas. Também lida com o gerenciamento de versão de componente e EMR e upgrades sem tempo de inatividade.
Crucialmente, o DPC oferece suporte inerente à multitarefa, projetada para entender e impor limites de locação do Data 360 e separação de recursos. Ele também garante segurança e conformidade aplicando imagens de máquina certificadas pelo Salesforce, gerenciando papéis IAM específicos do serviço e garantindo a criptografia em trânsito e em repouso. Para roteamento e controle de capacidade, a correspondência de trabalho para grupo é gerenciada usando marcas de cluster, e o roteamento baseado em capacidade usa uma configuração de simultaneidade de trabalho máxima para controlar de modo eficaz a utilização de recursos.
A experiência de cliente agnóstica na nuvem é um benefício essencial, pois a complexidade dos ambientes de nuvem subjacentes fica oculta dos serviços ao cliente, permitindo que eles se concentrem exclusivamente na lógica de negócios. Isso atinge a meta da Abstração do provedor de nuvem. Por fim, o DPC habilita o fácil Rastreamento de uso e custo, permitindo que a utilização do cluster e os custos sejam segmentados por serviço para uma contabilidade precisa. Em geral, o DPC segue uma arquitetura plugável que permite que novos mecanismos de execução (por exemplo, Flink, Ray) e substratos de nuvem (GKE/Dataproc) sejam integrados perfeitamente sem expor detalhes de infraestrutura subjacentes aos usuários. Esse design desconecta o plano de controle da camada de execução, garantindo uma experiência operacional e de API consistente independentemente do back-end.
### Processamento de dados no Data 360: de bruto para acionável
O Data 360 refina e aprimora dados brutos, preenchendo a lacuna entre informações brutas e consumo comercial acionável. Ele complementa o ciclo de vida do objeto de dados preparando dados complexos para ativação e análise sofisticadas. O Data 360 oferece suporte a vários tipos de processamento, incluindo Transformações de dados de streaming e lote, Insights calculados de streaming e lote, Processamento de dados não estruturado e Resolução de identidade. Para habilitar essas diversas operações de modo eficiente, especialmente em tempo quase real e em conjuntos de dados massivos, é necessário um mecanismo sofisticado para lidar com alterações de dados de modo eficaz.
#### Aprimoramento do processamento incremental
Para obter um processamento de dados eficiente quase em tempo real, especialmente com tabelas de terabytes e milhões de atualizações em potencial, o Data 360 precisava de um avanço. Ele exigiu uma maneira de notificar os sistemas precisamente quando os dados mudaram e, em seguida, identificar de modo eficiente quais dados foram alterados para que somente atualizações relevantes sejam processadas e somente quando forem atualizadas. Esse desafio levou a duas inovações complementares: Armazene eventos de alteração nativos (SNCE) para notificar quando algo é alterado e Alterar feed de dados (CDF) para identificar o que mudou.
##### Eventos de alteração nativa de armazenamento (SNCE)
A SNCE transformou fundamentalmente o Data 360 em uma plataforma de dados reativa e incremental. Essa mudança envolve a transição da pesquisa ativa no data lake para o monitoramento passivo para compromissos atômicos, usando um formato de evento padronizado e um sistema de entrega de mensagens de alta taxa.
Cada operação de gravação bem-sucedida (INSERT, UPDATE, DELETE) em uma tabela de iceberg culmina em uma troca atômica do ponteiro do arquivo de metadados atual da tabela no catálogo. A camada de armazenamento de objeto subjacente (por exemplo, S3) é configurada para emitir um evento de notificação nativo (como um evento do S3) sempre que um novo instantâneo de metadados é gravado no diretório da tabela.
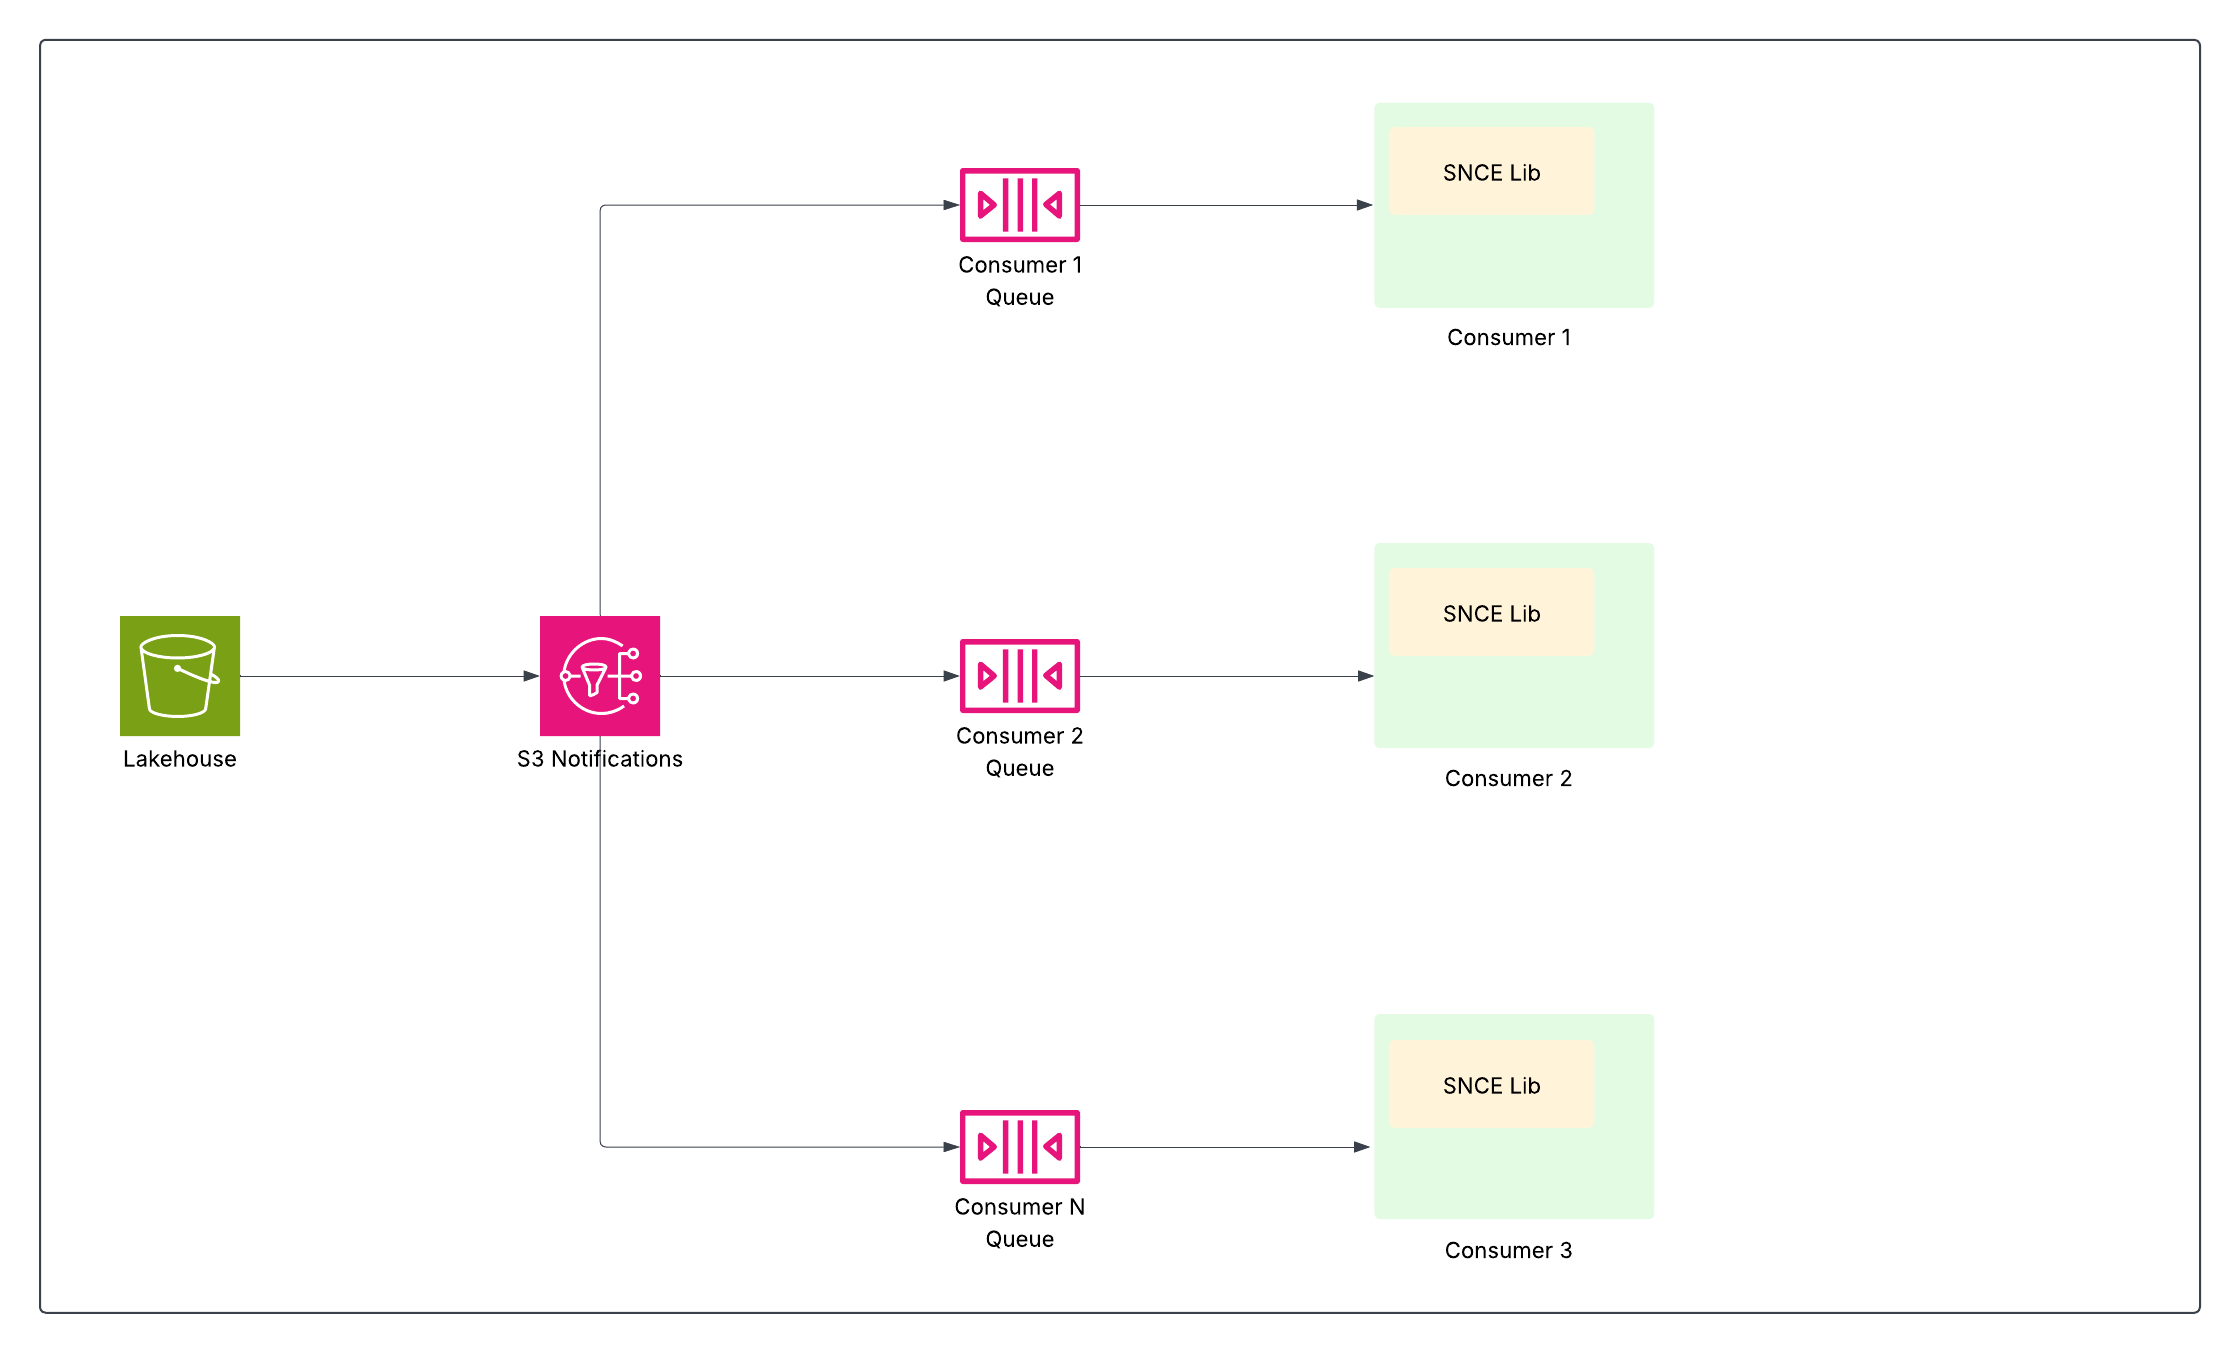 A biblioteca SNCE oferece um método padronizado para consumir esses eventos e também pode aprimorá-los com metadados de instantâneo mediante solicitação.
Isso habilita os pipelines de dados a jusante, como transmissão de percepções calculadas, resolução de identidade e segmentação, a assinar e agir apenas quando os dados mudaram, aumentando significativamente a eficiência evitando verificações de tabela completa caras.
##### Alterar o feed de dados (CDF)
Com base na SNCE, o Feed de alteração de dados (CDF) fornece um mecanismo simplificado para consumir e processar incrementalmente as alterações.
A CDF aproveita instantâneos do IceBerg para gerar de modo eficiente o fluxo de alterações. Crítico, o redator iceberg otimizado do Data 360 calcula e mantém as alterações como parte da própria operação de gravação, tornando a geração de CDF altamente eficiente e minimizando a sobrecarga adicional. Isso permite que trabalhos de processamento (como transformações de streaming ou percepções calculadas de streaming) processem de modo seletivo apenas os registros alterados, evitando o caro cálculo diferencial de instantâneo.
Essa estratégia incremental oferece vários benefícios para conjuntos de dados grandes, incluindo poupança de custo, menor latência e maior eficiência. Ele habilita recursos como transformações de streaming e resolução de identidade incremental, que, por sua vez, levam a percepções mais rápidas, cargas do sistema mais previsíveis, desempenho aprimorado e menores despesas operacionais.
### Conectar, ingerir e preparar
O Data 360 oferece recursos de ingestão robustos com suporte nativo para produtos do Salesforce, garantindo um fluxo de dados contínuo. Para origens externas, ele fornece uma extensa conectividade por meio de mais de 270 conectores, APIs, SDKs e MuleSoft. Além disso, o Data 360 oferece federação de cópia zero, permitindo BI e análise sem duplicação de dados.
#### Estrutura do conector do Data 360
A estrutura do conector do Data 360 (DCF) é a base para a maior parte da conectividade do Data 360. Ele habilita a ingestão, a federação e a saída por uma arquitetura unificada. O DCF define os padrões para criar e gerenciar conectores, da IU para configuração e administração à persistência de metadados, extração de dados e entrega no Lakehouse ou por meio de consultas ativas em origens externas. Também oferece suporte a opções de conectividade privada (como links privados, VPNs e túneis seguros) para garantir a segurança e a conformidade de dados de nível corporativo ao se conectar a ambientes de clientes ou parceiros. Ao fornecer uma abordagem consistente em todos os conectores, o DCF permite que o Data 360 se conecte perfeitamente ao ecossistema mais amplo garantindo extensibilidade, confiabilidade e integração segura.
#### Conectores do Data 360
O Data 360 fornece conectividade robusta a um vasto ecossistema de fontes de dados, oferecendo suporte a produtos nativos do Salesforce e a vários sistemas externos. Essa extensa conectividade é crucial para unificar dados corporativos isolados e habilitar aplicativos de IA/ML e Agência.
O Data 360 oferece mais de 270 conectores nativamente ou por meio do MuleSoft, de APIs e de SDKs para dar suporte a seus recursos de pipeline de dados de ponta a ponta com ingestão em tempo real, streaming ou lote. Esses conectores podem ser amplamente categorizados pelo tipo de sistema de origem que eles integram.
**Conectores nativos do Salesforce**
Esses conectores garantem um fluxo de dados integrado e nativo de produtos do Salesforce.
Os exemplos incluem conectores para Salesforce CRM, Data Cloud One, Marketing Cloud Engagement, Account Engagement do Marketing Cloud e B2C Commerce.
**Aplicativos externos e SaaS**
Conectores para vários aplicativos comerciais e serviços de nuvem permitem a ingestão de dados de plataformas de software externas.
Exemplos incluem Adobe Marketo Engage, Microsoft Dynamics 365, Mailchimp e Airtable.
**Bases de dados e armazéns de dados**
O Data 360 se conecta a uma variedade de plataformas de armazenamento de dados relacionais e baseadas na nuvem.
Exemplos incluem Amazon Redshift, Amazon DynamoDB, Amazon RDS (MySQL, PostgreSQL, Oracle), Google BigQuery e Microsoft SQL Server.
**Armazenamento de objetos em nuvem e sistemas de arquivos**
Esses conectores se integram a soluções de armazenamento de hiperescala para dados estruturados e não estruturados.
Exemplos incluem Amazon S3, Google Cloud Storage (GCS) e Armazenamento de Blobs do Azure.
**Serviços de mensagens e streaming**
Conectores que lidam com fluxos de dados em tempo real contínuos são essenciais para cenários conduzidos por evento e processamento em tempo real.
Um exemplo é o Conector do Amazon Kinesis.
**Plataformas de integração**
O MuleSoft Anypoint Connector estende o alcance do Data 360 integrando-o a uma gama mais ampla de aplicativos e bancos de dados por meio do Anypoint Exchange.
**Conectores de armazenamento de objetos de nuvem e dados não estruturados**
Esses conectores são essenciais para ingerir e fazer referência a dados não estruturados (dados que não têm um modelo predefinido) para habilitar os recursos de IA generativa.
Todos esses conectores são criados na estrutura do conector do Data 360, proporcionando uma experiência consistente.
#### Transformações de dados
A transformação de dados é um componente arquitetônico fundamental no Data 360, projetado para limpar, enriquecer e moldar dados brutos ingeridos em ativos de dados normalizados e acionáveis alinhados ao modelo de dados Customer 360. Esse processo é essencial para harmonização de dados, melhoria da qualidade e garantia de que os dados estejam prontos para casos de uso a jusante, como unificação de perfil, segmentação e ativação. As transformações aproveitam tanto objetos de data lake de origem (DLOs) quanto objetos de modelo de dados (DMOs) como entrada, produzindo os resultados para novos DLOs ou DMOs, respectivamente.
O Data 360 fornece dois paradigmas de transformação principais para lidar com diferentes requisitos de velocidade de dados: transformações de dados em lote e transformações de dados de streaming.
##### Transformações de dados em lote
As Transformações de dados em lote são projetadas para processamento de alto volume com base em uma agenda definida ou acionador sob demanda. Esse mecanismo é otimizado para lidar com operações de reestruturação complexas e com uso intensivo de recursos.
O processo Transformação em lote é configurado usando uma tela de pipeline visual com pouco código que permite que os usuários definam a lógica de transformação de vários estágios. Esse mecanismo oferece suporte exclusivo a operações de reestruturação complexas vitais para o alinhamento do modelo de dados canônico: estruturação e normalização de dados. Isso inclui dinamizar (descontinuar registros não normalizados em vários registros normalizados) e nivelar (reestruturar dados hierárquicos, como JSON, em tabelas estruturadas). O modo de execução do sistema oferece suporte à sincronização completa (processando todos os registros) e a um modo de processamento incremental altamente eficiente. O modo incremental reduz significativamente o tempo de processamento e o consumo de recursos processando apenas os registros que mudaram desde a última execução bem-sucedida. As transformações em lote são ideais para tarefas em que atualizações em tempo real não são essenciais, como agregações periódicas e reestruturação de dados complexa.
##### Transformações de dados de streaming
Os dados de streaming processam dados de modo contínuo e incremental quase em tempo real à medida que fluem para o sistema, tornando-os essenciais para casos de uso de baixa latência.
A interface principal é uma abordagem SQL-first, em que as transformações são definidas como uma consulta SQL SELECT que é executada continuamente em relação ao fluxo de alterações de registro recebido. Esse mecanismo dá suporte a funções de transformação principais, incluindo limpeza de dados e Padronização (por exemplo, validação de PII e padronização de formatos de dados) e aprimoramento e mesclagem de dados (usando Junções e Unções). Crítico, ele oferece suporte a junções de pesquisa de streaming para habilitar o aprimoramento de dados em tempo real e pesquisas em relação a dados de referência estáticos ou que mudam lentamente, garantindo atualizações de perfil instantâneas. Para otimizar o custo para atender, a arquitetura usa um design de trabalho de alta densidade (HD), que empacota várias definições de transformação de streaming para um único locatário em um único trabalho de computação subjacente, maximizando a utilização de recursos. As transformações de streaming são essenciais para casos de uso, como monitoramento de evento, personalização imediata e atualizações de perfil em tempo real.
### Federação de dados de cópia zero e compartilhamento de dados
O Data 360 revoluciona o gerenciamento de dados com o suporte à federação e ao compartilhamento de dados de Cópia zero, o que elimina a necessidade de mover ou duplicar dados. Esse recurso permite que os usuários acessem dados de várias origens externas de modo contínuo e direto e compartilhem dados com ambientes externos, reduzindo significativamente a complexidade, reduzindo os custos de armazenamento e garantindo que todas as decisões sejam baseadas nas informações mais recentes e confiáveis.
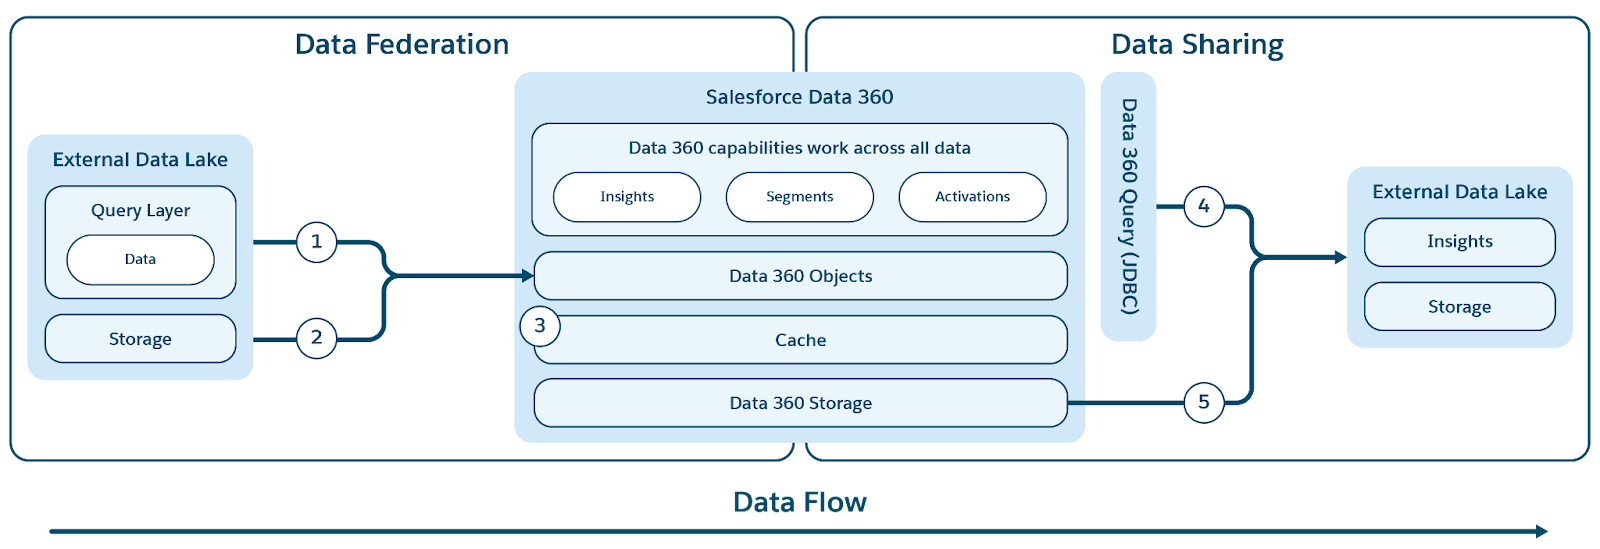 #### Federação de dados
O Data 360 oferece suporte à federação de cópia zero com armazéns de dados externos (Snowflake, Redshift), lagoas (Google BigQuery, Databricks, Azure Fabric), bancos de dados SQL e muitas outras fontes. Suas camadas de abstração permitem a consulta direta de dados externos sem duplicação, reduzindo o tempo de ingestão, os custos de armazenamento e garantindo informações atualizadas.
O Data 360 simplifica o acesso a dados externos e federados fornecendo uma camada de metadados unificada que abstrai tanto o Salesforce quanto objetos externos. Isso permite que toda a Salesforce Platform e seus aplicativos usem esses dados perfeitamente.
O Data 360 oferece suporte à federação baseada em arquivo e consulta, com a aceleração de acesso e consulta ativa, conforme mostrado na figura.
Os rótulos (1) e (2) ilustram a consulta do Data 360 (incluindo push-downs de consulta ativa) e a federação baseada em arquivo para acessar dados de data lakes / warehouses / origens de dados externas; e o rótulo (3) destaca a aceleração do acesso federado de data lakes / origens de dados externas.
##### Federação de consulta
O núcleo da funcionalidade de federação do Data 360 está na camada de federação de consulta, que gerencia o processo complexo de acessar dados externos e realizar push-ups de consulta inteligentes (ilustrado pelo rótulo 1). O Data 360 se conecta e recupera dados de origens usando o protocolo JDBC, aprimorado com lógica adicional para maior eficiência. A Camada de federação de consulta é responsável por entender e traduzir diferentes dialetos SQL, descobrir a parte mais ideal da consulta a ser enviada para sistemas externos para processamento eficiente, recuperar os resultados e realizar qualquer processamento adicional necessário para derivar percepções finais.
###### Armazenamento em cache (aceleração de consulta)
Para utilitários aprimorados, o Data 360 fornece um recurso de aceleração opcional para seus recursos federados.
Quando a Aceleração é ativada, o Data 360 armazena em cache os dados federados para obter acesso mais rápido e custos menores, pois evita acesso repetido e direto a origens externas. Esse cache é tratado como uma camada de aceleração e é atualizado incrementalmente para refletir rapidamente quaisquer alterações nos dados de origem externos, garantindo que a visualização acelerada permaneça quase em tempo real.
##### Federação de arquivos
O Data 360 oferece suporte à federação baseada em arquivo (ilustrada pelo rótulo 2) para acessar dados de data lakes e origens externas. A base técnica para esse recurso de cópia zero depende da padronização: os dados subjacentes devem estar no formato de arquivo Apache Parquet e usar o formato tabular Apache Iceberg. O Data 360 pode se federar em qualquer origem que expõe um Catálogo REST do Iceberg (IRC) para acesso a metadados e armazenamento, garantindo acesso contínuo e controlado a arquivos que residem fora da plataforma.
Com a federação baseada em arquivo, os computadores do Data 360 lidam com todo o processamento de dados porque acessam diretamente o armazenamento subjacente. Isso elimina a necessidade de consulta adicional e gerenciar vários dialetos SQL, que costumam ser necessários com federação baseada em consulta.
Além disso, a funcionalidade de Cópia zero também se estende a fontes de dados não estruturadas, como soluções de armazenamento em hiperescala (armazenamento S3/GCS/Azure), Slack e Google Drive, que podem ser acessadas pelos pipelines de processamento não estruturados do Data 360.
#### Compartilhamento de dados
O Data 360 facilita o compartilhamento baseado em consulta e baseado em arquivo de dados que ele gerencia com data lakes e armazéns externos (ilustrados pelos rótulos 4 e 5 no contexto da figura original).
##### Compartilhamento baseado em consulta
Para compartilhamento de dados baseado em consulta, o Data 360 expõe um driver JDBC usando o qual mecanismos e aplicativos externos podem obter acesso seguro aos dados. Esse mecanismo permite que sistemas externos conectem, autentiquem e executem consultas ativas diretamente com relação aos dados no Data 360.
##### Compartilhamento baseado em arquivos (compartilhamento de dados e DaaS)
O mecanismo principal para compartilhamento baseado em arquivo envolve dois conceitos: compartilhamento de dados e destino de compartilhamento de dados, que aproveitam a API DaaS (Dados como um serviço).
- Controle granular: O conceito de compartilhamento de dados permite que os clientes definam com precisão quais objetos (DLOs, DMOs, CIOs etc.) são compartilhados externamente, evitando a exposição inadvertida de dados.
- Direcionamento seguro: Ele também controla o destino do compartilhamento de dados, garantindo que os dados sejam disponibilizados apenas a ambientes externos, contas ou organizações parceiras explicitamente autorizadas (por exemplo, compartilhamento com uma instância específica do Redshift ou do Databricks).
A API DaaS fornece uma interface segura e gerenciada para mecanismos externos consumirem dados. Ele concede acesso aos metadados essenciais e ao armazenamento de tabela subjacente enquanto preserva toda a semântica do Data 360. Isso garante que os mecanismos externos acessem os dados em um contexto consistente e relevante de maneira segura.
### Conexão privada
Muitos clientes sensíveis à segurança, especialmente grandes empresas, setores regulamentados e organizações do setor público, restringem todo o acesso à Internet aos seus data lakes como parte de sua postura de segurança. Essa política, embora seja essencial para a conformidade e redução de riscos, também impede que o Salesforce Data 360 e Agentforce se conectem a esses ambientes por meio da Internet pública.
A maioria desses data lakes é implementada em ambientes de hiperescala, como AWS, Azure ou Google Cloud. Como o Data 360 em si é executado na AWS, acessar data lakes do cliente hospedados em um provedor de nuvem diferente requer uma conexão de rede entre nuvens. Sem uma opção de conectividade segura e privada que ignora a Internet pública, os clientes geralmente não conseguem ou não estão dispostos a adotar o Data 360 ou Agentforce para casos de uso que dependem desses data lakes.
#### Links privados
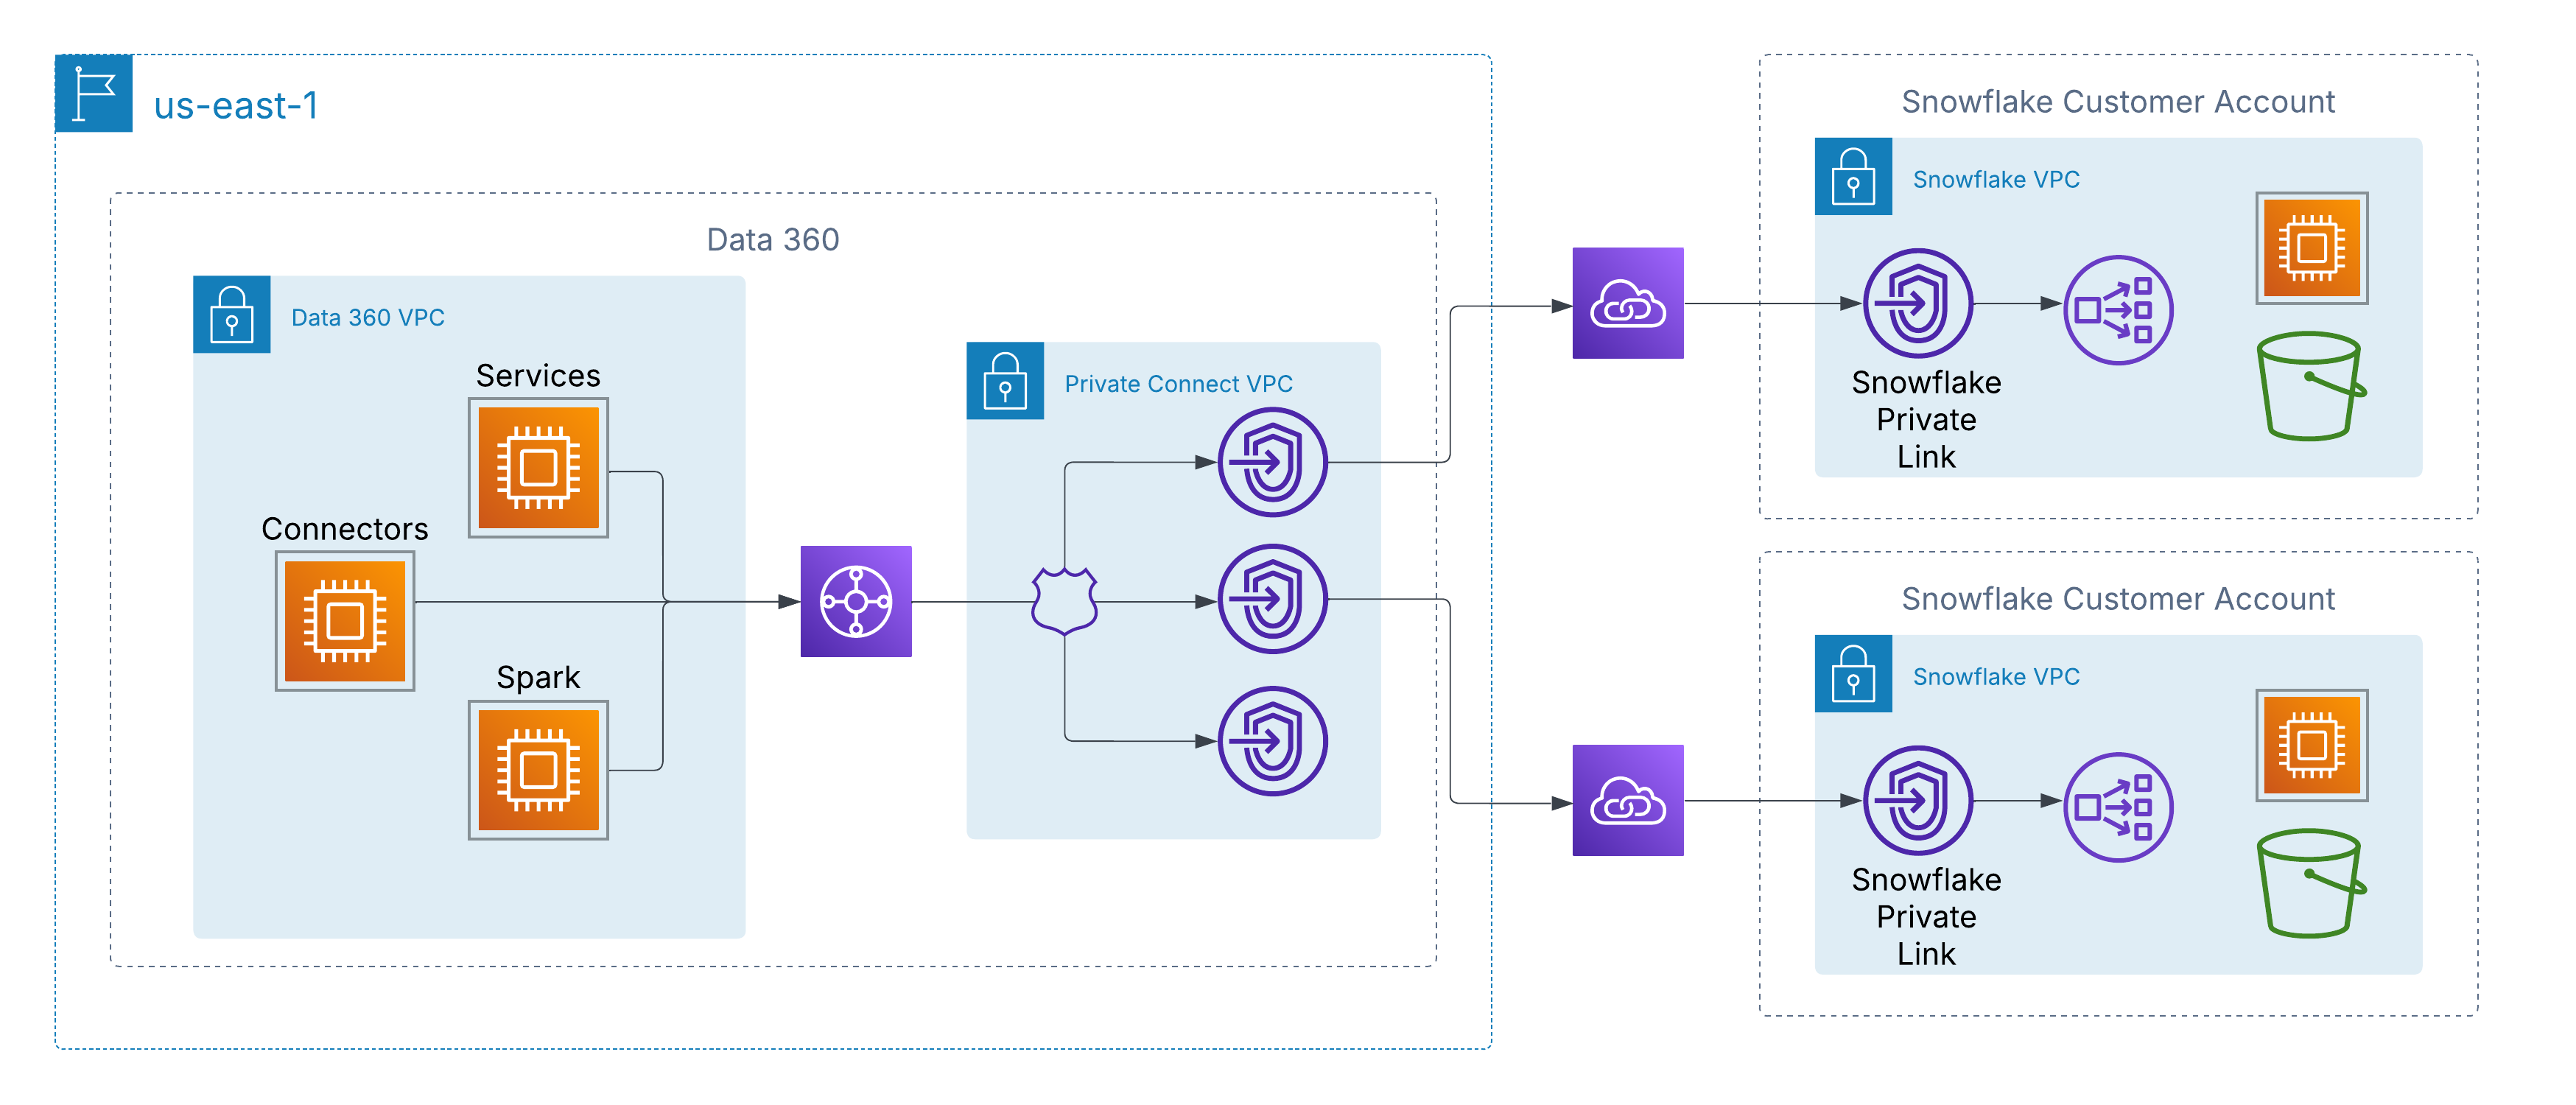 Para lidar com isso, o Data 360 oferece suporte à conectividade privada em nível de rede com fontes de dados gerenciadas pelo cliente em nuvens. Na AWS, isso é habilitado por meio do AWS PrivateLink, que permite que o Data 360 se conecte diretamente a pontos de extremidade provisionados pelo cliente, seja em suas próprias contas ou em ambientes de data lake de terceiros (por exemplo, Snowflake), sem atravessar a Internet pública.
Essa arquitetura garante que todo o tráfego permaneça inteiramente na base da AWS, usando endereço IP privado e caminhos de rede não roteáveis, satisfazendo, assim, os requisitos de segurança e conformidade rígidos e permitindo o acesso contínuo aos dados do cliente.
#### Interconexão privada
Para clientes com arquiteturas de várias nuvens, o Data 360 está estendendo a conectividade privada além da AWS por meio do suporte à interconexão entre nuvens. Isso habilita caminhos de rede seguros apenas de backbone do Data 360 para data lakes e serviços hospedados no Azure ou Google Cloud, preservando os mesmos princípios do AWS PrivateLink: endereço IP privado, roteamento não público e nenhuma exposição à Internet.
Os clientes podem escolher entre dois modelos de implementação:
- **Interconexão gerenciada pelo cliente**: Integre circuitos privados existentes, como Azure ExpressRoute, Google Cloud Interconnect ou Equinix Fabric diretamente com as VPCs do Data 360.
- **Interconexão gerenciada pelo Salesforce**: Use uma conexão totalmente gerenciada em que o Salesforce provisiona e opera o link entre nuvens, expondo pontos de extremidade privados na nuvem de destino.
Em ambos os modelos, a experiência é consistente: Os serviços do Data 360 se conectam a origens de dados externas em hiperescalers como se fossem locais, permitindo a ingestão, a ativação e consulta seguras sem atravessar a Internet pública.
### Governança de dados no Data 360: uma base de Trust e Controle
Para os arquitetos empresariais, uma governança de dados robusta não é apenas uma caixa de seleção de conformidade, mas um pilar fundamental para criar Inteligência do cliente confiável, dimensionável e acionável. O Salesforce Data 360 é arquitetado com uma estrutura de governança abrangente que garante a qualidade, a segurança e a adesão a mandatos regulatórios em todo o ciclo de vida dos dados.
O Data 360 funciona como um hub de governança centralizado, garantindo que todos os dados, da ingestão bruta às percepções ativadas, sejam gerenciados com integridade e controle.
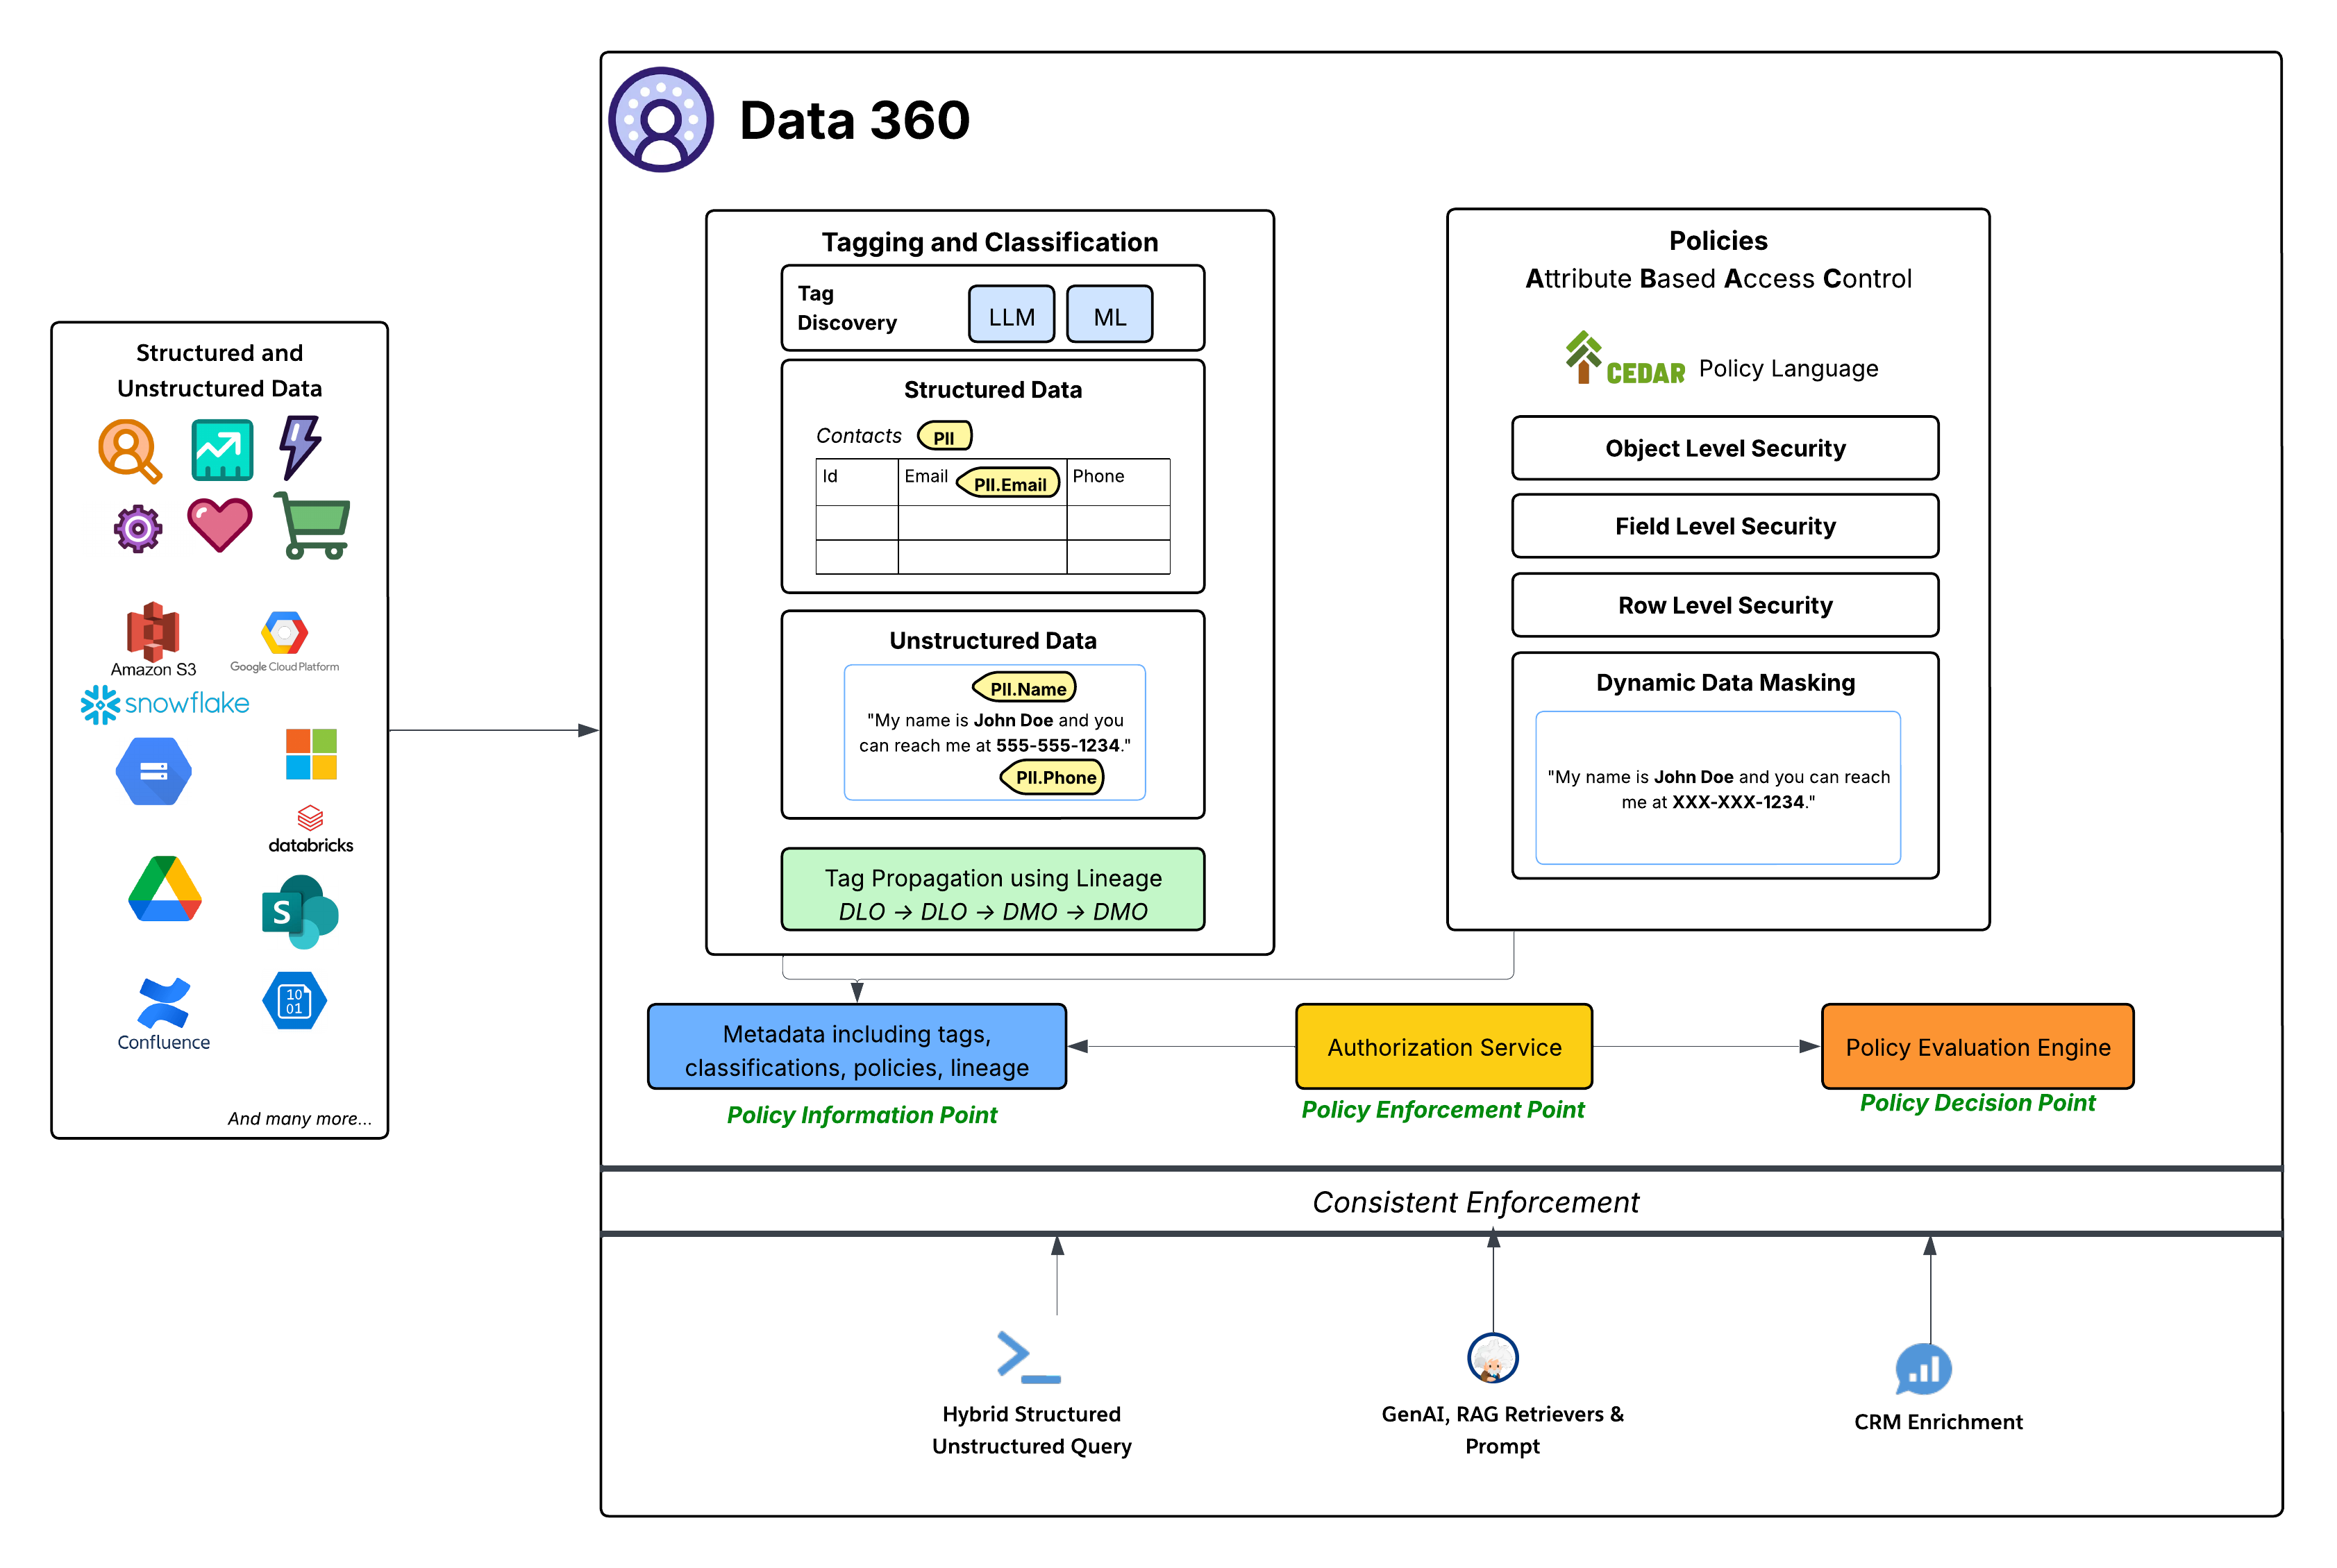 #### Controle de acesso avançado: Por que controle de acesso baseado em atributo (ABAC)
Embora o dataspace forneça controle de acesso granular para determinar o acesso a todos os objetos em um espaço de dados, as políticas baseadas em ABAC fornecem controle de acesso granular para objetos, campos e linhas individuais em um espaço de dados. O Data 360 adotou o Controle de acesso baseado em atributo (ABAC) como seu modelo de autorização principal para o controle de acesso granular. Essa opção estratégica oferece flexibilidade e escalabilidade superiores em comparação ao Controle de acesso baseado em papel (RBAC) tradicional, particularmente crucial para ambientes empresariais dinâmicos e complexos com grandes quantidades de dados e necessidades de acesso variadas. O ABAC permite que as decisões de acesso sejam baseadas em atributos do usuário (por exemplo, departamento, papel, local), os dados (por exemplo, PII, confidencialidade, espaço de dados) e o ambiente (por exemplo, hora do dia), em vez de apenas papéis predefinidos. Isso habilita políticas de acesso altamente granulares e contextuais que se adaptam à medida que os dados e os atributos do usuário mudam.
- **Linguagem da política do CEDAR**: No centro da implementação de ABAC do Data 360 está o uso da linguagem de política CEDAR. Essa linguagem de política formal criada com finalidade fornece uma maneira precisa e verificável de definir regras de autorização complexas, garantindo que as políticas sejam inequívocas e possam ser avaliadas de modo consistente em escala.
#### Arquitetura de governança: Informações sobre apólice, imposição e pontos de decisão
O sistema de governança no Data 360 adere a uma arquitetura ABAC padrão e robusta:
- **Marcação, classificação e elaboração de políticas (Ponto de informações sobre políticas – PIP)**:
- O Data 360 fornece mecanismos automatizados de Marcação e Classificação, aproveitando o LLM (Grande Modelo de Idiomas) e o ML (Aprendizado de Máquina) para identificar categorias de dados confidenciais (por exemplo, PII.Email, PII.Phone, PII.Name) e outras taxonomias criadas para fins específicos (PHI, FinancialData) em Dados estruturados (por exemplo, tabela de Contatos) e Dados não estruturados (por exemplo, do Google Drive).
- Crucialmente, a Propagação de marcação ocorre ao longo da Linha de dados (DLO -> DLO -> DMO), garantindo que as classificações sigam automaticamente transformações e derivações de dados, de dados brutos ingeridos para a camada de DMO harmonizada e por meio de dados derivados criados de definições de processo.
- Por fim, o painel de criação de política oferece uma experiência simples para aproveitar os dados e os atributos de usuário para definir regras de acesso dinâmico para uma organização.
- Esses metadados aprimorados (incluindo marcas, classificações, políticas e linhagem) são alimentados no Ponto de informações da política (PIP).
- **Serviço de Autorização (Ponto de Aplicação de Políticas - PEP)**:
- O Serviço de autorização atua como o Ponto de imposição de apólice (PEP). Ele intercepta todas as solicitações de acesso a dados de várias camadas de consumo (consulta estruturada/não estruturada híbrida, GenAI RAG Recuperadores e prompts, aprimoramento de CRM) e consulta o Ponto de decisão da política para determinar se o acesso é permitido.
- **Mecanismo de avaliação de políticas (Ponto de decisão de políticas - PDP)**:
- Esse mecanismo serve como o Ponto de decisão de política (PDP). Ele usa o contexto da solicitação de acesso do PEP, junto com as definições de política (no CEDAR) e atributos do PIP, para tomar uma decisão de acesso de autoridade.
#### Imposição e integração da política principal
- **Políticas de Segurança Granular**: As políticas definidas no CEDAR aplicam vários níveis de segurança, incluindo:
- **Segurança em nível de objeto**: Controle o acesso a DLOs ou DMOs inteiros com base em marcas associadas a esses objetos.
- **Segurança em nível de campo**: Restringir o acesso a campos confidenciais específicos em um objeto com base em marcas.
- **Segurança em nível de linha**: Filtrar dados em objetos específicos para mostrar apenas linhas relevantes com base nos atributos do usuário.
- **Mascaramento dinâmico de dados**: Mascare dinamicamente determinados dados (com base em marcas) no ponto de acesso sem alterar os dados subjacentes. Isso garante que as informações confidenciais sejam protegidas enquanto ainda permitem um utilitário amplo. Isso se aplica ao mascaramento de campos em dados estruturados, bem como conteúdo em dados não estruturados.
- **Imposição consistente**: Toda a estrutura ABAC garante a imposição consistente de políticas em todos os padrões de consumo do Data 360, seja consultas de dados diretas, recuperação para aplicativos de IA generativa (RAG) ou aprimoramento de experiências do Salesforce CRM por meio de Listas relacionadas, por exemplo.
- **Integração profunda com a Salesforce Platform**: Os recursos de governança do Data 360 são definidos e administrados diretamente na plataforma principal do Salesforce. Essa integração permite que os administradores gerenciem políticas de acesso, identidades de usuário e gerenciamento de atributos usando ferramentas familiares do Salesforce, garantindo uma camada de governança unificada e consistente em todo o ecossistema do Salesforce.
Ao criar essa estrutura ABAC sofisticada com políticas CEDAR, o Data 360 fornece aos arquitetos um nível inigualável de controle e flexibilidade, garantindo que os dados do cliente não sejam apenas acionáveis, mas também seguros, em conformidade e confiáveis em toda a empresa.
### Criptografia do Data 360: Traga sua própria chave
Em todos os setores, as organizações estão colocando maior ênfase na segurança de dados completa para garantir a proteção contra vazamento de dados, acesso não autorizado, adulteração ou destruição. A maioria das plataformas de dados, incluindo o Data 360 hoje, fornece criptografia em repouso usando uma chave de criptografia gerenciada pelo fornecedor. No entanto, as empresas (especialmente aquelas em setores regulamentados) estão cada vez mais exigindo recursos de criptografia gerenciada pelo cliente para dados em repouso e em trânsito.
Esse modelo permite que as empresas controlem suas próprias chaves de criptografia, garantindo que, mesmo no caso altamente improvável de uma violação no nível da plataforma ou acesso não autorizado, os dados permaneçam criptograficamente protegidos. Sem a chave proprietária do cliente, nenhuma entidade (incluindo o provedor da plataforma) pode descriptografar ou reconstruir os dados, mantendo a confidencialidade e o controle completos.
### Armazenamento e processamento de dados não estruturados
O Data 360 oferece suporte ao armazenamento e ao gerenciamento de dados estruturados (tabelas), semiestruturados (JSON) e não estruturados de modo contínuo em todos os mecanismos de ingestão, processamento, indexação e consulta de dados. O Data 360 oferece suporte a vários tipos de dados não estruturados além do texto, incluindo áudio, vídeo e imagens, ampliando o escopo do tratamento e da análise de dados. A figura abaixo ilustra os dois lados da fundamentação (ingestão e recuperação).
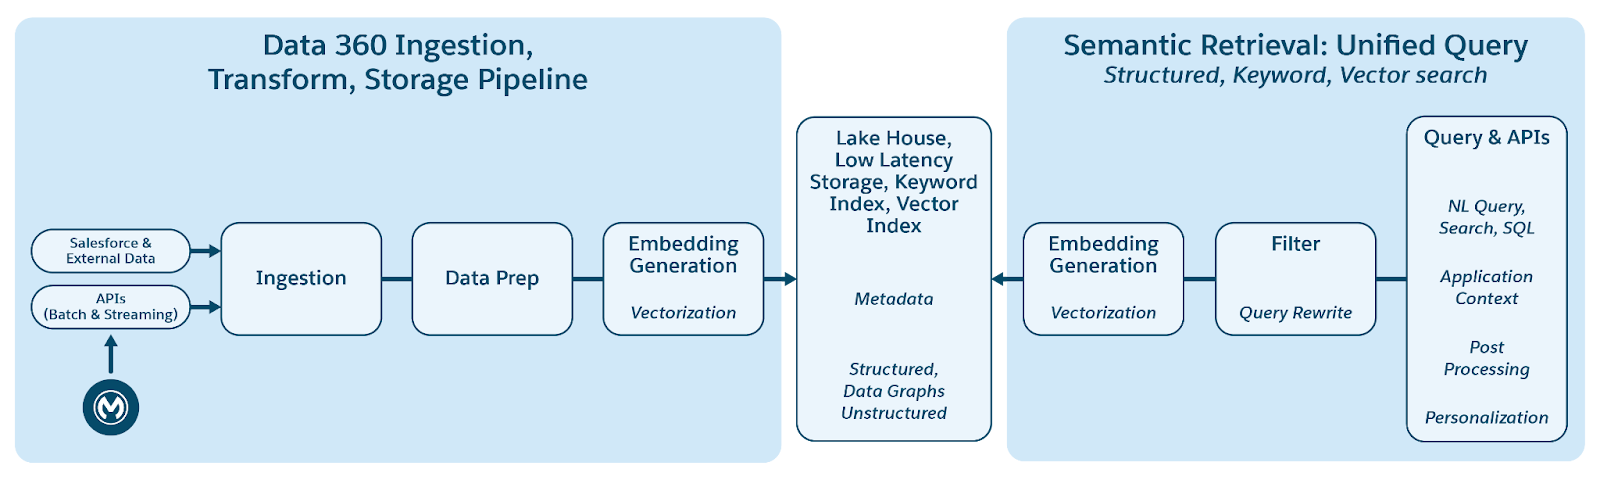 O Data 360 gerencia dados não estruturados armazenando-os em colunas como texto ou em arquivos para conjuntos de dados maiores. Ele oferece suporte à federação de dados para conteúdo não estruturado, o que permite a integração e o gerenciamento de dados de várias origens.
Os dados então são preparados e divididos em blocos, as integrações são geradas e processadas para indexação por palavra-chave e indexação vetorial. O Data 360 hospeda vários modelos prontos para uso e plugáveis para geração em blocos e integração. O Data 360 oferece suporte à transcrição automatizada e configurável de conteúdo de áudio e vídeo para processamento e indexação subsequentes. O serviço de pesquisa é usado para indexação de palavra-chave. Para indexação de vetores, o Data 360 oferece suporte à indexação nativa (com Hyper) e também utiliza bancos de dados vetoriais, como o Milvus de código aberto. O Data 360 também se integra à plataforma do Salesforce Search para dar suporte à indexação de palavras-chave em dados não estruturados. Essa indexação multimodal integrada no Data 360 permite pesquisar em qualquer dado não estruturado, conforme discutido na seção Pesquisa comercial do agente mais adiante no documento.
Para recuperação, o Data 360 fornece APIs para pesquisa. Nossa consulta unificada baseada em hiper facilita consultas de conjunto em índices estruturados, de palavra-chave e de vetores, mantendo a visibilidade e as permissões estritas, aprimorando assim o RAG e a pesquisa.
#### Pipelines extensíveis
O pipeline de indexação de dados não estruturado do Data 360 é projetado como uma arquitetura modular e extensível com cinco estágios principais:
1. Analisando
2. Pré-processamento
3. Particionamento
4. Pós-processamento
5. Integração
Todos os estágios também oferecem suporte ao processamento baseado em LLM, que permite que os clientes criem avisos personalizados. As fases pré-processamento e pós-processamento podem incluir várias etapas sequenciais, permitindo que transformações complexas sejam compostas de modo flexível. Cada estágio é totalmente orientado por metadados, permitindo uma configuração e uma extensão perfeitas sem alterações de código.
Exemplos de pré-processamento incluem operações como eliminação de ruído, normalização de linguagem e compreensão de imagem (reconhecimento e legenda de caracteres ópticos), enquanto os estágios de pós-processamento podem incluir aprimoramento de metadados, agrupamento semântico ou técnicas avançadas, como agrupamento em blocos Raptor.
O pipeline oferece suporte total à Extensão de código do Data 360, permitindo que clientes e equipes internas conectem lógica personalizada em qualquer estágio. Os componentes de extensão de código são funções do Python leves cujo ciclo de vida (execução, escala e tratamento de falhas) é totalmente gerenciado pelo Data 360\. Essa abordagem garante que a inovação e o processamento específico do domínio possam ser introduzidos rapidamente enquanto mantêm a consistência operacional e a governança em toda a plataforma.
##### Indexação de contexto
Para configurar RAG com processamento não estruturado, dois fatores críticos são essenciais:
1. Iteração **rápida**: A capacidade de validar rapidamente com consultas de teste de amostra.
2. **Conteúdo específico da pessoa**: A capacidade de configurar conteúdo personalizado para a persona consumidora.
A Indexação de contexto é uma ferramenta fácil de usar projetada para lidar com ambos os aspectos. Essa IU interativa é ativada por um pipeline em tempo real (RT) que executa todos os cinco estágios descritos anteriormente. O pipeline utiliza GPUs quando necessário para tarefas como geração de integração e reconhecimento de caracteres óptico (OCR). Além disso, ele permite que os clientes testem rapidamente o pipeline RAG com um agente antes de implementar a configuração para processamento de conteúdo abrangente.
##### IA do documento
A IA de documento do Data 360 permite ler e importar dados não estruturados ou semiestruturados de documentos como faturas, currículos, relatórios de laboratório e pedidos de compra. Esse recurso dá suporte ao processamento interativo ad hoc, bem como ao processamento em lote em massa. Essa é uma funcionalidade essencial que habilita a automação de processos de negócios para nossos clientes. Isso é desenvolvido com inteligência artificial, incluindo LLMs e modelos de ML.
### Knowledge corporativo
As empresas possuem grandes quantidades de Knowledge espalhadas por sistemas diferentes, como wikis, compartilhamentos de arquivos, sistemas de gerenciamento de conteúdo, bancos de dados internos e muito mais. Essa fragmentação dificulta que funcionários (especialmente agentes de serviço e representantes de vendas) e clientes encontrem informações relevantes de forma rápida e eficiente. Os principais problemas incluem: Falta de uma única experiência de busca unificada em todas as fontes do Knowledge; apresentação e renderização inconsistentes de conteúdos de diferentes fontes; falta de governança de acesso a informações confidenciais espalhadas entre sistemas; e dificuldade de aproveitar fontes de Knowledge autoritárias dentro dos fluxos de trabalho essenciais (por exemplo, anexar artigos relevantes a um caso).
O Enterprise Knowledge representa o conteúdo que foi selecionado, seja manualmente ou automaticamente, a partir do conjunto mais amplo de dados empresariais. A criação manual envolve ações deliberadas, como criar artigos do Salesforce Knowledge ou desenvolver Knowledge dentro de sistemas externos que são então ingeridos. Nós imaginamos a seleção automatizada que utiliza processos, como agentes e transformações do Salesforce, que executam dados ingeridos para gerar camadas refinadas e selecionadas, possivelmente misturando conteúdo estruturado e não estruturado. Seja selecionado manualmente ou automaticamente, internamente no Salesforce ou externamente antes da ingestão, o resultado é conteúdo de valor agregado diferente dos dados brutos.
A solução Enterprise Knowledge Hub aproveita os recursos do Data 360 para:
- **Ingestão e Armazenamento**: O CRM Connector está ingerindo artigos do Salesforce Knowledge, e os conectores não estruturados do Framework do conector de dados (DCF) ingerem conteúdo bruto e metadados de fontes externas. O conteúdo é ingerido no mapeamento de objetos de data lake não estruturados (UDLOs) específicos da origem para o conteúdo no SFDrive (ou origem no caso de cópia zero).
- **Harmonização e estruturação**: O pipeline de harmonização processa dados de UDLO e arquivo, realizando limpeza, normalização, enriquecimento (NLP, etc.), mascaramento de PII e transformação no formato intermediário harmonizado, armazenado no SF Drive e um UDLO harmonizado (HUDLO) que mapeia para ele.
- **Indexação**: O Pipeline não estruturado (UDS) é acionado no conteúdo harmonizado e os índices de pesquisa são configurados para cada HUDMO.
- **Consumo**: Os aplicativos consumidores incluem pesquisa, recuperação, renderização e vinculação a objetos de negócios como Caso. O engajamento consumindo aplicativos é coletado para fornecer análises de uso (como cliques, análises etc.)
### Insights calculados
Insights calculados (CIs) no Data 360 permitem que os clientes definam e gerem métricas agregadas com base em seus dados. Essas métricas então são usadas para engajamento, análise, segmentação e ativação oportunos do cliente. Os dados agregados calculados por CIs são gravados no Lakehouse e representados como um objeto de percepção calculada (CIO).
Há dois tipos principais de percepções calculadas:
- **Insights calculados em lote**: Projetado para agregação de dados complexo e de alto volume, em que as métricas podem ser calculadas periodicamente (por exemplo, diariamente ou semanalmente).
- **Insights de streaming**: Forneça a capacidade de gerar métricas e ações de dados de evento em tempo real, habilitando o engajamento imediato do cliente com baixa latência.
As percepções calculadas são definidas em objetos de modelo de dados (DMOs) e também podem ser definidas em outros objetos de percepção calculada. O serviço de percepções calculadas gerencia a orquestração de trabalhos em lote e de streaming.
Os cálculos de percepções em lote e de streaming usam o Spark. A principal diferença é que as percepções de streaming usam o Streaming estruturado do Spark, enquanto as CIs em lote são executadas usando trabalhos do Spark em lote periódicos agendados. Para eficiência de custo, os Insights de serviço calculados agrupam as CIs a serem calculadas juntas no mesmo trabalho de CI em lote ou trabalho de CI de streaming com base em fatores como dependências e sobreposição de objetos de dados de origem.
A SNCE e a CDF desempenham um papel significativo no cálculo de Insights de streaming.
### Resolução de identidade
A resolução de identidade é responsável por transformar dados diferentes de várias origens em um único Perfil unificado abrangente.
É importante entender que um perfil unificado não é um "registro de ouro" e que a resolução de identidade não seleciona valores vencedores nem substitui dados existentes ao unificar perfis. Os perfis unificados servem como um conjunto de chaves que desbloqueiam seus dados de origem identificando todos os registros correspondentes relacionados à mesma entidade, dentro de uma fonte de dados ou entre várias fontes. Com essas informações, você pode selecionar os dados do sistema de origem certos a serem usados para um determinado caso de uso de negócios.
A resolução de identidade pode consolidar uma variedade de tipos de registro, incluindo Indivíduos, Contas e Famílias. Também pode ser usado para combinar leads a contas existentes. O processo de unificação é essencial para obter uma visualização completa do Customer 360 e promover engajamento personalizado em tempo real em cenários B2C e B2B.
O pipeline de resolução de identidade é criado em uma estrutura nativa da nuvem altamente escalonável projetada para lidar com volumes enormes de dados continuamente. O processo envolve três etapas principais, dependendo de um poderoso índice de pesquisa para gerenciar o processo de correspondência:
- **Correspondência (Seleção de candidatos)**: O objetivo do processo de correspondência é pesquisar registros que podem pertencer à mesma entidade. Os registros são analisados em relação a um conjunto de regras personalizável, cada um contendo um conjunto de critérios que definem quais dados correspondem a qual nível de rigor. Para recuperar de modo eficiente possíveis correspondências do armazenamento de dados, o sistema gera índices para localizar registros correspondentes prováveis usando duas técnicas:
- **Bloquear chaves**: Uma chave de bloqueio é um valor gerado dos dados e regras de correspondência de um registro (como as primeiras letras de um nome, número de telefone normalizado etc.) para agrupar registros potencialmente semelhantes. Cada registro tem várias chaves de bloqueio que são indexadas e armazenadas como um índice invertido, garantindo que o sistema realize apenas comparações detalhadas em pequenos grupos de registros, em vez de em todo o conjunto de dados.
- **Locality Sensitive Hashing (LSH)**: Para regras de correspondência com correspondência parcial, os hashes são gerados com base em integrações de modelos treinados.
- **Deep Matching**: Depois que a etapa de seleção de candidato cria grupos menores de possíveis correspondências, o sistema inicia uma comparação mais detalhada. Nesse estágio, modelos de IA e algoritmos avançados analisam cada par de registros para calcular uma pontuação de correspondência probabilística. Essa pontuação quantifica a probabilidade de dois registros se referirem à mesma entidade comparando de modo inteligente campos que geralmente contêm erros de ortografia, variações ou diferenças de formatação.
- **Agrupamento e unificação**: Depois que registros correspondentes são identificados entre os candidatos, eles são agrupados em um cluster. Esse processo inclui criticamente a resolução de correspondências transitivas. Por exemplo, se o Registro A corresponder ao Registro B e o Registro B corresponder ao Registro C, todos os três serão vinculados ao mesmo cluster mesmo que A e C nunca tenham sido comparados diretamente. Esses grupos completos formam a estrutura básica do Perfil unificado. Esse processo de agrupamento garante que todos os registros de origem relacionados sejam vinculados corretamente sob um único identificador persistente.
- **Reconciliação**: Os valores de dados de todos os registros de origem agrupados são avaliados usando regras de reconciliação definidas (por exemplo, _Most Frequent_, _Most Recent_, ou _Source Priority_) para preencher o Perfil unificado resultante com um trecho de dados de perfil. A reconciliação não sobrescreve nenhum dado existente, pois todos os dados de origem estão disponíveis usando as chaves vinculadas ao perfil unificado.
#### Tipos de resolução de identidade
A arquitetura dá suporte à resolução de vários tipos de entidade para atender a uma variedade de casos de uso.
- **Correspondência individual**: Concentra-se na criação de perfis de Indivíduo unificado, que vinculam todos os identificadores pessoais conhecidos (email, números de telefone, IDs de fidelidade, cookies) a uma única pessoa.
- **Correspondência de conta**: Concentra-se na criação de perfis de Conta unificada, que vinculam dados sobre contas. Ao fazer a correspondência nos nomes da empresa, o mecanismo usa um modelo ajustado quando há correspondência parcial.
- **Combinar família**: Estende a lógica de correspondência para agregar registros de Indivíduo unificado em grupos de indivíduos relacionados.
- **Correspondência entre entidades**: Além da unificação, a resolução de identidade também cria links entre objetos de perfil usando as mesmas regras de correspondência. Por exemplo, um Lead pode ser vinculado a uma Conta usando correspondência parcial em Nome da conta.
#### Processamento quase em tempo real
Para garantir que o Perfil unificado esteja sempre atualizado, o mecanismo de resolução de identidade opera com uma arquitetura quase em tempo real. Essa arquitetura otimizada para nuvem é projetada para processamento contínuo, alcançando tempos de processamento rápidos. Embora a velocidade de processamento varie dependendo de como os dados de origem são recebidos, pequenos lotes de alterações podem ser processados pela resolução de identidade com frequência de 15 minutos.
#### Vinculação de perfil de origem
O sistema mantém objetos de link de identidade que mapeiam cada ID de registro de origem para seu ID de perfil unificado correspondente. Essa estrutura de dados fundamental permite que o mecanismo rastreie de modo eficiente os relacionamentos e propague rapidamente alterações e atualizações no perfil unificado, garantindo que as experiências do cliente, como personalização do site, recomendações de próxima melhor ação e segmentação, sempre aproveitem os dados do cliente mais recentes disponíveis.
### Segmentação
A segmentação é o processo central de transformar perfis de clientes unificados em públicos acionáveis. Essa funcionalidade é essencial para habilitar experiências personalizadas em canais de marketing, comércio e serviço. A plataforma de Segmentação do Salesforce Data 360 é projetada para operações em grande escala. Gerencia metadados complexos, trabalhando com um modelo de dados que inclui milhares de objetos e relacionamentos. A plataforma oferece suporte a regras complexas, filtros baseados em agregação e classificação baseada em janela, tudo ao mesmo tempo que garante um cálculo rápido e confiável em escala de petabytes.
#### Tipos e ritmos de segmentação
O Data 360 oferece suporte a vários tipos de segmento para atender a diferentes requisitos de negócios de velocidade, complexidade e hierarquia:
1. **Segmento padrão**: O tipo de segmento processado em lote primário. Ele publica em uma agenda personalizável, com um ritmo de Publicação padrão de no mínimo 12 horas até 24 horas, ou um ritmo de Publicação rápida mais rápido de 1 a 4 horas, otimizado para dados de engajamento recentes.
2. **Segmento em tempo real**: Esse segmento é concluído sob demanda em milissegundos para ação imediata com base em eventos recentes e dados de perfil. Ele é altamente otimizado para personalização instantânea, mas não pode utilizar critérios de exclusão ou segmentos aninhados.
3. **Segmento de cascata**: Uma estrutura hierárquica de subsegmentos usada para priorizar um cliente em um único segmento mais valioso se ele se qualificar para vários critérios.
4. **Segmento aninhado**: Isso permite reutilizar um segmento existente como um filtro para um segmento novo e mais específico (um refinamento de um segmento de base), herdam a agenda do segmento pai.
#### Mecanismo de segmentação: Fundamentos da arquitetura
O mecanismo de segmentação opera em uma arquitetura robusta nativa da nuvem que garante velocidade, escala e resiliência.
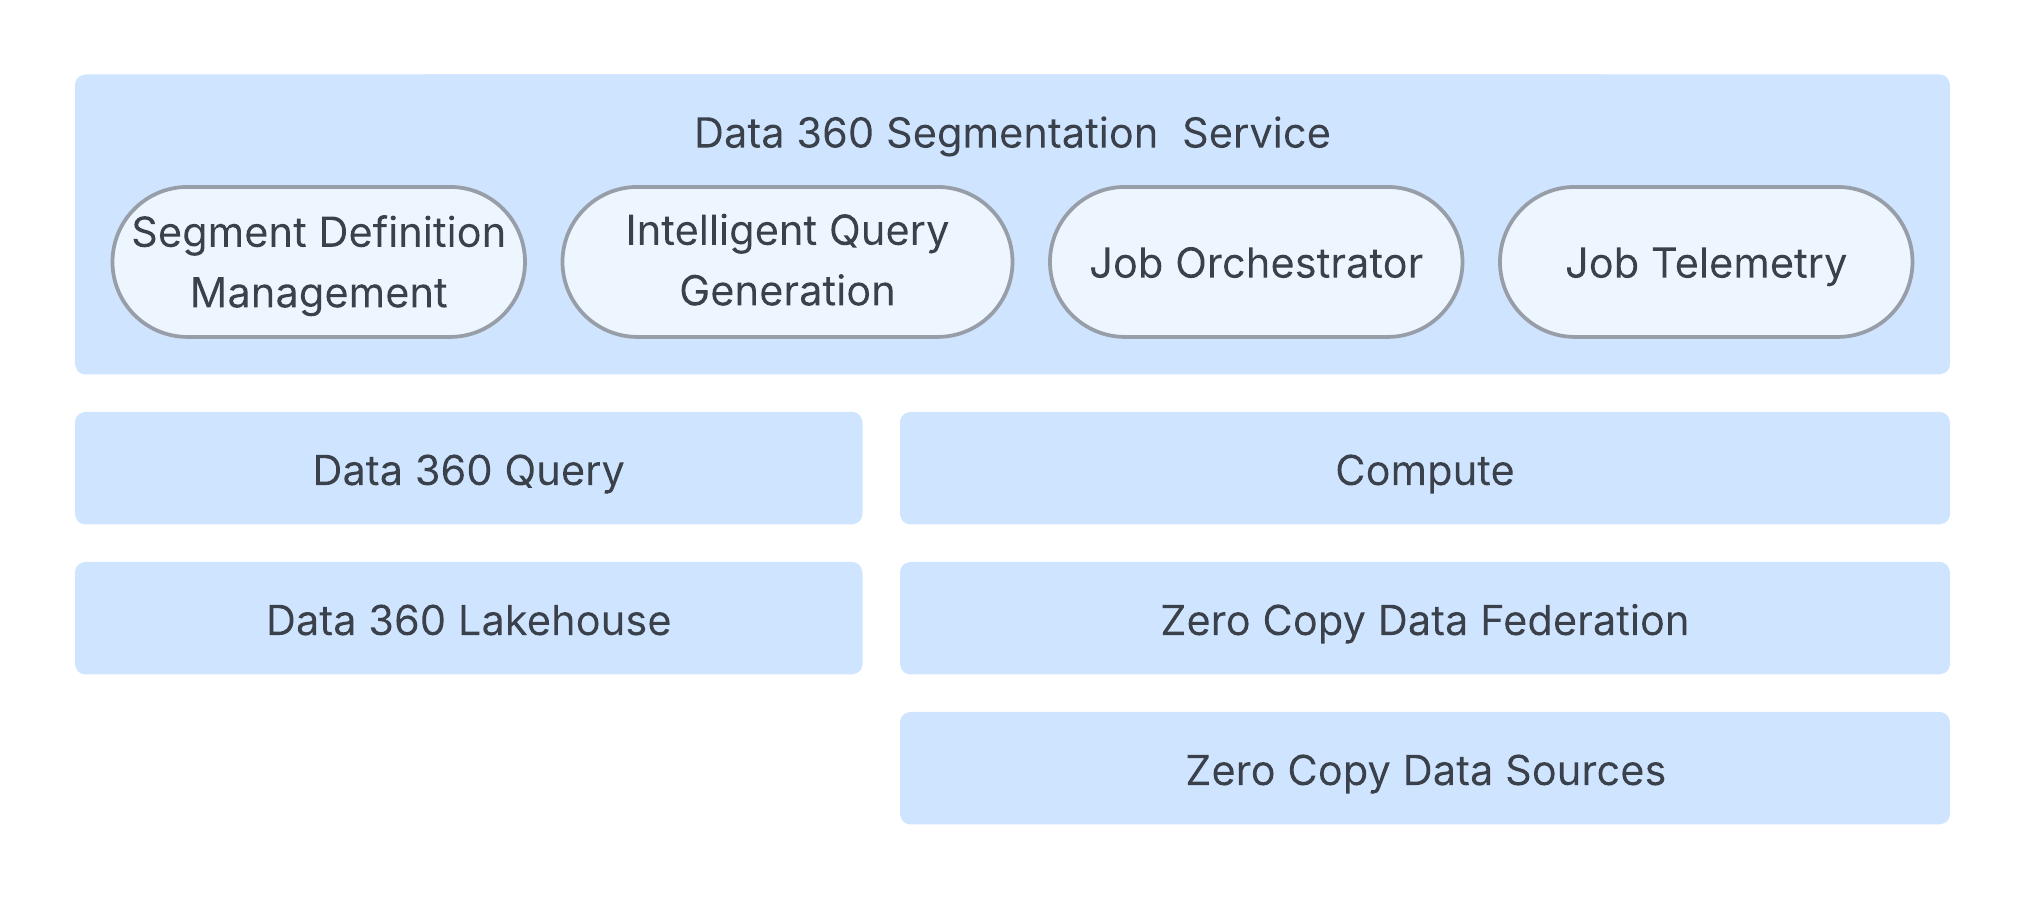 O processo principal é gerenciado por um serviço de orquestração de trabalho que controla o ciclo de vida do segmento, gerando a configuração de trabalho necessária e acionando a execução. Essa camada de orquestração mantém estado e metadados em um banco de dados particionado para escalabilidade.
Embora a Consulta do Data 360 lidar com cálculos de contagem de segmentação, a camada de computação do Spark é responsável por calcular a associação real do segmento. O aplicativo Spark executa consultas SQL do Spark em dados extensos do cliente. Esses dados podem residir no Data 360 Lakehouse, em sistemas externos por meio da federação de dados do Zero Copy ou em uma combinação de ambos.
O sistema é altamente otimizado por meio da geração de consulta inteligente, que refina a consulta SQL do Spark subjacente. Isso inclui técnicas como corte de partição inteligente para minimizar a leitura de dados e a eliminação de subexpressões redundantes. Para garantir a confiabilidade do serviço, a arquitetura oferece o gerenciamento de recursos adaptável que ajusta dinamicamente os recursos de computação com base no tamanho e na complexidade da carga de trabalho. Além disso, a adesão de SLO é gerenciada de modo proativo com durações adaptativas e lógica de nova tentativa. Para uma experiência de usuário rápida, as contagens de segmentos aceleradas usam uma abordagem baseada em amostragem para fornecer estimativas de tamanho rápidas durante a criação do segmento, evitando uma execução de consulta completa.
Por fim, um profundo foco na observabilidade e na atribuição de causa raiz é mantido por meio de métricas abrangentes de execução do Spark e classificação automatizada de erros (por exemplo, problemas do lado do cliente vs. do sistema), reduzindo significativamente o tempo de diagnóstico e garantindo uma plataforma de dados altamente resiliente.
### Ativação
A ativação é a etapa final crítica no ciclo de vida do Data 360. Sua função principal é transformar perfis de cliente estáticos, segmentados e unificados em dados acionáveis e aprimorados e entregar esses dados a pontos de extremidade internos e externos (como Marketing Cloud, Commerce Cloud e plataformas Adtech). Esse processo é projetado para acionar jornadas do cliente personalizadas e interações quase em tempo real. Ele oferece suporte a recursos avançados como atributos relacionados, filtragem de associação da ativação, filtragem de consentimento, limitação e classificação.
A ativação oferece três métodos distintos para entrega externa e conformidade de canal:
- **Ativação de lote**: Projetado para operações agendadas de alto volume, como campanhas de email em grande escala e atualizações de público de publicidade. Os dados são entregues preparando-os para os buckets internos seguros (Armazenamento de objetos na nuvem) ou por meio da Transferência segura de arquivos, seguidos por um processo de ingestão de API iniciado pelo sistema de destino. Ativações em lote podem usar um modo de atualização especial (incremental) para reduzir volumes enviados e processados por parceiros do Salesforce.
- **Ativação de streaming**: Otimizada para casos de uso quase em tempo real que exigem automação conduzida por evento. A entrega é realizada por meio de chamadas de API diretas enviadas ao ponto de extremidade de destino.
- **Fluxos acionados por ativação**: Esse canal altamente platformizado fornece uma abordagem sem código/baixo código para integrar Dados do público a centenas de plataformas de engajamento habilitadas para API do cliente. Após a conclusão da ativação, o Data 360 preenche um DMO de Público, que então aciona um Fluxo de alta escala. O mecanismo de Fluxo subsequentemente consome os dados do público e utiliza recursos de plataforma como Serviços externos e Destinos de saída do Mule para fazer chamadas ao destino final baseado em API. Esse método reduz significativamente o tempo necessário para integrar novos destinos da ativação.
A ativação usa os mesmos padrões de segmentação para gerenciamento de trabalhos, execução distribuída e monitoramento. Isso inclui os princípios do serviço de orquestração de trabalho para gerenciamento de ciclo de vida e da camada computacional (Spark) para processamento e depende da telemetria de trabalho para a observabilidade do desempenho e adesão ao objetivo de nível de serviço (SLO).
Além desses, a ativação tem -
O **Gerenciamento de destino da ativação** supervisiona as conexões, credenciais e configurações seguras para todos os pontos de extremidade de destino. Ela garante que os formatos de dados e os protocolos de segurança sejam padronizados, garantindo a entrega confiável de várias plataformas, incluindo Marketing Cloud, parceiros do Adtech e outros aplicativos externos.
A ativação ajusta a carga útil para metas específicas. Para o Salesforce Marketing Cloud, isso inclui Filtragem consciente da unidade de negócios (BU), suporte a vários EID e controles de polinização cruzada.
A **Communication Governance** atua como um gateway, garantindo que o uso e a comunicação de dados estejam de acordo com as preferências do cliente e requisitos legais. O modelo de consentimento centralizado unifica todas as preferências do cliente, desde recusas globais até consentimento específico de canal e finalidade, e é armazenado no Perfil de indivíduo unificado. Durante a execução, a plataforma impõe estritamente essas políticas usando a filtragem de exclusão para remover automaticamente indivíduos que não consentiram na carga útil final. Além disso, o sistema aplica regras de seleção de ponto de contato para garantir que ele use o ponto de contato único, mais compatível e preferencial para o canal pretendido antes de qualquer dado ser transmitido. Esse mecanismo de imposição é protegido pela estrutura de governança subjacente, que usa medidas de proteção, como mascaramento de dados dinâmico e controles de acesso, para proteger campos de dados confidenciais em todo o processo de ativação.
### Consulta unificada: Acesso aprimorado a todos os dados do cliente
O verdadeiro valor de uma plataforma de dados unificada reside na sua capacidade de fornecer acesso consistente e sem esforço a todos os seus ativos de dados, independentemente de sua origem ou estrutura. O recurso Consulta unificada do Salesforce Data 360 foi projetado com precisão para oferecer isso, abstraindo as complexidades subjacentes de vários repositórios de dados para fornecer uma única e eficiente interface de consulta.
A camada Consulta unificada oferece acesso sofisticado para vários padrões de consumo:
- **Consulta estruturada e não estruturada híbrida**: Ele oferece amplo suporte a SQL para consultar de modo aprimorado tanto os dados estruturados quanto os metadados estruturados de dados não estruturados. Isso é aprimorado pela extensibilidade do operador por meio de funções de tabela, habilitando a pesquisa especializada em tipos de texto, imagem e espaço.
- **Desempenho acelerado com Hyper**: Aproveitando o Hyper, um mecanismo de alto desempenho na memória, o Data 360 acelera consultas analíticas complexas e painéis interativos, fornecendo respostas quase instantâneas em conjuntos de dados massivos.
- **Abordagem unificada para IA e personalização**: Esse acesso unificado é crucial para gerar resultados direcionados e personalizados, facilitando diretamente respostas de LLM mais precisas usando a Geração aumentada de recuperação (RAG) baseando modelos de IA em dados corporativos avançados.
- **Integração com o consumo a jusante**: Ele serve como a camada de acesso a dados básica para experiências conduzidas por UI, APIs robustas, fluxos de trabalho de IA generativa e aprimoramento de CRM, conectando dados perfeitamente à ativação.
Ao fornecer uma única interface de consulta inteligente e de alto desempenho, a consulta unificada do Data 360 capacita os arquitetos a criar aplicativos ágeis orientados por dados que aproveitam totalmente todo o espectro de informações do cliente.
### Ações de dados
O Data 360 é uma plataforma ativa que dá suporte à ativação de pipelines em resposta a eventos de dados. Por exemplo, um evento significativo, como uma queda no saldo da conta de um cliente, pode acionar um Salesforce Flow para orquestrar uma ação correspondente. Da mesma forma, as atualizações nas principais métricas, como o gasto da vida útil, podem ser propagadas automaticamente para aplicativos relevantes.
Ações de dados monitoram continuamente dados incrementais para alterações usando eventos de alteração nativos (SNCE) de armazenamento e feed de alteração de dados (CDF). Esses dados são avaliados em relação às regras de ação configuradas pelo cliente, como monitoramento de limite ou alterações de estado. Quando essas regras são atendidas, um evento de ação de dados é gerado. Esse evento é aprimorado com informações adicionais (por exemplo, status de fidelidade do cliente) e enviado imediatamente para seu destino configurado, como o Salesforce Flow ou um aplicativo externo, para acionar orquestrações de negócios.
#### Plataforma de dados do cliente
O Data 360 oferece suporte a recursos nativos da CDP (Plataforma de dados do cliente), incluindo recursos avançados de resolução de identidade e criação de identificadores e perfis de indivíduo unificados junto com históricos de engajamento abrangentes. Essa plataforma é capaz de lidar com estruturas Business-to-Business (B2B) e Business-to-Consumer (B2C) com suporte para resolução de identidade e gráficos de identidade que usam regras de correspondência exatas e parciais, conforme descrito acima. Esses gráficos de identidade são aprimorados com dados de engajamento de vários canais, o que ajuda a criar gráficos de perfil detalhados com percepções e segmentos analíticos valiosos.
Um conceito-chave que dá suporte ao perfil do cliente é o gráfico de dados. O Data 360 oferece um gráfico de dados corporativos no formato JSON, que é um objeto não normalizado derivado de várias tabelas do Lakehouse e suas interrelações. Isso inclui um gráfico de dados "Perfil" criado pela CDP que engloba o histórico de compra e navegação de uma pessoa, o histórico de caso, o uso do produto e outras percepções calculadas e é extensível por clientes e parceiros. Esses Gráficos de dados são adaptados a aplicações específicas e melhoram a precisão do aviso de IA generativa fornecendo contexto relevante para o cliente ou o usuário. A camada em tempo real do Data 360 usa o gráfico de perfil para personalização e segmentação em tempo real. Imaginamos modelar o Contexto do Agentforce que engloba Conversas, Sessões e Memória do agente como Gráficos de dados.
Além disso, a CDP habilita a segmentação e ativação eficazes em diferentes plataformas, como o Marketing Cloud do Salesforce, o Facebook e o Google. Ele processa perfis do cliente em lote, quase em tempo real e em tempo real, o que permite tomada de decisão e personalização imediatas. Essa funcionalidade aprimora interações em cenários B2C e B2B, garantindo que as empresas possam responder de modo rápido e preciso às necessidades e comportamentos dos clientes.
### Camada em tempo real
A camada em tempo real do Data 360 é suportada pela CDP do Data 360 e estende seus conceitos para casos de uso em tempo real. A camada em tempo real do Data 360 é projetada para processar eventos como fluxos de cliques da Web e móveis, visitas, dados do carrinho e checkouts em latências de milissegundos, aprimorando a personalização da experiência do cliente. Ele monitora continuamente o engajamento do cliente e atualiza o perfil do cliente do Customer 360 com dados de engajamento em tempo real, segmentos e cálculos para personalização imediata.
Por exemplo, quando um consumidor compra um item em um site de compras, a camada em tempo real rapidamente detecta e ingere esse evento, identifica o consumidor e aprimora seu perfil com informações atualizadas sobre o gasto na vida útil. Isso permite a personalização da experiência deles no site em menos de segundos. Além disso, essa camada inclui recursos para acionamento e respostas em tempo real, habilitando ações imediatas com base nas interações com o cliente.
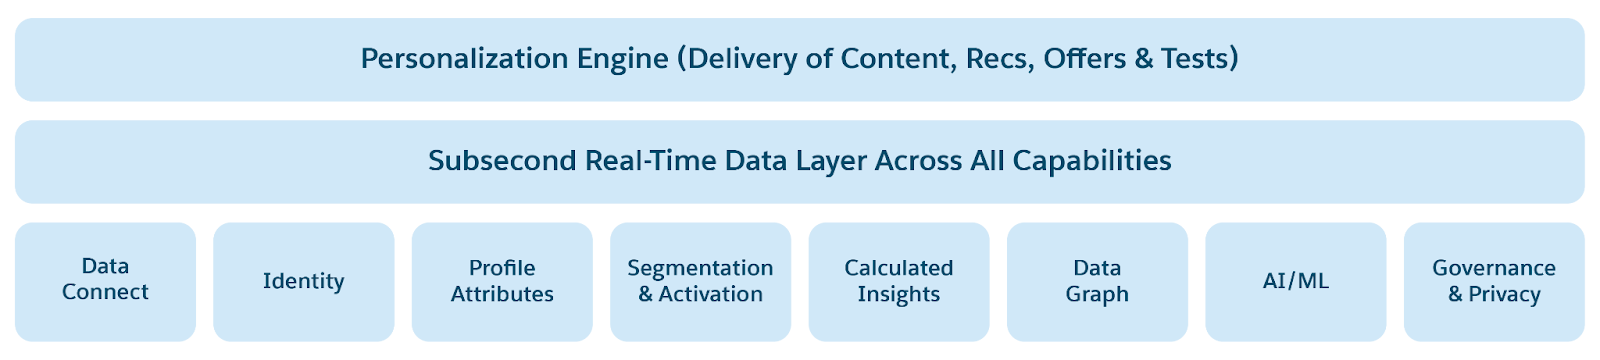 A plataforma Subsegundo em tempo real habilita essa transformação por meio de vários recursos importantes:
1. **Gráficos de dados em tempo real**: Um perfil do Customer 360 é criado usando um gráfico desnormalizado que inclui os principais objetos e campos mais relevantes para as marcas. Esses Gráficos de dados permitem processamento de dados em tempo real e fornecem conteúdo e percepções acionáveis em milissegundos
2. **Ingestão e transformação em tempo real**: Ingira eventos e perfis do usuário em milissegundos de fontes da Web e móveis.
3. **Resolução de identidade em tempo real**: Mescle perfis do cliente entre dispositivos, unificando usuários desconhecidos e conhecidos instantaneamente.
4. **Insights calculados em tempo real**: Calcule métricas como valor da vida útil (LTV) ou histórico de visitas do usuário em milissegundos para habilitar Personalização ou ofertas para Web, ChatBot ou agente de serviços.
5. **Segmentação em tempo real**: Segmente públicos rapidamente, personalizando mensagens e interações em tempo real.
6. **Ações em tempo real**: Permita que as marcas avaliem cada engajamento do usuário e realizem ações por meio do Salesforce Flow ou outros canais de comunicação relevantes.
No Data 360, criamos uma nova plataforma em tempo real com pipeline em tempo real, armazenamento de baixa latência e uma camada de processamento de dados de menos de um segundo. Conforme dados interativos rápidos são ingeridos de canais da Web e móveis, eles passam por uma série de processos rápidos.
Nossos SDKs da Web e móveis e APIs em tempo real coletam dados de aplicativos da Web/móvel (em interações futuras do agente) e os enviam para nosso servidor de sinalizadores. Esses dados então são roteados para a Camada em tempo real para processamento de milissegundo e para a Camada do Lakehouse para integração a dados em lote/fluxo. A camada em tempo real processa os dados recebidos em tempo real no contexto de um perfil de usuário (anônimo ou conectado), como atualizar o gasto total do usuário ou o valor da vida útil, etc., para personalização em tempo real na sessão. A Camada em tempo real é suportada pelo armazenamento de armazenamento de memória principal e NVme (SSD) para armazenar dados em tempo real e perfis do cliente. Quando os dados estão na Camada em tempo real, eles passam pelos seguintes processos antes de serem atualizados para o Gráfico de dados em tempo real:
- **Ingestão simples e transformações**: Os dados são ingeridos e transformados para processamento adicional.
- **Resolução de identidade**: As regras de correspondência exata são aplicadas para unificar perfis com todos os conjuntos de regras de correspondência existentes, de modo que os especialistas com conhecimento em dados não precisam criar novos conjuntos de regras de resolução de identidade especificamente para tempo real.
- Insights **computados**: Cada engajamento é avaliado, cálculos simples, como soma e contagem em milissegundos, são executados e os dados são atualizados no Gráfico de dados em tempo real.
- **Segmentos em tempo real**: Cada dado de engajamento é avaliado para determinar se ele atende aos critérios para segmentos em tempo real definidos e os usuários são adicionados a segmentos qualificados em milissegundos.
- **Ações e acionadores em tempo real**: Cada engajamento é avaliado em relação a regras definidas para acionar ações para uma variedade de metas em tempo real quando as regras são atendidas em milissegundos.
- **Gráfico de dados em tempo real e API**: O gráfico de dados em tempo real, que também inclui uma API em tempo real, permite que as marcas recuperem dados atualizados no formato JSON para cada usuário, garantindo que todas as interações com o cliente sejam informadas pelos dados mais recentes.
#### Personalização
A personalização envolve saber para quem focar, quando e onde entregar conteúdo e recomendações relevantes, o que dizer e qual frequência. A Plataforma de serviços de personalização é o orquestrador das decisões tomadas para otimizar a realização da meta por meio de experiências personalizadas.
Os **Serviços de Personalização** oferecem as seguintes funcionalidades:
- Conjunto consistente de modelos e maneiras de interpretar dados de perfil, atividade e ativo no Data 360
- Experimentação integrada de plataforma (A/B/n, bandido de vários braços)
- Integração de Metas no momento do design (configuração), tempo de treinamento de ML e tempo de execução (inferência de ML)
- Suporte à interação em tempo real e em lote em escala B2C (usuários anônimos, externo interativo em tempo real de alto volume, lote interno de alto volume)
- Analytics conduzido pelo Data 360
- Padrões para integrar o modelo de IA e o serviço de outras partes (interna e externa)
- Integração ao ecossistema de metadados principais (características PLATE)
- Implementações de OOTB de casos de uso conduzidos por IA de alto valor (Recomendações/decisões com vários algoritmos de ML, incluindo bandidos contextuais para promoção/seleção de conteúdo, recomendações de produto, decisões de precificação etc.)
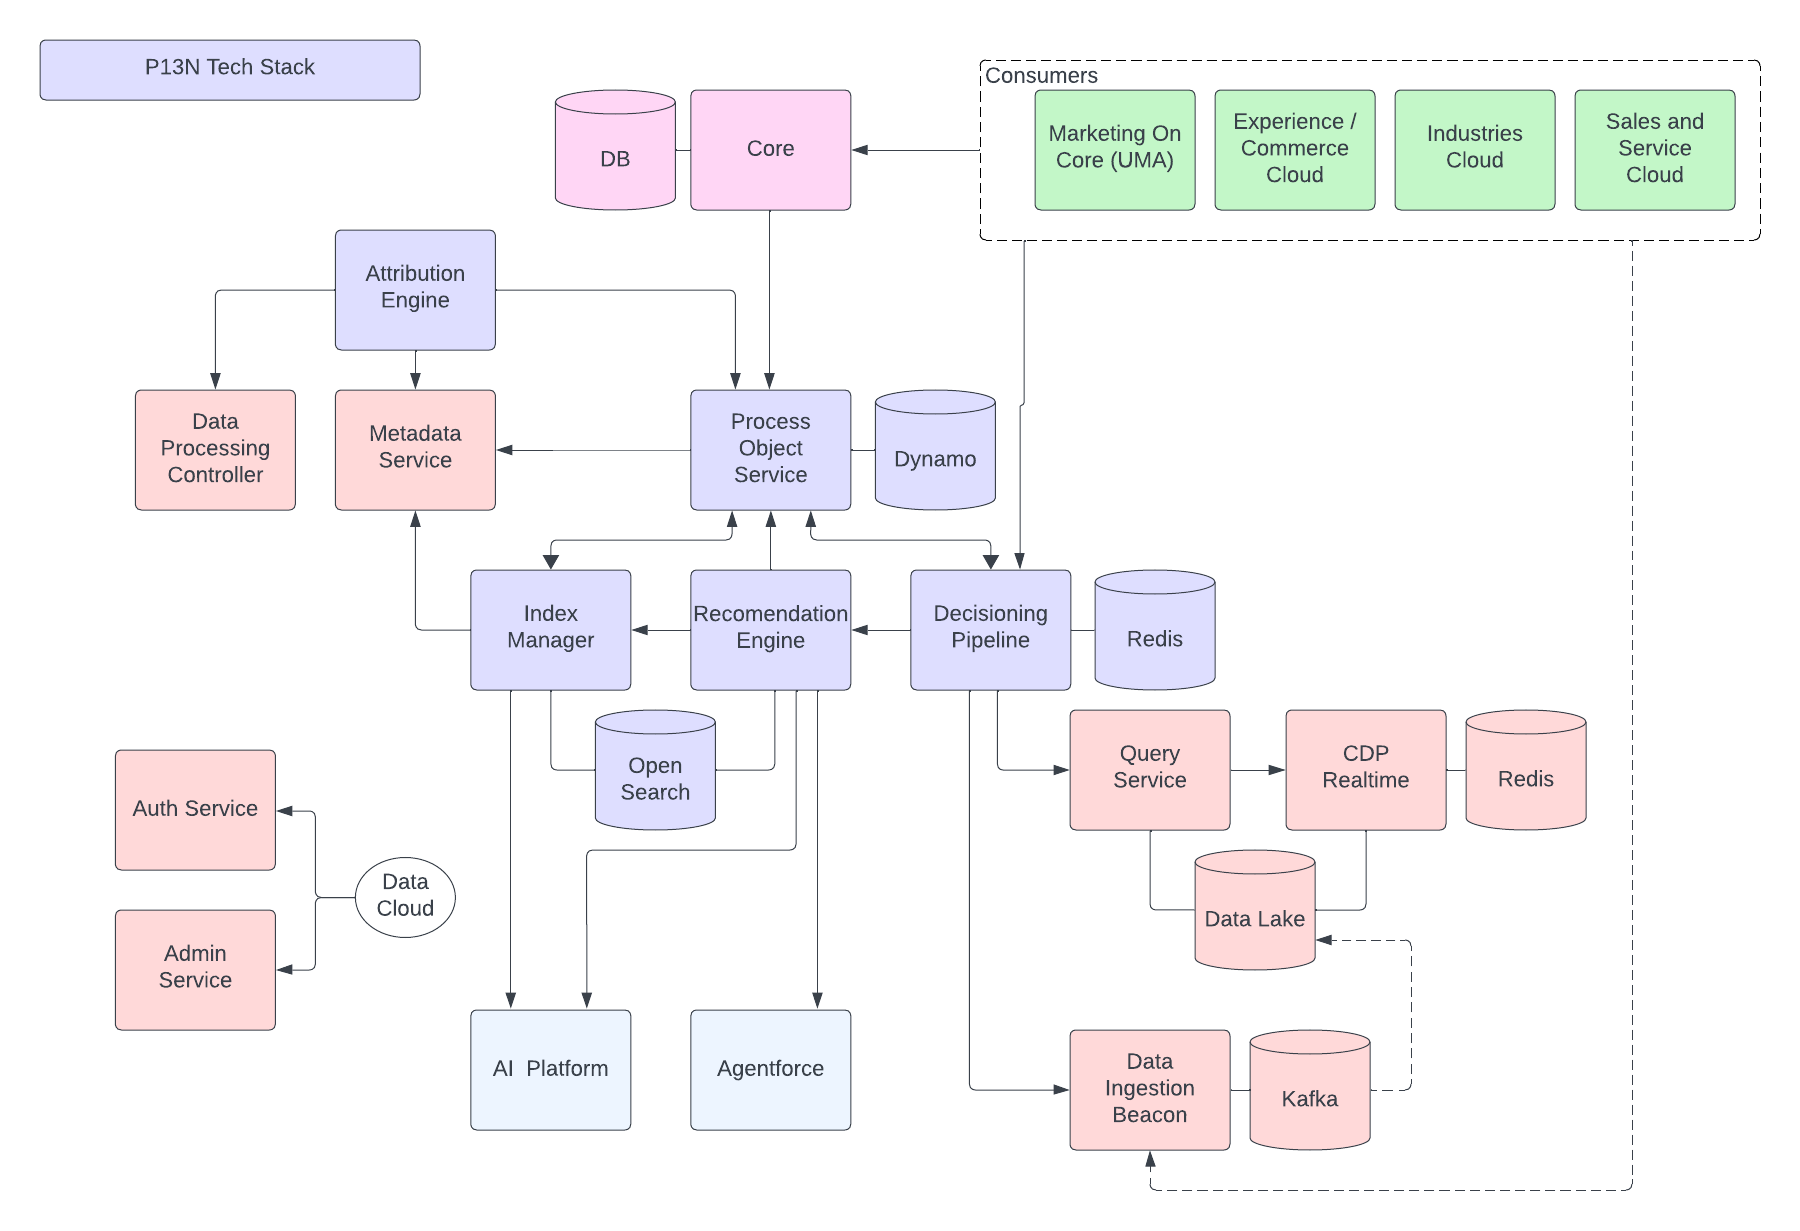 - **Pipeline de decisão**
- Atender solicitações externas para decisões de personalização, incluindo aumento de perfil, experimentação e recomendações.
- **Mecanismo de recomendação**
- Serviço de tempo de execução de recomendações baseadas em regra ou ML.
- **Gerenciador de índice**
- Gerencia/Orquestra o fluxo de trabalho para processos assíncronos, incluindo treinamentos de ML para modelos de recomendação
- **Serviço de objeto de processo**
- Responsável por sincronizar metadados de personalização entre o núcleo e fora dele
- **Mecanismo de Atribuição e Experimentação**
- Atribuição e experimentação de recomendações de personalização do Analytics
### Pesquisa empresarial agente
O Data 360 é projetado como uma plataforma robusta e avançada especificamente para dar suporte às experiências agentes emergentes. Nós alcançamos esses recursos com base em vários serviços existentes do Data 360 e através de uma profunda integração com Agentforce.
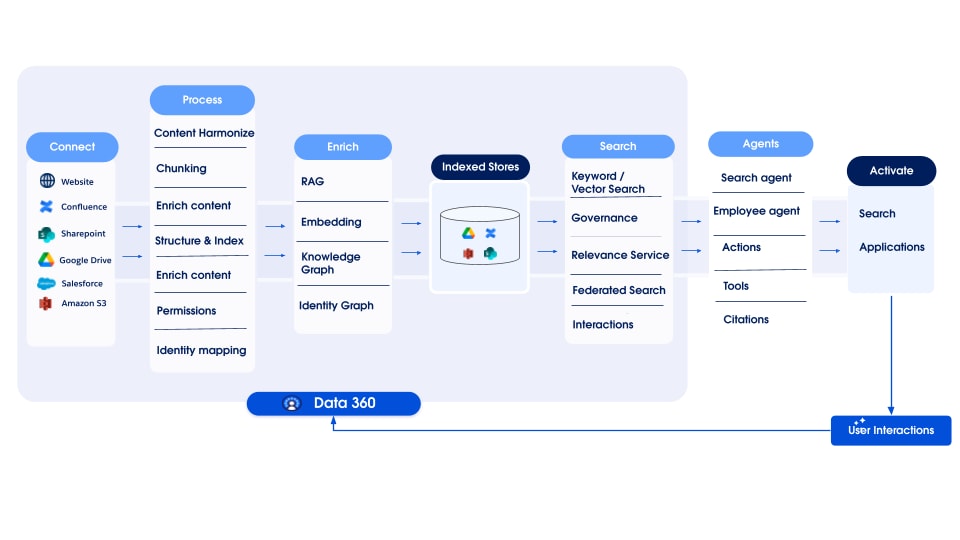 #### Aproveitando os principais pontos fortes do Data 360
Nossa abordagem da Pesquisa comercial agendada é baseada nos seguintes princípios:
- Os dados corporativos são mantidos em serviços ou lojas isoladas, com permissões seguras necessárias para acesso. A capacidade de acessar esses dados e processá-los enquanto mantém as permissões de origem é vital para garantir o Trust.
- A classificação cruzada e a relevância em todo o corpus completo de dados permitem resultados melhores, o que, por sua vez, pode fornecer um contexto melhor para experiências agentes.
Para oferecer essas experiências, a Pesquisa comercial de agência é criada com base nestes principais componentes arquitetônicos:
- **Conectores**: O amplo conjunto de conectores disponíveis no Data 360 permite que você acesse e ingira dados de uma ampla variedade de origens.
- **Processamento de dados não estruturados**: Isso é fundamental para lidar com conteúdo não tabular, permitindo que o sistema derive significado e contexto de dados diversos.
- **Governance**: Garanta a segurança, a conformidade e os controles de acesso em nível corporativo para todos os dados consumidos pela pesquisa. O suporte para permissões de visibilidade de origem garante que os dados estejam acessíveis apenas a usuários autorizados, tanto para experiências de pesquisa simples quanto para experiências agentes. Para garantir a recuperação rápida, as permissões de segurança são avaliadas e impostas nativamente pelos backends de pesquisa no primeiro estágio de acesso aos dados.
- **Caixa de recuperação unificada**: Para lidar com o desafio de dados isolados, os conectores alimentam uma camada abrangente de Recuperação unificada. Essa camada fornece um único ponto de acesso a todos os dados, estejam eles permanecendo em sistemas externos acessados por meio da Pesquisa federada ou gerenciados nativamente por meio de índices avançados para dados de cópia zero e dados ingeridos.
- **Compreensão inteligente de consulta**: Antes da recuperação, o sistema usa mecanismos habilitados por IA para interpretar a intenção do usuário. Além de incorporar representações da consulta para correspondência de vetor semântico, ele pode reescrever e expandir pesquisas baseadas em palavra-chave para melhorar a precisão.
- **Pesquisa híbrida e consulta avançada**: Para localizar as informações mais relevantes, a plataforma usa várias estratégias em paralelo. A pesquisa híbrida fornece uma correspondência precisa de palavras-chave com a pesquisa vetorial semântica em partes de dados otimizadas, enquanto a pesquisa de registro completo recupera simultaneamente documentos inteiros. Ambos são combinados para garantir a relevância semântica e a cobertura completa do conteúdo.
- **Classificação hierárquica**: Depois que os dados são recuperados, uma arquitetura de classificação hierárquica de vários estágios pontua, mescla e classifica novamente os resultados de cada origem e método. Esse processo cria uma única lista unificada que detecta as informações mais relevantes para o usuário ou agente.
#### Aplicativos de pesquisa agente
A IA generativa está mudando o consumidor principal da pesquisa corporativa de usuários humanos para Modelos de idioma grande (LLMs). O Data 360 Search foi desenvolvido do zero para atender a ambos. Ele é otimizado para lidar com consultas mais longas e complexas dos agentes e retornar os resultados contextuais avançados necessários para loops de consumo programático e raciocínio. Ao mesmo tempo, o sistema pode lidar com as consultas mais curtas, muitas vezes ambíguas, típicas de usuários humanos, fornecendo recursos como snippets e destaques para avaliação rápida em uma IU.
A entrega definitiva de experiências de pesquisa agente combina ambas as abordagens:
1. **Resultados da pesquisa direta**: o aplicativo pode exibir uma lista tradicional de resultados classificados usando uma API orientada por metadados criada na base de pesquisa unificada do Data 360.
2. **Resposta conversacionais agudas de vários turnos**: respostas agentes são implementadas por meio de integração nativa com Agentforce. Essa experiência conversacional é conduzida por um agente principal que orquestra ações e consultas, delegando todas as tarefas de recuperação de informações a um agente de pesquisa interno especializado.
Esse agente de pesquisa especializado é otimizado para recuperação de informações corporativas. Ele usa um loop de raciocínio para formular e executar pesquisas paralelas para explorar diferentes facetas da solicitação de um usuário. Ele utiliza um conjunto eficiente de ferramentas, incluindo a pesquisa unificada do Data 360 para todos os tipos de dados e idiomas de consulta estruturados para recuperar dados precisos de tabelas e entidades.
Por meio dessa síntese arquitetônica, o Data 360 capacita a criação de experiências de pesquisa corporativas altamente inteligentes, sensíveis ao contexto e acionáveis.
### Estender o Data 360 com código personalizado
A extensibilidade é um dos principais recursos da Salesforce Platform. A Extensão de código fornece extensibilidade no Data 360, permitindo que usuários de código profissional executem lógica do Python personalizada diretamente no ambiente do Data 360, complementando suas funcionalidades declarativas avançadas e de baixa codificação. Usando a Extensão de código, os usuários podem estender com segurança os recursos principais do Data 360, como Transformações e Pipelines de dados não estruturados (partilhamento personalizado).
Nosso design para Extensão de código prioriza flexibilidade, segurança, eficiência e uma experiência de desenvolvedor simplificada. Ele oferece suporte a dois modelos de execução primários, cada um personalizado para necessidades arquitetônicas específicas:
- **Modelo de script**:
- **Objetivo**: Para lógica personalizada abrangente que requer interação direta com o Data 360 Lakehouse.
- **Funcionalidade**: Os clientes escrevem scripts completos do Python usando o SDK Extensão de código, habilitando o acesso de leitura e gravação ao Lakehouse por meio de APIs do SDK. Ideal para preparação de dados personalizados/complexos ou manipulação de dados personalizada.
- **Isolamento e Segurança**: Enquanto os scripts acessam o Lakehouse, sua execução é limitada a um ambiente seguro e isolado dentro do tempo de execução do Data 360, impedindo interferência com outros processos ou acesso não autorizado ao sistema.
- **Modelo de função**:
- **Objetivo**: Análogo a uma função sem servidor, para cálculos modulares sem estado chamados de pipelines do Data 360 existentes (por exemplo, agrupamento personalizado em um pipeline não estruturado).
- **Funcionalidade**: Funções fornecidas pelo cliente recebem entrada, calculam e retornam saída.
- **Isolamento e Segurança**: Essas funções são projetadas para isolamento estrito; elas não têm acesso direto ao Lakehouse. Sua execução é de sandbox, sem estado e restrita a recursos, tornando-as adequadas para etapas de processamento focadas sem estado, garantindo segurança, execução previsível e minimizando o raio de explosão.
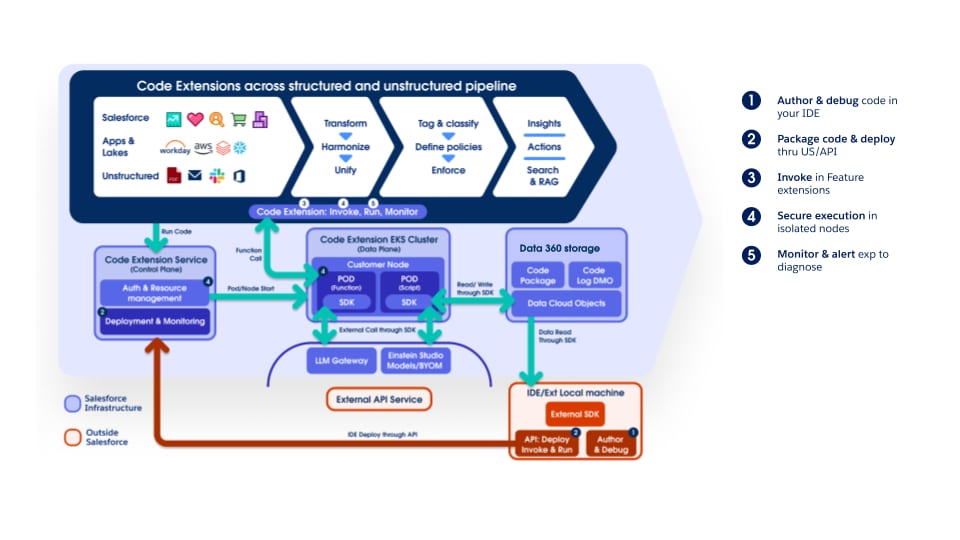 Os modelos Script e Function visam executar com segurança o código do cliente, impedindo que o código de um locatário afete outros ou obtenha acesso não autorizado a dados de outros locatários, recursos do Salesforce ou recursos externos. Essa segurança é alcançada por meio de uma arquitetura em camadas (defense-in-depth). Essa arquitetura fornece um ambiente de execução isolado para o código personalizado de cada locatário, incorporando várias proteções. Eles incluem isolamento lógico no nível de Kubernetes (K8s), isolamento de rede, sandbox de tempo de execução e permissões de privilégio mínimo, tudo complementado por monitoramento operacional e prontidão para resposta e detecção de incidentes.
#### Experiência do desenvolvedor e visibilidade operacional
Para oferecer suporte a um ciclo de vida de desenvolvimento robusto, a Extensão de código oferece:
- **Autoria externa e depuração**: Os desenvolvedores podem elaborar e depurar o código do Python em ambientes familiares, como VSCode, aproveitando o SDK.
- **Implantação flexível**: O código personalizado pode ser empacotado e implementado usando utilitários SDK, a IU do Data 360 ou a API, habilitando a integração ao CI/CD.
**Registros operacionais**: O acesso a registros de execução detalhados proporciona transparência e ajuda na solução de problemas na produção.
Ao oferecer esses recursos de extensão de código seguros e flexíveis, o Data 360 capacita os arquitetos a personalizar a plataforma para seus requisitos de processamento de dados mais exclusivos e complexos, realmente solidificando seu papel como um tecido de dados corporativo extensível.
### Estender o Data 360 trazendo seus próprios modelos de IA
Conforme as empresas aceleram a adoção da IA, a maioria mantém ecossistemas de ML heterogêneos, incluindo Amazon SageMaker, Google Vertex AI e ambientes baseados em Python personalizados, hospedando modelos que conduzem previsões críticas para a missão, como pontuação de risco de crédito, propensão de rotatividade, recomendações de produto e decisões de próxima melhor ação.
Tradicionalmente, a integração desses modelos externos ao Salesforce exigiu camadas de API personalizadas, pipelines de ETL ou orquestração de middleware, introduzindo duplicação de dados, sobrecarga de governança, latência e complexidade operacional – desafios que entram em conflito com uma visão unificada, em conformidade e em tempo real da Plataforma de dados do cliente (CDP).
**Traga o teu modelo (BYOM)**: Entregue por meio do Einstein Studio no Data 360, ele lida com esses desafios permitindo a invocação direta de modelos treinados externamente em fluxos de trabalho do Salesforce, lógica do Apex e ferramentas de automação sem mover ou replicar dados. Por meio da federação de cópia zero, o Data 360 atua como a única fonte de verdade governada, expondo dados do Customer 360 harmonizados para inferência em pontos finais externos. Saídas de previsão fluem de volta em tempo real, alimentando processos de negócios com inteligência dimensionável.
O BYOM elimina de modo eficaz a lacuna entre a ciência de dados e a execução operacional desacoplando o desenvolvimento de modelo, os dados governados e as camadas de consumo. Ela preserva a independência da plataforma, reduz a complexidade da integração, acelera a implantação de IA e mantém a governança sobre dados confidenciais.
A arquitetura opera da seguinte maneira: O Data 360 fornece uma base de dados unificada do Customer 360, enquanto o Einstein Studio orquestra conexões a plataformas ML externas (SageMaker, Vertex AI ou pontos de extremidade personalizados). Modelos externos executam a inferência em modos em tempo real, em lote ou de streaming. As camadas do Salesforce – APIs de Fluxo, Apex e Consulta – consomem saídas para fornecer percepções personalizadas, automatizadas e analíticas em Sales, Service, Marketing e Industry Clouds.
Do ponto de vista empresarial, o BYOM oferece:
- **Integridade dos dados e governança**: Elimina cópias de dados não controladas e impõe a conformidade da política.
- **Democratização da IA**: Torna modelos complexos acessíveis a usuários não técnicos por meio de ferramentas do Salesforce.
- **Aceleração de tempo para valor**: Modelos externos são ativados imediatamente em processos do Salesforce.
- **Suporte para escalabilidade e arquitetura híbrida**: Habilita a implantação em várias nuvens de cargas de trabalho de IA.
- **Arquitetura de IA pronta para o futuro**: Dá suporte a estratégias de IA composível, desacoplamentando camadas de dados, modelo e consumo para agilidade operacional.
**Traga o seu próprio LLM (BYO-LLM)**: Oferece o mesmo mecanismo de extensibilidade, mas para modelos generativos. Ao habilitar a invocação direta de LLMs externos, permitimos que os clientes os usem na Plataforma Agentforce em vez de modelos fornecidos pela Salesforce. Para empresas, o BYO-LLM permite:
- Acesso a modelos ajustados
- Integração de modelos não fornecidos atualmente pelo Salesforce
- Uso de modelos em contas fornecidas pelo cliente
### Colaboração de dados
As empresas modernas operam em um panorama de dados complexo caracterizado por dois desafios arquitetônicos importantes:
1. **Fragmentação intra-empresarial**: Organizações grandes costumam usar várias organizações do Salesforce (geralmente segmentadas por região, unidade de negócios ou aquisição histórica) e vários outros sistemas de dados. Essa fragmentação cria silos de dados internos, tornando impossível estabelecer uma visualização única, confiável e unificada do cliente para engajamento em tempo real em todo o negócio. O desafio é unificar esses dados sem consolidá-los fisicamente ou duplicá-los em todos os sistemas, garantindo que a governança permaneça intacta.
2. **Colaboração entre empresas**: As empresas costumam precisar compartilhar dados com parceiros e fornecedores para marketing, medição e inteligência de negócios conjuntos. O desafio é habilitar essa colaboração enquanto protege dados confidenciais e proprietários e cumpre normas de privacidade, como GDPR e CCPA, bem como barreiras da concorrência.
O Salesforce Data 360 lida com esses desafios com uma estrutura de Trust por design de cópia zero baseada no princípio de compartilhar acesso e percepções, em vez de mover ou duplicar dados.
#### Mecanismos de colaboração do Data 360
O Salesforce Data 360 lida com os desafios de fragmentação de dados e colaboração com o Data Cloud One, o Compartilhamento de dados entre o Data 360s e o Data Clean Rooms prioritário para a privacidade. Essas soluções unificam dados do cliente, permitem trocas de dados seguras e fornecem percepções de privacidade. Com uma abordagem de Trust por design de cópia zero, as organizações podem desbloquear o potencial de dados para engajamento em tempo real, parcerias aprimoradas e tomada de decisão inteligente. Cada uma dessas opções de colaboração de dados tem fins diferentes.
##### Habilitação corporativa interna com o Data Cloud One
O Data Cloud One é a solução de arquitetura básica para empresas que operam várias organizações do Salesforce. Sua finalidade vai além do simples compartilhamento de dados; é projetada para estabelecer uma única visualização do cliente confiável e habilitar recursos completos da plataforma Data 360 em toda a organização.
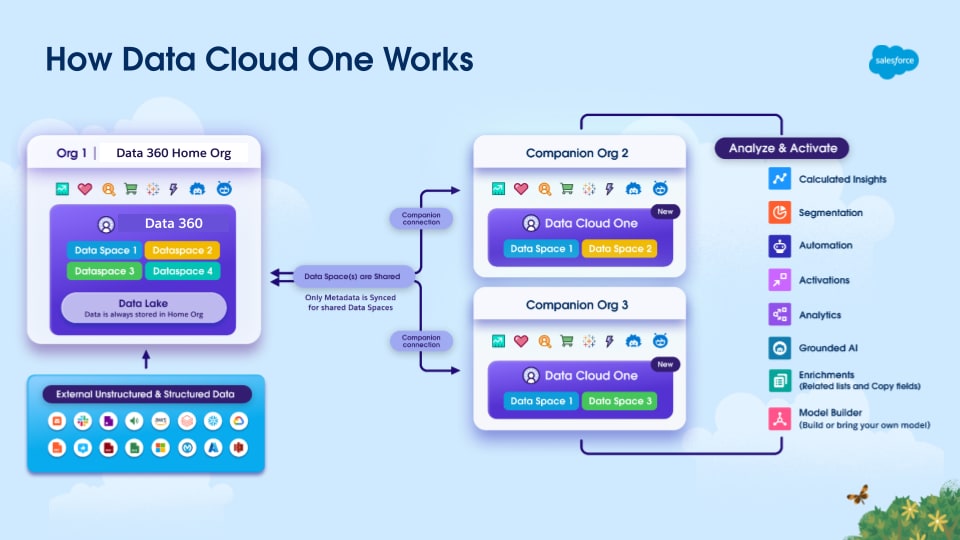 Esse mecanismo centraliza uma instância do Data 360 da organização inicial designada, que serve como a autoridade central para gerenciamento de dados e criação do perfil do cliente unificado. A organização inicial é a organização na qual o Data 360 está provisionado. Uma conexão do Data Cloud One é estabelecida entre o Data 360 e outras organizações do Salesforce, chamada de Organizações de companheiro. Como parte da conexão do Data Cloud One, o Data 360 compartilha um ou mais de seus espaços de dados com cada organização companheira, fornecendo acesso a dados e metadados em cada espaço de dados compartilhado. Isso é feito por meio de um modelo de federação de cópia zero e sincronização de metadados entre organizações.
O Data Cloud One também permite que as Organizações parceiras aproveitem a instância do Data 360 da organização inicial para suas próprias necessidades de ativação, personalização e inteligência. Essa estratégia é essencial para eliminar a fragmentação de dados internos e garantir que todas as unidades de negócios sejam ativadas em relação ao mesmo perfil de cliente unificado, regulamentado e unificado, maximizando o retorno sobre o investimento da implementação principal do Data 360.
##### Compartilhamento de dados entre organizações do Data 360
Para ambientes internos distribuídos (em que a centralização completa não é viável) e para colaboração com parceiros externos confiáveis, o compartilhamento de dados do Data 360-to-Data 360 conecta instâncias independentes do Data 360.
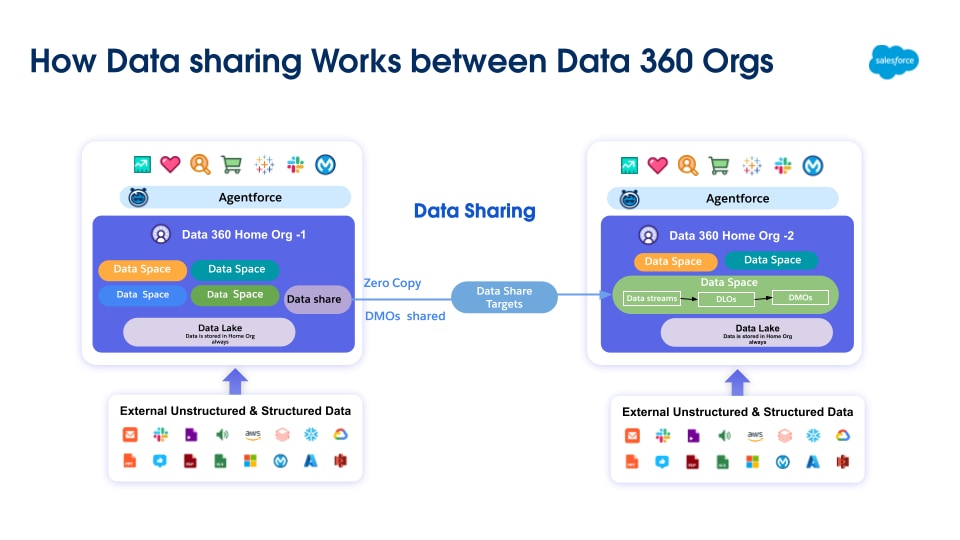 Esse modelo de compartilhamento de cópia zero estabelece uma conexão entre locatários separados do Data 360 provisionados em diferentes organizações do Salesforce para fins de troca segura de objetos de dados (DLOs, DMOs e CIOs). Depois de conectado, todo o objeto de dados fica acessível no Data 360 do destinatário. O administrador do Data 360 do destinatário pode então definir regras de governança para gerenciar o acesso do usuário a esses dados.
##### Colaboração com prioridade em privacidade com a Colaboração do Data 360 Clean Room
Quando a colaboração requer os mais altos níveis de privacidade e conformidade ou quando preocupações de concorrência proíbem o compartilhamento de dados brutos, o Data 360 Clean Rooms é arquitetonicamente obrigatório.
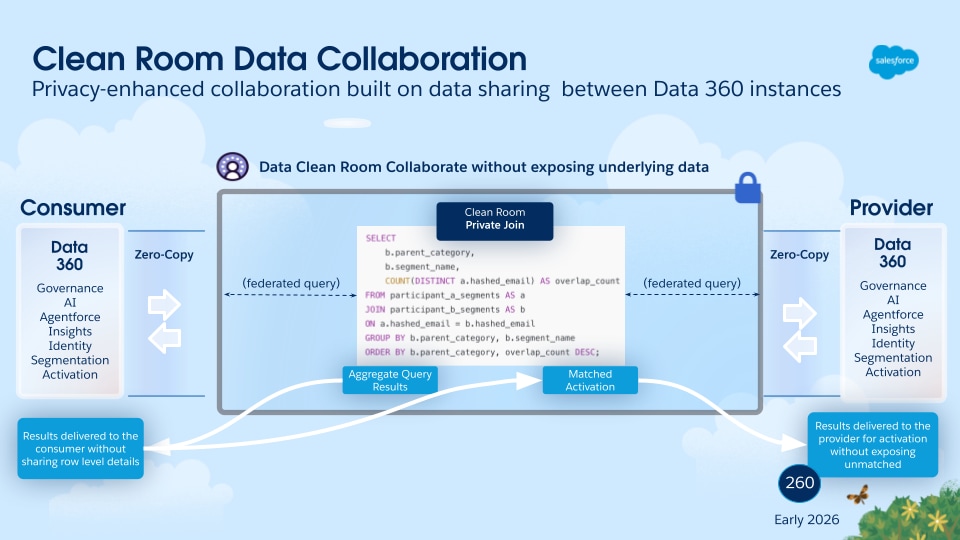 Arquitetonicamente, a Colaboração do Data 360 Clean Room é criada com base na estrutura de compartilhamento de cópia zero usada pelo compartilhamento de dados do Data 360-to-Data 360, mas com camadas adicionais de governança e restrições computacionais aplicadas. O Data 360 Clean Room fornece um ambiente de computação seguro e controlado em que as partes podem unir seus conjuntos de dados com base em chaves anonimizadas. Seu objetivo principal é permitir a análise conjunta e a geração de percepções sem expor os dados proprietários subjacentes. O ambiente aplica regras estritas e programáveis, como limites mínimos de agregação e identificadores não exportáveis. Essas regras garantem que apenas percepções aprovadas, aprimorando a privacidade e agregadas sejam derivadas e compartilhadas. Isso torna as salas limpas essenciais para casos de uso, como medição de campanha entre plataformas e análise de sobreposição de público confidencial.
## Conclusão: Salesforce Data 360: o backbone de dados indispensável para a empresa agente
O Data 360 é projetado como um tecido de dados inteligente, extensível e confiável necessário para habilitar a IA de próxima geração. Seu design arquitetônico lida com o problema de dados fragmentados, permitindo que as organizações unifiquem, processem e ativem todos os dados do cliente em escala, usando a Federação de dados de cópia zero para garantir a eficiência.
Sua organização de dados robusta estabelece uma visualização harmonizada de DLOs (incluindo dados não estruturados) para DMOs, todos protegidos dentro de espaços de dados particionados. Os recursos versáteis de processamento de dados do Data 360, incluindo transformações em lote e streaming, percepções calculadas, processamento de dados não estruturado e resolução de identidade, são alimentados pela arquitetura incremental SNCE e CDF, garantindo processamento eficiente quase em tempo real e poupança significativa de custos.
A extensibilidade é fornecida pela arquitetura Extensão de código, habilitando com segurança a lógica do Python personalizada por meio de scripts ou funções isoladas para requisitos exclusivos. Além disso, uma estrutura abrangente de governança de dados, criada com base no controle de acesso baseado em atributo (ABAC) com políticas do CEDAR, garante segurança granular, mascaramento de dados dinâmico e imposição consistente em todo o consumo de dados. Isso culmina em recursos sofisticados de segmentação e ativação, convertendo perfis de clientes unificados em estratégias de engajamento dinâmicas de vários canais com responsividade em tempo real.
Crucialmente, a capacidade do Data 360 de unificar dados vastos e diversificados, fornecer contexto em tempo real por meio de sua consulta unificada (incluindo pesquisa estruturada/não estruturada híbrida e hiperaceleração) e aplicar uma governança rígida é fundamental para capacitar agentes inteligentes de IA. Ele fornece os dados confiáveis, recentes e relevantes necessários para estabelecer fluxos de trabalho de IA generativa (RAG) e alimentar as capacidades de múltiplos turnos e orientadas a ações dos agentes acionados pelo Agentforce, garantindo que eles operem com precisão e precisão.
Ao fornecer uma plataforma pronta para o futuro em que os dados de origem são transformados em percepções acionáveis, o Data 360 serve como uma base arquitetônica indispensável para as organizações criarem experiências do cliente Agente. É a base vital que transforma os dados do cliente nas experiências sofisticadas e personalizadas do cliente que conduzem ao sucesso das organizações modernas de hoje.
# Visão geral
As arquiteturas do Salesforce modernas são cada vez mais alimentadas por processamento assíncrono; não como uma conveniência, mas como um requisito estratégico de escala. Nos últimos anos, vimos mais e mais empresas enfrentando volumes de dados crescentes, integrações complexas que envolvem vários pontos de contato e o surgimento de sistemas autônomos que funcionam 24/7/365\. Tudo isso leva os arquitetos a projetar sistemas que são assíncronos em primeiro lugar.
O processamento assíncrono no Salesforce geralmente significa projetar em torno dos limites e da complexidade do controlador. Esses limites atuam como proteções e restrições arquitetônicas que ajudam a produzir sistemas escalonáveis e seguros em massa. Embora nenhum limite de plataforma sirva diretamente para gerenciar a complexidade, os [padrões de design](https://refactoring.guru/design-patterns) podem ajudar a mitigar o risco nessa frente. Interna, o Salesforce frequentemente aprofunde os limites da plataforma para testar novos recursos e automatizar processos comerciais complexos. Criamos uma Estrutura de processamento assíncrono baseada em etapas para executar trabalhos assíncronos com um número arbitrário de etapas. Cada etapa pode ser executada, tentada novamente e reiniciada de modo independente com controles de governança compartilhados e visibilidade operacional total por meio de registro centralizado. Este documento descreve os principais componentes arquitetônicos: Apex enfileirável e finalizadores, fluxo agendado, cursores do Apex, ações invocáveis e integrações com o Slack. Juntos, esses componentes fornecem uma arquitetura modular, escalonável e observável adequada para necessidades empresariais em evolução.
## Principais transferências
- As arquiteturas modernas do Salesforce devem adotar uma abordagem assíncrona primeiro para alcançar escala, resiliência e transparência operacional.
- Dividir trabalho complexo em etapas executáveis de modo independente habilita desempenho previsível, novas tentativas mais seguras, pontuação de verificação, reversão e evolução modular sem reengenhar fluxos de trabalho principais.
- A estrutura fornece uma alternativa escalonável a trabalhos em lote monolíticos e antigos, chamadas assíncronas encadeadas e fluxos profundamente aninhados, e é criada para cargas de trabalho de alto volume que devem ser dimensionadas horizontalmente dentro do Salesforce sem orquestração fora da plataforma.
- A execução determinística e observável garante rastreamento de progresso, monitoramento de SLA, diagnóstico de falha e transparência em nível de auditoria por meio de registro e governança centralizados.
- Projetado para rigor de nível corporativo, incluindo governança unificada, conformidade e controle de estado distribuído em processos de negócios de longa duração.
## Melhores práticas de plataforma
Antes de revisar os requisitos, aqui estão algumas considerações sobre quando usar uma estrutura como esta. Acima de tudo, considere qual sistema é a única fonte da verdade. Se sua organização do Salesforce depender minimamente de dados externos, mas precisar escalar de centenas a milhões de registros, considere uma estrutura assíncrona baseada em etapas.
Use essa estrutura **se**:
- A maioria (ou todas) das informações com base nas quais realizar ações já existe em seu CRM.
- O custo inicial ou contínuo de manter um trabalho de Extrair carga de transformação (ETL) para harmonizar dados externos é muito alto.
- Você precisa adiar o processamento de um grande número de registros do Salesforce em uma agenda definida.
- Você pode dividir o processamento em etapas separadas. Por exemplo, você pode criar um conjunto hierárquico ou baseado em árvore de registros, especialmente se o volume de dados passar pela hierarquia ou pela árvore.
**Não** use essa estrutura se:
- Criar ou atualizar registros requer recálculo imediato.
- A integração é um desafio porque os sistemas externos hospedem dados primários para atualizações de registro. (Considere enviar dados atualizados por push ao Salesforce com a API em massa.)
Considerando essas práticas, vamos revisar nossos requisitos e começar a criar.
## Quebrar os requisitos
Considere a instrução de problema:
> Para um trabalho que precisa ser executado diariamente, verifique se determinados registros cumprem critérios predefinidos para processamento adicional. Se eles fizerem isso, inicie esses trabalhos de processamento. Processar registros pode significar extrair dados de vários sistemas externos para realizar cálculos. As etapas nos trabalhos devem notificar as pessoas por meio do Slack de que os registros processados estão prontos para revisão. As etapas também devem escalar as notificações para gerentes e superiores na hierarquia de papéis com base em um atraso configurável após a primeira rodada de notificações.
Esse problema envolve várias etapas diferentes, algumas das quais podem ocorrer independentemente uma da outra. Há muitas maneiras de dividir o trabalho. Aqui está um agrupamento:
- O agendador.
- A interface da etapa e as implementações concretas que processam registros (independentemente do tipo de processamento).
- O processador que organiza as etapas.
- O Apex invocável chamado pelo agendador.
- A parte da notificação. Usamos o [Slack SDK do Apex](https://developer.salesforce.com/docs/platform/salesforce-slack-sdk/guide/overview.html).
- Há alguma complexidade oculta na frase "delay configurable". Revisaremos essa complexidade mais adiante neste artigo.
Aqui está um diagrama definido para a estrutura integrada:
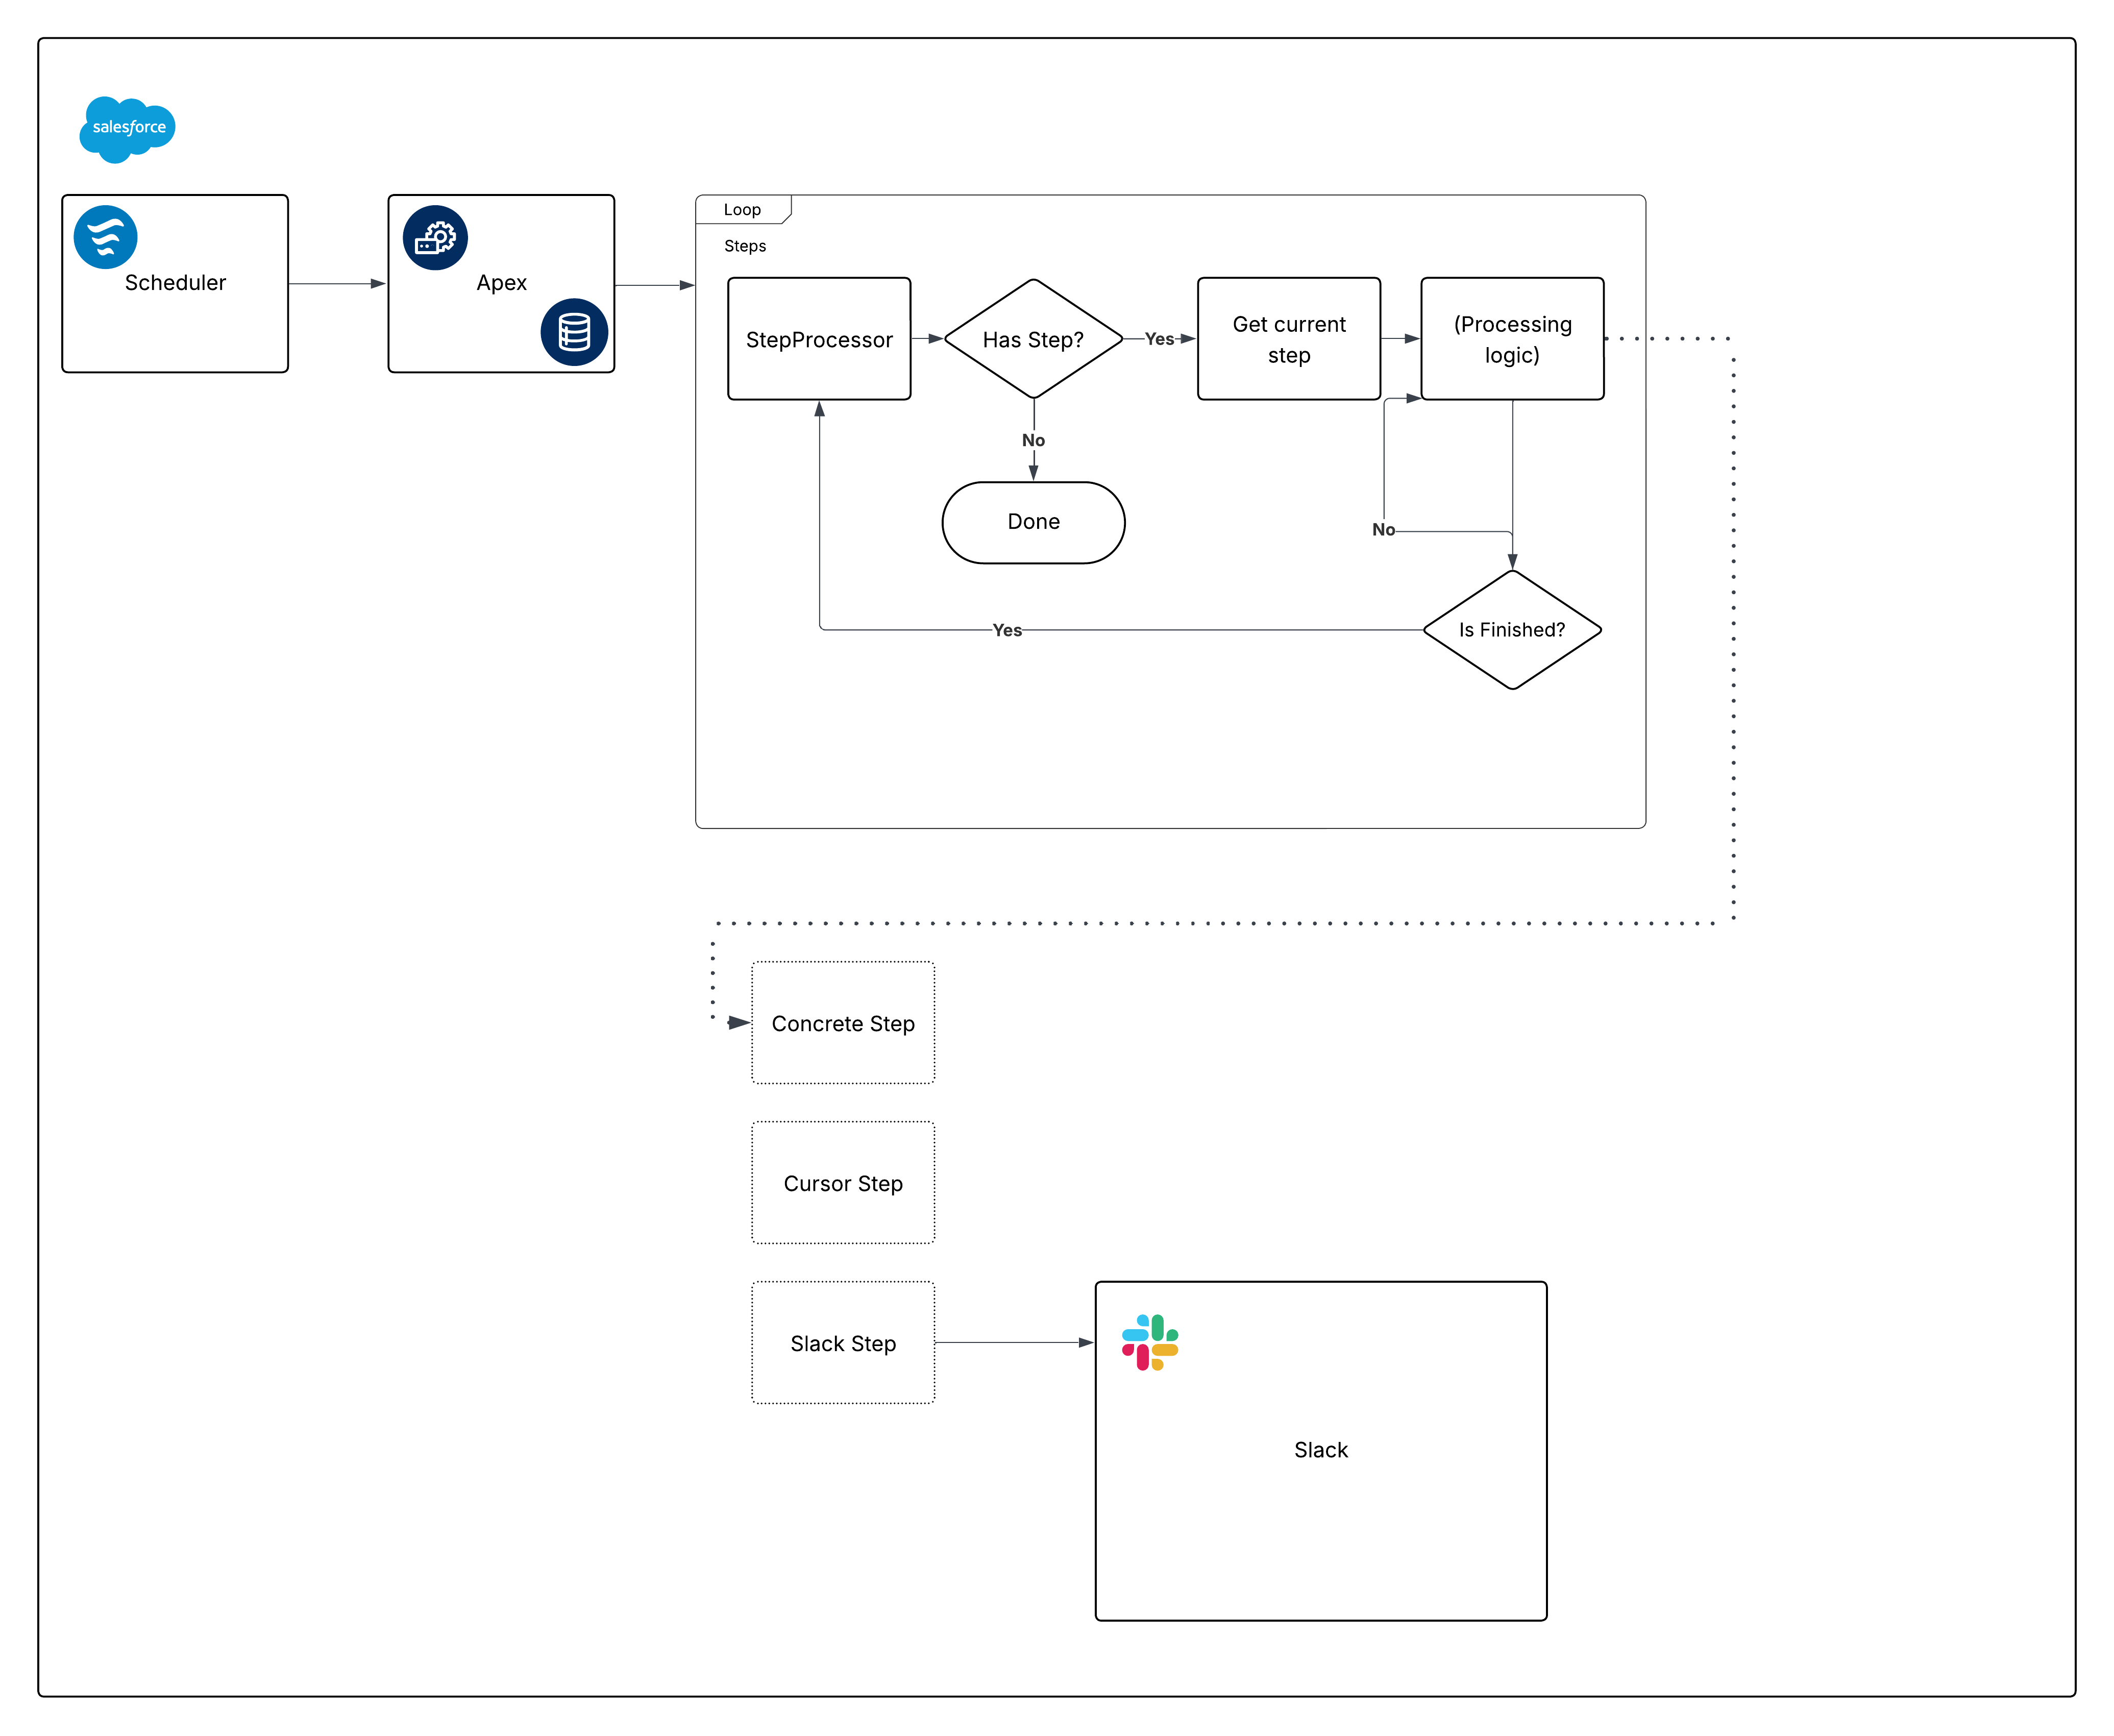 Agora, divida esse diagrama e comece a criar as peças.
## Agendamento com fluxo agendado
O Fluxo agendado oferece várias vantagens como mecanismo de agendamento:
- Fluxos agendados podem ser empacotados e implementados como metadados. Isso não se aplica a trabalhos agendados por meio do Apex (ou pela página Trabalhos agendados).
- O elemento Aguardar é crítico para estruturas que exigem chamadas. Ao usá-lo no Fluxo, as chamadas não são necessárias na parte Invocável da estrutura.
- A granularidade do agendamento atende aos requisitos: o intervalo mínimo para Fluxos agendados é diário. Se você precisar de uma frequência maior (por exemplo, por hora), reconsidere Fluxo agendado para esse requisito.
Outra consideração ao configurar o Fluxo agendado é o encaminhamento de ambiente. Antes de invocar a ação do Apex, adicione um elemento Decisão que avalie a variável `{!$Api.Enterprise_Server_URL_100}`. Isso garante que o trabalho seja executado apenas nos ambientes pretendidos, como UAT e Produção. Esse padrão é importante porque os sandboxes são atualizados com frequência ou recém-criados durante o SDLC, e sem uma verificação de ambiente explícita, um Fluxo agendado pode ser executado inadvertidamente em ambientes em que a estrutura não deve ser executada. Usar o operador `contains` no elemento Decisão torna a configuração resiliente a futuras criações de sandbox ou alterações de URL.
Por fim, considere como a estrutura deve capturar falhas. Sempre adicione um caminho de falha quando o Fluxo chamar qualquer Ação; por exemplo, você pode encaminhar falhas à ação "Adicionar entrada de registro" do [Nebula Logger](https://www.nebulalogger.com/). Como o Nebula Logger grava registros em objetos personalizados, os clientes devem estar cientes de que os dados de registro consomem o armazenamento da organização. Por padrão, os registros são armazenados por 14 dias em uma organização e, em seguida, são limpos. Esse período de retenção é configurável. O Nebula Logger também usa os Eventos da plataforma para publicar registros, de modo que as entradas do registro são salvas independentemente da transação principal de processamento de dados – isso garante que as falhas sejam capturadas mesmo que a ação principal do Fluxo ou do Apex seja revertida. Os clientes devem avaliar os requisitos de retenção e volume de registros esperados ao considerar a adição de uma estrutura de registro.
Esta é a aparência do Fluxo:
 Vamos passar para as primeiras partes do Apex code com o requisito de agendamento agora atendido.
## Criação de uma interface de etapa
Defina uma interface de `Step`:
```java
public interface Step {
void execute();
void finalize();
String getName();
Boolean shouldRestart();
}
```
Para este artigo, a interface de `step` é mostrada como uma classe externa para maior clareza. A estrutura em si é flexível – as equipes podem organizar a interface e suas implementações usando qualquer padrão de empacotamento do Apex que preferem, desde que todas as classes de Etapa façam referência à mesma interface.
Há alguns aspectos a serem considerados sobre os métodos definidos em nossa interface:
- `execute`, embora sem argumento no momento, melhora quando passamos uma classe de `State` (ou interface) para orquestrar dados entre etapas quando a ordem importa.
- Os `getName` podem retornar um valor de `System.Type` em vez de um `String`. A meta é dar à camada de orquestração uma maneira de registrar nomes de etapa sem expor outras propriedades.
Esta é a primeira implementação concreta para mostrar como essas peças se encaixam. Com uma exceção, recomendamos usar o Apex enfileirável para implementar processamento assíncrono no Apex; o Apex em lote normalmente não é necessário (e os métodos de `@future` são desencorajados). O Apex enfileirável é iniciado rapidamente e, com os Cursores do Apex, tem muitas vantagens em relação ao Apex em lote.
### Uma implementação semelhante a cursor do Apex
Os [Cursores do Apex](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_cursors.htm) oferecem uma alternativa moderna ao modelo Apex em lote tradicional. De modo semelhante ao processamento em lote, uma implementação de cursor pode buscar registros em blocos (até 2.000 por lote). No entanto, os cursores permitem várias busca em uma única transação, permitindo uma taxa de transferência significativamente maior para operações de grande volume.
Ao adotar cursores como parte dessa estrutura, as equipes devem estar cientes das limitações atuais de teste e simulação. Como o comportamento do cursor em testes pode ser diferente do comportamento de produção, é importante projetar estratégias de teste que evitem depender de elementos internos do cursor e validar a lógica de orquestração nos limites. Conforme a plataforma evolui, essas áreas continuarão melhorando, mas a orientação principal permanece: Os cursores proporcionam um desempenho maior e uma sobrecarga de orquestração reduzida em comparação ao Apex em lote para muitos casos de uso.
Para definir um limite claro entre o cursor fornecido pelo sistema e seu próprio código, recomendamos criar uma representação semelhante ao cursor ao implementar a interface de `Step`. Considere este código:
```java
public inherited sharing abstract class CursorStep implements Step {
private static final Integer MAX_CHUNK_SIZE = 2000;
protected Cursor cursor;
private Integer chunkSize = System.Limits.getLimitDMLRows();
private Integer position = 0;
protected abstract Cursor getCursor();
protected abstract void innerExecute(List