
|
A Plataforma Salesforce é uma plataforma abrangente baseada em IA que une funcionários, agentes de IA autônomos, dados da empresa e aplicativos em um único sistema confiável para aumentar a produtividade e a experiência do cliente. Ele permite a criação de uma "empresa ativa" conectando aplicativos Customer 360, Data Cloud e Slack para automação completa. |
|
O MuleSoft é a plataforma de integração líder da Salesforce que permite que as organizações conectem aplicativos, dados e dispositivos em ambientes locais e na nuvem. O MuleSoft é uma plataforma que dá aos TI as plataformas para desbloquear dados entre sistemas, desenvolver estruturas de integração e automação escalonáveis e criar experiências diferenciadas e conectadas rapidamente. |
| Ponto de decisão | Diretrizes |
|---|---|
| Notificações quase em tempo real | Os padrões de arquitetura conduzidos por evento, como publish/subscribe, fanout e streaming, tendem a funcionar bem em cenários em que vários aplicativos precisam ser notificados sobre alterações de status ou atualizações de registro quase em tempo real. |
| Processamento paralelo | Padrões como publicar/assinar tendem a funcionar bem em cenários em que grandes volumes de dados ou mensagens altamente complexas exigem a distribuição da carga de processamento entre vários sistemas. |
| Leitura de alto volume | Os padrões de Mensagens passadas e Enfileiramento são comumente usados em cenários em que as organizações têm surtos, e o volume de mensagens que estão sendo produzidas pode exceder a capacidade dos assinantes de processá-los imediatamente. |
| Gravações de alto volume | Os padrões de streaming e enfileiramento funcionam bem em muitos cenários em que as organizações têm aumento no número de mensagens produzidas. |
| Enviar os mesmos dados para diferentes sistemas | Embora a publicação/assinatura tende a ser uma solução bastante comum para organizações que precisam enviar os mesmos dados para vários sistemas, ela pode ser tratada pela maioria dos padrões abordados aqui. Certifique-se de revisá-los em detalhes para encontrar o melhor ajuste. |
| Introdução frequente de novos sistemas ou dispositivos | Os padrões de publicar/assinar, transmitir e enfileirar tendem a funcionar bem para cenários em que o panorama geral tende a estar em fluxo, com novos sistemas e dispositivos sendo adicionados regularmente. Nesse cenário, um novo sistema ou dispositivo simplesmente precisa se tornar um assinante do barramento de evento ou associado a uma fila para começar a receber mensagens, em vez de exigir uma integração de ponto a ponto personalizada. |
| Dispositivos de IoT | Como os dispositivos de IoT geralmente fornecem atualizações frequentes e também podem gerar uma onda de mensagens em alguns cenários, os padrões de streaming e enfileiramento tendem a funcionar bem ao integrá-los a um panorama de TI. |
| Dispositivos e sistemas móveis offline | Dispositivos móveis que precisam trabalhar em áreas com acesso à Internet de baixa qualidade ou não existente ou sistemas que podem estar offline no momento em que as mensagens são entregues se beneficiarão do padrão de enfileiramento, que permite que eles se conectem às filas e recuperem todas as mensagens relevantes quando estiverem online novamente. |
| Ponto de decisão | Orientação/perguntas a fazer |
|---|---|
| Requisitos operacionais | Há uma necessidade comercial genuína para alguma das funcionalidades descritas na seção [Quando usar uma arquitetura conduzida por evento](#quando usar-uma arquitetura conduzida por evento)? |
| Requisitos técnicos | A integração que você está projetando é um ajuste óbvio para um padrão diferente, como virtualização de dados, lote ou solicitação/resposta? Em outras palavras, você está tentando caber um pino quadrado em um buraco redondo? |
| Processos que exigem que os seres humanos aguardem respostas | Qualquer integração que envolva uma espera humana por uma resposta do sistema de destino não é adequada para arquiteturas conduzidas por evento, pois elas são projetadas para execução assíncrona e não podem garantir um tempo de resposta. Considere se processos como esse são ideais para sua organização antes de implementar soluções técnicas. Consulte [Bem-arquiteto – Excelência operacional](/docs/architect/pt-br/well-architected/guide/operational-excellence.html) para obter mais informações. |
| Alteração frequente dos dados de origem | Se os dados no seu sistema de origem mudarem com tanta frequência que atualizações periódicas sejam suficientes, você provavelmente poderá simplificar sua arquitetura usando [patrons em lote](https://developer.salesforce.com/docs/atlas.en-us.integration_patterns_and_practices.meta/integration_patterns_and_practices/integ_pat_batch_data_sync.htm) em vez de padrões conduzidos por evento. |
| Requisitos de execução | A maioria dos sistemas envolvidos em sua solução oferece suporte a arquiteturas conduzidas por evento? O que seria necessário para usar arquiteturas conduzidas por evento com os sistemas que não oferecem suporte a elas (por exemplo, upgrades, personalizações ou middleware)? Que nível de esforço seria necessário para cumprir esses requisitos? |
| Estabilidade da estrutura de mensagens | Com que frequência suas estruturas de mensagens precisarão mudar? Quais sistemas serão afetados por essa alteração e qual será o processo de remediação? |
| Governança organizacional | Você tem uma estrutura de governança em vigor para garantir que todas as partes interessadas sejam informadas e possam considerar alterações em estruturas de mensagens, acionadores e outras decisões relacionadas a arquitetura e processo? |
| Habilidades necessárias | Sua equipe tem experiência com arquiteturas conduzidas por evento e sabe como dar suporte a elas? |
| Padrão | Quase em tempo real | Cópia de mensagem única | Entrega de garantia | Reduzir o tamanho da mensagem | Transformar dados |
|---|---|---|---|---|---|
| Publicar/Assinar | ✓ | ✓ | ✓ | ||
| Fanout | ✓ | ✓ | ✓ | ||
| Mensagens passadas | ✓ | ✓ | ✓ | ✓ | |
| Streaming | ✓ | ✓ | ✓ | ||
| Enfileiramento | ✓ | ✓ | ✓ |
| Ferramenta | Descrição | Habilidades necessárias | |
|---|---|---|---|
| MuleSoft | Anypoint Platform | Plataforma que habilita a integração de dados usando camadas de APIs. | Código profissional |
| Conector de Pub/Sub do Salesforce | Conector para a API Pub/Sub, que fornece uma única interface para publicar e assinar eventos de plataforma, eventos de monitoramento de evento em tempo real e eventos de captura de dados de alteração. | Código profissional | |
| MuleSoft Anypoint JMS Connector | Conector que habilita o envio e o recebimento de mensagens para filas e tópicos para qualquer serviço de mensagens que implementa a especificação Java Message Service (JMS). | Código profissional | |
| MuleSoft Anypoint Apache Kafka Connector | Conector para mover dados entre o Apache Kafka e aplicativos e serviços corporativos. | Código profissional | |
| Conector do MuleSoft Anypoint Solace | Um conector para agentes de evento Solace PubSub+ com integração de API nativa usando o SDK Java JCSMP | Código profissional | |
| MuleSoft Anypoint MQ Connector | Um serviço de mensagens na nuvem de vários locatários que permite que os clientes realizem mensagens assíncronas avançadas entre seus aplicativos. | Código profissional | |
| Conector MQTT do MuleSoft Anypoint | Uma extensão do MuleSoft em conformidade com o protocolo v3.x MQTT (Transporte de telemetria de enfileiramento de mensagem). | Código profissional | |
| Conector do MuleSoft Anypoint AMQP | Um conector que permite que seu aplicativo publique e consuma mensagens usando um agente em conformidade com AMQP 0.9.1. | Código profissional | |
| API acionada por evento (ASync) do MuleSoft Anypoint | Idioma agnóstico do setor que dá suporte à publicação de APIs conduzidas por evento separando-as em camadas de evento, canal e transporte. | Código profissional | |
| MuleSoft Anypoint MQ | Serviço de mensagens de nuvem multilocatário que permite que os clientes realizem mensagens assíncronas avançadas entre seus aplicativos. | Código profissional | |
| MuleSoft Anypoint Data Streams | Estrutura disponível no MuleSoft Anypoint para publicar e assinar dados de streaming. | Código profissional | |
| Salesforce Platform | Apache Kafka on Heroku | Complemento do Heroku que fornece o Apache Kafka como um serviço com integração de plataforma completa à plataforma Heroku. | Código profissional |
| Captura de dados de alteração | Registro de eventos de alteração, que publica alterações em registros do Salesforce. As alterações incluem a criação de um novo registro, atualizações em um registro existente, exclusão de um registro e cancelamento da exclusão de um registro. | Baixo código para Pro-code | |
| Mensagens de saída | Ações que enviam mensagens XML a pontos de extremidade externos quando os valores de campo são atualizados no Salesforce. | Código baixo | |
| Eventos de plataforma | Mensagens seguras e escalonáveis que contêm dados de evento personalizados. | Baixo código para Pro-code | |
| Pub/Sub API | API que habilita assinaturas para eventos de plataforma, eventos de Captura de dados de alteração e/ou eventos de Monitoramento de evento em tempo real. | Código profissional | |
| Retransmissões de evento | Permite que eventos de plataforma e eventos de captura de dados de alteração sejam enviados do Salesforce para o Amazon EventBridge. Observe que as Retransmissões de evento se conectam apenas ao AWS Eventbridge. | Código baixo | |
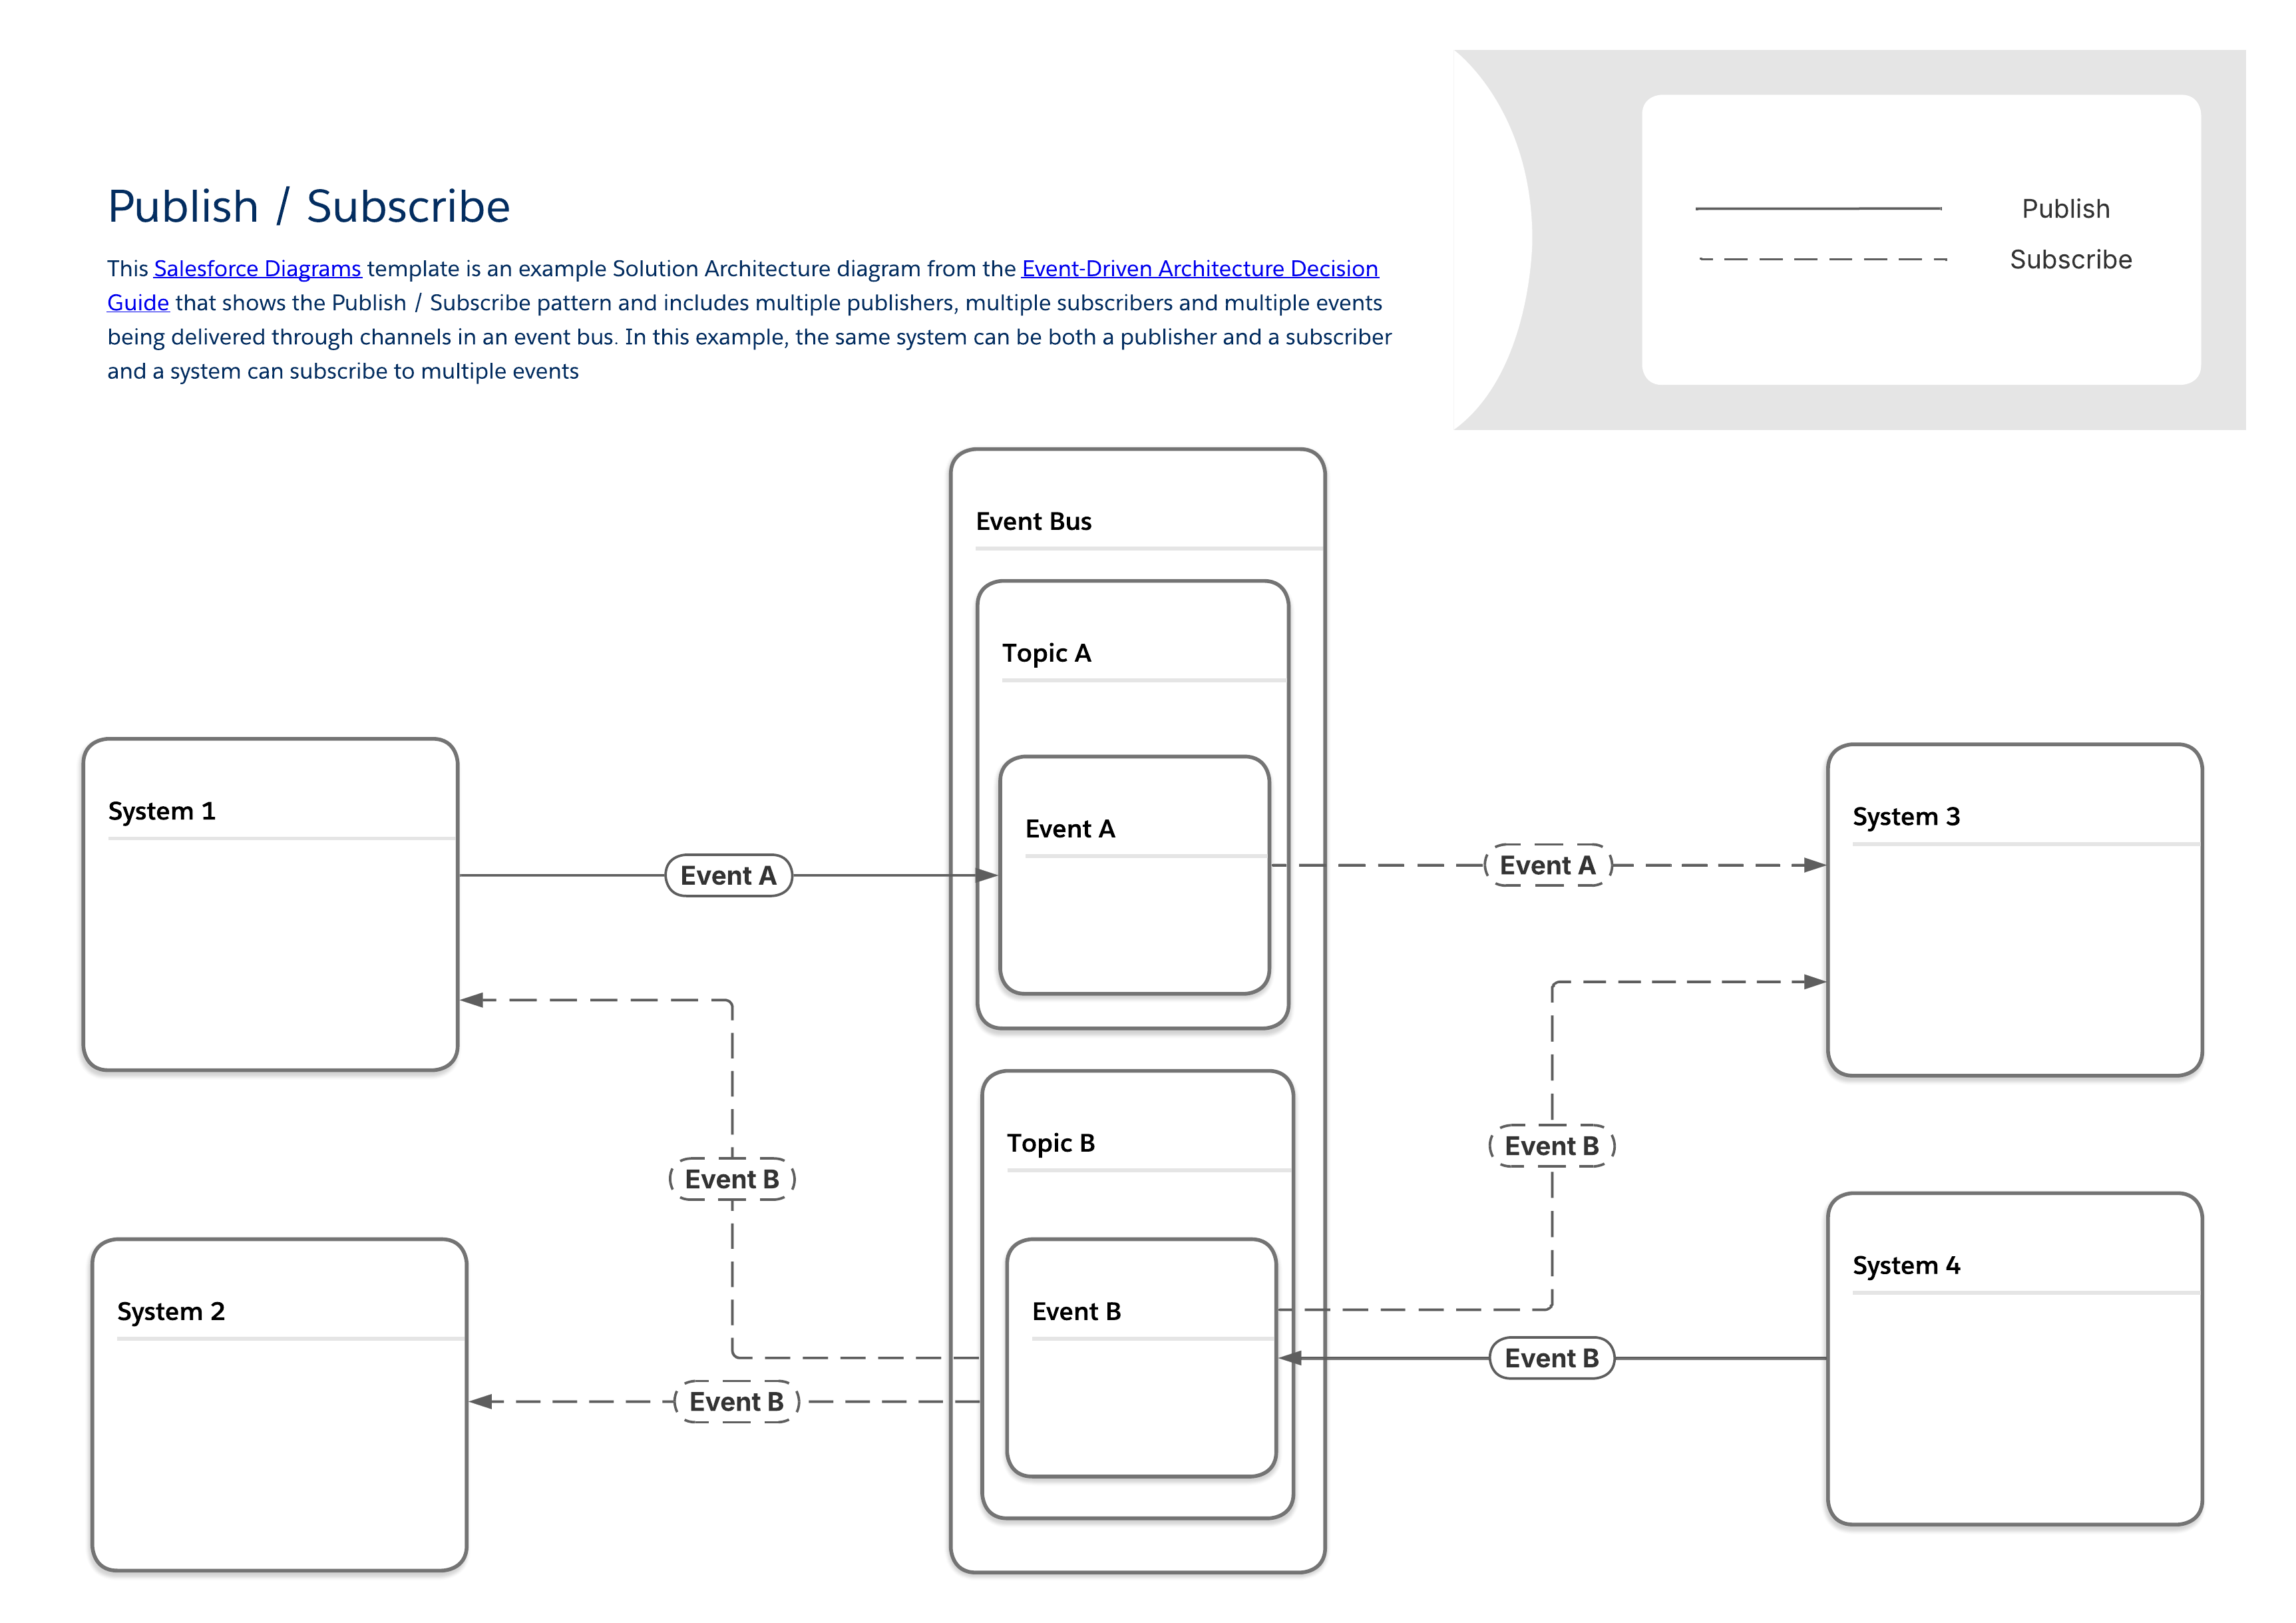 #### Ferramentas relevantes para o padrão Publicar/Assinar
| Fluxo e comportamento de evento | Considerações sobre carga útil | ||||||
|---|---|---|---|---|---|---|---|
| Ferramentas disponíveis | Habilidades necessárias | Publicar via | Assinar via | Período de repetição | Estrutura de carga útil | Limites de carga útil | |
| MuleSoft | Anypoint Platform | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum |
| Conector de Pub/Sub do Salesforce | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| MuleSoft Anypoint JMS Connector | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| MuleSoft Anypoint Apache Kafka Connector | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| Conector do MuleSoft Anypoint Solace | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| MuleSoft Anypoint MQ Connector | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| Conector MQTT do MuleSoft Anypoint | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| Conector do MuleSoft Anypoint AMQP | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| API acionada por evento (ASync) do MuleSoft Anypoint | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| MuleSoft Anypoint MQ | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| Salesforce Platform | Apache Kafka on Heroku | Código profissional | APIs, alterações de registro no Heroku Postgres | N/A | 1 a 6 semanas | Usuário definido | Usuário definido |
| Captura de dados de alteração | Baixo código para Pro-code | Alterações de registro | Apex, APIs, Componentes da Web Lightning (LWC) | 3 dias | Predefinido | 1 MB | |
| Mensagens de saída* | Código baixo | Regras de fluxo e fluxo de trabalho | N/A | 24 horas | Usuário definido | 100 notificações por mensagem | |
| Eventos de plataforma | Baixo código para Pro-code | APIs, Apex, Fluxo | Apex, APIs, Flow, LWC | 3 dias | Usuário definido | 1 MB | |
| Pub/Sub API | Código profissional | API ou APIs Pub/Sub, Apex, Fluxo | API Pub/Sub | 3 dias | Usuário definido | 1 MB | |
| Retransmissões de evento** | Código baixo | Eventos de plataforma, Captura de dados de alteração | API | 3 dias | Usuário definido | 1 MB | |
| *A Salesforce continuará oferecendo suporte a mensagens de saída nos recursos funcionais atuais, mas não planeja fazer mais investimentos nessa tecnologia. **Retransmissões de evento se conectam apenas ao AWS EventBridge | |||||||
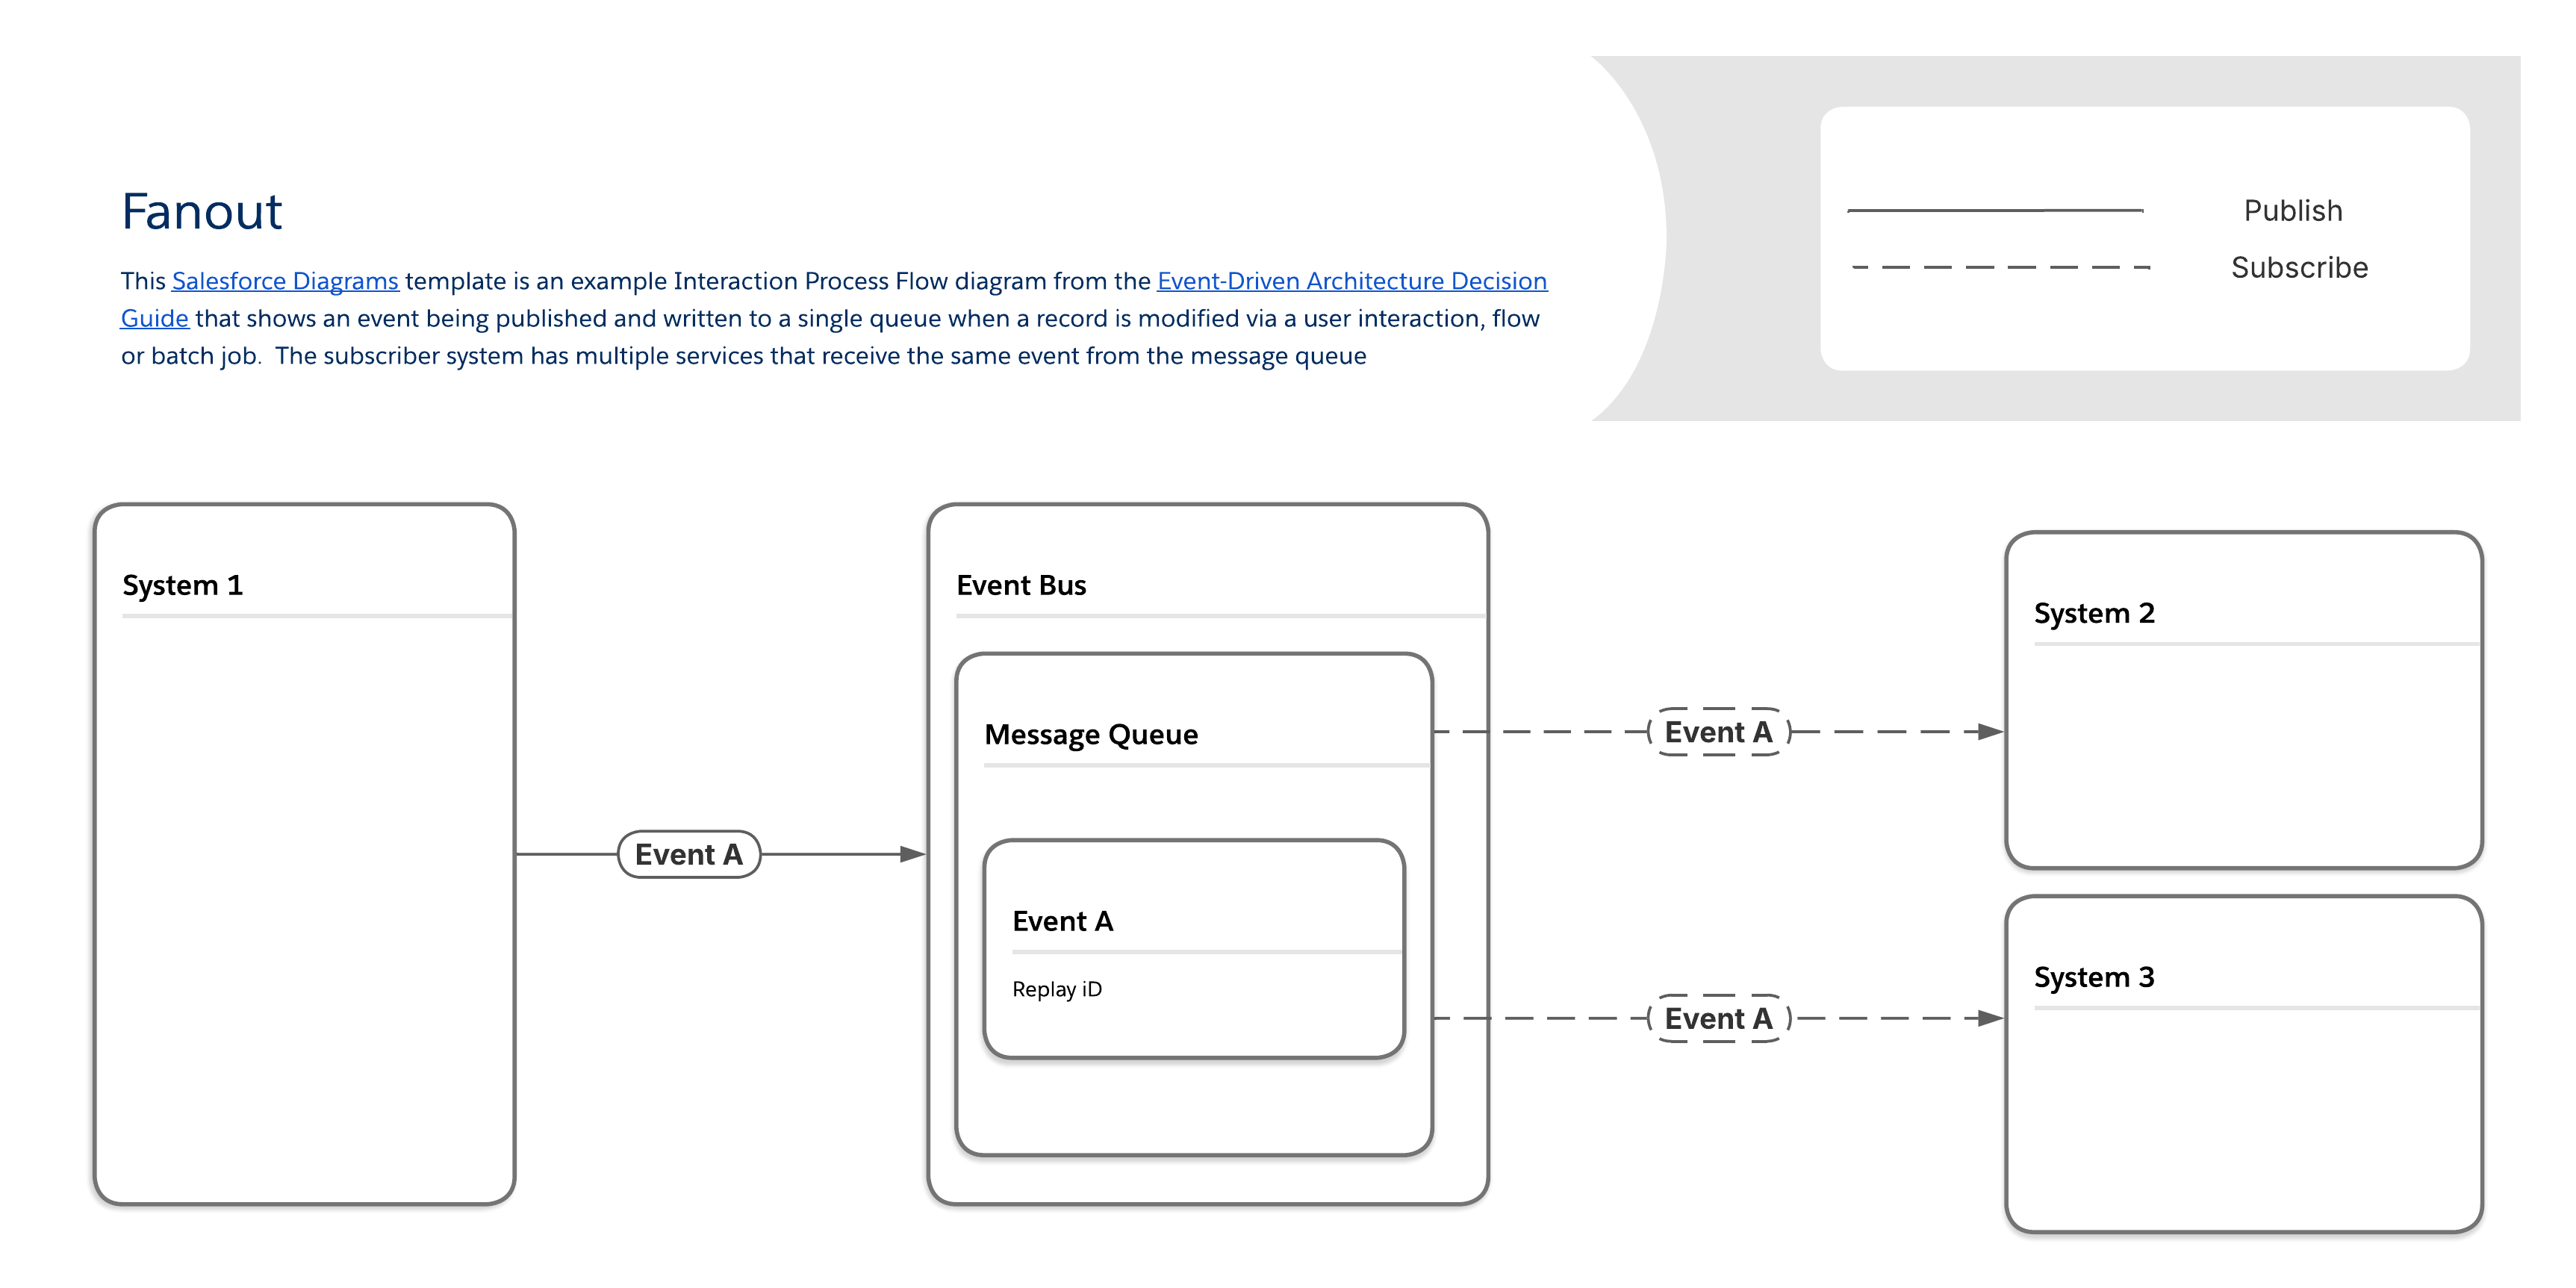 #### Ferramentas relevantes para o padrão do Fanout
| Fluxo e comportamento de evento | Considerações sobre carga útil | ||||||
|---|---|---|---|---|---|---|---|
| Ferramentas disponíveis | Habilidades necessárias | Publicar via | Assinar via | Período de repetição | Estrutura de carga útil | Limites de carga útil | |
| MuleSoft | MuleSoft Anypoint JMS Connector | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum |
| Conector de Pub/Sub do Salesforce | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| MuleSoft Anypoint Apache Kafka Connector | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| Conector do MuleSoft Anypoint Solace | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| MuleSoft Anypoint MQ Connector | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| Conector MQTT do MuleSoft Anypoint | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| Conector do MuleSoft Anypoint AMQP | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| MuleSoft Anypoint MQ | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| Salesforce Platform | Apache Kafka on Heroku | Código profissional | APIs, alterações de registro no Heroku Postgres | N/A | 1 a 6 semanas | Usuário definido | Usuário definido |
| Captura de dados de alteração | Baixo código para Pro-code | Alterações de registro | Apex, APIs, Componentes da Web Lightning (LWC) | 3 dias | Predefinido | 1 MB | |
| Eventos de plataforma | Baixo código para Pro-code | APIs, Apex, Fluxo | Apex, APIs, Flow, LWC | 3 dias | Usuário definido | 1 MB | |
| Pub/Sub API | Código profissional | API Pub/Sub ou Apex, APIs, Fluxo | API Pub/Sub | 3 dias | Usuário definido | 1 MB | |
| Retransmissões de evento* | Código baixo | Eventos de plataforma, Captura de dados de alteração | API | 3 dias | Usuário definido | 1 MB | |
| *Retransmissões de evento enviam dados apenas para o AWS EventBridge | |||||||
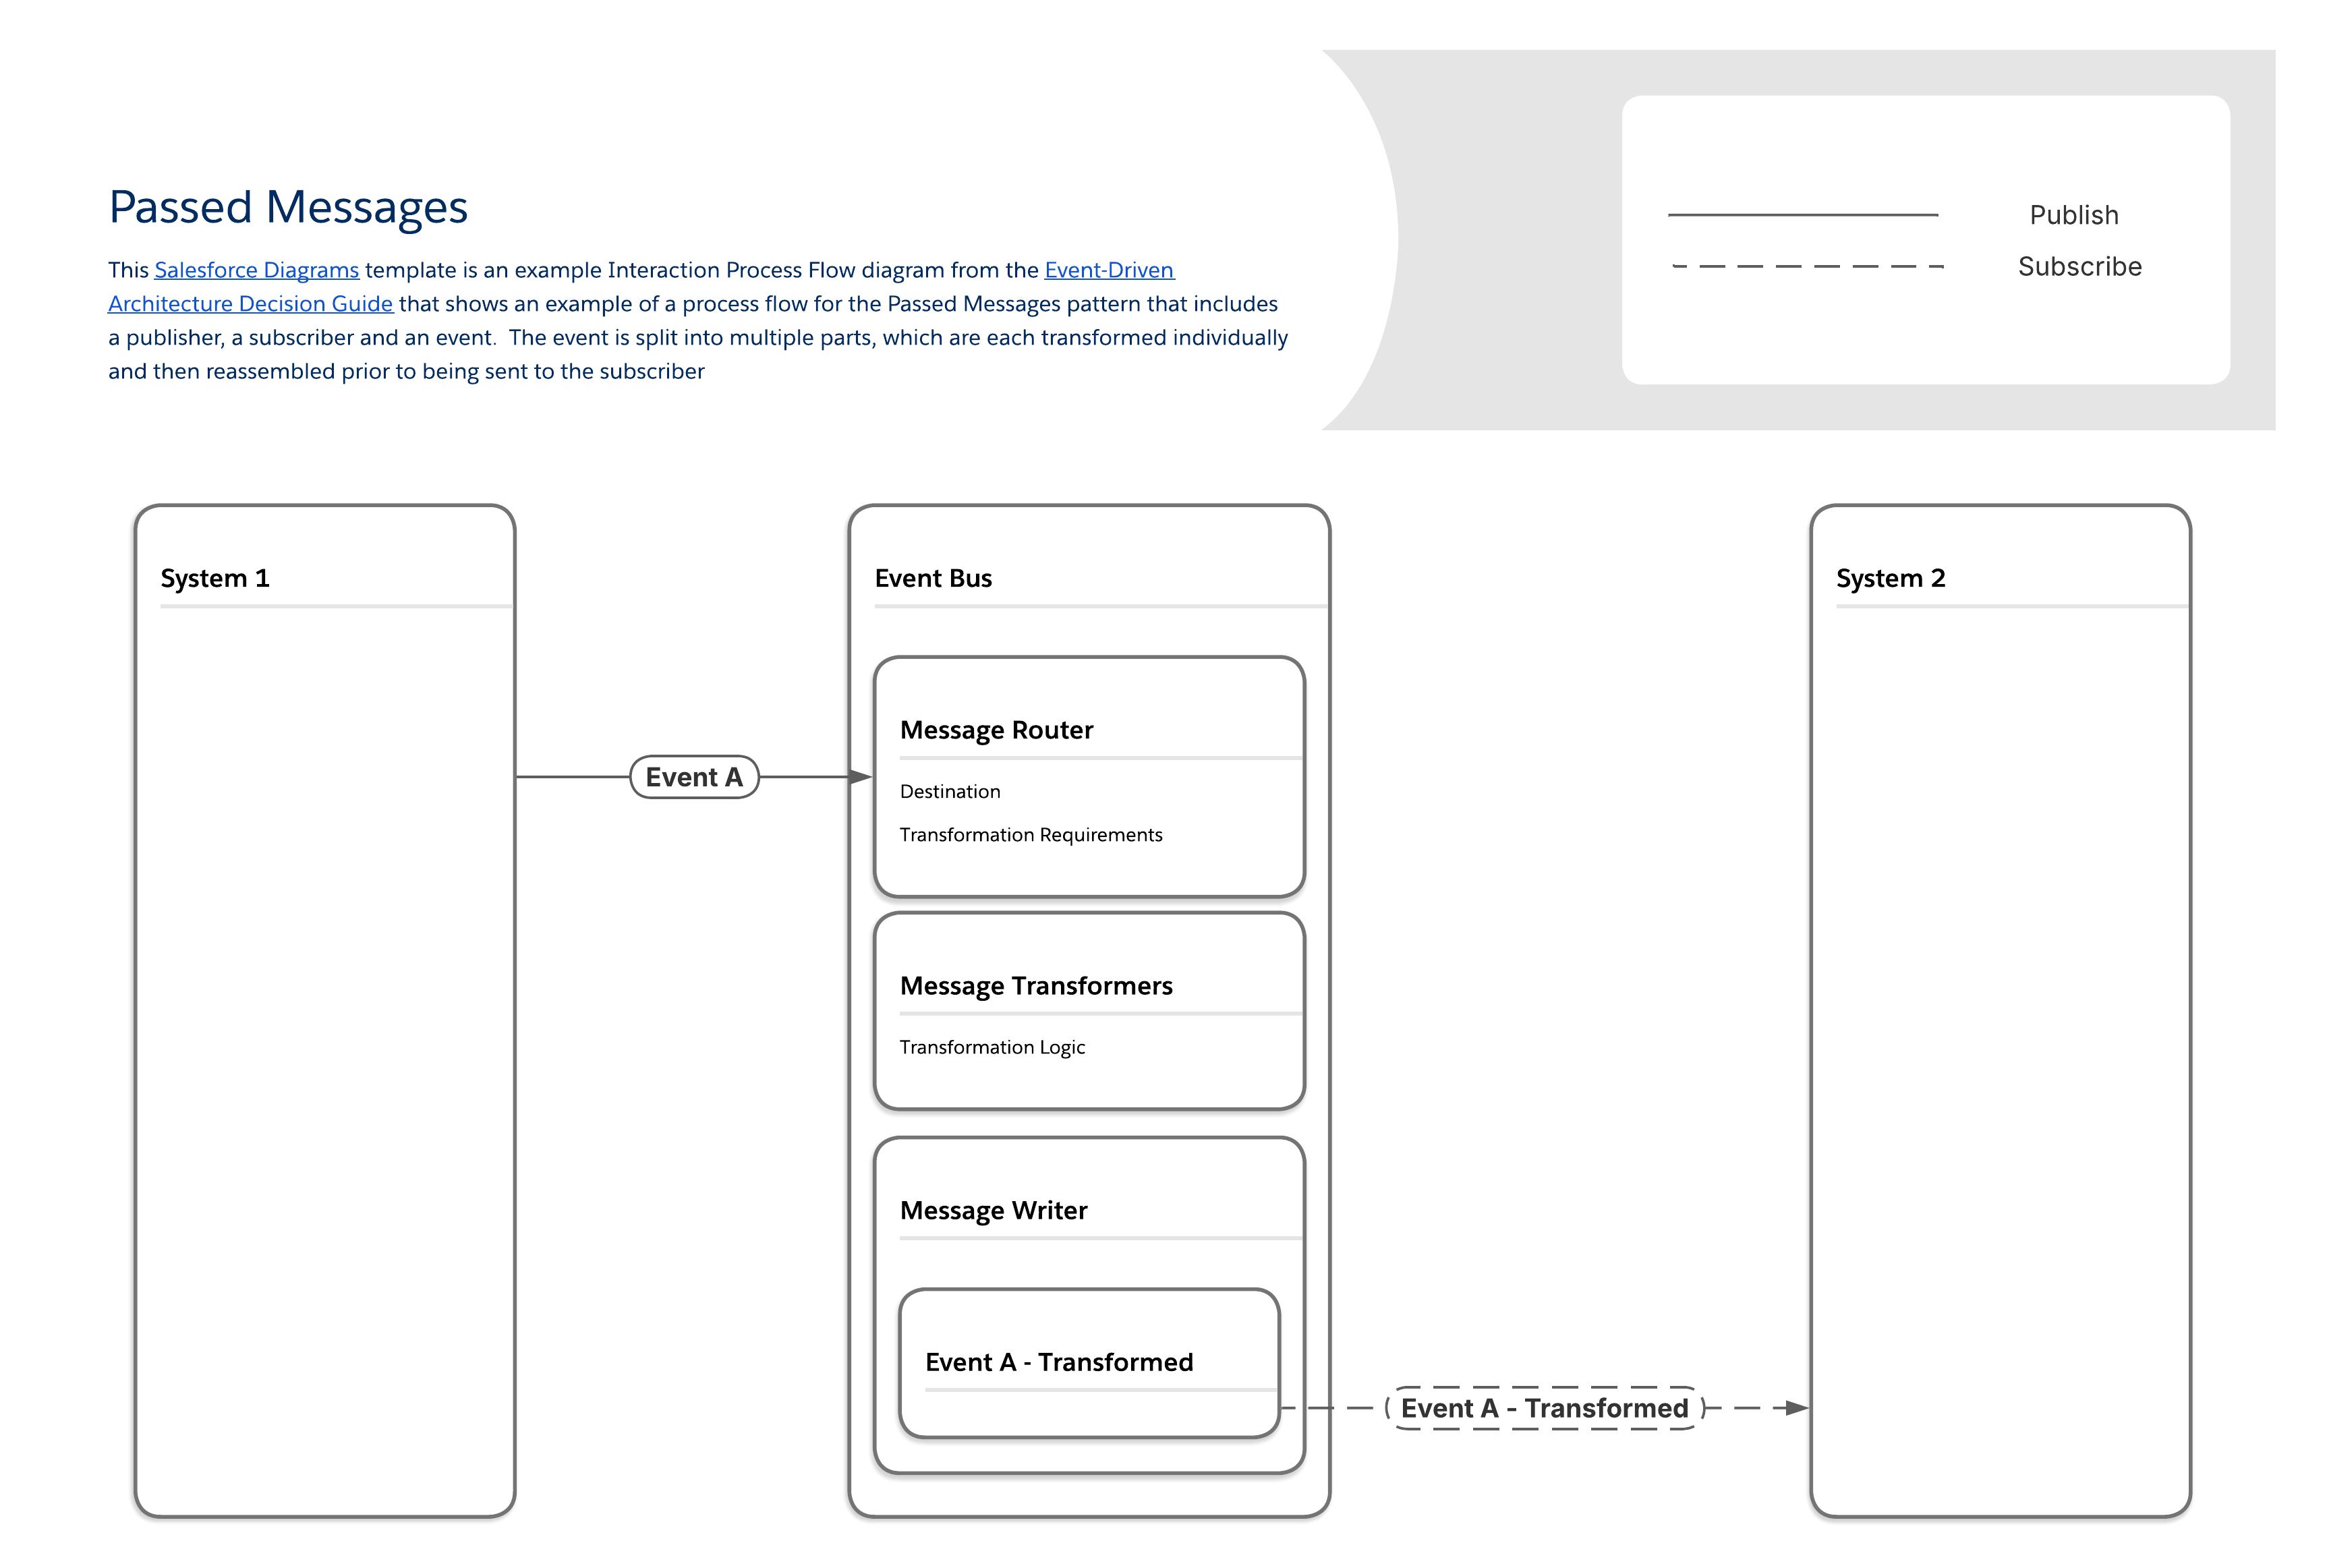 #### Ferramentas relevantes para o padrão de mensagens passadas
| Fluxo e comportamento de evento | Considerações sobre carga útil | ||||||
|---|---|---|---|---|---|---|---|
| Ferramentas disponíveis | Habilidades necessárias | Publicar via | Assinar via | Período de repetição | Estrutura de carga útil | Limites de carga útil | |
| MuleSoft | MuleSoft Anypoint Apache Kafka Connector | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum |
| Conector de Pub/Sub do Salesforce | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| Salesforce Platform | Apache Kafka on Heroku | Código profissional | APIs, alterações de registro no Heroku Postgres | N/A | 1 a 6 semanas | Usuário definido | Usuário definido |
| Captura de dados de alteração | Baixo código para Pro-code | Alterações de registro | Apex, APIs, Componentes da Web Lightning (LWC) | 3 dias | Predefinido | 1 MB | |
| Eventos de plataforma | Baixo código para Pro-code | APIs, Apex, Fluxo | Apex, APIs, Flow, LWC | 3 dias | Usuário definido | 1 MB | |
| Pub/Sub API | Código profissional | API ou APIs Pub/Sub, Fluxo do Apex | API Pub/Sub | 3 dias | Usuário definido | 1 MB | |
| Retransmissões de evento* | Código baixo | Eventos de plataforma, Captura de dados de alteração | API | 3 dias | Usuário definido | 1 MB | |
| *Retransmissões de evento enviam dados apenas para o AWS EventBridge | |||||||
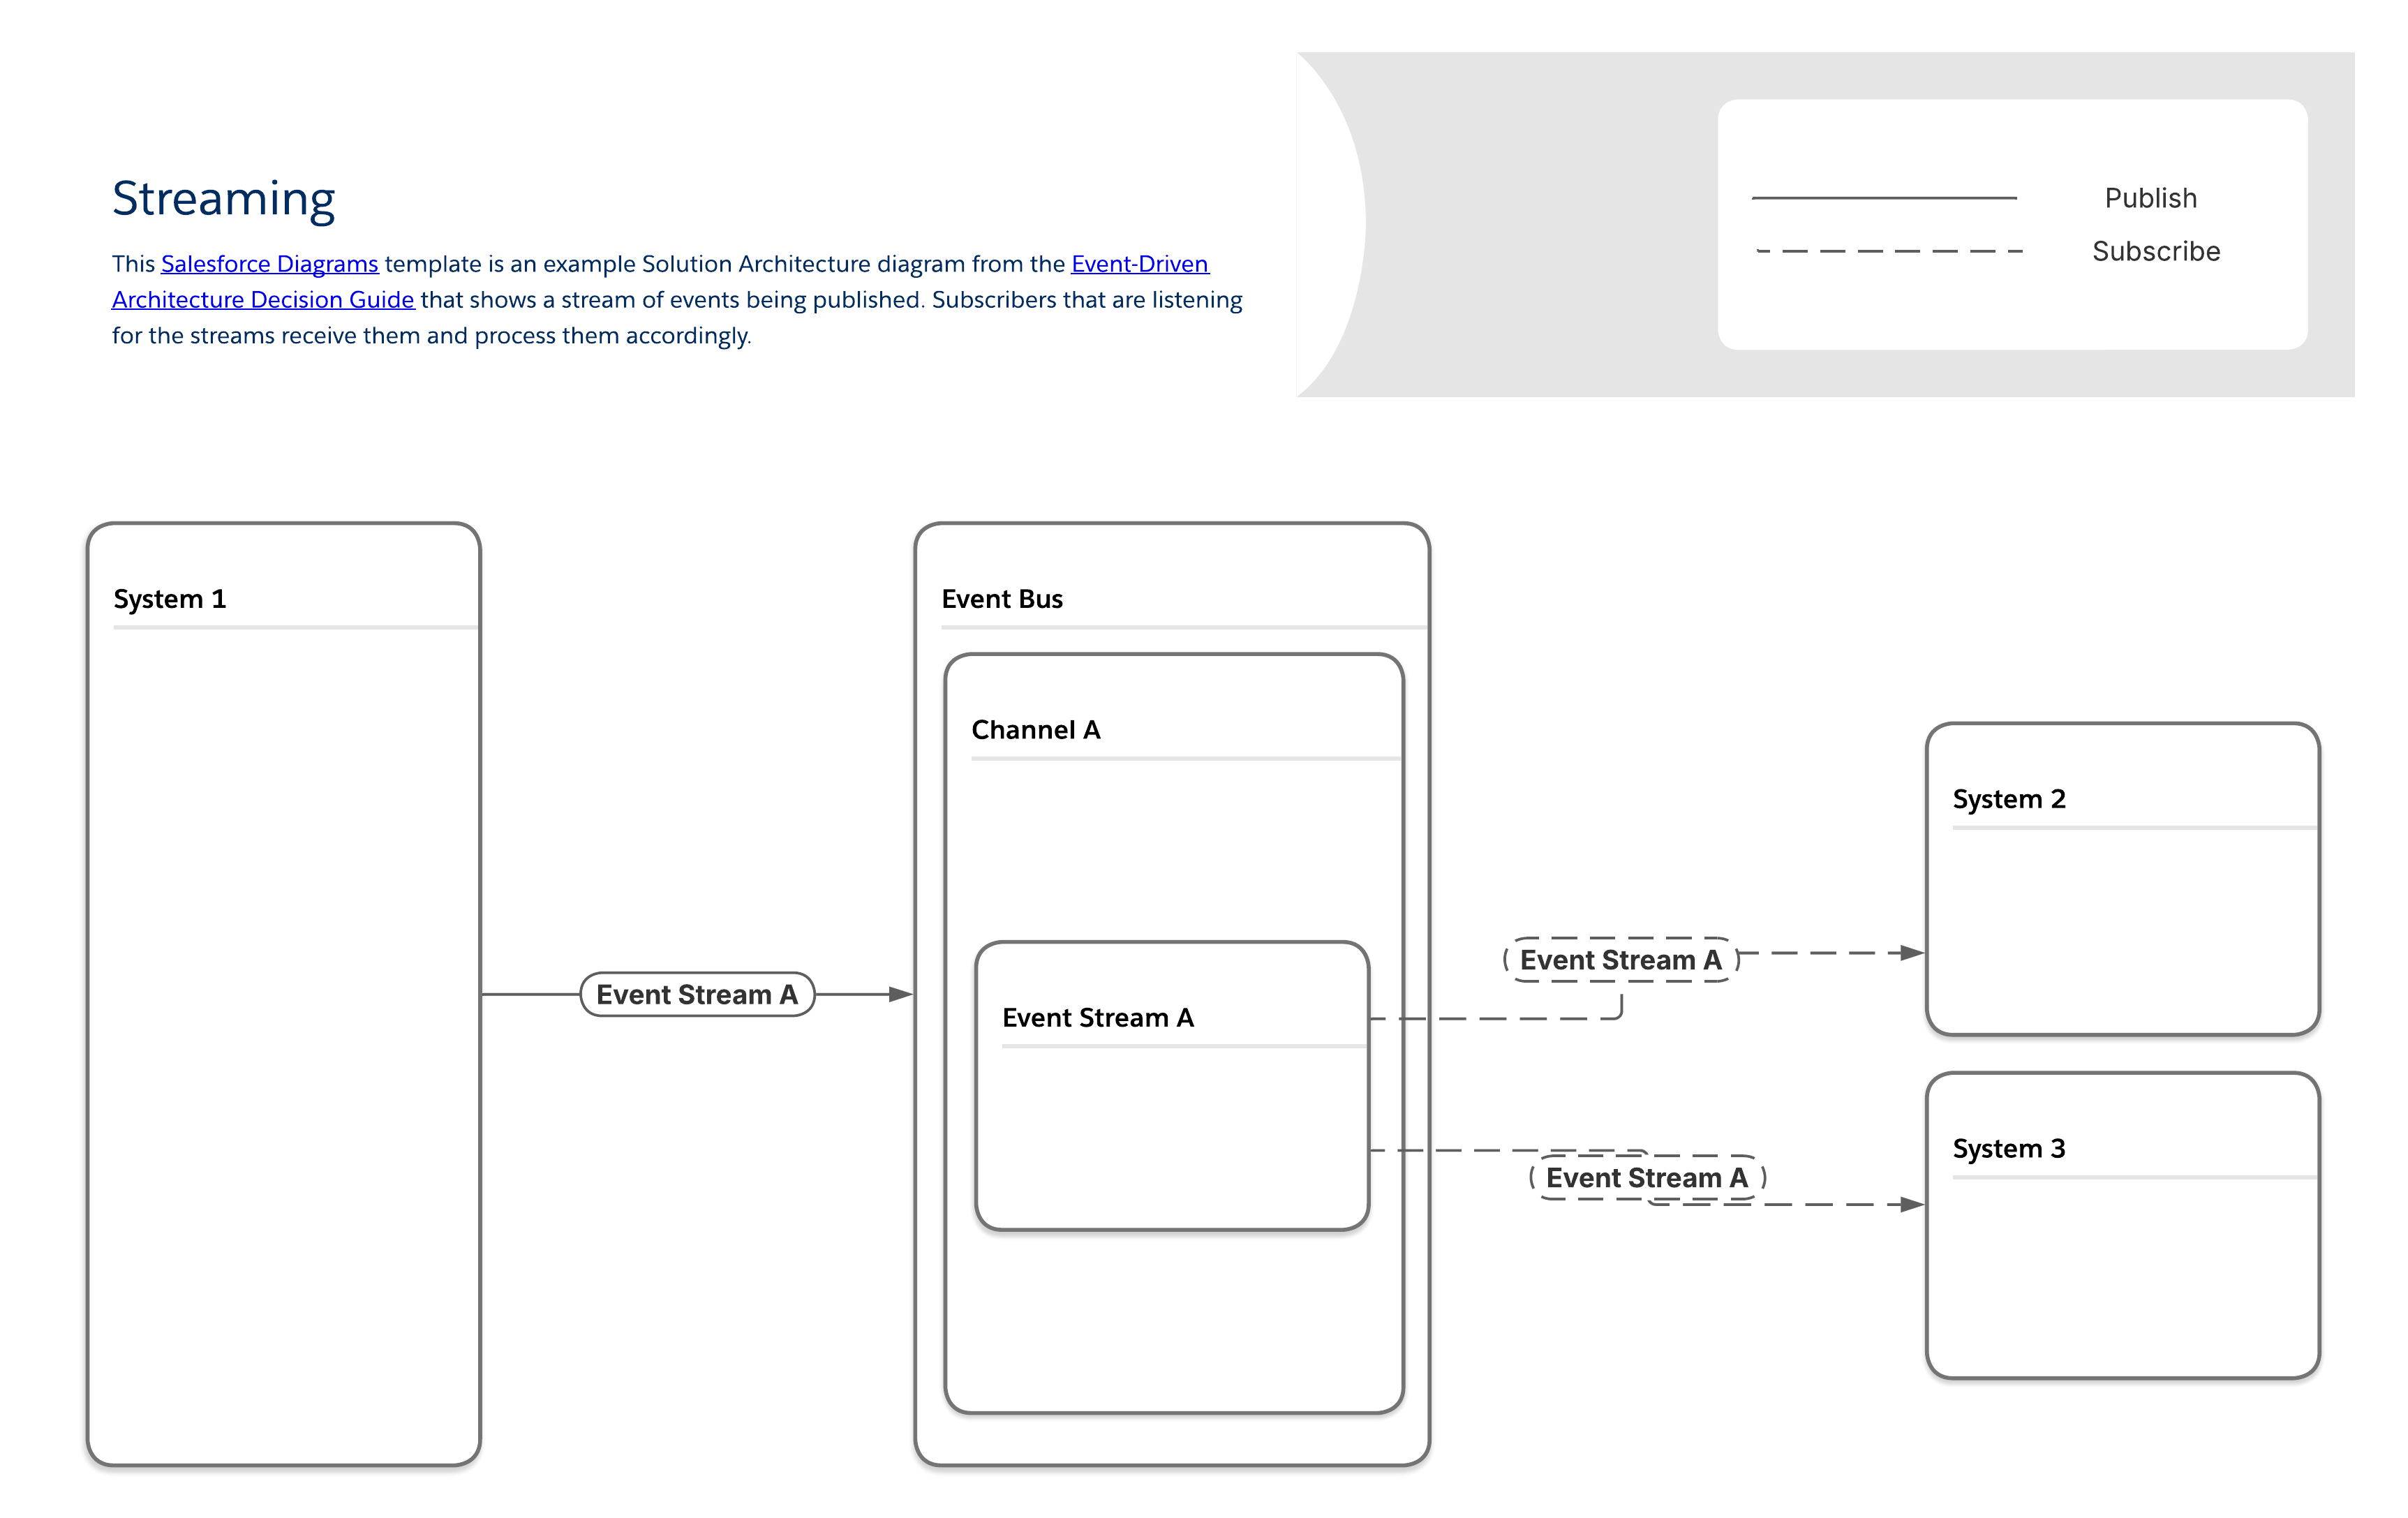 #### Ferramentas relevantes para o padrão de streaming
| Fluxo e comportamento de evento | Considerações sobre carga útil | ||||||
|---|---|---|---|---|---|---|---|
| Ferramentas disponíveis | Habilidades necessárias | Publicar via | Assinar via | Período de repetição | Estrutura de carga útil | Limites de carga útil | |
| MuleSoft | MuleSoft Anypoint Data Streams | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum |
| Conector de Pub/Sub do Salesforce | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| MuleSoft Anypoint Apache Kafka Connector | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| Salesforce Platform | Apache Kafka on Heroku | Código profissional | APIs, alterações de registro no Heroku Postgres | N/A | 1 a 6 semanas | Usuário definido | Usuário definido |
| Pub/Sub API | Código profissional | API ou APIs Pub/Sub, Fluxo do Apex | API Pub/Sub | 3 dias | Usuário definido | 1 MB | |
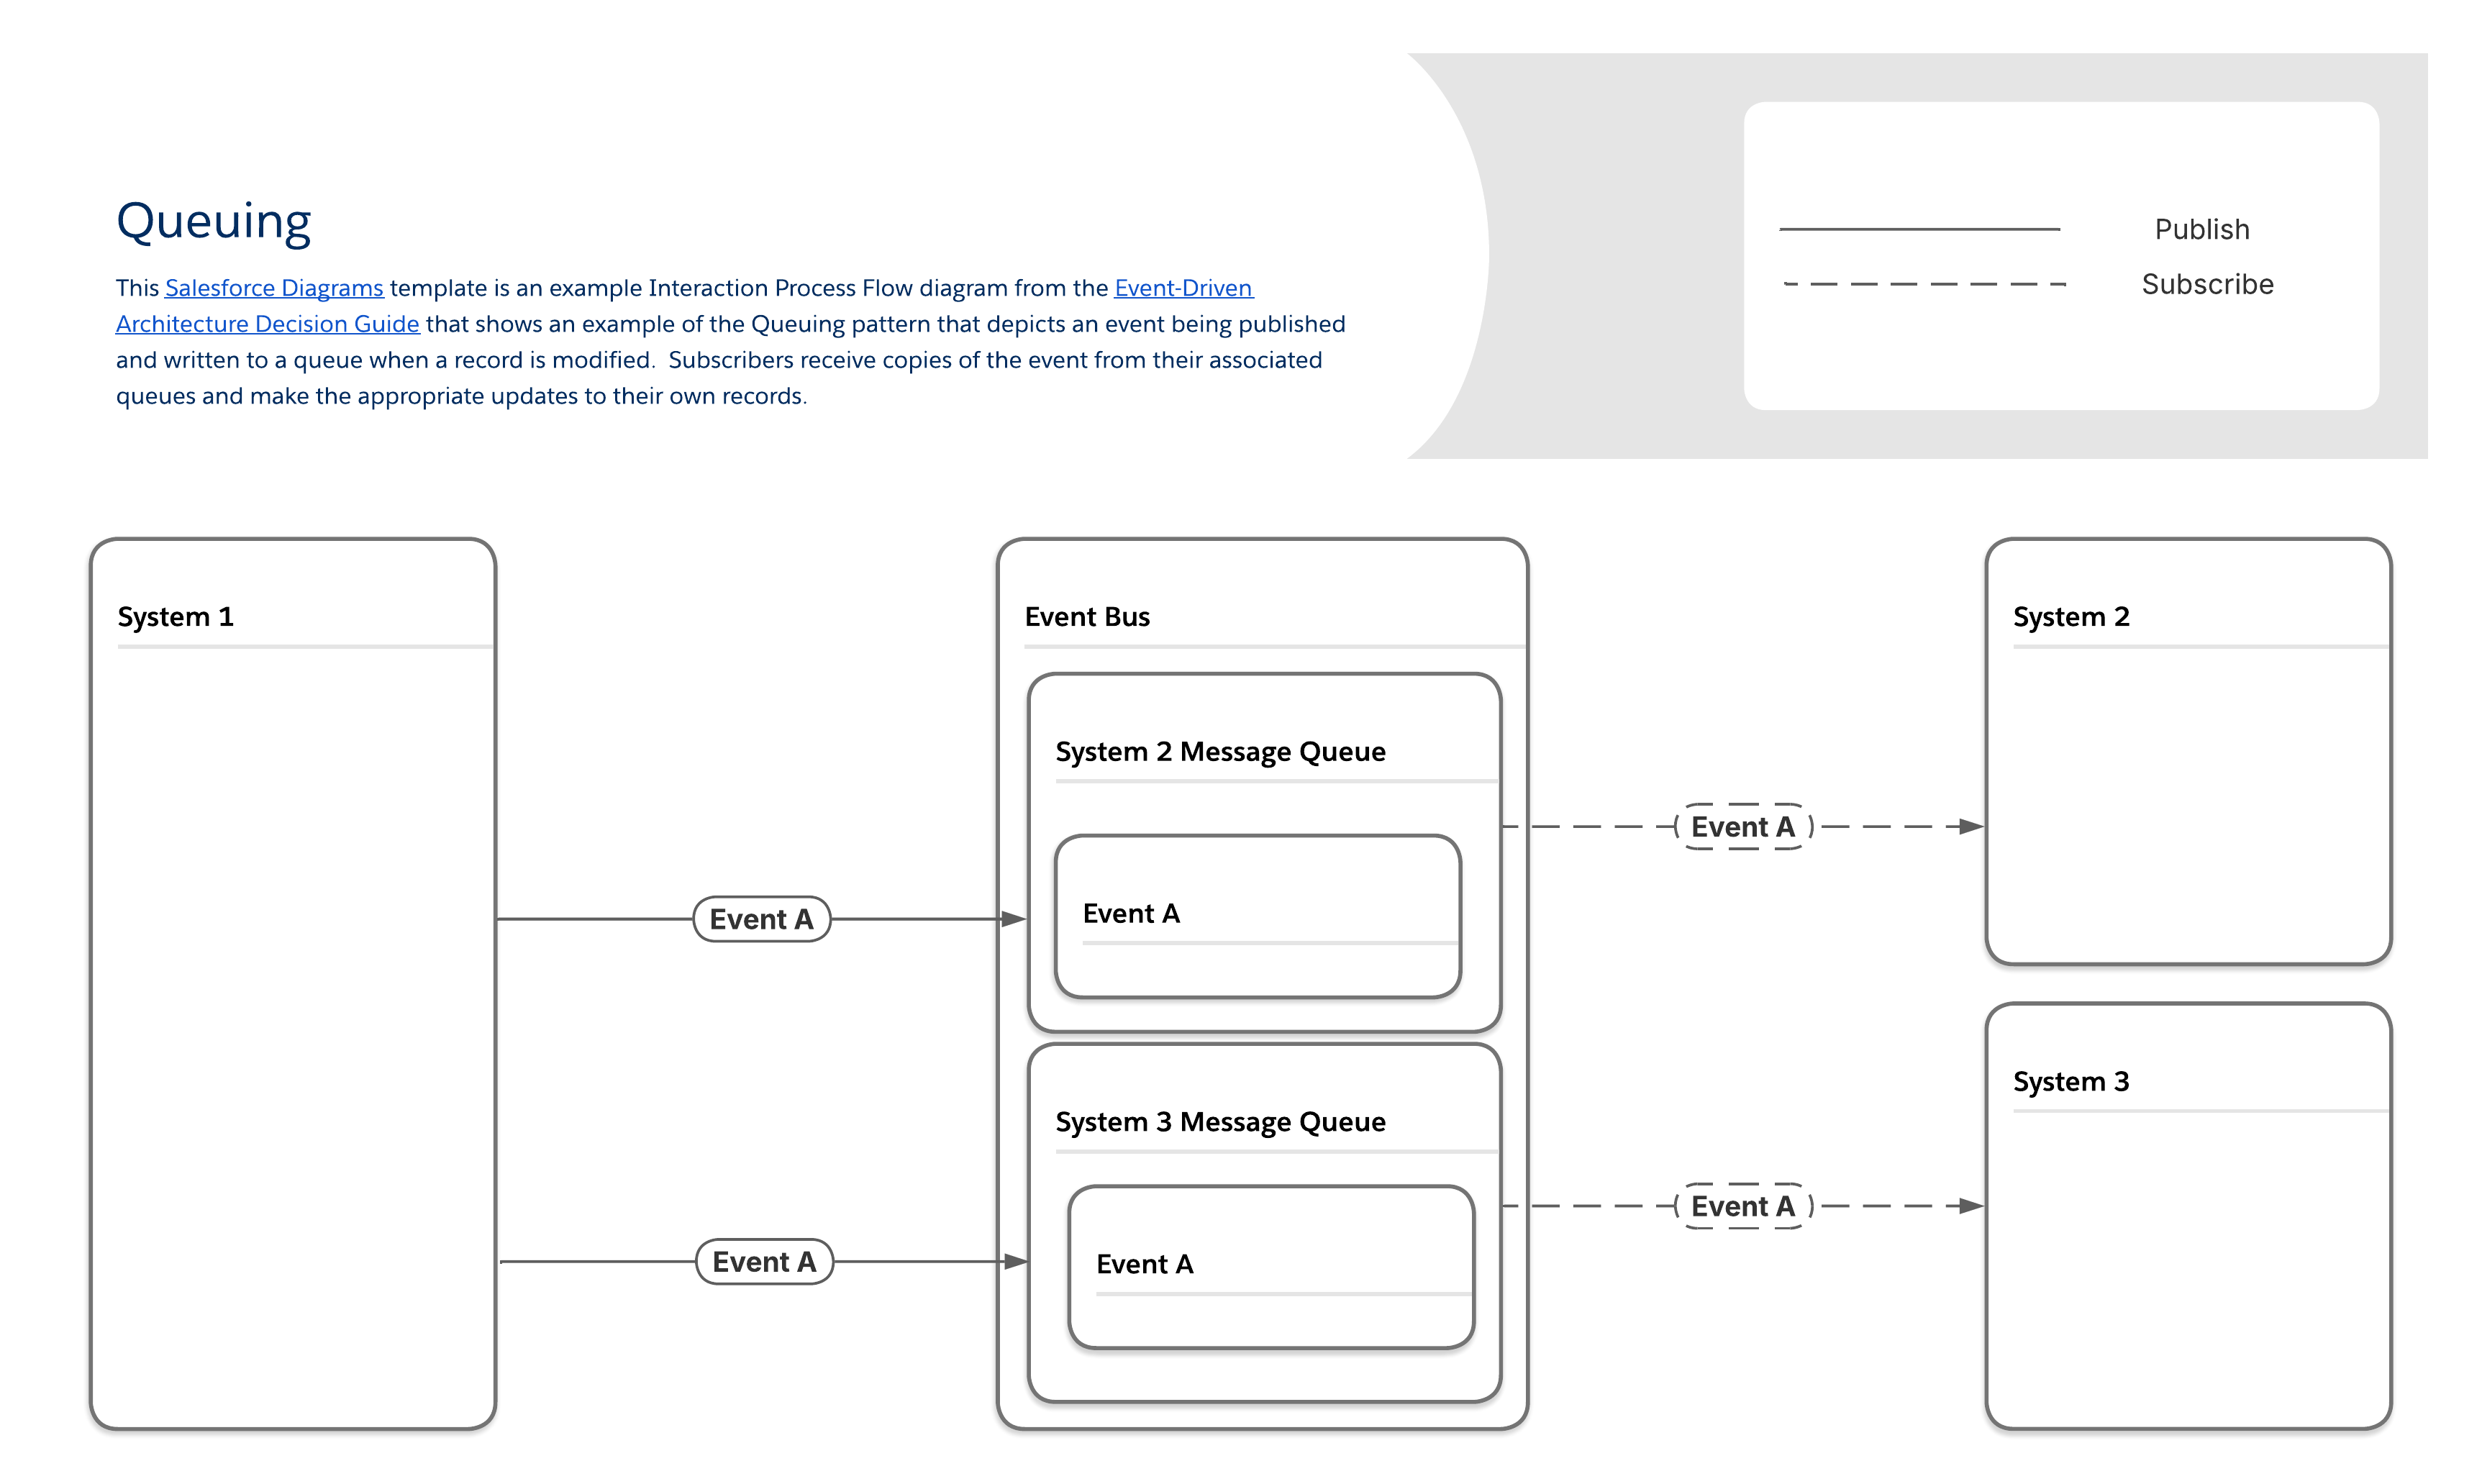 #### Ferramentas relevantes para o padrão de enfileiramento
| Fluxo e comportamento de evento | Considerações sobre carga útil | ||||||
|---|---|---|---|---|---|---|---|
| Ferramentas disponíveis | Habilidades necessárias | Publicar via | Assinar via | Período de repetição | Estrutura de carga útil | Limites de carga útil | |
| MuleSoft | MuleSoft Anypoint MQ | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum |
| Conector de Pub/Sub do Salesforce | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| MuleSoft Anypoint Apache Kafka Connector | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| MuleSoft Anypoint MQ Connector | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| Conector MQTT do MuleSoft Anypoint | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| Conector do MuleSoft Anypoint AMQP | Código profissional | APIs | APIs | Configurado | Usuário definido | Nenhum | |
| Salesforce Platform | Apache Kafka on Heroku | Código profissional | APIs, alterações de registro no Heroku Postgres | N/A | 1 a 6 semanas | Usuário definido | Usuário definido |
| Captura de dados de alteração | Baixo código para Pro-code | Alterações de registro | Apex, APIs, Componentes da Web Lightning (LWC) | 3 dias | Predefinido | 1 MB | |
| Eventos de plataforma | Baixo código para Pro-code | APIs, Apex, Fluxo | Apex, APIs, Flow, LWC | 3 dias | Usuário definido | 1 MB | |
| Pub/Sub API | Código profissional | API ou APIs Pub/Sub, Apex, Fluxo | API Pub/Sub | 3 dias | Usuário definido | 1 MB | |
| Retransmissões de evento* | Código baixo | Eventos de plataforma, Captura de dados de alteração | API | 3 dias | Usuário definido | 1 MB | |
| *Retransmissões de evento enviam dados apenas para o AWS EventBridge | |||||||
| Fluxo | O Fluxo Salesforce é uma ferramenta avançada de automação de apontar e clicar que permite aos usuários criar processos comerciais complexos, telas e lógica visualmente usando o Flow Builder, sem escrever código. Ele automatiza tarefas como atualizações de dados, envio de emails e orientação de usuários, oferecendo flexibilidade por meio de tipos como Fluxos de tela (interação do usuário) e Fluxos acionados (eventos de registro/agendamento). |
| Apex | O Salesforce Apex é uma linguagem de programação proprietária e orientada a objetos para a plataforma Salesforce, semelhante a Java, usada para criar lógica de negócios personalizada, automatizar processos e estender as principais funcionalidades do CRM além das ferramentas declarativas. |
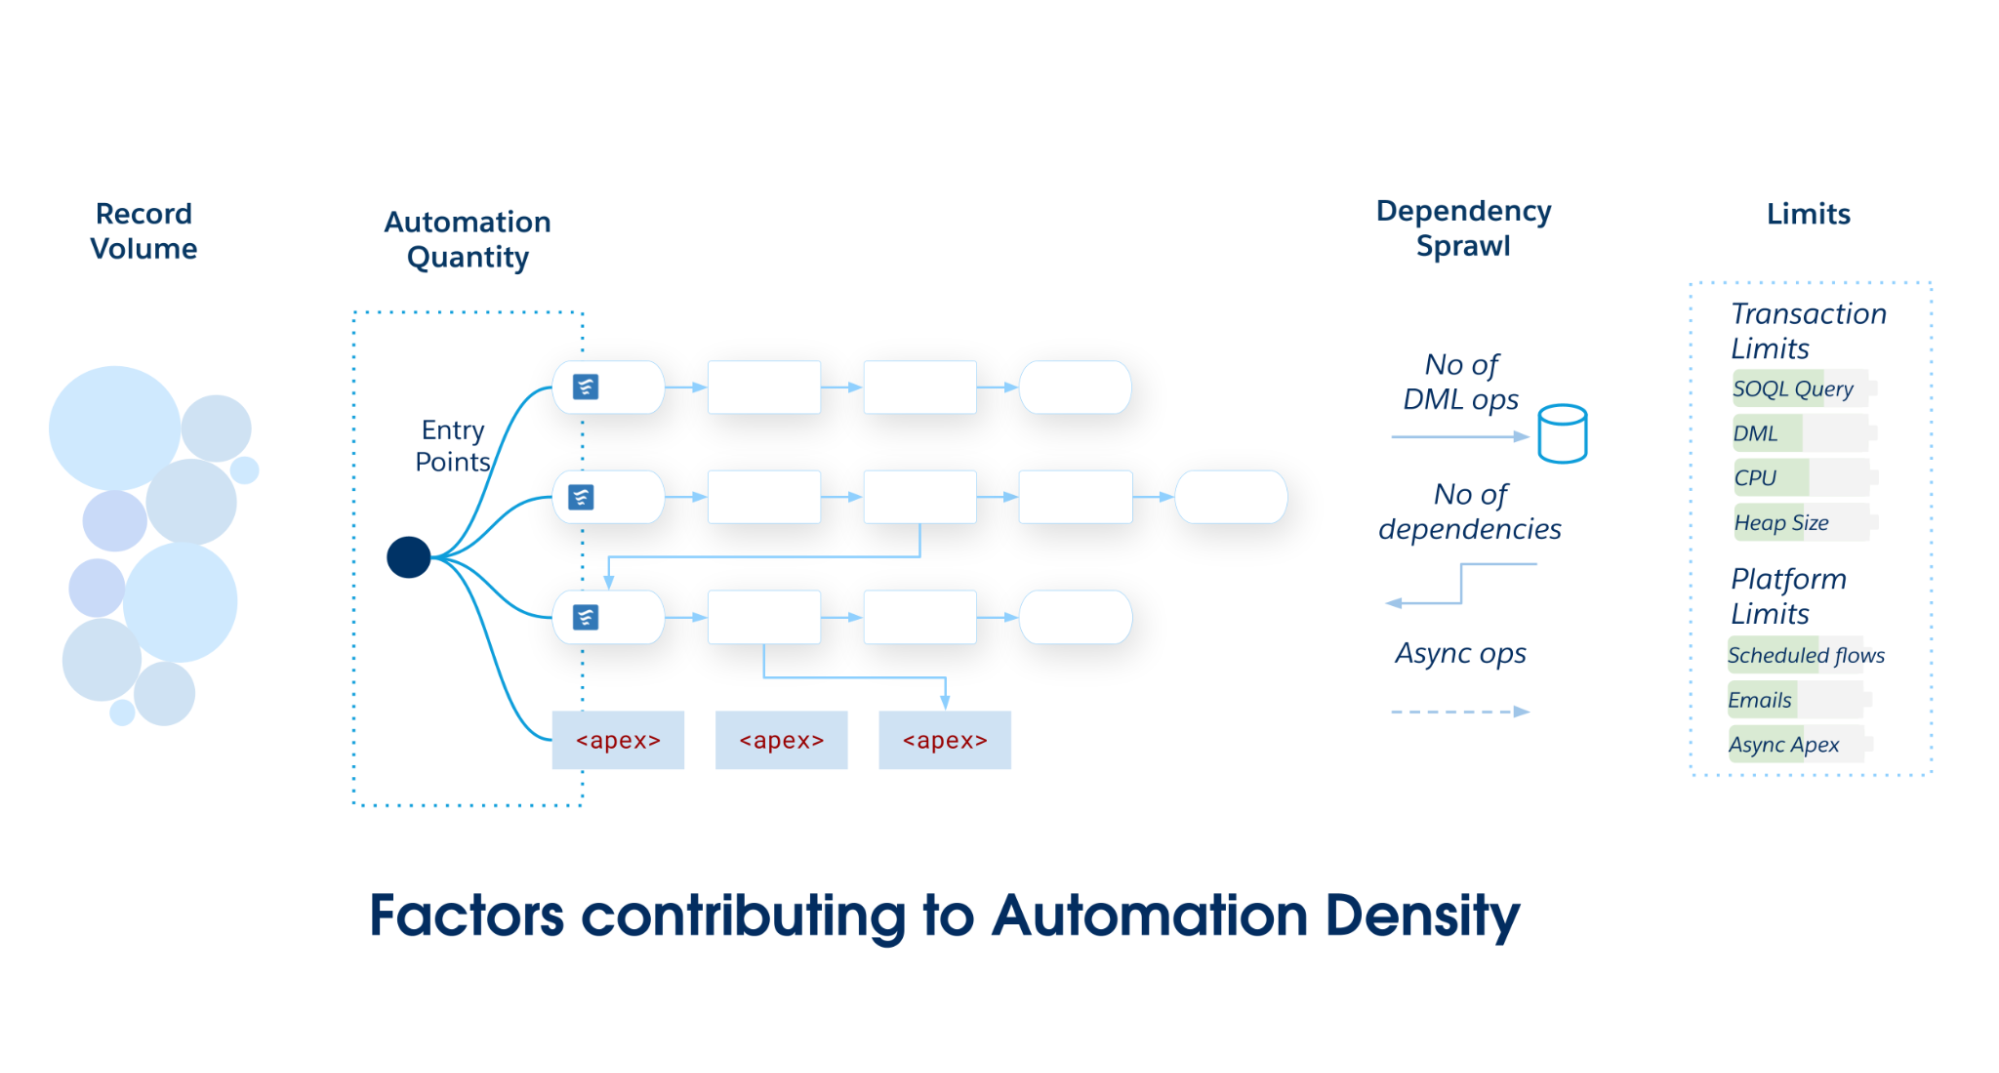 Conforme o escopo e a complexidade do seu aplicativo Salesforce aumentam, confirme-se com um único ponto de entrada principal: Fluxo acionado por registro ou Acionadores do Apex. Evite particionar automações entre vários mecanismos em um único objeto do Salesforce, pois isso leva à má capacidade de manutenção e à fragmentação da governança.
### A matriz de seleção de densidade
Use essa matriz para determinar o padrão de arquitetura necessário para seu objeto do Salesforce.
- O **Fluxo acionado por registro** é a solução preferida para baixa densidade de automação. Ele oferece um equilíbrio de poder e acessibilidade ideal para automações diretas e independentes umas das outras.
- **O padrão híbrido (Fluxo acionado por registro com Apex invocável)** é uma escolha poderosa e manejável para automações de média densidade com complexidade crescente. Esse padrão permite que as equipes mantenham a coreografia ordenada no Fluxo declarativo enquanto delegam operações pesadas em computação ao Apex, equilibrando acessibilidade e desempenho.
- Os acionadores **Apex** fornecem os blocos de construção necessários para uma base arquitetônica sólida para suportar automações de alta densidade. O desempenho, o controle granular e a abstração e o polimorfismo orientados a objetos do Apex são mais adequados para gerenciar a complexidade e a escala desses cenários.
| Nível de densidade | Quantidade de automação | Volume de dados (tamanho do lote) | Sprawl de dependência | Padrão arquitetônico |
|---|---|---|---|---|
| Baixo | < 15 Automações |
Padrão Interações de interface do usuário orientadas pelo usuário ou cargas de API pequenas (1 a 200 registros) |
Discreto Lógica independente. 0 a 1 operações de DML a jusante no mesmo objeto ou em um objeto relacionado. |
Fluxo acionado por registro |
| Médio | 15–30 Automações |
Moderar Processamento em lote padrão (com lógica que requer massificação cuidadosa) |
Acoplado Pai/filho atualiza de 2 a 4 operações de DML a jusante. Risco de recursão |
Padrão híbrido Fluxo + Apex invocável |
| Alto | > 30 Automações |
Alto Grandes volumes de dados com carregamentos de API em massa (2.000 a 10.000 registros) |
Complexo e Recursivo Gráfico de dependência profunda (5 operações DML a jusante). Risco de loops de recursão triangular |
Apex Trigger Metadata Framework |
| Capacidade | Fluxo acionado por registro | Acionador do Apex |
|---|---|---|
| Velocidade de entrega e manutenção | Recomendado A interface de usuário visual do Flow Builder permite que administradores e outros criadores declarativos criem e modifiquem automações mais rapidamente do que escrever, testar e implementar Apex code. Essa interface permite que uma gama mais ampla de membros da equipe ofereça valor comercial e reduza a dependência de recursos de desenvolvedor especializados para tarefas simples. |
Requer conhecimento O Apex exige que desenvolvedores de software habilitados para implementar, testar e manter o código. |
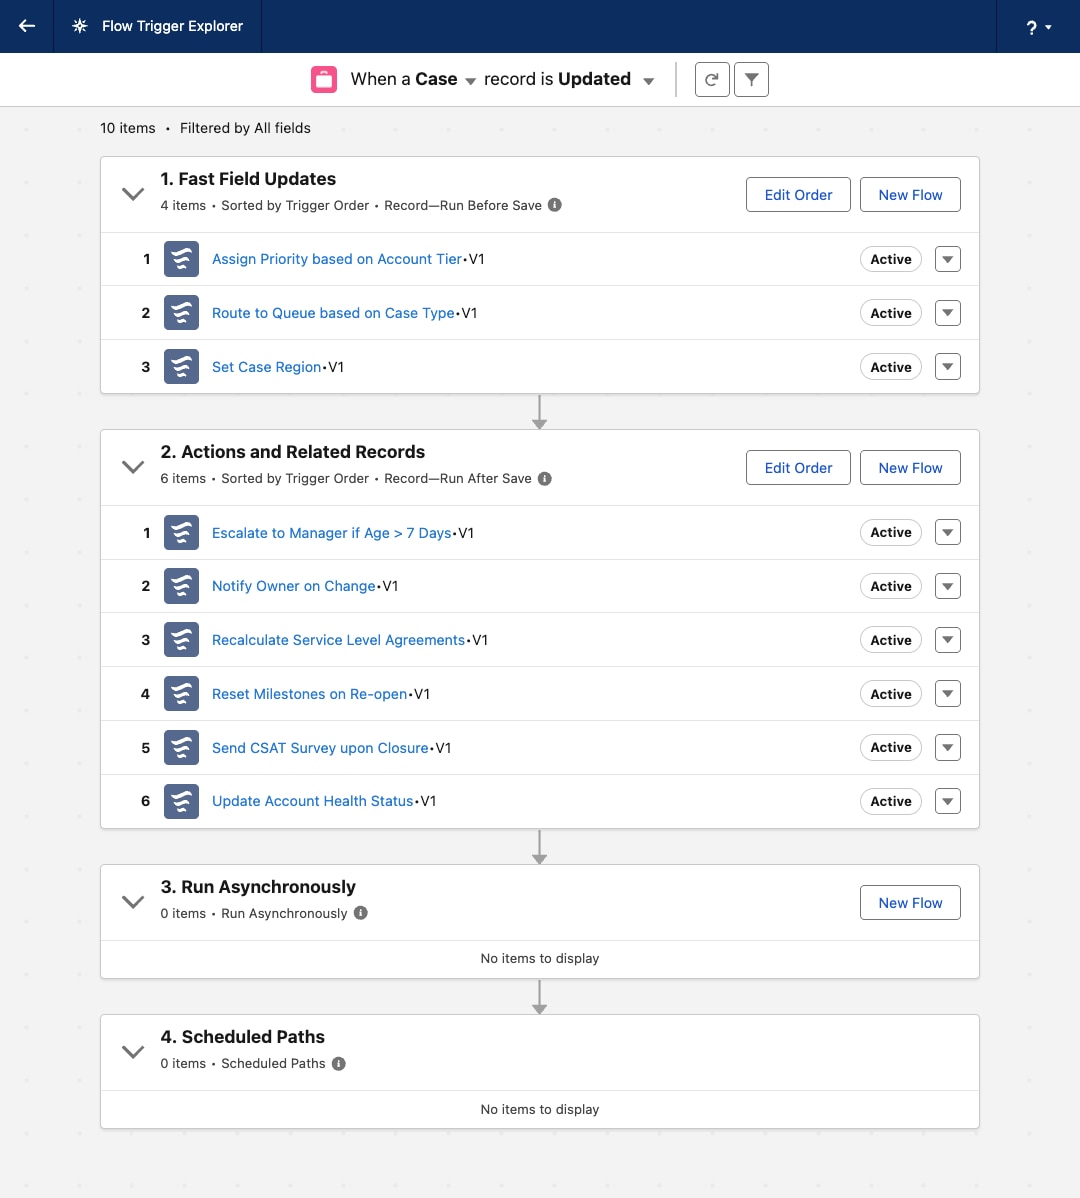
| Modularidade | Disponível Fluxos acionados por registro são modulares por padrão. Em vez de lógica monolítica, as equipes criam fluxos separados para requisitos específicos e os coreografam juntas usando o Explorador do Acionador de fluxo. Essa modularidade permite a modificação isolada e a extensão simples, reduzindo significativamente o custo de propriedade de longo prazo. |
Disponível O Apex é dividido em módulos funcionais por design. Cada classe do Apex tem como objetivo implementar um único módulo de funcionalidade. |
| Visibilidade e governança | Recomendado A natureza visual do Fluxo fornece uma representação intuitiva da lógica de negócios. O Explorador do acionador de fluxo fornece uma visualização consolidada de todos os fluxos em um objeto, tornando mais fácil para arquitetos e administradores entenderem, governarem e solucionarem problemas sem lerem código. |
Requer conhecimento Usar uma estrutura de metadados para organizar acionadores é vantajoso, mas o Apex exige uma equipe de desenvolvimento disciplinada para manter o código organizado e mantido. |
| Processamento de dados em massa de alto desempenho | Não recomendado Há um maior risco de atingir os limites do controlador ao lidar com lógica complexa ou grandes volumes de dados. |
Recomendado O Apex code é executado mais próximo dos serviços centrais da plataforma e oferece aos desenvolvedores um controle aprimorado sobre a otimização de consultas, o tratamento de dados e a eficiência algorítmica. Isso resulta em melhor desempenho e escala, especialmente em cenários complexos que envolvem grandes volumes de dados. |
| Lógica robusta e estruturas de dados | Disponível O Elemento Transformação de Fluxo pode ajudar com algumas tarefas complexas de processamento. No entanto, o Fluxo não tem estruturas de dados Mapear e Definir nativas, tornando o processamento de dados complexo complicado e computacionalmente ineficiente. |
Recomendado O Apex oferece acesso total a loops Map, Set e Programmatic para manipulação de dados altamente eficiente e segura em massa. Como uma linguagem de programação com recursos completos, o Apex também oferece acesso a construções lógicas complexas, estruturas de dados e padrões de design que podem ajudar a resolver problemas de negócios complexos de forma mantida e eficiente. O Apex inclui uma rica biblioteca padrão de funções avançadas (por exemplo, BusinessHours, Crypto) que atualmente não estão disponíveis em ferramentas declarativas. |
| Controlo da transação | Não disponível O fluxo não fornece acesso a operações de DML `Database.savepoint`, `Database.rollback` ou parcialmente bem-sucedidas para confirmações ou reversões de transações parciais. |
Disponível O Apex fornece controle completo e granular sobre a integridade da transação e cenários complexos de recuperação de erros. |
| Distribuição de email | Recomendado Enviar alertas por email pré-configurados de um fluxo acionado por registro é fácil e escalonável. Alertas por email personalizados podem ser elaborados e distribuídos no tempo de execução. Emails personalizados estão sujeitos a limites diários de envio de email. |
Disponível O Apex pode gerar e enviar mensagens de email personalizadas. Todos os emails enviados do Apex estão sujeitos aos limites diários de envio de email. |
| Aplicando salvaguardas de plataforma | Recomendado O fluxo inclui proteções integradas, como massificação automática e novas tentativas automáticas. Essas proteções aumentam a velocidade de valorização e impedem armadilhas de desempenho que exigem codificação manual complexa. |
Implementação manual necessária Proteções como massificação devem ser codificadas explicitamente (por exemplo, gerenciar coleções e evitar SOQL dentro de loops). As novas tentativas automáticas não são nativas de acionadores e exigem a implementação de uma lógica personalizada complexa. |
| Processamento assíncrono | Disponível O Fluxo oferece mecanismos fáceis para automações que exigem uma transação separada em um caminho assíncrono. Essas automações estão sujeitas a limites diários. |
Disponível O Apex permite o controle total por meio da Captura de dados de alteração e eventos enfileiráveis que são tratados por um assinante de acionador desacoplado. |
| Processamento agendado | Recomendado Os caminhos agendados do fluxo fornecem uma funcionalidade de agendamento exclusiva e eficiente (por exemplo, "desligar 3 dias antes da data de fechamento"). Essa funcionalidade inclui cancelamento automático e reagendamento se os dados do registro mudarem. Essas automações estão sujeitas a limites diários. |
Não disponível Um acionador do Apex não pode agendar nativamente um evento temporal específico do registro com cancelamento automático. Embora o Apex agendado exista, é um mecanismo fundamentalmente diferente que é executado em um horário específico e não é agendado durante o processamento de um registro individual como parte de um acionador. |
| Ordenamento e coreografia | Disponível O Explorador do acionador de fluxo permite que os administradores definam uma ordem de execução relativa para vários fluxos no mesmo objeto. |
Disponível Uma estrutura de acionador fornece controle granular sobre a ordem exata das automações. |
| Atualizações de campo de mesmo registro | Disponível (antes de salvar) O Fluxo acionado por registro é a opção declarativa de melhor desempenho para atualizar o registro acionador antes da confirmação DML inicial. |
Disponível (antes de salvar) O Apex oferece o melhor desempenho com pouca sobrecarga. |
| CRUD de objeto cruzado | Disponível (depois de salvar) O fluxo é adequado para operações de DML de objeto cruzado simples e de baixa complexidade. |
Disponível (depois de salvar) O Apex oferece controle superior sobre a remoção de duplicação, o tratamento de erros e o desempenho para operações DML entre objetos. |
| Deduplicação de cálculos caros | Disponível O fluxo se destaca na eliminação de consultas redundantes e instruções DML por meio de massificação automática. No entanto, o estado não pode ser armazenado em cache ou compartilhado entre diferentes acionadores de fluxo ou entre várias invocações do mesmo fluxo em uma transação. Essa limitação pode se tornar importante em cenários de desempenho extremo. |
Recomendado O Apex fornece mecanismos para desduplicar operações caras. Os desenvolvedores podem aproveitar o armazenamento em cache transacional usando propriedades e variáveis estáticas e o armazenamento em cache no nível da plataforma usando o Cache da plataforma para armazenar e reutilizar dados. Essas técnicas são importantes para reduzir o consumo de limites de controlador transacional, como consultas SOQL, e garantir alto desempenho e escalabilidade. |
| Tratamento de erros personalizados | Disponível O elemento CustomError pode bloquear uma operação de salvamento e exibir uma mensagem ao usuário. |
Recomendado O método addError() fornece mensagens de erro condicionais e em nível de campo flexíveis. |
| Caso de uso | Descrição | Melhor ajuste | Racionalidade |
|---|---|---|---|
| Processamento em lote de alto desempenho | Qualquer automação que precise processar milhares de registros de maneira eficiente | Apex | O Apex fornece APIs avançadas para interface com a plataforma e velocidade bruta. |
| Processamento de dados complexo | Cenários que exigem manipulação de dados avançada | Apex | O Apex fornece estruturas de dados, como Mapa e Conjunto, que não estão disponíveis nativamente no Fluxo e podem ser essenciais para escrever um código de alto desempenho e seguro em massa. |
| Controle transacional | Controlar mecanismos como pontos de salvamento, reversões e confirmações parciais | Apex | O Apex fornece acesso a mecanismos como Database.savepoint e Database.rollback e tem a capacidade de processar operações DML parcialmente bem-sucedidas. |
| Validação personalizada sofisticada | Validação de dados em vários campos em um registro | Apex | Embora o Fluxo possa impedir uma gravação com o elemento `CustomError', ele não está disponível em todos os tipos de fluxo, incluindo subfluxos. O método Apex addError() fornece várias mensagens de erro específicas do campo que podem ser adicionadas a um registro a qualquer momento durante o processamento do acionador. |
| Lógica moderadamente complexa em um processo simples | Lógica e manipulação de dados de complexidade moderada, simplificada por uma biblioteca padrão de funções avançadas, que ocorre como parte de um processo não complicado | Fluxo + Apex | O Fluxo acionado por registro atua como a camada de orquestração, enquanto operações de alta complexidade são encapsuladas no Apex invocável. |
| Lógica simples a moderadamente complexa | Manipulação de dados de baixa a moderada complexidade, com atualizações de acionador para os objetos de dados primários e relacionados | Fluxo | O fluxo costuma ser a opção recomendada, pois é baseado em um modelo declarativo que o torna acessível a administradores e desenvolvedores. |
| Notificações e mensagens de saída | Enviar emails e mensagens de saída | Fluxo | O fluxo torna o envio de alertas por email e mensagens de saída em alterações de registro fácil e altamente escalonável. |
| Processamento agendado | Automação em uma data futura e dinâmica (por exemplo, três dias antes de uma data de fechamento) | Fluxo | Os caminhos agendados fornecem um poder exclusivo ao Fluxo, pois a plataforma gerencia automaticamente o agendamento, o cancelamento e o reagendamento desses caminhos se os dados do registro mudarem. |
 ### A alternativa de trabalho agendado
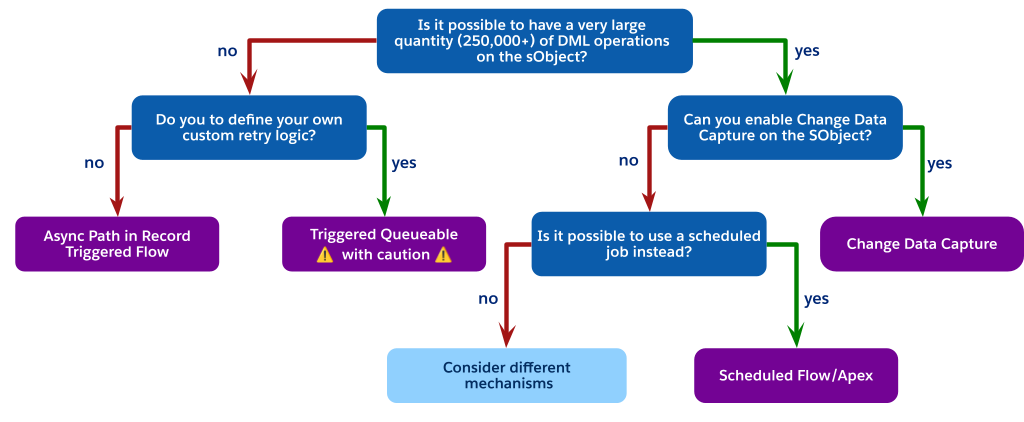
Como o fluxograma indica, quando você está enfrentando operações de DML de alto volume, mas não pode usar a Captura de dados de alteração (talvez devido a limites de objeto), a melhor escolha arquitetônica é muitas vezes evitar um processo invocado por acionador completamente.
Em vez disso, considere usar um processo agendado. Isso pode ser um Fluxo agendado ou Apex agendado. As etapas necessárias são:
1. Realize uma atualização simples e de baixo custo no acionador síncrono. Por exemplo, defina um campo de `Status__c` como "processamento pendente" ou insira um registro relacionado a baixo custo, como uma publicação do Chatter, para indicar que o registro precisa ser processado.
2. Crie um trabalho agendado, seja um fluxo agendado ou Apex agendado, que é executado periodicamente, como a cada 15 minutos ou a cada hora.
3. Tenha a consulta de trabalho agendada para todos os registros no estado pendente, execute a lógica complexa em um contexto controlado e de alto volume e atualize os registros conforme processados.
Esse padrão desconecta totalmente o processamento pesado do salvamento síncrono do usuário, não está sujeito ao limite de um trabalho por transação de um lote acionado pelo acionador e fornece uma solução altamente escalonável e regulável para requisitos não em tempo real.
Se a latência de um trabalho agendado não for aceitável para os requisitos de negócios e você ainda estiver impedido de usar o CDC ou uma fila acionada pelo acionador, isso indicará uma incompatibilidade arquitetônica significativa. Nesse ponto, diferentes mecanismos devem ser considerados. Reavaliar o design do aplicativo principal pode levar a determinadas conclusões, como:
- Comprar o complemento para remover limites de objeto da CDC.
- Desafiar fundamentalmente o requisito de negócios para determinar se o processamento quase em tempo real é realmente um "must-have" ou se a latência de um trabalho agendado é uma compensação aceitável para a estabilidade da plataforma.
## Considerações não funcionais
Além dos pontos de decisão, você precisará considerar considerações não funcionais, como complexidade e padrões.
### Complexidade
O nível de complexidade em uma implementação faz parte do custo total de propriedade de uma solução, bem como sua capacidade de se adaptar a mudanças nos requisitos de negócios. A complexidade pode afetar qualquer implementação se as práticas recomendadas não forem seguidas. Na seção Práticas recomendadas _relacionadas_ deste documento, há recomendações para reduzir a complexidade da sua solução, incluindo estes padrões:
- Padrão híbrido: Apex invocável para lógica complexa no fluxo
- Usando uma estrutura de metadados para acionadores do Apex
- Mega-fluxos vs. vários fluxos
### Processos e padrões
A documentação é tão importante quanto a automação em si. Não apenas garante a capacidade de manutenção, mas também é essencial para IA e ferramentas baseadas em agente. A documentação ajuda você a entender e gerenciar seus processos de negócios.
**Em fluxo**
- Estabeleça uma convenção de nomenclatura consistente para todos os elementos e variáveis.
- Use o campo Descrição do fluxo para explicar seu propósito geral, critérios de acionador e resultado pretendido.
- Use o campo Descrição em cada elemento individual (por exemplo, `Get Records`, `Action`, `Transform`). Essa prática é a melhor maneira de transmitir a intenção. É especialmente importante para ações e subfluxos invocáveis, em que a descrição é o principal lugar para explicar a lógica complexa realizada pela ação.
**No Apex**
- Comente seu código claramente para explicar o _porquê_ por trás de sua lógica, não apenas o _o quê_.
- Se estiver usando uma estrutura conduzida por metadados, garanta que seus registros de metadados incluam e preencham um campo de Descrição legível por humanos para explicar o que cada classe de manipulador faz e quando ela deve ser executada.
DevOps e controle de origem fazem parte de um ciclo de vida de desenvolvimento maduro. Sempre use uma ferramenta de controle de código-fonte, como Git para projetos do Salesforce. As classes do Apex e os Fluxos do Salesforce são metadados que definem sua lógica de negócios e devem ser controlados e gerenciados com controle de versão.
No contexto do gerenciamento de automações acionadas por registro, um pipeline DevOps moderno oferece benefícios essenciais.
- **Verificações de qualidade automatizadas:** Ferramentas como o [Salesforce Code Analyzer](https://developer.salesforce.com/docs/platform/salesforce-code-analyzer/overview) podem ser configuradas para ser executadas automaticamente em seu pipeline. A análise estática pode detectar padrões problemáticos em ambas as ferramentas de automação antes de serem promovidas, sinalizando problemas como elementos de `Get Records` ineficientes dentro de um loop de Fluxo ou consultas de `SOQL` dentro de um loop do Apex, que são causas comuns de degradação do desempenho.
- **Prevenção de regressão:** Conforme sua densidade de automação aumenta, uma mudança para um Fluxo ou classe do Apex pode ter consequências indesejadas para outras automações no mesmo objeto. Uma estratégia de teste DevOps robusta, em que os testes automatizados do Apex são executados em relação a qualquer alteração proposta, é a maneira mais confiável de garantir que uma nova versão do Fluxo não quebre a lógica do Apex existente (e vice-versa).
- **Colaboração e visibilidade:** O controle de origem é a "única fonte da verdade". Permite que administradores e desenvolvedores trabalhem em automação para o mesmo objeto em paralelo. Ela também fornece uma trilha de auditoria inestimável: Quando um processo de produção é interrompido, você pode ver instantaneamente _quem_ alterou a automação, _quando_ ela foi alterada e — através de mensagens de compromisso — _por que_ ela foi alterada.
Para equipes com uma combinação de administradores e desenvolvedores, o [DevOps Center](https://help.salesforce.com/s/articleView?id=platform.devops_center_overview.htm&type=5) fornece uma interface unificada para ajudar a organizar todas essas etapas, tornando um processo de desenvolvimento escalonável e baseado em controle de código-fonte acessível a todos na equipe.
Essa disciplina combinada de documentação e DevOps garante a integridade e a manutenção de longo prazo da sua organização, o que beneficiará todos os arquitetos e administradores que o seguem.
## Melhores práticas relacionadas
O guia de decisão acima é melhor usado antes de planejar sua implementação. Ele tem como objetivo ajudá-lo a escolher o melhor produto para seus casos de uso. Após a seleção do produto, é importante entender as práticas recomendadas existentes para sua implementação.
### Explorar o padrão híbrido: Apex invocável para lógica complexa no fluxo
O princípio _Uma ferramenta por objeto_ é crucial para gerenciar a automação de alta densidade, mas não o interprete como uma escolha binária entre uma pilha puramente declarativa ou puramente programática. Um padrão arquitetônico mais eficaz e mantido aproveita um modelo híbrido: Posicione o Fluxo acionado por registro como a camada de orquestração enquanto encapsula operações de alta complexidade no Apex invocável.
 #### A Camada de orquestração: Fluxo
O Fluxo acionado por registro serve como a camada de orquestração para o processo de negócios. Ele é o proprietário dos critérios de entrada e do contexto de execução (o _o que_ e _quando_). Ao reter a lógica de decisão e o roteamento nessa camada, a topologia de processo da arquitetura permanece transparente e gerenciável por meio do Explorador do acionador de fluxo, impedindo que a lógica de negócios crítica seja ocultada no código.
#### O componente complexo: Apex invocável
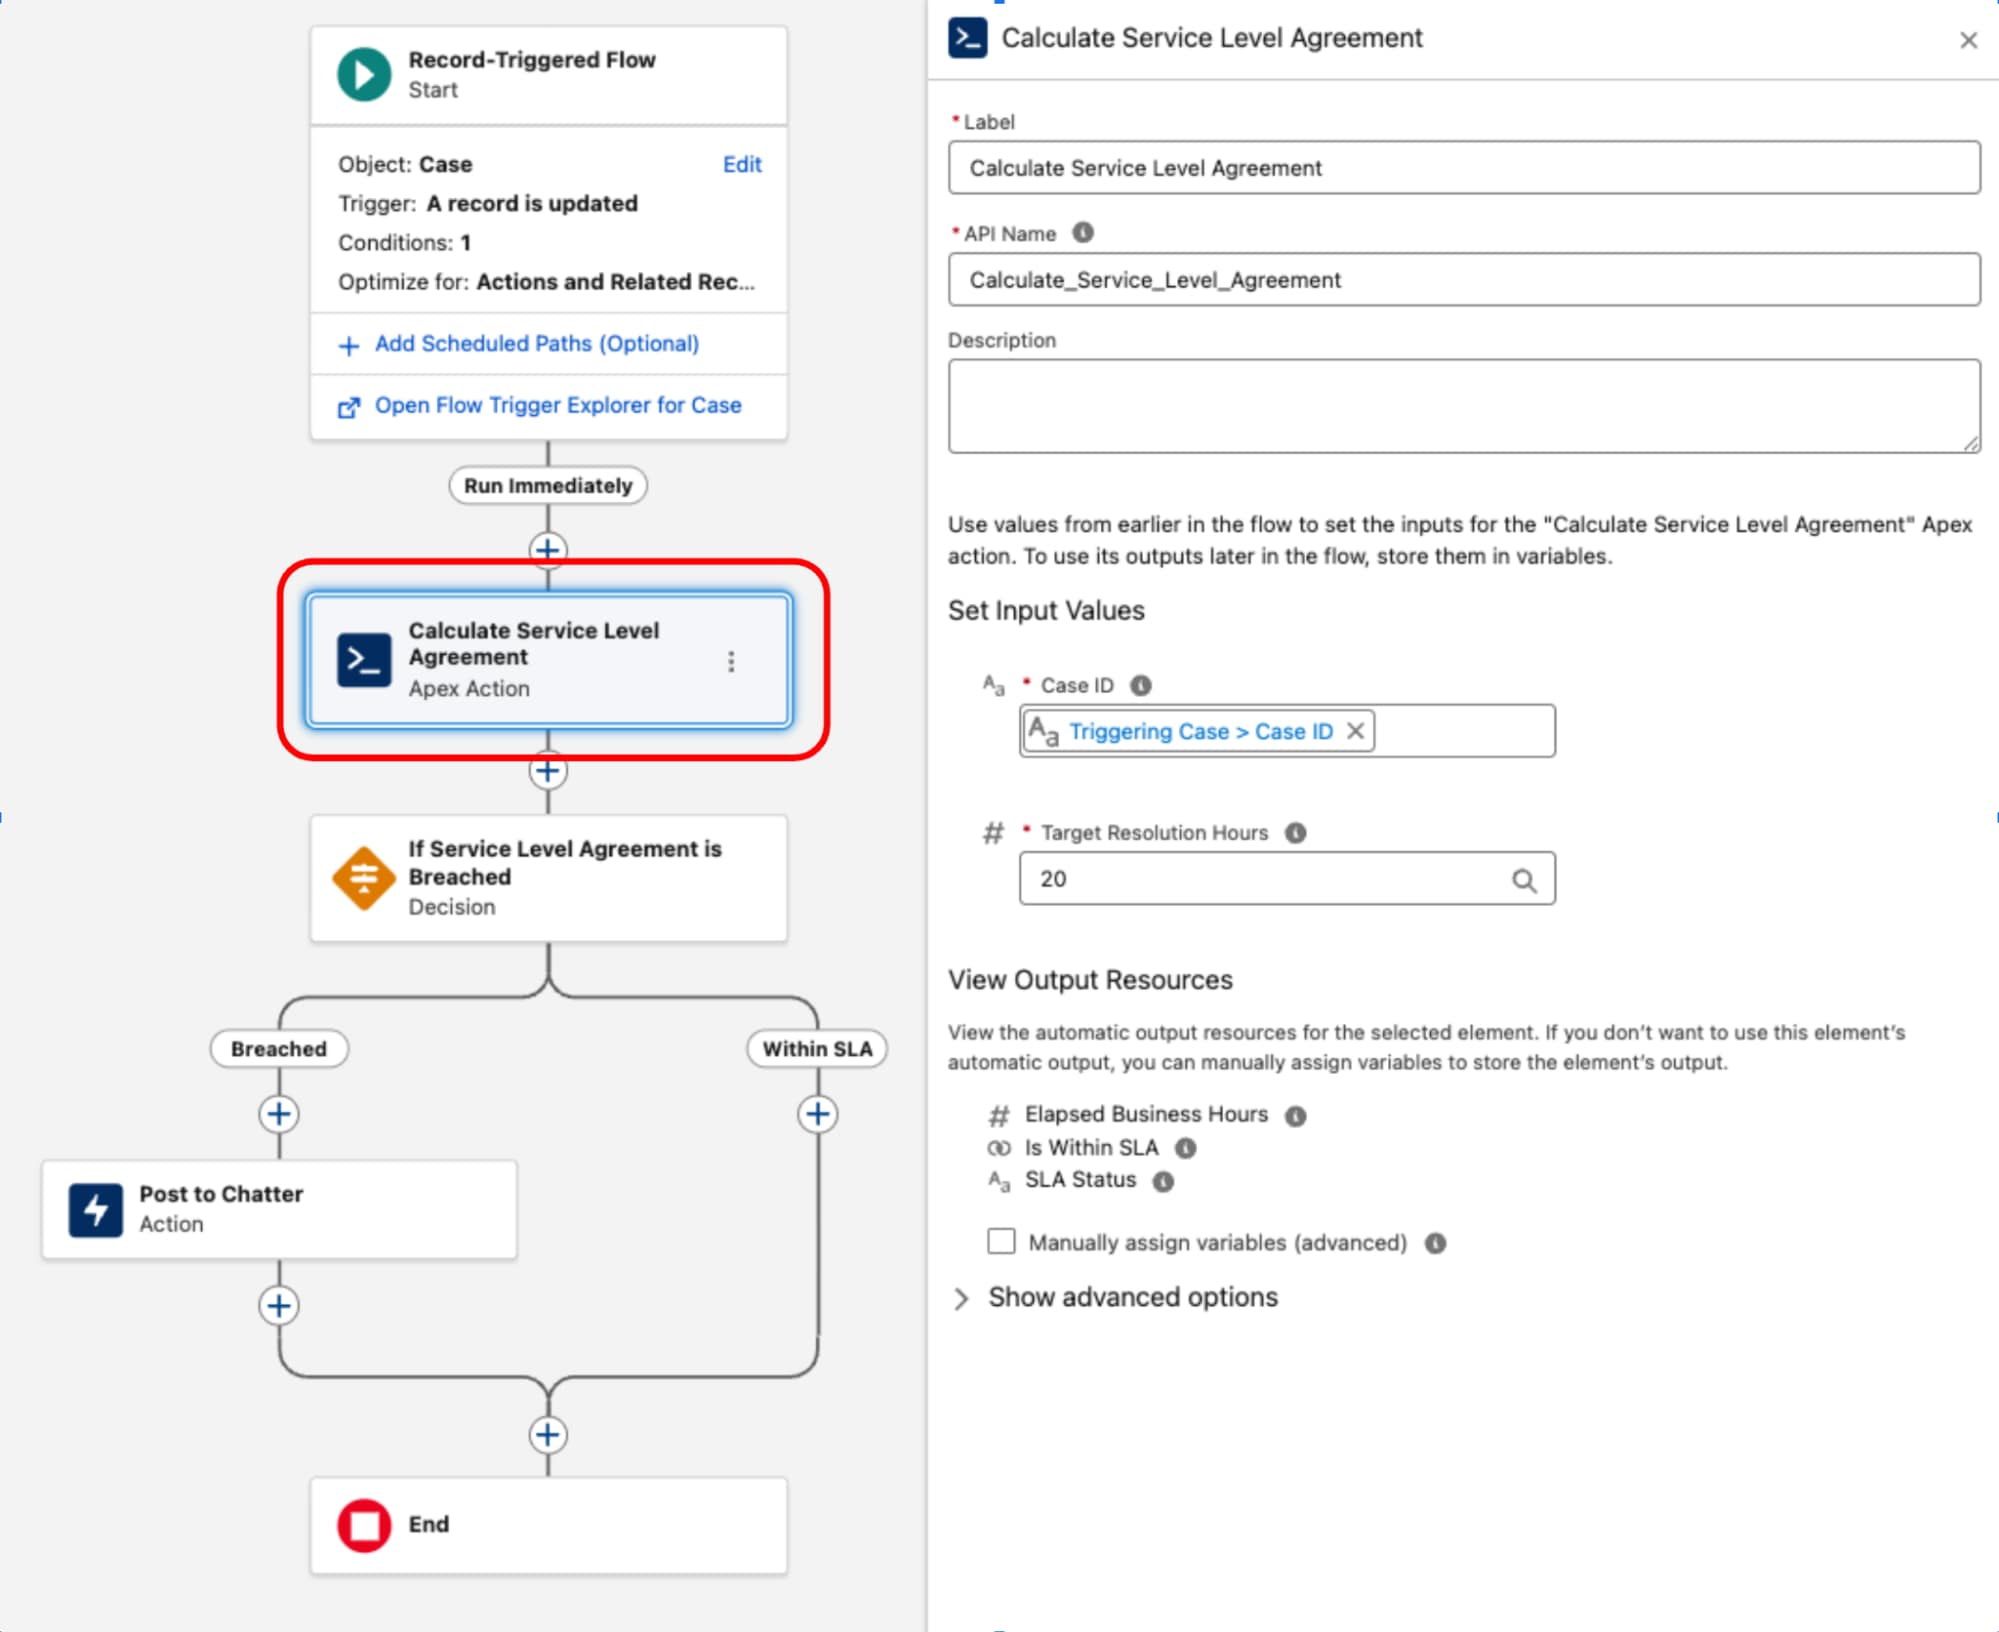
Um exemplo comum de um componente complexo é a implementação de cálculos de Acordo de nível de serviço (SLA) para registros de Caso. Como o objeto BusinessHours e sua lógica relacionada, essenciais para cálculos precisos que excluem horas de trabalho e feriados, não estão acessíveis nativamente no Fluxo, uma classe do Apex dedicada é usada. Essa classe, muitas vezes chamada de algo como `ServiceLevelAgreementCalculator`, é projetada com um único método estático, anotado com `@InvocableMethod`, para calcular o horário comercial decorrido, determinar se o SLA é "Dentro da meta" ou "Fechado" e retornar uma saída estruturada. Essa abordagem encapsula a lógica complexa e de alto desempenho no Apex, ao mesmo tempo que permite que ela seja executada e integrada na camada de orquestração declarativa de um fluxo acionado por registro.
Depois que a classe `ServiceLevelAgreementCalculator` do Apex for definida, ela estará disponível para uso em um fluxo acionado por registro:
Esse padrão demonstra uma separação rígida das preocupações. A camada declarativa é usada para gerenciar o ciclo de vida da transação e a orquestração enquanto o código é usado para execução de alta complexidade. Ao tratar o código como um utilitário funcional em vez da base, equilibramos o desempenho e a capacidade de manutenção.
#### Principais ganhos com o padrão híbrido
**Modularidade**: A decisão afasta-se da singularidade de usar o Apex ou o Fluxo para todo o processo. Em vez disso, a arquitetura encapsula a lógica complexa em unidades separadas, seguras em massa e testáveis de modo independente. Essas unidades funcionam como componentes reutilizáveis consumidos pela camada declarativa, garantindo as escalas de automação sem complicar o design arquitetônico.
**Reusabilidade**: A lógica é desacoplada do evento de acionador. Uma unidade de código bem projetada (como uma `InvocableMethod`) é escrita uma vez, mas aproveitada em vários pontos de entrada: Fluxos acionados por registro, fluxos de tela ou integrações externas. Essa reutilização de código elimina o desenvolvimento redundante.
**Manutenção**: A lógica de fluxo de processo permanece visível e gerenciável no Fluxo declarativo. Essa centralização reduz drasticamente a sobrecarga de depuração e garante que a ordem de execução do sistema seja determinista e transparente.
#### Limitações e compensações do padrão híbrido
Embora o modelo híbrido de usar o Apex invocável do fluxo seja poderoso, não é uma abordagem unidimensional. Os arquitetos devem estar cientes das limitações e compensações específicas antes de se comprometerem com uma solução híbrida.
- **Nenhum suporte antes de salvar**: Esta é a limitação mais crítica. Ações invocáveis estão disponíveis apenas no contexto após salvar (fluxos para ações e registros relacionados). Eles não podem ser usados no contexto de alto desempenho antes de salvar (fluxos para atualizações de campo rápido). Portanto, esse padrão não pode ser usado para delegar atualizações de campo do mesmo registro. Faça esse trabalho de alto desempenho usando elementos de Fluxo nativos em um fluxo antes de salvar ou em um acionador do Apex antes do contexto.
- **Sem suporte após a exclusão cancelada:** Atualmente, o Fluxo acionado por registro não oferece suporte ao contexto após a exclusão cancelada. Se um objeto do Salesforce tiver um requisito de negócio para executar a automação quando um registro for restaurado da lixeira, um acionador do Apex será a única solução.
- ** Sobrecarga de desempenho em cenários de alto volume:** A transição do tempo de execução do Fluxo para o tempo de execução do Apex não é uma operação de custo zero. Embora geralmente seja rápido, o ato de cair em uma Ação invocável do tempo de execução do Fluxo não é tão rápido computacionalmente quanto a execução nativa que permanece inteiramente dentro de um acionador do Apex. Para a maioria das automações de média densidade, essa sobrecarga é uma compensação insignificante e útil para a maior acessibilidade. No entanto, para cenários de alto desempenho e alto volume, uma estrutura somente do Apex terá uma vantagem de velocidade de computação bruta.
### Estratégias para automação legada
Embora a heurística de densidade de automação forneça orientação definitiva para uma arquitetura de greenfield mais recente, a realidade dos ambientes corporativos do Salesforce costuma ser mais detalhada. Em organizações maduras, é comum encontrar fluxos acionados por registro e acionadores do Apex que operam no mesmo objeto do Salesforce. Esse cenário é distinto do padrão híbrido explicado anteriormente: Aqui, os fluxos e acionadores do Apex não são acoplados nem projetados para trabalharem juntos.
Essa coexistência geralmente é resultado de funcionalidades de plataforma em evolução ou débito técnico legado. Embora esse seja um estado operacional tolerado, os arquitetos devem tratá-lo como uma compensação calculada em vez de um estado final.
A orquestração fragmentada gera uma sobrecarga significativa de governança e manutenção, tornando as atividades de desenvolvimento, teste e tratamento de incidentes desagrupadas e complicadas. Isso leva a um maior Tempo para resolução (TTR) e complexidade operacional.
- Para novos objetos do Salesforce, siga o princípio de densidade de automação como o guia principal.
- Para Objetos do Salesforce existentes com uma pegada híbrida e acionador Apex duplo e pontos de entrada de fluxo acionados por registro, avalie a densidade e, em seguida, arquite para o refator para um estado híbrido mantido.
- Para baixa densidade, o Apex refator aciona fluxos acionados por registro e especifica a ordem de execução, levando-os a um único ponto de entrada de automação.
- Para densidade média, o complexo do refator faz megafluxos em um subconjunto de fluxos com a ordem de execução certa. Introduza acionadores do Apex apenas quando absolutamente necessário, por exemplo, para dar suporte após a exclusão de contexto cancelada.
- Para alta densidade, implemente acionadores do Apex.
### Usando uma estrutura de metadados para acionadores do Apex
Conforme os processos de negócios de uma organização na Salesforce Platform amadurecem, o volume e a complexidade da automação acionada por registro aumentam inevitavelmente. Uma prática recomendada fundamental é manter _um acionador do Apex por objeto do Salesforce_. Essa regra é crítica porque a plataforma não garante a ordem de execução de vários acionadores no mesmo objeto para o mesmo evento. Essa limitação pode levar a comportamentos não deterministas, condições de corrida e problemas de depuração difíceis.
No entanto, aderir ao princípio de _um acionador_ introduz um desafio arquitetônico: como gerenciar e orquestrar toda a lógica de negócios invocada desse único ponto de entrada de maneira mantida e escalonável.
#### As limitações dos manipuladores do acionador clássico
A primeira evolução dessa arquitetura foi o padrão do Manipulador de acionador clássico. Nesta abordagem, o acionador Apex único delega toda a sua lógica a uma classe de manipulador correspondente (por exemplo, `OpportunityTriggerHandler`). Esse método separa a lógica do arquivo de acionador e fornece aos desenvolvedores controle determinístico sobre a ordem de execução dentro dos métodos da classe manipuladora (por exemplo, `afterInsert()`).
Embora seja uma melhoria, esse padrão geralmente leva a classes de manipulador monolíticas. Ao longo do tempo, à medida que mais requisitos de negócios são adicionados, a classe se torna grande, difícil de gerenciar e difícil de testar em isolamento. A ordem de execução de todos os processos individuais é codificada em um único método, tornando a classe propensas a conflitos de mesclagem, aumentando dramaticamente a sobrecarga de governança e manutenção em um ambiente corporativo grande.
#### A solução: Uma estrutura do acionador conduzida por metadados
Para resolver os problemas centrais da modularidade e da orquestração, os arquitetos mudam para uma **Quadro do acionador conduzido por metadados**. Este é um salto arquitetônico significativo que separa a própria lógica de automação da configuração de _como_ e _quando_ ela é executada.
Essa estrutura é baseada em três principais vantagens:
- **Particionamento:** Em vez de uma única classe de manipulador, a lógica de negócios principal é dividida em classes do Apex pequenas e atômicas (por exemplo, uma classe de `RecalculateAccountValues` ou uma classe de `NotifySalesLeads`), com cada classe aderindo ao _Princípio de Responsabilidade Única_. Essa modularidade facilita o teste, a depuração e a compreensão da lógica isoladamente.
- **Ordem e coreografia:** A ordem de execução não é mais codificada no Apex. Em vez disso, é definido declarativamente por registros de configuração, geralmente armazenados em um tipo de metadados personalizado (por exemplo, `TriggerAction__mdt`). Isso permite que os administradores reordene, adicione ou remova ações de automação simplesmente modificando um registro de metadados, o que não requer uma implantação ou alteração de código.
- **Funcionalidade de bypass:** A estrutura fornece uma funcionalidade de desvio granular padronizada. Cada ação de automação pode ser configurada por meio de seu registro de metadados para ser desativada globalmente ou ignorada para usuários administrativos específicos referenciando uma permissão personalizada.
O acionador Apex único para o objeto então serve apenas como um supervisor dinâmico. Ele não contém lógica de negócios, mas instancia uma classe central de `MetadataTriggerHandler`. Esse manipulador consulta os registros de metadados personalizados para determinar dinamicamente a sequência de execução e invocar as classes atômicas Apex corretas na ordem prescrita. A automação é unificada sob uma única camada transparente e governável.
### Removendo operações caras na transação
Uma vantagem importante do uso do Apex em uma estrutura robusta é a capacidade de gerenciar o estado transacional e otimizar o desempenho eliminando o trabalho redundante. Conforme a lógica se acumula, é comum que diferentes automações no pedido de salvamento executem de modo independente as mesmas operações caras, consumindo limites valiosos do regulador e aumentando o tempo de operação de DML.
A estrutura é arquitetada para lidar com isso com duas estratégias principais:
- **Gerenciamento de estado compartilhado:** No escopo de uma única transação do Apex, propriedades estáticas e variáveis são aproveitadas para armazenar dados em cache. Isso garante que uma operação cara, como uma consulta de `SOQL` para uma configuração de configuração, seja executada apenas uma vez, mesmo que a lógica de automação seja invocada várias vezes em diferentes registros ou fases do acionador. O consumo dos limites transacionais é significativamente reduzido.
- **Utilização de cache da plataforma:** Para ir além do simples armazenamento em cache dentro da transação, use o cache da plataforma para evitar consultar todo o banco de dados para determinados dados. Esse cache gerenciado na memória é ideal para recuperar dados que não sejam primitivos, sejam lidos com frequência na base de códigos e sejam imutáveis ao longo de uma transação (por exemplo, perfis, papéis, horário comercial). Usando a interface de `Cache.CacheBuilder`, o sistema verifica o cache primeiro e realiza a consulta de banco de dados apenas se os dados não estiverem presentes, maximizando o desempenho e a escalabilidade.
### Usar antes de salvar para atualizações de mesmo registro
Sempre use uma atualização antes de salvar quando sua automação precisar apenas alterar os valores de campo no registro que inicia a transação. Isso se aplica tanto a atualizações de campo rápido no Fluxo (que são executadas antes de salvar) quanto à lógica antes do contexto nos Acionadores do Apex (antes da inserção, antes da atualização).
Esse padrão tem desempenho, independentemente da ferramenta usada, pois evita uma segunda operação DML e um ciclo de salvamento recursivo. As alterações são feitas no registro na memória _antes_ de ele ser vinculado ao banco de dados e são salvas como parte da transação original. A sobrecarga de um segundo salvamento, que, caso contrário, reexecutaria todo o pedido de salvamento e acionaria toda a automação novamente, é eliminada.
### Evitando recursão não controlada
A recursão não controlada é uma armadilha comum em acionadores após a atualização, em que a lógica de um acionador realiza uma atualização de DML que, por sua vez, faz o mesmo acionador ser disparado novamente. Isso cria um loop infinito que termina com uma exceção de limite do regulador. Embora sinalizadores booleanos estáticos ou coleções de IDs de registro processados tenham sido usados historicamente para evitar essa recursão, um padrão mais preciso e robusto é criar a lógica por meio da comparação de valores de campo entre as versões novas e antigas do próprio registro.
Execute a lógica apenas se um campo específico de interesse tiver realmente mudado. Isso impede que o acionador execute sua lógica em operações de DML subsequentes na mesma transação em que os dados críticos permanecem inalterados.
#### Controlar a recursão no fluxo acionado por registro
Em um fluxo acionado por registro, evite a recursão não controlada definindo o fluxo para ser executado apenas quando o registro for atualizado para atender aos requisitos de condição:
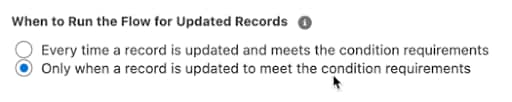 Se você optar por usar uma fórmula de critérios de entrada em seu fluxo, poderá evitar a recursão de escape comparando a variável global `$Record` (que representa os novos valores) com a variável global `$RecordPrior` (que representa os valores originais antes do salvamento). Por exemplo, para garantir que um fluxo seja executado apenas se o campo Valor em uma oportunidade tiver sido alterado, use isto nos critérios de entrada:
```
$Record.Amount != $Record__Prior.Amount
```
#### Controlando a recursão no Apex
Compare os valores de campo da nova versão do registro, `Trigger.new`, com os valores de campo da versão antiga do registro, `Trigger.oldMap`, para ver se a alteração específica que você está procurando ocorreu. Essa abordagem garante que a automação seja idempotente e seja executada apenas quando necessário, tornando o sistema mais eficiente e evitando loops recursivos catastróficos.
### Ignorar automação
Uma organização do Salesforce bem arquitetada requer um mecanismo consistente e confiável para contornar a automação. Esse não é um recurso opcional, mas um requisito operacional essencial para manter a integridade dos dados e habilitar tarefas administrativas.
Uma estrutura de desvio é essencial para alguns cenários:
- Ao carregar grandes volumes de dados, acionar acionadores para cada registro pode desacelerar drasticamente o processo, causar exceções de limite e criar registros relacionados e notificações incorretos. Um desvio permite que os dados sejam inseridos de maneira limpa e eficiente.
- Um usuário de integração pode precisar sincronizar dados de um sistema externo de registro. A automação que normalmente é acionada para uma alteração iniciada pelo usuário (por exemplo, enviar um email, criar uma tarefa) pode ser indesejável ou redundante quando a alteração se origina de outro sistema.
- Os administradores ou a equipe de suporte podem precisar realizar atualizações corretivas em registros. Um mecanismo de ignorar permite que eles façam essas alterações sem acionar a automação de negócios padrão, o que pode ter consequências indesejadas.
**Permissões personalizadas**: O padrão moderno e escalonável para implementar a lógica de desvio é permissões personalizadas. Esses métodos são superiores aos métodos mais antigos por diversos motivos:
- **Flexibilidade:** As permissões personalizadas podem ser atribuídas aos usuários por meio de conjuntos de permissões. Essa prática está alinhada ao moderno modelo de segurança e acesso do Salesforce, permitindo uma atribuição granular e flexível. Um desvio pode ser concedido a um usuário específico ou mesmo temporariamente com uma data/hora de expiração específica.
- **Manutenção:** O uso de permissões personalizadas evita que perfis de codificação permanente ou usuários entrem na lógica de automação. Se o papel de um usuário mudar ou um novo perfil precisar ignorar o acesso, a alteração será uma simples atribuição de Conjunto de permissões, não uma modificação de código ou fluxo que exija uma implantação.
- **Escalabilidade:** As permissões personalizadas fornecem uma estrutura dimensionável para gerenciar exceções em uma base de usuários complexa. Eles podem ser atribuídos a usuários por meio de conjuntos de permissões, grupos de conjuntos de permissões ou perfis. Sua associação a um conjunto de permissões ou perfil também é representável nos metadados de origem.
**Padrões de implementação**: Aplique um padrão de desvio consistente a todas as automações acionadas por registro na organização.
**Pular um fluxo acionado por registro**: A maneira mais eficiente de ignorar um fluxo é impedi-lo de ser executado. Isso é feito adicionando uma condição aos critérios de entrada do fluxo.
- No elemento Iniciar do fluxo acionado por registro, defina Requisitos da condição como Fórmula avaliada como verdadeira.
- No construtor de fórmula, incorpore uma verificação para a permissão personalizada usando a variável global `$Permission`. Combine a verificação com seus critérios de entrada existentes.
- Padrão de fórmula:
```
( ) && NOT($Permission.Bypass_This_Flow)
```
- Esse padrão garante que o fluxo seja executado somente se o usuário _não_ tiver a permissão personalizada especificada atribuída. Essa verificação é realizada antes mesmo da criação da entrevista de fluxo, tornando-a a abordagem com melhor desempenho.
**Excluindo uma estrutura de acionador do Apex**: No Apex, integre a lógica de desvio diretamente na estrutura de acionador orientada por metadados, permitindo um controle granular.
- O tipo de metadados personalizados `TriggerAction__mdt` deve incluir um campo de texto, por exemplo, `BypassPermission__c`.
- Na classe `MetadataTriggerHandler`, antes de executar uma ação dinamicamente, o código deve ler o valor desse campo.
- Se o campo for preenchido, o manipulador usará o método `FeatureManagement.checkPermission()` para determinar se o usuário em execução atual tem a permissão personalizada especificada.
- Se `checkPermission()` retornar verdadeiro, o manipulador ignora essa ação específica e avança para a próxima na sequência.
- Esse padrão é poderoso porque permite tanto um bypass global (se todos os registros de `TriggerAction__mdt` referenciarem a mesma permissão) quanto um bypass granular por ação (se diferentes registros referenciarem permissões diferentes ou se alguns não tiverem permissão de bypass).
### Mega-fluxos vs. vários fluxos
É um antipadrão consolidar toda a automação de um objeto em um único megafluxo maciço. Consolidar em um fluxo versus dividir a lógica em vários fluxos bem condicionados não tem um impacto significativo no desempenho. Os ganhos de desempenho mais significativos vêm de:
- Usar fluxos antes de salvar para atualizações de campo do mesmo registro.
- Escrever condições de entrada precisas para garantir que os fluxos sejam excluídos da execução em alterações que não afetam seu caso de uso específico.
O [Flow Trigger Explorer](https://trailhead.salesforce.com/content/learn/modules/record-triggered-flows/meet-flow-trigger-explorer) permite atribuir um valor de ordem a cada fluxo em um objeto, garantindo uma ordem de execução sequencial.
 ## Recursos
| Apex | Fluxo | Operações |
|---|---|---|
| Agentforce | Automação tradicional | Integração |
|---|---|---|
| Formulários dinâmicos | Os formulários dinâmicos no Criador de aplicativo Salesforce Lightning dividem componentes monolíticos de Detalhes do registro em campos e seções configuráveis individuais. Esse recurso permite que os administradores criem páginas flexíveis e de alto desempenho colocando campos em qualquer lugar e usando regras de visibilidade para mostrar ou ocultar componentes com base em perfil de usuário, dispositivo ou dados, o que ajuda a reduzir a bagunça de página. |
|---|---|
| Fluxo de tela | Um Salesforce Screen Flow é uma ferramenta de automação interativa no Flow Builder que exige a entrada do usuário para percorrer processos de negócios personalizados e passo a passo. Diferentemente dos fluxos de segundo plano automatizados, os Fluxos de tela fornecem uma interface do usuário semelhante a assistente para coletar dados, exibir informações ou executar ações por meio de Páginas do Lightning, botões ou aplicativos personalizados sem escrever código. |
| Omnistudio | O Salesforce Omnistudio é um conjunto de ferramentas de baixo código projetado para criar rapidamente experiências digitais guiadas específicas do setor e processos de negócios complexos. Ele permite que os desenvolvedores criem interfaces de usuário perfeitas para pixel (por exemplo, fluxos de trabalho guiados e painéis dinâmicos) usando componentes de arrastar e soltar, como Flexcards e OmniScripts. Com o OmniStudio, você pode criar LWCs de modo declarativo. |
| Componentes da Web Lightning | Os Componentes da Web do Salesforce Lightning são elementos HTML leves e personalizados criados usando HTML, CSS e JavaScript moderno e projetados para serem executados nativamente em navegadores para obter um desempenho superior na IU do Salesforce. Eles permitem que os desenvolvedores criem interfaces de usuário personalizadas que coexistem com componentes Aura, o que aumenta o desenvolvimento por meio de padrões da indústria e um ecossistema de componentes detalhado. |
| Configuração | Requisitos de licença adicionais | |
|---|---|---|
| Formulários dinâmicos | Código inferior | Nenhum |
| Fluxo de tela | Código inferior | Nenhum |
| Omnistudio | Código inferior + Código profissional | Pacote de Indústrias |
| Fluxo de tela mais Componentes da Web Lightning | Código inferior + Código profissional | Nenhum |
| Componentes da Web Lightning | Código profissional | Nenhum |
| Ponto de decisão | Diretrizes |
|---|---|
| Categorias de casos de uso de tempo de execução | |
| Escopo e navegação do formulário | Determine se todos os campos no formulário caberão de modo lógico em uma única tela ou se os usuários precisarão navegar entre várias telas. |
| Local | Identifique os locais em que você deseja integrar o formulário, que podem variar de dentro de um aplicativo Salesforce a um aplicativo móvel a um site externo. |
| Controlador | Identifique as ações ou a lógica que devem ser realizadas nos bastidores enquanto os usuários estão interagindo com seu formulário, incluindo transformações de dados e integrações com sistemas externos. |
| Validação | Determine se você tem requisitos adicionais de validação de entrada que vão além da validação no nível do sistema padrão que o Salesforce fornece. |
| Design de interação | Identifique os tipos de interações ou condições que devem acionar respostas dinâmicas no seu formulário. |
| Estilização | Determine o nível de sofisticação necessário para seus requisitos de estilo e CSS desejados. |
| Layout | Identifique os requisitos de layout do formulário (por exemplo, o número necessário de colunas, guias e acordeões) e a capacidade de exibir blocos de dados repetidos. |
| Tradução | Determine se o formulário deve ser localizado para outros idiomas. |
| Considerações não funcionais | |
| Segurança | Determine se o formulário deve verificar o acesso do usuário antes de realizar determinadas operações, se você deseja controlar quem pode acessar o formulário e se deseja controlar onde o formulário pode ser integrado. |
| Impacto do objeto | Determine se seu formulário operará em um único objeto ou em vários objetos. |
| Automação de testes de UI | Determine se seus processos DevOps exigem que seu formulário seja submetido a testes de unidade automatizados ou a testes completos automatizados. |
| Metricas | Identifique como você gostaria de rastrear o uso do formulário, incluindo visualizações de página, quantidade de tempo gasto no formulário, taxas de conclusão e taxas de sucesso. |
| Empacotamento e implantação | Determine como você deseja distribuir ou implementar seu formulário após ele ter sido criado. |
| Tela única | Formulário de várias telas | Indicadores de progresso | Navegação rápida entre etapas/tela | |
|---|---|---|---|---|
| Formulários dinâmicos | Disponível | Não disponível | Disponível | Não disponível |
| Fluxo de tela | Disponível | Disponível | Disponível | Não disponível |
| Omnistudio | Disponível | Disponível | Disponível | Disponível |
| Fluxo de tela + LWC | Disponível | Disponível | Disponível | Disponível |
| LWC | Disponível | Não ideal | Não ideal | Não ideal |
| Página de registro do Lightning | Página inicial do Lightning ou página de aplicativo | Sites do Experience Cloud do Aura | Sites do Experience Cloud do LWR | Snap-ins integrados | Barra de utilitários | Ação específica do objeto | Ação global | Aplicativo Salesforce móvel* | Field Service Mobile | SDK móvel | Sites e aplicativos externos | LWC personalizado | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Formulários dinâmicos | Disponível | Não disponível | Não disponível | Não disponível | Não disponível | Não disponível | Não disponível | Não disponível | Disponível | Não disponível | Não disponível | Não disponível | Não disponível |
| Fluxo de tela | Disponível | Disponível | Disponível | Disponível | Disponível | Disponível | Disponível | Não disponível | Disponível | Disponível** | Não disponível | Não disponível | Disponível |
| Omnistudio | Disponível | Disponível | Disponível | Não disponível | Não disponível | Disponível | Não disponível | Não disponível | Disponível | Não disponível | Não disponível | Disponível | Disponível |
| Fluxo de tela + LWC | Disponível | Disponível | Disponível | Disponível | Disponível | Disponível | Disponível | Não disponível | Disponível | Não disponível | Não disponível | Não ideal | Disponível |
| LWC | Disponível | Disponível | Disponível | Disponível | Disponível | Disponível | Não disponível | Não disponível | Disponível | Não disponível | Não disponível | Disponível | Disponível |
| * Fluxos e LWCs têm suporte no aplicativo Salesforce móvel, mas não têm suporte para todas as maneiras de integrar fluxos e LWCs (por exemplo, ações específicas de objeto têm suporte em dispositivos móveis, mas itens da barra de utilitários não). **O aplicativo Salesforce Field Service Mobile inclui a captura de dados, uma solução de formulários offline desenvolvida no mecanismo de Fluxo com um tempo de execução offline dedicado, com suporte para os recursos mais recentes do Fluxo. O aplicativo também inclui os Fluxos do Field Service Mobile legados, que são executados em um mecanismo offline personalizado mais antigo e não oferecem suporte a muitos dos recursos de Fluxo mais recentes. | |||||||||||||
| Registro e ações | Gerenciamento de dados hierárquico | Operar em uma transação | Operar entre várias transações | Integração | Design e reutilização modulares | Empacotamento | |
|---|---|---|---|---|---|---|---|
| Formulários dinâmicos | Não disponível | Não disponível | Não disponível | Não disponível | Não disponível | Não disponível | Disponível |
| Fluxo de tela | Disponível | Não disponível | Disponível | Disponível | Disponível | Disponível | Disponível |
| Omnistudio | Disponível | Disponível | Disponível | Disponível | Disponível | Disponível | Não disponível |
| Fluxo de tela + LWC | Disponível | Disponível | Disponível | Disponível | Disponível | Disponível | Disponível |
| LWC | Disponível | Disponível | Disponível | Disponível | Disponível | Disponível | Disponível |
| Respeitar validação no nível do sistema | Validação em nível de campo personalizada específica para este formulário | Validação em nível de campo personalizada | |
|---|---|---|---|
| Formulários dinâmicos | Disponível | Não disponível | Não disponível |
| Fluxo de tela | Disponível | Não disponível | Não disponível |
| Omnistudio | Disponível | Disponível | Disponível |
| Fluxo de tela + LWC | Disponível | Disponível | Disponível |
| LWC | Disponível | Disponível | Disponível |
| Executar operações de dados fora da tela | Valores condicionais e cálculos | Visibilidade condicional | Requisito condicional | Formatação condicional | Estado somente leitura condicional | Estado condicional desabilitado | |
|---|---|---|---|---|---|---|---|
| Formulários dinâmicos | Não disponível | Não disponível | Disponível | Não disponível | Disponível | Não disponível | Não disponível |
| Fluxo de tela | Disponível | Disponível* | Disponível | Disponível | Não disponível | Disponível | Disponível |
| Omnistudio | Disponível | Disponível | Disponível | Disponível | Disponível | Disponível | Disponível |
| Fluxo de tela + LWC | Disponível | Disponível | Disponível | Disponível | Disponível | Disponível | Disponível |
| LWC | Disponível | Disponível | Disponível | Disponível | Disponível | Disponível | Disponível |
| *Limitado a componentes que usam um seletor de recurso e não uma caixa de seleção estática | |||||||
| Manipulação de evento padrão (onblur, onfocus) | Manipulação de evento personalizado | |
|---|---|---|
| Formulários dinâmicos | Não disponível | Não disponível |
| Fluxo de tela | Não disponível | Não disponível |
| Omnistudio | Não disponível | Disponível* |
| Fluxo de tela + LWC | Disponível | Disponível |
| LWC | Disponível | Disponível |
| *O Tempo de execução padrão do OmniStudio não oferece suporte a Pub/Sub, mas oferece suporte a Windows postMessage | ||
| Estilização direta | Temas de organização e do Criador de experiências | Estilização perfeita para pixels | |
|---|---|---|---|
| Formulários dinâmicos | Não disponível | Disponível | Não disponível |
| Fluxo de tela | Não disponível | Disponível | Disponível** |
| Omnistudio | Disponível* | Não disponível | Disponível |
| Fluxo de tela + LWC | Não disponível | Disponível | Disponível |
| LWC | Não disponível | Disponível | Disponível |
| *Somente FlexCards **Certos atributos de estilo podem ser configurados para componentes de tela, mas não substituições de CSS. | |||
| 2 colunas | 4 colunas | Além de quatro colunas | Repetindo blocos de dados | Contêineres de guia | Contêineres de acordeão | |
|---|---|---|---|---|---|---|
| Formulários dinâmicos | Disponível | Não disponível | Não disponível | Não disponível | Disponível | Disponível |
| Fluxo de tela | Disponível | Disponível | Não disponível | Disponível | Não disponível | Disponível |
| Omnistudio | Disponível | Disponível | Disponível | Disponível | Disponível* | Disponível |
| Fluxo de tela + LWC | Disponível | Disponível | Disponível | Disponível | Disponível | Disponível |
| LWC | Disponível | Disponível | Disponível | Disponível | Disponível | Disponível |
| *As guias podem ser usadas ao integrar dados em um FlexCard em um OmniScript | ||||||
| Rótulos inseridos no Criador | Rótulos no código | |
|---|---|---|
| Formulários dinâmicos | Disponível* | Não disponível |
| Fluxo de tela | Disponível | Disponível |
| Omnistudio | Disponível | Disponível |
| Fluxo de tela + LWC | Disponível | Disponível |
| LWC | Não aplicável | Disponível |
| *Apenas cabeçalhos da seção de campo | ||
| Elevar permissões de usuário | Controlar quem tem acesso | Restringir locais permitidos | |
|---|---|---|---|
| Formulários dinâmicos | Não disponível | Disponível | Não disponível |
| Fluxo de tela | Disponível | Disponível | Não disponível |
| Omnistudio | Não disponível | Disponível | Não disponível** |
| Fluxo de tela + LWC | Disponível | Disponível | Não disponível |
| LWC | Disponível* | Disponível | Disponível |
| *Requer Apex **Enquanto os OmniScripts não podem ter um conjunto especificado de locais de destino, os FlexCards podem. | |||
| Testes de unidade | Automação de ponta a ponta | |
|---|---|---|
| Formulários dinâmicos | Não disponível | Disponível* |
| Fluxo de tela | Não disponível | Disponível* |
| Omnistudio | Disponível* | Disponível* |
| Fluxo de tela + LWC | Disponível* | Disponível* |
| LWC | Disponível | Disponível |
| *Requer código | ||
| Exibições de página | Tempo gasto no formulário | Rastrear conclusão do formulário | Rastrear a taxa de sucesso | |
|---|---|---|---|---|
| Formulários dinâmicos | Disponível** | Não disponível | Não disponível | Não disponível |
| Fluxo de tela | Disponível | Disponível* | Disponível | Disponível |
| Omnistudio | Disponível | Disponível* | Disponível | Disponível |
| Fluxo de tela + LWC | Disponível | Disponível* | Disponível | Disponível |
| LWC | Disponível** | Disponível* | Disponível | Disponível |
| *Disponível quando o Tempo de execução do OmniStudio baseado em pacote estiver habilitado** Disponível rastreando o uso de página pai do Lightning | ||||
| Pacotes gerenciados de primeira geração (1GP) | Pacotes gerenciados de segunda geração (2GP) | Pacotes desbloqueados | Conjuntos de alterações | DevOps Center | |
|---|---|---|---|---|---|
| Formulários dinâmicos | Disponível | Disponível | Disponível | Disponível | Disponível |
| Fluxo de tela | Disponível | Disponível | Disponível | Disponível | Disponível |
| Omnistudio | Não disponível | Não disponível | Não disponível | Não disponível* | Não disponível* |
| Fluxo de tela + LWC | Disponível | Disponível | Disponível | Disponível | Disponível |
| LWC | Disponível | Disponível | Disponível | Disponível | Disponível |
| *Use o Workbench do IDX para implementar soluções do OmniStudio em outras organizações. | |||||
| Formulários dinâmicos | - Dividir seus detalhes de registro com formulários dinâmicos - Obter ajuda para o Lightning App Builder |
| Fluxo de tela | - Usar fluxos de tela para interagir com os usuários - Automatizar tarefas com fluxos |
| Omnistudio | - Omnistudio - OmniScripts - Aplicação de desktop do Workbench do IDX - Newport Design System - Personalize OmniScripts e FlexCards com o Newport Design System |
| LWC | - Componentes da Web Lightning - Guia do desenvolvedor de componentes do Lightning Aura - Componentes da Web Lightning para desenvolvedores do Aura |
| Área a considerar | Perguntas comuns |
|---|---|
| Ferramentas e paisagem existentes | Existe uma solução de ETL ou ESB existente? Os dados envolvidos têm requisitos regulatórios ou de conformidade? Onde estão os sistemas que você está tentando integrar (na nuvem ou no local)? |
| Fluxo de dados (tempo, experiência do usuário esperada, direcionalidade) | Os dados precisam se mover de modo síncrono, assíncrono ou podem ser agendados/loteados? A replicação de dados é obrigatória? Qual sistema deve ser a fonte da verdade? Qual é a origem de dados? Qual é o destino? A interação do usuário é obrigatória? O usuário precisa ver o resultado da integração? Quais são as necessidades quanto ao gerenciamento de exceções (retomar, notificar, falhar)? Qual deve ser o nível de acoplamento dos sistemas? |
| Implementação | Qual é o nível de esforço para sistemas que não sejam do Salesforce? Quais equipes são responsáveis por fornecer integrações? Que ferramentas eles preferem usar? |
| Manutenção | Que equipes deverão manter a integração? Quais habilidades eles têm no momento? De quais habilidades eles precisarão no futuro? Qual é o custo total de propriedade ao longo do tempo? Qual é a importância da capacidade de testar, depurar e solucionar problemas com ferramentas de código baixo ou profissional? |
| Volume de dados | Quantos dados estão envolvidos na integração? Você estará trabalhando com grandes volumes de dados (LDV)? Com que frequência as alterações ocorrerão em massa? Que tipo de impacto as atualizações do singleton terão? Com que frequência eles ocorrerão? |
| Limites | Os dados precisarão passar por uma transformação complexa? Os dados precisam ser combinados de vários sistemas de origem? Com que frequência uma integração ocorrerá por usuário? Quantos usuários no total? Você planejou com antecedência para carregamentos de dados em massa (exemplo: carregamento de dados inicial para uma nova instância)? |
| Do Salesforce para sistema externo | Do sistema externo para o Salesforce | Execução | Licença adicional necessária | |
|---|---|---|---|---|
| Ações do Apex | Disponível | Disponível | Lado do servidor | Não |
| Captura de dados de alteração | Disponível | Não disponível | Lado do servidor | Não* |
| Apex personalizado (Serviços da Web REST e SOAP) | Disponível | Disponível | Lado do servidor | Não |
| Serviços externos | Disponível | Não disponível | Lado do servidor | Não |
| Heroku Connect | Disponível | Disponível | Lado do servidor | Sim |
| Data 360 | Disponível | Disponível | Lado do servidor | Sim |
| MuleSoft Anypoint | Disponível | Disponível | Lado do servidor | Sim |
| APIs nativas do Salesforce | Não disponível | Disponível | Lado do servidor | Não |
| OmniScript | Disponível | Disponível | Parte do cliente*** | Sim |
| Procedimento de integração do OmniStudio | Disponível | Disponível | Lado do servidor | Sim |
| Mensagens de saída | Não ideal | Não disponível | Lado do servidor | Não |
| Eventos de plataforma | Disponível | Disponível | Lado do servidor | Não** |
| Salesforce Connect/Objetos externos | Disponível | Disponível | Lado do servidor | Sim |
| Diretrizes | Licenciamento | Tempo | Volume e escala | Entrega e manutenção | Privacidade e segurança | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Quando usar | Licença adicional | Sincronizar (solicitação/resposta) ou assíncrono (ativar/esquecer) | Suporte para vários objetos | LDV/Bulk | Teste e implantação** | Depuração | Comportamento de retry/tratamento de erro integrado | Pode ser usado com dados criptografados em repouso | Protocolo de autenticação | |
| Captura de dados de alteração | Quando você precisa publicar alterações no nível do registro feitas no Salesforce em um sistema externo e não precisa de uma carga útil personalizada. | Obrigatório | Assíncrono | Não | Não | Sim | Com ferramentas de código profissional | Sim | Sim | OAuth |
| Serviços externos | Quando você está orquestrando um processo usando o Fluxo, o Apex, Bots do Einstein ou OmniStudio e as APIs do sistema externo são descritos usando especificações OpenAPI. | Não necessário | Sincronizar | Sim | Não | Sim | Com ferramentas de código profissional | Não | N/A | Credenciais nomeadas |
| Heroku Connect | Quando você deseja estender seus dados com sincronização bidirecional para habilitar aplicativos móveis e outros no Heroku e deseja que os dados também sejam replicados ao Salesforce. | Obrigatório | Assíncrono | Sim | Sim | Não | Com ferramentas de código profissional | Sim | Sim, por meio do Shield Connect | OAuth |
| Procedimento de integração do OmniStudio | Quando você precisa transformar dados sem interação com o usuário e melhorar o desempenho processando no servidor, em vez do navegador. | Obrigatório | Ambos | Sim | Sim | Sim | Suporte declarativo | Sim | Sim | Credenciais nomeadas |
| Salesforce Connect/Objetos externos | Quando você deseja que os dados apareçam na IU do Salesforce, mas que os dados sejam armazenados em um sistema externo. Os dados não são replicados para o Salesforce. | Obrigatório | Sincronizar | Não | Sim* | Sim | Com ferramentas de código profissional e um rastreador declarativo | Não | N/A | Credenciais nomeadas |
| *Adaptadores OData mais antigos que a versão 4.01 estão sujeitos a limites de chamada. Consulte Considerações sobre o limite de taxa de chamada OData para obter mais detalhes. ** Teste e implantação refere-se à capacidade de criar em um ambiente inferior e implantar por meio da API de metadados, pacotes ou conjuntos de alterações para produção. | ||||||||||
| Diretrizes | Licenciamento | Tempo | Volume e escala | Entrega e manutenção | Privacidade e segurança | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Quando usar | Licença adicional | Sincronizar (solicitação/resposta) ou assíncrono (ativar/esquecer) | Suporte para vários objetos | LDV/Bulk | Teste e implantação** | Depuração | Comportamento de retry/tratamento de erro integrado | Pode ser usado com dados criptografados em repouso | Protocolo de autenticação | |
| Ações do Apex | Quando você deseja automatizar chamadas para outro sistema por meio do Salesforce Flow. Um desenvolvedor pode escrever uma classe do Apex que um fluxo pode invocar ou você pode baixar uma solução predefinida do AppExchange. | Não necessário | Ambos | Sim | Não | Sim | Com ferramentas de código profissional | Não | Sim | Vários |
| Retransmissões de evento | Quando você precisar enviar eventos de plataforma e alterar eventos de captura de dados para o Amazon EventBridge do Salesforce. As retransmissões de evento se conectam apenas ao AWS Eventbridge | Não | Assíncrono | Sim | Não | Sim | Sim | Sim | Sim | HTTP/1.1 com TLS |
| Mensagens de saída | Quando você precisa enviar mensagens SOAP por HTTP(S) para um ponto de extremidade designado com recebimento garantido quando acionado por uma regra de fluxo de trabalho. | Não necessário | Assíncrono | Não | Não | Sim | Suporte declarativo | Sim | Sim | TLS bidirecional |
| Eventos de plataforma | Quando você precisa de uma carga útil personalizada e estruturada para alterações quase em tempo real no Salesforce ou em um sistema externo. | Não necessário* | Assíncrono | Sim | Não | Sim | Com ferramentas de código profissional | Sim | Sim | OAuth |
| Objetos externos do Salesforce Connect (com adaptadores personalizados do Apex) | Quando você deseja que os dados apareçam na interface do usuário do Salesforce, mas que os dados sejam armazenados em um sistema externo que não possa usar protocolos padrão como OData ou GraphQL. | Obrigatório | Ambos | Sim | Sim | Sim | Com ferramentas de código profissional | Não | N/A | Vários |
| Data 360 | Quando você deseja harmonizar dados de diferentes origens em um repositório de dados ou replicar seus dados para outras organizações do Salesforce ou para outros sistemas externos. | Obrigatório | Ambos | Sim | Sim | Sim | Sim | Sim | Sim | Vários |
| Diretrizes | Licenciamento | Tempo | Volume e escala | Entrega e manutenção | Privacidade e segurança | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Quando usar | Licença adicional | Sincronizar (solicitação/resposta) ou assíncrono (ativar/esquecer) | Suporte para vários objetos | LDV/Bulk | Teste e implantação** | Depuração | Comportamento de retry/tratamento de erro integrado | Pode ser usado com dados criptografados em repouso | Protocolo de autenticação | |
| Apex personalizado | Quando você precisa de mais funcionalidade do que está disponível em ferramentas com pouco código. | Não necessário | Ambos | Sim | Sim | Sim | Com ferramentas de código profissional | Não | Sim* | Vários |
| Serviços externos | A integração do código a APIs do sistema externo é descrita usando especificações OpenAPI. | Não necessário | Sincronizar | Sim | Não | Sim | Com ferramentas de código profissional | Não | N/A | Vários |
| MuleSoft Anypoint | Quando você precisa de uma única solução unificada de nível corporativo para criar, orquestrar e gerenciar suas integrações; quando precisa substituir uma arquitetura de ponto a ponto legada; ou quando precisa de suporte de gerenciamento de API. | Obrigatório | Ambos | Sim | Sim | Sim | Com ferramentas de código profissional | Não | Sim* | Vários |
| Diretrizes | Licenciamento | Tempo | Volume e escala | Entrega e manutenção | Privacidade e segurança | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Quando usar | Licença adicional | Sincronizar (solicitar/responder) ou assíncrono ( disparar/esquecer) | Suporte a vários objetos | LDV/Bulk | Teste e implantação* | Depuração | Comportamento de retry/tratamento de erro integrado | Pode ser usado com dados criptografados em repouso | Protocolo de autenticação | |
| Heroku Connect | Quando você deseja estender seus dados com sincronização bidirecional para habilitar aplicativos móveis e outros no Heroku e deseja que os dados também sejam replicados ao Salesforce. | Obrigatório | Assíncrono | Sim | Sim | Não | Com ferramentas de código profissional | Sim | Sim, por meio do Shield Connect | OAuth |
| Procedimento de integração do OmniStudio | Quando você precisa importar e transformar dados de fontes de terceiros sem interação com o usuário. | Obrigatório | Ambos | Sim | Sim | Sim | Suporte declarativo | Não | Sim | Credenciais nomeadas |
| Salesforce Connect/Objetos externos | Quando você deseja que os dados apareçam na interface do usuário do Salesforce, mas que os dados sejam armazenados em um sistema externo que possa usar protocolos padrão como OData ou GraphQL. | Obrigatório | Sincronizar | Sim | Sim | Sim | Com ferramentas de código profissional | Não | N/A | Vários |
| Diretrizes | Licenciamento | Tempo | Volume e escala | Entrega e manutenção | Privacidade e segurança | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Quando usar | Licença adicional | Sincronizar (solicitar/responder) ou assíncrono ( disparar/esquecer) | Suporte a vários objetos | LDV/Bulk | Teste e implantação** | Depuração | Comportamento de retry/tratamento de erro integrado | Pode ser usado com dados criptografados em repouso | Protocolo de autenticação | |
| Eventos de plataforma | Quando você precisa de uma carga útil personalizada e estruturada para alterações quase em tempo real no Salesforce ou em um sistema externo. | Não necessário* | Assíncrono | Sim | Não | Sim | Com ferramentas de código profissional | Sim | Sim | OAuth |
| Objetos externos do Salesforce Connect (com adaptadores personalizados do Apex) | Quando você precisa que os dados apareçam na interface do usuário do Salesforce, mas deseja que os dados sejam armazenados em um sistema externo que não possa usar os protocolos OData 2.0/4.0. | Obrigatório | Ambos | Sim | Sim | Sim | Com ferramentas de código profissional | Não | N/A | Vários |
| Data 360 | Quando você deseja harmonizar dados de diferentes origens em um repositório de dados ou replicar seus dados de outras organizações do Salesforce ou para outros sistemas externos. O Data 360 também oferece suporte à virtualização para algumas plataformas. | Obrigatório | Ambos | Sim | Sim | Sim | Não | Sim | Sim | Vários |
| Diretrizes | Licenciamento | Tempo | Volume e escala | Entrega e manutenção | Privacidade e segurança | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Quando usar | Licença adicional | Sincronizar (solicitar/responder) ou assíncrono ( disparar/esquecer) | Suporte a vários objetos | LDV/Bulk | Testar e implementar**** | Depuração | Comportamento de retry/tratamento de erro integrado | Pode ser usado com dados criptografados em repouso | Protocolo de autenticação | |
| Serviços da Web REST e SOAP do Apex personalizados | Quando você precisa de mais funcionalidades do que as fornecidas pelos pontos de extremidade de API nativos, como processamento de objetos cruzados ou outra lógica complexa. | Não necessário | Ambos | Sim | Sim | Sim | Com ferramentas de código profissional | Não | Sim*** | Vários |
| MuleSoft Anypoint | Quando você precisa de uma única solução unificada de nível corporativo para criar, orquestrar e gerenciar suas integrações; quando precisa substituir uma arquitetura de ponto a ponto legada; ou quando precisa de suporte de gerenciamento de API. | Obrigatório | Ambos | Sim | Sim | Sim | Com ferramentas de código profissional | Não | Sim*** | Vários |
| APIs nativas do Salesforce | Quando você precisa de mais controle ou tem um conjunto de habilidades de código profissional para criar integrações por meio da API REST, da API SOAP, da API em massa ou de APIs GraphQL ou gRPC. | Não necessário* | Ambos | Sim***** | Sim | Sim | Com ferramentas de código profissional | Sim** | Sim*** | Vários |
| Diretrizes | Custo | Tempo | Volume e escala | Entrega e manutenção | Privacidade e segurança | Ferramentas a implementar | |||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| Quando usar | Licença adicional | Sincronizar (solicitação/resposta) ou assíncrono (ativar/esquecer) | Suporte para vários objetos | LDV/Bulk | Teste e implantação* | Depuração | Comportamento de retry/tratamento de erro integrado | Pode ser usado com dados criptografados em repouso | Protocolo de autenticação | Código baixo → Código profissional | |
| Heroku Connect | Quando você deseja estender seus dados com sincronização bidirecional entre organizações do Salesforce e também habilitar o acesso aos dados de dispositivos móveis e outros aplicativos em execução no Heroku | Obrigatório | Assíncrono | Sim | Sim | Não | Com ferramentas de código profissional | Sim | Sim, por meio do Shield Connect | OAuth | Código inferior |
| MuleSoft Anypoint | Quando você precisa de uma única solução unificada de nível corporativo para criar, orquestrar e gerenciar suas integrações; quando precisa substituir uma arquitetura de ponto a ponto legada; ou quando precisa de suporte para gerenciamento de API | Obrigatório | Ambos | Sim | Sim | Sim | Com ferramentas de código profissional | Não | Sim** | Vários | Código profissional |
| APIs nativas do Salesforce | Quando o Salesforce ou o Heroku Connect não são uma opção ou você precisa de processamento mais complexo | Não necessário | Ambos | Não | Sim | Sim | Com ferramentas de código profissional | Não | Sim** | Vários | Código profissional |
| Captura de dados de alteração | Quando você precisa publicar alterações no nível do registro feitas no Salesforce em um sistema externo e não precisa de uma carga útil personalizada. | Obrigatório | Assíncrono | Não | Não | Sim | Com ferramentas de código profissional | Sim | Sim | OAuth | |
| Salesforce Connect com adaptador entre organizações | Quando você deseja que os usuários em uma organização visualizem ou editem registros em uma organização diferente sem replicação de dados | Obrigatório | Assíncrono | Sim | Sim | Sim | Com ferramentas de código profissional | N/A | N/A | Vários | Código inferior |
| Data 360 | Quando você deseja que os usuários em uma organização visualizem ou editem registros em uma organização diferente com dados replicados no Data 360. | Obrigatório | Ambos | Sim | Sim | Sim | Com ferramentas de código profissional | Sim | Sim | Vários | híbrido |
| Tipo de padrão | Modo/ferramenta | Benefícios | Considerações | Resultados |
|---|---|---|---|---|
| Ingestão de dados |
Em tempo real:
|
|
|
Agentforce:
|
Streaming:
|
|
|
Agentforce:
|
|
Lote:
|
|
|
Agentforce:
|
|
| Zero Copy |
Consulta ao vivo:
|
|
|
Agentforce:
|
Consulta acelerada (cache):
|
|
|
Agentforce:
|
|
Federação de arquivos:
|
|
|
Agentforce:
|
 #### Métodos de ingestão de dados
Os métodos de _ingestão de dados_ podem variar, dependendo do conector que você usa para ingerir seus dados. Alguns conectores oferecem uma variedade de métodos de ingestão, enquanto outros operam apenas no modo de lote ou streaming. Para obter uma lista completa de conectores e métodos disponíveis do _Data 360_, consulte [Data 360: Integrações e conectores](https://help.salesforce.com/s/articleView?id=data.c360_a_sources_targets.htm&type=5).
- **Em tempo real:**
- Fornece ingestão de subsegundo usando a _captura de dados de alteração (CDC)_
- Adequado para fluxos de trabalho urgentes (por exemplo, detecção de fraudes, personalização e painéis operacionais)
- Possui transformações e agregações por push no _Data 360_, o que ajuda a reduzir as I/O a jusante e otimizar o uso de computação
- Suporta o uso de CDC incremental para minimizar o desvio de dados
- **Streaming:**
- Fornece ingestão a cada 1 a 3 minutos em pequenos incrementos
- Balança a frescura e o custo
- Adequado para orquestração de campanha, engajamento quase ativo e relatórios operacionais
- Suporta o uso de microlotes para controlar picos de entrada/saída
- Agrega dados na origem (se possível) para reduzir volumes de transferência e otimizar o armazenamento
- **Lote (cargas agendadas):**
- Fornece ingestão periódica de conjuntos de dados grandes (por exemplo, por hora, diariamente e semanalmente)
- Fornece custo-benefício e confiabilidade para conjuntos de dados históricos, relatórios regulatórios e casos de uso de conformidade
- Garante que a localidade de computação esteja na mesma região que o armazenamento de origem para aprimorar o desempenho e otimizar os custos
#### Manual do arquiteto
- **Casos de uso de ingestão de dados:**
- **Gerar perfis unificados do Customer 360.** Crie uma única fonte da verdade para identidades e atributos do cliente.
- **Manter conjuntos de dados de conformidade regulatória.** Impor governança, lineagem e capacidade de auditoria para dados confidenciais.
- **Centralize a orquestração da campanha.** Garanta que marketing, vendas e serviço operem com base em conjuntos de dados consistentes e confiáveis.
- **Práticas de design:**
- Acomode a ingestão em lote para necessidades históricas ou com baixa tolerância a latência (por exemplo, relatórios de arquivo ou instantâneos periódicos).
- Use as APIs de streaming ou CDC para manter a atualidade dos fluxos de trabalho operacionais e de personalização para garantir atualizações quase em tempo real.
- Controle o armazenamento e o crescimento de computação aplicando cargas incrementais para otimizar o custo e a eficiência (em vez de recarregar conjuntos de dados inteiros).
- Alinhe os pipelines de ingestão com localidade de computação e processamento incremental para reduzir as I/O de rede.
- Aplique transformações dentro do _Data 360_ para evitar mover dados brutos desnecessariamente.
- **Considerações de custo:**
- A **Ingestão em tempo real** tem os custos de computação e pipeline mais altos, o que pode ser justificado para fluxos de trabalho de alto valor e sensíveis ao tempo (por exemplo, personalização, painéis operacionais ou ações conduzidas pelo Agentforce).
- A **Ingestão de streaming** tem custos moderados de computação e armazenamento, o que pode ser adequado para atualizações frequentes que podem tolerar pequenos atrasos (por exemplo, orquestração de campanha ou relatórios operacionais).
- A **Ingestão em lote** tem custos de computação mais baixos e armazenamento previsível, o que é adequado para conjuntos de dados históricos ou atualizações de baixa frequência. A ingestão de dados em lote de organizações do Salesforce usando determinados conectores é gratuita.
- **Modo de atualização** Permite que você selecione o modo _Atualização incremental_, o que reduz os custos totais de ingestão e computação. Na Salesforce, recomendamos usar a atualização _incremental_ sempre que possível para otimizar a eficiência em todos os tipos de ingestão.
- O **custo** também é afetado pelo volume de I/O da fonte para o _Data 360_. Otimizar tamanhos de lote, partições e alinhamento regional reduz os custos de transferência e melhora o desempenho.
- **Cenários da indústria:**
- **Finanças:** Os conjuntos de dados de ingestão são necessários para _conhecer seu cliente (KYC)_, _Anti Money Laundering (AML)_ e detecção de fraudes quando a capacidade de auditoria e a conformidade não são negociáveis.
- **Saúde:** Use a ingestão para resolução de identidade do paciente e registros em conformidade com HIPAA, o que habilita visualizações seguras e unificadas.
- **Retail:** Consolide dados de _ponto de venda (POS)_, comércio eletrônico e programa de fidelidade em perfis unificados para segmentação e personalização.
- **Telecom:** Dê suporte à prevenção de rotatividade e à análise de uso com dados canônicos de assinante regulamentados.
#### Critérios de decisão do método de ingestão de dados
| Recurso | Ingestão em tempo real | Ingestão de streaming | Ingestão em lote |
| :----------------------------------- | :------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------ | :------------------------------------------------------------------------------------------------------------------------------------------------------------ | :----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Latency e frescura** | Possui ingestão de latência subsegunda por meio de APIs de ingestão com suporte para _captura de dados de alteração (CDC)_. Fornece pipelines de streaming contínuos. Adequado para casos de uso operacionais de baixa latência. | Apresenta ingestão de microlote a cada 1 a 3 minutos por meio de conectores nativos. Dá suporte a atualizações incrementais. É esperada uma pequena latência. | A latência de dados é esperada. Permite carregamentos de grande volume agendados. Apresenta ingestão periódica (horária, diária e semanal). Não é adequado para operações que exigem tempo. |
| **Casos de uso primários** | Ideal para casos de uso operacionais e de personalização de baixa latência. Use para fluxos de trabalho urgentes. Dá suporte a fluxos de trabalho conduzidos por evento. Use para alertas de fraude em tempo real e alertas operacionais. | Adequado para processos moderadamente urgentes. Use para orquestração de campanha, engajamento quase ativo e relatórios operacionais. Use para acionadores de campanha oportunos. | Eficiente para conjuntos de dados massivos. Confiável para análise histórica. Use para agregação de histórico ou fluxos de trabalho de relatórios regulados. Adequado para conjuntos de dados históricos ou de baixa velocidade. |
| **Complexidade arquitetônica e I/O** | Inclui um alto custo e uma arquitetura complexa. Requer sistemas de origem de baixa latência. Intensivo de I/O. Origens de alto volume podem causar pipelines saturados. | Recebe uma arquitetura mais simples do que em tempo real. O I/O é moderado. Adequado para padrões de atualização repetidos e previsíveis. O tamanho do lote afeta a memória e os cálculos. | Fácil de implementar. Intensivo de I/O durante janelas de carregamento. A taxa de transferência de rede pode se tornar um gargalos para lotes grandes. |
| **Considerações de custo** | Inclui os custos de computação e pipeline mais altos. Justificável apenas para fluxos de trabalho de alto valor e urgentes. | Inclui moderar os custos de computação e armazenamento. Fornece uma abordagem de custo equilibrado versus frescura. Adequado para atualizações frequentes que podem tolerar pequenos atrasos. | Recorre a menores custos de computação e armazenamento previsível. Recomendado para conjuntos de dados históricos ou atualizações de baixa frequência. A ingestão por meio de pipelines internos do Salesforce é gratuita. |
| **Práticas de design** | Use a CDC incremental para minimizar o desvio de dados. Filtre e use campos seletivos para reduzir a sobrecarga. | Use microlotes para controlar picos de I/O. Considere a agregação com janelas para reduzir a carga de processamento. | Use para relatórios de arquivamento ou instantâneos periódicos. Certifique-se de que a localidade de computação esteja na mesma região que o armazenamento de origem para otimização de custo. |
### Federação de dados de cópia zero
#### Casos de uso de cópia zero
Use a _Cópia zero_ para consulta em tempo real de sistemas externos sem duplicação de dados para permitir a agilidade, a frescura e o acesso escalonável a conjuntos de dados grandes ou temporários. É adequado para painéis ativos, análise exploratória, treinamento de modelo de IA/ML e engajamento do cliente em tempo real diretamente no Salesforce _Data 360_.
 #### Métodos de cópia zero
Ao usar o _Zero Copy_, os arquitetos devem escolher entre três métodos de federação de dados disponíveis, cada um dos quais oferece seus próprios prós e contras entre frescura, desempenho e custo.
- **Consulta ativa**
- Executa consultas diretamente em sistemas externos (por exemplo, _Snowflake_, _Google BigQuery_, _Redshift_, _Databricks_, etc.) sem duplicação de dados.
- Minimize a movimentação de dados pela rede e reduza as entradas/saídas no cálculo do Salesforce _Data 360_, o que é ideal quando os predicados e agregações podem ser reduzidos.
- Adequado para percepções em tempo real e painéis operacionais de baixa latência.
- Dependendo do desempenho do sistema externo.
- **Cache (consulta acelerada)**
- Armazena temporariamente cópias em cache de dados federados no Salesforce _Data 360_.
- Reduz os custos de consulta repetida e a latência para conjuntos de dados acessados com frequência com duração configurável (minutos a dias).
- Os dados não são copiados permanentemente nem totalmente controlados, assim, a atualidade é gerenciada por meio de atualizações agendadas da origem.
- A _atualização incremental_ oferece suporte apenas a upserts. Registros excluídos não são removidos do cache.
- Realize uma atualização completa periodicamente para garantir que o cache permaneça sincronizado com a origem.
- **Nota:** O conector _Snowflake_ suporta a função _Descarregar_, que aumenta as taxas de aceleração usando um balde de preparação iniciado pelo Snowflake. Isso é ativado por padrão, mas pode ser desativado editando a conexão.
- **Federação de arquivos**
- Fornece acesso direto e somente leitura a conjuntos de dados em grande escala em repositórios de objetos (por exemplo, _S3_ e _GCS_ com _Iceberg_).
- Adequado para cargas de trabalho de IA/ML, análise histórica e relatórios em escala de petabytes sem mover dados.
- O desempenho da consulta depende muito do formato do objeto, do particionamento e das I/O de rede. As verificações grandes podem gerar I/O substanciais se não forem otimizadas.
#### Manual do arquiteto
- **Casos de uso**
- A **personalização em tempo real e os fluxos de trabalho adaptáveis** oferecem ofertas dinâmicas, recomendações e as melhores ações conforme o comportamento do cliente muda.
- **Painéis ativos e análise operacional** alimentam painéis e KPIs críticos para os negócios diretamente de armazéns externos.
- O **treinamento de modelo de IA/ML com grandes conjuntos de dados externos** aproveita dados em escala de petabytes de data lakes e armazéns sem movê-los via federação de arquivos.
- **Cenários da indústria**
- **Retail/Media:** Habilite recomendações personalizadas e engajamento do cliente em tempo real federando dados de interação de conteúdo ou fluxo de cliques.
- **Finanças:** Execute a detecção de fraudes e a pontuação de risco quase em tempo real consultando armazéns externos sem duplicar dados confidenciais.
- **Tech/Enterprise:** Dê suporte a relatórios entre nuvens, painéis de serviço de TI e análise operacional quando os conjuntos de dados residem em vários sistemas.
- **Práticas de design**
- **Consulta ativa**
- Use para consultas de alta QPS e baixa latência quando a frescura for crítica.
- Envie por push predicados e agregações para o sistema externo para reduzir o desvio de dados na rede.
- Evite consultas que verificam volumes de dados enormes desnecessariamente.
- Considere cortar a partição e filtros em vez disso.
- **Federação de arquivos**
- Acesse conjuntos de dados em escala de petabytes em lojas de objetos sem ingestão.
- Minimize os custos de latência e saída mantendo o armazenamento de objetos na mesma região de nuvem que o cálculo do Salesforce.
- Use formatos particionados em coluna (Parquet/ORC) e filtros de menu suspenso para reduzir a transferência de I/O e rede.
- Aproveite a consulta e o menu suspenso de predicado para filtrar e agregar dados na origem, o que reduz a movimentação dos dados.
- Evite o acesso a dados entre regiões, a menos que seja absolutamente necessário, pois isso aumenta a entrada/saída, a latência e os custos.
- **Cache (consulta acelerada)**
- Armazene em cache conjuntos de dados acessados com frequência para equilibrar custo e desempenho.
- Configure intervalos de atualização para equilibrar a frescura versus o custo da consulta.
- **Conformidade:** Imponha a governança na fonte aproveitando a _segurança em nível de linha (RLS)_ e mascarando políticas diretamente dentro de sistemas federados.
- Aqui estão algumas práticas recomendadas para RLS uniforme e mascaramento entre plataformas:
- **Usar um ID corporativo centralizado.** Mapeie usuários e entidades no Salesforce _Data 360_ para um identificador corporativo único e centralizado que corresponde a identidades em sistemas externos.
- **Align Políticas de segurança.** Garanta que o RLS e as políticas de mascaramento em sistemas federados sejam aplicados com base na identidade mapeada. Isso preserva a conformidade ao consultar dados externos.
- **Padronizar esquemas de identidade.** Mantenha atributos de identidade consistentes (email, ID do usuário, ID do cliente etc.) em todas as fontes de dados para evitar incompatibilidades e violações de acesso.
- **Considerações de custo**
- **Consulta ao vivo:** No modelo de pagamento por consulta, os custos se acumulam no cálculo externo da residência do lake, o que pode causar picos com QPS alto. Isso é adequado para casos de uso críticos de frescura em que o valor é maior que a variabilidade de custo.
- **Consulta acelerada (cache):** Esse método reduz o custo de consulta (em comparação com a _Questão ativa)_ reduzindo os encontros no sistema de origem; no entanto, aumenta os custos de ingestão de dados em lote para preenchimento e atualização do cache. Isso é adequado para conjuntos de dados acessados com frequência.
- **Federação de arquivos:** Essa é a opção de armazenamento mais econômica como dados na Loja de objetos; no entanto, os custos de consulta dependem do tamanho do arquivo, do particionamento e da redução. Isso é adequado para dados históricos ou em massa em escala de petabytes.
#### Critérios de decisão do método de cópia zero
| Ponto de decisão | Consulta ativa | Armazenamento em cache (consulta acelerada) | Federação de arquivos |
| :----------------------- | :---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | :--------------------------------------------------------------------------------------------------------------------------------------------------------- | :------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Local da fonte de dados** | Casas de data lake externas (por exemplo, _Snowflake_, _Google BigQuery_, _Redshift_ e _Databricks_) | Casas de data lake externas (por exemplo, _Snowflake_, _Google BigQuery_, _Redshift_ e _Databricks_) | Armazéns de objetos ou data lakes de nuvem (por exemplo, _S3_, _ADLS_ e _GCS_), que muitas vezes usam formatos de tabela aberta, como _Iceberg_. |
| **Objetivo/Caso de uso** | Adequado para análise interativa e painéis em tempo real. Adequado para personalização em tempo real e fluxos de trabalho dinâmicos. | Adequado para quando as consultas são frequentes, mas os resultados levemente obsoletos são aceitáveis. Adequado para painéis de BI e segmentação. | Adequado para processamento em lote em grande escala e treinamento de modelo de IA/ML. Adequado para análise histórica e relatórios em escala de petabytes. |
| **Fresqueza/Latency** | Fornece máxima atualidade Executa consultas diretamente em tempo real. Dá suporte à tomada de decisão em menos de um segundo quando o sistema de origem é otimizado para consultas de baixa latência com um menu suspenso de predicado eficaz. | Use quando resultados levemente obsoletos forem aceitáveis. A atualidade depende do intervalo de cache, que pode ser configurado de 15 minutos a 7 dias. | Adequado para trabalhos pesados em lote com alta taxa de transferência. Não é adequado para painel em tempo real. |
| **Padrão de acesso** | Adequado para consultas raras ou ad-hoc em que a atualidade é crítica e o volume de consultas é baixo. Os custos aumentam significativamente em QPS alto, portanto, é importante avaliar o armazenamento em cache (consulta acelerada) quando a frequência de consulta é alta. | Adequado para cenários de leitura de alta frequência. Melhora o desempenho para padrões de acesso frequente. | Fornece acesso somente r*ead*. Adequado para conjuntos de dados em escala de petabytes sem ingestão. |
| **Drivers de desempenho** | Altamente dependente do desempenho do sistema de origem externo. Adequado para quando predicados e agregações podem ser enviados para baixo para a origem. | Reduz a latência em comparação a consultas ativas repetidas. O desempenho depende do gerenciamento de cache e dos intervalos. | O desempenho depende muito do formato do objeto, do particionamento e da taxa de transferência do sistema externo. Use formatos particionados em colunas (Parquet/ORC). |
| **Implicações dos custos** | Esse é um modelo de pagamento por consulta, portanto, os custos se acumulam nos cálculos externos do Lake House. É econômico para consultas infrequentes, mas as despesas podem aumentar com alto volume de QPS. | O custo é menor que consultas ativas repetidas. Ele reduz a necessidade de consultar repetidamente a origem externa, mas adiciona armazenamento em cache e sobrecarga de atualização. | Esta é a opção de armazenamento mais barata. Para configurações da AWS na mesma região (por exemplo, _S3_ nos EUA-Leste-1 com um locatário do _Data Cloud_ que também está nos EUA-Leste-1), os créditos não são consumidos para as linhas acessadas. Configurações entre regiões ou entre nuvens (por exemplo, _Azure_, _GCS_ ou diferentes regiões da _AWS_) geram consumo de crédito para as linhas acessadas. Os custos de consulta também dependem do tamanho do arquivo, do particionamento e da otimização de menu suspenso de predicado. |
| **Consideração principal** | Evite consultas não filtradas que verificam volumes de dados enormes desnecessariamente. | Essa abordagem requer gerenciamento de cache. Não é adequado para tomada de decisão em menos de um segundo. | O desempenho da consulta depende fortemente da otimização por meio de particionamento e menu suspenso de predicado. |
### Abordagem híbrida
As arquiteturas híbridas permitem aos arquitetos ancorar conjuntos de dados críticos no _Data 360_ para governação centralizada, ao mesmo tempo que aproveitam consultas federadas para atualização, redução de duplicação e acesso escalonável a conjuntos de dados externos grandes. Essa abordagem balanceia os requisitos de I/O, localidade de computação, custo e conformidade.
#### Casos de uso híbridos
Use uma abordagem híbrida para uma governança equilibrada, frescura e eficiência operacional combinando ingestão de dados e cópia zero para fornecer percepções acionáveis em tempo real. Use a ingestão para conjuntos de dados regulados de alto valor em que rastreabilidade, RLS e mascaramento são necessários e federação para conjuntos de dados efetivos ou de alto volume em que a atualização e o desempenho são essenciais.
 #### Manual do arquiteto
- **Casos de uso**
- **Engajamento do Omni-Channel:** Combine dados históricos do cliente com comportamento em tempo real para proporcionar experiências consistentes sensíveis ao contexto.
- **Pipelines de IA/ML:** Treine modelos em conjuntos de dados canônicos selecionados enquanto os aprimora com sinais brutos ou em tempo real de fontes externas.
- **Necessidades de conformidade e agilidade mistas:** Aplique governança rígida para dados confidenciais e federação para agilidade operacional.
- **Cenários da indústria**
- **Retail:** Use a _ingestão_ para resolução de identidade e unificação de perfil, e a _federação_ para ofertas e personalização em tempo real.
- **Saúde:** Mantenha registros de pacientes dourados por meio da _ingestão_ enquanto usa a _federação em_ fluxos de dispositivos de IoT e dados de sensor para contexto imediato.
- **Serviços financeiros:** Ingira dados regulamentados em um lago de conformidade enquanto usa a _federação_ para consultas externas de detecção de fraudes e monitoramento de risco.
- **Práticas de design**
- **Ancora governança com ingestão:** Ingira dados de alto valor ou regulados em modelos canônicos para garantir Trust e conformidade.
- **Use Federação para frescura:** Permite que as casas de lago externas forneçam acesso a dados em tempo real ou em grande escala sem duplicação.
- **Custo do saldo vs. desempenho:** Analise as cargas de trabalho para determinar quando usar a _ingestão_ vs. a _federação_, o que minimiza os custos desnecessários de armazenamento e consulta.
- **Aplicar governança em camadas:** Imponha a governança centralizada para dados ingeridos enquanto aproveita os controles de segurança de sistemas federados (por exemplo, RLS e mascaramento).
- **Nota:** Ao projetar pipelines híbridos, é importante garantir a ingestão incremental para conjuntos de dados históricos e enviar agregações ou filtros por push a fontes federadas para otimizar o uso de I/O e computação.
- **Considerações de custo**
- Pesquise o custo total versus o desempenho combinando a _ingestão_ para conformidade ou dados críticos com a _federação_ quando a frescura for necessária.
- Considere a distribuição de I/O e computação ao misturar _a ingestão_ e a _federação_. Para reduzir o custo de computação de consultas repetidas em sistemas de origem, use o armazenamento em cache (consulta acelerada) para conjuntos de dados federados de alta leitura acessados com frequência.
- Use esta regra para orientar a decisão de ingestão vs. federação: Quando os dados são acessados com frequência, mas mudam com pouca frequência, a _consulta acelerada_ geralmente é mais econômica. No entanto, quando os dados mudam com frequência (em relação à frequência de acesso), a _consulta ao vivo_ ou a _ingestão_ é mais adequada. Aqui estão alguns exemplos de custo:
- **Aceleração ganha:** Um painel criado com base em 1 milhão de registros e atualizado diariamente com ~10 mil alterações é visualizado 20 vezes por dia. Os custos de _aceleração_ são equivalentes a aproximadamente ~600 créditos/mês vs. ~4.200 créditos/mês para _consultas ao vivo_.
- **Question ao vivo ganha:** Segmentos publicados 20 vezes por dia usando dados que mudam a cada 30 minutos. _As consultas ao vivo_ custam aproximadamente ~4.200 créditos/mês vs. ~28.800 créditos/mês para a _aceleração_ nessa frequência de atualização.
## Usar o Guia de decisão de caso
Vamos analisar em mais detalhes alguns arquetípicos comuns que ilustram como aplicar essa lógica.
- **O Arquétipo da "Fonte Única da Verdade": Centralizar e governar**
- **Cenário:** Você precisa criar perfis compatíveis e unificados do _Customer 360_ para toda a sua empresa global. Os dados vêm de uma dúzia de sistemas diferentes, devem cumprir os rigorosos regulamentos _GDPR_ e _CCPA_, e servirão como fonte de verdade para todas as interações de marketing e serviço.
- **Padrão recomendado:** **Ingestão de dados.** A prioridade aqui é governança, Trust e controle. Ingerir os dados no _Data 360_ é a única maneira de criar um perfil canônico totalmente auditável, isolado dos sistemas de origem.
- **O Arquiteto de Insights em tempo real: Analisar sem se mover**
- **Cenário:** Sua equipe de ciência de dados precisa executar consultas exploratórias em uma tabela de transações maciça e constantemente atualizada no _Snowflake_. Ao mesmo tempo, sua equipe executiva quer um painel _BI_ ativo que seja alimentado pelos mesmos dados. Mover petabytes de dados por dia é lento e caro.
- **Padrão recomendado:** **Federação de cópia zero.** A prioridade aqui é velocidade, agilidade e custo-benefício em escala. O _Zero Copy_ permite que você aproveite o poder do seu armazém de dados existente para consultas em tempo real sem sobrecarga e latência de duplicação de dados.
- **O Arquétipo de Inteligência Híbrida: Governar o núcleo, Federar a borda**
- **Cenário:** Você deseja aprimorar seus perfis de cliente administrados e ingeridos com sinais comportamentais em tempo real (por exemplo, cliques no site) de um data lake. Você precisa da estabilidade do perfil principal, mas da imediatez dos dados ativos para habilitar a personalização no momento.
- **Padrão recomendado:** **Uma abordagem híbrida.** Use a _Ingestão de dados_ para criar um núcleo estável e regulado para seus dados do cliente. Use a _Cópia zero_ para federar os dados de "frente" em tempo real e voláteis e, em seguida, uní-los no momento da consulta para obter uma visualização completa até o segundo.
## O caminho para frente
A estratégia de dados corporativos não é mais focada na escolha de um único padrão de integração, é sobre arquitetar flexibilidade controlada em um ecossistema de dados interoperável. A abordagem correta mapeia cada sistema de origem para o padrão mais adequado aos requisitos de atualidade, governança, custo e acesso:
- Ingira conjuntos de dados regulados essenciais para a missão no Salesforce _Data Cloud_ para conformidade, resolução de identidade e fluxos de trabalho operacionais.
- Federar dados por meio da _Cópia zero_ para análise ativa, exploratória e orientada por IA sem armazenamento duplicado.
- Aplicar _cache (consulta acelerada)_ para reduzir a carga do sistema de origem e o consumo de crédito quando a frequência de consulta é alta e a frequência de alteração de dados é baixa
O Salesforce _Data 360_ no _Hyperforce_ oferece resiliência e escalabilidade multi-região. Sua casa de lago aberto com mesas _Iceberg_ permite a separação de computação e a interoperabilidade com plataformas como _Snowflake_, _Databricks_ e _S3 Iceberg, que_ constitui a espinha dorsal de um ecossistema de dados multi-nuvem verdadeiramente interoperável.
Conforme os ecossistemas de dados evoluem, precisamos equilibrar continuamente a atualidade, o custo, o desempenho e a conformidade para manter a agilidade arquitetônica. É por isso que é importante preparar sua plataforma para o futuro unificando dados ingeridos e controlados com acesso federado. Isso habilita a inteligência em tempo real, a ativação de IA e a personalização em escala corporativa em nuvens, regiões e domínios de negócios.
Lembre-se de que soluções unidimensionais para todos não são adequadas à maioria das empresas. A estratégia ideal mapeia o padrão correto para o motor de negócios correto.
## Sobre os autores
**Yugandhar Bora** é um arquiteto de engenharia de software na Salesforce que é especialista em arquitetura de dados na plataforma de aplicativos de dados e inteligência. Ele lidera iniciativas do _Corpo de Revisão de Arquitetura Empresarial (EARB)_ que se concentram na governança de dados e modelos de dados unificados, além de contribuir para soluções de provisionamento de plataforma automatizadas.
**Jan Fernando** é um arquiteto principal no _Office of Chief Architect (OCA)_ da Salesforce que entrou para a Salesforce em 2012\. Ele traz uma rica experiência de sua época no ecossistema de startups. Antes de ingressar na OCA, ele passou mais de uma década na organização da _Plataforma_, onde liderou várias transformações tecnológicas importantes.
# Introdução aos guias de decisão da plataforma
Esta seção fornece orientação prática para tomar decisões arquitetônicas essenciais sobre os recursos da Salesforce Platform. Ele abrange processamento assíncrono, eventos acionados por registro, criação de formulário, automação de fluxo de trabalho agente e tradicional, arquitetura conduzida por evento e estruturas assíncronas baseadas em etapa para ajudar os arquitetos a projetar soluções de plataforma escalonáveis, manejáveis e de alto desempenho.
---
## Processamento assíncrono
O [Processamento assíncrono](/docs/architect/pt-br/decision-guides/guide/async-processing) fornece orientação sobre ferramentas e abordagens para operações assíncronas no Salesforce:
- **Ferramentas de processamento assíncrono**: Comparação de Apex enfileirável, Apex agendado, acionadores de evento de plataforma, captura de dados de alteração, caminho agendado (depois de fluxos de confirmação) e caminho assíncrono (fluxos acionados por registro), com orientação sobre casos de uso apropriados.
- **Processamento assíncrono no lado do servidor**: Padrões para operações de banco de dados de execução longa, chamadas externas e processamento de registro de grande volume.
- **Processamento assíncrono do lado do cliente**: Técnicas como Chamadas de continuação do Apex e processamento assíncrono no lado do cliente que podem ser executadas em navegadores ou aplicativos móveis.
- **Quadro de Decisão**: Considere a validação de caso de uso, a escalabilidade, a compreensão de quando as transações são verdadeiramente assíncronas, o monitoramento e o tratamento de eventos de carga extrema.
- **Práticas recomendadas e antipadrões**: Orientação para o uso adequado, incluindo integrações de saída, monitoramento e evitar armadilhas comuns.
Permite que os arquitetos implementem padrões assíncronos escalonáveis, confiáveis e mantidos, evitando armadilhas que comprometem o desempenho.
---
## Formulários de construção
O [Building Forms](/docs/architect/pt-br/decision-guides/guide/build-forms) orienta os arquitetos sobre as opções de criação de formulário do Salesforce:
- **Fórmulas de construção**: Comparação de Formulários dinâmicos, Fluxo de tela, OmniStudio, Fluxo de tela com Componentes da Web Lightning (LWC) e LWC, incluindo habilidades e considerações de licenciamento.
- **Quadro de Decisão**: Considere o impacto do objeto, o escopo do formulário, a navegação, o local (aplicativo, dispositivo móvel, Web), a UX e a automação de teste.
- **Orientação de seleção de ferramentas**: Recomendações de layouts de registro simples a assistentes de várias páginas e formulários voltados para o cliente com marca.
- **Padrões de combinação**: Orientação para combinar ferramentas, por exemplo, navegação de Fluxo de tela com estilo do LWC.
- **Recursos avançados**: Aprofunde-se em recursos e limitações para informar a escolha de ferramentas.
Ajuda os arquitetos a selecionar a abordagem de criação de formulário certa para seus requisitos de UX, funcional e de integração específicos.
---
## Determinação da automação de fluxo de trabalho agente e tradicional
[Determining Agentic and Traditional Workflow Automation](/docs/architect/pt-br/decision-guides/guide/determining-agentic-vs-traditional-workflow-automation.html) fornece uma estrutura para escolher entre automação tradicional e Agentforce usando a estrutura Densidade de orquestração:
- **Orquestração Densidade Estrutura**: Avalia a complexidade da automação com base no caminho de execução (totalmente especificável vs. não especificável), na complexidade da meta (tarefa única vs. metas concorrentes) e na combinação de modalidades (entrada estruturada vs. multimodal).
- **Paisagem do produto**: Comparação de fluxos, Apex, Agentforce, Agent Script, Agentforce Grid, Agentforce Operations e MuleSoft para diferentes cenários de automação.
- **Matriz de seleção de densidade**: Mapeie os níveis de densidade da orquestração (baixo, médio e alto) para padrões arquitetônicos, da automação acionada por registro à orquestração híbrida ao determinismo guiado com o script do agente.
- **Quadro de Decisão**: Processo de avaliação sequencial – inspecione primeiro o caminho de execução, depois a complexidade da meta e depois a combinação de modalidades – para determinar a ferramenta certa.
- **Usar orientação de caso**: Recomendações específicas para automação tradicional (baseada em regras, determinística), Agentforce Grid (tarefas de IA em massa), orquestração híbrida (processos complexos de ponta a ponta) e Agent Script (pontos de entrada não estruturados com necessidades de raciocínio).
Permite que os arquitetos tomem decisões bem informadas em todo o espectro de automação, equilibrando os recursos de raciocínio com controle determinístico para soluções escalonáveis, auditáveis e manejáveis.
---
## Arquitetura conduzida por evento
A [Arquitetura conduzida por evento](/docs/architect/pt-br/decision-guides/guide/event-driven) fornece um guia abrangente para ferramentas e padrões do Salesforce Eventing:
- **Ferramentas para Eventos**: Visão geral de Eventos de plataforma, Captura de dados de alteração, API Pub/Sub, MuleSoft Anypoint, API de streaming e considerações de integração.
- **Padrões conduzidos por evento**: Inclui padrões de publicação/assinatura, efetuação, mensagens passadas, streaming e enfileiramento para vários casos de uso conduzidos por evento.
- **Integração com MuleSoft**: Usar conectores do Anypoint (Pub/Sub, JMS, Kafka, Solace, MQ, MQTT, AMQP) para arquiteturas empresariais.
- **Eventos de plataforma e captura de dados de alteração**: Orientação sobre mecanismos preferenciais para publicar alterações de registro e campo, com migração de Eventos PushTopic/Generic.
- **Padrões de implementação**: Práticas recomendadas para escalabilidade, consistência, tratamento de erros e monitoramento.
Permite que os arquitetos projetem sistemas escalonáveis conduzidos por evento quase em tempo real que conectam vários sistemas de modo eficiente.
---
## Estrutura assíncrona baseada em etapas
O [Step-Based Async Framework](/docs/architect/pt-br/decision-guides/guide/step-based-async-framework) fornece uma estrutura para processamento de trabalho assíncrono modular e escalável:
- **Arquitetura de estrutura**: Os componentes incluem Apex enfileirável, finalizadores, fluxo agendado, cursores do Apex, ações invocáveis e integrações do Slack.
- **Processamento baseado em etapas**: Divide o trabalho em etapas independentes que podem ser executadas, tentadas novamente e reiniciadas com governança compartilhada e visibilidade operacional.
- **Orientação de Aplicação**: Padrões para interface de etapa, Processador de etapa, Camada invocável do Apex, tratamento de atraso e notificações.
- **Práticas recomendadas**: Recomendado quando a maioria das informações existe no CRM, para cargas de trabalho de alto volume e processamento de registro hierárquico ou baseado em árvore; orientação sobre quando não usar.
- **Recursos empresariais**: Governança, conformidade, estado distribuído, rastreamento de progresso, monitoramento de SLA, diagnóstico de falha e registro em nível de auditoria.
Fornece aos arquitetos uma alternativa escalonável a trabalhos em lote monolíticos e chamadas assíncronas encadeadas, oferecendo suporte a cargas de trabalho do Salesforce de alto volume com transparência operacional total.
---
## Automação acionada por registro
A [Automação acionada por registro](/docs/architect/pt-br/decision-guides/guide/record-triggered) fornece a estrutura para projetar a automação acionada por registro na Salesforce Platform:
- **Seleção de ferramentas**: Quando usar o Fluxo acionado por registro versus acionadores do Apex, guiado pela densidade de automação (baixo, médio, alto) e pela matriz de seleção de densidade.
- **Densidade de automação**: Como avaliar a quantidade de automação, o volume de registros e a disseminação de dependência para escolher Fluxo, fluxo híbrido (Fluxo com Apex invocável) ou acionadores do Apex.
- **Ponto de entrada e governança**: Um ponto de entrada por objeto do Salesforce; orientação sobre condições de entrada, controle de recursão e execução ordenada.
- **Invocação assíncrona**: Quando e como invocar processos assíncronos de fluxos acionados por registro ou Apex, com cuidado em relação ao tratamento de erros e limites do regulador.
- **Práticas recomendadas**: Padrões para massificação, design de Fluxo híbrido – Apex e evitar armadilhas comuns na automação do acionador.
Permite que os arquitetos projetem automação acionada por registro dimensionável, manejável e de desempenho alinhada aos padrões de plataforma.
# Introdução aos guias de decisão de integração
Esta seção fornece orientação prática para escolher as ferramentas e abordagens de integração de dados certas para o Salesforce. Ele abrange integrações de saída, integrações de entrada e cenários organizacionais cruzados, ajudando os arquitetos a projetar e implementar integrações de camada de dados que balanceiam desempenho, capacidade de manutenção e custo.
---
## Integração de dados com o Salesforce
A [Integração de dados com o Salesforce](/docs/architect/pt-br/decision-guides/guide/data-integration) apresenta uma visão geral abrangente das melhores práticas e ferramentas de integração de dados do Salesforce:
- **Paisagem de ferramentas de integração**: Visão geral das ferramentas de integração de dados do Salesforce, incluindo opções de código baixo, híbridas e de código profissional, com orientação sobre a seleção da ferramenta certa para casos de uso específicos.
- **Integrações de saída**: Métodos para enviar dados do Salesforce para sistemas externos, incluindo captura de dados, Serviços externos, Heroku Connect, Procedimentos de integração do OmniStudio, Salesforce Connect, MuleSoft Anypoint e soluções personalizadas do Apex.
- **Integrações de entrada**: Abordagens para trazer dados externos para o Salesforce, com orientação sobre replicação de dados versus virtualização e quando usar cada ferramenta.
- **Integrações entre organizações**: Métodos recomendados para compartilhar dados entre organizações do Salesforce, incluindo MuleSoft Anypoint, Heroku Connect, APIs nativas do Salesforce, Captura de dados de alteração e Salesforce Connect com adaptador entre organizações, incluindo orientação para substituir implementações legadas do Salesforce para Salesforce.
- **Quadro de Decisão**: Considerações importantes para selecionar ferramentas de integração, como ferramentas e paisagem existentes, requisitos de fluxo de dados (tempo, direcionalidade, experiência do usuário esperada), complexidade da implementação, capacidade de manutenção, volume de dados e limites da plataforma.
Permite que os arquitetos escolham as ferramentas e os padrões de integração certos para cada cenário, minimizando a replicação de dados desnecessária, aproveitando soluções ESB/ETL existentes e garantindo integrações dimensionáveis e manejáveis alinhadas aos princípios da arquitetura corporativa.
# Introdução aos guias de decisão do Data 360
Esta seção fornece orientação prática para tomar decisões arquitetônicas essenciais sobre o Salesforce Data 360, incluindo estratégias de provisionamento, conectividade de várias organizações e padrões de integração. Use esses guias para projetar e implementar arquiteturas de dados eficientes que unificam dados do cliente e habilitam recursos desenvolvidos com IA.
---
## Provisionamento do Data 360
O [Data 360 Provisioning](/docs/architect/pt-br/decision-guides/guide/data-360-provisioning) abrange decisões fundamentais ao provisionar o Salesforce Data 360:
- **Home Organização Seleção**: Decida se deseja provisionar o Data 360 em uma organização de produção existente ou criar uma organização dedicada, considerando a governança, a conformidade e o tempo de valorização.
- **Estratégia de várias organizações**: Escolha entre várias instâncias independentes do Data 360 ou use o Data Cloud One para unificar várias organizações do Salesforce, equilibrando a autonomia, a conformidade e o custo.
- **Arquitetura Data Cloud One**: Habilite várias organizações parceiras para compartilhar uma única instância do Data 360 com governança centralizada, compartilhamento de metadados e paridade de recursos entre organizações.
- **Compartilhamento de dados entre organizações do Data 360**: Use o compartilhamento de dados de cópia zero entre instâncias independentes para conformidade regional, colaboração da unidade de negócios ou painéis executivos federados.
- **Considerações sobre provisionamento**: Fatores na residência de dados, modelos de governança, latência, complexidade da integração, custo e prontidão de IA para implantações corporativas.
Ajuda os arquitetos a projetar estratégias de provisionamento que garantem simplicidade, consistência corporativa, conformidade e escalabilidade para Customer 360, IA e inovação entre plataformas.
---
## Interoperabilidade do Data 360
A [Interoperabilidade do Data 360](/docs/architect/pt-br/decision-guides/guide/data-360-interoperability) fornece uma estrutura para integrar o Data 360 a plataformas externas e data lakes:
- **Padrões de ingestão de dados**: Tempo real, streaming e ingestão em lote para criar conjuntos de dados canônicos gerenciados ideais para Customer 360, conformidade e governança centralizada.
- **Federação de dados de cópia zero**: Consultas ao vivo, consultas aceleradas (cache) e métodos de federação de arquivos para acessar sistemas externos em tempo real sem duplicação, habilitando personalização, painéis e cargas de trabalho de IA/ML.
- **Abordagem híbrida**: Combine ingestão governada para conjuntos de dados principais com federação de cópia zero para atualização e escalabilidade, com suporte para engajamento do Omni-Channel, ações conduzidas pelo Agentforce e análise corporativa.
- **Quadro de Decisão**: Avalie compensações em latência, custo, escalabilidade, governança e complexidade para selecionar o padrão de integração certo por fonte de dados.
- **Architect Playbooks**: Diretrizes específicas do setor, práticas de design e considerações de custo para cenários financeiros, de saúde, de varejo e de telecomunicações.
Orienta os arquitetos no equilíbrio entre a atualidade dos dados, a governança e a eficiência do pipeline para criar arquiteturas de dados escalonáveis, interoperáveis e prontas para IA que dão suporte a cargas de trabalho operacionais e analíticas.
# Processamento assíncrono
Use este guia para escolher a abordagem de processamento assíncrono do Salesforce certa para cada caso de uso.
## Visão geral do guia
Este guia vai ajudá-lo a avaliar a abordagem certa para seus requisitos de processamento assíncronos na Salesforce Platform. Ele explica cada abordagem, detalhando os pontos fortes e as limitações de cada uma. A maioria das abordagens está alinhada a um recurso de produto, mas algumas abordagens usam vários recursos em coordenação. O guia inclui casos de uso para destacar quando usar cada abordagem.
O processamento assíncrono oferece dois benefícios importantes para sua arquitetura. Primeiro, ele aumenta a escalabilidade porque os processos assíncronos têm limites de controlador maiores. Segundo, as solicitações assíncronas são executadas em seus próprios threads para que os usuários possam fazer outro trabalho enquanto as tarefas assíncronas são executadas em segundo plano.
Observe que este guia se concentra exclusivamente na escolha de uma tecnologia de processamento assíncrona na Salesforce Platform. Outros recursos para ajudar seu processo de decisão são listados na [seção Recursos](#recursos).
## Produtos no escopo deste guia
|
A Salesforce Lightning Platform é uma plataforma abrangente baseada em IA que une funcionários, agentes de IA autônomos, dados da empresa e aplicativos em um único sistema confiável para aumentar a produtividade e a experiência do cliente. Ele permite a criação de uma "empresa ativa" conectando os aplicativos Customer 360, o Data Cloud e o Slack para automação completa. |
| Abordagem | Descrição | Habilidades necessárias | Licenças e limites |
|---|---|---|---|
| Apex enfileirável | Use para processos que envolvem operações de banco de dados de execução longa ou chamadas de serviço da Web externo. O Apex enfileirável oferece recursos como IDs de trabalho, suporte para tipos não primitivos e encadeamento de trabalho. | Código profissional | O número de licenças pode aumentar os limites. |
| Apex de lote | Crie processos complexos de longa duração que envolvem milhões de registros dividindo seu conjunto de registros e processando-o em partes gerenciáveis. | Código profissional | O número de licenças pode aumentar os limites. |
| Apex agendado | Execute o Apex em um horário agendado definido por uma expressão cron. Embora o ato de agendar o Apex por meio da expressão cron seja um processo assíncrono, o código subjacente é executado de forma síncrona quando o trabalho é iniciado. | Código profissional | O número de licenças pode aumentar os limites. |
| Chamadas de continuação do Apex | Execute chamadas de métodos do Apex em execução em um contexto de transação síncrona. | Código profissional | Não |
| Caminho assíncrono (fluxos acionados por registro) | Execute uma operação que você deseja executar em seu próprio horário. Evite erros DML mistos que ocorram quando você atualiza um valor em um registro relacionado que não faz parte do registro que acionou um fluxo. | Código baixo | O número e o tipo de licenças podem aumentar os limites. |
| Caminho agendado (depois de fluxos de confirmação) | Execute em um horário dinamicamente agendado após um evento acionador, como quando um registro é criado, atualizado ou excluído. | Código baixo | O número e o tipo de licenças podem aumentar os limites. |
| Fluxos agendados | Execute um fluxo em segundo plano em um horário especificado e com uma frequência repetida (diária, semanal ou uma vez) para realizar ações em um lote de registros. | Código baixo | O número e o tipo de licenças podem aumentar os limites. |
| Acionadores de evento de plataforma | Combine o Salesforce com sistemas externos e se comunique entre componentes assíncronos dentro da Salesforce Platform. | Código inferior + Código profissional | Uma licença complementar é necessária para casos de uso de evento de plataforma de alto volume |
| Captura de dados de alteração | Capture e processe eventos de alteração de modo assíncrono após a transação do banco de dados ser confirmada. | Código profissional | Uma licença complementar é necessária para escalar acima da alocação de linha de base. |
| API em massa | Insira, atualize, insira e atualize, consulte ou exclua muitos registros de modo assíncrono e processe os resultados mais tarde. | Código profissional | Há limites. |
| Ações do Lightning | Permita que as páginas do Lightning interajam com o servidor sem forçar os usuários a atualizar completamente a página. | Código baixo | Não |
| Habilidades necessárias | Algumas das ferramentas descritas neste guia exigem código, enquanto outras podem ser configuradas declarativamente. Ao considerar suas opções, pense nos conjuntos de habilidades que os membros da sua equipe têm. Lembre-se de que, mesmo que os desenvolvedores estejam disponíveis para sua implementação inicial (por meio de um parceiro de implementação, por exemplo), talvez você precise modificar suas soluções no futuro. Se a sua equipe de manutenção não tiver desenvolvedores, uma opção com pouco código poderá ser mais adequada. |
| Tipo de limites de plataforma aplicados | Determine o tipo de limite que se aplica à execução. Conforme você projeta suas soluções, pense cuidadosamente em como o volume e a frequência das transações contam para os limites do regulador para a abordagem escolhida a cada dia. Calcule o número de execuções que ocorrerão a cada dia. Certifique-se de que os valores calculados estejam dentro dos limites associados às ferramentas selecionadas. |
| Latency | Determine a rapidez com que os resultados do processamento estarão disponíveis na plataforma. Para algumas abordagens, as alterações serão quase imediatas, enquanto para outras podem ser minutos ou horas. |
| Caso de uso | Descrição | Abordagem de primeira escolha | Racionalidade |
|---|---|---|---|
| Processamento em lote de alto desempenho | Qualquer automação que precise processar milhares ou milhões de registros de maneira eficiente | Lote Apex | O Apex em lote fornece APIs avançadas para interface com a plataforma e velocidade bruta. |
| Trabalho de limpeza de dados | Um trabalho que é executado de rotina ou sob demanda que limpa dados. Exemplos incluem desduplicação, verificação de endereço ou consolidação de dados. | Lote Apex | O Apex em lote fornece APIs avançadas para interface com a plataforma e velocidade bruta. |
| Trabalho de totalização noturna | Trabalho que calcula os dados de totalização no fim de um dia útil. | Lote Apex | O Apex em lote fornece APIs avançadas para interface com a plataforma e velocidade bruta. |
| Lógica acionada por registro | Execute a lógica em resposta a uma atualização de registro. | Varia | Consulte nosso guia de decisão de companheiro, Automação de eventos acionados por registro. Inclui uma árvore de decisão para casos de uso assíncronos, incluindo Apex enfileirável, Apex em lote, Apex agendado, Fluxo agendado, Fluxos de caminho assíncrono e Captura de dados de alteração. |
| Atualizações em cascata por meio de um gráfico de objeto | Permite que a ação de salvar de um usuário seja concluída rapidamente, adiando atualizações em cascata a outros objetos para execução assíncrona. | Apex enfileirável | O Apex enfileirável tem recursos poderosos de encadeamento que permitem que a lógica divida uma cadeia de atualizações em uma série de transações assíncronas. |
| Processamento agendado específico do registro | Automação em uma data dinâmica futura específica do registro (por exemplo, três dias antes de uma data de fechamento). | Fluxo com um caminho agendado | Os caminhos agendados fornecem um poder exclusivo ao Fluxo, pois a plataforma gerencia automaticamente o agendamento, o cancelamento e o reagendamento desses caminhos se os dados do registro mudarem. |
| Invocando vários serviços externos lentos em paralelo | Durante uma execução síncrona, vários serviços externos são chamados em paralelo para otimizar o tempo de execução geral. | Chamadas de continuação do Apex | Permitir que várias chamadas de execução lenta sejam executadas em paralelo minimiza o tempo geral para concluir o trabalho. |
| Migração de dados de registros de um sistema externo | Mova grandes quantidades de registros para a Salesforce Platform de um sistema externo. Um processo único ou agendado regularmente. | Bulk API | Essa é a abordagem mais eficiente e amigável para a migração de dados. |
| Executar lógica adicional em um sistema externo | Padrão de foco e esquecimento de notificar um sistema externo de um evento na plataforma, então permitindo que esse sistema processe o evento de modo assíncrono. | Eventos de plataforma ou captura de dados de alteração | Um modelo pub-sub funciona melhor aqui e permite que o sistema externo processe o evento quando ele estiver pronto. Consulte Arquitetura conduzida por evento para obter mais detalhes sobre esse padrão. |
 |
O Salesforce Data 360 é a plataforma de dados em larga escala em tempo real do Salesforce que harmoniza e unifica dados de qualquer origem (CRM, Web, móvel ou data lakes externos) em um único perfil de cliente acionável. Como um componente essencial da plataforma Customer 360, ele potencia a IA, a análise e as experiências personalizadas em vendas, serviços e marketing. |
| Consideração | Por que é importante | Cenários de exemplo |
|---|---|---|
| Residência e conformidade de dados | Determina onde os dados são armazenados e processados. Regras regulatórias podem exigir regiões específicas ou várias instâncias. | Um banco global provisiona um locatário do Data 360 em uma organização do Salesforce geograficamente localizada em Frankfurt para conformidade com o GDPR. Eles provisionam outro locatário em uma organização na Virgínia para a divisão dos EUA. |
| Governança e segurança | Identifique um administrador e a propriedade do Data 360, incluindo gerenciamento de políticas e estratégias de delegação. | Uma multinacional com TI central forte cria uma organização residencial dedicada gerenciada por um Centro de excelência. |
| Autonomia vs. centralização | Diferentes líderes podem querer uma propriedade separada dos dados. A autonomia favorece várias organizações do Data 360. A centralização favorece o Data Cloud One. | Uma empresa de holding com subsidiárias independentes permite que cada BU execute seu próprio Data 360. |
| Latência e desempenho | Impacta a velocidade e a experiência da consulta, especialmente para organizações companheiras conectadas a um locatário do Data 360 entre regiões. | Uma equipe de vendas em Londres que consulta dados de um locatário do Data 360 nos EUA pode ver uma latência maior. |
| Complexidade da integração | Mais locatários do Data 360 = mais pipelines, APIs e middleware. A consolidação simplifica a integração. | Um varejista evita criar 10 pipelines ETL consolidando-os em uma configuração do Data Cloud One. |
| Região da fonte de dados de cópia zero | Os requisitos de acesso entre regiões para alguns conectores podem limitar a região ou o local da sua organização do Data 360. | Uma empresa tem uma instância do Snowflake na região eu-west-1 da AWS. Eles podem usar o Zero Copy para federar dados em um Data 360 em sua região, mas não podem usar o Zero Copy para federar em um Data 360 na região dos EUA. |
| Compatibilidade entre regiões da Conexão privada | Às vezes, o suporte para Conexão privada depende de se a fonte de dados está na mesma região que o locatário do Data 360. | Uma empresa tem uma instância do Snowflake na região aws-east-1 que deseja conectar ao Data 360 por meio de cópia zero. Eles só poderão estabelecer uma conexão de rede de Conexão privada se a organização inicial do Data 360 estiver na mesma região. |
| Custo e licenciamento | Cada locatário do Data 360 aumenta o custo. Consolidar em menos instâncias otimiza o gasto. | Um provedor de saúde reduz os custos de licenciamento adotando o Data Cloud One em vez de várias instâncias independentes do Data 360. |
| Escalabilidade futura | As opções de provisionamento hoje estabelecem a base para o crescimento. | Uma empresa de SaaS começa com uma única instância do Data 360, mas planeja expandir-se para o Data Cloud One à medida que adquire subsidiárias com organizações do Salesforce. |
| Prontidão de IA corporativa | Os recursos de IA e Agentforce exigem um locatário do Data 360 conectado em cada organização. As decisões de provisionamento afetam como os modelos de IA são treinados e ativados em toda a empresa. | Uma empresa de serviços financeiros unifica dados no Data Cloud One para que seus modelos de IA do Einstein tenham acesso a dados de clientes em toda a empresa. |
 **Opção A: Provisionar o Data 360 em uma organização** existente
**Funciona melhor para:** Clientes com uma única organização do Salesforce ou clientes de várias organizações que já têm uma organização centralizada importante em que a maioria dos processos de negócios é executada.
 - **Prós:**
- Caminho mais simples: O Data 360 é provisionado onde seus dados do CRM estão.
- Acesso imediato aos dados locais de Vendas, Serviço e Marketing.
- Nenhuma integração adicional é necessária.
- Menos licenças e ambientes para gerenciar.
- Acelera a adoção antecipada, pilotos e casos de uso de produção.
- **Contras:**
- Pode herdar a governança ou o débito técnico de uma organização existente.
- Se não existir uma única "organização principal", a seleção de uma poderá criar debates de propriedade.
- Desempenho vinculado ao local da organização; pode não estar alinhado às necessidades de residência corporativas.
- Se várias unidades de negócios usarem organizações diferentes, o provisionamento local poderá levar à fragmentação se não for combinado ao Data Cloud One.
**Exemplo:**
Uma empresa de SaaS com uma organização do Salesforce provisiona o Data 360 nessa organização para unificar dados de assinatura e suporte do cliente.
**Opção B: Provisionar o Data 360 em uma nova organização dedicada**
**Funciona melhor para:** Clientes com várias organizações do Salesforce que não conseguem se alinhar em uma única organização principal ou empresas com um forte modelo de Centro de excelência (CoE).
 - **Prós:**
- Limpe o quadro para governança, sem complexidades da organização herdadas.
- Controle centralizado em várias linhas de negócios.
- Flexibilidade para escolher uma região com base nas necessidades de conformidade.
- Atua como uma organização de "atendimento compartilhado" neutra, não vinculada a uma unidade de negócios.
- Configure para a arquitetura futura do Data Cloud One (organização inicial com várias organizações parceiras).
- **Contras:**
- Os clientes devem licenciar uma nova organização do Salesforce na qual provisionar o Data 360.
- Integração adicional necessária para conectar a organização a um Data 360 por meio de uma conexão de companheiro do Data Cloud One.
- Pode adicionar sobrecarga administrativa (gerenciamento de usuários, segurança, identidade).
- Tempo para obter valor mais lento em comparação ao provisionamento em uma organização de produção existente.
**Exemplo:**
Uma empresa multinacional de serviços financeiros cria uma organização de origem dedicada para provisionar o Data 360\. Todas as organizações de unidade de negócios (Retail, Wealth, Commercial Banking) se conectam como organizações companheiras por meio do Data Cloud One.
**Critérios de decisão**
| Consideração | Organização existente como organização inicial (padrão preferencial) | Nova organização como organização residencial (alternativa) |
|---|---|---|
| Simplicidade | Cria na estrutura de dados e usuário existente para uma configuração mais rápida. O Data 360 é integrado por padrão à organização inicial . |
Requer licenciamento e configuração de uma nova organização do Salesforce e sobrecarga administrativa adicional para gerenciá-la |
| Tempo para valor | Uso imediato de dados locais do CRM | Rampas e integração mais lentas são necessárias. |
| Governança | Herda o modelo de governança básico da organização existente – usuários e conjuntos de permissões existentes (pode ser aceitável se a organização já é central ). | Limpe o quadro para governança. Ideal para modelos conduzidos por COE. |
| Conformidade | Residência vinculada à região da organização existente | Flexibilidade para selecionar uma região independente de organizações existentes |
| Desempenho | Melhor desempenho para consultas de CRM locais | Dependendo da conectividade da organização companheira, esteja ela na mesma região ou entre regiões para as outras organizações |
| Escalabilidade futura | Funciona bem se combinado ao Data Cloud One. É mais difícil mudar mais tarde se a organização errada for escolhida | Escala facilmente com o Data Cloud One. Projetado para neutralidade. |
| Custo | Custo incremental menor | Sobrecarga maior de ambientes adicionais |
 **Como o Data Cloud One funciona**
- **Ingestão e unificação de dados (organização inicial)**
- Todas as configurações de ingestão de dados (Salesforce CRM, origens externas, streaming, lote) ocorrem apenas na organização de origem.
- O locatário do Data 360 vinculado à organização de origem realiza resolução de identidade, harmonização, modelagem e unificação em perfis de clientes confiáveis.
- Administração, políticas de governança, marcação e mascaramento do Data 360 são aplicados centralmente na organização de origem.
- **Arquitetura de espaço de dados**
- Na organização de origem, os dados são organizados em espaços de dados, que atuam como contêineres lógicos para dados, metadados e processos.
- As empresas podem criar espaços de dados para marcas, regiões ou linhas de negócios.
- Compartilhamento de espaço de dados: Na organização de origem, espaços de dados específicos são compartilhados seletivamente com organizações companheiras. Isso garante que apenas os dados relevantes (e metadados associados) fluam para as organizações certas.
- **Compartilhamento de metadados**
Organizações parceiras recebem definições de metadados da organização de origem, incluindo objetos de modelo de dados (DMOs), esquema de perfil unificado, insights calculados, segmentos [e muito mais](https://help.salesforce.com/s/articleView?id=data.c360_a_companion_org_data_cloud_features.htm&type=5). Eles aparecem nativamente dentro da organização companheira como se fossem ativos locais, mas estão vinculados à organização de origem.
- **Capacidades em organizações iniciais vs. organizações companheiras**
O acesso ao recurso difere entre organizações iniciais e companheiras. Organizações parceiras não podem ingerir nem unificar dados e dependem da organização inicial para ingestão, modelagem e unificação. Organizações parceiras podem acessar dados do Data 360 para aprimorar recursos de plataforma desenvolvidos com o Data 360 e podem criar percepções, segmentos e fluxos locais com base nos dados compartilhados e confiáveis. Na visão futura, eles também podem acessar recursos de ativação.
| Capacidade | Organização residencial | Organização de companheiro |
|---|---|---|
| Conectar Configurar conectores, criar fluxos de dados, ingerir ou federar dados | ✅ | ❌ |
| Harmonizar e unificar Criar e executar transformações de dados e resolução de identidade | ✅ | ❌ |
| Governar Dados seguros com permissões e espaço de dados | ✅ | ✅ |
| Crie segmentos, percepções e crie modelos do Einstein Studio | ✅ | ✅ |
| Ativar ativações Everywhere, ações de dados | ✅ | ✅ |
| Recursos da plataforma: Criador de prompts, fluxos, relatórios, aprimoramento [e muito mais] (https://help.salesforce.com/s/articleView?id=data.c360_a_companion_org_data_cloud_features.htm&type=5) | ✅ | ✅ |
| Recursos habilitados pelo Data 360: Centro de prospecção, recursos de Vendas e Service Cloud, Agentforce e muito mais | ✅ | ✅ |
| Consideração | Várias organizações independentes do Data 360 | Um Data 360 compartilhado (Data Cloud One) |
|---|---|---|
| Autonomia | Alta autonomia para cada organização ou unidade de negócios | Governança centralizada, menos autonomia por organização |
| Conformidade | Útil quando a separação rígida é necessária (por exemplo, leis regionais) | Funciona melhor quando a residência permite a centralização |
| Custo | Custos de licenciamento e administrador maiores | Mais econômico; uma licença para muitas organizações |
| Governança | Fragmentado; as políticas diferem por organização | Políticas centralizadas e consistentes entre organizações |
| Silos de dados | Cada organização com sua própria visualização Sem o Enterprise 360 | Conjunto de dados unificado, sem duplicação |
| IA/Analytics | Limitado aos dados de cada organização | Modelos corporativos com maior precisão |
| Complexidade | Mais instâncias para gerenciar, mais integrações | Arquitetura mais simples, menos peças móveis |
| Desempenho | Melhor para casos de uso organizacionais | Potencial aumento na latência com acesso à organização companheira |
| Fator | Prós | Contras |
|---|---|---|
| Residência de dados | Dá suporte à separação regional enquanto ativa a colaboração. | Não elimina a necessidade de gerenciar várias organizações do Data 360. |
| Duplicação de dados | Cópia zero; nenhuma duplicação de objetos. | Requer seleção deliberada de objetos para inclusão em cada compartilhamento de dados. |
| Governança | O compartilhamento é explícito e deliberado (no nível do objeto). | Sem marcas ou fluxo de políticas; a organização de destino deve reaplicar a governança. |
| Complexidade | Ativa a colaboração seletiva sem centralização. | Requer o gerenciamento de várias organizações do Data 360 e compartilhamentos de dados. |
| **IA/Analytics** | IA/análise regional possível; as percepções podem ser compartilhadas entre organizações. | Nenhuma IA corporativa, a menos que os dados sejam compartilhados intencionalmente. |
| **Recursos da plataforma** | Os recursos desenvolvidos com o Data 360 de cada organização são executados de modo independente. | Sem compartilhamento automático. Risco de duplicação se não tiver sido projetado com cuidado. |
| Custo | Pode reduzir a necessidade de pipelines de ETL. | Ainda incorre o custo de várias organizações do Data 360. Consome créditos para consultas de dados e compartilhamento de dados. |
| Consideração | Data Cloud One (preferencial para várias organizações) | Compartilhamento de dados entre organizações do Data 360 |
|---|---|---|
| Fonte única da verdade | Sim – todas as organizações compartilham um modelo de dados. | Não – cada Data 360 tem seu próprio modelo de dados. |
| Conformidade | Funciona apenas quando a residência permite a centralização. | Necessário quando as leis de residência impedem a centralização. |
| Governança | Centralizado, consistente. | Federado; compartilhamentos deliberados no nível do objeto. |
| Complexidade | Menos peças móveis, mais simples. | Mais complexo – requer compartilhamentos de dados de configuração e várias organizações de dados. |
| IA/Analytics | Modelos de IA corporativa. | IA regional. Compartilhe percepções seletivamente. |
| Recursos de plataforma | O Data 360 compartilhado significa que todos os recursos funcionam de modo consistente entre o Início + os Companheiros. | Os recursos são executados de forma independente em cada Data 360; o compartilhamento deve ser explícito. |