| パターンタイプ | モード/ツール | 利点 | 考慮事項 | 結果 |
|---|---|---|---|---|
| データ取り込み |
リアルタイム:
|
|
|
Agentforce:
|
ストリーミング:
|
|
|
Agentforce:
|
|
バッチ:
|
|
|
Agentforce:
|
|
| Zero Copy |
ライブクエリ:
|
|
|
Agentforce:
|
高速化されたクエリ (キャッシング):
|
|
|
Agentforce:
|
|
ファイル統合:
|
|
|
Agentforce:
|
 #### データ取り込みメソッド
_データ取り込み_方法は、データの取り込みに使用するコネクタによって異なります。さまざまな取り込み方法を提供するコネクタもあれば、バッチモードまたはストリーミングモードでのみ動作するコネクタもあります。_Data 360_ コネクタと使用可能なメソッドの完全なリストについては、「[Data 360: Integrations and Connectors](https://help.salesforce.com/s/articleView?id=data.c360_a_sources_targets.htm&type=5) (Data 360: インテグレーションとコネクタ)」を参照してください。
- **リアルタイム:**
- _変更データキャプチャ (CDC)_ を使用して、1秒未満の取り込みを提供します。
- 時間的制約のあるワークフロー (不正行為の検出、パーソナライズ、運用ダッシュボードなど) に適しています。
- _Data 360_内のプッシュ変換と集約により、下流のI/Oを削減し、コンピューティング使用量を最適化
- インクリメンタルなCDCを使用して、データのシャッフルを最小限に抑えることをサポートします。
- **ストリーミング:**
- 1~3分ごとに小単位で取り込みます。
- 鮮度とコストのバランスをとります。
- キャンペーンオーケストレーション、ニアライブエンゲージメント、運用レポートに最適
- マイクロバッチを使用した I/O スパイクの制御をサポート
- ソースで可能な場合、データを集計して転送量を削減し、ストレージを最適化します。
- **バッチ (スケジュール済み読み込み):**
- 大規模なデータセットの定期的な取り込み(例:毎時、毎日、毎週など)を提供します。
- 履歴データセット、規制レポート、コンプライアンスの使用事例のコスト効率と信頼性を向上
- コンピューティングのローカル性をソースストレージと同じ領域に確保して、パフォーマンスを向上させ、コストを最適化
#### Architect Playbook (アーキテクトプレイブック)
- **データ取り込みのユースケース:**
- **Customer 360 統合プロファイルの生成。**顧客のIDおよび属性に関する唯一の信頼できる情報源を構築します。
- **規制コンプライアンスデータセットを管理します。**機密データに対して、ガバナンス、系統、監査可能性を確保します。
- **キャンペーンオーケストレーションを一元化します。**マーケティング、営業、サービスのすべてが一貫性のある信頼できるデータセットから実行されるようにします。
- **設計プラクティス:**
- 履歴データや低レイテンシーが許容されるニーズ(たとえば、アーカイブレポートや定期スナップショットなど)に合わせたバッチ取り込みに対応します。
- CDC またはストリーミング API を使用して、業務ワークフローとパーソナライズワークフローの新鮮さを維持し、ほぼリアルタイムで更新できるようにします。
- データセット全体の再読み込みに代えて、インクリメンタルな読み込みを適用することで、ストレージとコンピューティングの増加を制御し、コストと効率を最適化します。
- 取り込みパイプラインを、コンピューティングのローカリティおよびインクリメンタルな処理に合わせることで、ネットワークI/Oを削減します。
- _Data 360_ 内で変換を適用して、未加工データを不必要に移動しないようにします。
- **コストに関する考慮事項:**
- **リアルタイム取り込み**は、コンピューティングとパイプラインのコストが最も高く、価値が高く、時間的制約のあるワークフロー(パーソナライズ、運用ダッシュボード、Agentforce駆動型アクションなど)では妥当な可能性があります。
- **ストリーミング取り込み**には中程度のコンピューティングコストとストレージコストがかかるため、わずかな遅延を許容できる頻繁な更新 (キャンペーンオーケストレーションや運用レポートなど) に適しています。
- **バッチ取り込み**は、コンピューティング コストが低く、予測可能なストレージであるため、履歴データセットや頻度の低い更新に適しています。特定のコネクタを使用して Salesforce 組織から一括処理データを取り込むことは無料です。
- **更新モード**では、取り込みとコンピューティングの合計コストを削減する_インクリメンタルなリフレッシュ_モードを選択できます。Salesforceでは、可能な限り_インクリメンタルなリフレッシュ_を使用して、すべての取り込み種別の効率を最適化することをお勧めします。
- **コスト**は、ソースから_Data 360_へのI/O量にも影響されます。バッチサイズ、パーティション、地域調整を最適化すると、転送コストが削減され、パフォーマンスが向上します。
- **業種シナリオ:**
- **財務:**取り込みデータセットは、監査可能性とコンプライアンスが譲れない_顧客(KYC)_、_AML(マネー ロンダリング_対策)、不正行為の検出に必要です。
- **医療:** 患者の ID 解決と HIPAA 準拠のレコードの取得を使用して、安全で統合されたビューを実現します。
- **小売:** _販売時点管理(POS)_、eコマース、およびロイヤルティプログラムのデータを統合プロファイルに統合して、セグメンテーションとパーソナライズを行います。
- **通信:** 正規で管理された登録者データを使用して、離脱防止と利用状況の分析をサポートします。
#### データ取り込み方法の決定条件
| 機能 | リアルタイム取り込み | ストリーミング取り込み | 一括取り込み |
| :----------------------------------- | :------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------ | :------------------------------------------------------------------------------------------------------------------------------------------------------------ | :----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **レイテンシと鮮度** | _変更データキャプチャ(CDC)_をサポートする取り込みAPIを介した1秒未満のレイテンシの取り込みを特徴とします。継続的なストリーミングパイプラインを提供します。低遅延の運用ユースケースに適しています。 | ネイティブコネクタを使用して 1 ~ 3 分ごとにマイクロバッチを取り込みます。インクリメンタルな更新をサポートします。若干の遅延が予想されます。 | データ遅延が予想されます。スケジュール済みの大ボリューム読み込みを許可します。定期的な取り込み (毎時、毎日、毎週) を特徴とします。時間に敏感な操作には適していません。 |
| **主なユースケース** | 低遅延の運用およびパーソナライズのユースケースに最適です。時間的制約のあるワークフローに使用します。イベント駆動型ワークフローをサポートします。リアルタイムの不正行為アラートと業務アラートに使用します。 | 緊急度が中程度のプロセスに適しています。キャンペーンオーケストレーション、ニアライブエンゲージメント、運用レポートに使用します。タイムリーなキャンペーントリガーに使用します。 | 大規模なデータセットに対してコスト効率が高いです。履歴分析において信頼性が高いです。履歴集計または規制対象のレポートワークフローに使用します。履歴データセットまたは低速データセットに適しています。 |
| **アーキテクチャの複雑さと I/O** | 高コストで複雑なアーキテクチャが含まれる。低レイテンシのソースシステムが必要。I/O 集約型。大量のソースがあると、パイプラインが飽和する可能性があります。 | リアルタイムよりもシンプルなアーキテクチャを特徴としています。I/O は中程度です。予測可能で反復的な更新パターンに適しています。バッチサイズはメモリと計算に影響します。 | 実装が容易です。読み込みウィンドウ中は I/O が集中的になります。大規模なバッチでは、ネットワークのスループットがボトルネックになる可能性があります。 |
| **コストに関する考慮事項** | 最も高いコンピューティングコストとパイプラインコストが含まれます。価値が高く、時間的制約のあるワークフローでのみ有効です。 | 中程度のコンピューティングコストとストレージコストが含まれます。コストと鮮度のバランスに優れたアプローチを提供します。わずかな遅延を許容できる頻繁な更新に適しています。 | コンピューティング コストを抑え、予測可能なストレージを備えています。履歴データセットや頻度の低い更新にお勧めします。Salesforce 内部パイプラインを介した取り込みは無料です。 |
| **設計ベストプラクティス** | 増分 CDC を使用して、データの入れ替えを最小限に抑えます。必要な項目を絞り込んで使用し、オーバーヘッドを削減します。 | マイクロバッチを使用して、I/O スパイクを制御します。処理の負荷を軽減するために、ウィンドウ集計を検討します。 | アーカイブレポートまたは定期的なスナップショットに使用します。コストを最適化するために、計算の局所性がソースストレージと同じ領域にあることを確認します。 |
### Zero Copy Data Federation (ゼロコピーデータ統合)
#### Zero Copy のユースケース
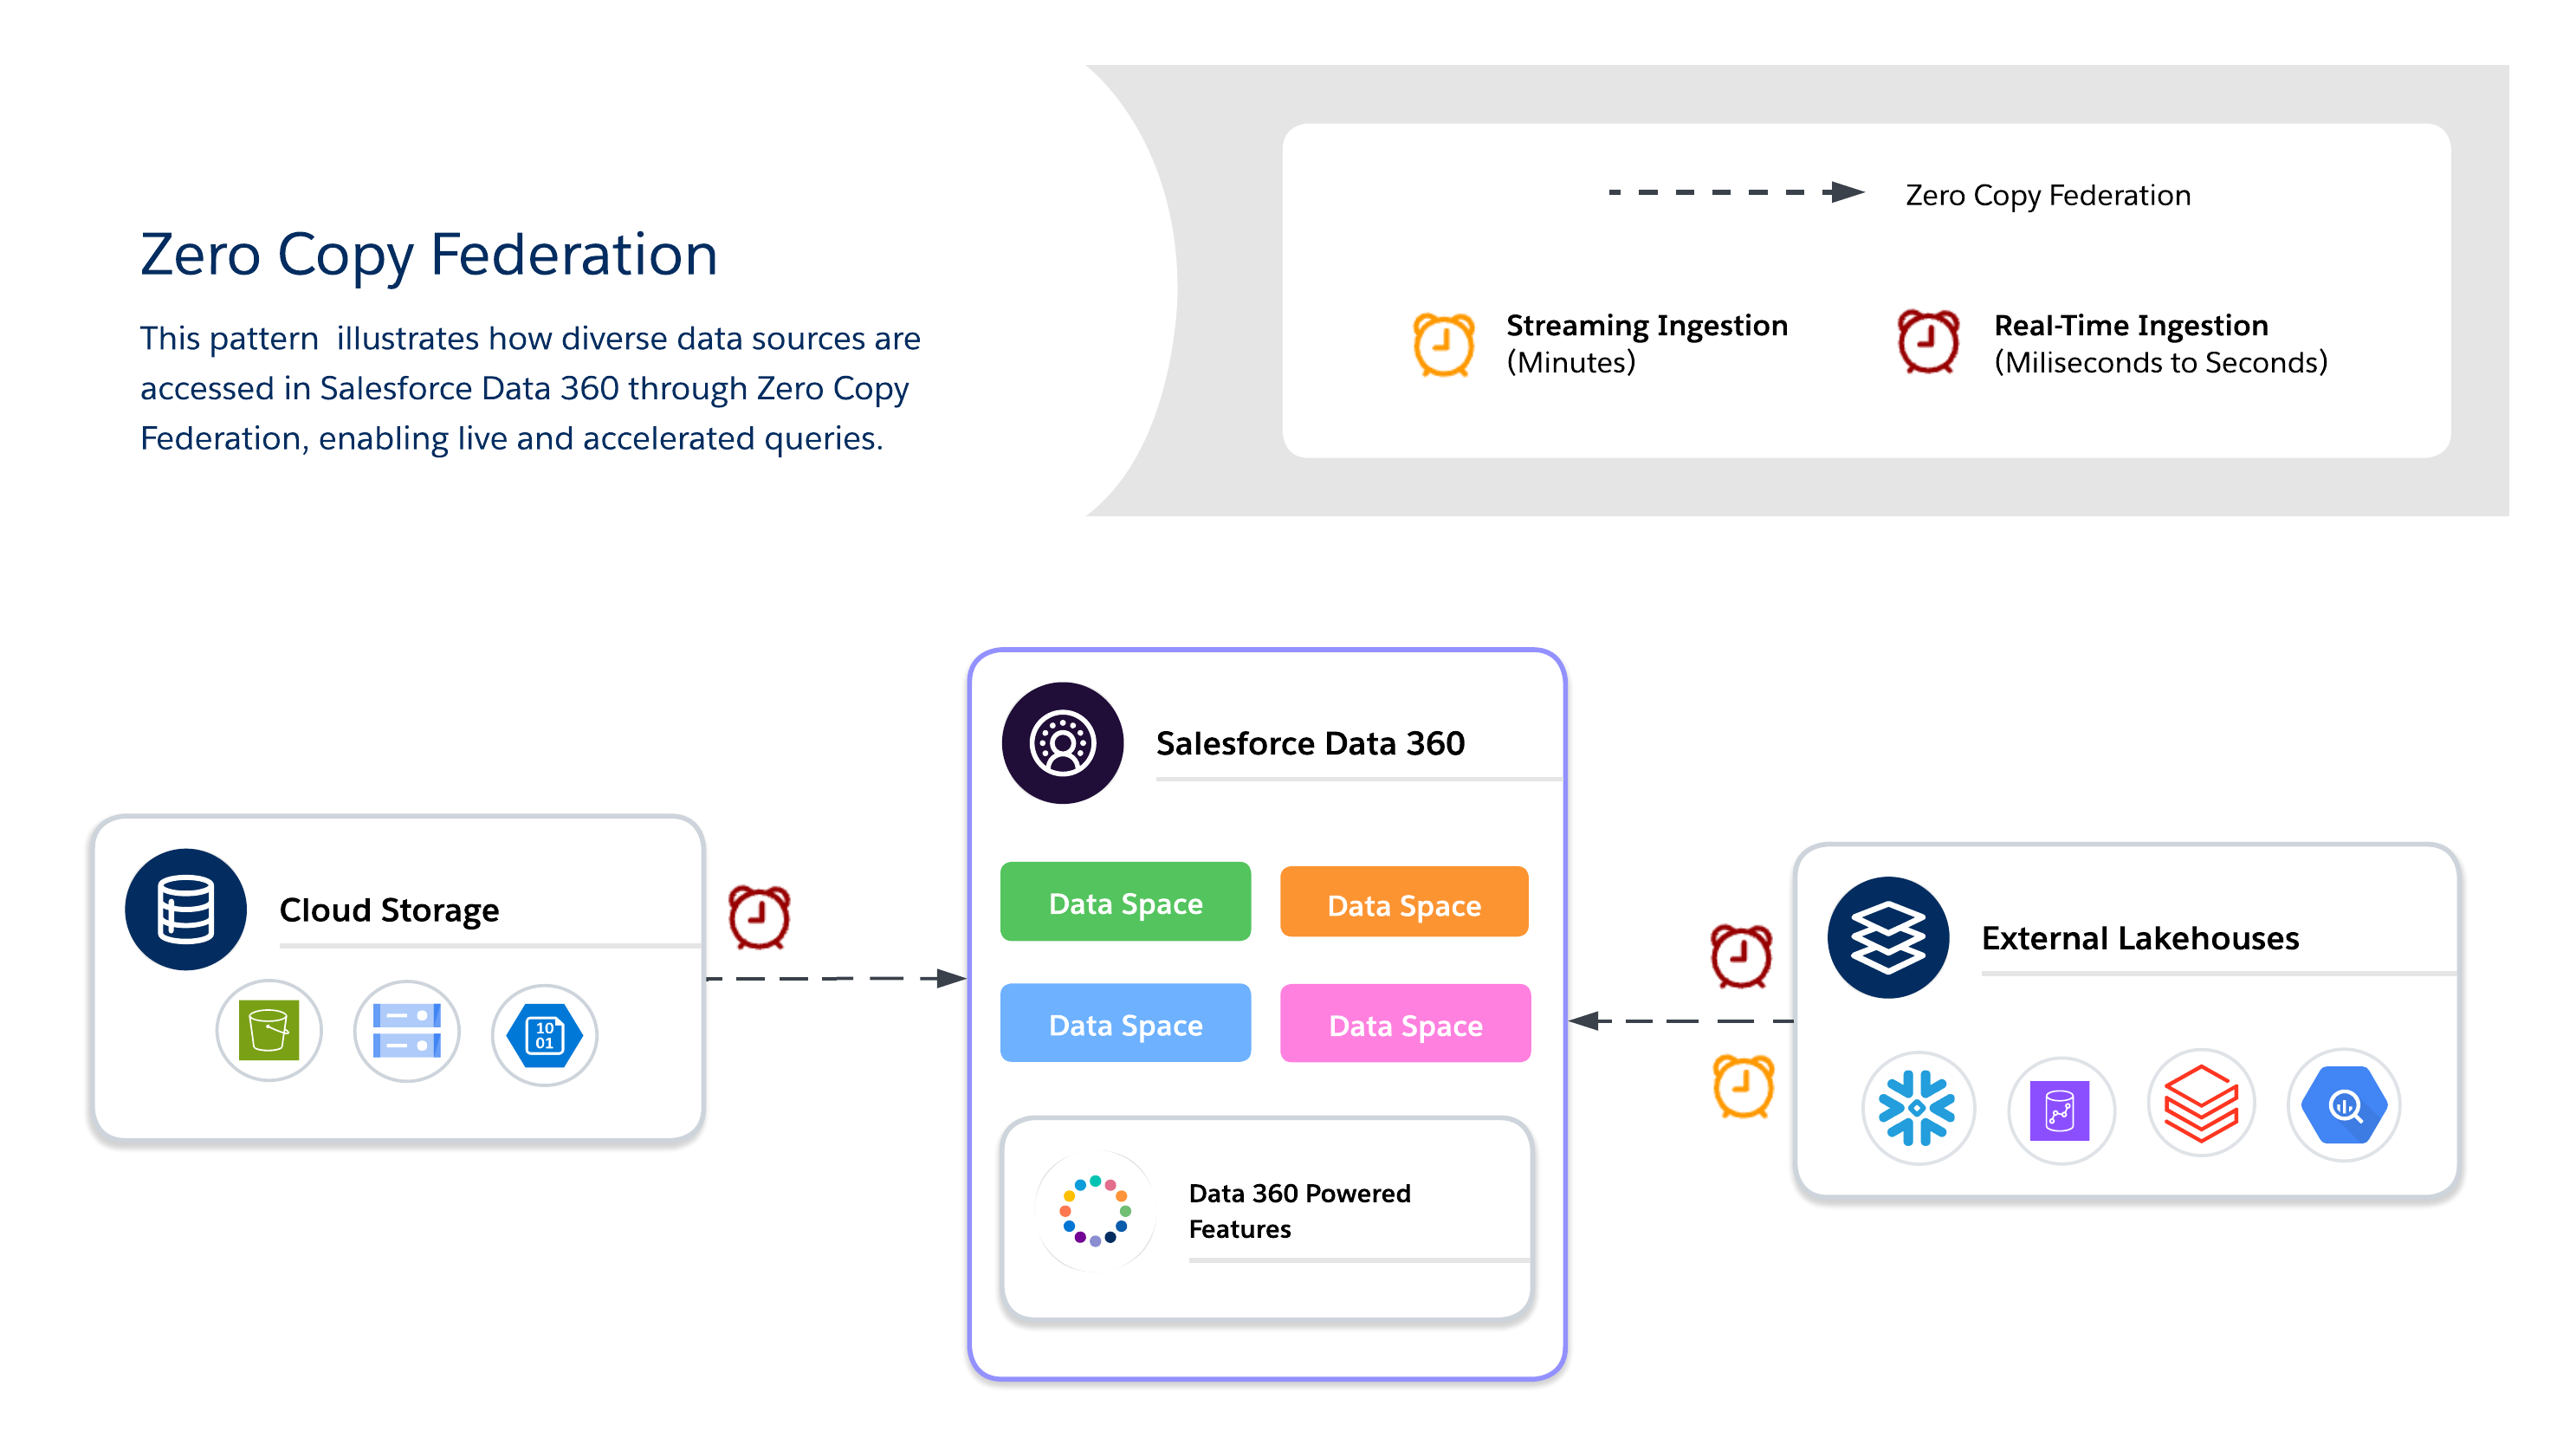
_ゼロ コピー_を使用して、データの重複のない外部システムのリアルタイム クエリを実行し、大規模データセットまたは一時的なデータセットへの俊敏性、最新性、拡張性の高いアクセスを実現します。ライブ ダッシュボード、探索的分析、AI/MLモデルのトレーニング、Salesforce _Data 360_を介したリアルタイムの顧客エンゲージメントに適しています。
 #### ゼロコピーメソッド
_ゼロ コピーを_使用する場合、アーキテクトは使用可能な3つのデータ統合方法のいずれかを選択する必要があります。それぞれに、新鮮さ、パフォーマンス、コストのトレードオフがあります。
- **ライブクエリ**
- 外部システム(_Snowflake_、_Google BigQuery_、_Redshift_、_Databricks_など)に対してデータの重複なしで直接クエリを実行します。
- ネットワーク上のデータ移動を最小限に抑え、Salesforce _Data 360_の計算におけるI/Oを削減します。述語や集計をプッシュダウンできる場合に最適です。
- リアルタイムのインサイトと低レイテンシの運用ダッシュボードに適しています。
- 外部システムのパフォーマンスによって異なります。
- **キャッシング (高速化されたクエリ)**
- 統合データのキャッシュされたコピーを Salesforce _Data 360_ に一時的に保存します。
- 期間 (分~日) を設定可能で、頻繁にアクセスされるデータセットの反復クエリコストと遅延を削減します。
- データは完全にはコピーされないため、更新はソースからのスケジュールされた更新で管理されます。
- _インクリメンタルなリフレッシュ_は、アップサートのみをサポートします。削除したレコードはキャッシュから削除されません。
- 定期的にフル更新を実行して、キャッシュがソースと同期されていることを確認します。
- **注:** _Snowflake_ コネクタでは、Snowflake が開始するステージングバケットを使用して加速率を高める_アンロード_機能がサポートされています。これはデフォルトで有効になっていますが、接続を編集することで無効にできます。
- **ファイル統合**
- オブジェクト ストアの大規模なデータセット(_Iceberg_を使用する_S3_や_GCS_など)への参照のみの直接アクセスを提供します。
- データを移動することなく、AI/ML ワークロード、履歴分析、ペタバイト規模のレポートに適しています。
- クエリのパフォーマンスは、オブジェクト形式、パーティショニング、ネットワーク I/O に大きく依存します。大規模なスキャンでは、最適化されていない場合、大量の I/O が生成される可能性があります。
#### アーキテクトプレイブック
- **使用事例**
- **リアルタイムのパーソナライズ**と適応型ワークフローにより、顧客の行動の変化に応じて動的な提案、おすすめ、Next Best Actionが提供されます。
- **ライブ ダッシュボードと運用分析**により、ビジネス クリティカルなダッシュボードとKPIを外部倉庫から直接利用できます。
- 大規模な外部データセットを使用する**AI/MLモデル**のトレーニングでは、ファイルフェデレーションを介して移動することなく、データレークやウェアハウスからペタバイト規模のデータを活用します。
- **業種シナリオ**
- **小売/メディア:** クリックストリームまたはコンテンツインタラクションデータを統合することで、パーソナライズされたおすすめとリアルタイムの顧客エンゲージメントを実現します。
- **財務:**機密データを重複させることなく外部倉庫を照会することで、不正行為の検出とリスク スコアリングをほぼリアルタイムで実行します。
- **Tech/Enterprise:** データセットが複数のシステムに存在する場合に、クロスクラウドレポート、ITサービスダッシュボード、運用分析をサポートします。
- **デザインプラクティス**
- **ライブクエリ**
- 新鮮度が重要な場合に、高QPSで低レイテンシのクエリに使用します。
- 述語と集計を外部システムに転送して、ネットワーク上のデータの入れ替えを減らします。
- 大量のデータを不必要にスキャンするクエリは避けてください。
- 代わりにパーティションのプルーニングとフィルターを検討してください。
- **ファイル統合**
- 取り込みなしでオブジェクトストアのペタバイト規模のデータセットにアクセスできます。
- オブジェクトストレージを Salesforce の計算と同じクラウド領域に保持することで、遅延と出力コストを最小限に抑えます。
- パーティション分割された列形式 (Parquet/ORC) とプッシュダウン検索条件を使用して、I/O とネットワーク転送を削減します。
- クエリと述語のプッシュダウンを活用して、ソースでデータを絞り込んで集計することで、データの移動を減らします。
- I/O、遅延、コストが増加するため、リージョン間データアクセスは、絶対に必要でない限り避けてください。
- **キャッシング (高速化されたクエリ)**
- コストとパフォーマンスのバランスを取るために、頻繁にアクセスするデータセットをキャッシングします。
- 更新間隔を設定して、新鮮度とクエリコストのバランスを取ります。
- **コンプライアンス:**統合システム内で_RLS(行レベルセキュリティ)_とマスキングポリシーを直接活用して、ソースでガバナンスを適用します。
- プラットフォーム間で統一された RLS とマスキングを行うためのベストプラクティスを次に示します。
- **一元化されたエンタープライズ ID を使用します。**Salesforce _Data 360_ のユーザーとエンティティを、外部システムの ID に対応する一意の一元化されたエンタープライズ識別子に対応付けます。
- **セキュリティポリシーを調整します。**対応付けられた ID に基づいて、統合システムの RLS およびマスキングポリシーが適用されるようにします。これにより、外部データを照会するときのコンプライアンスが保持されます。
- **ID スキーマの標準化。**不一致やアクセス違反を回避するために、すべてのデータソースで一貫した ID 属性 (メール、ユーザー ID、顧客 ID など) を維持します。
- **コストに関する考慮事項**
- **ライブクエリ:** クエリあたりの支払モデルでは、外部レイクハウスの計算でコストが発生するため、QPS が高いスパイクが発生する可能性があります。これは、コストの変動よりもその価値が大きい、新鮮さを重視するユースケースに適しています。
- **Accelerated Query (Caching):** この方法では、ソースシステムへのヒットを減らすことでクエリコストを (_ライブクエリ_と比較して) 削減できますが、キャッシュへの入力と更新のためのバッチデータの取り込みコストは増加します。これは、頻繁にアクセスされるデータセットに適しています。
- **ファイルフェデレーション:**これは、オブジェクトストアのデータとして最も安価なストレージオプションです。ただし、クエリコストは、ファイルサイズ、パーティション分割、およびプルーニングによって異なります。これは、ペタバイト規模の履歴データや一括データに適しています。
#### ゼロコピー方法の決定条件
| 決定ポイント | ライブクエリ | キャッシング (高速化されたクエリ) | ファイルフェデレーション |
| :----------------------- | :---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | :--------------------------------------------------------------------------------------------------------------------------------------------------------- | :------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **データソースの場所** | 外部データ レイク ハウス(_Snowflake_、_Google BigQuery_、_Redshift_、_Databricks_など) | 外部データ レイク ハウス(_Snowflake_、_Google BigQuery_、_Redshift_、_Databricks_など) | オブジェクト ストアまたはクラウド データ レイク(_S3_、_ADLS_、_GCS_など)。_Iceberg_のようなオープン テーブル形式がよく使用されます。 |
| **目的/使用事例** | 対話型の分析やリアルタイムダッシュボードに適しています。リアルタイムのパーソナライズと動的なワークフローに適しています。 | クエリが頻繁に発生するが、若干古い結果が許容される場合に適しています。BI ダッシュボードおよびセグメンテーションに適しています。 | 大規模なバッチ処理や AI/ML モデルのトレーニングに適しています。履歴分析やペタバイト規模のレポートに適しています。 |
| **鮮度/レイテンシ** | 最大限の新鮮さを提供 リアルタイムでクエリを直接実行します。効果的な述語プッシュダウンを用いてソースシステムが低レイテンシクエリ用に最適化されている場合、1秒未満の意思決定をサポートします。 | 若干古い結果が許容される場合に使用します。新鮮度は、15 分~ 7 日間の範囲で設定できるキャッシュ間隔によって異なります。 | バッチ負荷が高く、スループット要件の厳しいジョブに適しています。リアルタイムダッシュボードには適していません。 |
| **アクセスパターン** | 新鮮さが重要でクエリ量が少ない頻度の低いクエリやアドホッククエリに適しています。QPS が高いとコストが大幅に上昇するため、クエリ頻度が高いときにキャッシュ (Accelerated Query) を評価することが重要です。 | 高頻度の読み取りシナリオに適しています。頻繁なアクセスパターンのパフォーマンスが向上します。 | 読み*取り専用アクセス*を提供します。取り込みのないペタバイト規模のデータセットに適しています。 |
| **パフォーマンスの促進要因** | 外部システムのパフォーマンスに大きく依存します。述語と集計をソース側にプッシュダウンできる場合に適しています。 | 繰り返されるライブクエリと比較して遅延が短縮されます。パフォーマンスは、キャッシュ管理と間隔によって異なります。 | パフォーマンスは、オブジェクト形式、パーティショニング、外部システムのスループットに大きく依存します。パーティション分割された列形式 (Parquet/ORC) を使用します。 |
| **コストへの影響** | これはクエリごとの支払モデルであるため、外部レイクハウスの計算でコストが発生します。頻繁ではないクエリではコスト効率が高くなりますが、QPS 量が多いと経費が急増する可能性があります。 | コストは、繰り返されるライブクエリよりも低くなります。これにより、外部ソースを繰り返し照会する必要がなくなりますが、キャッシュストレージと更新オーバーヘッドが追加されます。 | これは最も安価なストレージオプションです。同じリージョン、同じクラウドのAWS設定の場合(US-East-1に_Data Cloud_テナントがあるUS-East-1の_S3_など)、アクセスされる行でクレジットは消費されません。クロス リージョンまたはクロス クラウド構成(_Azure_、_GCS_、異なる_AWS_リージョンなど)では、アクセスされる行のクレジット消費が発生します。クエリコストは、ファイルサイズ、パーティショニング、述語プッシュダウンの最適化によっても異なります。 |
| **主な考慮事項** | 大量のデータを不必要にスキャンする絞り込まれていないクエリは避けてください。 | この方法では、キャッシュ管理が必要です。1秒未満の意思決定には適していません。 | クエリのパフォーマンスは、パーティショニングと述語プッシュダウンによる最適化に大きく依存します。 |
### ハイブリッドアプローチ
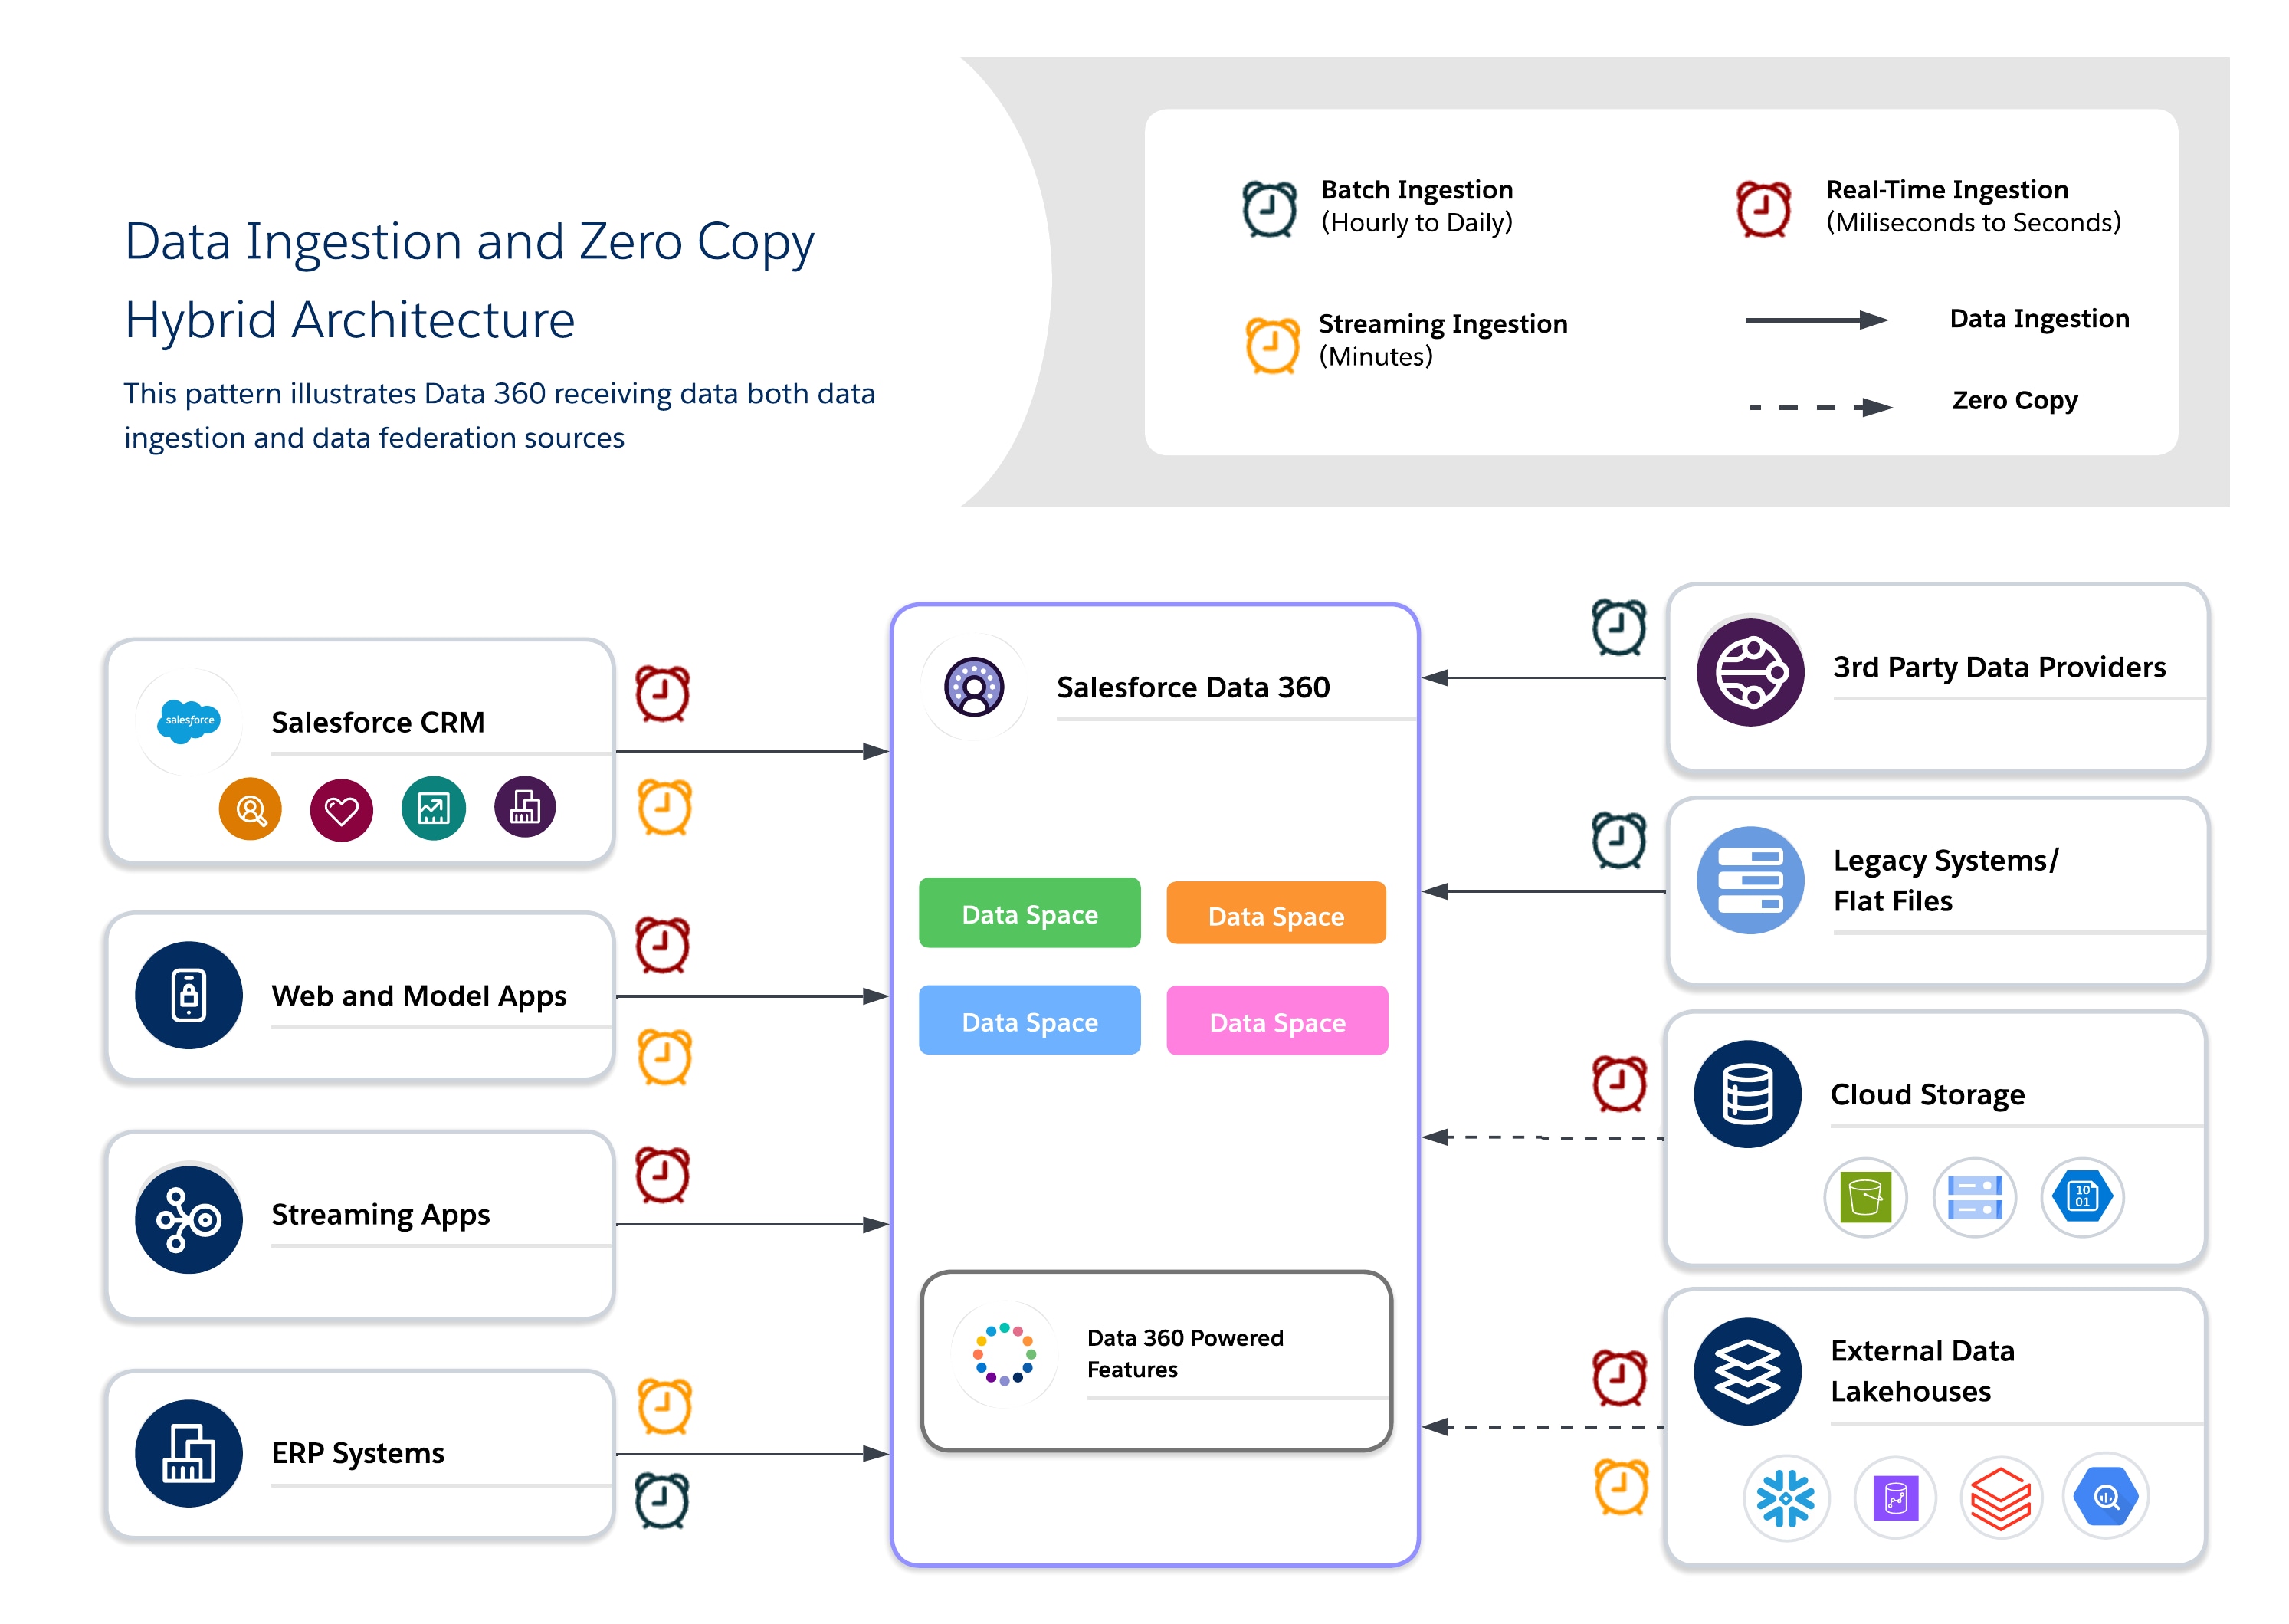
ハイブリッド アーキテクチャにより、アーキテクトは重要なデータセットを _Data 360_ に固定して一元化されたガバナンスを実現すると同時に、統合クエリを活用して、最新性、重複の削減、大規模な外部データセットへのスケーラブルなアクセスを実現できます。このアプローチでは、I/O、計算の局所性、コスト、コンプライアンスの要件のバランスを取ります。
#### ハイブリッドユースケース
ハイブリッドアプローチを使用して、データの取り込みとゼロコピーを組み合わせることで、バランスの取れたガバナンス、新鮮さ、運用効率を実現し、リアルタイムでアクション可能なインサイトを提供します。トレーサビリティ、RLS、マスキングが必要な価値の高い規制対象のデータセットには取り込みを使用し、新鮮さとパフォーマンスが重要な一時的または大量のデータセットには統合を使用します。
 #### アーキテクトプレイブック
- **使用事例**
- **オムニチャネルエンゲージメント:** 顧客の履歴データとリアルタイムの行動を組み合わせて、一貫性のあるコンテキスト対応環境を提供します。
- **AI/MLパイプライン:**厳選された正規データセットに基づいてモデルをトレーニングしながら、外部ソースからの未加工またはリアルタイムのシグナルで強化します。
- コンプライアンスと俊敏性の**混在ニーズ:** 機密データには厳格なガバナンスを適用し、運用の俊敏性には統合を適用します。
- **業種シナリオ**
- **リテール:** ID解決とプロファイル統合には_取り込み_を使用し、リアルタイムのオファーとパーソナライズには_federation_を使用します。
- **医療:**IoTデバイス ストリームとセンサー データ_の統合を_使用して即時のコンテキストを確保しながら、_取り込み_によってゴールデン 患者レコードを維持します。
- **金融サービス:**外部の不正検出およびリスク モニタリング クエリに_統合_を使用しながら、規制対象のデータをコンプライアンス管理対象のレイクに取り込みます。
- **設計手法**
- 取り込みによる**アンカーガバナンス:** 価値の高いデータや規制対象のデータを正規モデルに取り込み、Trustとコンプライアンスを確保します。
- **Use Federation for Freshness:**外部レイク ハウスが重複のないリアルタイムまたは大規模なデータ アクセスを提供できるようにします。
- **コストとパフォーマンス**のバランス: ワークロードをプロファイルして、_取り込み_と_統合_のどちらを使用するかを決定します。これにより、不要なストレージとクエリのコストを最小限に抑えます。
- **階層型ガバナンスの適用:**統合システムのセキュリティ制御(RLSやマスキングなど)を活用しながら、取り込まれたデータの一元的なガバナンスを適用します。
- **注:**ハイブリッド パイプラインを設計する場合、履歴データセットの増分取り込みを確保し、統合ソースに集計またはフィルターを転送してI/Oとコンピューティングの使用量を最適化することが重要です。
- **コストの考慮事項**
- コンプライアンスや重要なデータの_取り込み_と、新鮮さが必要な場合の_統合_を組み合わせて、総コストとパフォーマンスを比較します。
- _取り込み_と統合を混在させる場合、I/Oと_コンピューティング_の配分を考慮します。ソースシステムに対するクエリの繰り返しによる計算コストを削減するには、読み取り頻度が高く、頻繁にアクセスされる統合データセットのキャッシュ (Accelerated Query) を使用します。
- このルールを使用して、取り込みと統合に関する意思決定をガイドします。データへのアクセス頻度は高くても、変更頻度が低い場合、_Accelerated Query_のコスト パフォーマンスは通常高くなります。ただし、データが頻繁に (アクセス頻度に対して) 変更される場合は、_ライブクエリ_または_取り込み_の方が適しています。コストの例をいくつか紹介します。
- **高速化:** 100万件のレコードから作成され、毎日約1万件の変更で更新されるダッシュボードは、1日あたり20回参照されます。_高速化_のコストは、_ライブ クエリ_の場合は約4,200クレジット/月であるのに対して、約600クレジット/月です。
- **ライブ クエリが有利な場合:** 30分ごとに変化するデータを使用して、1日に20回公開されるセグメント。_ライブ クエリの_コストは、この更新頻度では_高速化_に必要な約4,200クレジット/月であるのに対し、約28,800クレジット/月です。
## 使用事例決定ガイド
このロジックを適用する方法を示すいくつかの一般的なアーキタイプを詳しく見てみましょう。
- **「Single Source of Truth」アーキタイプ: 一元化とガバナンス**
- **シナリオ:** グローバル企業全体の準拠した統合 _Customer 360_ プロファイルを作成する必要があります。データはさまざまなシステムから取得され、厳格な_GDPR_および_CCPA_規制に準拠する必要があります。また、データはすべてのマーケティングおよびサービスのやりとりの情報源として機能します。
- **推奨パターン:** **データ取り込み。**ここでの優先度は、ガバナンス、Trust、支配です。データを_Data 360_に取り込むことが、ソース システムから分離された、完全に監査可能な正規プロファイルを作成する唯一の方法です。
- **「リアルタイム・インサイト」の原型: 移動せずに分析**
- **シナリオ:**データ サイエンス チームは、_Snowflake_で絶えず更新される大量のトランザクション テーブルに対して探索クエリを実行する必要があります。同時に、経営陣は、同じデータを活用したライブ_BI_ダッシュボードを求めています。毎日数ペタバイトのデータを移動すると、時間とコストがかかります。
- **推奨パターン:** **ゼロコピーフェデレーション。**ここで優先されるのは、スピード、アジリティ、および大規模運用時の費用対効果です。_ゼロ コピー_では、既存のデータ ウェアハウスの機能を活用して、データの重複によるオーバーヘッドやレイテンシを発生させることなく、リアルタイムのクエリを実行できます。
- **「ハイブリッド インテリジェンス」のアーキタイプ: コアのガバナンス、エッジのフェデレーション**
- **シナリオ:** データレイクからのリアルタイムの行動シグナル (Web サイトのクリックなど) を使用して、管理され、取り込まれた顧客プロファイルを強化したいと考えています。コアプロフィールの安定性が必要ですが、ライブ データの即時性によって、その場でのパーソナライズを実現できます。
- **推奨パターン:****ハイブリッド アプローチ。**_データ取り込み_を使用して、本顧客データの安定した管理されたコアを作成します。_ゼロ コピー_を使用して、揮発性のリアルタイムの「エッジ」データを統合し、クエリ時にそれらを結合して、最新の完全なビューを作成します。
## 進むべきパス
エンタープライズデータ戦略は、もはや 1 つのインテグレーションパターンを選択することに焦点を絞るのではなく、相互運用性のあるデータエコシステム内で制御された柔軟性を構築することに重点を置いています。適切なアプローチでは、各ソースシステムをその新鮮さ、ガバナンス、コスト、アクセス要件に最も適したパターンに対応付けます。
- コンプライアンス、ID解決、運用ワークフローのために、ミッション クリティカルな規制対象のデータセットをSalesforce _Data Cloud_に取り込みます。
- _Zero Copy_を使用してデータを統合することで、ストレージを重複させることなく、ライブ、探索、AI主導の分析を行うことができます。
- クエリ頻度が高く、データ変更頻度が低い場合のソースシステムの負荷とクレジット消費を削減するための_キャッシュ (クエリ_の高速化) の適用
Salesforce _Data 360_ on _Hyperforce_は、複数リージョンの復元性と拡張性を実現します。_Iceberg_テーブルを備えたオープン レイク ハウスにより、コンピューティングの分離と、_Snowflake_、_Databricks_、_S3 Iceberg_などのプラットフォームとの相互運用性を実現し、真に相互運用性のあるマルチクラウド データ エコシステムのバックボーンを形成します。
データエコシステムが進化するにつれ、アーキテクチャのアジリティを維持するために、新鮮さ、コスト、パフォーマンス、コンプライアンスのバランスを継続的に保つ必要があります。そのため、取り込まれた管理データを統合アクセスで統合することで、プラットフォームを将来にわたって使用できることが重要です。これにより、クラウド、地域、ビジネスドメイン全体でリアルタイムインテリジェンス、AI の有効化、エンタープライズ規模のパーソナライズが可能になります。
汎用的なソリューションは、ほとんどのビジネスには適していません。最適な戦略では、適切なパターンを適切なビジネスドライバーにマッピングします。
## 著者について
**Yugandhar Bora**は、Salesforceのソフトウェアエンジニアリングアーキテクトで、データおよびインテリジェンスアプリケーションプラットフォーム内のデータアーキテクチャを専門としています。データ ガバナンスと統合データ モデルに重点を置き、自動化されたプラットフォーム プロビジョニング ソリューションにも貢献するEARB(_Enterprise Architecture Review Board_)イニシアティブを主導しています。
**Jan Fernando**は、Salesforceの_OCA(Office_ of the Chief Architect)のプリンシパル アーキテクトで、2012年にSalesforceに入社しました。スタートアップ エコシステム時代から豊富な経験があります。OCAに入社する前は、_プラットフォーム_組織で10年以上にわたり、いくつかの主要なテクノロジー トランスフォーメーションを率いていました。
# Data 360 プロビジョニング
Salesforce Data 360は、[Hyperforce](https://www.salesforce.com/platform/public-cloud-infrastructure/)上に構築されたデータ プラットフォームで、Salesforceと外部データを、すべての顧客またはアカウントの明確で完全、かつ信頼できる全方位的なビューに統合します。
合併や買収、地域の業務、職務の分離、または歴史的な理由により、多くの場合、企業は複数の Salesforce 組織を運営しています。アーキテクトは Data 360 に関するいくつかの決定を行う必要がありますが、これらはすべてガバナンス、コンプライアンス、コスト、レイテンシ、および AI と組織間プラットフォームの機能を拡張する組織の能力に影響します。
## ガイドの概要
このガイドでは、Data 360 を使用してプロビジョニングに関する意思決定を行うためのフレームワークについて説明します。
- 単一ホーム組織と複数組織構成の選択
- 複数の独立した Data 360 インスタンスのプロビジョニング
- Data Cloud One を使用して 1 つのインスタンスで組織を統合する
- Data 360 組織間のデータ共有を使用する独立した Data 360 インスタンス間のコラボレーション
Data 360 は、Data 360 ライセンスを受け取る本番組織で自動的にプロビジョニングされます。Data Cloud One は、1 つのホーム組織で Data 360 インスタンスをホストし、他の Salesforce 組織はコンパニオン組織として接続できる Salesforce の複数組織接続アーキテクチャです。Data 360 ライセンスを保持し、Data 360 ホーム組織となる組織の選択は、長期的な影響を伴う重要なアーキテクチャ上の決定です。
Salesforce Data 360 のプロビジョニング方法は、アーキテクチャに関する基本的な決定事項です。これにより、企業がどのように顧客データを統合し、ガバナンスを適用し、重要なプラットフォーム機能(特にAI、Agentforce、組織全体の分析)を有効にするかが決まります。組織のクラスターを 1 つの Data 360 に固定することで、統合データモデル、一元化されたガバナンスが提供され、全社的な AI 対応が可能になります。コンパニオン組織は、データがローカルにあるかのように共有メタデータと機能にアクセスできます。一方、規制、コンプライアンス、自律性の要件によって一元化が妨げられる場合は、複数の独立した Data 360 インスタンスが適しています。Data 360 組織間のデータ共有により、これらのインスタンス間で選択的なゼロコピーコラボレーションが可能になります。
この決定は、データガバナンスを制御するユーザー、データが存在する場所、プラットフォーム機能の有効化方法、将来のインテグレーションと AI イニシアチブのスムーズな拡張に影響します。現在 Data 360 を使用していない組織でも、今後 Data 360 アクセスを追加する戦略を立てることで、アーキテクチャを将来にわたって保証することが重要です。営業担当、サービス担当、マーケティング、コマース担当、業種、および Agentforce 全体で Salesforce の機能が Data 360 上に構築されることが増えています。これらのプラットフォーム機能を使用する組織は、独自の Data 360 をプロビジョニングするか、共有の Data 360 をコンパニオン組織として接続する必要があります。
このガイドは、アーキテクトがシンプルさ、エンタープライズ全体の一貫性、コンプライアンス、拡張性のバランスを取るプロビジョニング戦略を設計するのに役立ちます。これにより、組織は自信を持って Data 360 を Customer 360、AI、クロスプラットフォームのイノベーションに活用できます。このガイドを使用して、Data 360 が必要な組織と、Data Cloud One を使用するか、Data 360 組織間でデータ共有を使用するかを判断します。この戦略により、Data 360 中心の未来に向けた強固な基盤が確立されます。
## 範囲内の商品
|
Salesforce Data 360 は、任意のソース (CRM、Web、モバイル、外部データレイク) のデータを 1 つのアクション可能な顧客プロファイルにハーモナイズして統合する、Salesforce のリアルタイムのハイパースケールデータプラットフォームです。Customer 360プラットフォームの重要なコンポーネントとして、セールス、サービス、マーケティング全体のAI、分析、パーソナライズされたエクスペリエンスを強化します。 |
| 考慮事項 | 重要な理由 | シナリオの例 |
|---|---|---|
| データレジデンシーとコンプライアンス | データを保存および処理する場所を決定します。規制ルールでは、特定の地域または複数のインスタンスが必要になる場合があります。 | あるグローバル銀行は、GDPR に準拠するためにフランクフルトに地理的に存在する Salesforce 組織で Data 360 テナントをプロビジョニングしています。US ディビジョンのバージニアの組織に別のテナントをプロビジョニングします。 |
| ガバナンスとセキュリティ | ポリシー管理や委任戦略を含め、Data 360 の管理者と所有権を特定します。 | 強力な中央 IT を持つ多国籍企業が、Center of Excellence によって管理される専用の Home 組織を作成します。 |
| 自律性と集中管理 | 異なるリーダーがデータの個別の所有権を持ちたい場合があります。自律性を重視する場合は、複数の Data 360 組織が優先されます。一元化により、Data Cloud One が優先されます。 | 独立した子会社を持つ持株会社では、各ビジネスユニットが独自の Data 360 を運用できます。 |
| 遅延とパフォーマンス | 特にリージョン間で Data 360 テナントに接続されているコンパニオン組織の場合、クエリ速度とエクスペリエンスに影響します。 | ロンドンの営業チームが米国の Data 360 テナントからデータを照会すると、遅延が大きくなる場合があります。 |
| インテグレーションの複雑さ | Data 360 テナントが増えると、パイプライン、API、ミドルウェアが増えます。統合により、インテグレーションが簡素化されます。 | ある小売業者は、Data Cloud One 設定に統合することで、10 個の ETL パイプラインを構築する必要がなくなります。 |
| Zero Copy データソース リージョン | 一部のコネクタのクロスリージョンアクセス要件により、Data 360 組織の地域または場所が制限される場合があります。 | ある会社に AWS eu-west-1 リージョンの Snowflake インスタンスがあります。Zero Copy を使用して自分の地域の Data 360 にデータを統合できますが、Zero Copy を使用して米国地域の Data 360 に統合することはできません。 |
| プライベートコネクトのリージョン間の互換性 | データソースが Data 360 テナントと同じリージョンにあるかどうかによって、プライベートコネクトのサポートが異なる場合があります。 | aws-east-1 リージョンに Snowflake インスタンスがあり、ゼロコピーで Data 360 に接続したいとします。Data 360 ホーム組織が同じリージョンにある場合のみ、プライベートコネクトネットワーク接続を確立できます。 |
| コストとライセンス | 各 Data 360 テナントのコストが増加します。より少ないインスタンスに統合することで、支出が最適化されます。 | あるヘルスケア事業者は、複数の独立した Data 360 インスタンスではなく Data Cloud One を採用してライセンスコストを削減します。 |
| 将来の拡張性 | 今日のプロビジョニングの選択肢は、成長の基盤となります。 | ある SaaS 会社は、1 つの Data 360 インスタンスから開始し、Salesforce 組織の子会社を買収して Data Cloud One に拡張する予定です。 |
| 企業全体の AI 準備状況 | AI機能と Agentforce では、すべての org に接続された Data 360 テナントが必要です。プロビジョニングの決定は、AI モデルが企業全体でどのようにトレーニングおよび有効化されるかに影響します。 | ある金融サービス会社は、データをData Cloud Oneに統合し、Einstein AIモデルがエンタープライズ全体の本顧客データにアクセスできるようにします。 |
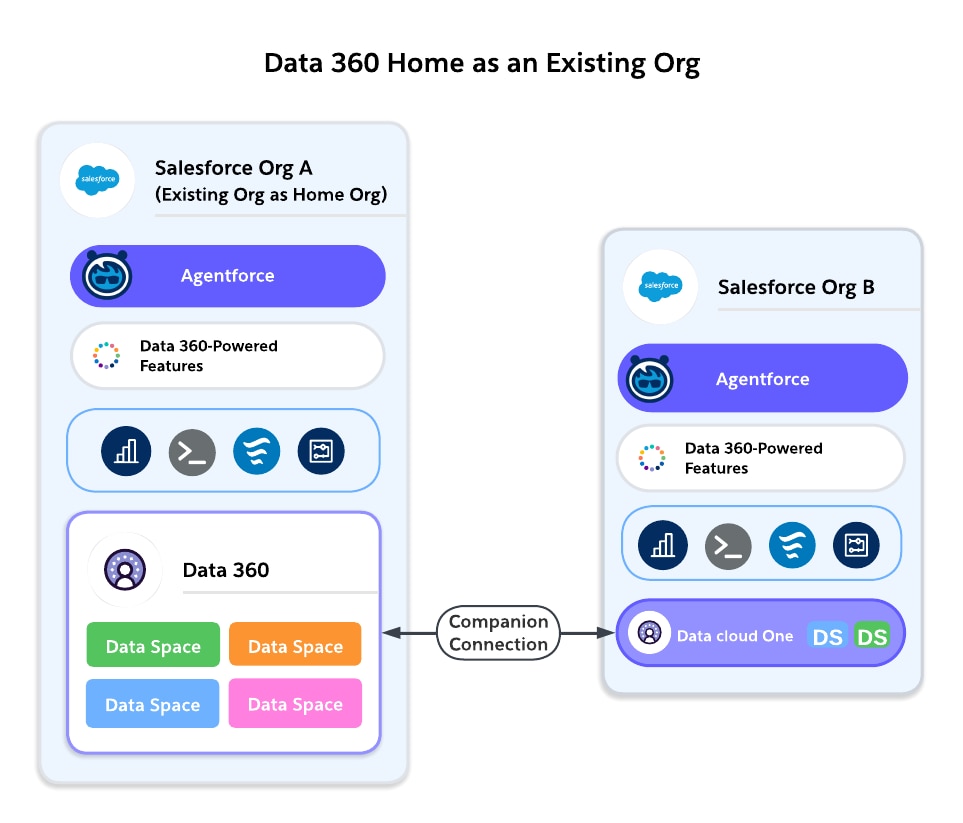
 **オプション A: 既存の組織での Data 360 のプロビジョニング**
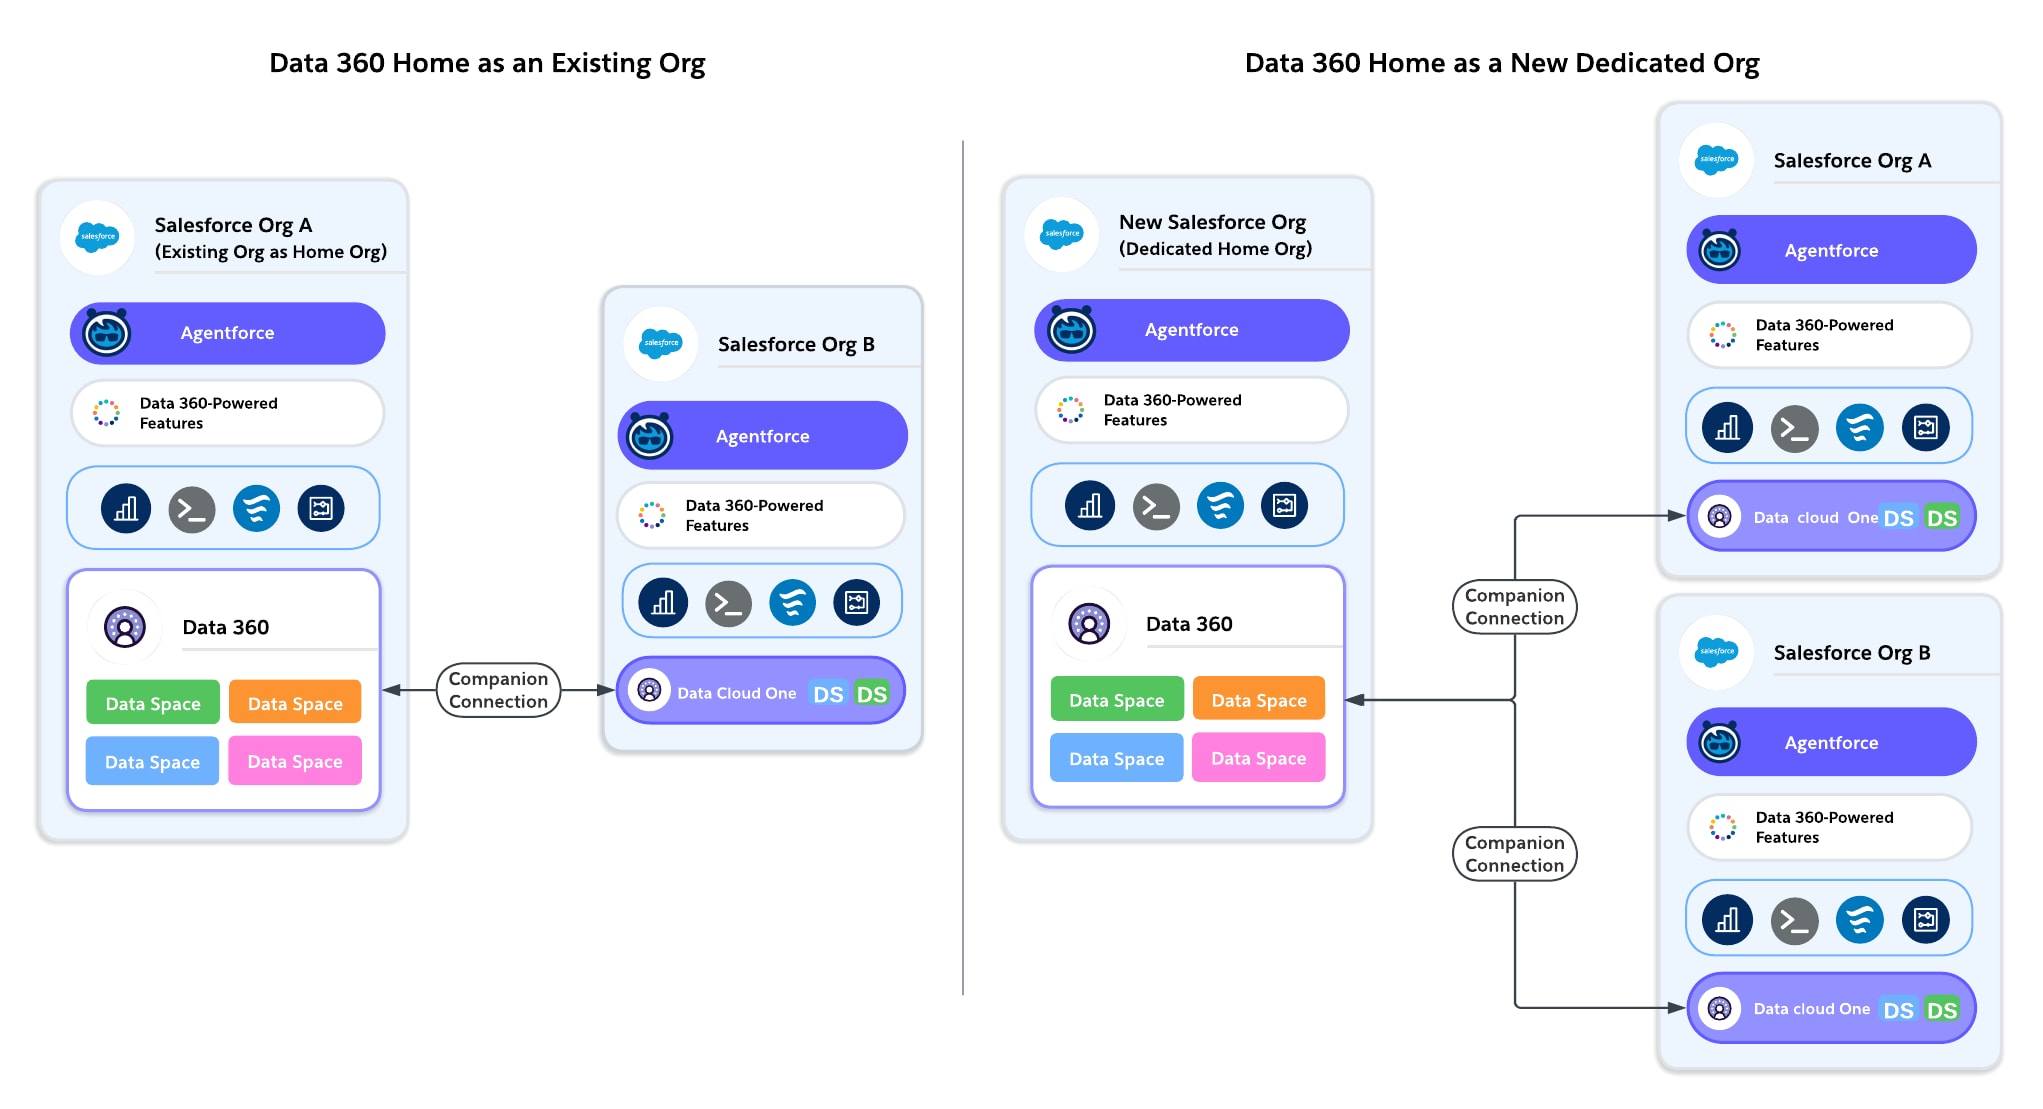
**最適な用途:** 1 つの Salesforce 組織を使用しているお客様、またはほとんどのビジネスプロセスを実行する主要な一元化された組織をすでに使用している複数組織のお客様。
 - **長所:**
- 最もシンプルなパス: Data 360 は CRM データが存在する場所でプロビジョニングされます。
- ローカルの営業、サービス、マーケティングデータにすぐにアクセスできます。
- 追加のインテグレーションは必要ありません。
- 管理するライセンスと環境が少ない。
- 早期導入、パイロット、および本番ユースケースを加速します。
- **短所:**
- 既存の組織のガバナンスまたは技術的負債を継承できます。
- 「メイン組織」が 1 つも存在しない場合、1 つを選択すると所有権に関する議論が生じる可能性があります。
- パフォーマンスは組織の場所に依存します。企業全体のレジデンシーのニーズと一致しない場合があります。
- 複数のビジネスユニットで異なる組織を使用している場合、ローカルプロビジョニングを Data Cloud One と組み合わせないと断片化が発生する可能性があります。
**例:**
1 つの Salesforce 組織を持つ SaaS 会社は、顧客のサブスクリプションデータとサポートデータを統合するために、その組織に Data 360 をプロビジョニングします。
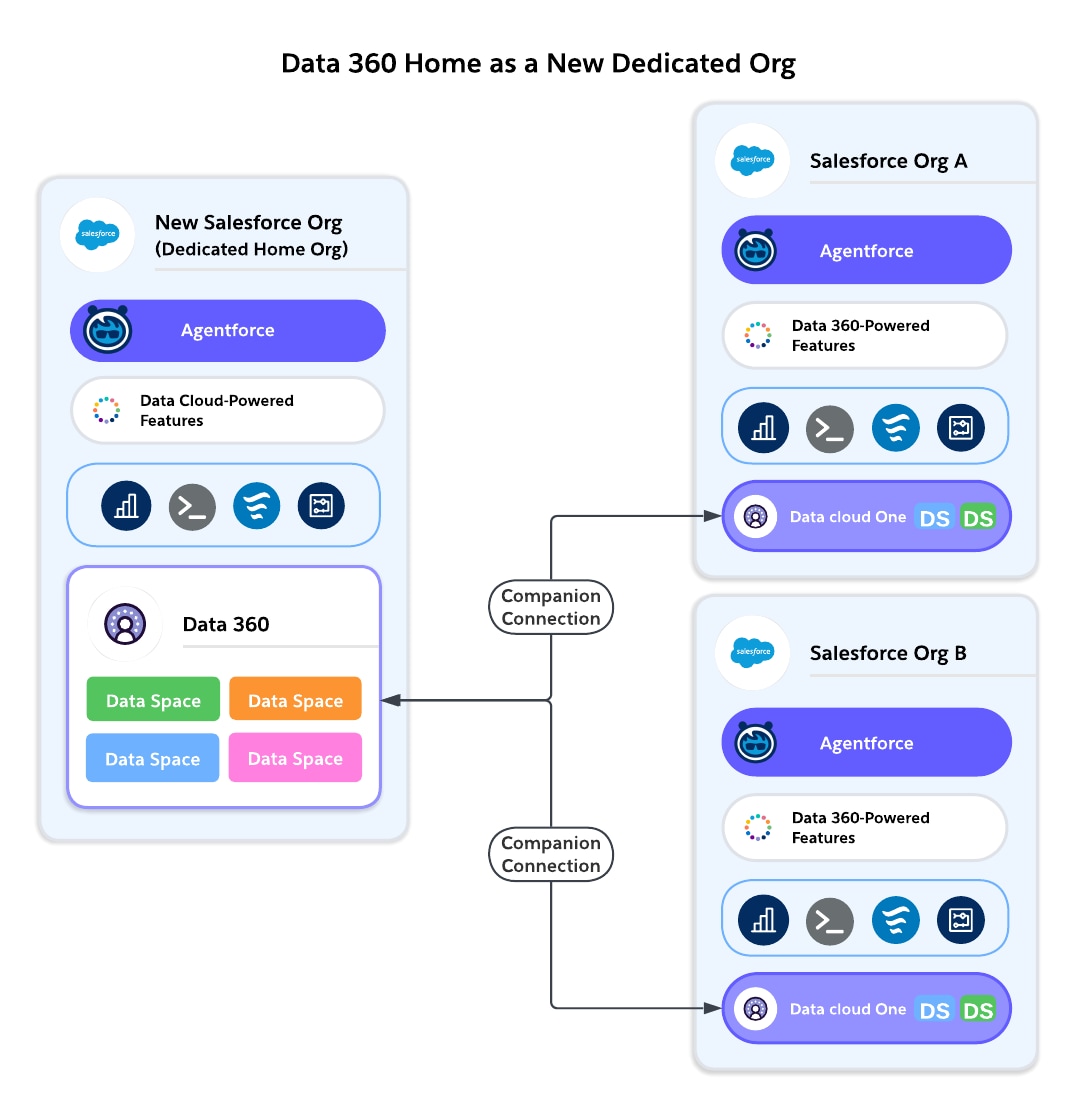
**オプション B: 新しい専用組織での Data 360 のプロビジョニング**
**最適な用途:** 1つの主要な組織で連携できない複数のSalesforce組織を使用しているお客様、または強力なCenter of Excellence(CoE)モデルを使用している企業。
 - **長所:**
- 継承された組織の複雑さがなく、ガバナンスがクリーンな状態から始められます。
- 複数の事業分野にまたがる一元管理。
- コンプライアンスのニーズに基づいて地域を柔軟に選択できます。
- 1 つのビジネスユニットに縛られず、中立的な「共有サービス」組織として機能します。
- 将来の Data Cloud One アーキテクチャ (複数のコンパニオン組織があるホーム組織) に合わせて設定します。
- **短所:**
- 顧客は、Data 360 をプロビジョニングする新しい Salesforce 組織のライセンスを取得する必要があります。
- Data Cloud One コンパニオン接続を介して組織を Data 360 に接続するには、追加のインテグレーションが必要です。
- 管理オーバーヘッド (ユーザー管理、セキュリティ、ID) を追加する場合があります。
- 既存の本番組織(Production Org)のプロビジョニングと比較して、タイム トゥ バリューが遅い。
**例:**
ある多国籍金融サービス会社は、Data 360 をプロビジョニングするための専用のホーム組織を作成します。 すべてのビジネスユニット組織 (リテール、ウェルス、コマースバンキング) は、Data Cloud One を介してコンパニオン組織として接続します。
**決定基準**
| 考慮事項 | Home Org としての既存の OrG(優先 Default) | Home Org としての新規 OrG(代替) |
|---|---|---|
| シンプルさ | 既存の本ユーザとデータ構造に基づいて構築され、より迅速に設定できます。 Data 360 はデフォルトでホーム組織と統合されています。 |
新しい Salesforce 組織のライセンスと設定、およびそれを管理するための追加の管理オーバーヘッドが必要 |
| タイム トゥ バリュー | ローカル CRM データの迅速な使用 | 立ち上がりが遅く、統合が必要です。 |
| ガバナンス | 既存の Org の基本ガバナンスモデル(既存の本ユーザと権限セット)を継承します(Org がすでに中心になっている場合は、許容されます)。 | ガバナンスを一新し、完全な白紙状態から始められます。COE 主導のモデルに最適です。 |
| コンプライアンス | 既存の組織の地域に関連付けられたレジデンシー | 既存の組織から独立した地域を柔軟に選択 |
| Performance | ローカル CRM クエリで最高のパフォーマンス | コンパニオン Org の接続性(同じリージョンか、他の Org とのクロスリージョンか)に依存します。 |
| 将来の拡張性 | Data Cloud One と組み合わせると適切に機能します。誤った Org を選択した場合、後からの移行が困難になります。 | Data Cloud One を使用して簡単に拡張できます。中立性を考慮した設計。 |
| Cost (コスト) | インクリメンタルなコストが低くなります。 | 環境の追加によるオーバーヘッドの増加 |
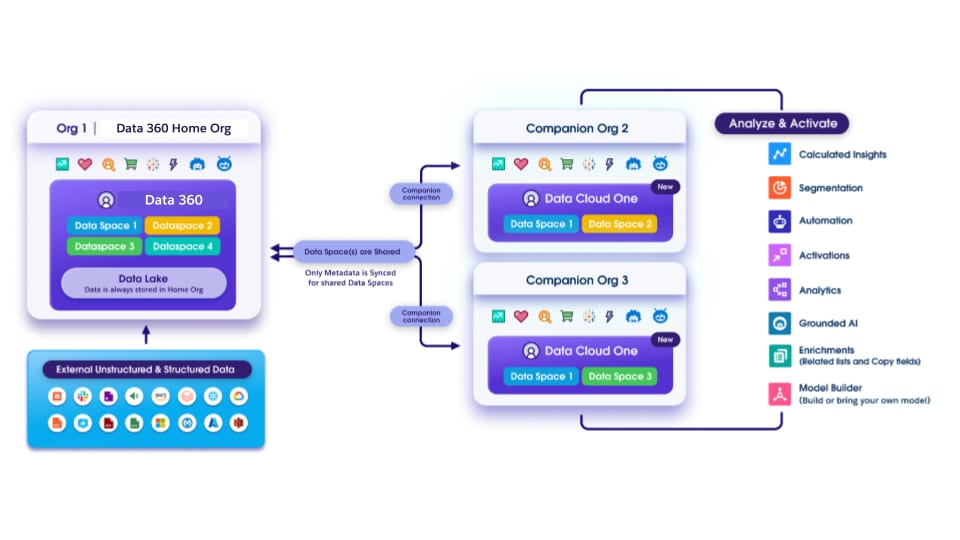 **Data Cloud One のしくみ**
- **データ取り込みと統合 (ホーム組織)**
- すべてのデータ取り込み設定 (Salesforce CRM、外部ソース、ストリーミング、バッチ) は、ホーム組織からのみ実行されます。
- ホーム組織に関連付けられたData 360テナントは、ID解決、ハーモナイゼーション、モデリング、信頼できるお客様のプロファイルへの統合を実行します。
- Data 360 の管理、ガバナンスポリシー、タギング、マスキングは、ホーム組織から一元的に適用されます。
- **データスペースアーキテクチャ**
- ホーム組織からデータはデータスペースに整理され、データスペースはデータ、メタデータ、プロセスの論理コンテナとして機能します。
- 企業は、ブランド、地域、または事業部門のデータスペースを作成できます。
- データスペース共有: ホーム組織から、特定のデータスペースがコンパニオン組織と選択的に共有されます。これにより、関連するデータ (および関連付けられたメタデータ) のみが適切な組織に転送されます。
- **メタデータ共有**
コンパニオン組織は、ホーム組織から、データモデルオブジェクト (DMO)、統合プロファイルスキーマ、計算済みインサイト、セグメント[など](https://help.salesforce.com/s/articleView?id=data.c360_a_companion_org_data_cloud_features.htm&type=5)のメタデータ定義を受け取ります。これらは、ローカルアセットのようにコンパニオン組織内にネイティブに表示されますが、ホーム組織にリンクされています。
- **ホーム組織とコンパニオン組織の機能**
機能へのアクセスは、ホーム組織とコンパニオン組織で異なります。コンパニオン組織はデータの取り込みや統合ができず、取り込み、モデリング、統合はホーム組織に依存します。コンパニオン組織は Data 360 データにアクセスして Data 360 プラットフォーム機能を強化し、共有された信頼できるデータの上にローカルインサイト、セグメント、フローを作成できます。将来のビジョンでは、有効化機能にもアクセスできます。
| 機能 | ホーム組織 | コンパニオン組織 |
|---|---|---|
| Connect コネクタの設定、データストリームの作成、データの取り込み、統合 | ✅ | ❌ |
| ハーモナイズと統合:データ変換と ID 解決の構築および実行 | ✅ | ❌ |
| データスペースと権限によるデータの保護 | ✅ | ✅ |
| セグメント化と予測 セグメント、インサイトの構築、Einstein Studioモデルの作成 | ✅ | ✅ |
| Everywhere の有効化、データアクション | ✅ | ✅ |
| プラットフォーム機能: プロンプトビルダー、フロー、レポート、強化、[さらに詳しく](https://help.salesforce.com/s/articleView?id=data.c360_a_companion_org_data_cloud_features.htm&type=5) | ✅ | ✅ |
| Data 360 搭載の機能: Prospecting Center、Sales Cloud および Service Cloud の機能、Agentforce など | ✅ | ✅ |
| 考慮事項 | 複数の独立した Data 360 組織 | 1 つの共有 Data 360 (Data Cloud One) |
|---|---|---|
| 自治 | 組織またはビジネスユニットごとの高度な自律性 | 一元化されたガバナンス、組織ごとの自律性の低下 |
| コンプライアンス | 厳密な分離が必要な場合 (地域の法律など) に便利です。 | レジデンシーで一元化が許可されている場合に最適 |
| Cost (コスト) | ライセンスコストと管理コストの増加 | コスト効率が向上: 多くの組織で 1 つのライセンスを使用 |
| ガバナンス | 断片化。ポリシーは組織ごとに異なる | 組織全体で一元化された一貫したポリシー |
| データサイロ | 各組織が独自のビューを持つ(エンタープライズ 360 なし) | 統合されたデータセット (重複なし) |
| AI/分析 | 各組織のデータに制限 | 精度が向上したエンタープライズ規模のモデル |
| 複雑さ | 管理するインスタンスの増加、インテグレーションの増加 | シンプルなアーキテクチャ、可動部品の削減 |
| Performance | 組織内ユースケースに最適 | コンパニオン組織のアクセスによる潜在的な遅延の増加 |
| 要素 | プラス面 | マイナス面 |
|---|---|---|
| データレジデンシー | コラボレーションを可能にしながら、地域の分離をサポートします。 | 複数の Data 360 組織を管理する必要がなくなるわけではありません。 |
| データの複製 | ゼロコピー、オブジェクトの重複なし。 | 各データ共有に含めるオブジェクトを慎重に選択する必要があります。 |
| ガバナンス | 共有は明示的かつ意図的に行われます (オブジェクトレベル)。 | タグまたはポリシーフローはありません。対象組織はガバナンスを再適用する必要があります。 |
| 複雑さ | 一元化なしで選択的なコラボレーションを可能にします。 | 複数の Data 360 組織とデータ共有の管理が必要です。 |
| **AI/Analytics** | リージョンごとの AI 分析が可能。インサイトを組織間で共有できます。 | データを意図的に共有しない限り、企業全体の AI は利用できません。 |
| **プラットフォーム機能** | 各組織の Data 360 搭載機能は独立して実行されます。 | 自動共有なし。慎重に設計しないと重複のリスクがあります。 |
| Cost (コスト) | ETL パイプラインの必要性を減らすことができる。 | 複数の Data 360 組織のコストは依然として発生します。データクエリとデータ共有の単位数を消費します。 |
| 考慮事項 | Data Cloud One (マルチ組織に推奨) | Data 360 組織間でのデータ共有 |
|---|---|---|
| 一元化された情報源 | はい — すべての組織でデータモデルが共有されます。 | いいえ — 各 Data 360 には独自のデータモデルがあります。 |
| コンプライアンス | レジデンシーで一元化が許可されている場合にのみ機能します。 | 居住法によって一元化が妨げられている場合に必要です。 |
| ガバナンス | 一元化され、一貫性があります。 | フェデレーテッド — 意図的なオブジェクトレベルの共有。 |
| 複雑さ | 可動部品が少なく、シンプル。 | より複雑 — 設定データ共有と複数のデータ組織が必要です。 |
| AI/分析 | 企業全体の AI モデル。 | 地域 AI。インサイトを選択的に共有する。 |
| プラットフォーム機能 | Shared Data 360 では、ホーム組織とコンパニオン組織全体で、すべての機能が一貫して動作します。 | 機能は Data 360 ごとに独立して実行されます。共有は明示的に行う必要があります。 |
 |
Salesforce Lightning Platformは、従業員、自律型AIエージェント、会社のデータ、アプリケーションを単一の信頼できるシステムに統合し、生産性とカスタマー エクスペリエンスを向上させる包括的なAI駆動型プラットフォームです。Customer 360アプリケーション、Data Cloud、Slackを接続してエンドツーエンドの自動化を実現することで、「エージェント エンタープライズ」の作成を可能にします。 |
| アプローチ | 説明 | 必要なスキル | ライセンスと制限 |
|---|---|---|---|
| Queueable Apex | 実行時間の長いデータベース操作や外部 Web サービスのコールアウトが含まれるプロセスに使用します。Queueable Apex には、ジョブ ID、プリミティブ型以外の種別のサポート、ジョブのチェーンなどの機能があります。 | プロコード | ライセンス数によって制限が増加する可能性があります。 |
| Apex の一括処理 | レコードセットを分割して管理可能なチャンクで処理することで、数百万件のレコードが含まれる複雑で実行時間の長いプロセスを構築します。 | プロコード | ライセンス数によって制限が増加する可能性があります。 |
| スケジュール済み Apex | cron 式で定義されたスケジュールされた時間に Apex を実行します。cron 式を使用して Apex をスケジュールする動作は非同期プロセスですが、基盤となるコードはジョブの開始時に同期して実行されます。 | プロコード | ライセンス数によって制限が増加する可能性があります。 |
| Apex 継続コールアウト | 同期トランザクション コンテキストで実行されている Apex メソッドからコールアウトを実行します。 | プロコード | いいえ |
| 非同期パス (レコードトリガーフロー) | 独自のタイミングで実行したい操作を実行します。フローをトリガーしたレコードに含まれていない関連レコードの値を更新したときに発生する混在 DML エラーを回避します。 | ローコード | ライセンスの数と種類によって制限が増加する可能性があります。 |
| スケジュール済みパス (確定後フロー) | トリガーイベント (レコードの作成、更新、削除など) 後の動的にスケジュールされた時間に実行します。 | ローコード | ライセンスの数と種類によって制限が増加する可能性があります。 |
| スケジュール済みフロー | 指定した時刻と、毎日、毎週、または一度といった繰り返し頻度で、バックグラウンドでフローを実行し、バッチ内のレコードに対してアクションを実行します。 | ローコード | ライセンスの数と種類によって制限が増加する可能性があります。 |
| プラットフォームイベントトリガー | Salesforce を外部システムと疎結合し、Salesforce Platform 内の非同期コンポーネント間で通信します。 | ローコード + プロコード | 大規模プラットフォームイベントの使用事例にはアドオンライセンスが必要 |
| 変更データキャプチャ | データベーストランザクションがコミットされた後に、変更イベントを非同期で取得して処理します。 | プロコード | ベースラインの割り当てを超える拡張を行うには、アドオン ライセンスが必要です。 |
| Bulk API | 多数のレコードを非同期で挿入、更新、アップサート、クエリ、削除し、その結果を後で処理します。 | プロコード | 制限があります。 |
| Lightning アクション | Lightning ページで、ユーザーにページの完全な更新を強制せずにサーバーとやりとりできるようにします。 | ローコード | いいえ |
| 必要なスキル | このガイドで説明されているツールには、コードが必要なものと、宣言的に設定できるものがあります。選択肢を検討するときに、チームメンバーのスキルセットについて考えます。最初の実装時(例えば、実装パートナーを通じて)に開発者が対応可能であったとしても、将来、ソリューションの変更が必要になる場合があります。メンテナンスチームに開発者が不在の場合は、ローコードの選択肢がより適している可能性があります。 |
| 適用されるプラットフォーム制限の種別 | 実行に適用される制限の種類を決定します。ソリューション設計時には、トランザクションのボリュームと頻度が、選択されたアプローチのガバナ制限にどのように反映されるかを慎重に検討してください。毎日実行される実行数を計算します。選択したツールに関連付けられた制限内に計算値が含まれていることを確認します。 |
| 遅延 | 処理の結果をプラットフォームでどの程度迅速に使用できるかを決定します。一部のアプローチでは、変更はほぼ即座に行われますが、別のアプローチでは数分から数時間かかる場合があります。 |
| 使用事例 | 説明 | First Choice Approach (第一選択肢アプローチ) | 根拠 |
|---|---|---|---|
| 高パフォーマンスのバッチ処理 | 何千、何百万ものレコードを効率的に処理する必要がある自動化 | Batch Apex | Batch Apex は、プラットフォームとのインタフェースと未フォーマット時の処理速度を実現する豊富な API を提供します。 |
| データクレンジングジョブ | データをクリーンアップするために定期的またはオンデマンドで実行されるジョブ。たとえば、重複除外、住所検証、データ統合などがあります。 | Batch Apex | Batch Apex は、プラットフォームとのインタフェースと未フォーマット時の処理速度を実現する豊富な API を提供します。 |
| 夜間積み上げ集計ジョブ | 営業日の終わりに積み上げ集計データを計算するジョブ。 | Batch Apex | Batch Apex は、プラットフォームとのインタフェースと未フォーマット時の処理速度を実現する豊富な API を提供します。 |
| レコードトリガーロジック | レコードの更新に応じてロジックを実行します。 | 不特定 | コンパニオン決定ガイド「Record Triggered Events Automation」を参照してください。これには、キュー可能 Apex、バッチ Apex、スケジュール済み Apex、スケジュール済みフロー、非同期パスフロー、変更データキャプチャなどの非同期ユースケースのディシジョンツリーが含まれます。 |
| オブジェクトグラフを用いたカスケード更新 | ユーザーの保存アクションが迅速に完了し、他のオブジェクトへのカスケード更新が非同期で実行されるようにします。 | Queueable Apex | Queueable Apex には、更新のチェーンを一連の非同期トランザクションに分割するロジックを可能にする強力なチェーン機能があります。 |
| レコード固有のスケジュール済み処理 | レコードに固有の将来の動的な日付 (完了予定日の 3 日前など) での自動化。 | フロー(スケジュール済みパス付き) | スケジュール済みパスは、レコードのデータが変更された場合にプラットフォームが自動的にこれらのパスのスケジュール、キャンセル、再スケジュールを処理するため、フローに独自の強みを提供します。 |
| 複数の低速外部サービスの並列呼び出し | 同期実行中は、全体的な実行時間を最適化するために複数の外部サービスが並列で呼び出されます。 | Apex 継続コールアウト | 実行に時間がかかる複数のコールアウトを並列で実行できるようにすることで、作業の完了までの全体的な時間を最小限に抑えます。 |
| 外部システムからのレコードのデータ移行 | 外部システムから大量のレコードを Salesforce Platform に移動します。一度限りのプロセスまたは定期的に実行されるプロセス。 | Bulk API | これは、データ移行において最も効率的かつ制限に配慮したアプローチです。 |
| 外部システムでの追加ロジックの実行 | プラットフォームのイベントを外部システムに通知し、そのシステムでイベントを非同期で処理できるようにする、ファイアーアンドフォーゲットパターン。 | プラットフォームイベントまたは変更データキャプチャ | pub-sub モデルはここで最適に機能し、準備が整ったら外部システムでイベントを処理できます。このパターンについての詳細は、「イベント駆動型アーキテクチャ」を参照してください。 |
| 考慮すべき領域 | よくある質問 |
|---|---|
| 既存のツールとランドスケープ | 既存の ESB または ETL ソリューションはありますか?関連するデータに規制要件またはコンプライアンス要件がありますか?統合しようとしているシステムはどこにありますか (クラウドまたは社内)? |
| データフロー (タイミング、予想されるユーザーエクスペリエンス、方向性) | データを同期または非同期で移動する必要がありますか? または一括処理/スケジュールできますか?データレプリケーションは必要か?どのようなシステムを情報源とすべきか?データソースですか?デスティネーションはどこですか?ユーザーインタラクションは必要ですか?ユーザーはインテグレーションの結果を確認する必要がありますか?例外処理 (再試行、通知、失敗) に関するニーズは?システムはどの程度緊密に結合する必要がありますか? |
| 実装 | Salesforce以外のシステムにかかる工数はどの程度ですか?インテグレーションの提供を担当するチームは?彼らが好んで使用するツールは何ですか? |
| メンテナンス性 | インテグレーションを維持することが期待されるチームはどのチームですか?現在どのようなスキルを持っているか?将来、どのようなスキルが必要になりますか?時間の経過に伴う総所有コストはどの程度ですか?ローコードツールまたはプロコードツールを使用してテスト、デバッグ、トラブルシューティングを行う能力はどの程度重要ですか? |
| データ量 | インテグレーションに含まれるデータ量は?大規模データボリューム(LDV)を使用する予定がありますか?一括変更の頻度はどのくらいですか?シングルトン更新はどのような影響がありますか?発生する頻度はどのくらいですか? |
| 制限 | データは複雑な変換を行う必要がありますか?複数のソースシステムのデータを結合する必要がありますか?インテグレーションはユーザーごとにどの程度の頻度で行われますか?合計ユーザー数は?一括データ読み込み (新規インスタンスの初期データ読み込みなど) を事前に計画していますか? |
| Salesforce から外部システムへ | 外部システムから Salesforce へ | 実行 | 追加ライセンス必須 | |
|---|---|---|---|---|
| Apex アクション | 利用可 | 利用可 | サーバー側 | いいえ |
| 変更データキャプチャ | 利用可 | 利用不可 | サーバー側 | いいえ* |
| カスタム Apex (REST および SOAP Web サービス) | 利用可 | 利用可 | サーバー側 | いいえ |
| 外部サービス | 利用可 | 利用不可 | サーバー側 | いいえ |
| Heroku Connect | 利用可 | 利用可 | サーバー側 | はい |
| Data 360 | 利用可 | 利用可 | サーバー側 | はい |
| MuleSoft Anypoint | 利用可 | 利用可 | サーバー側 | はい |
| ネイティブSalesforce API | 使用不可 | 利用可 | サーバー側 | いいえ |
| OmniScript | 利用可 | 利用可 | Client-Side*** | はい |
| OmniStudio インテグレーション手順 | 利用可 | 利用可 | サーバー側 | はい |
| アウトバウンドメッセージング | 理想的ではない | 使用不可 | サーバー側 | いいえ |
| プラットフォームイベント | 利用可 | 利用可 | サーバー側 | いいえ** |
| Salesforce Connect/外部オブジェクト | 利用可 | 利用可 | サーバー側 | はい |
| ガイダンス | ライセンス | タイミング | ボリューム&スケール | デリバリー&メンテナンス | プライバシーとセキュリティ | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| 使用するケース | 追加ライセンス | 同期 (要求/応答) または非同期 (起動/忘れ) | 複数オブジェクトのサポート | LDV/Bulk | テストと導入** | デバッグ | 組み込みエラーハンドリング/再試行動作 | 保存状態のデータが暗号化されている場合でも使用可能 | 認証プロトコル | |
| 変更データキャプチャ | Salesforce で行われたレコードレベルの変更を外部システムに公開する必要があり、カスタムペイロードが不要な場合。 | 必須 | 非同期 | なし | なし | はい | プロコードツールの使用 | はい | はい | OAuth |
| 外部サービス | フロー、Apex、Einstein Bots、OmniStudioを使用してプロセスを調整する場合、外部システムAPIはOpenAPI仕様を使用して記述されます。 | 不要 | 同期 | あり | いいえ | あり | プロコードツールの使用 | いいえ | なし | 指定ログイン情報 |
| Heroku Connect | 双方向同期を使用してデータを拡張して Heroku のモバイルアプリケーションや他のアプリケーションを有効にし、データを Salesforce にも複製する場合。 | 必須 | 非同期 | はい | はい | 不可 | プロコードツールの使用 | はい | はい、Shield Connect を使用 | OAuth |
| OmniStudio インテグレーション手順 | ユーザー操作なしでデータを変換し、ブラウザーではなくサーバーで処理することでパフォーマンスを向上させる必要がある場合。 | 必須 | 両方 | はい | はい | はい | 宣言型サポート | はい | はい | 指定ログイン情報 |
| Salesforce Connect/外部オブジェクト | Salesforce UI にデータを表示し、データを外部システムに保存する場合。データは Salesforce に複製されません。 | 必須 | 同期 | いいえ | はい* | はい | プロコードツールと宣言型トレーサーを使用 | いいえ | なし | 指定ログイン情報 |
| *バージョン4.01より古いOdataアダプタには、コールアウト制限が適用されます。詳細については、「Odata Callout Rate Limit Considerations」を参照してください。** テストおよびリリースとは、より低い環境で構築し、メタデータ API、パッケージ、または変更セットを使用して本番環境にリリースする機能を指します。 | ||||||||||
| ガイダンス | ライセンス | タイミング | ボリュームとスケール | 配送とメンテナンス | プライバシーとセキュリティ | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| 使用するケース | 追加ライセンス | 同期 (要求/応答) または非同期 (起動/忘れ) | 複数オブジェクトのサポート | LDV/Bulk | テストと導入** | デバッグ | 組み込みエラーハンドリング/再試行動作 | 保存データの暗号化と併用可能 | 認証プロトコル | |
| Apex アクション | Salesforce Flow を使用して別のシステムへのコールアウトを自動化する場合。開発者は、フローで呼び出すことができる Apex クラスを作成したり、AppExchange から事前作成済みソリューションをダウンロードしたりできます。 | 不要 | 両方 | あり | いいえ | あり | プロコードツールの使用 | いいえ | あり | 複数 |
| イベントリレー | プラットフォームイベントと変更データキャプチャチャイベントを Salesforce から Amazon EventBridge に送信する必要がある場合。イベントリレーは AWS Eventbridge にのみ接続 | いいえ | 非同期 | はい | いいえ | はい | はい | はい | はい | HTTP/1.1 with TLS |
| アウトバウンドメッセージング | ワークフロールールによってトリガーされた受信が保証された、指定されたエンドポイントに HTTP(S) 経由で SOAP メッセージを送信する必要がある場合。 | 不要 | 非同期 | なし | なし | はい | 宣言型サポート | はい | はい | 双方向 TLS |
| プラットフォームイベント | Salesforce または外部システムでほぼリアルタイムの変更を行うために、カスタム定義の構造化されたペイロードが必要な場合。 | 必須ではありません* | 非同期 | あり | いいえ | はい | プロコードツールの使用 | はい | はい | OAuth |
| Salesforce Connect/外部オブジェクト(カスタムApexアダプタを使用) | Salesforce UI にデータを表示するが、Odata や GraphQL などの標準プロトコルを使用できない外部システムにデータを保存する場合。 | 必須 | 両方 | はい | はい | はい | プロコードツールの使用 | いいえ | なし | 複数 |
| Data 360 | 1 つのデータストアで異なるソースのデータをハーモナイズする場合、または他の Salesforce 組織や他の外部システムにデータを複製する場合。 | 必須 | 両方 | はい | はい | はい | はい | はい | はい | 複数 |
| ガイダンス | ライセンス | タイミング | ボリュームおよびスケール | 提供およびメンテナンス | プライバシーとセキュリティ | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| 使用するケース | 追加ライセンス | 同期 (要求/応答) または非同期 (起動/忘れ) | 複数オブジェクトのサポート | LDV/Bulk | テストと導入** | デバッグ | 組み込みエラーハンドリング/再試行動作 | 保存時に暗号化されたデータでも使用可能 | 認証プロトコル | |
| カスタムApex | ローコードツールで使用できない機能が必要な場合。 | 不要 | 両方 | はい | はい | はい | プロコードツールの使用 | いいえ | はい* | 複数 |
| 外部サービス | コードから外部システム API へのインテグレーションは、OpenAPI 仕様を使用して記述されます。 | 不要 | 同期 | あり | いいえ | あり | プロコードツールの使用 | いいえ | なし | 複数 |
| MuleSoft Anypoint | インテグレーションを構築、オーケストレーション、管理するために単一のエンタープライズクラスの統合ソリューションが必要な場合、従来のポイントツーポイントアーキテクチャを置き換える必要がある場合、API 管理サポートが必要な場合。 | 必須 | 両方 | はい | はい | はい | プロコードツールの使用 | いいえ | はい* | 複数 |
| ガイダンス | ライセンス | タイミング | ボリューム & スケール | 提供およびメンテナンス | プライバシーとセキュリティ | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| 使用するケース | 追加ライセンス | 同期 (要求/返信) または非同期 (起動/忘れ) | 複数オブジェクトのサポート | LDV/Bulk | テストおよび展開* | デバッグ | 組み込みエラーハンドリング/再試行動作 | 保存時にデータが暗号化されている場合でも使用可能 | 認証プロトコル | |
| Heroku Connect | 双方向同期を使用してデータを拡張して Heroku のモバイルアプリケーションや他のアプリケーションを有効にし、データを Salesforce にも複製する場合。 | 必須 | 非同期 | はい | はい | 不可 | プロコードツールの使用 | はい | はい、Shield Connect 経由で | OAuth |
| OmniStudio インテグレーション手順 | ユーザー操作なしでサードパーティソースからデータをインポートおよび変換する必要がある場合。 | 必須 | 両方 | あり | あり | あり | 宣言型サポート | いいえ | あり | 指定ログイン情報 |
| Salesforce Connect/外部オブジェクト | Salesforce UI にデータを表示するが、データを Odata や GraphQL などの標準プロトコルを使用できる外部システムに保存する場合。 | 必須 | 同期 | あり | はい | はい | プロコードツールの使用 | いいえ | なし | 複数 |
| ガイダンス | ライセンス | タイミング | ボリューム & スケール | デリバリーおよびメンテナンス | プライバシーとセキュリティ | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| 使用するケース | 追加ライセンス | 同期 (要求/返信) または非同期 (起動/忘れ) | 複数オブジェクトのサポート | LDV/Bulk | テストおよび展開** | デバッグ | 組み込みエラーハンドリング/再試行動作 | 保存データを暗号化して使用可能 | 認証プロトコル | |
| プラットフォームイベント | Salesforce または外部システムでほぼリアルタイムの変更を行うために、カスタム定義の構造化されたペイロードが必要な場合。 | 必須ではありません* | 非同期 | はい | いいえ | はい | プロコードツールの使用 | はい | はい | OAuth |
| Salesforce Connect/外部オブジェクト(カスタムApexアダプタを使用) | Salesforce UI にデータを表示する必要があるが、Odata 2.0/4.0 プロトコルを使用できない外部システムにデータを保存する場合。 | 必須 | 両方 | はい | はい | はい | プロコードツールの使用 | いいえ | なし | 複数 |
| Data 360 | 1 つのデータストアで異なるソースのデータをハーモナイズする場合、または他の Salesforce 組織や他の外部システムにデータを複製する場合。Data 360 では、一部のプラットフォームで仮想化もサポートされています。 | 必須 | 両方 | はい | はい | はい | いいえ | はい | はい | 複数 |
| ガイダンス | ライセンス | タイミング | ボリューム & スケール | 提供およびメンテナンス | プライバシーとセキュリティ | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| 使用するケース | 追加ライセンス | 同期 (要求/返信) または非同期 (起動/忘れ) | 複数オブジェクトのサポート | LDV/Bulk | テストと展開**** | デバッグ | 組み込みエラーハンドリング/再試行動作 | 保存データを暗号化して使用可能 | 認証プロトコル | |
| カスタム Apex REST および SOAP Web サービス | クロスオブジェクト処理やその他の複雑なロジックなど、ネイティブ API エンドポイントで提供される以上の機能が必要な場合。 | 不要 | 両方 | はい | はい | はい | プロコードツールの使用 | いいえ | はい*** | 複数 |
| MuleSoft Anypoint | インテグレーションを構築、オーケストレーション、管理するために単一のエンタープライズクラスの統合ソリューションが必要な場合、従来のポイントツーポイントアーキテクチャを置き換える必要がある場合、API 管理サポートが必要な場合。 | 必須 | 両方 | はい | はい | はい | プロコードツールの使用 | いいえ | はい*** | 複数 |
| ネイティブSalesforce API | REST API、SOAP API、Bulk API、GraphQL API、または gRPC を使用してインテグレーションを構築するために、より詳細な制御が必要な場合や、プロコードスキルセットがある場合。 | 必須ではありません* | 両方 | はい***** | はい | はい | プロコードツールの使用 | はい** | はい*** | 複数 |
| ガイダンス | Cost (コスト) | タイミング | ボリュームとスケール | デリバリーおよびメンテナンス | プライバシーとセキュリティ | 実装するツール | |||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| 使用するケース | 追加ライセンス | 同期 (要求/応答) または非同期 (起動/忘れ) | 複数オブジェクトのサポート | LDV/Bulk | テストと導入* | デバッグ | 組み込みエラーハンドリング/リトライ動作 | 保存状態で暗号化されたデータと併用可能 | 認証プロトコル | ローコード → プロコード | |
| Heroku Connect | Salesforce 組織間で双方向同期を使用してデータを拡張し、Heroku で実行されているモバイルアプリケーションやその他のアプリケーションからのデータへのアクセスも有効にする場合 | 必須 | 非同期 | はい | はい | いいえ | プロコードツールを使用 | はい | はい、Shield Connect を使用 | OAuth | ローコード |
| MuleSoft Anypoint | インテグレーションを構築、オーケストレーション、管理するために単一のエンタープライズクラスの統合ソリューションが必要な場合、従来のポイントツーポイントアーキテクチャを置き換える必要がある場合、API 管理サポートが必要な場合 | 必須 | 両方 | はい | はい | はい | プロコードツールを使用 | いいえ | はい** | 複数 | プロコード |
| ネイティブSalesforce API | Salesforce または Heroku Connect が使用できない場合や、より複雑な処理が必要な場合 | 不要 | 両方 | いいえ | はい | はい | プロコードツールを使用 | いいえ | はい** | 複数 | プロコード |
| 変更データキャプチャ | Salesforce で行われたレコードレベルの変更を外部システムに公開する必要があり、カスタムペイロードが不要な場合。 | 必須 | 非同期 | なし | なし | あり | プロコードツールを使用 | あり | あり | OAuth | |
| Salesforce Connect with Cross-Org Adapter (組織間アダプタを使用した Salesforce Connect) | ある組織のユーザーがデータ複製を使用せずに別の組織のレコードを表示または編集できるようにする場合 | 必須 | 非同期 | はい | はい | はい | プロコードツールを使用 | なし | なし | 複数 | ローコード |
| Data 360 | ある組織のユーザーが、Data 360 で複製されたデータを使用して別の組織のレコードを表示または編集できるようにする場合。 | 必須 | 両方 | はい | はい | はい | プロコードツールを使用 | はい | はい | 複数 | ハイブリッド |
|
Salesforce Platformは、従業員、自律型AIエージェント、会社のデータ、アプリケーションを単一の信頼できるシステムに統合し、生産性とカスタマー エクスペリエンスを向上させる包括的なAI駆動型プラットフォームです。Customer 360アプリケーション、Data Cloud、Slackを接続してエンドツーエンドの自動化を実現することで、「エージェント エンタープライズ」の作成を可能にします。 |
 |
MuleSoftは、オン プレミス環境とクラウド環境でアプリケーション、データ、デバイスを接続できるSalesforceの主要な統合プラットフォームです。MuleSoft は、システム全体のデータをロック解除し、拡張性の高いインテグレーションおよび自動化フレームワークを開発し、差別化された接続された環境を迅速に作成するためのプラットフォームを IT 部門に提供するプラットフォームです。 |
| 決定ポイント | ガイダンス |
|---|---|
| ほぼリアルタイムの通知 | 公開/登録、ファンアウト、ストリーミングなどのイベント駆動型アーキテクチャパターンは、複数のアプリケーションに状況の変更やレコードの更新をほぼリアルタイムで通知する必要があるシナリオで適切に機能する傾向にあります。 |
| 並列処理 | 公開/登録などのパターンは、大量のデータや非常に複雑なメッセージで処理の負荷を複数のシステムに分散する必要がある場合に適しています。 |
| 大量読み取り | [合格メッセージ] および [キュー] パターンは、組織で急増が発生し、生成されるメッセージの量が登録者の即時処理能力を超える可能性があるシナリオでよく使用されます。 |
| 大量書き込み | ストリーミングとキューイングのパターンは、生成されるメッセージ数が急増する多くのシナリオで適切に機能します。 |
| 異なるシステムへの同じデータの送信 | 公開/登録は、同じデータを複数のシステムに送信する必要がある組織にとってかなり一般的なソリューションですが、ここで説明するほとんどのパターンで対処できます。必ず詳細に確認して、最適な方法を見つけてください。 |
| 新しいシステムまたはデバイスの頻繁な導入 | 公開/登録、ストリーミング、および順番待ちパターンは、新しいシステムやデバイスが定期的に追加され、全体的な状況が変動する傾向があるシナリオに適しています。このシナリオでは、新しいシステムまたはデバイスは、イベントバスの登録者になるか、キューに関連付けられているだけで、メッセージの受信を開始できます。カスタムのポイントツーポイントインテグレーションは必要ありません。 |
| IoTデバイス | 通常、IoTデバイスは頻繁に更新を行い、一部のシナリオではメッセージの急増も発生するため、ストリーミングおよびキューイングパターンはITランドスケープに統合する際に適切に機能する傾向にあります。 |
| オフラインモバイルデバイスおよびシステム | 品質が低い、または存在しないインターネットアクセスや、メッセージが配信された時点でオフラインになっている可能性があるシステムで作業する必要があるモバイルデバイスは、キューに接続して、オンラインに戻ったら関連するメッセージを取得できるようにするキューパターンを利用できます。 |
| 決定ポイント | ガイダンス/質問 |
|---|---|
| ビジネス要件 | 「イベント駆動型アーキテクチャを使用するケース」セクション(#イベント駆動型アーキテクチャを使用するケース)に記載されている機能のいずれかに、本当にビジネスニーズがありますか? |
| 技術要件 | 設計しているインテグレーションは、データ仮想化、バッチ、要求/応答など、明らかに異なるパターンに適していますか?つまり、丸い穴に四角い釘をはめ込もうとしているのでしょうか。 |
| 人間が応答を待機する必要があるプロセス | 対象システムからの応答を待機する人間が含まれるインテグレーションは、非同期実行を目的として設計されており、応答時間を保証できないため、イベント駆動型アーキテクチャには適していません。技術的なソリューションを実装する前に、このようなプロセスが組織にとって最適かどうかを検討します。詳細は、「適切に設計され、優れた運用性」を参照してください (/docs/architect/ja-jp/well-architected/guide/operational-excellence.html)。 |
| 頻繁に変更されないソースデータ | ソースシステムのデータの変更頻度が低すぎて定期的な更新で十分な場合は、イベント駆動型パターンではなく [バッチパターン] (https://developer.salesforce.com/docs/atlas.en-us.integration_patterns_and_practices.meta/integration_patterns_and_practices/integ_pat_batch_data_sync.htm) を使用してアーキテクチャを簡略化できます。 |
| 実装要件 | ソリューションに関与するシステムの大半はイベント駆動型アーキテクチャをサポートしていますか?イベント駆動型アーキテクチャをサポートしていないシステム (アップグレード、カスタマイズ、ミドルウェアなど) で使用するには何が必要ですか?これらの要件を満たすには、どの程度の努力が必要ですか? |
| メッセージ構造の安定性 | メッセージ構造の変更が必要になる頻度は?このような変更の影響を受けるシステムと、その修正プロセスは? |
| 組織ガバナンス | すべての関係者がメッセージ構造、トリガー、その他のアーキテクチャおよびプロセス関連の意思決定の変更について把握し、検討できるようにするためのガバナンス体制が確立されていますか? |
| 必須スキルセット | スタッフにイベント駆動型アーキテクチャの経験があり、サポート方法を理解しているか? |
| パターン | ほぼリアルタイム | 一意のメッセージコピー | 配信の保証 | メッセージサイズの削減 | データの変換 |
|---|---|---|---|---|---|
| 公開/登録 | ✓ | ✓ | ✓ | ||
| Fanout | ✓ | ✓ | ✓ | ||
| 通過したメッセージ | ✓ | ✓ | ✓ | ✓ | |
| ストリーミング | ✓ | ✓ | ✓ | ||
| キューイング | ✓ | ✓ | ✓ |
| ツール | 説明 | 必須スキル | |
|---|---|---|---|
| MuleSoft | Anypoint Platform | API レイヤーを使用してデータインテグレーションを可能にするプラットフォーム。 | プロコード |
| Salesforce Pub/Sub コネクタ | Pub/Sub API のコネクタ。プラットフォームイベント、リアルタイムイベント監視イベント、変更データキャプチャを 1 つのインターフェースで公開および登録できます。 | プロコード | |
| MuleSoft Anypoint JMS Connector | Java Message Service (JMS) 仕様を実装するメッセージサービスのキューおよびトピックへのメッセージの送受信を可能にするコネクタ。 | プロコード | |
| MuleSoft Anypoint Apache Kafka Connector | Apache Kafka とエンタープライズアプリケーションおよびサービス間でデータを移動するためのコネクタ。 | プロコード | |
| MuleSoft Anypoint Solace Connector | JCSMP Java SDK を使用したネイティブ API インテグレーションを備えた Solace PubSub+ イベントブローカーのコネクタ | プロコード | |
| MuleSoft Anypoint MQ Connector | 顧客がアプリケーション間で高度な非同期メッセージングを実行できるようにするマルチテナントのクラウドメッセージングサービス。 | プロコード | |
| MuleSoft Anypoint MQTT Connector | MQTT (Message Queuing Telemetry Transport) v3.x プロトコルに準拠した MuleSoft 拡張機能。 | プロコード | |
| MuleSoft Anypoint AMQP Connector | アプリケーションが AMQP 0.9.1 準拠のブローカーを使用してメッセージを公開および消費できるようにするコネクタ。 | プロコード | |
| MuleSoft Anypoint Event-Driven (ASync) API | イベント駆動型 API をイベントレイヤー、チャネルレイヤー、トランスポートレイヤーに分割して公開をサポートする、業種に依存しない言語。 | プロコード | |
| MuleSoft Anypoint MQ | 顧客がアプリケーション間で高度な非同期メッセージングを実行できるようにするマルチテナントクラウドメッセージングサービス。 | プロコード | |
| MuleSoft Anypoint Data Streams | MuleSoft Anypoint 内で使用可能な、ストリーミングデータの公開および登録用のフレームワーク。 | プロコード | |
| Salesforce Platform | Heroku での Apache Kafka | Heroku プラットフォームに完全に統合された Apache Kafka をサービスとして提供する Heroku アドオン。 | プロコード |
| 変更データキャプチャ | Salesforce レコードへの変更を公開するチェンジ・データキャプチャのログ。変更には、新規レコードの作成、既存のレコードの更新、レコードの削除、レコードの復元などがあります。 | ローコードからプロコード | |
| 送信メッセージ | Salesforce 内で項目値が更新されるときに XML メッセージを外部エンドポイントに送信するアクション。 | ローコード | |
| プラットフォームイベント | カスタムイベントデータを含む安全でスケーラブルなメッセージ。 | ローコードからプロコード | |
| Pub/Sub API | プラットフォームイベント、データキャプチャイベント、リアルタイムイベントモニタリングイベントのサブスクリプションを可能にする API。 | プロコード | |
| イベントリレー | プラットフォームイベントと変更データキャプチャチャイベントを Salesforce から Amazon EventBridge に送信できるようにします。イベントリレーは AWS Eventbridge にのみ接続します。 | ローコード | |
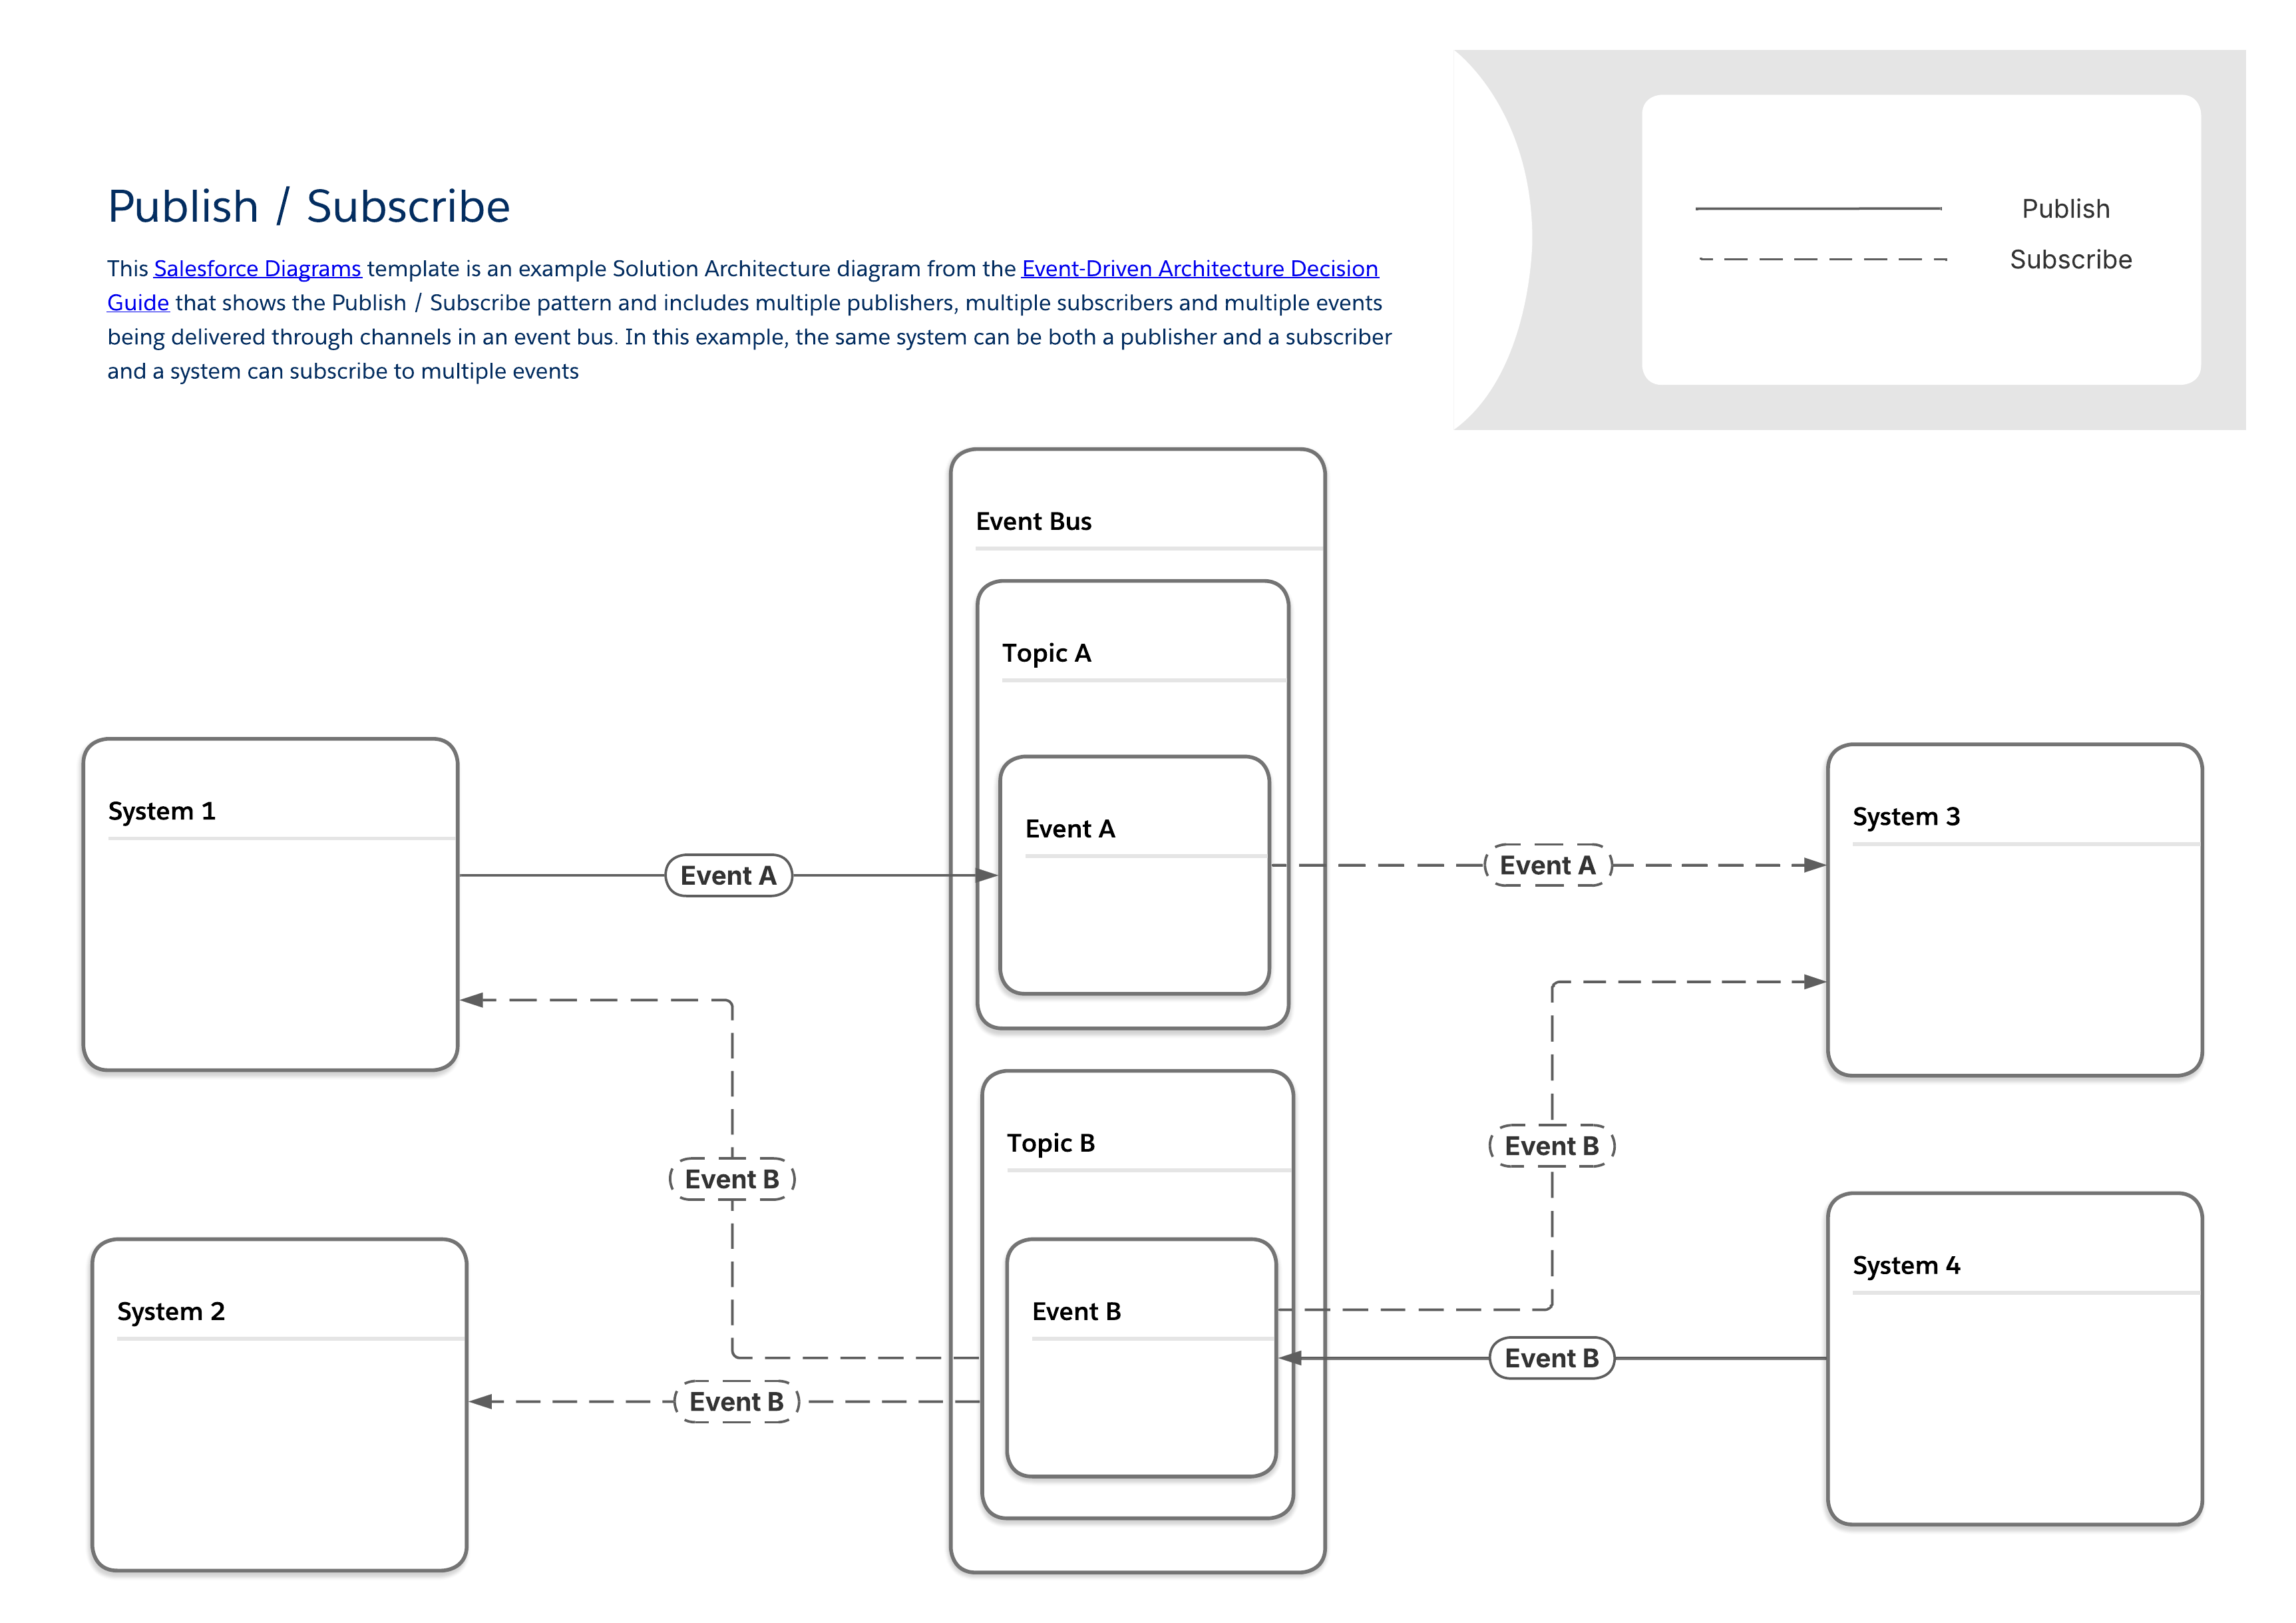 #### 公開/登録パターンに関連するツール
| イベントフローと動作 | ペイロードに関する考慮事項 | ||||||
|---|---|---|---|---|---|---|---|
| 使用可能なツール | 必須スキル | 公開方法 | 購読方法 | リプレイ期間 | ペイロード構造 | ペイロード制限 | |
| MuleSoft | Anypoint Platform | プロコード | API | API | As Configured | ユーザー定義 | なし |
| Salesforce Pub/Sub コネクタ | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint JMS Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint Apache Kafka Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint Solace Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint MQ Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint MQTT Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint AMQP Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint Event-Driven (ASync) API | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint MQ | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| Salesforce Platform | Heroku での Apache Kafka | プロコード | API、Heroku Postgres のレコード変更 | なし | 1 ~ 6 週間 | ユーザー定義 | ユーザー定義 |
| 変更データキャプチャ | ローコードからプロコード | レコードの変更 | Apex、API、Lightning Webコンポーネント(LWC) | 3 日 | 定義済み | 1 MB | |
| アウトバウンドメッセージ* | ローコード | フローおよびワークフロールール | なし | 24 時間 | ユーザー定義 | メッセージあたり 100 件の通知 | |
| プラットフォームイベント | ローコードからプロコード | API、Apex、フロー | Apex、API、フロー、LWC | 3 日 | ユーザー定義 | 1 MB | |
| Pub/Sub API | プロコード | Pub/Sub APIまたはAPI、Apex、フロー | Pub/Sub API | 3 日 | ユーザー定義 | 1 MB | |
| イベントリレー** | ローコード | プラットフォームイベント、変更データキャプチャ | API | 3 日 | ユーザー定義 | 1 MB | |
| *Salesforce では、引き続き現在の機能の範囲内でアウトバウンドメッセージをサポートしますが、この技術への追加投資は予定していません。* * イベントリレーは AWS Eventbridge にのみ接続します。 | |||||||
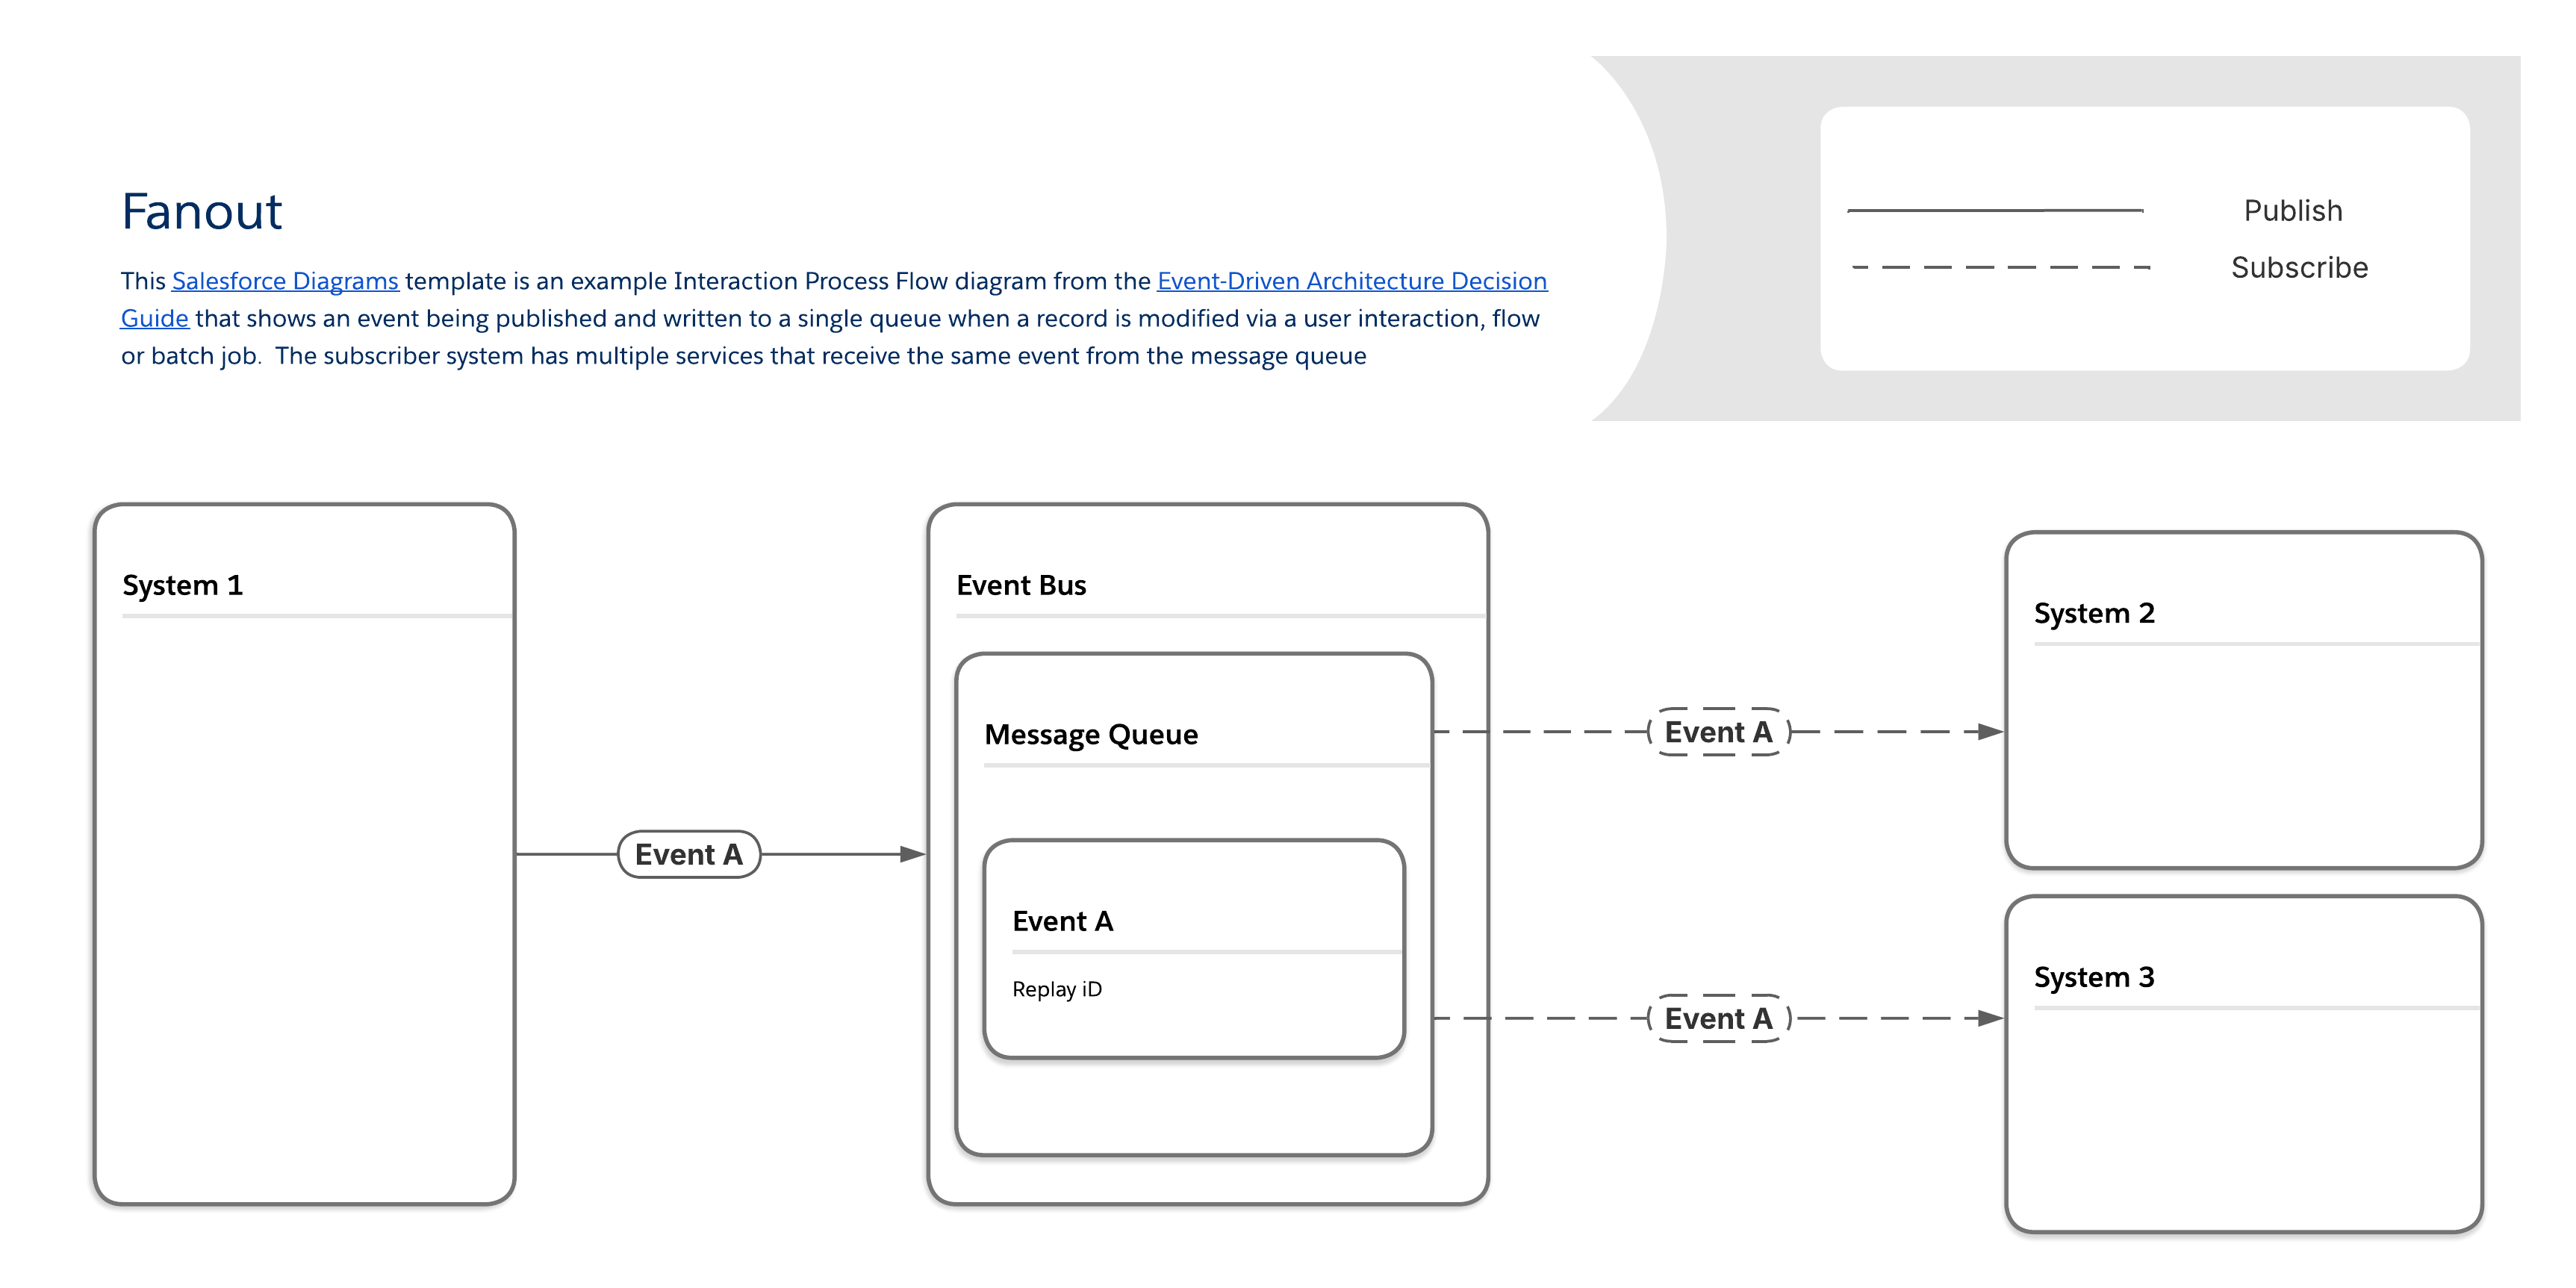 #### Fanout パターンに関連するツール
| イベントフローと動作 | ペイロードに関する考慮事項 | ||||||
|---|---|---|---|---|---|---|---|
| 使用可能なツール | 必須スキル | 公開方法 | 購読方法 | リプレイ期間 | ペイロード構造 | ペイロード制限 | |
| MuleSoft | MuleSoft Anypoint JMS Connector | プロコード | API | API | As Configured | ユーザー定義 | なし |
| Salesforce Pub/Sub コネクタ | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint Apache Kafka Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint Solace Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint MQ Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint MQTT Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint AMQP Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint MQ | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| Salesforce Platform | Heroku での Apache Kafka | プロコード | API、Heroku Postgres のレコード変更 | なし | 1 ~ 6 週間 | ユーザー定義 | ユーザー定義 |
| 変更データキャプチャ | ローコードからプロコード | レコードの変更 | Apex、API、Lightning Webコンポーネント(LWC) | 3 日 | 定義済み | 1 MB | |
| プラットフォームイベント | ローコードからプロコード | API、Apex、フロー | Apex、API、フロー、LWC | 3 日 | ユーザー定義 | 1 MB | |
| Pub/Sub API | プロコード | Pub/Sub APIまたはApex、API、フロー | Pub/Sub API | 3 日 | ユーザー定義 | 1 MB | |
| イベントリレー* | ローコード | プラットフォームイベント、変更データキャプチャ | API | 3 日 | ユーザー定義 | 1 MB | |
| *イベントリレーは AWS Eventbridge にのみデータを送信 | |||||||
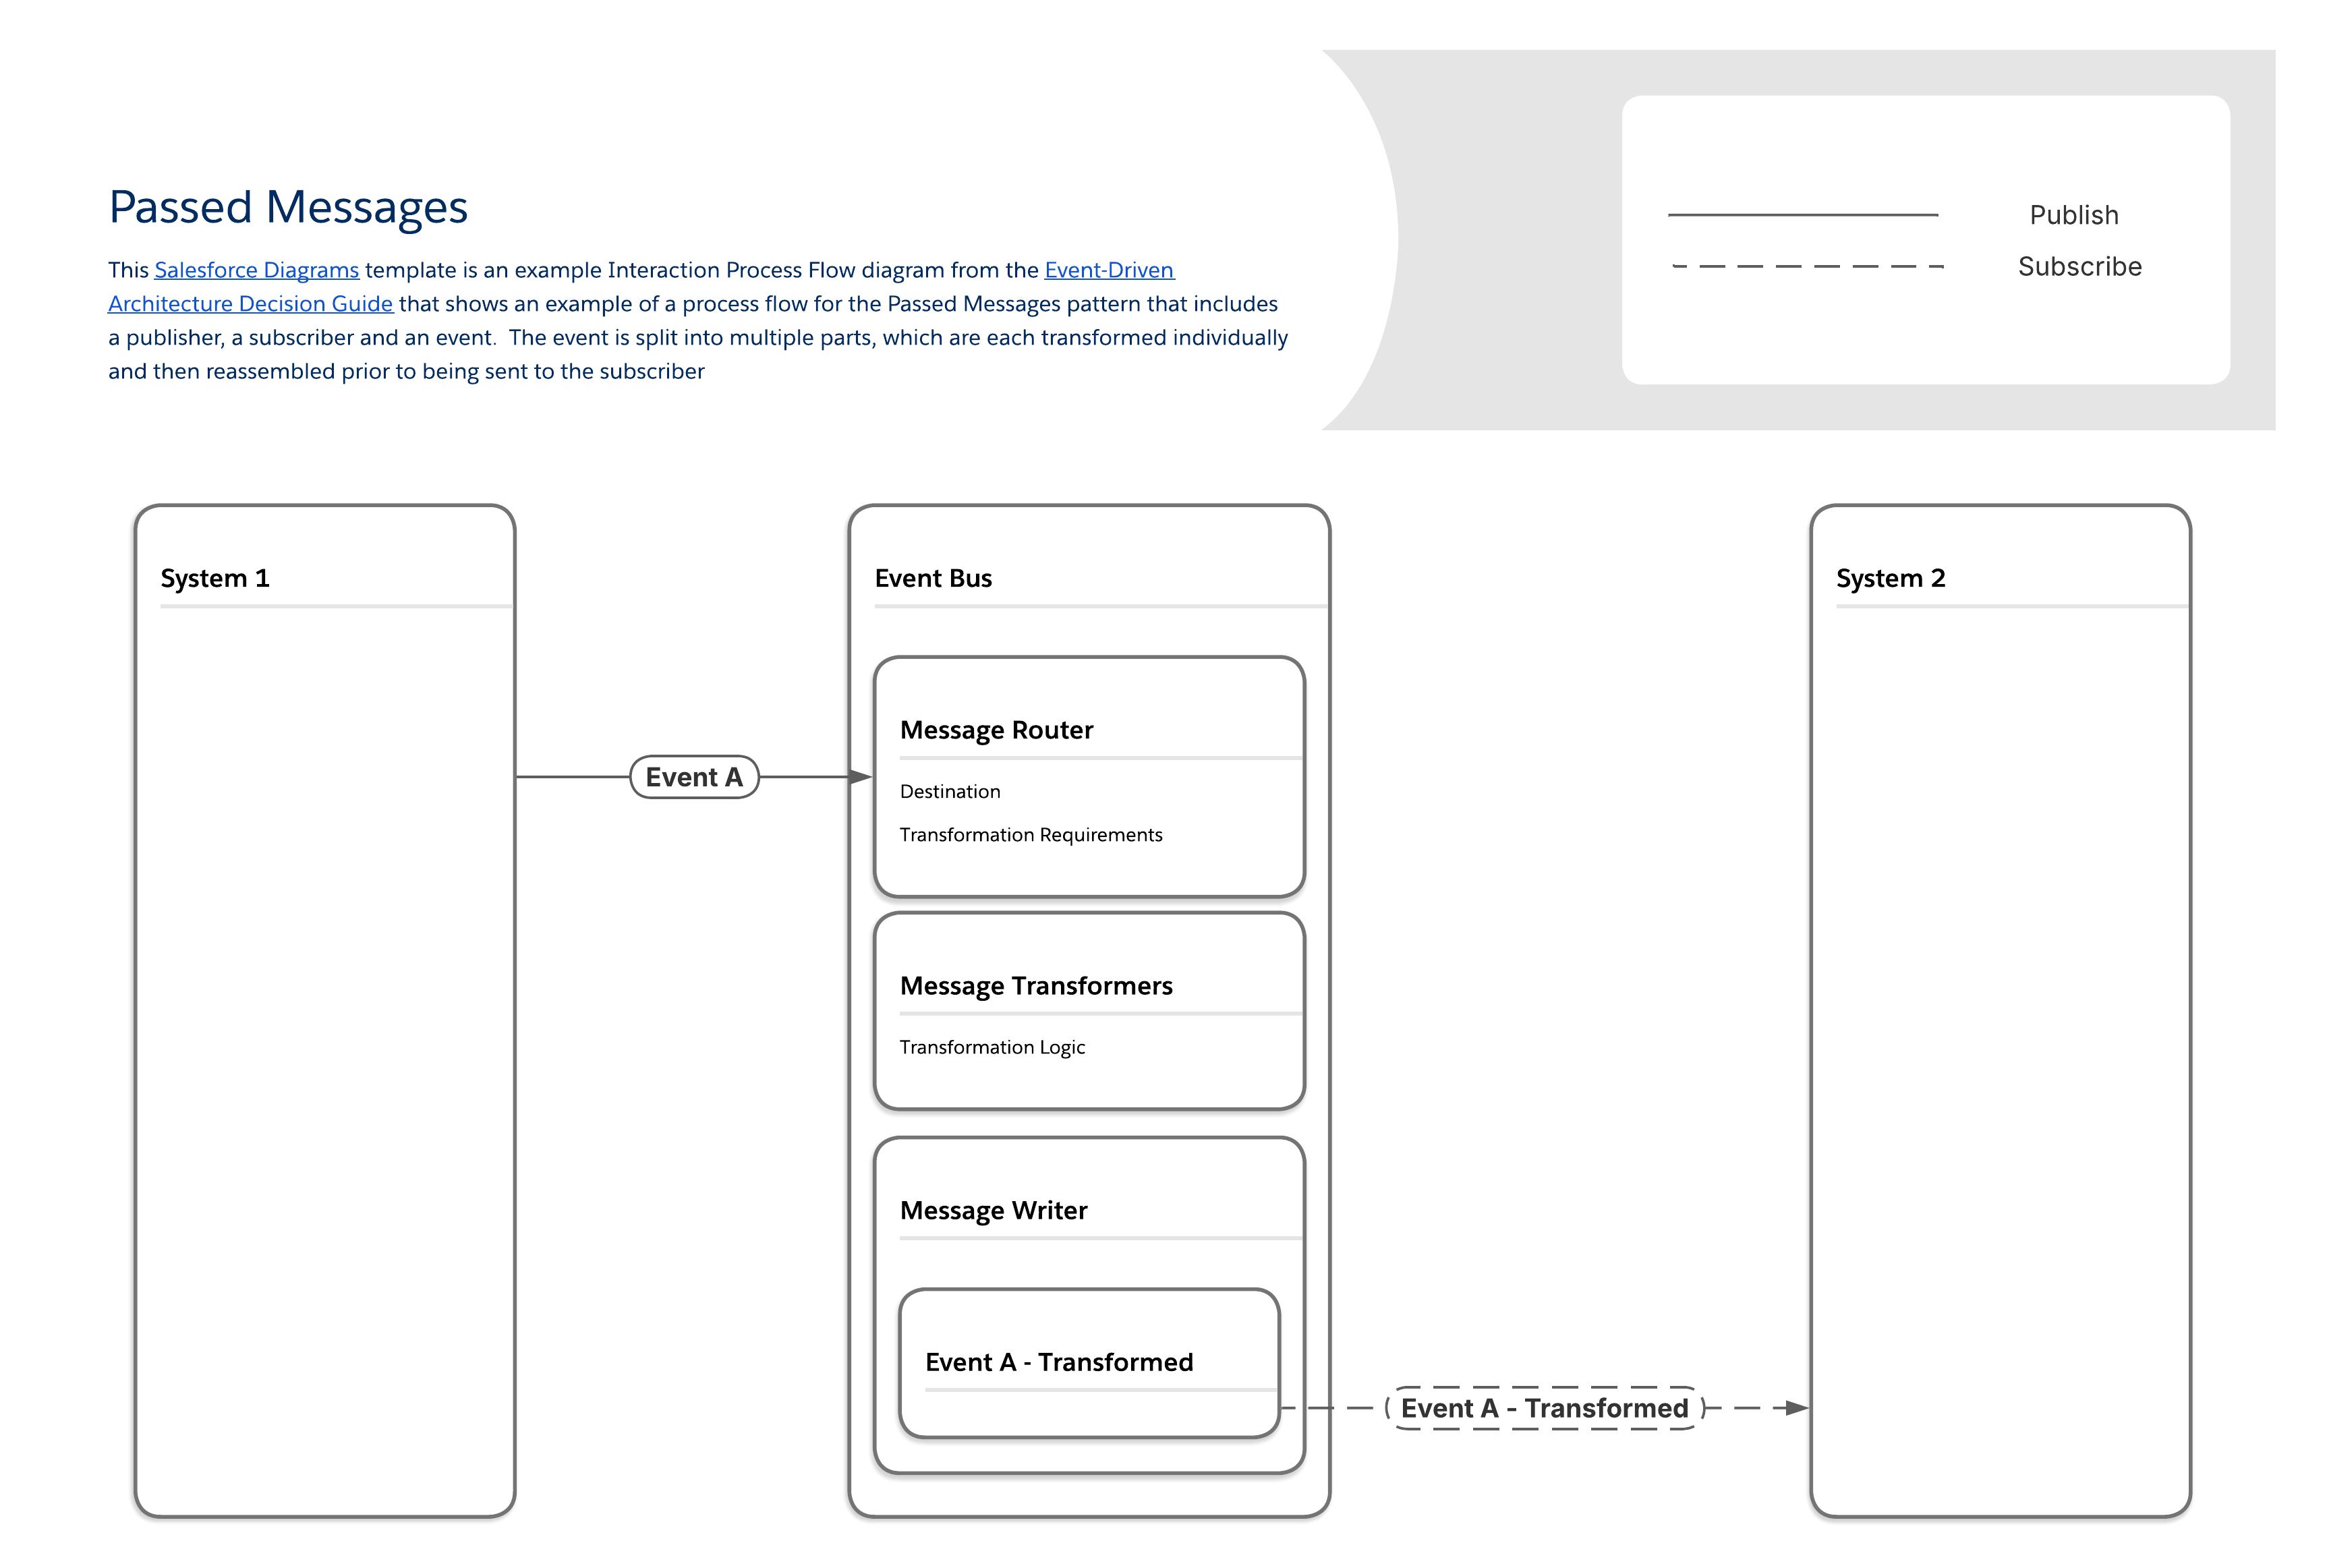 #### 渡されるメッセージパターンに関連するツール
| イベントフローと動作 | ペイロードに関する考慮事項 | ||||||
|---|---|---|---|---|---|---|---|
| 使用可能なツール | 必須スキル | 公開方法 | 購読経由 | リプレイ期間 | ペイロード構造 | ペイロード制限 | |
| MuleSoft | MuleSoft Anypoint Apache Kafka Connector | プロコード | API | API | As Configured | ユーザー定義 | なし |
| Salesforce Pub/Sub コネクタ | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| Salesforce Platform | Heroku での Apache Kafka | プロコード | API、Heroku Postgres のレコード変更 | なし | 1 ~ 6 週間 | ユーザー定義 | ユーザー定義 |
| 変更データキャプチャ | ローコードからプロコード | レコードの変更 | Apex、API、Lightning Webコンポーネント(LWC) | 3 日 | 定義済み | 1 MB | |
| プラットフォームイベント | ローコードからプロコード | API、Apex、フロー | Apex、API、フロー、LWC | 3 日 | ユーザー定義 | 1 MB | |
| Pub/Sub API | プロコード | Pub/Sub APIまたはAPI、Apexフロー | Pub/Sub API | 3 日 | ユーザー定義 | 1 MB | |
| イベントリレー* | ローコード | プラットフォームイベント、変更データキャプチャ | API | 3 日 | ユーザー定義 | 1 MB | |
| *イベントリレーは AWS Eventbridge にのみデータを送信 | |||||||
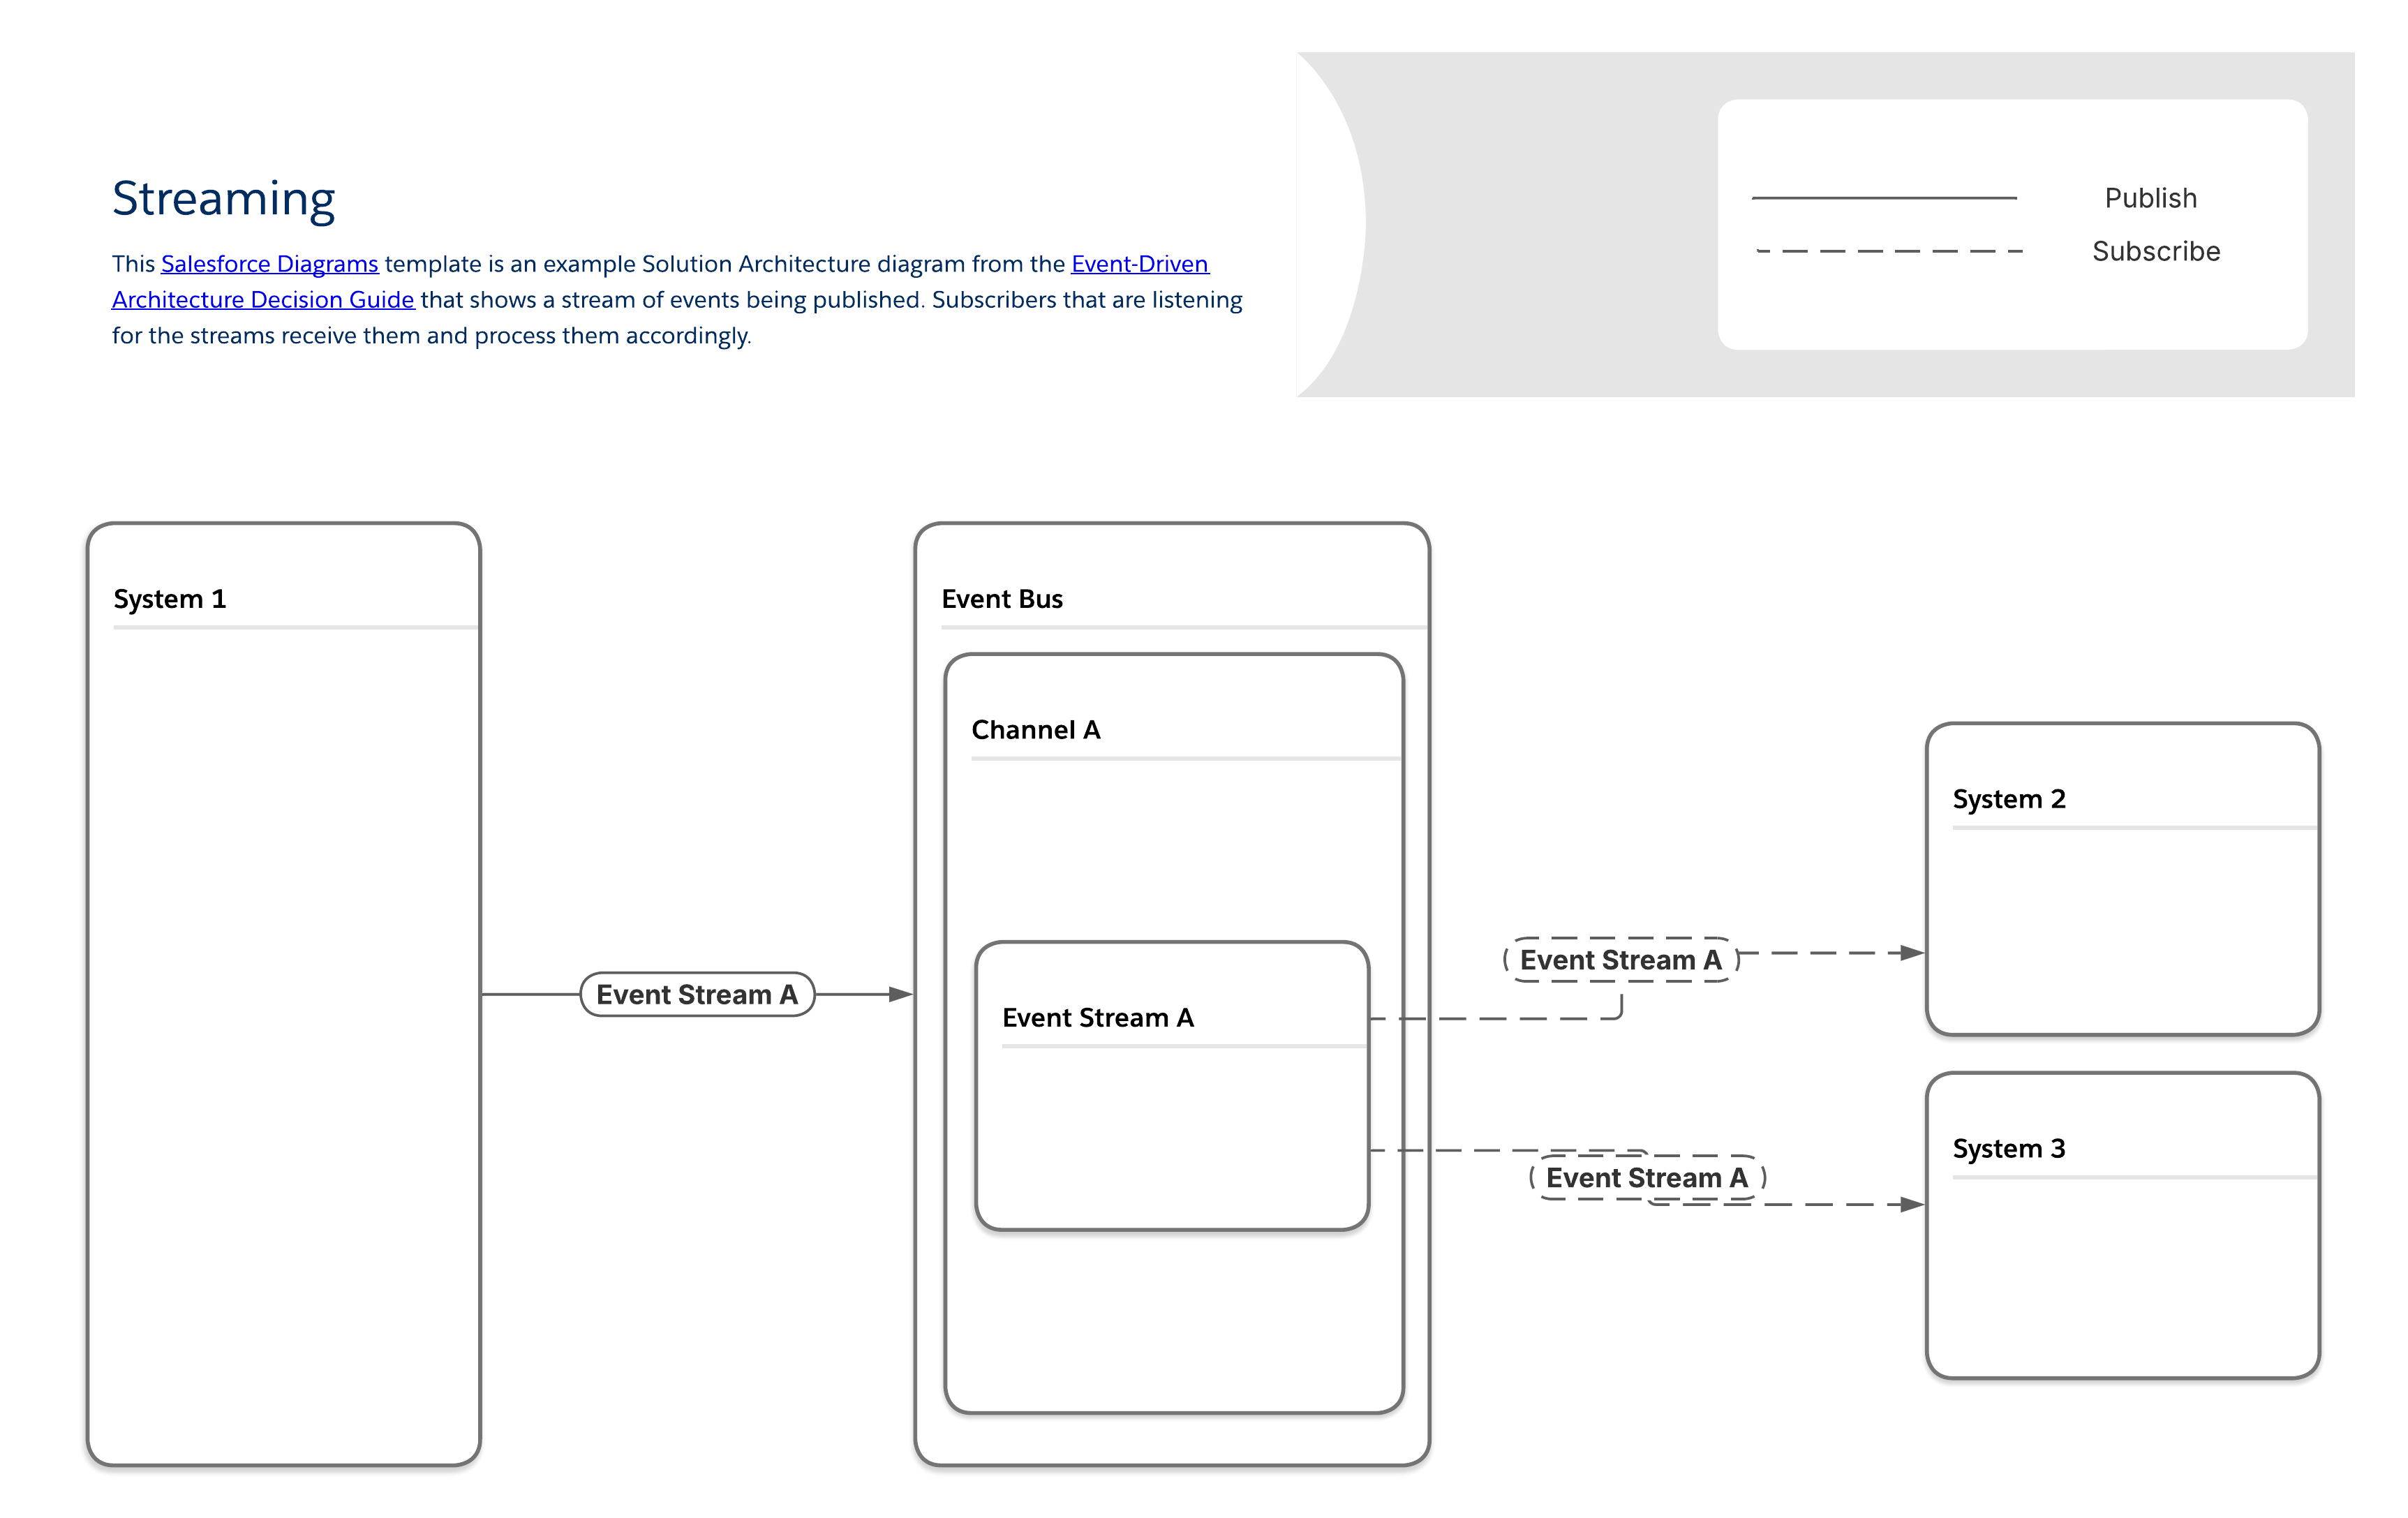 #### ストリーミングパターンに関連するツール
| イベントフローと動作 | ペイロードに関する考慮事項 | ||||||
|---|---|---|---|---|---|---|---|
| 使用可能なツール | 必須スキル | 公開方法 | 購読方法 | リプレイ期間 | ペイロード構造 | ペイロード制限 | |
| MuleSoft | MuleSoft Anypoint Data Streams | プロコード | API | API | As Configured | ユーザー定義 | なし |
| Salesforce Pub/Sub コネクタ | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint Apache Kafka Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| Salesforce Platform | Heroku での Apache Kafka | プロコード | API、Heroku Postgres のレコード変更 | なし | 1 ~ 6 週間 | ユーザー定義 | ユーザー定義 |
| Pub/Sub API | プロコード | Pub/Sub APIまたはAPI、Apexフロー | Pub/Sub API | 3 日 | ユーザー定義 | 1 MB | |
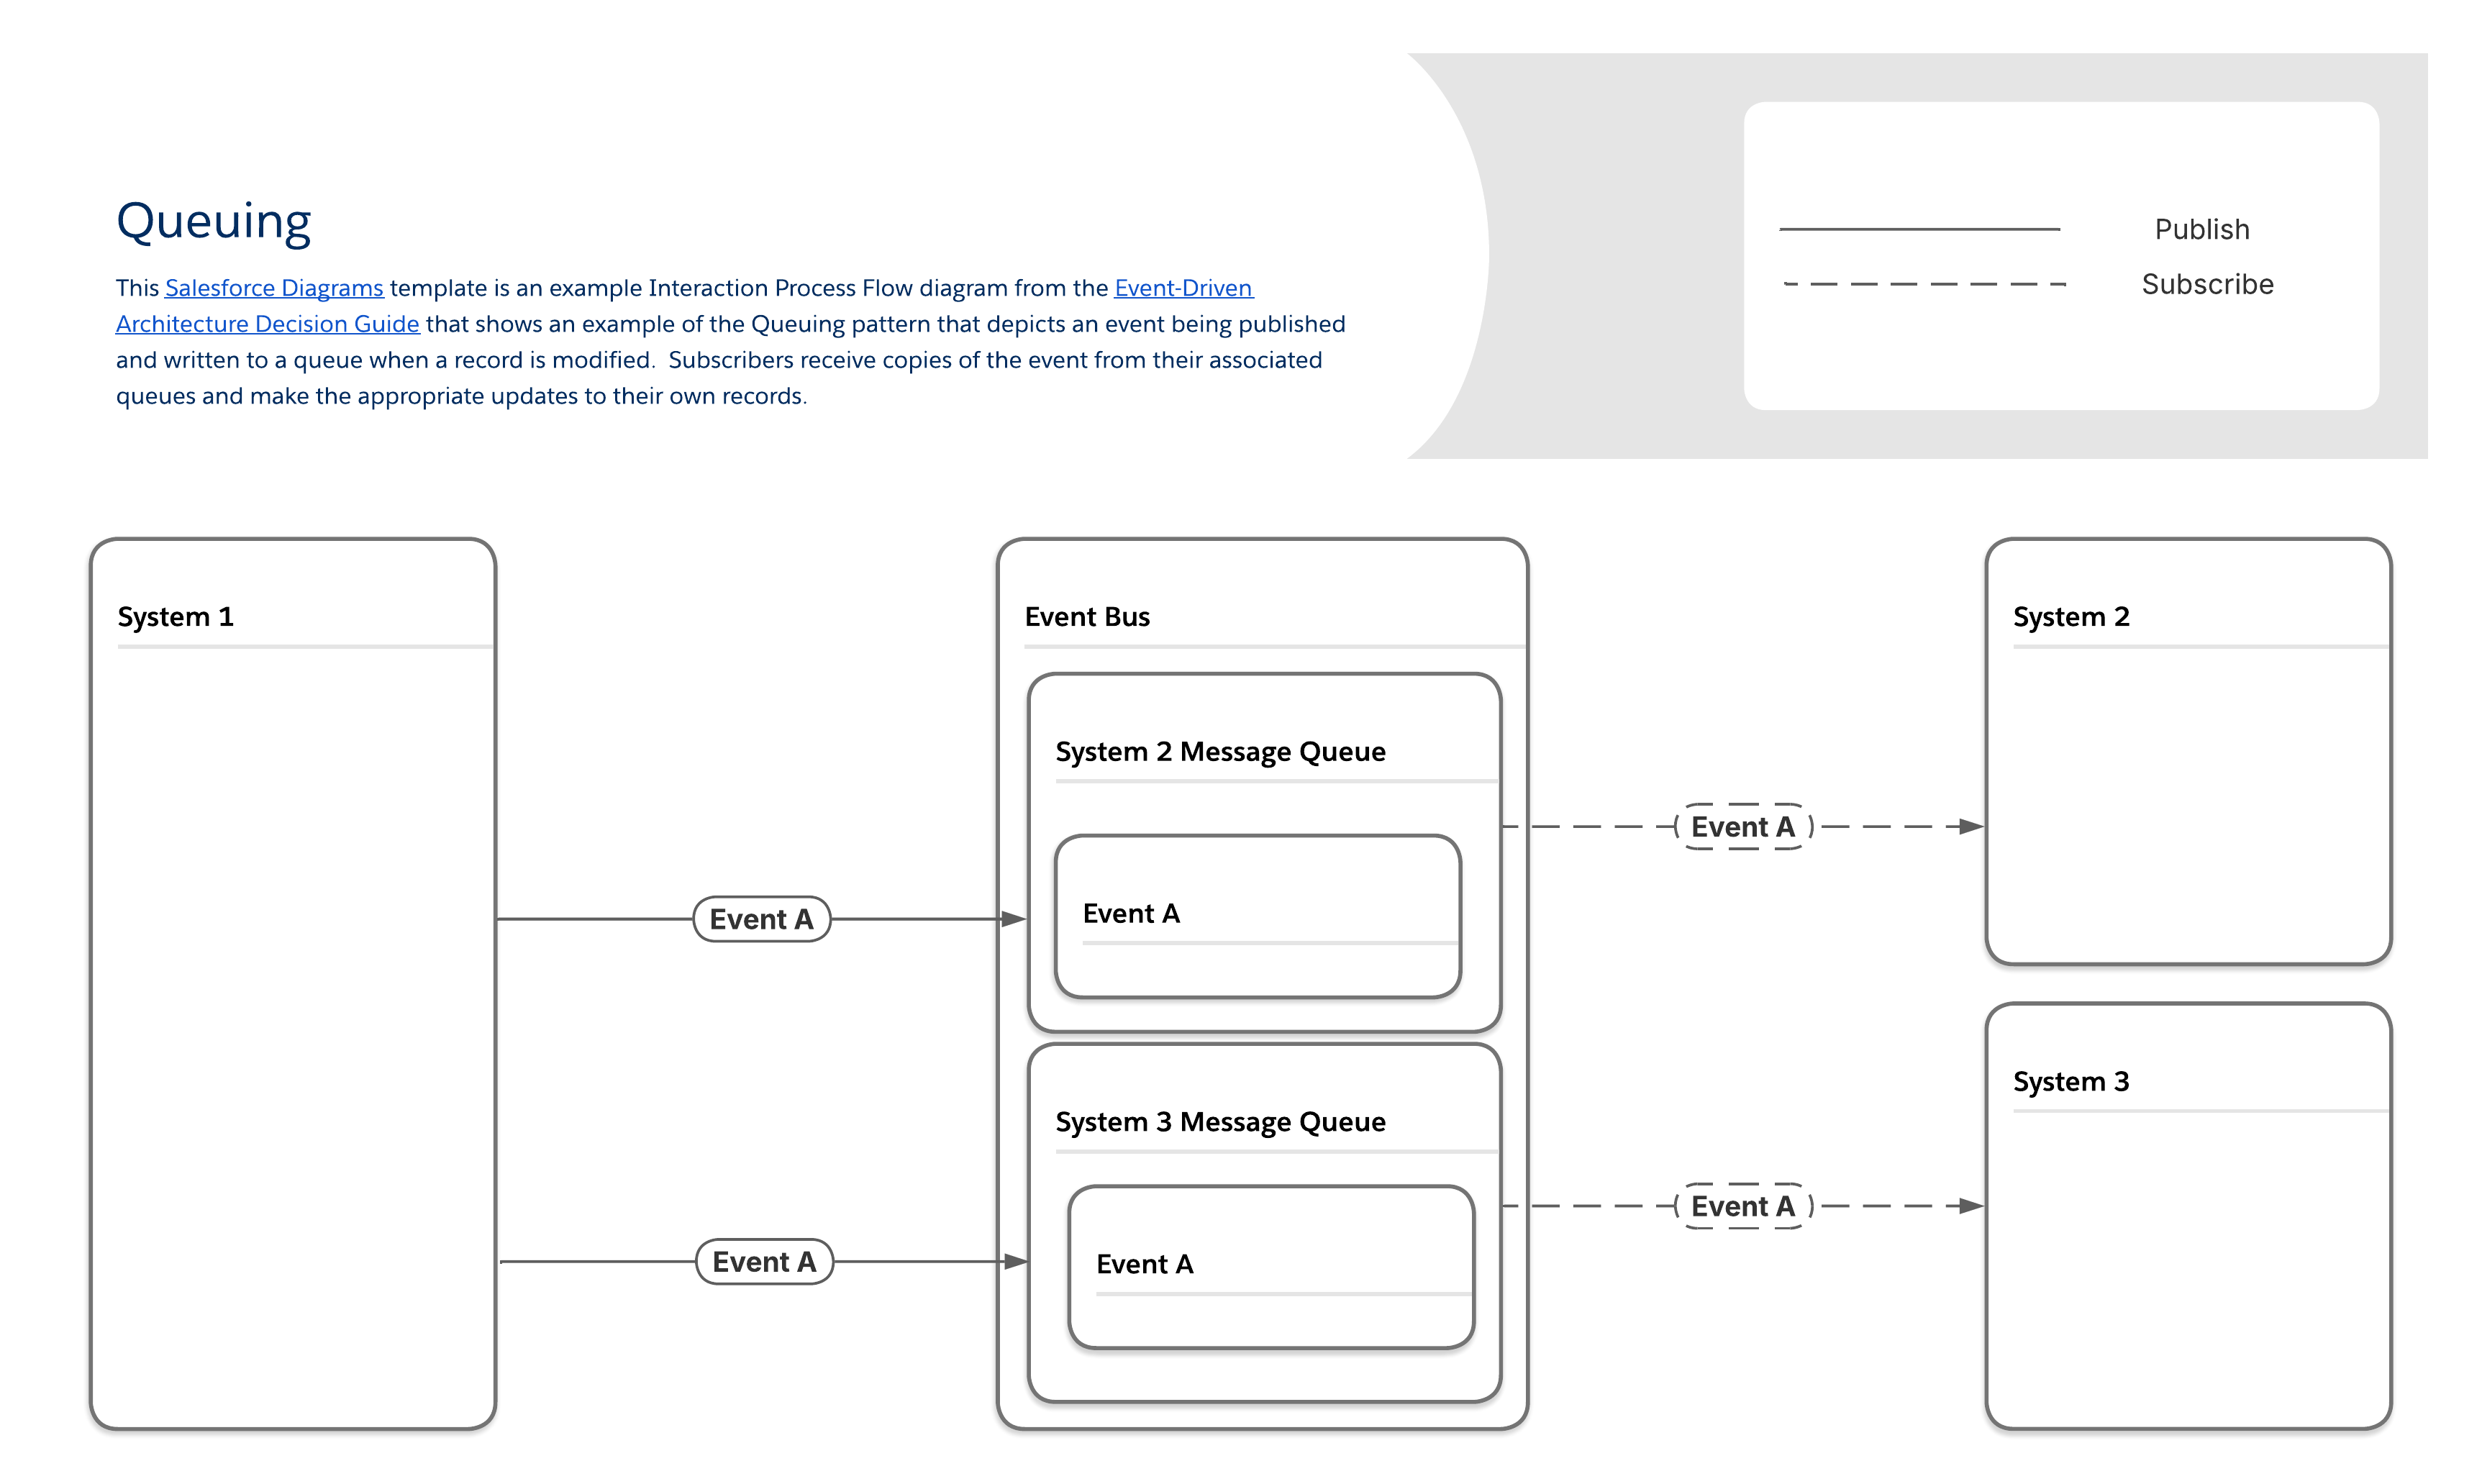 #### キューイングパターンに関連するツール
| イベントフローと動作 | ペイロードに関する考慮事項 | ||||||
|---|---|---|---|---|---|---|---|
| 使用可能なツール | 必須スキル | 公開方法 | 登録方法 | リプレイ期間 | ペイロード構造 | ペイロード制限 | |
| MuleSoft | MuleSoft Anypoint MQ | プロコード | API | API | As Configured | ユーザー定義 | なし |
| Salesforce Pub/Sub コネクタ | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint Apache Kafka Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint MQ Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint MQTT Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| MuleSoft Anypoint AMQP Connector | プロコード | API | API | As Configured | ユーザー定義 | なし | |
| Salesforce Platform | Heroku での Apache Kafka | プロコード | API、Heroku Postgres のレコード変更 | なし | 1 ~ 6 週間 | ユーザー定義 | ユーザー定義 |
| 変更データキャプチャ | ローコードからプロコード | レコードの変更 | Apex、API、Lightning Webコンポーネント(LWC) | 3 日 | 定義済み | 1 MB | |
| プラットフォームイベント | ローコードからプロコード | API、Apex、フロー | Apex、API、フロー、LWC | 3 日 | ユーザー定義 | 1 MB | |
| Pub/Sub API | プロコード | Pub/Sub APIまたはAPI、Apex、フロー | Pub/Sub API | 3 日 | ユーザー定義 | 1 MB | |
| イベントリレー* | ローコード | プラットフォームイベント、変更データキャプチャ | API | 3 日 | ユーザー定義 | 1 MB | |
| *イベントリレーは AWS Eventbridge にのみデータを送信 | |||||||
| Agentforce | 従来の自動化 | Integration の制限と考慮事項」 |
|---|---|---|
| 動的フォーム | Salesforce Lightningアプリケーションビルダーの動的フォームでは、モノリシックなレコード詳細コンポーネントが個別の設定可能な項目とセクションに分解されます。この機能により、管理者は項目を任意の場所に配置し、表示ルールを使用してユーザープロファイル、デバイス、データに基づいてコンポーネントを表示または非表示にすることで、柔軟でパフォーマンスの高いページを作成できます。これにより、ページが乱雑になるのを防ぐことができます。 |
|---|---|
| 画面フロー | Salesforce Screen Flow は、Flow Builder 内の対話型自動化ツールで、カスタマイズされたステップごとのビジネスプロセスを進むためにユーザー入力が必要です。自動化されたバックグラウンド フローとは異なり、画面フローには、コードを記述することなく、Lightningページ、ボタン、カスタム アプリケーションを使用してデータの収集、情報の表示、アクションの実行を行うためのウィザードのようなユーザー インターフェイスが用意されています。 |
| OmniStudio | Salesforce OmniStudioは、ガイド付きの業界固有のデジタル エクスペリエンスと複雑なビジネス プロセスを迅速に構築するために設計されたローコードのツール スイートです。開発者は、FlexCardやOmniScriptなどのドラッグアンドドロップ・コンポーネントを使用して、ピクセル単位のユーザー・インタフェース(ガイド付きワークフローや動的ダッシュボードなど)を作成できます。OmniStudio では、宣言的に LWC を作成できます。 |
| Lightning Web コンポーネント | Salesforce Lightning Web コンポーネントは、HTML、CSS、最新の JavaScript を使用して構築された軽量なカスタム HTML 要素で、優れた Salesforce UI パフォーマンスを実現するためにブラウザーでネイティブに動作するように設計されています。開発者は、Auraコンポーネントと共存するカスタムユーザーインターフェースを作成できるため、業界標準と詳細なコンポーネントエコシステムを通じて開発を促進できます。 |
| 設定 | その他のライセンス要件 | |
|---|---|---|
| 動的フォーム | ローコード | なし |
| 画面フロー | ローコード | なし |
| OmniStudio | ローコード + プロコード | 業種パッケージ |
| 画面フローと Lightning Web コンポーネント | ローコード + プロコード | なし |
| Lightning Web コンポーネント | プロコード | なし |
| 決定ポイント | ガイダンス |
|---|---|
| 実行時ユースケースカテゴリ | |
| Form Scope and Navigation → フォームのスコープとナビゲーション | フォームのすべての項目を 1 つの画面に論理的に収まるようにするか、ユーザーが複数の画面間を移動できるようにする必要があるかを決定します。 |
| 場所 | Salesforce アプリケーション内からモバイルアプリケーション、外部 Web サイトまで、フォームを埋め込む場所を特定します。 |
| コントローラー | データ変換や外部システムとのインテグレーションなど、ユーザーがフォームを操作しているときにバックグラウンドで実行する必要があるアクションやロジックを特定します。 |
| 入力規則 | Salesforce が提供する標準システムレベル検証を超える追加の入力検証要件があるかどうかを確認します。 |
| インタラクション設計 | フォーム内で動的応答をトリガーする必要があるインタラクションまたは条件の種別を特定します。 |
| スタイル | 目的のスタイルと CSS の要件に必要な洗練度を決定します。 |
| レイアウト | フォームのレイアウト要件 (必要な列数、タブ数、アコーディオン数など) と、繰り返しデータブロックを表示する機能を特定します。 |
| トランスレーション | フォームを他の言語にローカライズする必要があるかどうかを決定します。 |
| 機能以外の考慮事項 | |
| セキュリティ | 特定の操作を実行する前にフォームでユーザーのアクセス権を確認するかどうか、フォームにアクセスできるユーザーを制御するかどうか、フォームを埋め込む場所を制御するかどうかを決定します。 |
| オブジェクトへの影響 | フォームを 1 つのオブジェクトに対して操作するのか、複数のオブジェクトに対して操作するのかを決定します。 |
| UI テストの自動化 | DevOps プロセスでフォームの自動単体テストと自動エンドツーエンドテストのどちらを実行する必要があるかを判断します。 |
| メトリクス | ページビュー、フォームに費やした時間、完了率、成功率など、フォームの利用状況を追跡する方法を特定します。 |
| パッケージ化と展開 | フォームの作成後に配布または展開する方法を決定します。 |
| 単一画面 | マルチ画面フォーム | 進行状況インジケーター | ステップ/画面間のジャンプナビゲーション | |
|---|---|---|---|---|
| 動的フォーム | 利用可 | 利用不可 | 利用可 | 利用不可 |
| 画面フロー | 利用可 | 利用可 | 利用可 | 利用不可 |
| OmniStudio | 利用可 | 利用可 | 利用可 | 利用可 |
| 画面フロー + LWC | 利用可 | 利用可 | 利用可 | 利用可 |
| LWC | 利用可 | 理想的ではない | 理想的ではない | 理想的ではない |
| Lightning レコードページ | Lightning ホームページまたはアプリケーションページ | Aura Experience Cloud サイト | LWR Experience Cloud サイト | 組み込みSnap-Ins | ユーティリティバー | オブジェクト固有のアクション | グローバルアクション | Salesforce モバイルアプリケーション* | Field Service Mobile | Mobile SDK | 外部サイトおよびアプリケーション | カスタム LWC | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 動的フォーム | 利用可 | 利用不可 | 利用不可 | 利用不可 | 利用不可 | 利用不可 | 利用不可 | 利用不可 | 利用可 | 利用不可 | 利用不可 | 使用不可 | 使用不可 |
| 画面フロー | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 | 使用不可 | 利用可 | 使用可能** | 使用不可 | 使用不可 | 利用可 |
| OmniStudio | 利用可 | 利用可 | 利用可 | 使用不可 | 使用不可 | 利用可 | 使用不可 | 使用不可 | 利用可 | 使用不可 | 使用不可 | 利用可 | 利用可 |
| 画面フロー + LWC | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 | 使用不可 | 利用可 | 使用不可 | 使用不可 | 理想的ではない | 利用可 |
| LWC | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 | 利用不可 | 使用不可 | 利用可 | 利用不可 | 使用不可 | 利用可 | 利用可 |
| *フローと LWC は Salesforce モバイルアプリケーションでサポートされていますが、フローと LWC の埋め込み方法のすべてはサポートされていません (たとえば、オブジェクト固有のアクションはモバイルではサポートされますが、ユーティリティバー項目はサポートされません)。 ** Salesforce Field Service Mobile アプリケーションには、データキャプチャ が含まれます。Data Capture は、最新のフロー機能をサポートする、専用のオフラインランタイムを備えたフローエンジン上に構築されたオフラインファーストフォームソリューションです。このアプリケーションには、古いカスタムオフラインエンジンで実行される従来の Field Service Mobile フローも含まれますが、最新のフロー機能の多くはサポートされません。 | |||||||||||||
| ログとアクション | 階層データ管理 | 1 つのトランザクション内で操作 | 複数のトランザクションでの操作 | Integration の制限と考慮事項」 | モジュラー設計と再利用 | パッケージ | |
|---|---|---|---|---|---|---|---|
| 動的フォーム | 使用不可 | 使用不可 | 使用不可 | 使用不可 | 使用不可 | 使用不可 | 利用可 |
| 画面フロー | 利用可 | 使用不可 | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 |
| OmniStudio | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 | 利用不可 |
| 画面フロー + LWC | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 |
| LWC | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 |
| システムレベルの検証を尊重する | このフォームに固有のカスタムフィールドレベル検証 | カスタムフィールドレベル検証 | |
|---|---|---|---|
| 動的フォーム | 利用可 | 利用不可 | 利用不可 |
| 画面フロー | 利用可 | 利用不可 | 利用不可 |
| OmniStudio | 利用可 | 利用可 | 利用可 |
| 画面フロー + LWC | 利用可 | 利用可 | 利用可 |
| LWC | 利用可 | 利用可 | 利用可 |
| 画面外データ操作の実行 | 条件値と計算 | 条件付き表示 | 条件付き必須 | 条件付き書式 | 条件付き参照のみの状態 | 条件付き無効化状態 | |
|---|---|---|---|---|---|---|---|
| 動的フォーム | 利用不可 | 利用不可 | 利用可 | 利用不可 | 利用可 | 利用不可 | 利用不可 |
| 画面フロー | 利用可 | 使用可能* | 利用可 | 利用可 | 利用不可 | 利用可 | 利用可 |
| OmniStudio | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 |
| 画面フロー + LWC | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 |
| LWC | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 |
| *静的チェックボックスではなく、リソースピッカーを使用するコンポーネントに制限されます。 | |||||||
| 標準イベント処理 (onblur、onfocus) | カスタムイベント処理 | |
|---|---|---|
| 動的フォーム | 利用不可 | 利用不可 |
| 画面フロー | 利用不可 | 利用不可 |
| OmniStudio | 利用不可 | 使用可能* |
| 画面フロー + LWC | 利用可 | 利用可 |
| LWC | 利用可 | 利用可 |
| *OmniStudio 標準ランタイムでは Pub/Sub はサポートされていませんが、Windows postMessage はサポートされます。 | ||
| ダイレクトスタイル | 組織およびエクスペリエンスビルダーのテーマ | ピクセル単位のスタイル | |
|---|---|---|---|
| 動的フォーム | 利用不可 | 利用可 | 利用不可 |
| 画面フロー | 使用不可 | 利用可 | 使用可能** |
| OmniStudio | 使用可能* | 使用不可 | 利用可 |
| 画面フロー + LWC | 使用不可 | 利用可 | 利用可 |
| LWC | 使用不可 | 利用可 | 利用可 |
| *FlexCard のみ ** 画面コンポーネントには特定のスタイル属性を設定できますが、CSS の上書きは設定できません。 | |||
| 2 列 | 4 列 | 4 列以上 | データの繰り返しブロック | タブコンテナ | アコーディオン | |
|---|---|---|---|---|---|---|
| 動的フォーム | 利用可 | 使用不可 | 使用不可 | 使用不可 | 利用可 | 利用可 |
| 画面フロー | 利用可 | 利用可 | 使用不可 | 利用可 | 使用不可 | 利用可 |
| OmniStudio | 利用可 | 利用可 | 利用可 | 利用可 | 使用可能* | 利用可 |
| 画面フロー + LWC | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 |
| LWC | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 |
| *タブは、OmniScript の FlexCard にデータを埋め込む場合に使用できます。 | ||||||
| ビルダーに入力された表示ラベル | コードのラベル | |
|---|---|---|
| 動的フォーム | 使用可能* | 使用不可 |
| 画面フロー | 利用可 | 利用可 |
| OmniStudio | 利用可 | 利用可 |
| 画面フロー + LWC | 利用可 | 利用可 |
| LWC | 該当なし | 利用可 |
| *項目セクションの見出しのみ | ||
| ユーザー権限の昇格 | アクセス権を持つユーザーの制御 | 許可される場所の制限 | |
|---|---|---|---|
| 動的フォーム | 使用不可 | 利用可 | 使用不可 |
| 画面フロー | 利用可 | 利用可 | 使用不可 |
| OmniStudio | 使用不可 | 利用可 | 利用不可** |
| 画面フロー + LWC | 利用可 | 利用可 | 使用不可 |
| LWC | 使用可能* | 利用可 | 利用可 |
| *Apexが必要 * * OmniScript には指定された対象ロケーションのセットを含めることはできませんが、FlexCard では含めることができます。 | |||
| 単体テスト | エンドツーエンドの自動化 | |
|---|---|---|
| 動的フォーム | 使用不可 | 使用可能* |
| 画面フロー | 使用不可 | 使用可能* |
| OmniStudio | 使用可能* | 使用可能* |
| 画面フロー + LWC | 使用可能* | 使用可能* |
| LWC | 利用可 | 利用可 |
| *コードが必要 | ||
| ページビュー | フォームにかかった時間 | フォーム完了状況を追跡する | 成功率の追跡 | |
|---|---|---|---|---|
| 動的フォーム | 使用可能** | 使用不可 | 使用不可 | 使用不可 |
| 画面フロー | 利用可 | 使用可能* | 利用可 | 利用可 |
| OmniStudio | 利用可 | 使用可能* | 利用可 | 利用可 |
| 画面フロー + LWC | 利用可 | 使用可能* | 利用可 | 利用可 |
| LWC | 使用可能** | 使用可能* | 利用可 | 利用可 |
| *パッケージベースのOmniStudioランタイムが有効になっている場合に使用可能**親Lightningページの使用状況を追跡することで使用可能 | ||||
| 第一世代管理パッケージ (1GP) | 第二世代管理パッケージ (2GP) | ロック解除済みパッケージ | 変更セット | DevOps Center | |
|---|---|---|---|---|---|
| 動的フォーム | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 |
| 画面フロー | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 |
| OmniStudio | 使用不可 | 使用不可 | 使用不可 | 使用不可* | 使用不可* |
| 画面フロー + LWC | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 |
| LWC | 利用可 | 利用可 | 利用可 | 利用可 | 利用可 |
| *IDX ワークベンチを使用して、OmniStudio ソリューションを他の組織にリリースします。 | |||||
| フロー | Salesforce Flowは、強力なポイント・アンド・クリック自動化ツールです。ユーザーは、コードを記述せずに、Flow Builderを使用して複雑なビジネス・プロセス、画面、ロジックを視覚的に作成できます。データ更新、メールの送信、ユーザーへの案内などのタスクを自動化し、画面フロー (ユーザー操作) やトリガーフロー (レコード/スケジュール済みイベント) などの種別で柔軟性を提供します。 |
| Apex | Salesforce Apex は、Java に似た Salesforce Platform 用の独自のオブジェクト指向プログラミング言語で、カスタムビジネスロジックの構築、プロセスの自動化、宣言型ツール以外のコア CRM 機能の拡張に使用されます。 |
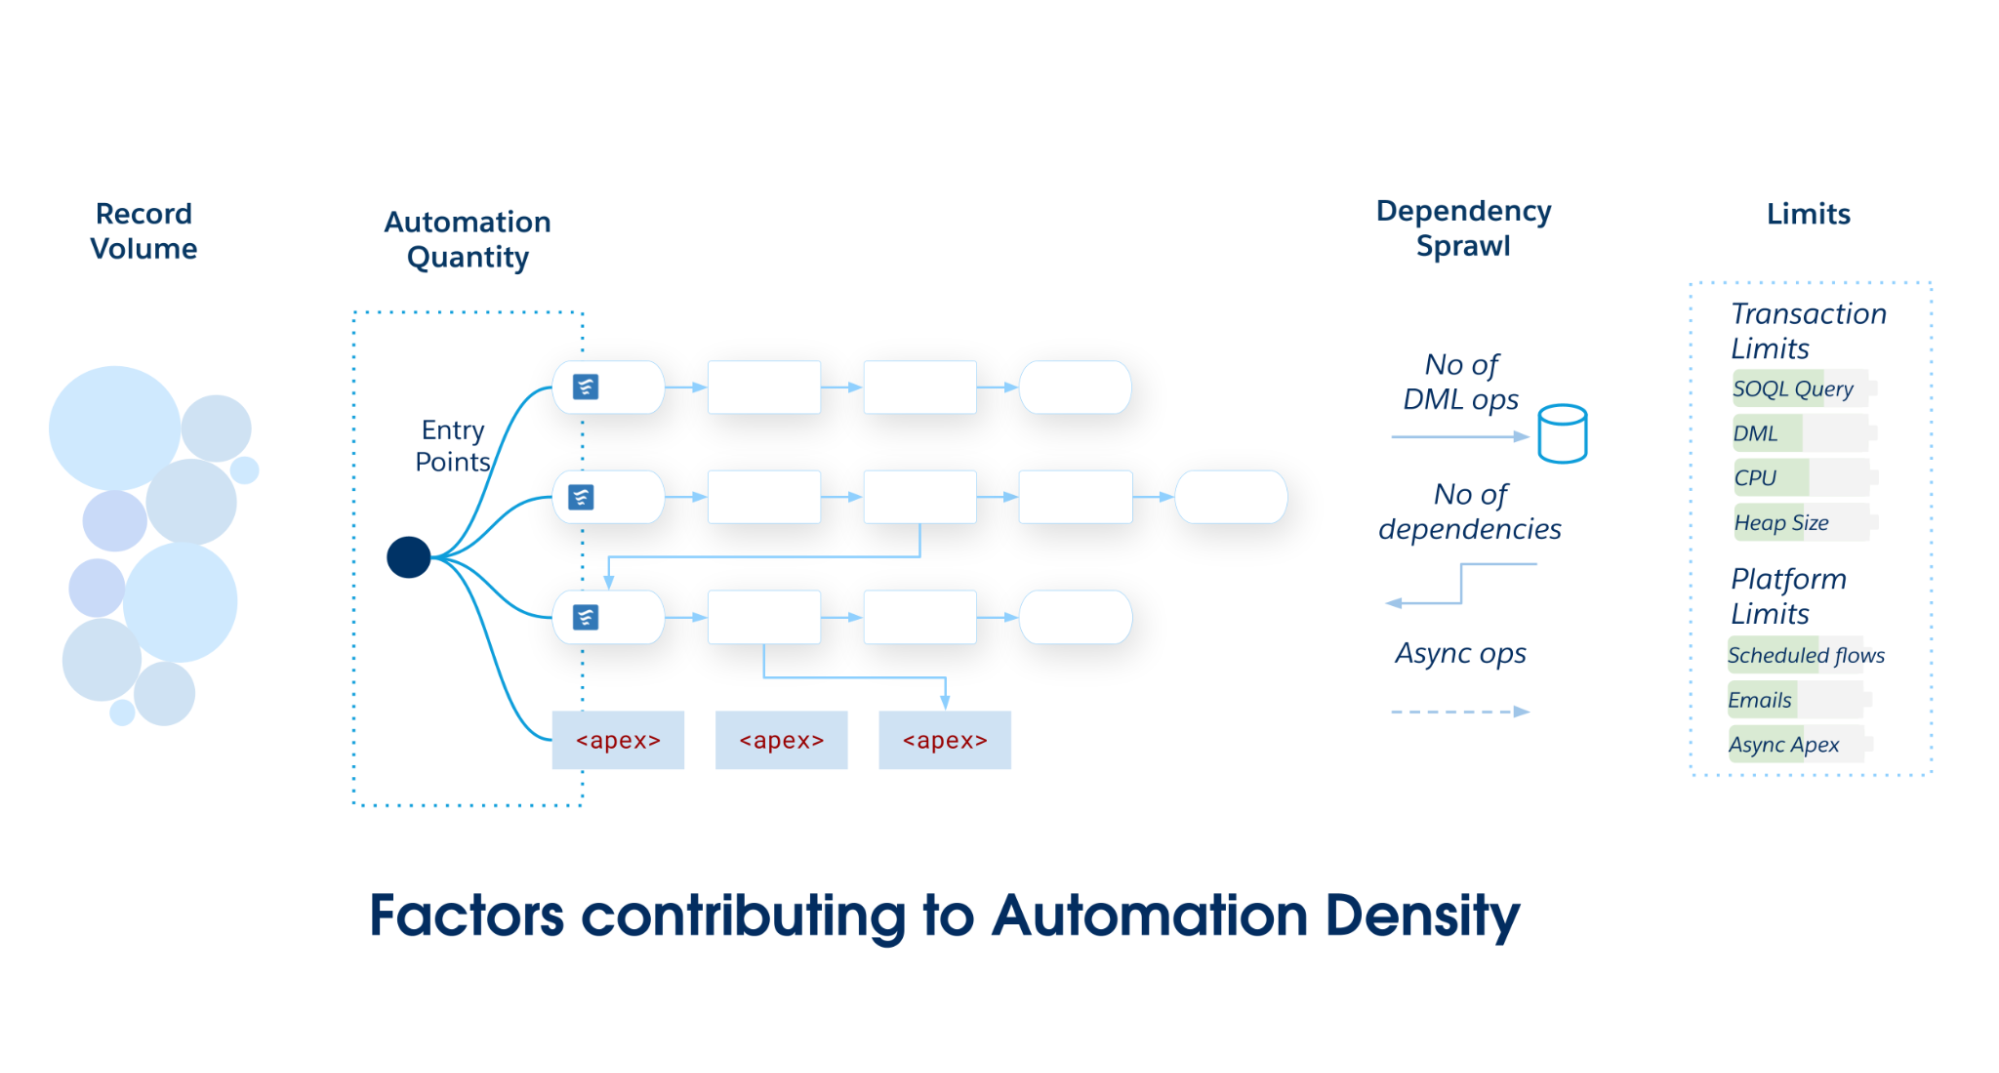 Salesforceアプリケーションのスコープと複雑さが増大するにつれて、レコードトリガーフローまたは Apexトリガーのいずれか、ひとつの主要なエントリーポイントに統一することを推奨します。1 つの Salesforce オブジェクトで複数のメカニズムにわたって自動化をパーティション分割すると、メンテナンス性が低下し、ガバナンスが断片化してしまうため、避けてください。
### 密度選択マトリックス
このマトリックスを使用して、Salesforce オブジェクトに必要なアーキテクチャ標準を決定します。
- **レコード トリガー フロー**は、自動化密度が低い場合に推奨されるソリューションです。互いに独立していてわかりやすいオートメーションに最適なパワーとアクセシビリティのバランスを実現します。
- **ハイブリッド パターン(**呼び出し可能なApexを使用したレコード トリガー フロー)は、複雑さが増している中密度の自動化に適した強力でメンテナンス可能な選択肢です。このパターンにより、チームは宣言型 Flow において整然とした処理の流れを維持しつつ、計算負荷の高い操作を Apex に委任し、アクセシビリティとパフォーマンスのバランスを実現できます。
- **Apexトリガー**は、高密度のオートメーションを支える堅牢なアーキテクチャ構築のための基本要素を提供します。Apexのパフォーマンス、詳細な制御、およびオブジェクト指向の抽象化と多態性は、これらのシナリオの複雑さと拡張性の管理に適しています。
| 密度レベル | 自動化数量 | データ量 (バッチサイズ) | 依存関係の無秩序な増加 | アーキテクチャ標準 |
|---|---|---|---|---|
| Low (低) | < 15 オートメーション |
標準 ユーザー主導の UI 操作または小さな API 読み込み (1 ~ 200 レコード) |
個別 自己完結型ロジック。同じオブジェクトまたは関連オブジェクトに対する 0 ~ 1 のダウンストリーム DML 操作。 |
レコードトリガーフロー |
| Medium (中) | 15–30 オートメーション |
中程度 標準バッチ処理 (慎重な一括処理が必要なロジックを使用) |
密結合 親/子の更新、2~4件のダウンストリーム DML 操作。再帰のリスク |
ハイブリッドパターン フロー + 呼び出し可能な Apex |
| High (高) | > 30 オートメーション |
High (高) 一括 API 読み込みを使用する大量のデータ (2,000 ~ 10,000 件以上のレコード) |
複雑および再帰的 深い依存関係グラフ (5 つ以上の下流 DML 操作)。三角再帰ループのリスク |
Apexトリガー メタデータ フレームワーク |
| 機能 | レコードトリガーフロー | Apex トリガー |
|---|---|---|
| デリバリーとメンテナンスの迅速性 | 推奨 Flow Builder のビジュアル・ユーザー・インタフェースを使用すると、管理者やその他の宣言型ビルダーは、Apexコードの作成、テスト、リリースよりも迅速に自動化を作成および変更できます。このインターフェースにより、より幅広いチームメンバーがビジネス上の価値を実現でき、単純なタスクの専門的な開発者リソースへの依存が軽減されます。 |
専門知識が必要 Apex では、コードの実装、テスト、管理に適切なスキルを持つソフトウェア開発者が必要です。 |
| モジュール性 | 利用可 レコードトリガーフローはデフォルトでモジュール化されています。モノリシックロジックではなく、チームは特定の要件に合わせて個別のフローを作成し、フロートリガーエクスプローラーを使用してそれらを一緒に振り付けます。このモジュール化により、変更が分離され、簡単に拡張できるため、長期的な所有コストを大幅に削減できます。 |
利用可 Apex は、設計上、機能モジュールに分割されています。各 Apex クラスは、1 つの機能モジュールを実装することを目的としています。 |
| 可視性とガバナンス | 推奨 フローの視覚的な性質により、ビジネスロジックが直感的に表現されます。フロートリガーエクスプローラーでは、オブジェクトのすべてのフローの統合ビューが提供されるため、アーキテクトやシステム管理者はコードを読むことなく簡単に理解、管理、トラブルシューティングできます。 |
専門知識が必要 メタデータ フレームワークを使用してトリガーを整理することは有益ですが、Apexでは、コードを整理して保守できるように、統制の取れた開発チームが必要です。 |
| 高パフォーマンスの一括データ処理 | 非推奨 複雑なロジックや大量のデータを処理する場合、ガバナ制限に達するリスクが高くなります。 |
推奨 Apexコードはプラットフォームのコア・サービスに近い場所で実行され、開発者はクエリの最適化、データ処理、アルゴリズムの効率性をより詳細に制御できます。これにより、特に大量のデータを含む複雑なシナリオでパフォーマンスと拡張性が向上します。 |
| 堅牢なロジックとデータ構造 | 利用可 フロー変換要素は、いくつかの複雑な処理タスクに役立ちます。ただし、フローにはネイティブの Map および Set データ構造がないため、複雑なデータ処理が煩雑になり、計算効率が低下します。 |
推奨 Apex では、対応付け、設定、プログラムによるループにフルアクセスして、効率性の高い安全な一括データ操作を実行できます。Apex は、フル機能のプログラミング言語であり、複雑なビジネス問題を保守可能かつ効率的に解決するのに役立つ複雑な論理構造、データ構造、設計パターンへのアクセスも提供します。Apexには、現在宣言型ツールでは使用できない高度な関数(BusinessHours、Cryptoなど)の豊富な標準ライブラリが含まれています。 |
| トランザクション制御 | 使用不可 フローでは、部分的なトランザクションの確定またはロールバックで `Database.savepoint`、`Database.rollback`、または部分的に成功した DML 操作にアクセスできません。 |
利用可 Apexは、トランザクションの整合性と複雑なエラー・リカバリのシナリオをフルかつ詳細に制御します。 |
| メール配信 | 推奨 レコードトリガーフローから事前設定されたメールアラートを送信するのは、簡単で拡張性があります。カスタムメールアラートは、実行時に作成および配布できます。カスタムメールには、毎日のメール送信制限が適用されます。 |
利用可 Apex はカスタム電子メール メッセージを生成および送信できます。Apex から送信されるすべてのメールには、1 日あたりのメール送信制限が適用されます。 |
| プラットフォーム保護の適用 | 推奨 フローには、自動一括処理や自動再試行などの組み込みの保護が含まれます。これらの保護により、価値実現までの時間を短縮し、複雑な手動コーディングを必要とするパフォーマンスの低下を回避できます。 |
手動実装が必要 一括処理などの保護は、明示的にコーディングする必要があります (コレクションの管理やループ内での SOQL の回避など)。自動再試行はトリガーに固有ではなく、実装するには複雑なカスタムロジックが必要です。 |
| 非同期処理 | 利用可 フローは、非同期パスで個別のトランザクションを必要とする自動化の簡単なメカニズムを提供します。これらの自動化には 1 日の制限が適用されます。 |
利用可 Apex では、変更データキャプチャと、分離されたトリガー登録者によって処理されるキュー可能なイベントを使用して、完全な制御が可能になります。 |
| スケジュール済み処理 | 推奨 フローのスケジュール済みパスには、ユニークで強力なスケジュール機能 (「完了予定日の 3 日前に開始」など) があります。この機能には、レコードのデータが変更された場合の自動キャンセルと再スケジュールが含まれます。これらの自動化には 1 日の制限が適用されます。 |
使用不可 Apex トリガーでは、自動キャンセルを使用する一時的なレコード固有のイベントをネイティブにスケジュールできません。スケジュール済み Apex は存在しますが、基本的に異なるメカニズムであり、特定の時間に実行され、トリガーの一部として個々のレコードの処理中にスケジュールされることはありません。 |
| 順序と調整 | 利用可 フロートリガーエクスプローラーでは、管理者は同じオブジェクトの複数のフローの相対的な実行順序を定義できます。 |
利用可 トリガーフレームワークでは、自動化の正確な順序を詳細に制御できます。 |
| 同じレコードの項目更新 | 入手可能 (保存前) レコードトリガーフローは、最初の DML 確定の前にトリガーレコードを更新するための最もパフォーマンスの高い宣言型オプションです。 |
入手可能 (保存前) Apex は、最小限のオーバーヘッドで最高のパフォーマンスを提供します。 |
| クロスオブジェクト CRUD | 入手可能 (保存後) フローは、シンプルで複雑度の低いクロスオブジェクト DML 操作に適しています。 |
入手可能 (保存後) Apexは、重複除外、エラー処理、クロスオブジェクトDML操作のパフォーマンスをより詳細に制御します。 |
| 高価な計算の重複排除 | 利用可 フローは、自動一括処理によって冗長なクエリと DML ステートメントを排除することに長けています。ただし、異なるフロートリガー間、または 1 つのトランザクション内の同じフローの複数の呼び出し間で状態をキャッシュまたは共有することはできません。この制限は、極端なパフォーマンスのシナリオでは重要になる場合があります。 |
推奨 Apexは、コストのかかる操作の重複除外メカニズムを提供します。開発者は、静的プロパティと変数を使用するトランザクションキャッシュと、プラットフォームキャッシュを使用するプラットフォームレベルのキャッシュを活用して、データを保存および再利用できます。これらの技術は、SOQL クエリなどのトランザクションガバナ制限の消費を減らし、高いパフォーマンスと拡張性を確保するために重要です。 |
| カスタムエラー処理 | 利用可 CustomError 要素は、保存操作をブロックし、ユーザーにメッセージを表示することができます。 |
推奨addError() メソッドは、柔軟な項目レベルおよび条件付きエラーメッセージングを提供します。 |
| 使用事例 | 説明 | Best-Fit | 根拠 |
|---|---|---|---|
| 高パフォーマンスのバッチ処理 | 何千ものレコードを効率的に処理する必要がある自動化 | Apex | Apex は、プラットフォームとのインタフェースと未フォーマット時の速度を実現する豊富な API を提供します。 |
| 複雑なデータ処理 | 高度なデータ操作が必要なシナリオ | Apex | Apex は、Map や Set などのデータ構造を提供します。これらは、フローではネイティブに使用できず、パフォーマンスが高く一括安全なコードを記述するために不可欠です。 |
| トランザクション制御 | セーブポイント、ロールバック、部分的な確定などの制御メカニズム | Apex | Apex は Database.savepoint や Database.rollback などのメカニズムへのアクセスを提供し、部分的に成功した DML 操作を処理する機能を備えています。 |
| 高度なカスタム検証 | レコードの複数の項目のデータ検証 | Apex | フローでは `CustomError` 要素を使用して保存を防ぐことができますが、サブフローを含むすべてのフロー種別で使用できるわけではありません。Apex addError() メソッドは、トリガー処理中にいつでもレコードに追加できる複数の項目固有のエラー メッセージを提供します。 |
| 単純なプロセス内のロジックがやや複雑 | 高度な関数の標準ライブラリによって簡略化された、中程度の複雑さのロジックとデータ操作 (複雑なプロセスの一部として発生) | フロー + Apex | レコードトリガーフローはオーケストレーションレイヤーとして機能し、高複雑度のオペレーションはInvocable Apex内にカプセル化されます。 |
| シンプルから適度に複雑なロジック | 主データオブジェクトと関連データオブジェクトの両方に対するトリガー更新による、低から中程度の複雑さのデータ操作 | フロー | フローは、システム管理者とデベロッパーの両方が扱いやすい宣言型モデルに基づいているため、通常は最適な選択肢となります。 |
| 通知および送信メッセージ | アウトバウンドメールおよびメッセージの送信 | フロー | フローを使用すると、レコードの変更時にメールアラートおよびアウトバウンドメッセージの送信が容易で、拡張性にも優れています。 |
| スケジュール済み処理 | 将来の動的な日付 (完了予定日の 3 日前など) での自動化 | フロー | スケジュールパスは、レコードのデータが変更された場合にプラットフォームがこれらのパスのスケジュール設定、キャンセル、再スケジュールを自動的に処理するため、フローに独自の強みをもたらします。 |
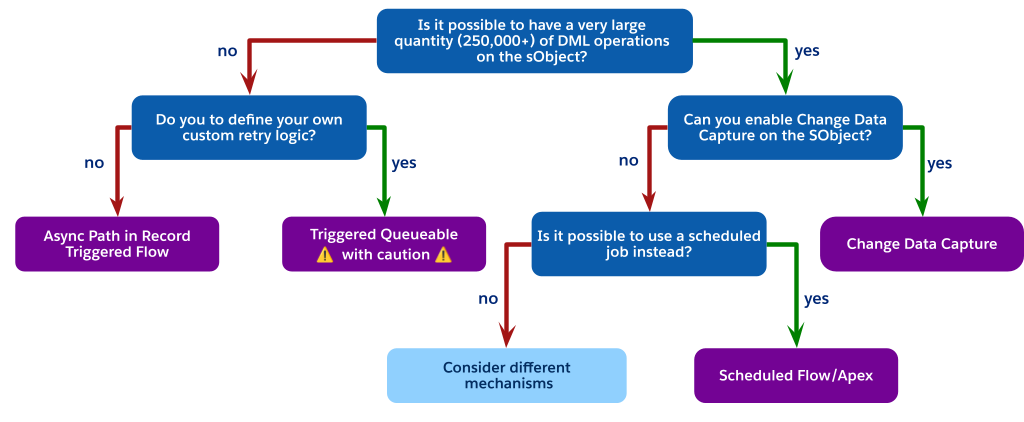 ### スケジュール済みジョブの代替
フローチャートが示すように、大規模な DML 操作に直面しているが (オブジェクトの制限などにより) 変更データキャプチャを使用できない場合、多くの場合、最適なアーキテクチャの選択はトリガーで呼び出されるプロセスを完全に回避することです。
代わりに、スケジュール済みプロセスを使用することを検討してください。これは、スケジュール済みフローまたはスケジュール済み Apex のいずれかです。必要な手順は次のとおりです。
1. 同期トリガーでシンプルで低コストの更新を実行します。たとえば、`Status__c` フィールドを「処理待機中」に設定したり、Chatter投稿などの低コストの関連レコードを挿入して、レコードの処理が必要であることを示します。
2. 15 分ごとや 1 時間ごとなど、定期的に実行されるスケジュール済みジョブ (スケジュール済みフローまたはスケジュール済み Apex) を作成します。
3. スケジュール済みジョブで待機中の状態のすべてのレコードを照会し、制御された大量のコンテキストで複雑なロジックを実行して、レコードを処理済みとして更新します。
このパターンは、重い処理をユーザーの同期保存から完全に分離し、トリガー起動バッチのトランザクションあたり1つのジョブの制限を受けず、非リアルタイム要件に対応する拡張性とガバナンスが高いソリューションを提供します。
スケジュール済みジョブのレイテンシがビジネス要件で許容できない場合、CDCまたはトリガー起動キューイブルの使用が引き続き制限されている場合は、アーキテクチャの重大な不一致を示します。この時点で、異なるメカニズムを考慮する必要があります。コアアプリケーション設計を再評価すると、次のような特定の結論に達する可能性があります。
- CDC オブジェクト制限を削除するアドオンの購入。
- ほぼリアルタイムの処理が本当に「必須」なのか、スケジュール済みジョブの遅延がプラットフォームの安定性にとって許容可能なトレードオフなのかを判断するビジネス要件に根本的に挑戦します。
## 機能以外の考慮事項
決定ポイントに加えて、複雑さや標準など、機能以外の考慮事項も考慮する必要があります。
### 複雑さ
実装の複雑さのレベルは、ソリューションの総所有コストだけでなく、変化するビジネス要件に適応する能力にも影響します。ベストプラクティスに従わないと、実装が複雑になる可能性があります。このドキュメントの「_Related Best Practices_ (関連するベストプラクティス)」セクションでは、ソリューションの複雑さを軽減するための推奨事項を次に示します。
- ハイブリッドパターン: フローでの複雑なロジックの呼び出し可能な Apex
- Apex トリガーでのメタデータフレームワークの使用
- メガフローと複数のフロー
### プロセスと標準
本ドキュメンテーションはオートメーション自体と同じくらい重要です。メンテナンス性が確保されるだけでなく、AI やエージェントベースのツールにとっても重要です。ドキュメントは、ビジネスプロセスの理解と管理に役立ちます。
**In Flow**
- すべての要素と変数に一貫した命名規則を設定します。
- フローの \[説明] 項目を使用して、フローの全体的な目的、トリガー条件、意図した結果を説明します。
- 個々の要素 (`Get Records`、`Action`、`Transform` など) で [説明] 項目を使用します。これは、意図を伝えるための最良の方法です。これは、呼び出し可能なアクションとサブフローで特に重要であり、説明はアクションによって実行される複雑なロジックを説明する主要な場所です。
**In Apex**
- ロジックの背後にある_理由_を、_何_であるかだけでなく、明確にコードにコメントします。
- メタデータ駆動型フレームワークを使用している場合は、メタデータレコードに人間が判読可能な \[説明] 項目が含まれていることを確認し、各ハンドラークラスが実行する内容と実行タイミングを説明します。
DevOps とソース管理は、成熟した開発ライフサイクルの一部です。Salesforce プロジェクトでは、Git などのソース管理ツールを常に使用します。Apex クラスと Salesforce フローはどちらもビジネス ロジックを定義するメタデータであり、バージョン管理する必要があります。
レコードトリガー自動化の管理のコンテキストでは、最新の DevOps パイプラインには不可欠な利点があります。
- **自動品質チェック:** [Salesforce Code Analyzer](https://developer.salesforce.com/docs/platform/salesforce-code-analyzer/overview) などのツールは、パイプライン内で自動的に実行するように設定できます。静的分析では、昇格前に両方の自動化ツールの問題パターンを検出し、パフォーマンス低下の一般的な原因である、フロー ループ内の非効率的な`Get Records`要素やループのApex内の`SOQL`クエリなどの問題にフラグを設定できます。
- **回帰防止:** 自動化の密度が高まると、1 つのフローまたは Apex クラスを変更すると、同じオブジェクトの他の自動化に意図しない結果が生じる可能性があります。提案された変更に対して自動化されたApexテストを実行する堅牢なDevOpsテスト戦略は、新しいフロー バージョンで既存のApexロジックが破損しないこと(およびその逆)を確認する最も信頼性の高い方法です。
- **コラボレーションと可視性:** ソース管理は「単一の情報源」です。これにより、システム管理者と開発者は同じオブジェクトの自動化に並行して取り組むことができます。また、貴重な監査証跡も提供されます。本番プロセスが中断すると、自動化を変更した_ユーザー_、自動化を変更した_タイミング_、および(確定メッセージを介して)自動化を変更した_理由_をすぐに確認できます。
管理者と開発者が混在するチームの場合、[DevOps Center](https://help.salesforce.com/s/articleView?id=platform.devops_center_overview.htm&type=5)では、これらのすべてのステップをコレオグラフィーするのに役立つ統合インターフェイスが提供され、拡張性の高いソース制御ベースの開発プロセスをチームの全員が利用できるようになります。
ドキュメントと DevOps のこの組み合わせにより、組織の長期的な健全性とメンテナンス性が確保され、フォローするすべてのアーキテクトとシステム管理者にメリットがもたらされます。
## 関連するベストプラクティス
上記の決定ガイドは、実装を計画する前に使用することをお勧めします。使用事例に最適な製品を選択できるようにすることを目的としています。製品を選択したら、実装の既存のベストプラクティスを理解することが重要です。
### ハイブリッドパターンの活用: フローでの複雑なロジック用の呼び出し可能な Apex
_オブジェクトあたり1_つのツールの原則は、高密度の自動化を管理するために重要ですが、それを純粋に宣言型か純粋にプログラム スタックかの二者択一として解釈しないでください。より効果的で管理しやすいアーキテクチャパターンでは、ハイブリッドモデルを活用します。つまり、レコードトリガーフローをオーケストレーションレイヤーとして配置しながら、呼び出し可能な Apex 内で高複雑度の操作がカプセル化されます。
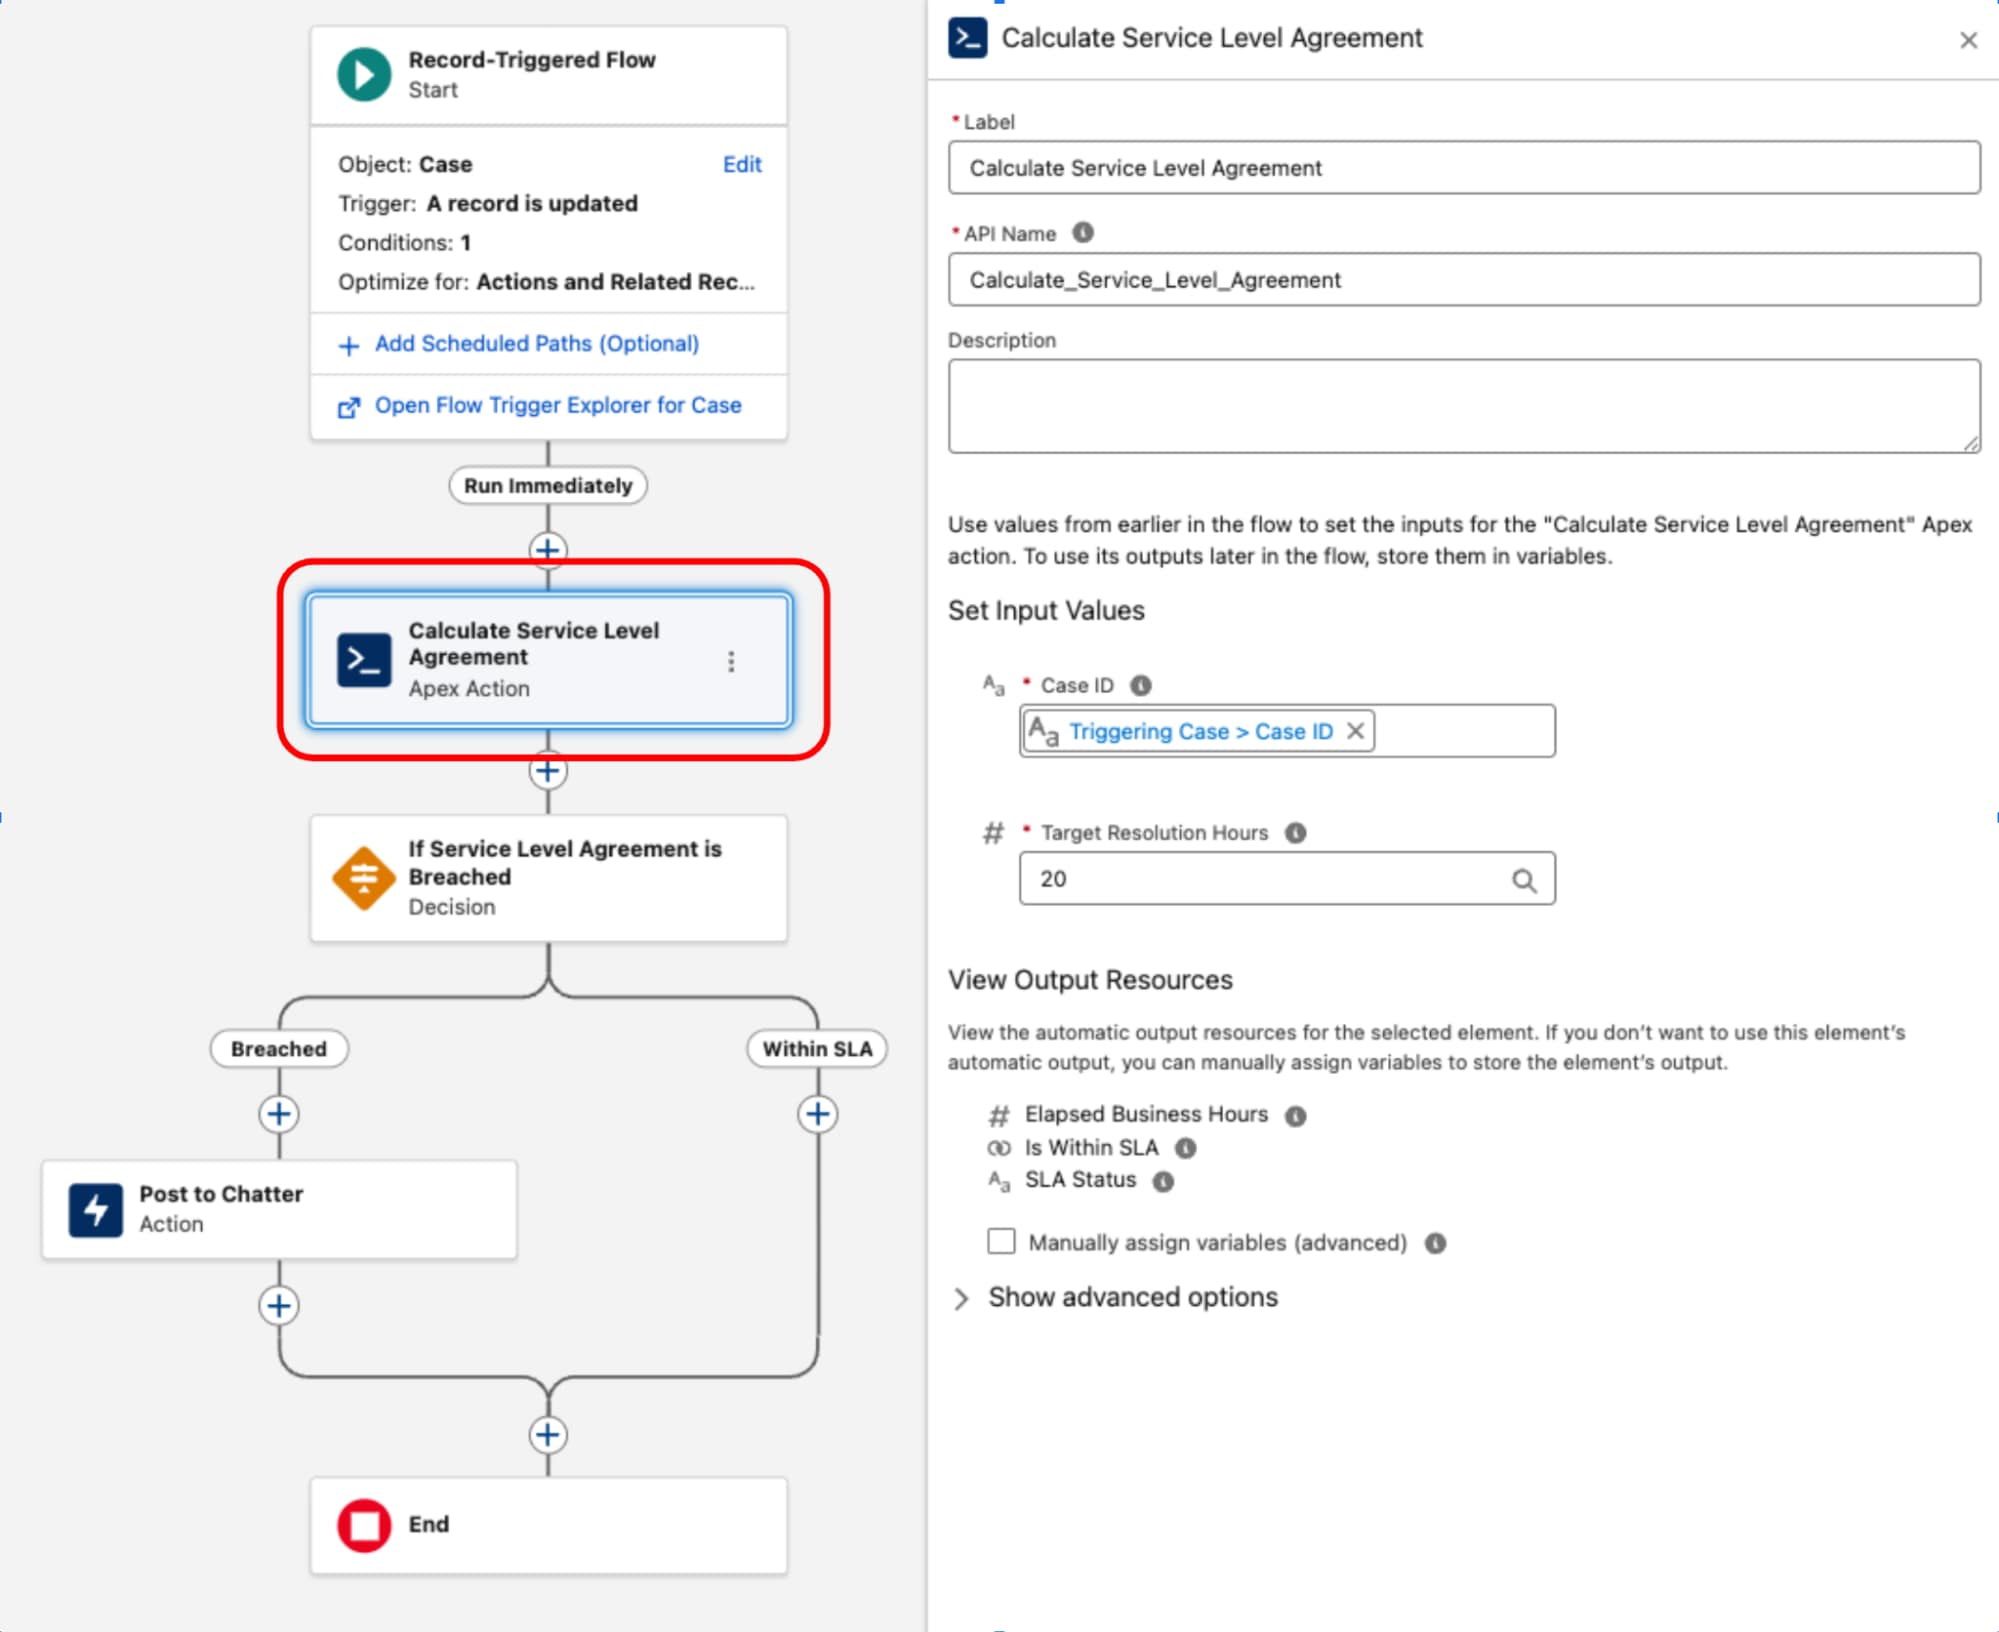 #### オーケストレーションレイヤー: フロー
レコードトリガーフローは、ビジネスプロセスのオーケストレーションレイヤーとして機能します。エントリ条件と実行コンテキスト (_何_と_いつ_) を所有します。このレイヤー内で決定ロジックとルーティングを保持することで、フロートリガーエクスプローラーでアーキテクチャのプロセストポロジーを透過的かつ管理可能にし、重要なビジネスロジックがコード内で不明瞭にならないようにします。
#### 複合コンポーネント: 呼び出し可能な Apex
複雑なコンポーネントの一般的な例として、ケースレコードのサービスレベル契約 (SLA) の計算の実装があります。BusinessHours オブジェクトとその関連ロジックは、非勤務時間と休日を除外する正確な計算に不可欠ですが、フローではネイティブにアクセスできないため、専用の Apex クラスが使用されます。このクラスは、多くの場合 `ServiceLevelAgreementCalculator` などと呼ばれ、`@InvocableMethod` で注釈が付けられた 1 つの静的メソッドを使用して設計され、経過した営業時間を計算し、SLA が「目標内」か「違反」かを判断し、構造化された出力を返します。このアプローチでは、Apexの複雑で高パフォーマンスのロジックをカプセル化しつつ、レコードトリガーフローの宣言型のオーケストレーションレイヤーにシームレスに実行・統合されます。
Apex `ServiceLevelAgreementCalculator` クラスが定義されると、レコードトリガーフロー内で使用できるようになります。
このパターンは、懸念の厳格な分離を示しています。宣言型レイヤーはトランザクションライフサイクルとオーケストレーションの管理に使用され、コードは高複雑度の実行に使用されます。コードを基盤ではなく機能的なユーティリティとして扱うことで、パフォーマンスとメンテナンス性のバランスを取ります。
#### ハイブリッドパターンの主な利点
**モジュール性**: この手法は、プロセス全体でApexまたはフローのみを使用するという一辺倒なアプローチから脱却しています。代わりに、アーキテクチャは複雑なロジックを、バルクセーフかつ個別にテスト可能なユニットにカプセル化します。これらのユニットは宣言型レイヤーで使用される再利用可能なコンポーネントとして機能し、アーキテクチャ設計を複雑にすることなく自動化を拡張できます。
**再利用性**: ロジックはトリガーイベントから分離されます。適切に設計されたコード ユニット(`InvocableMethod`など)は1回のみ記述され、複数のエントリー ポイント(レコードトリガー フロー、画面フロー、外部インテグレーション)で活用されます。このコードの再利用により、冗長な開発が排除されます。
**保守性**: プロセスフローロジックは宣言型フロー内で表示および管理可能なままです。この一元化により、デバッグのオーバーヘッドが大幅に削減され、システムの実行順序が確定的で透過的になります。
#### ハイブリッドパターンの制限とトレードオフ
フローから呼び出し可能な Apex を使用するハイブリッド モデルは強力ですが、汎用的なアプローチではありません。アーキテクトは、ハイブリッド ソリューションに取り組む前に、特定の制限とトレードオフを認識しておく必要があります。
- **No before-save support**: これは最も重要な制限事項です。呼び出し可能なアクションは、保存後コンテキスト (アクションと関連レコードのフロー) でのみ使用できます。高パフォーマンスな保存前コンテキスト(フィールドの高速更新のフロー)では使用できません。そのため、このパターンを使用して同じレコードのフィールドの更新を委任することはできません。保存前フローまたは保存前コンテキストのApexトリガー内でネイティブのフロー要素を使用して、高パフォーマンスの仕事を実行します。
- **No after-undelete support:** 現在、レコードトリガーフローでは復元後のコンテキストはサポートされていません。Salesforce オブジェクトに、ごみ箱からレコードを復元するときに自動化を実行するというビジネス要件がある場合、Apex トリガーが唯一のソリューションです。
- 大規模シナリオの**パフォーマンスオーバーヘッド:** フローランタイムから Apex ランタイムへの移行は、コストゼロの運用ではありません。一般に高速ですが、フローのランタイムから呼び出し可能アクションにドロップする動作は、Apex トリガー内に完全に収まるネイティブ実行ほど計算速度は速くありません。ほとんどの中密度のオートメーションでは、このマイクロオーバーヘッドは無視できるほど小さく、アクセシビリティの向上に十分見合うものです。ただし、極端に高パフォーマンスかつ高ボリュームのシナリオでは、Apexのみのフレームワークの方が純粋な計算速度の点で有利です。
### 従来の自動化の戦略
オートメーション密度のヒューリスティックは、新しいグリーンフィールドアーキテクチャには決定的な指針を提供しますが、企業のSalesforce環境における実情は、より複雑なことが多いです。成熟した組織では、同じ Salesforce オブジェクトで動作するレコードトリガーフローと Apex トリガーを見つけるのが一般的です。このシナリオは、前に説明したハイブリッド パターンとは異なります。ここでは、フローと Apex トリガーが結合されておらず、連携するように設計されていません。
この共存は、多くの場合、プラットフォーム機能の進化や従来の技術的負債が原因です。これは許容される運用状態ですが、アーキテクトはそれを最終状態ではなく、計算されたトレードオフとして捉える必要があります。
オーケストレーションが断片化することで、ガバナンスとメンテナンスのオーバーヘッドが大きくなり、開発、テスト、インシデント処理の作業がバラバラになり、煩雑になります。これにより、解決までの時間 (TTR) が増加し、運用が複雑になります。
- 新しい Salesforce オブジェクトの場合、主要なガイドとして自動化密度の原則に従います。
- 既存の Salesforce オブジェクトで、ハイブリッドなフットプリントを持ち、レコードトリガーフローと Apex トリガーの両方のエントリーポイントが存在する場合、密度を評価した上で、メンテナンス性を考慮したハイブリッド状態にリファクタリングするよう設計します。
- 低密度の場合は、Apexトリガーをレコード トリガー フローにリファクタリングし、実行順序を指定して、1つの自動化エントリ ポイントに取り込みます。
- 中密度の場合は、複雑な大規模フローを、適切な実行順序を保ったまま、フローのサブセットにリファクタリングします。Apex トリガーは、削除取消後のコンテキストをサポートするなど、どうしても必要な場合にのみ導入してください。
- 高密度の場合は、Apexトリガーの実装をお勧めします。
### Apex トリガーでメタデータフレームワークを使用する
Salesforce Platform での組織のビジネスプロセスが成熟するにつれて、レコードトリガー自動化の量と複雑さは必然的に増加します。基本的なベストプラクティスは、_ApexトリガーをSalesforceオブジェクト_ごとに1つ管理することです。プラットフォームでは、同じイベントに対して同じオブジェクトに対する複数のトリガーの実行順序が保証されないため、このルールは非常に重要です。この制限により、動作が不安定になったり、競合状態になったり、デバッグが困難になったりする可能性があります。
ただし、_ワン トリガー_の原則に従うと、アーキテクチャ上の課題が生じます。つまり、その1つのエントリー ポイントから呼び出されるすべてのビジネス ロジックを、メンテナンス可能で拡張可能な方法で管理およびオーケストレーションする方法です。
#### Classic トリガハンドラの制限事項
このアーキテクチャの最初の進化は Classic トリガハンドラパターンでした。この方法では、1 つの Apex トリガーですべてのロジックが対応するハンドラ クラス(`OpportunityTriggerHandler` など)に委任されます。このメソッドにより、ロジックがトリガーファイルから分離され、開発者はハンドラクラスのメソッド (`afterInsert()` など) 内の実行順序を決定的に制御できます。
このパターンは改善されていますが、多くの場合、ハンドラークラスがモノリシックになります。ビジネス要件が追加されるにつれ、クラスは大規模になり、管理が難しくなり、単独でテストすることも困難になります。すべての個々のプロセスの実行順序が 1 つのメソッド内でハードコードされるため、クラスがマージの競合を起こしやすく、大規模なエンタープライズ環境でのガバナンスとメンテナンスのオーバーヘッドが大幅に増加します。
#### 解決策: メタデータ駆動型トリガーフレームワーク
モジュール性とオーケストレーションのコア問題を解決するために、アーキテクトは**メタデータ駆動型トリガー フレームワーク**に移行します。これは、自動化ロジック自体を実行_方法_と実行_タイミング_の設定から分離する、アーキテクチャ上の重要な飛躍です。
このフレームワークは、次の3つの主要な利点に基づいて構築されています。
- **パーティショニング:** 1 つのハンドラ クラスではなく、コア ビジネス ロジックが小さな原子 Apex クラス (`RecalculateAccountValues` クラスや `NotifySalesLeads` クラスなど) に分割され、各クラスが \[_Single Responsibility Principle_ (単一責任の原則)] に従います。このモジュール化により、ロジックを個別にテスト、デバッグ、および理解しやすくなっています。
- **順序と振付:** Apex で実行順序がハードコードされなくなりました。代わりに、通常はカスタムメタデータ型 (`TriggerAction__mdt` など) に保存されている設定レコードによって宣言的に定義されます。これにより、管理者はリリースやコードの変更を必要としないメタデータレコードを変更するだけで、自動化アクションの並び替え、追加、削除ができます。
- **バイパス機能:** このフレームワークは、標準化された詳細なバイパス機能を提供します。各自動化アクションは、そのメタデータレコードを使用してグローバルに無効にするか、カスタム権限を参照して特定の管理ユーザーに対してスキップするように設定できます。
オブジェクトの単一の Apex トリガーは、動的ディスパッチャーとしてのみ機能します。ビジネスロジックが含まれておらず、代わりに中央`MetadataTriggerHandler`クラスがインスタンス化されます。このハンドラは、カスタムメタデータレコードを照会して実行順序を動的に決定し、指定された順序で正しいアトミック Apex クラスを呼び出します。自動化は、1 つの透過的で管理可能なレイヤーで統合されます。
### トランザクションでの高価な操作の重複排除
堅牢なフレームワークでApexを使用する重要なメリットは、トランザクションの状態を管理でき、重複作業を排除してパフォーマンスを最適化できることです。ロジックが蓄積されると、保存順序内のさまざまなオートメーションが同じ高価な操作を個別に実行し、貴重なガバナ制限を消費して DML 操作時間が増加することがよくあります。
このフレームワークは、次の 2 つの主な戦略でこれに対処するように設計されています。
- **共有状態管理:** 1つのApexトランザクションの範囲内で、静的プロパティと変数を使用してデータをキャッシュします。これにより、設定の`SOQL`クエリなどの高価な操作は、トリガーの異なるレコードまたはフェーズで自動化ロジックが複数回呼び出された場合でも、1 回のみ実行されます。トランザクション制限の消費が大幅に削減されます。
- **プラットフォームキャッシュ利用**率: 単純なトランザクション内キャッシュだけでなく、プラットフォームキャッシュを使用して、データベース全体で特定のデータを照会しないようにします。この管理対象のメモリ内キャッシュは、非プリミティブで、コードベース全体で頻繁に参照され、トランザクション全体 (プロファイル、ロール、営業時間など) で不変のデータを取得する場合に最適です。`Cache.CacheBuilder` インターフェイスを使用して、システムは最初にキャッシュを確認し、データが存在しない場合にのみデータベースクエリを実行するため、パフォーマンスと拡張性が最大限に高まります。
### 同じレコードの更新には保存前更新を使用
オートメーションでトランザクションを開始するレコードの項目値のみを変更する必要がある場合は、必ず保存前更新を使用してください。これは、フローにおける高速フィールド更新(保存前に実行)と、Apex トリガーにおける保存前のコンテキストロジック(挿入前、更新前)の両方に適用されます。
このパターンは、2 回目の DML 操作と再帰的な保存サイクルが回避されるため、どのツールを使用してもパフォーマンスは優れています。変更は、データベースにコミット_される前_にメモリ内のレコードに対して行われ、元のトランザクションの一部として保存されます。保存順序全体を再実行し、すべてのオートメーションを再度実行する2回目の保存のオーバーヘッドが排除されます。
### 非制御再帰の防止
非制御再帰は、更新後のトリガーでよく発生する落とし穴で、トリガーのロジックによって DML 更新が実行され、同じトリガーが再度起動されます。これにより、最終的にガバナ制限例外で終了する無限ループが発生します。これまで、静的 Boolean フラグや処理済みレコード ID のコレクションは、このような再帰を防ぐために使用されてきましたが、より正確で堅牢なパターンは、レコード自体の新しいバージョンと古いバージョン間で項目値を比較してロジックをゲートすることです。
ロジックは、関心のある特定の項目が実際に変更された場合にのみ実行します。これにより、重要なデータが変更されない同じトランザクション内の後続の DML 操作でトリガーのロジックが実行されなくなります。
#### レコードトリガーフローでの再帰の制御
レコードトリガーフローでは、条件の要件を満たすようにレコードが更新されたときにのみ実行されるようにフローを設定することで、非制御の再帰を防止します。
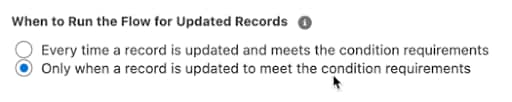 フローで入力条件数式を使用する場合、`$Record` グローバル変数 (新しい値を表す) と `$RecordPrior` グローバル変数 (保存前の元の値を表す) を比較することで、暴走を回避できます。たとえば、商談の \[金額] 項目が変更された場合にのみフローが実行されるようにするには、次のように入力条件で使用します。
```
$Record.Amount != $Record__Prior.Amount
```
#### Apex での再帰制御
新しいバージョンのレコード `Trigger.new` の項目値と古いバージョンのレコード `Trigger.oldMap` の項目値を比較し、探している特定の変更が行われているかどうかを確認します。このアプローチにより、自動化が即効性を発揮し、必要な場合にのみ実行されるため、システムの効率が向上し、破滅的な再帰ループを回避できます。
### 自動化のスキップ
優れた設計の Salesforce 組織には、オートメーションをバイパスするための一貫して信頼性の高いメカニズムが必要です。これは省略可能な機能ではなく、データの整合性を維持し、管理タスクを有効にするためのコア業務要件です。
次のようなシナリオでは、バイパスフレームワークが不可欠です。
- 大量のデータを読み込む場合、レコードごとにトリガーをトリガーすると、プロセスが大幅に遅くなり、制限例外が発生し、誤った関連レコードと通知が作成される可能性があります。バイパスを使用すると、データをクリーンかつ効率的に挿入できます。
- インテグレーションユーザーは、外部の記録システムからデータを同期する必要がある場合があります。ユーザーが開始した変更 (メールの送信、ToDo の作成など) で通常起動される自動化は、変更が別のシステムから行われた場合に望ましくない場合や冗長になる場合があります。
- システム管理者またはサポートスタッフは、レコードの修正更新を実行する必要がある場合があります。バイパスメカニズムを使用すると、意図しない結果になる可能性がある標準のビジネスオートメーションをトリガーせずにこれらの変更を行うことができます。
**カスタム権限**: バイパス ロジックを実装するための最新のスケーラブルな標準はカスタム権限です。これらは、いくつかの理由で古い方法よりも優れています。
- **柔軟性:** 権限セットを使用してカスタム権限をユーザーに割り当てることができます。この手法は、最新の Salesforce セキュリティおよびアクセスモデルに準拠しているため、きめ細かく柔軟な割り当てが可能です。バイパスは特定のユーザーに付与することも、特定の有効期限で一時的に付与することもできます。
- **保守性:** カスタム権限を使用すると、プロファイルやユーザーを自動化ロジックにハードコードする必要がありません。ユーザーのロールが変更されたり、新しいプロファイルにアクセスをバイパスする必要がある場合、変更は単純な権限セットの割り当てであり、リリースを必要とするコードやフローの変更ではありません。
- **拡張性:** カスタム権限は、複雑なユーザーベース全体で例外を管理するためのスケーラブルなフレームワークを提供します。権限セット、権限セットグループ、またはプロファイルを使用してユーザーに割り当てることができます。権限セットまたはプロファイルへの関連付けもソースメタデータで表現できます。
**実装パターン**: 組織内のすべてのレコードトリガー自動化に一貫したバイパスパターンを適用します。
**レコードトリガーフローのバイパス**: フローをバイパスする最も効率的な方法は、フローの実行を一切防止することです。これは、フローのエントリ条件に条件を追加することで実現されます。
- レコードトリガーフローの開始要素で、\[エントリ条件] を \[数式が True と評価] に設定します。
- 数式ビルダーで、`$Permission` グローバル変数を使用してカスタム権限のチェックを組み込みます。チェックを既存のエントリ条件と組み合わせます。
- 数式パターン:
```
( ) && NOT($Permission.Bypass_This_Flow)
```
- このパターンにより、指定されたカスタム権限がユーザーに割り当てられ_ていない_場合にのみフローが実行されます。このチェックは、フローインタビューが作成される前に実行されるため、最もパフォーマンスの高い方法です。
**Apex トリガー フレームワーク**のバイパス:Apex で、バイパス ロジックをメタデータ駆動型トリガー フレームワークに直接統合し、詳細な制御を可能にします。
- `TriggerAction__mdt` カスタムメタデータ型には、`BypassPermission__c` などのテキストフィールドを含める必要があります。
- `MetadataTriggerHandler` クラスでは、アクションを動的に実行する前に、コードがこの項目の値を読み取る必要があります。
- フィールドに値が入力されている場合、ハンドラは `FeatureManagement.checkPermission()` メソッドを使用して、現在の実行ユーザーに指定したカスタム権限があるかどうかを判断します。
- `checkPermission()` が true を返すと、ハンドラはその特定のアクションをスキップし、シーケンスの次のアクションに進みます。
- このパターンは、グローバルバイパス (すべての`TriggerAction__mdt`レコードが同じ権限を参照している場合) とアクションごとの詳細なバイパス (異なるレコードが異なる権限を参照している場合、または一部のレコードにまったくバイパス権限がない場合) の両方を可能にするため、強力です。
### メガフローと複数のフロー
これは、オブジェクトのすべてのオートメーションを 1 つの巨大なメガフローに統合するのはアンチパターンです。1つのフローに統合するのと、ロジックを複数の条件が整ったフローに分割するのとでは、パフォーマンスに大きな影響はありません。最も大きなパフォーマンス向上は、次の点から得られます。
- 同一レコードの項目自動更新に、保存前フローを使用します。
- 特定の使用事例に影響しない変更に対してフローの実行が除外されるように、正確なエントリ条件を記述します。
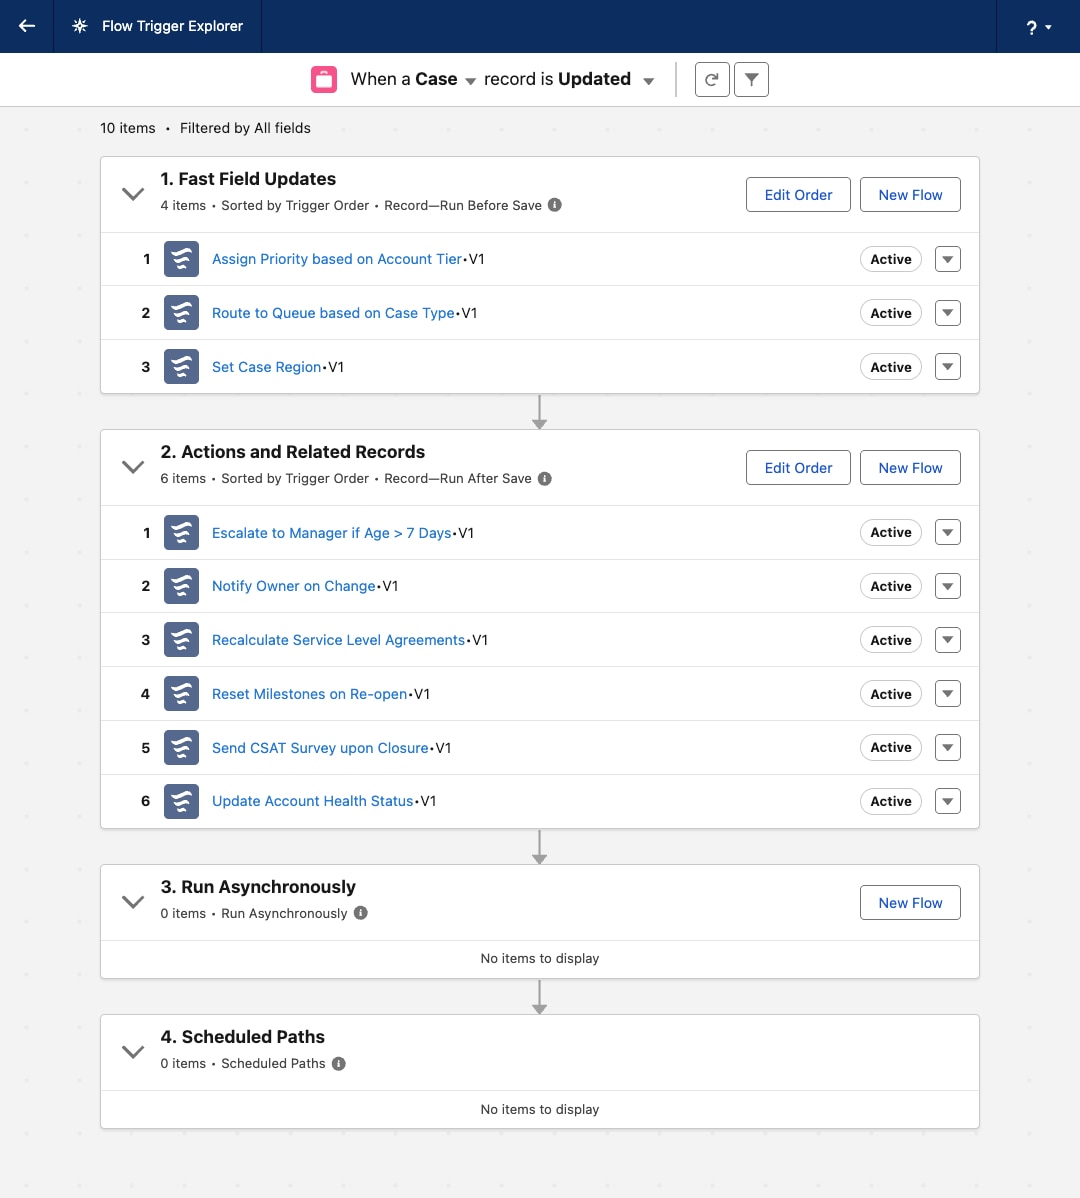
[フロートリガーエクスプローラー](https://trailhead.salesforce.com/content/learn/modules/record-triggered-flows/meet-flow-trigger-explorer)では、オブジェクトの各フローに順序値を割り当てて、順次実行順序を保証できます。
 ## リソース
| Apex | フロー | 業務 |
|---|---|---|