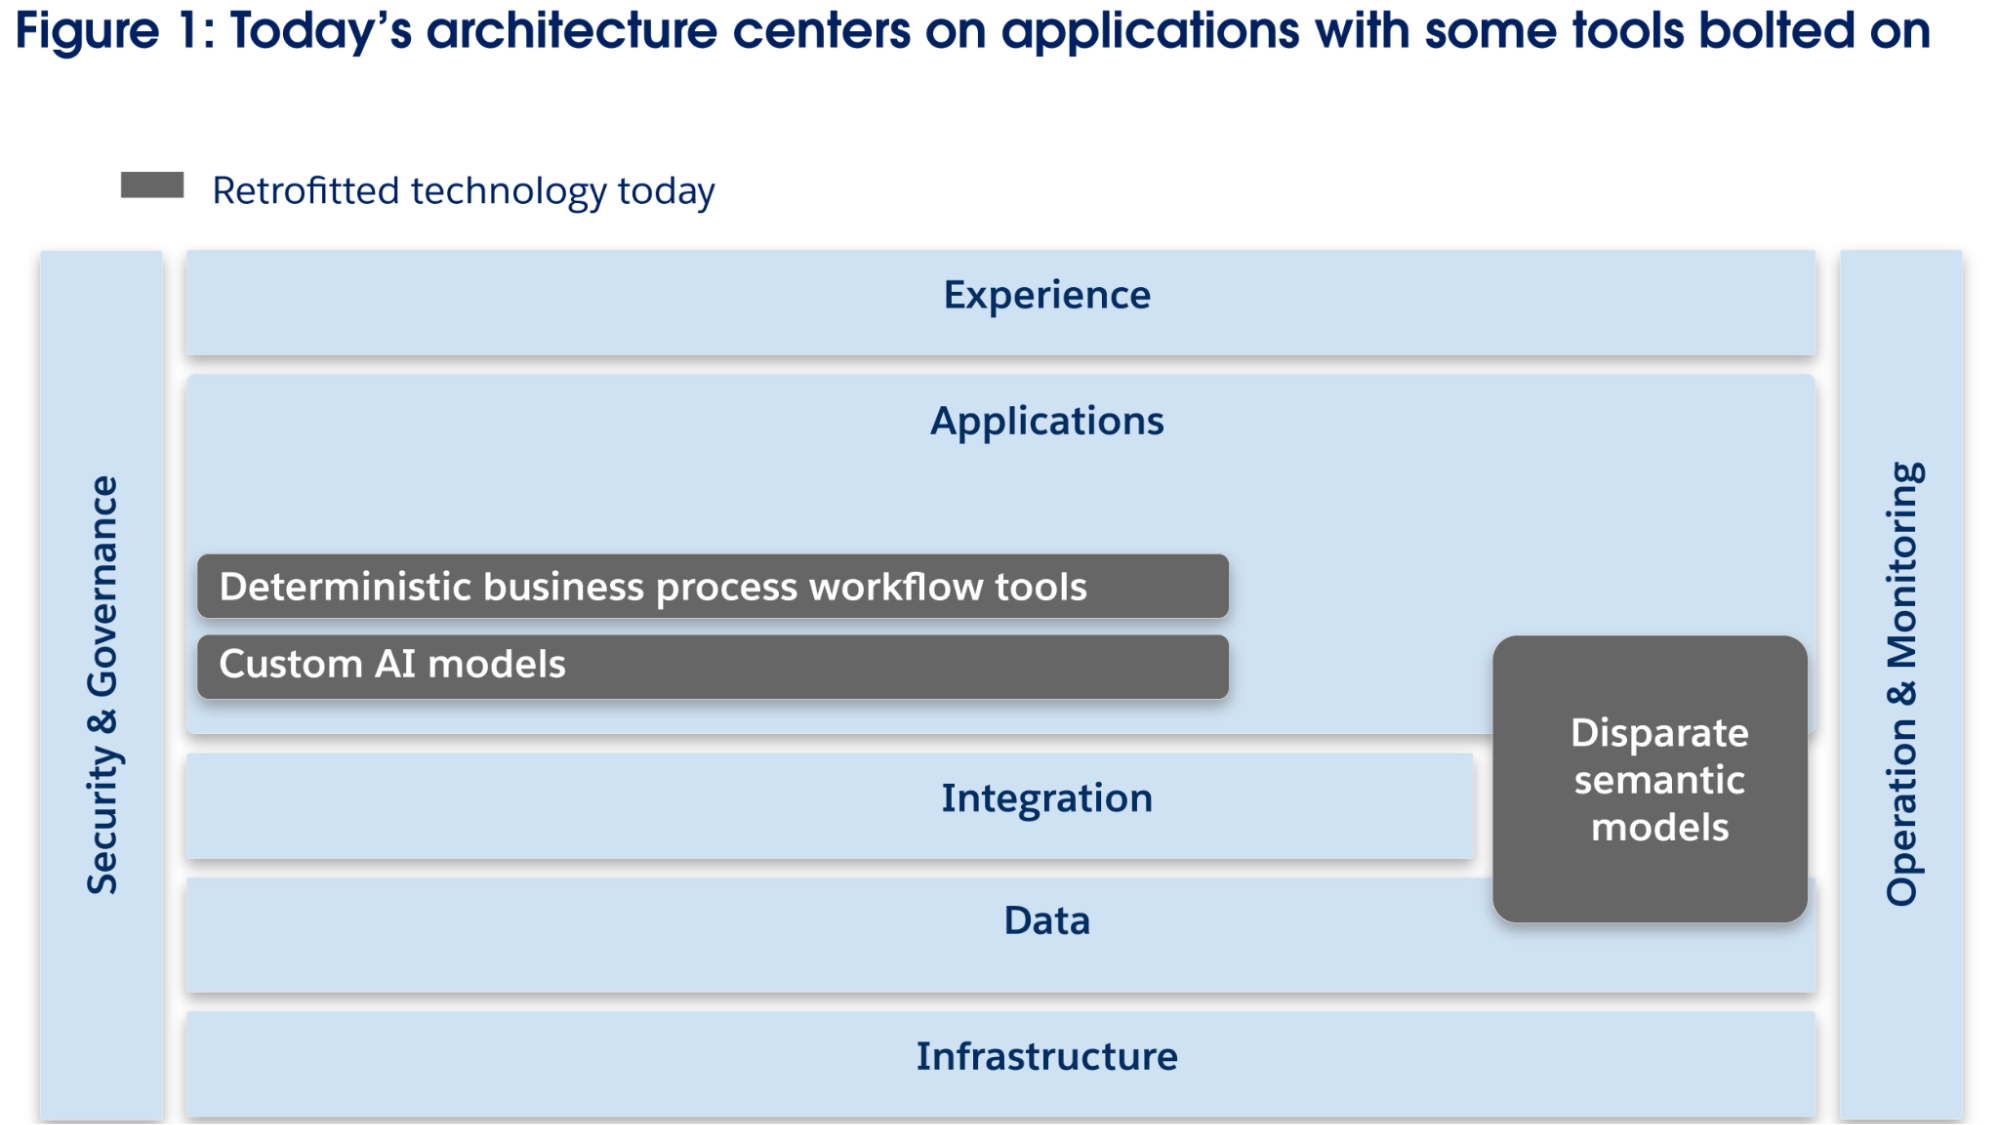
 Benché l'architettura tradizionale supporti oggi distribuzioni sottoscala di agenti AI, non è in grado di offrire appieno le funzionalità aziendali dell'organizzazione agente descritte sopra. La realizzazione di queste funzionalità richiede un'architettura IT progettata per la distribuzione su larga scala di agenti di intelligenza artificiale potenti che possono gestire casi d'uso ampi anziché essere limitati a distribuzioni limitate destinate a casi d'uso ristretti.
Gli agenti dell'intelligenza artificiale continueranno a migliorare nei prossimi 5 anni e l'architettura IT dovrà evolversi per realizzare il valore di agenti dell'intelligenza artificiale più potenti e intelligenti, per diventare a prova di futuro. In primo luogo, gli agenti diventeranno più intelligenti man mano che i modelli di intelligenza artificiale sottostanti (ad esempio, LLM multimodali) e le architetture cognitive degli agenti si evolveranno (ad esempio, pianificazione a più fasi, decomposizione delle operazioni e così via). In secondo luogo, gli agenti dell'intelligenza artificiale avranno migliori capacità di apprendimento e adattamento con miglioramenti della memoria, capacità di auto-riflessione e la capacità di imparare dai feedback. In terzo luogo, gli agenti AI avranno una maggiore capacità di interagire con altri agenti, strumenti e dati, come evidenziato dall'ecosistema in rapida evoluzione di standard tecnologici aperti (ad esempio, Model Context Protocol, Agent2Agent e così via). Sebbene queste tre tendenze tecnologiche consentiranno agli agenti dell'intelligenza artificiale di essere più potenti nell'esecuzione di operazioni più astratte e complesse, introdurranno anche numerose sfide per l'architettura IT odierna.
In primo luogo, gli agenti AI si basano fondamentalmente su modelli AI, sia sviluppati internamente che di origine esterna, che evolvono rapidamente e richiedono una gestione dei modelli AI/ML sofisticata, condivisa e standardizzata. Oggi, i modelli di intelligenza artificiale sono agganciati per casi d'uso specifici in un'applicazione, non come funzionalità condivise per il riutilizzo con strumenti comuni per la formazione, la distribuzione, la governance e la gestione del rischio. In futuro, le aziende dovranno essere in grado di utilizzare modelli di intelligenza artificiale diversi per vari casi d'uso agentici che richiedono strumenti che consentano agli agenti di sostituire i modelli sottostanti (ad esempio, modello di base e modello più piccolo specifico del dominio) in base al contesto aziendale. Ciò richiede la gestione di modelli di intelligenza artificiale sviluppati internamente o ospitati con strumenti unificati per il ciclo di vita per garantire coerenza, riutilizzabilità, scalabilità ed efficienza. Analogamente, l'accesso ai modelli di intelligenza artificiale ospitati esternamente richiede un framework di controllo a livello aziendale per garantire prestazioni, sicurezza, conformità, disponibilità e affidabilità ottimali.
In secondo luogo, gli agenti AI hanno schemi di scalabilità e requisiti operativi distinti, ad esempio hosting, sviluppo, ragionamento, apprendimento, gestione della memoria e operazioni, che richiedono un confine architettonico separato e dedicato per gli agenti. L'integrazione di questa funzionalità direttamente nell'odierna architettura di applicazione statica e deterministica introdurrebbe una complessità e un rischio architetturale inutili. Inoltre, gli agenti AI dovrebbero interagire con le applicazioni esistenti tramite interfacce standardizzate o sistemi di messaggistica per l'interazione in tempo reale.
In terzo luogo, gli agenti di intelligenza artificiale devono essere in grado di ragionare su serie di dati diverse e collaborare tra loro, spesso in pile di applicazioni in silo, ma nell'architettura odierna non esiste una funzionalità semantica comune che fornisca una comprensione condivisa per questi agenti per ragionare su serie di dati diverse. Di conseguenza, sebbene gli agenti monouso possano essere distribuiti con successo, la loro scalabilità per operare in gran numero su operazioni complesse tra silos rimane difficile e rischiosa.
Infine, l'attuale architettura IT aziendale non dispone di un modo efficace per orchestrare, ottimizzare e governare i processi aziendali end-to-end che includono i flussi di lavoro dinamici eseguiti da agenti più potenti, che aumenteranno e in alcuni casi sostituiranno il ruolo svolto dai lavoratori umani in quel processo. Oggi, gli strumenti di automazione vengono utilizzati per gestire flussi di lavoro lineari e deterministici che in genere seguono una sequenza predefinita, documentata in linguaggi specifici dei processi e si basano su una logica statica che cambia raramente. Le tecnologie AI possono migliorare alcuni di questi processi lineari (ad esempio, utilizzando modelli ML anziché regole aziendali codificate per calcolare le soglie di approvazione dei prestiti), ma gli aspetti strategici ed esecutivi della maggior parte dei processi aziendali critici rimangono per loro natura dinamici e flessibili. Operazioni come lo sviluppo di strategie di marketing, la risoluzione di problemi complessi dei clienti o la ricerca di clienti potenziali hanno obiettivi chiari (soddisfazione dei clienti, velocità di risoluzione dei casi e così via) ma non seguono una sequenza di esecuzione fissa e predefinita.
Attualmente, le aziende tradizionali si affidano principalmente agli esseri umani per coordinare ed eseguire questi processi aziendali complessi (ad esempio, impostare la strategia e gestire programmi complessi). Man mano che gli agenti dell'intelligenza artificiale continueranno a evolversi (maggiore capacità di intelligenza, apprendimento e interazione) nei prossimi 3-5 anni, la loro capacità di eseguire tali processi dinamici in autonomia aumenterà in modo significativo, introducendo complessità e sfide di integrazione che superano di gran lunga le funzionalità degli strumenti di integrazione e automazione esistenti. La natura adattiva e dinamica degli agenti AI crea un forte bisogno di nuove funzionalità di orchestrazione per garantire un controllo a livello aziendale, una visibilità completa e un allineamento coerente con gli obiettivi strategici a livello aziendale, in particolare nella gestione di flussi di lavoro complessi, lunghi e in più fasi che includono agenti AI, persone, strumenti di automazione e altri sistemi deterministici.
L'architettura IT di Agentic Enterprise stabilisce una piattaforma per azioni intelligenti integrando perfettamente lavoratori umani, agenti AI e sistemi deterministici. Questa architettura consente sia agli agenti umani che agli agenti dell'intelligenza artificiale di accedere dinamicamente a Knowledge aziendale unificata da fonti di dati diverse e di sfruttarla, arricchita da contesto semantico, per eseguire in modo efficiente flussi di lavoro e processi complessi in linea con gli obiettivi aziendali strategici. L'architettura IT esistente di un insieme di piattaforme e soluzioni puntuali in silo si evolverà verso un insieme di servizi applicativi componibili, strumenti semantici e di dati e reti di agenti AI supervisionati e governati da nuovi strumenti di orchestrazione intelligente dei processi aziendali.
Questa architettura consente agli agenti di percepire, ragionare e agire nei rispettivi ambiti, lavorare all'interno e tra i domini aziendali e imparare, migliorare e adattarsi continuamente. Ciò richiede una progettazione incentrata su meccanismi efficaci per accedere a dati e Knowledge (comprensione semantica), protocolli e interfacce di comunicazione flessibili e standardizzati (ad esempio, da agente ad agente, da agente a sistemi deterministici e da agente a umano) e, in modo critico, orchestrare flussi di lavoro e processi tra agenti, esseri umani e strumenti di automazione e sistemi deterministici.
### Principi di architettura
Per realizzare la visione architettonica di una piattaforma per azioni intelligenti, si consiglia di seguire questi principi di progettazione come procedura ottimale:
- **Componibilità e modularità:** Progettare gli elementi architettonici come componenti modulari con interfacce standardizzate per consentire un assemblaggio rapido e dinamico delle capacità degli agenti, dei flussi di lavoro e delle superfici rivolte al pubblico. Assegnare priorità a contratti di interfaccia chiari e astrazione per consentire agli agenti dell'intelligenza artificiale la massima flessibilità di composizione dei flussi di lavoro.
- **Prima i dati e la semantica:** Garantire un accesso completo, preciso, rapido, sicuro ed economico ai dati, con una comprensione semantica condivisa per consentire agli agenti di ragionare in modo efficace tra i sistemi in silo. Ciò richiede il trattamento dei dati (e dei metadati) come prodotto, con strumenti che garantiscano qualità, discendenza, governance e accesso, nonché un modo per fornire una comprensione semantica condivisa tra agenti e persone.
- **Osservabilità IT e aziendale incorporata:** Incorporare funzionalità di monitoraggio, tracciamento, valutazione e spiegabilità end-to-end nell'intera architettura per ottenere informazioni sul ragionamento, i comportamenti, le interazioni di sistema e l'impatto degli agenti sui KPI aziendali per consentire l'ottimizzazione continua delle prestazioni degli agenti. Ciò include l'ottimizzazione dei costi (FinOps), le metriche di sostenibilità e la telemetria operativa mantenendo Trust, conformità e consumo responsabile delle risorse. Poiché gli agenti AI sono per loro natura non deterministici, l'osservabilità è fondamentale per garantire che gli agenti AI possano operare in modo affidabile, conforme e controllabile con la supervisione umana.
- **Truste in tutto:** Applicare autorizzazioni dinamiche e granulari basate sull'intento delle operazioni dell'agente (accesso ai dati, azioni e così via) e implementare procedure di sicurezza complete che includono il teaming rosso, la scansione CVE automatica, il rilevamento delle vulnerabilità e i controlli di convalida basati sui rischi. Sono necessari controlli più granulari e dinamici dato il rischio che gli agenti causino rischi a catena a causa della loro capacità di operare a velocità della macchina. Assicurarsi che tutti gli output generati dall'intelligenza artificiale (da agenti o modelli) siano rigorosamente convalidati rispetto alle policy definite per conformità, sicurezza, tossicità e distorsione prima dell'uso o della consegna, richiedendo meccanismi di registrazione e spiegabilità con percorsi di controllo verificabili per decisioni, azioni, contenuti e previsioni dell'intelligenza artificiale.
- **Agente primo con supervisione umana:** Abilitare gli agenti dell'intelligenza artificiale come strumento predefinito per risolvere i casi d'uso aziendali, escludendo altre considerazioni (ad esempio, costo, preparazione tecnica) e progettare sistemi IT in modo che siano accessibili per i flussi di lavoro degli agenti. Ciò include la possibilità per gli esseri umani di monitorare, intervenire e ignorare qualsiasi fase del processo di un agente. Gli agenti richiedono capacità di auto-riflesso per cercare in modo proattivo una guida umana se la loro fiducia nel processo decisionale scende al di sotto delle soglie pre-programmate.
- **Interazione reattiva e multimodale:** Abilitare l'architettura per supportare meccanismi completi di invocazione e risposta degli agenti in tutti i tipi di interazione, inclusi protocolli da agente ad agente, input multimodali umani (voce, testo, visivo), eventi aziendali, segnali di sistema e dati in streaming. Abilitare le funzionalità di elaborazione basate sugli eventi e in tempo reale per garantire che gli agenti possano reagire a qualsiasi segnale tempestivo da qualsiasi fonte o formato.
- **Infrastruttura AI-ready:** Assicurarsi che l'infrastruttura possa scalare in modo elastico con la ridondanza incorporata per gestire carichi di lavoro AI fluttuanti e integrare le pipeline ML/LLM nell'architettura dei dati e delle applicazioni, mantenendo la conformità ai requisiti di residenza dei dati.
- **Ecosistema aperto:** Assegnare priorità all'interoperabilità ed evitare il blocco tecnologico privilegiando standard aperti, protocolli e interfacce ben definite (API, eventi) per trarre vantaggio dall'ecosistema tecnologico.
## Livelli architettura
Per abilitare e scalare con successo la trasformazione agente, le aziende devono andare oltre il semplice miglioramento dei livelli attuali; devono valutare la possibilità di introdurre esplicitamente quattro livelli architetturali aggiuntivi (Figura 2) progettati specificamente per soddisfare le esigenze degli agenti AI.
Il **livello agente** è dedicato allo sviluppo e alla gestione degli agenti AI, che comprende capacità cognitive come pianificazione, ragionamento, memoria, utilizzo degli strumenti, gestione dello stato e controllo del ciclo di vita. Questo livello soddisfa i requisiti tecnici e operativi specifici degli agenti AI, garantisce l'interoperabilità tra applicazioni e archivi di dati tramite protocolli standardizzati e facilita la collaborazione tra agenti. Il livello di applicazione esistente si evolverà in servizi di applicazione per essere composto dinamicamente per i flussi di lavoro degli agenti.
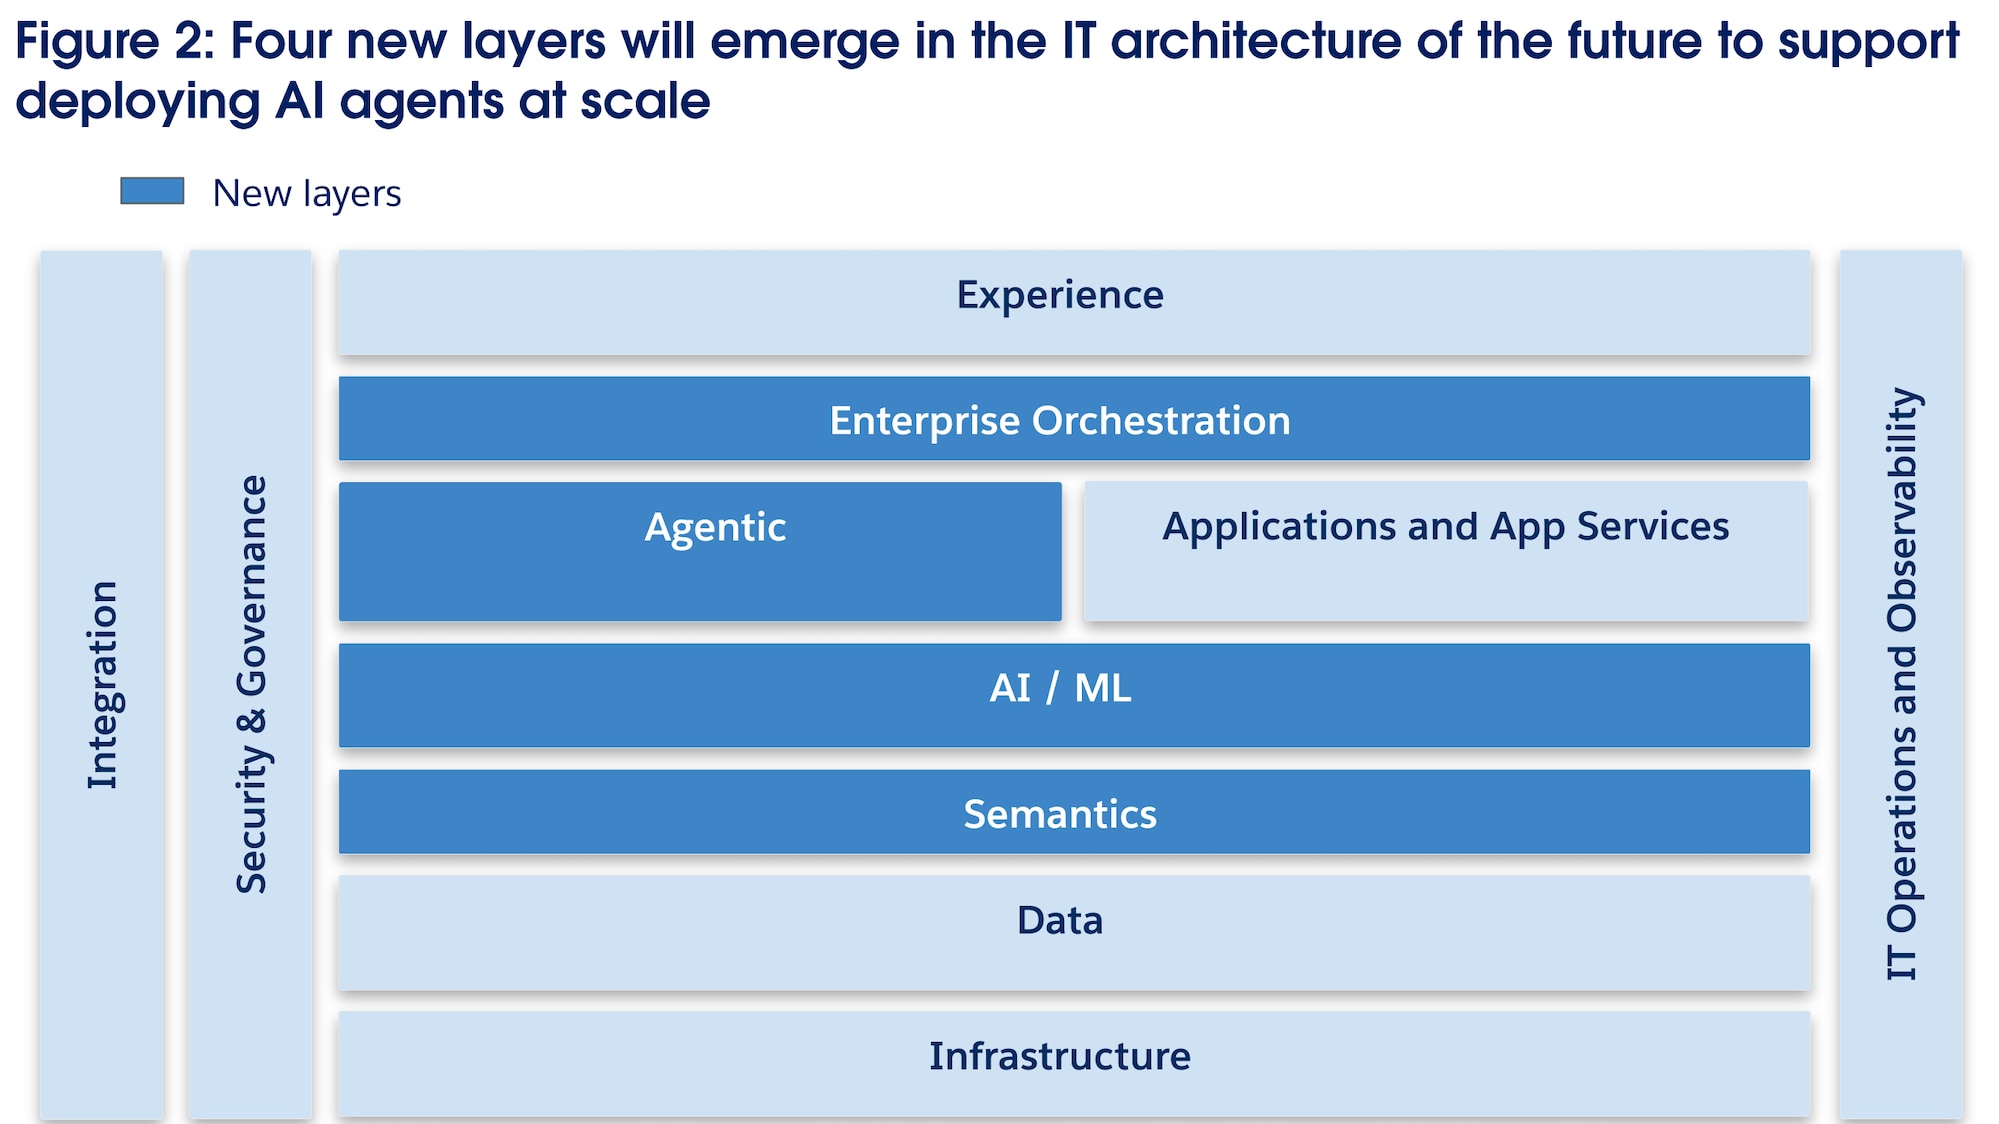 Il **livello semantico** viene introdotto per risolvere il divario tra i dati aziendali non elaborati e la comprensione semantica necessaria agli agenti dell'intelligenza artificiale. Codifica e gestisce in modo esplicito entità aziendali, concetti, definizioni e interrelazioni, creando un'ontologia aziendale e una rappresentazione di Knowledge aziendale per consentire una comprensione semantica condivisa che supporta flussi di lavoro multi-agente più complessi che eseguono operazioni di livello superiore. Oltre a un catalogo di dati, il livello semantico traduce una query per linguaggio naturale in query precise su archivi di dati specifici, armonizza i risultati e restituisce una risposta contestuale e più completa per l'agente. Nel frattempo, il livello di dati esistente viene unificato tramite l'adozione di lakehouse centralizzati e l'accesso ai dati viene ampliato tramite un data fabric predisposto per l'intelligenza artificiale per supportare i principi del modello operativo mesh di dati.
Il **livello AI/ML** centralizza la gestione delle funzionalità di intelligenza artificiale aziendali, inclusi modelli di linguaggio di grandi dimensioni, modelli di azione di grandi dimensioni e modelli ML specifici del dominio, gestendo sia i modelli di intelligenza artificiale sviluppati internamente durante il loro ciclo di vita che l'accesso/utilizzo controllato ai servizi di intelligenza artificiale esterni. A differenza delle architetture tradizionali in cui i modelli AI sono incorporati nelle applicazioni, questo livello stabilisce i modelli AI come componenti di prima classe e servizi condivisi nell'azienda. Si concentra sulle funzionalità AI controllate dall'azienda (non sulle funzionalità AI fornite da fornitori esterni). Questo livello fornisce informazioni per vari agenti e altri carichi di lavoro AI nell'azienda con meccanismi standardizzati per Trust, sicurezza, conformità e distribuzione.
L'**Enterprise Orchestration Layer** è l'astrazione funzionale per coordinare, governare e ottimizzare flussi di lavoro e processi aziendali complessi in più fasi che coprono agenti AI, persone, strumenti di automazione e sistemi deterministici. Questo livello sfrutta un modello di orchestrazione mista che consente ai singoli agenti e sistemi di gestire autonomamente le operazioni coreografate localmente utilizzando protocolli aperti come MCP e A2A, fornendo al contempo una supervisione end-to-end centralizzata e il coordinamento dell'intero processo. Per implementare il modello di orchestrazione mista, questo livello rappresenta i processi aziendali critici in formati semanticamente completi leggibili che definiscono sia le fasi deterministiche (modellate in fase di progettazione) che le fasi dinamiche (decise dagli agenti in fase di esecuzione) di un processo aziendale, creando la base del modello di processo per la governance e l'ottimizzazione.
Tradizionalmente, porzioni significative dei processi aziendali gestiti dalle persone rimangono non documentate o inaccessibili in forme leggibili dai computer. Tuttavia, l'osservabilità dettagliata delle attività degli agenti AI, che include dati completi e metadati sulle loro operazioni e azioni, consente di acquisire, documentare e integrare il lavoro dinamico, precedentemente non strutturato, con flussi di lavoro lineari deterministici per creare modelli di processo completi. La documentazione dettagliata del processo acquisisce le interdipendenze delle operazioni e i percorsi di esecuzione precedentemente invisibili, consentendo all'azienda di ottimizzare continuamente l'efficienza operativa, risolvere efficacemente i colli di bottiglia e codificare sistematicamente le procedure consigliate identificate dagli agenti in playbook riutilizzabili a livello aziendale. Ciò si traduce in un gemello digitale olistico dei singoli processi e, se scalato, dell'intera azienda.
Ad esempio, processi complessi come l'esecuzione di strategie di vendita complete o l'inserimento di nuovi dipendenti comportano numerose fasi interdipendenti in cui il livello di orchestrazione può garantire livelli appropriati di coinvolgimento umano (ad esempio, la gestione delle eccezioni), un'autonomia limitata per gli agenti AI e imporre la conformità. Durante questi processi, il livello di orchestrazione dall'alto verso il basso aggiunge prevedibilità e governance, tiene traccia e valuta continuamente gli indicatori di prestazione chiave (KPI), garantisce l'integrità transazionale dei flussi di lavoro e la logica di ritiro e mantiene la visibilità in ogni fase del flusso di lavoro per garantire l'allineamento con gli obiettivi aziendali generali. Per implementare questa funzionalità, questo livello utilizza policy, regole e guardrail del livello di sicurezza e governance (tramite policy-as-code) e obiettivi aziendali e KPI memorizzati nel livello semantico. Data la natura autonoma e rapida delle interazioni basate sull'intelligenza artificiale, affidarsi esclusivamente a una coreografia decentralizzata rischia di generare disallineamenti strategici o violazioni della conformità, soprattutto nei flussi di lavoro a più fasi di lunga durata. L'approccio di orchestrazione mitiga questi rischi integrando le regole aziendali a livello aziendale, i controlli di conformità e l'applicazione delle policy direttamente in flussi di lavoro complessi e integrando la supervisione umana nei momenti critici.
Ciascuno di questi 11 livelli contribuisce con funzionalità specifiche alla distribuzione di agenti AI su larga scala in modo sicuro, affidabile ed efficace che sblocca tutto il potenziale dell'intelligenza artificiale agente per trasformare il modo in cui viene svolto il lavoro in un'azienda. La sezione seguente descrive la funzione del livello, le nuove modifiche dovute all'aumento degli agenti AI e le sue funzionalità tecnologiche chiave.
### Livello esperienza
**Funzione:** Il Livello di esperienza funge da interfaccia principale per gli utenti umani, abilitando l'interazione multimodale acquisendo input (testo, voce, visivo) e fornendo risposte pertinenti al contesto su più dispositivi. Trasmette facilmente le intenzioni degli utenti al livello agente per l'azione, fornendo anche l'interfaccia utente dinamica e le visualizzazioni che facilitano l'inoltro al livello superiore e le approvazioni all'interno dei flussi di lavoro agentici.
**Cosa c'è di diverso rispetto a oggi:** L'intelligenza artificiale aumenterà le interfacce basate su GUI tradizionali con elaborazione del linguaggio naturale, consapevolezza contestuale e supporto proattivo alle decisioni. Gli agenti dell'intelligenza artificiale saranno in grado di avviare interazioni in modo proattivo, fornendo consigli personalizzati in tempo reale in tutti i canali e le modalità.
**Capacità tecnologiche chiave:**
- **AI conversazionale e assistenti digitali:** Abilitare l'unità operativa per impostazione predefinita per offrire assistenza AI a supporto degli utenti umani.
- **Interfaccia utente Attribuzione e trasparenza:** Rendere spiegabili le risposte nell'interfaccia utente, ad esempio visualizzare le citazioni, le fonti dei file/sistemi e l'approccio/ragionevolezza delle decisioni.
- **Servizio di notifica proattivo e ambientale:** Consente agli agenti di inviare in modo proattivo approfondimenti o avvisi agli utenti sul canale e sul fattore di forma più appropriati, in base al contesto corrente dell'utente.
- **Esperienze Omnicanale:** Offre un'esperienza unificata, coerente e senza interruzioni in tutti i canali con continuità del journey, in cui le conversazioni e le operazioni seguono la persona anziché l'app.
- **Capacità multimodali:** Consente alle persone di interagire con agenti e applicazioni tramite testo, voce, immagine, tocco, video e AR/VR in modo che gli agenti possano comprendere e presentare le informazioni nella modalità più efficiente.
- **Personalizzazione sensibile al contesto e interfaccia utente dinamica:** Abilita esperienze utente in tempo reale sensibili al contesto (tempo, posizione, azioni utente) per consentire la personalizzazione, inclusa la generazione immediata dell'interfaccia utente.
### Livello agente
**Funzione:** Il livello agentico funge da ambiente di runtime predefinito per l'esecuzione del lavoro nell'azienda in cui gli agenti AI scompongono le operazioni dal livello esperienza ed eseguono le operazioni assemblando dinamicamente i flussi di lavoro utilizzando gli strumenti del livello applicazioni e servizi app e del livello dati. Lo stato di configurazione degli agenti AI viene memorizzato e gestito in questo livello. Gli agenti vengono istanziati per operazioni specifiche e le istanze specifiche degli agenti vengono ritirate in seguito. Questa implementazione consente agli agenti di essere sempre richiamati dallo stato di configurazione più recente in base alle ottimizzazioni offline (utilizzando funzionalità AI/ML, osservabilità e livelli di orchestrazione). Questo livello è responsabile della gestione completa del ciclo di vita, del coordinamento e della governance degli agenti AI.
**Cosa c'è di diverso rispetto a oggi:** Questo livello emergerà dall'attuale serie disparata di piloti e distribuzioni di agenti limitate. Benché esistano bot basati su regole, sono pochi i programmi software adattativi, non deterministici e orientati agli obiettivi distribuiti su larga scala.
**Capacità tecnologiche chiave:**
- **Ambiente Runtime agente:** Gestisce il ciclo di vita, l'esecuzione e l'allocazione delle risorse per gli agenti AI.
- **Suite di gestione del ciclo di vita degli agenti:** Include framework di sviluppo, tool di sviluppo e test e sistemi di gestione per le attività degli agenti e il controllo delle versioni.
- **Motore di ragionamento agente:** Un framework cognitivo che consente agli agenti di scomporre gli obiettivi, pianificare e decidere quali strumenti utilizzare per risolvere problemi complessi.
- **Memoria agente e punto vendita contesto:** Consente alle istanze degli agenti di richiamare e mantenere il contesto relativo alle interazioni precedenti, garantendo coerenza e personalizzazione.
- **Protocolli di interoperabilità degli agenti:** Interfacce standardizzate per la comunicazione da agente ad agente (A2A) e per l'interfacciamento degli agenti con sistemi esterni (ad esempio tramite il protocollo contesto del modello).
- **Registro strumenti:** Insieme curato di strumenti interni ed esterni supportati che gli agenti possono invocare per eseguire una determinata operazione.
- **Registro agenti:** Un ecosistema curato di soluzioni AI e agenti predefiniti che supporta l'individuazione e l'abbinamento delle funzionalità.
- **Applicazione policy agente distribuita:** Consente una governance a livello aziendale consentendo agli agenti di autocontrollare la conformità prima di intraprendere azioni.
- **Framework di autoriflessione e adattamento degli agenti:** Fornisce un meccanismo per consentire a un agente di analizzare le proprie prestazioni e, con l'approvazione umana, attivare miglioramenti o suggerire modifiche a se stesso.
### Livello AI/ML
**Funzione:** Questo livello funziona come un hub di intelligenza centralizzato, offrendo modelli di intelligenza artificiale come un insieme di servizi condivisi che possono essere utilizzati dal livello agente (e dalle applicazioni) per potenziare le sue capacità di ragionamento e decisione con framework di sicurezza e monitoraggio integrati.
**Cosa c'è di diverso rispetto a oggi:** Tradizionalmente, i modelli AI erano incorporati in applicazioni specifiche. Nell'architettura IT di Agentic Enterprise, il livello AI/ML sarà una serie di servizi centralizzati di prima classe che supportano molte applicazioni e agenti, supportando l'intero ciclo di vita del modello dallo sviluppo al servizio in tempo reale su larga scala.
**Capacità tecnologiche chiave:**
- **Modelli di base predefiniti:** Modelli ML di grandi dimensioni addestrati su un ampio spettro di dati, in grado di eseguire un'ampia varietà di operazioni generali.
- **Generazione aumentata di recupero (RAG):** Una pipeline incentrata sull'intelligenza artificiale che basa i modelli di base in dati specifici dell'azienda per migliorare la precisione e ridurre le allucinazioni.
- **AI Trust, Safety e Governance Hub:** Una suite di strumenti integrati nel ciclo di vita del modello per applicare principi di intelligenza artificiale responsabili come il rilevamento delle distorsioni, la spiegabilità e il monitoraggio della sicurezza.
- **Gateway modello:** Motore di instradamento che funge da singolo punto di ingresso per tutte le richieste di inferenza del modello, gestendo le chiamate a vari modelli interni ed esterni per ottimizzare costi, prestazioni e conformità.
- **Area di lavoro sviluppo modello:** Un ambiente di sviluppo integrato per i data scientist con strumenti per la preelaborazione dei dati, l'addestramento del modello e la sperimentazione.
- **MLOps & Lifecycle Automation Pipeline (MLOps e pipeline di automazione del ciclo di vita):** Motore CI/CD per il machine learning, che automatizza il ciclo di vita completo dei modelli dall'addestramento alla distribuzione e al ritiro.
- **Serving del modello e runtime di inferenza:** Un ambiente scalabile e a bassa latenza per la distribuzione di modelli addestrati come endpoint API protetti per il consumo in tempo reale.
- **Registro modelli e asset:** Un repository centralizzato e controllato dalle versioni per tutti gli asset AI/ML, inclusi modelli, serie di dati e codice sorgente, che garantisce riproducibilità e verificabilità.
- **Generazione e gestione dei dati sintetici:** Strumento per generare e gestire dati sintetici che mantengono le proprietà statistiche dei dati reali senza esporre informazioni sensibili.
### Livello orchestrazione Enterprise
**Funzione:** Enterprise Orchestration Layer è il piano di controllo per il lavoro end-to-end in un'azienda agente. Garantisce che i flussi di lavoro e le interazioni degli agenti rispettino gli obiettivi aziendali e le policy di governance. Utilizza la telemetria osservabile da altri livelli per creare modelli di processi aziendali completi, consentendo l'ottimizzazione rispetto agli indicatori di prestazioni chiave tratti dal livello semantico. Questo livello fornisce il contesto condiviso e la memoria di lunga durata a ogni nuova istanza di un agente AI per i flussi di lavoro critici.
**Cosa c'è di diverso rispetto a oggi:** Questo livello offre una visibilità unificata dei processi aziendali creando modelli leggibili dai computer che acquisiscono sia fasi strutturate e deterministiche che il lavoro dinamico e non strutturato eseguito da persone e agenti. Supera i modelli di collaborazione e governance incentrati sulle persone di oggi codificando a livello di programmazione gli obiettivi aziendali e le regole di conformità come vincoli nei flussi di lavoro degli agenti per governare la forza lavoro degli agenti.
**Capacità tecnologiche chiave:**
- **Motore di esecuzione flusso di lavoro ibrido:** Runtime centrale che esegue il "modello di orchestrazione misto", fornendo una supervisione centralizzata e consentendo la coreografia degli agenti locali.
- **Process Governance & Constraint Engine:** Un servizio di governance in tempo reale che utilizza e applica regole aziendali, policy e vincoli dichiarativi a tutti i processi in volo.
- **Memoria condivisa e gestione del contesto:** Un livello di memoria condiviso accessibile a tutti gli attori di un flusso di lavoro per mantenere continuità e coerenza in più fasi.
- **Process Modeling Studio:** Un ambiente in fase di progettazione per la creazione e la gestione di modelli di processo leggibili dai computer e ricchi di contenuti semantici che definiscono fasi deterministiche e dinamiche orientate agli obiettivi.
- **Ottimizzazione e simulazione dei processi:** Una funzionalità che costruisce simulazioni digitali dei processi aziendali per analisi avanzate, simulazioni What-If e ottimizzazione predittiva.
- **Process Discovery & Health Monitoring (Rilevamento dei processi e monitoraggio dello stato):** Inserisce modelli di processo e dati in tempo reale per generare rapporti sulle metriche aziendali dello stato dei processi.
- **Digital Twin Process Modeling (Modellazione processo Digital Twin):** Uno specchio in tempo reale dei flussi di lavoro live per testare, simulare le modifiche e ottimizzare senza influire sulla produzione.
### Livello Servizi applicazione e app
**Funzione:** Questo livello espone le funzionalità delle applicazioni aziendali esistenti come strumenti e servizi componibili e modulari che gli agenti possono utilizzare. Funge anche da runtime di presentazione per l'incorporamento delle funzionalità degli agenti nell'esperienza utente. Le applicazioni continuano a essere il sistema dei record ma vengono riprogettate per essere funzionalità "headless" per gli agenti.
**Cosa c'è di diverso rispetto a oggi:** Le applicazioni si evolveranno da interfacce utente monolitiche a "servizi di back-end" che gli agenti possono chiamare dinamicamente tramite API ed eventi. Questo livello sarà integrato in modo nativo con agenti e modelli AI e la proliferazione di LLM di generazione codice porterà a un aumento del numero di micro-applicazioni personalizzate create dagli agenti.
**Capacità tecnologiche chiave:**
- **Servizi di applicazione modulari:** Logica aziendale scomposta dalle applicazioni tradizionali, pubblicate come azioni leggibili automaticamente che gli agenti possono chiamare.
- **SDK di incorporamento degli agenti:** Toolkit e librerie che consentono agli sviluppatori di incorporare in modo sicuro gli agenti direttamente nelle interfacce utente delle applicazioni.
- **Servizi di generazione interfaccia utente dinamica:** Servizi che consentono a un agente AI di generare o modificare i componenti dell'interfaccia utente in tempo reale in base al contesto dell'utente.
- **Framework dell'interfaccia utente nativi AI:** Framework front-end progettati con supporto incorporato per la gestione delle interfacce utente basate sull'intelligenza artificiale, ad esempio la gestione dei dati probabilistici e delle risposte di testo in streaming.
- **Sistemi di coinvolgimento infusi dagli agenti:** Applicazioni di produttività e collaborazione aziendali che incorporano funzionalità degli agenti AI tramite componenti visivi.
- **Sviluppo di applicazioni low-code / no-code ottimizzate AI:** Strumenti che consentono a utenti e agenti di creare app e servizi personalizzati utilizzando linguaggio naturale e prompt.
- **Guardrail dell'app per l'utilizzo da parte degli agenti:** Controlli lato applicazione per l'utilizzo da parte degli agenti, ad esempio limitazione dei tassi, autorizzazioni limitate e telemetria.
### Livello semantico
**Funzione:** Il livello semantico offre una comprensione unificata di dati e Knowledge in tutta l'azienda, consentendo sia agli esseri umani che agli agenti AI di interpretare e agire in modo coerente sulle informazioni. Utilizza strumenti di rappresentazione Knowledge come ontologie e grafici Knowledge per tradurre le query in linguaggio naturale in query di dati precise e sensibili al contesto.
**Cosa c'è di diverso rispetto a oggi:** Mentre le aziende odierne dispongono di archivi di metadati diversi, l'architettura IT di Agentic Enterprise richiede un EKG (Enterprise Knowledge Graph) centralizzato che collega i dati tra i domini con relazioni semantiche definite esplicitamente. Questo fornisce il contesto completo che gli agenti di intelligenza artificiale possono attraversare per eseguire ragionamenti complessi, creando requisiti per una serie di funzionalità tecniche che supportano i grafici Knowledge che coprono più domini funzionali.
**Capacità tecnologiche chiave:**
- **Servizio metadati:** Fornisce metadati descrittivi, tra cui discendenza dei dati, proprietà e classificazioni.
- **Glossario aziendale e gestione tassonomia:** Uno strumento che consente agli utenti aziendali di definire e concordare condizioni aziendali standard.
- **Gestione dei modelli semantici:** Area di lavoro per ingegneri Knowledge per creare, gestire e governare modelli semantici e ontologie.
- **Enterprise Knowledge Graph (EKG):** Un'istanziazione in fase di esecuzione dell'ontologia aziendale che memorizza e mappa le relazioni tra entità aziendali.
- **Motore di inserimento e armonizzazione metadati:** Una pipeline automatica che compila e gestisce Enterprise Knowledge Graph da vari sistemi di origine.
- **Motore di query semantiche**: Interpreta le query in linguaggio naturale e costruisce query strutturate basate sull'ECG per recuperare i dati da fonti diverse.
- **Motore di ragionamento semantico:** Analizza e deriva Knowledge implicito e relazioni nascoste dall'ECG.
### Livello dati
**Funzione:** Il livello di dati è la fonte fondamentale della verità e consente di gestire e fornire un accesso sicuro e regolato a tutti i dati aziendali che il livello semantico può interpretare, il livello AI/ML da utilizzare per l'addestramento, le applicazioni da utilizzare per le transazioni e gli agenti per il ragionamento.
**Cosa c'è di diverso rispetto a oggi:** Il livello di dati si evolve per essere più unificato, in tempo reale e incentrato sulla governance, spesso centrato su un data lakehouse su scala cloud. Deve gestire un volume e una varietà maggiori di dati e passare dall'elaborazione orientata ai batch allo streaming in tempo reale per supportare gli agenti reattivi. La governance e la qualità dei dati assumono un'importanza ancora maggiore per evitare che dati scadenti creino output AI difettosi.
**Capacità tecnologiche chiave:**
- **VectorDB:** Database specializzato ottimizzato per l'archiviazione e la query di incorporamenti vettoriali ad alta dimensione, fondamentali per RAG.
- **Pipeline di dati analitici intelligenti:** Un servizio automatico basato sui metadati per l'inserimento, la trasformazione e il caricamento dei dati (ETL/ELT) nel livello di dati.
- **Enterprise Data Lakehouse:** Un repository centrale per dati strutturati, semi-strutturati e non strutturati, ottimizzato per carichi di lavoro di analisi e intelligenza artificiale.
- **Federazione e ricerca dati copia zero:** Tecniche di accesso, query e ricerca dei dati in più punti vendita senza spostamento fisico dei dati.
- **Da linguaggio naturale a SQL:** Una tecnica per convertire query in linguaggio naturale in SQL.
- **Servizio Catalogo dati aziendali e Discovery:** Inventario centralizzato e ricercabile di tutti gli asset di dati dell'azienda.
- **Gestione dati master e di riferimento (MDM):** Gestisce il "golden record" per entità aziendali critiche come Cliente e Prodotto.
- **Servizio di qualità dei dati adattiva:** Un servizio di monitoraggio continuo che utilizza l'intelligenza artificiale per rilevare e risolvere automaticamente i Problemi di qualità dei dati in tempo reale.
- **Contratti sui dati:** Accordi a lettura ottica tra produttori di dati e consumatori che specificano lo schema, la semantica e gli SLA dello scambio di dati.
- **Data Store specializzati AI:** Database progettati per casi d'uso AI specifici, ad esempio serie temporali o database di grafici.
- **Fabbrica di dati AI-Ready:** Livello di astrazione dei dati logico che offre una visualizzazione unificata e virtualizzata dei dati in sistemi fisici diversi.
- **Elaborazione dei dati in tempo reale:** Funzionalità per l'elaborazione e l'analisi continua di stream di dati multimodali alla velocità della macchina.
### Livello infrastruttura
**Funzione:** Il livello Infrastruttura supporta tutti gli altri livelli, fornendo le funzionalità di elaborazione, storage, rete e cloud necessarie per eseguire carichi di lavoro AI e agenti su larga scala in modo resiliente ed economico.
**Cosa c'è di diverso rispetto a oggi:** I carichi di lavoro AI richiedono maggiore scalabilità ed elasticità per gestire la natura probabilistica dei sistemi agentici. L'infrastruttura deve supportare il provisioning rapido, hardware specializzato come le GPU e traffico di rete a bassa latenza e ad alta produttività per la comunicazione tra agenti.
**Capacità tecnologiche chiave:**
- **Infrastruttura come codice:** Provisioning e gestione automatizzati dell'infrastruttura con opportunità di distribuzione CI/CD.
- **Infrastruttura AI ibrida e multi-cloud:** Sfrutta l'elasticità del cloud pubblico e l'infrastruttura specializzata per i carichi di lavoro di intelligenza artificiale generativa.
- **Calcolazione, archiviazione e rete ottimizzati per AI:** Alloca e scala in modo dinamico le risorse dell'infrastruttura in base alla domanda variabile dei carichi di lavoro AI.
- **Infrastruttura Edge AI:** Consente la distribuzione di modelli e agenti AI ai margini della rete per i casi d'uso con requisiti di latenza o privacy specifici.
- **Infrastruttura di autoguarigione:** Utilizza l'intelligenza artificiale per gestire il ripristino del sistema senza input manuale, garantendo un'elevata disponibilità.
- **Informatica AI sostenibile:** Approcci efficienti dal punto di vista energetico per mitigare l'impatto ambientale dei carichi di lavoro AI.
- **Autoscala sensibile ai costi e alle emissioni di CO2:** Utilizza FinOps e i segnali di sostenibilità per favorire la scalabilità e il posizionamento della capacità.
### Livello di integrazione
**Funzione:** Il livello di integrazione funge da tessuto di comunicazione universale per tutti i sistemi (legacy e nuovi) tramite API, eventi, protocolli e middleware per garantire che gli agenti possano individuare e interagire con servizi, dati e strumenti in modo semplice.
**Cosa c'è di diverso rispetto a oggi:** L'integrazione deve evolvere per supportare gli schemi di comunicazione dinamici molti-a-molti degli agenti AI, anziché limitarsi a gestire interazioni statiche predeterminate tra pochi sistemi noti. Richiede l'elaborazione dei dati in tempo reale e deve adattarsi all'individuazione e alla collaborazione ad hoc tra gli agenti.
**Capacità tecnologiche chiave:**
- **Opportunità in corso di realizzazione di connettività dati operativa:** Strumenti assistiti dall'intelligenza artificiale per la mappatura automatica degli schemi, la trasformazione dei dati e la generazione di flussi di lavoro, incluse le funzionalità basate su API, basate sugli eventi e Reverse ETL.
- **Gestione API adattiva e Service Mesh:** Gateway API e tecnologia Service Mesh in grado di registrare, individuare e governare dinamicamente i servizi con l'imposizione di policy adattive per gli agenti.
- **Adattatori Semantic Knowledge:** Componente di integrazione che fornisce un vocabolario e un modello di dati condivisi tra agenti e applicazioni per un'interpretazione coerente dei dati.
- **Fabbrica di integrazione basata sugli eventi:** Backbone di messaggistica e streaming a bassa latenza e ad alta produttività che consente la comunicazione disaccoppiata e asincrona.
- **Gateway protocollo agente:** Gateway per i servizi MCP che consente agli agenti di scoprire in modo sicuro gli strumenti e attivare le azioni, collegando MCP ad API ed eventi interni.
- **Catalogo e marketplace di capacità componibili:** Un catalogo centralizzato e gestito per tutte le funzionalità aziendali (API, servizi, competenze degli agenti, modelli e serie di dati) annotato con metadati semantici per la composizione on-demand.
### Livello Operazioni IT e osservabilità
**Funzione:** Questo livello monitora e gestisce lo stato e le prestazioni operative degli agenti e dell'intero sistema (principio incorporato di osservabilità), offrendo trasparenza e controllo generando approfondimenti per consentire l'ottimizzazione di controllo, debug, spiegabilità, costi e risorse della forza lavoro dell'azienda.
**Cosa c'è di diverso rispetto a oggi**: Questo livello diventa ancora più cruciale se si considera il rischio che gli agenti dell'intelligenza artificiale creino errori alla velocità della macchina. Deve espandersi oltre il monitoraggio delle infrastrutture per includere il comportamento imprevedibile degli agenti autonomi, che richiedono nuovi tipi di telemetria e la capacità di comprendere la correttezza semantica, non solo le prestazioni tecniche.
**Capacità tecnologiche chiave:**
- **Piattaforma di monitoraggio e osservabilità in tempo reale:** Raccoglie continuamente registri, metriche e tracce in tutto l'ambiente IT, con estensioni per le metriche ML e il comportamento degli agenti.
- **Gestione dei costi di FinOps & Cloud:** Responsabile del monitoraggio, dell'analisi e dell'ottimizzazione dei costi di infrastruttura associati all'intelligenza artificiale e ai carichi di lavoro degli agenti.
- **Monitoraggio specifico di agenti e ML:** Registra ogni fase dell'esecuzione di un agente in un itinerario di controllo immutabile e profila continuamente i comportamenti degli agenti per rilevare deviazioni dalle norme stabilite.
- **AIOps, Gestione degli incidenti e del cambiamento:** Utilizza AI/ML per prevedere potenziali problemi IT, identificare le cause principali e creare flussi di lavoro di risoluzione.
- **Loop di feedback sull'apprendimento chiuso:** Integra la telemetria osservabile dagli agenti nelle opportunità in corso di realizzazione MLOps, abilitando la riconversione automatica del modello o la pronta rettifica.
- **Motore di osservabilità semantica:** Integra l'osservabilità con il livello semantico per la contestualizzazione per consentire il rilevamento di anomalie semantiche nel comportamento degli agenti.
### Livello di sicurezza e governance
**Scopo:** Questo livello incorpora Trust e sicurezza in tutta l'architettura proteggendo gli asset aziendali dalle minacce, gestendo i rischi e garantendo la conformità ai requisiti normativi. Comprende la gestione dell'identità, il rilevamento delle minacce, le misure di sicurezza specifiche di GRC e AI.
**Cosa c'è di diverso rispetto a oggi:** Il livello di sicurezza deve evolvere per gestire le nuove superfici di attacco presentate dai modelli e dagli agenti di intelligenza artificiale, ad esempio l'iniezione rapida e l'avvelenamento del modello. La gestione delle identità e degli accessi deve passare da controlli statici basati sui ruoli ad autorizzazioni dinamiche basate sugli intenti che vengono concesse just in time e revocate immediatamente dopo l'uso.
**Capacità tecnologiche chiave:**
- **Sicurezza di input/output e guardrail LLM:** I guardrail aziendali sono stati applicati al prompt e al momento della risposta per bloccare contenuti non sicuri, fughe di informazioni personali e jailbreak.
- **Architettura Zero Trust con verifica AI:** Autenticazione continua ottimizzata dall'analisi comportamentale basata su AI, con accesso just in time granulare per gli agenti in base alla loro operazione specifica.
- **Framework di sicurezza degli agenti:** Modelli di autorizzazione a grana fine, monitoraggio dei comportamenti dannosi e meccanismi di contenimento per interrompere in modo sicuro le attività degli agenti.
- **Sicurezza del modello AI:** Una strategia di difesa approfondita con controlli in ogni fase del ciclo di vita del modello per proteggersi da avvelenamento, estrazione e attacchi contrari.
- **AI che protegge la privacy:** Tecniche come l'apprendimento federato e la privacy differenziale per proteggere i dati sensibili.
- **GRC ottimizzato AI:** Utilizzo di agenti AI per monitorare continuamente la conformità dell'architettura IT ai controlli.
- **Motore di policy come codice:** Un'unica fonte di dati per definire le regole aziendali e i vincoli di conformità in un formato dichiarativo e leggibile dai computer per impostare guardrail per il comportamento degli agenti.
- **Continuo Red-Teaming:** Test automatici e in corso dei modelli e degli agenti di intelligenza artificiale per identificare le vulnerabilità prima che gli aggressori le sfruttino.
## Roadmap architetturale di riferimento per l'azienda agente
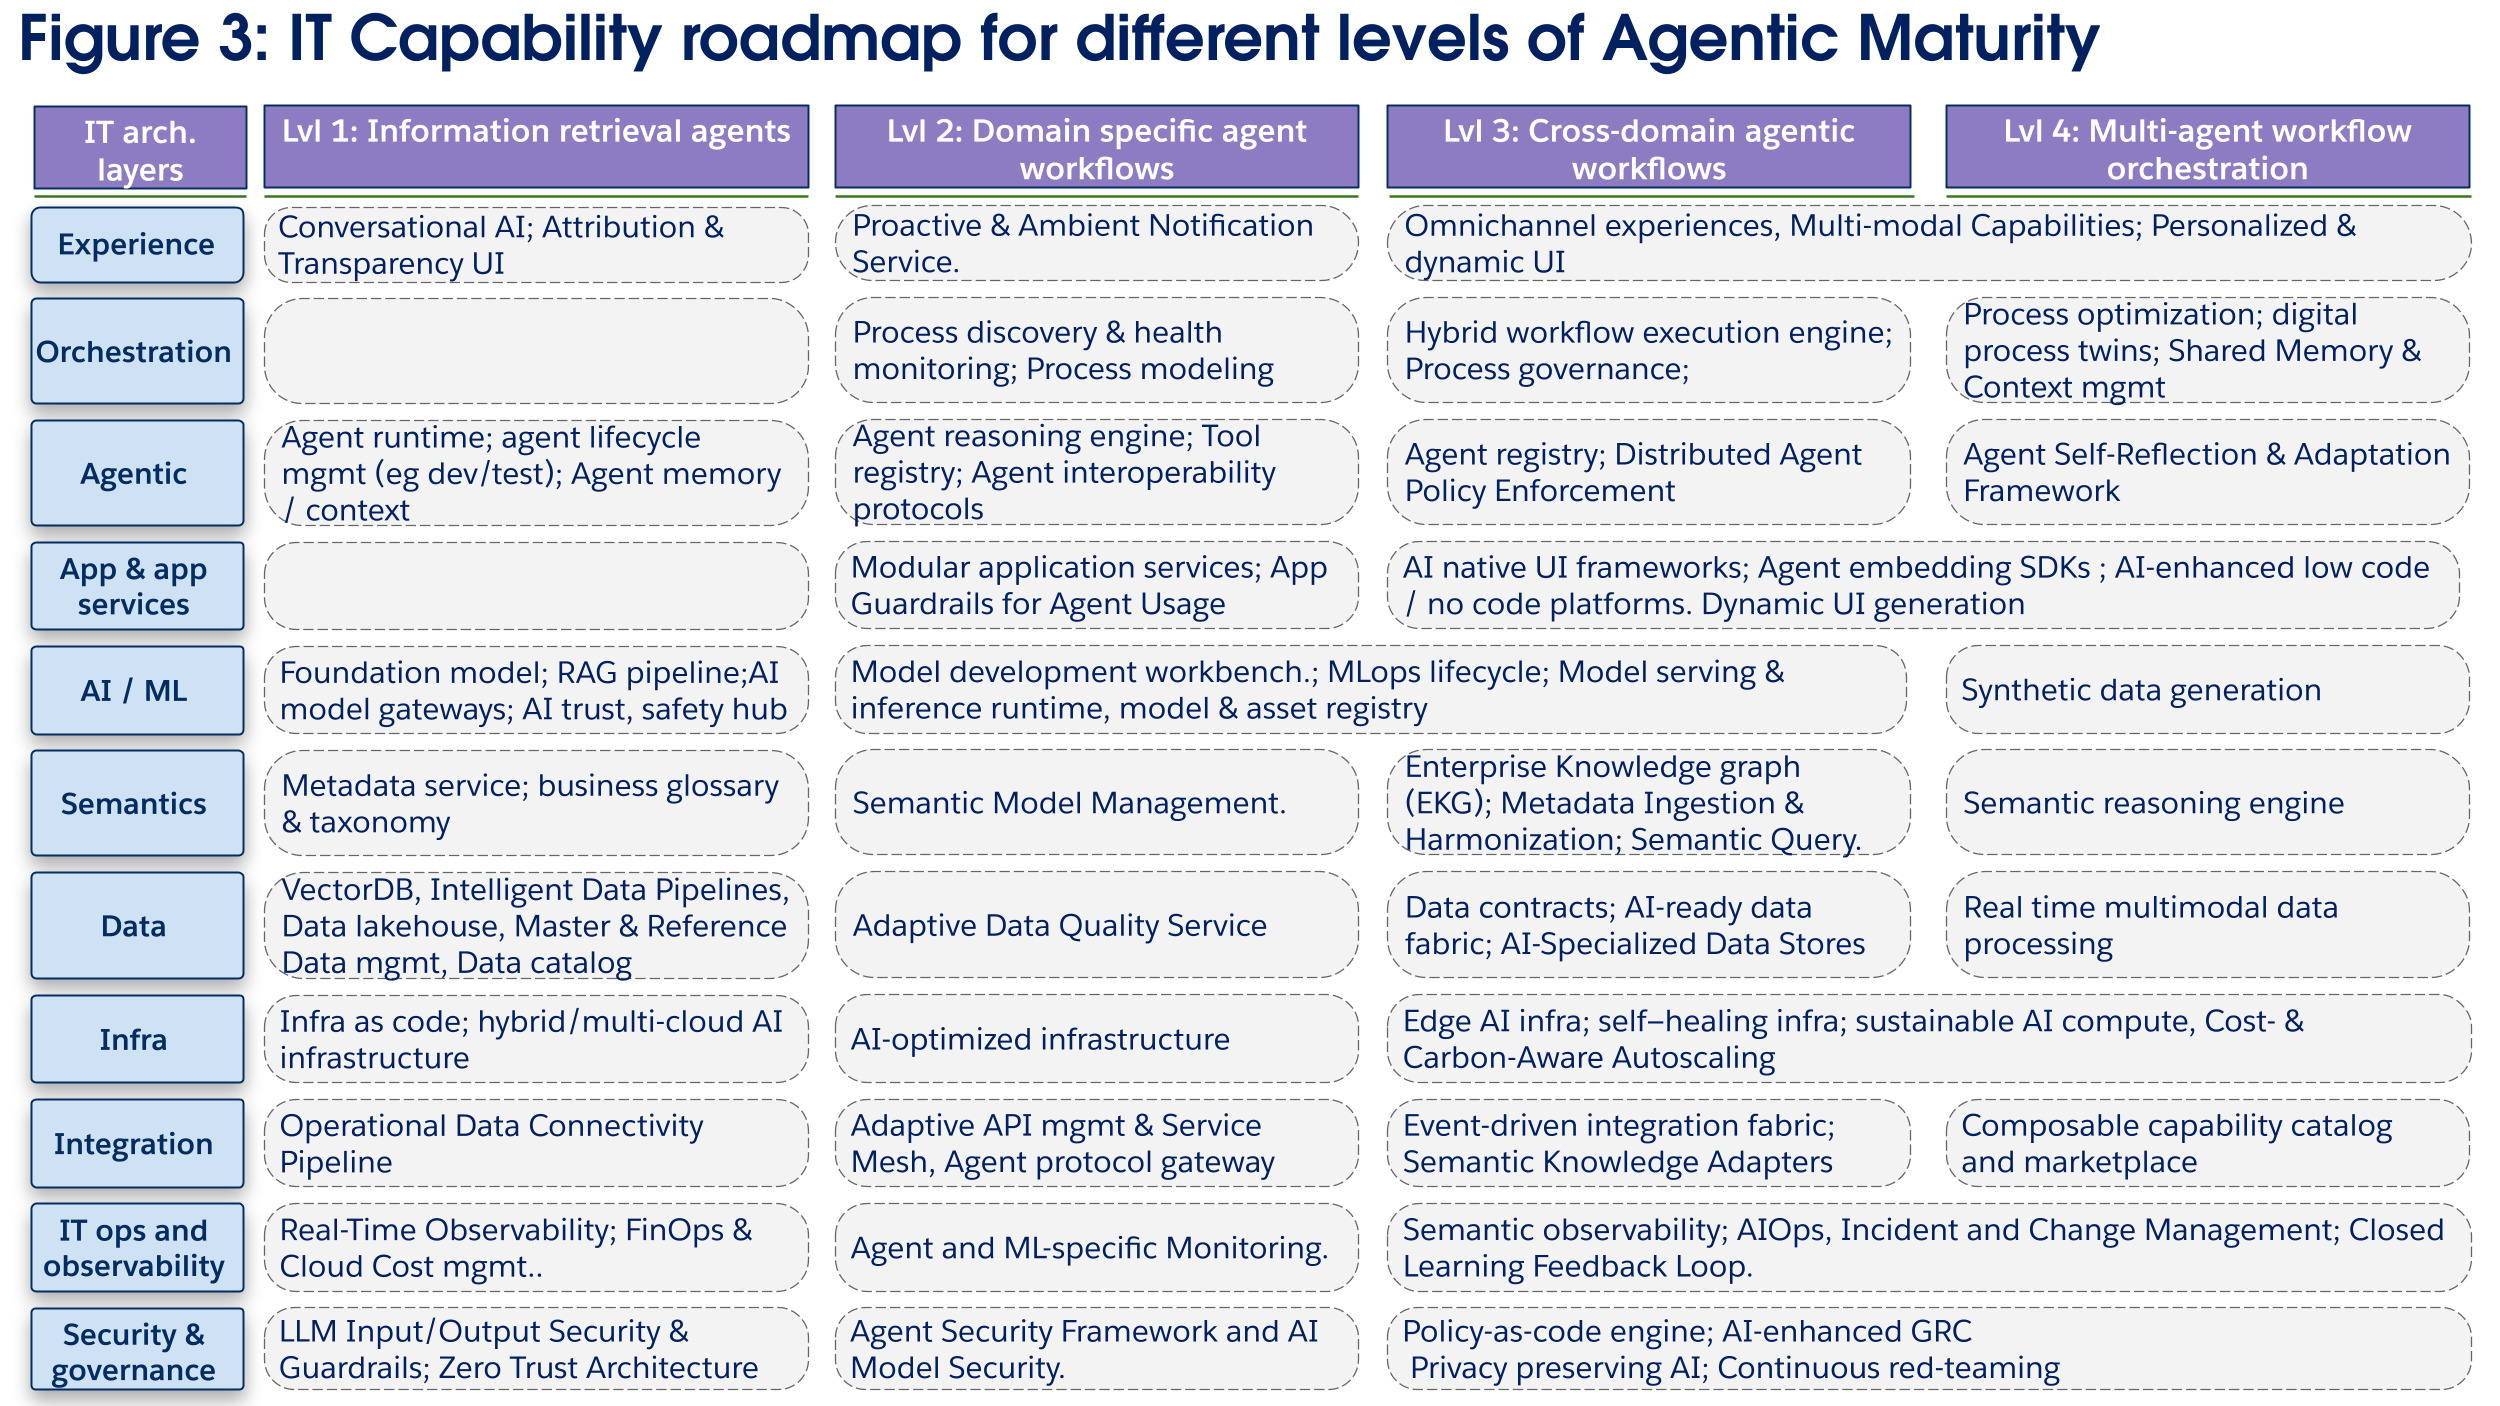
La trasformazione in Agentic Enterprise richiede di seguire un journey in più fasi, impostando le basi tecnologiche e creando al contempo un valore aziendale tangibile (vedere la Figura 3 di seguito). Sebbene la roadmap precisa dipenda dalla strategia, dalla cultura, dal modello di governance AI e dal punto di partenza dell'architettura IT dell'azienda, la maggior parte delle organizzazioni dovrebbe adottare un approccio scaglionato poiché i continui investimenti IT potenziano gli agenti con una portata, una complessità e una creazione di valore crescenti. Il [modello di maturità](https://www.salesforce.com/news/stories/agentic-maturity-model/) agenti di Salesforce offre alle aziende un utile framework di livelli di maturità per la strategia della trasformazione, descrivendo come le capacità degli agenti possono crescere dal recupero di informazioni di base (livello 1) all'orchestrazione di flussi di lavoro multi-dominio più complessi (livello 2 e 3) e multi-agente (livello 4). Per progredire con successo in queste fasi, l'architettura IT deve evolvere in modo concertato, con investimenti mirati in diversi livelli dell'architettura in ogni fase per soddisfare le esigenze delle distribuzioni più complesse e di valore più elevato degli agenti AI. Per ogni livello di maturità, le capacità tecnologiche specifiche richieste negli 11 livelli architettonici sono identificate con una logica per l'investimento.
 **Livello di maturità 1: Agenti di recupero** delle informazioni
**Obiettivo e valore aziendale: Migliorare la produttività dei lavoratori fornendo un'interfaccia conversazionale affidabile per interrogare Enterprise Knowledge.** Il valore principale è aumentare le capacità umane, non sostituirle. Questi agenti assistono le persone recuperando informazioni e consigliando azioni.
**Focus architettonico:** L'obiettivo è creare una base di dati sicura e affidabile e i componenti AI di base necessari per il recupero delle informazioni. Governance e osservabilità sono fondamentali fin dal primo giorno per creare Trust tra gli utenti e controllare i costi.
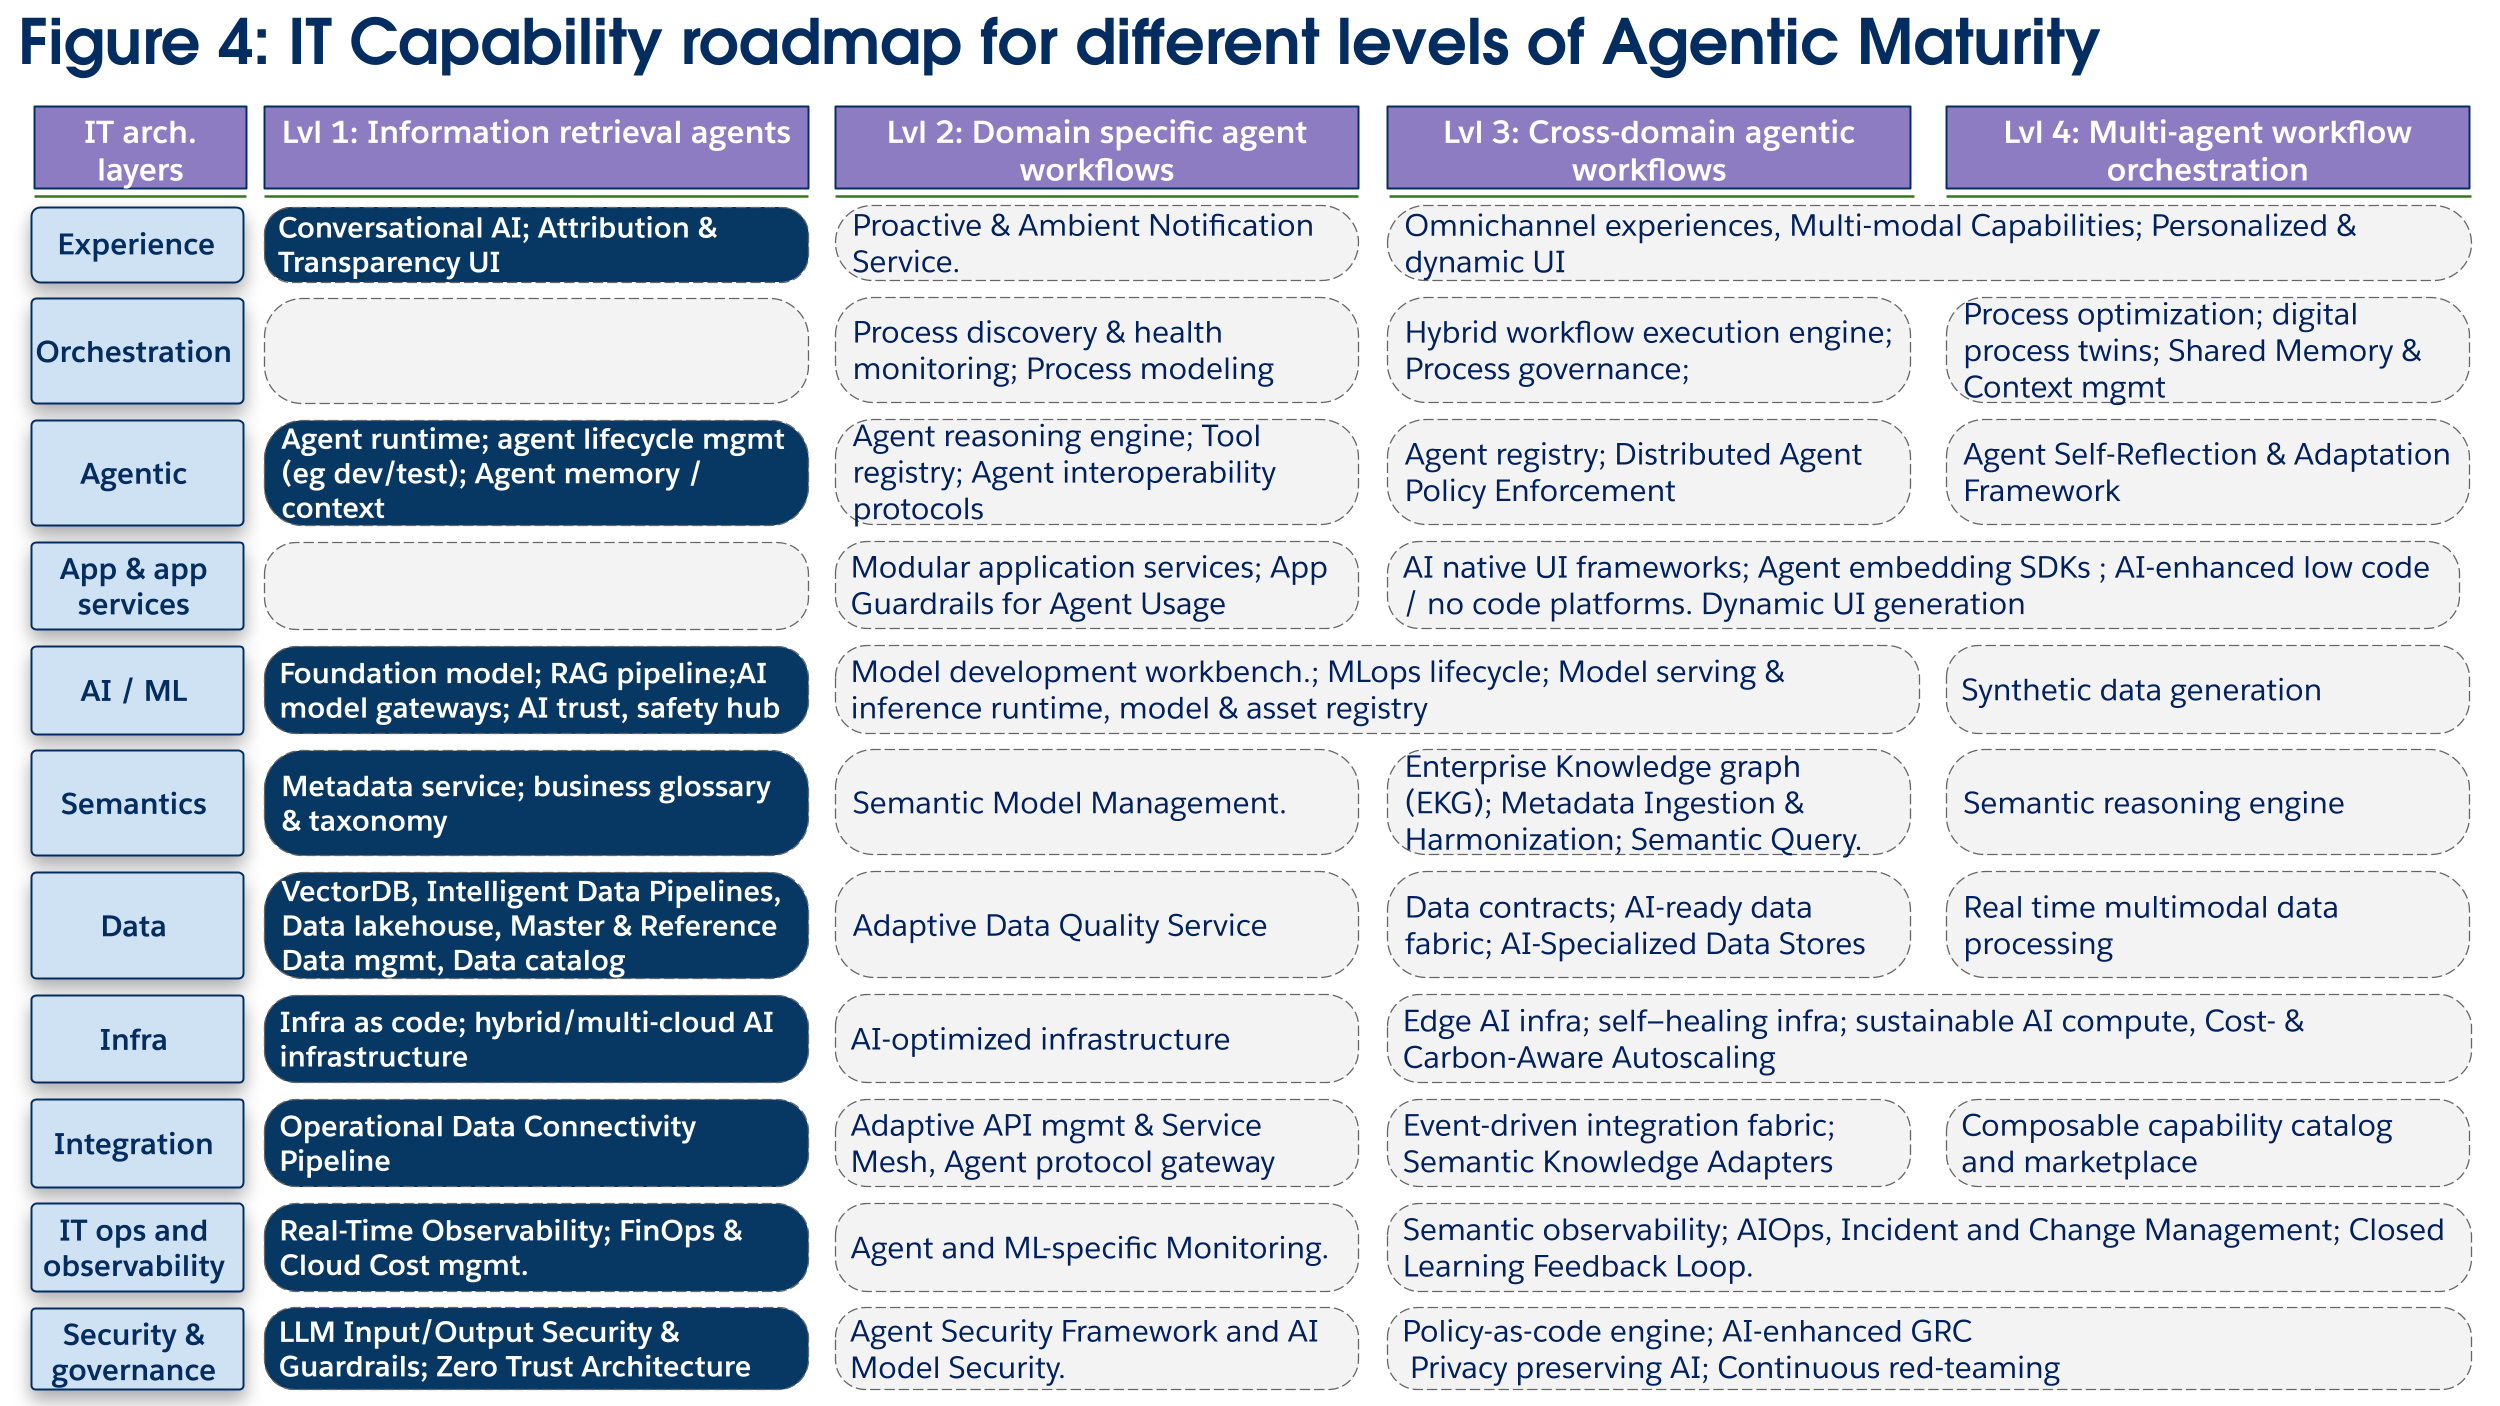
**Investimenti tecnologici chiave (figura 4):**
In questa fase, l'IT dovrebbe concentrarsi sulla creazione di una pipeline affidabile da dati ad agenti e di altre funzionalità di base. Le tecnologie nel **Data Layer**, ad esempio **VectorDB**, sono essenziali per abilitare le tecniche di generazione aumentata di recupero (RAG) che supportano gli agenti di recupero delle informazioni. Questo è abbinato a un **livello AI/ML** centralizzato che include un **gateway modello** per un accesso sicuro e a costi controllati ai modelli di base e un **AI Trust, Safety & Governance Hub** per monitorare la presenza di output non sicuri e garantire la conformità. La **gestione dei dati** master e i **glossari aziendali** nel **livello** **semantico** sono fondamentali per consentire agli agenti di recuperare informazioni accurate. Le funzionalità di runtime e ciclo di vita degli agenti sono necessarie per garantire che gli agenti creati in questa fase possano essere modificati ed estesi per i casi d'uso futuri. Per offrire valore e creare fiducia negli utenti, il **livello Experience** deve incorporare un'**interfaccia utente Attribution & Transparency** (Attribuzione e trasparenza), che rende spiegabili le risposte degli agenti visualizzando le citazioni e le fonti delle relative informazioni. Gli investimenti fondamentali in osservabilità e sicurezza (ad esempio **zero** **Trust**) devono iniziare l'implementazione per preparare il terreno per le future distribuzioni degli agenti.
 **Livello di maturità 2: Orchestrazione semplice, agenti di** dominio singolo
**Obiettivo e valore aziendale: Automatizzare le operazioni di routine e orchestrare flussi di lavoro a bassa complessità all'interno di un unico dominio aziendale.** Ciò migliora l'efficienza operativa e riduce il lavoro manuale, consentendo ai lavoratori umani di concentrarsi su attività di valore superiore.
**Focus architettonico:** Il cambiamento architetturale chiave è il recupero dei dati di sola lettura all'esecuzione di azioni. Ciò richiede l'avvio di un journey più lungo per modularizzare le funzionalità delle applicazioni (spesso esposte come API) a cui gli agenti possono accedere, l'implementazione di una sicurezza efficace per le azioni degli agenti e la creazione di funzionalità di sviluppo semantico e AI per migliorare l'intelligenza degli agenti AI.
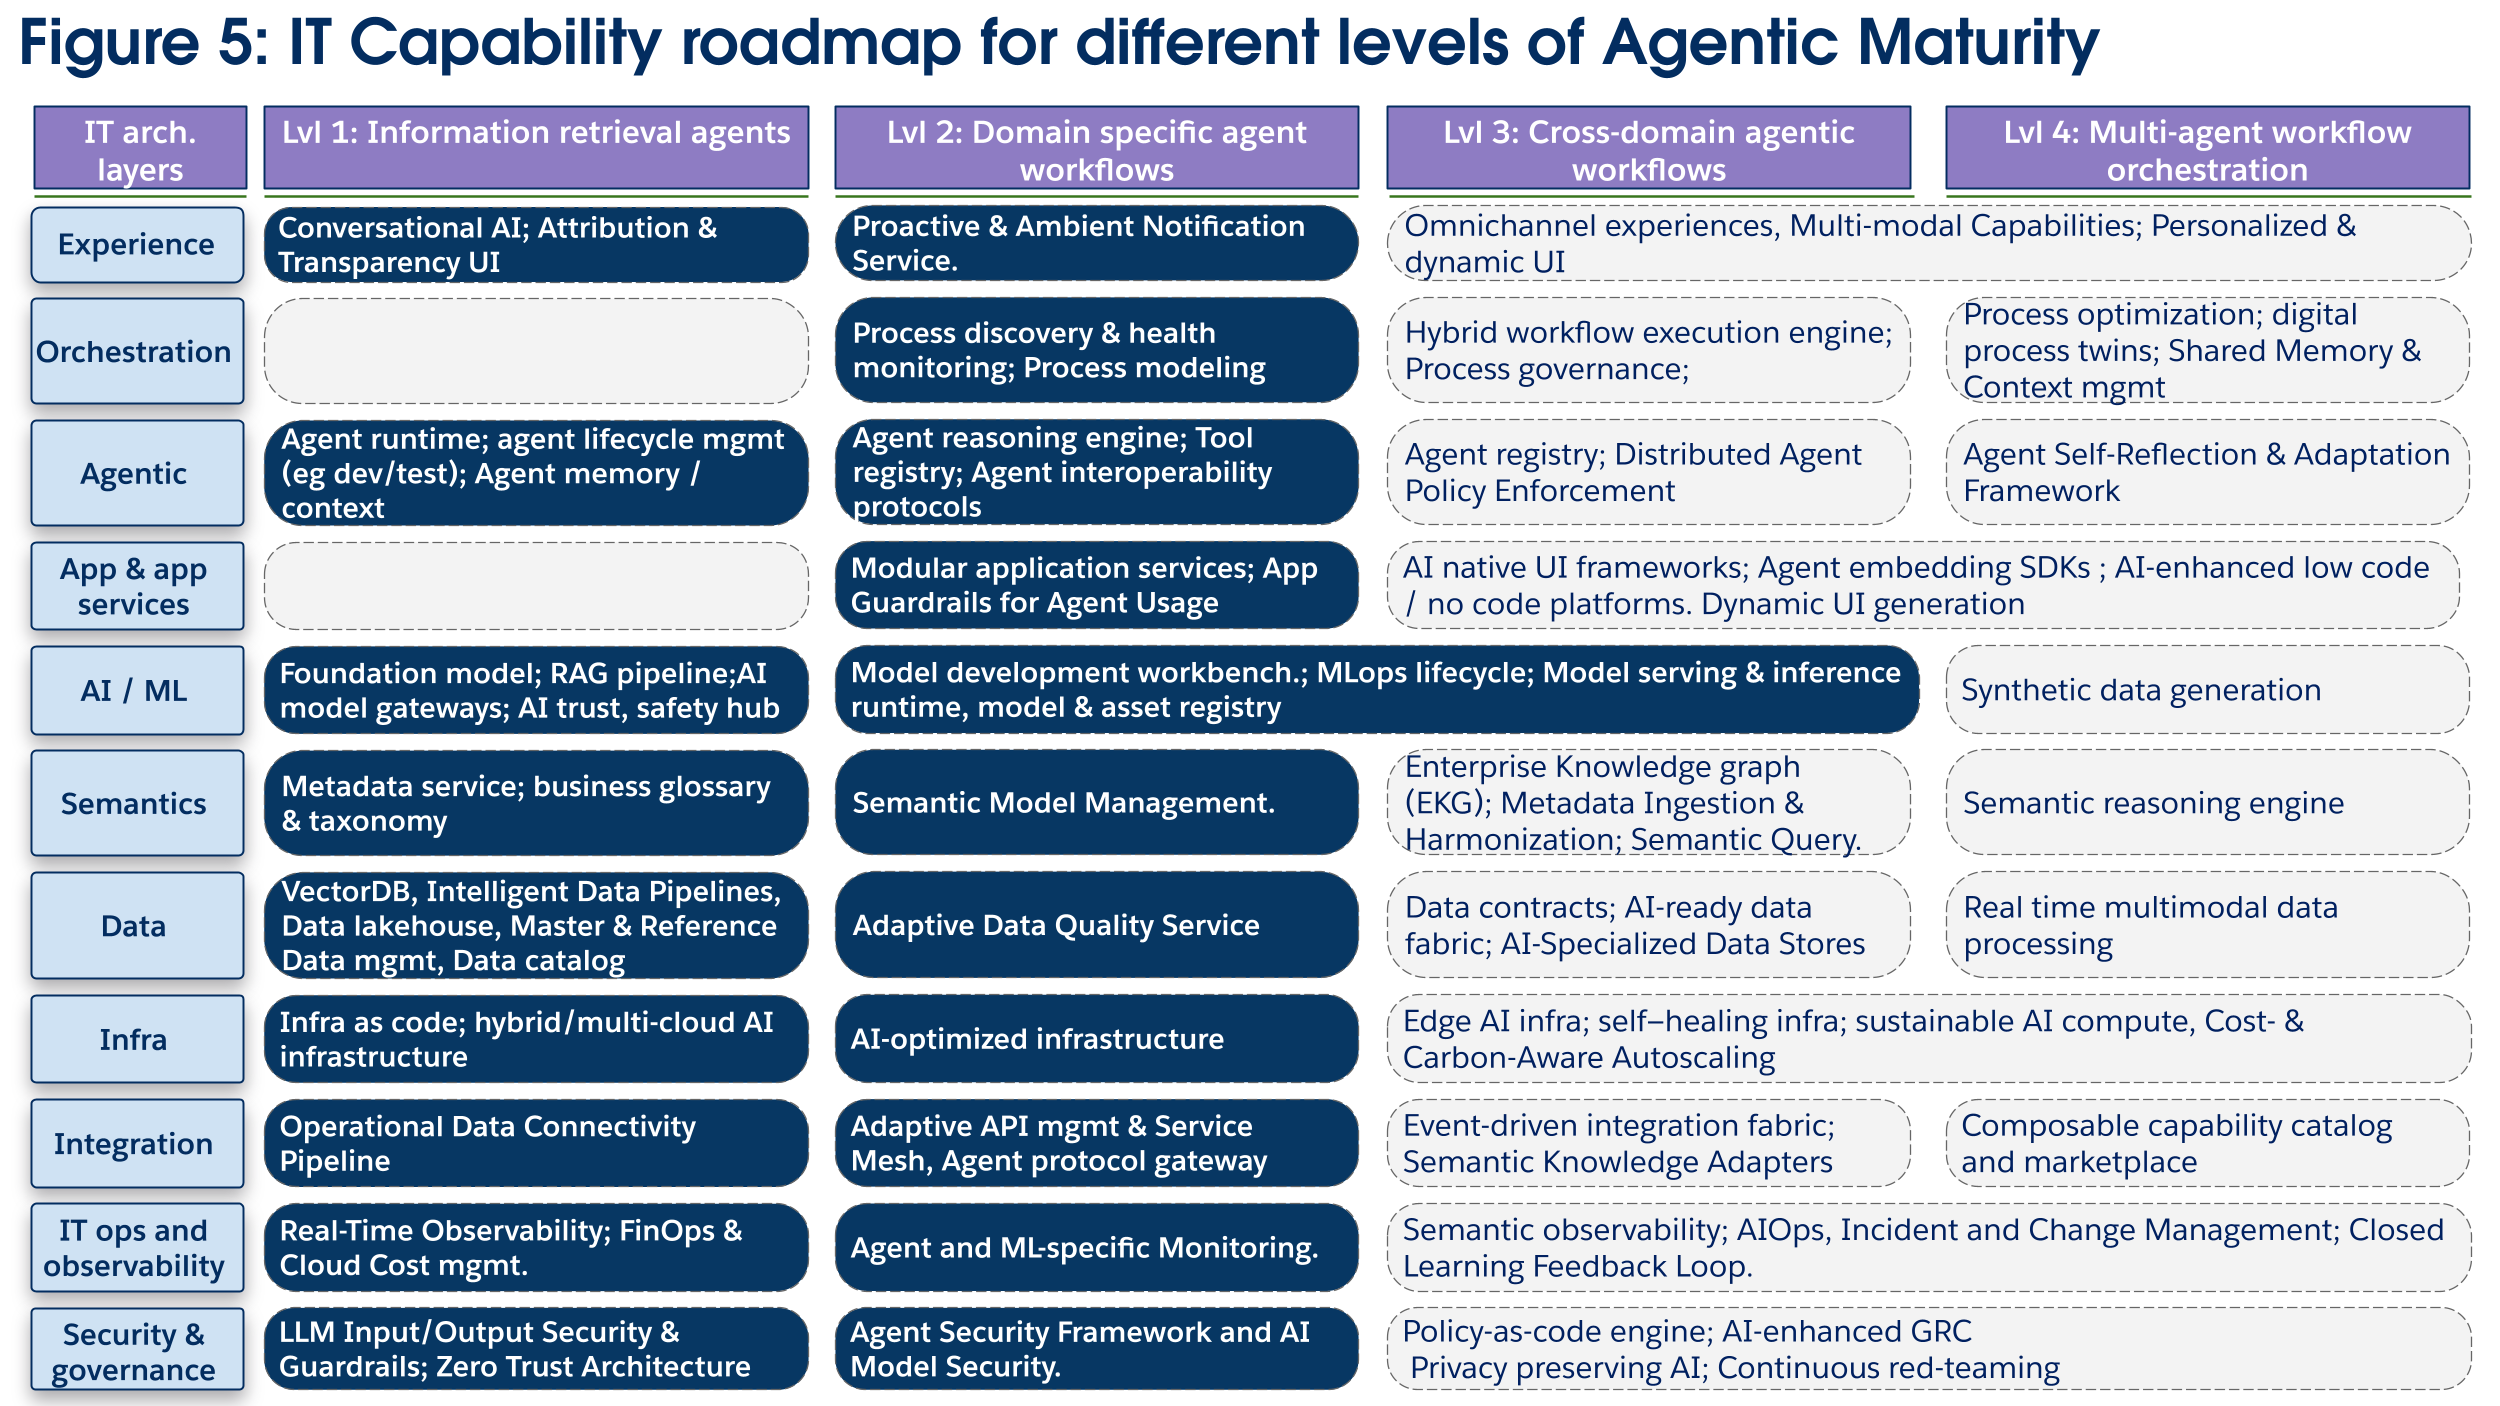
**Investimenti tecnologici chiave (figura 5):**
Gli investimenti si concentrano tematicamente sul consentire agli agenti dell'intelligenza artificiale di agire con una governance adeguata. Il livello **Applications and App Services** subisce un cambiamento critico, poiché la logica aziendale monolitica viene scomposta in **servizi applicativi modulari** (API) che gli agenti possono chiamare. Questi sono protetti dai **guardrail dell'app** per evitare che gli agenti sovraccarichino i sistemi, con integrazioni negli strumenti di osservabilità. Per potenziare questi agenti, è necessario investire nel ragionamento degli agenti, nei protocolli degli strumenti (ad esempio MCP) e nei **registri**. Ciò introduce nuovi rischi, rendendo un **Framework sicurezza agente** dedicato e un modello AI e funzionalità di monitoraggio degli agenti essenziali per la governance e la sicurezza. Infine, le aziende possono iniziare a scalare le funzionalità AI/ML per i modelli personalizzati per potenziare questi agenti che si occupano di operazioni specifiche del dominio.
 **Livello di maturità 3: Agenti dell'orchestrazione** multi-dominio
**Obiettivo e valore aziendale:** **Automatizzare processi aziendali complessi e completi che si estendono oltre i confini organizzativi e funzionali** (ad esempio "preventivo a cassa", "lead to order"). Il valore sta nello scomporre i silos, accelerare i tempi dei cicli dei processi e ottimizzare intere catene del valore all'interno dell'azienda. Sono possibili cambiamenti più elevati nella produttività dei lavoratori umani poiché le barriere organizzative iniziano a crollare e gli esseri umani iniziano a concentrarsi maggiormente sulla supervisione degli agenti AI.
**Focus architettonico:** L'architettura deve ora supportare questioni tecniche trasversali. Una comprensione semantica condivisa in tutta l'azienda, un motore di orchestrazione centralizzato per la governance e un tessuto di integrazione disaccoppiato e basato sugli eventi diventano gli elementi abilitanti critici.
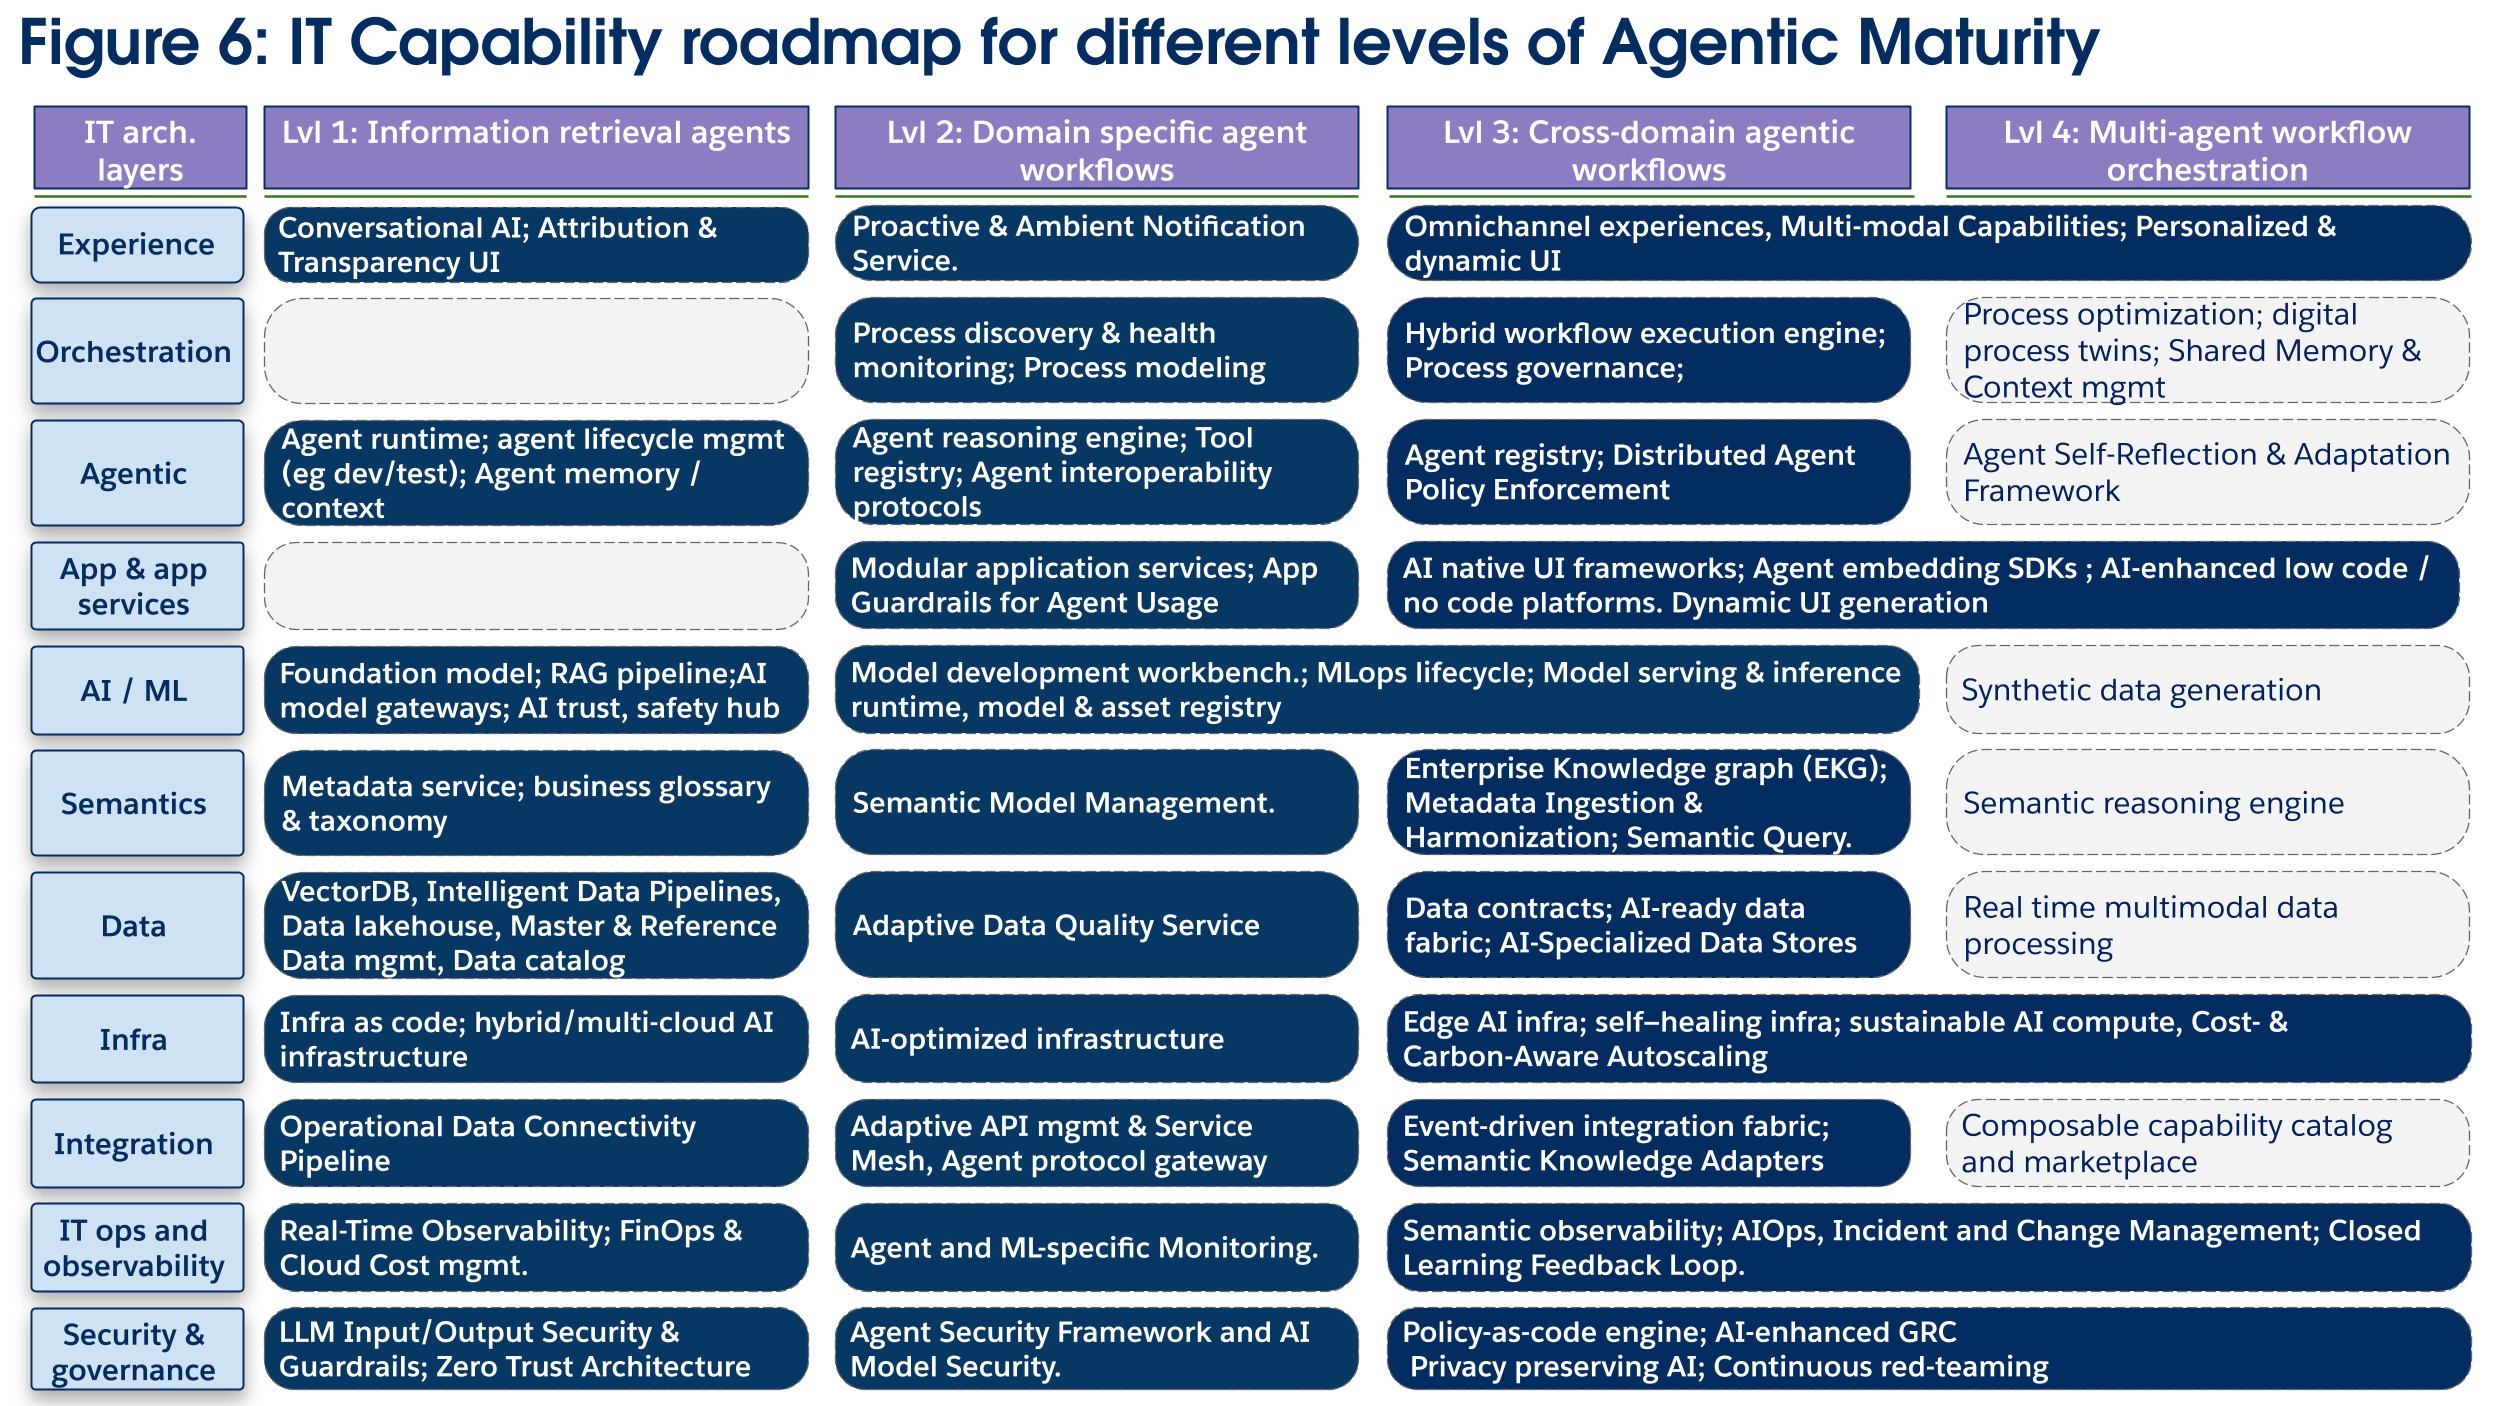 **Investimenti tecnologici chiave (figura 6):**
Gli investimenti tecnologici sono focalizzati tematicamente sull'orchestrazione di processi su scala aziendale tra persone, agenti e sistemi deterministici. L'**Enterprise Orchestration Layer** diventa il fulcro dell'investimento, richiedendo un **motore di esecuzione** del flusso di lavoro per coordinare le attività e un **motore Process Governance & Constraint** Engine per applicare le regole aziendali e le policy di conformità ai processi in volo poiché gli agenti lavorano in più domini, spesso con policy e definizioni semantiche diverse. Questo coordinamento tra domini è possibile solo con un **livello semantico** maturo dotato di un **Enterprise Knowledge Graph (**EKG), che crea una comprensione condivisa del modo in cui le entità aziendali si correlano tra i domini. Il **livello di integrazione** deve evolversi per includere un **Framework di integrazione** basato sugli eventi, che utilizza una dorsale streaming per disaccoppiare i sistemi e abilitare la comunicazione resiliente e asincrona tipica dei processi aziendali di lunga durata. Dato il valore più elevato di questi flussi di lavoro e i rischi associati, diventano fondamentali ulteriori investimenti nella sicurezza e nel monitoraggio (ad esempio **AIOps, policy-as-code**). Infine, ulteriori investimenti devono essere effettuati nel livello Applicazione e Servizi (ad esempio, LCNC **abilitato per AI,** esperienze utente più dinamiche e multimodali) man mano che gli utenti umani iniziano a monitorare e collaborare con agenti AI più capaci.
**Livello di maturità 4: Multi-agente, orchestrazione multi-dominio**
**Obiettivo e valore aziendale: Riprogettare e ottimizzare le operazioni aziendali in tutti i domini per favorire cambiamenti di produttività ed efficienza.** Questa fase consente di creare una simulazione digitale olistica (digital twin) dell'azienda per il miglioramento continuo e la pianificazione strategica nei principali processi aziendali e flussi di lavoro.
**Focus architettonico:** La fase finale si concentra sull'abilitazione di una collaborazione dinamica ed emergente tra gli agenti. Ciò richiede protocolli di comunicazione A2A avanzati, capacità di autoapprendimento degli agenti, ulteriori investimenti nella maturazione dei livelli Orchestrazione, Dati e Semantica e un'infrastruttura completamente dinamica e self-healing per supportare le crescenti esigenze dei carichi di lavoro di intelligenza artificiale dinamici man mano che gli agenti vengono ridimensionati in tutta l'azienda.
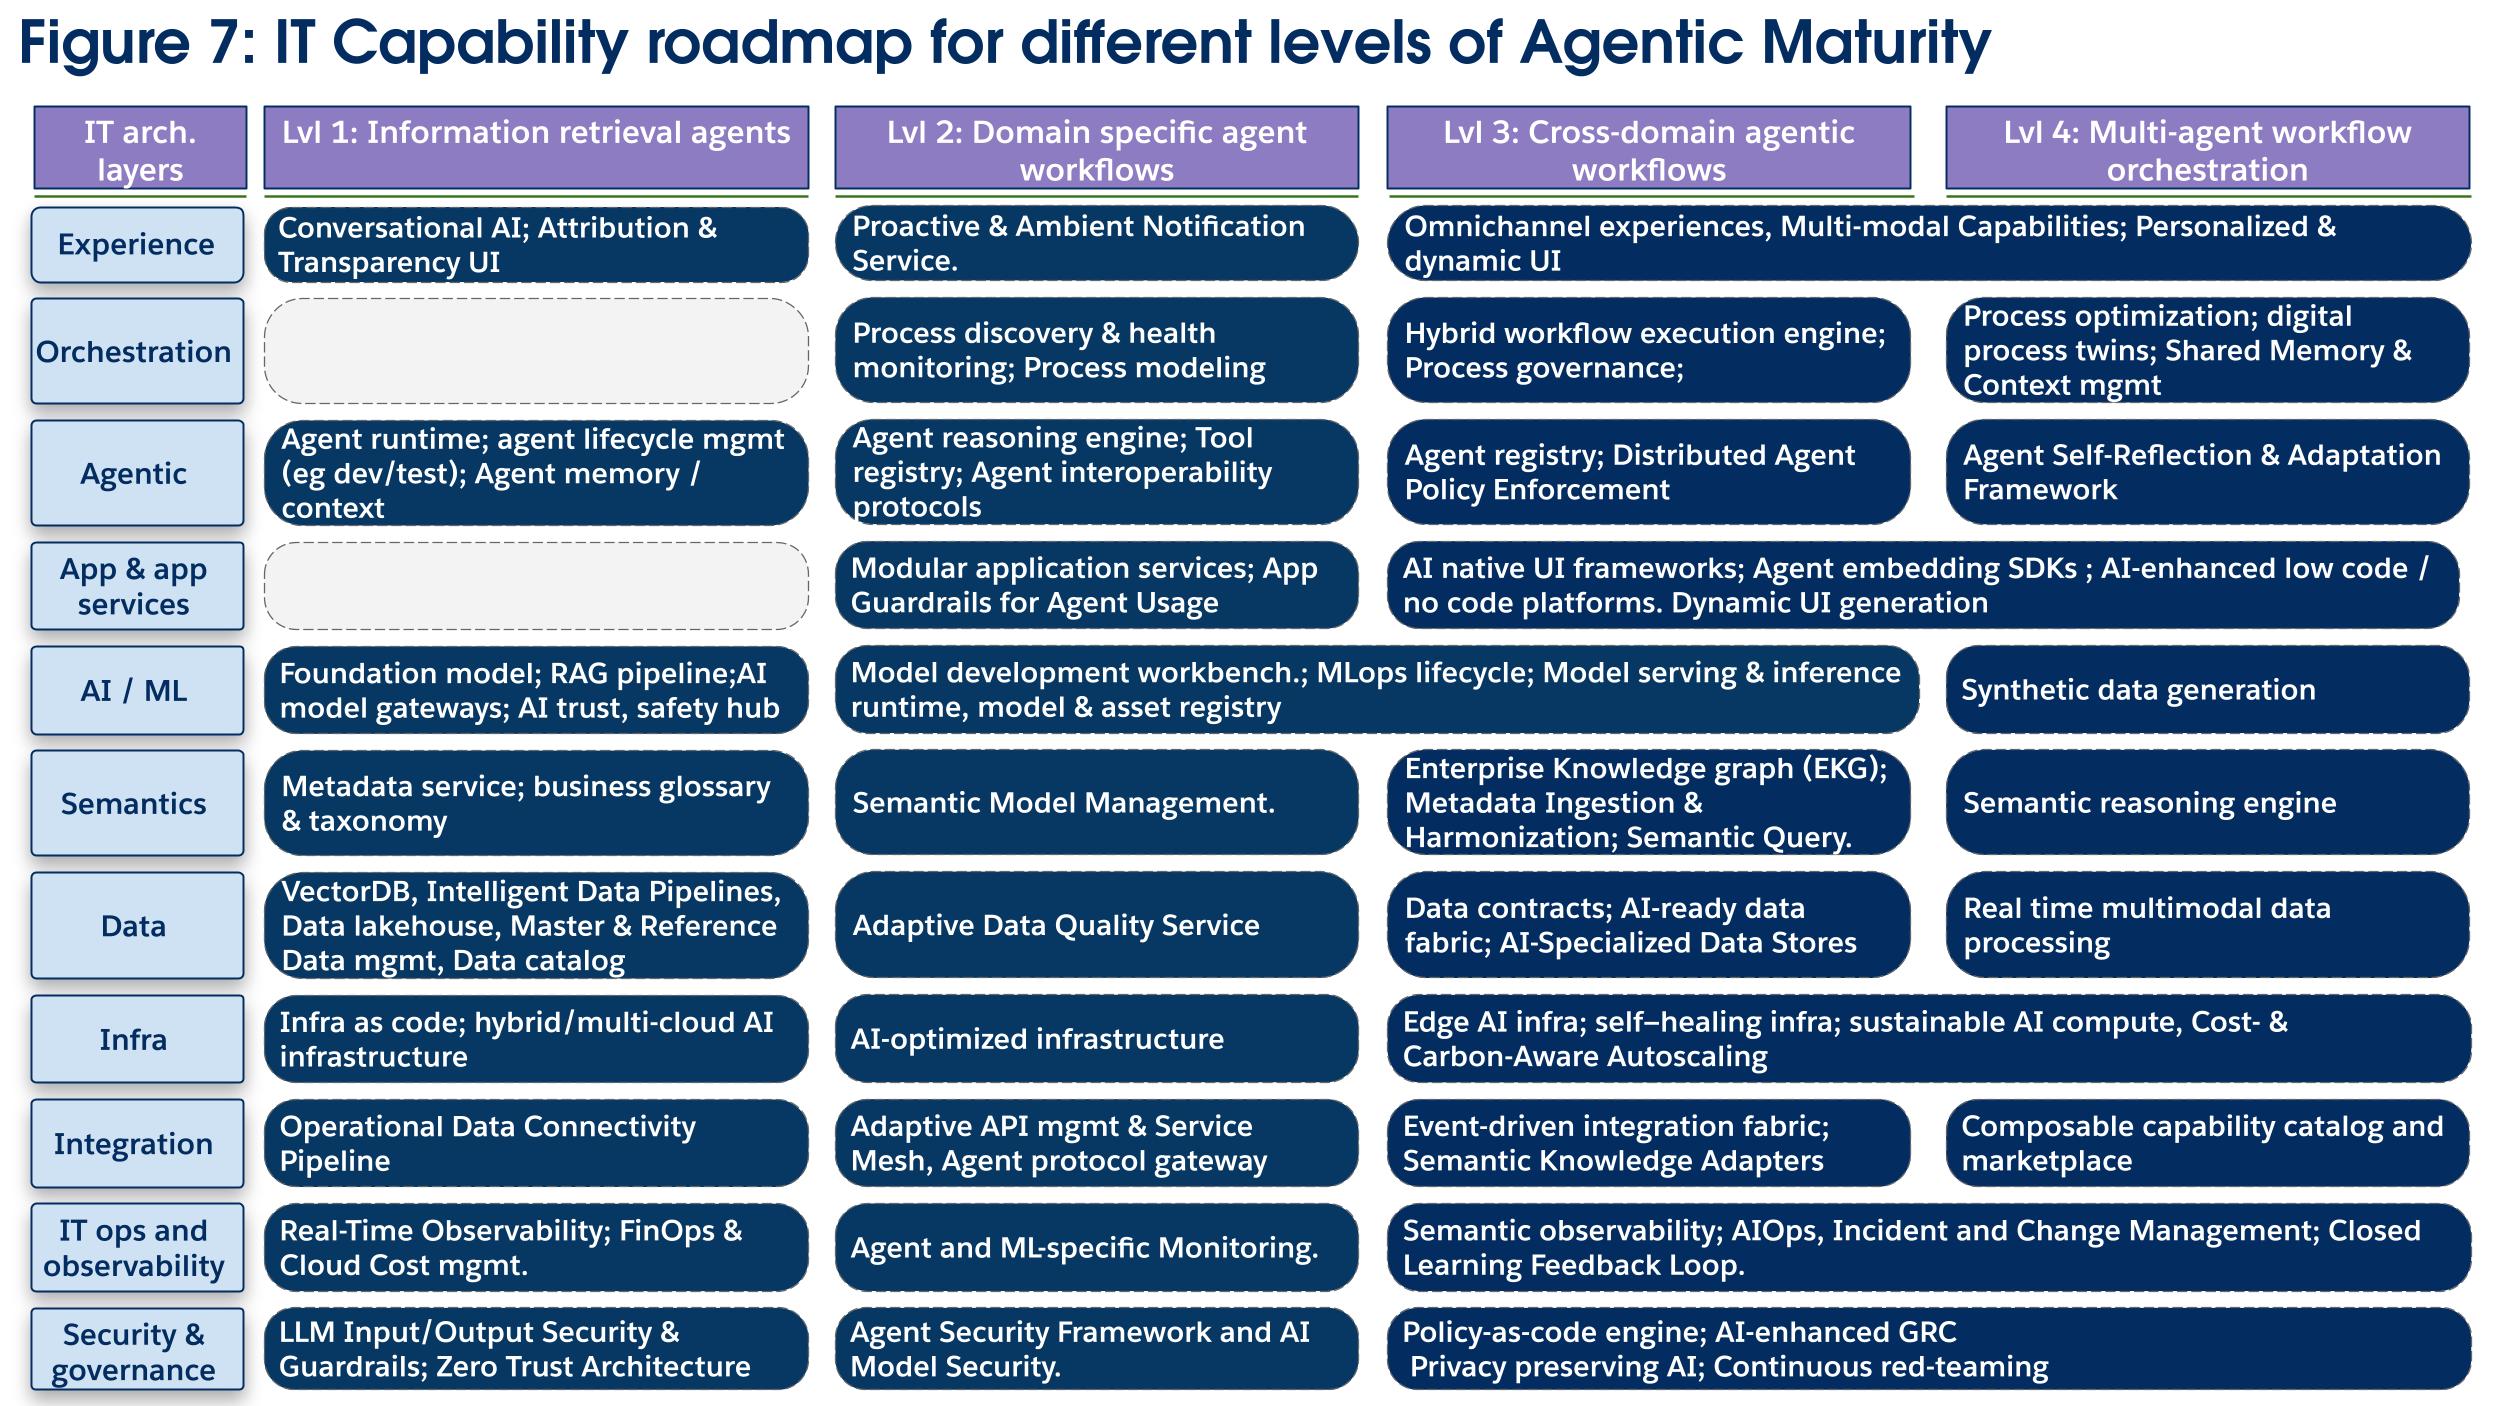 **Investimenti tecnologici chiave (figura 7):**
Gli investimenti tematici si concentrano sulla creazione di un sistema autonomo e automigliorante. Nel **livello agente**, un **Framework Autoriflessione e adattamento** fornisce un meccanismo che consente a un agente di analizzare i propri registri delle prestazioni e attivare miglioramenti. Questo apprendimento è supportato dall'**IT Operations and Observability Layer**, che implementa un **Closed Learning Feedback Loop** per reinserire automaticamente i dati osservabili nelle pipeline MLOps per la riaddestramento del modello, che può anche sfruttare la generazione di dati sintetici per ottimizzare ulteriormente le prestazioni del modello. Con le reti di agenti distribuite tra i reparti e le attività di modularizzazione delle applicazioni in corso, diventano necessari ulteriori investimenti nella sicurezza e, soprattutto, un **catalogo di funzionalità** componibile per consentire agli agenti di comporre dinamicamente le funzionalità per risolvere operazioni più astratte e di valore più elevato. Questi processi sono tutti orchestrati e ottimizzati tramite una nuova **funzionalità Digital Twin Process Modeling** che utilizza dati in tempo reale per creare simulazioni per l'analisi "what-if" e l'ottimizzazione predittiva, consentendo all'azienda di testare e distribuire in modo sicuro nuove distribuzioni agentiche.
**Conclusione**
La roadmap verso un'azienda agente segue un'evoluzione dell'architettura IT. Gli architetti Enterprise saranno i driver cruciali di questa trasformazione, guidando le decisioni di investimento critiche, insieme ad altri partner nel business e nell'IT, necessarie all'organizzazione per realizzare il valore dalle nuove capacità aziendali dell'azienda Agentic Enterprise.
## Panoramica
Le aziende gestiscono un'ampia gamma di tipi di documenti, tra cui fatture, ordini di acquisto, contratti legali e manuali tecnici. L'elaborazione manuale è lenta, soggetta a errori e consuma circa il 15-25% del tempo dei dipendenti. Gli approcci di automazione precedenti (ad esempio, _Robotic Process Automation (RPA)_, _Optical Character Recognition (_OCR) e strumenti di flusso di lavoro) hanno ridotto parte del carico, ma hanno prodotto pipeline rigide, elevati costi di manutenzione e adozione in silo tra i singoli team aziendali.
I documenti contengono un contesto strutturale RTF (ad esempio, gerarchie di tabelle, relazioni tra campi spaziali e sezioni con riferimenti incrociati) che l'elaborazione di testo piatto non può mantenere. La rimozione di un documento dal testo normale elimina il contesto aziendale che rende l'estrazione precisa e utile, degradando la qualità dell'analisi a valle, dell'inferenza dell'_intelligenza artificiale_ e dell'automazione dei processi.
Per essere efficaci, i sistemi di _elaborazione intelligente dei_ documenti devono classificare i documenti in base al tipo, estrarre i dati strutturati in modo preciso dai layout variabili e fornire tali dati in un formato governato e interrogabile ai sistemi a valle. Gli IDP devono inoltre gestire la variabilità dei documenti su larga scala senza richiedere la configurazione per modello per ogni nuovo formato di documento e devono essere centralizzati e accessibili tra le unità operative. Questa sfida è aggravata dall'enorme volume del problema chiave: i dati non strutturati rappresentano circa l'80% di tutti i dati aziendali e la maggior parte si accumula sotto forma di documenti in file system, cloud storage e archivi di contenuti che non sono alla portata dei sistemi _CRM (Customer Relationship Management)_, degli agenti AI e delle piattaforme di analisi.
_Data 360 Document AI_ è la funzionalità di elaborazione documenti di Salesforce all'interno di _Data 360_, progettata per risolvere questa lacuna. Estrae, classifica e analizza il contenuto di documenti non strutturati e semi-strutturati utilizzando _modelli LLM (Large Language Models)_, _Riconoscimento ottico caratteri_, _elaborazione linguaggio naturale_ e _apprendimento automatico_. L'output è costituito da dati strutturati, governati e interrogabili che si integrano nella pipeline di _Data 360_ a cui gli agenti _Agenteforce_, gli strumenti di analisi e i flussi di lavoro di automazione possono accedere tramite interfacce standard senza richiedere livelli di estrazione o trasformazione personalizzati.
## Perché l'intelligenza artificiale dei documenti è importante?
Le piattaforme dati aziendali elaborano dati strutturati e tabulari. Tuttavia, la maggior parte dei dati aziendali arriva sotto forma di documenti e rimane inaccessibile agli agenti CRM, ERP, AI e alle opportunità di analisi finché qualcuno non li estrae manualmente. Si tratta di una lacuna architettonica, non di un problema di flusso di lavoro.
### Limitazioni dell'estrazione basata su regole
Gli approcci precedenti combinavano reimpaginazione manuale, OCR basato su regole e script RPA. Questi metodi funzionavano su piccola scala, ma non erano in grado di gestire il volume, la varietà e la velocità dei tipi di documenti generati dalle aziende moderne. Gli strumenti basati su regole richiedono modelli espliciti per variante di layout. Qualsiasi modifica del formato interrompe l'estrazione e richiede uno sviluppatore, un nuovo modello e un ciclo di distribuzione.
Su larga scala, ciò produce soluzioni fragili senza governance centralizzata, schema condiviso e percorso per la preparazione all'intelligenza artificiale. Pipeline di estrazione incoerenti si propagano a valle. In altre parole, gli analytics ereditano le incoerenze dei dati, i modelli di intelligenza artificiale producono output inaffidabili e contenuti regolamentati come _Personal Health Information (PHI)_ e _Personaly Identifiable Information (PII)_ non dispongono di una governance sistematica.
### Elaborazione documenti nativa AI
Gli LLM estraggono i campi senza modelli espliciti. Un'unica configurazione dello schema regola l'estrazione tra le varianti di layout, le lingue e i formati, adattandosi al documento anziché richiedere che il documento sia conforme a una struttura fissa. In questo modo l'elaborazione dei documenti passa da un'operazione di manutenzione pesante e in silo a una funzionalità gestita e centralizzata.
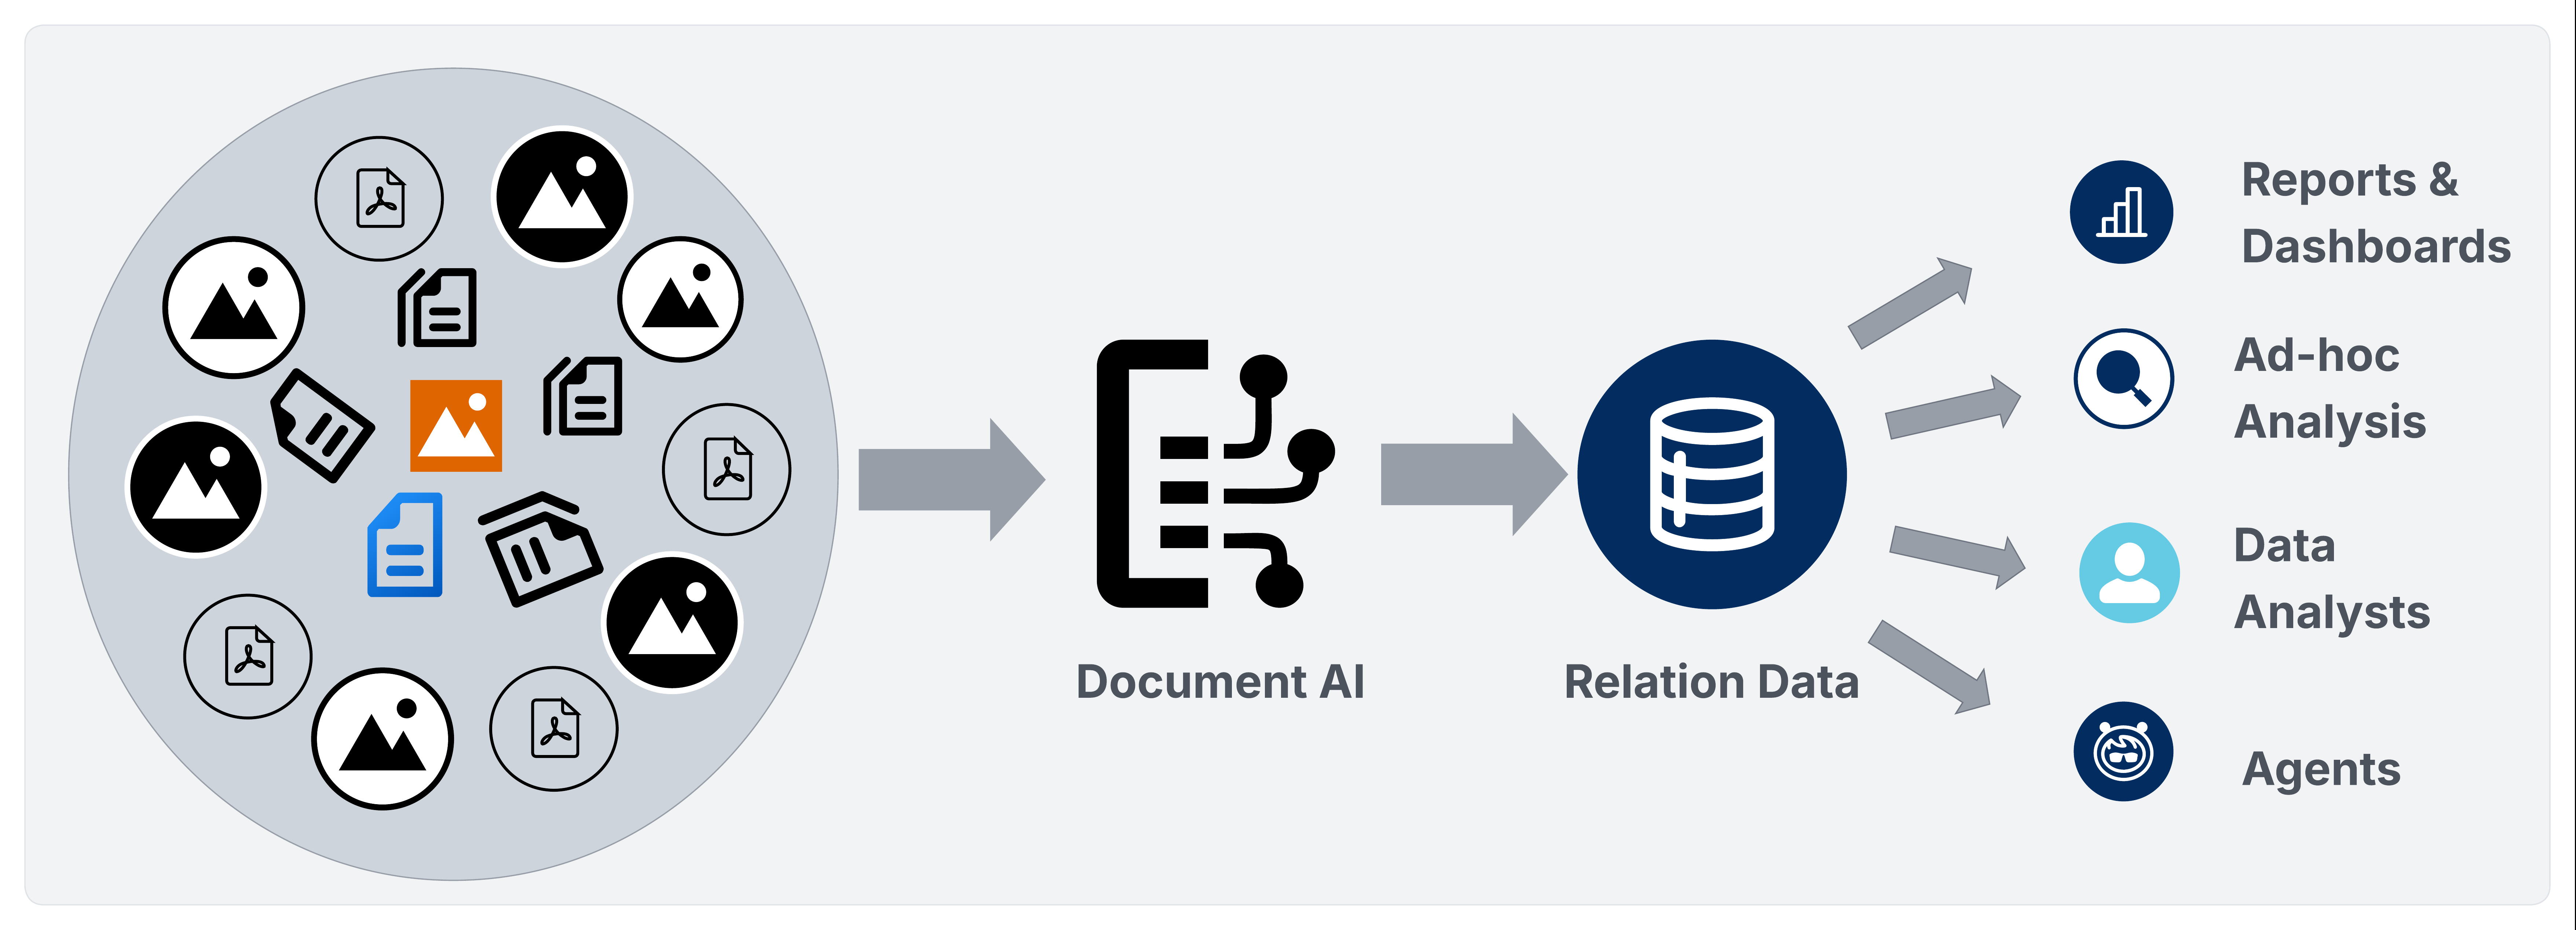
_Data 360 Document AI_ rende operativa l'elaborazione dei documenti all'interno della piattaforma _Data 360_ tramite due opportunità in corso di realizzazione.
- La pipeline _batch_ instrada i dati estratti attraverso l'inserimento, la risoluzione dell'identità, gli approfondimenti calcolati, le attivazioni, gli analytics e l'attivazione Agentforce.
- La pipeline di _elaborazione transazionale_ espone un'API REST che restituisce _JSON_ strutturato in modo sincrono, che consente agli architetti di instradare i dati derivati da documenti a _SObject_ Salesforce, alla pipeline _Data Lake Object_/_Data Model Object (DLO/DMO)_ o a database e magazzini esterni senza sovraccarico di impostazione batch.
In entrambi i casi, i dati estratti entrano in un modello governato basato su schema anziché in un insieme frammentato di strumenti puntuali.
## Prodotto nell'ambito
[Data 360 Document AI](https://help.salesforce.com/s/articleView?id=data.c360_a_document_ai.htm&type=5) è la funzionalità nativa di _elaborazione documenti intelligente_ di Salesforce all'interno della piattaforma _Data 360_. Converte il contenuto di documenti non strutturati e semistrutturati in dati governati e interrogabili che partecipano completamente all'intero ciclo di vita di _Data 360_.
## Che cos'è Data 360 Document AI?
[Data 360 Document AI](https://help.salesforce.com/s/articleView?id=data.c360_a_document_ai.htm&type=5) è la funzionalità nativa di _elaborazione documenti intelligente_ di Salesforce all'interno di _Data 360_. Inserisce documenti non strutturati e semistrutturati, estrae dati strutturati utilizzando una configurazione schema dichiarativa e li consegna alle opportunità in corso di realizzazione _di Data 360_ per l'armonizzazione, la risoluzione dell'identità, l'analisi e l'attivazione Agentforce.
L'intelligenza artificiale dei documenti di Data 360 supporta due modalità di elaborazione:
- **Elaborazione batch in blocco:** Elabora insiemi di documenti di grandi dimensioni definiti negli _oggetti modello di_ dati basati sugli eventi.
- **Elaborazione transazionale:** Elabora un singolo documento tramite l'API REST e restituisce un payload _JSON_ strutturato in modo sincrono. Gli architetti possono quindi instradare il payload alle pipeline _DLO/DMO Data 360_, _agli SObject_ Salesforce o ai database e magazzini esterni tramite pipeline _MuleSoft_, chiamate _Apex_ o _Einstein Trust Layer (ETL)_. Il livello di destinazione è una decisione architetturale determinata dai requisiti di latenza, governance e residenza dei dati.
L'intelligenza artificiale dei documenti attualmente supporta file PDF, file di immagine (JPEG, PNG) e documenti scritti a mano.
## Componenti principali
_Data 360 Document AI_ riunisce quattro tecnologie di elaborazione in un'unica pipeline gestita. Ogni componente gestisce una fase distinta del ciclo di vita da documento a dati:
- **Riconoscimento ottico dei caratteri (OCR):** Converte le immagini acquisite, il contenuto scritto a mano e i PDF basati su immagini in testo leggibile dal computer prima dell'elaborazione LLM. Per un'estrazione affidabile si consiglia un minimo di 150 DPI.
- **Modelli di lingua grandi (LLM):** Instradare l'estrazione attraverso il gateway _Einstein_ LLM utilizzando il modello scelto dall'utente. LLM riceve l'output OCR insieme alla configurazione dello schema _JSON_ e restituisce un payload di estrazione strutturato. _Gemini_ e altri modelli sono in fase di pianificazione per la futura implementazione.
- **Elaborazione del linguaggio naturale (NLP):** Esegue la comprensione contestuale, il riconoscimento delle entità, l'analisi della data e l'estrazione semantica dei campi direttamente all'interno del LLM tramite l'ingegneria dei prompt strutturati: il prompt definito dallo schema e l'output OCR fungono da unici input. Tutte le interazioni LLM vengono instradate attraverso l'ETL, che impone la conservazione zero dei dati con i provider del modello e maschera le _informazioni personali_ negli input basati su testo prima che raggiungano il modello. Non viene utilizzato un motore NLP separato.
- **Elaborazione multimodale:** Elabora le immagini incorporate all'interno dei PDF come input di estrazione separati, il che consente all'LLM di estrarre i dati da diagrammi, tabelle di rendering delle immagini e pagine a contenuto misto che l'OCR da solo non può analizzare.
Oltre alle quattro tecnologie di elaborazione, _Document AI_ gestisce anche:
- **Strato Einstein Trust:** Instrada tutte le interazioni LLM attraverso l'ETL, che impone la conservazione zero dei dati con i provider di modelli e maschera le _informazioni personali_ prima che gli input raggiungano l'ETL, ad eccezione dei dati multimodali (ad esempio, i documenti allegati elaborati tramite _Document AI_) in cui il mascheramento delle informazioni personali non è attualmente supportato e i dati vengono inviati così come sono ai modelli esterni. L'ETL governa solo il percorso di interazione LLM. I dati estratti scritti in _Oggetti data lake (DLO)_ sono memorizzati così come sono; il mascheramento a livello di campo a riposo deve essere gestito tramite controlli di governance dei dati a valle.
- **Limite delle dimensioni dei file:** _Document AI_ elabora file fino a 10 MB per richiesta. I limiti di lunghezza del contesto LLM possono limitare ulteriormente l'elaborazione di documenti densi e multipagina all'interno di questo confine.
## Principi architettonici chiave
Gli architetti Enterprise che distribuiscono _Data 360 Document AI_ devono applicare questi principi prima di impegnarsi in una progettazione dell'implementazione.
- **Selezionare la pipeline prima di progettare lo schema.** Le pipeline di elaborazione _batch_ e _transazionale si_ differenziano per modello di inserimento, binding dello schema, flessibilità del target e latenza. È importante confermare quali opportunità in corso di realizzazione richiede ogni caso d'uso prima di definire lo schema, poiché l'adattamento successivo aggiunge una rielaborazione evitabile.
- **Progettare schemi a livello di tipo di documento.** L'utilizzo di un unico schema ben elaborato per tipo di documento è più manutenibile rispetto all'utilizzo di configurazioni per caso d'uso ed è anche la leva più grande per la qualità dell'estrazione. Per eseguire correttamente questa operazione è necessario utilizzare una serie di documenti diversificata, inclusi i casi limite, anziché progettare da un singolo esempio. Utilizzare i prompt in modo iterativo a livello di _campo_, _tabella_ e _schema_ per trovare lacune e quindi testarli e perfezionarli in base a più esempi di documenti prima di finalizzare. Tenere presente che uno schema che funziona bene su un documento può non essere sufficiente su altri, quindi l'ampiezza e l'iterazione sono essenziali. La flessibilità dello schema, inclusa la rimozione delle colonne che non vengono estratte in modo affidabile tra i vari tipi di documento, è altrettanto importante. Mantenere i campi che introducono rumore o incoerenza compromette la qualità complessiva dell'estrazione, quindi è importante considerare la rimozione delle colonne come una decisione di progettazione di prima classe.
- **Scegliere il livello di destinazione corretto per gruppo di campi.** I campi che determinano i flussi di lavoro o le approvazioni CRM vengono scritti in _SObjects_. I campi che arricchiscono il profilo unificato o l'analisi dei feed appartengono alla pipeline _DLO/DMO_. I campi che servono sistemi esterni appartengono al livello _RDBMS_. Tenere presente che un singolo schema può estendersi contemporaneamente a più livelli.
- **Applicare la governance prima di elaborare i contenuti regolamentati.** I dati regolamentati necessitano di protezione a ogni livello. Ecco perché è importante configurare il mascheramento _delle informazioni personali_, i tag di classificazione dei dati e l'_ABAC (Attribute-Based Access Control_) dopo che i dati estratti sono stati memorizzati nei _DLO (Data Lake Objects_) di output Ciò offre un'applicazione più precisa e un accesso sensibile al contesto basato sulla classificazione dei dati, sul ruolo utente e sul contesto organizzativo. La _governance_ è suddivisa in due percorsi: l'_ELT_ governa l'interazione LLM, mentre i dati estratti archiviati nei DLO devono essere governati separatamente, direttamente a livello di DLO e database, tramite le configurazioni dello _spazio dati_, gli _insiemi di autorizzazioni_ e le policy _ABAC_. Questi controlli devono mantenere la coerenza a livello di memoria, non solo a livello di applicazione, in modo che le restrizioni di accesso rimangano intatte indipendentemente dal modo in cui si accede ai dati dopo l'inserimento. Tenere presente che eventuali lacune in qualsiasi livello possono esporre i dati regolamentati a valle anche quando altri sono configurati correttamente.
- **Progettare per le modalità di errore prima della produzione.** Risolvere la gestione dei campi nulli, le soglie di qualità OCR, la pre-convalida delle dimensioni del file, l'overflow del contesto LLM, l'impotenza di scrittura RDBMS e i limiti del budget di credito prima della prima esecuzione batch di produzione. Non si tratta di casi limite, ma di superfici di errore prevedibili che devono essere gestite in modo esplicito nella progettazione delle opportunità in corso di realizzazione e non rilevate in fase di esecuzione.
- **Trattare i punteggi di confidenza come un segnale di calcolo del percorso di prima classe, non come un ripensamento diagnostico.** I risultati dell'estrazione contengono valori di confidenza a livello di campo derivati dalle probabilità di registrazione (logprobs) dell'output del modello sottostante. Per ogni campo, tabella o colonna estratta, il punteggio riflette la certezza a livello di token del valore estratto del modello. Ciò rende i punteggi di confidenza un segnale basato su dati statistici sufficientemente affidabile da fungere da porta principale per le soglie di inoltro al livello superiore _di Human-in-the-Loop (HITL)_. Utilizzare i punteggi di confidenza per identificare sistematicamente le estrazioni di bassa qualità e avviare controlli HITL per i valori dei campi con bassa confidenza, corrispondenze ambigue dello schema o errori ripetuti delle opportunità in corso di realizzazione anziché affidarsi all'euristica o a controlli manuali a campione. Quando il ripristino automatico non è possibile, il calcolo del punteggio di confidenza basato su HITL garantisce che il giudizio umano venga applicato esattamente dove necessario.
- **Progettare i percorsi di attivazione in parallelo alla progettazione dello schema.** Il valore di _Document AI_ deriva dalla possibilità di attivare i dati estratti all'interno dei flussi di lavoro e degli agenti Salesforce. Consente di progettare _azioni_ Agentforce, _flussi_ e _approfondimenti calcolati_ insieme alla progettazione dello schema di estrazione, non dopo.
## Architettura: Pipeline AI documento Data 360
_Document AI_ opera all'interno di due opportunità in corso di realizzazione:
- Una pipeline _batch_ per l'elaborazione a volume elevato, supportata da UDMO
- Una pipeline di _elaborazione_ _transazionale_ per l'estrazione in tempo reale basata sull'API
Entrambe le opportunità in corso di realizzazione condividono lo stesso contratto di configurazione dello schema e la stessa governance ETL, ma differiscono per il modo in cui i documenti entrano nel sistema e dove finiscono i dati estratti.
Vediamo più nel dettaglio ogni pipeline.
### Pipeline di elaborazione batch
La pipeline _batch_ elabora gli insiemi di documenti ricorrenti definiti da un UDMO. Si adatta ai casi d'uso pianificati o basati sugli eventi in cui i documenti vengono inseriti dall'archiviazione aziendale, quindi passano attraverso l'estrazione dei documenti e vengono consegnati alla pipeline _DLO/DMO Data 360_ per l'armonizzazione, la risoluzione dell'identità e l'attivazione.
**Scenario reale**
Ogni giorno, un operatore assicurativo riceve migliaia di documenti relativi alle richieste mediche dai portali operatori che vengono caricati come PDF in _Amazon S3_. L'UDMO definisce l'insieme di documenti nell'ambito e invia tutti i PDF delle richieste al bucket `/claims/incoming/` entro 24 ore.
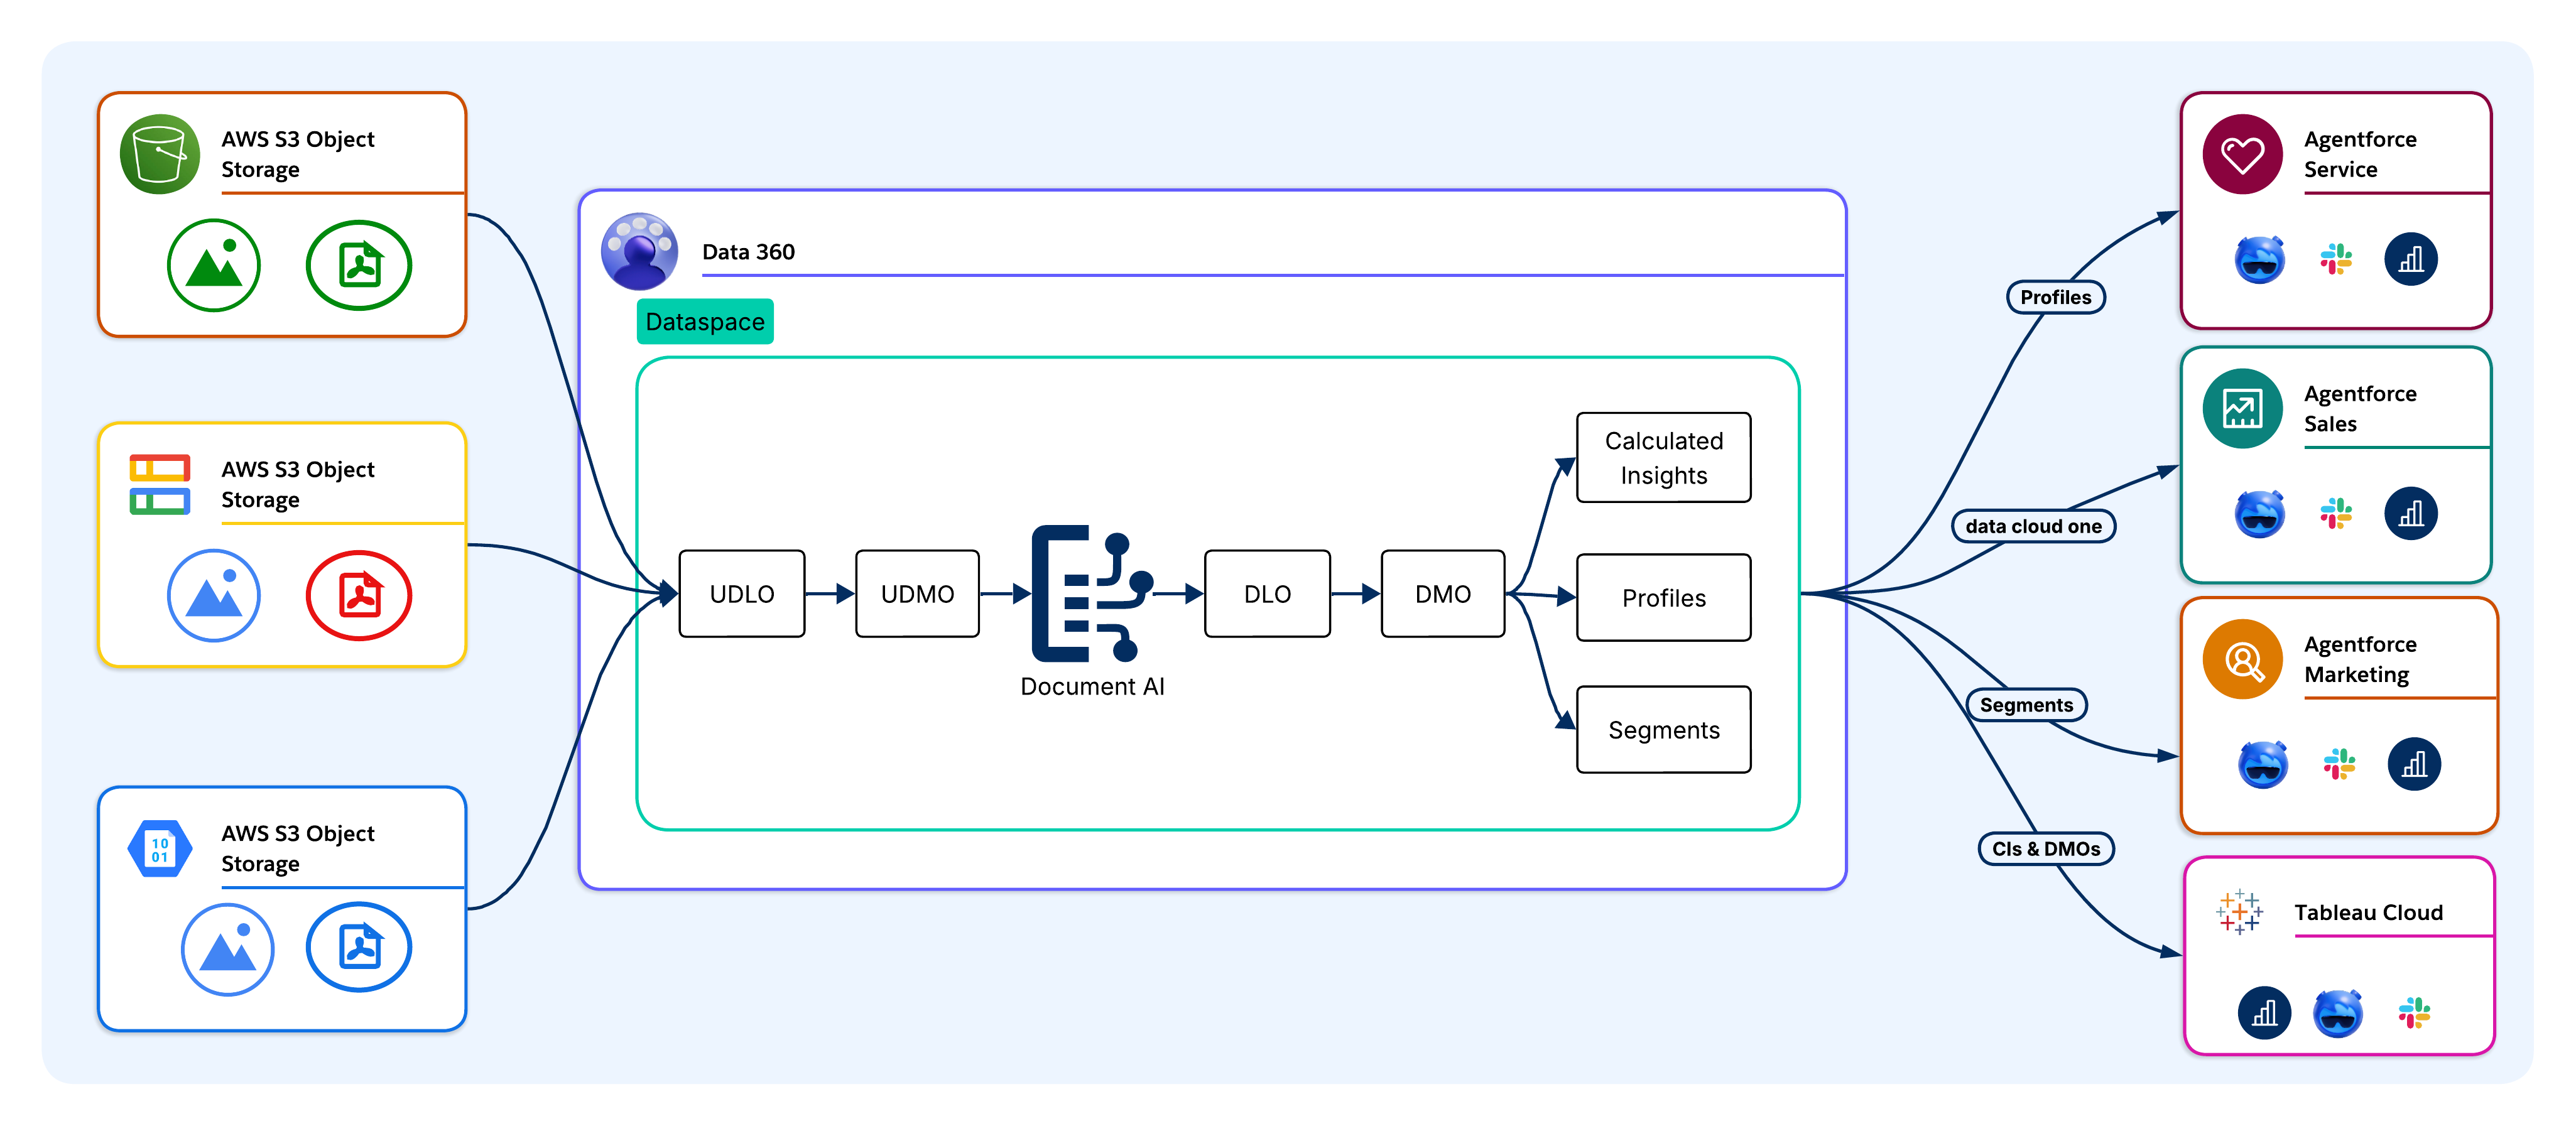
#### Fase 1: Inserisci
I documenti vengono inseriti in _Data 360_ dai sistemi di origine aziendali senza duplicazione fisica. Le fonti supportate includono _Amazon S3_, _Google Cloud Storage_, oggetti di file Salesforce CRM, pipeline _orchestrate da MuleSoft_ e caricamenti API diretti. Nelle distribuzioni _Headless 360_, i documenti vengono inseriti tramite connettori di archiviazione cloud o l'_API di inserimento_, che ignora il livello CRM. Il server _Model Context Protocol (MCP)_ espone l'inserimento come strumento di chiamata per gli agenti AI esterni e i client LLM.
Al momento dell'inserimento, i documenti non strutturati vengono memorizzati come _Oggetti data lake non_ strutturati, che vengono mappati alla posizione fisica e ai metadati di ogni documento senza spostare o trasformare il file di origine.
**Esempio:**
I PDF delle richieste vengono inseriti da _S3_ in _Data 360_ tramite il connettore di archiviazione cloud. Ogni documento è memorizzato come UDLO che punta all'oggetto _S3_. Non si verifica alcuna duplicazione fisica.
#### Fase 2: Estrai
_Document AI_ elabora ogni UDLO in base a una configurazione schema che definisce i campi da estrarre insieme ai relativi tipi di dati di destinazione. L'UDMO definisce i documenti che rientrano nell'ambito di applicazione. LLM (_GPT-4o_, _Gemini_ o _Claude_) legge ogni documento e restituisce un payload di estrazione strutturato.
**Esempio:**
_L'intelligenza artificiale_ elabora ogni UDLO in base a uno schema delle richieste che definisce campi come: ClaimID, PatientName, DiagnosisCode, BillingAmount e ServiceDate. Gli LLM leggono quindi ogni PDF e restituiscono un payload di estrazione strutturato.
#### Fase 3: Persistere
Una volta estratti, i dati persistono nei DLO, che sono lo strato di memoria non formattato di _Data 360_. I DLO conservano i campi estratti senza imporre una logica aziendale, che mantiene una rappresentazione fisica accurata per la trasformazione e la tracciabilità a valle. L'UDLO mantiene un riferimento al documento di origine per abilitare la discendenza a livello di campo in qualsiasi punto della pipeline.
**Esempio:**
Tutti i campi estratti vengono inseriti in un _DLO Richieste_, che mantiene una rappresentazione grezza e precisa di ogni richiesta con una discendenza completa che può essere ricondotta al PDF di origine.
#### Fase 4: Armonizza
I campi DLO vengono mappati a DMO allineati al _Customer 360 Data Model_ standard. Questo è il confine in cui i dati derivati dai documenti passano dai campi estratti non elaborati alle entità significative per l'azienda. Il _DLO Fattura viene_ mappato a un _DMO Fattura_ e campi come _CustomerID_ e _BillingAmount_ diventano chiavi join e attributi di corrispondenza all'interno del modello di dati unificato. I dati dei documenti armonizzati partecipano alla segmentazione, agli _approfondimenti calcolati_ e all'attivazione tramite le stesse interfacce utilizzate da CRM e dai dati transazionali.
**Esempio:**
Il _DLO Richieste_ viene mappato a un _DMO Richieste_. I campi PatientID e PolicyNumber diventano chiavi join che collegano i record richiesta ai profili paziente unificati.
#### Fase 5: Unificare
I dati DMO armonizzati partecipano alla risoluzione dell'identità. I campi estratti (ad esempio, nomi di clienti, indirizzi email o numeri di account) fungono da chiavi di corrispondenza per collegare i record documento a _Persone unificate (Golden Record)_, colmando così il divario tra documenti e profili.
**Esempio:**
I campi di estrazione (ad esempio PatientName, DateOfBirth e PolicyNumber) fungono da chiavi di corrispondenza per la risoluzione dell'identità, che collega i record richiesta alla _Persona unificata_ corretta. Ciò si verifica anche se lo stesso paziente appare con ortografie leggermente diverse nei documenti.
#### Fase 6: Approfondimenti derivati
Gli architetti definiscono gli _approfondimenti calcolati_, ovvero metriche aggregate calcolate in base ai dati dei documenti armonizzati (ad esempio, la spesa totale di varie voci in fattura, i punteggi del rischio di rinnovo dei contratti e gli indici di gravità delle richieste).
**Esempio:**
_Gli approfondimenti calcolati_ calcolano TotalClaimsPerPatient, AverageClaimAmount e HighRiskClaimScore nei dati delle richieste armonizzati per le query Agentforce.
#### Fase 7: Atto
I dati armonizzati e risolti in base all'identità sono accessibili agli agenti Agentforce, a _Tableau_, alle piattaforme di marketing e agli _SObject_ Salesforce. Il livello di destinazione è una decisione architettonica determinata dai requisiti di latenza, governance e residenza dei dati.
**Esempio:**
Un _agente Claims Adjudication Agentforce_ esegue una query sui DMO e gli IC _di Data 360_ per trovare richieste ad alto rischio per la revisione della priorità. I cruscotti digitali _di Tableau_ mostrano il volume delle richieste e le tendenze delle anomalie. I record richiesta approvati tornano all'_oggetto Richieste_ per avviare i flussi di lavoro di pagamento.
Nelle architetture _Headless 360_, l'attivazione viene instradata direttamente ai sistemi esterni tramite le destinazioni attivazione del data warehouse _Query API_, _API Pub/Sub_ o Cloud. Quindi, il server MCP trova i dati dei documenti armonizzati e _gli approfondimenti calcolati_ come strumenti richiamabili per gli agenti AI esterni.
### Pipeline di elaborazione transazionale
La pipeline di _elaborazione transazionale_ gestisce l'estrazione di un singolo documento in fase di esecuzione senza un UDMO o un UDLO pre-inserito, il che si adatta ai casi d'uso basati sugli eventi (ad esempio, un cliente che carica un modulo, un agente che riceve un PDF o un sistema esterno che avvia l'estrazione all'interno di un flusso di lavoro di elaborazione transazionale). La governance ETL si applica a entrambe le opportunità in corso di realizzazione in modo identico.
**Scenario reale**
Durante la richiesta di un prestito, un cliente bancario carica un PDF della bolletta tramite l'app mobile della banca. L'evento avvia l'estrazione in tempo reale, il che significa che non sono coinvolti UDLO o UDMO pre-inseriti.
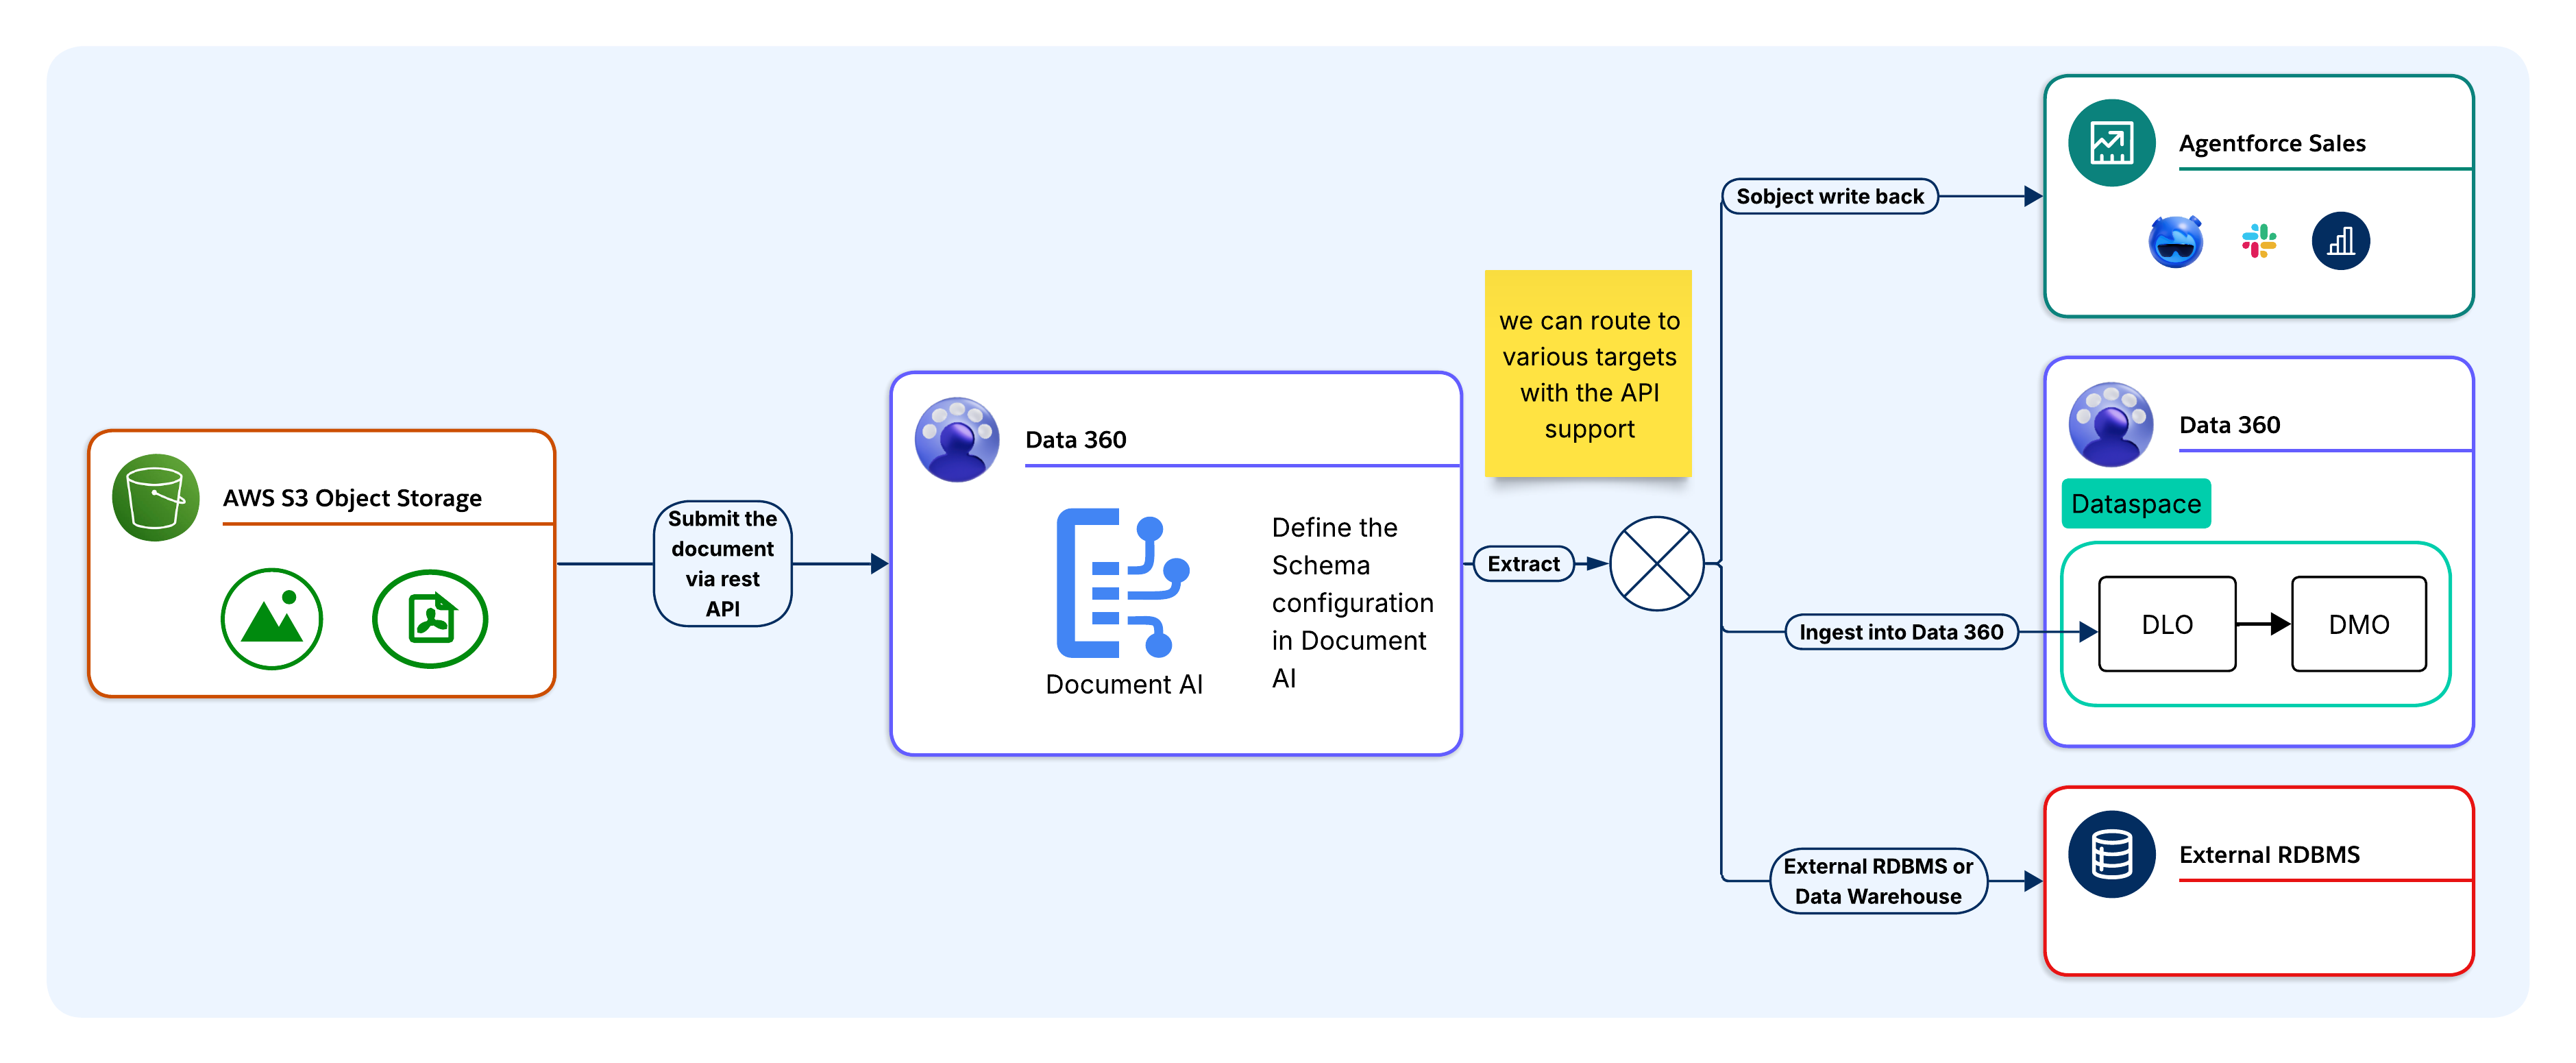
#### Fase 1: Definizione della configurazione dello schema
Prima di invocare l'API, gli architetti devono definire e archiviare in _Data 360_ uno schema che specifica i campi, i tipi di dati e le istruzioni di estrazione in formato _JSON Schema_. A ogni schema viene assegnato un _ID schema_ univoco. In fase di esecuzione, l'applicazione chiamante fa riferimento all'ID schema per mantenere centralizzata la logica di estrazione in _Data 360_ anziché incorporarla nel codice dell'applicazione.
**Esempio:**
Il team della banca ha uno schema di `ProofOfAddress` predefinito in _Data 360_, che specifica campi come `CustomerName`, `AddressLine1`, `City`, `PostCode` e `DocumentDate`. Queste informazioni sono memorizzate come configurazione con versione a cui può fare riferimento un _ID schema_.
#### Fase 2: Invia documenti
L'applicazione chiamante invia il documento e l'ID schema in una singola richiesta API REST come payload con codifica base64 o riferimento al file. Non è necessario alcun inserimento UDLO. _Document AI_ applica l'estrazione del documento e restituisce l'output strutturato in base allo schema fornito.
**Esempio:**
L'app mobile invia la bolletta come payload con codifica base64 insieme all'ID schema `ProofOfAddress` in una singola chiamata API REST. Questo processo non richiede una fase di inserimento UDLO.
#### Fase 3: Estrai
LLM elabora l'output OCR rispetto allo schema e restituisce un payload JSON strutturato in modo sincrono. I campi non trovati nel documento vengono restituiti come _nulli_. Il chiamante è titolare della risposta JSON completa e procede all'instradamento.
**Esempio:**
_L'intelligenza artificiale_ applica OCR al PDF e LLM restituisce un payload JSON strutturato con campi indirizzo estratti. I campi che non vengono trovati (ad esempio, se il `PostCode` manca nella fattura) vengono restituiti come _nulli_.
#### Fase 4: Percorso a destinazione (facoltativo)
Una volta estratto, il payload JSON può essere instradato a uno o più livelli di destinazione a seconda del caso d'uso:
- **SObject Salesforce:** Mappa direttamente ai campi _SObject_ tramite _Apex_ o _Flusso_ per i flussi di lavoro e le approvazioni CRM.
- **Pipeline DLO/DMO di Data 360:** Instrada a un DLO per armonizzazione, risoluzione dell'identità, _approfondimenti calcolati_ e radicamento Agentforce.
- **RDBMS esterno o Data Warehouse:** Instrada tramite _MuleSoft_, chiamata _Apex_, _Eventi piattaforma_ o ETL per i sistemi esterni a Salesforce.
- **Integrazione personalizzata:** Restituisce payload JSON strutturati all'applicazione chiamante per l'archiviazione in qualsiasi sistema esterno o archivio dati.
- **Flusso a valle o agente:** Passa l'output JSON strutturato direttamente a un flusso o a un agente a valle senza alcuna persistenza in un _SObject_. Questo è uno schema comune per i clienti che utilizzano _l'intelligenza artificiale documenti_ come fase di estrazione in tempo reale all'interno di un flusso di lavoro di automazione o agente più ampio.
Tenere presente che un singolo schema può estendersi contemporaneamente a più livelli, con gruppi di campi diversi che instradano a destinazioni diverse dallo stesso punto di estrazione.
**Esempio:**
Un payload `ProofOfAddress` può essere distribuito contemporaneamente a tre livelli (ad esempio, `CustomerName` e `AddressLine1` scrivono nel _Contact SObject_), il che avvia un _flusso di_ verifica dell'indirizzo. Quindi, il payload completo viene instradato in un DLO per l'armonizzazione e il calcolo del punteggio del rischio, e una copia viene instradata al sistema KYC della banca tramite _MuleSoft_ per la registrazione della conformità normativa.
#### Fase 5: Atto
Una volta scritti, i dati estratti si attivano immediatamente nel sistema di destinazione. Per le destinazioni _SObject_, i trigger, i flussi e i processi di approvazione vengono attivati nel record inserito con aggiornamento. Per le destinazioni _DLO/DMO_, i dati entrano nella pipeline di _armonizzazione e risoluzione_ dell'identità e nel contesto Agentforce. Per le destinazioni _RDBMS_ esterne, i dati sono disponibili per le query a valle non appena viene completata la scrittura.
**Esempio:**
Il _flusso di verifica_ dell'indirizzo si attiva immediatamente nel record _Referente_ inserito con aggiornamento, il che fa avanzare la richiesta di prestito alla fase successiva. L'_agente dei prestiti_ Agentforce trova l'indirizzo verificato da _Data 360_ e il sistema KYC registra l'invio del documento per scopi di controllo.
## Quando utilizzare l'intelligenza artificiale dei documenti?
_Document AI_ è più adatto a condizioni architettoniche specifiche. L'applicazione al di fuori di tali condizioni introduce una complessità inutile e costi aggiuntivi.
In qualità di architetti, è importante valutare questo criterio prima di impegnarsi a utilizzare _Document AI_ come meccanismo di estrazione.
**Utilizzare AI documento quando:**
- **I documenti sono la fonte di dati principale.** Le informazioni richieste esistono solo sotto forma di documento e non sono disponibili da un'API o un database strutturato (ad esempio, contratti scansionati, rapporti di laboratorio, moduli di accettazione o richieste di risarcimento assicurativo).
- **I layout dei documenti variano a seconda delle fonti.** Lo stesso tipo di documento arriva da più fornitori, partner o regioni con posizioni e formati di campo diversi. L'estrazione LLM basata su schema si adatta senza manutenzione per layout.
- **I dati estratti devono alimentare Data 360 o Agentforce.** L'estrazione deve partecipare alla risoluzione dell'identità, agli _approfondimenti calcolati_ o al radicamento Agentforce. _L'intelligenza artificiale_ viene fornita direttamente nella pipeline _DLO/DMO_ senza un livello ETL separato.
- **Il volume giustifica l'automazione governata.** Il volume dei documenti supera quello che l'elaborazione manuale può gestire senza costi di manodopera misurabili o rischi per la qualità dei dati.
- **I documenti contengono contenuti regolamentati.** _I dati personali_, _le informazioni personali_ o i dati finanziari devono passare attraverso un livello di mascheramento delle informazioni personali a conservazione zero prima di raggiungere un livello LLM. L'ETL soddisfa questo requisito in modo nativo. I clienti che non richiedono la permanenza del contenuto estratto in alcun punto devono anche considerare il flusso _API transazionale_, che restituisce l'output strutturato direttamente all'applicazione chiamante senza scrivere in alcun _SObject_ o archivio dati.
- **Il caso d'uso è basato sugli eventi.** Un documento arriva in fase di esecuzione (ad esempio, il caricamento di un cliente, un allegato PDF dell'agente o un trigger di sistema esterno). La pipeline di _elaborazione delle transazioni_ gestisce l'estrazione sincrona di un singolo documento senza impostazione batch.
**Non utilizzare l'intelligenza artificiale dei documenti quando:**
- **I dati di origine sono già strutturati.** Se il sistema a monte espone un'API REST, una tabella di database o un file strutturato (ad esempio, CSV, JSON o XML), utilizzare un connettore _Data 360_ standard. L'esecuzione di dati strutturati attraverso una pipeline di estrazione LLM aumenta i costi di latenza e credito senza ulteriori vantaggi.
- **I documenti vengono generati automaticamente con uno schema fisso.** I PDF generati dal sistema da un sistema ERP o una piattaforma di fatturazione nota con un layout stabile sono più adatti per un parser deterministico. L'estrazione LLM è progettata per la variabilità e applicarla ai documenti a schema fisso spreca contesto e crediti.
- **I requisiti di precisione superano le soglie di confidenza LLM.** _L'intelligenza artificiale_ non garantisce una precisione di estrazione del 100%. Casi d'uso in cui un valore di campo mancante o errato comporta un rischio finanziario, legale o clinico significativo richiede una fase di convalida HITL. Non utilizzare _Document AI_ come unico livello di estrazione per le decisioni con rischi elevati senza un flusso di lavoro di convalida.
- **I documenti superano i vincoli della piattaforma.** L'attuale limite di 10 MB di dimensione del file e i vincoli di lunghezza del contesto LLM rendono _Document AI_ inadatto a documenti di grandi o grandi dimensioni senza pre-elaborazione per suddividerli e riassemblarli all'esterno della piattaforma.
- **Nota:** Salesforce sta migliorando attivamente questi guardrail di accettazione per espandere le dimensioni dei file, i conteggi delle pagine e le estensioni dei file supportate. I vincoli continueranno a evolversi in futuro.
## Casi d'uso: Rivedere gli schemi nella pratica
### Casi d'uso delle opportunità in corso di realizzazione batch
Vediamo in dettaglio diversi scenari che utilizzano la pipeline _Batch AI documento_ supportata da un oggetto di origine UDMO. In questi casi, i dati estratti vengono instradati attraverso la pipeline _DLO/DMO Data 360_ per l'armonizzazione, la risoluzione dell'identità, _gli approfondimenti calcolati_ e l'attivazione Agentforce. Ogni caso d'uso è più adatto per l'elaborazione pianificata o basata sugli eventi di documenti a volume elevato.
**Agenteforce Sales: Intelligence** su contratti e fatture
I PDF dei _contratti_ vengono inseriti da Cloud Storage tramite la pipeline _batch_. Lo schema estrae ContractValue, RenewalDate, PaymentTerms e CounterpartyName e li mappa ai DMO _Account_ e _Contract_. Gli _approfondimenti calcolati_ derivano i punteggi del rischio di rinnovo. Agentforce avvisa i responsabili account prima della chiusura delle finestre di rinnovo, eliminando la revisione manuale dei contratti e i mancati rinnovi.
**Servizio Agentforce: Deviazione del caso e Knowledge Grounding**
I PDF _dei sondaggi_ e gli allegati dei casi vengono inseriti tramite la pipeline _batch_. Lo schema estrae gli indicatori di sentiment, le categorie di problemi e le note di risoluzione e li mappa ai DMO _Caso_ e _Articolo Knowledge_. Agentforce esegue una query nella Knowledge Base armonizzata quando il caso viene aperto e individua le fasi pertinenti per la risoluzione dei problemi, riducendo il sovraccarico di ricerca dell'agente.
**Agenteforce Health: Elaborazione** di documenti clinici
I rapporti di laboratorio, i PDF di accettazione e i moduli clinici scritti a mano vengono inseriti tramite la pipeline _batch_. Lo schema estrae i campi, inclusi _PatientID_, _DiagnosisCode_, _MedicationName_ e _TestResult_, e li mappa ai DMO di _Health Cloud_, che supportano il coordinamento dell'assistenza allineato all'HIPAA e i flussi di lavoro di ricerca clinica.
**Servizi finanziari: Automazione** dei documenti di prestiti e imposte
Le richieste di prestito, le dichiarazioni dei redditi e i rendiconti dei redditi vengono inseriti tramite la pipeline batch. Lo schema estrae i campi, inclusi AnnualIncome, TaxYear e EmployerName, e li mappa ai DMO _dell'account finanziario_. Gli _approfondimenti calcolati_ uniscono i dati di reddito derivati da documenti e i dati CRM per facilitare il calcolo automatico del punteggio del rischio di credito. Agentforce individua i dettagli del prestito estratto in linea durante le interazioni con il servizio clienti. Questo schema supporta direttamente il caso d'uso [Agente prequalifica prestito](https://developer.salesforce.com/developer-centers/agentic-enterprise-solutions) pubblicato nel centro per sviluppatori Salesforce _Agentic Enterprise Solutions_.
**HR: Elaborazione** documenti del personale
I documenti di orientamento, i moduli fiscali e i PDF di certificazione vengono inseriti tramite la pipeline _batch_. I campi estratti vengono mappati ai DMO _Record dipendente_ e quindi collegati al profilo _Dipendente unificato_. _Flussi_ specifici avviano operazioni di onboarding e controlli di conformità basati sui dati estratti. Questo schema supporta direttamente il caso d'uso Agentic [Automatizza ripresa elaborazione](https://developer.salesforce.com/developer-centers/agentic-enterprise-solutions). _L'intelligenza artificiale_ estrae competenze, precedenti lavorativi e qualifiche dai file PDF di ripresa, che Agentforce utilizza quindi per abbinare i candidati ai criteri dei ruoli aperti e instradarli ai flussi di lavoro di assunzione.
**Servizi professionali: Intelligence** delle proposte e della ricerca
Le serie di proposte e i rapporti di ricerca vengono inseriti tramite la pipeline _batch_. I framework, i benchmark e i riepiloghi coinvolgimento estratti vengono mappati ai DMO personalizzati e quindi indicizzati per la ricerca vettoriale. Agentforce recupera i consigli pertinenti al contesto al momento della query, basati sul contenuto del documento estratto. Questo schema estende lo schema [Ground Agentforce on Website Content](https://developer.salesforce.com/developer-centers/agentic-enterprise-solutions). I documenti vengono indicizzati tramite _Document AI_ e svolgono la stessa funzione di base per le risposte degli agenti del contenuto del sito Web indicizzato tramite i connettori _Data 360_.
**Stato conformità HIPAA:**
Gli schemi _Health Cloud_ descritti in questo documento applicano controlli ETL (ad esempio, conservazione dei dati zero e mascheramento PHI) per gli input di testo. Questi controlli da soli non costituiscono una certificazione HIPAA. Gli architetti che stanno progettando per ambienti clinici regolamentati devono confermare lo stato di certificazione HIPAA corrente con il team di conformità Salesforce prima di impegnarsi in un'architettura basata su _AI documento_ in tali contesti.
### Casi d'uso delle opportunità in corso di realizzazione di elaborazione transazionale
Vediamo più in dettaglio diversi scenari che invocano l'API REST _AI documento_ con uno schema che non è legato a un UDMO. I payload JSON estratti vengono instradati direttamente ai sistemi esterni in modo sincrono in fase di esecuzione.
**Filiera: Elaborazione fatture fornitore a ERP**
Quando un PDF _della fattura fornitore_ arriva in un bucket di archiviazione monitorato o in un gateway email, un trigger evento chiama l'API REST _AI documento_ con la fattura e un ID schema predefinito. Lo schema estrae VendorID, InvoiceNumber, LineItems, TotalAmount, TaxAmount e DueDate. Il payload JSON viene instradato tramite _MuleSoft_ al modulo _ERP Accounts Payable_ con convalida _completa_ dei campi e logica di inserimento con aggiornamento idempotente, che elimina la manutenzione del modello per la variabilità del formato del fornitore.
**Operazioni legali: Revisione del contratto a CLM**
Quando un PDF _contratto_ viene caricato nel portale legale, il backend chiama l'API REST _AI documento in_ modo sincrono. Lo schema estrae GoverningLaw, IndemnityCapAmount, TerminationNoticePeriod, AutoRenewalClause e CounterpartySignatory. Il payload JSON viene instradato tramite chiamata _Apex_ al sistema di _gestione del ciclo_ di vita. Tutti i campi che non vengono trovati vengono restituiti come _nulli_ e il CLM applica le regole di obbligo predefinite ai valori mancanti.
**Richieste assicurative: Primo avviso di elaborazione** delle perdite
Quando un contraente invia un modulo _First Notice of Loss (FNOL)_, il portale di backend chiama l'API REST _AI documento in_ modo sincrono. Lo schema estrae PolicyNumber, IncidentDate, IncidentLocation, DamageDescription, ClaimantName e ContactPhone. Il payload JSON viene instradato al database di _gestione delle richieste_ tramite chiamata _Apex_ o ETL, il che crea un record richiesta precompilato che i rettificatori possono esaminare prima dell'apertura della richiesta formale.
## Considerazioni sulla progettazione e modalità di errore
Prima di passare alla produzione, è necessario creare progetti per questi scenari di errore.
- **Gestione campi nulli:** LLM restituisce _nullo_ per i campi che non può individuare o estrarre con sicurezza. Convalidare la logica di gestione dei valori nulli durante la progettazione dello schema e implementare la logica dei valori predefiniti o dei rifiuti nel livello di integrazione prima di scrivere in qualsiasi destinazione con vincoli _NOT NULL_ o chiavi di corrispondenza richieste.
- **Degradazione della qualità OCR:** La precisione OCR si degrada al di sotto dei 150 DPI, su una scrittura irregolare o su scansioni rumorose. Le letture non corrette si propagano nell'estrazione LLM come input danneggiato senza segnali di errore. Applicare una qualità di scansione minima all'inserimento e implementare controlli della soglia di confidenza sui campi numerici e data.
- **Disallineamento versione schema:** L'aggiornamento di una configurazione dello schema dopo la pianificazione di un processo batch provoca l'elaborazione dei documenti in volo rispetto alla versione precedente, il che produce campi mancanti o rinominati che interrompono la mappatura a valle. Schemi di versione in modo esplicito e coordinare gli aggiornamenti con le pianificazioni dei processi batch.
- **Limite delle dimensioni dei file:** I documenti che superano i 10 MB vengono rifiutati. Gli errori delle opportunità in corso di realizzazione batch sono silenziosi senza il monitoraggio configurato e i chiamanti transazionali ricevono un errore _4xx_. Pre-convalidare le dimensioni dei file all'inserimento e implementare la pre-elaborazione per suddividere o comprimere i documenti che si avvicinano regolarmente al limite.
- **Overflow contesto LLM:** I documenti densi o multipagina possono superare la finestra di contesto LLM entro il limite di 10 MB. LLM rilascia silenziosamente il contenuto che supera il contesto. Implementare una strategia di suddivisione che suddivide i documenti in base all'intervallo di pagine e riassembla i campi estratti prima di trasferirli nella destinazione.
- **Mascheramento livello Trust che influisce sull'estrazione:** L'ETL funziona a livello di prompt, non a livello di documento, quindi il mascheramento non si applica al contenuto del documento che passa attraverso _l'intelligenza artificiale_. I campi dello schema che dipendono dai valori _PII_ del documento non sono interessati dalle policy di mascheramento ETL.
- **Impotenza di scrittura RDBMS esterno:** La pipeline di _elaborazione delle transazioni_ non ha alcuna impotenza incorporata per le destinazioni _RDBMS_ esterne. I tentativi del _livello di integrazione_ creano righe duplicate a meno che la logica di scrittura non gestisca esplicitamente la deduplicazione. Implementare inserimenti con aggiornamento idempotenti utilizzando un fingerprint documento o un ID esterno in tutti i percorsi di scrittura esterni.
- **Esaurimento del credito a metà corsa:** Le esecuzioni batch di grandi dimensioni possono esaurire i crediti _Digital Wallet_ prima che tutti i documenti vengano elaborati, il che produce serie di dati DLO incomplete che le fasi a valle visualizzano come completate. Impostare gli avvisi di consumo sul 75% e 90% dei crediti disponibili e limitare le dimensioni dei batch per rispettare il budget di credito per ogni ciclo.
- **Limite campi schema — Vincolo architettonico:** _Document AI_ impone un limite di 50 campi per i campi a livello principale in una configurazione dello schema. Questo è un vincolo di tempo di progettazione, non un errore di runtime, e gli architetti devono tenerne conto durante la progettazione del modello di dati e dello schema.
- Per i casi d'uso che richiedono un'estrazione più ampia:
- Assegnare priorità senza pietà. Restringere lo schema ai campi che determinano il valore dell'automazione, non alla copertura completa dei documenti.
- Sfruttare gli oggetti nidificati (fino a 3 livelli; modalità batch solo con l'oggetto di origine) per ridurre il conteggio dei campi a livello di radice senza sacrificare la profondità di estrazione.
- Scomporre documenti complessi in più configurazioni _AI documento_ destinate a sezioni documento distinte, scrivere i risultati in DLO separati che si uniscono a valle in _Data 360_.
- **Limite dei tassi API:** _Document AI_ impone un limite di 50 chiamate API di estrazione al minuto per tenant. Il limite teorico e' di 300 chiamate al minuto, che e' regolato dal _Gateway Einstein LLM_. Le integrazioni transazionali a volume elevato devono essere progettate con backoff esponenziale, inserimento in area di attesa delle richieste e calcolo del budget della produttività a livello di tenant. Non presumere che la capacità di burst sia disponibile in ambienti di produzione multi-tenant.
- **Profilo di latenza API:** Le API di estrazione _AI dei documenti_ sono completamente sincrone. I tempi di risposta tipici variano da 5 a 15 secondi e variano in base alle dimensioni del file e alla complessità dello schema.
- Ciò ha implicazioni dirette per l'architettura di integrazione:
- Impostare i timeout del chiamante su un minimo di 30 secondi.
- Non invocare l'_intelligenza artificiale documento_ nei flussi con requisiti SLA inferiori al secondo.
- Tenere presente la latenza nei calcoli della produttività rispetto al limite di traffico per le opportunità in corso di _elaborazione batch_.
- **Documenti crittografati e protetti da password:** _Document AI_ non elabora i file protetti da password (per aprire i file sono necessarie password utente) o i file PDF crittografati con una password titolare/autorizzazioni, inclusi i file che si aprono normalmente ma limitano la copia, la stampa o la modifica a livello di _autorizzazione PDF_.
- Questo vincolo si trova al confine dell'inserimento:
- Progettare le opportunità di _accettazione dei documenti_ per rilevare e instradare i file crittografati a un percorso di _rifiuto_ o _elaborazione manuale_ prima che raggiungano _l'intelligenza artificiale_.
- Non affidarsi alla gestione degli errori in fase di esecuzione come cancello principale.
## Allineamento ben progettato
_Data 360 Document AI_ è in linea con diversi pilastri del _Well-Architected Framework_ di Salesforce.
- **Trust:** L'ETL impone la conservazione zero dei dati con i provider LLM, maschera gli input _PII_ prima che raggiungano il modello e analizza gli output alla ricerca di contenuti sensibili. Gli architetti devono estendere questa postura ai dati estratti a riposo. Il mascheramento a livello di campo nei DLO non viene applicato dall'ETL e richiede policy e _insiemi di autorizzazioni_ _dello spazio dati_ a valle.
- **Affidabilità:** Ogni modalità di errore nella sezione _Considerazioni sulla progettazione_ (estrazione campo nullo, lettura errata OCR, mancata corrispondenza della versione dello schema, violazione delle dimensioni del file, overflow del contesto LLM, interferenza del mascheramento ETL, impotenza di scrittura RDBMS ed esaurimento del credito) rappresenta una classe di errore distinta con un segnale di rilevamento documentato e un percorso di risoluzione.
- **Eccellenza operativa (gestione del cambiamento):** Il modello di estrazione basato su schema disaccoppia la logica di estrazione dal layout del documento. Quando un fornitore modifica un formato di fattura o un modulo normativo viene aggiornato, gli architetti devono aggiornare una sola configurazione dello schema anziché modificare il codice di integrazione.
- **Eccellenza operativa (manutenibilità):** Centralizzare le configurazioni degli schemi in _Data 360_ anziché incorporare la logica di estrazione nel codice dell'applicazione rende l'intento di estrazione esplicito, con versione e controllabile. Tutti i target a valle utilizzano lo stesso contratto schema indipendentemente dal loro livello target.
- **Eccellenza operativa (riutilizzo integrazione):** _L'intelligenza artificiale_ espone l'estrazione in più superfici di integrazione: API REST, _Apex_, _Flusso_, _MuleSoft_, _Azioni_ Agentforce e il server MCP. Una singola configurazione dello schema si estende contemporaneamente a più livelli di destinazione senza ricreare la capacità di estrazione per consumatore.
- **Ottimizzazione delle risorse e dei costi:** La guida alla selezione delle opportunità in corso di realizzazione, il limite di 10 MB per le dimensioni del file e i vincoli di lunghezza del contesto LLM pre-assemblaggio rappresentano decisioni di progettazione attente alle prestazioni. La sezione _Quando utilizzare_ formalizza le condizioni per i casi in cui _l'intelligenza artificiale_ non è lo strumento giusto (ad esempio, requisiti di latenza al di sotto del secondo, dati di origine completamente strutturati e documenti generati automaticamente a schema fisso).
## Guida introduttiva per architetti
Questo è un punto di partenza strutturato per la configurazione di _Data 360 Document AI_ in un ambiente Sandbox. Completare tutte le fasi nel Sandbox prima di passare alla produzione.
### Prima di iniziare
Prima di iniziare la configurazione, è necessario confermare:
- **Dimensione file:** Verificare che le dimensioni rappresentative dei documenti siano inferiori a 10 MB.
- In **corso di realizzazione:** Verificare se il caso d'uso richiede la pipeline _batch_ (supportata da UDMO, a volume elevato) o la pipeline di _elaborazione transazionale_ (gestita da API, a documento singolo). Questo determina tutte le configurazioni successive.
- **Livello target:** Verificare dove si trovano i dati estratti: _SObject_ Salesforce, DLO/DMO _Data 360_, RDBMS esterno o una combinazione.
- **Dipendenza Agentforce:** Prima di distribuire qualsiasi elaborazione di documenti basata su Agentforce, verificare che nell'organizzazione sia abilitato un [LLM](https://help.salesforce.com/s/articleView?id=ai.generative_ai_large_language_model_support.htm&type=5) supportato (ad esempio, _GPT-4o_) tramite le impostazioni ETL. Agentforce è un prerequisito della piattaforma per _Document AI_. L'intera superficie della funzione _AI documento_, incluse tutte le API di estrazione, non è disponibile finché Agentforce non è attivo nell'organizzazione di destinazione. Tenerne conto nelle valutazioni della preparazione dell'organizzazione e nella sequenza di provisioning. Attendere alcuni minuti perché la disponibilità API si stabilizzi dopo l'abilitazione.
- **Impatto disabilitazione Agentforce:** Se Agentforce viene disabilitato dopo che _l'intelligenza artificiale documento_ è stata configurata e distribuita, tutte le operazioni di estrazione (interfaccia utente e API) verranno bloccate immediatamente. Lo stesso vale per la disabilitazione del modello. La disabilitazione del modello sottostante ha un effetto equivalente sulla disponibilità di _AI documento_. In entrambi i casi, le configurazioni dello schema esistenti vengono mantenute e rimarranno visibili (non si verificherà alcuna configurazione o perdita di dati), ma la funzionalità è completamente inutilizzabile finché Agentforce e il modello non vengono riabilitati. Progettare runbook operativi per trattare la disponibilità Agentforce e l'abilitazione del modello come dipendenze sanitarie _AI documento_.
- **Consumo di credito/Prezzi:** Utilizzare i crediti _Data 360_ o i _crediti Flex_ per le stime del TCO derivate da documenti di esempio rappresentativi.
#### Fase 1: Configurazione di schemi e opportunità in corso di realizzazione
- **Creare la configurazione dello schema.** Definire i campi di estrazione, i tipi di dati e le istruzioni in formato _schema JSON_ nell'impostazione di _Data 360 Document AI_. Per la pipeline _batch_, associarla a un UDMO. Per la pipeline di _elaborazione delle transazioni_, crearla senza un oggetto di origine. Registrare l'ID schema.
- **Allineare i nomi dei campi al livello di destinazione.** Abbinare i nomi dei campi alle definizioni delle colonne DLO, ai nomi API _SObject_ o ai nomi delle colonne RDBMS. I nomi non allineati creano un sovraccarico di mappatura nel livello di integrazione.
- **Configurare l'oggetto di origine UDMO (solo batch).** Definire l'ambito dei documenti e configurare la connettività della fonte di inserimento (ad esempio, _S3_, _Google Cloud Storage_, _Salesforce Files_ o _MuleSoft)_. Verificare che l'account del servizio di inserimento abbia l'ambito delle credenziali _IAM_ o _OAuth_ richiesto.
- **Applicare policy di mascheramento delle informazioni personali.** Configurare le policy di _mascheramento dei dati_ nelle impostazioni ETL prima di elaborare qualsiasi contenuto regolamentato. Definire i tipi di campo (_PHI_, _PII_ e identificatori finanziari) da mascherare prima che gli input raggiungano il livello di dettaglio. **Non** rimandare questo passaggio.
- **Assegnare l'ambito Spazio dati e gli insiemi di autorizzazioni.** Limitare l'elaborazione allo _Spazio dati_ appropriato e configurare gli _insiemi di autorizzazioni_ per controllare la creazione dello schema, l'esecuzione dei processi batch, la chiamata dell'API REST e l'attivazione a valle.
- **Configurare l'autenticazione API (solo pipeline di elaborazione delle transazioni).** Creare un'_applicazione connessa_ con ambiti _OAuth_ cdp_ingest_api e api. Per i chiamanti interni all'organizzazione, utilizzare una _credenziale denominata_ che si collega a una _credenziale esterna_. Per i chiamanti esterni, configurare le credenziali client _OAuth 2.0_ o un flusso JWT-bearer. Testare e convalidare l'estrazione prima di procedere.
#### Fase 2: Integrazione e configurazione di destinazione
- **SObject write-back:** Implementare un elemento _Apex_ (@InvocableMethod) o _Flow_ che mappa i campi di risposta JSON ai campi _SObject_. Utilizzare Database.upsert() con un ID esterno per evitare duplicati. Applicare la _protezione a livello_ di campo ai campi _SObject di_ destinazione.
- **Condotte DLO/DMO di Data 360:** Mappare i campi DLO estratti ai DMO allineati al _Customer 360 Data Model_. Configurare le regole di risoluzione dell'identità per collegare i record documento a _Persone unificate_. Definire _gli approfondimenti calcolati_ e aggiungere DMO per Agentforce. Per la pipeline di elaborazione delle transazioni, instradare prima il payload JSON a un DLO tramite l'API di _inserimento_.
- **RDBMS esterno o data warehouse:** Selezionare lo schema di integrazione: _MuleSoft_ (tessuto di integrazione esistente), chiamata HTTP _Apex_ (leggera, nativa dell'organizzazione), _Eventi piattaforma_ con abbonato _Pub/Sub_ (gestito da eventi) o ETL (batch a volume elevato). Implementare inserimenti con aggiornamento idempotenti utilizzando un fingerprint documento o un ID esterno in tutti i percorsi di scrittura esterni.
- **Percorsi di attivazione:** Connettere le azioni Agentforce alle configurazioni dello schema per l'estrazione interattiva. Configurare i trigger _di flusso_ o _Apex_ per i flussi di lavoro di elaborazione automatica e stabilire le destinazioni attivazione per ogni gruppo di campi.
- **Gestione degli errori (solo pipeline di elaborazione delle transazioni).** Configurare la superficie di risposta HTTP completa: **200** (_esito positivo_, incluse le risposte _nulle_ parziali), **400** (_richiesta non corretta_ o _ID schema non trovato_), **413** (file superiore a 10 MB), **5xx** (errore di servizio). Implementare il backoff esponenziale per _5xx_ tentativi con un massimo di 3 tentativi. Registrare la risposta JSON non formattata e l'ID schema a ogni chiamata.
#### Fase 3: Convalida e preparazione per la produzione
- **Testare gli schemi con documenti di esempio.** Inviare esempi rappresentativi tramite l'interfaccia _AI documento_ o l'API REST. Verificare la precisione dell'estrazione, la copertura dei campi e la gestione dei valori nulli nelle variazioni del layout.
- **Convalidare la gestione dei campi nulli.** Verificare che tutte le destinazioni a valle possano gestire valori _nulli_ per i _campi non trovati_ in un documento. Tenere presente che i vincoli _NOT NULL_ non vengono gestiti in modo esplicito senza valori nulli.
- **Pre-convalidare le dimensioni dei file.** Verificare che i documenti di produzione rimangano inferiori a 10 MB. Implementare la preelaborazione per suddividere o comprimere i documenti che si avvicinano regolarmente al limite.
- **Convalidare l'estrazione end-to-end.** Per la pipeline _batch_, avviare un'esecuzione completa e verificare che i campi estratti atterrino correttamente in ogni livello di destinazione. Per la pipeline di _elaborazione delle transazioni_, tracciare la risposta JSON attraverso il livello di _integrazione_ fino alla destinazione. Verificare l'esecuzione del trigger e del flusso per le destinazioni _SObject_, il collegamento di risoluzione dell'identità per le destinazioni _DLO/DMO_ e l'impotenza per le destinazioni _RDBMS_.
- **Confermare il comportamento del livello Trust.** L'ETL non applica il mascheramento _delle informazioni personali_ al contenuto del documento, quindi l'LLM restituirà i dati delle _informazioni personali_ nei campi estratti così come sono. Verificare che i campi dello schema, l'instradamento dei dati e l'archiviazione a valle siano progettati per gestire in modo appropriato l'output contenente informazioni personali e assicurarsi che gli eventuali requisiti di conformità o conservazione vengano soddisfatti all'esterno della piattaforma.
- **Imposta avvisi Digital Wallet.** Configurare gli avvisi consumo al 75% e al 90% dei crediti disponibili. Stabilire limiti di dimensioni dei batch e stime dei tassi ad hoc all'interno del budget di credito per ogni ciclo.
- **Convalidare il monitoraggio batch (solo pipeline batch).** Rivedere le percentuali di esito positivo dell'estrazione, le percentuali di campi nulli e il completamento dei processi nella console di monitoraggio di _Data 360_. Confermare la propagazione del tag dall'UDLO attraverso il DLO al DMO nella discendenza dei dati.
- **Convalida la gestione degli errori API (solo pipeline di elaborazione delle transazioni).** Testare tutte le condizioni di errore: **413** (documenti superiori a 10 MB), **400** (ID schema non validi), **200** (estrazioni valide con valori nulli parziali). Verificare che la logica di nuovo tentativo venga attivata sulle risposte **5xx** simulate senza creare scritture duplicate.
## Conclusione
Questo documento evidenzia le basi architettoniche di _Data 360 Document AI_:
- Due pipeline di elaborazione e quando utilizzarle
- Modello di configurazione dello schema
- Quadro decisionale livello target
- Vincoli della tecnologia di base
- Modalità di errore
- Allineamento del _framework ben progettato_
La [Guida introduttiva per architetti](/docs/architect/it-it/fundamentals/guide/data360-document-ai#guida-introduttiva-per-architetti) fornisce la sequenza di configurazione per una prova di concetto Sandbox.
L'impostazione dell'architettura di base supporta i dati derivati da documenti gestiti a livello di _schema_, elaborati tramite una pipeline LLM imposta da ETL e consegnati allo stesso ciclo di vita dei dati _di Data 360_ che governa tutti gli altri dati aziendali.
Gli architetti che applicano questi principi (selezione delle opportunità in corso di realizzazione corrette, progettazione di schemi a livello di tipo di documento e progettazione di modalità di errore prima della produzione) creano capacità di estrazione che si estendono e resistono ai requisiti di governance del settore regolamentati.
### Informazioni sugli autori
**Yugandhar Bora** è un architetto di ingegneria del software di Salesforce specializzato in architettura dei dati all'interno della piattaforma _Data and Intelligence Applications_. Dirige iniziative dell'_Enterprise Architecture Review Board (EARB)_ incentrate sulla governance dei dati e sui modelli di dati unificati, contribuendo anche alle soluzioni di provisioning automatico della piattaforma.
**Ananth Anto** è Direttore della gestione dei prodotti di Salesforce _Data 360_ e guida le iniziative di _intelligenza artificiale documentale e grafico dati_. Con sede a Bangalore, collabora con i clienti aziendali per risolvere le sfide legate all'elaborazione dei documenti e all'intelligenza dei dati nel mondo reale. Si diverte a esplorare i casi d'uso _aziendali_ per l'_intelligenza artificiale generativa (Gen AI)_.
**Nishan Naseer** è un architetto di ingegneria del software di Salesforce che si occupa di _elaborazione dati non_ strutturati, pipeline _RAG_ e _intelligence documentale_. È appassionato di sfruttare la potenza dell'intelligenza artificiale per affrontare le sfide del mondo reale e trovare soluzioni creative a problemi complessi dei clienti.
# Panoramica
Questo documento descrive le opzioni correnti per la distribuzione delle applicazioni in CloudHub 2.0 per soddisfare i requisiti di disponibilità elevata e ripristino di emergenza. Utilizza la regione degli Stati Uniti come esempio e può essere applicato ad altre regioni.
CloudHub 2.0 è una piattaforma di integrazione nativa del cloud completamente gestita che elimina il sovraccarico dell'infrastruttura automatizzando la distribuzione, la scalabilità e la gestione delle API e delle integrazioni MuleSoft nel cloud. È la moderna piattaforma di distribuzione cloud di MuleSoft, eseguita sull'infrastruttura AWS Amazon.
## Requisiti per il ripristino di emergenza
Nella maggior parte dei casi, l'Alta disponibilità (HA) e il Ripristino di emergenza (DR) predefiniti forniti da CloudHub 2.0 sono sufficienti. CloudHub 2.0 fornisce HA e DR a livello regionale (per ulteriori dettagli, vedere [CloudHub 2.0 Outage Scenarys](#scenari-di-interruzione-di-cloudhub-20)). [La sezione Considerazioni chiave](#considerazioni-chiave-su-cloudhub-20) fornisce ulteriori dettagli su HA e DR supportati da CloudHub-2.0.
Le condizioni che impongono una progettazione oltre la disponibilità predefinita di CloudHub 2.0 includono:
- Un'applicazione deve garantire l'assenza di perdite di dati in uno scenario di emergenza (ad esempio, una regione dell'Amazzonia che cade).
- Un'applicazione dipende dall'Object Store e deve garantire la continuità in caso di guasto della regione di distribuzione.
## Ipotesi
- I sistemi di backend sono configurati per una disponibilità equivalente. CloudHub 2.0 può talvolta fornire affidabilità tramite aree di attesa o meccanismi simili, ma sia che l'integrazione sia in tempo reale o asincrona, i sistemi di backend devono supportare un livello comparabile di HA e DR.
- Quando un guasto a livello di regione AWS influisce sui sistemi di backend, si presume che il ripristino venga eseguito in parallelo al ripristino CloudHub 2.0.
- L'impostazione dello spazio privato è completa in più regioni.
## Fuori dall'ambito
Le opzioni di progettazione di questa guida si concentrano sulle soluzioni per la disponibilità delle applicazioni in CloudHub 2.0 quando un'intera zona o area geografica di disponibilità AWS non è disponibile.
Questa guida **non** affronta questi scenari di ripristino, anche se prende nota delle implicazioni laddove pertinenti:
- Ripristino di sistemi di backend, applicazioni, database, componenti di rete e data center gestiti e forniti all'esterno di Anypoint CloudHub, in locale o nel cloud.
- Ripristino dei link VPN tra CloudHub 2.0 e il data center privato del cliente (ad esempio, tunnel IPsec e gateway VPN). Alcune opzioni di DR in questa guida possono risolvere parzialmente questi scenari.
- Modifiche agli IP di uscita MuleSoft durante il ripristino di emergenza quando l'elenco IP consentiti viene utilizzato per le integrazioni. Alcune opzioni di DR in questa guida possono risolvere parzialmente questi scenari.
- Sistemi di messaggistica esterni utilizzati nelle soluzioni per i clienti, forniti da MuleSoft (ad esempio Anypoint MQ) o da altri fornitori (ad esempio AWS MSK o Heroku Kafka).
## Considerazioni chiave su CloudHub 2.0
Quando si valuta CloudHub 2.0 per i [requisiti di ripristino](#requisiti-per-il-ripristino-di-emergenza), tenere presenti le seguenti considerazioni chiave.
**Dipendenza CloudHub 2.0 dalla disponibilità regionale AWS**
- CloudHub 2.0 viene eseguito su AWS; la sua disponibilità è legata alle regioni AWS.
- Le distribuzioni e la disponibilità delle applicazioni sono organizzate per regione. Queste regioni corrispondono alle regioni AWS.
Se un'intera regione AWS non riesce, le applicazioni in quella regione non sono disponibili e non vengono replicate automaticamente altrove.
**Alta disponibilità delle applicazioni e gestione delle repliche**
- CloudHub 2.0 ridistribuisce automaticamente le applicazioni all'interno della stessa regione in caso di guasto hardware, ma un'applicazione con una singola replica può riscontrare tempi di inattività.
- Le applicazioni con più repliche vengono distribuite in zone di disponibilità separate per impostazione predefinita, fornendo HA in tutte le zone.
- Se la zona di disponibilità di un'applicazione a replica singola non riesce, l'applicazione viene automaticamente visualizzata in un'altra zona di disponibilità all'interno della stessa regione.
**Impatto specifico sulla regione orientale degli Stati Uniti**
- In caso di guasto della regione US East:
- L'interfaccia utente di gestione CloudHub 2.0 e i servizi REST di distribuzione non sono disponibili e non è possibile distribuire nuove applicazioni.
- Le applicazioni in altre regioni non sono interessate nella maggior parte degli scenari di errore. Queste applicazioni continuano a funzionare normalmente; tuttavia, le funzionalità di monitoraggio e gestione tramite il piano di controllo non saranno disponibili durante il guasto.
- I moduli Core CloudHub 2.0 (ad esempio le impostazioni delle applicazioni) vengono mantenuti negli Stati Uniti orientali, quindi le impostazioni non possono essere modificate durante il guasto.
**Monitoraggio e avvisi**
- Configurare gli avvisi per gli errori a livello di zona di disponibilità o di regione tramite [status.mulesoft.com](http://status.mulesoft.com).
- Utilizzare un meccanismo separato di controllo dello stato e di avviso all'esterno di CloudHub 2.0 in modo che i team ricevano una notifica se le repliche non riescono o se le applicazioni non rispondono più.
**Persistenza dei dati (Object Store V2)**
- Object Store V2 è legato alla regione in cui l'applicazione viene distribuita per la _prima volta_.
- Se si sposta l'applicazione in un'altra regione, Object Store V2 rimane nella regione originale per evitare perdite di dati.
- Se la regione in cui è distribuito Object Store V2 non riesce, l'Object Store non è disponibile.
**Controller di ingresso e spazi privati**
- I controller di ingresso di CloudHub 2.0 sono altamente disponibili a livello regionale.
- In uno spazio condiviso, se una regione non riesce, un controller di ingresso in un'altra regione rimane disponibile ma può servire solo le applicazioni distribuite in quella regione.
- In uno spazio privato, se una regione non riesce, i controller di ingresso in altre regioni non sono disponibili a meno che non siano stati impostati in precedenza.
- L'impostazione dello spazio privato è regionale; se una regione non riesce, lo spazio privato non è disponibile a meno che non sia stata impostata un'altra regione.
## Scenari di interruzione di CloudHub 2.0
CloudHub 2.0 offre resilienza su più livelli: replica, zona di disponibilità e regione. Questa sezione descrive le responsabilità di Salesforce e le opzioni del cliente per ogni scenario di interruzione.
### Replica / Disponibilità Zona / Regione Disservizi
#### Responsabilità Salesforce
| Stato componente | Responsabilità Salesforce |
| -------------------------- | :------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Replica giù** | **Azione**: CloudHub 2.0 riavvia automaticamente la replica in una zona di disponibilità diversa se si verifica un errore nella zona di disponibilità corrente. Tuttavia, l'applicazione sarà offline fino a quando la nuova replica non sarà completamente avviata. **Condizione**: Configurazione predefinita. **Tempo impiegato**: Circa 2-15 minuti a seconda della complessità dell'applicazione e delle dimensioni della replica. |
| **Zona disponibilità ridotta** | **Azione**: Come la replica giù. **Condizione**: Configurazione predefinita. **Tempo impiegato**: Come la replica giù. **Notifica**: Come la replica giù. |
| **Regione giù** | **Azione**: Nessun ripristino automatico. Deve essere disponibile un progetto di failover. |
#### Responsabilità del cliente
| Stato componente | Responsabilità del cliente |
| -------------------------- | :----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Replica giù** | **Notifica**: Eseguire controlli periodici dello stato utilizzando un meccanismo Heartbeat integrato nelle API. **Mitigazione**: Distribuire l'applicazione a più repliche nella stessa regione. **Test / simulazione:** Alza un ticket con il supporto MuleSoft e supporterà un test di failover per verificare se una nuova replica viene eseguita in un'AZ diversa in 1-15 minuti. |
| **Zona disponibilità ridotta** | **Notifica**: Come la replica giù. **Mitigazione**: Distribuire l'applicazione a più repliche nella stessa regione o in regioni diverse. **Test / simulazione:** Lo scenario AZ Down è difficile da simulare. Richiede il coinvolgimento di MuleSoft Engineering per supportare possibili scenari di test. |
| **Regione giù** | **Notifica**: Come la replica giù. Controllare anche gli aggiornamenti di stato all'indirizzo [https://status.aws.amazon.com](https://status.aws.amazon.com). **Mitigazione**: Come AZ Down. Piano di emergenza di ripristino: 2 spazi privati con la stessa configurazione in regioni diverse. **Test / simulazione:** Come AZ Down. |
### Gateway VPN e interruzioni del controller di ingresso
#### Responsabilità Salesforce
| Stato componente | Responsabilità Salesforce |
| :------------------------------------------ | :-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Gateway VPN disattivato** | **Stato replica**: In esecuzione ma non in grado di connettersi ad alcuna risorsa ospitata in loco e raggiungibile attraverso il tunnel VPN. **Azione**: Nessun ripristino automatico. Deve essere disponibile un progetto di failover. |
| **Controllo degli ingressi (spazio condiviso) disattivato** | **Stato replica**: Il controller Ingress è un'impostazione in cluster con più istanze, simile alle repliche delle applicazioni. Se una replica dell'applicazione non riesce, viene creata e avviata automaticamente una nuova replica. Se un'istanza del controller di immissione non riesce, le applicazioni rimangono disponibili tramite l'altra istanza. Se l'intero controller Ingress non è attivo, la regione viene considerata negativa. |
| **Controllo dell'ingresso (spazio privato)** | **Stato replica:** Come il controller di ingresso nello spazio condiviso verso il basso. |
#### Responsabilità del cliente
| Stato componente | Responsabilità del cliente |
| :-------------------------------------- | :-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Gateway VPN disattivato | **Notifica**: Eseguire controlli periodici dello stato utilizzando un meccanismo Heartbeat integrato nelle API. **Mitigazione**: I gateway VPN CloudHub 2.0 supportano l'alta disponibilità tramite un'architettura a due tunnel con failover automatico tra i tunnel; questo schema deve essere configurato dal cliente. **Test / simulazione:** Lo scenario Gateway Down VPN è difficile da simulare. Richiede il coinvolgimento di MuleSoft Engineering per supportare possibili scenari di test. |
| Controller di ingresso (spazio condiviso) giù | **Notifica**: Come Gateway VPN giù. **Mitigazione**: Come Regione giù. Eseguire la migrazione delle applicazioni in uno spazio standby o attivo in un'altra regione. **Test / simulazione:** Come Gateway VPN giù. |
| Controller di ingresso (spazio privato) giù | **Notifica**: Come Gateway VPN giù. **Mitigazione**: Come Regione giù. Eseguire la migrazione delle applicazioni in uno spazio privato in standby o attivo in un'altra regione, in coordinamento con la configurazione AWS Route 53 (o equivalente). **Test / simulazione:** Come Gateway VPN giù. |
### Punti vendita oggetti e aree di attesa persistenti
**Panoramica Servizi piattaforma Down Scenario – Object Store**
 I componenti di base dell'architettura di rete CloudHub 2.0 sono:
- Un bilanciamento del carico HTTP
- Mule replica record DNS
- Spazi privati
- Servizi regionali
Per ulteriori dettagli, vedere [CloudHub 2.0 Networking Architecture](https://docs.mulesoft.com/cloudhub-2/ch2-networking-guide).
**Domini vanità**
Quando viene creato, uno spazio privato riceve un nome di destinazione DNS nel formato: \
 CloudHub 2.0 supporta anche i domini personalizzati, o vanity, configurandoli all'interno di uno spazio privato utilizzando contesti TLS e record DNS. Per creare un contesto TLS in Runtime Manager per uno spazio privato, caricare il certificato pubblico e la chiave privata, quindi aggiungere un endpoint personalizzato nelle impostazioni dell'applicazione per utilizzare quel dominio. Creare un record DNS (ad esempio un CNAME) che punti il dominio Vanity al nome host predefinito dello spazio privato.
Ad esempio, un'applicazione denominata test-api distribuita in us-west-2 con DNS predefinito 42y52r.usa-w2.cloudhub.io ha un endpoint API di:
https://test-api-mwsklu-42y52r.usa-w2.cloudhub.io
Questo URL non utilizza un dominio vanity o personalizzato. Per utilizzare `acme.com` in modo che gli URL API appaiano come `https://test-api.acme.com`, seguire questa procedura.
1. Creare il contesto TLS in Runtime Manager con chiavi pubbliche e private.
2. Aggiungere un dominio di vanità nelle impostazioni dell'applicazione per utilizzare quel dominio.
3. Creare un record DNS in AWS Route 53 e configurare una policy di instradamento semplice (ad esempio, CNAME) in modo che il vanity domain venga risolto nel nome host predefinito dello spazio privato.
Per i domini personalizzati, è possibile utilizzare AWS Route 53 o qualsiasi altro servizio CDN globale con policy di instradamento. Nel diagramma seguente, AWS Route 53 viene utilizzato con una policy di instradamento "semplice". Quando un consumatore da una rete pubblica (esterna) richiede acme.com, AWS Route 53 instrada la richiesta al controller di ingresso spazio privato MuleSoft.
 ## Strategia di failover
Utilizzare questa opzione quando le applicazioni richiedono il failover: distribuire un'istanza nella regione principale (ad esempio, us-west-2) e un'altra in una regione secondaria (ad esempio, us-east-1).
Ove possibile, utilizzare un ambiente esistente nella regione secondaria; la creazione di un nuovo ambiente richiede ulteriori sforzi.
**Esempio di app distribuite in una regione (Stati Uniti Ovest 2) con failover in un'altra regione ( Stati Uniti Est 1)**
 | Nome record | Valore/Instrada traffico a | Policy di instradamento | ID controllo dello stato |
| :---------: | :-----------------------: | :------------: | :-------------: |
| acme.com | 42y52r.usa-w2.cloudhub.io | Failover | 31s3wseq121 |
| acme.com | 31e51s.usa-e1.cloudhub.io | Failover | 43e131s131sq |
In questa configurazione, AWS Route 53 instrada il traffico ai controller di ingresso per gli spazi privati negli Stati Uniti Ovest 2 e Est 1\. Viene configurata una policy di instradamento di failover con un controllo dello stato.
## Alta disponibilità e bassa latenza
Per una latenza inferiore e una disponibilità elevata, utilizzare la strategia di distribuzione descritta nello schema. Con questa strategia, le app possono essere distribuite in due regioni (US-west-2 e US-east-1 in questo esempio).
Utilizzare la policy di instradamento della latenza in AWS Route 53 per instradare le richieste alla regione che offre la latenza più bassa mantenendo l'alta disponibilità. Policy di instradamento della "latenza" in AWS Route 53 per instradare la richiesta di latenza più bassa che ha ancora un'alta disponibilità.
**App distribuite in entrambe le regioni (Stati Uniti Ovest 2 e Stati Uniti Est 1) per una latenza inferiore e un'elevata disponibilità**
 | Nome record | Valore/Instrada traffico a | Policy di instradamento | ID controllo dello stato |
| :---------: | :-----------------------: | :------------: | :-------------: |
| acme.com | 42y52r.usa-w2.cloudhub.io | Latenza | 31s3wseq121 |
| acme.com | 31e51s.usa-e1.cloudhub.io | Latenza | 43e131s131sq |
## Conclusione
MuleSoft CloudHub 2.0 offre una solida base per la resilienza all'interno dell'area geografica, sfruttando principalmente la ridondanza automatica delle repliche e il bilanciamento intelligente del carico. All'interno di una singola area cloud, la distribuzione di applicazioni con più repliche garantisce che, se un'istanza non riesce, gli altri possano immediatamente assumere il carico di lavoro. Il bilanciamento del carico integrato distribuisce in modo efficiente il traffico in entrata in queste repliche sane, riducendo al minimo i tempi di inattività e garantendo una disponibilità di servizio continua in condizioni operative normali.
Tuttavia, affidarsi esclusivamente a questa architettura a una sola regione, anche con elevata ridondanza, presenta un rischio significativo di un guasto regionale generalizzato e catastrofico. La storia ha dimostrato che anche i provider di cloud più affidabili e tecnologicamente avanzati sono suscettibili di incidenti dirompenti che possono interessare un'intera area geografica. Questi singoli punti di errore, sebbene rari, possono derivare da vari eventi, tra cui:
- Incidenti infrastrutturali su larga scala
- Gravi interruzioni di corrente
- Interruzioni diffuse della rete
Pertanto, per ottenere una vera disponibilità elevata (HA) e un ripristino di emergenza (DR), è necessario progettare un'architettura che superi le limitazioni di un modello a regione singola. La strategia consigliata è la distribuzione in più regioni geograficamente distinte. Questa resilienza interregionale garantisce che se un'intera area cloud non è disponibile a causa di un disastro imprevisto, il traffico può essere trasferito senza problemi a un'istanza dell'applicazione in esecuzione in una regione separata e non interessata, garantendo interruzioni minime del servizio e raggiungendo gli obiettivi di tempo di attività massimo.
## Riferimenti
[Architettura di rete CloudHub 2.0](https://docs.mulesoft.com/cloudhub-2/ch2-networking-guide)
[Configurazione del failover tra regioni per le aree di attesa standard](https://docs.mulesoft.com/mq/mq-failover)
[Regioni di distribuzione Object Store V2](https://docs.mulesoft.com/object-store/osv2-faq#osv2-regions)
[Regione di distribuzione del punto vendita oggetti](https://docs.mulesoft.com/object-store/osv2-faq#is-object-store-v2-persistent-in-the-same-region-as-the-worker)
## Informazioni sugli autori
Gulal Kumar è un architetto di ingegneria del software presso Salesforce, con particolare attenzione all'architettura dei dati e dell'integrazione. Con oltre 20 anni di esperienza in integrazione e API, programmi di modernizzazione, sicurezza e iniziative AIML, offre una vasta gamma di competenze. Gulal si è impegnata a promuovere iniziative di trasformazione aziendale, migliorare la sicurezza e la resilienza, promuovere l'eccellenza dell'architettura e guidare iniziative AIML in vari domini.
Ajay Nagaraju è Enterprise Architect e Senior Director presso MuleSoft con oltre 28 anni di esperienza nell'architettura aziendale, nell'integrazione di sistemi e nella trasformazione digitale su larga scala. Ha diretto l'architettura e la consegna di programmi complessi multimilionari nelle organizzazioni Fortune 100 e Fortune 500, con una profonda esperienza nella connettività basata su API, SOA, tecnologie cloud e schemi di integrazione aziendale. Ajay ha collaborato strettamente con la dirigenza per modernizzare i processi aziendali, le piattaforme dati e gli ecosistemi di integrazione ed è appassionata di creare architetture scalabili, di guidare i team e di favorire risultati aziendali misurabili attraverso la tecnologia.
# Introduzione
Il modello di condivisione Salesforce è un elemento essenziale per la capacità dell'organizzazione di fornire un accesso sicuro ai dati delle applicazioni. Pertanto, è fondamentale progettare correttamente il modello di condivisione per soddisfare i requisiti di accesso ai dati attuali e futuri. In questo documento esamineremo i componenti di accessibilità dei dati, i casi d'uso dei modelli di condivisione e le soluzioni di condivisione dei clienti reali e forniremo alcune linee guida per la risoluzione dei problemi.
## Pubblico di destinazione e prerequisiti
Questo documento è destinato agli amministratori di sistema avanzati e agli architetti. Per comprendere i concetti, è necessario avere una Knowledge di funzionamento del modello di condivisione e protezione Salesforce. I prerequisiti di questa guida sono:
- Guida [di Salesforce: Impostazioni di condivisione](https://help.salesforce.com/s/articleView?id=sf.managing_the_sharing_model.htm)
- [Modulo Trailhead: Sicurezza dei dati](https://trailhead.salesforce.com/en/content/learn/modules/data_security)
- [Progettazione dell'accesso ai record su scala aziendale](https://developer.salesforce.com/docs/atlas.en-us.draes.meta/draes/draes_preface.htm)
- [Salesforce ben progettato - Trust](/docs/architect/it-it/well-architected/guide/trust.html)
### Accesso ai dati non coperto
Questa guida si concentra sulle funzioni principali utilizzate per controllare l'accesso a livello di record agli oggetti standard e personalizzati. Gli argomenti non trattati in questa guida includono:
- Accesso alle cartelle
- Accesso ai contenuti
- Accesso Chatter
- Accesso alla Knowledge Base
- Accesso Idee, Domande/Risposte
- Accessibilità dei dati mobili
## Tipi di accesso ai dati
La protezione a livello di record consente di concedere agli utenti l'accesso ad alcuni record di oggetti, ma non ad altri. Come per la maggior parte delle applicazioni, l'accesso ai dati inizia con un utente. L'applicazione deve sapere chi è l'utente prima di concedere l'accesso. Per Salesforce esistono diversi tipi di utenti e, a volte, il livello di accesso è diverso in base al tipo. Anziché esaminare ogni attributo di ogni tipo di licenza, ci concentreremo qui sugli attributi interessanti che hanno un impatto significativo sull'accesso ai dati. La proprietà dei record e l'accesso completo sono sinonimi e intercambiabili e offrono all'utente il massimo livello di accesso a un record.
### Utenti e licenze
**_Utenti a volume elevato_**
Gli utenti a volume elevato (inclusi gli utenti con i tipi di licenza Customer Community, High Volume Customer Portal e Authenticated Website) non utilizzano il modello di condivisione, perché i loro tipi di licenza non supportano i ruoli. Queste licenze hanno un proprio modello di condivisione che funziona in base alla corrispondenza della chiave esterna tra l'utente (titolare della licenza) e i dati nelle ricerche di account e referenti. Gli amministratori possono creare insiemi di condivisione o gruppi di condivisione per concedere agli utenti a volume elevato l'accesso ai record.
**_Licenze Chatter Free e Chatter External_**
Le licenze Chatter Free e Chatter External non seguono il modello di condivisione standard. Queste licenze non hanno accesso ai record CRM (oggetti standard o personalizzati) e alla funzionalità Contenuto e non supportano i ruoli, pertanto non è possibile condividere.
Per il resto di questo documento, si presuppone che un tipo di utente Salesforce utilizzi un modello di condivisione completo. Per ulteriori informazioni su ogni tipo di licenza disponibile, vedere [Licenze utente](https://help.salesforce.com/apex/HTViewHelpDoc?id=users_understanding_license_types.htm).
### Componenti
**_Profili e insiemi di autorizzazioni_**
I profili e gli insiemi di autorizzazioni offrono una protezione a livello di oggetto determinando quali tipi di dati vengono visualizzati dagli utenti e se possono modificare, creare o eliminare i record. Per ogni oggetto, le autorizzazioni "Visualizza tutto" e "Modifica tutto" ignorano le regole e le impostazioni di condivisione, consentendo agli amministratori di concedere rapidamente l'accesso ai record associati a un determinato oggetto in tutta l'organizzazione. Queste autorizzazioni sono spesso alternative preferibili alle autorizzazioni amministrative "Visualizza tutti i dati" e "Modifica tutti i dati", che consentono agli utenti di visualizzare o modificare tutte le app e i dati.
I profili e gli insiemi di autorizzazioni controllano anche la protezione a livello di campo, che determina i campi all'interno di ogni oggetto a cui gli utenti possono accedere. Ad esempio, un oggetto può avere 20 campi, ma la protezione a livello di campo può essere impostata per impedire agli utenti di visualizzare cinque dei 20 campi.
Si consiglia vivamente di utilizzare gli insiemi di autorizzazioni e i gruppi di insiemi di autorizzazioni anziché i profili per gestire le autorizzazioni oggetto degli utenti. Poiché è possibile riutilizzare componenti base di insiemi di autorizzazioni più piccoli, è possibile evitare di creare decine o persino centinaia di profili per ogni utente e funzione lavorativa.
**_Titolarità dei record e aree di attesa_**
Ogni record deve essere di proprietà di un singolo utente o di un'area di attesa. Il titolare ha accesso al record in base alle impostazioni oggetto del profilo del titolare. Ad esempio, se il profilo del titolare dispone dell'autorizzazione Crea e Lettura per un oggetto ma non dell'autorizzazione Modifica o Elimina, il titolare può creare un record per l'oggetto e visualizzare il nuovo record. Tuttavia, il titolare non potrà modificare o eliminare il record. Gli utenti di livello superiore in una gerarchia (ruolo o territorio) ereditano lo stesso accesso ai dati dei loro subordinati per gli oggetti standard. Se il subordinato dispone dell'accesso in sola lettura, lo saranno anche gli utenti che occupano una posizione superiore nella gerarchia dei ruoli. Questo accesso si applica ai record di proprietà degli utenti e ai record condivisi con loro.
Le aree di attesa consentono di assegnare priorità, distribuire e assegnare record ai team che condividono i carichi di lavoro. I membri dell'area di attesa e gli utenti di livello superiore nella gerarchia dei ruoli possono accedere alle aree di attesa dalle visualizzazioni elenco e diventare titolari dei record di un'area di attesa.
Se un singolo utente è titolare di più di 10.000 record, è consigliabile:
- Il record utente del titolare non deve avere un ruolo nella gerarchia dei ruoli.
- Se il record utente del titolare deve contenere un ruolo, posizionare il ruolo in cima alla gerarchia nel proprio ramo della gerarchia dei ruoli.
Per ulteriori informazioni, vedere [Salesforce Well-Architected - Affidabilità](/docs/architect/it-it/well-architected/guide/reliability.html).
**_Impostazioni predefinite organizzazione_**
Le impostazioni di condivisione dell'organizzazione specificano il livello predefinito di accesso degli utenti ai record degli altri utenti. Le impostazioni di condivisione dell'organizzazione consentono di bloccare i dati al livello più restrittivo. Utilizzare gli altri strumenti di protezione e condivisione a livello di record per concedere l'accesso in modo selettivo ad altri utenti. Ad esempio, gli utenti dispongono delle autorizzazioni a livello di oggetto per leggere e modificare le opportunità e l'impostazione di condivisione a livello di organizzazione è Sola lettura. Per impostazione predefinita, questi utenti possono leggere tutti i record opportunità, ma non possono modificarli a meno che non siano titolari del record o dispongano di altre autorizzazioni.
Le impostazioni predefinite dell'organizzazione possono essere modificate da un'impostazione all'altra (Privato a Controllato da società controllante, quindi di nuovo a Privato). Tuttavia, queste modifiche richiedono un ricalcolo della condivisione e, a seconda del volume, potrebbero causare lunghi tempi di elaborazione.
Solo per gli oggetti personalizzati, è possibile configurare l'impostazione Concedi accesso tramite le gerarchie. Se l'opzione è deselezionata (è selezionata l'impostazione predefinita), agli utenti di livello superiore nella gerarchia dei ruoli viene impedito di ereditare l'accesso. Questa impostazione si trova nelle impostazioni predefinite dell'organizzazione.
**_Gerarchia dei ruoli_**
Una gerarchia dei ruoli rappresenta un livello di accesso ai dati necessario per un utente o un gruppo di utenti. La gerarchia dei ruoli garantisce che i responsabili abbiano sempre accesso agli stessi dati dei dipendenti, indipendentemente dalle impostazioni predefinite dell'organizzazione. Le gerarchie dei ruoli non devono necessariamente corrispondere esattamente all'organigramma. Ogni ruolo nella gerarchia dovrebbe invece rappresentare un livello di accesso ai dati necessario per un utente o un gruppo di utenti.
Nelle organizzazioni Salesforce create nel rilascio Spring '21 o successivi, è possibile creare fino a 5.000 ruoli. Nelle organizzazioni create prima del rilascio Spring '21, è possibile creare fino a 500 ruoli e contattare l'Assistenza clienti Salesforce per aumentare questo limite. È consigliabile mantenere il numero di ruoli interni a 25.000 e il numero di ruoli esterni a 100.000.
È consigliabile mantenere la gerarchia dei ruoli a non più di 10 livelli di rami nella gerarchia.
Quando il ruolo di un utente cambia, tutte le regole di condivisione pertinenti vengono valutate per correggere l'accesso in base alle esigenze. I pari all'interno dello stesso ruolo non garantiscono loro l'accesso reciproco ai dati.
La modellazione della gerarchia dei ruoli inizia dalla comprensione della struttura dell'organizzazione. Questo di solito si basa sulla comprensione dell'ambito di un responsabile, iniziando dall'alto. Il CEO supervisiona l'intera società. Il CEO di solito ha dei riporti diretti che possono essere segmentati per unità operativa (Vendite o Assistenza) o area geografica (EMEA, APAC). Quella persona ha quindi rapporti diretti che potrebbero essere ulteriormente segmentati e così via. Benché questo sembri molto simile a un organigramma delle risorse umane, quando si modella l'accesso ai dati, concentrarsi sull'accessibilità dei dati con una considerazione alla generazione di rapporti sulle risorse umane.
Le sovrapposizioni sono sempre la parte difficile della gerarchia. Se si trovano nella loro filiale, dovranno disporre di regole di condivisione, team o gestione dei territori per ottenere l'accesso necessario. Se vengono inseriti nella gerarchia, potrebbero esserci implicazioni in termini di rapporti.
È importante dedicare tempo alla configurazione della gerarchia dei ruoli perché è uno degli aspetti fondamentali del modello di condivisione.
| Casi d'uso della gerarchia dei ruoli |
| --------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Accesso alla gestione: la possibilità per i responsabili di vedere e fare tutto ciò che i loro subordinati possono vedere e fare. |
| Rapporti gestionali: la possibilità di riportare i rapporti in modo gerarchico in modo che chiunque nella gerarchia veda più dati di quelli subordinati. |
| Segregazione tra le filiali dell'organizzazione: le diverse unità operative non hanno bisogno di visualizzare i dati l'una dell'altra; avere una gerarchia in cui è possibile definire filiali separate consente di separare la visibilità all'interno delle unità operative, continuando a estendere la visibilità ai livelli esecutivi superiori a tali unità. |
| Segregazione all'interno di un ruolo: in molte organizzazioni/applicazioni, le persone che svolgono tutte lo stesso ruolo non devono necessariamente vedere i dati degli altri. La presenza di ruoli gerarchici consente di definire un nodo “foglia” in cui tutti i dati sono essenzialmente privati e di riportare i dati a un ruolo controllante che li può visualizzare tutti. |
**_Gruppi pubblici_**
Un gruppo pubblico è un insieme di singoli utenti, ruoli, territori e così via, che hanno tutti una funzione in comune. I gruppi pubblici possono essere costituiti da:
- Utenti
- Utenti del Portale Clienti
- Utenti partner
- Ruoli
- Ruoli e subordinati interni
- Ruoli, subordinati interni e portale
- Ruoli portale
- Ruoli portale e subordinati
- Territori
- Territori e subordinati
- Altri gruppi pubblici (nidificazione)
I gruppi possono essere nidificati (Gruppo A nidificato nel Gruppo B), ma non nidificare più di cinque livelli. La nidificazione ha un impatto sulla manutenzione e sulle prestazioni dei gruppi a causa del calcolo dell'appartenenza ai gruppi. È consigliabile mantenere il numero totale di gruppi pubblici per un'organizzazione a 100.000.
| Casi d'uso di gruppi pubblici |
| --------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Quando è necessario concedere l'accesso a un gruppo arbitrario di persone, creare un gruppo pubblico per raccoglierle e quindi utilizzare altri strumenti di condivisione per concedere al gruppo l'accesso necessario. La sola appartenenza ai gruppi non fornisce l'accesso ai dati. |
| I gruppi possono anche essere nidificati l'uno all'interno dell'altro, consentendo quindi a un gruppo nidificato di ottenere lo stesso accesso del gruppo in cui è contenuto. Ciò consente la creazione di gerarchie più piccole e ad hoc che non interagiscono necessariamente con le gerarchie dei ruoli o dei territori. Se il Gruppo A è membro del Gruppo B, i membri del Gruppo A avranno accesso ai dati condivisi con il Gruppo B allo stesso livello di accesso dei membri del Gruppo B. |
| I gruppi hanno anche la possibilità di proteggere i dati condivisi nel gruppo dall'essere resi accessibili alle persone nella gerarchia dei ruoli al di sopra dei membri del gruppo. Questo (e l'accesso dei titolari dei record e della loro gerarchia di gestione) consente la creazione di gruppi in cui è possibile condividere informazioni molto riservate: i dati saranno accessibili SOLO ai membri del gruppo e a nessun altro membro dell'organizzazione. A questo scopo, utilizzare l'impostazione Concedi accesso tramite le gerarchie. |
**_Regole di condivisione basate sul titolare_**
Le regole di condivisione basate sul titolare consentono eccezioni alle impostazioni predefinite dell'organizzazione e alla gerarchia dei ruoli che consentono ad altri utenti di accedere ai record di cui non sono titolari. Le regole di condivisione basate sul titolare si basano solo sul titolare del record.
Le regole di condivisione basate sul titolare del referente non si applicano ai referenti privati o ai referenti che non sono associati a un account.
Il limite totale di regole di condivisione per oggetto è 300.
| Casi d'uso delle regole di condivisione basate sul titolare |
| ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Gestione a matrice basata sui ruoli o situazioni di sovrapposizione: una persona in Service deve essere in grado di visualizzare alcuni dati di Sales, ma vive in rami diversi della gerarchia, quindi è possibile creare una regola che condivide i dati tra ruoli in rami diversi. |
| Fornire l'accesso ai dati a colleghi che ricoprono lo stesso ruolo o territorio. |
| Fornire l'accesso ai dati ad altri gruppi di utenti (gruppi pubblici, portale, ruoli, territori). I membri dei raggruppamenti titolari dei record possono essere condivisi con i membri di altri raggruppamenti. |
**_Regole di condivisione basate su criteri_**
Le regole di condivisione basate su criteri forniscono l'accesso ai record in base ai valori dei campi (criteri) del record. Se i criteri sono soddisfatti (uno o più valori di campo), viene creato un record condivisione per la regola. La proprietà dei record non è una considerazione.
Il limite di regole di condivisione basate su criteri e utenti guest per oggetto è 50.
| Caso d'uso delle regole di condivisione basate su criteri |
| -------------------------------------------------------------------------------------- |
| Fornire l'accesso ai dati a utenti o gruppi in base al valore di un campo del record. |
**_Regole di condivisione utenti guest_**
Una regola di condivisione utente guest è un tipo speciale di regola di condivisione basata su criteri utilizzata per concedere l'accesso ai record agli utenti guest non autenticati. Il limite di regole di condivisione basate su criteri e utenti guest per oggetto è 50.
> **Avvertenza:** Il tipo di regola di condivisione utente guest concede l'accesso agli utenti guest senza credenziali di accesso. Creando una regola di condivisione per gli utenti guest si consente a chiunque l'accesso immediato e illimitato a tutti i record che soddisfano i criteri della regola di condivisione. Per proteggere i dati Salesforce e consentire agli utenti guest di accedere a ciò di cui hanno bisogno, considerare tutti i casi d'uso e le implicazioni della creazione di questo tipo di regola di condivisione. Implementare i controlli di sicurezza che si ritengono appropriati per la riservatezza dei dati. Salesforce non è responsabile dell'esposizione dei dati a utenti non autenticati in base a questa modifica delle impostazioni predefinite.
| Caso d'uso regola di condivisione utenti guest |
| ------------------------------------------------------ |
| Fornire l'accesso ai dati agli utenti guest non autenticati. |
**_Condivisione manuale_**
A volte è impossibile definire un gruppo coerente di utenti che necessitano dell'accesso a un determinato insieme di record. I titolari dei record o altri utenti con privilegi adeguati, ad esempio gli amministratori di sistema, possono utilizzare la condivisione manuale per concedere le autorizzazioni di lettura e modifica agli utenti che non hanno accesso in altro modo. La condivisione manuale non è automatizzata come le impostazioni di condivisione dell'organizzazione, le gerarchie dei ruoli o le regole di condivisione. Offre tuttavia ai titolari dei record la flessibilità di condividere i record con gli utenti che devono visualizzarli.
La condivisione manuale viene rimossa quando cambia il titolare del record o quando l'accesso in condivisione concesso non concede un accesso aggiuntivo oltre il livello di accesso predefinito di condivisione dell'oggetto a livello di organizzazione. Questo vale anche per le condivisioni manuali create a livello di programmazione.
I record condivisione manuale sono definiti come record condivisione con la causale riga impostata su condivisione manuale.
Tutti i record di condivisione (oggetti standard e personalizzati) con una causa riga impostata su _condivisione manuale_ possono essere modificati ed eliminati dal pulsante **_Condividi_** nel layout di pagina dell'oggetto, anche se il record di condivisione è stato creato a livello di programmazione.
| Caso d'uso di condivisione manuale |
| ------------------------------------------------------------------------------------------------------------------------------------- |
| Fornire all'utente la possibilità di concedere l'accesso (sola lettura o lettura/scrittura) al record corrente ad altri utenti, gruppi o ruoli. |
**_Team_**
Un team è un gruppo di utenti che lavorano insieme su un account, un'opportunità di vendita o un caso. I titolari dei record possono creare un team per ogni record di cui sono titolari. Il titolare del record aggiunge i membri del team e specifica il livello di accesso di ogni membro del team al record. Alcuni membri del team possono avere accesso in sola lettura, mentre altri hanno accesso in lettura/scrittura.
Solo i titolari, le persone di grado superiore nella gerarchia e gli amministratori possono aggiungere membri del team e fornire un accesso più ampio al membro. Un membro del team con accesso in lettura/scrittura può aggiungere un altro membro che ha già accesso al record a cui è associato il team. Il membro del team non può fornire un accesso aggiuntivo.
La creazione di un membro del team nell'app crea due record: un record team e un record condivisione associato. Se si creano membri del team a livello di programmazione, è necessario gestire sia il record team che il record condivisione associato. È presente un solo team per record (Account, Opportunità o Caso). Se sono necessari più team, a seconda delle esigenze specifiche, valutare la gestione dei territori o la condivisione a livello di programmazione
| Casi d'uso del team |
| ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Fornire all'utente la possibilità di concedere l'accesso (sola lettura o lettura/scrittura) a un singolo gruppo di utenti (il team). |
| Se i team sono gestiti esternamente, ad esempio tramite una commissione esterna o un sistema di gestione dei territori, è possibile utilizzare l'integrazione per gestire il team account. Esistono casi in cui la gestione dei territori in un sistema esterno può allinearsi a una soluzione di team in Salesforce. |
| Il team account può gestire più titolari di un account. |
| Un singolo gruppo di utenti (team) richiede l'accesso in sola lettura o lettura/scrittura a un record opportunità. (Team opportunità) |
**_Gerarchia dei territori_**
Quando si utilizza Gestione territorio di livello aziendale, si imposta una gerarchia dei territori che mostra la struttura dei territori di un modello e funge da punto di interazione principale. Se Gestione territorio di livello aziendale è abilitata, è necessario gestire sia la gerarchia dei ruoli che la gerarchia dei territori. Per ulteriori informazioni, vedere [Gestione dei territori](https://help.salesforce.com/articleView?id=sf.tm2_intro.htm) aziendali nella Guida di Salesforce.
**_Condivisione gestita Apex_**
La condivisione gestita Apex (detta anche condivisione a livello di programmazione) consente di utilizzare il codice per creare impostazioni di condivisione sofisticate e dinamiche quando un requisito di accesso ai dati non può essere soddisfatto con altri mezzi.
Se si crea un record condivisione a livello di programmazione e viene utilizzata la causa della riga pronta all'uso (_condivisione manuale_), è possibile mantenere questo record condivisione con il pulsante **_Condividi_** nell'app. Il record condivisione è soggetto a tutte le regole con la causa della riga di condivisione manuale, ad esempio l'eliminazione al trasferimento del titolare.
È anche possibile creare i propri motivi di condivisione Apex per gli oggetti personalizzati per tenere traccia del motivo di un record con un utente o un gruppo di utenti e semplificare il codice necessario per eseguire aggiornamenti ed eliminazioni dei record di condivisione.
Per ulteriori informazioni, consultare [Condivisione di un record con Apex](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_bulk_sharing_creating_with_apex.htm) prima di valutare l'uso della condivisione a livello di programmazione.
| Casi d'uso di condivisione gestiti Apex |
| ------------------------------------------------------------------------------------------------------------------------------------------------- |
| Nessun altro metodo di condivisione (dichiarativo) soddisfa le esigenze di accesso ai dati. |
| Esiste già un sistema di verifica esterno per le assegnazioni dell'accesso utente che continuerà a favorire l'accesso e a integrarlo con Salesforce. |
| Scarse prestazioni utilizzando componenti di condivisione nativi. (In genere si applica a volumi di dati molto elevati) |
| Funzionalità del team sugli oggetti personalizzati. |
**_Regole di restrizione_**
Nella configurazione di accesso ai dati, può essere opportuno impedire agli utenti di visualizzare record che possono contenere dati sensibili o semplicemente non essenziali per il loro lavoro. È possibile utilizzare le regole di restrizione per consentire agli utenti di accedere solo ai record che soddisfano i criteri specificati. Quando si applica una regola di restrizione a un utente, i record a cui l'utente ha accesso tramite le impostazioni predefinite dell'organizzazione, le regole di condivisione e altri meccanismi di condivisione vengono filtrati in base ai criteri specificati. Le regole di restrizione funzionano in modo opposto rispetto ai componenti di condivisione descritti in questo argomento; anziché aprire l'accesso agli utenti, lo limitano ulteriormente.
Le regole di restrizione sono disponibili per oggetti personalizzati, oggetti esterni, contratti, eventi, operazioni, schede attività e voci scheda attività. È possibile creare fino a due regole di restrizione attive per oggetto nelle versioni Enterprise Edition e Developer Edition e fino a cinque regole di restrizione attive per oggetto nelle versioni Performance Edition e Unlimited Edition. Le regole di restrizione vengono applicate alle seguenti funzioni di Salesforce:
- Visualizzazioni elenco
- Ricerche
- Elenchi correlati
- Rapporti
- Ricerca
- SOQL
- SOSL
| Casi d'uso delle regole di restrizione |
| ---------------------------------------------------------------------------------------------------------------------------------- |
| Si desidera che determinati utenti visualizzino solo un insieme specifico di record. |
| Semplificare il controllo dell'accesso ai record con informazioni sensibili o riservate. |
| Rendere veramente privato l'accesso a contratti, operazioni ed eventi, poiché questo può essere difficile da ottenere utilizzando le impostazioni predefinite dell'organizzazione. |
**_Condivisione implicita_**
La condivisione implicita è automatica. Non è possibile disattivarlo né attivarlo: è nativo dell'applicazione. In altre parole, la condivisione implicita non è un'impostazione configurabile; tuttavia, è importante che ogni architetto comprenda. La condivisione implicita controllante fornisce l'accesso ai record controllanti (solo account) quando un utente ha accesso a opportunità controllate, casi o referenti per quell'account. Salesforce ha una policy di accesso ai dati che indica se un utente può visualizzare un referente (o un'opportunità, un caso o un ordine), quindi l'utente vede implicitamente l'account associato. La condivisione implicita controllata fornisce l'accesso ai record controllati di un account al titolare dell'account. Questo accesso è definito in corrispondenza del ruolo del titolare nella gerarchia dei ruoli. La condivisione implicita controllata si applica solo agli oggetti referente, opportunità e caso (controllati dell'account). I livelli di accesso che possono essere forniti sono Visualizza, Modifica e Nessun accesso per ciascuno degli oggetti secondari quando viene creato il ruolo. Impostando su Visualizza, il titolare dell'account può visualizzare implicitamente i record oggetto associati (referente, opportunità o caso). Impostando su Modifica, il titolare dell'account può modificare implicitamente l'oggetto associato (referente, opportunità o caso).
La condivisione implicita non si applica agli oggetti personalizzati.
## Scenari di implementazione del cliente
Non esiste un modello di condivisione adatto a tutte le organizzazioni Salesforce. Ogni organizzazione ha requisiti e sfide diversi quando tenta di progettare il modello di condivisione migliore. È fondamentale utilizzare i componenti di accesso ai dati più appropriati per soddisfare i requisiti di condivisione dell'organizzazione. Gli scenari seguenti sono sfide comuni quando si tenta di progettare un modello di condivisione.
### Assegnazione team gestita esternamente tramite il sistema master del cliente
| **Requisiti o sfide** | **Soluzione** |
| ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Due in una scatola: un responsabile vendite di un'area di copertura geografica desidera anche accedere a un'altra area di copertura geografica per fornire assistenza. | Regola di condivisione basata sul titolare: Qui funziona una regola di condivisione basata sul titolare perché questi sono casi limite e non la norma. È accettabile anche che la regola di condivisione basata sul titolare fornisca un accesso maggiore di quello realmente necessario poiché si tratta di un responsabile, ovvero di una persona affidabile. |
| Gli utenti delle operazioni basate sul paese devono poter accedere a tutti i dati di vendita del paese. | Regola di condivisione basata sul titolare: Un uso molto comune di una regola di condivisione è quando un reparto diverso (diverso dalle vendite) necessita dell'accesso ai dati di vendita. |
| Almeno l'80% delle volte, è presente un team "core 4" in un account (Dirigente account, Agente di vendita interno, Consulente di vendita, Agente di vendita tecnico). Il sistema di record per l'assegnazione del team account è esterno. Esiste sempre un solo team per un account. | Team: Poiché è sempre presente un solo team per account, anche se sono presenti molti membri diversi con ruoli diversi, la funzionalità del team account soddisfa questo requisito. |
| I responsabili del team devono avere lo stesso accesso dei loro subordinati. | Gerarchia dei ruoli: La gerarchia dei ruoli risolve questo requisito consentendo ai responsabili di accedere ai dati dei loro subordinati. |
| Il team account assegnato non deve essere modificabile. | Team: Questo requisito non viene effettivamente soddisfatto con la funzionalità del team account. Tuttavia, ciò non dovrebbe impedire di continuare a utilizzare i team account. Tuttavia, ci sono diversi modi per bloccare le squadre. In questo caso, viene utilizzata la rimozione del layout di pagina del team account. |
| Deve essere presente una funzionalità "compagno" in modo che, quando qualcuno è malato o in vacanza, qualcuno senza accesso standard a un account o a un'opportunità possa essere accessibile e coperto durante il tempo libero. | Team: Un "amico" può essere semplicemente un ruolo nel team che soddisfa questo requisito. Tuttavia, la sfida deriva dal requisito precedente in cui i team non devono essere modificabili. L'unica soluzione è avere un gruppo di persone che possono modificare i team per creare il ruolo di amico quando necessario. |
| Quando una trattativa richiede una soluzione personalizzata, altre persone (che non fanno necessariamente parte dell'organizzazione di vendita) devono avere accesso alla trattativa. | Team: Un utilizzo abbastanza standard del team opportunità ottenuto aggiungendo manualmente un nuovo membro al team opportunità (tramite elenco correlato). Può essere eseguita anche tramite un trigger se si sa sempre chi deve essere aggiunto. In questo caso, è opportunità per opportunità. |
### Gestione dei territori pronta all'uso
| **Requisiti o sfide** | **Soluzione** |
| ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Due team opportunità diversi di due unità operative distinte (Vendite al dettaglio e Remarketing) devono accedere allo stesso record account. Devono condividere i referenti ed essere a conoscenza di tutte le attività sull'account. Queste due unità operative hanno una gerarchia e roll-up propri. | Gestione dei territori: Il modo migliore per pensare a questo requisito è avere due rami di una gerarchia che possono essere strutturati in modo diverso. Ciò che giustifica la gestione dei territori è che esistono due livelli di queste due filiali diverse (entrambi i livelli con membri = team opportunità per quell'unità operativa) che necessitano dell'accesso all'account. Anche se si sarebbe potuto soddisfare questo requisito con un concetto di Teaming, era troppo granulare. La segmentazione delle vendite non era a livello di account ma a livello di gerarchia. |
| Esiste un gruppo separato di sviluppatori aziendali a cui è assegnato l'accesso ad account specifici per un team opportunità specifico (un territorio). Gli sviluppatori aziendali sono risorse condivise per i team opportunità, il che significa che ogni sviluppatore aziendale può essere assegnato a uno o più account per uno o più team opportunità. | Gestione dei territori: Poiché si tratta di un gruppo di utenti (o di un team) e ogni team di sviluppo aziendale può essere diverso in base all'account, e poiché la gestione dei territori era necessaria per un altro motivo, l'approccio probabilmente migliore è creare sottoterritori o filiali separate che rappresentano questi team di sviluppo aziendale. |
| Esistono ruoli di assistenza alle vendite non basati su commissione che necessitano di accedere agli account una tantum. | Team: La parte chiave del requisito è "base una tantum". Ciò significa che viene eseguito account per account in modo che i team account lo forniscano in modo nativo. |
| Il reparto crediti deve poter accedere a tutti gli account di una determinata unità operativa. | Regola di condivisione basata sul titolare: Questa è una situazione in cui in generale, per una determinata unità operativa, un gruppo di utenti deve vedere tutto. Questo requisito può essere soddisfatto con una regola di condivisione per un ruolo a cui appartiene il gruppo, un ramo della gerarchia dei ruoli a cui appartiene il gruppo (ruolo e subordinati) o anche un gruppo pubblico.Gestione dei territori: È anche possibile soddisfare questo requisito modellando il reparto credito come territorio con la stessa logica per l'unità operativa specificata. |
| I responsabili devono avere lo stesso accesso dei loro subordinati. | Gerarchia dei ruoli: La gerarchia dei ruoli risolve questo requisito consentendo ai responsabili di accedere ai dati dei loro subordinati. |
## Considerazioni
### Considerazioni sull'implementazione di Gestione territorio di livello aziendale
- Che cosa accade alla gerarchia dei ruoli?
- Non accade nulla alla gerarchia dei ruoli se si utilizza anche una gerarchia dei territori. Tuttavia, se si utilizzano insieme sia le previsioni basate sul territorio che le previsioni basate sui ruoli, è necessario gestire due gerarchie. In questo caso, si consiglia di utilizzare la gerarchia dei ruoli per modellare la struttura dei rapporti HR, quindi utilizzare la gerarchia dei territori per modellare la gerarchia delle vendite effettiva. La gerarchia dei territori è più adatta per modellare una struttura di rapporti a matrice, in cui qualcuno può fare capo a più responsabili.
Se non si utilizzano insieme previsioni basate sul territorio e previsioni basate sui ruoli, è possibile utilizzare solo la gerarchia dei territori come gerarchia delle vendite. In questo scenario, è meglio semplificare o appiattire il più possibile la gerarchia.
Non è consigliabile rendere identici la gerarchia dei ruoli e la gerarchia dei territori perché si verificano attività di condivisione non necessarie.
- È ancora possibile utilizzare i team?
- Sì, sì. Tuttavia, se è possibile soddisfare i requisiti di accesso all'interno della gerarchia dei territori (ad esempio le sovrapposizioni), è meglio farlo lì che utilizzare i team. Si stanno già mantenendo più gerarchie (ruolo e territorio), quindi nel tentativo di semplificare il più possibile le cose, implementare i team solo se nessun altro componente di condivisione esistente soddisfa il requisito.
### Altre considerazioni
- Riallineamento e riassegnazione
- Esistono due tipi di modifiche: l'appartenenza a ruoli, team o territori e la struttura della gerarchia. I cambi di appartenenza possono in genere avvenire ogni giorno, anche ogni ora. I cambiamenti strutturali della gerarchia (riallineamenti) si verificano generalmente meno spesso (trimestrale, semestrale o annuale) e possono essere costosi per le risorse. Ciò che deve essere considerato sono il volume delle modifiche e il numero di modifiche a catena che ogni modifica causerà. Come regola generale, i cambiamenti strutturali non devono avvenire più di un trimestre e tutti i cambiamenti di volume elevato (cambiamenti in blocco o di massa) devono essere ben pianificati, testati e coordinati.
- Grandi volumi di dati
- Sia che si tratti di modellare per l'implementazione iniziale o di pianificare una modifica del riallineamento, è necessario prestare molta attenzione al volume dei dati. Esistono soglie in cui le prestazioni possono diventare un fattore, quindi è altamente consigliabile testare le modifiche in un Sandbox prima di procedere alla produzione. Questo test fornirà anche una base di riferimento per la durata della modifica.
Se si dispone di più di due milioni di account e sono stati implementati team o Gestione territorio di livello aziendale, è necessario prestare particolare attenzione alle prestazioni. Si tratta di componenti modello di condivisione complessi che possono generare un volume enorme di record condivisione e quindi transazioni di lunga durata.
- Rinvio dei calcoli di condivisione
- Se si dispone di un oggetto che utilizza la condivisione e ha un volume elevato di record (ad esempio più di due milioni di account) ed è necessario apportare una modifica in blocco (ad esempio un riallineamento trimestrale che richiede una modifica della gerarchia), esiste una funzione che l'Assistenza clienti Salesforce può abilitare per rinviare i calcoli automatici della condivisione. In modo nativo, ogni singola modifica alla gerarchia dei ruoli, alla gerarchia dei territori, ai gruppi, alle regole di condivisione, ai ruoli utente, all'appartenenza ai team o alla proprietà dei record può avviare calcoli di condivisione automatici. Quando viene apportata una modifica in blocco, viene avviata una serie di ricalcoli automatici della condivisione. Sospendendo temporaneamente questi ricalcoli, è possibile apportare la modifica e quindi fare in modo che i calcoli di condivisione vengano eseguiti tutti insieme. Questo metodo è in genere più efficiente e più performante per le modifiche in blocco.
- Dati e differenze di proprietà
- Le differenze di dati sono definite come pochi record controllanti con molti record controllati. Queste distorsioni possono davvero danneggiarti quando alcuni account hanno molti referenti, opportunità o casi. Il rapporto in cui iniziamo a vedere un peggioramento delle prestazioni è 1:10.000. È consigliabile mantenere il rapporto il più vicino possibile a quello (è preferibile un rapporto più basso).
Le differenze di proprietà sono simili alle differenze di dati, tranne per il fatto che ci si riferisce a un singolo utente, ruolo o gruppo titolare di molti record per un oggetto. Come per le distorsioni dei dati, anche queste possono causare transazioni di lunga durata, causando un peggioramento delle prestazioni quando si verificano modifiche. Anche il rapporto consigliato tra titolare e numero di record è 1:10.000.
Se un singolo utente è titolare di più di 10.000 record, è consigliabile:
- Il record utente del titolare non deve avere un ruolo nella gerarchia dei ruoli.
- Se il record utente del titolare deve contenere un ruolo, posizionare il ruolo in cima alla gerarchia nel proprio ramo della gerarchia dei ruoli.
- Impatto delle gerarchie account sull'accesso ai dati
- Molte persone fanno un cattivo presupposto quando implementano una gerarchia account. Presumono che gli utenti che possono accedere a un account controllante possano accedere anche agli account controllati. Il semplice fatto di avere solo una relazione controllante/controllato tra due record non determina l'accesso. Sebbene la gerarchia dei ruoli e la gerarchia dei territori funzionino in questo modo, la gerarchia degli account non funziona.
## Risoluzione dei problemi
Una volta completata l'architettura del modello di condivisione, probabilmente ci si chiederà perché un utente possa o non possa vedere un record. In genere, non si sente quando gli utenti possono vedere qualcosa che non dovrebbero, ma se necessario, esiste un modo per vedere ogni utente che ha accesso a un record e perché.
La sfida più difficile, e probabilmente più comune, è il motivo per cui un utente non può visualizzare un record. I livelli di sicurezza progettati determinano da dove iniziare. Se si conosce bene il modello di condivisione, probabilmente si sa quale componente dovrebbe aver fornito l'accesso e può iniziare da lì. Tuttavia, se si ha meno dimestichezza con il modello di condivisione, iniziare con la gerarchia dei ruoli e separare ogni livello per determinare quale deve fornire l'accesso. Di seguito è riportato un flusso per la risoluzione dei problemi.
1. Verificare che l'utente disponga delle autorizzazioni per accedere all'oggetto.
2. Identificare il ruolo dell'utente che non può visualizzare il record e annotarlo.
3. Identificare il titolare del ruolo del record e prenderne nota.
4. Esaminare la gerarchia dei ruoli e verificare che questi due ruoli si trovino in due rami diversi (dovrebbero essere).
5. Ora è necessario rivedere le regole di condivisione per l'oggetto e assicurarsi che non esista una regola che conceda l'accesso all'utente. Se necessario, cercare anche nei gruppi pubblici. Forse l'utente è stato escluso da un gruppo in cui esiste una regola di condivisione o ha senso creare una nuova regola di condivisione per concedere l'accesso all'utente? Questa scelta dipende dall'architettura che si sta tentando di mantenere e si applica sia alle regole di condivisione basate sul titolare che alle regole di condivisione basate sui criteri.
6. Se si utilizzano i team, questo utente deve essere nel team per quel record? Come vengono mantenuti i team e come si è verificato l'errore?
7. Se si utilizza la condivisione manuale, è possibile che l'utente abbia perso l'accesso perché è cambiato il titolare del record. Le condivisioni manuali vengono eliminate quando cambia la proprietà. La condivisione manuale potrebbe anche essere stata rimossa utilizzando il pulsante **Condividi**.
8. Se si utilizza Gestione territorio di livello aziendale, l'utente manca da uno dei territori? Dove viene mantenuta l'appartenenza ai territori e come si è verificata la mancanza? Oppure, forse il record non è stato assegnato al territorio di cui l'utente è membro.
9. Se si stanno creando condivisioni a livello di programmazione e sono presenti criteri per la creazione della condivisione nel codice, esaminare il codice per capire perché questo utente è stato omesso.
# Contesto
Le piattaforme dati si sono evolute per oltre tre decenni. Inizialmente, il settore era dominato da database operativi/OLTP locali, centralizzati e strutturati (per lo più relazionali). Questo si è esteso per includere piattaforme OLAP/Big Data per i data warehouse che sono state utilizzate principalmente per l'elaborazione analitica e sono rimaste relazionali e centralizzate. Lo storage cloud ha determinato architetture distribuite come data warehouse, lakehouse e storage disaggregato. Tuttavia, le piattaforme operative e le piattaforme analitiche sono rimaste separate. Oggi, il cloud computing e la rivoluzione dell'intelligenza artificiale stanno cambiando radicalmente l'architettura della piattaforma dati.
Le aziende investono già in piattaforme Big Data mature come Snowflake, Databricks, BigQuery e Redshift. Ma queste piattaforme fungono da silos di dati. I clienti non derivano valore aziendale dai loro dati perché non è possibile intervenire sui dati direttamente all'interno dei flussi aziendali e delle applicazioni. Queste soluzioni non dispongono di elaborazione dell'intelligenza artificiale generativa e non sono in grado di fornire l'accesso ai dati in tempo reale, quindi non sono in grado di offrire personalizzazione basata sull'intelligenza artificiale al momento del coinvolgimento dei clienti e di altre funzioni leader del settore.
Il futuro delle piattaforme dati è caratterizzato da un'infrastruttura dati unificata, flessibile, accessibile e aperta. Questa nuova architettura si basa sulle moderne tendenze di elaborazione e archiviazione (GPU, memoria di grandi dimensioni, SSD NVMe e cloud storage) per integrarsi con il cloud computing e l'intelligenza artificiale. Sono in grado di fornire approfondimenti in tempo reale, potenziare il processo decisionale autonomo e favorire le applicazioni in tempo reale. Ciò include l'aumento dell'intelligenza artificiale agente, dell'intelligenza artificiale predittiva, dell'analisi, dei database OLTP su larga scala in tempo reale, dei data lake e delle lakehouse. Queste moderne piattaforme dati sono progettate per offrire semplicità, scalabilità, agilità, prestazioni, sicurezza, disponibilità ed efficienza in termini di costi.
## Tendenze chiave nell'architettura di Data Platform di nuova generazione
Le seguenti tendenze dei dati determinano l'architettura della piattaforma dati di nuova generazione.
- **AI, machine learning e Analytics al centro**: L'ascesa dell'intelligenza artificiale agente modificherà in modo sostanziale lo sviluppo, la distribuzione e l'utilizzo/accesso della piattaforma dati. L'intelligenza artificiale agente comprenderà l'intento della conversazione/query, pianificherà, genererà flussi di lavoro e automatizzerà il processo decisionale. La memoria agentica (a breve e a lungo termine) è basata sulla cronologia delle conversazioni per personalizzare la pianificazione e le decisioni degli agenti, la modellazione delle conversazioni in tempo reale e il supporto della personalizzazione nelle piattaforme dati. Gli agenti aiuteranno ad automatizzare "funzionalità" operative come la governance dei dati (ad esempio, sicurezza, conformità, Trust), le prestazioni (ad esempio, scalabilità automatica per concomitanza, produttività e latenza), il failover e la disponibilità e l'osservabilità e la manutenzione. Analytics, previsioni, elaborazione del linguaggio naturale (NLP) basata su AI per le domande/risposte analitiche e analisi su dati non strutturati (testo come PDF, immagini, audio, video) saranno standard, consentendo alle aziende di derivare approfondimenti più approfonditi da fonti di dati diverse.
- **Decentralizzazione dei dati ma accesso ai dati unificato**: Gli agenti hanno bisogno di dati aziendali per ricavare approfondimenti e prendere decisioni e automatizzare le attività aziendali. I dati sono per loro natura decentralizzati nelle aziende, in applicazioni e piattaforme dati diverse. Ma non è facile unificare senza problemi i silos tra le diverse unità operative all'interno dell'azienda e con partner esterni all'azienda. L'unificazione dei dati prevede la condivisione dei dati, tramite inserimento da fonti o federazione con fonti di dati; dati grezzi provenienti da preparazione, armonizzazione e modellazione dei dati per l'elaborazione analitica e AI; archiviazione e gestione dei dati su larga scala per un accesso efficiente con bassa CTS; e accesso ai dati tramite vari meccanismi e strumenti di query e analisi, profondamente integrati con le piattaforme di archiviazione e accesso ai dati sottostanti
- **Open Lakehouse basati su cloud**: Le piattaforme OLP (Big Data) basate su cloud stanno convergendo nell'adozione di formati di file aperti (Parquet) e formati di tabella (Iceberg) che abilitano la federazione dei dati (data in) e la condivisione (data out).
- **Trattamento dati non**: strutturati Con l'emergere, l'avanzamento e l'adozione dell'intelligenza artificiale generativa, le aziende stanno iniziando a trarre informazioni preziose e valore aziendale dal corpus di dati aziendale che costituisce grandi volumi di documenti di testo, trascrizioni audio, registrazioni video e altri media. L'elaborazione di dati non strutturati, inclusi suddivisione in blocchi, vettorializzazione, ricerca semantica e grafici Knowledge, rendono possibili questi approfondimenti. Tecniche come RAG (retrieval augmented generation) e CAG (cache augmented generation) stanno diventando i principali motori della ricerca veloce e agente in tutto il corpus di dati.
- **Knowledge Management**: Knowledge va oltre il semplice contenuto grezzo (documenti, articoli, video). Rappresenta l'aumento di quel contenuto derivando significato, curando i metadati e inserendolo nel contesto per sviluppare una comprensione condivisa del contenuto in un'organizzazione o in un'azienda. Knowledge stesso è generalmente strutturato. La gestione Knowledge include la gestione dei contenuti, l'estrazione Knowledge, la rappresentazione tramite modelli come i grafici e la navigazione.
- **Accesso RTF ai dati**: Un accesso completo ai dati significa che i dati, gli strumenti di analisi e intelligenza artificiale devono essere accessibili a una varietà di profili, inclusi utenti finali, utenti aziendali, amministratori e analisti. L'accessibilità viene raggiunta attraverso meccanismi come la query insiemi (con query relazionali, parola chiave e semantica), il linguaggio naturale per la query SQL (NL2SQL), l'accesso in tempo reale e così via.
- **Elaborazione in tempo reale**: Le applicazioni agenti prendono decisioni in tempo reale in base allo stato corrente e ai nuovi eventi, personalizzando le risposte e le azioni, il che richiede l'accesso, l'elaborazione e l'utilizzo di dati in tempo reale. L'elaborazione in tempo reale richiede dati aggiornati (latenza dei dati) e accesso interattivo (latenza di accesso). Tali dati e latenza di accesso richiedono che la piattaforma dati sottostante supporti l'accesso aggiornato ai dati dagli archivi operativi e analitici, l'elaborazione a bassa latenza (ricerche di punti e query), l'elevata scalabilità dei dati e l'elevata produttività.
- **Sicurezza dei dati, governance e residenza**: L'intelligenza artificiale agentiale e conversazionale semplifica l'interfaccia utente delle applicazioni, consentendo a chiunque, dai consumatori ai dipendenti fino ad altri agenti di intelligenza artificiale, di interagire con le applicazioni conversazionalmente utilizzando un linguaggio naturale parlato o scritto. I preziosi dati personali e dei clienti che devono essere archiviati e modellati per le applicazioni Agentic devono essere protetti e governati con policy di accesso e condivisione ben definite. Sempre più spesso, molti clienti devono rispettare i regolamenti che richiedono la residenza dei dati nel proprio paese o regione, in particolare quelli governativi o che lavorano con i governi.
Salesforce Data 360 è progettato per il futuro per gestire queste tendenze dei dati. Data 360 è una piattaforma di dati nativa per il cloud basata sui metadati che unifica i dati in silo in tutta l'azienda, consentendo alle organizzazioni di archiviare, modellare ed elaborare i propri dati per abilitare applicazioni analitiche, AI, machine learning e agenti.
Questo documento è una guida essenziale per gli architetti aziendali e i CTO. Vengono descritti l'architettura, le funzionalità, i principi di progettazione e i casi d'uso di Data 360\. Vengono presentati i concetti fondamentali dell'architettura Data 360 come primer, seguiti da una serie di approfondimenti approfonditi sui suoi principali elementi di differenziazione, come l'interoperabilità con le piattaforme dati esistenti, tra cui strategia multi-organizzazioni, sicurezza, governance e privacy, attivazione in tempo reale e camere bianche dei dati.
## Principi di progettazione
Salesforce Data 360 si basa su una serie di principi fondamentali che rendono i dati aziendali operativi, affidabili e in tempo reale.
- **Apertura e interoperabilità**: Creato per gli ecosistemi multi-cloud. Si unisce a piattaforme dati come Snowflake, Databricks, BigQuery e Redshift senza duplicazioni, estendendo Customer 360 pur preservando gli investimenti esistenti.
- **Separazione memoria-calcolo**: Scala l'archiviazione e l'elaborazione (batch, streaming e interattiva) in modo indipendente. Offre elasticità ed efficienza per carichi di lavoro a volume elevato e prestazioni elevate.
- **Memoria ed elaborazione multimodello**: Supporta diversi tipi di dati strutturati e non strutturati come testo, audio immagine e video. Offre archiviazione efficiente, elaborazione in tempo reale e in batch, indicizzazione ampliabile, ricerca unificata, query e analisi.
- **Progettazione basata sui metadati**: Le applicazioni sono definite dai metadati anziché dal codice. I metadati vengono trattati come asset di prima classe, consentendo una governance unificata, flessibilità e una profonda integrazione nella piattaforma Salesforce.
- **Elaborazione ibrida in tempo reale**: Supporta query a bassa latenza e processi decisionali istantanei, oltre all'elaborazione batch e ai carichi di lavoro analitici.
- **Dati intelligenti e attivi**: Inserisce, analizza e invia continuamente approfondimenti direttamente nei flussi di lavoro aziendali. Alimenta l'automazione senza codice, low-code, pro-code e basata sull'intelligenza artificiale con il contesto più attuale.
- **Governance e privacy by Design**: La discendenza, il controllo degli accessi, la residenza, la crittografia dei dati e la conformità sono integrate.
- **Tenancy uno a molti**: Un'organizzazione Data 360 centralizzata funge da singola fonte di dati per Customer 360, supportando in modo semplice gli ambienti Salesforce multi-organizzazioni ampiamente utilizzati dai clienti Salesforce.
Questi principi garantiscono che Data 360 renda i dati aperti, intelligenti e fruibili in tempo reale.
### Dai principi alle funzionalità
Salesforce Data 360 è una piattaforma dati moderna basata su principi di progettazione che tengono conto delle tendenze attuali dei dati. Le funzionalità dell'architettura garantiscono che i dati aziendali siano affidabili, unificati e fruibili in tempo reale, in linea con i principi guida.
- **Fondazione nativa del cloud**: Funziona su Hyperforce, distribuito su Hyperscalers (come AWS), con un'infrastruttura immutabile basata su microservizi. Offre scalabilità elastica, sicurezza zero Trust, consegna continua e conformità globale.
- **Gestione dei metadati di Salesforce (Core)**: I metadati sono progettati, modellati e archiviati come metadati Salesforce che consentono l'uso immediato da parte di TUTTE le applicazioni Salesforce. Tali metadati sono archiviati in un RDBMS completamente compatibile con ACID. Garantisce governance, coerenza del ciclo di vita e una profonda integrazione con Salesforce Lightning Platform.
- **Stoccaggio: Lakehouse** Basato su Apache Iceberg e Parquet, combina la scalabilità del data lake con la governance del magazzino che supporta l'evoluzione dello schema, i viaggi nel tempo e gli aggiornamenti a volume elevato. Data 360 archivia, modella ed elabora dati strutturati e non strutturati con un'archiviazione su larga scala con moderni standard aperti e con funzionalità complete di trasformazione ed elaborazione dati per carichi di lavoro basati su batch ed eventi.
- **Opportunità dati in corso di realizzazione end-to-end con inserimento flessibile**: Copre l'intero ciclo di vita (inserimento, preparazione, modellazione, unificazione, analisi e attivazione) riducendo la dipendenza da soluzioni di punti frammentate. Supporta batch, quasi in tempo reale e streaming con più di 270 connettori e MuleSoft. L'approccio ELT-first consente una rapida disponibilità dei dati con flessibilità di trasformazione a valle.
- **Interoperabilità dei dati aziendali con framework aperti e federazione**: Unisce i dati in silo in tutta l'azienda con la federazione bidirezionale Copia zero con Snowflake, Databricks, BigQuery e Redshift evitando la migrazione o la duplicazione dei dati.
- **Classificazione, modellazione e organizzazione dei dati**: Data 360 organizza i dati come dati inseriti non elaborati, dati puliti e archiviati e dati modellati in base allo schema informativo comune noto come SSOT (Single Source of Truth). Tali oggetti SSOT costituiscono la base per la definizione di modelli di dati semantici (SDM) e altri modelli curati e specifici delle applicazioni.
- **Modellazione semantica incorporata** per analisi estendibili con API di query semantiche aperte, che guidano Tableau Next e abilitano analisi specifiche dell'applicazione.
- **Motore di query** Data 360 SQL che supporta una query unificata su dati strutturati, non strutturati e grafici.
- **Memorie dati a bassa latenza**: Archiviazione dei valori chiave per i dati caldi con tempi di risposta in millisecondi. Abilita la personalizzazione e gli scenari basati sugli eventi in tempo reale. Raccoglie ed elabora i dati di coinvolgimento dei clienti in tempo reale. Unisce le identità, le interazioni e le conversazioni in un unico profilo Customer 360 e grafico del contesto affidabili.
- **Pipeline di elaborazione** dati non strutturate per un supporto flessibile ed estensibile per l'archiviazione di dati non strutturati, la suddivisione, la generazione di incorporamento (vettorializzazione), l'estrazione di metadati (aumento), il riepilogo, l'indicizzazione, l'estrazione Knowledge, l'elaborazione intelligente dei documenti, la creazione di memoria a breve e lungo termine (conversazione) e così via.
- **Indicizzazione nativa parola chiave, vettore e ibrida** per un accesso preciso ed efficiente ai dati non strutturati come ricerca rapida e agente, RAG, estrazione Knowledge, derivazione della memoria agente, ecc.
- **Servizi Profilo, Personalizzazione, Contesto** per l'abilitazione di applicazioni AI/ML e Agentic.
- **Governance e sicurezza** integrate a ogni livello per il tracciamento dei lignaggi, il mascheramento dei dati, la residenza dei dati e la sicurezza zero Trust per garantire conformità e Trust.
- **Tessuto elastico di calcolo**: Tessuto di elaborazione multi-tenant nativo di Kubernetes. Esegue Spark per l'elaborazione distribuita e Hyper per i carichi di lavoro SQL. Scala in modo elastico in processi diversi e supporta l'isolamento per l'esecuzione di codice non affidabile.
Tutto questo viene eseguito su Hyperforce, la base cloud di Salesforce. Hyperforce fornisce:
- **Sicurezza Zero Trust** con policy di crittografia, isolamento e privilegi minimi.
- **Resilienza** attraverso distribuzioni multiregione. Benché Salesforce Data 360 tragga vantaggio dalla resilienza multiregione e dalla tolleranza ai guasti a livello di piattaforma di Hyperforce, il vero disaster recovery (DR) di livello aziendale richiede un'architettura più ampia simile a qualsiasi piattaforma dati con funzionalità chiave: pipeline di inserimento riproducibili, replica e reidratazione basata sui metadati in tutti gli ecosistemi dipendenti.
- **Osservabilità** con monitoraggio, metriche e tracciamento integrati.
- **Scala automatica e consapevolezza** FinOps per l'efficienza senza overflow dei costi.
Data 360 non sostituisce gli investimenti aziendali esistenti. Data 360 rende invece i dati di cui ci si è già fidati, gestiti e fruibili, offrendo un coinvolgimento in tempo reale basato sull'intelligenza artificiale dove è più importante. In breve, Salesforce trasforma tutti i dati aziendali, inclusi i dati esterni, come oggetti basati sui metadati (Salesforce) e abilita le applicazioni Agentic per l'individuazione, il processo decisionale e l'esecuzione di azioni.
La figura seguente illustra l'architettura di riferimento di Data 360:
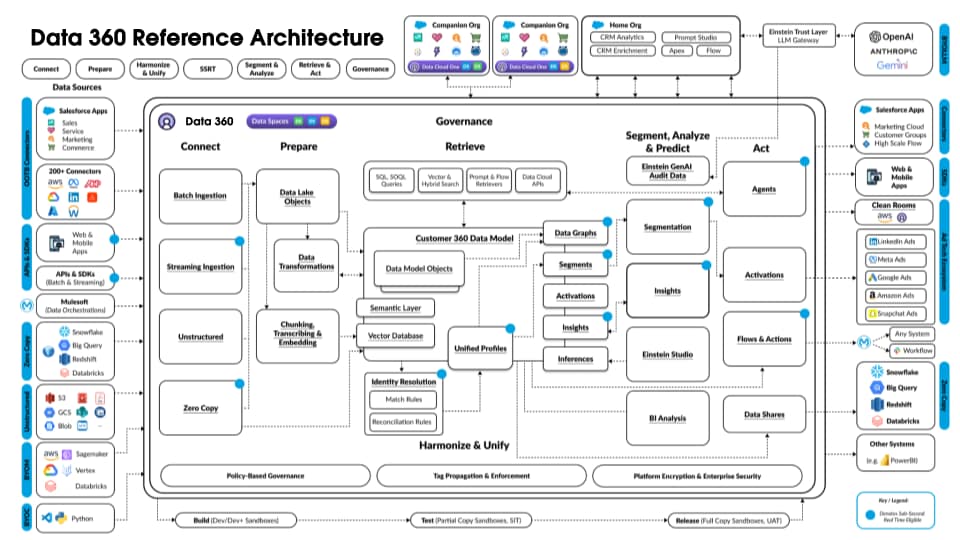 Si consideri un ipotetico Agentforce Loan Agent stratificato in Data 360 per descrivere un flusso di architettura di esempio. Si supponga che l'agente prestiti sia un agente rivolto al cliente in cui i clienti (consumatori) richiedono prestiti e ottengono approvazioni immediate dei prestiti.
Data 360 esegue questi passaggi come pianificato, preparando i dati per l'uso da parte dell'agente del prestito.
- Data 360 inserisce i dati strutturati dell'account cliente da CRM e li archivia nel data lake.
- Data 360 elabora i dati non strutturati relativi a prestiti aziendali e polizze finanziarie.
- Data 360 federa i dati personali di una fonte di dati esterna come Snowflake.
- Trasforma e modella i dati inseriti e federati in Data 360.
- Data 360 crea e gestisce il grafico dei dati del profilo.
Ogni volta che un cliente richiede un prestito, vengono eseguite queste azioni.
- Un cliente accede all'agente del prestito, che avvia una sessione del cliente nel livello in tempo reale. Il profilo unificato del cliente viene inserito nel livello in tempo reale.
- Il cliente completa una richiesta di prestito fornendo le informazioni richieste.
- Il cliente carica documenti finanziari (ad esempio dichiarazioni dei redditi, investimenti, estratti conto) in Data 360 per l'elaborazione di dati non strutturati.
- I dati caricati vengono suddivisi in blocchi e vettorializzati (generazione di incorporamento) e vengono creati gli indici (parola chiave e vettore).
- Quindi, il cliente compila il documento di richiesta di prestito e lo carica. Data 360 estrae l'ammontare e la durata del prestito in tempo reale.
- L'agente del prestito recupera i dati finanziari pertinenti utilizzando query di Data 360 e ricerca ibrida su profili e altri indici pre-creati.
- L'agente del prestito attiva un agente di approvazione con i dati del prestito e altri dati del profilo finanziario per prendere la decisione di approvazione del prestito.
- L'agente del prestito risponde al cliente con una decisione.
- Anche l'intera interazione tra il cliente e l'agente del prestito viene acquisita e archiviata in Data 360.
L'esempio precedente offre una panoramica dei componenti dell'architettura di Data 360 utilizzati per creare un'applicazione Agentic come un agente di prestito. Nella sezione successiva descriviamo i livelli e i componenti dell'architettura Data 360.
## Architettura di Data 360
In questa sezione, approfondiremo i componenti base di Salesforce Data 360, iniziando con il suo modello di archiviazione robusto e successivamente esplorando i meccanismi di connessione, inserimento e preparazione dei dati. Esamineremo quindi come vengono memorizzati, modellati ed elaborati i dati strutturati e non strutturati, culminando in una comprensione delle loro capacità di armonizzazione, unificazione, recupero e attivazione intelligente.
### Archiviazione di Data 360
Salesforce Data 360 è basato su un modello di archiviazione a livelli ma integrato che combina i punti di forza di una lakehouse con l'archiviazione in tempo reale. Il livello lakehouse offre uno spazio di archiviazione scalabile ed economico per grandi volumi di dati storici e batch, abilitando casi d'uso avanzati di analisi e machine learning. La memoria in tempo reale, invece, è ottimizzata per l'accesso a bassa latenza e gli aggiornamenti ad alta frequenza, assicurando che le interazioni con i clienti, i profili e i segnali di coinvolgimento siano sempre aggiornati. Insieme, questi livelli funzionano perfettamente, consentendo ai dati di spostarsi in modo fluido tra contesti storici e in tempo reale, offrendo profondità e immediatezza in una base di dati unificata per personalizzazione, intelligenza artificiale e attivazione.
#### Lakehouse
Data 360 dispone di un'architettura lakehouse nativa basata su Iceberg/Parquet, progettata per gestire la gestione e l'elaborazione dei dati su larga scala per scenari batch, streaming e in tempo reale che supportano dati sia strutturati che non strutturati, cruciali per le applicazioni di intelligenza artificiale e analisi.
Nei data lake basati su cloud come Azure, AWS o GCP, l'unità di archiviazione fondamentale è un file, in genere organizzato in cartelle e gerarchie. Lakehouse ottimizza questa struttura introducendo astrazioni strutturali e semantiche di livello superiore per facilitare operazioni come query ed elaborazione AI/ML. L'astrazione principale è una tabella con metadati che ne definisce la struttura e la semantica, incorporando elementi di progetti open source come Iceberg o Delta Lake, con livelli semantici aggiuntivi aggiunti da Data 360.
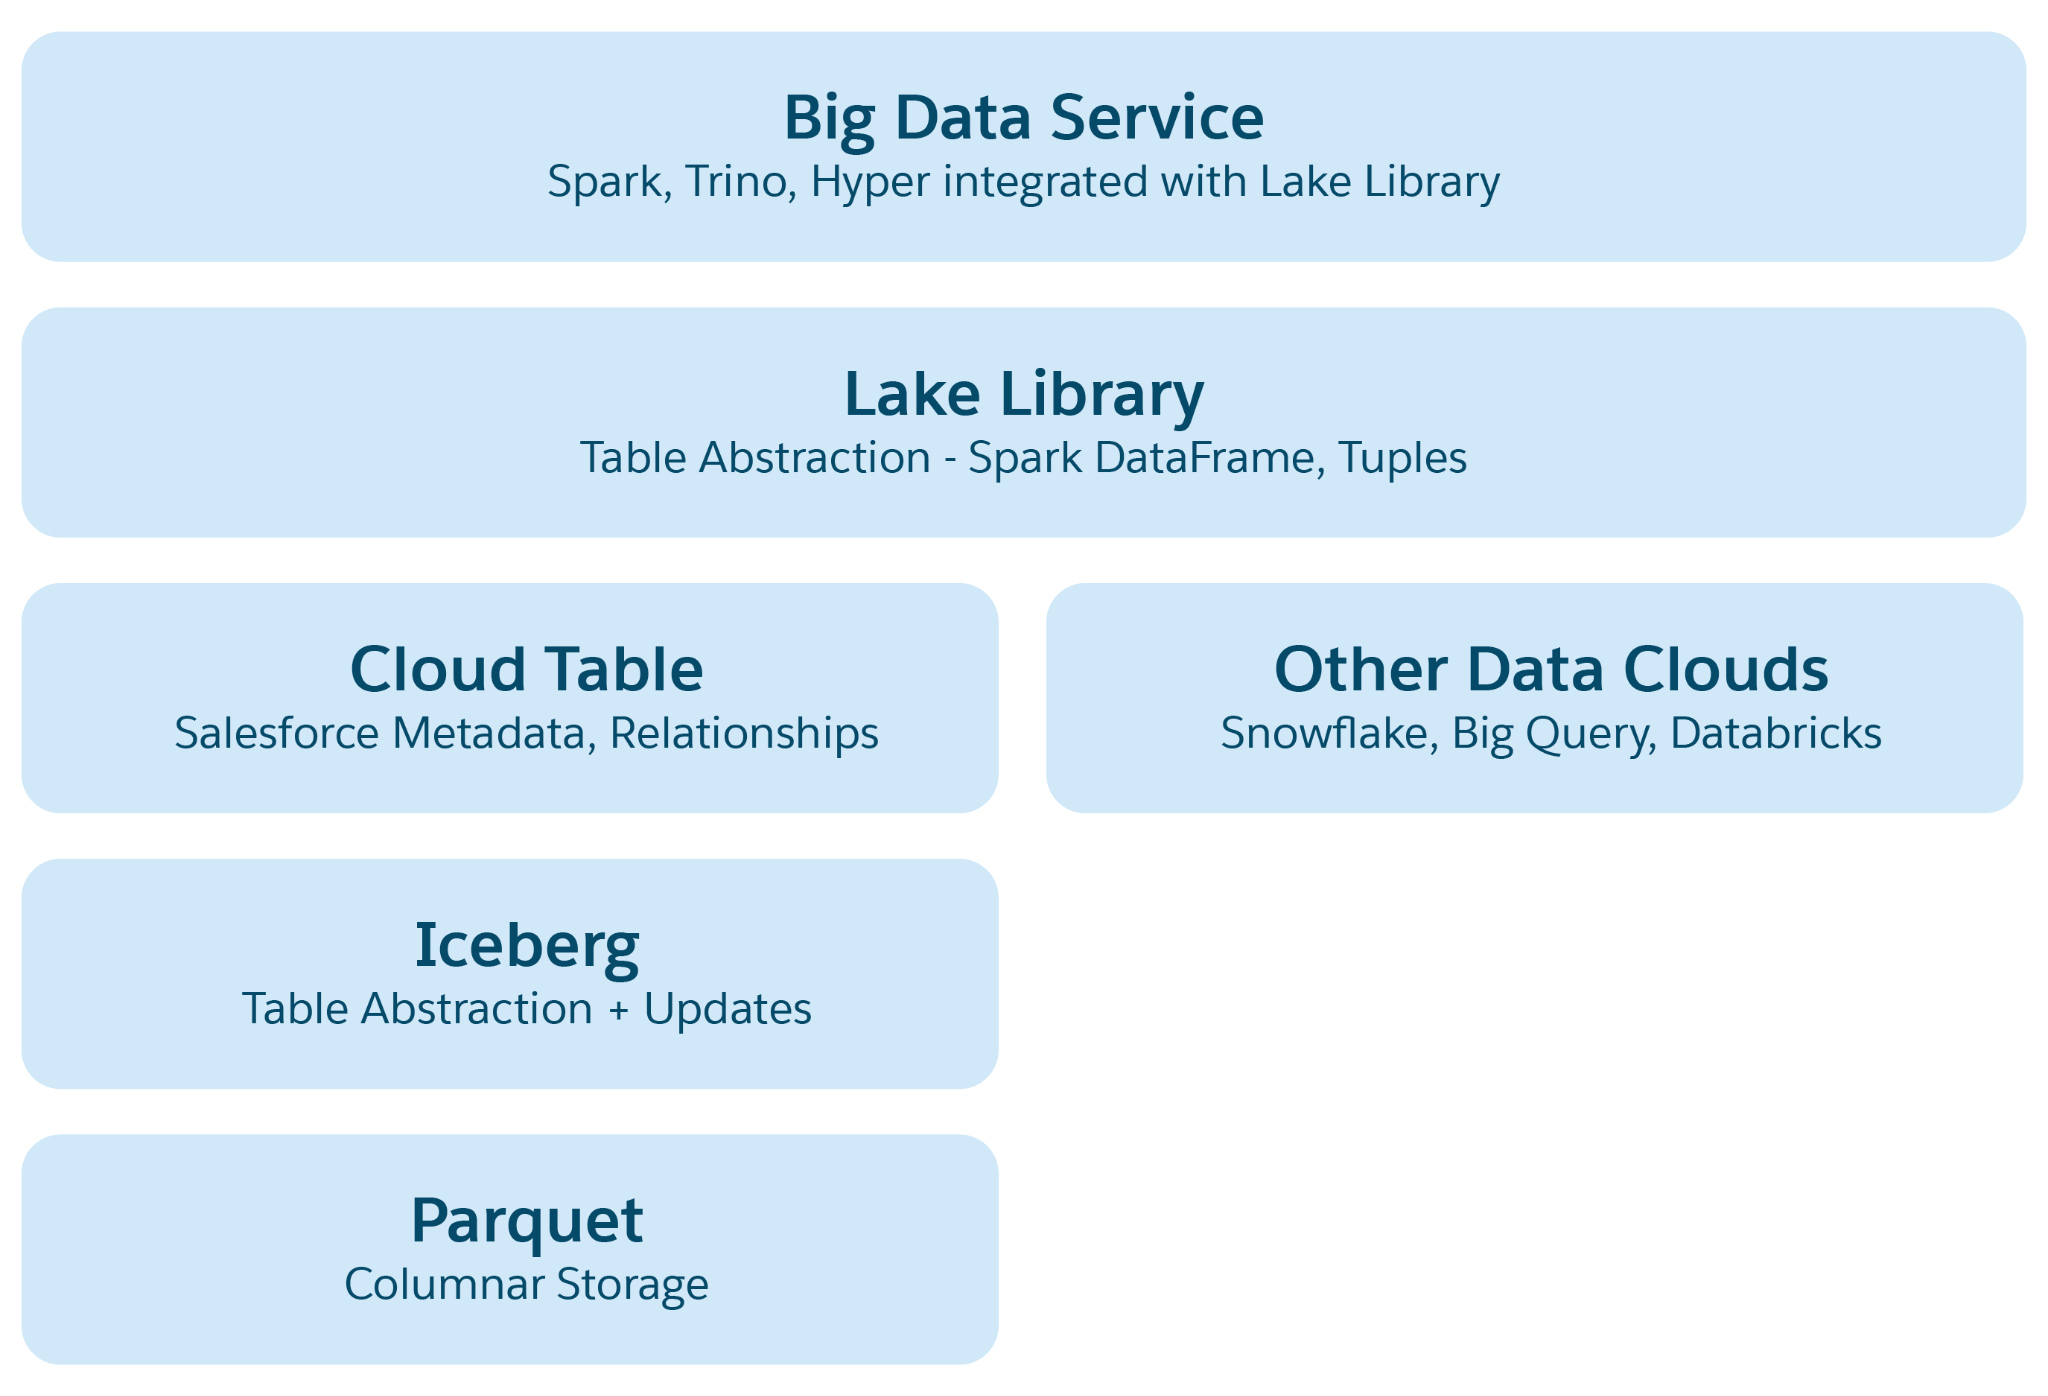 Strati di astrazione in Lakehouse:
1. **Astrazione file Parquet**: Alla base, lo storage è costituito da file data lake (ad esempio S3 in AWS o Blob in Azure) in formato Parquet. I dati di una tabella di origine sono memorizzati in più partizioni come file Parquet, e ogni tabella è una raccolta di questi file.
2. **Astrazione tabella Iceberg**: Le tabelle sono organizzate come cartelle, con partizioni di dati memorizzate come file Parquet all'interno di queste cartelle. Le modifiche apportate a una partizione generano nuovi file Parquet come istantanee. Iceberg gestisce un file di metadati per ogni tabella, descrivendo gli schemi, le specifiche delle partizioni e le istantanee.
3. **Astrazione tabella Salesforce Cloud**: Basato su Iceberg, questo livello aggiunge metadati semantici come nomi e relazioni delle colonne, oltre a configurazioni come le dimensioni e la compressione dei file di destinazione. Astrae le tabelle in varie piattaforme come Snowflake e Databricks, proteggendo le applicazioni Data 360 dalle specifiche della piattaforma di archiviazione sottostante.
4. **Libreria di accesso al lago**: Questa libreria fornisce l'accesso alla tabella Salesforce Cloud, gestendo sia i dati che i metadati e astraendo i meccanismi di archiviazione sottostanti per gli sviluppatori di applicazioni.
5. **Astrazione del servizio Big Data**: Sono inclusi framework di elaborazione come Hyper per le query e Spark per l'elaborazione in qualsiasi piattaforma di tabelle cloud.
#### Archiviazione in tempo reale
Per supportare applicazioni analitiche e agenti in tempo reale, Data 360 potenzia l'archiviazione Big Data di Lakehouse con Low Latency Store. Livello in tempo reale di Data 360 elabora i segnali in tempo reale e i dati di coinvolgimento in memoria. Tuttavia, poiché la capacità di memoria è limitata, tutti i dati non possono essere inseriti e l'elaborazione potrebbe non essere eseguita in tempo reale. Data 360 aggiunge un archivio a bassa latenza (LLS) per rimuovere tali limitazioni, abilitando l'elaborazione scalabile in tempo reale.
Il punto vendita a bassa latenza è un livello di memoria NVMe (SSD) con scala di petabyte in Lakehouse. Non tutti i dati devono essere conservati nell'archivio a bassa latenza. È una cache durevole. La maggior parte dei dati alla fine arriva a Lakehouse per la persistenza a lungo termine. I dati in sessione nel livello in tempo reale possono essere trasferiti all'archivio a bassa latenza per un successivo accesso rapido. Ad esempio, in una conversazione agente, i messaggi recenti possono essere elaborati in memoria; i messaggi più vecchi possono essere trasferiti nell'archivio a bassa latenza. Se è necessaria una conversazione precedente, è possibile accedervi entro pochi millisecondi dallo Store a bassa latenza. L'archiviazione basata su NVMe consente di archiviare e accedere a grandi quantità di dati a latenze di millisecondi. I dati possono arrivare allo spazio di archiviazione cloud Lakehouse per persistenza a lungo termine. Inoltre, i dati di Lakehouse necessari per l'elaborazione in tempo reale o per migliorare le esperienze in tempo reale vengono recuperati e conservati nell'archivio a bassa latenza. Ad esempio, il contesto del profilo cliente viene pre-recuperato o portato da Lakehouse e memorizzato nella cache nell'archivio a bassa latenza. Inoltre, tutti gli oggetti lakehouse e altri oggetti necessari per l'elaborazione in tempo reale durante l'elaborazione in sessione possono essere memorizzati nella cache anche nell'archivio a bassa latenza.
L'archivio a bassa latenza di Data 360 abilita il livello Real Timer in una vera gerarchia di memoria con livelli di memoria Lakehouse (SSD), con la migrazione dei dati tra questi livelli senza problemi. Il livello Real Time di Data 360 verrà descritto più avanti in questo documento.
### Organizzazione dei dati
Salesforce Data 360 è progettato per standardizzare, armonizzare e attivare tutti i dati dei clienti, strutturati e non, seguendo un rigoroso ciclo di vita che trasforma l'input non formattato in un modello di dati aggiornato e unificato.
#### Ciclo di vita dei dati e tipi di oggetti
Il ciclo di vita si concentra sull'acquisizione di vari input di dati esterni e la loro strutturazione in oggetti persistenti e modellati. I dati modellati possono essere armonizzati nei profili unificati Customer 360.
**Dati inseriti non elaborati e trasformazioni iniziali**
Il processo inizia con i dati non elaborati inseriti così come sono dai sistemi di origine (CRM, Marketing, file, ecc.). Sono inclusi i carichi completi di dati e gli eventi di modifica continua (delta), che vengono gestiti e uniti con dati persistenti per mantenere lo stato corrente.
Le **trasformazioni in linea** (ad esempio, tronca, normalizza, concatena) vengono applicate immediatamente durante l'inserimento per garantire la qualità e la pulizia preliminari dei dati.
##### Oggetti data lake (DLO): Il livello persistente
I **DLO** (Data Lake Objects) costituiscono il livello di archiviazione persistente centrale in Data 360\. Memorizzano i dati puliti e trasformati e fungono da repository organizzato a lungo termine per tutte le informazioni sui clienti.
Le **trasformazioni dati avanzate** (ad esempio join, aggregazioni, approfondimenti calcolati) vengono applicate ai DLO di origine per produrre nuovi DLO derivati altamente curati.
I dati resi disponibili tramite Zero Copy Data Federation sono rappresentati direttamente come DLO.
**Organizzazione di dati e metadati non strutturati**
Per i contenuti non strutturati (come testo, media, documenti), Data 360 incorpora i dati estraendo e conservando i metadati strutturati all'interno di DLO specifici denominati oggetti data lake non strutturati (UDLO).
Questi DLO specializzati funzionano come tabelle di directory, fornendo una mappa alla posizione fisica e al contesto degli asset non strutturati. Questa funzionalità consente agli architetti di correlare in modo semplice i metadati dei dati non strutturati con il resto dei dati strutturati dei clienti, consentendo query unificate e armonizzazione.
##### Oggetti modello di dati (DMO): Il livello armonizzato
I **DMO** (Data Model Objects) rappresentano il livello di dati finale, armonizzato e strutturato.
Vengono creati mappando i campi DLO (dai DLO di origine, derivati e non strutturati) al modello di dati Customer 360 standard.
Il livello DMO funge da unica fonte di dati per tutti i dati dei clienti, consentendo la creazione, la segmentazione e l'attivazione unificate dei profili in tutto l'ecosistema più ampio.
#### Spazio dati: Il contenitore logico
Uno spazio dati è il contenitore logico fondamentale per organizzare tutti i dati e i metadati in Data 360, inclusi tutti i DLO (strutturati e non) e i DMO. Gli spazi dati offrono un ambiente sicuro e isolato per l'elaborazione e la modellazione dei dati.
Gli spazi dati fungono da confini logici e di governance, abilitando la multi-tenancy interna separando i dati per entità distinte come unità operative, regioni o marchi, pur mantenendo visibilità, discendenza e conformità a livello aziendale, fungendo da base per la definizione di un controllo degli accessi di base.
L'isolamento all'interno degli spazi dati viene applicato a più livelli della piattaforma:
- **Isolamento a livello di dati**: Ogni DLO/DMO appartiene a un unico spazio dati, il che garantisce che query, trasformazioni e mappature di oggetti non possano superare i confini dello spazio dati a meno che non siano esplicitamente autorizzate.
- **Integrazione controllo accessi**: Gli insiemi di autorizzazioni sono collegati in modo nativo agli spazi dati, consentendo il controllo sulle operazioni di lettura, scrittura e amministrazione. Ciò garantisce che solo gli utenti e i servizi autorizzati possano accedere a oggetti, approfondimenti e attivazioni all'interno di uno spazio dati.
- **Governance e audit**: Tutte le operazioni all'interno di uno spazio dati vengono registrate con percorsi di controllo di livello aziendale, consentendo la tracciabilità per conformità, gestione e rapporti normativi.
L'accesso e le autorizzazioni vengono gestiti tramite gli insiemi di autorizzazioni, garantendo visibilità granulare, aggiornamenti controllati e prevenzione di fughe di dati tra domini diversi. Integrando i confini dello spazio dati con l'architettura di sicurezza e governance di Data 360, gli architetti possono implementare con sicurezza strategie di governance sia centralizzate che decentralizzate, mantenendo la coerenza in più cloud e domini aziendali.
#### Calcola tessuto
Il tessuto di elaborazione di Data 360 offre un livello unificato per la gestione e l'esecuzione di tutti i carichi di lavoro Big Data, semplificando le complessità dell'infrastruttura sottostante. Il suo componente principale è il controller di elaborazione dati (DPC).
DPC è un servizio completo di orchestrazione dell'elaborazione dati multi-carico di lavoro che offre funzionalità Job-as-a-Service (JaaS) in diversi ambienti di cloud computing. Astrae la complessità dell'infrastruttura e unifica l'esecuzione dei processi per framework come Spark (EMR su EC2 e EMR su EKS) e carichi di lavoro Kubernetes Resource Controller (KRC). Fungendo da gateway del piano di controllo centralizzato, DPC orchestra, pianifica e monitora i processi su più piani dati, garantendo affidabilità, scalabilità, efficienza dei costi e un'esperienza dello sviluppatore coerente.
L'esigenza di DPC deriva dalle limitazioni dell'interazione diretta con sistemi di gestione dei cluster nativi come EMR.
##### Astrazione di infrastrutture e cloud
Benché EMR offra API per cluster, operazioni e fasi, continua a gravare i team clienti su operazioni critiche di gestione dell'infrastruttura come provisioning, scalabilità, ottimizzazione delle prestazioni e ottimizzazione dei costi. DPC risolve questo problema offrendo un'API semplificata a livello di piattaforma per l'invio dei processi. Supporta la gestione automatica dei guasti, i tentativi e il bilanciamento dinamico del carico. Offre efficienza in termini di costi tramite nodi basati su binpacking, spot e gravitoni. Offre una sicurezza elevata con TLS, PKI, isolamento IAM e patching automatico. Gestisce gli aggiornamenti delle versioni runtime Spark ed EMR per offrire miglioramenti delle prestazioni, patch di sicurezza e miglioramenti delle funzioni.
Inoltre, DPC fornisce un'interfaccia unificata e indipendente dal cloud per l'invio e la gestione dei processi di dati, astraendo le complessità e le API proprietarie del substrato cloud sottostante (AWS, futuri provider). Ciò garantisce che i team client interagiscano esclusivamente con un'interfaccia di invio dei processi comune basata sull'API Data 360 che elimina le complessità dei responsabili delle risorse sottostanti come Kubernetes e YARN. Ciò consente ai team client di inviare processi Spark tramite un'API semplice e unificata senza dover gestire direttamente pod, pool di nodi o configurazioni di cluster Spark.
La regolazione manuale dei parametri Spark richiede competenze specifiche e configurazioni errate possono rallentare l'esecuzione dei processi. Il team DPC centralizza questa esperienza, fornendo configurazioni ottimizzate per evitare problemi di prestazioni comuni. Questo team specializzato integra continuamente Knowledge della comunità open source per garantire prestazioni ottimali in tutti i carichi di lavoro gestiti dal controller.
DPC non è limitato a Spark; supporta un'ampia gamma di carichi di lavoro. Questi includono:
- Carichi di lavoro di elaborazione in tempo reale
- Funzione di consegna evento per le azioni dati
- Gestione di Milvus (il database vettoriale per l'indicizzazione dei dati non strutturati)
- Infrastruttura di storage a bassa latenza
DPC sfrutta anche il framework **Kubernetes Resource Controller (KRC)**, che supporta carichi di lavoro come Trino per Query, Event Delivery per le azioni dati, Processi di estrazione dati per i connettori ed elaborazione in tempo reale. Per tutti i carichi di lavoro del CCR, DPC offre funzionalità Job-as-a-Service centralizzate, che gestiscono il provisioning, la distribuzione e la gestione del calcolo con un'astrazione dei processi di alto livello.
##### Vantaggi e architettura JaaS
Il modello Job-as-a-Service, fornito da DPC, garantisce una pipeline di elaborazione dei processi conveniente e resiliente.
Gli utenti forniscono specifiche semplici per i cluster, concentrandosi su CPU, memoria, memoria, conteggi delle istanze e conteggi e tag dei cluster Min/Max necessari per la corrispondenza dei cluster. DPC gestisce automaticamente i dettagli astratti dell'infrastruttura, tra cui la selezione degli SKU VM ottimali, la gestione dei parchi istanze, la determinazione del rapporto tra i nodi Core e Task e la gestione delle istanze On-Demand e Spot in base agli input. Gestisce anche la gestione delle versioni EMR e dei componenti e gli aggiornamenti senza tempi di inattività.
Fondamentalmente, il DPC supporta intrinsecamente la multi-tenancy, progettata per comprendere e applicare i confini della tenancy di Data 360 e la separazione delle risorse. Garantisce inoltre sicurezza e conformità imponendo immagini delle macchine certificate Salesforce, gestendo ruoli IAM specifici del servizio e garantendo la crittografia sia in transito che a riposo. Per l'instradamento e il controllo della capacità, l'abbinamento da processo a cluster viene gestito utilizzando i tag cluster e l'instradamento basato sulla capacità utilizza un'impostazione di concomitanza massima dei processi per controllare efficacemente l'utilizzo delle risorse.
Cloud Agnostic Client Experience è un vantaggio fondamentale, poiché la complessità degli ambienti cloud sottostanti è nascosta ai servizi client, consentendo loro di concentrarsi esclusivamente sulla logica aziendale. In questo modo si raggiunge l'obiettivo dell'astrazione del provider cloud. Infine, DPC consente un facile tracciamento dell'utilizzo e dei costi, consentendo di segmentare l'utilizzo e i costi dei cluster in base al servizio per una contabilizzazione precisa. Nel complesso, DPC segue un'architettura plug-in che consente l'integrazione senza problemi di nuovi motori di esecuzione (ad esempio Flink, Ray) e substrati cloud (GKE/Dataproc) senza esporre agli utenti i dettagli dell'infrastruttura sottostante. Questa progettazione separa il piano di controllo dal livello di esecuzione, garantendo un'API e un'esperienza operativa coerenti indipendentemente dal backend.
### Elaborazione dei dati in Data 360: Da grezzo a fruibile
Data 360 perfeziona e arricchisce i dati grezzi, colmando il divario tra informazioni grezze e consumo aziendale fruibile. Integra il ciclo di vita dell'oggetto dati preparando dati complessi per un'attivazione e un'analisi sofisticate. Data 360 supporta vari tipi di elaborazione, tra cui trasformazioni dati batch e streaming, approfondimenti calcolati batch e streaming, elaborazione dati non strutturati e risoluzione dell'identità. Per consentire queste diverse operazioni in modo efficiente, soprattutto quasi in tempo reale e in serie di dati di grandi dimensioni, è necessario un meccanismo sofisticato per gestire le modifiche dei dati in modo efficace.
#### Potenziamento dell'elaborazione incrementale
Per ottenere un'elaborazione dei dati efficiente e quasi in tempo reale, in particolare con tabelle di dimensioni pari a terabyte e milioni di potenziali aggiornamenti, Data 360 necessitava di una svolta. Richiedeva un modo per informare i sistemi con precisione quando i dati cambiano e quindi identificare in modo efficiente quali dati sono stati modificati in modo che vengano elaborati solo gli aggiornamenti pertinenti e solo quando vengono aggiornati. Questa sfida ha portato a due innovazioni complementari: Archiviazione degli eventi di modifica nativi (SNCE) per informare quando viene modificato qualcosa e del feed di dati di modifica (CDF) per identificare ciò che è cambiato.
##### Archiviazione di eventi di modifica nativi (SNCE)
SNCE ha trasformato Data 360 in una piattaforma dati reattiva e incrementale. Questo passaggio prevede il passaggio dal polling attivo del data lake al monitoraggio passivo degli eventi di conferma atomici, utilizzando un formato di evento standardizzato e un sistema di consegna dei messaggi ad alta produttività.
Ogni operazione di scrittura riuscita (INSERT, UPDATE, DELETE) in una tabella Iceberg culmina in uno scambio atomico del puntatore al file di metadati corrente della tabella nel catalogo. Il livello di memoria dell'oggetto sottostante (si supponga S3) è configurato per l'emissione di un evento di notifica nativo (ad esempio un evento S3) ogni volta che viene scritta una nuova istantanea dei metadati nella directory della tabella.
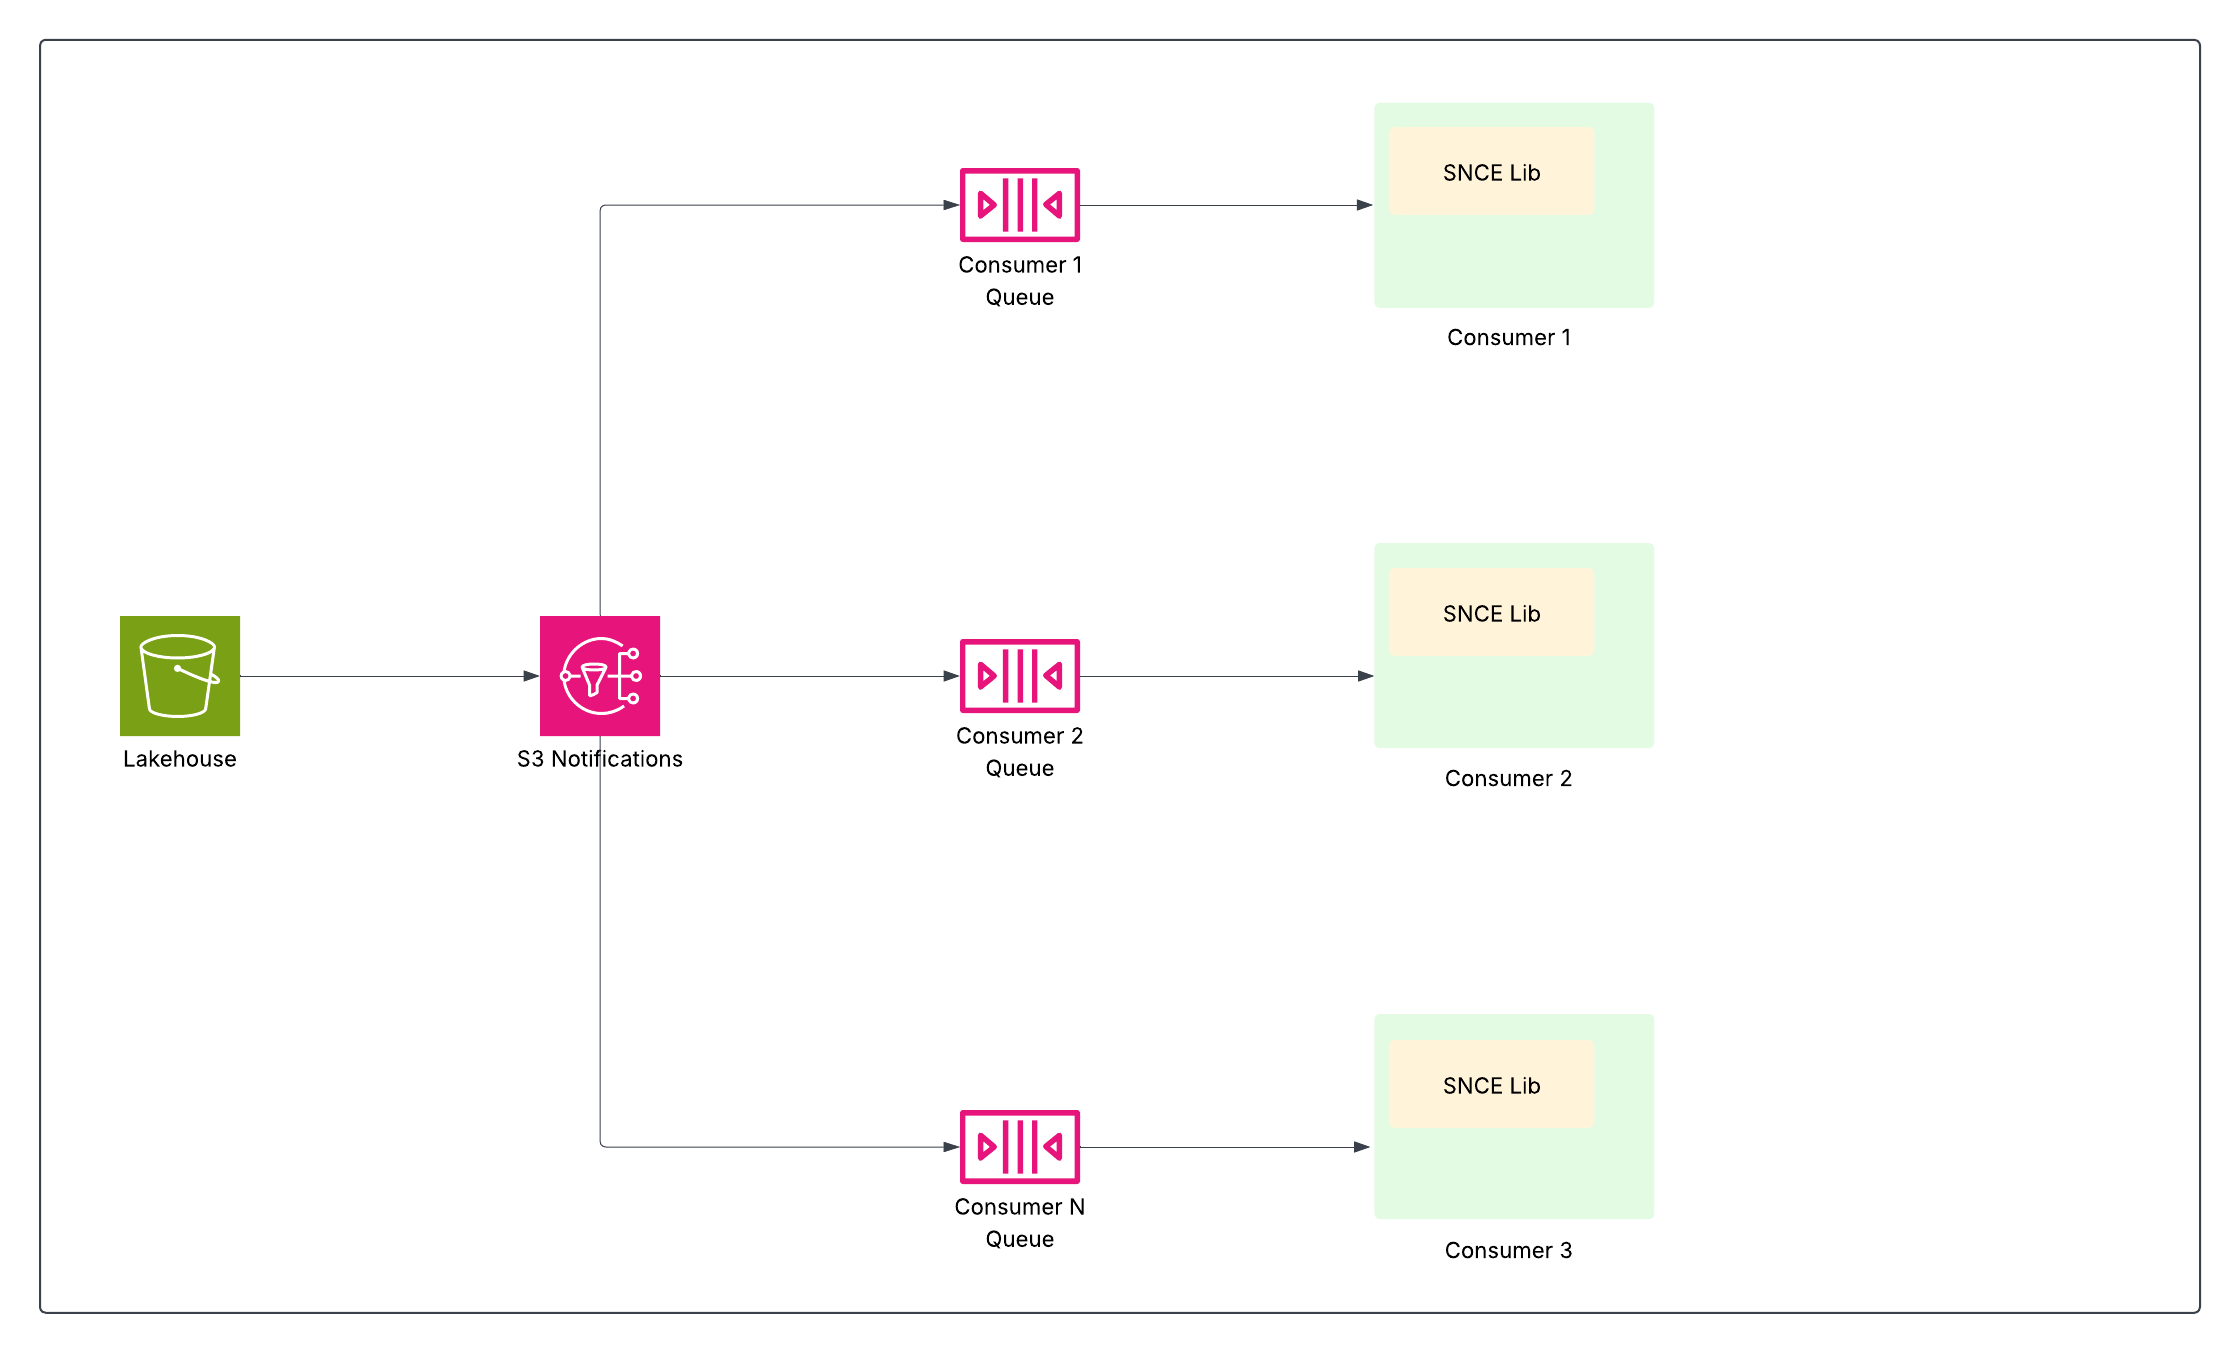 La libreria SNCE offre un metodo standardizzato per consumare questi eventi e su richiesta può anche arricchirli con metadati di istantanee.
Ciò consente alle pipeline di dati a valle, ad esempio approfondimenti calcolati in streaming, risoluzione dell'identità e segmentazione, di abbonarsi e agire solo quando i dati sono cambiati, aumentando in modo significativo l'efficienza evitando costose analisi a tabella intera.
##### Modifica feed di dati (CDF)
Basandosi su SNCE, il Change Data Feed (CDF) offre un meccanismo semplificato per consumare ed elaborare in modo incrementale le modifiche.
CDF sfrutta le istantanee Iceberg per generare in modo efficiente lo stream di modifiche. Il writer Iceberg ottimizzato di Data 360 calcola e mantiene le modifiche come parte dell'operazione di scrittura, rendendo la generazione di CDF estremamente efficiente e riducendo al minimo il sovraccarico aggiuntivo. Ciò consente ai processi di elaborazione (come le trasformazioni streaming o gli approfondimenti calcolati in streaming) di elaborare in modo selettivo solo i record alterati evitando il costoso calcolo delle differenze tra le istantanee.
Questa strategia incrementale offre diversi vantaggi per le serie di dati di grandi dimensioni, tra cui risparmio sui costi, latenza ridotta e maggiore efficienza. Abilita funzioni come le trasformazioni streaming e la risoluzione incrementale dell'identità, che a loro volta consentono approfondimenti più rapidi, caricamenti del sistema più prevedibili, prestazioni ottimizzate e minori spese operative.
### Connessione, inserimento e preparazione
Data 360 offre potenti funzionalità di inserimento con supporto nativo per i prodotti Salesforce, garantendo un flusso di dati senza interruzioni. Per le fonti esterne, offre un'ampia connettività attraverso oltre 270 connettori, API, SDK e MuleSoft. Inoltre, Data 360 è dotato di federazione copia zero, che consente di eseguire BI e analisi senza duplicazioni dei dati.
#### Framework connettore Data 360
Il framework connettore Data 360 (DCF) è la base per la maggior parte della connettività Data 360. Consente l'inserimento, la federazione e l'uscita tramite un'architettura unificata. DCF definisce gli standard per la creazione e la gestione dei connettori, dall'interfaccia utente per l'impostazione e l'amministrazione alla persistenza dei metadati, all'estrazione dei dati e alla consegna in Lakehouse o tramite query live su fonti esterne. Supporta anche opzioni di connettività privata (ad esempio link privati, VPN e tunnel protetti) per garantire la sicurezza e la conformità dei dati di livello aziendale durante la connessione agli ambienti di clienti o partner. Fornendo un approccio coerente in tutti i connettori, DCF consente a Data 360 di connettersi perfettamente all'ecosistema più ampio garantendo estensibilità, affidabilità e integrazione sicura.
#### Connettori Data 360
Data 360 offre una connettività affidabile a un vasto ecosistema di fonti di dati, supportando sia prodotti Salesforce nativi che numerosi sistemi esterni. Questa ampia connettività è fondamentale per unificare i dati aziendali in silo e abilitare le applicazioni AI/ML e Agentic.
Data 360 offre oltre 270 connettori in modo nativo o tramite MuleSoft, API e SDK per supportare le funzionalità end-to-end delle pipeline di dati con inserimento batch, streaming o in tempo reale. Questi connettori possono essere classificati in generale in base al tipo di sistema sorgente che integrano.
**Connettori Salesforce nativi**
Questi connettori garantiscono un flusso di dati nativo e senza interruzioni dai prodotti Salesforce.
Gli esempi includono connettori per Salesforce CRM, Data Cloud One, Marketing Cloud Engagement, Marketing Cloud Account Engagement e B2C Commerce.
**Applicazioni esterne e SaaS**
I connettori per varie applicazioni aziendali e servizi cloud consentono l'inserimento di dati da piattaforme software esterne.
Alcuni esempi sono Adobe Marketo Engage, Microsoft Dynamics 365, Mailchimp e Airtable.
**Banche dati e data warehouse**
Data 360 si connette a una varietà di piattaforme di archiviazione dati relazionali e basate su cloud.
Alcuni esempi sono Amazon Redshift, Amazon DynamoDB, Amazon RDS (MySQL, PostgreSQL, Oracle), Google BigQuery e Microsoft SQL Server.
**Archiviazione oggetti cloud e file system**
Questi connettori si integrano con soluzioni di archiviazione iperscala per dati strutturati e non strutturati.
Alcuni esempi sono Amazon S3, Google Cloud Storage (GCS) e Archiviazione BLOB di Azure.
**Servizi di streaming e messaggistica**
I connettori che gestiscono stream di dati continui in tempo reale sono fondamentali per gli scenari basati sugli eventi e l'elaborazione in tempo reale.
Un esempio è il connettore Amazon Kinesis.
**Piattaforme di integrazione**
Il connettore MuleSoft Anypoint estende la portata di Data 360 integrandolo con una gamma più ampia di applicazioni e database tramite Anypoint Exchange.
**Connettori di archiviazione di dati non strutturati e oggetti cloud**
Questi connettori sono fondamentali per inserire e fare riferimento a dati non strutturati (dati che non hanno un modello predefinito) per potenziare le funzionalità di intelligenza artificiale generativa.
Tutti questi connettori sono basati sul framework del connettore Data 360 che offre un'esperienza coerente.
#### Trasformazioni dati
La trasformazione dei dati è un componente architettonico fondamentale in Data 360, progettato per pulire, arricchire e modellare i dati inseriti non elaborati in asset di dati normalizzati e fruibili in linea con il modello di dati Customer 360. Questo processo è essenziale per l'armonizzazione dei dati, il miglioramento della qualità e la preparazione dei dati per casi d'uso a valle come l'unificazione, la segmentazione e l'attivazione dei profili. Le trasformazioni sfruttano sia gli oggetti data lake di origine (DLO) che gli oggetti modello di dati (DMO) come input, producendo i risultati rispettivamente per i nuovi DLO o DMO.
Data 360 fornisce due paradigmi di trasformazione principali per soddisfare diversi requisiti di velocità dei dati: trasformazioni dati batch e trasformazioni dati in streaming.
##### Trasformazioni dati batch
Le trasformazioni dati batch sono progettate per l'elaborazione a volume elevato in base a una pianificazione definita o a un trigger on-demand. Questo motore è ottimizzato per la gestione di operazioni di ristrutturazione complesse e che richiedono molte risorse.
Il processo di trasformazione batch viene configurato utilizzando un'area di disegno delle opportunità in corso di realizzazione visiva a basso codice che consente agli utenti di definire una logica di trasformazione a più fasi. Questo motore supporta in modo univoco operazioni di ristrutturazione complesse essenziali per l'allineamento del modello di dati canonico: la strutturazione e la normalizzazione dei dati. Ciò include il pivoting (decomposizione dei record denormalizzati in più record normalizzati) e l'appiattimento (ristrutturazione dei dati gerarchici, ad esempio JSON, in tabelle strutturate). La modalità di esecuzione del sistema supporta sia la sincronizzazione completa (elaborazione di tutti i record) che una modalità di elaborazione incrementale altamente efficiente. La modalità incrementale riduce in modo significativo il tempo di elaborazione e il consumo di risorse elaborando solo i record che sono cambiati dall'ultima esecuzione riuscita. Le trasformazioni batch sono ideali per le operazioni in cui gli aggiornamenti in tempo reale non sono essenziali, ad esempio aggregazioni periodiche e ristrutturazioni complesse dei dati.
##### Trasformazioni dati in streaming
Le trasformazioni dati in streaming elaborano i dati in modo continuo e incrementale quasi in tempo reale mentre fluiscono nel sistema, rendendoli essenziali per i casi d'uso a bassa latenza.
L'interfaccia principale è un approccio SQL-first, in cui le trasformazioni sono definite come una query SQL SELECT che viene eseguita continuamente sullo stream in entrata delle modifiche dei record. Questo motore supporta le principali funzioni di trasformazione, tra cui la pulitura e la standardizzazione dei dati (ad esempio, la convalida delle informazioni personali e la standardizzazione dei formati dei dati) e l'arricchimento e l'unione dei dati (utilizzando join e unioni). Supporta gli Streaming Lookup JOIN per abilitare l'arricchimento dei dati in tempo reale e le ricerche rispetto ai dati di riferimento statici o che cambiano lentamente, garantendo aggiornamenti istantanei dei profili. Per ottimizzare il cost-to-serve, l'architettura utilizza un processo ad alta densità (HD), che raggruppa più definizioni di trasformazione streaming per un singolo tenant in un unico processo di elaborazione sottostante, massimizzando l'utilizzo delle risorse. Le trasformazioni streaming sono essenziali per i casi d'uso come il monitoraggio degli eventi, la personalizzazione immediata e gli aggiornamenti dei profili in tempo reale.
### Federazione dati copia zero e condivisione dati
Data 360 rivoluziona la gestione dei dati supportando la federazione Copia zero e la condivisione dei dati, eliminando la necessità di spostare o duplicare i dati. Questa funzionalità consente agli utenti di accedere in modo semplice e diretto ai dati da fonti esterne diverse e di condividere i dati con ambienti esterni, riducendo in modo significativo la complessità, riducendo i costi di archiviazione e garantendo che tutte le decisioni siano basate sulle informazioni più aggiornate e affidabili.
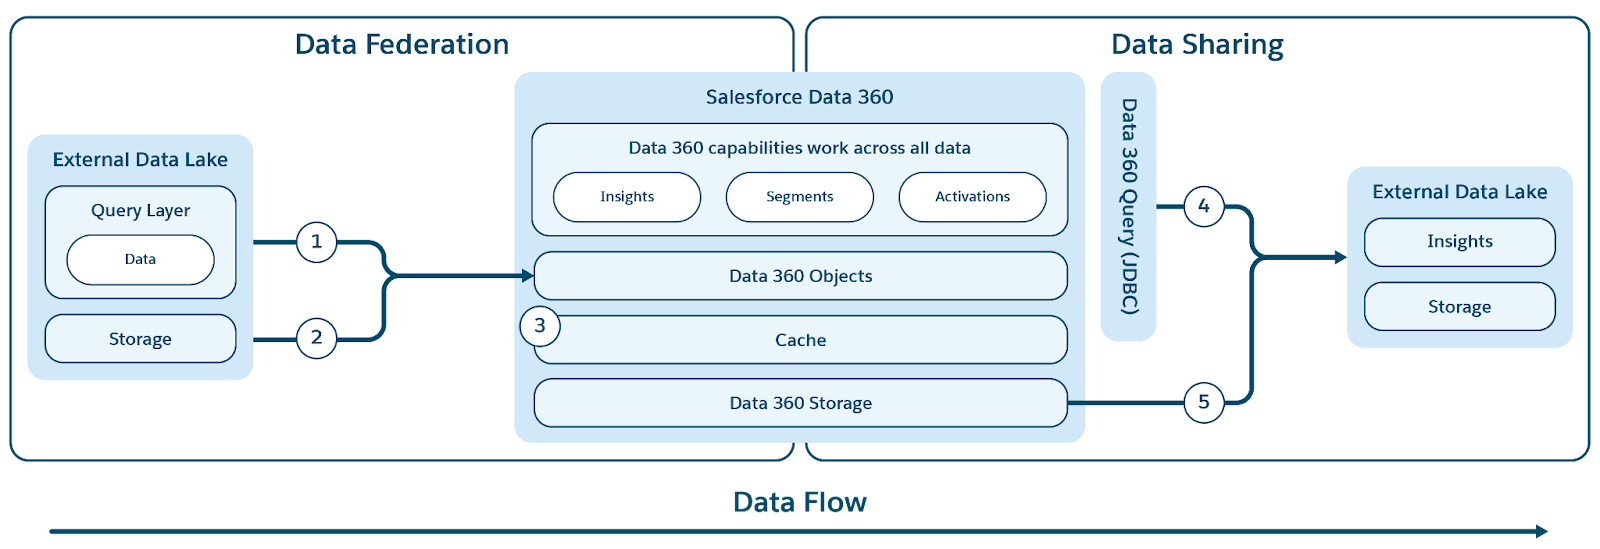 #### Federazione dei dati
Data 360 supporta la federazione copia zero con data warehouse esterni (Snowflake, Redshift), lakehouse (Google BigQuery, Databricks, Azure Fabric), database SQL e molte altre fonti. I livelli di astrazione consentono di eseguire query dirette sui dati esterni senza duplicazioni, riducendo i tempi di inserimento, i costi di archiviazione e garantendo informazioni aggiornate.
Data 360 semplifica l'accesso ai dati esterni e federati offrendo un livello di metadati unificato che astrae sia Salesforce che gli oggetti esterni. Ciò consente all'intera piattaforma Salesforce e alle relative applicazioni di utilizzare senza problemi questi dati.
Data 360 supporta la federazione basata su file e query, con query live e accelerazione dell'accesso come mostrato nella figura.
Le etichette (1) e (2) illustrano la query di Data 360 (inclusi i pushdown delle query live) e la federazione basata su file per l'accesso ai dati da data lake/warehouse/fonti di dati esterne; l'etichetta (3) evidenzia l'accelerazione dell'accesso federato da data lake/fonti di dati esterne.
##### Federazione delle query
Il cuore della funzionalità di federazione di Data 360 risiede nel suo livello di federazione delle query, che gestisce il complesso processo di accesso ai dati esterni e l'esecuzione di pushdown intelligenti delle query (illustrato dall'etichetta 1). Data 360 si connette e recupera i dati dalle fonti utilizzando il protocollo JDBC, ottimizzato con logica aggiuntiva per una maggiore efficienza. Il Query Federation Layer è responsabile della comprensione e della traduzione dei diversi dialetti SQL, della definizione della parte più ottimale della query da inviare ai sistemi esterni per un'elaborazione efficiente, del recupero dei risultati e dell'esecuzione di ogni ulteriore elaborazione necessaria per derivare approfondimenti finali.
###### Caching (accelerazione delle query)
Per l'utilità ottimizzata, Data 360 offre una funzione di accelerazione facoltativa per le sue funzionalità federate.
Quando è attivata l'accelerazione, Data 360 memorizza nella cache i dati federati per ottenere un accesso più rapido e costi inferiori, evitando accessi diretti e ripetuti a fonti esterne. Questa cache viene trattata come un livello di accelerazione e viene aggiornata in modo incrementale per riflettere rapidamente eventuali modifiche nei dati di origine esterni, assicurando che la visualizzazione accelerata rimanga quasi in tempo reale.
##### Federazione file
Data 360 supporta la federazione basata su file (illustrata dall'etichetta 2) per l'accesso ai dati da data lake e fonti esterne. La base tecnica di questa funzionalità di copia zero si basa sulla standardizzazione: i dati sottostanti devono essere nel formato di file Apache Parquet e utilizzare il formato tabulare Apache Iceberg. Data 360 può essere federato in qualsiasi fonte che espone un IRC (Iceberg REST Catalog) per l'accesso ai metadati e all'archiviazione, garantendo un accesso senza interruzioni e regolamentato ai file che risiedono all'esterno della piattaforma.
Con la federazione basata su file, Data 360 compute gestisce tutta l'elaborazione dei dati perché accede direttamente all'archiviazione sottostante. Ciò elimina la necessità di eseguire query pushdown e gestire vari dialetti SQL, che spesso sono richiesti con la federazione basata su query.
Oltre a questo, la funzionalità Copia zero si estende anche a fonti di dati non strutturate come le soluzioni di archiviazione hyperscaler (archiviazione S3/GCS/Azure), Slack e Google Drive, a cui è possibile accedere dalle pipeline di elaborazione non strutturate di Data 360.
#### Condivisione dei dati
Data 360 facilita sia la condivisione basata su query che su file dei dati che gestisce con data lake e warehouse esterni (illustrata dalle etichette 4 e 5 nel contesto della figura originale).
##### Condivisione basata su query
Per la condivisione dei dati basata su query, Data 360 espone un driver JDBC che consente a motori e applicazioni esterni di accedere in modo sicuro ai dati. Questo meccanismo consente ai sistemi esterni di connettersi, autenticarsi ed eseguire query live direttamente sui dati in Data 360.
##### Condivisione basata su file (condivisione dati e DaaS)
Il meccanismo principale per la condivisione basata su file prevede due concetti: condivisione dati e destinazione condivisione dati, che sfruttano l'API DaaS (Data as a Service).
- Controllo granulare: Il concetto di condivisione dati consente ai clienti di definire con precisione gli oggetti (DLO, DMO, CIO, ecc.) condivisi esternamente, impedendo l'esposizione involontaria dei dati.
- Targetizzazione sicura: Controlla anche la destinazione della condivisione dati, assicurando che i dati siano resi disponibili solo ad ambienti esterni, account o organizzazioni partner esplicitamente autorizzati (ad esempio, la condivisione con un'istanza specifica di Redshift o Databricks).
L'API DaaS fornisce un'interfaccia sicura e gestita per i motori esterni per l'utilizzo dei dati. Concede l'accesso sia ai metadati essenziali che all'archiviazione della tabella sottostante, conservando tutta la semantica di Data 360. Ciò garantisce che i motori esterni accedano ai dati in un contesto coerente e significativo in modo sicuro.
### Connettività privata
Molti clienti sensibili alla sicurezza, in particolare le grandi aziende, i settori regolamentati e le organizzazioni del settore pubblico, limitano l'accesso a Internet ai propri data lake come parte del loro comportamento di sicurezza. Questa policy, pur essendo essenziale per la conformità e la riduzione dei rischi, impedisce anche a Salesforce Data 360 e Agentforce di connettersi a tali ambienti tramite Internet pubblico.
La maggior parte di questi data lake viene distribuita in ambienti hyperscaler come AWS, Azure o Google Cloud. Poiché Data 360 viene eseguito su AWS, l'accesso ai data lake dei clienti ospitati su un provider cloud diverso richiede una connessione di rete tra cloud. Senza un'opzione di connettività privata sicura che ignori Internet pubblico, i clienti spesso non possono o non vogliono adottare Data 360 o Agentforce per i casi d'uso basati su tali data lake.
#### Link privati
 Per risolvere questo problema, Data 360 supporta la connettività privata a livello di rete alle fonti di dati gestite dai clienti nei cloud. In AWS, questo è abilitato tramite AWS PrivateLink, che consente a Data 360 di connettersi direttamente agli endpoint forniti dai clienti, sia all'interno dei propri account che all'interno di ambienti data lake di terze parti (ad esempio Snowflake), senza dover navigare su Internet pubblico.
Questa architettura garantisce che tutto il traffico rimanga interamente sulla backbone AWS, utilizzando indirizzi IP privati e percorsi di rete non instradabili, soddisfacendo così rigidi requisiti di sicurezza e conformità e consentendo al contempo un accesso senza interruzioni ai dati dei clienti.
#### Interconnessione privata
Per i clienti con architetture multi-cloud, Data 360 estende la connettività privata oltre AWS tramite il supporto dell'interconnessione tra cloud. Ciò consente percorsi di rete sicuri e solo backbone da Data 360 ai data lake e ai servizi ospitati in Azure o Google Cloud, mantenendo gli stessi principi di AWS PrivateLink: indirizzamento IP privato, instradamento non pubblico e zero esposizione a Internet.
I clienti possono scegliere tra due modelli di distribuzione:
- **Interconnessione gestita dal cliente**: Integrare circuiti privati esistenti come Azure ExpressRoute, Google Cloud Interconnect o Equinix Fabric direttamente con i VPC di Data 360.
- **Interconnessione gestita da Salesforce**: Utilizzare una connessione chiavi in mano completamente gestita in cui Salesforce esegue il provisioning e il funzionamento del collegamento tra cloud, esponendo gli endpoint privati nel cloud di destinazione.
In entrambi i modelli, l'esperienza è coerente: I servizi Data 360 si connettono a fonti di dati esterne tramite hyperscaler come se fossero locali, abilitando l'inserimento, l'attivazione e l'esecuzione di query sicure senza navigare in Internet pubblico.
### Governance dei dati in Data 360: Una base di Trust e Controllo
Per gli architetti aziendali, una governance dei dati efficace non è solo una casella di controllo della conformità, ma un pilastro fondamentale per creare Intelligence clienti affidabile, scalabile e fruibile. Salesforce Data 360 è progettato con un framework di governance completo che garantisce la qualità dei dati, la sicurezza e l'osservanza dei mandati normativi in tutto il ciclo di vita dei dati.
Data 360 funziona come un hub di governance centralizzato, garantendo che tutti i dati, dall'inserimento non formattato agli approfondimenti attivati, siano gestiti con integrità e controllo.
 #### Controllo accesso avanzato: Perché il controllo dell'accesso basato sugli attributi (ABAC)
Mentre lo spazio dati fornisce un controllo dell'accesso a livello di dettaglio per determinare l'accesso a tutti gli oggetti all'interno di uno spazio dati, le policy basate su ABAC forniscono un controllo dell'accesso a livello di dettaglio a singoli oggetti, campi e righe all'interno di uno spazio dati. Data 360 ha adottato l'ABAC (Attribute-Based Access Control) come modello di autorizzazione principale per il controllo degli accessi a grana fine. Questa scelta strategica offre una flessibilità e una scalabilità superiori rispetto al tradizionale controllo dell'accesso basato sui ruoli (RBAC), particolarmente cruciale per ambienti aziendali dinamici e complessi con grandi quantità di dati e diverse esigenze di accesso. ABAC consente alle decisioni di accesso di basarsi sugli attributi dell'utente (ad esempio, reparto, ruolo, posizione), sui dati (ad esempio, informazioni personali, sensibilità, spazio dati) e sull'ambiente (ad esempio, ora del giorno), anziché solo sui ruoli predefiniti. Ciò consente policy di accesso altamente granulari e contestuali che si adattano al variare dei dati e degli attributi utente.
- **Lingua: della policy CEDAR** Il cuore dell'implementazione ABAC di Data 360 è l'uso del linguaggio della policy CEDAR. Questo linguaggio formale appositamente creato per le policy offre un modo preciso e verificabile per definire regole di autorizzazione complesse, assicurando che le policy siano univoche e possano essere valutate in modo coerente su larga scala.
#### Architettura di governance: Informazioni sulle policy, applicazione e punti decisionali
Il sistema di governance di Data 360 aderisce a un'architettura ABAC standard e robusta:
- **Tag, classificazione e creazione di policy (Policy Information Point - PIP)**:
- Data 360 offre meccanismi automatici di creazione di tag e classificazione, sfruttando LLM (modello di linguaggio grande) e ML (apprendimento automatico) per identificare le categorie di dati sensibili (ad esempio, PII.Email, PII.Phone, PII.Name) e altre tassonomie create appositamente (PHI, FinancialData) sia in Dati strutturati (ad esempio, tabella Referenti) che in Dati non strutturati (ad esempio, da Google Drive).
- Fondamentalmente, la propagazione dei tag avviene lungo la discendenza dei dati (DLO -> DLO -> DMO), assicurando che le classificazioni seguano automaticamente le trasformazioni e le derivazioni dei dati, dai dati non elaborati inseriti al livello DMO armonizzato e attraverso i dati derivati creati a partire dalle definizioni dei processi.
- Infine, il riquadro di creazione della policy offre un'esperienza semplice per sfruttare i dati e gli attributi utente per definire regole di accesso dinamiche per un'organizzazione.
- Questi metadati arricchiti (inclusi tag, classificazioni, policy e discendenza) vengono inseriti nel Punto di informazione sulla policy (PIP).
- **Servizio di autorizzazione (Policy Enforcement Point - PEP)**:
- Il servizio di autorizzazione funge da punto di applicazione della policy (PEP). Intercetta tutte le richieste di accesso ai dati da vari livelli di consumo (Query strutturata/non strutturata ibrida, GenAI RAG Retrievers & Prompt, CRM Enrichment) e consulta il Policy Decision Point per determinare se l'accesso è consentito.
- **Motore di valutazione delle policy (punto di decisione delle policy - PDP)**:
- Questo motore funge da punto di decisione della policy (PDP). Prende il contesto della richiesta di accesso dal PEP, insieme alle definizioni delle policy (in CEDAR) e agli attributi dal PIP, per prendere una decisione di accesso autorevole.
#### Applicazione e integrazione delle policy chiave
- **Polizze di sicurezza granulari**: Le policy definite in CEDAR impongono vari livelli di sicurezza, tra cui:
- **Protezione a livello di oggetto**: Controllo dell'accesso a interi DLO o DMO in base ai tag associati a questi oggetti.
- **Protezione a livello**: di campo Limitazione dell'accesso a campi sensibili specifici all'interno di un oggetto in base ai tag.
- **Protezione livello riga**: Filtrare i dati su oggetti specifici per visualizzare solo le righe pertinenti in base agli attributi utente.
- **Mascheramento dati dinamico**: È possibile mascherare in modo dinamico alcuni dati (in base ai tag) nel punto di accesso, senza alterare i dati sottostanti. Ciò garantisce che le informazioni sensibili siano protette pur consentendo un'ampia utilità. Questo vale per il mascheramento dei campi nei dati strutturati e dei contenuti nei dati non strutturati.
- **Coerente applicazione**: L'intero framework ABAC garantisce l'applicazione coerente delle policy in tutti gli schemi di consumo di Data 360, ad esempio tramite query dirette sui dati, recupero per applicazioni Generative AI (RAG) o arricchimento delle esperienze Salesforce CRM tramite gli elenchi correlati.
- **Profonda integrazione con Salesforce Platform**: Le funzionalità di governance di Data 360 vengono definite e amministrate direttamente nella piattaforma centrale Salesforce. Questa integrazione consente agli amministratori di gestire le policy di accesso, le identità degli utenti e la gestione degli attributi utilizzando strumenti Salesforce familiari, garantendo un livello di governance unificato e coerente in tutto l'ecosistema Salesforce.
Con la creazione di questo sofisticato framework ABAC con policy CEDAR, Data 360 offre agli architetti un livello di controllo e flessibilità senza pari, assicurando che i dati dei clienti non siano solo fruibili ma anche sicuri, conformi e affidabili in tutta l'azienda.
### Crittografia di Data 360: Porta la tua chiave
In tutti i settori, le organizzazioni stanno ponendo maggiore enfasi sulla sicurezza dei dati end-to-end per garantire la protezione da fughe di dati, accesso non autorizzato, manomissione o distruzione. La maggior parte delle piattaforme dati, incluso Data 360, fornisce la crittografia a riposo utilizzando una chiave di crittografia gestita dal fornitore. Tuttavia, le imprese (in particolare quelle dei settori regolamentati) richiedono sempre più capacità di crittografia gestite dai clienti sia per i dati a riposo che per quelli in transito.
Questo modello consente alle aziende di controllare le proprie chiavi di crittografia, assicurando che anche nell'eventualità altamente improbabile di una violazione a livello di piattaforma o di un accesso non autorizzato, i dati rimangano protetti crittograficamente. Senza la chiave proprietaria del cliente, nessuna entità (incluso il fornitore della piattaforma) può decrittografare o ricostruire i dati, mantenendo così la massima riservatezza e controllo.
### Archiviazione ed elaborazione di dati non strutturati
Data 360 supporta l'archiviazione e la gestione di dati strutturati (tabelle), semi-strutturati (JSON) e non strutturati in modo semplice nei meccanismi di inserimento, elaborazione, indicizzazione e query dei dati. Data 360 supporta diversi tipi di dati non strutturati oltre al testo, inclusi audio, video e immagini, ampliando l'ambito della gestione e dell'analisi dei dati. La figura sotto illustra i due lati della messa a terra (inserimento e recupero).
 Data 360 gestisce i dati non strutturati archiviandoli in colonne come testo o in file per serie di dati più grandi. Supporta la federazione dei dati per i contenuti non strutturati, che consente l'integrazione e la gestione dei dati provenienti da più fonti.
I dati vengono quindi preparati e suddivisi in blocchi, gli incorporamenti vengono generati ed elaborati per l'indicizzazione delle parole chiave e l'indicizzazione vettoriale. Data 360 ospita più modelli pronti all'uso e collegabili per la generazione di blocchi e incorporamento. Data 360 supporta la trascrizione automatica e configurabile di contenuti audio e video per l'elaborazione e l'indicizzazione successive. Il servizio di ricerca viene utilizzato per l'indicizzazione delle parole chiave. Per l'indicizzazione vettoriale, Data 360 supporta sia l'indicizzazione nativa (con Hyper) che database vettoriali come Milvus open source. Data 360 si integra anche con la piattaforma di ricerca Salesforce per supportare l'indicizzazione delle parole chiave sui dati non strutturati. Questa indicizzazione multimodale integrata in Data 360 consente la ricerca su tutti i dati non strutturati, come descritto nella sezione Ricerca aziendale agente più avanti nel documento.
Per il recupero, Data 360 fornisce API per la ricerca. La query unificata Hyper-based facilita le query complessive in indici strutturati, indici di parole chiave e vettoriali, mantenendo visibilità e autorizzazioni rigorose, ottimizzando così RAG e Ricerca.
#### Pipeline estensibili
La pipeline di indicizzazione dei dati non strutturati di Data 360 è progettata come un'architettura modulare e ampliabile che comprende cinque fasi centrali:
1. Analisi
2. Pre-elaborazione
3. Suddivisione
4. Post-elaborazione
5. Incorporamento
Tutte le fasi supportano anche l'elaborazione basata su LLM che consente ai clienti di creare prompt personalizzati. Sia la fase di pre-elaborazione che la fase di post-elaborazione possono includere più fasi sequenziali, consentendo la composizione flessibile di trasformazioni complesse. Ogni fase è interamente basata sui metadati, consentendo una configurazione e un'estensione senza interruzioni senza modifiche del codice.
Gli esempi di pre-elaborazione includono operazioni come l'eliminazione del rumore, la normalizzazione del linguaggio e la comprensione delle immagini (riconoscimento ottico dei caratteri e sottotitoli), mentre le fasi di post-elaborazione possono includere l'arricchimento dei metadati, il raggruppamento semantico o tecniche avanzate come la suddivisione in blocchi di Raptor.
La pipeline supporta completamente l'estensione Data 360 Code, consentendo ai clienti e ai team interni di inserire logica personalizzata in qualsiasi fase. I componenti dell'estensione codice sono funzioni Python leggere il cui ciclo di vita (esecuzione, scalabilità e gestione degli errori) è completamente gestito da Data 360\. Questo approccio garantisce che l'innovazione e l'elaborazione specifica del dominio possano essere introdotte rapidamente mantenendo la coerenza operativa e la governance in tutta la piattaforma.
##### Indicizzazione contesto
Per impostare RAG con elaborazione non strutturata, due fattori critici sono fondamentali:
1. **Iterazione rapida**: Possibilità di convalidare rapidamente con query di test di esempio.
2. **Contenuto specifico**: Capacità di configurare contenuti su misura per il profilo consumatore.
L'indicizzazione del contesto è uno strumento intuitivo progettato per gestire entrambi questi aspetti. Questa interfaccia utente interattiva è basata su una pipeline in tempo reale che esegue tutte e cinque le fasi descritte in precedenza. La pipeline utilizza le GPU quando necessario per operazioni come la generazione di incorporamento e il riconoscimento ottico dei caratteri (OCR). Inoltre, consente ai clienti di testare rapidamente la pipeline RAG con un agente prima di distribuire la configurazione per un'elaborazione completa dei contenuti.
##### AI documento
L'intelligenza artificiale dei documenti di Data 360 consente di leggere e importare dati non strutturati o semi-strutturati da documenti come fatture, curriculum, rapporti di laboratorio e ordini di acquisto. Questa funzione supporta l'elaborazione interattiva ad hoc e l'elaborazione batch in blocco. Questa è una funzionalità chiave che consente l'automazione dei processi aziendali per i nostri clienti. Questo è basato sull'intelligenza artificiale che include LLM e modelli ML.
### Enterprise Knowledge
Le aziende possiedono grandi quantità di Knowledge sparse in diversi sistemi come wiki, condivisioni di file, sistemi di gestione dei contenuti, database interni e altro ancora. Questa frammentazione rende difficile per i dipendenti (soprattutto per gli agenti dell'assistenza e di vendita) e i clienti trovare le informazioni pertinenti in modo rapido ed efficiente. I problemi principali includono: Mancanza di un'unica esperienza di ricerca unificata in tutte le fonti Knowledge; presentazione e rendering incoerenti di contenuti provenienti da fonti diverse; mancanza di governance dell'accesso alle informazioni sensibili sparse nei sistemi; difficoltà a utilizzare fonti Knowledge autorevoli all'interno dei flussi di lavoro aziendali principali (ad esempio, allegare articoli pertinenti a un caso).
Enterprise Knowledge rappresenta il contenuto che è stato curato, manualmente o automaticamente, dalla più ampia serie di dati aziendali. La cura manuale prevede azioni deliberate, ad esempio la creazione di articoli Salesforce Knowledge o lo sviluppo di Knowledge all'interno di sistemi esterni che vengono quindi inseriti. Prevediamo una gestione automatizzata che utilizza processi, come gli agenti e le trasformazioni Salesforce, che eseguono i dati inseriti per generare livelli raffinati e curati, potenzialmente mescolando contenuti strutturati e non strutturati. Sia che vengano modificati manualmente o automaticamente, internamente a Salesforce o esternamente prima dell'inserimento, il risultato è un contenuto a valore aggiunto distinto dai dati non elaborati.
La soluzione Enterprise Knowledge Hub sfrutta le funzionalità di Data 360 per:
- **Inserimento e memorizzazione**: CRM Connector inserisce articoli di Salesforce Knowledge e i connettori non strutturati DCF (Data Connector Framework) inseriscono contenuti non elaborati e metadati da fonti esterne. Il contenuto viene inserito in oggetti data lake non strutturati (UDLO) specifici della fonte mappati al contenuto in SFDrive (o origine in caso di copia zero).
- **Armonizzazione e strutturazione**: Armonizzazione in corso di realizzazione elabora i dati UDLO e file, eseguendo operazioni di pulitura, normalizzazione, arricchimento (NLP, ecc.), mascheramento delle informazioni personali e trasformazione nel formato intermedio armonizzato, memorizzato in SF Drive e in un UDLO armonizzato (HUDLO) che vi viene mappato.
- **Indicizzazione**: Pipeline non strutturate (UDS) viene attivato sopra il contenuto armonizzato e gli indici di ricerca vengono configurati per ogni HUDMO.
- **Consumo**: Le applicazioni che consumano includono la ricerca, il recupero, il rendering e il collegamento a oggetti aziendali come Caso. Il coinvolgimento da parte delle applicazioni consumate viene raccolto per fornire analisi dell'utilizzo (ad esempio clic, recensioni, ecc.)
### Approfondimenti calcolati
Gli approfondimenti calcolati in Data 360 consentono ai clienti di definire e generare metriche aggregate dai loro dati. Queste metriche vengono quindi utilizzate per il coinvolgimento, l'analisi, la segmentazione e l'attivazione puntuali dei clienti. I dati aggregati calcolati dagli approfondimento calcolato vengono scritti in Lakehouse e rappresentati come oggetto approfondimento calcolato (CIO).
Esistono due tipi principali di approfondimenti calcolati:
- **Approfondimenti calcolati in batch**: Progettato per l'aggregazione di dati complessi a volume elevato, in cui le metriche possono essere calcolate periodicamente (ad esempio, quotidianamente o settimanalmente).
- **Approfondimenti streaming**: Offrire la possibilità di generare metriche e azioni dai dati degli eventi in tempo reale, abilitando il coinvolgimento immediato dei clienti a bassa latenza.
Gli approfondimenti calcolati sono definiti per gli oggetti modello di dati (DMO) e possono essere definiti anche per altri oggetti approfondimento calcolato. Il servizio di approfondimenti calcolati gestisce l'orchestrazione dei processi batch e streaming.
Sia i calcoli batch che quelli degli approfondimenti streaming utilizzano Spark. La differenza principale è che gli approfondimenti streaming utilizzano Spark Structured Streaming, mentre gli IC batch vengono eseguiti utilizzando processi Spark batch periodici e pianificati. Per ottimizzare i costi, il servizio Approfondimenti calcolati raggruppa gli IC da calcolare insieme nello stesso processo batch CI o streaming CI, in base a fattori come le dipendenze e la sovrapposizione degli oggetti dati di origine.
SNCE e CDF svolgono un ruolo significativo nel calcolo degli approfondimenti streaming.
### Risoluzione dell'identità
La risoluzione dell'identità è responsabile della trasformazione di dati diversi provenienti da più fonti in un unico profilo unificato completo.
È importante capire che un profilo unificato non è un "golden record" e che la risoluzione dell'identità non seleziona i valori vincenti né sostituisce i dati esistenti durante l'unificazione dei profili. I profili unificati fungono da serie di chiavi che sbloccano i dati di origine identificando tutti i record corrispondenti correlati alla stessa entità, all'interno di una sola fonte di dati o in più fonti. Con queste informazioni è possibile selezionare i dati del sistema di origine giusti da utilizzare per un determinato caso d'uso aziendale.
La risoluzione dell'identità può consolidare una varietà di tipi di record, tra cui Persone, Account e Famiglie. Può essere utilizzato anche per abbinare i lead agli account esistenti. Il processo di unificazione è essenziale per ottenere una visualizzazione Customer 360 completa e favorire il coinvolgimento personalizzato in tempo reale in scenari sia B2C che B2B.
La pipeline di risoluzione dell'identità è basata su un framework nativo del cloud altamente scalabile progettato per gestire volumi elevati di dati in modo continuo. Il processo prevede tre fasi chiave, affidandosi a un potente indice di ricerca per gestire il processo di corrispondenza:
- **Corrispondenza (selezione candidato)**: L'obiettivo del processo di corrispondenza è cercare i record che possono appartenere alla stessa entità. I record vengono analizzati in base a una serie di regole personalizzabili, ciascuna delle quali contiene una serie di criteri che definiscono i dati da soddisfare a quale livello di rigore. Per recuperare in modo efficiente le potenziali corrispondenze dall'archivio dati, il sistema genera indici per trovare i record corrispondenti probabili utilizzando due tecniche:
- **Chiavi di blocco**: Una chiave di blocco è un valore generato dai dati e dalle regole di corrispondenza di un record (ad esempio le prime lettere di un nome, un numero di telefono normalizzato, ecc.) per raggruppare record potenzialmente simili. Ogni record ha più chiavi di blocco che vengono indicizzate e memorizzate come indice invertito, garantendo che il sistema esegua confronti dettagliati solo su piccoli gruppi di record, anziché sull'intera serie di dati.
- **Hashing sensibile alla località (LSH)**: Per le regole di corrispondenza con corrispondenza "fuzzy", gli hash vengono generati in base agli incorporamenti di modelli addestrati.
- **Corrispondenza profonda**: Dopo che la fase di selezione del candidato ha creato gruppi più piccoli di potenziali corrispondenze, il sistema avvia un confronto più dettagliato. In questa fase, i modelli AI e gli algoritmi avanzati analizzano ogni coppia di record per calcolare un punteggio di corrispondenza probabilistico. Questo punteggio quantifica la probabilità che due record facciano riferimento alla stessa entità confrontando in modo intelligente i campi che spesso contengono errori di ortografia, variazioni o differenze di formattazione.
- **Clustering e unificazione**: Una volta identificati i record corrispondenti dai candidati, vengono raggruppati in un cluster. Questo processo include in modo critico la risoluzione delle corrispondenze transitive. Ad esempio, se il record A corrisponde al record B e il record B corrisponde al record C, tutti e tre sono collegati nello stesso cluster anche se A e C non sono mai stati confrontati direttamente. Questi cluster completi costituiscono la struttura di base del Profilo unificato. Questo processo di clustering garantisce che tutti i record di origine correlati siano collegati correttamente sotto un unico identificatore persistente.
- **Conciliazione**: I valori dei dati di tutti i record di origine raggruppati in cluster vengono valutati utilizzando regole di riconciliazione definite (ad esempio, _Più frequente_, _Più recente_ o _Priorità fonte_) che compilano il Profilo unificato risultante con un estratto dei dati del profilo. La riconciliazione non sovrascrive alcun dato esistente, poiché tutti i dati di origine sono disponibili utilizzando le chiavi collegate al profilo unificato.
#### Tipi di risoluzione dell'identità
L'architettura supporta la risoluzione di più tipi di entità per soddisfare una varietà di casi d'uso.
- **Corrispondenza individuale**: Si concentra sulla creazione dei profili Persona unificata, che collegano tutti gli identificativi personali noti (email, numeri di telefono, ID fedeltà, cookie) a una singola persona.
- **Corrispondenza account**: Si concentra sulla creazione dei profili Account unificato, che collegano i dati sugli account. Quando esegue la corrispondenza in base ai nomi delle società, il motore utilizza un modello finemente ottimizzato quando esegue la corrispondenza "fuzzy".
- **Corrispondenza famiglia**: Estende la logica di corrispondenza per aggregare i record Persona unificata in gruppi di persone correlate.
- **Corrispondenza tra entità**: Oltre all'unificazione, la risoluzione dell'identità crea anche link tra gli oggetti profilo utilizzando le stesse regole di corrispondenza. Ad esempio, un lead può essere collegato a un account utilizzando la corrispondenza "fuzzy" su Nome account.
#### Elaborazione quasi in tempo reale
Per garantire che il Profilo unificato sia sempre aggiornato, il motore di risoluzione dell'identità funziona con un'architettura quasi in tempo reale. Questa architettura ottimizzata per il cloud è progettata per l'elaborazione continua, con tempi di elaborazione rapidi. Mentre la velocità di elaborazione varia a seconda del modo in cui vengono ricevuti i dati di origine, piccoli batch di modifiche possono essere elaborati con la risoluzione dell'identità ogni 15 minuti.
#### Collegamento profilo di origine
Il sistema mantiene gli oggetti link identità che mappano ogni ID record di origine all'ID profilo unificato corrispondente. Questa struttura di dati di base consente al motore di tenere traccia in modo efficiente delle relazioni e di propagare rapidamente modifiche e aggiornamenti al Profilo unificato, assicurando che le esperienze dei clienti, ad esempio la personalizzazione del sito Web, i consigli Next Best Action e la segmentazione, sfruttino sempre i dati dei clienti più aggiornati disponibili.
### Segmentazione
La segmentazione è il processo fondamentale per trasformare i profili cliente unificati in pubblici fruibili. Questa funzionalità è fondamentale per offrire esperienze personalizzate nei canali di marketing, commercio e assistenza. La piattaforma di segmentazione di Salesforce Data 360 è progettata per le operazioni su larga scala. Gestisce metadati complessi, utilizzando un modello di dati che comprende migliaia di oggetti e relazioni. La piattaforma supporta regole complesse, filtri basati su aggregazione e classificazione basata su finestre, il tutto garantendo un calcolo rapido e affidabile su scala petabyte.
#### Tipi di segmentazione e cadenze
Data 360 supporta diversi tipi di segmento per soddisfare requisiti aziendali distinti per velocità, complessità e gerarchia:
1. **Segmento standard**: Tipo di segmento principale elaborato in batch. La pubblicazione avviene secondo una pianificazione personalizzabile, con una cadenza di pubblicazione standard da un minimo di 12 ore a 24 ore o una cadenza di pubblicazione rapida più rapida da 1 a 4 ore, ottimizzata per i dati di coinvolgimento recenti.
2. **Segmento in tempo reale**: Questo segmento viene completato on-demand in millisecondi per un'azione immediata in base agli eventi recenti e ai dati del profilo. È altamente ottimizzato per la personalizzazione immediata ma non può utilizzare criteri di esclusione o segmenti nidificati.
3. **Segmento cascata**: Struttura gerarchica di sottosegmenti utilizzata per assegnare la priorità a un cliente in un unico segmento di maggior valore se soddisface più criteri.
4. **Segmento nidificato**: Ciò consente di riutilizzare un segmento esistente come filtro per un nuovo segmento più specifico (perfezionamento di un segmento di base), ereditando la pianificazione del segmento controllante.
#### Motore di segmentazione: Nozioni di base sull'architettura
Il motore di segmentazione opera su un'architettura robusta e nativa del cloud che garantisce velocità, scalabilità e resilienza.
 Il processo centrale è gestito da un servizio di orchestrazione processi che controlla il ciclo di vita del segmento, generando la configurazione del processo necessaria e attivando l'esecuzione. Questo livello di orchestrazione mantiene lo stato e i metadati in un database shard per la scalabilità.
Benché Query Data 360 gestisca i calcoli del conteggio della segmentazione, il livello di calcolo Spark è responsabile del calcolo dell'effettiva appartenenza ai segmenti. L'applicazione Spark esegue query Spark SQL su dati completi dei clienti. Questi dati possono risiedere in Data 360 Lakehouse, in sistemi esterni tramite la federazione dei dati Copia zero o in una combinazione di entrambi.
Il sistema è altamente ottimizzato tramite la generazione di query intelligenti, che perfeziona la query Spark SQL sottostante. Ciò include tecniche come la potatura intelligente delle partizioni per ridurre al minimo la scansione dei dati e l'eliminazione delle sottoespressioni ridondanti. Per garantire l'affidabilità del servizio, l'architettura dispone di una gestione adattiva delle risorse che regola dinamicamente le risorse di calcolo in base alle dimensioni e alla complessità del carico di lavoro. Inoltre, l'osservanza degli SLO viene gestita in modo proattivo con durate adattive e logica di tentativo. Per un'esperienza utente rapida, i conteggi accelerati dei segmenti utilizzano un approccio basato sul campionamento per fornire stime rapide delle dimensioni durante la creazione del segmento, evitando un'esecuzione completa delle query.
Infine, viene mantenuta una profonda attenzione all'osservabilità e all'attribuzione delle cause principali attraverso metriche di esecuzione Spark complete e la classificazione automatica degli errori (ad esempio, problemi lato cliente e problemi di sistema), riducendo in modo significativo i tempi di diagnosi e garantendo una piattaforma dati altamente resiliente.
### Attivazione
L'attivazione è il passaggio finale fondamentale del ciclo di vita di Data 360. La sua funzione principale è trasformare i profili cliente statici, segmentati e unificati in dati fruibili e arricchiti e fornire questi dati a endpoint interni ed esterni (ad esempio, piattaforme Marketing Cloud, Commerce Cloud e Adtech). Questo processo è progettato per attivare customer journey personalizzati e interazioni quasi in tempo reale. Supporta funzionalità avanzate come gli attributi correlati, i filtri di appartenenza all'attivazione, i filtri del consenso, la limitazione e la classificazione.
L'attivazione offre tre metodi distinti per la consegna esterna e la conformità del canale:
- **Attivazione batch**: Progettato per operazioni pianificate a volume elevato, ad esempio campagne email su larga scala e aggiornamenti del pubblico pubblicitario. I dati vengono forniti eseguendo la gestione temporanea in bucket interni protetti (Cloud Object Storage) o tramite Trasferimento file protetto, seguito da un processo di inserimento API avviato dal sistema di destinazione. Le attivazioni batch possono utilizzare una modalità di aggiornamento speciale, incrementale, per ridurre i volumi inviati ed elaborati dai partner Salesforce.
- **Attivazione streaming**: Ottimizzato per i casi d'uso quasi in tempo reale che richiedono un'automazione basata sugli eventi. La consegna avviene tramite chiamate API dirette inviate all'endpoint di destinazione.
- **Flussi attivati da attivazione**: Questo canale altamente piattaforma offre un approccio senza codice/low-code per integrare i dati del pubblico con centinaia di piattaforme di coinvolgimento abilitate per l'API del cliente. Al termine dell'attivazione, Data 360 compila un DMO Pubblico che attiva un flusso su larga scala. Il motore di flusso successivamente consuma i dati del pubblico e utilizza funzionalità della piattaforma come Servizi esterni e destinazioni Mule Outbound per effettuare chiamate alla destinazione finale basata su API. Questo metodo riduce in modo significativo il tempo necessario per l'inserimento di nuove destinazioni attivazione.
L'attivazione utilizza gli stessi schemi della segmentazione per la gestione dei processi, l'esecuzione distribuita e il monitoraggio. Ciò include i principi del servizio di orchestrazione dei processi per la gestione del ciclo di vita e del livello di elaborazione (Spark) e si basa sulla telemetria dei processi per l'osservabilità delle prestazioni e l'osservanza degli obiettivi del livello di servizio (SLO).
Oltre a quelli, l'attivazione ha -
**Gestione destinazioni attivazione** supervisiona le connessioni, le credenziali e le configurazioni protette per tutti gli endpoint di destinazione. Garantisce che i formati dei dati e i protocolli di sicurezza siano standardizzati, garantendo una consegna in uscita affidabile a varie piattaforme, inclusi Marketing Cloud, partner Adtech e altre applicazioni esterne.
L'attivazione personalizza il payload per target specifici. Per Salesforce Marketing Cloud, sono inclusi i filtri sensibili alle unità operative (BU), il supporto multi-EID e i controlli dell'impollinazione incrociata.
**La governance delle** comunicazioni agisce da gatekeeper, garantendo che l'utilizzo dei dati e la comunicazione siano conformi alle preferenze dei clienti e ai requisiti legali. Il modello di consenso centralizzato unifica tutte le preferenze dei clienti, dal rifiuto esplicito globale al consenso specifico del canale e dello scopo, e vengono memorizzati nel profilo Persona unificata. Durante l'esecuzione, la piattaforma applica rigorosamente queste policy utilizzando i filtri di esclusione per rimuovere automaticamente le persone non consenzienti dal payload finale. Inoltre, il sistema applica regole di selezione del punto di contatto per garantire che utilizzi il punto di contatto unico, più conforme e preferito per il canale previsto prima che vengano trasmessi i dati. Questo meccanismo di applicazione è protetto dal framework di governance sottostante, che utilizza misure di protezione come il mascheramento dinamico dei dati e i controlli di accesso per proteggere i campi di dati sensibili durante tutto il processo di attivazione.
### Query unificata: Accesso senza interruzioni a tutti i dati dei clienti
Il vero valore di una piattaforma di dati unificata risiede nella sua capacità di fornire un accesso semplice e coerente a tutti i suoi asset di dati, indipendentemente dalla loro origine o struttura. La funzionalità Query unificata di Salesforce Data 360 è stata progettata appositamente per offrire questo risultato, astraendo le complessità sottostanti di archivi di dati diversi per fornire un'unica e potente interfaccia di query.
Il livello Query unificata offre un accesso sofisticato per diversi modelli di consumo:
- **Query strutturate e non strutturate ibride**: Fornisce un ampio supporto SQL per eseguire query senza problemi sia sui dati strutturati che sui metadati strutturati dei dati non strutturati. Ciò è ottimizzato dall'estendibilità dell'operatore tramite le funzioni di tabella, abilitando la ricerca specializzata in tipi di testo, immagine e spazio.
- **Prestazioni accelerate con Hyper**: Sfruttando Hyper, un motore in memoria ad alte prestazioni, Data 360 accelera query analitiche complesse e cruscotti digitali interattivi, offrendo risposte quasi istantanee su serie di dati di grandi dimensioni.
- **Approccio unificato per AI e personalizzazione**: Questo accesso unificato è fondamentale per generare risultati mirati e personalizzati, facilitando direttamente risposte LLM più precise utilizzando la generazione aumentata di recupero (RAG) basando i modelli AI su dati aziendali completi.
- **Integrazione con il consumo a valle**: Funge da livello di accesso ai dati di base per esperienze basate sull'interfaccia utente, API efficaci, flussi di lavoro di intelligenza artificiale generativi e arricchimento CRM, collegando facilmente i dati all'attivazione.
Fornendo un'unica interfaccia di query intelligente e altamente performante, la query unificata di Data 360 consente agli architetti di creare applicazioni agili basate sui dati che sfruttano al meglio la gamma completa di informazioni sui clienti.
### Azioni dati
Data 360 è una piattaforma attiva che supporta l'attivazione di opportunità in corso di realizzazione in risposta a eventi dati. Ad esempio, un evento significativo, ad esempio un calo del saldo account di un cliente, può attivare un flusso Salesforce per orchestrare un'azione corrispondente. Analogamente, gli aggiornamenti alle metriche chiave, ad esempio la spesa per tutta la vita, possono essere propagati automaticamente alle applicazioni pertinenti.
Le azioni dati monitorano continuamente i dati incrementali per le modifiche utilizzando gli eventi di modifica nativi (SNCE) e il feed di dati di modifica (CDF). Questi dati vengono valutati in base alle regole di azione configurate dal cliente, ad esempio il monitoraggio della soglia o le modifiche dello stato. Quando vengono soddisfatte queste regole, viene generato un evento azione dati. Questo evento viene arricchito con informazioni aggiuntive (ad esempio, lo stato fedeltà del cliente) e inviato immediatamente alla destinazione configurata, ad esempio Flusso Salesforce o un'applicazione esterna, per attivare le orchestrazioni aziendali.
#### Customer Data Platform
Data 360 supporta funzioni native CDP (Customer Data Platform), tra cui funzionalità avanzate di risoluzione dell'identità e la creazione di identificatori e profili persona unificati, oltre a cronologie complete del coinvolgimento. Questa piattaforma è in grado di gestire sia framework business-to-business (B2B) che business-to-consumer (B2C) supportando la risoluzione dell'identità e i grafici dell'identità che utilizzano regole di corrispondenza esatte e "fuzzy", come descritto sopra. Questi grafici dell'identità sono arricchiti con dati di coinvolgimento di vari canali, che consentono di creare grafici dettagliati dei profili con approfondimenti analitici e segmenti preziosi.
Un concetto chiave che supporta il profilo del cliente è il grafico dei dati. Data 360 offre un grafico dei dati aziendali in formato JSON, ovvero un oggetto denormalizzato derivato da varie tabelle Lakehouse e dalle relative interrelazioni. Questo include un grafico dei dati "Profilo" creato da CDP che include la cronologia degli acquisti e della navigazione di una persona, la cronologia dei casi, l'utilizzo dei prodotti e altri approfondimenti calcolati ed è ampliabile da clienti e partner. Questi Grafici dati sono personalizzati per applicazioni specifiche e migliorano la precisione dei prompt generativi AI fornendo il contesto pertinente del cliente o dell'utente. Il livello in tempo reale di Data 360 utilizza il grafico Profilo per la personalizzazione e la segmentazione in tempo reale. È prevista la modellazione del contesto Agentforce che includa conversazioni, sessioni e memoria agente come Grafici dati.
Inoltre, il CDP consente una segmentazione e un'attivazione efficaci in diverse piattaforme, ad esempio Marketing Cloud, Facebook e Google di Salesforce. Elabora i profili dei clienti in batch, quasi in tempo reale e in tempo reale, consentendo decisioni e personalizzazioni immediate. Questa funzionalità migliora le interazioni sia negli scenari B2C che B2B, assicurando che le aziende possano rispondere in modo rapido e preciso alle esigenze e ai comportamenti dei clienti.
### Livello in tempo reale
Il livello in tempo reale di Data 360 è supportato dal CDP di Data 360 e ne estende i concetti per i casi d'uso in tempo reale. Il livello in tempo reale di Data 360 è progettato per elaborare eventi come clickstream Web e mobili, visite, dati del carrello e pagamenti con latenze al millisecondo, migliorando la personalizzazione dell'esperienza dei clienti. Monitora continuamente il coinvolgimento dei clienti e aggiorna il profilo cliente da Customer 360 con dati, segmenti e calcoli di coinvolgimento in tempo reale per una personalizzazione immediata.
Ad esempio, quando un consumatore acquista un articolo su un sito Web di acquisto, il livello in tempo reale rileva e inserisce rapidamente questo evento, identifica il consumatore e arricchisce il suo profilo con informazioni aggiornate sulla spesa per tutta la vita. Ciò consente la personalizzazione della loro esperienza sul sito in pochi secondi. Inoltre, questo livello include funzionalità per l'attivazione e le risposte in tempo reale, abilitando azioni immediate basate sulle interazioni con i clienti.
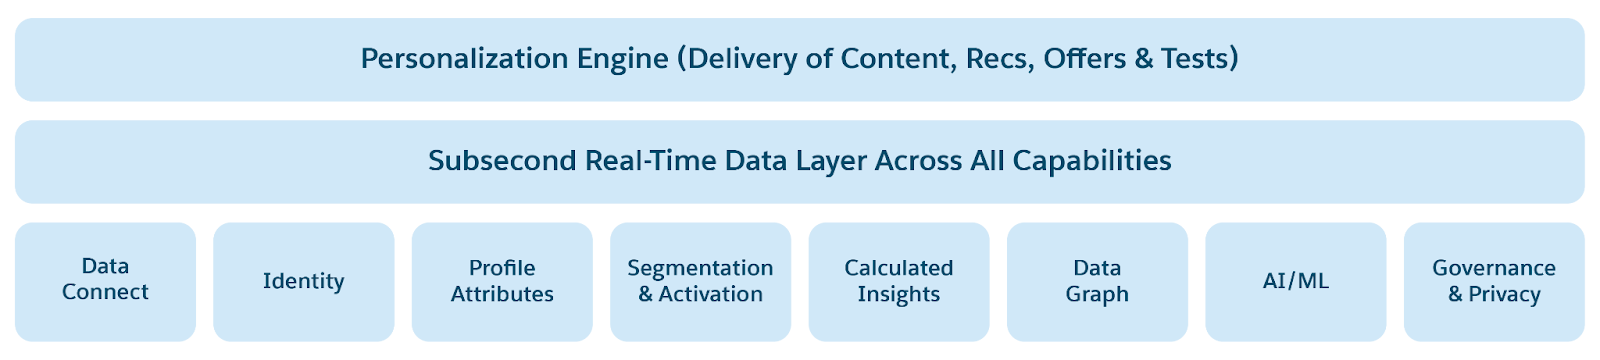 La piattaforma in tempo reale Sub-Second potenzia questa trasformazione attraverso diverse funzioni chiave:
1. **Grafici dati in tempo reale**: Un profilo Customer 360 viene creato utilizzando un grafico denormalizzato che include gli oggetti chiave e i campi più pertinenti ai marchi. Questi Grafici dati consentono l'elaborazione dei dati in tempo reale e offrono contenuti e approfondimenti di immediato valore pratico in pochi millisecondi
2. **Inserimento e trasformazione in tempo reale**: Inserire eventi e profili utente in millisecondi da fonti Web e mobili.
3. **Risoluzione dell'identità in tempo reale**: È possibile unire i profili dei clienti tra i vari dispositivi, unificando immediatamente gli utenti sconosciuti e noti.
4. **Approfondimenti calcolati in tempo reale**: Calcolare metriche come il valore di durata (LTV) o la cronologia delle visite degli utenti in millisecondi per abilitare Personalizzazione o Offerte per Web, ChatBot o agente dell'assistenza.
5. **Segmentazione in tempo reale**: Segmentare i pubblici al volo, personalizzando messaggi e interazioni in tempo reale.
6. **Azioni in tempo reale**: Consentire ai marchi di valutare ogni coinvolgimento degli utenti e di intraprendere azioni tramite il flusso Salesforce o altri canali di comunicazione pertinenti.
In Data 360, abbiamo creato una nuova piattaforma in tempo reale con opportunità in corso di realizzazione in tempo reale, memoria a bassa latenza e un livello di elaborazione dati inferiore al secondo. Poiché i dati interattivi veloci vengono inseriti dai canali Web e Mobile, vengono sottoposti a una serie di processi rapidi.
I nostri SDK Web e Mobile e le API in tempo reale raccolgono i dati dalle applicazioni Web/mobili (nelle future interazioni degli agenti) e li inviano al nostro server beacon. Questi dati vengono quindi instradati al livello in tempo reale per l'elaborazione in millisecondi e al livello Lakehouse per l'integrazione con i dati batch/streaming. Il livello Real-Time elabora i dati in entrata in tempo reale nel contesto di un profilo utente (anonimo o connesso), ad esempio aggiornando la spesa totale o il valore durata dell'utente, ecc. per la personalizzazione in tempo reale in sessione. Il livello in tempo reale è supportato dalla memoria principale e dalla memoria di archiviazione NVme (SSD) per l'archiviazione di dati in tempo reale e profili cliente. Una volta inseriti nel Livello in tempo reale, i dati vengono sottoposti ai seguenti processi prima di essere aggiornati nel Grafico dati in tempo reale:
- **Inserimento semplice e trasformazioni**: I dati vengono inseriti e trasformati per un'ulteriore elaborazione.
- **Risoluzione dell'identità**: Le regole di corrispondenza esatta vengono applicate per unificare i profili con tutti gli insiemi di regole di corrispondenza esistenti, in modo che gli specialisti data-aware non debbano creare nuovi insiemi di regole di risoluzione dell'identità appositamente per il tempo reale.
- **Approfondimenti calcolati**: Ogni coinvolgimento viene valutato, vengono eseguiti calcoli semplici come somma e conteggio in millisecondi e i dati vengono aggiornati nel grafico dei dati in tempo reale.
- **Segmenti in tempo reale**: Ogni dato di coinvolgimento viene valutato per determinare se soddisfa i criteri per i segmenti in tempo reale definiti e gli utenti vengono aggiunti ai segmenti qualificanti in millisecondi.
- **Azioni e trigger in tempo reale**: Ogni coinvolgimento viene valutato in base a regole definite per attivare azioni su una serie di target in tempo reale quando le regole vengono soddisfatte in millisecondi.
- **Grafico dati in tempo reale e API**: Il grafico dei dati in tempo reale, che include anche un'API in tempo reale, consente ai marchi di recuperare dati in formato JSON aggiornati per ogni utente, assicurando che tutte le interazioni con i clienti siano informate dai dati più aggiornati.
#### Personalizzazione
La personalizzazione consiste nel sapere a chi rivolgersi, quando e dove fornire contenuti e consigli pertinenti, cosa dire e quale frequenza. Personalization Services Platform è l'orchestratore delle decisioni prese per ottimizzare il raggiungimento degli obiettivi attraverso esperienze personalizzate.
I **Servizi di personalizzazione** offrono le seguenti funzionalità:
- Insieme coerente di modelli e modi per interpretare i dati di profili, attività e asset in Data 360
- Sperimentazione integrata piattaforma (A/B/n, Bandito multibraccio)
- Integrazione degli obiettivi in fase di progettazione (configurazione), tempo di addestramento ML e runtime (inferenza ML)
- Supporto dell'interazione in tempo reale e batch con scala B2C (utenti anonimi, esterno interattivo/in tempo reale a volume elevato, batch interno a volume elevato)
- Analytics guidata da Data 360
- Schemi per integrare il modello AI e il servizio di altre parti (interne ed esterne)
- Integrazione nell'ecosistema dei metadati Core (caratteristiche PLATE)
- Implementazioni OOTB di casi d'uso basati sull'intelligenza artificiale di alto valore (consigli/decisioni con vari algoritmi ML, inclusi banditi contestuali per la selezione di promozioni/contenuti, consigli sui prodotti, decisioni sui prezzi, ecc.)
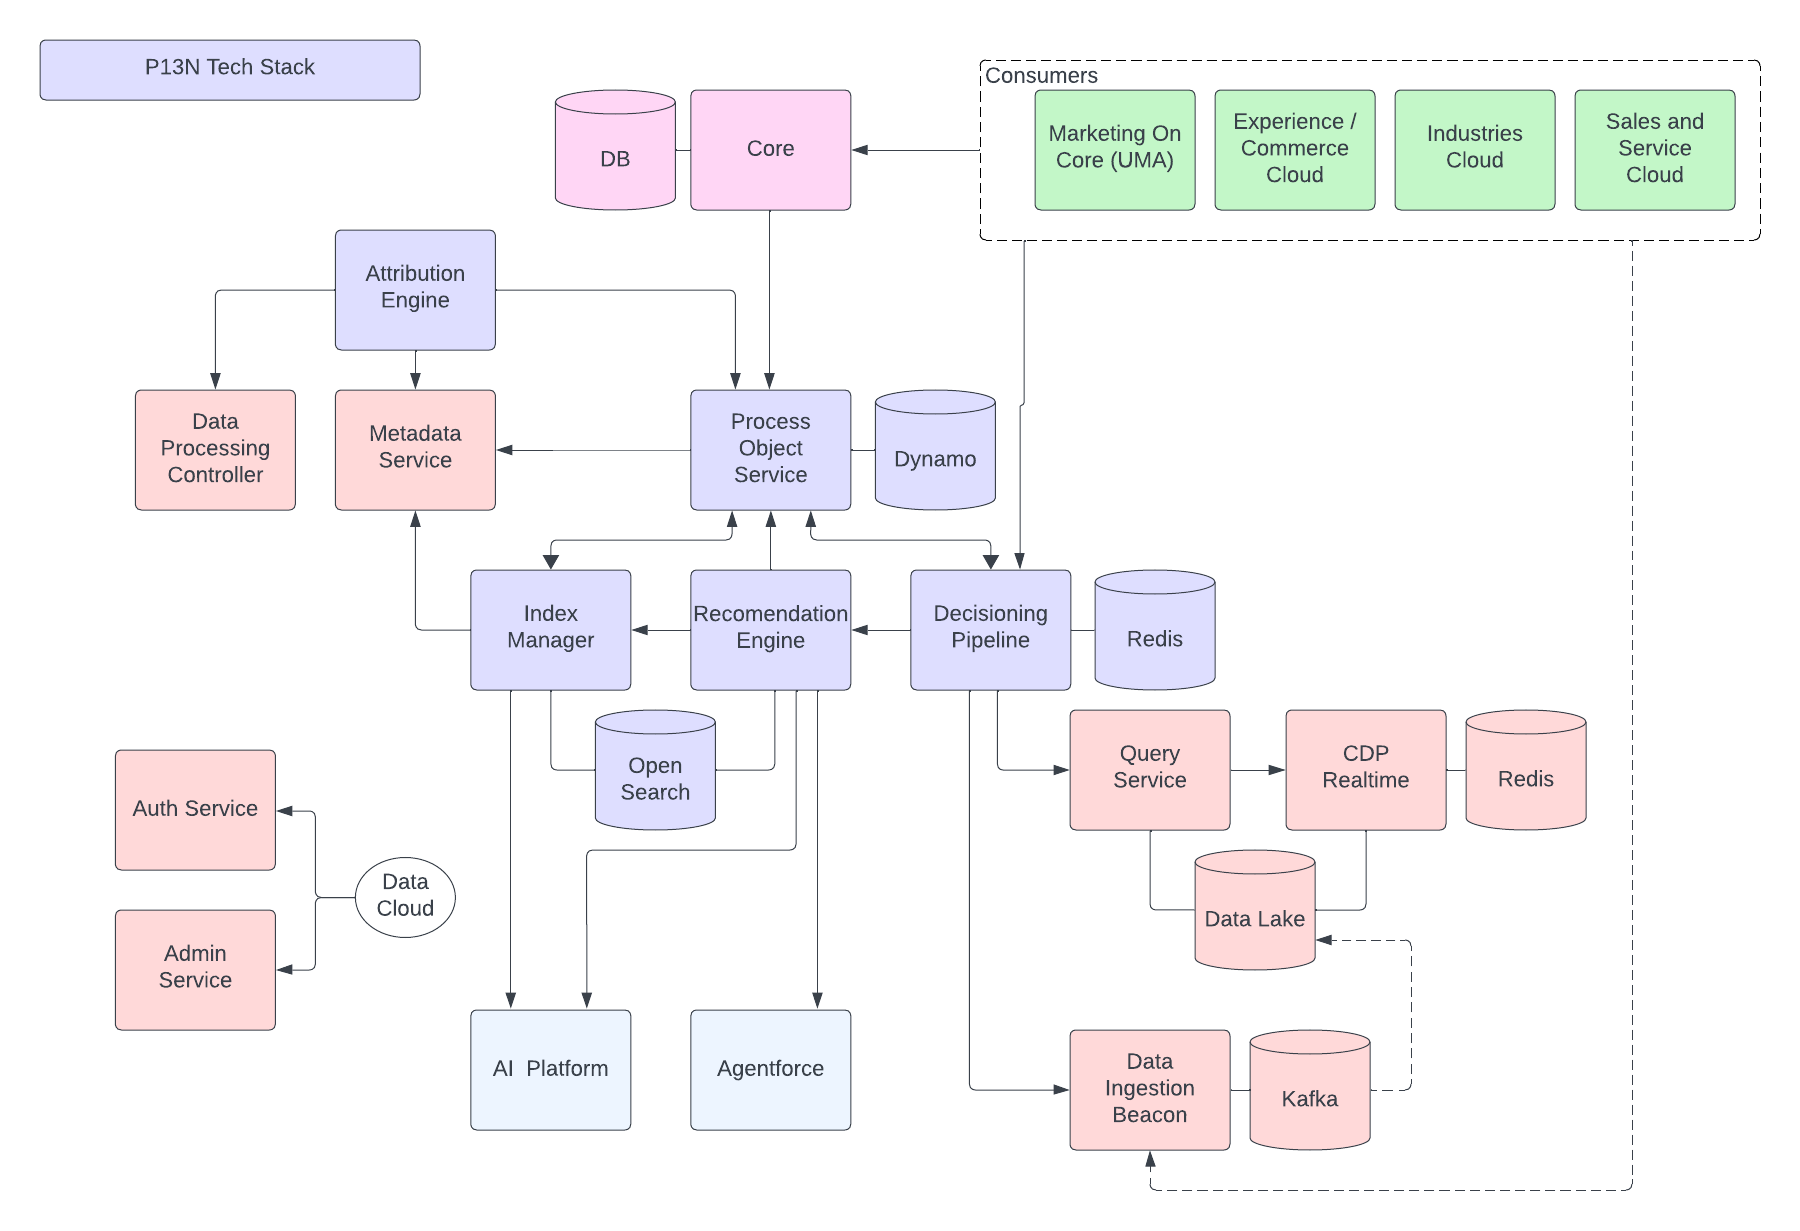 - **Decisione in corso** di realizzazione
- Gestione delle richieste esterne per le decisioni di personalizzazione, inclusi l'aumento dei profili, la sperimentazione e i consigli.
- **Motore di consigli**
- Servizio in fase di esecuzione di consigli basati su regole o ML.
- **Index Manager**
- Gestisce/orchestra il flusso di lavoro per i processi asincroni, inclusi i corsi di ML per i modelli di consiglio
- **Servizio oggetto processo**
- Responsabile della sincronizzazione dei metadati di personalizzazione tra core e off-core
- **Motore di attribuzione e sperimentazione**
- Attribuzione Analytics e sperimentazione dei consigli di personalizzazione
### Ricerca aziendale agentica
Data 360 è progettato come una piattaforma solida e completa specificamente per supportare le esperienze degli agenti emergenti. Queste funzionalità si ottengono utilizzando vari servizi Data 360 esistenti e grazie a una profonda integrazione con Agentforce.
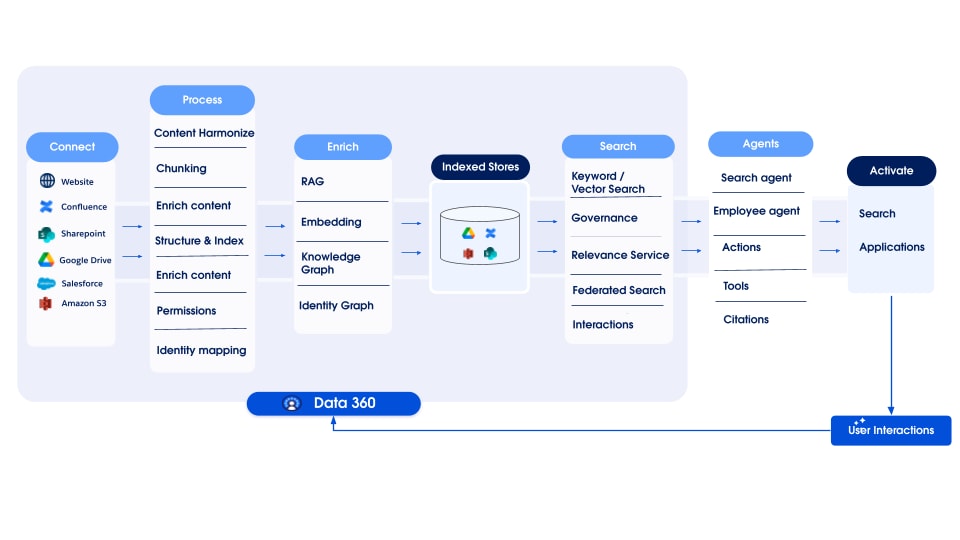 #### Sfruttare i principali punti di forza di Data 360
Il nostro approccio alla ricerca aziendale agentica si basa sui seguenti principi:
- I dati aziendali vengono conservati in servizi o punti vendita in silo, con autorizzazioni protette necessarie per l'accesso. La possibilità di accedere a questi dati ed elaborarli mantenendo le autorizzazioni di origine è fondamentale per garantire Trust.
- La classificazione incrociata e la pertinenza nell'intero corpus di dati consentono risultati migliori, che a loro volta possono fornire un contesto migliore per le esperienze degli agenti.
Per offrire queste esperienze, Agentic Enterprise Search si basa sui seguenti componenti architetturali chiave:
- **Connettori**: L'ampia gamma di connettori disponibili in Data 360 consente di accedere e inserire dati da un'ampia varietà di fonti.
- **Trattamento dati non**: strutturati Questo è fondamentale per la gestione dei contenuti non tabulari, consentendo al sistema di derivare significato e contesto da dati diversi.
- **Governance**: Garantire sicurezza, conformità e controlli di accesso di livello aziendale per tutti i dati consumati dalla ricerca. Il supporto per le autorizzazioni di visibilità sorgente garantisce che i dati siano accessibili solo agli utenti autorizzati, sia per le esperienze di ricerca semplice che per quelle degli agenti. Per garantire un recupero rapido, le autorizzazioni di protezione vengono valutate e applicate in modo nativo dai backend di ricerca nella prima fase dell'accesso ai dati.
- **Livello di recupero unificato**: Per affrontare la sfida dei dati in silo, i connettori vengono inseriti in un livello di recupero unificato completo. Questo livello fornisce un unico punto di accesso a tutti i dati, sia che rimangano in sistemi esterni a cui si accede tramite Ricerca federata o che vengano gestiti in modo nativo tramite indici avanzati per i dati a copia zero e inseriti.
- **Comprensione delle query intelligenti**: Prima del recupero, il sistema utilizza meccanismi basati sull'intelligenza artificiale per interpretare l'intento dell'utente. Oltre a incorporare rappresentazioni della query per la corrispondenza semantica vettoriale, può riscrivere ed espandere le ricerche basate su parole chiave per migliorare la precisione.
- **Ricerca ibrida e query avanzate**: Per trovare le informazioni più pertinenti, la piattaforma utilizza più strategie in parallelo. La ricerca ibrida offre una corrispondenza precisa delle parole chiave con la ricerca vettoriale semantica su blocchi di dati ottimizzati, mentre la ricerca record completo recupera contemporaneamente interi documenti. Entrambi sono combinati per garantire sia la pertinenza semantica che la copertura completa del contenuto.
- **Classifica gerarchica**: Dopo il recupero dei dati, un'architettura di classificazione gerarchica a più fasi calcola il punteggio, unisce e riclassifica i risultati di ogni fonte e metodo. Questo processo crea un unico elenco unificato che mette in evidenza le informazioni più pertinenti per l'utente o l'agente.
#### Applicazioni di ricerca agentica
L'intelligenza artificiale generativa sta spostando il consumatore principale della ricerca aziendale dagli utenti umani ai modelli di linguaggio di grandi dimensioni (LLM). Data 360 Search è progettato da zero per servire entrambi. È ottimizzato per gestire le query più lunghe e complesse degli agenti e restituire i risultati completi e contestuali necessari per il consumo a livello di programmazione e i loop di ragionamento. Allo stesso tempo, il sistema è in grado di gestire le query più brevi, spesso ambigue, tipiche degli utenti umani, fornendo funzioni come gli snippet e l'evidenziazione per una valutazione rapida in un'interfaccia utente.
L'offerta finale di esperienze di ricerca agenti combina entrambi gli approcci:
1. **Risultati della ricerca diretta**: l'applicazione può visualizzare un elenco tradizionale di risultati classificati utilizzando un'API basata sui metadati basata sulla ricerca unificata di Data 360.
2. **Risposte conversazionali agentiche** a più turni: le risposte agentiche vengono implementate tramite l'integrazione nativa con Agentforce. Questa esperienza di conversazione è guidata da un agente principale che orchestra le azioni e le query, delegando tutte le operazioni di recupero delle informazioni a un agente di ricerca interno specializzato.
Questo Search Agent specializzato è ottimizzato per il recupero delle informazioni aziendali. Utilizza un loop di ragionamento per formulare ed eseguire ricerche parallele per esplorare diversi aspetti della richiesta di un utente. Utilizza un potente insieme di strumenti, tra cui la ricerca unificata di Data 360 per tutti i tipi di dati e i linguaggi di query strutturati per recuperare dati precisi da tabelle ed entità.
Attraverso questa sintesi architettonica, Data 360 consente la creazione di esperienze di ricerca aziendale altamente intelligenti, sensibili al contesto e fruibili da parte degli agenti.
### Estensione di Data 360 con codice personalizzato
L'estensibilità è una funzione chiave della piattaforma Salesforce. Code Extension offre estendibilità in Data 360, consentendo agli utenti pro-code di eseguire logica Python personalizzata direttamente nell'ambiente Data 360, integrando le sue funzionalità dichiarative e low-code. Utilizzando l'estensione codice, gli utenti possono estendere in modo sicuro le funzionalità principali di Data 360 come le trasformazioni e le opportunità in corso di realizzazione di dati non strutturati (chunking personalizzato).
La progettazione di Code Extension dà priorità a flessibilità, sicurezza, efficienza e a un'esperienza utente semplificata. Supporta due modelli di esecuzione principali, ciascuno personalizzato per esigenze architettoniche specifiche:
- **Modello di script**:
- **Scopo**: Per una logica personalizzata completa che richiede un'interazione diretta con Data 360 Lakehouse.
- **Funzionalità**: I clienti scrivono script Python completi utilizzando Code Extension SDK, abilitando l'accesso in lettura e scrittura a Lakehouse tramite le API SDK. Ideale per la preparazione di dati personalizzati/complessi o per la manipolazione dei dati su misura.
- **Isolamento e sicurezza**: Mentre gli script accedono a Lakehouse, la loro esecuzione è confinata in un ambiente sicuro e isolato all'interno del runtime di Data 360, impedendo interferenze con altri processi o accessi non autorizzati al sistema.
- **Modello di funzione**:
- **Scopo**: Analogamente a una funzione serverless, per i calcoli modulari senza stato richiamati dalle pipeline Data 360 esistenti (ad esempio, la suddivisione personalizzata in una pipeline non strutturata).
- **Funzionalità**: Le funzioni fornite dal cliente accettano input, calcolano e restituiscono output.
- **Isolamento e sicurezza**: Queste funzioni sono progettate per un rigoroso isolamento; non hanno accesso diretto a Lakehouse. La loro esecuzione è in modalità Sandbox, stateless e con risorse limitate, il che li rende adatti a fasi di elaborazione mirate e stateless, garantendo sicurezza, esecuzione prevedibile e riducendo al minimo il raggio di esplosione.
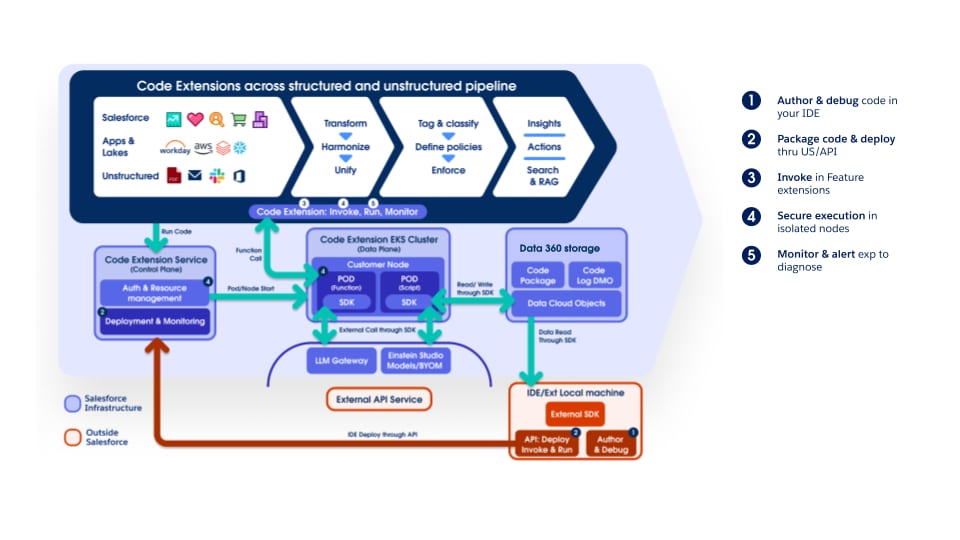 Sia il modello Script che il modello Function mirano a eseguire in modo sicuro il codice del cliente, evitando che il codice di un tenant influisca su altri o ottenga l'accesso non autorizzato ai dati di altri tenant, alle risorse Salesforce o alle risorse esterne. Questa sicurezza è ottenuta attraverso un'architettura a livelli (difesa in profondità). Questa architettura fornisce un ambiente di esecuzione isolato per il codice personalizzato di ogni tenant, incorporando vari guardrail. Questi includono l'isolamento logico a livello di Kubernetes (K8s), l'isolamento della rete, il Sandboxing in fase di esecuzione e le autorizzazioni con privilegi minimi, il tutto completato dal monitoraggio operativo e dalla preparazione alla risposta agli incidenti per il rilevamento e la risposta.
#### Esperienza degli sviluppatori e visibilità operativa
Per supportare un ciclo di vita di sviluppo efficiente, Code Extension offre:
- **Creazione esterna e debug**: Gli sviluppatori possono creare ed eseguire il debug del codice Python in ambienti familiari come VSCode, utilizzando l'SDK.
- **Distribuzione flessibile**: Il codice personalizzato può essere inserito in un pacchetto e distribuito utilizzando le utilità SDK, l'interfaccia utente di Data 360 o l'API, abilitando l'integrazione in CI/CD.
**Registri operativi**: L'accesso a registri esecuzioni dettagliati offre trasparenza e facilita la risoluzione dei problemi in produzione.
Offrendo queste funzionalità di estensione codice sicura e flessibile, Data 360 consente agli architetti di adattare la piattaforma ai loro requisiti di elaborazione dati più specifici e complessi, consolidando davvero il suo ruolo di tessuto di dati aziendale estendibile.
### Estensione di Data 360 con modelli AI personalizzati
Man mano che le aziende accelerano l'adozione dell'intelligenza artificiale, la maggior parte gestisce ecosistemi ML eterogenei, inclusi Amazon SageMaker, Google Vertex AI e ambienti Python personalizzati, che ospitano modelli che guidano previsioni mission-critical, come il calcolo del punteggio del rischio di credito, la propensione all'abbandono, i consigli sui prodotti e le decisioni Next Best Action.
Tradizionalmente, l'integrazione di questi modelli esterni in Salesforce richiedeva livelli API personalizzati, pipeline ETL o orchestrazione middleware, introducendo la duplicazione dei dati, l'overhead di governance, la latenza e la complessità operativa, sfide che contrastano con una visione CDP (Customer Data Platform) unificata, conforme e in tempo reale.
**Porta il tuo modello (BYOM)**: Fornito tramite Einstein Studio in Data 360, risolve queste sfide abilitando la chiamata diretta di modelli addestrati esternamente nei flussi di lavoro, nella logica Apex e negli strumenti di automazione di Salesforce, senza spostare o replicare i dati. Tramite la federazione copia zero, Data 360 funge da singola fonte di dati controllata, esponendo i dati Customer 360 armonizzati per l'inferenza in endpoint esterni. Gli output delle previsioni ritornano in tempo reale, potenziando i processi aziendali con un'intelligenza scalabile.
BYOM colma efficacemente il divario tra scienza dei dati ed esecuzione operativa separando lo sviluppo del modello, i dati governati e i livelli di consumo. Mantiene l'indipendenza della piattaforma, riduce la complessità dell'integrazione, accelera la distribuzione dell'intelligenza artificiale e mantiene la governance sui dati sensibili.
L'architettura funziona come segue: Data 360 fornisce una base di dati Customer 360 unificata, mentre Einstein Studio orchestra le connessioni alle piattaforme ML esterne (SageMaker, Vertex AI o endpoint personalizzati). I modelli esterni eseguono l'inferenza in tempo reale, in batch o in streaming. I livelli Salesforce (API Flusso, Apex e Query) utilizzano gli output per offrire approfondimenti personalizzati, automatizzati e analitici in Sales Cloud, Service Cloud, Marketing e Industry Cloud.
Dal punto di vista aziendale, BYOM offre:
- **Integrità e governance dei dati**: Elimina le copie dei dati non controllate e impone la conformità alle policy.
- **Democratizzazione: AI** Rende accessibili i modelli complessi agli utenti non tecnici tramite gli strumenti Salesforce.
- **Accelerazione time-to-value**: I modelli esterni si attivano immediatamente all'interno dei processi Salesforce.
- **Supporto della scalabilità e dell'architettura ibrida**: Abilita la distribuzione multi-cloud dei carichi di lavoro AI.
- **Architettura AI pronta per il futuro**: Supporta strategie di intelligenza artificiale componibili, separando i livelli di dati, modello e consumo per l'agilità operativa.
**Porta il tuo LLM (BYO-LLM)**: Offre lo stesso meccanismo di estensibilità ma per i modelli generativi. Abilitando la chiamata diretta di LLM esterni, consentiamo ai clienti di utilizzarli in Agentforce Platform al posto dei modelli forniti da Salesforce. Per le imprese BYO-LLM consente:
- Accesso ai modelli perfezionati
- Integrazione di modelli attualmente non forniti da Salesforce
- Utilizzo dei modelli negli account forniti dai clienti
### Collaborazione sui dati
Le aziende moderne operano all'interno di un panorama di dati complesso caratterizzato da due principali sfide architettoniche:
1. **Frammentazione intra-aziendale**: Le grandi organizzazioni utilizzano spesso più organizzazioni Salesforce (spesso segmentate per regione, unità operativa o acquisizione storica) e numerosi altri sistemi di dati. Questa frammentazione crea silos di dati interni, rendendo impossibile stabilire una visualizzazione unificata, affidabile e unificata del cliente per il coinvolgimento in tempo reale in tutta l'azienda. La sfida è unificare questi dati senza consolidarli fisicamente o duplicarli in tutti i sistemi, garantendo che la governance rimanga intatta.
2. **Collaborazione tra imprese**: Le aziende spesso hanno bisogno di condividere i dati con partner e fornitori per attività congiunte di marketing, misurazione e business intelligence. La sfida è abilitare questa collaborazione proteggendo i dati sensibili e proprietari e rispettando regolamenti sulla privacy come GDPR e CCPA, oltre alle barriere competitive.
Salesforce Data 360 affronta queste sfide con un framework Trust by Design a copia zero basato sul principio di condivisione dell'accesso e degli approfondimenti anziché spostare o duplicare i dati.
#### Meccanismi di collaborazione di Data 360
Salesforce Data 360 affronta le sfide legate alla frammentazione dei dati e alla collaborazione con Data Cloud One, la condivisione dei dati tra Data 360 e le Data Clean Room con priorità alla privacy. Queste soluzioni unificano i dati dei clienti, consentono lo scambio sicuro dei dati e offrono approfondimenti che salvaguardano la privacy. Con un approccio Trust by Design a copia zero, le organizzazioni possono sbloccare il potenziale dei dati per il coinvolgimento in tempo reale, partnership ottimizzate e processi decisionali intelligenti. Ciascuna di queste opzioni di collaborazione sui dati ha scopi diversi.
##### Abilitazione di Internal Enterprise con Data Cloud One
Data Cloud One è la soluzione architettonica di base per le aziende che gestiscono più organizzazioni Salesforce. Il suo scopo va oltre la semplice condivisione dei dati; è progettato per stabilire una visualizzazione cliente unica e affidabile e abilitare le funzionalità complete della piattaforma Data 360 in tutta l'organizzazione.
 Questo meccanismo si basa su un'istanza designata di Home Org Data 360, che funge da autorità centrale per la gestione dei dati e la creazione del profilo cliente unificato. L'organizzazione iniziale è l'organizzazione di cui viene eseguito il provisioning di Data 360. Viene stabilita una connessione a Data Cloud One tra Data 360 e altre organizzazioni Salesforce, denominate organizzazioni partner. Come parte della connessione a Data Cloud One, Data 360 condivide uno o più dei suoi spazi dati con ogni organizzazione associata, fornendo l'accesso sia ai dati che ai metadati in ogni spazio dati condiviso. Questo viene ottenuto tramite un modello di federazione a copia zero e la sincronizzazione dei metadati tra organizzazioni.
Data Cloud One consente anche alle organizzazioni di supporto di sfruttare l'istanza Data 360 dell'organizzazione di residenza per le proprie esigenze di attivazione, personalizzazione e intelligenza. Questa strategia è essenziale per eliminare la frammentazione dei dati interni e garantire che tutte le unità operative si attivino in base allo stesso profilo cliente, governato e unificato, massimizzando il ROI dell'implementazione di Data 360 principale.
##### Condivisione dei dati tra organizzazioni Data 360
Per gli ambienti interni distribuiti (in cui la centralizzazione completa non è possibile) e per la collaborazione con partner esterni affidabili, la condivisione dei dati da Data 360 a Data 360 collega istanze di Data 360 indipendenti.
 Questo modello di condivisione copia zero stabilisce una connessione tra tenant di Data 360 separati forniti in organizzazioni Salesforce diverse allo scopo di uno scambio sicuro di oggetti dati (DLO, DMO e CIO). Una volta connesso, l'intero oggetto dati diventa accessibile nel destinatario Data 360\. L'amministratore di Data 360 del destinatario può quindi impostare regole di governance per gestire l'accesso degli utenti a questi dati.
##### Collaborazione Privacy-First con Data 360 Clean Room
Quando la collaborazione richiede i massimi livelli di privacy e conformità o quando le preoccupazioni della concorrenza impediscono la condivisione di dati non elaborati, le camere bianche di Data 360 sono architetturalmente obbligatorie.
 Dal punto di vista architettonico, Data 360 Clean Room Collaboration è basato sul framework di condivisione Zero-Copy utilizzato dalla condivisione dei dati da Data 360 a Data 360, ma con ulteriori livelli di governance e vincoli computazionali applicati. La Clean Room di Data 360 offre un ambiente di elaborazione sicuro e controllato in cui le parti possono unire le proprie serie di dati in base a chiavi anonime. Il suo scopo principale è consentire l'analisi congiunta e la generazione di approfondimenti senza esporre i dati proprietari sottostanti. L'ambiente applica regole rigorose e programmabili, ad esempio soglie minime di aggregazione e identificatori non esportabili. Queste regole garantiscono che solo gli approfondimenti approvati, che tutelano la privacy e aggregati vengano derivati e condivisi. Ciò rende le camere bianche essenziali per casi d'uso come la misurazione delle campagne multipiattaforma e l'analisi sensibile della sovrapposizione del pubblico.
## Conclusione: Salesforce Data 360: Backbone di dati indispensabile per l'azienda agente
Data 360 è progettato come un data fabric intelligente, ampliabile e affidabile necessario per potenziare l'intelligenza artificiale di prossima generazione. La sua progettazione architettonica affronta il problema della frammentazione dei dati, consentendo alle organizzazioni di unificare, elaborare e attivare tutti i dati dei clienti su larga scala, utilizzando Zero Copy Data Federation per garantire l'efficienza.
La sua organizzazione dei dati affidabile stabilisce una visualizzazione armonizzata dai DLO (inclusi i dati non strutturati) ai DMO, tutti protetti all'interno di spazi dati partizionati. Le versatili funzionalità di elaborazione dati di Data 360, tra cui trasformazioni batch e streaming, approfondimenti calcolati, elaborazione dati non strutturati e risoluzione dell'identità, si basano sull'architettura SNCE e CDF incrementale, garantendo un'elaborazione efficiente quasi in tempo reale e un significativo risparmio sui costi.
L'estendibilità è garantita dall'architettura Code Extension, che abilita in modo sicuro la logica Python personalizzata tramite script o funzioni isolate per esigenze specifiche. Inoltre, un framework di governance dei dati completo, basato sul controllo dell'accesso basato sugli attributi (ABAC) con policy CEDAR, garantisce una sicurezza granulare, un mascheramento dinamico dei dati e un'applicazione coerente in tutto il consumo di dati. Ciò si traduce in sofisticate funzionalità di segmentazione e attivazione, che traducono i profili cliente unificati in strategie di coinvolgimento dinamiche multicanale con reattività in tempo reale.
Fondamentalmente, la capacità di Data 360 di unificare dati vasti e diversificati, fornire contesto in tempo reale tramite la query unificata (inclusa la ricerca ibrida strutturata/non strutturata e l'accelerazione Hyper) e imporre una governance rigorosa è fondamentale per potenziare gli agenti di intelligenza artificiale intelligenti. Fornisce i dati affidabili, aggiornati e pertinenti necessari per mettere a terra i flussi di lavoro di intelligenza artificiale generativa (RAG) e per alimentare le funzionalità multi-turno orientate all'azione degli agenti basati su Agentforce, assicurando che funzionino con precisione e accuratezza.
Fornendo una piattaforma a prova di futuro in cui i dati di origine vengono trasformati in approfondimenti di immediato valore pratico, Data 360 funge da base architettonica indispensabile per le organizzazioni che creano esperienze cliente Agentic. È la spina dorsale fondamentale che trasforma i dati dei clienti in esperienze cliente sofisticate e personalizzate che guidano il successo delle organizzazioni moderne di oggi.
# Panoramica
Salesforce Data 360 trasforma il modo in cui le aziende connettono, armonizzano e attivano i dati dei clienti su larga scala. Il suo vero punto di forza, tuttavia, risiede nella sicurezza con cui i dati vengono gestiti durante il loro ciclo di vita. Questa architettura di riferimento per la sicurezza offre un modello pratico e completo per la protezione degli ambienti Data 360. Per impostazione predefinita, otteniamo questo risultato attraverso i principi fondamentali di privilegi minimi, progettazione zero Trust e governance.
Alla base di tutto, la sicurezza in Data 360 è un modello di responsabilità condiviso. Salesforce protegge l'infrastruttura, la rete, i servizi di crittografia, la piattaforma, la conformità e l'applicazione stessa in conformità a standard globali come ISO 27001, SOC 2 e Regolamento generale sulla protezione dei dati (GDPR). Gli amministratori Salesforce proteggono i dati dell'organizzazione all'interno della piattaforma definendo l'accesso, imponendo la privacy e gestendo le integrazioni. Ciò include l'implementazione di una gestione forte dell'identità e dell'accesso (IAM) che concede solo l'accesso necessario, l'imposizione dell'autenticazione a due fattori (2FA) e l'adesione al principio dei privilegi minimi e ai mandati aziendali e normativi.
Data 360 Governance collega questi livelli di responsabilità, garantendo che sicurezza e conformità rimangano allineate. Garantisce che i ruoli, le policy, le autorizzazioni e le regole di gestione dei dati siano definiti e continuamente applicati in tutto il processo, dall'inserimento all'attivazione. La discendenza dei dati, la classificazione dei metadati e la consapevolezza del consenso sono integrate in ogni oggetto e processo. Ciò trasforma la governance da una funzione di supervisione manuale a un piano di controllo operativo.
Salesforce offre una base resiliente e conforme in cui le aziende mantengono una completa autorità sul comportamento dei dati, sulle impostazioni della privacy e sui limiti dell'integrazione. Insieme, creano un tessuto di sicurezza e governance in cui ogni serie di dati, policy e azione dell'utente è tracciabile, coerente e ancorata al Trust.
La protezione in Data 360 va oltre i controlli statici. È incorporato in ogni fase del ciclo di vita dei dati. Dal momento in cui vengono inseriti, i dati vengono crittografati, convalidati e classificati nelle policy aziendali. Man mano che viene unificata e arricchita, la discendenza dei metadati e gli attributi di consenso vengono mantenuti per garantire la responsabilità. Quando vengono attivati approfondimenti per uso aziendale o AI, i flussi in uscita sono protetti attraverso canali crittografati, autenticazione e autorizzazione avanzate, governance attenta alle policy e applicazione del consenso, garantendo che i dati rimangano affidabili, conformi e sicuri dall'inserimento all'attivazione.
## Base di sicurezza di Data 360
Data 360 offre una base sicura per la progettazione basata sull'architettura Hyperforce con funzionalità native per il cloud.
### Basato su Hyperforce
Salesforce Data 360 è una piattaforma dati nativa per cloud creata interamente sull'architettura Hyperforce di Salesforce, che offre una base sicura, conforme e scalabile per le operazioni globali.
### Fondazione Secure-by-Design
* Hyperforce offre sicurezza e conformità come funzionalità incorporate, non come componenti aggiuntivi. Offre una serie di controlli di base comuni profondamente integrati nelle piattaforme e nelle applicazioni Salesforce, garantendo che ogni livello, dall'infrastruttura all'esperienza dell'app, sia progettato con sicurezza, privacy e conformità al centro.
* Data 360 eredita solidi controlli di accesso, crittografia e framework di conformità ai regolamenti direttamente dai controlli di base di Hyperforce.
* Questo modello predefinito riduce al minimo le vulnerabilità e semplifica l'erogazione di servizi dati affidabili e conformi.
### Architettura nativa del cloud
* Data 360 viene eseguito all'interno di un dominio funzionale dedicato ospitato in Hyperforce, una piattaforma cloud unificata che garantisce isolamento, prestazioni e sicurezza multi-tenant.
* Data 360 utilizza un'architettura di microservizi, con tutti i servizi in contenitore e orchestrati tramite Kubernetes.
* Applicando i principi di zero Trust, la mesh di servizio Istio gestisce una comunicazione interservizi sicura e offre la gestione del traffico, l'osservabilità e l'imposizione delle policy.
### Distribuzione scalabile e modulare
* I servizi di Data 360 vengono forniti e funzionano con il cloud privato virtuale gestito (VPC) di Salesforce, abilitando la separazione, il controllo efficiente e l'ottimizzazione della rete interna.
* L'architettura supporta la scalabilità orizzontale, garantendo che Data 360 possa gestire carichi di lavoro di elaborazione dati su scala petabyte.
### Integrazione ed estensibilità
* Data 360 espone API ben definite per l'integrazione con le applicazioni Salesforce CRM e altre fonti di dati.
* Supporta sia le organizzazioni first party (1P) che le organizzazioni Salesforce CRM basate su Hyperforce, garantendo un'ampia compatibilità tra gli ambienti.
* Data Cloud One consente ai clienti di connettere più organizzazioni Salesforce CRM con una singola istanza di Data 360.
### Modello di responsabilità condivisa
La protezione all'interno di Salesforce Data 360 opera in base a [un modello di responsabilità](https://compliance.salesforce.com/en/documents/a006e000010nW2FAAU) condiviso, un framework utilizzato anche dai principali provider di cloud come Amazon Web Services (AWS), Microsoft Azure e Google Cloud.
Questo modello definisce un confine chiaro: Salesforce è responsabile della sicurezza **del** cloud e i clienti sono responsabili della sicurezza **nel** cloud. Comprendere e rendere operativa questa distinzione è essenziale per mantenere un ecosistema di dati resiliente, conforme e sicuro.
 #### Salesforce: Sicurezza del cloud
Salesforce è responsabile della protezione e del mantenimento dell'integrità della piattaforma Data 360 e della relativa infrastruttura globale. Ciò include:
* **Sicurezza fisica e ambientale:** Hyperforce è ospitato nell'infrastruttura AWS e Amazon ha la responsabilità delegata della protezione dei propri data center globali attraverso controlli di accesso, sorveglianza e misure di salvaguardia ambientale.
* **Difesa della rete e del perimetro:** Mitigazione del Distributed Denial of Service (DDoS), rilevamento delle intrusioni e crittografia per tutto il traffico in transito (TLS 1.2 e versioni successive) e a riposo (AES-256).
* **Indurimento piattaforma e gestione patch:** Gestione continua delle vulnerabilità, distribuzione delle patch e protezione di base a livello di sistema operativo.
* **Conformità e certificazione:** Controlli continui rispetto a standard come SOC 1/2/3, ISO 27001, ISO 27017, ISO 27018 e preparazione per framework come GDPR.
Questi controlli assicurano che la piattaforma Data 360 rimanga sicura, affidabile e conforme, consentendo ai clienti di concentrarsi sulla logica aziendale e sulla gestione dei dati anziché sulla difesa dell'infrastruttura.
#### Cliente: Sicurezza nel cloud
I clienti sono responsabili della protezione dei dati, delle configurazioni e dei processi operativi all'interno delle loro organizzazioni Salesforce Data 360. Le principali aree di responsabilità includono:
* **Gestione dell'identità e dell'accesso (IAM):** Definire i ruoli, applicare l'autenticazione a più fattori (MFA) e il Single Sign-On (SSO) e applicare il principio dei privilegi minimi.
* **Governance dei dati:** Classificare i dati sensibili, applicare il mascheramento dove necessario e applicare controlli di accesso a livello di oggetto, campo e record.
* **Sicurezza dell'integrazione:** Gestire l'accesso API tramite OAuth 2.0, JSON Web Token JWT e altri standard di autenticazione utilizzando credenziali denominate e credenziali esterne.
* **Monitoraggio e risposta:** Utilizzare il monitoraggio degli eventi e gli itinerari di controllo e inoltrare i registri a un sistema SIEM (Security Information and Event Management) per il rilevamento avanzato delle minacce.
Salesforce fornisce le basi sicure, ma i clienti determinano il loro effettivo comportamento di sicurezza attraverso le loro configurazioni, controlli e vigilanza.
#### Responsabilità umano-centrica
La sicurezza non è solo un costrutto tecnico, è una disciplina organizzativa. La protezione dei dati in Salesforce Data 360 è garantita dalla collaborazione tra team di architettura, operativi e di governance.
**Le imprese dovrebbero:**
* Esaminare e ritirare continuamente gli account inutilizzati o con privilegi eccessivi.
* Automatizzare l'imposizione utilizzando le policy come pipeline di codice e CD/IC.
* Eseguire esercizi da tavolo che simulano incidenti come l'attivazione o l'esfiltrazione non autorizzata dei dati per migliorare la preparazione alla risposta.
L'efficacia di Data 360 non dipende solo dalle funzioni, ma anche dal modo in cui i clienti le rendono operative in modo responsabile.
#### Sicuro per impostazione predefinita: Una posizione di sicurezza proattiva
Salesforce Data 360 adotta una filosofia di sicurezza predefinita, che consiste nel passaggio dal controllo reattivo alla progettazione preventiva. Anziché iniziare ad aprirsi e stringersi in un secondo momento, ogni nuova organizzazione Data 360 inizia ora con lo stato "Nega tutto", applicando i principi zero Trust dalla prima distribuzione.
#### Dal controllo reattivo alla progettazione preventiva
Negli ambienti più datati, i clienti hanno ereditato un modello "Consenti tutto" per un orientamento più rapido. Anche se conveniente, questo creava il rischio di sovraesposizione accidentale e configurazione errata.
La nuova architettura secure-by-default inverte questo approccio:
* Nessun utente o sistema ha accesso implicito.
* Tutte le autorizzazioni devono essere esplicitamente concesse.
* I controlli di accesso ai dati, integrazione e governance vengono applicati a partire dal giorno 0.
Ciò impone privilegi minimi fin dalla progettazione, riducendo drasticamente il rischio di esposizione accidentale o di inoltro dei privilegi al livello superiore.
#### Impatto operativo e di governance
Questo modello ha implicazioni sia tecniche che comportamentali:
* I team devono pianificare deliberatamente i modelli di accesso, allineando le autorizzazioni alla conformità e ai confini aziendali.
* La governance diventa un requisito di progettazione incorporata, non un ripensamento.
* La proprietà e la responsabilità dei dati sono definite fin dall'inizio.
Per le organizzazioni Data 360 legacy che operano ancora in "Consenti tutto", gli amministratori devono restringere manualmente le configurazioni per allinearsi alla nuova base di riferimento, un passaggio fondamentale in qualsiasi modernizzazione della sicurezza o programma di maturità di Data 360.
#### Trust by Design
Per impostazione predefinita, l'accesso è zero e richiede definizioni esplicite delle policy, Salesforce Data 360 stabilisce Trust by Design, un'evoluzione fondamentale nella sicurezza dei dati aziendali.
Questo approccio garantisce che:
* L'accesso non autorizzato e i rischi di fuga di dati sono ridotti al minimo.
* I framework di governance vengono applicati in modo strutturale, non facoltativo.
* Le aziende acquisiscono un comportamento di sicurezza più prevedibile, controllabile e resiliente in tutti gli ambienti.
In sostanza, la sicurezza non è più una funzione che si aggiunge, ma la base da cui si parte.
## Gestione delle identità e degli accessi: Gateway ai dati
IAM (Identity and Access Management) in **Salesforce Data 360** è il primo e più importante livello di difesa. Determina **chi** può accedere alla piattaforma e **quali** azioni possono eseguire una volta all'interno. Un framework IAM ben implementato è il controllo più efficace di cui un'azienda dispone per proteggere i dati dei propri clienti e garantire l'integrità operativa.
### Autenticazione: Verifica "Chi sei"
L'autenticazione stabilisce un **digital Trust,** confermando che ogni utente, servizio o sistema esterno che accede a Salesforce Data 360 è legittimo.
### Gestione federata delle identità
Data 360 supporta l'**autenticazione federata** con provider di identità (IdP) di livello aziendale come [**Microsoft Entra ID (Azure AD)**](https://learn.microsoft.com/en-us/entra/identity/saas-apps/salesforce-tutorial), [**Okta**](https://help.okta.com/en-us/content/topics/provisioning/salesforce/sfdc-provision.htm) o [**Ping Identity**](https://docs.pingidentity.com/configuration_guides/salesforce/config_saml_salesforce_pf.html) utilizzando [**SAML 2.0**](https://help.salesforce.com/s/articleView?id=xcloud.sso_saml.htm&type=5), OpenID Connect ([**OIDC**](https://help.salesforce.com/s/articleView?id=xcloud.sso_provider_openid_connect.htm&type=5)) o il sistema per la gestione dell'identità tra domini ([**SCIM**](https://help.salesforce.com/s/articleView?id=xcloud.identity_scim_overview.htm&type=5)).
Questa federazione estende il ciclo di vita dell'identità aziendale direttamente in Salesforce. Quando un dipendente entra, trasferisce o lascia l'azienda, il suo accesso si adegua automaticamente, riducendo gli account rimasti orfani e migliorando la preparazione alla conformità.
### Single Sign-On (SSO)
Con [**Single Sign-On (SSO)**](https://help.salesforce.com/s/articleView?id=xcloud.sso_about.htm&type=5), gli utenti eseguono l'autenticazione una volta sola utilizzando le credenziali aziendali e ottengono l'accesso sicuro alle applicazioni Salesforce senza password separate. Ciò riduce l'affaticamento delle credenziali e riduce al minimo i rischi di riutilizzo delle password o phishing.
### Accesso adattivo e condizionale
Il provider di identità (IdP) diventa l'autorità singola per le decisioni di autenticazione, imponendo l'autenticazione a più fattori (MFA), l'accesso condizionale e i controlli basati sul rischio. L'autenticazione si evolve da evento singolo a valutazione continua del Trust, reattiva al comportamento e al contesto degli utenti.
L'autenticazione federata fornisce:
* **Applicazione centralizzata delle policy:** Gli standard di autenticazione vengono gestiti in un'unica posizione in tutti gli ambienti Salesforce.
* **Tracciabilità end-to-end:** Gli itinerari di controllo unificati collegano ogni azione a un'identità verificata.
* **Esperienza umano-centrica:** Un processo di accesso sicuro e senza problemi consente ai team di concentrarsi sugli approfondimenti e non sulle credenziali.
### Autorizzazione: Definizione di "cosa si può fare"
Una volta verificato un utente, l'autorizzazione definisce gli elementi a cui può accedere, visualizzare o modificare. Definisce i confini operativi che proteggono i dati sensibili e impongono i privilegi minimi.
**Principio dei privilegi minimi (PoLP):** A ogni utente e sistema vengono concesse solo le autorizzazioni necessarie per la loro funzione lavorativa, niente di più. Questo principio limita notevolmente i danni potenziali dovuti a credenziali compromesse o configurazioni errate.
**Controllo dell'accesso basato sui ruoli (RBAC):** Salesforce Data 360 utilizza gli insiemi di autorizzazioni e i gruppi di insiemi di autorizzazioni per assegnare funzionalità granulari in linea con i ruoli aziendali. Ad esempio:
* Un ingegnere dei dati può gestire le opportunità di inserimento in corso di realizzazione e le trasformazioni con l'aiuto dell'insieme di autorizzazioni Data 360 Architect.
* Un analista marketing può eseguire query sui dati armonizzati ma non modificare i modelli con l'aiuto dell'insieme di autorizzazioni Gestore attivazione di Data 360.
* Un Responsabile attivazione può eseguire campagne in uscita ma non può accedere ai dati di origine con l'aiuto dell'insieme di autorizzazioni Responsabile attivazione di Data 360
L'accesso è gestito e controllabile a livello centrale, garantendo la responsabilità per tutto il ciclo di vita dei dati. Quando sono integrate con IdP come Entra ID, Okta o Ping Identity, le policy di accesso si estendono in modo semplice a tutta l'azienda tramite provisioning SCIM e federazione SAML/SSO.
### Informazioni sui ruoli e le autorizzazioni standard in Data 360
Salesforce fornisce insiemi di autorizzazioni predefiniti che contengono le procedure consigliate per la separazione dei compiti e la conformità agli standard di settore, ad esempio ISO 27001.
| Ruolo | Responsabilità principale | Principio di progettazione dell'accesso |
|---|---|---|
| Amministratore di sistema | Impostazione, provisioning e configurazione dell'ambiente | Nessun accesso alle serie di dati sottostanti: garantisce la separazione tra sistema e controllo dei dati |
| Architetto Data 360 | Inserimento, trasformazione, risoluzione dell'identità e modellazione dei dati | Impossibile eseguire l'attivazione dei dati per mantenere i limiti dell'esposizione ai dati |
| Gestore attivazione Data 360 | Creazione del segmento, gestione del canale e attivazione | Accesso in sola visualizzazione ai modelli di dati; nessun privilegio di modifica |
| Utente Data 360 | Consuma dati analitici e approfondimenti | Sola lettura; zero privilegi di modifica |
| Data 360 Un utente | Accesso tra organizzazioni tramite l'organizzazione compagna | Governato da autorizzazioni spazio condiviso e policy di accesso con ambito |
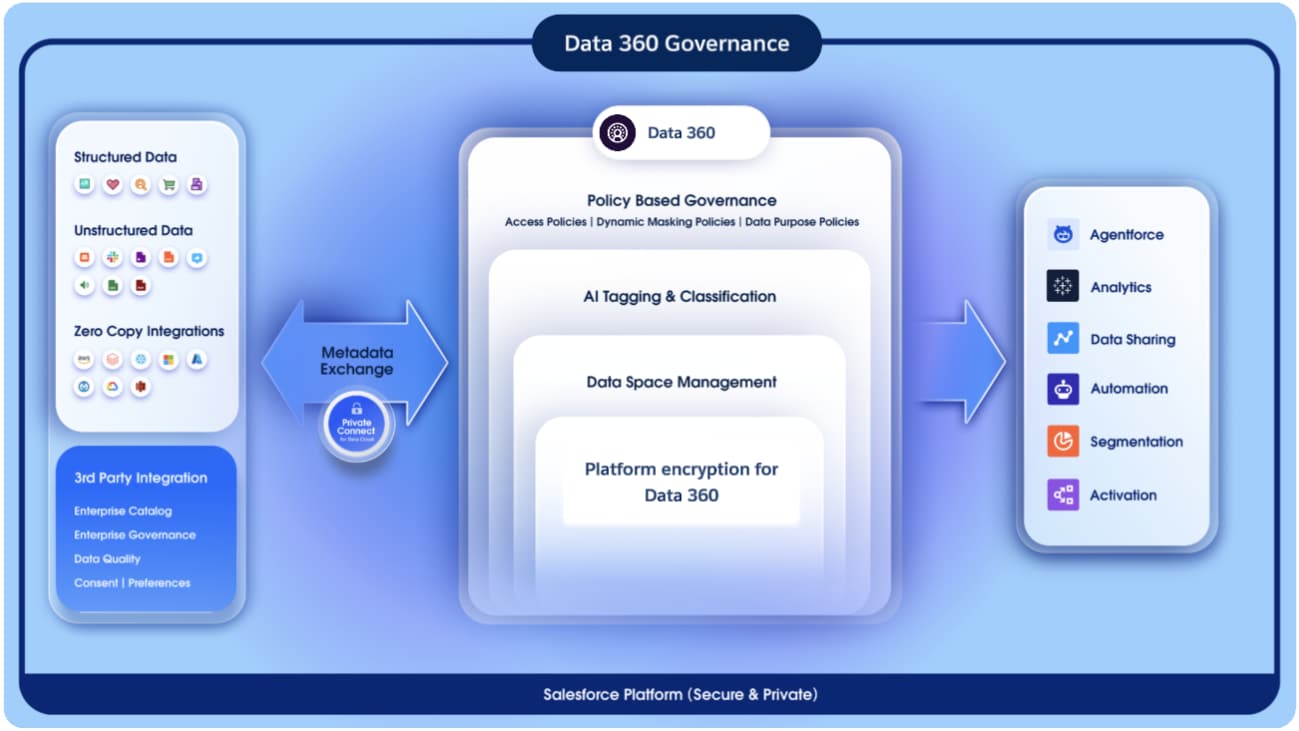 ### Governance come piano di controllo
Data 360 è strutturato attorno a un modello di governance first, che garantisce che ogni interazione con i dati, dall'inserimento all'attivazione degli approfondimenti, sia sensibile alle policy, controllabile e conforme. La governance funge da piano di controllo centrale, gestendo le modalità di rilevamento, classificazione e protezione dei dati in tutto il ciclo di vita.
Questo piano di controllo unificato garantisce che:
* L'**accesso dati è**: solo gli utenti giusti, con le policy giuste, possono agire sui dati giusti.
* La **governance è incorporata sia nel livello semantico che operativo**, garantendo la coerenza tra il modo in cui i dati vengono modellati e come vengono protetti.
* Vengono applicati i principi di **Zero Trust e Least Privilege**: dove identità, contesto e policy vengono valutati in tempo reale prima di concedere l'accesso.
Grazie a questa architettura, Salesforce Data 360 trasforma la governance da gestione delle autorizzazioni statiche in un livello di orchestrazione dinamico basato sulle policy. Una soluzione che si adatta continuamente al contesto, impone la conformità fin dalla progettazione e sostiene Trust su scala aziendale.
### Segregazione logica dei dati con gli spazi dati
A livello di macro, gli spazi dati offrono la separazione logica e l'isolamento dei domini di dati aziendali, consentendo alle organizzazioni con modelli operativi multimarca, multiregione o multi-tenant di gestire i dati all'interno di un'unica piattaforma unificata. Gli spazi dati possono essere allineati ai domini aziendali (ad esempio Vendite, Marketing o Customer Success) o ai confini normativi e geografici (ad esempio, UE, AMER o APAC), consentendo ai controlli di governance e accesso di rispecchiare la struttura operativa e di conformità dell'organizzazione senza frammentare la piattaforma dati sottostante.
* Ogni spazio dati funge da confine virtuale, definendo le raccolte di dati con cui un utente o un team può visualizzare o interagire.
* L'accesso all'interno di uno spazio dati viene concesso in modo esplicito, senza autorizzazioni implicite o contaminazione incrociata della visibilità dei dati.
* Ciò consente la proprietà federata: ogni unità operativa può governare il proprio dominio in modo indipendente, mantenendo la supervisione e la conformità centralizzate.
Per progettazione, gli spazi dati offrono il primo livello di governance, stabilendo chiarezza strutturale e responsabilità nelle serie di dati aziendali.
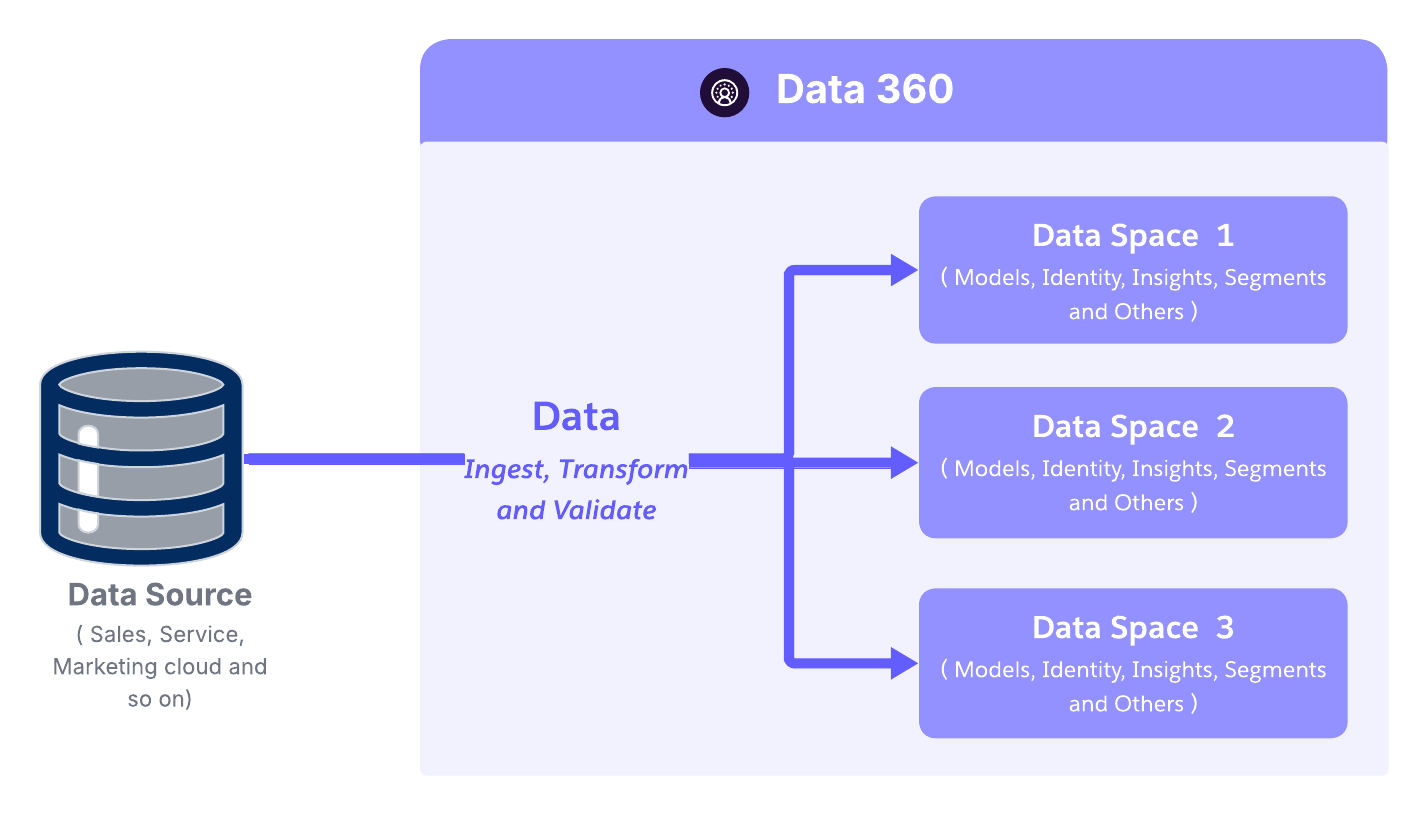 ### Da RBAC ad ABAC: Avanzamento verso l'autorizzazione contestuale
In Salesforce Data 360, RBAC e ABAC hanno scopi distinti ma complementari e vengono applicati a diversi livelli della piattaforma.
RBAC viene utilizzato principalmente per l'accesso alla piattaforma e alle funzionalità. Determina chi può accedere ai costrutti e alle funzioni di Data 360, ad esempio gli spazi dati, la creazione dei processi, le funzionalità amministrative e l'accesso agli strumenti. RBAC viene implementato tramite autorizzazioni e insiemi di autorizzazioni, ad esempio assegnando agli utenti l'accesso a uno spazio dati con funzioni specifiche abilitate.
ABAC viene utilizzato per l'imposizione dell'accesso ai dati. Le policy ABAC sono interamente responsabili della determinazione degli utenti che possono accedere a quali oggetti e attributi di dati, inclusi la protezione a livello di oggetto (OLS), l'accesso a livello di campo e i vincoli a livello di riga. Queste decisioni vengono prese dinamicamente valutando l'azione, gli attributi utente e gli attributi risorsa in fase di esecuzione.
In ABAC, le autorizzazioni rimangono parte del modello, ma è la policy stessa a determinare l'accesso, non solo il ruolo. Le policy valutano il contesto, ad esempio unità operativa, regione, riservatezza dei dati, scopo d'uso o vincoli normativi per consentire o negare l'accesso.
Ad esempio:
* RBAC consente a un utente di accedere a uno spazio dati Data 360 e alle funzioni di analisi.
* ABAC determina se lo stesso utente può leggere una serie di dati cliente specifica, quali righe può visualizzare e quali attributi sono mascherati o limitati.
Questa netta separazione consente a Data 360 di scalare in modo sicuro:
* RBAC offre un accesso controllato alle funzionalità della piattaforma e ai flussi di lavoro.
* ABAC offre un accesso ai dati preciso e basato sulle policy in linea con i requisiti di conformità, residenza e protezione dei dati.
Insieme, consentono la democratizzazione dei dati governata senza confondere le autorizzazioni piattaforma con la logica di autorizzazione dei dati.
In sostanza, RBAC impone l'accesso in base all'assegnazione delle autorizzazioni, mentre ABAC valuta le autorizzazioni nel contesto, combinando attributi di azione, utente e risorsa per offrire un controllo dell'accesso adattivo e preciso in Salesforce Data 360
### ABAC: Una gerarchia di sicurezza a più livelli
Il cuore del controllo degli accessi di Salesforce Data 360 è il controllo degli accessi basato sugli attributi (ABAC, basato sul linguaggio della policy CEDAR).
A differenza delle autorizzazioni statiche basate sui ruoli, ABAC valuta in modo dinamico *chi* richiede l'accesso, a *cosa* sta tentando di accedere e *a quali condizioni*, assicurando che ogni interazione con i dati sia in linea con le policy aziendali e i limiti Trust.
#### Valutazione dinamica delle policy
Il motore ABAC di Data 360 valuta le decisioni di accesso in base a una combinazione di tre tipi di attributi principali:
* **Attributi utente:** reparto, posizione, livello di autorizzazione
* **Attributi dati:** classificazione, riservatezza (PII, PHI, Dati finanziari), spazio dati
Questo modello flessibile basato sulle policy consente all'imposizione di adattarsi automaticamente all'evoluzione dei ruoli utente, delle classificazioni dei dati o delle condizioni operative, il che è essenziale per le grandi imprese distribuite e regolamentate.
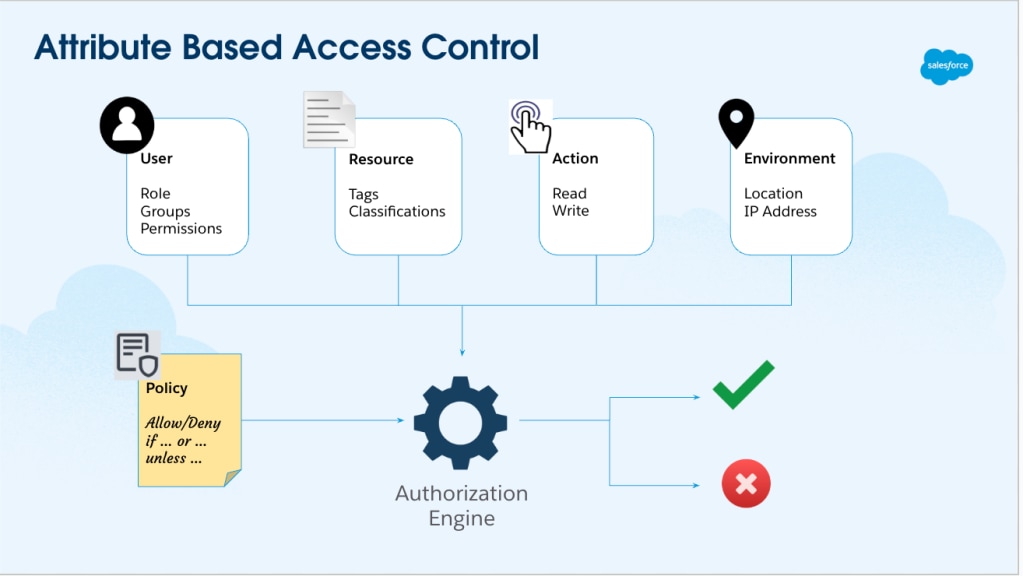 #### Componenti dell'architettura ABAC in Salesforce Data 360
Salesforce Data 360 implementa un'architettura Abac (Attribute-Based Access Control) basata su standard in linea con le procedure consigliate del settore per la governance dei dati basata sulle policy. È composto da tre componenti funzionali principali:
* **Punto di informazione sulle policy (PIP) - Policy, metadati arricchiti e classificazione:**
* Ospita le definizioni delle policy, incluse le policy di accesso, classificazione, mascheramento, conservazione e utilizzo dei dati aziendali.
* Gestisce metadati arricchiti come tag, classificazioni, contesto aziendale e discendenza end-to-end.
* Utilizza la classificazione basata su LLM e ML per assegnare automaticamente tag ai dati sensibili (ad esempio, PII.Email, PII.Phone, PHI).
* La propagazione dei tag garantisce che le classificazioni scorrano automaticamente lungo la discendenza dei dati (DLO → DLO → DMO).
* Mantenere la riservatezza e la conformità nelle trasformazioni.
* **Punto di decisione politica (PDP)**: Il PDP è il motore decisionale che interpreta le policy CEDAR.
* Inserisce input contestuali dal PEP (identità utente, metadati della richiesta) e attributi di riferimento dal PIP.
* Valuta le policy in modo deterministico per fornire decisioni di accesso coerenti, spiegabili e scalabili.
* Supporta valutazioni in tempo reale e batch, garantendo prestazioni e precisione anche in ambienti a volume elevato.
* **Punto di applicazione delle politiche (PEP)**: Il PEP è il luogo in cui le decisioni di autorizzazione vengono eseguite in fase di esecuzione.
* Intercetta le richieste di accesso ai dati in tutti i canali di interazione, ad esempio API, query dell'interfaccia utente, arricchimento CRM o pipeline GenAI Retrieval-Augmented Generation (RAG).
* Applica istantaneamente gli esiti PDP, assicurando che ogni query e recupero sia conforme alle policy di accesso aziendali.
Insieme, la triade PIP-PDP-PEP costituisce un tessuto di governance distribuito, che impone un controllo coerente basato sulle policy in tutti i servizi e le modalità di accesso di Data 360.
È importante notare che [ABAC](https://help.salesforce.com/s/articleView?id=data.c360_a_policy_based_governance_dg.htm&type=5) in Data 360 è configurato, non creato. Gli architetti non assemblano piani di controllo personalizzati o logica di applicazione. Compilano e connettono invece tre componenti architettonici nativi che operano insieme come tessuto di governance unificato.
A livello pratico, l'implementazione segue un semplice avanzamento: classificare i dati, definire le policy e consentire alla piattaforma di applicarle automaticamente. Una volta configurato, il controllo dell'accesso diventa un comportamento di sistema anziché un processo manuale o procedurale.
Questo tessuto di governance distribuito garantisce un'**applicazione coerente delle policy**, creando un confine Trust unificato in Data 360.
#### Applicazione di policy a più livelli
Il framework ABAC di Data 360 supporta i confini di accesso a livelli, garantendo che i dati siano protetti non solo a livello di oggetto, ma anche all'interno di campi e record specifici.
* **Protezione a livello di oggetto (OLS)**: Il confine più esterno del controllo degli accessi.
Gestisce l'accesso a intere strutture di dati, ad esempio oggetti data lake (DLO) o oggetti modello di dati (DMO).
Esempio: Concessione dell'accesso all'oggetto *Cliente*, ma non alle *transazioni*.
* **Protezione a livello di campo (FLS)**: Controlla l'accesso a campi specifici all'interno di un oggetto.
Esempio: Un utente marketing può visualizzare i nomi dei clienti ma non i numeri delle carte di credito o gli identificativi nazionali.
* **Record-Level Security (RLS)**: Il livello di controllo più granulare.
Determina quali singoli record all'interno di una serie di dati un utente può visualizzare o modificare.
Esempio: Un responsabile regionale può accedere solo ai dati dei clienti legati alla regione assegnata.
* **DDM (Dynamic Data Masking):** Abilita la protezione dei dati in tempo reale. A complemento di ABAC, il DDM impone l'oscuramento basato sulle policy delle informazioni sensibili senza alterare la serie di dati sottostante. In fase di query, DDM maschera automaticamente campi come informazioni personali o dati finanziari in base al ruolo utente, al contesto o alle regole di conformità.
* I dati sensibili rimangono protetti nelle visualizzazioni interfaccia utente, nelle API e nei flussi di lavoro AI.
* Riduce i rischi di fuga di dati garantendo un mascheramento coerente in tutti i livelli di consumo.
* Mantiene la possibilità di controllo. Ogni query mascherata viene registrata e tracciabile all'interno del framework di governance di Data 360.
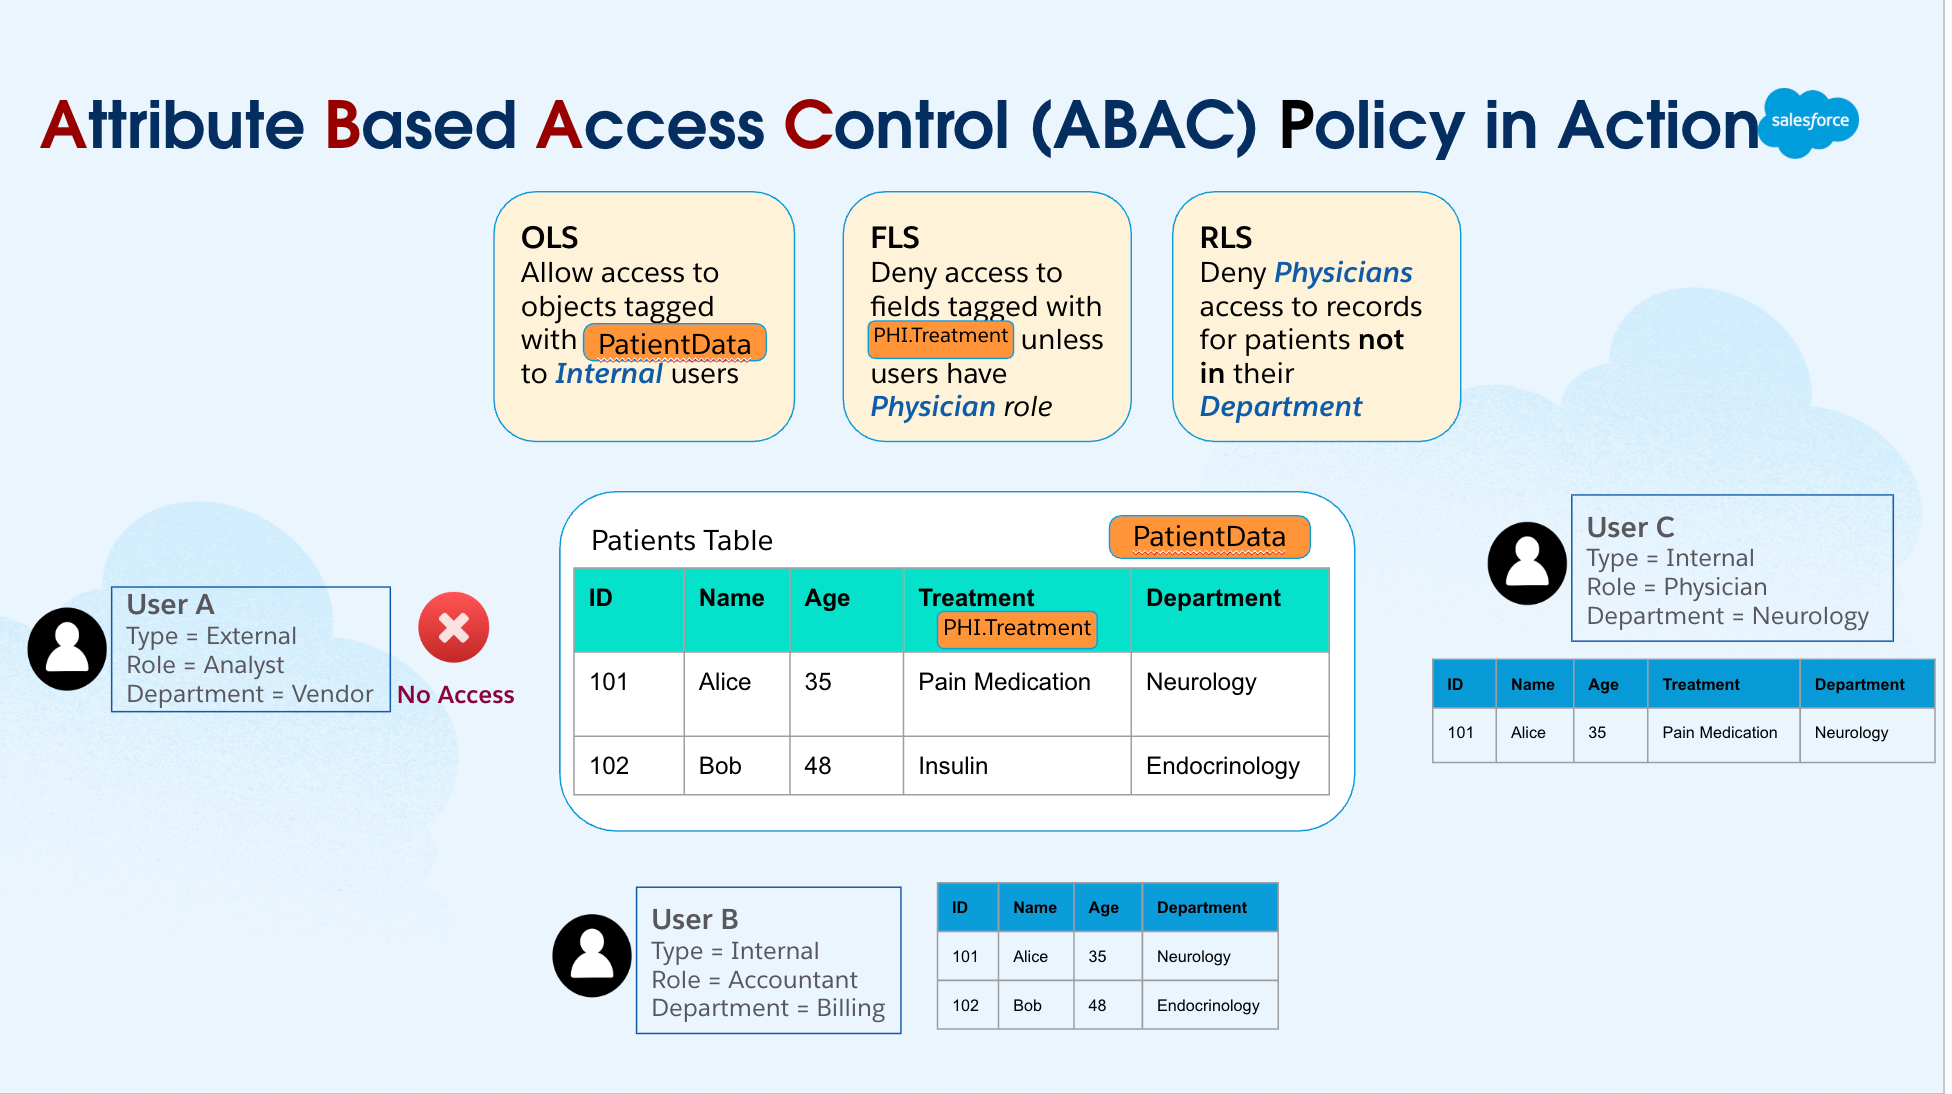 Questa architettura trasforma il controllo degli accessi da un modello di autorizzazione statico in un tessuto di policy dinamico e sensibile al contesto. Combinando la semplicità strutturata di RBAC con la profondità contestuale di ABAC, Salesforce Data 360 ottiene:
* Applicazione coerente delle policy in fase di inserimento, armonizzazione e attivazione.
* Governance adattiva che si evolve con i dati, i ruoli e le esigenze di conformità.
* Confini di Unified Trust per l'intero ciclo di vita dei dati, dall'inserimento all'attivazione dell'intelligenza artificiale.
#### Integrazione profonda con Salesforce Platform
Il modello di governance di Salesforce Data 360 è incorporato in modo nativo in Salesforce Platform, consentendo la sicurezza unificata, la conformità e il controllo dell'accesso sia ai dati operativi che analitici. Ereditando le funzionalità di base di Salesforce per la gestione delle identità e degli accessi, ad esempio la federazione delle identità, gli insiemi di autorizzazioni, la creazione centralizzata delle policy e la crittografia della piattaforma, Data 360 applica policy Trust coerenti nei cloud senza introdurre stack di governance paralleli. Anziché considerare l'isolamento, l'autorizzazione e la discendenza come preoccupazioni separate, la piattaforma li integra in un unico tessuto Trust attento all'esecuzione che copre l'intero ciclo di vita dei dati.
A livello strutturale, questo tessuto di governance è costituito da tre livelli complementari che operano di concerto:
* **Spazi dati**, che stabiliscono confini logici chiari per l'isolamento dei dati e la segmentazione normativa
* **Attribute-Based Access Control (ABAC)**, che consente decisioni di autorizzazione precise e sensibili al contesto in base agli attributi di identità, scopo e dati
* **Discendenza semantica**, che preserva il significato aziendale, la riservatezza e la tracciabilità man mano che i dati passano dall'inserimento all'approfondimento e all'attivazione
Insieme, creano un modello di governance in cui le decisioni di accesso sono spiegabili, l'applicazione è automatica e la conformità è continua anziché retroattiva. Il risultato è una piattaforma in cui la governance non è più un fattore limitante o un ripensamento. Diventa invece un livello abilitante, che consente agli architetti di progettare prodotti dati e flussi di lavoro basati sull'intelligenza artificiale con la certezza che Trust, privacy e requisiti normativi vengono applicati dal sistema stesso.
Questo approccio compositivo garantisce che i dati aziendali rimangano non solo utilizzabili, ma fruibili in modo responsabile, supportando approfondimenti, attivazione e automazione su larga scala senza compromettere la trasparenza, la sicurezza o il controllo.
## Protezione del ciclo di vita dei dati: Dall'inserimento all'attivazione
Nell'era delle aziende basate sull'intelligenza artificiale, la protezione dei dati non è un evento occasionale ma un processo continuo che protegge le informazioni dal momento in cui entrano nell'ecosistema fino a quando non vengono attivate per l'uso aziendale o AI.
Salesforce Data 360 incorpora controlli di sicurezza e governance in ogni fase del ciclo di vita dei dati, garantendo che integrità, riservatezza e Trust dei dati vengano preservati dall'inserimento all'attivazione degli approfondimenti.
### Fondamento della protezione: Crittografia a riposo e in transito
Il modello di protezione di Salesforce Data 360 si basa su Platform Encryption for Data 360, un framework di crittografia trasparente e ad alte prestazioni che protegge i dati sia a riposo che in transito, senza compromettere la fruibilità o la scalabilità.
#### Crittografia a riposo: Protezione livello di memoria
I dati conservati nel data lake di Data 360 vengono **crittografati automaticamente a livello** di memoria, assicurando che i dati rimangano illeggibili anche in caso di accesso fisico o non autorizzato. Le funzionalità principali includono:
* **Crittografia data lake trasparente:** Tutti i dati presenti nel data lake vengono crittografati a livello di memoria utilizzando le chiavi gestite dal cliente (CMK). Ciò garantisce che, anche in caso di accesso non autorizzato alla memoria fisica, i dati rimangano illeggibili e indecifrabili.
* **Chiavi gestite dal cliente (CMK):** I clienti mantengono il controllo completo sulle chiavi di crittografia, una funzionalità cruciale per i settori regolamentati come i servizi finanziari, l'assistenza sanitaria e il governo. CMK consente il controllo granulare, il controllo e la prova della sovranità dei dati, allineandosi direttamente ai mandati normativi come GDPR, HIPAA e ISO 27001.
* **Gestione esterna delle chiavi (EKM):** Con Gestione chiavi esterne, una funzione di Crittografia piattaforma per Data 360, i clienti saranno in grado di crittografare i dati in Data 360 utilizzando le chiavi memorizzate negli account AWS KMS dei clienti. Ciò offre ai clienti una maggiore flessibilità, pur mantenendo protetti e protetti i loro dati in Data 360.
* **Porta la tua chiave (BYOK):** Basandosi su CMK ed EKM, Data 360 consente ora ai clienti di caricare il proprio materiale della chiave direttamente in Salesforce per crittografare i dati a riposo e cercare gli indici. Questa ottimizzazione offre un ulteriore livello di protezione per le informazioni personali, i dati sensibili, riservati e proprietari, senza che i clienti debbano creare o gestire le chiavi in AWS KMS.
* **Rotazione delle chiavi e gestione del ciclo di vita:** La rotazione delle chiavi viene gestita con eleganza. I nuovi dati vengono crittografati con la nuova chiave, mentre i dati più vecchi rimangono crittografati con la chiave originale, evitando tempi di inattività o peggioramento delle prestazioni. Questo meccanismo di rotazione rafforza la conformità senza interruzioni operative.
#### Crittografia in transito: Protezione a livello di rete
Ogni dato trasmesso tra i servizi, le API e i connettori di Data 360 è protetto mediante TLS (Transport Layer Security) 1.2 o versione successiva, che offre una crittografia end-to-end in movimento.
Ciò garantisce che:
* I dati non possono essere intercettati o alterati durante il trasferimento.
* Le comunicazioni tra i servizi Salesforce, i connettori affidabili e gli endpoint dei clienti rimangono private e verificabili.
* La sicurezza si estende in modo coerente a opportunità di inserimento in corso di realizzazione, processi di armonizzazione, flussi di lavoro di attivazione e integrazioni API esterne.
Combinando la crittografia gestita dal cliente a riposo con la crittografia continua in transito, Salesforce Data 360 crea un'architettura di difesa che protegge i dati dei clienti sia da attacchi esterni che da minacce all'infrastruttura interna.
### Protezione dell'integrazione da sistema a sistema (Integrazione dati) in Data 360
Mentre i controlli di crittografia e accesso salvaguardano i dati all'interno di Salesforce Data 360, la protezione della circolazione dei dati tra i sistemi è altrettanto fondamentale. Le aziende moderne operano in ambienti multi-cloud e ibridi, dove i dati sensibili fluiscono tra Salesforce, piattaforme di analisi, API esterne e data lake.
Per risolvere questo problema, Salesforce ha progettato un framework di integrazione sicuro incentrato sulle credenziali denominate (NC) e sulle credenziali esterne (EC), offrendo una base basata su policy e allineata a zero Trust per una connettività sicura.
#### Framework di integrazione sicura di Salesforce
Salesforce ha progettato un solido **[framework di integrazione](https://developer.salesforce.com/docs/platform/named-credentials/guide/get-started.html)**, incentrato sulle credenziali denominate (NC) e sulle credenziali esterne (EC). Insieme, eliminano la complessità delle credenziali, impongono l'accesso con privilegi minimi e consentono una gestione dell'autenticazione coerente in tutte le integrazioni, senza esporre segreti nel codice o nella configurazione.
Questo framework astrae le complessità della sicurezza, applica le procedure consigliate e stabilisce un **piano di controllo** per tutte le connessioni esterne, in linea con i principi **Zero Trust** e **security by design** di Salesforce.
##### Credenziali denominate
Le credenziali denominate (NC) sono la chiave di volta dell'architettura di integrazione sicura di Salesforce. Forniscono un meccanismo dichiarativo centralizzato per definire gli endpoint esterni e i relativi parametri di autenticazione, eliminando la necessità di codificare credenziali sensibili come nomi utente, password o token in Apex Code o file di configurazione. Gli sviluppatori e gli amministratori fanno invece semplicemente riferimento a un alias di credenziale denominata (ad esempio SnowflakeConnector_NC) e Salesforce gestisce automaticamente l'autenticazione e la gestione delle connessioni sottostanti.
**Vantaggi architettonici e di sicurezza:**
* **Manutenzione semplificata:** Gli NC consolidano gli URL degli endpoint esterni e i parametri di autenticazione in un unico record gestito. Qualsiasi aggiornamento, ad esempio la modifica di un endpoint o la rotazione delle credenziali, richiede modifiche solo al record NC, evitando la ridistribuzione di codice o flussi tra gli ambienti.
* **Sicurezza avanzata:** Le credenziali sono archiviate in modo sicuro nell'archivio segreto crittografato di Salesforce, impedendo l'esposizione in archivi di codice, file di configurazione o registri. Il processo di autenticazione viene gestito automaticamente in fase di esecuzione, riducendo gli errori umani e il rischio di fughe.
**Conformità Adherence:** La separazione delle credenziali dalla logica aziendale semplifica la conformità a regolamenti sulla protezione dei dati come **GDPR, HIPAA e PCI DSS**. Gli auditor possono verificare facilmente che l'accesso ai dati esterni rispetti le policy di sicurezza e governance aziendali.
* **Ignora le impostazioni del sito remoto:** Gli NC eliminano il requisito legacy per le impostazioni dei siti remoti, semplificando la configurazione e la distribuzione, in particolare per le implementazioni aziendali su larga scala o multiambiente.
 #### Credenziali esterne
Le credenziali esterne (EC) definiscono il protocollo e il flusso di autenticazione utilizzati da Salesforce per la connessione a un servizio esterno, rispondendo di fatto "come eseguire l'autenticazione". Una singola EC può essere riutilizzata in più NC che condividono lo stesso tipo di autenticazione, promuovendo il riutilizzo della configurazione e un'applicazione coerente della sicurezza.
**Protocolli di autenticazione supportati:**
* OAuth 2.0 (tutte le varianti supportate)
* JWT (JSON Web Token)
* Autenticazione di base
* AWS Signature v4
* Autenticazione personalizzata
* Nessuna autenticazione (per API aperte o endpoint pubblici)
Le credenziali esterne e le credenziali denominate sono progettate intorno a una chiara separazione dei doveri. Una credenziale esterna definisce le modalità di autenticazione, specificando il protocollo di autenticazione, il tipo di token e il comportamento di aggiornamento per la connessione ai sistemi esterni. Una credenziale denominata, invece, definisce dove connettersi, ovvero l'URL endpoint e quale credenziale esterna utilizzare per quella connessione. Questa progettazione garantisce che la logica di autenticazione e la configurazione dell'endpoint rimangano disaccoppiate, consentendo a Salesforce di supportare protocolli di integrazione diversi in modo sicuro mantenendo una gestione delle credenziali centralizzata e coerente in tutta l'azienda.
### Come i connettori Data 360 sfruttano questo framework
Mentre l'interfaccia utente di Data 360 astrae gran parte della configurazione sottostante, il framework Credenziale denominata e Credenziale esterna viene spesso utilizzato in background dai connettori e dagli stream di dati nativi. Ciò significa che, anche quando gli amministratori stanno semplicemente "aggiungendo una connessione dati" tramite un'interfaccia utente guidata, Data 360 continua ad applicare questo modello di sicurezza standardizzato in background.
Implicazioni architettoniche:
* **Modello di sicurezza unificato:** Tutti i connettori, sia quelli per un database esterno, AWS S3 o un'API aziendale, beneficiano degli stessi standard di crittografia, autenticazione e gestione delle chiavi imposti dalle credenziali denominate ed esterne.
* **Astrazione sviluppatore:** Gli sviluppatori e gli amministratori non devono gestire manualmente i flussi di autenticazione o la rotazione delle credenziali. Salesforce gestisce automaticamente il ciclo di vita, la scadenza e l'aggiornamento dei token.
* **Coerente applicazione delle policy:** Questo framework garantisce che tutti i connettori rispettino policy di autenticazione, controllo e registrazione coerenti, fondamentali per l'inserimento su larga scala di più fonti nei settori regolamentati.
* **Estendibilità a prova di futuro:** Man mano che Salesforce migliora lo stack di autenticazione (ad esempio per supportare nuovi flussi OAuth o standard FIDO2), questi miglioramenti si propagano automaticamente in tutti i connettori senza richiedere refactoring o ridistribuzioni.
### Protezione e governance del connettore Data 360
Salesforce Data 360 offre un'ampia suite di connettori pronti all'uso che semplificano l'integrazione dei dati da varie fonti. Ciò consente alle aziende di consolidare e utilizzare i propri dati in modo efficiente. Salesforce offre diversi tipi di connettori, inclusi connettori Salesforce nativi, connettori di archiviazione cloud, connettori di database e connettori API e di applicazioni. Oltre ai connettori offerti, sono supportati anche gli strumenti ETL zero. I connettori Salesforce consentono una perfetta integrazione tra i prodotti Salesforce, ad esempio Sales Cloud, Service Cloud e Marketing Cloud, con Data 360\. Inoltre, è disponibile una gamma di connettori per i provider di cloud storage, tra cui Amazon S3, Google Cloud Storage e Azure Data Lake. I connettori predefiniti per database come Snowflake, Redshift e BigQuery consentono alle aziende di collegare i data warehouse esistenti a Data 360\. Inoltre, Data 360 fornisce connettori per varie applicazioni e API di terze parti, ad esempio annunci Google, annunci Facebook e altre piattaforme di marketing. Per ottimizzare la flessibilità, Data 360 si integra con strumenti ETL come MuleSoft e Informatica.
 #### Connettori Data Security e Salesforce Data 360
La sicurezza dei dati archiviati in Salesforce Data 360 è stata al centro di molte conversazioni correlate a Data 360. Nell'ambito dell'impegno di Salesforce per un approccio di sicurezza improntato alla difesa, viene data pari importanza alla protezione delle modalità di inserimento dei dati nell'ambiente Data 360.
Salesforce riconosce che le aziende operano in ecosistemi di dati diversi, che spesso si estendono su più piattaforme cloud, soluzioni di archiviazione e strumenti di analisi. I connettori Data 360 fungono da ponte tra questi ambienti. Il connettore consente un'integrazione dei dati sicura, scalabile ed efficiente mantenendo gli elevati standard di sicurezza di Salesforce. Questi connettori facilitano un flusso di dati senza interruzioni senza compromettere l'integrità o la privacy.
I tre componenti essenziali della protezione del connettore Data 360 sono:
* **Mappatura di autenticazione/autorizzazione**: La gestione sicura degli accessi è fondamentale per la sicurezza dei dati. Diversi connettori cloud utilizzano meccanismi di autenticazione e autorizzazione diversi per convalidare e controllare l'accesso degli utenti. L'autenticazione garantisce che gli utenti o i sistemi siano entità legittime, mentre l'autorizzazione definisce il livello di accesso concesso. Salesforce garantisce che, ove possibile, i connettori utilizzino gli standard del settore.
* **Interoperabilità della funzione Copia zero (ZETL)**: La duplicazione dei dati presenta problemi di sicurezza e operativi. Ciò comporta anche costi di memoria inutili, incoerenze dei dati e una maggiore esposizione al rischio. L'approccio Zero Extract, Transform and Load (ZETL) di Salesforce garantisce che la condivisione dei dati in tempo reale tra le piattaforme possa avvenire senza richiedere la replica fisica dei dati. Ciò significa che i dati possono rimanere nel loro ambiente originale pur essendo accessibili per l'elaborazione, la generazione di rapporti e l'analisi. Inoltre, questo riduce in modo significativo la superficie di attacco e migliora la potenziale conformità alle leggi sulla residenza dei dati.
* **Supporto della federazione dei dati**: Negli ambienti multi-cloud odierni, le organizzazioni necessitano di un accesso completo ai dati senza inutili spostamenti dei dati. Il modello di dati federato del connettore Data 360 supporta sia la federazione dei dati basata su file che quella basata su query, consentendo alle aziende di sfruttare le fonti di dati esterne in tempo reale. Sia che si acceda a database strutturati, registri semi-strutturati o file non strutturati, i connettori Salesforce assicurano che i dati rimangano protetti per tutto il ciclo di vita.
Salesforce mira a fornire ai propri clienti la trasparenza necessaria per affrontare le complessità della sicurezza e della conformità dei dati, anche con le integrazioni. Sia che si integrino con AWS S3, Google Cloud Storage, Snowflake o altre piattaforme, i nostri connettori Data 360 sono progettati per garantire Trust, trasparenza e controllo sui dati aziendali critici.
##### Mappatura di sicurezza e autenticazione del connettore Salesforce Data 360
| Tipo di connettore | Supporto del tipo di connessione | Tipi di autenticazione principali | Aspetti e note chiave sulla sicurezza |
|---|---|---|---|
| Salesforce CRM | N/D (interno) | Basato su sessioni (interno) | Utilizza il solido modello IAM (Internal Identity & Access Management) di Salesforce. Tutti i dati vengono crittografati in transito e a riposo nell'infrastruttura Salesforce. |
| Coinvolgimento in Marketing Cloud | Solo Internet pubblico | OAuth 2.0, nome utente/password | Per l'autenticazione sicura vengono utilizzati protocolli OAuth 2.0 standard. I dati vengono crittografati in transito (TLS) su Internet pubblico. |
| B2C Commerce | Solo Internet pubblico | OAuth 2.0 | OAuth 2.0 standard. Si basa su protocolli Internet pubblici protetti (TLS) per il trasferimento dei dati. |
| App Web e mobile | Solo Internet pubblico | Chiavi API, OAuth 2.0 | Dati inseriti tramite API (API di inserimento, Streaming API). Sicurezza gestita tramite la gestione delle chiavi API e i protocolli Web standard. |
| Amazon S3 | Private Connect & Public (Connessione privata e pubblica) | Ruoli IAM, credenziali esterne | Supporta AWS PrivateLink per una connessione privata protetta. La connessione pubblica utilizza credenziali protette. I dati vengono crittografati in transito e a riposo (le chiavi gestite dal cliente in S3 sono facoltative). |
| Snowflake | Private Connect & Public (Connessione privata e pubblica) | OAuth 2.0, Autenticazione chiave privata, Nome utente/password | Supporta la connessione privata VPC (AWS PrivateLink). Connessione pubblica disponibile con metodi di autenticazione sicuri. I dati possono essere crittografati con le chiavi del cliente in Snowflake. |
| Amazon Redshift | Private Connect & Public (Connessione privata e pubblica) | Nome utente/password, autenticazione IAM | Supporta la connessione privata (AWS PrivateLink). La connessione pubblica utilizza le procedure consigliate di sicurezza standard. |
| Microsoft Azure (Memoria/SQL) | Solo Internet pubblico | Token SAS, OAuth 2.0, Nome utente/Password | Le connessioni si basano su token SAS o OAuth protetti per l'autenticazione. I dati attraversano Internet pubblico tramite canali crittografati (TLS). |
| Google Cloud Storage (GCS) | Solo Internet pubblico | OAuth 2.0, Account di servizio | Le connessioni si basano su OAuth 2.0 protetto. I dati attraversano Internet pubblico tramite canali crittografati (TLS). |
| MuleSoft (API) | Solo Internet pubblico | OAuth 2.0, chiave API | Si connette tramite API. La sicurezza è gestita tramite l'autenticazione API standard e policy di governance efficaci implementate tramite MuleSoft Anypoint Platform. |
| Fase | Meccanismo | Controlli di sicurezza / governance |
|---|---|---|
| Configurazione attivazione | Definito nell'impostazione dell'attivazione di Data 360 | Protetto tramite credenziali denominate e credenziali esterne |
| Preparazione dei dati | Filtrati e uniti dai DMO | Metadati di consenso e privacy applicati |
| Trasferimento in uscita | Crittografato tramite TLS / Private Connect | Applicazione delle policy e astrazione delle credenziali |
| Consegna esterna | SFTP / Cloud Storage / API | Accedi a una consegna controllata e controllabile |
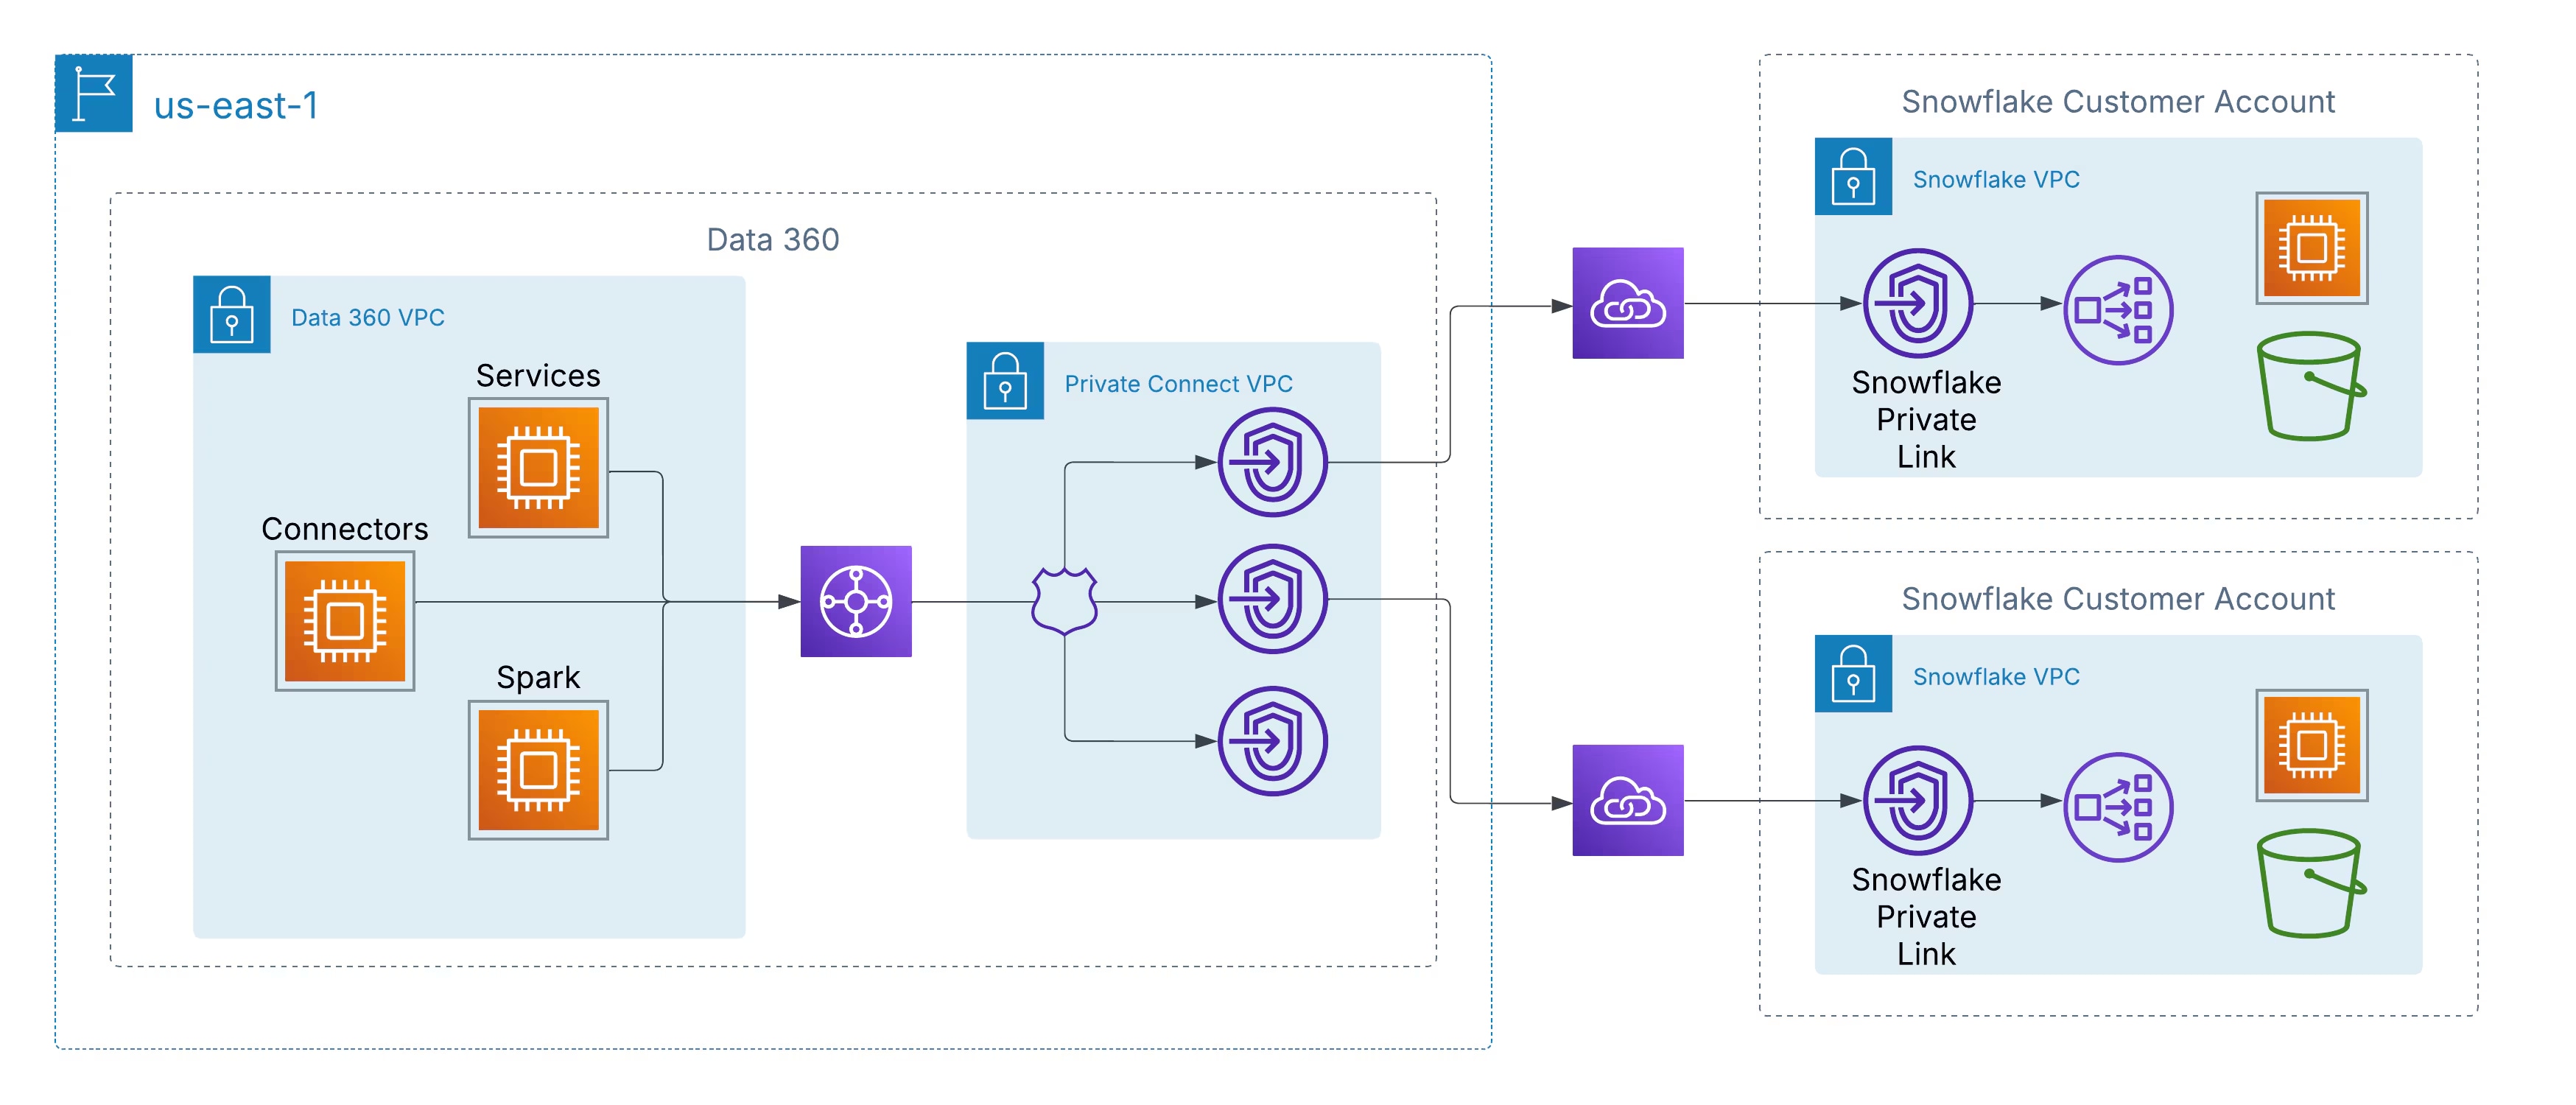 Tutte le comunicazioni rimangono all'interno della backbone AWS, utilizzando indirizzi IP privati e percorsi di rete non instradabili, eliminando così il rischio di intercettazione dei dati in transito e soddisfacendo rigorosi requisiti di sicurezza aziendali e normativi.
Questa architettura garantisce:
* **Esposizione zero a Internet:** I dati non escono mai dalla rete privata AWS.
* **Comunicazione IP privata:** Il traffico rimane isolato e non affrontabile esternamente.
* **Allineamento conformità:** Soddisfa standard di sicurezza come ISO 27001, SOC 2 e FedRAMP.
#### Interconnessione privata: Estensione della sicurezza tra i cloud
Per supportare i clienti che operano in ambienti multi-cloud, Salesforce sta estendendo gli stessi principi di sicurezza oltre AWS tramite Private Interconnect. Questa funzionalità consente la connettività privata tra cloud tra Data 360 e data lake ospitati in Azure o Google Cloud, mantenendo le stesse garanzie di instradamento privato, zero viaggi su Internet e traffico solo backbone crittografato.
Sono disponibili due modelli di distribuzione architettonica:
* **Interconnessione gestita dal cliente:** I clienti integrano i circuiti di rete privati esistenti, ad esempio Azure ExpressRoute, Google Cloud Interconnect o Equinix Fabric, direttamente con i VPC Data 360.
* **Interconnessione gestita Salesforce:** Salesforce esegue il provisioning e gestisce il collegamento tra cloud, esponendo gli endpoint del servizio privato nell'ambiente cloud di destinazione del cliente per un'impostazione chiavi in mano.
### Protezione dei cancelli: Funzionalità di sicurezza API in Salesforce Data 360
Salesforce Data 360, una potente piattaforma per l'unificazione dei dati aziendali, è dotata di controlli di sicurezza efficaci e a più livelli. Per i clienti, la gestione della sicurezza API è una parte fondamentale di una strategia di protezione dei dati completa, che consente loro di controllare l'accesso, gestire le integrazioni e monitorare l'utilizzo in modo efficace.
Di seguito sono riportate le funzionalità chiave disponibili per i clienti per configurare, controllare e gestire la protezione API in Salesforce Data 360.
#### Funzioni e funzionalità chiave di sicurezza API
I clienti possono utilizzare diverse funzioni Salesforce incorporate per garantire un accesso API sicuro alle istanze di Data 360:
##### 1\. Autenticazione e autorizzazione avanzate (OAuth 2.0)
Salesforce impone un'autenticazione rigorosa per le API Data 360, con OAuth 2.0 come protocollo standard e consigliato.
* **App connesse**: I clienti creano e configurano le applicazioni connesse per gestire l'accesso alle applicazioni esterne. Questo è il meccanismo principale per l'autenticazione e la concessione dell'accesso alle API di inserimento e query di Data 360.
* **Ambiti OAuth**: Gli amministratori possono definire ambiti OAuth specifici (ad esempio, cdp_ingest_api, api) per richiedere le autorizzazioni minime richieste, rispettando il principio dei privilegi minimi.
* **Autenticazione a più fattori (MFA)**: Salesforce Authenticator e altre soluzioni MFA possono essere applicate, aggiungendo un livello di sicurezza essenziale e assicurando che solo gli utenti verificati possano accedere al sistema, anche tramite gli accessi API.
##### 2\. Controllo dell'accesso granulare e autorizzazioni
I clienti hanno un controllo preciso su quali utenti e applicazioni possono accedere ai dati e quali azioni possono eseguire.
* **Controllo dell'accesso API (funzionalità)**: Una volta abilitata dall'Assistenza Salesforce, questa funzione consente agli amministratori di approvare esplicitamente quali applicazioni connesse possono essere utilizzate per accedere alle API. Tutte le app non approvate vengono bloccate automaticamente, riducendo in modo significativo il rischio di estrazione di dati non autorizzata.
* **Insiemi di autorizzazioni e profili**: Gli amministratori gestiscono l'accesso API assegnando l'autorizzazione "API abilitata" tramite i profili utente o gli insiemi di autorizzazioni dedicati. Ciò garantisce che gli utenti abbiano accesso solo alle funzioni lavorative.
* **Controllo dell'accesso basato sui ruoli (RBAC)**: In Data 360, i clienti possono creare e gestire policy di controllo dell'accesso basate sui ruoli per definire i livelli di accesso ai dati (protezione a livello di oggetto, campo e record), garantendo coerenza e controllo in tutta la piattaforma.
* **Utenti integrazione dedicati**: Le procedure consigliate consigliano di creare utenti "Solo API" specifici per le integrazioni, limitando le loro autorizzazioni solo a quanto necessario per la chiamata API, anziché utilizzare un account amministratore di sistema.
##### 3\. Controlli della sicurezza di rete
* **Intervalli IP di whitelisting/accesso**: I clienti possono limitare l'accesso API a un intervallo definito di indirizzi IP affidabili. Qualsiasi tentativo di accesso da un intervallo IP non approvato può essere negato o contestato per la verifica.
* **Connessione privata**: Basata su AWS PrivateLink, questa funzione consente agli amministratori di gestire i dati sensibili senza esporre gli endpoint a Internet pubblico, eliminando il rischio di attacchi agli endpoint visibili pubblicamente.
* **Crittografia in transito e a riposo**: Tutti i dati sono crittografati in transito (utilizzando TLS) e a riposo, proteggendo le informazioni sensibili da accessi non autorizzati anche se intercettati.
##### 4\. Monitoraggio, controllo e governance
La visibilità è fondamentale per la sicurezza. Salesforce offre strumenti completi per il monitoraggio e il controllo dell'attività API.
* **Monitoraggio evento**: Fornisce il tracciamento quasi in tempo reale di vari eventi, incluse le chiamate API e i tentativi di accesso. I clienti possono utilizzare questi dati per il controllo e per creare policy sulla sicurezza delle transazioni.
* **Centro di sicurezza**: Questa funzione offre una visualizzazione unica e consolidata delle metriche di sicurezza, conformità e governance in tutte le organizzazioni Salesforce, semplificando il monitoraggio e la gestione.
* **Traccia di controllo**: Aiuta i clienti a tenere traccia degli accessi e della cronologia dei campi, a monitorare le modifiche alle impostazioni e ad adempiere agli obblighi di controllo e di conservazione dei dati.
* **Funzioni di governance dei dati**: Include l'assegnazione e la classificazione dei dati, l'imposizione delle policy e il mascheramento dinamico dei dati per garantire l'applicazione di policy di governance coerenti in tutti i punti di contatto dei dati, inclusi quelli a cui si accede tramite API.
#### Impostazione e gestione della sicurezza API: Un customer journey
1. Abilita controlli centrali: Iniziare abilitando le impostazioni predefinite dell'organizzazione come la MFA e le restrizioni IP.
2. Richiedi controllo accesso API: Registrare un caso con l'Assistenza Salesforce per abilitare la funzione "Controllo accessi API" nell'organizzazione.
3. Configura applicazioni connesse: Creare applicazioni connesse specifiche per ogni integrazione, definendo gli ambiti OAuth richiesti e assegnandoli ai profili/insiemi di autorizzazioni autorizzati.
4. Implementa privilegi minimi: Assicurarsi che tutti gli utenti integrazione dispongano delle autorizzazioni "Solo API" e di un accesso minimo ai dati.
5. Monitoraggio e controllo: Utilizzare regolarmente il Centro di monitoraggio e sicurezza eventi per esaminare l'utilizzo dell'API, rilevare anomalie ed eseguire valutazioni delle vulnerabilità.
6. Applica procedure consigliate: Applicare sempre TLS, archiviare in modo sicuro i token di aggiornamento, ruotare gli ID sessione e convalidare gli input di dati.
Sfruttando queste funzionalità efficaci e configurabili dai clienti, le aziende possono mantenere un ambiente sicuro e conforme per tutte le interazioni API all'interno di Salesforce Data 360.
### Conformità, controllo e monitoraggio continuo
#### Disponibilità del servizio e residenza dei dati
Salesforce Data 360 è progettato per soddisfare i requisiti di residenza dati globale e sovranità attraverso il modello di distribuzione distribuito geograficamente. Il servizio è attualmente disponibile in più regioni regolamentate, tra cui Stati Uniti, Canada, Brasile, Germania, India, Australia e Giappone.
La residenza dei dati viene determinata mappando l'istanza Core Org di ogni cliente all'istanza regionale Data 360 corrispondente più vicina. Ad esempio, le organizzazioni centrali situate negli Stati Uniti o in Canada sono abbinate a un'istanza di Data 360 nella regione degli Stati Uniti, mentre le organizzazioni centrali all'interno dell'Unione europea sono mappate a un'istanza ospitata in Germania. Analogamente, le organizzazioni Core in India, Australia, Nuova Zelanda o Singapore sono associate a un'istanza di Data 360 ospitata in India.
L'infrastruttura Hyperforce di Salesforce è alla base di questo modello, fornendo le basi per il controllo dei dati geografici, l'isolamento della sicurezza e la conformità alle normative. Hyperforce garantisce che i dati dei clienti, inclusi metadati, backup e serie di dati derivate, rimangano entro confini regionali definiti. Questa architettura consente alle aziende di soddisfare i requisiti locali di residenza dei dati e conformità, come GDPR, FFIEC, HIPAA e le leggi regionali sulla privacy in APAC ed EMEA.
Salesforce continua a espandere la disponibilità di Data 360 in altre regioni Hyperforce per allinearsi agli standard globali in continua evoluzione in materia di privacy, ai requisiti di conformità regionali e alle aspettative dei clienti per il controllo sovrano dei dati.
#### Abilitazione della conformità normativa
Salesforce Data 360 è progettato per aiutare le aziende a soddisfare i severi requisiti globali in materia di privacy e normative come GDPR e CCPA. La piattaforma offre funzionalità native per la gestione dei diritti degli interessati (DSR), tra cui l'accesso, l'esportazione e l'eliminazione dei dati ("Diritto all'oblio"), garantendo una gestione conforme dei dati personali in tutto il suo ciclo di vita.
Mentre il cliente mantiene la responsabilità finale della conformità, Salesforce opera come "fornitore di servizi" certificato in base a regolamenti come il CCPA, offrendo i controlli a livello di piattaforma, le garanzie di sicurezza e i meccanismi contrattuali che consentono alle organizzazioni di implementare i propri framework di conformità in modo efficiente e su larga scala.
#### Foundational Trust: Certificazioni e attestazioni
Trust è la pietra angolare della piattaforma Salesforce e tale Trust si guadagna attraverso la convalida indipendente. Salesforce mantiene un ampio portafoglio di certificazioni e attestazioni di sicurezza globali che dimostrano il suo costante impegno a proteggere i dati dei clienti e a rispettare i più elevati standard di sicurezza nel cloud.
Queste certificazioni non sono semplici caselle di controllo: rappresentano controlli rigorosi e ricorrenti che verificano la solidità e la coerenza dei controlli di sicurezza, dei processi e dell'infrastruttura Salesforce. Insieme, costituiscono la spina dorsale del modello Trust fondamentale di Salesforce.
**Le certificazioni e le attestazioni chiave includono:**
* **ISO/IEC 27001:** Convalida il sistema di gestione completo della sicurezza delle informazioni di Salesforce.
* **ISO/IEC 27017:** Stabilisce le procedure consigliate per i controlli di sicurezza specifici del cloud.
* **ISO/IEC 27018:** Si concentra sulla protezione delle informazioni personali (PII) nel cloud.
* **SOC 1, SOC 2 e SOC 3:** Rapporti indipendenti che confermano la progettazione e l'efficacia operativa dei controlli di sicurezza e privacy di Salesforce.
* **PCI DSS:** Garantisce l'elaborazione e l'archiviazione sicure delle informazioni della carta di pagamento.
* **FedRAMP High & DoD Impact Livello 4:** Certifica Salesforce Government Cloud per l'utilizzo da parte delle agenzie federali degli Stati Uniti che gestiscono carichi di lavoro sensibili.
Mantenendo questo insieme completo di certificazioni, Salesforce offre ai clienti la certezza che i loro dati vengono gestiti all'interno di una piattaforma che soddisfa, e spesso supera, le aspettative di conformità e sicurezza globali.
### Massimizzare la visibilità: Registrazione, monitoraggio e osservabilità in Salesforce Data 360
Nel panorama digitale frenetico di oggi, avere una visione a 360 gradi dei dati dei clienti è fondamentale, ma altrettanto importante è avere una visione a 360 gradi della piattaforma che gestisce tali dati. Salesforce Data 360 offre funzionalità avanzate di registrazione, monitoraggio e osservabilità che consentono ai clienti di garantire qualità, sicurezza e prestazioni dei dati.
Questi strumenti consentono di passare dalla risoluzione reattiva dei problemi alla gestione proattiva, garantendo che l'implementazione di Data 360 funzioni in modo fluido ed efficiente.
#### Rilevamento e risposta proattivi alle minacce
La sicurezza non si esaurisce con la prevenzione, ma si evolve con la vigilanza. In un panorama di minacce in costante cambiamento, Salesforce combina funzionalità avanzate di monitoraggio della piattaforma con processi di revisione gestiti dai clienti per garantire una protezione continua e proattiva.
Salesforce offre potenti strumenti nativi per la visibilità e il rilevamento delle minacce:
* L'**itinerario di controllo** delle impostazioni acquisisce una cronologia completa delle modifiche amministrative, aiutando i team a tenere traccia della configurazione o degli aggiornamenti delle policy.
* **Monitoraggio evento** offre informazioni approfondite sul comportamento degli utenti, sull'attività API e sugli schemi di accesso ai dati. Questa telemetria può essere integrata perfettamente con una soluzione SIEM (**Security Information and** Event Management) per l'analisi e la correlazione centralizzate.
#### 1\. Monitoraggio evento: Il polso dell'organizzazione
Monitoraggio evento, parte dell'offerta Salesforce Shield, è l'hub centrale per tenere traccia dell'attività dettagliata degli utenti e dei dati sulle prestazioni del sistema nell'organizzazione Salesforce, incluse le azioni specifiche di Data 360. Acquisisce una vasta gamma di "eventi" in file di registro e oggetti per l'analisi.
* **File del registro eventi (ELF):** Forniscono dettagli granulari dell'attività degli utenti e degli eventi di sistema, disponibili per il download dopo un breve ritardo (ogni ora o ogni giorno). È possibile accedere a un massimo di 30 giorni di dati tramite API o il browser Event Log File, con l'opzione di esportazione per l'archiviazione a lungo termine.
* **Monitoraggio evento in tempo reale:** Per approfondimenti immediati, gli eventi in tempo reale vengono trasmessi in streaming come eventi piattaforma, consentendo di monitorare e rilevare l'attività quasi in tempo reale. Questo è fondamentale per la sicurezza e le prestazioni, consentendo di intervenire immediatamente se necessario.
* **Eventi specifici di Data 360:** Monitoraggio evento include tipi di eventi specifici per l'utilizzo di Data 360, ad esempio Visualizzazione pagina Lightning, Interazione Lightning ed Evento rapporto correlato alle pagine e ai dati di Data 360.
* **Integrazione con strumenti esterni:** Salesforce facilita l'integrazione con le più diffuse soluzioni di monitoraggio di terze parti come Splunk, Datadog, New Relic e Sumo Logic. È possibile inviare in streaming o esportare i dati di Monitoraggio evento a queste piattaforme per un'osservabilità consolidata in tutto lo stack tecnologico.
#### 2\. Monitoraggio e ottimizzazione delle prestazioni
Comprendere le prestazioni dell'implementazione di Data 360 è fondamentale per un'esperienza utente ottimale.
* **App Utilizzo Lightning:** Questa applicazione incorporata offre una visualizzazione aggregata delle metriche delle prestazioni, ad esempio i tempi di caricamento delle pagine (Experienced Page Time o EPT) e le prestazioni del browser, per le pagine Data 360 in Lightning Experience.
* **Rapporti e cruscotti digitali personalizzati:** È possibile creare rapporti e cruscotti digitali personalizzati utilizzando gli oggetti Data 360 e i dati di Monitoraggio evento, anche utilizzando un'app CRM Analytics basata su modelli gratuita denominata Monitoraggio evento Plus. Queste visualizzazioni consentono di individuare rapidamente le tendenze e i colli di bottiglia delle prestazioni.
Ma la tecnologia da sola non basta. Una vera resilienza richiede una collaborazione disciplinata tra rilevamento automatico e riesame umano. Gli avvisi automatici possono evidenziare anomalie in tempo reale, ma le minacce subdole o a lungo termine, ad esempio l'esfiltrazione lenta e non autorizzata dei dati da parte di un utente valido, vengono spesso identificate meglio attraverso controlli periodici e analisi delle tendenze.
Salesforce fornisce la telemetria, i registri di controllo e gli hook di integrazione; i clienti apportano il rigore del processo, la cadenza operativa e l'intelligenza specifica del contesto. Insieme, costituiscono un **modello di difesa** approfondita che combina automazione, analisi e supervisione umana per rilevare, analizzare e rispondere alle minacce prima che diventino incidenti.
### Guidare decisioni informate: Rapporti, cruscotti digitali, metriche e notifiche in Salesforce Data 360
Salesforce Data 360 non si limita a unificare i dati dei clienti, ma li rende intelligenti e fruibili. Una parte fondamentale di questa proposta di valore è la fornitura di rapporti efficaci, cruscotti digitali potenti, metriche approfondite e funzioni di notifica in tempo reale. Questi strumenti consentono ai clienti di monitorare lo stato dei dati, monitorare le prestazioni e automatizzare le azioni in base ai dati unificati, il tutto all'interno del familiare ambiente Salesforce.
#### Rapporti e cruscotti digitali: Hub di visualizzazione dei dati
Le funzionalità native di rapporti e cruscotti digitali di Salesforce si estendono perfettamente in Data 360, consentendo di visualizzare e analizzare i dati unificati senza uscire dalla piattaforma.
#### Creazione di rapporti sui dati unificati
È possibile creare rapporti standard e personalizzati sui dati archiviati in Data 360, inclusi dati unificati provenienti da varie fonti e approfondimenti calcolati.
* **Tipi di rapporti standard e personalizzati:** Data 360 introduce nuovi tipi di rapporto specifici per gli oggetti Data 360, ad esempio Stream di dati, Segmenti, Attivazioni, Risoluzione dell'identità e Approfondimenti calcolati. Ciò consente di eseguire query sui dati unificati con i generatori di rapporti Salesforce standard.
* **Analisi granulare:** I rapporti supportano fino a 10 raggruppamenti di righe, consentendo una segmentazione più precisa e un'analisi dettagliata degli attributi e delle tendenze dei clienti.
* **Formule e riepiloghi:** È possibile utilizzare le formule a livello di riga e di riepilogo per valutare ogni record o gruppo di record, consentendo di tenere traccia di metriche dettagliate e riepiloghi aggregati di alto livello in un unico rapporto.
#### Cruscotti digitali dinamici per visualizzazioni olistiche
I cruscotti digitali offrono una visualizzazione visiva delle principali metriche e tendenze dell'implementazione di Data 360.
* **Visualizzazione unificata:** È possibile combinare i dati di più rapporti di Data 360 o persino combinare i rapporti di Data 360 con rapporti CRM standard in un unico cruscotto digitale per una visione olistica delle attività e degli approfondimenti sui clienti.
* **Widget personalizzabili:** Utilizzare vari tipi di grafico (a barre, a linee, a torta, a indicatore, ecc.) e tabelle per visualizzare i dati del rapporto in modo efficace.
* **Approfondimenti in tempo reale:** I cruscotti digitali possono essere aggiornati per fornire informazioni aggiornate, facilitando un processo decisionale rapido e basato sui dati.
#### Metriche e KPI: Misurare il successo
Data 360 consente di definire e tenere traccia degli indicatori di prestazione chiave (KPI) pertinenti ai propri obiettivi aziendali. Questi possono essere generati tramite:
* **Approfondimenti calcolati:** Creare metriche efficaci utilizzando i dati elaborati in batch a volume elevato. Ad esempio, calcolare metriche come "Valore medio durata cliente" o "Reddito totale attivo contratto" e utilizzarle come dimensioni o misure nei rapporti e nei cruscotti digitali.
* **Approfondimenti streaming:** Elaborare i dati da fonti di streaming quasi in tempo reale per creare aggregazioni di serie temporali, ad esempio dati di coinvolgimento di siti Web o dispositivi mobili. Queste metriche possono favorire orchestrazioni immediate e azioni sui dati.
#### Notifiche e avvisi: Rimanere informati e proattivi
Salesforce offre potenti funzioni di automazione e notifica per garantire la conoscenza di eventi critici o modifiche dei dati in Data 360.
* **Notifiche basate sui flussi:** È possibile impostare Flussi di processo per attivare azioni e inviare notifiche basate sugli eventi negli oggetti Data 360 come Stream di dati, Segmenti e Attivazioni.
* **Avvisi personalizzati:** Creare notifiche personalizzate che attivano un messaggio email o vengono visualizzate nella Campana delle notifiche di Salesforce quando vengono soddisfatte condizioni specifiche. Ad esempio, è possibile ricevere un avviso se uno stream di dati non riesce, se una regola di risoluzione dell'identità rileva un errore o se una metrica chiave supera una determinata soglia.
* **Servizio di notifica degli eventi (ENS):** Per gli sviluppatori, il servizio di notifica evento API-first consente ai sistemi esterni di ricevere notifiche quando si verificano determinati eventi, consentendo un'integrazione senza interruzioni e reazioni in tempo reale in tutto lo stack tecnologico.
* **Azioni dati:** In base agli approfondimenti streaming, è possibile attivare azioni dati, che possono essere configurate per inviare avvisi, invocare eventi piattaforma o integrarsi con altre applicazioni SaaS tramite webhook.
Sfruttando queste funzionalità complete, i clienti di Salesforce Data 360 possono monitorare efficacemente il proprio ecosistema di dati, visualizzare le metriche chiave e ricevere avvisi tempestivi per favorire il coinvolgimento proattivo e l'eccellenza operativa.
### Raccomandazioni strategiche per l'adozione a livello aziendale
L'adozione di Salesforce Data 360 su scala aziendale non richiede solo l'abilitazione tecnica: richiede un'architettura deliberata e basata sulla sicurezza. I seguenti consigli strategici offrono ai CTO e agli architetti aziendali una roadmap per creare Trust, resilienza e conformità in ogni livello della distribuzione di Data 360.
* **Attuazione di un approccio "Secure by Design":** La sicurezza non deve essere adattata, deve essere fondamentale. Iniziare con la policy *"Nega tutto"* predefinita di Salesforce e concedere esplicitamente l'accesso in base alle esigenze. Definire governance, policy e framework di accesso prima di inserire o attivare i dati. La creazione della sicurezza fin dal primo giorno elimina il rischio di esposizioni nascoste e semplifica la conformità a lungo termine.
* **Applicare una strategia di gestione dell'identità e dell'accesso (IAM) efficace:** Centralizzare l'identità tramite SSO federato e applicare l'autenticazione a più fattori (MFA) per ridurre la compromissione delle credenziali. Limitare l'accesso in base agli intervalli IP di accesso e utilizzare le funzionalità IdP (Identity Provider) di Salesforce per stabilire la responsabilità end-to-end tra gli utenti e le integrazioni. Un livello IAM unificato riduce la complessità operativa e indurisce la superficie di autenticazione.
* **Applicare il principio dei privilegi minimi :** Progettare i ruoli per precisione, non per praticità. Utilizzare gli insiemi di autorizzazioni standard di Salesforce come base per la separazione dei doveri, assicurando che gli utenti accedano solo a ciò che è necessario. Evitare un'eccessiva personalizzazione delle autorizzazioni: ogni deviazione aumenta il sovraccarico di manutenzione e il rischio di accesso non intenzionale.
* **Istituzione di un framework di governance dei dati a più livelli:** Separare i dati in base all'unità operativa o al marchio utilizzando gli spazi dati e applicare il controllo dell'accesso basato sugli attributi (ABAC) con la protezione a livello di oggetto, campo e record (OLS, FLS, RLS). Utilizzare il mascheramento dinamico dei dati per proteggere le informazioni sensibili in tempo reale senza ostacolare l'analisi o la fruibilità. Questo modello a livelli garantisce che la governance rimanga coerente man mano che i dati vengono scalati tra i domini.
* **Sfruttare strategicamente la crittografia e le integrazioni sicure:** Per i carichi di lavoro sensibili, distribuire Crittografia piattaforma con chiavi gestite dal cliente (CMK) per mantenere la sovranità sul ciclo di vita della crittografia. Utilizzare le credenziali denominate e Private Connect per proteggere tutte le integrazioni da sistema a sistema, eliminando i segreti codificati e garantendo che tutto il traffico rimanga privato, conforme e controllabile.
* **Creazione di un programma di operazioni di sicurezza continua :** La sicurezza non si esaurisce con la configurazione, ma si basa sulla disciplina operativa. Integrare il monitoraggio automatico con revisioni periodiche dei registri eventi e degli itinerari di accesso. Creare una funzione SecOps (Security Operations) dedicata per identificare le anomalie, analizzare le minacce e convalidare la conformità. L'obiettivo: rilevare precocemente, rispondere rapidamente e migliorare continuamente la postura.
### Percorso in avanti: Creazione di Data 360 affidabili e resilienti
Il percorso verso un'azienda sicura e intelligente non si conclude con la distribuzione: si evolve attraverso disciplina, design e Trust. Salesforce Data 360 fornisce le basi dell'architettura, ma il vero valore emerge quando le organizzazioni mettono in atto sicurezza, governance e intelligence come un'unica azione unificata.
Le aziende dovrebbero approcciare Data 360 non come un'altra piattaforma dati, ma come un livello Trust sicuro e componibile che collega dati, intelligenza artificiale e coinvolgimento dei clienti in un unico framework di governance. Adottando una filosofia *protetta fin dalla progettazione*, imponendo privilegi minimi a ogni livello ed estendendo la connettività privata a tutti i flussi di dati, le organizzazioni trasformano la conformità da casella di controllo a vantaggio competitivo.
Il passo successivo è la continua modernizzazione, ovvero l'integrazione dell'automazione del controllo, dell'applicazione delle policy e della gestione del ciclo di vita della crittografia nelle attività quotidiane. Man mano che le aziende si evolvono verso architetture basate sull'intelligenza artificiale, gli stessi principi che proteggono i dati oggi costituiranno la spina dorsale della governance dell'intelligenza artificiale domani, assicurando che ogni modello, agente e decisione sia spiegabile, consapevole delle policy e conforme fin dalla progettazione.
In definitiva, il Trust diventa la nuova valuta della trasformazione digitale. Con Salesforce Data 360, le aziende possono scalare con sicurezza il proprio ecosistema di dati, sapendo che ogni byte, connessione e approfondimento sono protetti, governati e attivati con integrità.
## Informazioni sugli autori
**Krishna Chalamasandra** è un esperto esperto di sicurezza informatica con oltre 25 anni di esperienza nella tecnologia e conformità della sicurezza delle informazioni. In Salesforce, svolge il ruolo di consulente di fiducia per i clienti e di leader chiave nella funzione Security and Compliance Customer Trust all'interno dell'organizzazione CISO. In precedenza, Krishna ha trascorso 10 anni in Cisco, guidando l'architettura di sicurezza in IAM, sicurezza di rete e PKI e guidando certificazioni chiave come ISO 27001, SOC 1–3, PCI, FedRAMP e FIPS 140-2. Ha inoltre trascorso oltre 8 anni in Novell implementando controlli a livello di infrastruttura e supportando revisioni della sicurezza complesse per i clienti globali regolamentati.
**Yugandhar Bora** è un architetto di ingegneria del software di Salesforce, specializzato in architettura dei dati all'interno della piattaforma Data & Intelligence Applications. Dirige iniziative del Comitato di revisione dell'architettura aziendale (EARB) incentrate sulla governance dei dati e sui modelli di dati unificati, contribuendo al contempo alle soluzioni di provisioning automatico della piattaforma.
# Informazioni su questo whitepaper
**Enterprise Agentic Architecture and Design Patterns** struttura le possibilità delle architetture multi-agente, identificando ed evidenziando come le nuove funzionalità per gli agenti AI possano essere combinate per offrire soluzioni agenti affidabili, ripetibili, scalabili e gestibili. Prendendo ispirazione dai “Design Patterns” per la programmazione orientata agli oggetti, definiamo schemi che possono essere combinati ed estesi per risolvere le molte sfide entusiasmanti che prima delle tecnologie agentiche si trovavano al di fuori dell’ambito dei sistemi aziendali basati sulle tecnologie deterministiche tradizionali.
A seguito della discussione sulla logica per le architetture multi-agente, vengono introdotti numerosi schemi agentici, da schemi semplici che sfruttano l'elaborazione del linguaggio naturale per determinare l'intento degli utenti a schemi multi-agente che prevedono la separazione delle preoccupazioni tra gli agenti, a schemi agentici UX che apportano il ragionamento agente alla presentazione e all'interazione con sistemi, informazioni e contenuti.
## Che cosa otterrete da questo documento?
Prima di tutto si otterrà un nuovo modo di pensare agli agenti - agenti come componenti, agenti come compositori, agenti come attori, agenti come collaboratori e, soprattutto, agenti all'interno di un'architettura più ampia che agiscono con intenti e agiscono nell'ambito delle loro preoccupazioni individuali.
Si otterranno i suggerimenti necessari per concepire soluzioni agentiche complete che coprono i journey degli utenti e informano esperienze agenti significative, esperienze che non sono mai state possibili prima.
Le sezioni iniziali di questo documento forniscono la logica per le architetture multi-agente. Leggere questi articoli per comprendere meglio le sfide e le opportunità che le architetture multi-agente presentano.
Di seguito sono riportate le definizioni e le descrizioni degli schemi agenti, da semplici a complessi, che coprono schemi che supportano interazioni, schemi per agenti specializzati, schemi per operazioni in background e schemi di lunga durata. Ogni schema include un diagramma dei componenti chiave che realizzano lo schema, oltre a consigli per l'utilizzo e casi d'uso rappresentativi.
Infine, l'appendice include esempi di come questi schemi vengono combinati in soluzioni agentiche olistiche a supporto di un'esperienza agente più ampia, ad esempio per supportare il Servizio clienti o le Vendite con broker. Fare riferimento a questa sezione per vedere come un'esperienza agente completa sfrutta la scomposizione e la separazione delle preoccupazioni a livello di agente e di azione per favorire il riutilizzo a livello di interazione, con agenti condivisi che supportano componenti interni ed esterni, sia in modalità assistita che autonoma.
## 1\. Architettura di sistema multiagente
Poiché gli architetti aziendali integrano l'intelligenza artificiale generativa nei loro ecosistemi, devono rispondere a una serie di domande comuni sulla progettazione:
- Quanti agenti sono richiesti?
- Come interagiranno gli agenti?
- Qual è la divisione del lavoro tra agenti e umani?
- Come vengono assemblati questi componenti in un sistema coerente?
Questo documento presenta una metodologia basata su schemi per progettare e creare soluzioni agentiche.
Gli agenti _monolitici_ sono il punto di partenza per la maggior parte delle soluzioni agentiche. Gli agenti, e più specificamente gli agenti Agentforce, sono esperti in una vasta gamma di argomenti. Per i casi d'uso più comuni, iniziare con un singolo agente.
Man mano che l'organizzazione cresce, le architetture multi-agente sono l'approccio preferito. L'_architettura multiagente_ consente una maggiore scalabilità, controllo e flessibilità rispetto ai sistemi monolitici a agente singolo.
L'architettura multiagente offre i seguenti vantaggi chiave:
- **Maggiori prestazioni e suddivisione della complessità**: Un sistema di più agenti specializzati offre maggiori funzionalità e semplifica l'osservanza delle istruzioni.
- **Modularità ed estensibilità**: I singoli agenti possono essere aggiunti, sostituiti, modificati e testati con maggiore facilità, il che promuove l'agilità.
- **Resilienza e tolleranza ai guasti**: Il guasto di un singolo componente non compromette l'intero sistema, il che porta a una migliore resilienza complessiva.
- **Governance decentralizzata**: La risoluzione dei problemi e la gestione possono essere isolate per agenti specifici e le relative applicazioni, semplificando la manutenzione e la supervisione.
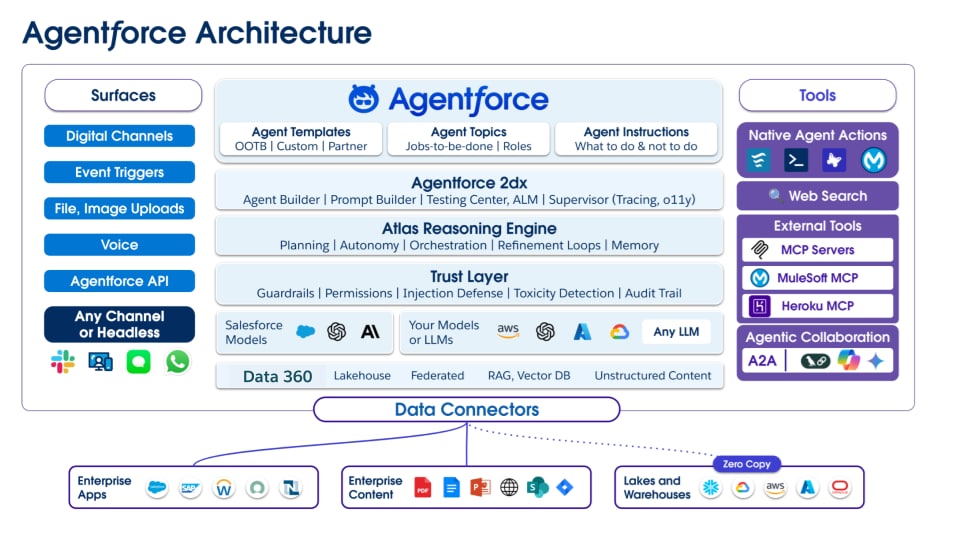 ## 2\. Principi architettonici fondamentali
La razionalizzazione di un'architettura multi-agente inizia con la proiezione dei principi fondamentali dell'architettura sulle capacità e sulla struttura degli agenti. Le architetture multi-agente risultanti sono quindi una manifestazione dei principi di progettazione di sistema e architettura di sistema fondamentali che sono allineati con il "granello" unico delle tecnologie AI.
I principi chiave che guidano questa architettura sono:
- Gestire la complessità tramite la decomposizione
- Migliorare la resilienza e ridurre la fragilità attraverso il disaccoppiamento
- Migliorare l'affidabilità e l'efficienza attraverso il riutilizzo del codice
- Migliorare l'affidabilità degli agenti limitando l'ambito delle preoccupazioni di un agente
- Migliorare la manutenzione e l'evoluzione del sistema attraverso la modularità e l'estensibilità
- Semplificare la gestione e la responsabilità degli agenti grazie alla specializzazione
A differenza delle architetture agenti più primitive (ad esempio, quelle che si concentrano sugli LLM come costrutto architettonico centrale), _Agenteforce fu progettato_ per l'orchestrazione multiagente. L'orchestrazione multi-agente è alla base del motore di ragionamento Atlas e del ragionamento agente per creare percorsi di programmazione dinamici ed efficaci all'interno di una risposta agente per espandere in modo significativo la capacità di offrire un ampio e profondo potenziamento agente all'esperienza utente (UX).
In Agentforce questo tipo di coordinamento è abilitato dai seguenti protocolli chiave aperti e interoperabili e dai prodotti Salesforce:
- **Agenteforce** fornisce un sottosistema Agente per incapsulare tutti gli elementi chiave di un agente: argomenti, istruzioni, azioni, guardrail, contesto, invocazioni, output, dettagli di esecuzione, registri, ecc.
- **Azioni**: fornire hook per accedere ai dati, chiamare flussi, invocare sistemi esterni e chiamare altri agenti.
- **Data 360**: fornisce un livello di virtualizzazione dei dati per offrire all'agente un contesto specifico e personalizzato (sfruttando il profilo unificato e la catena di chiavi di Data 360 per estrarre informazioni specifiche da tutta l'azienda).
E per gli agenti di tutta l'azienda o per accedere ad agenti o risorse, supportiamo:
- **Model Context Protocol (MCP)**: è un livello di comunicazione sicuro che collega gli agenti a strumenti aziendali, dati e Knowledge per garantire la precisione del contesto.
- **Protocollo A2A (**Agent-to-Agent): è una stretta di mano standardizzata per la delega tra agenti che consente un coordinamento sicuro e regolamentato tra sistemi, organizzazioni e fornitori.
Questi principi costituiscono la base per la creazione di un sistema scalabile e governabile di intelligenza orchestrata.
### Considerazioni aggiuntive
Soluzioni agenti solide richiedono approcci chiari ai requisiti non funzionali alla base di un'efficace fornitura di tecnologia:
- Sicurezza e governance (gestione dell'identità e degli accessi, privacy dei dati, sicurezza dei dati e modellazione delle minacce).
- Osservabilità e monitoraggio (tracciamento distribuito, registrazione centralizzata, metriche e cruscotti digitali).
- Operatività e gestione del ciclo di vita (specifica, generazione di casi di test, test, feedback, apprendimento continuo, deprecazione).
Queste sono considerazioni architetturali chiave per la creazione di soluzioni Enterprise Agentic non trattate in questo whitepaper; tuttavia, verranno affrontate nelle pubblicazioni future.
## 3\. Tassonomia degli agenti Enterprise
Per gestire un panorama agentico a livello aziendale, gli architetti devono classificare gli agenti attraverso due lenti complementari: funzione tecnica e impatto sul business.
### 3.1 Classificazione dei ruoli funzionali
Questa tassonomia classifica i ruoli funzionali che gli agenti possono assumere all'interno di un'architettura.
- **Ruoli canale/UX**: Definire la modalità di interazione (ad esempio Headless, Prompt, Chat e messaggi o Aree di lavoro gestite da AI).
- **Ruoli specialistici**: Incapsulare Knowledge di dominio profondo (ad esempio, Esperto di dominio, Minion Knowledge, Assistente o Pianificatore).
- **Ruoli servizio utilità**: Eseguire operazioni transazionali discrete (ad esempio, Generazione, Riepilogo, Trasformazione o Configurazione).
- **Ruoli di servizio proattivi e di manutenzione**: Concentrarsi sullo stato e la qualità dei dati (ad esempio, Cura, Conformazione, Qualità dei dati o Arricchimento dei dati).
- **Ruoli di lunga durata**: Gestire i processi per periodi di tempo estesi (ad esempio, Concierge, Project Manager, Nurturer o Watcher/Alerter).
## 4\. Modello di mappa agente
Per facilitare la progettazione e la comunicazione chiare, la **mappa agente** è il modello standard per descrivere le soluzioni agenti. Definisce entità, sistemi e interazioni chiave all'interno di uno schema di progettazione specifico.
Di seguito sono riportati i componenti del modello Mappa agente:
- **I livelli utente** definiscono gli attori umani del sistema (ad esempio, Clienti, Dipendenti autenticati (SF-Utenti) e Dipendenti non autenticati).
- I **Livelli agente** descrivono gli agenti richiesti, gli schemi presentati, le relazioni reciproche e le istruzioni utilizzate per attualizzare schemi specifici.
- **Contesto/Azioni** sono le risorse, le capacità o le azioni gestite o a cui l'agente accede.
- Le **fonti** sono i dati, le applicazioni, le Knowledge Base sottostanti e altri sistemi a cui gli agenti si connettono.
Le appendici A e B illustrano gli schemi agentici a livello di sistema dimostrandone la composizione all'interno delle swimlane del modello di mappa agente.
## 5\. Framework di schemi agenti
Salesforce utilizza una libreria di schemi degli agenti per organizzare e offrire soluzioni agenti affidabili e prevedibili. Questi schemi sono i nostri modelli per risolvere i problemi architettonici comuni.
Sono raggruppati in quattro categorie principali:
- **Schemi di interazione**: Concentrarsi sul coinvolgimento degli agenti e sull'esperienza utente (UX).
- **Schemi specialistici/lavoratori**: Incapsulare deep Knowledge o competenze specifiche all'interno di un dominio specifico.
- **Utilità e schemi di gestione dei dati**: Eseguire operazioni specifiche, spesso ripetibili, che supportano altri agenti o processi.
- **Schemi di lunga durata**: Gestire i processi e i flussi di lavoro che si verificano in periodi estesi, che includono più fasi.
Le sezioni seguenti descrivono gli schemi chiave di ogni categoria. Ogni descrizione dello schema fornisce una **panoramica**, un **tipo di output**, una **guida all'uso** dello schema, **casi d'uso rappresentativi** e un **diagramma della soluzione**, oltre alla mappatura alla **rubrica Salesforce Agentic Maturity**.
## 6\. Schemi di interazione
Gli _schemi di interazione_ sono strutture di base incentrate sul coinvolgimento degli agenti e sull'esperienza degli utenti.
### Schema di saluto
- **Panoramica**: Lo _schema Greeter_ è uno schema semplice e facile da implementare che utilizza il linguaggio naturale per determinare l'intento dell'utente. Quindi, instrada l'utente all'agente umano appropriato.
- **Tipo di output**: Hand-off/Inoltra al livello superiore alla risorsa successiva.
- **Valore aziendale**: Facilitare un primo contatto semplice ed efficiente per i clienti ottimizzando la risoluzione degli intenti e la raccolta del contesto per i fornitori di servizi.
- **Guida all'uso degli schemi**: Configurare l'agente come risorsa di coinvolgimento principale per i canali del marchio. Fornire istruzioni su marchio, prodotti e servizi abbinate a istruzioni di instradamento basate sull'intento dell'utente. L'agente raccoglie e riepiloga l'intento di fornire un caloroso passaggio di consegne.
- **Caso d'uso rappresentativo**: Si immagini una pagina Web che utilizza un chat bot per presentare un menu di opzioni in cui gli utenti devono fare clic su tutte le opzioni prima di essere instradati a un essere umano. Per migliorare la produttività e l'efficienza del back-office, i chatbot utilizzano spesso percorsi di lavoro e interazioni complessi e complessi. Questo porta a uno scenario di stanchezza "compila, scegli e clicca" per i clienti che spesso si traduce in frustrazione se il loro contesto non rientra nelle opzioni di menu disponibili. Sostituendo i chatbot tradizionali con _Agentic Front Door_, che utilizza interazioni basate sul linguaggio naturale, si alleggerisce il carico e si crea un'interazione simile a quella umana.
- **Procedimento Agentforce**:
- agente dell'assistenza Agentforce: [Assemblaggio di un agente dell'assistenza con Agentforce Builder](https://trailhead.salesforce.com/content/learn/modules/quick-start-assemble-a-service-agent-with-agentforce-builder)
- L'agente dell'assistenza inserito nel pacchetto dispone di funzionalità di trasferimento configurabili che supportano il trasferimento:
- Per gli agenti umani
- Agli agenti AI
- Agli agenti esterni
- Modelli specifici del settore che contengono esempi di codice
- **Diagramma**:
 - **Maturità agente Salesforce**: Livello 1 (o Livello 0 se si utilizza l'agente dell'assistenza pronto all'uso con trasferimento e inoltro al livello superiore incorporati)
### Schema operatore
- **Panoramica**: Lo _schema Operatore si_ basa sullo _schema Greeter_ instradando le richieste all'agente specializzato appropriato o all'intento umano e negoziale (se necessario).
- **Tipo di output**: Passaggio di consegne/Trasferimento alla risorsa successiva.
- **Guida all'uso degli schemi**: Abbinare le istruzioni specifiche del marchio e del servizio alle istruzioni su dove inviare l'utente in base all'intento. Definire le risorse di inoltro al livello superiore, che possono essere persone o altri agenti.
- **Caso d'uso rappresentativo**: Utilizzare la _Porta principale agente_ per gli scenari in cui è presente un alto grado di specializzazione tra i rappresentanti umani o AI.
- **Diagramma**:
 - **Maturità agente Salesforce**: Livello 2
### Schema orchestratore
- **Panoramica**: Lo _schema Orchestrator_ gestisce un "intervento collettivo" dell'agente AI. Quando riceve una richiesta utente, passa l'enunciazione a uno o più agenti specializzati e quindi aggrega le risposte per l'utente. A differenza dello _schema Operatore_, rimane il primo punto di contatto (POC).
- **Tipo di output**: Raccogliere e preparare le risposte degli agenti lavoratori.
- **Guida all'uso degli schemi**: Configurato come coinvolgimento principale. Fornire istruzioni per ogni lavoratore dell'assistenza (ad esempio, un Prioritizer o una PMI del dominio) che consenta all'orchestratore di trasmettere le enunciazioni.
- **Caso d'uso rappresentativo**: Utilizzare lo _schema Orchestrator_ come porta principale dell'agente per assistere i clienti che potrebbero avere bisogno di discutere di più argomenti per conversazione, il che richiede soluzioni multi-agente e interazioni coerenti. In un'architettura multi-sistema, considerare lo _schema Orchestrator_ per coordinare le risposte tra i sistemi e con la collaborazione di agenti esterni.
- **Diagramma**:
 - **Maturità agente Salesforce**: Livello 3
### Schema listener/feed
- **Panoramica**: Lo _schema Ascoltatore/Feed_ mette in evidenza il contesto e gli approfondimenti durante il flusso di una conversazione. L'_ascoltatore_ viene attivato durante ogni turno di conversazione per trovare e visualizzare le informazioni pertinenti per un dipendente.
- **Tipo di output**: Fornire il contesto pertinente in base alla conversazione, che può essere formattata per l'effetto (ad esempio, effettuare confronti o evidenziare punti chiave).
- **Guida all'uso degli schemi**: Collegare l'ascoltatore a un canale a turni (ad esempio, chat, voce o SMS). Definire gli argomenti per ogni area tematica. L'agente consuma la trascrizione, identifica gli argomenti e invoca le azioni per cercare e pubblicare contenuti pertinenti in un feed in esecuzione per il dipendente.
- **Caso d'uso rappresentativo**: Utilizzare l'_Assistente universale_ per fornire assistenza al Servizio clienti o agli agenti di vendita.
- **Diagramma**:
 - **Maturità agente Salesforce**: Livello 3
### Schema dell'area di lavoro (Radar O'Reilly)
- **Panoramica**: Lo _schema Area di lavoro_ gestisce un'interfaccia utente reattiva a un unico riquadro di vetro nel flusso di una conversazione. Elabora ogni enunciazione per aggiornare porzioni dell'unità operativa con contenuti pertinenti.
- **Tipo di output**: Fornire il contesto pertinente che si trova in un portlet all'interno di una visualizzazione a vetro singolo più grande.
- **Guida all'uso degli schemi**: Un agente _orchestratore_ passa le enunciazioni a una suite di agenti _Argomento_. Ogni agente dell'argomento valuta l'istruzione per determinare se è necessario un aggiornamento UX. In caso affermativo, invia tramite push gli aggiornamenti dinamici al LWC corrispondente.
- **Caso d'uso rappresentativo**: Questo funziona come una porta principale agente avanzata.
- **Diagramma**:
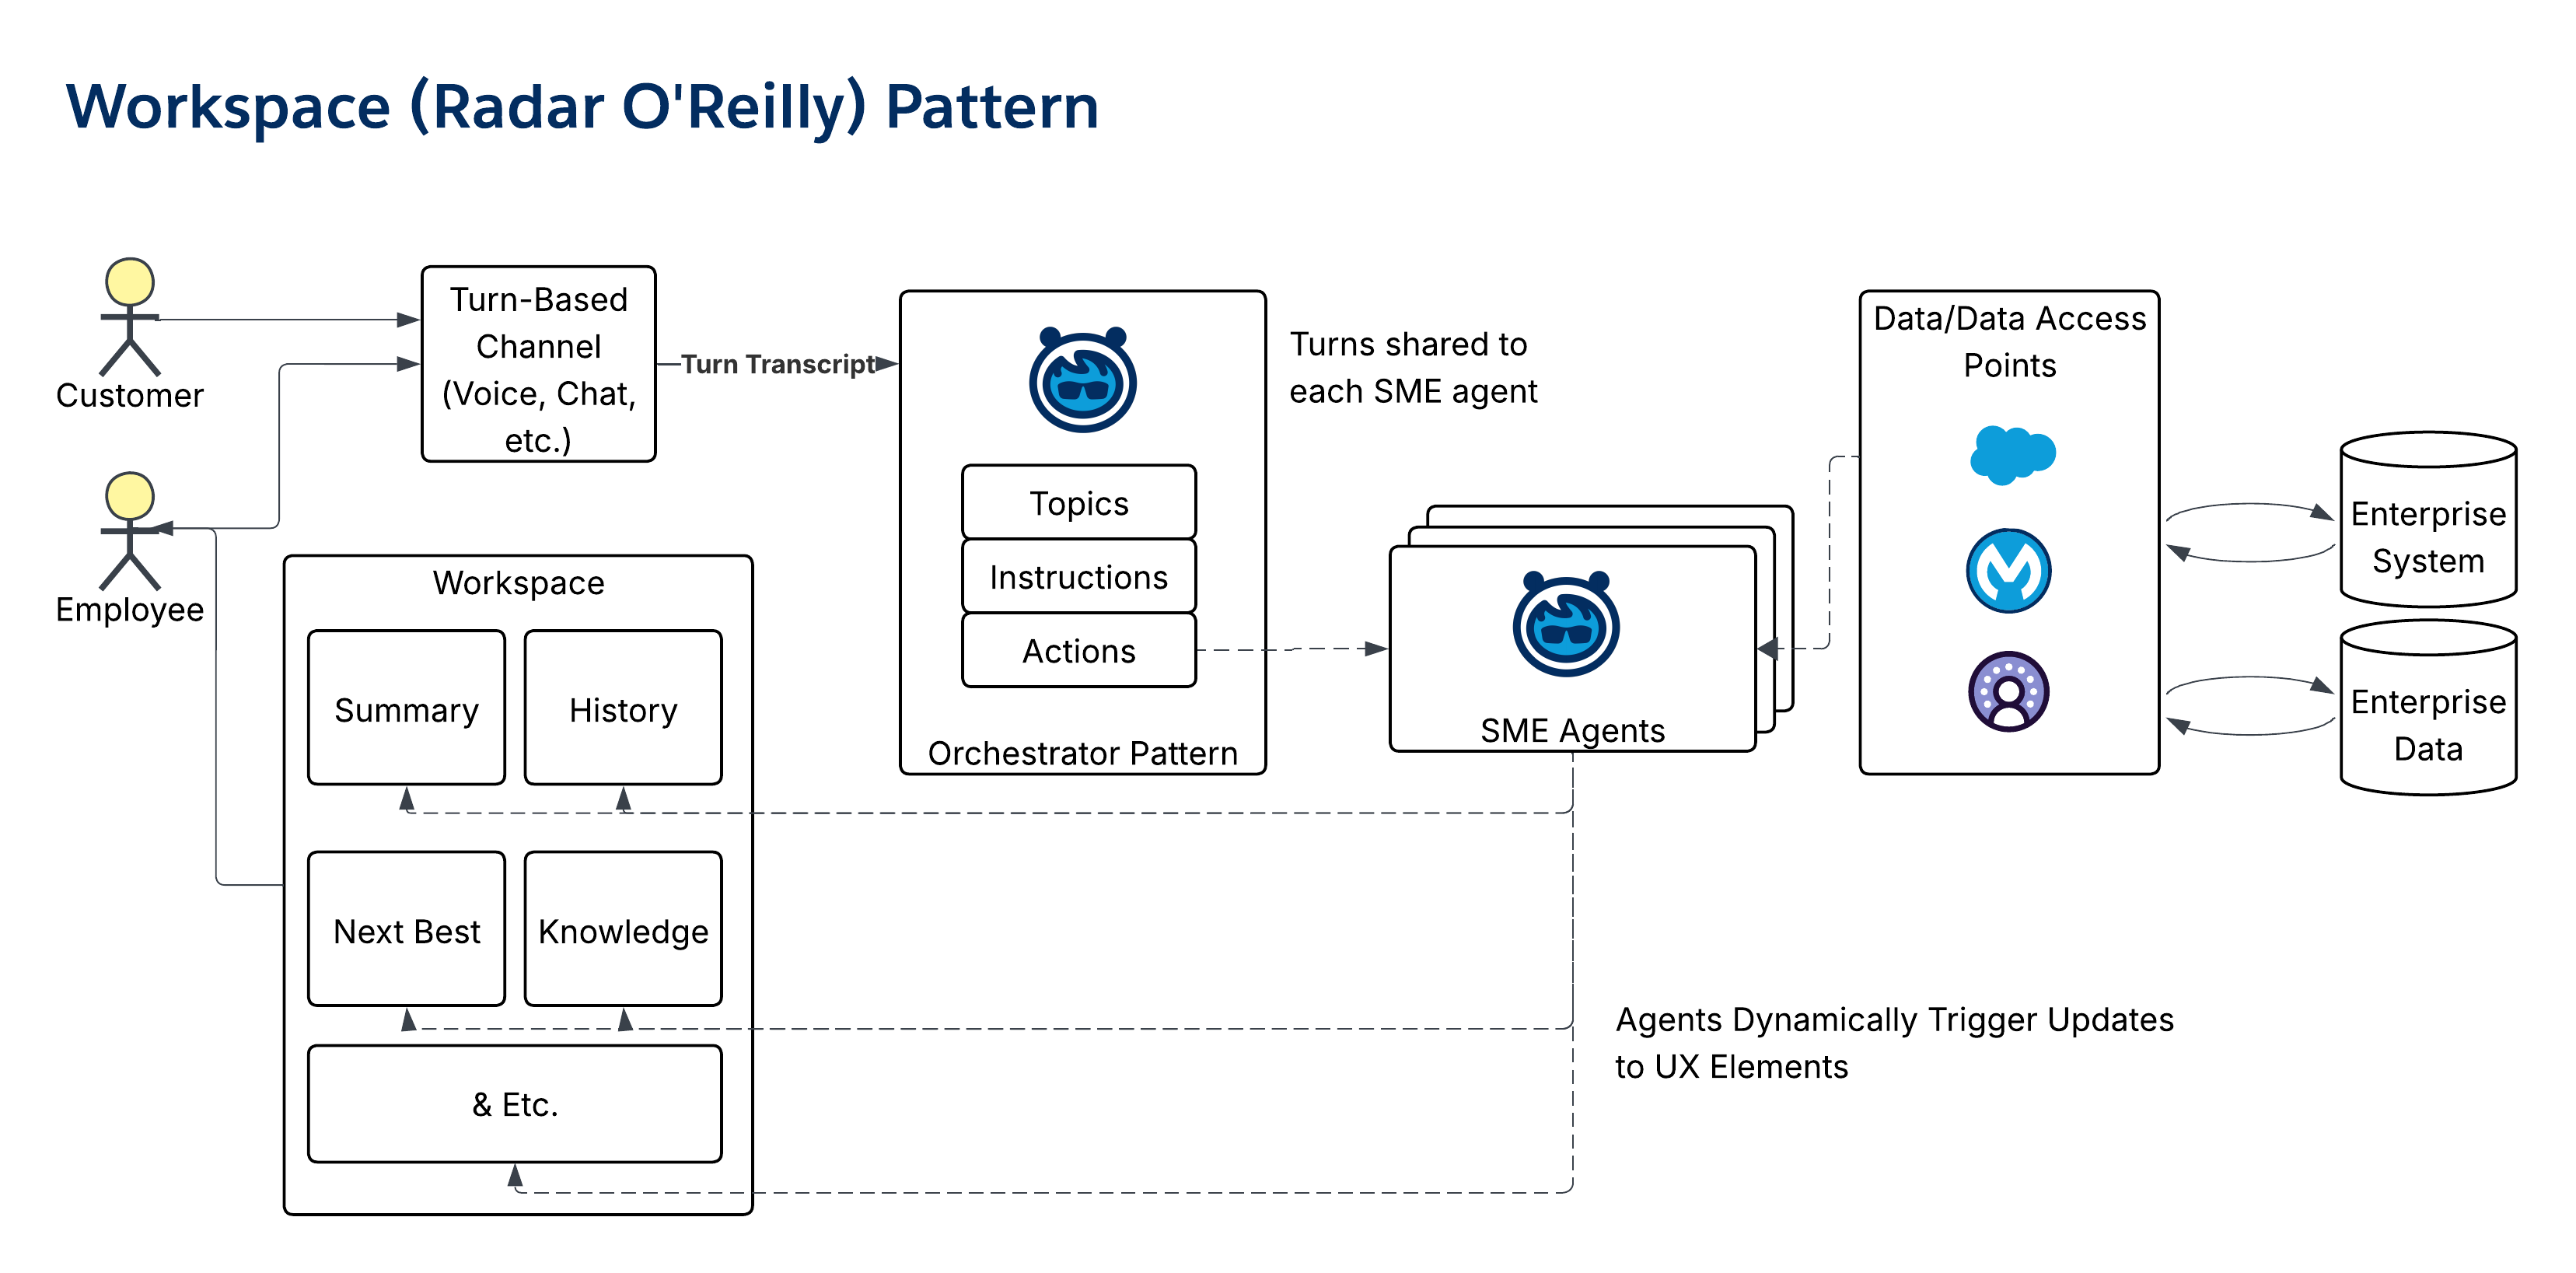 - **Maturità agente Salesforce**: Livello 3
## 7\. Schemi specialistici
Gli _schemi specialistici_ incapsulano Knowledge o competenze approfondite in un particolare dominio, e in genere sono orchestrati da _schemi di interazione_.
### Schema Answerbot
- **Panoramica**: Lo _schema di risposta_ è uno schema efficace per il self-service che utilizza GenAI per determinare il linguaggio naturale per il recupero Knowledge, non solo le parole chiave.
- **Tipo di output**: Knowledge riepilogato e riferimenti/citazioni a materiali di supporto.
- **Guida all'uso degli schemi**: Organizzare e inserire materiali di origine affidabili (ad esempio, Knowledge Store o Domande frequenti) per configurare l'agente. Posizionare l'agente sui siti Web aziendali o all'interno dei portali interni. Monitorare le domande per identificare e risolvere le lacune Knowledge.
- **Caso d'uso rappresentativo**: Facilitare le ricerche per linguaggio naturale su un sito Web aziendale, interagire con un bot vantaggi per le risorse umane e fornire componenti self-service per tutti gli studenti.
- **Diagramma**:
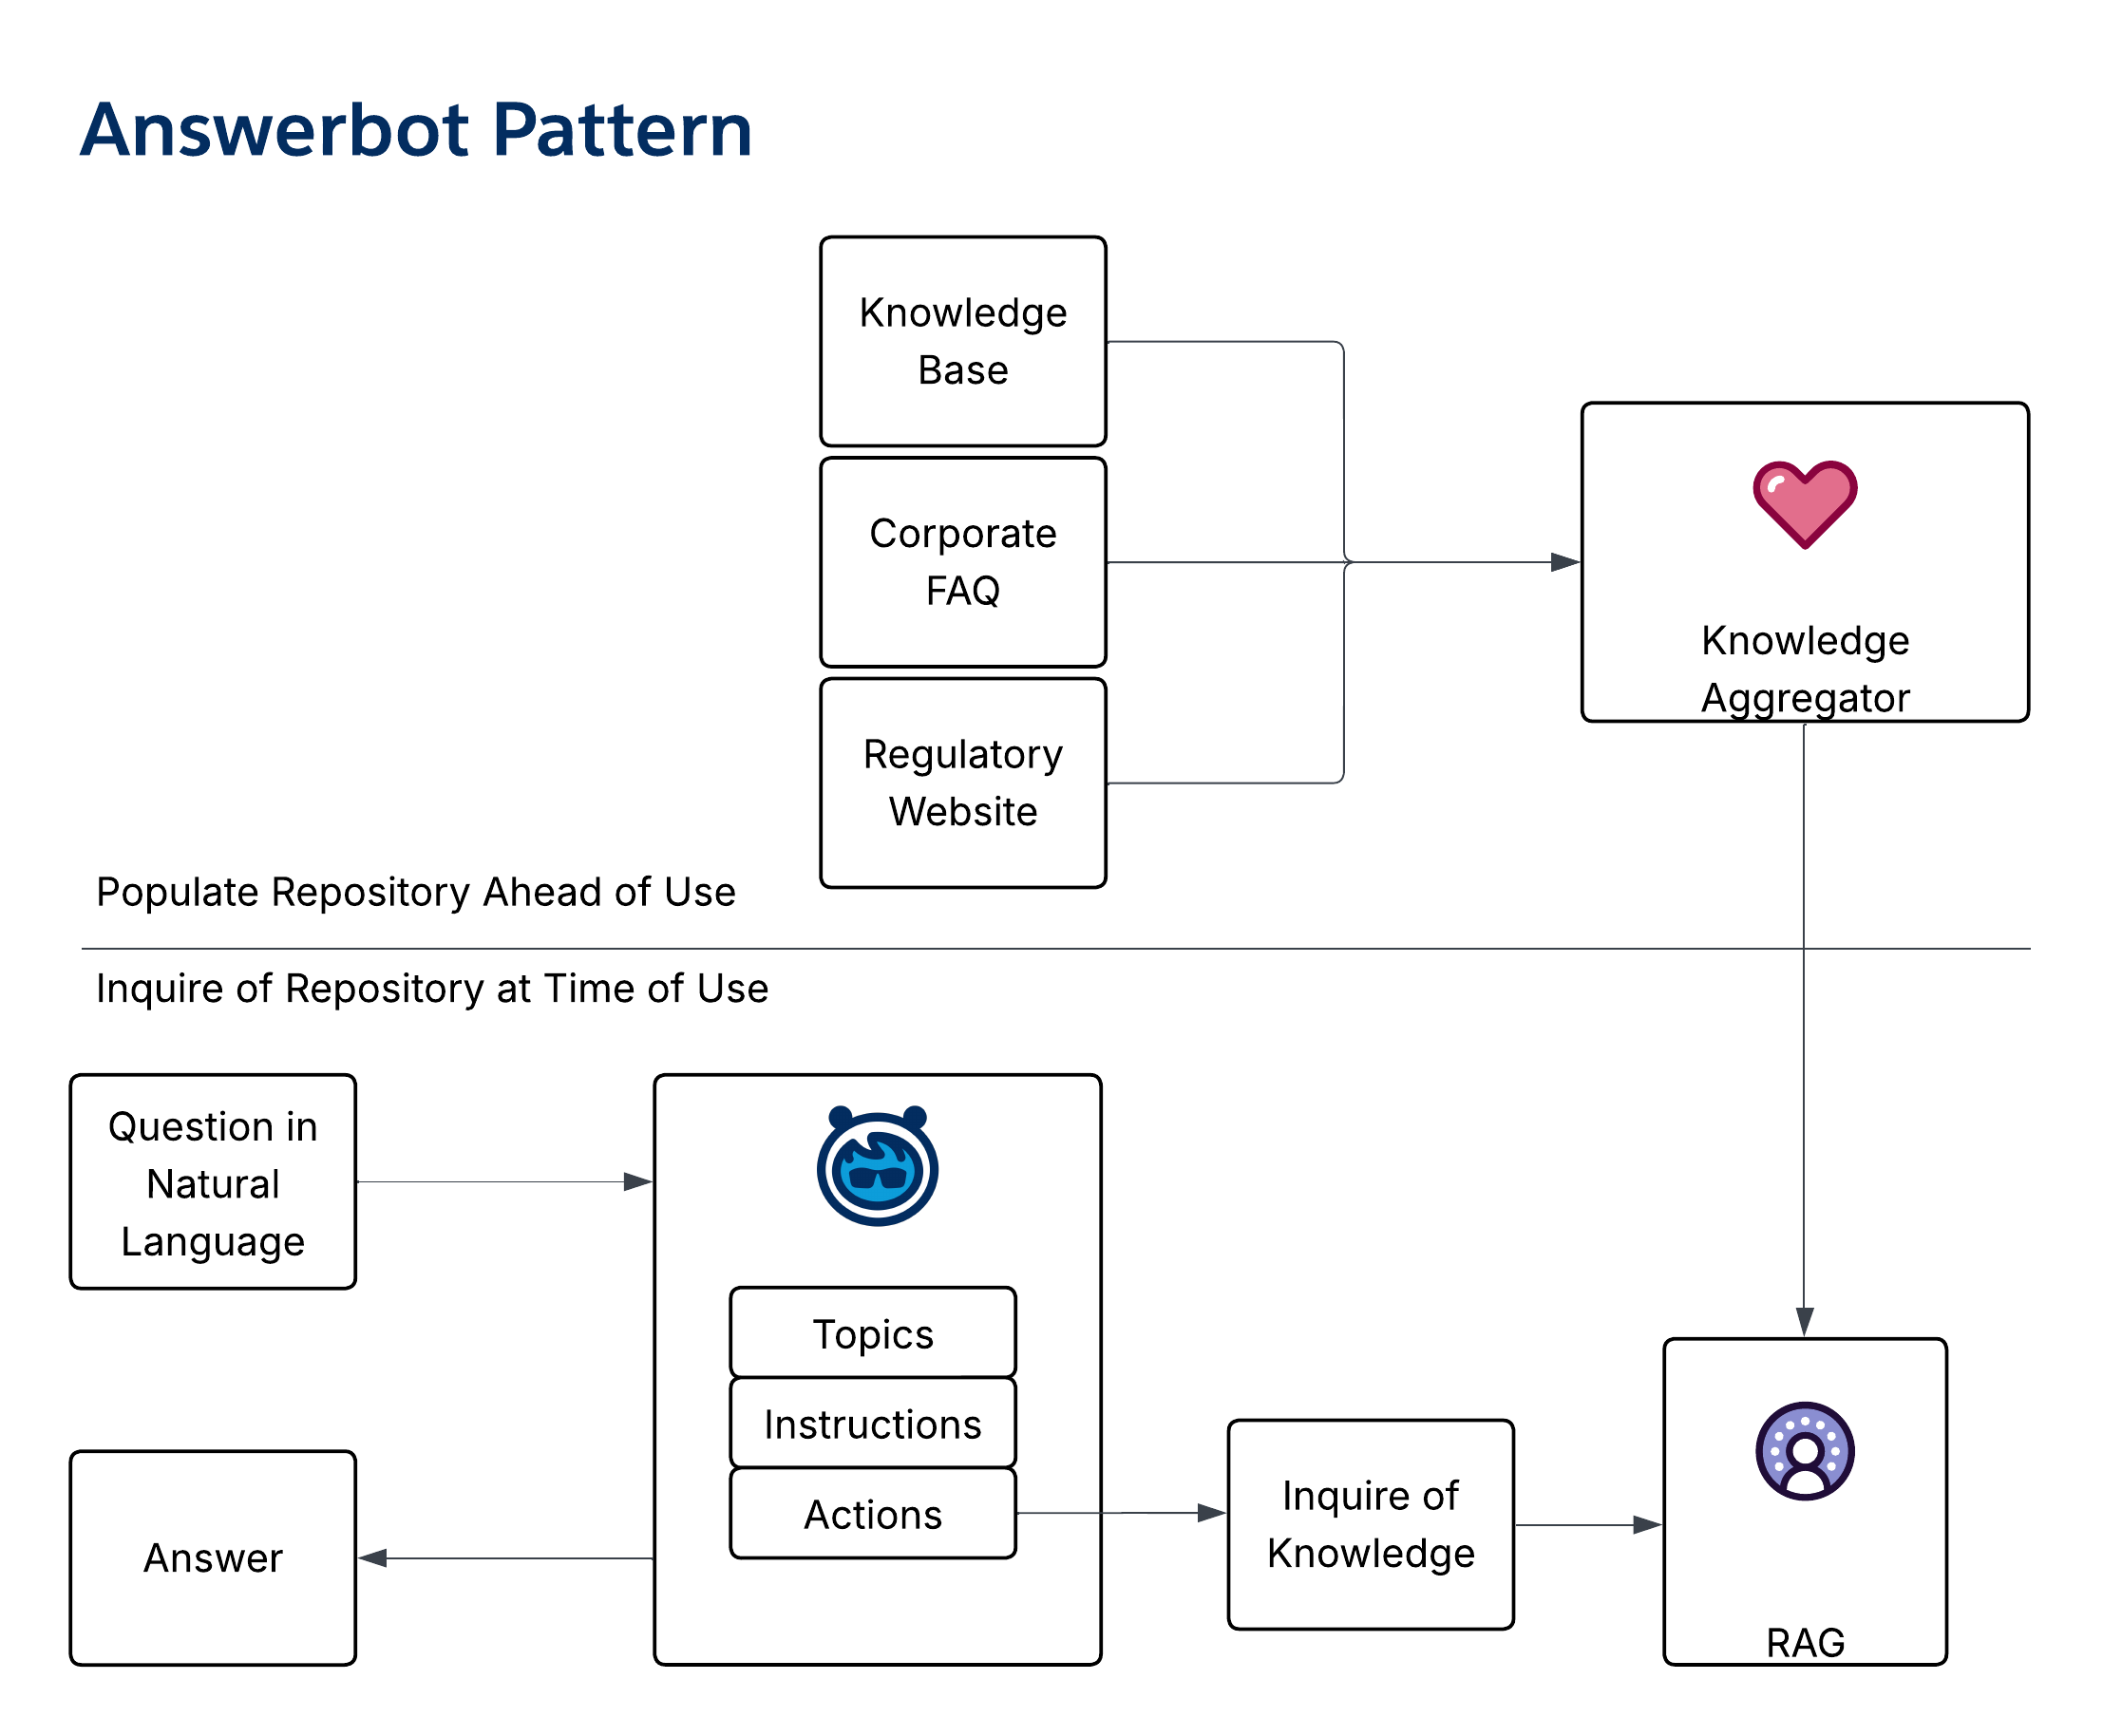 - **Maturità agente Salesforce**: Livello 1
### Schema PMI dominio
- **Panoramica**: Lo _schema PMI dominio_ è uno schema di base che fornisce un front-end per linguaggio naturale per un dominio aziendale (ad esempio, Ordini o Richieste).
- **Tipo di output**: Fornire contenuti, argomenti, dati e informazioni formattate pertinenti sul dominio.
- **Guida all'uso degli schemi**: Utilizzare questo schema per incapsulare un oggetto o un dominio aziendale. Configurare l'agente con la possibilità di eseguire operazioni CRUD appropriate. Rendere disponibili questi agenti tramite gli [_schemi di interazione_](/docs/architect/it-it/fundamentals/guide/enterprise-agentic-architecture#6-schemi-di-interazione) (ad esempio, - Orchestratore o Ascoltatore).
- **Caso d'uso rappresentativo**: Gatekeeping di un dominio di dati aziendali, fornitura di un "agente dell'ordine" o di un "agente dell'inventario" e fornitura di un'interfaccia agente per un dominio aziendale.
- **Diagramma**:
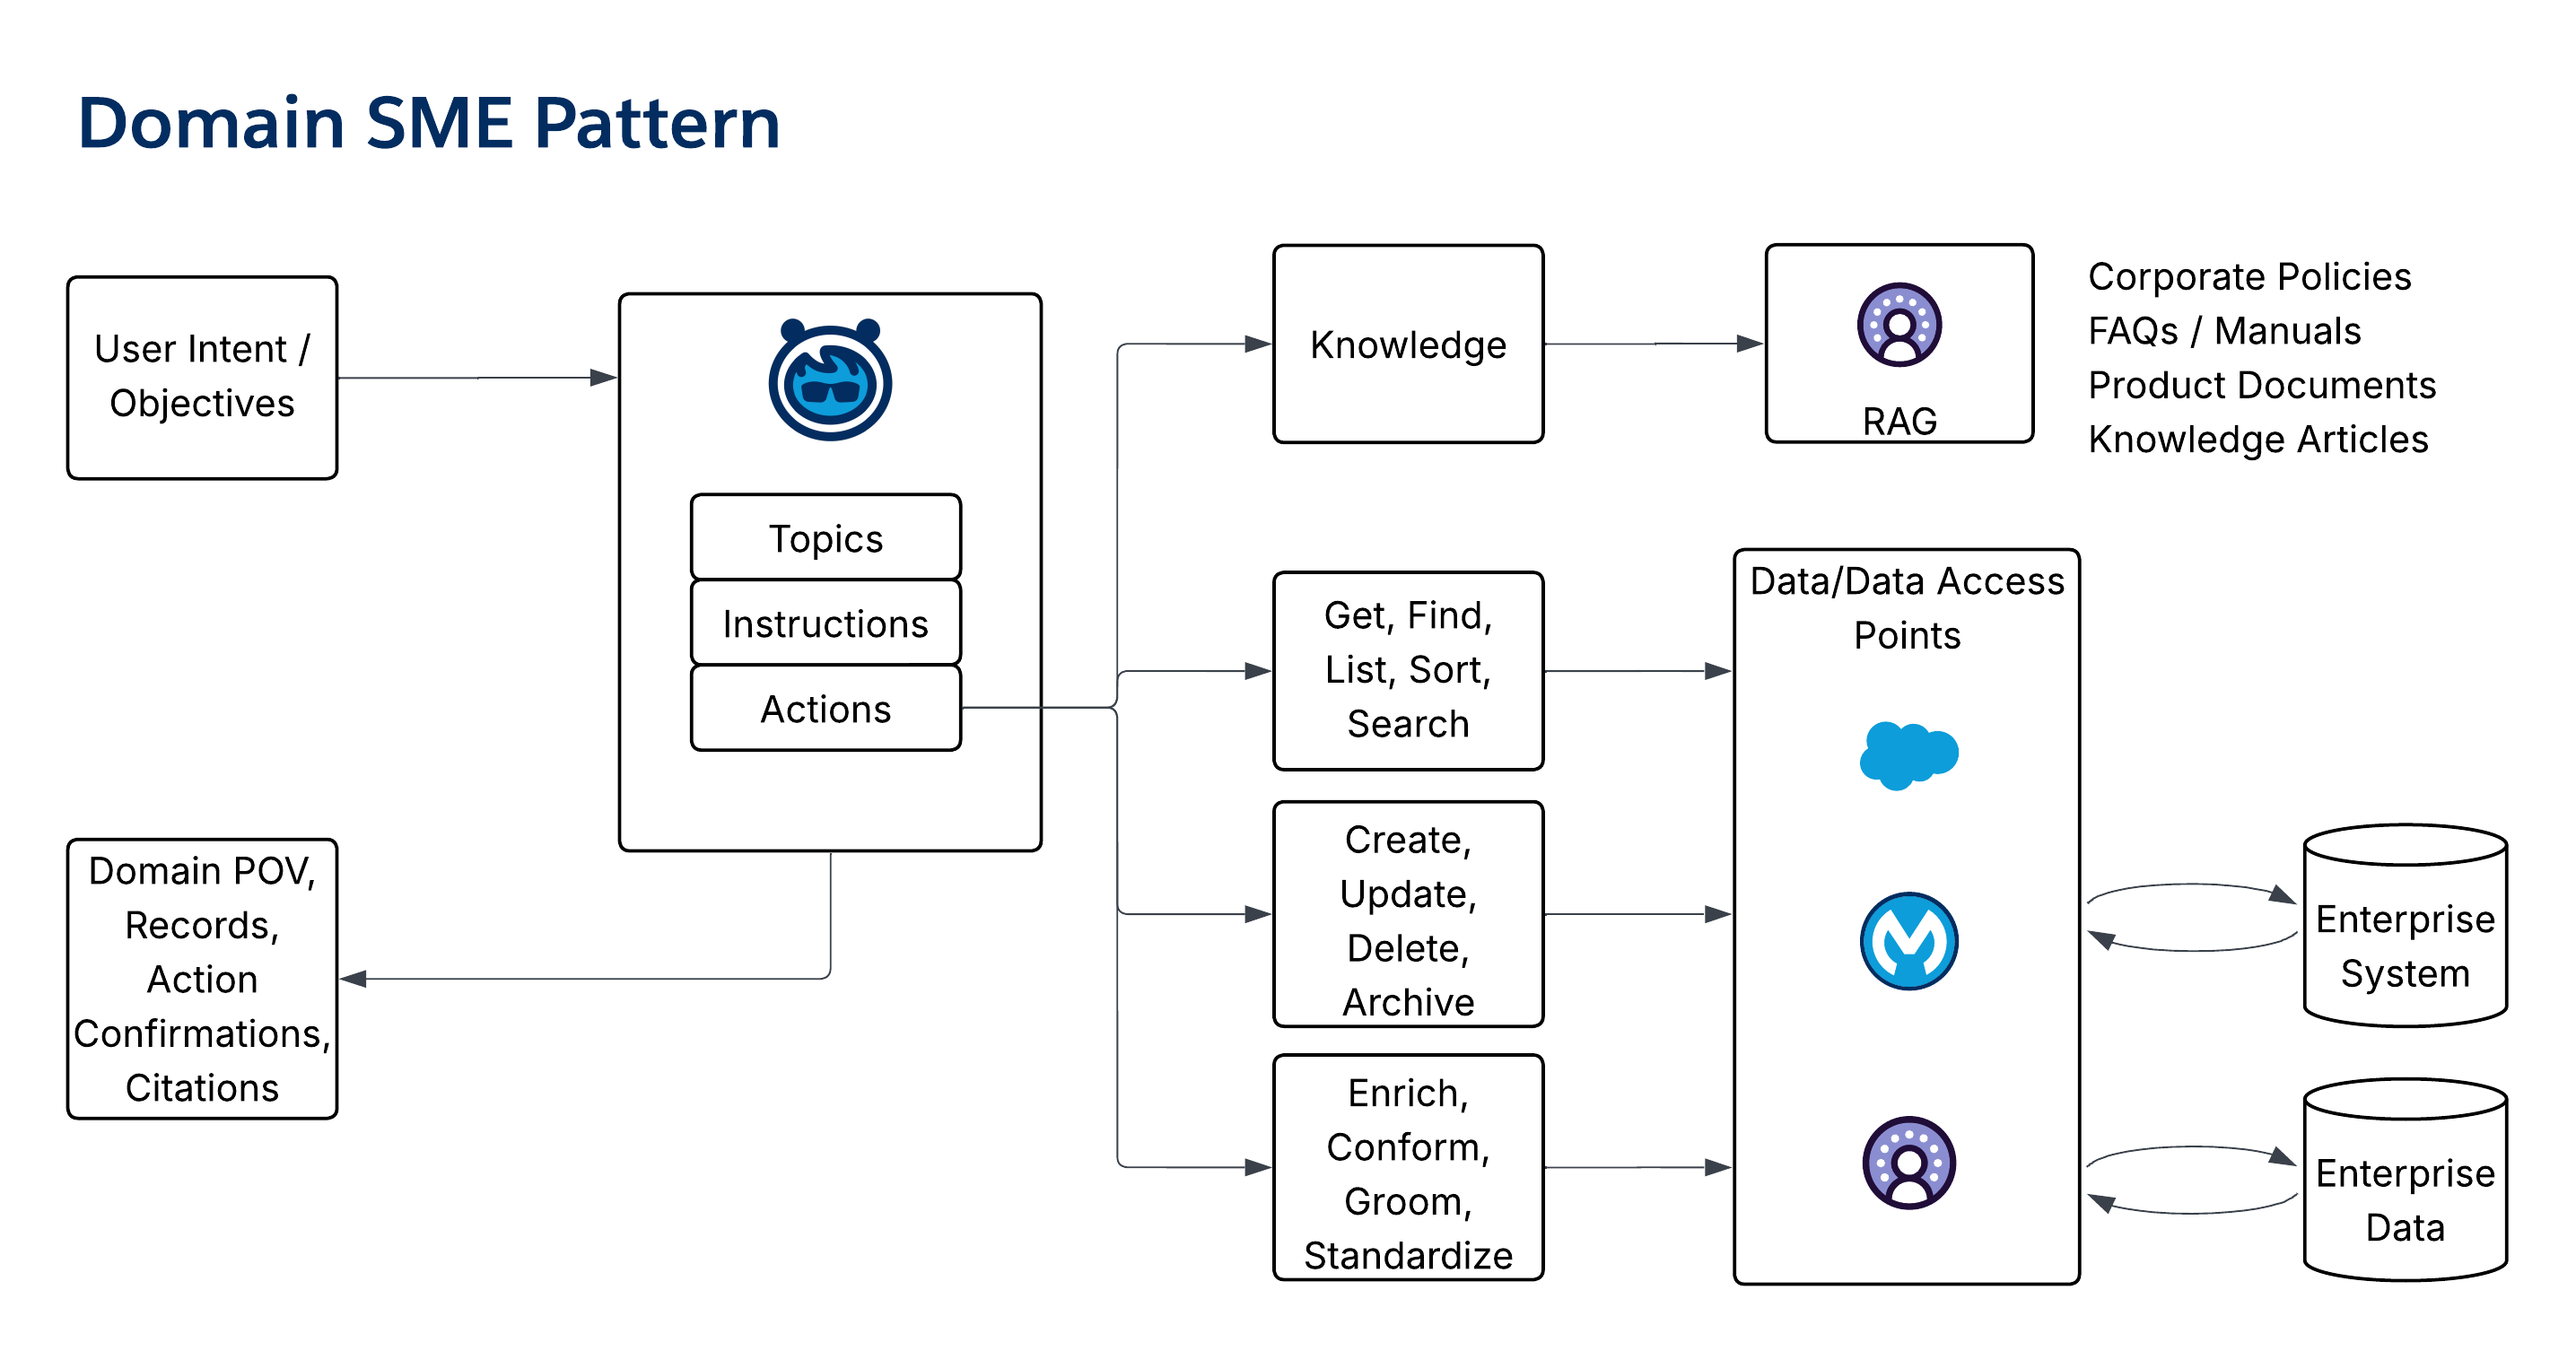 - **Maturità agente Salesforce**: Livello 2
### Schema interrogatore
- **Panoramica**: Lo _schema Interrogator_ è un agente PMI che può essere interrogato su un argomento per riunire il contesto di più fonti per rispondere alle domande. La funzionalità agente chiave sfruttata è la capacità di estrarre il contesto e connettere i concetti in un corpo di contenuto, come farebbe un essere umano dopo aver letto e interiorizzato il contenuto. Questo schema attenua la necessità di "integrazione sedia girevole".
- **Tipo di output**: Fornire risposte alle domande.
- **Guida all'uso degli schemi**: È spesso configurato come widget console collegato al contesto corrente dell'utente in modo che possa porre domande direttamente. Viene utilizzato anche in combinazione con risorse Knowledge come Domande frequenti, Policy e cataloghi di prodotti. Abbinare lo _schema Interrogator_ ai prompt standard per ridimensionare le risposte comuni alle domande comuni.
- **Caso d'uso rappresentativo**: Utilizzare come agente assistente a contratto; Assistente richieste di prestazioni o agente lavoratore specializzato in schemi multi-agente (ad esempio, Ascoltatore o Area di lavoro).
- **Diagramma**:
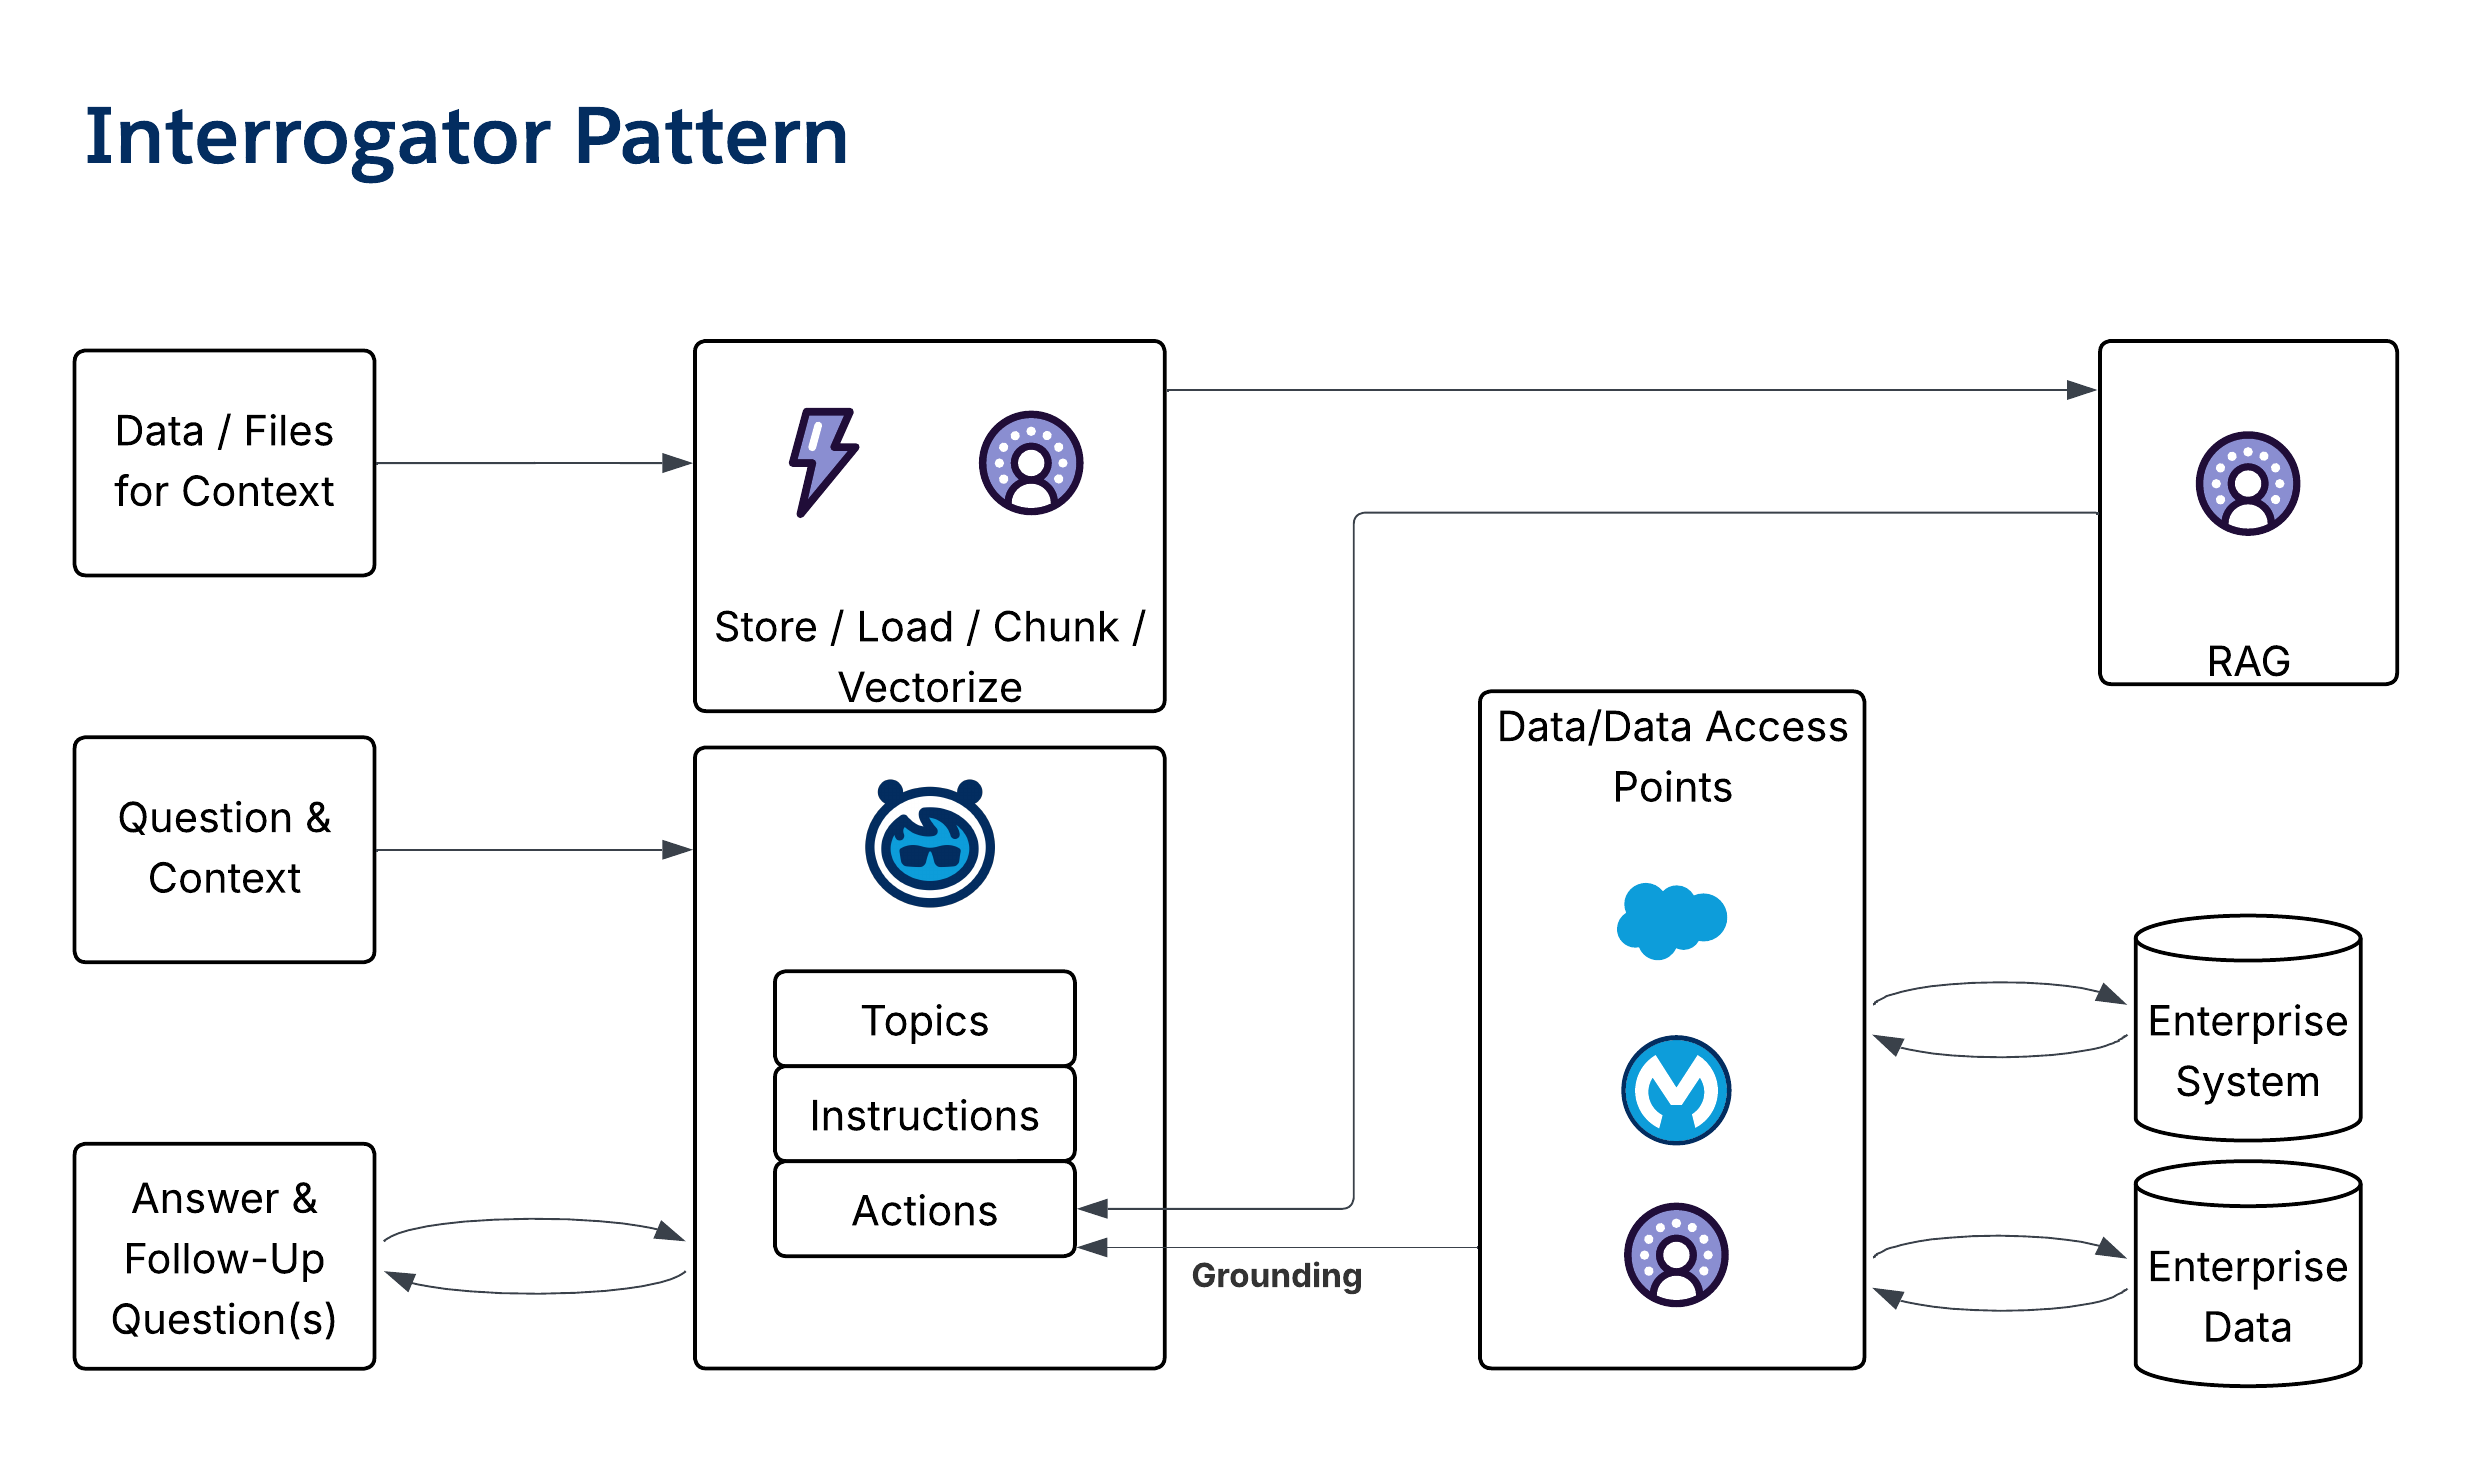 - **Maturità agente Salesforce**: Livello 2
### Schema di priorità
- **Panoramica**: Lo _schema Priority_ viene utilizzato per ordinare una serie di operazioni o oggetti di lavoro in base a un obiettivo definito. Sfrutta GenAI per analisi qualitative, analisi dei dati non strutturati o analisi integrativa in più domini di dati.
- **Tipo di output**: Fornire approfondimenti generativi.
- **Guida all'uso degli schemi**: Utilizzare il linguaggio naturale per descrivere le qualità desiderate per l'assegnazione delle priorità. Basare l'agente su una serie di opzioni selezionabili. Combinarlo con lo schema Listener per creare una "Next Best Action" reattiva nel flusso di lavoro.
- **Caso d'uso rappresentativo**: Utilizzare come generatore _Next Best Action_ o agente lavoratore specializzato in schemi di lunga durata o multi-agente.
- **Diagramma**:
 - **Maturità agente Salesforce**: Livello 2
## 8\. Utilità e schemi di dati
Gli _schemi di utilità_ eseguono operazioni specifiche e ripetibili che supportano altri agenti o processi.
### Schema generatore
- **Panoramica**: Lo _schema Generator_ è uno schema di base per la creazione di nuovo contenuto (ad esempio, riepiloghi casi o bozze di email) da input e standard esistenti. Viene spesso implementato come prompt e può essere incorporato in altri agenti.
- **Tipo di output**: Fornire contenuti generati conformi al formato e all'intento richiesti.
- **Guida all'uso degli schemi**: Lo _schema Generator_ può essere utilizzato nella maggior parte degli altri schemi o come modello indipendente. Il contesto può essere fornito tramite la richiesta, l'idratazione durante l'esecuzione o ulteriori fasi di arricchimento.
- **Caso d'uso rappresentativo**: Fornire riepiloghi dei casi, bozze di email, articoli Knowledge o proposte/risposte ai QBR.
- **Diagramma**:
 - **Maturità agente Salesforce**: Livello 1
### Schema di steward dati
- **Panoramica**: Lo _schema Data Steward_ è uno schema autonomo in background che introduce una fase agente nelle operazioni sui dati per garantire qualità, conformità e arricchimento coerenti dei dati.
- **Tipo di output**: Fornire campi record e dati aggiornati prima del salvataggio.
- **Guida all'uso degli schemi**: Incorporare la qualità dei dati al momento della creazione aggiungendo gli steward dei dati che registrano i flussi di attivazione prima di salvare i dati. Aiuta a garantire un'applicazione coerente dei dati di classificazione, riepilogo e stato.
- **Caso d'uso rappresentativo**: Garantire aggiornamenti coerenti dello stile "Pizza-Tracker", arricchire i dati degli account ed eliminare codici postali e indirizzi non corrispondenti.
- **Diagramma**:
 - **Maturità agente Salesforce**: Livello 2
### Schema Zen Data Gardener
- **Panoramica**: Lo _schema Zen Data Gardener_ è uno schema in background pianificato utilizzato per preparare e standardizzare i dati, utilizzando ragionamenti a basso costo per convalidare, arricchire e conformare i dati in domini di dati altrimenti non connessi.
- **Tipo di output**: Fornire record aggiornati e/o operazioni di gestione dei dati.
- **Guida all'uso degli schemi**: Utilizzare lo schema per abilitare la revisione e la convalida periodiche e periodiche dei dati. Per i dati che cambiano lentamente, pianificare l'agente con una cadenza lenta (ad esempio, mensile). Combinarla con lo [schema Data Steward](/docs/architect/it-it/fundamentals/guide/enterprise-agentic-architecture#schema-di-steward-dati) per fornire operazioni di qualità dei dati prospettiche e retrospettive.
- **Caso d'uso rappresentativo**: Garantire l'allineamento tra i vantaggi venduti e il sistema di richieste, nonché la convalida periodica delle licenze broker rispetto ai registri nazionali.
- **Diagramma**:
 - **Maturità agente Salesforce**: Livello 4
### Schema configuratore
- **Panoramica**: Lo _schema Configuratore_ genera artefatti di configurazione (ad esempio, SQL/SOQL, JSON e CSV) dai requisiti del linguaggio naturale. Può anche essere eseguito in senso inverso per convalidare una configurazione esistente in base ai requisiti.
- **Tipo di output**: Fornire record aggiornati, operazioni di gestione dei dati o creare problemi/errori per la correzione.
- **Guida all'uso degli schemi**: Basare l'agente su standard, linee guida o esempi specifici. Configurare i requisiti di creazione utilizzando fonti come contratti o specifiche di prodotto. Collegare lo _schema Configuratore_ al sistema di destinazione per inviare tramite push la configurazione generata.
- **Caso d'uso rappresentativo**: Generazione di record di configurazione prodotto per i prodotti assicurativi sanitari e convalida delle condizioni di contratto/pagamento per gli operatori sanitari.
- **Diagramma**:
 - **Maturità agente Salesforce**: Livello 4
### Schema giudice e giuria
- **Panoramica**: Lo _schema Giudice & Giuria_ è progettato per ridurre al minimo le allucinazioni utilizzando un insieme di agenti "giurati" e un agente "giudice" che valuta la congruenza delle risposte per assicurarsi che siano materialmente coerenti e fondate.
- L'_approccio Ensemble_ è incorporato in Agentforce e nel motore di ragionamento Atlas per gestire la veridicità e la pertinenza delle risposte. Lo _schema Giudice e Giuria_ si basa su questa funzionalità quando sono essenziali livelli elevati di precisione.
- Anche la combinazione di _Data Grounding_ (ad esempio, "trova la risposta in questi record/documenti") e _Prompt Engineering_ (ad esempio, "restituisci una risposta solo se è presente in questi record" o "convalida la risposta con questa fonte esterna") sono metodi efficaci per ridurre al minimo le allucinazioni.
- **Tipo di output**: Fornire approfondimenti generativi.
- **Guida all'uso degli schemi**: Utilizzare quando vi è una forte esigenza di output generativi coerenti e fondati. Un _agente giurato_ compila un prompt basato e lo passa a due o più _agenti giurati_, quindi il giudice valuta le risposte. Per risultati ottimali, utilizzare modelli diversi (ad esempio, uno di OpenAI e un altro di Anthropic) per ogni agente del giurato.
- **Caso d'uso rappresentativo**: Fornire risposte ad alta fedeltà e basate sui fatti per ridurre al minimo le allucinazioni.
- **Diagramma**:
 - **Maturità agente Salesforce**: Livello 2
### Modello di modello di modelli
- **Panoramica**: Lo _schema Modello di modelli_ sfrutta più agenti esperti per generare un'ampia gamma di prospettive e quindi estrae il consenso. A differenza dello [schema Giudice & Giuria](/docs/architect/it-it/fundamentals/guide/enterprise-agentic-architecture#schema-giudice-e-giuria), questo schema abbraccia più punti di vista per migliorare la ricchezza.
- Questo schema può anche essere chiamato schema Panel di esperti quando esistono modelli esperti con diversi punti di vista (POV) che può essere utile toccare.
- A differenza dello schema Giudice e Giuria, in cui l'intento è garantire che la risposta dell'agente converga su una "verità" comunemente accessibile, lo _schema Modello di modelli_ estende l'ambito della risposta sfruttando la diversità nell'ambiente agente.
- Questo schema presuppone che vi siano altri agenti con un POV distinto. Ad esempio, in un ambiente multi-organizzazione, multi-agente o con più agenti forniti dal fornitore in pile tecnologiche, lo _schema Modello di modelli_ fornisce una struttura per l'integrazione di più POV.
- Quando si considera questo schema, considerare anche altri approcci, spesso più leggeri:
- Anziché definire più agenti esperti, specificare più prompt e fare in modo che il sistema funzioni come un insieme di prompt.
- Sfruttare il "basamento" tramite azioni che accedono a dati appropriati per il contesto.
- **Tipo di output**: Fornire approfondimenti generativi.
- **Guida all'uso degli schemi**: Il ruolo di un agente _Aggregatore_ è quello di formare e restituire un POV completo in base ai concetti chiave restituiti dagli agenti Modello. Gli agenti modello determinano una risposta in base al loro POV univoco.
- **Caso d'uso rappresentativo**: Utilizzare in situazioni che possono trarre vantaggio dall'unione di punti di vista diversi per migliorare la qualità delle risposte.
Ad esempio, un ambiente agente multi-sistema in cui gli agenti con privilegi (ad esempio, un _agente ERP_) possono avere un POV utile e altrimenti inaccessibile.
- **Diagramma**:
 - **Maturità agente Salesforce**: Livello 2
## 9\. Schemi di processo di lunga durata
Gli _schemi di processo_ gestiscono i processi che si verificano in periodi estesi e coinvolgono più fasi e attori.
### Schema responsabile progetto
- **Panoramica**: Lo _schema Project Manager_ è uno schema complesso che supervisiona un progetto di lunga durata. Coordina le attività, tiene traccia del completamento, invia notifiche agli utenti e rappresenta lo stato del progetto agli stakeholder.
- **Tipo di output**: Esistono più output (ad esempio casi, operazioni, aggiornamenti di stato e notifiche).
- **Guida all'uso degli schemi**: Utilizzare come schema ombrello per supportare attività regolari, ripetute e a più fasi. Lo _schema Project Manager_ prende un modello di input/una struttura di un progetto (comprese operazioni, ruoli e dipendenze), quindi istanzia i casi e le attività e li assegna agli utenti.
- **Caso d'uso rappresentativo**: Utilizzare per la gestione dell'installazione degli account e il coinvolgimento delle vendite aziendali.
- **Diagramma**:
 - **Maturità agente Salesforce**: Livello 4
## 10\. Archetipi di orchestrazione Enterprise
Mentre gli schemi descrivono i ruoli degli agenti, gli _archetipi di orchestrazione_ definiscono i modelli a livello di sistema per la collaborazione di un parco agenti. Questi archetipi chiariscono i ruoli di _Agenteforce_ come cervello di orchestrazione e _MuleSoft_ come connettore e adattatore universale.
**Archetipo 1: SOMA (organizzazione singola, più agenti)**
- **Definizione**: Più agenti collaborano all'interno di un'unica organizzazione Salesforce che utilizza dati e governance condivisi.
- **Flusso architettonico**: In Agentforce, un _agente supervisore_ funge da singola porta principale, instradando le richieste agli _agenti specializzati_ all'interno dell'organizzazione. Per le funzionalità esterne, gli agenti utilizzano il _client MCP Agentforce_ con MuleSoft che funge da MCP-wrapper per le API non abilitate per MCP.
- **Considerazioni chiave**: Questo schema centralizza la logica di orchestrazione in Salesforce (simile al contesto CRM e a Data 360) per mantenere governance, identità, autorizzazioni e osservabilità unificate.
**Archetipo 2: MOMA (organizzazione multipla, più agenti)**
- **Definizione**: Gli agenti collaborano tra più organizzazioni Salesforce, il che richiede un coordinamento sicuro tra i confini dei dati e delle autorizzazioni.
- **Flusso architettonico**: Un _agente supervisore_ di un'organizzazione delega un'operazione a un agente di un'altra organizzazione tramite il protocollo standardizzato _da agente ad agente_. Questa stretta di mano garantisce Trust a livello di organizzazione, flusso di identità utente e contesto di conversazione condiviso.
- **Considerazioni chiave**: Questo schema mantiene l'autonomia dell'organizzazione e abilita i flussi di lavoro a livello aziendale, il che fornisce una base per operazioni agenti coerenti in strutture complesse multi-organizzazione.
**Archetipo 3: A2A multi-vendor (orchestrazione guidata da Salesforce)**
- **Definizione**: Un _agente supervisore_ di Salesforce coordina il lavoro di un mix di agenti nativi di Salesforce e agenti di altri fornitori (ad esempio Google/Vertex o LangGraph) tramite il protocollo A2A.
- **Flusso architettonico**: L'_agente supervisore_ elabora la richiesta e orchestra un piano, richiamando gli agenti interni ed esterni del fornitore tramite il protocollo A2A. Per i sistemi esterni che non supportano A2A, _MuleSoft_ può esporre una "facciata agente leggera" che avvolge lo strumento esistente e comunica con A2A.
- **Considerazioni chiave**: Questo archetipo mantiene il cervello dell'orchestrazione vicino a CRM e Data 360 utilizzando A2A per produrre una composizione pulita e governabile senza un livello di orchestrazione separato.
**Archetipo 4: A2A multi-vendor (orchestrazione guidata da MuleSoft)**
- **Definizione**: L'orchestrazione viene avviata da un punto di ingresso non Salesforce, che richiede un orchestratore esterno neutrale per eseguire il ragionamento e l'instradamento.
- **Flusso architettonico**: Un _agente dell'interfaccia_ utente in un sistema esterno inoltra la richiesta a un servizio di orchestrazione (concepito come _MuleSoft Conductor_), che interpreta l'intento e pianifica l'operazione. Il conduttore utilizza quindi A2A per instradare le chiamate agli agenti del fornitore, inclusi gli agenti Agentforce per le azioni CRM o di servizio.
- **Considerazioni chiave**: Questo schema è per i punti di ingresso non Salesforce in cui è preferibile un orchestratore neutrale dal punto di vista architettonico. Mantiene l'interfaccia utente nel sistema di dominio centralizzando il ragionamento, la governance, la policy e l'osservabilità in MuleSoft.
## 11\. Assemblaggio soluzioni: Composizione di schemi
Questi schemi individuali e archetipi di orchestrazione sono componenti architettonici progettati per essere composti in soluzioni complete. La mappa delle soluzioni agentiche viene utilizzata per visualizzare come questi componenti sono cablati insieme.
- Una _soluzione Member Services_ per un operatore sanitario è un'implementazione standard dell'archetipo SOMA. Utilizza un Answerbot per gli utenti anonimi, un _Orchestrator_ per i membri autenticati e più _agenti PMI del_ dominio (ad esempio Caso, Richieste e Vantaggi) per gestire richieste specifiche.
- Un _portale Broker B2C_ è una composizione complessa che utilizza un agente _Orchestratore_ portale per invocare un _agente Project Manager_ di lunga durata per un processo RFP, che a sua volta utilizza _agenti headless_, _datasteward_ e _interrogatori_ per le operazioni sui dati di back-office.
## 12\. Conclusione
Una metodologia basata su modelli di progettazione agenti fornisce la disciplina architettonica necessaria per creare sistemi di intelligenza artificiale aziendali robusti, scalabili e manutenbili. Suddividendo la complessità e promuovendo la modularità, questi schemi consentono agli architetti di offrire soluzioni agentiche affidabili e prevedibili.
La scelta dell'archetipo di orchestrazione è una decisione strategica basata su dove lavorano gli utenti, dove risiede il contesto e come l'azienda governa l'interazione tra persone, agenti e sistemi. Comprendendo la distinzione tra agenti edili e orchestrandoli e sfruttando protocolli aperti come _MCP_ e _A2A_, gli architetti possono andare oltre la creazione di bot isolati per progettare un sistema di ragionamento aziendale coerente, governato e distribuito. Questo approccio fornisce un linguaggio condiviso e una serie di modelli riutilizzabili per creare un'architettura agente sostenibile.
## Appendice: Mappe delle soluzioni e architetture di sistema
Questa appendice fornisce esempi concreti di come gli schemi agentici sono composti in soluzioni a livello di sistema.
### Appendice A: Esempio di composizione schema di base
Questo diagramma illustra come collegare cinque schemi di base per creare un flusso di lavoro comune per l'assistenza clienti.
 1. **Rispostabot**: Un utente anonimo pone una domanda, gestita da un agente basato su Knowledge.
2. **Operatore**: La domanda di un dipendente viene analizzata da un Operatore, che la mette in campo e la passa a un agente più specializzato.
3. **Orchestratore**: Un utente autenticato (SF User) interagisce con un orchestratore che coordina più agenti per gestire una richiesta potenzialmente complessa.
4. **PMI di dominio**: Gli agenti specializzati (ad esempio, gli agenti delle risorse umane o gli agenti dei benefit) vengono richiamati dall'orchestratore per eseguire aggiornamenti dell'oggetto e recuperare dati specifici.
5. **Generatore**: Gli agenti delle utilità vengono utilizzati per riepilogare i dettagli dell'account o concludere un caso al termine dell'interazione.
### Appendice B: Mappa delle soluzioni agentiche - Servizi per i membri
Questa mappa della soluzione descrive i dettagli di un'architettura agente per un caso d'uso di Servizi per i membri, dimostrando la composizione di più schemi.
- **Profili utente**: La soluzione serve tre tipi di utenti distinti: Utente anonimo, Membro autenticato e Utente SF (ad esempio, un CSR umano).
- **Schemi di interazione**: Un _Answerbot_ gestisce le query "Find-A-Doc" anonime, mentre un Orchestrator (Agentic Front Door) gestisce le richieste degli utenti autenticati. Uno _schema Listener/Feed_ assiste l'utente SF.
- **Riutilizzo agente dominio**: Gli _agenti PMI del_ dominio specializzati (ad esempio Agente caso, Agente richieste o Agente vantaggi) vengono riutilizzati in diversi flussi di interazione.
- **Autonomo & Assistente**: Il sistema combina _agenti autonomi_ (per indirizzare l'interazione degli utenti) e _agenti ausiliari_ (per aumentare i CSR umani).
- **Fonti di dati**: L'architettura integra un mix di fonti di dati pubbliche ed aziendali, con un ampio uso di _Data 360_ e _MuleSoft_ per la connettività.
 ### Appendice C: Architettura di sistema - Call center
Questo diagramma illustra un'architettura logica per una soluzione di intelligenza artificiale assistita in un call center, organizzata in livelli funzionali.
- **Agenti orchestratori**: Gestire le esperienze utente per profili diversi (ad esempio, Anonimo, Membro esterno o CSR) e orchestrare il flusso di interazione generale.
- **Agenti lavoratori**: _Più agenti PMI_ si concentrano su domini di business chiave come Knowledge, Caso/Richieste/Vantaggi e Elenco operatori. È incluso anche un agente _Next Best Action_.
- **Utilità Agenti**: Eseguire operazioni specifiche e riutilizzabili come Traduzione, Conclusione casi e Riepilogo chiamate.
Integrazione e sistemi principali: L'intero sistema agente è connesso tramite un livello di integrazione multipiattaforma alle risorse di dati non strutturate, alle risorse di dati strutturate e ai sistemi aziendali principali.
- **Governance**: Un livello di governance offre osservabilità, valutazione e gestione per gli LLM/SLM utilizzati dagli agenti.
 ### Appendice D: Mappa delle soluzioni agentiche - Portale broker
Questa mappa della soluzione descrive in dettaglio un'interazione agente complessa e di lunga durata per un portale broker assicurativo sanitario B2B. Il modello include un _agente del portale_ (_Orchestratore_) che facilita il percorso del broker attraverso più fasi (ad esempio, l'invio di una RFP e la ricezione di una proposta). Questo orchestratore invoca un agente _Responsabile progetto_, che a sua volta coordina diversi agenti headless per la qualità e le trasformazioni dei dati di back-office, ad esempio un estrattore RFP, una trasformazione censuaria e uno steward dati.
 ### Appendice E: Architettura di sistema - Agenti broker B2C
Questo diagramma mostra un'architettura logica per una soluzione di broker B2C, che dimostra un approccio a livelli simile al call center. Include _agenti orchestratori_ per profili utente diversi, _agenti lavoratori_ riutilizzabili per domini chiave (ad esempio, Knowledge, Servizi per i membri o Commissioni) e _agenti utilità_ per funzioni specifiche come la traduzione e il riepilogo.
 ### Appendice F: Architettura di sistema - Provider Contractor
Questo diagramma mostra un'architettura logica per una soluzione Provider Contracting. Gli agenti _orchestratori_ gestiscono interazioni complete, _gli agenti lavoratori_ gestiscono intenti specifici all'interno di un dominio (ad esempio, un agente PMI contraente) e gli agenti _delle utilità_ eseguono operazioni discrete come il confronto dei contratti o la generazione di approfondimenti.
 ### Appendice G: Tabella di riepilogo degli schemi di interazione
La tabella seguente riassume diversi schemi di interazione chiave, esperienze utente tipiche e scopi architettonici principali.
| Schema | Esperienza utente (UX) | Scopo |
|---|---|---|
| Saluto | Testo turn-by-turn (Chat, Voice, SMS e così via) che termina con il trasferimento dell'interazione a una persona | Questo è uno schema semplice utilizzato per determinare l'intento dell'utente e quindi instradarlo all'agente umano appropriato. |
| Operatore | Testo turn-by-turn (Chat, Voice, SMS e così via) che termina con il trasferimento dell'interazione da parte del risponditore a un agente umano o specialista | Viene utilizzato per instradare le richieste agli agenti ibridi appropriati. Basandosi su Greeter, è uno schema semplice che negozia l'intento e quindi trasferisce l'interazione a un agente umano o AI specializzato. |
| Orchestrator | Testo turn-by-turn (Chat, Voice, SMS e così via) con il risponditore che raccoglie e aggrega le risposte degli agenti specializzati e le consegna all'unità operativa | Viene utilizzato per coordinare un "intervento collettivo" gestito dall'agente AI che risponde a una conversazione mentre procede. Un agente orchestratore passa il testo di ogni turno a uno o più agenti specializzati e quindi aggrega le risposte di ciascuno di essi. |
| Answerbot | Prompt e risposta | Questa è un'interfaccia per linguaggio naturale che utilizza risorse Knowledge, domande frequenti, policy e così via per formare le risposte. |
| Interrogatore | Prompt e risposta | Si tratta di un'interfaccia per linguaggio naturale utilizzata per porre domande in un dominio o in un'area specifica. |
| Ascoltatore / Feed | Testo turn-by-turn (Chat, Voice, SMS e così via) che termina con lo schema Orchestrator che alimenta un feed lineare | Viene utilizzato per mettere in evidenza il contesto e gli approfondimenti nel flusso di conversazione. |
| Area di lavoro (Radar O'Reilly) | Testo turn-by-turn (Chat, Voice, SMS e così via) che termina con un head-up-display adattivo su un unico pannello di vetro | Questo viene utilizzato per gestire un'interfaccia utente reattiva a un unico riquadro nel flusso di conversazione. |
| Misure della selettività pre-query | Scrittura della query finale di accesso al database, forzando... | |
| Utente | Filtro | |
| Basso | Basso | ... loop nidificati join, drive utilizzando la visualizzazione delle righe che l'utente può vedere |
| Basso | Alto | ... utilizzo dell'indice correlato al filtro |
| Alto | Basso | ... join hash ordinato, drive con MT_DATA |
| Alto | Alto | ... utilizzo del filtro correlato all'indice |
 In questo modello, le camere bianche dei dati fungono da confine Trust delle moderne architetture dei dati. Consentono alle organizzazioni di lavorare con partner e società controllate senza perdere il controllo dei loro dati, di imporre la privacy e il consenso tramite controlli di sistema anziché la sola policy e di operare su cloud rispettando la residenza dei dati e i limiti contrattuali.
Per i casi d'uso di attivazione, analisi e intelligenza artificiale, le camere bianche offrono un modo sicuro per generare approfondimenti da dati esterni senza esporre informazioni sensibili. Consentono il passaggio dalla condivisione dei dati alla collaborazione affidabile. Per i casi d'uso di attivazione, le camere bianche offrono un modo sicuro per generare pubblici che possono essere attivati direttamente a una destinazione consentita. Tutto questo viene realizzato senza esporre alcuna informazione di identificazione personale (PII) a nessuna delle parti. Questo segna un punto di svolta nell'architettura dei dati aziendali. Le camere bianche dei dati non sono più strumenti di nicchia. Stanno diventando un'infrastruttura di base per piattaforme dati federate, rispettose della privacy e pronte per l'intelligenza artificiale.
## Personaggi degli stakeholder e protezioni tecniche
Un'architettura data clean room di successo è un sistema multiinterfaccia progettato per risolvere le pressioni concorrenti di utilità, sicurezza e velocità dei dati. Esistono tre profili principali i cui punti di attrito distinti devono essere affrontati dal progetto tecnico sottostante.
### Il responsabile della privacy e della conformità (The Risk Mitigator)
I responsabili della privacy e della conformità utilizzano la clean room dei dati come strumento di governance. La loro preoccupazione principale è la deriva della conformità, il rischio che gli ambienti di collaborazione esterni non riescano a imporre gli stessi standard rigorosi dei sistemi interni.
* **Punti di attrito:** Esposizione normativa (GDPR, CCPA, DMA) e attacchi di "phishing" in cui un partner tenta di triangolare l'identità di un utente tramite query granulari ripetute.
### Data Scientist and Analyst (Ottimizzatore delle utilità)
Gli esperti di dati considerano la camera bianca dei dati un rifugio sicuro per la modellazione avanzata. La loro preoccupazione principale è la conservazione delle utilità, assicurando che le misure di privacy non rendano i dati statisticamente inutili.
* **Punti di attrito:** Latenza elevata e accesso limitato agli attributi granulari necessari per il machine learning (ML), la modellazione lookalike e la previsione di abbandono.
### L'utente marketing e aziendale (Realizzatore di valore)
Questo profilo è incentrato esclusivamente sul time to value (TTV). La loro preoccupazione è che i progetti di data clean room spesso diventano colli di bottiglia tecnici che richiedono settimane di supporto per l'ingegneria dei dati.
* **Punti di attrito:** Processi di impostazione complessi, pulizia manuale dei dati e il problema della "pagina vuota" di dover scrivere codice per ottenere risultati di sovrapposizione semplici.
### Il modello Persona "Business First"
Mentre le architetture tradizionali si concentrano sulla creazione del livello di dati prima del livello utente, il nostro approccio strategico, in linea con la metodologia "Business First", inverte questo modello. Diamo la priorità a un approccio senza codice a pochi clic che consente agli utenti aziendali di generare approfondimenti e intraprendere azioni immediate.
**Flusso di lavoro "Approfondimenti all'azione":** L'architettura è progettata come area di lavoro attiva anziché come repository passivo. Fornendo modelli di casi d'uso (ad esempio, sovrapposizione dei segmenti, attivazione e prestazioni delle campagne), consentiamo agli utenti aziendali di offrire approfondimenti in modo self-service. Ciò garantisce che un approfondimento, ad esempio un segmento lookalike ottimizzato, sia immediatamente disponibile per l'attivazione in tutto l'ecosistema di marketing senza la necessità di un tecnico dei dati per spostare manualmente i file.
**Federazione senza copia come asset strategico:** Per ottimizzare il TTV, l'architettura adotta una logica di copia zero. Anziché il tradizionale processo ETL, che introduce rischi di latenza e sicurezza, la nostra architettura federa le query direttamente nella posizione in cui risiedono i dati (ad esempio Snowflake, BigQuery o Amazon S3). Ciò trasforma l'investimento di dati esistente dell'organizzazione in un asset strategico, consentendo agli utenti aziendali di agire sui dati più aggiornati in tempo reale, mantenendo una governance rigorosa ed eliminando il costo della ridondanza dei dati.
## Casi d'uso chiave delle clean room dei dati
Le camere bianche dei dati sono emerse nella pubblicità come risposta alla deprecazione dei cookie e alla regolamentazione della privacy, ma si sono evolute oltre misura in casi d'uso di analisi dei clienti, segmentazione del pubblico e attivazione in tutti i settori. Secondo il rapporto State of Retail Media 2025, il 66% delle organizzazioni ora utilizza le camere bianche in una certa misura, spinto dalla necessità di una collaborazione rispettosa della privacy che offra risultati aziendali misurabili.
Lo schema è coerente tra i vari settori: i dati rimangono di proprietà del titolare, il calcolo è regolato e vengono condivisi solo gli approfondimenti protetti dalla privacy.
### Marketing e pubblicità: Misurazione senza cookie di terze parti
**La sfida:** Gli esperti di marketing devono misurare l'efficacia delle campagne, evitare impressioni pubblicitarie duplicate e ottimizzare la copertura/frequenza, ma non possono più fare affidamento sui cookie o sugli identificatori di dispositivi di terze parti.
**Soluzione per camera bianca:**
* Gli inserzionisti contribuiscono con dati di esposizione di clienti o campagne con hashing
* I publisher contribuiscono con segnali di impression e coinvolgimento
* Clean Room calcola portata, frequenza, attribuzione e lift
* L'attivazione avviene tramite piattaforme approvate senza esportazioni di dati non elaborati
**Risultati aziendali:** Le camere bianche offrono un'attribuzione a ciclo chiuso che collega le impressioni degli annunci alle transazioni effettive, un'analisi dell'incrementalità che isola il vero lift della campagna e una misurazione unificata tra i canali, funzionalità che la pubblicità digitale tradizionale non può offrire.
**Prove del settore:** La misurazione è oggi il caso d'uso più affermato per le camere bianche, con le principali reti di media come Pinterest, Disney e Paramount che creano le proprie camere bianche.
### Retail Media e CPG: Monetizzazione dei dati first party
**La sfida:** I marchi CPG spendono molto sui media retail ma non hanno visibilità sui risultati degli acquisti. I rivenditori sono titolari di dati completi sui punti vendita ma non possono esporli senza violare gli impegni in materia di privacy.
**Soluzione per camera bianca:**
* I retailer e le aziende CPG combinano i dati dei punti vendita delle sedi di vendita con i dati di marketing per ottimizzare le attività promozionali
* I marchi contribuiscono con identificatori CRM con hashing o fedeltà
* Link alle camere bianche e esposizione ad acquisti interni/online
* L'attivazione rimane all'interno dell'ecosistema multimediale del rivenditore
**Risultati aziendali:**
* I retailer monetizzano i dati first party senza vendere informazioni sui clienti non elaborate
* I marchi ottengono l'attribuzione a circuito chiuso che mostra quali campagne hanno spinto gli acquisti
* Retail Media Networks scalabile senza rischi per la privacy
**Prove del settore:** Retail Media Network come Luminate di Walmart e Kroger Precision Marketing offrono camere bianche che aiutano i marchi CPG ad analizzare il comportamento dei clienti e a ottimizzare le strategie di marketing utilizzando i dati dei rivenditori.
### Servizi finanziari: Rilevamento collaborativo delle frodi
**La sfida:** Le reti antifrode operano tra gli istituti, ma le banche non possono condividere apertamente i dati dei clienti o delle transazioni a causa di regolamenti come la GLBA e le leggi sulla privacy emergenti.
**Soluzione per camera bianca:**
* Più banche riuniscono dati anonimizzati per identificare schemi indicativi di frode, ad esempio insolite attività tra banche
* Analisi federate o modelli eseguiti attraverso segnali di frode condivisi
* Nessun istituto vede i dati a livello di cliente di un altro
**Risultati aziendali:**
* Rilevamento precoce degli schemi di frode tra istituti
* Meno falsi positivi grazie a insiemi di segnali più completi
* Conformità normativa senza centralizzare i dati sensibili
**Prove del settore:** Le soluzioni per i servizi finanziari di Experian e TransUnion offrono tecnologie per camere bianche che consentono a banche e assicurazioni di collaborare all'individuazione delle frodi e alla valutazione del rischio mantenendo rigidi controlli sulla privacy dei dati.
### Assistenza sanitaria e scienze della vita: Ricerca senza esposizione dei dati dei pazienti
**La sfida:** Le aziende farmaceutiche hanno bisogno di risultati reali per lo sviluppo dei farmaci, ma i dati risiedono in sistemi sanitari sanitari protetti dall'HIPAA e da regolamenti simili.
**Soluzione per camera bianca:**
* Medici e ricercatori farmaceutici condividono i dati all'interno di una camera bianca per capire come i pazienti reagiscono ai trattamenti.
* I dati dei pazienti rimangono all'interno degli ambienti degli operatori.
* I ricercatori eseguono analisi statistiche approvate tramite una camera bianca.
* La privacy differenziale impedisce la reidentificazione.
**Risultati aziendali:**
* Prove del mondo reale statisticamente valide su larga scala
* Semplificare il reclutamento dei pazienti per gli studi clinici abbinando i dati anonimi dei pazienti ai criteri di sperimentazione, trovando i candidati idonei senza violare le leggi sulla privacy dell'assistenza sanitaria
* Dipendenza ridotta da popolazioni limitate di studi clinici
**Prove del settore:** Le camere bianche incentrate sull'assistenza sanitaria come Datavant offrono ambienti conformi all'HIPAA per i ricercatori e le organizzazioni sanitarie per analizzare in modo sicuro i dati dei pazienti per gli studi clinici e lo sviluppo di farmaci.
### Schemi intersettoriali: L'imperativo della collaborazione
Oltre a questi casi d'uso principali, le camere bianche consentono di:
* **Ottimizzazione della supply chain:** Produttori e fornitori collaborano per condividere i dettagli dell'inventario, le pianificazioni di produzione e le previsioni della domanda, consentendo un migliore coordinamento e proteggendo le informazioni proprietarie.
* **M&A Due Diligence:** Quando un'azienda ne acquisisce un'altra, la due diligence richiede l'esame delle proiezioni finanziarie e dei database dei clienti senza condividere direttamente informazioni sensibili; le camere bianche rivelano approfondimenti come l'allineamento dei segmenti di clienti e i rischi di conformità.
* **Media e intrattenimento:** I publisher dimostrano il valore del pubblico per gli inserzionisti proteggendo le identità degli abbonati, abilitando CPM premium supportati da misurazioni affidabili anziché dalla destinazione probabilistica
Nelle aree AdTech, retail, servizi finanziari, sanità e media, le Data Clean Room sono diventate un'infrastruttura Trust fondamentale. Consentono una collaborazione di alto valore che in precedenza era bloccata da vincoli di privacy, normativi o competitivi. Le camere bianche sono **componenti architettonici fondamentali** che consentono una collaborazione sicura e controllata, sbloccando approfondimenti e monetizzazione senza rinunciare al controllo o alla conformità dei dati.
## Data Clean Rooms (Stanze pulite dati): La base della collaborazione sui dati affidabili
Una camera bianca dei dati è un ambiente sicuro e gestito che consente a più parti di generare approfondimenti congiunti senza esporre o scambiare dati non elaborati. Anziché replicare le serie di dati, vengono eseguiti i carichi di lavoro di analisi, intelligenza artificiale e attivazione approvati e vengono restituiti solo output conformi alle policy. Se l'attivazione richiede record a livello di persona, i dati vengono consegnati direttamente alla destinazione prevista senza essere esposti alle parti che collaborano.
Dal punto di vista architettonico, le camere bianche spostano la collaborazione dalla condivisione dei dati al calcolo controllato. Ogni partecipante mantiene la custodia dei propri dati, mentre l'imposizione in fase di esecuzione regola il comportamento delle query, i vincoli di output, il consenso e le policy di utilizzo.
La collaborazione è ulteriormente abilitata attraverso meccanismi di allineamento degli identificatori che salvaguardano la privacy, consentendo la correlazione delle serie di dati di parti diverse senza esporre gli identificatori sottostanti, una funzionalità spiegata in modo più dettagliato più avanti in questo documento.
Di conseguenza, le camere bianche dei dati fungono da infrastruttura di base per le aziende regolamentate dalla privacy, multi-cloud e basate sull'intelligenza artificiale che utilizzano strategie basate su dati federati e copia zero.
 Le prime camere bianche dei dati seguivano un modello di "bunker" centralizzato. A tutti i partecipanti è stato richiesto di copiare i dati in un ambiente neutro di terze parti per l'analisi. Pur essendo semplice nel concetto, questo approccio ha introdotto un notevole attrito. Lo spostamento dei dati ha aumentato la latenza e i costi, complicato gli accordi legali e di conformità e costretto le organizzazioni a rinunciare al controllo diretto dei dati sensibili. Nei settori regolamentati, questi compromessi spesso rendevano impraticabile la collaborazione.
Le moderne camere bianche dei dati si sono evolute verso un modello distribuito e federato. I dati rimangono nell'ambiente del titolare e le analisi vengono eseguite tramite query federate. La camera bianca funziona come un livello di governance che intercetta ogni query, applica i controlli della privacy e delle policy in fase di esecuzione e restituisce solo output aggregati approvati.
| Dimensione | Camera bianca tradizionale (modello "Bunker") | Camera pulita moderna (modello distribuito/federato) |
|---|---|---|
| Posizione dati | I dati vengono copiati in un ambiente centralizzato di terze parti | I dati rimangono nell'ambiente del titolare |
| Spostamento dati | Richiede il trasferimento fisico e la duplicazione delle serie di dati | Nessun movimento di dati non elaborati, vengono eseguite query |
| Controllo e custodia | Custodia parzialmente ceduta a piattaforma di terze parti | Proprietà e custodia dei dati non elaborati conservate da ciascuna parte |
| Modello di architettura | Aggregazione centralizzata | Calcolo distribuito e federato |
| Applicazione della governance | Policy applicate dopo lo spostamento dei dati | Policy applicate in fase di esecuzione della query |
| Modello di privacy | Si basa fortemente sui controlli contrattuali e procedurali | Applicato tecnicamente tramite controlli in fase di esecuzione e soglie di aggregazione |
| Latenza | Latenza superiore dovuta all'inserimento e alla sincronizzazione | Latenza inferiore, query federate quasi in tempo reale |
| Struttura dei costi | Maggiori costi di archiviazione, trasferimento e duplicazione | Duplicazione ridotta, poiché l'elaborazione avviene dove risiedono i dati |
| Complessità della conformità | Accordi giuridici complessi dovuti alla circolazione transfrontaliera dei dati | Conformità semplificata poiché i dati non lasciano il confine della fonte |
| Scalabilità | La scalabilità richiede più memoria e replica dei dati | Scala attraverso l'elaborazione distribuita senza duplicare i dati |
| Adattamento al settore regolamentato | Spesso impraticabile a causa di problemi di custodia e residenza | Migliore allineamento ai vincoli di sovranità, consenso e regolamentazione |
 ### Fondamenti della piattaforma per le clean room dati scalabili
A livello di infrastruttura, Salesforce Data 360 viene eseguito su Hyperforce, il runtime nativo del cloud di Salesforce che astrae le risorse hyperscaler (AWS, Azure, GCP) dietro un piano di controllo unificato. Questa architettura consente ai dati di rimanere all'interno dell'area geografica per soddisfare i requisiti di sovranità e residenza, abilitando al contempo le operazioni delle camere bianche gestite a livello globale.
Questa base consente la collaborazione tra cloud nelle camere bianche, inclusa l'interoperabilità nativa con le camere bianche AWS. Utilizzando Data 360 come livello di orchestrazione e governance, le aziende possono collaborare con partner che operano direttamente su AWS senza forzare la migrazione dei dati nello storage gestito da Salesforce. Le query vengono inviate all'origine, le regole sulla privacy vengono applicate in modo coerente e solo i risultati aggregati conformi vengono scambiati tra le piattaforme.
Compliance e Trust vengono imposti a livello di infrastruttura e di esecuzione, anziché a livello di applicazione, offrendo una base durevole per la collaborazione multi-cloud e multi-parte su larga scala.
### Pipeline di Data 360 dall'inserimento all'attivazione
Data 360 implementa una pipeline di dati tracciabile end-to-end, assicurando che le operazioni nelle clean room vengano eseguite su dati armonizzati, governati e sensibili all'identità anziché su estrazioni non elaborate.
Le fasi chiave includono:
* **Connessione**: Inserimento dati e virtualizzazione tramite connettori pronti all'uso, API, SDK, MuleSoft o connettori copia zero
* **Persistere**: Archiviazione di dati non elaborati in formati nativi (Parquet / Iceberg)
* **Armonizza**: Mappatura a oggetti modello di dati (DMO) canonici per join coerenti
* **Unifica**: La risoluzione dell'identità crea i Golden Record
* **Approfondimenti derivati**: Gli approfondimenti calcolati calcolano le metriche aggregate all'interno del confine governato
* **Atto**: Gli output gestiti vengono inviati alle organizzazioni Salesforce, alle piattaforme di marketing, alle reti pubblicitarie, alle piattaforme dati esterne **o ad altre** clean room, chiudendo il ciclo di approfondimenti sull'azione
Questa pipeline garantisce che le camere bianche funzionino con dati di livello aziendale, non con estrazioni ad hoc.
### Integrazione nativa e "Clicks-Not-Code"
A differenza delle piattaforme clean room dati indipendenti che richiedono provisioning e sviluppo SQL separati, le clean room Salesforce sono incorporate in modo nativo in Data 360\. Ciò consente il riutilizzo di DMO, regole di identità, modelli di consenso e policy di governance, eliminando i livelli di sicurezza duplicati.
Il modello di camera bianca basato su modello di Salesforce è un acceleratore chiave che utilizza:
* **Modelli pronti all'**uso per supportare schemi di collaborazione comuni come sovrapposizione del pubblico, soppressione, raggiungimento e misurazione del lift.
* **Modelli personalizzati** che consentono ad architetti e utenti esperti di definire una logica analitica riutilizzabile su misura per esigenze specifiche del settore o dei partner, senza esporre dati non elaborati o complessità delle policy.
Questo approccio standardizza la collaborazione pur consentendo flessibilità, consentendo alle camere bianche di scalare come funzionalità aziendale ripetibile, non come progetto di analisi una tantum.
### Il “Sentiero d’oro” – Chiusura del loop Approfondimento-azione
Data 360 risolve una modalità di errore comune delle camere bianche tradizionali: l'Attivation Gap. Il framework Golden Path garantisce che gli approfondimenti generati all'interno di una camera bianca possano essere utilizzati immediatamente, senza esportare dati non elaborati.
* **Impostazione e Discovery**: I partner condividono i metadati dello schema e i modelli di leva per valutare la fattibilità prima della finalizzazione dei contratti.
* **Analisi**: I modelli predefiniti e personalizzati consentono l'analisi delle sovrapposizioni, la soppressione, la modellazione lookalike e la misurazione dell'ascensore, tutte eseguite all'interno del confine governato.
* **Attivazione**: I segmenti approvati vengono inviati direttamente a Marketing Cloud, alle piattaforme pubblicitarie o ai sistemi partner, condividendo solo i risultati aggregati e conformi.
I modelli diventano percorsi di esecuzione ponderati, garantendo che la collaborazione passi in modo prevedibile dall'analisi all'attivazione.
## Playbook per le camere bianche di Salesforce Data 360
La distribuzione di una Clean Room di Salesforce Data 360 non è solo un esercizio di configurazione: è un flusso di lavoro architetturale disciplinato che copre la preparazione dei dati, la progettazione della governance, la connettività protetta e il monitoraggio operativo.
### Fase 1: Definizione del caso d'uso di collaborazione (iniziare con l'intento)
Prima di toccare i dati o la configurazione, gli architetti devono definire chiaramente:
* A quale domanda stiamo cercando di rispondere?
* Quale esito si prevede? (ad esempio, analisi della sovrapposizione, misurazione del lift, soppressione, rilevamento delle frodi)
* Quale livello di aggregazione è richiesto?
* Quali vincoli normativi o contrattuali si applicano?
* Quale percorso di attivazione consumerà i risultati?
La comprensione dell'obiettivo del collaboratore determina tutto ciò che segue: chiavi di join, regole di identità, soglie di governance e modellazione dei costi. Le camere bianche sono ambienti creati appositamente. Devono essere progettate intorno a un obiettivo analitico definito, non all'esposizione generica dei dati.
### Fase 2: Preparazione dei dati per la collaborazione in camera bianca
Prima di iniziare la collaborazione, i dati aziendali devono essere preparati strutturalmente e semanticamente. Le camere bianche amplificano sia i punti di forza che i punti deboli dei dati sottostanti. La spazzatura dentro, la spazzatura fuori è ancora più vera qui.
**Inserimento:** Collegare sistemi di origine come Salesforce CRM, Marketing Cloud, AWS S3 e Google Cloud Storage a Data 360\. Ove possibile, utilizzare connettori copia zero (ad esempio Snowflake) per evitare movimenti o duplicazioni inutili dei dati.
**Mappatura semantica:** Mappare gli stream di dati al modello di dati Customer 360. Standardizzare campi chiave come numeri di telefono (formato E.164), codici paese/provincia (standard ISO) e indirizzi email. Un disallineamento (ad esempio, una parte che utilizza "CA" e un'altra "California") può non riuscire silenziosamente a raggiungere i join e ridurre i tassi di corrispondenza.
**Risoluzione dell'identità:** Configurare le regole deterministiche (corrispondenza esatta) e probabilistiche (corrispondenza fuzzy) per creare una Persona unificata (Golden Record). Questa entità unificata è la superficie per la corrispondenza delle camere bianche.
La qualità della risoluzione dell'identità influisce direttamente sul valore della collaborazione. Una maggiore precisione delle corrispondenze aumenta le percentuali di sovrapposizione, la confidenza analitica e riduce i falsi negativi.
### Fase 3: Provisioning della Clean Room
Una volta armonizzati i dati, è necessario eseguire il provisioning della camera bianca per definire i confini della collaborazione.
**Convalida della licenza:** Verificare che tutte le organizzazioni partecipanti dispongano dei diritti necessari per Data 360 e le camere bianche.
**Ambito spazio dati:** Gli oggetti camera bianca devono essere limitati a uno spazio dati specifico. Solo gli oggetti mappati a quello spazio dati sono visibili alla camera bianca. Ciò garantisce che la collaborazione sia logicamente isolata senza richiedere la creazione di un nuovo spazio dati esclusivamente per le camere bianche.
**Definizione delle regole di governance:** Stabilire policy in modo dichiarativo prima di eseguire le query:
* **Soglie aggregazione:** ad esempio, un minimo di 100 record per output
* **Join Keys:** ad esempio Email_Hash_SHA256
* **Operazioni consentite:** solo funzioni di aggregazione come COUNT, SUM, AVG
* **Restrizioni esplicite:** bloccare le esportazioni a livello di riga (SELECT \*)
Le regole di governance vengono applicate al momento dell'esecuzione, rendendo le proprietà di privacy e conformità a livello di sistema anziché indicazioni procedurali.
### Fase 4: Definizione di una connettività multiparte sicura
Le camere bianche spesso superano i confini dell'organizzazione e della piattaforma. La connettività deve essere esplicita e strettamente controllata.
**Collegamento account:**
* **Da Salesforce a Salesforce:** Utilizzare Data Cloud One o i meccanismi di condivisione tra organizzazioni approvati.
* **Scenari multi-cloud:** Convalidare l'allineamento delle regioni e la residenza prima di abilitare le query.
**Autenticazione e autorizzazione:** Configurare l'accesso basato su OAuth per gli utenti integrazione dedicati con il principio dei privilegi minimi: limitare l'accesso strettamente agli spazi dati necessari ed evitare le autorizzazioni amministrative.
Gli errori di sicurezza spesso derivano da utenti integrazione con autorizzazioni eccessive anziché da debolezze nella crittografia o nei controlli della piattaforma.
### Fase 5: Esecuzione, monitoraggio e controllo dei carichi di lavoro delle camere bianche
Una volta attivata, l'attenzione si sposta sulla supervisione operativa, sulla qualità delle query e sulla gestione dei costi.
**Esecuzione di query:** Gli analisti o i flussi di lavoro eseguono analisi delle sovrapposizioni e aggregazioni tramite Approfondimenti calcolati o interfacce SQL approvate. Tutte le query impongono automaticamente soglie di aggregazione e controlli della privacy.
**Audit e tracciabilità:** Le camere bianche di Salesforce Data 360 offrono percorsi di controllo sotto forma di oggetto modello di dati (DMO) di controllo. In questo modo si acquisiscono metadati sull'attività della query, incluso chi ha eseguito la query, quando è stata eseguita e quali policy sono state applicate. Il DMO Controllo abilita la creazione di rapporti sulla conformità, la convalida della governance e la tracciabilità forense, assicurando che la collaborazione sia sicura per la privacy e rivedibile.
**Monitoraggio del consumo:** Data Cloud utilizza un modello di credito basato sul consumo. I fattori chiave includono:
* Righe elaborate (ad esempio, 1M righe = unità di credito di riferimento)
* Complessità delle query
* Operazioni di risoluzione dell'identità (moltiplicatore superiore)
* Inserimento batch (moltiplicatore inferiore)
**Digital Wallet e avvisi:** Utilizzare Digital Wallet per tenere traccia del consumo in tempo reale e configurare avvisi con soglie del 50%, 75% e 90%. Correlare i picchi a carichi di lavoro specifici per evitare costi imprevisti.
Tenere presente che la copia zero non elimina i costi di calcolo. Mentre la duplicazione fisica viene rimossa, l'esecuzione avviene nel sistema di origine. Gli architetti devono gestire gli schemi di query, unire la selettività e la frequenza di esecuzione per controllare i costi e le prestazioni.
## Governance, sicurezza e conformità
### Progettazione di camere bianche per Trust su larga scala
Nelle aziende moderne, il Trust non è legato a una camera bianca dei dati. È un risultato architettonico. Salesforce Data 360 applica la governance, la sicurezza e la conformità in modo continuo e automatico, spostando le camere bianche dagli ambienti basati sulle policy ai sistemi gestiti dalla piattaforma.
I controlli del tempo di esecuzione (identità bloccate, tracciati di controllo e privacy differenziale) si applicano in modo coerente indipendentemente dal fatto che la collaborazione avvenga all'interno di Salesforce, tra partner o tra cloud.
### Execution-Time Trust e governance
Il cambiamento più importante per gli architetti è che il Trust viene imposto durante l'esecuzione, non assunto in precedenza. Salesforce Data 360 raggiunge questo obiettivo attraverso una serie di controlli centrali della piattaforma:
* **Identità bloccata:** L'accesso dei partner è crittografato alle identità verificate dell'organizzazione Salesforce, impedendo lo spoofing o la partecipazione non autorizzata.
* **Percorsi di controllo:** Ogni query, join, sovrapposizione di segmenti e attivazione viene registrata per garantire la piena verificabilità e conformità ai regolamenti.
* **Privacy differenziale:** L'ispezione a livello di riga è strutturalmente impossibile. Gli output sono aggregati e statisticamente limitati. I collaboratori visualizzano solo risultati che proteggono la privacy, ad esempio le metriche di raggiungimento o le percentuali di lift, mai singole transazioni o identità.
Questi controlli sostituiscono il Contract Trust con garanzie matematiche e applicazione a livello di piattaforma, riducendo il rischio operativo e legale.
### AI Governance tramite Einstein Trust Layer
Man mano che gli agenti AI interagiscono sempre più con i dati delle camere bianche, Salesforce introduce Einstein Trust Layer. Funge da camera stagna architetturale tra i dati aziendali sensibili e gli LLM esterni. Ciò garantisce che gli approfondimenti sulle camere bianche possano supportare in modo sicuro le decisioni basate sull'intelligenza artificiale senza esporre i dati sottostanti.
**Capacità principali:**
* **Conservazione dei dati zero:** I dati inviati agli LLM sono effimeri. I provider di modelli non possono memorizzare prompt o risposte per l'addestramento.
* **Rilevamento del linguaggio tossico e mascheramento delle informazioni personali:** Gli input e gli output vengono analizzati automaticamente e le informazioni personali vengono mascherate in base alle policy di mascheramento dei dati configurate in Data 360.
### Isolamento logico tramite spazi dati e insiemi di autorizzazioni
Gli **spazi dati** offrono un isolamento logico all'interno di un'organizzazione e dovrebbero allinearsi ai confini normativi, geografici e di partnership come:
* Spazio dati UE
* Spazio dati Nord America
Solo le serie di dati assegnate a uno spazio dati sono visibili all'interno delle sue clean room, impedendo l'esposizione accidentale oltre confine.
Gli insiemi di autorizzazioni offrono un controllo preciso su chi può creare o gestire le camere bianche, eseguire query o attivare segmenti. Le autorizzazioni data-aware impongono restrizioni a livello di campo all'interno degli oggetti modello di dati, ad esempio gli esperti di marketing possono visualizzare i nomi dei segmenti e le dimensioni del pubblico ma non gli indicatori di reddito o di salute.
La sicurezza viene applicata a livello semantico, consentendo agli utenti aziendali un self-service sicuro senza una supervisione IT costante.
### Conformità e consenso per progettazione
I segnali di consenso si propagano automaticamente attraverso Data 360 nell'esecuzione in camera bianca. Gli utenti che revocano il consenso sono esclusi dall'analisi e dall'attivazione per impostazione predefinita, garantendo che la conformità sia imposta dal sistema e non controllata manualmente.
Salesforce Data 360 considera governance, sicurezza e conformità come elementi primitivi dell'architettura di prima classe, non come componenti aggiuntivi facoltativi. Combinando la possibilità di controllare il tempo di esecuzione, le identità bloccate, la privacy differenziale, gli spazi dati, la risoluzione dell'identità consapevole del consenso e Einstein Trust Layer, le aziende possono scalare la collaborazione nelle camere bianche tra partner, sistemi multi-cloud e carichi di lavoro basati sull'intelligenza artificiale, il tutto senza compromettere Trust, privacy o conformità normativa.
## Conclusione e percorso da seguire
### Un percorso pratico per gli architetti
Per acquisire l'intero valore delle camere bianche dei dati, gli architetti devono trattarle come un'infrastruttura architettonica di base, non come strumenti di analisi isolati. Le seguenti priorità definiscono un percorso pragmatico e scalabile:
**Trasformare la collaborazione in una preoccupazione architettonica di prima classe:** La collaborazione sui dati esterni deve essere progettata con lo stesso rigore dell'integrazione interna. Le camere bianche dovrebbero essere incorporate in architetture di riferimento aziendali insieme a piattaforme dati, livelli di integrazione e sistemi AI, non distribuite come estensioni ad hoc. Man mano che l'interoperabilità si espande (ad esempio, l'integrazione delle camere bianche di Data 360 con le camere bianche AWS e la futura compatibilità tra camere bianche), gli architetti devono progettare schemi di collaborazione che anticipino gli ecosistemi multipiattaforma anziché i silos a fornitore singolo.
**Progettazione della privacy per impostazione predefinita alla fonte**
**Progettazione per la fluidità dei dati: **Piuttosto che utilizzare per impostazione predefinita ETL e replica centralizzata pesanti, gli architetti dovrebbero prima considerare la federazione e l'accesso copia zero. Lo spostamento del calcolo nei dati (quando appropriato) riduce le duplicazioni inutili, riduce i costi e preserva l'integrità della fonte della verità. “Connect vs. copy” dovrebbe essere una decisione architettonica consapevole, non un’abitudine ereditata.
**Colmare il divario tra approfondimenti e azioni:** Le camere bianche che si fermano all'analisi non offrono valore aziendale. Le architetture devono collegare in modo nativo gli output delle camere bianche ai sistemi di attivazione e ai flussi di lavoro AI. I cicli di feedback, la misurazione delle prestazioni e l'esecuzione a valle devono essere progettati fin dall'inizio.
**Prepararsi per l'Enterprise Agente:** Poiché gli agenti dell'intelligenza artificiale utilizzano sempre più i dati aziendali, le clean room fungeranno da ambienti di esecuzione controllati in cui gli agenti possono operare senza esporre dati non elaborati. Gli architetti che allineano la strategia per le camere bianche ai framework di governance e Trust AI saranno nella posizione migliore per questa fase successiva.
### Conclusione
Le moderne camere bianche dei dati rappresentano un cambiamento fondamentale nell'architettura dei dati aziendali. Risolvono l'annosa tensione tra utilità dati e privacy abilitando la collaborazione senza esposizione dei dati.
Architetture come Salesforce Data 360 dimostrano che questo compromesso non è una considerazione "o-o". Separando l'archiviazione dei dati dall'attivazione tramite schemi copia zero e incorporando tecnologie che ottimizzano la privacy direttamente nell'esecuzione, le aziende possono collaborare su analisi di alto valore senza rinunciare al controllo dei propri dati. La privacy passa dall’obbligo contrattuale alla garanzia architettonica.
Soprattutto, le camere bianche trasformano i dati da un asset statico in silo in una risorsa gestita e di immediato valore pratico. Quando sono connessi in modo nativo ai livelli di attivazione e intelligenza artificiale, gli approfondimenti non sono più in stallo nei cruscotti digitali. Confluiscono direttamente in decisioni, campagne e sistemi autonomi, chiudendo il ciclo tra dati, azioni ed esiti su scala aziendale.
## Informazioni sugli autori
**Yugandhar Bora** è un architetto di ingegneria del software di Salesforce, specializzato in architettura dei dati all'interno della piattaforma Data and Intelligence Applications. Dirige iniziative del Comitato di revisione dell'architettura aziendale (EARB) incentrate sulla governance dei dati e sui modelli di dati unificati, contribuendo al contempo alle soluzioni di provisioning automatico della piattaforma.
**Birendra Kumar Singh** è un membro principale dello staff tecnico, specializzato in piattaforma e architettura dei dati all'interno di Data 360 in Salesforce. È membro principale della piattaforma di attivazione e guida l'iniziativa Clean Room incentrata sulla fornitura di infrastrutture per camere bianche dati ai clienti di Data 360.
**Priyanka Kshirsagar** è Senior Product Manager di Salesforce, alla guida delle Clean Room di Data 360, una capacità che ha creato da zero per consentire ai clienti aziendali di collaborare sui dati first party in un ambiente che tutela la privacy. Guida la visione per i casi d'uso basati su intelligenza artificiale e ML, inclusa la modellazione lookalike e l'arricchimento dell'identità nelle camere bianche, e ha portato il prodotto attraverso la disponibilità generale e un lancio Dreamforce di livello 1.
# Introduzione
Nello sviluppo software tradizionale, il Ciclo di vita dello sviluppo software (SDLC) offre un approccio strutturato e scaglionato alla creazione di applicazioni. Stabilisce la qualità, riduce i rischi e fornisce una roadmap chiara dall'idea al rilascio. L'ADLC (Agent Development Lifecycle) è una metodologia simile che è distintamente personalizzata per affrontare le complessità specifiche della creazione di agenti autonomi.
Gli agenti non sono applicazioni passive; sono sistemi che ragionano, agiscono e apprendono all'interno di ambienti di esecuzione dinamici. Il loro comportamento non deterministico rende insufficiente il controllo di qualità tradizionale. L'ADLC (Agent Development Lifecycle), promosso da piattaforme come Agentforce, affronta questo aspetto in cinque fasi: Ideazione e progettazione, sviluppo (il "loop interno"), test e convalida, distribuzione e monitoraggio e messa a punto continui (il "loop esterno").
Questo documento funge da guida completa per gli sviluppatori e gli architetti Enterprise che hanno già familiarità con le complessità del ciclo di vita dello sviluppo software (SDLC) e desiderano espandere la loro esperienza nei sistemi basati sugli agenti. Il nostro obiettivo principale è facilitare una comprensione rapida del ciclo di vita dello sviluppo degli agenti (ADLC) evidenziandone le distinzioni chiave dalle metodologie SDLC tradizionali e fornendo un framework strutturato per concettualizzare l'intero processo di creazione, distribuzione e gestione degli agenti intelligenti.
Il documento è organizzato in tre capitoli distinti, ciascuno progettato per costruire progressivamente le tue Knowledge e abilità pratiche:
- **Capitolo 1: Framework ADLC.** Questo capitolo introduce l'ADLC (Agent Development Lifecycle), descrivendone le differenze rispetto all'SDLC a causa delle sfide specifiche dello sviluppo di agenti autonomi. Stabilisce un framework per la progettazione, lo sviluppo, il test e la distribuzione degli agenti.
- **Capitolo 2: Agentforce Platform.** Questo capitolo esplora Agentforce, una piattaforma unificata che semplifica e accelera l'intero ciclo di vita dello sviluppo degli agenti. Agentforce offre strumenti per la progettazione degli agenti, l'elaborazione dei dati, l'addestramento dei modelli, la distribuzione e il monitoraggio continuo, semplificando le operazioni complesse e migliorando l'efficienza.
- **Capitolo 3: Implementazione pro-codice.** Questa guida utilizza gli strumenti pro-code di Agentforce per fornire istruzioni pratiche e dettagliate ed esempi concreti per lo sviluppo degli agenti. Copre l'intero ciclo di vita dello sviluppo degli agenti, dalla prototipazione e l'ingegneria delle funzioni alla distribuzione del modello, al perfezionamento delle prestazioni e alla manutenzione, fornendo agli sviluppatori le competenze necessarie per creare agenti pronti per la produzione.
Questo documento si propone di fornire le Knowledge teoriche e pratiche degli strumenti pro-code di Agentforce. Imparerai a creare, distribuire e monitorare gli agenti in modo efficiente, sicuro e affidabile, acquisendo una comprensione completa dell'ADLC e massimizzando il potenziale di Agentforce nello sviluppo intelligente degli agenti.
## Capitolo 1: Presentazione del ciclo di vita di sviluppo degli agenti
La natura non deterministica degli agenti AI richiede un framework di sviluppo specializzato. Questo capitolo descrive questo framework introducendo l'ADLC (Agent Development Lifecycle). Questo capitolo offre una panoramica completa delle cinque fasi centrali dell'ADLC, dall'ideazione e progettazione iniziali al monitoraggio e alla messa a punto continui. Questo capitolo stabilisce le Knowledge di base necessarie per creare agenti affidabili e affidabili.
Questa sezione mappa i concetti SDLC alle cinque fasi dell'ADLC.
### Fase 1: Ideazione e Design
Questa è la fase fondamentale in cui vengono definiti lo scopo strategico e i confini operativi di un agente. Una fase di progettazione ben strutturata è il passaggio più critico per il successo, poiché traduce un'esigenza aziendale in un modello tecnico. Il processo di progettazione garantisce che l'agente non sia solo funzionale ma anche responsabile e in linea con le aspettative degli utenti. È dove il "cosa" e il "perché" vengono stabiliti prima di scrivere qualsiasi codice.
1. **Definizione di obiettivi e funzionalità degli agenti**: Innanzitutto, è necessario articolare chiaramente l'obiettivo principale dell'agente e le operazioni specifiche e misurabili che eseguirà. Ciò comporta la definizione del suo ruolo (ad esempio, "Assistente dell'assistenza clienti"), delle sue funzioni centrali (ad esempio, "prenotazione di appuntamenti", "risposta a domande sui prodotti") e delle metriche di successo per ciascuno di essi.
2. **Creazione di guardrail personali ed etici**: Questo passaggio prevede la progettazione della personalità dell'agente e la definizione dei suoi confini etici per garantire che sia affidabile e sicuro. Stabilisce il tono dell'agente (ad esempio, "formale", "amichevole") e implementa regole rigorose per prevenire risposte dannose, distorte o inappropriate.
3. **Mappatura del contesto e comprensione**: È necessario determinare quali informazioni l'agente deve comprendere e ricordare per essere efficace. Ciò include la definizione dell'ambito della sua Knowledge Base e della sua memoria conversazionale, che consente di avere conversazioni coerenti e a più turni.
4. **Identificazione di strumenti e integrazioni di sistemi**: Ciò comporta l'inventario dei sistemi esterni, delle API e delle fonti di dati con cui l'agente deve connettersi per eseguire le operazioni. Ogni strumento (ad esempio, un'API di prenotazione, un database clienti) viene identificato e la sua funzione viene mappata a una funzionalità specifica dell'agente.
5. **Piano per l'inoltro al livello superiore di Human-in-the-Loop**: È fondamentale definire le condizioni in cui un agente passa a un essere umano. Ciò comporta la revisione dei potenziali punti di errore e dei "punti morti" della conversazione per determinare quando un agente deve passare a un operatore umano. La progettazione deve descrivere come verrà eseguito questo trasferimento per garantire che venga trasferito un contesto sufficiente, in modo che possa essere utilizzato rapidamente per garantire un'esperienza cliente senza interruzioni.
#### Fase 2: Sviluppo
Questa è la fase di costruzione pratica in cui il modello di progettazione viene trasformato in un agente funzionale. Gli sviluppatori creano l'agente, lo collegano ai suoi strumenti e gli forniscono i dati necessari per svolgere le proprie mansioni. Questo "anello interno" iterativo di costruzione e raffinazione è il punto in cui l'agente prende veramente vita.
1. **Configurazione della logica e del processo decisionale dell'agente**: Questo passaggio prevede la definizione del ragionamento dell'agente collegando il suo framework decisionale al contesto, agli strumenti e alle fonti di dati. Il ruolo dello sviluppatore è definire il comportamento dell'agente creando API o riutilizzando API esistenti, impostando guardrail operativi e specificando in che modo l'agente seleziona e utilizza gli strumenti disponibili per completare operazioni complesse in più fasi.
2. **Prompt tecnici e modelli di fine-tuning**: Il profilo, le istruzioni e i vincoli dell'agente vengono codificati attraverso una meticolosa progettazione rapida. Questo processo prevede la creazione del prompt principale che guida il modello Large Language (LLM) e, per i casi d'uso più avanzati, l'ottimizzazione del modello sui dati specifici del dominio per migliorarne le prestazioni.
3. **Integrazione e protezione degli strumenti AI**: Le funzioni e le API identificate durante la fase di progettazione sono collegate all'agente. Utilizzando un SDK, gli sviluppatori inseriscono le funzioni esistenti o ne creano di nuove, rendendole chiamabili in modo sicuro dall'agente e assicurando che dispongano dell'autenticazione e della gestione degli errori appropriate.
4. **Creazione di dati e opportunità in corso di realizzazione RAG**: Per fornire all'agente Knowledge esterno, gli sviluppatori creano le pipeline di dati per la generazione aumentata di recupero (RAG). Ciò implica la connessione e l'indicizzazione dei dati da fonti come archivi vettoriali, database relazionali, database grafici o documenti interni, rendendo tali informazioni accessibili all'agente per fornire risposte accurate e sensibili al contesto.
#### Fase 3: Test e convalida
Il test degli agenti AI introduce un cambiamento di paradigma rispetto alla convalida deterministica del software tradizionale. Mentre un'applicazione convenzionale viene testata per la correttezza (un input specifico deve produrre un singolo output previsto), la natura non deterministica di un agente richiede un approccio più sofisticato. L'obiettivo non è convalidare una singola risposta corretta, ma garantire che il comportamento dell'agente sia allineato allo scopo previsto, sia efficace contro input imprevisti e rimanga affidabile in una gamma di risultati accettabili.
1. **Test di unità**: Questo livello si concentra sui componenti deterministici non AI dell'agente. Include test di unità tradizionali per confermare che ogni singolo strumento e funzione funzioni funzioni correttamente isolatamente, garantendo una base affidabile prima di applicare il ragionamento complesso dell'agente.
2. **Test end-to-end (E2E)**: Questa fase valuta la capacità dell'agente di raggiungere gli obiettivi in scenari realistici, che è fondamentale data la sua natura non deterministica. Anziché cercare un output esatto, questi test end-to-end verificano che l'agente completi correttamente le operazioni e che le sue prestazioni non peggiorino man mano che vengono apportate modifiche.
3. **Test del contraddittorio e della robustezza**: Questa è la pratica di provare intenzionalmente a rompere l'agente per scoprire in modo proattivo i suoi punti deboli. I tester utilizzano richieste ambigue, prompt dannosi e altri casi limite per esporre le vulnerabilità e garantire che l'agente rimanga resiliente e sicuro sotto pressione.
4. **Valutazione Human-in-the-Loop (HITL)**: Poiché i test automatici non possono misurare qualità diverse come il tono o il flusso conversazionale, questa fase si basa sul feedback umano. I tester interagiscono con l'agente per calcolare il punteggio delle sue risposte in termini di utilità e di esperienza utente complessiva, fornendo dati essenziali per perfezionarne il comportamento.
5. **Test di prestazioni e scalabilità**: Questo è un passaggio fondamentale per evitare che le strozzature delle prestazioni abbiano effetto sugli utenti. Questo processo simula scenari di picco di utilizzo realistici per garantire che agenti e applicazioni possano gestire volumi elevati in modo fluido e prevedibile. Verifica che la soluzione non sia solo corretta, ma anche scalabile.
#### Fase 4: Distribuzione e rilascio
La distribuzione di un agente AI è un processo gestito incentrato sulla garanzia che l'agente convalidato sia quello con cui gli utenti interagiscono in modo affidabile e ripetibile. Ciò richiede un approccio strutturato che sposta l'agente da un asset controllato da versione a un servizio live e monitorato.
1. **Confezionamento e controllo delle versioni**: L'intera definizione dell'agente, inclusi i prompt e gli strumenti, viene acquisita come metadati in un file e archiviata in un sistema di controllo sorgente come Git. Questo crea un'unica fonte di dati veritieri e una cronologia controllabile di tutte le modifiche.
2. **Pipeline: CI/CD** Il percorso verso la produzione è automatizzato per eliminare gli errori umani e garantire la coerenza. Queste opportunità in corso di realizzazione promuovono automaticamente l'agente negli ambienti di sviluppo, test e produzione, eseguendo test end-to-end in ogni fase per fungere da porta di accesso alla qualità.
3. **Strategie di implementazione graduale**: Per ridurre al minimo il rischio, le nuove versioni degli agenti vengono rilasciate per la prima volta a un piccolo sottoinsieme di utenti utilizzando strategie come Rilasci Canary. Ciò consente il monitoraggio delle prestazioni del mondo reale prima di un'implementazione completa, con la possibilità di ripristinare rapidamente eventuali problemi.
4. **Attivazione e governance**: Il passaggio fondamentale nell'implementazione di un agente consiste nell'attivare in modo sicuro l'agente con le autorizzazioni corrette e assicurarsi che sia connesso agli strumenti di monitoraggio. Ciò offre una visibilità immediata dello stato e delle prestazioni dell'agente appena distribuito dal momento in cui viene reso disponibile.
#### Fase 5: Monitoraggio e ottimizzazione
La distribuzione non è la fine del ciclo di vita dello sviluppo degli agenti, ma l'inizio del suo continuo "loop esterno". Gli agenti sono sistemi dinamici che operano in ambienti reali imprevedibili. Questa fase è dedicata all'osservazione delle prestazioni live dell'agente, alla raccolta di approfondimenti dalle sue interazioni e all'utilizzo di tali dati per perfezionare e migliorare sistematicamente l'efficacia, la sicurezza e l'efficienza nel tempo.
1. **Monitoraggio delle prestazioni in tempo reale**: Si tratta della procedura di monitoraggio delle principali metriche operative dell'agente durante l'interazione con gli utenti. I cruscotti digitali vengono utilizzati per monitorare la latenza, il consumo di token (costo) e i tassi di errore API, offrendo una visione immediata e generale dello stato e dell'efficienza dell'agente.
2. **Analisi comportamentale e di successo**: Ciò comporta l'analisi dei registri di conversazione per capire in che modo l'agente sta _effettivamente_ eseguendo le proprie mansioni. Si concentra sul monitoraggio delle percentuali di completamento delle operazioni, sull'identificazione dei punti di errore comuni o dei "punti morti" conversazionali e sulla misurazione della soddisfazione degli utenti per determinare se l'agente sta raggiungendo con successo i propri obiettivi. Ad esempio, per gli agenti dell'assistenza, potrebbe fornire metriche sulla frequenza e sul motivo per cui un agente viene inoltrato a una persona.
3. **Sintonizzazione e perfezionamento intelligenti**: Si tratta del processo attivo di utilizzo degli approfondimenti del monitoraggio per migliorare l'agente. Questo può andare dalla progettazione rapida all'ottimizzazione degli strumenti.
4. **Ottimizzazione RAG basata sui dati**: La qualità della Knowledge Base dell'agente viene continuamente migliorata in base alle query del mondo reale. Il monitoraggio può rivelare che l'agente è alle prese con determinati argomenti, il che porta a un perfezionamento delle fonti di dati o del processo di recupero (perfezionamento RAG) per migliorare la precisione delle risposte.
5. **Apprendimento continuo e adattamento**: Ciò comporta la creazione di un loop di feedback in cui i dati di produzione vengono utilizzati per rendere l'agente più intelligente. Con l'etichettatura dei registri di interazione, con supervisione umana o basata su LLM, viene creata una serie di dati curata che può essere utilizzata per perfezionare il modello sottostante e consigliare ulteriori miglioramenti
## Capitolo 2: Ciclo di vita dello sviluppo degli agenti _Agenteforce_
Agentforce supporta ogni fase di ADLC con strumenti integrati per progettazione, sviluppo, test, distribuzione, monitoraggio e analisi, il tutto all'interno di un'unica piattaforma unificata per creare e testare rapidamente agenti efficaci.
Agentforce ADLC si basa sui seguenti principi guida:
- **Creato sia per codice basso che per codice pro**: Supporto per la distribuzione basata su configurazione (low-code) e l'estendibilità a livello di programma (pro-code).
- **Assistenza continua basata sull'intelligenza artificiale e loop di feedback**: Acquisisce e analizza i dati conversazionali per informare gli agenti sulla messa a punto di un miglioramento continuo basato sull'intelligenza artificiale.
- **Sviluppo basato su test a tutti i livelli**: Test rigorosi in tutte le fasi, convalidando i componenti deterministici attraverso i test di unità tradizionali e fornendo nuovi approcci per testare il ragionamento degli agenti e il comportamento non deterministico.
- **Osservabilità dei dirigenti e dei LOB**: Metriche di costo, utilizzo e prestazioni per gli stakeholder operativi e dirigenti.
 Questo capitolo mostra come Agentforce supporta ogni fase dell'ADLC all'**interno di un'unica piattaforma unificata.**
#### Fase 1: Ideazione e Design
##### Ideazione
La fase di ideazione è la fase fondamentale dell'ADLC, in cui vengono formulati la visione iniziale e i requisiti per gli agenti. Comprende un'approfondita comprensione del problema, l'identificazione delle potenziali soluzioni e la descrizione delle funzionalità principali dell'agente.
Avviare il processo di ideazione dell'agente definendone gli attributi chiave:
1. **Scopo/Obiettivo**: Definire chiaramente l'obiettivo principale dell'agente. Quale problema specifico si propone di risolvere, o quale compito si intende svolgere? Chi deve servire l'agente? Questa dovrebbe essere una dichiarazione concisa e misurabile che guida l'intero processo di sviluppo.
2. **Personale**: Sviluppare un profilo dettagliato per l'agente. Ciò include la definizione dell'identità, dello stile di comunicazione e del ruolo che svolgerà nell'interazione con gli utenti o altri sistemi. Considerare il tono, il livello di formalità e le eventuali caratteristiche specifiche che lo renderanno efficace nel contesto previsto.
3. **Schema**: Identificare e collegare gli schemi agenti e le strategie di implementazione pertinenti. Si tratta di progetti architettonici o procedure consigliate che possono influenzare la struttura e il comportamento dell'agente. "[Schemi e implementazione degli agenti in Salesforce Agentforce: Un whitepaper tecnico](/docs/architect/it-it/fundamentals/guide/agentic-patterns)", serve come risorsa preziosa per questo passaggio, offrendo approfondimenti sulla progettazione efficace degli agenti sulla piattaforma Salesforce e Agentforce.
##### Progettazione
La fase di progettazione traduce i concetti dall'ideazione in un modello dettagliato per la costruzione dell'agente. Ciò comporta la definizione dell'architettura dell'agente, dei flussi utente, dei modelli di interazione e di specifiche tecniche come argomenti, strumenti e guardrail.
Durante la fase di progettazione, verrà creato un modello dettagliato per la costruzione dell'agente che include:
- **Progettazione agente**: Descrivere la struttura interna dell'agente, compresi i componenti, i moduli e il modo in cui interagiscono. Ciò potrebbe comportare la definizione della Knowledge Base, della configurazione e della logica per controllare il comportamento degli agenti, i componenti di elaborazione del linguaggio naturale (NLP) e i punti di integrazione con altri sistemi.
- **Flussi utente/Progettazione interazione**: Mappare il journey utente completo e le interazioni dell'agente. Definire flussi di conversazione, alberi decisionali, gestione degli errori e meccanismi di feedback per creare esperienze intuitive ed efficaci.
- **Specifiche tecniche**: Documentare i requisiti tecnici non funzionali per l'agente, ad esempio metriche delle prestazioni, considerazioni sulla scalabilità, protocolli di sicurezza e specifiche di integrazione.
- **Prototipazione e modelli**: Creare rappresentazioni visive o prototipi interattivi dell'interfaccia e delle interazioni dell'agente. Ciò consente test e feedback tempestivi, contribuendo a perfezionare la progettazione prima che inizi lo sviluppo su larga scala.
- **Dati**: Quando si determinano il tipo e le fonti di dati richieste da un agente, identificare le serie di dati, le API, i database e gli archivi a cui l'agente deve accedere. Per Agentforce, concentrarsi sui dati forniti come contesto, se sono strutturati o non strutturati e se sono in tempo reale o batch. La piattaforma Agentforce è basata su una profonda integrazione con Data 360, che consente di utilizzare sia dati strutturati che non strutturati provenienti da Salesforce CRM e da altre fonti. Il contenuto non strutturato può essere suddiviso e indicizzato in modo nativo per RAG. MuleSoft consente di connettersi a sistemi esterni.
- **Strumenti**: Identificare le azioni che l'agente deve eseguire. Utilizzare le azioni Agentforce per esporre gli strumenti che raggiungono gli obiettivi aziendali. Queste azioni sfruttano gli asset Salesforce esistenti, ad esempio Prompt tramite Generatore di prompt, MuleSoft, Apex, Flussi e API con specifiche OpenAPI. Qualsiasi azione invocabile può essere integrata in Agentforce e utilizzata dall'agente, rendendo tutti gli strumenti di sviluppo Salesforce più comuni immediatamente disponibili come azioni Agentforce.
- **Dati di input per gli agenti**: Nell'SDLC tradizionale, gli input sono specificati con precisione. Nell'ADLC, gli input sono spesso enunciazioni naturali, non deterministiche e in formato libero. Raccogliere un corpus rappresentativo di enunciazioni che dovrebbero produrre risposte appropriate.
#### Fase 2: Sviluppo
La fase di sviluppo si concentra sulla traduzione dello scopo, delle capacità e dell'ambito operativo dell'agente definito determinato nella fase di ideazione e progettazione in un nuovo agente Agentforce.
Per aiutare gli sviluppatori a creare agenti, Agentforce fornisce sia **Agent Builder** che **Agenteforce Developer Experience (AFDX).** Questi strumenti di base fungono da ambienti principali per la creazione e la configurazione dell'agente.
- **Agent Builder** offre un'esperienza dell'interfaccia utente per definire le funzionalità principali dell'agente.
- **AFDX** fornisce un'interfaccia programmatica per la personalizzazione e l'integrazione con altri sistemi.
Lo sviluppo e la creazione di un agente prevede questi passaggi che possono essere eseguiti utilizzando il Generatore di agenti o AFDX:
1. **Definizione del profilo**: Un aspetto cruciale della progettazione degli agenti è la definizione di un profilo distinto. Ciò comporta la configurazione di:
- **Descrizione agente**: Descrizione dettagliata del ruolo, degli obiettivi e delle operazioni specifiche dell'assistenza clienti che è progettato per gestire.
- **Tono**: Lo stile di comunicazione dell'agente, il livello di empatia e le eventuali linee guida specifiche del marchio a cui deve attenersi.
2. **Definizione di argomenti e azioni degli agenti**: Per rendere un agente sofisticato e in grado di gestire una vasta gamma di operazioni è essenziale suddividere le sue capacità in argomenti distinti con azioni corrispondenti.
- **Argomenti**: Ogni argomento può essere concettualizzato come il proprio agente specializzato con un insieme univoco di istruzioni e strumenti.
- **Architettura modulare.** L'approccio modulare agli argomenti consente una maggiore organizzazione e scalabilità. Definendo più argomenti, l'agente può gestire una gamma più ampia di scenari complessi. Ad esempio, un agente potrebbe avere argomenti separati per "Gestione ordini", "Domande frequenti (FAQ), "Assistenza tecnica" e "Richieste di fatturazione".
- **Istruzioni argomento (Guardrail)**: Ogni argomento viene fornito con istruzioni specifiche che fungono da guardrail, definendo l'ambito di ciò che l'agente può discutere o fare all'interno dell'argomento. Queste istruzioni evitano che l'agente si allontani dall'argomento o fornisca informazioni irrilevanti. Aiutano anche a mantenere coerenza e precisione nelle risposte.
- **Azioni**: Gli argomenti sono inoltre dotati di "strumenti", che rappresentano le azioni che l'agente può intraprendere. Questi strumenti possono essere:
- **Azioni informative**: Recupero di dati da una Knowledge Base o da un sistema esterno per rispondere a una query.
- **Azioni transazionali**: Eseguire azioni per conto dell'utente, ad esempio effettuare un ordine, aggiornare il record di un cliente o avviare un processo di rimborso. Queste azioni sono spesso integrate con altri sistemi (ad esempio CRM, ERP).
#### Fase 3: Test e convalida
Quando valutano le prestazioni e l'affidabilità degli agenti AI, i tester spesso incontrano una serie di sfide che possono compromettere l'esperienza utente. Questi problemi vanno dall'interpretazione errata dell'intento dell'utente all'esecuzione non corretta delle operazioni.
##### Scenari comuni di errore degli agenti
La creazione di un agente affidabile richiede di capire come e dove può fallire. La tabella seguente elenca i problemi più comuni riscontrati durante il ciclo di vita dell'agente, dal ragionamento errato al recupero Knowledge insufficiente. Utilizzare questa opzione come guida strategica durante lo sviluppo e come elenco di controllo durante i test per assicurarsi che l'agente non sia solo funzionale ma anche affidabile e intuitivo per l'utente finale. Questi scenari di errore dovrebbero aiutare a definire i casi di test.
| Categoria | Descrizione | Esempi di errore |
|---|---|---|
| Classificazione argomenti | L'agente non riesce a identificare correttamente l'intento o l'obiettivo dell'utente. |
|
| Qualità della risposta | Errori nel contenuto, nella precisione e nel formato delle risposte dell'agente. |
|
| Esecuzione di azioni | L'agente non riesce quando tenta di eseguire una funzione o un'operazione specifica. |
|
| Parapetti e istruzioni | L'agente viola regole, vincoli o limiti di conversazione predefiniti. |
|
| Recupero Knowledge | L'agente ha problemi a reperire e presentare informazioni dalla sua Knowledge Base. |
|
| Guida strutturata | L'agente fatica a guidare gli utenti nei processi a più fasi. |
|
| Oggetto data lake/oggetto modello di dati | Descrizione |
|---|---|
| Sessione AIAgent | Un contenitore overarching che acquisisce interazioni contigue con uno o più agenti AI. |
| AIAgentSessionParticipant | Un'entità (umana o AI) che partecipa a una sessione AIAgent. |
| AIAgentInteraction | Un segmento all'interno di una sessione. In genere inizia con la richiesta di un utente e termina quando l'agente AI fornisce una risposta a tale richiesta. |
| Fase AIAgentInteraction | Un'azione o operazione discreta eseguita durante un'interazione per soddisfare la richiesta dell'utente. |
| Messaggio AIAgentInteraction | Una singola comunicazione fornita dall'utente o generata dall'agente AI durante una sessione. |
 ##### Analisi delle enunciazioni
L'analisi delle enunciazioni mostra in che modo gli utenti Agentforce (predefiniti) utilizzano gli agenti, che cosa richiedono e se l'agente è stato in grado di gestire queste richieste. Questi rapporti personalizzabili possono aiutare a perfezionare gli argomenti e le azioni in modo che gli agenti rispondano in modo più efficace e preciso.
 ##### Agentforce Python SDK: Monitoraggio con le integrazioni di Data 360
L'implementazione di Agent SDK utilizza il monitoraggio e l'analisi avanzati con il connettore Python Data 360, stabilendo la connessione a Salesforce Data 360, eseguendo query sulle metriche delle prestazioni degli agenti e creando cruscotti digitali di monitoraggio completi.
Il sistema tiene traccia dei tempi di risposta, delle percentuali di successo, della soddisfazione degli utenti e delle metriche dei costi per fornire approfondimenti concreti per l'ottimizzazione degli agenti.
```py
# Data 360 Python Connector Integration
from salesforce_cdp_connector import SalesforceCDPConnector
# Initialize Data 360 Connector
cdp_connector = SalesforceCDPConnector(
client_id='your_client_id',
client_secret='your_client_secret',
username='your_username@example.com',
password='your_password'
)
# Query agent performance data
performance_data = cdp_connector.query("""
SELECT timestamp, response_time_ms, success_rate, user_satisfaction
FROM AgentPerformanceMetrics
WHERE agent_id = 'Coral_Cloud_Resorts_Resort_Manager'
""")
# Create monitoring dashboard
def create_monitoring_dashboard(performance_data):
fig = go.Figure()
fig.add_trace(go.Scatter(
x=performance_data['timestamp'],
y=performance_data['response_time_ms'],
mode='lines+markers'
))
return fig
```
##### Agentforce DX: Monitoraggio agente
L'implementazione utilizza comandi AFDX standard con gestione degli agenti basata su CLI, mantenendo l'agente aggiornato con le modifiche della piattaforma e incorporando i commenti degli utenti per un miglioramento continuo.
```zsh
# List all agents and their status
sf agent list --target-org "production-org"
# Get detailed agent information
sf agent get \
--api-name "Resort_Manager" --target-org "production-org"
# Activate agent if needed
sf agent activate --api-name "Resort_Manager" --target-org "production-org"
# Query agent performance data
sf data query \
--query "SELECT Id, Name, Status, LastModifiedDate FROM BotDefinition WHERE DeveloperName = 'Resort_Manager'" \
--target-org "production-org"
```
```python
# AgentforceDX Dashboard Creation (Similar to Agent SDK)
import pandas as pd
import plotly.graph_objects as go
from salesforce_cdp_connector import SalesforceCDPConnector
# Initialize Data 360 Connector for AgentforceDX
cdp_connector = SalesforceCDPConnector(
client_id='your_client_id',
client_secret='your_client_secret',
username='your_username@example.com',
password='your_password'
)
# Query agent performance data from Data 360
performance_data = cdp_connector.query("""
SELECT timestamp, agent_id, response_time_ms, success_rate, user_satisfaction
FROM AgentPerformanceMetrics
WHERE agent_id = 'Resort_Manager'
AND timestamp >= CURRENT_DATE - 30
ORDER BY timestamp DESC
""")
```
Fare riferimento al repository GitHub [qui](https://github.com/akshatasawant9699/ADLC_Whitepaper) per l'implementazione di ADLC utilizzando Agent SDK e AFDX.
## Procedure consigliate
Per padroneggiare il ciclo di vita dello sviluppo degli agenti è necessario attenersi a una serie di principi fondamentali che garantiscono efficienza, affidabilità e allineamento strategico. Le seguenti linee guida sintetizzano le lezioni chiave di ogni fase dell'ADLC in un quadro strategico per architetti e sviluppatori.
**1\. Pianificazione e ideazione**
Questa fase iniziale si concentra sull'allineamento dello scopo dell'agente agli obiettivi aziendali e sulla garanzia che sia costruito su una solida base.
- **Dare priorità all'impatto sul business**: Iniziare mappando i potenziali casi d'uso direttamente agli obiettivi aziendali strategici. Utilizzare una matrice di priorità per calcolare il punteggio del loro impatto potenziale e iniziare con un unico caso d'uso mirato con KPI chiari.
- **Coinvolgere precocemente gli stakeholder**: Raccogliere approfondimenti sui punti deboli e garantire l'allineamento.
- **Sfruttare Approfondimenti dati**: Un agente è valido solo quanto i suoi dati. Utilizzare Data 360 per esplorare i dati strutturati e non strutturati disponibili per informare il contesto e le funzionalità dell'agente. Esaminare i rapporti e i cruscotti digitali esistenti per identificare le tendenze correnti che possono influenzare la selezione del caso d'uso.
- **Utilizzo dei framework per l'ideazione**: Applicare metodi di ideazione strutturati per fare brainstorming e perfezionare potenziali applicazioni, ad esempio il design thinking o l'analisi SWOT.
**2\. Agenti immobiliari**
Questa fase descrive le procedure consigliate per la creazione di un agente efficiente e ad alte prestazioni.
- **Evitare troppi argomenti**: Limitare il numero di argomenti per ridurre il rischio di creare argomenti simili o sovrapposti che potrebbero confondere l'agente.
- **Mantenere istruzioni e prompt concisi**: Utilizzare un linguaggio diretto e semplice e fornire enunciazioni di esempio per guidare l'agente in modo efficace.
- **Variabili di leva e azioni deterministiche**: Utilizzare questi strumenti per guidare il comportamento dell'agente e ottimizzarne le prestazioni per risultati più prevedibili.
- **Mantenere gli output delle azioni piccoli e concisi**: Assicurarsi che le risposte dell'agente siano brevi e pertinenti. Gli output più lunghi utilizzano più contesto e sono più lenti da generare.
- **Ottimizzazione delle azioni per la velocità**: Progettare i flussi e le classi Apex in modo che restituiscano dati minimi richiesti. Cercare di avere meno azioni necessarie per generare una risposta pre-elaborando, ove possibile.
- **Definizione di un ambito chiaro**: Scrivere descrizioni, istruzioni e ambiti di intervento appropriati per impedire all'agente di chiamare RAG (Generazione aumentata recupero) per domande fuori ambito.
- **Utilizza la ricerca ibrida con parsimonia**: Utilizzare la ricerca ibrida solo se è assolutamente necessaria, poiché può influire negativamente sulla latenza.
**3\. Test, monitoraggio e ottimizzazione**
Questa fase iterativa è fondamentale per perfezionare la precisione e le prestazioni dell'agente.
- **Creazione di un flusso di test**: Seguire un ciclo di test coerente:
1. **Esegui test batch**: Eseguire una serie completa di test.
2. **Visualizzazione di punteggi/errori**: Analizzare le metriche delle prestazioni e identificare gli errori.
3. **Ispezione degli errori**: Esaminare ogni riga di errore per capire la discrepanza.
4. **Aggiorna agente**: Apportare le modifiche necessarie all'agente o ai suoi dati di valutazione.
- **Rivedi informazioni di tracciamento della sessione**: Utilizzare il modello di dati di traccia della sessione e Agentforce Interaction Explorer per eseguire l'analisi delle cause principali quando vengono rilevati problemi o comportamenti imprevisti. Sintonizzare l'agente in base alle informazioni e continuare a ripetere l'agente.
## Conclusione
Il _ciclo di vita_ rappresenta un'evoluzione critica dei principi di sviluppo software tradizionali, progettati per l'era dei sistemi intelligenti e autonomi.
- **Evoluzione, non sostituzione**: Il Ciclo di vita dello sviluppo degli agenti estende e ottimizza la tradizionale Gestione del ciclo di vita delle applicazioni senza sostituirla.
- **Dati come cittadino di prima classe**: I dati svolgono un ruolo molto più dinamico e centrale nello sviluppo degli agenti.
- **Attrezzature e competenze specializzate**: Richiede nuovi strumenti e un insieme più ampio di competenze specialistiche in scienza dei dati, ingegneria ML e sviluppo degli agenti.
- **Apprendimento continuo**: Lo sviluppo degli agenti aggiunge _l'apprendimento_ continuo e l'_adattamento_ del sistema stesso.
- **Impatto futuro**: L'intelligenza artificiale agente promette di automatizzare e ottimizzare ulteriormente le operazioni IT complesse e i flussi di lavoro di sviluppo software.
# Panoramica della guida
L'elaborazione asincrona aumenta [la scalabilità](/docs/architect/it-it/well-architected/guide/reliability.html#scalability-and-capacity-planning) consentendo limiti più elevati per contesto. Le richieste asincrone vengono eseguite nei propri thread in background, quindi gli utenti possono continuare a lavorare sul lato client mentre le operazioni asincrone vengono eseguite in background.
Salesforce Lightning Platform offre una varietà di tecnologie asincrone che possono essere utilizzate per risolvere un determinato caso d'uso. Ogni tecnologia presenta vantaggi e limiti che sarà necessario considerare quando si seleziona un approccio per ogni caso d'uso.
Quando si sceglie una tecnologia per l'implementazione, tenere presenti tre considerazioni importanti:
1. L'elaborazione asincrona non è l'approccio migliore per ogni problema. Può essere allettante pensare a qualsiasi processo che non richieda direttamente l'interazione dell'utente come a un buon candidato per l'elaborazione asincrona, ma ci sono alcuni svantaggi. In primo luogo, i processi asincroni non hanno SLA, il che significa che non vi è alcuna garanzia che un processo asincrono venga completato entro un determinato periodo di tempo. In secondo luogo, non è garantita una latenza di risposta costante. Se un processo asincrono viene completato entro un determinato periodo di tempo, il completamento di un processo successivo può richiedere un periodo di tempo diverso. Pertanto, anche se un utente non è direttamente in attesa di una risposta, l'elaborazione asincrona potrebbe non essere adatta allo scenario se si hanno processi successivi che dipendono da una risposta o se si teme che tempi di risposta eccessivi possano causare la perdita di sincronizzazione dei dati con i dati di un sistema esterno.
2. Esistono diversi modi per elaborare le richieste asincrone in Salesforce Platform, quindi assicurarsi di scegliere l'approccio migliore. Le tecnologie che supportano l'elaborazione asincrona in Salesforce Platform funzionano in modo diverso e alcune sono state progettate per casi d'uso molto specifici.
3. Se una tecnologia è asincrona sul lato client, non significa necessariamente che tutta l'elaborazione end-to-end venga eseguita in parallelo. A seconda delle scelte effettuate, a volte i messaggi del client possono comunque essere serializzati sul lato server.
Se si utilizzano tecnologie sbagliate o combinazioni di tecnologie sbagliate per un processo, possono verificarsi conseguenze indesiderate che annullano i vantaggi dell'elaborazione asincrona. Questa guida fornisce spiegazioni e consigli, nonché potenziali inconvenienti e schemi contrari per vari casi d'uso asincroni, insieme alla motivazione di tali consigli. Offre inoltre informazioni sul funzionamento e la regolamentazione di varie tecniche di implementazione asincrona in Salesforce Platform.
Se si sta decidendo quale tecnologia utilizzare, è disponibile una [Guida alle decisioni](/docs/architect/it-it/decision-guides/guide/async-processing) mirata che offre una mappatura rapida dei casi d'uso tipici alla tecnologia più adatta.
## Prodotti nell'ambito
 |
Salesforce Lightning Platform è una piattaforma completa basata sull'intelligenza artificiale che unifica dipendenti, agenti autonomi dell'intelligenza artificiale, dati aziendali e applicazioni in un unico sistema affidabile per migliorare la produttività e l'esperienza dei clienti. Consente la creazione di un'"azienda autentica" collegando le app Customer 360, Data Cloud e Slack per l'automazione end-to-end. |
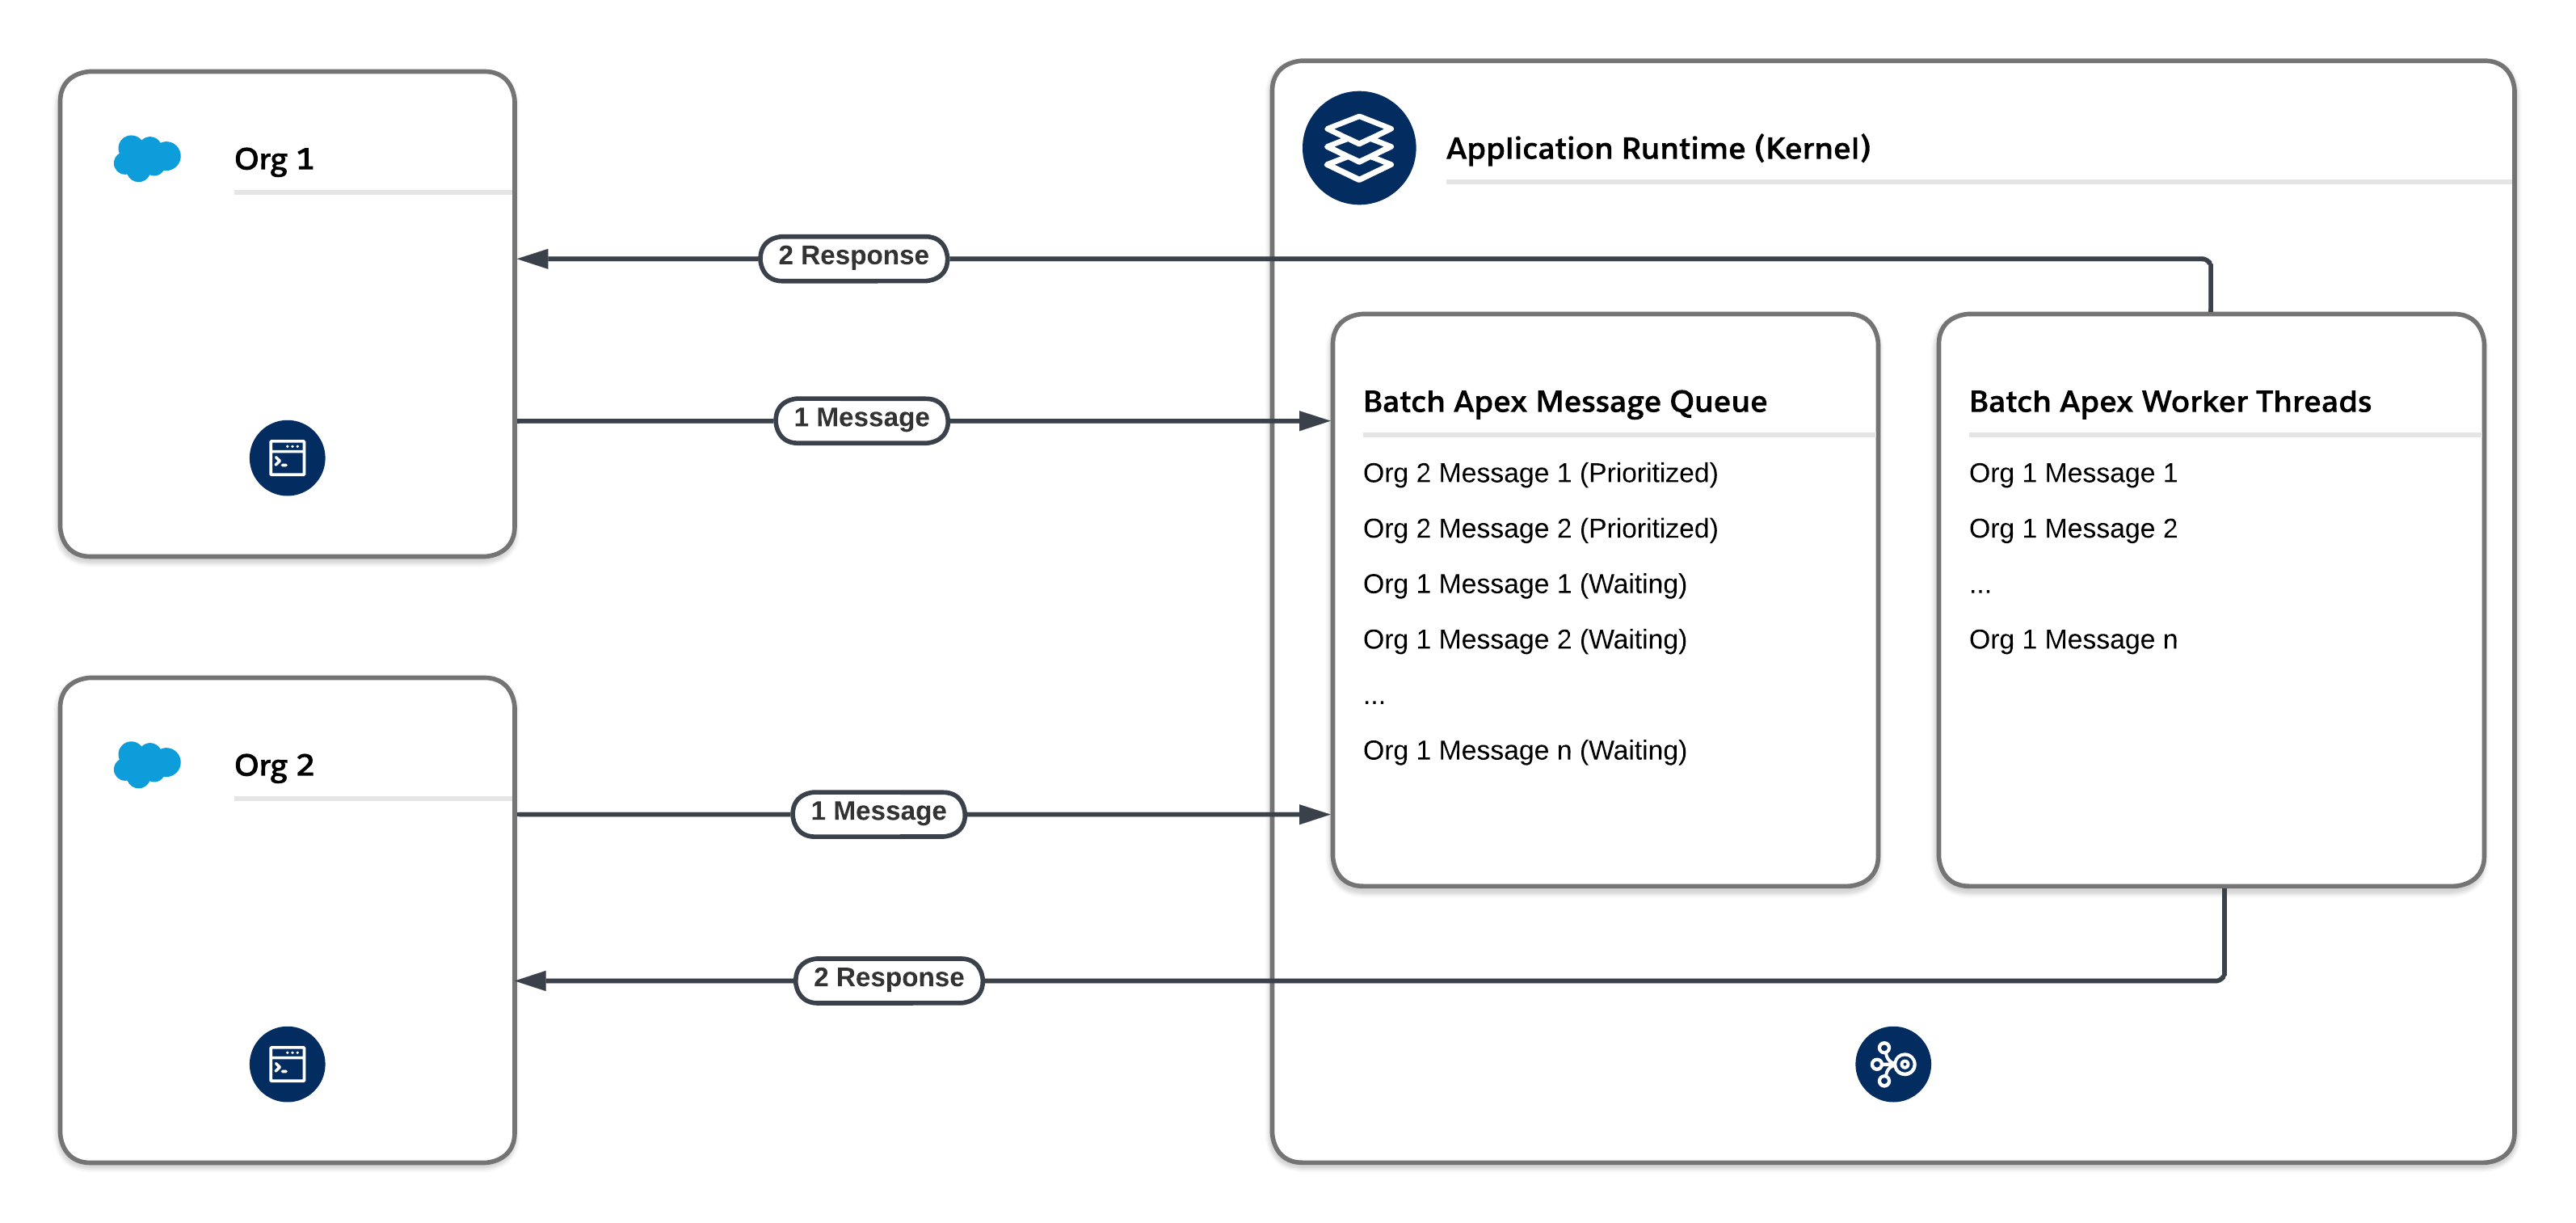 #### Utilizzo equo
Il meccanismo di utilizzo equo della piattaforma implementa un sistema basato su livelli. Il sistema garantisce che ogni organizzazione in Salesforce Platform riceva una giusta parte del tempo di elaborazione per un determinato tipo di messaggio, inclusi i tipi di messaggio Futuro, In area di attesa e Batch. Se un'organizzazione domina un determinato tipo di messaggio nello stesso periodo in cui altre organizzazioni sono in attesa di eseguire il lavoro sullo stesso tipo di messaggio, l'algoritmo di utilizzo equo riduce il numero di thread disponibili per quel particolare tipo di messaggio.
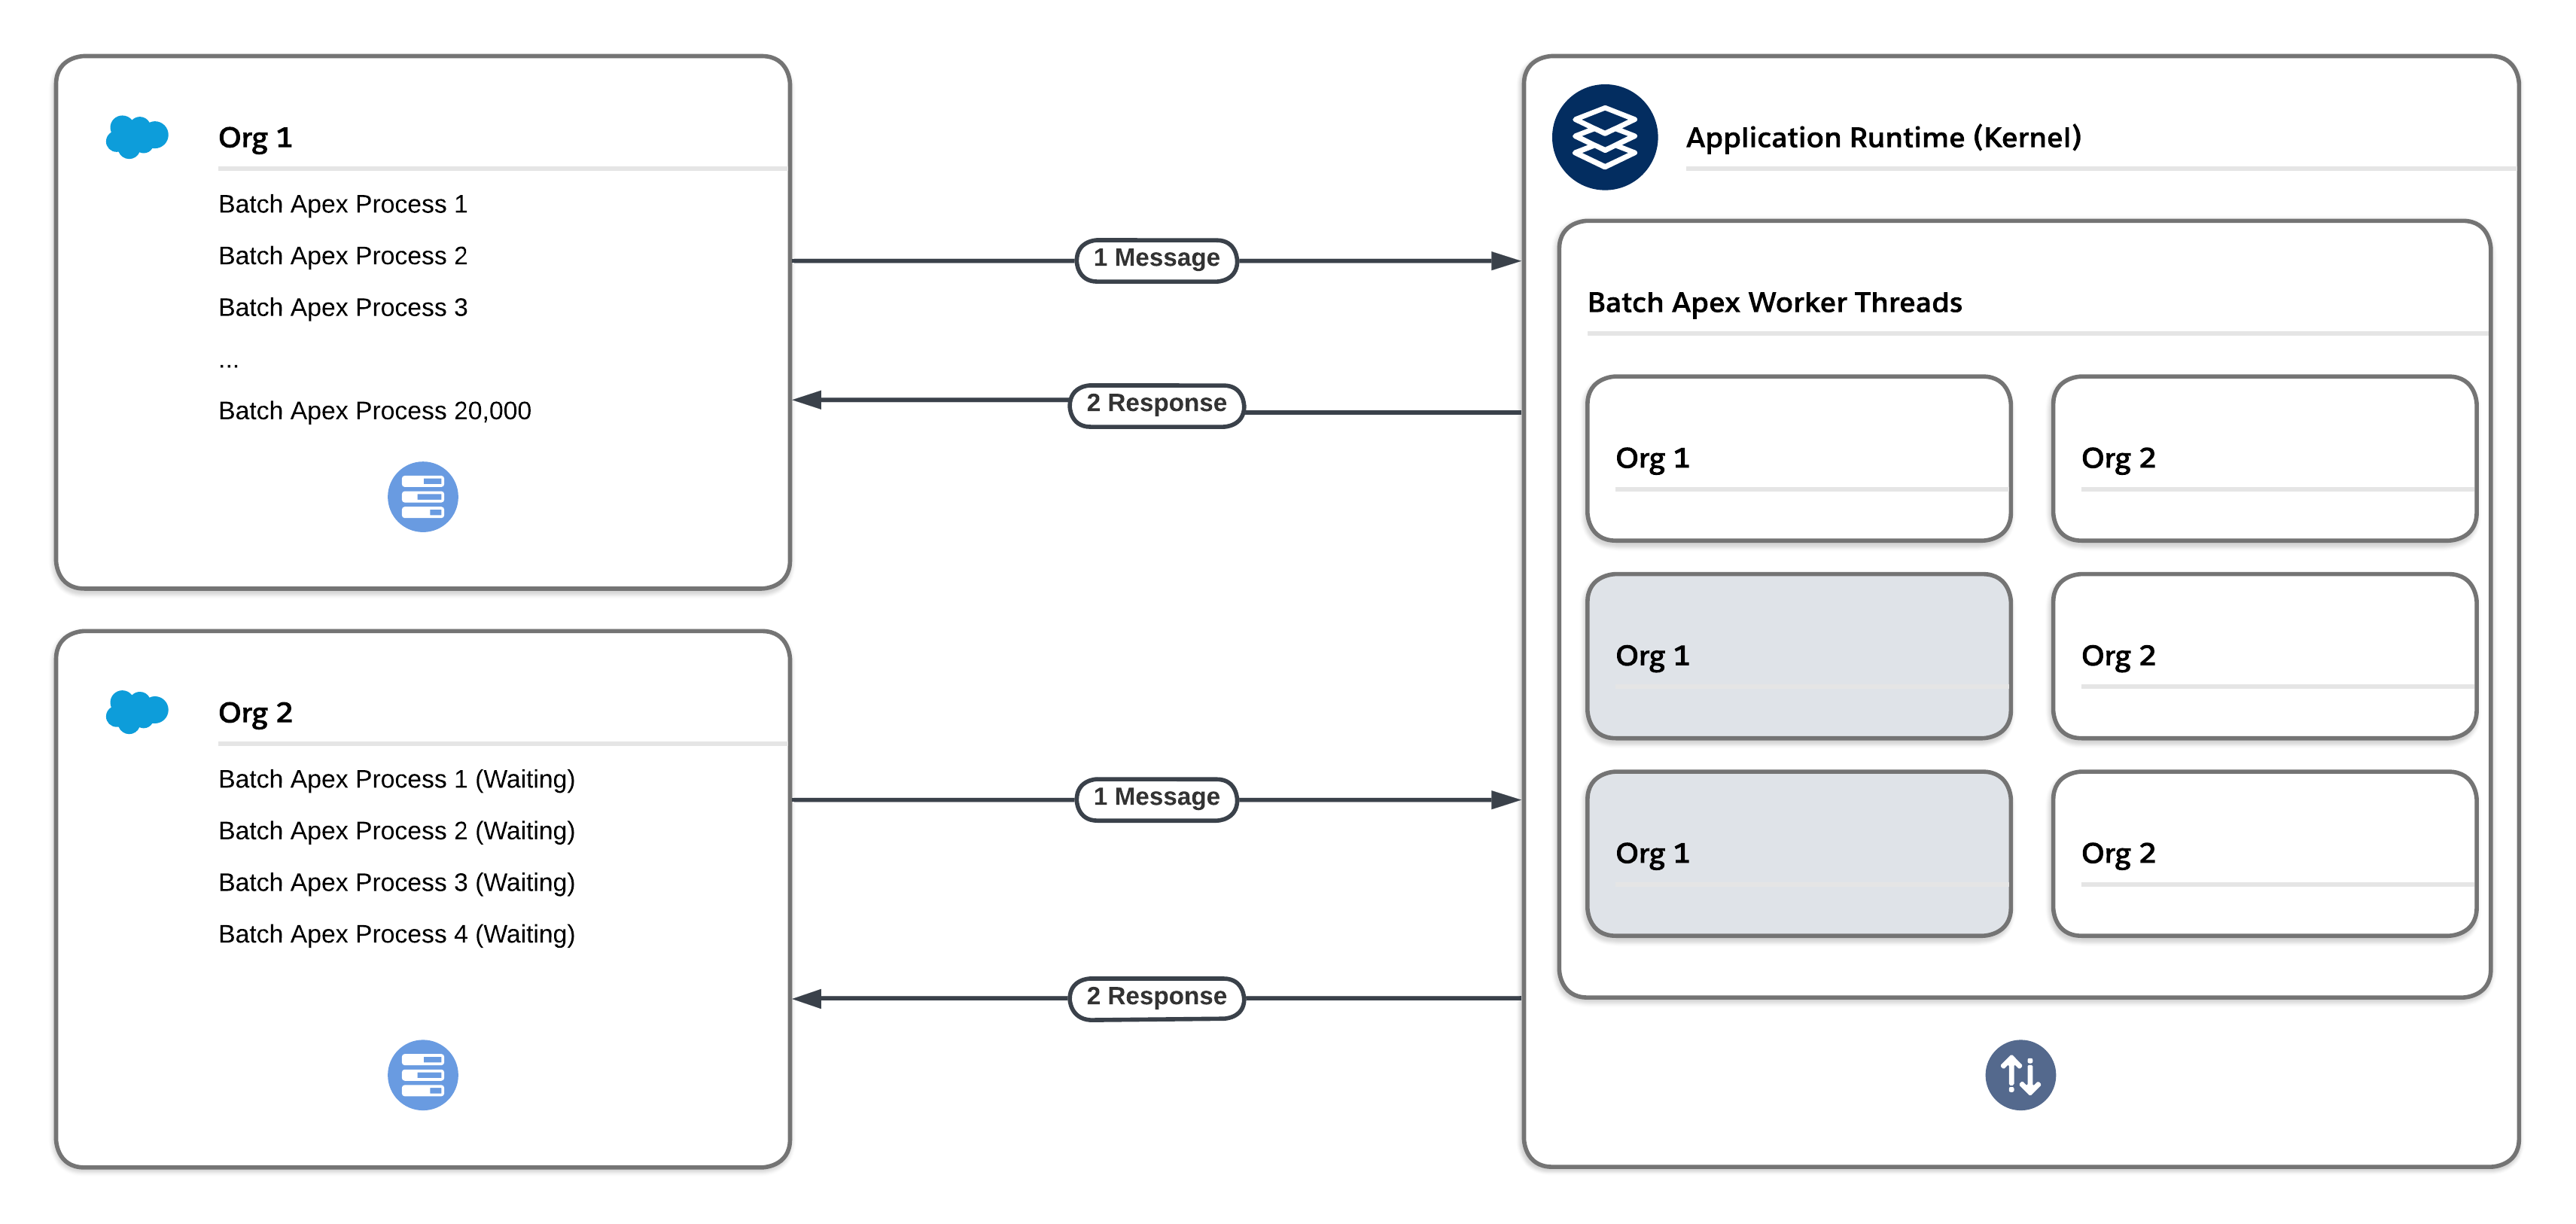 Un vantaggio dell'utilizzo dei metodi Apex asincroni è che alcuni limiti del governor, ad esempio i limiti delle query SOQL e delle dimensioni dell'heap, sono più elevati. Tuttavia, non affidarsi troppo a questi metodi. A causa delle risorse limitate allocate all'infrastruttura asincrona, l'utilizzo intensivo di Apex futuro, accodabile e batch può causare ritardi di elaborazione dovuti a limitazioni basate su un utilizzo equo e sul controllo del flusso.
#### Considerazioni speciali per le chiamate in uscita tramite Apex asincrono
Le chiamate in uscita che utilizzano Apex asincrono vengono conteggiate nel limite Apex asincrono. Il limite giornaliero è attualmente 250.000 o 200 volte il numero di licenze utente applicabili, a seconda di quale sia il valore maggiore. Questo limite può essere un problema per i casi d'uso a volume elevato. Se si supera il limite, i processi Apex asincroni e le chiamate in uscita associate avranno esito negativo.
Inoltre, poiché la piattaforma ha un numero finito di thread asincroni disponibili, le integrazioni in uscita tramite Apex asincrono hanno una scalabilità limitata. Qualsiasi integrazione in uscita a volume elevato che supera il numero di thread disponibili può richiedere lunghi tempi di elaborazione e causare ritardi.
Per i casi d'uso a volume elevato, considerare i seguenti approcci alternativi. Le chiamate API con questi approcci vengono conteggiate nel limite giornaliero di richieste API, che è significativamente superiore al limite Apex asincrono giornaliero. Pertanto, questi approcci sono più scalabili. Tenere presente, tuttavia, che esistono ancora limitazioni fisiche al numero di richieste simultanee che qualsiasi CPU può elaborare.
- **Middleware Scheduled Pull.** Evitare ritardi associati a processi di integrazione in uscita a volume elevato utilizzando middleware per estrarre i dati su base pianificata anziché inviarli tramite Apex asincrono. Il middleware, ad esempio MuleSoft Anypoint Platform, può utilizzare l'API SOAP nativa o l'API REST in modo sincrono in modo che vengano introdotti pochi ritardi. Middleware può anche utilizzare l'API in blocco nativa per volumi di dati elevati.
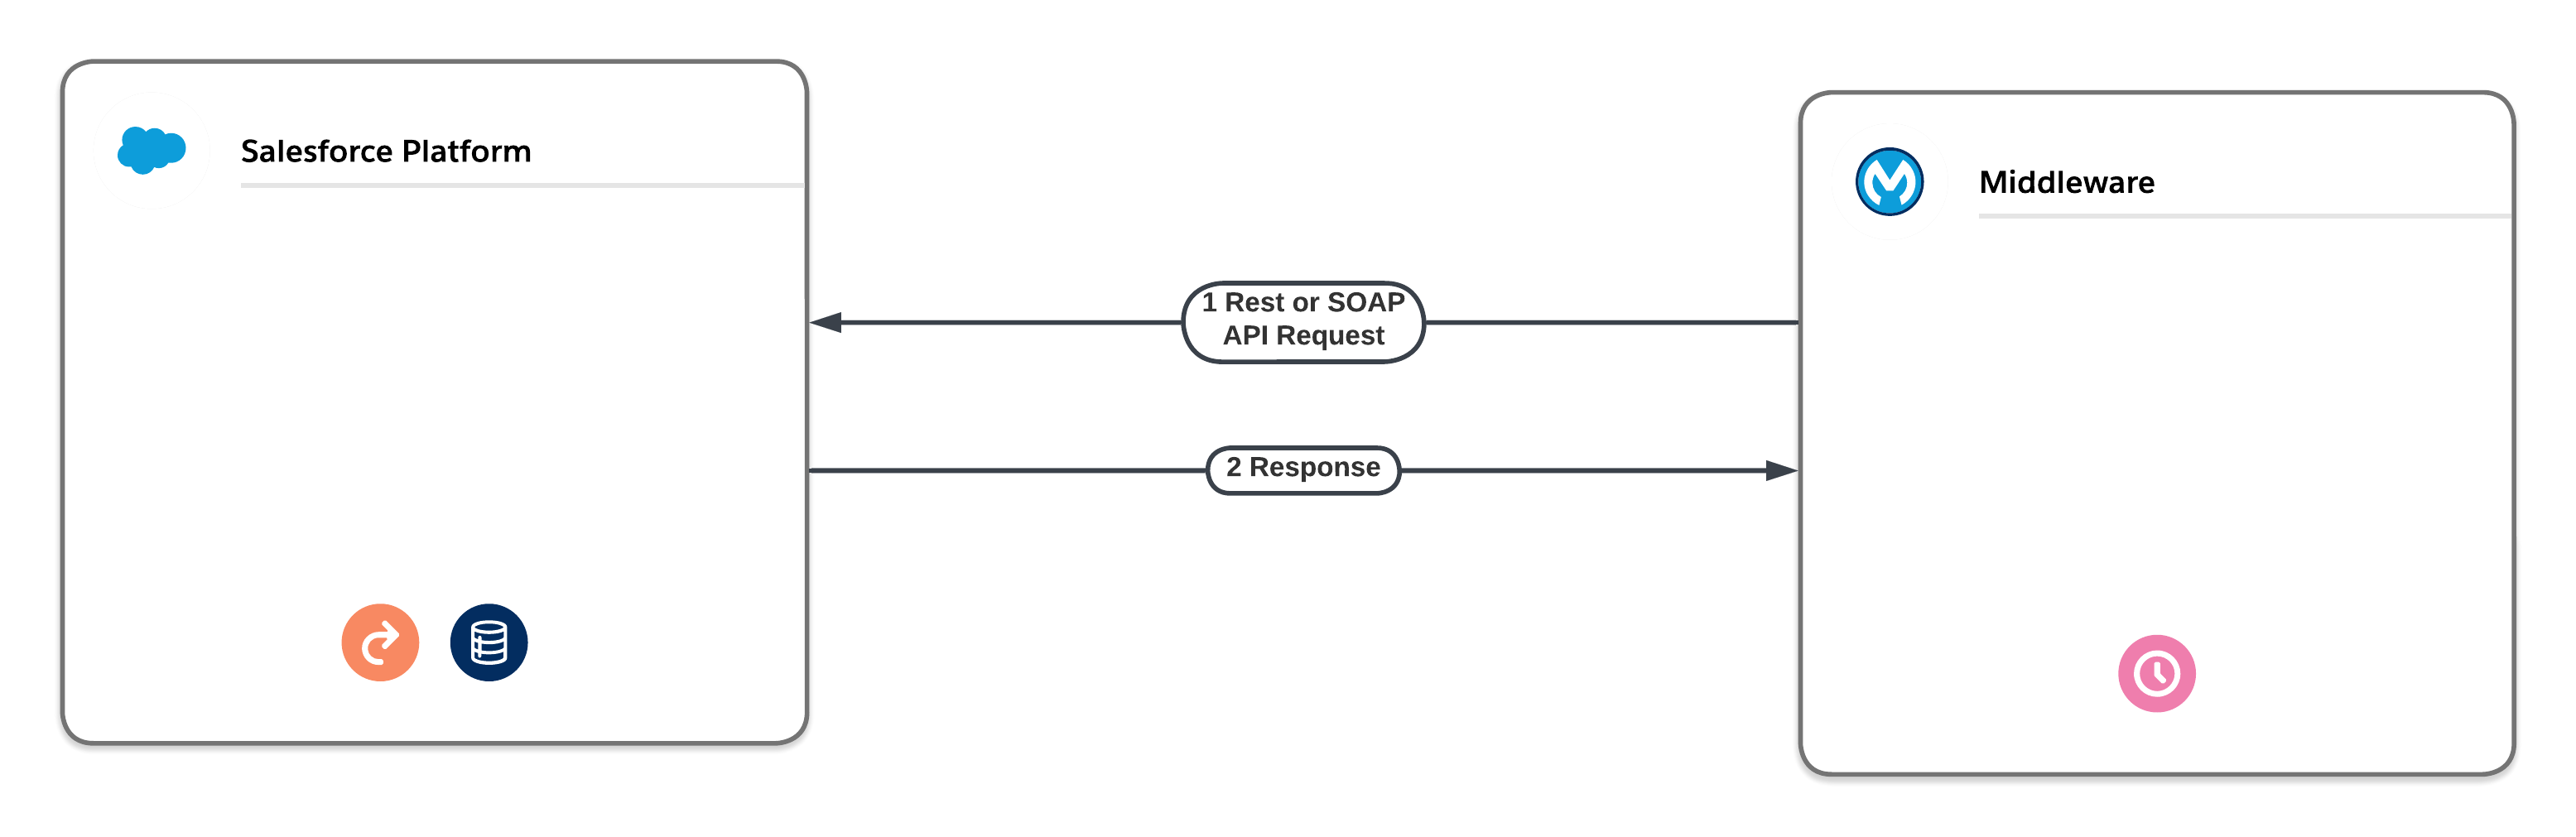 - **Trascinamento middleware tramite notifica evento piattaforma.** Anziché mettere in area di attesa Apex asincrono Future, Queueable o Batch per eseguire integrazioni in uscita, è possibile utilizzare gli eventi piattaforma. L'evento piattaforma può fornire da solo le informazioni in uscita o indicare a uno strumento middleware di estrarre le informazioni richieste tramite un'API nativa e consegnarle alla destinazione finale. Nessuno di questi approcci è soggetto ai ritardi a cui è soggetto Apex asincrono. Tuttavia, rimangono validi i [limiti degli eventi](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_events_limits_default.htm) piattaforma.
 #### Tradeoff Apex asincroni
| Prodotto/approccio | Casi d'uso | Competenze richieste | Asincrono rispetto al cliente | Asincrono rispetto al server | Tipo di limiti della piattaforma applicati |
|---|---|---|---|---|---|
| Metodi futuri Apex | Si consiglia di utilizzare Queueable Apex anziché i metodi futuri Apex. Le aree di attesa hanno gli stessi casi d'uso dei metodi futuri ma offrono ulteriori vantaggi. | Pro-code | Sì | Sì | Asynchronous |
| Apex in area di attesa | Preferiamo questo approccio ai metodi futuri. Utilizzare per processi che comportano operazioni di database di lunga durata o chiamate a servizi Web esterni. Queueable Apex offre ulteriori vantaggi rispetto ai metodi futuri, inclusi ID processo, supporto per i tipi non primitivi e concatenamento dei processi. | Pro-code | Sì | Sì | Asynchronous |
| Apex pianificato | Eseguire Apex a un'ora pianificata definita da un'espressione cron. Sebbene l'atto di pianificare Apex tramite l'espressione cron sia un processo asincrono, il codice sottostante viene eseguito in modo sincrono all'avvio del processo. | Pro-code | Sì | Sì | Synchronous |
| Chiamate continuazione Apex | Chiamate da metodi Apex eseguite in un contesto di transazione sincrona. | Pro-code | Sì | Sì | Synchronous |
 Gli eventi pubblicati sul bus tramite [publish after commit](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_events_intro.htm) vengono consegnati in ordine e possono essere elaborati in blocco dal trigger o dal flusso in un contesto sincrono separato. Il contesto è sincrono e impone tutti i limiti del governor sincrono. Scegliere con attenzione il trigger evento piattaforma/la dimensione del batch di flusso per evitare di superare i limiti.
| Prodotto/approccio | Casi d'uso | Competenze richieste | Asincrono rispetto al cliente | Asincrono rispetto al server | Tipo di limiti della piattaforma applicati |
|---|---|---|---|---|---|
| Trigger evento piattaforma | Associare liberamente Salesforce ai sistemi esterni e comunicare tra i componenti asincroni della piattaforma. | Low-code + Pro-code | Sì | Sì | Synchronous |
| Prodotto/approccio | Casi d'uso | Competenze richieste | Asincrono rispetto al cliente | Asincrono rispetto al server | Tipo di limiti della piattaforma applicati |
|---|---|---|---|---|---|
| Percorso pianificato (dopo l'impegno dei flussi) | Eseguire a orari pianificati dinamicamente dopo l'attivazione degli eventi. | Basso codice | Sì | Sì | Asynchronous |
| Percorso asincrono (flussi attivati da record) | Eseguire un'operazione che si desidera eseguire al momento opportuno per evitare errori DML misti. | Basso codice | Sì | Sì | Asynchronous |
| Prodotto/approccio | Casi d'uso | Competenze richieste | Asincrono rispetto al cliente | Asincrono rispetto al server | Tipo di limiti della piattaforma applicati |
|---|---|---|---|---|---|
| Messaggi in uscita | Condividere i dati con sistemi di terze parti quasi in tempo reale tramite il protocollo SOAP | Basso codice | N/D | Sì | N/D |
| Prodotto/approccio | Casi d'uso | Competenze richieste | Asincrono rispetto al cliente | Asincrono rispetto al server | Tipo di limiti della piattaforma applicati |
|---|---|---|---|---|---|
| Email a caso | Creare automaticamente i casi e compilare i campi dei casi in base ai valori dei messaggi email in entrata. | Basso codice | Sì | Sì* | Synchronous |
| * Email a caso viene gestito sia come sincronizzazione che come asincrono, ma con limiti Apex sincroni | |||||
| Prodotto/approccio | Casi d'uso | Competenze richieste | Asincrono rispetto al cliente | Asincrono rispetto al server | Tipo di limiti della piattaforma applicati |
|---|---|---|---|---|---|
| Batch Apex | Processi complessi e di lunga durata che coinvolgono migliaia di record | Pro-code | Sì | Sì | Asynchronous |
| Flussi attivati da pianificazione | Eseguire azioni su un batch di record in background a un'ora specificata e con frequenza ripetuta tramite un flusso. | Basso codice | Sì | Sì | Synchronous |
| Bulk API | Inserire, aggiornare, inserire con aggiornamento, eseguire query o eliminare molti record in modo asincrono. | Pro-code | Sì | Sì | Asynchronous |
 Ora, scomponi il diagramma e inizia a costruire i pezzi.
## Pianificazione con flusso pianificato
Flusso pianificato offre diversi vantaggi come meccanismo di pianificazione:
- I flussi pianificati possono essere inseriti in pacchetti e distribuiti come metadati. Questo non è vero per i processi pianificati tramite Apex (o tramite la pagina Processi pianificati).
- L'elemento Attesa è fondamentale per i framework che richiedono chiamate. Utilizzandola nel flusso, le chiamate non sono necessarie nella parte Invocabile del framework.
- La granularità della pianificazione soddisfa i requisiti: l'intervallo minimo per i flussi pianificati è giornaliero. Se è necessaria una frequenza più alta (ad esempio, oraria), riconsiderare Flusso pianificato per questo requisito.
Un'altra considerazione quando si configura il flusso pianificato è il gating dell'ambiente. Prima di invocare l'azione Apex, aggiungere un elemento Decisione che valuta la variabile `{!$Api.Enterprise_Server_URL_100}`. Ciò garantisce che il processo venga eseguito solo negli ambienti previsti, ad esempio UAT e Produzione. Questo schema è importante perché i Sandbox vengono aggiornati di frequente o creati di recente durante l'SDLC e, senza un controllo esplicito dell'ambiente, un flusso pianificato potrebbe essere eseguito involontariamente in ambienti in cui il framework non è progettato per l'esecuzione. L'uso dell'operatore `contains` nell'elemento Decisione rende l'impostazione resiliente alle future creazioni Sandbox o modifiche degli URL.
Infine, considerare in che modo il framework dovrebbe acquisire gli errori. Aggiungere sempre un percorso di errore quando il flusso chiama un'azione; ad esempio, è possibile collegare i guasti all'azione "Aggiungi voce registro" [di Nebula Logger](https://www.nebulalogger.com/). Nebula Logger scrive i registri negli oggetti personalizzati, quindi i clienti devono sapere che i dati dei registri consumano memoria dell'organizzazione: per impostazione predefinita, i registri vengono memorizzati per 14 giorni all'interno di un'organizzazione e quindi puliti; questo periodo di conservazione è configurabile. Nebula Logger utilizza anche Eventi piattaforma per pubblicare i registri, quindi le voci di registro vengono salvate indipendentemente dalla transazione di elaborazione dati principale, in modo da garantire l'acquisizione degli errori anche se l'azione Flusso principale o Apex viene ritirata. I clienti devono valutare il volume dei registri previsto e i requisiti di conservazione quando valutano l'aggiunta di un framework di registrazione.
Ecco come si presenta il flusso:
 Passiamo alle prime parti di Apex Code con il requisito di pianificazione ora soddisfatto.
## Creazione di un'interfaccia fase
Definire un'interfaccia `Step`:
```java
public interface Step {
void execute();
void finalize();
String getName();
Boolean shouldRestart();
}
```
Per questo articolo, l'interfaccia `step` viene visualizzata come classe esterna per chiarezza. Il framework è flessibile: i team possono organizzare l'interfaccia e le relative implementazioni utilizzando qualsiasi schema di creazione pacchetti Apex preferito, a condizione che tutte le classi Fase facciano riferimento alla stessa interfaccia.
Ci sono alcune cose da notare sui metodi definiti nella nostra interfaccia:
- La `execute`, anche se al momento non richiede argomenti, migliora quando si passa una classe di `State` (o interfaccia) per orchestrare i dati tra le fasi quando l'ordine è importante.
- `getName` potrebbe restituire un valore `System.Type` anziché un `String`. L'obiettivo è fornire al livello di orchestrazione un modo per registrare i nomi delle fasi senza esporre altre proprietà.
Ecco la prima implementazione concreta che mostra come questi pezzi si adattano. Con un'eccezione in seguito, si consiglia di utilizzare Queueable Apex per implementare l'elaborazione asincrona in Apex; Batch Apex è in genere inutile (e i metodi di `@future` sono scoraggiati). Queueable Apex si avvia rapidamente e, con i cursori Apex, presenta molti vantaggi rispetto a Batch Apex.
### Un'implementazione Apex Cursor-Like
I [cursori Apex](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_cursors.htm) offrono un'alternativa moderna al modello Apex batch tradizionale. Analogamente all'elaborazione batch, un'implementazione Cursore può recuperare i record in blocchi (fino a 2.000 per batch). Tuttavia, i Cursori consentono più recuperi all'interno di una singola transazione, consentendo una produttività significativamente superiore per le operazioni a volume elevato.
Quando si adottano i Cursori come parte di questo framework, i team devono essere consapevoli delle limitazioni attuali dei test e della possibilità di falsificazione. Il comportamento del cursore nei test può essere diverso dal comportamento di produzione, quindi è importante progettare strategie di test che evitino di affidarsi ai componenti interni del cursore e convalidino invece la logica di orchestrazione ai confini. Man mano che la piattaforma si evolve, queste aree continueranno a migliorare, ma le linee guida principali rimangono: I cursori offrono prestazioni superiori e un sovraccarico di orchestrazione ridotto rispetto ad Apex batch per molti casi d'uso.
Per definire un confine chiaro tra il Cursore fornito dal sistema e il proprio codice, si consiglia di creare una rappresentazione simile al Cursore quando si implementa l'interfaccia `Step`. Considerare questo codice:
```java
public inherited sharing abstract class CursorStep implements Step {
private static final Integer MAX_CHUNK_SIZE = 2000;
protected Cursor cursor;
private Integer chunkSize = System.Limits.getLimitDMLRows();
private Integer position = 0;
protected abstract Cursor getCursor();
protected abstract void innerExecute(List