
|
Salesforce Platform è una piattaforma completa basata sull'intelligenza artificiale che unifica dipendenti, agenti autonomi dell'intelligenza artificiale, dati aziendali e applicazioni in un unico sistema affidabile per migliorare la produttività e l'esperienza dei clienti. Consente la creazione di un'"azienda autentica" collegando le app Customer 360, Data Cloud e Slack per l'automazione end-to-end. |
|
MuleSoft è la piattaforma di integrazione leader di Salesforce che consente alle organizzazioni di connettere applicazioni, dati e dispositivi in ambienti locali e cloud. MuleSoft è una piattaforma che offre all'IT le piattaforme per sbloccare i dati tra i sistemi, sviluppare framework di integrazione e automazione scalabili e creare esperienze connesse e differenziate in modo rapido. |
| Punto Decisione | Guida |
|---|---|
| Notifiche quasi in tempo reale | Gli schemi di architettura basati sugli eventi come pubblicazione/abbonamento, fanout e streaming tendono a funzionare bene negli scenari in cui più applicazioni devono essere informate delle modifiche dello stato o degli aggiornamenti dei record quasi in tempo reale. |
| Elaborazione parallela | Schemi come pubblicazione/abbonamento tendono a funzionare bene negli scenari in cui volumi elevati di dati o messaggi molto complessi richiedono la distribuzione del carico di elaborazione tra più sistemi. |
| Letture a volume elevato | Gli schemi Messaggi passati e Area di attesa sono comunemente utilizzati negli scenari in cui le organizzazioni subiscono picchi e il volume dei messaggi prodotti può superare la capacità degli abbonati di elaborarli immediatamente. |
| Scritture a volume elevato | Gli schemi Streaming e Area di attesa funzionano bene in molti scenari in cui le organizzazioni sperimentano un aumento del numero di messaggi prodotti. |
| Invio degli stessi dati a sistemi diversi | Benché la pubblicazione/abbonamento sia una soluzione piuttosto comune per le organizzazioni che necessitano di inviare gli stessi dati a più sistemi, può essere affrontata dalla maggior parte degli schemi descritti qui. Assicurarsi di esaminarli in dettaglio per trovare la misura migliore. |
| Introduzione frequente di nuovi sistemi o dispositivi | Gli schemi di pubblicazione/abbonamento, streaming e inserimento in area di attesa tendono a funzionare bene per gli scenari in cui il panorama generale tende a essere in movimento, con nuovi sistemi e dispositivi aggiunti regolarmente. In questo scenario, un nuovo sistema o dispositivo deve semplicemente diventare abbonato al bus degli eventi o associato a un'area di attesa per iniziare a ricevere messaggi anziché richiedere un'integrazione point-to-point personalizzata. |
| Dispositivi IoT | Poiché i dispositivi IoT in genere forniscono aggiornamenti frequenti e possono anche generare un'impennata di messaggi in alcuni scenari, gli schemi Streaming e Area di attesa tendono a funzionare bene quando li integrano in un panorama IT. |
| Dispositivi e sistemi mobili offline | I dispositivi mobili che devono lavorare in aree con accesso a Internet di bassa qualità o inesistente o sistemi che potrebbero essere offline al momento della consegna dei messaggi beneficeranno dello schema di inserimento in area di attesa, che consente loro di connettersi alle aree di attesa e recuperare tutti i messaggi pertinenti una volta che sono di nuovo online. |
| Punto Decisione | Guida/Domande da porre |
|---|---|
| Requisiti aziendali | Esiste una reale esigenza aziendale per una delle funzionalità descritte nella sezione [Quando utilizzare un'architettura basata sugli eventi] (#when-to-use-an-event-driven-architecture)? |
| Requisiti tecnici | L'integrazione che si sta progettando è adatta a uno schema diverso, ad esempio virtualizzazione dei dati, batch o richiesta/risposta? In altre parole, stai cercando di inserire un piolo quadrato in un foro rotondo? |
| Processi che richiedono agli esseri umani di attendere le risposte | Qualsiasi integrazione che prevede un essere umano in attesa di una risposta dal sistema di destinazione non è adatta alle architetture basate sugli eventi, poiché sono progettate per l'esecuzione asincrona e non possono garantire un tempo di risposta. Prima di implementare le soluzioni tecniche, valutare se processi di questo tipo sono ottimali per la propria organizzazione. Vedere [Well-Architected - Operational Excellence](/docs/architect/it-it/well-architected/guide/operational-excellence.html) per ulteriori informazioni. |
| Modificare raramente i dati di origine | Se i dati nel sistema di origine cambiano così di rado che gli aggiornamenti periodici sono sufficienti, è probabile semplificare l'architettura utilizzando [batch pattern] (https://developer.salesforce.com/docs/atlas.en-us.integration_patterns_and_practices.meta/integration_patterns_and_practices/integ_pat_batch_data_sync.htm) anziché schemi basati sugli eventi. |
| Requisiti di implementazione | La maggior parte dei sistemi coinvolti nella soluzione supporta architetture basate sugli eventi? Che cosa sarebbe necessario per utilizzare architetture basate sugli eventi con i sistemi che non le supportano (ad esempio, aggiornamenti, personalizzazioni o middleware)? Quale livello di impegno sarebbe necessario per soddisfare tali requisiti? |
| Stabilità della struttura del messaggio | Con che frequenza sarà necessario modificare le strutture dei messaggi? Quali sistemi saranno interessati da tale modifica e quale sarà il processo di risanamento? |
| Governance organizzativa | Esiste una struttura di governance per garantire che tutti gli stakeholder siano informati e in grado di intervenire sulle modifiche alle strutture dei messaggi, ai trigger e ad altre decisioni relative all'architettura e ai processi? |
| Insiemi di competenze richiesti | Il personale ha esperienza con le architetture basate sugli eventi e sa come supportarle? |
| Schema | Quasi in tempo reale | Copia messaggio univoco | Consegna garantita | Ridurre le dimensioni dei messaggi | Trasforma dati |
|---|---|---|---|---|---|
| Pubblica / Abbonati | ✓ | ✓ | ✓ | ||
| Fanout | ✓ | ✓ | ✓ | ||
| Messaggi passati | ✓ | ✓ | ✓ | ✓ | |
| Streaming | ✓ | ✓ | ✓ | ||
| Area di attesa | ✓ | ✓ | ✓ |
| Strumento | Descrizione | Competenze richieste | |
|---|---|---|---|
| MuleSoft | Anypoint Platform | Piattaforma che consente l'integrazione dei dati utilizzando livelli di API. | Pro-code |
| Connettore Salesforce Pub/Sub | Connettore per l'API Pub/Sub, che offre un'unica interfaccia per la pubblicazione e l'abbonamento a eventi piattaforma, eventi di monitoraggio evento in tempo reale ed eventi di acquisizione dati di modifica. | Pro-code | |
| Connettore JMS MuleSoft Anypoint | Connettore che consente di inviare e ricevere messaggi ad aree di attesa e argomenti per qualsiasi servizio di messaggistica che implementa la specifica JMS (Java Message Service). | Pro-code | |
| MuleSoft Anypoint Apache Kafka Connector | Connettore per spostare i dati tra Apache Kafka e applicazioni e servizi aziendali. | Pro-code | |
| Connettore MuleSoft Anypoint Solace | Un connettore per i broker di eventi Solace PubSub+ con integrazione API nativa utilizzando JCSMP Java SDK | Pro-code | |
| Connettore MuleSoft Anypoint MQ | Un servizio di messaggistica cloud multi-tenant che consente ai clienti di eseguire messaggi asincroni avanzati tra le loro applicazioni. | Pro-code | |
| Connettore MuleSoft Anypoint MQTT | Un'estensione MuleSoft compatibile con il protocollo MQTT (Message Queuing Telemetry Transport) v3.x. | Pro-code | |
| Connettore MuleSoft Anypoint AMQP | Un connettore che consente all'applicazione di pubblicare e utilizzare messaggi utilizzando un broker compatibile con AMQP 0.9.1. | Pro-code | |
| API MuleSoft Anypoint basata sugli eventi (sincronizzazione) | Linguaggio indipendente dal settore che supporta la pubblicazione di API basate sugli eventi separandole in livelli evento, canale e trasporto. | Pro-code | |
| MuleSoft Anypoint MQ | Servizio di messaggistica cloud multitenant che consente ai clienti di eseguire messaggi asincroni avanzati tra le loro applicazioni. | Pro-code | |
| Stream di dati MuleSoft Anypoint | Framework disponibile in MuleSoft Anypoint per la pubblicazione e l'abbonamento ai dati in streaming. | Pro-code | |
| Salesforce Platform | Apache Kafka su Heroku | Componente aggiuntivo Heroku che fornisce Apache Kafka come servizio con integrazione completa della piattaforma nella piattaforma Heroku. | Pro-code |
| Modifica acquisizione dati | Registro eventi di modifica, che pubblica le modifiche ai record Salesforce. Le modifiche includono la creazione di un nuovo record, gli aggiornamenti di un record esistente, l'eliminazione di un record e l'annullamento dell'eliminazione di un record. | Da codice basso a codice pro | |
| Messaggi in uscita | Azioni che inviano messaggi XML a endpoint esterni quando i valori dei campi vengono aggiornati in Salesforce. | Basso codice | |
| Eventi piattaforma | Messaggi sicuri e scalabili contenenti dati di eventi personalizzati. | Da codice basso a codice pro | |
| Pub/Sub API | API che abilita abbonamenti a eventi piattaforma, eventi di acquisizione dati di modifica e/o eventi di Monitoraggio evento in tempo reale. | Pro-code | |
| Relay evento | Abilita l'invio di eventi piattaforma ed eventi acquisizione dati di modifica da Salesforce ad Amazon EventBridge. Tenere presente che i relay evento si connettono solo ad AWS Eventbridge. | Basso codice | |
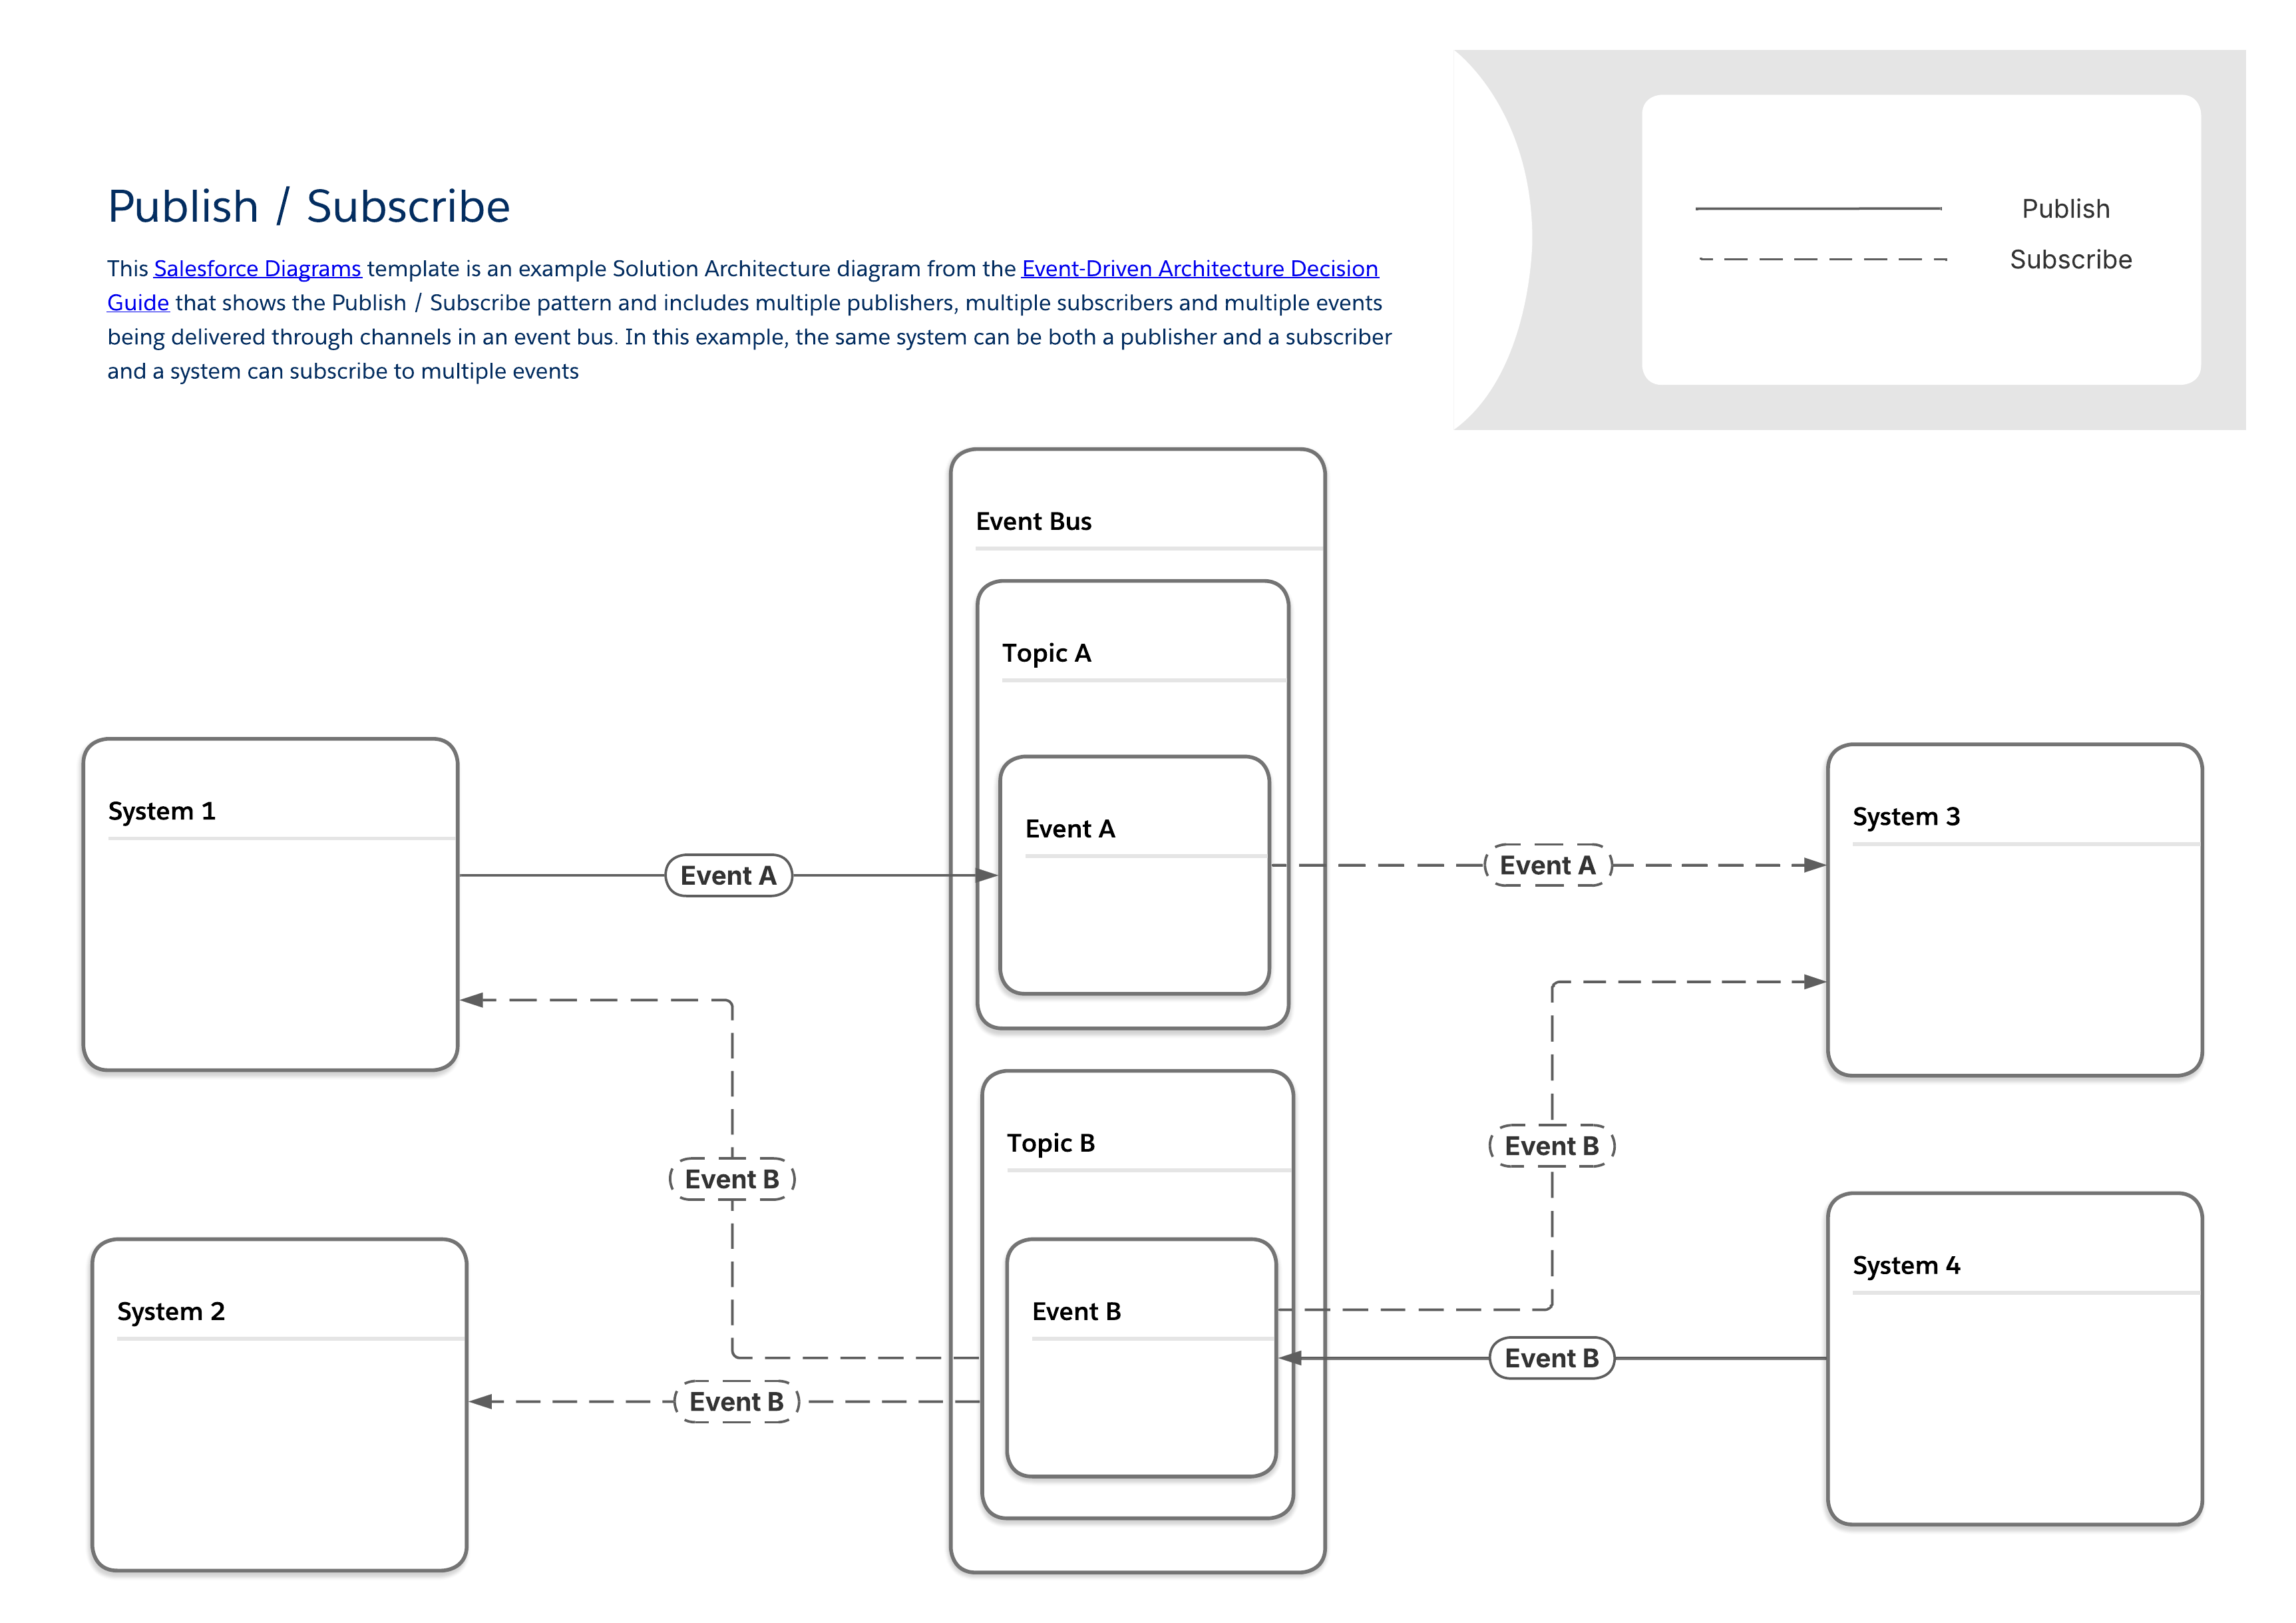 #### Strumenti pertinenti allo schema di pubblicazione/iscrizione
| Flusso e comportamento dell'evento | Considerazioni sul payload | ||||||
|---|---|---|---|---|---|---|---|
| Strumenti disponibili | Competenze richieste | Pubblica tramite | Abbonamento tramite | Periodo di riproduzione | Struttura payload | Limiti del payload | |
| MuleSoft | Anypoint Platform | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno |
| Connettore Salesforce Pub/Sub | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| Connettore JMS MuleSoft Anypoint | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| MuleSoft Anypoint Apache Kafka Connector | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| Connettore MuleSoft Anypoint Solace | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| Connettore MuleSoft Anypoint MQ | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| Connettore MuleSoft Anypoint MQTT | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| Connettore MuleSoft Anypoint AMQP | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| API MuleSoft Anypoint basata sugli eventi (sincronizzazione) | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| MuleSoft Anypoint MQ | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| Salesforce Platform | Apache Kafka su Heroku | Pro-code | API, modifiche dei record in Heroku Postgres | N/D | 1-6 settimane | Definito dall'utente | Definito dall'utente |
| Modifica acquisizione dati | Da codice basso a codice pro | Modifiche record | Apex, API, componenti Web Lightning (LWC) | 3 giorni | Predefinito | 1 MB | |
| Messaggi in uscita* | Basso codice | Regole di flusso e di flusso di lavoro | N/D | 24 ore | Definito dall'utente | 100 notifiche per messaggio | |
| Eventi piattaforma | Da codice basso a codice pro | API, Apex, Flusso | Apex, API, Flusso, LWC | 3 giorni | Definito dall'utente | 1 MB | |
| Pub/Sub API | Pro-code | API o API Pub/Sub, Apex, Flusso | API Pub/Sub | 3 giorni | Definito dall'utente | 1 MB | |
| Relay evento** | Basso codice | Eventi piattaforma, Acquisizione dati modifica | API | 3 giorni | Definito dall'utente | 1 MB | |
| *Salesforce continuerà a supportare i messaggi in uscita nell'ambito delle attuali funzionalità, ma non prevede di effettuare ulteriori investimenti in questa tecnologia. **I relay evento si connettono solo ad AWS Eventbridge | |||||||
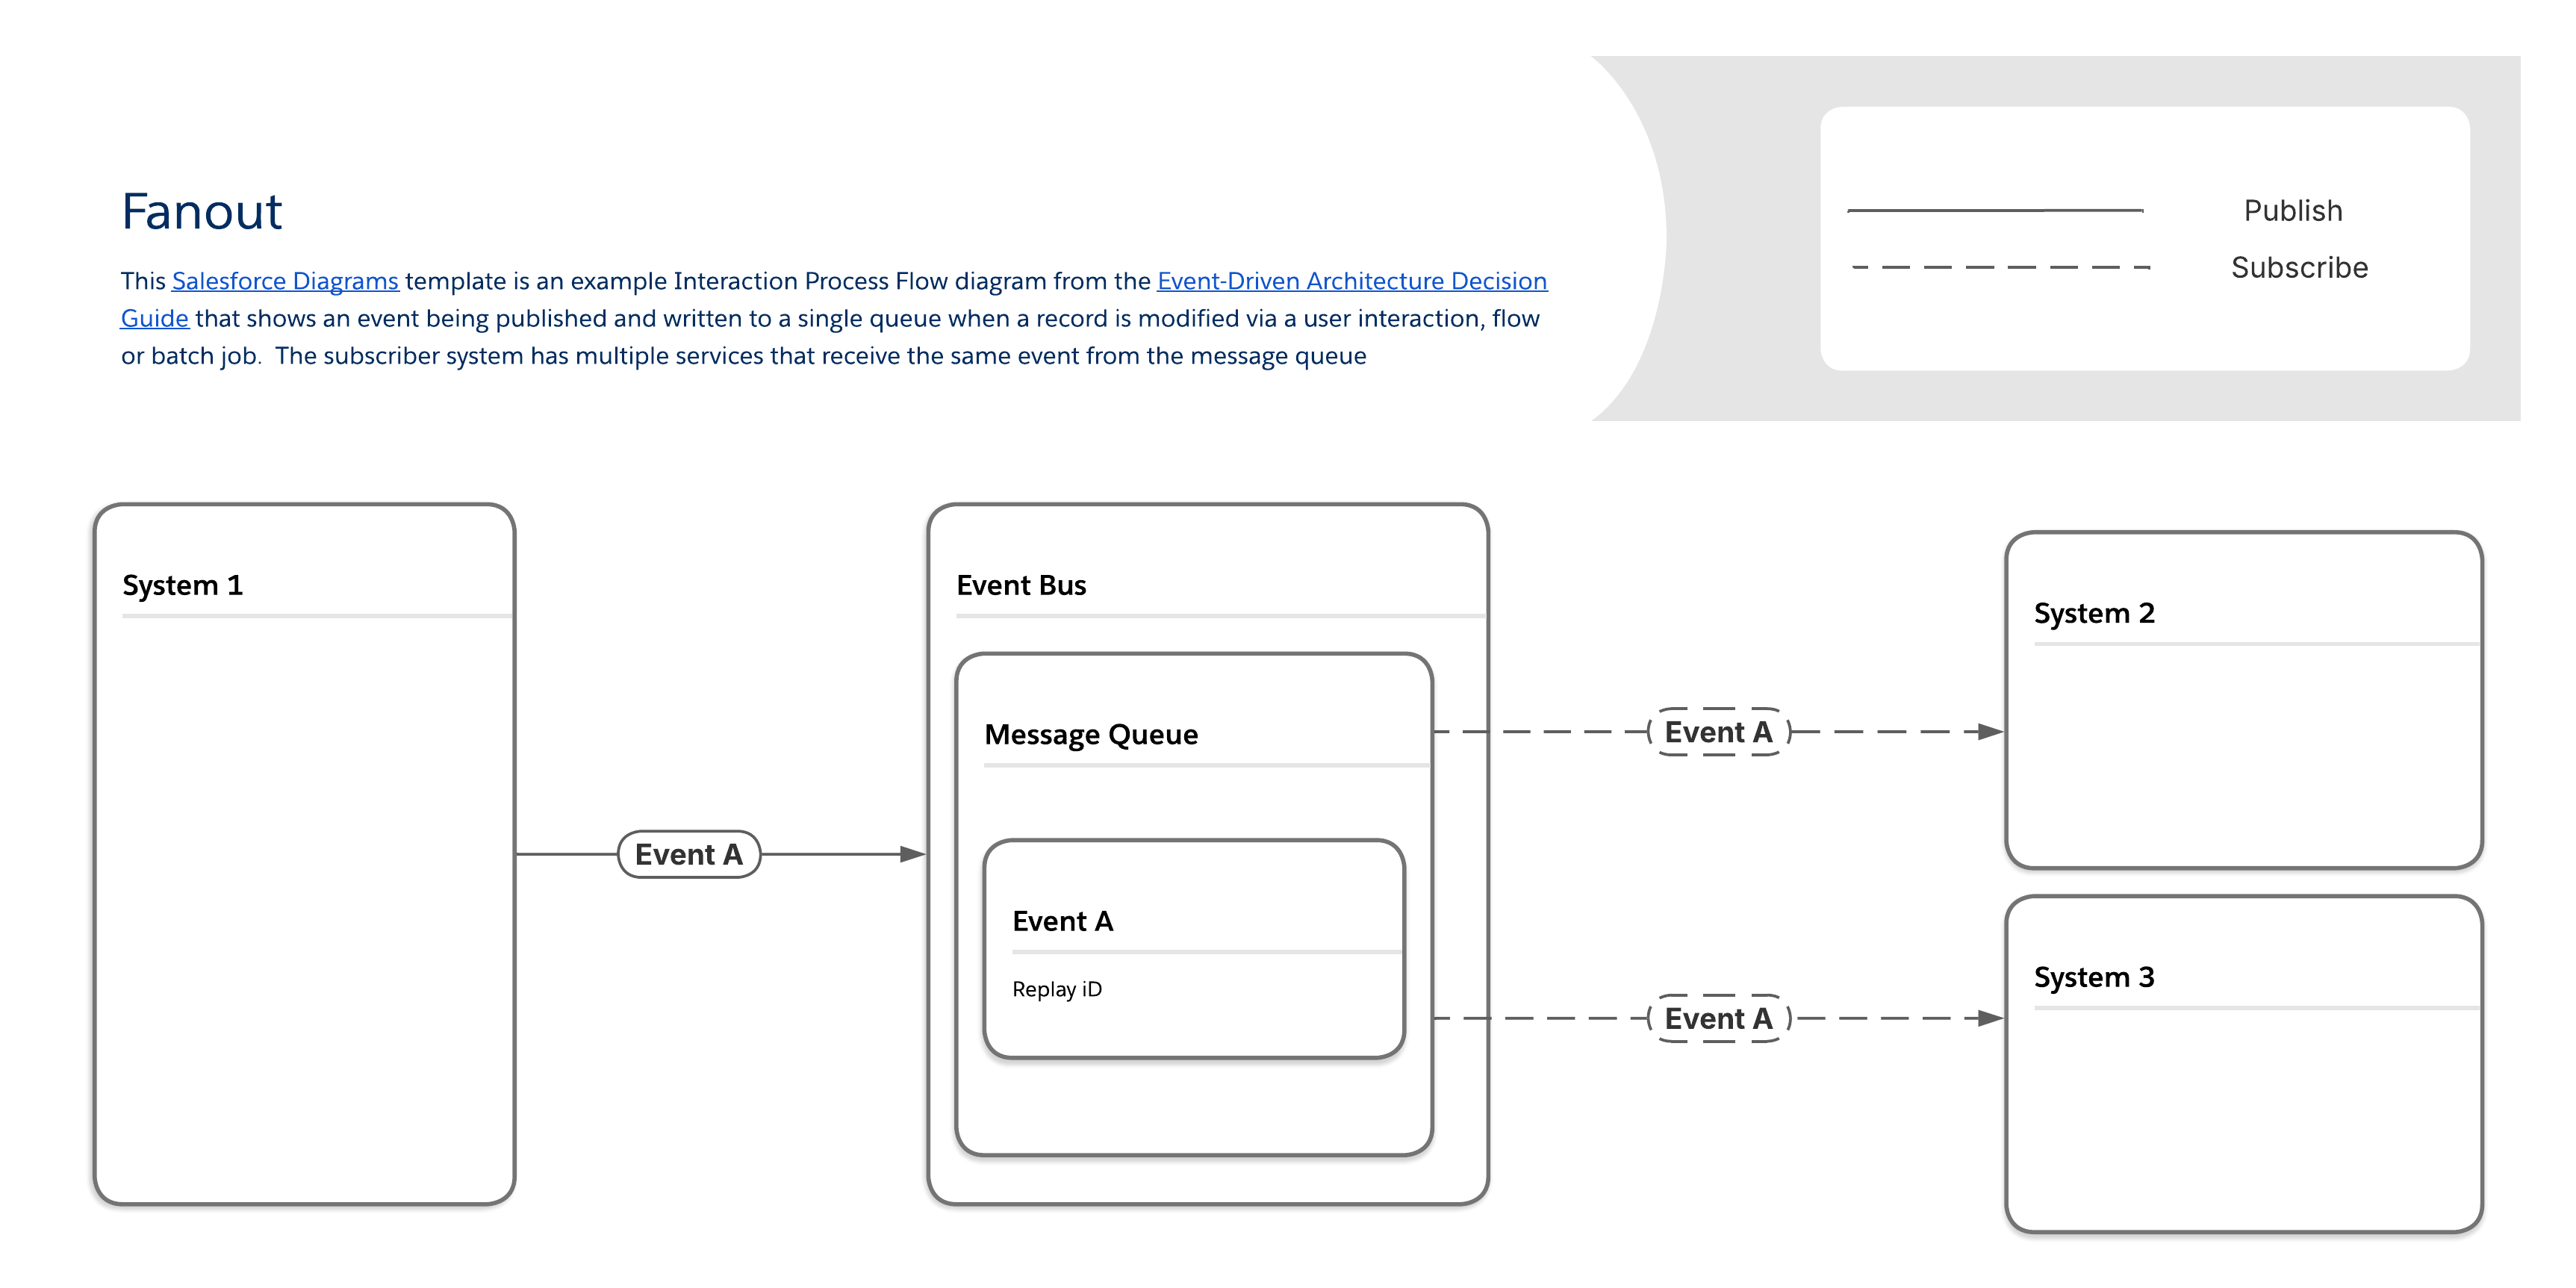 #### Strumenti pertinenti allo schema Fanout
| Flusso e comportamento dell'evento | Considerazioni sul payload | ||||||
|---|---|---|---|---|---|---|---|
| Strumenti disponibili | Competenze richieste | Pubblica tramite | Abbonamento tramite | Periodo di riproduzione | Struttura payload | Limiti del payload | |
| MuleSoft | Connettore JMS MuleSoft Anypoint | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno |
| Connettore Salesforce Pub/Sub | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| MuleSoft Anypoint Apache Kafka Connector | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| Connettore MuleSoft Anypoint Solace | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| Connettore MuleSoft Anypoint MQ | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| Connettore MuleSoft Anypoint MQTT | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| Connettore MuleSoft Anypoint AMQP | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| MuleSoft Anypoint MQ | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| Salesforce Platform | Apache Kafka su Heroku | Pro-code | API, modifiche dei record in Heroku Postgres | N/D | 1-6 settimane | Definito dall'utente | Definito dall'utente |
| Modifica acquisizione dati | Da codice basso a codice pro | Modifiche record | Apex, API, componenti Web Lightning (LWC) | 3 giorni | Predefinito | 1 MB | |
| Eventi piattaforma | Da codice basso a codice pro | API, Apex, Flusso | Apex, API, Flusso, LWC | 3 giorni | Definito dall'utente | 1 MB | |
| Pub/Sub API | Pro-code | API Pub/Sub o Apex, API, Flusso | API Pub/Sub | 3 giorni | Definito dall'utente | 1 MB | |
| Relay evento* | Basso codice | Eventi piattaforma, Acquisizione dati modifica | API | 3 giorni | Definito dall'utente | 1 MB | |
| *I relay evento inviano i dati solo ad AWS Eventbridge | |||||||
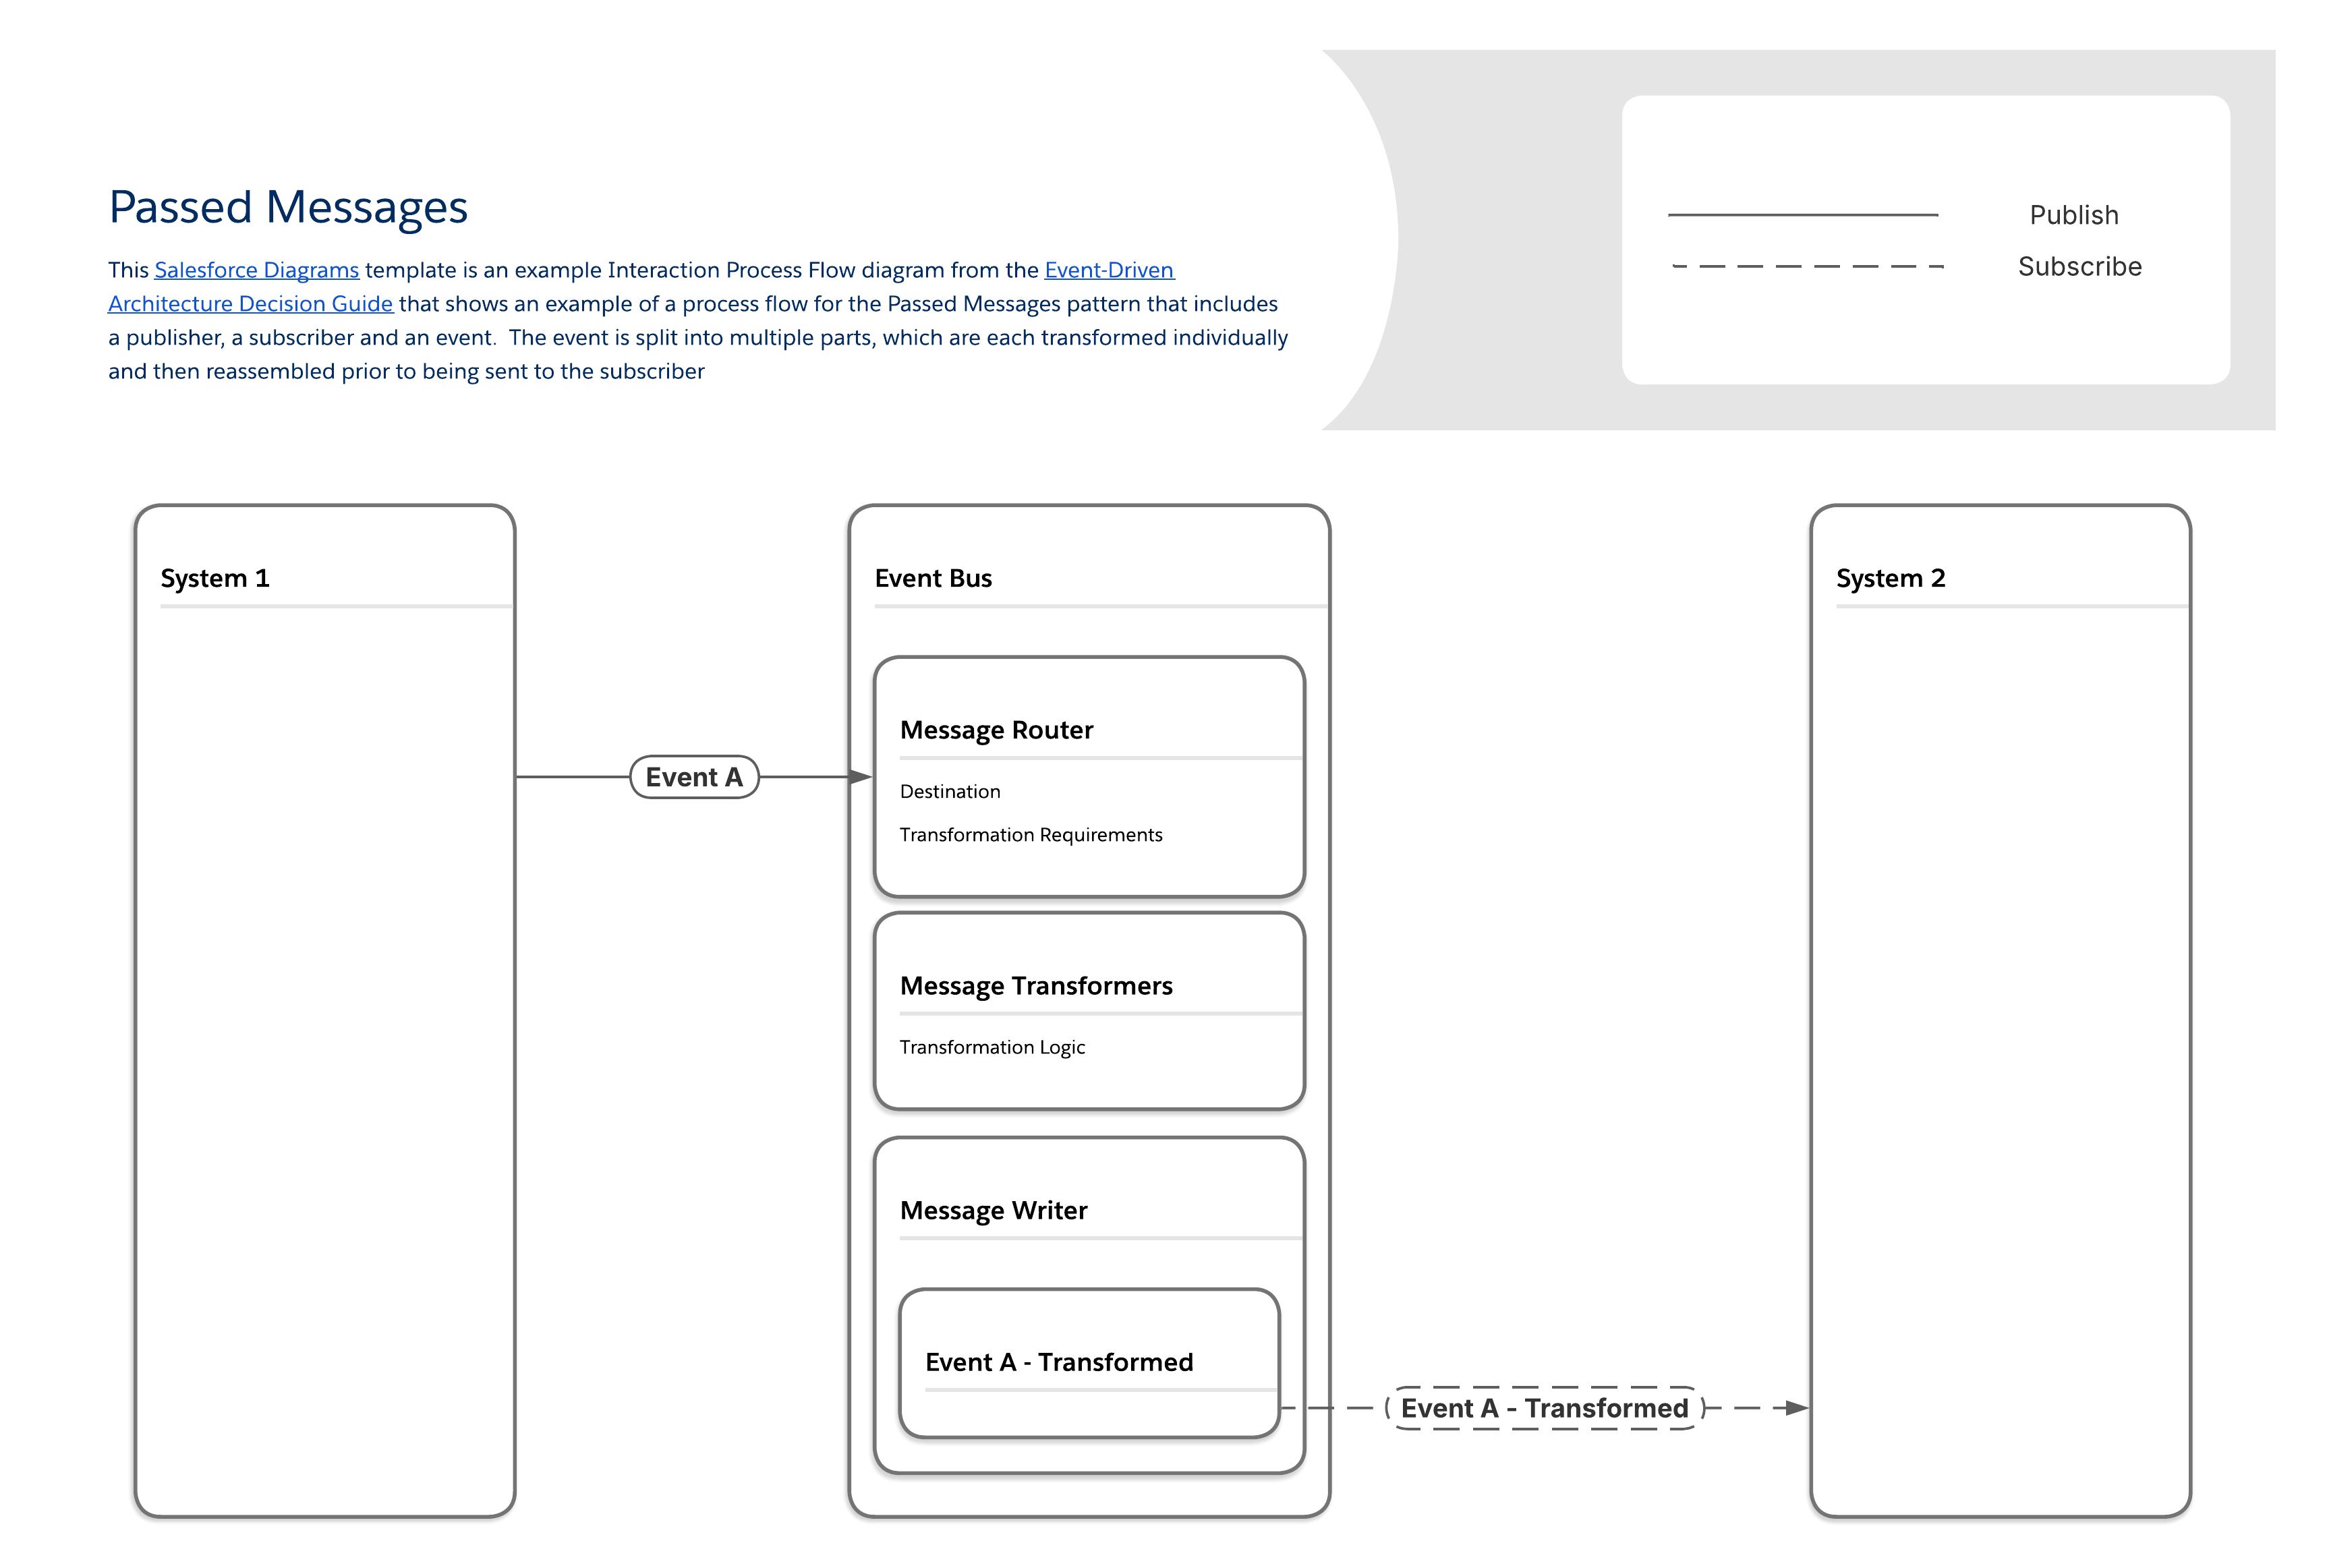 #### Strumenti pertinenti allo schema dei messaggi passati
| Flusso e comportamento dell'evento | Considerazioni sul payload | ||||||
|---|---|---|---|---|---|---|---|
| Strumenti disponibili | Competenze richieste | Pubblica tramite | Abbonamento tramite | Periodo di riproduzione | Struttura payload | Limiti del payload | |
| MuleSoft | MuleSoft Anypoint Apache Kafka Connector | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno |
| Connettore Salesforce Pub/Sub | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| Salesforce Platform | Apache Kafka su Heroku | Pro-code | API, modifiche dei record in Heroku Postgres | N/D | 1-6 settimane | Definito dall'utente | Definito dall'utente |
| Modifica acquisizione dati | Da codice basso a codice pro | Modifiche record | Apex, API, componenti Web Lightning (LWC) | 3 giorni | Predefinito | 1 MB | |
| Eventi piattaforma | Da codice basso a codice pro | API, Apex, Flusso | Apex, API, Flusso, LWC | 3 giorni | Definito dall'utente | 1 MB | |
| Pub/Sub API | Pro-code | API Pub/Sub o API, flusso Apex | API Pub/Sub | 3 giorni | Definito dall'utente | 1 MB | |
| Relay evento* | Basso codice | Eventi piattaforma, Acquisizione dati modifica | API | 3 giorni | Definito dall'utente | 1 MB | |
| *I relay evento inviano i dati solo ad AWS Eventbridge | |||||||
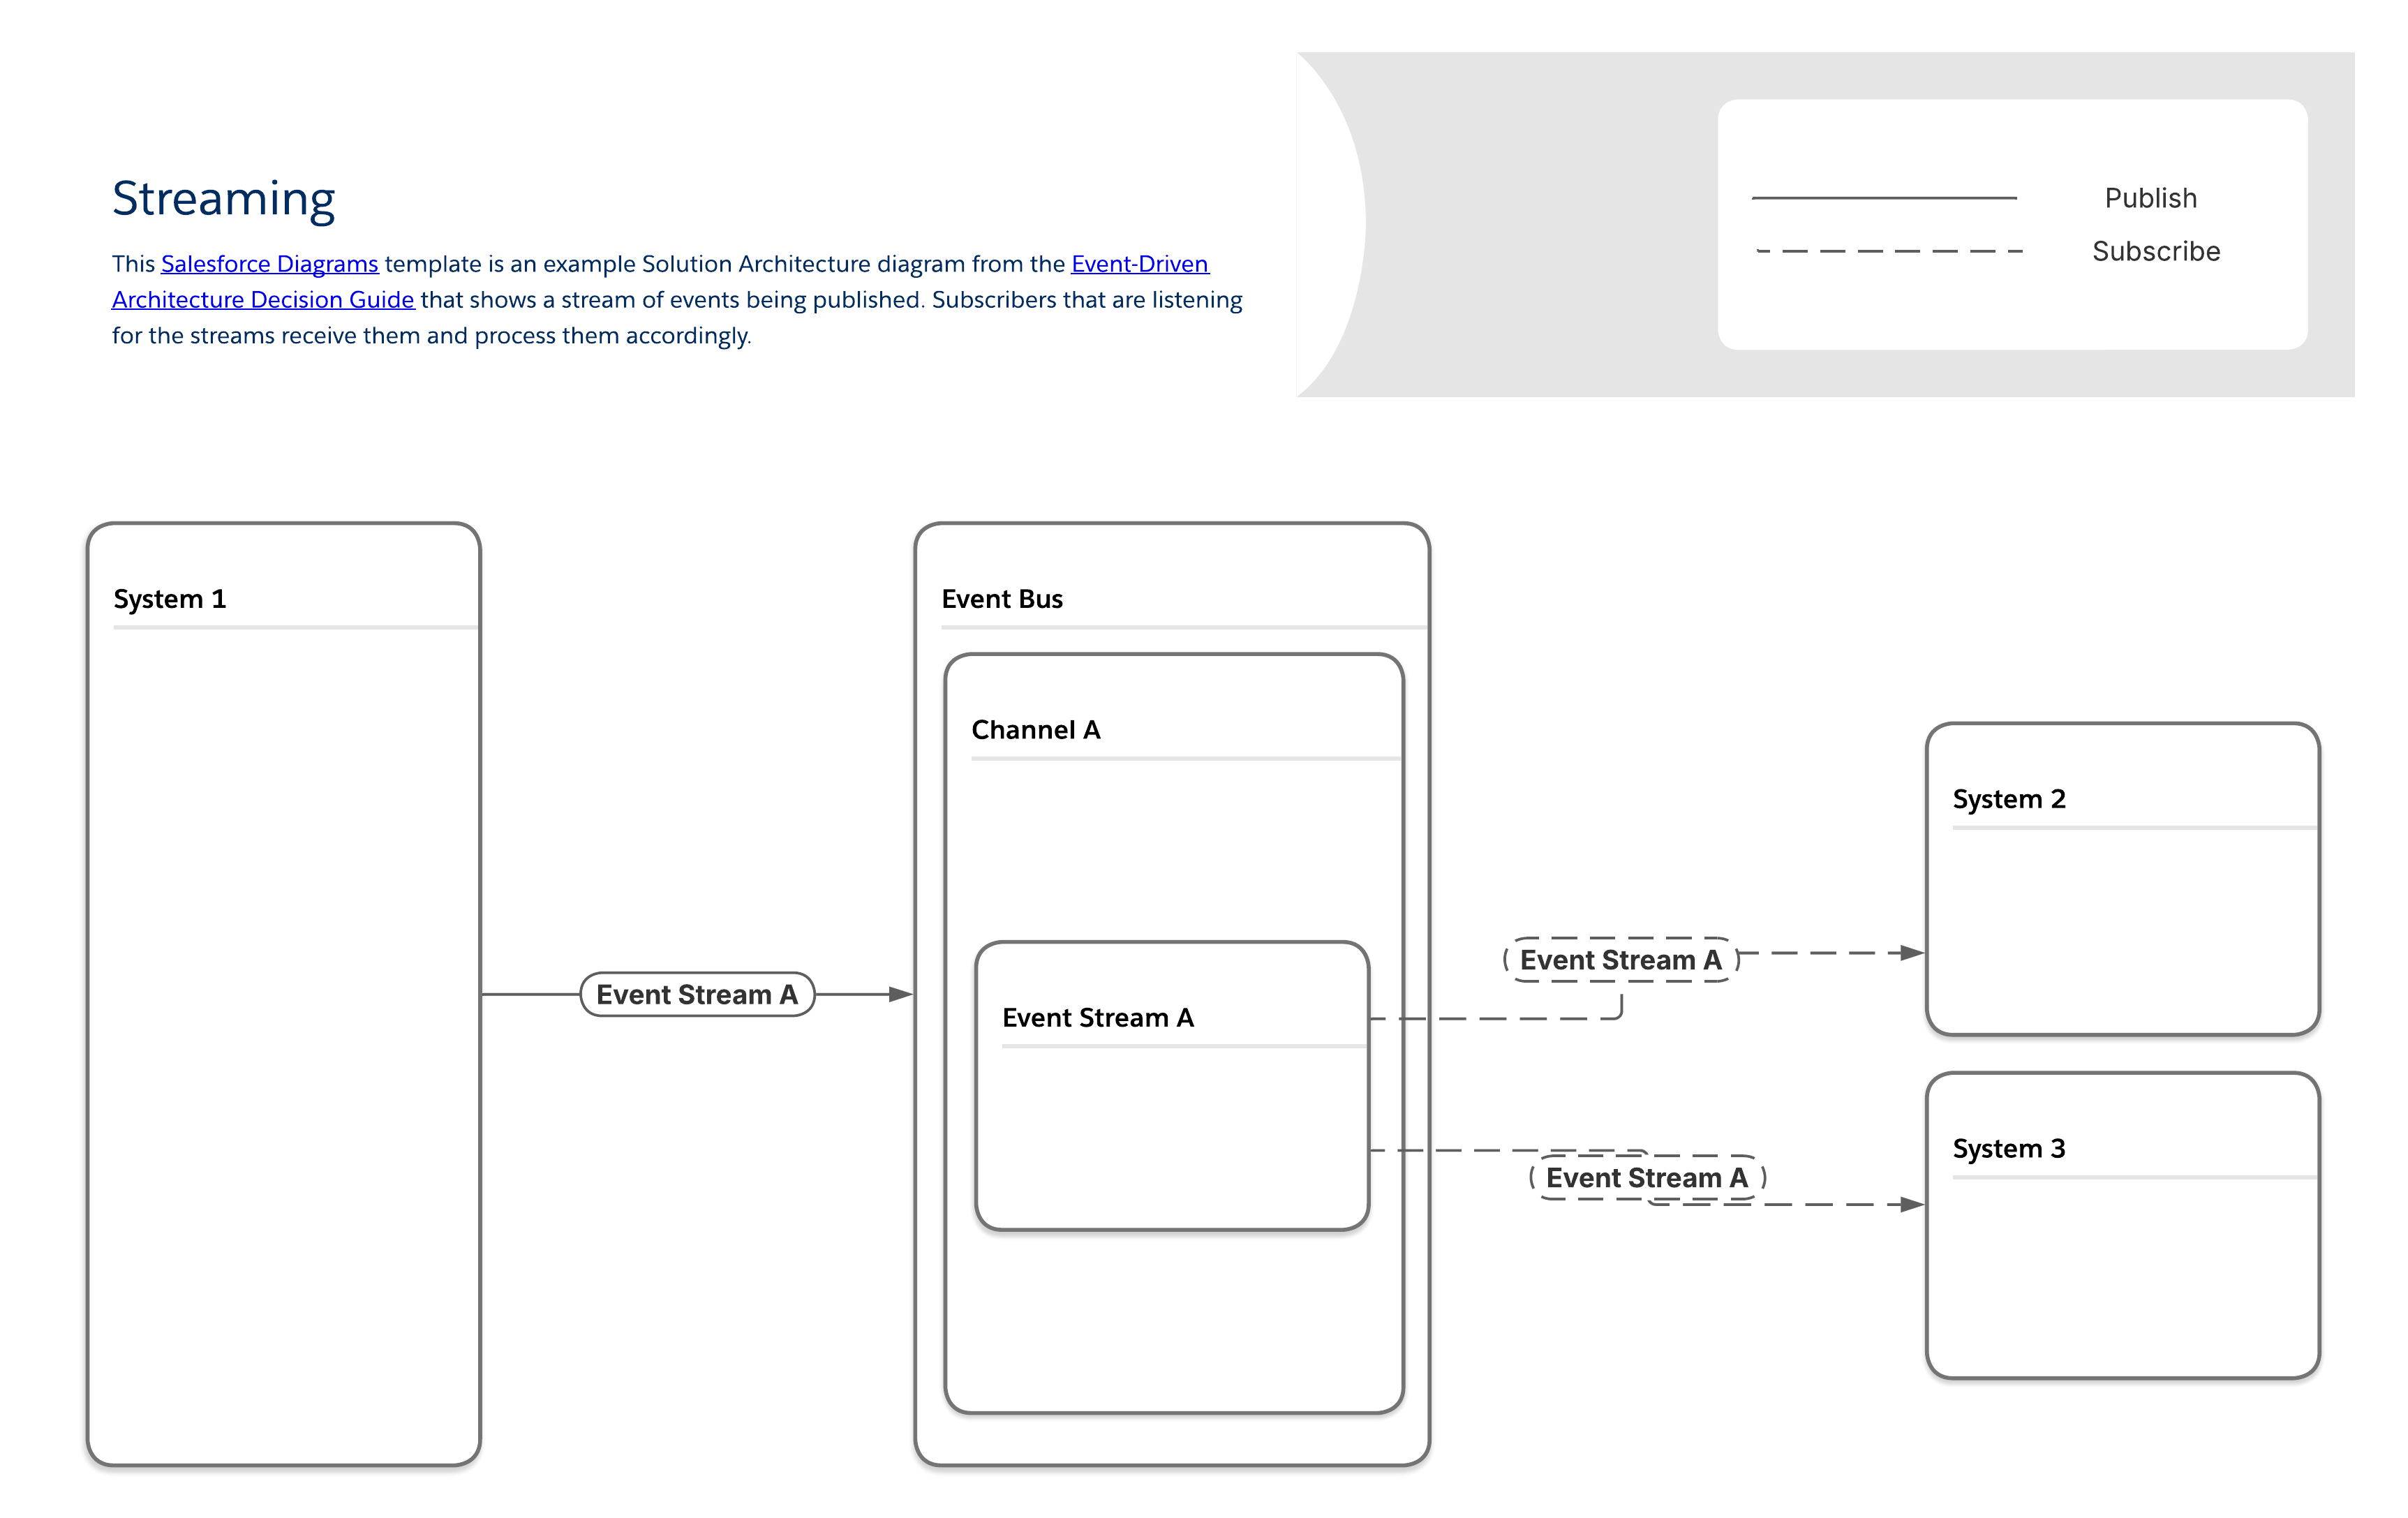 #### Strumenti pertinenti allo schema di streaming
| Flusso e comportamento dell'evento | Considerazioni sul payload | ||||||
|---|---|---|---|---|---|---|---|
| Strumenti disponibili | Competenze richieste | Pubblica tramite | Abbonamento tramite | Periodo di riproduzione | Struttura payload | Limiti del payload | |
| MuleSoft | Stream di dati MuleSoft Anypoint | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno |
| Connettore Salesforce Pub/Sub | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| MuleSoft Anypoint Apache Kafka Connector | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| Salesforce Platform | Apache Kafka su Heroku | Pro-code | API, modifiche dei record in Heroku Postgres | N/D | 1-6 settimane | Definito dall'utente | Definito dall'utente |
| Pub/Sub API | Pro-code | API Pub/Sub o API, flusso Apex | API Pub/Sub | 3 giorni | Definito dall'utente | 1 MB | |
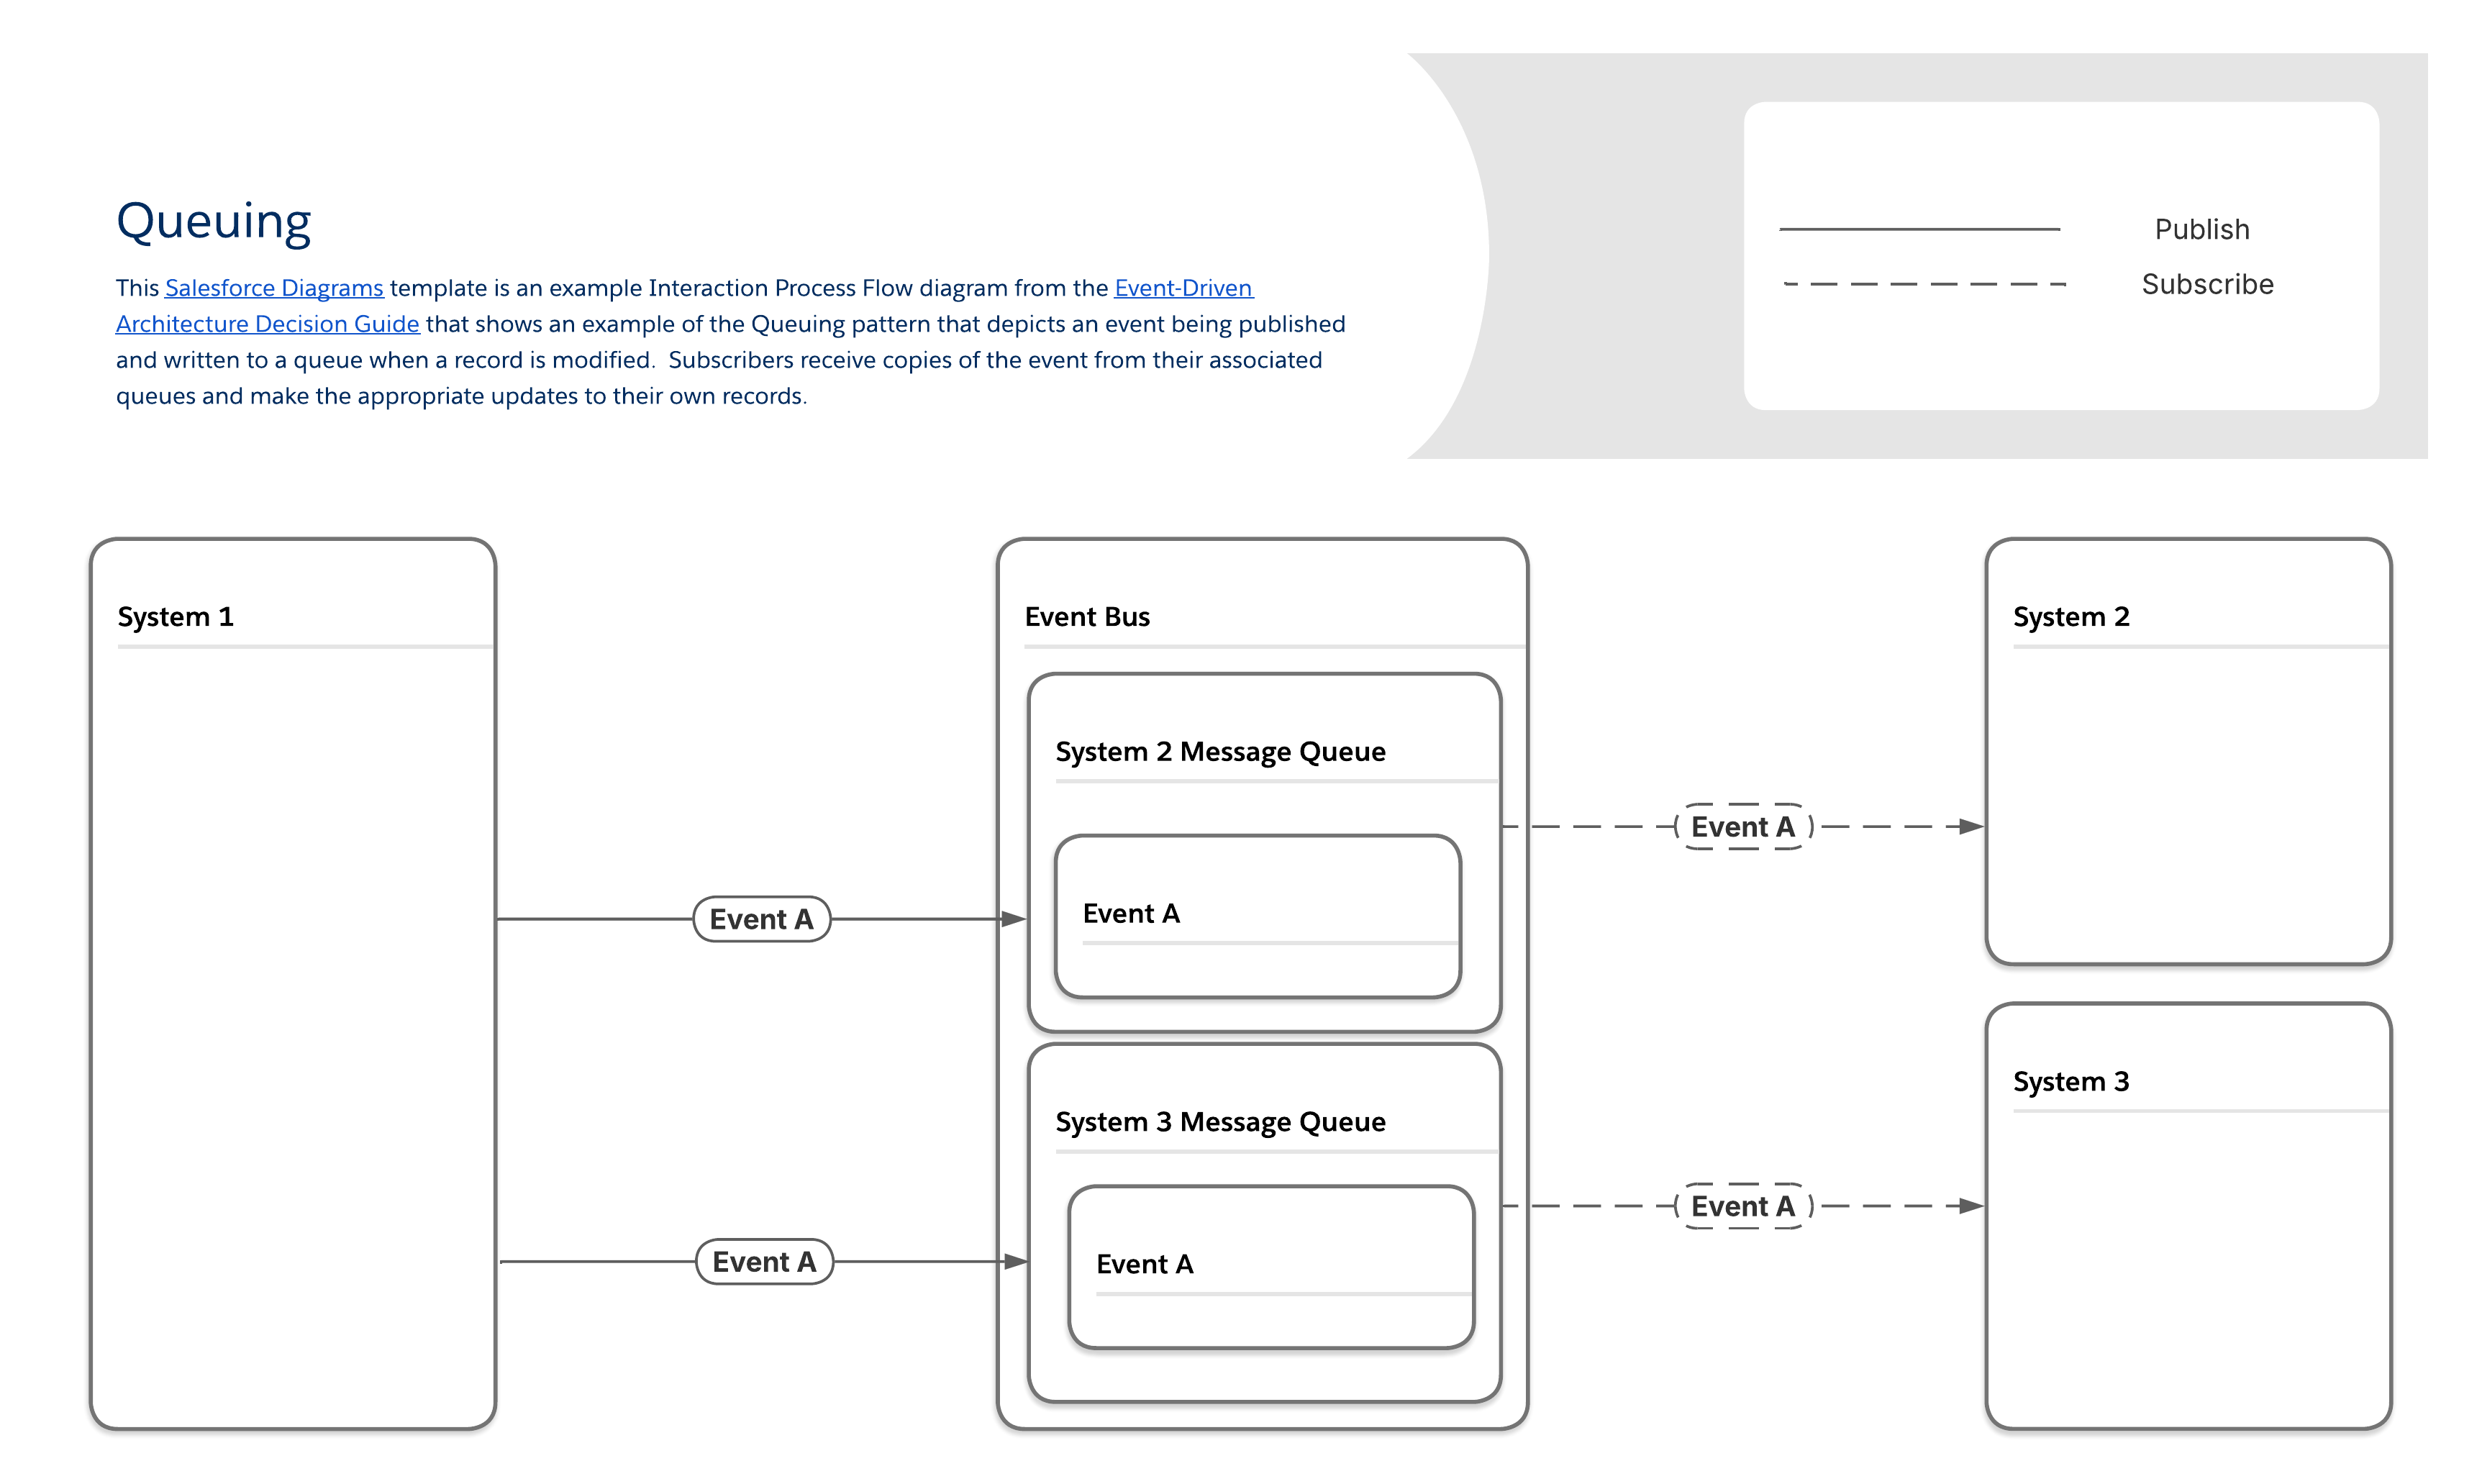 #### Strumenti pertinenti allo schema di area di attesa
| Flusso e comportamento dell'evento | Considerazioni sul payload | ||||||
|---|---|---|---|---|---|---|---|
| Strumenti disponibili | Competenze richieste | Pubblica tramite | Abbonamento tramite | Periodo di riproduzione | Struttura payload | Limiti del payload | |
| MuleSoft | MuleSoft Anypoint MQ | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno |
| Connettore Salesforce Pub/Sub | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| MuleSoft Anypoint Apache Kafka Connector | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| Connettore MuleSoft Anypoint MQ | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| Connettore MuleSoft Anypoint MQTT | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| Connettore MuleSoft Anypoint AMQP | Pro-code | APIs | APIs | Come configurato | Definito dall'utente | Nessuno | |
| Salesforce Platform | Apache Kafka su Heroku | Pro-code | API, modifiche dei record in Heroku Postgres | N/D | 1-6 settimane | Definito dall'utente | Definito dall'utente |
| Modifica acquisizione dati | Da codice basso a codice pro | Modifiche record | Apex, API, componenti Web Lightning (LWC) | 3 giorni | Predefinito | 1 MB | |
| Eventi piattaforma | Da codice basso a codice pro | API, Apex, Flusso | Apex, API, Flusso, LWC | 3 giorni | Definito dall'utente | 1 MB | |
| Pub/Sub API | Pro-code | API o API Pub/Sub, Apex, Flusso | API Pub/Sub | 3 giorni | Definito dall'utente | 1 MB | |
| Relay evento* | Basso codice | Eventi piattaforma, Acquisizione dati modifica | API | 3 giorni | Definito dall'utente | 1 MB | |
| *I relay evento inviano i dati solo ad AWS Eventbridge | |||||||
| Flusso | Salesforce Flow è un potente strumento di automazione point-and-click che consente agli utenti di creare processi aziendali complessi, schermate e logica visivamente utilizzando Flow Builder, senza scrivere codice. Automatizza operazioni come l'aggiornamento dei dati, l'invio di email e la guida degli utenti, offrendo flessibilità attraverso tipi come Flussi schermata (interazione dell'utente) e Flussi attivati (eventi record/pianificati). |
| Apex | Salesforce Apex è un linguaggio di programmazione proprietario orientato agli oggetti per la piattaforma Salesforce, simile a Java, utilizzato per creare logiche aziendali personalizzate, automatizzare i processi ed estendere le funzionalità CRM principali oltre gli strumenti dichiarativi. |
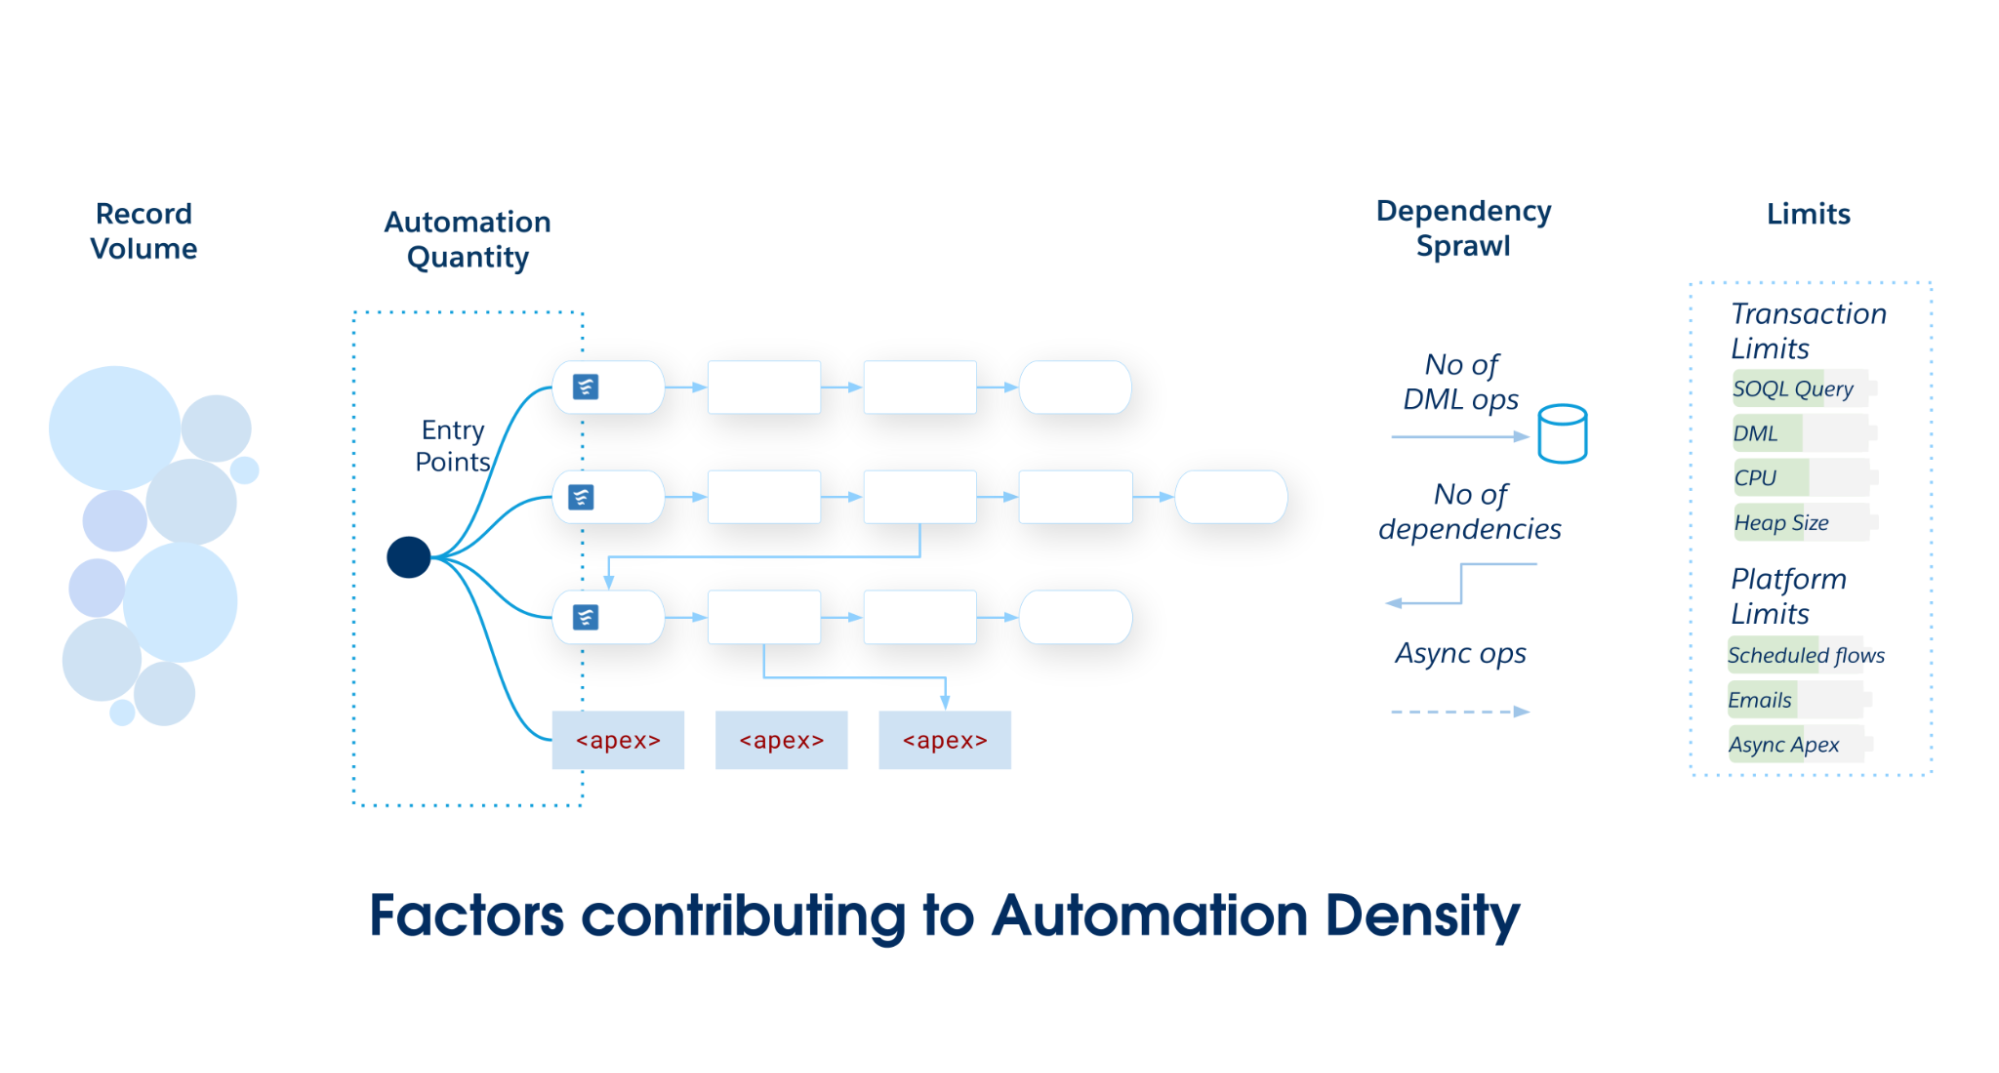 Man mano che l'ambito e la complessità dell'applicazione Salesforce aumentano, impegnarsi in un unico punto di ingresso principale, Flusso attivato da record o Trigger Apex. Evitare di suddividere le automazioni in più meccanismi in un unico oggetto Salesforce, poiché ciò causa una scarsa manutenibilità e una governance frammentata.
### La matrice di selezione della densità
Utilizzare questa matrice per determinare lo standard architettonico richiesto per l'oggetto Salesforce.
- Il **flusso attivato da** record è la soluzione preferita per una bassa densità di automazione. Offre un equilibrio di potenza e accessibilità ideale per automazioni semplici e indipendenti l'una dall'altra.
- **Lo schema ibrido (Record-Triggered Flow with Invocable Apex)** è una scelta potente e manutenibile per le automazioni a media densità con complessità crescente. Questo schema consente ai team di mantenere coreografie ordinate in un flusso dichiarativo delegando al contempo le operazioni complesse di calcolo ad Apex, bilanciando l'accessibilità con le prestazioni.
- **I trigger Apex** forniscono i componenti base necessari per una solida base architettonica per supportare automazioni ad alta densità. Le prestazioni, il controllo granulare e l'astrazione e il polimorfismo orientati agli oggetti di Apex sono più adatti per gestire la complessità e la scala di questi scenari.
| Livello di densità | Quantità automazione | Volume di dati (dimensioni batch) | Dependance Sprawl (Diffusione delle dipendenze) | Standard architettonico |
|---|---|---|---|---|
| Basso | < 15 Automazioni |
Standard Interazioni dell'interfaccia utente basate sugli utenti o piccoli carichi API (1-200 record) |
Discreto Logica autonoma. 0–1 operazioni DML a valle sullo stesso oggetto o su un oggetto correlato. |
Flusso attivato da record |
| Medio | 15–30 Automazioni |
Modera Elaborazione batch standard (con logica che richiede un'attenta messa in blocco) |
Accoppiato Parent/Child aggiorna da 2 a 4 operazioni DML a valle. Rischio di ricorsione |
Schema ibrido Flusso + Apex invocabile |
| Alto | > 30 Automazioni |
Alto Grandi volumi di dati con caricamenti API in blocco (2.000 - 10.000+ record) |
Complesso e ricorsivo Grafico delle dipendenze profonde (5+ operazioni DML a valle). Rischio di loop di ricorsione triangolari |
Framework di metadati trigger Apex |
| Capacità | Flusso attivato da record | Trigger Apex |
|---|---|---|
| Velocità di consegna e manutenzione | Consigliato L'interfaccia utente visiva di Flow Builder consente agli amministratori e ad altri generatori dichiarativi di creare e modificare l'automazione più rapidamente rispetto alla scrittura, al test e alla distribuzione di Apex Code. Questa interfaccia consente a una gamma più ampia di membri del team di offrire valore aziendale e riduce la dipendenza da risorse per sviluppatori specializzate per operazioni semplici. |
Richiede esperienza Apex richiede sviluppatori di software esperti per implementare, testare e gestire il codice. |
| Modularità | Disponibile I flussi attivati da record sono modulari per impostazione predefinita. Anziché la logica monolitica, i team creano flussi discreti per esigenze specifiche e li coreografano insieme utilizzando Explorer trigger di flusso. Questa modularità consente la modifica isolata e l'estensione semplice, riducendo notevolmente il costo di proprietà a lungo termine. |
Disponibile Apex è suddiviso in moduli funzionali in base alla progettazione. Ogni classe Apex è destinata a implementare un singolo modulo di funzionalità. |
| Visibilità e governance | Consigliato La natura visiva del flusso offre una rappresentazione intuitiva della logica aziendale. Explorer trigger di flusso offre una visualizzazione consolidata di tutti i flussi di un oggetto, semplificando la comprensione, il governo e la risoluzione dei problemi per architetti e amministratori senza leggere il codice. |
Richiede esperienza L'utilizzo di un framework di metadati per organizzare i trigger è vantaggioso, ma Apex richiede un team di sviluppo disciplinato per mantenere il codice organizzato e manutenibile. |
| Elaborazione in blocco dei dati ad alte prestazioni | Sconsigliato Esiste un rischio elevato di superare i limiti del governor quando si ha a che fare con logica complessa o volumi di dati elevati. |
Consigliato Apex Code viene eseguito più vicino ai servizi principali della piattaforma e offre agli sviluppatori un controllo avanzato sull'ottimizzazione delle query, la gestione dei dati e l'efficienza algoritmica. Ciò si traduce in prestazioni e scalabilità migliori, soprattutto in scenari complessi che coinvolgono volumi di dati elevati. |
| Logica e strutture di dati solide | Disponibile L'elemento Trasforma flusso può essere utile per alcune operazioni di elaborazione complesse. Tuttavia, il flusso non dispone di strutture di dati native Map and Set (Mappa e imposta), il che rende l'elaborazione dei dati complessa complessa complessa e inefficiente dal punto di vista computazionale. |
Consigliato Apex offre accesso completo ai loop Map, Set e programmatic per una manipolazione dei dati altamente efficiente e sicura in blocco. Essendo un linguaggio di programmazione completo, Apex offre anche l'accesso a costrutti logici complessi, strutture di dati e schemi di progettazione che possono aiutare a risolvere problemi aziendali complessi in modo manutenibile ed efficiente. Apex include una ricca libreria standard di funzioni avanzate (ad esempio, BusinessHours, Crypto) attualmente non disponibili negli strumenti dichiarativi. |
| Controllo delle transazioni | Non disponibile Il flusso non fornisce alcun accesso a `Database.savepoint`, `Database.rollback` o a operazioni DML parzialmente riuscite per conferme o rollback parziali delle transazioni. |
Disponibile Apex offre un controllo completo e granulare sull'integrità delle transazioni e su scenari di ripristino degli errori complessi. |
| Distribuzione email | Consigliato L'invio di avvisi tramite email preconfigurati da un flusso attivato da record è semplice e scalabile. Gli avvisi tramite email personalizzati possono essere creati e distribuiti in fase di esecuzione. I messaggi email personalizzati sono soggetti a limiti giornalieri. |
Disponibile Apex può generare e inviare messaggi email personalizzati. Tutte le email inviate da Apex sono soggette ai limiti giornalieri. |
| Applicazione di protezioni piattaforma | Consigliato Il flusso include protezioni incorporate, ad esempio la bulkificazione automatica e i tentativi automatici. Queste protezioni aumentano la velocità di calcolo e impediscono insidie nelle prestazioni che altrimenti richiedono una codifica manuale complessa. |
Implementazione manuale richiesta Le protezioni come la creazione in blocco devono essere codificate in modo esplicito (ad esempio, la gestione delle raccolte ed evitare SOQL all'interno dei loop). I tentativi automatici non sono nativi dei trigger e richiedono una complessa logica personalizzata per essere implementati. |
| Elaborazione asincrona | Disponibile Il flusso offre meccanismi semplici per le automazioni che richiedono una transazione separata in un percorso asincrono. Queste automazioni sono soggette a limiti giornalieri. |
Disponibile Apex consente il controllo completo tramite Acquisizione dati di modifica ed eventi in area di attesa gestiti da un abbonato trigger disaccoppiato. |
| Elaborazione pianificata | Consigliato I percorsi pianificati del flusso offrono una funzionalità di pianificazione unica e potente (ad esempio, "attiva 3 giorni prima della data di chiusura"). Questa funzionalità include l'annullamento automatico e la riprogrammazione se i dati del record cambiano. Queste automazioni sono soggette a limiti giornalieri. |
Non disponibile Un trigger Apex non può pianificare in modo nativo un evento temporale specifico del record con annullamento automatico. Sebbene esista Apex pianificato, si tratta di un meccanismo fondamentalmente diverso che viene eseguito in un momento specifico e non viene pianificato durante l'elaborazione di un singolo record come parte di un trigger. |
| Ordinamento e coreografia | Disponibile Explorer trigger di flusso consente agli amministratori di definire un ordine di esecuzione relativo per più flussi sullo stesso oggetto. |
Disponibile Un framework trigger offre un controllo granulare sull'ordine esatto delle automazioni. |
| Aggiornamenti di campo dello stesso record | Disponibile (prima del salvataggio) Il flusso attivato da record è l'opzione dichiarativa più efficace per aggiornare il record di attivazione prima della conferma DML iniziale. |
Disponibile (prima del salvataggio) Apex offre le prestazioni più elevate con un sovraccarico minimo. |
| CRUD oggetti incrociati | Disponibile (dopo il salvataggio) Il flusso è adatto per operazioni DML tra oggetti semplici, di bassa complessità. |
Disponibile (dopo il salvataggio) Apex offre un controllo superiore su deduplica, gestione degli errori e prestazioni per le operazioni DML oggetti incrociate. |
| Deduplicazione di calcoli costosi | Disponibile Il flusso eccelle nell'eliminazione delle query ridondanti e delle istruzioni DML tramite il blocco automatico. Tuttavia, lo stato non può essere memorizzato nella cache o condiviso tra trigger di flusso diversi o tra più chiamate dello stesso flusso all'interno di una sola transazione. Questa limitazione può diventare importante in scenari di prestazioni estreme. |
Consigliato Apex fornisce meccanismi per deduplicare operazioni costose. Gli sviluppatori possono sfruttare il caching transazionale utilizzando proprietà e variabili statiche e il caching a livello di piattaforma utilizzando la cache piattaforma per archiviare e riutilizzare i dati. Queste tecniche sono importanti per ridurre il consumo dei limiti del governor transazionale, ad esempio le query SOQL, e garantire prestazioni e scalabilità elevate. |
| Gestione errori personalizzati | Disponibile L'elemento CustomError può bloccare un'operazione di salvataggio e visualizzare un messaggio all'utente. |
Consigliato Il metodo addError() offre una messaggistica di errore flessibile a livello di campo e condizionale. |
| Caso d'uso | Descrizione | Più adatta | Motivo |
|---|---|---|---|
| Elaborazione batch ad alte prestazioni | Qualsiasi automazione che deve elaborare migliaia di record in modo efficiente | Apex | Apex fornisce API complete per l'interfacciamento con la piattaforma e per la velocità di stampa. |
| Elaborazione dati complessa | Scenari che richiedono una manipolazione avanzata dei dati | Apex | Apex fornisce strutture di dati, ad esempio Mappa e Imposta, che non sono disponibili in modo nativo in Flusso e possono essere fondamentali per scrivere codice efficiente e sicuro in blocco. |
| Controllo transazionale | Meccanismi di controllo come savepoint, rollback e conferme parziali | Apex | Apex fornisce l'accesso a meccanismi come Database.savepoint e Database.rollback e ha la capacità di elaborare operazioni DML parzialmente riuscite. |
| Convalida personalizzata sofisticata | Convalida dei dati in più campi di un record | Apex | Sebbene il flusso possa impedire il salvataggio con l'elemento 'CustomError', non è disponibile in tutti i tipi di flusso, inclusi i sottoflussi. Il metodo Apex addError() fornisce più messaggi di errore specifici del campo che possono essere aggiunti a un record in qualsiasi momento durante l'elaborazione del trigger. |
| Logica moderatamente complessa in un processo semplice | Logica e manipolazione dei dati di moderata complessità, semplificate da una libreria standard di funzioni avanzate, che si verificano nell'ambito di un processo semplice | Flusso + Apex | Il flusso attivato da record funge da livello di orchestrazione, mentre le operazioni di elevata complessità sono incapsulate in Apex invocabile. |
| Logica da semplice a moderatamente complessa | Manipolazione dei dati di complessità da bassa a moderata, con aggiornamenti dei trigger sia agli oggetti dati principali che a quelli correlati | Flusso | Il flusso è in genere l'opzione da seguire, poiché è basato su un modello dichiarativo che lo rende accessibile sia agli amministratori che agli sviluppatori. |
| Notifiche e messaggi in uscita | Invio di email e messaggi in uscita | Flusso | Il flusso consente di inviare avvisi tramite email e messaggi in uscita sulle modifiche dei record in modo semplice e altamente scalabile. |
| Elaborazione pianificata | Automazione in una data futura e dinamica (ad esempio, 3 giorni prima di una data di chiusura) | Flusso | I percorsi pianificati rappresentano un punto di forza unico per il flusso, poiché la piattaforma gestisce automaticamente la pianificazione, l'annullamento e la riprogrammazione di questi percorsi se i dati del record cambiano. |
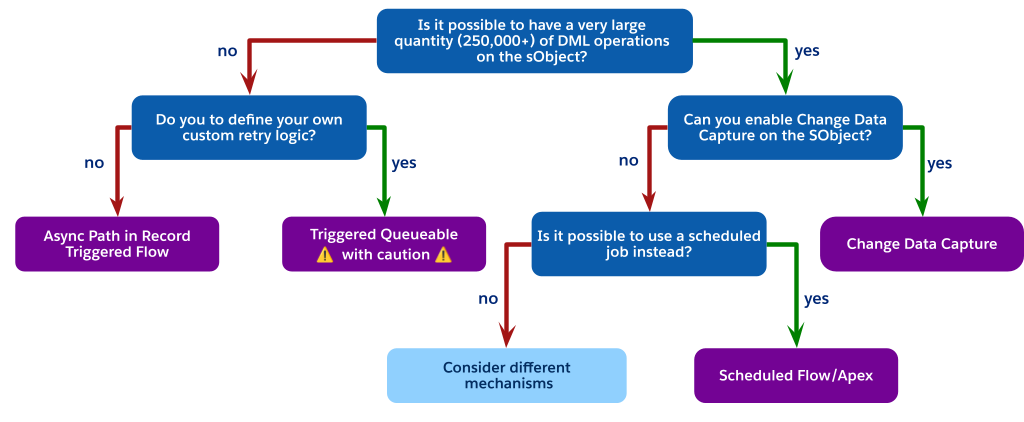 ### L'alternativa al lavoro pianificato
Come indica il diagramma di flusso, quando ci si trova di fronte a operazioni DML a volume elevato ma non è possibile utilizzare Acquisizione dati di modifica (forse a causa dei limiti degli oggetti), la scelta architettonica migliore è spesso evitare completamente un processo invocato da trigger.
Valutare invece la possibilità di utilizzare un processo pianificato. Può essere un flusso pianificato o Apex pianificato. I passaggi obbligatori sono:
1. Eseguire un aggiornamento semplice e a basso costo nel trigger sincrono. Ad esempio, impostare un campo `Status__c` su "elaborazione in sospeso" o inserire un record correlato a basso costo, ad esempio un post Chatter, per indicare che il record deve essere elaborato.
2. Creare un processo pianificato, un flusso pianificato o Apex pianificato, che viene eseguito periodicamente, ad esempio ogni 15 minuti o ogni ora.
3. Fare in modo che la query del processo pianificata per tutti i record nello stato In sospeso, eseguire la logica complessa in un contesto controllato a volume elevato e quindi aggiornare i record come elaborati.
Questo schema separa completamente l'elaborazione pesante dal salvataggio sincrono dell'utente, non è soggetto al limite di un processo per transazione di un batch attivato da trigger e offre una soluzione altamente scalabile e governabile per i requisiti non in tempo reale.
Se la latenza di un processo pianificato non è accettabile per i requisiti aziendali e si è ancora costretti a non utilizzare CDC o un trigger in attesa, ciò indica una significativa non corrispondenza architettonica. A questo punto occorre considerare diversi meccanismi. Rivalutando la progettazione dell'applicazione di base si possono trarre alcune conclusioni, ad esempio:
- Acquisto del componente aggiuntivo per rimuovere i limiti degli oggetti CDC.
- È fondamentale mettere in discussione il requisito aziendale di determinare se l'elaborazione quasi in tempo reale è davvero un "must-have" o se la latenza di un processo pianificato è un compromesso accettabile per la stabilità della piattaforma.
## Considerazioni non funzionali
Oltre ai punti di decisione, è necessario tenere conto di considerazioni non funzionali come la complessità e gli standard.
### Complessità
Il livello di complessità di un'implementazione fa parte del costo totale di proprietà di una soluzione, nonché della sua capacità di adattarsi alle mutevoli esigenze aziendali. La complessità può influire su qualsiasi implementazione se non vengono seguite le procedure consigliate. Nella sezione _Procedure consigliate correlate_ di questo documento sono riportati i consigli per ridurre la complessità della soluzione, inclusi questi schemi:
- Schema ibrido: Apex invocabile per logica complessa nel flusso
- Utilizzo di un framework di metadati per trigger Apex
- Megaflussi rispetto a più flussi
### Processi e standard
La documentazione è importante tanto quanto l'automazione stessa. Non solo garantisce la manutenibilità, ma è anche fondamentale per l'intelligenza artificiale e gli strumenti basati sugli agenti. La documentazione consente di comprendere e gestire i processi aziendali.
**Nel flusso**
- Stabilire una convenzione di denominazione coerente per tutti gli elementi e le variabili.
- Utilizzare il campo Descrizione del flusso per spiegarne lo scopo generale, i criteri di attivazione e l'esito previsto.
- Utilizzare il campo Descrizione per ogni singolo elemento (ad esempio, `Get Records`, `Action`, `Transform`). Questa procedura è il modo migliore per trasmettere l'intento. È particolarmente importante per le azioni invocabili e i sottoflussi, dove la descrizione è il punto principale per spiegare la complessa logica eseguita dall'azione.
**In Apex**
- Commentare chiaramente il codice per spiegare il _perché_ della logica, non solo il _cosa_.
- Se si utilizza un framework basato sui metadati, assicurarsi che i record dei metadati includano e compilino un campo Descrizione in formato leggibile per spiegare le operazioni di ogni classe di handler e quando deve essere eseguita.
DevOps e il controllo sorgente fanno parte di un ciclo di vita di sviluppo maturo. Utilizzare sempre uno strumento di controllo sorgente come Git per i progetti Salesforce. Sia le classi Apex che i flussi Salesforce sono metadati che definiscono la logica aziendale e devono essere modificati e gestiti.
Nel contesto della gestione delle automazioni attivate da record, una pipeline DevOps moderna offre vantaggi essenziali.
- **Controlli di qualità automatici:** Strumenti come [Salesforce Code Analyzer](https://developer.salesforce.com/docs/platform/salesforce-code-analyzer/overview) possono essere configurati per l'esecuzione automatica nelle opportunità in corso di realizzazione. L'analisi statica può rilevare schemi problematici in entrambi gli strumenti di automazione prima che vengano promossi, segnalando problemi come elementi di `Get Records` inefficienti all'interno di un loop di flusso o query di `SOQL` all'interno di un loop Apex per il loop, che sono cause comuni di deterioramento delle prestazioni.
- **Prevenzione della regressione:** Man mano che la densità di automazione aumenta, la modifica a una classe Flusso o Apex può avere conseguenze indesiderate per altre automazioni sullo stesso oggetto. Una strategia di test DevOps efficace, in cui i test Apex automatici vengono eseguiti in base a qualsiasi modifica proposta, è il modo più affidabile per assicurarsi che una nuova versione del flusso non interrompa la logica Apex esistente (e viceversa).
- **Collaborazione e visibilità:** Il controllo sorgente è la "singola fonte della verità". Consente ad amministratori e sviluppatori di lavorare sull'automazione per lo stesso oggetto in parallelo. Offre anche un itinerario di controllo prezioso: quando un processo di produzione si interrompe, è possibile vedere immediatamente _chi_ ha modificato l'automazione, _quando_ l'ha modificata e, tramite messaggi di conferma, _perché_ l'ha modificata.
Per i team con un mix di amministratori e sviluppatori, [DevOps Center](https://help.salesforce.com/s/articleView?id=platform.devops_center_overview.htm&type=5) fornisce un'interfaccia unificata che aiuta a coreografare tutte queste fasi, rendendo un processo di sviluppo scalabile e basato sul controllo sorgente accessibile a tutti i membri del team.
Questa disciplina combinata di documentazione e DevOps garantisce la salute e la manutenibilità a lungo termine dell'organizzazione, a vantaggio di ogni architetto e amministratore che vi segue.
## Procedure consigliate correlate
La guida alle decisioni riportata sopra è consigliabile prima di pianificare l'implementazione. Ha lo scopo di aiutare l'utente a scegliere il prodotto migliore per i propri casi d'uso. Dopo la selezione del prodotto, è importante conoscere le procedure consigliate esistenti per l'implementazione.
### Sfruttare lo schema ibrido: Apex invocabile per logica complessa nel flusso
Il principio _One Tool Per Object_ è fondamentale per la gestione dell'automazione ad alta densità, ma non lo si interpreta come una scelta binaria tra uno stack puramente dichiarativo o puramente programmatico. Un modello architetturale più efficace e manutenibile sfrutta un modello ibrido: posizionare il flusso attivato da record come livello di orchestrazione, incapsulando al contempo le operazioni di elevata complessità in Apex invocabile.
 #### Il livello orchestrazione: Flusso
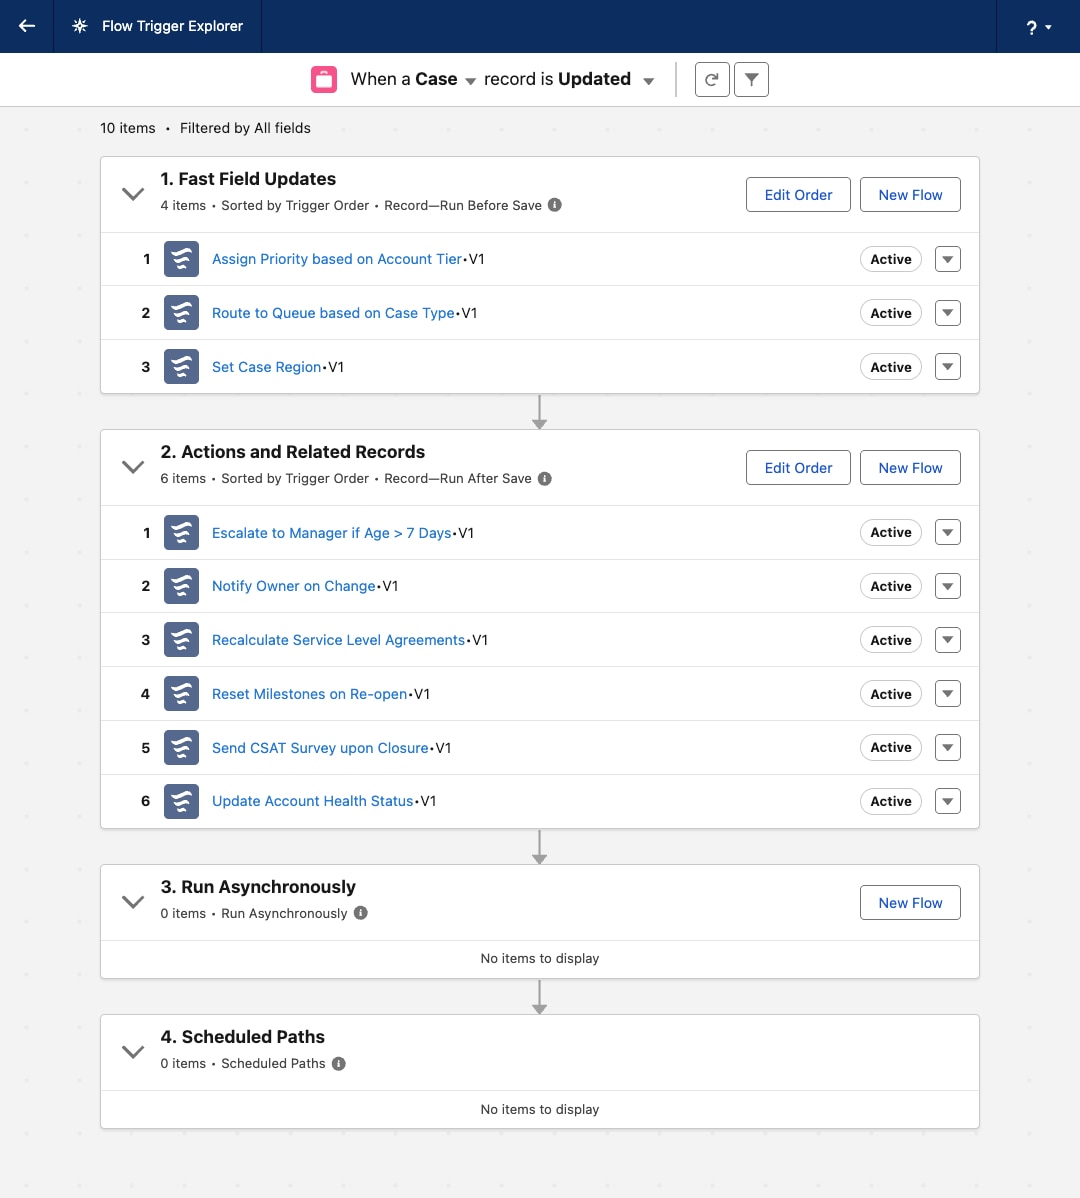
Il flusso attivato da record funge da livello di orchestrazione per il processo aziendale. È titolare dei criteri di immissione e del contesto di esecuzione (_cosa_ e _quando_). Mantenendo la logica decisionale e l'instradamento all'interno di questo livello, la topologia dei processi dell'architettura rimane trasparente e gestibile tramite Explorer trigger di flusso, evitando che la logica aziendale critica venga oscurata nel codice.
#### Il componente complesso: Apex invocabile
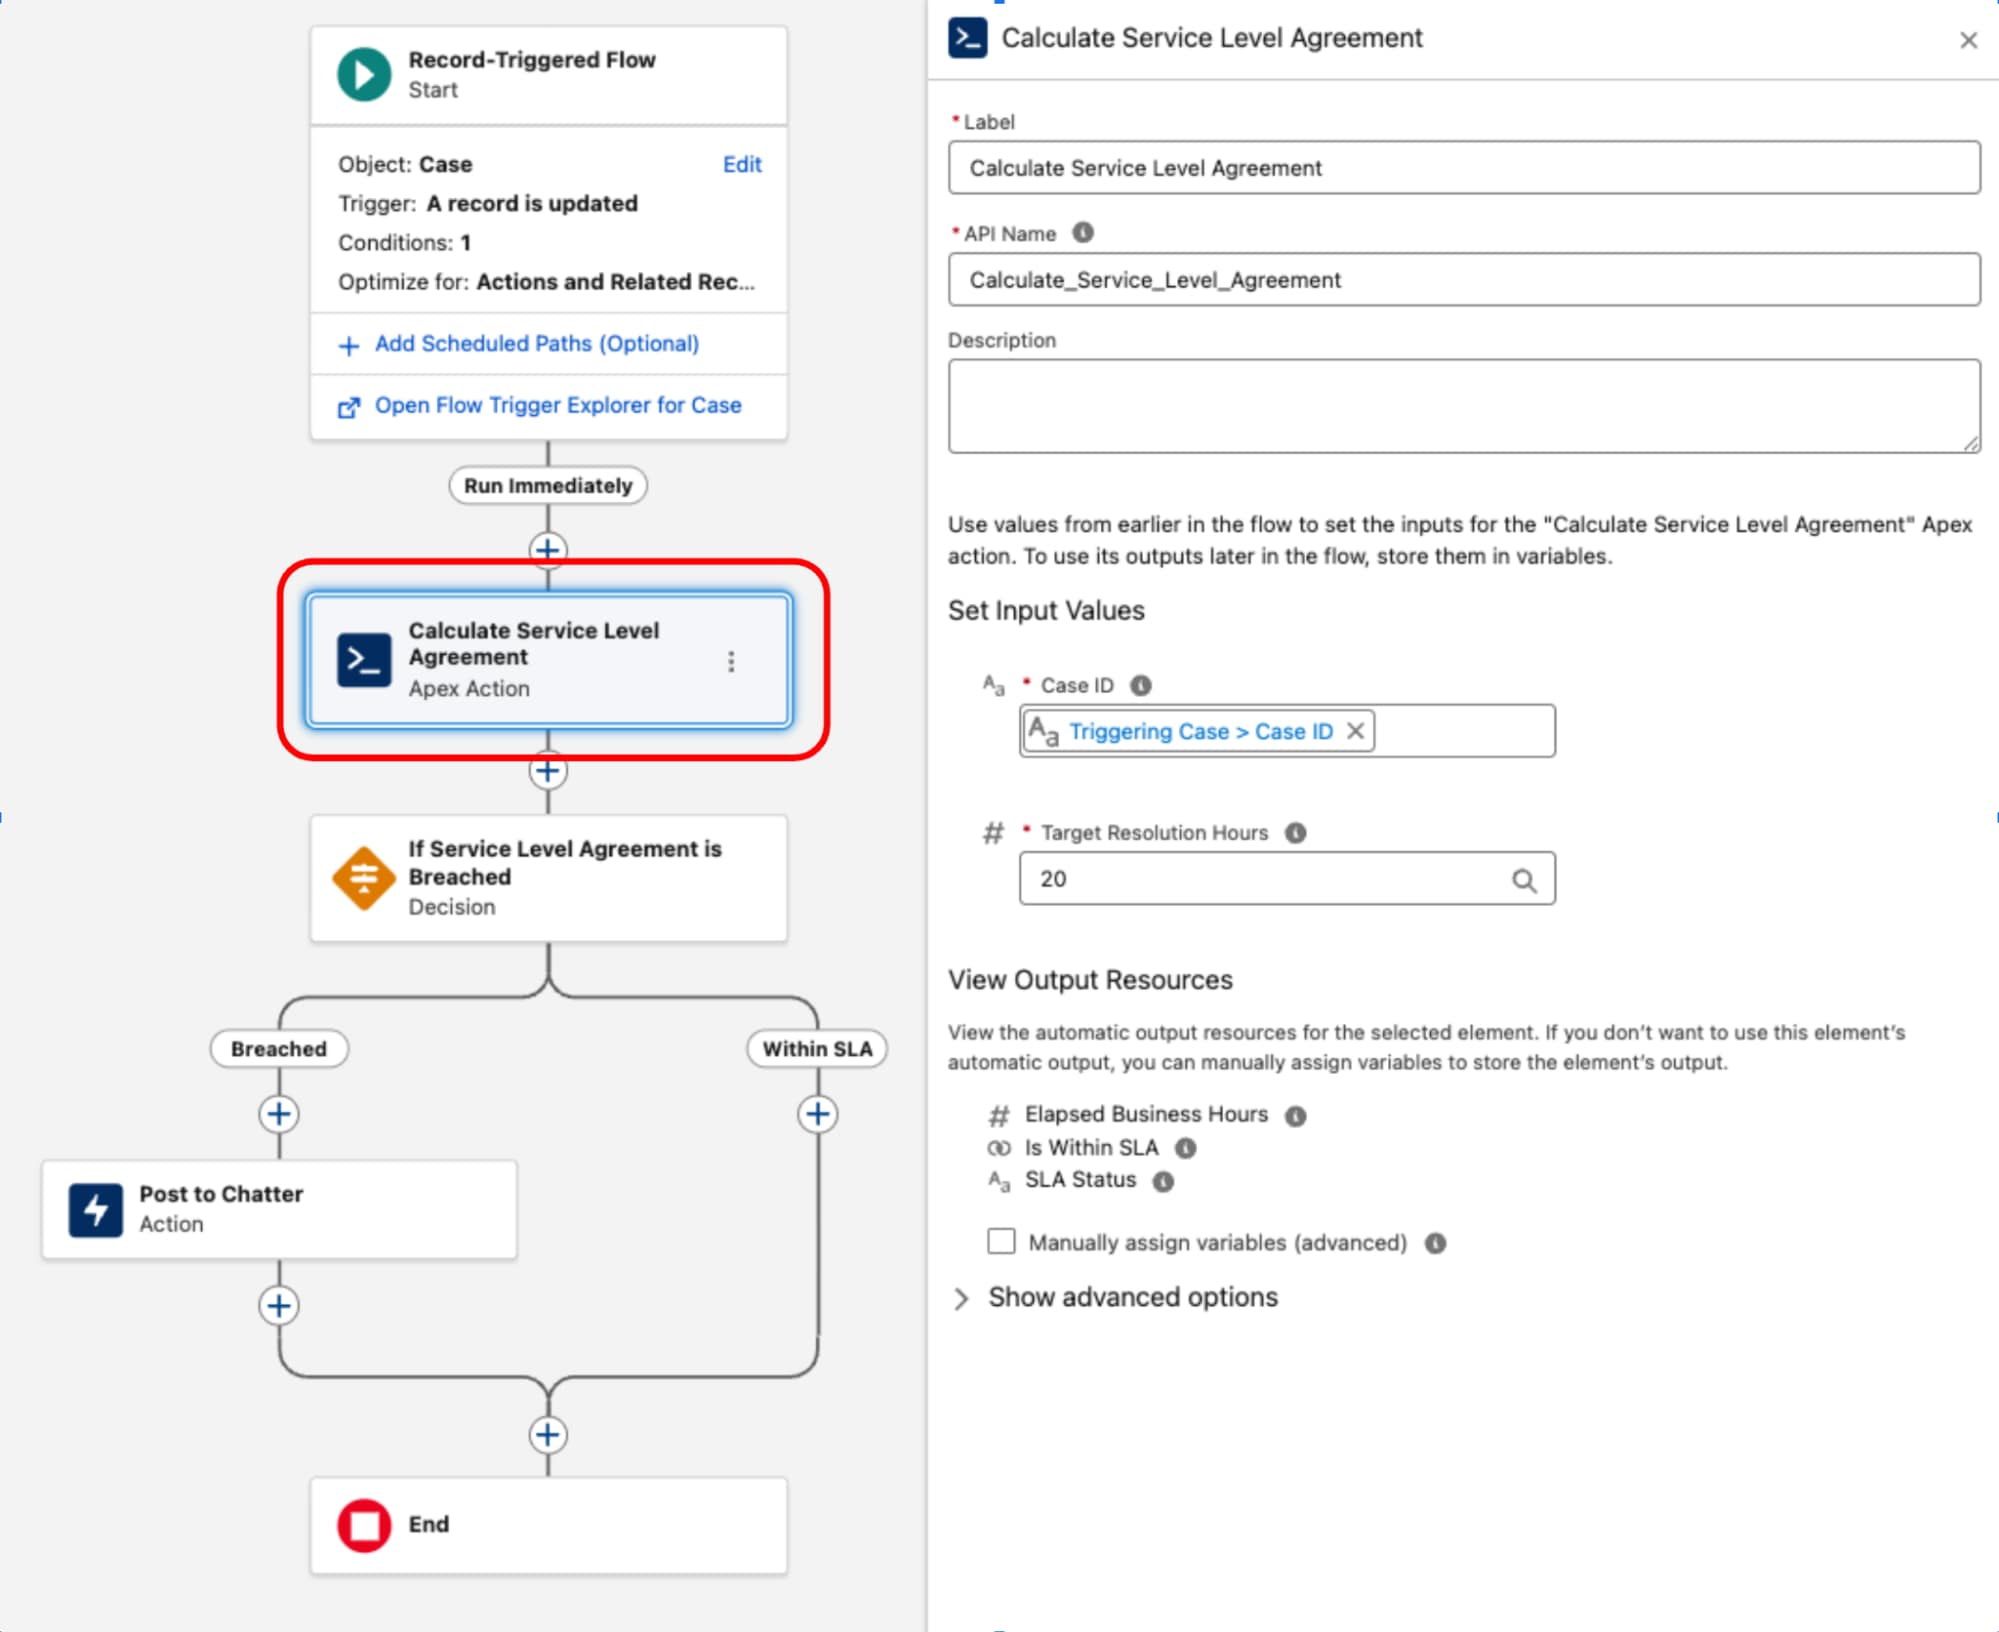
Un esempio comune di componente complesso è l'implementazione dei calcoli del contratto sul livello di servizio (SLA) per i record Caso. Poiché l'oggetto BusinessHours e la relativa logica, essenziali per calcoli accurati che escludono le ore non lavorative e i giorni festivi, non sono accessibili in modo nativo in Flusso, viene utilizzata una classe Apex dedicata. Questa classe, spesso denominata `ServiceLevelAgreementCalculator`, è progettata con un unico metodo statico, annotato con `@InvocableMethod`, per calcolare l'orario di ufficio trascorso, determinare se il contratto sul livello di servizio è "Entro il target" o "Violato" e restituire un output strutturato. Questo approccio incapsula la complessa logica ad alte prestazioni di Apex consentendo al contempo di eseguirla e integrarla senza problemi nel livello di orchestrazione dichiarativa di un flusso attivato da record.
Una volta definita, la classe di `ServiceLevelAgreementCalculator` Apex è disponibile per l'uso all'interno di un flusso attivato da record:
Questo schema dimostra una rigorosa separazione delle preoccupazioni. Il livello dichiarativo viene utilizzato per gestire il ciclo di vita delle transazioni e l'orchestrazione, mentre il codice viene utilizzato per l'esecuzione di elevata complessità. Considerando il codice come un'utilità funzionale anziché come la base, bilanciamo prestazioni e manutenibilità.
#### Vantaggi chiave con lo schema ibrido
**Modularità**: La decisione si allontana dalla singolarità dell'utilizzo di Apex o Flusso per l'intero processo. L'architettura incapsula invece la logica complessa in unità discrete, sicure in blocco e testabili in modo indipendente. Queste unità funzionano come componenti riutilizzabili consumati dallo strato dichiarativo, garantendo le scale di automazione senza complicare la progettazione architettonica.
**Riutilizzabilità**: La logica viene disaccoppiata dall'evento trigger. Un'unità di codice ben progettata (ad esempio un `InvocableMethod`) viene scritta una sola volta ma utilizzata in più punti di ingresso: Flussi attivati da record, flussi schermata o integrazioni esterne. Questo riutilizzo del codice elimina lo sviluppo ridondante.
**Gestibilità**: La logica del flusso del processo rimane visibile e gestibile all'interno del flusso dichiarativo. Questa centralizzazione riduce drasticamente il sovraccarico di debug e garantisce che l'ordine di esecuzione del sistema sia deterministico e trasparente.
#### Limitazioni e compromessi dello schema ibrido
Sebbene il modello ibrido di utilizzo di Apex invocabile da Flusso sia potente, non è un approccio adatto a tutti. Gli architetti devono essere consapevoli delle limitazioni e dei compromessi specifici prima di impegnarsi in una soluzione ibrida.
- **Nessun supporto prima del salvataggio**: Questa è la limitazione più importante. Le azioni invocabili sono disponibili solo nel contesto dopo il salvataggio (flussi per azioni e record correlati). Non possono essere utilizzati nel contesto prima del salvataggio ad alte prestazioni (flussi per aggiornamenti rapidi dei campi). Pertanto, questo schema non può essere utilizzato per delegare gli aggiornamenti di campo dello stesso record. Eseguire questo lavoro ad alte prestazioni utilizzando elementi Flusso nativi in un flusso before-save o all'interno di un trigger Apex before-context.
- **Nessun supporto dopo l'annullamento dell'eliminazione:** Attualmente, il flusso attivato da record non supporta il contesto di annullamento dell'eliminazione. Se un oggetto Salesforce ha un requisito aziendale per eseguire l'automazione quando un record viene ripristinato dal Cestino, l'unica soluzione è un trigger Apex.
- **Overhead delle prestazioni in scenari a volume elevato:** La transizione dal runtime del flusso al runtime Apex non è un'operazione a costo zero. Benché in genere sia veloce, l'esecuzione di un'azione invocabile dal runtime del flusso non è altrettanto veloce dal punto di vista computazionale dell'esecuzione nativa che rimane interamente all'interno di un trigger Apex. Per la maggior parte delle automazioni a media densità, questo micro-overhead è un compromesso trascurabile e utile per una maggiore accessibilità. Tuttavia, per gli scenari estremamente performanti e a volume elevato, un framework solo Apex puro avrà un vantaggio in termini di velocità di calcolo.
### Strategie per l'automazione legacy
Mentre l'euristica della densità di automazione fornisce indicazioni definitive per la nuova architettura greenfield, la realtà degli ambienti Salesforce aziendali è spesso più sfumata. Nelle organizzazioni mature, è comune trovare flussi attivati da record e trigger Apex che operano sullo stesso oggetto Salesforce. Questo scenario è distinto dallo schema ibrido spiegato in precedenza: qui, i flussi e i trigger Apex non sono accoppiati né progettati per funzionare insieme.
Questa coesistenza è spesso il risultato dell'evoluzione delle capacità della piattaforma o del debito tecnico legacy. Sebbene questo sia uno stato operativo tollerato, gli architetti devono trattarlo come un compromesso calcolato anziché come uno stato finale.
L'orchestrazione frammentata causa un notevole sovraccarico di governance e manutenzione, rendendo le attività di sviluppo, test e gestione degli incidenti disgiunte e farraginose. Ciò determina un aumento del Time to Resolution (TTR) e della complessità operativa.
- Per i nuovi oggetti Salesforce, attenersi al principio della densità di automazione come guida principale.
- Per gli oggetti Salesforce esistenti con impronta ibrida e doppio trigger Apex e punti di ingresso del flusso attivati da record, valutare la densità e quindi eseguire l'architettura per il refactoring a uno stato ibrido manutenibile.
- Per una bassa densità, rifattorizzare i trigger Apex in flussi attivati da record e specificare l'ordine di esecuzione, riportandoli a un unico punto di ingresso dell'automazione.
- Per una densità media, rifattorizzare i flussi mega complessi in un sottoinsieme di flussi, con il giusto ordine di esecuzione. Introdurre trigger Apex solo quando è assolutamente necessario, ad esempio per supportare dopo l'annullamento dell'eliminazione del contesto.
- Per una densità elevata, preferire l'implementazione dei trigger Apex.
### Utilizzo di un framework di metadati per trigger Apex
Man mano che i processi aziendali di un'organizzazione sulla piattaforma Salesforce maturano, il volume e la complessità dell'automazione attivata da record aumentano inevitabilmente. Una procedura ottimale fondamentale è mantenere _un trigger Apex per oggetto Salesforce_. Questa regola è fondamentale perché la piattaforma non garantisce l'ordine di esecuzione di più trigger sullo stesso oggetto per lo stesso evento. Questa limitazione può causare comportamenti non deterministici, condizioni di gara e problemi di difficile risoluzione dei problemi.
Tuttavia, l’adesione al principio _one trigger_ introduce una sfida architettonica: come gestire e orchestrare tutta la logica aziendale richiamata da quel singolo punto di ingresso in modo manutenibile e scalabile.
#### Limitazioni degli handler trigger Classic
La prima evoluzione di questa architettura è stato lo schema Classic Trigger Handler. In questo approccio, il singolo trigger Apex delega tutta la sua logica a una classe di handler corrispondente (ad esempio, `OpportunityTriggerHandler`). Questo metodo separa la logica dal file trigger e offre agli sviluppatori un controllo deterministico sull'ordine di esecuzione all'interno dei metodi della classe handler (ad esempio, `afterInsert()`).
Sebbene sia un miglioramento, questo schema spesso porta a classi di handler monolitici. Con il passare del tempo, man mano che si aggiungono ulteriori requisiti aziendali, la classe diventa grande, difficile da gestire e difficile da testare isolatamente. L'ordine di esecuzione di tutti i singoli processi è codificato all'interno di un unico metodo, rendendo la classe soggetta a conflitti di unione, aumentando notevolmente il sovraccarico di governance e manutenzione in un ambiente aziendale di grandi dimensioni.
#### Soluzione: Framework di trigger basato sui metadati
Per risolvere i problemi principali della modularità e dell'orchestrazione, gli architetti passano a un **trigger framework basato** sui metadati. Si tratta di un salto architettonico significativo che separa la logica di automazione stessa dalla configurazione di _come_ e _quando_ viene eseguita.
Questo framework si basa su tre vantaggi chiave:
- **Partizionamento:** Anziché una singola classe di handler, la logica aziendale centrale è suddivisa in piccole classi Apex atomiche (ad esempio, una classe `RecalculateAccountValues` o una classe `NotifySalesLeads`), con ciascuna classe che aderisce al _principio responsabilità unica_. Questa modularità semplifica il test, il debug e la comprensione della logica separatamente.
- **Ordine e coreografia:** L'ordine di esecuzione non è più codificato in Apex. È invece definito in modo dichiarativo dai record di configurazione, in genere memorizzati in un tipo di metadati personalizzato (ad esempio, `TriggerAction__mdt`). Ciò consente agli amministratori di riordinare, aggiungere o rimuovere le azioni di automazione semplicemente modificando un record di metadati, che non richiede una distribuzione o una modifica del codice.
- **Funzionalità di bypass:** Il framework offre funzionalità di bypass granulari standardizzate. Ogni azione di automazione può essere configurata tramite il relativo record di metadati per essere disattivata globalmente o ignorata per utenti amministrativi specifici facendo riferimento a un'autorizzazione personalizzata.
Il trigger Apex singolo per l'oggetto funge quindi solo da dispatcher dinamico. Non contiene alcuna logica aziendale, ma istanzia una classe di `MetadataTriggerHandler` centrale. Questo handler esegue query sui record di metadati personalizzati per determinare dinamicamente la sequenza di esecuzione e invocare le classi Apex atomiche corrette nell'ordine prescritto. L'automazione è unificata sotto un unico livello trasparente e controllabile.
### Deduplicazione di operazioni costose nella transazione
Un vantaggio importante dell'utilizzo di Apex in un framework solido è la possibilità di gestire lo stato delle transazioni e ottimizzare le prestazioni eliminando il lavoro ridondante. Man mano che la logica si accumula, è comune che automazioni diverse all'interno dell'ordine di salvataggio eseguano in modo indipendente le stesse operazioni costose, consumando limiti del governor preziosi e aumentando il tempo di operazione DML.
Il framework è progettato per affrontare questo problema con due strategie principali:
- **Gestione condivisa dello stato:** Nell'ambito di una singola transazione Apex, le proprietà statiche e le variabili vengono utilizzate per memorizzare nella cache i dati. Ciò garantisce che un'operazione costosa, ad esempio una query `SOQL` per un'impostazione di configurazione, venga eseguita una sola volta, anche se la logica di automazione viene richiamata più volte in diversi record o fasi del trigger. Il consumo dei limiti delle transazioni è significativamente ridotto.
- **Utilizzo della cache piattaforma:** Per andare oltre il semplice caching intra-transazioni, utilizzare la cache della piattaforma per evitare di eseguire query sull'intero database per determinati dati. Questa cache in memoria gestita è ideale per recuperare dati non primitivi, letti spesso nella codebase e immutabili nel corso di una transazione (ad esempio profili, ruoli, orari di ufficio). Utilizzando l'interfaccia `Cache.CacheBuilder`, il sistema controlla prima la cache ed esegue la query sul database solo se i dati non sono presenti, ottimizzando le prestazioni e la scalabilità.
### Utilizzo di Prima del salvataggio per gli aggiornamenti dello stesso record
Utilizzare sempre un aggiornamento prima del salvataggio quando l'automazione deve solo modificare i valori dei campi del record che avvia la transazione. Questo vale sia per gli aggiornamenti di campo veloce nel flusso (che vengono eseguiti prima del salvataggio) che per la logica before-context nei trigger Apex (prima dell'inserimento, prima dell'aggiornamento).
Questo schema è performante, indipendentemente dallo strumento utilizzato, perché evita una seconda operazione DML e un ciclo di salvataggio ricorsivo. Le modifiche vengono apportate al record in memoria _prima_ che venga confermato nel database e vengono salvate come parte della transazione originale. Viene eliminato il sovraccarico di un secondo salvataggio, che altrimenti eseguirebbe nuovamente l'intero ordine di salvataggio e attiverebbe nuovamente tutta l'automazione.
### Impedire la ricorsione incontrollata
La ricorsione incontrollata è un'insidia comune nei trigger dopo l'aggiornamento, in cui la logica di un trigger esegue un aggiornamento DML che a sua volta provoca la riattivazione dello stesso trigger. Questo crea un loop infinito che alla fine termina con un'eccezione del limite governor. Mentre i flag booleani statici o le raccolte di ID record elaborati sono stati storicamente utilizzati per impedire tale ricorsione, uno schema più preciso e robusto è quello di bloccare la logica confrontando i valori dei campi tra la nuova e la vecchia versione del record stesso.
Eseguire la logica solo se un campo specifico di interesse è stato effettivamente modificato. Ciò impedisce al trigger di eseguire la sua logica nelle operazioni DML successive all'interno della stessa transazione in cui i dati critici rimangono invariati.
#### Controllo della ricorsione nel flusso attivato da record
In un flusso attivato da record, impedire la ricorsione incontrollata impostando l'esecuzione del flusso solo quando il record viene aggiornato per soddisfare i requisiti della condizione:
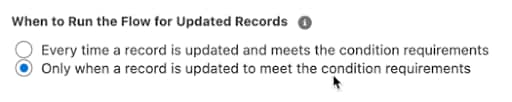 Se si sceglie di utilizzare una formula di criteri di immissione nel flusso, è possibile evitare la ricorsione in fuga confrontando la variabile globale `$Record` (che rappresenta i nuovi valori) con la variabile globale `$RecordPrior` (che rappresenta i valori originali prima del salvataggio). Ad esempio, per assicurarsi che un flusso venga eseguito solo se il campo Ammontare di un'opportunità è stato modificato, utilizzare questo criterio nei criteri di immissione:
```
$Record.Amount != $Record__Prior.Amount
```
#### Controllo della ricorsione in Apex
Confrontare i valori dei campi della nuova versione del record, `Trigger.new`, con i valori dei campi della vecchia versione del record, `Trigger.oldMap`, per vedere se si è verificata la modifica specifica desiderata. Questo approccio garantisce che l'automazione sia idempotente e venga eseguita solo quando necessario, rendendo il sistema più efficiente e prevenendo loop ricorsivi catastrofici.
### Ignorare l'automazione
Un'organizzazione Salesforce ben progettata richiede un meccanismo coerente e affidabile per ignorare l'automazione. Non si tratta di una funzione facoltativa, ma di un requisito operativo fondamentale per mantenere l'integrità dei dati e abilitare le operazioni amministrative.
Un framework di bypass è essenziale per alcuni scenari:
- Quando si caricano grandi volumi di dati, l'attivazione di trigger per ogni record può rallentare drasticamente il processo, causare eccezioni ai limiti e creare record e notifiche correlati errati. Un bypass consente di inserire i dati in modo pulito ed efficiente.
- Un utente integrazione può avere la necessità di sincronizzare i dati di un sistema di record esterno. L'automazione che normalmente viene attivata per una modifica avviata dall'utente (ad esempio, l'invio di un messaggio email, la creazione di un'operazione) può essere indesiderata o ridondante quando la modifica ha origine da un altro sistema.
- Gli amministratori o il personale di assistenza potrebbero dover eseguire aggiornamenti correttivi sui record. Un meccanismo di bypass consente di apportare queste modifiche senza attivare l'automazione aziendale standard, che potrebbe avere conseguenze indesiderate.
**Autorizzazioni personalizzate**: Lo standard moderno e scalabile per l'implementazione della logica di bypass sono le autorizzazioni personalizzate. Questi sono superiori ai metodi precedenti per diversi motivi:
- **Flessibilità:** Le autorizzazioni personalizzate possono essere assegnate agli utenti tramite gli insiemi di autorizzazioni. Questa procedura è in linea con il moderno modello di sicurezza e accesso di Salesforce, consentendo un'assegnazione granulare e flessibile. Un bypass può essere concesso a un utente specifico o anche temporaneamente con una data/ora di scadenza specifica.
- **Gestibilità:** L'uso delle autorizzazioni personalizzate evita il codificaggio dei profili o degli utenti in una logica di automazione. Se il ruolo di un utente cambia o un nuovo profilo deve ignorare l'accesso, la modifica è una semplice assegnazione di insiemi di autorizzazioni, non una modifica del codice o del flusso che richiede una distribuzione.
- **Scalabilità:** Le autorizzazioni personalizzate offrono un framework scalabile per la gestione delle eccezioni in una base di utenti complessa. Possono essere assegnati agli utenti tramite insiemi di autorizzazioni, gruppi di insiemi di autorizzazioni o profili. La loro associazione a un insieme di autorizzazioni o a un profilo è rappresentabile anche nei metadati di origine.
**Modelli di implementazione**: Applicare uno schema di bypass coerente a tutte le automazioni attivate da record dell'organizzazione.
**Ignorare un flusso attivato da record**: Il modo più efficiente per ignorare un flusso è impedirne l'esecuzione. A questo scopo, aggiungere una condizione ai criteri di immissione del flusso.
- Nell'elemento iniziale del flusso attivato da record, impostare Requisiti della condizione su La formula valuta True.
- Nel Generatore di formule, incorporare una verifica dell'autorizzazione personalizzata utilizzando la variabile globale `$Permission`. Combinare il controllo con i criteri di immissione esistenti.
- Schema di formula:
```
( ) && NOT($Permission.Bypass_This_Flow)
```
- Questo schema garantisce che il flusso venga eseguito solo se all'utente _non_ è assegnata l'autorizzazione personalizzata specificata. Questo controllo viene eseguito prima ancora di creare l'intervista del flusso, rendendolo l'approccio più efficace.
**Ignorare un trigger framework Apex**: In Apex, integrare la logica di bypass direttamente nel framework di trigger basato sui metadati, consentendo un controllo granulare.
- Il tipo di metadati personalizzato `TriggerAction__mdt` deve includere un campo di testo, ad esempio `BypassPermission__c`.
- Nella classe `MetadataTriggerHandler`, prima di eseguire dinamicamente un'azione, il codice deve leggere il valore di questo campo.
- Se il campo è compilato, l'handler utilizza il metodo `FeatureManagement.checkPermission()` per determinare se l'utente corrente in esecuzione dispone dell'autorizzazione personalizzata specificata.
- Se `checkPermission()` restituisce true, l'handler salta quell'azione specifica e passa a quella successiva nella sequenza.
- Questo schema è efficace perché consente sia un bypass globale (se tutti i record `TriggerAction__mdt` fanno riferimento alla stessa autorizzazione) che un bypass granulare per azione (se record diversi fanno riferimento a autorizzazioni diverse o se alcuni non dispongono di alcuna autorizzazione di bypass).
### Megaflussi rispetto a più flussi
È un anti-schema per consolidare tutta l'automazione di un oggetto in un unico enorme flusso. Il consolidamento in un flusso anziché la suddivisione della logica in più flussi ben condizionati non ha un impatto significativo sulle prestazioni. I guadagni di prestazioni più significativi provengono da:
- Utilizzo dei flussi before-save per gli aggiornamenti di campo dello stesso record.
- Scrivere condizioni di immissione precise per garantire che i flussi siano esclusi dall'esecuzione per le modifiche che non influiscono sul loro caso d'uso specifico.
[Flow Trigger Explorer](https://trailhead.salesforce.com/content/learn/modules/record-triggered-flows/meet-flow-trigger-explorer) consente di assegnare un valore ordine a ogni flusso di un oggetto, garantendo un ordine di esecuzione sequenziale.
 ## Risorse
| Apex | Flusso | Operazioni |
|---|---|---|
| Moduli dinamici | I moduli dinamici del Generatore di app suddividono i componenti monolitici Dettagli record in singoli campi e sezioni configurabili. Questa funzione consente agli amministratori di creare pagine flessibili e ad alte prestazioni posizionando i campi in qualsiasi punto e utilizzando le regole di visibilità per visualizzare o nascondere i componenti in base al profilo utente, al dispositivo o ai dati, riducendo così il disordine delle pagine. |
|---|---|
| Flusso schermata | Un flusso schermata Salesforce è uno strumento di automazione interattivo all'interno di Flow Builder che richiede l'input dell'utente per spostarsi attraverso processi aziendali personalizzati e passo per passo. A differenza dei flussi in background automatici, i flussi schermata offrono un'interfaccia utente simile a quella di una procedura guidata per raccogliere dati, visualizzare informazioni o eseguire azioni tramite pagine Lightning, pulsanti o app personalizzate senza scrivere codice. |
| OmniStudio | Salesforce OmniStudio è una suite di strumenti low-code progettata per creare rapidamente esperienze digitali guidate specifiche del settore e processi aziendali complessi. Consente agli sviluppatori di creare interfacce utente pixel perfette (ad esempio flussi di lavoro guidati e cruscotti digitali dinamici) utilizzando componenti con trascinamento della selezione come Flexcard e OmniScript. Con OmniStudio è possibile creare LWC in modo dichiarativo. |
| Componenti Web Lightning | I componenti Web Lightning Salesforce sono elementi HTML personalizzati leggeri creati utilizzando HTML, CSS e JavaScript moderno e progettati per essere eseguiti in modo nativo nei browser per prestazioni superiori dell'interfaccia utente Salesforce. Consentono agli sviluppatori di creare interfacce utente personalizzate che coesistono con i componenti Aura, il che aumenta lo sviluppo attraverso standard di settore e un ecosistema di componenti dettagliato. |
| Configurazione | Requisiti di licenza aggiuntivi | |
|---|---|---|
| Moduli dinamici | Codice basso | Nessuno |
| Flusso schermata | Codice basso | Nessuno |
| OmniStudio | Codice basso + Codice pro | Pacchetto Settori |
| Flusso schermata più componenti Web Lightning | Codice basso + Codice pro | Nessuno |
| Componenti Web Lightning | Codice professionale | Nessuno |
| Punto Decisione | Guida |
|---|---|
| Categorie di casi d'uso in fase di esecuzione | |
| Ambito e navigazione del modulo | Determinare se tutti i campi del modulo si adatteranno logicamente a un'unica schermata o se gli utenti devono poter navigare tra più schermate. |
| Posizione | Identificare la posizione o le posizioni in cui si desidera incorporare il modulo, che può andare da un'app Salesforce a un'app mobile o a un sito Web esterno. |
| Controllatore | Identificare le azioni o la logica da eseguire in background mentre gli utenti interagiscono con il modulo, incluse le trasformazioni dei dati e le integrazioni con sistemi esterni. |
| Convalida | Determinare se sono presenti ulteriori requisiti di convalida degli input che vanno oltre la convalida standard a livello di sistema fornita da Salesforce. |
| Progettazione di interazioni | Identificare i tipi di interazioni o condizioni che devono attivare risposte dinamiche all'interno del modulo. |
| Stile | Determinare il livello di raffinatezza necessario per lo stile desiderato e i requisiti CSS. |
| Layout | Identificare i requisiti di layout del modulo (ad esempio, il numero richiesto di colonne, schede e fisarmoniche) e la possibilità di visualizzare blocchi di dati ripetuti. |
| Traduzione | Determinare se il modulo deve essere localizzato per altre lingue. |
| Considerazioni non funzionali | |
| Sicurezza | Determinare se il modulo deve controllare l'accesso dell'utente prima di eseguire determinate operazioni, se si desidera controllare chi può accedere al modulo e se si desidera controllare dove il modulo può essere incorporato. |
| Impatto oggetto | Determinare se il modulo funzionerà su un singolo oggetto o su più oggetti. |
| Automazione test interfaccia utente | Determinare se i processi DevOps richiedono che il modulo venga sottoposto a test di unità automatici o a test end-to-end automatici. |
| Metriche | Identificare come si desidera tenere traccia dell'utilizzo del modulo, incluse le visualizzazioni pagina, la quantità di tempo trascorso sul modulo, le percentuali di completamento e le percentuali di successo. |
| Imballaggio e distribuzione | Determinare come distribuire o distribuire il modulo dopo che è stato creato. |
| Schermata singola | Modulo multischermo | Indicatori di avanzamento | Navigazione saltata tra fasi/schermate | |
|---|---|---|---|---|
| Moduli dinamici | Disponibile | Non disponibile | Disponibile | Non disponibile |
| Flusso schermata | Disponibile | Disponibile | Disponibile | Non disponibile |
| OmniStudio | Disponibile | Disponibile | Disponibile | Disponibile |
| Flusso schermata + LWC | Disponibile | Disponibile | Disponibile | Disponibile |
| LWC | Disponibile | Non ideale | Non ideale | Non ideale |
| Pagina record Lightning | Pagina iniziale o pagina dell'app Lightning | Siti Experience Cloud Aura | Siti Experience Cloud LWR | Snap incorporati | Barra delle utilità | Azione specifica dell'oggetto | Azione globale | App mobile Salesforce* | Field Service Mobile | Mobile SDK | App e siti esterni | LWC personalizzato | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Moduli dinamici | Disponibile | Non disponibile | Non disponibile | Non disponibile | Non disponibile | Non disponibile | Non disponibile | Non disponibile | Disponibile | Non disponibile | Non disponibile | Non disponibile | Non disponibile |
| Flusso schermata | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Non disponibile | Disponibile | Disponibile** | Non disponibile | Non disponibile | Disponibile |
| OmniStudio | Disponibile | Disponibile | Disponibile | Non disponibile | Non disponibile | Disponibile | Non disponibile | Non disponibile | Disponibile | Non disponibile | Non disponibile | Disponibile | Disponibile |
| Flusso schermata + LWC | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Non disponibile | Disponibile | Non disponibile | Non disponibile | Non ideale | Disponibile |
| LWC | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Non disponibile | Non disponibile | Disponibile | Non disponibile | Non disponibile | Disponibile | Disponibile |
| *I flussi e i componenti LWC sono supportati nell'app mobile Salesforce, ma non in tutti i modi per incorporare i flussi e i componenti LWC (ad esempio, le azioni specifiche degli oggetti sono supportate nell'app mobile, ma le voci della barra delle utilità non lo sono). **L'app mobile Salesforce Field Service include Acquisizione dati, una soluzione offline basata sul motore di flusso con runtime offline dedicato, che supporta le funzionalità più recenti del flusso. L'app include anche i flussi Field Service Mobile legacy, che vengono eseguiti su un motore offline personalizzato più datato e non supportano molte delle funzionalità più recenti dei flussi. | |||||||||||||
| Registro e azioni | Gestione gerarchica dei dati | Operazione con una sola transazione | Operazione su più transazioni | Integrazione | Progettazione modulare e riutilizzo | Pacchetti | |
|---|---|---|---|---|---|---|---|
| Moduli dinamici | Non disponibile | Non disponibile | Non disponibile | Non disponibile | Non disponibile | Non disponibile | Disponibile |
| Flusso schermata | Disponibile | Non disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile |
| OmniStudio | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Non disponibile |
| Flusso schermata + LWC | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile |
| LWC | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile |
| Rispettare la convalida a livello di sistema | Convalida a livello di campo personalizzata specifica di questo modulo | Convalida a livello di campo personalizzata | |
|---|---|---|---|
| Moduli dinamici | Disponibile | Non disponibile | Non disponibile |
| Flusso schermata | Disponibile | Non disponibile | Non disponibile |
| OmniStudio | Disponibile | Disponibile | Disponibile |
| Flusso schermata + LWC | Disponibile | Disponibile | Disponibile |
| LWC | Disponibile | Disponibile | Disponibile |
| Esecuzione di operazioni sui dati fuori schermo | Valori condizionali e calcoli | Visibilità condizionale | Requisito condizionale | Formattazione condizionale | Stato di sola lettura condizionale | Stato disabilitato condizionale | |
|---|---|---|---|---|---|---|---|
| Moduli dinamici | Non disponibile | Non disponibile | Disponibile | Non disponibile | Disponibile | Non disponibile | Non disponibile |
| Flusso schermata | Disponibile | Disponibile* | Disponibile | Disponibile | Non disponibile | Disponibile | Disponibile |
| OmniStudio | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile |
| Flusso schermata + LWC | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile |
| LWC | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile |
| *Limitato ai componenti che utilizzano un selettore di risorse e non una casella di controllo statica | |||||||
| Gestione eventi standard (onblur, onfocus) | Gestione evento personalizzata | |
|---|---|---|
| Moduli dinamici | Non disponibile | Non disponibile |
| Flusso schermata | Non disponibile | Non disponibile |
| OmniStudio | Non disponibile | Disponibile* |
| Flusso schermata + LWC | Disponibile | Disponibile |
| LWC | Disponibile | Disponibile |
| * Runtime standard OmniStudio non supporta Pub/Sub, ma supporta Windows postMessage | ||
| Stile diretto | Temi di organizzazioni e Generatore di esperienze | Stile pixel perfetto | |
|---|---|---|---|
| Moduli dinamici | Non disponibile | Disponibile | Non disponibile |
| Flusso schermata | Non disponibile | Disponibile | Disponibile** |
| OmniStudio | Disponibile* | Non disponibile | Disponibile |
| Flusso schermata + LWC | Non disponibile | Disponibile | Disponibile |
| LWC | Non disponibile | Disponibile | Disponibile |
| * Solo FlexCard **Alcuni attributi di stile possono essere configurati per i componenti schermata, ma non per le esclusioni CSS. | |||
| 2 colonne | 4 colonne | Oltre 4 colonne | Blocchi ripetuti di dati | Contenitori scheda | Contenitori per fisarmonica | |
|---|---|---|---|---|---|---|
| Moduli dinamici | Disponibile | Non disponibile | Non disponibile | Non disponibile | Disponibile | Disponibile |
| Flusso schermata | Disponibile | Disponibile | Non disponibile | Disponibile | Non disponibile | Disponibile |
| OmniStudio | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile* | Disponibile |
| Flusso schermata + LWC | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile |
| LWC | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile |
| *Le schede possono essere utilizzate se si incorporano dati in una FlexCard in un OmniScript | ||||||
| Etichette immesse nel Generatore | Etichette nel codice | |
|---|---|---|
| Moduli dinamici | Disponibile* | Non disponibile |
| Flusso schermata | Disponibile | Disponibile |
| OmniStudio | Disponibile | Disponibile |
| Flusso schermata + LWC | Disponibile | Disponibile |
| LWC | Non applicabile | Disponibile |
| *Solo intestazioni sezione campo | ||
| Elevazione delle autorizzazioni utente | Controllo degli utenti autorizzati | Limitazione delle posizioni consentite | |
|---|---|---|---|
| Moduli dinamici | Non disponibile | Disponibile | Non disponibile |
| Flusso schermata | Disponibile | Disponibile | Non disponibile |
| OmniStudio | Non disponibile | Disponibile | Non disponibile** |
| Flusso schermata + LWC | Disponibile | Disponibile | Non disponibile |
| LWC | Disponibile* | Disponibile | Disponibile |
| * Richiede Apex **Anche se gli OmniScript non possono avere un insieme specificato di posizioni di destinazione, le FlexCard possono averlo. | |||
| Test di unità | Automazione end-to-end | |
|---|---|---|
| Moduli dinamici | Non disponibile | Disponibile* |
| Flusso schermata | Non disponibile | Disponibile* |
| OmniStudio | Disponibile* | Disponibile* |
| Flusso schermata + LWC | Disponibile* | Disponibile* |
| LWC | Disponibile | Disponibile |
| * Richiede codice | ||
| Visualizzazioni pagina | Tempo trascorso sul modulo | Tracciamento del completamento del modulo | Monitoraggio della percentuale di successo | |
|---|---|---|---|---|
| Moduli dinamici | Disponibile** | Non disponibile | Non disponibile | Non disponibile |
| Flusso schermata | Disponibile | Disponibile* | Disponibile | Disponibile |
| OmniStudio | Disponibile | Disponibile* | Disponibile | Disponibile |
| Flusso schermata + LWC | Disponibile | Disponibile* | Disponibile | Disponibile |
| LWC | Disponibile** | Disponibile* | Disponibile | Disponibile |
| *Disponibile quando è abilitato Runtime OmniStudio basato su pacchetto** Disponibile monitorando l'utilizzo delle pagine Lightning controllanti | ||||
| Pacchetti gestiti di prima generazione (1GP) | Pacchetti gestiti di seconda generazione (2GP) | Pacchetti sbloccati | Serie di modifiche | DevOps Center | |
|---|---|---|---|---|---|
| Moduli dinamici | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile |
| Flusso schermata | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile |
| OmniStudio | Non disponibile | Non disponibile | Non disponibile | Non disponibile* | Non disponibile* |
| Flusso schermata + LWC | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile |
| LWC | Disponibile | Disponibile | Disponibile | Disponibile | Disponibile |
| *Utilizzare Area di lavoro IDX per distribuire le soluzioni OmniStudio ad altre organizzazioni. | |||||
| Agentforce | Automazione tradizionale | Integrazione |
|---|---|---|
|
Salesforce Lightning Platform è una piattaforma completa basata sull'intelligenza artificiale che unifica dipendenti, agenti autonomi dell'intelligenza artificiale, dati aziendali e applicazioni in un unico sistema affidabile per migliorare la produttività e l'esperienza dei clienti. Consente la creazione di un'"azienda autentica" collegando le app Customer 360, Data Cloud e Slack per l'automazione end-to-end. |
| Approccio | Descrizione | Competenze richieste | Licenze e limiti |
|---|---|---|---|
| Apex in area di attesa | Utilizzare per processi che comportano operazioni di database di lunga durata o chiamate a servizi Web esterni. Queueable Apex offre funzioni come ID processo, supporto per tipi non primitivi e concatenamento dei processi. | Pro-code | Il numero di licenze può aumentare i limiti. |
| Batch Apex | Creare processi complessi e di lunga durata che coinvolgono milioni di record suddividendo l'insieme di record ed elaborandolo in blocchi gestibili. | Pro-code | Il numero di licenze può aumentare i limiti. |
| Apex pianificato | Eseguire Apex a un'ora pianificata definita da un'espressione cron. Sebbene l'atto di pianificare Apex tramite l'espressione cron sia un processo asincrono, il codice sottostante viene eseguito in modo sincrono all'avvio del processo. | Pro-code | Il numero di licenze può aumentare i limiti. |
| Chiamate continuazione Apex | Eseguire chiamate dai metodi Apex in esecuzione in un contesto di transazione sincrona. | Pro-code | No |
| Percorso asincrono (flussi attivati da record) | Eseguire un'operazione che si desidera eseguire nel proprio tempo. Evitare errori DML misti che si verificano quando si aggiorna un valore di un record correlato che non fa parte del record che ha attivato un flusso. | Basso codice | Il numero e il tipo di licenze possono aumentare i limiti. |
| Percorso pianificato (dopo l'impegno dei flussi) | Eseguire l'esecuzione in un momento pianificato dinamicamente dopo un evento di attivazione, ad esempio quando viene creato, aggiornato o eliminato un record. | Basso codice | Il numero e il tipo di licenze possono aumentare i limiti. |
| Flussi pianificati | Eseguire un flusso in background a un'ora specificata e con una frequenza ripetuta (giornaliera, settimanale o una volta) per eseguire azioni su un batch di record. | Basso codice | Il numero e il tipo di licenze possono aumentare i limiti. |
| Trigger evento piattaforma | Associare liberamente Salesforce a sistemi esterni e comunicare tra componenti asincroni all'interno di Salesforce Platform. | Low-code + Pro-code | Per i casi d'uso di eventi piattaforma a volume elevato è necessaria una licenza aggiuntiva |
| Modifica acquisizione dati | Acquisire ed elaborare gli eventi di modifica in modo asincrono dopo la conferma della transazione del database. | Pro-code | Per scalare al di sopra dell'allocazione di base è necessaria una licenza aggiuntiva. |
| Bulk API | Inserire, aggiornare, inserire con aggiornamento, eseguire query o eliminare molti record in modo asincrono ed elaborare i risultati in un secondo momento. | Pro-code | Ci sono dei limiti. |
| Azioni Lightning | Consente alle pagine Lightning di interagire con il server senza costringere gli utenti ad aggiornare completamente la pagina. | Basso codice | No |
| Competenze richieste | Alcuni degli strumenti descritti in questa guida richiedono codice, mentre altri possono essere configurati in modo dichiarativo. Quando si valutano le opzioni disponibili, pensare alle competenze dei membri del team. Tenere presente che anche se gli sviluppatori sono disponibili per l'implementazione iniziale (ad esempio tramite un partner di implementazione), potrebbe essere necessario modificare le soluzioni in futuro. Se il team di manutenzione non dispone di sviluppatori, un'opzione low-code può essere più adatta. |
| Tipo di limiti della piattaforma applicati | Determinare il tipo di limiti che si applicano all'esecuzione. Durante la progettazione delle soluzioni, riflettere attentamente su come il volume e la frequenza delle transazioni verranno conteggiati ogni giorno nei limiti stabiliti dal governor per l'approccio scelto. Calcolare il numero di esecuzioni che si verificheranno ogni giorno. Assicurarsi che i valori calcolati rientrino nei limiti associati agli strumenti selezionati. |
| Latenza | Determinare la velocità con cui i risultati dell'elaborazione saranno disponibili nella piattaforma. Per alcuni approcci, i cambiamenti saranno quasi immediati, mentre per altri possono essere minuti o ore. |
| Caso d'uso | Descrizione | Approccio di prima scelta | Motivo |
|---|---|---|---|
| Elaborazione batch ad alte prestazioni | Qualsiasi automazione che deve elaborare migliaia o milioni di record in modo efficiente | Batch Apex | Batch Apex fornisce API complete per l'interfacciamento con la piattaforma e per la velocità di stampa. |
| Processo di pulitura dati | Un processo eseguito regolarmente o su richiesta che pulisce i dati. Gli esempi includono l'annullamento della duplicazione, la verifica dell'indirizzo o il consolidamento dei dati. | Batch Apex | Batch Apex fornisce API complete per l'interfacciamento con la piattaforma e per la velocità di stampa. |
| Nightly Roll-up Job (Lavoro di roll-up notturno) | Processo che calcola i dati di roll-up al termine di una giornata lavorativa. | Batch Apex | Batch Apex fornisce API complete per l'interfacciamento con la piattaforma e per la velocità di stampa. |
| Logica attivata da record | Eseguire la logica in risposta a un aggiornamento di record. | Varia | Vedere la guida alle decisioni associata, Automazione eventi attivati da record. Include un albero decisionale per i casi d'uso asincroni, tra cui Apex inseribile in area di attesa, Apex batch, Apex pianificato, Flusso pianificato, Flussi percorso asincrono e Acquisizione dati di modifica. |
| Aggiornamenti a catena tramite un grafico a oggetti | Consente di completare rapidamente l'azione di salvataggio di un utente, rinviando l'esecuzione asincrona degli aggiornamenti a catena ad altri oggetti. | Apex in area di attesa | Queueable Apex dispone di potenti funzioni di concatenazione che consentono alla logica di suddividere una catena di aggiornamenti in una serie di transazioni asincrone. |
| Elaborazione pianificata specifica del record | Automazione in una data futura e dinamica specifica del record (ad esempio, 3 giorni prima di una data di chiusura). | Flusso con un percorso pianificato | I percorsi pianificati rappresentano un punto di forza unico per il flusso, poiché la piattaforma gestisce automaticamente la pianificazione, l'annullamento e la riprogrammazione di questi percorsi se i dati del record cambiano. |
| Invocazione di più servizi esterni lenti in parallelo | Durante un'esecuzione sincrona, più servizi esterni vengono richiamati in parallelo per ottimizzare il tempo di esecuzione complessivo. | Chiamate continuazione Apex | Consentendo l'esecuzione parallela di più callout a esecuzione lenta si riduce al minimo il tempo complessivo per completare il lavoro. |
| Migrazione dei dati dei record da un sistema esterno | Spostare grandi quantità di record in Salesforce Platform da un sistema esterno. Un processo singolo o pianificato regolarmente. | API in bulco | Questo è l'approccio più efficiente e rispettoso dei limiti per la migrazione dei dati. |
| Esecuzione di logica aggiuntiva in un sistema esterno | Schema Fire-and-forget che prevede la notifica di un evento sulla piattaforma a un sistema esterno e quindi l'elaborazione asincrona dell'evento. | Eventi piattaforma o acquisizione dati modifica | Un modello pub-sub funziona meglio qui e consente al sistema esterno di elaborare l'evento quando è pronto. Per ulteriori dettagli su questo schema, vedere Architettura basata sugli eventi. |
| Area da considerare | Domande comuni |
|---|---|
| Strumenti e paesaggio esistenti | Esiste già una soluzione ESB o ETL? I dati interessati hanno requisiti normativi o di conformità? Dove si trovano i sistemi che si sta tentando di integrare (nel cloud o in locale)? |
| Flusso di dati (tempistica, esperienza utente prevista, direzionalità) | I dati devono essere spostati in modo sincrono, asincrono o possono essere raggruppati in batch/pianificati? È necessaria la replica dei dati? Quale sistema dovrebbe essere la fonte della verità? Qual è la fonte di dati? Qual è la destinazione? È necessaria l'interazione dell'utente? L'utente deve visualizzare il risultato dell'integrazione? Quali sono le esigenze relative alla gestione delle eccezioni (riprovare, notificare, non riuscire)? Quanto dovrebbero essere stretti i sistemi? |
| Implementazione | Qual è il livello di impegno per i sistemi non Salesforce? Quali team sono responsabili dell'implementazione delle integrazioni? Quali strumenti preferiscono utilizzare? |
| Gestibilità | Quali team dovranno mantenere l'integrazione? Quali competenze hanno attualmente? Quali competenze avranno bisogno in futuro? Qual è il costo totale di proprietà nel tempo? Quanto è importante la capacità di testare, eseguire il debug, risolvere i problemi con strumenti di codice basso o professionale? |
| Volume di dati | Quanti dati sono coinvolti nell'integrazione? Lavorerai con grandi volumi di dati (LDV)? Con che frequenza avverranno le modifiche in blocco? Che tipo di impatto avranno gli aggiornamenti Singleton? Con che frequenza si verificheranno? |
| Limiti | I dati dovranno subire trasformazioni complesse? È necessario combinare i dati di più sistemi di origine? Con che frequenza avverrà un'integrazione per utente? Quanti utenti totali? Sono stati pianificati in anticipo i caricamenti di dati in blocco (esempio: caricamento dati iniziale per una nuova istanza)? |
| Da Salesforce al sistema esterno | Dal sistema esterno a Salesforce | Esecuzione | Licenza aggiuntiva richiesta | |
|---|---|---|---|---|
| Azioni Apex | Disponibile | Disponibile | Lato server | No |
| Modifica acquisizione dati | Disponibile | Non disponibile | Lato server | No* |
| Apex personalizzato (servizi Web REST e SOAP) | Disponibile | Disponibile | Lato server | No |
| Servizi esterni | Disponibile | Non disponibile | Lato server | No |
| Heroku Connect | Disponibile | Disponibile | Lato server | Sì |
| Data 360 | Disponibile | Disponibile | Lato server | Sì |
| MuleSoft Anypoint | Disponibile | Disponibile | Lato server | Sì |
| API native Salesforce | Non disponibile | Disponibile | Lato server | No |
| OmniScript | Disponibile | Disponibile | Lato client*** | Sì |
| Procedura di integrazione OmniStudio | Disponibile | Disponibile | Lato server | Sì |
| Messaggi in uscita | Non ideale | Non disponibile | Lato server | No |
| Eventi piattaforma | Disponibile | Disponibile | Lato server | No** |
| Salesforce Connect/Oggetti esterni | Disponibile | Disponibile | Lato server | Sì |
| Guida | Licenze | Tempistica | Volume e scala | Consegna e manutenzione | Privacy e sicurezza | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Quando utilizzare | Licenza aggiuntiva | Sincronizzazione (Richiesta/Risposta) o Asincrona (Attiva/Dimentica) | Supporto multi-oggetto | LDV/Bulk | Test e distribuzione** | Debug | Comportamento di gestione/riprova degli errori incorporato | Può essere utilizzato con dati crittografati a riposo | Protocollo di autenticazione | |
| Modifica acquisizione dati | Quando è necessario pubblicare le modifiche a livello di record apportate in Salesforce in un sistema esterno e non è necessario un payload personalizzato. | Obbligatorio | Asincrono | No | No | Sì | Con strumenti pro-code | Sì | Sì | OAuth |
| Servizi esterni | Quando si orchestra un processo utilizzando Flusso, Apex, Bot Einstein o OmniStudio e le API del sistema esterno sono descritte utilizzando specifiche OpenAPI. | Non richiesto | Sincronizzazione | Sì | No | Sì | Con strumenti pro-code | No | N/D | Credenziali denominate |
| Heroku Connect | Quando si desidera estendere i dati con la sincronizzazione bidirezionale per abilitare le app mobili e di altro tipo in Heroku e si desidera che i dati vengano replicati anche in Salesforce. | Obbligatorio | Asincrono | Sì | Sì | No | Con strumenti pro code | Sì | Sì, tramite Shield Connect | OAuth |
| Procedura di integrazione OmniStudio | Quando è necessario trasformare i dati senza l'interazione dell'utente e migliorare le prestazioni elaborandoli sul server anziché sul browser. | Obbligatorio | Entrambi | Sì | Sì | Sì | Supporto dichiarativo | Sì | Sì | Credenziali denominate |
| Salesforce Connect/Oggetti esterni | Quando si desidera che i dati compaiano nell'interfaccia utente di Salesforce ma si desidera che i dati vengano memorizzati in un sistema esterno. I dati non vengono replicati in Salesforce. | Obbligatorio | Sincronizzazione | No | Sì* | Sì | Con strumenti pro-code e un tracciatore dichiarativo | No | N/D | Credenziali denominate |
| *Gli adattatori OData precedenti alla versione 4.01 sono soggetti a limiti di chiamata. Vedere Considerazioni sui limiti di traffico per ulteriori dettagli. ** Test e distribuzione si riferisce alla capacità di creare in un ambiente inferiore e distribuire tramite l'API dei metadati, pacchetti o serie di modifiche in produzione. | ||||||||||
| Guida | Licenze | Tempistica | Volume e scala | Consegna e manutenzione | Privacy e sicurezza | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Quando utilizzare | Licenza aggiuntiva | Sincronizzazione (Richiesta/Risposta) o Asincrona (Attiva/Dimentica) | Supporto multi-oggetto | LDV/Bulk | Test e distribuzione** | Debug | Comportamento di gestione/riprova degli errori incorporato | Può essere utilizzato con dati crittografati a riposo | Protocollo di autenticazione | |
| Azioni Apex | Quando si desidera automatizzare le chiamate a un altro sistema tramite Flusso Salesforce. Uno sviluppatore può scrivere una classe Apex che un flusso può invocare oppure scaricare una soluzione predefinita da AppExchange. | Non richiesto | Entrambi | Sì | No | Sì | Con strumenti pro-code | No | Sì | Più |
| Relay evento | Quando è necessario inviare eventi piattaforma ed eventi di acquisizione dati di modifica ad Amazon EventBridge da Salesforce. I relay evento si connettono solo ad AWS Eventbridge | No | Asincrono | Sì | No | Sì | Sì | Sì | Sì | HTTP/1.1 con TLS |
| Messaggi in uscita | Quando è necessario inviare messaggi SOAP su HTTP(S) a un endpoint designato con ricezione garantita quando attivato da una regola di flusso di lavoro. | Non richiesto | Asincrono | No | No | Sì | Supporto dichiarativo | Sì | Sì | TLS bidirezionale |
| Eventi piattaforma | Quando è necessario un payload strutturato e definito su misura per le modifiche quasi in tempo reale in Salesforce o in un sistema esterno. | Non obbligatorio* | Asincrono | Sì | No | Sì | Con strumenti pro-code | Sì | Sì | OAuth |
| Salesforce Connect/Oggetti esterni (con adattatori Apex personalizzati) | Quando si desidera che i dati compaiano nell'interfaccia utente di Salesforce ma si desidera che vengano memorizzati in un sistema esterno che non può utilizzare protocolli standard come OData o GraphQL. | Obbligatorio | Entrambi | Sì | Sì | Sì | Con strumenti pro-code | No | N/D | Più |
| Data 360 | Quando si desidera armonizzare i dati di fonti diverse in un unico archivio dati o replicare i dati in altre organizzazioni Salesforce o in altri sistemi esterni. | Obbligatorio | Entrambi | Sì | Sì | Sì | Sì | Sì | Sì | Più |
| Guida | Licenze | Tempistica | Volume e scala | Consegna e manutenzione | Privacy e sicurezza | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Quando utilizzare | Licenza aggiuntiva | Sincronizzazione (Richiesta/Risposta) o Asincrona (Attiva/Dimentica) | Supporto multi-oggetto | LDV/Bulk | Test e distribuzione** | Debug | Comportamento di gestione/riprova degli errori incorporato | Può essere utilizzato con dati crittografati a riposo | Protocollo di autenticazione | |
| Apex personalizzato | Quando sono necessarie più funzionalità di quelle disponibili negli strumenti low-code. | Non richiesto | Entrambi | Sì | Sì | Sì | Con strumenti pro-code | No | Sì* | Più |
| Servizi esterni | L'integrazione da codice con le API di sistema esterne è descritta utilizzando le specifiche OpenAPI. | Non richiesto | Sincronizzazione | Sì | No | Sì | Con strumenti pro-code | No | N/D | Più |
| MuleSoft Anypoint | Quando è necessaria una singola soluzione unificata di livello aziendale per creare, orchestrare e gestire le integrazioni, quando è necessario sostituire un'architettura point-to-point legacy o quando è necessario il supporto per la gestione API. | Obbligatorio | Entrambi | Sì | Sì | Sì | Con strumenti pro-code | No | Sì* | Più |
| Guida | Licenze | Tempistica | Volume e scala | Consegna e manutenzione | Privacy e sicurezza | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Quando utilizzare | Licenza aggiuntiva | Sincronizzazione (Richiesta/Risposta) o Asincrona (Attiva/Dimentica) | Supporto multi-oggetto | LDV/Bulk | Test e distribuzione* | Debug | Comportamento di gestione/ritentativo degli errori incorporato | Può essere utilizzato con dati crittografati a riposo | Protocollo di autenticazione | |
| Heroku Connect | Quando si desidera estendere i dati con la sincronizzazione bidirezionale per abilitare le app mobili e di altro tipo in Heroku e si desidera che i dati vengano replicati anche in Salesforce. | Obbligatorio | Asincrono | Sì | Sì | No | Con strumenti pro-code | Sì | Sì, tramite Shield Connect | OAuth |
| Procedura di integrazione OmniStudio | Quando è necessario importare e trasformare dati da fonti di terze parti senza interazione dell'utente. | Obbligatorio | Entrambi | Sì | Sì | Sì | Supporto dichiarativo | No | Sì | Credenziali denominate |
| Salesforce Connect/Oggetti esterni | Quando si desidera che i dati compaiano nell'interfaccia utente di Salesforce ma si desidera che vengano memorizzati in un sistema esterno che può utilizzare protocolli standard come OData o GraphQL. | Obbligatorio | Sincronizzazione | Sì | Sì | Sì | Con strumenti pro-code | No | N/D | Più |
| Guida | Licenze | Tempistica | Volume e scala | Consegna e manutenzione | Privacy e sicurezza | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Quando utilizzare | Licenza aggiuntiva | Sincronizzazione (Richiesta/Risposta) o Asincrona (Attiva/Dimentica) | Supporto multi-oggetto | LDV/Bulk | Test e distribuzione** | Debug | Comportamento di gestione/ritentativo degli errori incorporato | Può essere utilizzato con dati crittografati a riposo | Protocollo di autenticazione | |
| Eventi piattaforma | Quando è necessario un payload strutturato e definito su misura per le modifiche quasi in tempo reale in Salesforce o in un sistema esterno. | Non obbligatorio* | Asincrono | Sì | No | Sì | Con strumenti pro-code | Sì | Sì | OAuth |
| Salesforce Connect/Oggetti esterni (con adattatori Apex personalizzati) | Quando è necessario che i dati compaiano nell'interfaccia utente di Salesforce ma si desidera archiviarli in un sistema esterno che non può utilizzare i protocolli OData 2.0/4.0. | Obbligatorio | Entrambi | Sì | Sì | Sì | Con strumenti pro-code | No | N/D | Più |
| Data 360 | Quando si desidera armonizzare i dati di fonti diverse in un unico archivio dati o replicare i dati di altre organizzazioni Salesforce o di altri sistemi esterni. Data 360 supporta anche la virtualizzazione per alcune piattaforme. | Obbligatorio | Entrambi | Sì | Sì | Sì | No | Sì | Sì | Più |
| Guida | Licenze | Tempistica | Volume e scala | Consegna e manutenzione | Privacy e sicurezza | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Quando utilizzare | Licenza aggiuntiva | Sincronizzazione (Richiesta/Risposta) o Asincrona (Attiva/Dimentica) | Supporto multi-oggetto | LDV/Bulk | Test e distribuzione**** | Debug | Comportamento di gestione/ritentativo degli errori incorporato | Può essere utilizzato con dati crittografati a riposo | Protocollo di autenticazione | |
| Servizi Web Apex REST & SOAP personalizzati | Quando sono necessarie più funzionalità di quelle fornite dagli endpoint API nativi, ad esempio l'elaborazione oggetti incrociata o un'altra logica complessa. | Non richiesto | Entrambi | Sì | Sì | Sì | Con strumenti pro-code | No | Sì*** | Più |
| MuleSoft Anypoint | Quando è necessaria una singola soluzione unificata di livello aziendale per creare, orchestrare e gestire le integrazioni, quando è necessario sostituire un'architettura point-to-point legacy o quando è necessario il supporto per la gestione API. | Obbligatorio | Entrambi | Sì | Sì | Sì | Con strumenti pro-code | No | Sì*** | Più |
| API native Salesforce | Quando si necessita di un maggiore controllo o si dispone di competenze professionali per creare integrazioni tramite API REST, API SOAP, API in blocco o API GraphQL o gRPC. | Non obbligatorio* | Entrambi | Sì***** | Sì | Sì | Con strumenti pro-code | Sì** | Sì*** | Più |
| Guida | Costo | Tempistica | Volume e scala | Consegna e manutenzione | Privacy e sicurezza | Strumenti da implementare | |||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| Quando utilizzare | Licenza aggiuntiva | Sincronizzazione (Richiesta/Risposta) o Asincrona (Attiva/Dimentica) | Supporto multi-oggetto | LDV/Bulk | Test e distribuzione* | Debug | Comportamento di gestione/riprova degli errori incorporato | Può essere utilizzato con dati crittografati a riposo | Protocollo di autenticazione | Codice basso → Pro Code | |
| Heroku Connect | Quando si desidera estendere i dati con la sincronizzazione bidirezionale tra le organizzazioni Salesforce e abilitare l'accesso ai dati anche da dispositivi mobili e altre app in esecuzione su Heroku | Obbligatorio | Asincrono | Sì | Sì | No | Con strumenti pro-code | Sì | Sì, tramite Shield Connect | OAuth | Codice basso |
| MuleSoft Anypoint | Quando si necessita di una singola soluzione unificata di livello aziendale per creare, orchestrare e gestire le integrazioni, quando si deve sostituire un'architettura point-to-point legacy o quando si necessita del supporto per la gestione API | Obbligatorio | Entrambi | Sì | Sì | Sì | Con strumenti pro-code | No | Sì** | Più | Codice professionale |
| API native Salesforce | Quando Salesforce o Heroku Connect non sono un'opzione o è necessaria un'elaborazione più complessa | Non richiesto | Entrambi | No | Sì | Sì | Con strumenti pro-code | No | Sì** | Più | Codice professionale |
| Modifica acquisizione dati | Quando è necessario pubblicare le modifiche a livello di record apportate in Salesforce in un sistema esterno e non è necessario un payload personalizzato. | Obbligatorio | Asincrono | No | No | Sì | Con strumenti pro-code | Sì | Sì | OAuth | |
| Salesforce Connect con adattatore tra organizzazioni | Quando si desidera che gli utenti di un'organizzazione visualizzino o modifichino i record di un'organizzazione diversa senza replica dei dati | Obbligatorio | Asincrono | Sì | Sì | Sì | Con strumenti pro-code | N/D | N/D | Più | Codice basso |
| Data 360 | Quando si desidera che gli utenti di un'organizzazione visualizzino o modifichino i record di un'organizzazione diversa con dati replicati in Data 360. | Obbligatorio | Entrambi | Sì | Sì | Sì | Con strumenti pro-code | Sì | Sì | Più | Ibrido |
| Tipo di schema | Modalità/Strumento | Vantaggi | Considerazioni | Esiti |
|---|---|---|---|---|
| Inserimento dati |
In tempo reale:
|
|
|
Agenteforce:
|
Streaming:
|
|
|
Agenteforce:
|
|
Lotto:
|
|
|
Agenteforce:
|
|
| Copia zero |
Query live:
|
|
|
Agenteforce:
|
Query accelerata (Caching):
|
|
|
Agenteforce:
|
|
Federazione file:
|
|
|
Agenteforce:
|
 #### Metodi di inserimento dati
I metodi _di inserimento dati_ possono variare a seconda del connettore utilizzato per inserire i dati. Alcuni connettori offrono una varietà di metodi di inserimento, mentre altri funzionano solo in modalità batch o streaming. Per un elenco completo dei connettori _Data 360_ e dei metodi disponibili, vedere [Data 360: Integrazioni e connettori](https://help.salesforce.com/s/articleView?id=data.c360_a_sources_targets.htm&type=5).
- **In tempo reale:**
- Fornisce l'inserimento al di sotto del secondo utilizzando _Acquisizione dati (CDC)_
- Adatto a flussi di lavoro sensibili al tempo (ad esempio, rilevamento di frodi, personalizzazione e cruscotti digitali operativi)
- Le funzioni spingono le trasformazioni e le aggregazioni all'interno di _Data 360_, il che consente di ridurre l'I/O a valle e ottimizzare l'utilizzo del calcolo
- Supporta l'utilizzo di CDC incrementale per ridurre al minimo lo shuffle dei dati
- **Streaming:**
- Fornisce l'inserimento ogni 1–3 minuti in piccoli incrementi
- Equilibrio tra freschezza e costo
- Adatto per l'orchestrazione delle campagne, il coinvolgimento quasi live e la generazione di rapporti operativi
- Supporta l'utilizzo di micro batch per controllare i picchi di I/O
- Aggrega i dati alla fonte (se possibile) per ridurre i volumi di trasferimento e ottimizzare l'archiviazione
- **Batch (carichi pianificati):**
- Fornisce l'inserimento periodico di serie di dati di grandi dimensioni (ad esempio, ogni ora, ogni giorno e ogni settimana)
- Offre efficienza e affidabilità in termini di costi per le serie di dati storiche, i rapporti normativi e i casi d'uso di conformità
- Garantisce che la località di calcolo si trovi nella stessa regione dello storage di origine per migliorare le prestazioni e ottimizzare i costi
#### Playbook architetto
- **Casi d'uso di inserimento dati:**
- **Generazione di profili unificati Customer 360.** Creare un'unica fonte di dati per le identità e gli attributi dei clienti.
- **Gestire le serie di dati di conformità ai regolamenti.** Imponi governance, discendenza e verificabilità per i dati sensibili.
- **Centralizzare l'orchestrazione delle campagne.** Assicurarsi che marketing, vendite e assistenza funzionino tutti da serie di dati coerenti e affidabili.
- **Pratiche di progettazione:**
- Consente l'inserimento in batch per esigenze storiche o tolleranti la bassa latenza (ad esempio, rapporti di archiviazione o istantanee periodiche).
- Utilizzare le API CDC o streaming per mantenere la freschezza dei flussi di lavoro operativi e di personalizzazione e garantire aggiornamenti quasi in tempo reale.
- Controllare la crescita dello storage e del calcolo applicando carichi incrementali per ottimizzare i costi e l'efficienza (anziché ricaricare intere serie di dati).
- Allineare le opportunità di inserimento in corso di realizzazione con la località di calcolo e l'elaborazione incrementale per ridurre gli I/O della rete.
- Applicare trasformazioni all'interno di _Data 360_ per evitare di spostare dati non elaborati inutilmente.
- **Considerazioni sui costi:**
- **L'inserimento in tempo reale** presenta i costi di calcolo e pipeline più elevati, il che può essere giustificato per flussi di lavoro sensibili al tempo e di valore elevato (ad esempio, personalizzazione, cruscotti digitali operativi o azioni basate su Agentforce).
- **L'inserimento streaming** ha costi di elaborazione e archiviazione moderati, che possono essere adatti per aggiornamenti frequenti che possono tollerare lievi ritardi (ad esempio, l'orchestrazione delle campagne o la generazione di rapporti operativi).
- **L'inserimento batch** ha costi di calcolo inferiori e memoria prevedibile, adatti per le serie di dati storiche o gli aggiornamenti a bassa frequenza. L'inserimento di dati batch da organizzazioni Salesforce utilizzando determinati connettori è gratuito.
- **Modalità di aggiornamento** Consente di selezionare la modalità di _aggiornamento incrementale_, che riduce i costi totali di inserimento e calcolo. In Salesforce, si consiglia di utilizzare _l'aggiornamento incrementale_ ove possibile per ottimizzare l'efficienza in tutti i tipi di inserimento.
- Il **costo** è influenzato anche dal volume di I/O dalla fonte a _Data 360_. L'ottimizzazione delle dimensioni dei batch, delle partizioni e dell'allineamento regionale riduce i costi di trasferimento e migliora le prestazioni.
- **Scenari di settore:**
- **Finanza:** Le serie di dati di inserimento sono necessarie per _conoscere il cliente_, _Antiriciclaggio (AML)_ e il rilevamento di frodi in cui la verificabilità e la conformità non sono negoziabili.
- **Assistenza sanitaria:** Utilizzare l'inserimento per la risoluzione dell'identità del paziente e i record conformi all'HIPAA, che consente visualizzazioni unificate e protette.
- **Dettaglio:** Consolidare i dati dei _punti vendita (POS)_, dell'eCommerce e dei programmi fedeltà in profili unificati per la segmentazione e la personalizzazione.
- **Telecom:** Supportare la prevenzione dell'abbandono e l'analisi dell'utilizzo con dati canonici degli abbonati regolati.
#### Criteri decisionali del metodo di inserimento dati
| Funzione | Inserimento in tempo reale | Inserimento streaming | Inserimento batch |
| :----------------------------------- | :------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------ | :------------------------------------------------------------------------------------------------------------------------------------------------------------ | :----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Latenza e freschezza** | Include l'inserimento di latenza al di sotto del secondo tramite le API di inserimento con supporto per l'_acquisizione dati (CDC)_. Fornisce opportunità in streaming continue. Adatto a casi d'uso operativi a bassa latenza. | Include l'inserimento di micro batch ogni 1–3 minuti tramite connettori nativi. Supporta gli aggiornamenti incrementali. È prevista una leggera latenza. | La latenza dei dati è prevista. Consente carichi pianificati a volume elevato. Include l'inserimento periodico (orario, giornaliero e settimanale). Non adatto per operazioni sensibili al tempo. |
| **Casi d'uso principali** | Ideale per casi d'uso operativi e di personalizzazione a bassa latenza. Utilizzare per i flussi di lavoro sensibili al tempo. Supporta i flussi di lavoro basati sugli eventi. Utilizzare per gli avvisi di frode in tempo reale e gli avvisi operativi. | Adatto per processi moderatamente urgenti. Utilizzare per l'orchestrazione delle campagne, il coinvolgimento quasi live e la generazione di rapporti operativi. Utilizzare per trigger campagna tempestivi. | Economico per serie di dati di grandi dimensioni. Affidabile per l'analisi storica. Utilizzare per l'aggregazione storica o i flussi di lavoro dei rapporti regolamentati. Adatto a serie di dati storiche o a bassa velocità. |
| **Complessità architettonica e I/O** | Include un costo elevato e un'architettura complessa. Richiede sistemi di origine a bassa latenza. I/O intensivo. Fonti a volume elevato possono causare pipeline sature. | Presenta un'architettura più semplice rispetto a quella in tempo reale. I/O è moderato. Adatto a schemi di aggiornamento prevedibili e ripetuti. Le dimensioni del batch influiscono sulla memoria e sul calcolo. | Facile da implementare. I/O intensivo durante le finestre di carico. La produttività della rete può diventare un collo di bottiglia per batch di grandi dimensioni. |
| **Considerazioni sui costi** | Include i costi di elaborazione e pipeline più elevati. Giustificabile solo per i flussi di lavoro di valore elevato e sensibili al tempo. | Include costi moderati di elaborazione e memoria. Offre un approccio bilanciato tra costo e freschezza. Adatto per aggiornamenti frequenti che possono tollerare lievi ritardi. | Offre costi di calcolo inferiori e memoria prevedibile. Consigliato per le serie di dati storiche o gli aggiornamenti a bassa frequenza. L'inserimento tramite pipeline interne Salesforce è gratuito. |
| **Processi di progettazione** | Utilizzare CDC incrementale per ridurre al minimo il rimescolamento dei dati. Filtrare e utilizzare i campi selettivi per ridurre il sovraccarico. | Utilizzare i micro batch per controllare i picchi di I/O. Considerare l'aggregazione con finestre per ridurre il carico di elaborazione. | Utilizzare per rapporti di archivio o istantanee periodiche. Assicurarsi che la località di calcolo si trovi nella stessa regione dello spazio di archiviazione sorgente per ottimizzare i costi. |
### Federazione dati copia zero
#### Casi d'uso copia zero
Utilizzare _Copia zero_ per eseguire query in tempo reale su sistemi esterni senza duplicazione dei dati per consentire agilità, freschezza e accesso scalabile a serie di dati di grandi dimensioni o temporanee. È adatto per cruscotti digitali live, analisi esplorative, formazione sui modelli AI/ML e coinvolgimento dei clienti in tempo reale direttamente tramite Salesforce _Data 360_.
 #### Metodi copia zero
Quando si utilizza _Zero Copy_, gli architetti devono scegliere tra tre metodi di federazione dei dati disponibili, ciascuno dei quali offre i propri compromessi tra freschezza, prestazioni e costo.
- **Query live**
- Esegue query direttamente sui sistemi esterni (ad esempio, _Snowflake_, _Google BigQuery_, _Redshift_, _Databricks_ e così via) senza duplicazione dei dati.
- Riduce al minimo lo spostamento dei dati sulla rete e riduce l'I/O nel calcolo di Salesforce _Data 360_, che è ottimale quando predicati e aggregazioni possono essere sottoposti a push.
- Adatto per approfondimenti in tempo reale e cruscotti digitali operativi a bassa latenza.
- Dipende dalle prestazioni del sistema esterno.
- **Caching (query accelerata)**
- Archivia temporaneamente le copie memorizzate nella cache dei dati federati in Salesforce _Data 360_.
- Riduce i costi di query ripetute e la latenza per le serie di dati a cui si accede di frequente con durata configurabile (da minuti a giorni).
- Poiché i dati non vengono copiati in modo permanente o completamente governati, l'aggiornamento viene gestito tramite aggiornamenti pianificati dall'origine.
- L'_aggiornamento incrementale_ supporta solo gli inserimenti con aggiornamento. I record eliminati non vengono rimossi dalla cache.
- Eseguire periodicamente un aggiornamento completo per assicurarsi che la cache rimanga sincronizzata con l'origine.
- **Nota:** Il connettore _Snowflake_ supporta la funzione _Scarica_, che migliora le percentuali di accelerazione utilizzando un bucket di gestione temporanea avviato da Snowflake. Questa opzione è abilitata per impostazione predefinita, ma può essere disabilitata modificando la connessione.
- **Federazione file**
- Fornisce accesso diretto in sola lettura alle serie di dati su larga scala negli archivi di oggetti (ad esempio, _S3_ e _GCS_ con _Iceberg_).
- Adatto per carichi di lavoro AI/ML, analisi storica e rapporti su scala petabyte senza spostare i dati.
- Le prestazioni delle query dipendono fortemente dal formato dell'oggetto, dal partizionamento e dall'ingresso/uscita di rete. Le analisi di grandi dimensioni possono generare I/O sostanziali se non sono ottimizzate.
#### Playbook architetto
- **Casi d'uso**
- La **personalizzazione in tempo reale e** i flussi di lavoro adattativi offrono offerte dinamiche, consigli e azioni Next Best quando cambiano i comportamenti dei clienti.
- I **cruscotti digitali live e** i cruscotti digitali e i KPI business critical vengono utilizzati direttamente dai magazzini esterni.
- L'**addestramento del modello AI/ML con serie di dati esterne di grandi dimensioni** sfrutta i dati su scala petabyte di data lake e magazzini senza spostarli tramite federazione file.
- **Scenari di settore**
- **Retail/Media:** Abilitare i consigli personalizzati e il coinvolgimento dei clienti in tempo reale federando i dati di clickstream o di interazione con i contenuti.
- **Finanza:** Eseguire il rilevamento delle frodi e il calcolo del punteggio del rischio quasi in tempo reale eseguendo query sui magazzini esterni senza duplicare dati sensibili.
- **Tecnologia/impresa:** Supportare i rapporti tra cloud, i cruscotti digitali dei servizi IT e l'analisi operativa quando le serie di dati risiedono in più sistemi.
- **Processi di progettazione**
- **Query live**
- Utilizzare per query con QPS elevato e bassa latenza quando la freschezza è critica.
- Inviare tramite push predicati e aggregazioni al sistema esterno per ridurre il rimescolamento dei dati sulla rete.
- Evitare query che eseguono inutilmente analisi di volumi di dati elevati.
- Considerare invece la potatura delle partizioni e i filtri.
- **Federazione file**
- Accedere alle serie di dati su scala petabyte negli archivi di oggetti senza inserimento.
- Ridurre al minimo i costi di latenza e uscita mantenendo lo spazio di archiviazione degli oggetti nella stessa area Cloud del calcolo Salesforce.
- Utilizzare formati partizionati e colonnari (Parquet/ORC) e filtri pushdown per ridurre il trasferimento di I/O e di rete.
- Sfruttare il pushdown di query e predicati per filtrare e aggregare i dati alla fonte, riducendo così lo spostamento dei dati.
- Evitare l'accesso ai dati tra regioni, a meno che non sia assolutamente necessario, perché aumenta I/O, latenza e costi.
- **Caching (query accelerata)**
- Inserire nella cache le serie di dati a cui si accede di frequente per bilanciare costi e prestazioni.
- Configurare gli intervalli di aggiornamento per bilanciare freschezza e costo delle query.
- **Conformità:** Applicare la governance all'origine sfruttando la _protezione a livello_ di riga e mascherando le policy direttamente all'interno dei sistemi federati.
- Di seguito sono riportate alcune procedure consigliate per uniformare l'RLS e il mascheramento tra le piattaforme:
- **Utilizzare un ID Enterprise centralizzato.** Mappare utenti ed entità in Salesforce _Data 360_ a un identificatore aziendale centralizzato univoco che corrisponde alle identità nei sistemi esterni.
- **Allineare le policy di sicurezza.** Assicurarsi che le policy di protezione dal traffico e mascheramento nei sistemi federati vengano applicate in base all'identità mappata. Ciò mantiene la conformità durante le query sui dati esterni.
- **Standardizzare gli schemi di identità.** Mantenere attributi di identità coerenti (email, ID utente, ID cliente e così via) in tutte le fonti di dati per evitare mancate corrispondenze e violazioni dell'accesso.
- **Considerazioni sui costi**
- **Query live:** Nel modello pay-per-query, i costi si accumulano per il calcolo delle case sul lago esterne, che può causare picchi con QPS elevato. Questo è adatto per i casi d'uso critici per la freschezza in cui il valore è maggiore della variabilità dei costi.
- **Query accelerata (Caching):** Questo metodo riduce il costo delle query (rispetto a _Live Query)_ riducendo gli attacchi al sistema di origine; tuttavia, aumenta i costi di inserimento dati batch per il riempimento e l'aggiornamento della cache. È adatto per le serie di dati a cui si accede di frequente.
- **Federazione file:** Questa è l'opzione di archiviazione più economica come dati nell'archivio oggetti; tuttavia, i costi delle query dipendono dalle dimensioni del file, dal partizionamento e dalla potatura. Questo è adatto per i dati storici o in blocco su scala petabyte.
#### Criteri decisionali metodo copia zero
| Punto Decisione | Live query | Caching (query accelerata) | Federazione file |
| :----------------------- | :---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | :--------------------------------------------------------------------------------------------------------------------------------------------------------- | :------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Posizione fonte di dati** | Case data lake esterni (ad esempio, _Snowflake_, _Google BigQuery_, _Redshift_ e _Databricks_) | Case data lake esterni (ad esempio, _Snowflake_, _Google BigQuery_, _Redshift_ e _Databricks_) | Object Store o data lake Cloud (ad esempio, _S3_, _ADLS_ e _GCS_), che spesso utilizzano formati di tabelle aperte come _Iceberg_. |
| **Scopo/Caso d'uso** | Adatto per analisi interattive e cruscotti digitali in tempo reale. Adatto alla personalizzazione in tempo reale e ai flussi di lavoro dinamici. | Adatto per quando le query sono frequenti, ma i risultati leggermente obsoleti sono accettabili. Adatto per cruscotti digitali BI e segmentazione. | Adatto per l'elaborazione batch su larga scala e l'addestramento del modello AI/ML. Adatto per analisi storiche e rapporti su scala petabyte. |
| **Freschezza/latenza** | Esegue le query direttamente in tempo reale. Supporta le decisioni al di sotto dei secondi quando il sistema di origine è ottimizzato per le query a bassa latenza con pushdown del predicato efficace. | Utilizzare quando i risultati leggermente obsoleti sono accettabili. La freschezza dipende dall'intervallo di cache, che è configurabile da 15 minuti a 7 giorni. | Adatto per lavori intensivi e con un'elevata produttività. Non adatto per il cruscotto digitale in tempo reale. |
| **Schema di accesso** | Adatto per query rare o ad hoc in cui la freschezza è fondamentale e il volume delle query è basso. I costi aumentano in modo significativo con QPS elevato, quindi è importante valutare il caching (query accelerata) quando la frequenza delle query è elevata. | Adatto a scenari di lettura ad alta frequenza. Migliora le prestazioni per gli schemi di accesso frequenti. | Fornisce l'accesso *di sola lettura*. Adatto per serie di dati su scala petabyte senza inserimento. |
| **Driver delle prestazioni** | Molto dipendente dalle prestazioni del sistema sorgente esterno. Adatto per quando predicati e aggregazioni possono essere inviati alla fonte. | Riduce la latenza rispetto alle query live ripetute. Le prestazioni dipendono dalla gestione della cache e dagli intervalli. | Le prestazioni dipendono fortemente dal formato dell'oggetto, dal partizionamento e dalla produttività del sistema esterno. Utilizzare formati partizionati e colonnari (Parquet/ORC). |
| **Implicazioni sui costi** | Questo è un modello pay-per-query, quindi i costi si accumulano sui calcoli delle case sul lago esterne. È conveniente per le query poco frequenti, ma le spese possono aumentare con un volume QPS elevato. | Il costo è inferiore rispetto alle query live ripetute. Riduce la necessità di eseguire ripetutamente query sulla fonte esterna, ma aggiunge memoria cache e sovraccarico di aggiornamento. | Questa è l'opzione di memoria più economica. Per le impostazioni AWS same-region e same-cloud (ad esempio, _S3_ in US-East-1 con un tenant _Data Cloud_ presente anche in US-East-1), i crediti non vengono consumati per le righe a cui si accede. Le configurazioni tra regioni o tra cloud (ad esempio, _Azure_, _GCS_ o regioni _AWS_ diverse) comportano il consumo di credito per le righe a cui si accede. I costi delle query dipendono anche dalle dimensioni del file, dal partizionamento e dall'ottimizzazione del pushdown del predicato. |
| **Considerazione chiave** | Evitare le query non filtrate che eseguono la scansione di volumi di dati elevati inutilmente. | Questo approccio richiede la gestione della cache. Non adatto per decisioni subsecondarie. | Le prestazioni delle query dipendono fortemente dall'ottimizzazione tramite partizionamento e pushdown del predicato. |
### Approccio ibrido
Le architetture ibride consentono agli architetti di ancorare le serie di dati critiche in _Data 360_ per una governance centralizzata, sfruttando al contempo le query federate per garantire freschezza, riduzione delle duplicazioni e accesso scalabile a serie di dati esterne di grandi dimensioni. Questo approccio bilancia I/O, località di calcolo, costi e requisiti di conformità.
#### Casi d'uso ibridi
Utilizzare un approccio ibrido per una governance equilibrata, freschezza ed efficienza operativa combinando l'inserimento dei dati e la copia zero per offrire approfondimenti fruibili in tempo reale. Utilizzare l'inserimento per le serie di dati regolamentate di valore elevato in cui sono richiesti tracciabilità, RLS e mascheramento e la federazione per le serie di dati effimere o a volume elevato in cui freschezza e prestazioni sono fondamentali.
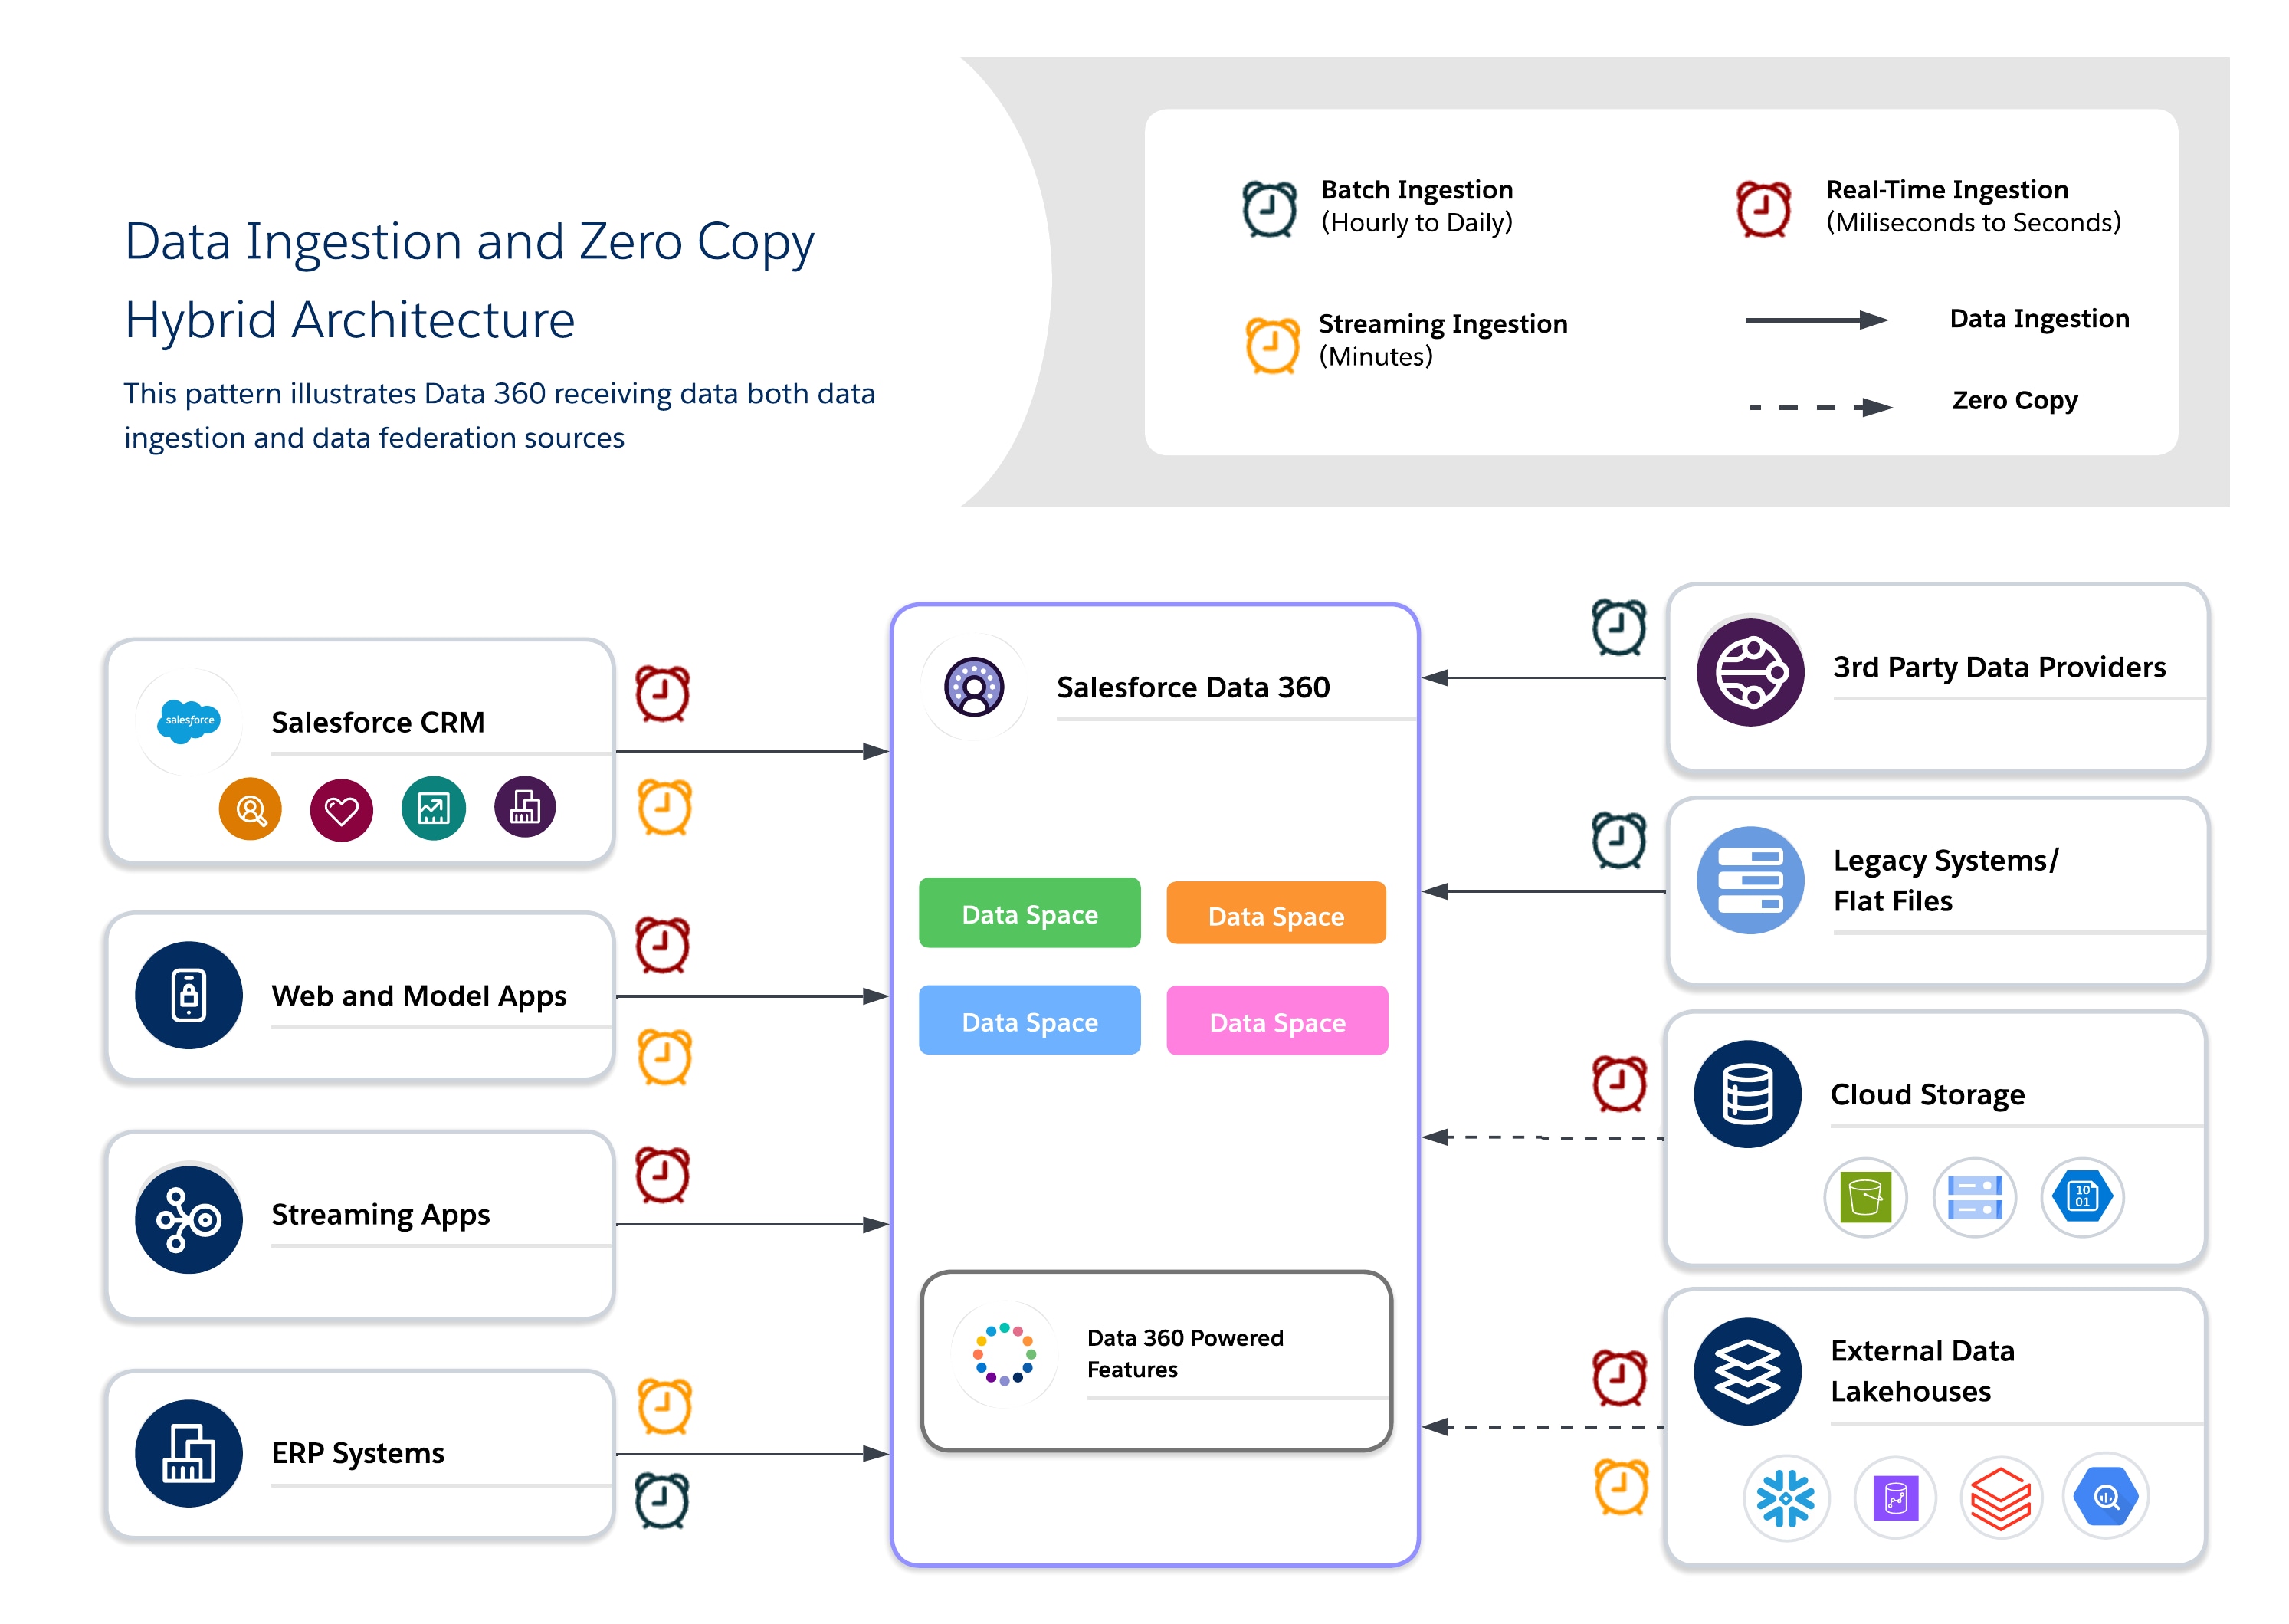 #### Playbook architetto
- **Casi d'uso**
- **Coinvolgimento Omnicanale:** Combinare i dati storici dei clienti con il comportamento in tempo reale per offrire esperienze coerenti e sensibili al contesto.
- **Condotte AI/ML:** Addestrare i modelli su serie di dati canoniche curate arricchendole con segnali grezzi o in tempo reale provenienti da fonti esterne.
- **Conformità mista e agilità richiedono:** Applicare una governance rigorosa per i dati sensibili e una federazione per l'agilità operativa.
- **Scenari di settore**
- **Dettaglio:** Utilizzare _l'inserimento_ per la risoluzione dell'identità e l'unificazione dei profili e _la federazione_ per le offerte e la personalizzazione in tempo reale.
- **Assistenza sanitaria:** Gestire i record paziente dorati tramite _inserimento_ utilizzando _federation sugli_ stream di dispositivi IoT e i dati dei sensori per il contesto immediato.
- **Servizi finanziari:** Inserire i dati regolamentati in un lago regolamentato dalla conformità utilizzando _federation_ per il rilevamento delle frodi esterne e le query di monitoraggio del rischio.
- **Processi di progettazione**
- **Ancora governance con inserimento:** Inserire dati di valore elevato o regolamentati nei modelli canonici per garantire Trust e conformità.
- **Utilizza Federation for Freshness:** Consente alle case sul lago esterne di fornire l'accesso ai dati in tempo reale o su larga scala senza duplicazioni.
- **Costo del bilanciamento rispetto alle prestazioni:** Profilare i carichi di lavoro per determinare quando utilizzare _l'inserimento_ rispetto alla _federazione_, riducendo al minimo i costi di archiviazione e query non necessari.
- **Applica governance a livelli:** Applicare una governance centralizzata per i dati inseriti sfruttando i controlli di sicurezza dei sistemi federati (ad esempio, RLS e mascheramento).
- **Nota:** Quando si progettano opportunità ibride in corso di realizzazione, è importante garantire l'inserimento incrementale delle serie di dati storiche e inviare aggregazioni push o filtri alle fonti federate per ottimizzare l'I/O e l'utilizzo del calcolo.
- **Considerazioni sui costi**
- Soppesare il costo totale rispetto alle prestazioni combinando _l'inserimento_ di dati critici o di conformità con la _federazione_ quando è necessario un aggiornamento.
- Tenere conto degli I/O e della distribuzione dei calcoli quando si combinano _inserimento_ e _federazione_. Per ridurre il costo di calcolo delle query ripetute rispetto ai sistemi di origine, utilizzare il caching (Query accelerata) per le serie di dati federate di lettura elevata e accesso frequente.
- Utilizzare questa regola per guidare la decisione di inserimento e federazione: quando l'accesso ai dati è frequente ma le modifiche non sono frequenti, la _query accelerata_ è in genere più conveniente. Tuttavia, quando i dati cambiano spesso (in base alla frequenza di accesso), è più appropriato eseguire _una Live Query_ o _un'inserimento_. Ecco alcuni esempi di costi:
- **L'accelerazione vince:** Un cruscotto digitale creato a partire da 1 milione di record e aggiornato quotidianamente con circa 10.000 modifiche viene visualizzato 20 volte al giorno. I costi _di accelerazione_ equivalgono a circa ~600 crediti/mese rispetto a ~4.200 crediti/mese per _le query live_.
- **La Live Query vince:** Segmenti pubblicati 20 volte al giorno utilizzando dati che cambiano ogni 30 minuti. _Le query live_ costano circa ~ 4.200 crediti/mese rispetto a ~ 28.800 crediti/mese per l'_accelerazione_ con questa frequenza di aggiornamento.
## Guida alle decisioni dei casi d'uso
Vediamo più in dettaglio alcuni archetipi comuni che illustrano come applicare questa logica.
- **L'archetipo "Un'unica fonte di verità": Centralizzare e gestire**
- **Scenario:** È necessario creare profili _Customer 360_ unificati conformi per l'intera azienda globale. I dati provengono da una dozzina di sistemi diversi, devono rispettare rigidi regolamenti _GDPR_ e _CCPA_ e fungeranno da fonte di verità per tutte le interazioni di marketing e servizio.
- **Schema consigliato:** **Inserimento dati.** La priorità qui è governance, Trust e controllo. L'inserimento dei dati in _Data 360_ è l'unico modo per creare un profilo canonico completamente controllabile e isolato dai sistemi di origine.
- Archetipo **di "Approfondimenti in tempo reale": Analisi senza spostamento**
- **Scenario:** Il team di data science deve eseguire query esplorative su una tabella di transazioni massiccia e in costante aggiornamento in _Snowflake_. Allo stesso tempo, il team direttivo desidera un cruscotto digitale _BI_ live basato sugli stessi dati. Lo spostamento giornaliero di petabyte di dati è lento e costoso.
- **Schema consigliato:** **Federazione copia zero.** La priorità in questo caso sono velocità, agilità ed efficienza economica su larga scala. _Zero Copy_ consente di sfruttare la potenza del data warehouse esistente per le query in tempo reale senza sovraccarico e latenza di duplicazione dei dati.
- Archetipo **di "Intelligenza ibrida": Governare il core, federare l'edge**
- **Scenario:** Si desidera arricchire i profili cliente governati e inseriti con segnali comportamentali in tempo reale (ad esempio, clic sul sito Web) provenienti da un data lake. È necessaria la stabilità del profilo centrale ma l'immediatezza dei dati live per favorire la personalizzazione immediata.
- **Schema consigliato:** **Un approccio ibrido.** Utilizzare _l'inserimento dati_ per creare un nucleo stabile governato per i dati dei clienti. Utilizzare _Copia zero_ per federare i dati volatili in tempo reale e unirli insieme al momento della query per una visualizzazione completa e aggiornata.
## Percorso in avanti
La strategia per i dati aziendali non si concentra più sulla scelta di un unico modello di integrazione, ma sull'architettura di una flessibilità controllata all'interno di un ecosistema di dati interoperabile. L'approccio corretto mappa ogni sistema di origine allo schema più adatto ai suoi requisiti di freschezza, governance, costo e accesso:
- Inserire serie di dati regolamentate mission-critical in Salesforce _Data Cloud_ per la conformità, la risoluzione dell'identità e i flussi di lavoro operativi.
- Federare i dati tramite _Zero Copy_ per analisi live, esplorative e basate sull'intelligenza artificiale senza duplicare l'archiviazione.
- Applicazione del _caching (query accelerata)_ per ridurre il carico del sistema di origine e il consumo di credito quando la frequenza delle query è alta e la frequenza di modifica dei dati è bassa
Salesforce _Data 360_ su _Hyperforce_ offre resilienza e scalabilità multiregione. La sua casa sul lago aperta con tabelle _Iceberg_ consente la separazione dei calcoli e l'interoperabilità con piattaforme come _Snowflake_, _Databricks_ e _S3 Iceberg,_ che costituisce la spina dorsale di un ecosistema di dati multi-cloud davvero interoperabile.
Man mano che gli ecosistemi di dati si evolvono, dobbiamo bilanciare costantemente freschezza, costo, prestazioni e conformità per mantenere l'agilità dell'architettura. Ecco perché è importante rendere la piattaforma a prova di futuro unificando i dati gestiti inseriti con accesso federato. Ciò consente l'intelligenza in tempo reale, l'attivazione dell'intelligenza artificiale e la personalizzazione su scala aziendale in cloud, regioni e domini aziendali.
Tenere presente che le soluzioni valide per tutti non sono adatte alla maggior parte delle aziende. La strategia ottimale mappa lo schema corretto al driver aziendale corretto.
## Informazioni sugli autori
**Yugandhar Bora** è un architetto di ingegneria del software di Salesforce specializzato in architettura dei dati all'interno della piattaforma Data and Intelligence Applications. Dirige iniziative dell'_Enterprise Architecture Review Board_ incentrate sulla governance dei dati e sui modelli di dati unificati, contribuendo anche alle soluzioni di provisioning automatico della piattaforma.
**Jan Fernando** è Principal Architect presso lo _Office of the Chief Architect (_OCA) di Salesforce, che è entrato a far parte di Salesforce nel 2012. Prima di entrare nell'OCA, ha trascorso oltre un decennio nell'organizzazione _Platform_, dove ha guidato diverse trasformazioni tecnologiche chiave.
# Provisioning di Data 360
Salesforce Data 360 è una piattaforma dati basata su [Hyperforce](https://www.salesforce.com/platform/public-cloud-infrastructure/) che unifica Salesforce e i dati esterni in una visione chiara, completa e affidabile a 360 gradi di ogni cliente o account.
Le aziende spesso gestiscono più organizzazioni Salesforce a causa di fusioni e acquisizioni, operazioni regionali, separazione funzionale o per motivi storici. Gli architetti devono prendere diverse decisioni su Data 360, che influiscono su governance, conformità, costo, latenza e capacità dell'organizzazione di scalare l'intelligenza artificiale e le funzionalità tra organizzazioni.
## Panoramica della guida
Questa guida fornisce un framework per prendere decisioni sul provisioning con Data 360\. Queste decisioni includono:
- Selezione di una singola organizzazione iniziale rispetto a una configurazione multi-organizzazione
- Provisioning di più istanze di Data 360 indipendenti
- Utilizzare Data Cloud One per unificare le organizzazioni in un'unica istanza
- Collaborazione tra istanze di Data 360 indipendenti che utilizzano la condivisione dei dati tra le organizzazioni Data 360
Data 360 viene eseguito automaticamente il provisioning in qualsiasi organizzazione di produzione che riceve una licenza Data 360. Data Cloud One è l'architettura di connettività multi-organizzazioni di Salesforce che consente a una singola organizzazione domestica di ospitare l'istanza di Data 360, mentre le altre organizzazioni Salesforce si connettono come organizzazioni secondarie. La scelta dell'organizzazione che detiene la licenza Data 360 e che quindi diventa un'organizzazione di casa Data 360 è una decisione architettonica critica con conseguenze a lungo termine.
Il modo in cui si esegue il provisioning di Salesforce Data 360 è una decisione architettonica fondamentale. Determina in che modo l'azienda unifica i dati dei clienti, impone la governance e abilita le funzioni critiche della piattaforma, in particolare AI, Agentforce e Analytics in tutta l'organizzazione. L'ancoraggio di un cluster di organizzazioni a un unico Data 360 fornisce un modello di dati unificato, una governance centralizzata e consente la preparazione dell'intelligenza artificiale a livello aziendale. Le organizzazioni associate possono accedere ai metadati e alle funzioni condivise come se i dati fossero locali. Al contrario, più istanze indipendenti di Data 360 sono appropriate quando i requisiti normativi, di conformità o di autonomia impediscono la centralizzazione. La condivisione dei dati tra le organizzazioni Data 360 consente la collaborazione selettiva e senza copia tra queste istanze.
Questa decisione influenza chi controlla la governance dei dati, dove risiedono i dati, come sono abilitate le funzioni della piattaforma e quanto facilmente le integrazioni future e le iniziative di intelligenza artificiale possano scalare. Anche per le organizzazioni che attualmente non dispongono di Data 360, può essere importante sviluppare una strategia per aggiungere l'accesso a Data 360 in futuro. Sempre più spesso, le funzioni di Salesforce in Sales, Service, Marketing, Commerce, Industries e Agentforce sono basate su Data 360\. Le organizzazioni che desiderano utilizzare queste funzioni della piattaforma devono eseguire il provisioning di Data 360 o connettersi a Data 360 condiviso come organizzazioni secondarie.
Questa guida aiuta gli architetti a progettare una strategia di provisioning che bilancia semplicità, coerenza a livello aziendale, conformità e scalabilità, garantendo che l'organizzazione possa sfruttare con sicurezza Data 360 per Customer 360, AI e innovazione multipiattaforma. Utilizzare questa guida per determinare quali organizzazioni richiedono Data 360 e se utilizzare Data Cloud One o la condivisione dei dati tra le organizzazioni Data 360. Questa strategia getta le basi per un futuro incentrato su Data 360.
## Prodotti nell'ambito
 |
Salesforce Data 360 è la piattaforma dati iperscala in tempo reale di Salesforce che armonizza e unifica i dati di qualsiasi fonte (CRM, Web, mobile o data lake esterni) in un unico profilo cliente fruibile. Come componente fondamentale della piattaforma Customer 360, supporta l'intelligenza artificiale, l'analisi e le esperienze personalizzate in termini di vendite, assistenza e marketing. |
| Considerazione | Perché è importante | Scenari di esempio |
|---|---|---|
| Data Residency e conformità | Determina dove vengono memorizzati ed elaborati i dati. Le norme normative possono richiedere regioni specifiche o più istanze. | Una banca globale esegue il provisioning di un tenant Data 360 in un'organizzazione Salesforce geolocalizzata a Francoforte per la conformità al GDPR. Fornisce un altro tenant in un'organizzazione in Virginia per la divisione statunitense. |
| Governance e sicurezza | Identificare un amministratore e la proprietà di Data 360, incluse la gestione delle policy e le strategie di delega. | Una multinazionale con forte centralità IT crea un'organizzazione home dedicata gestita da un Centro di Eccellenza. |
| Autonomia e centralizzazione | Leader diversi possono volere una proprietà separata dei dati. L'autonomia favorisce più organizzazioni Data 360. La centralizzazione favorisce Data Cloud One. | Una holding con società controllate indipendenti consente a ogni unità operativa di eseguire il proprio Data 360. |
| Latenza e prestazioni | Influisce sulla velocità e l'esperienza delle query, in particolare per le organizzazioni associate a un tenant di Data 360 nelle varie regioni. | Un team di vendita di Londra che esegue query sui dati di un tenant di Data 360 negli Stati Uniti può riscontrare una latenza più elevata. |
| Complessità dell'integrazione | Altri tenant di Data 360 = altre opportunità in corso di realizzazione, API e middleware. Il consolidamento semplifica l'integrazione. | Un rivenditore evita la creazione di 10 pipeline ETL consolidandole in una configurazione Data Cloud One. |
| Regione fonte di dati copia zero | I requisiti di accesso tra regioni per alcuni connettori possono limitare la regione o la posizione dell'organizzazione Data 360. | Una società ha un'istanza Snowflake nella regione AWS eu-west-1. Possono utilizzare Copia zero per federare i dati in un Data 360 nella loro regione, ma non possono utilizzare Copia zero per federare in un Data 360 nella regione degli Stati Uniti. |
| Compatibilità tra regioni di Private Connect | A volte, il supporto di Private Connect dipende dal fatto che la fonte di dati si trovi nella stessa regione del tenant di Data 360. | Una società ha un'istanza Snowflake nella regione aws-east-1 che desidera connettersi a Data 360 tramite copia zero. Possono stabilire una connessione di rete Private Connect solo se l'organizzazione di casa Data 360 si trova nella stessa regione. |
| Costo e licenze | Ogni tenant di Data 360 aggiunge un costo. Il raggruppamento in meno istanze ottimizza la spesa. | Un operatore sanitario riduce i costi delle licenze adottando Data Cloud One anziché più istanze di Data 360 indipendenti. |
| Scalabilità futura | Le scelte di provisioning oggi gettano le basi per la crescita. | Una società SaaS inizia con una singola istanza di Data 360 ma prevede di espandersi a Data Cloud One quando acquisisce società controllate con organizzazioni Salesforce. |
| Preparazione AI a livello aziendale | Le funzioni AI e Agentforce richiedono un tenant Data 360 connesso in ogni organizzazione. Le decisioni di provisioning influiscono sul modo in cui i modelli di intelligenza artificiale si addestrano e si attivano in tutta l'azienda. | Una società di servizi finanziari unifica i dati in Data Cloud One in modo che i suoi modelli Einstein AI abbiano accesso ai dati dei clienti a livello aziendale. |
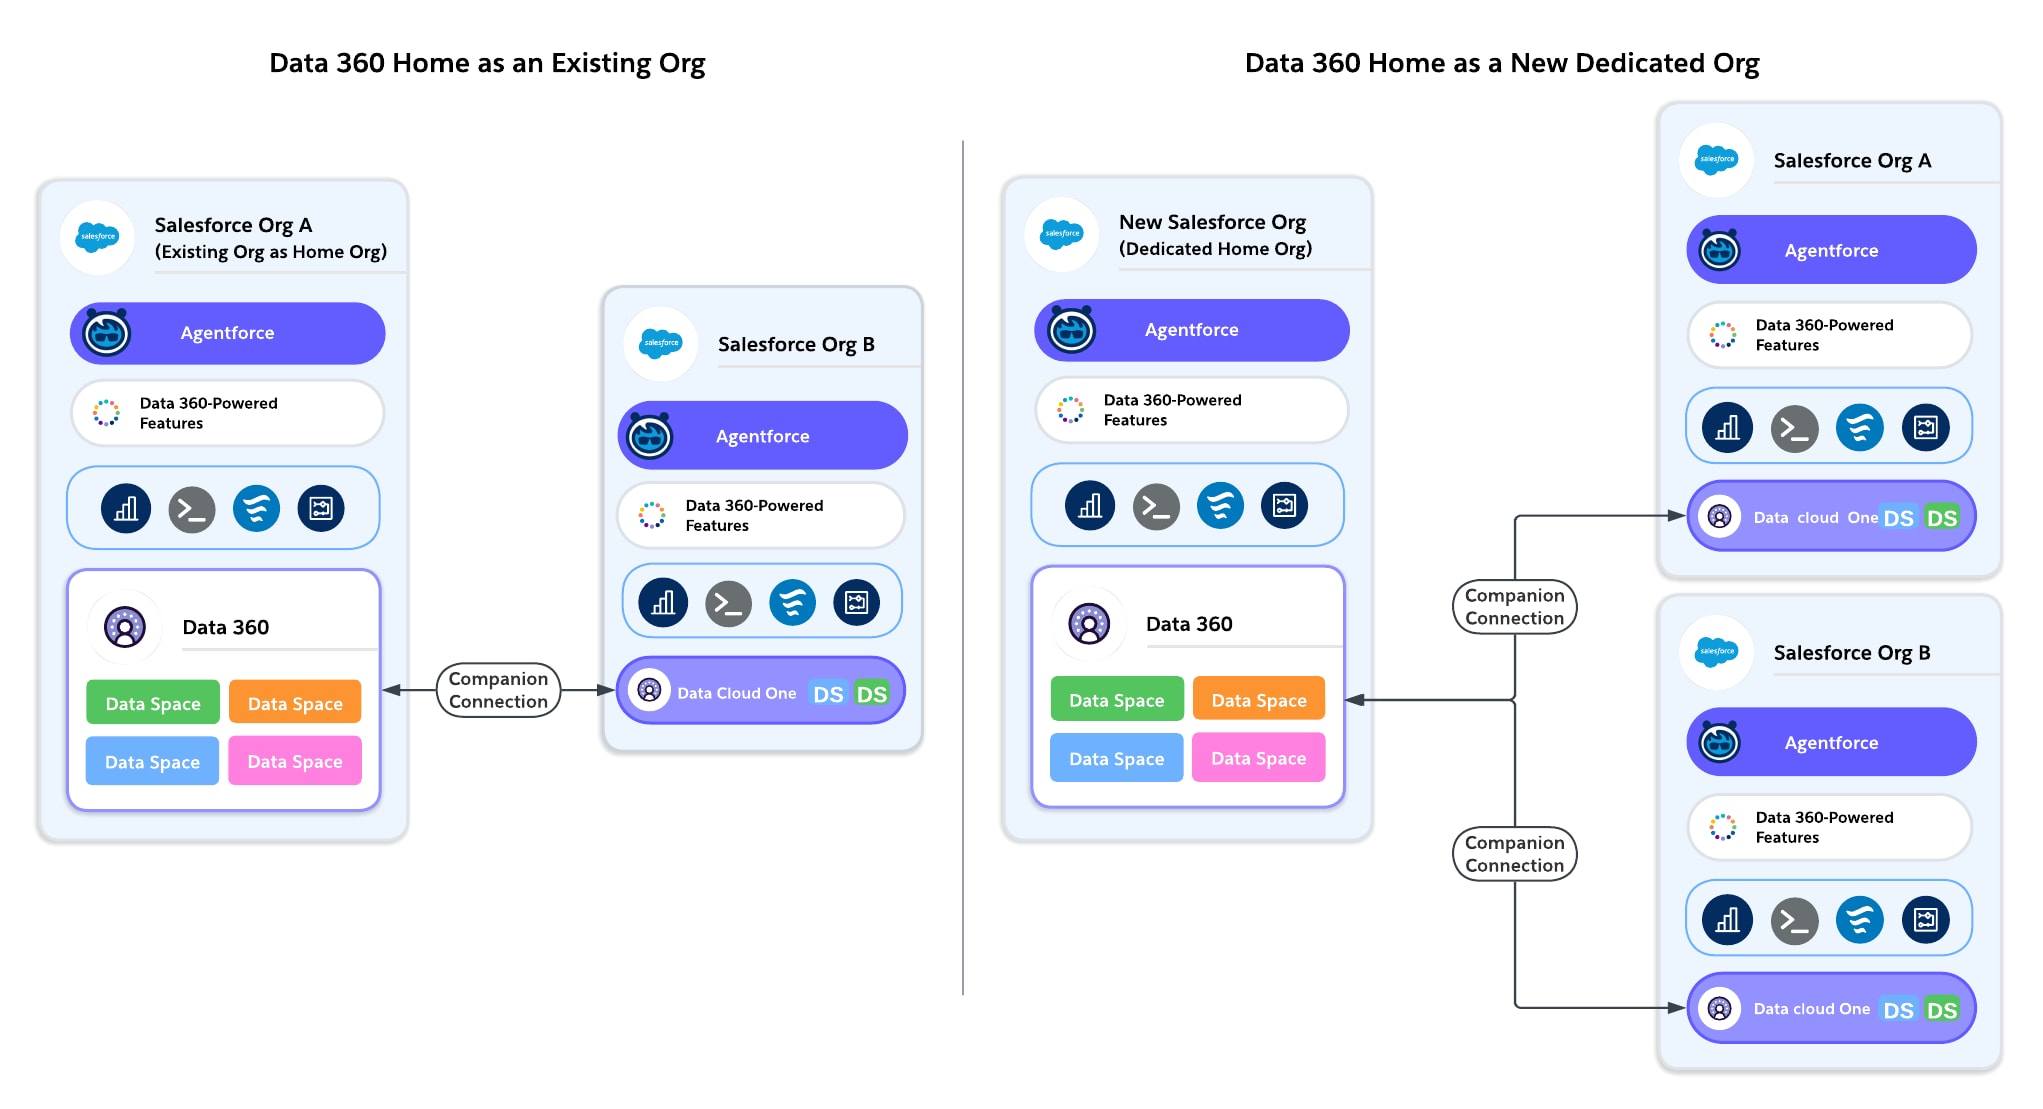 **Opzione A: Provisioning di Data 360 in un'organizzazione esistente**
**Funziona meglio per:** Clienti con una singola organizzazione Salesforce o clienti multi-organizzazione che hanno già un'organizzazione centralizzata principale in cui vengono eseguiti la maggior parte dei processi aziendali.
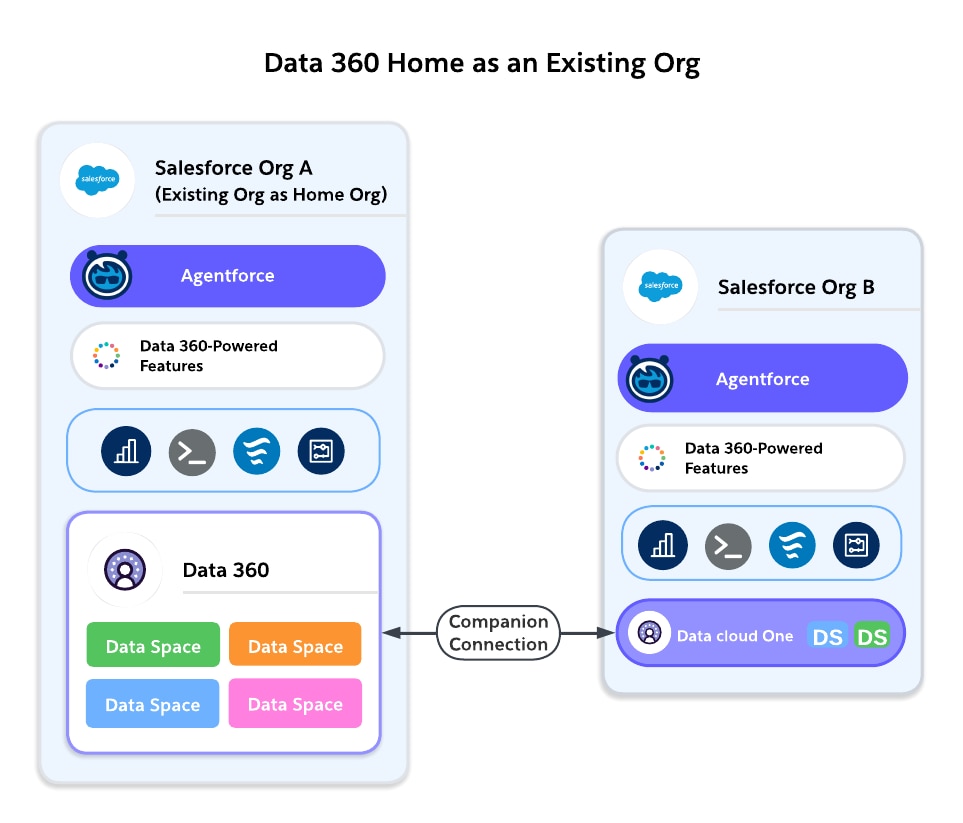 - **Punti positivi:**
- Percorso più semplice: Data 360 viene eseguito il provisioning nella posizione in cui si trovano i dati CRM.
- Accesso immediato ai dati di vendita, assistenza e marketing locali.
- Non è necessaria alcuna integrazione aggiuntiva.
- Meno licenze e ambienti da gestire.
- Accelera l'adozione precoce, i casi d'uso pilota e di produzione.
- **Contro:**
- Può ereditare la governance o il debito tecnico di un'organizzazione esistente.
- Se non esiste una singola "organizzazione principale", selezionandone una si possono creare dibattiti sulla proprietà.
- Le prestazioni sono legate alla posizione dell'organizzazione; potrebbero non essere in linea con le esigenze di residenza a livello aziendale.
- Se più unità operative utilizzano organizzazioni diverse, il provisioning locale può causare frammentazione se non abbinato a Data Cloud One.
**Esempio:**
Una società SaaS con un'organizzazione Salesforce esegue il provisioning di Data 360 in tale organizzazione per unificare i dati di abbonamento e assistenza dei clienti.
**Opzione B: Provisioning di Data 360 in una nuova organizzazione dedicata**
**Funziona meglio per:** Clienti con più organizzazioni Salesforce che non possono allinearsi su una singola organizzazione principale o aziende con un modello di Centro di eccellenza (CoE) forte.
 - **Punti positivi:**
- Parte pulita per la governance, senza complessità dell'organizzazione ereditate.
- Controllo centralizzato in più linee di business.
- Flessibilità di scegliere una regione in base alle esigenze di conformità.
- Agisce come un'organizzazione di "servizio condiviso" neutrale, non collegata a un'unità operativa.
- Impostazione per la futura architettura Data Cloud One (organizzazione iniziale con più organizzazioni associate).
- **Contro:**
- I clienti devono disporre della licenza per una nuova organizzazione Salesforce in cui eseguire il provisioning di Data 360.
- Integrazione aggiuntiva necessaria per connettere l'organizzazione a Data 360 tramite una connessione Data Cloud One.
- Può aggiungere spese amministrative (gestione utenti, sicurezza, identità).
- Time-to-value più lento rispetto al provisioning in un'organizzazione di produzione esistente.
**Esempio:**
Una società multinazionale di servizi finanziari crea un'organizzazione domestica dedicata per il provisioning di Data 360.Tutte le organizzazioni unità operative (Retail, Wealth, Commercial Banking) si connettono come organizzazioni secondarie tramite Data Cloud One.
**Criteri decisionali**
| Considerazione | Organizzazione esistente come organizzazione iniziale (predefinita preferita) | Nuova organizzazione come organizzazione iniziale (alternativa) |
|---|---|---|
| Semplicità | Si basa sulla struttura di utenti e dati esistente per un'impostazione più rapida. Data 360 è integrato per impostazione predefinita con l'organizzazione iniziale. |
Richiede la licenza e l'impostazione di una nuova organizzazione Salesforce e ulteriori oneri amministrativi per la gestione |
| Time-to-Value | Utilizzo immediato dei dati CRM locali | È necessaria una rampa e un'integrazione più lente. |
| Governance | Eredita il modello di governance di base dell'organizzazione esistente: utenti e insiemi di autorizzazioni esistenti (può essere accettabile se l'organizzazione è già centrale). | Da zero per la governance. Ideale per modelli con COE. |
| Conformità | Residenza legata alla regione dell'organizzazione esistente | Flessibilità di selezionare una regione indipendente dalle organizzazioni esistenti |
| Prestazioni | Migliori prestazioni per le query CRM locali | A seconda della connettività dell'organizzazione associata, sia che si tratti della stessa regione o di un'area trasversale alle altre organizzazioni |
| Scalabilità futura | Funziona bene se abbinato a Data Cloud One. Più difficile spostarsi in seguito se viene scelta l'organizzazione sbagliata | Scala facilmente con Data Cloud One. Progettato per la neutralità. |
| Costo | Minor costo incrementale | Maggiore sovraccarico da ambienti aggiuntivi |
 **Come funziona Data Cloud One**
- **Inserimento e unificazione dei dati (organizzazione iniziale)**
- Tutte le configurazioni di inserimento dati (Salesforce CRM, fonti esterne, streaming, batch) avvengono solo dall'organizzazione di origine.
- Il tenant di Data 360 collegato all'organizzazione di origine esegue operazioni di risoluzione dell'identità, armonizzazione, modellazione e unificazione in profili cliente affidabili.
- L'amministrazione, le policy di governance, i tag e il mascheramento di Data 360 vengono applicati centralmente dall'organizzazione di origine.
- **Architettura spazio dati**
- Dall'organizzazione iniziale, i dati sono organizzati in spazi dati, che fungono da contenitori logici per dati, metadati e processi.
- Le aziende possono creare spazi dati per marchi, regioni o linee di business.
- Condivisione spazio dati: Dall'organizzazione iniziale, spazi dati specifici vengono condivisi in modo selettivo con le organizzazioni associate. Ciò garantisce che solo i dati pertinenti (e i metadati associati) vengano trasferiti alle organizzazioni giuste.
- **Condivisione dei metadati**
Le organizzazioni associate ricevono definizioni dei metadati dall'organizzazione di origine, inclusi oggetti modello di dati (DMO), schema del profilo unificato, approfondimenti calcolati, segmenti [e altro](https://help.salesforce.com/s/articleView?id=data.c360_a_companion_org_data_cloud_features.htm&type=5) ancora. Questi vengono visualizzati in modo nativo all'interno dell'organizzazione compagna come se fossero asset locali, ma sono collegati all'organizzazione di origine.
- **Funzioni nelle organizzazioni Home Org vs. Companion**
L'accesso alle funzioni è diverso tra le organizzazioni iniziali e le organizzazioni secondarie. Le organizzazioni associate non possono inserire o unificare i dati e si affidano all'organizzazione di origine per l'inserimento, la modellazione e l'unificazione. Le organizzazioni associate possono accedere ai dati di Data 360 per potenziare le funzioni della piattaforma basate su Data 360 e possono creare approfondimenti locali, segmenti e flussi oltre ai dati condivisi e affidabili. Nella visione futura, possono anche accedere alle funzioni di attivazione.
| Capacità | Organizzazione iniziale | Organizzazione compagna |
|---|---|---|
| Configurare i connettori, creare stream di dati, inserire o federare i dati | ✅ | ❌ |
| Creazione ed esecuzione di trasformazioni dati e risoluzione dell'identità | ✅ | ❌ |
| Protezione dei dati con spazio dati e autorizzazioni | ✅ | ✅ |
| Segmentare e prevedere Creare segmenti, approfondimenti e creare modelli Einstein Studio | ✅ | ✅ |
| Attiva attivazioni Ovunque, azioni dati | ✅ | ✅ |
| Funzioni della piattaforma: Generatore di prompt, flussi, rapporti, arricchimento [e altro](https://help.salesforce.com/s/articleView?id=data.c360_a_companion_org_data_cloud_features.htm&type=5) | ✅ | ✅ |
| Funzioni basate su Data 360: Centro clienti potenziali, funzioni di Sales e Service Cloud, Agentforce e altro ancora | ✅ | ✅ |
| Considerazione | Più organizzazioni Data 360 indipendenti | Una condivisione di dati 360 (Data Cloud One) |
|---|---|---|
| Autonomia | Elevata autonomia per ogni organizzazione o unità operativa | Governance centralizzata, minore autonomia per organizzazione |
| Conformità | Utile quando è richiesta una separazione rigorosa (ad esempio, leggi regionali) | Funziona meglio quando la residenza consente la centralizzazione |
| Costo | Licenze e costi amministrativi più elevati | Più conveniente; una licenza per molte organizzazioni |
| Governance | Frammentato; le policy variano a seconda dell'organizzazione | Policy centralizzate e coerenti tra le organizzazioni |
| Silos di dati | Ogni organizzazione con la propria visualizzazione Nessuna azienda 360 | Serie di dati unificata, nessuna duplicazione |
| AI/Analytics | Limitato ai dati di ogni organizzazione | Modelli Enterprise con una maggiore precisione |
| Complessità | Più istanze da gestire, più integrazioni | Architettura più semplice, meno parti mobili |
| Prestazioni | Ideale per i casi d'uso all'interno dell'organizzazione | Potenziale aumento della latenza con l'accesso all'organizzazione companion |
| Fattore | Pro | Contro |
|---|---|---|
| Residenza dati | Supporta la separazione regionale abilitando la collaborazione. | Non elimina la necessità di gestire più organizzazioni Data 360. |
| Duplicazione dei dati | Copia zero; nessuna duplicazione di oggetti. | Richiede la selezione deliberata degli oggetti da includere in ogni condivisione dati. |
| Governance | La condivisione è esplicita e deliberata (a livello di oggetto). | Nessun flusso di tag o policy; l'organizzazione di destinazione deve riapplicare la governance. |
| Complessità | Abilita la collaborazione selettiva senza centralizzazione. | Richiede la gestione di più organizzazioni Data 360 e condivisioni dati. |
| **AI/Analytics** | Analisi artificiale regionale possibile; gli approfondimenti possono essere condivisi tra le organizzazioni. | Nessuna intelligenza artificiale a livello aziendale a meno che i dati non vengano deliberatamente condivisi. |
| **Funzioni della piattaforma** | Le funzioni basate su Data 360 di ogni organizzazione vengono eseguite in modo indipendente. | Nessuna condivisione automatica. Rischio di duplicazione se non accuratamente progettato. |
| Costo | Può ridurre la necessità di pipeline ETL. | Sostiene comunque il costo di più organizzazioni Data 360. Consuma crediti per le query sui dati e la condivisione dei dati. |
| Considerazione | Data Cloud One (Preferito per più organizzazioni) | Condivisione dei dati tra organizzazioni Data 360 |
|---|---|---|
| Singola fonte di verità | Sì: tutte le organizzazioni condividono un modello di dati. | No: ogni Data 360 ha il proprio modello di dati. |
| Conformità | Funziona solo quando la residenza consente la centralizzazione. | Necessario quando le leggi sulla residenza impediscono la centralizzazione. |
| Governance | Centralizzato, coerente. | Federato; condivisioni deliberate a livello di oggetto. |
| Complessità | Meno parti mobili, più semplice. | Più complesso: richiede condivisioni dati di configurazione e più organizzazioni Dati. |
| AI/Analytics | Modelli di intelligenza artificiale a livello aziendale. | AI regionale. Condividere gli approfondimenti in modo selettivo. |
| Funzioni della piattaforma | Shared Data 360 significa che tutte le funzioni funzionano in modo coerente in casa + compagni. | Le funzioni vengono eseguite in modo indipendente in ogni Data 360; la condivisione deve essere esplicita. |