| Tipo di schema | Modalità/Strumento | Vantaggi | Considerazioni | Esiti |
|---|---|---|---|---|
| Inserimento dati |
In tempo reale:
|
|
|
Agenteforce:
|
Streaming:
|
|
|
Agenteforce:
|
|
Lotto:
|
|
|
Agenteforce:
|
|
| Copia zero |
Query live:
|
|
|
Agenteforce:
|
Query accelerata (Caching):
|
|
|
Agenteforce:
|
|
Federazione file:
|
|
|
Agenteforce:
|
 #### Metodi di inserimento dati
I metodi _di inserimento dati_ possono variare a seconda del connettore utilizzato per inserire i dati. Alcuni connettori offrono una varietà di metodi di inserimento, mentre altri funzionano solo in modalità batch o streaming. Per un elenco completo dei connettori _Data 360_ e dei metodi disponibili, vedere [Data 360: Integrazioni e connettori](https://help.salesforce.com/s/articleView?id=data.c360_a_sources_targets.htm&type=5).
- **In tempo reale:**
- Fornisce l'inserimento al di sotto del secondo utilizzando _Acquisizione dati (CDC)_
- Adatto a flussi di lavoro sensibili al tempo (ad esempio, rilevamento di frodi, personalizzazione e cruscotti digitali operativi)
- Le funzioni spingono le trasformazioni e le aggregazioni all'interno di _Data 360_, il che consente di ridurre l'I/O a valle e ottimizzare l'utilizzo del calcolo
- Supporta l'utilizzo di CDC incrementale per ridurre al minimo lo shuffle dei dati
- **Streaming:**
- Fornisce l'inserimento ogni 1–3 minuti in piccoli incrementi
- Equilibrio tra freschezza e costo
- Adatto per l'orchestrazione delle campagne, il coinvolgimento quasi live e la generazione di rapporti operativi
- Supporta l'utilizzo di micro batch per controllare i picchi di I/O
- Aggrega i dati alla fonte (se possibile) per ridurre i volumi di trasferimento e ottimizzare l'archiviazione
- **Batch (carichi pianificati):**
- Fornisce l'inserimento periodico di serie di dati di grandi dimensioni (ad esempio, ogni ora, ogni giorno e ogni settimana)
- Offre efficienza e affidabilità in termini di costi per le serie di dati storiche, i rapporti normativi e i casi d'uso di conformità
- Garantisce che la località di calcolo si trovi nella stessa regione dello storage di origine per migliorare le prestazioni e ottimizzare i costi
#### Playbook architetto
- **Casi d'uso di inserimento dati:**
- **Generazione di profili unificati Customer 360.** Creare un'unica fonte di dati per le identità e gli attributi dei clienti.
- **Gestire le serie di dati di conformità ai regolamenti.** Imponi governance, discendenza e verificabilità per i dati sensibili.
- **Centralizzare l'orchestrazione delle campagne.** Assicurarsi che marketing, vendite e assistenza funzionino tutti da serie di dati coerenti e affidabili.
- **Pratiche di progettazione:**
- Consente l'inserimento in batch per esigenze storiche o tolleranti la bassa latenza (ad esempio, rapporti di archiviazione o istantanee periodiche).
- Utilizzare le API CDC o streaming per mantenere la freschezza dei flussi di lavoro operativi e di personalizzazione e garantire aggiornamenti quasi in tempo reale.
- Controllare la crescita dello storage e del calcolo applicando carichi incrementali per ottimizzare i costi e l'efficienza (anziché ricaricare intere serie di dati).
- Allineare le opportunità di inserimento in corso di realizzazione con la località di calcolo e l'elaborazione incrementale per ridurre gli I/O della rete.
- Applicare trasformazioni all'interno di _Data 360_ per evitare di spostare dati non elaborati inutilmente.
- **Considerazioni sui costi:**
- **L'inserimento in tempo reale** presenta i costi di calcolo e pipeline più elevati, il che può essere giustificato per flussi di lavoro sensibili al tempo e di valore elevato (ad esempio, personalizzazione, cruscotti digitali operativi o azioni basate su Agentforce).
- **L'inserimento streaming** ha costi di elaborazione e archiviazione moderati, che possono essere adatti per aggiornamenti frequenti che possono tollerare lievi ritardi (ad esempio, l'orchestrazione delle campagne o la generazione di rapporti operativi).
- **L'inserimento batch** ha costi di calcolo inferiori e memoria prevedibile, adatti per le serie di dati storiche o gli aggiornamenti a bassa frequenza. L'inserimento di dati batch da organizzazioni Salesforce utilizzando determinati connettori è gratuito.
- **Modalità di aggiornamento** Consente di selezionare la modalità di _aggiornamento incrementale_, che riduce i costi totali di inserimento e calcolo. In Salesforce, si consiglia di utilizzare _l'aggiornamento incrementale_ ove possibile per ottimizzare l'efficienza in tutti i tipi di inserimento.
- Il **costo** è influenzato anche dal volume di I/O dalla fonte a _Data 360_. L'ottimizzazione delle dimensioni dei batch, delle partizioni e dell'allineamento regionale riduce i costi di trasferimento e migliora le prestazioni.
- **Scenari di settore:**
- **Finanza:** Le serie di dati di inserimento sono necessarie per _conoscere il cliente_, _Antiriciclaggio (AML)_ e il rilevamento di frodi in cui la verificabilità e la conformità non sono negoziabili.
- **Assistenza sanitaria:** Utilizzare l'inserimento per la risoluzione dell'identità del paziente e i record conformi all'HIPAA, che consente visualizzazioni unificate e protette.
- **Dettaglio:** Consolidare i dati dei _punti vendita (POS)_, dell'eCommerce e dei programmi fedeltà in profili unificati per la segmentazione e la personalizzazione.
- **Telecom:** Supportare la prevenzione dell'abbandono e l'analisi dell'utilizzo con dati canonici degli abbonati regolati.
#### Criteri decisionali del metodo di inserimento dati
| Funzione | Inserimento in tempo reale | Inserimento streaming | Inserimento batch |
| :----------------------------------- | :------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------ | :------------------------------------------------------------------------------------------------------------------------------------------------------------ | :----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Latenza e freschezza** | Include l'inserimento di latenza al di sotto del secondo tramite le API di inserimento con supporto per l'_acquisizione dati (CDC)_. Fornisce opportunità in streaming continue. Adatto a casi d'uso operativi a bassa latenza. | Include l'inserimento di micro batch ogni 1–3 minuti tramite connettori nativi. Supporta gli aggiornamenti incrementali. È prevista una leggera latenza. | La latenza dei dati è prevista. Consente carichi pianificati a volume elevato. Include l'inserimento periodico (orario, giornaliero e settimanale). Non adatto per operazioni sensibili al tempo. |
| **Casi d'uso principali** | Ideale per casi d'uso operativi e di personalizzazione a bassa latenza. Utilizzare per i flussi di lavoro sensibili al tempo. Supporta i flussi di lavoro basati sugli eventi. Utilizzare per gli avvisi di frode in tempo reale e gli avvisi operativi. | Adatto per processi moderatamente urgenti. Utilizzare per l'orchestrazione delle campagne, il coinvolgimento quasi live e la generazione di rapporti operativi. Utilizzare per trigger campagna tempestivi. | Economico per serie di dati di grandi dimensioni. Affidabile per l'analisi storica. Utilizzare per l'aggregazione storica o i flussi di lavoro dei rapporti regolamentati. Adatto a serie di dati storiche o a bassa velocità. |
| **Complessità architettonica e I/O** | Include un costo elevato e un'architettura complessa. Richiede sistemi di origine a bassa latenza. I/O intensivo. Fonti a volume elevato possono causare pipeline sature. | Presenta un'architettura più semplice rispetto a quella in tempo reale. I/O è moderato. Adatto a schemi di aggiornamento prevedibili e ripetuti. Le dimensioni del batch influiscono sulla memoria e sul calcolo. | Facile da implementare. I/O intensivo durante le finestre di carico. La produttività della rete può diventare un collo di bottiglia per batch di grandi dimensioni. |
| **Considerazioni sui costi** | Include i costi di elaborazione e pipeline più elevati. Giustificabile solo per i flussi di lavoro di valore elevato e sensibili al tempo. | Include costi moderati di elaborazione e memoria. Offre un approccio bilanciato tra costo e freschezza. Adatto per aggiornamenti frequenti che possono tollerare lievi ritardi. | Offre costi di calcolo inferiori e memoria prevedibile. Consigliato per le serie di dati storiche o gli aggiornamenti a bassa frequenza. L'inserimento tramite pipeline interne Salesforce è gratuito. |
| **Processi di progettazione** | Utilizzare CDC incrementale per ridurre al minimo il rimescolamento dei dati. Filtrare e utilizzare i campi selettivi per ridurre il sovraccarico. | Utilizzare i micro batch per controllare i picchi di I/O. Considerare l'aggregazione con finestre per ridurre il carico di elaborazione. | Utilizzare per rapporti di archivio o istantanee periodiche. Assicurarsi che la località di calcolo si trovi nella stessa regione dello spazio di archiviazione sorgente per ottimizzare i costi. |
### Federazione dati copia zero
#### Casi d'uso copia zero
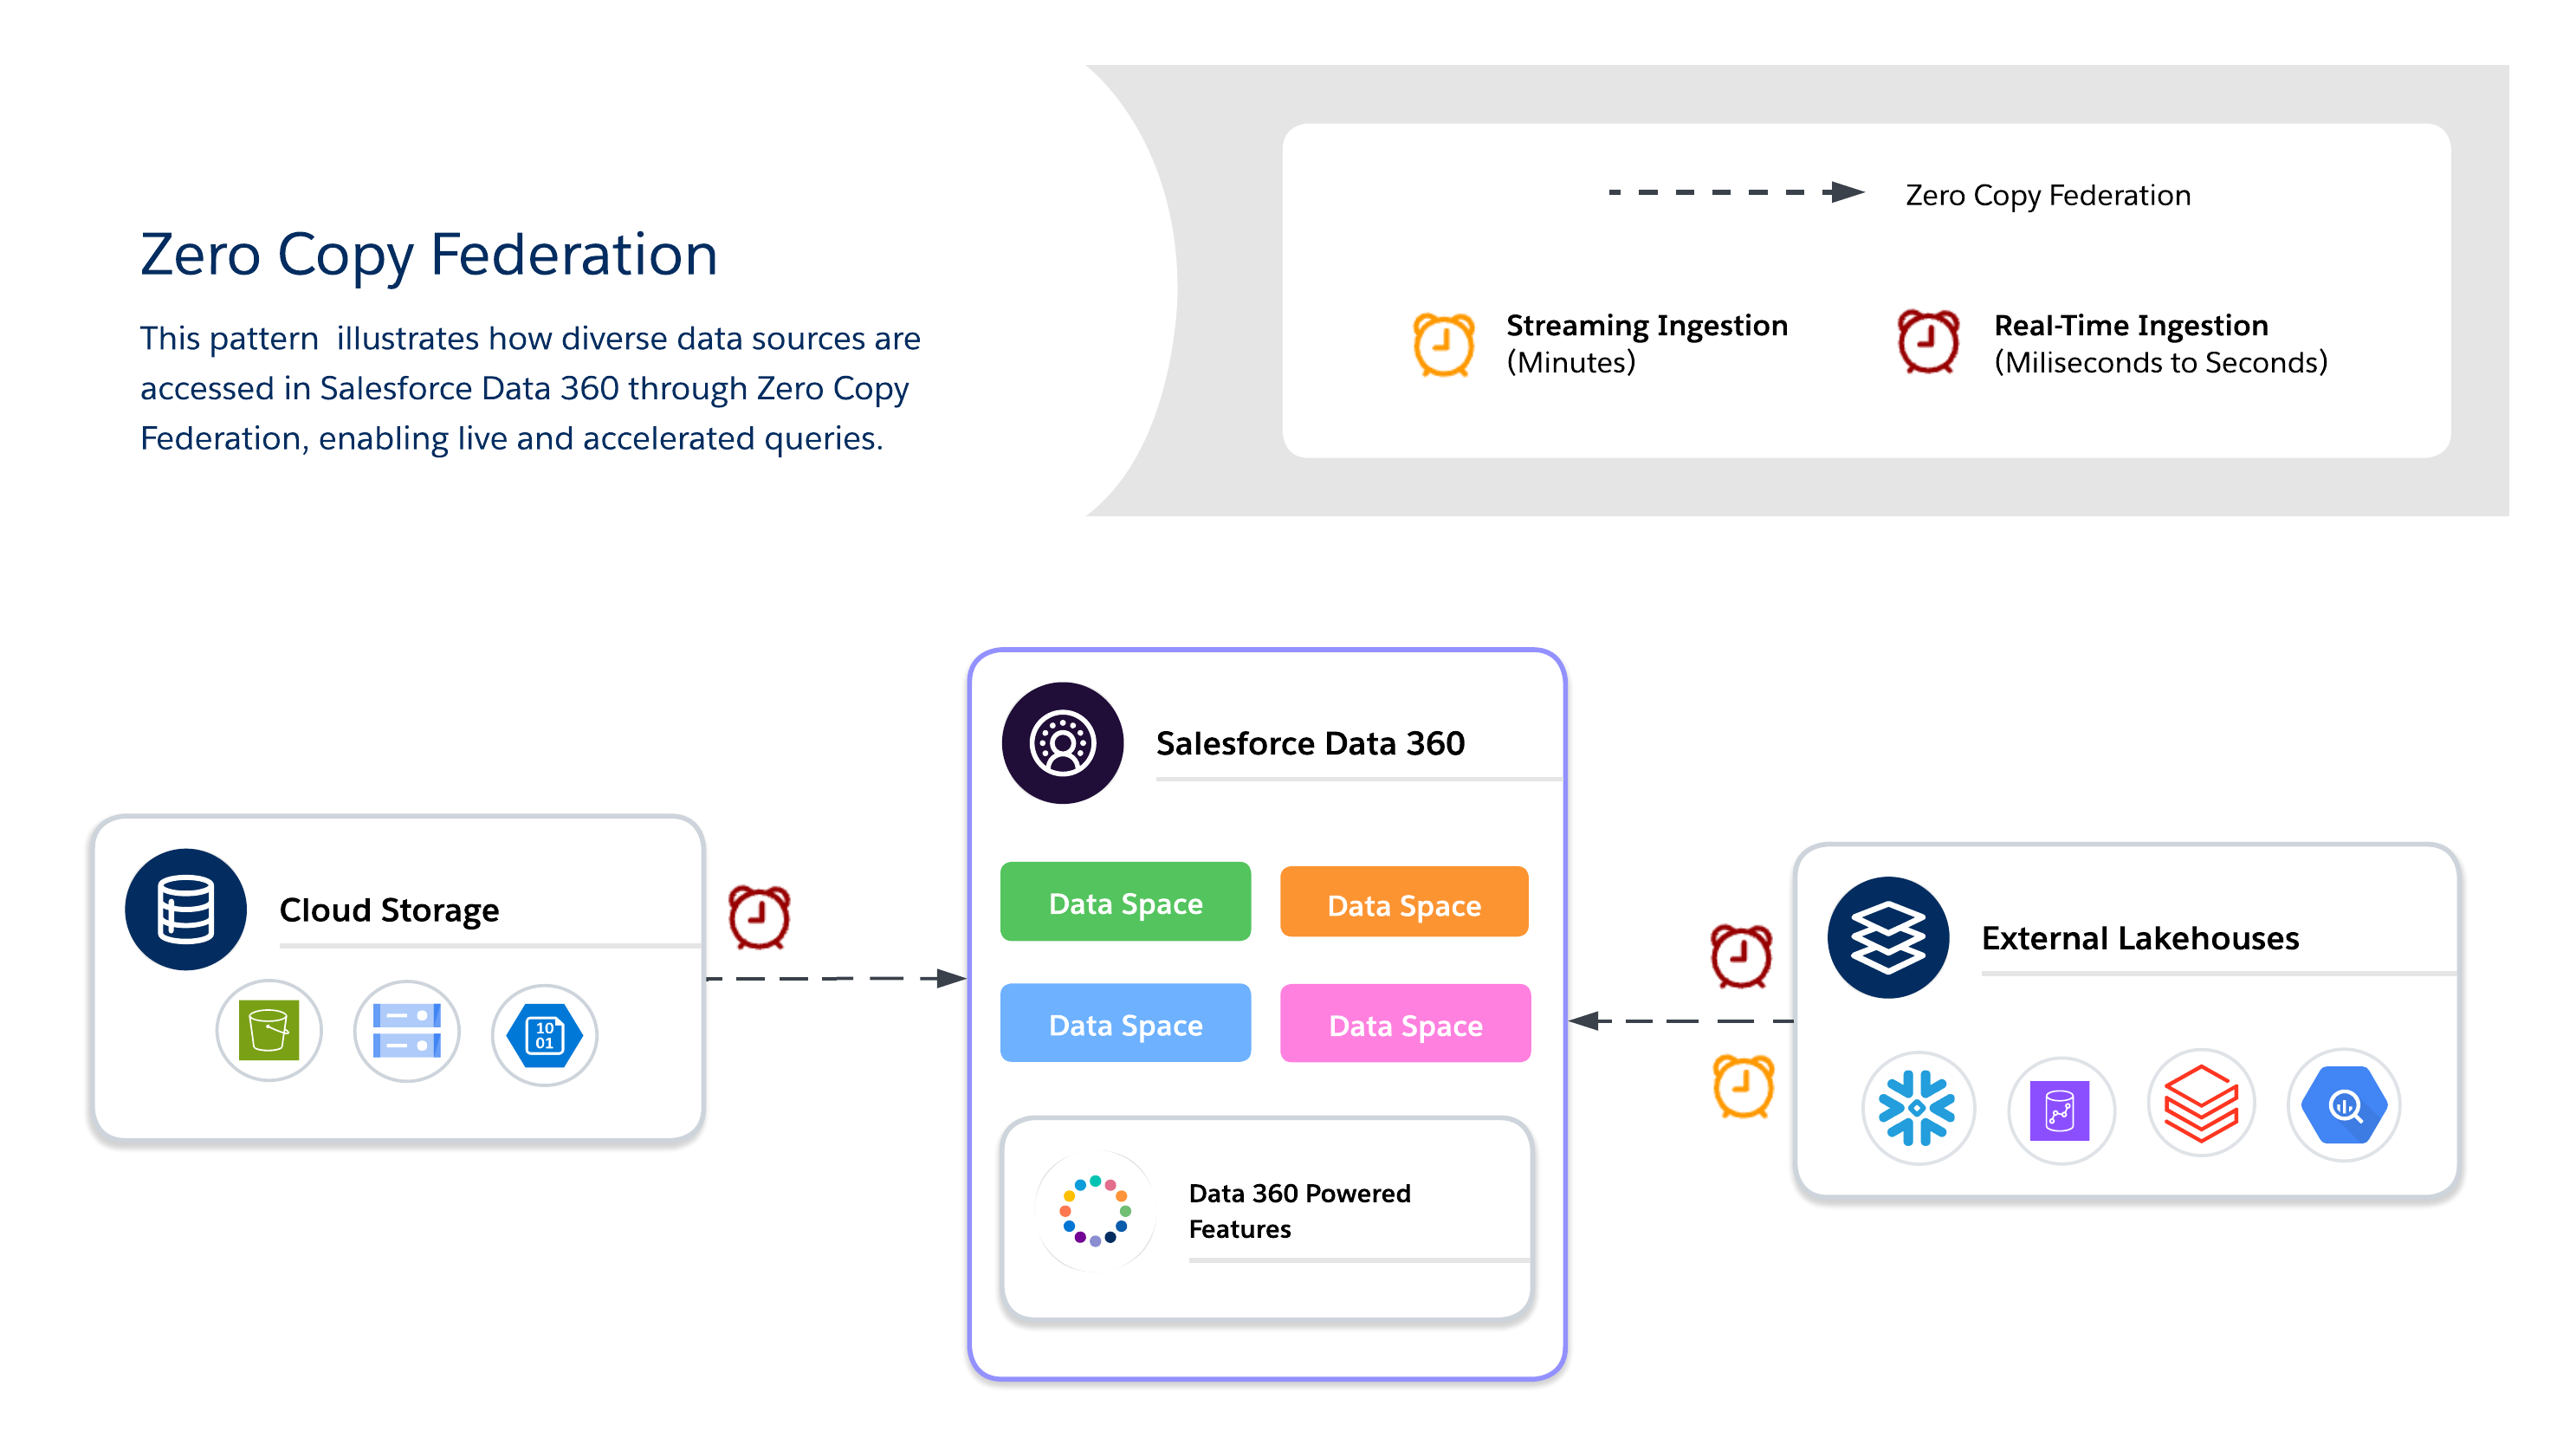
Utilizzare _Copia zero_ per eseguire query in tempo reale su sistemi esterni senza duplicazione dei dati per consentire agilità, freschezza e accesso scalabile a serie di dati di grandi dimensioni o temporanee. È adatto per cruscotti digitali live, analisi esplorative, formazione sui modelli AI/ML e coinvolgimento dei clienti in tempo reale direttamente tramite Salesforce _Data 360_.
 #### Metodi copia zero
Quando si utilizza _Zero Copy_, gli architetti devono scegliere tra tre metodi di federazione dei dati disponibili, ciascuno dei quali offre i propri compromessi tra freschezza, prestazioni e costo.
- **Query live**
- Esegue query direttamente sui sistemi esterni (ad esempio, _Snowflake_, _Google BigQuery_, _Redshift_, _Databricks_ e così via) senza duplicazione dei dati.
- Riduce al minimo lo spostamento dei dati sulla rete e riduce l'I/O nel calcolo di Salesforce _Data 360_, che è ottimale quando predicati e aggregazioni possono essere sottoposti a push.
- Adatto per approfondimenti in tempo reale e cruscotti digitali operativi a bassa latenza.
- Dipende dalle prestazioni del sistema esterno.
- **Caching (query accelerata)**
- Archivia temporaneamente le copie memorizzate nella cache dei dati federati in Salesforce _Data 360_.
- Riduce i costi di query ripetute e la latenza per le serie di dati a cui si accede di frequente con durata configurabile (da minuti a giorni).
- Poiché i dati non vengono copiati in modo permanente o completamente governati, l'aggiornamento viene gestito tramite aggiornamenti pianificati dall'origine.
- L'_aggiornamento incrementale_ supporta solo gli inserimenti con aggiornamento. I record eliminati non vengono rimossi dalla cache.
- Eseguire periodicamente un aggiornamento completo per assicurarsi che la cache rimanga sincronizzata con l'origine.
- **Nota:** Il connettore _Snowflake_ supporta la funzione _Scarica_, che migliora le percentuali di accelerazione utilizzando un bucket di gestione temporanea avviato da Snowflake. Questa opzione è abilitata per impostazione predefinita, ma può essere disabilitata modificando la connessione.
- **Federazione file**
- Fornisce accesso diretto in sola lettura alle serie di dati su larga scala negli archivi di oggetti (ad esempio, _S3_ e _GCS_ con _Iceberg_).
- Adatto per carichi di lavoro AI/ML, analisi storica e rapporti su scala petabyte senza spostare i dati.
- Le prestazioni delle query dipendono fortemente dal formato dell'oggetto, dal partizionamento e dall'ingresso/uscita di rete. Le analisi di grandi dimensioni possono generare I/O sostanziali se non sono ottimizzate.
#### Playbook architetto
- **Casi d'uso**
- La **personalizzazione in tempo reale e** i flussi di lavoro adattativi offrono offerte dinamiche, consigli e azioni Next Best quando cambiano i comportamenti dei clienti.
- I **cruscotti digitali live e** i cruscotti digitali e i KPI business critical vengono utilizzati direttamente dai magazzini esterni.
- L'**addestramento del modello AI/ML con serie di dati esterne di grandi dimensioni** sfrutta i dati su scala petabyte di data lake e magazzini senza spostarli tramite federazione file.
- **Scenari di settore**
- **Retail/Media:** Abilitare i consigli personalizzati e il coinvolgimento dei clienti in tempo reale federando i dati di clickstream o di interazione con i contenuti.
- **Finanza:** Eseguire il rilevamento delle frodi e il calcolo del punteggio del rischio quasi in tempo reale eseguendo query sui magazzini esterni senza duplicare dati sensibili.
- **Tecnologia/impresa:** Supportare i rapporti tra cloud, i cruscotti digitali dei servizi IT e l'analisi operativa quando le serie di dati risiedono in più sistemi.
- **Processi di progettazione**
- **Query live**
- Utilizzare per query con QPS elevato e bassa latenza quando la freschezza è critica.
- Inviare tramite push predicati e aggregazioni al sistema esterno per ridurre il rimescolamento dei dati sulla rete.
- Evitare query che eseguono inutilmente analisi di volumi di dati elevati.
- Considerare invece la potatura delle partizioni e i filtri.
- **Federazione file**
- Accedere alle serie di dati su scala petabyte negli archivi di oggetti senza inserimento.
- Ridurre al minimo i costi di latenza e uscita mantenendo lo spazio di archiviazione degli oggetti nella stessa area Cloud del calcolo Salesforce.
- Utilizzare formati partizionati e colonnari (Parquet/ORC) e filtri pushdown per ridurre il trasferimento di I/O e di rete.
- Sfruttare il pushdown di query e predicati per filtrare e aggregare i dati alla fonte, riducendo così lo spostamento dei dati.
- Evitare l'accesso ai dati tra regioni, a meno che non sia assolutamente necessario, perché aumenta I/O, latenza e costi.
- **Caching (query accelerata)**
- Inserire nella cache le serie di dati a cui si accede di frequente per bilanciare costi e prestazioni.
- Configurare gli intervalli di aggiornamento per bilanciare freschezza e costo delle query.
- **Conformità:** Applicare la governance all'origine sfruttando la _protezione a livello_ di riga e mascherando le policy direttamente all'interno dei sistemi federati.
- Di seguito sono riportate alcune procedure consigliate per uniformare l'RLS e il mascheramento tra le piattaforme:
- **Utilizzare un ID Enterprise centralizzato.** Mappare utenti ed entità in Salesforce _Data 360_ a un identificatore aziendale centralizzato univoco che corrisponde alle identità nei sistemi esterni.
- **Allineare le policy di sicurezza.** Assicurarsi che le policy di protezione dal traffico e mascheramento nei sistemi federati vengano applicate in base all'identità mappata. Ciò mantiene la conformità durante le query sui dati esterni.
- **Standardizzare gli schemi di identità.** Mantenere attributi di identità coerenti (email, ID utente, ID cliente e così via) in tutte le fonti di dati per evitare mancate corrispondenze e violazioni dell'accesso.
- **Considerazioni sui costi**
- **Query live:** Nel modello pay-per-query, i costi si accumulano per il calcolo delle case sul lago esterne, che può causare picchi con QPS elevato. Questo è adatto per i casi d'uso critici per la freschezza in cui il valore è maggiore della variabilità dei costi.
- **Query accelerata (Caching):** Questo metodo riduce il costo delle query (rispetto a _Live Query)_ riducendo gli attacchi al sistema di origine; tuttavia, aumenta i costi di inserimento dati batch per il riempimento e l'aggiornamento della cache. È adatto per le serie di dati a cui si accede di frequente.
- **Federazione file:** Questa è l'opzione di archiviazione più economica come dati nell'archivio oggetti; tuttavia, i costi delle query dipendono dalle dimensioni del file, dal partizionamento e dalla potatura. Questo è adatto per i dati storici o in blocco su scala petabyte.
#### Criteri decisionali metodo copia zero
| Punto Decisione | Live query | Caching (query accelerata) | Federazione file |
| :----------------------- | :---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | :--------------------------------------------------------------------------------------------------------------------------------------------------------- | :------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Posizione fonte di dati** | Case data lake esterni (ad esempio, _Snowflake_, _Google BigQuery_, _Redshift_ e _Databricks_) | Case data lake esterni (ad esempio, _Snowflake_, _Google BigQuery_, _Redshift_ e _Databricks_) | Object Store o data lake Cloud (ad esempio, _S3_, _ADLS_ e _GCS_), che spesso utilizzano formati di tabelle aperte come _Iceberg_. |
| **Scopo/Caso d'uso** | Adatto per analisi interattive e cruscotti digitali in tempo reale. Adatto alla personalizzazione in tempo reale e ai flussi di lavoro dinamici. | Adatto per quando le query sono frequenti, ma i risultati leggermente obsoleti sono accettabili. Adatto per cruscotti digitali BI e segmentazione. | Adatto per l'elaborazione batch su larga scala e l'addestramento del modello AI/ML. Adatto per analisi storiche e rapporti su scala petabyte. |
| **Freschezza/latenza** | Esegue le query direttamente in tempo reale. Supporta le decisioni al di sotto dei secondi quando il sistema di origine è ottimizzato per le query a bassa latenza con pushdown del predicato efficace. | Utilizzare quando i risultati leggermente obsoleti sono accettabili. La freschezza dipende dall'intervallo di cache, che è configurabile da 15 minuti a 7 giorni. | Adatto per lavori intensivi e con un'elevata produttività. Non adatto per il cruscotto digitale in tempo reale. |
| **Schema di accesso** | Adatto per query rare o ad hoc in cui la freschezza è fondamentale e il volume delle query è basso. I costi aumentano in modo significativo con QPS elevato, quindi è importante valutare il caching (query accelerata) quando la frequenza delle query è elevata. | Adatto a scenari di lettura ad alta frequenza. Migliora le prestazioni per gli schemi di accesso frequenti. | Fornisce l'accesso *di sola lettura*. Adatto per serie di dati su scala petabyte senza inserimento. |
| **Driver delle prestazioni** | Molto dipendente dalle prestazioni del sistema sorgente esterno. Adatto per quando predicati e aggregazioni possono essere inviati alla fonte. | Riduce la latenza rispetto alle query live ripetute. Le prestazioni dipendono dalla gestione della cache e dagli intervalli. | Le prestazioni dipendono fortemente dal formato dell'oggetto, dal partizionamento e dalla produttività del sistema esterno. Utilizzare formati partizionati e colonnari (Parquet/ORC). |
| **Implicazioni sui costi** | Questo è un modello pay-per-query, quindi i costi si accumulano sui calcoli delle case sul lago esterne. È conveniente per le query poco frequenti, ma le spese possono aumentare con un volume QPS elevato. | Il costo è inferiore rispetto alle query live ripetute. Riduce la necessità di eseguire ripetutamente query sulla fonte esterna, ma aggiunge memoria cache e sovraccarico di aggiornamento. | Questa è l'opzione di memoria più economica. Per le impostazioni AWS same-region e same-cloud (ad esempio, _S3_ in US-East-1 con un tenant _Data Cloud_ presente anche in US-East-1), i crediti non vengono consumati per le righe a cui si accede. Le configurazioni tra regioni o tra cloud (ad esempio, _Azure_, _GCS_ o regioni _AWS_ diverse) comportano il consumo di credito per le righe a cui si accede. I costi delle query dipendono anche dalle dimensioni del file, dal partizionamento e dall'ottimizzazione del pushdown del predicato. |
| **Considerazione chiave** | Evitare le query non filtrate che eseguono la scansione di volumi di dati elevati inutilmente. | Questo approccio richiede la gestione della cache. Non adatto per decisioni subsecondarie. | Le prestazioni delle query dipendono fortemente dall'ottimizzazione tramite partizionamento e pushdown del predicato. |
### Approccio ibrido
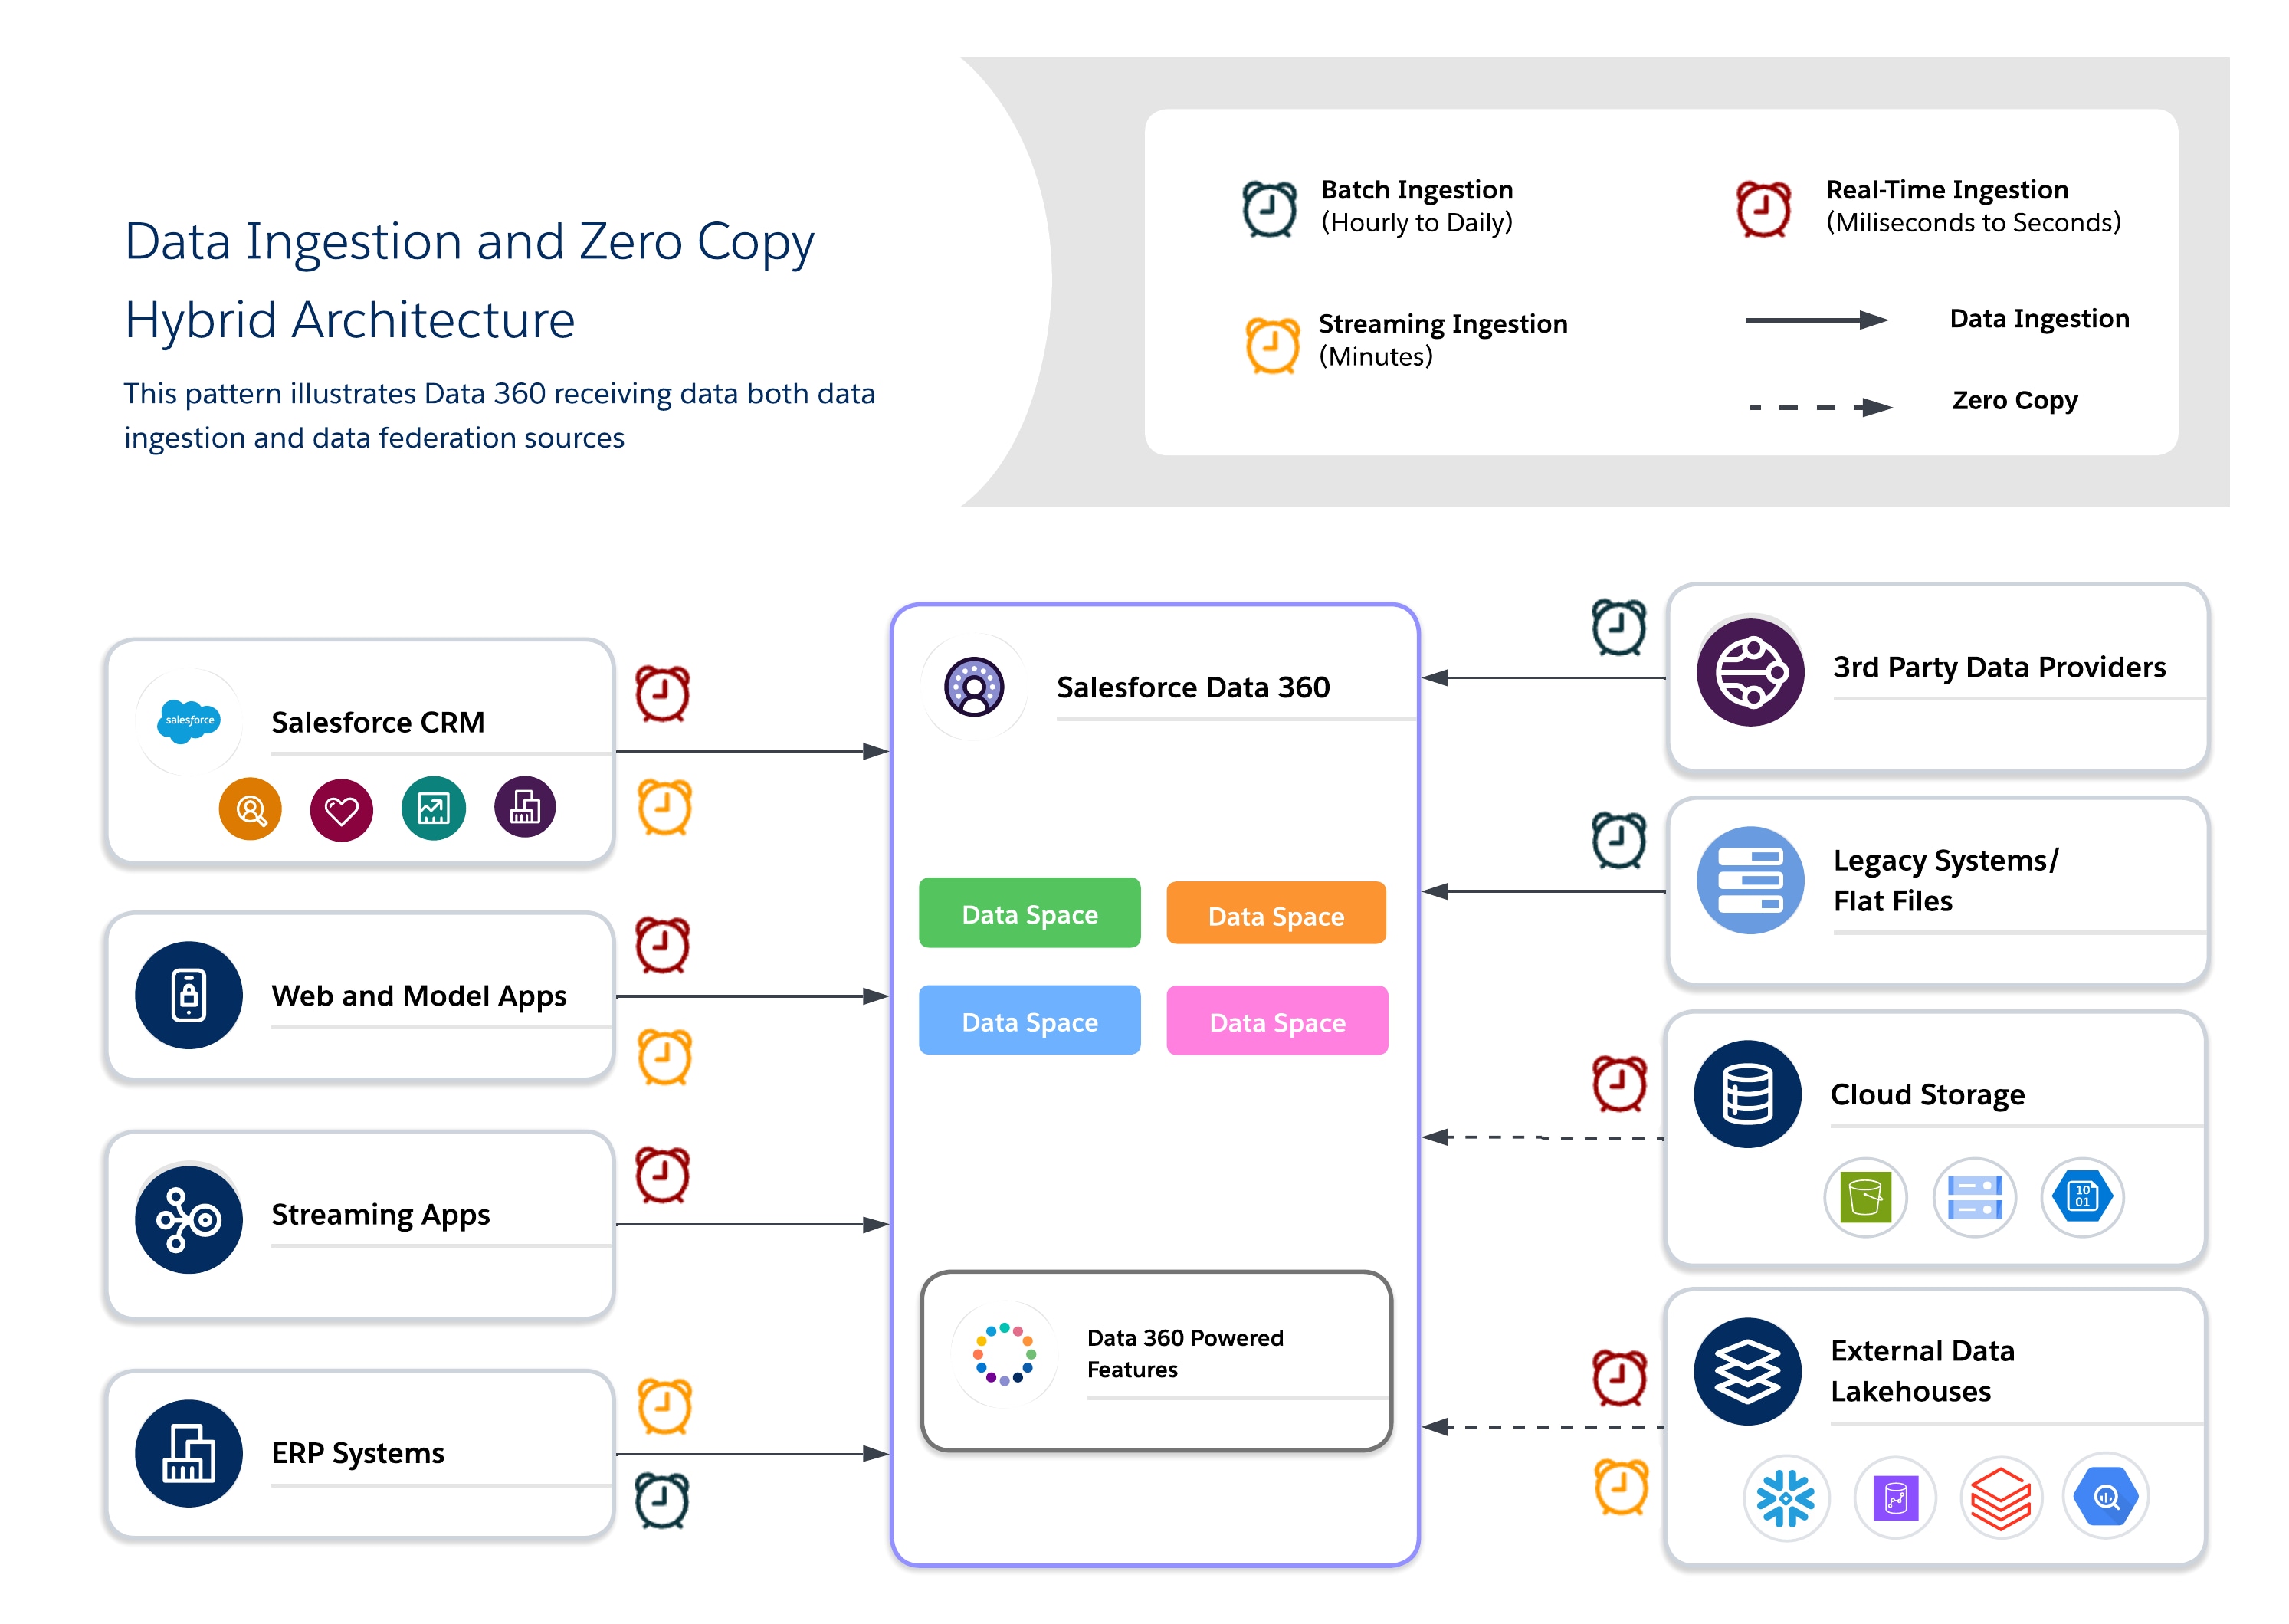
Le architetture ibride consentono agli architetti di ancorare le serie di dati critiche in _Data 360_ per una governance centralizzata, sfruttando al contempo le query federate per garantire freschezza, riduzione delle duplicazioni e accesso scalabile a serie di dati esterne di grandi dimensioni. Questo approccio bilancia I/O, località di calcolo, costi e requisiti di conformità.
#### Casi d'uso ibridi
Utilizzare un approccio ibrido per una governance equilibrata, freschezza ed efficienza operativa combinando l'inserimento dei dati e la copia zero per offrire approfondimenti fruibili in tempo reale. Utilizzare l'inserimento per le serie di dati regolamentate di valore elevato in cui sono richiesti tracciabilità, RLS e mascheramento e la federazione per le serie di dati effimere o a volume elevato in cui freschezza e prestazioni sono fondamentali.
 #### Playbook architetto
- **Casi d'uso**
- **Coinvolgimento Omnicanale:** Combinare i dati storici dei clienti con il comportamento in tempo reale per offrire esperienze coerenti e sensibili al contesto.
- **Condotte AI/ML:** Addestrare i modelli su serie di dati canoniche curate arricchendole con segnali grezzi o in tempo reale provenienti da fonti esterne.
- **Conformità mista e agilità richiedono:** Applicare una governance rigorosa per i dati sensibili e una federazione per l'agilità operativa.
- **Scenari di settore**
- **Dettaglio:** Utilizzare _l'inserimento_ per la risoluzione dell'identità e l'unificazione dei profili e _la federazione_ per le offerte e la personalizzazione in tempo reale.
- **Assistenza sanitaria:** Gestire i record paziente dorati tramite _inserimento_ utilizzando _federation sugli_ stream di dispositivi IoT e i dati dei sensori per il contesto immediato.
- **Servizi finanziari:** Inserire i dati regolamentati in un lago regolamentato dalla conformità utilizzando _federation_ per il rilevamento delle frodi esterne e le query di monitoraggio del rischio.
- **Processi di progettazione**
- **Ancora governance con inserimento:** Inserire dati di valore elevato o regolamentati nei modelli canonici per garantire Trust e conformità.
- **Utilizza Federation for Freshness:** Consente alle case sul lago esterne di fornire l'accesso ai dati in tempo reale o su larga scala senza duplicazioni.
- **Costo del bilanciamento rispetto alle prestazioni:** Profilare i carichi di lavoro per determinare quando utilizzare _l'inserimento_ rispetto alla _federazione_, riducendo al minimo i costi di archiviazione e query non necessari.
- **Applica governance a livelli:** Applicare una governance centralizzata per i dati inseriti sfruttando i controlli di sicurezza dei sistemi federati (ad esempio, RLS e mascheramento).
- **Nota:** Quando si progettano opportunità ibride in corso di realizzazione, è importante garantire l'inserimento incrementale delle serie di dati storiche e inviare aggregazioni push o filtri alle fonti federate per ottimizzare l'I/O e l'utilizzo del calcolo.
- **Considerazioni sui costi**
- Soppesare il costo totale rispetto alle prestazioni combinando _l'inserimento_ di dati critici o di conformità con la _federazione_ quando è necessario un aggiornamento.
- Tenere conto degli I/O e della distribuzione dei calcoli quando si combinano _inserimento_ e _federazione_. Per ridurre il costo di calcolo delle query ripetute rispetto ai sistemi di origine, utilizzare il caching (Query accelerata) per le serie di dati federate di lettura elevata e accesso frequente.
- Utilizzare questa regola per guidare la decisione di inserimento e federazione: quando l'accesso ai dati è frequente ma le modifiche non sono frequenti, la _query accelerata_ è in genere più conveniente. Tuttavia, quando i dati cambiano spesso (in base alla frequenza di accesso), è più appropriato eseguire _una Live Query_ o _un'inserimento_. Ecco alcuni esempi di costi:
- **L'accelerazione vince:** Un cruscotto digitale creato a partire da 1 milione di record e aggiornato quotidianamente con circa 10.000 modifiche viene visualizzato 20 volte al giorno. I costi _di accelerazione_ equivalgono a circa ~600 crediti/mese rispetto a ~4.200 crediti/mese per _le query live_.
- **La Live Query vince:** Segmenti pubblicati 20 volte al giorno utilizzando dati che cambiano ogni 30 minuti. _Le query live_ costano circa ~ 4.200 crediti/mese rispetto a ~ 28.800 crediti/mese per l'_accelerazione_ con questa frequenza di aggiornamento.
## Guida alle decisioni dei casi d'uso
Vediamo più in dettaglio alcuni archetipi comuni che illustrano come applicare questa logica.
- **L'archetipo "Un'unica fonte di verità": Centralizzare e gestire**
- **Scenario:** È necessario creare profili _Customer 360_ unificati conformi per l'intera azienda globale. I dati provengono da una dozzina di sistemi diversi, devono rispettare rigidi regolamenti _GDPR_ e _CCPA_ e fungeranno da fonte di verità per tutte le interazioni di marketing e servizio.
- **Schema consigliato:** **Inserimento dati.** La priorità qui è governance, Trust e controllo. L'inserimento dei dati in _Data 360_ è l'unico modo per creare un profilo canonico completamente controllabile e isolato dai sistemi di origine.
- Archetipo **di "Approfondimenti in tempo reale": Analisi senza spostamento**
- **Scenario:** Il team di data science deve eseguire query esplorative su una tabella di transazioni massiccia e in costante aggiornamento in _Snowflake_. Allo stesso tempo, il team direttivo desidera un cruscotto digitale _BI_ live basato sugli stessi dati. Lo spostamento giornaliero di petabyte di dati è lento e costoso.
- **Schema consigliato:** **Federazione copia zero.** La priorità in questo caso sono velocità, agilità ed efficienza economica su larga scala. _Zero Copy_ consente di sfruttare la potenza del data warehouse esistente per le query in tempo reale senza sovraccarico e latenza di duplicazione dei dati.
- Archetipo **di "Intelligenza ibrida": Governare il core, federare l'edge**
- **Scenario:** Si desidera arricchire i profili cliente governati e inseriti con segnali comportamentali in tempo reale (ad esempio, clic sul sito Web) provenienti da un data lake. È necessaria la stabilità del profilo centrale ma l'immediatezza dei dati live per favorire la personalizzazione immediata.
- **Schema consigliato:** **Un approccio ibrido.** Utilizzare _l'inserimento dati_ per creare un nucleo stabile governato per i dati dei clienti. Utilizzare _Copia zero_ per federare i dati volatili in tempo reale e unirli insieme al momento della query per una visualizzazione completa e aggiornata.
## Percorso in avanti
La strategia per i dati aziendali non si concentra più sulla scelta di un unico modello di integrazione, ma sull'architettura di una flessibilità controllata all'interno di un ecosistema di dati interoperabile. L'approccio corretto mappa ogni sistema di origine allo schema più adatto ai suoi requisiti di freschezza, governance, costo e accesso:
- Inserire serie di dati regolamentate mission-critical in Salesforce _Data Cloud_ per la conformità, la risoluzione dell'identità e i flussi di lavoro operativi.
- Federare i dati tramite _Zero Copy_ per analisi live, esplorative e basate sull'intelligenza artificiale senza duplicare l'archiviazione.
- Applicazione del _caching (query accelerata)_ per ridurre il carico del sistema di origine e il consumo di credito quando la frequenza delle query è alta e la frequenza di modifica dei dati è bassa
Salesforce _Data 360_ su _Hyperforce_ offre resilienza e scalabilità multiregione. La sua casa sul lago aperta con tabelle _Iceberg_ consente la separazione dei calcoli e l'interoperabilità con piattaforme come _Snowflake_, _Databricks_ e _S3 Iceberg,_ che costituisce la spina dorsale di un ecosistema di dati multi-cloud davvero interoperabile.
Man mano che gli ecosistemi di dati si evolvono, dobbiamo bilanciare costantemente freschezza, costo, prestazioni e conformità per mantenere l'agilità dell'architettura. Ecco perché è importante rendere la piattaforma a prova di futuro unificando i dati gestiti inseriti con accesso federato. Ciò consente l'intelligenza in tempo reale, l'attivazione dell'intelligenza artificiale e la personalizzazione su scala aziendale in cloud, regioni e domini aziendali.
Tenere presente che le soluzioni valide per tutti non sono adatte alla maggior parte delle aziende. La strategia ottimale mappa lo schema corretto al driver aziendale corretto.
## Informazioni sugli autori
**Yugandhar Bora** è un architetto di ingegneria del software di Salesforce specializzato in architettura dei dati all'interno della piattaforma Data and Intelligence Applications. Dirige iniziative dell'_Enterprise Architecture Review Board_ incentrate sulla governance dei dati e sui modelli di dati unificati, contribuendo anche alle soluzioni di provisioning automatico della piattaforma.
**Jan Fernando** è Principal Architect presso lo _Office of the Chief Architect (_OCA) di Salesforce, che è entrato a far parte di Salesforce nel 2012. Prima di entrare nell'OCA, ha trascorso oltre un decennio nell'organizzazione _Platform_, dove ha guidato diverse trasformazioni tecnologiche chiave.