
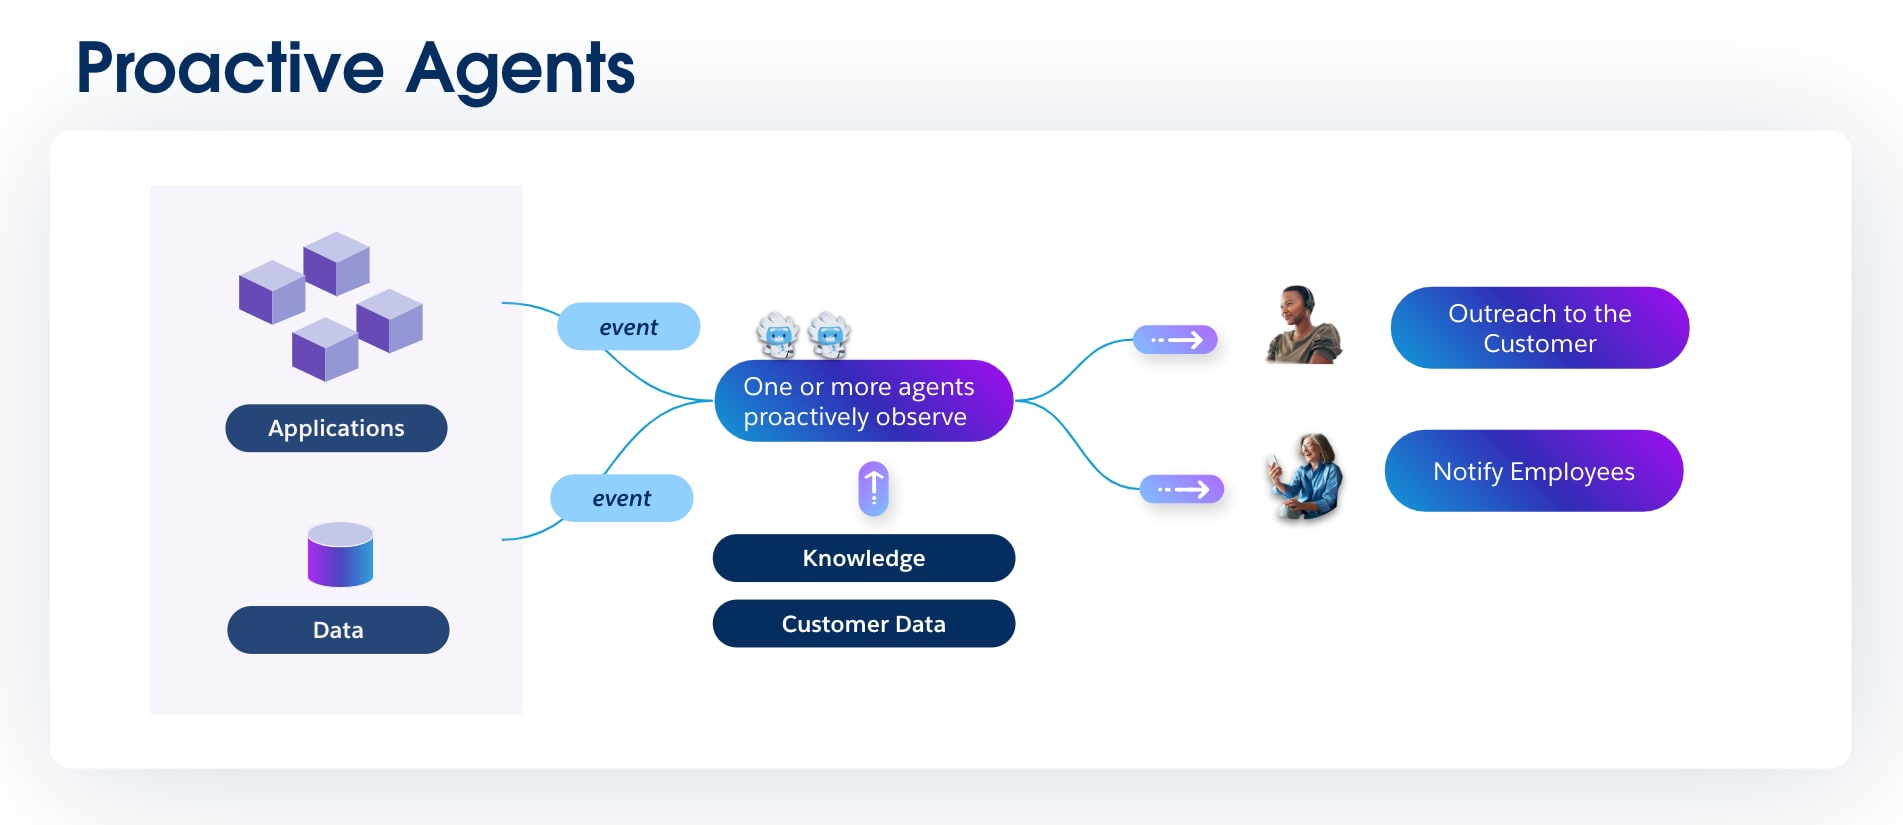
 ### 1.2 Proaktive Agenten
**Definition:** Im Gegensatz zu Unterhaltungsagenten, die auf eine Aufforderung warten, agieren proaktive Agenten als wachsame Beobachter. Sie werden durch bestimmte Ereignisse, Datenänderungen oder vordefinierte Bedingungen innerhalb eines Systems ausgelöst. Wenn sie ausgelöst werden, führen sie eine Aufgabe aus oder initiieren einen Workflow, ohne dass eine direkte Benutzerinteraktion erforderlich ist.
**Wichtigkeit:** Proaktive Agenten wandeln ein System von einem passiven Datenspeicher in einen aktiven Teilnehmer an Geschäftsprozessen um. Sie identifizieren Opportunities und Risiken, sobald sie entstehen, und ermöglichen es Unternehmen, auf wichtige Signale in Echtzeit zu reagieren.
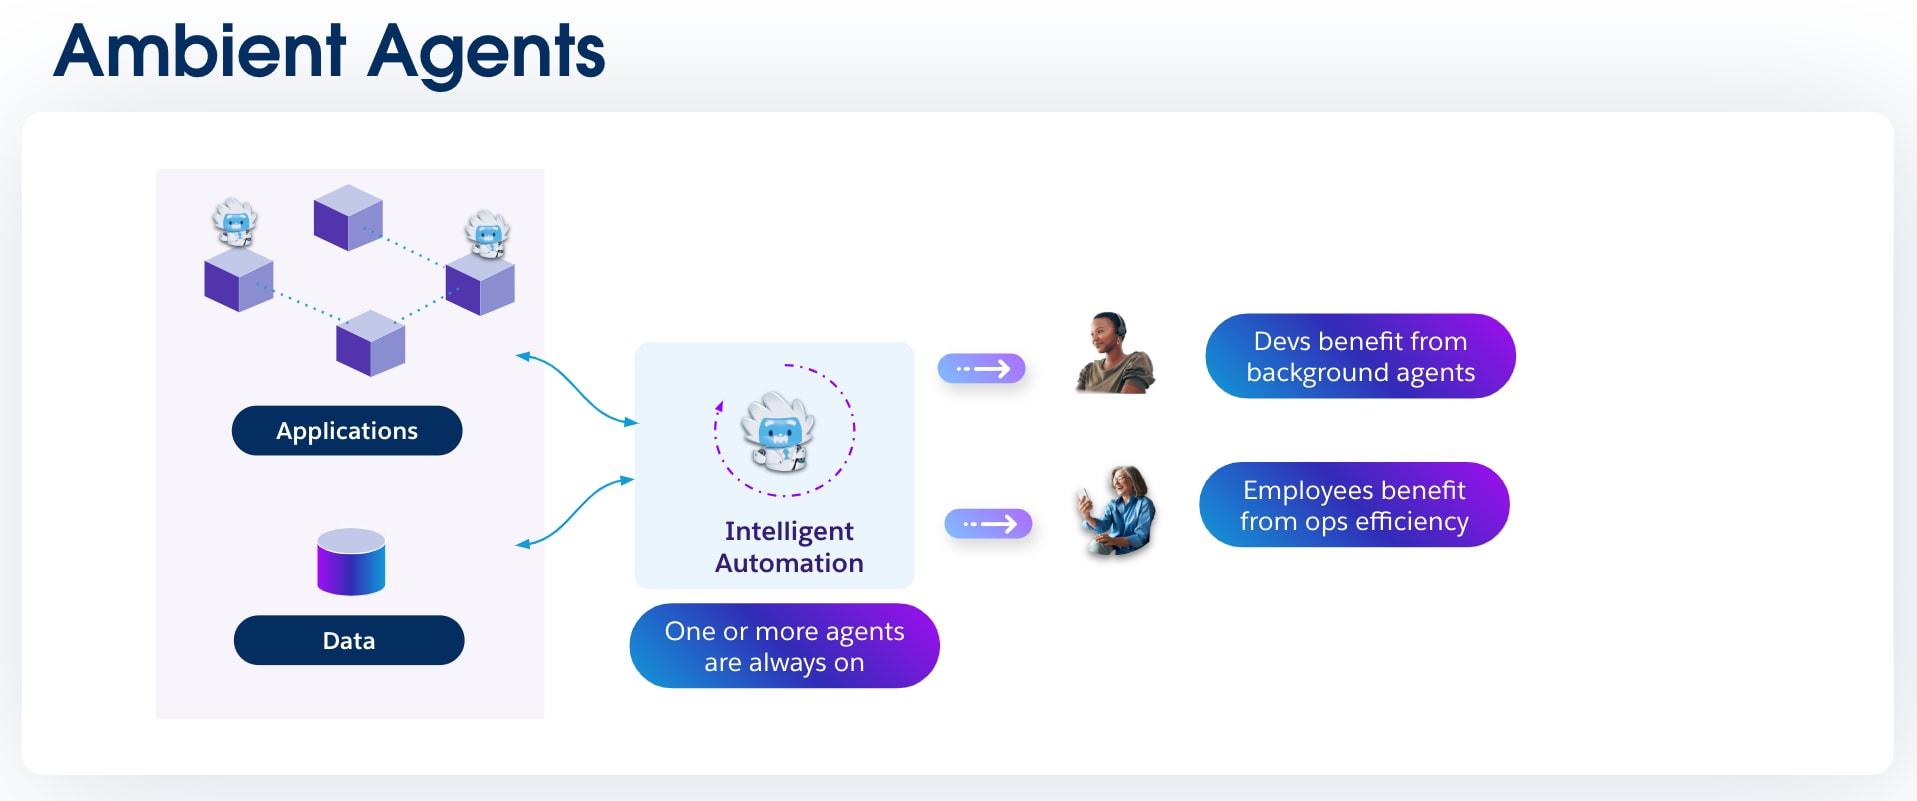
 ### 1.3 Umgebungsagenten
**Definition:** Umgebungsagenten sind ein bestimmter Typ proaktiver Agenten, die kontinuierlich im Hintergrund des Workflows eines Benutzers arbeiten, ohne explizite Befehle zu benötigen. Benutzer profitieren oft von ihren Aktionen, ohne sich ihrer Funktionsweise bewusst zu sein, da sie die menschlichen Fähigkeiten erweitern und gleichzeitig unauffällig bleiben.
**Wichtigkeit:** Das Ziel eines Umgebungsagenten besteht darin, die kognitive Belastung für Benutzer zu reduzieren, indem die alltägliche "Arbeit über Arbeit" automatisiert wird. Sie verbessern Prozesse, indem sie nahtlos in die Tools integriert werden, die Mitarbeiter täglich verwenden, und erfassen und strukturieren Informationen automatisch.
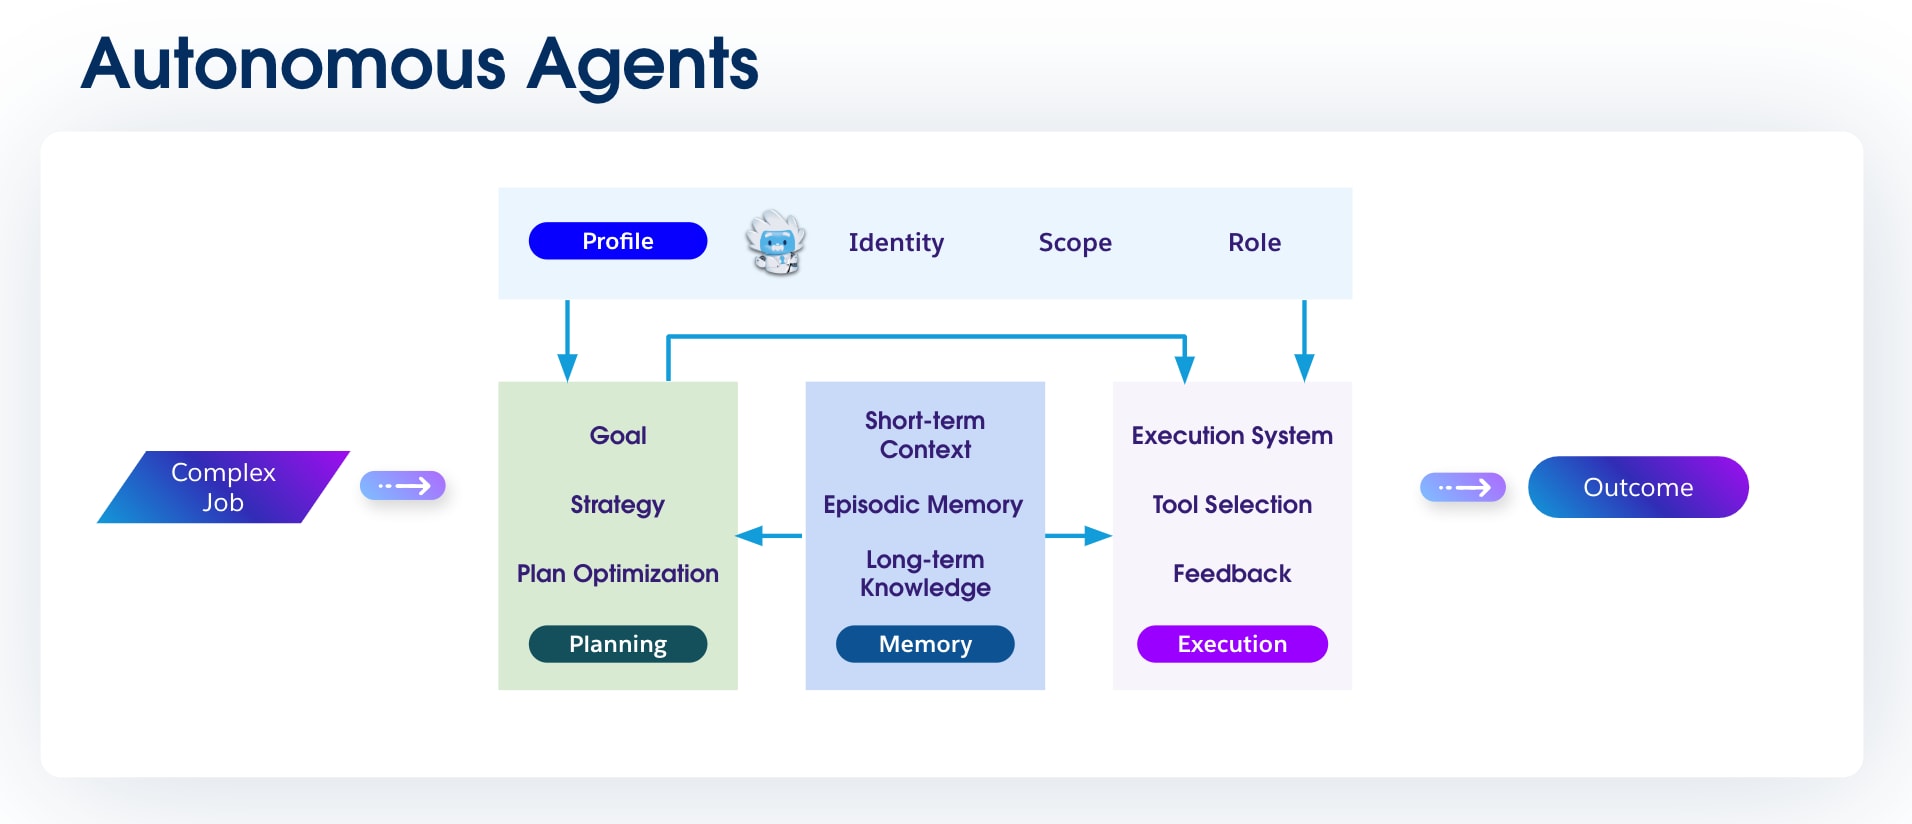
 ### 1.4 Autonome Agenten
**Definition:** Autonome Agenten stellen einen erheblichen Komplexitätssprung dar. Sie erhalten ein übergeordnetes Ziel und sind in der Lage, eine Sequenz von Schritten zur Erreichung dieses Ziels eigenständig zu planen und auszuführen. Sie können Überlegungen anstellen, Entscheidungen treffen und sogar aus ihren Aktionen lernen, um die Leistung im Laufe der Zeit zu verbessern.
**Wichtigkeit:** Das ist das, was wir einem echten digitalen Mitarbeiter am nächsten kommen. Autonomen Agenten kann ein komplexes, aus mehreren Schritten bestehendes Ziel wie "Generieren von 50 neuen qualifizierten Leads im Fertigungssektor in diesem Quartal" delegiert werden. Zudem kann darauf vertraut werden, dass sie einen Plan zur Erreichung dieses Ziels formulieren und ausführen.
 ### 1.5 Gemeinschaftliche Agenten (Agentenbearbeitung)
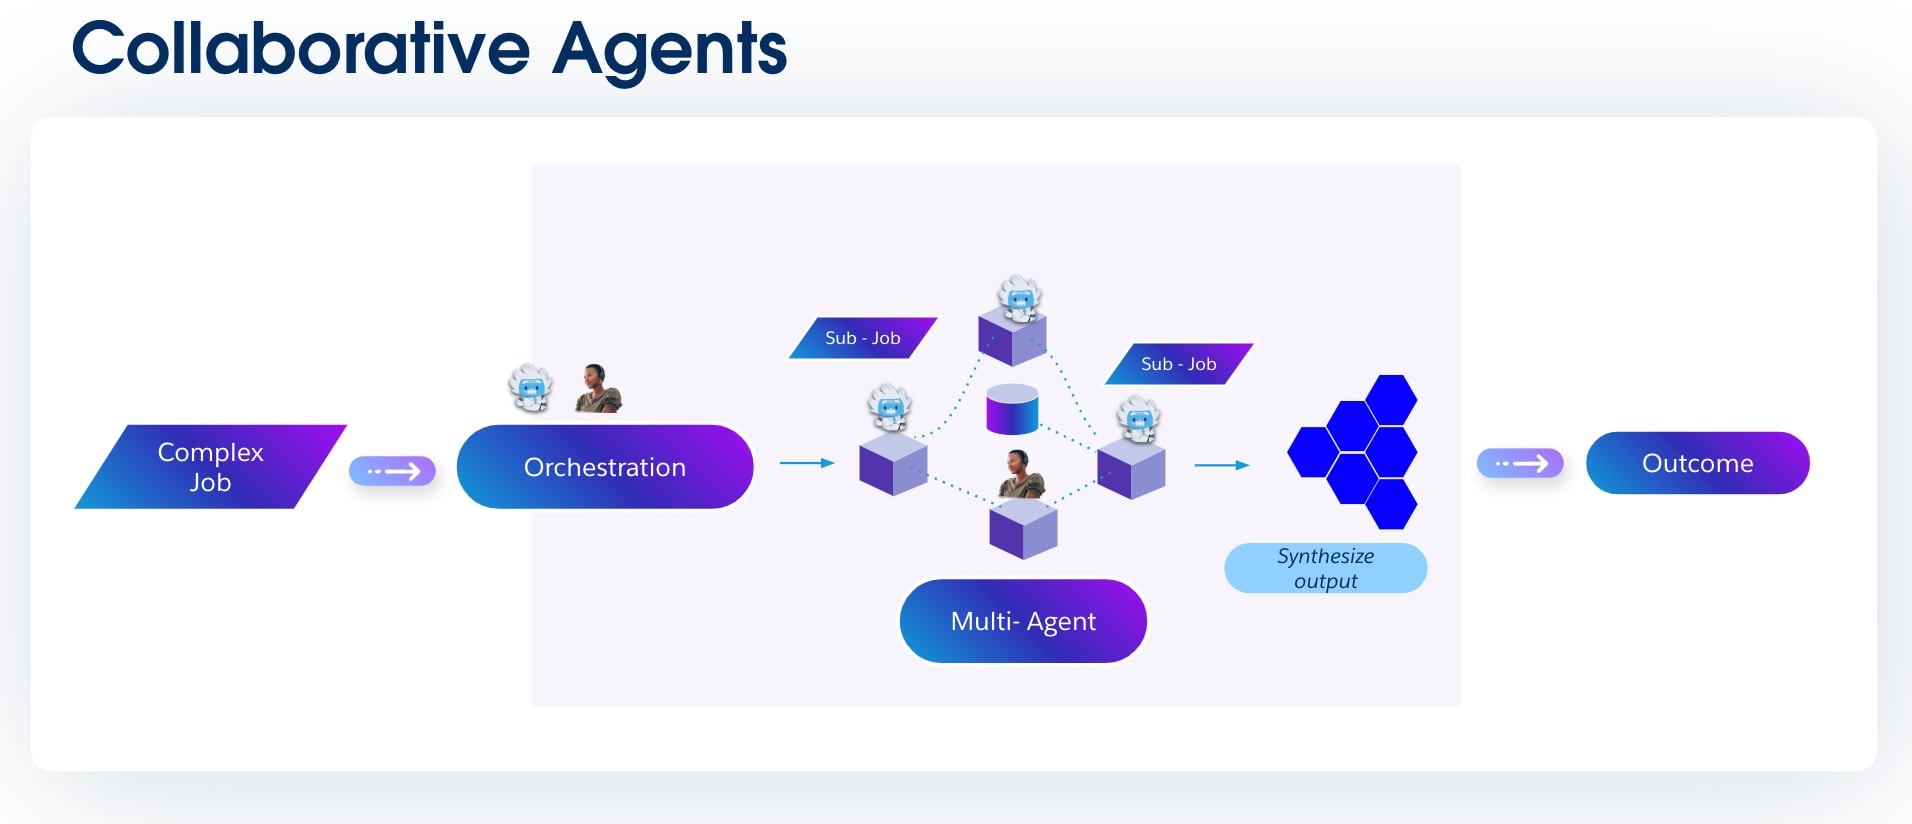
**Definition:** "Gemeinschaftliche Agenten", oft auch "Agentenbearbeitung" genannt, sind eine Sammlung spezialisierter Agenten, die zusammenarbeiten, um ein Problem zu lösen, das für einen einzelnen Agenten zu komplex ist. Ein "Orchestrator" oder "Master"-Agent zerlegt oft eine große Aufgabe, delegiert Teilaufgaben an die entsprechenden spezialisierten Agenten und synthetisiert dann ihre Ausgaben. Ein zuverlässiges Agent2Agent-Kommunikationsprotokoll (A2A) erreicht dies.
**Wichtigkeit:** Dieser Ansatz spiegelt ein menschliches Team wider. Durch Aufschlüsselung eines komplexen Problems kann jeder spezialisierte Agent seine einzigartigen Fertigkeiten einsetzen: Eine davon ist auf Datenanalysen spezialisiert, eine andere auf Kundenkommunikation und eine dritte auf Systemintegration, was zu einer robusteren und umfassenderen Lösung führt.
 ## Kapitel 2: Agentforce-Architekturmuster
Nachdem die Taxonomie von AI-Agenten untersucht wurde, bleibt eine entscheidende Frage: Wie kombinieren wir diese Elemente, um reale Geschäftsprobleme effizient und zuverlässig zu lösen? In diesem Kapitel wird diese Frage beantwortet, indem ein Repository mit gängigen Agenten-Designmustern bereitgestellt wird. Jedes Muster ist eine bewährte Lösung für eine wiederkehrende Herausforderung und bietet eine Blaupause für alles – von einfachen Einzweckagenten bis hin zu komplexen gemeinschaftlichen Agentenbearbeitungen.
### 2.1 Unterhaltungsagentenmuster
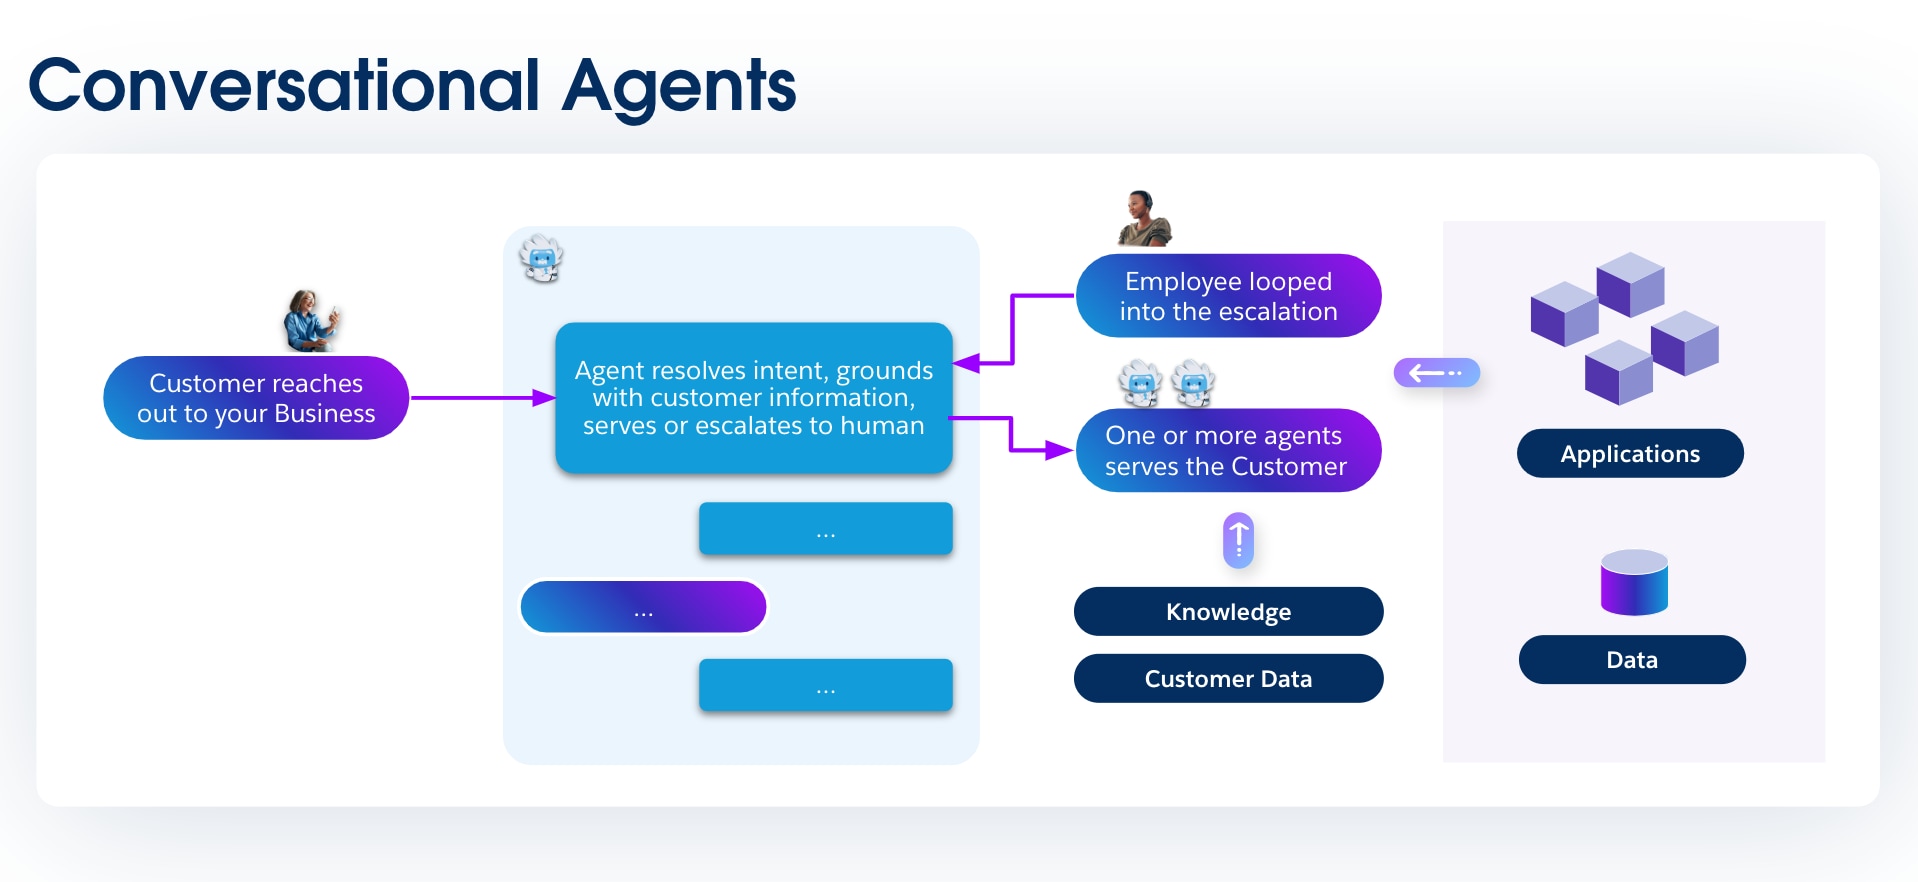
Unterhaltungsagenten sind oft die Eingangstür zu den AI-Funktionen einer Organisation. Sie zeichnen sich durch ihre Fähigkeit aus, in einem Dialog mit mehreren Runden zu interagieren, der als primäre Oberfläche fungiert, über die Benutzer Aufgaben ausführen und Informationen mithilfe natürlicher Sprache abrufen können. In diesem Abschnitt werden zwei wichtige Rezepte zum Erstellen von Unterhaltungsagenten vorgestellt, die jeweils auf einen bestimmten Kanal zugeschnitten sind: eine für den schnellen interaktiven Austausch von Messaging-Clients und eine andere für die strukturierte, asynchrone Natur von E-Mails.
Die Intelligenz eines Unterhaltungsagenten leitet sich von seiner Fähigkeit ab, zur richtigen Zeit auf die richtigen Daten zuzugreifen und sie zu begründen. Dieses Muster basiert auf einer komplexen Datengrundlage, die eine Verbindung mit Kundendatensätzen, Knowledge-Artikeln und Geschäftsanalysen herstellt. Die vollständigen wiederverwendbaren Rezepte für diese Integrationen sind in [Kapitel 4: Integrationsmuster](#kapitel-4-integrationsmuster-für-agenten) verfügbar.
#### 2.1.a Unterhaltungsagent: Client-Muster für interaktives Messaging
**Problem**
Kunden interagieren über viele digitale Kanäle hinweg und erwarten **sofortige, kontextbezogene und intelligente Antworten.** Herkömmliche Chatbots sind entweder **skriptbasiert** oder **datenblind,** was zu schlechter Personalisierung, frühzeitiger Eskalation für Menschen und hohen Servicekosten führt.
**Context**
- Ihre Organisation verfügt über digitales Engagement mit mehreren Kanälen (WhatsApp, SMS, Slack und Salesforce Experience Cloud).
- Die Kunden Ihrer Organisation interagieren in [mehreren Sprachen](https://help.salesforce.com/s/articleView?id=ai.service_agent_considerations.htm&type=5) mit Ihrer Organisation.
- Ihre Organisation muss Service- und Vertriebs-Workflows um Agenten erweitern, die:
- Abrufen von vertrauenswürdigen Kundendaten in Echtzeit
- Berücksichtigen von Leitplanken und Compliance-Anforderungen
- Eskalieren an menschliche Agenten nur bei Bedarf
 **Schlüsselkomponenten**
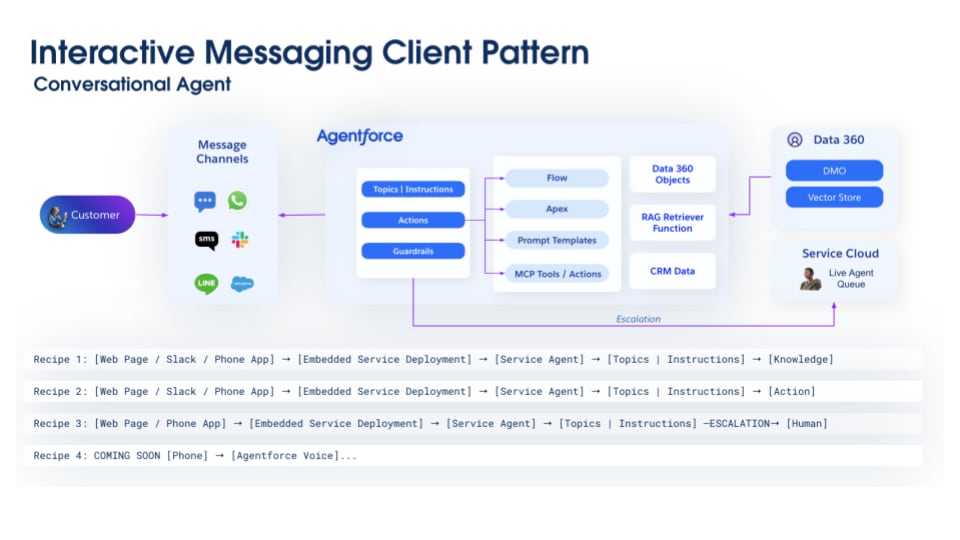
- **Kanalabstraktion:** Mit dem erweiterten Service Cloud-Chat (ehemals "Messaging in der Anwendung und online") kann der Agent über mehrere Kanäle hinweg über eine einzige Erfahrung kommunizieren.
- **Agentforce Serviceagent:** Das Verhalten und der Zweck des Agenten werden durch die folgenden Komponenten definiert.
- **Themen und Anweisungen:** Definiert die Persona und den Unterhaltungszweck des Agenten für die direkte Benutzerinteraktion. Dazu gehören die Kernaufgabe (z. B. "Sie sind Experte beim Lösen von Kundensupportproblemen"), Anweisungen zur Beibehaltung eines einfühlsamen und professionellen Tons und klare Leitplanken zum Umfang der Anfragen, zu deren Bearbeitung er berechtigt ist.
- **Aktionen:** Serviceorientierte Aktionen, bei denen es sich um Tools handelt, die der Agent verwendet, um Kundenprobleme in Echtzeit zu diagnostizieren und zu lösen. Diese Tools wurden entwickelt, um Aufgaben wie die Überprüfung des Status eines Auftrags, die Suche in einer Knowledge Base nach Lösungen oder die Erstellung eines neuen Support-Kundenvorgangs direkt über die Unterhaltungsoberfläche auszuführen.
- **Guardrails:** Leitplanken fungieren als eine Reihe konfigurierbarer Regeln und Laufzeitüberprüfungen, die das Verhalten des Agenten einschränken. Dient als Sicherheitsebene, die Aufforderungen abfangen, die vorgeschlagenen Aktionen des Agenten validieren und seine endgültige Antwort filtern kann, um schädliche Inhalte zu verhindern, Geschäftsregeln durchzusetzen und sicherzustellen, dass der Agent innerhalb seines angegebenen Umfangs arbeitet.
- **Aufforderungsvorlagen:** Wiederverwendbare Vorlagen, die über Briefvorlagenfelder oder semantische Daten aus Data 360 RAG Retrievers dynamisch mit Live-CRM-Daten ausgefüllt werden. Mit diesen Vorlagen können Agenten kontextbezogenen markenspezifischen Inhalt generieren, während die Einstein Trust Layer vertrauliche Informationen sicher maskiert, bevor die Anweisungen an die LLM gesendet werden.
- **Daten 360**
- Data 360-Komponenten, einschließlich DLOs, DMOs, Vektorspeichern und RAG-Abrufern, bieten dem Agenten eine einheitliche Ansicht aller relevanten Unternehmensdaten – von strukturierten Kundendatensätzen bis hin zu unstrukturierten Knowledge Artikeln. So wird sichergestellt, dass die Antworten genau und kontextbasiert sind.
- **Service Cloud**
- **CRM-Daten:** Verbindet den Agenten mit dem vollständigen Kundenvorgangsverlauf und bietet entscheidenden Kontext zu Accountdetails, Kontaktdatensätzen und Ansprüchen
- **Live Agent-Warteschlange:** Unterstützung für Eskalation und Weiterleitung an einen Mitarbeiter des menschlichen Service mit dem gesamten Unterhaltungskontext
**Interaktionen**
1. Der Kunde Ihrer Organisation initiiert die Unterhaltung über einen Kanal.
2. Die Nachricht wird an **Agentforce** weitergeleitet, das den Umfang (Themen) bestimmt und Leitplanken anwendet.
3. AI verfasst Antworten mithilfe von **Aufforderungsvorlagen,** während Flow oder Apex möglicherweise eine Backend-Logik auslösen.
4. Der Kontext wird über den RAG-Retriever aus **Data 360-Objekten,** Vektorspeichern und CRM abgerufen.
5. AI gibt eine kontextbezogene Antwort zurück.
6. Wenn die AI nicht aufgelöst werden kann, eskaliert die Unterhaltung zum **Service Cloud Live Agent.**
**Trade-Offs**
| Aspekt | Gewinn | Kosten |
|---|---|---|
| Antwortgeschwindigkeit | Sofortige Always-On-Antworten | Latenz von 2+ Sekunden für komplexe Abfragen |
| Genauigkeit | Basiert auf realen Daten über RAG | Erfordert einen gepflegten, aktuellen Vektorspeicher |
| Skalierbarkeit | Nahezu unbegrenzte Anzahl gleichzeitiger Unterhaltungen | Kosten müssen durch Zwischenspeichern, Qualifizieren und Filtern optimiert werden |
| Flexibilität | Verarbeitet offene Abfragen | Erfordert komplexe Aufforderungstechnik |
| Human Touch | Mitarbeiter des menschlichen Service bearbeiten nur komplexe Kundenvorgänge | Kundenfrustration bei falschen Eskalationsschwellenwerten |
| Unterhaltungsvielfalt | Große Anzahl an Intents, die unterschiedliche Knowledge, Fertigkeiten und Tools erfordern | Kontinuierliche Themen- und Anweisungenabstimmung erforderlich, um Genauigkeit und Latenz zu optimieren |
 **Schlüsselkomponenten**
- **E-Mail-Kanal:** Verarbeitet die Erfassung eingehender Nachrichten, das Analysieren ihrer Inhalte und Anhänge und die Aufrechterhaltung der Thread-Kontinuität, um asynchrone Unterhaltungen zu ermöglichen.
- **Agentforce SDR Agent:** Das Verhalten und der Zweck des Agenten werden durch die folgenden Komponenten definiert.
- **Themen und Anweisungen:** Definiert die Mission des Agenten, eingehende Leads durch Unterhaltung zu interagieren und zu qualifizieren. Dies beinhaltet Anweisungen zum Verständnis der Anforderungen potenzieller Kunden, zum Erfassen wichtiger Qualifikationsdaten (z. B. Budget, Autorität und Zeitachse) und zum Leiten der Unterhaltung hin zu einem klaren nächsten Schritt, beispielsweise der Planung einer Besprechung mit einem Kundenbeauftragten.
- **Aktionen:** Spezialisierte Vertriebsaktionen, mit denen der Agent den Leadlebenszyklus verwalten kann. Diese Tools wurden entwickelt, um zentrale SDR-Aufgaben auszuführen, beispielsweise das Anreichern von Leaddaten, das Senden von Folge-E-Mails mit Vorlagen oder die Integration in Kalendersysteme zum Buchen von Discovery-Anrufen.
- **Guardrails:** Leitplanken fungieren als eine Reihe konfigurierbarer Regeln und Laufzeitüberprüfungen, die das Verhalten des Agenten einschränken. Dient als Sicherheitsebene, die Aufforderungen abfangen, die vorgeschlagenen Aktionen des Agenten validieren und seine endgültige Antwort filtern kann, um schädliche Inhalte zu verhindern, Geschäftsregeln durchzusetzen und sicherzustellen, dass der Agent innerhalb seines angegebenen Umfangs arbeitet.
- **Aufforderungsvorlagen:** Wiederverwendbare Vorlagen, die über Briefvorlagenfelder oder semantische Daten aus Data 360 RAG Retrievers dynamisch mit Live-CRM-Daten ausgefüllt werden. Mit diesen Vorlagen können Agenten kontextbezogenen markenspezifischen Inhalt generieren, während die Einstein Trust Layer vertrauliche Informationen sicher maskiert, bevor die Anweisungen an die LLM gesendet werden.
- **Daten 360**
- Data 360-Komponenten, einschließlich DLOs, DMOs, Vektorspeichern und RAG-Abrufern, bieten dem Agenten eine einheitliche Ansicht aller relevanten Unternehmensdaten – von strukturierten Kundendatensätzen bis hin zu unstrukturierten Knowledge Artikeln. So wird sichergestellt, dass die Antworten genau und kontextbasiert sind.
- **Sales Cloud**
- **CRM-Daten:** Verbindet den Agenten mit dem vollständigen Kundenvorgangsverlauf und bietet entscheidenden Kontext zu Accountdetails, Kontaktdatensätzen und Ansprüchen
- **Terminbesprechung zwischen Kunde und SDR:** Die SDR Live Agent-Übergabe kann so konfiguriert werden, dass eine Live-Besprechung mithilfe der Aufgaben- und Besprechungsplanung (Nächste Aktionen) eingerichtet wird.
- **Aktivitätsprotokollierung:** Erfassen Sie Ereignisse, Aufgaben und E-Mail-Aktivitäten und verknüpfen Sie sie mit Leads, Accounts und Opportunities infolge von SDR-Agenteninteraktionen.
**Interaktionen**
1. Der Kunde sendet und empfängt E-Mails über den Kanal, der an Agentforce weitergeleitet wird.
2. Agentforce wendet Themen, Aktionen und Leitplanken zum Analysieren von Intents an.
3. Agentforce entwirft kontextbezogene Antworten mithilfe von Aufforderungsvorlagen, die mit CRM- und Data 360-Kontext angereichert sind.
4. Eine mehrfache E-Mail-Unterhaltung wird bis zur Lösung oder Richtlinien fortgesetzt.
5. Agentforce plant für qualifizierte Leads eine Besprechung und aktualisiert CRM.
6. Wenn der Intent den AI-Geltungsbereich überschreitet, eskaliert Agentforce zu Sales Cloud SDR für eine Antwort von Mitarbeitern des menschlichen Service.
**Trade-Offs**
| Aspekt | Gewinn | Kosten |
|---|---|---|
| Antwortgeschwindigkeit | < 5 min erstes Ansprechen (versus 8–24 Stunden) | Weniger personalisierte anfängliche Kontaktaufnahme im Vergleich zum Telefon |
| SDR-Kapazität | 2- bis 5-fache Erhöhung der Leadabdeckung | Verlust früher beziehungsaufbauender Kontaktpunkte |
| Qualifikationskonsistenz | Asynchrones Erfassen der Abdeckung von Budget, Autorität, Bedarf und Zeitachse | Kann nuancierte Signale übersehen |
| Inhaltsgenauigkeit | RAG gewährleistet aktuelle Informationen | Erfordert ein verwaltetes Vertriebsprodukt und eine Enablement-Bibliothek. Multiturn kann anstrengend sein |
| Besprechungskonvertierung | Deutlich höherer Umsatz | Einige Besprechungen mit Leads mit geringerer Qualität, wenn BANT-Lücken vorhanden sind |
| Kosteneffizienz | Kosteneffizienter als menschliche SDR | Entwicklungs- und Wartungskosten |
 **Schlüsselkomponenten**
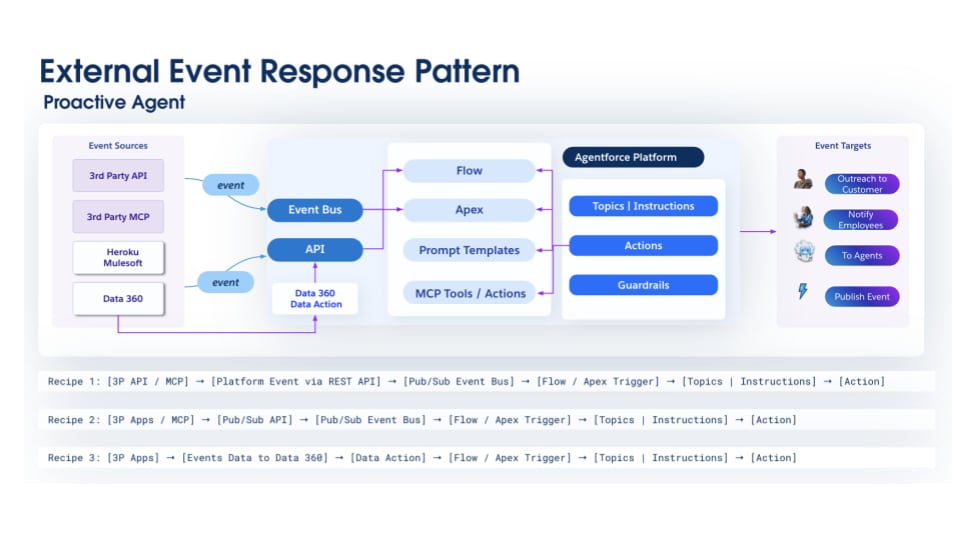
- **Ereignisquelle**
- Durch Datenaktion ausgelöste Ereignisse, nachdem externe Daten in Data 360 aufgenommen wurden
- MCP-Server von Drittanbietern oder Salesforce Heroku, die Ereignisse über die Salesforce Pub/Sub-API an Salesforce senden können
- Externe Anwendung, die Ereignisbenachrichtigungen über die Salesforce Pub/Sub-API senden kann
- **Optionale Middleware:** MuleSoft oder Data 360 für Transformationen
- **Agentforce Agent:** Das Verhalten und der Zweck des Agenten werden durch die folgenden Komponenten definiert.
- **Themen und Anweisungen:** Gibt die Kernaufgabe des Agenten und seine Auslöser an, einschließlich der Definition seines primären Ziels (z. B. "Überwachen Sie alle Kundenvorgänge mit hoher Priorität und verhindern Sie SLA-Verstöße"). Enthält die spezifischen Ereignisse oder Datenbedingungen, auf die der Agent achten sollte, um seine Aufgaben zu initiieren
- **Aktionen:** Durch Ereignisse ausgelöste und geplante Aktionen, die auf externe Ereignisse reagieren sollen. Diese Aktionen funktionieren zwar autonom für Routineaufgaben, beinhalten jedoch oft die Möglichkeit, Workflows zu orchestrieren, die menschliche Eingriffe beinhalten, und sie an Benutzer weiterzuleiten, um Szenarien zu überprüfen, zu genehmigen oder zu bearbeiten, die menschliches Urteilsvermögen erfordern.
- **Guardrails:** Leitplanken fungieren als eine Reihe konfigurierbarer Regeln und Laufzeitüberprüfungen, die das Verhalten des Agenten einschränken. Dient als Sicherheitsebene, die Aufforderungen abfangen, die vorgeschlagenen Aktionen des Agenten validieren und seine endgültige Antwort filtern kann, um schädliche Inhalte zu verhindern, Geschäftsregeln durchzusetzen und sicherzustellen, dass der Agent innerhalb seines angegebenen Umfangs arbeitet.
- **Aufforderungsvorlagen:** Wiederverwendbare Vorlagen, die über Briefvorlagenfelder oder semantische Daten aus Data 360 RAG Retrievers dynamisch mit Live-CRM-Daten ausgefüllt werden. Mit diesen Vorlagen können Agenten kontextbezogenen markenspezifischen Inhalt generieren, während die Einstein Trust Layer vertrauliche Informationen sicher maskiert, bevor die Anweisungen an die LLM gesendet werden.
- **Daten 360**
- Data 360-Komponenten, einschließlich **DLOs und DMOs,** die [von externen Systemen generierte](https://developer.salesforce.com/docs/data/data-cloud-int/guide/c360-a-create-eventbusconnector-data-stream.html) Ereignisdaten speichern und Streaming- oder Echtzeitstatistiken umwandeln und erstellen
- **Berechnete, Streaming-** und Echtzeitstatistiken stellen Agenten sofortige relevante Daten zu Kunden bereit. Dadurch wird eine präventive Problemlösung ermöglicht, wodurch die Eskalation abgemildert wird. **Datendiagramme** zeigen proaktiv Beziehungen und Statistiken aus unterschiedlichen Datenquellen an, wodurch Muster oder Anomalien, die für das Kundenengagement, die Aktivität und das Profil relevant sind, frühzeitig erkannt werden können.
- Der **Data 360-Vektorspeicher und RAG**-Abrufer bieten dem Agenten eine einheitliche Ansicht aller relevanten Unternehmensdaten und unstrukturierten Knowledge-Artikel, wodurch sichergestellt wird, dass die Antworten genau und kontextbasiert sind.
- **Ereignisziele**
- Mitarbeiter proaktiv benachrichtigen oder Kunden kontaktieren
- Erweiterbar auf Agenten (siehe Muster [für Umgebungsagenten](#23-umgebungs-agentenmuster) und [autonome Agenten](#25-autonome-agentenmuster))
**Interaktionen**
1. Im externen System findet eine erhebliche Änderung statt.
2. Das externe System sendet ein Ereignis aus und veröffentlicht es über die API (erstellt ein Plattformereignis) oder die Pub/Sub-API im Salesforce-Ereignis-Bus oder Ereignisdaten werden an Data 360 gestreamt.
3. Abonnenten des Ereignisses werden ausgelöst. Ein Flow wird ausgelöst.
4. Der Flow ruft die [Agentenaktion](https://help.salesforce.com/s/articleView?id=platform.automate_flow_ref_elements_actions_generate_ai_agent_response.htm&type=5) mit den Ereignisdaten auf. Der Agent bestimmt die richtige Vorgehensweise und führt sie aus.
5. Das Ergebnis ist, dass eine Benachrichtigung oder ein Workflow ausgelöst wird. Benachrichtigungen werden einem Benutzer in einem Tool für die Zusammenarbeit (z. B. Slack) zugestellt. Aufgaben oder Ereignisse werden ebenfalls generiert. Außerdem können Aktionen externe Systeme aufrufen. Die Ereignisse gehen daher nicht verloren, sondern werden proaktiv ausgeführt, signalisiert und umgesetzt, wodurch menschlicher Aufwand oder komplexe Automatisierungen zum Erkennen der Ereignisse entfallen.
**Trade-Offs**
| Aspekt | Gewinn | Kosten |
|---|---|---|
| Echtzeitintegration | Ereignisse lösen Aktionen innerhalb von Sekunden aus. | API-Eingangskomplexität (Partner-SLA-Variabilität) |
| Intelligente Antwort | AI-gestützte Entscheidungen mit CRM und externem Kontext | Durch die Anreicherung werden Latenz- und veraltete Daten hinzugefügt (z. B. Ereignisse außerhalb der Reihenfolge). |
| Lose Kupplung | Externe Systeme unabhängig von Salesforce-Logik | Die asynchrone Verarbeitung führt schließlich zu Konsistenz. |
| Skalierbarkeit | Verarbeitet Burst-Ereignisse | API-Obergrenzen, Ereignisspeicherkosten |
| Bidirektional | Salesforce kann auf externe Systeme reagieren. | Externe API-Abhängigkeiten, Fehlerszenarien |
| Sicherheit | Signierte überprüfte Ereignisse, Zugriff mit den geringsten (oder null) Berechtigungen durch externe Systeme | Wiedergabeschutz, Schlüsselrotation und operativer Overhead |
 **Schlüsselkomponenten**
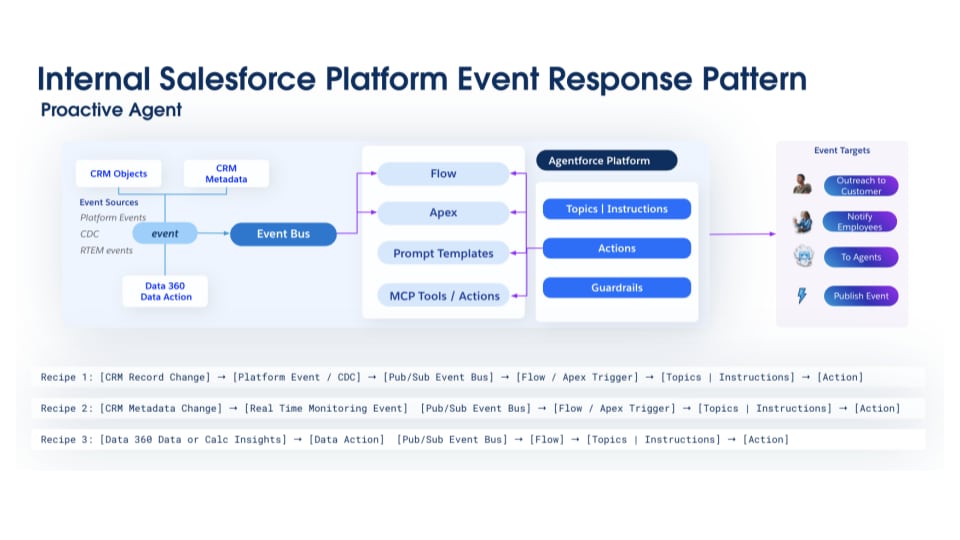
- **Ereignisquellebene**
- CRM-Daten, Plattformereignisse, CDC-Daten (Change Datenerfassung) und RTEM-Daten (Real-Time Event Monitoring) aus Plattformaktivitäten auf niedriger Ebene
- **Daten 360**
- Data 360-Komponenten, einschließlich **DLOs und DMOs,** die [durch CRM- oder Plattformereignisse generierte](https://developer.salesforce.com/docs/data/data-cloud-int/guide/c360-a-create-eventbusconnector-data-stream.html) Ereignisdaten speichern und Streaming- oder Echtzeitstatistiken umwandeln und erstellen
- **Berechnete, Streaming-** und Echtzeitstatistiken stellen Agenten sofortige relevante Daten zu Kunden-, Mitarbeiteraktivitäts- oder Metadatenänderungen im System bereit. Dadurch wird eine präventive Problemlösung ermöglicht, wodurch die Eskalation abgemildert wird. Durch diese Echtzeit-Situationsbewusstsein können Agenten zeitnahe Interventionen für die Verwaltung und den operativen Compliance-Durchsatz bereitstellen.
- **Datendiagramme** zeigen proaktiv Beziehungen und Statistiken aus unterschiedlichen Datenquellen an, wodurch Muster oder Anomalien, die für das Kundenengagement, die Aktivität und das Profil relevant sind, frühzeitig erkannt werden können.
- Der **Data 360-Vektorspeicher und RAG**-Abrufer bieten dem Agenten eine einheitliche Ansicht aller relevanten Unternehmensdaten und unstrukturierten Knowledge-Artikel, wodurch sichergestellt wird, dass die Antworten genau und kontextbasiert sind.
- **Agentforce Agent:** Das Verhalten und der Zweck des Agenten werden durch die folgenden Komponenten definiert.
- **Themen und Anweisungen:** Gibt die Mission des Agenten an, Geschäftsregeln durchzusetzen und Prozesse anhand von Datenänderungen in Salesforce zu automatisieren. Sie definiert das Ziel des Agenten (z. B. "Sicherstellen, dass alle Opportunities mit einem primären Kontakt aktualisiert werden, bevor die Verhandlungsphase erreicht wird") und die spezifischen Datensatzerstellungen, Feldaktualisierungen usw., die den Agenten auslösen.
- **Aktionen:** Durch Ereignisse ausgelöste und geplante Aktionen, die auf interne Salesforce-Ereignisse reagieren sollen. Diese Aktionen funktionieren zwar autonom für Routineaufgaben, beinhalten jedoch oft die Möglichkeit, Workflows zu orchestrieren, die menschliche Eingriffe beinhalten, und sie an Benutzer weiterzuleiten, um Szenarien zu überprüfen, zu genehmigen oder zu bearbeiten, die menschliches Urteilsvermögen erfordern.
- **Guardrails:** Leitplanken fungieren als eine Reihe konfigurierbarer Regeln und Laufzeitüberprüfungen, die das Verhalten des Agenten einschränken. Dient als Sicherheitsebene, die Aufforderungen abfangen, die vorgeschlagenen Aktionen des Agenten validieren und seine endgültige Antwort filtern kann, um schädliche Inhalte zu verhindern, Geschäftsregeln durchzusetzen und sicherzustellen, dass der Agent innerhalb seines angegebenen Umfangs arbeitet.
- **Aufforderungsvorlagen:** Wiederverwendbare Vorlagen, die über Briefvorlagenfelder oder semantische Daten aus Data 360 RAG Retrievers dynamisch mit Live-CRM-Daten ausgefüllt werden. Mit diesen Vorlagen können Agenten kontextbezogenen markenspezifischen Inhalt generieren, während die Einstein Trust Layer vertrauliche Informationen sicher maskiert, bevor die Anweisungen an die LLM gesendet werden.
- **Ereignisziele**
- Benachrichtigen Sie Mitarbeiter proaktiv oder kontaktieren Sie Kunden.
- Erweiterbar auf Anrufe anderer Agenten (siehe Muster [der Umgebungs-AI](#23-umgebungs-agentenmuster) und [der autonomen AI](#25-autonome-agentenmuster))
**Interaktionen**
1. Im internen System findet eine erhebliche Änderung statt, beispielsweise eine Aktualisierung eines CRM-Datensatzes, eine Metadatenänderung oder eine über Data 360 ausgelöste Datenaktion.
2. Das interne System sendet ein Ereignis aus und veröffentlicht es über die API (erstellt ein Plattformereignis) oder die Pub/Sub-API im Salesforce-Ereignis-Bus. Alternativ werden Ereignisdaten an Data 360 übertragen.
3. Abonnenten des Ereignisses werden ausgelöst und aktivieren einen Flow oder Apex.
4. Der aktivierte Flow oder Apex ruft die [Agentenaktion auf](https://help.salesforce.com/s/articleView?id=platform.automate_flow_ref_elements_actions_generate_ai_agent_response.htm&type=5).
5. Das Ergebnis ist, dass eine Benachrichtigung oder ein Workflow ausgelöst wird. Benachrichtigungen werden einem Benutzer in einem Tool für die Zusammenarbeit (z. B. Slack) zugestellt. Aufgaben oder Ereignisse werden ebenfalls generiert. Außerdem können Aktionen externe Systeme aufrufen.
6. Die Ereignisse gehen daher nicht verloren, sondern werden proaktiv ausgeführt, signalisiert und umgesetzt, wodurch menschlicher Aufwand oder komplexe Automatisierungen zum Erkennen der Ereignisse entfallen.
**Trade-Offs**
| Aspekt | Gewinn | Kosten |
|---|---|---|
| Echtzeitintegration | Ereignisse lösen Aktionen innerhalb von Sekunden aus. | Weitere Ebenen können für eine einfache Ereignisverarbeitung zu Latenzen führen. |
| Intelligente Antwort | AI-gestützte Entscheidungen mit CRM und externem Kontext | Durch die Anreicherung werden Latenz- und veraltete Daten hinzugefügt (z. B. Ereignisse außerhalb der Reihenfolge). |
| Lose Kupplung | Auffächern (mehr Abonnenten) und Erweitern | Die asynchrone Verarbeitung führt schließlich zu Konsistenz zwischen Abonnenten. |
| Skalierbarkeit | Verarbeiten von Burst-Ereignissen | API-Obergrenzen |
| Sicherheit | Von der Plattform bereitgestellte Trust Layer | Nicht verhandelbarer operativer Overhead |
| Aspekt | Gewinn | Kosten |
|---|---|---|
| Fenstergröße | Kleines Fenster – geringere Latenz, schnelleres Coaching | Hat auch weniger Kontext, geringere Genauigkeit |
| Verarbeitungsmodus | In Echtzeit wird eine sofortige Assistenten-Opportunity angezeigt. | Ressourcenintensiv |
| Stream-Auflösung | Hochwertige Audio- und Videoqualität kann eine höhere Genauigkeit aufweisen, aber die Latenz erhöhen. | Mehr Speicher und Berechnung |
| Aufbewahrungszeitraum | Große Datenmengen können für Schulungen und Compliance verwendet werden. | Mehr Speicherkosten, kann zu Rauschen führen |
| Multi-Modal | Mehr Kontext, ganzheitliches Verständnis | Synchronisierungskomplexität |
| Ambience | Kann dem menschlichen Benutzer konsistente Unterstützung bieten | Datenschutz/Erzwingung von Richtlinien |
| Aspekt | Gewinn | Kosten |
|---|---|---|
| Geltungsbereich | Eine breite Palette von Aktivitäten, Agent kann den Kontext in verschiedenen Modalfenstern (E-Mail, Kalender, Anwendungsseiten) freigeben | Berechnungskosten |
| Intelligente Automatisierung | Kann ein Modul sein und sich auf vollständig autonome AI erstrecken und Menschen aus dem Kreislauf eliminieren, wenn die Richtlinie klar ist | Weitere Agentenauswertung. Risiko falsch positiver oder falscher Fehler, kann in einem angemessenen Zeitraum unentdeckt bleiben |
| Abhörkomplexität | Kann von Echtzeitanalysen profitieren. Kann beispielsweise Betrug oder Bedrohung erkennen und Transaktionen verhindern | Agenten- und menschliche Workflows müssen synchronisiert werden |
| Kontexttiefe | Tiefere Kontexte führen zu intelligenten Entscheidungen | Muss kontextvollständig sein |
| Agentenautonomie | Headless-Agenten arbeiten im Hintergrund, ohne dass der Benutzer dazu aufgefordert wird, sodass weniger Reibung entsteht | Weniger Transparenz bei der Entscheidungsfindung von Agenten, mehr Audit Trails |
| Multiagent | Headless-Agenten können zusammen spezialisierte Agenten bilden | Headless-Orchestrierung und zusätzliche Komplexität |
| Aspekt | Gewinn | Kosten |
|---|---|---|
| Oberflächen für die native Zusammenarbeit | Agenten können teilnehmen und sofort zum menschlichen Arbeitsfluss beitragen | Benutzerakzeptanz erfordert zusätzliche Schulung und Aktivierung |
| Bidirektionale Kontextfreigabe | Agenten können Kontext anzeigen und für alle Beteiligten freigeben, sodass Informationen für alle verfügbar sind. | Absichtliche asymmetrische sensible Informationen erfordern zusätzliche Schutzmaßnahmen. |
| Zusammenarbeit | Agenten ermöglichen die Zusammenarbeit in Echtzeit und bieten sofortiges Feedback und schnellere Lösungszeiten. | Schnellere Lösungen bedeuten aktiveres Arbeiten in der Warteschlange für Menschen, was zu Ermüdung führen kann |
| Spezialisierung | Domänenspezifische Agenten bieten wertvolle Unterstützung. | Erhöhte Anforderungen an begrenzte Kontexte und Domänenspezifität. Komplexität zur Anpassung an Änderungen |
| Beobachtbarkeit | Bereitstellen von Argumenten, Prüfprotokollen, Erstellen von Trusts für Agentenbewertungen | Erhöhte Telemetriekosten |
| Aspekt | Gewinn | Kosten |
|---|---|---|
| Geschwindigkeit | Agenten erledigen die Aufgaben in Stunden bis Tagen und nicht in Wochen bis Monaten. | Erfordert Aktivierung für autonomen Agentenbetrieb |
| Autonomy | Agenten erreichen vollständige Ausführung ohne menschliches Eingreifen | Intervention ist begrenzt und kostspielig während der Ausführung |
| Skalierbarkeit | Einfache Skalierung für Agenten | Es müssen Ratenobergrenzen festgelegt werden, um das Sperren von Ressourcen zu verhindern. |
| Konsistenz | Agenten halten sich über Leitplanken an Richtlinien | Die Handhabung neuer Szenarios erfordert eine Inspektion, um das richtige Ergebnis sicherzustellen. |
| Kosten | Agenten meiden Menschen auf dem Laufenden | Der Prozess ist teuer in der Erstellung |
| Personalwesen | Agenten geben wichtige und Expertenressourcen frei | Experten fehlt es an Erfahrungssichtbarkeit, wodurch Prozessverbesserungen nicht mehr erkannt werden können |
| Qualitätskontrolle | Kann überwacht und überprüft werden | Hohe Behebungskosten, wenn Agentenfehler nicht sofort erkannt werden |
| Genauigkeit | Agenten können Kontext und Richtlinien verwenden, um die richtige Entscheidung zu treffen. | Kontext und Daten müssen zusammengestellt und gepflegt werden, um Mehrdeutigkeiten oder Pattsituationen zu vermeiden. |
| Einrichten des erweiterten Chats | → | Serviceagenten erstellen | → | Thema 'Supportaufträge definieren' | → | Aktion "Auftrag abrufen" erstellen |
| ↓ | ||||||
| Hinzufügen eines ausgehenden Omnikanal-Flows zur Eskalation | ← | Thema "Eskalation erstellen" | ← | Hinzufügen von Aktionen zu Themen | ← | Aktion 'Status abrufen' erstellen |
| ↓ | ||||||
| Veröffentlichen des Agenten |
| Konfigurieren von Omnikanal | → | Definieren von Eskalationsregeln in Anweisungen | → | Festlegen von Prioritäten und Kapazitäten | → | Testen und validieren |
| Zuordnen von Kontextdaten | → | Erstellen von MuleSoft-API-Anmeldeinformationen | → | Registrieren des externen MuleSoft-Service |
| Benutzerdefiniertes Kontaktfeld erstellen | → | Definieren eines neuen Plattformereignisses |
| Erstellen von AWS S3-Anmeldeinformationen | → | Erstellen eines neuen S3-Datenstroms | → | Konfigurieren und Bereitstellen des Streams | → | Suchindex erstellen |
| ↓ | ||||||
| Testabruffunktion | ← | Konfigurieren und Bereitstellen des Index |
| Agent aus Vorlage erstellen | → | Hinzufügen des Themas "VIP-Einkaufswagen wiederherstellen" | → | Hinzufügen von Themenanweisungen | → | Aktion 'Slack-Benachrichtigung erstellen' |
| ↓ | ||||||
| Hinzufügen von Aktionen zum Thema | ← | Journey-Registrierungsaktion erstellen | ← | Aktion "Rabattangebot erstellen" | ← | Aufgabe "Einkaufswagenwiederherstellung erstellen" |
| Durch Ereignisse ausgelösten Flow erstellen | → | Plattformereignis abonnieren | → | Aufrufbare Agentenaktion hinzufügen | → | Übergeben von Ereignisdaten an Agenten |
| Kunde verlässt Einkaufswagen | → | Commerce Cloud veröffentlicht Ereignis | → | Plattformereignis löst Flow aus | → | Flow ruft Mitarbeiteragent auf |
| ↓ | ||||||
| Analysen für Rabattangebote | ← | Erstellt Aufgabe für Manager | ← | Benachrichtigungsmanager in Slack | ← | Agent führt Wiederherstellungsthema aus |
| ↓ | ||||||
| Registriert Kunde in Journey | → | Kunde löst das Angebot ein | → | Agent analysiert Ergebnis für Feedback |
| Agent aus Vorlage erstellen | → | Thema 'Assistentenanruf hinzufügen' | → | Hinzufügen von Themenanweisungen | → | Aktion 'Abschriftsanalyse erstellen' |
| ↓ | ||||||
| Hinzufügen von Aktionen zum Thema | ← | Aktion zum Erstellen von Slack-Statistiken | ← | Aktion "Produktspezifikation erstellen" |
| Neue Datenbibliothek erstellen | → | Knowledge Artikel hinzufügen | → | Systemblöcke und -indizes | → | Bodenbibliothek in Aktion |
| Server empfängt Audioabschrift | → | Server veröffentlicht Plattformereignis |
| Durch Ereignisse ausgelösten Flow erstellen | → | Abonnieren des Abschriftsereignisses | → | Aufrufbare Agentenaktion hinzufügen | → | Nutzlast an Agent senden |
| ↓ | ||||||
| Agent sendet Slack DM |
| Benutzer startet Zoom-Anruf | → | Serverabschriften und -veröffentlichungen | → | Flow ruft Antwortagent auf | → | Knowledge Base für Agentenabfragen |
| ↓ | ||||||
| Analytics optimiert die Agentenleistung | ← | Agent erstellt Anrufzusammenfassung | ← | Agent hört weiter zu | ← | Agent sendet Slack DM |
| Research Agent sammelt Informationen | → | Qualifikationsagent bewertet Lead | → | SDR-Agent beginnt mit der Kontaktaufnahme |
| Erstellen eines neuen Datenbereichs | → | Aufnehmen von Salesforce CRM-Daten | → | Ingest ZoomInfo data | → | Aufnehmen von Lieferantendatenbankdaten |
| Erstellen eines neuen Plattformereignisses |
| Agent aus Vorlage erstellen | → | Thema 'Parse-Ziel hinzufügen' | → | Hinzufügen von Themenanweisungen | → | Aktion 'Zielereignis erstellen' |
| ↓ | ||||||
| Aktion zum Thema hinzufügen |
| Forschungsthema erstellen | → | Deduplizierungsaktion erstellen | → | Aktion "Lead-Anreicherung erstellen" | → | Aktion "Leadbewertung erstellen" |
| ↓ | ||||||
| Hinzufügen von Aktionen zum Thema | ← | Aktion 'Leadqualifizierung erstellen' |
| Erstellen von SDR-Agenten aus Vorlage | → | Knowledge Base für Agenten konfigurieren | → | Konfigurieren von Agenten-E-Mail-Einstellungen | → | Festlegen von Leadzuweisungsregeln |
| ↓ | ||||||
| Definieren von qualifizierenden Leadkriterien |
| Durch Ereignisse ausgelösten Flow erstellen | → | Ereignis "Agentenziel abonnieren" | → | Aufrufbare Agentenaktion hinzufügen |
| Benutzer weist übergeordnetes Ziel zu | → | Orchestrator-Agent erstellt Ereignis | → | Flow leitet Ziel an Agenten weiter | → | Research Agent qualifiziert Lead |
| ↓ | ||||||
| Überwachen von Agenten mit Analysen | ← | Besprechung für SDR-Agentenpläne | ← | SDR-Agent beginnt mit der Kontaktaufnahme |
| Agent aus Vorlage erstellen | → | Definieren des Themas "Abrechnungsanfrage" | → | Benutzerdefinierte Flow-Aktion erstellen | → | Aktion zum Thema hinzufügen |
| Agent aus Vorlage erstellen | → | Thema 'Versandüberprüfung definieren' | → | Benutzerdefinierte Flow-Aktion erstellen | → | Aktion zum Thema hinzufügen |
| Agent aus Vorlage erstellen | → | Thema "Serviceprüfung definieren" | → | Benutzerdefinierte Flow-Aktion erstellen | → | Aktion zum Thema hinzufügen |
| Anzeigen von Agenten über MuleSoft | → | Registrieren von Agenten in der Registrierung |
| Serviceagenten erstellen | → | Untersuchungsthema definieren | → | Benachrichtigungsaktion erstellen | → | Orchestrierungsthema definieren |
| ↓ | ||||||
| Thema 'Eskalation definieren' | ← | Aktion "Kundenvorgang erstellen" | ← | Aktion "Anrufagent erstellen" | ← | Agentenorchestrierungs-Flow erstellen |
| ↓ | ||||||
| Omnikanal-Flow erstellen | → | Connect-Flow für Eskalation |
| Agentforce-Hilfeagent | → | MuleSoft-Agentenmakler | → | Abrechnungsagent als A2A-Server | → | Logistikagent als A2A-Server |
| ↓ | ||||||
| Hilfeagent erhält Antwort | ← | Broker aggregiert Antwort | ← | Beschaffungsagent als A2A-Server |
| Kunde startet Chat | → | Kunde gibt mehrere Probleme an | → | Agent untersucht Auftragsdetails | → | Orchestrator ruft spezialisierte Agenten auf |
| ↓ | ||||||
| Orchestrator erstellt Lösungsplan | ← | Provisioning Agent findet Problem | ← | Logistikagent bestätigt Fehler | ← | Abrechnungsagent findet Diskrepanz |
| ↓ | ||||||
| Agent eskaliert zum Servicemitarbeiter | → | Servicemitarbeiter bietet Lösung an | → | Systemagent führt Aufgaben aus | → | Agent aktualisiert und schließt Kundenvorgang |
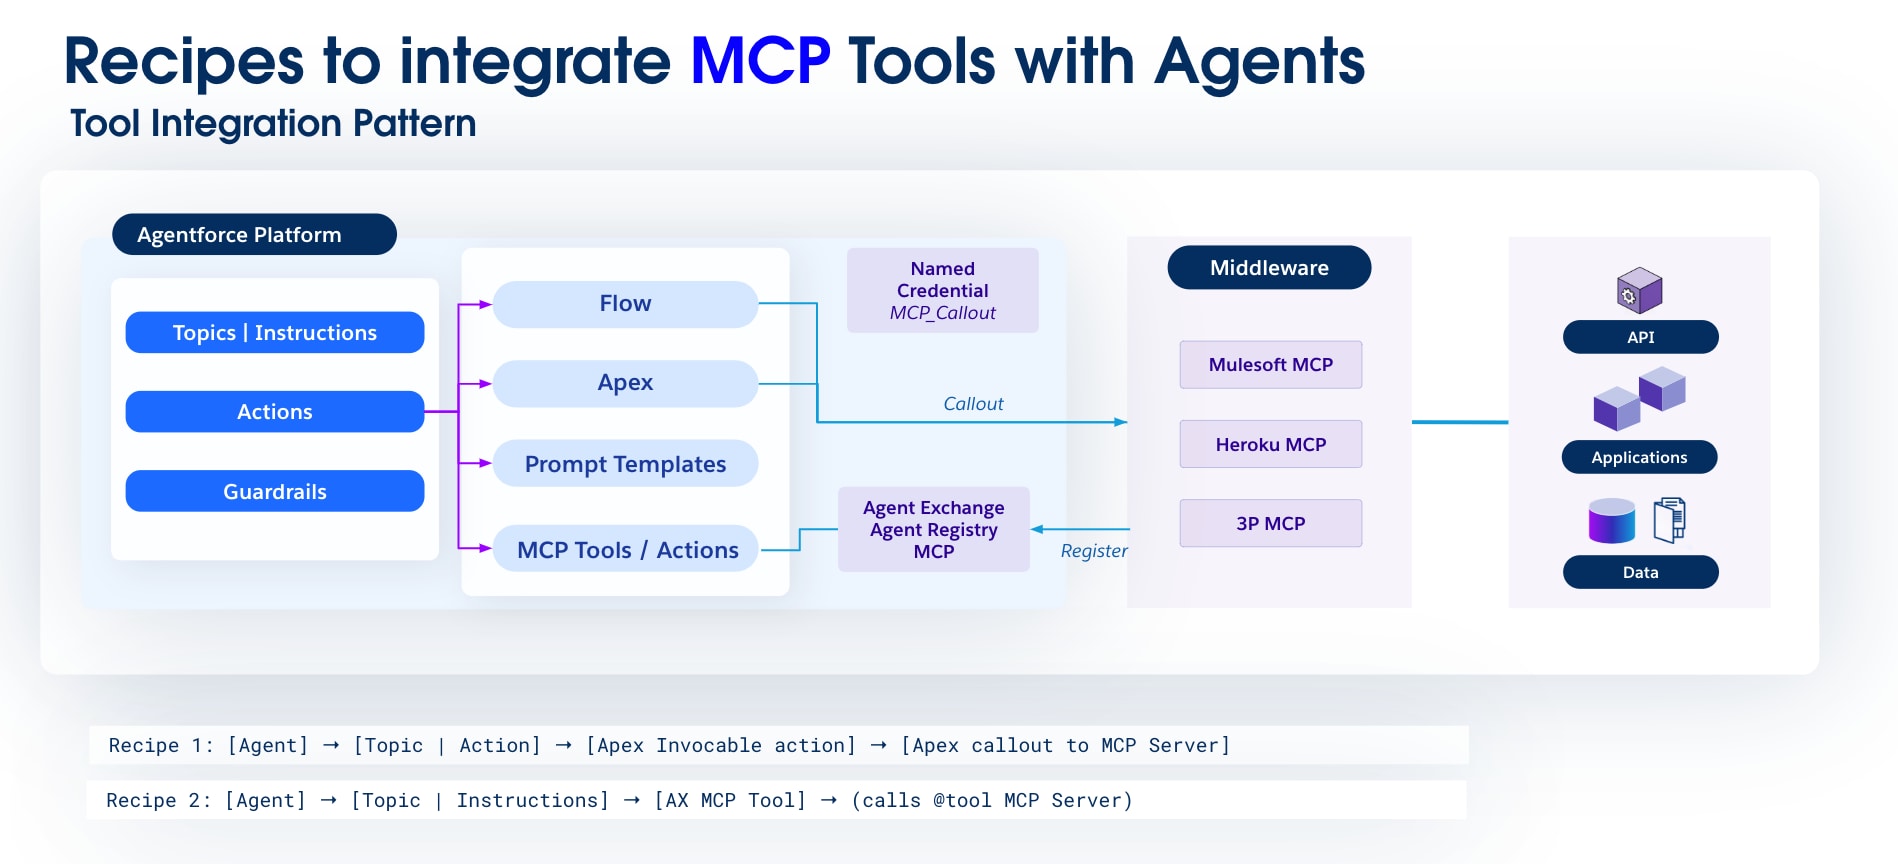 **Rezept 1:** **Aktivieren externer Tools mit MCP**
**Problem**
Organisationen werden mit einer Kombination aus veralteten ERPs und modernem SaaS ausgeführt. Die Integration in einen Agenten ist jedoch schwierig, da es kein gemeinsames Protokoll gibt. Jedes Tool verfügt über seine eigenen APIs, Authentifizierung und Datenmodelle. Entwickler entwickeln und warten schließlich benutzerdefinierte Punkt-zu-Punkt-Konnektoren für jedes Tool, was zu empfindlichen, nicht skalierbaren und kostspieligen Integrationen führt.
**Muster**
Der Agent ruft über eine strukturierte Aktion ein externes Tool auf (das über MCP bereitgestellt wird), wodurch er spezielle Tools über die Salesforce Platform hinaus verwenden kann.
**Context**
- Der Agent fungiert als Proxy für eine Reihe von Tools, die außerhalb der Salesforce Platform vorhanden sind.
- Diese externen Tools können verschiedene APIs, Authentifizierungsmechanismen und Datenformate aufweisen.
- Für die nahtlose Interaktion zwischen dem Agenten und diesen externen Tools ist ein standardisiertes Kommunikationsprotokoll erforderlich.
- Die Wiederverwendbarkeit ist ein wichtiges Anliegen, da dieselben externen Tools von mehreren Agenten für unterschiedliche Zwecke verwendet werden können.
**Interaktionen**
1. **Trigger:** Für eine Benutzeranforderung oder ein internes Ereignis in Agentforce muss ein externes Tool verwendet werden.
2. **Handlungsabsicht:** Der Agentforce Agent identifiziert den Intent und bestimmt, dass ein externes MCP-basiertes Tool erforderlich ist.
3. **Planer (intern):** Der Planer des Agentforce Agenten wählt das entsprechende MCP-Tool oder die entsprechende MCP-Aktion anhand der konfigurierten Anweisungen und verfügbaren Tools aus.
4. **Ausführung:** Der Agentforce Agent sendet eine MCP-konforme Anforderung an den externen MCP-Server (beispielsweise über einen Apex Callout an einen MuleSoft-Endpunkt, der dann an den externen MCP-Server weitergeleitet wird).
5. **Externe Verarbeitung:** Der externe MCP-Server verarbeitet die Anforderung, interagiert mit der zugrunde liegenden externen Anwendung und bereitet eine MCP-konforme Antwort vor.
6. **Ergebnis**: Der externe MCP-Server gibt die Antwort an den Agentforce Agent zurück.
7. **Follow-up:** Der Agentforce Agent verarbeitet die Antwort, aktualisiert seinen internen Status und setzt seine Aufgabe fort oder gibt dem Benutzer Feedback.
**Trade-Offs**
| Aspekt | Gewinn | Kosten |
|---|---|---|
| Flexibilität | Zugriff auf verschiedene externe Funktionen | Anfangsentwicklung für MCP-Server/Integrationsebene |
| Modularität | Agentenfunktionen sind von externen Tools entkoppelt | Erfordert sorgfältiges API-Design und -Versionierung |
| Skalierbarkeit | Verwendet die Skalierbarkeit des externen Systems | Die Leistung des externen Systems wird abhängig |
| Standardisierung | Standardisiertes Protokoll (MCP) | Akzeptanz und/oder Wrapper |
| Sicherheit | Zentrale Sicherheit für externen Zugriff | Verwaltung von Anmeldeinformationen und Zugriffsrichtlinien für externe Systeme |
| Wartungsfähigkeit | Aktualisierungen an externen Tools erfordern keine Agentenänderungen. MCP kann Änderungen signalisieren | Kosten für häufige Änderungen |
| Aspekt | Gewinn | Kosten |
|---|---|---|
| Geschwindigkeit | Ein Tool-Aufruf | Mehr Verwaltungsaufwand |
| Identität und Sicherheit | Sichere Wiederholungen | Implementierung zur Unterstützung von Deduplizierung und Idempotenz |
| Skalierbarkeit | Kann einfach skaliert werden | Verbindungs-Overhead |
| Konsistenz | Klar und explizit | Atomar |
| Sicherheit | Leitplanken und Richtlinien können implementiert werden. | Operation Overhead to cascade policy changes (Änderungen an der Kaskadenrichtlinie über den Betriebsaufwand) |
| Beobachtbarkeit | Korrelation und Überprüfung sind für den Betrieb verfügbar. | Erhöhte Telemetriekosten |
| Aspekt | Gewinn | Kosten |
|---|---|---|
| Geschwindigkeit | Ein Aufruf für mehrere verteilte Vorgänge | Entwicklungs- und Betriebskosten |
| Identität und Sicherheit | Sichere Wiederholungen/SAGA-Unterstützung | Komplexität |
| Skalierbarkeit | Kann leicht skaliert werden, kann asynchron sein | Eventuelle Konsistenz für Asynchron |
| Sicherheit | Richtlinien in API-Ebene | Operation Overhead to cascade policy changes (Änderungen an der Kaskadenrichtlinie über den Betriebsaufwand) |
| Beobachtbarkeit | Korrelation und Überprüfung für die Verfolgung verfügbar | Erhöhte Telemetriekosten |
| Aspekt | Gewinn | Kosten |
|---|---|---|
| Datenbewegung | Keine; null Kopie | Kosten berechnen |
| Latenz | Von Tagen oder Wochen bis nahezu in Echtzeit | SLAs |
| Skalierbarkeit | Unbegrenztes Datenvolumen | Kosten berechnen |
| Aspekt | Gewinn | Kosten |
|---|---|---|
| Latenz | In Sekunden verfügbar | Berechnungs- und Implementierungskosten |
| Kopplung | Hersteller sind unabhängig von Verbrauchern. | Schwerer zu debuggen und zu verfolgen |
| Skalierbarkeit | Kann skaliert werden | Obergrenzen |
| Bestellung | Inkrementelle Kontexterstellung | Nicht bestellte Ankunft |
| Wert | Fast-Echtzeit-Statistik | Governance- und Compliance-Overhead |
| Aspekt | Gewinn | Kosten |
|---|---|---|
| Genauigkeit | Höheres Trust (begründete Antworten mit Zitat) | Dokumentpflege und Hygiene |
| Abruf | Verarbeitet natürliche Sprache und Stichwörter | Mehr Speicherplatz, Tuning-Aufwand |
| Sicherheit | Kann berechtigten Zugriff erzwingen | Laufzeit-Overhead, Cache-Komplexität |
| Chunking | Bessere Relevanz | Mehr Vorverarbeitung und Abstimmung |
| Versioning | Filtert veraltetes Knowledge | Wartungs- und Governance-Kosten |
| Aspekt | Gewinn | Kosten |
|---|---|---|
| Genauigkeit | Höheres Trust (basierte Antworten mit überprüfbaren Beziehungen) | Harmonisierung und Diagrammmodellierung von Daten |
| Abruf | Verarbeitet komplexe relationale Abfragen | Die Diagrammtraversierung kann für sehr große Diagramme rechenintensiv sein |
| Sicherheit | Kann privilegierten Zugriff anhand von Beziehungen erzwingen | Laufzeit-Overhead, komplexe Zugriffssteuerung |
| Kontexttiefe | Umfangreiches, ganzheitliches Verständnis von Entitäten und deren Verbindungen | Mehr Vorverarbeitung und Optimierung für die Diagrammoptimierung |
| Wartungsfähigkeit | Zentralisiertes Datenmodell für Beziehungen | Kontinuierliche Anpassung von DMOs an sich ändernde Geschäftsanforderungen |
 ## 2\. Kernprinzipien der Architektur
Die Rationalisierung einer Architektur mit mehreren Agenten beginnt mit der Projektion zentraler Architekturprinzipien auf die Fähigkeiten und die Struktur von Agenten. Die daraus resultierenden Multi-Agent-Architekturen sind dann eine Manifestation des zentralen Systemdesigns und der Systemarchitekturprinzipien, die auf das einzigartige „Granulat“ der AI-Technologien abgestimmt sind.
Zu den wichtigsten Prinzipien, die diese Architektur steuern, zählen:
- Verwalten von Komplexität durch Aufschlüsselung
- Verbessern der Elastizität und Reduzieren der Sprödigkeit durch Entkopplung
- Verbessern der Zuverlässigkeit und Effizienz durch Wiederverwendung von Code
- Verbessern der Agentenzuverlässigkeit durch Einschränken der Bedenken eines Agenten
- Verbessern der Systemwartung und -entwicklung durch Modularität und Erweiterbarkeit
- Vereinfachen der Agentenverwaltung und der Rechenschaftspflicht durch Spezialisierung
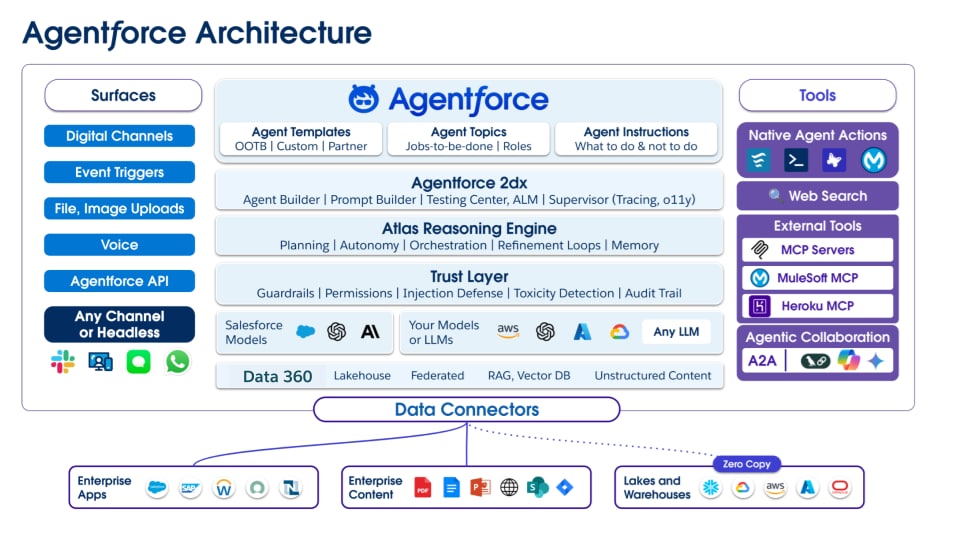
Im Gegensatz zu primitiveren agentischen Architekturen (beispielsweise solchen, die sich auf LLMs als zentrales Architekturkonstrukt konzentrieren) _war Agentforce von Anfang an für die Orchestrierung von mehreren Agenten konzipiert_. Die Multi-Agenten-Orchestrierung basiert auf dem Atlas Reasoning-Modul und der agentischen Argumentation, um dynamische, effektive Programmierpfade innerhalb einer agentischen Antwort zu erstellen und die Fähigkeit zur Bereitstellung einer umfassenden, tiefgreifenden Erweiterung der Benutzererfahrung (UX) drastisch zu erweitern.
Innerhalb von Agentforce wird diese Art der Koordinierung durch die folgenden offenen, interoperablen Schlüsselprotokolle und Salesforce-Produkte aktiviert:
- **Agentforce** stellt ein Agenten-Untersystem bereit, um alle wichtigen Elemente eines Agenten zu kapseln: Themen, Anweisungen, Aktionen, Leitplanken, Kontext, Aufrufe, Ausgaben, Ausführungsdetails, Protokolle usw.
- **Aktionen**: Stellen Sie Hooks bereit, um auf Daten zuzugreifen, Flows aufzurufen, externe Systeme aufzurufen und andere Agenten anzurufen.
- **Daten 360**: stellt eine Datenvirtualisierungsebene bereit, um dem Agenten einen spezifischen, individuellen Kontext bereitzustellen (mithilfe des vereinheitlichten Profils und der Schlüsselkette von Data 360, um spezifische Informationen aus dem gesamten Unternehmen abzurufen).
Für Agenten im gesamten Unternehmen oder für den Zugriff auf Agenten oder Ressourcen wird Folgendes unterstützt:
- **Modellkontextprotokoll (Model Context Protocol, MCP)**: ist eine sichere Kommunikationsebene, die Agenten mit Unternehmenstools, -daten und Knowledge verbindet, um die Kontextgenauigkeit zu gewährleisten.
- **Protokoll zwischen Agenten (A2A)**: ist ein standardisierter Handshake für die Delegation zwischen Agenten, der eine sichere, gesteuerte Koordination zwischen Systemen, Organisationen und Anbietern ermöglicht.
Diese Prinzipien bilden die Grundlage für den Aufbau eines skalierbaren, regelbaren Systems orchestrierter Intelligenz.
### Zusätzliche Überlegungen
Zuverlässige agentische Lösungen erfordern klare Ansätze für die nicht funktionalen Anforderungen, die eine effektive Technologiebereitstellung unterstützen:
- Sicherheit und Governance (Identitäts- und Zugriffsverwaltung, Datenschutz, Datensicherheit und Bedrohungsmodellierung).
- Beobachtbarkeit und Überwachung (Verteilte Verfolgung, zentralisierte Protokollierung, Kennzahlen und Dashboards).
- Operationalisierung und Lebenszyklusverwaltung (Spezifikation, Generierung von Testfällen, Tests, Feedback, kontinuierliches Lernen, Einstellung).
Dies sind wichtige architektonische Überlegungen zum Erstellen von Enterprise Agentic-Lösungen, die in diesem Whitepaper nicht behandelt werden. Sie werden jedoch in künftigen Veröffentlichungen behandelt.
## 3\. Unternehmensagent-Taxonomie
Zum Verwalten einer unternehmensweiten Agentenlandschaft müssen Architekten Agenten über zwei komplementäre Linsen klassifizieren: technische Funktion und geschäftliche Auswirkungen.
### 3.1 Funktionale Rollenklassifizierung
Diese Taxonomie kategorisiert die Funktionsrollen, die Agenten in einer Architektur übernehmen können.
- **Kanal-/UX-Rollen**: Definieren Sie die Modalität der Interaktion (z. B. Headless, Aufforderung, Chats und Nachrichten oder AI-verwaltete Arbeitsumgebungen).
- **Spezialistenrollen**: Verkapseln Sie Deep Domain Knowledge (z. B. Domänenexperte, Knowledge Minion, Assistent oder Planer).
- **Dienstprogramm-Servicerollen**: Führen Sie diskrete transaktionale Aufgaben aus (z. B. Generierung, Zusammenfassung, Transformation oder Konfiguration).
- **Wartung und proaktive Servicerollen**: Konzentrieren Sie sich auf die Integrität und Qualität der Daten (z. B. Kuratierung, Anpassung, Datenqualität oder Datenanreicherung).
- **Langfristige Rollen**: Verwalten Sie Prozesse über einen längeren Zeitraum (z. B. Concierge, Projektmanager, Pflegefachkraft oder Watcher/Alerter).
## 4\. Die Agentenkartenvorlage
Die **Agentenkarte** ist die Standardvorlage zum Beschreiben von Agentenlösungen, um eine klare Gestaltung und Kommunikation zu ermöglichen. Sie definiert wichtige Entitäten, Systeme und Interaktionen innerhalb eines bestimmten Designmusters.
Im Folgenden finden Sie die Komponenten der Vorlage "Agentenkarte":
- **Benutzerebenen** definieren die menschlichen Akteure im System (z. B. Kunden, authentifizierte Mitarbeiter (SF-Benutzer) und nicht authentifizierte Mitarbeiter).
- **Agentenebenen** beschreiben erforderliche Agenten, angezeigte Muster, Beziehungen zueinander und Anweisungen, die zum Aktualisieren bestimmter Muster verwendet werden.
- **Kontext/Aktionen** sind die Ressourcen, Funktionen oder Aktionen, die der Agent verwaltet oder auf die er zugreift.
- **Quellen** sind die zugrunde liegenden Daten, Anwendungen, Knowledge Bases und anderen Systeme, mit denen die Agenten eine Verbindung herstellen.
In den Anhängen A und B werden Agentenmuster auf Systemebene veranschaulicht, indem ihre Zusammensetzung in den Schwimmbädern für Agentenkartenvorlagen demonstriert wird.
## 5\. Frameworks für Agentenmuster
Salesforce verwendet eine Bibliothek von Agentenmustern, um zuverlässige, vorhersehbare Agentenlösungen zu organisieren und bereitzustellen. Diese Muster sind unsere Blaupausen zur Lösung allgemeiner architektonischer Probleme.
Sie werden in vier primäre Kategorien gruppiert:
- **Interaktionsmuster**: Konzentrieren Sie sich auf das Agentenengagement und die Benutzererfahrung.
- **Spezialisten-/Mitarbeitermuster**: Kapseln Sie Deep Knowledge oder bestimmte Fertigkeiten in einer bestimmten Domäne.
- **Versorgungs- und Datenverwaltungsmuster**: Führen Sie bestimmte, oft wiederholbare Aufgaben aus, die andere Agenten oder Prozesse unterstützen.
- **Langfristige Muster**: Verwalten Sie Prozesse und Workflows, die über längere Zeiträume hinweg auftreten und mehrere Schritte umfassen.
In den folgenden Abschnitten werden wichtige Muster aus jeder Kategorie beschrieben. Jede Musterbeschreibung enthält eine **Übersicht**, einen **Ausgabetyp**, eine **Anleitung zur Musternutzung**, **repräsentative Anwendungsfälle** und ein **Lösungsdiagramm** sowie eine Zuordnung zur **Salesforce-Reifenreiferubrik**.
## 6\. Interaktionsmuster
Bei _Interaktionsmustern_ handelt es sich um grundlegende Designs, die sich auf das Agentenengagement und die Benutzererfahrung konzentrieren.
### Begrüßungsmuster
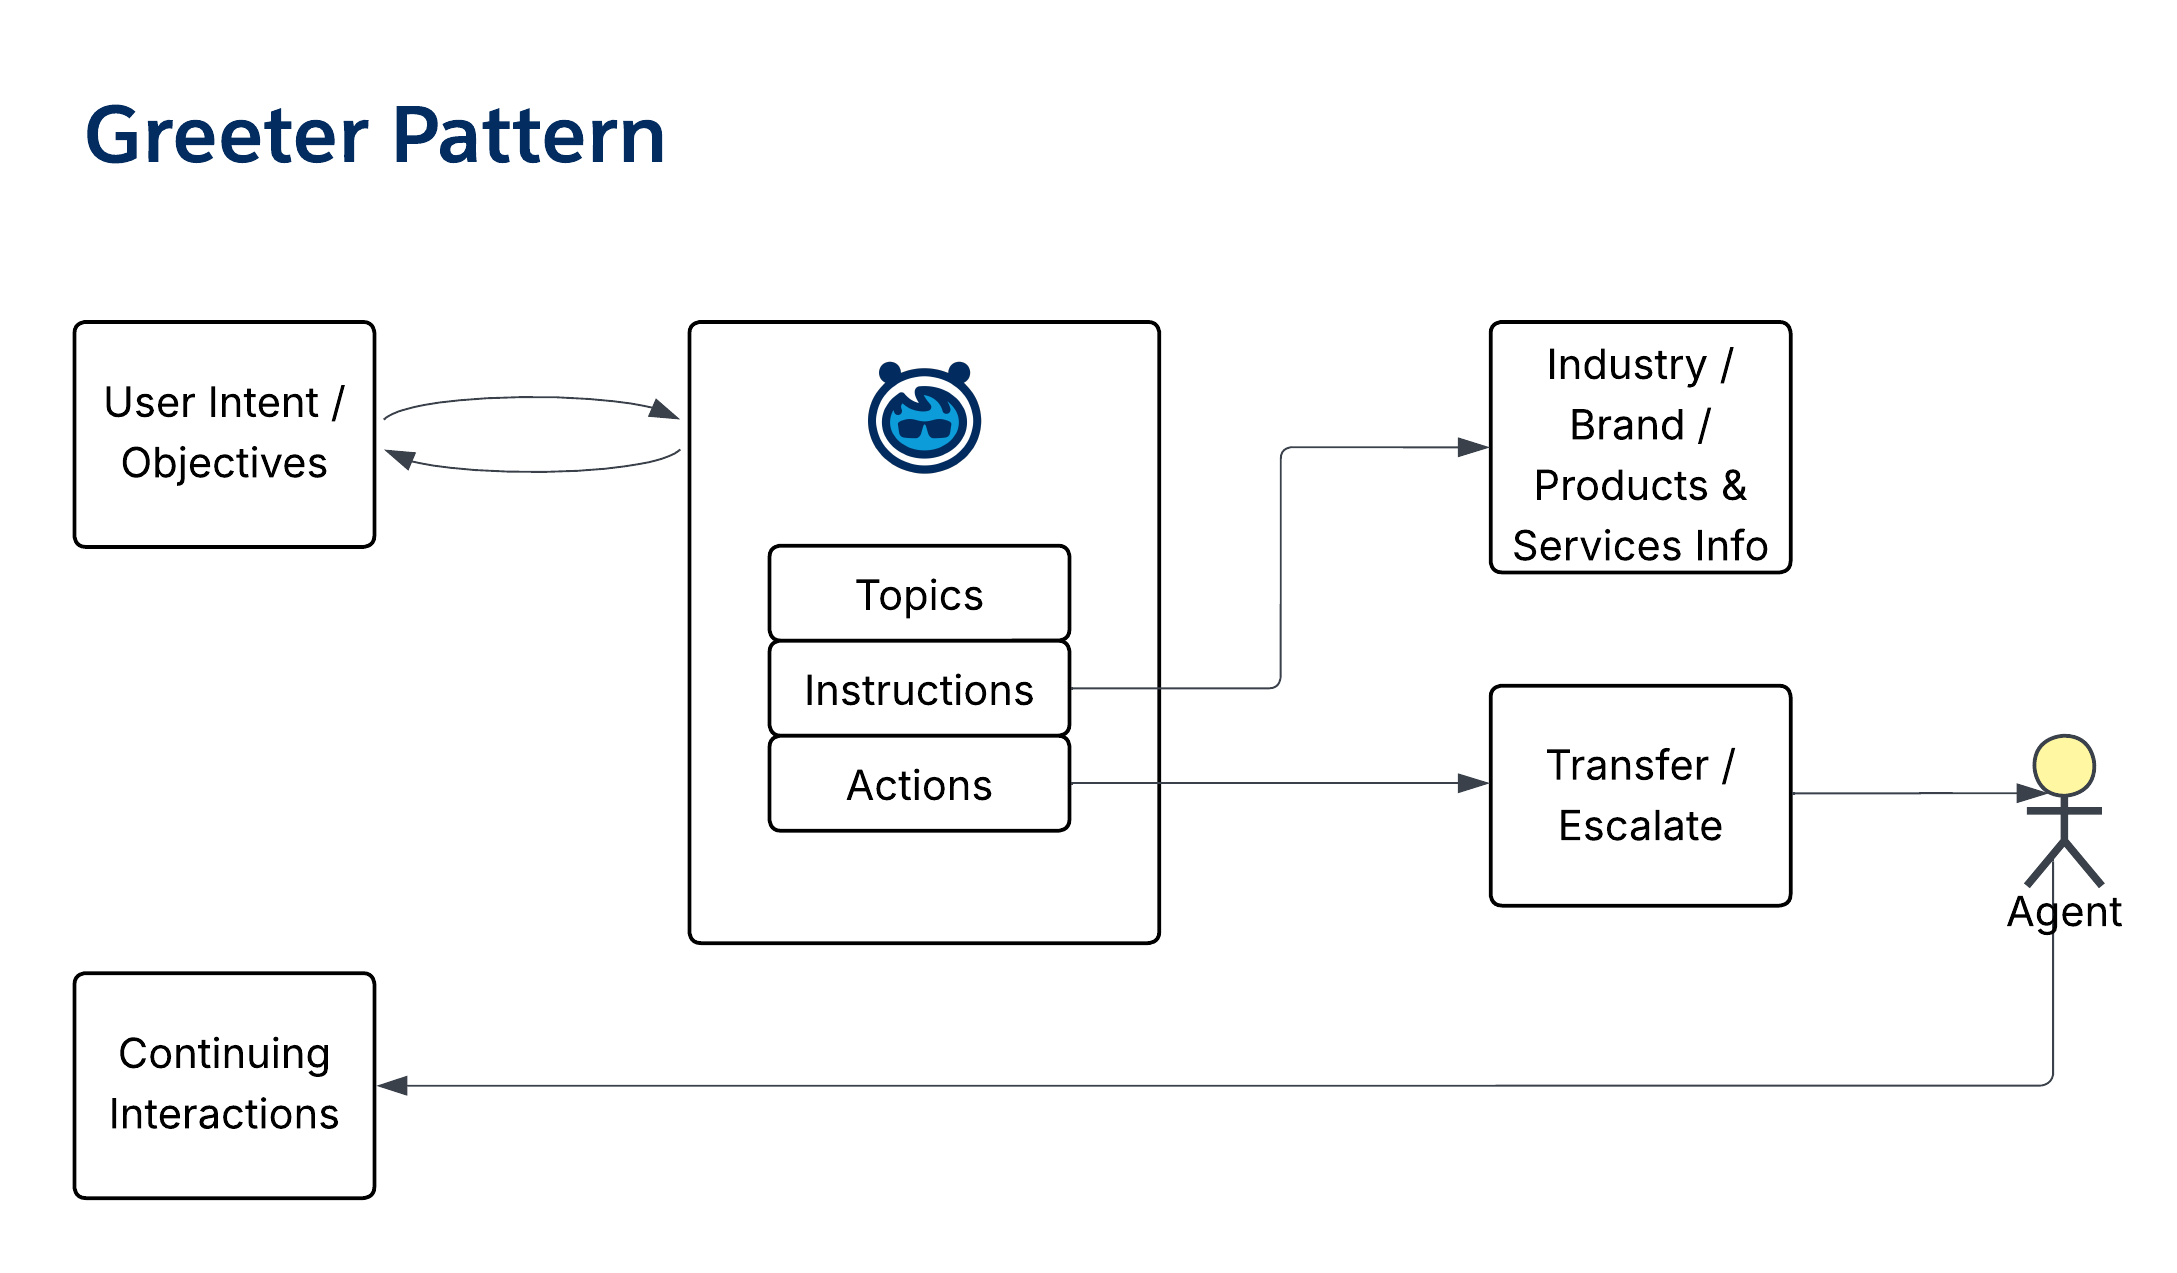
- **Übersicht**: Bei dem _Begrüßungsmuster_ handelt es sich um ein einfaches, einfach zu implementierendes Muster, das die Benutzerabsichten in natürlicher Sprache bestimmt. Anschließend wird der Benutzer an den entsprechenden menschlichen Agenten weitergeleitet.
- **Ausgabetyp**: Übergabe/Eskalierung an die nächste Ressource.
- **Geschäftswert**: Ermöglichen Sie einen nahtlosen, effizienten Erstkontakt für Kunden und maximieren Sie gleichzeitig die Intent-Lösung und die Kontexterfassung für Serviceanbieter.
- **Anleitung zur Musternutzung**: Konfigurieren Sie den Agenten als primäre Engagementressource für Markenkanäle. Stellen Sie Anweisungen zu Marke, Produkten und Services bereit, die mit Weiterleitungsanweisungen auf der Grundlage des Benutzer-Intents verknüpft sind. Der Agent erfasst und fasst den Intent für eine warme Übergabe zusammen.
- **Repräsentativer Anwendungsfall**: Stellen Sie sich eine Webseite vor, die einen Chat-Bot verwendet, um ein Menü mit Optionen anzuzeigen, auf dem Benutzer sich durch alle Optionen klicken müssen, bevor sie an einen Menschen weitergeleitet werden. Chatbots verwenden oft komplexe, komplizierte Arbeitspfade und Interaktionen, um die Produktivität und Effizienz im Back-Office zu verbessern. Dies führt bei Kunden zu einem Ermüdungsszenario vom Typ "Ausfüllen, Auswählen und Klicken", das oft zu Frustration führt, wenn ihr Kontext außerhalb der verfügbaren Menüoptionen liegt. Durch das Ersetzen herkömmlicher Chatbots durch die _Agentische Eingangstür_, die Interaktionen mit natürlicher Sprache verwendet, wird die Arbeit erleichtert und eine menschenähnliche Interaktion ermöglicht.
- **Agentforce Rezept**:
- Agentforce Service Agent: [Zusammenstellen eines Serviceagenten mit Agentforce Builder](https://trailhead.salesforce.com/content/learn/modules/quick-start-assemble-a-service-agent-with-agentforce-builder)
- Der im Paket enthaltene Serviceagent verfügt über konfigurierbare Übertragungsfunktionen, die die Übertragung unterstützen:
- An menschliche Agenten
- An AI-Agenten
- An externe Agenten
- Branchenspezifische Muster, die Codebeispiele enthalten
- **Diagramm**:
 - **Reifegrad für Salesforce-Agenten**: Stufe 1 (oder Stufe 0, wenn Sie den vorkonfigurierten Serviceagenten mit integrierter Übertragung und Eskalation verwenden)
### Operatormuster
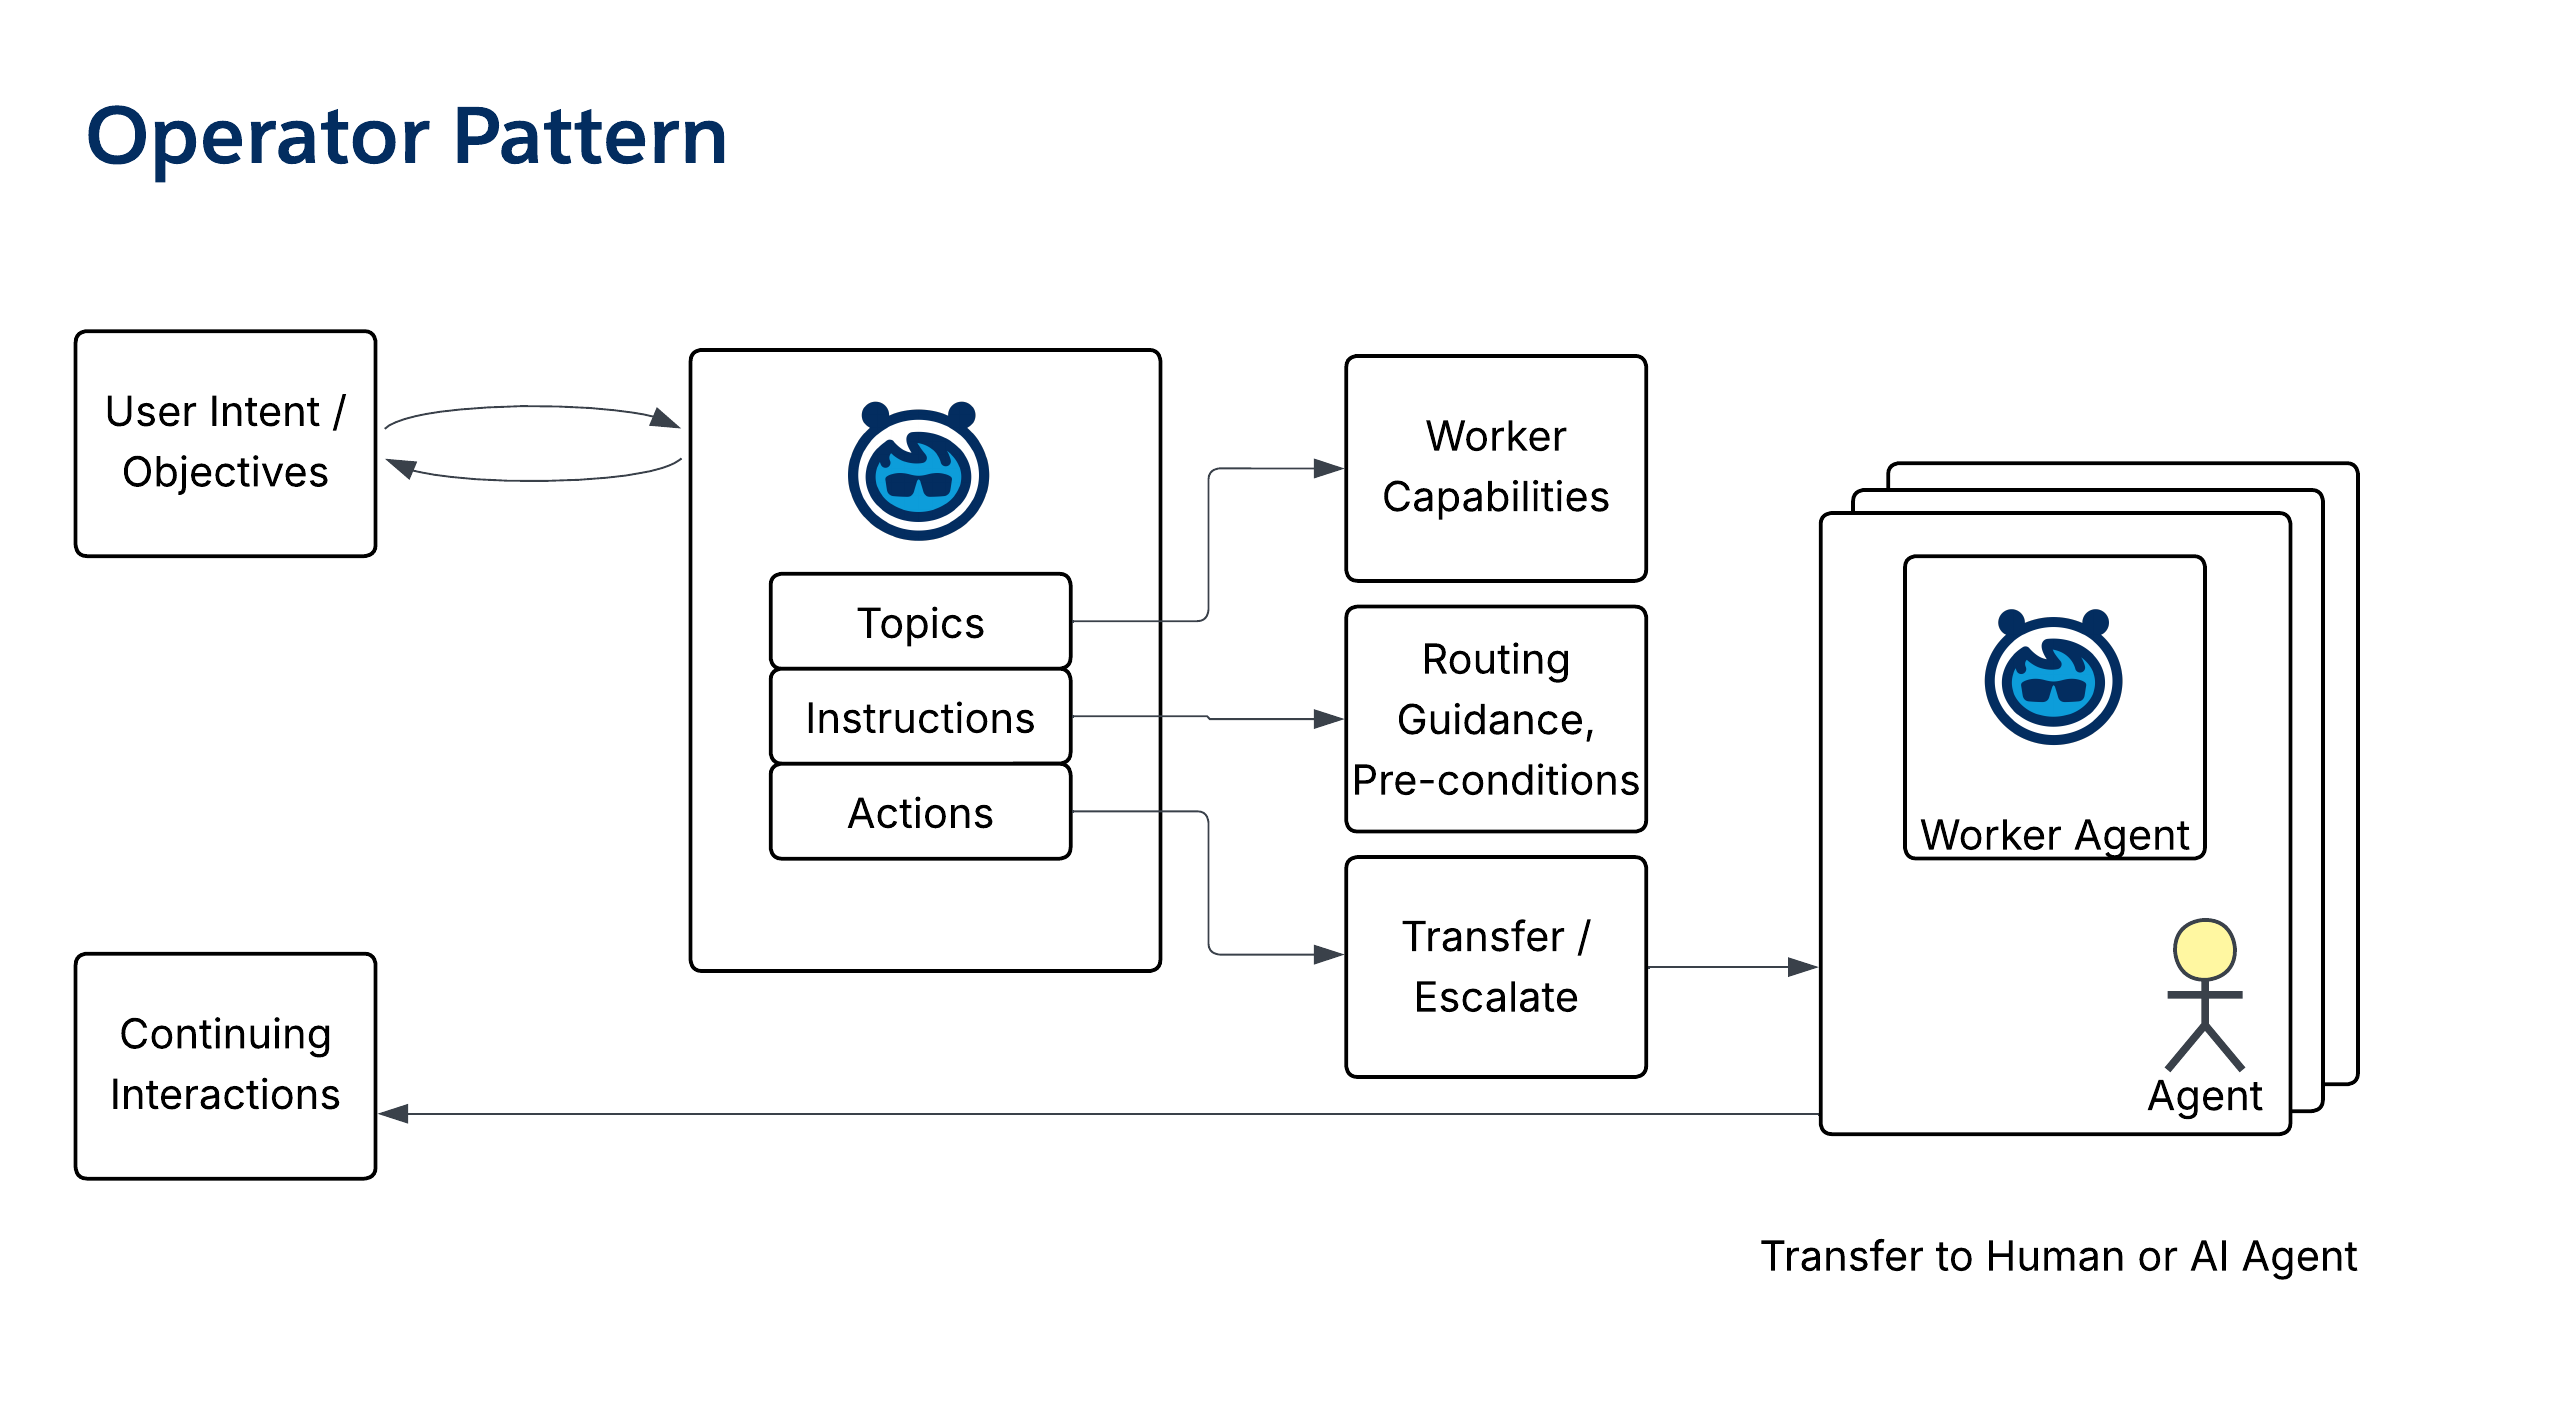
- **Übersicht**: Das _Bedienermuster_ baut auf dem _Begrüßungsmuster_ auf, indem Anforderungen an den entsprechenden Fachagenten oder an den entsprechenden Mitarbeiter weitergeleitet werden und (sofern erforderlich) verhandelt wird.
- **Ausgabetyp**: Übergabe/Übertragung an die nächste Ressource.
- **Anleitung zur Musternutzung**: Kombinieren Sie marken- und servicespezifische Anweisungen mit Anweisungen dazu, wohin der Benutzer basierend auf dem Intent geleitet werden soll. Definieren Sie Eskalationsressourcen, bei denen es sich um Menschen oder andere Agenten handeln kann.
- **Repräsentativer Anwendungsfall**: Verwenden Sie die _Agentic Front Door_ für Szenarien, in denen ein hoher Grad an Spezialisierung unter menschlichen oder AI-Mitarbeitern besteht.
- **Diagramm**:
 - **Reifegrad für Salesforce-Agenten**: Level 2
### Orchestrator-Muster
- **Übersicht**: Das _Orchestrator-Muster_ verwaltet den AI-Agenten "Swarm". Wenn eine Benutzeranforderung eingeht, wird die Äußerung an einen oder mehrere Fachagenten weitergegeben und die Antworten werden dann für den Benutzer aggregiert. Im Gegensatz zum _Operatormuster_ bleibt er der erste Kontaktpunkt.
- **Ausgabetyp**: Sammeln und bereiten Sie Antworten von Mitarbeiteragenten vor.
- **Anleitung zur Musternutzung**: Konfiguriert als primärer Engagierer. Stellen Sie Anweisungen für jeden unterstützenden Mitarbeiteragenten bereit (z. B. einen Priorizer oder ein Domänen-KMU), mit denen der Orchestrierer Äußerungen an ihn weiterleiten kann.
- **Repräsentativer Anwendungsfall**: Verwenden Sie das _Orchestrator Pattern_ als agentische Eingangstür, um Kunden zu unterstützen, die möglicherweise mehrere Themen pro Unterhaltung besprechen müssen, was Lösungen für mehrere Agenten und konsistente Interaktionen erfordert. In einer Architektur mit mehreren Systemen sollten Sie das _Orchestratormuster_ berücksichtigen, um Antworten systemübergreifend und unter Mitwirkung externer Agenten zu koordinieren.
- **Diagramm**:
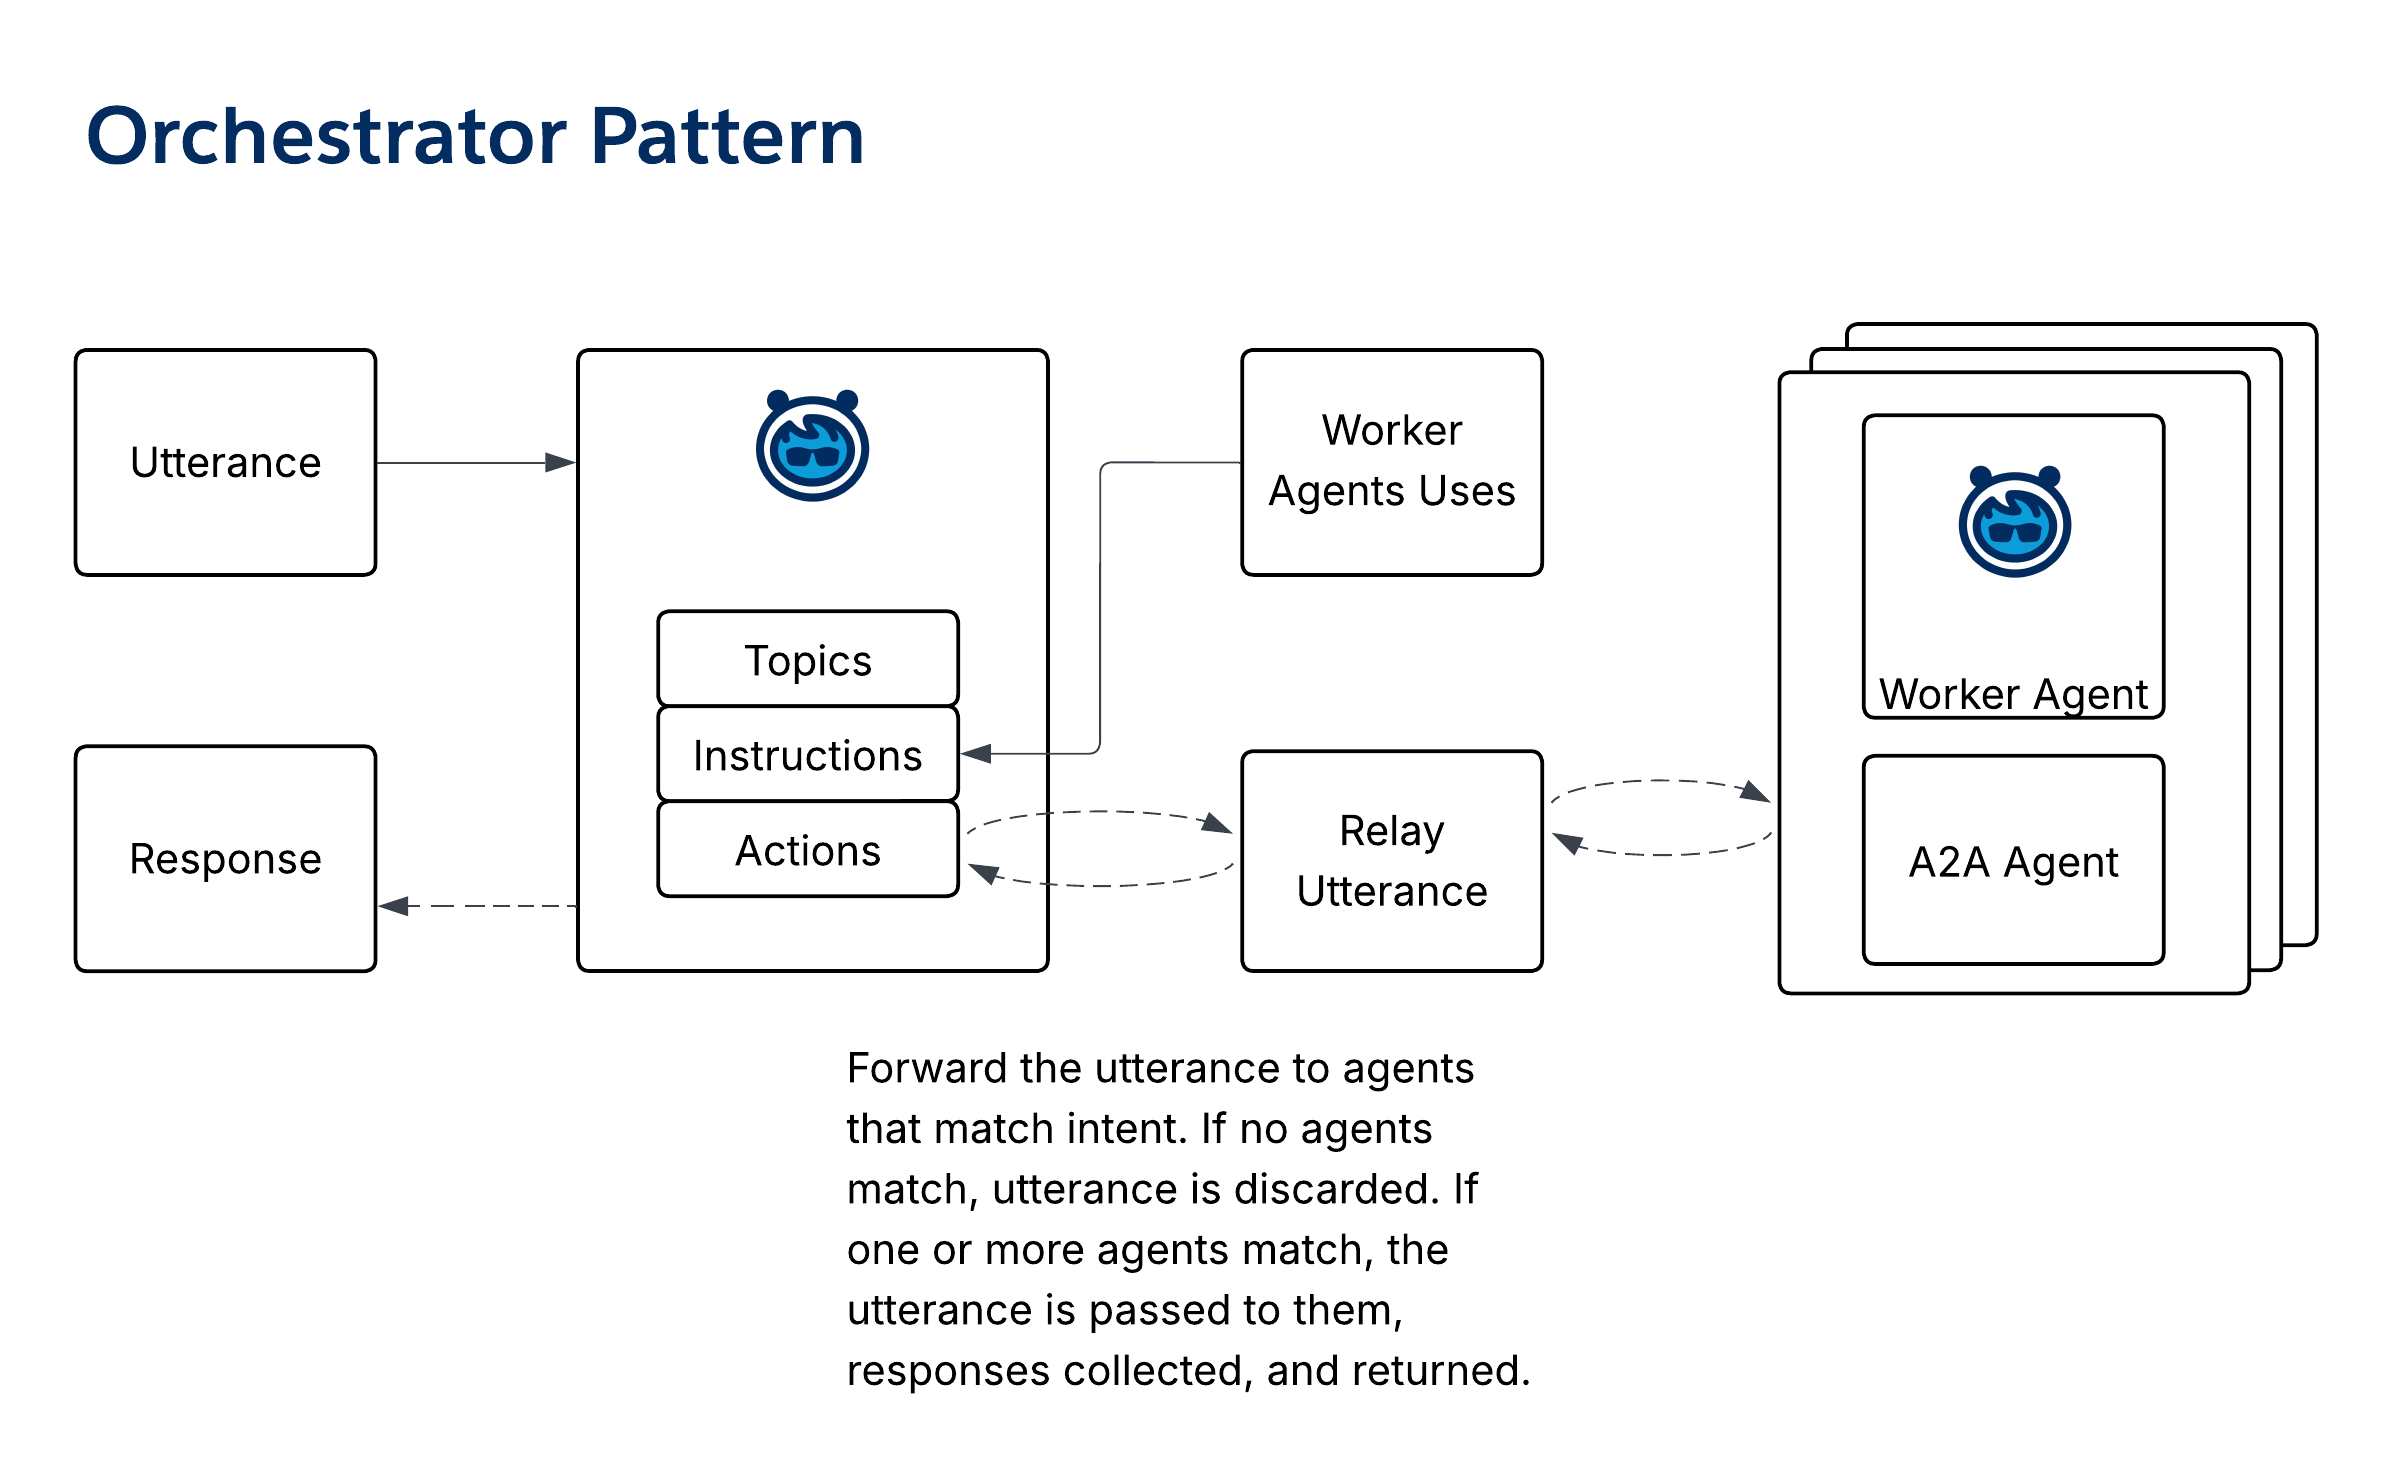 - **Reifegrad für Salesforce-Agenten**: Level 3
### Listener/Feed Pattern (Listener/Feed-Muster)
- **Übersicht**: Das _Listener/Feed-Muster_ zeigt Kontext und Statistiken während des Flows einer Unterhaltung an. Der _Listener_ wird während jeder Unterhaltungsrunde ausgelöst, um relevante Informationen für einen Mitarbeiter zu finden und anzuzeigen.
- **Ausgabetyp**: Stellen Sie relevanten Kontext auf der Grundlage von Unterhaltungen bereit, die entsprechend formatiert werden können (z. B. Vergleiche anstellen oder wichtige Punkte hervorheben).
- **Anleitung zur Musternutzung**: Hängen Sie den Listener an einen rundenbasierten Kanal an (z. B. Chat, Voice oder SMS). Definieren Sie Themen für jeden Themenbereich. Der Agent verwendet die Abschrift, identifiziert Themen und ruft Aktionen auf, um relevante Inhalte zu suchen und in einem aktuellen Feed für den Mitarbeiter zu posten.
- **Repräsentativer Anwendungsfall**: Verwenden Sie den _Universal-Assistenten_, um den Kundendienst oder Vertriebsmitarbeiter zu unterstützen.
- **Diagramm**:
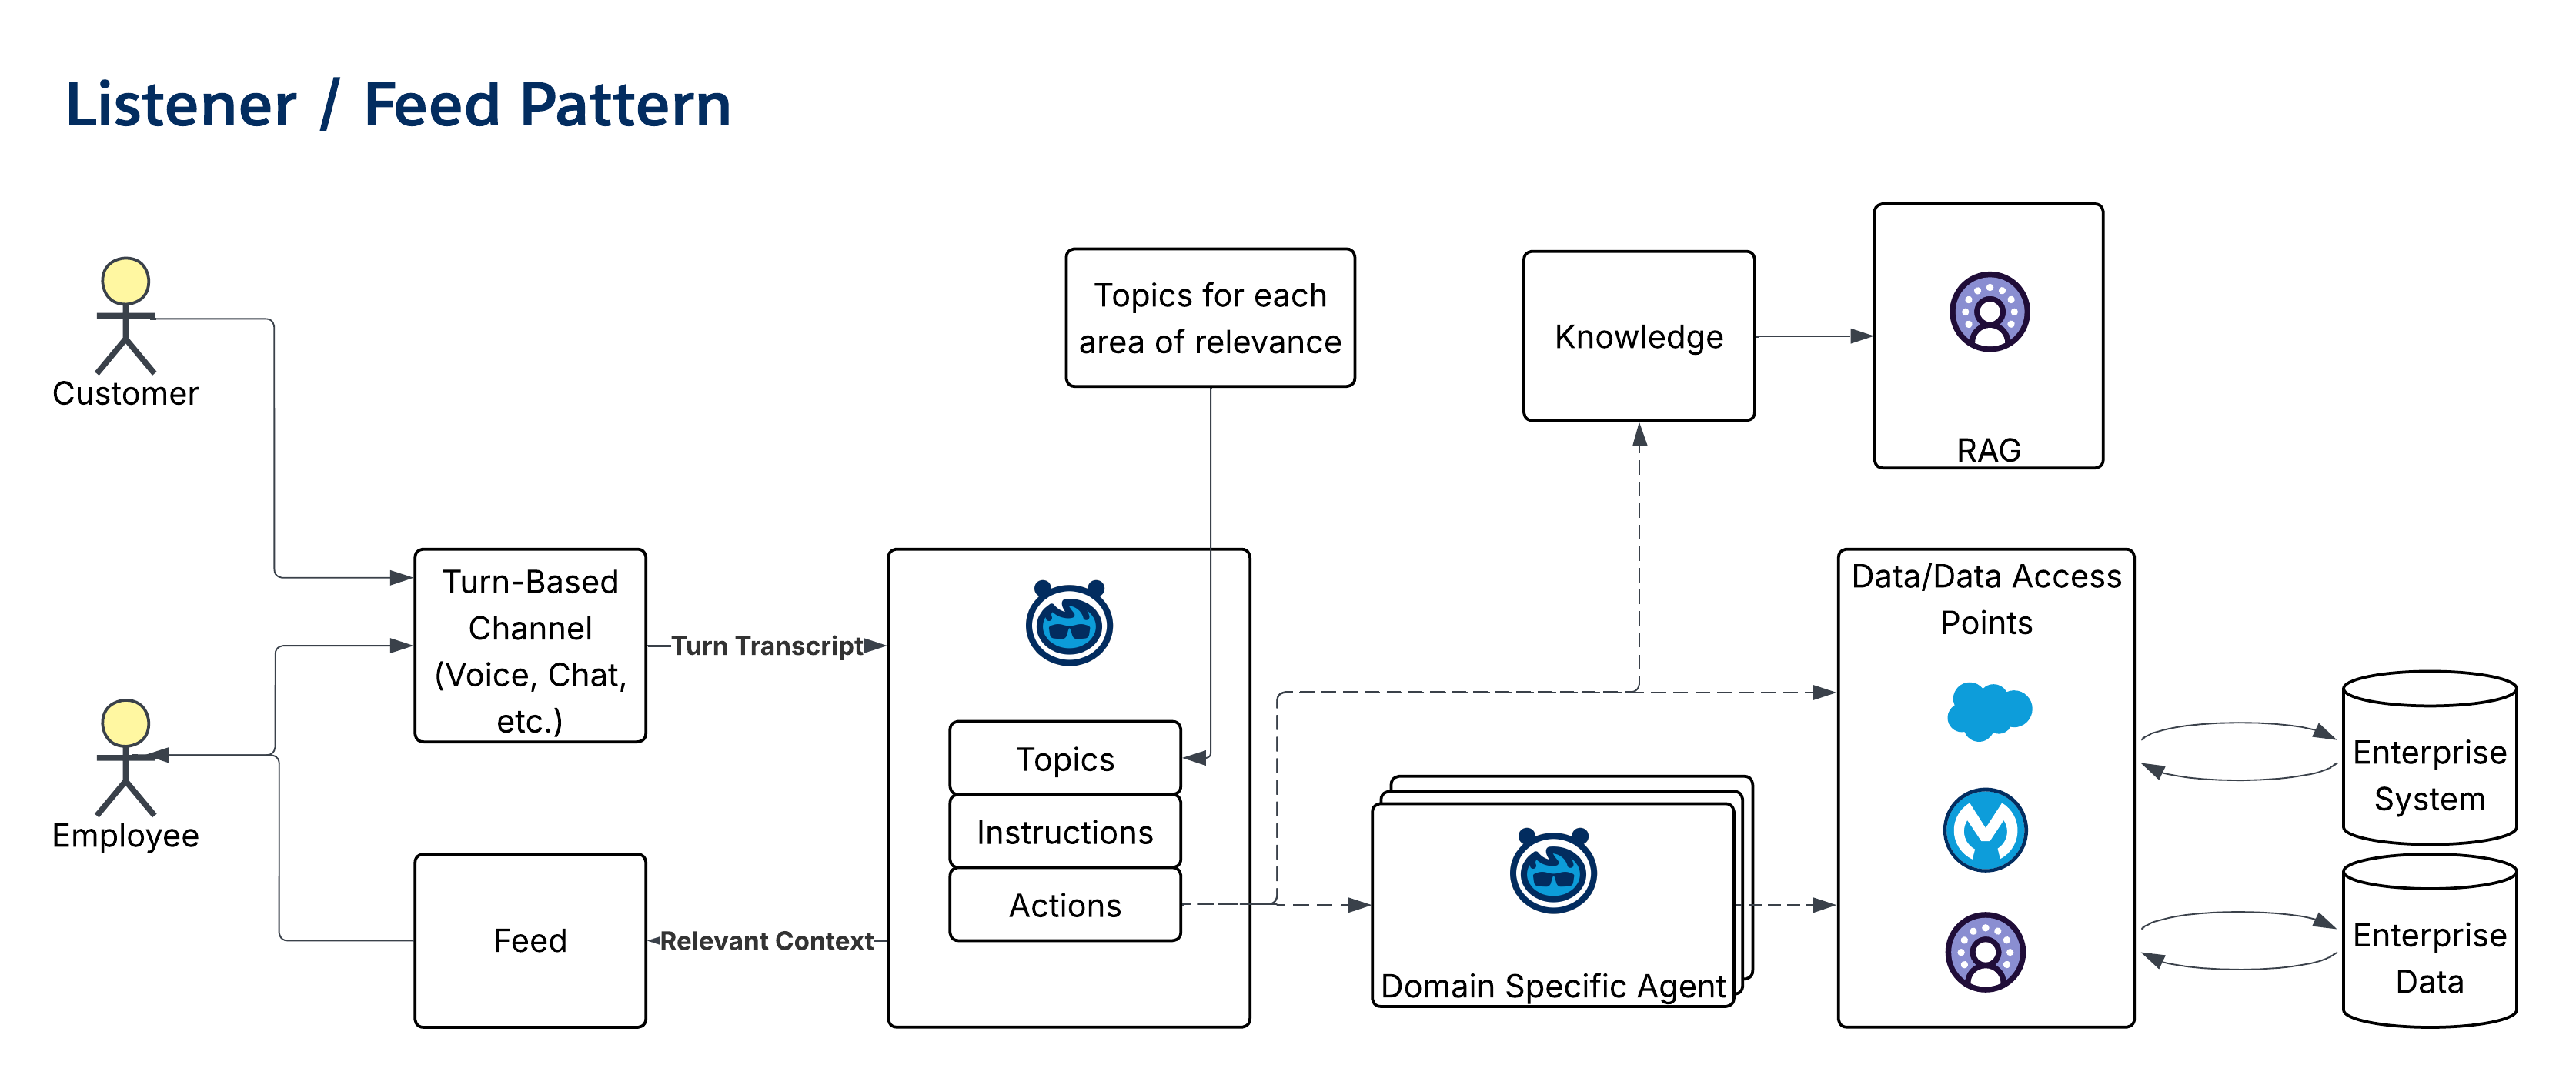 - **Reifegrad für Salesforce-Agenten**: Level 3
### Muster der Arbeitsumgebung (Radar O'Reilly)
- **Übersicht**: Mit dem _Muster "Arbeitsumgebung (Radar O'Reilly)"_ wird eine reaktionsschnelle Einzelscheibe im Flow einer Unterhaltung verwaltet. Sie verarbeitet jede Äußerung, um Teile des UX mit relevantem Inhalt zu aktualisieren.
- **Ausgabetyp**: Stellen Sie einen relevanten Kontext bereit, der sich in einem Portlet in einer größeren Einzelglasansicht befindet.
- **Anleitung zur Musternutzung**: Ein _Orchestrator-_Agent übergibt Äußerungen an eine Suite von _Themenagenten_. Jeder Themenagent bewertet die Anweisung, um festzustellen, ob eine UX-Aktualisierung erforderlich ist. In diesem Fall werden dynamische Aktualisierungen an die entsprechende LWC übertragen.
- **Repräsentativer Anwendungsfall**: Dies funktioniert wie eine erweiterte Haustür für Agenten.
- **Diagramm**:
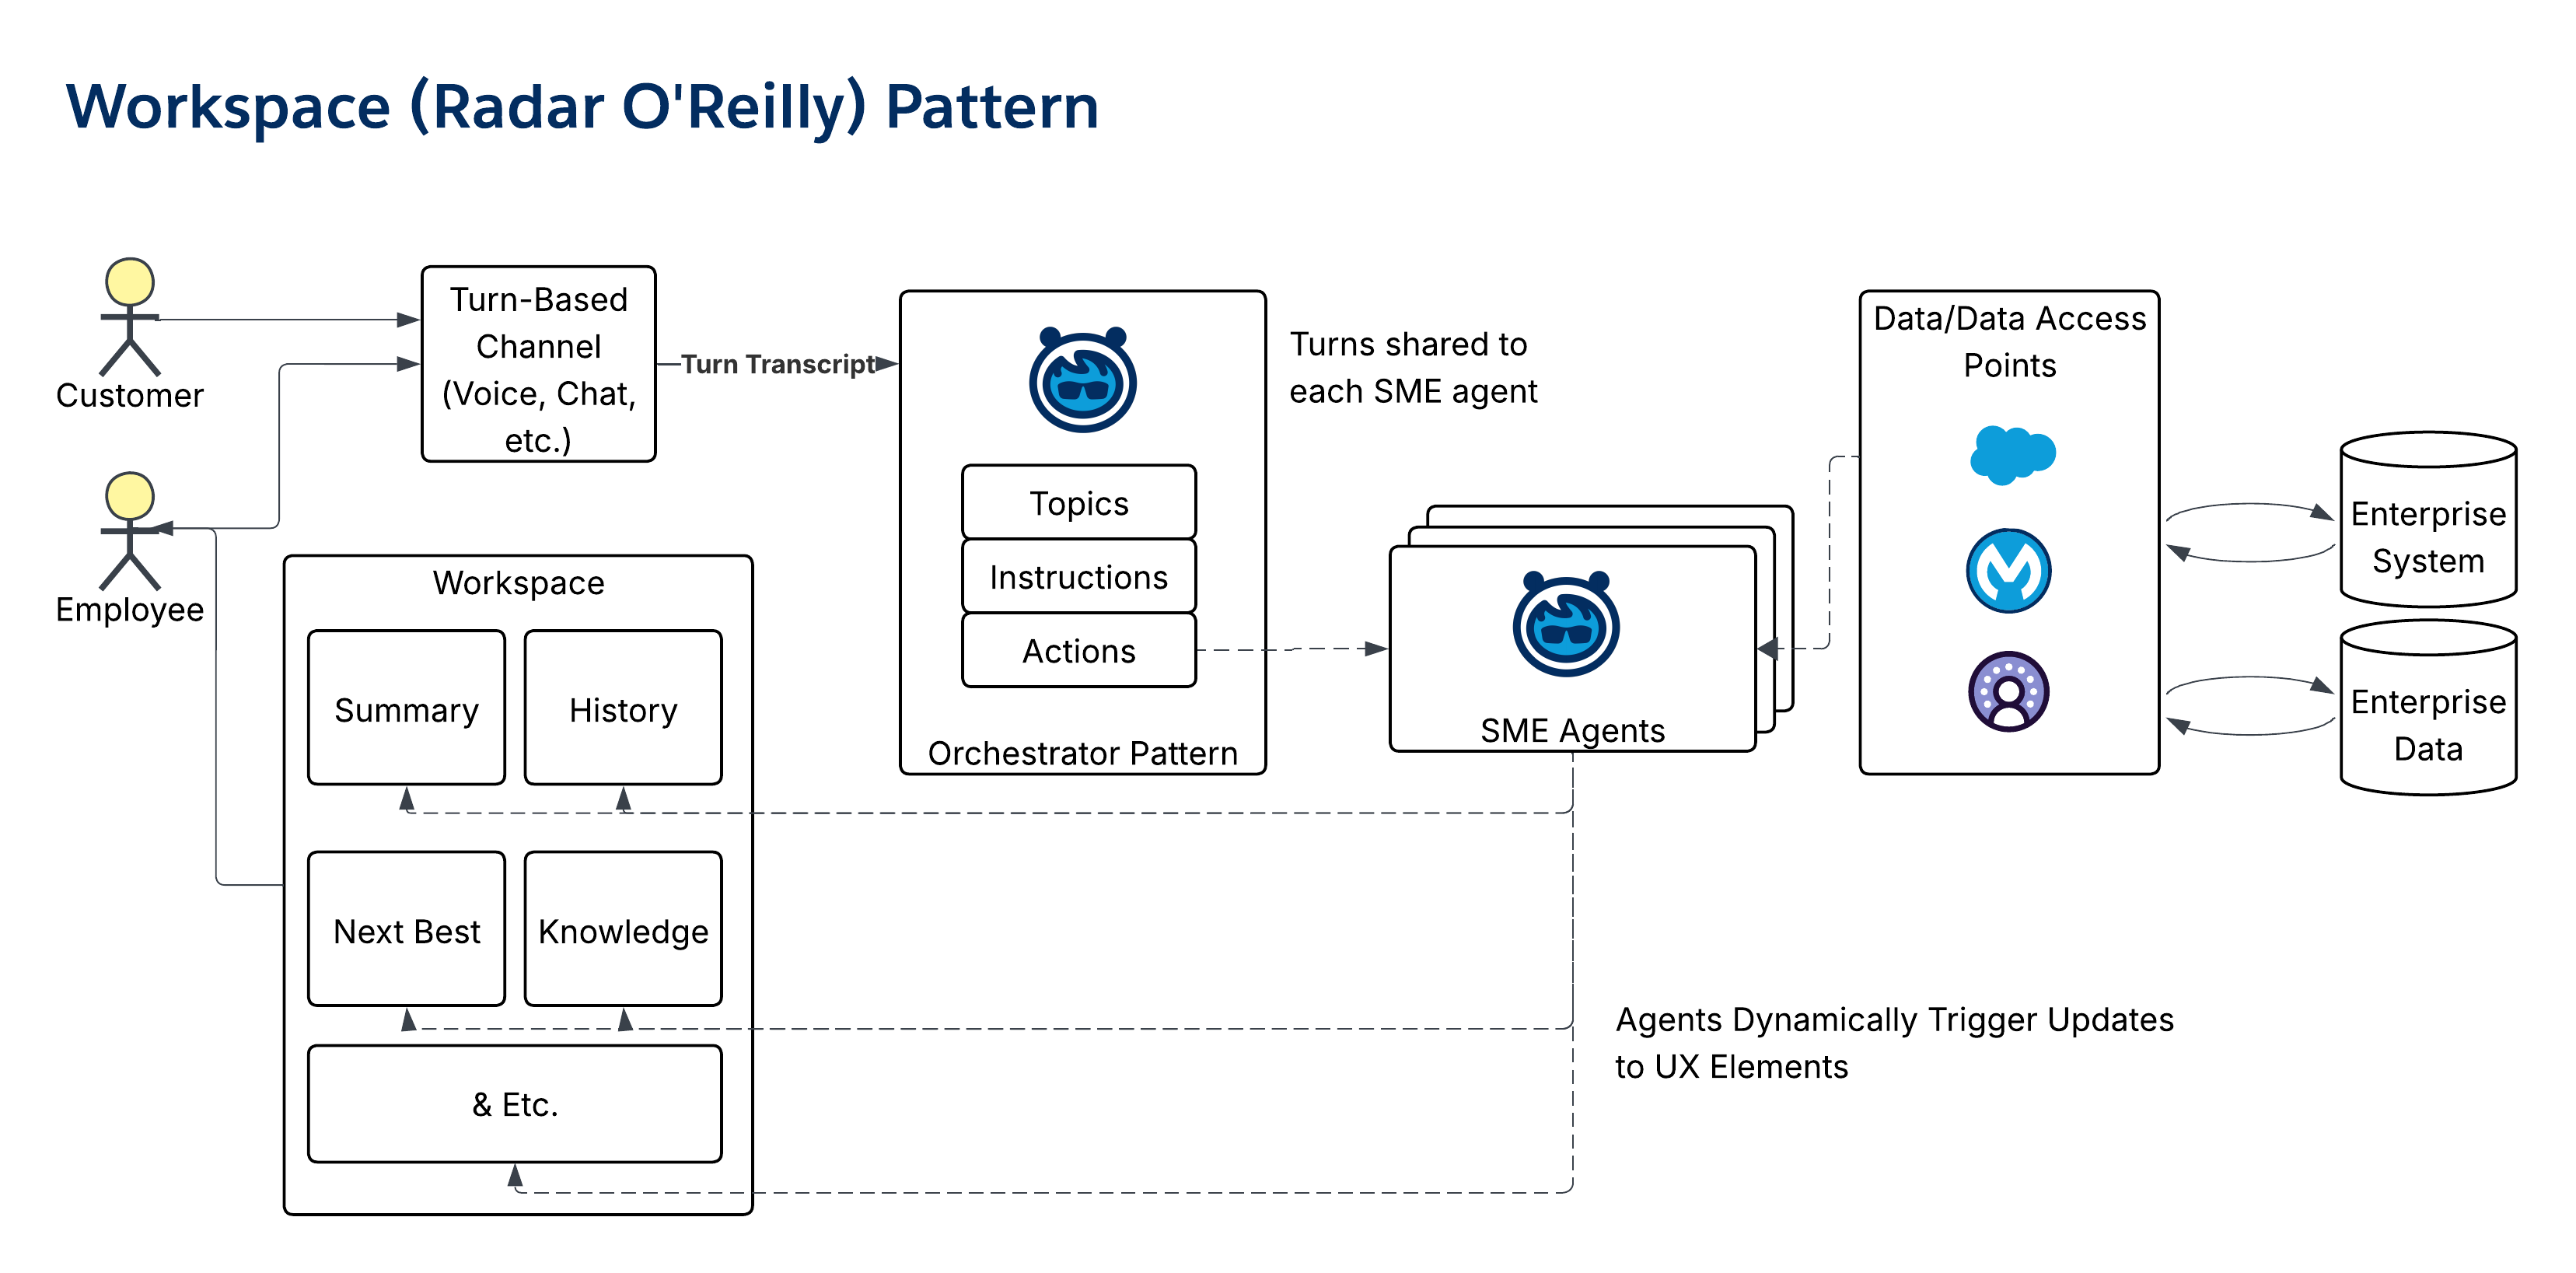 - **Reifegrad für Salesforce-Agenten**: Level 3
## 7\. Spezialistenmuster
_Spezielle Muster_ fassen tiefes Knowledge oder Fertigkeiten in einer bestimmten Domäne zusammen und werden in der Regel durch _Interaktionsmuster_ orchestriert.
### Answerbot-Muster
- **Übersicht**: Das _Antwortbot-Muster_ ist ein effektives Muster für Self-Service, bei dem GenAI verwendet wird, um die natürliche Sprache für Knowledge Retrieval zu bestimmen, nicht nur Stichwörter.
- **Ausgabetyp**: Zusammengefasstes Knowledge und Verweise/Zitate auf unterstützende Materialien.
- **Anleitung zur Musternutzung**: Organisieren und erfassen Sie zuverlässige Quellmaterialien (z. B. Knowledge Stores oder häufig gestellte Fragen), um den Agenten zu konfigurieren. Positionieren Sie den Agenten auf Unternehmenswebsites oder in internen Portalen. Überwachen Sie Fragen, um Knowledge Lücken zu identifizieren und zu schließen.
- **Repräsentativer Anwendungsfall**: Erleichtern der Suche mit natürlicher Sprache auf einer Unternehmenswebsite, Interagieren mit einem Bot für HR-Vorteile und Bereitstellen von Self-Service-Komponenten für alle Zugehörigen.
- **Diagramm**:
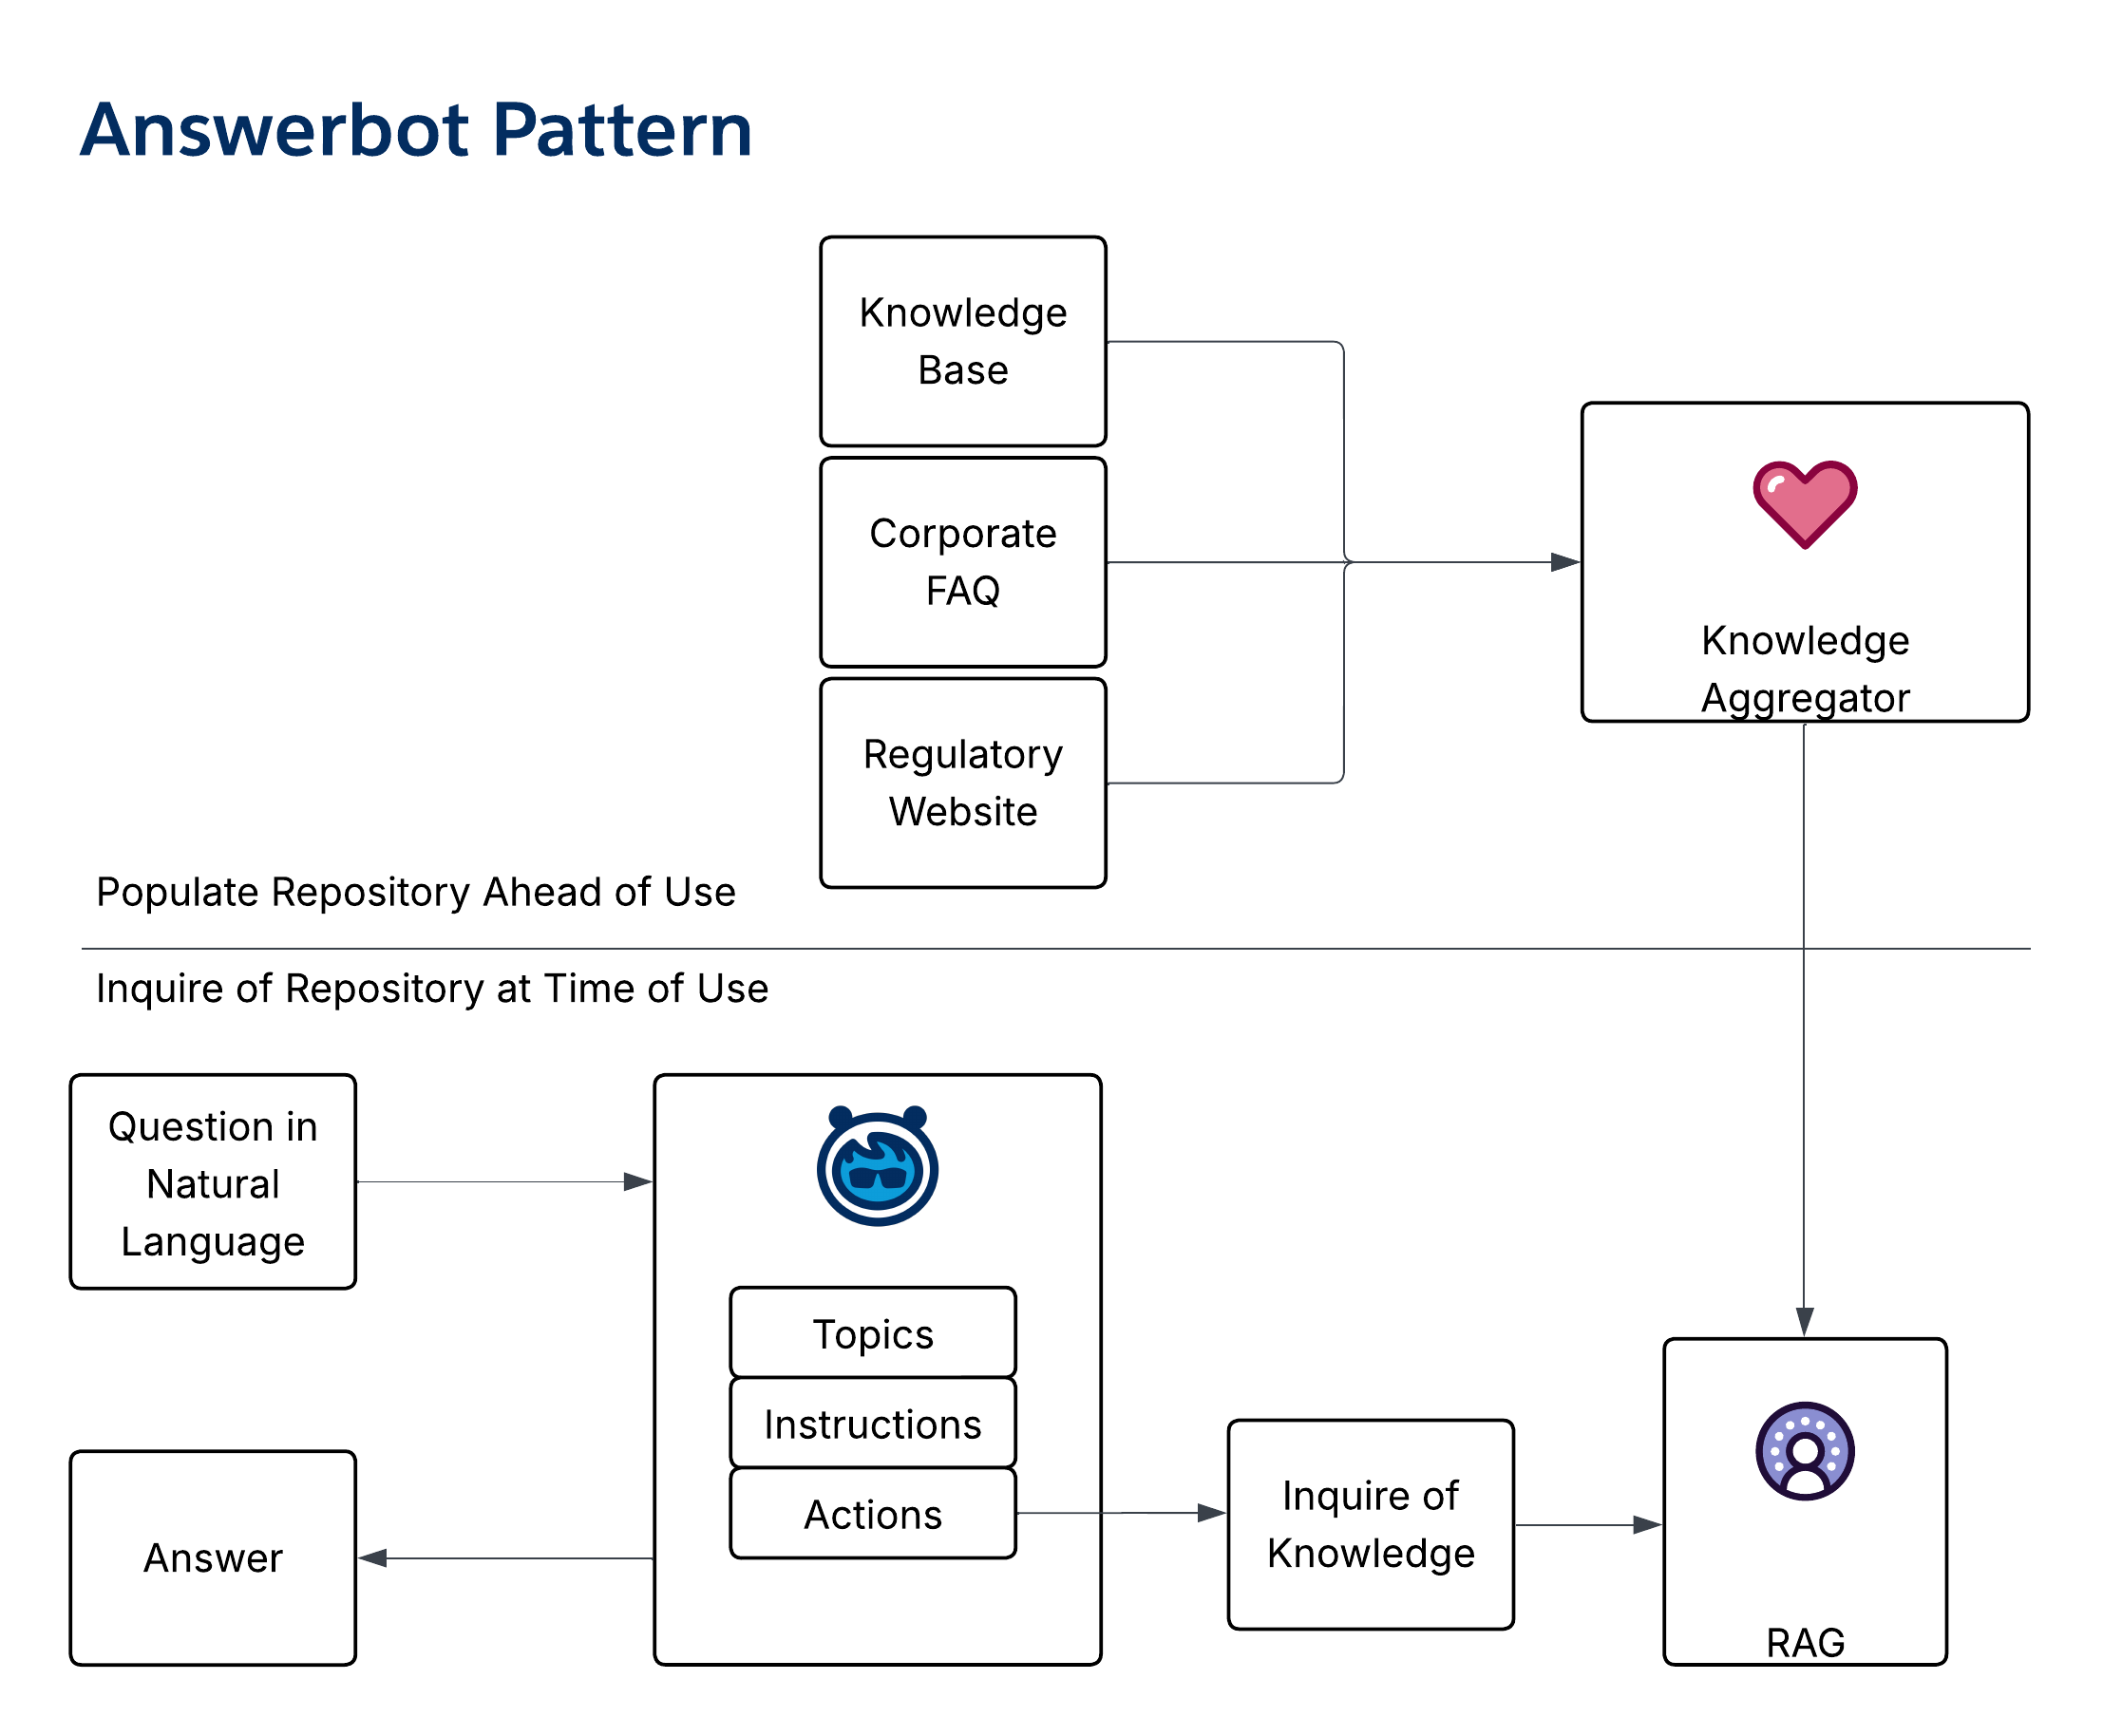 - **Reifegrad für Salesforce-Agenten**: Level 1
### Domänen-KMU-Muster
- **Übersicht**: Bei dem _Muster "Domäne_ – KMU" handelt es sich um ein grundlegendes Muster, das ein Front-End mit natürlicher Sprache für eine Geschäftsdomäne (z. B. Aufträge oder Ansprüche) bereitstellt.
- **Ausgabetyp**: Stellen Sie relevante Inhalte, Themen, Daten und formatierte Informationen zur Domäne bereit.
- **Anleitung zur Musternutzung**: Verwenden Sie dieses Muster, um einen Betreff oder eine Geschäftsdomäne zu verkapseln. Konfigurieren Sie den Agenten mit der Möglichkeit, geeignete CRUD-Vorgänge auszuführen. Stellen Sie diese Agenten über [_Interaktionsmuster_](/docs/architect/de-de/fundamentals/guide/enterprise-agentic-architecture#6-interaktionsmuster) zur Verfügung (z. B. Orchestrierer oder Listener).
- **Repräsentativer Anwendungsfall**: Gatekeeping einer Geschäftsdatendomäne, Bereitstellen eines "Auftragsagenten" oder "Inventaragenten" und Bereitstellen einer Agentenschnittstelle für eine Geschäftsdomäne.
- **Diagramm**:
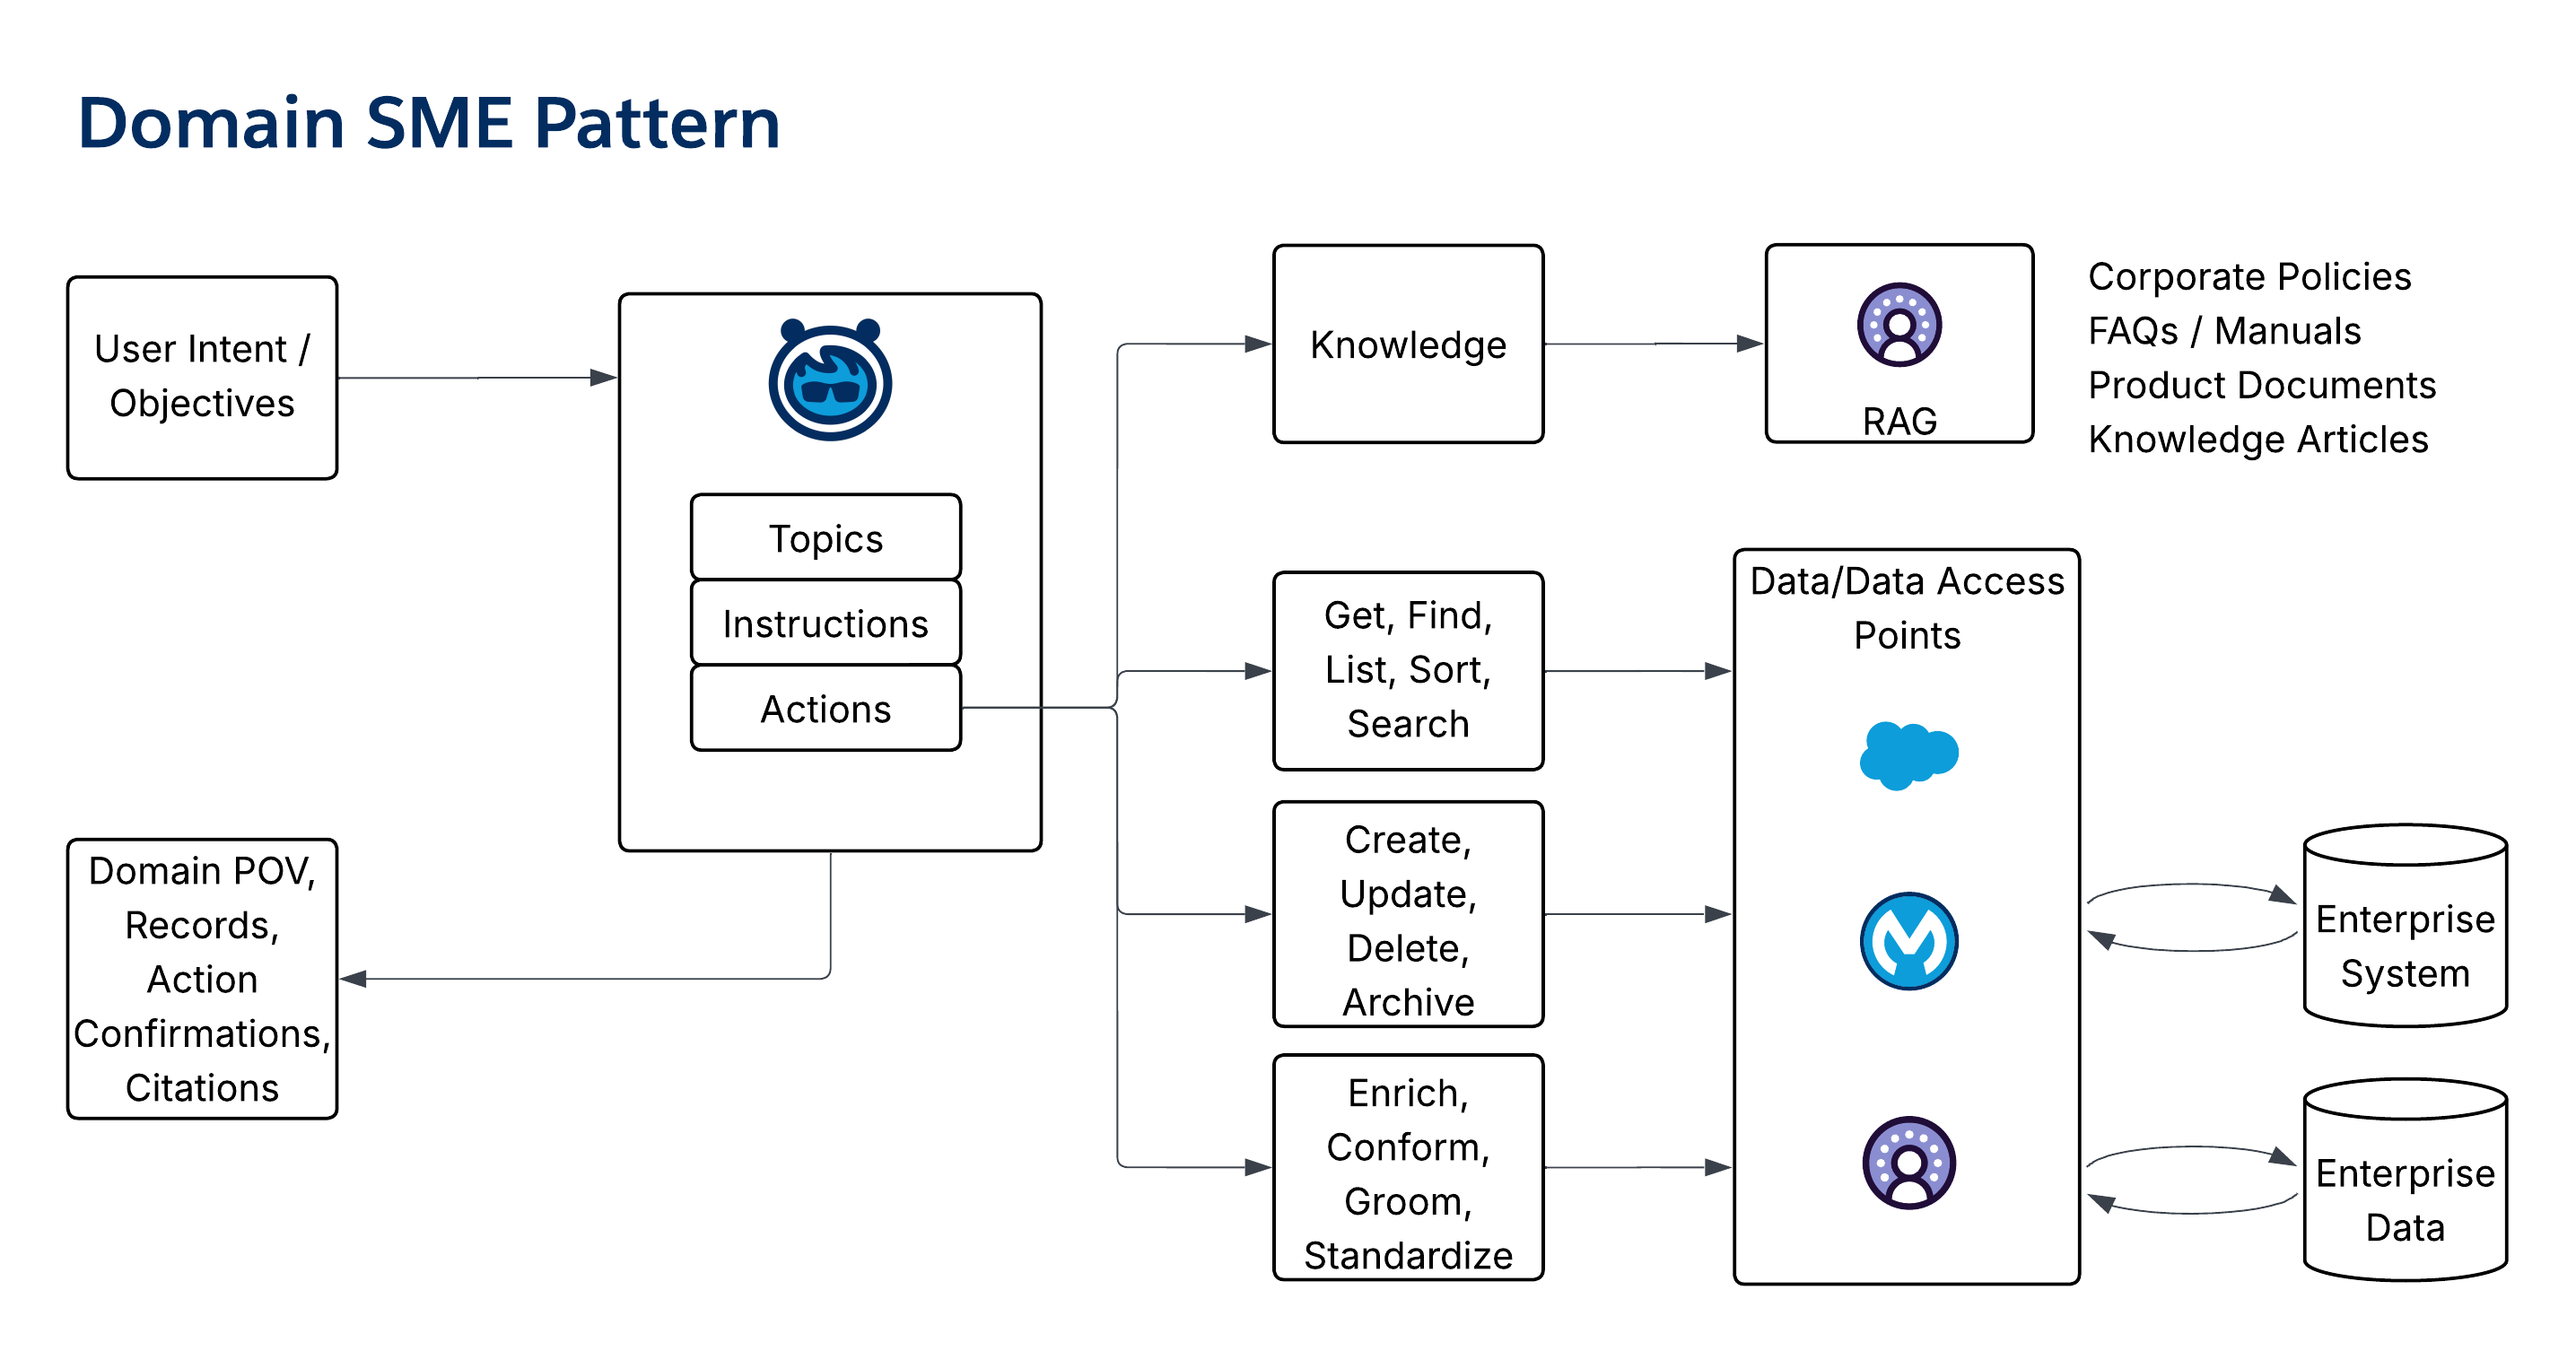 - **Reifegrad für Salesforce-Agenten**: Level 2
### Vernehmungsmuster
- **Übersicht**: Das _Abfragemuster_ ist ein KMU-Agent, der zu einem Thema abgefragt werden kann, um Kontext aus mehreren Quellen zusammenzustellen und Fragen zu beantworten. Die Schlüsselfunktionen der Agenten sind die Möglichkeit, Kontext abzurufen und Konzepte über einen Inhaltskörper hinweg zu verbinden, wie es ein Mensch nach dem Lesen und Internalisieren des Inhalts tun würde. Dieses Muster mindert die Notwendigkeit der "Drehstuhlintegration".
- **Ausgabetyp**: Stellen Sie Antworten auf Fragen bereit.
- **Anleitung zur Musternutzung**: Es wird häufig als Konsolen-Widget konfiguriert, das mit dem aktuellen Kontext des Benutzers verbunden ist, sodass er direkt Fragen stellen kann. Sie wird auch in Verbindung mit Knowledge-Ressourcen wie häufig gestellten Fragen, Richtlinien und Produktkatalogen verwendet. Kombinieren Sie das _Abfragemuster_ mit Standardaufforderungen, um allgemeine Antworten auf allgemeine Fragen zu skalieren.
- **Repräsentativer Anwendungsfall**: Als Vertragsassistent, Assistent für Vorteilsanfragen oder Facharbeiteragent in Mustern mit mehreren Agenten (z. B. Listener oder Arbeitsumgebung) verwenden.
- **Diagramm**:
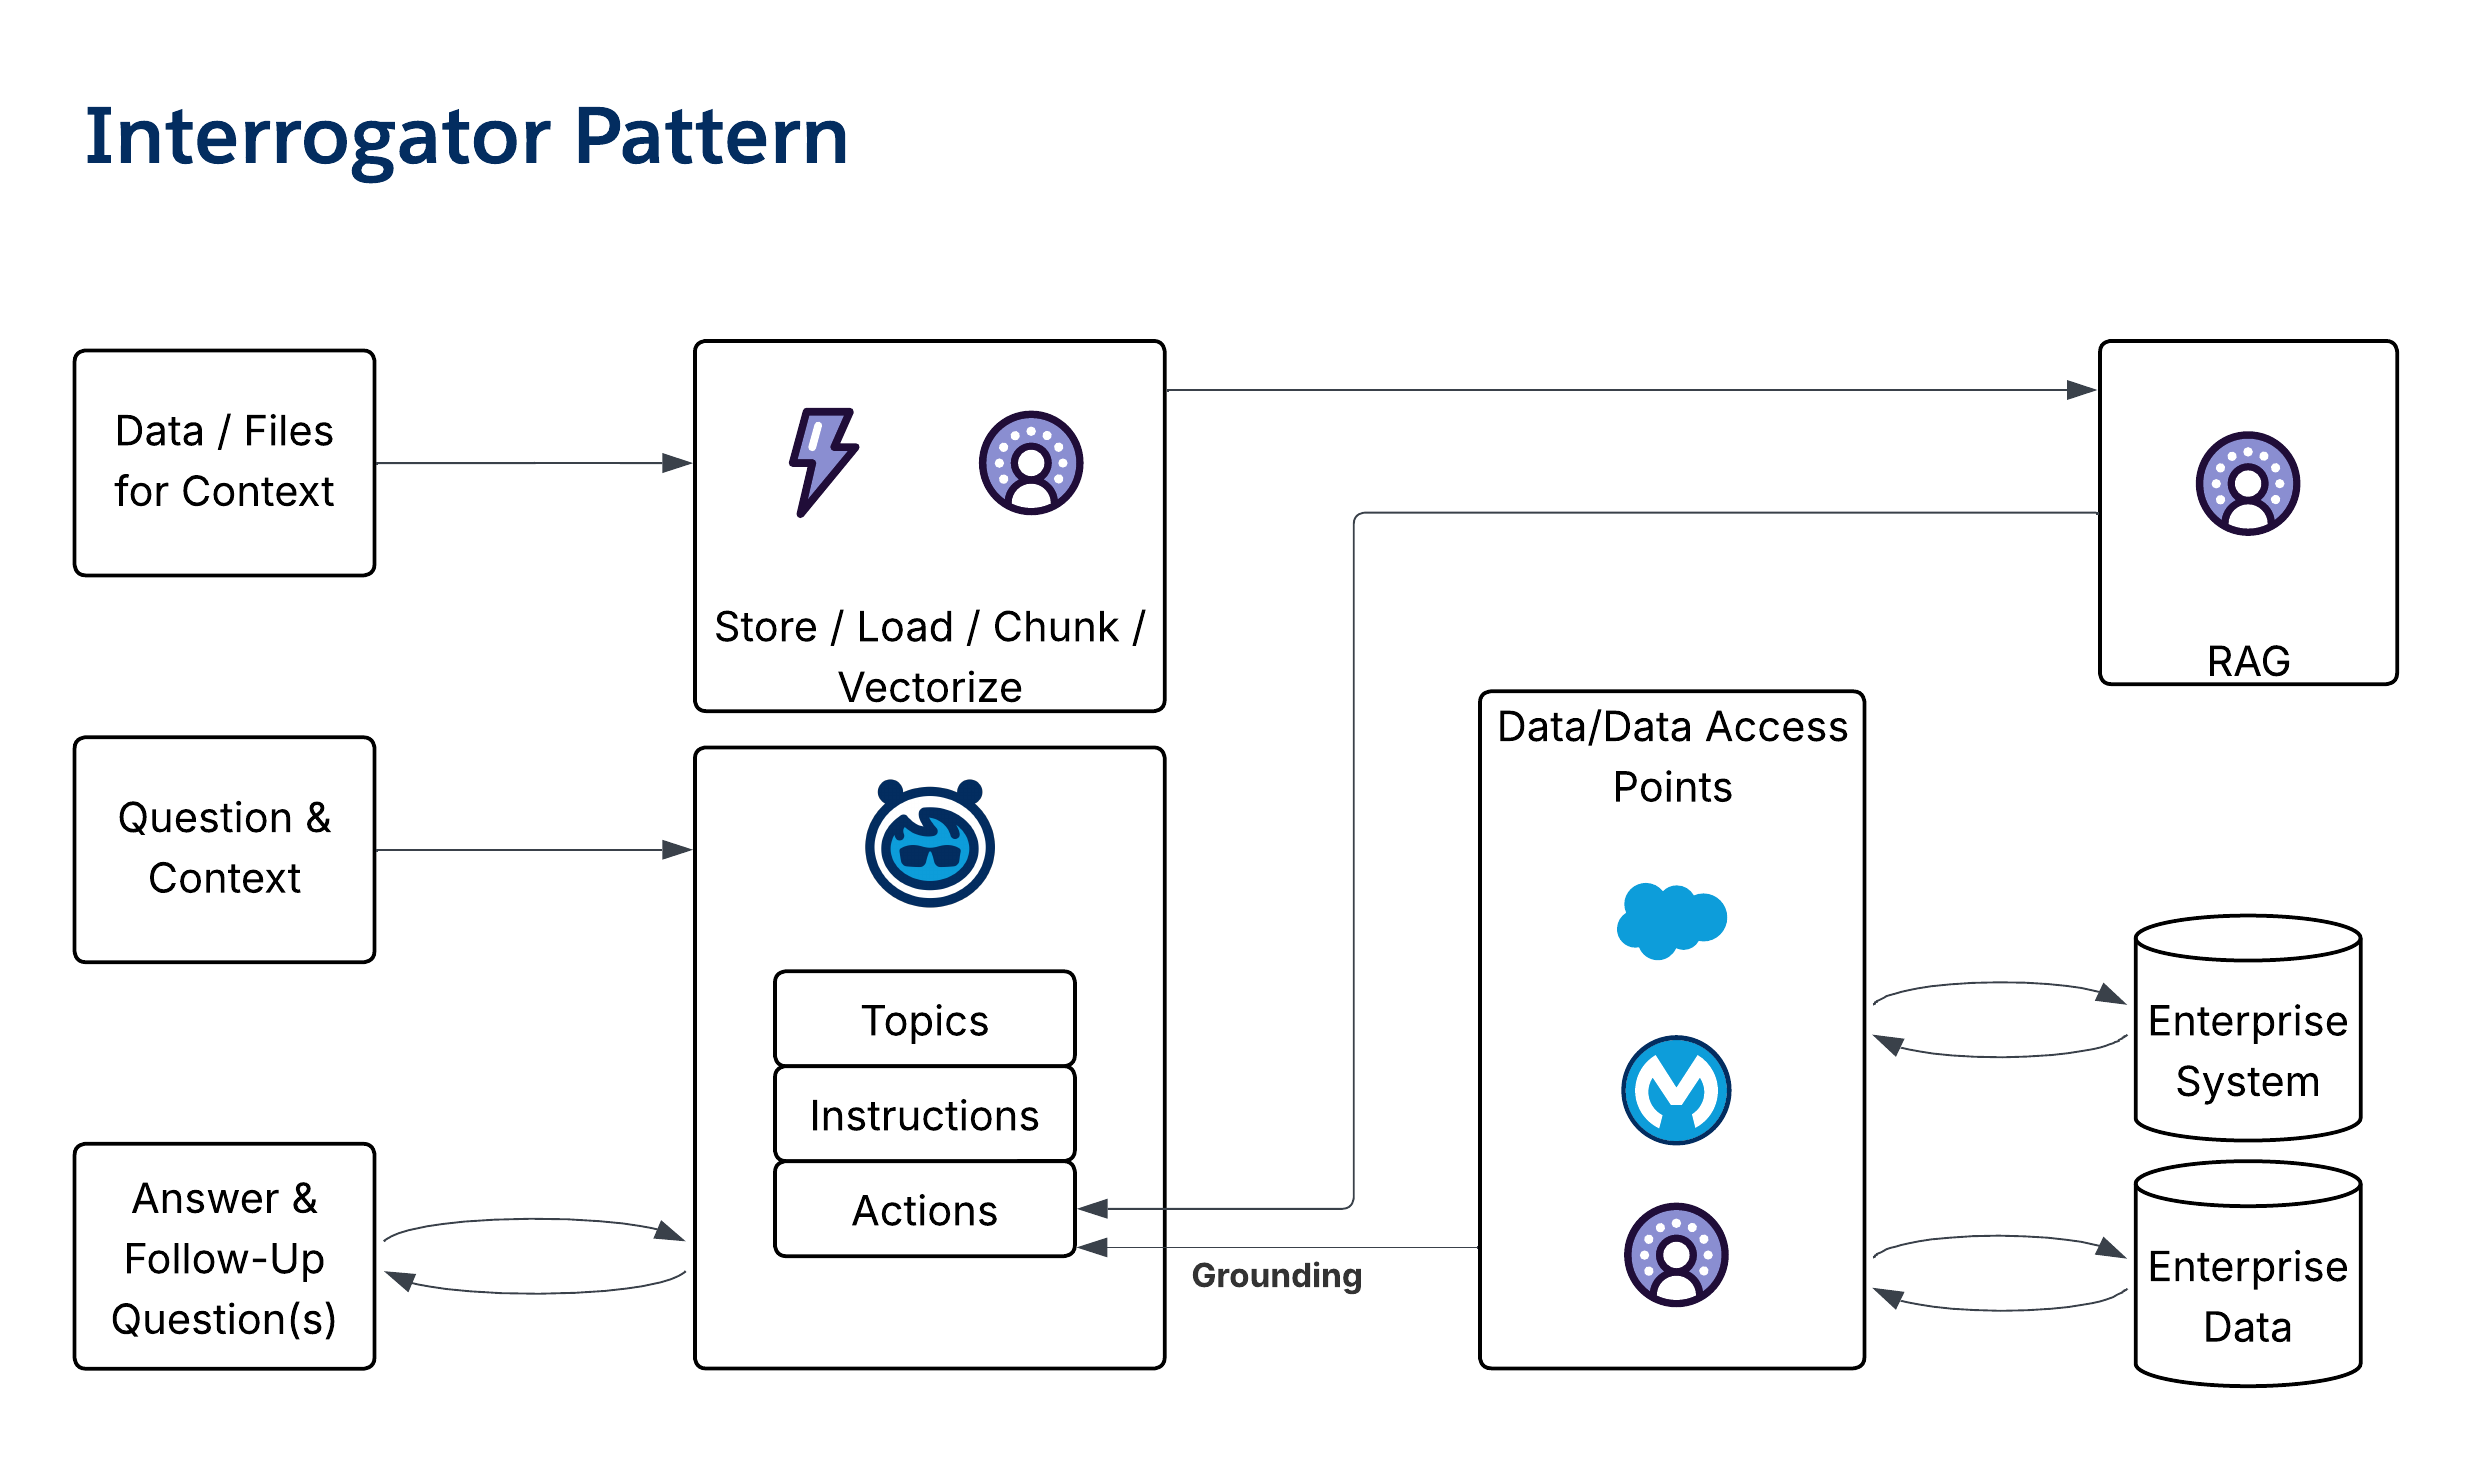 - **Reifegrad für Salesforce-Agenten**: Level 2
### Priorisierungsmuster
- **Übersicht**: Das _Priorizer-Muster_ wird verwendet, um eine Reihe von Aufgaben oder Arbeitsobjekten anhand einer definierten Zielsetzung anzuordnen. Sie nutzt GenAI für qualitative Analysen, unstrukturierte Datenanalysen oder integrative Analysen über mehrere Datendomänen hinweg.
- **Ausgabetyp**: Stellen Sie generative Statistiken bereit.
- **Anleitung zur Musternutzung**: Verwenden Sie natürliche Sprache, um die gewünschten Qualitäten für die Priorisierung zu beschreiben. Hausarrest für den Agenten mithilfe einer Reihe auswählbarer Optionen. Kombinieren Sie sie mit dem Listener-Muster, um eine anpassungsfähige "Next Best Action" im Arbeitsablauf zu erstellen.
- **Repräsentativer Anwendungsfall**: Verwenden Sie sie als Generator für _Next Best Action_ oder als spezialisierten Mitarbeiteragenten in langfristigen Mustern oder Mustern mit mehreren Agenten.
- **Diagramm**:
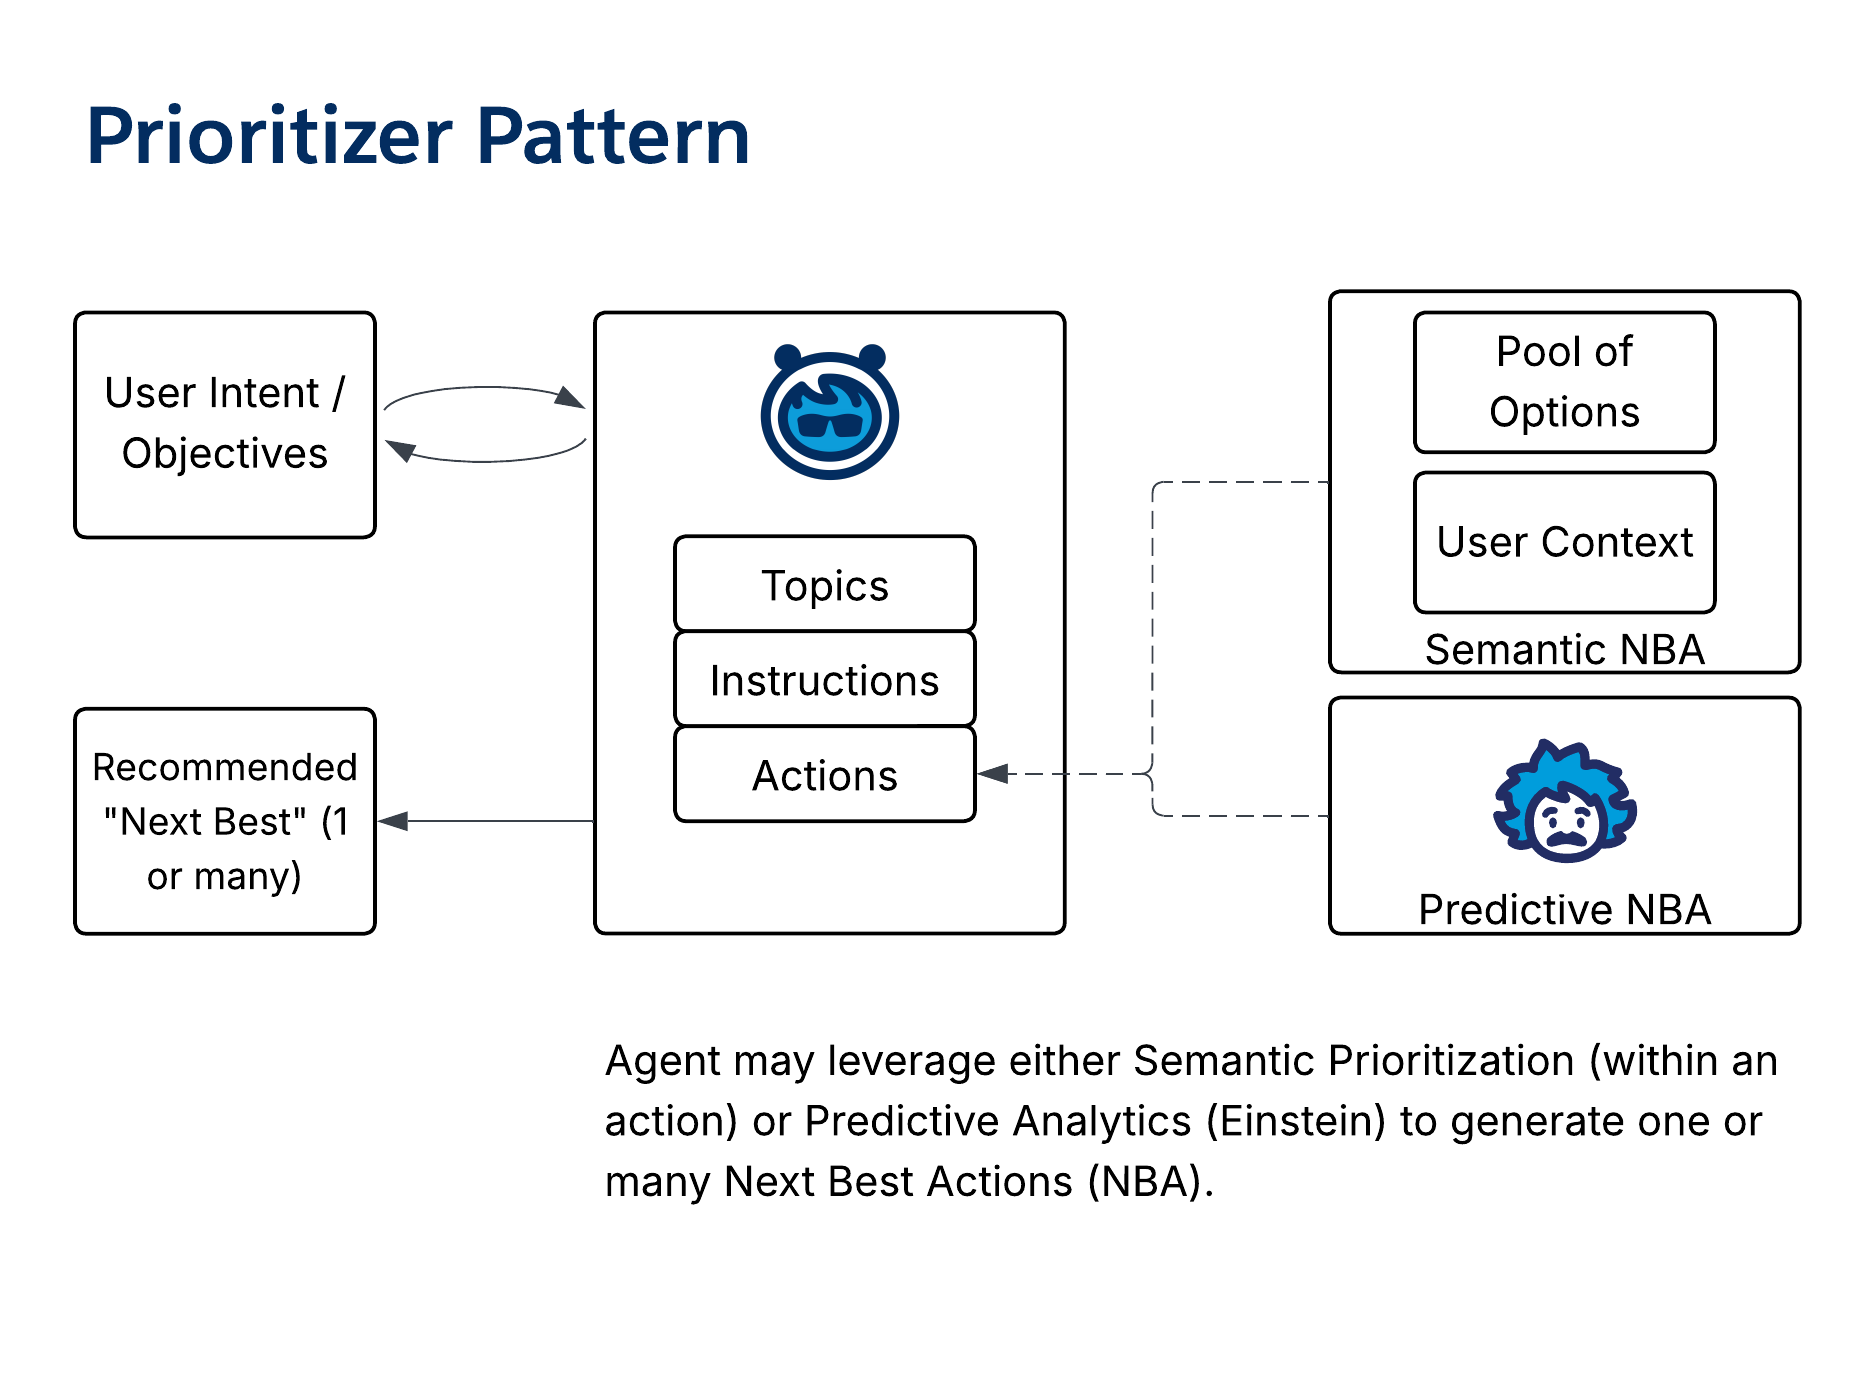 - **Reifegrad für Salesforce-Agenten**: Level 2
## 8\. Dienstprogramm- und Datenmuster
_Dienstprogrammmuster_ führen bestimmte, wiederholbare Aufgaben aus, die andere Agenten oder Prozesse unterstützen.
### Generatormuster
- **Übersicht**: Das _Generatormuster_ ist ein grundlegendes Muster zum Erstellen neuer Inhalte (z. B. Kundenvorgangszusammenfassungen oder E-Mail-Entwürfe) aus vorhandenen Eingaben und Standards. Sie wird oft als Aufforderung implementiert und kann in andere Agenten eingebettet werden.
- **Ausgabetyp**: Stellen Sie generierten Inhalt bereit, der dem angeforderten Format und Intent entspricht.
- **Anleitung zur Musternutzung**: Das _Generatormuster_ kann in den meisten anderen Mustern oder als eigenständiges Muster verwendet werden. Kontext kann über die Anforderung, die Hydration während der Ausführung oder zusätzliche Anreicherungsschritte bereitgestellt werden.
- **Repräsentativer Anwendungsfall**: Stellen Sie QBRs Kundenvorgangszusammenfassungen, E-Mail-Entwürfe, Knowledge-Artikel oder Vorschläge/Antworten bereit.
- **Diagramm**:
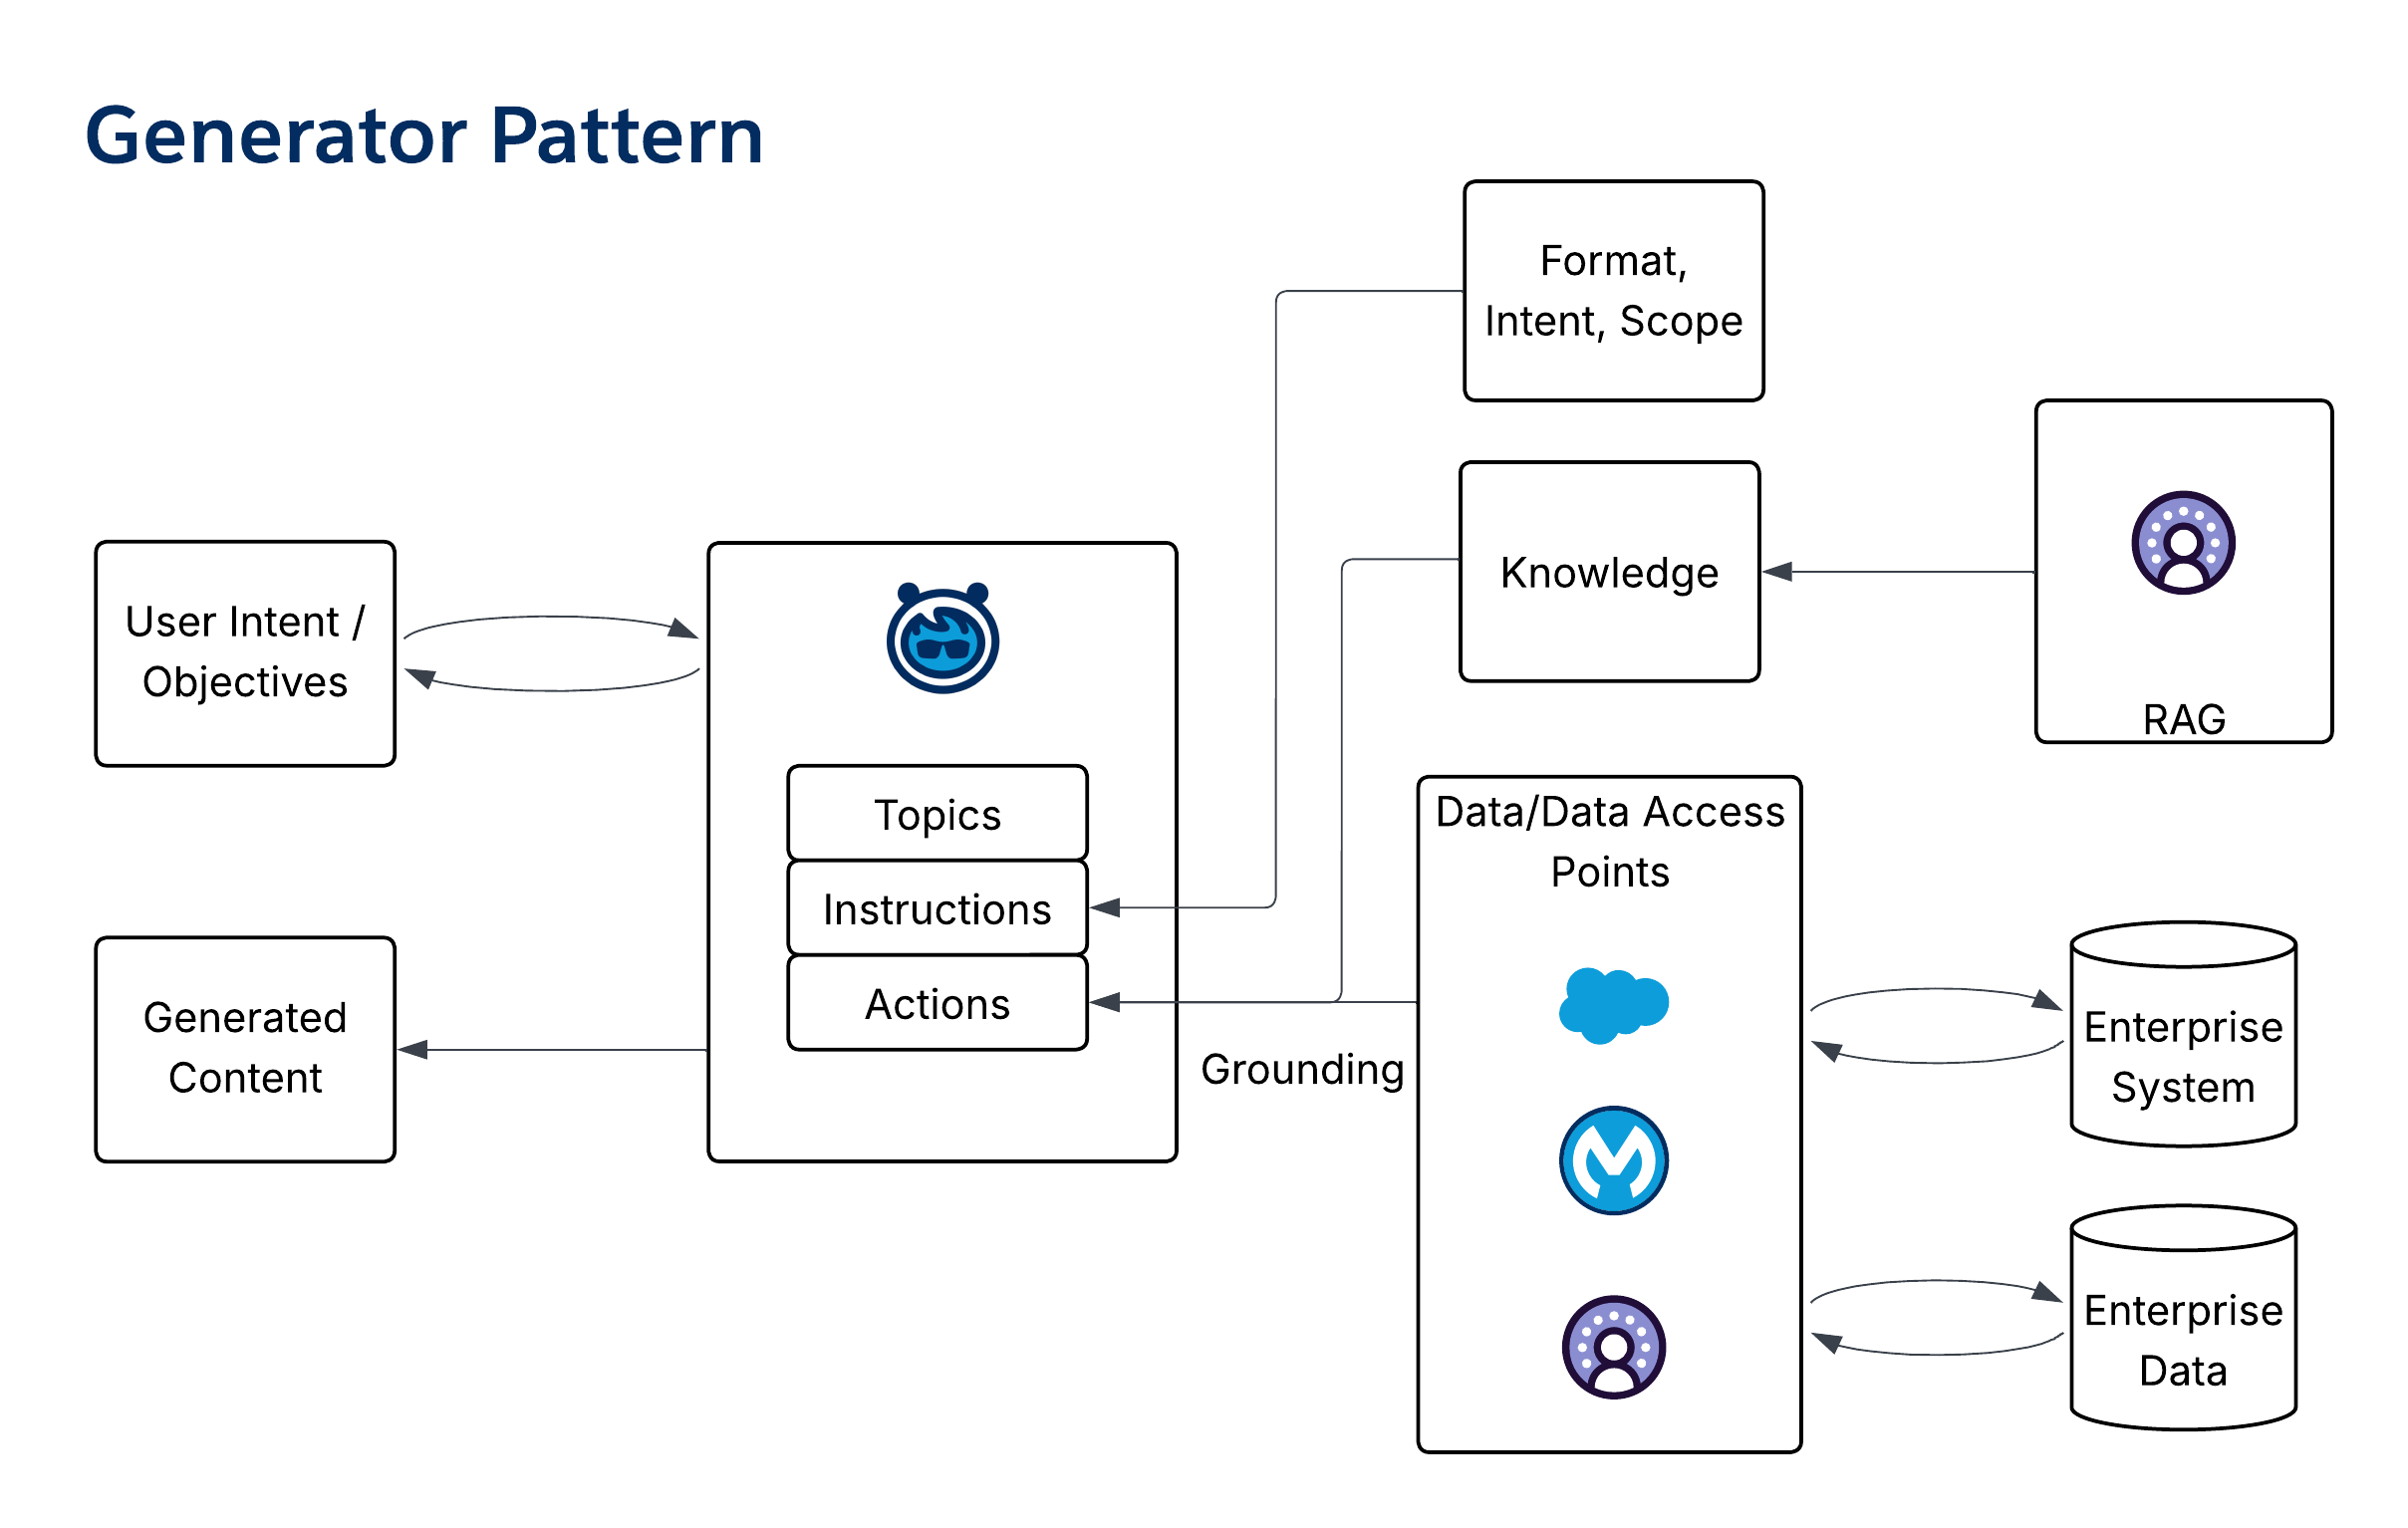 - **Reifegrad für Salesforce-Agenten**: Level 1
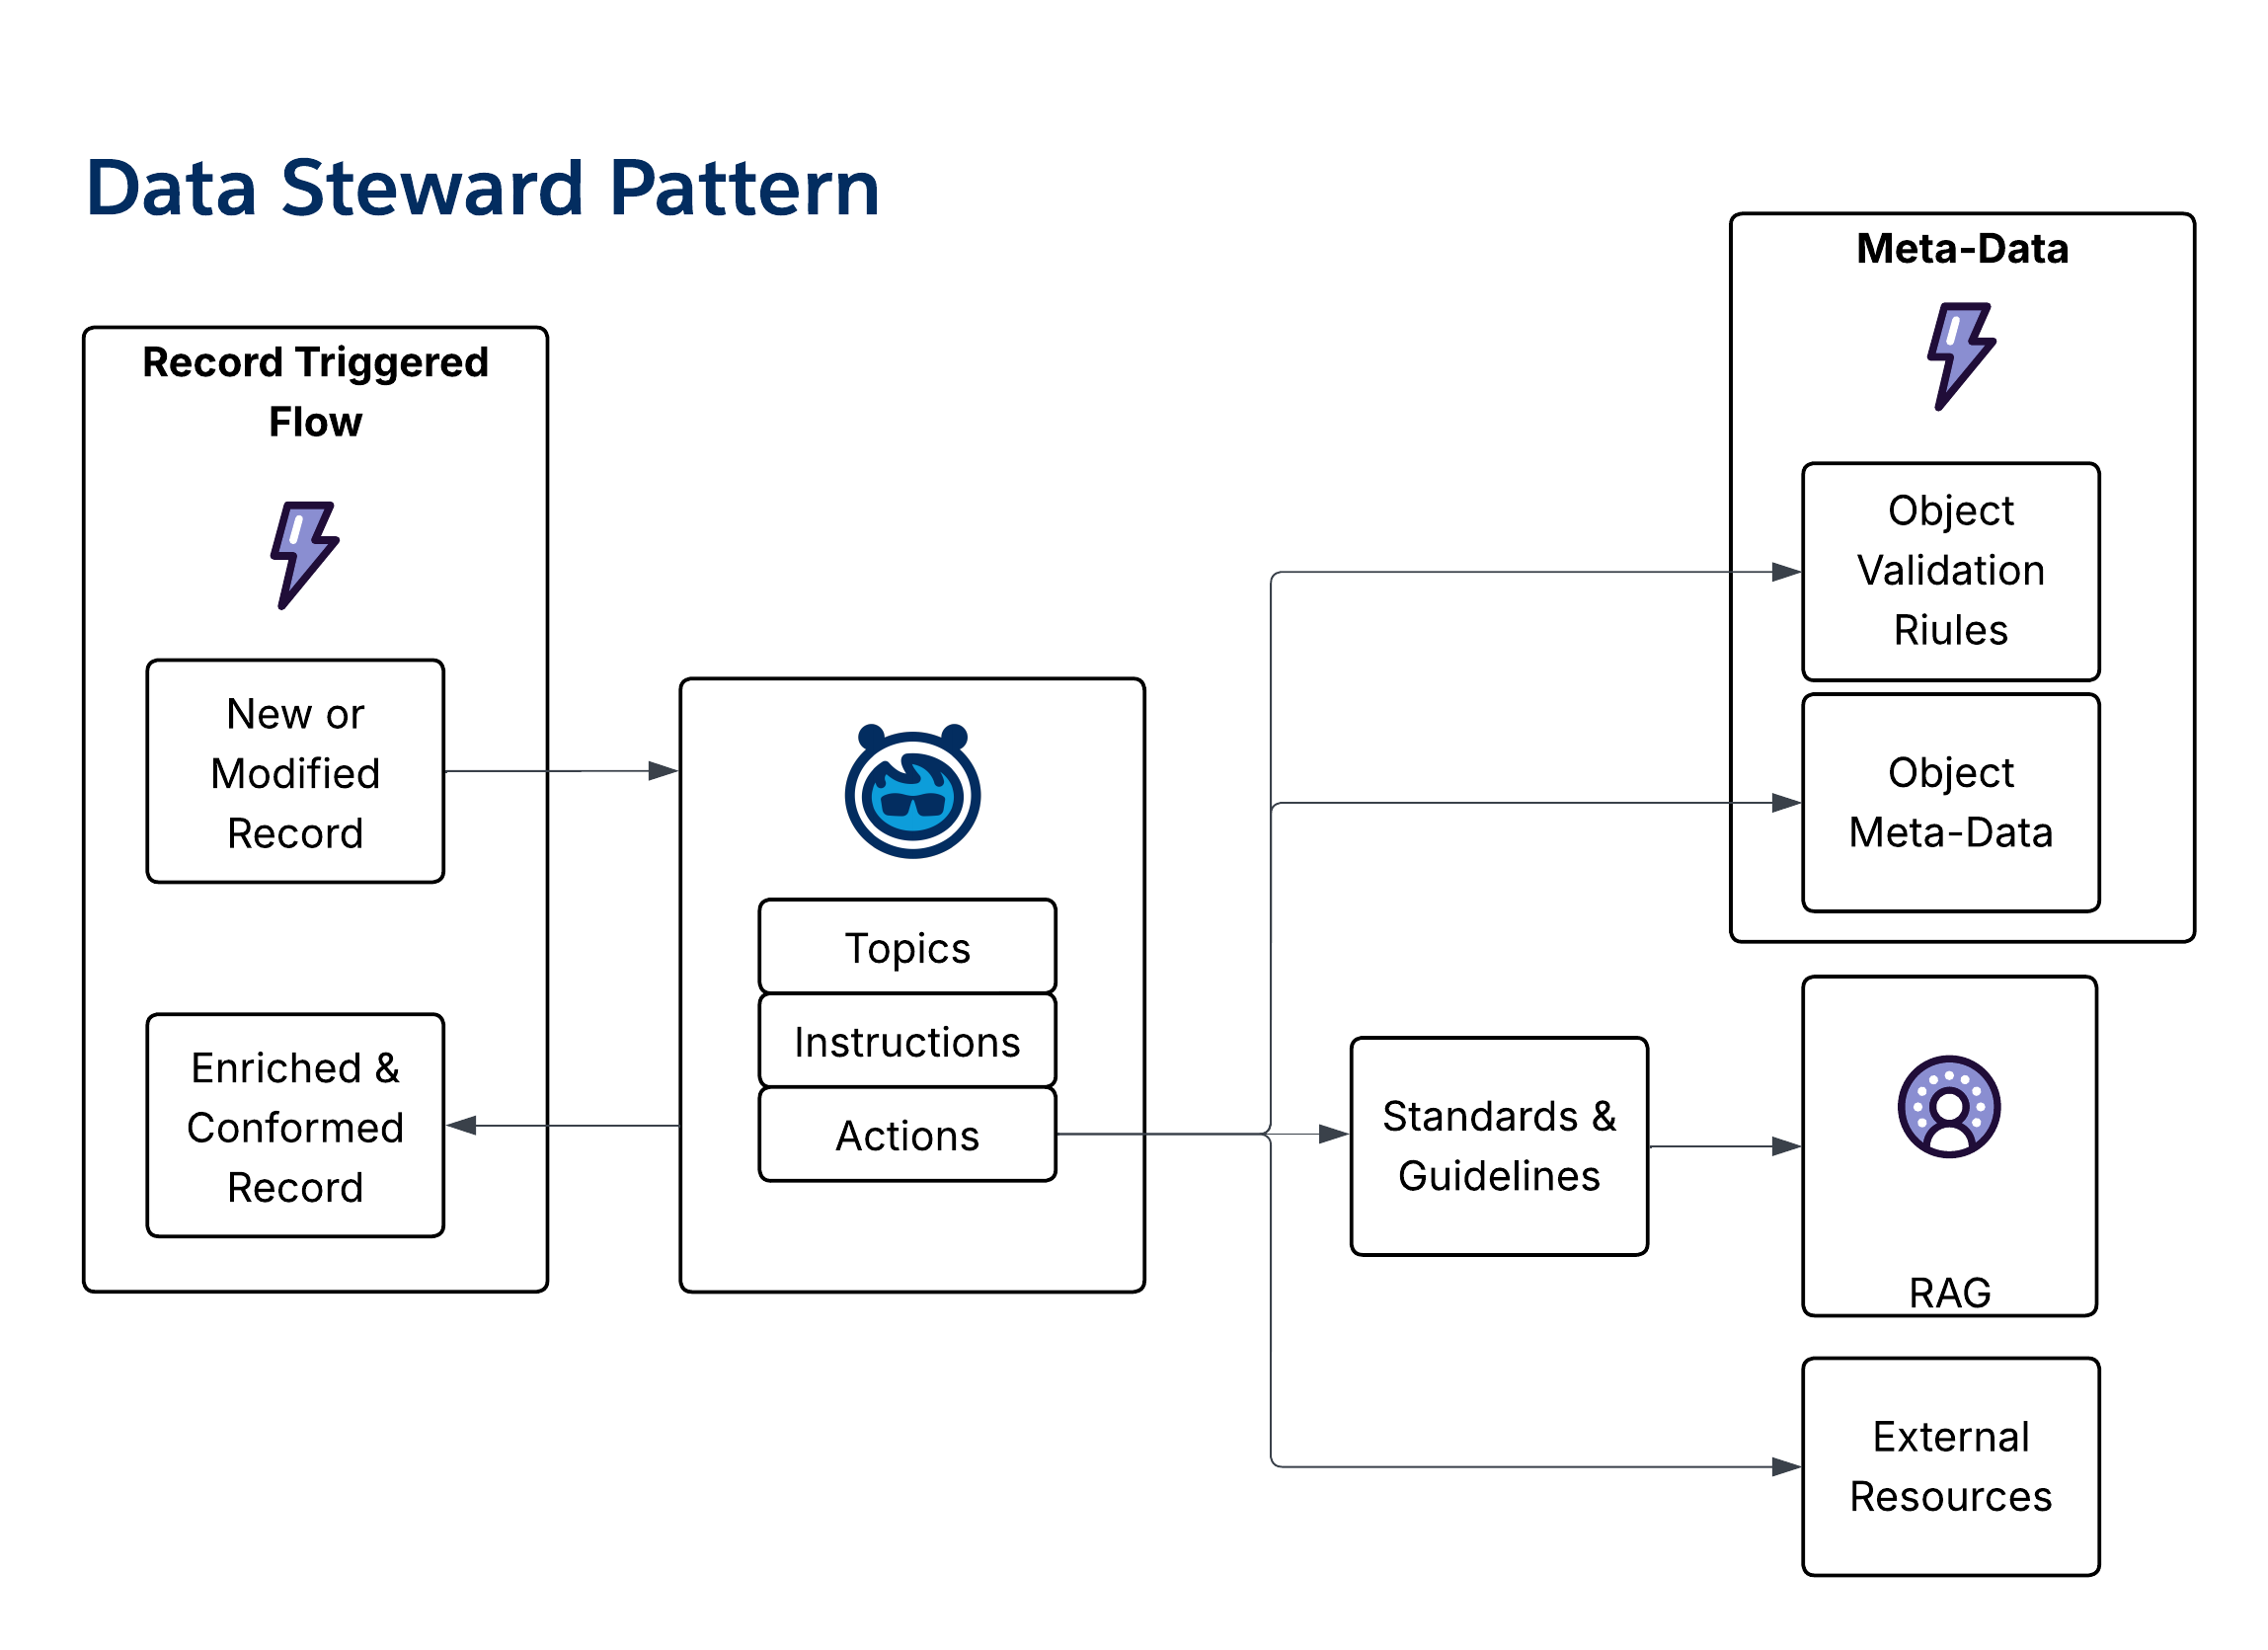
### Datenweiterleitungsmuster
- **Übersicht**: Bei dem _Muster "Datenweiterleitung_" handelt es sich um ein autonomes Hintergrundmuster, das einen agentenbasierten Schritt in Datenvorgänge einführt, um eine konsistente Datenqualität, Konformität und Anreicherung zu gewährleisten.
- **Ausgabetyp**: Geben Sie vor dem Speichern aktualisierte Datensatz- und Datenfelder an.
- **Anleitung zur Musternutzung**: Betten Sie die Datenqualität zum Zeitpunkt der Datenerstellung ein, indem Sie Datenverwalter hinzufügen, die Flows vor dem Speichern von Daten auslösen. Hilft, die konsistente Anwendung von Kategorisierungs-, Zusammenfassungs- und Statusdaten sicherzustellen.
- **Repräsentativer Anwendungsfall**: Gewährleistung konsistenter Aktualisierungen des Pizza-Tracker-Stils, Anreicherung von Accountdaten und Beseitigung nicht übereinstimmender Postleitzahlen und Adressen.
- **Diagramm**:
 - **Reifegrad für Salesforce-Agenten**: Level 2
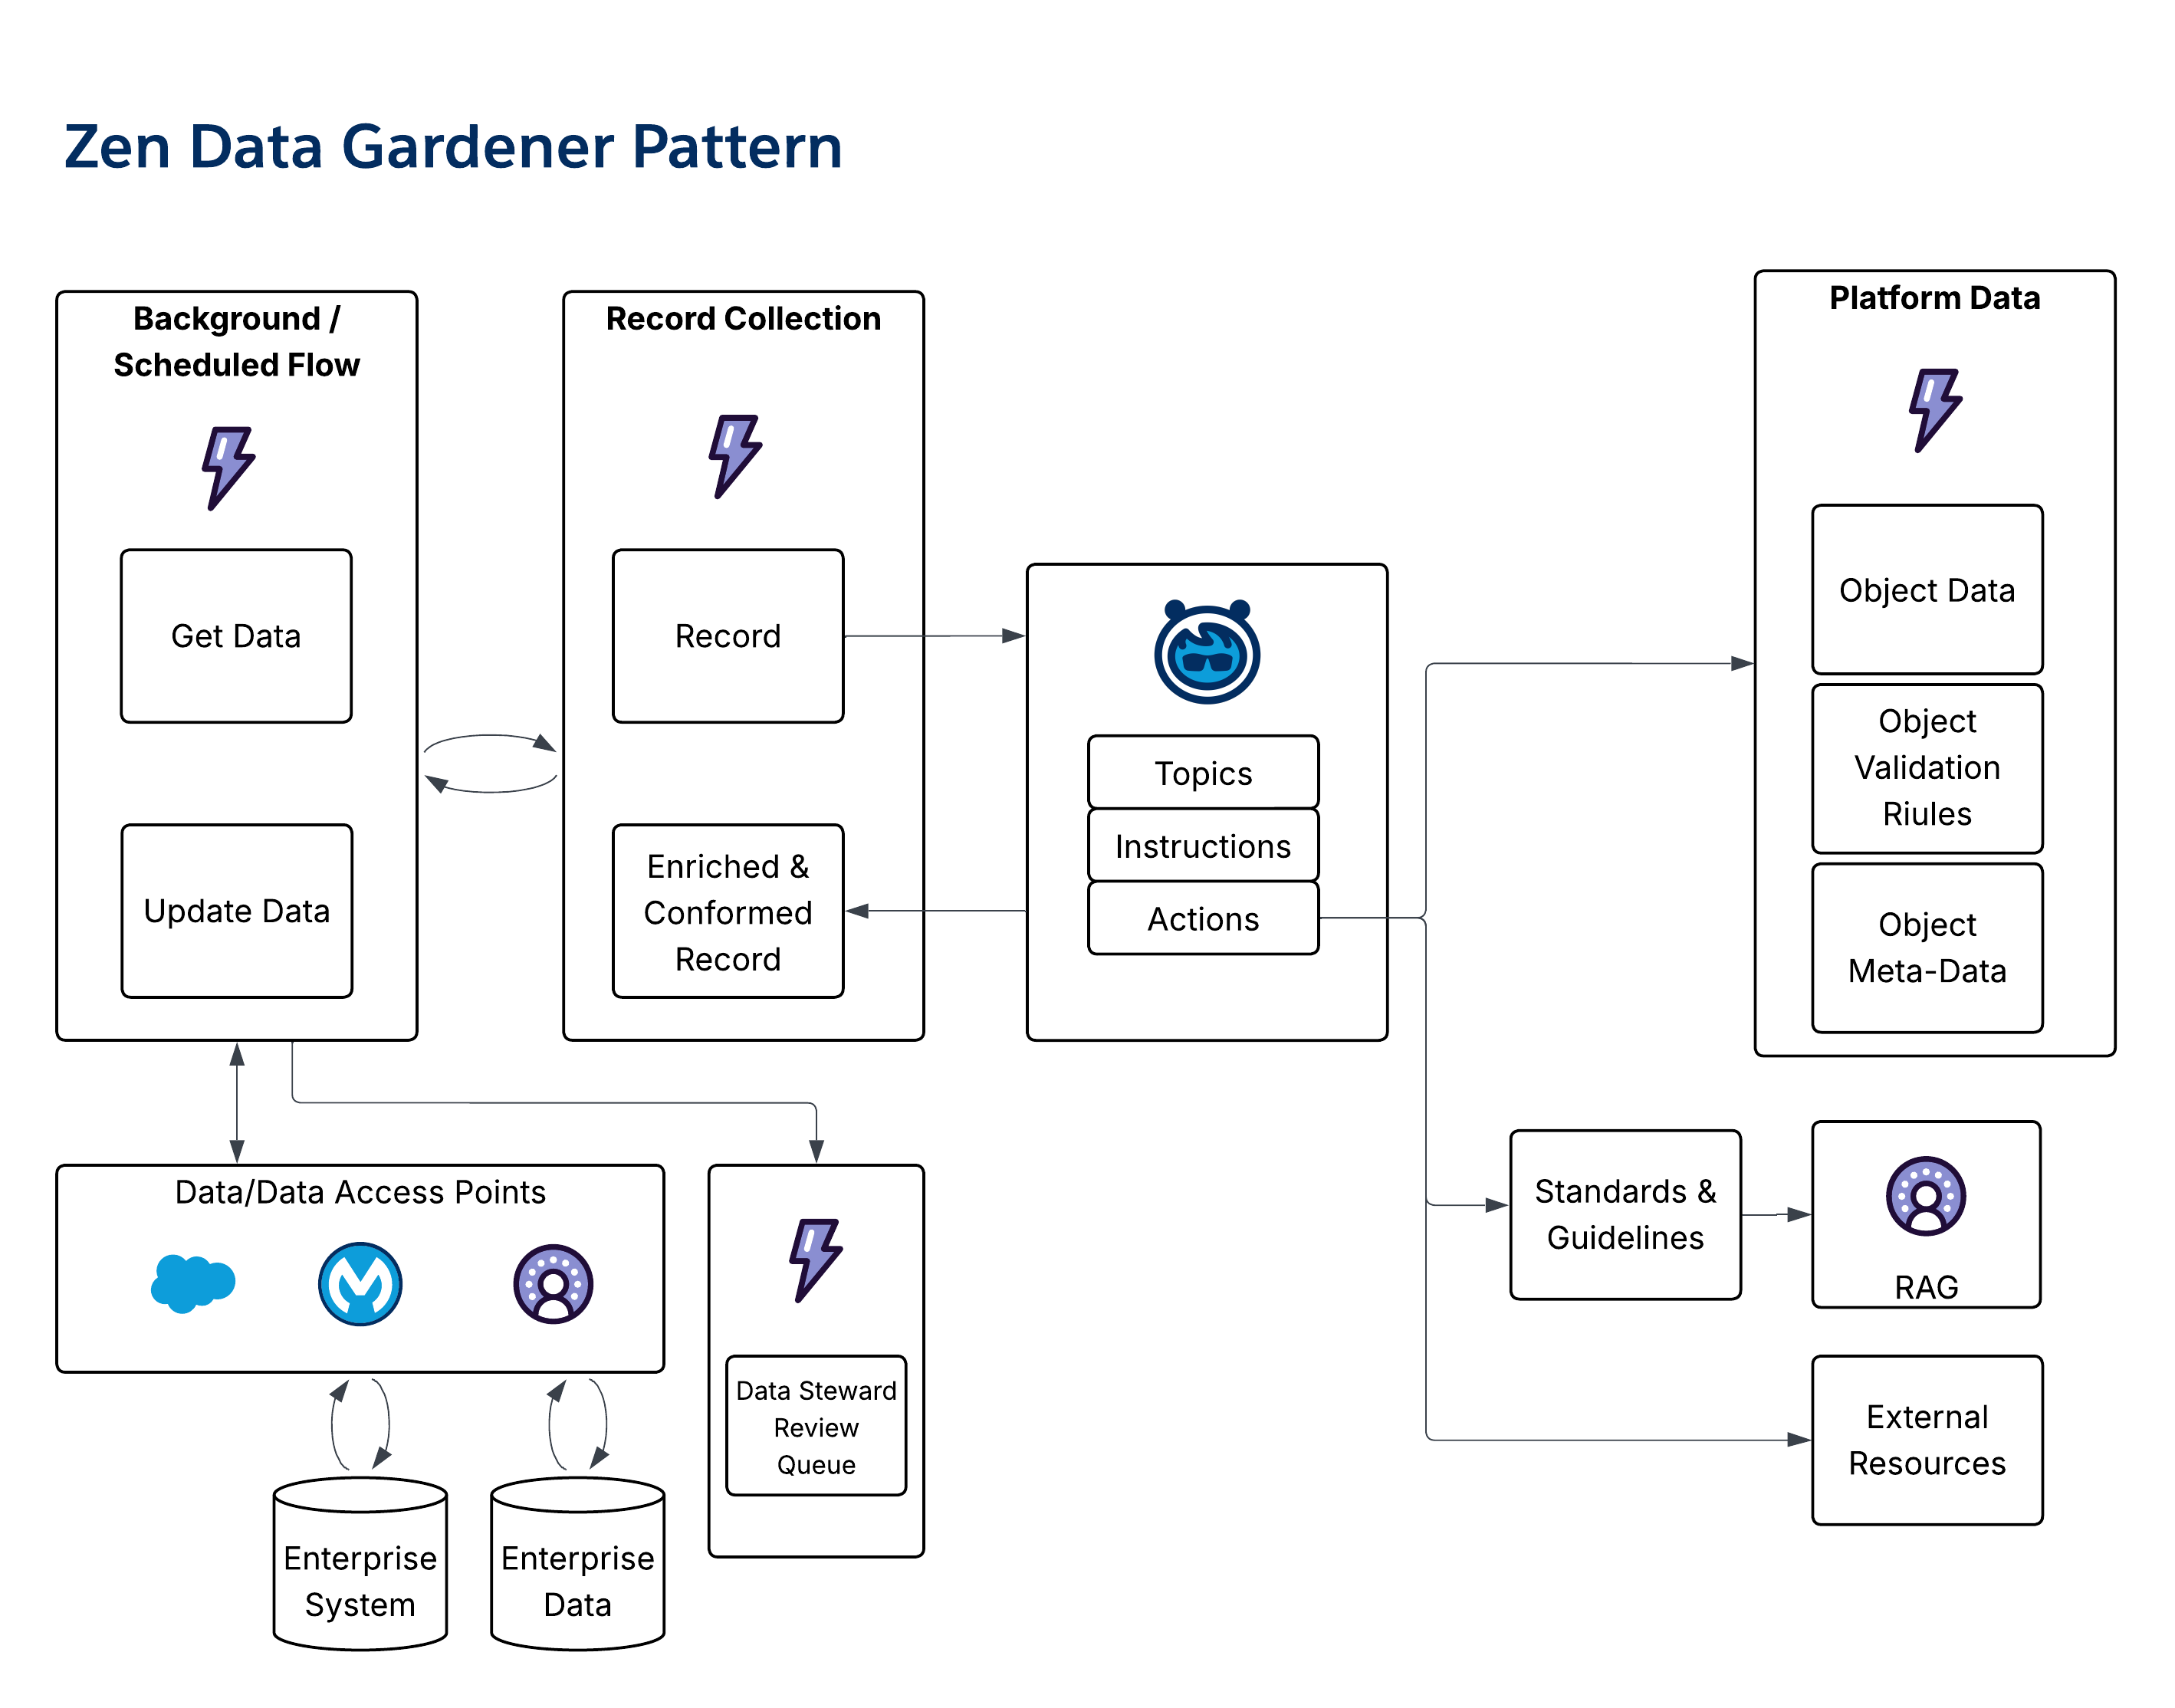
### Zen Data Gardener Pattern (Muster für Zen-Datengärtner)
- **Übersicht**: Bei dem _Zen Data Gardener-Muster_ handelt es sich um ein geplantes Hintergrundmuster, das zum Pflegen und Standardisieren von Daten verwendet wird und kostengünstige Argumente nutzt, um Daten in anderen nicht verbundenen Datendomänen zu validieren, anzureichern und zu konformisieren.
- **Ausgabetyp**: Stellen Sie aktualisierte Datensätze und/oder Datenverwaltungsaufgaben bereit.
- **Anleitung zur Musternutzung**: Verwenden Sie das Muster, um eine regelmäßige, regelmäßige Datenüberprüfung und -validierung zu ermöglichen. Planen Sie den Agenten bei sich langsam ändernden Daten in einem langsamen Rhythmus (beispielsweise monatlich). Kombinieren Sie sie mit dem [Datenverwaltungsmuster](/docs/architect/de-de/fundamentals/guide/enterprise-agentic-architecture#datenweiterleitungsmuster), um Vorgänge zur Datenqualität in Zukunft und im Nachhinein bereitzustellen.
- **Repräsentativer Anwendungsfall**: Sicherstellung der Abstimmung zwischen verkauften Vorteilen und dem Anspruchssystem sowie regelmäßige Validierung von Maklerlizenzen für nationale Register.
- **Diagramm**:
 - **Reifegrad für Salesforce-Agenten**: Level 4
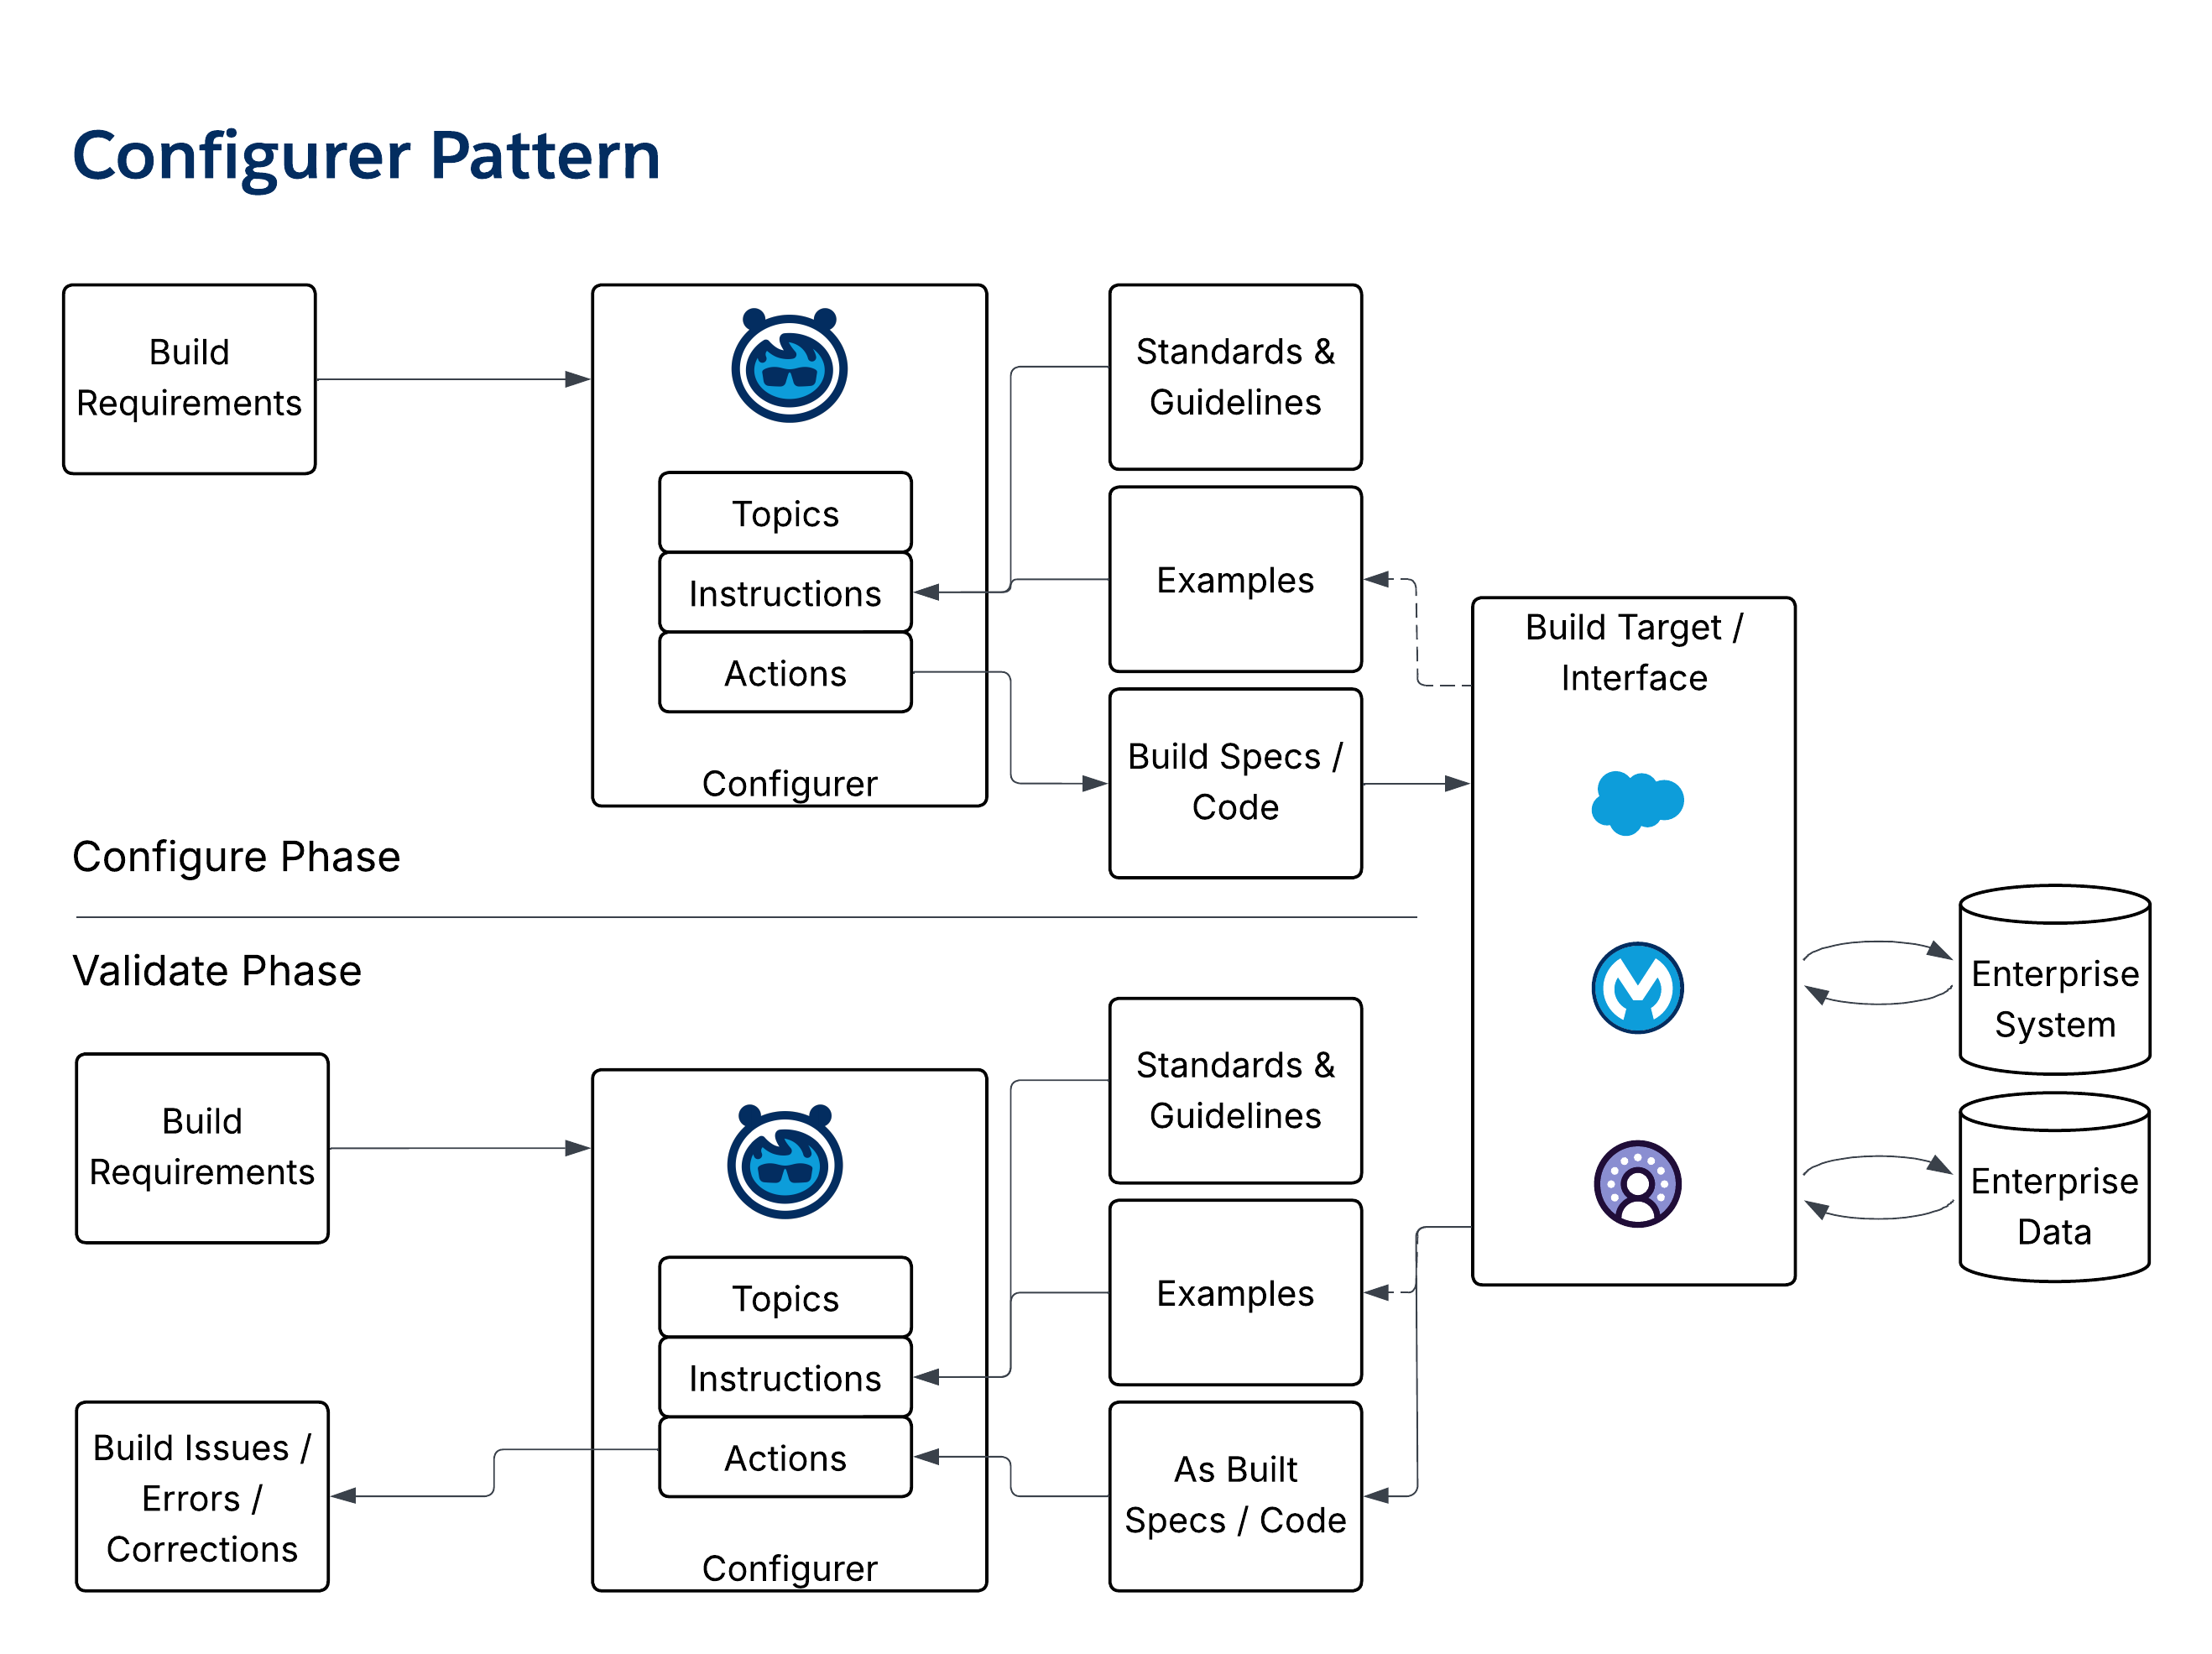
### Konfiguratormuster
- **Übersicht**: Das _Konfiguratormuster_ generiert Konfigurationsartefakte (z. B. SQL/SOQL, JSON und CSVs) aus den Anforderungen der natürlichen Sprache. Sie kann auch umgekehrt ausgeführt werden, um eine vorhandene Konfiguration anhand von Anforderungen zu validieren.
- **Ausgabetyp**: Stellen Sie aktualisierte Datensätze, Datenverwaltungsaufgaben oder Erstellungsprobleme/Fehler für Korrekturen bereit.
- **Anleitung zur Musternutzung**: Verwenden Sie bestimmte Standards, Richtlinien oder Beispiele für den Agenten. Konfigurieren Sie Erstellungsanforderungen mithilfe von Quellen wie Verträgen oder Produktspezifikationen. Verbinden Sie das _Konfiguratormuster_ mit dem Zielsystem, um die generierte Konfiguration zu übertragen.
- **Repräsentativer Anwendungsfall**: Generieren von Produktkonfigurationsdatensätzen für Krankenversicherungsprodukte und Validieren von Vertrags-/Zahlungsbedingungen für Gesundheitsanbieter.
- **Diagramm**:
 - **Reifegrad für Salesforce-Agenten**: Level 4
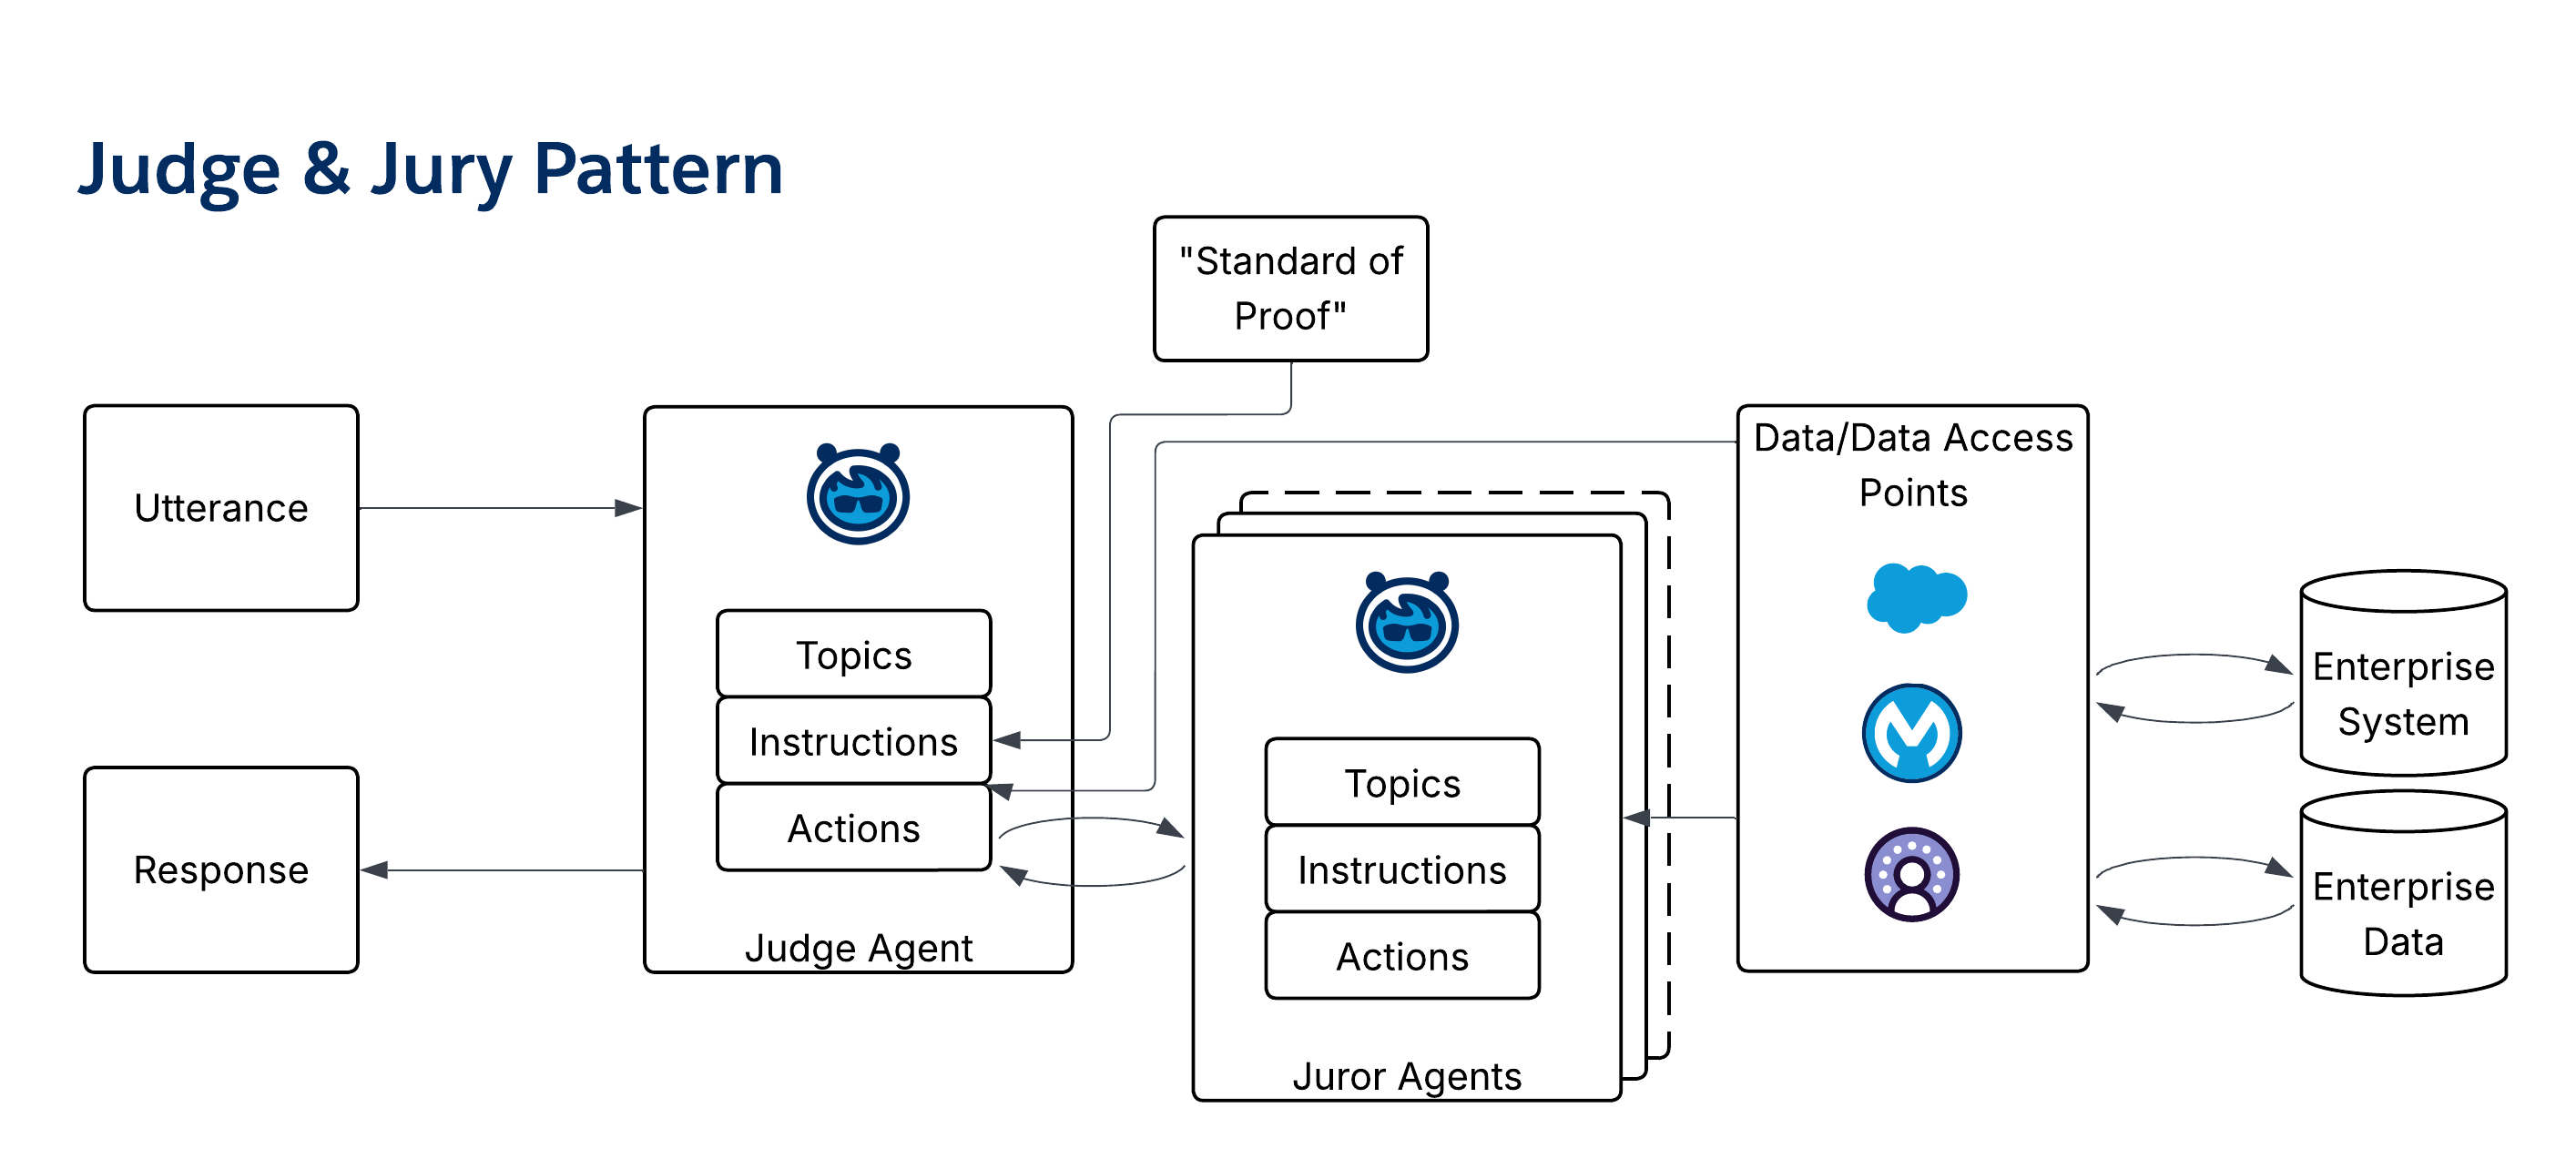
### Richter- und Jurymuster
- **Übersicht**: Das _Muster "Richter und Jury_" wurde entwickelt, um Halluzinationen zu minimieren, indem ein Ensemble von "Juror"-Agenten und ein "Richter"-Agent verwendet wird, die die Kongruenz der Antworten bewerten, um sicherzustellen, dass sie materiell konsistent und fundiert sind.
- Der _Ensemble-Ansatz_ ist in Agentforce und das Atlas Reasoning-Modul eingebettet, um die Richtigkeit und Relevanz von Antworten zu ermitteln. Das _Muster "Richter und Jury_" baut auf dieser Fähigkeit auf, wenn es auf eine hohe Genauigkeit ankommt.
- Die Kombination aus _Datengrundlage_ (z. B. "Ihre Antwort in diesen Datensätzen/Dokumenten finden") und _Aufforderungstechnik_ (z. B. "Antwort nur zurückgeben, wenn sie in diesen Datensätzen gefunden wird" oder "Antwort anhand dieser externen Quelle validieren") sind ebenfalls effektive Möglichkeiten, Halluzinationen zu minimieren.
- **Ausgabetyp**: Stellen Sie generative Statistiken bereit.
- **Anleitung zur Musternutzung**: Wird verwendet, wenn ein starker Bedarf an konsistenten und fundierten generativen Ausgaben besteht. Ein _Richteragent_ stellt eine begründete Aufforderung zusammen und übergibt sie an zwei oder mehr _Juroragenten_. Anschließend bewertet der Richter die Antworten. Verwenden Sie für optimale Ergebnisse für jeden Juroragenten unterschiedliche Modelle (beispielsweise eines von OpenAI und ein anderes von Anthropic).
- **Repräsentativer Anwendungsfall**: Stellen Sie faktenbasierte Antworten mit hoher Genauigkeit bereit, um Halluzinationen zu minimieren.
- **Diagramm**:
 - **Reifegrad für Salesforce-Agenten**: Level 2
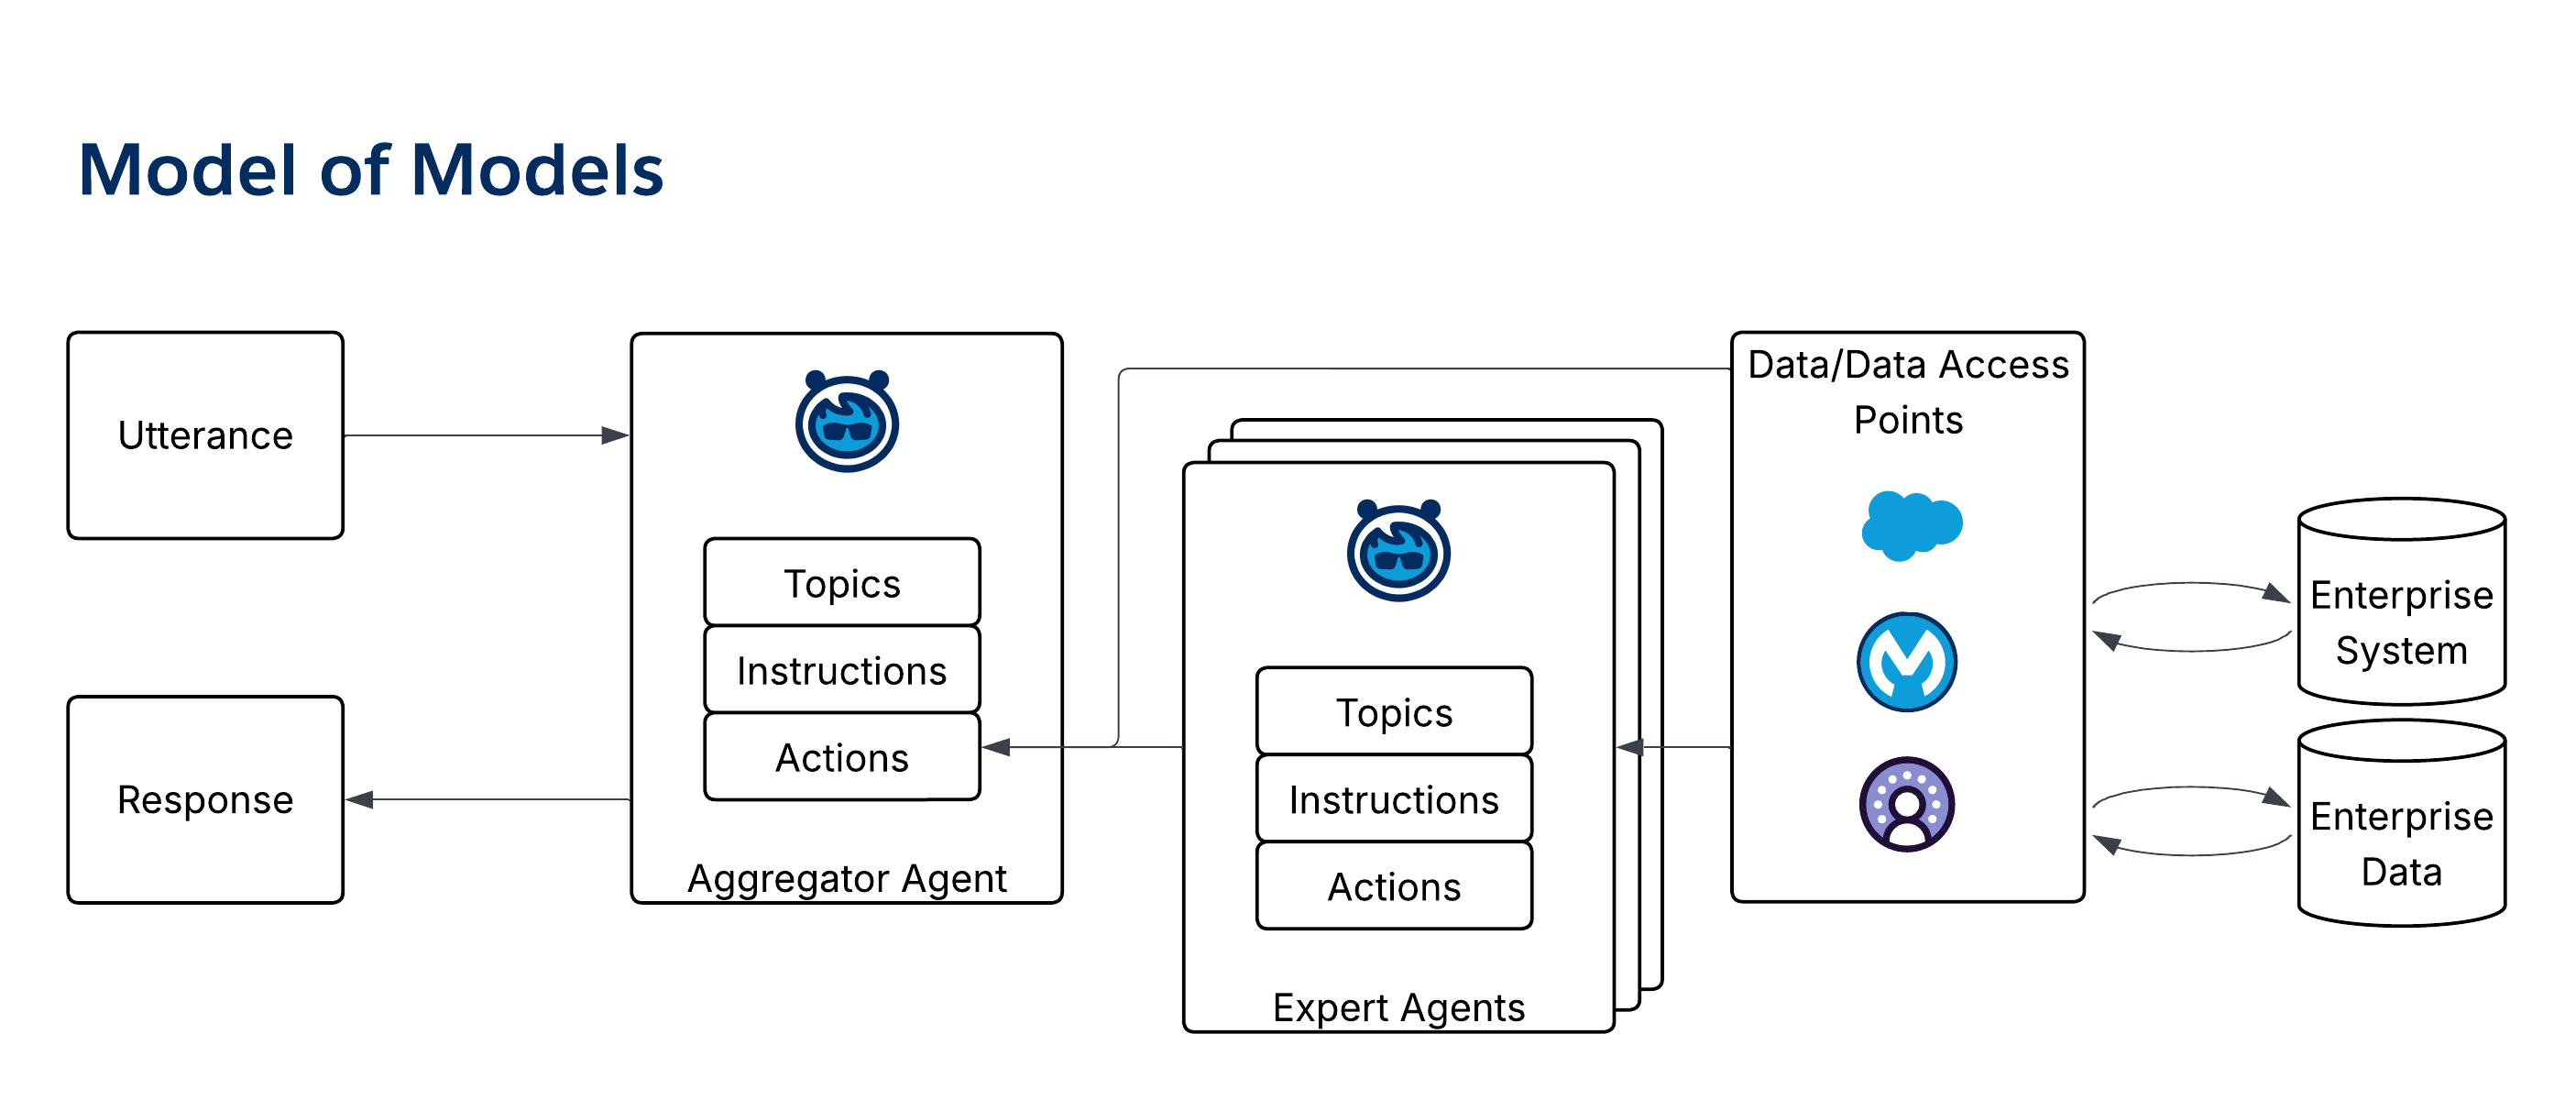
### Modell des Modellmusters
- **Übersicht**: Das _Muster "Modell von Modellen_" nutzt mehrere Expertenagenten, um eine Vielzahl von Perspektiven zu generieren, und extrahiert dann den Konsens. Im Gegensatz zum [Muster "Richter & Jury](/docs/architect/de-de/fundamentals/guide/enterprise-agentic-architecture#richter--und-jurymuster)" umfasst dieses Muster mehrere Standpunkte, um den Reichtum zu steigern.
- Dieses Muster kann auch als Expertenpanel-Muster bezeichnet werden, wenn Expertenmodelle mit unterschiedlichen Standpunkten (Points of View, POV) vorhanden sind, auf die möglicherweise getippt werden kann.
- Im Gegensatz zum Muster "Richter und Jury", bei dem sichergestellt werden soll, dass die Agentenantwort auf einer allgemein zugänglichen "Wahrheit" konvergiert, erweitert das _Modellmuster_ den Umfang der Antwort, indem die Vielfalt in der Agentenumgebung genutzt wird.
- Bei diesem Muster wird davon ausgegangen, dass es zusätzliche Agenten mit einem unterschiedlichen POV gibt. In einer Umgebung mit mehreren Organisationen, mehreren Agenten oder einer Umgebung mit mehreren vom Anbieter bereitgestellten Agenten über mehrere Tech-Stacks hinweg bietet das _Modellmuster_ beispielsweise eine Struktur für die Integration mehrerer POVs.
- Berücksichtigen Sie bei der Betrachtung dieses Musters auch andere, oft leichtere Ansätze:
- Statt mehrere Expertenagenten zu definieren, geben Sie mehrere Eingabeaufforderungen an und lassen Sie das System als Ensemble von Eingabeaufforderungen arbeiten.
- Nutzen Sie die Kontextbildung durch Aktionen, die auf kontextabhängige Daten zugreifen.
- **Ausgabetyp**: Stellen Sie generative Statistiken bereit.
- **Anleitung zur Musternutzung**: Die Rolle eines _Aggregator-_Agenten besteht darin, ein umfangreiches POV zu erstellen und zurückzugeben, das auf den Schlüsselkonzepten basiert, die die Modellagenten zurückgegeben haben. Modellagenten bestimmen eine Antwort anhand ihres eindeutigen POV.
- **Repräsentativer Anwendungsfall**: Wird in Situationen verwendet, in denen die Kombination unterschiedlicher Standpunkte von Vorteil sein kann, um die Qualität der Antworten zu verbessern.
Beispielsweise kann eine agentische Umgebung mit mehreren Systemen, in der privilegierte Agenten (beispielsweise ein _ERP-Agent_) über ein wertvolles und anderweitig nicht zugängliches POV verfügen.
- **Diagramm**:
 - **Reifegrad für Salesforce-Agenten**: Level 2
## 9\. Langfristige Prozessmuster
Mit _langfristigen Prozessmustern werden_ Prozesse verwaltet, die über einen längeren Zeitraum auftreten und mehrere Schritte und Akteure umfassen.
### Project Manager Pattern
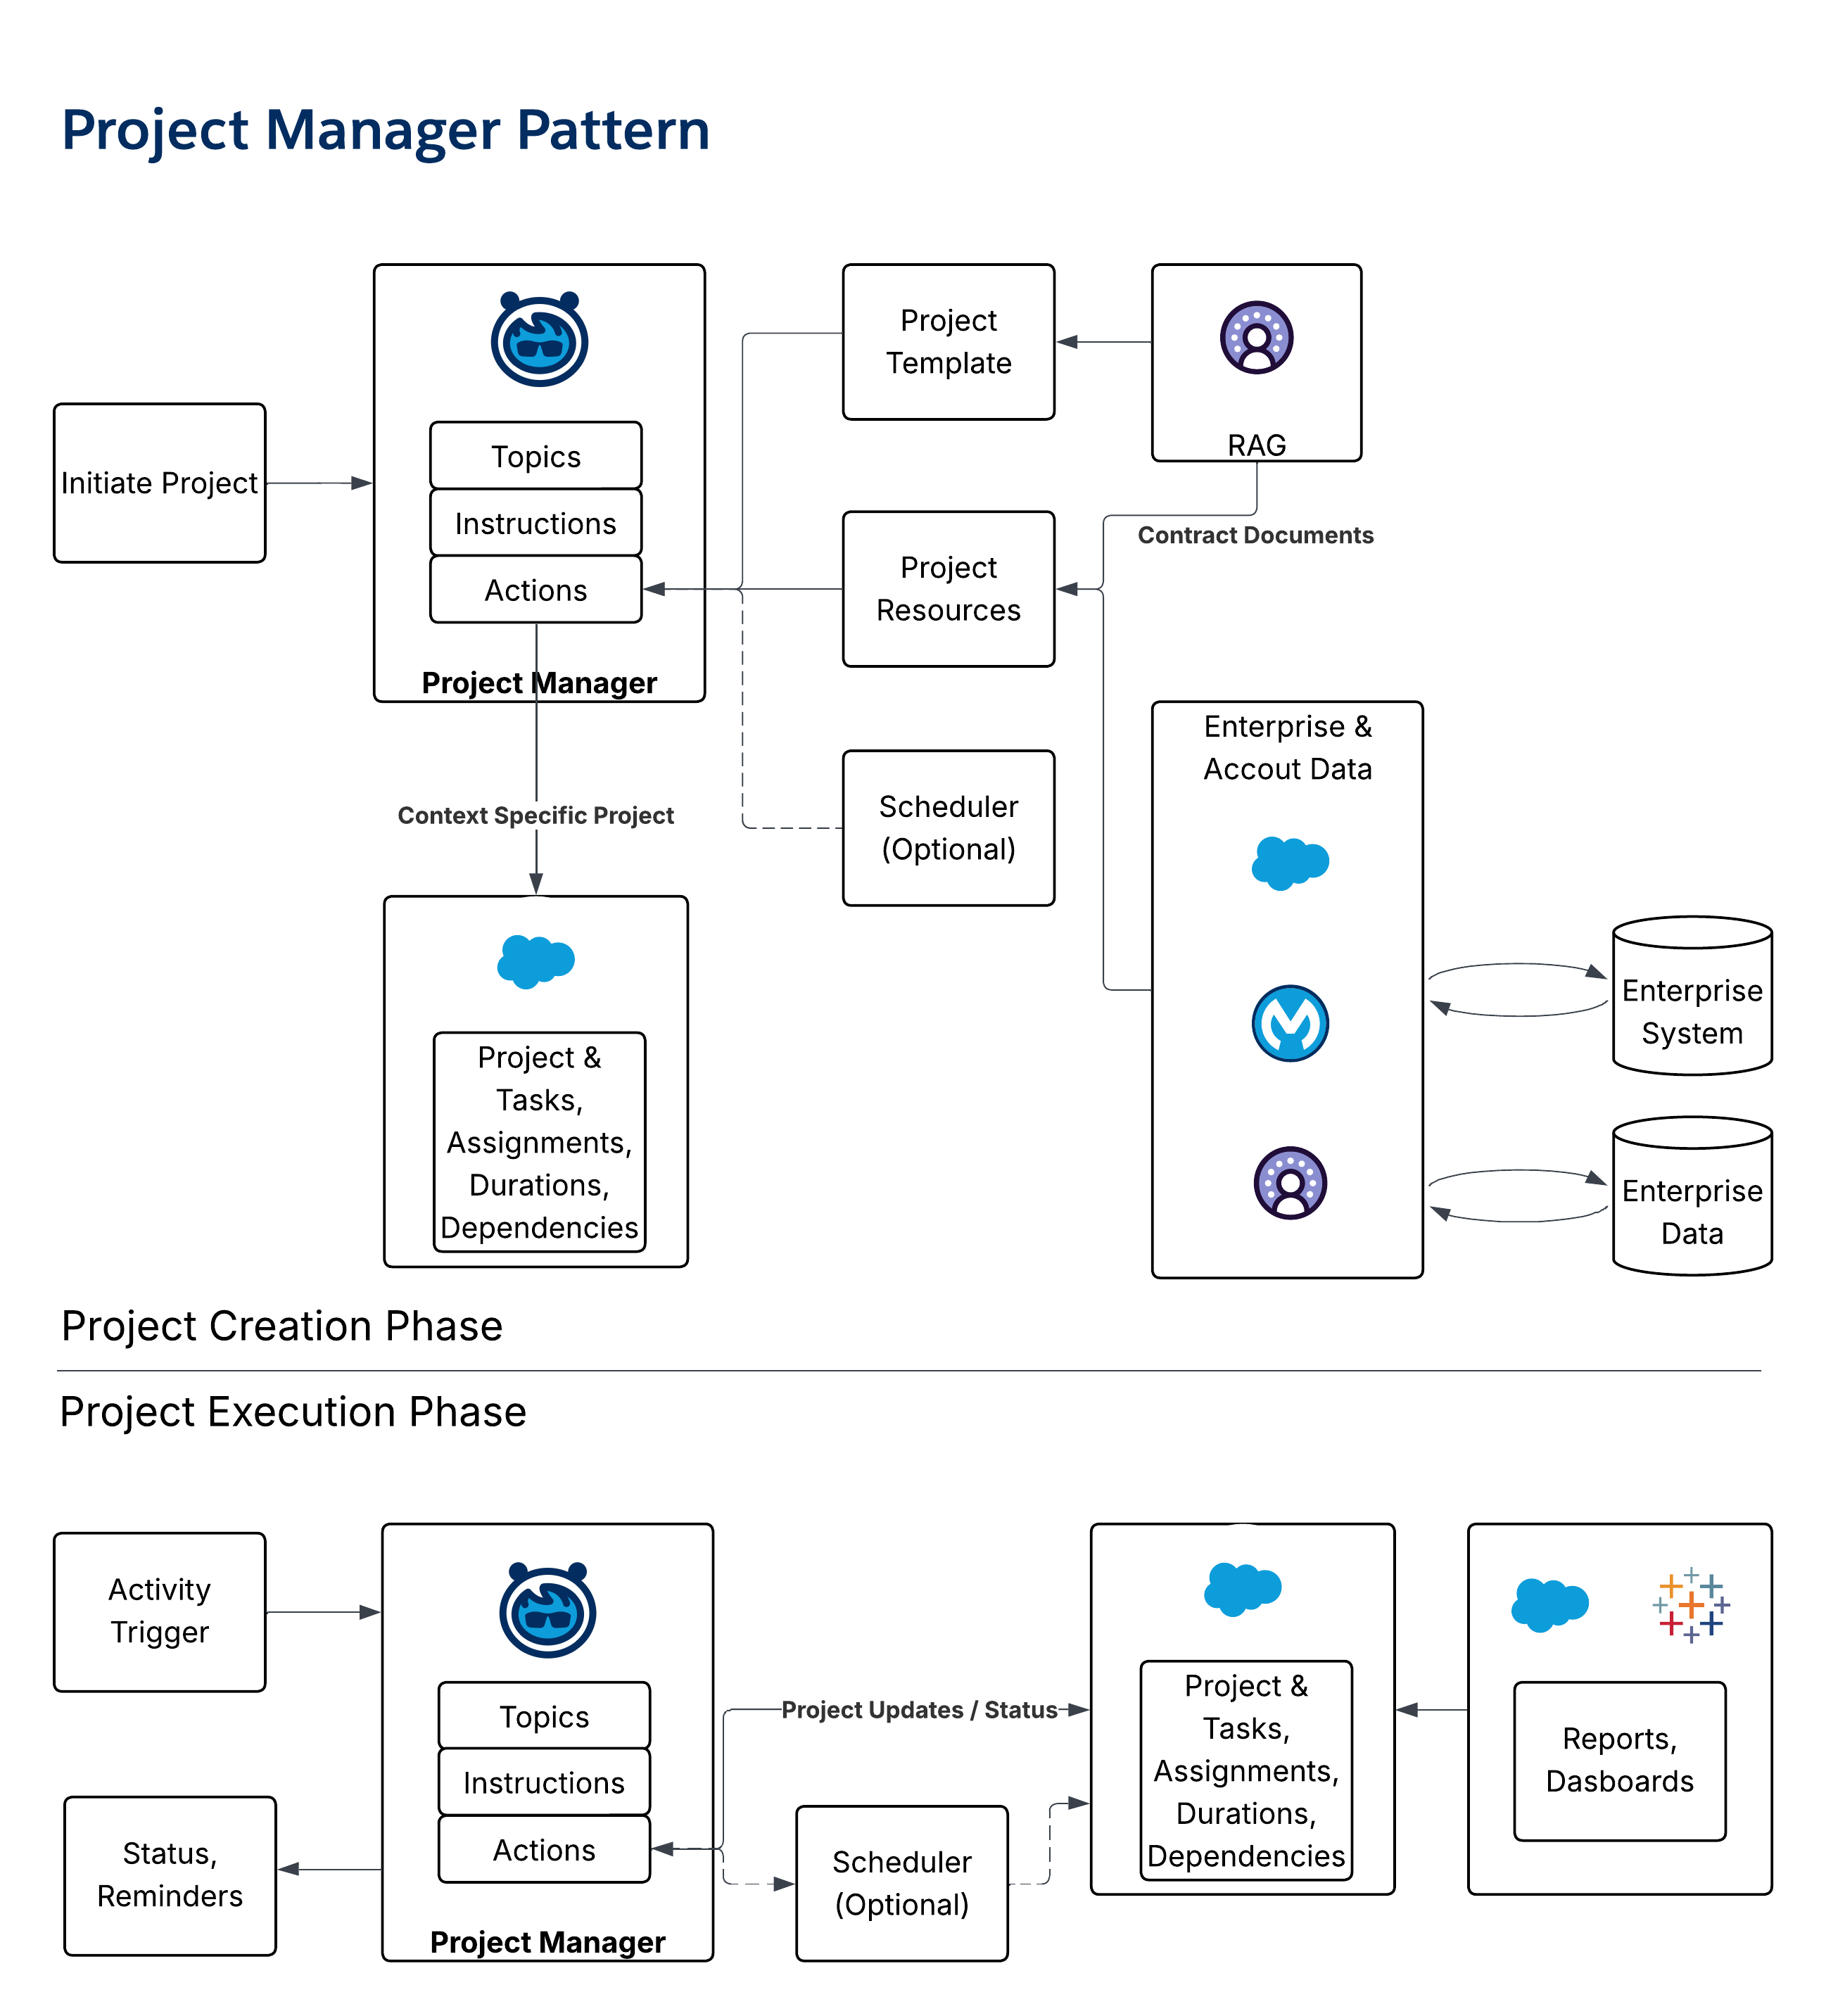
- **Übersicht**: Das _Projekt-Manager-Muster_ ist ein komplexes Muster, das ein langfristiges Projekt überwacht. Sie koordiniert Aktivitäten, verfolgt den Abschluss, benachrichtigt Benutzer und stellt den Projektstatus für Beteiligte dar.
- **Ausgabetyp**: Es gibt mehrere Ausgaben (z. B. Kundenvorgänge, Aufgaben, Statusaktualisierungen und Benachrichtigungen).
- **Anleitung zur Musternutzung**: Als Schirmmuster zur Unterstützung regelmäßiger, wiederholter Aktivitäten in mehreren Schritten. Das _Projekt-Manager-Muster_ verwendet eine Eingabevorlage/-skizze eines Projekts, einschließlich Aufgaben, Rollen und Abhängigkeiten. Anschließend werden Kundenvorgänge und Aktivitäten instanziiert und Benutzern zugewiesen.
- **Repräsentativer Anwendungsfall**: Zur Verwendung für die Accountinstallationsverwaltung und das Engagement im Unternehmensvertrieb.
- **Diagramm**:
 - **Reifegrad für Salesforce-Agenten**: Level 4
## 10\. Enterprise-Orchestrierungsarchetypen
Während Muster Agentenrollen beschreiben, definieren _Orchestrierungsarchetypen_ die Blaupausen auf Systemebene für die Zusammenarbeit einer Agentenflotte. Diese Archetypen verdeutlichen die Rolle von _Agentforce_ als Orchestrierungshirn und _MuleSoft_ als universeller Konnektor und Adapter.
**Archetyp 1: SOMA (Single Org, Multiple Agents)**
- **Definition**: Mehrere Agenten arbeiten in einer Salesforce-Organisation zusammen, die freigegebene Governance und Daten verwendet.
- **Architektur-Flow**: In Agentforce fungiert ein _Supervisor-Agent_ als zentrale Tür und leitet Anforderungen an _Fachagenten_ in der Organisation weiter. Für externe Funktionen verwenden Agenten den _Agentforce MCP Client_, wobei MuleSoft als MCP-Wrapper für nicht MCP-fähige APIs fungiert.
- **Wichtige Überlegungen**: Dieses Muster zentralisiert die Orchestrierungslogik in Salesforce (ähnlich wie im CRM-Kontext und in Data 360), um die einheitliche Verwaltung, Identität, Berechtigungen und Beobachtbarkeit beizubehalten.
**Archetyp 2: MOMA (Multi-Org, Multiple Agents)**
- **Definition**: Agenten arbeiten über mehrere Salesforce-Organisationen hinweg zusammen, was eine sichere Koordination über Daten- und Berechtigungsgrenzen hinweg erfordert.
- **Architektur-Flow**: Ein _Supervisor-Agent_ in einer Organisation delegiert eine Aufgabe über das standardisierte _Agent-zu-Agent_-Protokoll an einen Agenten in einer anderen Organisation. Durch diesen Handshake werden Trust auf Organisationsebene, der Benutzeridentitäts-Flow und der freigegebene Unterhaltungskontext sichergestellt.
- **Wichtige Überlegungen**: Durch dieses Muster wird die Organisationsautonomie gewahrt und gleichzeitig unternehmensweite Workflows ermöglicht, was eine Grundlage für kohärente Agentenvorgänge in komplexen Anwesen mit mehreren Organisationen bietet.
**Archetyp 3: Multi-Vendor A2A (Salesforce-geführte Orchestrierung)**
- **Definition**: Ein _Supervisor-Agent_ in Salesforce koordiniert über das A2A-Protokoll eine Mischung aus Salesforce-nativen Agenten und Agenten anderer Anbieter (z. B. Google/Vertex oder LangGraph).
- **Architektur-Flow**: Der _Supervisor-Agent_ verarbeitet die Anforderung und orchestriert einen Plan, wobei interne und externe Anbieteragenten über das A2A-Protokoll aufgerufen werden. Bei externen Systemen, die nicht A2A-fähig sind, kann _MuleSoft_ eine "leichte Agentenfassade" freilegen, die das vorhandene Tool umschließt und mit dem A2A kommuniziert.
- **Wichtige Überlegungen**: Durch diesen Archetyp bleibt das Orchestrierungshirn in der Nähe von CRM und Data 360, indem A2A verwendet wird, um saubere, regelbare Kompositionen ohne separate Orchestrierungsstufe zu erstellen.
**Archetyp 4: Multi-Vendor A2A (MuleSoft-geführte Orchestrierung)**
- **Definition**: Die Orchestrierung wird über einen Nicht-Salesforce-Eingangspunkt initiiert, für den ein neutraler externer Orchestrierer die Argumentation und Weiterleitung ausführen muss.
- **Architektur-Flow**: Ein _Benutzeroberflächenagent_ in einem externen System leitet die Anforderung an einen Orchestrierungsservice (konzipiert als _MuleSoft Conductor_) weiter, der den Intent interpretiert und die Aufgabe plant. Anschließend leitet der Leiter Anrufe mithilfe von A2A an Anbieteragenten weiter, einschließlich Agentforce Agenten für CRM- oder Serviceaktionen.
- **Wichtige Überlegungen**: Dieses Muster gilt für Nicht-Salesforce-Eintrittspunkte, bei denen ein neutraler Orchestrierer architektonisch vorzuziehen ist. Sie behält die Benutzeroberfläche im Domänensystem bei und zentralisiert gleichzeitig Argumentation, Governance, Richtlinie und Beobachtbarkeit in MuleSoft.
## 11\. Lösungszusammenstellung: Erstellen von Mustern
Diese individuellen Muster und Orchestrierungsarchetypen sind architektonische Bausteine, die zu durchgängigen Lösungen zusammengesetzt werden sollen. Die Karte der Agentenlösung dient zur Visualisierung der Verdrahtung dieser Komponenten.
- Eine _Mitgliederservicelösung_ für einen Gesundheitsanbieter ist eine Standardimplementierung des SOMA-Archetyps. Es verwendet einen Answerbot für anonyme Benutzer, einen _Orchestrator_ für authentifizierte Mitglieder und mehrere _Domänen-KMU-Agenten_ (z. B. Kundenvorgang, Ansprüche und Vorteile), um bestimmte Anforderungen zu bearbeiten.
- Bei einem _B2C-Brokerportal_ handelt es sich um eine komplexe Zusammensetzung, die einen Portal-_Orchestrator-_Agenten verwendet, um einen langfristigen _Projektmanager-Agenten_ für einen RFP-Prozess aufzurufen, der wiederum _Headless-_, _Datenweiterleitungs-_ und _Abfrageagenten_ für Back-Office-Datenvorgänge verwendet.
## 12\. Fazit
Eine Methode für agentische Designmuster bietet die Architekturdisziplin, die zum Erstellen robuster, skalierbarer und wartungsfreundlicher Enterprise AI-Systeme erforderlich ist. Durch die Aufschlüsselung der Komplexität und die Förderung der Modularität ermöglichen diese Muster es Architekten, zuverlässige, vorhersehbare agentische Lösungen bereitzustellen.
Die Auswahl des Orchestrierungsarchetyps ist eine strategische Entscheidung, die darauf basiert, wo Benutzer arbeiten, wo sich der Kontext befindet und wie das Unternehmen die Interaktion zwischen Menschen, Agenten und Systemen steuert. Indem Architekten die Unterscheidung zwischen der Erstellung von Agenten und deren Orchestrierung verstehen und offene Protokolle wie _MCP_ und _A2A_ nutzen, können sie nicht mehr nur isolierte Bots erstellen, sondern auch ein kohärentes, gesteuertes und verteiltes unternehmensorientiertes System entwickeln. Dieser Ansatz bietet eine gemeinsame Sprache und eine Reihe wiederverwendbarer Blaupausen zum Erstellen einer nachhaltigen Agentenarchitektur.
## Anhang: Lösungskarten und Systemarchitekturen
Dieser Anhang enthält konkrete Beispiele dafür, wie Agentenmuster zu Lösungen auf Systemebene zusammengesetzt werden.
### Anlage A: Beispiel für eine grundlegende Musterzusammensetzung
In diesem Diagramm wird veranschaulicht, wie fünf grundlegende Muster miteinander verdrahtet werden können, um einen gemeinsamen Kundendienst-Workflow zu erstellen.
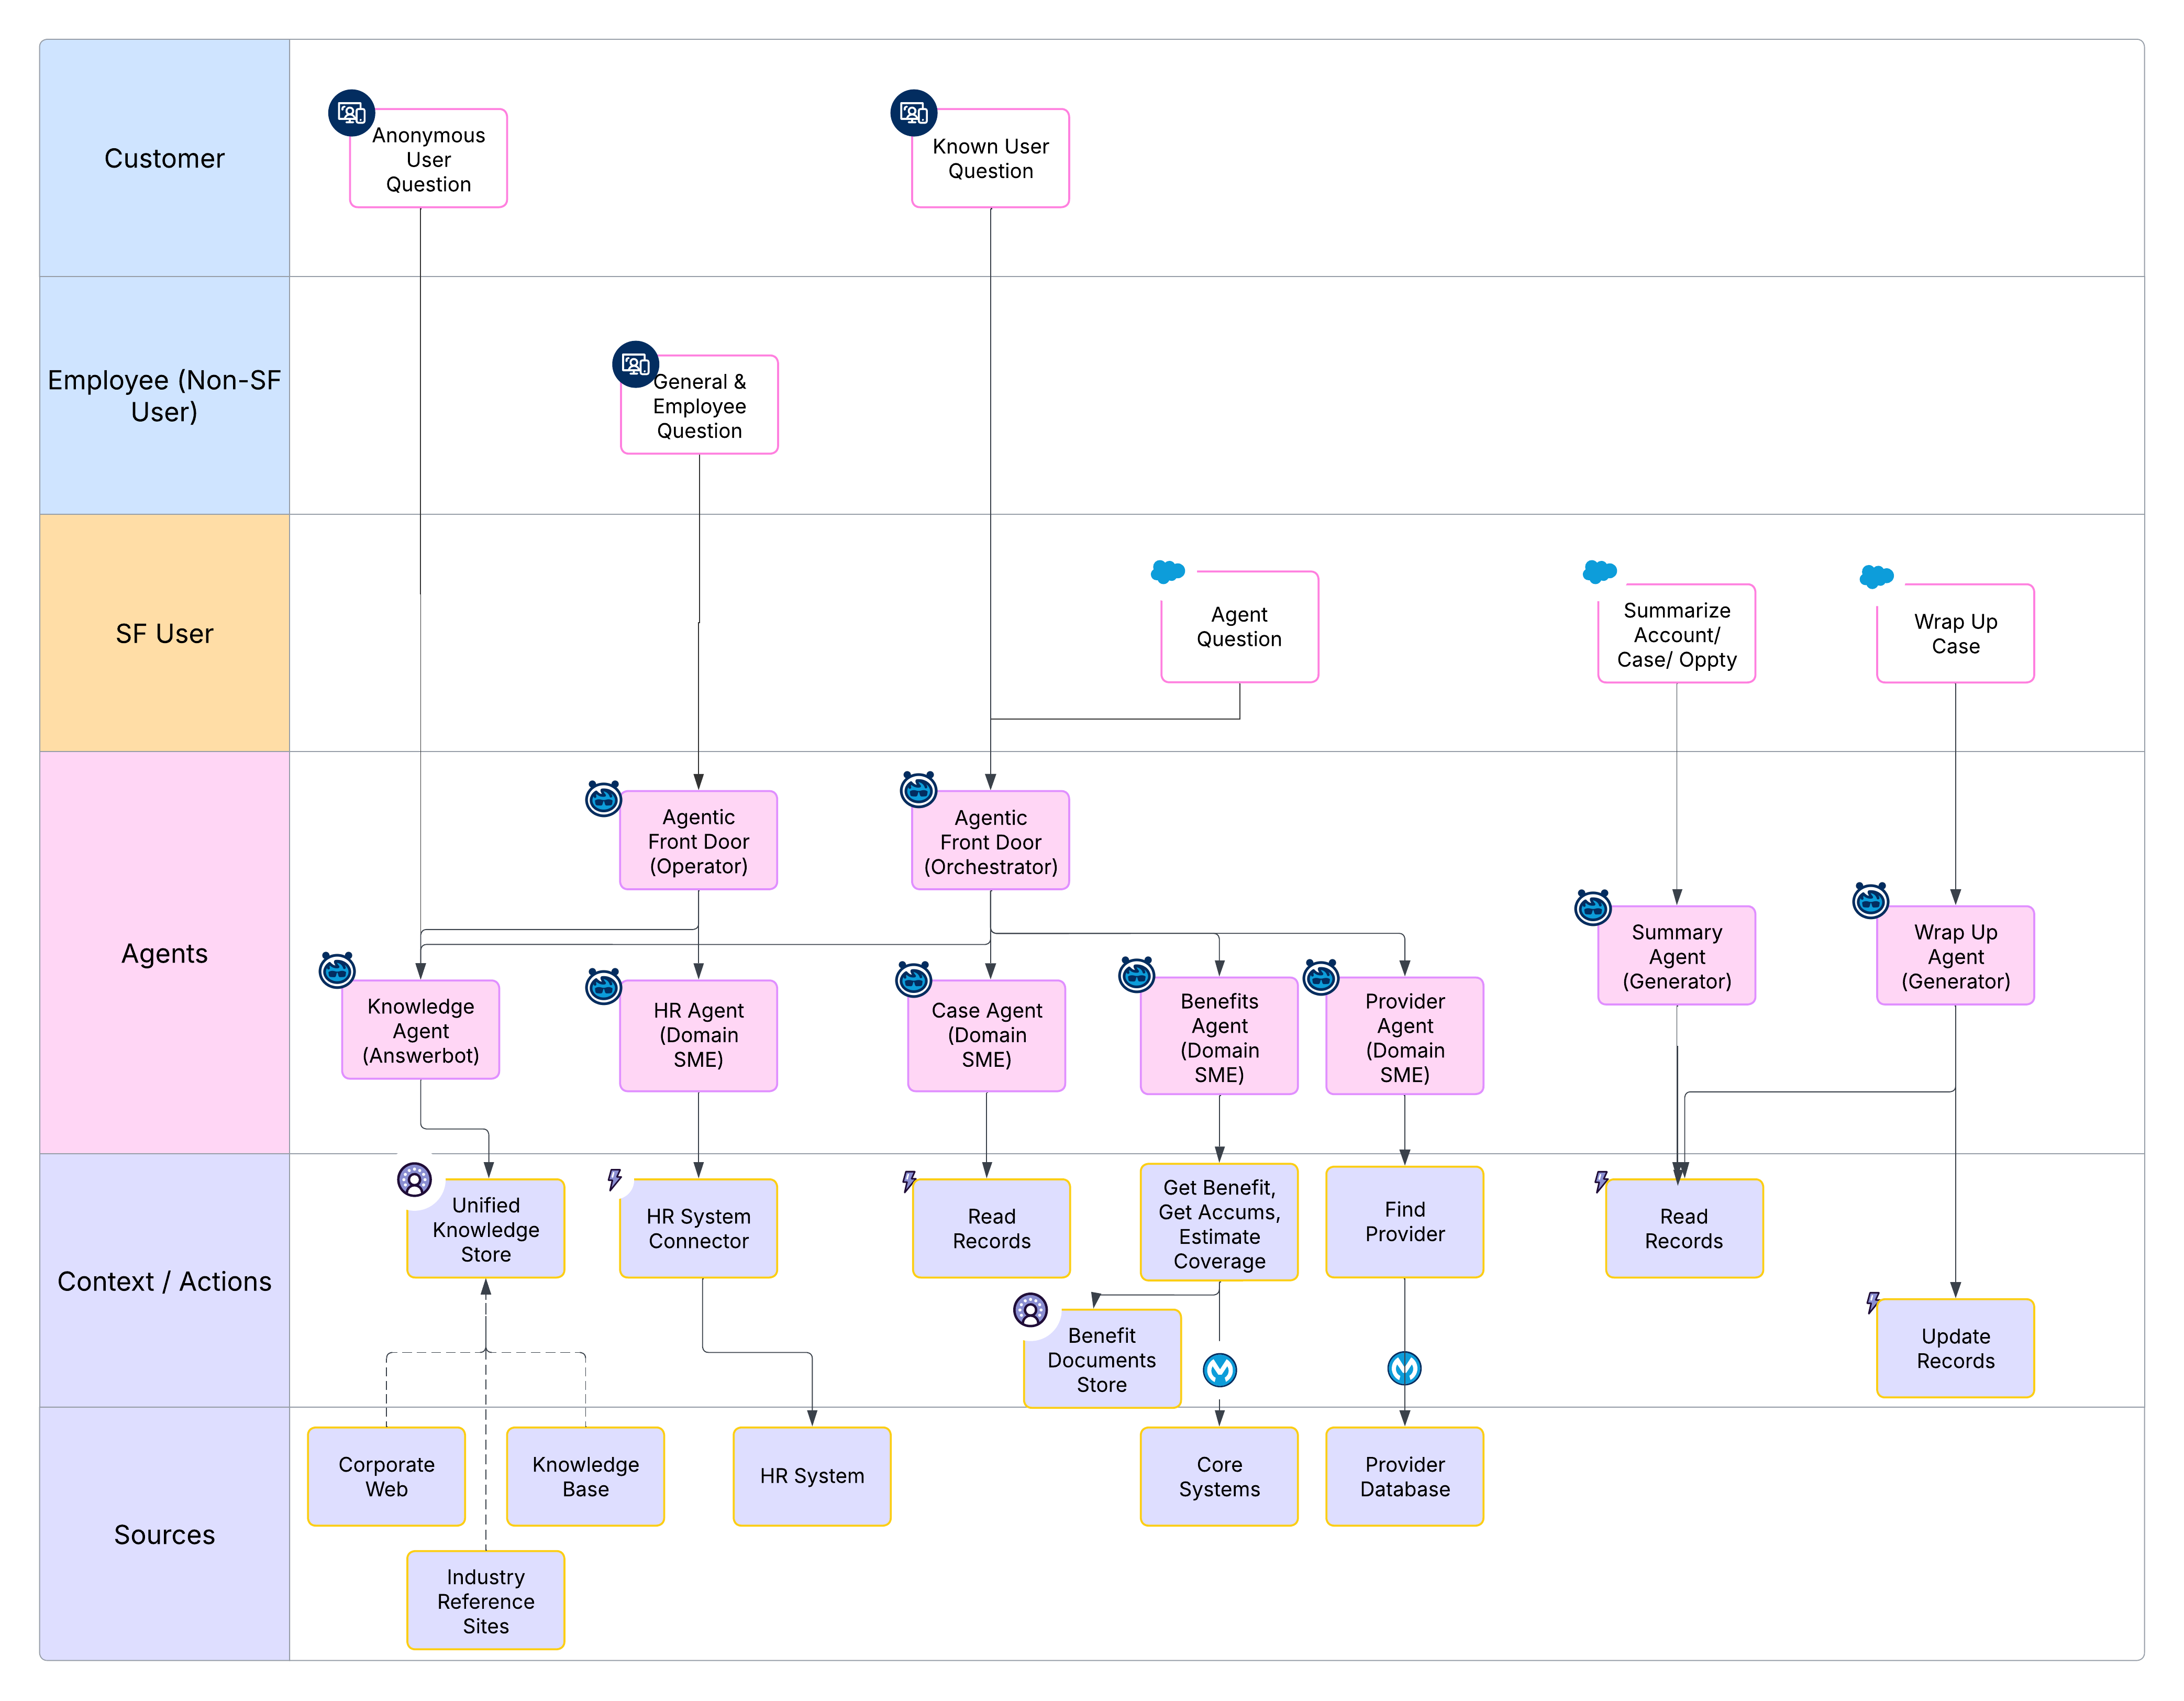 1. **Answerbot**: Ein anonymer Benutzer stellt eine Frage, die von einem Knowledge-basierten Agenten bearbeitet wird.
2. **Operator**: Die Frage eines Mitarbeiters wird von einem Operator geprüft, der die Unterhaltung ausfüllt und sie an einen spezialisierteren Agenten übergibt.
3. **Orchestrator**: Ein authentifizierter Benutzer (SF-Benutzer) interagiert mit einem Orchestrierer, der mehrere Agenten koordiniert, um eine Anfrage zu bearbeiten, die potenziell vielfältig ist.
4. **Domänen-KMU**: Fachagenten (z. B. HR-Agenten oder Vorteilsagenten) werden vom Orchestrierer aufgerufen, Themenaktualisierungen durchzuführen und bestimmte Daten abzurufen.
5. **Generator**: Dienstprogrammagenten werden verwendet, um Accountdetails zusammenzufassen oder einen Kundenvorgang nach Abschluss der Interaktion abzuschließen.
### Anlage B: Zuordnung der Agentenlösung – Mitgliederservices
Diese Lösungszuordnung enthält Details zu einer Agentenarchitektur für einen Mitgliedsserviceanwendungsfall, die die Zusammensetzung mehrerer Muster veranschaulicht.
- **Benutzerprofile**: Die Lösung bietet drei verschiedene Benutzertypen: Anonymer Benutzer, authentifiziertes Mitglied und SF-Benutzer (beispielsweise ein menschlicher Kundendienstmitarbeiter).
- **Interaktionsmuster**: Ein _Antwortbot_ verarbeitet anonyme "Find-A-Doc"-Abfragen, während ein Orchestrator (Agentic Front Door) authentifizierte Benutzeranfragen verwaltet. Ein _Listener/Feed-Muster_ unterstützt den SF-Benutzer.
- **Wiederverwendung von Domänenagenten**: Spezialisierte _KMU-Agenten für Domänen_ (z. B. Kundenvorgangsagent, Anspruchsagent oder Vorteilsagent) werden in verschiedenen Interaktions-Flows wiederverwendet.
- **Autonom und unterstützend**: Das System kombiniert _autonome Agenten_ (zur direkten Benutzerinteraktion) und _assistierende Agenten_ (zur Erweiterung der menschlichen Kundendienstanforderungen).
- **Datenquellen**: Die Architektur integriert eine Mischung aus öffentlichen und Unternehmensdatenquellen, wobei _Data 360_ und _MuleSoft_ für die Konnektivität umfassend verwendet werden.
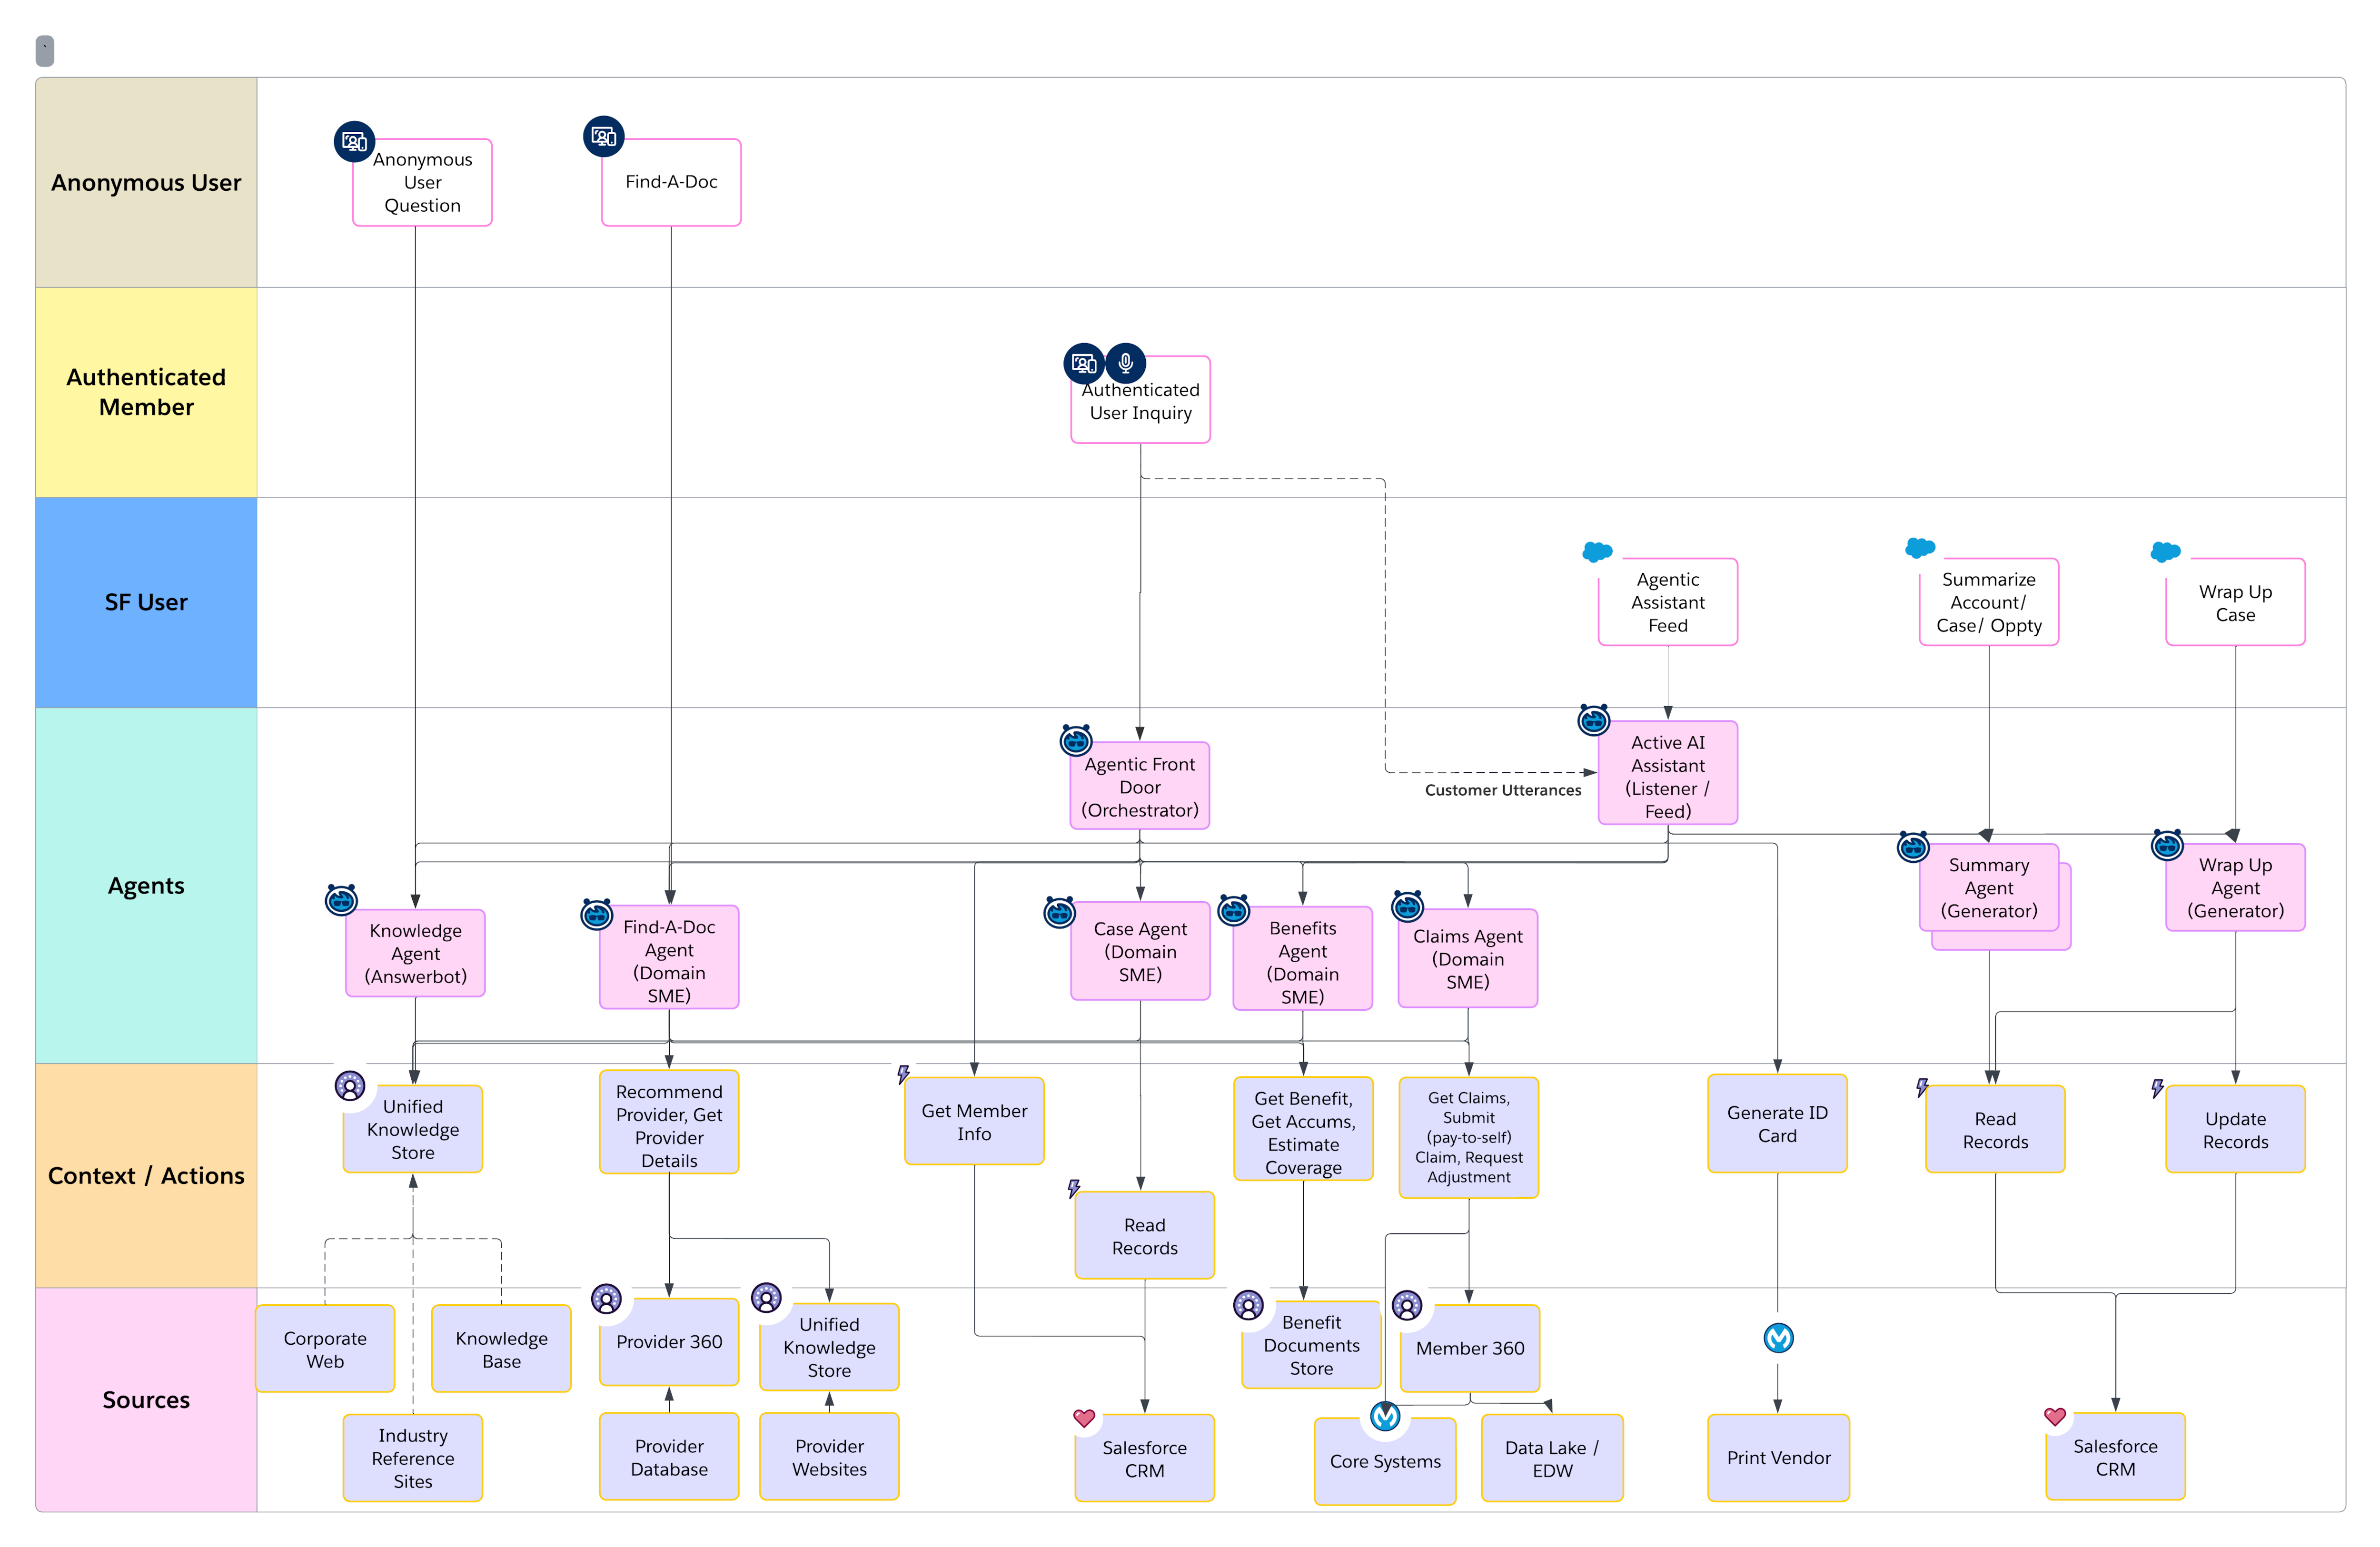 ### Anlage C: Systemarchitektur – Kontaktcenter
In diesem Diagramm wird eine logische Architektur für eine Lösung mit assistierender AI in einem Kontaktcenter veranschaulicht, die in Funktionsebenen organisiert ist.
- **Orchestratoragenten**: Verwalten Sie Benutzererfahrungen für verschiedene Personas (z. B. Anonym, Externes Mitglied oder Kundendienstmitarbeiter) und orchestrieren Sie den gesamten Interaktions-Flow.
- **Mitarbeiteragenten**: _Mehrere KMU-Agenten_ konzentrieren sich auf Kerngeschäftsdomänen wie Knowledge, Kundenvorgang/Ansprüche/Leistungen und Anbieterverzeichnis. Ein _Next Best Action_-Agent ist ebenfalls enthalten.
- **Dienstprogrammagenten**: Führen Sie bestimmte wiederverwendbare Aufgaben wie "Übersetzung", "Kundenvorgangsnachbearbeitung" und "Anrufzusammenfassung" aus.
Integrations- und Kernsysteme: Das gesamte Agentensystem ist über eine plattformübergreifende Integrationsebene mit unstrukturierten Datenressourcen, strukturierten Datenressourcen und zentralen Unternehmenssystemen verbunden.
- **Governance**: Eine Governance-Ebene bietet die Beobachtbarkeit, Auswertung und Verwaltung der von den Agenten verwendeten LLMs/SLMs.
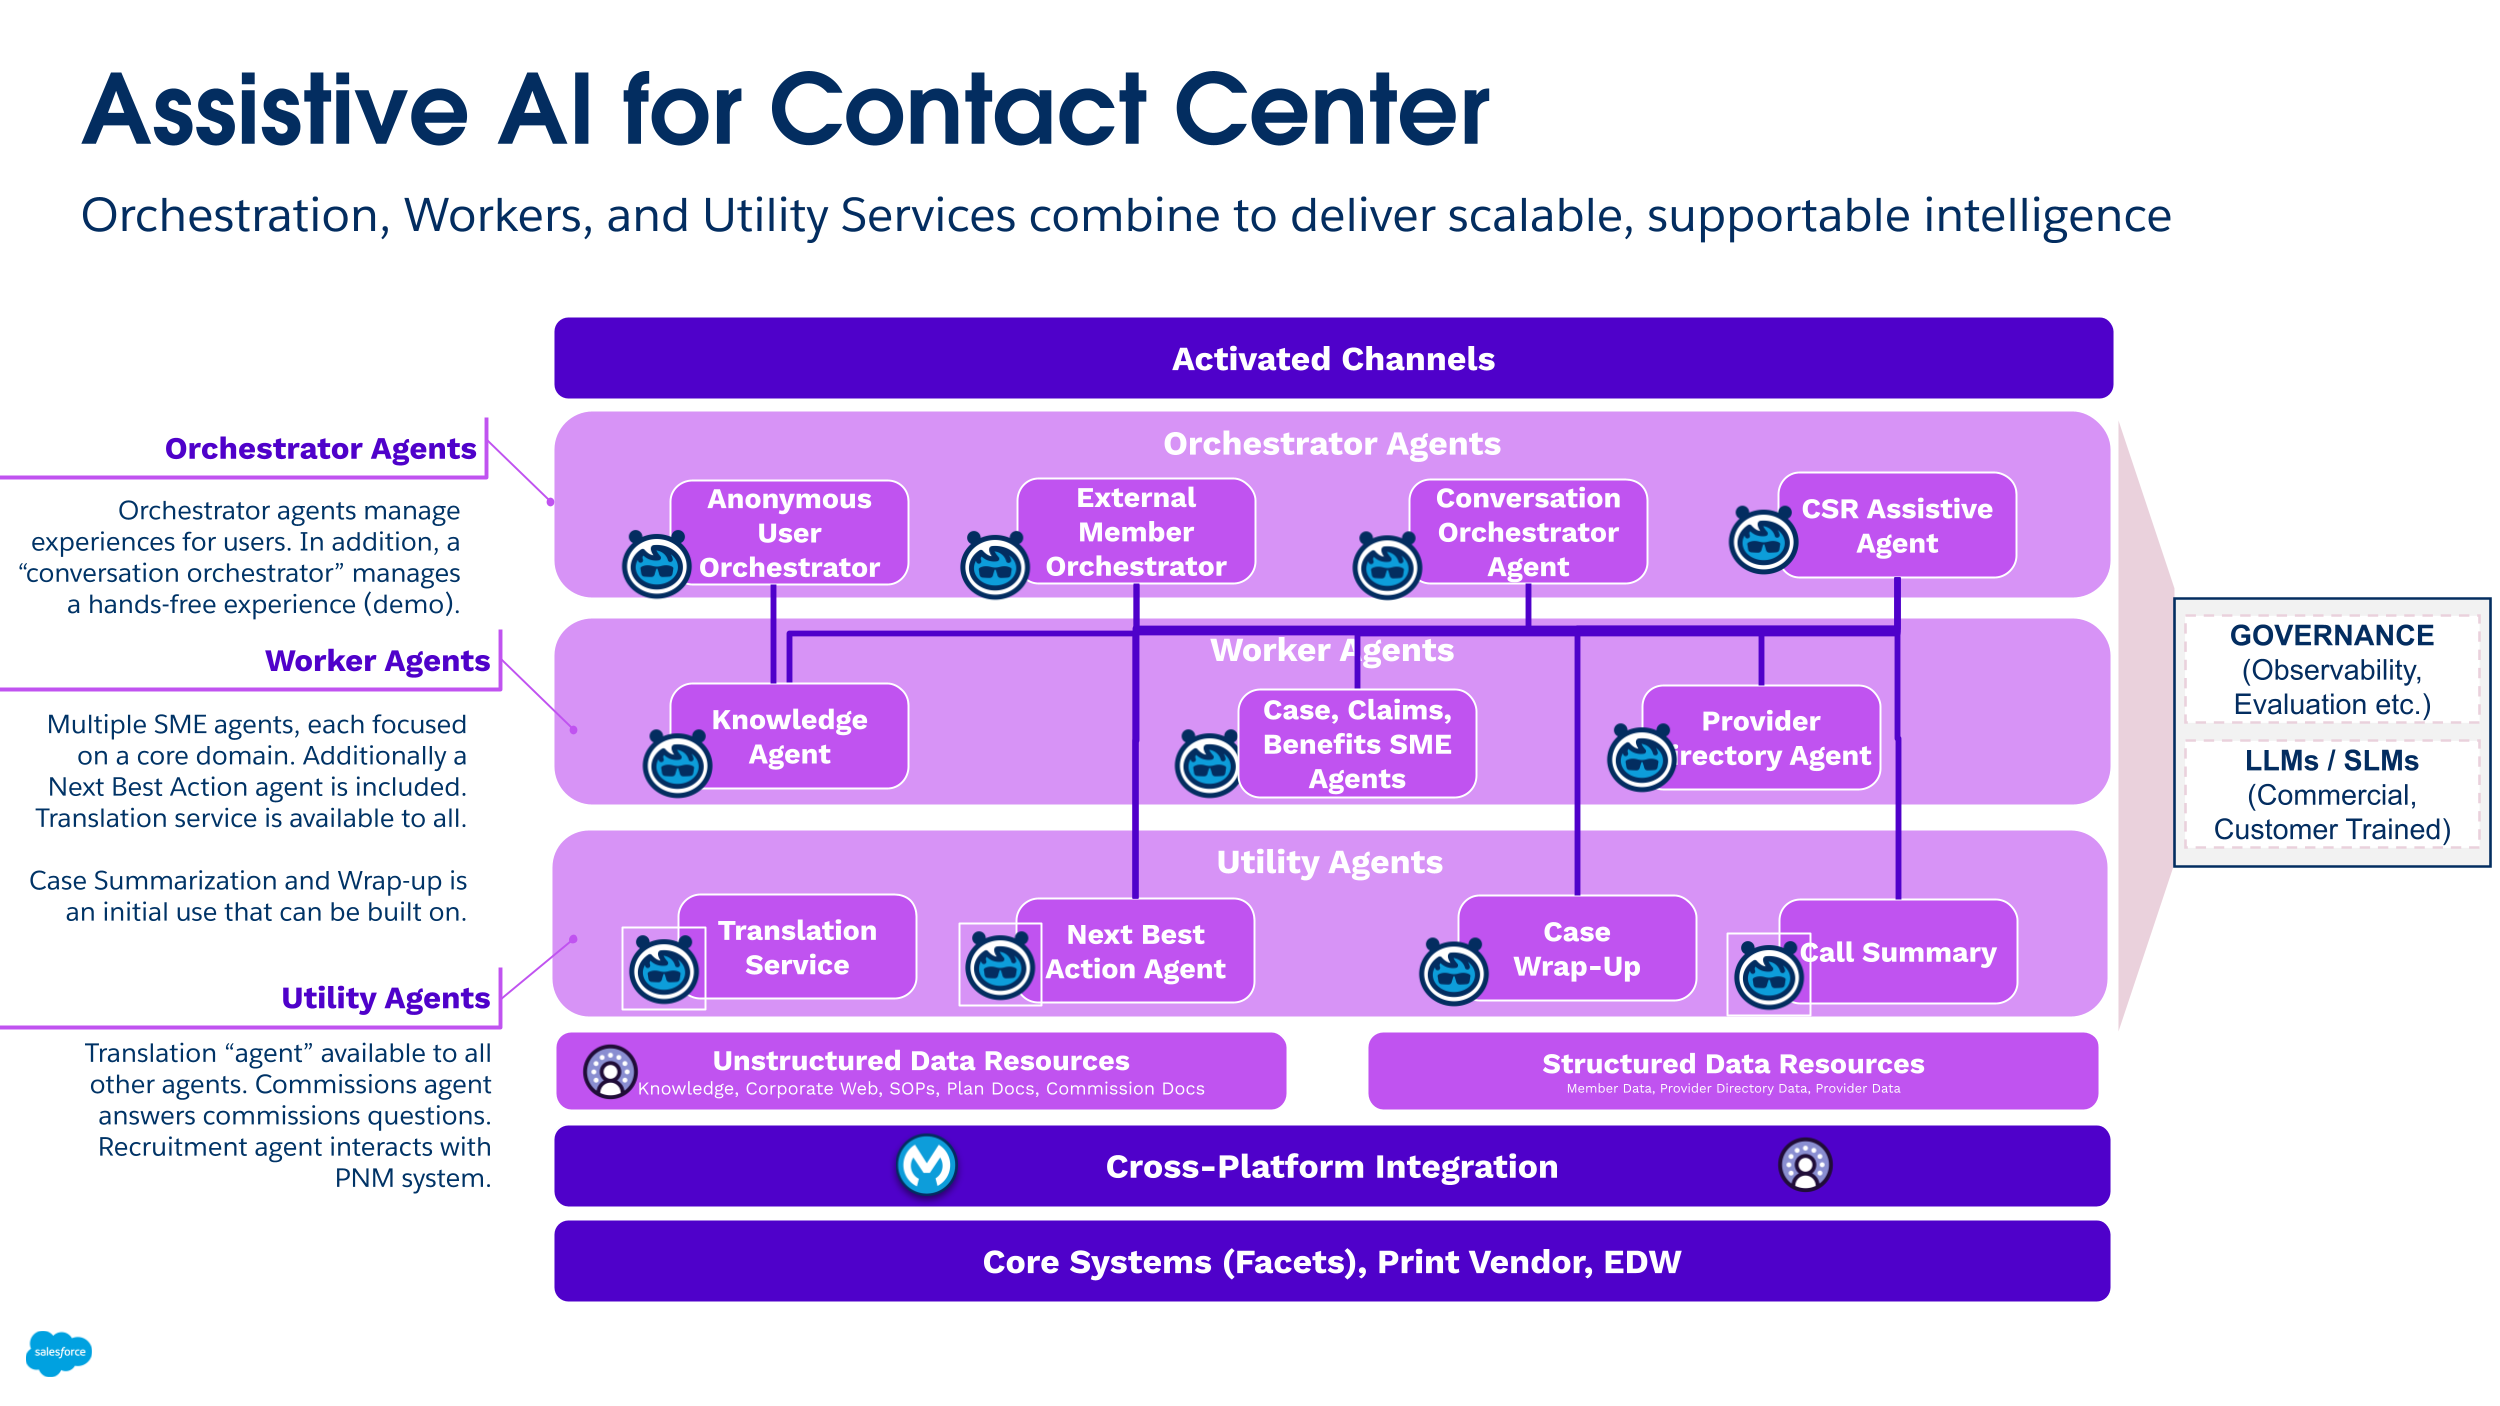 ### Anlage D: Zuordnung der Agentenlösung – Maklerportal
Diese Lösungskarte enthält Details zu einer komplexen, langfristigen Agenteninteraktion für ein Portal für B2B-Krankenversicherungsmakler. Das Modell enthält einen _Portalagenten_ (_Orchestrator_), der dem Makler den Weg durch mehrere Schritte erleichtert (z. B. das Senden eines Angebots und das Empfangen eines Angebots). Dieser Orchestrierer ruft einen _Projektmanager-_Agenten auf, der wiederum mehrere Headless-Agenten für die Back-Office-Datenqualität und -Transformationen koordiniert, beispielsweise einen RFP-Extraktor, eine Zensustransformation und eine Datenweiterleitung.
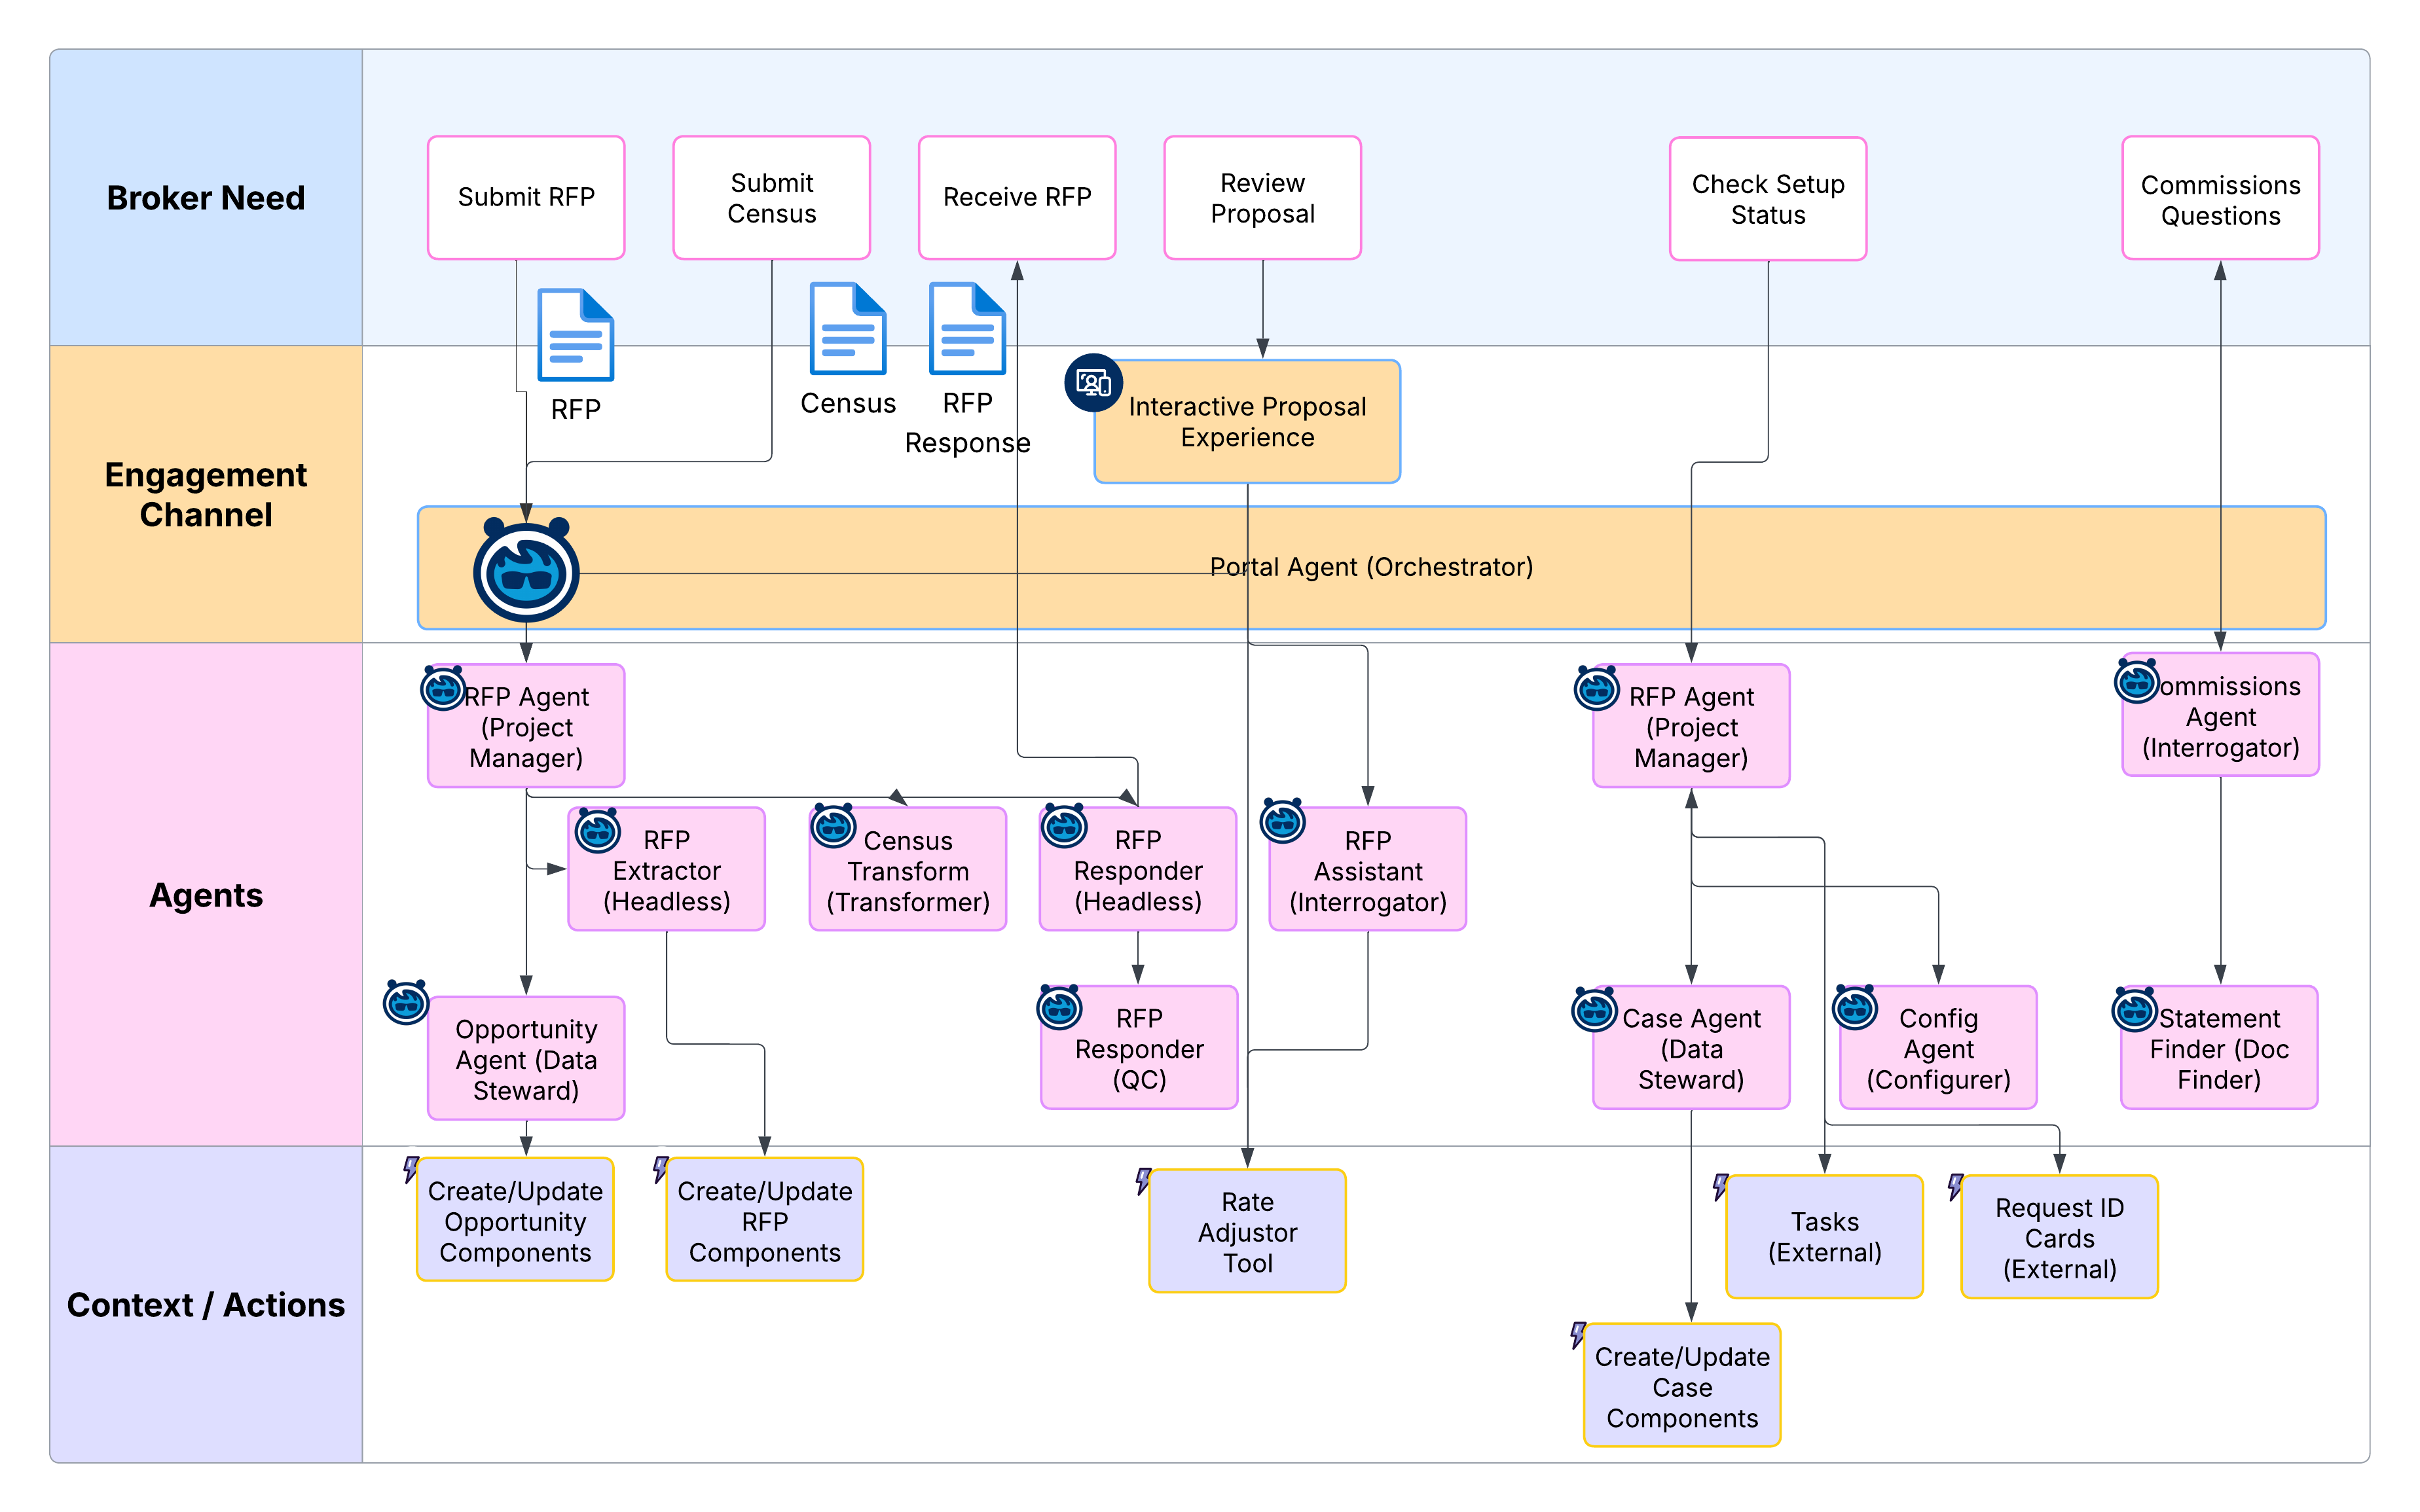 ### Anlage E: Systemarchitektur – B2C-Broker-Agenten
Dieses Diagramm zeigt eine logische Architektur für eine B2C Broker-Lösung, die einen ähnlichen mehrschichtigen Ansatz wie das Kontaktcenter zeigt. Sie umfasst _Orchestrator-Agenten_ für unterschiedliche Benutzer-Personas, wiederverwendbare _Mitarbeiter-Agenten_ für wichtige Domänen (z. B. Knowledge, Mitgliederservices oder Provisionen) und _Dienstprogramm-Agenten_ für bestimmte Funktionen wie Übersetzung und Zusammenfassung.
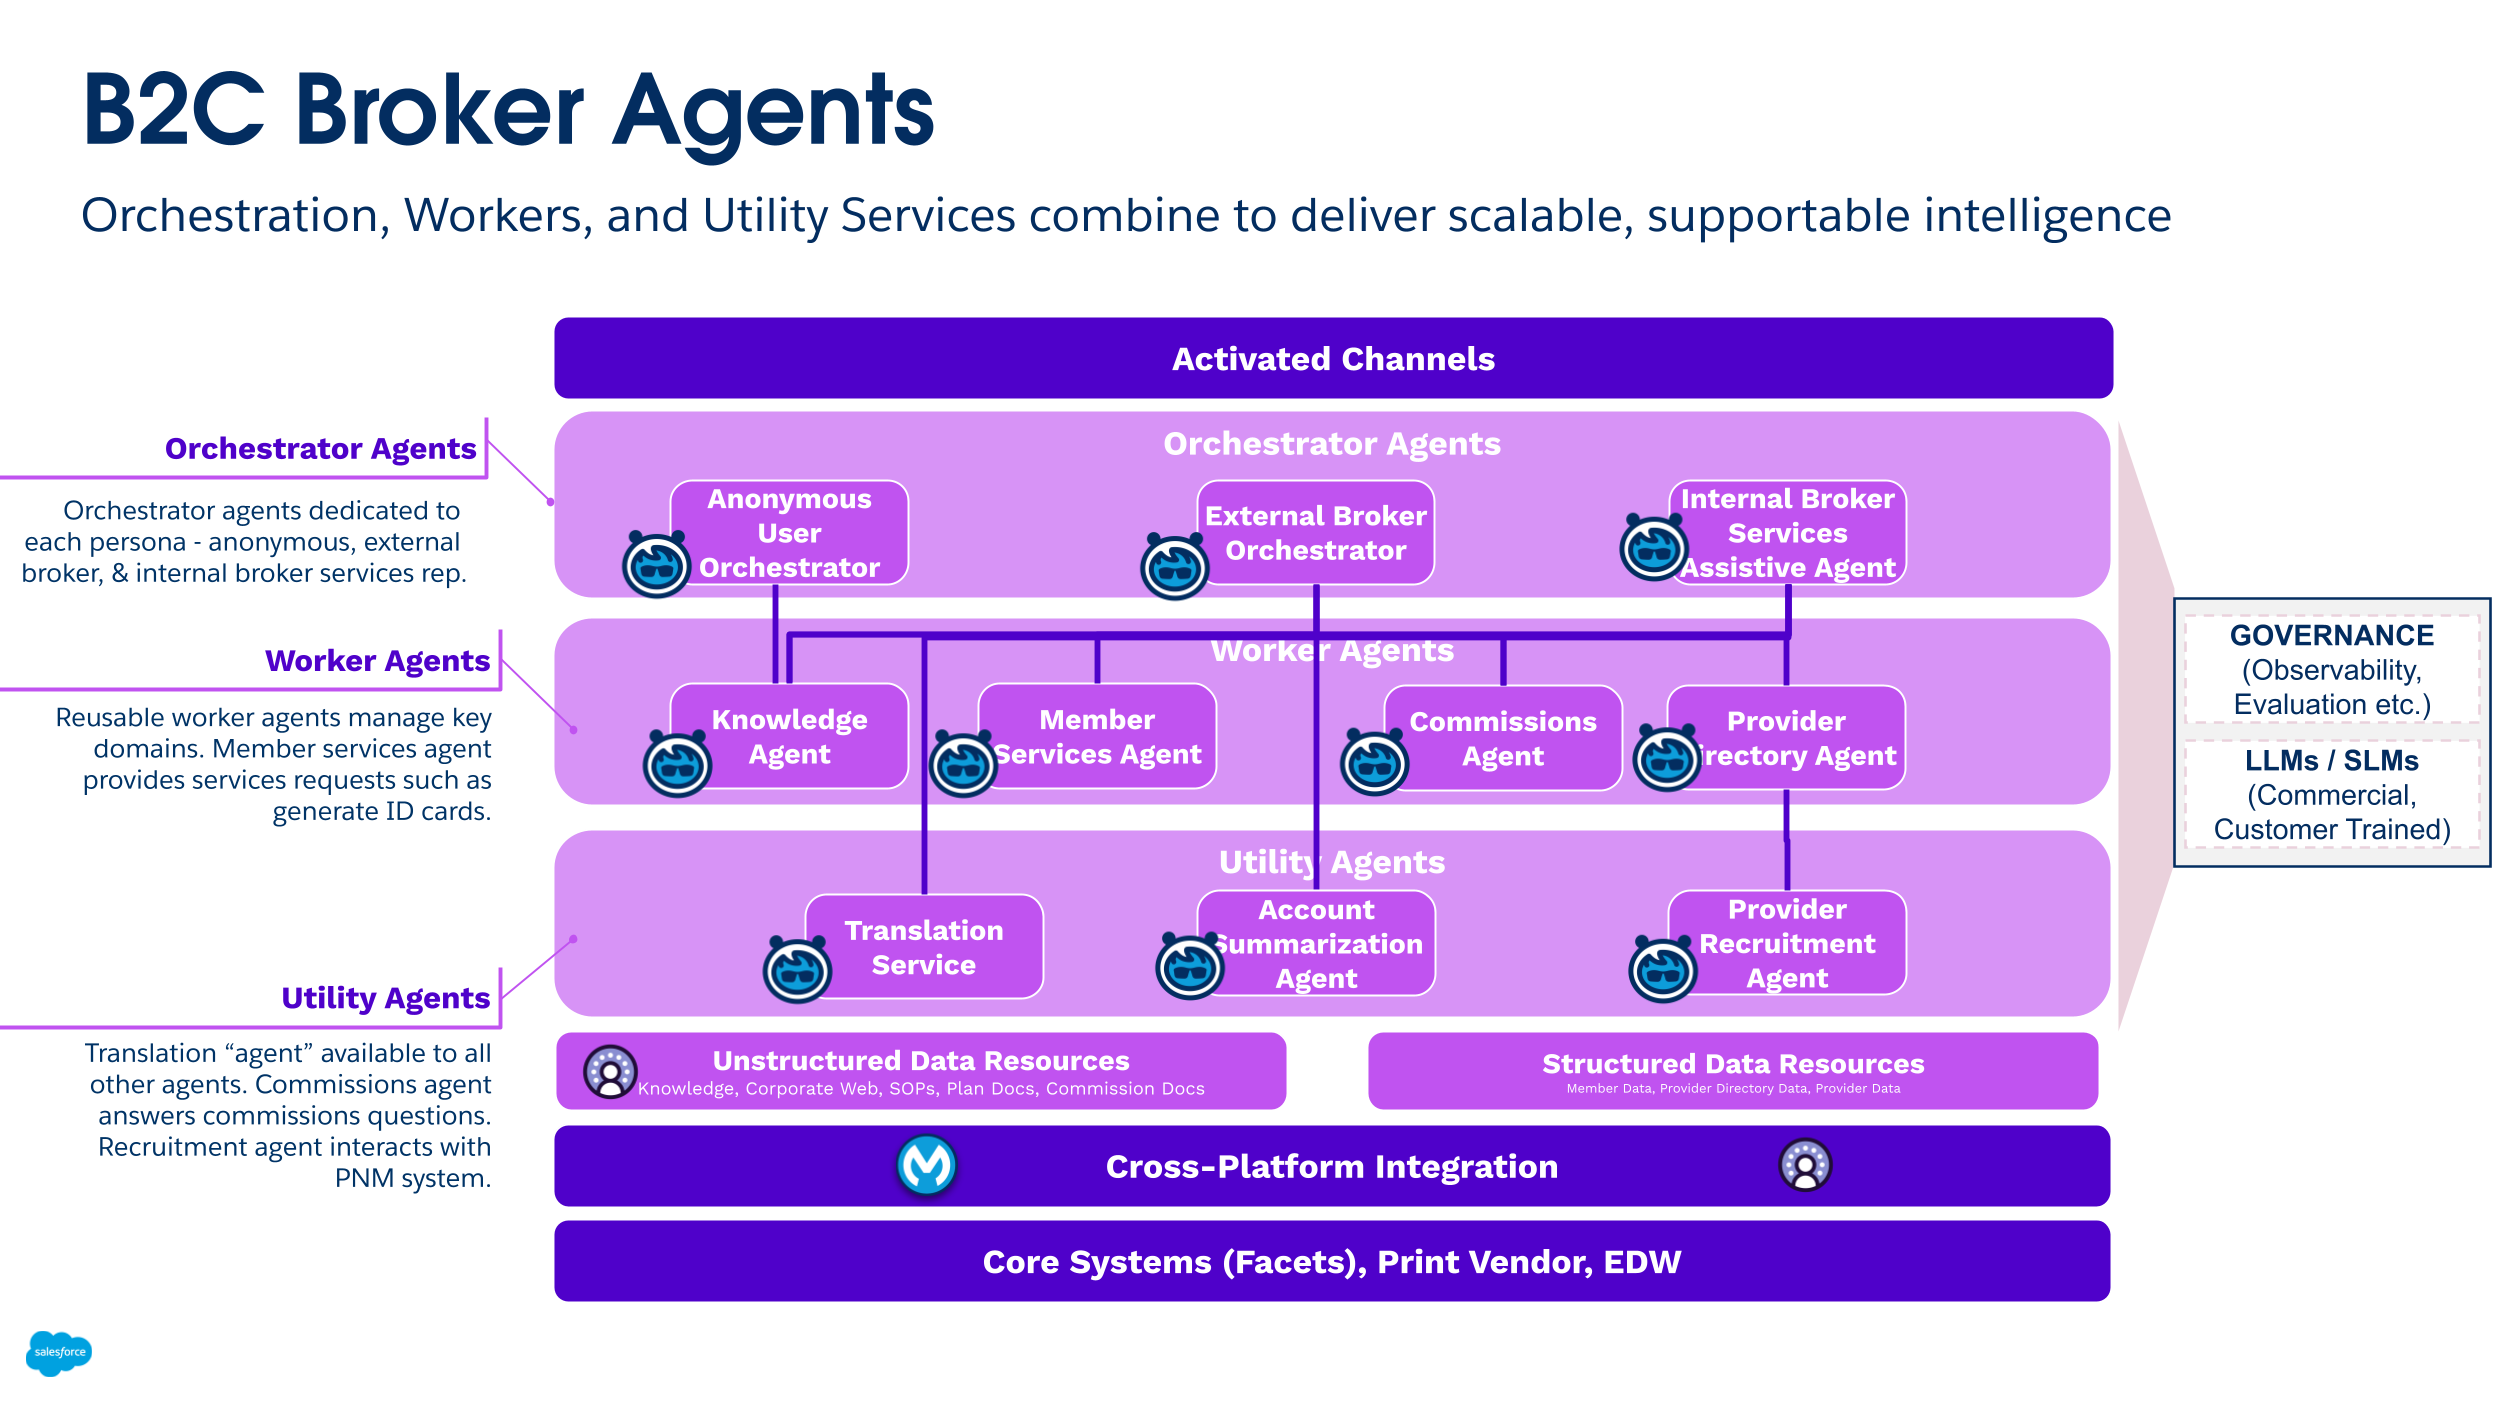 ### Anlage F: Systemarchitektur – Anbietervertrag
Dieses Diagramm zeigt eine logische Architektur für eine Lösung vom Typ "Anbietervertrag". _Orchestrator-_Agenten verwalten vollständige Interaktionen, _Mitarbeiter-Agenten_ verwalten bestimmte Intents in einer Domäne (beispielsweise einen Agenten für KMU im Vertragswesen) und _Dienstprogramm-_Agenten erledigen diskrete Aufgaben wie das Vergleichen von Verträgen oder das Generieren von Statistiken.
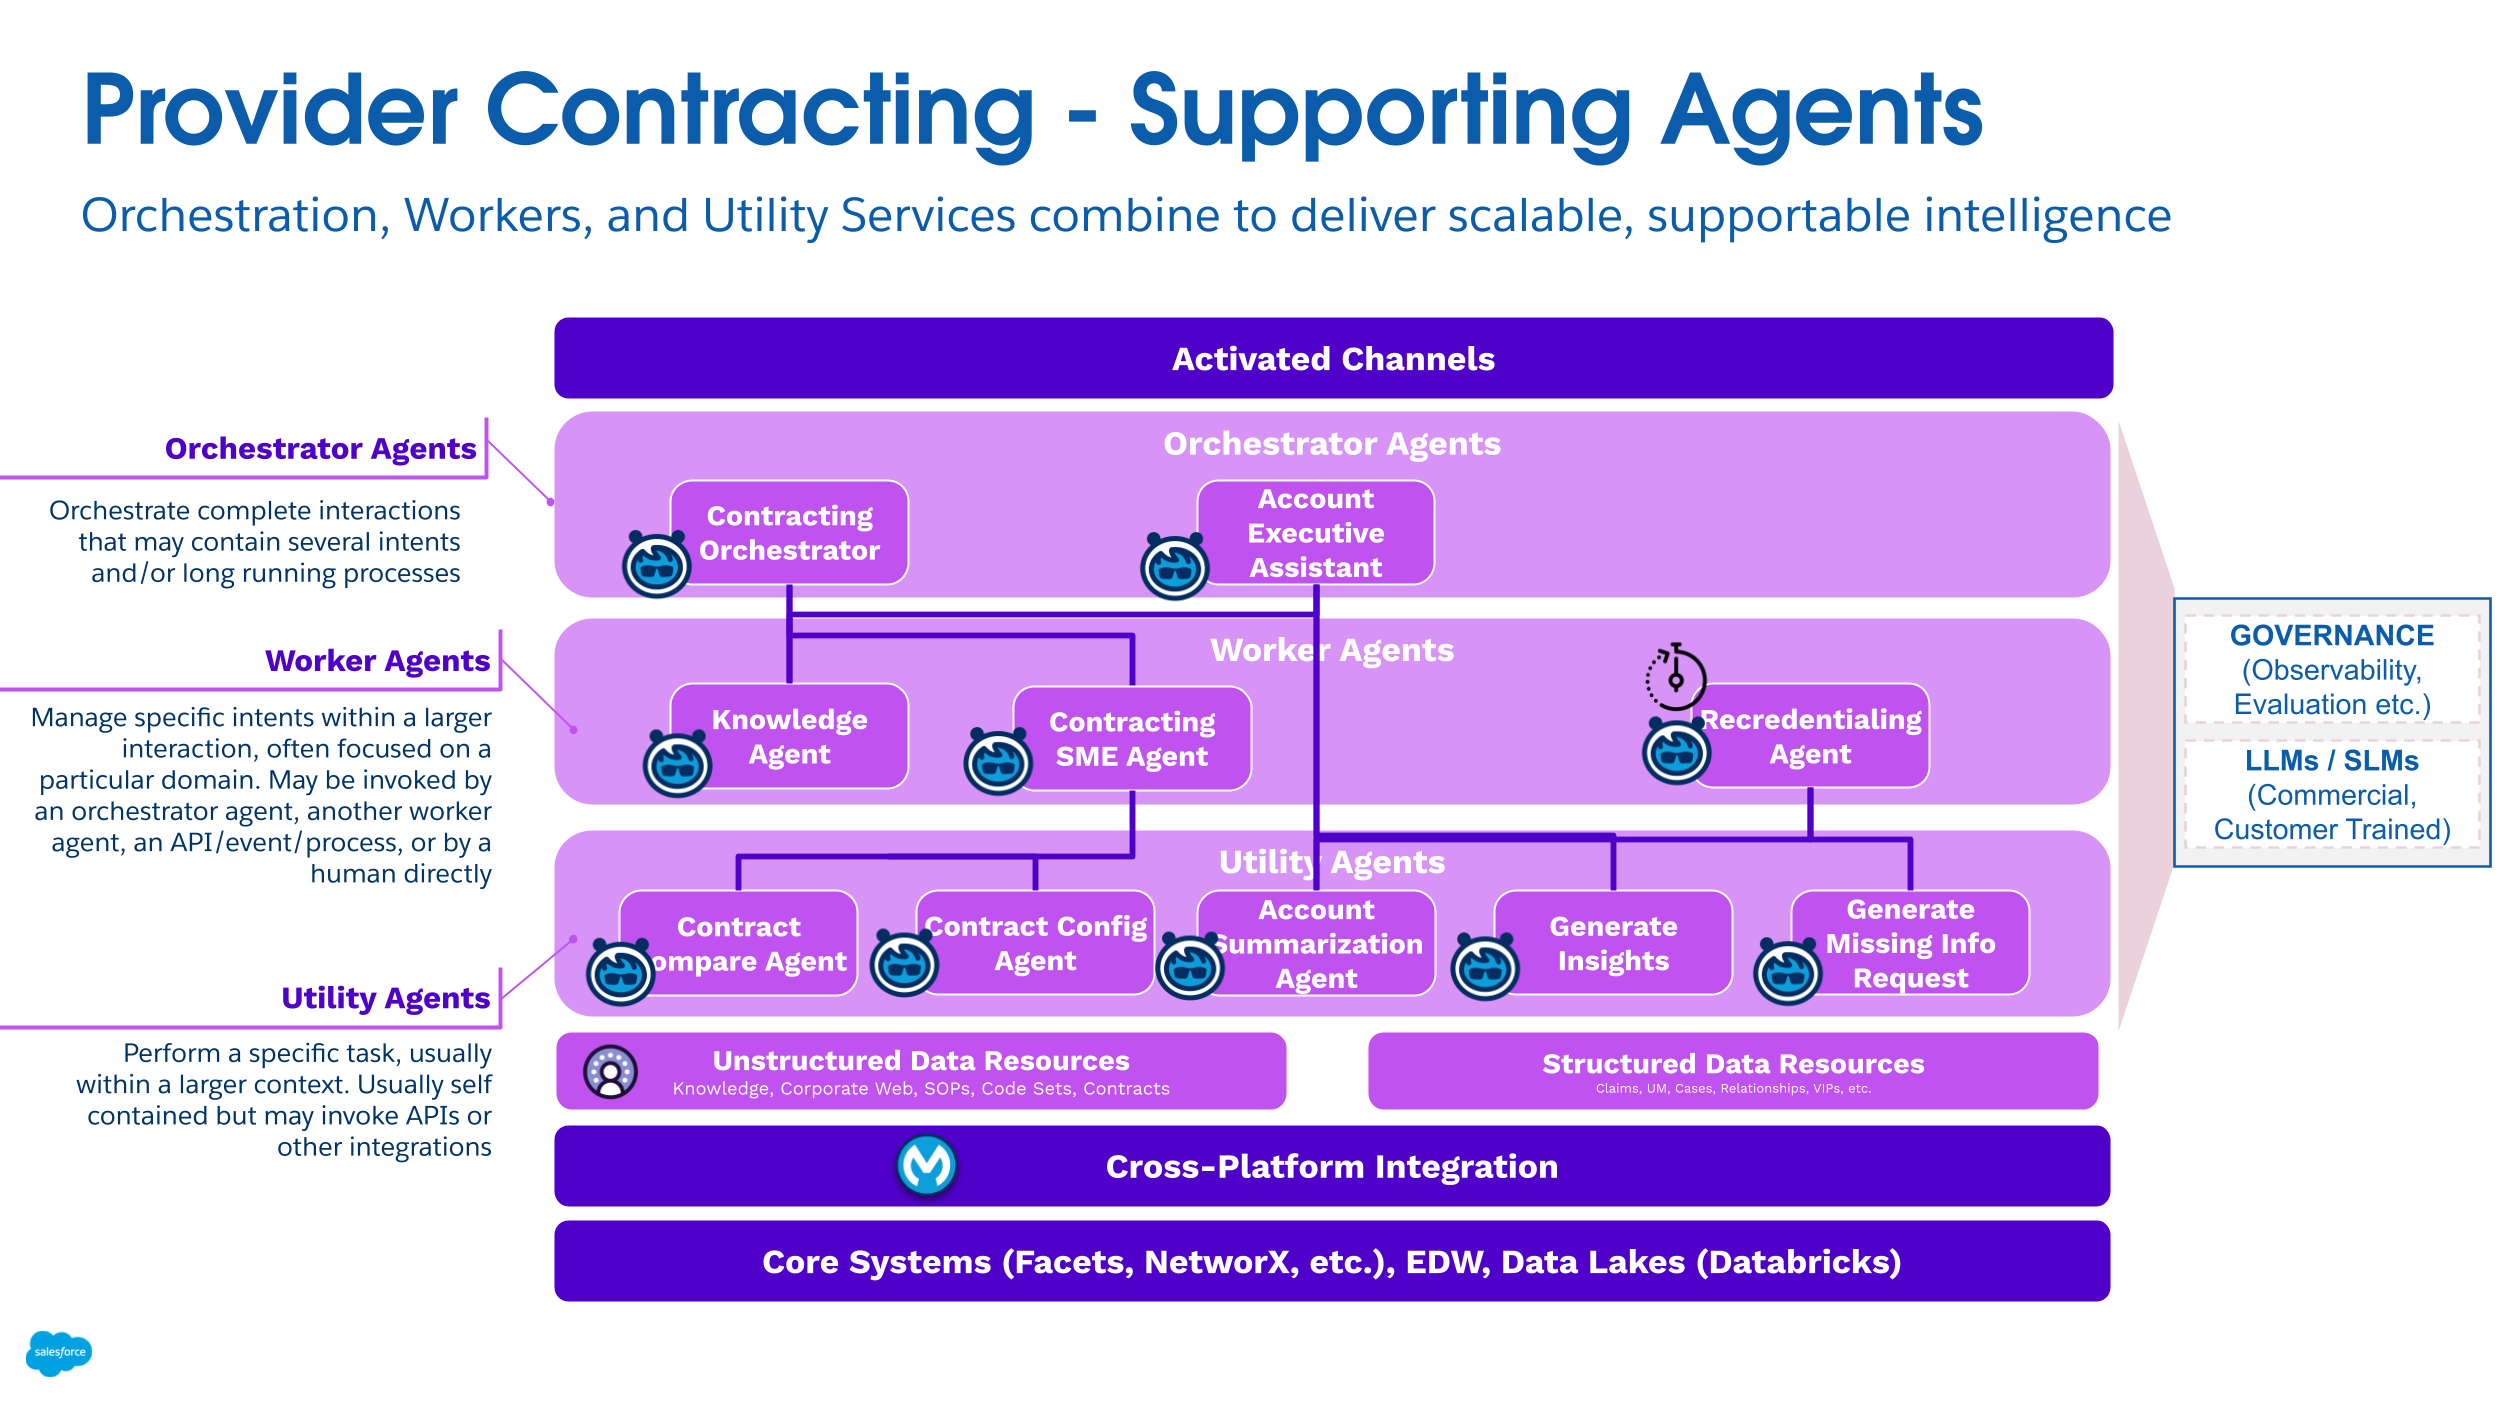 ### Anlage G: Übersichtstabelle für Interaktionsmuster
In der folgenden Tabelle sind verschiedene wichtige Interaktionsmuster, typische Benutzererfahrungen und primäre Architekturzwecke zusammengefasst.
| Muster | Benutzererfahrung (UX) | Zweck |
|---|---|---|
| Begrüßung | Turn-by-Turn-Text (Chat, Voice, SMS usw.), der mit der Übertragung der Interaktion an einen Menschen endet | Hierbei handelt es sich um ein einfaches Muster, das verwendet wird, um den Benutzer-Intent zu bestimmen und den Benutzer dann an den entsprechenden menschlichen Agenten weiterzuleiten. |
| Operator | Turn-by-Turn-Text (Chat, Voice, SMS usw.), der mit der Übertragung der Interaktion an einen menschlichen oder spezialisierten Agenten endet | Damit werden Anforderungen an die entsprechenden Hybridagenten weitergeleitet. Aufbauend auf der Begrüßung handelt es sich um ein einfaches Muster, das den Intent aushandelt und die Interaktion dann an einen spezialisierten menschlichen oder AI-Agenten überträgt. |
| Orchestrator | Turn-by-Turn-Text (Chat, Voice, SMS usw.) mit dem Responder, der Antworten von Spezialisten sammelt, aggregiert und an die Benutzeroberfläche zustellt | Dies wird verwendet, um einen verwalteten AI-Agenten "Bearbeiten als Team" zu koordinieren, der im Laufe der Unterhaltung auf eine Unterhaltung antwortet. Ein Orchestrator-Agent leitet den Text jedes Zuges an einen oder mehrere Fachagenten weiter und aggregiert dann die Antworten aus jedem einzelnen. |
| Answerbot | Eingabeaufforderung und Antwort | Hierbei handelt es sich um eine Oberfläche mit natürlicher Sprache, auf der Knowledge Ressourcen, häufig gestellte Fragen, Richtlinien usw. zum Erstellen von Antworten verwendet werden. |
| Interrogator | Eingabeaufforderung und Antwort | Hierbei handelt es sich um eine Oberfläche mit natürlicher Sprache, die verwendet wird, um Fragen in einer bestimmten Domäne oder einem bestimmten Bereich zu stellen. |
| Listener / Feed | Turn-by-Turn-Text (Chat, Voice, SMS usw.), der mit dem Orchestrierungsmuster endet, das einen linearen Feed einspeist | Dadurch werden Kontext und Statistiken im Unterhaltungsfluss angezeigt. |
| Arbeitsumgebung (Radar O'Reilly) | Turn-by-Turn-Text (Chat, Voice, SMS usw.), der mit einem adaptiven Heads-up-Display mit einem einzigen Glasfenster endet | Dies wird zum Verwalten einer reaktionsfähigen Einzelscheibe im Unterhaltungsfluss verwendet. |
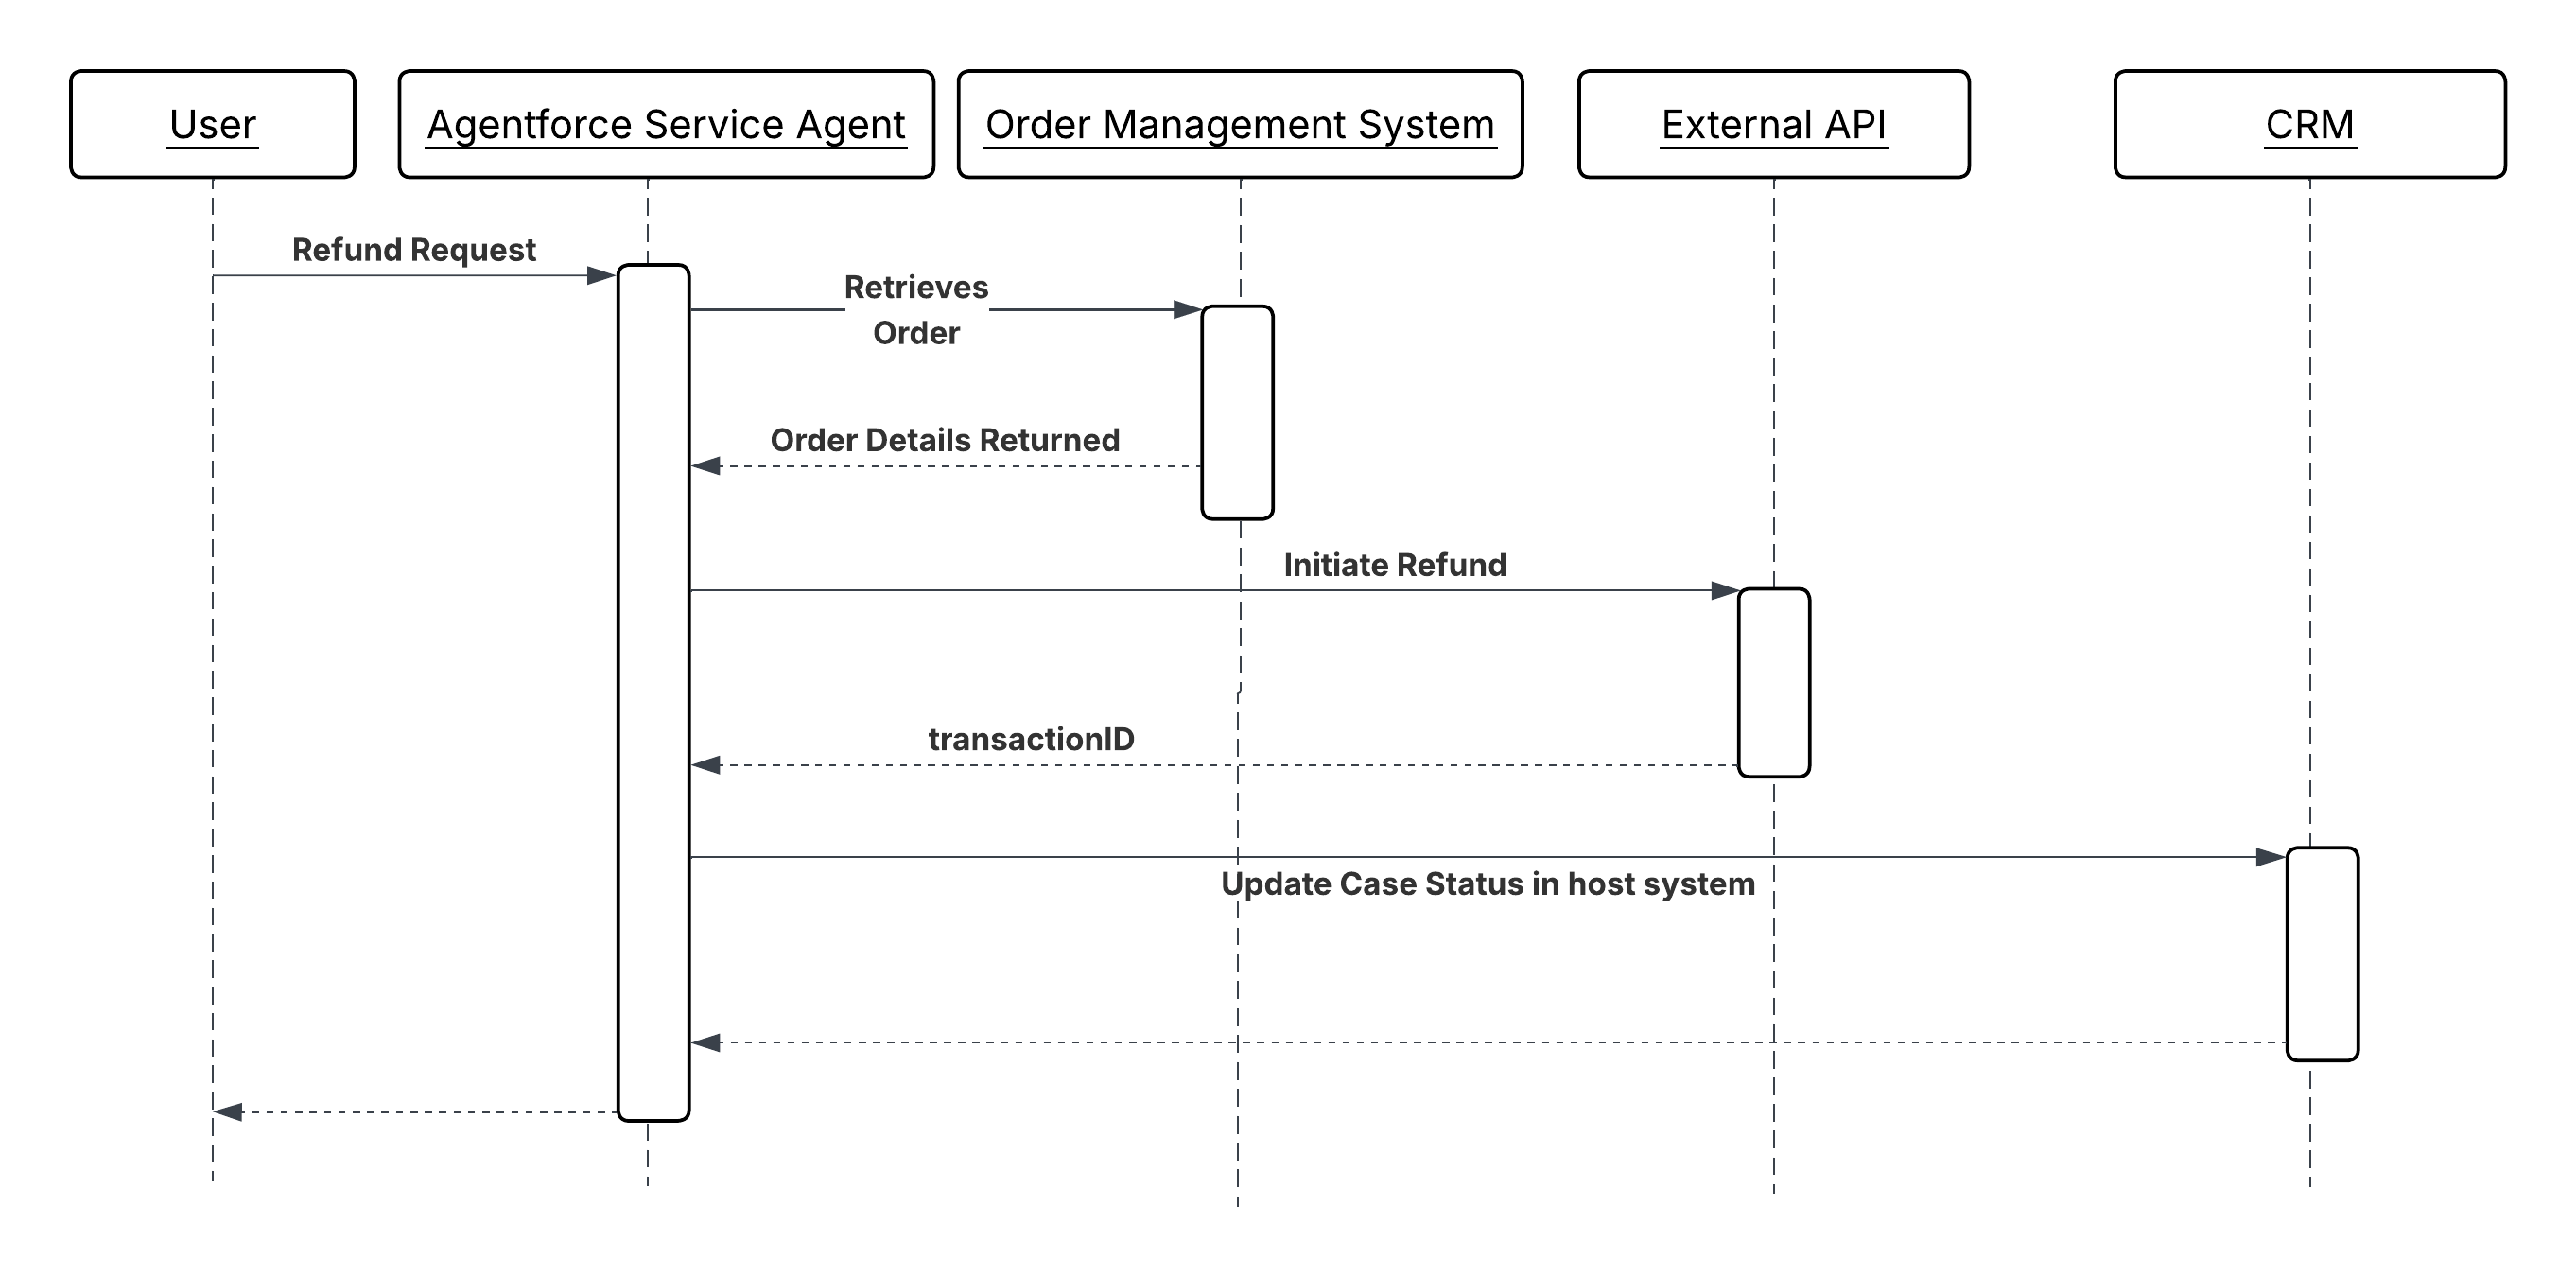 **Ergebnisse**
Der Agent führt einen systemübergreifenden Workflow als kohärente, überwachte Sequenz und nicht als Feuer-und-Vergessen-Skript aus. Das Ergebnis jedes Schritts wird ausgewertet, bevor der nächste Schritt aufgerufen wird. Auf diese Weise erkennt der Agent Fehler zum frühestmöglichen Zeitpunkt, statt einen Teilabschluss nach der Tat zu erkennen.
Das Hostsystem (Salesforce CRM) wird erst aktualisiert, nachdem der Remote-Vorgang den Status bestätigt hat (Erfolg oder Fehler). Von externen Systemen zurückgegebene Kennzeichner und Status, beispielsweise Abrechnungsaccountnummern, Transaktions-IDs und Bestätigungscodes, werden durch die Kette übernommen und beibehalten, wodurch ein vollständiger, rückverfolgbarer Datensatz des Workflow-Ergebnisses erstellt wird.
Der Agent ist für die Argumentation der Ergebnisse und die Sequenzierung der Entscheidungen verantwortlich. Jede Aktion ist nur für ihren eigenen Vorgang und für das Zurückgeben eines strukturierten Ergebnisses verantwortlich. Keine der Ebenen codiert die Logik der anderen.
**Überlegungen zum Design**
Plattformunabhängige Anleitung
- Stellen Sie sicher, dass jede Aktion in der Kette eine semantische Beschreibung enthält, die in Intent-basierter Sprache und nicht als Signatur der technischen Methode geschrieben wurde. Der Agent wählt Aktionen anhand dieser Beschreibungen aus. Eine Beschreibung mit der Aufschrift "Rechnungsstellungs-API aufrufen" ist weniger nützlich als eine mit der Aufschrift "Rechnungsstellungsaccount im Abrechnungssystem und Rückgabe des neuen Accountkennzeichners".
- Legen Sie alle Schreibvorgänge in der Kette als idempotent fest. Die Argumentationsschleife des Agenten kann eine Aktion wiederholen, wenn sie eine mehrdeutige Antwort erhält. Die Aktion muss bei wiederholtem Aufruf dasselbe Ergebnis liefern.
- Validieren Sie alle abgeleiteten LLM-Eingabeparameter defensiv an der Aktionsgrenze. Gehen Sie niemals davon aus, dass die vom Agenten übergebenen Parameter gut ausgebildet sind, innerhalb des Bereichs liegen oder den erwarteten Typ aufweisen.
- Entwerfen Sie jede Aktion für eine einzelne Verantwortung. Eine Aktion, die einen Abrechnungsaccount erstellt und im selben Anruf eine Bestätigungs-E-Mail sendet, ist schwieriger zu wiederholen, schwieriger zu testen und für den Agenten schwieriger zu erklären, dass es sich um zwei separate Aktionen handelt.
Salesforce-Implementierungshinweise
- Anmerkung **für Apex Aktionen**: @InvocableMethod(label=’...“ description='...'). Die "Beschreibung" wird vom Agenten gelesen, um zu bestimmen, wann die Aktion aufgerufen werden soll. Deklarieren Sie alle Eingabe- und Ausgabevariablen mit @InvocableVariable unter Verwendung der aussagekräftigen Felder "label" und "description". Geben Sie strukturierte Ergebnisobjekte mit expliziten Erfolgs-/Fehlerindikatoren und menschenlesbaren Fehlermeldungen zurück.
- **Für Flow-Aktionen** verwenden Sie ausschließlich automatisch gestartete Flows. Bildschirm-Flows werden in Kontexten autonomer Agenten nicht unterstützt. Halten Sie jeden Flow atomar; eine Aktion, eine Verantwortung. Konfigurieren Sie Fehlerpfade für jedes externe Callout-Element, um Integrationsfehler zu erkennen und handlungsrelevante Fehlermeldungen an den Agenten zurückzugeben, statt die Sitzung durch nicht erkannte Ausnahmen beenden zu lassen.
- Importieren Sie **für "Externe Services**" die OpenAPI-Spezifikation des Zielsystems und registrieren Sie die generierten Aktionen im Thema "Agentforce". Wickeln Sie die generierten Stubs in Anmeldeinformationen mit Namen ein, um Endpunkte oder Anmeldeinformationen mit harter Codierung in der Aktionsdefinition zu vermeiden.
- Legen Sie **für alle externen Callouts** explizite Callout-Timeouts fest. Ein Callout, der ohne Zeitüberschreitung angehängt wird, blockiert den Überlegungenzyklus des Agenten, bis die Sitzungsobergrenze erreicht ist. Geben Sie bei Überschreitung der Zeitüberschreitung einen schwerwiegenden Fehler mit einer aussagekräftigen Fehlermeldung zurück. Alle externen Callouts weisen eine konfigurierbare Zeitüberschreitung von bis zu 120 Sekunden auf. Außerdem unterliegen sie den Obergrenzen für synchrone Apex-Transaktionen. Daher sollten Sie das Risiko minimieren, dass mehr als 50 Transaktionen instanziiert werden, die jeweils länger als fünf Sekunden ausgeführt werden.
**Fehlerbehandlung und -behebung**
- Der Agent bewertet jeden Schritt anhand des expliziten Erfolgs des Vorgängers des Schritts. Aktionen müssen ein strukturiertes Ergebnis zurückgeben, das einen eindeutigen Erfolgs- oder Fehlerindikator enthält. Der Agent kann allein aus einer fehlenden oder Nullantwort nicht zuverlässig auf einen Fehler schließen.
- Wenn eine Aktion fehlschlägt, verwendet der Agent die von der Aktion zurückgegebene Fehlermeldung, um den nächsten Schritt zu bestimmen: Fordern Sie den Benutzer zur korrigierten Eingabe auf, versuchen Sie eine Selbstheilung mit angepassten Parametern oder halten Sie die Kette an und protokollieren Sie den Fehler zur menschlichen Überprüfung. Daher müssen Fehlermeldungen spezifisch und handlungsrelevant sein: "Ungültiger Datumsbereich: endDate kann startDate nicht vorangehen" verwendet werden, 400 Statuscode allein nicht.
- Bei Ketten, bei denen die Teilvervollständigung zu einem inkonsistenten Zustand führt (beispielsweise wurde der Abrechnungsaccount erstellt, der CRM-Datensatz jedoch nicht aktualisiert), ruft der Agent eine Entschädigungsaktion auf, um den Teilstatus zurückzusetzen oder zu kennzeichnen, bevor der Fehler angezeigt wird. Entwerfen Sie Kompensationspfade als benannte Aktionen neben dem Vorwärtspfad.
- Wenn eine Schreibaktion potenziell erfolgreich war, jedoch eine mehrdeutige Antwort zurückgegeben hat (Netzwerk-Timeout, keine Bestätigung), muss für den Wiederholungsversuch derselbe Identitätsschlüssel oder dieselbe externe Referenz-ID wie für den ursprünglichen Aufruf verwendet werden. Stellen Sie niemals einen nicht aktivierten Wiederholungsversuch für einen nicht idempotenten Schreibvorgang aus.
**Sicherheitsüberlegungen**
- Wickeln Sie alle externen Callouts in Anmeldeinformationen mit Namen ein. Hartcodieren Sie niemals Endpunkte oder Anmeldeinformationen in Apex Code- oder Flow-Konfigurationen. Diese müssen über den sicheren Anmeldeinformationenspeicher der Plattform verwaltet und ohne Codeänderungen rotiert werden.
- Wenden Sie das Prinzip der geringsten Berechtigung auf den Integrationsbenutzer oder die verbundene Anwendung an, die von den einzelnen Aktionen verwendet werden. Eine Aktion, die nur Auftragsdaten liest, sollte nicht über Schreibberechtigungen für das Abrechnungssystem verfügen. Scope-Anmeldeinformationen für die minimalen Vorgänge, die für die Aktion erforderlich sind.
- Protokollieren Sie den Aufruf jeder Aktion in der Kette mit der zugehörigen Sitzungs-ID, den Eingabeparametern (die von sensiblen Werten bereinigt wurden) und dem Ergebnis. Wenn das Ergebnis bestritten wird, ist dieser Überprüfungsprotokoll der primäre Mechanismus, um zu rekonstruieren, warum der Agent eine bestimmte Sequenz von Aktionen ausgeführt hat.
- Bereinigen Sie alle Eingabeparameter, die aus vom Benutzer bereitgestelltem Text stammen, bevor Sie sie an externe Systeme übergeben. Die über den Agenten an einen externen API-Callout weitergegebene Benutzereingabe ist ein potenzieller Injektionsvektor. Validieren Sie Typ, Format und Bereich an der Aktionsgrenze, bevor der Callout erfolgt.
**Beispiel**
Ein Kundendienstagent, der eine Rückerstattungsanforderung bearbeitet, führt eine sequenzielle Kette aus vier Schritten aus:
1. `GetOrderDetails` (Apex-Aktion) ruft den Auftragsdatensatz mithilfe der vom Benutzer angegebenen Auftrags-ID aus dem Auftragsverwaltungssystem ab. Er gibt den Auftragsstatus, Belegposten, Kaufdatum und Zahlungsweise zurück. Der Agent wertet aus, ob sich der Auftrag in einem erstattungsfähigen Zustand befindet, bevor er fortfährt.
2. `ValidateRefundEligibility` (Automatisch gestarteter Flow) wendet die Geschäftsregeln für den Rückerstattungsanspruch an, einschließlich Rückgabefenster, Produktkategorieeinschränkungen und vorheriger Rückerstattungsverläufe. Es wird ein boolescher Wert für "berechtigt" zurückgegeben und, falls nicht zulässig, ein eindeutiger Grund, aus dem der Agent dem Benutzer angezeigt werden kann.
3. `InitiateRefund` (Apex Action) ruft die externe Zahlungs-Gateway-API mit der Auftrags-ID und dem Rückerstattungsbetrag auf. Gibt bei Erfolg eine "refundTransactionId" zurück. Diese Aktion ist idempotent. Wird er ein zweites Mal mit derselben Auftrags-ID aufgerufen, wird die vorhandene Transaktions-ID zurückgegeben, statt eine doppelte Rückerstattung zu erstellen.
4. `UpdateCaseStatus` (Automatisch gestarteter Flow) aktualisiert den CRM-Kundenvorgangsdatensatz mit der Rückerstattungstransaktions-ID, legt den Kundenvorgangsstatus auf "Gelöste Rückerstattung ausgestellt" fest und erstellt eine Folgeaufgabe für den Accountinhaber. Dieser Schritt wird erst ausgeführt, nachdem "InitiateRefund" eine bestätigte Transaktions-ID zurückgegeben hat.
Wenn bei der `InitiateRefund` eine Zeitüberschreitung auftritt oder ein Fehler zurückgegeben wird, hält der Agent die Kette an, ruft keine `UpdateCaseStatus` auf und zeigt dem Benutzer eine handlungsrelevante Meldung an. Der Kundenvorgang bleibt offen und ungelöst, wobei der genaue Status im CRM beibehalten wird.
## Aufruf paralleler Aktionen (ausgehend)
**Kontext**
Sequenzielle Aktionsketten sind effizient, wenn Ausführungsschritte voneinander abhängig sind. Ein Schritt führt zum nächsten. Viele Workflows enthalten jedoch eine Reihe von Schritten, die keine gegenseitigen Abhängigkeiten aufweisen. Beispielsweise können Schritte, die das Abrufen von Produktinventar, das Abrufen von Kundenansprüchen und das Überprüfen einer Versandschätzung umfassen, alle gleichzeitig ausgeführt werden, da für die Eingabe eines Schritts keine Ausgabe eines anderen erforderlich ist. Durch die sequenzielle Ausführung dieser Schritte wird Zeit verschwendet, die proportional zur Anzahl der Schritte ist.
In einem parallelen Aufrufmuster identifiziert der Agent, dass eine Reihe von Aktionen unabhängig sind, und ruft sie gleichzeitig und nicht nacheinander auf. Die gesamte Workflow-Zeit ist an die langsamste Einzelaktion und nicht an die Summe aller Aktionszeiten gebunden. Sobald alle Ergebnisse zurückgegeben wurden, aggregiert der Agent sie zu einer einzigen kohärenten Antwort oder verwendet sie zusammen als Eingaben für die nächste Phase der Argumentation.
Die wichtigste architektonische Herausforderung ist nicht der parallele Aufruf selbst. Sie verwaltet die Fan-Out-Erfahrung innerhalb von Plattformgleichzeitigkeitseinschränkungen und stellt sicher, dass der Aggregationsschritt Teilfehler ordnungsgemäß verarbeitet, ohne die erfolgreichen Ergebnisse zu verwerfen.
**Probleme**
Wie orchestriert ein Agent effizient die gleichzeitige Ausführung mehrerer unabhängiger Funktionen und aggregiert die einzelnen Ergebnisse zu einer einzigen, zusammenhängenden Antwort für den Benutzer oder nachfolgende Schritte?
**Kräfte**
Beantworten Sie beim Anwenden dieses Musters die folgenden Fragen:
- Welche Überlegungen gelten für Aktionen zur Thread-Sicherheit und zur Freigabe des stummgeschalteten Zustands?
- Wie kann die Lösung Salesforce-Obergrenzen für parallele Apex Callouts innerhalb einer einzelnen Transaktion verwalten und vermeiden?
- Müssen asynchrone Muster (wie warteschlangenfähiges Apex oder Plattformereignisse) verwendet werden, um Obergrenzen zu vermeiden?
- Ist eine synchrone Aggregation der Ergebnisse erforderlich, bevor der Agent fortfahren kann?
**Anwendung für Salesforce-Muster**
| Lösung | Passend | Kommentare |
| ------------------- | --------------------------------------------------------------------- | ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Middleware-Ansatz | Bestens geeignet für hohe Lüfterauslastungen (> 5 Endpunkte) und plattformübergreifende Aggregation | Sie benötigen eine Middleware-Ebene. Der Agent sendet einen Callout an die Middleware. Anschließend aggregiert die Middleware die Daten und sendet eine einzelne Antwort an den Agenten zurück. Dies ist bevorzugt, wenn der Agent viele heterogene externe Systeme aufrufen muss. Die Middleware absorbiert die Komplexität von Fanouts und gibt eine einzelne aggregierte Antwort zurück. |
| Warteschlangenfähiger Apex | Optimal für interne Salesforce-Parallelität | Sie müssen mehrere warteschlangenfähige Aufträge auslösen. Während Salesforce die Warteschlange verwaltet, können diese gleichzeitig ausgeführt werden, wenn Sie über genügend "Zeitfenster" in Ihrer Gleichzeitigkeitsobergrenze verfügen.Wird verwendet, wenn sich parallele Vorgänge in der Salesforce-Organisation befinden und Gleichzeitigkeitszeitfenster verfügbar sind. Dies ist nicht geeignet, wenn eine sofortige aggregierte Antwort erforderlich ist. |
| Plattformereignisse | Optimal für die Konsistenz von Feuervergessenheit oder -ereignissen | Die Ergebnisse müssen nicht synchron aggregiert werden. Jedes Ereignis löst eine isolierte Transaktion aus, wodurch der Durchsatz maximiert wird, jedoch eine nachgelagerte Schlichtung erforderlich ist. Verwenden Sie diesen Mechanismus, wenn die endgültige Konsistenz akzeptabel ist und der Durchsatz wichtiger ist als die Antwortlatenz. |
**Skizze**
_Sequenzdiagramm für parallelen Aktionsaufruf_
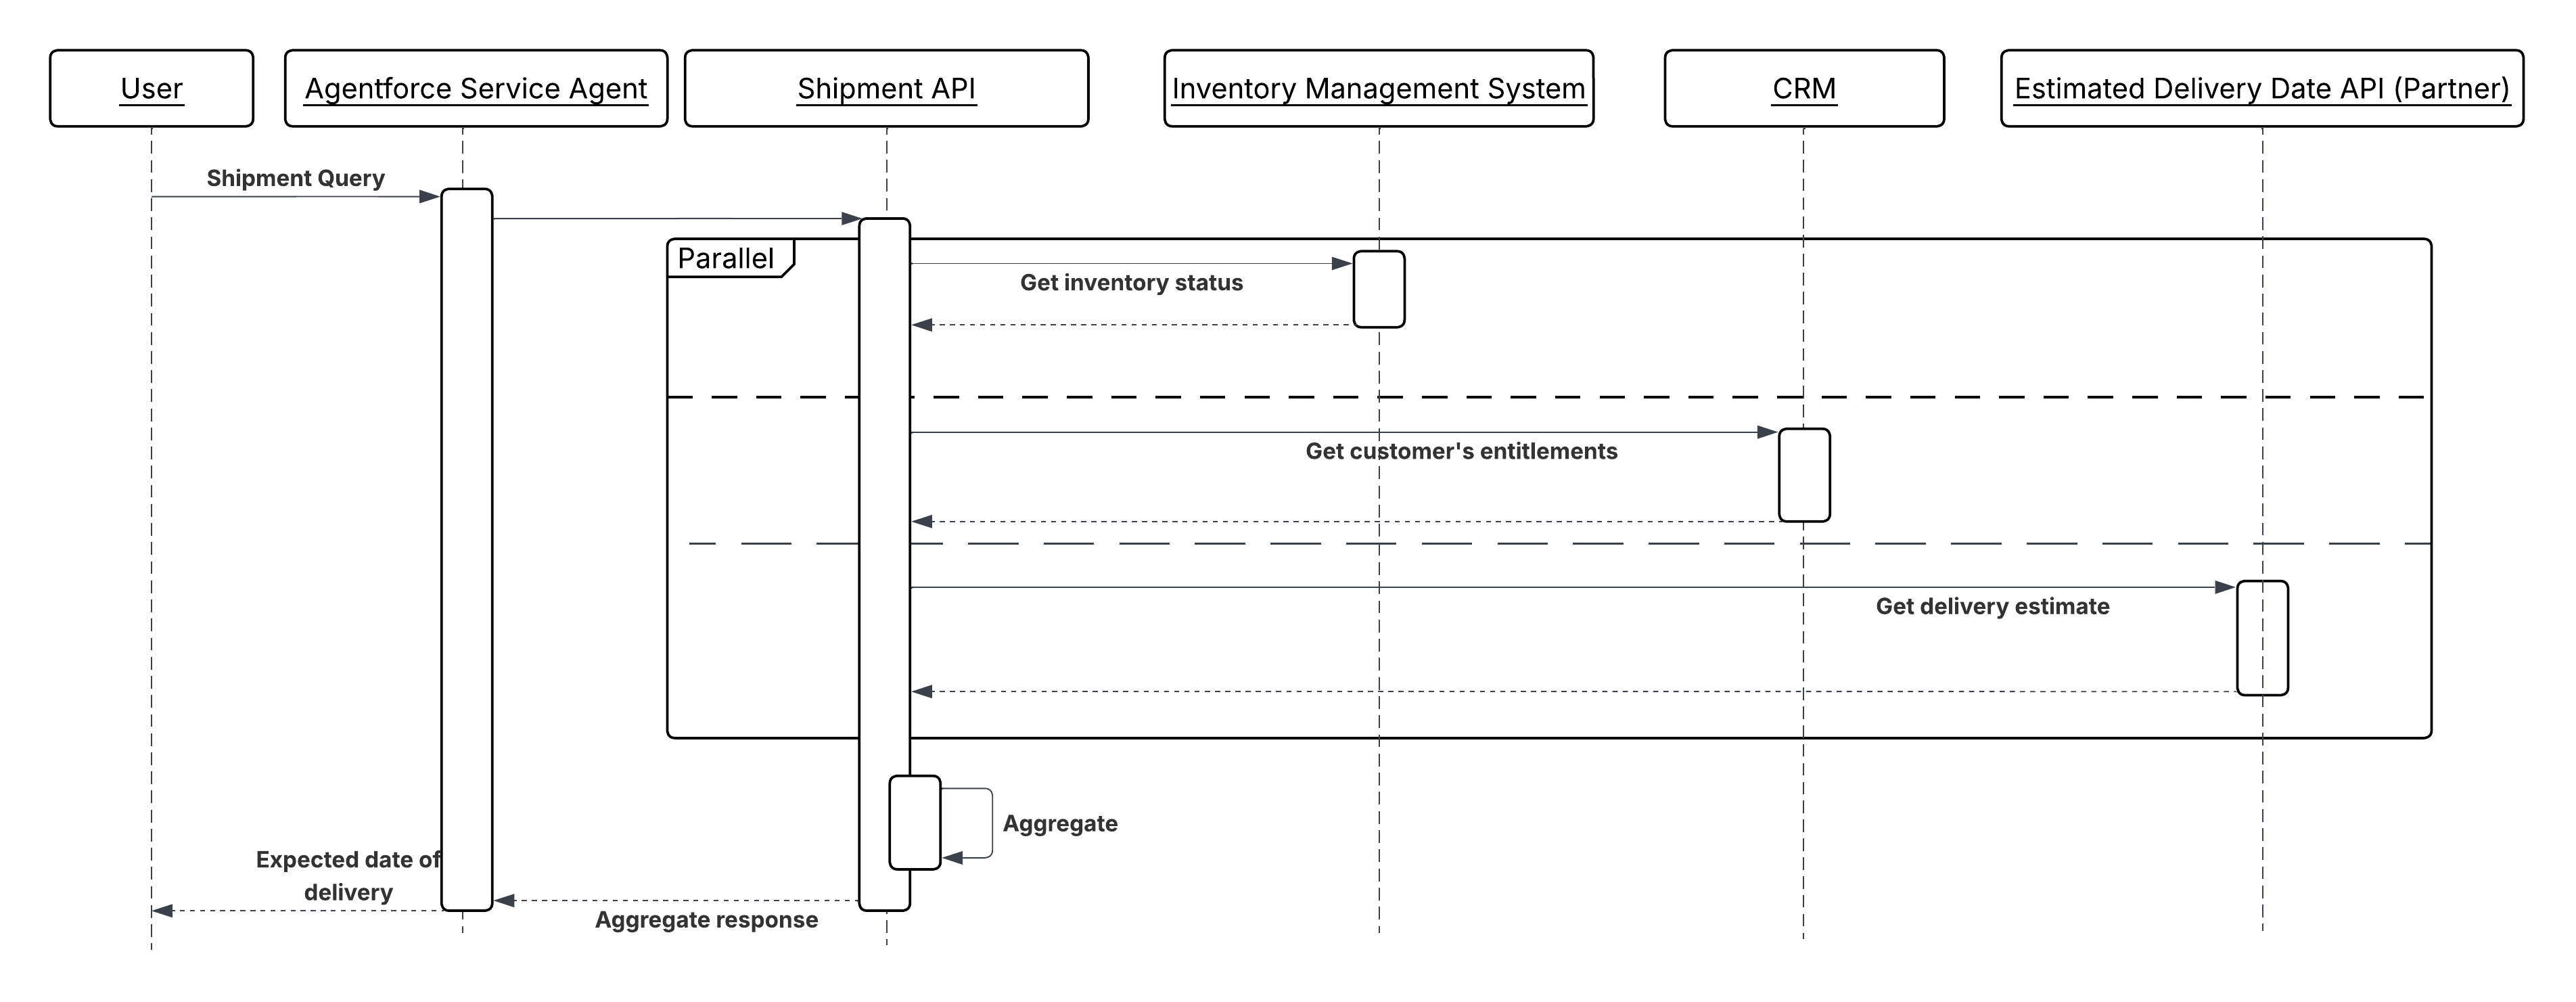 **Ergebnisse**
Wenn unabhängige Aktionen parallel ausgeführt werden, ist die durchgängige Workflow-Zeit an die langsamste Einzelaktion und nicht an die Summe aller Aktionen gebunden. Bei einem Workflow mit drei unabhängigen Callouts mit einer durchschnittlichen Dauer von je 300 ms wird die parallele Ausführung in etwa 300 ms abgeschlossen. Die sequenzielle Ausführung dauert etwa 900 ms. Im richtigen Maßstab wird dieser Unterschied für jede gleichzeitig ausgeführte Agentensitzung addiert.
**Überlegungen zum Design**
Plattformunabhängige Anleitung
- Bestätigen Sie die Unabhängigkeit vor dem Parallelisieren. Aktionen können nur dann sicher parallel ausgeführt werden, wenn keine der Aktionen den von der anderen Aktion geschriebenen Status liest und keiner der beiden Fehler die andere Aktion abbrechen sollte. Wenn eine Abhängigkeit vorhanden ist, auch eine weiche, verwenden Sie stattdessen die sequenzielle Verkettung.
- Entwerfen Sie den Aggregationsschritt explizit. Definieren Sie im Voraus, wie eine vollständige Ergebnismenge aussieht, was eine Teilergebnismenge für die nachgelagerte Argumentation bedeutet und ob der Agent auf alle Ergebnisse warten oder fortfahren soll, sobald ein Schwellenwert (beispielsweise fünf von sieben Gesamtaufrufen) zurückgegeben wurde.
- Alle parallelen Schreibvorgänge müssen idempotent sein. Jeder Vorgang wird isoliert ohne gemeinsame Transaktionsgrenze ausgeführt, sodass beim erneuten Versuch einer einzelnen Verzweigung keine doppelten Nebenwirkungen auftreten können.
Salesforce-Implementierungshinweise
- **Für warteschlangenfähigen Apex:** Senden Sie alle Aufträge innerhalb einer einzelnen Transaktion, um die Wahrscheinlichkeit einer gleichzeitigen Ausführung zu maximieren. Beachten Sie, dass verfügbare Gleichzeitigkeitszeitfenster in der gesamten Organisation freigegeben sind. Entwerfen Sie Zeitfenster mit der Annahme, dass sie möglicherweise nicht immer verfügbar sind, und erstellen Sie einen Rückfall in die sequenzielle Ausführung, wenn dies nicht der Fall ist.
- **Für Plattformereignisse:** Schreiben Sie das Ergebnis jedes Vorgangs in einen dedizierten Staging-Datensatz (verschlüsselt durch eine freigegebene Korrelations-ID), statt den Zieldatensatz direkt zu aktualisieren. Ein endgültiger Aggregations-Flow oder Apex-Auslöser liest alle Staging-Datensätze, sobald die erwartete Anzahl erreicht ist, und wendet dann die konsolidierte Aktualisierung atomar an.
- **Für Middleware-Fanout:** Legen Sie eine explizite Zeitüberschreitung für den einzelnen Callout fest, die länger ist als die erwartete Worst-Case-Antwortzeit des langsamsten Backends, sich jedoch noch innerhalb der Salesforce-Callout-Zeitüberschreitungsobergrenze befindet. Die Middleware gibt Teilergebnisse mit einer eindeutigen Angabe der fehlgeschlagenen Backends zurück, statt die gesamte Antwort zeitlich zu verzögern.
**Fehlerbehandlung und -behebung**
- Behandeln Sie Teilerfolg als erstklassiges Ergebnis. Wenn drei oder vier parallele Vorgänge erfolgreich sind, verwendet der Agent die drei erfolgreichen Ergebnisse und verarbeitet den Fehler explizit, indem er ihn dem Benutzer anzeigt, ihn für den erneuten Versuch protokolliert oder eine Ausgleichsaktion aufruft, statt alle Ergebnisse zu verwerfen oder so vorzugehen, als wäre der Fehler nicht aufgetreten.
- Verwenden Sie für Muster vom Typ "Warteschlangenfähig" und "Plattformereignis" eine Korrelations-ID (wird zum Zeitpunkt der Fan-Out-Erfassung generiert), um alle parallelen Verzweigungen wieder mit der ursprünglichen Agentensitzung zu verknüpfen. Diese ID ist erforderlich, um Ergebnisse erneut zusammenzustellen und Fehler in Protokollen bis zur Quelle zurückzuverfolgen.
- Wenn eine parallele Verzweigung fehlschlägt und der Vorgang sicher wiederholt werden kann, stellen Sie nur die fehlgeschlagene Verzweigung erneut in die Warteschlange, indem Sie die ursprüngliche Korrelations-ID und den Identitätsschlüssel verwenden. Rufen Sie nicht alle Zweige erneut auf.
- Definieren Sie einen Zeitüberschreitungsschwellenwert für den Aggregationsschritt. Wenn nicht alle Ergebnisse innerhalb des Schwellenwerts eintreffen, fahren Sie mit den verfügbaren Ergebnissen fort und kennzeichnen Sie den unvollständigen Satz, statt unbegrenzt zu warten.
**Sicherheitsüberlegungen**
- Jeder Kontext der parallelen Ausführung, unabhängig davon, ob es sich um einen warteschlangenfähigen Auftrag, einen Plattformereignisauslöser oder einen Middleware-Callout handelt, muss dieselben Zugriffssteuerungen anwenden wie ein sequenzieller Callout. Parallelität lockert die Datenzugriffsregeln nicht. Jede Verzweigung muss dieselben Anmeldeinformationen mit den geringsten Berechtigungen aufweisen, die sie bei einem Aufruf allein hätte.
- Bei Middleware-Fanouts speichert oder protokolliert die Middleware-Ebene keine Antwortnutzlasten aus einzelnen Backends über das Aggregationsfenster hinaus. Die Antwort jedes Backends kann sensible Daten enthalten, die nicht außerhalb des Umfangs des sofortigen Vorgangs verbleiben sollten.
- Stellen Sie sicher, dass die für die Plattformereignisaggregation verwendeten Staging-Datensätze für den Endbenutzer des Agenten nicht lesbar sind. Diese Datensätze können Zwischendaten enthalten, die teilweise noch nicht verwendet werden können.
**Beispiel**
Ein Serviceagent beantwortet eine komplexe Abwicklungsfrage: "Können Sie mir diese Bestellung bis Freitag senden?" Für die Antwort sind Daten aus allen unabhängigen Systemen gleichzeitig erforderlich, wie im Folgenden erläutert:
1. Der Agent identifiziert drei unabhängige Datenanforderungen: die aktuelle Inventarstufe, die aktiven Ansprüche des Kunden und das geschätzte Zustellungsfenster des Anbieters für den Standort des Kunden.
2. Drei Aktionen werden parallel aufgerufen: `GetInventoryStatus` (aus dem externen Inventarsystem über Middleware), `GetCustomerEntitlements` (aus Salesforce CRM) und `GetDeliveryEstimate` (aus der Carrier-API über Middleware).
3. Jede Aktion wird unabhängig zurückgegeben. Der Agent wartet, bis alle drei Antworten eingegangen sind (oder die Aggregationszeitüberschreitung erreicht ist).
4. Wenn alle drei Ergebnisse verfügbar sind, begründet der Agent die kombinierten Daten und bewertet, ob das Inventar ausreicht, deckt der Anspruch des Kunden den Expressversand ab und der Anbieter bestätigt, dass die Zustellung am Freitag für die Postleitzahl des Kunden möglich ist.
5. Der Agent gibt dem Benutzer eine einzelne fundierte Antwort zurück, die aus drei Systemen stammt, und zwar in der Zeit, in der die Antwort den langsamsten der drei Anrufe erforderte.
## Aufruf asynchroner Aktionen (ausgehend)
**Kontext**
Einige vom Agenten initiierte Vorgänge führen nicht zu einem Ergebnis, das der Agent benötigt, um seinen aktuellen Argumentationszyklus fortzusetzen. Das Senden einer Benachrichtigung, das Auslösen eines nachgelagerten Batch-Prozesses, das Veröffentlichen eines Ereignisses in einer Nachrichtenwarteschlange oder das Senden eines langfristigen Auftrags sind alle Vorgänge, bei denen die Verpflichtung des Agenten beim Versand endet. Das nachgelagerte System übernimmt die Inhaberschaft und führt die Arbeit unabhängig aus.
In der traditionellen Automatisierung werden diese als Callouts mit Feuer und Vergessen oder Plattformereignisveröffentlichungen modelliert. In einem Agentensystem entscheidet der Agent bei der Überlegung, dass der Vorgang nicht blockiert wird, disponiert ihn, zeichnet die Versandbestätigung auf und setzt den Vorgang fort oder schließt ihn ab, ohne auf das nachgelagerte Ergebnis zu warten.
Dieses Muster ist das agentische Gegenstück zu [Remote Process Invocation – Fire and Forget](https://architect.salesforce.com/docs/architect/de-de/fundamentals/guide/integration-patterns#remote-prozessaufruf--fire-and-forget) (Prozessaufruf aus der Ferne – Feuer und Vergessen) im Leitfaden zu Integrationsmustern. Das Agentenmuster erweitert es, indem die Dispositionsentscheidung Teil der Überlegungen des Agenten wird und sichergestellt wird, dass die Disposition auch dann verfolgt werden kann, wenn keine Antwort an den Agenten zurückgegeben wird.
**Probleme**
Wenn ein Agent einen nachgelagerten Vorgang initiieren muss, der über den Sitzungs- oder Argumentationszyklus des Agenten hinausgeht, müssen drei Herausforderungen angegangen werden:
- **Nicht blockierender Aufruf:** Der Agent muss den Vorgang starten und die Zustellung bestätigen, ohne den Überlegungenzyklus geöffnet zu lassen und auf ein Ergebnis zu warten.
- **Zustellungsbestätigung:** Der Agent muss zwischen einer erfolgreichen Disposition (die Nachricht wurde akzeptiert) und einem erfolgreichen Ergebnis (der nachgelagerte Prozess wurde abgeschlossen) unterscheiden. Sie kann nur Ersteres behaupten.
- **Verfolgbarkeit:** Da der Agent kein Ergebnis erhält, muss der Vorgang über Protokolle, Ereignisdatensätze oder die Plattformüberwachung unabhängig von der Agentensitzung beobachtet werden können.
**Kräfte**
Beantworten Sie beim Anwenden dieses Musters die folgenden Fragen:
- Benötigt der Agent das Ergebnis dieses Vorgangs, um seinen aktuellen Zug abzuschließen?
Falls ja, ist dies nicht das richtige Muster. Verwenden Sie stattdessen Aufruf der sequenziellen Aktion.
- Ist das nachgelagerte System in der Lage, die disponierte Nachricht oder das disponierte Ereignis ohne synchrone Bestätigung zu empfangen und zuverlässig zu verarbeiten?
Das Zielsystem muss langlebig sein. Die Nachricht darf nicht verloren gehen, wenn sie vorübergehend nicht verfügbar ist.
- Ist der Vorgang idempotent oder muss der doppelte Versand bewacht werden?
Wiederholungen auf Netzwerkebene und Wiederholungen von Agentenüberlegungen können dazu führen, dass dieselbe Disposition mehrmals versucht wird. Wenn der nachgelagerte Vorgang nicht idempotent ist, muss die Aktion einen Deduplizierungsschlüssel enthalten.
- Muss der Benutzer oder ein nachgelagerter Prozess wissen, wann der Vorgang abgeschlossen ist?
Der Agent kann nur den Versand bestätigen. Wenn der Abschlussstatus erforderlich ist, entwerfen Sie einen separaten Benachrichtigungs- oder Folgemechanismus. Ein Plattformereignis, eine Kundenvorgangsaktualisierung oder eine Rückmeldung, die sich außerhalb dieses Überlegungszyklus befindet.
**Anwendung für Salesforce-Muster**
| Lösung | Passend | Kommentare |
| ------------------------------------ | ---------------------------------------------------- | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Pub/Sub-API | Bestens geeignet für Streaming bei hohem Durchsatz oder externen Ereignissen | Der Agent ruft eine Apex-Aktion auf, die ein Ereignis über gRPC in der Salesforce Pub/Sub-API veröffentlicht. Die Aktion gibt dem Agenten eine `PublishResult` replayId als Versandbestätigung zurück. Wird verwendet, wenn es sich bei den nachgelagerten Verbrauchern um externe Systeme handelt, die über die Pub/Sub-API und nicht über Salesforce-native Flow- oder Apex-Auslöser abonnieren, oder wenn das Streaming von Ereignissen mit hohem Durchsatz erforderlich ist. |
| Plattformereignisse (Apex-Aktion) | Optimal für die asynchrone Disposition innerhalb Salesforce | Der Agent ruft eine Apex-Aktion auf, die ein Plattformereignis veröffentlicht. Das Ereignis wird allen Abonnenten asynchron zugestellt. Die Aktion gibt eine Veröffentlichungsbestätigung an den Agenten zurück. Sie gibt kein Verarbeitungsergebnis zurück. Wird verwendet, wenn sich der nachgelagerte Verbraucher innerhalb der Salesforce Platform befindet. Der Agent ruft eine Apex Aktion auf, die `EventBus.publish()` aufruft. Die Aktion gibt eine `SaveResult` zurück, die die Annahme bestätigt. |
| Apex Queueable / Batch (Apex-Aktion) | Optimal für die langfristige Hintergrundverarbeitung | Der Agent ruft eine Apex-Aktion auf, die einen Queueable- oder Batchauftrag in die Warteschlange stellt. Der Auftrag wird außerhalb der Transaktion des Agenten ausgeführt. Die Aktion gibt eine Auftrags-ID zurück, die der Agent dem Benutzer als Referenz anzeigen kann. Wird verwendet, wenn es sich bei der nachgelagerten Arbeit um eine langfristige Salesforce-Vorgangsdatenverarbeitung, Aktualisierungen von mehreren Objekten oder externe Callouts handelt, die synchrone Obergrenzen überschreiten. `System.enqueueJob()` gibt eine Auftrags-ID der Agentendatensätze als Referenz zurück. |
| Asynchroner MuleSoft-Flow | Bestens geeignet für den Versand von Warteschlangen für externe Nachrichten | Der Agent ruft eine MuleSoft-exponierte Aktion auf, die eine Nachricht in eine externe Warteschlange (Kafka, JMS, SQS) stellt. MuleSoft übernimmt die Protokollübersetzung und die Zustellungsbestätigung. Der Agent erhält die Bestätigung, dass die Nachricht von MuleSoft akzeptiert wurde, nicht, dass sie nachgelagert verarbeitet wurde. |
| Externer REST-Endpunkt (Apex-Aktion) | Am besten für die Einreichung von Ereignissen externer Systeme | Das Zielsystem stellt einen Endpunkt bereit, der eine Einreichung akzeptiert, und gibt sofort eine Bestätigungs-ID zurück, wodurch die Verarbeitung asynchron abgeschlossen wird. Der Agent erhält die Bestätigungs-ID und zeichnet sie auf. |
**Skizze**
_Sequenzdiagramm für Aufruf asynchroner Aktionen_
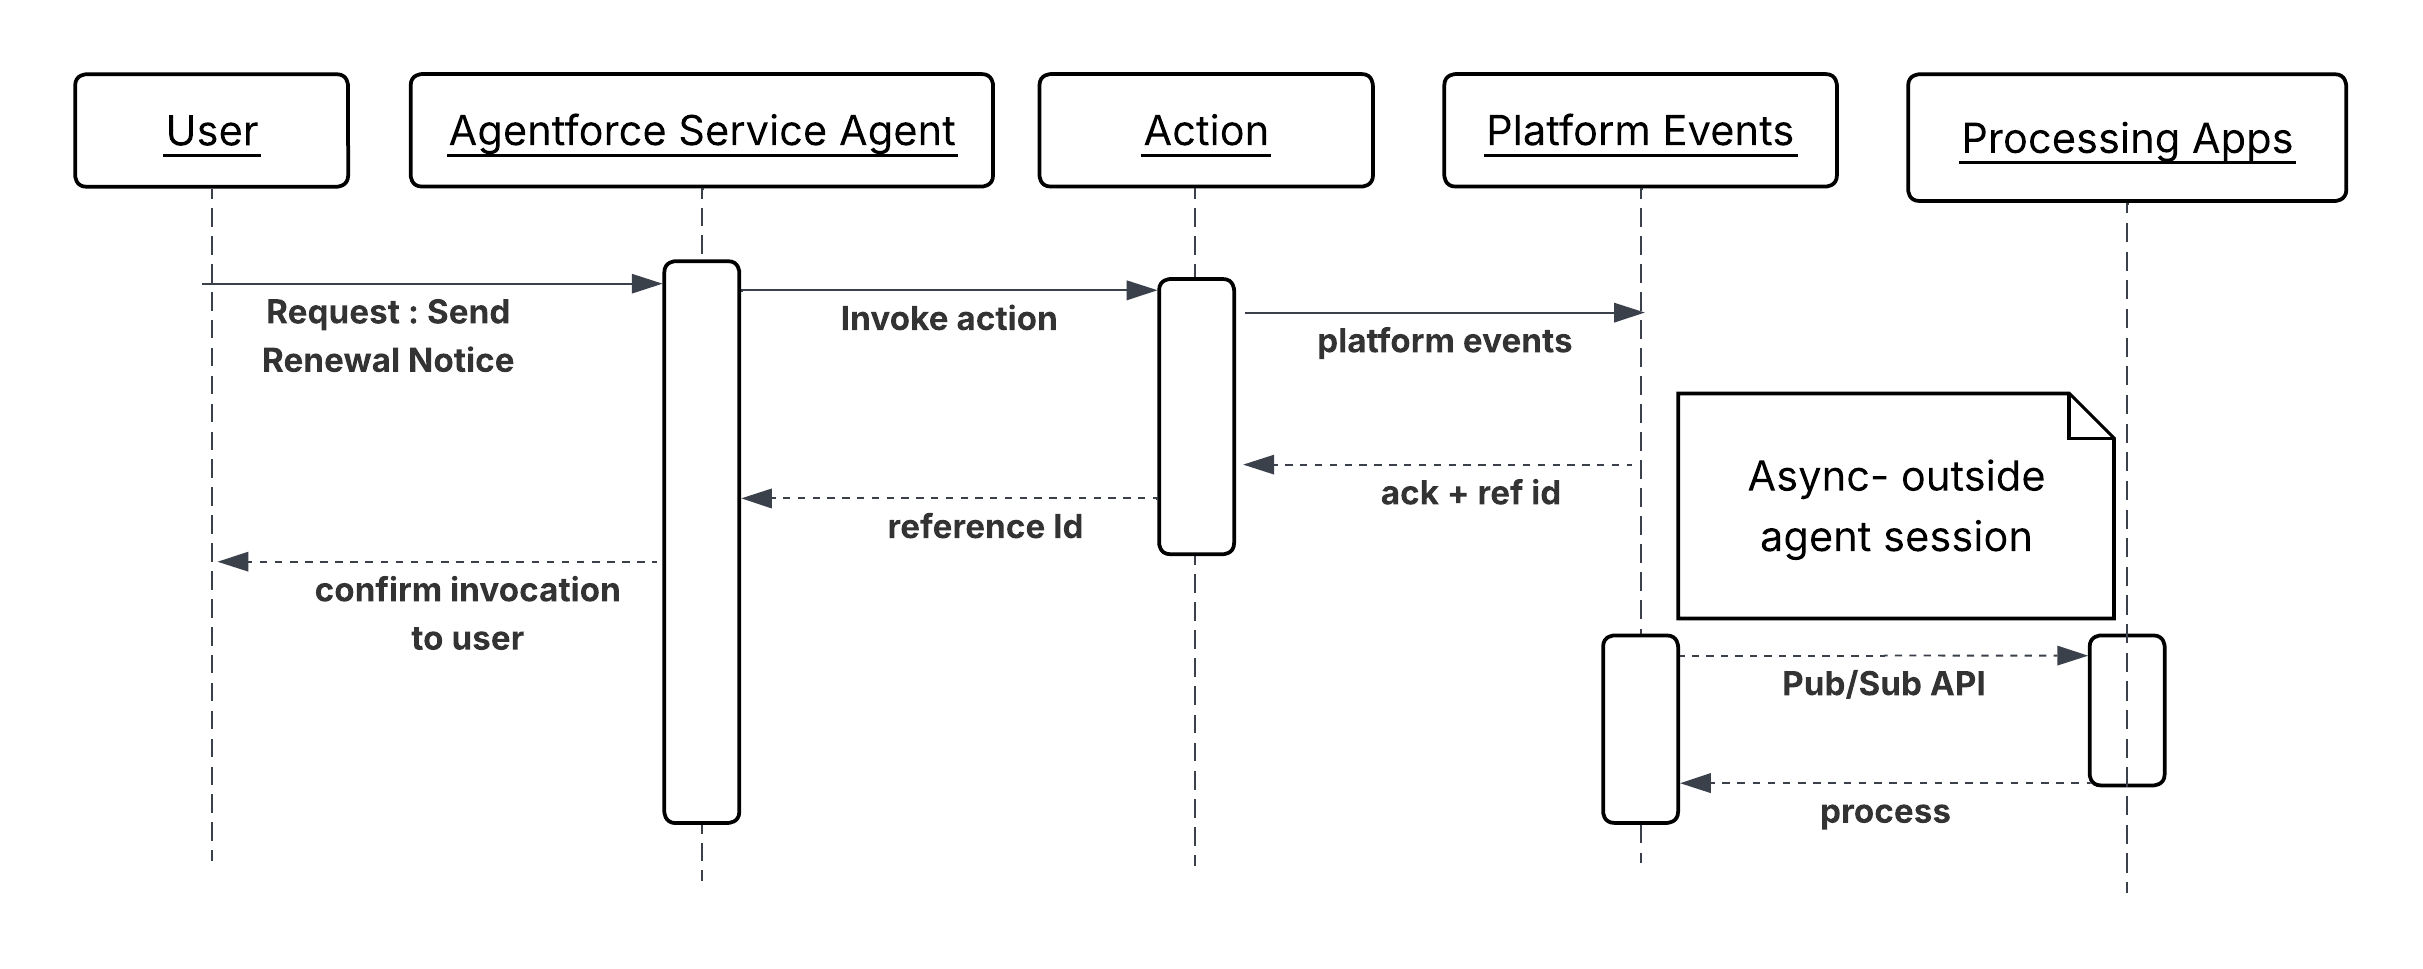 **Ergebnisse**
Der Agent ruft einen nachgelagerten Vorgang auf, ohne seinen Argumentationszyklus für das Ergebnis zu blockieren. Der Vorgang wird mit der Bestätigung abgeschlossen, dass der Vorgang akzeptiert wurde, nicht dass er abgeschlossen wurde. Das nachgelagerte System übernimmt die vollständige Inhaberschaft der Ausführung. Der disponierte Vorgang kann über Plattformereignisabonnenten, Auftrags-IDs oder externe Warteschlangenbestätigungs-IDs verfolgt werden, die zum Dispositionszeitpunkt im CRM aufgezeichnet werden. Wenn der nachgelagerte Vorgang fehlschlägt, wird dieser Fehler durch die eigene Überwachung des nachgelagerten Systems und nicht durch die Agentensitzung, die ihn initiiert hat, festgestellt.
**Überlegungen zum Design**
Plattformunabhängige Anleitung
- Schreiben Sie Aktionsbeschreibungen in Intent-basierter Sprache. Beispielsweise ist "Sendet eine Verlängerungsbenachrichtigung an die Messaging-Warteschlange und gibt eine Disponentenverweis-ID zurück" für den Agenten nützlicher als "ruft den Benachrichtigungsendpunkt auf".
- Beschreiben Sie eine Dispositionsaktion niemals als "sendet und bestätigt die Zustellung von". Der Agent kann nur die Annahme bestätigen. Die nachgelagerte Zustellung und Verarbeitung liegt außerhalb der Beobachtbarkeit des Agenten.
Salesforce-Implementierungshinweise
- Geben Sie eine Referenz-ID aus jeder Aufrufaktion zurück, beispielsweise eine Plattformereignis-`ReplayId`, eine warteschlangenfähige Auftrags-ID, eine Pub/Sub-API-`PublishResult` replayId oder ein externes Bestätigungstoken. Zeichnen Sie sie zum Zeitpunkt des Aufrufs in einem CRM-Datensatz auf. Dies ist der einzige Audit-Trail, den die Agentensitzung erstellt.
- Bei der Pub/Sub-API ruft der Agent eine Apex-Aktion auf, die einen gRPC-Callout an den Pub/Sub-API-Endpunkt "/Publish" sendet. Die Aktion muss den Schemaregistrierungsschritt verarbeiten. Ereignisse müssen im Avro-Format mit dem registrierten Schema serialisiert werden. Geben Sie die `PublishResult ‘replayId’` als Disponentenreferenz an den Agenten zurück.
- Rufen Sie für Plattformereignisse `EventBus.publish()` innerhalb der Apex Aktion auf und überprüfen Sie das SaveResult auf Fehler, bevor Sie dem Agenten eine Erfolgsanzeige zurückgeben. Gehen Sie nicht von einem Veröffentlichungserfolg aus, sondern validieren Sie ihn.
- Implementieren Sie für warteschlangenfähige Aufträge die Schnittstelle "Warteschlange" und rufen Sie System.enqueueJob() innerhalb der Aktion auf. Geben Sie die resultierende AsyncApexJob-ID an den Agenten zurück.
- Bei externen asynchronen Endpunkten muss der Zielendpunkt sofort eine Bestätigung (HTTP 202 Accepted) mit einer Referenz-ID zurückgeben. Wenn der Endpunkt blockiert wird, bis die Verarbeitung abgeschlossen ist, ist er synchron und dieses Muster trifft nicht zu.
**Fehlerbehandlung und -behebung**
- Bei einer Aufrufaktion muss zwischen einem Dispositionsfehler (die Nachricht wurde nicht akzeptiert) und einem Verarbeitungsfehler (die Nachricht wurde akzeptiert, der nachgelagerte Vorgang ist später fehlgeschlagen) unterschieden werden. Der Agent kann nur Ersteres verarbeiten.
- Wenn der Aufruf fehlschlägt, muss die Aktion einen strukturierten Fehler mit einem eindeutigen Grund zurückgeben. Der Agent kann die Disposition wiederholen, zu einer Person eskalieren oder einen fehlgeschlagenen Disponentendatensatz protokollieren, einen nachgelagerten Verarbeitungsfehler jedoch nicht innerhalb derselben Sitzung beheben.
- Entwerfen Sie für Vorgänge, bei denen ein nachgelagerter Fehler schließlich festgestellt werden muss, eine separate Feedbackschleife, beispielsweise ein vom nachgelagerten Prozess veröffentlichtes Plattformereignis, einen geplanten Flow, der den Auftragsstatus überprüft, oder einen Folgevorgang, der sich außerhalb der Agentensitzung befindet.
**Sicherheitsüberlegungen**
- Wickeln Sie alle externen asynchronen Callouts in Anmeldeinformationen mit Namen ein. Die Aufrufaktion bettet keine Endpunkt-URLs oder Anmeldeinformationen in Code ein.
- Validieren und bereinigen Sie alle an die Aufrufaktion übergebenen Parameter, bevor sie in die Ereignisnutzlast oder den Nachrichtentext eingebettet werden. Der vom Benutzer bereitgestellte Text, der in eine asynchrone Nachricht übergeben wird, ist ein potenzieller Injektionsvektor im nachgelagerten Verbraucher.
- Protokollieren Sie jede Disposition mit Sitzungs-ID, Referenz-ID und bereinigter Nutzlast zum Zeitpunkt der Disposition. Da dem Agenten keine Antwort zurückgegeben wird, ist dieses Protokoll der primäre Mechanismus zum Rekonstruieren dessen, was der Agent initiiert hat.
- Wenden Sie die geringsten Berechtigungen auf den Integrationsbenutzer oder die verbundene Anwendung an. Eine Disponentenaktion, die in einer Benachrichtigungswarteschlange veröffentlicht wird, sollte keine Anmeldeinformationen enthalten, die Lese- oder Schreibzugriff auf nicht verwandten Systemen zulassen.
**Beispiel**
Ein Verlängerungsverwaltungsagent, der einen Vertrag bearbeitet, der kurz vor dem Ablauf steht, bestimmt, dass der Kunde für eine Benachrichtigung über die automatische Verlängerung qualifiziert ist. Der Agent benötigt vor Abschluss des Vorgangs keine Bestätigung, dass die E-Mail zugestellt wurde.
1. `CheckRenewalEligibility` (Automatisch gestarteter Flow) wertet Vertragsbedingungen, Kundenstufe und Abmeldestatus aus. Gibt einen "geeigneten" booleschen Wert und den bevorzugten Benachrichtigungskanal zurück.
2. `DispatchRenewalNotification` (Apex Action) veröffentlicht ein `RenewalNotification\_\_e`-Plattformereignis, das die Vertrags-ID, die Kunden-ID, den Benachrichtigungskanal und einen generierten Identitätsschlüssel enthält. Gibt eine ReplayId zurück, die bestätigt, dass das Ereignis von der Plattform akzeptiert wurde.
3. `UpdateContractRecord` (Automatisch gestarteter Flow) schreibt den `ReplayId`\- und Dispositionszeitstempel in den Vertragsdatensatz und legt die Statuskennzeichnung "Benachrichtigung versendet" fest.
## On-Demand Agent Invocation (Inbound) (Aufruf von Agenten nach Bedarf (eingehend))
**Kontext**
Externe Anwendungen wie Kundenportale, mobile Anwendungen, SaaS-Drittanbieterplattformen und Partnersysteme müssen Agenten programmgesteuert aufrufen, um Serviceanforderungen zu bearbeiten, Workflows zu initiieren oder AI-gestützte Antworten auf ihren eigenen Oberflächen anzuzeigen. Der Agent fungiert als intelligenter Backend-Service. Das externe System stellt Kontext bereit, der Agent gründet und handelt und der Anrufer verwendet die Antwort.
Zunehmend ist der Anrufer selbst ein AI-Agent oder -Orchestrator und keine Anwendung mit menschlichem Gesicht. In diesen AI-zu-AI-Mustern delegiert ein Orchestrierungsagent einen Argumentationsschritt, einen CRM-Nachschlagevorgang oder eine Aktion als separaten Tool-Aufruf an Agentforce. Zur Unterstützung dieses Musters muss ein MCP-Server (Model Context Protocol) bereitgestellt werden.
**Probleme**
Wenn ein externes System oder AI-Agent die Funktionen eines Agentforce-Agenten bei Bedarf nutzen muss, wie authentifiziert er sich, erstellt eine Agentensitzung, übergibt die erforderlichen Unterhaltungs- und Kontextdaten und erhält zuverlässig die strukturierte Antwort des Agenten, um seine eigene nachgelagerte Logik zu steuern?
**Kräfte**
Beantworten Sie beim Anwenden dieses Musters die folgenden Fragen:
- Erwartet der externe Anrufer eine synchrone Antwort mit geringer Latenz oder ist eine asynchrone Rückmeldung akzeptabel?
- Wie wird die Identität des Anrufers hergestellt und in den Ausführungskontext des Agenten für den Datenzugriff und die Personalisierung übernommen?
- Wie hoch ist das erwartete Volumen gleichzeitiger durch die API ausgelöster Sitzungen und wie interagiert dies mit den Salesforce-API-Raten- und -Gleichzeitigkeitsobergrenzen?
- Muss das externe System die Sitzungskontinuität über mehrere Runden hinweg aufrechterhalten (Multiturn-Unterhaltung) oder ist jede Anforderung statuslos?
- Wie sollte die Antwort des Agenten strukturiert sein, damit das aufrufende System sie analysieren und programmgesteuert darauf reagieren kann?
- Handelt es sich bei dem Aufrufer um eine Anwendung, die direkt in den REST integriert werden muss, oder um einen AI-Agenten oder -Orchestrierer, der Agentforce über ein Standardprotokoll wie MCP als Tool aufrufen kann?
**Anwendung für Salesforce-Muster**
| Lösung | Passend | Kommentare |
| ------------------------------------------------------- | ------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Agentforce Agent API – Single Turn (Synchron) (Einzel-Turn (synchron)) | Bestens geeignet für Integrationen ohne Status in Anforderungen und Antworten | Das Anrufsystem erfordert eine sofortige strukturierte Antwort und es wird erwartet, dass die Argumentation des Agenten innerhalb der Zeitüberschreitungstoleranz des Anrufers abgeschlossen ist. Das aufrufende System verwaltet die vollständigen Phasen des Sitzungslebenszyklus – Erstellung, Wendungen und Beendigung. Das externe System authentifiziert sich, erstellt eine Sitzung mit Kontextvariablen, sendet eine einzelne Nachricht, empfängt die Antwort des Agenten und schließt die Sitzung. Diese Agentforce API ist die primäre REST-Schnittstelle, über die externe Systeme Sitzungen erstellen, Nachrichten austauschen und Sitzungen programmgesteuert schließen können. Der gesamte Austausch wird innerhalb eines HTTP-Anforderungs-Antwort-Zyklus abgeschlossen. Antworten umfassen die Ausgabe in natürlicher Sprache des Agenten und alle strukturierten Ausgabevariablen, die durch Aktionen generiert werden, die der Agent während der Überlegungen aufgerufen hat. |
| Agentforce Agent API – Multi-Turn (Sitzungskontinuität) | Bestens geeignet für Unterhaltungsintegrationen, bei denen ein Zustand über mehrere Runden hinweg erforderlich ist | Die externe Oberfläche ist konversativ (z. B. ein Chat-Widget oder eine Sprachschnittstelle) und die Interaktion erfordert mehrere Austausche, um eine Lösung zu erreichen. Das externe System erstellt einmal eine Sitzung und verwendet die Sitzungs-ID über mehrere Nachrichtenaustausche hinweg wieder. Der Agent behält den Unterhaltungskontext zwischen Runden bei, beispielsweise vorherige Fragen, abgerufene Daten oder Entscheidungen, die getroffen wurden, ohne dass der Anrufer sie erneut angibt. |
| Asynchron mit Abstimmung oder Webhook-Rückmeldung | Bestens geeignet für Workflows für Argumentation mit hoher Latenz oder zeitkritische Benutzeroberflächen | Die Verarbeitungszeit des Agenten ist nicht trivial und das Halten einer offenen HTTP-Verbindung würde die Benutzererfahrung des Anrufers beeinträchtigen oder vorgelagerte Zeitüberschreitungen auslösen. Das externe System sendet die Anforderung und erhält sofort eine Bestätigung mit einer Auftrags- oder Sitzungs-ID. Anschließend fragt es einen Statusendpunkt ab oder registriert einen Webhook, um die Antwort des Agenten nach Abschluss der Überlegungen zu erhalten. Derzeit kann dieses Muster mit einer Wrapper-API implementiert werden, die auf einer Middleware wie MuleSoft gehostet wird. Externer Verbraucher ruft diese Wrapper-API auf und registriert den Webhook-Endpunkt. Nach dem Aufruf von Agentforce Agent sendet die Wrapper-API die Bestätigung zurück an das externe System. Diese Wrapper-API behält auch die Agentforce Agentensitzung bei und gibt die Antwort mithilfe des registrierten Webhook-Endpunkts an das externe System zurück, sobald der Agent antwortet. |
| Agentforce über MCP (Salesforce Headless 360) | Bestens geeignet für AI-zu-AI-Aufrufe, bei denen der Anrufer ein MCP-kompatibler Client ist | Der aufrufende MCP-Client ruft Agentforce über den vorkonfigurierten MCP-Server von Salesforce Headless 360 als Tool auf. Der Sitzungslebenszyklus wird transparent vom MCP-Server verwaltet und der aufrufende Agent interagiert über standardmäßigen Tool-Aufruf, ohne eine benutzerdefinierte REST-Integration zu erstellen. Verwenden Sie diese Lösung, wenn es sich bei dem Anrufer um einen MCP-Client handelt, der Argumentation, CRM-Kontextabruf oder Aktionsausführung als separaten Schritt in einem umfassenderen Agenten-Workflow an Agentforce delegieren muss. |
**Skizze**
_Sequenzdiagramm für den Agentenaufruf bei Bedarf_
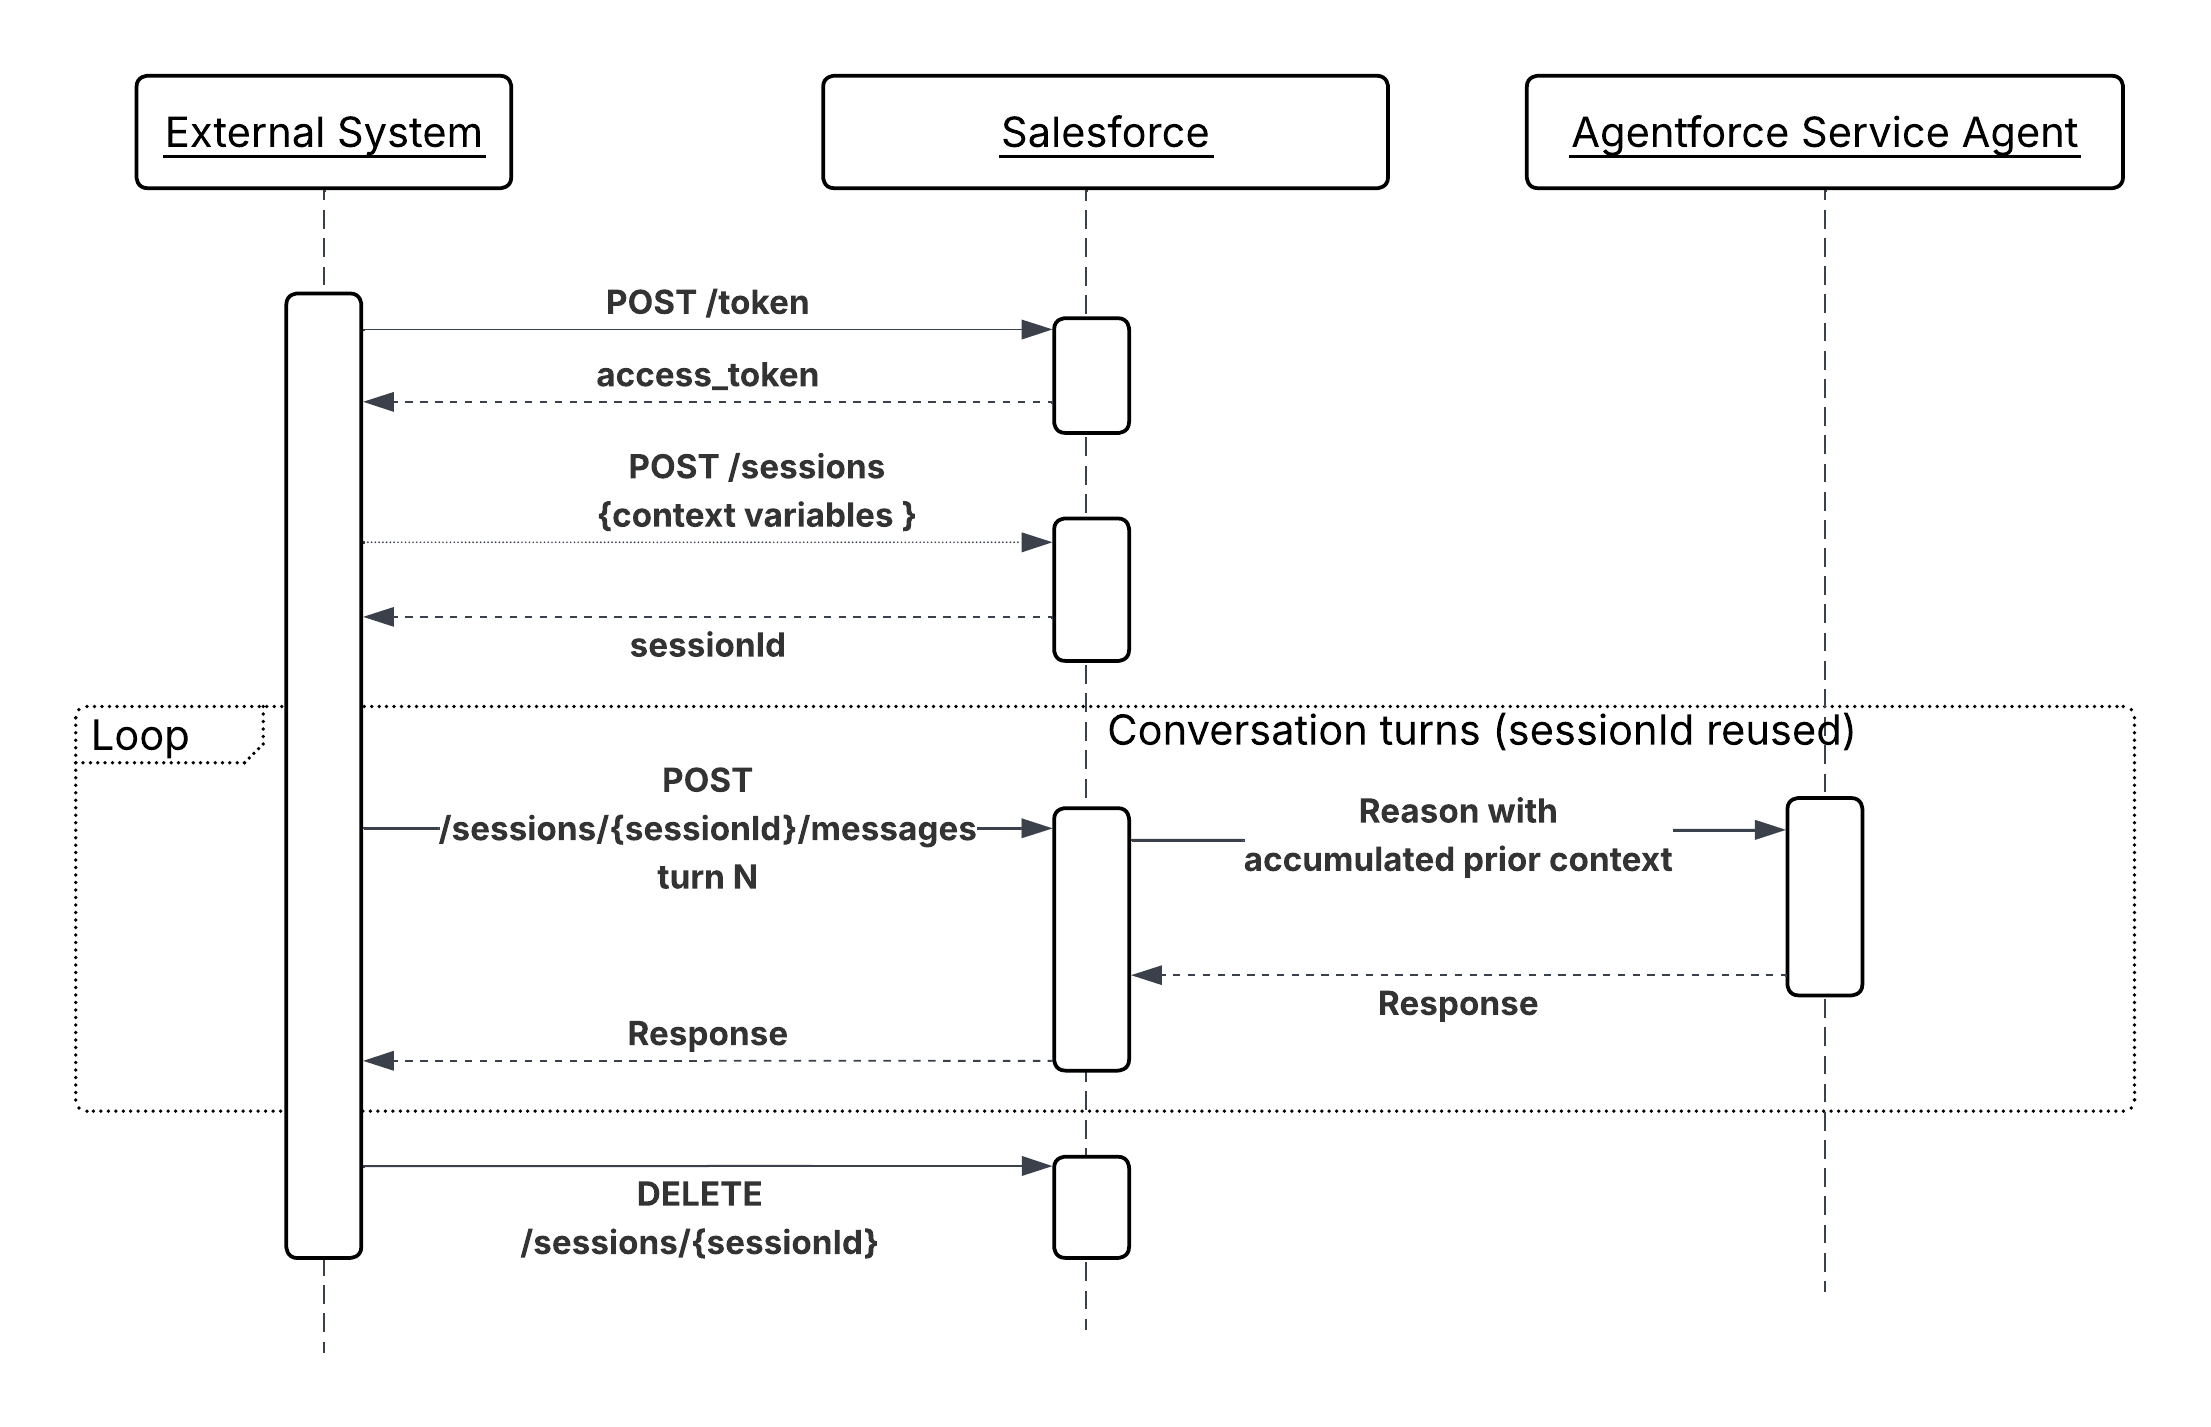 **Ergebnisse**
Durch dieses Muster wird Agentforce als aufrufbarer AI-Service dargestellt. Externe Systeme erhalten Zugriff auf die Argumentation, die Tools und den CRM-Kontext des Agenten, ohne diese Logik zu reproduzieren. Der Anrufer bleibt für die Sitzungslebenszyklus-Verwaltung und das Rendern der Antwort verantwortlich. Der Agent bleibt für alle Argumente, die Toolauswahl und die Antwortsynthese verantwortlich.
Wenn es sich bei dem Anrufer um einen AI-Agenten oder -Orchestrierer handelt, ist durch den MCP-Mechanismus von Agentforce (vorkonfiguriert über Salesforce Headless 360 verfügbar) keine benutzerdefinierte REST-Integration mehr erforderlich. Der MCP-Server verarbeitet den Sitzungslebenszyklus im Namen des aufrufenden Agenten, wodurch Agentforce ohne zusätzliche Installation als erstklassiges Tool an Workflows mit mehreren Agenten teilnehmen kann.
**Überlegungen zum Design**
Plattformunabhängige Anleitung
- Vermeiden Sie es, den externen API-Aufruf synchron zu gestalten und in zeitkritischen Benutzeroberflächen-Flows zu blockieren. Verwenden Sie ein Abfrage- oder Webhook-Rückmeldungsmuster, bei dem die Antwortzeiten des Agenten nicht trivial sind, um die Benutzererfahrung von der Verarbeitungszeit des Agenten zu entkoppeln.
- Wählen Sie den Anrufmechanismus anhand der Art des Anrufers und nicht anhand der Verfügbarkeit aus. Für menschenorientierte Anwendungen und Systemintegrationen sollte die Agenten-API direkt verwendet werden. Tools, die MCPs unterstützen, sollten den Agentforce MCP-Server verwenden. Die Kombination von Mechanismen für denselben Anrufertyp erhöht unnötige Komplexität ohne architektonischen Nutzen.
Salesforce-Implementierungshinweise
- Fügen Sie Sitzungskontext in die POST-Anforderung für die Sitzungserstellung ein, nicht in die erste Benutzernachricht. Wenn das externe System die Sitzung erstellt, hat es die Möglichkeit, strukturierte Kontextvariablen (Account-ID, Anspruchsdaten, vorherige Interaktionszusammenfassung) direkt als Sitzungsparameter mit Namen weiterzugeben. Diese Variablen stehen dem Agenten zur Verfügung, bevor er einen einzelnen Zug verarbeitet. Daher beginnt er mit der Argumentation, ohne Nachschlageaufrufe zu senden, um festzustellen, wer der Kunde ist oder worauf er Anspruch hat. Wenn der Agent stattdessen dieselben Daten innerhalb des Nachrichtentexts weitergibt, muss er unstrukturierten Text analysieren, um Fakten zu extrahieren, die er als eingegebene Variablen erhalten haben könnte. Dies erhöht die Latenz, führt zu Extraktionsfehlern und verbraucht Argumentationsschritte, die keinen geschäftlichen Mehrwert bieten.
- Gestalten Sie Agentenantworten so, dass sie strukturiert und maschinenlesbar sind. Verwenden Sie Ausgabevariablenkonventionen und Aufforderungsanweisungen, die den Agenten anleiten, JSON-freundliche oder klar abgegrenzte Antworten zurückzugeben, wenn der Aufrufer ein System und kein Mensch ist.
- Sitzungslebenszyklus explizit verwalten. Beenden Sie Sitzungen sofort nach der Verwendung von `DELETE /einstein/ai-agent/v1/sessions/{sessionId}`, um Gleichzeitigkeitszeitfenster freizugeben und zu vermeiden, dass veralteter Kontext über nicht zugehörige Interaktionen hinweg bestehen bleibt.
- Berücksichtigen Sie die Obergrenzen für gleichzeitige Salesforce-Sitzungen. Implementieren Sie für Szenarien mit hohem Durchsatz einen Sitzungspool oder eine Warteschlangenebene im aufrufenden System, um die Ablehnung von Anforderungen während der Spitzenlast zu verhindern.
- Wenn Sie Agentforce über MCP aufrufen, übergeben Sie Kontext als Eingabeparameter und nicht als Sitzungsvariablen. Der MCP-Server verwaltet den Sitzungslebenszyklus transparent. Daher kann der aufrufende Agent keine Sitzungsparameter mit Namen direkt zum Zeitpunkt der Erstellung festlegen. Stellen Sie sicher, dass der gesamte erforderliche Kontext (Datensatz-IDs, Benutzeridentität, Anspruchsdaten) in der Tool-Aufrufnutzlast enthalten ist, damit der Agent von einem fundierten Status aus mit der Argumentation beginnt.
- Behandeln Sie die transparente Sitzungsverwaltung des MCP-Servers als Bequemlichkeit und nicht als Gleichzeitigkeitsumgehung. Jeder Tool-Aufruf verbraucht weiterhin ein Sitzungsfenster für Salesforce-Agenten. Hochfrequente Orchestrierer, die Agentforce im großen Maßstab über MCP aufrufen, müssen dieselben Obergrenzen für gleichzeitige Sitzungen berücksichtigen, die für direkte Agenten-API-Aufrufer gelten.
**Fehlerbehandlung und -behebung**
- Die Agenten-API gibt standardmäßige HTTP-Fehlercodes zurück. Das aufrufende System muss "429 zu viele Anforderungen" (Ratenobergrenze) mit exponentieller Absicherung und "503-Service nicht verfügbar" mit Wiederholungslogik verarbeiten.
- Wenn der Agent selbst auf einen nicht behebbaren Toolfehler stößt, wird ein Fehler in natürlicher Sprache im Antworttext zurückgegeben. Das aufrufende System erkennt diese Sentinel-Antworten (z. B. Überprüfung auf das Statusfeld "Fehler" in der Antwort) und leitet sie entsprechend weiter, indem es entweder versucht, es mit zusätzlichem Kontext zu wiederholen, eine Ausweicherfahrung darzustellen oder eskaliert.
- Beim Aufruf über MCP werden Fehler auf zwei unterschiedlichen Ebenen angezeigt: MCP-Transportfehler (fehlgeformte Tool-Aufrufe, Server-Nichtverfügbarkeit) und Agentforce-Ursachungsfehler (Fehler bei der Tool-Ausführung, nicht behebbare Aktionen). Der Orchestrierungsagent muss beide Ebenen unabhängig voneinander verarbeiten. MCP-Transportfehler sollten Wiederholungsversuche auf Protokollebene auslösen. In der Tool-Antwort zurückgegebene Agentforce-Begründungsfehler sollten durch die eigene Ausweich- oder Eskalationslogik des Orchestrators behoben werden.
**Sicherheitsüberlegungen**
- Verwenden Sie möglichst enge OAuth-Geltungsbereiche für die externe Client-Anwendung. Eine Integration, die nur einen Agenten aufrufen muss, sollte keine Umfänge für den Datenzugriff enthalten, die über die Anforderungen des Agenten selbst hinausgehen.
- Validieren und bereinigen Sie alle Eingaben aus dem externen System, bevor Sie sie als Sitzungsvariablen injizieren. Externe Eingaben sind eine Angriffsfläche für die Eingabeaufforderung. Beispielsweise kann ein bösartiger Anrufer ein Feld "customerQuery" erstellen, das Agentenanweisungen überschreiben soll.
- Wenden Sie die IP-Zulassungsliste auf die externe Client-Anwendung an, um einzuschränken, welche externen Systeme die Agenten-API authentifizieren und aufrufen können.
- Protokollieren Sie alle durch die eingehende API ausgelösten Sitzungen mit Anruferidentität, Sitzungs-ID und Anforderungs-/Antwort-Metadaten zu Überwachungs- und Sicherheitszwecken.
- Wenn Agentforce über MCP aufgerufen wird, authentifiziert sich der MCP-Server im Namen des aufrufenden Benutzers bei Salesforce. Stellen Sie sicher, dass die Anmeldeinformationen der verbundenen Anwendung des MCP-Servers auf die erforderlichen Mindestberechtigungen beschränkt sind und dass die Identität des Endbenutzers (mit MCP-Tools wie Claude) explizit über Toolsingabeparameter in den Sitzungskontext übernommen wird.
**Beispiel**
Ein Finanzdienstleistungsportal löst aus, dass ein Agentforce eine Hypothekenanfrage bearbeitet.
1. Das Portal authentifiziert sich mithilfe des OAuth-Flows für Client-Anmeldeinformationen und ruft ein Bearer-Token ab.
2. Er ruft "POST /Einstein/ai-agent/v1/sessions" mit Sitzungsvariablen auf: "{ "accountId": "001xx...", "productType": "mortgage", "loanAmount": 450000 }".
3. Der Benutzer sendet seine Frage: "Welche Dokumente benötige ich, um meine Bewerbung auszufüllen?"
4. Das Portal ruft "POST /Einstein/ai-agent/v1/sessions/{sessionId}/messages" mit dem Text des Benutzers auf.
5. Der Agentforce ruft die Flow-Aktion "GetDocumentChecklist" auf, ruft die darlehenstypspezifischen Anforderungen ab und gibt eine strukturierte Liste zurück.
6. Das Portal stellt die Antwort des Agenten inline dar und schließt die Sitzung beim Beenden des Benutzers.
## Autonome ereignisgesteuerte Agentenausführung (eingehend)
**Kontext**
Nicht alle Agenten-Workflows stammen aus einer menschlichen Anforderung. Geschäftskritische Signale wie ein plötzlicher Rückgang der Produktnutzungskennzahlen, ein Verlassen des Einkaufswagens mit hohem Wert oder ein Zahlungsausfall beim Überschreiten eines Risikoschwellenwerts treten häufig in Betriebsdaten auf. Wenn diese Signale intelligente Antworten aus mehreren Schritten erfordern, führt das Warten darauf, dass ein Mensch es bemerkt und handelt, zu einer Latenz, die sich zu den realen Geschäftskosten addiert.
Dieses Muster beschreibt, wie Echtzeitereignisse als autonome Eintrittspunkte für Agenten dienen. Der Agent wird durch eine Datenbedingung und nicht durch einen Benutzer aufgerufen, er hat Gründe für den Ereigniskontext und führt einen Antwort-Workflow aus – alles ohne menschliche Initiierung.
**Probleme**
Wenn ein Geschäftsereignis in Echtzeit in Data 360 oder auf der Salesforce Platform auftritt, wie kann dieses Ereignis eine Agentensitzung autonom instanziieren, die Ereignisnutzlast als Kontext bereitstellen und einen Workflow für nicht unterhaltungsbasierte Aktionen zum Abschluss bringen, ohne dass eine Person die Interaktion initiiert oder leitet?
**Kräfte**
Beantworten Sie beim Anwenden dieses Musters die folgenden Fragen:
- Ist eine Antwort sofort zu dem Zeitpunkt erforderlich, zu dem das Ereignis ausgelöst wird, oder ist eine Verarbeitung nahezu in Echtzeit (Sekunden bis Minuten) akzeptabel?
- Enthält die Ereignisnutzlast genügend Kontext, um den Agenten zu erden, oder muss der Agent zusätzliche Nachschlagevorgänge ausführen, bevor er effektiv argumentieren kann?
- Wie hoch sind das erwartete Ereignisvolumen und die erwartete Häufigkeit? Ereignisströme mit hohem Durchsatz erfordern eine Ratenverwaltung, um Obergrenzen für die gleichzeitige Nutzung von Agenten zu vermeiden.
- Kann dasselbe Ereignis mehrmals für dieselbe Geschäftseinheit ausgelöst werden (mindestens einmal Zustellung)? Ist dies der Fall, müssen Aktionen idempotent sein.
- Gibt es einen menschlichen Eskalationspfad, wenn der Agent das Ereignis nicht autonom lösen kann?
- Wie sollte die fehlerhafte Ereignisverarbeitung angezeigt werden? Mit einer Warteschlange mit totem Brief, einer Benachrichtigung oder einer Kundenvorgangserstellung?
**Anwendung für Salesforce-Muster**
| Lösung | Passend | Kommentare |
| -------------------------------------------- | -------------------------------------------------- | -------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Durch Data 360 ausgelöste Flows | Bestens geeignet für verhaltensbasierte und kennzahlbasierte Signale | Dies ist am besten geeignet, wenn die Auslöserbedingung als Änderung der Data 360-Segmentmitgliedschaft oder als Schwellenwert für Kennzahlen definiert ist. Data 360 erkennt den Geschäftszustand (z. B. Verlassen des Einkaufswagens, Rückgang der Nutzung) und löst einen ausgelösten Flow aus. Der Flow ordnet Agentensitzungsvariablen Ereignisnutzlastattribute zu und erstellt die Agentforce-Sitzung. |
| Plattformereignisse + Automatisch gestarteter Flow oder Apex | Bestens geeignet für plattforminterne und systemübergreifende Ereignisse | Verwenden Sie diese Lösung, wenn sich die Ereignisquelle innerhalb der Salesforce Platform befindet oder wenn eine Middleware-Ebene das Ereignis veröffentlicht, nachdem die Bedingung in einem externen System erkannt wurde. Ein von einem beliebigen Salesforce-Prozess oder externen System veröffentlichtes Plattformereignis löst einen Apex-Auslöser oder automatisch gestarteten Flow aus, der die Agentensitzung mit der Ereignisnutzlast als Kontext erstellt. |
**Skizze**
_Sequenzdiagramm für die ereignisgesteuerte Agentenausführung_
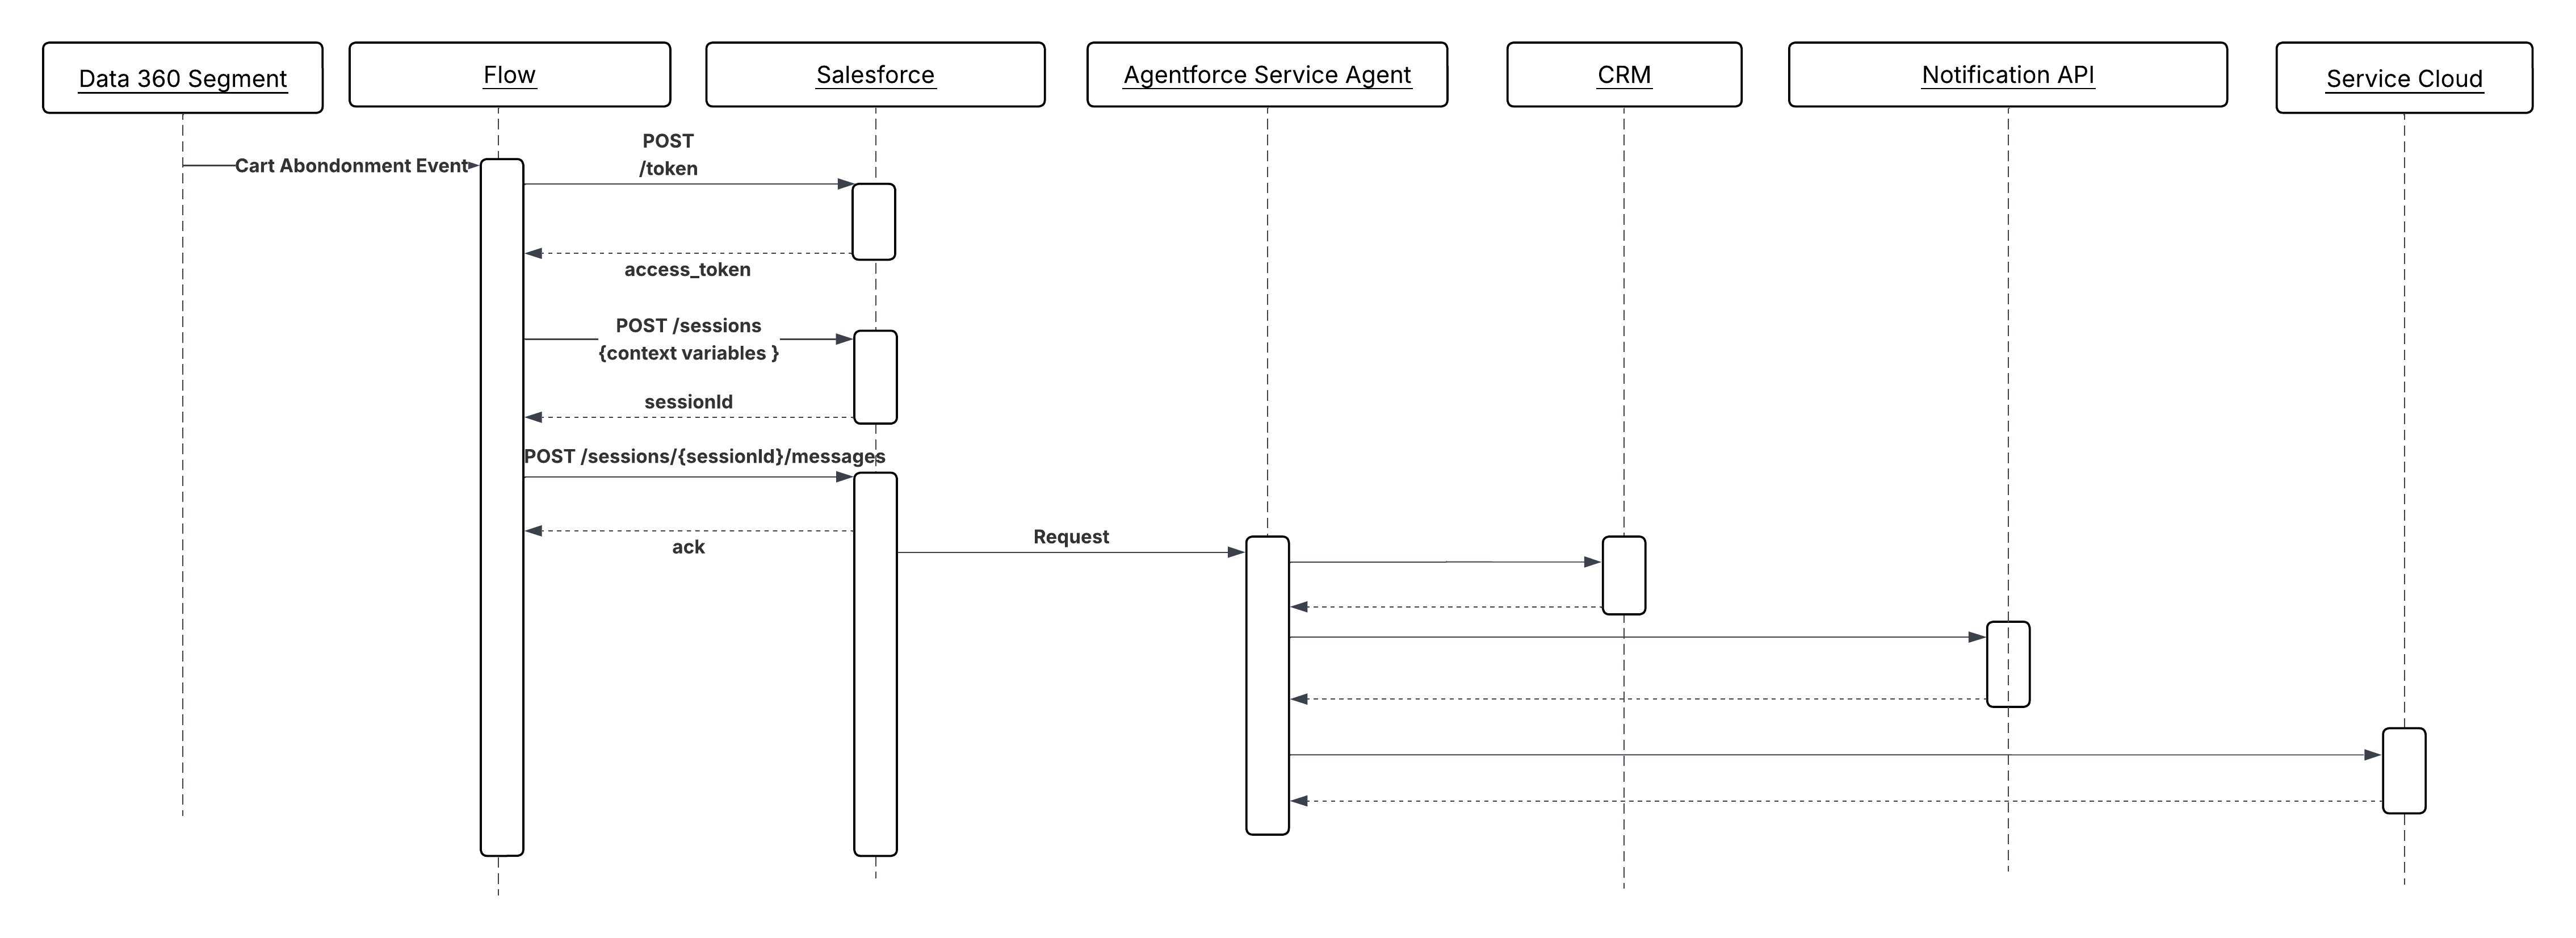 **Ergebnisse**
Agenten werden zu reaktiven Teilnehmern an Echtzeitgeschäften und nicht zu passiven Antworten auf menschliche Anfragen. Durch Ereignisse ausgelöste Agenten können Wiederherstellungs-, Triage- und Eskalations-Workflows mit Datengeschwindigkeit statt mit menschlicher Aufmerksamkeit ausführen.
Das auslösende System (Data 360 oder Plattformereignisse) bleibt für die Ereigniserkennung und die Nutzlastbildung verantwortlich. Der Agent bleibt für die Argumentation über diese Nutzlast und die Auswahl der richtigen Aktionskette verantwortlich. Es ist keine Unterhaltung erforderlich. Die Ereignisnutzlast ist die vollständige Eingabe.
**Überlegungen zum Design**
Plattformunabhängige Anleitung
- Entwerfen Sie alle Aktionen für den Aufruf ohne Unterhaltung. Es gibt keinen Benutzerwechsel. Der Agent muss eine Lösung nur aus dem anfänglichen Kontext der Kontextbildung erreichen. Aktionen sollten strukturierte, deterministische Ausgaben zurückgeben, statt sie zur Klarstellung aufzufordern.
- Stellen Sie sicher, dass die Ereignisnutzlast genügend Kontext enthält, bevor die Agentensitzung erstellt wird. Eine schlanke Nutzlast, die den Agenten zwingt, mehrere Nachschlageaufrufe zu tätigen, bevor er die Ursache dafür finden kann, erhöht die Latenz und den Gleichzeitigkeitsverbrauch.
- Legen Sie alle Schreibvorgänge, die durch ereignisgesteuerte Agenten ausgelöst werden, als idempotent fest. Ereigniszustellungssysteme bieten in der Regel mindestens einmal Garantien. Die Verarbeitung doppelter Ereignisse kann keine doppelten Nebenwirkungen verursachen.
Salesforce-Implementierungshinweise
- Ordnen Sie in durch Data 360 ausgelöste Flows Ereignisnutzlastattribute (z. B. "accountId", "eventType", "metricValue", "productIds") direkt benannten Sitzungsvariablen zum Zeitpunkt der Sitzungserstellung zu. Dadurch wird der Agent ab dem ersten Argumentationsschritt konsolidiert, ohne dass eine Abrufaktion erforderlich ist.
- Verwenden Sie für Plattformereignisauslöser einen automatisch gestarteten Flow anstelle eines Bildschirm-Flows. Bildschirm-Flows werden in autonomen Kontexten ohne Unterhaltung nicht unterstützt.
- Legen Sie eine explizite Sitzungs-Timeout für durch Ereignisse ausgelöste Sitzungen fest. Im Gegensatz zu Unterhaltungssitzungen gibt es keinen Benutzer, der die Interaktion erweitern kann. Eine Sitzung, die bei einer fehlgeschlagenen Aktion ins Stocken gerät, sollte nicht unbegrenzt Zeitfenster enthalten.
- Verwenden Sie Flow-Fehlerpfade, um Fehler bei der Erstellung von Agentensitzungen zu beheben. Wenn die Sitzung nicht erstellt werden kann, sollte der Fehlerpfad ein kompensierendes Ereignis veröffentlichen oder einen Kundenvorgang für die menschliche Weiterverfolgung erstellen, statt das Ereignis stillschweigend zu verwerfen.
**Fehlerbehandlung und -behebung**
- Ereignisse, die aufgrund von Gleichzeitigkeitsobergrenzen, Fehlern bei der Sitzungserstellung oder Fehlern bei der Nutzlastvalidierung keine Agentensitzung erfolgreich auslösen können, sollten an einen Fehlerpfad weitergeleitet werden, der einen Kundenvorgang erstellt, eine Benachrichtigung auslöst oder das Ereignis zur erneuten Verarbeitung in einer Warteschlange mit auslaufendem Brief veröffentlicht.
- Agentenfehler während der Ausführung (z. B. Zeitüberschreitung einer erforderlichen Aktion) sollten mit der ursprünglichen Ereignis-ID protokolliert werden. Da die Auslösung asynchron ist und kein wartender Anrufer vorhanden ist, basiert die Fehleroberfläche vollständig auf der Beobachtbarkeit: Protokolle, Dashboards und Benachrichtigungsschwellenwerte.
- Implementieren Sie eine Obergrenze für Wiederholungen. Wenn ein Ereignis zuverlässig zu einem Agentenausfall führt, werden die Obergrenzen für die Gleichzeitigkeit durch nicht begrenzte Wiederholungen ausgeschöpft. Leiten Sie das Ereignis nach einer konfigurierbaren maximalen Anzahl von Versuchen an eine Warteschlange für menschliche Überprüfungen weiter, wobei der vollständige Kontext angehängt ist.
- Verfolgen Sie die Ereignis-ID durch den gesamten Lebenszyklus der Agentensitzung. Durch diese Verfolgung wird eine Korrelation zwischen dem ursprünglichen Datensignal und allen nachgelagerten Aktionen für die Überprüfung und das Debuggen ermöglicht.
**Sicherheitsüberlegungen**
- Validieren und bereinigen Sie alle Ereignisnutzlastattribute, bevor Sie sie als Agentensitzungsvariablen injizieren. Ereignisnutzlasten aus Data 360 oder externen Publishern sind eine Angriffsfläche für die Eingabeaufforderung. Beispielsweise kann ein gestaltetes Nutzlastfeld so konzipiert sein, dass Agentenanweisungen überschrieben werden.
- Führen Sie durch Ereignisse ausgelöste Agentensitzungen unter einem dedizierten Integrationsbenutzer mit den geringsten Berechtigungen und nicht unter einer Administratoridentität mit hohen Berechtigungen aus. Der Agent verfügt nur über die Berechtigungen, die zum Ausführen seines definierten Aktionssatzes erforderlich sind.
- Protokollieren Sie alle durch Ereignisse ausgelösten Sitzungen mit der ursprünglichen Ereignis-ID, dem Ereignistyp und den bei der Erstellung eingefügten Sitzungsvariablen. Dieser Prüfpfad ist erforderlich, um zu rekonstruieren, warum der Agent eine bestimmte Aktion ausgeführt hat, wenn das Ergebnis umstritten ist.
**Beispiel**
Ein Einzelhandelsunternehmen verwendet Data 360, um das Einkaufswagenverhalten in Echtzeit zu verfolgen. Wenn ein Einkaufswagen mit einem Wert über einem definierten Schwellenwert verlassen wird:
1. Data 360 erkennt das Verlassenssignal und löst einen ausgelösten Flow mit der Ereignisnutzlast: "customerId", "cartValue", "productIds" und "abandonmentTimestamp".
2. Der Flow ordnet diese Attribute Agentforce-Sitzungsvariablen zu und erstellt eine neue Agentensitzung. Es ist keine Benutzerinteraktion erforderlich.
3. Der Agent wertet den Kaufverlauf, die aktuellen Ansprüche und die Einkaufswagenzusammensetzung des Kunden mithilfe der verfügbaren Abrufaktionen aus.
4. Der Agent ruft eine `SelectRecoveryOffer` auf, die die entsprechende Rabattklasse basierend auf dem Kundensegment anwendet, und eine `SendProactiveNotification`, um das Angebot über den bevorzugten Kanal des Kunden bereitzustellen.
5. Der Agent ruft `CreateFollowUpTask` auf, um die Interaktion im CRM für die Sichtbarkeit des Accountinhabers zu protokollieren.
6. Die Sitzung wird nach Abschluss der Aktionskette automatisch geschlossen. Die ursprüngliche Ereignis-ID wird zur Rückverfolgbarkeit im Sitzungsprotokoll beibehalten.
## Knowledge-Kontextbildung aus Unternehmensinhalten (ausgehend)
**Kontext**
LLMs werden anhand öffentlicher Daten trainiert. Sie haben keine Knowledge über die Produkte, Richtlinien, den Kundenvorgangsverlauf oder die Verträge Ihrer Organisation, es sei denn, diese Informationen werden explizit zum Zeitpunkt der Überlegungen bereitgestellt. Ohne Kontextbildung wird ein Agent nach dem Serviceanspruch eines Kunden oder den Bedingungen eines bestimmten Vertrags gefragt, um eine Antwort zu halluzinieren oder zuzugeben, dass er es nicht weiß. Keines der Ergebnisse ist in einem Unternehmenskontext akzeptabel.
Die Abruf-Augmented Generation (RAG) löst dies, indem sie relevante Dokumente aus einem Knowledge Store für Unternehmen abruft und sie in das Kontextfenster des Agenten einfügt, bevor eine Antwort generiert wird. Der Agent hat Gründe für abgerufene Inhalte, beispielsweise einen Knowledge-Artikel, eine Lösung für Kundenvorgänge in der Vergangenheit oder eine Produktspezifikation, als hätte er diese Informationen direkt erhalten. Der LLM liefert die Überlegungen, die Abrufebene die Fakten.
Ein Serviceagent, der einen komplexen Garantieanspruch bearbeitet, muss beispielsweise keine Gewährleistungsbedingungen in seine Anweisungen eingebettet haben. Wenn der Kunde sein Problem beschreibt, führt der Agent stattdessen eine semantische Suche oder eine hybride Suche (Stichwortsuche + semantische Suche) anhand eines Vektorindex der Garantiedokumentation aus, ruft die entsprechenden Bedingungen ab und verwendet sie, um die Berechtigung und die nächsten Schritte zu bestimmen. Die Antwort basiert auf dem aktuellen, maßgeblichen Richtliniendokument und nicht auf den Trainingsdaten des Modells.
**Probleme**
Ein Agent muss eine Frage beantworten oder eine Entscheidung treffen, die von proprietärem Knowledge wie Richtlinien, Verträgen, Produktdokumentationen oder historischen Kundenvorgangsdaten abhängt, die nicht Teil der Schulungsdaten des LLM waren. Wie ruft der Agent die relevantesten Inhalte zum Zeitpunkt der Überlegungen ab, stellt sicher, dass die abgerufenen Inhalte aktuell und verbindlich sind, und fügt sie mit ausreichender Genauigkeit in den Kontext ein, um Störungen zu vermeiden?
**Kräfte**
Beantworten Sie beim Anwenden dieses Musters die folgenden Fragen:
- Ist der Knowledge Inhalt statisch und wird selten aktualisiert (z. B. Produkthandbücher) oder ändert er sich kontinuierlich (z. B. Kundenvorgangslösungen, Bestandsbeschreibungen)? Die Aktualisierungshäufigkeit bestimmt das Design der Aufnahme-Pipeline.
- Wie groß ist der Inhalt? Eine kleine Knowledge Base kann vollständig abgerufen werden. Eine große Knowledge Base erfordert eine Aufteilung, Einbettung und semantische Indizierung, um nur die relevantesten Passagen zurückzugeben.
- Profitiert die Abfrage von einem einzelnen fokussierten Abruf oder würde die Kombination von Ergebnissen aus mehreren Knowledge Quellen (z. B. Dokumentation und vergangenen Kundenvorgängen) zu einer fundierteren Antwort führen? Letzteres erfordert einen Ensembleabruf.
- Müssen abgerufene Inhalte vor der semantischen Rangfolge nach Metadaten gefiltert werden, um beispielsweise die Ergebnisse auf Dokumente zu beschränken, die für die Produktklasse oder die geografische Lage des Kunden relevant sind?
- Wie sensibel sind die Knowledge Inhalte? Abgerufener Inhalt wird in das LLM-Kontextfenster eingefügt und beeinflusst die Antwort des Agenten. Inhalte, die bestimmten Benutzern nicht angezeigt werden sollen, müssen auf der Abrufebene gesteuert werden und dürfen nicht nach LLM gefiltert werden.
**Anwendung für Salesforce-Muster**
| Lösung | Passend | Kommentare |
| -------------------------------------------------- | ---------------------------------------------------------------- | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Abruf-erweiterte Generierung (RAG) mit Data 360 | Bestens geeignet für Enterprise-Anwendungsfälle | Der Agent führt eine semantische Suche anhand von Data 360-Vektorindizes durch, bevor er eine Antwort generiert. Die abgerufenen Inhalte wie Knowledge-Artikel, vergangene Kundenvorgänge und Produktdokumentation werden als Kontextbildung in den LLM-Kontext eingefügt. Dies kann mit Abrufaktionen, Flow oder benutzerdefiniertem Apex aufgerufen werden. Beachten Sie, dass Data 360 eine integrierte Pipeline vom Rohinhalt bis zum für Agenten geeigneten Kontext unterstützt, nicht nur einen Vektorspeicher:
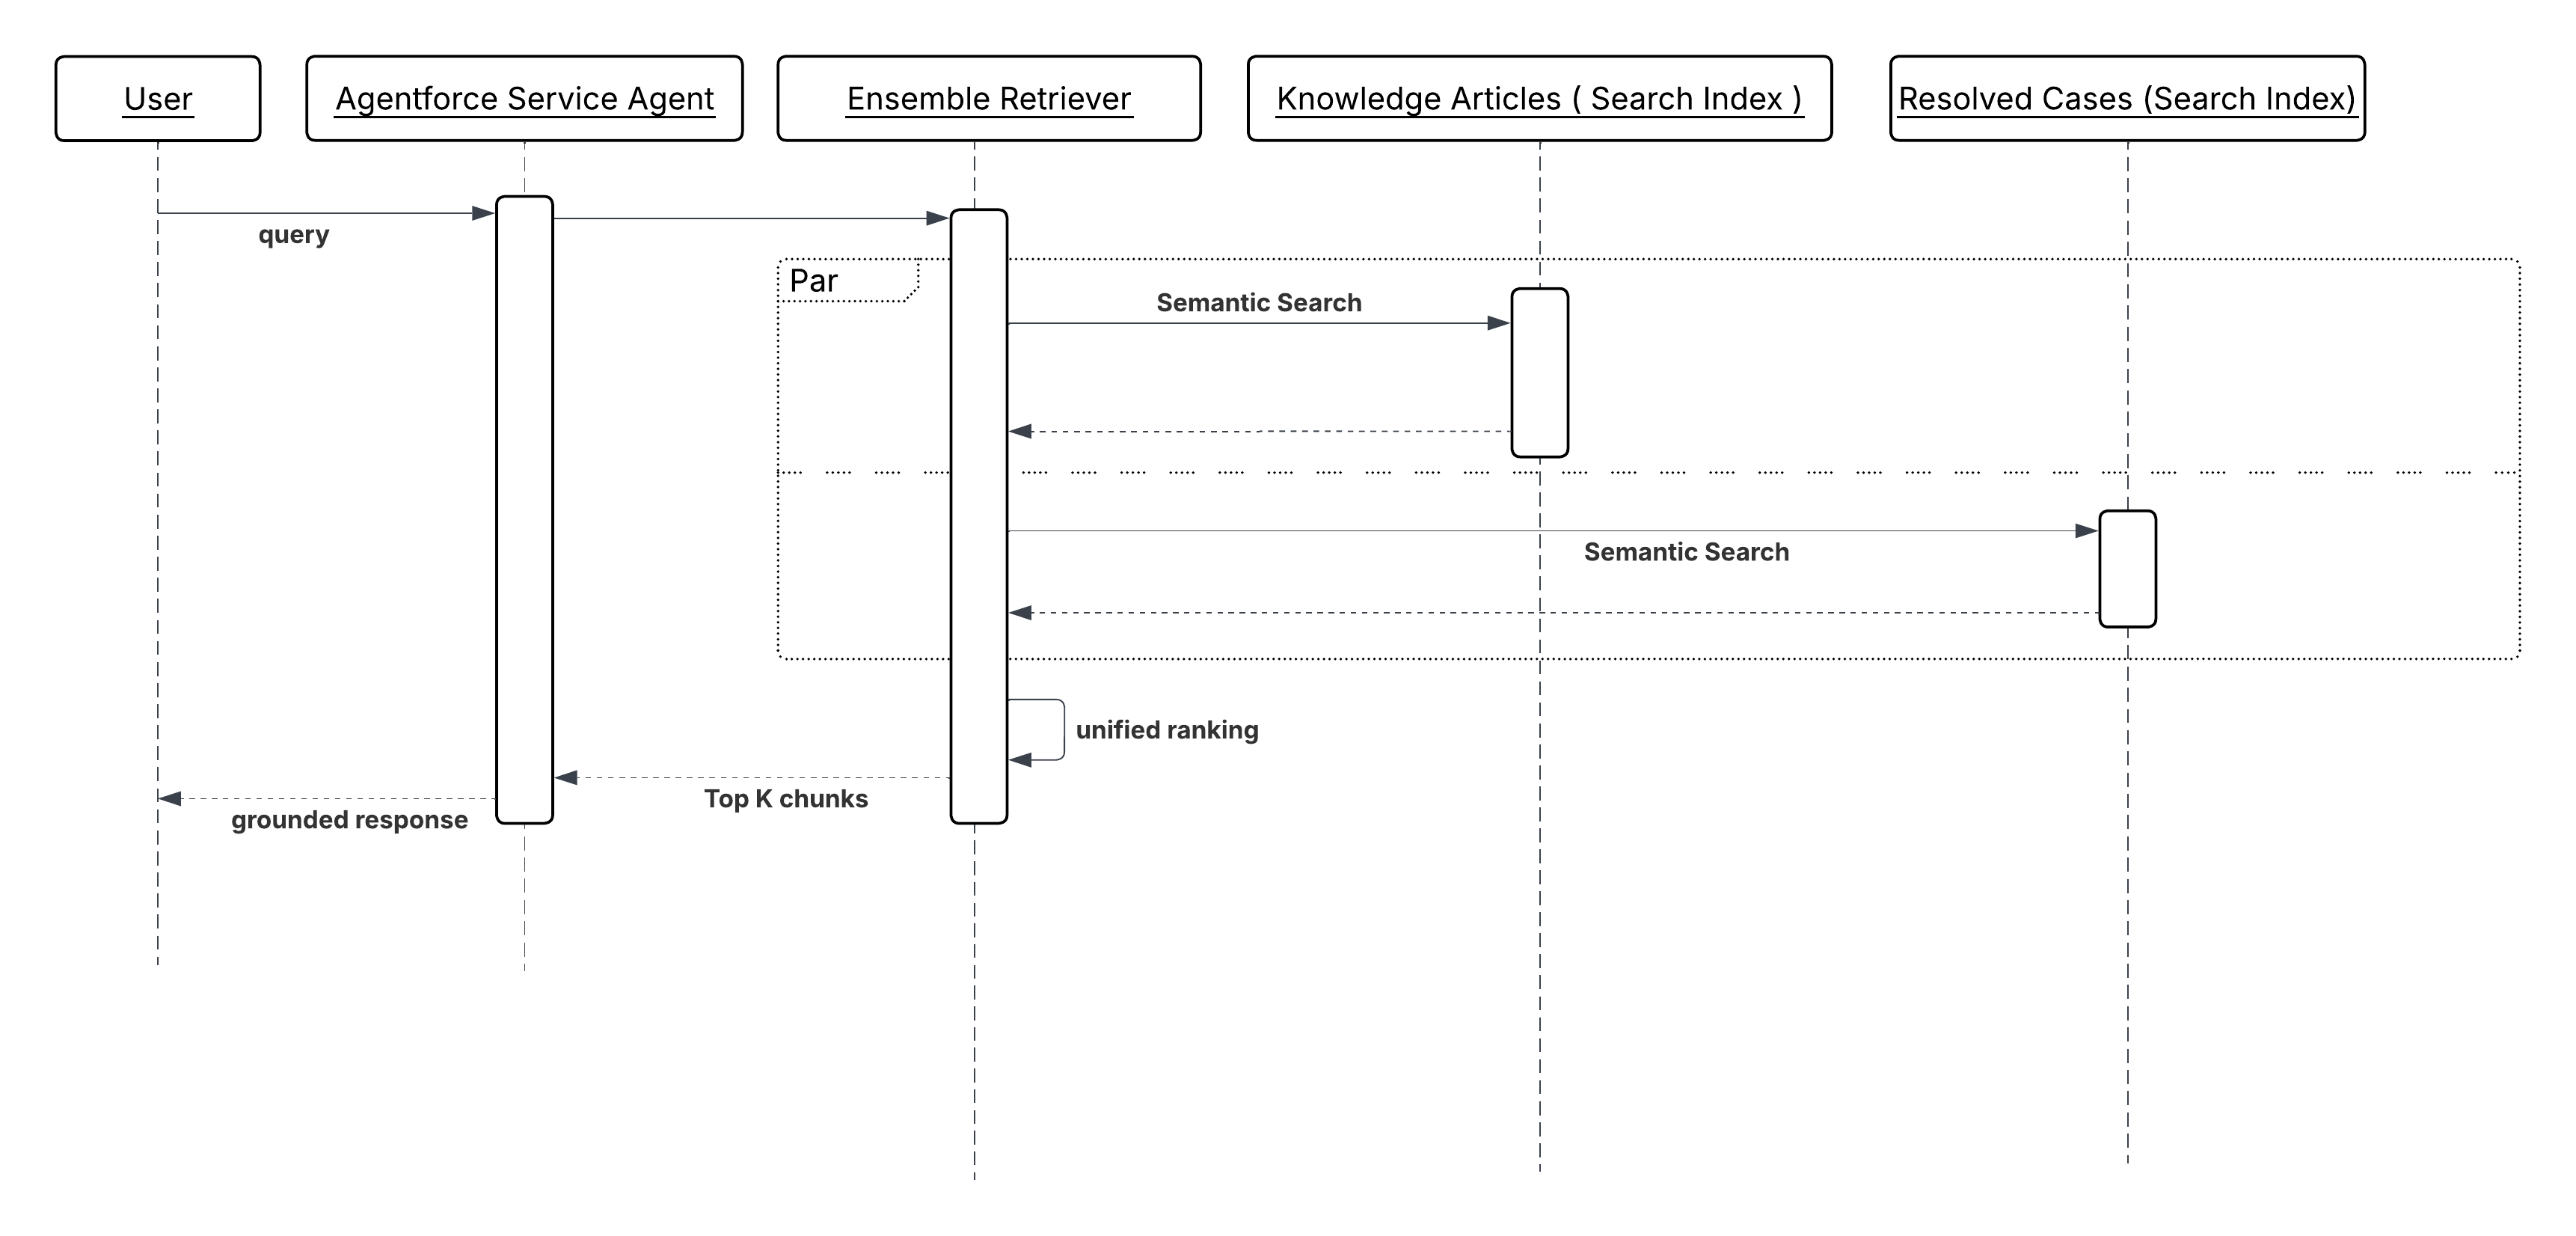 **Ergebnisse**
Die Antworten des Agenten basieren auf dem aktuellen, maßgeblichen Knowledge der Organisation und nicht auf den Trainingsdaten des LLM. Das Halluzinationsrisiko bei faktischen Fragen wie Policenbedingungen, Produktspezifikationen und Anspruchsdetails wird reduziert, da das Modell über abgerufene Nachweise sinniert und nicht aus dem Speicher generiert wird.
Die Knowledge Inhalte bleiben unabhängig voneinander verwaltbar. Das Aktualisieren eines Richtliniendokuments oder das Hinzufügen einer neuen Kundenvorgangslösung zum Index wird sofort für alle nachfolgenden Agenteninteraktionen wirksam, ohne das Modell neu zu trainieren oder bereitzustellen.
Der Abruf bietet auch einen impliziten Prüfpfad. Da die Antwort des Agenten aus bestimmten abgerufenen Dokumenten abgeleitet wird, kann der Quellinhalt zusammen mit der Antwort protokolliert werden, wodurch verfolgt werden kann, warum der Agent eine bestimmte Antwort gegeben hat.
**Überlegungen zum Design**
Plattformunabhängige Anleitung
- Verteilen und betten Sie Knowledge Content in der richtigen Granularität ein. Zu große Blöcke verwässern die Relevanz. Bei zu kleinen Blöcken geht der Kontext verloren, den das LLM benötigt, um richtig zu argumentieren. Bei den meisten Unternehmensdokumenttypen sorgt die Aufteilung auf Absatzebene mit sich überschneidenden Kontextfenstern für die beste Abrufqualität.
- Behandeln Sie die Abrufgenauigkeit als erstklassiges Designanliegen. Das Einfügen von Inhalten mit geringer Relevanz in das Kontextfenster des Agenten ist nicht neutral. Es führt zu Rauschen, das die Antwortqualität beeinträchtigt. Optimieren Sie Abrufschwellenwerte und Obergrenzen, um den Abruf mit der Genauigkeit für jede Knowledge Domäne abzugleichen.
- Die Aufnahmelatenz ist eine operative SLA. Wenn ein Policendokument aktualisiert wird, der Vektorindex jedoch nicht aktualisiert wurde, ruft der Agent veraltete Informationen ab und reagiert darauf. Definieren Sie für jeden Inhaltstyp eine zulässige Toleranz für veraltete Inhalte und entwerfen Sie die Aufnahmepipelines entsprechend.
Salesforce-Implementierungshinweise
- Füllen Sie Data 360-Vektorindizes über die entsprechende Aufnahme-Pipeline für die Inhaltsaktualisierungshäufigkeit aus. Verwenden Sie die Batch-Aufnahme für statische Dokumente und die Streaming- oder Change Datenerfassung (CDC) für Datensätze, die sich kontinuierlich ändern.
- Konfigurieren Sie für Ensemble Retrievers die Relevanzranggewichtungen pro Quelle. Ein Index für gelöste Kundenvorgänge benötigt möglicherweise eine Aktualitätsverzerrung, ein Richtliniendokumentationsindex hingegen nicht. Stimmen Sie die Gewichtungen anhand der Abfragetypen ab, die der Agent verarbeiten soll.
- Verwenden Sie Metadatenfilter in benutzerdefiniertem Apex oder Flow Retriever, um den Abruf vor der Ausführung der semantischen Suche zu begrenzen. Das Filtern nach Produktlinie, Region oder Dokumenttyp vor dem Rang reduziert das Rauschen und verbessert die Genauigkeit der in den Kontext eingefügten Elemente.
- Fügen Sie nicht das vollständige abgerufene Dokument in den LLM-Kontext ein. Geben Sie nur die relevanten Blöcke oder Auszüge weiter. Große Kontextinjektionen verbrauchen das Token-Budget, erhöhen die Latenz und reduzieren den Anteil des Kontextfensters, der für die Argumentation des Agenten verfügbar ist.
**Fehlerbehandlung und -behebung**
- Wenn beim Abruf keine Ergebnisse zurückgegeben werden, geben Sie den expliziten Status "Keine Ergebnisse gefunden" zurück, statt ohne Grundlage fortzufahren. Anschließend kann der Agent die Abfrage erweitern, den Benutzer um Klarstellung bitten oder zu einer Person eskalieren.
- Jeder von den Abrufern zurückgegebene Block enthält eine Relevanzbewertung. Abhängig vom Anwendungsfall sollte ein bestimmter Konfidenz-/Relevanzschwellenwert konfiguriert werden, oberhalb dessen der Agent den Abruf als sicher behandeln sollte, andernfalls sollte er auf eine Klarstellung oder Eskalation zurückgreifen.
- Wenn der Vektorindex oder Abrufservice vorübergehend nicht verfügbar ist, sollte die Abrufaktion oder der Apex Callout einen strukturierten Fehler mit einem aussagekräftigen Grund zurückgeben. Protokollieren Sie den Fehler mit der Sitzungs-ID und der Abfrage, damit Abruflücken identifiziert und der Index oder Service auf Verfügbarkeit überwacht werden kann.
- Implementieren Sie für zeitkritische Knowledge Domänen eine Aktualisierungsprüfung als Teil der Abrufantwort. Wenn das letzte übereinstimmende Dokument zuletzt über einen definierten Schwellenwert für die Pattsituation hinaus aktualisiert wurde, kennzeichnen Sie dies dem Agenten, damit er seine Antwort oder Aufforderung zur Überprüfung qualifizieren kann.
**Sicherheitsüberlegungen**
- Beim Abruf müssen die Datenzugriffsberechtigungen des Benutzers berücksichtigt werden, in dessen Namen der Agent handelt. Eine Agentensitzung, die im Kontext einer kundenorientierten Interaktion ausgeführt wird, darf keine internen Betriebsdokumente, Preisstrategiehinweise oder Datensätze abrufen, auf die der Endbenutzer andernfalls keinen Zugriff hätte. Wenden Sie die Feldebenen- und Datensatzebenensicherheit auf der Abrufebene an. Verlassen Sie sich nicht darauf, dass die LLM vertrauliche abgerufene Inhalte zurückhält.
- Abgerufener Inhalt wird in das LLM-Kontextfenster eingefügt und kann die Antwort des Agenten beeinflussen oder in ihr angezeigt werden. Behandeln Sie jedes Dokument im Abrufinhalt als potenziell für den Endbenutzer sichtbar und regeln Sie die Inhaltsmitgliedschaft entsprechend.
- Protokollieren Sie alle Abrufabfragen und die Dokumentkennzeichner der abgerufenen Blöcke zusammen mit der Sitzungs-ID. Dieser Prüfpfad ermöglicht die Rekonstruktion der Nachweise, die der Agent beim Antworten verwendet hat, was für Compliance-, Streitbeilegungs- oder Erklärbarkeitsverpflichtungen erforderlich sein kann.
**Beispiel**
Ein Finanzdienstleistungsagent verarbeitet eine Kundenanfrage zu Strafen für vorzeitige Rückzahlungen für ein Sparprodukt mit fester Laufzeit:
1. Der Kunde fragt: "Welche Strafe würde ich verhängen, wenn ich mein Geld sechs Monate früher abheben würde?"
2. Der Agent ruft eine Aktion vom Typ "Einzelpersonenabrufer" auf, die für einen Vektorindex der Produktbedingungen konfiguriert ist.
3. Der Abrufer führt eine semantische Suche anhand des Abfragekontexts wie Produkttyp und Kundenaccount und der spezifischen Frage aus und gibt die drei relevantesten Dokumentblöcke zurück – die Klausel zur vorzeitigen Einlösung, die Tabelle zur Strafberechnung und die für Härtefälle geltenden Ausnahmen.
4. Die abgerufenen Blöcke werden zusammen mit der Frage des Kunden in das Kontextfenster des Agenten eingefügt.
5. Der Agent begründet die abgerufenen Bedingungen, identifiziert den anwendbaren Strafsatz für die Produktklasse und die Einlösungszeitachse des Kunden und gibt eine präzise, richtlinienbasierte Antwort unter Angabe des Datums des Inkrafttretens der verwendeten Bedingungen zurück.
6. Die Dokumentkennzeichner der abgerufenen Blöcke werden mit dem Sitzungsdatensatz protokolliert, um die Überprüfbarkeit zu gewährleisten.
## Überprüfte Kundenkontextinjektion (ausgehend)
**Kontext**
LLMs sind von Natur aus probabilistisch. Wenn sie gefragt werden, ob sie über einen bestimmten Kunden nachdenken möchten, folgern, schätzen oder halluzinieren sie Fakten, die ihnen nicht explizit genannt wurden. Ein Agent, der eine Preisaktion aufruft, ohne zu wissen, dass der Kunde ein Unternehmensaccount mit hohem Wert in einer bevorzugten Klasse ist, wendet möglicherweise die falsche Rabattlogik an. Ein Agent, der einen Supportvorgang eskaliert, ohne die Abwanderungsrisikobewertung des Kunden zu kennen, kann einen Account, der Tage von der Abwanderung entfernt ist, entpriorisieren.
Die verifizierte Kundenkontextinjektion behebt dies, indem vorab Aktionseingabeparameter mit überprüften strukturierten Attributen aus dem zusammengeführten Profil ausgefüllt werden, bevor der Agent eine Aktion aufruft. Der Agent schließt nicht auf den Trend des Kundensegments, den Lebenszeitwert oder die Kundenzufriedenheit. Sie erhält diese Fakten als Kontexteingaben und Gründe dafür. Dieses Muster reduziert das Halluzinationsrisiko bei kundenspezifischen Entscheidungen und eliminiert redundante Nachschlageaufrufe während des Argumentationszyklus.
Bevor ein Preisagent beispielsweise eine Aktion vom Typ "GenerateQuote" aufruft, fügt die Unteragentenkonfiguration automatisch das Segment, die Klasse und den Lebenszeitwert des Kunden aus seinem zusammengeführten Profil ein. Die Aktion erhält überprüfte Fakten anstelle von abgeleiteten Näherungen mit LLM und das Angebot ist mit der tatsächlichen Geschäftsbeziehung des Kunden verknüpft.
Dies ist keine Alternative zum Muster "Knowledge Grounding from Enterprise Content". Ein gut konzipierter Agent kann beides verwenden: "Knowledge Grounding from Enterprise Content" (Knowledge-Kontextbildung aus Unternehmensinhalt) bietet dokumentenbasiertes Knowledge, während "Verified Customer Context Injection" (Verifizierte Kundenkontextinjektion) die Identität des Kunden festlegt.
**Probleme**
Wie können Sie sicherstellen, dass ein Agent über genaue, kundenspezifische Fakten wie Segment, Stufe, Lebenszeitwert, Abwanderungsrisiko oder andere Profilattribute verfügt, bevor er eine Aktion ausführt, statt diese Fakten selbst zu erraten?
**Kräfte**
Beantworten Sie beim Anwenden dieses Musters die folgenden Fragen:
- Welche Aktionseingabeparameter stellen kundenspezifische Fakten dar, die bei Rückschluss und nicht bei Quellenangaben zu falschen oder inkonsistenten Ergebnissen führen würden?
- Sind die erforderlichen Profilattribute als standardmäßige vereinheitlichte Data 360-Profilfelder verfügbar oder erfordern sie berechnete Statistiken, die aus rohen Verhaltens- und Transaktionsdaten abgeleitet werden?
- Wie häufig ändern sich die relevanten Profilattribute? Attribute wie die Abwanderungsrisikobewertung oder der CSAT-Trend erfordern eine Aktualisierungsgarantie; veraltete Profildaten führen zu denselben falschen Ergebnissen wie halluzinierte Daten.
- Sollen Profilattribute zum Zeitpunkt der Sitzungserstellung (konstant für die Dauer der Sitzung) injiziert oder zum Zeitpunkt des Aktionsaufrufs neu abgerufen werden (um Statusänderungen während der Sitzung widerzuspiegeln)?
- Muss der Agent direkt über die Profilattribute nachdenken oder werden sie nur von der Aktion verbraucht und sind für die Argumentationsschleife des Agenten opak?
**Anwendung für Salesforce-Muster**
| Lösung | Passend | Kommentare |
| --------------------------------------------------- | --------------------------------------- | -------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Subagentkonfiguration – Profilattributzuordnung | Bestens geeignet für statisches Grounding auf Sitzungsebene | Am besten geeignet, wenn die Profilattribute innerhalb einer einzelnen Interaktion stabil sind. Ordnen Sie die Attribute des zusammengeführten Data 360-Profils (z. B. "customerSegment", "tier", "lifetimeValue") direkt den Eingabeparametern für Aktionen in der Konfiguration der Agentforce-Unteragenten zu. Attribute werden bei der Sitzungserstellung aufgelöst und für die Dauer der Sitzung konstant gehalten. |
| Verbundene Data 360-Flows | Bestens geeignet für dynamische Aktualisierungen oder Sitzungsaktualisierungen | Wird verwendet, wenn sich Profilattribute häufig ändern oder wenn für die Aktion der aktuellste Status erforderlich ist. Verwenden Sie einen verbundenen Data 360-Flow als Aktionsschritt, um den neuesten Profilstatus zum Zeitpunkt des Aufrufs anzuzeigen.Der Flow fragt das zusammengeführte Profil ab, wendet die erforderliche Transformation an und gibt die Attribute als Ausgabevariablen zurück, die von der nächsten Aktion in der Kette verbraucht werden. |
| Berechnete Statistiken als Aktionseingaben | Bestens geeignet für komplexe abgeleitete Kennzahlen | Wird verwendet, wenn Agenten über berechnete Geschäftskennzahlen (Abwanderungsrisikobewertung, CSAT-Trends, Produktakzeptanzindex) nachdenken müssen, statt Rohdaten zu interpretieren. Definiert in Data 360 als abgeleitete Kennzahlen, die über Verhaltens-, Transaktions- und Interaktionsdaten berechnet werden. Berechnete Statistiken werden als abfragbare Profilattribute angezeigt und können über die Themenkonfiguration oder einen verbundenen Flow Aktionseingaben zugeordnet werden. |
**Skizze**
_Sequenzdiagramm für die überprüfte Kundenkontextinjektion_
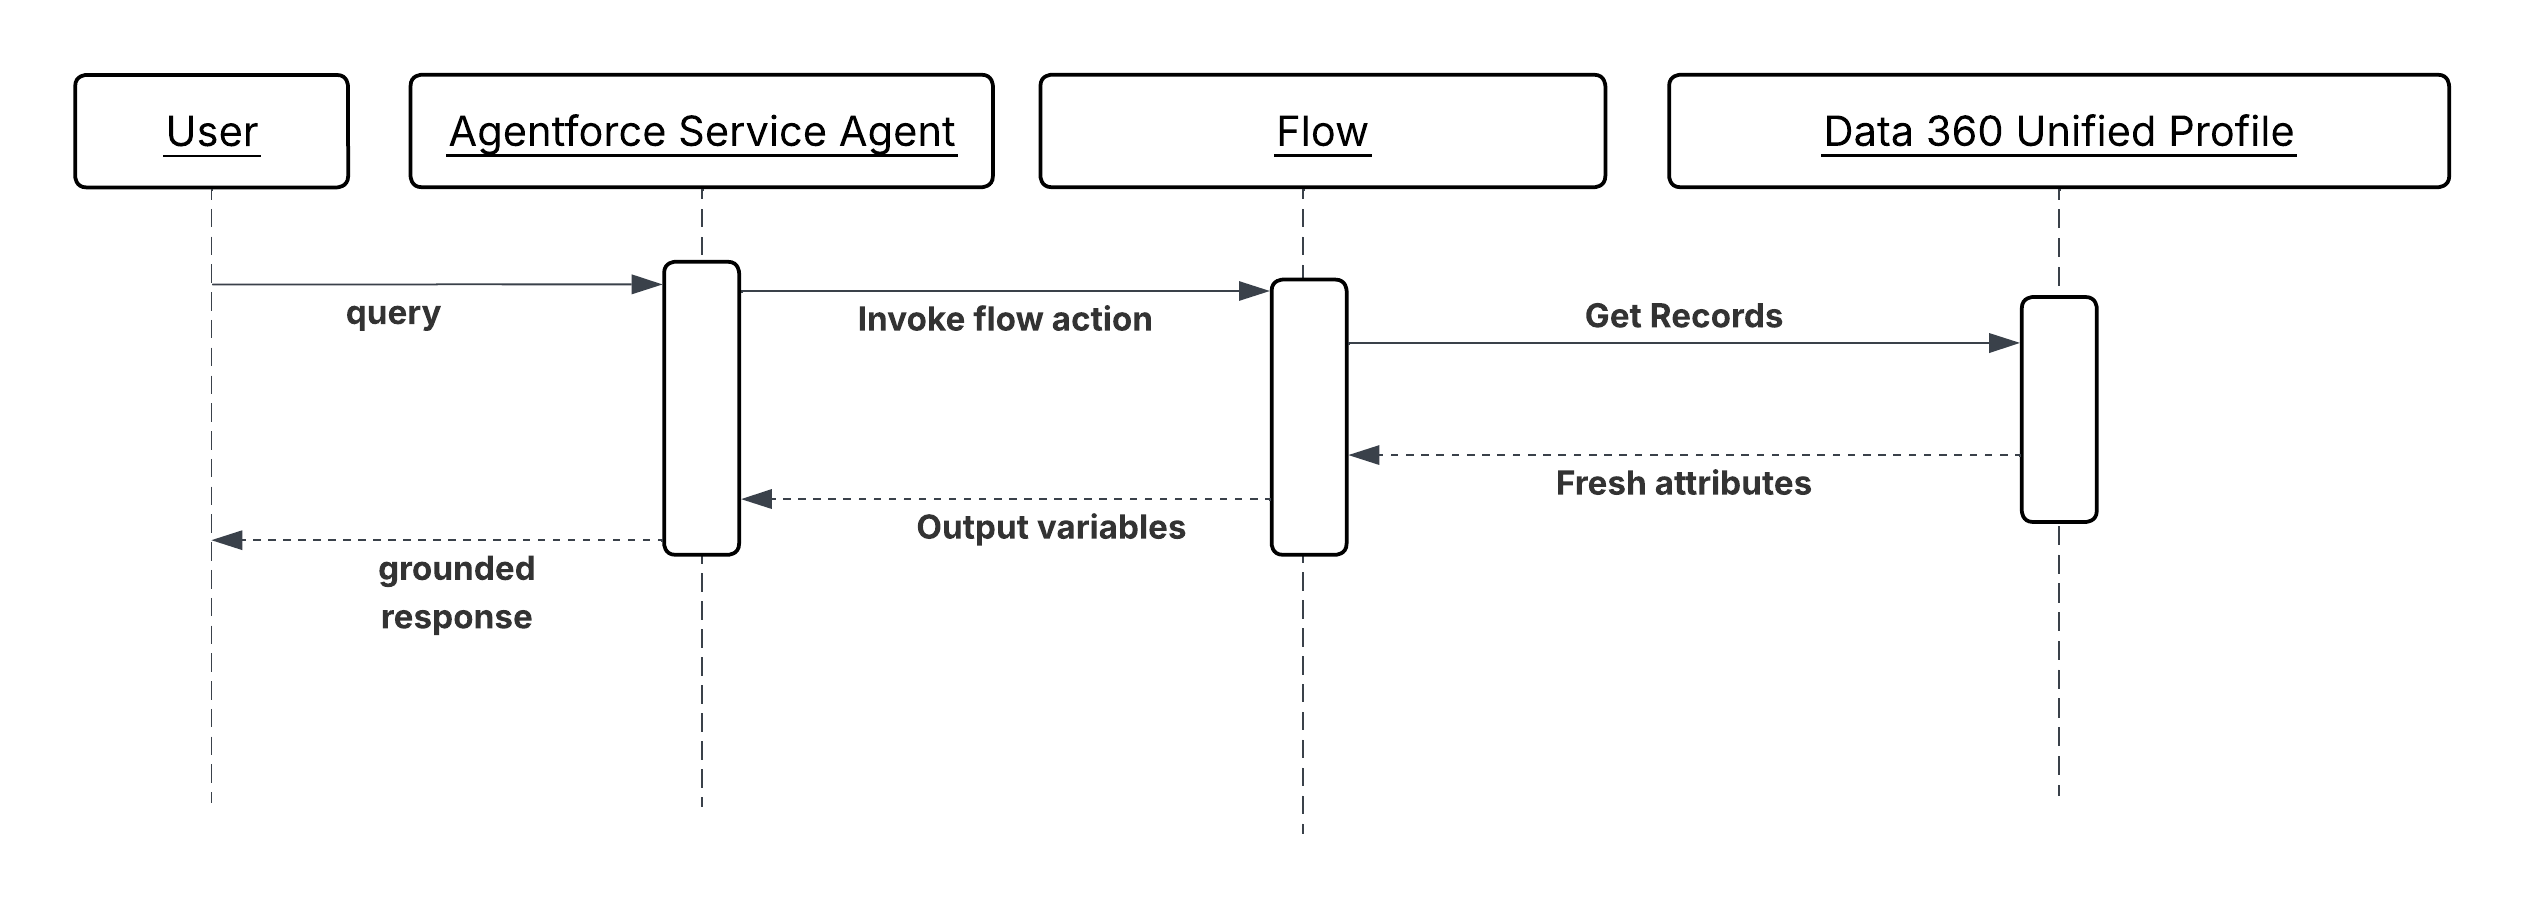 **Ergebnisse**
Aktionen erhalten überprüfte, strukturierte Kundenfakten anstelle von abgeleiteten LLM-Annäherungen. Die Überlegungen des Agenten sind auf den tatsächlichen Profilstatus des Kunden ausgerichtet und reduzieren das Halluzinationsrisiko bei Entscheidungen, bei denen die faktische Genauigkeit die Ergebnisqualität bestimmt, beispielsweise Preise, Anspruchsprüfungen, Eskalationsweiterleitung und Aufbewahrungsangebote.
Die Profilbildung reduziert zudem die Argumentationslatenz. Wenn der Agent keine Nachschlageaufrufe ausführen muss, um einen grundlegenden Kundenkontext herzustellen, ist der Überlegungszyklus kürzer und die Gleichzeitigkeit wird für weniger Runden verbraucht.
Das zusammengeführte Data 360-Profil bleibt die maßgebliche Quelle für Kundenfakten. Die Subagentenkonfiguration oder der verbundene Flow ist die Integrationsnaht. Der Agent ist für die Argumentation dieser Fakten und die Auswahl von Aktionen verantwortlich, nicht für die Beschaffung der Fakten selbst.
**Überlegungen zum Design**
Plattformunabhängige Anleitung
- Identifizieren Sie alle Aktionseingaben, die ein Halluzinationsrisiko bergen – wobei die LLM-Rückschlussfolgerung zu einem falschen Ergebnis anstelle eines überprüften Werts führen könnte. Eingaben mit Halluzinationsrisiko sind Kandidaten für die Profilbildung. Nicht jede Eingabe erfordert eine Kontextbildung. Wenn Profildaten überschrieben werden, wird das Kontextfenster des Agenten verzerrt.
- Behandeln Sie die Profilfrische als Designentscheidung und nicht als nachträglichen Gedanken. Definieren Sie die zulässige Toleranz für die Pattalität für jedes begründete Attribut und wählen Sie den Injektionsmechanismus entsprechend aus: Zuordnung auf Sitzungsebene für stabile Attribute, Flow-basierte Aktualisierung für volatile Attribute.
- Berechnete Statistiken sollten Geschäftslogik und keine Rohkennzahlen codieren. Eine Agentenüberlegungen zu einem "churnRiskScore" von 0,87 ist effektiver als eine Agentenüberlegungen zu 14 unverarbeiteten Verhaltenssignalen. Berechnen Sie die Interpretation in Data 360 und übergeben Sie das Ergebnis an den Agenten.
Salesforce-Implementierungshinweise
- Die Profilbildung ist nur so vertrauenswürdig wie die Vereinheitlichung dahinter. Beispielsweise hängt der Wert des zusammengeführten Profils vollständig von der Qualität der Identitätsbestimmung im Vorfeld ab. Wenn ein Kunde über fragmentierte Identitäten in Quellsystemen verfügt, die nicht zusammengeführt wurden, sind die Profilattribute, die der Agent erhält, unvollständig oder stellen nur eine Teilansicht dar (z. B. "Lebenswert", der mit Daten aus einem Kanal berechnet wird, aber nicht aus einem anderen).
- Verwenden Sie für verbundene Data 360-Flows das Element "Datensätze abrufen" mit einem Filter für die "recordId" oder "accountId" der aktuellen Sitzung, um nur den entsprechenden Profildatensatz abzurufen. Geben Sie nur die Attribute zurück, die für die nachgelagerte Aktion erforderlich sind. Geben Sie nicht das vollständige Profilobjekt zurück.
- Berechnete Statistiken müssen über Data 360-Aufnahmepipelines auf dem aktuellen Stand gehalten werden. Richten Sie Streaming oder Aktualisierungen nahezu in Echtzeit für Statistiken ein, die bei zeitkritischen Entscheidungen verwendet werden (z. B. Abwanderungsrisiko in einem Aufbewahrungs-Workflow). Batch-aktualisierte Statistiken sind für langsamere Attribute (z. B. die Vertragswertklasse pro Jahr) akzeptabel.
- Überprüfen Sie vor dem Aktionsaufruf, ob die zugeordneten Profilattribute ungleich null sind. Eine an eine Preisaktion übergebene Null "customerTier" ist so schädlich wie ein halluzinierter Wert. Verwenden Sie Flow-Entscheidungselemente, um fehlende Profildaten zu erkennen und an ein Ausweichobjekt weiterzuleiten, das entweder eine Standardeinstellung abruft oder zur Klarstellung auffordert.
- Ordnen Sie in der Unteragentenkonfiguration Profilattribute mithilfe aussagekräftiger, semantisch eindeutiger Variablennamen (z. B. "customerTier", "lifetimeValueUSD", "churnRiskScore") Aktionseingabeparametern zu. Der LLM liest diese Namen beim Auswählen und Verfassen von Aktionen. Mehrdeutige Namen beeinträchtigen die Genauigkeit der Auswahl.
**Fehlerbehandlung und -behebung**
- Wenn ein erforderliches Profilattribut zum Zeitpunkt des Aktionsaufrufs null oder nicht verfügbar ist, sollte der Agent nicht mit einer möglicherweise falschen Standardeinstellung fortfahren. Die Aktion sollte einen strukturierten Fehler zurückgeben, der das fehlende Attribut angibt, und der Agent sollte den Benutzer entweder zur Klarstellung auffordern oder zu einer Person eskalieren, wenn er nicht unterhaltungsbasiert arbeitet.
- Wenn ein mit Data 360 verbundener Flow keine Profildaten abrufen kann (beispielsweise aufgrund einer Unterbrechung des Data 360-Service), sollte der Fehlerpfad des Flows einen strukturierten Fehler an den Agenten mit der spezifischen Fehlerursache zurückgeben. Der Agent kann dann entscheiden, ob er es erneut versuchen, mit einer verschlechterten Erfahrung fortfahren oder den Fehler dem Benutzer anzeigen möchte.
- Protokollieren Sie alle Profilattributwerte, die bei der Sitzungserstellung oder beim Aktionsaufruf eingegeben wurden, zusammen mit der Sitzungs-ID. Auf diese Weise wird sichergestellt, dass jede strittige Agentenentscheidung mit genau den Kundendaten rekonstruiert werden kann, die dem Agenten zu dem Zeitpunkt gegeben wurden.
**Sicherheitsüberlegungen**
- In den Agentenkontext eingefügte Profilattribute unterliegen denselben Datenzugriffssteuerungen wie alle CRM-Datensätze. Stellen Sie sicher, dass der Integrationsbenutzer oder die verbundene Anwendung, der bzw. die zum Auflösen von Profilattributen verwendet wird, nur über die für die anzuzeigenden Attribute erforderlichen Feldebenenberechtigungen verfügt und nicht über einen umfassenderen Profillesezugriff.
- Berechnete Statistiken, die sensible abgeleitete Kennzahlen codieren (z. B. prognostizierte Gesundheitsbewertung, finanzielle Risikostufe), sollten als sensible Felder behandelt werden und durch dieselben Zugriffssteuerungen wie die zugrunde liegenden Daten gesteuert werden. Wenn Sie einem Agenten, der in einem kundenorientierten Kontext arbeitet, eine hohe Abwanderungsrisikobewertung bereitstellen möchten, müssen Sie sorgfältig überlegen, was der Agent kommunizieren kann.
- Zeigen Sie keine Profilattribute an, die für die Aktion nicht erforderlich sind. Jedes zusätzliche Attribut im Kontextfenster des Agenten ist ein zusätzliches Datenelement, das in der Antwort des Agenten reproduziert werden könnte. Wenden Sie ein minimal erforderliches Prinzip auf die Profilbildung an.
- Überprüfen Sie alle Sitzungen, in denen berechnete Statistiken oder sensible Profilattribute als Eingaben eingefügt wurden. Diese Sitzungen stellen Entscheidungen dar, die auf der Grundlage abgeleiteter Kundenintelligenz getroffen werden, und unterliegen in bestimmten Branchen möglicherweise Erklärbarkeits- oder behördlichen Anforderungen.
**Beispiel**
Ein Telekommunikationsunternehmen verwendet Agentforce, um Aufbewahrungsunterhaltungen mit Kunden zu verarbeiten, die eine Stornierungsanforderung initiiert haben.
- Wenn ein Stornierungsvorgang geöffnet wird, wird die Agentensitzung mit der "accountId" des Kunden als Kontext erstellt.
- Die Konfiguration des Unteragenten ordnet Sitzungsvariablen zum Zeitpunkt der Erstellung drei Attribute des zusammengeführten Data 360-Profils zu: "customerTier" (Unternehmen), "lifetimeValueUSD" (42.000) und "contractRenewalDate" (60 Tage).
- Eine berechnete Statistik wie "churnRiskScore" (0,91, berechnet aus Nutzungsrückgang, Support-Ticket-Häufigkeit und NPS-Trend) wird als zusätzliche Sitzungsvariable über einen verbundenen Data 360-Flow zugeordnet, der als erster Aktionsschritt aufgerufen wird.
- Der Agent, der nun auf überprüften Kundenfakten basiert, ruft die Aktion "SelectRetentionOffer" auf. Da die Eingaben "customerTier = Enterprise", "lifetimeValueUSD = 42000" und "churnRiskScore = 0,91" enthalten, gibt die Aktion das maximale Aufbewahrungsangebot und nicht ein Standardangebot zurück.
- Der Agent ruft "PresentOffer" auf, um das Angebot in der Unterhaltung bereitzustellen, und "LogRetentionAttempt", um die Interaktion im CRM aufzuzeichnen, wobei alle grundierten Attribute für die Überprüfbarkeit beibehalten werden.
## Systemübergreifende Tool-Integration (Ausgehend)
**Kontext**
Unternehmensdaten sind fragmentiert. Ein Agent, der nur auf das reagieren kann, was sich in der Salesforce Platform befindet, ist auf einen Bruchteil der Informationen beschränkt, die er für eine effektive Argumentation benötigt. Zum Beantworten einer Servicefrage muss möglicherweise das offene Ticket eines Kunden in Service Cloud gelesen werden. Zum Vorbereiten eines Vorschlags muss möglicherweise eine Datei aus Google Drive abgerufen werden. Zum Analysieren der Produktnutzung muss möglicherweise ein Data Warehouse abgefragt werden. Jedes dieser Systeme verfügt über seine eigenen APIs, sein eigenes Authentifizierungsmodell und sein eigenes Datenschema. Die Kosten für das Schreiben von maßgeschneidertem Integrationscode für jedes einzelne System haben die Verbindung zwischen Agenten in der Vergangenheit teuer und anfällig gemacht.
MCP ist ein offener Standard, der dies direkt angeht. Sie definiert eine einheitliche Oberfläche, über die ein Agent Tools finden und aufrufen kann, die von einem MCP-kompatiblen Server bereitgestellt werden, unabhängig vom zugrunde liegenden System. Jeder MCP-Server fungiert als Adapter: Sie umschließt die nativen Schnittstellen eines Zielsystems in einer standardisierten, toolorientierten Oberfläche, die der Agent abfragen, aufrufen und verfassen kann, ohne etwas über die spezifischen Protokolle oder Schemas des Systems zu wissen.
Aus Sicht des Agenten sehen die Verbindungen mit Slack, einer Datenbank mit strukturierter Abfragesprache (SQL) und einem Dokumentverwaltungssystem identisch aus. Dabei handelt es sich um drei MCP-Server, die jeweils eine Reihe beschriebener aufrufbarer Tools bereitstellen. Der Agent wählt sie anhand ihrer semantischen Beschreibungen und des Ziels, das er erreichen möchte, aus und sequenziert sie.
**Probleme**
Wenn ein Agent Informationen abrufen oder Aktionen über mehrere externe Systeme hinweg auslösen muss – jedes mit unterschiedlichen APIs, Authentifizierungen und Schemas –, wie kann er dann seine Funktionen ohne angepassten Integrationscode pro System oder enge Kopplung mit einer beliebigen Systemimplementierung erkennen, aufrufen und zusammenstellen?
**Kräfte**
Beantworten Sie beim Anwenden dieses Musters die folgenden Fragen:
- Muss der Agent Systeme außerhalb der Salesforce Platform erreichen, beispielsweise Dokumentspeicher, Tools für die Zusammenarbeit, Datenbanken oder SaaS-Drittanbieter, deren APIs nicht nativ als Agentforce-Aktionen dargestellt werden?
- Ist die Erkennung dynamischer Tools erforderlich, bei denen der Agent den richtigen Integrationsendpunkt zum Zeitpunkt der Überlegungen anhand der aktuellen Anforderung identifiziert, statt Integrationen in seiner Konfiguration hartcodiert zu haben?
- Ändert sich die Integrationslandschaft häufig; neue Systeme wurden hinzugefügt, bestehende aktualisiert und andere Änderungen können es erfordern, dass ein maßgeschneiderter Ansatz pro System zu einem nicht nachhaltigen Wartungsaufwand führt?
- Muss die Argumentationsebene des Agenten von den Implementierungsdetails der nachgelagerten Systeme getrennt werden, damit eine Änderung an der API eines Zielsystems keine Änderungen an den Anweisungen oder der Konfiguration des Unteragenten erfordert?
- Gehören die Zielsysteme unterschiedlichen Teams oder Anbietern, die jeweils für die Offenlegung ihrer eigenen Funktionen verantwortlich sind, wodurch ein anbieterseitiges MCP-Server-Modell praktischer wird als eine verbraucherseitige Integration pro Agent?
**Anwendung für Salesforce-Muster**
| Lösung | Passend | Kommentare |
| --------------------------- | ----------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Salesforce MCP-Server | Optimal für Salesforce-Ökosystemziele | Wird verwendet, wenn sich das Zielsystem im Salesforce-Ökosystem befindet und ein MCP-Server des Erstanbieters verfügbar ist. Salesforce Headless 360 stellt MCP-Server für seine eigenen Plattformfunktionen bereit und stellt CRM-Daten, -Flows und -Plattformaktionen als MCP-kompatible Tools bereit. Reduziert den Implementierungsaufwand auf die Konfiguration und nicht auf die Entwicklung. **Notiz**: Derzeit unterstützen Salesforce MCP-Server nur Endbenutzeranmeldeinformationen für die Authentifizierung und Autorisierung. |
| Benutzerdefinierte MuleSoft-MCP-Server | Am besten, wenn kein Erstanbieter-MCP-Server vorhanden ist | Die Verwendung für ältere Systeme, proprietäre interne Anwendungen oder SaaS-Plattformen von Drittanbietern ist vor dem MCP-Standard. Wenn ein Zielsystem keinen eigenen MCP-Server bereitstellt, kann eine MuleSoft-Integrationsebene in einen benutzerdefinierten MCP-Server eingeschlossen werden, der die Funktionen des Systems als Tools bereitstellt. Sie kann auch mit Salesforce-APIs verwendet werden, wenn MCPs erforderlich sind, damit Agenten nur mit Systembenutzeranmeldeinformationen verwendet werden können. MuleSoft übernimmt die Protokollübersetzung, -authentifizierung und -datentransformation. Die MCP-Ebene macht das Ergebnis für Agenten erkennbar. |
| Drittanbieter-MCP-Server | Bestens geeignet für Rohstoffsysteme mit aktiven MCP-Ökosystemen | Für Ihre Plattform (GitHub, Google Workspace) ist ein vom Anbieter verwalteter MCP-Server vorhanden, der die Sicherheits- und Wartungsanforderungen erfüllt. Immer mehr Unternehmensplattformen wie GitHub, Google Workspace und andere veröffentlichen ihre eigenen MCP-Server. Wenn ein produktionsbereiter, vom Anbieter verwalteter Server vorhanden ist, ziehen Sie ihn dem Erstellen eines benutzerdefinierten Servers vor. Bewerten Sie den Sicherheitsstatus und das Wartungsengagement vor der Übernahme. |
**Skizze**
_Sequenzdiagramm für die überprüfte Kundenkontextinjektion_
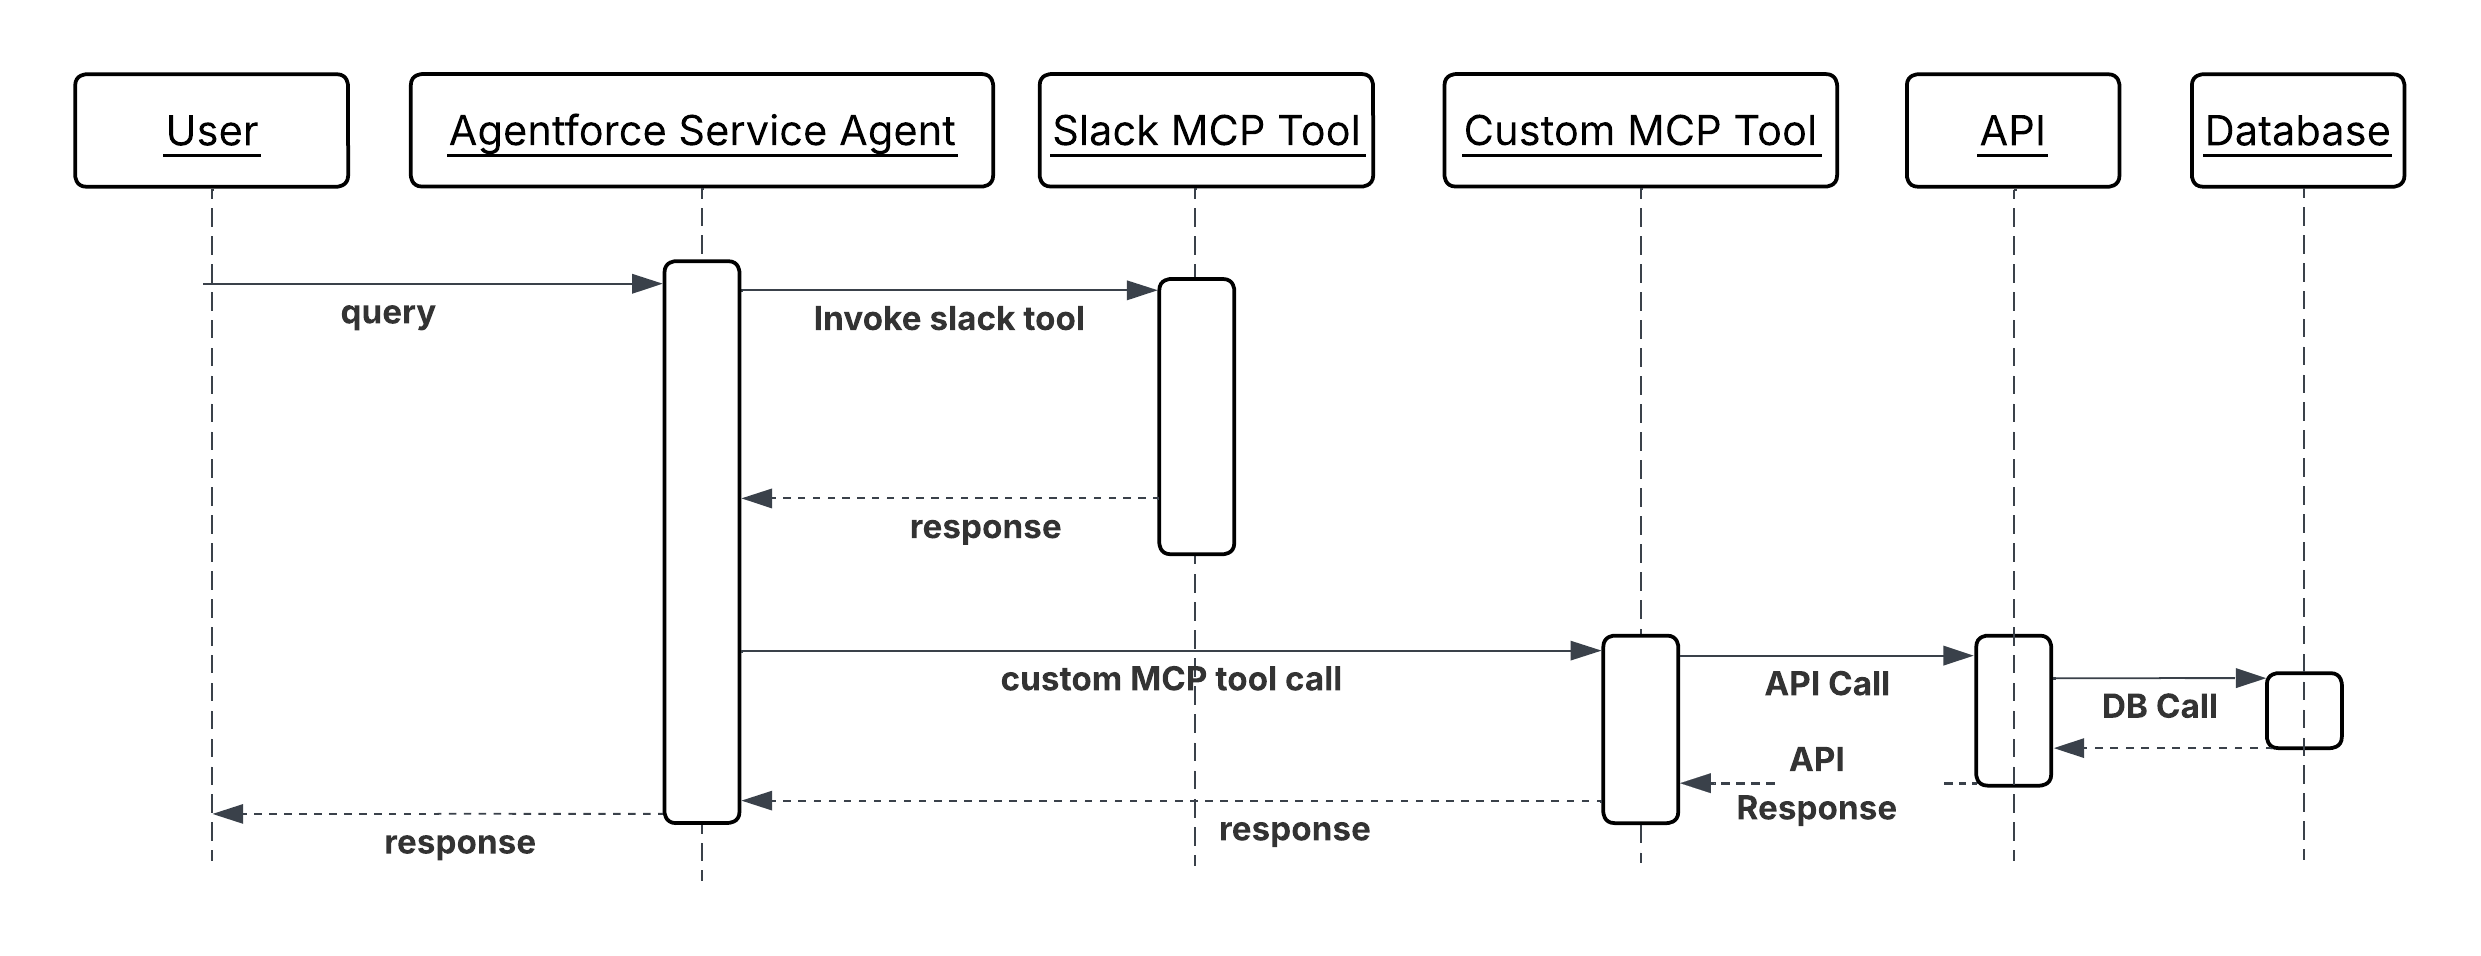 **Ergebnisse**
Die erreichbare Oberfläche des Agenten wird erweitert, ohne die Integrationskomplexität zu erhöhen. Wenn Sie ein neues externes System hinzufügen, müssen Sie dafür einen MCP-Server bereitstellen oder konfigurieren und keine maßgeschneiderten Apex Callouts oder Flow-Integrationen pro Agent schreiben. Die Argumentationsebene des Agenten bleibt unverändert. Sie erkennt die neuen Tools und ruft sie allein anhand ihrer semantischen Beschreibungen auf.
Der MCP-Standard erstellt auch eine saubere Trennung der Inhaberschaft: Das für ein System verantwortliche Team stellt seine Funktionen als MCP-Server bereit. Das Agententeam nutzt diese Funktionen, ohne die internen Funktionen des Systems verstehen zu müssen. Diese Grenze reduziert den Koordinationsaufwand mit zunehmender Anzahl integrierter Systeme.
Die Zusammensetzbarkeit von Tools ist ein direktes Ergebnis. Da alle Tools dieselbe Aufrufoberfläche verwenden, kann der Agent Tools aus unterschiedlichen Systemen verketten, eine Datei aus Google Drive abrufen, Daten daraus extrahieren und das Ergebnis in einen CRM-Datensatz schreiben, so natürlich wie Verkettungsaktionen innerhalb eines Systems.
**Überlegungen zum Design**
Plattformunabhängige Anleitung
- Toolbeschreibungen sind die einzige Grundlage für den Agenten, um zu entscheiden, ob und wie ein Tool aufgerufen werden soll. Schreiben Sie Beschreibungen in einer klaren, intent-basierten Sprache, in der angegeben ist, was das Tool tut, wann es angewendet wird und was es zurückgibt. Eine Beschreibung, in der es heißt "fragt die CRM-Datenbank ab", ist weniger nützlich als "ruft die offenen Kundenvorgänge des Accounts nach Priorität sortiert für eine bestimmte Account-ID ab". Schlechte Beschreibungen führen zu einer schlechten Toolauswahl.
- Begrenzen Sie jedes MCP-Tool auf eine einzelne atomare Funktion. Ein Tool, das ein Dokument abruft und auch eine Zusammenfassung in das Quellsystem zurückschreibt, ist für den Agenten schwieriger zu überlegen, bei Fehlern schwerer zu wiederholen und schwerer zu schützen als zwei separate Tools. Ein Werkzeug, eine Verantwortung.
- Entwerfen Sie Tools so, dass Ausgaben zusammengesetzte Eingaben sind. Das Ergebnis eines Abruftools sollte so strukturiert sein, dass es auf natürliche Weise den Eingabeparametern der Aktionstools zugeordnet wird, die in der Regel darauf folgen, wodurch die Transformationsarbeit reduziert wird, die der Agent zwischen den Schritten ausführen muss.
- Remote-Host-MCP-Server. Lokale Binärinstallationen verursachen eine Bereitstellungs- und Versionierungskomplexität, die mit der Anzahl der Agentenumgebungen wächst. Ein remote gehosteter Server kann unabhängig von den Agenten aktualisiert werden, die ihn verwenden.
Salesforce-Implementierungshinweise
- Wenn Sie eine konsistente MCP-Authentifizierung, eine Ratenobergrenze und Nutzlastvalidierungen für alle ausgehenden MCP-Aufrufe wünschen, verwenden Sie das AI-Gateway wie MuleSoft Omni Gateway, das MCP-Server unterstützt, und konfigurieren Sie es, bevor Sie Agenten einen MCP-Server bereitstellen.
- Verwenden Sie OAuth 2.0-Anmeldeinformationen für alle für MCP-Server-Verbindungen erforderlichen Anmeldeinformationen. Anmeldeinformationen dürfen nicht in Toolparametern, Aktionskonfigurationen oder Apex Code angezeigt werden.
- Einige MCP-Tools benötigen möglicherweise Endbenutzeranmeldeinformationen, um je nach Geschäftsanwendungsfall (z. B. Mittelübertragung) einige Aktionen ausführen zu können. Verwenden Sie zum Übertragen von Endbenutzer-Identitätstoken die Richtlinie [OAuth 2.0 Im Namen der Injektion](https://docs.mulesoft.com/gateway/latest/policies-outbound-oauth-obo?_ga=2.13731188.2103534092.1779677345-1473519780.1778951013) von Anmeldeinformationen, die derzeit von MuleSoft Omni Gateway unterstützt wird.
- Für benutzerdefinierte MuleSoft-MCP-Server: Definieren Sie das MCP-Toolschema in der API-Spezifikation von MuleSoft und registrieren Sie den Endpunkt des Servers im Agentforce Toolkatalog. Testen Sie Toolbeschreibungen anhand von repräsentativen Agentenabfragen, um sicherzustellen, dass der Agent das richtige Tool für die richtige Aufgabe auswählt, bevor er sie in der Produktion bereitstellt.
**Fehlerbehandlung und -behebung**
- Wenn ein MCP-Tool-Aufruf einen Fehler zurückgibt, überprüft der Agent den maschinenlesbaren Fehlercode, um die entsprechende Wiederherstellungsaktion zu ermitteln: Anfordern fehlender Parameter vom Benutzer, erneuter Versuch mit korrigierter Eingabe oder Eskalation zu einem Menschen. Sie verwendet niemals stillschweigend Fehler oder führt die Argumentation fort, als ob der Tool-Aufruf erfolgreich war.
- Der Agent implementiert die Wiederholungslogik für vorübergehende Fehler direkt.
- Protokollieren Sie jeden Aufruf des MCP-Tools auf Client-Seite mit dem Toolnamen, den bereinigten Eingabeparametern und dem Ergebnis. Diese clientseitige Verfolgung in Kombination mit serverseitigen Protokollen ist der primäre Mechanismus zur Diagnose, warum ein Agent einen bestimmten Aktionspfad eingeschlagen hat, wenn ein Workflow nicht das erwartete Ergebnis liefert.
**Sicherheitsüberlegungen**
- Alle ausgehenden MCP-Serververbindungen werden über das Gateway geleitet. Das Gateway erzwingt die Überprüfung der Authentifizierung, die Ratenbegrenzung, um Werkzeugmissbrauch zu verhindern, und die Nutzlastüberprüfung, um Eingabeversuche in Werkzeugparametern zu erkennen. Direkte, nicht vermittelte Verbindungen von Agenten zu MCP-Servern umgehen diese Steuerelemente und sind nicht zulässig.
- Grenzen Sie die MCP-Serververbindungen jedes Agenten nur auf die Server ein, deren Tools der Agent tatsächlich benötigt. Ein Agent, der mit Zugriff auf alle verfügbaren MCP-Server konfiguriert ist, verfügt über eine größere Angriffsfläche als ein Agent, der nur mit den Tools verbunden ist, die seine definierten Aufgaben erfordern.
- Validieren und bereinigen Sie die Eingabeparameter des Tools, bevor Sie sie an das Tool übergeben, insbesondere wenn Parameterwerte aus vom Benutzer bereitgestelltem Text oder LLM-generiertem Inhalt stammen. Übergeben Sie nicht validierte LLM-Ausgaben nicht direkt als Tool-Parameter. Ein Angreifer, der die Argumentation des Agenten beeinflussen kann, kann diesen Pfad verwenden, um schädliche Werte in nachgelagerte Systemaufrufe einzuschleusen.
- Behandeln Sie die Liste der verbundenen MCP-Server und deren Tool-Inventare als sensible Konfiguration. Ein Angreifer, der weiß, welche Tools einem Agenten zur Verfügung stehen und welche Parameter er akzeptiert, verfügt über eine Zuordnung zum Erstellen von Eingabeaufforderungs-Nutzlasten, mit denen diese Tools missbraucht werden sollen.
**Beispiel**
Ein Vertriebsagent bereitet eine umfassende Accountbesprechung vor, bevor ein Kundenanruf von hohem Wert erfolgt:
1. Der Agent erhält die folgende Anforderung: "Bereiten Sie eine Besprechung über Acme Corp. vor, bevor morgen über die Verlängerung diskutiert wird."
2. Der Agent fragt den MCP-Toolkatalog ab und identifiziert drei relevante Tools auf zwei MCP-Servern: `GetRecentEmails`, `GetOpenOpportunities` und `GetSupportTicketSummary`.
3. Der Agent ruft alle drei Tools parallel auf. Jeder MCP-Server übersetzt den Aufruf in die native API seines Zielsystems, ruft die relevanten Daten ab und gibt ein strukturiertes Ergebnis zurück.
4. Der Agent erhält die drei Ergebnisse. Aktuelle E-Mail-Threads, die offene Verlängerungs-Opportunity mit Geschäftsvolumen und -phase sowie eine Zusammenfassung der offenen Support-Tickets nach Priorität und fasst sie zu einer strukturierten Account-Briefing zusammen.
5. Der Agent ruft `CreateAccountNote` auf, um die Einweisung im Accountdatensatz zu speichern, und gibt dem anfordernden Benutzer eine Zusammenfassung zurück.
6. Alle vier Aufrufe von MCP-Tools werden vom Gateway mit Toolnamen, Serveridentitäten und Ergebnissen für den Sitzungsüberprüfungsdatensatz protokolliert.
## Geschäftsmöglichkeiten als aufrufbare Tools (eingehend)
**Kontext**
Das ausgehende MCP-Muster beschreibt einen Agentforce-Agenten, der Tools von externen MCP-Servern verwendet. Das eingehende Muster kehrt dies um. Salesforce Platform-Funktionen wie CRM-Datensätze, Flows, Apex-Logik und Data 360-Statistiken werden als MCP-Tools angezeigt, die externe Agenten in einem beliebigen LLM-Framework entdecken und aufrufen können.
Dieses Muster ist wichtig, da Enterprise AI-Bereitstellungen selten aus einem Guss bestehen. Der auf einem anderen Framework basierende Agent eines Partners muss möglicherweise den Accountstatus eines Kunden in Salesforce nachschlagen. Ein internes Data Science-Team, das einen Python-basierten Agenten ausführt, muss möglicherweise einen Salesforce-Flow auslösen, um einen Genehmigungsprozess zu starten. Ohne standardisierten Belichtungsmechanismus benötigt jeder externe Verbraucher eine maßgeschneiderte Integration. Durch die Bereitstellung von Salesforce-Funktionen als MCP-Server erhält jeder MCP-kompatible Agent eine einheitliche, auffindbare Oberfläche für die Tools der Plattform, unabhängig davon, wie der aufrufende Agent erstellt ist.
Beispielsweise muss der Beschaffungsagent eines Partners, der auf einem Drittanbieter-Framework basiert, den Vertragsstatus eines Lieferanten in Salesforce überprüfen, bevor er einen Auftrag genehmigt. Statt eine direkte REST-Integration zu erstellen, wird ein `GetContractStatus` auf dem Salesforce MCP-Server aufgerufen. Das Tool erzwingt dieselben Zugriffssteuerungen wie alle nativen Salesforce-Vorgänge. Dem aufrufenden Agenten wird nur das Ergebnis angezeigt.
**Probleme**
Wenn ein externer Agent, der auf einem anderen Framework basiert, einem Partner gehört oder anderweitig außerhalb der Salesforce Platform ausgeführt wird, Salesforce-Funktionen als Teil seines eigenen Workflows aufrufen muss, wie können diese Funktionen auf standardisierte, auffindbare und sicher gesteuerte Weise verfügbar gemacht werden, die keine maßgeschneiderte Integration pro externem Verbraucher erfordern?
**Kräfte**
Beantworten Sie beim Anwenden dieses Musters die folgenden Fragen:
- Basieren die externen Agenten, die Salesforce-Funktionen nutzen müssen, auf Frameworks, die den MCP-Standard unterstützen? Andernfalls ist eine REST-API oder ein Webhook-Ansatz möglicherweise besser geeignet als MCP.
- Welche Salesforce-Funktionen müssen verfügbar gemacht werden – schreibgeschützter Datenabruf, Schreibvorgänge, Flow-Aufrufe oder eine Kombination? Der Umfang der Exposition bestimmt direkt den Sicherheitsbereich, der geregelt werden muss.
- Wie sollte die Identität des externen Anrufagenten überprüft werden und unter welchen Salesforce-Berechtigungen sollten seine Aufrufe ausgeführt werden? Für Anrufe zwischen Agenten und Plattformen dürfen keine umfassenderen Berechtigungen übernommen werden, als für den jeweiligen Vorgang erforderlich.
- Ist der Salesforce MCP-Server für interne Verbraucher (Agenten anderer Teams innerhalb derselben Organisation) oder externe Verbraucher (Partner- und Kundenagenten) vorgesehen? Das Trust Model und die Authentifizierungsanforderungen unterscheiden sich erheblich zwischen diesen Zielgruppen.
- Wie wird sich der Satz an verfügbaren Tools im Laufe der Zeit entwickeln? Neue Salesforce-Funktionen, die dem MCP-Server hinzugefügt wurden, können sofort von allen verbundenen Agenten erkannt werden. Die Offenlegung nicht beabsichtigter Tools muss durch einen bewussten Veröffentlichungsprozess gesteuert werden.
**Anwendung für Salesforce-Muster**
| Lösung | Passend | Kommentare |
| --------------------------------- | ---------------------------------------------------------------- | ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Salesforce als MCP-Server (nativ) | Bestens geeignet für die Bereitstellung von Salesforce-Funktionen von Erstanbietern | Wird verwendet, wenn die anzuzeigenden Tools direkt vorhandenen Salesforce Platform-Vorgängen zugeordnet werden und die aufrufenden Agenten MCP-kompatibel sind. Mit der nativen MCP-Serverfunktion von Salesforce Headless 360 können Plattformvorgänge wie Datensatzabfragen, Flow-Aufrufe und Apex-Aktionen als MCP-Tools deklariert und allen mit MCP kompatiblen externen Agenten zur Verfügung gestellt werden. Der Zugriff wird durch das Salesforce-Berechtigungsmodell gesteuert. Beachten Sie, dass derzeit nur mit Endbenutzeranmeldeinformationen auf diese Headless 360-MCP-Server zugegriffen werden kann. |
| MuleSoft als MCP-Server-Fassade | Am besten, wenn Transformation oder Multi-System-Aggregation erforderlich ist | Wird verwendet, wenn der anrufende Agent eine Funktion benötigt, die Daten aus mehr als einem Salesforce-Objekt, eine Transformation vor der Zustellung oder die Zusammensetzung mit Daten aus anderen Systemen erfordert. Die MCP-Schnittstelle bleibt übersichtlich und einfach. Die Komplexität wird von MuleSoft absorbiert. Eine MuleSoft-MCP-Ebene befindet sich vor Salesforce und stellt das aggregierte Ergebnis mehrerer Plattformvorgänge als einzelnes MCP-Tool bereit. Diese Lösung kann auch von Agenten verwendet werden, bei denen die Endbenutzeridentität nicht für die Salesforce-Authentifizierung und -Autorisierung übernommen werden kann. Wenn Agentforce Agenten beispielsweise MCP-Server mit Systemanmeldeinformationen benötigen, müssen wir uns auf benutzerdefinierte MCP-Server verlassen, beispielsweise auf einen mit MuleSoft erstellten und gehosteten. |
**Skizze**
_Sequenzdiagramm für Geschäftsfunktionen als aufrufbares Tool_
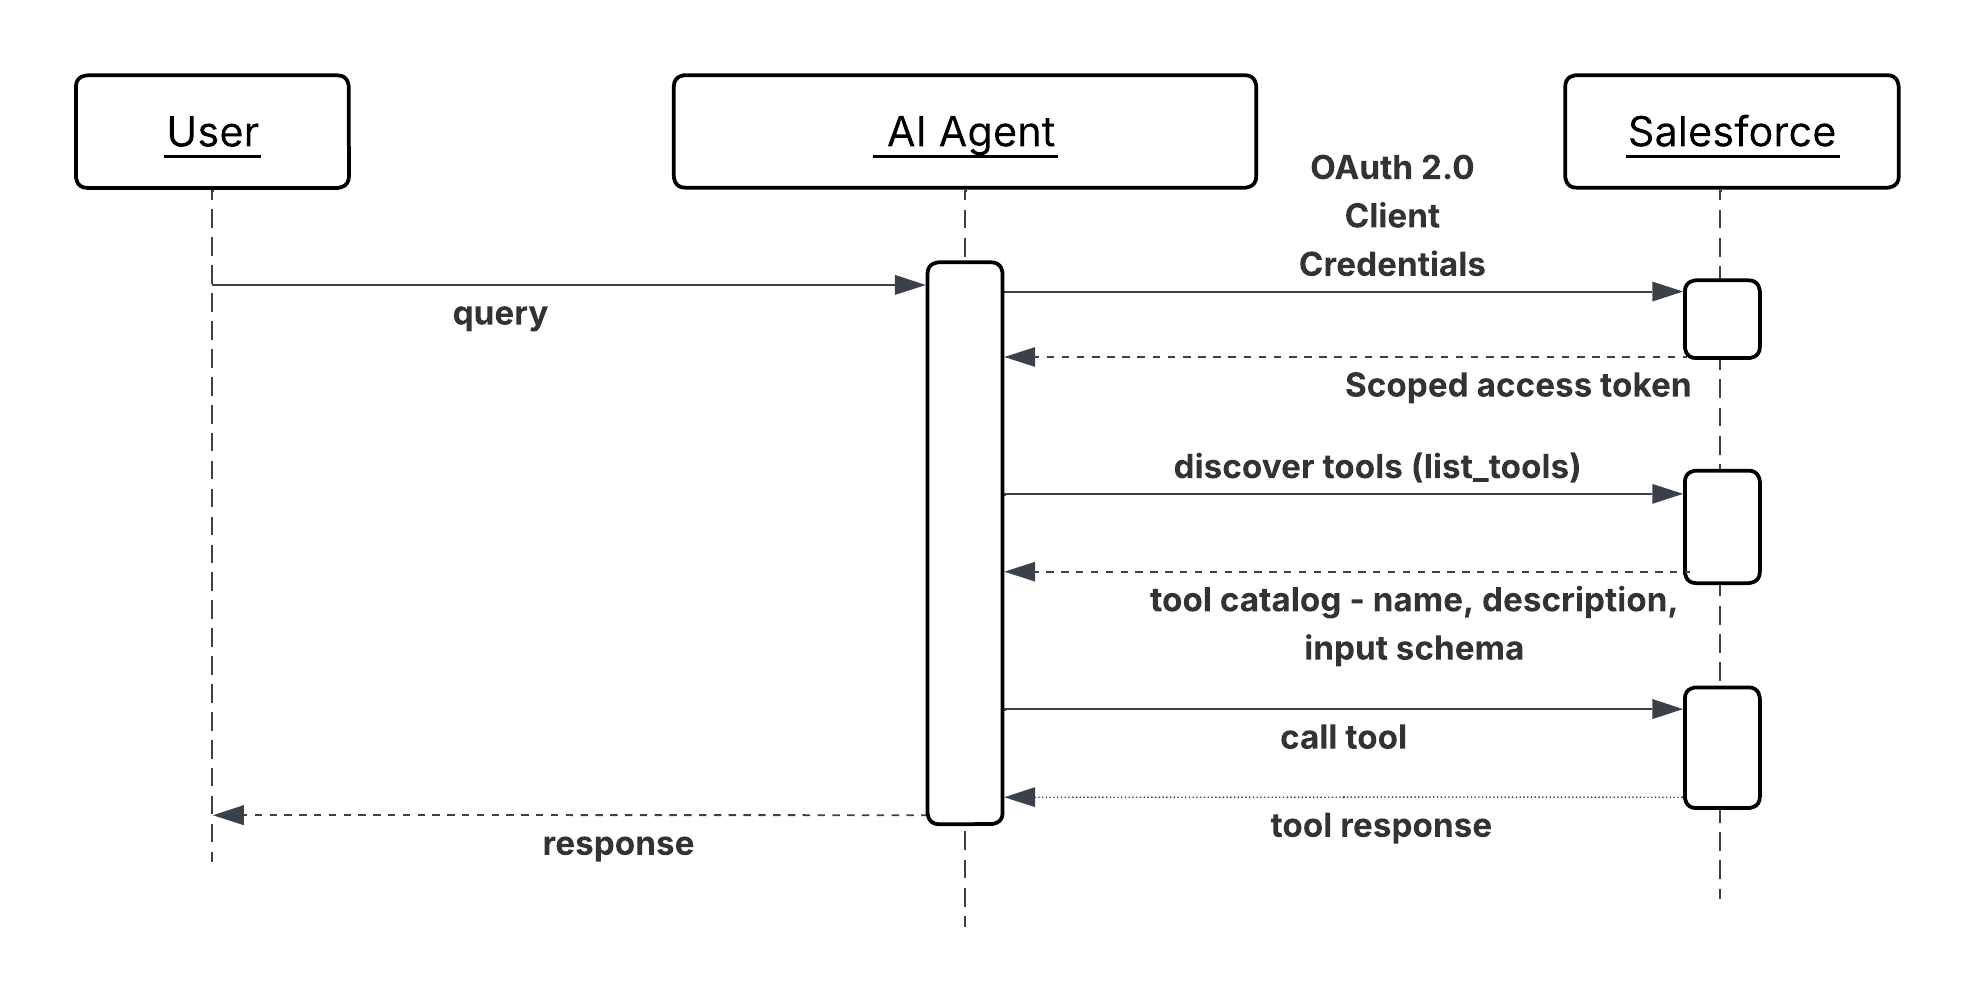 **Ergebnisse**
Salesforce wird ein erstklassiger Teilnehmer an Ökosystemen für mehrere Anbieter. Externe Agenten können Plattformfunktionen entdecken und nutzen, ohne dass eine benutzerdefinierte REST-Integration pro Verbraucher oder Anwendungsfall erforderlich ist. Die Anzahl der Verbraucher kann wachsen, ohne dass der Aufwand für die Integrationswartung proportional steigt.
Bei Headless 360 regelt das Salesforce-Berechtigungsmodell jeden eingehenden Tool-Aufruf. Externe MCP-Clients umgehen vorhandene Datenzugriffssteuerungen nicht. Sie funktionieren innerhalb dieser. Das bedeutet, dass die Sicherheitsposition der Bereitstellung von Funktionen über MCP der Offenlegung über eine andere authentifizierte API-Oberfläche entspricht.
Die Auffindbarkeit von Werkzeugen ist ein zusammengesetzter Vorteil. Wenn dem Toolkatalog des MCP-Servers neue Salesforce-Funktionen hinzugefügt werden, stehen sie sofort allen verbundenen externen Agenten zur Verfügung, ohne dass diese Agenten ihre Konfigurationen aktualisieren müssen.
**Überlegungen zum Design**
Plattformunabhängige Anleitung
- Veröffentlichen Sie nur das, was externe Agenten benötigen. Jedes Tool, das dem Katalog des MCP-Servers hinzugefügt wird, erweitert die Angriffsfläche und den Verwaltungsaufwand. Überprüfen Sie den Werkzeugbestand bewusst. Definieren Sie, welche Funktionen für die externe Nutzung genehmigt werden, und behandeln Sie die nicht genehmigte Offenlegung als Konfigurationslücke und nicht als Standard.
- Schreiben Sie Toolbeschreibungen für externe Verbraucher. Der Operator eines externen Agenten hat keine Knowledge über Ihr internes Datenmodell oder Ihre Benennungskonventionen. Halten Sie Beschreibungen in sich: was das Tool macht, was die einzelnen Parameter bedeuten, was das Ergebnis darstellt und welche Einschränkungen oder Voraussetzungen der Aufrufer erfüllen muss.
- Versionstools explizit, wenn sich ihre Eingabe- oder Ausgabeschemas ändern. Ein externer Agent, der vom aktuellen Schema eines Tools abhängt, wird stillschweigend beschädigt, wenn sich das Schema ohne vorherige Ankündigung ändert. Behandeln Sie fehlerhafte Änderungen an der Oberfläche eines MCP-Tools mit derselben Disziplin wie fehlerhafte Änderungen an einer öffentlichen REST-API.
Salesforce-Implementierungshinweise
- Führen Sie jeden eingehenden Aufruf des MCP-Tools (Headless 360) von Salesforce Out-of-the-Box (OOTB) unter einem Endbenutzer aus, dessen Berechtigungen nur auf die Vorgänge beschränkt sind, die für die angezeigten Tools erforderlich sind. Führen Sie keine eingehenden Agentenaufrufe unter einer Administratoridentität mit hohen Berechtigungen aus.
- Verwenden Sie das AI-Gateway wie MuleSoft Omni Gateway, um die Authentifizierung, die Ratenbegrenzung, die Schemavalidierung und die Erkennung personenbezogener Daten (Personally Identifiable Information, PII) konsistent auf alle MCP-Tools anzuwenden.
- Definieren Sie für MuleSoft-MCP-Fassaden das MCP-Toolschema in MuleSoft unabhängig vom zugrunde liegenden Salesforce-API-Schema. Die MCP-Schnittstelle sollte die konzeptionellen Anforderungen des aufrufenden Agenten widerspiegeln und nicht die Form des Salesforce-Objekts, das sie unterstützt. Durch diese Entkopplung kann sich die Salesforce-Implementierung weiterentwickeln, ohne den Vertrag für externe Tools zu verletzen.
**Fehlerbehandlung und -behebung**
- Fehler beim Toolaufruf müssen strukturierte MCP-Fehlerantworten mit einem maschinenlesbaren Code und einer Beschreibung in einfacher Sprache zurückgeben. Der aufrufende externe Agent hat keinen Einblick in die internen Daten der Salesforce Platform, da Fehlermeldungen in sich geschlossen und handlungsrelevant sein müssen, ohne dass Knowledge über Salesforce-spezifische Fehlercodes oder Objektmodelle erforderlich ist.
- Ratenobergrenzenfehler und Authentifizierungsfehler müssen umgehend mit genügend Informationen zurückgegeben werden, damit der Operator des externen Agenten diagnostizieren und beheben kann, welche Ratenobergrenze erreicht wurde oder welche Anmeldeinformationen abgelehnt wurden, ohne interne Konfigurationsdetails offenzulegen.
- Protokollieren Sie alle eingehenden MCP-Tool-Aufrufe im Omni-Gateway mit der Identität des aufrufenden Agenten, dem aufgerufenen Tool, den Eingabeparametern (mit Bereinigung vertraulicher Werte) und dem Ergebnis. Dieses Protokoll ist der primäre Nachweis für die Diagnose von Fehlern, die von externen Verbrauchern gemeldet wurden, und für die Überprüfung, auf welche externen Agenten zugegriffen wurde.
**Sicherheitsüberlegungen**
- Jede eingehende MCP-Verbindung muss sich authentifizieren, bevor ein Tool erreichbar ist. Lassen Sie keine nicht authentifizierte Entdeckung des Toolkatalogs zu. Die Liste der bereitgestellten Funktionen enthält selbst vertrauliche Informationen.
- Wenden Sie zusätzlich zur Authentifizierung auf Verbindungsebene die Autorisierung auf Werkzeugebene an. Ein registrierter externer Agent sollte nur die spezifischen Tools aufrufen können, auf die er explizit Zugriff erhalten hat, nicht den vollständigen Katalog. Erzwingen Sie dies am Gateway, nicht auf der Anwendungsebene.
- Validieren und bereinigen Sie alle eingehenden Tool-Parameter, bevor Sie sie an Salesforce Platform-Vorgänge übergeben. Parameter von externen Agenten sind eine nicht vertrauenswürdige Eingabeoberfläche. Ein in böser Absicht erstellter Parameter könnte versuchen, Abfragefilter zu überschreiben, SOQL-Fragmente (Salesforce Object Query Language) einzufügen oder Flow-Variablen zu beeinflussen. Validieren Sie Typ, Format und Bereich an der MCP-Server- oder Fassadengrenze.
- Führen Sie eine regelmäßige Zugriffsüberprüfung registrierter externer Verbraucher durch. Widerrufen Sie die Anmeldeinformationen für Agenten, die nicht mehr aktiv sind oder deren Zugriffsumfang geändert wurde. Eine ruhende, aber gültige Anmeldeinformation für eine außer Betrieb genommene Partnerintegration ist ein unnötiges Dauerrisiko.
- Schützen Sie sich vor Verstößen gegen Plattformobergrenzen, indem Sie eingehende MCP-Nachrichten im Gateway auf Raten begrenzen. Begrenzen Sie den Datenverkehr von nicht kritischen Agenten unter Last mithilfe von SLA-basierten Stufenrichtlinien.
**Beispiel**
Ein von einem Logistikpartner betriebener Beschaffungsagent muss den Vertrags- und Kreditstatus eines Lieferanten überprüfen, bevor er einen Auftrag mit hohem Wert genehmigt:
1. Der Agent des Partners authentifiziert sich beim Gateway mit seinen registrierten OAuth 2.0-Client-Anmeldeinformationen und erhält ein Zugriffstoken mit Umfang.
2. Der Agent fragt den Toolkatalog des Salesforce MCP-Servers ab und identifiziert zwei relevante Tools: `GetSupplierContractStatus` und `GetAccountCreditSummary`.
3. Der Agent ruft `GetSupplierContractStatus` mit der Kennung des Lieferanten auf. Der MCP-Server übersetzt dies in eine Salesforce-Datensatzabfrage, wendet die Feldebenensicherheit des Integrationsbenutzers an und gibt den aktuellen Status des Vertrags, das Ablaufdatum und alle gekennzeichneten Compliance-Vorgaben zurück.
4. Der Agent ruft `GetAccountCreditSummary` auf, das über die MuleSoft-MCP-Fassade weitergeleitet wird. Die Fassade aggregiert den ausstehenden Rechnungssaldo und den Zahlungsverlauf des Lieferanten aus zwei Salesforce-Objekten und gibt eine einzelne zusammengesetzte Gutschriftszusammenfassung zurück.
5. Mit beiden Ergebnissen bestimmt der Agent des Partners, ob der Vertrag aktiv ist und die Gutschriftsposition innerhalb akzeptabler Grenzen liegt, und genehmigt den Auftrag in seinem eigenen System.
6. Beide Tool-Aufrufe werden vom Gateway mit der Identität des Partneragenten, den aufgerufenen Tools und den Ergebnissen protokolliert, wodurch ein überprüfbarer Datensatz darüber erstellt wird, welcher externe Zugriff gewährt wurde und welche Daten zurückgegeben wurden.
## Agentenübergreifende Delegation (Ausgehend)
**Kontext**
Enterprise-Systeme basieren nun auf der Bearbeitung von gemeinschaftlichen Agenten oder Netzwerken, in denen komplexe Anforderungen zerlegt und an spezialisierte Agenten über verschiedene Domänen oder Anbieterplattformen hinweg delegiert werden. Diese Agenten, die jeweils über ihre eigene Rolle, Funktionen und Tools verfügen, benötigen eine standardisierte, sichere Kommunikationsmethode, um sich auf gemeinsame Ziele zu koordinieren, ohne dass bei jedem Schritt ein menschliches Eingreifen erforderlich ist.
**Probleme**
Wie kann ein aufrufender AI-Agent komplexe oder domänenspezifische Aufgaben dynamisch erkennen, sicher damit interagieren und an einen Remote-Peer-Agenten delegieren, der auf einem anderen Framework basieren oder von einem anderen Anbieter betrieben wird und strukturierte Ergebnisse erhält, um einen größeren Unternehmens-Workflow abzuschließen?
**Kräfte**
Beantworten Sie beim Anwenden dieses Musters die folgenden Fragen:
- Wie interagieren Agenten, die mit verschiedenen Frameworks entwickelt wurden oder über isolierte Anwendungsbereiche hinweg arbeiten?
- Wie können Agenten zusammenarbeiten und Aufgaben delegieren, ohne ihre interne Logik, ihren Arbeitsspeicher oder ihre proprietären Tools offenzulegen?
- Wie unterstützen Agenten komplexe, langfristige Aufgaben und bieten gleichzeitig Echtzeit-Statusaktualisierungen, Streaming und Push-Benachrichtigungen?
- Wie erzwingen Agenten die Sicherheit auf Unternehmensebene (Authentifizierung, Autorisierung) und die Richtlinieneinhaltung für die agentenübergreifende Kommunikation?
- Wie handhaben Agenten strukturierte Aufgaben-Workflows (Initiierung, Fortschritt, Abschluss), die über einfache API-Aufrufe hinausgehen?
**Anwendung für Salesforce-Muster**
Das A2A-Protokoll ist ein offener Standard, mit dem Agenten andere Agenten als gleichrangige Personen entdecken, delegieren und mit ihnen zusammenarbeiten können. Sie bietet Agenten eine gemeinsame Sprache, um Informationen sicher auszutauschen und Aktionen zwischen verschiedenen Plattformen und Anbietern zu koordinieren. A2A konzentriert sich auf die Peer-to-Peer-Kommunikation und ergänzt MCP, das sich auf die Verbindung von Agenten mit Tools und APIs konzentriert.
| Lösung | Passend | Kommentare |
| ------------------------------------------- | ----------------------------------------------------------------------------------- | --------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Multi-Agent-Orchestrierung (SOMA) für einzelne Organisationen | Am besten, wenn alle Domänenagenten in einer Organisation leben und keine anbieterübergreifende Weiterleitung erforderlich ist | Ein Superagent (Orchestrator) zerlegt Anforderungen und leitet sie mithilfe der LLM-basierten Weiterleitung (Atlas Reasoning Engine liest Unteragentenbeschreibungen) oder der deterministischen Weiterleitung (Agentenskript) an bis zu 7 verbundene Unteragenten weiter. Dies ist das standardmäßig empfohlene Muster, bevor Sie nach A2A greifen. Unterstützte Kombinationen: Agentforce Serviceagent→Agentforce Serviceagent Agentforce Mitarbeiteragent→ Agentforce Mitarbeiteragent Agentforce Mitarbeiteragent→Agentforce Serviceagent Nur der Orchestrierer kann zu einem Menschen eskalieren, Unteragenten nicht. |
| Delegation mehrerer Agenten unter Leitung des Orchestrators | Bestens geeignet für komplexe Workflows, die mehrere spezialisierte Agenten erfordern | Wird verwendet, wenn sich der Workflow über mehrere Domänen erstreckt, beispielsweise Beschaffung, Überprüfung und Genehmigung, die jeweils einem anderen Agenten gehören. Ein Orchestriereragent zerlegt die Anforderung der obersten Ebene und delegiert Teilaufgaben nacheinander oder parallel an zwei oder mehr gleichrangige Agenten. Jeder Peer-Agent führt seine spezialisierte Domänenfunktion aus und gibt ein Artefakt zurück. Der Orchestrierer aggregiert die Ergebnisse und führt den nächsten Schritt aus. |
**Skizze**
Die Architektur besteht darin, dass ein aufrufender Agent die Kommunikation initiiert, was durch einen Agentenkatalog/eine Agentenregistrierung zur Erkennung erleichtert wird:
_Sequenzdiagramm für die agentenübergreifende Delegation_
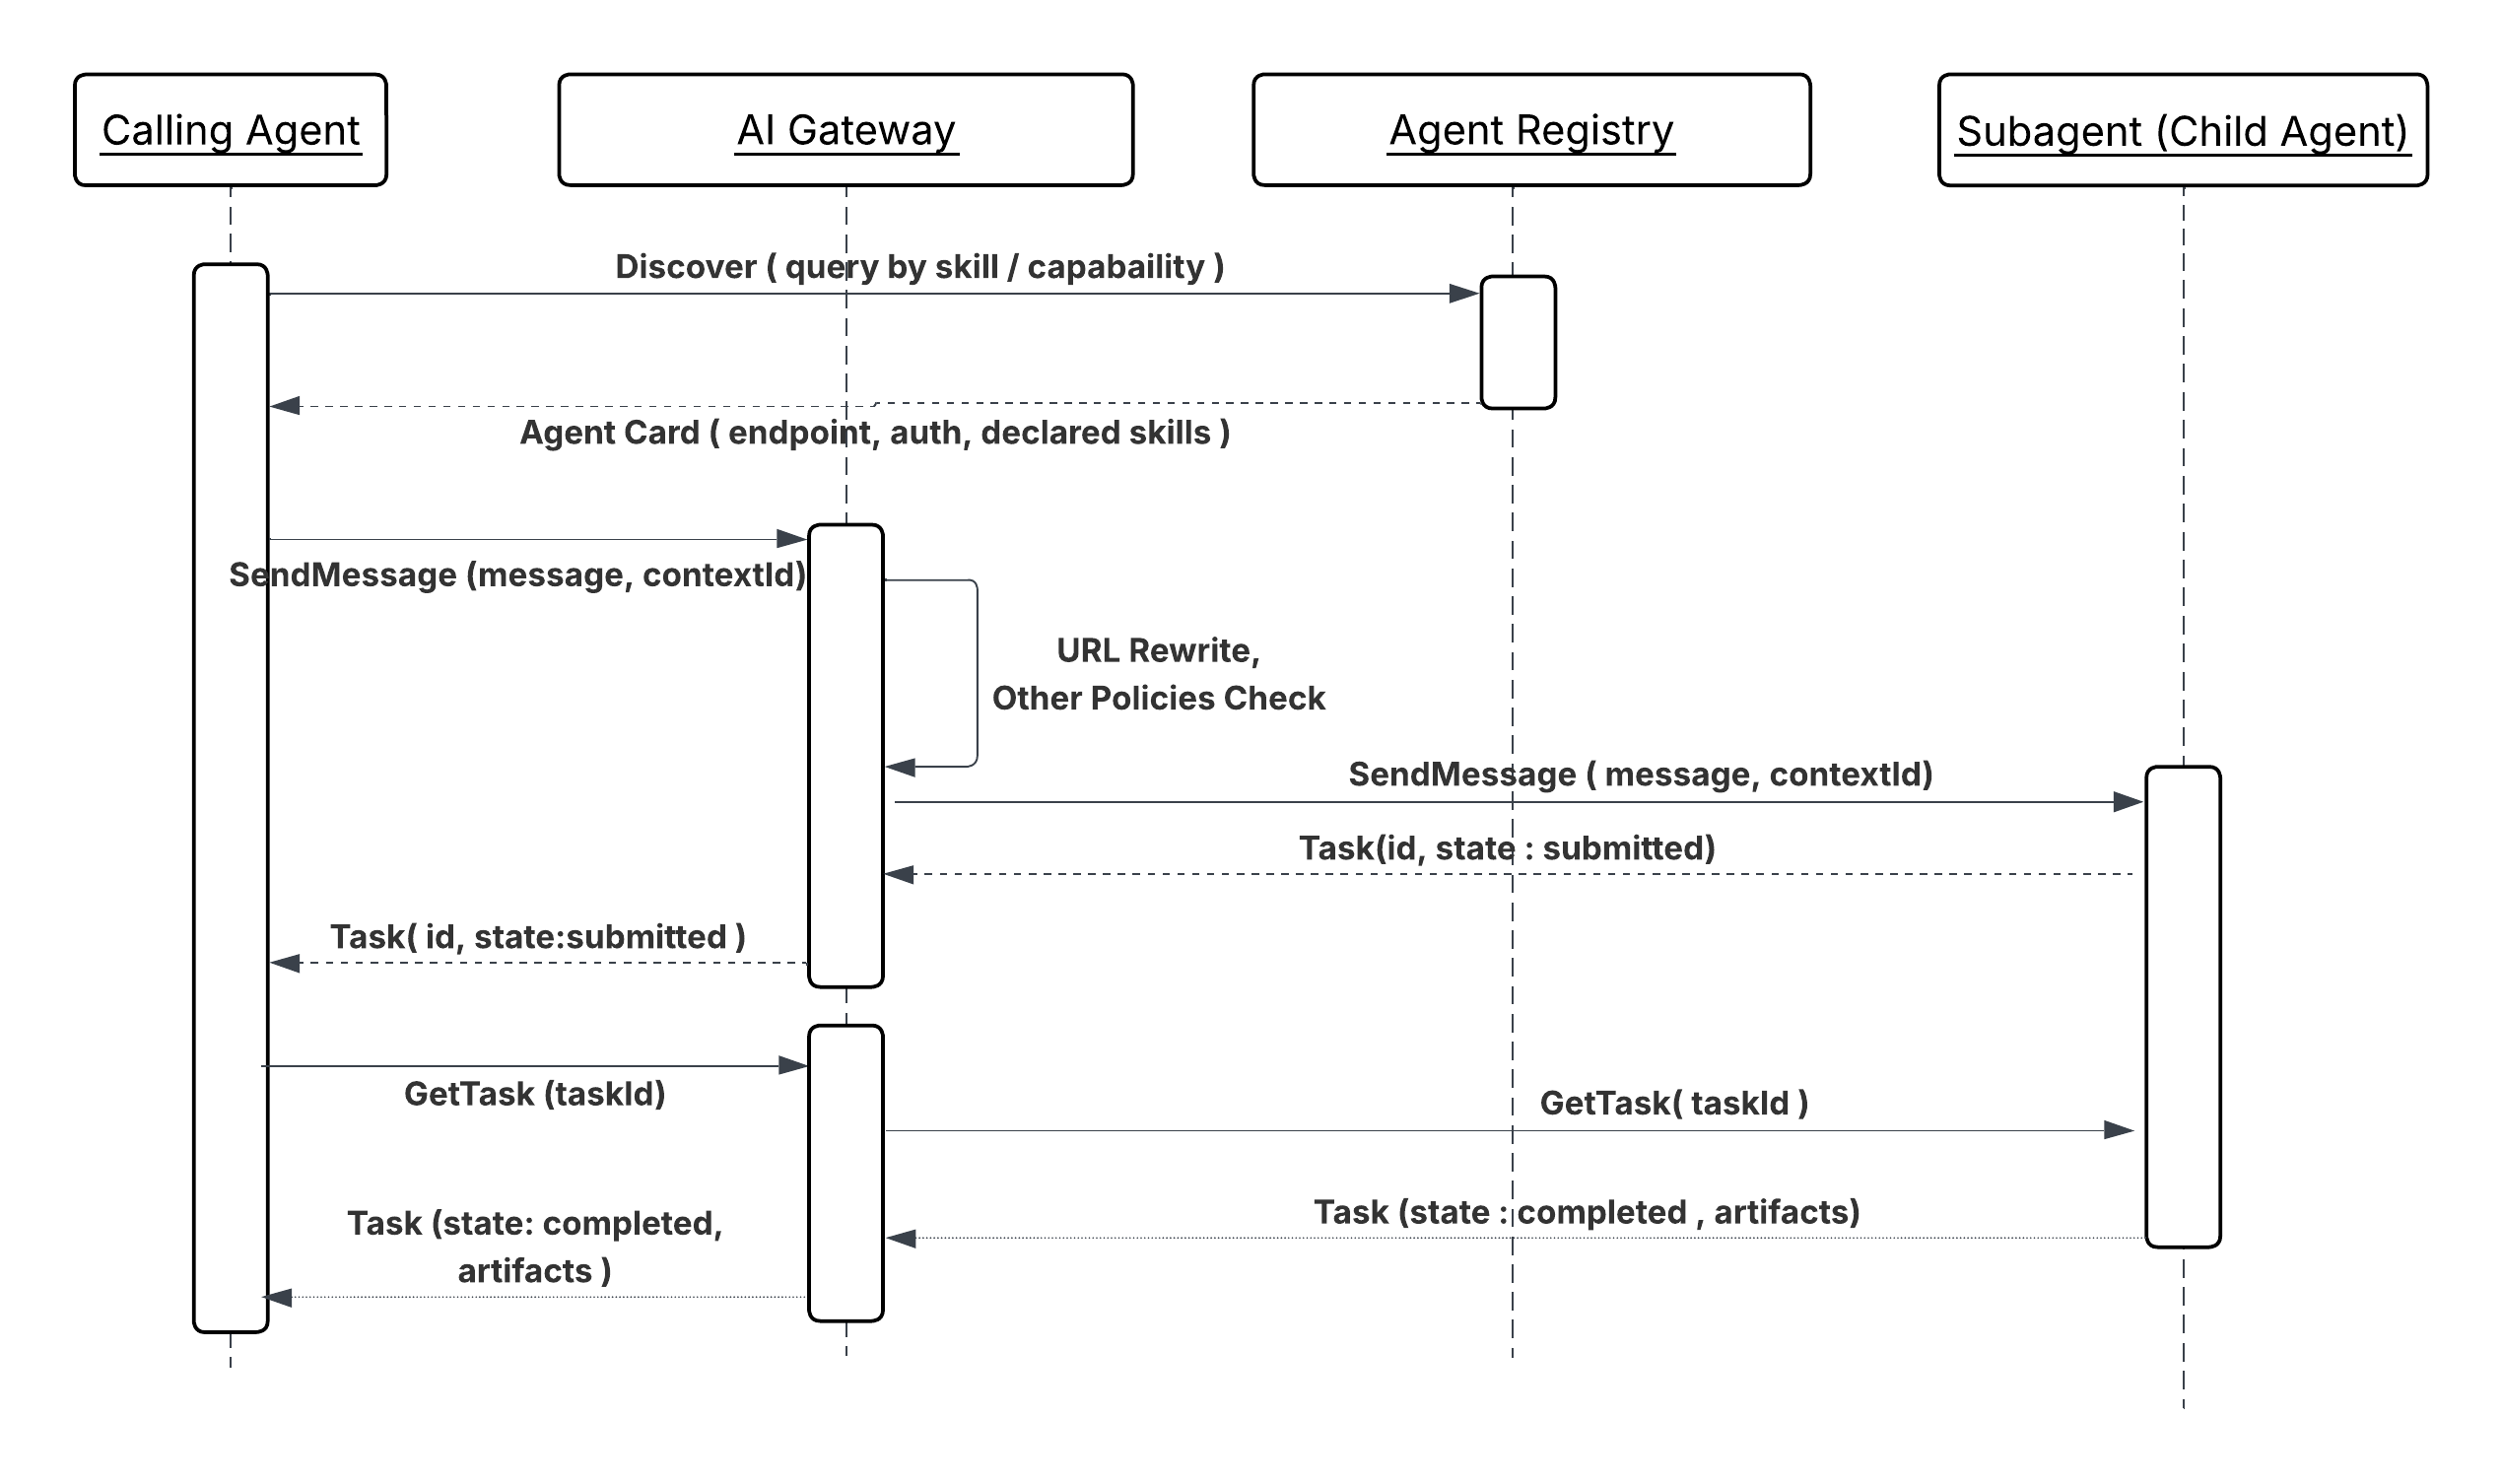 Der Peer-Agent verarbeitet die Anforderung mithilfe seiner domänenspezifischen Logik, seines Arbeitsspeichers und seiner Tools und gibt dann strukturierte Ergebnisse an den aufrufenden Agenten zurück.
**Ergebnisse**
Die A2A-Delegierung trennt die Domäneninhaberschaft von der Workflow-Orchestrierung. Der aufrufende Agent muss nicht wissen, wie der Peer-Agent aufgebaut ist, auf welcher Plattform er ausgeführt wird oder welche Tools er intern verwendet. Er delegiert eine Aufgabe und erhält ein strukturiertes Artefakt. Diese Grenze bedeutet, dass ein spezialisierter Agent (Hintergrundüberprüfung, finanzielle Risikobewertung, Logistikweiterleitung) unabhängig von den aufrufenden Workflows entwickelt, bereitgestellt und verbessert werden kann.
Das Aufgabenlebenszyklus-Modell des Protokolls (gesendet, funktioniert, abgeschlossen, fehlgeschlagen) unterstützt
langfristige Vorgänge nativ. Der aufrufende Agent kann sich für Statusaktualisierungen registrieren.
Halten einer blockierenden Verbindung, d. h., A2A-Aufgaben können Minuten oder Stunden umfassen
ohne dass der Orchestrierungsagent durchgehend aktiv bleiben muss.
**Überlegungen zum Design**
Plattformunabhängige Anleitung
- In komplexen Szenarien kann ein Agentenmakler als intelligenter Weiterleitungsservice oder "intelligente Vermittlungsstelle" fungieren, um die Aufgabendelegation zwischen spezialisierten Agenten zu koordinieren und Prozesse in mehreren Schritten zu verwalten.
- Da A2A langfristige Aufgaben unterstützt, muss die Kommunikation auf den Abschluss von Aufgaben ausgerichtet sein, einen Lebenszyklus für das Aufgabenobjekt definieren und Echtzeit-Statusaktualisierungen und -benachrichtigungen bereitstellen.
- Das Protokoll unterstützt verschiedene Inhaltstypen, einschließlich Text, Dateien, strukturierter Daten, Audio und Video-Streaming.
- Die Beziehungen und Abhängigkeiten zwischen Agenten und ihren Funktionen werden in einer Konfigurationsdatei (z. B. "agent-network.yaml") deklarativ definiert und in der Agentenregistrierung veröffentlicht.
Salesforce-Implementierungshinweise
- Halten Sie verbundene Unteragenten unter 7 für eine effektive SOMA-Orchestrierung, um die Weiterleitungsqualität beizubehalten.
- Derzeit wird nur die einzelne Delegationsebene unterstützt (Superagent → Unteragent). Tiefere Ketten übertragen die Latenz auf eine "nicht deaktivierbare Rate". Derzeit können Unteragenten nicht an andere verbundene Unteragenten delegieren.
- Die menschliche Übergabe wird nur auf Orchestriererebene unterstützt. Unteragenten können nicht eskalieren.
- Verwenden Sie in SOMA das Agentenskript, wenn die LLM-basierte Weiterleitung bei mehrdeutigen Eingaben für die deterministische Weiterleitung zu einer falschen Weiterleitung führt. Das Agentenskript aktiviert den zusammengestellten freigegebenen Kontext zwischen Agenten.
**Fehlerbehandlung und -behebung**
Das A2A-Protokoll definiert umfassende Fehlercodes, um das zuverlässige Debugging und die Fehlerverwaltung zu erleichtern.
- **Wiederherstellungslogik:** Agenten sollten Richtlinien für Wiederholungen (Wiederholungen), Failover-Logik für alternative fähige Agenten und explizite Zeitüberschreitungen integrieren.
- **Aufgabenstatusverfolgung:** Der Aufgabenverwaltungs-Workflow stellt sicher, dass Agenten mit dem neuesten Status einer Aufgabe synchron bleiben können, was die Wiederherstellung im Falle einer Unterbrechung erleichtert.
- **Beobachtbarkeit:** Die Protokollierung von Interaktionsdetails wie Latenz, Erfolgsraten und Fehlerhäufigkeiten ist entscheidend für die Überwachung der Qualität und Fehlerbehebung.
**Sicherheitsüberlegungen**
- **Unternehmensauthentifizierung:** A2A wurde entwickelt, um mit Authentifizierungs- und Autorisierungsstandards auf Unternehmensebene wie OAuth 2.0 und JWT abzustimmen, die oft von externen Plattformen wie Okta verwaltet werden.
- **Gateway zum Schützen von A2A:** Ein Gateway (z. B. MuleSoft Omni Gateway) ist wichtig, um Richtlinien für alle A2A-Kommunikationen zu erzwingen, und fungiert sowohl als Eingangs- als auch als Ausgangs-Gateway, um Agenten zu schützen und den ausgehenden Datenverkehr an externe Agenten und Services zu steuern.
- **Policenerzwingung:** "Agent Card Rewrite" (Agentenkartenumschreibung), "Schemavalidierung", "Spike Control" (Speichensteuerung), "PII Detector" (personenbezogene Daten) und andere Richtlinien sollten für A2A-Server und Datenschutz angewendet werden.
**Beispiel**
**Workflow für die Kandidatenbeschaffung**
Ein Einstellungsmanager beauftragt seinen zentralen Orchestriereragenten, Kandidaten zu finden, die mit einer Stellenanzeige und einer Fertigkeit übereinstimmen.
1. **Entdeckung:** Der Orchestriereragent fragt die Agentenregistrierung ab und erkennt einen spezialisierten Anwerbungsagenten und einen Agenten mit Hintergrundüberprüfung (beide gleichrangige Agenten).
2. **Delegierung (A2A):** Der Orchestriereragent sendet eine strukturierte Aufgabenanforderung (A2A-Nachricht) an den Anwerbungsagenten, um Kandidaten zu quellen.
3. **Peer Processing (Verarbeitung durch gleichrangige Personen):** Der Anwerbungsagent führt seinen eigenen Workflow aus (z. B. Aufrufen eines externen LinkedIn-Tools über MCP).
4. **Artefaktrückgabe (A2A):** Der Anwerbungsagent gibt eine Liste der vorgeschlagenen Kandidaten (das Artefakt) zurück.
5. **Sequenzielle Delegation:** Anschließend delegiert der Orchestriereragent eine weitere Aufgabe (A2A) an den Agenten für die Hintergrundüberprüfung des wichtigsten Kandidaten. Dieser Agent führt die Überprüfung durch und gibt das Ergebnis zurück, wodurch die Gesamtaufgabe abgeschlossen wird.
## Agenten als anrufbare Services (eingehend)
**Kontext**
Für komplexe Unternehmens-Workflows sind häufig spezialisierte Agenten erforderlich, die auf externen Plattformen oder Partnersystemen gehostet werden, um Aufgaben zu initiieren, Anfragen zu delegieren oder interne Agenten (z. B. auf der Salesforce Platform) zu aktualisieren. Mit diesem Muster wird festgelegt, wie ein interner Agentforce-Agent Anforderungen von einem Remote-Agenten mit Peer-Funktion sicher und zuverlässig empfängt und verarbeitet.
**Probleme**
Wie kann ein interner spezialisierter AI-Agent (z. B. ein Agent mit Hintergrundüberprüfung in Agentforce) seine domänenspezifischen Funktionen sicher externen Peer-Agenten bereitstellen, eine eingehende strukturierte A2A-Anforderung verarbeiten und den Aufgabenlebenszyklus (einschließlich Echtzeit-Statusaktualisierungen) verwalten, um strukturierte Artefakte an den Remote-Anrufagenten zurückzugeben?
**Kräfte**
Beantworten Sie beim Anwenden dieses Musters die folgenden Fragen:
- Wie können Sie die Funktionen interner Agenten externen Agenten sicher zur Verfügung stellen, ohne interne Logik oder Tools zu beeinträchtigen?
- Wie erzwingen Sie Sicherheitsrichtlinien auf Unternehmensebene, um die Identität und die delegierte Autorität des Anrufagenten vor der Verarbeitung von Anforderungen zu überprüfen?
- Wie handhaben Sie langfristige eingehende Aufgaben und stellen strukturierte, asynchrone Statusaktualisierungen bereit?
- Wie können Sie eine nahtlose Interaktion mit Agenten sicherstellen, die auf verschiedenen externen Frameworks basieren?
**Anwendung für Salesforce-Muster**
Das A2A-Protokoll bietet den offenen Standard für eine sichere, gleichrangige Delegation und Zusammenarbeit. Der interne Agent fungiert als gleichrangiger Agent, bewirbt seine Funktionen über einen Agentenkatalog/eine Registrierung und verwendet A2A über sichere Kanäle (HTTPS/SSE), um strukturierte Anforderungen zu empfangen und zu beantworten.
| Lösung | Passend | Kommentare |
| ------------------------------------ | -------------------------------------------------------------------------------------------------------------------------------------------------------------------- | --------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Verbundener Agentforce-Unteragent (SOMA) | Am besten, wenn der anrufende Agent ein anderer Agentforce Agent in derselben Organisation ist | Wird verwendet, wenn beide Agenten in derselben Salesforce-Organisation leben und der Anrufer ein Agentforce Orchestrator ist. Der Agent wird über Agentforce Builder als Unteragent verbunden und dem Orchestrierer über seine Beschreibung und seine deklarierten Aktionen angezeigt. Der Orchestrierer leitet Aufgaben mithilfe der LLM-basierten Weiterleitung (Atlas Reasoning Engine) oder der deterministischen Weiterleitung (Agentenskript) weiter. Es ist kein A2A-Protokoll, Gateway oder externe Registrierung erforderlich. Unterstützte Kombinationen: Agentforce Serviceagent→Agentforce Serviceagent Agentforce Mitarbeiteragent→ Agentforce Mitarbeiteragent Agentforce Mitarbeiteragent→Agentforce Serviceagent Nur der Orchestrierer kann zu einem Menschen eskalieren, Unteragenten nicht. |
| Agent Broker Routing (Eingehend) | Am besten, wenn die Organisation mehrere Agentforce Agenten mit komplementären Funktionen hostet und der aufrufende Agent kein bestimmtes Ziel auswählen _kann_ oder _sollte_ | Wird verwendet, wenn der anrufende Agent außerhalb von Salesforce oder einer anderen Salesforce-Organisation ist und nicht wissen muss, welcher bestimmte interne Agent (Agentforce oder andere Anbieteragenten) seine Anforderung bearbeitet. Zwischen dem MuleSoft Omni Gateway und dem Pool der internen Agentforce Agenten befindet sich ein MuleSoft Agent Broker. Sie empfängt die eingehende A2A-Aufgabe, wertet die angegebenen Funktionen der verfügbaren internen Agenten anhand der Anforderungen der Aufgabe aus und leitet die Anforderung an den am besten geeigneten Agenten weiter. Der Makler verarbeitet auch das Failover, wenn der primäre Zielagent nicht verfügbar ist oder einen Fehler zurückgibt. Der Makler leitet eine Weiterleitung an einen entsprechenden Agenten aus, ohne den Versuch an den externen Anrufer weiterzuleiten. Der externe Anrufer ist sich nie der internen Weiterleitungsentscheidungen oder Wiederholungen bewusst. |
**Skizze**
_Sequenzdiagramm für Agenten als aufrufbare Services_
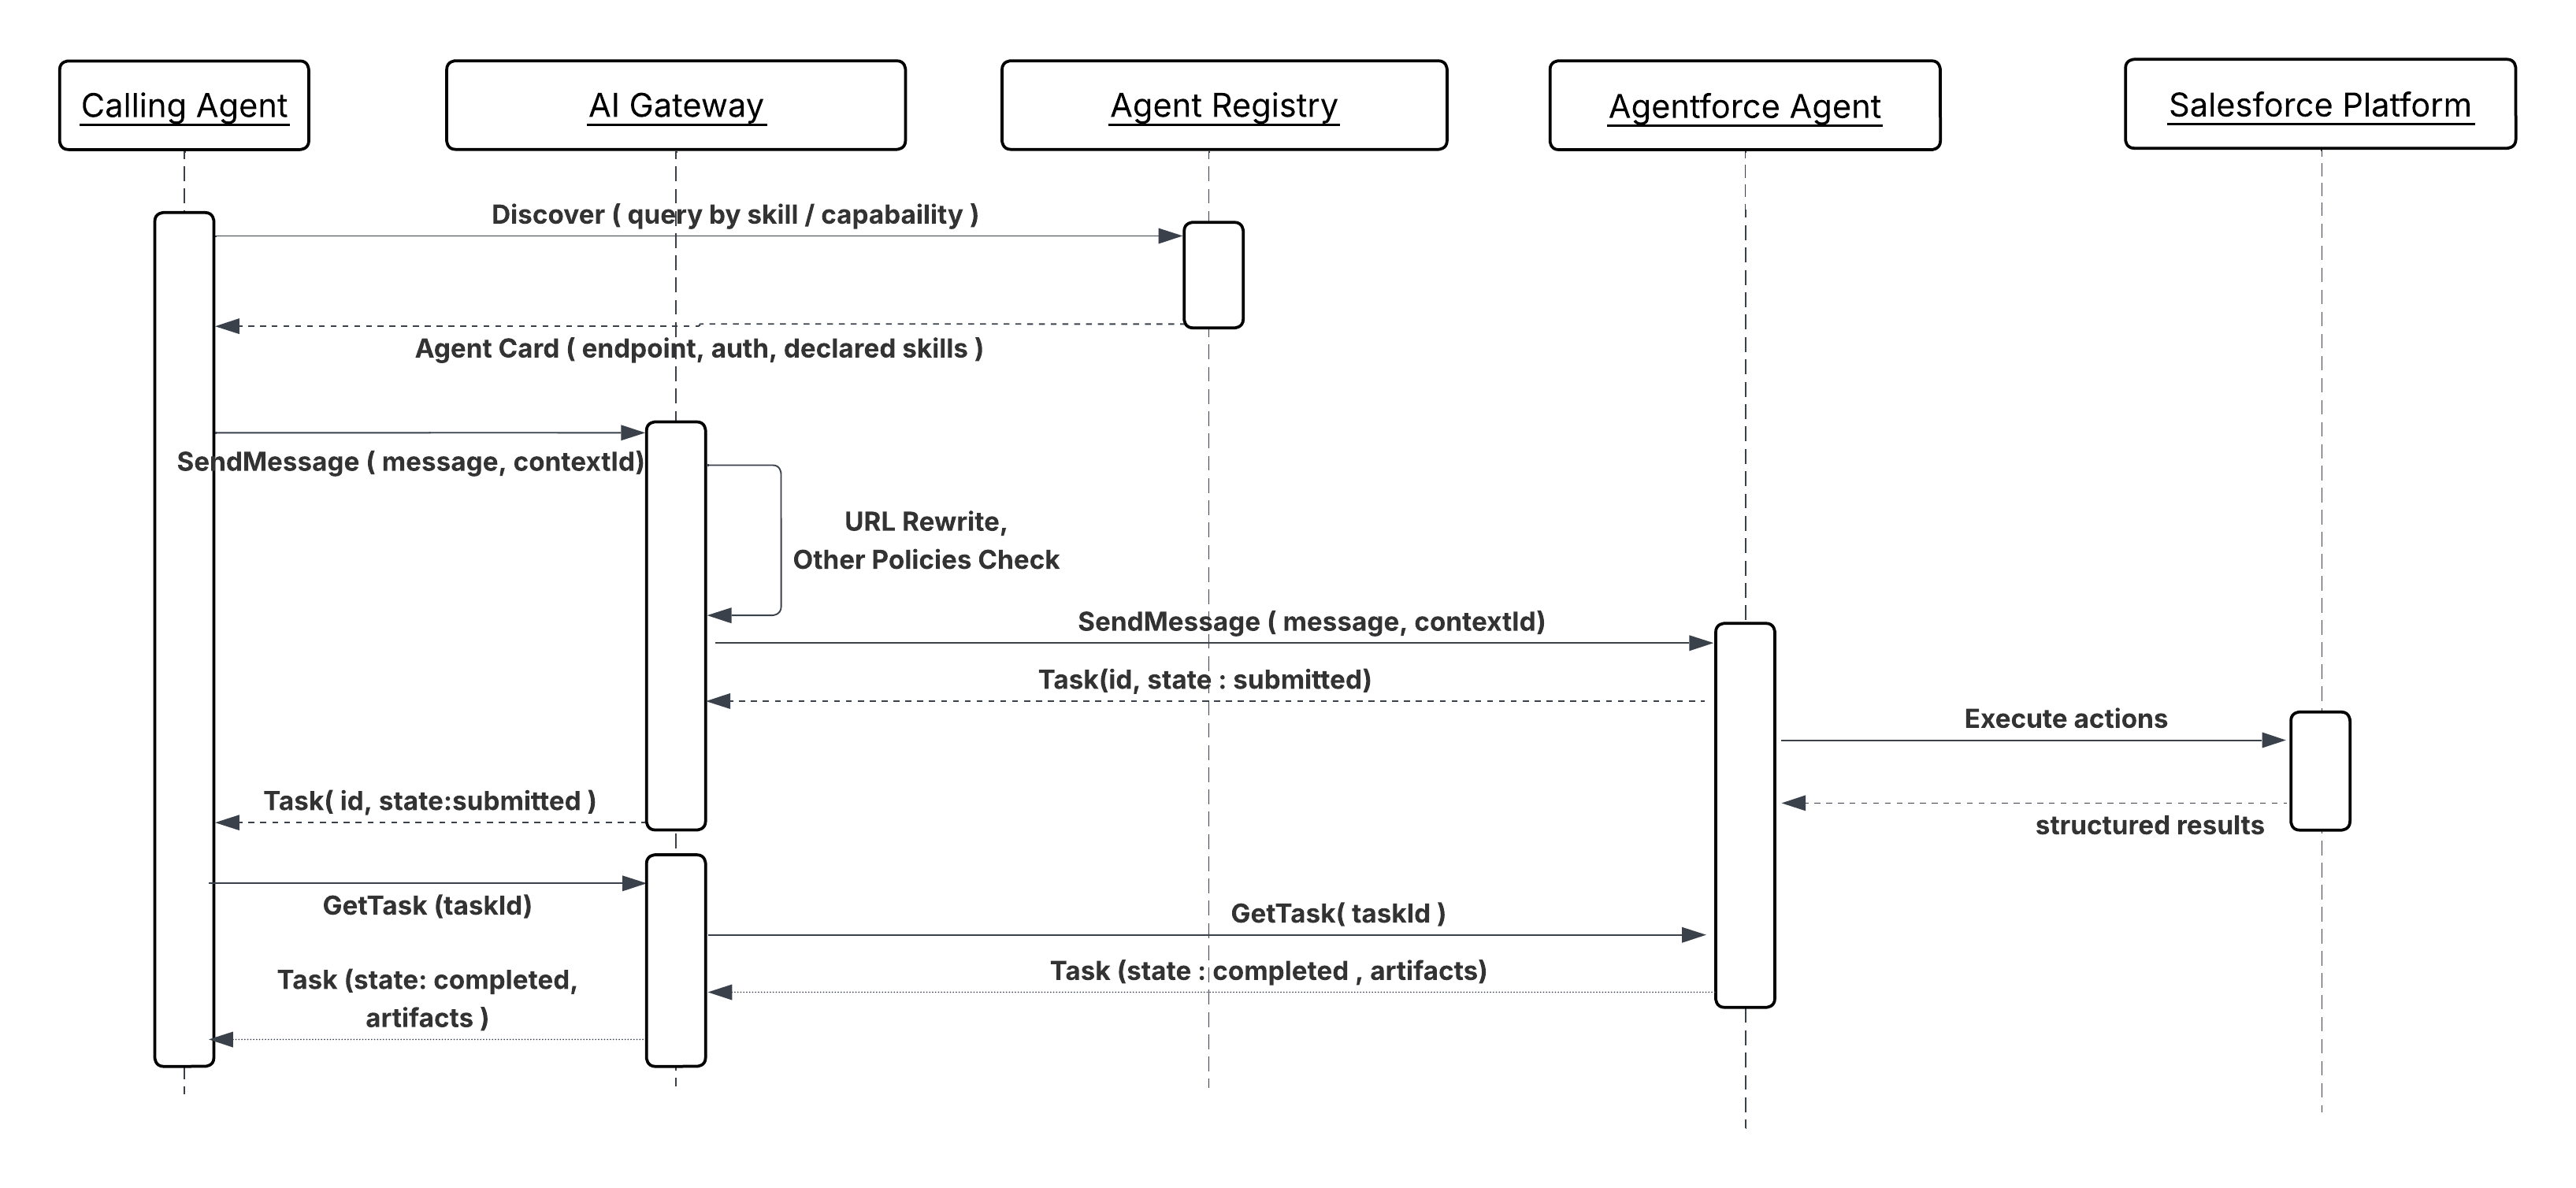 **Ergebnisse**
Durch dieses Muster werden interne Agenten als spezialisierte Services in einem Netzwerk mit mehreren Agenten angezeigt. Externe Agenten können Aufgaben sicher an interne Funktionen delegieren, während die Organisation die Kontrolle, Überprüfbarkeit und Durchsetzung von Richtlinien behält.
**Überlegungen zum Design**
Plattformunabhängige Anleitung
- Ein Gateway (z. B. MuleSoft Omni Gateway) muss als Eingangspunkt positioniert sein, um Richtlinien, einschließlich Ratenbegrenzung, Authentifizierung und Nutzlastvalidierung, für alle eingehenden A2A-Anforderungen zu erzwingen.
- Interne Agenten müssen den Status des Aufgabenobjekts von der externen Initiierung bis zum Abschluss verwalten, um sicherzustellen, dass der Remote-Anrufagent konsistente, überprüfbare Statusaktualisierungen erhält.
- Stellen Sie sicher, dass die veröffentlichten Funktionen des Agenten auf der Agentenkarte klar und intentbasiert sind und die erforderlichen Sicherheitsumfänge für die Delegierung enthalten.
**Fehlerbehandlung und -behebung**
- **Strukturierte Fehlercodes:** Bei einem Fehler muss der interne Agent A2A-konforme strukturierte Fehlermeldungen an den aufrufenden Agenten zurückgeben, um Remote-Wiederholungslogik oder alternative Failover-Mechanismen zu aktivieren.
- **Idempotenz:** Der Agent muss überprüfen, ob alle Nebenwirkungen, die durch eine erneute A2A-Anforderung eines externen Agenten (aufgrund einer Netzwerkunterbrechung oder -wiederherstellung) ausgelöst werden, idempotent sind.
**Sicherheitsüberlegungen**
- **Erzwingung eingehender Policen**: Das Gateway muss Richtlinien für die Zulassung/Blockierung externer Agenten und die Validierung von JWT/OAuth 2.0-Token erzwingen, um die Identität und die delegierte Autorität des _anrufenden Agenten_ zu überprüfen.
- **Eingangsbereinigung:** Validieren und bereinigen Sie alle eingehenden Anforderungsnutzlasten, um potenzielle Eingabeaufforderungen oder Angriffe mit bösartigen Daten zu vermeiden.
- **Identitätsübernahme:** Ordnen Sie die Identität des externen Agenten und seine delegierte Autorität Kontexten der internen Sicherheit (z. B. Salesforce-Benutzerprofilen) sicher zu, bevor Sie Aktionen gegen interne Systeme ausführen.
**Beispiel**
_Externe Systemanfrage_
1. **Anforderung:** Ein Anwerbungsagent in einem Partnersystem sendet eine A2A-Aufgabenanforderung an einen internen Mitarbeiterüberprüfungsagenten (Peer Agent) in Agentforce, um den Beschäftigungsstatus eines neuen Kandidaten zu bestätigen.
2. **Verarbeitung:** Der Mitarbeiterüberprüfungsagent empfängt die Anforderung über das Gateway, überprüft die Anmeldeinformationen des Partneragenten, führt seinen internen Workflow aus (beispielsweise durch Aufrufen eines internen HR-Systems) und formatiert die Antwort.
3. **Antwort:** Der Peer-Agent gibt ein strukturiertes A2A-Artefakt (z. B. Startdatum der Beschäftigung und Stellenbezeichnung) an den Remote-Anwerbungsagenten zurück, der dann mit seinem externen Workflow fortfährt.
## Weitere Sicherheitsüberlegungen
1. **Gateway zum Schutz von MCPs, A2As und APIs**
Für den gesamten Datenverkehr zwischen Agenten und Systemen ist ein Gateway als zentraler Erzwingungspunkt erforderlich.
- **Gesicherte Verbindungen**: Ein Gateway stellt sicher, dass nur authentifizierte und autorisierte Agenten mit MCP-, A2A- und API-Endpunkten interagieren, indem der Zugriff eingeschränkt wird.
- **Erzwungene SLAs:** Ein Gateway kann Ratenobergrenzen erzwingen, wodurch Organisationen die Leistungsanforderungen erfüllen und eine Überlastung von MCP- und A2A-Servern verhindert wird.
- **Vereinfachte Unternehmensführung:** Ein Gateway bietet zentralisierte Transparenz und Kontrolle über alle Serverinteraktionen und vereinfacht so die Verwaltung und Überwachung der Agentenaktivität.
- **Datenkonsistenz und -schutz:** Richtlinien wie die Schemavalidierung, die Erzwingung der Datenkonsistenz und die Erkennung personenbezogener Daten können sensible Informationen schützen.
**MueleSoft Omni Gateway**
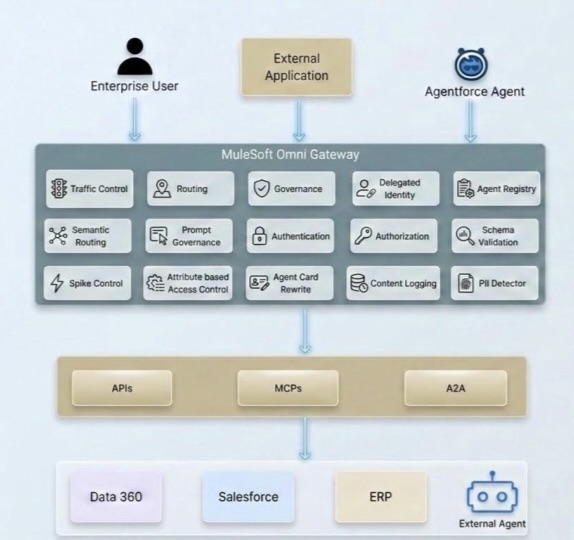 2. **Identitätsübernahmekette**
Da Unternehmen das Agentenparadigma akzeptieren, stellt sich eine neue Sicherheitsherausforderung: Wie durchläuft die Endbenutzeridentität ein Netzwerk autonomer AI-Agenten? In traditionellen API-Architekturen authentifiziert sich ein Benutzer einmal und die Anwendung ruft Backend-Services im Namen des Benutzers auf. Die Identitätskette ist kurz, gut verstanden und wird in der Regel in einer einzelnen Trust Domäne verwaltet.
Agentenarchitekturen weisen jedoch wesentlich längere Ketten auf, in denen eine einzelne Anforderung über verschiedene Agenten, Services und MCP-Server verteilt ist, wobei jeder potenziell Servicegrenzen, Trust Domänen und sogar Organisationsgrenzen überschreitet. Ohne eine bewusste Strategie zur Identitätsübermittlung stehen Unternehmen vor der Wahl zwischen Sicherheit und Funktionalität – ein Dilemma, das kein Architekt angehen muss.
MuleSoft behebt die Komplexität der Identitätsübertragung mit der Funktion "[Identität des vertrauenswürdigen Agenten](https://www.mulesoft.com/ai/trusted-agent-identity/announcement)". Diese Lösung verwendet eine richtlinienbasierte, Gateway-verwaltete Strategie, um sicherzustellen, dass die Endbenutzeridentität über verschiedene Interaktionstypen hinweg beibehalten wird, einschließlich A2A-Protokollen, MCP-Toolaufrufen und REST-API-Anforderungen. Durch die Zentralisierung der Identitätsverwaltung auf Omni-Gateway-Ebene durch [ausgehende Authentifizierungsrichtlinien](https://docs.mulesoft.com/gateway/latest/policies-outbound-directory) können Unternehmen ihr gesamtes Agentennetzwerk schützen, ohne Backend-Services oder Agenten zu ändern. Weitere Details finden Sie unter [Trusted Agent Identity for the Agentic Enterprise](https://architect.salesforce.com/docs/architect/de-de/fundamentals/guide/end-user-identity-propagation).
3. **RAG-Sicherheit in Data 360**
Data 360 unterstützt die attributbasierte Zugriffssteuerung (ABAC) auf Objekt-, Feld- und Zeilenebene über die Einstellungen der Datenverwaltungsrichtlinie. Dies ist die primäre Möglichkeit, zu steuern, welche Daten für wen sichtbar sind, auch in RAG-Suchindizes. Bei strukturierten Daten werden Benutzerzugriffsbedingungen mithilfe von Benutzerattributen und Berechtigungssätzen implementiert. Bei unstrukturierten Daten kann die Metadatenfilterung (Vorfilterung für Suchindizes) einschränken, was abgerufen wird.
Die Kommunikation mit dem LLM erfolgt über die Einstein Trust Layer, die vertrauliche/personenbezogene Daten maskiert, bevor sie das Modell zum Schutz des Datenschutzes nicht nur während der Suche, sondern auch vor der Generierung erreichen.
Stellen Sie zum Schutz vor RAG-Vergiftungen sicher, dass strenge Datenverwaltungs- und Validierungsregeln angewendet werden, bevor Daten für die Vektorsuche verfügbar werden. Die Einstein Trust Layer kann auch die sofortige Maskierung/Toxizitätsprüfung erzwingen. Sie können strenge Berechtigungssätze auf das Profil "Agentenbenutzer" anwenden.
4. **Neues Anmeldeinformationsmodell mit Namen**
Salesforce hat seine Authentifizierungsarchitektur umgestaltet, indem es ein zweistufiges Modell für Anmeldeinformationen mit Namen eingeführt hat, das die Bedenken zwischen Konnektivität und Identität klar voneinander trennt. Verwenden Sie dies, wenn Sie Callouts über Apex vornehmen, und vermeiden Sie die Erstellung Ihres eigenen Authentifizierungsprotokolls. Dieses Modell bietet zudem Erweiterbarkeit und erhöhte Sicherheit.
Externe Anmeldeinformationen bilden die Grundlage dieses Modells. Sie speichern die tatsächlichen Authentifizierungsdetails und unterstützen einen umfangreichen Satz an Protokollen, einschließlich OAuth 2.0-Client-Anmeldeinformationen, JWT-Bearer und AWS Signature V4, während sie auch definieren, wie Prinzipale zugeordnet werden: entweder als einzelner benannter Prinzipal (für alle Benutzer freigegeben) oder als benutzerbasierter Prinzipal (wobei sich jeder Benutzer mit seiner eigenen Identität authentifiziert).
Anmeldeinformationen mit Namen fungieren wiederum als Endpunktebene. Sie definieren den Callout-URL und verweisen auf externe Anmeldeinformationen, um den Authentifizierungs-Handshake zu verarbeiten und die Endpunktkonfiguration sauber von der Anmeldeinformationenverwaltung zu trennen.
Zum Aktivieren von Flows zur Authentifizierung pro Benutzer ordnen Administratoren Berechtigungssätze dem entsprechenden Prinzipal für externe Anmeldeinformationen zu, sodass nur Benutzer mit der richtigen Berechtigungssatzzuweisung Callouts unter ihrer eigenen Identität aufrufen können. Dieses zweistufige Design vereinfacht nicht nur die sichere Callout-Konfiguration, sondern bietet Architekten auch viel mehr Flexibilität und Kontrolle darüber, wie Integrationen in Salesforce-verbundenen Systemen authentifiziert werden. Weitere Details finden Sie in der [Dokumentation zu Anmeldeinformationen](https://help.salesforce.com/s/articleView?id=xcloud.named_credentials_about.htm&type=5) mit Namen.
## Überlegungen zur Compliance
In diesem Abschnitt werden die Datenverarbeitungsmuster der Architektur den Compliance-Verpflichtungen zugeordnet, die bei regulierten Unternehmensbereitstellungen am häufigsten auftreten.
**Zugriffssteuerung:** Das in den Integrationsmustern beschriebene Benutzermodell für die Integration mit den geringsten Berechtigungen (Named Credentials, OAuth 2.0-Geltungsbereiche pro Agent, Gateway-Zulassungslisten) wird direkt logischen Zugriffssteuerungen zugeordnet. Behalten Sie den Nachweis bei, dass der Umfang der Anmeldeinformationen jedes Agenten überprüft und genehmigt wurde.
**Aktivierungsprotokollierung:** Die Anforderungen an die Protokollierung pro Muster (Sitzungs-ID, Toolaufrufe, Eingabeparameter, die durch sensible Werte bereinigt wurden, Ergebnisse) erfüllen die Überwachungs- und Protokollierungssteuerungen. Stellen Sie sicher, dass Protokolle manipulationssicher sind, für den erforderlichen Zeitraum aufbewahrt werden und für das Sicherheitsteam zugänglich sind, ohne dass Zugriff auf Produktionssysteme erforderlich ist.
**Änderungsverwaltung:** Änderungen am MCP-Tool-Schema und A2A-Agentenkartenaktualisierungen, die sich auf Verbraucher auswirken, stellen Schnittstellenänderungen dar und sollten Änderungsverwaltungssteuerungen unterliegen. Versionstools explizit (im eingehenden Muster für MCP erwähnt) und behandeln fehlerhafte Änderungen als Konfigurationsereignisse, die genehmigt werden müssen.
**Verfügbarkeit:** Obergrenzen für die Agentengleichzeitigkeit, Obergrenzen für Wiederholungen bei durch Ereignisse ausgelösten Mustern und die Weiterleitung von toten Briefen bei fehlgeschlagenen Ereignissen stellen Verfügbarkeitskontrollen dar. Dokumentieren Sie die erwartete Durchsatzhülle und das Fehlerverhalten für jedes bereitgestellte Muster als Teil des Verfügbarkeitsnachweispakets.
**Notiz**: Diese Liste stellt keine vollständige Anleitung zur Gewährleistung der Konformität Ihrer Agentenlösungen dar. Alle geltenden regulatorischen Anforderungen müssen erfüllt sein.
## Ressourcen
- [Erste Schritte mit der Agenten-API](https://developer.salesforce.com/docs/ai/agentforce/guide/agent-api-get-started.html)
- [Aktivieren von vertrauenswürdigen Agenten mit Data 360](https://trailhead.salesforce.com/content/learn/modules/data-cloud-powered-agentforce/enable-trusted-agents-with-data-cloud)
- [MuleSoft Omni Gateway – Übersicht](https://docs.mulesoft.com/gateway/latest/)
- [Richtlinie zur Injektion von Anmeldeinformationen im Namen von OAuth 2.0](https://docs.mulesoft.com/gateway/latest/policies-outbound-oauth-obo)
- [Identität des vertrauenswürdigen Agenten für das Agentenunternehmen](https://architect.salesforce.com/docs/architect/de-de/fundamentals/guide/end-user-identity-propagation)
## Über die Autoren
Gulal Kumar ist Software-Entwickler bei Salesforce und verfügt über mehr als 20 Jahre Erfahrung. Seine Expertise erstreckt sich auf AI, Integration, APIs und Unternehmensarchitektur, wobei er sich darauf konzentriert, die Geschäftstransformation durch sichere, belastbare und innovative AI-Lösungen voranzutreiben. Verbinden Sie sich mit ihm über [LinkedIn](https://www.linkedin.com/in/gulal/).
# Einführung
Die Salesforce Customer 360 Platform bietet jeder einzelnen Salesforce-Mandanteninstanz (auch als "Organisation" bezeichnet) eine leistungsstarke mandantenfähige [metadatengestützte Architektur](/docs/architect/de-de/fundamentals/guide/platform-multitenant-architecture). Dieses grundlegende Dokument zur Architektur bietet einen Überblick über die Bereiche, in denen die zugrunde liegende Architektur der Salesforce Platform eine wichtige Überlegung für die Architekturen der auf der Plattform basierenden Lösungen darstellt.
Beim Entwerfen von Architekturen auf Salesforce Platform sind drei wichtige Bereiche zu verstehen:
- [Transaktionen](/docs/architect/de-de/fundamentals/guide/architecture-basics#transaktionen)
- [Metadaten im Vergleich zu Daten](/docs/architect/de-de/fundamentals/guide/architecture-basics#metadaten-im-vergleich-zu-daten)
- [Plattform-APIs](/docs/architect/de-de/fundamentals/guide/architecture-basics#plattform-apis)
## Transaktionen
Auf der Salesforce Platform kann eine Transaktion durch Codeausführung und/oder einen Datenbankvorgang instanziiert werden. Eine grundlegende Kompetenz für die Salesforce-Architektur besteht darin, zu verstehen, wie die Plattform Transaktionen für Mandanten definiert und steuert. Um Ressourcen für alle Mandanten zu verwalten, legt Salesforce für jeden Mandanten Obergrenzen fest, die auf Transaktions- und Organisationsbasis berechnet werden.
Auf Transaktionsebene legt Salesforce [Obergrenzen für die](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_gov_limits.htm) Ausführung fest, um sicherzustellen, dass einzelne Instanzen der Codeausführung und Datenbanktransaktionen gemeinsam genutzte Rechenressourcen nicht monopolisieren. Auf organisationsweiter Ebene legt Salesforce Obergrenzen auf der Grundlage der [Edition und des Funktionstyps](https://help.salesforce.com/s/articleView?id=sf.overview_limits_general.htm&type=5) fest. Organisationsweite Obergrenzen umfassen auch eine fortlaufende Berechnung der API-Nutzung für alle Transaktionen in der Organisation, für die [API-Obergrenzen](https://developer.salesforce.com/docs/atlas.en-us.salesforce_app_limits_cheatsheet.meta/salesforce_app_limits_cheatsheet/salesforce_app_limits_platform_api.htm) gelten.
Sehen wir uns zwei wichtige Teile von Transaktionen auf der Salesforce Platform genauer an: Ausführungskontext und Datenbankmanipulation.
### Ausführungskontext
Salesforce berechnet Transaktionsobergrenzen anhand des Konzepts des [Ausführungskontexts](https://trailhead.salesforce.com/content/learn/modules/apex_basics_dotnet/execution_context). Es ist wichtig zu wissen, dass dies bei Salesforce-Anwendungen nicht ausschließlich für die Ausführung von benutzerdefiniertem Code in einer einzelnen Salesforce-Organisation gilt. Der Ausführungskontext basiert auf dem Plattform-Laufzeitmodul und dem gesamten Code, der dem Laufzeitmodul für einen bestimmten Mandanten zur Verfügung steht. Das bedeutet, dass benutzerdefinierter Code, der in der Organisation eines Mandanten definiert ist, Code aus Paketen, die in dieser Organisation installiert sind, sowie Code, der in Salesforce Platform-Services enthalten ist, eine Transaktion instanziieren können. Die Plattform unterscheidet zwischen verschiedenen Apex Code-Typen und berechnet anhand dieser Unterschiede Obergrenzen.
Weitere Informationen zu [Apex Transaktionsobergrenzen](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_gov_limits.htm) finden Sie im Apex Developer Guide.
### Datenbankmanipulation
Wenn eine Transaktion Datenbankmanipulationen beinhaltet, wird in einer integrierten [Ausführungsreihenfolge](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_triggers_order_of_execution.htm) das Verhalten der verschiedenen Teile der Konfiguration und des Codes Ihrer Organisation festgelegt. Ein Schlüssel zum Verständnis der richtigen Verwendung der Ausführungsreihenfolge in Ihren Salesforce-Anwendungen besteht darin, die zuverlässige Datenintegrität zu verstehen, die dieses Verhalten für Ihre Salesforce-Anwendungen bietet.
| Verhalten | Daten | Metadata |
|---|---|---|
| Aus der Produktion in Sandbox-Umgebungen kopiert | Nein* | Ja |
| Migrieren nach Metadaten-API | Nein | Ja** |
| Migrieren nach Datenladevorgang | Ja | Nein |
| Kann in Pakete aufgenommen werden | Nein | Ja** |
| Wird auf Datenspeicherobergrenzen angerechnet | Ja | Nein |
| * Vollständige und Teilkopie-Sandbox-Instanzen ermöglichen den Abgleich von Daten aus der Produktion. ** Einige Metadatentypen sind nicht für die Verwendung mit der Metadaten-API und/oder Paketen verfügbar. Ausnahmen finden Sie im Bericht zur Metadatenabdeckung. |
||
|
Bei der Salesforce Lightning Platform handelt es sich um eine umfassende AI-gestützte Plattform, die Mitarbeiter, autonome AI-Agenten, Unternehmensdaten und Anwendungen in einem einzigen, vertrauenswürdigen System zusammenführt, um die Produktivität und die Kundenerfahrung zu steigern. Durch die Verbindung von Customer 360-Anwendungen, Data Cloud und Slack für eine durchgängige Automatisierung kann ein "Agentenunternehmen" erstellt werden. |
 #### Faire Nutzung
Der Mechanismus für die faire Nutzung der Plattform implementiert ein stufenbasiertes System. Das System stellt sicher, dass jede Organisation auf der Salesforce Platform einen angemessenen Teil der Verarbeitungszeit für einen bestimmten Nachrichtentyp erhält, einschließlich der Nachrichtentypen "Zukunft", "Warteschlange" und "Batch". Wenn eine Organisation einen bestimmten Nachrichtentyp dominiert, während andere Organisationen darauf warten, Arbeit an demselben Nachrichtentyp auszuführen, reduziert der Algorithmus für die faire Nutzung die Anzahl der Threads, die der Organisation für diesen bestimmten Nachrichtentyp zur Verfügung stehen.
 Ein Vorteil der Verwendung asynchroner Apex-Methoden besteht darin, dass einige Obergrenzen, beispielsweise SOQL-Abfrageobergrenzen und Obergrenzen für die Heap-Größe, höher sind. Verlassen Sie sich jedoch nicht zu sehr auf diese Methoden. Aufgrund der begrenzten Ressourcen, die der asynchronen Infrastruktur zugewiesen sind, kann die starke Nutzung von Future, Queueable und Batch Apex zu Verarbeitungsverzögerungen führen, die auf Einschränkungen aufgrund der fairen Nutzung und der Flow-Steuerung zurückzuführen sind.
#### Besondere Überlegungen zu ausgehenden Callouts über asynchrones Apex
Ausgehende Callouts, die asynchrones Apex verwenden, werden auf die Obergrenze für asynchrones Apex angerechnet. Die tägliche Obergrenze beträgt derzeit das 250.000- oder 200-fache der Anzahl der anwendbaren Benutzerlizenzen, je nachdem, welcher Wert höher ist. Diese Obergrenze kann bei Anwendungsfällen mit hohem Volumen ein Problem darstellen. Wenn Sie die Obergrenze überschreiten, schlagen Ihre asynchronen Apex-Aufträge und die zugehörigen ausgehenden Callouts fehl.
Da die Plattform über eine begrenzte Anzahl asynchroner Threads verfügt, sind ausgehende Integrationen über asynchrones Apex zudem nur eingeschränkt skalierbar. Alle ausgehenden Integrationen mit hohem Volumen, die die Anzahl der verfügbaren Threads überschreiten, können lange Verarbeitungszeiten aufweisen und zu Verzögerungen führen.
Bei Anwendungsfällen mit hohem Volumen sollten Sie die folgenden alternativen Ansätze in Betracht ziehen. API-Aufrufe mit diesen Ansätzen werden auf die tägliche Obergrenze für API-Anforderungen angerechnet, die deutlich über der täglichen Obergrenze für asynchrones Apex liegt. Dadurch sind diese Ansätze besser skalierbar. Beachten Sie jedoch, dass die Anzahl der gleichzeitigen Anforderungen, die von einer CPU verarbeitet werden können, weiterhin physisch begrenzt ist.
- **Geplanter Pull für Middleware.** Vermeiden Sie Verzögerungen bei ausgehenden Integrationsaufträgen mit hohem Volumen, indem Sie Middleware verwenden, um die Daten planmäßig abzurufen, statt sie über asynchrones Apex zu übertragen. Middleware wie die MuleSoft Anypoint Platform kann die native SOAP-API oder die REST-API synchron verwenden, sodass nur wenige oder gar keine Verzögerungen auftreten. Middleware kann auch die native Bulk-API für große Datenmengen verwenden.
 - **Middleware-Abruf über Plattformereignisbenachrichtigung.** Statt Future, Queueable oder asynchronen Apex-Batch in die Warteschlange zu stellen, um ausgehende Integrationen auszuführen, können Sie Plattformereignisse verwenden. Das Plattformereignis kann die ausgehenden Informationen entweder selbst bereitstellen oder ein Middleware-Tool anweisen, die erforderlichen Informationen über eine native API abzurufen und an sein endgültiges Ziel zu liefern. Keiner dieser Ansätze unterliegt den Verzögerungen, die für asynchrones Apex gelten. Es gelten jedoch weiterhin [Obergrenzen für Plattformereignisse](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_events_limits_default.htm).
 #### Asynchrone Apex Kompromisse
| Produkt / Ansatz | Anwendungsfälle | Erforderliche Fertigkeiten | Asynchron in Bezug auf Client | Asynchron in Bezug auf Server | Typ der erzwungenen Plattformobergrenzen |
|---|---|---|---|---|---|
| Künftige Apex-Methoden | Es wird empfohlen, künftig warteschlangenfähiges Apex anstelle von Apex zu verwenden. Warteschlangen weisen dieselben Anwendungsfälle wie künftige Methoden auf, bieten jedoch zusätzliche Vorteile. | Pro-Code | Ja | Ja | Asynchron |
| Queueable Apex | Dieser Ansatz wird zukünftigen Methoden vorgezogen. Wird für Prozesse verwendet, die langfristige Datenbankvorgänge oder Callouts für externe Webservices beinhalten. Warteschlangenfähiger Apex bietet zusätzliche Vorteile gegenüber künftigen Methoden, einschließlich Auftrags-IDs, Unterstützung für nicht primitive Typen und Auftragsverkettung. | Pro-Code | Ja | Ja | Asynchron |
| Geplantes Apex | Führen Sie Apex zu einem geplanten Zeitpunkt aus, der durch einen Cron-Ausdruck definiert ist. Obwohl es sich bei der Planung von Apex über den Ausdruck cron um einen asynchronen Prozess handelt, wird der zugrunde liegende Code synchron ausgeführt, wenn der Auftrag gestartet wird. | Pro-Code | Ja | Ja | Synchronous |
| Apex-Fortsetzungs-Callouts | Callouts aus Apex-Methoden, die in einem synchronen Transaktionskontext ausgeführt werden. | Pro-Code | Ja | Ja | Synchronous |
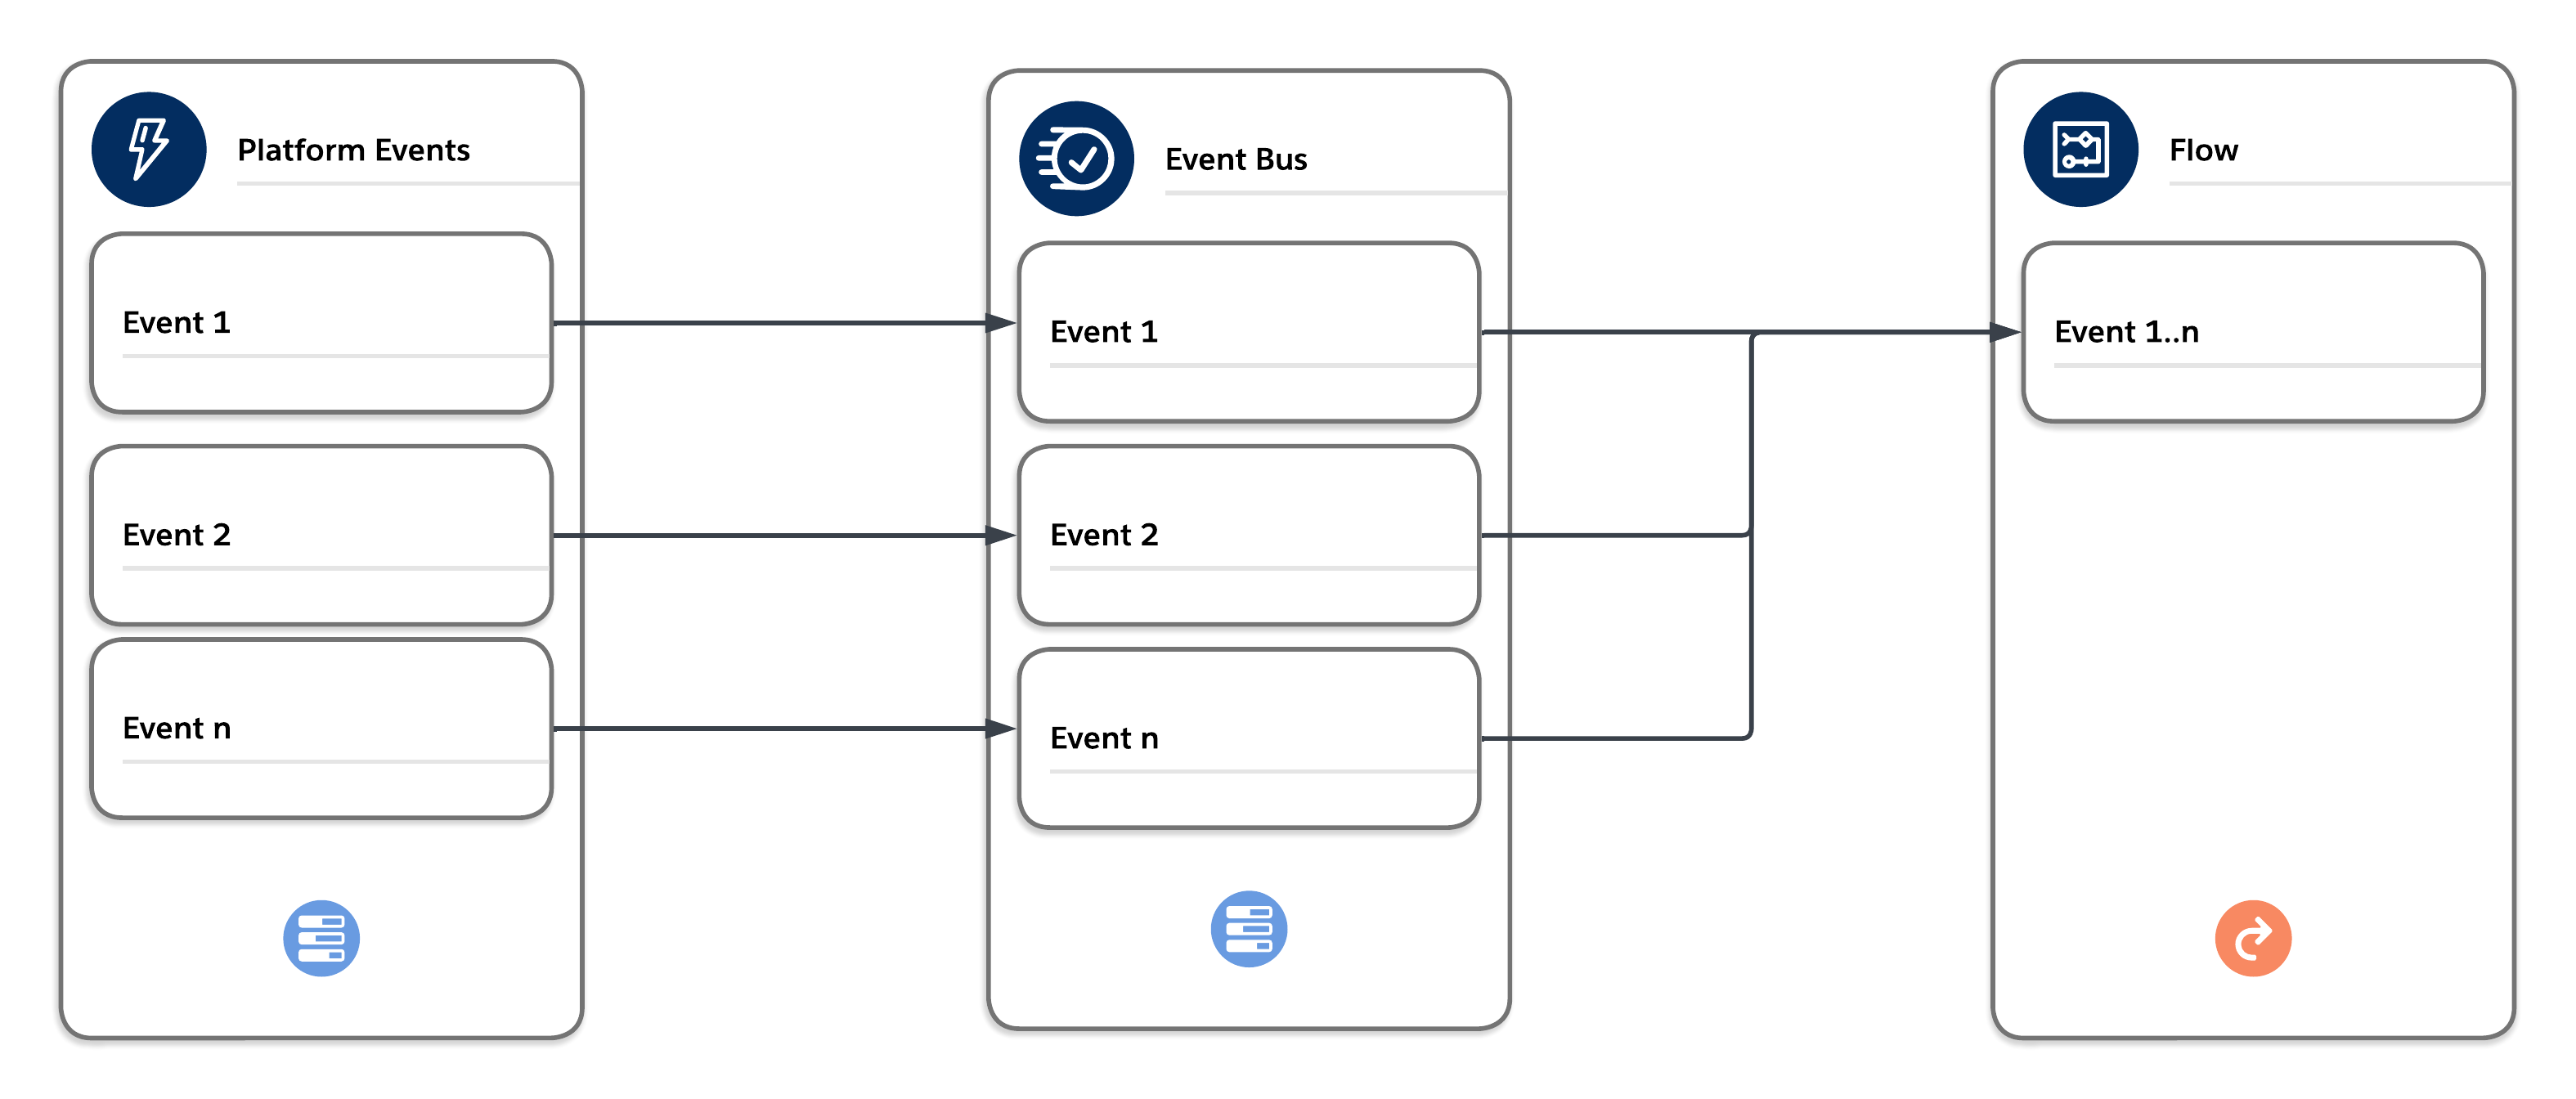 Die Ereignisse, die [nach dem Commit](https://developer.salesforce.com/docs/atlas.en-us.platform_events.meta/platform_events/platform_events_intro.htm) per Veröffentlichung auf dem Bus veröffentlicht werden, werden der Reihe nach zugestellt und können vom Auslöser oder Flow in einem separaten synchronen Kontext per Massenvorgang verarbeitet werden. Der Kontext ist synchron und erzwingt alle synchronen Obergrenzen. Wählen Sie den Plattformereignisauslöser/die Flow-Batchgröße sorgfältig aus, um zu vermeiden, dass Obergrenzen erreicht werden.
| Produkt / Ansatz | Anwendungsfälle | Erforderliche Fertigkeiten | Asynchron in Bezug auf Client | Asynchron in Bezug auf Server | Typ der erzwungenen Plattformobergrenzen |
|---|---|---|---|---|---|
| Plattformereignisauslöser | Koppeln Sie Salesforce lose mit externen Systemen und kommunizieren Sie zwischen asynchronen Plattformkomponenten. | Low-Code + Pro-Code | Ja | Ja | Synchronous |
| Produkt / Ansatz | Anwendungsfälle | Erforderliche Fertigkeiten | Asynchron in Bezug auf Client | Asynchron in Bezug auf Server | Typ der erzwungenen Plattformobergrenzen |
|---|---|---|---|---|---|
| Geplanter Pfad (nach Commit-Flows) | Führen Sie die Ausführung zu dynamisch geplanten Zeiten nach dem Auslösen von Ereignissen aus. | Low-Code | Ja | Ja | Asynchron |
| Asynchroner Pfad (durch Datensätze ausgelöste Flows) | Führen Sie einen Vorgang aus, den Sie eigenständig ausführen möchten, um gemischte DML-Fehler zu vermeiden. | Low-Code | Ja | Ja | Asynchron |
| Produkt / Ansatz | Anwendungsfälle | Erforderliche Fertigkeiten | Asynchron in Bezug auf Client | Asynchron in Bezug auf Server | Typ der erzwungenen Plattformobergrenzen |
|---|---|---|---|---|---|
| Ausgehende Nachrichten | Freigeben von Daten für Drittanbietersysteme nahezu in Echtzeit über das SOAP-Protokoll | Low-Code | N/A | Ja | N/A |
| Produkt / Ansatz | Anwendungsfälle | Erforderliche Fertigkeiten | Asynchron in Bezug auf Client | Asynchron in Bezug auf Server | Typ der erzwungenen Plattformobergrenzen |
|---|---|---|---|---|---|
| E-Mail-Vorgangserfassung | Erstellen Sie automatisch Kundenvorgänge und füllen Sie Kundenvorgangsfelder anhand von Werten in eingehenden E-Mails aus. | Low-Code | Ja | Ja* | Synchronous |
| * Die Erfassung von Kundenvorgängen über E-Mail wird sowohl synchron als auch asynchron verarbeitet, jedoch mit synchronen Apex Obergrenzen | |||||
| Produkt / Ansatz | Anwendungsfälle | Erforderliche Fertigkeiten | Asynchron in Bezug auf Client | Asynchron in Bezug auf Server | Typ der erzwungenen Plattformobergrenzen |
|---|---|---|---|---|---|
| Batch Apex | Komplexe, langfristige Prozesse mit Tausenden von Datensätzen | Pro-Code | Ja | Ja | Asynchron |
| Durch einen Zeitplan ausgelöste Flows | Führen Sie Aktionen für einen Datensatzbatch im Hintergrund zu einer angegebenen Zeit und mit wiederholter Häufigkeit über einen Flow aus. | Low-Code | Ja | Ja | Synchronous |
| Bulk API | Fügen Sie viele Datensätze asynchron ein, aktualisieren, aktualisieren, einfügen, abfragen oder löschen Sie sie. | Pro-Code | Ja | Ja | Asynchron |
| Objektspeicher im Speicher | Persistenter Objektspeicher v2 | |
|---|---|---|
| Speicherort der Daten | Nur lokal für die Anwendung. | In derselben Region, in der die MuleSoft-Anwendung erstmals bereitgestellt wurde. |
| Abgleichsübergreifend freigegeben? | Nein | Ja |
| Objektspeicherwiederherstellung in Anwendungen | Daten gehen verloren. Alle Daten im Arbeitsspeicher gehen beim Neustart der Anwendung, bei einer neuen Bereitstellung oder bei einem Replikatfehler verloren. | Daten gehen nicht verloren. es sei denn, die Anwendung wird gelöscht. |
| Objektspeicherwiederherstellung innerhalb der Region | Daten gehen verloren (wie oben). | Daten gehen nicht verloren (wie oben). |
| Regionale Erholung | Wie oben. | Daten sind nicht verfügbar. Selbst bei einer aktiv aktiven DR-Konfiguration ist der Objektspeicher nur in der ursprünglichen Bereitstellungsregion verfügbar. |
| Eindämmung | Externalisieren Sie Daten für die regionale Wiederherstellung. | Die Daten bleiben verfügbar, solange die ursprüngliche Bereitstellungsregion verfügbar ist. Externisieren Sie für regionsübergreifende HAs oder DRs Daten außerhalb des Objektspeichers. |
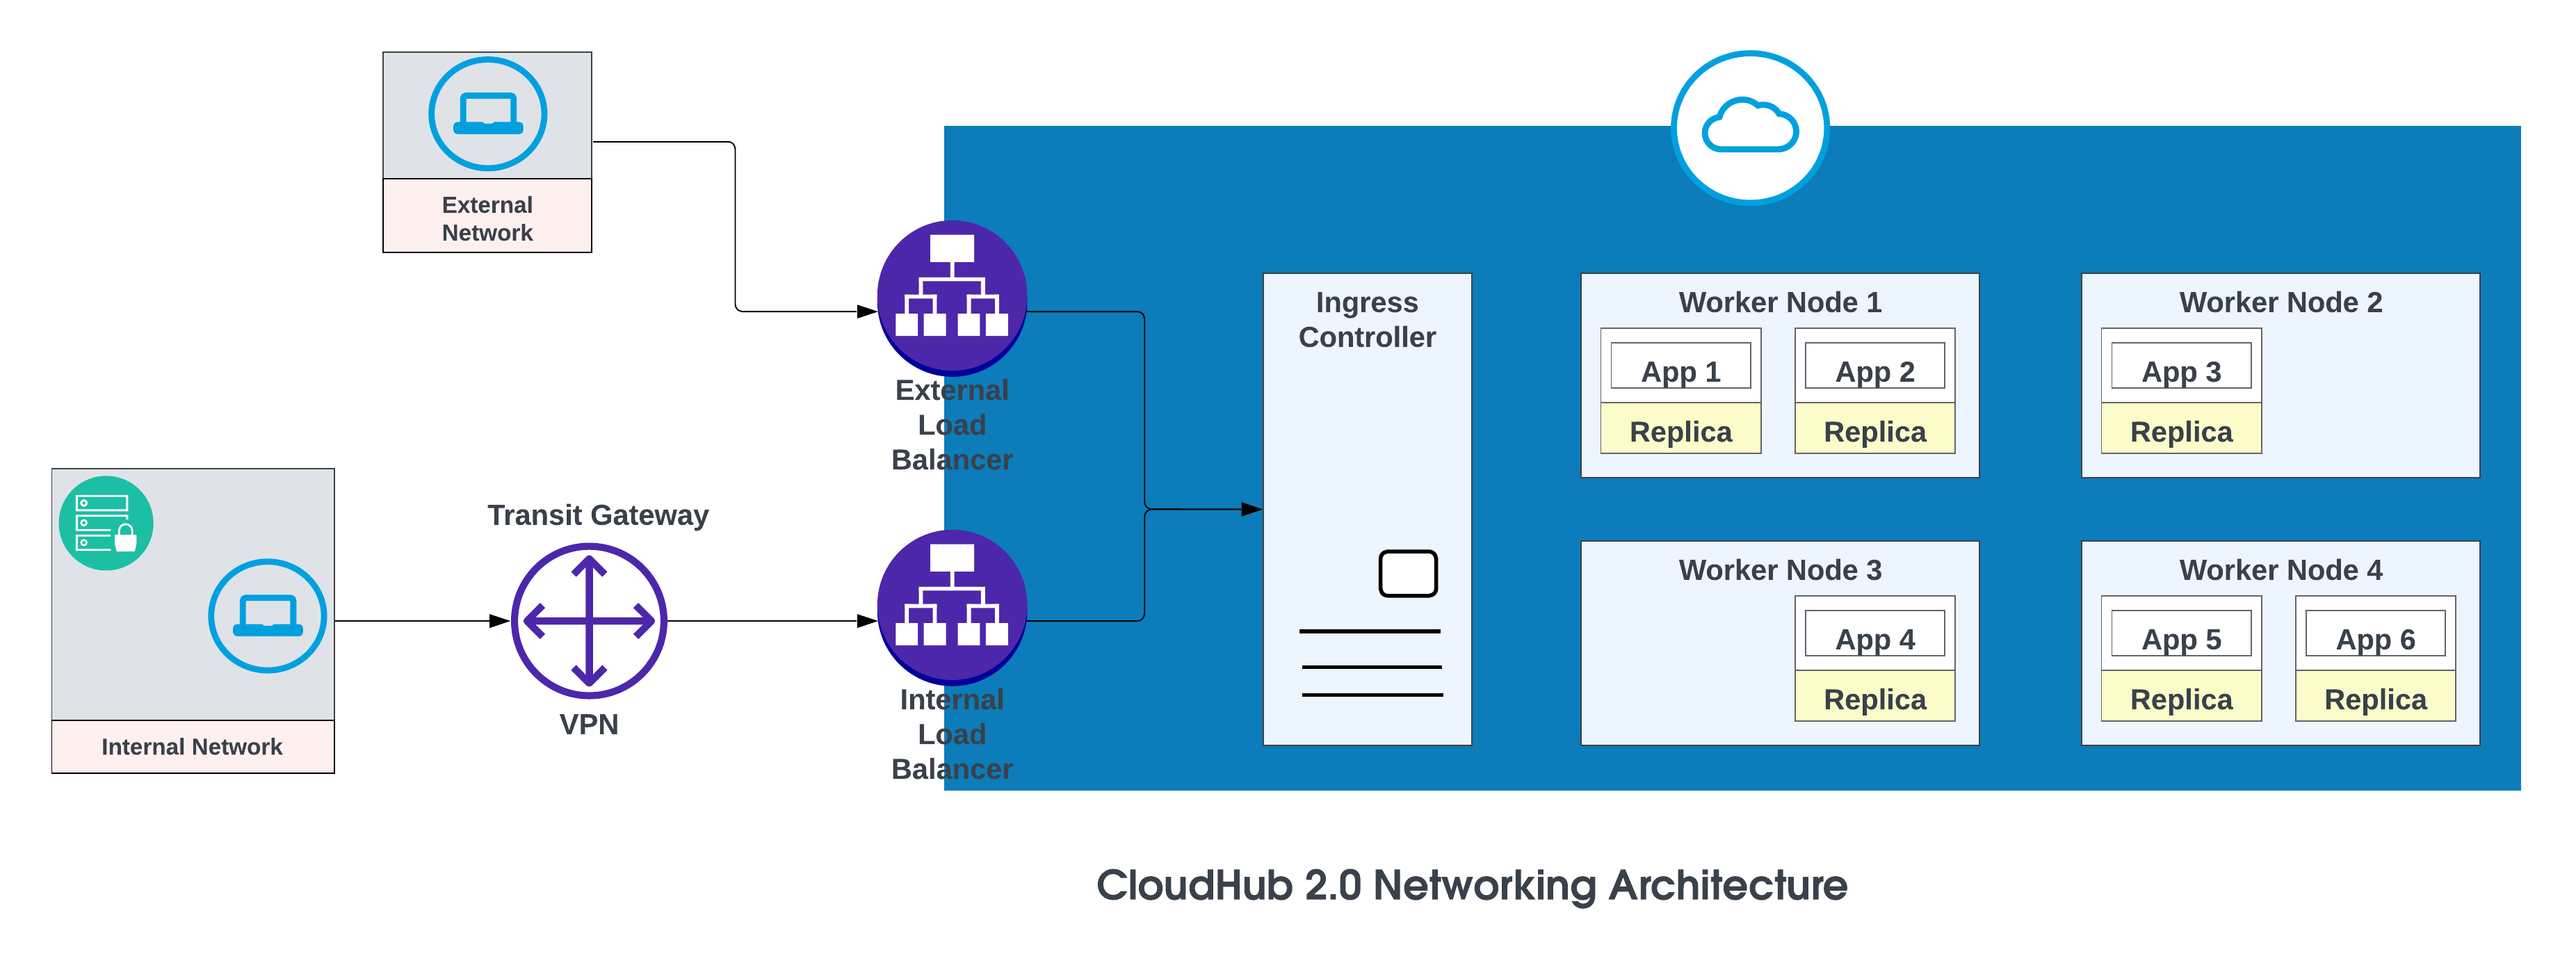 Die grundlegenden Komponenten der CloudHub 2.0-Netzwerkarchitektur sind:
- Ein HTTP-Lastausgleich
- Mule-Replikat-DNS-Datensätze
- Private Bereiche
- Regionale Dienstleistungen
Weitere Details finden Sie unter [CloudHub 2.0-Netzwerkarchitektur](https://docs.mulesoft.com/cloudhub-2/ch2-networking-guide).
**Vanity-Domänen**
Wenn ein privater Bereich erstellt wird, erhält er einen DNS-Zielnamen im Format: \
 CloudHub 2.0 unterstützt auch benutzerdefinierte Domänen oder Vanity-Domänen, indem es sie in einem privaten Bereich mithilfe von TLS-Kontexten und DNS-Datensätzen konfiguriert. Laden Sie zum Erstellen eines TLS-Kontexts im Laufzeit-Manager für einen privaten Bereich das öffentliche Zertifikat und den privaten Schlüssel hoch und fügen Sie dann einen benutzerdefinierten Endpunkt in den Einstellungen Ihrer Anwendung hinzu, um diese Domäne zu verwenden. Erstellen Sie einen DNS-Datensatz (z. B. einen CNAME), der Ihre Vanity-Domäne auf den standardmäßigen Hostnamen Ihres privaten Bereichs verweist.
Beispielsweise weist eine in us-west-2 bereitgestellte Anwendung mit dem Namen test-api mit dem Standard-DNS 42y52r.usa-w2.cloudhub.io den folgenden API-Endpunkt auf:
https://test-api-mwsklu-42y52r.usa-w2.cloudhub.io
Dieser URL verwendet keine Eitelkeit oder benutzerdefinierte Domäne. Führen Sie die folgenden Schritte aus, um `acme.com` zu verwenden, damit API-URLs als `https://test-api.acme.com` angezeigt werden.
1. Erstellen Sie TLS-Kontext im Laufzeit-Manager mit öffentlichen und privaten Schlüsseln.
2. Fügen Sie in den Einstellungen der Anwendung eine Vanity-Domäne hinzu, um diese Domäne zu verwenden.
3. Erstellen Sie einen DNS-Datensatz in AWS Route 53 und konfigurieren Sie eine einfache Weiterleitungsrichtlinie (z. B. CNAME), damit die Vanity-Domäne zum Standard-Hostnamen des privaten Bereichs aufgelöst wird.
Bei benutzerdefinierten Domänen können Sie AWS Route 53 oder andere globale CDN-Services mit Weiterleitungsrichtlinien verwenden. Im folgenden Diagramm wird AWS Route 53 mit der Richtlinie für die "einfache" Weiterleitung verwendet. Wenn ein Verbraucher aus einem öffentlichen (externen) Netzwerk acme.com anfordert, leitet AWS Route 53 die Anforderung an das MuleSoft-Steuerfeld für den Eingang des privaten Bereichs weiter.
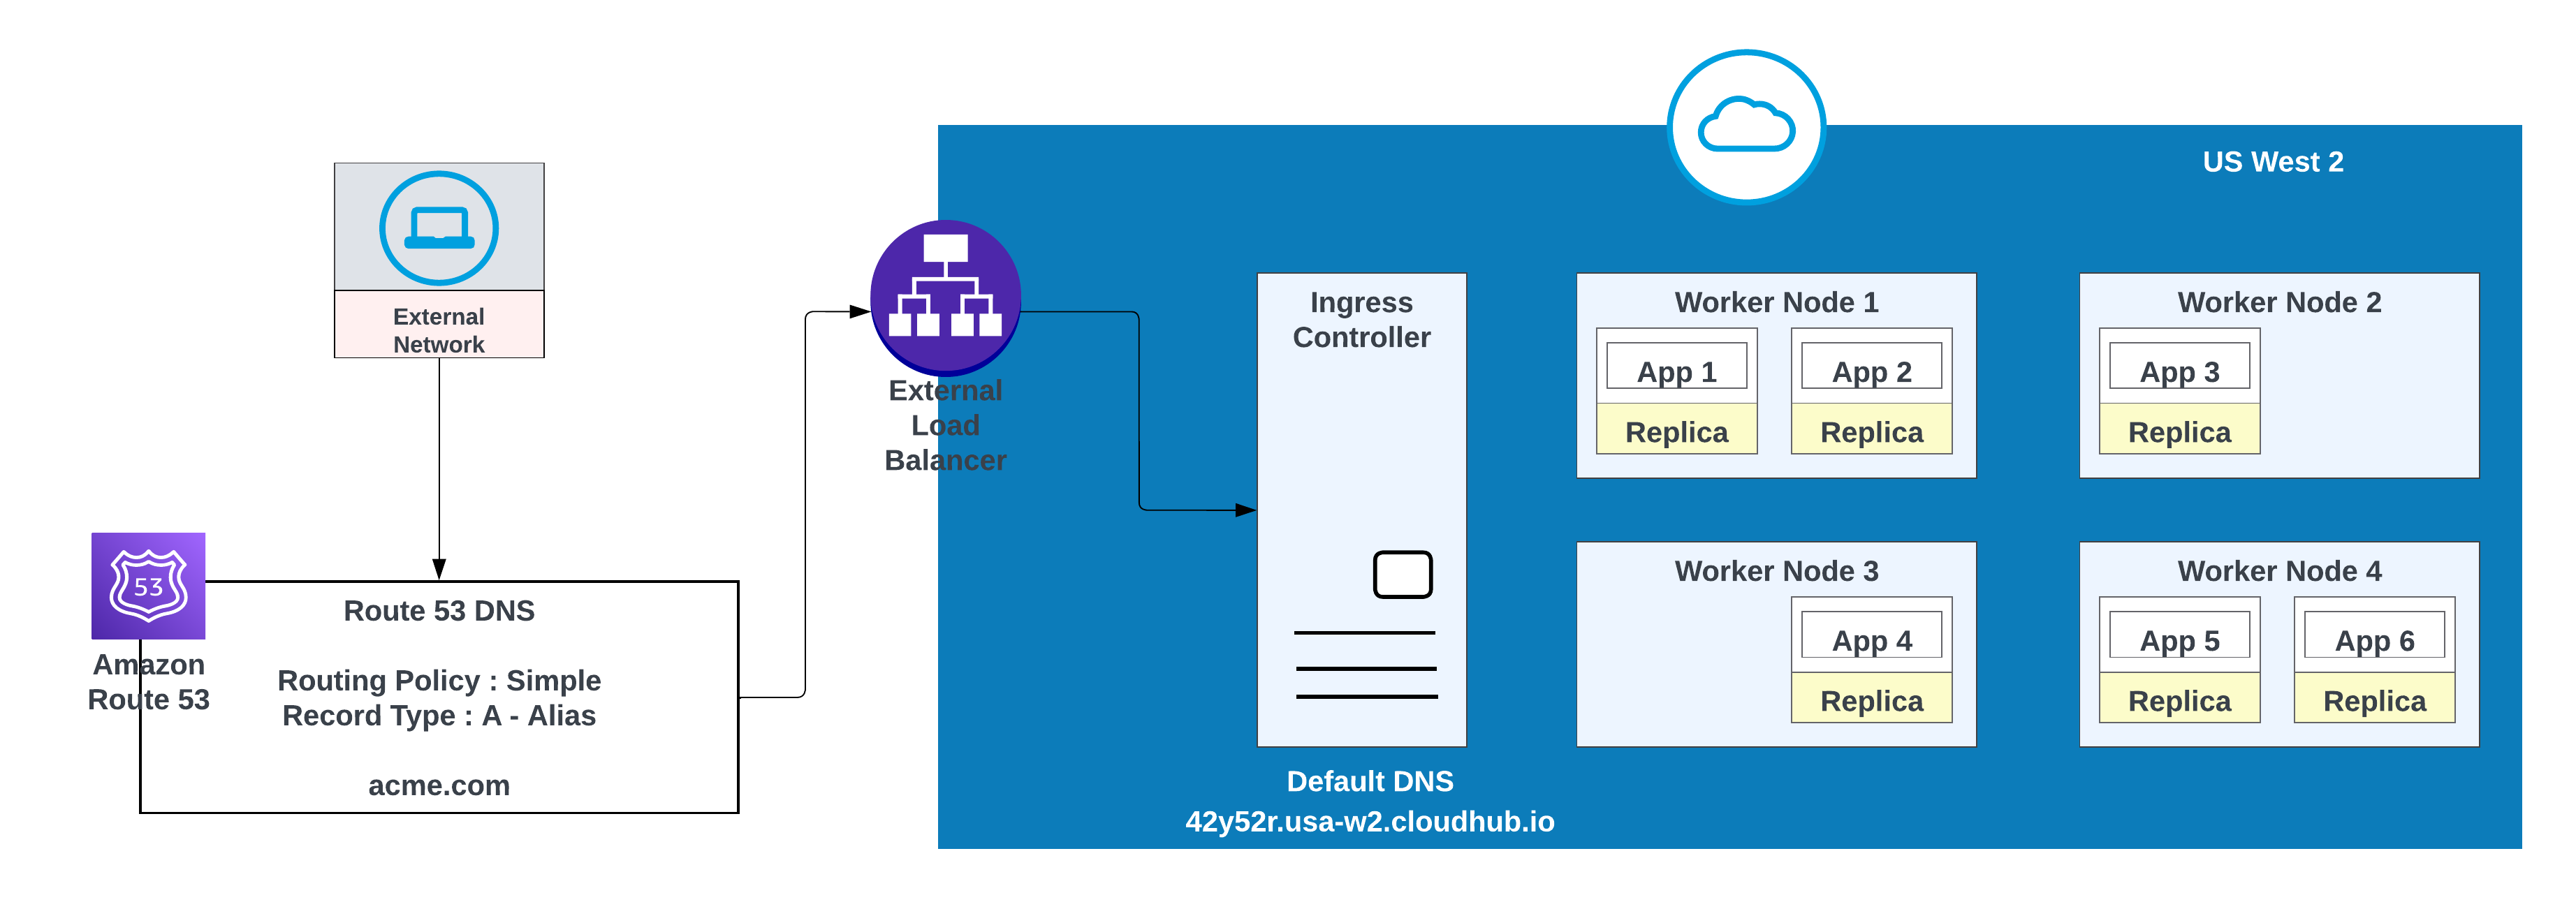 ## Failover-Strategie
Verwenden Sie diese Option, wenn Anwendungen ein Failover erfordern: Stellen Sie eine Instanz in der primären Region (z. B. us-west-2) und eine andere in einer sekundären Region (z. B. us-east-1) bereit.
Verwenden Sie nach Möglichkeit eine vorhandene Umgebung in der sekundären Region. Das Erstellen einer neuen Umgebung erfordert zusätzlichen Aufwand.
**Beispiel für Anwendungen, die in einer Region (USA-West 2) mit einem Failover in eine andere Region (USA-Ost 1) bereitgestellt wurden**
 | Datensatzname | Wert/Weiterleiten des Datenverkehrs an | Weiterleitungsrichtlinie | Integritätsprüfungs-ID |
| :---------: | :-----------------------: | :------------: | :-------------: |
| acme.com | 42y52r.usa-w2.cloudhub.io | Failover | 31s3wseq121 |
| acme.com | 31e51s.usa-e1.cloudhub.io | Failover | 43e131s131sq |
In dieser Konfiguration leitet AWS Route 53 den Datenverkehr an die Eingabesteuerfelder für die privaten Bereiche in US West 2 und US East 1 weiter. Eine Failover-Weiterleitungsrichtlinie wird mit einer Integritätsprüfung konfiguriert.
## Hohe Verfügbarkeit und geringe Latenz
Verwenden Sie für eine geringere Latenz bei gleichzeitig hoher Verfügbarkeit die im Diagramm beschriebene Bereitstellungsstrategie. Mit dieser Strategie können Anwendungen in zwei Regionen bereitgestellt werden (in diesem Beispiel us-west-2 und us-east-1).
Verwenden Sie die Latenzweiterleitungsrichtlinie in AWS Route 53, um Anforderungen an die Region weiterzuleiten, die die niedrigste Latenz aufweist, und gleichzeitig die hohe Verfügbarkeit beizubehalten. Weiterleitungsrichtlinie "Latenz" in AWS Route 53, um die Anforderung für eine niedrigere Latenz mit weiterhin hoher Verfügbarkeit weiterzuleiten.
**In beiden Regionen (USA West 2 und USA East 1) bereitgestellte Anwendungen für geringere Latenz und hohe Verfügbarkeit**
 | Datensatzname | Wert/Weiterleiten des Datenverkehrs an | Weiterleitungsrichtlinie | Integritätsprüfungs-ID |
| :---------: | :-----------------------: | :------------: | :-------------: |
| acme.com | 42y52r.usa-w2.cloudhub.io | Latenz | 31s3wseq121 |
| acme.com | 31e51s.usa-e1.cloudhub.io | Latenz | 43e131s131sq |
## Schlussfolgerung
MuleSoft CloudHub 2.0 bietet eine robuste Grundlage für die Resilienz innerhalb der Region und nutzt in erster Linie die automatisierte Abgleichsredundanz und den intelligenten Lastausgleich. In einer einzelnen Cloud-Region wird durch die Bereitstellung von Anwendungen mit mehreren Replikaten sichergestellt, dass bei einem Fehler einer Instanz sofort andere die Arbeitslast übernehmen können. Der integrierte Lastenausgleich verteilt eingehenden Datenverkehr effizient auf diese gesunden Abgleiche, minimiert Ausfallzeiten und gewährleistet eine kontinuierliche Serviceverfügbarkeit unter normalen Betriebsbedingungen.
Wenn Sie sich jedoch ausschließlich auf diese einzelne Regionsarchitektur verlassen, auch auf eine Architektur mit hoher Redundanz, besteht ein erhebliches Risiko eines weitreichenden, katastrophalen regionalen Ausfalls. Die Geschichte hat gezeigt, dass selbst die zuverlässigsten und technologisch fortschrittlichsten Cloud-Anbieter anfällig für störende Vorfälle sind, die sich auf eine gesamte geografische Region auswirken können. Diese einzelnen Fehlerpunkte sind zwar selten, können jedoch durch verschiedene Ereignisse verursacht werden, darunter:
- Groß angelegte Infrastrukturvorfälle
- Schwere Stromausfälle
- Weit verbreitete Netzwerkunterbrechungen
Um eine echte Hochverfügbarkeit (HA) und Notfallwiederherstellung (DR) zu erreichen, muss eine Architektur daher so konzipiert sein, dass sie die Einschränkungen eines Einzelregionsmodells überschreitet. Die empfohlene Strategie ist die Bereitstellung in mehreren geografisch unterschiedlichen Regionen. Durch diese regionsübergreifende Resilienz wird sichergestellt, dass der Datenverkehr nahtlos auf eine Anwendungsinstanz umgeschaltet werden kann, die in einer separaten, nicht betroffenen Region ausgeführt wird, wenn eine gesamte Cloud-Region aufgrund einer unerwarteten Katastrophe nicht verfügbar ist. Dies garantiert minimale Serviceunterbrechungen und das Erreichen maximaler Betriebszeitziele.
## Verweise
[CloudHub 2.0-Netzwerkarchitektur](https://docs.mulesoft.com/cloudhub-2/ch2-networking-guide)
[Konfigurieren von regionsübergreifendem Failover für Standardwarteschlangen](https://docs.mulesoft.com/mq/mq-failover)
[Bereitstellungsregionen für Objektspeicher V2](https://docs.mulesoft.com/object-store/osv2-faq#osv2-regions)
[Ihre Objektspeicher-Bereitstellungsregion](https://docs.mulesoft.com/object-store/osv2-faq#is-object-store-v2-persistent-in-the-same-region-as-the-worker)
## Über die Autoren
Gulal Kumar ist Software-Engineering-Architekt bei Salesforce mit Schwerpunkt auf Daten- und Integrationsarchitektur. Mit über 20 Jahren Erfahrung in Integration und APIs, Modernisierungsprogrammen, Sicherheit und AIML-Initiativen bringt er eine Fülle von Expertise mit. Gulal hat sich verpflichtet, Initiativen zur Geschäftstransformation voranzutreiben, Sicherheit und Widerstandsfähigkeit zu erhöhen, Architekturexzellenz zu fördern und AIML-Initiativen in verschiedenen Bereichen voranzutreiben.
Ajay Nagaraju ist Enterprise Architect und Senior Director bei MuleSoft mit über 28 Jahren Erfahrung in der Unternehmensarchitektur, Systemintegration und der groß angelegten digitalen Transformation. Er hat die Architektur und Bereitstellung komplexer Programme im Wert von mehreren Millionen Dollar in Fortune 100- und Fortune 500-Organisationen geleitet und verfügt über umfassende Expertise in API-gestützter Konnektivität, SOA, Cloud-Technologien und Unternehmensintegrationsmustern. Ajay hat eng mit Führungskräften zusammengearbeitet, um Geschäftsprozesse, Datenplattformen und Integrationsökosysteme zu modernisieren, und ist leidenschaftlich daran interessiert, skalierbare Architekturen zu entwickeln, Teams zu betreuen und messbare Geschäftsergebnisse durch Technologie voranzutreiben.
# Einführung
In diesem Dokument wird ein Standpunkt dargestellt, der die IT-Architektur beschreibt, die Unternehmen in den nächsten 3-5 Jahren benötigen werden, um den Wert einer Agentenbelegschaft vollständig zu erfassen. Es wird die IT-Transformation beschrieben, die erforderlich ist, um die Bereitstellung von AI-Agenten im großen Umfang zu unterstützen. Das Ziel ist es, einen strategischen Leitfaden und eine Referenzarchitektur bereitzustellen, die CIOs, CDOs und IT-Führungskräften bei der Planung ihres Wegs zum Agentenunternehmen helfen.
Leistungsfähige AI-Modelle ermöglichen die Schaffung einer Agentenbelegschaft, die in der Lage ist, die Umgebung zu erfassen, über Daten nachzudenken, autonome Entscheidungen zu treffen, Aufgaben auszuführen und effektiv mit menschlichen Mitarbeitern zusammenzuarbeiten. Diese neue Belegschaft verspricht einen entscheidenden Wandel in puncto Innovation, Produktivität und Agilität und schafft so Mehrwert für Aktionäre und Kunden. Um diese Vision zu verwirklichen, müssen Organisationen eine Geschäfts- und IT-Transformation durchlaufen, um zu Agentenunternehmen zu werden.
## Geschäftsmöglichkeiten des Agentenunternehmens
Heute sieht sich das traditionelle Unternehmen mit betrieblichen Ineffizienzen konfrontiert, die sich aus Informationssilos, Mitarbeitern, die in manueller Arbeit begraben sind, falsch ausgerichteten Anreizen in Organisationsstrukturen und uneinheitlichen Feedbackschleifen zwischen Strategien und Ergebnissen ergeben. Diese Probleme führen zu suboptimalen Kundenerfahrungen, ineffizienten Prozessen und verpassten Wachstumschancen.
Das Agentic Enterprise überwindet diese Einschränkungen, indem es eine digitale Belegschaft intelligenter AI-Agenten in menschliche Mitarbeiter integriert. Mit dieser neuen AI-gestützten Belegschaft kann eine Organisation Innovationen für Wachstum fördern, operative Spitzenleistungen steigern und die Widerstandsfähigkeit von Unternehmen mit verschiedenen Arten neuer Geschäftsfunktionen aufbauen.
**Neue Geschäftsmöglichkeiten zur Innovationsförderung:**
- Erhöhte menschliche Produktivität: Die Schnelligkeit, Skalierbarkeit und die ständige Verfügbarkeit von AI-Agenten ermöglichen es Unternehmen, sich wiederholende Arbeiten zu automatisieren, und ermöglichen es menschlichen Mitarbeitern, sich auf hochwertigere und kreativere Aufgaben zu konzentrieren.
- Verbesserung der Anpassungsfähigkeit: Da die Argumentation von AI-Agenten beobachtet werden kann, können sie dynamisch lernen und neue Fertigkeiten bereitstellen, wodurch das Unternehmen die Leistung kontinuierlich verbessern kann, um Geschäftsziele zu erreichen und sich schnell an neue Marktchancen anzupassen.
_Beispiel in Aktion – Innovation der Kundenerfahrung in Finanzdienstleistungen:_ Eine Vermögensverwaltungsfirma kann einen AI-Agenten verwenden, um ihr Kundenengagementmodell neu zu erfinden. Der Agent überwacht Portfolios autonom, identifiziert wichtige Momente für eine Kundenüberprüfung und bereitet den Plan vor dem Anruf für den Berater vor, wobei er den Plan anpasst, sobald Nachrichten veröffentlicht werden. Dadurch kann der menschliche Berater eine proaktive, personalisierte Kundenerfahrung im richtigen Maßstab bereitstellen, Beziehungen stärken und neue Opportunities aufdecken.
**Neue Geschäftsfunktionen zum Schutz und zur Gewährleistung der Widerstandsfähigkeit der Organisation:**
- Elastische Belegschaftskapazität: Unternehmen können ihre Fähigkeit zur Bewältigung des Anstiegs der Arbeitslast aufgrund sich ändernder Geschäftsbedingungen schnell skalieren, ohne die Kosten und Verzögerungen durch die Steigerung einer vollständig menschlichen Belegschaft.
- Prognostizierte betriebliche Resilienz: AI-Agenten sind rund um die Uhr in der Lage, Betriebs-, Compliance- und Sicherheitsrisiken in Echtzeit autonom zu antizipieren, zu modellieren und zu minimieren. So wird sichergestellt, dass das Unternehmen das Trust seiner Kunden und Beteiligten aufrechterhält.
_Beispiel in Aktion – Schützen von Kundendaten:_ Ein großes Unternehmen kann einen AI-Datenverwaltungsagenten bereitstellen, der die regulatorische Umgebung auf Änderungen der Datenschutzgesetze überprüft, sensible Informationen in Unternehmensdatensets erkennt und klassifiziert und dann die entsprechende Governance-Richtlinie anwendet. Der Agent kann Datenzugriffsanforderungen überprüfen und Ausnahmen zur Überprüfung an einen menschlichen Analysten weiterleiten, wodurch das Compliance-Risiko reduziert und gleichzeitig die vertrauenswürdige Verwendung von Daten ermöglicht wird.
**Neue Geschäftsfunktionen zur Optimierung der Betriebsexzellenz:**
- Autonome Prozessausführung: Eine digitale Belegschaft kann komplexe, aus mehreren Schritten bestehende Aufgaben rund um die Uhr in Maschinengeschwindigkeit ausführen (mit Menschen auf dem Laufenden), wodurch Kosten reduziert und Prozesse effizient skaliert werden.
- Grenzüberschreitende Orchestrierung: AI-Agenten können über die Informations- und Anreizsilos hinweg arbeiten, die normalerweise menschliche Mitarbeiter einschränken, und so die Agilität für funktionsübergreifende Prozesse fördern.
_Beispiel in Aktion – Optimierung des Marketing-Trichters im Einzelhandel:_ Ein Einzelhandelsmarketingteam kann einen AI-Agenten einsetzen, um seinen Kampagnenprozess als Reaktion auf neue Verbrauchertrends zu beschleunigen. Der Agent kann Marketingpläne generieren, mit Marketing-, Produkt- und Vertriebsteams zur Überprüfung zusammenarbeiten und dann automatisch digitale Sicherheiten erstellen und über mehrere Kanäle hinweg ausführen, wobei die Kampagne basierend auf Echtzeit-Feedback dynamisch angepasst wird.
## IT-Architektur des Agentenunternehmens
In diesem Abschnitt wird untersucht, wie sich die traditionelle IT-Architektur weiterentwickeln muss, um autonome AI-Agenten zu unterstützen, die zusammen mit menschlichen Mitarbeitern denken und Maßnahmen ergreifen.
### Die Grenzen der traditionellen IT-Architektur
Die IT-Architektur des Unternehmens kann mithilfe eines Ebenenkonstrukts dargestellt werden. Die Schichten gruppieren zugehörige technische Funktionen logisch und erleichtern strukturiertes Denken, bedeuten jedoch nicht notwendigerweise spezifische Implementierungen oder den Grad, in dem eine Schicht monolithisch oder heterogener ausgestaltet sein sollte. In dieser Ebenenansicht (Abbildung 1) besteht die traditionelle IT-Architektur aus fünf Hauptebenen: Infrastruktur, Daten, Integration, Anwendung und Erfahrung. Zwei Ebenen – Sicherheit und IT-Vorgänge – erstrecken sich über diese Ebenen, um Governance, Überwachung und Schutz zu gewährleisten.
Die traditionelle IT-Architektur wurde für ein Paradigma entwickelt, bei dem die Intelligenz des Unternehmens auf menschlichen Mitarbeitern beruhte, die Aktionen in Anwendungen ergriffen, um auf Daten zuzugreifen, Geschäftslogik anzuwenden, die Zusammenarbeit zu erleichtern und Workflows auszuführen. Sie ist nicht für ein Paradigma konzipiert, bei dem AI-Agenten bestimmte Anwendungsfälle, die zuvor von Menschen durchgeführt wurden (oder gar nicht durchgeführt wurden), bedenken und ergreifen können, während Menschen die AI-Agenten überwachen und sich auf kreativere und mehrdeutige Aufgaben konzentrieren.
 Obwohl die traditionelle Architektur heute Bereitstellungen von AI-Agenten in untergeordneten Dimensionen unterstützt, kann sie die oben beschriebenen Geschäftsfunktionen des Agentic Enterprise nicht vollständig bereitstellen. Für die Realisierung dieser Funktionen ist eine IT-Architektur erforderlich, die für die weit verbreitete Bereitstellung leistungsstarker AI-Agenten konzipiert ist, die breite Anwendungsfälle abdecken können, statt sich auf begrenzte Bereitstellungen für enge Anwendungsfälle zu beschränken.
AI-Agenten werden sich in den nächsten 5 Jahren weiter verbessern und die IT-Architektur muss sich weiterentwickeln, um den Wert leistungsfähigerer und intelligenter AI-Agenten zu realisieren und zukunftssicher zu werden. Erstens werden Agenten intelligenter, wenn sich die zugrunde liegenden AI-Modelle (wie multimodale LLMs) und die kognitiven Architekturen der Agenten weiterentwickeln (z. B. Planung in mehreren Schritten, Aufgabenaufteilung usw.). Zweitens verfügen AI-Agenten über verbesserte Lern- und Anpassungsfähigkeiten mit Gedächtnisverbesserungen, Selbstreflexionsfunktionen und der Möglichkeit, aus Feedback zu lernen. Drittens können AI-Agenten besser mit anderen Agenten, Tools und Daten interagieren, wie das sich schnell entwickelnde Ökosystem offener Technologiestandards (z. B. Model Context Protocol, Agent2Agent usw.) zeigt. Diese drei Technologietrends werden es AI-Agenten ermöglichen, bei abstrakteren und komplexeren Aufgaben leistungsfähiger zu sein, sie werden jedoch auch zahlreiche Herausforderungen für die heutige IT-Architektur mit sich bringen.
Erstens stützen sich AI-Agenten grundsätzlich auf AI-Modelle, die intern entwickelt und extern bezogen werden und sich schnell weiterentwickeln und eine komplexe, gemeinsame und standardisierte AI/ML-Modellverwaltung erfordern. Heute werden AI-Modelle für bestimmte Anwendungsfälle in einer Anwendung verwendet, nicht als freigegebene Funktionen für die Wiederverwendung mit gemeinsamen Tools für Schulungen, Bereitstellung, Governance und Risikomanagement. Künftig müssen Unternehmen unterschiedliche AI-Modelle für verschiedene Anwendungsfälle für Agenten verwenden können, die Tools erfordern, die es Agenten ermöglichen, die zugrunde liegenden Modelle (z. B. das Grundlagenmodell im Vergleich zu einem domänenspezifischen kleineren Modell) je nach Geschäftskontext auszutauschen. Dazu müssen intern entwickelte oder gehostete AI-Modelle mit einheitlichen Lebenszyklus-Tools verwaltet werden, um Konsistenz, Wiederverwendbarkeit, Skalierbarkeit und Effizienz zu gewährleisten. Ebenso erfordert der Zugriff auf extern gehostete AI-Modelle ein unternehmensweites Kontroll-Framework, um optimale Leistung, Sicherheit, Compliance, Verfügbarkeit und Zuverlässigkeit zu gewährleisten.
Zweitens verfügen AI-Agenten über unterschiedliche Skalierungsmuster und betriebliche Anforderungen wie Hosting, Entwicklung, Überlegungen, Lernen, Speicherverwaltung und Vorgänge, die eine separate und dedizierte architektonische Grenze für Agenten erfordern. Eine direkte Einbettung dieser Funktionalität in die heutige statische und deterministische Anwendungsarchitektur würde unnötige architektonische Komplexität und Risiken mit sich bringen. Darüber hinaus sollten AI-Agenten über standardisierte Schnittstellen oder Messaging-Systeme mit vorhandenen Anwendungen interagieren, um in Echtzeit interagieren zu können.
Drittens müssen AI-Agenten in der Lage sein, über unterschiedliche Datensets nachzudenken und miteinander zusammenzuarbeiten, oft über isolierte Anwendungsstapel hinweg. In der heutigen Architektur gibt es jedoch keine gemeinsame semantische Funktion, die es diesen Agenten ermöglicht, über unterschiedliche Datensets nachzudenken. Obwohl Einzweckagenten erfolgreich bereitgestellt werden können, bleibt es daher schwierig und riskant, sie so zu skalieren, dass sie in großer Anzahl bei komplexen, siloübergreifenden Aufgaben eingesetzt werden.
Schließlich fehlt es der aktuellen IT-Architektur für Unternehmen an einer effektiven Möglichkeit, durchgängige Geschäftsprozesse zu orchestrieren, zu optimieren und zu steuern, die dynamische Workflows enthalten, die von leistungsfähigeren Agenten ausgeführt werden, was die Rolle der menschlichen Mitarbeiter in diesem Prozess erweitern und in einigen Fällen ersetzen wird. Heute werden Automatisierungstools genutzt, um lineare, deterministische Workflows zu verwalten, die in der Regel einer vordefinierten Sequenz folgen, in prozessspezifischen Sprachen dokumentiert sind und auf statischer Logik basieren, die sich selten ändert. AI-Technologien können einige dieser linearen Prozesse verbessern (beispielsweise die Verwendung von ML-Modellen anstelle hartcodierter Geschäftsregeln zur Berechnung von Schwellenwerten für die Darlehensgenehmigung), die strategischen und Ausführungsaspekte der meisten wichtigen Geschäftsprozesse bleiben jedoch von Natur aus dynamisch und flexibel. Aufgaben wie das Entwickeln von Marketingstrategien, das Lösen komplexer Kundenprobleme oder potenzieller Kunden haben klare Ziele (Kundenzufriedenheit, Kundenvorgangslösungsgeschwindigkeit usw.), folgen jedoch nicht einer festen, vordefinierten Ausführungsreihenfolge.
Derzeit verlassen sich traditionelle Unternehmen in erster Linie auf den Menschen, um diese komplexen Geschäftsprozesse zu koordinieren und durchzuführen (z. B. die Festlegung einer Strategie und die Verwaltung komplexer Programme). Da sich AI-Agenten in den nächsten 3-5 Jahren ständig weiterentwickeln (größere Intelligenz, Lern- und Interaktionsfunktionen), wird sich ihre Fähigkeit, solche dynamischen Prozesse autonom auszuführen, erheblich erweitern, was Komplexitäten und Integrationsherausforderungen mit sich bringt, die weit über die Möglichkeiten der vorhandenen Integrations- und Automatisierungstools hinausgehen. Die anpassungsfähige und dynamische Natur von AI-Agenten schafft einen starken Bedarf an neuen Orchestrierungsfunktionen, um die Kontrolle auf Unternehmensebene, umfassende Transparenz und konsistente Ausrichtung an unternehmensweiten strategischen Zielen zu gewährleisten, insbesondere bei der Verwaltung komplexer, langwieriger und aus mehreren Schritten bestehender Workflows, die AI-Agenten, Menschen, Automatisierungstools und andere deterministische Systeme umfassen.
Die IT-Architektur des Agentic Enterprise schafft eine Plattform für intelligente Aktionen, indem sie menschliche Mitarbeiter, AI-Agenten und deterministische Systeme nahtlos integriert. Mit dieser Architektur können Mitarbeiter und AI-Agenten dynamisch auf vereinheitlichtes Enterprise Knowledge aus verschiedenen Datenquellen zugreifen und es nutzen, um komplexe Workflows und Prozesse effizient auszuführen, die auf strategische Geschäftsziele ausgerichtet sind. Die bestehende IT-Architektur einer Reihe isolierter Plattformen und Punktlösungen wird sich zu einer Reihe von zusammengesetzten Anwendungsservices, semantischen und Datentools und Netzwerken von AI-Agenten entwickeln, die von neuen intelligenten Tools zur Orchestrierung von Geschäftsprozessen überwacht und gesteuert werden.
Diese Architektur ermöglicht es Agenten, ihren jeweiligen Umfang zu erkennen, zu begründen und zu handeln, innerhalb und bereichsübergreifend zu arbeiten und kontinuierlich zu lernen, sich zu verbessern und anzupassen. Dies erfordert ein Design, das sich auf zuverlässige Mechanismen für den Zugriff auf Daten und Knowledge (semantisches Verständnis), flexible und standardisierte Kommunikationsprotokolle und -schnittstellen (z. B. Agent zu Agent, Agent zu deterministischen Systemen und Agent zu Mensch) konzentriert und Workflows und Prozesse über Agenten, Menschen und Automatisierungstools und deterministische Systeme hinweg orchestriert.
### Architekturprinzipien
Zur Realisierung der architektonischen Vision einer Plattform für intelligente Aktionen werden die folgenden Designprinzipien als bewährte Vorgehensweisen empfohlen:
- **Zusammensetzbarkeit und Modularität:** Entwerfen Sie Architekturelemente als modulare Komponenten mit standardisierten Schnittstellen, um eine schnelle und dynamische Zusammenstellung von Agentenfunktionen, Workflows und menschlichen Oberflächen zu ermöglichen. Priorisieren Sie Verträge mit klarer Oberfläche und Abstraktion, um AI-Agenten die größtmögliche Flexibilität beim Erstellen von Workflows zu ermöglichen.
- **Daten und semantische zuerst:** Stellen Sie einen umfassenden, genauen, schnellen, sicheren und kosteneffizienten Zugriff auf Daten sicher, mit einem gemeinsamen semantischen Verständnis für Agenten, die effektiv über isolierte Systeme hinweg argumentieren können. Dazu müssen Daten (und Metadaten) wie ein Produkt behandelt werden, mit Tools, die Qualität, Herkunft, Governance und Zugriff sicherstellen, sowie einer Möglichkeit, semantisches Verständnis bereitzustellen, das zwischen Agenten und Menschen geteilt wird.
- **Eingebettete IT- und Geschäftsbeobachtbarkeit:** Betten Sie durchgängige Überwachungs-, Verfolgungs-, Bewertungs- und Erklärbarkeitsfunktionen in die gesamte Architektur ein, um Einblicke in die Überlegungen, Verhaltensweisen, Systeminteraktionen und Auswirkungen von Agenten auf Geschäfts-KPIs zu erhalten und die Leistung von Agenten kontinuierlich zu optimieren. Dazu zählen Kostenoptimierung (FinOps), Nachhaltigkeitskennzahlen und betriebliche Telemetrie bei gleichzeitiger Wahrung von Trust, Compliance und verantwortungsvollem Ressourcenverbrauch. Da AI-Agenten von Natur aus nicht deterministisch sind, ist die Beobachtbarkeit von entscheidender Bedeutung, um sicherzustellen, dass AI-Agenten vertrauenswürdig, konform und überprüfbar mit der menschlichen Aufsicht arbeiten können.
- **Trust-out:** Erzwingen Sie dynamische, detaillierte Berechtigungen, die auf dem Intent der Aufgaben des Agenten (Datenzugriff, Aktionen usw.) basieren, und implementieren Sie umfassende Sicherheitspraktiken, einschließlich roter Teams, automatisierter CVE-Scans, Schwachstellenerkennung und risikobasierter Validierungskontrollen. Angesichts des Risikos, dass Agenten aufgrund ihrer Fähigkeit, mit Maschinengeschwindigkeiten zu arbeiten, eskalierende Risiken verursachen, sind genauere und dynamischere Kontrollen erforderlich. Stellen Sie sicher, dass alle AI-generierten Ausgaben (von Agenten oder Modellen) vor der Verwendung oder Bereitstellung streng anhand definierter Richtlinien für Compliance, Sicherheit, Toxizität und Verzerrung validiert werden, was Protokollierungs- und Erklärbarkeitsmechanismen mit überprüfbaren Prüfprotokollen für AI-Entscheidungen, -Aktionen, -Inhalte und -Prognosen erfordert.
- **Agent zuerst mit menschlicher Aufsicht:** Legen Sie fest, dass AI-Agenten das Standardtool zum Lösen von Geschäftsanwendungsfällen sein können, wobei andere Überlegungen (z. B. Kosten, technische Anpassung) außer Acht gelassen werden, und entwerfen Sie IT-Systeme so, dass sie für Agenten-Workflows zugänglich sind. Dazu gehört auch die Möglichkeit für Menschen, jeden Schritt des Prozesses eines Agenten zu überwachen, in ihn einzugreifen und ihn zu überschreiben. Agenten benötigen selbstreflektierende Fähigkeiten, um proaktiv nach menschlicher Anleitung zu suchen, wenn ihr Vertrauen in die Entscheidungsfindung unter vorprogrammierte Schwellenwerte fällt.
- **Reaktive und multimodale Interaktion:** Aktivieren Sie die Architektur, um umfassende Agentenaufruf- und -antwortmechanismen für alle Interaktionstypen zu unterstützen, einschließlich Agent-zu-Agent-Protokollen, menschlichen multimodalen Eingaben (Sprache, Text, visuell), Geschäftsereignissen, Systemsignalen und Streaming-Daten. Aktivieren Sie sowohl ereignisgesteuerte als auch Echtzeitverarbeitungsfunktionen, um sicherzustellen, dass Agenten auf zeitnahe Signale aus jeder Quelle oder jedem Format reagieren können.
- **AI-fähige Infrastruktur:** Stellen Sie sicher, dass die Infrastruktur mit integrierter Redundanz elastisch skaliert werden kann, um schwankende AI-Arbeitslasten zu bewältigen, und integrieren Sie ML/LLM-Pipelines in die Daten- und Anwendungsarchitektur, während Sie die Anforderungen an die Datenresidenz erfüllen.
- **Offenes Ökosystem:** Priorisieren Sie die Interoperabilität und vermeiden Sie Technologiebindungen, indem Sie offene Standards, Protokolle und genau definierte Schnittstellen (APIs, Ereignisse) bevorzugen, um vom Technologieökosystem zu profitieren.
## Architekturebenen
Um die Agententransformation erfolgreich zu aktivieren und zu skalieren, müssen Unternehmen über die bloße Verbesserung der aktuellen Ebenen hinausgehen. Sie müssen die Einführung von vier zusätzlichen Architekturebenen (Abbildung 2) in Erwägung ziehen, die speziell auf die Anforderungen von AI-Agenten zugeschnitten sind.
Die **Agentic Layer** ist der Entwicklung und Verwaltung von AI-Agenten gewidmet und umfasst kognitive Funktionen wie Planung, Überlegungen, Arbeitsspeicher, Werkzeugauslastung, Statusverwaltung und Lebenszykluskontrolle. Diese Schicht erfüllt die individuellen technischen und betrieblichen Anforderungen von AI-Agenten, gewährleistet die Interoperabilität zwischen Anwendungen und Datenspeichern durch standardisierte Protokolle und erleichtert die Zusammenarbeit zwischen Agenten. Die vorhandene Anwendungsebene wird zu Anwendungsservices weiterentwickelt, die dynamisch für Agenten-Workflows erstellt werden.
 Die **semantische Ebene** wird eingeführt, um die Trennung zwischen Unternehmensrohdaten und dem semantischen Verständnis zu beheben, das AI-Agenten benötigen. Sie codiert und verwaltet explizit Geschäftseinheiten, Konzepte, Definitionen und Beziehungen zwischen Unternehmen. Dadurch wird eine Unternehmensontologie und die Darstellung von Business Knowledge erstellt, um ein gemeinsames semantisches Verständnis zu ermöglichen, das komplexere Workflows mit mehreren Agenten unterstützt, die Aufgaben auf höherer Ebene ausführen. Über einen Datenkatalog hinaus übersetzt die semantische Ebene eine Abfrage mit natürlicher Sprache in präzise Abfragen für bestimmte Datenspeicher, harmonisiert die Ergebnisse und gibt dem Agenten eine kontextbezogene und umfassendere Antwort zurück. Die vorhandene Datenebene wird unterdessen durch die Übernahme zentraler Lakehouses vereinheitlicht und der Datenzugriff über eine AI-fähige Datenstruktur erweitert, um die Prinzipien des Betriebsmodells für Datenmaschen zu unterstützen.
Die **AI/ML-Ebene** zentralisiert die Verwaltung der AI-Funktionen von Unternehmen, einschließlich großer Sprachmodelle, großer Aktionsmodelle und domänenspezifischer ML-Modelle. Dabei werden sowohl intern entwickelte AI-Modelle während ihres gesamten Lebenszyklus als auch der kontrollierte Zugriff auf externe AI-Services verarbeitet. Im Gegensatz zu herkömmlichen Architekturen, in denen AI-Modelle in Anwendungen eingebettet sind, etabliert diese Ebene AI-Modelle als erstklassige Komponenten und gemeinsam genutzte Services im Unternehmen. Sie konzentriert sich auf unternehmensgesteuerte AI-Funktionen (nicht auf AI-Funktionen, die von externen Anbietern bereitgestellt werden). Diese Schicht bietet standardisierte Mechanismen für Trust, Sicherheit, Compliance und Bereitstellung und bietet Informationen für verschiedene Agenten und andere AI-Arbeitslasten im Unternehmen.
Die **Enterprise Orchestration Layer** ist die funktionale Abstraktion zur Koordinierung, Steuerung und Optimierung komplexer, aus mehreren Schritten bestehender Workflows und Geschäftsprozesse, die sich auf AI-Agenten, Menschen, Automatisierungstools und deterministische Systeme erstrecken. Diese Ebene nutzt ein gemischtes Orchestrierungsmodell, das es einzelnen Agenten und Systemen ermöglicht, lokal choreographierte Aufgaben mithilfe offener Protokolle wie MCP und A2A autonom zu bearbeiten, während gleichzeitig eine zentrale durchgängige Überwachung und Koordination des gesamten Prozesses gewährleistet wird. Zum Implementieren des gemischten Orchestrierungsmodells stellt diese Ebene wichtige Geschäftsprozesse in semantisch umfangreichen, semantisch lesbaren Formaten dar, die sowohl die deterministischen Schritte (modelliert während der Entwurfszeit) als auch die dynamischen Schritte (entschieden von Agenten während der Laufzeit) eines Geschäftsprozesses definieren und so die Grundlage für das Prozessmodell für die Verwaltung und Optimierung bilden.
In der Regel sind erhebliche Teile der menschengesteuerten Geschäftsprozesse in maschinenlesbaren Formen undokumentiert oder unzugänglich. Die detaillierte Beobachtbarkeit der Aktivitäten von AI-Agenten, einschließlich umfangreicher Daten und Metadaten zu ihren Aufgaben und Aktionen, ermöglicht jedoch die Erfassung, Dokumentation und Integration dynamischer, zuvor unstrukturierter Arbeit in deterministische lineare Workflows, um umfassende Prozessmodelle zu erstellen. In der detaillierten Prozessdokumentation werden bisher unsichtbare Abhängigkeiten zwischen Aufgaben und Ausführungspfade erfasst. Dadurch kann das Unternehmen die betriebliche Effizienz kontinuierlich optimieren, Engpässe effektiv beheben und von Agenten identifizierte bewährte Vorgehensweisen systematisch in wiederverwendbare unternehmensweite Playbooks kodifiziert werden. Dies führt zu einem ganzheitlichen digitalen Zwilling einzelner Prozesse und bei der Skalierung zum gesamten Unternehmen.
Komplexe Prozesse wie die Ausführung umfassender Vertriebsstrategien oder die Einarbeitung neuer Mitarbeiter umfassen beispielsweise zahlreiche voneinander abhängige Schritte, bei denen die Orchestrierungsebene eine angemessene Beteiligung der Mitarbeiter (z. B. die Bearbeitung von Ausnahmen), begrenzte Autonomie für AI-Agenten und die Durchsetzung der Compliance sicherstellen kann. Bei diesen Prozessen sorgt die Orchestrierungsebene von oben nach unten für mehr Berechenbarkeit und Governance, verfolgt und wertet wichtige Leistungsindikatoren (KPIs) kontinuierlich aus, gewährleistet die transaktionale Integrität von Workflows und Rollback-Logik und behält die Transparenz in jeder Phase des Workflows bei, um die Ausrichtung auf übergreifende Geschäftsziele sicherzustellen. Zum Implementieren dieser Funktion verwendet diese Ebene Richtlinien, Regeln und Leitplanken aus der Sicherheits- und Governance-Ebene (per Code-Richtlinie) sowie Geschäftsziele und KPIs, die in der semantischen Ebene gespeichert sind. Angesichts der Autonomie und Schnelligkeit von AI-gestützten Interaktionen besteht die Gefahr strategischer Fehlausrichtungen oder Compliance-Verstöße, insbesondere bei langfristigen, mehrstufigen Workflows. Der Ansatz der gemischten Orchestrierung mindert diese Risiken, indem unternehmensweite Geschäftsregeln, Compliance-Prüfungen und Richtlinienerzwingung direkt in komplexe Workflows eingebettet werden und die menschliche Aufsicht an kritischen Stellen integriert wird.
Jede dieser 11 Ebenen bietet spezifische Funktionen für die Bereitstellung von AI-Agenten in großem Umfang auf sichere, vertrauenswürdige und effektive Weise, die das volle Potenzial der Agenten-AI nutzen, um die Art und Weise zu verändern, wie Arbeit in einem Unternehmen erledigt wird. Im folgenden Abschnitt werden die Funktion der Ebene, die neuen Änderungen aufgrund der Zunahme von AI-Agenten und ihre wichtigen Technologiefunktionen beschrieben.
### Erfahrungsebene
**Funktion:** Die Erfahrungsebene fungiert als primäre Oberfläche für menschliche Benutzer und ermöglicht multimodale Interaktionen, indem Eingaben (Text, Sprache, visuell) erfasst und kontextbezogen relevante Antworten auf mehreren Geräten bereitgestellt werden. Sie übergibt Benutzerabsichten nahtlos zur Aktion an die Agentenebene und bietet gleichzeitig die dynamische Benutzeroberfläche und Visualisierungen, die menschliche Eskalationen und Genehmigungen in Agenten-Workflows erleichtern.
**Was ist anders als heute:** AI wird traditionelle GUI-basierte Oberflächen mit natürlicher Sprachverarbeitung, Kontextbewusstsein und proaktiver Entscheidungsunterstützung erweitern. AI-Agenten können proaktiv Interaktionen initiieren und personalisierte Echtzeitempfehlungen über alle Kanäle und Modalitäten hinweg bereitstellen.
**Wichtige Technologiefunktionen:**
- **Unterhaltungs-AI und digitale Assistenten:** Aktivieren Sie die Benutzeroberfläche standardmäßig, um AI-Unterstützung zur Unterstützung menschlicher Benutzer zu bieten.
- **Benutzeroberfläche für Attribution und Transparenz:** Geben Sie Antworten auf der Benutzeroberfläche erklärbar an, z. B. durch Anzeigen von Zitaten, Datei-/Systemquellen und des Ansatzes/Rationals für die Entscheidungen.
- **Service für proaktive und Umgebungsbenachrichtigungen:** Ermöglicht es Agenten, Statistiken oder Warnungen proaktiv auf dem am besten geeigneten Kanal und Formfaktor basierend auf dem aktuellen Kontext des Benutzers an Benutzer zu übertragen.
- **Omnikanal-Erfahrungen:** Bietet eine nahtlose, konsistente und einheitliche Erfahrung über alle Kanäle hinweg mit Journey-Kontinuität, bei der Unterhaltungen und Aufgaben der Person statt der Anwendung folgen.
- **Multi-Modal-Funktionen:** Ermöglicht es Menschen, mit Agenten und Anwendungen über Text, Sprache, Bild, Touch, Video und AR/VR zu interagieren, damit Agenten Informationen in der effizientesten Modalität verstehen und präsentieren können.
- **Kontextbezogene Personalisierung und dynamische Benutzeroberfläche:** Ermöglicht kontextbezogene Echtzeit-Benutzererfahrungen (Zeit, Standort, Benutzeraktionen), um die Personalisierung, einschließlich der direkten Generierung von Benutzeroberflächen, zu ermöglichen.
### Agentenebene
**Funktion:** Die Agentenebene fungiert als standardmäßige Laufzeitumgebung für die Arbeit im Unternehmen, in der AI-Agenten Aufgaben aus der Erfahrungsebene aufschlüsseln und ausführen, indem sie Workflows mithilfe von Tools aus der Anwendungsebene und der Datenebene dynamisch zusammenstellt. Der Konfigurationsstatus von AI-Agenten wird in dieser Ebene gespeichert und verwaltet. Agenten werden für bestimmte Aufgaben instanziiert und die spezifischen Agenteninstanzen anschließend außer Betrieb genommen. Durch diese Implementierung können Agenten immer vom aktuellen Konfigurationsstatus aus basierend auf Offline-Optimierungen aufgerufen werden (mit Funktionen aus AI/ML, Beobachtbarkeit und Orchestrierungsebenen). Diese Ebene ist für die umfassende Lebenszyklusverwaltung, Koordination und Governance der AI-Agenten verantwortlich.
**Was ist anders als heute:** Diese Ebene wird aus dem aktuellen ungleichen Satz an Pilotprogrammen und begrenzten Agentenbereitstellungen hervorgehen. Obwohl regelbasierte Bots vorhanden sind, werden nur wenige adaptive, nicht deterministische und zielgerichtete Softwareprogramme in großem Umfang bereitgestellt.
**Wichtige Technologiefunktionen:**
- **Agent Runtime Environment (Agentenlaufzeitumgebung):** Verwaltet den Lebenszyklus, die Ausführung und die Ressourcenzuteilung für AI-Agenten.
- **Agent Lifecycle Management Suite:** Enthält Entwicklungs-Frameworks, Entwicklungs- und Testtools sowie Verwaltungssysteme für Agentenaktivitäten und Versionskontrolle.
- **Agent Reasoning Engine (Modul für Agentenüberlegungen):** Ein kognitives Framework für Agenten, um Ziele aufzuschlüsseln, zu planen und zu entscheiden, welche Tools zur Lösung komplexer Probleme verwendet werden sollen.
- **Agentenspeicher und Kontextspeicher:** Ermöglicht Agenteninstanzen das Abrufen und Verwalten des Kontexts zu vorherigen Interaktionen, wodurch Konsistenz und Personalisierung gewährleistet werden.
- **Agenteninteroperabilitätsprotokolle:** Standardisierte Schnittstellen für die Kommunikation zwischen Agenten (A2A) und für Agenten zur Schnittstelle mit externen Systemen (z. B. über das Modellkontextprotokoll).
- **Tool Registry (Tool-Registrierung):** Ein zusammengestellter Satz interner und extern unterstützter Tools, die Agenten zum Erledigen einer bestimmten Aufgabe aufrufen können.
- **Agentenregister:** Ein zusammengestelltes Ökosystem aus vorgefertigten AI-Lösungen und Agenten, das die Erkennung und den Abgleich von Funktionen unterstützt.
- **Erzwingung der Richtlinie für verteilte Agenten:** Ermöglicht die unternehmensweite Unternehmensführung, indem Agenten die Einhaltung selbst überprüfen können, bevor sie Maßnahmen ergreifen.
- **Framework für Agentenselbstreflexion und -anpassung:** Stellt einen Mechanismus bereit, mit dem ein Agent seine eigene Leistung analysieren und mit menschlicher Genehmigung Verbesserungen auslösen oder Änderungen an sich selbst vorschlagen kann.
### AI/ML-Ebene
**Funktion:** Diese Ebene fungiert als zentralisiertes Intelligenzzentrum und bietet AI-Modelle als eine Reihe gemeinsamer Services, die von der Agentenebene (und Anwendungen) verwendet werden können, um ihre Argumentations- und Entscheidungsfindungsfunktionen mit integrierten Sicherheits-Frameworks und Überwachungsfunktionen zu unterstützen.
**Was ist anders als heute:** AI-Modelle wurden in der Regel in bestimmte Anwendungen eingebettet. In der IT-Architektur von Agentic Enterprise wird die AI/ML-Ebene ein erstklassiger zentraler Satz von Services sein, der viele Anwendungen und Agenten unterstützt und den gesamten Modelllebenszyklus von der Entwicklung bis zur Bereitstellung in Echtzeit unterstützt.
**Wichtige Technologiefunktionen:**
- **Vorgefertigte Grundlagenmodelle:** Große ML-Modelle, die auf einem breiten Spektrum von Daten trainiert wurden und eine Vielzahl allgemeiner Aufgaben ausführen können.
- **Abrufvergrößerte Generierung (RAG):** Eine AI-zentrierte Pipeline, die Grundlagenmodelle auf unternehmensspezifischen Daten basiert, um die Genauigkeit zu erhöhen und Halluzinationen zu reduzieren.
- **AI Trust, Safety, & Governance Hub (AI Trust, Safety und Governance-Zentrum):** Eine Suite von Tools, die in den Modelllebenszyklus integriert sind, um verantwortungsvolle AI-Prinzipien wie Verzerrungserkennung, Erklärbarkeit und Sicherheitsüberwachung durchzusetzen.
- **Modell-Gateway:** Ein Weiterleitungsmodul, das als zentraler Einstiegspunkt für alle Modellrückschlussanforderungen fungiert und Aufrufe an verschiedene interne und externe Modelle verwaltet, um Kosten, Leistung und Compliance zu optimieren.
- **Modellentwicklungsworkbench:** Eine integrierte Entwicklungsumgebung für Datenwissenschaftler mit Tools für die Datenvorverarbeitung, das Modelltraining und Experimente.
- **MLOps und Lifecycle Automation Pipeline:** Das CI/CD-Modul für maschinelles Lernen, das den durchgängigen Lebenszyklus von Modellen von der Schulung bis zur Bereitstellung und Einstellung automatisiert.
- **Modellbereitstellungs- und Rückschlusslaufzeit:** Eine skalierbare Umgebung mit geringer Latenz zum Bereitstellen trainierter Modelle als sichere API-Endpunkte für den Echtzeitverbrauch.
- **Modell- und Vermögenswertregister:** Ein zentralisiertes, versionsgesteuertes Repository für alle AI/ML-Datenbestände, einschließlich Modelle, Datensets und Quellcode, um die Reproduzierbarkeit und Überprüfbarkeit zu gewährleisten.
- **Generierung und Verwaltung synthetischer Daten:** Tool zum Generieren und Verwalten synthetischer Daten, das die statistischen Eigenschaften realer Daten beibehält, ohne sensible Informationen offenzulegen.
### Enterprise-Orchestrierungsebene
**Funktion:** Die Enterprise-Orchestrierungsebene ist die Steuerungsebene für die durchgängige Arbeit in einem Agentenunternehmen. Dadurch wird sichergestellt, dass die agentischen Workflows und Interaktionen den Unternehmenszielen und Governance-Richtlinien entsprechen. Sie nutzt die Telemetrie der Beobachtbarkeit aus anderen Ebenen, um umfassende Geschäftsprozessmodelle zu erstellen und die Optimierung anhand von KPIs zu ermöglichen, die aus der semantischen Ebene stammen. Diese Ebene stellt den freigegebenen Kontext und den Langzeitspeicher für jede neue Instanz eines AI-Agenten für wichtige Workflows bereit.
**Was ist anders als heute:** Diese Ebene bietet einen einheitlichen Einblick in Geschäftsprozesse, indem maschinenlesbare Modelle erstellt werden, die sowohl strukturierte, deterministische Schritte als auch die unstrukturierte, dynamische Arbeit von Menschen und Agenten erfassen. Sie geht über die heutigen Modelle für die humanzentrierte Zusammenarbeit und Unternehmensführung hinaus, indem Geschäftsziele und Compliance-Regeln als Einschränkungen programmgesteuert in Agenten-Workflows zur Steuerung der Agentenbelegschaft codiert werden.
**Wichtige Technologiefunktionen:**
- **Hybrid Workflow Execution Engine:** Die Kernlaufzeit, die das "gemischte Orchestrierungsmodell" ausführt, bietet eine zentrale Übersicht und ermöglicht gleichzeitig die Choreografie lokaler Agenten.
- **Prozessführung und Einschränkungsmodul:** Ein Echtzeit-Governance-Service, der deklarative Geschäftsregeln, Richtlinien und Einschränkungen für alle laufenden Prozesse verwendet und anwendet.
- **Freigegebener Speicher und Kontextverwaltung:** Eine freigegebene Speicherebene, auf die alle Akteure in einem Workflow zugreifen können, um Kontinuität und Kohärenz über mehrere Schritte hinweg zu gewährleisten.
- **Prozessmodellierungs-Studio:** Eine Design-Zeit-Umgebung zum Erstellen und Verwalten maschinenlesbarer, semantisch reichhaltiger Prozessmodelle, die sowohl deterministische als auch dynamische zielgerichtete Schritte definieren.
- **Prozessoptimierung und -simulation:** Eine Funktion, die digitale Simulationen von Geschäftsprozessen für erweiterte Analysen, Was-wäre-wenn-Simulationen und Prognoseoptimierungen erstellt.
- **Prozesserkennung und Gesundheitsüberwachung:** Erfasst Prozessmodelle und Echtzeitdaten, um Berichte zu Geschäftskennzahlen des Prozesszustands zu erstellen.
- **Digitale Zwillingsprozessmodellierung:** Ein Echtzeit-Spiegel von Live-Workflows zum Testen, Simulieren von Änderungen und Optimieren ohne Auswirkungen auf die Produktion.
### Anwendungs- und Anwendungsserviceebene
**Funktion:** Auf dieser Ebene werden vorhandene Geschäftsanwendungsfunktionen als zusammengesetzte und modulare Tools und Services für Agenten zur Verfügung gestellt. Sie dient auch als Präsentationslaufzeit zum Einbetten von Agentenfunktionen in die Benutzererfahrung. Anwendungen sind weiterhin das System der Datensätze, werden jedoch so umgestaltet, dass sie für Agenten "headless"-Funktionen sind.
**Was ist anders als heute:** Anwendungen werden sich von monolithischen Benutzeroberflächen zu "Backend-Services" entwickeln, die Agenten dynamisch über APIs und Ereignisse aufrufen können. Diese Ebene wird nativ in AI-Agenten und -Modelle integriert und die Zunahme von LLMs zur Codegenerierung wird zu einer Erhöhung der Anzahl benutzerdefinierter, von Agenten erstellter Mikroanwendungen führen.
**Wichtige Technologiefunktionen:**
- **Modulare Anwendungsservices:** Zerlegte Geschäftslogik aus traditionellen Anwendungen, die als maschinenlesbare Aktionen veröffentlicht wurden, die Agenten aufrufen können.
- **Agent Embedding SDKs:** Toolkits und Bibliotheken, mit denen Entwickler Agenten sicher direkt in Anwendungsbenutzeroberflächen einbetten können.
- **Services zur Generierung dynamischer Benutzeroberflächen:** Services, mit denen ein AI-Agent Benutzeroberflächenkomponenten basierend auf dem Benutzerkontext in Echtzeit generieren oder ändern kann.
- **Native AI-Benutzeroberflächen-Frameworks:** Front-End-Frameworks mit integrierter Unterstützung für die Verarbeitung AI-gesteuerter Benutzeroberflächen, beispielsweise die Verwaltung probabilistischer Daten und das Streamen von Textantworten.
- **Agentenbasierte Interaktionssysteme:** Anwendungen für Produktivität und Zusammenarbeit in Unternehmen, die AI-Agentenfunktionen über visuelle Komponenten integrieren.
- **AI-erweiterte Low-Code/No-Code-Anwendungsentwicklung:** Tools, mit denen Benutzer und Agenten benutzerdefinierte Anwendungen und Services mit natürlicher Sprache und Aufforderungen erstellen können.
- **Anwendungsleitplanken für die Agentennutzung:** Anwendungsseitige Steuerelemente für die Agentennutzung, beispielsweise Ratenbegrenzung, Berechtigungen mit Umfang und Telemetrie.
### Semantische Ebene
**Funktion:** Die semantische Ebene bietet ein einheitliches Verständnis von Daten und Knowledge im gesamten Unternehmen und ermöglicht es Menschen und AI-Agenten, Informationen konsistent zu interpretieren und darauf zu reagieren. Knowledge Representation Tools wie Ontologien und Knowledge Diagramme werden verwendet, um Abfragen mit natürlicher Sprache in präzise Datenabfragen mit Kontextbewusstsein zu übersetzen.
**Was ist anders als heute:** Heutige Unternehmen verfügen zwar über unterschiedliche Metadatenspeicher, die IT-Architektur des Agentic Enterprise erfordert jedoch ein zentralisiertes Enterprise Knowledge Graph (EKG), das Daten domänenübergreifend mit explizit definierten semantischen Beziehungen verknüpft. Dies bietet den umfassenden Kontext, den AI-Agenten zum Ausführen komplexer Überlegungen durchlaufen können, wodurch Anforderungen für eine Reihe technischer Funktionen geschaffen werden, die Knowledge Diagramme unterstützen, die sich über mehrere Funktionsbereiche erstrecken.
**Wichtige Technologiefunktionen:**
- **Metadatenservice:** Stellt aussagekräftige Metadaten bereit, einschließlich Datenherkunft, Inhaberschaft und Klassifizierungen.
- **Business Glossary & Taxonomy Management:** Ein Tool, mit dem Geschäftsbenutzer Standardgeschäftsbedingungen definieren und vereinbaren können.
- **Semantic Model Management:** Eine Workbench für Knowledge Engineers zum Erstellen, Verwalten und Steuern semantischer Modelle und Ontologien.
- **Enterprise Knowledge Graph (EKG):** Eine Laufzeitinstanziierung der Unternehmensontologie, die die Beziehungen zwischen Geschäftseinheiten speichert und zuordnet.
- **Modul für die Metadatenaufnahme und Harmonisierung:** Eine automatisierte Pipeline, die das Enterprise Knowledge Graph aus verschiedenen Quellsystemen ausfüllt und verwaltet.
- **Semantisches Abfragemodul**: Interpretiert Abfragen mit natürlicher Sprache und erstellt strukturierte Abfragen anhand des EKG, um Daten aus verschiedenen Quellen abzurufen.
- **Semantisches Argumentationsmodul:** Analysiert implizites Knowledge und verborgene Beziehungen und leitet sie aus dem EKG ab.
### Datenebene
**Funktion:** Die Datenebene ist die grundlegende Quelle der Wahrheit. Sie verwaltet und bietet sicheren, gesteuerten Zugriff auf alle Unternehmensdaten, die von der semantischen Ebene interpretiert werden können, die für Schulungen zu verwendende AI/ML-Ebene, für Transaktionen zu verwendende Anwendungen und Agenten für Argumente.
**Was ist anders als heute:** Die Datenebene entwickelt sich zu einer einheitlicheren, echtzeitorientierteren und Governance-orientierteren Ebene, die sich oft auf ein Data-Lakehouse im Cloud-Stil konzentriert. Sie muss ein größeres Volumen und eine größere Vielfalt an Daten verarbeiten und von der Batch-orientierten Verarbeitung zum Echtzeit-Streaming wechseln, um reaktive Agenten zu unterstützen. Datenverwaltung und Qualität gewinnen noch mehr an Bedeutung, um zu verhindern, dass schlechte Daten fehlerhafte AI-Ausgaben erzeugen.
**Wichtige Technologiefunktionen:**
- **VectorDB:** Eine spezialisierte Datenbank, die für das Speichern und Abfragen von hochdimensionalen Vektoreinbettungen optimiert ist, die für RAG wichtig sind.
- **Intelligente Analysedatenpipelines:** Ein automatisierter, metadatengesteuerter Service für die Datenaufnahme, -transformation und -ladung (ETL/ELT) in die Datenebene.
- **Enterprise Data Lakehouse:** Ein zentrales Repository für strukturierte, halbstrukturierte und unstrukturierte Daten, optimiert für Analysen und AI-Arbeitslasten.
- **Zero-Copy Data Federation & Search (Zero-Copy-Datenverbund und -suche):** Techniken zum Zugreifen auf, Abfragen und Durchsuchen von Daten in mehreren Shops ohne physische Datenbewegung.
- **Natürliche Sprache zu SQL:** Eine Technik zum Konvertieren von Abfragen mit natürlicher Sprache in SQL.
- **Service für Unternehmensdatenkatalog und -erkennung:** Ein zentralisiertes, durchsuchbares Inventar aller Datenbestände im gesamten Unternehmen.
- **Master & Reference Data Management (MDM):** Verwaltet den "goldenen Datensatz" für wichtige Geschäftseinheiten wie "Kunde" und "Produkt".
- **Service für die adaptive Datenqualität:** Ein kontinuierlicher Überwachungsservice, der mithilfe von KI Datenqualitätsprobleme automatisch in Echtzeit erkennt und behebt.
- **Datenverträge:** Maschinenlesbare Vereinbarungen zwischen Datenproduzenten und Verbrauchern, die das Schema, die Semantik und die SLAs des Datenaustauschs angeben.
- **AI-spezifische Datenspeicher:** Datenbanken, die für bestimmte AI-Anwendungsfälle entwickelt wurden, beispielsweise Zeitreihen- oder Diagrammdatenbanken.
- **AI-fähiges Datengewebe:** Eine logische Datenabstraktionsebene, die eine vereinheitlichte, virtualisierte Ansicht der Daten in verschiedenen physischen Systemen bietet.
- **Echtzeit-Datenverarbeitung:** Funktionen zum kontinuierlichen Verarbeiten und Analysieren multimodaler Datenströme mit Maschinengeschwindigkeiten.
### Infrastrukturebene
**Funktion:** Die Infrastrukturebene bildet die Grundlage für alle anderen Ebenen und bietet die Rechen-, Speicher-, Netzwerk- und Cloud-Funktionen, die erforderlich sind, um AI- und Agentenarbeitslasten skalierbar und kosteneffizient auszuführen.
**Was ist anders als heute:** AI-Arbeitslasten erfordern eine höhere Skalierbarkeit und Elastizität, um die probabilistische Natur von Agentensystemen zu bewältigen. Die Infrastruktur muss eine schnelle Bereitstellung, spezielle Hardware wie GPUs und Netzwerkdatenverkehr mit geringer Latenz und hohem Durchsatz für die Kommunikation zwischen Agenten unterstützen.
**Wichtige Technologiefunktionen:**
- **Infrastruktur als Code:** Automatisierte Bereitstellung und Verwaltung der Infrastruktur mit CI/CD-Bereitstellungs-Pipelines.
- **Hybrid- und Multi-Cloud-AI-Infrastruktur:** Nutzen Sie die Elastizität der öffentlichen Cloud und die spezielle Infrastruktur für generative AI-Arbeitslasten.
- **AI-optimierte Berechnung, Speicherung und Netzwerk:** Ordnet Infrastrukturressourcen basierend auf der variablen Nachfrage aus AI-Arbeitslasten dynamisch zu und skaliert sie.
- **Edge AI-Infrastruktur:** Ermöglicht die Bereitstellung von AI-Modellen und Agenten am Rande des Netzwerks für Anwendungsfälle mit individuellen Latenz- oder Datenschutzanforderungen.
- **Selbstheilungsinfrastruktur:** Verwendet AI, um die Systemwiederherstellung ohne manuelle Eingabe zu verwalten und so eine hohe Verfügbarkeit zu gewährleisten.
- **Nachhaltiges AI-Computing:** Energieeffiziente Ansätze zur Verringerung der Umweltauswirkungen von AI-Arbeitslasten.
- **Autoskalierung mit Kosten- und CO2-Aspekten:** Verwendet FinOps- und Nachhaltigkeitssignale, um die Skalierung und Platzierung von Kapazitäten voranzutreiben.
### Integrationsebene
**Funktion:** Die Integrationsebene dient als universelles Kommunikationsgewebe für alle (alten und neuen) Systeme über APIs, Ereignisse, Protokolle und Middleware, um sicherzustellen, dass Agenten Services, Daten und Tools nahtlos finden und mit ihnen interagieren können.
**Was ist anders als heute:** Die Integration muss sich weiterentwickeln, um die dynamischen n:n-Kommunikationsmuster von AI-Agenten zu unterstützen, statt nur vorbestimmte statische Interaktionen zwischen einigen bekannten Systemen zu verarbeiten. Sie erfordert eine Echtzeit-Datenverarbeitung und muss Ad-hoc-Erkenntnisse und die Zusammenarbeit zwischen Agenten ermöglichen.
**Wichtige Technologiefunktionen:**
- **Pipeline für die Betriebsdatenkonnektivität:** AI-gestützte Tools für die automatische Schemazuordnung, Datentransformation und Workflow-Generierung, einschließlich API-geführter, ereignisgesteuerter und umgekehrter ETL-Funktionen.
- **Adaptive API Management and Service Mesh (Adaptive API-Verwaltung und Service-Mesh):** API-Gateways und Service-Mesh-Technologie, die Services dynamisch registrieren, entdecken und steuern können, mit adaptiver Richtlinienerzwingung für Agenten.
- **Semantic Knowledge Adapter:** Eine Integrationskomponente, die ein gemeinsames Vokabular und Datenmodell für Agenten und Anwendungen bereitstellt, um eine konsistente Dateninterpretation zu ermöglichen.
- **Ereignisgesteuertes Integrationsgewebe:** Ein Messaging- und Streaming-Backbone mit hohem Durchsatz und geringer Latenz, das eine entkoppelte, asynchrone Kommunikation ermöglicht.
- **Agent Protocol Gateway (Agentenprotokoll-Gateway):** Ein Gateway für MCP-Services, mit dem Agenten Tools sicher entdecken und Aktionen auslösen können, um MCP mit internen APIs und Ereignissen zu verbinden.
- **Composable Capability Catalog & Marketplace (Komponierbarer Funktionskatalog und Marktplatz):** Ein zentralisierter, gesteuerter Katalog für alle Unternehmensfunktionen – APIs, Services, Agentenfertigkeiten, Modelle und Datensets – mit Anmerkungen zu semantischen Metadaten für die On-Demand-Zusammenstellung.
### IT-Vorgänge und Beobachtbarkeitsebene
**Funktion:** Diese Ebene überwacht und verwaltet die Gesundheits- und Betriebsleistung von Agenten und des gesamten Systems (eingebettetes Prinzip der Beobachtbarkeit) und bietet Transparenz und Kontrolle, indem Statistiken generiert werden, die die Überprüfung, das Debugging, die Erklärbarkeit, die Kosten und die Ressourcenoptimierung der Agentenbelegschaft des Unternehmens ermöglichen.
**Was ist anders als heute?**: Diese Ebene wird noch wichtiger, da AI-Agenten Fehler in Maschinengeschwindigkeit verursachen können. Sie muss über die Infrastrukturüberwachung hinaus erweitert werden, um das unvorhersehbare Verhalten autonomer Agenten einzubeziehen, was neue Arten der Telemetrie und die Fähigkeit erfordert, die semantische Korrektheit zu verstehen, nicht nur die technische Leistung.
**Wichtige Technologiefunktionen:**
- **Plattform für Echtzeitüberwachung und -beobachtung:** Erfasst kontinuierlich Protokolle, Kennzahlen und Verfolgungen in der gesamten IT-Umgebung mit Erweiterungen für ML-Kennzahlen und das Agentenverhalten.
- **FinOps & Cloud Cost Management:** Verantwortlich für die Überwachung, Analyse und Optimierung der Infrastrukturkosten im Zusammenhang mit AI und Agentenarbeitslasten.
- **Agenten- und ML-spezifische Überwachung:** Protokolliert jeden Schritt der Ausführung eines Agenten in einem unveränderlichen Überwachungsprotokoll und profiliert kontinuierlich das Verhalten des Agenten, um Abweichungen von bestehenden Normen zu erkennen.
- **AIOps, Vorfalls- und Änderungsverwaltung:** Verwendet AI/ML, um potenzielle IT-Probleme zu prognostizieren, Ursachen zu identifizieren und Workflows zur Behebung zu erstellen.
- **Geschlossene Feedbackschleife für Lerninhalte:** Integriert die Beobachtbarkeitstelemetrie von Agenten wieder in MLOps-Pipelines und ermöglicht so eine automatisierte Modellneuschulung oder eine sofortige Anpassung.
- **Semantic Observability Engine:** Integriert die Beobachtbarkeit in die semantische Ebene zur Kontextualisierung, um die Erkennung semantischer Anomalien im Agentenverhalten zu ermöglichen.
### Sicherheits- und Governance-Ebene
**Zweck:** Diese Schicht integriert Trust und Sicherheit in der gesamten Architektur, indem sie die Vermögenswerte des Unternehmens vor Bedrohungen schützt, Risiken verwaltet und die Einhaltung gesetzlicher Anforderungen sicherstellt. Sie umfasst Identitätsverwaltung, Bedrohungserkennung, GRC und AI-spezifische Sicherheitsmaßnahmen.
**Was ist anders als heute:** Die Sicherheitsebene muss weiterentwickelt werden, um neue Angriffsflächen anzugehen, die von AI-Modellen und -Agenten dargestellt werden, beispielsweise die sofortige Injektion und die Modellvergiftung. Die Identitäts- und Zugriffsverwaltung muss von statischen, rollenbasierten Steuerelementen zu dynamischen, intent-basierten Berechtigungen wechseln, die just-in-time erteilt und sofort nach der Verwendung widerrufen werden.
**Wichtige Technologiefunktionen:**
- **LLM Input/Output Security & Guardrails (LLM-Eingabe-/Ausgabesicherheit und -Leitplanken):** Unternehmensleitplanken, die zur Aufforderungs- und Antwortzeit angewendet wurden, um unsichere Inhalte, personenbezogene Daten und Jailbreaks zu blockieren.
- **Zero Trust-Architektur mit AI-Überprüfung:** Kontinuierliche Authentifizierung durch AI-basierte Verhaltensanalysen mit detailliertem Just-in-Time-Zugriff für Agenten basierend auf ihrer spezifischen Aufgabe.
- **Agentensicherheits-Framework:** Detaillierte Berechtigungsmodelle, Überwachung auf schädliches Verhalten und Eindämmungsmechanismen zum sicheren Unterbrechen von Agentenaktivitäten.
- **AI-Modellsicherheit:** Eine detaillierte Verteidigungsstrategie mit Kontrollen in jeder Phase des Modelllebenszyklus zum Schutz vor Vergiftung, Extraktion und gegnerischen Angriffen.
- **Datenschutz-KI:** Techniken wie Verbundlernen und differenzieller Datenschutz zum Schutz vertraulicher Daten.
- **AI-erweitertes GRC:** Einsatz von AI-Agenten zur kontinuierlichen Überwachung der Einhaltung von Steuerelementen durch die IT-Architektur.
- **Modul für Policen als Code:** Eine zentrale Informationsquelle für die Definition von Geschäftsregeln und Compliance-Einschränkungen in einem deklarativen, maschinenlesbaren Format, um Leitfäden für das Verhalten von Agenten festzulegen.
- **Kontinuierliches Red-Teaming:** Automatisierte, fortlaufende kontradiktorische Tests von AI-Modellen und Agenten, um Schwachstellen zu identifizieren, bevor Angreifer sie ausnutzen.
## Eine Referenzarchitektur-Roadmap für das Agentenunternehmen
Die Umwandlung in Agentic Enterprise erfordert eine mehrstufige Journey, bei der die technologischen Grundlagen geschaffen und gleichzeitig ein spürbarer Geschäftswert geschaffen wird (siehe Abbildung 3). Während die genaue Roadmap von der Strategie, der Kultur, dem AI-Governance-Modell und dem Ausgangspunkt der IT-Architektur des Unternehmens abhängt, sollten die meisten Organisationen einen phasenweisen Ansatz verfolgen, da fortlaufende IT-Investitionen Agenten mit wachsendem Umfang, Komplexität und Wertschöpfung antreiben. Das [Agentic Reifegradmodell](https://www.salesforce.com/news/stories/agentic-maturity-model/) von Salesforce bietet Unternehmen ein nützliches Framework für Reifegrade, um ihre Transformation zu strategisieren. Darin wird dargelegt, wie Agentenfunktionen vom grundlegenden Informationsabruf (Ebene 1) zur Orchestrierung komplexerer Workflows mit mehreren Domänen (Ebene 2 und 3) und mehreren Agenten (Ebene 4) wachsen können. Um diese Phasen erfolgreich zu durchlaufen, muss sich die IT-Architektur konzertiert weiterentwickeln, wobei in jeder Phase gezielt in verschiedene Ebenen der Architektur investiert werden muss, um die Anforderungen komplexerer und hochwertiger Bereitstellungen von AI-Agenten zu erfüllen. Für jeden Reifegrad werden die spezifischen Technologiefähigkeiten, die für die 11 Architekturebenen erforderlich sind, mit einer Begründung für Investitionen identifiziert.
 **Reifegrad 1: Agenten zum Abrufen von Informationen**
**Geschäftsziel und Wert: Steigern Sie die Produktivität menschlicher Mitarbeiter, indem Sie eine vertrauenswürdige Unterhaltungsoberfläche für die Abfrage von Enterprise Knowledge bereitstellen.** Der primäre Wert besteht darin, die menschlichen Fähigkeiten zu erweitern und nicht zu ersetzen. Diese Agenten unterstützen Menschen, indem sie Informationen abrufen und Aktionen empfehlen.
**Architekturfokus:** Der Fokus liegt auf der Schaffung einer sicheren, zuverlässigen Datengrundlage und den grundlegenden AI-Komponenten, die für den Informationsabruf erforderlich sind. Governance und Beobachtbarkeit sind vom ersten Tag an wichtig, um User Trust aufzubauen und die Kosten zu kontrollieren.
**Wichtige Technologieinvestitionen (Abbildung 4):**
In dieser Phase sollte sich die IT auf die Erstellung einer vertrauenswürdigen Pipeline für die Datenzuweisung zu Agenten und andere Grundlagenfunktionen konzentrieren. Technologien in der **Datenebene** wie eine **VectorDB** sind für die Aktivierung der RAG-Techniken (Retrieval Augmented Generation) wichtig, die Agenten zum Abrufen von Informationen unterstützen. Dies ist mit einer zentralisierten **AI/ML-Ebene** gekoppelt, die ein **Modell-Gateway** für sicheren, kostengesteuerten Zugriff auf Grundlagenmodelle und ein **AI Trust, Safety & Governance Hub** zur Überwachung unsicherer Ausgaben und zur Sicherstellung der Einhaltung von Vorschriften enthält. **Die Stammdatenverwaltung** und **Geschäftsglossare** in der **semantischen** **Ebene** sind die Grundlage für Agenten, um genaue Informationen abzurufen. Agentenlaufzeit und Lebenszyklusfunktionen sind erforderlich, um sicherzustellen, dass in dieser Phase erstellte Agenten geändert und für künftige Anwendungsfälle erweitert werden können. Die **Erfahrungsebene** muss eine **Benutzeroberfläche für Attribution** und Transparenz enthalten, die Agentenantworten durch die Anzeige von Zitaten und Quellen ihrer Informationen erklärbar macht, um einen Mehrwert zu bieten und das Vertrauen der Benutzer zu stärken. Grundlegende Investitionen in Beobachtbarkeit und Sicherheit (z. B. **Null** **Trust**) müssen mit der Umsetzung beginnen, um die Weichen für künftige Bereitstellungen von Agenten zu stellen.
 **Reifegrad 2: Einfache Orchestrierung, Agenten mit einer Domäne**
**Geschäftsziel und Wert: Automatisieren Sie Routineaufgaben und orchestrieren Sie Workflows mit geringer Komplexität in einer einzigen Geschäftsdomäne.** Dies verbessert die betriebliche Effizienz und reduziert die manuelle Arbeit, sodass sich die Mitarbeiter auf Tätigkeiten mit höherem Wert konzentrieren können.
**Architekturfokus:** Die wichtigste architektonische Verschiebung besteht darin, Daten schreibgeschützt abzurufen und Aktionen auszuführen. Dies erfordert den Beginn einer längeren Reise zur Modularisierung der Anwendungsfunktionen (oft als APIs verfügbar), auf die Agenten zugreifen können, die Implementierung zuverlässiger Sicherheit für Agentenaktionen und die Erstellung semantischer und AI-Entwicklungsfunktionen, um die Intelligenz von AI-Agenten zu verbessern.
**Wichtige Technologieinvestitionen (Abbildung 5):**
Die Investitionen konzentrieren sich thematisch darauf, AI-Agenten in die Lage zu versetzen, Maßnahmen mit ordnungsgemäßer Unternehmensführung zu ergreifen. Die **Ebene "Anwendungen und Anwendungsservices**" unterliegt einer wichtigen Änderung, da monolithische Geschäftslogik in **modulare Anwendungsservices** (APIs) zerlegt wird, die Agenten aufrufen können. Diese sind durch **Anwendungsleitplanken** geschützt, um zu verhindern, dass Agenten Systeme überfordern, und Integrationen in Tools zur Beobachtung möglich. Damit diese Agenten unterstützt werden, müssen Investitionen in Agentenüberlegungen, Toolprotokolle (wie MCP) und **Registrierungen** getätigt werden. Dies birgt neue Risiken, sodass ein spezielles **Agentensicherheits-Framework und AI-Modell sowie Agentenüberwachungsfunktionen** für die Verwaltung und Sicherheit unerlässlich sind. Schließlich können Unternehmen mit der Skalierung ihrer AI/ML-Funktionen für benutzerdefinierte Modelle beginnen, um diese Agenten bei domänenspezifischen Aufgaben zu unterstützen.
 **Reifestufe 3: Multi-Domain Orchestration Agents (Orchestrierungsagenten mit mehreren Domänen)**
**Geschäftsziel und Wert:** **Automatisieren Sie komplexe durchgängige Geschäftsprozesse, die organisatorische und funktionale Grenzen umfassen** (z. B. "Angebotserfassung", "Auftragsverwaltung"). Der Wert liegt darin, Silos abzubauen, Prozesszykluszeiten zu beschleunigen und ganze Wertschöpfungsketten innerhalb des Unternehmens zu optimieren. Höhere Änderungen bei der Produktivität menschlicher Mitarbeiter sind möglich, da organisatorische Barrieren abzubauen beginnen und sich die Menschen mehr auf die Beaufsichtigung von AI-Agenten konzentrieren.
**Architekturfokus:** Die Architektur muss nun übergreifende technische Probleme unterstützen. Ein gemeinsames semantisches Verständnis im gesamten Unternehmen, ein zentralisiertes Orchestrierungsmodul für die Unternehmensführung und ein entkoppeltes, ereignisgesteuertes Integrationsgefüge werden zu den entscheidenden Enablern.
 **Wichtige Technologieinvestitionen (Abbildung 6):**
Technologieinvestitionen konzentrieren sich thematisch auf die Orchestrierung von Prozessen im Unternehmensmaßstab über Menschen, Agenten und deterministische Systeme hinweg. Die **Unternehmensorchestrierungsebene** rückt in den Fokus von Investitionen, da ein **Hybrid-Workflowausführungsmodul** zur Koordinierung von Aktivitäten und ein **Prozessführungs- und Beschränkungsmodul** zur Durchsetzung von Geschäftsregeln und Compliance-Richtlinien in laufenden Prozessen erforderlich sind, da Agenten domänenübergreifend arbeiten, oft mit unterschiedlichen Richtlinien und semantischen Definitionen. Diese domänenübergreifende Koordinierung ist nur mit einer ausgereiften **Semantic Layer** möglich, die ein **Enterprise Knowledge Graph (EKG)** aufweist, das ein gemeinsames Verständnis der domänenübergreifenden Beziehungen zwischen Unternehmenseinheiten schafft. Die **Integrationsebene** muss zu einer **ereignisgesteuerten Integrations-Fabrik** weiterentwickelt werden, die ein Streaming-Backbone verwendet, um Systeme zu entkoppeln und die für langfristige Unternehmensprozesse typische robuste, asynchrone Kommunikation zu ermöglichen. Angesichts des höheren Werts dieser Workflows und der damit verbundenen Risiken sind zusätzliche Investitionen in Sicherheit und Überwachung von entscheidender Bedeutung (z. B. **AIOps, Policy-as-Code**). Schließlich müssen weitere Investitionen in die Anwendungs- und Serviceebene (z. B. **AI-fähige LCNC, dynamischere und multimodalere** Benutzererfahrungen) getätigt werden, wenn menschliche Benutzer beginnen, leistungsfähigere AI-Agenten zu überwachen und mit ihnen zusammenzuarbeiten.
**Reifegrad 4: Multiagent-Orchestrierung mit mehreren Domänen**
**Geschäftsziel und Wert: Konzipieren und optimieren Sie Geschäftsvorgänge domänenübergreifend, um schrittweise Änderungen an Produktivität und Effizienz voranzutreiben.** In dieser Phase wird eine ganzheitliche digitale Simulation (digitaler Zwilling) des Unternehmens für die kontinuierliche Verbesserung und strategische Planung über wichtige Geschäftsprozesse und Workflows hinweg erstellt.
**Architekturfokus:** In der letzten Phase steht die dynamische, neu entstehende Zusammenarbeit zwischen Agenten im Mittelpunkt. Dies erfordert erweiterte A2A-Kommunikationsprotokolle (Agent-zu-Agent), Funktionen zum Selbstlernen von Agenten, weitere Investitionen in die Ausreifung der Orchestrierungs-, Daten- und Semantikebenen sowie eine vollständig dynamische und selbstheilende Infrastruktur, um die wachsenden Anforderungen an dynamische AI-Arbeitslasten zu erfüllen, da Agenten im gesamten Unternehmen skaliert wurden.
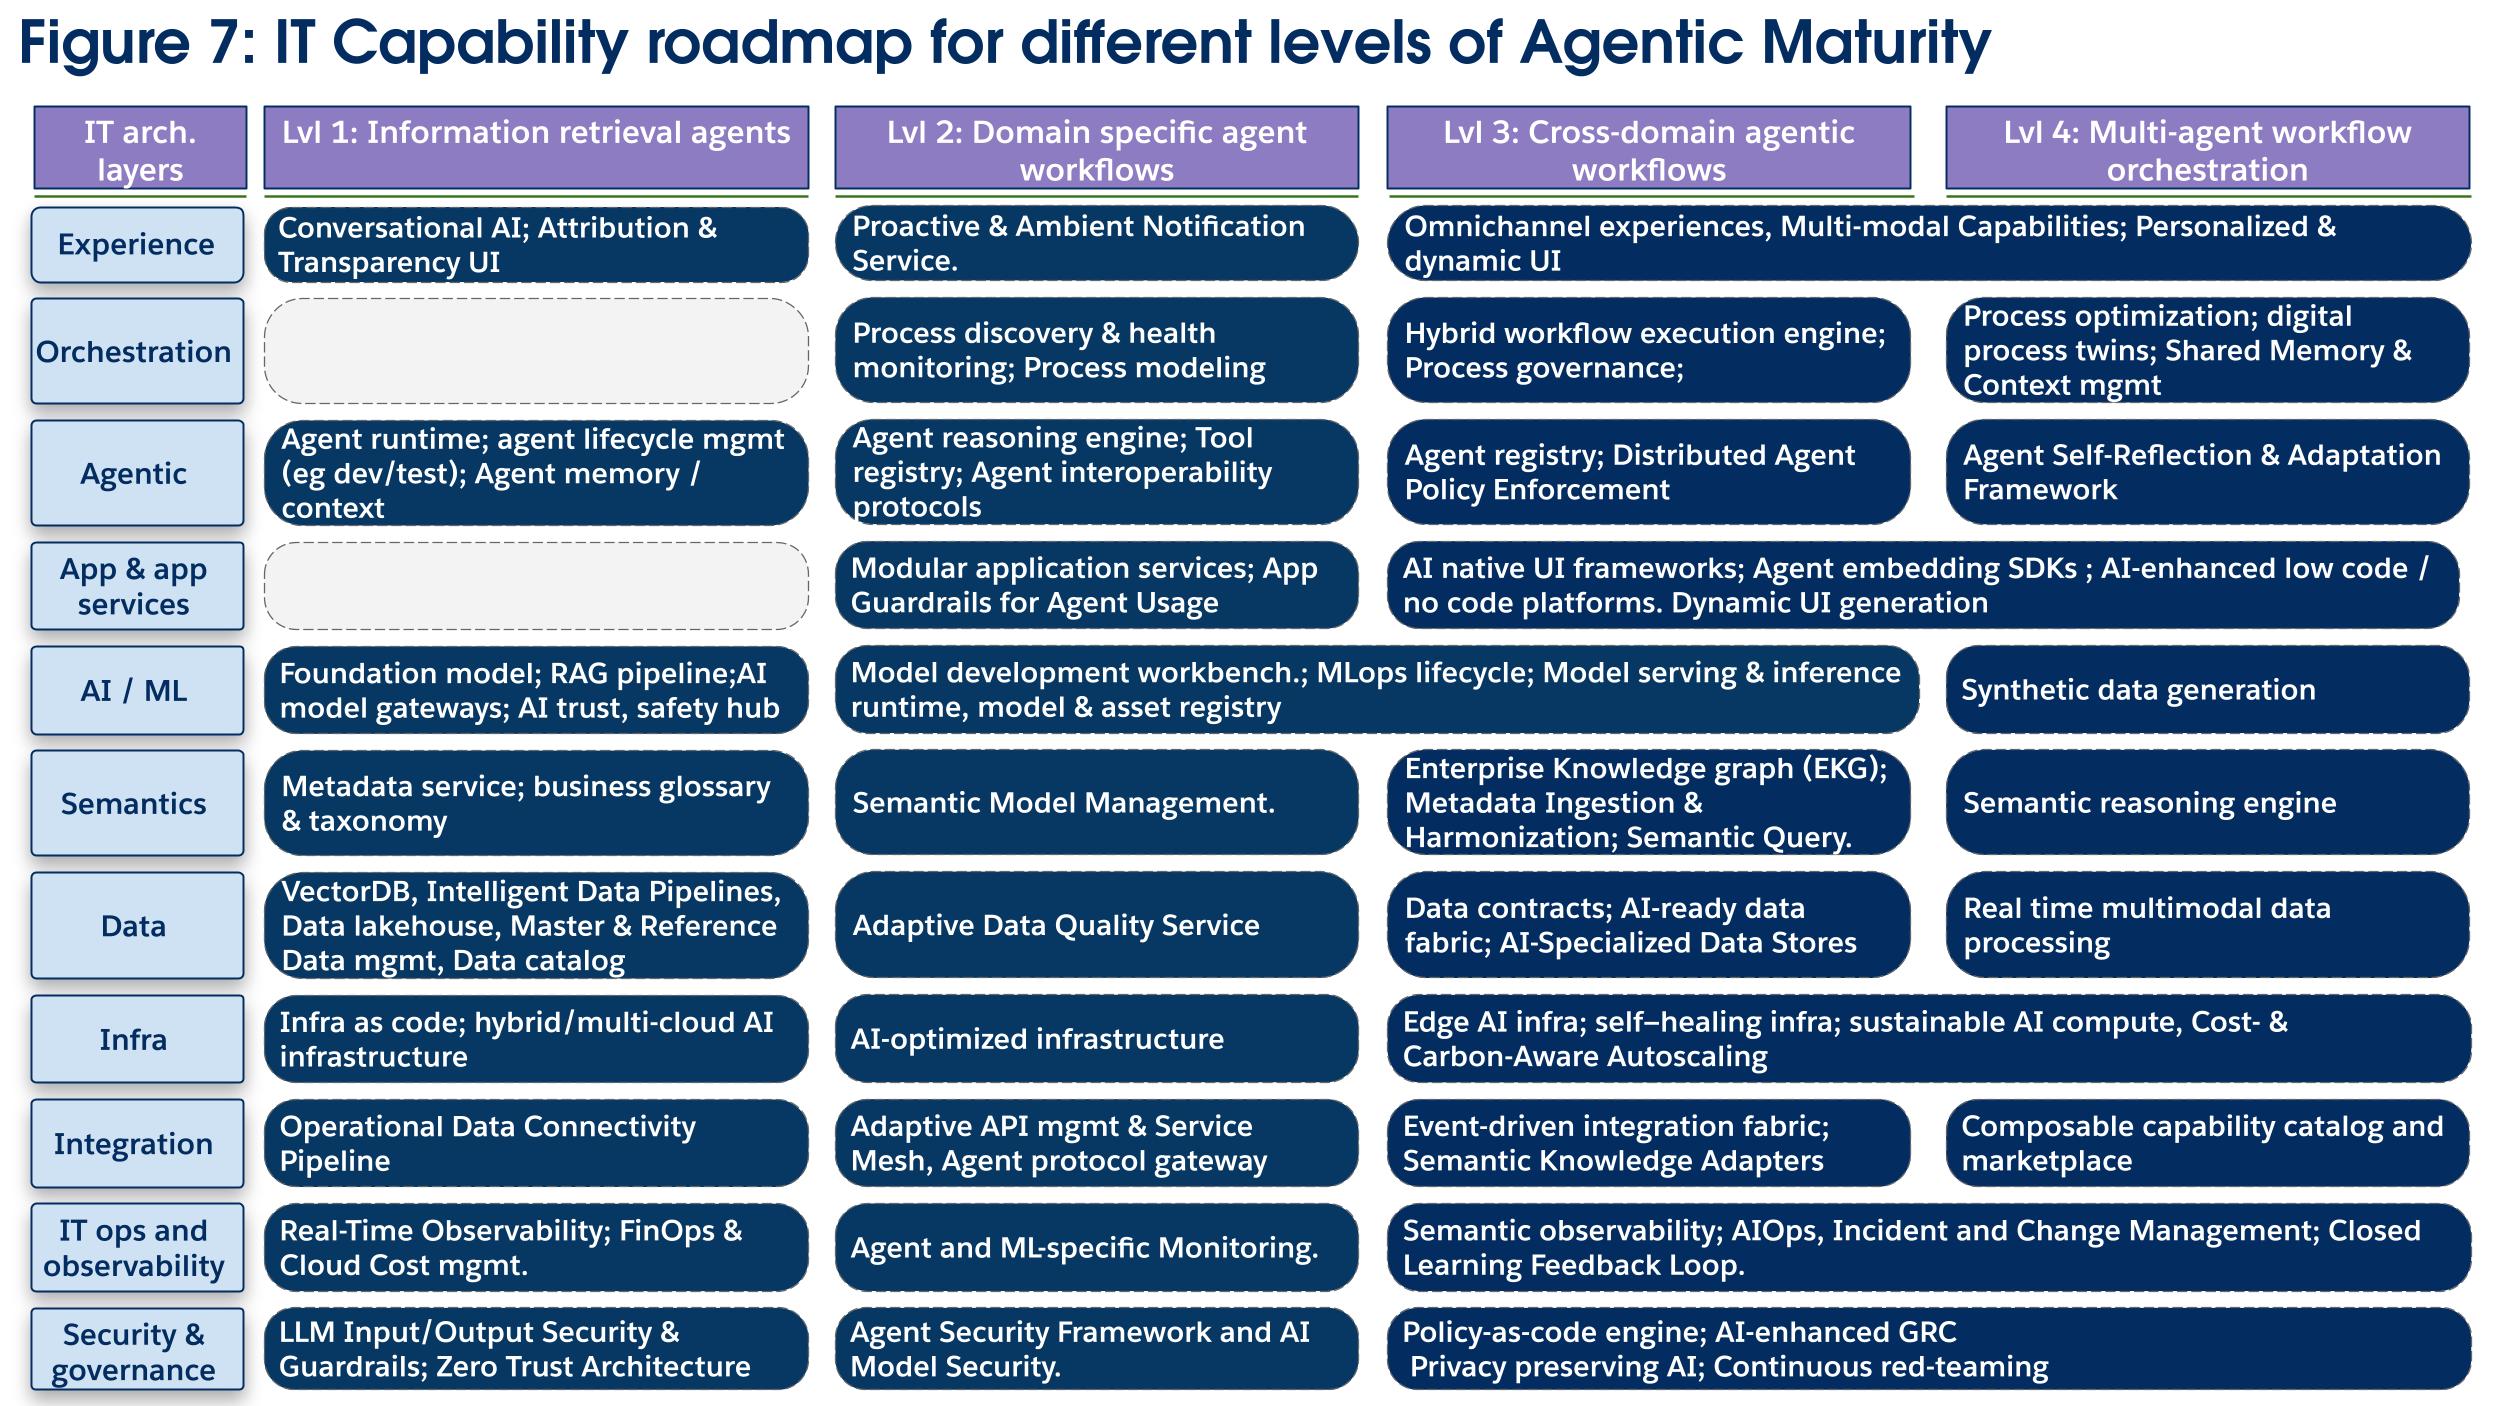 **Wichtige Technologieinvestitionen (Abbildung 7):**
Thematische Investitionen konzentrieren sich auf die Schaffung eines sich selbst verbessernden, autonomen Systems. Auf der **Agentenebene** bietet ein **Agenten-Selbstreflexions- und -anpassungs-Framework** den Mechanismus, mit dem ein Agent seine eigenen Leistungsprotokolle analysieren und Verbesserungen auslösen kann. Dieses Lernen wird von der **IT Operations and Observability Layer** (Ebene für IT-Vorgänge und Beobachtungsfähigkeit) unterstützt, die eine **geschlossene Lernfeedbackschleife** implementiert, um automatisch Beobachtungsdaten in MLOps-Pipelines für die Modellneuschulung zurückzugeben, wodurch auch die Generierung synthetischer Daten genutzt werden kann, um die Modellleistung weiter zu optimieren. Da Agentennetzwerke abteilungsübergreifend bereitgestellt werden und die Modularisierung von Anwendungen kontinuierlich vorangetrieben wird, sind weitere Investitionen in die Sicherheit und vor allem ein **komponierbarer Funktionskatalog** erforderlich, damit Agenten Funktionen dynamisch zusammenstellen können, um abstraktere und hochwertigere Aufgaben zu lösen. Diese Prozesse werden alle über die neue **Funktion "Digital Twin Process Modeling**" (Digitale Zwillingsprozessmodellierung) orchestriert und optimiert, die Echtzeitdaten verwendet, um Simulationen für Was-wäre-wenn-Analysen und Prognoseoptimierungen zu erstellen, sodass Unternehmen neue Agentenbereitstellungen sicher testen und bereitstellen können.
**Schlussfolgerung**
Die Roadmap zu einem Agentic Enterprise durchläuft eine IT-Architekturentwicklung. Enterprise-Architekten werden die entscheidenden Treiber dieser Transformation sein und zusammen mit anderen Partnern im Geschäft und in der IT die wichtigen Investitionsentscheidungen treffen, die für die Organisation erforderlich sind, um den Wert der neuen Geschäftsfunktionen des Agentic Enterprise zu realisieren.
# Context
Datenplattformen entwickeln sich seit über drei Jahrzehnten weiter. Zunächst wurde die Branche von lokalen, zentralisierten und strukturierten (meist relationalen) Betriebs-/OLTP-Datenbanken dominiert. Diese wurde auf Data Warehouses-OLAP-/Big Data-Plattformen erweitert, die hauptsächlich für die analytische Verarbeitung verwendet wurden und relational und zentralisiert blieben. Cloud-Speicher steuerte verteilte Architekturen wie Data Warehouses, Lakehouses und disaggregierten Speicher. Vorgangsplattformen und Analyseplattformen blieben jedoch getrennt. Cloud Computing und die AI-Revolution verändern heute die Architektur der Datenplattform grundlegend.
Unternehmen investieren bereits in ausgereifte Big Data-Plattformen wie Snowflake, Databricks, BigQuery und Redshift. Diese Plattformen dienen jedoch als Datensilos. Kunden leiten aus ihren Daten keinen Geschäftswert ab, da die Daten nicht direkt in den Geschäfts-Flows und -Anwendungen bearbeitet werden können. Diesen Lösungen fehlt die Verarbeitung generativer Agentischer AI und sie können den Datenzugriff nicht in Echtzeit bereitstellen. Daher können sie keine AI-gestützte Personalisierung zum Zeitpunkt des Kundenengagements und anderer branchenführender Funktionen bereitstellen.
Die Zukunft von Datenplattformen ist durch eine einheitliche, flexible, zugängliche und offene Dateninfrastruktur gekennzeichnet. Diese neue Architektur basiert auf modernen Rechen- und Speichertrends – GPUs, großer Speicher, NVMe-SSDs und Cloud-Speicher –, die in Cloud Computing und AI integriert werden können. Sie können Echtzeitstatistiken bereitstellen, autonome Entscheidungen treffen und Echtzeitanwendungen vorantreiben. Dies umfasst die Zunahme von Agenten-AI, Prognose-AI, Analysen, Echtzeit-OLTP-Datenbanken, Data Lakes und Lakehouses. Diese modernen Datenplattformen sind auf Einfachheit, Skalierbarkeit, Agilität, Leistung, Sicherheit, Verfügbarkeit und Kosteneffizienz ausgelegt.
## Wichtige Trends in der Data Platform-Architektur der nächsten Generation
Die folgenden Datentrends steuern die Datenplattformarchitektur der nächsten Generation.
- **KI, maschinelles Lernen und Analytics im Mittelpunkt**: Der Aufstieg der Agenten-AI wird die Entwicklung, Bereitstellung und Nutzung/Zugriff auf die Datenplattform grundlegend verändern. Agentische AI versteht den Unterhaltungs-/Abfrage-Intent, plant, generiert Workflows und automatisiert die Entscheidungsfindung. Der Speicher für Agenten (kurz- und langfristig) wird anhand des Unterhaltungsverlaufs für die Personalisierung der Agentenplanung und -entscheidungen, die Echtzeit-Unterhaltungsmodellierung und die Personalisierungsunterstützung erstellt, die auf Datenplattformen wichtig sind. Agenten unterstützen Sie bei der Automatisierung betrieblicher "Funktionen" wie Datenverwaltung (z. B. Sicherheit, Compliance, Trust), Leistung (z. B. automatische Skalierung für Gleichzeitigkeit, Durchsatz und Latenz), Failover und Verfügbarkeit sowie Beobachtbarkeit und Wartung. AI-gestützte Analysen, Prognosen, die Verarbeitung natürlicher Sprache (Natural Language Processing, NLP) für Fragen/Antworten in Analysen und Analysen unstrukturierter Daten (Text wie PDFs, Bilder, Audio, Video) werden Standard sein, sodass Unternehmen tiefere Statistiken aus verschiedenen Datenquellen ableiten können.
- **Dezentralisierung von Daten, aber einheitlicher Datenzugriff**: Agenten benötigen Unternehmensdaten, um Statistiken abzuleiten und Entscheidungen zu treffen und Geschäftsaktivitäten zu automatisieren. Daten sind in Unternehmen, in unterschiedlichen Anwendungen und Datenplattformen von Natur aus dezentralisiert. Es ist jedoch nicht einfach, die Silos zwischen verschiedenen Geschäftseinheiten innerhalb des Unternehmens und mit Partnern außerhalb des Unternehmens nahtlos zu vereinheitlichen. Die Vereinheitlichung von Daten umfasst die gemeinsame Nutzung von Daten entweder über die Aufnahme aus Quellen oder die Verknüpfung mit Datenquellen, Rohdaten aus der Datenvorbereitung, Harmonisierung und Modellierung für die Analyse und AI-Verarbeitung, die Speicherung und Verwaltung von Daten im richtigen Maßstab für effizienten Zugriff mit niedrigem CTS und den Datenzugriff über verschiedene Abfrage- und Analysemechanismen und -tools, die tief in die zugrunde liegenden Speicher- und Datenzugriffsplattformen integriert sind.
- **Cloudbasierte offene Lakehouses**: Cloud-basierte Big Data-Plattformen (OLAP) arbeiten daran, offene Dateiformate (Parquet) und Tabellenformate (Iceberg) zu übernehmen, um die Datenzusammenführung (data in) und die Freigabe (data out) zu ermöglichen.
- **Unstrukturierte Datenverarbeitung**: Mit dem Aufkommen, der Weiterentwicklung und der Einführung der generativen AI beginnen Unternehmen, wertvolle Statistiken und Geschäftswerte aus dem Datenbestand des Unternehmens abzuleiten, der große Mengen an Textdokumenten, Audioabschriften, Videoaufzeichnungen und anderen Medien umfasst. Unstrukturierte Datenverarbeitung, einschließlich Blockierung, Vektorisierung, semantische Suche und Knowledge Diagramme, ermöglichen diese Statistiken. Techniken wie RAG (Retrieval Augmented Generation) und CAG (Cache Augmented Generation) werden zu Haupttreibern der schnellen und agentenbasierten Suche im gesamten Datenkorpus.
- **Knowledge Management**: Knowledge geht über den Rohinhalt selbst hinaus (Dokumente, Artikel, Videos). Sie stellt eine Erweiterung dieses Inhalts dar, indem Bedeutung abgeleitet, Metadaten zusammengestellt und in einen Kontext gesetzt werden, um ein gemeinsames Verständnis von Inhalten in einer Organisation oder einem Unternehmen zu entwickeln. Knowledge selbst ist in der Regel strukturiert. Knowledge Management umfasst Inhaltsverwaltung, Knowledge Extrahierung, Darstellung durch Modelle wie Diagramme und Navigation.
- **Reichweitendatenzugriff**: Rich-Data-Zugriff bedeutet, dass Daten, Analysen und AI-Tools für eine Vielzahl von Personas zugänglich sein müssen, einschließlich Endbenutzern, Geschäftsbenutzern, Administratoren und Analysten. Der barrierefreie Zugriff erfolgt über Mechanismen wie Ensembleabfrage (mit relationaler, Stichwort- und semantischer Abfrage), Abfrage natürlicher Sprache in SQL (NL2SQL), Echtzeitzugriff usw.
- **Echtzeitverarbeitung**: Agentische Anwendungen treffen Echtzeitentscheidungen auf der Grundlage des aktuellen Zustands und auf der Grundlage neuer Ereignisse, wodurch Antworten und Aktionen personalisiert werden, was den Zugriff auf, die Verarbeitung und das Reagieren auf Echtzeitdaten erfordert. Die Echtzeitverarbeitung erfordert aktuelle Daten (Datenlatenz) und interaktiven Zugriff (Zugriffslatenz). Für solche Daten und Zugriffslatenz muss die zugrunde liegende Datenplattform den aktuellen Datenzugriff aus operativen und analytischen Shops, die Verarbeitung des Zugriffs mit geringer Latenz (Punktsuche und Abfrage), die hohe Datenskalierung und den hohen Durchsatz unterstützen.
- **Datensicherheit, Unternehmensführung und -residenz**: Agenten- und Unterhaltungs-AI vereinfacht die Benutzeroberfläche der Anwendung und ermöglicht es jedem – von Verbrauchern über Mitarbeiter bis hin zu anderen AI-Agenten –, mit Anwendungen in natürlicher Sprache zu interagieren. Die wertvollen Kunden- und persönlichen Daten, die für Agentenanwendungen gespeichert und modelliert werden müssen, müssen durch klar definierte Zugriffs- und Freigaberichtlinien geschützt und verwaltet werden. Viele Kunden müssen sich zunehmend an Vorschriften halten, die eine Datenresidenz in ihrem eigenen Land oder ihrer Region vorschreiben, insbesondere an Behörden oder Behörden.
Salesforce Data 360 ist für die Zukunft konzipiert, um diesen Datentrends gerecht zu werden. Data 360 ist eine Cloud-native, metadatengestützte Datenplattform, die isolierte Daten im gesamten Unternehmen vereinheitlicht und es Organisationen ermöglicht, ihre Daten zu speichern, zu modellieren und zu verarbeiten, um Analysen, AI, maschinelles Lernen und Agentenanwendungen zu ermöglichen.
Dieses Dokument ist ein wichtiger Leitfaden für Unternehmensarchitekten und CTOs. Es werden die Architektur, Funktionen, Designprinzipien und Anwendungsfälle von Data 360 erläutert. Es werden die Grundlagen der Data 360-Architektur als Vorbereitung vorgestellt. Es folgen eine Reihe tiefer Einblicke in die wichtigsten Unterschiede, beispielsweise die Interoperabilität mit vorhandenen Datenplattformen, einschließlich Strategie für mehrere Organisationen, Sicherheit, Governance und Datenschutz, Echtzeitaktivierung und Datenreinräume.
## Designprinzipien
Salesforce Data 360 basiert auf einer Reihe von Kernprinzipien, die Unternehmensdaten einsatzbereit, vertrauenswürdig und in Echtzeit bereitstellen.
- **Offenheit und Interoperabilität**: Für Multi-Cloud-Ökosysteme entwickelt. Verbindet sich ohne Duplikate mit Datenplattformen wie Snowflake, Databricks, BigQuery und Redshift und erweitert Customer 360 unter Beibehaltung vorhandener Investitionen.
- **Speicher-Berechnungstrennung**: Skaliert die Speicherung und Verarbeitung (Batch, Streaming und interaktiv) unabhängig voneinander. Bietet Elastizität und Effizienz für hohe Arbeitslasten mit hohem Volumen.
- **Speichern und Verarbeiten von mehreren Modellen**: Unterstützt strukturierte und verschiedene unstrukturierte Datentypen wie Text, Bildaudio und Video. Bietet effizienten Speicher, Echtzeit- und Batchverarbeitung, erweiterbare Indizierung, vereinheitlichte Suche, Abfrage und Analyse.
- **Metadatengesteuertes Design**: Anwendungen werden durch Metadaten und nicht durch Code definiert. Metadaten werden als erstklassiger Vermögenswert behandelt und ermöglichen eine einheitliche Verwaltung, Flexibilität und eine umfassende Integration in Salesforce Platform.
- **Hybridverarbeitung in Echtzeit**: Unterstützt Abfragen mit geringer Latenz und sofortige Entscheidungsfindung sowie Batchverarbeitung und analytische Arbeitslasten.
- **Intelligente und aktive Daten**: Erfasst, analysiert und überträgt Statistiken kontinuierlich direkt in Geschäfts-Workflows. Unterstützt die Automatisierung ohne Code, Low-Code, Pro-Code und AI mit dem neuesten Kontext.
- **Governance und Datenschutz nach Design**: Herkunft, Zugriffskontrolle, Residenz, Datenverschlüsselung und Compliance sind integriert und das Vertrauen in die Vorschriften wird auf jeder Ebene gestärkt.
- **Mandantenverhältnis 1:1**: Eine zentralisierte Data 360-Organisation fungiert als einzige Quelle der Wahrheit für Customer 360 und unterstützt nahtlos Salesforce-Umgebungen mit mehreren Organisationen, die von Salesforce-Kunden häufig verwendet werden.
Diese Grundsätze stellen sicher, dass Daten in Echtzeit offen, intelligent und handlungsrelevant sind.
### Von Prinzipien zu Funktionen
Salesforce Data 360 ist eine moderne Datenplattform, die auf Designprinzipien basiert, die aktuelle Datentrends berücksichtigen. Seine Architekturfunktionen stellen sicher, dass Unternehmensdaten in Echtzeit vertrauenswürdig, vereinheitlicht und handlungsrelevant sind und mit seinen Leitprinzipien übereinstimmen.
- **Cloud-native Foundation**: Wird in Hyperforce ausgeführt, das in Hyperscalern (wie AWS) mit unveränderlicher Microservices-basierter Infrastruktur bereitgestellt wird. Bietet elastische Skalierung, Zero Trust Security, kontinuierliche Bereitstellung und globale Compliance.
- **Salesforce (Core)-Metadatengesteuert**: Metadaten werden als Salesforce-Metadaten konzipiert, modelliert und gespeichert, sodass sie sofort von ALLEN Salesforce-Anwendungen verwendet werden können. Solche Metadaten werden in einem vollständig ACID-konformen RDBMS gespeichert. Gewährleistet Governance, Lebenszykluskonsistenz und eine umfassende Integration in Salesforce Lightning Platform.
- **Lakehouse-Speicher**: Basiert auf Apache Iceberg und Parquet, kombiniert Data-Lake-Skalierung mit Lagerhaus-Governance, die Schemaentwicklung, Zeitreisen und Aktualisierungen mit hohem Volumen unterstützt. Data 360 speichert, modelliert und verarbeitet strukturierte und unstrukturierte Daten mit extrem großem Speicher mit modernen offenen Standards und umfangreichen Transformations- und Datenverarbeitungsfunktionen für Batch- und ereignisgesteuerte Arbeitslasten.
- **Durchgängige Datenpipeline mit flexibler Aufnahme**: Deckt den gesamten Lebenszyklus ab – Aufnahme, Vorbereitung, Modellierung, Vereinheitlichung, Analyse und Aktivierung – und reduziert die Abhängigkeit von fragmentierten Punktlösungen. Unterstützt Batch, nahezu in Echtzeit und Streaming mit mehr als 270 Konnektoren und MuleSoft. Der ELT-first-Ansatz ermöglicht eine schnelle Datenverfügbarkeit mit Flexibilität bei der nachgelagerten Transformation.
- **Interoperabilität von Unternehmensdaten mit offenen Frameworks und Verbund**: Vereinheitlicht silo'd-Daten im gesamten Unternehmen durch die bidirektionale Zero Copy-Verbundorganisation mit Snowflake, Databricks, BigQuery und Redshift, wodurch Datenmigration oder -duplizierung vermieden werden.
- **Datenklassifizierung, Modellierung und Organisation**: Data 360 organisiert Daten als Rohdaten, bereinigte und gespeicherte Daten und Datenmodelle, die dem allgemeinen Informationsschema SSOT (Single Source of Truth) entsprechen. Solche SSOT-Objekte bilden die Grundlage für die Definition von semantischen Datenmodellen (SDM) und anderen zusammengestellten und anwendungsspezifischen Modellen.
- **Integrierte semantische Datenmodellierung** für erweiterbare Analysen mit offenen semantischen Abfrage-APIs, die Tableau Next vorantreiben und anwendungsspezifische Analysen aktivieren.
- Das **High Performance SQL-Abfragemodul** unterstützt eine vereinheitlichte Data 360 SQL-Abfrage für strukturierte, unstrukturierte und Diagrammdaten.
- **Datenspeicher mit geringer Latenz**: Schlüsselwertspeicher für heiße Daten mit Millisekunden-Antwortzeiten. Ermöglicht die Personalisierung und ereignisgesteuerte Szenarien in Echtzeit. Erfasst und verarbeitet Kundenengagementdaten in Echtzeit. Vereinheitlicht Identitäten, Interaktionen und Unterhaltungen in einem einzigen, vertrauenswürdigen Diagramm "Customer 360 Profile and Context" (Kunden 360-Profil und -Kontext).
- **Unstrukturierte Datenverarbeitungspipelines** zur flexiblen und erweiterbaren Unterstützung für unstrukturierte Datenspeicherung, Chunking, Generierung von Einbettungen (Vektorisierung), Metadatenextraktion (Vergrößerung), Zusammenfassung, Indizierung, Knowledge Extraktion, intelligente Dokumentverarbeitung, Erstellung von Kurz- und Langzeitspeichern (Unterhaltung) usw.
- **Native Keyword, Vector und Hybrid Indexing** für genauen und effizienten unstrukturierten Datenzugriff wie Fast and Agentic Search, RAG, Knowledge Extraction, Agentic Memory Derivation usw.
- **Profil-, Personalisierungs-, Kontextservices** zum Aktivieren von AI/ML- und Agentenanwendungen.
- **Integrierte Governance und Sicherheit** auf jeder Ebene für die Verfolgung von Abstammungen, die Maskierung von Daten, die Datenresidenz und die Sicherheit von Zero Trust gewährleisten Compliance und Trust.
- **Elastisches Rechengewebe**: Kubernetes natives, mandantenfähiges Rechengewebe. Führt Spark für die verteilte Verarbeitung und Hyper für SQL-Arbeitslasten aus. Skaliert elastisch über verschiedene Aufträge hinweg und unterstützt die Isolation beim Ausführen von nicht vertrauenswürdigem Code.
All dies wird in Hyperforce ausgeführt, der Cloud-Grundlage von Salesforce. Hyperforce bietet Folgendes:
- **Null Trust Sicherheit** mit Verschlüsselungs-, Isolations- und Richtlinien mit den geringsten Berechtigungen.
- **Resilienz** durch Bereitstellungen in mehreren Regionen. Salesforce Data 360 profitiert zwar von Hyperforces Resilienz in mehreren Regionen und Fehlertoleranz auf Plattformebene, die echte Notfallwiederherstellung auf Unternehmensebene erfordert jedoch eine breitere Architektur, die jeder Datenplattform mit wichtigen Funktionen ähnelt: wiedergebbare Aufnahmepipelines, Abgleich und metadatengesteuerte Rehydrierung in allen abhängigen Ökosystemen.
- **Beobachtbarkeit** mit integrierter Überwachung, Kennzahlen und Verfolgung.
- **Automatisierte Skalierung und FinOps-Bewusstsein** für Effizienz ohne Kostenüberlauf.
Data 360 ersetzt keine vorhandenen Unternehmensinvestitionen. Stattdessen macht Data 360 die Daten, denen Sie bereits vertraut sind, reguliert und handlungsrelevant und bietet AI-gestütztes Engagement in Echtzeit, wo es am wichtigsten ist. Kurz gesagt, Salesforce wandelt alle Unternehmensdaten, einschließlich externer Daten, in (Salesforce-) metadatengesteuerte Objekte um und aktiviert Agentenanwendungen für die Erkennung, Entscheidungsfindung und zum Ergreifen von Aktionen.
Die folgende Abbildung veranschaulicht die Data 360-Referenzarchitektur:
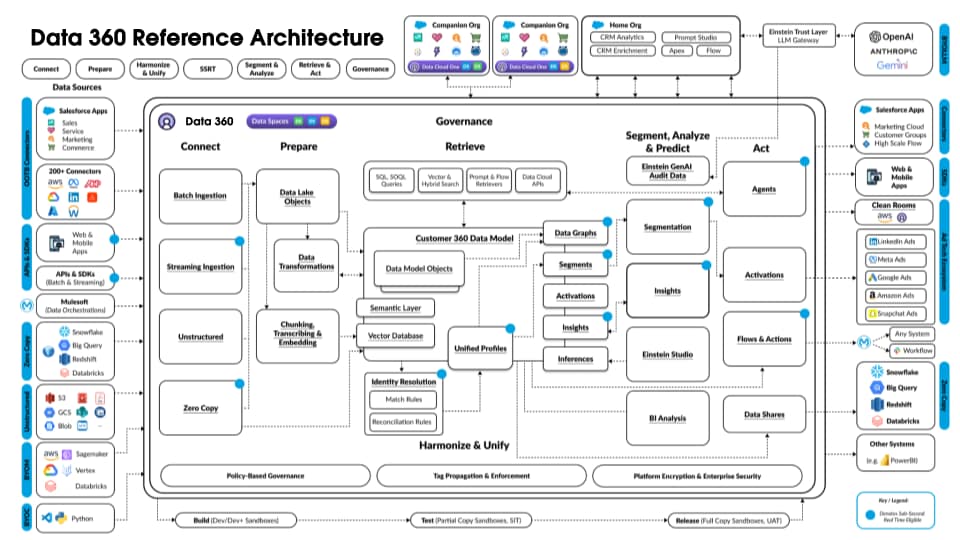 Im Folgenden wird ein hypothetischer Agentforce Loan Agent beschrieben, der in Data 360 überlagert ist. Angenommen, der Darlehensagent ist ein kundenorientierter Agent, bei dem Kunden (Verbraucher) Darlehen beantragen und sofortige Darlehensgenehmigungen erhalten.
Data 360 führt diese Schritte wie geplant aus und bereitet Daten für die Verwendung durch den Darlehensagenten vor.
- Data 360 erfasst strukturierte Kundenaccount-Daten aus CRM und speichert sie im Data Lake.
- Data 360 verarbeitet unstrukturierte Daten zu Unternehmensdarlehen und Finanzpolicen.
- Data 360 führt personenbezogene Daten aus einer externen Datenquelle wie Snowflake zusammen.
- Data 360 transformiert und modelliert aufgenommene und verbundene Daten.
- Data 360 erstellt und verwaltet das Profildatendiagramm.
Jedes Mal, wenn ein Kunde ein Darlehen beantragt, werden diese Aktionen ausgeführt.
- Ein Kunde meldet sich beim Darlehensagenten an, wodurch eine Kundensitzung auf der Echtzeitebene beginnt. Das zusammengeführte Profil des Kunden wird in die Echtzeitebene abgerufen.
- Der Kunde füllt einen Darlehensantrag unter Angabe der erforderlichen Informationen aus.
- Der Kunde lädt Finanzdokumente (wie Steuererklärungen, Investitionen, Kontoauszüge) zur unstrukturierten Datenverarbeitung in Data 360 hoch.
- Hochgeladene Daten werden in Gruppen unterteilt und vektorisiert (Generierung von Einbettungen) und Indizes (Stichwort und Vektor) werden erstellt.
- Als Nächstes füllt der Kunde das Darlehensantragsdokument aus und lädt es hoch. Data 360 extrahiert den Darlehensbetrag und die Laufzeit in Echtzeit.
- Der Darlehensagent ruft relevante Finanzdaten mithilfe der Data 360-Abfrage und der hybriden Suche über das Profil und andere vordefinierte Indizes ab.
- Der Darlehensagent aktiviert einen Genehmigungsagenten mit Darlehensdaten und anderen Finanzprofildaten, um die Darlehensgenehmigungsentscheidung zu treffen.
- Der Darlehensagent antwortet dem Kunden mit einer Entscheidung.
- Diese gesamte Interaktion zwischen dem Kunden und dem Darlehensagenten wird ebenfalls in Data 360 erfasst und gespeichert.
Das obige Beispiel bietet eine Übersicht über Data 360-Architekturkomponenten, die zum Erstellen einer Agentenanwendung wie eines Darlehensagenten verwendet werden. Im nächsten Abschnitt werden die Data 360-Architekturebenen und -Komponenten beschrieben.
## Data 360-Architektur
In diesem Abschnitt werden die grundlegenden Bausteine von Salesforce Data 360 erläutert, beginnend mit dem robusten Speichermodell und anschließend mit den Mechanismen für die Verbindung, Aufnahme und Vorbereitung von Daten. Anschließend wird untersucht, wie strukturierte und unstrukturierte Daten gespeichert, modelliert und verarbeitet werden, was zu einem besseren Verständnis ihrer Harmonisierung, Vereinheitlichung, Abrufbarkeit und intelligenten Aktivierungsfunktionen führt.
### Data 360-Speicher
Salesforce Data 360 basiert auf einem mehrstufigen, aber integrierten Speichermodell, das die Stärken eines Lakehouse mit Echtzeitspeicher kombiniert. Die Lakehouse-Ebene bietet skalierbaren, kosteneffizienten Speicher für große Mengen an historischen Daten und Batch-Daten und ermöglicht erweiterte Analysen und Anwendungsfälle für maschinelles Lernen. Die Echtzeitspeicherung hingegen ist für Zugriffe mit geringer Latenz und Aktualisierungen mit hoher Häufigkeit optimiert, um sicherzustellen, dass Kundeninteraktionen, Profile und Interaktionssignale immer aktuell sind. Zusammen funktionieren diese Stufen nahtlos, sodass Daten flüssig zwischen historischen Kontexten und Echtzeitkontexten wechseln können und eine einheitliche Datengrundlage für Personalisierung, AI und Aktivierung bieten.
#### Lakehouse
Data 360 verfügt über eine native Lakehouse-Architektur, die auf Iceberg/Parquet basiert und für die Verwaltung und Verarbeitung umfangreicher Daten für Batch-, Streaming- und Echtzeitszenarien konzipiert wurde, die strukturierte und unstrukturierte Daten unterstützen, was für AI- und Analyseanwendungen entscheidend ist.
In Cloud-basierten Data Lakes wie Azure, AWS oder GCP ist die grundlegende Speichereinheit eine Datei, die in der Regel in Ordnern und Hierarchien organisiert ist. Lakehouse erweitert diese Struktur, indem strukturelle und semantische Abstraktionen auf übergeordneter Ebene eingeführt werden, um Vorgänge wie Abfragen und die AI/ML-Verarbeitung zu vereinfachen. Bei der primären Abstraktion handelt es sich um eine Tabelle mit Metadaten, die ihre Struktur und Semantik definiert und Elemente aus Open-Source-Projekten wie Iceberg oder Delta Lake mit zusätzlichen semantischen Ebenen enthält, die durch Data 360 hinzugefügt wurden.
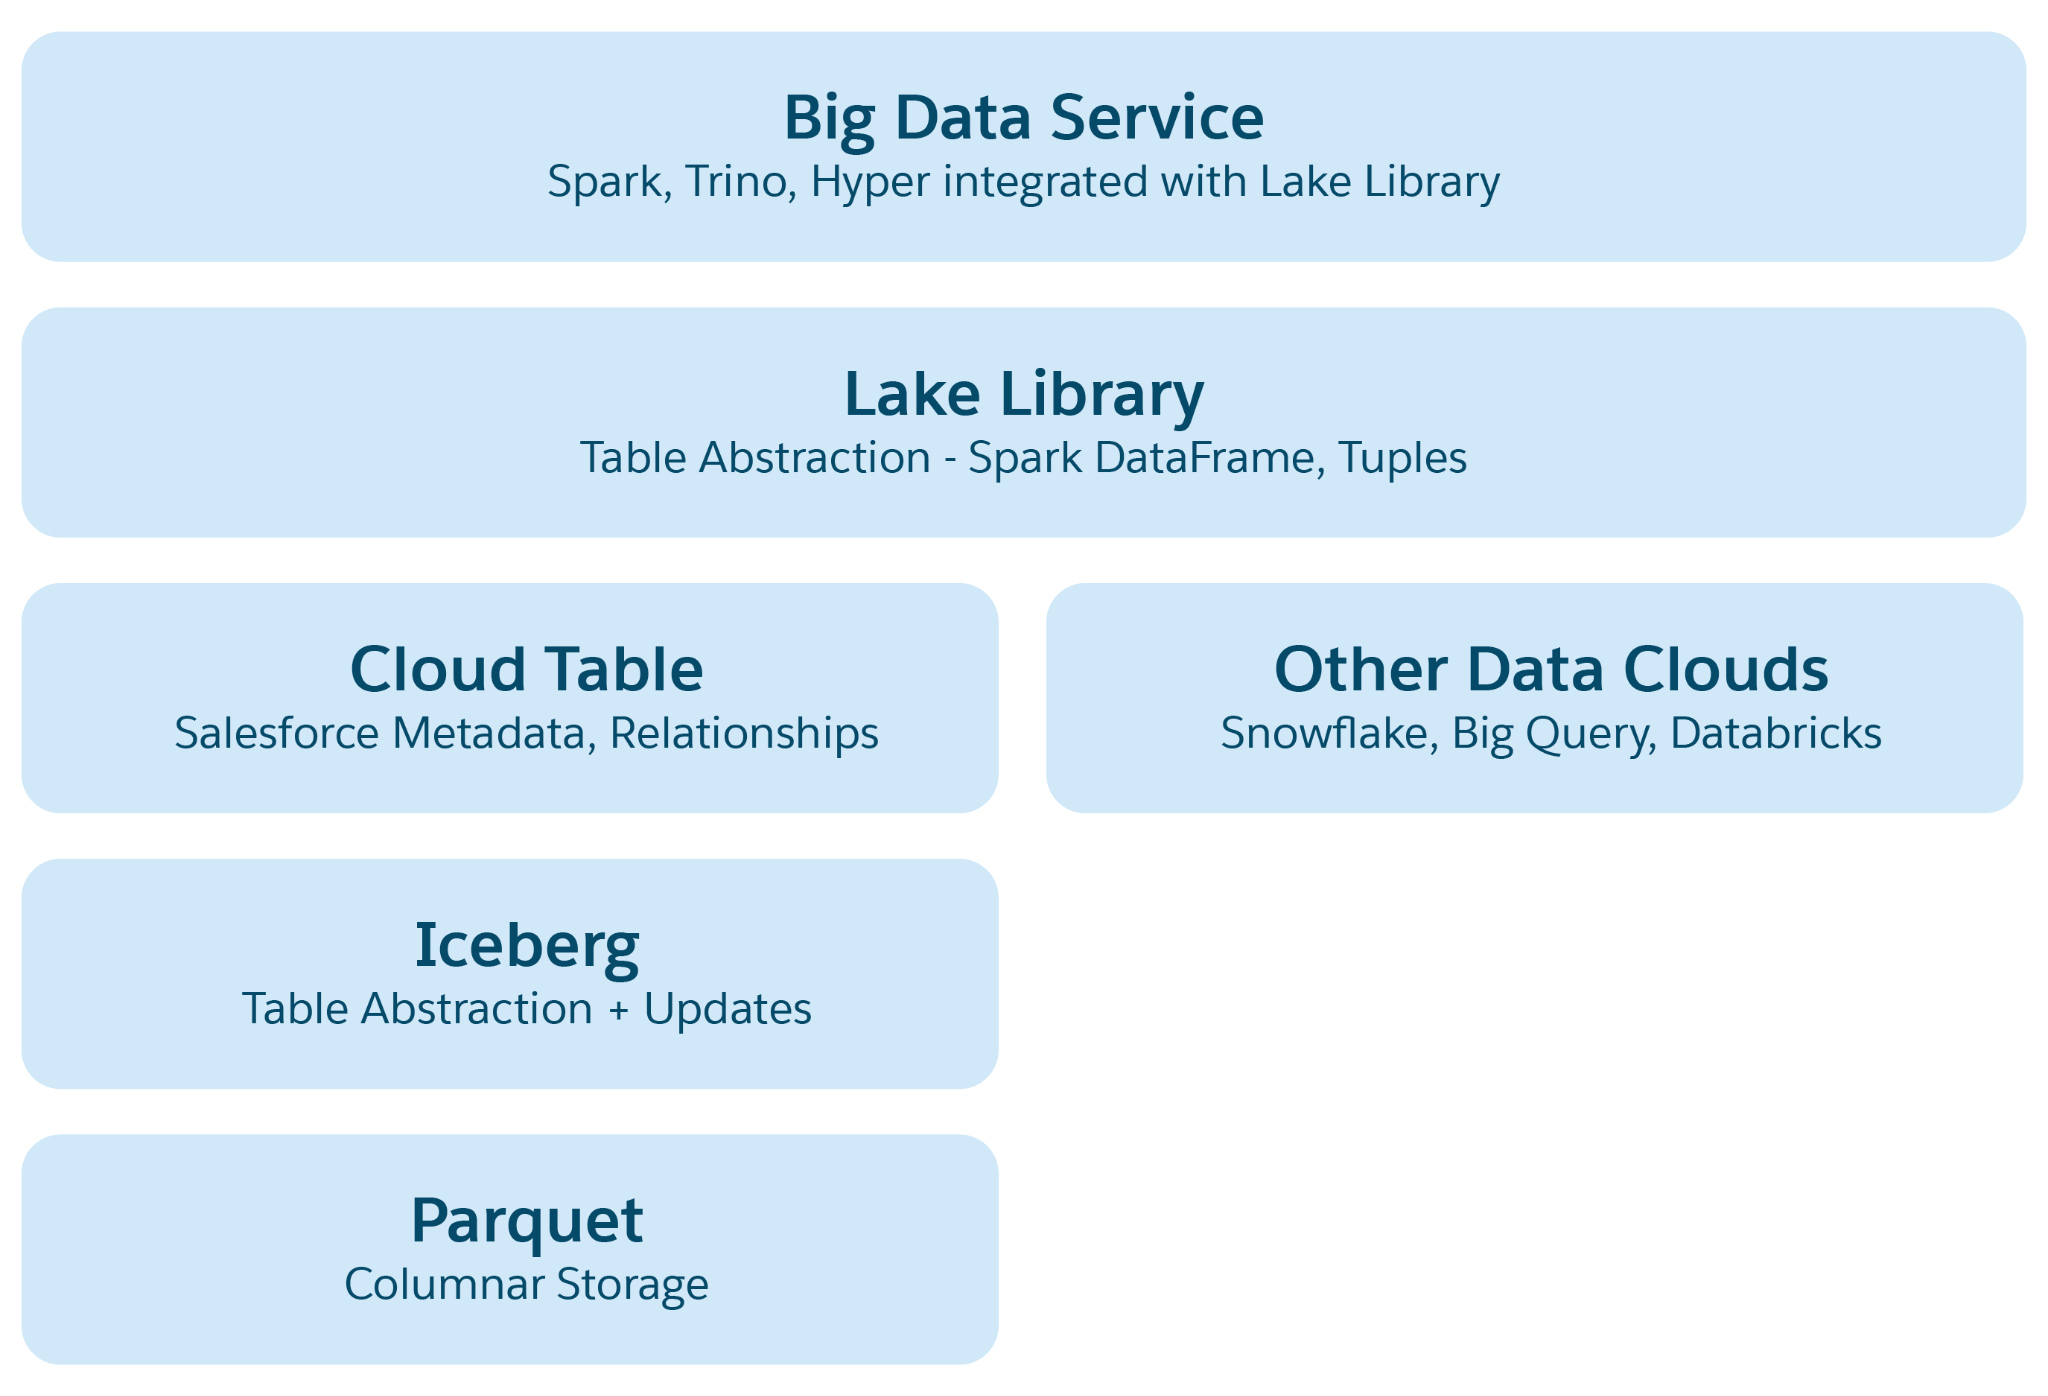 Abstraktionsebenen in Lakehouse:
1. **Parquet File Abstract (Parquet-Dateiabstraktion)**: Auf der Basis besteht der Speicher aus Data-Lake-Dateien (z. B. S3 in AWS oder Blob in Azure) im Parquet-Format. Daten für eine Quelltabelle werden in mehreren Partitionen als Parquet-Dateien gespeichert, wobei jede Tabelle eine Sammlung dieser Dateien ist.
2. **Iceberg-Tabellenabstraktion**: Tabellen sind als Ordner organisiert, wobei Datenpartitionen in diesen Ordnern als Parquet-Dateien gespeichert sind. Änderungen an einer Partition führen zu neuen Parquet-Dateien als Snapshots. Iceberg verwaltet eine Metadatendatei für jede Tabelle mit detaillierten Schemas, Partitionsspezifikationen und Snapshots.
3. **Salesforce Cloud-Tabellenabstraktion**: Aufbauend auf Iceberg fügt diese Ebene semantische Metadaten wie Spaltennamen und Beziehungen sowie Konfigurationen wie die Zieldateigröße und die Komprimierung hinzu. Sie abstrahiert Tabellen auf verschiedenen Plattformen wie Snowflake und Databricks und schützt Data 360-Anwendungen vor den zugrunde liegenden Besonderheiten der Speicherplattform.
4. **Bibliothek für Seezugriff**: Diese Bibliothek bietet Zugriff auf die Salesforce Cloud-Tabelle, verarbeitet Daten und Metadaten und abstrahiert die zugrunde liegenden Speichermechanismen für Anwendungsentwickler.
5. **Big Data-Service-Abstraktion**: Dies umfasst Verarbeitungs-Frameworks wie Hyper für Abfragen und Spark für die Verarbeitung auf jeder Cloud-Tabellenplattform.
#### Echtzeitspeicherung
Data 360 erweitert den Big Data-Speicher von Lakehouse um den Low Latency Store, um Echtzeitanalysen und agentische Anwendungen zu unterstützen. Data 360-Echtzeitebene verarbeitet Echtzeitsignale und Interaktionsdaten im Arbeitsspeicher. Da die speicherbasierte Speicherkapazität jedoch begrenzt ist, können nicht alle Daten passen und die Verarbeitung kann nicht in Echtzeit erfolgen. Data 360 fügt einen Store mit geringer Latenz hinzu, um solche Einschränkungen zu beseitigen und so eine skalierbare Echtzeitverarbeitung zu ermöglichen.
Bei dem Speicher mit niedriger Latenz handelt es sich um eine NVMe-Speicherschicht (SSD) im Petabyte-Format im Lakehouse. Nicht alle Daten müssen im Speicher mit niedriger Latenz aufbewahrt werden. Es ist ein dauerhafter Cache. Die meisten Daten gelangen schließlich zur langfristigen Aufbewahrung ins Lakehouse. Sitzungsdaten in der Echtzeitebene können in den Speicher mit niedriger Latenz gefiltert werden, um anschließend schnell darauf zugreifen zu können. In einer Agentenunterhaltung können beispielsweise aktuelle Nachrichten im Arbeitsspeicher verarbeitet werden. Ältere Nachrichten können in den Speicher mit niedriger Latenz geleert werden. Wenn eine vorherige Unterhaltung erforderlich ist, kann innerhalb weniger Millisekunden über den Speicher mit niedriger Latenz darauf zugegriffen werden. Mit NVMe-basiertem Speicher können große Datenmengen gespeichert und mit Latenzen von Millisekunden aufgerufen werden. Die Daten gelangen möglicherweise in den Lakehouse Cloud-Speicher, um sie langfristig zu speichern. Darüber hinaus werden Daten aus Lakehouse abgerufen und im Speicher mit niedriger Latenz aufbewahrt, die für die Echtzeitverarbeitung oder zur Verbesserung der Echtzeiterfahrungen erforderlich sind. Beispielsweise wird der Kundenprofilkontext vorab abgerufen oder aus dem Lakehouse abgerufen und im Shop mit niedriger Latenz zwischengespeichert. Außerdem können alle Lakehouse-Objekte und anderen Objekte, die für die Echtzeitverarbeitung während der Verarbeitung in der Sitzung erforderlich sind, auch im Speicher mit niedriger Latenz zwischengespeichert werden.
Data 360-Speicher mit niedriger Latenz ermöglicht die Echtzeit-Ebene in einer echten Speicherhierarchie mit Speicherschichten (SSD) in Lakehouse, wobei Daten nahtlos zwischen diesen Schichten migriert werden. Die Data 360-Echtzeitebene wird später in diesem Dokument erläutert.
### Datenorganisation
Salesforce Data 360 wurde entwickelt, um alle Kundendaten – strukturierte und unstrukturierte – nach einem strengen Lebenszyklus zu standardisieren, zu harmonisieren und zu aktivieren, der Rohdaten in ein vereinheitlichtes aktuelles Datenmodell umwandelt.
#### Datenlebenszyklus und Objekttypen
Der Lebenszyklus konzentriert sich darauf, verschiedene externe Dateneingaben zu übernehmen und sie in persistente, modellierte Objekte zu strukturieren. Modellierte Daten können zu vereinheitlichten Customer 360 Profilen harmonisiert werden.
**Rohdaten und anfängliche Transformationen**
Der Prozess beginnt mit Rohdaten, die im Ist-Zustand aus Quellsystemen (CRM, Marketing, Dateien usw.) aufgenommen werden. Dies umfasst vollständige Datenladevorgänge und kontinuierliche Änderungsereignisse (deltas), die verwaltet und mit persistenten Daten zusammengeführt werden, um einen aktuellen Status aufrechtzuerhalten.
**Inline-Transformationen** (z. B. Trimmen, Normalisieren, Verketten) werden sofort während der Aufnahme angewendet, um die vorläufige Datenqualität und Sauberkeit zu gewährleisten.
##### Data-Lake-Objekte (DLOs): Die persistente Ebene
**DLOs** (Data-Lake-Objekte) bilden die zentrale persistente Speicherebene in Data 360 und speichern die bereinigten, umgewandelten Daten und dienen als organisiertes langfristiges Repository für alle Kundeninformationen.
**Erweiterte Datentransformationen** (z. B. Verknüpfungen, Aggregationen, berechnete Statistiken) werden auf Quell-DLOs angewendet, um neue, hochgradig zusammengestellte abgeleitete DLOs zu erstellen.
Daten, die über die Zero Copy Data Federation zur Verfügung gestellt werden, werden direkt als DLOs dargestellt.
**Organisation unstrukturierter Daten und Metadaten**
Bei unstrukturierten Inhalten (wie Text, Medien, Dokumenten) integriert Data 360 die Daten, indem die strukturierten Metadaten in bestimmten DLOs, sogenannten Unstructured Data Lake Objects (UDLOs), extrahiert und beibehalten werden.
Diese spezialisierten DLOs fungieren als Verzeichnistabellen und bieten eine Zuordnung zum physischen Standort und Kontext der unstrukturierten Vermögenswerte. Dadurch können Architekten die Metadaten unstrukturierter Daten nahtlos mit den restlichen strukturierten Kundendaten verknüpfen und so eine einheitliche Abfrage und Harmonisierung ermöglichen.
##### Datenmodellobjekte (DMOs): Die harmonisierte Ebene
**DMOs** (Datenmodellobjekte) stellen die endgültige, harmonisierte und strukturierte Datenebene dar.
Sie werden erstellt, indem DLO-Felder (aus Quell-, abgeleiteten und unstrukturierten Metadaten-DLOs) dem Customer 360-Standarddatenmodell zugeordnet werden.
Die DMO-Ebene fungiert als zentrale Informationsquelle für alle Kundendaten und ermöglicht die Erstellung, Segmentierung und Aktivierung von vereinheitlichten Profilen im gesamten Ökosystem.
#### Datenbereich: Der logische Container
Ein Datenbereich ist der grundlegende logische Container für die Organisation aller Daten und Metadaten in Data 360, einschließlich aller DLOs (strukturiert und unstrukturiert) und DMOs. Datenbereiche bieten eine sichere, isolierte Umgebung für die Datenverarbeitung und -modellierung.
Datenbereiche fungieren als logische und Governance-Grenzen und ermöglichen die interne Multimanenz, indem Daten für unterschiedliche Einheiten wie Geschäftseinheiten, Regionen oder Marken getrennt werden. Gleichzeitig werden die unternehmensweite Transparenz, Herkunft und Compliance gewahrt, was als Grundlage für die Definition der groben Zugriffssteuerung dient.
Die Isolierung in Datenbereichen wird auf mehreren Ebenen der Plattform erzwungen:
- **Isolation auf Datenebene**: Jedes DLO/DMO gehört zu einem einzelnen Datenbereich. Dadurch wird sichergestellt, dass Abfragen, Transformationen und Objektzuordnungen die Grenzen des Datenbereichs nur überschreiten können, wenn sie explizit autorisiert sind.
- **Zugriffssteuerungsintegration**: Berechtigungssätze sind nativ an Datenbereiche gebunden und ermöglichen die Kontrolle über Lese-, Schreib- und Verwaltungsvorgänge. Dadurch wird sichergestellt, dass nur autorisierte Benutzer und Services auf Objekte, Statistiken und Aktivierungen in einem Datenbereich zugreifen können.
- **Governance und Audit**: Alle Vorgänge innerhalb eines Datenbereichs werden mit unternehmensspezifischen Prüfprotokollen protokolliert, wodurch die Rückverfolgbarkeit für Compliance, Stewardship und behördliche Berichte ermöglicht wird.
Der Zugriff und die Berechtigungen werden über Berechtigungssätze verwaltet, wodurch eine genaue Sichtbarkeit, kontrollierte Aktualisierungen und die Vermeidung von domänenübergreifenden Datenlecks gewährleistet werden. Durch die Integration von Datenbereichsgrenzen in die Sicherheits- und Governance-Architektur von Data 360 können Architekten sowohl zentralisierte als auch dezentrale Governance-Strategien sicher implementieren und gleichzeitig die Konsistenz über mehrere Clouds und Geschäftsdomänen hinweg aufrechterhalten.
#### Compute Fabric (Gewebe berechnen)
Die Data 360-Rechenstruktur bietet eine einheitliche Ebene zum Verwalten und Ausführen aller Big Data-Arbeitslasten und vereinfacht so die zugrunde liegenden Infrastrukturkomplexe. Kernkomponente ist das Datenverarbeitungssteuerfeld (DPC).
DPC ist ein umfassender Orchestrierungsservice für die Datenverarbeitung mit mehreren Arbeitslasten, der JaaS-Funktionen (Job-as-a-Service) in verschiedenen Cloud-Rechenumgebungen bereitstellt. Sie abstrahiert die Infrastrukturkomplexität und vereinheitlicht die Auftragsausführung für Frameworks wie Spark (EMR in EC2 und EMR in EKS) und Kubernetes Resource Controller (KRC). Durch die Verwendung als zentrales Gateway für Steuerungsebenen orchestriert, plant und überwacht DPC Aufträge über mehrere Datenebenen hinweg und gewährleistet so Zuverlässigkeit, Skalierbarkeit, Kosteneffizienz und eine konsistente Entwicklererfahrung.
Der Bedarf an DPC ergibt sich aus den Einschränkungen der direkten Interaktion mit nativen Cluster-Verwaltungssystemen wie EMR.
##### Infrastruktur und Cloud-Abstraktion
EMR bietet zwar APIs für Cluster, Aufgaben und Schritte, belastet Kundenteams jedoch weiterhin mit wichtigen Infrastrukturverwaltungsaufgaben wie Bereitstellung, Skalierung, Leistungsoptimierung und Kostenoptimierung. DPC behebt dies, indem es eine vereinfachte API auf Plattformebene für die Einreichung von Aufträgen bereitstellt. Sie unterstützt die automatische Fehlerbehandlung, Wiederholungen und dynamische Lastenverteilung. Bietet Kosteneffizienz durch Binpacking-, Spot- und Gravitationsknoten. Bietet starke Sicherheit mit TLS, PKI, IAM-Isolation und automatisiertem Patching. Verwaltet Upgrades der Spark- und EMR-Laufzeitversion, um Leistungsverbesserungen, Sicherheitspatches und Funktionsverbesserungen bereitzustellen.
Darüber hinaus bietet DPC eine einheitliche, Cloud-agnostische Oberfläche zum Senden und Verwalten von Datenaufträgen und abstrakte die Komplexitäten und proprietären APIs des zugrunde liegenden Cloud-Substrats (AWS, zukünftige Anbieter). Dadurch wird sichergestellt, dass Kundenteams ausschließlich mit einer gemeinsamen Data 360-API-basierten Auftragseinreichungsoberfläche interagieren, die die Komplexität zugrunde liegender Ressourcenmanager wie Kubernetes und YARN abstrahiert. Dadurch können Clientteams Spark-Aufträge über eine einfache, einheitliche API senden, ohne Pods, Knotenpools oder Spark-Clusterkonfigurationen direkt verwalten zu müssen.
Das manuelle Abstimmen von Spark-Parametern erfordert spezielle Fertigkeiten und falsche Konfigurationen können zu einer langsamen Auftragsausführung führen. Das DPC-Team zentralisiert diese Expertise und bietet optimierte Konfigurationen, um allgemeine Leistungsprobleme zu vermeiden. Dieses spezialisierte Team integriert kontinuierlich Knowledge aus der Open-Source-Community, um eine optimale Leistung für alle vom Controller verwalteten Arbeitslasten zu gewährleisten.
DPC ist nicht auf Spark beschränkt, sondern unterstützt eine Vielzahl von Arbeitslasten. Dazu zählen:
- Echtzeitverarbeitungsarbeitslasten
- Ereigniszustellung für die Funktion "Datenaktionen"
- Verwaltung von Milvus (der Vektordatenbank für die unstrukturierte Datenindizierung)
- Speicherinfrastruktur mit geringer Latenz
DPC nutzt auch das Framework **Kubernetes Resource Controller (KRC)**, das Arbeitslasten wie Trino für Abfragen, Ereigniszustellungen für Datenaktionen, Datenextraktionsaufträge für Konnektoren und Echtzeitverarbeitung unterstützt. Für alle KRC-Arbeitslasten bietet DPC zentrale Job-as-a-Service-Funktionen, die die Bereitstellung, Bereitstellung und Verwaltung von Rechenaufgaben auf einer allgemeinen Auftragsabstraktion übernehmen.
##### Vorteile und Architektur von JaaS
Das von DPC bereitgestellte Job-as-a-Service-Modell gewährleistet eine kostengünstige und belastbare Auftragsverarbeitungs-Pipeline.
Benutzer stellen einfache Cluster-Spezifikationen bereit, die sich auf die erforderliche CPU, den Speicher, den Speicher, die Instanzanzahl und die Anzahl der Min/Max-Cluster und Tags für den Clusterabgleich konzentrieren. Anschließend verwaltet DPC automatisch abstrakte Infrastrukturdetails. Dazu zählen die Auswahl optimaler VM-SKUs, die Verwaltung von Instanzflotten, die Bestimmung des Verhältnisses von Knoten vom Typ "Kern" im Vergleich zu "Aufgabe" und die Verwaltung von On-Demand- im Vergleich zu Spot-Instanzen anhand von Eingaben. Außerdem werden EMR- und Komponentenversionsverwaltung sowie Upgrades ohne Ausfallzeiten verarbeitet.
Entscheidend ist, dass DPC von Natur aus die Multitenance unterstützt, die entwickelt wurde, um die Data 360-Mandantengrenzen und die Ressourcentrennung zu verstehen und durchzusetzen. Darüber hinaus gewährleistet sie Sicherheit und Compliance, indem sie Salesforce-zertifizierte Maschinenbilder erzwingt, servicespezifische IAM-Rollen verwaltet und die Verschlüsselung sowohl bei der Übertragung als auch im Leerlauf gewährleistet. Bei der Weiterleitung und Kapazitätssteuerung wird der Abgleich zwischen Aufträgen mithilfe von Cluster-Tags verwaltet und bei der kapazitätsbasierten Weiterleitung wird eine maximale Einstellung für die Auftragsgleichzeitigkeit verwendet, um die Ressourcenauslastung effektiv zu steuern.
Die Cloud Agnostic Client Experience ist ein zentraler Vorteil, da die Komplexität der zugrunde liegenden Cloud-Umgebungen für Kundenservices ausgeblendet ist und sie sich ausschließlich auf Geschäftslogik konzentrieren können. Dadurch wird das Ziel der Cloud-Anbieterabstraktion erreicht. Schließlich ermöglicht DPC eine einfache Nutzung und Kostenverfolgung, wodurch die Clusterauslastung und die Kosten nach Service segmentiert werden können, um eine genaue Buchhaltung zu ermöglichen. Insgesamt folgt DPC einer steckbaren Architektur, die es ermöglicht, neue Ausführungsmodule (z. B. Flink, Ray) und Cloud-Substrate (GKE/Dataproc) nahtlos zu integrieren, ohne Benutzern die zugrunde liegenden Infrastrukturdetails zur Verfügung zu stellen. Durch dieses Design wird die Steuerebene von der Ausführungsebene entkoppelt, wodurch eine konsistente API und Betriebserfahrung unabhängig vom Backend gewährleistet wird.
### Datenverarbeitung in Data 360: Von "Roh" zu "Handlungsrelevant"
Data 360 optimiert und erweitert Rohdaten und schließt die Lücke zwischen Rohinformationen und dem handlungsrelevanten Geschäftsverbrauch. Es ergänzt den Lebenszyklus von Datenobjekten, indem es komplexe Daten für eine komplexe Aktivierung und Analyse vorbereitet. Data 360 unterstützt verschiedene Verarbeitungstypen, darunter Batch- und Streaming-Datentransformationen, berechnete Statistiken zum Batch und Streaming, unstrukturierte Datenverarbeitung und Identitätsbestimmung. Um diese vielfältigen Vorgänge effizient zu ermöglichen, insbesondere in nahezu Echtzeit und über massive Datensets hinweg, ist ein komplexer Mechanismus erforderlich, um Datenänderungen effektiv zu verarbeiten.
#### Unterstützen der inkrementellen Verarbeitung
Data 360 benötigte einen Durchbruch, um eine effiziente Datenverarbeitung nahezu in Echtzeit zu erreichen, insbesondere mit Tabellen in Terabyte-Größe und Millionen potenzieller Aktualisierungen. Sie erforderte eine Möglichkeit, Systeme genau zu benachrichtigen, wenn sich Daten ändern, und dann effizient zu identifizieren, welche Daten geändert wurden, sodass nur relevante Aktualisierungen verarbeitet werden und nur, wenn sie aktualisiert werden. Diese Herausforderung führte zu zwei sich ergänzenden Innovationen: Speichern von nativen Änderungsereignissen (SNCE) zum Benachrichtigen, wenn etwas geändert wird, und Ändern des Datenfeeds (CDF) zum Identifizieren, was geändert wurde.
##### Native Speicheränderungsereignisse (SNCE)
SNCE hat Data 360 grundlegend in eine reaktive und inkrementelle Datenplattform umgewandelt. Diese Umstellung beinhaltet den Übergang von der aktiven Abfrage des Data Lakes zur passiven Überwachung auf Atom-Commit-Ereignisse mithilfe eines standardisierten Ereignisformats und eines Nachrichtenzustellungssystems mit hohem Durchsatz.
Jeder erfolgreiche Schreibvorgang (EINFÜGEN, AKTUALISIEREN, LÖSCHEN) in eine Iceberg-Tabelle gipfelt in einem Atomtausch des aktuellen Metadatendateizeigers der Tabelle im Katalog. Die zugrunde liegende Objektspeicherebene (beispielsweise S3) ist so konfiguriert, dass ein natives Benachrichtigungsereignis (beispielsweise ein S3-Ereignis) ausgegeben wird, sobald ein neuer Metadaten-Snapshot in das Verzeichnis der Tabelle geschrieben wird.
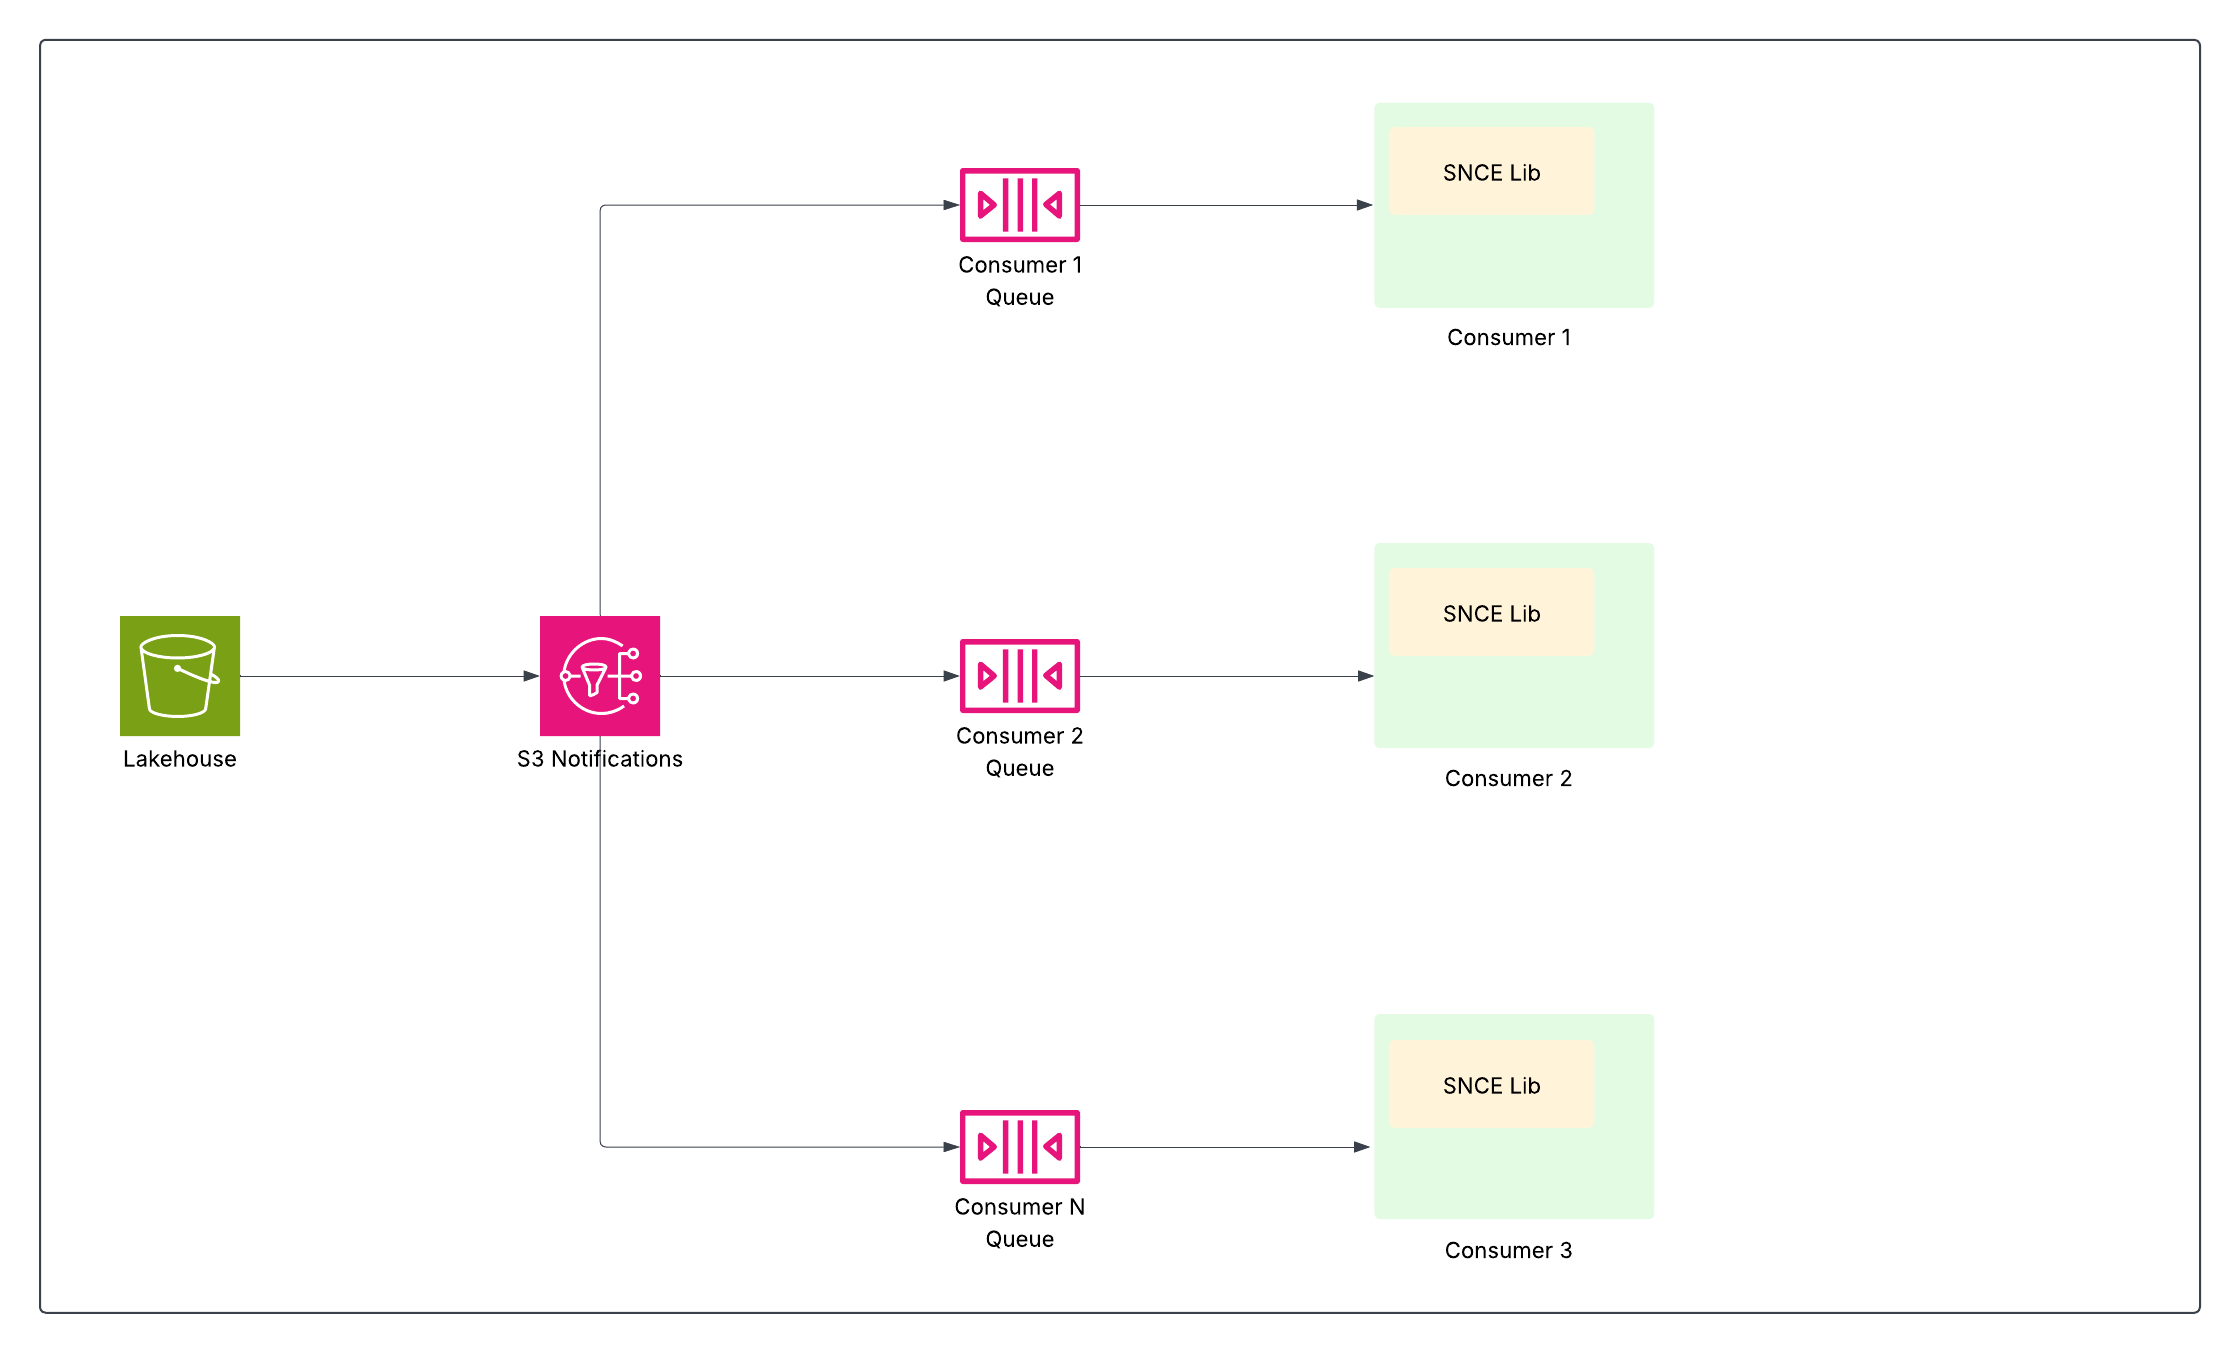 Die SNCE-Bibliothek bietet eine standardisierte Methode zum Verwenden dieser Ereignisse und kann sie auf Anfrage auch mit Snapshot-Metadaten anreichern.
Dadurch können nachgelagerte Datenpipelines wie Streaming berechneter Statistiken, Identitätsbestimmung und Segmentierung nur dann abonniert werden und reagieren, wenn sich Daten geändert haben. Dies erhöht die Effizienz erheblich, da kostspielige Scans mit vollständiger Tabelle vermieden werden.
##### Datenfeed ändern (CDF)
Aufbauend auf SNCE bietet der Change Data Feed (CDF) einen optimierten Mechanismus zum Verbrauchen und inkrementellen Verarbeiten der Änderungen.
CDF nutzt Iceberg-Snapshots, um den Stream der Änderungen effizient zu generieren. Entscheidend ist, dass der optimierte Iceberg-Schreiber von Data 360 die Änderungen als Teil des Schreibvorgangs selbst berechnet und beibehält, wodurch die CDF-Generierung hocheffizient ist und der zusätzliche Overhead minimiert wird. Dadurch können Verarbeitungsaufträge (wie Streaming-Transformationen oder berechnete Streaming-Statistiken) selektiv nur die geänderten Datensätze verarbeiten, wodurch die aufwendige Snapshot-Diff-Berechnung vermieden wird.
Diese inkrementelle Strategie bietet mehrere Vorteile für große Datensets, einschließlich Kosteneinsparungen, reduzierter Latenz und verbesserter Effizienz. Sie ermöglicht Funktionen wie Streaming-Transformationen und die inkrementelle Identitätsbestimmung, die wiederum zu schnelleren Statistiken, vorhersehbareren Systemlasten, höherer Leistung und niedrigeren Betriebskosten führen.
### Verbinden, Aufnehmen und Vorbereiten
Data 360 bietet zuverlässige Aufnahmefunktionen mit nativer Unterstützung für Salesforce-Produkte und gewährleistet so einen nahtlosen Datenfluss. Für externe Quellen bietet sie umfangreiche Konnektivität über mehr als 270 Konnektoren, APIs, SDKs und MuleSoft. Darüber hinaus bietet Data 360 eine Zero-Copy-Verbundfunktion, die BI und Analysen ohne Datenduplizierung ermöglicht.
#### Data 360-Konnektor-Framework
Das Data 360-Konnektor-Framework (DCF) ist die Grundlage für die meisten Data 360-Konnektivitäten. Sie ermöglicht die Aufnahme, den Verbund und die Beendigung über eine einheitliche Architektur. DCF definiert die Standards für das Erstellen und Verwalten von Konnektoren – von der Benutzeroberfläche für Setup und Verwaltung bis hin zur Metadatenpersistenz, Datenextraktion und Bereitstellung in Lakehouse oder über Live-Abfragen für externe Quellen. Sie unterstützt auch private Konnektivitätsoptionen (z. B. private Links, VPNs und sichere Tunnel), um die Datensicherheit und Compliance bei der Verbindung mit Kunden- oder Partnerumgebungen auf Unternehmensebene zu gewährleisten. Durch die Bereitstellung eines konsistenten Ansatzes für alle Konnektoren ermöglicht DCF Data 360 eine nahtlose Verbindung mit dem größeren Ökosystem, indem Erweiterbarkeit, Zuverlässigkeit und sichere Integration gewährleistet werden.
#### Data 360-Konnektoren
Data 360 bietet zuverlässige Verbindungen zu einem umfangreichen Ökosystem von Datenquellen und unterstützt native Salesforce-Produkte sowie zahlreiche externe Systeme. Diese umfangreiche Konnektivität ist entscheidend für die Vereinheitlichung isolierter Unternehmensdaten und die Aktivierung von AI/ML- und Agentenanwendungen.
Data 360 bietet mehr als 270 Konnektoren nativ oder über MuleSoft, APIs und SDKs, um seine durchgängigen Datenpipeline-Funktionen mit Batch-, Streaming- oder Echtzeitaufnahme zu unterstützen. Diese Konnektoren können grob nach dem Typ des Quellsystems kategorisiert werden, das sie integrieren.
**Native Salesforce-Konnektoren**
Diese Konnektoren gewährleisten einen nahtlosen und nativen Datenfluss aus Salesforce-Produkten.
Beispiele sind Konnektoren für Salesforce CRM, Data Cloud One , Marketing Cloud Engagement, Marketing Cloud Account Engagement und B2C Commerce.
**Externe Anwendungen und SaaS**
Konnektoren für verschiedene Geschäftsanwendungen und Cloud-Services ermöglichen die Datenaufnahme von externen Softwareplattformen.
Beispiele sind Adobe Marketo Engage, Microsoft Dynamics 365, Mailchimp und Airtable.
**Datenbanken und Data Warehouses**
Data 360 stellt eine Verbindung zu einer Vielzahl von relationalen und Cloud-basierten Datenspeicherplattformen her.
Beispiele sind Amazon Redshift, Amazon DynamoDB, Amazon RDS (MySQL, PostgreSQL, Oracle), Google BigQuery und Microsoft SQL Server.
**Cloud-Objektspeicher und Dateisysteme**
Diese Konnektoren können in Hyperscaler-Speicherlösungen für strukturierte und unstrukturierte Daten integriert werden.
Beispiele sind Amazon S3, Google Cloud Storage (GCS) und Azure Blob Storage.
**Streaming- und Messaging-Services**
Konnektoren, die kontinuierliche Echtzeit-Datenströme verarbeiten, sind für ereignisgesteuerte Szenarien und die Echtzeitverarbeitung entscheidend.
Ein Beispiel ist der Amazon Kinesis-Konnektor.
**Integrationsplattformen**
Der MuleSoft Anypoint-Konnektor erweitert die Reichweite von Data 360, indem er über Anypoint Exchange in eine breitere Palette von Anwendungen und Datenbanken integriert wird.
**Konnektoren für nicht strukturierte Daten und Cloud-Objektspeicher**
Diese Konnektoren sind wichtig für die Aufnahme und Referenzierung unstrukturierter Daten (Daten, für die kein vordefiniertes Modell vorhanden ist), um die Funktionen der generativen AI zu unterstützen.
Alle diese Konnektoren basieren auf dem Data 360-Konnektor-Framework und bieten eine konsistente Erfahrung.
#### Datentransformationen
Die Datentransformation ist eine grundlegende Architekturkomponente in Data 360, die entwickelt wurde, um die erfassten Rohdaten zu bereinigen, anzureichern und in normalisierte, handlungsrelevante Datenbestände umzuwandeln, die mit dem Customer 360 Datenmodell übereinstimmen. Dieser Prozess ist wichtig für die Harmonisierung, Qualitätsverbesserung und die Sicherstellung, dass Daten für nachgelagerte Anwendungsfälle wie die Profilvereinheitlichung, Segmentierung und Aktivierung bereit sind. Transformationen verwenden sowohl Data-Lake-Quellobjekte (DLOs) als auch Datenmodellobjekte (DMOs) als Eingabe und generieren die Ergebnisse in neue DLOs bzw. DMOs.
Data 360 bietet zwei primäre Transformationsparadigmen, um unterschiedliche Anforderungen an die Datengeschwindigkeit zu erfüllen: Batch-Datentransformationen und Streaming-Datentransformationen.
##### Batch-Datentransformationen
Batch-Datentransformationen sind für die Verarbeitung großer Volumen auf der Grundlage eines definierten Zeitplans oder On-Demand-Auslösers konzipiert. Dieses Modul ist für komplexe, ressourcenintensive Umstrukturierungen optimiert.
Der Batch-Transformationsprozess wird mithilfe eines visuellen Low-Code-Pipeline-Zeichenbereichs konfiguriert, mit dem Benutzer mehrstufige Transformationslogik definieren können. Dieses Modul unterstützt komplexe Umstrukturierungsvorgänge, die für die Ausrichtung des kanonischen Datenmodells wichtig sind: Datenstrukturierung und -normalisierung. Dies beinhaltet das Pivoten (Aufschlüsseln denormalisierter Datensätze in mehrere normalisierte Datensätze) und das Vereinfachen (Umstrukturieren hierarchischer Daten wie JSON in strukturierte Tabellen). Der Ausführungsmodus des Systems unterstützt sowohl die vollständige Synchronisierung (Verarbeitung aller Datensätze) als auch einen hocheffizienten inkrementellen Verarbeitungsmodus. Der inkrementelle Modus reduziert die Verarbeitungszeit und den Ressourcenverbrauch erheblich, da nur Datensätze verarbeitet werden, die sich seit der letzten erfolgreichen Ausführung geändert haben. Batch-Transformationen eignen sich ideal für Aufgaben, bei denen Echtzeitaktualisierungen nicht erforderlich sind, beispielsweise regelmäßige Aggregationen und komplexe Datenumstrukturierungen.
##### Streaming-Datentransformationen
Streaming-Datentransformationen verarbeiten Daten kontinuierlich und inkrementell nahezu in Echtzeit, während sie in das System fließen, was sie für Anwendungsfälle mit geringer Latenz unerlässlich macht.
Die primäre Schnittstelle ist ein SQL-first-Ansatz, bei dem Transformationen als SQL SELECT-Abfrage definiert sind, die kontinuierlich für den eingehenden Datensatzänderungsstrom ausgeführt wird. Dieses Modul unterstützt zentrale Transformationsfunktionen, einschließlich Datenbereinigung und Standardisierung (z. B. Validierung personenbezogener Daten und Standardisierung von Datenformaten) und Datenanreicherung und -zusammenführung (mit Verknüpfungen und Unionen). Von entscheidender Bedeutung ist, dass Streaming-Nachschlageverknüpfungen unterstützt werden, um die Echtzeit-Datenanreicherung und Nachschlagevorgänge für statische oder sich langsam ändernde Referenzdaten zu ermöglichen und sofortige Profilaktualisierungen zu gewährleisten. Zur Optimierung der Kosten für die Bereitstellung verwendet die Architektur ein Auftragsdesign mit hoher Dichte (HD), das mehrere Streaming-Transformationsdefinitionen für einen einzelnen Mandanten in einen einzelnen zugrunde liegenden Rechenauftrag bündelt und so die Ressourcenauslastung maximiert. Streaming-Transformationen sind für Anwendungsfälle wie die Ereignisüberwachung, sofortige Personalisierung und Echtzeit-Profilaktualisierungen unerlässlich.
### Zero Copy Data Federation und Datenfreigabe
Data 360 revolutioniert die Datenverwaltung durch die Unterstützung der Zero Copy-Verbund- und -Datenfreigabe, wodurch keine Daten verschoben oder dupliziert werden müssen. Durch diese Funktion können Benutzer nahtlos und direkt auf Daten aus verschiedenen externen Quellen zugreifen und Daten für externe Umgebungen freigeben, wodurch die Komplexität erheblich reduziert, die Speicherkosten gesenkt und sichergestellt wird, dass alle Entscheidungen auf den neuesten und zuverlässigsten Informationen basieren.
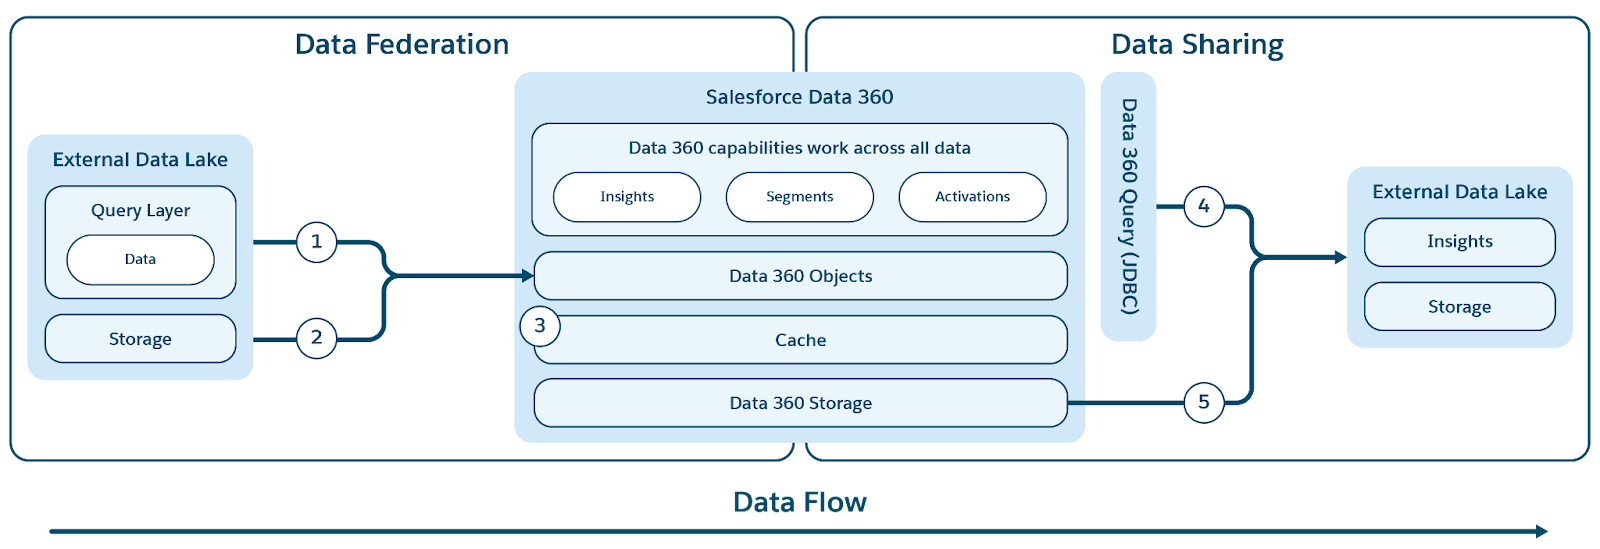 #### Datenverbund
Data 360 unterstützt Zero-Copy-Verbunde mit externen Data Warehouses (Snowflake, Redshift), Lakehouses (Google BigQuery, Databricks, Azure Fabric), SQL-Datenbanken und vielen anderen Quellen. Seine Abstraktionsebenen ermöglichen die direkte Abfrage externer Daten ohne Duplikate, wodurch die Aufnahmezeit, die Speicherkosten und die Gewährleistung aktueller Informationen reduziert werden.
Data 360 vereinfacht den Zugriff auf externe und Verbunddaten, indem eine einheitliche Metadatenebene bereitgestellt wird, die Salesforce und externe Objekte abstrahiert. Dadurch können die gesamte Salesforce Platform und ihre Anwendungen diese Daten nahtlos verwenden.
Data 360 unterstützt die datei- und abfragebasierte Zuordnung mit Live-Abfrage und Zugriffsbeschleunigung, wie in der Abbildung gezeigt.
Die Bezeichnungen (1) und (2) veranschaulichen die Abfrage von Data 360 (einschließlich Pushdowns für Live-Abfragen) und die dateibasierte Zuordnung für den Zugriff auf Daten aus externen Data Lakes/Warehouses/Datenquellen. Die Bezeichnung (3) hebt die Beschleunigung des Verbundzugriffs aus externen Data Lakes/Datenquellen hervor.
##### Abfrageverbund
Der Kern der Verbundfunktion von Data 360 liegt in der Abfrageverbundebene, die den komplexen Prozess des Zugriffs auf externe Daten und der Durchführung intelligenter Abfrage-Pushdowns (veranschaulicht durch Bezeichnung 1) verwaltet. Data 360 stellt mithilfe des JDBC-Protokolls eine Verbindung zu und ruft Daten aus Quellen ab. Zusätzliche Logik sorgt für mehr Effizienz. Die Abfrageverbundebene ist dafür verantwortlich, verschiedene SQL-Dialekte zu verstehen und zu übersetzen, den optimalen Teil der Abfrage zu ermitteln, der für eine effiziente Verarbeitung an externe Systeme übertragen werden soll, die Ergebnisse abzurufen und alle erforderlichen weiteren Verarbeitungen durchzuführen, um endgültige Statistiken abzuleiten.
###### Zwischenspeicherung (Abfragebeschleunigung)
Data 360 bietet für erweiterte Dienstprogramme eine optionale Beschleunigungsfunktion für seine Verbundfunktionen.
Wenn die Beschleunigung aktiviert ist, speichert Data 360 die Verbunddaten zwischen, um einen schnelleren Zugriff und niedrigere Kosten zu erzielen, da wiederholter direkter Zugriff auf externe Quellen vermieden wird. Dieser Cache wird als Beschleunigungsebene behandelt und schrittweise aktualisiert, um Änderungen an den externen Quelldaten schnell zu berücksichtigen und sicherzustellen, dass die beschleunigte Ansicht nahezu in Echtzeit erhalten bleibt.
##### Dateiverbund
Data 360 unterstützt die dateibasierte Zuordnung (dargestellt durch Bezeichnung 2) für den Zugriff auf Daten aus externen Data Lakes und Quellen. Die technische Grundlage für diese Zero-Copy-Funktion basiert auf der Standardisierung: Die zugrunde liegenden Daten müssen im Apache-Parquet-Dateiformat vorliegen und das tabellarische Apache Iceberg-Format verwenden. Data 360 kann in eine beliebige Quelle integriert werden, die einen Iceberg-REST-Katalog (IRC) für den Metadaten- und Speicherzugriff bereitstellt, um einen nahtlosen, geregelten Zugriff auf Dateien außerhalb der Plattform zu gewährleisten.
Mit der dateibasierten Zuordnung verarbeitet Data 360 die gesamte Datenverarbeitung, da sie direkt auf den zugrunde liegenden Speicher zugreifen. Dadurch müssen keine Abfrage-Pushdown-Vorgänge mehr ausgeführt und verschiedene SQL-Dialekte verwaltet werden, die bei der abfragebasierten Zuordnung häufig erforderlich sind.
Darüber hinaus erstreckt sich die Zero Copy-Funktion auch auf unstrukturierte Datenquellen wie Hyperscaler-Speicherlösungen (S3/GCS/Azure-Speicher), Slack und Google Drive, auf die über die unstrukturierten Verarbeitungspipelines von Data 360 zugegriffen werden kann.
#### Datenfreigabe
Data 360 ermöglicht die abfragebasierte und dateibasierte Freigabe der von Data 360 verwalteten Daten für externe Data Lakes und Lagerhäuser (im ursprünglichen Abbildungskontext durch die Bezeichnungen 4 und 5 veranschaulicht).
##### Abfragebasierte Freigabe
Für die abfragebasierte Datenfreigabe stellt Data 360 einen JDBC-Treiber bereit, mit dem externe Engines und Anwendungen sicheren Zugriff auf die Daten erhalten können. Durch diesen Mechanismus können externe Systeme Live-Abfragen direkt mit den Daten in Data 360 verbinden, authentifizieren und ausführen.
##### Dateibasierte Freigabe (Datenfreigabe und DaaS)
Der primäre Mechanismus für die dateibasierte Freigabe umfasst zwei Konzepte: Datenfreigabe und Datenfreigabeziel, die die DaaS-API (Data as a Service) nutzen.
- Granular Control (Granulare Kontrolle): Das Datenfreigabekonzept ermöglicht es Kunden, genau zu definieren, welche Objekte (DLOs, DMOs, CIOs usw.) extern freigegeben werden, um eine unbeabsichtigte Datenoffenlegung zu verhindern.
- Sicheres Targeting: Sie steuert auch das Datenfreigabeziel und stellt sicher, dass Daten nur explizit autorisierten externen Umgebungen, Accounts oder Partnerorganisationen zur Verfügung gestellt werden (z. B. Freigabe für eine bestimmte Redshift- oder Databricks-Instanz).
Die DaaS-API bietet eine sichere und geregelte Schnittstelle für externe Engines zum Verbrauchen von Daten. Er gewährt Zugriff auf die wesentlichen Metadaten und den zugrunde liegenden Tabellenspeicher, wobei die gesamte Data 360-Semantik erhalten bleibt. Dadurch wird sichergestellt, dass externe Engines auf sichere Weise in einem konsistenten und aussagekräftigen Kontext auf die Daten zugreifen.
### Private Konnektivität
Viele sicherheitskritische Kunden, insbesondere große Unternehmen, regulierte Branchen und Organisationen des öffentlichen Sektors, schränken den gesamten Internetzugang auf ihre Data Lakes als Teil ihres Sicherheitsstatus ein. Diese Richtlinie ist für die Einhaltung der Vorschriften und die Risikominderung wichtig, verhindert jedoch auch, dass Salesforce Data 360 und Agentforce über das öffentliche Internet eine Verbindung zu diesen Umgebungen herstellen.
Die meisten dieser Data Lakes werden in Hyperscaler-Umgebungen wie AWS, Azure oder Google Cloud bereitgestellt. Da Data 360 selbst auf AWS ausgeführt wird, ist für den Zugriff auf Kunden-Data-Lakes, die auf einem anderen Cloud-Anbieter gehostet werden, eine cloudübergreifende Netzwerkverbindung erforderlich. Ohne eine sichere, private Konnektivitätsoption, die das öffentliche Internet umgeht, können oder wollen Kunden Data 360 oder Agentforce für Anwendungsfälle, die auf diesen Data Lakes basieren, oft nicht übernehmen.
#### Private Links
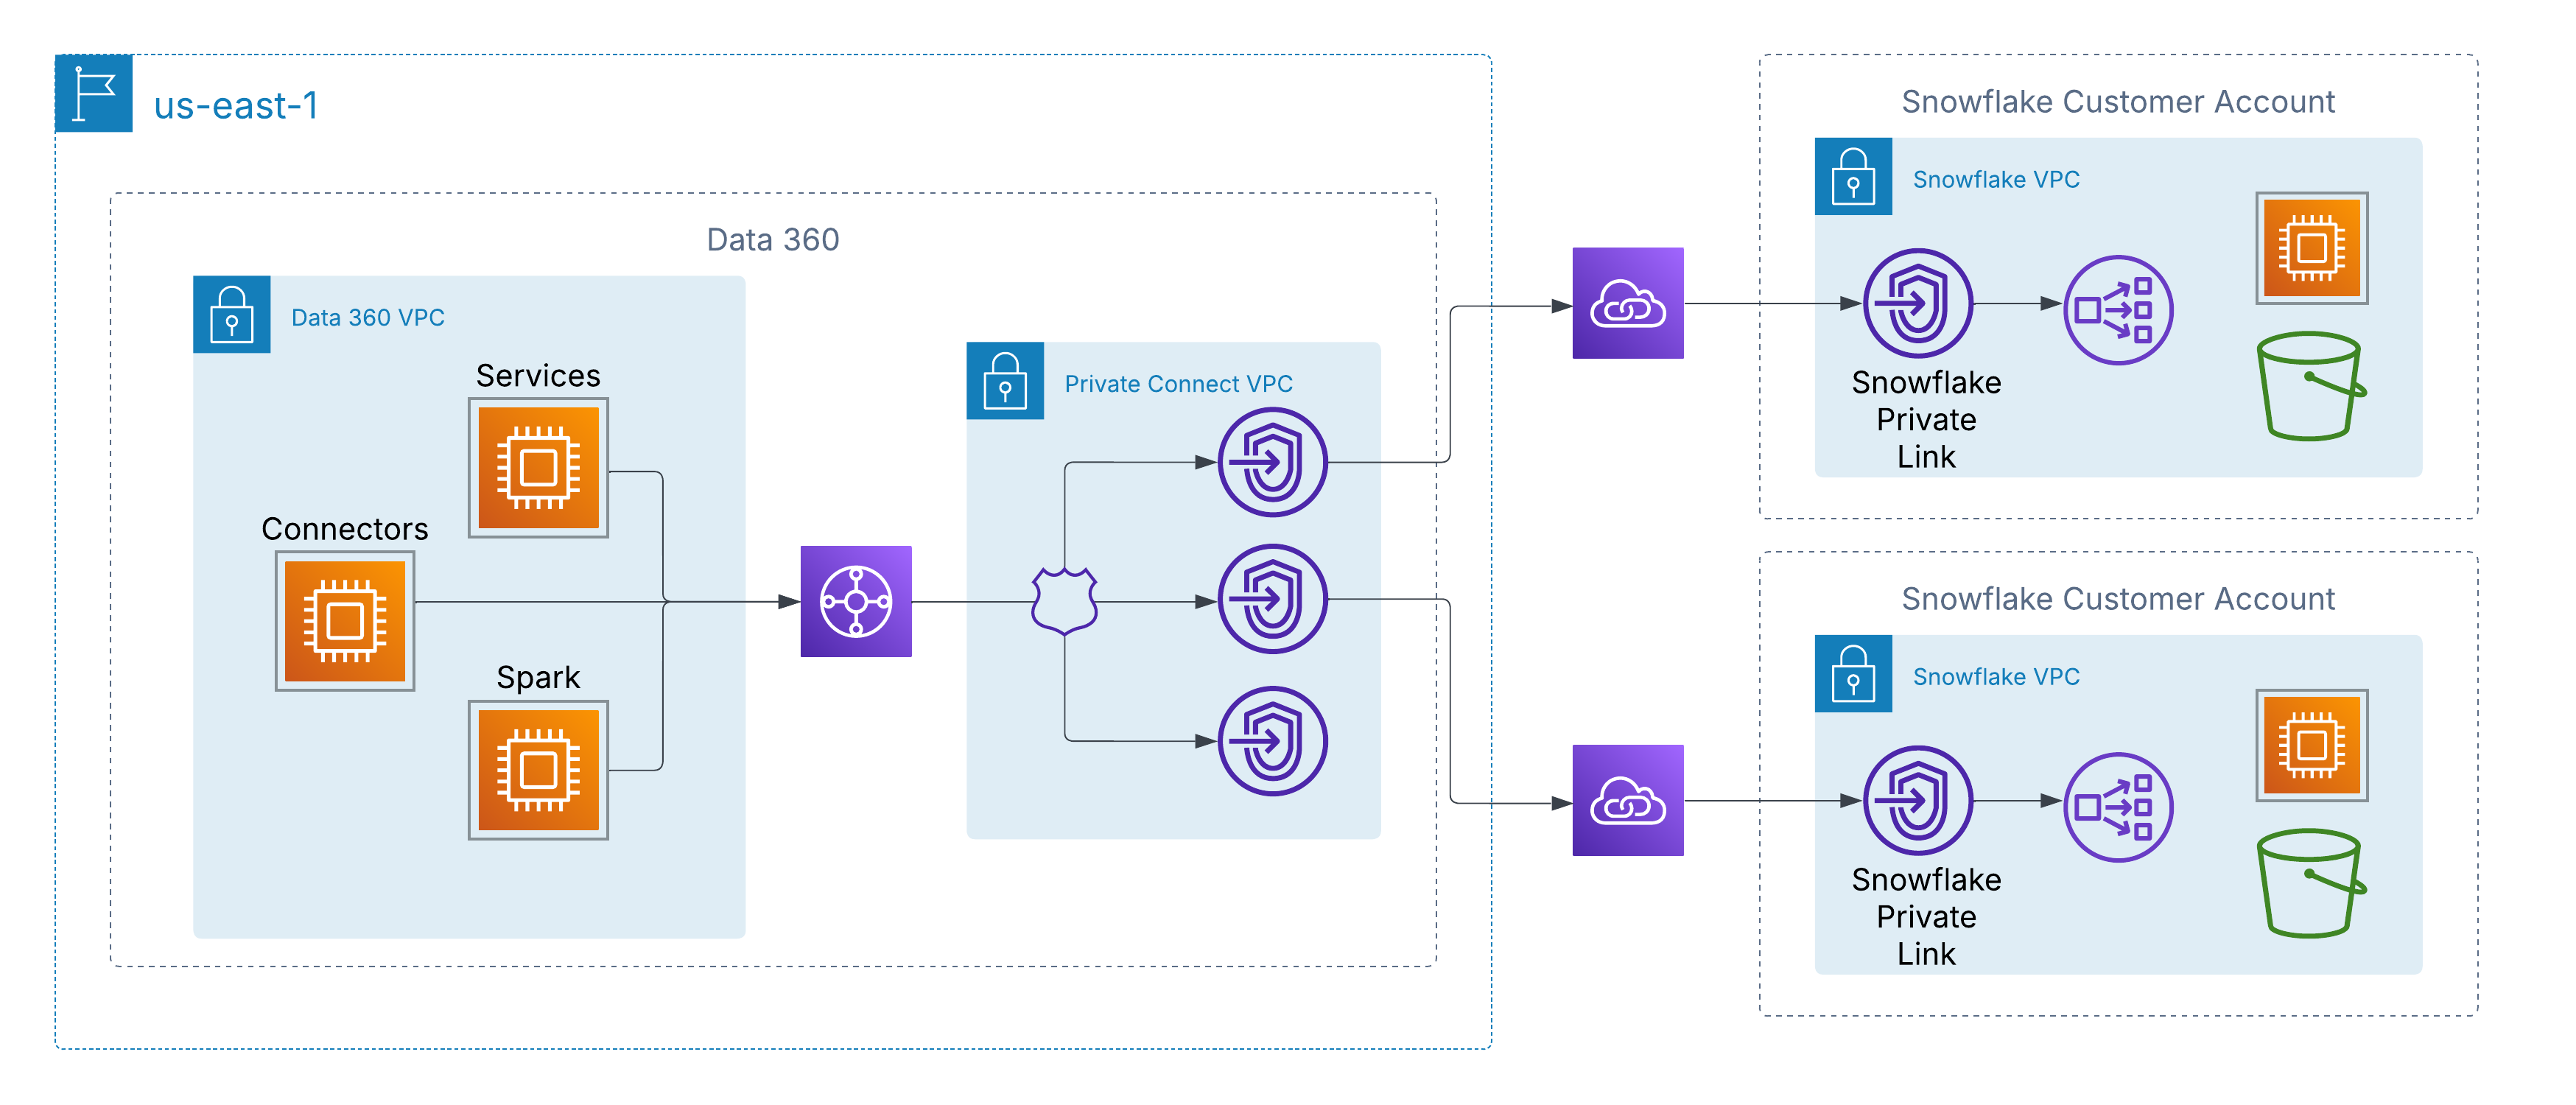 Data 360 unterstützt private Verbindungen auf Netzwerkebene mit vom Kunden verwalteten Datenquellen in verschiedenen Clouds. In AWS wird dies über AWS PrivateLink aktiviert, mit dem Data 360 direkt mit vom Kunden bereitgestellten Endpunkten verbunden werden kann, entweder in ihren eigenen Accounts oder in Data-Lake-Umgebungen von Drittanbietern (z. B. Snowflake), ohne das öffentliche Internet zu durchlaufen.
Diese Architektur stellt sicher, dass der gesamte Datenverkehr vollständig auf dem AWS-Backbone verbleibt, indem private IP-Adressierung und nicht weiterleitbare Netzwerkpfade verwendet werden. Dadurch werden strenge Sicherheits- und Compliance-Anforderungen erfüllt und gleichzeitig ein nahtloser Zugriff auf Kundendaten ermöglicht.
#### Private Interconnect
Für Kunden mit Multi-Cloud-Architekturen erweitert Data 360 die private Konnektivität über AWS hinaus durch Unterstützung der cloudübergreifenden Verbindung. Dadurch werden sichere, reine Backbone-Netzwerkpfade von Data 360 zu Data Lakes und Services ermöglicht, die in Azure oder Google Cloud gehostet werden, wobei dieselben Prinzipien wie bei AWS PrivateLink beibehalten werden: private IP-Adressierung, nicht öffentliche Weiterleitung und keine Internetverbindung.
Kunden können zwischen zwei Bereitstellungsmodellen wählen:
- **Vom Kunden verwaltete Verbindungsleitung**: Integrieren Sie vorhandene private Schaltungen wie Azure ExpressRoute, Google Cloud Interconnect oder Equinix Fabric direkt in die VPCs von Data 360.
- **Salesforce-Managed Interconnect**: Verwenden Sie eine vollständig verwaltete, schlüsselfertige Verbindung, bei der Salesforce den cloudübergreifenden Link bereitstellt und betreibt, wodurch private Endpunkte in der Ziel-Cloud verfügbar gemacht werden.
In beiden Modellen ist die Erfahrung konsistent: Data 360-Services stellen über Hyperskalierer hinweg eine Verbindung mit externen Datenquellen her, als ob sie lokal wären, und ermöglichen eine sichere Aufnahme, Aktivierung und Abfrage, ohne das öffentliche Internet zu durchlaufen.
### Data 360: Grundlagen von Trust und Kontrolle
Für Unternehmensarchitekten ist die zuverlässige Datenverwaltung nicht nur ein Kontrollkästchen für die Einhaltung von Vorschriften, sondern eine grundlegende Säule für den Aufbau vertrauenswürdiger, skalierbarer und handlungsrelevanter Kundenintelligenzen. Salesforce Data 360 wurde mit einem umfassenden Governance-Framework entwickelt, das Datenqualität, Sicherheit und die Einhaltung gesetzlicher Vorschriften über den gesamten Datenlebenszyklus hinweg gewährleistet.
Data 360 fungiert als zentralisiertes Governance-Zentrum und stellt sicher, dass alle Daten – von der Roherfassung bis hin zu aktivierten Statistiken – integritätssicher und kontrolliert verwaltet werden.
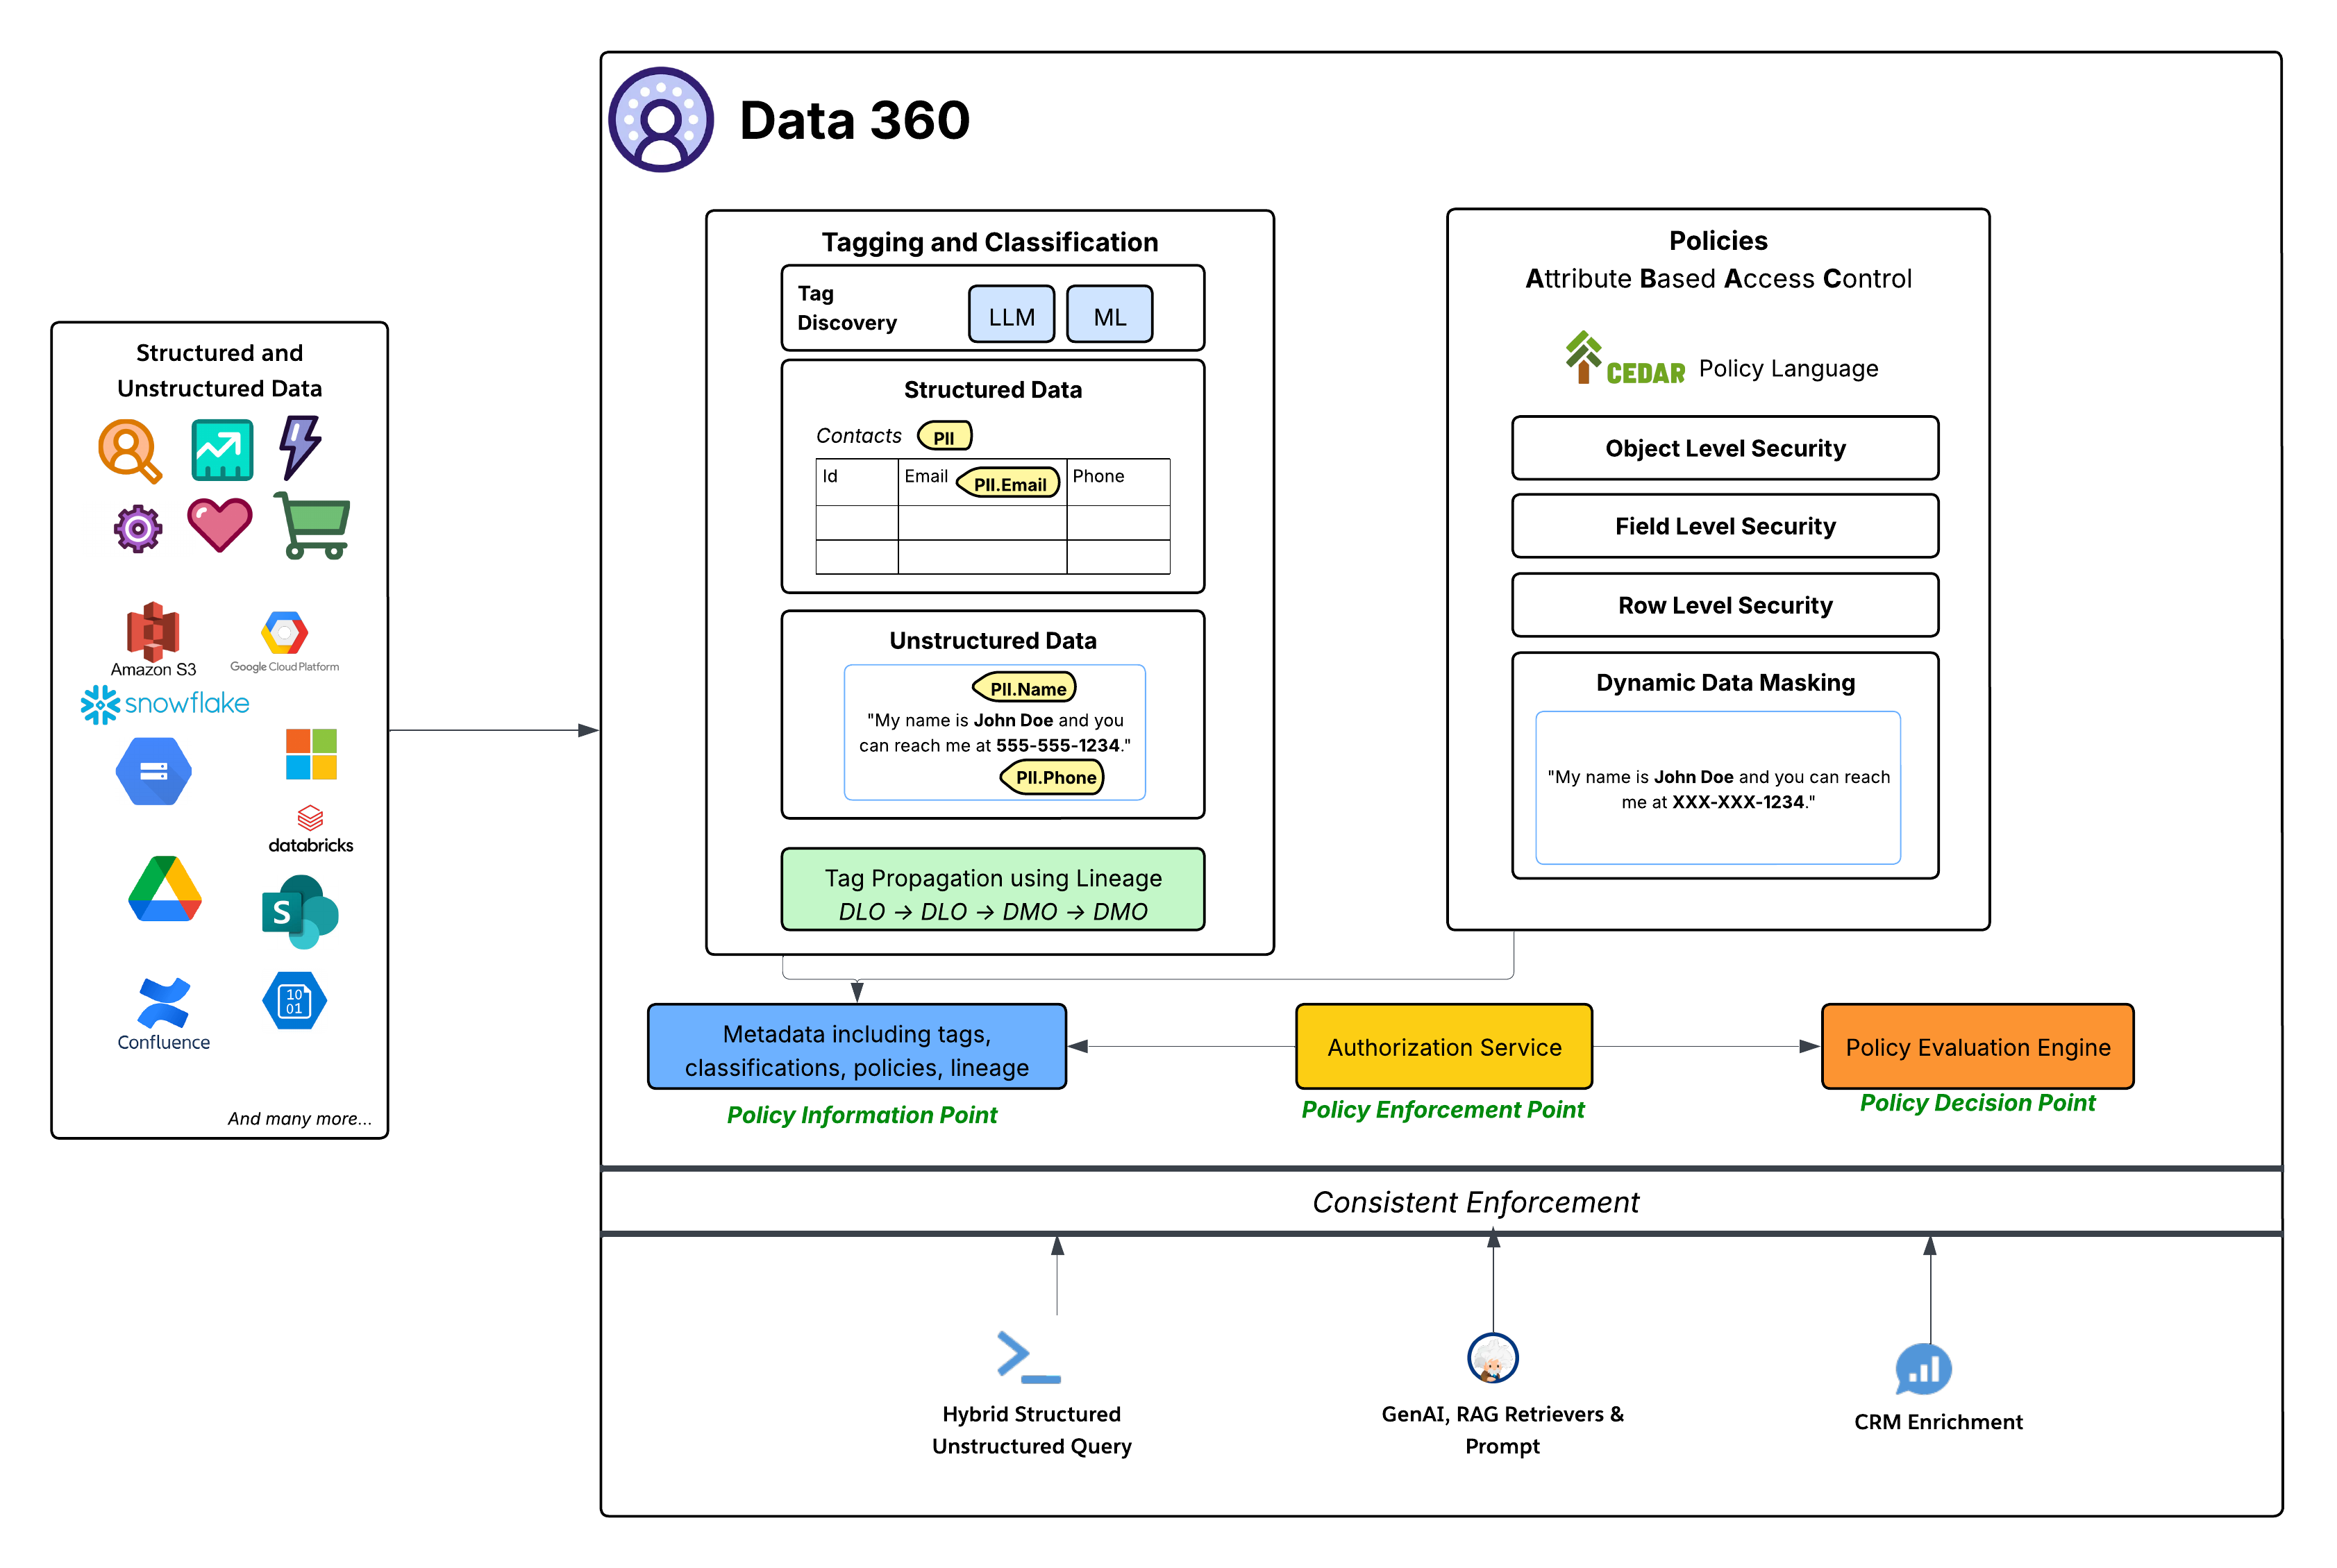 #### Erweiterte Zugriffssteuerung: Warum die attributbasierte Zugriffssteuerung (ABAC)
Während der Datenbereich eine grob skalierte Zugriffssteuerung bietet, um den Zugriff auf alle Objekte in einem Datenbereich zu bestimmen, bieten ABAC-basierte Richtlinien eine fein skalierte Zugriffssteuerung für einzelne Objekte, Felder und Zeilen in einem Datenbereich. Data 360 hat die attributbasierte Zugriffssteuerung (ATtribut-Based Access Control, ABAC) als zentrales Autorisierungsmodell für die genaue Zugriffssteuerung übernommen. Diese strategische Entscheidung bietet eine überlegene Flexibilität und Skalierbarkeit im Vergleich zur herkömmlichen rollenbasierten Zugriffssteuerung (RBAC). Dies ist besonders wichtig für dynamische, komplexe Unternehmensumgebungen mit riesigen Datenmengen und unterschiedlichen Zugriffsanforderungen. Mit ABAC können Zugriffsentscheidungen auf Attributen des Benutzers (z. B. Abteilung, Rolle, Standort), der Daten (z. B. personenbezogene Daten, Sensibilität, Datenbereich) und der Umgebung (z. B. Uhrzeit) basieren und nicht nur auf vordefinierten Rollen. Dadurch werden sehr detaillierte und kontextbezogene Zugriffsrichtlinien ermöglicht, die an sich ändernde Daten und Benutzerattribute angepasst werden.
- **CEDAR Policy Language (Sprache der Cedar-Richtlinie)**: Das Herzstück der ABAC-Implementierung von Data 360 ist die Verwendung der CEDAR-Richtliniensprache. Diese speziell entwickelte, formale Richtliniensprache bietet eine präzise und überprüfbare Möglichkeit, komplexe Autorisierungsregeln zu definieren, wodurch sichergestellt wird, dass Richtlinien eindeutig sind und einheitlich im richtigen Maßstab ausgewertet werden können.
#### Governance-Architektur: Richtlinieninformationen, Erzwingung und Entscheidungspunkte
Das Governance-System in Data 360 basiert auf einer standardmäßigen, robusten ABAC-Architektur:
- **Tagging, Klassifizierung und Richtlinienerstellung (Policy Information Point, PIP)**:
- Data 360 bietet automatisierte Tagging- und Klassifizierungsmechanismen, die LLM (Large Language Model) und ML (Machine Learning) verwenden, um sensible Datenkategorien (z. B. PII.Email, PII.Phone, PII.Name) und andere zweckgebundene Taxonomien (PHI, FinancialData) in strukturierten Daten (z. B. Tabelle "Kontakte") und unstrukturierten Daten (z. B. aus Google Drive) zu identifizieren.
- Entscheidend ist, dass die Tag-Übernahme entlang der Datenherkunft (DLO -> DLO -> DMO) erfolgt. Dadurch wird sichergestellt, dass Klassifizierungen automatisch Datentransformationen und -ableitungen folgen, von den aufgenommenen Rohdaten bis zur harmonisierten DMO-Ebene und über abgeleitete Daten, die aus Prozessdefinitionen erstellt wurden.
- Schließlich bietet der Richtlinienerstellungsbereich eine einfache Erfahrung zum Definieren dynamischer Zugriffsregeln für eine Organisation.
- Diese angereicherten Metadaten (einschließlich Tags, Klassifizierungen, Richtlinien und Abstammung) werden in den Policeninformationspunkt (Police Information Point, PIP) übernommen.
- **Autorisierungsservice (Policy Enforcement Point, PEP)**:
- Der Autorisierungsservice fungiert als Policy Enforcement Point (PEP). Sie fängt alle Datenzugriffsanforderungen aus verschiedenen Verbrauchsebenen ab (Hybridstrukturierte/Unstrukturierte Abfrage, GenAI RAG Retrievers & Prompt, CRM-Anreicherung) und konsultiert den Richtlinienentscheidungspunkt, um festzustellen, ob der Zugriff zulässig ist.
- **Policy Evaluation Engine (Policy Decision Point, PDP) (Policy-Bewertungsmodul für Policen (Policy Decision Point, PDP))**:
- Dieses Modul fungiert als "Policy Decision Point" (PDP). Es verwendet den Zugriffsanforderungskontext aus dem PEP zusammen mit Richtliniendefinitionen (in CEDAR) und Attributen aus dem PIP, um eine autorisierende Zugriffsentscheidung zu treffen.
#### Durchsetzung und Integration wichtiger Richtlinien
- **Granulare Sicherheitsrichtlinien**: Die in CEDAR definierten Richtlinien erzwingen verschiedene Sicherheitsebenen, darunter:
- **Objektebenensicherheit**: Steuern des Zugriffs auf gesamte DLOs oder DMOs anhand von Tags, die diesen Objekten zugeordnet sind.
- **Feldebenensicherheit**: Einschränken des Zugriffs auf bestimmte sensible Felder in einem Objekt anhand von Tags.
- **Sicherheit auf Zeilenebene**: Filtern von Daten für bestimmte Objekte, um nur relevante Zeilen basierend auf Benutzerattributen anzuzeigen.
- **Dynamische Datenmaskierung**: Maskieren Sie bestimmte Daten (basierend auf Tags) am Zugriffspunkt dynamisch, ohne die zugrunde liegenden Daten zu ändern. Dadurch wird sichergestellt, dass vertrauliche Informationen geschützt sind und dennoch ein breites Dienstprogramm ermöglicht wird. Dies gilt für Maskierungsfelder in strukturierten Daten sowie für Inhalte in unstrukturierten Daten.
- **Konsistente Durchsetzung**: Das gesamte ABAC-Framework gewährleistet die konsistente Durchsetzung von Richtlinien in allen Data 360-Verbrauchsmustern, unabhängig davon, ob es sich um Direktdatenabfragen, Abrufe für Anwendungen der generativen AI (RAG) oder die Anreicherung von Salesforce CRM-Erfahrungen über beispielsweise Themenlisten handelt.
- **Tiefe Integration in Salesforce Platform**: Die Governance-Funktionen von Data 360 werden direkt in der Salesforce Core Platform definiert und verwaltet. Diese Integration ermöglicht es Administratoren, Zugriffsrichtlinien, Benutzeridentitäten und die Attributverwaltung mit vertrauten Salesforce-Tools zu verwalten und so eine einheitliche und konsistente Governance-Ebene im gesamten Salesforce-Ökosystem zu gewährleisten.
Durch die Entwicklung dieses komplexen ABAC-Frameworks mit CEDAR-Richtlinien bietet Data 360 Architekten ein unvergleichliches Maß an Kontrolle und Flexibilität und stellt sicher, dass Kundendaten nicht nur handlungsrelevant, sondern auch unternehmensweit sicher, konform und vertrauenswürdig sind.
### Data 360-Verschlüsselung: Bring Your Own Key
Branchenübergreifend legen Organisationen verstärkt Wert auf durchgängige Datensicherheit, um den Schutz vor Datenlecks, unbefugtem Zugriff, Manipulationen oder Zerstörung zu gewährleisten. Die meisten Datenplattformen, einschließlich Data 360, bieten Verschlüsselung im Leerlauf mit einem vom Anbieter verwalteten Verschlüsselungsschlüssel. Unternehmen (insbesondere Unternehmen in regulierten Sektoren) verlangen jedoch zunehmend von Kunden verwaltete Verschlüsselungsfunktionen für Daten im Leerlauf und bei der Übertragung.
Mit diesem Modell können Unternehmen ihre eigenen Verschlüsselungsschlüssel steuern und so sicherstellen, dass die Daten auch im höchst unwahrscheinlichen Fall eines Verstoßes auf Plattformebene oder unbefugten Zugriffs kryptographisch geschützt bleiben. Ohne den proprietären Schlüssel des Kunden kann keine Einheit (einschließlich des Plattformanbieters) die Daten entschlüsseln oder rekonstruieren, wodurch die vollständige Vertraulichkeit und Kontrolle gewahrt bleibt.
### Unstrukturierte Datenspeicherung und -verarbeitung
Data 360 unterstützt die Speicherung und Verwaltung von strukturierten (Tabellen), halbstrukturierten (JSON) und unstrukturierten Daten nahtlos über die Mechanismen der Datenaufnahme, -verarbeitung, -indizierung und -abfrage hinweg. Data 360 unterstützt verschiedene unstrukturierte Datentypen über Text hinaus, einschließlich Audio, Video und Bildern, was den Umfang der Datenverarbeitung und -analyse erweitert. Die folgende Abbildung veranschaulicht die beiden Seiten der Erdung (Aufnahme und Abruf).
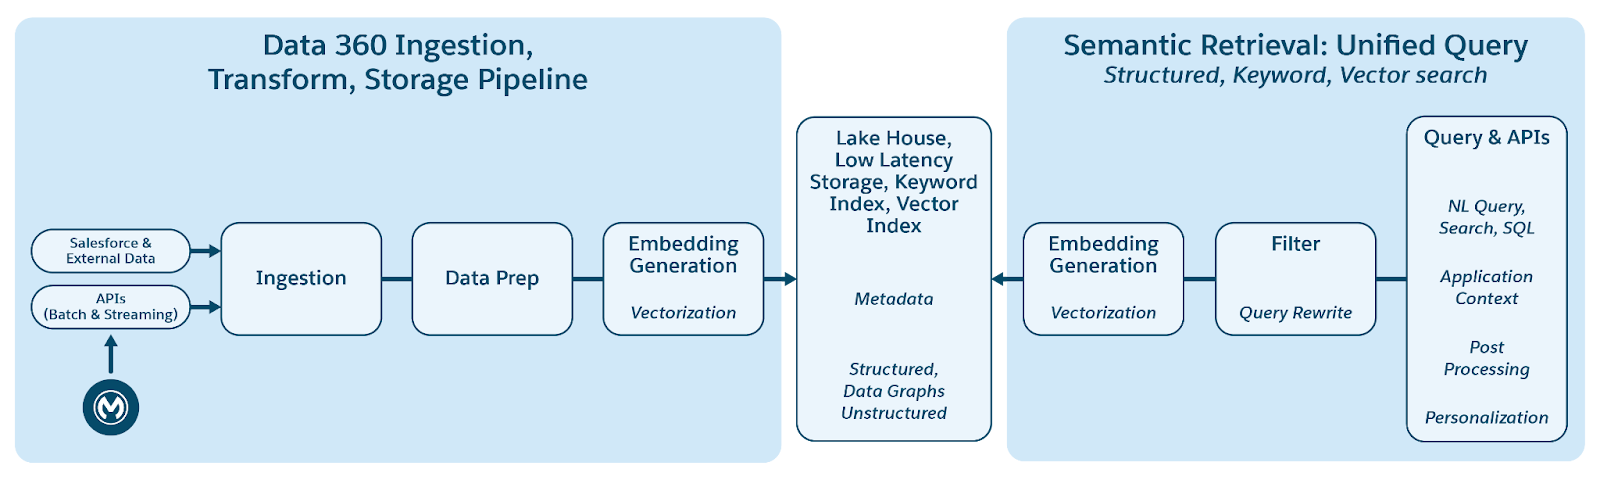 Data 360 verwaltet unstrukturierte Daten, indem es sie in Spalten als Text oder in Dateien für größere Datensets speichert. Sie unterstützt die Datenzuordnung für unstrukturierte Inhalte, wodurch Daten aus mehreren Quellen integriert und verwaltet werden können.
Anschließend werden die Daten vorbereitet und in Gruppen unterteilt, Einbettungen generiert und für die Stichwortindizierung und Vektorindizierung verarbeitet. Data 360 hostet mehrere vorkonfigurierte und steckbare Modelle für die Chunking- und Einbettungsgenerierung. Data 360 unterstützt die automatisierte und konfigurierbare Abschrift von Audio- und Videoinhalten für die nachfolgende Verarbeitung und Indizierung. Der Suchservice wird für die Stichwortindizierung verwendet. Bei der Vektorindizierung unterstützt Data 360 sowohl die native Indizierung (mit Hyper) als auch Vektordatenbanken wie Open-Source-Milvus. Data 360 kann auch in die Salesforce Search-Plattform integriert werden, um die Stichwortindizierung für unstrukturierte Daten zu unterstützen. Diese integrierte multimodale Indizierung in Data 360 ermöglicht die Suche nach unstrukturierten Daten, wie im Abschnitt "Agentische Unternehmenssuche" weiter unten im Dokument erläutert.
Zum Abrufen stellt Data 360 APIs für die Suche bereit. Unsere hyperbasierte zusammengeführte Abfrage erleichtert Ensembleabfragen über strukturierte, Stichwortindex- und Vektorindizes hinweg und behält strenge Sichtbarkeit und Berechtigungen bei, wodurch RAG und Suche verbessert werden.
#### Erweiterbare Pipelines
Die unstrukturierte Datenindizierungs-Pipeline von Data 360 ist als modulare, erweiterbare Architektur mit fünf Kernphasen konzipiert:
1. Analysieren
2. Vorverarbeitung
3. Chunking
4. Nachbearbeitung
5. Einbetten
Alle Phasen unterstützen auch die LLM-basierte Verarbeitung, wodurch Kunden benutzerdefinierte Eingabeaufforderungen erstellen können. Sowohl die Vor- als auch die Nachbearbeitungsphase können mehrere sequenzielle Schritte umfassen, sodass komplexe Transformationen flexibel zusammengestellt werden können. Jede Phase ist vollständig metadatengesteuert und ermöglicht eine nahtlose Konfiguration und Erweiterung ohne Codeänderungen.
Beispiele für die Vorverarbeitung sind Vorgänge wie Rauschentfernung, Sprachnormalisierung und Bildverständnis (optische Zeichenerkennung und Bildunterschrift), während Phasen nach der Verarbeitung Metadatenanreicherung, semantische Gruppierung oder erweiterte Techniken wie Raptor-Blockierung umfassen können.
Die Data 360 Code Extension wird von der Pipeline vollständig unterstützt, sodass Kunden und interne Teams in jeder Phase benutzerdefinierte Logik einbinden können. Bei den Codeerweiterungskomponenten handelt es sich um leichte Python-Funktionen, deren Lebenszyklus – Ausführung, Skalierung und Fehlerverarbeitung – vollständig von Data 360 verwaltet wird. Dieser Ansatz stellt sicher, dass Innovationen und domänenspezifische Verarbeitungen schnell eingeführt werden können, während gleichzeitig die betriebliche Konsistenz und die Steuerung auf der gesamten Plattform gewahrt bleiben.
##### Kontextindizierung
Für die Einrichtung von RAG mit unstrukturierter Verarbeitung sind zwei wichtige Faktoren entscheidend:
1. **Schnelle Iteration**: Die Möglichkeit, schnell mit Beispieltestabfragen zu validieren.
2. **Personenspezifische Inhalte**: Die Fähigkeit, Inhalte zu konfigurieren, die auf die verbrauchende Persona zugeschnitten sind.
Bei der Kontextindizierung handelt es sich um ein benutzerfreundliches Tool, das beide Aspekte berücksichtigen soll. Diese interaktive Benutzeroberfläche wird von einer Echtzeit-Pipeline unterstützt, die alle fünf zuvor beschriebenen Phasen ausführt. Die Pipeline verwendet bei Bedarf GPUs für Aufgaben wie die Generierung von Einbettungen und die optische Zeichenerkennung. Darüber hinaus können Kunden die RAG-Pipeline schnell mit einem Agenten testen, bevor sie die Konfiguration für die umfassende Inhaltsverarbeitung bereitstellen.
##### Dokument-AI
Mit der Data 360-Dokumenten-AI können unstrukturierte oder halbstrukturierte Daten aus Dokumenten wie Rechnungen, Lebensläufen, Laborberichten und Bestellungen gelesen und importiert werden. Diese Funktion unterstützt die interaktive Ad-hoc-Verarbeitung sowie die Verarbeitung per Massenvorgang. Dies ist eine Schlüsselfunktion, die die Automatisierung von Geschäftsprozessen für unsere Kunden ermöglicht. Dies wird durch künstliche Intelligenz unterstützt, einschließlich LLMs und ML-Modellen.
### Enterprise Knowledge
Unternehmen verfügen über umfangreiche Knowledge-Mengen, die über verschiedene Systeme wie Wikis, Dateifreigaben, Inhaltsverwaltungssysteme, interne Datenbanken und mehr verteilt sind. Diese Fragmentierung erschwert es Mitarbeitern (insbesondere Serviceagenten und Vertriebsmitarbeitern) und Kunden, relevante Informationen schnell und effizient zu finden. Zu den wichtigsten Problemen zählen: Fehlende einheitliche Sucherfahrung in allen Knowledge Quellen, inkonsistente Darstellung und Darstellung von Inhalten aus unterschiedlichen Quellen, mangelnde Zugriffssteuerung auf sensible Informationen, die über mehrere Systeme verstreut sind, und Schwierigkeiten bei der Nutzung der Quelle "Autoritative Knowledge" in zentralen Geschäfts-Workflows (z. B. beim Anhängen relevanter Artikel an einen Kundenvorgang).
Enterprise Knowledge stellt Inhalte dar, die manuell oder automatisch aus dem größeren Pool an Unternehmensdaten zusammengestellt wurden. Bei der manuellen Pflege handelt es sich um gezielte Aktionen wie das Erstellen von Salesforce Knowledge-Artikeln oder das Entwickeln von Knowledge in externen Systemen, die dann aufgenommen werden. Es wird eine automatisierte Kuratierung ins Auge gefasst, die Prozesse wie Salesforce-Agenten und -Transformationen verwendet, die über aufgenommene Daten ausgeführt werden, um raffinierte, zusammengestellte Ebenen zu generieren, die möglicherweise strukturierte und unstrukturierte Inhalte mischen. Unabhängig davon, ob sie manuell oder automatisch, intern in Salesforce oder extern vor der Aufnahme erstellt werden, ergibt sich ein Mehrwertinhalt, der sich von Rohdaten unterscheidet.
Die Enterprise Knowledge Hub-Lösung nutzt Data 360-Funktionen für Folgendes:
- **Aufnahme und Speicherung**: Der CRM-Konnektor erfasst Salesforce Knowledge-Artikel und nicht strukturierte Konnektoren des Datenkonnektor-Frameworks (DCF) Rohinhalte und Metadaten aus externen Quellen. Der Inhalt wird in quellspezifische unstrukturierte Data-Lake-Objekte (UDLOs) aufgenommen, die dem Inhalt auf SFDrive zugeordnet sind (oder im Falle einer Nullkopie in die Quelle).
- **Harmonisierung und Strukturierung**: Die Harmonisierung verarbeitet UDLO- und Dateidaten, führt Bereinigungen, Normalisierungen, Anreicherungen (NLP usw.), Maskierungen und Transformationen der personenbezogenen Daten in das harmonisierte Zwischenformat durch, das in SF Drive gespeichert ist, und ein harmonisiertes UDLO (HUDLO), das ihm zugeordnet ist.
- **Indizierung**: Unstrukturierte Pipeline (UDS) wird über den harmonisierten Inhalt ausgelöst und Suchindizes werden für jedes HUDMO konfiguriert.
- **Verbrauch**: Verbrauchende Anwendungen umfassen Suchen, Abrufen, Rendern und Verknüpfen mit Geschäftsobjekten wie "Kundenvorgang". Interaktion durch Nutzung von Anwendungen wird gesammelt, um Nutzungsanalysen (wie Klicks, Bewertungen usw.) bereitzustellen.
### Berechnete Statistiken
Mit berechneten Statistiken in Data 360 können Kunden aggregierte Kennzahlen aus ihren Daten definieren und generieren. Diese Kennzahlen werden dann für eine zeitnahe Kundeninteraktion, Analyse, Segmentierung und Aktivierung verwendet. Die von CIs berechneten aggregierten Daten werden in Lakehouse geschrieben und als Objekt für berechnete Statistiken (CIO) dargestellt.
Es gibt zwei Haupttypen berechneter Statistiken:
- **Batch-Berechnete Statistiken**: Konzipiert für die komplexe Datenaggregation mit hohem Volumen, bei der Kennzahlen regelmäßig (z. B. täglich oder wöchentlich) berechnet werden können.
- **Streaming-Statistiken**: Bieten Sie die Möglichkeit, Kennzahlen und Aktionen anhand von Echtzeit-Ereignisdaten zu generieren und so ein sofortiges Kundenengagement mit geringer Latenz zu ermöglichen.
Berechnete Statistiken werden für Datenmodellobjekte (DMOs) definiert und können auch für andere Objekte der berechneten Statistik definiert werden. Der Service für berechnete Statistiken verwaltet die Orchestrierung von Batch- und Streamingaufträgen.
Berechnungen für Batch- und Streaming-Statistiken verwenden Spark. Der Hauptunterschied besteht darin, dass Streaming-Statistiken Spark Structured Streaming verwenden, während Batch-CIs mit regelmäßigen geplanten Spark-Batchaufträgen ausgeführt werden. Aus Kostengründen gruppiert der Service für berechnete Statistiken CIs, die zusammen im selben Batch-CI-Auftrag oder Streaming-CI-Auftrag berechnet werden sollen, basierend auf Faktoren wie Abhängigkeiten und Überschneidungen von Quelldatenobjekten.
SNCE und CDF spielen bei der Berechnung von Streaming-Statistiken eine wichtige Rolle.
### Identitätsbestimmung
Die Identitätsbestimmung ist für die Umwandlung unterschiedlicher Daten aus mehreren Quellen in ein einzelnes, umfassendes zusammengeführtes Profil verantwortlich.
Es ist wichtig zu verstehen, dass ein zusammengeführtes Profil kein "goldener Datensatz" ist und dass die Identitätsbestimmung beim Zusammenführen von Profilen keine Gewinnerwerte auswählt oder vorhandene Daten außer Kraft setzt. Vereinheitlichte Profile dienen als Schlüsselsatz, der Ihre Quelldaten entsperrt, indem alle übereinstimmenden Datensätze identifiziert werden, die sich auf dieselbe Einheit beziehen, in einer Datenquelle oder in vielen Quellen. Mit diesen Informationen können Sie die richtigen Quellsystemdaten für einen bestimmten Geschäftsanwendungsfall auswählen.
Die Identitätsbestimmung kann eine Vielzahl von Datensatztypen konsolidieren, darunter Einzelpersonen, Accounts und Haushalte. Sie kann auch verwendet werden, um Leads vorhandenen Accounts zuzuordnen. Der Vereinheitlichungsprozess ist wichtig, um eine vollständige Customer 360-Ansicht zu erhalten und das personalisierte Engagement in Echtzeit in B2C- und B2B-Szenarien zu fördern.
Die Identitätsbestimmungs-Pipeline basiert auf einem hochgradig skalierbaren, Cloud-nativen Framework, das für die kontinuierliche Verarbeitung großer Datenmengen konzipiert ist. Der Abgleichsprozess besteht aus drei wichtigen Phasen und basiert auf einem leistungsstarken Suchindex:
- **Abgleich (Kandidatenauswahl)**: Das Ziel des Abgleichsprozesses besteht darin, nach Datensätzen zu suchen, die möglicherweise zur selben Einheit gehören. Datensätze werden anhand eines anpassbaren Satzes von Regeln analysiert, von denen jede eine Reihe von Kriterien enthält, die definieren, welche Daten mit welcher Strengestufe abgeglichen werden sollen. Um potenzielle Übereinstimmungen effizient aus dem Datenspeicher abzurufen, generiert das System Indizes, um wahrscheinlich übereinstimmende Datensätze mithilfe von zwei Techniken zu finden:
- **Blockieren von Schlüsseln**: Ein Sperrschlüssel ist ein Wert, der aus den Daten eines Datensatzes generiert wird und Regeln (wie die ersten Buchstaben eines Namens, eine normalisierte Telefonnummer usw.) abgleicht, um potenziell ähnliche Datensätze zu gruppieren. Jeder Datensatz verfügt über mehrere Sperrschlüssel, die indiziert und als invertierter Index gespeichert werden. Dadurch wird sichergestellt, dass das System nur detaillierte Vergleiche für kleine Gruppen von Datensätzen durchführt und nicht für das gesamte Datenset.
- **Locality Sensitive Hashing (LSH)**: Bei Abgleichsregeln mit Fuzzyübereinstimmungen werden Hashes anhand von Einbettungen aus trainierten Modellen generiert.
- **Deep Matching**: Nachdem der Schritt der Kandidatenauswahl kleinere Gruppen potenzieller Übereinstimmungen erstellt hat, beginnt das System mit einem detaillierteren Vergleich. In dieser Phase analysieren AI-Modelle und erweiterte Algorithmen jedes Datensatzpaar, um eine probabilistische Übereinstimmungsbewertung zu berechnen. Diese Bewertung quantifiziert die Wahrscheinlichkeit, dass sich zwei Datensätze auf dieselbe Einheit beziehen, indem Felder, die häufig Schreibfehler, Variationen oder Formatierungsunterschiede enthalten, intelligent verglichen werden.
- **Clustering und Zusammenführung**: Sobald übereinstimmende Datensätze anhand der Kandidaten identifiziert wurden, werden sie in einem Cluster gruppiert. Dieser Prozess beinhaltet die Lösung transitiver Übereinstimmungen. Wenn beispielsweise Datensatz A mit Datensatz B übereinstimmt und Datensatz B mit Datensatz C übereinstimmt, werden alle drei mit demselben Cluster verknüpft, selbst wenn A und C nie direkt verglichen wurden. Diese vollständigen Cluster bilden die grundlegende Struktur des zusammengeführten Profils. Durch diesen Clustering-Prozess wird sichergestellt, dass alle zugehörigen Quelldatensätze unter einem einzigen persistenten Kennzeichner richtig verknüpft sind.
- **Abstimmung**: Datenwerte aus allen geclusterten Quelldatensätzen werden mithilfe definierter Schlichtungsregeln (z. B. _Häufigste_, _Aktuellste_ oder _Quellpriorität_) ausgewertet, sodass das resultierende zusammengeführte Profil mit einem Auszug der Profildaten ausgefüllt wird. Bei der Schlichtung werden keine vorhandenen Daten überschrieben, da alle Quelldaten mithilfe der mit dem zusammengeführten Profil verknüpften Schlüssel verfügbar sind.
#### Identitätsbestimmungstypen
Die Architektur unterstützt die Auflösung mehrerer Einheitentypen, um eine Vielzahl von Anwendungsfällen zu erfüllen.
- **Individueller Abgleich**: Konzentriert sich auf die Erstellung der Profile "Zusammengeführte Einzelperson", die alle bekannten persönlichen Kennzeichner (E-Mails, Telefonnummern, Treue-IDs, Cookies) mit einer einzelnen Person verknüpfen.
- **Accountabgleich**: Konzentriert sich auf die Erstellung der Profile für zusammengeführte Accounts, die Daten zu Accounts verknüpfen. Beim Abgleich von Unternehmensnamen verwendet das Modul beim Fuzzyabgleich ein genau abgestimmtes Modell.
- **Haushaltsabgleich**: Erweitert die Abgleichslogik, um Datensätze vom Typ "Zusammengeführte Einzelperson" zu Gruppen verwandter Einzelpersonen zu aggregieren.
- **Einheitenübergreifender Abgleich**: Abgesehen von der Vereinheitlichung erstellt die Identitätsbestimmung auch Links zwischen Profilobjekten mithilfe derselben Abgleichsregeln. Beispielsweise kann ein Lead mithilfe des Fuzzyabgleichs für "Accountname" mit einem Account verknüpft werden.
#### Nahezu Echtzeitverarbeitung
Damit das zusammengeführte Profil immer aktuell ist, arbeitet das Identitätsbestimmungsmodul mit einer Architektur nahezu in Echtzeit. Diese Cloud-optimierte Architektur wurde für die kontinuierliche Verarbeitung entwickelt, um schnelle Verarbeitungszeiten zu erzielen. Die Verarbeitungsgeschwindigkeit variiert je nachdem, wie Quelldaten empfangen werden. Kleine Batches von Änderungen können jedoch bis zu 15 Minuten lang durch Identitätsbestimmung verarbeitet werden.
#### Quellprofilverknüpfung
Das System verwaltet Identitätslinkobjekte, die jede Quelldatensatz-ID ihrer entsprechenden zusammengeführten Profil-ID zuordnen. Diese grundlegende Datenstruktur ermöglicht es dem Modul, Beziehungen effizient zu verfolgen und Änderungen und Aktualisierungen am zusammengeführten Profil schnell zu übernehmen. So wird sichergestellt, dass Kundenerfahrungen wie die Website-Personalisierung, Next-Best-Action-Empfehlungen und die Segmentierung immer die neuesten verfügbaren Kundendaten nutzen.
### Segmentierung
Die Segmentierung ist der Kernprozess der Umwandlung von zusammengeführten Kundenprofilen in handlungsrelevante Zielgruppen. Diese Funktion ist entscheidend für die Unterstützung personalisierter Erfahrungen in Marketing-, Commerce- und Servicekanälen. Die Salesforce Data 360-Segmentierungsplattform ist für umfangreiche Vorgänge konzipiert. Sie verwaltet komplexe Metadaten und arbeitet mit einem Datenmodell, das Tausende von Objekten und Beziehungen umfasst. Die Plattform unterstützt komplexe Regeln, aggregationsbasierte Filter und fensterbasierte Rangfolge und gewährleistet gleichzeitig eine schnelle und zuverlässige Berechnung im Petabyte-Bereich.
#### Segmentierungstypen und Rhythmen
Data 360 unterstützt verschiedene Segmenttypen, um unterschiedliche Geschäftsanforderungen an Geschwindigkeit, Komplexität und Hierarchie zu erfüllen:
1. **Standardsegment**: Der primäre, im Batch verarbeitete Segmenttyp. Die Veröffentlichung erfolgt nach einem anpassbaren Zeitplan mit einem Standardveröffentlichungsrhythmus von mindestens 12 Stunden bis zu 24 Stunden oder einem schnelleren Schnellveröffentlichungsrhythmus von 1 bis 4 Stunden, der für aktuelle Engagementdaten optimiert ist.
2. **Echtzeitsegment**: Dieses Segment wird basierend auf aktuellen Ereignissen und Profildaten nach Bedarf in Millisekunden für sofortige Maßnahmen abgeschlossen. Sie ist hochgradig für die sofortige Personalisierung optimiert, kann jedoch keine Ausschlusskriterien oder verschachtelten Segmente verwenden.
3. **Wasserfallsegment**: Eine hierarchische Struktur von Untersegmenten, die verwendet wird, um einen Kunden in ein einzelnes, wertvollstes Segment zu priorisieren, wenn er mehrere Kriterien erfüllt.
4. **Geschachteltes Segment**: Dies ermöglicht die Wiederverwendung eines vorhandenen Segments als Filter für ein neues, spezifischeres Segment (eine Verfeinerung eines Basissegments), wobei der Zeitplan des übergeordneten Segments übernommen wird.
#### Segmentation Engine: Architekturgrundlagen
Das Segmentierungsmodul arbeitet auf einer robusten, Cloud-nativen Architektur, die Geschwindigkeit, Skalierbarkeit und Widerstandsfähigkeit gewährleistet.
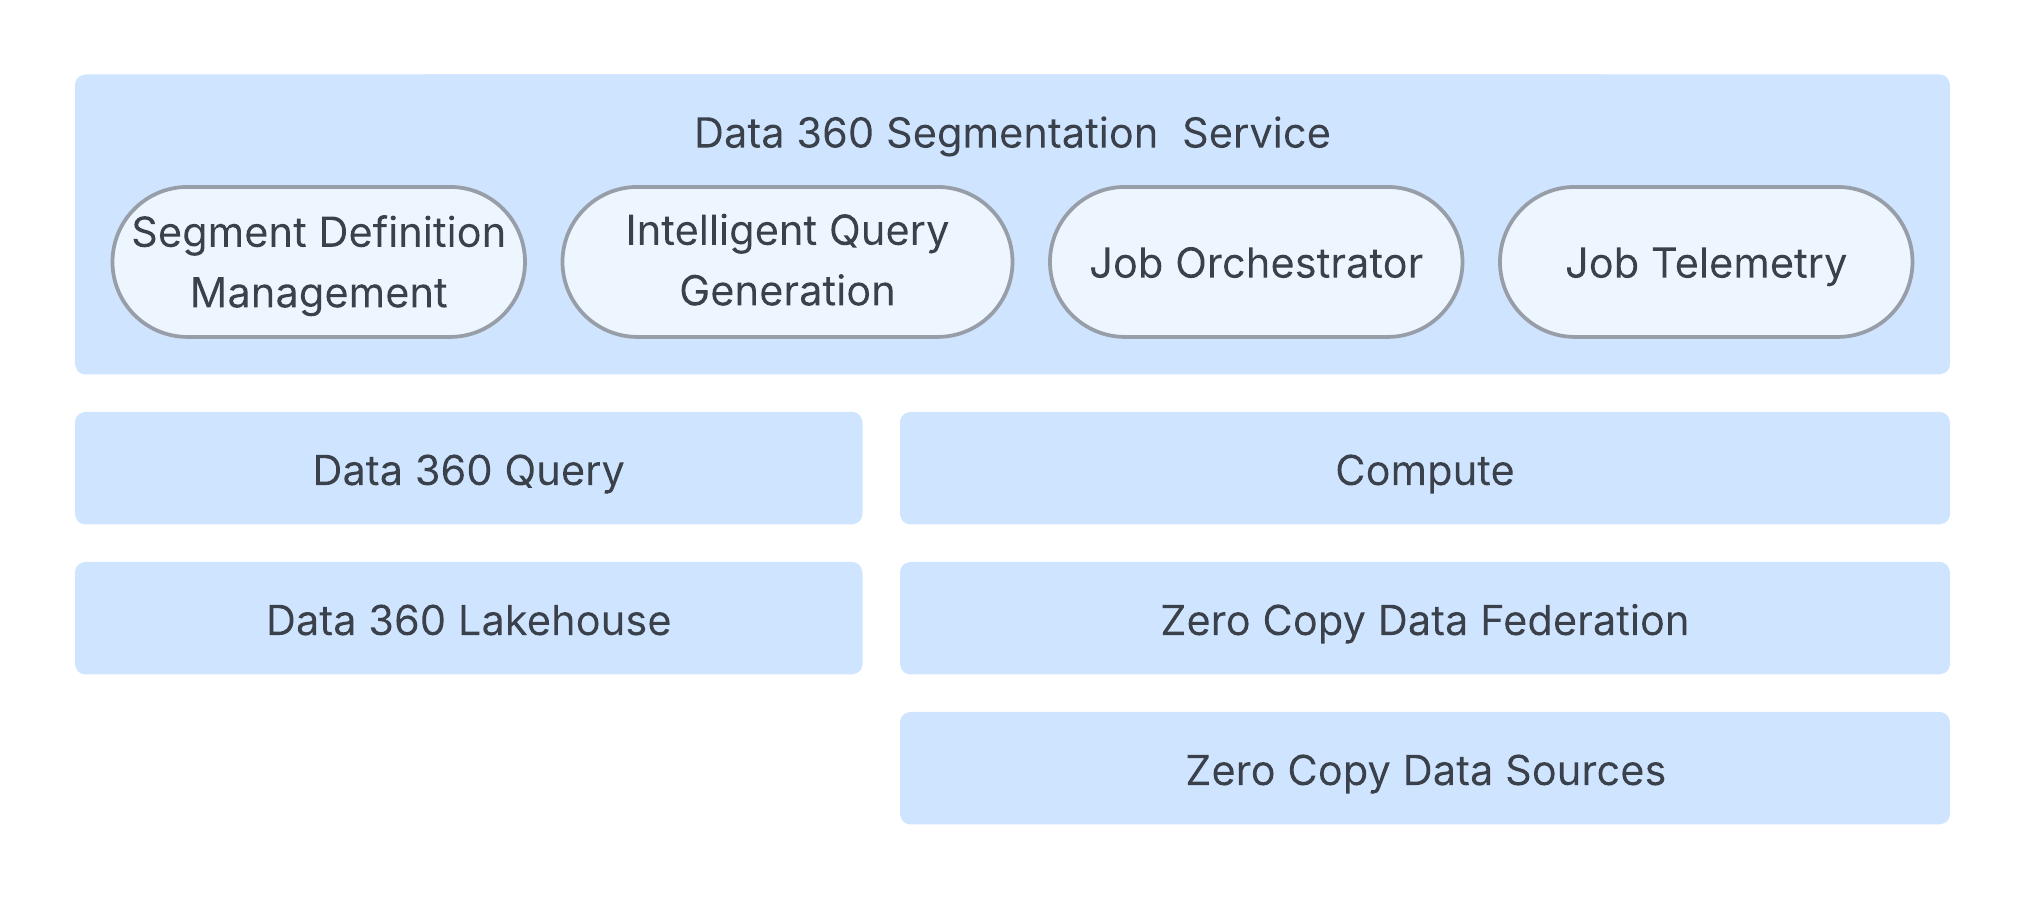 Der Kernprozess wird durch einen Service zur Auftragsorchestrierung verwaltet, der den Lebenszyklus des Segments steuert, die erforderliche Auftragskonfiguration generiert und die Ausführung auslöst. Diese Orchestrierungsebene bewahrt Status- und Metadaten in einer freigegebenen Datenbank auf, um die Skalierbarkeit zu gewährleisten.
Obwohl die Data 360-Abfrage Segmentierungsanzahlberechnungen verarbeitet, ist die Spark-Berechnungsebene für die Berechnung der tatsächlichen Segmentmitgliedschaft verantwortlich. Die Spark-Anwendung führt Spark SQL-Abfragen für umfangreiche Kundendaten aus. Diese Daten können sich im Data 360-Lakehouse, in externen Systemen über die Zero Copy-Datenverbundorganisation oder in einer Kombination aus beidem befinden.
Das System wurde durch die intelligente Abfragegenerierung, die die zugrunde liegende Spark SQL-Abfrage optimiert, stark optimiert. Dazu zählen Techniken wie der intelligente Partitionsschnitt, um das Scannen von Daten zu minimieren und redundante Teilausdrücke zu vermeiden. Zum Sicherstellen der Servicezuverlässigkeit verfügt die Architektur über eine adaptive Ressourcenverwaltung, die Rechenressourcen dynamisch an die Arbeitslastgröße und -komplexität anpasst. Darüber hinaus wird die SLO-Einhaltung proaktiv mit adaptiven Dauern und Wiederholungslogik verwaltet. Für eine schnelle Benutzererfahrung verwenden beschleunigte Segmentzählungen einen Stichproben-basierten Ansatz, um während der Segmenterstellung schnelle Größenschätzungen bereitzustellen und so eine vollständige Abfrageausführung zu vermeiden.
Schließlich wird der Fokus auf die Beobachtbarkeit und die Ursachenzuordnung durch umfassende Spark-Ausführungskennzahlen und die automatisierte Klassifizierung von Fehlern (z. B. kundenseitige und Systemprobleme) aufrechterhalten, wodurch die Diagnosezeit erheblich reduziert und eine hochgradig widerstandsfähige Datenplattform gewährleistet wird.
### Aktivierung
Die Aktivierung ist der entscheidende letzte Schritt im Data 360-Lebenszyklus. Ihre Kernfunktion besteht darin, statische, segmentierte, zusammengeführte Kundenprofile in handlungsrelevante und angereicherte Daten umzuwandeln und diese Daten an interne und externe Endpunkte (z. B. Marketing Cloud, Commerce Cloud und Adtech-Plattformen) bereitzustellen. Dieser Prozess soll personalisierte Kunden-Journeys und Interaktionen nahezu in Echtzeit auslösen. Sie unterstützt erweiterte Funktionen wie zugehörige Attribute, Filterung der Aktivierungsmitgliedschaft, Einwilligungsfilterung, Begrenzung und Rangfolge.
Die Aktivierung bietet drei unterschiedliche Methoden für die externe Zustellung und die Kanal-Compliance:
- **Batch-Aktivierung**: Konzipiert für geplante Vorgänge mit hohem Volumen, beispielsweise große E-Mail-Kampagnen und Werbezielgruppenaktualisierungen. Die Daten werden durch Staging in Secure Internal Buckets (Cloud Object Storage) oder über die sichere Dateiübertragung bereitgestellt, gefolgt von einem API-Aufnahmeprozess, der vom Zielsystem initiiert wurde. Bei Batch-Aktivierungen kann ein spezieller Aktualisierungsmodus – inkrementell – verwendet werden, um die an Salesforce-Partner gesendeten und von ihnen verarbeiteten Mengen zu reduzieren.
- **Streaming-Aktivierung**: Optimiert für Anwendungsfälle nahezu in Echtzeit, die eine ereignisgesteuerte Automatisierung erfordern. Die Zustellung erfolgt über direkte API-Aufrufe, die an den Zielendpunkt gesendet werden.
- **Durch Aktivierung ausgelöste Flows**: Dieser hochgradig plattformbasierte Kanal bietet einen No-Code/Low-Code-Ansatz für die Integration von Zielgruppendaten in Hunderte von API-fähigen Engagementplattformen für Kunden. Nach Abschluss der Aktivierung füllt Data 360 ein Zielgruppen-DMO aus, das dann einen Flow mit hohem Umfang auslöst. Das Flow-Modul verwendet anschließend die Zielgruppendaten und Plattformfunktionen wie externe Services und Mule Outbound-Ziele, um Aufrufe an das endgültige API-basierte Ziel zu senden. Durch diese Methode wird die für die Einarbeitung neuer Aktivierungsziele benötigte Zeit erheblich reduziert.
Die Aktivierung verwendet dieselben Muster wie die Segmentierung für die Auftragsverwaltung, die verteilte Ausführung und die Überwachung. Dies beinhaltet die Prinzipien des Auftragsorchestrierungsservice für die Lebenszyklusverwaltung und die Rechenebene (Spark) für die Verarbeitung und basiert auf der Auftragstelemetrie für die Beobachtbarkeit der Leistung und die Einhaltung von Service Level Objective (SLO).
Zusätzlich dazu verfügt die Aktivierung über:
Die **Aktivierungszielverwaltung** überwacht die sicheren Verbindungen, Anmeldeinformationen und Konfigurationen für alle Zielendpunkte. Sie garantiert, dass Datenformate und Sicherheitsprotokolle standardisiert sind, um eine zuverlässige ausgehende Zustellung an verschiedene Plattformen, einschließlich Marketing Cloud, Adtech-Partnern und anderen externen Anwendungen, zu gewährleisten.
Die Aktivierung passt die Nutzlast für bestimmte Ziele an. Für Salesforce Marketing Cloud umfasst dies die bewusste Filterung der Geschäftseinheit (Business Unit, BU), die Unterstützung mehrerer IDs und Steuerelemente für die Kreuzbestäubung.
Die **Kommunikationsverwaltung** fungiert als Gatekeeper und stellt sicher, dass die Datennutzung und -kommunikation den Kundenpräferenzen und gesetzlichen Anforderungen entspricht. Das zentralisierte Einwilligungsmodell vereinheitlicht alle Kundenpräferenzen – von der globalen Abmeldung bis hin zur kanal- und zweckspezifischen Einwilligung – und wird im Profil der zusammengeführten Einzelperson gespeichert. Während der Ausführung erzwingt die Plattform diese Richtlinien streng, indem sie Ausschlussfilter verwendet, um nicht zustimmende Einzelpersonen automatisch aus der endgültigen Nutzlast zu entfernen. Darüber hinaus wendet das System Kontaktpunkt-Auswahlregeln an, um sicherzustellen, dass der einzelne, konformeste und bevorzugte Kontaktpunkt für den vorgesehenen Kanal verwendet wird, bevor Daten übertragen werden. Dieser Erzwingungsmechanismus wird durch das zugrunde liegende Governance-Framework geschützt, das Schutzmaßnahmen wie dynamische Datenmaskierung und Zugriffssteuerungen verwendet, um sensible Datenfelder während des Aktivierungsprozesses zu schützen.
### Vereinheitlichte Abfrage: Nahtloser Zugriff auf alle Kundendaten
Der wahre Wert einer vereinheitlichten Datenplattform liegt in ihrer Fähigkeit, mühelosen, konsistenten Zugriff auf alle ihre Datenbestände zu bieten, unabhängig von ihrer Herkunft oder Struktur. Die Funktion "Zusammengeführte Abfrage" von Salesforce Data 360 wurde genau dafür entwickelt, die zugrunde liegenden Komplexitäten verschiedener Datenspeicher zu abstrahieren und so eine einzige leistungsstarke Abfrageoberfläche bereitzustellen.
Die Ebene "Zusammengeführte Abfrage" bietet einen komplexen Zugriff auf verschiedene Verbrauchsmuster:
- **Hybridstrukturierte und unstrukturierte Abfrage**: Sie bietet umfassende SQL-Unterstützung, um strukturierte Daten und die strukturierten Metadaten unstrukturierter Daten nahtlos abzufragen. Dies wird durch die Erweiterbarkeit des Operators über Tabellenfunktionen verbessert, wodurch eine spezielle Suche über Text-, Bild- und räumliche Typen hinweg ermöglicht wird.
- **Beschleunigte Leistung mit Hyper**: Data 360 nutzt Hyper, ein leistungsstarkes Modul im Arbeitsspeicher, um komplexe analytische Abfragen und interaktive Dashboards zu beschleunigen und nahezu sofortige Antworten auf massive Datensets bereitzustellen.
- **Einheitlicher Ansatz für AI und Personalisierung**: Dieser vereinheitlichte Zugriff ist entscheidend für die Generierung zielgerichteter und personalisierter Ergebnisse, wodurch präzisere LLM-Antworten mithilfe der erweiterten Abrufgenerierung (Retrieval Augmented Generation, RAG) direkt ermöglicht werden, indem AI-Modelle auf umfangreichen Unternehmensdaten basieren.
- **Integration in nachgelagerten Verbrauch**: Sie dient als grundlegende Datenzugriffsebene für benutzeroberflächengesteuerte Erfahrungen, robuste APIs, Workflows mit generativer AI und CRM-Anreicherung und verbindet Daten nahtlos mit der Aktivierung.
Durch die Bereitstellung einer einzigen, intelligenten und hochleistungsfähigen Abfrageoberfläche können Architekten mit der einheitlichen Abfrage von Data 360 agile, datengestützte Anwendungen erstellen, die ihr gesamtes Spektrum an Kundeninformationen vollständig nutzen.
### Datenaktionen
Data 360 ist eine aktive Plattform, die die Aktivierung von Pipelines als Reaktion auf Datenereignisse unterstützt. Beispielsweise kann ein wichtiges Ereignis, beispielsweise ein Rückgang des Accountsaldos eines Kunden, einen Salesforce-Flow auslösen, um eine entsprechende Aktion zu orchestrieren. Ebenso können Aktualisierungen an wichtigen Kennzahlen wie Lebenszeitausgaben automatisch in relevante Anwendungen übernommen werden.
Datenaktionen überwachen kontinuierlich inkrementelle Daten auf Änderungen mithilfe von nativen Speicheränderungsereignissen (SNCE) und Änderungsdatenfeeds (CDF). Diese Daten werden anhand von vom Kunden konfigurierten Aktionsregeln wie Schwellenwertüberwachung oder Statusänderungen ausgewertet. Wenn diese Regeln erfüllt sind, wird ein Datenaktionsereignis generiert. Dieses Ereignis wird mit zusätzlichen Informationen (z. B. Kundentreuestatus) angereichert und sofort an sein konfiguriertes Ziel gesendet, beispielsweise Salesforce-Flow oder eine externe Anwendung, um Geschäftsorchestrierungen auszulösen.
#### Customer Data Platform (Kundendatenplattform)
Data 360 unterstützt native CDP-Funktionen (Customer Data Platform), einschließlich erweiterter Identitätsbestimmungsfunktionen und der Erstellung von Kennzeichnern und Profilen für zusammengeführte Einzelpersonen sowie umfassender Interaktionsverläufe. Diese Plattform ist in der Handhabung von Business-to-Business-Frameworks (B2B) und Business-to-Consumer-Frameworks (B2C) durch die Unterstützung von Identitätsbestimmungs- und Identitätsdiagrammen, die sowohl exakte als auch Fuzzy-Abgleichsregeln verwenden, wie oben beschrieben, versiert. Diese Identitätsdiagramme werden mit Interaktionsdaten aus verschiedenen Kanälen angereichert, wodurch detaillierte Profildiagramme mit wertvollen analytischen Statistiken und Segmenten erstellt werden können.
Ein wichtiges Konzept, das das Kundenprofil unterstützt, ist das Datendiagramm. Data 360 bietet ein Unternehmensdatendiagramm im JSON-Format, bei dem es sich um ein denormalisiertes Objekt handelt, das aus verschiedenen Lakehouse-Tabellen und ihren Beziehungen abgeleitet wurde. Dies beinhaltet ein von CDP erstelltes "Profil"-Datendiagramm, das den Kauf- und Browserverlauf einer Person, den Kundenvorgangsverlauf, die Produktnutzung und andere berechnete Statistiken umfasst und von Kunden und Partnern erweitert werden kann. Diese Datendiagramme sind auf bestimmte Anwendungen zugeschnitten und verbessern die Genauigkeit der Eingabeaufforderungen mit generativer AI, indem sie relevanten Kunden- oder Benutzerkontext bereitstellen. Die Echtzeitebene von Data 360 verwendet das Profildiagramm für die Echtzeitpersonalisierung und -segmentierung. Die Modellierung von Agentforce Context umfasst Unterhaltungen, Sitzungen und Agentenspeicher als Datendiagramme.
Darüber hinaus ermöglicht das CDP eine effektive Segmentierung und Aktivierung auf verschiedenen Plattformen wie Marketing Cloud, Facebook und Google. Es verarbeitet Kundenprofile in Batch-, nahezu Echtzeit- und Echtzeit, was eine sofortige Entscheidungsfindung und Personalisierung ermöglicht. Diese Funktion verbessert die Interaktionen in B2C- und B2B-Szenarien und stellt sicher, dass Unternehmen schnell und genau auf Kundenanforderungen und -verhalten reagieren können.
### Echtzeitebene
Die Echtzeitebene von Data 360 wird durch das Data 360 CDP unterstützt und erweitert seine Konzepte für Echtzeitanwendungsfälle. Die Echtzeitebene von Data 360 wurde entwickelt, um Ereignisse wie Web- und mobile Clickstreams, Besuche, Einkaufswagendaten und Checkouts mit Latenzen von Millisekunden zu verarbeiten und so die Personalisierung der Kundenerfahrung zu verbessern. Sie überwacht kontinuierlich das Kundenengagement und aktualisiert das Kundenprofil aus Customer 360 mit Echtzeit-Interaktionsdaten, -Segmenten und -Berechnungen, um es sofort zu personalisieren.
Wenn ein Verbraucher beispielsweise einen Artikel auf einer Einkaufswebsite kauft, erkennt und erfasst die Echtzeitebene dieses Ereignis schnell, identifiziert den Verbraucher und reichert sein Profil mit aktualisierten Informationen zu Lebenszeitausgaben an. Dies ermöglicht die Personalisierung ihrer Erfahrung auf der Site in Sekundenschnelle. Darüber hinaus enthält diese Ebene Funktionen für Echtzeitauslöser und -antworten, die sofortige Aktionen basierend auf Kundeninteraktionen ermöglichen.
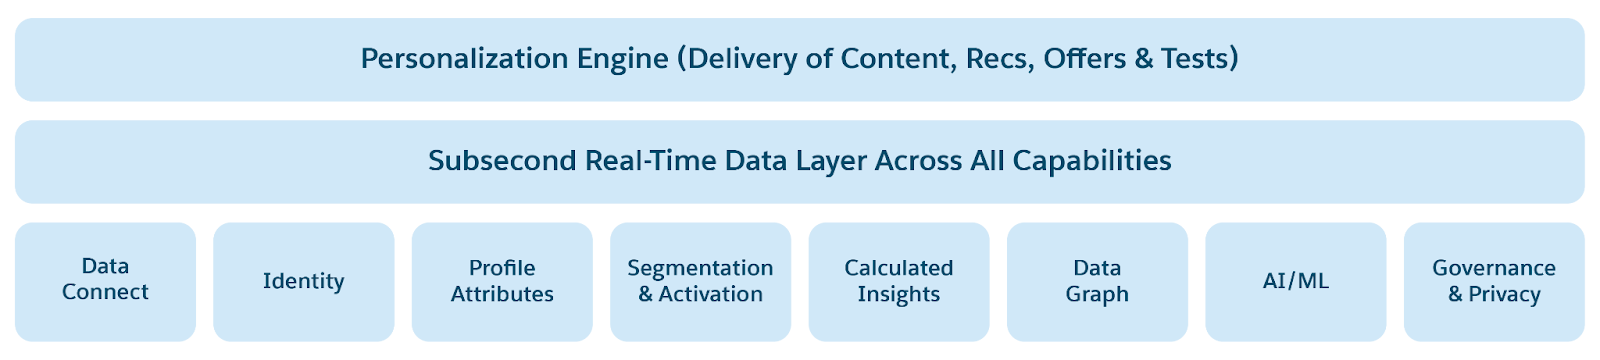 Die Sub-Second Real-Time Platform unterstützt diese Transformation durch mehrere wichtige Funktionen:
1. **Echtzeit-Datendiagramme**: Ein Customer 360 Profil wird mithilfe eines denormalisierten Diagramms erstellt, das wichtige Objekte und Felder enthält, die für Marken am relevantesten sind. Diese Datendiagramme ermöglichen die Echtzeit-Datenverarbeitung und liefern handlungsrelevante Inhalte und Statistiken innerhalb von Millisekunden.
2. **Echtzeitaufnahme und -transformation**: Erfassen Sie Benutzerereignisse und -profile in Millisekunden aus Web- und mobilen Quellen.
3. **Echtzeit-Identitätsbestimmung**: Führen Sie Kundenprofile geräteübergreifend zusammen und vereinheitlichen Sie unbekannte und bekannte Benutzer sofort.
4. **Berechnete Statistiken in Echtzeit**: Berechnen Sie Kennzahlen wie den Lebenszeitwert oder den Benutzerbesuchsverlauf in Millisekunden, um die Personalisierung oder Angebote für Web, ChatBot oder Serviceagenten zu aktivieren.
5. **Echtzeitsegmentierung**: Segmentieren Sie Zielgruppen direkt und personalisieren Sie Nachrichten und Interaktionen in Echtzeit.
6. **Echtzeitaktionen**: Geben Sie Marken die Möglichkeit, jedes Benutzerengagement auszuwerten und über den Salesforce-Flow oder andere relevante Kommunikationskanäle Maßnahmen zu ergreifen.
In Data 360 wurde eine neue Echtzeitplattform mit Echtzeit-Pipeline, Speicher mit geringer Latenz und einer Datenverarbeitungsebene im Sekundenbereich entwickelt. Da schnelle interaktive Daten aus Web- und mobilen Kanälen aufgenommen werden, durchlaufen sie eine Reihe schneller Prozesse.
Unsere Web- und Mobile-SDKs und Echtzeit-APIs erfassen Daten aus Web-/Mobilanwendungen (in künftigen Agenteninteraktionen) und senden sie an unseren Beacon-Server. Diese Daten werden dann zur Verarbeitung in Millisekunden an die Echtzeitebene und zur Integration in Batch-/Streaming-Daten an die Lakehouse-Ebene weitergeleitet. Die Echtzeitebene verarbeitet die eingehenden Echtzeitdaten im Kontext eines Benutzerprofils (anonym oder angemeldet), beispielsweise zur Aktualisierung der Gesamtausgaben oder des Lebenszeitwerts des Benutzers usw. für die Echtzeitpersonalisierung in der Sitzung. Die Echtzeitebene wird durch Arbeitsspeicher und NVme-Speicher (SSD) zum Speichern von Echtzeitdaten und Kundenprofilen unterstützt. Sobald sich die Daten in der Echtzeitebene befinden, durchlaufen sie die folgenden Prozesse, bevor sie in das Echtzeit-Datendiagramm aktualisiert werden:
- **Einfache Aufnahme und Transformationen**: Die Daten werden aufgenommen und zur weiteren Verarbeitung umgewandelt.
- **Identitätsbestimmung**: Genaue Abgleichsregeln werden angewendet, um Profile mit allen vorhandenen Abgleichsregelsätzen zu vereinheitlichen, sodass Spezialisten mit Datenbewusstsein keine neuen Regelsätze für die Identitätsbestimmung speziell für Echtzeit erstellen müssen.
- **Berechnete Statistiken**: Jedes Engagement wird ausgewertet, einfache Berechnungen wie Summe und Anzahl in Millisekunden werden ausgeführt und die Daten werden im Echtzeit-Datendiagramm aktualisiert.
- **Echtzeitsegmente**: Alle Interaktionsdaten werden ausgewertet, um festzustellen, ob sie die Kriterien für definierte Echtzeitsegmente erfüllen, und Benutzer werden in Millisekunden zu qualifizierenden Segmenten hinzugefügt.
- **Echtzeitaktionen und -auslöser**: Jedes Engagement wird anhand definierter Regeln ausgewertet, um Aktionen für eine Reihe von Zielen in Echtzeit auszulösen, wenn Regeln in Millisekunden erfüllt sind.
- **Echtzeit-Datendiagramm und API**: Mit dem Echtzeit-Datendiagramm, das auch eine Echtzeit-API enthält, können Marken aktualisierte Daten im JSON-Format für jeden Benutzer abrufen und so sicherstellen, dass alle Kundeninteraktionen durch die neuesten Daten informiert werden.
#### Personalisierung
Bei der Personalisierung geht es darum, zu wissen, wer wann und wo relevante Inhalte und Empfehlungen bereitstellen soll, was zu sagen ist und wie häufig. Die Personalization Services Platform ist der Orchestrierer der Entscheidungen, die getroffen werden, um die Zielerreichung durch personalisierte Erfahrungen zu optimieren.
Die **Personalisierungsservices** bieten die folgenden Funktionen:
- Konsistenter Satz an Modellen und Möglichkeiten zur Interpretation von Profil-, Aktivitäts- und Vermögenswertdaten in Data 360
- Plattformintegrierte Experimente (A/B/n, Multi-Arm Bandit)
- Integration von Zielen zur Entwurfszeit (Konfiguration), zur ML-Trainingszeit und zur Laufzeit (ML-Rückschluss)
- Unterstützung von Echtzeit- und Batchinteraktionen im B2C-Bereich (anonyme Benutzer, Echtzeit mit hohem Volumen/interaktiver externer Batch mit hohem Volumen)
- Analytics wird durch Data 360 gesteuert
- Muster zur Integration von AI-Modell und Service von anderen Beteiligten (intern und extern)
- Integration in das zentrale Metadaten-Ökosystem (PLATE-Eigenschaften)
- OOTB-Implementierungen hochwertiger AI-gestützter Anwendungsfälle (Empfehlungen/Entscheidungen mit verschiedenen ML-Algorithmen einschließlich Kontextbanditen für Sonderangebote/Inhaltsauswahl, Produktempfehlungen, Preisentscheidungen usw.)
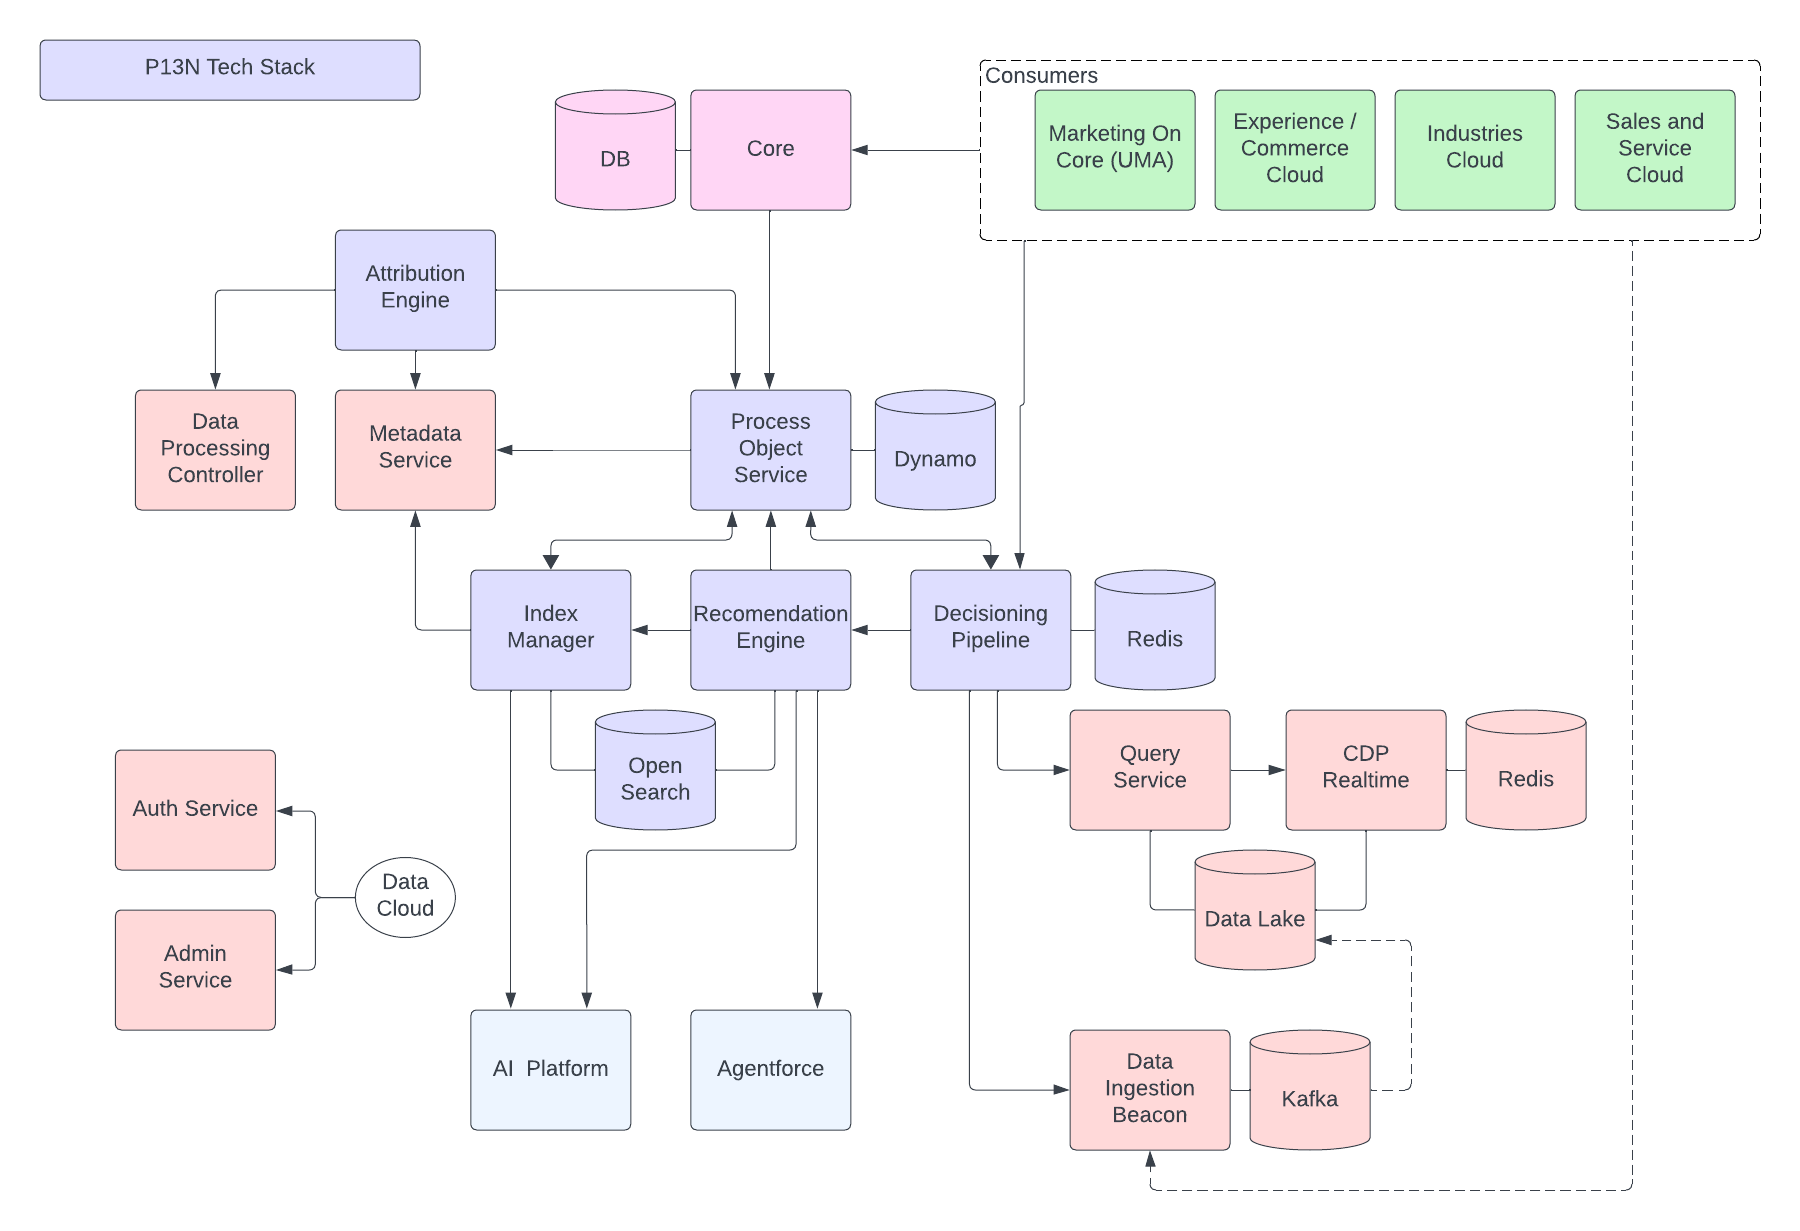 - **Entscheidende Pipeline**
- Erledigen externer Anforderungen für Personalisierungsentscheidungen, einschließlich Profilvergrößerung, Experimentieren und Empfehlungen.
- **Empfehlungsmodul**
- Laufzeitservice für regel- oder ML-basierte Empfehlungen.
- **Index Manager**
- Verwaltet/Orchestriert Workflow für asynchrone Prozesse, einschließlich ML-Schulungen für Empfehlungsmodelle
- **Prozessobjektservice**
- Verantwortlich für die Synchronisierung von Personalisierungsmetadaten zwischen Core und Off-Core
- **Attributionsmodul und Experimente**
- Analytics-Attribution und Experimentieren von Personalisierungsempfehlungen
### Agentische Unternehmenssuche
Data 360 ist eine robuste und umfassende Plattform, die speziell für die Unterstützung der neuen Agentenerfahrungen entwickelt wurde. Diese Funktionen werden durch verschiedene vorhandene Data 360-Services und durch eine umfassende Integration in Agentforce erreicht.
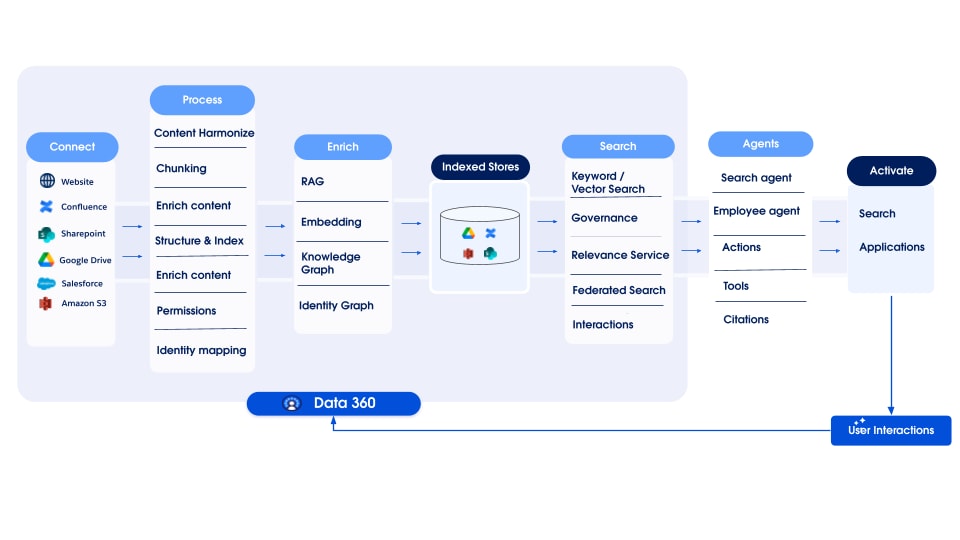 #### Nutzen der Kernstärken von Data 360
Unser Ansatz für die Agentenunternehmenssuche basiert auf den folgenden Prinzipien:
- Unternehmensdaten werden in isolierten Services oder Geschäften aufbewahrt, wobei sichere Berechtigungen für den Zugriff erforderlich sind. Die Möglichkeit, auf diese Daten zuzugreifen und sie zu verarbeiten, während gleichzeitig die Quellberechtigungen beibehalten werden, ist entscheidend, um Trust sicherzustellen.
- Die übergreifende Zuordnung und Relevanz über den gesamten Datenbestand hinweg ermöglichen bessere Ergebnisse, was wiederum einen besseren Kontext für Agentenerfahrungen bieten kann.
Zum Bereitstellen dieser Erfahrungen basiert die Agentenunternehmenssuche auf den folgenden wichtigen Architekturkomponenten:
- **Konnektoren**: Mit den in Data 360 verfügbaren Konnektoren können Sie auf Daten aus einer Vielzahl von Quellen zugreifen und sie aufnehmen.
- **Unstrukturierte Datenverarbeitung**: Dies ist die Grundlage für die Verarbeitung nicht tabellarischer Inhalte, sodass das System Bedeutung und Kontext aus verschiedenen Daten ableiten kann.
- **Governance**: Gewährleistung der Sicherheit, Compliance und Zugriffssteuerung für alle Daten, die von der Suche verbraucht werden. Die Unterstützung von Quellsichtbarkeitsberechtigungen stellt sicher, dass nur autorisierte Benutzer auf die Daten zugreifen können, sowohl für die einfache Suche als auch für Agentenerfahrungen. Damit ein schneller Abruf gewährleistet ist, werden Sicherheitsberechtigungen von den Such-Backends in der frühesten Phase des Datenzugriffs nativ ausgewertet und erzwungen.
- **Zusammengeführte Abrufebene**: Die Konnektoren werden in eine umfassende Ebene für den einheitlichen Abruf integriert, um die Herausforderung isolierter Daten zu bewältigen. Diese Ebene bietet einen einzigen Zugriffspunkt auf alle Daten, unabhängig davon, ob sie in externen Systemen verbleiben, auf die über die Verbundsuche zugegriffen wird, oder nativ über erweiterte Indizes für Nullkopie- und aufgenommene Daten verwaltet werden.
- **Intelligentes Abfrageverständnis**: Vor dem Abruf verwendet das System AI-gestützte Mechanismen zum Interpretieren des Benutzer-Intents. Zusätzlich zum Einbetten von Darstellungen der Abfrage für den semantischen Vektorabgleich können stichwortbasierte Suchen umgeschrieben und erweitert werden, um die Genauigkeit zu erhöhen.
- **Hybridsuche und erweiterte Abfrage**: Um die relevantesten Informationen zu finden, verwendet die Plattform mehrere Strategien parallel. Die Hybridsuche bietet einen präzisen Stichwortabgleich mit der semantischen Vektorsuche für optimierte Datenblöcke, während die Suche mit vollständigen Datensätzen gleichzeitig ganze Dokumente abruft. Beides wird kombiniert, um sowohl die semantische Relevanz als auch die vollständige Inhaltsabdeckung zu gewährleisten.
- **Hierarchischer Rang**: Nachdem Daten abgerufen wurden, bewertet, führt eine mehrstufige hierarchische Rangarchitektur die Ergebnisse aus jeder Quelle und Methode zusammen und ordnet sie neu an. Bei diesem Vorgang wird eine einzige, einheitliche Liste erstellt, die die relevantesten Informationen für den Benutzer oder Agenten anzeigt.
#### Anwendungen für die Agentensuche
Die generative AI verschiebt den primären Verbraucher der Unternehmenssuche von menschlichen Benutzern zu großen Sprachmodellen (LLMs). Data 360 Search wurde von Grund auf für beides entwickelt. Sie ist optimiert, um die längeren, komplexeren Abfragen von Agenten zu verarbeiten und die umfangreichen kontextbezogenen Ergebnisse zurückzugeben, die für die programmgesteuerte Nutzung und Argumentationsschleifen erforderlich sind. Gleichzeitig kann das System die kürzeren, oft mehrdeutigen Abfragen verarbeiten, die für menschliche Benutzer typisch sind, und bietet Funktionen wie Auszüge und Hervorhebungen für eine schnelle Bewertung auf einer Benutzeroberfläche.
Die ultimative Bereitstellung von Agentensucherfahrungen kombiniert beide Ansätze:
1. **Direkte Suchergebnisse**: Die Anwendung kann mithilfe einer metadatengesteuerten API, die auf der Grundlage der vereinheitlichten Data 360-Suche basiert, eine traditionelle Liste der Ergebnisse mit Rang anzeigen.
2. **Agentische Multiturn-Unterhaltungsantworten**: Agentenantworten werden durch native Integration in Agentforce implementiert. Diese Unterhaltungserfahrung wird von einem primären Agenten gesteuert, der Aktionen und Abfragen orchestriert und alle Informationen an einen spezialisierten internen Suchagenten delegiert.
Dieser spezialisierte Suchagent ist für den Abruf von Unternehmensinformationen optimiert. Sie verwendet eine Argumentationsschleife, um parallele Suchvorgänge zu formulieren und auszuführen, um verschiedene Bereiche der Anforderung eines Benutzers zu erkunden. Es verwendet eine Reihe leistungsstarker Tools, einschließlich der einheitlichen Data 360-Suche für alle Datentypen und strukturierter Abfragesprachen, um genaue Daten aus Tabellen und Einheiten abzurufen.
Durch diese architektonische Synthese ermöglicht Data 360 die Erstellung hochintelligenter, kontextbezogener und handlungsrelevanter Agentensucherfahrungen für Unternehmen.
### Erweitern von Data 360 mit benutzerdefiniertem Code
Die Erweiterbarkeit ist eine wichtige Funktion in Salesforce Platform. Die Code-Erweiterung bietet Erweiterbarkeit in Data 360 und ermöglicht es Pro-Code-Benutzern, benutzerdefinierte Python-Logik direkt in der Data 360-Umgebung auszuführen, was die umfangreichen deklarativen und Low-Code-Funktionen ergänzt. Mithilfe der Codeerweiterung können Benutzer Data 360-Kernfunktionen wie Transformationen und unstrukturierte Datenpipelines (benutzerdefiniertes Chunking) sicher erweitern.
Unser Design für die Code-Erweiterung setzt auf Flexibilität, Sicherheit, Effizienz und eine optimierte Entwicklererfahrung. Es unterstützt zwei primäre Ausführungsmodelle, die jeweils auf bestimmte architektonische Anforderungen zugeschnitten sind:
- **Skriptmodell**:
- **Zweck**: Für umfassende benutzerdefinierte Logik, die eine direkte Interaktion mit Data 360 Lakehouse erfordert.
- **Funktionalität**: Kunden schreiben vollständige Python-Skripts mithilfe des Code Extension SDK, wodurch Lese- und Schreibzugriff auf Lakehouse über SDK-APIs ermöglicht wird. Ideal für die benutzerdefinierte/komplexe Datenvorbereitung oder für maßgeschneiderte Datenmanipulationen.
- **Isolation und Sicherheit**: Während Skripts auf das Lakehouse zugreifen, ist ihre Ausführung auf eine sichere, isolierte Umgebung innerhalb der Data 360-Laufzeit beschränkt, was Störungen anderer Prozesse oder nicht autorisierten Systemzugriff verhindert.
- **Funktionsmodell**:
- **Zweck**: Analog zu einer serverlosen Funktion für modulare Berechnungen ohne Status, die aus vorhandenen Data 360-Pipelines aufgerufen werden (z. B. benutzerdefiniertes Blockieren in einer unstrukturierten Pipeline).
- **Funktionalität**: Vom Kunden bereitgestellte Funktionen übernehmen Eingabe-, Berechnungs- und Rückgabeausgaben.
- **Isolation und Sicherheit**: Diese Funktionen sind für eine strikte Isolation ausgelegt. Sie verfügen nicht über direkten Lakehouse-Zugriff. Ihre Ausführung erfolgt in Sandbox-Instanzen, zustandslos und ressourcenbeschränkt. Dadurch eignen sie sich für fokussierte Verarbeitungsschritte ohne Zustand, gewährleisten Sicherheit, prognostizierte Ausführung und minimieren den Explosionsradius.
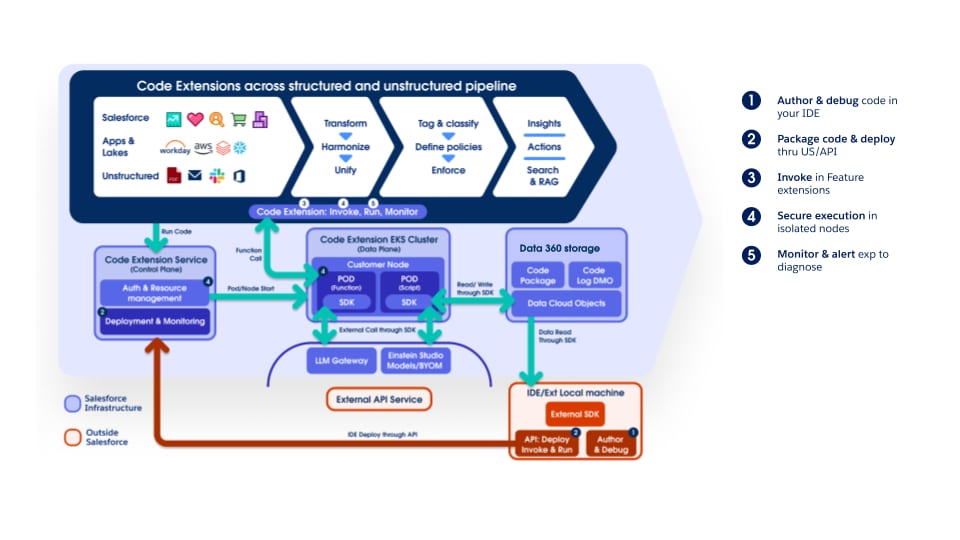 Sowohl das Skript- als auch das Funktionsmodell zielen darauf ab, Kundencode sicher auszuführen und so zu verhindern, dass sich der Code eines Mandanten auf andere auswirkt oder unbefugten Zugriff auf die Daten anderer Mandanten, Salesforce-Ressourcen oder externe Ressourcen erhält. Diese Sicherheit wird durch eine mehrschichtige (verteidigende) Architektur erreicht. Diese Architektur bietet eine isolierte Ausführungsumgebung für den benutzerdefinierten Code jedes Mandanten, die verschiedene Leitplanken enthält. Dazu zählen die logische Isolation auf Kubernetes-Ebene (K8s), die Netzwerkisolation, die Laufzeit-Sandbox-Instanz und Berechtigungen mit den geringsten Berechtigungen, ergänzt durch die Betriebsüberwachung und die Bereitschaft zur Reaktion auf Vorfälle zur Erkennung und Reaktion.
#### Entwicklererfahrung und betriebliche Sichtbarkeit
Code Extension bietet Folgendes, um einen robusten Entwicklungslebenszyklus zu unterstützen:
- **Externes Erstellen und Debuggen**: Entwickler können Python-Code mithilfe des SDK in vertrauten Umgebungen wie VSCode erstellen und debuggen.
- **Flexible Bereitstellung**: Benutzerdefinierter Code kann mithilfe von SDK-Dienstprogrammen, der Data 360-Benutzeroberfläche oder der API in Pakete aufgenommen und bereitgestellt werden, was die Integration in CI/CD ermöglicht.
**Betriebsprotokolle**: Der Zugriff auf detaillierte Ausführungsprotokolle bietet Transparenz und erleichtert die Fehlerbehebung in der Produktion.
Data 360 bietet diese sicheren und flexiblen Codeerweiterungsfunktionen und ermöglicht es Architekten, die Plattform an ihre individuellen und komplexesten Datenverarbeitungsanforderungen anzupassen und so ihre Rolle als erweiterbare Unternehmensdatenstruktur zu festigen.
### Erweitern von Data 360 durch Bereitstellen eigener AI-Modelle
Während Unternehmen die AI-Akzeptanz beschleunigen, pflegen die meisten heterogene ML-Ökosysteme – einschließlich Amazon SageMaker, Google Vertex AI und benutzerdefinierter Python-basierter Umgebungen –, die Modelle hosten, die geschäftskritische Prognosen vorantreiben, beispielsweise Kreditrisikobewertung, Abwanderungsneigung, Produktempfehlungen und Next-Best-Action-Entscheidungen.
Für die Integration dieser externen Modelle in Salesforce waren in der Regel maßgeschneiderte API-Schichten, ETL-Pipelines oder Middleware-Orchestrierungen erforderlich. Außerdem wurden Datenduplizierung, Verwaltungsaufwand, Latenz und betriebliche Komplexität eingeführt – Herausforderungen, die mit einer einheitlichen, konformen und echtzeitfähigen Customer Data Platform-Vision (CDP) in Konflikt stehen.
**Bring Your Own Model (BYOM)**: Über Einstein Studio in Data 360 bereitgestellt, werden diese Herausforderungen angegangen, indem der direkte Aufruf extern trainierter Modelle in Salesforce-Workflows, Apex-Logik und Automatisierungstools ermöglicht wird, ohne Daten verschieben oder replizieren zu müssen. Durch die Zero-Copy-Verbundorganisation fungiert Data 360 als die gesteuerte einzige Datenquelle und stellt harmonisierte Customer 360-Daten für Rückschlüsse an externen Endpunkten bereit. Prognoseausgaben fließen in Echtzeit zurück und unterstützen Geschäftsprozesse mit skalierbarer Intelligenz.
BYOM schließt effektiv die Lücke zwischen Data Science und der operativen Ausführung, indem die Modellentwicklung, die regulierten Daten und die Verbrauchsebenen voneinander getrennt werden. Sie behält die Plattformunabhängigkeit bei, reduziert die Integrationskomplexität, beschleunigt die AI-Bereitstellung und verwaltet sensible Daten.
Die Architektur funktioniert wie folgt: Data 360 bietet eine einheitliche Customer 360-Datengrundlage, während Einstein Studio Verbindungen zu externen ML-Plattformen (SageMaker, Vertex AI oder benutzerdefinierte Endpunkte) orchestriert. Externe Modelle führen Rückschlüsse im Echtzeit-, Batch- oder Streaming-Modus aus. Salesforce-Ebenen – Flow-, Apex- und Abfrage-APIs – verwenden Ausgaben, um personalisierte, automatisierte und analytische Statistiken für Sales, Service, Marketing und Industry Cloud bereitzustellen.
Aus Unternehmenssicht bietet BYOM Folgendes:
- **Datenintegrität und -verwaltung**: Eliminiert unkontrollierte Datenkopien und erzwingt die Einhaltung von Richtlinien.
- **AI-Demokratisierung**: Macht komplexe Modelle für nicht technische Benutzer über Salesforce-Tools zugänglich.
- **Beschleunigung der Zeit bis zum Wert**: Externe Modelle werden sofort in Salesforce-Prozessen aktiviert.
- **Unterstützung von Skalierbarkeit und Hybridarchitektur**: Ermöglicht die Bereitstellung von AI-Arbeitslasten in mehreren Clouds.
- **Zukunftsfähige AI-Architektur**: Unterstützt zusammengesetzte AI-Strategien, das Entkoppeln von Daten, Modellen und Verbrauchsebenen für die betriebliche Agilität.
**Bring Your Own LLM (BYO-LLM)**: Bietet denselben Erweiterbarkeitsmechanismus, jedoch für generative Modelle. Durch das Aktivieren des direkten Aufrufs externer Sprachmodelle können Kunden sie auf der Agentforce Platform anstelle der von Salesforce bereitgestellten Modelle verwenden. Für Unternehmen erlaubt BYO-LLM Folgendes:
- Zugriff auf optimierte Modelle
- Integration von Modellen, die derzeit nicht von Salesforce bereitgestellt werden
- Verwendung von Modellen in vom Kunden bereitgestellten Accounts
### Datenzusammenarbeit
Moderne Unternehmen arbeiten in einer komplexen Datenlandschaft, die durch zwei große architektonische Herausforderungen gekennzeichnet ist:
1. **Unternehmensinterne Fragmentierung**: Große Organisationen verwenden häufig mehrere Salesforce-Organisationen (oft segmentiert nach Region, Geschäftseinheit oder historischer Erfassung) und zahlreiche andere Datensysteme. Durch diese Fragmentierung werden interne Datensilos erstellt, sodass es nicht möglich ist, eine einzelne, vertrauenswürdige und einheitliche Ansicht des Kunden für die Echtzeitinteraktion im gesamten Unternehmen zu erstellen. Die Herausforderung besteht darin, diese Daten zu vereinheitlichen, ohne sie physisch in allen Systemen zu konsolidieren oder zu duplizieren, um sicherzustellen, dass die Verwaltung intakt bleibt.
2. **Unternehmensübergreifende Zusammenarbeit**: Unternehmen müssen oft Daten für gemeinsames Marketing, Messung und Business Intelligence mit Partnern und Lieferanten teilen. Die Herausforderung besteht darin, diese Zusammenarbeit zu ermöglichen und gleichzeitig sensible, proprietäre Daten zu schützen und Datenschutzbestimmungen wie DSGVO und CCPA sowie Wettbewerbsbarrieren einzuhalten.
Salesforce Data 360 meistert diese Herausforderungen mit einem Zero-Copy-Framework für Trust-by-Design, das auf dem Prinzip der Freigabe von Zugriff und Statistiken basiert, statt Daten zu verschieben oder zu duplizieren.
#### Data 360-Zusammenarbeitsmechanismen
Salesforce Data 360 bewältigt Herausforderungen bei der Datenfragmentierung und Zusammenarbeit mit Data Cloud One, der Datenfreigabe zwischen Data 360s und den Datenreinigungsräumen vom Typ "Privacy First". Diese Lösungen vereinheitlichen Kundendaten, ermöglichen einen sicheren Datenaustausch und bieten Statistiken zum Schutz der Privatsphäre. Mit einem Zero-Copy-Ansatz vom Typ Trust by Design können Organisationen Datenpotenziale für Echtzeitinteraktionen, erweiterte Partnerschaften und intelligente Entscheidungsfindung erschließen. Jede dieser Optionen für die Datenzusammenarbeit dient unterschiedlichen Zwecken.
##### Interne Unternehmensaktivierung mit Data Cloud One
Data Cloud One ist die grundlegende Architekturlösung für Unternehmen, die mehrere Salesforce-Organisationen betreiben. Ihr Zweck geht über die einfache Datenfreigabe hinaus. Sie wurde entwickelt, um eine einzelne, vertrauenswürdige Kundenansicht zu erstellen und vollständige Data 360-Plattformfunktionen in der gesamten Organisation zu ermöglichen.
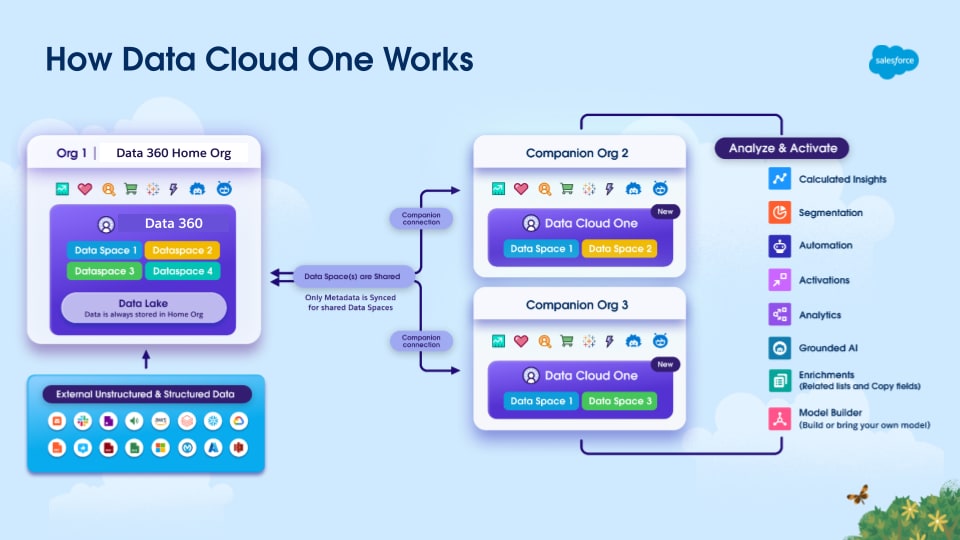 Dieser Mechanismus konzentriert sich auf eine angegebene Instanz vom Typ "Home Org Data 360", die als zentrale Instanz für die Datenverwaltung und die Erstellung des zusammengeführten Kundenprofils fungiert. Die Startseitenorganisation ist die Organisation, in der Data 360 bereitgestellt wird. Es wird eine Data Cloud One-Verbindung zwischen Data 360 und anderen Salesforce-Organisationen hergestellt, die als Begleitorganisationen bezeichnet werden. Als Teil der Data Cloud One-Verbindung gibt Data 360 einen oder mehrere seiner Datenbereiche für jede Begleitorganisation frei und bietet so Zugriff auf Daten und Metadaten in jedem freigegebenen Datenbereich. Dies wird durch ein Verbundmodell ohne Kopierzugriff und eine organisationsübergreifende Metadatensynchronisierung erreicht.
Data Cloud One ermöglicht es Begleitorganisationen auch, die Data 360-Instanz der Heimorganisation für ihre eigenen Aktivierungs-, Personalisierungs- und Intelligenzanforderungen zu nutzen. Diese Strategie ist wichtig, um die interne Datenfragmentierung zu beseitigen und sicherzustellen, dass alle Geschäftseinheiten auf der Grundlage desselben verwalteten und vereinheitlichten Kundenprofils aktiviert werden, wodurch der ROI der zentralen Data 360-Implementierung maximiert wird.
##### Datenfreigabe zwischen Data 360-Organisationen
Bei verteilten internen Umgebungen (in denen eine vollständige Zentralisierung nicht möglich ist) und bei der Zusammenarbeit mit vertrauenswürdigen externen Partnern verbindet die Data 360-zu-Data 360-Datenfreigabe unabhängige Data 360-Instanzen.
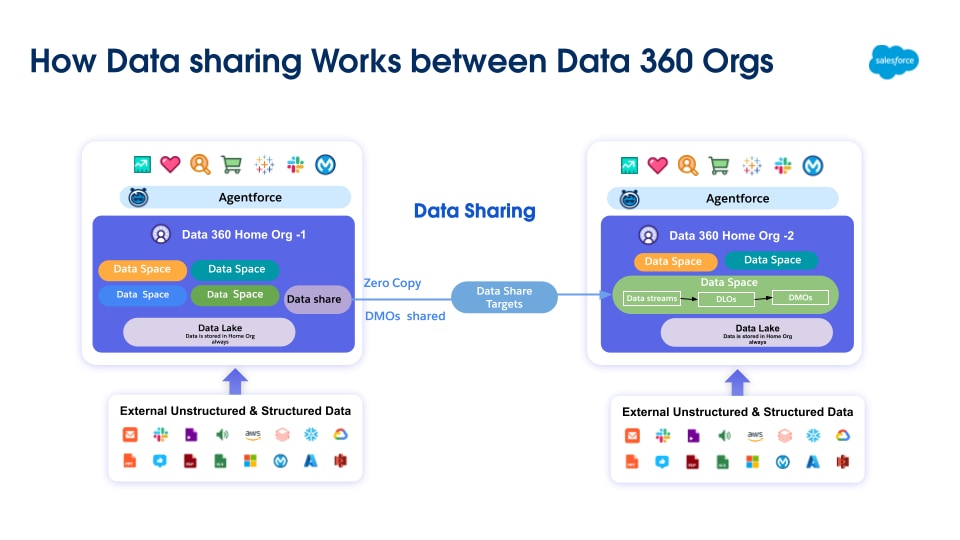 Dieses Zero-Copy-Freigabemodell stellt eine Verbindung zwischen separaten Data 360-Mandanten her, die in verschiedenen Salesforce-Organisationen bereitgestellt werden, um Datenobjekte (DLOs, DMOs und CIOs) sicher auszutauschen. Sobald eine Verbindung hergestellt ist, kann im Empfänger Data 360 auf das gesamte Datenobjekt zugegriffen werden. Der Administrator von Data 360 kann dann Governance-Regeln festlegen, um den Benutzerzugriff auf diese Daten zu verwalten.
##### Zusammenarbeit an erster Stelle bei Datenschutz mit Data 360-Reinraumzusammenarbeit
Wenn für die Zusammenarbeit ein Höchstmaß an Datenschutz und Compliance erforderlich ist oder Wettbewerbsbedenken die Freigabe von Rohdaten verhindern, werden Data 360-Reinräume architektonisch vorgeschrieben.
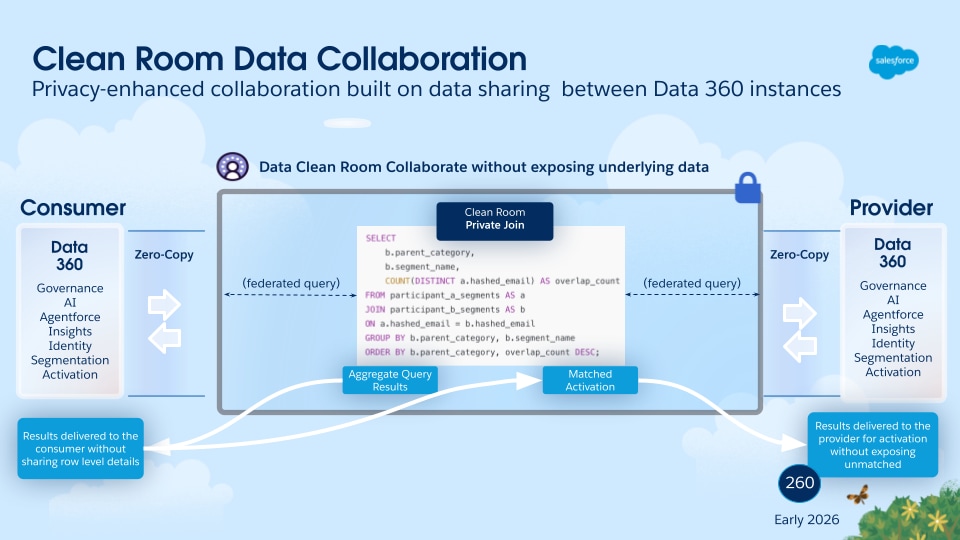 Architektonisch basiert die Data 360-Reinraumzusammenarbeit auf dem Zero-Copy-Freigabe-Framework, das von der Data 360-zu-Data 360-Datenfreigabe verwendet wird, wobei jedoch zusätzliche Verwaltungsebenen und Recheneinschränkungen gelten. Der Data 360-Reinraum bietet eine sichere, kontrollierte Rechenumgebung, in der Beteiligte ihre Datensets anhand anonymisierter Schlüssel verknüpfen können. Ihr Kernzweck besteht darin, eine gemeinsame Analyse und Statistikgenerierung zu ermöglichen, ohne die zugrunde liegenden proprietären Daten offenzulegen. Die Umgebung erzwingt strenge, programmierbare Regeln wie Mindestaggregationsschwellenwerte und nicht exportierbare Kennzeichner. Diese Regeln stellen sicher, dass nur genehmigte, datenschutzoptimierte und aggregierte Statistiken abgeleitet und freigegeben werden. Dadurch sind Reinräume für Anwendungsfälle wie die plattformübergreifende Kampagnenmessung und die Analyse sensibler Zielgruppenüberschneidungen unerlässlich.
## Schlussfolgerung: Salesforce Data 360: Das unverzichtbare Datenrückgrat für das Unternehmen "Agentic Enterprise"
Data 360 wurde als intelligente, erweiterbare und vertrauenswürdige Datenstruktur entwickelt, die für die AI der nächsten Generation erforderlich ist. Das Architekturdesign zielt auf das Problem der fragmentierten Daten ab und ermöglicht Organisationen die Vereinheitlichung, Verarbeitung und Aktivierung sämtlicher Kundendaten im richtigen Maßstab.
Die zuverlässige Datenorganisation erstellt eine harmonisierte Ansicht von DLOs (einschließlich unstrukturierter Daten) zu DMOs, die alle in partitionierten Datenbereichen geschützt sind. Die vielseitigen Datenverarbeitungsfunktionen von Data 360 – einschließlich Batch- und Streaming-Transformationen, berechneter Statistiken, unstrukturierter Datenverarbeitung und Identitätsbestimmung – werden durch die inkrementelle SNCE- und CDF-Architektur unterstützt, was eine effiziente Verarbeitung nahezu in Echtzeit und erhebliche Kosteneinsparungen gewährleistet.
Die Erweiterbarkeit wird durch die Code Extension-Architektur bereitgestellt, die benutzerdefinierte Python-Logik über Skripts oder isolierte Funktionen für individuelle Anforderungen sicher aktiviert. Darüber hinaus garantiert ein umfassendes Framework für die Datenverwaltung, das auf der attributbasierten Zugriffssteuerung (ABAC) mit CEDAR-Richtlinien basiert, detaillierte Sicherheit, dynamische Datenmaskierung und konsistente Durchsetzung des gesamten Datenverbrauchs. Dies gipfelt in komplexen Segmentierungs- und Aktivierungsfunktionen, die zusammengeführte Kundenprofile in dynamische Multi-Channel-Engagementstrategien mit Reaktionsfähigkeit in Echtzeit übersetzen.
Die Fähigkeit von Data 360, umfangreiche, vielfältige Daten zu vereinheitlichen, Echtzeitkontext über seine vereinheitlichte Abfrage bereitzustellen (einschließlich strukturierter/unstrukturierter Hybridsuche und Hyperbeschleunigung) und strenge Governance-Vorgaben durchzusetzen, ist von entscheidender Bedeutung für die Unterstützung intelligenter AI-Agenten. Sie stellt die erforderlichen vertrauenswürdigen, aktuellen und relevanten Daten bereit, um Workflows mit generativer AI (Generative AI Workflows, RAG) zu unterstützen und die handlungsorientierten Funktionen von Agentforce Agenten zu erweitern und sicherzustellen, dass sie mit Präzision und Genauigkeit arbeiten.
Data 360 bietet eine zukunftssichere Plattform, auf der Quelldaten in handlungsrelevante Statistiken umgewandelt werden, und ist eine unverzichtbare architektonische Grundlage für Organisationen, die Agentic-Kundenerfahrungen erstellen. Es ist das wichtige Rückgrat, das Kundendaten in die komplexen, personalisierten Kundenerfahrungen verwandelt, die den Erfolg moderner Organisationen steigern.
## Übersicht
Unternehmen verarbeiten eine Vielzahl von Dokumenttypen, einschließlich Rechnungen, Bestellungen, Rechtsverträgen und technischen Handbüchern. Die manuelle Verarbeitung ist langsam, fehleranfällig und beansprucht geschätzte 15–25 % der Mitarbeiterzeit. Frühere Automatisierungsansätze (z. B. _Robotic Process Automation (RPA)_, _Optical Character Recognition (OCR)_ und Workflow-Tools) reduzierten einen Teil der Belastung, führten jedoch zu starren Pipelines, hohem Wartungsaufwand und isolierter Akzeptanz in einzelnen Geschäftsteams.
Dokumente weisen einen umfangreichen strukturellen Kontext auf (z. B. Tabellenhierarchien, räumliche Feldbeziehungen und querverwiesene Abschnitte), den die Flachtextverarbeitung nicht beibehalten kann. Durch das Entfernen eines Dokuments auf Nur-Text wird der Geschäftskontext verworfen, der die Extraktion genau und nützlich macht, was die Qualität von nachgelagerten Analysen, Rückschlüssen auf _künstliche Intelligenz (KI)_ und Prozessautomatisierung beeinträchtigt.
Damit _die intelligente Dokumentverarbeitung_ effektiv ist, müssen sie Dokumente nach Typ klassifizieren, strukturierte Daten genau aus Variablenlayouts extrahieren und diese Daten in einer geregelten, abfragbaren Form an nachgelagerte Systeme bereitstellen. IDPs müssen auch die Dokumentvariabilität im richtigen Maßstab verarbeiten, ohne dass für jedes neue Dokumentformat eine Konfiguration pro Vorlage erforderlich ist, und sie müssen zentralisiert und geschäftseinheitsübergreifend zugänglich sein. Diese Herausforderung wird durch das Volumen des Schlüsselproblems noch verstärkt: Unstrukturierte Daten machen etwa 80 % aller Unternehmensdaten aus und der Großteil wird in Dokumentform in Dateisystemen, Cloud-Speichern und Inhalts-Repositorys gesammelt, die sich außerhalb der Reichweite von _Customer Relationship Management (CRM)_-Systemen, AI-Agenten und Analyseplattformen befinden.
Bei der _Data 360-Dokument-AI_ handelt es sich um die Salesforce-Dokumentverarbeitungsfunktion in _Data 360_, mit der diese Lücke geschlossen werden soll. Sie extrahiert, klassifiziert und analysiert unstrukturierte und halbstrukturierte Dokumentinhalte mithilfe von _Large Language Models (LLMs)_, _Optical Character Recognition (OCR)_, _Natural Language Processing (NLP)_ und _Machine Learning (ML)_. Bei der Ausgabe handelt es sich um strukturierte, gesteuerte und abfragbare Daten, die in die _Data 360_-Pipeline integriert werden, wo _Agentforce_-Agenten, Analysetools und Automatisierungs-Workflows über Standardschnittstellen darauf zugreifen können, ohne dass benutzerdefinierte Extrahierungs- oder Transformationsebenen erforderlich sind.
## Warum ist Dokument-AI wichtig?
Enterprise-Datenplattformen verarbeiten strukturierte tabellarische Daten. Die meisten Unternehmensdaten werden jedoch als Dokumente erfasst und bleiben für CRM-, ERP-, AI-Agenten und Analyse-Pipelines unzugänglich, bis sie manuell extrahiert werden. Dies ist eine architektonische Lücke und kein Workflow-Problem.
### Einschränkungen der regelbasierten Extraktion
Frühere Ansätze kombinierten die manuelle Neuschlüsselung, regelbasierte OCR- und RPA-Skripts. Diese Methoden funktionierten in kleinem Umfang, konnten jedoch das Volumen, die Vielfalt und die Geschwindigkeit der Dokumenttypen, die moderne Unternehmen generieren, nicht verarbeiten. Regelbasierte Tools erfordern explizite Vorlagen pro Layoutvariante. Jede Formatänderung unterbricht die Extraktion und erfordert einen Entwickler, eine neue Vorlage und einen Bereitstellungszyklus.
Im großen Maßstab führt dies zu anfälligen Punktlösungen ohne zentralisierte Verwaltung, gemeinsames Schema und Pfad zur AI-Bereitschaft. Inkonsistente Extraktionspipelines werden nachgelagert übernommen. Anders ausgedrückt: Analysen übernehmen Dateninkonsistenzen, AI-Modelle produzieren unzuverlässige Ausgaben und regulierte Inhalte wie _Persönliche Gesundheitsinformationen (PHI)_ und _Persönlich identifizierbare Informationen (PII)_ weisen keine systematische Steuerung auf.
### Native AI-Dokumentverarbeitung
LLMs extrahieren Felder ohne explizite Vorlagen. Eine einzelne Schemakonfiguration steuert die Extraktion über Layoutvarianten, Sprachen und Formate hinweg, die sich an das Dokument anpasst, statt das Dokument an eine feste Struktur anzupassen. Dadurch wird die Dokumentverarbeitung von einem wartungsintensiven, isolierten Vorgang zu einer gesteuerten, zentralisierten Funktion verschoben.
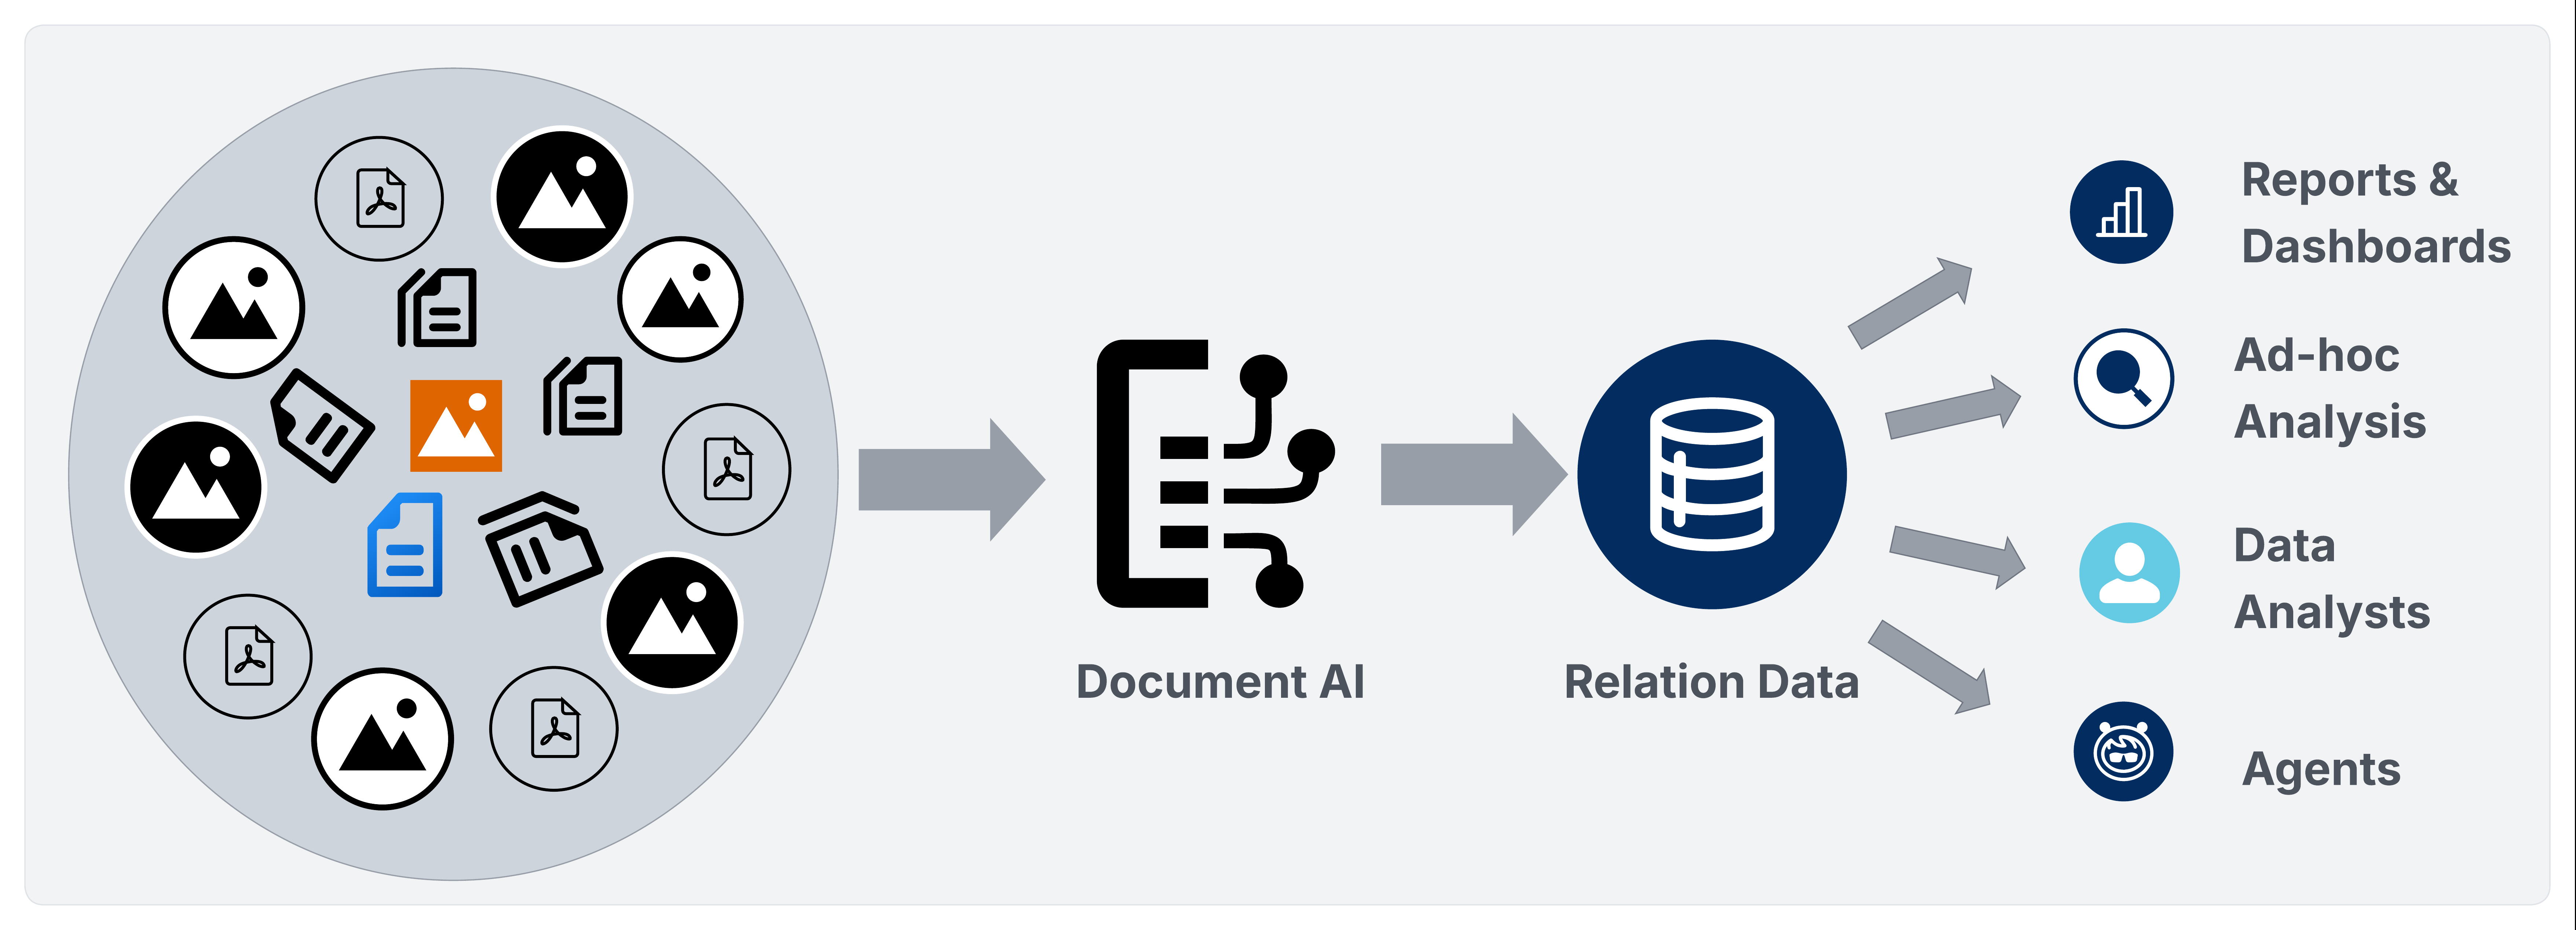
Die Dokumentverarbeitung auf der _Data 360_-Plattform wird über zwei Pipelines von der _Data 360-Dokumenten-AI_ operationalisiert.
- Die _Batch-Pipeline_ leitet extrahierte Daten durch die Aufnahme, Identitätsbestimmung, berechnete Statistiken, Aktivierungen, Analysen und Agentforce Aktivierung weiter.
- Die _Transaktionsverarbeitungspipeline_ stellt eine REST-API bereit, die strukturierte _JSON_ synchron zurückgibt. Dadurch können Architekten dokumentenabgeleitete Daten an Salesforce-_SObjects_, die Pipeline _Data 360 Data Lake Object_ / _Data Model Object (DLO/DMO)_ oder externe Datenbanken und Lagerhäuser ohne Batch-Setup-Aufwand weiterleiten.
In beiden Fällen werden extrahierte Daten in ein geregeltes, schemagesteuertes Modell und nicht in einen fragmentierten Satz von Punkttools eingegeben.
## Produkt im Umfang
Bei der [Data 360-Dokumenten-AI](https://help.salesforce.com/s/articleView?id=data.c360_a_document_ai.htm&type=5) handelt es sich um die native Salesforce-Funktion _für die intelligente Dokumentverarbeitung_ auf der _Data 360_-Plattform. Sie wandelt unstrukturierte und halbstrukturierte Dokumentinhalte in geregelte, abfragbare Daten um, die während des gesamten _Data 360-_Lebenszyklus vollständig beteiligt sind.
## Was ist Data 360-Dokument-AI?
Bei der [Data 360-Dokumenten-AI](https://help.salesforce.com/s/articleView?id=data.c360_a_document_ai.htm&type=5) handelt es sich um die native Salesforce-Funktion _für die intelligente Dokumentverarbeitung_ in _Data 360_. Sie nimmt unstrukturierte und halbstrukturierte Dokumente auf, extrahiert strukturierte Daten mithilfe einer deklarativen Schemakonfiguration und stellt diese Daten zur Harmonisierung, Identitätsbestimmung, Analyse und Agentforce Aktivierung an die _Data 360_-Pipeline bereit.
Data 360-Dokument-AI unterstützt zwei Verarbeitungsmodalitäten:
- **Verarbeitung von Massenvorgängen:** Verarbeitet große Dokumentsets, die in _Unstrukturierten Datenmodellobjekten (_UDMOs) definiert sind, ereignisgesteuert.
- **Transaktionsverarbeitung:** Verarbeitet ein einzelnes Dokument über die REST-API und gibt synchron eine strukturierte _JSON-_Nutzlast zurück. Architekten können diese Nutzlast dann über _MuleSoft_, _Apex_ Callouts oder _Einstein Trust Layer (ETL)_-Pipelines an die _Data 360 DLO/DMO_-Pipeline, Salesforce-_SObjects_ oder externe Datenbanken und Lagerhäuser weiterleiten. Die Zielklasse ist eine architektonische Entscheidung, die von Latenz-, Governance- und Datenresidenzanforderungen gesteuert wird.
Die Dokument-AI unterstützt derzeit PDF-Dateien, Bilddateien (JPEG, PNG) und handschriftliche Dokumente.
## Kernkomponenten
Die _AI von Data 360_-Dokumenten vereint vier Verarbeitungstechnologien in einer einzigen geregelten Pipeline. Jede Komponente verarbeitet eine unterschiedliche Phase des Lebenszyklus von Dokumenten zu Daten:
- **Optische Zeichenerkennung (OCR):** Wandelt gescannte Bilder, handgeschriebene Inhalte und bildbasierte PDFs vor der LLM-Verarbeitung in maschinenlesbaren Text um. Für eine zuverlässige Extraktion werden mindestens 150 DPI empfohlen.
- **Large Language Models (LLMs):** Leiten Sie die Extraktion mithilfe des vom Benutzer ausgewählten Modells durch das _Einstein_ LLM-Gateway weiter. Der LLM empfängt die OCR-Ausgabe zusammen mit der _JSON-_Schemakonfiguration und gibt eine strukturierte Extraktionsnutzlast zurück. _Gemini-_ und zusätzliche Modelle sind für die zukünftige Implementierung geplant.
- **Natürliche Sprachverarbeitung:** Führt Kontextverständnis, Einheitenerkennung, Datumsanalyse und semantische Feldextraktion direkt in der LLM über strukturiertes Aufforderungs-Engineering durch – die schemadefinierte Aufforderung und die OCR-Ausgabe dienen als einzige Eingaben. Alle LLM-Interaktionen werden über das ETL weitergeleitet. Dadurch wird eine Datenaufbewahrung von null bei Modellanbietern erzwungen und _personenbezogene Daten_ werden in textbasierten Eingaben maskiert, bevor sie das Modell erreichen. Es wird kein separates NLP-Modul verwendet.
- **Multimodale Verarbeitung:** Verarbeitet eingebettete Bilder in PDFs als separate Extraktionseingaben, wodurch die LLM Daten aus Diagrammen, bildgerenderten Tabellen und Seiten mit gemischtem Inhalt extrahieren kann, die OCR allein nicht analysieren kann.
Zusätzlich zu den vier Verarbeitungstechnologien verarbeitet die _Dokument-AI_ auch Folgendes:
- **Einstein Trust Layer:** Leitet alle LLM-Interaktionen durch das ETL weiter, wodurch die Aufbewahrung von Daten mit Modellanbietern null wird und _personenbezogene Daten_ maskiert werden, bevor Eingaben das LLM erreichen. Dies gilt jedoch nicht für multimodale Daten (z. B. angehängte Dokumente, die über die _Dokument-AI_ verarbeitet werden), bei denen die Maskierung personenbezogener Daten derzeit nicht unterstützt wird und Daten unverändert an externe Modelle gesendet werden. Das ETL steuert nur den LLM-Interaktionspfad. Extrahierte Daten, die in _Data-Lake-Objekte (DLOs)_ geschrieben werden, werden unverändert gespeichert. Die Maskierung auf Feldebene im Leerlauf muss über nachgelagerte Steuerelemente für die Datenverwaltung behoben werden.
- **Obergrenzen für Dateigrößen:** _Die Dokument-AI_ verarbeitet Dateien mit einer Größe von bis zu 10 MB pro Anforderung. Obergrenzen für die LLM-Kontextlänge können die Verarbeitung für dichte, mehrseitige Dokumente innerhalb dieser Grenze weiter einschränken.
## Wichtige architektonische Prinzipien
Unternehmensarchitekten, die _Data 360-Dokument-AI_ bereitstellen, sollten diese Prinzipien anwenden, bevor sie sich auf ein Implementierungsdesign festlegen.
- **Wählen Sie die Pipeline aus, bevor Sie das Schema entwerfen.** Die Pipelines für die _Batch-_ und _Transaktionsverarbeitung_ unterscheiden sich hinsichtlich Aufnahmemodell, Schemabindung, Zielflexibilität und Latenz. Es ist wichtig, zu überprüfen, welche Pipeline für jeden Anwendungsfall erforderlich ist, bevor Sie das Schema definieren, da die Nachrüstung vermeidbare Nacharbeit hinzufügt.
- **Entwerfen Sie Schemas auf Dokumenttypebene.** Die Verwendung eines einzelnen, gut ausgearbeiteten Schemas pro Dokumenttyp ist pflegeleichter als die Verwendung von Konfigurationen pro Anwendungsfall und zudem der größte Hebel für die Extraktionsqualität. Um dies richtig zu tun, müssen Sie eine Vielzahl von Dokumenten – einschließlich Edge-Kundenvorgängen – verwenden, statt sie anhand eines einzelnen Beispiels zu entwerfen. Verwenden Sie Eingabeaufforderungen iterativ auf _Feld-_, _Tabellen-_ und _Schemaebene_, um Lücken zu finden, und testen Sie sie dann und verfeinern Sie sie anhand mehrerer Dokumentbeispiele, bevor Sie sie abschließen. Beachten Sie, dass ein Schema, das für ein Dokument gut funktioniert, bei anderen möglicherweise zu kurz kommt. Daher sind Breite und Iteration unerlässlich. Ebenso wichtig ist die Flexibilität des Schemas, einschließlich des Entfernens von Spalten, die nicht zuverlässig über Dokumenttypen hinweg extrahiert werden. Das Festhalten an Feldern, die zu Rauschen oder Inkonsistenzen führen, untergräbt die Gesamtextraktionsqualität. Daher ist es wichtig, die Spaltenentfernung als erstklassige Designentscheidung zu behandeln.
- **Wählen Sie die richtige Zielklasse pro Feldgruppe aus.** Felder, die CRM-Workflows oder -Genehmigungen steuern, werden in _SObjects_ geschrieben. Felder, die das zusammengeführte Profil anreichern oder Analysen einspeisen, gehören zur _DLO/DMO-_Pipeline. Felder, die externe Systeme bereitstellen, gehören zur _RDBMS-_Klasse. Beachten Sie, dass ein einzelnes Schema möglicherweise mehrere Stufen gleichzeitig umfasst.
- **Erzwingen Sie die Verwaltung, bevor Sie regulierte Inhalte verarbeiten.** Regulierte Daten müssen auf jeder Ebene geschützt werden. Daher ist es wichtig, _die personenbezogene_ Maskierung, Datenklassifizierungs-Tags und die _attributbasierte Zugriffssteuerung_ zu konfigurieren, nachdem extrahierte Daten in den Ausgabe-_Data-Lake-Objekten (DLOs)_ gespeichert wurden Dies bietet eine optimierte Erzwingung und kontextbezogenen Zugriff, der auf der Datenklassifizierung, der Benutzerrolle und dem Organisationskontext basiert. Die _Governance_ ist auf zwei Pfade aufgeteilt: Das _ELT_ steuert die LLM-Interaktion, während die extrahierten Daten, die in DLOs gespeichert sind, separat – direkt auf DLO- und Datenbankebene – über _Datenbereichskonfigurationen_, _Berechtigungssätze_ und _ABAC-_Richtlinien verwaltet werden müssen. Diese Steuerelemente müssen die Konsistenz auf der Speicherebene – nicht nur auf der Anwendungsebene – aufrechterhalten, sodass die Zugriffsbeschränkungen intakt bleiben, unabhängig davon, wie nach der Aufnahme auf Daten zugegriffen wird. Beachten Sie, dass Lücken in einer beliebigen Ebene regulierte Daten nachgelagert offenlegen können, selbst wenn andere richtig konfiguriert sind.
- **Design für Fehlermodi vor der Produktion.** Berücksichtigen Sie die Akzeptanz von Nullfeldern, OCR-Qualitätsschwellenwerte, die Vorvalidierung der Dateigröße, den LLM-Kontextüberlauf, die RDBMS-Schreibidempotenz und Obergrenzen für das Gutschriftsbudget vor der Ausführung des ersten Produktionsbatches. Hierbei handelt es sich nicht um Edge-Kundenvorgänge, sondern um vorhersehbare Fehleroberflächen, die explizit im Pipeline-Design behandelt und während der Laufzeit nicht erkannt werden müssen.
- **Behandeln Sie Konfidenzbewertungen als erstklassiges Weiterleitungssignal und nicht als Diagnosenachbearbeitung.** Extraktionsergebnisse enthalten Konfidenzwerte auf Feldebene, die aus den Protokollwahrscheinlichkeiten (logprobs) der zugrunde liegenden Modellausgabe abgeleitet werden. Für jedes extrahierte Feld, jede extrahierte Tabelle oder jede extrahierte Spalte spiegelt die Bewertung die Sicherheit des Modells auf Tokenebene für den extrahierten Wert wider. Dadurch werden Konfidenzbewertungen zu einem statistisch fundierten Signal, das zuverlässig genug ist, um als primäres Tor für Eskalationsschwellenwerte _vom Typ "Human-in-the-Loop_" zu fungieren. Verwenden Sie Konfidenzbewertungen, um systematisch Extraktionen mit geringer Qualität zu identifizieren und HITL-Prüfpunkte für Feldwerte mit geringer Konfidenz, mehrdeutige Schemaübereinstimmungen oder wiederholte Pipeline-Fehler zu initiieren, statt sich auf Heuristiken oder manuelle Stichprobenüberprüfungen zu verlassen. Wenn eine automatisierte Wiederherstellung nicht möglich ist, wird durch die HITL-gestützte Konfidenzbewertung sichergestellt, dass das menschliche Urteilsvermögen genau dort angewendet wird, wo es benötigt wird.
- **Entwerfen Sie Aktivierungspfade parallel zum Schemadesign.** Der Wert der _Dokument-AI_ besteht darin, extrahierte Daten in Salesforce-Workflows und -Agenten aktivieren zu können. Damit können Sie Agentforce _Aktionen_, _Flows_ und _berechnete Statistiken_ zusammen mit dem Entwurf des Extraktionsschemas entwerfen und nicht erst danach.
## Architektur: Data 360-Dokument-AI-Pipeline
Die _Dokument-AI_ funktioniert in zwei Pipelines:
- Eine _Batch-_Pipeline für die Verarbeitung mit hohem Volumen und UDMO-Unterstützung
- Eine _transaktionale_ _Verarbeitungs-_Pipeline für die API-gesteuerte Extraktion in Echtzeit
Beide Pipelines haben denselben Schemakonfigurationsvertrag und dieselbe ETL-Governance, unterscheiden sich jedoch darin, wie Dokumente in das System gelangen und wo extrahierte Daten landen.
Sehen wir uns die einzelnen Pipelines genauer an.
### Batchverarbeitungs-Pipeline
Die _Batch-_Pipeline verarbeitet wiederkehrende Dokumentsätze, die durch ein UDMO definiert sind. Sie eignet sich für geplante oder ereignisgesteuerte Anwendungsfälle, in denen Dokumente aus dem Unternehmensspeicher aufgenommen werden, dann die Dokumentextraktion durchlaufen und zur Harmonisierung, Identitätsbestimmung und Aktivierung an die _Data 360 DLO/DMO_-Pipeline geliefert werden.
**Real-World-Szenario**
Jeden Tag erhält ein Versicherungsunternehmen Tausende medizinische Anspruchsdokumente von Anbieterportalen, die als PDFs in _Amazon S3_ hochgeladen werden. Das UDMO definiert den Dokumentsatz im Umfang und sendet alle Anspruchs-PDFs innerhalb eines 24-Stunden-Fensters an den `/claims/incoming/`-Bucket.
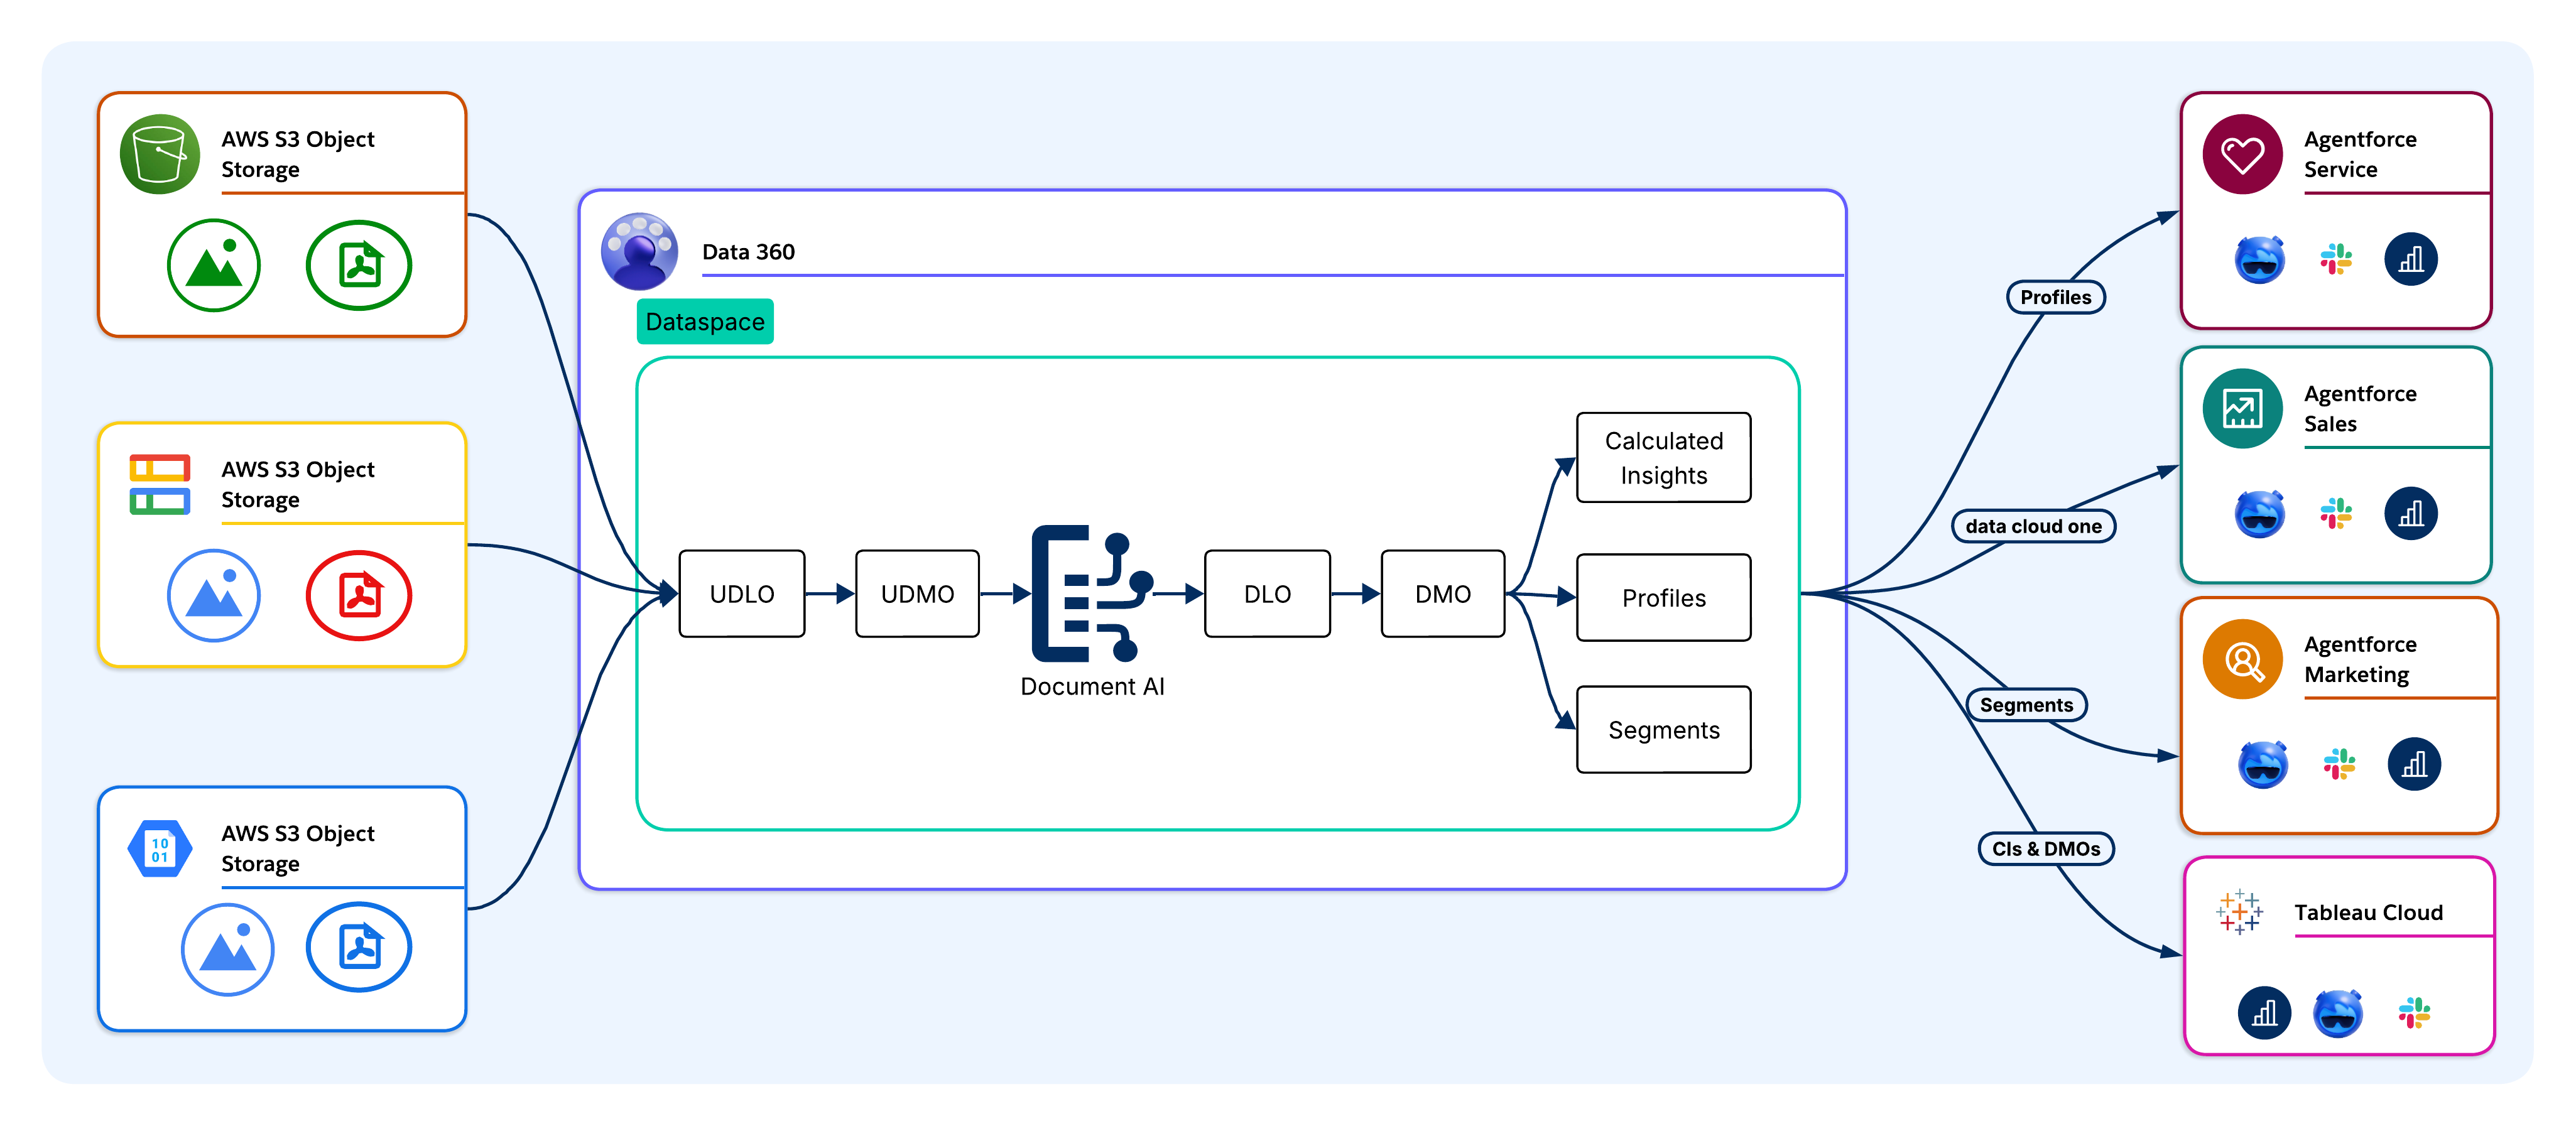
#### Phase 1: Aufnahme
Dokumente werden ohne physische Duplikate aus Unternehmensquellsystemen in _Data 360_ aufgenommen. Zu den unterstützten Quellen zählen _Amazon S3_, _Google Cloud Storage_, Salesforce CRM-Dateiobjekte, _MuleSoft-orchestrierte_ Pipelines und direkte API-Uploads. Bei _Headless 360-_Bereitstellungen werden Dokumente über Cloud-Speicher-Konnektoren oder die _Aufnahme-API_ aufgenommen, wodurch die CRM-Ebene umgangen wird. Der Server _Model Context Protocol (MCP)_ stellt die Aufnahme als aufrufbares Tool für externe AI-Agenten und LLM-Clients bereit.
Bei der Aufnahme werden Rohdokumente als _Unstrukturierte Data-Lake-Objekte (_UDLOs) gespeichert, die dem physischen Speicherort und den Metadaten jedes Dokuments zugeordnet werden, ohne die Quelldatei zu verschieben oder umzuwandeln.
**Beispiel:**
Über den Cloud-Speicher-Konnektor werden Anspruchs-PDFs aus _S3_ in _Data 360_ aufgenommen. Jedes Dokument wird als UDLO gespeichert, das auf das _S3-_Objekt verweist. Es erfolgt keine physische Duplizierung.
#### Phase 2: Extrahieren
_Die Dokument-AI_ verarbeitet jedes UDLO anhand einer Schemakonfiguration, die definiert, welche Felder zusammen mit ihren Zieldatentypen extrahiert werden sollen. Das UDMO definiert, welche Dokumente in den Geltungsbereich fallen. Der LLM (_GPT-4o_, _Gemini_ oder _Claude_) liest jedes Dokument und gibt eine strukturierte Extraktionsnutzlast zurück.
**Beispiel:**
_Die Dokument-AI_ verarbeitet jedes UDLO anhand eines Anspruchsschemas, das Felder wie die folgenden definiert: ClaimID, PatientName, DiagnosisCode, BillingAmount und ServiceDate. LLMs lesen dann jede PDF und geben eine strukturierte Extraktionsnutzlast zurück.
#### Phase 3: Persistieren
Sobald die Daten extrahiert wurden, werden sie in DLOs beibehalten, bei denen es sich um die Rohspeicherebene von _Data 360_ handelt. DLOs behalten extrahierte Felder bei, ohne Geschäftslogik aufzuzwingen, wodurch eine genaue physische Darstellung für die nachgelagerte Transformation und Rückverfolgbarkeit erhalten bleibt. Das UDLO behält einen Verweis auf das Quelldokument bei, um die Abstammung auf Feldebene an jedem Punkt der Pipeline zu aktivieren.
**Beispiel:**
Alle extrahierten Felder werden in einem _Claims-DLO_ angezeigt, das eine rohe, genaue Darstellung jedes Anspruchs mit vollständiger Abstammung bewahrt, die bis zur Quell-PDF zurückverfolgt werden kann.
#### Phase 4: Harmonisieren
DLO-Felder werden DMOs zugeordnet, die mit dem standardmäßigen _Customer 360 Data Model_ übereinstimmen. Dies ist die Grenze, an der dokumentabgeleitete Daten von rohen, extrahierten Feldern zu geschäftsrelevanten Einheiten übergehen. Das _DLO "Rechnung_" wird einem _DMO "Rechnung_" zugeordnet und Felder wie _CustomerID_ und _BillingAmount_ werden zu Verknüpfungsschlüsseln und gleichen Attribute im vereinheitlichten Datenmodell ab. Harmonisierte Dokumentdaten sind über dieselben Schnittstellen wie CRM- und Transaktionsdaten an der Segmentierung, _berechneten Statistiken_ und Aktivierung beteiligt.
**Beispiel:**
Das _DLO "Claims_" (Ansprüche) wird einem _DMO für Ansprüche_ zugeordnet. Die Felder PatientID und PolicyNumber werden zu Verknüpfungsschlüsseln, die Anspruchsdatensätze mit vereinheitlichten Patientenprofilen verknüpfen.
#### Phase 5: Zusammenführen
Harmonisierte DMO-Daten sind an der Identitätsbestimmung beteiligt. Extrahierte Felder (z. B. Kundennamen, E-Mail-Adressen oder Accountnummern) dienen als Abgleichsschlüssel für die Verknüpfung von Dokumentdatensätzen mit _zusammengeführten Einzelpersonen (Goldene Datensätze)_, wodurch die Lücke zwischen Dokument und Profil geschlossen wird.
**Beispiel:**
Extraktionsfelder (z. B. PatientName, DateOfBirth und PolicyNumber) dienen als Abgleichsschlüssel für die Identitätsbestimmung, wodurch Anspruchsdatensätze mit der richtigen _zusammengeführten Einzelperson_ verknüpft werden. Dies geschieht selbst dann, wenn derselbe Patient in den Dokumenten unter leicht unterschiedlichen Namen angezeigt wird.
#### Phase 6: Ableiten von Statistiken
Architekten definieren _berechnete Statistiken_. Hierbei handelt es sich um aggregierte Kennzahlen, die über harmonisierte Dokumentdaten hinweg berechnet werden (z. B. die Gesamtausgaben aus verschiedenen Rechnungsposten, Risikobewertungen für Vertragsverlängerungen und Indizes zum Schweregrad von Ansprüchen).
**Beispiel:**
_Berechnete Statistiken_ berechnen TotalClaimsPerPatient, AverageClaimAmount und HighRiskClaimScore für harmonisierte Anspruchsdaten für Agentforce-Abfragen.
#### Phase 7: Handeln
Agentforce Agenten, _Tableau_, Marketingplattformen und Salesforce-_SObjects_ können auf harmonisierte, identitätsaufgelöste Daten zugreifen. Die Zielklasse ist eine architektonische Entscheidung, die von Latenz-, Governance- und Datenresidenzanforderungen bestimmt wird.
**Beispiel:**
Ein _Agentforce Agent_ für die Beurteilung von Ansprüchen fragt die _Data 360_-DMOs und -CIs ab, um Ansprüche mit hohem Risiko für die Prioritätsüberprüfung zu finden. In _Tableau-_Dashboards werden Trends zum Anspruchsvolumen und zur Anomalie angezeigt. Genehmigte Anspruchsdatensätze kehren zum _SObject "Claims_" zurück, um Zahlungs-Workflows zu initiieren.
In _Headless 360_-Architekturen wird die Aktivierung direkt über die _Abfrage-API_, die _Pub/Sub-API_ oder die Cloud Data Warehouse-Aktivierungsziele an externe Systeme weitergeleitet. Anschließend findet der MCP-Server harmonisierte Dokumentdaten und _berechnete Statistiken_ als aufrufbare Tools für externe AI-Agenten.
### Transaktionsverarbeitungs-Pipeline
Die _Transaktionsverarbeitungs-_Pipeline verarbeitet die Einzeldokumentextraktion zur Laufzeit ohne ein UDMO oder ein vorintegriertes UDLO, das für ereignisgesteuerte Anwendungsfälle geeignet ist (beispielsweise wenn ein Kunde ein Formular hochlädt, ein Agent eine PDF empfängt oder ein externes System die Extraktion innerhalb eines Transaktionsverarbeitungs-Workflows initiiert). Die ETL-Governance gilt für beide Pipelines identisch.
**Real-World-Szenario**
Beim Beantragen eines Darlehens lädt ein Bankkunde über die mobile Anwendung der Bank eine PDF seiner Versorgungsrechnung hoch. Das Ereignis initiiert die Extraktion in Echtzeit, d. h., es ist kein vorgefertigtes UDLO oder UDMO beteiligt.
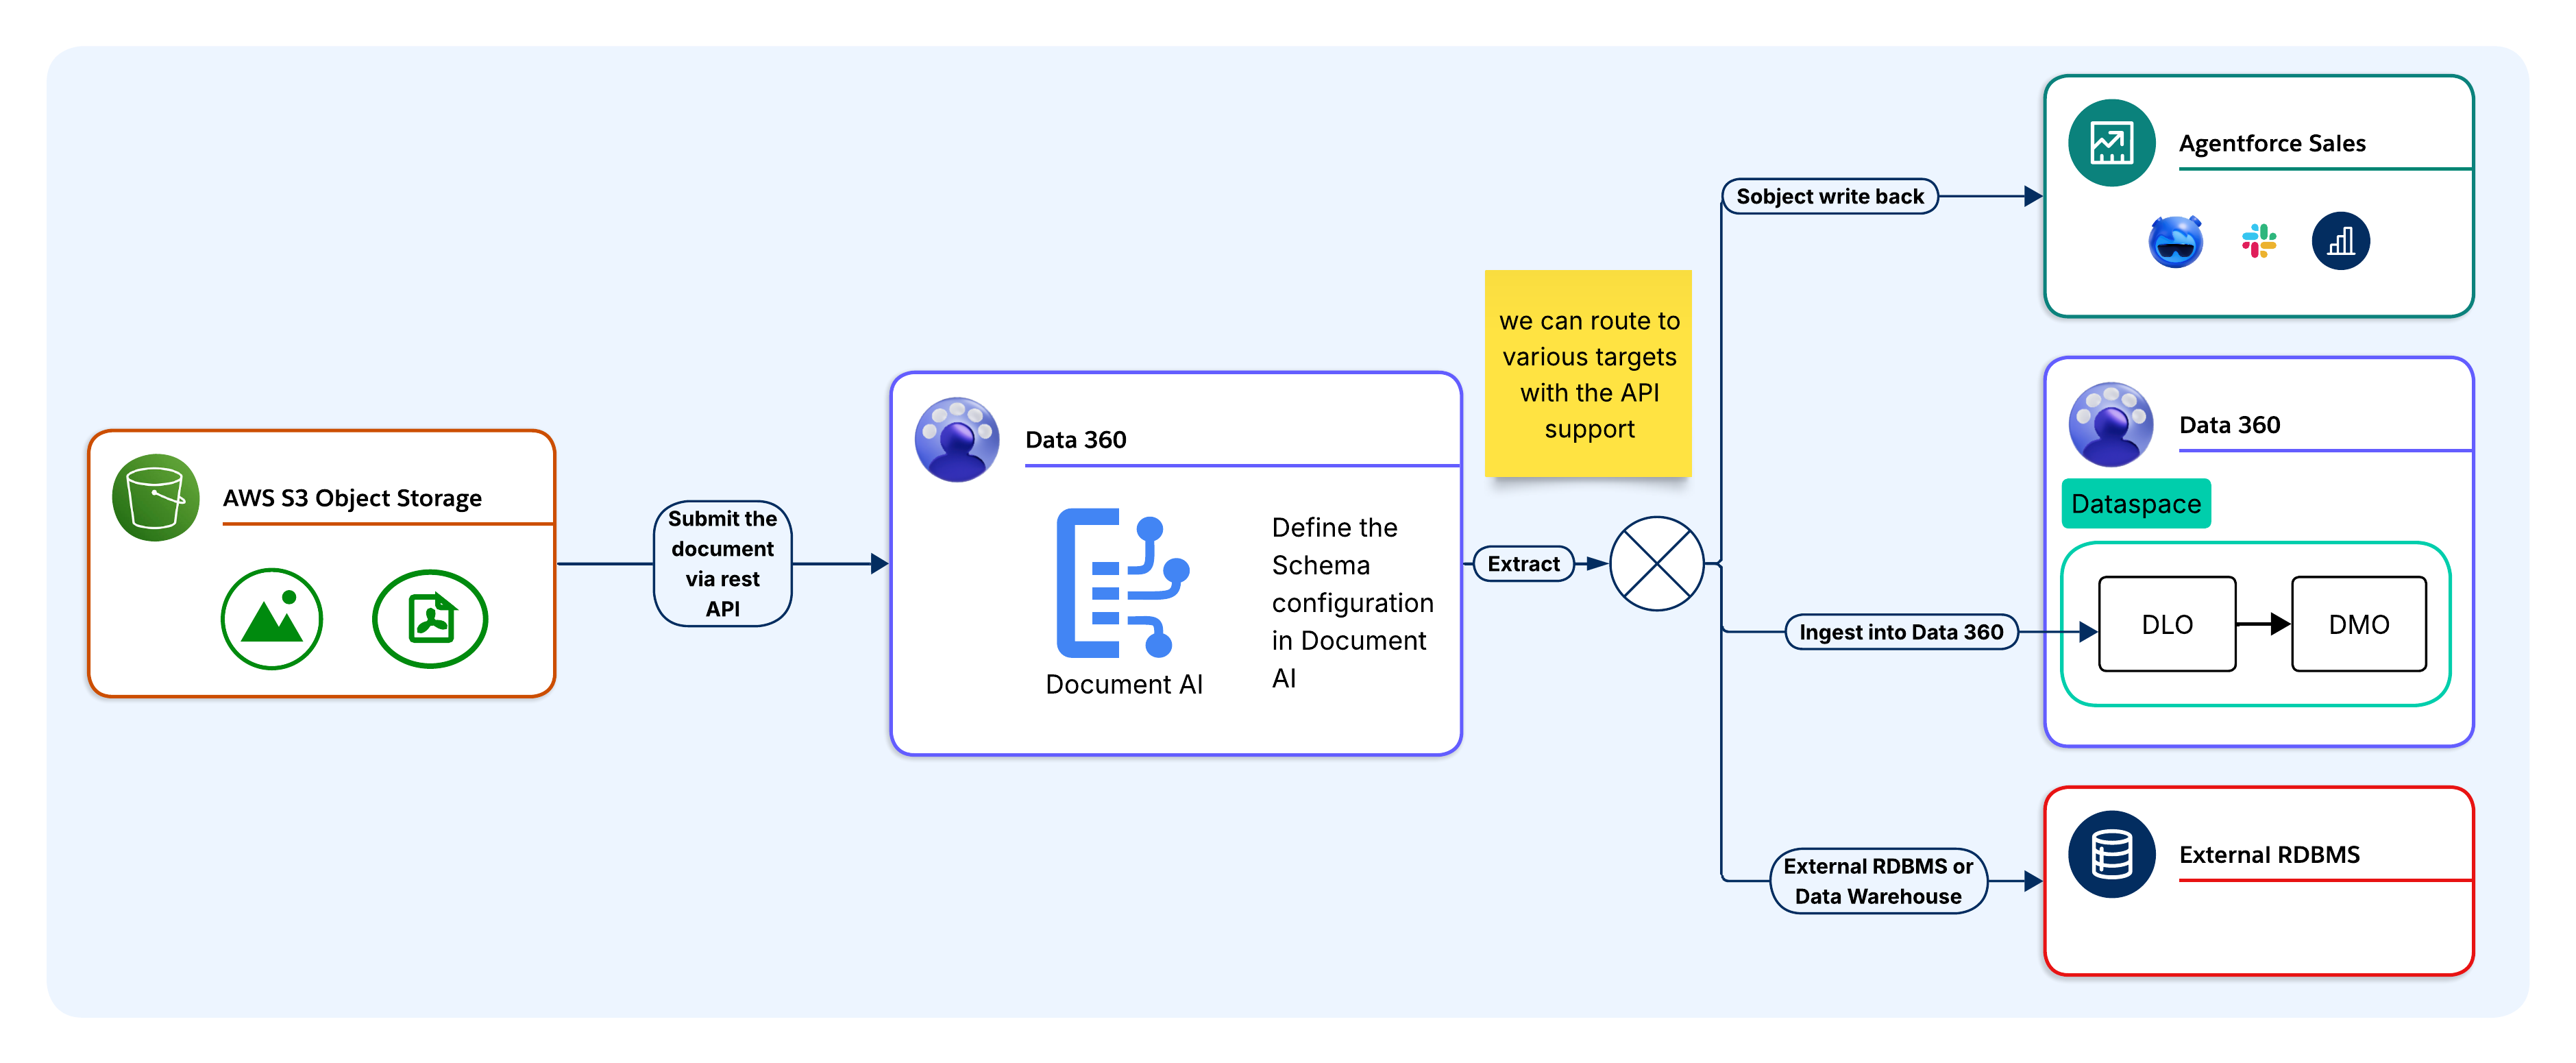
#### Phase 1: Definieren der Schemakonfiguration
Vor dem Aufrufen der API müssen Architekten ein Schema in _Data 360_ definieren und speichern, das die Felder, Datentypen und Extraktionsanweisungen im _JSON-Schemaformat_ angibt. Jedem Schema wird eine eindeutige _Schema-ID_ zugewiesen. Zur Laufzeit verweist die aufrufende Anwendung auf die Schema-ID, um die Extraktionslogik in _Data 360_ zentral zu halten, statt sie in Anwendungscode einzubetten.
**Beispiel:**
Das Team der Bank verfügt über ein vordefiniertes `ProofOfAddress` in _Data 360_, das Felder wie `CustomerName`, `AddressLine1`, `City`, `PostCode` und `DocumentDate` angibt. Diese Informationen werden als versionierte Konfiguration gespeichert, auf die über eine _Schema-ID_ verwiesen werden kann.
#### Phase 2: Senden von Dokumenten
Die aufrufende Anwendung sendet das Dokument und die Schema-ID in einer einzelnen REST-API-Anforderung als base64-codierte Nutzlast oder Dateireferenz. Es ist keine UDLO-Aufnahme erforderlich. _Die Dokument-AI_ wendet die Dokumentextraktion an und gibt die strukturierte Ausgabe basierend auf dem bereitgestellten Schema zurück.
**Beispiel:**
Die mobile Anwendung sendet die Versorgungsrechnung als base64-codierte Nutzlast zusammen mit der `ProofOfAddress`-Schema-ID in einem einzelnen REST-API-Aufruf. Für diesen Prozess ist kein UDLO-Aufnahmeschritt erforderlich.
#### Phase 3: Extrahieren
Der LLM verarbeitet die OCR-Ausgabe anhand des Schemas und gibt synchron eine strukturierte JSON-Nutzlast zurück. Felder, die im Dokument nicht gefunden werden, werden als _null_ zurückgegeben. Der Aufrufer ist Inhaber der vollständigen JSON-Antwort und fährt mit der Weiterleitung fort.
**Beispiel:**
_Die Dokument-AI_ wendet OCR auf die PDF an und der LLM gibt eine strukturierte JSON-Nutzlast mit extrahierten Adressfeldern zurück. Felder, die nicht gefunden werden (beispielsweise wenn der `PostCode` in der Rechnung fehlt), werden als _null_ zurückgegeben.
#### Phase 4: Route to Target (Optional)
Nach der Extraktion kann die JSON-Nutzlast je nach Anwendungsfall an eine oder mehrere Zielklassen weitergeleitet werden:
- **Salesforce-Objekte:** Ordnet _SObject-_Feldern direkt über _Apex_ oder _Flow_ für CRM-Workflows und -Genehmigungen zu.
- **Data 360-DLO/DMO-Pipeline:** Leitet sie zur Harmonisierung, Identitätsbestimmung, _berechneten Statistiken_ und Agentforce-Kontextbildung an ein DLO weiter.
- **Externes RDBMS oder Data Warehouse:** Leitet über _MuleSoft_, _Apex_ Callout, _Plattformereignisse_ oder ETL für Systeme weiter, die sich außerhalb von Salesforce befinden.
- **Benutzerdefinierte Integration:** Gibt strukturierte JSON-Nutzlasten zur Speicherung in einem externen System oder Datenspeicher an die aufrufende Anwendung zurück.
- **Nachgelagerter Flow oder Agent:** Übergibt die strukturierte JSON-Ausgabe direkt an einen nachgelagerten Flow oder Agenten ohne Persistenz in ein _SObject_. Dies ist ein gängiges Muster für Kunden, die die _Dokument-AI_ als Echtzeitextraktionsschritt innerhalb eines größeren Automatisierungs- oder Agenten-Workflows verwenden.
Beachten Sie, dass ein einzelnes Schema möglicherweise mehrere Stufen gleichzeitig umfasst, wobei unterschiedliche Feldgruppen vom selben Extraktionspunkt aus an unterschiedliche Ziele weitergeleitet werden.
**Beispiel:**
Eine `ProofOfAddress`-Nutzlast kann auf drei Klassen gleichzeitig aufgefächert werden (beispielsweise durch Schreiben von `CustomerName` und `AddressLine1` in das _Kontakt-SObject_), wodurch ein _Flow zur_ Adressüberprüfung initiiert wird. Anschließend wird die vollständige Nutzlast zur Harmonisierung und Risikobewertung in ein DLO und eine Kopie zur Protokollierung der Einhaltung gesetzlicher Vorschriften über _MuleSoft_ an das KYC-System der Bank weitergeleitet.
#### Phase 5: Handeln
Sobald die extrahierten Daten geschrieben wurden, werden sie sofort im Zielsystem aktiviert. Bei _SObject-_Zielen werden die Auslöser, Flows und Genehmigungsprozesse im aktualisierten eingefügten Datensatz aktiviert. Bei _DLO/DMO_-Zielen gelangen Daten in die Pipeline für _Harmonisierung und Identitätsbestimmung_ und in den Kontext von Agentforce. Bei externen _RDBMS-_Zielen sind Daten für nachgelagerte Abfragen verfügbar, sobald der Schreibvorgang abgeschlossen ist.
**Beispiel:**
Der _Adressüberprüfungs-Flow_ wird sofort im aktualisierten _Kontaktdatensatz_ aktiviert, wodurch der Darlehensantrag in die nächste Phase übergeht. Der Agentforce _Darlehenssachbearbeiter Agent_ findet die überprüfte Adresse aus _Data 360_ und das KYC-System zeichnet die Vorlage des Dokuments zu Prüfungszwecken auf.
## Wann sollten Sie Dokument-AI verwenden?
_Dokument-AI_ eignet sich am besten für spezifische architektonische Bedingungen. Die Anwendung außerhalb dieser Bedingungen führt zu unnötiger Komplexität und zusätzlichen Kosten.
Als Architekten ist es wichtig, diese Kriterien auszuwerten, bevor Sie sich auf die _Dokument-AI_ als Extraktionsmechanismus festlegen.
**Verwenden Sie Dokument-AI in folgenden Fällen:**
- **Dokumente sind die primäre Datenquelle.** Die erforderlichen Informationen sind nur in Dokumentform vorhanden und über eine strukturierte API oder Datenbank (z. B. gescannte Verträge, Laborberichte, Aufnahmeformulare oder Versicherungsansprüche) nicht verfügbar.
- **Dokumentlayouts variieren je nach Quelle.** Derselbe Dokumenttyp stammt von mehreren Anbietern, Partnern oder Regionen mit unterschiedlichen Außendienstpositionen und -formaten. Die schemagesteuerte LLM-Extraktion wird ohne Layoutwartung angepasst.
- **Extrahierte Daten müssen Data 360 oder Agentforce zuführen.** Die Extraktion muss an der Identitätsbestimmung, _berechneten Statistiken_ oder Agentforce-Kontextbildung beteiligt sein. Die _Dokument-AI_ wird ohne separate ETL-Ebene direkt in die _DLO/DMO-_Pipeline bereitgestellt.
- **Das Volumen rechtfertigt eine geregelte Automatisierung.** Das Dokumentvolumen übersteigt die Möglichkeiten der manuellen Verarbeitung ohne messbare Arbeitskosten oder Datenqualitätsrisiken.
- **Dokumente enthalten regulierte Inhalte.** _PHI-_, _PII-_ oder Finanzdaten müssen durch eine Zero-Data-Retention-Schicht mit PII-Maskierung geleitet werden, bevor sie eine LLM erreichen. Die ETL erfüllt dies nativ. Kunden, die möchten, dass zu keinem Zeitpunkt extrahierter Inhalt beibehalten wird, sollten auch den _Transaktions-API_-Flow in Betracht ziehen, der die strukturierte Ausgabe direkt an die aufrufende Anwendung zurückgibt, ohne in ein _SObject_ oder einen Datenspeicher schreiben zu müssen.
- **Der Anwendungsfall ist ereignisgesteuert.** Ein Dokument kommt zur Laufzeit an (beispielsweise ein Kunden-Upload, ein PDF-Anhang für Agenten oder ein externer Systemauslöser). Die _Transaktionsverarbeitungs-_Pipeline verarbeitet die synchrone Extraktion mit einem einzelnen Dokument ohne Batch-Setup.
**Verwenden Sie in folgenden Fällen keine Dokument-AI:**
- **Quelldaten sind bereits strukturiert.** Wenn das Upstream-System eine REST-API, eine Datenbanktabelle oder eine strukturierte Datei (z. B. CSV, JSON oder XML) bereitstellt, verwenden Sie einen standardmäßigen _Data 360-_Konnektor. Die Ausführung strukturierter Daten durch eine LLM-Extraktions-Pipeline führt zu Latenz- und Kreditkosten ohne zusätzliche Vorteile.
- **Dokumente werden mit einem festen Schema maschinell generiert.** Systemgenerierte PDFs aus einer bekannten ERP- oder Abrechnungsplattform mit stabilem Layout eignen sich besser für einen deterministischen Parser. Die LLM-Extraktion ist auf Variabilität ausgelegt und bei der Anwendung auf Dokumente mit festem Schema werden Kontext und Gutschriften verschwendet.
- **Genauigkeitsanforderungen überschreiten LLM-Konfidenzschwellenwerte.** _Die Dokument-AI_ garantiert keine 100 %ige Extraktionsgenauigkeit. Anwendungsfälle, in denen ein verpasster oder falscher Feldwert ein erhebliches finanzielles, rechtliches oder klinisches Risiko birgt, erfordern einen HITL-Validierungsschritt. Verwenden Sie _die Dokument-AI_ nicht als einzige Extraktionsebene für Entscheidungen mit hohem Einsatz ohne Validierungs-Workflow.
- **Dokumente überschreiten Plattformeinschränkungen.** Aufgrund der derzeitigen Obergrenze von 10 MB Dateigröße und der begrenzten LLM-Kontextlänge ist _die Dokument-AI_ für große oder dichte Dokumente ohne Vorverarbeitung ungeeignet, um sie außerhalb der Plattform aufzuteilen und wieder zusammenzufügen.
- **Hinweis:** Bei Salesforce werden diese Akzeptanzrichtlinien aktiv verbessert, um die unterstützten Dateigrößen, Seitenzahlen und Dateierweiterungen zu erweitern. Einschränkungen werden sich auch in Zukunft weiterentwickeln.
## Anwendungsfälle: Überprüfen der Muster in der Praxis
### Anwendungsfälle der Batch-Pipeline
Sehen wir uns einige Szenarien genauer an, in denen die _Document AI Batch_-Pipeline verwendet wird, die durch ein UDMO-Quellobjekt unterstützt wird. In diesen Fällen werden extrahierte Daten zur Harmonisierung, Identitätsbestimmung, _berechneten Statistiken_ und Agentforce-Aktivierung durch die _Data 360 DLO/DMO_-Pipeline geleitet. Jeder Anwendungsfall eignet sich am besten für die geplante oder ereignisgesteuerte Dokumentverarbeitung mit hohem Volumen.
**Agentforce Sales: Vertrags- und Rechnungsintelligenz**
_Vertrags-_PDFs werden über die _Batch-_Pipeline aus dem Cloud-Speicher aufgenommen. Das Schema extrahiert "ContractValue", "RenewalDate", "PaymentTerms" und "CounterpartyName" und ordnet sie dann den Datenmodellobjekten "_Account_" und "_Vertrag"_ zu. _Berechnete Statistiken_ leiten Bewertungen für Verlängerungsrisiken ab. Agentforce benachrichtigt Kundenbeauftragte vor dem Schließen von Verlängerungszeitfenstern, wodurch die manuelle Vertragsüberprüfung und verpasste Verlängerungen entfallen.
**Agentforce Services: Kundenvorgangsableitung und Knowledge Grounding**
_Umfrage-_PDFs und Kundenvorgangsanhänge werden über die _Batch-_Pipeline aufgenommen. Das Schema extrahiert Stimmungsindikatoren, Problemkategorien und Lösungshinweise und ordnet sie dann den DMOs für _Kundenvorgänge_ und _Knowledge-Artikel_ zu. Agentforce fragt beim Öffnen des Kundenvorgangs die harmonisierte Knowledge Base ab und sucht relevante Schritte zur Fehlerbehebung, wodurch der Aufwand für die Agentensuche reduziert wird.
**Agentforce Health: Klinische Dokumentverarbeitung**
Laborberichte, Aufnahme-PDFs und handschriftliche klinische Formulare werden über die _Batch-_Pipeline aufgenommen. Das Schema extrahiert Felder wie _PatientID_, _DiagnosisCode_, _MedicationName_ und _TestResult_ und ordnet sie dann den DMOs der _Health Cloud_ zu, die HIPAA-konforme Workflows für die Versorgungskoordination und die klinische Forschung unterstützen.
**Finanzdienstleistungen: Automatisierung von Darlehens- und Steuerdokumenten**
Darlehensanträge, Steuererklärungen und Gewinn- und Verlustrechnungen werden über die Batch-Pipeline aufgenommen. Das Schema extrahiert Felder wie "Jahreseinkommen", "Steuerjahr" und "EmployerName" und ordnet sie dann den Datenmodellobjekten für _Finanz-Accounts_ zu. _Berechnete Statistiken_ verbinden dokumentenbasierte Einkommensdaten und CRM-Daten, um die automatisierte Kreditrisikobewertung zu erleichtern. Agentforce sucht die extrahierten Darlehensdetails während der Kundendienstinteraktionen inline. Dieses Muster unterstützt direkt den Anwendungsfall "[Darlehenspräqualifikationsagent](https://developer.salesforce.com/developer-centers/agentic-enterprise-solutions)", der im Salesforce _Agentic Enterprise Solutions_-Entwicklercenter veröffentlicht wird.
**HR: Belegschaftsdokumentverarbeitung**
Einarbeitungsdokumente, Steuerformulare und Zertifizierungs-PDFs werden über die _Batch-_Pipeline aufgenommen. Die extrahierten Felder werden den Datensatz-DMOs für _Mitarbeiter_ zugeordnet und dann mit dem Profil "_Zusammengeführter Mitarbeiter_" verknüpft. Bestimmte _Flows_ initiieren Aufgaben für die Einarbeitung und Compliance-Prüfungen anhand der extrahierten Daten. Dieses Muster unterstützt direkt den Anwendungsfall "[Automatische Fortsetzung – Verarbeitungsagent](https://developer.salesforce.com/developer-centers/agentic-enterprise-solutions)". _Die Dokument-AI_ extrahiert Fertigkeiten, den Beschäftigungsverlauf und Qualifikationen aus Lebenslauf-PDFs, die Agentforce dann verwendet, um Kandidaten anhand offener Rollenkriterien abzugleichen und sie an Einstellungs-Workflows weiterzuleiten.
**Professionelle Dienstleistungen: Vorschlags- und Forschungsintelligenz**
Vorschlagsdecks und Forschungsberichte werden über die _Batch-_Pipeline aufgenommen. Extrahierte Frameworks, Benchmarks und Engagementzusammenfassungen werden benutzerdefinierten DMOs zugeordnet und dann für die Vektorsuche indiziert. Agentforce ruft zum Abfragezeitpunkt kontextrelevante Empfehlungen ab, die auf extrahiertem Dokumentinhalt basieren. Dieses Muster erweitert das Muster "[Ground Agentforce on Website Content](https://developer.salesforce.com/developer-centers/agentic-enterprise-solutions)" (Grundlegende Agentforce für Websiteinhalte). Dokumente werden über _die Dokument-AI_ indiziert und dienen für Agentenantworten der gleichen Kontextfunktion wie Website-Inhalte, die über _Data 360-_Konnektoren indiziert werden.
**HIPAA-Compliance-Status:**
Die in diesem Papier beschriebenen _Health Cloud_-Muster wenden ETL-Steuerelemente (z. B. Null-Datenaufbewahrung und PHI-Maskierung) für Texteingaben an. Diese Steuerelemente allein stellen keine HIPAA-Zertifizierung dar. Architekten, die für regulierte klinische Umgebungen konzipieren, müssen den aktuellen HIPAA-Zertifizierungsstatus beim Salesforce-Compliance-Team bestätigen, bevor sie sich in diesen Kontexten auf eine _AI-_basierte Dokumentarchitektur festlegen.
### Anwendungsfälle der Pipeline für die Transaktionsverarbeitung
Sehen wir uns einige Szenarien genauer an, in denen die REST-API für _Dokument-AI_ mit einem Schema aufgerufen wird, das nicht an ein UDMO gebunden ist. Extrahierte JSON-Nutzlasten werden zur Laufzeit synchron direkt an externe Systeme weitergeleitet.
**Lieferkette: Lieferantenrechnungsverarbeitung für ERP**
Wenn eine PDF-_Lieferantenrechnung_ in einem überwachten Speicher-Bucket oder E-Mail-Gateway eingeht, ruft ein Ereignisauslöser die REST-API der _Dokument-AI_ mit der Rechnung und einer vordefinierten Schema-ID auf. Das Schema extrahiert die VendorID, InvoiceNumber, LineItems, TotalAmount, TaxAmount und DueDate. Die JSON-Nutzlast wird über _MuleSoft_ an das Modul "_ERP Accounts Payable_" (Zahlungspflichtige _ERP-Accounts_) mit Validierung des Nullfelds und idempotenter Aktualisierungs-Einfügelogik weitergeleitet, wodurch die Vorlagenwartung für die Varianz des Lieferantenformats entfällt.
**Rechtsgeschäfte: Vertragsüberprüfung an CLM**
Wenn eine _Vertrags-_PDF in das Rechtsportal hochgeladen wird, ruft das Backend die REST-API für _die Dokument-AI_ synchron auf. Das Schema extrahiert "GoverningLaw", "IndemnityCapAmount", "TerminationNoticePeriod", "AutoRenewalClause" und "CounterpartySignatory". Die JSON-Nutzlast wird über _Apex_ Callout an das System _Contract Lifecycle Management (CLM)_ weitergeleitet. Alle Felder, die nicht gefunden werden, werden als _null_ zurückgegeben und das CLM wendet die Standardpflichtregeln auf die fehlenden Werte an.
**Versicherungsansprüche: Erste Meldung der Verlustverarbeitung**
Wenn ein Versicherungsnehmer ein Formular für die _erste Verlustanzeige_ sendet, ruft das Backend-Portal die REST-API _der Dokument-AI_ synchron auf. Das Schema extrahiert "PolicyNumber", "IncidentDate", "IncidentLocation", "DamageDescription", "ClaimantName" und "ContactPhone". Die JSON-Nutzlast wird über _Apex_ Callout oder ETL an die _Anspruchsverwaltungsdatenbank_ weitergeleitet, wodurch ein vorab ausgefüllter Anspruchsdatensatz erstellt wird, der von den Anpassungen überprüft werden kann, bevor der formelle Anspruch geöffnet wird.
## Überlegungen zum Design und Fehlermodi
Bevor Sie in die Produktion wechseln, müssen Sie Entwürfe für diese Fehlerszenarien erstellen.
- **Null-Feldverarbeitung:** Der LLM gibt _null_ für Felder zurück, die nicht gefunden oder sicher extrahiert werden können. Validieren Sie die Nullverarbeitungslogik beim Schemadesign und implementieren Sie die Standardwert- oder Ablehnungslogik in der Integrationsebene, bevor Sie Ziele mit _NICHT NULL-_Einschränkungen oder erforderlichen Übereinstimmungsschlüsseln schreiben.
- **OCR-Qualitätsminderung:** Die OCR-Genauigkeit nimmt unter 150 DPI, bei unregelmäßiger Handschrift oder bei verrauschten Scans ab. Fehlanzeigen werden als beschädigte Eingabe ohne Fehlersignale in die LLM-Extraktion übernommen. Erzwingen Sie die Mindestscanqualität bei der Aufnahme und implementieren Sie Konfidenzschwellenwertprüfungen für numerische Felder und Datumsfelder.
- **Nicht übereinstimmende Schemaversion:** Wenn Sie eine Schemakonfiguration aktualisieren, nachdem ein Batchauftrag geplant wurde, werden Dokumente im laufenden Betrieb mit der vorherigen Version verglichen, wodurch fehlende oder umbenannte Felder erzeugt werden, die die nachgelagerte Zuordnung beeinträchtigen. Versionsschemas explizit und koordinieren Aktualisierungen mit Batchauftragsplänen.
- **Obergrenzen für Dateigrößen:** Dokumente, die größer als 10 MB sind, werden abgelehnt. Batch-Pipeline-Fehler sind ohne konfigurierte Überwachung stumm und Transaktionsanrufer erhalten einen Fehler vom Typ _4xx_. Validieren Sie die Dateigrößen bei der Aufnahme vorab und implementieren Sie die Vorverarbeitung, um Dokumente aufzuteilen oder zu komprimieren, die sich regelmäßig der Obergrenze nähern.
- **LLM-Kontextüberlauf:** Dichte oder mehrseitige Dokumente können das LLM-Kontextfenster innerhalb der Obergrenze von 10 MB überschreiten. Der LLM verwirft Inhalte, die den Kontext überschreiten. Implementieren Sie eine Blockierungsstrategie, die Dokumente nach Seitenbereich aufteilt und die extrahierten Felder erneut zusammenstellt, bevor sie an das Ziel übertragen werden.
- **Trust Layer Masking Affecting Extraction (Vertrauensebenenmaskierung mit Auswirkungen auf die Extraktion):** Die ETL wird auf Aufforderungsebene ausgeführt, nicht auf Dokumentebene. Daher wird die Maskierung nicht auf Dokumentinhalte angewendet, die _die Dokument-AI_ durchlaufen. Schemafelder, die von _den personenbezogenen_ Werten im Dokument abhängen, sind von Richtlinien für die ETL-Maskierung nicht betroffen.
- **Externe RDBMS-Schreibidentität:** Die Pipeline für die _Transaktionsverarbeitung_ verfügt nicht über eine integrierte Identität für externe _RDBMS-_Ziele. Bei Wiederholungen auf _Integrationsebene_ werden doppelte Zeilen erstellt, es sei denn, die Schreiblogik verarbeitet die Duplizierung explizit. Implementieren Sie idempotente Upserts mithilfe eines Dokumentfingerabdrucks oder einer externen ID für alle externen Schreibpfade.
- **Krediterschöpfung zur Mitte der Ausführung:** Bei großen Batch-Ausführungen kann es sein, dass _Digital Wallet_-Guthaben vor der Verarbeitung aller Dokumente erschöpft ist, was unvollständige DLO-Datensets zur Folge hat, die von nachgelagerten Schritten als abgeschlossen betrachtet werden. Legen Sie Verbrauchsbenachrichtigungen auf 75 % und 90 % der verfügbaren Gutschriften fest und begrenzen Sie die Batchgrößen, um für jeden Zyklus innerhalb des Gutschriftsbudgets zu bleiben.
- **Schemafeldobergrenze – architektonische Einschränkung:** _Die Dokument-AI_ erzwingt eine Obergrenze von 50 Feldern für Felder auf Stammebene in einer Schemakonfiguration. Hierbei handelt es sich um eine Design-Zeit-Einschränkung – kein Laufzeitfehler –, die Architekten beim Datenmodell- und Schemadesign berücksichtigen müssen.
- Für Anwendungsfälle, die eine umfassendere Extraktion erfordern:
- Priorisieren Sie rücksichtslos. Grenzen Sie das Schema auf Felder ein, die den Automatisierungswert steigern, nicht auf eine vollständige Dokumentabdeckung.
- Verwenden Sie verschachtelte Objekte (bis zu 3 Ebenen; Batch-Modus nur mit Quellobjekt), um die Anzahl der Stammfelder zu reduzieren, ohne die Extraktionstiefe zu beeinträchtigen.
- Zerlegen Sie komplexe Dokumente über mehrere _Dokument-AI_-Konfigurationen hinweg, die auf unterschiedliche Dokumentabschnitte abzielen, und schreiben Sie Ergebnisse in separate DLOs, die in _Data 360_ nachgelagert verbunden werden.
- **API-Ratenobergrenzen:** Die _Dokument-AI_ erzwingt eine Obergrenze von 50 Extraktions-API-Aufrufen pro Minute und Mandant. Die theoretische Obergrenze liegt bei 300 Aufrufen pro Minute, was durch das _Einstein LLM Gateway_ geregelt wird. Transaktionsintegrationen mit hohem Volumen müssen mit exponentiellem Backoff, Warteschlangen für Anforderungen und Budgetierung des Durchsatzes auf Mandantenebene konzipiert werden. Gehen Sie nicht davon aus, dass die Burst-Kapazität in Produktionsumgebungen mit mehreren Mandanten verfügbar ist.
- **API-Latenzprofil:** Die Extraktions-APIs für _die Dokument-AI_ sind vollständig synchron. Typische Antwortzeiten liegen zwischen 5 und 15 Sekunden und variieren je nach Dateigröße und Schemakomplexität.
- Dies hat direkte Auswirkungen auf die Integrationsarchitektur:
- Legen Sie die Anrufer-Timeouts auf mindestens 30 Sekunden fest.
- Rufen Sie keine _Dokument-AI_ in Flows mit SLA-Anforderungen im Sekundenbereich auf.
- Latenz bei der Berechnung des Durchsatzes im Vergleich zur Ratenobergrenze für _Batch-Verarbeitungspipelines_.
- **Verschlüsselte und kennwortgeschützte Dokumente:** _Dokument-AI_ verarbeitet keine kennwortgeschützten Dateien (Benutzerkennwörter sind zum Öffnen von Dateien erforderlich) oder PDFs, die mit einem Kennwort für Inhaber/Berechtigungen verschlüsselt sind. Dies gilt auch für Dateien, die normal geöffnet werden, jedoch das Kopieren, Drucken oder Bearbeiten auf der Ebene der _PDF-Berechtigungen_ einschränken.
- Diese Einschränkung befindet sich an der Aufnahmegrenze:
- Entwerfen Sie Pipelines zur _Dokumentaufnahme_, um verschlüsselte Dateien zu erkennen und an einen _Ablehnungs-_ oder _manuellen Verarbeitungspfad_ weiterzuleiten, bevor sie _die Dokument-AI_ erreichen.
- Verlassen Sie sich nicht auf die Fehlerverarbeitung während der Laufzeit als primäres Gate.
## Gut durchdachte Ausrichtung
Die _Data 360-Dokument-AI_ ist auf mehrere Säulen des Salesforce _Well-Architected Framework_ abgestimmt.
- **Trust:** Das ETL erzwingt die Aufbewahrung von Nullwerten bei LLM-Anbietern, maskiert _personenbezogene_ Eingaben, bevor sie das Modell erreichen, und scannt Ausgaben auf sensible Inhalte. Architekten müssen diesen Status auf extrahierte Daten im Leerlauf erweitern. Die Feldebenenmaskierung in DLOs wird vom ETL nicht angewendet und erfordert nachgelagerte _Datenbereichsrichtlinien_ und _Berechtigungssätze_.
- **Zuverlässigkeit:** Jeder Fehlermodus im Abschnitt "_Überlegungen zum Design_" (Extraktion von Nullfeldern, OCR-Fehllesung, Schemaversionsabweichung, Dateigrößenverletzung, LLM-Kontextüberlauf, ETL-Maskierungsinterferenz, RDBMS-Schreibidentität und Krediterschöpfung) stellt eine eindeutige Fehlerklasse mit dokumentiertem Erkennungssignal und Lösungspfad dar.
- **Operational Excellence (Änderungsverwaltung):** Das schemagesteuerte Extraktionsmodell entkoppelt die Extraktionslogik vom Dokumentlayout. Wenn ein Anbieter ein Rechnungsformat ändert oder ein behördliches Formular aktualisiert wird, müssen Architekten nur eine Schemakonfiguration aktualisieren, statt den Integrationscode zu ändern.
- **Operational Excellence (Wartbarkeit):** Wenn Sie Schemakonfigurationen in _Data 360_ zentralisieren und keine Extraktionslogik in Anwendungscode einbetten, wird der Extraktionsabsicht explizit, versioniert und überprüfbar. Alle nachgelagerten Ziele verwenden denselben Schemavertrag unabhängig von ihrer Zielklasse.
- **Operational Excellence (Wiederverwendung der Integration):** _Dokument-AI_ stellt die Extraktion über mehrere Integrationsoberflächen hinweg bereit: REST-API, _Apex_, _Flow_, _MuleSoft_, Agentforce _Actions_ und der MCP-Server. Eine einzelne Schemakonfiguration wird gleichzeitig auf mehrere Zielklassen aufgefächert, ohne die Extraktionsfunktion pro Verbraucher neu erstellen zu müssen.
- **Ressourcen- und Kostenoptimierung:** Die Pipeline-Auswahlanleitung, die Dateigrößenbegrenzung von 10 MB und die LLM-Kontextlänge vor der Montage stellen leistungsorientierte Designentscheidungen dar. Im Abschnitt "_Verwendungszweck"_ werden die Bedingungen für den Fall formalisiert, dass _die Dokument-AI_ nicht das richtige Tool ist (z. B. Latenzanforderungen im Sekundenbereich, vollständig strukturierte Quelldaten und maschinell generierte Dokumente mit festem Schema).
## Kurzanleitung für Architekten
Dies ist ein strukturierter Ausgangspunkt für die Konfiguration der _AI von Data 360_-Dokumenten in einer Sandbox-Umgebung. Schließen Sie alle Phasen in der Sandbox ab, bevor Sie in die Produktion wechseln.
### Bevor Sie beginnen
Bevor Sie mit der Konfiguration beginnen, müssen Sie Folgendes bestätigen:
- **Dateigröße:** Überprüfen Sie, ob die repräsentativen Dokumentgrößen unter 10 MB liegen.
- **Pipeline:** Überprüfen Sie, ob für den Anwendungsfall die _Batch-_Pipeline (UDMO-gestützt, hohes Volumen) oder die _Transaktionsverarbeitungs-_Pipeline (API-gesteuert, einzelnes Dokument) erforderlich ist. Dies steuert die gesamte nachfolgende Konfiguration.
- **Zielstufe:** Bestätigen Sie, wo die extrahierten Daten landen: Salesforce _SObject_, _Data 360_ DLO/DMO, externes RDBMS oder eine Kombination.
- **Agentforce Abhängigkeit:** Stellen Sie vor dem Bereitstellen einer von Agentforce unterstützten Dokumentverarbeitung sicher, dass eine unterstützte [LLM](https://help.salesforce.com/s/articleView?id=ai.generative_ai_large_language_model_support.htm&type=5) (z. B. _GPT-4o_) in Ihrer Organisation über die ETL-Einstellungen aktiviert ist. Agentforce ist eine harte Plattformvoraussetzung für die _Dokument-AI_. Die gesamte Oberfläche der _AI-_Funktion für Dokumente, einschließlich aller Extraktions-APIs, ist erst verfügbar, wenn Agentforce in der Zielorganisation aktiv ist. Berücksichtigen Sie dies bei der Bewertung der Organisationsbereitschaft und der Bereitstellungsreihenfolge. Es kann einige Minuten dauern, bis die API-Verfügbarkeit nach der Aktivierung stabilisiert ist.
- **Auswirkung der Agentforce-Deaktivierung:** Wenn Agentforce deaktiviert ist, nachdem die _Dokument-AI_ konfiguriert und bereitgestellt wurde, wird die gesamte Extraktionsverarbeitung (Benutzeroberfläche und API) sofort blockiert. Dasselbe gilt für die Modelldeaktivierung. Das Deaktivieren des zugrunde liegenden Modells hat eine entsprechende Auswirkung auf die Verfügbarkeit _von Dokument-AI_. In beiden Fällen werden die vorhandenen Schemakonfigurationen beibehalten und bleiben sichtbar – es treten keine Konfigurationen oder Datenverluste auf –, die Funktion ist jedoch erst dann vollständig funktionsunfähig, wenn Agentforce und das Modell erneut aktiviert sind. Entwerfen Sie operationelle Runbooks, um die Agentforce-Verfügbarkeit und die Modellaktivierung als Gesundheitsabhängigkeiten _der Dokument-AI_ zu behandeln.
- **Kreditverbrauch/-preise:** Verwenden Sie _Data 360_-Gutschriften oder _Flex-Gutschriften_ für TCO-Schätzungen, die aus repräsentativen Beispieldokumenten abgeleitet werden.
#### Phase 1: Schema- und Pipeline-Konfiguration
- **Erstellen Sie die Schemakonfiguration.** Definieren Sie Extraktionsfelder, Datentypen und Anweisungen im _JSON-Schemaformat_ im AI-Setup für _Data 360-Dokumente_. Binden Sie sie für die _Batch-_Pipeline an ein UDMO. Erstellen Sie für die _Transaktionsverarbeitungs-_Pipeline diese ohne Quellobjekt. Notieren Sie sich die Schema-ID.
- **Passen Sie Feldnamen an die Zielklasse an.** Gleichen Sie Feldnamen mit DLO-Spaltendefinitionen, _SObject_-API-Namen oder RDBMS-Spaltennamen ab. Falsch ausgerichtete Namen verursachen den Zuordnungs-Overhead in der Integrationsebene.
- **Konfigurieren Sie das UDMO-Quellobjekt (nur Batch).** Definieren Sie Dokumente im Umfang und konfigurieren Sie die Aufnahmequellenkonnektivität (z. B. _S3_, _Google Cloud Storage_, _Salesforce Files_ oder _MuleSoft)_. Stellen Sie sicher, dass der Aufnahmeservice-Account über den erforderlichen Umfang für _IAM-_ oder _OAuth-_Anmeldeinformationen verfügt.
- **Wenden Sie Richtlinien für die Maskierung personenbezogener Daten an.** Konfigurieren Sie Richtlinien für die _Datenmaskierung_ in den ETL-Einstellungen, bevor Sie regulierte Inhalte verarbeiten. Definieren Sie, welche Feldtypen (_PHI_, _PII_ und Finanzkennzeichner) maskiert werden sollen, bevor Eingaben in das LLM gelangen. Stellen Sie diesen Schritt **nicht** zurück.
- **Umfang und Berechtigungssätze für den Datenbereich zuweisen.** Grenzen Sie die Verarbeitung auf den entsprechenden _Datenbereich_ ab und konfigurieren Sie _Berechtigungssätze_, um die Schemaerstellung, die Ausführung von Batchaufträgen, den REST-API-Aufruf und die nachgelagerte Aktivierung zu steuern.
- **Konfigurieren der API-Authentifizierung (nur Transaktionsverarbeitungs-Pipeline).** Erstellen Sie eine _verbundene Anwendung_ mit den _OAuth-_Geltungsbereichen cdp_ingest_api und api. Verwenden Sie für organisationsinterne Anrufer _Anmeldeinformationen mit Namen_, die auf _externe Anmeldeinformationen_ verweisen. Konfigurieren Sie für externe Anrufer _OAuth 2.0-_Client-Anmeldeinformationen oder einen JWT-Bearer-Flow. Testen und validieren Sie die Extraktion, bevor Sie fortfahren.
#### Phase 2: Integration und Zielkonfiguration
- **SObject Write-back:** Implementieren Sie ein _Apex_ (@InvocableMethod)- oder _Flow-_Element, das JSON-Antwortfelder _SObject-_Feldern zuordnet. Verwenden Sie Database.upsert() mit einer externen ID, um Duplikate zu verhindern. Wenden Sie _die Feldebenensicherheit_ auf _SObject-_Zielfelder an.
- **Data 360 DLO/DMO-Pipeline:** Ordnen Sie extrahierte DLO-Felder DMOs zu, die mit dem _Customer 360 Data Model_ übereinstimmen. Konfigurieren Sie Regeln für die Identitätsbestimmung, um Dokumentdatensätze mit _zusammengeführten Einzelpersonen_ zu verknüpfen. Definieren Sie _berechnete Statistiken_ und fügen Sie DMOs für Agentforce hinzu. Leiten Sie für die Transaktionsverarbeitungs-Pipeline die JSON-Nutzlast zunächst über die _Aufnahme-_API an ein DLO weiter.
- **Externes RDBMS oder Data Warehouse:** Wählen Sie das Integrationsmuster aus: _MuleSoft_ (vorhandenes Integrationsgewebe), _Apex_ HTTP-Callout (leichtgewichtig, organisationsnativ), _Plattformereignisse_ mit dem _Pub/Sub-_Abonnenten (ereignisgesteuert) oder ETL (Batch mit hohem Volumen). Implementieren Sie idempotente Upserts mithilfe eines Dokumentfingerabdrucks oder einer externen ID für alle externen Schreibpfade.
- **Aktivierungspfade:** Verbinden Sie Agentforce-Aktionen mit Schemakonfigurationen für die interaktive Extraktion. Konfigurieren Sie _Flow_\- oder _Apex_-Auslöser für automatisierte Verarbeitungs-Workflows und richten Sie die Aktivierungsziele für jede Feldgruppe ein.
- **Fehlerbehandlung (nur Transaktionsverarbeitungs-Pipeline).** Konfigurieren der vollständigen HTTP-Antwortoberfläche: **200** (_erfolgreich_, einschließlich teilweiser _Null-_Antworten), **400** (_fehlgebildete Anforderung_ oder _Schema-ID nicht gefunden_), **413** (Datei größer als 10 MB), **5xx** (Servicefehler). Implementieren Sie eine exponentielle Sicherung für _5xx_ Wiederholungen mit maximal 3 Versuchen. Protokollieren Sie die JSON-Rohantwort und die Schema-ID bei jedem Aufruf.
#### Phase 3: Validieren und Vorbereiten auf die Produktion
- **Testen Sie Schemas anhand von Beispieldokumenten.** Senden Sie repräsentative Beispiele über die _Dokument-AI_-Schnittstelle oder die REST-API. Bestätigen Sie die Extraktionsgenauigkeit, die Feldabdeckung und die Akzeptanz von Nullwerten über Layoutvariationen hinweg.
- **Validieren Sie die Akzeptanz von Nullfeldern.** Stellen Sie sicher, dass alle nachgelagerten Ziele _Nullwerte_ für _Felder_ verarbeiten können, die in einem Dokument nicht gefunden werden. Beachten Sie, dass _NICHT NULL_-Einschränkungen ohne explizite Nullverarbeitung fehlschlagen.
- **Dateigrößen vorab validieren.** Stellen Sie sicher, dass Produktionsdokumente unter 10 MB bleiben. Implementieren Sie die Vorverarbeitung, um Dokumente aufzuteilen oder zu komprimieren, die sich regelmäßig der Obergrenze nähern.
- **Validieren Sie die durchgängige Extraktion.** Initiieren Sie für die _Batch-_Pipeline eine vollständige Ausführung und überprüfen Sie, ob die extrahierten Felder in jeder Zielklasse richtig landen. Verfolgen Sie für die Pipeline zur _Transaktionsverarbeitung_ die JSON-Antwort über die _Integrationsebene_ bis zum Ziel. Überprüfen Sie den Auslöser und die Flow-Ausführung für die _SObject-_Ziele, die Identitätsbestimmungsverknüpfung für die _DLO/DMO-_Ziele und die Identitätsbestimmung für die _RDBMS-_Ziele.
- **Verhalten der Trust Layer bestätigen.** Die ETL wendet keine _personenbezogene_ Maskierung auf Dokumentinhalte an. Daher gibt die LLM _personenbezogene_ Daten in extrahierten Feldern unverändert zurück. Stellen Sie sicher, dass Ihre Schemafelder, die Datenweiterleitung und der nachgelagerte Speicher für die angemessene Verarbeitung personenbezogener Daten ausgelegt sind, und stellen Sie sicher, dass alle Compliance- oder Aufbewahrungsanforderungen außerhalb der Plattform erfüllt werden.
- **Legen Sie Digital Wallet-Benachrichtigungen fest.** Konfigurieren Sie Verbrauchsbenachrichtigungen bei 75 % und 90 % der verfügbaren Gutschriften. Legen Sie für jeden Zyklus Obergrenzen für die Batchgröße und Ad-hoc-Satzschätzungen im Kreditbudget fest.
- **Batchüberwachung validieren (nur Batch-Pipeline).** Überprüfen Sie in der _Data 360_-Überwachungskonsole die Erfolgsraten bei der Extraktion, die Nullfeldraten und den Auftragsabschluss. Bestätigen Sie die Tag-Übertragung aus dem UDLO über das DLO in das DMO in der Datenherkunft.
- **API-Fehlerbehandlung validieren (nur Transaktionsverarbeitungs-Pipeline).** Testen Sie alle Fehlerbedingungen: **413** (Dokumente über 10 MB), **400** (ungültige Schema-IDs), **200** (gültige Extraktionen mit Teilnullwerten). Stellen Sie sicher, dass die Wiederholungslogik auf simulierte **5xx-**Antworten ausgelöst wird, ohne doppelte Schreibvorgänge zu erstellen.
## Schlussfolgerung
In diesem Dokument werden die architektonischen Grundlagen der _Data 360 Document AI_: hervorgehoben.
- Zwei Verarbeitungspipelines und wann sie verwendet werden sollen
- Das Schemakonfigurationsmodell
- Das Entscheidungs-Framework der Zielklasse
- Kerntechnologieneinschränkungen
- Fehlermodi
- _Gute Framework_-Ausrichtung
Die [Schnellstartanleitung für Architekten](/docs/architect/de-de/fundamentals/guide/data360-document-ai#kurzanleitung-für-architekten) bietet die Konfigurationsreihenfolge für einen Sandbox-Konzeptnachweis.
Der zentrale Architekturstatus unterstützt dokumentenabgeleitete Daten, die auf der _Schemaebene_ geregelt, über eine ETL-erzwungene LLM-Pipeline verarbeitet und an denselben _Data 360-_Datenlebenszyklus bereitgestellt werden, der auch alle anderen Unternehmensdaten regelt.
Architekten, die diese Prinzipien anwenden – die Auswahl der richtigen Pipeline, das Entwerfen von Schemas auf Dokumenttypebene und das Entwerfen von Fehlermodi vor der Produktion –, erstellen Extraktionsfunktionen, die entsprechend den regulierten Anforderungen an die Unternehmensführung skaliert und dauerhaft sind.
### Über die Autoren
**Yugandhar Bora** ist Software-Entwickler bei Salesforce und hat sich auf die Datenarchitektur innerhalb der Plattform für _Daten- und Intelligenzanwendungen_ spezialisiert. Er leitet Initiativen des _Enterprise Architecture Review Board (EARB)_, die sich auf die Datenverwaltung und vereinheitlichte Datenmodelle konzentrieren, und trägt gleichzeitig zu automatisierten Plattformbereitstellungslösungen bei.
**Annth Anto** ist Director of Product Management bei Salesforce _Data 360_ und leitet die Initiativen _für Dokument-AI und Datendiagramme_. Er lebt in Bangalore und arbeitet mit Unternehmenskunden zusammen, um die Herausforderungen der realen Dokumentverarbeitung und Datenintelligenz zu lösen. Es macht ihm Spaß, _Unternehmensanwendungsfälle_ für _generative AI (Generative AI)_ zu erkunden.
**Nishan Naseer** ist Software-Entwickler bei Salesforce und beschäftigt sich mit _unstrukturierter Datenverarbeitung_, _RAG-_Pipelines und _Dokumentintelligenz_. Er nutzt mit Leidenschaft die Leistungsfähigkeit der KI, um reale Herausforderungen anzugehen und kreative Lösungen für komplexe Kundenprobleme zu finden.
# Übersicht
Moderne Salesforce-Integrationen müssen weit mehr unterstützen als den einfachen Datenaustausch. Es wird erwartet, dass sie Kundenerfahrungen in Echtzeit unterstützen, Aktionen über mehrere Systeme hinweg koordinieren und zuverlässig im Unternehmensmaßstab arbeiten – und dies alles unter Einhaltung strenger Sicherheits- und Compliance-Anforderungen. Die Wahl des richtigen Integrationsansatzes ist daher eine wichtige architektonische Entscheidung und kein Implementierungsdetail.
Stellen Sie sich ein allgemeines Unternehmensszenario vor. Ein Kunde schließt einen Kauf in einer mobilen Anwendung ab und löst eine Echtzeit-Anspruchsprüfung für ein personalisiertes Angebot aus. Gleichzeitig müssen Transaktionsdaten in einem ERP-System aufgezeichnet, Kundenattribute in Salesforce aktualisiert und Analysen an einen Data Lake übertragen werden, ohne Latenz, Datenduplizierung oder Compliance-Risiko einzuführen. Szenarien wie diese sind nun typisch in modernen Salesforce-Umgebungen, in denen Salesforce selten isoliert arbeitet und sich nahtlos in ein breiteres Ökosystem von Anwendungen und Datenplattformen integrieren muss.
Dieser Leitfaden soll Architekten und Entwicklern helfen, diese Integrationen klar und sicher zu entwerfen. Statt sich auf Punkt-zu-Punkt-Implementierungen zu konzentrieren, werden **bewährte Integrationsmuster** vorgestellt, die sich auf wiederkehrende Unternehmensszenarien wie die Prozessorchestrierung, die Datensynchronisierung und den Echtzeit-Datenzugriff beziehen. Jedes Muster legt den Schwerpunkt auf architektonische Absichten, Kompromisse und Ausführungsmodelle, sodass Teams fundierte Designentscheidungen treffen können, die skaliert und dauerhaft sind.
In diesem Dokument finden Sie Folgendes:
* Integrationsmuster, die allgemeine Unternehmens-„Archetypen“ in Prozess-, Daten- und virtuellen Zugriffsszenarien darstellen
* Ein Musterauswahl-Framework, das hilft, den richtigen Ansatz basierend auf Integrationsabsicht und Ausführungszeit zu identifizieren
* Praktische Anleitung zu Skalierbarkeit, Resilienz, Governance und Sicherheitsaspekten
* Bewährte Vorgehensweisen aus realen Salesforce- und Data 360-Implementierungen
Das Ziel dieses Dokuments besteht darin, eine gemeinsame Architektursprache für die Integration bereitzustellen und Teams dabei zu unterstützen, Lösungen zu entwickeln, die Leistung, Flexibilität und Trust in Einklang mit Unternehmensdaten und Governance-Strategien bringen.
## Zweck und Umfang
Dieses Dokument richtet sich an Designer und Architekten, die Daten aus anderen Anwendungen in ihrem Unternehmen in Salesforce Data 360 (ehemals Data Cloud) integrieren müssen. Dieser Inhalt ist eine Zusammenfassung vieler erfolgreicher Implementierungen von Salesforce-Architekten und -Partnern.
Wenn Sie sich mit den Integrationsfunktionen und -optionen vertraut machen möchten, die für die umfassende Einführung von Data 360 verfügbar sind, lesen Sie die Abschnitte "Musterübersicht" und "Musterauswahlanleitung" weiter unten. Architekten und Entwickler sollten diese Musterdetails und bewährten Vorgehensweisen während der Entwurfs- und Implementierungsphase von Dateninteraktionsprojekten in Data 360 berücksichtigen.
Wenn diese Muster ordnungsgemäß implementiert werden, können Sie so schnell wie möglich zur Produktion gelangen und über die stabilsten, skalierbarsten und wartungsfreien Anwendungen verfügen. Die eigenen beratenden Architekten von Salesforce verwenden diese Muster als Referenzpunkte bei Architekturüberprüfungen und pflegen und verbessern sie aktiv.
Wie bei allen Mustern deckt dieser Inhalt die meisten Integrationsszenarien ab, jedoch nicht alle. Salesforce ermöglicht zwar beispielsweise die Integration von Mashups auf der Benutzeroberfläche (UI), diese Integration fällt jedoch nicht in den Geltungsbereich dieses Dokuments.
### Mustervorlage
Jedes Integrationsmuster folgt einer konsistenten Struktur. Dies sorgt für Konsistenz bei den in den einzelnen Mustern bereitgestellten Informationen und erleichtert zudem den Vergleich von Mustern.
* **Name**: Der Musterkennzeichner, der auch den im Muster enthaltenen Integrationstyp angibt.
* **Context:** Das allgemeine Integrationsszenario, auf das sich das Muster bezieht. Kontext enthält Informationen darüber, was Benutzer erreichen möchten und wie sich die Anwendung verhält, um die Anforderungen zu erfüllen.
* **Problem:** Als Frage ausgedrückt, ist dies das Szenario, das das Muster lösen soll. Lesen Sie diesen Abschnitt, um nachzuvollziehen, ob das Muster für Ihr Integrationsszenario geeignet ist.
* **Kräfte:** Die Einschränkungen und Umstände, die die Lösung des angegebenen Szenarios erschweren.
* **Lösung:** Die empfohlene Lösung für das Integrationsszenario.
* **Skizze:** Ein UML-Sequenzdiagramm, das Ihnen zeigt, wie die Lösung das Szenario angeht.
* **Ergebnisse:** Erläutert, wie die Lösung auf Ihr Integrationsszenario angewendet wird und wie die mit diesem Szenario verbundenen Kräfte aufgelöst werden. Dieser Abschnitt enthält auch neue Herausforderungen, die durch die Anwendung des Musters auftreten können.
* **Randleisten:** Zusätzliche Abschnitte zum Muster, die wichtige technische Probleme, Variationen des Musters, musterspezifische Bedenken usw. enthalten.
* **Beispiel:** Ein reales Szenario, das beschreibt, wie das Designmuster in einem realen Salesforce-Szenario verwendet wird. Im Beispiel werden die Integrationsziele erläutert und erläutert, wie das Muster implementiert wird, um diese Ziele zu erreichen.
## Musterübersicht
Verwenden Sie diese Tabelle als Inhaltsverzeichnis für die in diesem Dokument enthaltenen Integrationsmuster.
### Liste der Muster
| Musterebene1 | Musterebene2 | Muster | Szenario |
|---|---|---|---|
| Datenaufnahmemuster – Eingehende Daten | Batch-Aufnahmemuster | Massendatenaufnahme aus Cloud-Speicher | Daten werden aus einer Enterprise Cloud-Speicherquelle wie Amazon S3, Azure Blob oder Google Cloud Storage in Data 360 in Form großer Batches mit Rohdaten (z. B. Transaktionen oder Produktprotokollen) aufgenommen. |
| Massendatenaufnahme aus Salesforce Clouds | Data 360 empfängt CRM-Daten per Massenvorgang aus mehreren Salesforce-Organisationen (z. B. Sales Cloud, Service Cloud), um zusammengeführte Kundenprofile zu erstellen. | ||
| Streaming und Echtzeit-Aufnahmemuster | Ereignisgesteuerte Aufnahme über die Aufnahme-API – Streaming | Data 360 abonniert Streaming-Aufnahmeendpunkte, die kontinuierliche Ereignisnutzlasten (z. B. Kaufereignisse, IoT-Telemetrie) von Unternehmenssystemen empfangen, um Profilaktualisierungen in Echtzeit vorzunehmen. | |
| Aufnahme von Web- und mobilem Verhalten in Echtzeit | Data 360 erfasst und verarbeitet Verhaltensdaten von Websites und mobilen Anwendungen in Echtzeit über SDKs, um Interaktionskennzahlen und Personalisierungsmodelle anzureichern. | ||
| CRM-Synchronisierung nahezu in Echtzeit über Streaming | Data 360 empfängt CRM-Datenaktualisierungen (z. B. Kontakt-, Kundenvorgangs- oder Opportunity-Änderungen) nahezu in Echtzeit über Ereignisströme, um eine kontinuierlich synchronisierte Customer 360 Ansicht aufrechtzuerhalten. | ||
| Ereignisstromaufnahme aus Cloud-Messaging-Plattformen – Kinesis und MSK | Data 360 verwendet Streaming-Daten direkt von Cloud-Ereignisplattformen wie AWS Kinesis oder Kafka (MSK), um hochfrequente betriebliche oder IoT-Ereignisse zu verarbeiten. | ||
| Null Kopiermuster – Eingehend und ausgehend | Eingehende Nullkopie – externe Plattformen für Data 360 | Data 360 fragt externe Datensets (z. B. Snowflake, BigQuery) bei Bedarf über die Aufnahme von Nullkopien ab, ohne Daten physisch in Salesforce zu verschieben. | |
| Ausgehende Nullkopie – Data 360 für externe Plattformen | Externe Systeme wie Databricks oder Tableau greifen über ausgehende Zero Copy-Verbindungen ohne Datenreplikation auf angereicherte Segmente und Statistiken in Data 360 zu. | ||
| Zusammengeführte Datenplattform für mehrere Organisationen mit Data Cloud One | Data Cloud One vereinheitlicht mehrere Salesforce-Organisationen und externe Datenquellen unter einem gemeinsamen Metadaten- und semantischen Modell und bietet so eine konsistente Customer 360 ohne Datenduplizierung. | ||
| Datenaktivierungsmuster – Ausgehende Daten | Batch-Aktivierungsmuster | Segmentaktivierung für Marketing- und Werbeplattformen | Data 360 aktiviert verwaltete Kundensegmente direkt in Marketing Cloud, Meta, Google Ads oder anderen Anzeigenplattformen für die Bereitstellung personalisierter Kampagnen |
| Datenexport in Cloud-Speicher | Data 360 exportiert zusammengeführte oder gefilterte Datensets (z. B. Datensätze vom Typ "Zustimmung zu Kunden") als CSV- oder Parquet-Dateien in den Enterprise Cloud-Speicher für Analysen oder die Compliance-Archivierung. | ||
| API-basierte On-Demand-Aktivierung | Benutzerdefinierte Anwendungsintegration über die Connect-API | Externe Anwendungen rufen die Data 360 Connect-API in Echtzeit auf, um personalisierte Aktionen (z. B. Treuebilanzprüfung oder Generierung von AI-Angeboten) basierend auf aktuellen Kundendaten abzurufen oder auszulösen.Benutzerdefinierte Web- oder mobile Anwendungen rufen harmonisierte Data 360-Statistiken sicher über die Connect-REST-API ab, um sie auf der Benutzeroberfläche von Unternehmen oder Partnern anzuzeigen. | |
| Abschließen des Kundenprofilabrufs über die Datendiagramm-API | Ein System ruft das vereinheitlichte Profil eines Kunden mithilfe der Datendiagramm-API ab und gibt eine vorverknüpfte JSON-Darstellung in Echtzeit der vollständigen 360°-Ansicht zur Entscheidungsfindung oder Personalisierung zurück. | ||
| Echtzeit-Datenaktionen | Echtzeit-Datenaktion zum Umwandeln von Kundensignalen in sofortige Aktionen | Data 360 erkennt und verarbeitet ein Live-Ereignis (z. B. Einwilligungsaktualisierung, Kaufauslöser) und ruft sofort ein verbundenes System oder einen Salesforce-Flow für nachgelagerte Aktionen auf.Ein Kundenaktivitätssignal (z. B. erkanntes Abwanderungsrisiko) in Data 360 löst eine sofortige Echtzeitaktion aus, beispielsweise das Aktualisieren von CRM, das Aufrufen von Einstein-Bewertungen oder das Starten einer Aufbewahrungs-Journey. |
| Typ | Zeitpunkt | Überlegungen zu "Ausgehend" |
|---|---|---|
| Datenintegration | Asynchron | Segmentaktivierung für Marketing- und Werbeplattformen |
| Prozess-/Datenintegration | Synchronous | Benutzerdefinierte Anwendungsintegration über die Connect-API Abschließen des Kundenprofilabrufs über die Datendiagramm-API |
| Datenintegration | Synchronous | Echtzeit-Datenaktion zum Umwandeln von Kundensignalen in sofortige Aktionen |
| Virtuelle Integration (mit Zero Copy) | Asynchron | Ausgehende Nullkopie – Data 360 für externe Plattformen |
| Virtuelle Integration | Asynchron | Zusammengeführte Datenplattform für mehrere Organisationen mit Data Cloud One |
| Typ | Zeitpunkt | Eingehende Überlegungen |
|---|---|---|
| Datenintegration | Asynchron | Massendatenaufnahme aus Cloud-Speicher Massendatenaufnahme aus Salesforce Clouds |
| Datenintegration | Asynchron | Ereignisstromaufnahme aus Cloud-Messaging-Plattformen – Kinesis und MSK CRM-Synchronisierung nahezu in Echtzeit über Streaming |
| Prozessintegration | Synchronous | Ereignisgesteuerte Aufnahme über die Aufnahme-API – Streaming Aufnahme von Web- und mobilem Verhalten in Echtzeit |
| Virtuelle Integration | Asynchron | Eingehende Nullkopie – externe Plattformen für Data 360 |
| Term | Definition |
|---|---|
| Ereignisverarbeitung | Die Ereignisverarbeitung bezieht sich auf das Empfangen, Weiterleiten und Reagieren auf identifizierbare Vorkommnisse aus einem Quellsystem oder einer Anwendung. Die Middleware verarbeitet Ereignisse, indem sie den Zielendpunkt identifiziert, das Ereignis weiterleitet und die erforderliche Geschäftsaktion auslöst (z. B. Protokollierung, Wiederholungen oder Aktivierung nachgelagerter Services). In Data 360-Architekturen ist die Ereignisverarbeitung wichtig für die Echtzeit-Datenaufnahme, Aktivierungsauslöser und Veröffentlichungs-/Abonnementmuster. Ereignisse können von externen Systemen (Kafka, AWS Kinesis) oder Salesforce Platform-Ereignissen stammen und von Middleware oder dem Data 360-Ereignis-Bus zur sofortigen Verarbeitung weitergeleitet werden. |
| Protokollkonvertierung | Die Protokollkonvertierung ermöglicht die Kommunikation zwischen Systemen, die unterschiedliche Datentransportstandards verwenden. Middleware übersetzt proprietäre oder ältere Protokolle (wie AMQP, MQTT, FTP) in unterstützte Data 360-Protokolle (REST, gRPC oder HTTPS). Dadurch wird die Interoperabilität über heterogene Systeme hinweg gewährleistet. Da Data 360 die Protokollkonvertierung nicht nativ verarbeitet, stellt Middleware die Anpassungsebene bereit, um Nachrichten in ein Format zu kapseln oder umzuwandeln, das Data 360-APIs und -Konnektoren interpretieren können. |
| Übersetzung und Transformation | Die Übersetzung und Transformation gewährleisten die Interoperabilität, indem sie ein Datenformat oder Schema einem anderen zuordnen. Middleware führt diese Transformationen aus, um verschiedene Datennutzlasten (CSV, XML, JSON) an Data 360-Datenmodellobjekten (DMOs) und Objekten der einheitlichen Datenebene (Unified Data Layer Objects, UDLOs) auszurichten. Dies umfasst die Bereinigung, Anreicherung und Anwendung der semantischen oder ontologiebasierten Zuordnung vor der Aufnahme. Salesforce bietet Transformationstools wie Rezepte für die Datenvorbereitung. Komplexe Transformationen (insbesondere für die semantische Harmonisierung) lassen sich jedoch am besten in Middleware verarbeiten. |
| Warteschlange und Pufferung | Warteschlange und Pufferung basieren auf der asynchronen Nachrichtenweitergabe, um eine belastbare, entkoppelte Kommunikation zu gewährleisten. Middleware-Plattformen (z. B. MuleSoft, Kafka oder Azure Event Hub) stellen persistente Warteschlangen bereit, in denen Daten temporär gespeichert werden, wenn Data 360 oder nachgelagerte Systeme ausgelastet oder nicht erreichbar sind. Dadurch wird Datenverlust verhindert und die Aufnahme oder Aktivierung nahezu in Echtzeit unterstützt. Data 360 unterstützt die Streaming-Aufnahme und das Flow-basierte ausgehende Messaging. Die dauerhafte Warteschlange und die garantierte Zustellung werden jedoch in der Regel von Middleware verarbeitet. |
| Synchrone Transportprotokolle | Synchrone Transportprotokolle beinhalten Blockierungs-/Antwortvorgänge in Echtzeit. Der Absender wartet auf eine Antwort, bevor er fortfährt. In Data 360 werden sie für API-basierte On-Demand-Aktivierungen, Echtzeitanreicherungen oder Profilnachschlagevorgänge verwendet, bei denen Antworten sofort erforderlich sind. Middleware gewährleistet die Verbindungszuverlässigkeit und verwaltet Wiederholungen oder Ausweichvorgänge für synchrone Data 360-API-Aufrufe. |
| Asynchrone Transportprotokolle | Asynchrone Transportprotokolle unterstützen die nicht blockierende, entkoppelte Kommunikation, bei der der Absender die Verarbeitung fortsetzt, ohne auf eine Antwort zu warten. Middleware verarbeitet asynchrone Flows für Batch-Aktivierungen, die Streaming-Aufnahme und die ereignisgesteuerte Aktivierung. Dies ermöglicht einen hohen Durchsatz und Widerstandsfähigkeit – entscheidend für das Streaming von Ereignissen und die nahezu Echtzeit-Datenaufnahme in Data 360. |
| Vermittlungsweiterleitung | Die Vermittlungsweiterleitung definiert einen komplexen Nachrichtenfluss zwischen Systemen und stellt sicher, dass die richtigen Daten oder Ereignisse den richtigen Verbraucher erreichen. Middleware fungiert als Vermittler und verarbeitet Weiterleitungslogik basierend auf Regeln, Kopfzeilen, Inhalten oder Ereignistypen. In Data 360-Integrationen stellt die Mediation sicher, dass Ereignisse und Profilaktualisierungen aus mehreren Systemen ordnungsgemäß an Datenaufnahme-APIs, Aktivierungsendpunkte oder externe Verbraucher weitergeleitet werden. Dies vereinfacht die Orchestrierung und unterstützt die Datensynchronisierung mit mehreren Systemen. |
| Prozesschoreografie und Serviceorchestrierung | Prozesschoreografie und Orchestrierung koordinieren Prozesse mit mehreren Systemen. Die Choreografie unterstützt autonome, asynchrone ereignisgesteuerte Flows, bei denen Systeme auf der Grundlage gemeinsamer Regeln ohne zentrale Steuerung agieren. Die Orchestrierung ist ein zentral verwalteter Flow, der die Serviceausführung steuert. In Data 360-Architekturen verwaltet Middleware die Orchestrierung für die systemübergreifende Aufnahme und Aktivierung, während Salesforce-Workflows oder -Flows leichte Choreografien innerhalb der Plattform verarbeiten. Auf Middleware-Ebene wird eine komplexe Orchestrierung empfohlen, die eine Transaktionskoordination oder eine Verwaltung des Status erfordert. |
| Transaktionalität (Verschlüsselung, Signieren, zuverlässige Zustellung, Transaktionsverwaltung) | Die Transaktionalität gewährleistet systemübergreifend atomare, konsistente, isolierte und langlebige Vorgänge (ACID). Salesforce und Data 360 sind Transaktionen innerhalb ihrer Grenzen, unterstützen jedoch keine verteilten Transaktionen über externe Systeme hinweg. Middleware übernimmt die globale Transaktionssteuerung, einschließlich Verschlüsselung, Nachrichtensignatur, Rollback, Vergütung und zuverlässiger Zustellung. Bei geschäftskritischen Datenflüssen (z. B. Finanz- oder Einwilligungsaktualisierungen) gewährleistet Middleware die durchgängige Integrität und Wiederherstellung von Data 360 und externen Systemen. |
| Weiterleitung | Die Weiterleitung gibt den gesteuerten Fluss von Nachrichten oder Daten zwischen Komponenten an. Sie kann auf Kopfzeilen, Inhaltstypen, Prioritäten oder Regeln basieren. Middleware verarbeitet die Weiterleitungslogik für Ereignisse und Aktivierungen, die Data 360 betreffen, beispielsweise die Weiterleitung von Segmenten für angereicherte Zielgruppen an verschiedene nachgelagerte Systeme (Anzeigenplattformen, Lagerhäuser, CRM-Anwendungen). Obwohl die Weiterleitung in Salesforce (Apex, Flows) implementiert werden kann, wird die Middleware-Weiterleitung aus Gründen der Skalierbarkeit, Flexibilität und Governance bevorzugt. |
| Extrahieren, Umwandeln und Laden | Bei der ETL werden Daten aus Quellsystemen extrahiert, in ein konsistentes Schema umgewandelt und in ein Ziel (wie Data 360) geladen. Middleware- oder ETL-Tools verarbeiten diese Vorgänge vor der Datenaufnahme. Data 360 kann ETL-Ausgaben über APIs, Konnektoren oder Massenaufnahmepipelines empfangen und unterstützt zudem die Datenerfassung (CDC) für die Synchronisierung nahezu in Echtzeit. Middleware-ETL-Prozesse sind wichtig für die Integration veralteter Systeme und die Sicherstellung der Datenqualität vor der Vereinheitlichung in Data 360. |
| Lange Abstimmung | Long Polling (Comet-Programmierung) ist eine Methode zur Aufrechterhaltung einer offenen Kommunikation zwischen Systemen für Echtzeitaktualisierungen. Der Client sendet eine Anforderung und der Server hält sie so lange, bis ein Ereignis auftritt. Anschließend antwortet er und öffnet erneut eine Verbindung. Salesforce verwendet dies in den Streaming-API- und CometD/Bayeux-Protokollen für die ereignisgesteuerte Datensynchronisierung. Middleware kann diese Ereignisse abonnieren und sie an Data 360 weiterleiten, um Echtzeit-Aufnahme- oder Aktivierungsauslöser zu erhalten und so eine minimale Latenz zwischen Unternehmenssystemen zu gewährleisten. |
| Lösung | Fit | Kommentare |
|---|---|---|
| Verwenden von nativen Cloud-Speicher-Konnektoren (Amazon S3, Google Cloud Storage, Azure Blob Storage) | Best | Dies ist das empfohlene und zuverlässigste Muster für die umfangreiche, wiederkehrende dateibasierte Aufnahme in Data 360\. Native Konnektoren bieten verwaltete Authentifizierung, Schemazuordnung und sichere Datenverschiebung direkt in Data Lake Objects (DLOs) von Data 360. Ideal für geplante Batch-Ladungen, bei denen die Latenz nicht kritisch ist (z. B. stündliche oder tägliche Planung). |
| Umgang mit großen Datensets (über Konnektorobergrenzen hinaus) | Am besten mit Vorverarbeitung | Jeder Konnektor erzwingt Aufnahmeobergrenzen (z. B. S3: 100 Millionen Zeilen oder 50 GB pro Objekt). Implementieren Sie bei größeren Datensets einen ETL-Vorverarbeitungsschritt, um Daten in kleinere Dateien/Ordner zu partitionieren, die unter diese Schwellenwerte fallen. Konfigurieren Sie dann mehrere Datenströme, um jede Partition parallel aufzunehmen, und verwenden Sie den Knoten append in einer Batch-Datentransformation) in Data 360, um die Partitionen erneut zu einem vereinheitlichten Datenset zu kombinieren. |
| Sicherheit und Governance | Best | Alle Konnektoren unterstützen die sichere Authentifizierung über Cloud-native Methoden (IAM-Rollen, Serviceaccounts oder Zugriffsschlüssel). Schränken Sie den Zugriff auf Data 360-IP-Bereiche über die Zulassungsliste des Cloud-Anbieters ein, um mehr Kontrolle zu erhalten. Die Datenübertragung erfolgt über verschlüsselte Kanäle, wobei die Dateien während der Aufnahme in einer temporären sicheren Staging-Ebene gespeichert werden. |
| Wann nicht verwenden | Suboptimal | Dieses Muster ist nicht optimal für:
|
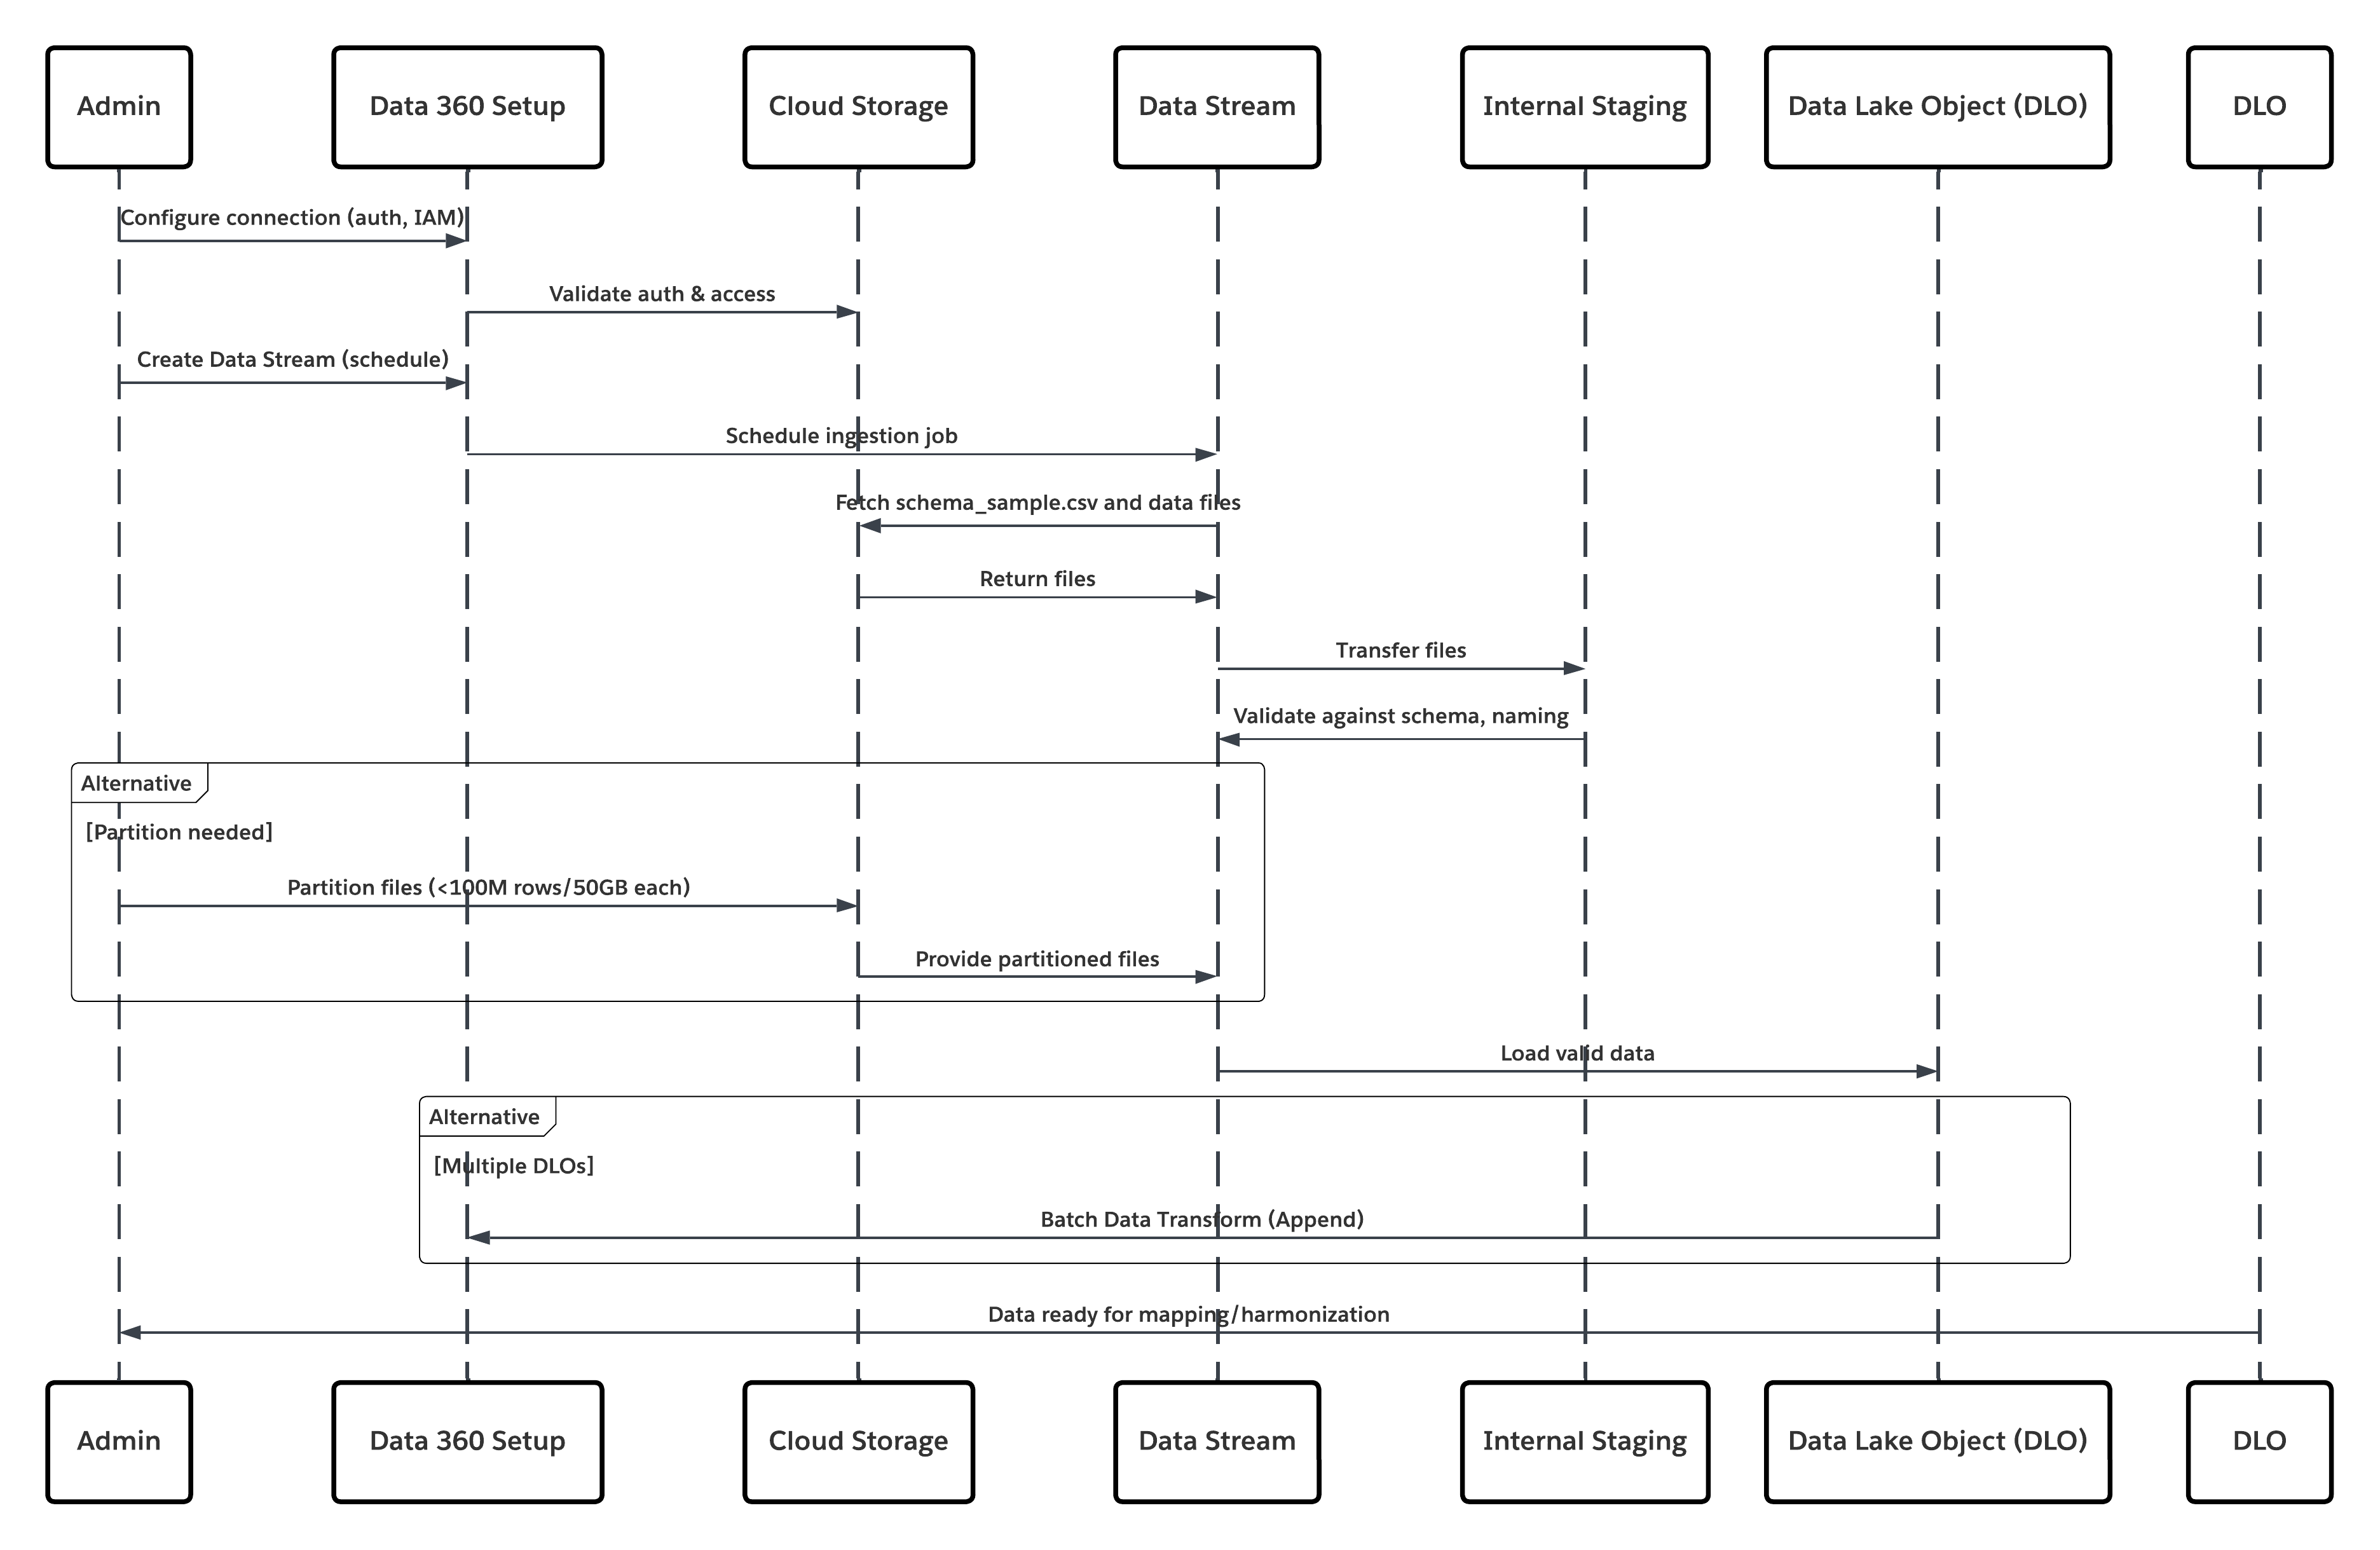 In diesem Szenario:
* Der Administrator konfiguriert eine Verbindung mit dem Cloud-Speicher über die Setup-Schnittstelle für Data 360 (mit Angabe der Authentifizierung, der Bucket-Details, der IAM-Rollen und der Positivliste).
* Die Data Cloud-Setup-Schnittstelle authentifiziert sich bei der Cloud-Speicherplattform und überprüft Anmeldeinformationen und Zugriff.
* Der Administrator erstellt einen Datenstrom in Data 360, verknüpft den Datenstrom mit dem Objekt/Ordner im Cloud-Speicher und definiert den Aufnahmeplan.
* Beim Planauslöser fordert der Datenstrom Quelldateien (z. B. CSV, Parquet) von der Cloud Storage Platform an.
* Die Cloud Storage Platform stellt Dateien bereit, einschließlich der erforderlichen gültigen Datei schema_sample.csv und anderer Datendateien, die mit Benennungskonventionen konform sind.
* Der Datenstrom überträgt Dateien an die interne Staging-Umgebung in Data 360.
* Data 360 Pipeline verarbeitet die Dateien: Verwendet die Schemadefinition aus schema_sample.csv Validiert Struktur, Feldnamen und dividiert die Last, wenn sie über den Aufnahmeschwellenwerten (100 Millionen Zeilen/50 GB pro Datei) liegt. Wenn große Dateien erkannt werden, wird ein Partitionierungsschritt vor der Verarbeitung (dem Administrator für die nächste Ausführung mitgeteilt) extern ausgeführt.
* Datensätze werden aus der Staging-Instanz in ein Data-Lake-Objekt (DLO) importiert.
* Verwenden Sie bei Bedarf den Knoten append in einer Batch-Datentransformation, um mehrere DLOs zu kombinieren.
* Data 360 protokolliert Erfolg/Fehler, aktualisiert den Status für die Überwachung und signalisiert, dass Daten für die Zuordnung, Harmonisierung und Vereinheitlichung bereit sind.
##### Ergebnisse
Die Anwendung dieses Musters ermöglicht die sichere, geplante und umfangreiche Aufnahme strukturierter oder unstrukturierter Dateien aus Enterprise Cloud-Speicherplattformen in Data 360\. Der Prozess ist automatisiert, skalierbar und widerstandsfähig. Rohdaten werden in Data-Lake-Objekten (DLOs) bereitgestellt, die als Grundlage für die Harmonisierung und Zuordnung zum Customer 360-Datenmodell dienen.
###### Aufnahmemechanismen
Der Aufnahmemechanismus hängt vom Konnektor und der in Data 360 definierten Planungsstrategie ab.
| Aufnahmemechanismus | Beschreibung |
|---|---|
| Native Cloud Storage Connector (Amazon S3, GCS, Azure) | Empfohlen für die direkte Aufnahme von Dateien im CSV- oder Parquet-Format aus dem Cloud-Data-Lake des Unternehmens. Diese Konnektoren unterstützen inkrementelle und vollständige Aktualisierungspläne. Beispielsweise kann eine Bank eine tägliche Synchronisierung von Kundentransaktionsdateien aus einem S3-Bucket in ein DLO konfigurieren. |
| Partitionierte Dateistrategie | Bei sehr großen Datensets (über 100 Millionen Zeilen oder 50 GB pro Objekt) werden die Daten in kleinere logische Sätze partitioniert (z. B. nach Monat oder Region). Jede Partition wird als separater Datenstrom verwaltet und später mithilfe einer Batch-Datentransformation mit einem Knoten vom Typ "Anhängen" neu kombiniert. |
| Automatisierte geplante Synchronisierung | Data 360 bietet eine deklarative Planung (Stunden-, Tages- oder benutzerdefinierter Rhythmus), die Aufnahmeaufträge automatisch auslöst und so die Aktualisierung der Daten ohne manuelle Eingriffe sicherstellt. |
| Konnektortyp | Endpunktanforderungen |
|---|---|
| Amazon S3 Connector | S3-Bucket mit entsprechender IAM-Richtlinie und schema\_sample.csv-Datei, die das Schema definiert. |
| Google Cloud Storage Connector | Serviceaccount-Anmeldeinformationen und Bucket-Zugriff mit einheitlichen Benennungskonventionen. |
| Azurblauer Speicher-Konnektor | Greifen Sie auf die Schlüssel- oder SAS-Token-basierte Authentifizierung zu. Blob- oder Ordnerstrukturen müssen den Data 360-Konventionen entsprechen. |
| Lösungsbereich | Fit | Kommentare / Implementierungsdetails |
|---|---|---|
| Lösungsanpassung | Best | Verwenden Sie den nativen Salesforce CRM-Konnektor und den Marketing Cloud Engagement-Konnektor in Data 360\. Beginnen Sie mit Starter-Datenpaketen für Standardanwendungsfälle und beschleunigen Sie die Einarbeitung. Verwenden Sie die manuelle Stream-Anpassung für maßgeschneiderte oder domänenspezifische Datenmodelle. |
| Umgang mit hochgradig angepassten CRM-Instanzen | Am besten mit Zuordnungsworkshop | Behandeln Sie Starter-Pakete als Grundlage und führen Sie einen Zuordnungsworkshop durch, um Folgendes zu ermitteln: Benutzerdefinierte Objekte und Beziehungen. Formel- oder berechnete Felder. Erweiterungen für verwaltete Pakete. Berechnen Sie bei schweren Formelfeldern Werte in einem vorgelagerten ETL oder in Data 360-Transformationen, um die API-Last in Quellorganisationen zu minimieren. |
| Wann nicht verwenden | Suboptimale Szenarien | Vermeiden Sie dieses Muster in folgenden Fällen: Sie benötigen die Aufnahme von Ereignissen mit hoher Häufigkeit oder in Echtzeit (verwenden Sie stattdessen Streaming-Konnektoren, Plattformereignisse oder Zero-Copy-Verbund). Die API-Kapazität der Quellorganisation ist begrenzt und geplante Extraktionen können nicht ohne Drosselung oder Warteschlangenverzögerungen unterstützt werden. |
| Sicherheit und Governance | Obligatorische Steuerelemente | Grundsatz der geringsten Berechtigung: Verwenden Sie einen dedizierten Integrationsbenutzer mit minimalem Lesezugriff. Verwenden Sie niemals organisationsweite Administratoren. Authentifizierung: Verwenden Sie OAuth 2.0 und verbundene Anwendungen, rotieren Sie Client-Geheimnisse regelmäßig und überwachen Sie die Verwendung von Aktualisierungstoken. Überprüfung und Rückverfolgbarkeit: Protokollieren Sie alle Aufnahmeausführungen, Schemaänderungen und Konnektorereignisse. Leiten Sie Protokolle zur Überprüfungsbereitschaft an SIEM- oder Compliance-Systeme weiter. Datenklassifizierung: Wenden Sie das PII/PHI-Tagging und die attributbasierte Zugriffssteuerung (ABAC) mit CEDAR-Richtlinien unmittelbar nach der Aufnahme an, um Maskierung, Einwilligung und Einhaltung nachgelagerter Vorschriften zu erzwingen. |
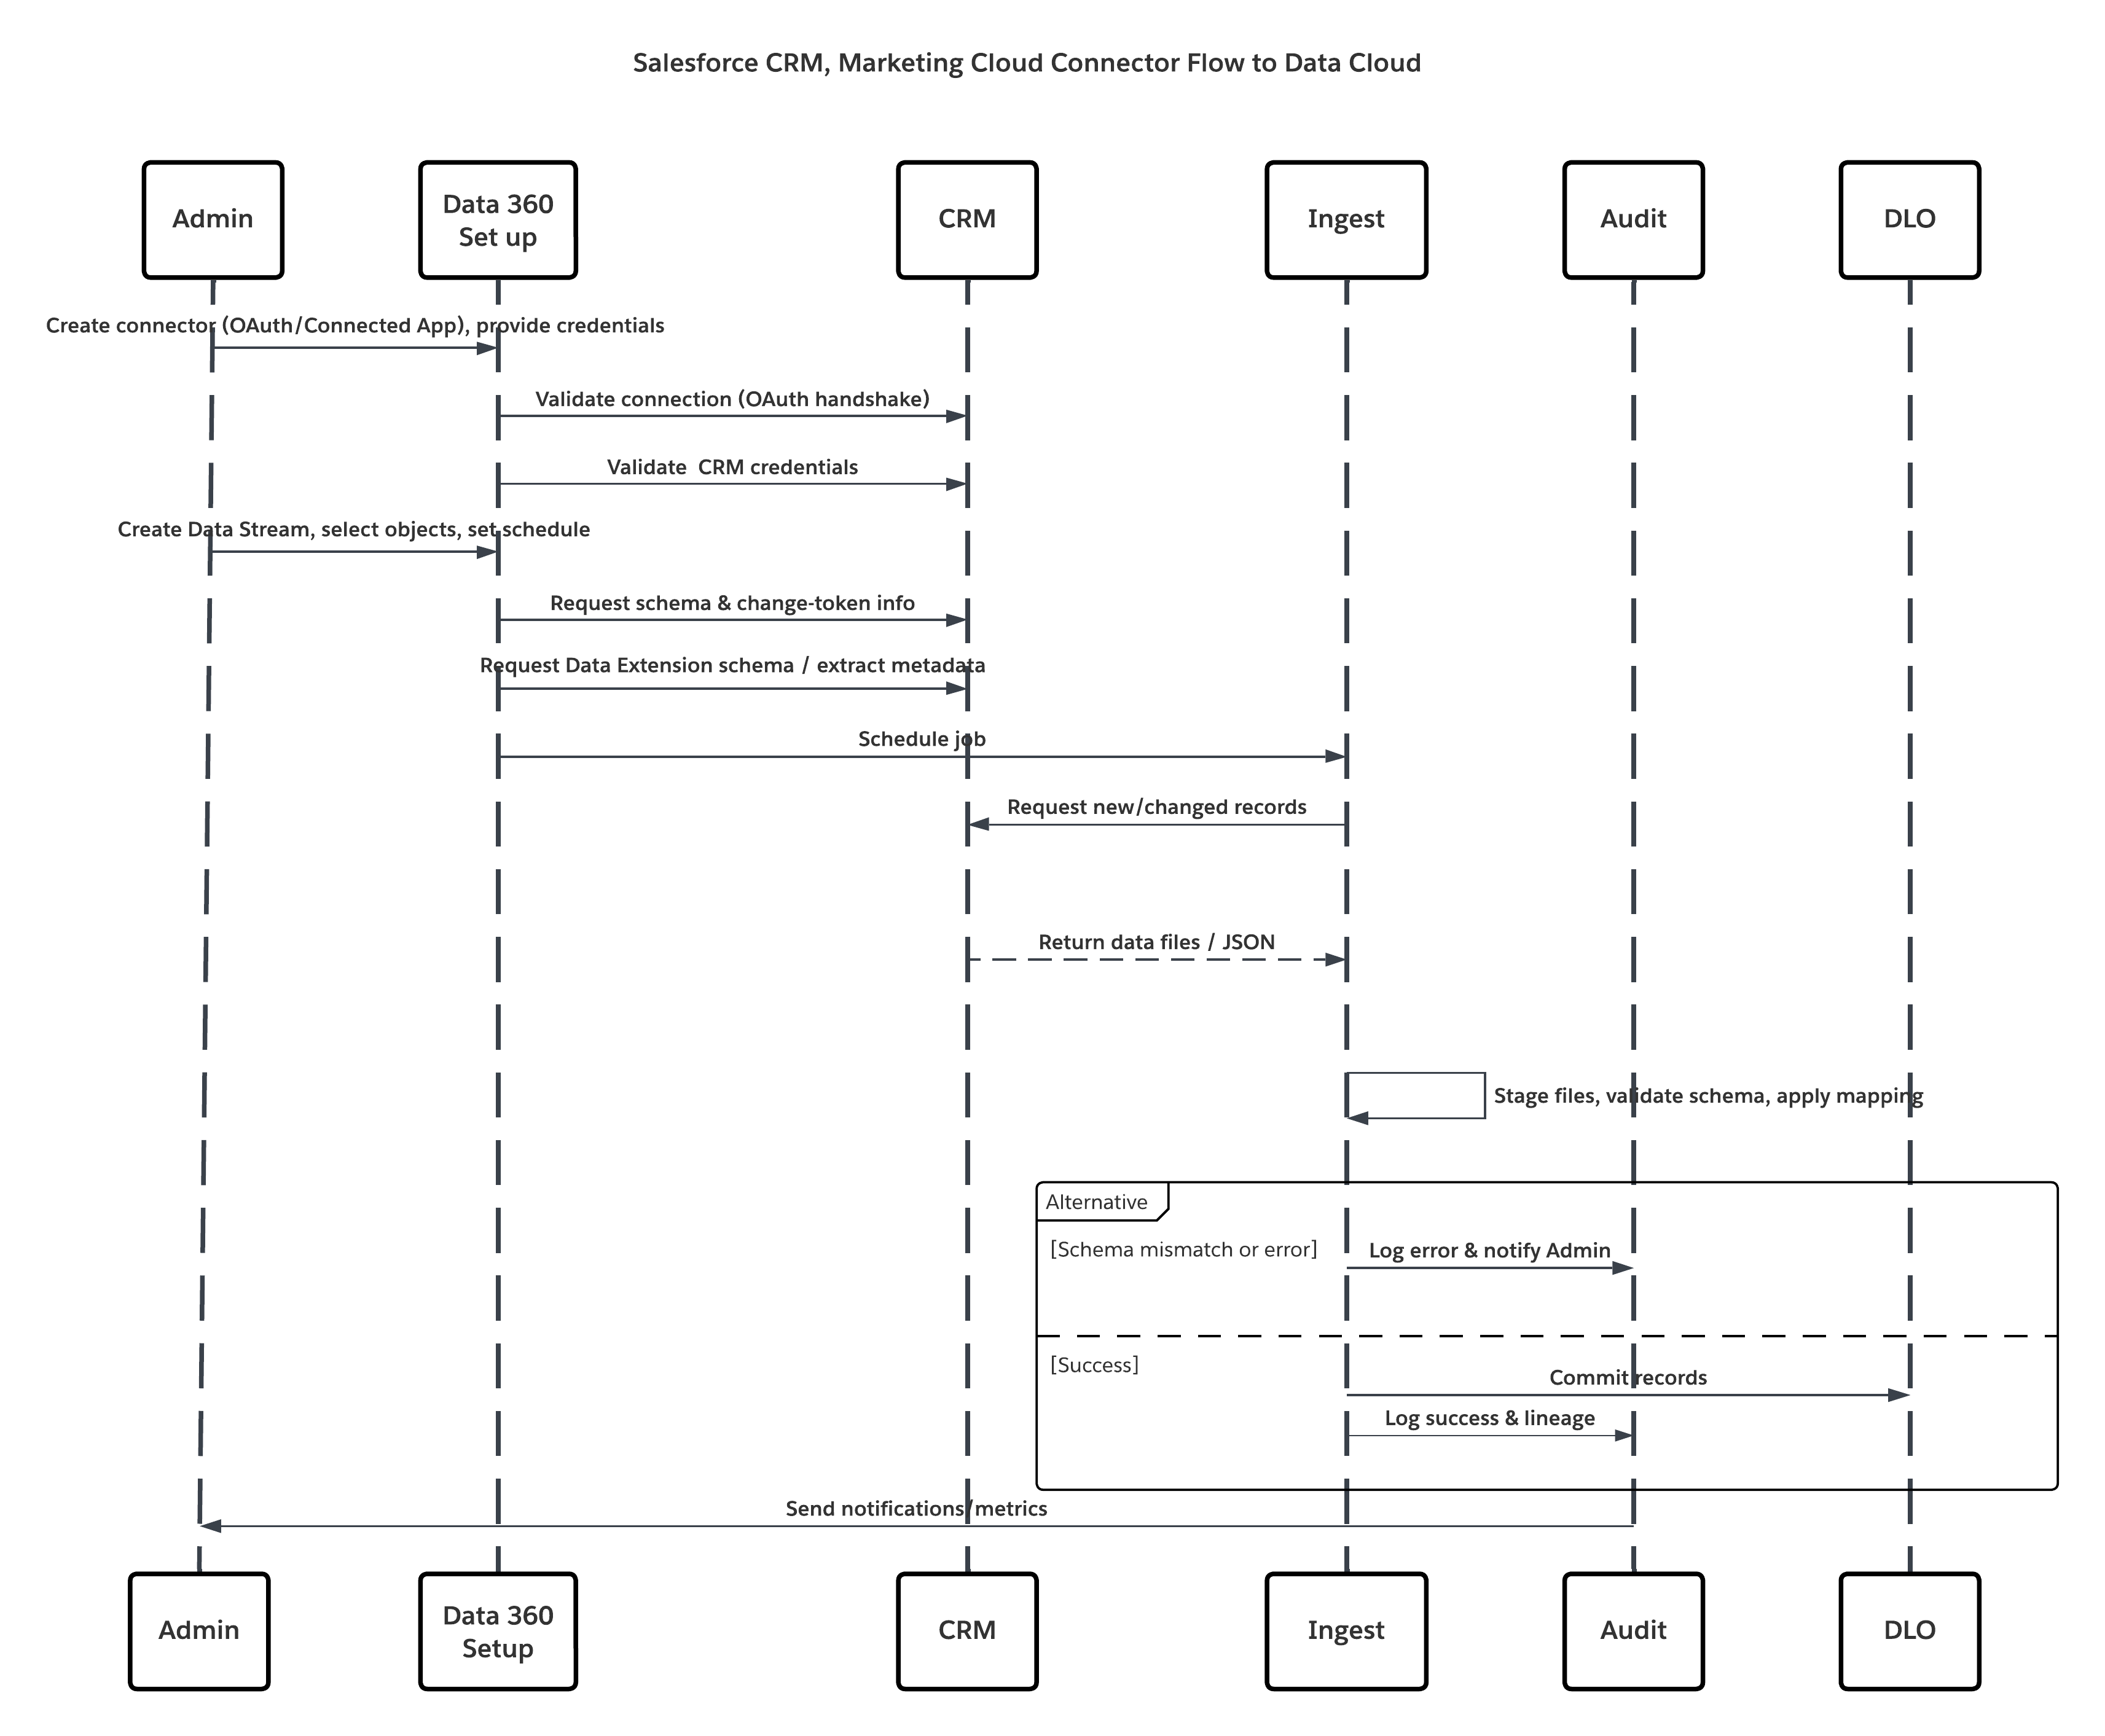 In diesem Szenario:
* Der **Administrator stellt Integrationsbenutzer bereit** und weist Konnektorberechtigungssätze in Quellorganisationen zu.
* Der **Administrator konfiguriert Konnektoren** im Setup von Data 360 (stellt über OAuth/verbundene Anwendung eine Verbindung mit Salesforce CRM und Marketing Cloud her).
* Der **Administrator erstellt Datenströme**, wählt Objekte und Data Extensions aus, wählt die vollständige Aktualisierung oder Delta-Aktualisierung aus und legt Zeitpläne fest.
* **Bei geplanter Ausführung** fordert Data 360 Schema- und Delta-Token von der/den Quelle(n) an.
* **Quellsysteme geben Datensätze zurück** (Delta oder vollständige Nutzlast). Marketing Cloud kann Auszüge bereitstellen. CRM kann JSON-/Abfrageergebnisse zurückgeben.
* **Data 360 stellt Dateien** im internen sicheren Staging-Bereich bereit und validiert sie anhand des zugeordneten Schemas.
* **Wenn die Validierung fehlschlägt**, wird ein Fehler bei der Aufnahme protokolliert, der Administrator wird benachrichtigt und der Commit wird angehalten. Wenn die Validierung erfolgreich ist, überträgt Data 360 Datensätze atomar an das Ziel-DLO.
* Die **Überwachungs- und Prüfungsprotokolle** werden mit Abstammung, Ausführungsdauer, Zeilenzahl und Anmeldeinformationen aktualisiert. Benachrichtigungen für Administratoren, wenn Schwellenwerte oder Fehler ausgelöst wurden.
##### Ergebnisse
Daten zu Kundenbeziehungen und Marketinginteraktionen werden als Data-Lake-Objekte (DLOs) in Data 360 aufgenommen. Daraus ergibt sich:
* **Zusammengeführtes Datenset** mit Profilen, Kundenvorgängen, Opportunities und Kennzahlen für E-Mail/Engagement.
* **Grundlage für die** Identitätsbestimmung und Erstellung von Profilen für zusammengeführte Einzelpersonen.
* **Betriebsbereitschaft** für die nachgelagerte Harmonisierung, Anreicherung, AI-Modellierung und Aktivierung unter Beibehaltung der Governance und Überprüfbarkeit.
###### Aufnahmemechanismen
Der Aufnahmemechanismus hängt vom Konnektor und der in Data 360 definierten Planungsstrategie ab.
| Mechanismus | Wann zu verwenden |
|---|---|
| Salesforce CRM-Konnektor (nativ) | Ideal für standardmäßige/benutzerdefinierte CRM-Objekte; unterstützt vollständige und Delta-Aktualisierungen. |
| Marketing Cloud Engagement-Konnektor (nativ) | Ideal für Data Extensions, Sends und Tracking-Extraktionen; unterstützt Full/Delta-Modi. |
| Starter-Datenpakete | Beschleunigen Sie die Einarbeitung für allgemeine Sales/Service/Marketing-Objekte. |
| Benutzerdefinierte Streams + Vorverarbeitung | Wird verwendet, wenn komplexe Transformationen oder eine schwere Schemanormalisierung erforderlich ist. |
| Konnektor | Endpunktanforderungen |
|---|---|
| Salesforce CRM-Konnektor | Die Quellorganisation muss eine verbundene Anwendung, OAuth-Token und einen dedizierten Integrationsbenutzer mit Leseberechtigungen zulassen. |
| Marketing Cloud-Konnektor | Marketing Cloud-API-Anmeldeinformationen oder installiertes Paket; Data Extensions müssen Daten über Extrakte/API bereitstellen. |
| Lösungsbereich | Fit | Kommentare / Implementierungsdetails |
|---|---|---|
| Lösungsanpassung | Am besten für die Ereigniserfassung mit geringer Latenz | Verwenden Sie die Data 360-Aufnahme-API (Streaming-JSON) zum Pushen einzelner Ereignisse oder Mikro-Batchs. Konfigurieren Sie den Aufnahme-API-Konnektor mit einem strengen OAS 3.0-Schema (.yaml). Verwenden Sie die Massen-CSV-Aufnahme für größere, weniger häufige Synchronisierungen. |
| Verarbeitung von Schemaänderungen | Streng / Verwaltet | Schemaänderungen sind fehlerhaft: Aktualisieren Sie OAS .yaml, versionieren Sie den Konnektor und führen Sie Vertragstests durch. Implementieren Sie die Migration rollierender Schemas, wenn Hersteller nicht gleichzeitig Änderungen vornehmen können. |
| Wann nicht verwenden | Suboptimal | Nicht ideal, wenn eine Vorverarbeitung erforderlich ist (z. B. Deduplizierung, garantierter Auftrag usw.) oder wenn extrem große Massenlasten auftreten (verwenden Sie native Massenkonnektoren oder Batch-ETL). Wenn die Quelle keine schemagültigen Nutzlasten erzeugen oder sich nicht sicher authentifizieren kann, verwenden Sie alternative Aufnahmemethoden. |
| Sicherheit und Unternehmensführung | Pflichtfeld | Verwenden Sie OAuth 2.0 mit den geringsten Berechtigungsbereichen, drehen Sie Schlüssel und protokollieren Sie die Tokennutzung. Erzwingen Sie TLS 1.2+, validieren Sie bei Bedarf Client-IPs und stellen Sie das PII-Tagging für Nutzlasten sicher. Alle Ereignisse müssen Provenienz-Metadaten enthalten (Quelle, Zeitstempel, Schemaversion, Identitätsschlüssel). |
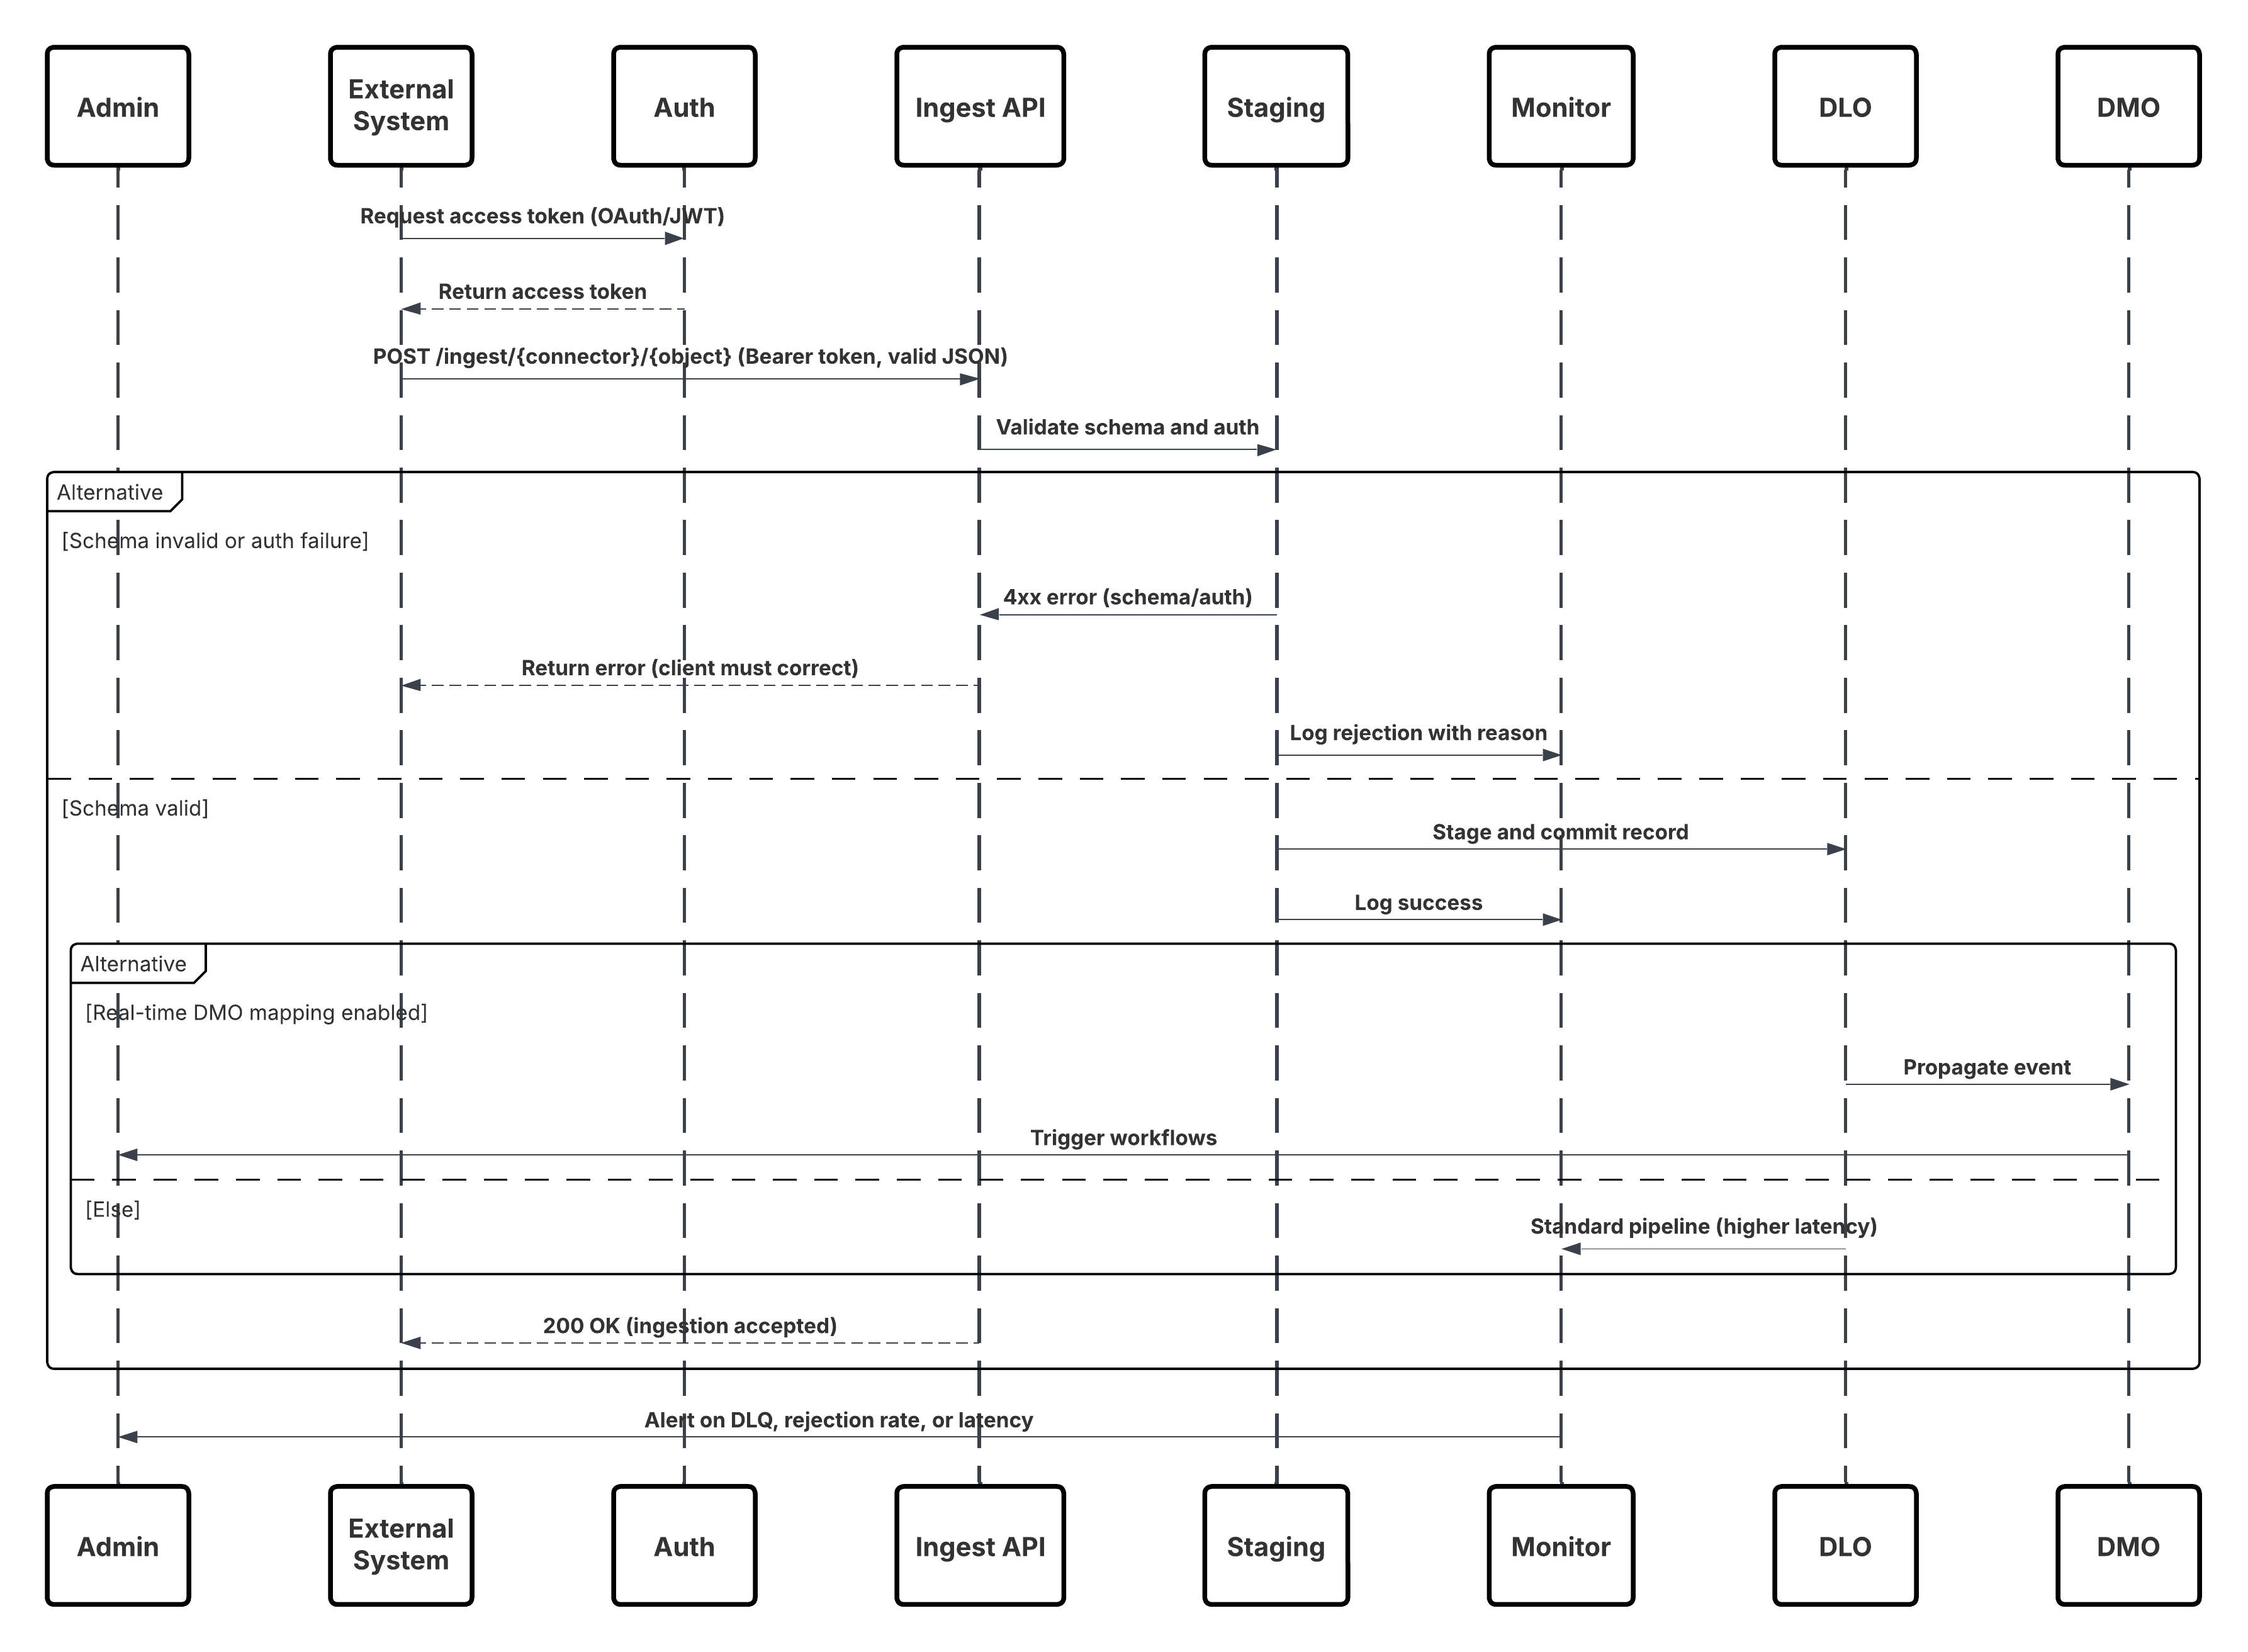 **In diesem Szenario:**
* Das externe System fordert die Authentifizierung über OAuth/JWT vom Auth Server an.
* Auth Server gibt Zugriffstoken an "Externes System" zurück.
* Das externe System sendet die POST-Anforderung zur Datenaufnahme mit Autorisierung und JSON-Nutzlast an die Data 360-Aufnahme-API.
* Die Aufnahme-API validiert Anforderungsschema und Authentifizierung über das Modul "Staging & Validation".
* Bei Schema-/Authentifizierungsfehlern:
* Fehler, der an "Externes System" zurückgegeben wurde.
* Ablehnung zur Überwachung und Warnung protokolliert.
* Bei erfolgreicher Validierung:
* Datensätze, die in Data Lake Object (DLO) inszeniert und übernommen wurden.
* Erfolgsprotokollierung zur Überwachung.
* Wenn diese Option aktiviert ist, werden die Daten in das Echtzeit-Datendiagramm (DMO) übernommen, wodurch nachgelagerte Workflows ausgelöst werden.
* Andernfalls werden Daten über die standardmäßige Batch-Pipeline oder die Pipeline mit höherer Latenz verarbeitet.
* Die Aufnahme-API bestätigt den Erfolg des externen Systems.
* Überwachungskomponenten benachrichtigen den Administrator bei Warteschlangen mit auslaufenden Briefen, Ablehnungsraten oder Latenzproblemen.
##### Ergebnisse
Externe Ereignisdaten werden mit geringer Latenz in Data 360-DLOs aufgenommen. Wenn das Ziel-DMO Teil des Echtzeitdiagramms ist, sind die Daten für die sofortige Segmentierung, Agenten-Workflows, AI-Modelle und die operative Aktivierung verfügbar. Dadurch können Sie schnell auf Ereignisse reagieren, die aus einem verbundenen System stammen.
###### Aufnahmemechanismen
Der Aufnahmemechanismus hängt vom Konnektor und der in Data 360 definierten Planungsstrategie ab.
| Mechanismus | Wann zu verwenden |
|---|---|
| Streaming-JSON (Aufnahme-API) | Einzelne Ereignisse, Micro-Batchs, Verhaltensereignisse, Clickstreams, IoT-Telemetrie – wenn eine geringe Latenz erforderlich ist. |
| Massen-CSV (Aufnahme-API-Massenmodus) | Größere, regelmäßige Uploads mit gelockerten Latenzanforderungen. |
| Edge / Middleware | Wird verwendet, wenn Sie Validierung, Transformation, Anreicherung oder Ratenbegrenzung benötigen, bevor Sie die Aufnahme-API übertragen. |
| Lösungsbereich | Fit | Kommentare / Implementierungsdetails |
|---|---|---|
| SDK-basierte Ereigniserfassung | Best | Stellen Sie das Salesforce-SDK für Interaktionen (web) oder das native SDK (mobil) bereit. Diese kompakten Bibliotheken erfassen und serialisieren Benutzerinteraktionen in Echtzeit und hängen Metadaten (Sitzungs-ID, Zeitstempel, Kontext) an. |
| Streaming-Pipeline für Ereignisse | Best | Ereignisse werden über sicheres HTTPS an den Ereignis-Streaming-Service von Marketing Cloud Personalization gesendet. Diese Ebene ist horizontal skalierbar und für die Übertragung mit geringer Latenz (< 2s) optimiert. |
| Data 360-Integration | Best | Der Personalisierungs-Konnektor von Data 360 abonniert den Streaming-Feed und nimmt jedes Ereignis nahezu in Echtzeit in ein Data-Lake-Objekt (DLO) auf. |
| Datenmodellzuordnung | Bewährte Vorgehensweisen | Das aufgenommene DLO wird Customer 360 Data Model Objects (DMOs) zugeordnet. Dadurch können anonyme und bekannte Benutzer über die Identitätsbestimmung verknüpft werden. |
| Aktivierung von Echtzeitdiagrammen | Optional / Empfohlen | Fügen Sie zugeordnete DMOs in das Echtzeitdiagramm ein, um sie sofort zu segmentieren und so personalisierte Aktionen über Einstein oder Agentforce auszulösen. |
| Wann nicht verwenden | Suboptimal | Dieses Muster ist in folgenden Fällen nicht ideal: Die Quelldaten sind Webclient und Ereignisse (verwenden Sie stattdessen die Aufnahme-API). Der Organisation fehlt die Kontrolle über webbasierte/mobile Clients. Eine Echtzeit-Verhaltensverfolgung ist nicht erforderlich (Batch-Aufnahme verwenden). |
| Verarbeitung der Schemaänderungen | Verwaltete Evolution | Ereignisschemas entwickeln sich, wenn neue Interaktionen hinzugefügt werden. SDKs sollten Ereignisdefinitionen versionieren. Abwärtskompatible Änderungen (Hinzufügen von optionalen Feldern) sind sicher. Änderungen, die fehlerhaft sind, erfordern eine Neukonfiguration des Konnektors und Vertragstests. |
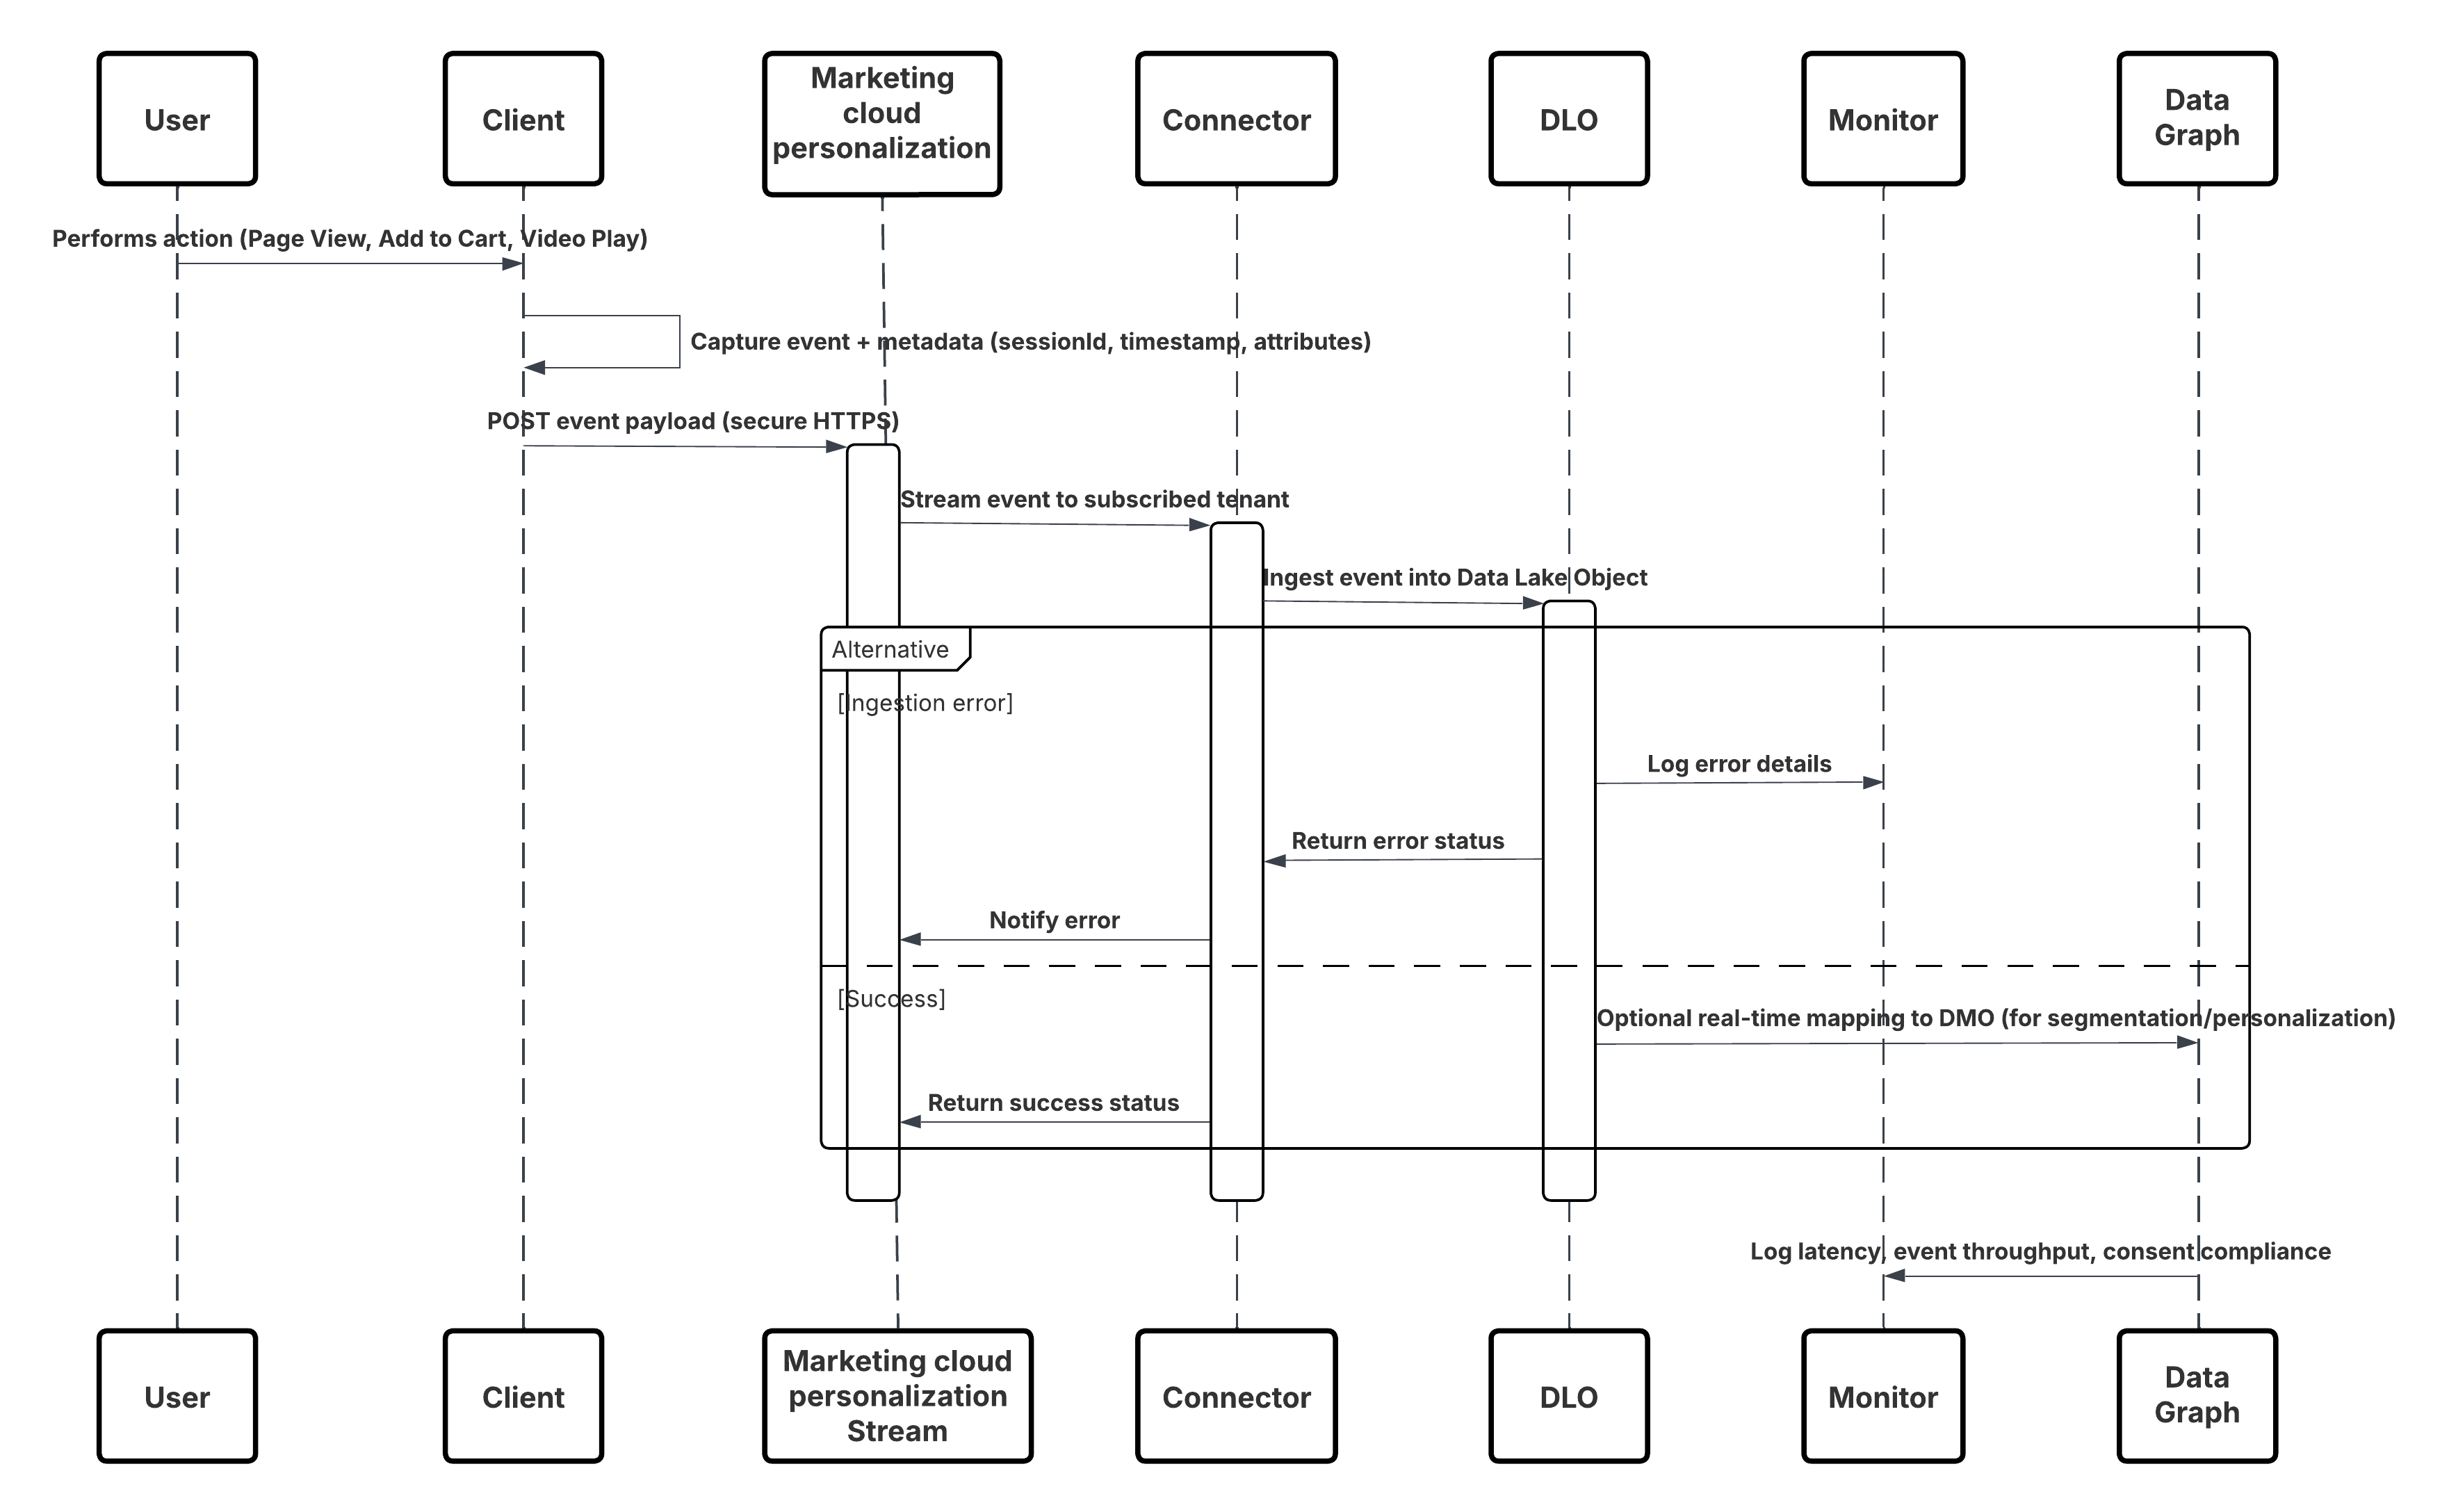 **In diesem Szenario:**
* Stellen Sie das SDK in Web- oder mobilen Kanälen bereit (Benutzerinteraktionserfassung).
* Konfigurieren Sie das SDK mit Steuerelementen für Mandanten-ID, Umgebung und Einwilligung.
* Streamen Sie erfasste JSON-Ereignisse (Metadaten + Attribute) an den Marketing Cloud-Streaming-Endpunkt.
* Erstellen und konfigurieren Sie im Setup von Data 360 den Personalisierungskonnektor für den Mandanten.
* Nehmen Sie Ereignisse in ein DLO auf und ordnen Sie das DLO → DMO in Data 360 zu.
* Aktivieren Sie das DMO im Echtzeitdiagramm für die sofortige Aktivierung.
* Überwachen Sie Latenz, Schemakonformität, Einwilligungskennzeichnungen, Durchsatz und Fehlerraten.
* Stellen Sie die Bereitstellung in der Produktion bereit und überwachen Sie sie kontinuierlich.
##### Ergebnisse
Ein kontinuierlicher Stream von Verhaltensereignissen mit geringer Latenz fließt aus digitalen Kanälen in Data 360\. Innerhalb von Sekunden ist jede Benutzeraktion für die Echtzeitsegmentierung, die Prognosemodellierung oder die ausgelöste Personalisierung verfügbar, was eine wirklich adaptive Kundenerfahrung ermöglicht.
###### Aufnahmemechanismen
Der Aufnahmemechanismus hängt vom Konnektor und der in Data 360 definierten Planungsstrategie ab.
| Mechanismus | Wann zu verwenden |
|---|---|
| SDK für Interaktionen (Web) | Echtzeiterfassung über Webbrowser und SPAs. |
| Mobile SDK | Echtzeiterfassung aus nativen mobilen Anwendungen. |
| Personalisierungs-Konnektor | Verwaltetes Abonnement zwischen Marketing Cloud und Data 360\. |
| Echtzeitdiagrammzuordnung | Aktiviert die sofortige Aktivierung in Segmentierung, Einstein und Journeys. |
| Lösungsbereich | Fit | Kommentare / Implementierungsdetails |
|---|---|---|
| CDC-basierter Streaming-Konnektor | Best | Nativer Salesforce-Mechanismus, vollständig verwaltet und in die Plattformereignisinfrastruktur integriert. |
| Ereignisabonnement und -zustellung | Best | Der Konnektor abonniert ChangeEvent-Kanäle (z. B. /data/ContactChangeEvent) über dauerhafte IDs für die erneute Wiedergabe. |
| Datenzuordnung und Schemaentwicklung | Bewährte Vorgehensweisen | Ordnen Sie gestreamte Nutzlasten dem entsprechenden DLO zu. Verarbeiten Sie die Schemaversionierung in Metadaten, um Aufnahmeunterbrechungen zu vermeiden. |
| Wiedergabe und Fehlerbehebung | Empfohlen | Verwenden Sie IDs für die erneute Wiedergabe und Identitätsschlüssel, um Duplikate zu vermeiden und vorübergehende Fehler zu beheben. |
| Hybridmodus (Streaming + Batch) | Optional | Verwenden Sie bei nicht unterstützten Objekten oder beim anfänglichen Massenladen die Batch-Aufnahme in Kombination mit CDC-Streaming. |
| Wann nicht verwenden | Suboptimal | Dieses Muster kann in folgenden Fällen suboptimal sein: Das Quellobjekt ist nicht CDC-fähig. Für den Anwendungsfall sind keine Echtzeitaktualisierungen erforderlich (Batch ist ausreichend). Der Netzwerkaustritt aus der Quellorganisation wird eingeschränkt oder Ereignisobergrenzen werden überschritten. |
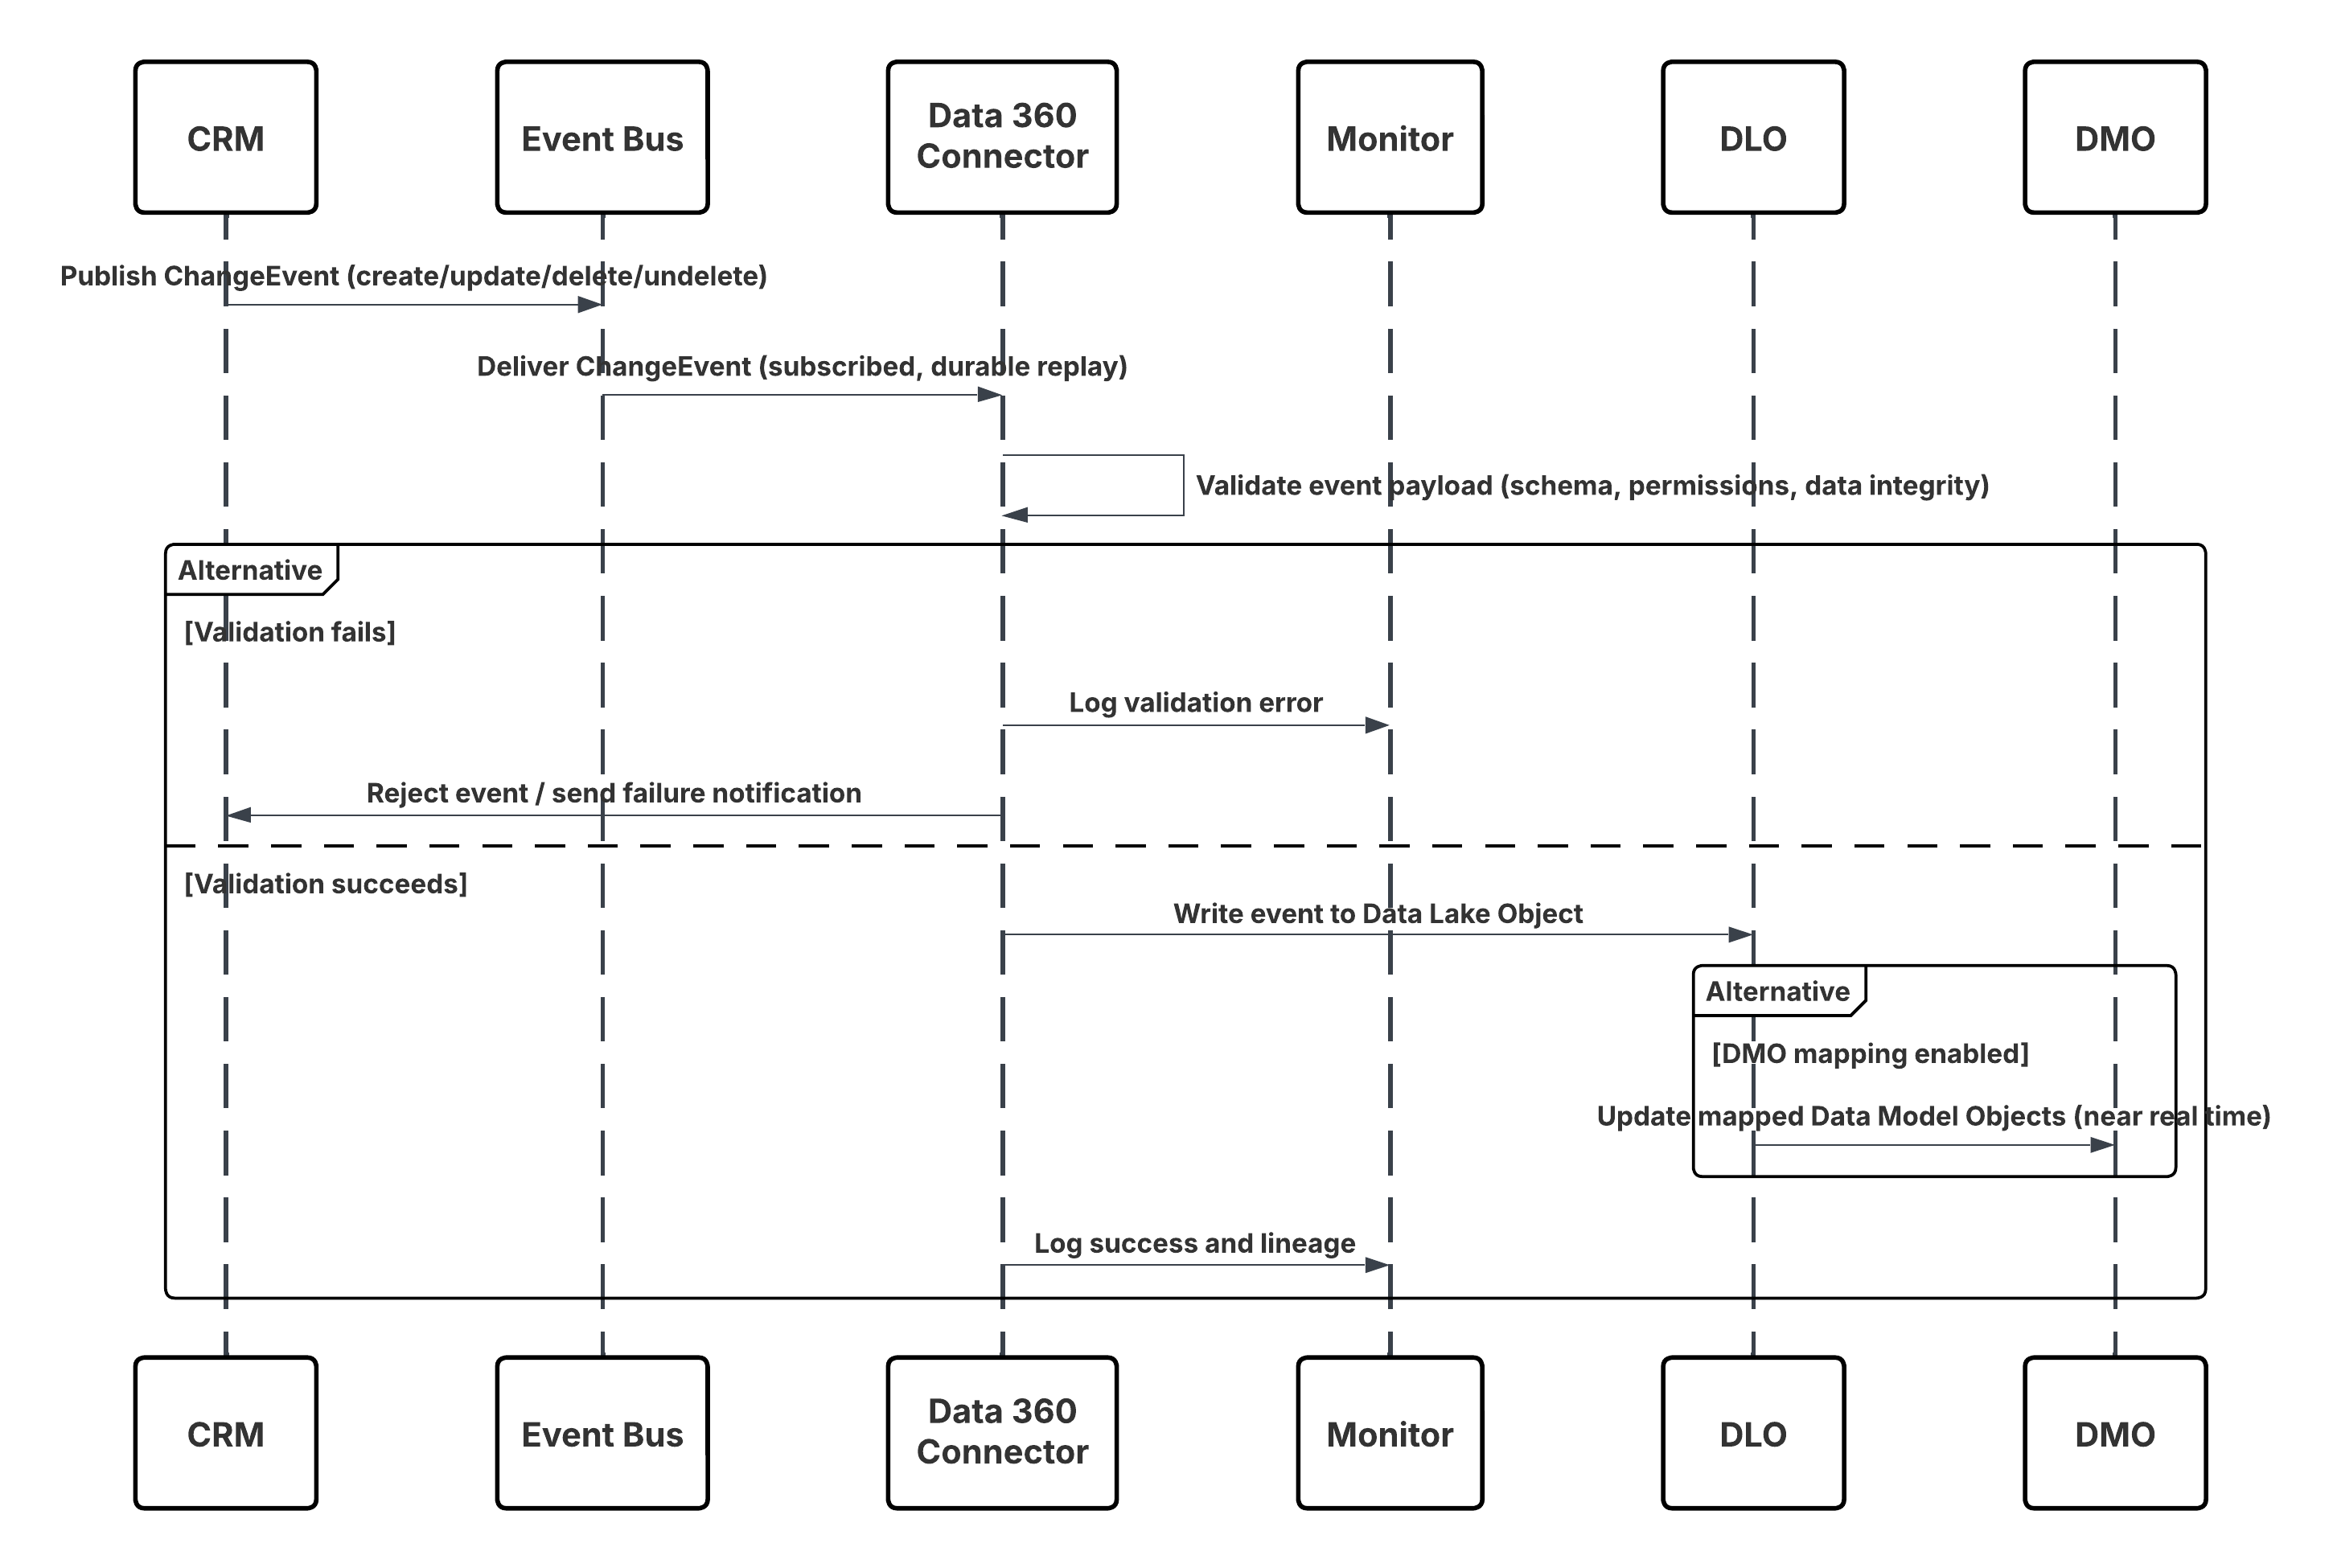 **In diesem Szenario:**
* Die Änderung erfolgt in Salesforce CRM (Erstellen/Aktualisieren/Löschen/Rückgängigmachen).
* CDC veröffentlicht ein ChangeEvent im internen Salesforce-Ereignis-Bus.
* Der Data 360 CRM-Konnektor abonniert den Ereignis-Bus mit einem dauerhaften Cursor für die erneute Wiedergabe.
* Die Ereignisnutzlast wird auf Schema, Berechtigungen und Datenintegrität überprüft.
* Data 360 schreibt das validierte Ereignis in das zugeordnete **Data-Lake-Objekt (DLO)**.
* Wenn diese Option aktiviert ist, werden zugeordnete **Datenmodellobjekte (DMOs)** in nahezu Echtzeit aktualisiert, was die Segmentierung und Aktivierung unterstützt.
##### Ergebnisse
Data 360 behält einen kontinuierlich synchronisierten Spiegel wichtiger CRM-Daten bei.
Dadurch wird Folgendes ermöglicht:
* Echtzeitauslöser (z. B. Journey wird gestartet, wenn ein Kundenvorgang erstellt wird).
* Aktuelle Segmentierung (z. B. Übertragen von Kunden in das Segment "Gold" bei Accountstatusänderung).
* Genauere Analysen und Personalisierung basierend auf dem Live-CRM-Kontext.
###### Aufnahmemechanismen
Der Aufnahmemechanismus für dieses Muster wird nativ über den Salesforce CRM-Konnektor mit aktivierter Datenerfassung verwaltet. Data 360 fungiert als Abonnent des CDC-Ereignisstroms und gewährleistet eine zuverlässige Synchronisierung mit geringer Latenz zwischen der CRM-Quellorganisation und Data 360.
| Mechanismus | Wann zu verwenden |
|---|---|
| Streaming über CDC (bevorzugt) | Für alle unterstützten standardmäßigen und benutzerdefinierten Salesforce-Objekte, bei denen eine Synchronisierung nahezu in Echtzeit erforderlich ist. |
| Hybrid Mode (CDC + Batch) | Bei Objekten, die noch nicht CDC-fähig sind oder bei denen ein anfänglicher historischer Ladevorgang erforderlich ist. |
| Abonnementmodus erneut wiedergeben | Für die Neusynchronisierung nach Ausfallzeiten oder Bereitstellungen. |
| Fehlerisolationsmodus | Für Test- und Validierungsumgebungen. |
| Lösungsbereich | Fit | Kommentare / Implementierungsdetails |
|---|---|---|
| Nativer Kinesis-Konnektor | Best | First-Party-Integration in AWS Kinesis; unterstützt die kontinuierliche Aufnahme mit hohem Durchsatz. |
| MSK Native-Konnektor | Best | Verwaltete Kafka-Aufnahme mit OIDC und schlüsselbasierter Authentifizierungsunterstützung. |
| Schemazuordnung und -validierung | Bewährte Vorgehensweisen | Hochladeschema (.json/.avro), das die Ereignisstruktur definiert; erzwingt die Konsistenz während der Aufnahme. |
| IAM-Konfiguration | Empfohlen | Weisen Sie die IAM-Rolle mit den geringsten Berechtigungen und Lesezugriff auf den Kinesis-Ziel-Stream oder das MSK-Thema zu. |
| Private Netzwerkweiterleitung | Optional | Konfigurieren Sie PrivateLink/VPC-Endpunkte für die sichere interne Weiterleitung. |
| Hybridmuster (Streaming + Batch) | Optional | Verwenden Sie Streaming für Deltas und die Batch-Aufnahme für Backfills oder historische Ladevorgänge. |
| Fehlerisolationsmodus | Empfohlen | Schemaablehnungen und vorübergehende Fehler zur erneuten Wiedergabe an DLQ weiterleiten |
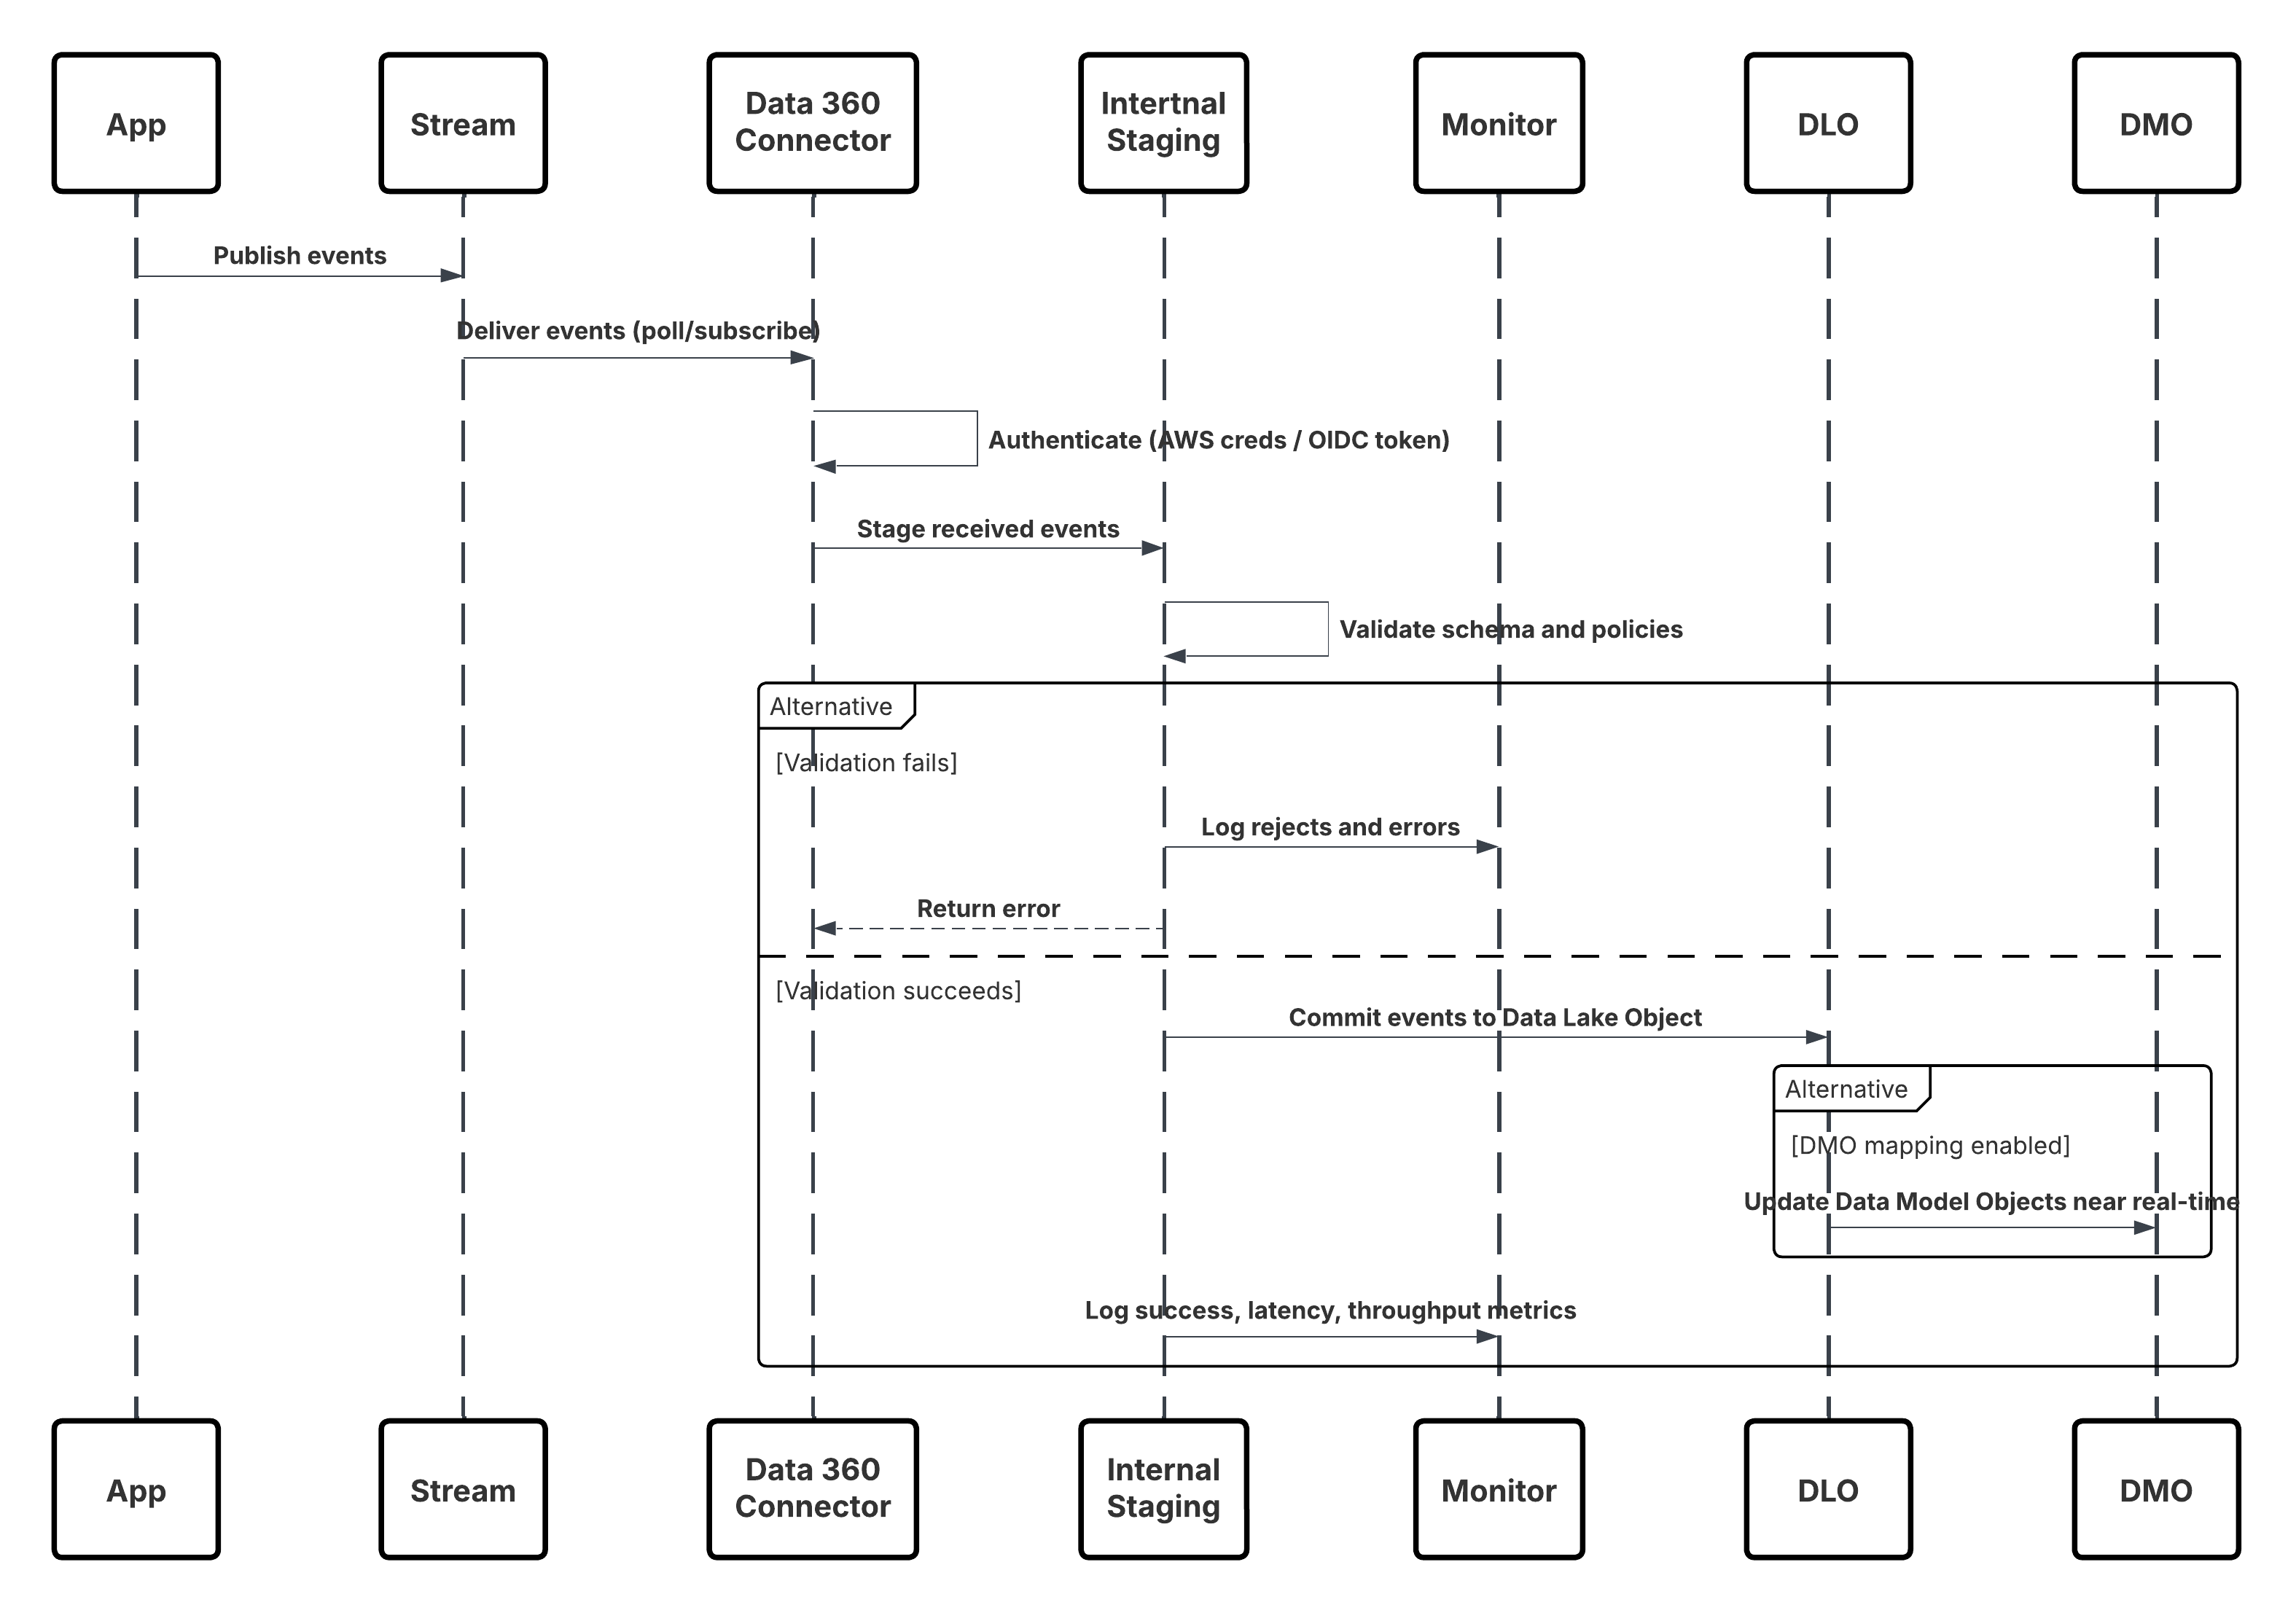 **In diesem Szenario:**
* Anwendungen oder Geräte veröffentlichen Ereignisse im Kinesis-Stream oder MSK-Thema.
* Der Data 360-Konnektor authentifiziert sich mit AWS-Anmeldeinformationen oder OIDC-Token.
* Der Konnektor ruft den Stream kontinuierlich ab oder abonniert ihn.
* Ereignisse werden inszeniert, für Schemas und Richtlinien validiert und dann in das Data-Lake-Objekt (DLO) übernommen.
* Wenn sie zugeordnet sind, werden Datenmodellobjekte (DMOs) zur Aktivierung nahezu in Echtzeit aktualisiert.
* Die Überwachungsebene verfolgt Kennzahlen, Schemaablehnungen und Latenz.
##### Ergebnisse
Kontinuierliche Aufnahme strukturierter Daten mit geringer Latenz direkt aus AWS Kinesis oder MSK in Data 360\. Daten sind sofort verfügbar für:
* Identitätsbestimmung
* Echtzeitsegmentierung
* Aktivierung von Einstein AI
* Agentforce Auslöser
Eliminiert die Abhängigkeit von Batch-ETL und ermöglicht streambasierte Architekturen, die auf ereignisgesteuerte Unternehmensdesigns abgestimmt sind.
###### Aufnahmemechanismen
| Mechanismus | Wann zu verwenden |
|---|---|
| Kinesis-Konnektor (bevorzugt) | Für AWS-native Streaming-Quellen, die eine kontinuierliche Aufnahme von strukturierten Daten mit hohem Volumen erfordern. |
| MSK-Konnektor | Für Organisationen, die Ereignis-Pipelines auf Kafka-kompatiblen Plattformen ausführen. |
| Hybrid (Streaming + Batch) | Für die inkrementelle Ereignisaufnahme in Kombination mit periodischen Massenlasten. |
| Lösungsbereich | Fit | Kommentare / Implementierungsdetails |
|---|---|---|
| Snowflake Zero Copy Connector | Best | Native Integration von Erstanbietern: Stellt den Live-Abfrageverbund über die Datenfreigabe-API oder die externe Tabellen-API von Snowflake her. |
| Databricks Zero Copy-Konnektor | Best | Unterstützt direkten Live-Zugriff auf Tabellen/Ansichten in Delta Lake. Pushdown-Abfragen werden in der Databricks-Laufzeit ausgeführt. |
| Dateiverbund (Apache Iceberg / Delta / Parquet) | Neue bewährte Vorgehensweisen | Data 360 liest offene Tabellenformate direkt aus dem Objektspeicher, ohne dass eine externe Berechnungsabhängigkeit besteht. Ideal für massive Datensets. |
| Private Netzwerkkonfiguration | Empfohlen | Verwenden Sie Salesforce Private Connect oder VPC Peering für eine sichere Verbundorganisation auf Netzwerkebene. |
| Authentifizierung und Schlüsselverwaltung | Bewährte Vorgehensweisen | Implementieren Sie die sichere schlüsselbasierte oder OAuth-basierte Authentifizierung mit regelmäßiger Rotation und Tresorverwaltung. |
| Schemaregistrierung | Erforderlich | Data 360 ruft ein externes Schema ab und ordnet es einem externen Data-Lake-Objekt (External DLO) zu. |
| Gesteuerte Metadaten | Empfohlen | Alle externen DLOs übernehmen Klassifizierungs-, Einwilligungs- und Abstammungsmetadaten für die Compliance-Sichtbarkeit. |
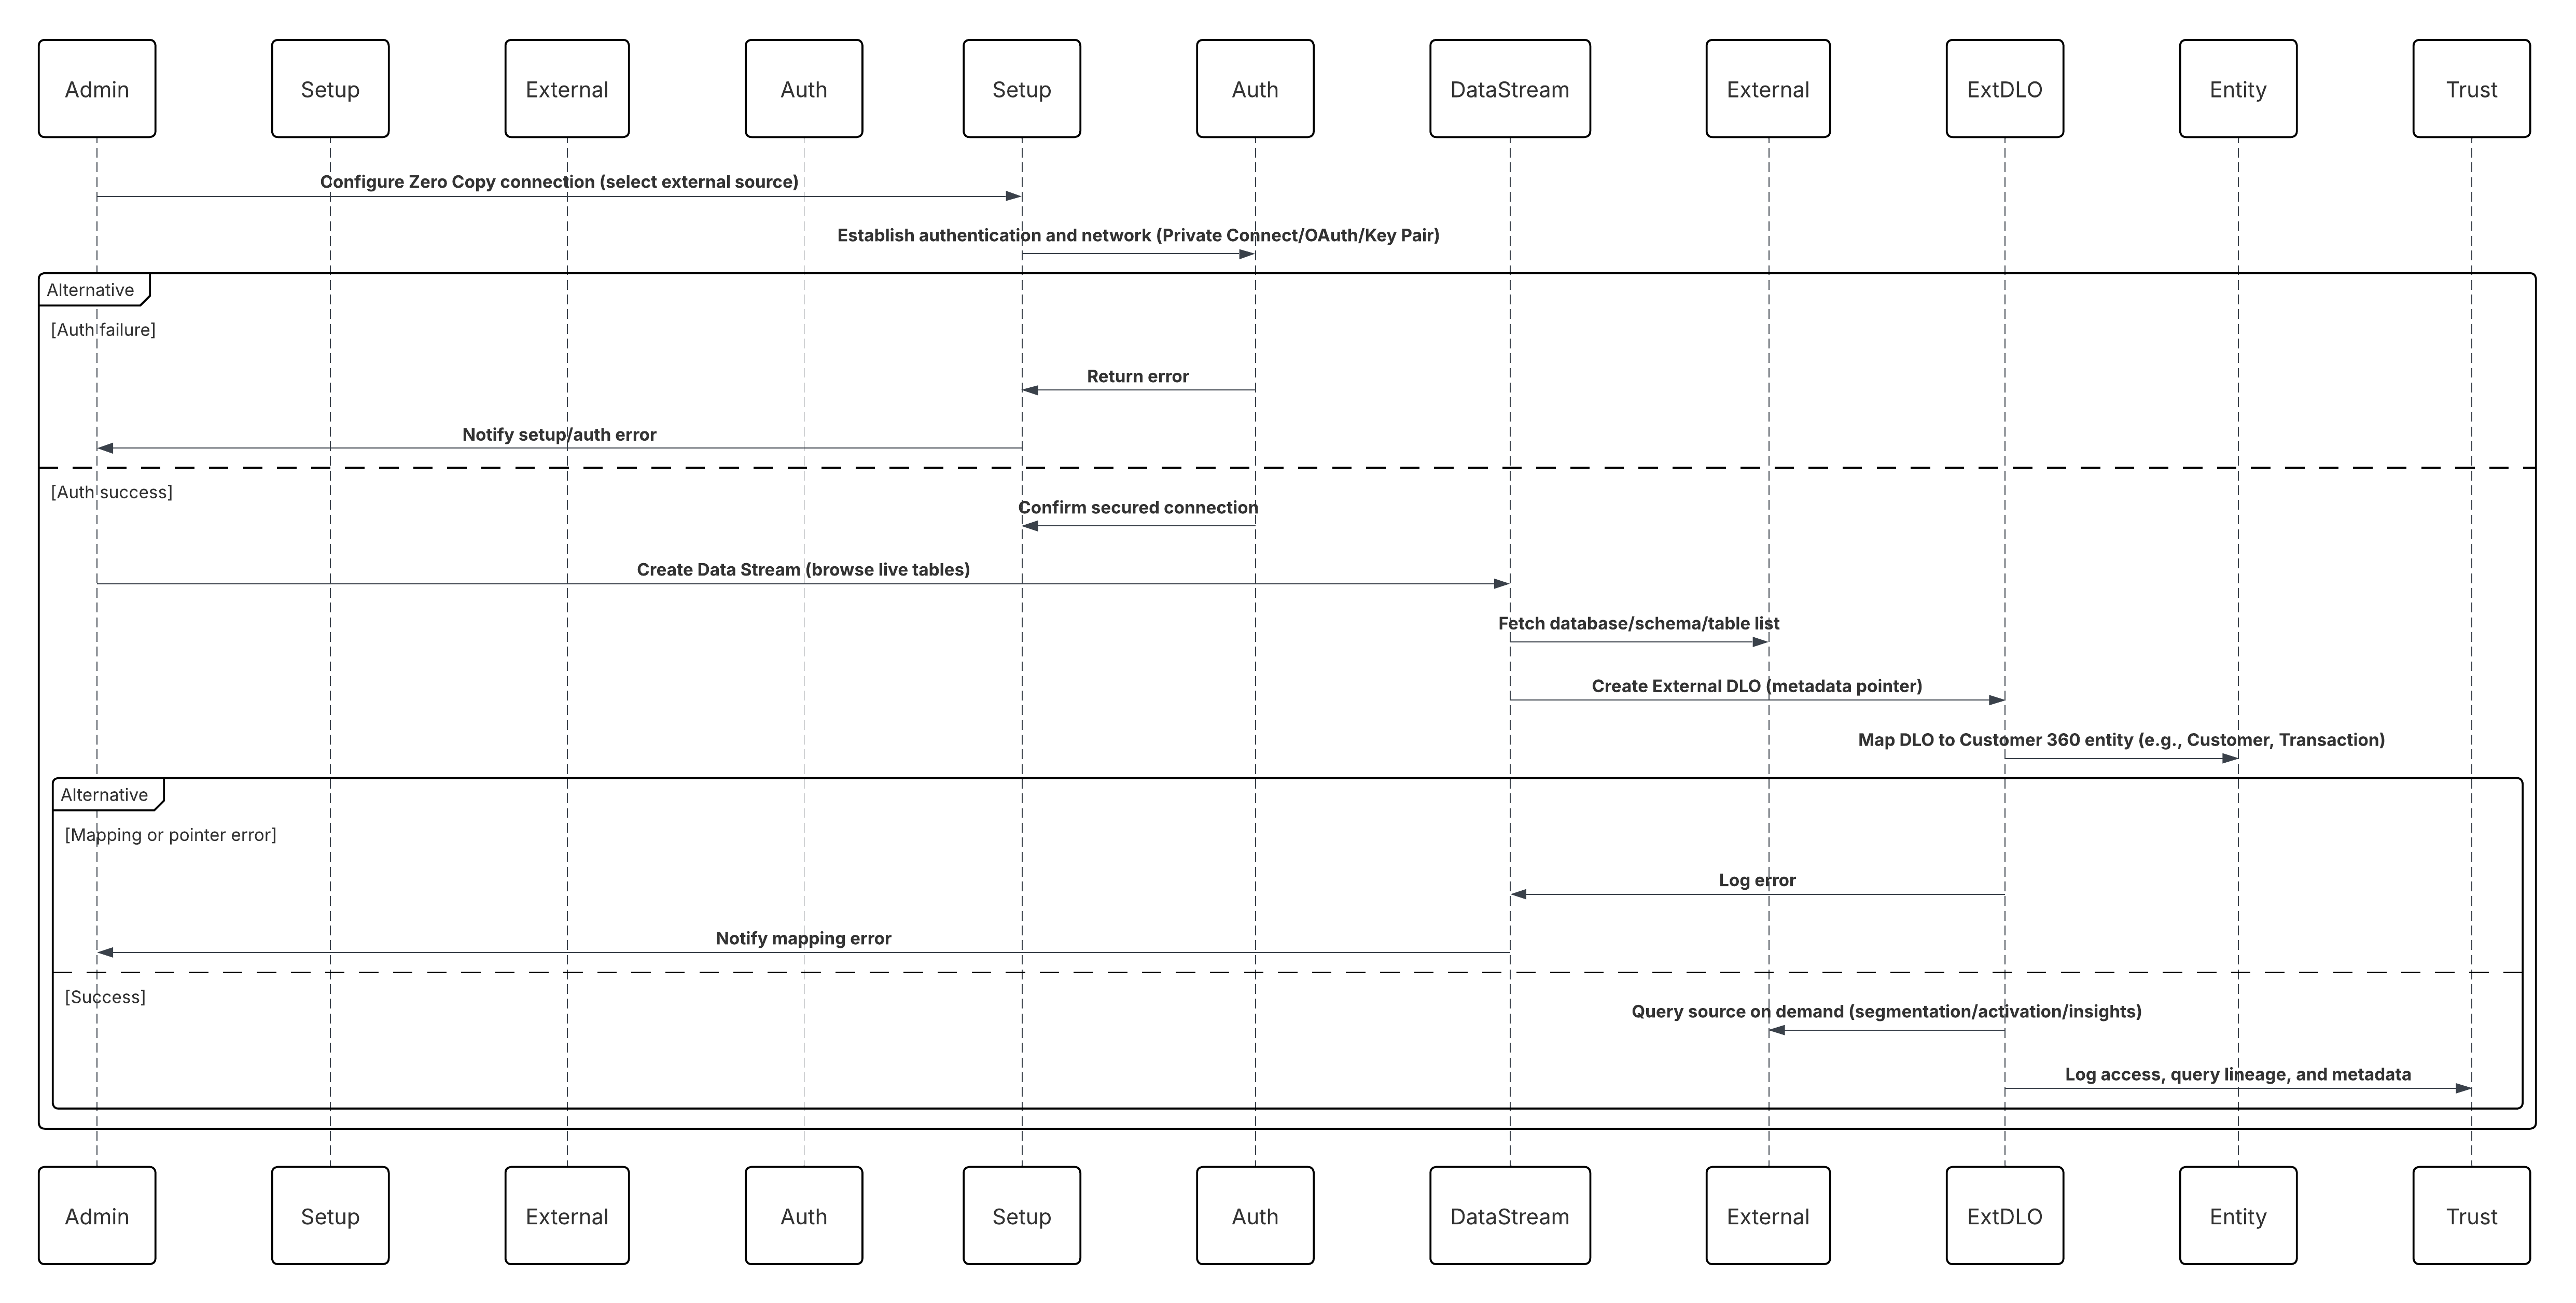 In diesem Szenario:
* Der Administrator konfiguriert im Setup von Data 360 (Snowflake, Databricks oder Dateiverbund) eine Zero Copy-Verbindung.
* Die sichere Authentifizierung und die Netzwerkweiterleitung werden eingerichtet (Private Connect / OAuth / Schlüsselpaar).
* Der Administrator erstellt einen Datenstrom, der die externe Quelle auswählt und Live-Datenbanken, Schemas und Tabellen durchsucht.
* Statt Daten zu kopieren, erstellt Data 360 ein externes DLO (Data Lake Object) – einen Metadatenzeiger, der auf die Live-Tabelle oder die Iceberg-Datei verweist.
* Externe DLOs werden Customer 360 Einheiten zugeordnet (z. B. Kunde, Transaktion, Produkt).
* Data 360 fragt die vorhandene Quelle während der Segmentierung, Aktivierung oder Statistikberechnung ab.
* Alle Zugriffs-, Abfragestamm- und Metadaten werden innerhalb der Data 360 Trust Layer überprüft.
##### Ergebnisse
* Externe Daten verbleiben in Snowflake, Databricks oder S3 – kein ETL, kein Duplikat und kein zusätzlicher Speicher.
* Data 360 erhält Echtzeit-Lesezugriff auf Daten im Unternehmensmaßstab für die Identitätsbestimmung, berechnete Statistiken und Aktivierung.
* Organisationen behalten die vollständige Kontrolle über ihre vorhandenen Governance-, Verschlüsselungs- und Compliance-Frameworks.
* Dieses Muster ermöglicht eine echte Zero Copy-Architektur, die die Leistung des lokalen Zugriffs mit der Verwaltung des Verbundspeichers kombiniert.
###### Aufrufmechanismen
Der Aufrufmechanismus hängt von der Lösung ab, die zur Implementierung dieses Musters ausgewählt wurde.
| Mechanismus | Wann zu verwenden |
|---|---|
| Snowflake-Verbund (bevorzugt) | Für den Live-Abfrageverbund mit verwalteten Enterprise Data Warehouses. |
| Databricks-Verbund | Für vereinheitlichte Analysen und Lakehouse-Umgebungen mit Delta- oder Parquet-gestützten Datensets. |
| Dateiverbund (Apache-Eisberg / Deltasee) | Für umfangreiche Datensets im Objektspeicher, bei denen die Berechnungstrennung und die Kostenoptimierung entscheidend sind. |
| Hybridmodus (Nullkopie + Aufnahme) | Wenn Verlaufsdaten einmalig aufgenommen werden müssen, jedoch über Zero Copy auf Live-Daten zugegriffen wird. |
| Lösungsbereich | Fit | Kommentare / Implementierungsdetails |
|---|---|---|
| Erstellung von Datenfreigaben | Best | Der Administrator erstellt eine Datenfreigabe in Data 360 und fügt ausgewählte DMOs und CIOs hinzu (z. B. "Zusammengeführte Einzelperson", "Kundengesundheitsbewertung"). |
| Zielkonfiguration | Best | Erstellen Sie ein Datenfreigabeziel, das Snowflake- oder Databricks-Accountkennzeichner und Authentifizierungsparameter angibt. |
| Freigabeveröffentlichung | Bewährte Vorgehensweisen | Verknüpfen Sie die Datenfreigabe mit dem Datenfreigabeziel, um sie sicher zu veröffentlichen. |
| Lagerannahme | Erforderlich | Der externe Administrator akzeptiert die Freigabe und materialisiert freigegebene Objekte als schreibgeschützte Ansichten/Tabellen im Lagerhaus. |
| Granulare Zugriffssteuerung | Empfohlen | Wenden Sie objekt- und rollenbasierte Berechtigungen in Data 360 an. Passen Sie sich an die rollenbasierte Zugriffssteuerung auf Lagerhausebene an. |
| Zugriff auf Verbundabfragen | Best | Analysten fragen freigegebene Live-Daten über standardmäßiges SQL ab. Verknüpft mit nativen Lagerhausdaten für nachgelagerte Analysen und ML. |
| Option 'Dateiverbund' | Optional | Nutzen Sie für große Datensets die Apache Iceberg-basierte Verbundfunktion für direkte S3- oder Delta Lake-Lesungen ohne Rechenabhängigkeit. |
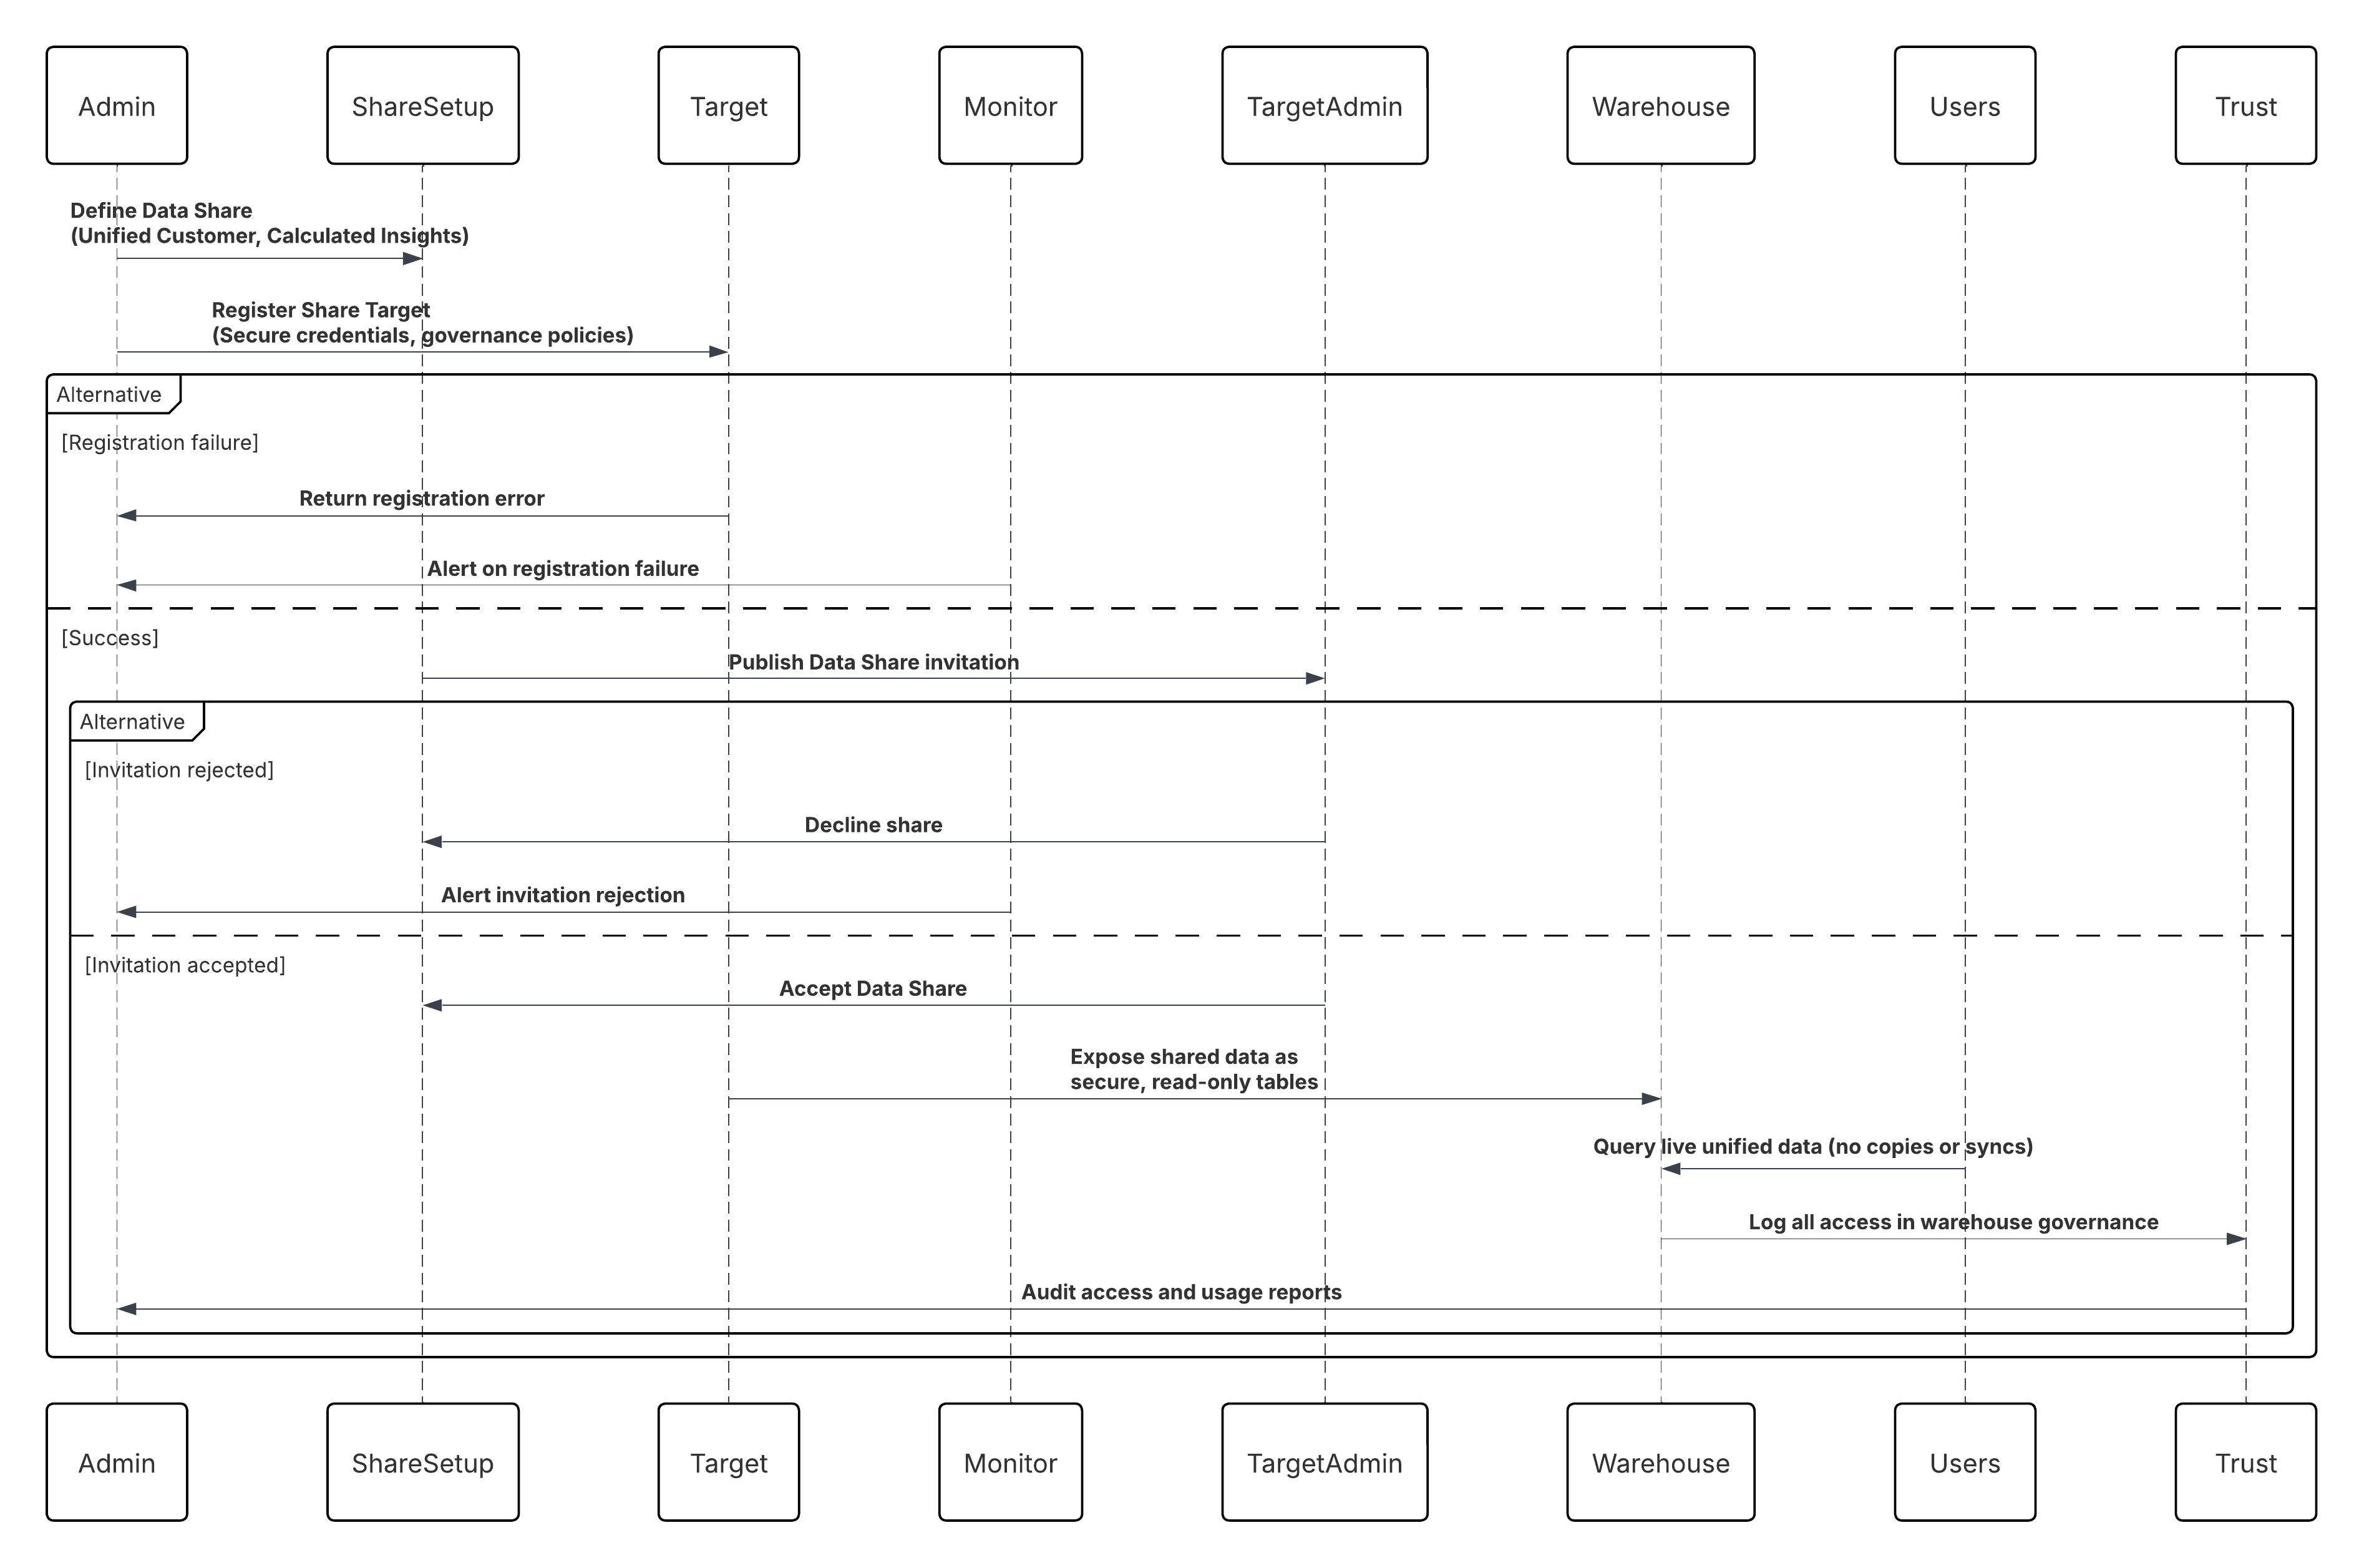 **In diesem Szenario:**
* Data 360-Administrator definiert eine Datenfreigabe, einschließlich der Objekte "Zusammengeführter Kunde" und "Berechnete Statistik".
* Ein Datenfreigabeziel (Snowflake- oder Databricks-Account) wird mit sicheren Anmeldeinformationen und Governance-Richtlinien registriert.
* Data 360 veröffentlicht die Freigabe. Snowflake/Databricks-Administratoren akzeptieren sie.
* Freigegebene Daten werden als sichere, schreibgeschützte Tabellen im Lagerhaus angezeigt.
* Analysten, BI-Tools oder ML-Pipelines fragen die zusammengeführten Live-Kundendaten ab, ohne sie kopieren oder synchronisieren zu müssen.
* Der gesamte Zugriff wird innerhalb der Data 360 Trust Layer- und Lagerhausverwaltungsprotokolle überprüft.
##### Ergebnisse
* Externe Lagerhäuser erhalten in Echtzeit abfragbaren Zugriff auf harmonisierte Data 360-Daten.
* Eliminiert umgekehrte ETL-Pipelines, wodurch der Betriebsaufwand und die Latenz reduziert werden.
* Aktiviert AI/ML-Training, Prognosemodellierung und erweiterte BI direkt für vereinheitlichte Daten.
* Bewahrt keine Duplikate, eine starke Governance und eine sichere Zugriffskontrolle nach Design auf.
* Schließt die bidirektionale Zero Copy-Schleife ab, bei der die eingehende Verbundfreigabe und die ausgehende Freigabe unter einem einzigen Governance-Modell nebeneinander vorhanden sind.
###### Aufrufmechanismen
Der Aufrufmechanismus hängt von der Lösung ab, die zur Implementierung dieses Musters ausgewählt wurde.
| Mechanismus | Wann zu verwenden |
|---|---|
| Snowflake-sichere Datenfreigabe (bevorzugt) | Wird verwendet, wenn Ihr Unternehmens-Warehouse Snowflake ist und Sie Live-Zugriff auf harmonisierte Data 360-Datensets ohne Datenverschiebung oder Duplikate benötigen. Ideal für Analysen, AI und Compliance-gestützte Arbeitslasten, die eine Freigabe ohne Latenz und die Erzwingung nativer Abstammung erfordern. |
| Databricks Delta Freigeben | Wird verwendet, wenn nachgelagerte Verbraucher in Databricks- oder Delta Lake-Umgebungen arbeiten und über das offene Delta-Freigabeprotokoll schreibgeschützten Echtzeitzugriff auf zusammengeführte oder aktivierte Datensets benötigen. |
| Freigabe für externe Tabellen (Apache Iceberg / Parquet) | Wird verwendet, wenn offene Architekturen im Objektspeicher (S3, ADLS oder GCS) verwaltet werden und eine interoperable, kostengünstige Freigabe über Analysemodule wie Athena, BigQuery oder Snowflake-on-Iceberg hinweg erforderlich ist. |
| API für Datenfreigabe (programmgesteuerter Zugriff) | Wird verwendet, wenn benutzerdefinierte Anwendungen oder Middleware (z. B. MuleSoft) freigegebene Datensets sicher über APIs entdecken, abonnieren oder verwenden müssen, mit ereignisbasierten Aktualisierungsbenachrichtigungen und einer detaillierten Zugriffssteuerung. |
| Hybridfreigabe (Nullkopie + ausgehende Freigabe) | Verwenden Sie diese Option bei der Implementierung von Mustern für den bidirektionalen Austausch, indem Sie Zero Copy für eingehende Daten und die Freigabe ausgehender Daten für die Veröffentlichung von Statistiken verwenden und so die semantische Konsistenz und Governance auf allen Unternehmensdatenebenen gewährleisten. |
| Lösungsbereich | Fit | Kommentare / Implementierungsdetails |
|---|---|---|
| Bereitstellung der Startseitenorganisation | Best | Legen Sie eine Salesforce-Organisation als "Startorganisation" fest, in der Data 360 bereitgestellt wird. Dies wird zum zentralen Datenspeicher und Governance-Zentrum. |
| Verbindung der Begleitorganisation | Best | Konfigurieren Sie Companion-Verbindungen über die Startseite einer oder mehrerer Companion-Organisationen über die Data Cloud One-Anwendung – kein benutzerdefinierter Code erforderlich. |
| Datenbereichsdefinition | Bewährte Vorgehensweisen | Definieren Sie Datenbereiche innerhalb der Startseite, um Daten logisch zu segmentieren (z. B. Einzelhandel, Service, Marketing) und Zugriffsgrenzen zu isolieren. |
| Freigabe von Datenbereichen | Best | Geben Sie ausgewählte Datenbereiche aus der Heimatorganisation explizit für Begleitorganisationen frei, um eine geregelte, rollenbasierte Sichtbarkeit der zusammengeführten Daten zu gewährleisten. |
| Zugriffskonfiguration | Erforderlich | Aktivieren Sie in Begleitorganisationen die Data Cloud One-Anwendung und weisen Sie Benutzerberechtigungen für den Profil-, Statistik- und Segmentzugriff zu. |
| Governance und Richtlinienkontrolle | Empfohlen | Zentralisieren Sie alle Aufnahme-, Identitätsbestimmungs- und Trust Konfigurationen in der Startseitenorganisation und behalten Sie die durchgängige Verwaltung bei. |
| Synchronisierung mehrerer Organisationen | Best | Datenänderungen und berechnete Statistiken in der Startseitenorganisation werden in Echtzeit in Begleitorganisationen über verwaltete Synchronisierungspipelines berücksichtigt. |
| Hybridbereitstellungsoption | Optional | Bei großen Unternehmen können mehrere Begleitorganisationen eine Verbindung zu einer einzelnen Home-Organisation herstellen und gleichzeitig lokale Kontext- und Compliance-Grenzen beibehalten. |
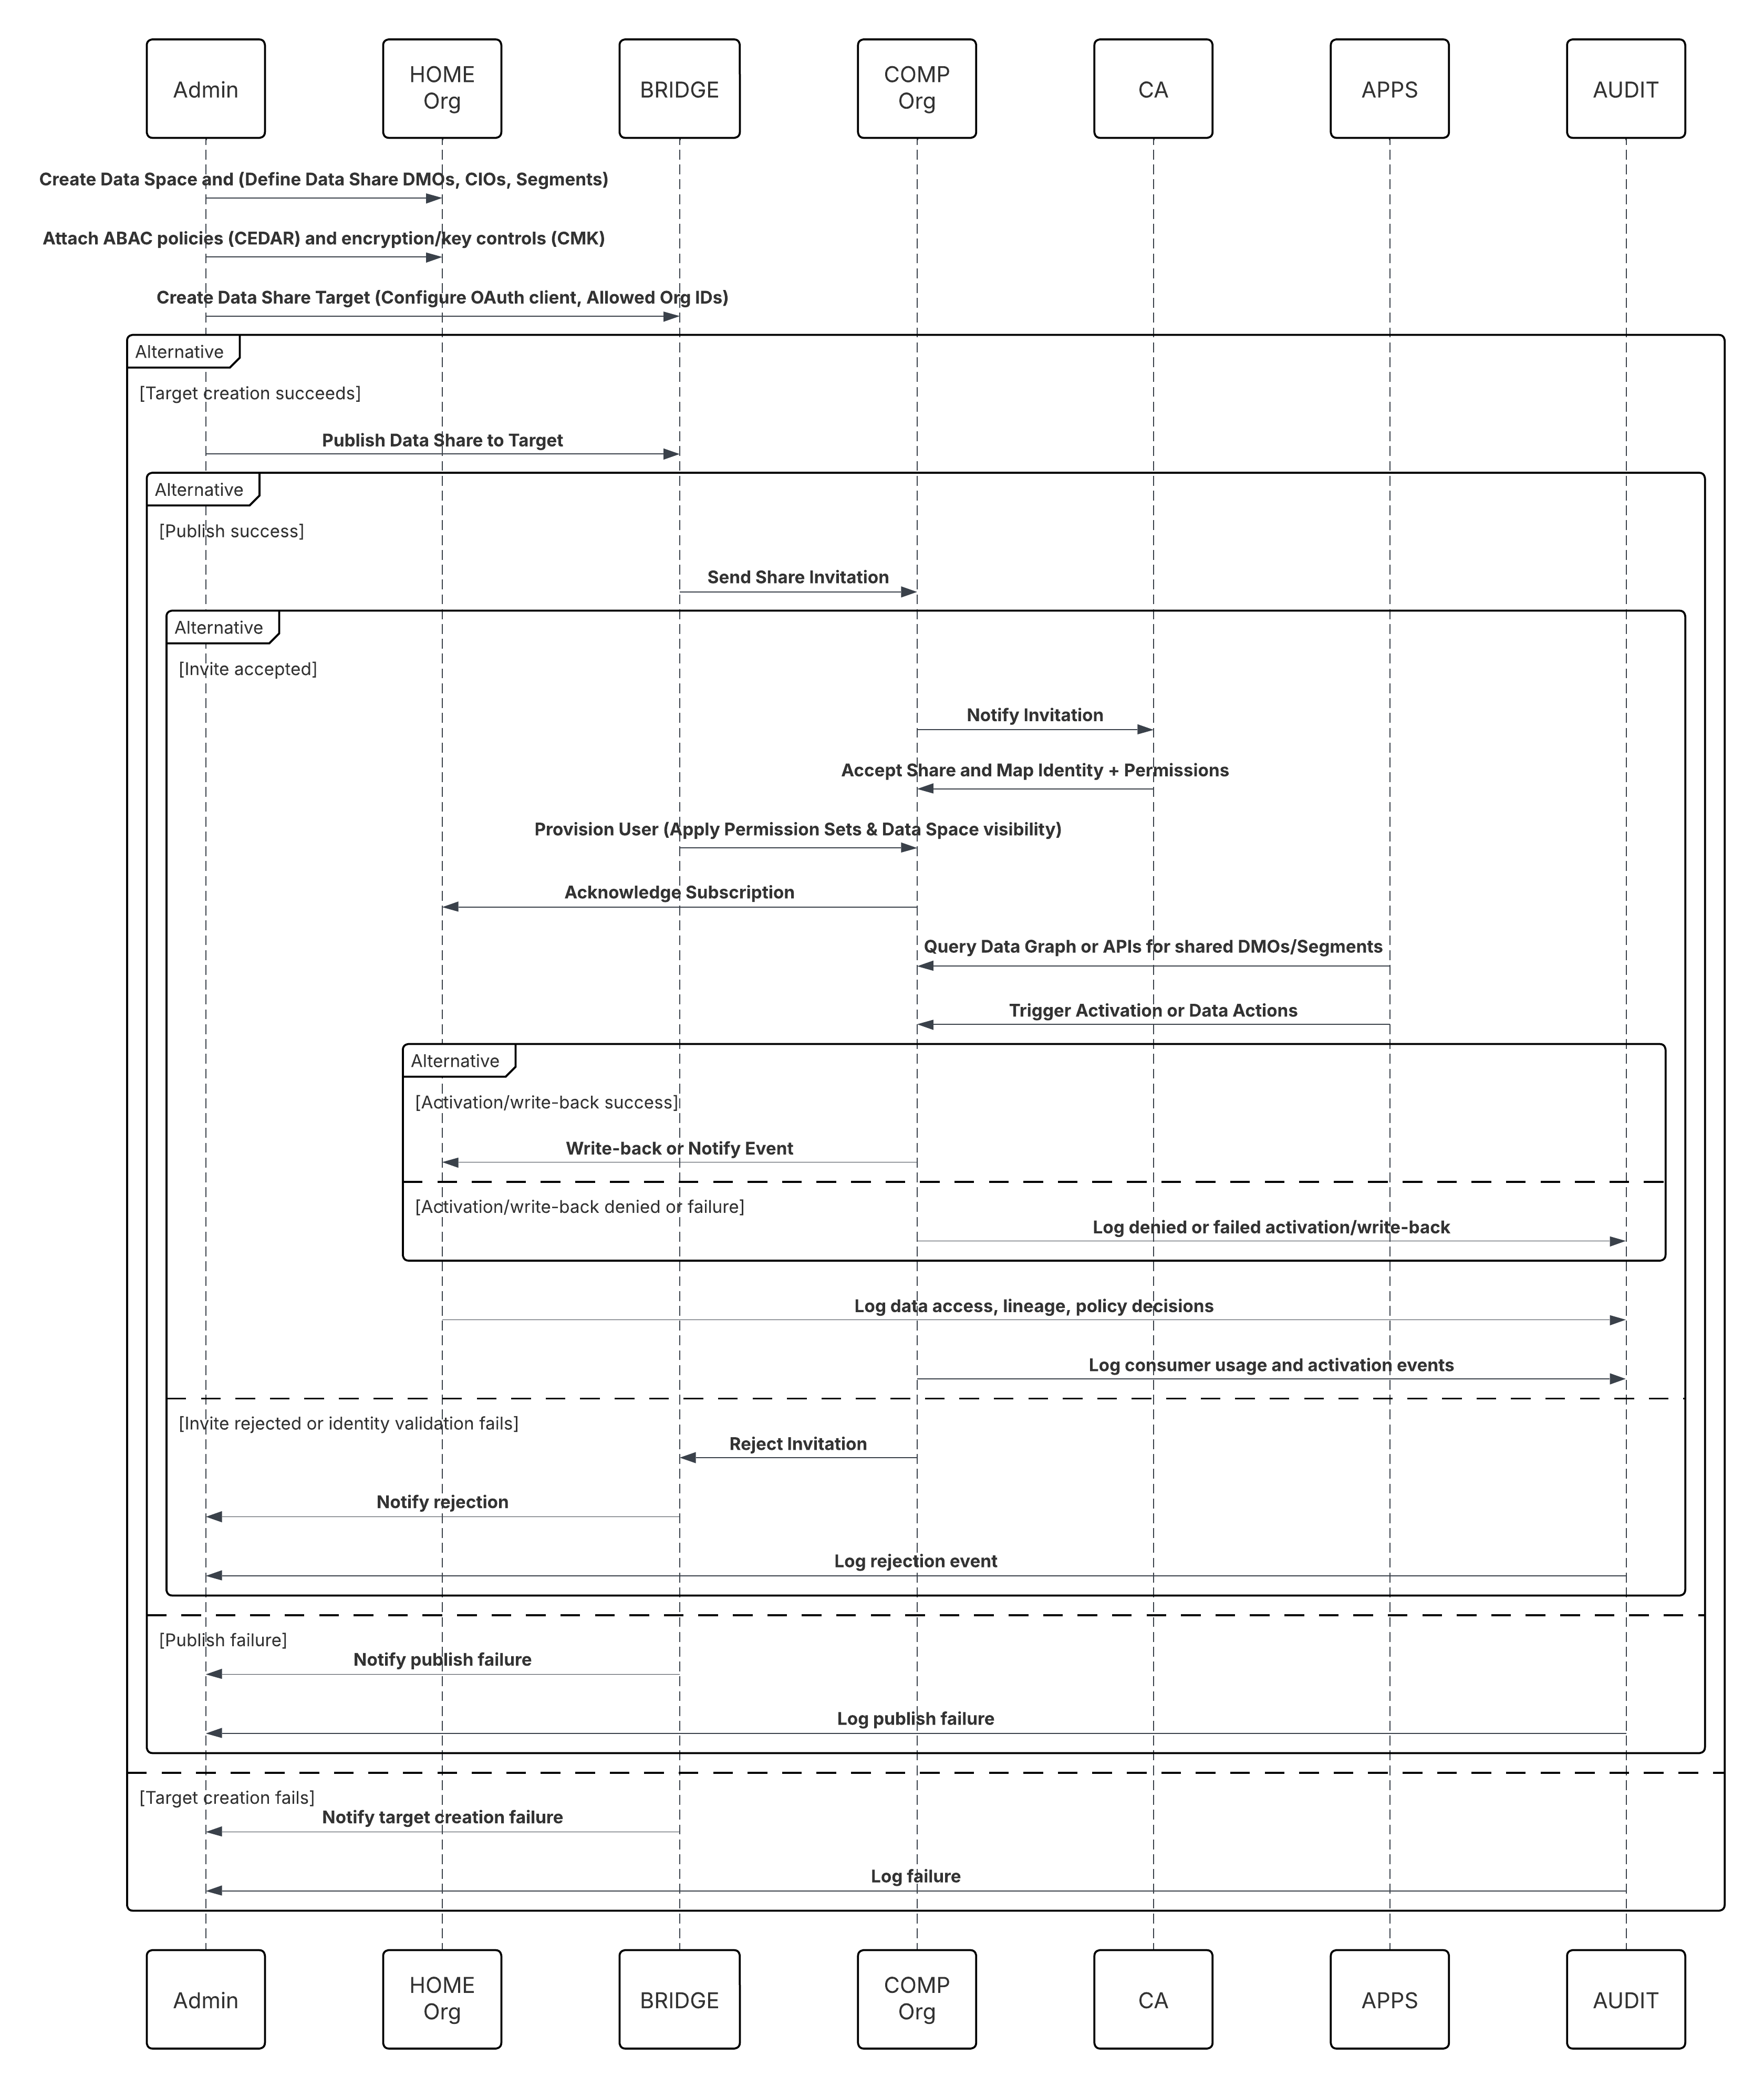 **In diesem Szenario:**
* **Startadministrator**: Datenbereich erstellen und Datenfreigabe definieren (Auswahl von DMOs/CIOs, Segmenten).
* **Startadministrator**: Erstellen Sie das Datenfreigabeziel für Begleitorganisationen und konfigurieren Sie Trust (OAuth-Client, zulässige Organisations-IDs).
* **Startadministrator**: Veröffentlichen der Datenfreigabe im Ziel; Anhängen von ABAC-Richtlinien (CEDAR) und Verschlüsselungs-/Schlüsselsteuerungen (CMK, falls erforderlich).
* **Begleitorganisationsadministrator**: empfängt Einladungen, validiert die Identitätszuordnung und akzeptiert Freigaben.
* **Begleitorganisation**: Data Cloud One Bridge stellt einen Data Cloud One-Benutzer bereit und wendet die Sichtbarkeit von Berechtigungssätzen und Datenbereichen an.
* **Anwendungen für Begleitorganisationen (Flows / Einstein / Apex)**: Fragen Sie ein Datendiagramm ab oder rufen Sie Data Cloud One-APIs auf, um freigegebene DMOs oder Segmente zu lesen.
* **Aktivierung**: Die Begleitorganisation löst die Aktivierung aus oder schreibt über Datenaktionen zurück (sofern zulässig).
##### Ergebnisse
* Eine **einzige Quelle der Wahrheit** für Kundendaten (Customer 360) in allen verbundenen Organisationen – keine redundanten Data 360-Instanzen.
* **Eine schnellere Zeit bis zum Wert.** Begleitorganisationen können in Minutenschnelle auf zusammengeführte Daten und Data 360-gestützte Funktionen zugreifen, statt wochenlang benutzerdefinierte Codierungen vorzunehmen.
* **Gesteuerte Datenfreigabe.** Nur autorisierte Datenbereiche werden freigegeben, wodurch Sicherheit und Governance gewahrt bleiben und gleichzeitig die geschäftliche Agilität ermöglicht wird.
* Geschäftsfunktionen (Vertrieb, Service, Marketing) basieren auf derselben einheitlichen Datengrundlage und ermöglichen konsistente Kennzahlen, Aktivierungen und Statistiken im gesamten Unternehmen.
###### Aufrufmechanismen
Der Aufrufmechanismus hängt von der Lösung ab, die zur Implementierung dieses Musters ausgewählt wurde.
| Mechanismus | Wann zu verwenden |
|---|---|
| Native Data Cloud One-Freigabe (bevorzugt) | Wird verwendet, wenn mehrere Salesforce-Organisationen (Vertrieb, Service oder Industry Cloud) Echtzeitzugriff auf zusammengeführte Kundendaten direkt über Data 360 benötigen. Dadurch werden Abgleiche vermieden und der Zugriff auf Goldene Datensätze, Segmente und berechnete Statistiken ohne Latenz ermöglicht. |
| Freigabe über Data Cloud One-Brücke | Wird verwendet, wenn mehrere Geschäftseinheiten oder Tochtergesellschaften in separaten Salesforce-Organisationen arbeiten, jedoch über eine zentrale Data 360-Instanz gemeinsam auf gemeinsame Kundendaten und Segmente zugreifen müssen. Ideal für Unternehmen mit mehreren Organisationen, die unabhängige Betriebssysteme unterhalten. |
| Plattformabfrage-APIs für Einstein 1 | Wird verwendet, wenn Salesforce-Anwendungen, Flow oder Einstein Copilot Data 360-Daten programmgesteuert abfragen oder aktivieren müssen. Ermöglicht das Abrufen von zusammengeführten Profilen, Kennzahlen oder Aktivierungsergebnissen in Echtzeit in andere Salesforce-Anwendungen ohne Batch-Exporte. |
| Aktivierung in Salesforce-Kanälen | Wird verwendet, wenn Data 360-Daten (Segmente, Statistiken oder Attribute) für Marketing Cloud, Service Cloud oder Commerce Cloud aktiviert werden müssen, um Personalisierungs-, Kampagnenausführungs- oder Agentenunterstützungserfahrungen zu ermöglichen. |
| Datendiagrammzugriff (semantische Abfrageebene) | Wird verwendet, wenn Sie über das Salesforce-Datendiagramm auf semantischer Ebene auf das vereinheitlichte Datenmodell zugreifen müssen und Copilot, AI-Workflows und cloudübergreifende Analysen in Echtzeit ohne manuelle Verknüpfungen oder Transformationen unterstützen. |
| Lösungsbereich | Fit | Kommentare / Implementierungsdetails |
|---|---|---|
| Segmenterstellung | Best | Ein Marketingexperte oder Analyst erstellt ein Segment im Zeichenbereich der visuellen Segmentierung, indem er Filter auf ein beliebiges Datenmodellobjekt (DMO) oder ein Objekt der berechneten Statistik (CIO) anwendet. Dadurch wird die Zielgruppe für die Aktivierung definiert. |
| Aktivierungs-Setup | Best | Der Benutzer erstellt eine Aktivierung und wählt das Segment aus, das er gerade erstellt hat. Dadurch wird definiert, welche Zielgruppe Data 360 in nachgelagerte Systeme exportiert. |
| Aktivierungszielauswahl | Bewährte Vorgehensweisen | Der Marketingexperte wählt ein vorkonfiguriertes Aktivierungsziel aus (z. B. Marketing Cloud, Google Ads, LinkedIn Ads). Jedes Ziel ist in Data 360 mit Authentifizierungsanmeldeinformationen und Feldzuordnungen registriert. |
| Nutzlastdefinition | Erforderlich | Der Marketingexperte definiert die Nutzlast, indem er Kontaktkennzeichner (z. B. E-Mail, Mobilgerät, gehashte ID) und zusätzliche Profilattribute (z. B. Vorname, Treuestufe oder CLV) zur Anreicherung im Zielsystem auswählt. |
| Planung und Häufigkeit | Empfohlen | Aktivierungen können so geplant werden, dass sie einmalig oder wiederkehrend (z. B. täglich oder wöchentlich) ausgeführt werden. Durch die Planung wird sichergestellt, dass nachgelagerte Zielgruppen synchronisiert und aktuell bleiben. |
| Ausführung und Export | Best | Wenn der Aktivierungsauftrag ausgeführt wird, fragt Data 360 das Segment ab, erfasst die ausgewählten Attribute, wendet Einwilligungsfilter an und exportiert die Daten auf die Zielplattform. Bei Marketing Cloud führt dies in der Regel zur Erstellung oder Aktualisierung einer freigegebenen Data Extension. |
| Governance und Compliance | Erforderlich | Die Trust Layer erzwingt Schemavalidierungen, Einwilligungsmetadaten und Richtlinienkontrollen, um die Einhaltung von Datenschutz- und Marketingbestimmungen (z. B. DSGVO, CCPA) sicherzustellen. |
| Überwachung und Überprüfbarkeit | Bewährte Vorgehensweisen | Im Trust Layer Monitoring-Dashboard wird jede Aktivierungsausführung mit Erfolgs-/Fehlerkennzahlen, Ausführungsprotokollen und Abstammungssichtbarkeit verfolgt, was betriebliche Transparenz und SLA-Sicherung ermöglicht. |
 ##### Ergebnisse
* Gezielte, angereicherte Zielgruppensegmente aus Data 360 werden direkt auf nachgelagerten Marketing- und Werbeplattformen zur Verfügung gestellt.
* Zielgruppen werden automatisch aktualisiert und mit den neuesten zusammengeführten Kundendaten synchronisiert, wodurch die Kampagnenrelevanz in Echtzeit erhalten bleibt.
* Marketingexperten können diese aktivierten Zielgruppen als Eingangsquellen für Marketing Cloud-Journeys, E-Mail-Kampagnen oder benutzerdefinierte Zielgruppen auf digitalen Anzeigenplattformen wie Google Ads, Meta oder LinkedIn Ads verwenden.
* Bei jeder Aktivierungsausführung wird die durchgängige Abstammung beibehalten, wodurch die Compliance, die Rückverfolgbarkeit und die Konsistenz zwischen Data 360 und externen Systemen gewährleistet werden.
* Geschäftsbenutzer können mithilfe einer vollständigen und vertrauenswürdigen Customer 360-Ansicht hochgradig personalisierte, datengesteuerte Erfahrungen bereitstellen.
###### Aufrufmechanismen
Der Aufrufmechanismus hängt von der Zielplattform und der Aktivierungszielkonfiguration ab.
| Mechanismus | Wann zu verwenden |
|---|---|
| Marketing Cloud Engagement Activation (Preferred) | Wird bei der Ausführung von E-Mail- oder kanalübergreifenden Journeys verwendet, die dynamische Segmente, personalisierte Attribute und Echtzeitaktualisierungen in Marketing Cloud erfordern. Data 360 wird zur Kampagnenaktivierung direkt in freigegebene Data Extensions exportiert. |
| Anzeigenplattformaktivierung (Google Ads, LinkedIn Ads, Meta Ads) | Wird verwendet, wenn Data 360-Segmente als benutzerdefinierte Zielgruppen auf Werbeplattformen für das Retargeting oder die Ähnlichkeitsmodellierung aktiviert werden. Unterstützt gehashte Kennzeichner und die Zustellung mit Einwilligungsbewusstsein. |
| CRM-Aktivierung (Vertrieb oder Service Cloud) | Wird verwendet, wenn Sie angereicherte Kundendaten, Statistiken oder Neigungsbewertungen für CRM-Benutzer für personalisierte Vertriebsengagements oder Serviceinteraktionen freigeben. Daten werden als angereicherte Datensätze oder Statistiken über Datenaktionen oder Komponenten des zusammengeführten Profils zur Verfügung gestellt. |
| Externe Aktivierung über MuleSoft oder API | Wird verwendet, wenn die Aktivierung Nicht-Salesforce-Systeme wie Treue-, E-Commerce- oder Drittanbieter-Data Warehouses erreichen muss. MuleSoft oder die Data 360-Aktivierungs-API gewährleisten eine sichere, richtliniengesteuerte Zustellung mit ereignisbasierten Aktualisierungsoptionen. |
| Hybridaktivierung (Batch + durch Ereignis ausgelöst) | Wird verwendet, wenn geplante Batch-Aktivierungen mit ereignisbasierten Auslösern kombiniert werden. Dadurch wird die Personalisierung für zeitkritische Kampagnen wie Warnungen zu verlassenen Einkaufswagen oder Abwanderungsrisiken immer aktiviert. |
| Lösungsbereich | Fit | Kommentare / Implementierungsdetails |
|---|---|---|
| Segmentauswahl | Best | Analysten wählen eine vorhandene Segment- oder Abfragedefinition in Data 360\ aus. Das Segment bestimmt, welche Datensätze und Attribute exportiert werden. |
| Aktivierungs-Setup | Best | Benutzer erstellen eine neue Aktivierung und wählen das Segment als Quelle und das Cloud-Speicherziel (z. B. S3) als Ziel aus. |
| Aktivierungszielkonfiguration | Erforderlich | Administratoren konfigurieren das Ziel mit Anmeldeinformationen, IAM-Rollen und Ausgabepfad vor. Zu den unterstützten Formaten zählen CSV, Parquet und JSON. |
| Nutzlastdefinition | Bewährte Vorgehensweisen | Definieren Sie das Exportschema, indem Sie die erforderlichen Attribute auswählen (z. B. ID, Name, E-Mail, Region, Einwilligungskennzeichnung). Das System erzwingt die Verwaltung auf Attributebene. |
| Planung und Häufigkeit | Empfohlen | Exporte können in einem definierten Rhythmus (täglich, wöchentlich, monatlich) geplant oder bei Bedarf manuell ausgelöst werden. |
| Ausführung & Zustellung | Best | Bei der Ausführung fragt Data 360 das Segment ab, kompiliert die Exportdatei, verschlüsselt sie und schreibt sie mithilfe der API des Cloud-Anbieters in den konfigurierten Bucket/Ordner. |
| Governance und Compliance | Erforderlich | Die Trust Layer von Data 360 stellt sicher, dass alle Exporte Einwilligungsrichtlinien, Schemavalidierungen und Compliance-Filter einhalten. |
| Überwachung und Überprüfbarkeit | Bewährte Vorgehensweisen | Jeder Export wird im Trust Layer Monitoring-Dashboard mit Status-, Ausführungsprotokoll- und Abstammungsmetadaten verfolgt. |
 ##### Ergebnisse
* Gezielte, angereicherte Zielgruppensegmente aus Data 360 werden direkt auf nachgelagerten Marketing- und Werbeplattformen zur Verfügung gestellt.
* Zielgruppen werden automatisch aktualisiert und mit den neuesten zusammengeführten Kundendaten synchronisiert, wodurch die Kampagnenrelevanz in Echtzeit erhalten bleibt.
* Marketingexperten können diese aktivierten Zielgruppen als Eingangsquellen für Marketing Cloud-Journeys, E-Mail-Kampagnen oder benutzerdefinierte Zielgruppen auf digitalen Anzeigenplattformen wie Google Ads, Meta oder LinkedIn Ads verwenden.
* Bei jeder Aktivierungsausführung wird die durchgängige Abstammung beibehalten, wodurch die Compliance, die Rückverfolgbarkeit und die Konsistenz zwischen Data 360 und externen Systemen gewährleistet werden.
* Geschäftsbenutzer können mithilfe einer vollständigen und vertrauenswürdigen Customer 360-Ansicht hochgradig personalisierte, datengesteuerte Erfahrungen bereitstellen.
###### Aufrufmechanismen
Der Aufrufmechanismus hängt von der Ziel-Cloud-Speicherplattform und der Aktivierungskonfiguration ab.
| Mechanismus | Wann zu verwenden |
|---|---|
| Amazon S3-Aktivierung | Wird verwendet, wenn Ihr Unternehmens-Data-Lake in AWS gehostet wird. Data 360 schreibt mithilfe von IAM-Rollen oder temporären Anmeldeinformationen direkt in einen S3-Bucket und gewährleistet so einen sicheren und skalierbaren Export. |
| Azurblaue Blob-Speicheraktivierung | Wird verwendet, wenn Ihre Organisation Microsoft Azure verwendet. Data 360 verwendet SAS-Token oder Serviceprinzipale, um verschlüsselte Dateien in Blob-Container zu schreiben. |
| Google Cloud Storage (GCS) Activation | Wird verwendet, wenn Ihre Data Science- oder Analytics-Arbeitslasten mit GCP ausgeführt werden. Data 360 verwendet OAuth-Anmeldeinformationen, um Dateien in GCS-Buckets im CSV- oder Parquet-Format zu exportieren. |
| SFTP oder externes Datei-Gateway | Wird verwendet, wenn gesetzliche oder ältere Systeme eine sichere Dateizustellung über SFTP-Endpunkte oder von Unternehmen verwaltete Dateiübertragungsplattformen erfordern. |
| Hybridexport (Datei + API) | Wird verwendet, wenn eine nachgelagerte Anwendung sowohl einen dateibasierten Export für Analysen als auch einen API-Auslöser für die Workflow-Orchestrierung benötigt (z. B. MuleSoft-Flow). |
| Lösungsbereich | Fit | Kommentare / Implementierungsdetails |
|---|---|---|
| Authentifizierung und Anwendungsregistrierung | Erforderlich | Erstellen Sie eine verbundene Anwendung in Salesforce für die OAuth 2.0-basierte Authentifizierung. Konfigurieren Sie Umfänge für den Data 360-API-Zugriff. |
| Datenzugriff (Profile, Segmente, Statistiken) | Best | Verwenden Sie Connect-API-Endpunkte (/services/data/vXX.X/connect), um harmonisierte Data 360-Daten, zusammengeführte Profile und berechnete Statistiken abzufragen. |
| Benutzeroberflächenintegration | Best | Front-End-Anwendungen (React, Angular, iOS, Android) rufen die Connect-API auf, um Data 360-Daten in Dashboards, Portalen oder mobilen Oberflächen darzustellen. |
| Datendiagrammabfrage | Empfohlen | Kombinieren Sie die Connect-API mit der Datendiagramm-API für Abfragen auf semantischer Ebene, die komplexe Verknüpfungen und Beziehungen vereinfachen. |
| Echtzeitaktualisierung | Optional | Verwenden Sie die Connect-API mit WebSocket oder Streaming-Erweiterungen für Live-Datenaktualisierungen. |
| Sicherheit und Unternehmensführung | Erforderlich | Erzwingen Sie die Datensichtbarkeit mithilfe von OAuth-Geltungsbereichen, Data 360-Richtlinien und dem Trust Layer-Audit-Framework. |
 ##### Ergebnisse
Entwickler können sichere Anwendungen mit benutzerdefiniertem Branding erstellen, die eng in Data 360 integriert sind. Diese Anwendungen können:
* Zeigen Sie harmonisierte Kundenprofile und Statistiken in Echtzeit an.
* Zeigen Sie Data 360-Daten zusammen mit CRM oder benutzerdefinierten Objekten über vereinheitlichte APIs an.
* Nutzen Sie konsistente Authentifizierungs-, Autorisierungs- und Überwachungssteuerungen über die Trust Layer.
* Bieten Sie Geschäftsbenutzern oder Partnern nahtlosen, gesteuerten Zugriff auf vertrauenswürdige Kundenintelligenz über mehrere Erfahrungen hinweg.
##### Aufrufmechanismen
Der Aufrufmechanismus hängt von der Ziel-Cloud-Speicherplattform und der Aktivierungskonfiguration ab.
| Mechanismus | Wann zu verwenden |
|---|---|
| Connect-REST-API (bevorzugt) | Wird beim Erstellen von Web-, mobilen oder Drittanbieteranwendungen verwendet, die Echtzeitzugriff auf Data 360-Daten in einem benutzerfreundlichen JSON-Format erfordern. |
| Datendiagramm-API | Wird verwendet, wenn die Anwendung Abfragen auf semantischer Ebene über mehrere Objekte hinweg ausführen muss (z. B. Kunde → Transaktionen → Kampagnen). |
| Abfrage-API | Wird beim Ausführen von SOQL-ähnlichen Abfragen verwendet, um harmonisierte Datensets mit hoher Genauigkeit abzurufen. |
| Plattform-APIs für Einstein 1 | Wird verwendet, wenn AI-gestützte Statistiken oder von Copilot generierte Empfehlungen in benutzerdefinierte Benutzeroberflächen integriert werden. |
| MuleSoft oder Apex Gateway Wrapper | Wird verwendet, wenn eine zusätzliche Orchestrierung, Zwischenspeicherung oder Richtlinienerzwingung zwischen der Anwendung und der Connect-API erforderlich ist. |
| Lösungsbereich | Fit | Kommentare / Implementierungsdetails |
|---|---|---|
| Datendiagrammdefinition | Erforderlich | Architekten definieren ein Datendiagramm, das mehrere DMOs in einer einzigen semantischen Einheit kombiniert (z. B. "UnifiedCustomerProfile"). |
| Profil-Nachschlageabruf | Best | Anwendungen rufen GET /api/v1/dataGraph/{entity}/{id} auf, um vollständige denormalisierte Profile nach eindeutiger ID oder Schlüssel abzurufen. |
| Live-Parameternutzung | Optional | Hängen Sie ?live=true an, um eine neue Berechnung anstelle eines zwischengespeicherten Abrufs zu erzwingen. Dies eignet sich für Entscheidungen mit hohem Wert. |
| Authentifizierung | Erforderlich | Verwenden Sie OAuth 2.0 über verbundene Anwendungen, um API-Aufrufe sicher zu authentifizieren. |
| Antwortanalyse | Bewährte Vorgehensweisen | Anwendungen analysieren die JSON-Antwort direkt auf ihrer Benutzeroberfläche oder in ihrem Entscheidungsmodul. Es sind keine weiteren Verknüpfungen erforderlich. |
| Cache-Strategie | Empfohlen | Implementieren Sie die kurzfristige lokale Zwischenspeicherung (z. B. im Arbeitsspeicher oder CDN) für wiederholte Profilnachschlagevorgänge. |
| Überwachung und Beobachtbarkeit | Erforderlich | Verwenden Sie Trust Layer-Dashboards, um die Abfrageleistung, die Antwortzeiten und die Richtlinieneinhaltung zu überwachen. |
 ##### Ergebnisse
Anwendungen können nun sofort ein vollständiges, vorverknüpftes Kundenprofil abrufen und so Echtzeitinteraktionen wie Personalisierung, Service und Entscheidungsautomatisierung unterstützen.
Dieses Muster gewährleistet Folgendes:
* Antwortzeiten innerhalb von Sekunden für die sofortige Entscheidungsfindung.
* Konsistenter, gesteuerter Datenabruf, der auf das semantische Data 360-Modell abgestimmt ist.
* Vereinfachte Anwendungslogik: Keine Verknüpfungen, keine Schemaabstimmung.
* Verfolgen und konformer Zugriff über die Trust Layer für Überprüfung und Beobachtbarkeit.
###### Aufrufmechanismen
Der Aufrufmechanismus hängt von der Ziel-Cloud-Speicherplattform und der Aktivierungskonfiguration ab.
| Mechanismus | Wann zu verwenden |
|---|---|
| Datendiagramm-API (bevorzugt) | Wird zum sofortigen Abrufen vollständiger, vormaterialisierter Profile nach ID oder Schlüssel verwendet. |
| Datendiagramm-API mit live=true | Wird für Anwendungsfälle mit hohem Wert (z. B. Betrugserkennung, Live-Angebote) verwendet, in denen die neuesten Daten benötigt werden, wobei eine etwas höhere Latenz akzeptiert wird. |
| Connect-API (Fallback) | Wird für Szenarien zusammengesetzter Anwendungen verwendet, in denen Datendiagrammabrufe mit anderen Salesforce-Daten kombiniert werden. |
| Abfrage-API | Wird beim Erstellen von Ad-hoc-Abfragen oder analytischen Lesevorgängen anstelle des sofortigen Profilabrufs verwendet. |
| MuleSoft API Proxy | Wird verwendet, wenn Datendiagrammaufrufe über Unternehmens-Gateways weitergeleitet werden oder wenn eine zusätzliche Orchestrierung/Erzwingung von Richtlinien erforderlich ist. |
| Lösungsbereich | Fit | Kommentare / Implementierungsdetails |
|---|---|---|
| Echtzeit-Datenaktion | Best | Stellen Sie den Endpunkt für Lese-/Schreibzugriff und Aktionsauslöser mit einem Datensatz bereit. Authentifizieren über OAuth/JWT. |
| Identitätsbestimmung | Erforderlich | Lösen Sie eingehende Kennzeichner (E-Mail, externalId, Cookie) inline in die ID der zusammengeführten Einzelperson auf. Verwenden Sie einen deterministischen Resolver mit Cache. |
| Policenerzwingung (CEDAR) | Bewährte Vorgehensweisen | Evaluieren Sie Einwilligungs-, ABAC- und Maskierungsrichtlinien zur Anforderungszeit. Verweigern oder maskieren Sie Felder pro Richtlinienentscheidung. |
| Edge/Cache Layer | Empfohlen | Verwenden Sie Kurz-TTL-Caches für Profilfragmente und berechnete Statistiken, um die Latenz zu reduzieren und bei Änderungsereignissen ungültig zu machen. |
| Leichtbautransformationen | Empfohlen | Wenden Sie einfache Anreicherungen oder berechnete Felder im Aktionspfad an. Schwere Transformationen sollten vorausberechnet werden. |
| Aktionsorchestrierung | Best | Unterstützen Sie synchrone Einzelschrittaktionen (z. B. Rückgabeangebotstoken) und asynchrone Orchestrierungen (Warteschlange \+ Webhook) für komplexe Flows. |
| Beobachtbarkeit und Verfolgung | Erforderlich | Protokollieren Sie Anforderungen/Antworten, Richtlinienentscheidungen und die Abstammung zur Trust Layer/ SIEM für die Überprüfung und das Debugging. |
| Ratenbegrenzung und -drosselung | Erforderlich | Erzwingen Sie Kundenquoten und anmutige Verschlechterungsstrategien für Momente mit hohem Datenverkehr. |
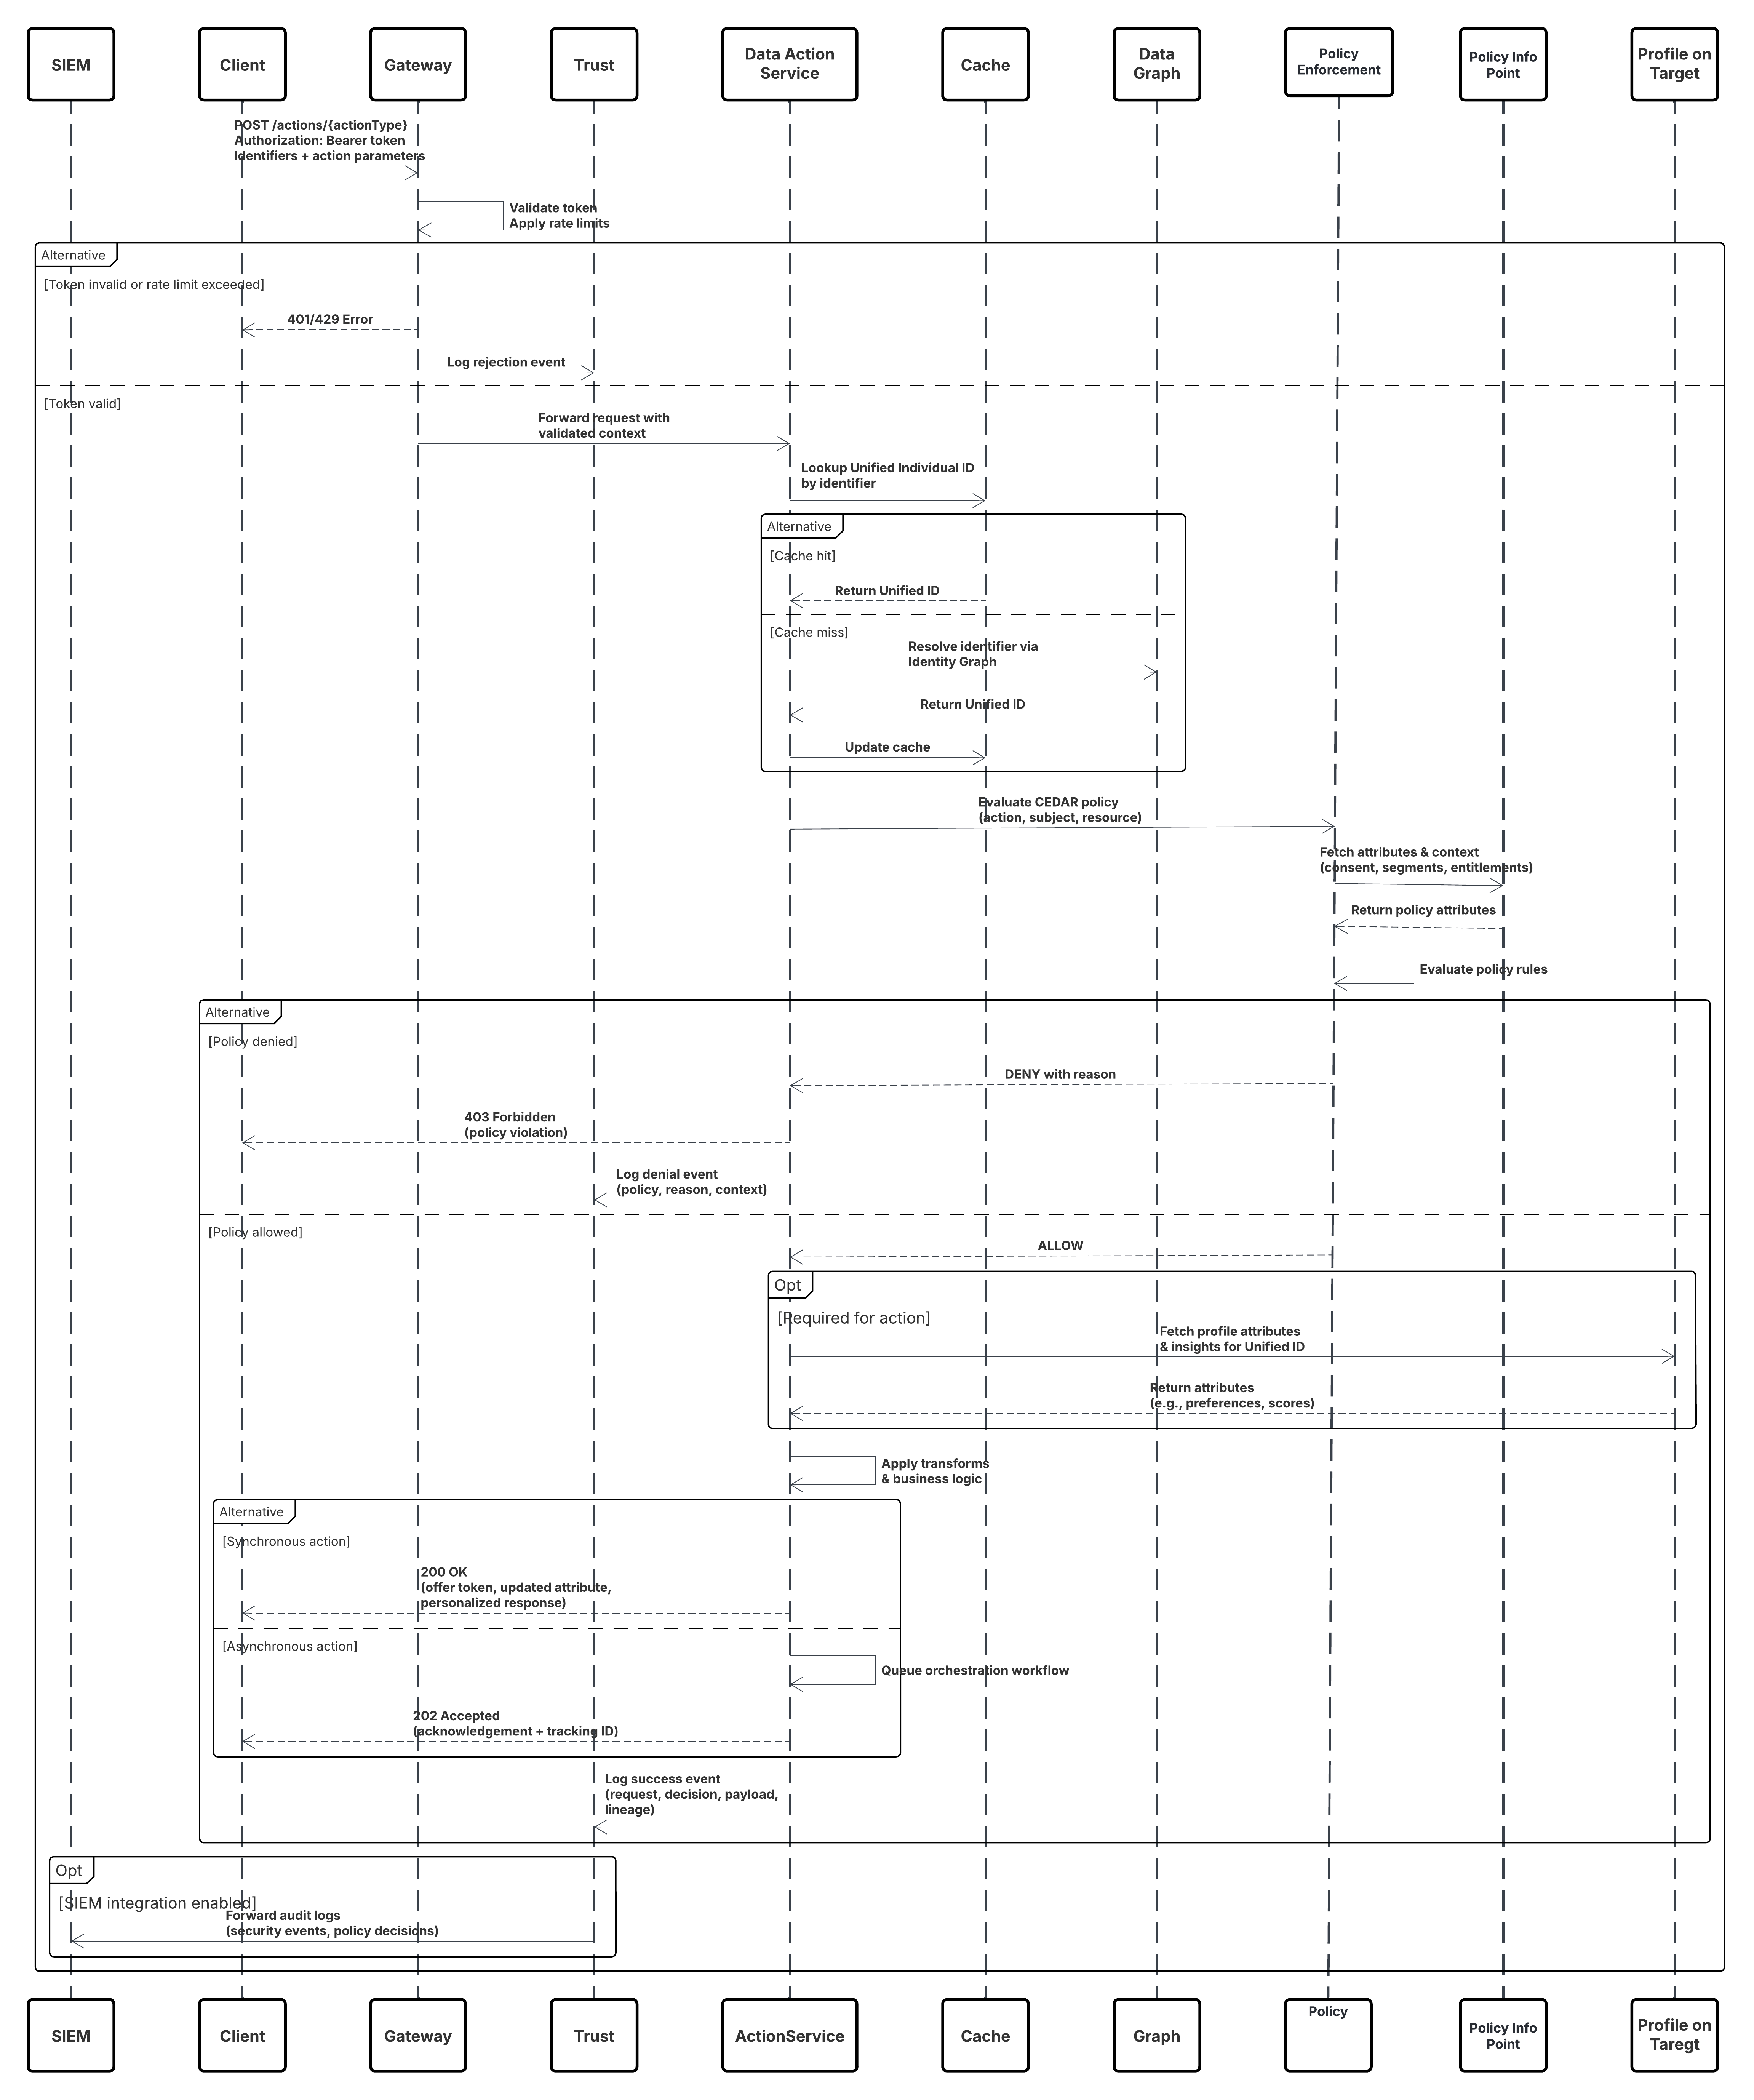 ##### Ergebnisse
* Anwendungen erhalten sofortigen, richtliniengesteuerten Zugriff auf Lese-/Schreibzugriff auf zusammengeführte Profile und Aktionsauslöser mit Latenz zwischen Sekunden und Sekunden.
* Personalisierungs-, Entscheidungs- und betriebliche Workflows in Echtzeit (z. B. Angebote, Agentenunterstützung, Inventaraktualisierungen) werden ohne Batch-Verzögerungen aktiviert.
* Alle Aktionen sind überprüfbar, stimmen zu und erzwingen Maskierungen auf Attributebene, um Datenschutz und Compliance zu gewährleisten.
###### Aufrufmechanismen
Der Aufrufmechanismus hängt von der Zielplattform und der Aktivierungszielkonfiguration ab.
| Mechanismus | Wann zu verwenden |
|---|---|
| API für RESTful-Datenaktionen | Bevorzugt für Web-/Mobilanwendungen und Middleware, die synchrone Profillesungen oder Aktionsantworten benötigen. |
| gRPC / Binär-RPC | Wird für Enterprise-Services mit extrem niedriger Latenz oder interne Microservices mit persistenten Verbindungen verwendet. |
| GraphQL-Einzeldatensatzabfragen | Wird verwendet, wenn Kunden eine flexible Feldauswahl benötigen und Nutzlasten minimieren möchten. |
| Durch Ereignisse ausgelöste Webhooks | Wird für asynchrone Workflows verwendet, bei denen Aktionen nachgelagerte Prozesse auslösen (z. B. eine Journey starten). |
| Plattformereignisse / PubSub | Wird für Fan-Out-Szenarien verwendet, in denen mehrere Systeme auf ein einzelnes Aktionsereignis reagieren müssen. |
| Edge SDK (Client-Bibliotheken) | Wird für Clients mit geringer Latenz verwendet, die Profilfragmente zwischenspeichern und die API für Datenaktionen nur bei Bedarf aufrufen. |
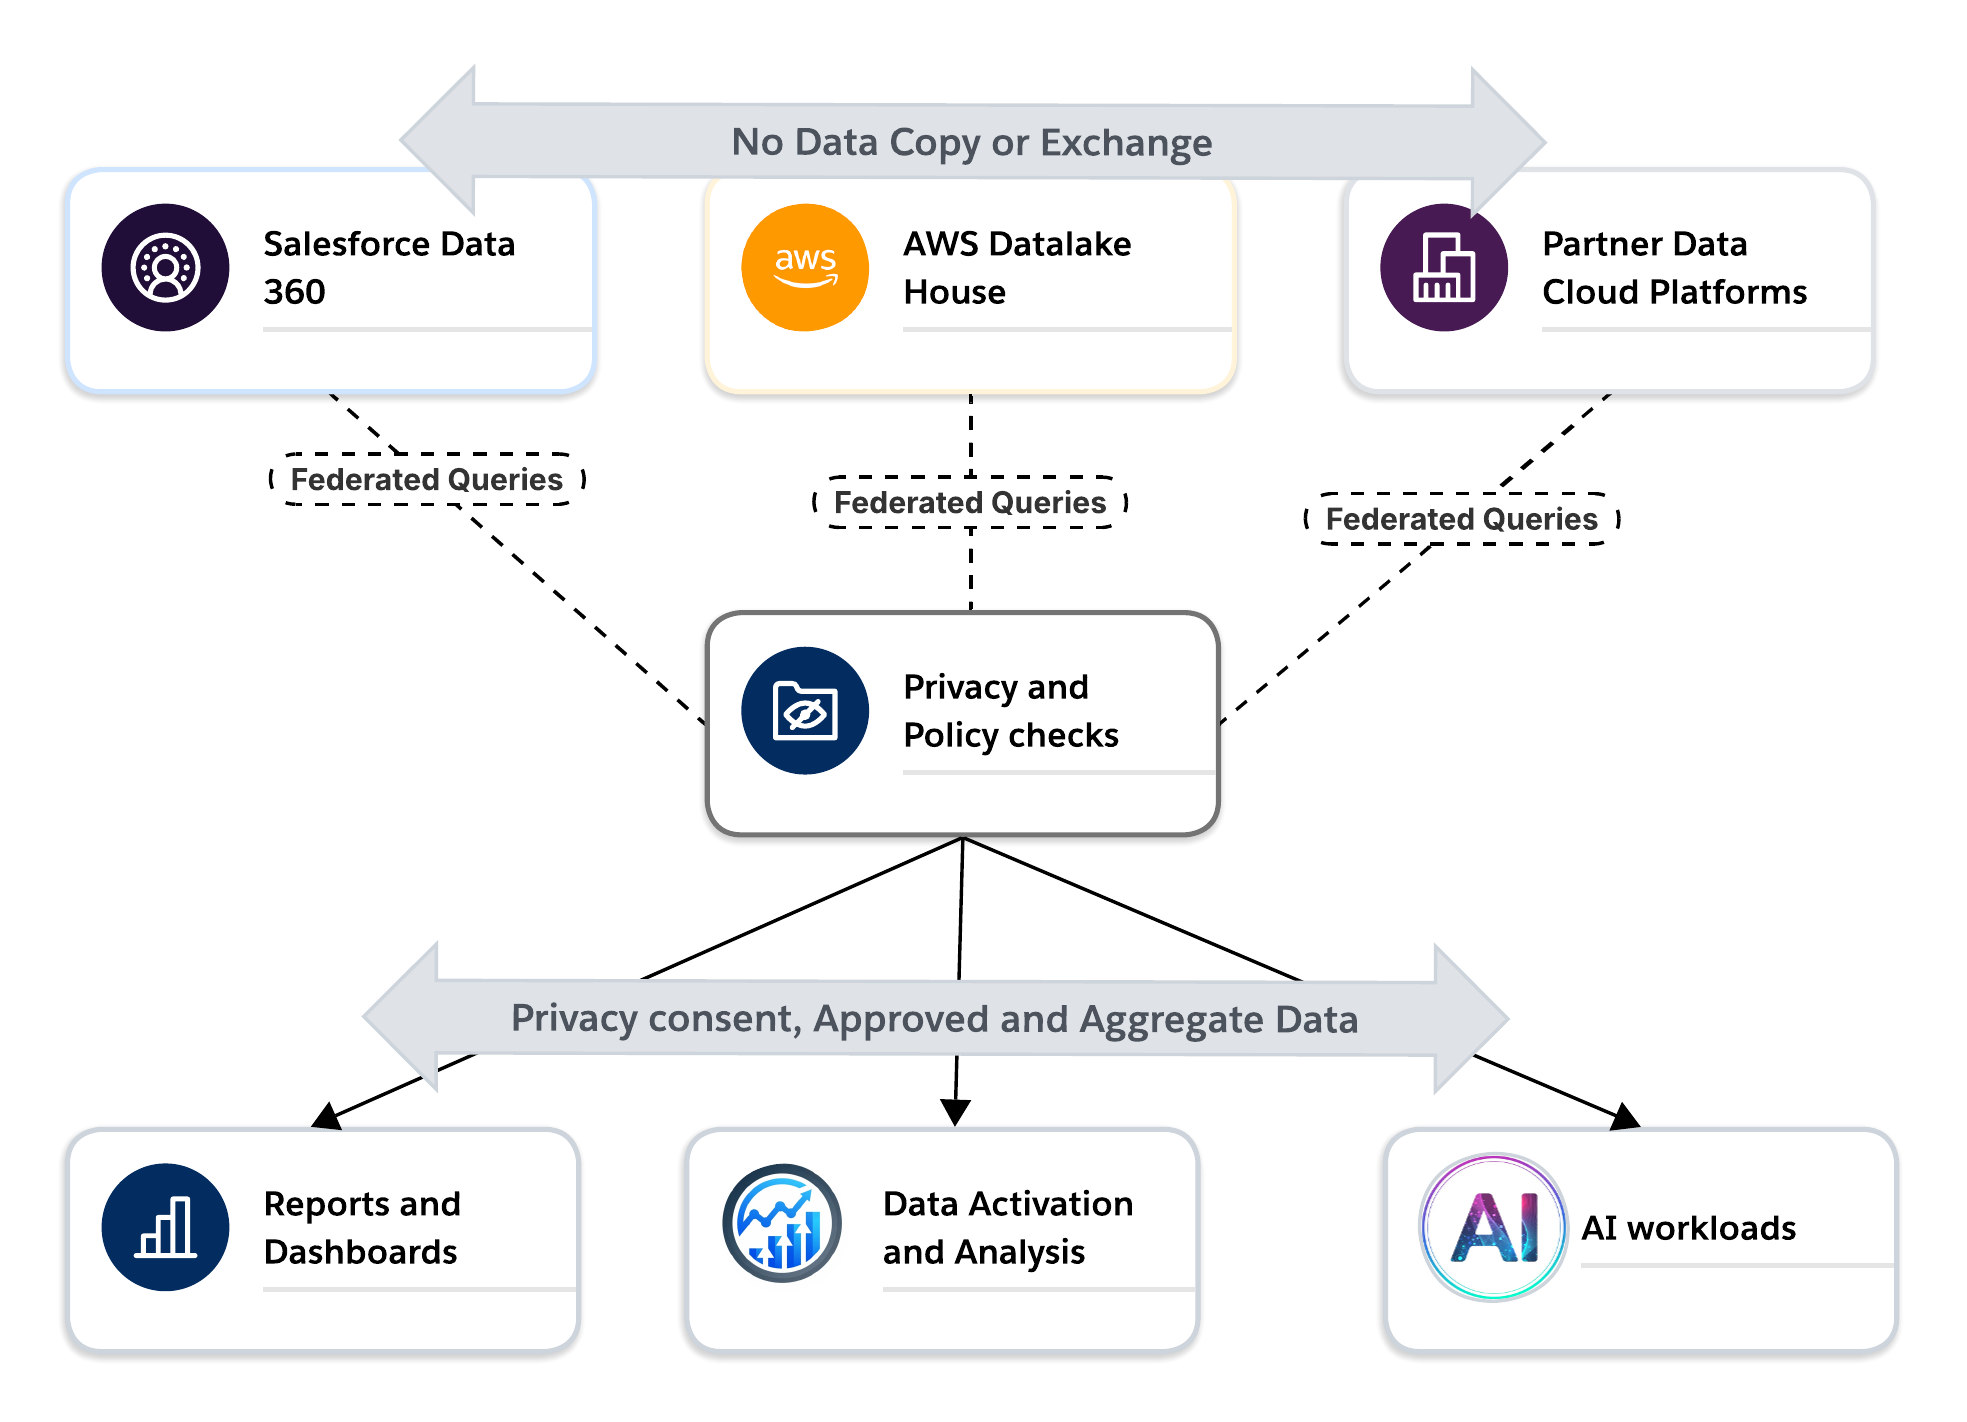 In diesem Modell fungieren Datenreinräume als Trust Grenze moderner Datenarchitekturen. Sie ermöglichen es Organisationen, mit Partnern und Tochtergesellschaften zusammenzuarbeiten, ohne die Kontrolle über ihre Daten zu verlieren, Datenschutz und Einwilligung durch Systemsteuerungen statt durch Richtlinien allein zu erzwingen und Cloud-übergreifend zu arbeiten, während die Obergrenzen für die Datenresidenz und den Vertrag eingehalten werden.
Für Aktivierungs-, Analyse- und AI-Anwendungsfälle bieten Reinräume eine sichere Möglichkeit, Statistiken aus externen Daten zu generieren, ohne sensible Informationen offenzulegen. Sie ermöglichen den Wechsel von der Datenfreigabe zur vertrauenswürdigen Zusammenarbeit. Für Aktivierungsanwendungsfälle bieten Reinräume eine sichere Möglichkeit, Zielgruppen zu generieren, die direkt an einem zulässigen Ziel aktiviert werden können. All dies wird erreicht, ohne dass eine der Parteien personenbezogene Daten offenlegt.Dies markiert einen Wendepunkt in der Unternehmensdatenarchitektur. Data Clean Rooms sind keine Nischentools mehr. Sie entwickeln sich zu einer zentralen Infrastruktur für Verbunddatenplattformen, die die Privatsphäre wahren und AI-fähig sind.
## Personas und technische Leitplanken für Beteiligte
Eine erfolgreiche Datenreinraumarchitektur ist ein System mit mehreren Schnittstellen, das entwickelt wurde, um den konkurrierenden Druck hinsichtlich Datendienstleistung, Sicherheit und Geschwindigkeit zu lösen. Es gibt drei primäre Personas, deren unterschiedliche Reibungspunkte durch das zugrunde liegende technische Design behoben werden müssen.
### Der Datenschutz- und Compliance-Beauftragte (Risikominderer)
Datenschutz- und Compliance-Beauftragte verwenden den Datenreinraum als Governance-Tool. Ihr Hauptanliegen ist die Abweichung von der Compliance, also das Risiko, dass externe Zusammenarbeitsumgebungen nicht dieselben strengen Standards wie interne Systeme durchsetzen können.
* **Reibungspunkte:** Regulatorische Offenlegung (DSGVO, CCPA, DMA) und "Phishing"-Angriffe, bei denen ein Partner versucht, die Identität eines Benutzers durch wiederholte detaillierte Abfragen zu triangulieren.
### Der Datenwissenschaftler und Analyst (The Utility Optimizer)
Datenwissenschaftler betrachten den Datenreinraum als sicheren Zufluchtsort für die erweiterte Modellierung. Ihr Hauptanliegen ist die Beibehaltung des Versorgungsunternehmens, um sicherzustellen, dass Datenschutzmaßnahmen die Daten nicht statistisch unbrauchbar machen.
* **Reibungspunkte:** Hohe Latenz und eingeschränkter Zugriff auf granulare Attribute, die für maschinelles Lernen (ML), Ähnlichkeitsmodellierung und Abwanderungsprognose erforderlich sind.
### Der Marketing- und Geschäftsbenutzer (der Wertverwirklicher)
Diese Persona konzentriert sich ausschließlich auf Time to Value (TTV). Ihre Sorge ist, dass Datenreinraumprojekte oft zu technischen Engpässen werden, die wochenlange Unterstützung bei der Datentechnik erfordern.
* **Reibungspunkte:** Komplexe Setup-Prozesse, manuelle Datenbereinigung und das Problem "Leerseite", Code schreiben zu müssen, um einfache Überschneidungsergebnisse zu erhalten.
### Das Persona-Modell "Business First"
Während sich traditionelle Architekturen darauf konzentrieren, die Datenebene vor der Benutzerebene zu erstellen, wird dieses Modell durch unseren strategischen Ansatz, der auf der "Business First"-Methodik basiert, umgekehrt. Wir priorisieren einen Ansatz ohne Code bis hin zu wenigen Klicks, mit dem Geschäftsbenutzer Statistiken generieren und sofortige Maßnahmen ergreifen können.
**Workflow 'Statistiken zum Handeln':** Die Architektur ist als aktive Arbeitsumgebung und nicht als passives Repository konzipiert. Durch die Bereitstellung von Anwendungsfallvorlagen (z. B. Segmentüberschneidung, Aktivierung und Kampagnenleistung) können Geschäftsbenutzer Self-Service-Statistiken bereitstellen. Dadurch wird sichergestellt, dass Statistiken, beispielsweise ein optimiertes Ähnlichkeitssegment, sofort für die Aktivierung im gesamten Marketing-Ökosystem verfügbar sind, ohne dass ein Dateningenieur Dateien manuell verschieben muss.
**Zero-Copy-Verbund als strategischer Vermögenswert:** Zum Maximieren von TTV verwendet die Architektur eine Nullkopielogik. Anstelle des herkömmlichen ETL-Prozesses, der Latenz- und Sicherheitsrisiken mit sich bringt, führt unsere Architektur Abfragen direkt an den Speicherort der Daten (z. B. Snowflake, BigQuery oder Amazon S3) weiter. Dadurch wird die vorhandene Dateninvestition der Organisation zu einem strategischen Vermögenswert, wodurch Geschäftsbenutzer in Echtzeit auf die neuesten Daten reagieren können, während sie eine strenge Verwaltung aufrechterhalten und die Kosten für die Datenredundanz vermeiden.
## Anwendungsfälle für den Reinraum mit wichtigen Daten
Datenreinräume entstanden in der Werbung als Reaktion auf die Cookie-Verschlechterung und die Datenschutzregulierung, haben sich jedoch branchenübergreifend zu Kundenanalysen, Zielgruppensegmentierung und Aktivierungsanwendungsfällen entwickelt. Laut dem State of Retail Media Report 2025 nutzen 66 % der Unternehmen Reinräume in einer gewissen Kapazität, was auf die Notwendigkeit einer datenschutzgerechten Zusammenarbeit zurückzuführen ist, die zu messbaren Geschäftsergebnissen führt.
Das Muster ist branchenübergreifend einheitlich: Die Daten verbleiben beim Inhaber, die Berechnung wird gesteuert und es werden nur datenschutzsichere Statistiken freigegeben.
### Marketing und Werbung: Messung ohne Cookies von Drittanbietern
**Die Herausforderung:** Marketingexperten müssen die Kampagneneffektivität messen, doppelte Anzeigenaufrufe vermeiden und die Reichweite/Häufigkeit optimieren – können sich jedoch nicht mehr auf Cookies oder Gerätekennzeichner von Drittanbietern verlassen.
**Die Reinraumlösung:**
* Werbetreibende tragen gehashte Kunden- oder Kampagnen-Expositionsdaten bei
* Publisher steuern Impressions- und Engagementsignale bei
* Reinraumberechnungen für Reichweite, Häufigkeit, Attribution und Lift
* Die Aktivierung erfolgt über genehmigte Plattformen ohne Rohdatenexporte
**Geschäftsergebnis:** Reinräume bieten Attribution im geschlossenen Kreislauf, die Anzeigenimpressionen mit tatsächlichen Transaktionen verknüpft, Inkrementalitätsanalysen isoliert die wahre Kampagnensteigerung und einheitliche Messwerte über alle Kanäle hinweg – Funktionen, die herkömmliche digitale Werbung nicht bieten kann.
**Branchennachweise:** Die Messung ist heute der etablierteste Anwendungsfall für Reinräume. Große Mediennetzwerke wie Pinterest, Disney und Paramount erstellen ihre eigenen Reinräume.
### Einzelhandelsmedien und CPG: Monetarisieren von Erstanbieterdaten
**Die Herausforderung:** CPG-Marken geben viel für Einzelhandelsmedien aus, haben jedoch keinen Einblick in die Kaufergebnisse. Einzelhändler sind Inhaber umfangreicher Point-of-Sale-Daten, können sie jedoch nicht offenlegen, ohne gegen Datenschutzverpflichtungen zu verstoßen.
**Die Reinraumlösung:**
* Einzelhändler und CPG-Unternehmen kombinieren Point-of-Sale-Daten von Einzelhandelsstandorten mit Marketingdaten, um Werbeaktivitäten zu optimieren
* Marken tragen gehashte CRM- oder Treuekennzeichner bei
* Reinraum-Links zur Anzeige von Einkäufen im Geschäft/Online
* Aktivierung bleibt im Medienökosystem des Einzelhändlers
**Geschäftsergebnis:**
* Einzelhändler monetarisieren Erstanbieterdaten, ohne Rohkundeninformationen zu verkaufen
* Marken erhalten geschlossene Attribution, die anzeigt, welche Kampagnen Käufe ankurbelten
* Skalieren von Retail Media Networks ohne Datenschutzrisiko
**Branchennachweise:** Retail Media Networks wie Walmart's Luminate und Kroger Precision Marketing bieten Reinräume, mit denen CPG-Marken das Kundenverhalten analysieren und Marketingstrategien mithilfe von Händlerdaten optimieren können.
### Finanzdienste: Erkennung von gemeinschaftlichem Betrug
**Die Herausforderung:** Betrugsnetzwerke funktionieren institutsübergreifend. Banken können jedoch aufgrund von Vorschriften wie GLBA und neuen Datenschutzgesetzen keine Kunden- oder Transaktionsdaten offen freigeben.
**Die Reinraumlösung:**
* Mehrere Banken bündeln anonymisierte Daten, um Muster zu identifizieren, die auf Betrug hinweisen, beispielsweise ungewöhnliche bankübergreifende Aktivitäten
* Verbundanalysen oder -modelle werden über freigegebene Betrugssignale hinweg ausgeführt
* Kein Institut sieht die Daten auf Kundenebene eines anderen
**Geschäftsergebnis:**
* Früheres Erkennen von institutsübergreifenden Betrugsmustern
* Weniger falsch positive Signale durch umfangreichere Signalsätze
* Einhaltung gesetzlicher Vorschriften ohne Zentralisierung sensibler Daten
**Branchennachweise:** Finanzdienstleistungslösungen von Experian und TransUnion bieten Reinraumtechnologien, mit denen Banken und Versicherer bei der Betrugserkennung und Risikobewertung zusammenarbeiten und gleichzeitig strenge Datenschutzkontrollen einhalten können.
### Gesundheit und Biowissenschaften: Forschung ohne Offenlegung von Patientendaten
**Die Herausforderung:** Pharmaunternehmen benötigen reale Patientenergebnisse für die Arzneimittelentwicklung, die Daten befinden sich jedoch in Krankenhaus-EHR-Systemen, die durch HIPAA und ähnliche Vorschriften geschützt sind.
**Die Reinraumlösung:**
* Ärzte und Pharmaforscher geben Daten innerhalb eines Reinraums frei, um zu erfahren, wie Patienten auf Behandlungen reagieren.
* Patientendaten verbleiben in Anbieterumgebungen.
* Forscher führen genehmigte statistische Analysen über einen Reinraum aus.
* Unterschiedlicher Datenschutz verhindert die erneute Identifizierung.
**Geschäftsergebnis:**
* Statistisch valide reale Daten im Maßstab
* Optimierte Patientenrekrutierung für klinische Studien durch Abgleichen anonymisierter Patientendaten mit Testkriterien, Auffinden geeigneter Kandidaten ohne Verstoß gegen die Datenschutzgesetze im Gesundheitswesen
* Reduzierte Abhängigkeit von begrenzten Populationen klinischer Studien
**Branchennachweise:** Gesundheitsorientierte Reinräume wie Datavant bieten HIPAA-konforme Umgebungen für Forscher und Gesundheitsorganisationen, um Patientendaten für klinische Studien und die Arzneimittelentwicklung sicher zu analysieren.
### Branchenübergreifende Muster: Das Gebot der Zusammenarbeit
Über diese primären Anwendungsfälle hinaus ermöglichen Reinräume Folgendes:
* **Versorgungskettenoptimierung:** Hersteller und Lieferanten arbeiten zusammen, um Inventardetails, Produktionspläne und Bedarfsprognosen freizugeben, was eine bessere Koordinierung ermöglicht und gleichzeitig geschützte Informationen schützt.
* **M&A Due Diligence:** Wenn ein Unternehmen ein anderes erwirbt, müssen bei der Due Diligence Finanzprognosen und Kundendatenbanken untersucht werden, ohne sensible Informationen direkt freizugeben. Reinräume bieten Statistiken wie die Ausrichtung des Kundensegments und Compliance-Risiken.
* **Medien und Unterhaltung:** Publisher beweisen Werbetreibenden den Zielgruppenwert und schützen gleichzeitig die Abonnentenidentität, indem sie Premium-CPMs aktivieren, die durch eine vertrauenswürdige Messung statt durch probabilistisches Targeting unterstützt werden
Data Clean Rooms sind in AdTech, Einzelhandel, Finanzdienstleistungen, Gesundheitswesen und Medien zu einer grundlegenden Trust Infrastruktur geworden. Sie ermöglichen eine hochwertige Zusammenarbeit, die zuvor durch Datenschutz-, behördliche oder Wettbewerbsbeschränkungen blockiert wurde. Reinräume sind **zentrale architektonische Komponenten**, die eine sichere, gesteuerte Zusammenarbeit ermöglichen und Einblicke und Monetarisierung ermöglichen, ohne die Datenkontrolle oder Compliance aufzugeben.
## Datenreinräume: Die Grundlage der Zusammenarbeit mit vertrauenswürdigen Daten
Bei einem Datenreinraum handelt es sich um eine sichere, kontrollierte Umgebung, in der mehrere Beteiligte gemeinsame Statistiken generieren können, ohne Rohdaten offenzulegen oder auszutauschen. Statt Datensets zu replizieren, werden genehmigte Analyse-, AI- und Aktivierungsarbeitslasten ausgeführt und nur richtlinienkonforme Ausgaben zurückgegeben. Wenn für die Aktivierung Datensätze auf Einzelpersonenebene erforderlich sind, werden die Daten direkt an das vorgesehene Ziel gesendet, ohne dass sie für beteiligte Personen zugänglich sind.
Architektonisch verlagern Reinräume die Zusammenarbeit von der Datenfreigabe zur kontrollierten Berechnung. Jeder Teilnehmer behält die Aufbewahrung seiner Daten bei, während die Erzwingung der Laufzeit das Abfrageverhalten, die Ausgabeeinschränkungen, die Einwilligung und die Nutzungsrichtlinien regelt.
Die Zusammenarbeit wird weiter durch Mechanismen zur Kennzeichnerausrichtung ermöglicht, die die Privatsphäre wahren und es ermöglichen, Datensets verschiedener Parteien zu korrelieren, ohne die zugrunde liegenden Kennzeichner offenzulegen. Diese Funktion wird später in diesem Dokument näher erläutert.
Daher dienen Datenreinräume als grundlegende Infrastruktur für datenschutzregulierte Unternehmen mit mehreren Clouds und AI, die auf Zero-Copy-Strategien für Verbunddaten basieren.
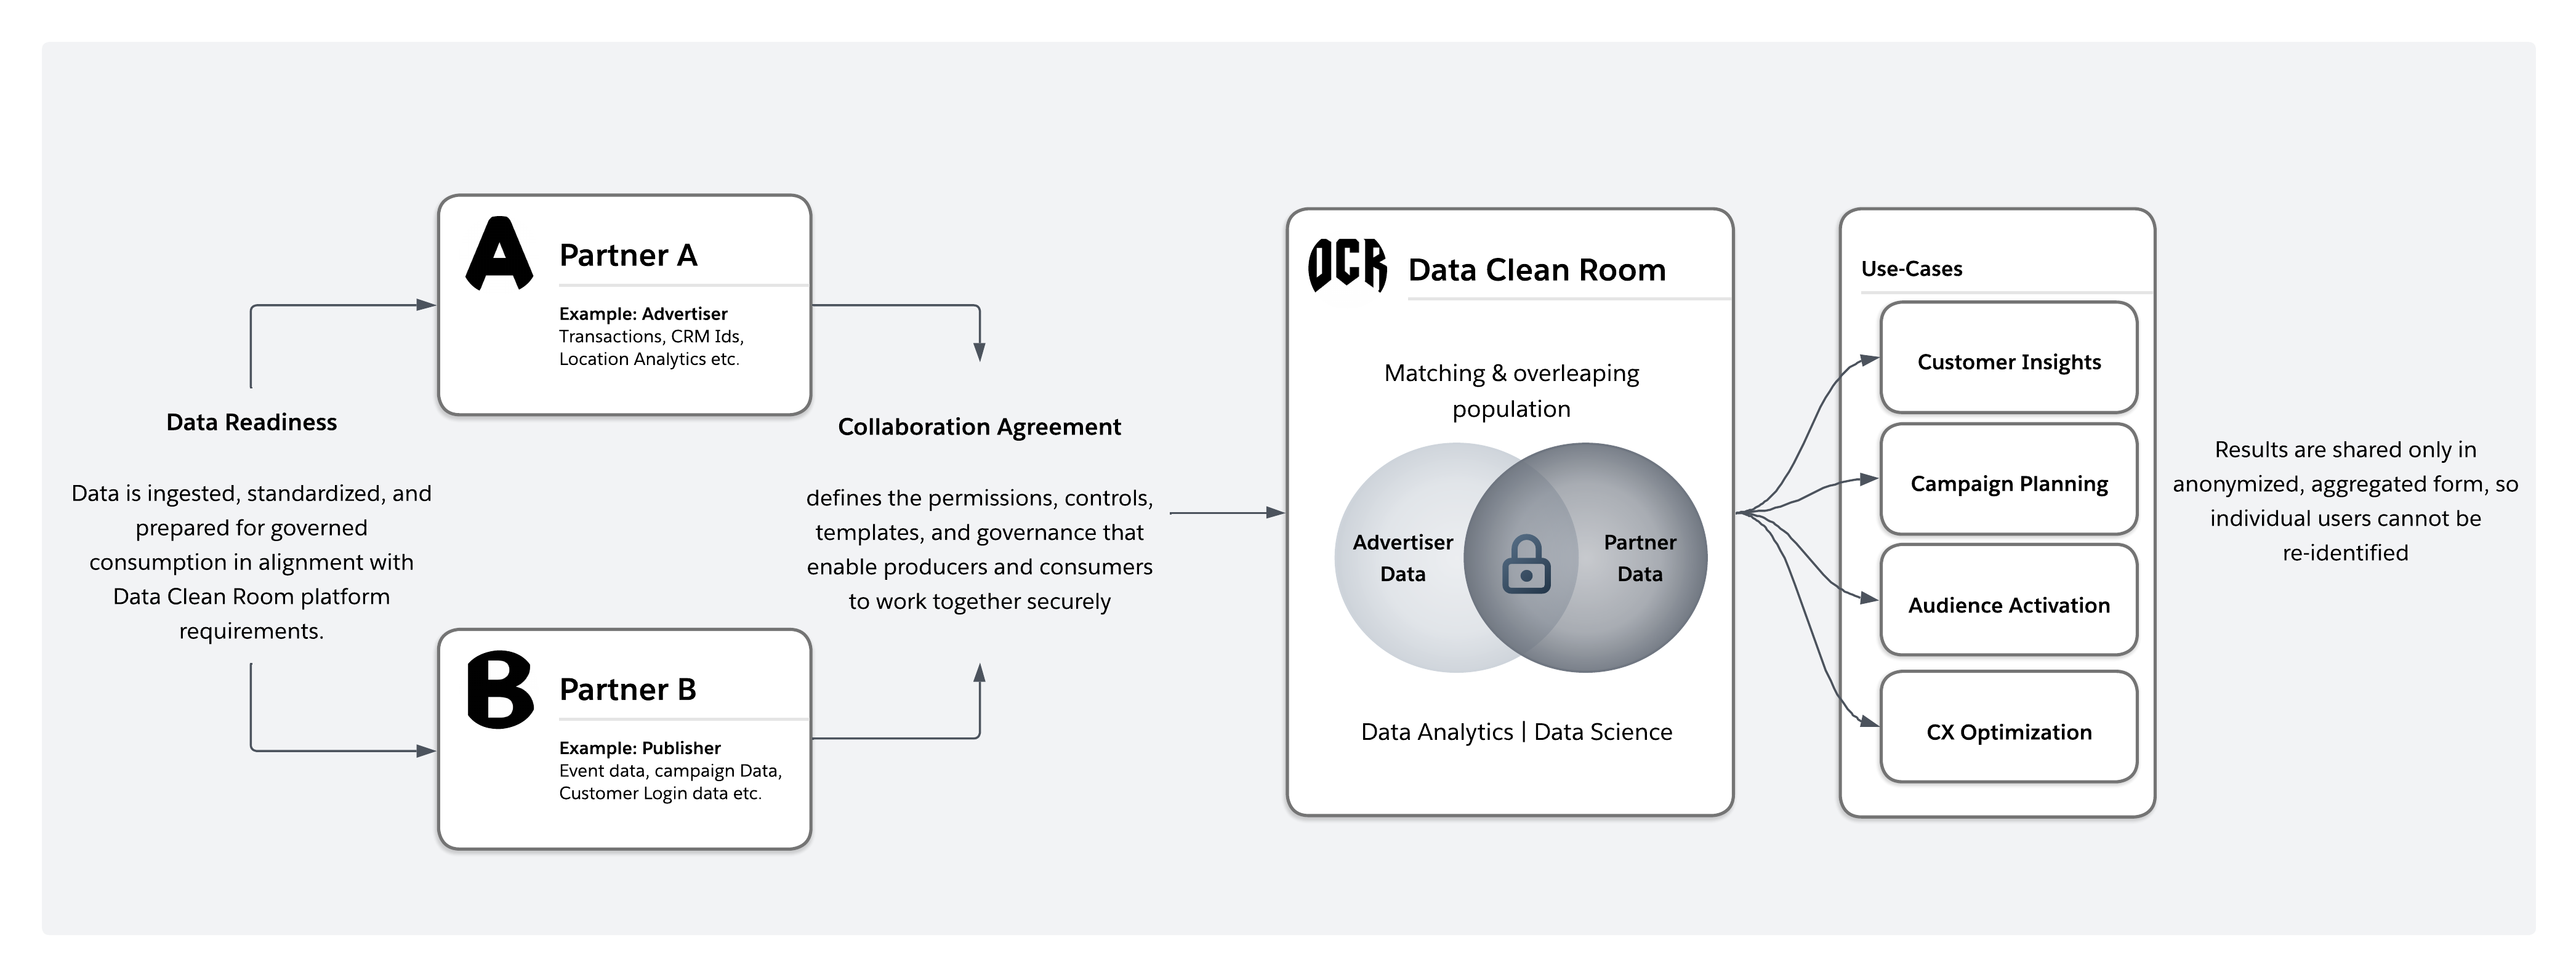 Frühdaten-Reinigungsräume folgten einem zentralisierten Bunkermodell. Alle Teilnehmer mussten Daten zur Analyse in eine neutrale Drittanbieterumgebung kopieren. Dieser Ansatz war zwar konzeptionell einfach, führte jedoch zu erheblichen Reibungen. Die Datenbewegung erhöhte die Latenz und die Kosten, komplizierte Rechts- und Compliance-Vereinbarungen und zwang Organisationen, die direkte Kontrolle über sensible Daten aufzugeben. In regulierten Branchen machten diese Kompromisse die Zusammenarbeit oft unpraktisch.
Moderne Datenbereinigungsräume haben sich zu einem verteilten Verbundmodell entwickelt. Die Daten verbleiben in der Umgebung des Inhabers und Analysen werden über Verbundabfragen ausgeführt. Der Reinraum selbst fungiert als Governance-Ebene, die jede Abfrage abfängt, Datenschutz- und Richtlinienkontrollen zur Ausführungszeit erzwingt und nur genehmigte, aggregierte Ausgaben zurückgibt.
| Dimension | Traditioneller Reinraum ("Bunker"-Modell) | Moderner Reinraum (verteiltes/verbundenes Modell) |
|---|---|---|
| Datenstandort | Daten werden in eine zentralisierte Drittanbieterumgebung kopiert | Daten verbleiben in der Umgebung des Inhabers |
| Datenbewegung | Erfordert physische Übertragung und Duplizierung von Datensets | Keine Rohdatenbewegung, Abfragen werden ausgeführt |
| Steuerung und Aufbewahrung | Aufbewahrung teilweise an Drittanbieterplattform abgegeben | Inhaberschaft und Aufbewahrung von Rohdaten durch die einzelnen Parteien |
| Architekturmodell | Zentralisierte Aggregation | Verteilte Verbundberechnung |
| Governance-Erzwingung | Nach dem Verschieben von Daten angewendete Richtlinien | Richtlinien, die zum Zeitpunkt der Abfrageausführung erzwungen werden |
| Datenschutzmodell | Stark von vertraglichen und verfahrenstechnischen Kontrollen abhängig | Technisch erzwungen durch Laufzeitsteuerungen und Aggregationsschwellenwerte |
| Latenz | Höhere Latenz durch Aufnahme und Synchronisierung | Geringere Latenz, nahezu Echtzeit-Verbundabfragen |
| Kostenstruktur | Höhere Speicher-, Übertragungs- und Duplizierungskosten | Reduzierte Duplikate, ascompute tritt dort auf, wo sich Daten befinden |
| Compliance-Komplexität | Komplexe rechtliche Vereinbarungen durch grenzüberschreitende Datenverschiebung | Vereinfachte Compliance, da Daten die Quellgrenze nicht verlassen |
| Skalierbarkeit | Skalierung erfordert mehr Speicherplatz und Datenreplikation | Skalieren durch verteilte Berechnungen ohne Duplizieren von Daten |
| Geregelte Branchenanpassung | Oft unpraktisch aufgrund von Sorge- und Aufenthaltsproblemen | Besser auf Souveränität, Einwilligung und behördliche Einschränkungen abgestimmt |
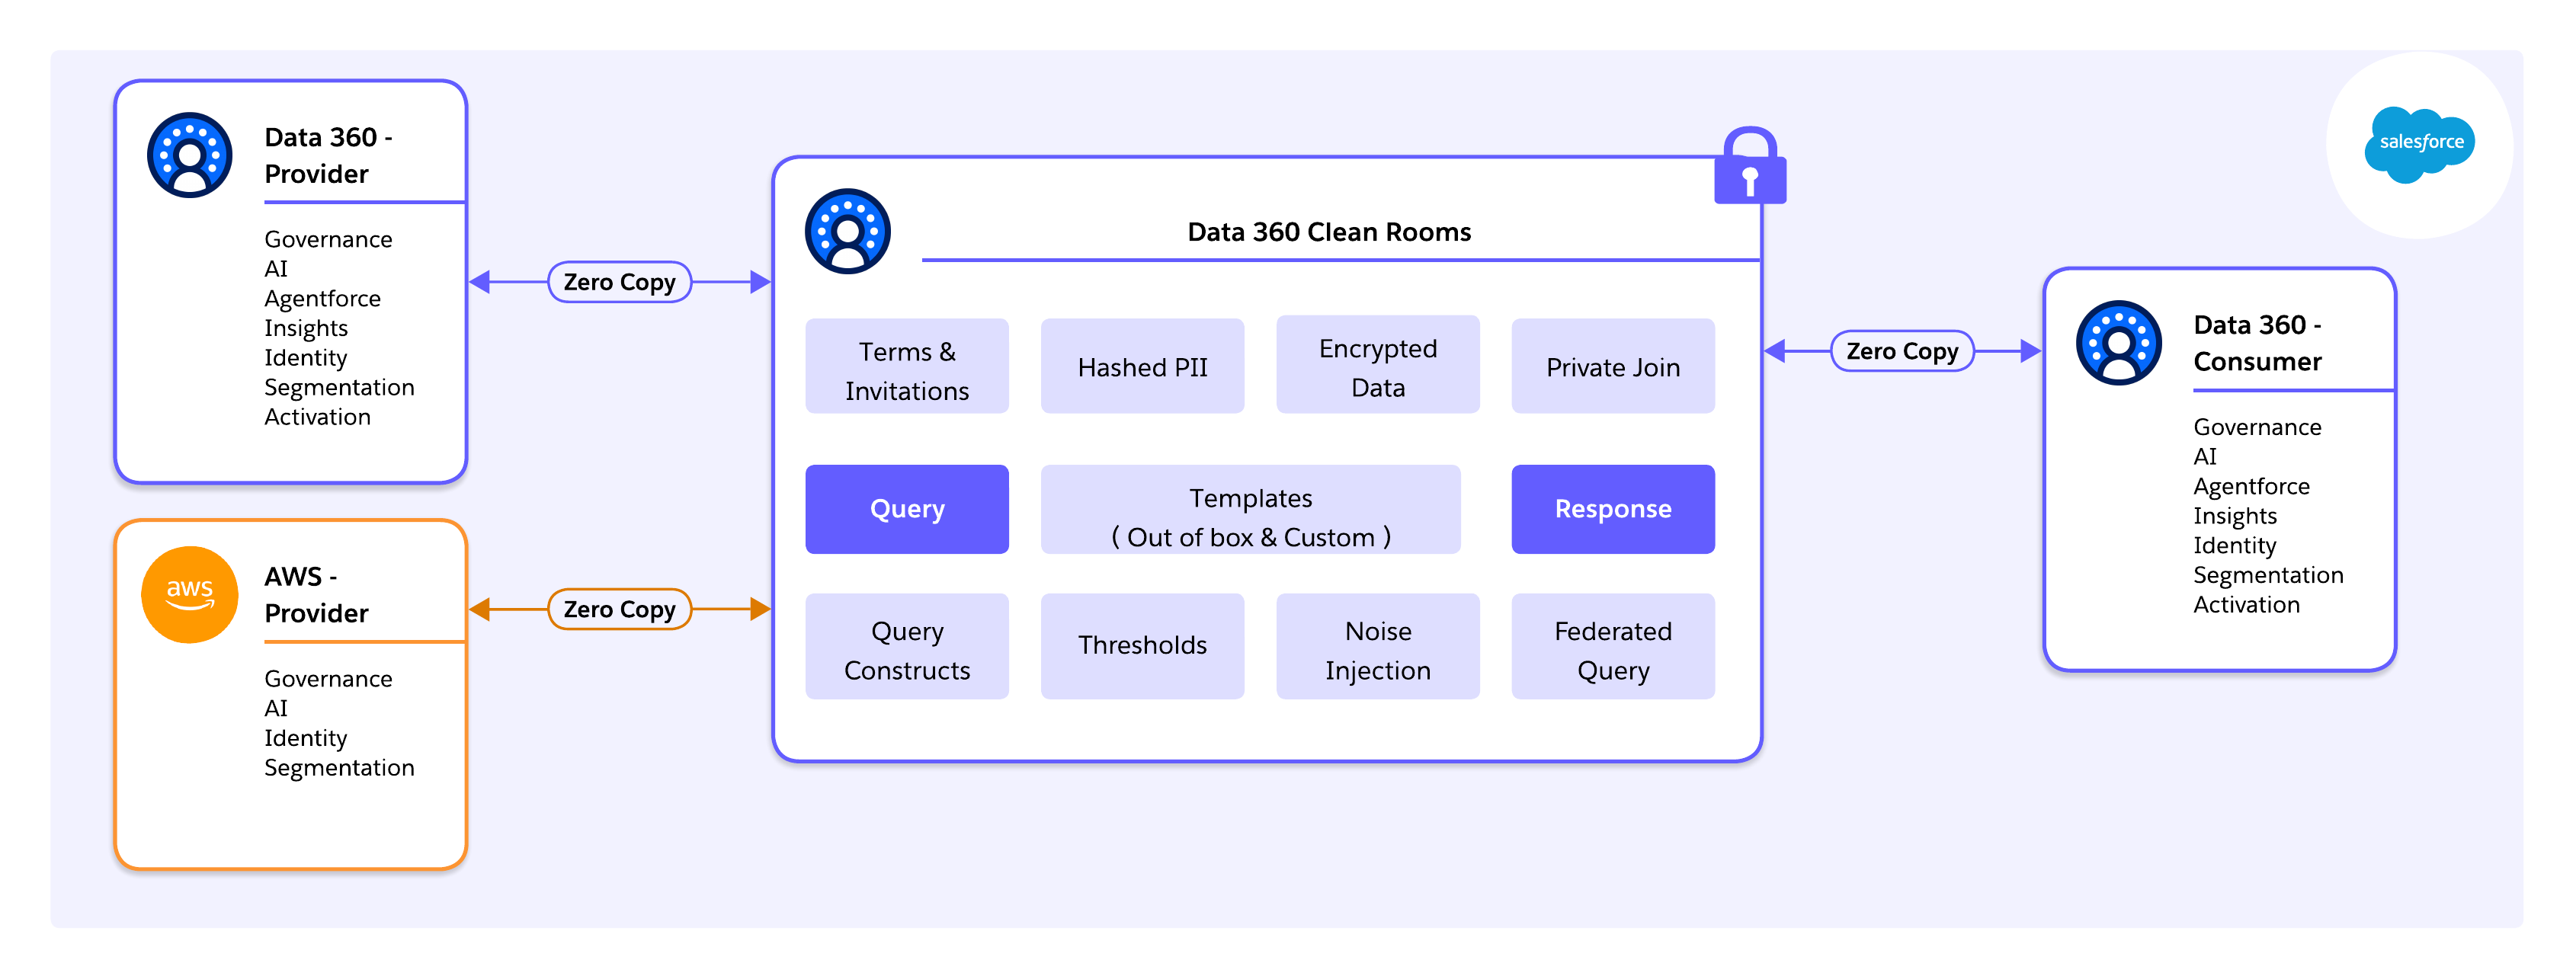 ### Plattformgrundlagen für skalierbare Datenreinräume
Auf Infrastrukturebene wird Salesforce Data 360 mit Hyperforce ausgeführt, der cloudnativen Laufzeit von Salesforce, die Hyperscaler-Ressourcen (AWS, Azure, GCP) hinter einer einheitlichen Steuerungsebene abstrahiert. Diese Architektur ermöglicht es, dass Daten in der Region verbleiben, um die Anforderungen an die Souveränität und die Residenz zu erfüllen, und ermöglicht gleichzeitig einen geregelten Reinraumbetrieb weltweit.
Entscheidend ist, dass diese Grundlage die cloudübergreifende Reinraumzusammenarbeit ermöglicht, einschließlich der nativen Interoperabilität mit AWS Clean Rooms. Mit Data 360 als Orchestrierungs- und Governance-Ebene können Unternehmen mit Partnern zusammenarbeiten, die direkt in AWS arbeiten, ohne die Datenmigration in den von Salesforce verwalteten Speicher zu erzwingen. Abfragen werden an die Quelle übertragen, Datenschutzregeln werden einheitlich erzwungen und nur konforme, aggregierte Ergebnisse werden plattformübergreifend ausgetauscht.
Compliance und Trust werden an der Infrastruktur- und Ausführungsgrenze erzwungen und nicht auf Anwendungsebene nachgerüstet. Dies bietet eine dauerhafte Grundlage für die Zusammenarbeit mit mehreren Beteiligten in mehreren Clouds.
### Die Data 360-Pipeline von der Aufnahme bis zur Aktivierung
Data 360 implementiert eine rückverfolgbare, durchgängige Datenpipeline und stellt sicher, dass Reinraumvorgänge über harmonisierte, geregelte und identitätsbewusste Daten statt über Rohextrakte ausgeführt werden.
Wichtige Phasen sind:
* **Verbinden**: Datenaufnahme und Virtualisierung über vorkonfigurierte Konnektoren, APIs, SDKs, MuleSoft oder Zero-Copy-Konnektoren
* **Beharren**: Speichern von Rohdaten in nativen Formaten (Parquet / Iceberg)
* **Harmonisieren**: Zuordnung zu kanonischen Datenmodellobjekten (DMOs) für konsistente Verknüpfungen
* **Zusammenführen**: Identitätsbestimmung erstellt Goldene Datensätze
* **Ableiten von Statistiken**: Berechnete Statistiken berechnen aggregierte Kennzahlen innerhalb der festgelegten Grenze
* **Act**: Gesteuerte Ausgaben fließen in Salesforce-Organisationen, Marketingplattformen, Anzeigennetzwerke, externe Datenplattformen **oder andere Reinräume** und schließen die Statistik-to-Action-Schleife
Durch diese Pipeline wird sichergestellt, dass Reinräume mit Daten auf Unternehmensebene arbeiten und nicht mit Ad-hoc-Extrakten.
### Native Integration und "Clicks-Not-Code"
Anders als eigenständige Datenreinraumplattformen, die eine separate Bereitstellung und SQL-Entwicklung erfordern, sind Salesforce-Reinräume nativ in Data 360 eingebettet. Dadurch wird die Wiederverwendung von DMOs, Identitätsregeln, Einwilligungsmodellen und Governance-Richtlinien ermöglicht, wodurch doppelte Sicherheitsebenen vermieden werden.
Das vorlagengesteuerte Reinraummodell von Salesforce ist ein wichtiger Beschleuniger und verwendet Folgendes:
* **Vorkonfigurierte Vorlagen** zur Unterstützung allgemeiner Zusammenarbeitsmuster wie Zielgruppenüberschneidung, Unterdrückung, Reichweite und Lift-Messung.
* **Benutzerdefinierte Vorlagen**, mit denen Architekten und fortgeschrittene Benutzer wiederverwendbare Analyselogik definieren können, die auf branchenspezifische oder partnerspezifische Anforderungen zugeschnitten ist, ohne Rohdaten oder Richtlinienkomplexität offenzulegen.
Dieser Ansatz standardisiert die Zusammenarbeit und ermöglicht gleichzeitig Flexibilität, sodass Reinräume als wiederholbare Unternehmensfunktion und nicht als einmaliges Analyseprojekt skaliert werden können.
### Der „Goldene Pfad“ – Schließen der Insight-to-Action-Schleife
Data 360 behebt einen häufigen Fehlermodus herkömmlicher Reinräume: die Aktivierungslücke. Das Framework "Goldener Pfad" stellt sicher, dass innerhalb eines Reinraums generierte Statistiken sofort verarbeitet werden können, ohne Rohdaten exportieren zu müssen.
* **Setup und Discovery**: Partner geben Schema-Metadaten frei und nutzen Vorlagen, um die Durchführbarkeit zu bewerten, bevor Verträge abgeschlossen werden.
* **Analyse**: Vorgefertigte und benutzerdefinierte Vorlagen steuern die Überschneidungsanalyse, Unterdrückung, Ähnlichkeitsmodellierung und Lift-Messung, die alle innerhalb der festgelegten Grenze ausgeführt werden.
* **Aktivierung**: Genehmigte Segmente werden direkt in Marketing Cloud, Anzeigenplattformen oder Partnersysteme übertragen, wobei nur aggregierte, konforme Ergebnisse freigegeben werden.
Vorlagen werden zu Ausführungspfaden mit Meinungen, wodurch sichergestellt wird, dass die Zusammenarbeit vorhersehbar von der Analyse zur Aktivierung übergeht.
## Ein Playbook für Salesforce Data 360-Reinräume
Die Bereitstellung eines Salesforce Data 360-Reinraums ist nicht nur eine Konfigurationsaufgabe, sondern ein disziplinierter architektonischer Workflow, der Datenbereitschaft, Governance-Design, sichere Konnektivität und Betriebsüberwachung umfasst.
### Schritt 1: Definieren des Anwendungsfalls "Zusammenarbeit" (Beginn mit Intent)
Vor dem Berühren von Daten oder Konfigurationen müssen Architekten Folgendes klar definieren:
* Welche Frage versuchen wir zu beantworten?
* Welches Ergebnis wird erwartet? (z.B. Überschneidungsanalyse, Lift-Messung, Unterdrückung, Betrugserkennung)
* Welche Aggregationsebene ist erforderlich?
* Welche regulatorischen oder vertraglichen Einschränkungen gelten?
* Welcher Aktivierungspfad verwendet die Ergebnisse?
Wenn Sie die Zielsetzung des Mitarbeiters verstehen, ist dies alles, was folgt: Verknüpfungsschlüssel, Identitätsregeln, Governance-Schwellenwerte und Kostenmodellierung. Reinräume sind zweckgerichtete Umgebungen. Sie sollten auf ein definiertes Analyseziel ausgerichtet sein und nicht auf eine allgemeine Datenexposition.
### Schritt 2: Vorbereiten der Daten für die Reinraumzusammenarbeit
Bevor die Zusammenarbeit beginnen kann, müssen Unternehmensdaten strukturell und semantisch vorbereitet werden. Reinräume verstärken Stärken und Schwächen der zugrunde liegenden Daten. Müll rein, Müll raus ist hier umso wahrer.
**Aufnahme:** Verbinden Sie Quellsysteme wie Salesforce CRM, Marketing Cloud, AWS S3 und Google Cloud Storage mit Data 360\. Verwenden Sie nach Möglichkeit Zero-Copy-Konnektoren (z. B. Snowflake), um unnötige Verschiebungen oder Duplikate von Daten zu vermeiden.
**Semantische Zuordnung:** Ordnen Sie dem Customer 360 Datenmodell Datenströme zu. Standardisieren Sie wichtige Felder wie Telefonnummern (E.164-Format), Länder-/Bundeslandcodes (ISO-Standards) und E-Mail-Adressen. Fehlausrichtungen (beispielsweise eine Seite, die "CA" und eine andere "California" verwendet) können bei Verknüpfungen stillschweigend fehlschlagen und die Übereinstimmungsraten reduzieren.
**Identitätsbestimmung:** Konfigurieren Sie deterministische (genaue Übereinstimmung) und probabilistische (Fuzzyübereinstimmung) Regeln, um eine zusammengeführte Einzelperson (Goldener Datensatz) zu erstellen. Diese zusammengeführte Einheit ist die Oberfläche für den Reinraumabgleich.
Die Qualität der Identitätsbestimmung wirkt sich direkt auf den Wert der Zusammenarbeit aus. Eine höhere Übereinstimmungsgenauigkeit erhöht die Überschneidungsraten, die analytische Konfidenz und reduziert falsch negative Werte.
### Schritt 3: Bereitstellen des Reinraums
Sobald die Daten harmonisiert sind, muss der Reinraum selbst bereitgestellt werden, um Grenzen für die Zusammenarbeit zu definieren.
**Lizenzvalidierung:** Stellen Sie sicher, dass alle teilnehmenden Organisationen über die erforderlichen Data 360- und Reinraumansprüche verfügen.
**Umfang des Datenbereichs:** Reinraumobjekte müssen auf einen bestimmten Datenbereich begrenzt sein. Nur diesem Datenbereich zugeordnete Objekte sind für den Reinraum sichtbar. Dadurch wird die Zusammenarbeit logisch isoliert, ohne dass ein neuer Datenbereich ausschließlich für Reinräume erstellt werden muss.
**Leitungsregeln definieren:** Richten Sie Richtlinien deklarativ ein, bevor Abfragen ausgeführt werden:
* **Aggregationsschwellenwerte:** beispielsweise mindestens 100 Datensätze pro Ausgabe
* **Verknüpfungsschlüssel:** beispielsweise Email_Hash_SHA256
* **Zulässige Vorgänge:** Nur Aggregatfunktionen wie COUNT, SUM, AVG
* **Ausdrückliche Einschränkungen:** Exporte auf Zeilenebene blockieren (SELECT \*)
Governance-Regeln werden zur Ausführungszeit erzwungen, wodurch Eigenschaften auf Datenschutz- und Compliance-Systemebene anstelle von Verfahrensanleitungen verwendet werden.
### Schritt 4: Herstellen einer sicheren Multi-Party-Konnektivität
Reinräume erstrecken sich oft über Organisations- und Plattformgrenzen. Die Konnektivität muss explizit und streng kontrolliert sein.
**Accountverknüpfung:**
* **Salesforce-to-Salesforce:** Verwenden Sie Data Cloud One oder genehmigte organisationsübergreifende Freigabemechanismen.
* **Szenarien mit mehreren Clouds:** Validieren Sie die Regionsausrichtung und die Residenz, bevor Abfragen aktiviert werden.
**Authentifizierung und Autorisierung:** Konfigurieren Sie den OAuth-basierten Zugriff für dedizierte Integrationsbenutzer mit dem Prinzip der geringsten Berechtigung – beschränken Sie den Zugriff strikt auf die erforderlichen Datenbereiche und vermeiden Sie administrative Berechtigungen.
Sicherheitsfehler sind häufig auf überberechtigte Integrationsbenutzer zurückzuführen und nicht auf Schwächen in der Kryptografie oder bei Plattformsteuerungen.
### Schritt 5: Ausführen, Überwachen und Steuern von Reinraumarbeitslasten
Sobald Sie live sind, konzentrieren Sie sich auf die operative Aufsicht, die Abfragequalität und das Kostenmanagement.
**Abfrageausführung:** Analysten oder Workflows führen Überschneidungsanalysen und -aggregationen über berechnete Statistiken oder genehmigte SQL-Schnittstellen aus. Alle Abfragen erzwingen automatisch Aggregationsschwellenwerte und Datenschutzkontrollen.
**Aktivierung und Rückverfolgbarkeit:** Salesforce Data 360-Reinräume bieten Audit Trails in Form eines Audit-Datenmodellobjekts (DMO). Dadurch werden Metadaten über die Abfrageaktivität erfasst, einschließlich der Benutzer, die die Abfrage ausgeführt haben, wann sie ausgeführt wurde und welche Richtlinien angewendet wurden. Das Datenmodellobjekt für Prüfungen ermöglicht Compliance-Berichte, Governance-Validierung und forensische Rückverfolgbarkeit und stellt sicher, dass die Zusammenarbeit sowohl datenschutzgerecht als auch überprüfbar ist.
**Verbrauchsüberwachung:** Data Cloud verwendet ein verbrauchsbasiertes Kreditmodell. Zu den wichtigsten Faktoren zählen:
* Verarbeitete Zeilen (z. B. 1 Million Zeilen = Basisgutschriftseinheit)
* Abfragekomplexität
* Vorgänge zur Identitätsbestimmung (höherer Multiplikator)
* Batchaufnahme (niedriger Multiplikator)
**Digital Wallet und Warnmeldungen:** Verwenden Sie Digital Wallet, um den Echtzeitverbrauch zu verfolgen und Benachrichtigungen mit Schwellenwerten von 50 %, 75 % und 90 % zu konfigurieren. Korrelieren Sie Spitzen mit bestimmten Arbeitslasten, um unerwartete Kosten zu vermeiden.
Beachten Sie, dass die Berechnungskosten durch Nullkopie nicht beseitigt werden. Während physische Duplikate entfernt werden, erfolgt die Ausführung im Quellsystem. Architekten müssen Abfragemuster, Verknüpfungsselektivität und Ausführungshäufigkeit verwalten, um Kosten und Leistung zu steuern.
## Governance, Sicherheit und Compliance
### Erstellen von Reinräumen für Trust im großen Maßstab
In modernen Unternehmen ist Trust nicht an einen Datenreinigungsraum gebunden. Es ist ein architektonisches Ergebnis. Salesforce Data 360 erzwingt kontinuierlich und automatisch Governance, Sicherheit und Compliance und verlagert Reinräume von richtliniengesteuerten Umgebungen zu plattformgesteuerten Systemen.
Kontrollen der Ausführungszeit (gesperrte Identitäten, Prüfungsprotokolle und differenzieller Datenschutz) werden einheitlich angewendet, unabhängig davon, ob die Zusammenarbeit innerhalb von Salesforce, partnerübergreifend oder cloudübergreifend erfolgt.
### Trust and Governance für die Ausführungszeit
Die wichtigste Veränderung für Architekten besteht darin, dass Trust während der Ausführung erzwungen und nicht im Voraus vorausgesetzt wird. Salesforce Data 360 erreicht dies durch eine Reihe zentraler Plattformsteuerungen:
* **Gesperrte Identität:** Der Partnerzugriff ist kryptografisch mit überprüften Salesforce-Organisationsidentitäten verknüpft, wodurch Spoofing oder nicht autorisierte Teilnahme verhindert werden.
* **Audit Trails:** Jede Abfrage, Verknüpfung, Segmentüberschneidung und Aktivierung wird protokolliert, um die vollständige Überprüfbarkeit und Einhaltung gesetzlicher Vorschriften zu gewährleisten.
* **Unterschiedliche Datenschutzbestimmungen:** Eine Inspektion auf Zeilenebene ist strukturell nicht möglich. Ausgaben werden aggregiert und statistisch begrenzt. Mitarbeitern werden nur datenschutzsichere Ergebnisse wie Reichweitenkennzahlen oder Lift-Prozentsätze angezeigt, niemals einzelne Transaktionen oder Identitäten.
Diese Steuerelemente ersetzen vertraglichen Trust durch mathematische Garantien und die Durchsetzung auf Plattformebene, was das betriebliche und rechtliche Risiko reduziert.
### AI-Governance über die Einstein Trust Layer
Da AI-Agenten zunehmend mit Reinraumdaten interagieren, führt Salesforce die Einstein Trust Layer ein. Sie fungiert als architektonische Schleuse zwischen sensiblen Unternehmensdaten und externen LLMs. Auf diese Weise wird sichergestellt, dass Reinraumstatistiken KI-gestützte Entscheidungen sicher vorantreiben können, ohne zugrunde liegende Daten offenzulegen.
**Wichtige Funktionen:**
* **Datenaufbewahrung null:** Die an LLMs gesendeten Daten sind vorübergehend. Modellanbieter können keine Aufforderungen oder Antworten für Schulungen speichern.
* **Toxische Spracherkennung und Maskierung personenbezogener Daten:** Eingaben und Ausgaben werden automatisch gescannt und personenbezogene Daten werden entsprechend den in Data 360 konfigurierten Datenmaskierungsrichtlinien maskiert.
### Logische Isolation durch Datenbereiche und Berechtigungssätze
**Datenbereiche** stellen eine logische Isolation innerhalb einer Organisation dar und sollten mit regulatorischen, geografischen und Partnerschaftsgrenzen in Einklang stehen, beispielsweise:
* EU-Datenbereich
* Nordamerika-Datenbereich
Nur Datensets, die einem Datenbereich zugewiesen sind, sind in seinen Reinräumen sichtbar, wodurch eine versehentliche grenzüberschreitende Offenlegung verhindert wird.
Berechtigungssätze bieten eine genaue Kontrolle darüber, wer Reinräume erstellen oder verwalten, Abfragen ausführen oder Segmente aktivieren kann. Berechtigungen mit Datenbewusstsein erzwingen Einschränkungen auf Feldebene in Datenmodellobjekten. Beispielsweise können Marketingexperten Segmentnamen und Zielgruppengröße anzeigen, nicht jedoch Einkommens- oder Gesundheitsindikatoren.
Die Sicherheit wird auf semantischer Ebene erzwungen, was Geschäftsbenutzern einen sicheren Self-Service ohne ständige IT-Aufsicht ermöglicht.
### Compliance und Einwilligung nach Design
Einwilligungssignale werden automatisch über Data 360 in die Reinraumausführung übernommen. Benutzer, die die Einwilligung widerrufen, werden standardmäßig von der Analyse und Aktivierung ausgeschlossen. So wird sichergestellt, dass die Einhaltung vom System erzwungen und nicht manuell überwacht wird.
Salesforce Data 360 behandelt Governance, Sicherheit und Compliance als erstklassige architektonische Primitiven und nicht als optionale Add-Ons. Durch die Kombination von Überprüfbarkeit zur Ausführungszeit, gesperrten Identitäten, unterschiedlicher Privatsphäre, Datenbereichen, der Identitätsbestimmung mit Einwilligungsbewusstsein und der Einstein Trust Layer können Unternehmen die Zusammenarbeit im Reinraum zwischen Partnern, Multi-Cloud-Systemen und AI-gestützten Arbeitslasten skalieren, ohne Trust, Datenschutz oder die Einhaltung gesetzlicher Vorschriften zu beeinträchtigen.
## Schlussfolgerung und Weg nach vorn
### Praktischer Weg für Architekten
Um den vollen Wert von Datenreinräumen zu erfassen, müssen Architekten sie als zentrale architektonische Infrastruktur und nicht als isolierte Analysetools behandeln. Die folgenden Prioritäten definieren einen pragmatischen und skalierbaren Weg nach vorn:
**Machen Sie Zusammenarbeit zu einem erstklassigen architektonischen Anliegen:** Die Zusammenarbeit mit externen Daten sollte mit der gleichen Strenge wie die interne Integration konzipiert werden. Reinräume sollten neben Datenplattformen, Integrationsebenen und AI-Systemen in Unternehmensreferenzarchitekturen eingebettet sein und nicht als Ad-hoc-Erweiterungen bereitgestellt werden. Mit zunehmender Interoperabilität (z. B. Data 360-Reinraumintegration in AWS-Reinräume und künftige Reinraum-übergreifende Kompatibilität) müssen Architekten Zusammenarbeitsmuster entwerfen, die plattformübergreifende Ökosysteme anstelle von Silos mit einem einzelnen Anbieter antizipieren.
**Standardmäßiges Entwerfen für Datenschutz an der Quelle**
**Design für Datenfluidität: **Anstatt standardmäßig auf eine umfangreiche ETL und einen zentralen Abgleich zu setzen, sollten Architekten zunächst Verbund- und Zero-Copy-Zugriff in Betracht ziehen. Durch das Verschieben der Berechnung auf Daten (sofern angemessen) werden unnötige Duplikate reduziert, Kosten gesenkt und die Integrität der Quelle der Wahrheit gewahrt. "Verbinden vs. kopieren" sollte eine bewusste architektonische Entscheidung sein und keine übernommene Gewohnheit.
**Schließen der Handlungslücke für Statistiken:** Reinräume, die bei der Analyse stehen bleiben, bieten keinen Geschäftswert. Architekturen müssen Reinraumausgaben nativ mit Aktivierungssystemen und AI-Workflows verbinden. Feedbackschleifen, die Leistungsmessung und die nachgelagerte Ausführung müssen von Anfang an konzipiert sein.
**Vorbereiten auf das Agentic Enterprise:** Da AI-Agenten zunehmend Unternehmensdaten verwenden, dienen Reinräume als kontrollierte Ausführungsumgebungen, in denen Agenten arbeiten können, ohne Rohdaten offenzulegen. Architekten, die die Reinraumstrategie auf AI Governance und Trust Frameworks abstimmen, sind für diese nächste Phase am besten aufgestellt.
### Schlussfolgerung
Moderne Datenreinräume stellen eine grundlegende Veränderung in der Unternehmensdatenarchitektur dar. Sie lösen die langjährige Spannung zwischen Datendienstprogramm und Datenschutz, indem sie die Zusammenarbeit ohne Offenlegung von Daten ermöglichen.
Architekturen wie Salesforce Data 360 zeigen, dass dieser Kompromiss keine Überlegung vom Typ "Entweder oder" ist. Durch die Entkopplung des Datenspeichers von der Aktivierung durch Zero-Copy-Muster und die direkte Integration von Technologien zur Verbesserung des Datenschutzes in die Ausführung können Unternehmen an hochwertigen Analysen zusammenarbeiten, ohne die Kontrolle über ihre Daten aufzugeben. Datenschutz wird von der vertraglichen Verpflichtung zur architektonischen Garantie.
Am wichtigsten ist, dass Reinräume Daten aus einem statischen, isolierten Vermögenswert in eine verwaltete, handlungsrelevante Ressource umwandeln. Wenn Statistiken nativ mit Aktivierungs- und AI-Ebenen verbunden sind, werden sie in Dashboards nicht mehr verzögert. Sie fließen direkt in Entscheidungen, Kampagnen und autonome Systeme ein und schließen so den Kreis zwischen Daten, Aktionen und Ergebnissen im Unternehmensmaßstab.
## Über die Autoren
**Yugandhar Bora** ist Software-Engineering-Architekt bei Salesforce und spezialisiert sich auf die Datenarchitektur innerhalb der Plattform für Daten- und Intelligenzanwendungen. Er leitet Initiativen des Enterprise Architecture Review Board (EARB), die sich auf die Datenverwaltung und vereinheitlichte Datenmodelle konzentrieren, und trägt gleichzeitig zu automatisierten Plattformbereitstellungslösungen bei.
**Birendra Kumar Singh** ist Principal Member of Technical Staff und spezialisiert sich auf Plattform- und Datenarchitektur in Data 360 bei Salesforce. Er ist ein zentrales Mitglied der Aktivierungsplattform und leitet die Initiative "Reinraum", die sich auf die Bereitstellung der Datenreinraum-Infrastruktur für Data 360-Kunden konzentriert.
**Priyanka Kshirsagar** ist Senior Product Manager bei Salesforce und leitet Data 360-Reinräume. Sie hat diese Funktion von Grund auf neu entwickelt, um Unternehmenskunden die Zusammenarbeit an Erstanbieterdaten in einer Umgebung zu ermöglichen, in der die Privatsphäre gewahrt bleibt. Sie treibt die Vision für agentenbasierte AI und ML-gestützte Anwendungsfälle voran, einschließlich Ähnlichkeitsmodellierung und Identitätsanreicherung in Reinräumen, und hat das Produkt über die allgemeine Verfügbarkeit und eine Einführung von Tier-1-Dreamforce eingeführt.
# Übersicht
Salesforce Data 360 verändert die Art und Weise, wie Unternehmen Kundendaten im richtigen Maßstab verbinden, harmonisieren und aktivieren. Ihre wahre Stärke liegt jedoch darin, wie sicher diese Daten über ihren Lebenszyklus hinweg verwaltet werden. Diese Sicherheitsreferenzarchitektur bietet eine praktische durchgängige Blaupause zum Schutz von Data 360-Umgebungen. Dies wird standardmäßig durch die Kernprinzipien "Least Privilegies" (geringste Berechtigungen), "Null Trust Design" (Null-Vertrauens-Design) und "Governance" erreicht.
Die Sicherheit in Data 360 ist ein Modell der gemeinsamen Verantwortung. Salesforce schützt die Infrastruktur, das Netzwerk, die Verschlüsselungsdienste, die Plattform, die Compliance und die Anwendung selbst mit globalen Standards wie ISO 27001, SOC 2 und der Datenschutz-Grundverordnung (DSGVO). Salesforce-Administratoren schützen die Daten ihrer Organisation auf der Plattform, indem sie Zugriff definieren, Datenschutz erzwingen und Integrationen verwalten. Dazu zählen die Implementierung eines starken Identitäts- und Zugriffsmanagements (IAM), das nur den erforderlichen Zugriff gewährt, die Erzwingung der Zwei-Faktoren-Authentifizierung (2FA) und die Einhaltung des Prinzips der geringsten Berechtigungen sowie von Unternehmens- und behördlichen Mandaten.
Data 360 Governance verbindet diese Verantwortungsebenen und stellt sicher, dass Sicherheit und Compliance aufeinander abgestimmt bleiben. Sie stellt sicher, dass Rollen, Richtlinien, Berechtigungen und Regeln für die Datenverarbeitung definiert und kontinuierlich über den gesamten Prozess hinweg erzwungen werden, von der Aufnahme bis zur Aktivierung. Datenherkunft, Metadatenklassifizierung und Einwilligungsbewusstsein sind in jedes Objekt und jeden Prozess integriert. Dadurch wird die Verwaltung von einer manuellen Aufsichtsfunktion in eine operative Steuerungsebene umgewandelt.
Salesforce bietet eine robuste, konforme Grundlage, auf der Unternehmen hinsichtlich ihres Datenbestands, ihrer Datenschutzeinstellungen und Integrationsgrenzen uneingeschränkte Autorität behalten. Zusammen bilden sie ein Sicherheits- und Governance-Gefüge, in dem jedes Datenset, jede Richtlinie und jede Benutzeraktion verfolgt, konsistent und in Trust verankert werden kann.
Die Sicherheit in Data 360 geht über statische Steuerelemente hinaus. Sie ist in jede Phase des Datenlebenszyklus eingebettet. Ab dem Zeitpunkt der Datenaufnahme werden sie verschlüsselt, validiert und unter Unternehmensrichtlinien klassifiziert. Da sie vereinheitlicht und angereichert ist, werden Metadaten-Überlieferungs- und Einwilligungsattribute beibehalten, um die Verantwortlichkeit zu gewährleisten. Wenn Statistiken für die Geschäfts- oder AI-Nutzung aktiviert werden, werden ausgehende Flows durch verschlüsselte Kanäle, eine sichere Authentifizierung und Autorisierung, richtlinienbewusste Governance und die Erzwingung von Einwilligungen geschützt. Dadurch wird sichergestellt, dass die Daten von der Aufnahme bis zur Aktivierung vertrauenswürdig, konform und sicher bleiben.
## Die Sicherheitsgrundlage von Data 360
Data 360 bietet eine sichere und designbasierte Grundlage, die auf der Hyperforce Architektur mit nativen Cloud-Funktionen basiert.
### Aufbauend auf Hyperforce
Salesforce Data 360 ist eine Cloud-native Datenplattform, die vollständig auf der Hyperforce Architektur von Salesforce basiert und eine sichere, kompatible und skalierbare Grundlage für globale Vorgänge bietet.
### Secure-by-Design-Grundlage
* Hyperforce bietet Sicherheit und Compliance als integrierte Funktionen und nicht als Add-Ons. Sie bietet einen gemeinsamen Satz grundlegender Steuerelemente, die tief in die Plattformen und Anwendungen von Salesforce integriert sind, um sicherzustellen, dass jede Ebene – von der Infrastruktur bis zur Anwendungserfahrung – auf Sicherheit, Datenschutz und Compliance ausgelegt ist.
* Data 360 übernimmt zuverlässige Zugriffssteuerungen, Verschlüsselung und Compliance-Frameworks direkt von den grundlegenden Steuerelementen von Hyperforce.
* Dieses sichere Standardmodell minimiert Schwachstellen und vereinfacht die Bereitstellung vertrauenswürdiger, konformer Datenservices.
### Cloud-native Architektur
* Data 360 wird in einer dedizierten Funktionsdomäne ausgeführt, die auf Hyperforce gehostet wird. Hierbei handelt es sich um eine vereinheitlichte Cloud-Plattform, die Isolation, Leistung und Mandantensicherheit gewährleistet.
* Data 360 verwendet eine Microservices-Architektur, wobei alle Services über Kubernetes in Containern zusammengefasst und orchestriert werden.
* Das Istio-Service-Mesh wendet die Prinzipien von Zero Trust an und verwaltet die sichere dienstübergreifende Kommunikation sowie die Datenverkehrsverwaltung, die Beobachtbarkeit und die Durchsetzung von Richtlinien.
### Skalierbare und modulare Bereitstellung
* Data 360-Services werden mit der verwalteten virtuellen Private Cloud (VPC) von Salesforce bereitgestellt und funktionieren, was die Trennung, effiziente Steuerung und optimierte interne Vernetzung ermöglicht.
* Die Architektur unterstützt horizontale Skalierbarkeit und stellt sicher, dass Data 360 Datenverarbeitungsarbeitslasten im Petabyte-Bereich verarbeiten kann.
### Integration und Erweiterbarkeit
* Data 360 stellt gut definierte APIs für die Integration in Salesforce CRM-Anwendungen und andere Datenquellen bereit.
* Es unterstützt Salesforce CRM-Organisationen, die auf Erstanbietern (1P) und Hyperforce basieren, und gewährleistet so eine umfassende Kompatibilität zwischen Umgebungen.
* Mit Data Cloud One können Kunden mehrere Salesforce CRM-Organisationen mit einer einzigen Data 360-Instanz verbinden.
### Das Modell der gemeinsamen Verantwortung
Die Sicherheit in Salesforce Data 360 basiert auf [einem gemeinsamen Verantwortungsmodell](https://compliance.salesforce.com/en/documents/a006e000010nW2FAAU), das auch von führenden Cloud-Anbietern wie Amazon Web Services (AWS), Microsoft Azure und Google Cloud verwendet wird.
Dieses Modell definiert eine klare Grenze: Salesforce ist für die Sicherheit **der** Cloud und die Kunden für die Sicherheit **in** der Cloud verantwortlich. Das Verständnis und die Operationalisierung dieser Unterscheidung sind entscheidend für die Aufrechterhaltung eines robusten, konformen und sicheren Datenökosystems.
 #### Salesforce: Sicherheit der Cloud
Salesforce ist für die Sicherung und Aufrechterhaltung der Integrität der Data 360-Plattform und ihrer globalen Infrastruktur verantwortlich. Dazu zählen:
* **Physische und ökologische Sicherheit:** Hyperforce wird in der AWS-Infrastruktur gehostet und Amazon trägt die delegierte Verantwortung für den Schutz seiner globalen Rechenzentren durch Zugriffskontrollen, Überwachung und Umweltschutzmaßnahmen.
* **Netzwerk- und Perimeterverteidigung:** Minderung, Erkennung und Verschlüsselung des verteilten Denial-of-Service (DDoS) für den gesamten Datenverkehr während der Übertragung (TLS 1.2 und höher) und im Leerlauf (AES-256).
* **Plattformhärtung und Patch-Verwaltung:** Kontinuierliche Schwachstellenverwaltung, Patch-Bereitstellung und Basissicherheit auf Betriebssystemebene.
* **Compliance und Zertifizierung:** Kontinuierliche Prüfungen anhand von Standards wie SOC 1/2/3, ISO 27001, ISO 27017, ISO 27018 und Bereitschaft für Frameworks wie DSGVO.
Diese Steuerelemente stellen sicher, dass die Data 360-Plattform sicher, zuverlässig und konform bleibt, sodass sich Kunden auf Geschäftslogik und Datenverwaltung konzentrieren können und nicht auf die Infrastrukturabwehr.
#### Kunde: Sicherheit in der Cloud
Kunden sind dafür verantwortlich, ihre Daten, Konfigurationen und betrieblichen Prozesse in ihren Salesforce Data 360-Organisationen zu schützen. Zu den wichtigsten Bereichen der Rechenschaftspflicht zählen:
* **Identitäts- und Zugriffsverwaltung (IAM):** Definieren Sie Rollen, erzwingen Sie die Multi-Faktor-Authentifizierung (MFA) und Single Sign-On (SSO) und wenden Sie das Prinzip der geringsten Berechtigung an.
* **Datenverwaltung:** Klassifizieren Sie sensible Daten, wenden Sie bei Bedarf Maskierungen an und erzwingen Sie Zugriffssteuerungen auf Objekt-, Feld- und Datensatzebene.
* **Integrationssicherheit:** Verwalten Sie den API-Zugriff über OAuth 2.0, JSON-Webtoken-JWT und andere Authentifizierungsstandards mithilfe von Anmeldeinformationen mit Namen und externen Anmeldeinformationen.
* **Überwachung und Reaktion:** Verwenden Sie Ereignisüberwachungs- und Überwachungsprotokolle und leiten Sie Protokolle an ein System für die Sicherheitsinformations- und Ereignisverwaltung (SIEM) weiter, um eine erweiterte Bedrohungserkennung zu ermöglichen.
Salesforce bietet die sichere Grundlage, Kunden bestimmen jedoch ihren tatsächlichen Sicherheitsstatus durch ihre Konfigurationen, Steuerelemente und Wachsamkeit.
#### Humanzentrierte Verantwortung
Sicherheit ist nicht nur ein technisches Konstrukt, sondern eine Organisationsdisziplin. Der Datenschutz in Salesforce Data 360 wird durch die Zusammenarbeit zwischen Architektur-, Betriebs- und Governance-Teams erreicht.
**Unternehmen sollten:**
* Überprüfen und beenden Sie kontinuierlich nicht verwendete oder überprivilegierte Accounts.
* Automatisieren Sie die Erzwingung mithilfe von Richtlinien als Code und CI/CD-Pipelines.
* Führen Sie Tabletop-Übungen durch, um Vorfälle wie nicht autorisierte Datenaktivierung oder Exfiltration zu simulieren, um die Antwortbereitschaft zu erhöhen.
Die Effektivität von Data 360 skaliert nicht nur nach Funktionen, sondern auch danach, wie verantwortungsvoll Kunden sie operationalisieren.
#### Sicher nach Standard: Proaktiver Sicherheitsstatus
Salesforce Data 360 verfolgt eine sichere und standardmäßige Philosophie, d. h. einen Übergang von der reaktiven Steuerung zum präventiven Design. Statt später mit dem Öffnen und Straffen zu beginnen, beginnt jede neue Data 360-Organisation nun mit dem Status "Deny All" (Alle verweigern), wodurch die Grundsätze des Zero Trust ab der ersten Bereitstellung erzwungen werden.
#### Von der reaktiven Steuerung zum präventiven Design
In älteren Umgebungen haben Kunden das freizügige Modell "Alle zulassen" übernommen, um die Einarbeitung zu beschleunigen. Dies war zwar praktisch, führte jedoch zu einer versehentlichen Überbelichtung und Fehlkonfiguration.
Die neue sichere Standardarchitektur kehrt diesen Ansatz um:
* Kein Benutzer oder System verfügt über impliziten Zugriff.
* Alle Berechtigungen müssen explizit erteilt werden.
* Datenzugriffs-, Integrations- und Governance-Steuerungen werden ab Tag 0 erzwungen.
Dadurch werden die geringsten Berechtigungen erzwungen, was das Risiko einer versehentlichen Offenlegung oder einer Eskalation der Berechtigungen drastisch reduziert.
#### Operative und Governance-Auswirkungen
Dieses Modell hat sowohl technische als auch verhaltensbezogene Auswirkungen:
* Teams müssen Zugriffsmodelle bewusst planen und Berechtigungen an die Compliance und Geschäftsgrenzen anpassen.
* Governance wird zu einer integrierten Designanforderung und nicht zu einem späteren Gedanken.
* Inhaberschaft und Verantwortlichkeit für Daten werden von Anfang an definiert.
Bei älteren Data 360-Organisationen, die weiterhin unter "Alle zulassen" arbeiten, müssen Administratoren die Konfigurationen manuell anpassen, um sie an die neue Basislinie anzupassen. Dies ist ein wichtiger Schritt bei jeder Sicherheitsmodernisierung oder jedem Data 360-Reifeprogramm.
#### Trust nach Design
Salesforce Data 360 ist standardmäßig auf null Zugriff eingestellt und erfordert explizite Richtliniendefinitionen. Dies ist eine grundlegende Entwicklung in der Unternehmensdatensicherheit.
Dieser Ansatz gewährleistet Folgendes:
* Unautorisierter Zugriff und Datenleckrisiken werden minimiert.
* Governance-Frameworks werden strukturell erzwungen, nicht optional.
* Unternehmen erhalten einen berechenbareren, überprüfbaren und widerstandsfähigeren Sicherheitsstatus in allen Umgebungen.
Im Grunde genommen ist Sicherheit keine Funktion mehr, die Sie hinzufügen, sondern die Grundlage, mit der Sie beginnen.
## Identitäts- und Zugriffsverwaltung: Das Gateway zu Ihren Daten
Die Identitäts- und Zugriffsverwaltung in **Salesforce Data 360** ist die erste und wichtigste Verteidigungsebene. Sie regelt, **wer** auf die Plattform zugreifen kann und **welche** Aktionen sie einmal innerhalb der Plattform ausführen können. Ein gut implementiertes IAM-Framework ist die stärkste Kontrolle, die ein Unternehmen hat, um seine Kundendaten zu schützen und die betriebliche Integrität zu gewährleisten.
### Authentifizierung: Überprüfen von "Wer Sie sind"
Durch die Authentifizierung wird **Digital Trust** eingerichtet, wodurch bestätigt wird, dass jeder Benutzer, jeder Service oder jedes externe System, der oder das auf Salesforce Data 360 zugreift, legitim ist.
### Verbundidentitätsverwaltung
Data 360 unterstützt die **verbundene Authentifizierung** mit Identitätsanbietern (Enterprise-grade IdPs) wie [**Microsoft Entra ID (Azure AD)**](https://learn.microsoft.com/en-us/entra/identity/saas-apps/salesforce-tutorial), [**Okta**](https://help.okta.com/en-us/content/topics/provisioning/salesforce/sfdc-provision.htm) oder [**Ping Identity**](https://docs.pingidentity.com/configuration_guides/salesforce/config_saml_salesforce_pf.html) mit [**SAML 2.0**](https://help.salesforce.com/s/articleView?id=xcloud.sso_saml.htm&type=5), OpenID Connect ([**OIDC**](https://help.salesforce.com/s/articleView?id=xcloud.sso_provider_openid_connect.htm&type=5)) oder dem System für die domänenübergreifende Identitätsverwaltung ([**SCIM**](https://help.salesforce.com/s/articleView?id=xcloud.identity_scim_overview.htm&type=5)).
Dieser Verbund erweitert Ihren Corporate Identity-Lebenszyklus direkt in Salesforce. Wenn ein Mitarbeiter dem Unternehmen beitritt, es überträgt oder es verlässt, wird sein Zugriff automatisch angepasst, wodurch verwaiste Accounts reduziert und die Compliance-Bereitschaft verbessert wird.
### Single Sign-On (SSO)
Mit [**Single Sign-On (SSO)**](https://help.salesforce.com/s/articleView?id=xcloud.sso_about.htm&type=5) authentifizieren sich Benutzer einmal mit ihren Unternehmensanmeldeinformationen und erhalten sicheren Zugriff auf Salesforce-Anwendungen ohne separate Kennwörter. Dies reduziert die Ermüdung der Anmeldeinformationen und minimiert Risiken durch die Wiederverwendung von Kennwörtern oder Phishing.
### Adaptiver und bedingter Zugriff
Der Identitätsanbieter (IdP) wird zur zentralen Instanz für Authentifizierungsentscheidungen und erzwingt die Multi-Faktor-Authentifizierung (MFA), den bedingten Zugriff und risikobasierte Kontrollen. Die Authentifizierung entwickelt sich von einem einzelnen Ereignis zu einer kontinuierlichen Auswertung von Trust, je nach Benutzerverhalten und Kontext.
Die Verbundauthentifizierung bietet Folgendes:
* **Zentralisierte Richtliniendurchsetzung:** Authentifizierungsstandards werden zentral in allen Salesforce-Umgebungen verwaltet.
* **Durchgängige Rückverfolgbarkeit:** Vereinheitlichte Überwachungsprotokolle verknüpfen jede Aktion mit einer überprüften Identität.
* **Humanzentrische Erfahrung:** Durch einen reibungslosen und sicheren Anmeldeprozess können sich Teams auf Statistiken und nicht auf Anmeldeinformationen konzentrieren.
### Autorisierung: Definieren von "Was Sie tun können"
Sobald ein Benutzer überprüft wurde, definiert die Autorisierung, worauf er zugreifen, was er anzeigen oder ändern kann. Sie legt die betrieblichen Grenzen fest, die sensible Daten schützen und die geringsten Berechtigungen erzwingen.
**Grundsatz der geringsten Berechtigung (PoLP):** Jedem Benutzer und System werden nur die Berechtigungen erteilt, die für seine Aufgaben erforderlich sind. Dieses Prinzip begrenzt den potenziellen Schaden durch kompromittierte Anmeldeinformationen oder Fehlkonfigurationen erheblich.
**Rollenbasierte Zugriffssteuerung (RBAC):** Salesforce Data 360 verwendet Berechtigungssätze und Berechtigungssatzgruppen, um granulare Funktionen zuzuweisen, die auf Geschäftsrollen abgestimmt sind. Beispiel:
* Ein Dateningenieur kann Aufnahme-Pipelines und -Transformationen mithilfe des Berechtigungssatzes "Data 360 Architect" verwalten.
* Ein Marketinganalyst kann harmonisierte Daten abfragen, Modelle jedoch nicht mithilfe des Berechtigungssatzes "Data 360 Activation Manager" ändern.
* Ein Aktivierungsmanager kann ausgehende Kampagnen ausführen, jedoch nicht mit dem Berechtigungssatz "Data 360-Aktivierungsmanager" auf Quelldaten zugreifen.
Der Zugriff ist zentral verwaltet und überprüfbar, wodurch die Verantwortlichkeit während des gesamten Datenlebenszyklus gewährleistet wird. Wenn sie in IdPs wie Entra ID, Okta oder Ping Identity integriert sind, können Zugriffsrichtlinien über die SCIM-Bereitstellung und SAML/SSO-Verbund nahtlos im gesamten Unternehmen angewendet werden.
### Grundlegendes zu Standardrollen und Berechtigungen in Data 360
Salesforce stellt vordefinierte Berechtigungssätze bereit, die bewährte Vorgehensweisen für die Aufgabentrennung und die Einhaltung von Branchenstandards wie ISO 27001 enthalten.
| Rolle | Hauptverantwortung | Zugriff auf das Designprinzip |
|---|---|---|
| Systemadministrator | Einrichtung, Bereitstellung und Konfiguration der Umgebung | Kein Zugriff auf zugrunde liegende Datensets – gewährleistet die Trennung zwischen System- und Datensteuerung |
| Data 360-Architekt | Datenaufnahme, Transformation, Identitätsbestimmung und Modellierung | Datenaktivierung zum Beibehalten der Datenexpositionsgrenzen kann nicht ausgeführt werden |
| Data 360-Aktivierungsmanager | Segmenterstellung, Kanalverwaltung und Aktivierung | Nur-Anzeige-Zugriff auf Datenmodelle; keine Änderungsberechtigungen |
| Data 360-Benutzer | Verbraucht Analysen und Statistiken | Schreibgeschützt; null Änderungsberechtigungen |
| Data 360 One-Benutzer | Organisationsübergreifender Zugriff über die Begleitorganisation | Geregelt durch Berechtigungen für freigegebenen Bereich und Zugriffsrichtlinien mit Umfang |
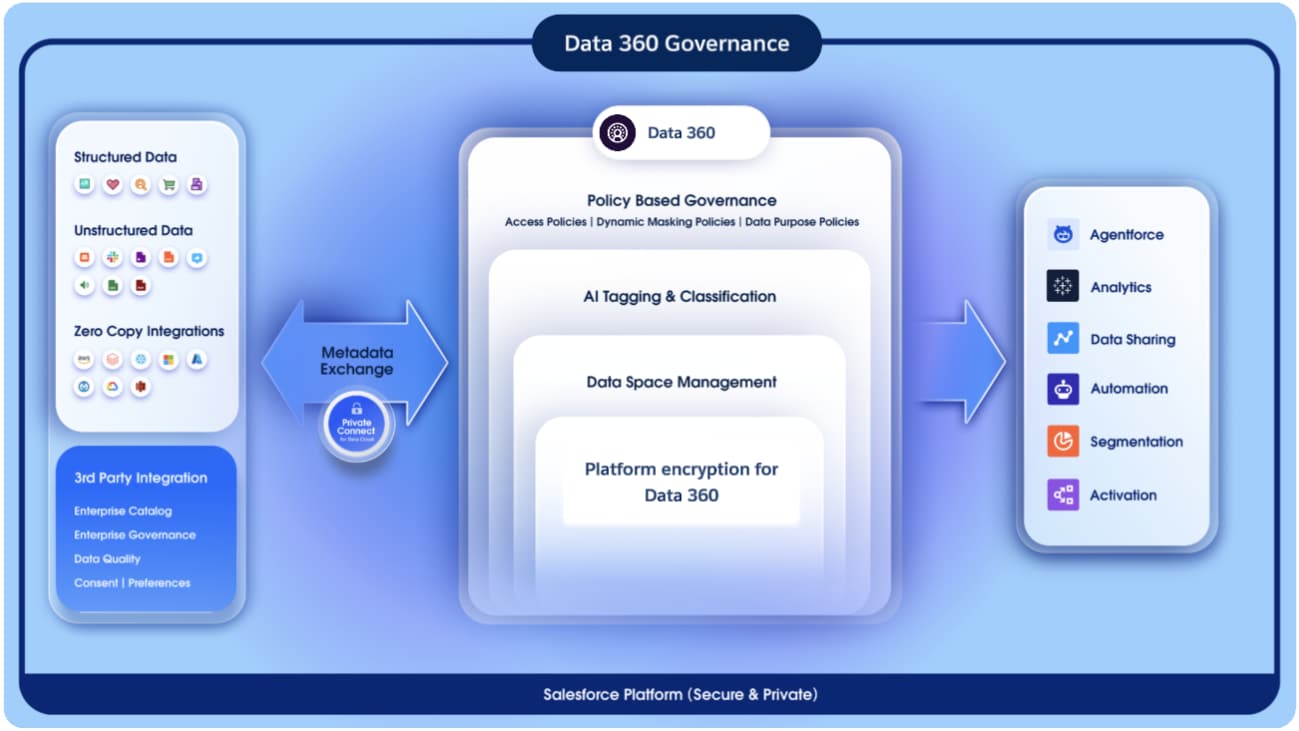 ### Governance als Steuerungsebene
Data 360 basiert auf einem Governance-First-Modell und stellt sicher, dass jede Dateninteraktion – von der Aufnahme bis zur Statistikaktivierung – richtlinienbewusst, überprüfbar und konform ist. Die Verwaltung fungiert als zentrale Steuerungsebene und verwaltet, wie Daten über ihren Lebenszyklus hinweg erkannt, klassifiziert und geschützt werden.
Diese vereinheitlichte Steuerebene gewährleistet Folgendes:
* **Datenzugriff ist kontextabhängig autorisiert**: Nur die richtigen Benutzer können unter den richtigen Richtlinien auf die richtigen Daten reagieren.
* Die **Governance ist sowohl in die semantische als auch in die operative Ebene eingebettet** und gewährleistet die Konsistenz zwischen der Modellierung und dem Schutz von Daten.
* Die Grundsätze **Zero Trust und Least Privilege** werden erzwungen: wobei Identität, Kontext und Richtlinie in Echtzeit ausgewertet werden, bevor Zugriff erteilt wird.
Durch diese Architektur verwandelt Salesforce Data 360 die Verwaltung statischer Berechtigungen in eine dynamische, richtliniengesteuerte Orchestrierungsebene. Eine, die sich kontinuierlich an den Kontext anpasst, die Compliance durch Design erzwingt und Trust im Unternehmensmaßstab aufrechterhält.
### Logische Datentrennung mit Datenbereichen
Auf Makroebene bieten Datenbereiche eine logische Trennung und Isolierung von Unternehmensdatendomänen, sodass Organisationen mit Betriebsmodellen für mehrere Marken, Regionen oder Mandanten Daten auf einer einzigen einheitlichen Plattform verwalten können. Datenbereiche können an Geschäftsdomänen (z. B. Vertrieb, Marketing oder Kundenerfolg) oder an regulatorischen und geografischen Grenzen (z. B. EU, AMER oder APAC) ausgerichtet werden, sodass die Unternehmensführung und Zugriffssteuerungen die Betriebs- und Compliance-Struktur der Organisation widerspiegeln, ohne die zugrunde liegende Datenplattform zu fragmentieren.
* Jeder Datenbereich fungiert als virtuelle Grenze und definiert, welche Datensammlungen ein Benutzer oder Team anzeigen oder mit ihnen interagieren kann.
* Der Zugriff innerhalb eines Datenbereichs wird explizit gewährt, wobei sichergestellt wird, dass keine impliziten Berechtigungen oder Kreuzkontaminationen der Datensichtbarkeit auftreten.
* Dadurch wird die Verbundinhaberschaft aktiviert: Jede Geschäftseinheit kann ihre Domäne unabhängig voneinander verwalten und gleichzeitig die zentrale Aufsicht und Compliance gewährleisten.
Datenbereiche stellen konzeptionell die erste Ebene der Unternehmensführung dar und schaffen strukturelle Klarheit und Verantwortlichkeit für die Unternehmensdatensets.
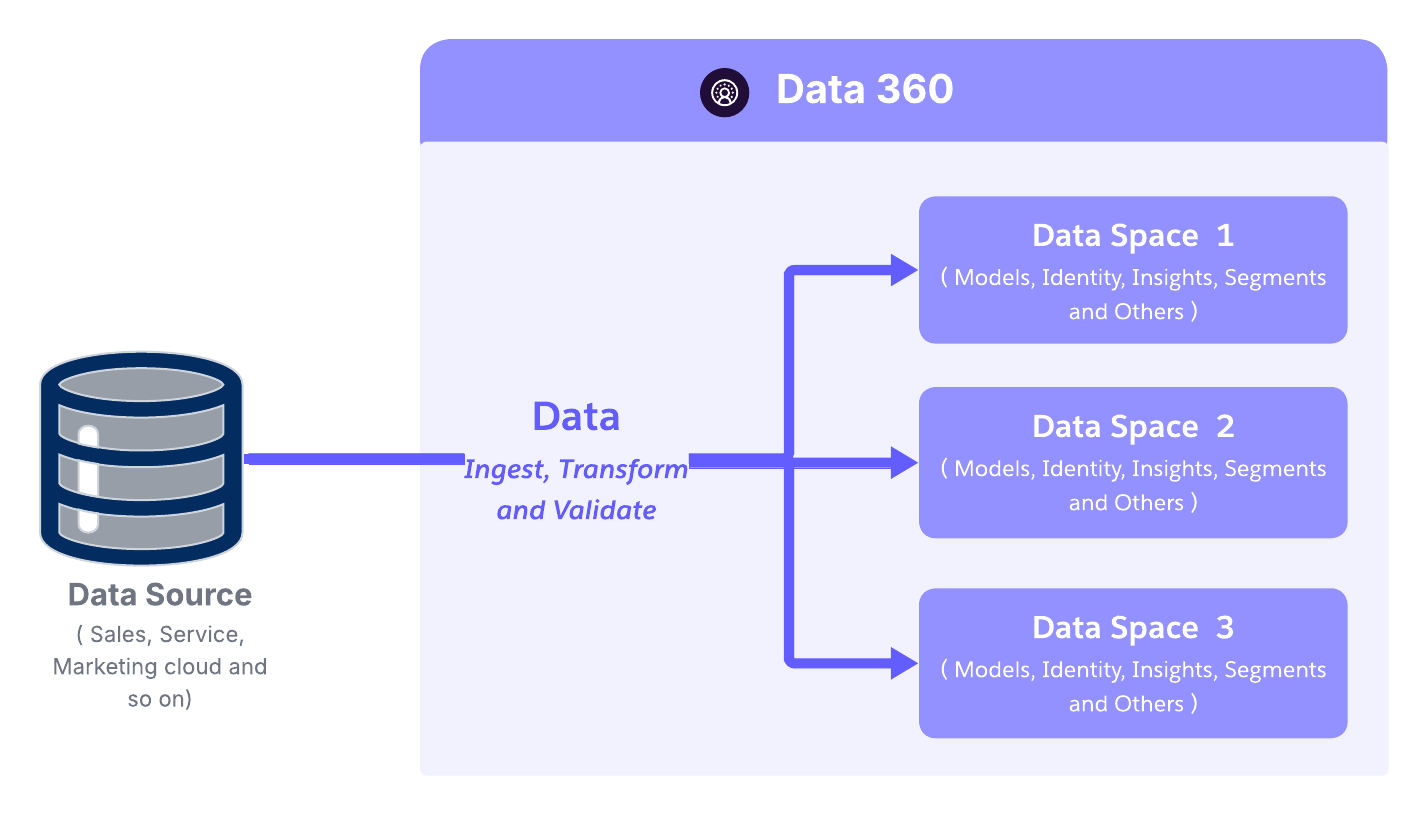 ### Von RBAC zu ABAC: Übergang zur kontextbezogenen Autorisierung
In Salesforce Data 360 dienen RBAC und ABAC unterschiedlichen, sich jedoch ergänzenden Zwecken und werden auf verschiedenen Ebenen der Plattform angewendet.
RBAC wird hauptsächlich für den Plattform- und Funktionszugriff verwendet. Sie regelt, wer auf Data 360-Konstrukte und -Funktionen wie Datenbereiche, Prozesserstellung, Verwaltungsfunktionen und Tooling-Zugriff zugreifen kann. RBAC wird über Berechtigungen und Berechtigungssätze implementiert, beispielsweise indem Benutzern Zugriff auf einen Datenbereich mit bestimmten aktivierten Funktionen zugewiesen wird.
ABAC wird für die Erzwingung des Datenzugriffs verwendet. ABAC-Richtlinien sind vollständig dafür verantwortlich, zu bestimmen, wer auf welche Datenobjekte und Attribute zugreifen kann, einschließlich Objektebenensicherheit (Object-Level Security, OLS), Zugriff auf Feldebene und Einschränkungen auf Zeilenebene. Diese Entscheidungen werden dynamisch getroffen, indem die Aktion, die Benutzerattribute und die Ressourcenattribute zur Laufzeit ausgewertet werden.
In ABAC bleiben Berechtigungen Teil des Modells, der Zugriff wird jedoch durch die Richtlinie selbst bestimmt, nicht durch die Rolle allein. Richtlinien werten Kontexte wie Geschäftseinheit, Region, Datenvertraulichkeit, Verwendungszweck oder behördliche Einschränkungen aus, um den Zugriff zuzulassen oder zu verweigern.
Beispiel:
* RBAC ermöglicht es einem Benutzer, auf einen Data 360-Datenbereich und Analysefunktionen zuzugreifen.
* ABAC bestimmt, ob derselbe Benutzer ein bestimmtes Kundendatenset lesen kann, welche Zeilen er sehen kann und welche Attribute maskiert oder eingeschränkt sind.
Durch diese klare Trennung kann Data 360 sicher skaliert werden:
* RBAC bietet kontrollierten Zugriff auf Plattformfunktionen und Workflows.
* ABAC bietet detaillierten, richtliniengesteuerten Datenzugriff, der den Compliance-, Residenz- und Datenschutzanforderungen entspricht.
Zusammen ermöglichen sie eine kontrollierte Datendemokratisierung, ohne Plattformberechtigungen mit Datenautorisierungslogik zu verwechseln.
Im Wesentlichen erzwingt RBAC den Zugriff anhand der Berechtigungszuweisung, während ABAC Berechtigungen im Kontext auswertet und Aktions-, Benutzer- und Ressourcenattribute kombiniert, um eine angepasste, detaillierte Zugriffssteuerung in Salesforce Data 360 bereitzustellen.
### ABAC: Eine mehrschichtige Sicherheitshierarchie
Das Herzstück der detaillierten Zugriffssteuerung von Salesforce Data 360 ist die attributbasierte Zugriffssteuerung (ABAC, unterstützt durch die CEDAR-Richtliniensprache).
Im Gegensatz zu statischen, rollenbasierten Berechtigungen wertet ABAC dynamisch aus, *wer* Zugriff anfordert, *worauf* er zuzugreifen versucht und *unter welchen Bedingungen* – um sicherzustellen, dass jede Dateninteraktion mit Unternehmensrichtlinien und Trust Grenzen übereinstimmt.
#### Dynamische Richtlinienauswertung
Das ABAC-Modul von Data 360 wertet Zugriffsentscheidungen anhand einer Kombination von drei zentralen Attributtypen aus:
* **Benutzerattribute:** Abteilung, Standort, Freigabeebene
* **Datenattribute:** Klassifizierung, Sensibilität (PII, PHI, Finanzdaten), Datenbereich
Dieses flexible, richtliniengesteuerte Modell ermöglicht die automatische Anpassung der Erzwingung an die Entwicklung von Benutzerrollen, Datenklassifizierungen oder Betriebsbedingungen, was für große, verteilte und regulierte Unternehmen unerlässlich ist.
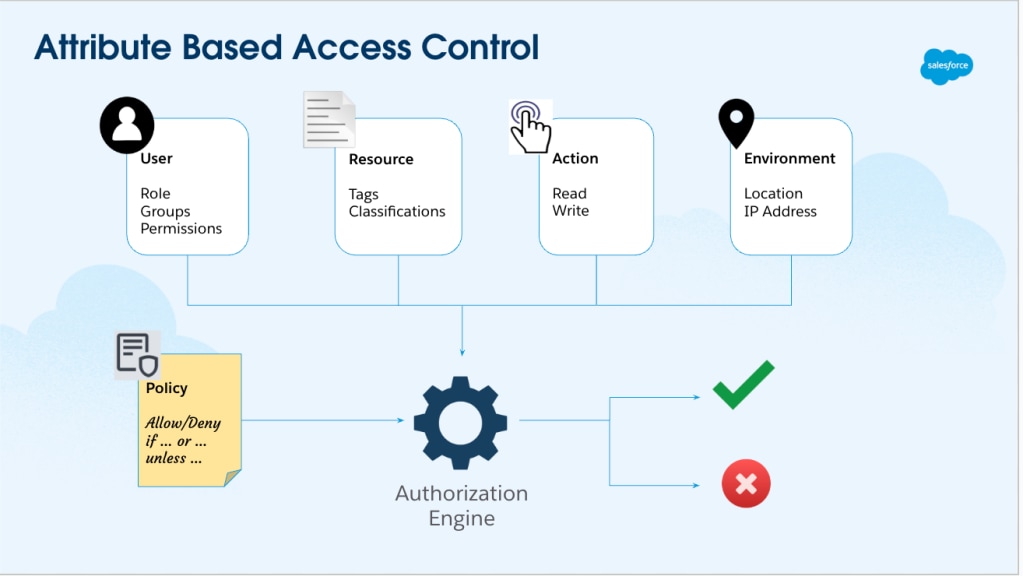 #### ABAC-Architekturkomponenten in Salesforce Data 360
Salesforce Data 360 implementiert eine standardbasierte Architektur für die attributbasierte Zugriffssteuerung, die mit den bewährten Vorgehensweisen der Branche für die richtliniengesteuerte Datenverwaltung in Einklang steht. Sie besteht aus drei primären Funktionskomponenten:
* **Policy Information Point (PIP) – Policies, Enriched Metadata and Classification (Policy Information Point, PIP) (Policy-Informationspunkt – Richtlinien, erweiterte Metadaten und Klassifizierung):**
* Enthält Richtliniendefinitionen selbst, einschließlich Datenzugriffs-, Klassifizierungs-, Maskierungs-, Aufbewahrungs- und Nutzungsrichtlinien für Unternehmensdaten.
* Verwaltet angereicherte Metadaten wie Tags, Klassifizierungen, Geschäftskontext und durchgängige Abstammung.
* Verwendet die LLM- und ML-gesteuerte Klassifizierung, um sensible Daten automatisch mit Tags zu versehen (z. B. PII.Email, PII.Phone, PHI).
* Die Tag-Übertragung stellt sicher, dass Klassifizierungen automatisch entlang der Datenherkunft (DLO → DLO → DMO) fließen.
* Wahrung der Sensibilität und Compliance über Transformationen hinweg.
* **Policy Decision Point (PDP) (Entscheidungspunkt für Policen)**: Das PDP ist das Entscheidungsmodul, das CEDAR-Richtlinien interpretiert.
* Erfasst kontextbezogene Eingaben aus dem PEP (Benutzeridentität, Anforderungsmetadaten) und Verweisattribute aus dem PIP.
* Wertet Richtlinien deterministisch aus, um konsistente, erklärbare und skalierbare Zugriffsentscheidungen zu treffen.
* Unterstützt Echtzeit- und Batch-Auswertungen und gewährleistet so Leistung und Präzision auch in Umgebungen mit hohem Volumen.
* **Durchsetzungspunkt für Policen**: Im PEP werden Autorisierungsentscheidungen zur Laufzeit erzwungen.
* Fängt Datenzugriffsanforderungen über alle Interaktionskanäle hinweg ab, beispielsweise APIs, Benutzeroberflächenabfragen, CRM-Anreicherung oder RAG-Pipelines (GenAI Retrieval-Augmented Generation).
* Wendet PDP-Ergebnisse sofort an und stellt sicher, dass jede Abfrage und jeder Abruf mit den Unternehmenszugriffsrichtlinien konform ist.
Zusammen bildet die Triade "PIP–PDP–PEP" ein verteiltes Governance-Gefüge und erzwingt eine konsistente, richtlinienbasierte Kontrolle über alle Data 360-Services und -Zugriffsmodi.
Wichtig ist, dass [ABAC](https://help.salesforce.com/s/articleView?id=data.c360_a_policy_based_governance_dg.htm&type=5) in Data 360 konfiguriert und nicht erstellt ist. Architekten stellen keine benutzerdefinierten Steuerebenen oder Erzwingungslogik zusammen. Stattdessen werden drei native Architekturkomponenten ausgefüllt und miteinander verbunden, die als einheitliches Governance-Gefüge fungieren.
Praktisch folgt die Implementierung einem einfachen Fortschritt: Klassifizieren Sie die Daten, definieren Sie die Richtlinien und lassen Sie sie von der Plattform automatisch erzwingen. Nach der Konfiguration wird die Zugriffssteuerung zu einem Systemverhalten und nicht zu einem manuellen oder prozeduralen Prozess.
Dieses verteilte Governance-Gefüge gewährleistet eine **konsistente Richtlinienerzwingung über alle Zugriffskanäle** hinweg und schafft eine einheitliche Trust-Grenze in Data 360.
#### Durchsetzung mehrstufiger Richtlinien
Das ABAC-Framework von Data 360 unterstützt mehrschichtige Zugriffsgrenzen und stellt sicher, dass Daten nicht nur auf Objektebene, sondern auch in bestimmten Feldern und Datensätzen geschützt sind.
* **Objektebenensicherheit (OLS)**: Die äußerste Grenze der Zugriffssteuerung.
Steuert den Zugriff auf gesamte Datenstrukturen wie Data-Lake-Objekte (DLOs) oder Datenmodellobjekte (DMOs).
Beispiel: Gewähren von Zugriff auf das Objekt "*Kunde*", nicht jedoch auf *Transaktionen*.
* **Feldebenensicherheit**: Steuert den Zugriff auf bestimmte Felder in einem Objekt.
Beispiel: Ein Marketingbenutzer kann Kundennamen anzeigen, kann jedoch weder Kreditkartennummern noch nationale Kennzeichner anzeigen.
* **Datensatzsicherheit (RLS)**: Die detaillierteste Steuerebene.
Legt fest, welche einzelnen Datensätze in einem Datenset ein Benutzer anzeigen oder ändern kann.
Beispiel: Ein regionaler Manager kann nur auf Kundendaten zugreifen, die mit seiner zugewiesenen Region verknüpft sind.
* **Dynamische Datenmaskierung (DDM):** Aktiviert den Echtzeit-Datenschutz. Als Ergänzung zu ABAC erzwingt DDM die richtliniengesteuerte Verschleierung vertraulicher Informationen, ohne das zugrunde liegende Datenset zu ändern. Zum Abfragezeitpunkt maskiert DDM automatisch Felder wie personenbezogene Daten oder Finanzdaten basierend auf Benutzerrolle, Kontext oder Compliance-Regeln.
* Sensible Daten bleiben über Benutzeroberflächenansichten, APIs und AI-Workflows hinweg geschützt.
* Verringert das Risiko von Datenlecks, indem eine konsistente Maskierung über alle Verbrauchsschichten hinweg gewährleistet wird.
* Behält die Überprüfbarkeit bei. Jede maskierte Abfrage wird im Governance-Framework von Data 360 protokolliert und kann verfolgt werden.
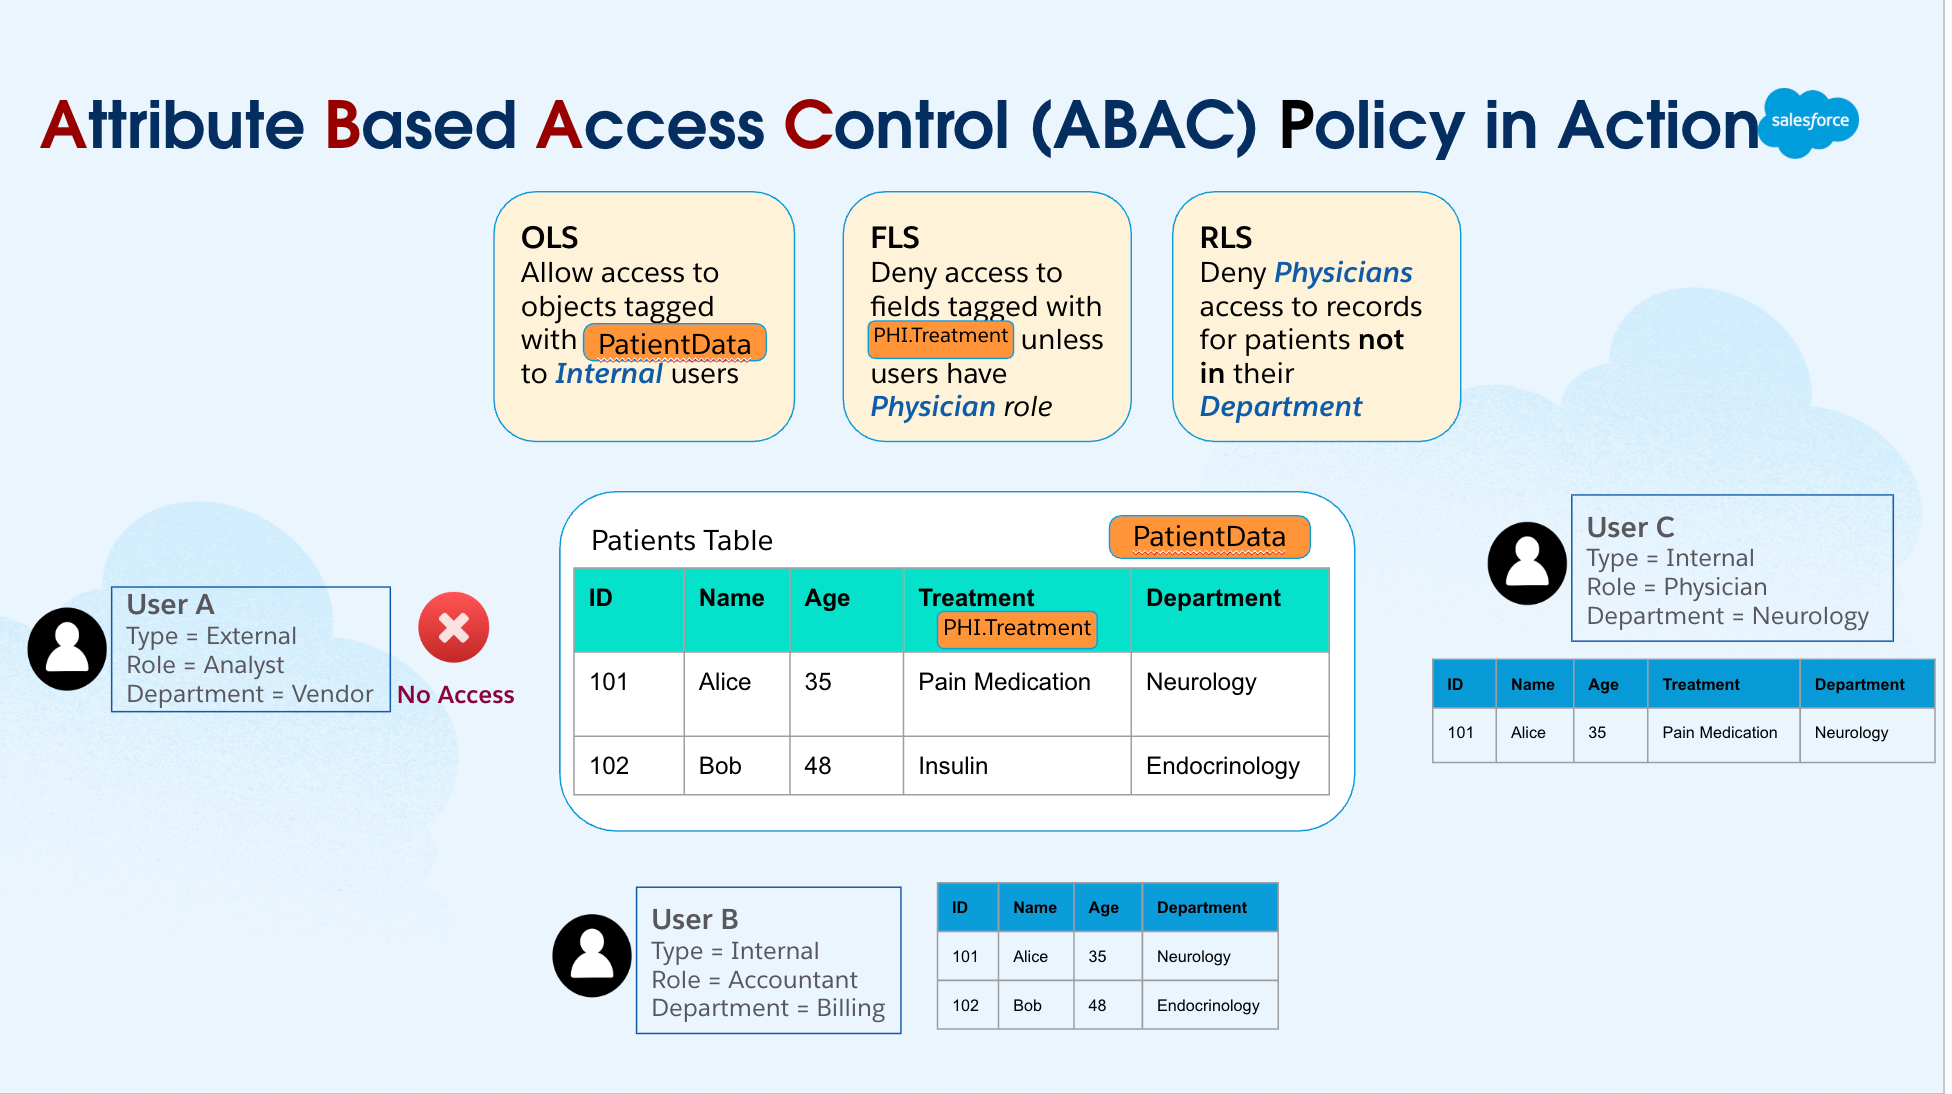 Diese Architektur wandelt die Zugriffssteuerung von einem statischen Berechtigungsmodell in ein dynamisches, kontextbezogenes Richtliniengewebe um. Durch die Kombination der strukturierten Einfachheit von RBAC mit der Kontexttiefe von ABAC erreicht Salesforce Data 360 Folgendes:
* Konsistente Richtlinienerzwingung bei der Aufnahme, Harmonisierung und Aktivierung.
* Adaptive Governance, die sich mit Daten, Rollen und Compliance-Anforderungen ändert.
* Grenzen für vereinheitlichte Trusts über den gesamten Datenlebenszyklus hinweg – von der Aufnahme bis zur AI-Aktivierung.
#### Tiefe Integration in Salesforce Platform
Das Governance-Modell von Salesforce Data 360 ist nativ in die Salesforce Platform eingebettet und ermöglicht einheitliche Sicherheit, Compliance und Zugriffskontrolle für betriebliche und analytische Daten. Data 360 übernimmt die zentralen Identitäts- und Zugriffsverwaltungsfunktionen von Salesforce, beispielsweise die Identitätszuordnung, Berechtigungssätze, die zentralisierte Richtlinienerstellung und die Plattformverschlüsselung, und wendet Cloud-übergreifend konsistente Trust Policies an, ohne parallele Governance-Stacks einzuführen. Statt Isolation, Autorisierung und Abstammung als separate Anliegen zu behandeln, integriert die Plattform sie in ein einzelnes Trust Fabric mit Ausführungsbewusstsein, das den gesamten Datenlebenszyklus abdeckt.
Auf struktureller Ebene besteht dieses Governance-Gefüge aus drei sich ergänzenden Ebenen, die gemeinsam arbeiten:
* **Datenbereiche**, die klare logische Grenzen für die Datenisolierung und behördliche Segmentierung festlegen
* **Attributbasierte Zugriffssteuerung**, die detaillierte Autorisierungsentscheidungen anhand von Identität, Zweck und Datenattributen ermöglicht
* **Semantische Abstammung**, die Geschäftsbedeutung, Sensibilität und Rückverfolgbarkeit beibehält, wenn Daten von der Aufnahme zu Statistiken und Aktivierungen gelangen
Gemeinsam erstellen sie ein Governance-Modell, bei dem Zugriffsentscheidungen erklärbar sind, die Erzwingung automatisch erfolgt und die Compliance kontinuierlich und nicht nachträglich erfolgt. Das Ergebnis ist eine Plattform, auf der Governance nicht mehr als begrenzender Faktor oder als Folgegedanke fungiert. Stattdessen wird sie zu einer aktivierenden Ebene, sodass Architekten Datenprodukte und AI-gestützte Workflows mit der Gewissheit entwerfen können, dass Trust, Datenschutz und behördliche Anforderungen vom System selbst erzwungen werden.
Dieser Ansatz der Zusammensetzung stellt sicher, dass Unternehmensdaten nicht nur nutzbar, sondern auch verantwortungsvoll handlungsfähig bleiben – er unterstützt Statistiken, Aktivierungen und Automatisierungen in großem Umfang, ohne Transparenz, Sicherheit oder Kontrolle zu beeinträchtigen.
## Schützen des Datenlebenszyklus: Von der Aufnahme bis zur Aktivierung
Im Zeitalter von AI-gestützten Unternehmen ist die Sicherung von Daten kein einmaliges Ereignis, sondern ein kontinuierlicher Prozess, der Informationen vom Eintritt in das Ökosystem bis zur Aktivierung für Geschäfts- oder AI-Nutzung schützt.
Salesforce Data 360 integriert Sicherheits- und Governance-Steuerungen in jeder Phase des Datenlebenszyklus und stellt so sicher, dass Datenintegrität, Vertraulichkeit und Trust von der Aufnahme bis zur Aktivierung von Statistiken gewahrt bleiben.
### Grundlage des Schutzes: Verschlüsselung im Leerlauf und während der Übertragung
Kernstück des Salesforce Data 360-Schutzmodells ist die Plattformverschlüsselung für Data 360 – ein transparentes, leistungsstarkes Verschlüsselungs-Framework, das Daten im Leerlauf und bei der Übertragung schützt, ohne die Benutzerfreundlichkeit oder Skalierbarkeit zu beeinträchtigen.
#### Verschlüsselung im Leerlauf: Speicherebenensicherheit
Die im Data 360 Data Lake gespeicherten Daten werden **automatisch auf Speicherebene verschlüsselt**, wodurch sichergestellt wird, dass die Daten auch dann unlesbar bleiben, wenn physischer oder nicht autorisierter Zugriff erfolgt. Zu den wichtigsten Funktionen zählen:
* **Transparente Data-Lake-Verschlüsselung:** Alle im Data Lake beibehaltenen Daten werden auf Speicherebene mit kundenverwalteten Schlüsseln verschlüsselt. Dadurch wird sichergestellt, dass die Daten selbst bei nicht autorisiertem Zugriff auf den physischen Speicher unlesbar und nicht entschlüsselbar bleiben.
* **Von Kunden verwaltete Schlüssel (CMK):** Kunden behalten die vollständige Kontrolle über Verschlüsselungsschlüssel – eine wichtige Funktion für regulierte Branchen wie Finanzdienste, Gesundheitswesen und Behörden. CMK ermöglicht eine genaue Überprüfung, Kontrolle und den Nachweis der Datensouveränität und steht dabei in direkter Übereinstimmung mit gesetzlichen Vorgaben wie DSGVO, HIPAA und ISO 27001.
* **Externe Schlüsselverwaltung (EKM):** Mit der Verwaltung externer Schlüssel, einer Funktion der Plattformverschlüsselung für Data 360, können Kunden Daten in Data 360 mithilfe von Schlüsseln verschlüsseln, die in den AWS KMS-Accounts der Kunden gespeichert sind. Dadurch erhalten Kunden mehr Flexibilität, während ihre Daten in Data 360 sicher und geschützt bleiben.
* **Bring your own Key (BYOK):** Data 360 basiert auf CMK und EKM und ermöglicht es Kunden nun, ihr eigenes Schlüsselmaterial direkt in Salesforce hochzuladen, um Daten im Leerlauf und Suchindizes zu verschlüsseln. Diese Verbesserung bietet eine zusätzliche Schutzebene für personenbezogene, vertrauliche und proprietäre Daten, ohne dass Kunden Schlüssel in AWS KMS erstellen oder verwalten müssen.
* **Schlüsselrotation und Lebenszyklusverwaltung:** Die Schlüsselrotation wird anmutig verarbeitet. Neue Daten werden mit dem neuen Schlüssel verschlüsselt, während ältere Daten mit dem ursprünglichen Schlüssel verschlüsselt bleiben, wodurch Ausfallzeiten oder Leistungseinbußen vermieden werden. Dieser Rotationsmechanismus stärkt die Compliance ohne Betriebsunterbrechungen.
#### Verschlüsselung bei der Übertragung: Sicherheit auf Netzwerkebene
Alle zwischen Data 360-Services, -APIs und -Konnektoren übertragenen Daten werden mit Transport Layer Security (TLS) 1.2 oder höher geschützt und bieten eine durchgängige Verschlüsselung.
Dadurch wird Folgendes sichergestellt:
* Daten können während der Übertragung nicht abgefangen oder geändert werden.
* Die Kommunikation zwischen Salesforce-Services, vertrauenswürdigen Konnektoren und Kundenendpunkten bleibt privat und überprüfbar.
* Die Sicherheit erstreckt sich einheitlich über Aufnahmepipelines, Harmonisierungen, Aktivierungs-Workflows und externe API-Integrationen.
Durch die Kombination der vom Kunden verwalteten Verschlüsselung im Leerlauf mit der kontinuierlichen Verschlüsselung während der Übertragung schafft Salesforce Data 360 eine Architektur, die Kundendaten vor externen Angriffen und Bedrohungen der internen Infrastruktur schützt.
### Sichere System-zu-System-Integration (Datenintegration) in Data 360
Verschlüsselung und Zugriffssteuerungen schützen zwar Daten in Salesforce Data 360, die Sicherung der systemübergreifenden Datenbewegung ist jedoch ebenso wichtig. Moderne Unternehmen arbeiten in Multi-Cloud- und Hybridumgebungen, in denen sensible Daten zwischen Salesforce, Analyseplattformen, externen APIs und Data Lakes fließen.
Salesforce hat ein sicheres Integrations-Framework entwickelt, das sich auf Anmeldeinformationen mit Namen (Named Credentials, NCs) und externe Anmeldeinformationen (External Credentials, ECs) konzentriert.
#### Sicheres Integrations-Framework von Salesforce
Salesforce hat ein robustes **[sicheres Integrations-Framework](https://developer.salesforce.com/docs/platform/named-credentials/guide/get-started.html)** entwickelt, das sich auf Anmeldeinformationen mit Namen und externe Anmeldeinformationen konzentriert. Zusammen entfernen sie die Komplexität der Anmeldeinformationen, erzwingen den Zugriff mit den geringsten Berechtigungen und ermöglichen eine einheitliche Authentifizierungsverwaltung über alle Integrationen hinweg, ohne Geheimnisse im Code oder in der Konfiguration offenzulegen.
Dieses Framework abstrahiert Sicherheitskomplexitäten, erzwingt bewährte Vorgehensweisen und richtet eine **richtliniengesteuerte Steuerungsebene** für alle externen Verbindungen ein, die den Salesforce-Prinzipien **Zero Trust** und **security-by-design** entspricht.
##### Anmeldeinformationen mit Namen
Anmeldeinformationen mit Namen sind die Eckpfeiler der sicheren Integrationsarchitektur von Salesforce. Sie bieten einen deklarativen, zentralisierten Mechanismus zum Definieren externer Endpunkte und ihrer Authentifizierungsparameter, wodurch sensible Anmeldeinformationen wie Benutzernamen, Kennwörter oder Token in Apex-Code oder Konfigurationsdateien nicht mehr hartcodiert werden müssen. Stattdessen verweisen Entwickler und Administratoren einfach auf einen Alias für Anmeldeinformationen mit Namen (z. B. SnowflakeConnector_NC) und Salesforce übernimmt automatisch die zugrunde liegende Authentifizierung und Verbindungsverwaltung.
**Architektur- und Sicherheitsvorteile:**
* **Vereinfachte Wartung:** NCs konsolidieren externe Endpunkt-URLs und Authentifizierungsparameter in einem einzigen verwalteten Datensatz. Alle Aktualisierungen, beispielsweise das Ändern eines Endpunkts oder rotierende Anmeldeinformationen, erfordern nur Änderungen am NC-Datensatz, wodurch eine erneute Bereitstellung von Code oder Flows in Umgebungen vermieden wird.
* **Erhöhte Sicherheit:** Anmeldeinformationen werden sicher im verschlüsselten geheimen Speicher von Salesforce gespeichert und verhindern so die Offenlegung in Code-Repositorys, Konfigurationsdateien oder Protokollen. Der Authentifizierungsprozess selbst wird zur Laufzeit automatisch verwaltet, wodurch menschliche Fehler und das Risiko von Leckagen reduziert werden.
**Compliance-Einhaltung:** Die Trennung von Anmeldeinformationen und Geschäftslogik vereinfacht die Einhaltung von Datenschutzbestimmungen wie **DSGVO, HIPAA und PCI DSS**. Prüfer können einfach überprüfen, ob der externe Datenzugriff den Sicherheits- und Governance-Richtlinien des Unternehmens entspricht.
* **Umgeht Einstellungen für Remote-Standorte:** NCs müssen nicht mehr an Remote-Standorteinstellungen angepasst werden, wodurch die Konfiguration und Bereitstellung optimiert werden, insbesondere bei Unternehmensimplementierungen mit großem Umfang oder mehreren Umgebungen.
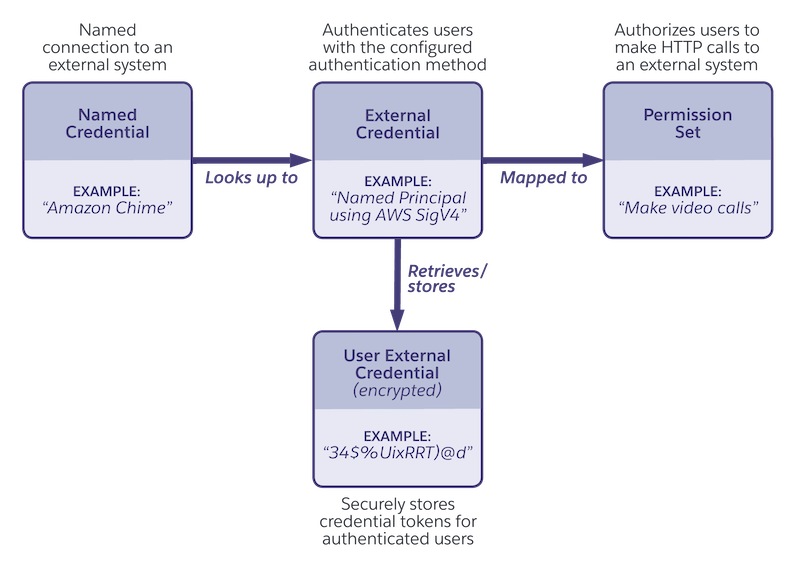 #### Externe Anmeldeinformationen
Externe Anmeldeinformationen definieren das Authentifizierungsprotokoll und den Authentifizierungs-Flow, die Salesforce beim Herstellen einer Verbindung mit einem externen Service verwendet, und beantworten so effektiv, wie die Authentifizierung erfolgen soll. Eine einzelne EC kann über mehrere NCs hinweg wiederverwendet werden, die denselben Authentifizierungstyp verwenden, was die Wiederverwendung von Konfigurationen und die konsistente Erzwingung von Sicherheit fördert.
**Unterstützte Authentifizierungsprotokolle:**
* OAuth 2.0 (alle Varianten werden unterstützt)
* JWT (JSON-Webtoken)
* Grundlegende Authentifizierung
* AWS Signature v4
* Benutzerdefinierte Authentifizierung
* Keine Authentifizierung (für offene APIs oder öffentliche Endpunkte)
Externe Anmeldeinformationen und Anmeldeinformationen mit Namen sind auf eine klare Aufgabentrennung ausgelegt. Mit "Externe Anmeldeinformationen" wird definiert, wie die Authentifizierung erfolgt. Dabei werden das Authentifizierungsprotokoll, der Tokentyp und das Aktualisierungsverhalten für die Verbindung mit externen Systemen angegeben. Anmeldeinformationen mit Namen definieren hingegen, wo eine Verbindung hergestellt werden soll – den Endpunkt-URL und welche externen Anmeldeinformationen für diese Verbindung verwendet werden sollen. Durch dieses Design wird sichergestellt, dass die Authentifizierungslogik und die Endpunktkonfiguration entkoppelt bleiben, sodass Salesforce verschiedene Integrationsprotokolle sicher unterstützen und gleichzeitig die zentralisierte und konsistente Anmeldeinformationenverwaltung im gesamten Unternehmen aufrechterhalten kann.
### Wie Data 360-Konnektoren dieses Framework nutzen
Obwohl die Benutzeroberfläche von Data 360 einen Großteil der zugrunde liegenden Konfiguration abstrahiert, wird das Framework für Anmeldeinformationen mit Namen und externe Anmeldeinformationen häufig von seinen nativen Konnektoren und Datenströmen verwendet. Dies bedeutet, dass Data 360 dieses standardisierte Sicherheitsmodell auch dann noch im Hintergrund anwendet, wenn Administratoren einfach über eine geführte Benutzeroberfläche "eine Datenverbindung hinzufügen".
Architektonische Implikationen:
* **Vereinheitlichtes Sicherheitsmodell:** Jeder Konnektor – ob für eine externe Datenbank , AWS S3 oder eine Unternehmens-API – profitiert von denselben Verschlüsselungs-, Authentifizierungs- und Schlüsselverwaltungsstandards, die auch durch Anmeldeinformationen mit Namen und externe Anmeldeinformationen erzwungen werden.
* **Entwicklerabstraktion:** Entwickler und Administratoren müssen Authentifizierungs-Flows oder die Rotation von Anmeldeinformationen nicht manuell verarbeiten. Salesforce verwaltet den Tokenlebenszyklus, den Ablauf und die Aktualisierung automatisch.
* **Konsistente politische Durchsetzung:** Dieses Framework stellt sicher, dass alle Konnektoren konsistente Authentifizierungs-, Überwachungs- und Protokollierungsrichtlinien einhalten – entscheidend für die Aufnahme von mehreren Quellen in regulierten Branchen im großen Umfang.
* **Zukunftssichere Erweiterbarkeit:** Wenn Salesforce seinen Authentifizierungsstapel erweitert (z. B. um neue OAuth-Flows oder FIDO2-Standards zu unterstützen), werden diese Verbesserungen automatisch über alle Konnektoren hinweg übernommen, ohne dass eine erneute Faktorisierung oder Bereitstellung erforderlich ist.
### Sicherheit und Governance des Data 360-Konnektors
Salesforce Data 360 bietet eine große Suite vorkonfigurierter Konnektoren, die die Datenintegration aus verschiedenen Quellen optimieren. Dadurch können Unternehmen ihre Daten effizient konsolidieren und nutzen. Salesforce bietet mehrere Konnektortypen, einschließlich nativer Salesforce-Konnektoren, Cloud-Speicher-Konnektoren, Datenbank-Konnektoren sowie Anwendungs- und API-Konnektoren. Zusätzlich zu den angebotenen Konnektoren werden auch Zero-ETL-Tools unterstützt. Salesforce-Konnektoren ermöglichen eine nahtlose Integration zwischen Salesforce-Produkten wie Sales Cloud, Service Cloud und Marketing Cloud in Data 360\. Zusätzlich werden eine Reihe von Konnektoren für Cloud-Speicheranbieter wie Amazon S3, Google Cloud Storage und Azure Data Lake angeboten. Mit den vordefinierten Konnektoren für Datenbanken wie Snowflake, Redshift und BigQuery können Unternehmen ihre vorhandenen Data Warehouses mit Data 360 verknüpfen. Data 360 bietet zudem Konnektoren für verschiedene Drittanbieteranwendungen und APIs wie Google Ads, Facebook Ads und andere Marketingplattformen. Data 360 kann in ETL-Tools wie MuleSoft und Informatica integriert werden, um die Flexibilität zu erhöhen.
 #### Datensicherheit und Salesforce Data 360-Konnektoren
Die Sicherheit der in Salesforce Data 360 gespeicherten Daten stand bei vielen Data 360-bezogenen Unterhaltungen im Vordergrund. Im Rahmen des Engagements von Salesforce für einen tiefgreifenden Sicherheitsansatz wird der Sicherung der Datenerfassung in der Data 360-Umgebung gleichermaßen große Bedeutung beigemessen.
Salesforce erkennt, dass Unternehmen in verschiedenen Datenökosystemen arbeiten, die sich oft über mehrere Cloud-Plattformen, Speicherlösungen und Analysetools erstrecken. Unsere Data 360-Konnektoren dienen als Brücke zwischen diesen Umgebungen. Der Konnektor ermöglicht eine sichere, skalierbare und effiziente Datenintegration unter Beibehaltung der hohen Sicherheitsstandards von Salesforce. Diese Konnektoren ermöglichen einen nahtlosen Datenfluss, ohne die Integrität oder den Datenschutz zu beeinträchtigen.
Die drei wesentlichen Komponenten der Data 360-Konnektorsicherheit sind:
* **Authentifizierung/Autorisierungszuordnung**: Die sichere Zugriffsverwaltung ist die Grundlage für die Datensicherheit. Unterschiedliche Cloud-Konnektoren verwenden unterschiedliche Authentifizierungs- und Autorisierungsmechanismen, um den Benutzerzugriff zu validieren und zu steuern. Die Authentifizierung stellt sicher, dass Benutzer oder Systeme legitime Einheiten sind, während die Autorisierung die Zugriffsebene definiert, die gewährt wird. Salesforce stellt sicher, dass seine Konnektoren nach Möglichkeit Branchenstandards verwenden.
* **Zero Copy (ZETL)-Funktionsinteroperabilität**: Die Datenduplizierung stellt die Sicherheit und den Betrieb vor Herausforderungen. Dies ist auch mit unnötigen Speicherkosten, Dateninkonsistenzen und einem erhöhten Risiko verbunden. Der Zero Extract, Transform and Load (ZETL)-Ansatz von Salesforce stellt sicher, dass die Echtzeit-Datenfreigabe plattformübergreifend erfolgen kann, ohne dass ein physischer Datenabgleich erforderlich ist. Das bedeutet, dass Daten in ihrer ursprünglichen Umgebung verbleiben können, während sie für die Verarbeitung, Berichterstellung und Analyse zugänglich sind. Darüber hinaus wird dadurch auch die Angriffsfläche deutlich reduziert und die potenzielle Einhaltung der Datenresidenzgesetze verbessert.
* **Unterstützung der Datenzuordnung**: In den heutigen Multi-Cloud-Umgebungen benötigen Organisationen umfassenden Datenzugriff ohne unnötige Datenverschiebung. Das Verbund-Datenmodell des Data 360-Konnektors unterstützt die dateibasierte und abfragebasierte Datenzuordnung, sodass Unternehmen externe Datenquellen in Echtzeit nutzen können. Unabhängig davon, ob Sie auf strukturierte Datenbanken, halbstrukturierte Protokolle oder unstrukturierte Dateien zugreifen, stellen die Salesforce-Konnektoren sicher, dass die Daten während ihres gesamten Lebenszyklus sicher bleiben.
Salesforce ist bestrebt, seinen Kunden die Transparenz zu bieten, die sie benötigen, um in den komplexen Bereichen Datensicherheit und Compliance zu navigieren, selbst bei unseren Integrationen. Ob in AWS S3, Google Cloud Storage, Snowflake oder andere Plattformen integriert, unsere Data 360-Konnektoren wurden entwickelt, um Trust, Transparenz und Kontrolle über wichtige Geschäftsdaten zu gewährleisten.
##### Salesforce Data 360-Konnektorsicherheit und -Authentifizierungszuordnung
| Konnektortyp | Unterstützung von Verbindungstypen | Primäre Authentifizierungstypen | Wichtige Sicherheitsaspekte und Hinweise |
|---|---|---|---|
| Salesforce CRM | N/A (intern) | Sitzungsbasiert (intern) | Verwendet das zuverlässige interne Identitäts- und Zugriffsverwaltungsmodell (IAM) von Salesforce. Alle Daten werden während der Übertragung und im Leerlauf innerhalb der Salesforce-Infrastruktur verschlüsselt. |
| Marketing Cloud Engagement | Nur öffentliches Internet | OAuth 2.0, Benutzername/Kennwort | Für die sichere Authentifizierung werden OAuth 2.0-Standardprotokolle verwendet. Die Daten werden im öffentlichen Internet verschlüsselt. |
| B2C Commerce | Nur öffentliches Internet | OAuth 2.0 | Standardmäßiger OAuth 2.0-Standard. Verwendet sichere öffentliche Internetprotokolle (TLS) für die Datenübertragung. |
| Web- und mobile Anwendung | Nur öffentliches Internet | API-Schlüssel, OAuth 2.0 | Über APIs aufgenommene Daten (Aufnahme-API, Streaming-API). Die Sicherheit wird über die API-Schlüsselverwaltung und standardmäßige Webprotokolle verwaltet. |
| Amazon S3 | Private Connect & Public | IAM-Rollen, externe Anmeldeinformationen | Unterstützt AWS PrivateLink für eine sichere private Verbindung. Bei der öffentlichen Verbindung werden sichere Anmeldeinformationen verwendet. Die Daten werden während der Übertragung und im Leerlauf verschlüsselt (vom Kunden verwaltete Schlüssel in S3 optional). |
| Snowflake | Private Connect & Public | OAuth 2.0, Authentifizierung mit privatem Schlüssel, Benutzername/Kennwort | Unterstützt die private VPC-Verbindung (AWS PrivateLink). Öffentliche Verbindung mit sicheren Authentifizierungsmethoden verfügbar. Daten können mit Kundenschlüsseln in Snowflake verschlüsselt werden. |
| Amazon Redshift | Private Connect & Public | Benutzername/Kennwort, IAM-Authentifizierung | Unterstützt die private Verbindung (AWS PrivateLink). Für die öffentliche Verbindung werden bewährte Vorgehensweisen für die Standardsicherheit verwendet. |
| Microsoft Azure (Speicher/SQL) | Nur öffentliches Internet | SAS-Token, OAuth 2.0, Benutzername/Kennwort | Verbindungen basieren auf sicheren SAS-Token oder OAuth für die Authentifizierung. Die Daten werden über verschlüsselte Kanäle (TLS) im öffentlichen Internet traversiert. |
| Google Cloud Storage (GCS) | Nur öffentliches Internet | OAuth 2.0, Service-Accounts | Verbindungen basieren auf sicherem OAuth 2.0. Daten werden über verschlüsselte Kanäle (TLS) im öffentlichen Internet traversiert. |
| MuleSoft (API) | Nur öffentliches Internet | OAuth 2.0, API-Schlüssel | Wird über APIs verbunden. Die Sicherheit wird über die standardmäßige API-Authentifizierung und zuverlässige Governance-Richtlinien verwaltet, die über die MuleSoft Anypoint Platform implementiert sind. |
| Phase | Mechanismus | Sicherheits-/Governance-Kontrollen |
|---|---|---|
| Aktivierungskonfiguration | Definiert im Setup der Data 360-Aktivierung | Geschützt durch Anmeldeinformationen mit Namen und externe Anmeldeinformationen |
| Datenvorbereitung | Aus DMOs gefiltert und verbunden | Angewendete Einwilligungs- und Datenschutz-Metadaten |
| Ausgehende Übertragung | Verschlüsselt über TLS / Private Connect | Durchsetzung von Policen und Abstraktion von Anmeldeinformationen |
| Externe Zustellung | SFTP / Cloud-Speicher / API | Zugreifen auf kontrollierte und überprüfbare Zustellungen |
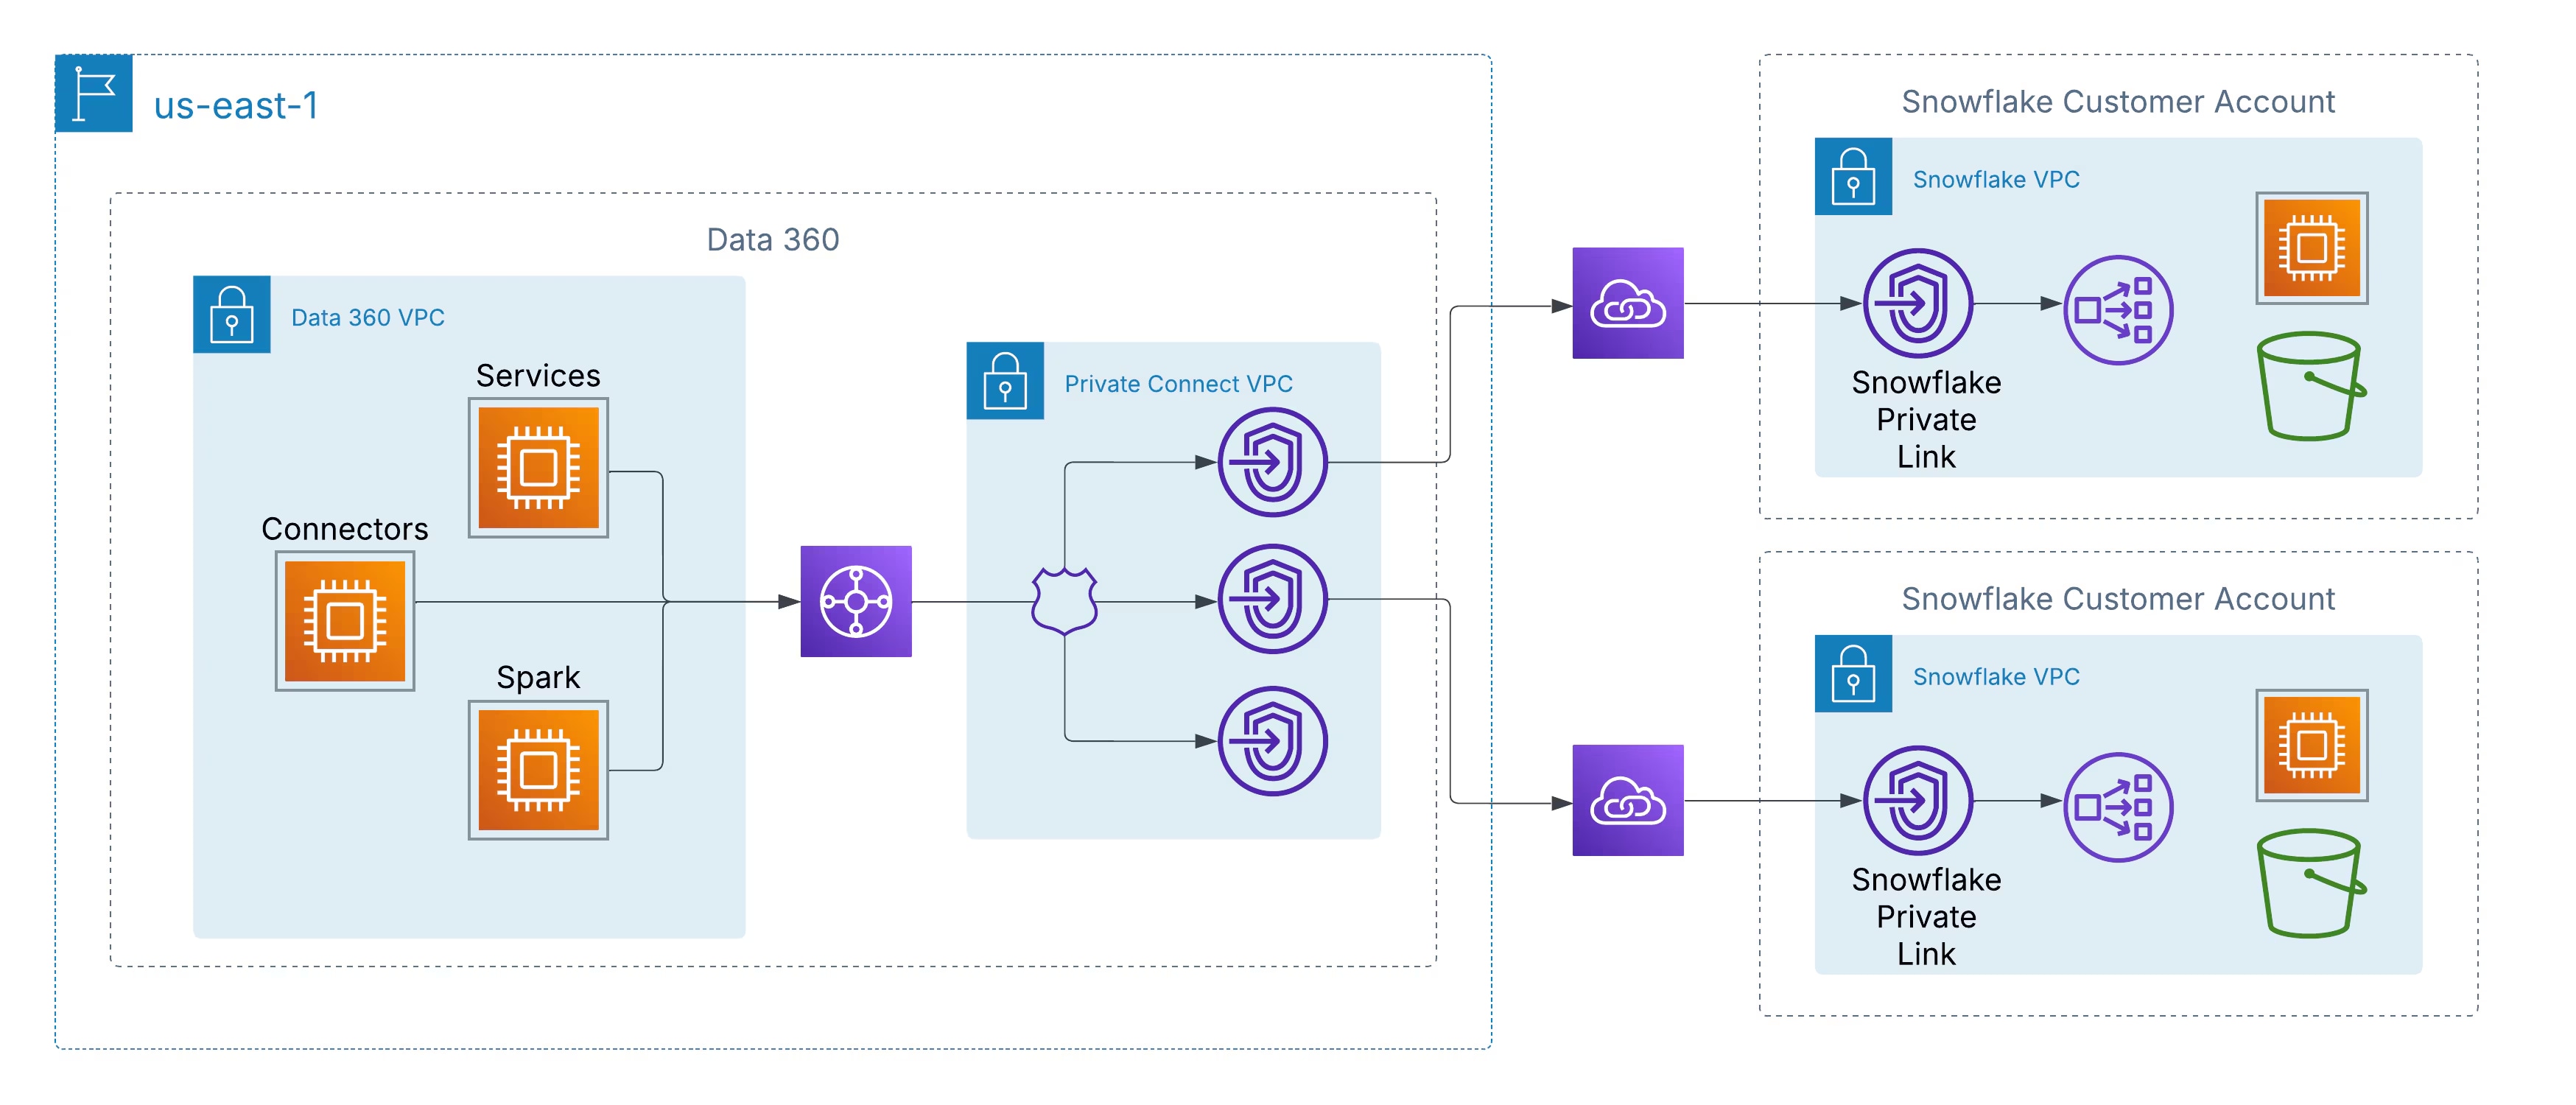 Die gesamte Kommunikation bleibt im AWS-Backbone und verwendet private IP-Adressierung und nicht weiterleitbare Netzwerkpfade, wodurch das Risiko des Abfangens von Daten während der Übertragung vermieden wird und die strengen Sicherheitsanforderungen von Unternehmen und Behörden erfüllt werden.
Diese Architektur gewährleistet Folgendes:
* **Zero Internet Exposure:** Daten verlassen niemals das private AWS-Netzwerk.
* **Private IP-Kommunikation:** Der Datenverkehr bleibt isoliert und extern nicht adressierbar.
* **Compliance-Ausrichtung:** Erfüllt Sicherheitsstandards wie ISO 27001, SOC 2 und FedRAMP.
#### Private Interconnect: Erweitern der Sicherheit über Clouds hinweg
Salesforce erweitert dieselben Sicherheitsprinzipien über AWS hinaus über Private Interconnect, um Kunden zu unterstützen, die in Multi-Cloud-Umgebungen arbeiten. Diese Funktion ermöglicht die cloudübergreifende private Konnektivität zwischen Data 360 und Data Lakes, die in Azure oder Google Cloud gehostet werden, wobei dieselben Garantien für die private Weiterleitung, die Null-Internet-Traversierung und verschlüsselten reinen Backbone-Datenverkehr beibehalten werden.
Es sind zwei Architekturbereitstellungsmodelle verfügbar:
* **Vom Kunden verwaltete Verbindungsleitung:** Kunden integrieren ihre vorhandenen privaten Netzwerkschaltungen wie Azure ExpressRoute, Google Cloud Interconnect oder Equinix Fabric direkt in Data 360 VPCs.
* **Salesforce-Managed Interconnect:** Salesforce stellt den cloudübergreifenden Link bereit und verwaltet ihn. Dadurch werden private Service-Endpunkte in der Ziel-Cloud-Umgebung des Kunden für eine schlüsselfertige Einrichtung zur Verfügung gestellt.
### Schützen der Tore: API-Sicherheitsfunktionen in Salesforce Data 360
Salesforce Data 360, eine leistungsstarke Plattform zum Vereinheitlichen von Unternehmensdaten, wurde mit robusten, mehrschichtigen Sicherheitssteuerungen entwickelt. Für Kunden ist die Verwaltung der API-Sicherheit ein wichtiger Teil einer umfassenden Datenschutzstrategie, mit der sie den Zugriff steuern, Integrationen verwalten und die Nutzung effektiv überwachen können.
Im Folgenden finden Sie die wichtigsten Funktionen und Funktionen, die Kunden zum Einrichten, Steuern und Verwalten der API-Sicherheit in Salesforce Data 360 zur Verfügung stehen.
#### Wichtige API-Sicherheitsfunktionen
Kunden können mehrere integrierte Salesforce-Funktionen nutzen, um den sicheren API-Zugriff auf ihre Data 360-Instanzen zu gewährleisten:
##### 1\. Robuste Authentifizierung und Autorisierung (OAuth 2.0)
Salesforce schreibt eine strenge Authentifizierung für seine Data 360-APIs vor, wobei OAuth 2.0 das Standardprotokoll und das empfohlene Protokoll ist.
* **Verbundene Anwendungen**: Kunden erstellen und konfigurieren verbundene Anwendungen, um den Zugriff auf externe Anwendungen zu verwalten. Dies ist der primäre Mechanismus zum Authentifizieren und Gewähren von Zugriff auf die Data 360-Aufnahme- und Abfrage-APIs.
* **OAuth-Geltungsbereiche**: Administratoren können bestimmte OAuth-Geltungsbereiche definieren (z. B. cdp_ingest_api, api), um die mindestens erforderlichen Berechtigungen anzufordern und dabei das Prinzip der geringsten Berechtigung zu beachten.
* **Multi-Faktor-Authentifizierung (MFA)**: Salesforce Authenticator und andere MFA-Lösungen können erzwungen werden. Dadurch wird eine wichtige Sicherheitsebene hinzugefügt und sichergestellt, dass nur überprüfte Benutzer auf das System zugreifen können, auch über API-Anmeldungen.
##### 2\. Granulare Zugriffssteuerung und Berechtigungen
Kunden können genau steuern, welche Benutzer und Anwendungen auf Daten zugreifen und welche Aktionen sie ausführen können.
* **API-Zugriffssteuerung (Funktion)**: Nach der Aktivierung durch den Salesforce-Support können Administratoren mit dieser Funktion explizit genehmigen, welche verbundenen Anwendungen für den Zugriff auf die APIs verwendet werden können. Alle nicht genehmigten Anwendungen werden automatisch blockiert, wodurch das Risiko einer nicht autorisierten Datenextraktion erheblich reduziert wird.
* **Berechtigungssätze und Profile**: Administratoren verwalten den API-Zugriff, indem sie die Berechtigung "API aktiviert" über Benutzerprofile oder dedizierte Berechtigungssätze zuweisen. Dadurch wird sichergestellt, dass Benutzer nur über Zugriff verfügen, der für ihre Auftragsfunktionen relevant ist.
* **Rollenbasierte Zugriffssteuerung**: In Data 360 können Kunden Richtlinien für die rollenbasierte Zugriffssteuerung erstellen und verwalten, um Datenzugriffsebenen (Objekt-, Feld- und Datensatzebenensicherheit) zu definieren und so Konsistenz und Kontrolle über die gesamte Plattform zu gewährleisten.
* **Spezialisierte Integrationsbenutzer**: Bewährte Vorgehensweisen empfehlen, bestimmte "Nur API"-Benutzer für Integrationen zu erstellen und ihre Berechtigungen auf das zu beschränken, was für den API-Aufruf erforderlich ist, statt einen Systemadministratoraccount zu verwenden.
##### 3\. Netzwerksicherheitssteuerungen
* **IP-Positivierungslisten/Anmelde-IP-Bereiche**: Kunden können den API-Zugriff auf einen definierten Bereich vertrauenswürdiger IP-Adressen einschränken. Anmeldeversuche aus einem nicht genehmigten IP-Bereich können abgelehnt oder zur Überprüfung angefochten werden.
* **Private Connect**: Diese auf AWS PrivateLink basierende Funktion ermöglicht es Administratoren, sensible Daten zu verwalten, ohne Endpunkte dem öffentlichen Internet zugänglich zu machen, wodurch das Risiko von Angriffen auf öffentlich sichtbare Endpunkte eliminiert wird.
* **Verschlüsselung im Transit und im Leerlauf**: Alle Daten werden während der Übertragung (mit TLS) und im Leerlauf verschlüsselt und schützen sensible Informationen vor unbefugtem Zugriff, selbst wenn sie abgefangen werden.
##### 4\. Monitoring, Auditing und Governance
Sichtbarkeit ist der Schlüssel zur Sicherheit. Salesforce bietet umfangreiche Tools zum Überwachen und Überprüfen der API-Aktivität.
* **Ereignisüberwachung**: Bietet nahezu in Echtzeit Verfolgung verschiedener Ereignisse, einschließlich API-Aufrufen und Anmeldeversuchen. Kunden können diese Daten zur Überprüfung und zum Erstellen von Transaktionssicherheitsrichtlinien verwenden.
* **Sicherheitscenter**: Diese Funktion bietet eine einheitliche, konsolidierte Ansicht der Kennzahlen für den Sicherheitsstatus, die Compliance und die Unternehmensführung in allen Salesforce-Organisationen und vereinfacht so die Überwachung und Verwaltung.
* **Feld-Aktivierungsprotokoll**: Hilft Kunden, den Anmelde- und Feldverlauf zu verfolgen, Setup-Änderungen zu überwachen und die Überwachungs- und Datenaufbewahrungs-Compliance-Verpflichtungen zu erfüllen.
* **Datenverwaltungsfunktionen**: Enthält Daten-Tagging und -Klassifizierung, Richtlinienerzwingung und dynamische Datenmaskierung, um sicherzustellen, dass konsistente Governance-Richtlinien auf alle Datenkontaktpunkte angewendet werden, einschließlich derjenigen, auf die über APIs zugegriffen wird.
#### Einrichten und Verwalten der API-Sicherheit: Eine Kunden-Journey
1. Aktivieren der zentralen Steuerelemente: Aktivieren Sie zunächst organisationsweite Standardeinstellungen wie MFA- und IP-Einschränkungen.
2. API-Zugriffssteuerung anfordern: Protokollieren Sie einen Kundenvorgang beim Salesforce-Support, um die Funktion "API-Zugriffssteuerung" in Ihrer Organisation zu aktivieren.
3. Konfigurieren verbundener Anwendungen: Erstellen Sie für jede Integration spezifische verbundene Anwendungen, definieren Sie die erforderlichen OAuth-Geltungsbereiche und weisen Sie sie autorisierten Profilen/Berechtigungssätzen zu.
4. Implementieren der geringsten Berechtigung: Stellen Sie sicher, dass alle Integrationsbenutzer über "Nur API"-Berechtigungen und minimalen Datenzugriff verfügen.
5. Überwachen und Überprüfen: Verwenden Sie das Ereignisüberwachungs- und Sicherheits-Center regelmäßig, um die API-Nutzung zu überprüfen, Anomalien zu erkennen und Schwachstellenbewertungen durchzuführen.
6. Bewährte Vorgehensweisen erzwingen: Erzwingen Sie immer TLS, speichern Sie Aktualisierungstoken sicher, rotieren Sie Sitzungs-IDs und validieren Sie Dateneingaben.
Durch die Nutzung dieser robusten, vom Kunden konfigurierbaren Funktionen können Unternehmen eine sichere und kompatible Umgebung für alle API-Interaktionen in Salesforce Data 360 aufrechterhalten.
### Compliance, Auditing und kontinuierliche Überwachung
#### Serviceverfügbarkeit und Datenresidenz
Salesforce Data 360 wurde entwickelt, um die globalen Anforderungen an die Datenresidenz und die Souveränität durch sein geografisch verteiltes Bereitstellungsmodell zu erfüllen. Der Service ist derzeit in mehreren regulierten Regionen verfügbar, einschließlich der USA, Kanada, Brasilien, Deutschland, Indien, Australien und Japan.
Die Datenresidenz wird bestimmt, indem die Core Org-Instanz jedes Kunden der nächstgelegenen entsprechenden Data 360-Regionsinstanz zugeordnet wird. Beispielsweise werden Kernorganisationen in den USA oder Kanada mit einer Data 360-Instanz in der Region "USA" verknüpft, während Kernorganisationen in der Europäischen Union einer Instanz zugeordnet werden, die in Deutschland gehostet wird. Ebenso sind Kernorganisationen in Indien, Australien, Neuseeland oder Singapur einer Data 360-Instanz zugeordnet, die in Indien gehostet wird.
Die Hyperforce-Infrastruktur von Salesforce bildet die Grundlage für die Kontrolle geografischer Daten, die Sicherheitsisolation und die Einhaltung gesetzlicher Vorschriften. Hyperforce stellt sicher, dass Kundendaten, einschließlich Metadaten, Sicherungen und abgeleiteter Datensets, innerhalb definierter regionaler Grenzen bleiben. Diese Architektur ermöglicht es Unternehmen, lokale Datenresidenz- und Compliance-Mandate wie DSGVO, FFIEC, HIPAA und regionale Datenschutzgesetze in APAC und EMEA zu erfüllen.
Salesforce erweitert die Verfügbarkeit von Data 360 weiterhin auf zusätzliche Hyperforce Regionen, um sie an die sich wandelnden globalen Datenschutzstandards, die regionalen Compliance-Anforderungen und die Erwartungen der Kunden an die souveräne Datenkontrolle anzupassen.
#### Aktivierung der Einhaltung gesetzlicher Vorschriften
Salesforce Data 360 wurde entwickelt, um Unternehmen dabei zu unterstützen, strenge globale Datenschutz- und behördliche Anforderungen wie DSGVO und CCPA zu erfüllen. Die Plattform bietet native Funktionen zum Verwalten der Rechte betroffener Personen, einschließlich Datenzugriff, Export und Löschung ("Recht auf Vergessenwerden"), um den konformen Umgang mit personenbezogenen Daten während ihres gesamten Lebenszyklus sicherzustellen.
Während der Kunde die ultimative Verantwortung für die Compliance behält, fungiert Salesforce als zertifizierter „Serviceanbieter“ gemäß Vorschriften wie der CCPA und stellt die Kontrollen, Sicherheitszusicherungen und vertraglichen Mechanismen auf Plattformebene bereit, mit denen Organisationen ihre Compliance-Frameworks effizient und skalierbar implementieren können.
#### Foundational Trust: Zertifizierungen und Bescheinigungen
Trust ist der Eckpfeiler der Salesforce-Plattform und wird durch unabhängige Validierung erworben. Salesforce verfügt über ein breites Portfolio an globalen Sicherheitszertifizierungen und -zertifikaten, die sein anhaltendes Engagement für den Schutz von Kundendaten und die Einhaltung der höchsten Standards für die Cloud-Sicherheit belegen.
Bei diesen Zertifizierungen handelt es sich nicht nur um Kontrollkästchen, sie stellen strenge, wiederkehrende Prüfungen dar, die die Stärke und Konsistenz der Sicherheitskontrollen, Prozesse und Infrastruktur von Salesforce überprüfen. Zusammen bilden sie das Rückgrat des grundlegenden Trust Modells von Salesforce.
**Wichtige Zertifizierungen und Bescheinigungen:**
* **ISO/IEC 27001:** Validiert das umfassende Informationssicherheitsmanagementsystem von Salesforce.
* **ISO/IEC 27017:** Legt bewährte Vorgehensweisen für Cloud-spezifische Sicherheitssteuerungen fest.
* **ISO/IEC 27018:** Konzentriert sich auf den Schutz personenbezogener Daten in der Cloud.
* **SOC 1, SOC 2 und SOC 3:** Unabhängige Berichte, die das Design und die betriebliche Effektivität der Sicherheits- und Datenschutzkontrollen von Salesforce bestätigen.
* **PCI DSS:** Gewährleistet die sichere Verarbeitung und Speicherung von Zahlungskarteninformationen.
* **FedRAMP High & DoD Impact Level 4:** Zertifiziert Salesforce Government Cloud für die Verwendung durch US-Bundesbehörden, die sensible Arbeitslasten verwalten.
Durch die Beibehaltung dieses umfassenden Satzes an Zertifizierungen gibt Salesforce Kunden die Gewissheit, dass ihre Daten auf einer Plattform verwaltet werden, die die globalen Compliance- und Sicherheitserwartungen erfüllt und oft übertrifft.
### Maximieren der Sichtbarkeit: Protokollierung, Überwachung und Beobachtbarkeit in Salesforce Data 360
In der heutigen, schnelllebigen digitalen Landschaft ist es wichtig, dass Sie einen umfassenden Überblick über Ihre Kundendaten haben. Ebenso wichtig ist jedoch, dass Sie einen umfassenden Überblick über die Plattform haben, die diese Daten verwaltet. Salesforce Data 360 bietet zuverlässige, integrierte Protokollierungs-, Überwachungs- und Beobachtbarkeitsfunktionen, mit denen Kunden Datenqualität, Sicherheit und Leistung gewährleisten können.
Mit diesen Tools können Sie von der reaktiven Problemlösung zur proaktiven Verwaltung wechseln und sicherstellen, dass Ihre Data 360-Implementierung reibungslos und effizient ausgeführt wird.
#### Proaktive Bedrohungserkennung und -reaktion
Sicherheit endet nicht mit Prävention, sondern mit Wachsamkeit. In einer sich ständig verändernden Bedrohungslandschaft kombiniert Salesforce erweiterte Plattformüberwachungsfunktionen mit vom Kunden verwalteten Überprüfungsprozessen, um einen proaktiven, kontinuierlichen Schutz zu gewährleisten.
Salesforce bietet leistungsstarke native Tools für die Sichtbarkeit und Bedrohungserkennung:
* Das **Setup-Aktivierungsprotokoll** erfasst einen vollständigen Verlauf der administrativen Änderungen und hilft Teams, Konfigurations- oder Richtlinienaktualisierungen zu verfolgen.
* Die **Ereignisüberwachung** bietet detaillierte Einblicke in das Benutzerverhalten, die API-Aktivität und die Datenzugriffsmuster. Diese Telemetrie kann nahtlos in eine Lösung für die **Sicherheitsinformations- und Ereignisverwaltung (SIEM)** integriert werden, um eine zentralisierte Analyse und Korrelation zu ermöglichen.
#### 1\. Ereignisüberwachung: Der Puls Ihrer Organisation
Die zum Salesforce Shield-Angebot gehörende Ereignisüberwachung ist das zentrale Zentrum für die Verfolgung detaillierter Benutzeraktivitäts- und Systemleistungsdaten in Ihrer Salesforce-Organisation, einschließlich Data 360-spezifischer Aktionen. Es erfasst eine Vielzahl von "Ereignissen" in Protokolldateien und Objekten für Ihre Analyse.
* **Ereignisprotokolldateien (ELFs):** Diese enthalten detaillierte Details zu Benutzeraktivitäten und Systemereignissen, die nach einer kurzen Verzögerung (stündlich oder täglich) heruntergeladen werden können. Sie können über die API oder den Browser "Ereignisprotokolldatei" auf Daten von bis zu 30 Tagen zugreifen und sie für eine längere Speicherung exportieren.
* **Echtzeit-Ereignisüberwachung:** Für sofortige Statistiken werden Echtzeitereignisse als Plattformereignisse gestreamt, sodass Sie Aktivitäten nahezu in Echtzeit überwachen und erkennen können. Dies ist wichtig für Sicherheit und Leistung, sodass Sie bei Bedarf sofort Maßnahmen ergreifen können.
* **Bestimmte Data 360-Ereignisse:** Die Ereignisüberwachung umfasst Ereignistypen, die speziell auf die Data 360-Nutzung zugeschnitten sind, beispielsweise Lightning Page View (Lightning-Seitenansicht), Lightning Interaction (Lightning-Interaktion) und Report Event (Berichtsereignis), die sich auf Data 360-Seiten und -Daten beziehen.
* **Integration mit externen Tools:** Salesforce ermöglicht die nahtlose Integration in beliebte Drittanbieter-Überwachungslösungen wie Splunk, Datadog, New Relic und Sumo Logic. Sie können Ereignisüberwachungsdaten auf diese Plattformen streamen oder exportieren, um die konsolidierte Beobachtbarkeit in Ihrem gesamten Technologiestapel zu gewährleisten.
#### 2\. Leistungsüberwachung und -optimierung
Ein besseres Verständnis der Leistung Ihrer Data 360-Implementierung ist der Schlüssel zu einer großartigen Benutzererfahrung.
* **Lightning-Nutzungsanwendung:** Diese integrierte Anwendung bietet eine aggregierte Ansicht der Leistungskennzahlen für Data 360-Seiten in Lightning Experience, beispielsweise Seitenladezeiten (Experienced Page Time, EPT) und Browserleistung.
* **Benutzerdefinierte Berichte und Dashboards:** Sie können benutzerdefinierte Berichte und Dashboards mithilfe von Data 360-Objekten und Ereignisüberwachungsdaten erstellen, einschließlich der kostenlosen CRM Analytics-Anwendung mit Vorlagen namens "Ereignisüberwachung Plus". Mithilfe dieser Visualisierungen können Sie Trends erkennen und Leistungsengpässe schnell identifizieren.
Doch Technologie allein reicht nicht aus. Wahre Widerstandsfähigkeit erfordert eine disziplinierte Partnerschaft zwischen automatisierter Erkennung und menschlicher Überprüfung. Automatisierte Benachrichtigungen können Anomalien in Echtzeit aufdecken, aber subtile oder langfristige Bedrohungen wie langsame, nicht autorisierte Datenexfiltration durch einen gültigen Benutzer werden oft am besten durch regelmäßige Prüfungen und Trendanalysen identifiziert.
Salesforce stellt die Telemetrie, die Überwachungsprotokolle und die Integrations-Hooks bereit. Kunden verfügen über die nötige Prozessgenauigkeit, den Betriebsrhythmus und die kontextspezifische Intelligenz. Zusammen bilden sie ein **Verteidigungsmodell**, das Automatisierung, Analysen und menschliche Aufsicht miteinander verbindet, um Bedrohungen zu erkennen, zu untersuchen und darauf zu reagieren, bevor sie zu Vorfällen werden.
### Fahren von fundierten Entscheidungen: Berichte, Dashboards, Kennzahlen und Benachrichtigungen in Salesforce Data 360
Bei Salesforce Data 360 geht es nicht nur darum, Ihre Kundendaten zu vereinheitlichen, sondern darum, diese Daten intelligent und handlungsrelevant zu gestalten. Ein zentraler Bestandteil dieses Wertversprechens besteht in der Bereitstellung zuverlässiger Berichte, leistungsstarker Dashboards, aussagekräftiger Kennzahlen und Echtzeit-Benachrichtigungsfunktionen. Mit diesen Tools können Kunden den Datenstatus überwachen, die Leistung verfolgen und Aktionen auf der Grundlage vereinheitlichter Daten automatisieren – und das alles in der vertrauten Salesforce-Umgebung.
#### Berichte und Dashboards: Ihr Datenvisualisierungszentrum
Die nativen Berichterstellungs- und Dashboard-Funktionen von Salesforce lassen sich nahtlos in Data 360 integrieren, sodass Sie Ihre zusammengeführten Daten visualisieren und analysieren können, ohne die Plattform verlassen zu müssen.
#### Erstellen von Berichten zu zusammengeführten Daten
Sie können standardmäßige und benutzerdefinierte Berichte zu in Data 360 gespeicherten Daten erstellen, einschließlich zusammengeführter Daten aus verschiedenen Quellen und berechneter Statistiken.
* **Standardmäßige und benutzerdefinierte Berichtstypen:** Data 360 führt neue Berichtstypen speziell für Data 360-Objekte wie Datenströme, Segmente, Aktivierungen, Identitätsbestimmung und berechnete Statistiken ein. Dadurch können Sie Ihre zusammengeführten Daten mit standardmäßigen Salesforce-Berichtsgeneratoren abfragen.
* **Granularanalyse:** Berichte unterstützen bis zu 10 Zeilengruppierungen, was eine genauere Segmentierung und detaillierte Analyse von Kundenattributen und Trends ermöglicht.
* **Formeln und Zusammenfassungen:** Sie können Formeln auf Zeilenebene und Zusammenfassungsformeln verwenden, um jeden Datensatz oder jede Gruppe von Datensätzen auszuwerten. Auf diese Weise können Sie detaillierte Kennzahlen und allgemeine Aggregatzusammenfassungen in einem einzelnen Bericht verfolgen.
#### Dynamische Dashboards für ganzheitliche Ansichten
Dashboards bieten eine visuelle Darstellung wichtiger Kennzahlen und Trends in Ihrer Data 360-Implementierung.
* **Zusammengeführte Ansicht:** Kombinieren Sie Daten aus mehreren Data 360-Berichten oder kombinieren Sie Data 360-Berichte sogar mit CRM-Standardberichten in einem einzigen Dashboard, um eine ganzheitliche Ansicht Ihrer Vorgänge und Kundenstatistiken zu erhalten.
* **Anpassbare Widgets:** Verwenden Sie verschiedene Diagrammtypen (Balken, Linien, Kreise, Messdiagramme usw.) und Tabellen, um Berichtsdaten effektiv anzuzeigen.
* **Echtzeitstatistiken:** Dashboards können aktualisiert werden, um aktuelle Informationen bereitzustellen und so eine schnelle, datengestützte Entscheidungsfindung zu ermöglichen.
#### Kennzahlen und KPIs: Messen des Erfolgs
Mit Data 360 können Sie wichtige Leistungsindikatoren (KPIs) definieren und verfolgen, die für Ihre Geschäftsziele relevant sind. Diese können generiert werden durch:
* **Berechnete Statistiken:** Erstellen Sie leistungsstarke Kennzahlen mithilfe von Daten, die in Batches mit hohem Volumen verarbeitet werden. Berechnen Sie beispielsweise Kennzahlen wie "Average Customer Lifetime Value" (Durchschnittlicher Kundenlebenszeitwert) oder "Total Active Contract Revenue" (Aktiver Vertragsumsatz insgesamt) und verwenden Sie diese als Dimensionen oder Maßeinheiten in Ihren Berichten und Dashboards.
* **Streaming-Statistiken:** Verarbeiten Sie Daten aus Streaming-Quellen nahezu in Echtzeit, um Zeitreihenaggregationen wie Website- oder mobile Interaktionsdaten zu erstellen. Diese Kennzahlen können sofortige Orchestrierungen und Datenaktionen steuern.
#### Benachrichtigungen und Warnungen: Bleiben Sie informiert und proaktiv
Salesforce bietet leistungsstarke Automatisierungs- und Benachrichtigungsfunktionen, um sicherzustellen, dass Sie über wichtige Ereignisse oder Datenänderungen in Data 360 informiert sind.
* **Flow-basierte Benachrichtigungen:** Sie können Prozess-Flows so einrichten, dass Aktionen ausgelöst und Benachrichtigungen basierend auf Ereignissen in Data 360-Objekten wie Datenströmen, Segmenten und Aktivierungen gesendet werden.
* **Benutzerdefinierte Warnungen:** Erstellen Sie benutzerdefinierte Benachrichtigungen, die eine E-Mail auslösen oder in der Salesforce-Benachrichtigungsglocke angezeigt werden, wenn bestimmte Bedingungen erfüllt sind. Beispielsweise können Sie eine Benachrichtigung erhalten, wenn ein Datenstrom fehlschlägt, eine Identitätsbestimmungsregel einen Fehler feststellt oder eine Schlüsselkennzahl einen bestimmten Schwellenwert überschreitet.
* **Ereignisbenachrichtigungsservice (ENS):** Für Entwickler ermöglicht der API-First Event Notification Service es externen Systemen, Benachrichtigungen zu empfangen, wenn bestimmte Ereignisse auftreten, was eine nahtlose Integration und Echtzeitreaktionen in Ihren gesamten Technikstapel ermöglicht.
* **Datenaktionen:** Basierend auf Streaming-Statistiken können Sie Datenaktionen auslösen, die so konfiguriert werden können, dass Benachrichtigungen gesendet, Plattformereignisse aufgerufen oder über Webhooks in andere SaaS-Anwendungen integriert werden.
Durch die Nutzung dieser umfassenden Funktionen können Salesforce Data 360-Kunden ihr Datenökosystem effektiv überwachen, wichtige Kennzahlen visualisieren und zeitnahe Benachrichtigungen erhalten, um das proaktive Engagement und die betriebliche Exzellenz zu steigern.
### Strategische Empfehlungen für die Unternehmensakzeptanz
Die Einführung von Salesforce Data 360 im Unternehmensmaßstab erfordert mehr als die technische Aktivierung – sie erfordert eine bewusste Architektur an erster Stelle der Sicherheit. Die folgenden strategischen Empfehlungen bieten CTOs und Unternehmensarchitekten eine Roadmap, mit der sie Trust, Resilienz und Compliance auf jeder Ebene ihrer Data 360-Bereitstellung aufbauen können.
* **Implementieren eines "Secure-by-Design"-Ansatzes:** Sicherheit sollte nicht nachgerüstet werden – sie sollte grundlegend sein. Beginnen Sie mit der Salesforce-Standardrichtlinie *"Alle verweigern"* und erteilen Sie explizit Zugriff nach Bedarf. Definieren Sie Governance, Richtlinien und Zugriffs-Frameworks, bevor Sie Daten aufnehmen oder aktivieren. Die Gebäudesicherheit vom ersten Tag an eliminiert das Risiko versteckter Offenlegungen und vereinfacht die langfristige Einhaltung.
* **Erzwingen einer robusten Identitäts- und Zugriffsverwaltungsstrategie:** Zentralisieren Sie die Identität über Verbund-SSO und erzwingen Sie die Multi-Faktor-Authentifizierung (MFA), um Kompromisse bei Anmeldeinformationen zu vermeiden. Schränken Sie den Zugriff nach Anmelde-IP-Bereichen ein und verwenden Sie die Identitätsanbieterfunktionen von Salesforce, um eine durchgängige Verantwortlichkeit zwischen Benutzern und Integrationen herzustellen. Eine vereinheitlichte IAM-Ebene reduziert die betriebliche Komplexität und härtet Ihre Authentifizierungsoberfläche.
* **Anwendung des Prinzips der geringsten Berechtigung:** Gestalten Sie Rollen für Präzision, nicht für Komfort. Verwenden Sie die Salesforce-Standardberechtigungssätze als Grundlage für die Aufgabentrennung und stellen Sie sicher, dass Benutzer nur auf das Notwendige zugreifen können. Vermeiden Sie eine Überanpassung der Berechtigungen – jede Abweichung erhöht den Wartungsaufwand und das Risiko eines unbeabsichtigten Zugriffs.
* **Einrichten eines mehrschichtigen Data Governance-Frameworks:** Trennen Sie Daten mithilfe von Datenbereichen nach Geschäftseinheit oder Marke und erzwingen Sie die attributbasierte Zugriffssteuerung mit Objekt-, Feld- und Datensatzebenensicherheit (OLS, FLS, RLS). Verwenden Sie die dynamische Datenmaskierung, um sensible Informationen in Echtzeit zu schützen, ohne die Analyse oder die Benutzerfreundlichkeit zu beeinträchtigen. Dieses mehrschichtige Modell stellt sicher, dass die Verwaltung konsistent bleibt, da Daten domänenübergreifend skaliert werden.
* **Strategische Nutzung von Verschlüsselung und sicheren Integrationen:** Stellen Sie bei sensiblen Arbeitslasten die Plattformverschlüsselung mit vom Kunden verwalteten Schlüsseln bereit, um die Souveränität über Ihren Verschlüsselungslebenszyklus beizubehalten. Verwenden Sie Anmeldeinformationen mit Namen und Private Connect, um alle System-zu-System-Integrationen zu schützen. Dadurch werden hartcodierte Geheimnisse eliminiert und der gesamte Datenverkehr bleibt privat, konform und überprüfbar.
* **Build a Continuous Security Operations Program (Programm für fortlaufende Sicherheitsvorgänge):** Sicherheit endet nicht bei der Konfiguration, sie lebt von betrieblicher Disziplin. Ergänzen Sie die automatisierte Überwachung durch regelmäßige Überprüfungen von Ereignisprotokollen und Zugriffsprotokollen. Richten Sie eine dedizierte Funktion für Sicherheitsvorgänge (Security Operations, SecOps) ein, um Anomalien zu identifizieren, Bedrohungen zu untersuchen und die Einhaltung zu validieren. Das Ziel: Erkennen Sie frühzeitig, reagieren Sie schnell und verbessern Sie kontinuierlich die Haltung.
### Pfad vorwärts: Erstellen von zuverlässigen vertrauenswürdigen Daten 360
Der Weg zu einem sicheren und intelligenten Unternehmen endet nicht mit der Bereitstellung, sondern mit Disziplin, Design und Trust. Salesforce Data 360 bietet die architektonische Grundlage, aber der wahre Wert kommt zum Tragen, wenn Organisationen Sicherheit, Governance und Intelligenz als eine einheitliche Bewegung operationalisieren.
Unternehmen sollten Data 360 nicht als eine andere Datenplattform betrachten, sondern als eine sichere, zusammengesetzte Trust Layer, die Daten, KI und Kundenengagement in einem einzigen Governance-Framework verbindet. Durch die Übernahme einer Philosophie *des sicheren Designs*, der Erzwingung der geringsten Berechtigungen auf jeder Ebene und der Ausweitung der privaten Konnektivität auf alle Datenflüsse wandeln Organisationen die Compliance von einem Kontrollkästchen in einen Wettbewerbsvorteil um.
Der nächste Schritt ist die kontinuierliche Modernisierung – die Integration der Überprüfungsautomatisierung, der Richtlinienerzwingung und der Verschlüsselungslebenszyklus-Verwaltung in den täglichen Betrieb. Während Unternehmen sich zu agentenbasierten, AI-gestützten Architekturen entwickeln, werden dieselben Prinzipien, die heute Daten schützen, morgen das Rückgrat der AI-Governance bilden. So wird sichergestellt, dass jedes Modell, jeder Agent und jede Entscheidung erklärbar, richtlinienbewusst und konform ist.
Trust wird schließlich zur neuen Währung der digitalen Transformation. Mit Salesforce Data 360 können Unternehmen ihr Datenökosystem sicher skalieren – mit der Gewissheit, dass jedes Byte, jede Verbindung und jede Statistik integritätsgesichert, gesteuert und aktiviert ist.
## Über die Autoren
**Krishna Chalamasandra** ist eine erfahrene Cybersicherheitsexpertin mit mehr als 25 Jahren Erfahrung in den Bereichen Informationssicherheit und Compliance. Bei Salesforce fungiert er als vertrauenswürdiger Berater für Kunden und ist ein wichtiger Leiter der Funktion "Security and Compliance Customer Trust" innerhalb der CISO-Organisation. Zuvor war Krishna 10 Jahre bei Cisco als Leiter der Sicherheitsarchitektur für IAM, Netzwerksicherheit und PKI tätig und hat wichtige Zertifizierungen wie ISO 27001, SOC 1–3, PCI, FedRAMP und FIPS 140-2 vorangetrieben. Außerdem war er über 8 Jahre bei Novell tätig, um Kontrollen auf Infrastrukturebene zu implementieren und komplexe Sicherheitsüberprüfungen für globale, regulierte Kunden zu unterstützen.
**Yugandhar Bora** ist Software-Entwickler bei Salesforce und spezialisiert sich auf die Datenarchitektur innerhalb der Plattform "Data & Intelligence Applications". Er leitet Initiativen des Enterprise Architecture Review Board (EARB), die sich auf die Datenverwaltung und vereinheitlichte Datenmodelle konzentrieren, und trägt gleichzeitig zu automatisierten Plattformbereitstellungslösungen bei.
## Übersicht
Die meisten Unternehmensintegrations-Pipelines zwischen Salesforce und externen Analyseplattformen basieren auf benutzerdefiniertem Code. Sie funktionieren, bis etwas kaputt geht. Schemaabweichungen, API-Erschöpfung und Lücken beim endgültigen Löschen erfordern ständige technische Eingriffe. Da Unternehmen auf agile, bürgerentwicklerfähige Architekturen umsteigen, wird dieses Modell zu einem Engpass: Analytics-Teams warten in Engineering-Sprints darauf, einem nachgelagerten Schema ein Salesforce-Feld hinzuzufügen, fehlgeschlagene nächtliche Ladevorgänge verzögern die Berichterstellung am Montagmorgen und einfache Konfigurationsänderungen erfordern Codeüberprüfungen und Bereitstellungen.
CRM Analytics, die native Salesforce Analytics- und Business Intelligence-Plattform, löst dieses Problem, indem Unternehmen Daten erkunden, interaktive Dashboards erstellen und AI-gestützte Statistiken aufdecken können, ohne das Salesforce-Ökosystem zu verlassen. Zentral für diese Funktion ist eine deklarative Low-Code-Datensynchronisierungsfunktion, die nativ in die Plattform integriert ist: CRM Analytics SyncOut und CRM Analytics SyncIn.
CRM Analytics SyncOut verschiebt Salesforce-Datensätze nach einem konfigurierten Zeitplan in externe Datenspeicher. Verwenden Sie dazu die Datenerfassung (CDC) für inkrementelle Ladevorgänge und die integrierte Verfolgung der endgültigen Löschung, um dauerhaft entfernte Datensätze zu kennzeichnen. CRM Analytics SyncIn integriert externe Daten wieder in Salesforce, ordnet Objektfeldern Spalten zu und aktualisiert Datensätze mithilfe der Bulk-API 2.0\. Beide werden vollständig über das Salesforce-Setup konfiguriert. Keine Pipelines, keine Staging-Skripts, keine benutzerdefinierte Überwachung. Administratoren konfigurieren einen Synchronisierungsauftrag in einer einzelnen Setup-Sitzung. Die Plattform übernimmt die Ausführung, Wiederholung, Fehlerprotokollierung und Schemazuordnung automatisch.
In dieser Anleitung wird das Muster erläutert, wann es verwendet werden soll, wie es mit Snowflake als einem bearbeiteten Beispiel implementiert werden kann und welche architektonischen Überlegungen darüber entscheiden, ob es zu einem bestimmten Integrationsproblem passt.
## Produkte im Umfang
 |
CRM Analytics ist die native Salesforce Analytics- und Business Intelligence-Plattform, mit der Benutzer Daten erkunden, interaktive Dashboards erstellen und AI-gestützte Statistiken aufdecken können – und das alles im Salesforce-Ökosystem. Diese Plattform überträgt Daten zwischen Salesforce und externen Systemen durch zwei wichtige Funktionen: CRM Analytics SyncOut und CRM Analytics SyncIn. CRM Analytics SyncOut überträgt Salesforce-Objektdaten an eine externe Datenplattform und unterstützt den vollständigen und inkrementellen Synchronisierungsmodus (CDC) mit integrierter Verfolgung der endgültigen Löschung. CRM Analytics SyncIn vervollständigt die bidirektionale Schleife, indem Daten von einer externen Plattform mithilfe der Bulk-API 2.0 wieder in Salesforce-Objekte abgerufen werden, um sicherzustellen, dass große Datenmengen zuverlässig und effizient verarbeitet werden. |
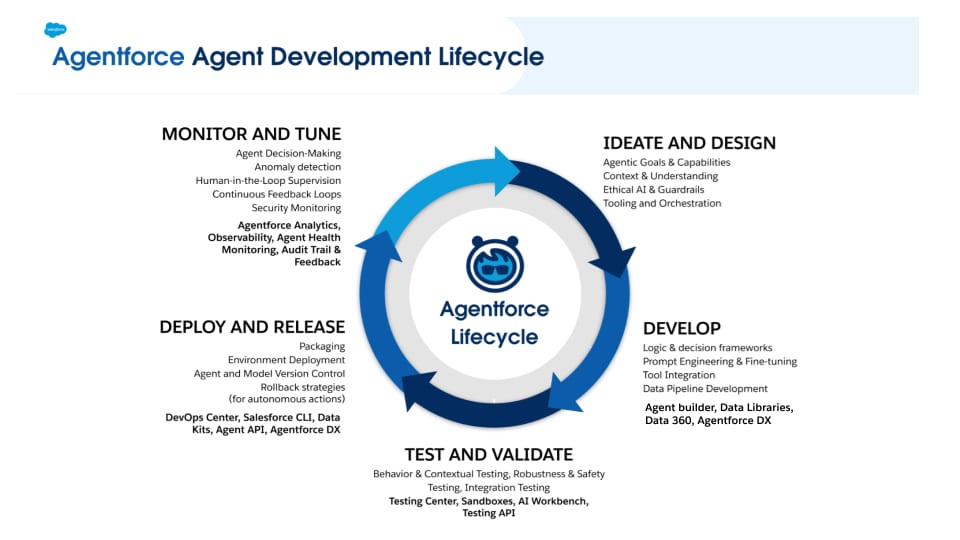 In diesem Kapitel wird gezeigt, wie Agentforce jede Phase des ADLC unterstützt**.**
#### Phase 1: Idee und Design
##### Idee
Die Ideenphase ist die grundlegende Phase des ADLC, in der die anfängliche Vision und die Anforderungen an Agenten formuliert werden. Es beinhaltet einen tiefen Einblick in das Problem, das Identifizieren potenzieller Lösungen und das Darlegen der Kernfunktionen des Agenten.
Starten Sie den Ideenfindungsprozess Ihres Agenten, indem Sie seine wichtigsten Attribute definieren:
1. **Zweck/Ziel**: Definieren Sie das primäre Ziel des Agenten eindeutig. Welches spezifische Problem soll mit ihr gelöst werden oder welche Aufgabe soll sie erfüllen? Wem sollte der Agent dienen? Dies sollte eine präzise und messbare Aussage sein, die den gesamten Entwicklungsprozess steuert.
2. **Persona**: Entwickeln Sie eine detaillierte Persona für den Agenten. Dies beinhaltet die Definition der Identität, des Kommunikationsstils und der Rolle, die er bei der Interaktion mit Benutzern oder anderen Systemen spielt. Beachten Sie den Tonfall, das Formalitätsniveau und alle spezifischen Merkmale, die sie im vorgesehenen Kontext wirksam machen.
3. **Muster**: Identifizieren Sie relevante Agentenmuster und Implementierungsstrategien und verknüpfen Sie sie mit ihnen. Dazu gehören Architekturentwürfe oder bewährte Vorgehensweisen, die die Struktur und das Verhalten des Agenten beeinflussen können. "[Agentische Muster und Implementierung in Salesforce Agentforce: Ein technisches Whitepaper](/docs/architect/de-de/fundamentals/guide/agentic-patterns)" stellt eine wertvolle Ressource für diesen Schritt dar und bietet Statistiken zum effektiven Agentendesign auf Salesforce Platform und Agentforce.
##### Design
In der Designphase werden die Konzepte aus der Idee in eine detaillierte Blaupause für die Konstruktion des Agenten übersetzt. Dazu zählen die Definition der Architektur, der Benutzer-Flows, der Interaktionsmodelle und der technischen Spezifikationen wie Themen, Tools und Leitplanken.
Während der Designphase erstellen Sie eine detaillierte Blaupause für die Konstruktion Ihres Agenten, die Folgendes enthält:
- **Agentendesign**: Erläutern Sie die interne Struktur des Agenten, einschließlich seiner Komponenten, Module und ihrer Interaktion. Dazu gehören möglicherweise die Definition der Knowledge Base, Konfiguration und Logik zum Steuern des Agentenverhaltens, der NLP-Komponenten (Natural Language Processing) und der Integrationspunkte in andere Systeme.
- **Benutzer-Flows/Interaktionsdesign**: Ordnen Sie die vollständige Benutzer-Journey und die Interaktionen des Agenten zu. Definieren Sie Unterhaltungs-Flows, Entscheidungsstrukturen, Fehlerbehandlung und Feedback-Mechanismen, um intuitive und effektive Erfahrungen zu erstellen.
- **Technische Spezifikationen**: Dokumentieren Sie die technischen nicht funktionalen Anforderungen an den Agenten, beispielsweise Leistungskennzahlen, Überlegungen zur Skalierbarkeit, Sicherheitsprotokolle und Integrationsspezifikationen.
- **Prototyping & Mockups**: Erstellen Sie visuelle Darstellungen oder interaktive Prototypen der Benutzeroberfläche und Interaktionen des Agenten. Dies ermöglicht frühzeitige Tests und Feedback und hilft so, das Design zu optimieren, bevor die umfassende Entwicklung beginnt.
- **Daten**: Identifizieren Sie beim Bestimmen des Datentyps und der Datenquellen, die ein Agent benötigt, Datensets, APIs, Datenbanken und Repositorys, auf die der Agent zugreifen muss. Konzentrieren Sie sich bei Agentforce darauf, welche Daten als Kontext bereitgestellt werden, ob sie strukturiert oder unstrukturiert sind und ob sie in Echtzeit oder Batch vorliegen. Die Agentforce Platform wurde mit einer umfassenden Integration in Data 360 entwickelt, sodass Sie strukturierte und unstrukturierte Daten aus Salesforce CRM und anderen Quellen verwenden können. Unstrukturierte Inhalte können nativ in Gruppen unterteilt und für RAG indiziert werden. Mit MuleSoft können Sie eine Verbindung zu externen Systemen herstellen.
- **Tools**: Identifizieren Sie die Aktionen, die der Agent ausführen muss. Verwenden Sie Agentforce Actions (Agentforce-Aktionen), um Tools zum Erreichen von Geschäftszielen bereitzustellen. Diese Aktionen nutzen vorhandene Salesforce-Datenbestände wie Eingabeaufforderungen über Eingabeaufforderungsgenerator, MuleSoft, Apex, Flows und APIs mit OpenAPI-Spezifikationen. Jede aufrufbare Aktion kann in Agentforce integriert und vom Agenten verwendet werden, sodass alle vertrauten Salesforce-Entwicklungstools als Agentforce-Aktionen verfügbar sind.
- **Eingabedaten für Agenten**: Bei herkömmlichen SDLCs werden Eingaben genau angegeben. Im ADLC sind Eingaben oft natürliche, nicht deterministische Freiformäußerungen. Erfassen Sie ein repräsentatives Korpus von Äußerungen, von denen erwartet wird, dass sie entsprechende Antworten hervorrufen.
#### Phase 2: Entwicklung
Der Fokus der Entwicklungsphase liegt auf der Übersetzung des in der Ideen- und Designphase festgelegten Zwecks, der Funktionen und des operativen Umfangs des definierten Agenten in einen neuen Agentforce Agent.
Agentforce unterstützt Entwickler beim Erstellen von Agenten mit dem **Agentengenerator** und **Agentforce Developer Experience (AFDX).** Diese grundlegenden Tools dienen als primäre Umgebungen für die Erstellung und Konfiguration des Agenten.
- Der **Agentengenerator** bietet eine Benutzeroberfläche zum Definieren der Kernfunktionen des Agenten.
- **AFDX** bietet eine programmgesteuerte Oberfläche für die Anpassung und Integration in andere Systeme.
Zum Entwickeln und Erstellen eines Agenten sind die folgenden Schritte erforderlich, die mit dem Agentengenerator oder AFDX ausgeführt werden können:
1. **Definieren der Persona**: Ein entscheidender Aspekt des Agentendesigns besteht darin, eine eigene Persona zu etablieren. Dies beinhaltet die Konfiguration der:
- **Agentenbeschreibung**: Eine detaillierte Beschreibung der Rolle, der Ziele und der spezifischen Kundendienstaufgaben des Agenten.
- **Ton**: Der Kommunikationsstil des Agenten, sein Einfühlungsvermögen und alle spezifischen Markenrichtlinien, die eingehalten werden müssen.
2. **Definieren von Agententhemen und -aktionen**: Damit ein Agent raffiniert ist und eine Vielzahl von Aufgaben bewältigen kann, ist es wichtig, seine Funktionen in verschiedene Themen mit entsprechenden Aktionen aufzuschlüsseln.
- **Themen**: Jedes Thema kann als eigener spezialisierter Agent mit einem einzigartigen Satz an Anweisungen und Tools konzipiert werden.
- **Modulare Architektur.** Der modulare Ansatz für Themen ermöglicht eine bessere Organisation und Skalierbarkeit. Durch das Definieren mehrerer Themen kann der Agent eine breitere Palette komplexer Szenarien verarbeiten. Beispielsweise kann ein Agent über separate Themen für "Auftragsverwaltung", "Häufig gestellte Fragen", "Technischer Support" und "Abrechnungsanfragen" verfügen.
- **Themenanweisungen (Leitplanken)**: Jedes Thema enthält spezifische Anweisungen, die als Leitplanken fungieren und den Umfang definieren, den der Agent in diesem Thema besprechen oder tun kann. Diese Anweisungen verhindern, dass der Agent vom Thema abweicht oder irrelevante Informationen bereitstellt. Sie tragen auch dazu bei, die Konsistenz und Genauigkeit der Antworten aufrechtzuerhalten.
- **Aktionen**: Themen sind auch mit "Tools" ausgestattet, die die Aktionen darstellen, die der Agent ausführen kann. Folgende Tools können verwendet werden:
- **Informationsaktionen**: Abrufen von Daten aus einer Knowledge Base oder einem externen System zum Beantworten einer Abfrage.
- **Transaktionsaktionen**: Ausführen von Aktionen im Namen des Benutzers, beispielsweise Erteilen eines Auftrags, Aktualisieren eines Kundendatensatzes oder Initiieren eines Rückerstattungsprozesses. Diese Aktionen sind häufig in andere Systeme (z. B. CRM, ERP) integriert.
#### Phase 3: Testen und Validieren
Bei der Bewertung der Leistung und Zuverlässigkeit von AI-Agenten sehen sich Tester oft mit einer Reihe von Herausforderungen konfrontiert, die die Benutzererfahrung beeinträchtigen können. Diese Probleme reichen von der falschen Interpretation des Benutzer-Intents bis hin zur fehlerhaften Ausführung von Aufgaben.
##### Allgemeine Agentenfehlerszenarien
Zum Erstellen eines zuverlässigen Agenten müssen Sie wissen, wie und wo Fehler auftreten können. In der folgenden Tabelle werden häufige Probleme während des Agentenlebenszyklus kategorisiert, von fehlerhafter Argumentation bis hin zum schlechten Knowledge Retrieval. Verwenden Sie dies als strategische Anleitung während der Entwicklung und als Checkliste während des Tests, um sicherzustellen, dass Ihr Agent nicht nur funktional, sondern auch zuverlässig und intuitiv für den Endbenutzer ist. Diese Fehlerszenarien sollten Ihnen beim Definieren von Testfällen helfen.
| Kategorie | Beschreibung | Fehlerbeispiele |
|---|---|---|
| Themenklassifizierung | Der Agent kann den Intent oder das Ziel des Benutzers nicht richtig identifizieren. |
|
| Antwortqualität | Fehler beim Inhalt, der Genauigkeit und dem Format der Antworten des Agenten. |
|
| Aktionsausführung | Der Agent schlägt fehl, wenn er versucht, eine bestimmte Funktion oder Aufgabe auszuführen. |
|
| Leitplanken und Anweisungen | Der Agent verstößt gegen vordefinierte Regeln, Einschränkungen oder Unterhaltungsgrenzen. |
|
| Knowledge-Abruf | Der Agent hat Probleme bei der Beschaffung und Darstellung von Informationen aus seiner Knowledge Base. |
|
| Strukturierte Anleitung | Der Agent hat Schwierigkeiten, Benutzer durch mehrstufige Prozesse zu führen. |
|
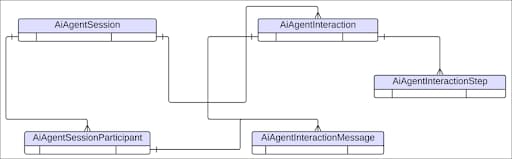
| Data-Lake-Objekt/Datenmodellobjekt | Beschreibung |
|---|---|
| AIAgentSession | Ein übergreifender Container, der zusammenhängende Interaktionen mit einem oder mehreren AI-Agenten erfasst. |
| AIAgentSessionParticipant | Eine Einheit (menschlich oder AI), die an einer AIAgentSession teilnimmt. |
| AIAgentInteraction | Ein Segment innerhalb einer Sitzung. Sie beginnt in der Regel mit der Anforderung eines Benutzers und endet, wenn der AI-Agent eine Antwort auf diese Anforderung gibt. |
| AIAgentInteractionStep | Eine diskrete Aktion oder ein diskreter Vorgang, die bzw. der während einer Interaktion ausgeführt wird, um die Anforderung des Benutzers zu erfüllen. |
| AIAgentInteractionMessage | Eine einzelne Kommunikation, die vom Benutzer bereitgestellt oder vom AI-Agenten während einer Sitzung generiert wird. |
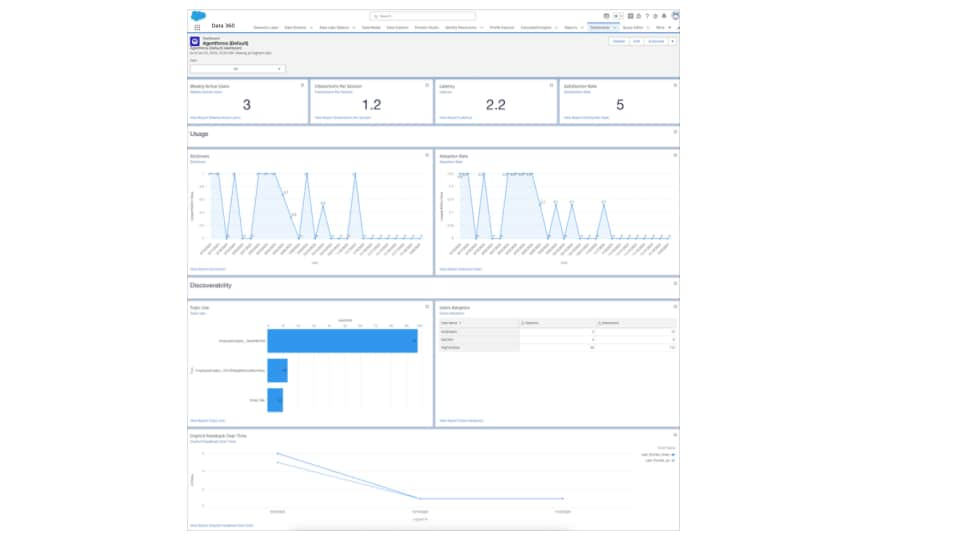 ##### Äußerungsanalyse
Die Äußerungsanalyse zeigt, wie Agentforce-Benutzer (Standard) Agenten verwenden, was sie anfordern und ob der Agent diese Anforderungen verarbeiten konnte. Mit diesen anpassbaren Berichten können Sie Ihre Themen und Aktionen optimieren, damit Ihre Agenten effektiver und genauer reagieren können.
 ##### Agentforce Python SDK: Überwachen mit Data 360-Integrationen
Die Agenten-SDK-Implementierung verwendet die erweiterte Überwachung und Analyse mit dem Data 360-Python-Konnektor, stellt eine Verbindung mit Salesforce Data 360 her, fragt Kennzahlen zur Agentenleistung ab und erstellt umfassende Überwachungs-Dashboards.
Das System verfolgt Antwortzeiten, Erfolgsraten, Benutzerzufriedenheit und Kostenkennzahlen, um handlungsrelevante Statistiken für die Agentenoptimierung bereitzustellen.
```py
# Data 360 Python Connector Integration
from salesforce_cdp_connector import SalesforceCDPConnector
# Initialize Data 360 Connector
cdp_connector = SalesforceCDPConnector(
client_id='your_client_id',
client_secret='your_client_secret',
username='your_username@example.com',
password='your_password'
)
# Query agent performance data
performance_data = cdp_connector.query("""
SELECT timestamp, response_time_ms, success_rate, user_satisfaction
FROM AgentPerformanceMetrics
WHERE agent_id = 'Coral_Cloud_Resorts_Resort_Manager'
""")
# Create monitoring dashboard
def create_monitoring_dashboard(performance_data):
fig = go.Figure()
fig.add_trace(go.Scatter(
x=performance_data['timestamp'],
y=performance_data['response_time_ms'],
mode='lines+markers'
))
return fig
```
##### Agentforce DX: Agentenüberwachung
Die Implementierung verwendet standardmäßige AFDX-Befehle mit der CLI-basierten Agentenverwaltung, um den Agenten hinsichtlich Plattformänderungen auf dem Laufenden zu halten und Benutzerfeedback für eine kontinuierliche Verbesserung zu integrieren.
```zsh
# List all agents and their status
sf agent list --target-org "production-org"
# Get detailed agent information
sf agent get \
--api-name "Resort_Manager" --target-org "production-org"
# Activate agent if needed
sf agent activate --api-name "Resort_Manager" --target-org "production-org"
# Query agent performance data
sf data query \
--query "SELECT Id, Name, Status, LastModifiedDate FROM BotDefinition WHERE DeveloperName = 'Resort_Manager'" \
--target-org "production-org"
```
```python
# AgentforceDX Dashboard Creation (Similar to Agent SDK)
import pandas as pd
import plotly.graph_objects as go
from salesforce_cdp_connector import SalesforceCDPConnector
# Initialize Data 360 Connector for AgentforceDX
cdp_connector = SalesforceCDPConnector(
client_id='your_client_id',
client_secret='your_client_secret',
username='your_username@example.com',
password='your_password'
)
# Query agent performance data from Data 360
performance_data = cdp_connector.query("""
SELECT timestamp, agent_id, response_time_ms, success_rate, user_satisfaction
FROM AgentPerformanceMetrics
WHERE agent_id = 'Resort_Manager'
AND timestamp >= CURRENT_DATE - 30
ORDER BY timestamp DESC
""")
```
Informationen zur ADLC-Implementierung mit dem Agenten-SDK und AFDX finden Sie [hier](https://github.com/akshatasawant9699/ADLC_Whitepaper) im GitHub-Repository.
## Bewährte Vorgehensweisen
Zum Beherrschen des Agentenentwicklungslebenszyklus müssen eine Reihe von Kernprinzipien eingehalten werden, die Effizienz, Zuverlässigkeit und strategische Ausrichtung gewährleisten. Die folgenden Richtlinien fassen die wichtigsten Lektionen aus jeder Phase des ADLC zu einem strategischen Framework für Architekten und Entwickler zusammen.
**1\. Planung und Ideenfindung**
Diese Anfangsphase konzentriert sich darauf, den Zweck des Agenten an den Geschäftszielen auszurichten und sicherzustellen, dass er auf einer soliden Grundlage basiert.
- **Priorität für Geschäftsauswirkungen**: Ordnen Sie zunächst potenzielle Anwendungsfälle direkt strategischen Geschäftszielen zu. Verwenden Sie eine Priorisierungsmatrix, um ihre potenziellen Auswirkungen zu bewerten, und beginnen Sie mit einem einzelnen, fokussierten Anwendungsfall mit klaren KPIs.
- **Beteiligte frühzeitig einbinden**: Sammeln Sie Statistiken zu Schwachpunkten und stellen Sie die Ausrichtung sicher.
- **Nutzen von Datenstatistiken**: Ein Agent ist nur so gut wie seine Daten. Verwenden Sie Data 360, um verfügbare strukturierte und unstrukturierte Daten zu erkunden und den Kontext und die Funktionen des Agenten zu ermitteln. Überprüfen Sie vorhandene Berichte und Dashboards, um aktuelle Trends zu identifizieren, die Ihre Anwendungsfallauswahl beeinflussen können.
- **Verwenden von Frameworks für die Idee**: Wenden Sie strukturierte Ideenmethoden an, um potenzielle Anwendungen wie Design Thinking oder SWOT-Analysen zu brainstormen und zu verfeinern.
**2\. Bauagenten**
In dieser Phase werden die bewährten Vorgehensweisen zum Erstellen eines leistungsstarken und effizienten Agenten beschrieben.
- **Zu viele Themen vermeiden**: Begrenzen Sie die Anzahl der Themen, um das Risiko zu reduzieren, dass ähnliche oder sich überschneidende Themen erstellt werden, die den Agenten verwirren könnten.
- **Halten Sie Anweisungen und Eingabeaufforderungen kurz**: Verwenden Sie eine direkte, einfache Sprache und stellen Sie Beispieläußerungen bereit, um den Agenten effektiv zu führen.
- **Hebelvariablen und deterministische Aktionen**: Verwenden Sie diese Tools, um das Verhalten des Agenten zu steuern und seine Leistung für besser vorhersehbare Ergebnisse zu optimieren.
- **Aktionsausgaben klein und prägnant halten**: Stellen Sie sicher, dass die Antworten des Agenten kurz und präzise sind. Längere Ausgaben verwenden mehr Kontext und sind langsamer zu generieren.
- **Optimieren von Aktionen für die Geschwindigkeit**: Entwerfen Sie Flows und Apex Klassen, um minimal erforderliche Daten zurückzugeben. Ziel ist es, dass weniger Aktionen erforderlich sind, um eine Antwort zu generieren, indem Sie sie nach Möglichkeit vorverarbeiten.
- **Definieren eines klaren Umfangs**: Schreiben Sie angemessene Beschreibungen, Anweisungen und Aktionsbereiche, um zu verhindern, dass der Agent bei Fragen außerhalb des Umfangs RAG (Retrieval-Augmented Generation) aufruft.
- **Sparsamer Umgang mit der Hybridsuche**: Verwenden Sie die Hybridsuche nur, wenn sie unbedingt erforderlich ist, da sie sich negativ auf die Latenz auswirken kann.
**3\. Testen, Überwachen und Tunen**
Diese iterative Phase ist entscheidend für die Optimierung der Genauigkeit und Leistung des Agenten.
- **Einrichten eines Test-Flows**: Befolgen Sie einen einheitlichen Testzyklus:
1. **Batch-Test ausführen**: Führen Sie einen umfassenden Satz an Tests aus.
2. **Bewertungen/Fehler anzeigen**: Analysieren Sie die Leistungskennzahlen und identifizieren Sie Fehler.
3. **Fehler untersuchen**: Untersuchen Sie jede Fehlerzeile, um die Diskrepanz zu verstehen.
4. **Agent aktualisieren**: Nehmen Sie die erforderlichen Anpassungen am Agenten oder an seinen Auswertungsdaten vor.
- **Informationen zur Sitzungsverfolgung überprüfen**: Verwenden Sie das Sitzungsverfolgungsdatenmodell und den Agentforce Interaction Explorer, um Ursachenanalysen durchzuführen, wenn Probleme oder unerwartete Verhaltensweisen identifiziert werden. Stimmen Sie Ihren Agenten anhand der Informationen ab und setzen Sie die Iteration Ihres Agenten fort.
## Schlussfolgerung
Der _Lebenszyklus der Agentenentwicklung_ stellt eine wichtige Entwicklung traditioneller Softwareentwicklungsprinzipien dar, die für die Ära intelligenter, autonomer Systeme entwickelt wurde.
- **Evolution, nicht Ersatz**: Der Lebenszyklus der Agentenentwicklung erweitert und verbessert die herkömmliche Anwendungslebenszyklus-Verwaltung, ohne sie zu ersetzen.
- **Daten als Bürger erster Klasse**: Daten spielen bei der Agentenentwicklung eine viel dynamischere und zentralere Rolle.
- **Spezialisierte Tools und Fertigkeiten**: Erfordert neue Tools und eine breitere Palette spezialisierter Fertigkeiten in den Bereichen Data Science, ML Engineering und Agentenentwicklung.
- **Kontinuierliches Lernen**: Durch die Agentenentwicklung wird das System selbst kontinuierlich _erlernt_ und _angepasst_.
- **Künftige Auswirkungen**: Agentische AI verspricht, komplexe IT-Vorgänge und Workflows für die Softwareentwicklung weiter zu automatisieren und zu optimieren.
# Von der Composable Integration zum Governed Agentic Enterprise
Die Umstellung auf Agentic Enterprise stellt die bedeutendste architektonische Veränderung seit Beginn der Cloud dar. Sie verspricht ein bisher unerreichtes Maß an Produktivität und Automatisierung, bringt jedoch auch tiefgreifende Herausforderungen mit sich, die sich auf die Verwaltung, die Sicherheit und die betriebliche Komplexität beziehen. Die Verwendung eines schrittweisen Ansatzes – das Bereitstellen von Agenten in Silos ohne Einigungsstrategie – ist ein direkter Weg zu technischer Verschuldung und Organisationschaos.
Die Bereitstellung von Agenten ohne zentrale Verwaltungsebene führt zu einem erheblichen betrieblichen Risiko, einschließlich Sicherheitslücken durch direkten Systemzugriff, mangelnder Beobachtbarkeit von Agenteninteraktionen und -aktionen und hoher Kosten aufgrund redundanter Punkt-zu-Punkt-Integrationen. Diese isolierte Bereitstellungsstrategie führt zu einer brüchigen Umgebung, die im Maßstab schwer zu verwalten ist. Für ein nachhaltiges Modell ist eine einheitliche Plattform für die Integration und Verwaltung von Agenten erforderlich.
_MuleSoft_ bietet eine umfassende, vereinheitlichte und offene Plattform, die Unternehmen auf ihrem Weg sicher begleitet. Sie nutzt die vorhandene API-Landschaft des Unternehmens als Grundlage für Agentenaktionen und beschleunigt die Erstellung neuer agentenfähiger Vermögenswerte durch einen vertrauenswürdigen, AI-gestützten Entwicklungslebenszyklus. Durch die Unterstützung offener Standards wie des Modellkontextprotokolls (Model Context Protocol, MCP) und der Agent2Agent-Protokolle (A2A) auf Unternehmensebene können diese Datenbestände sowohl für einfache Befehle als auch für die komplexe Zusammenarbeit mit mehreren Agenten verwendet werden, unabhängig davon, wie sich die AI-Landschaft entwickelt. [_MuleSoft Agent Fabric_](https://docs.mulesoft.com/agent-fabric/) bietet eine Lösung zum Erkunden, Orchestrieren, Steuern und Beobachten des gesamten Agentenökosystems. Durch diesen integrierten Ansatz bietet _MuleSoft Agent Fabric_ eine bewährte Grundlage für die Skalierung eines Netzwerks Vertrauenswürdiger AI Agenten, das das Versprechen der AI in konkrete automatisierte Geschäftsergebnisse umwandelt und das volle Potenzial des intelligenten Unternehmens ausschöpft.
## **Die Composable Foundation für handlungsrelevante AI**
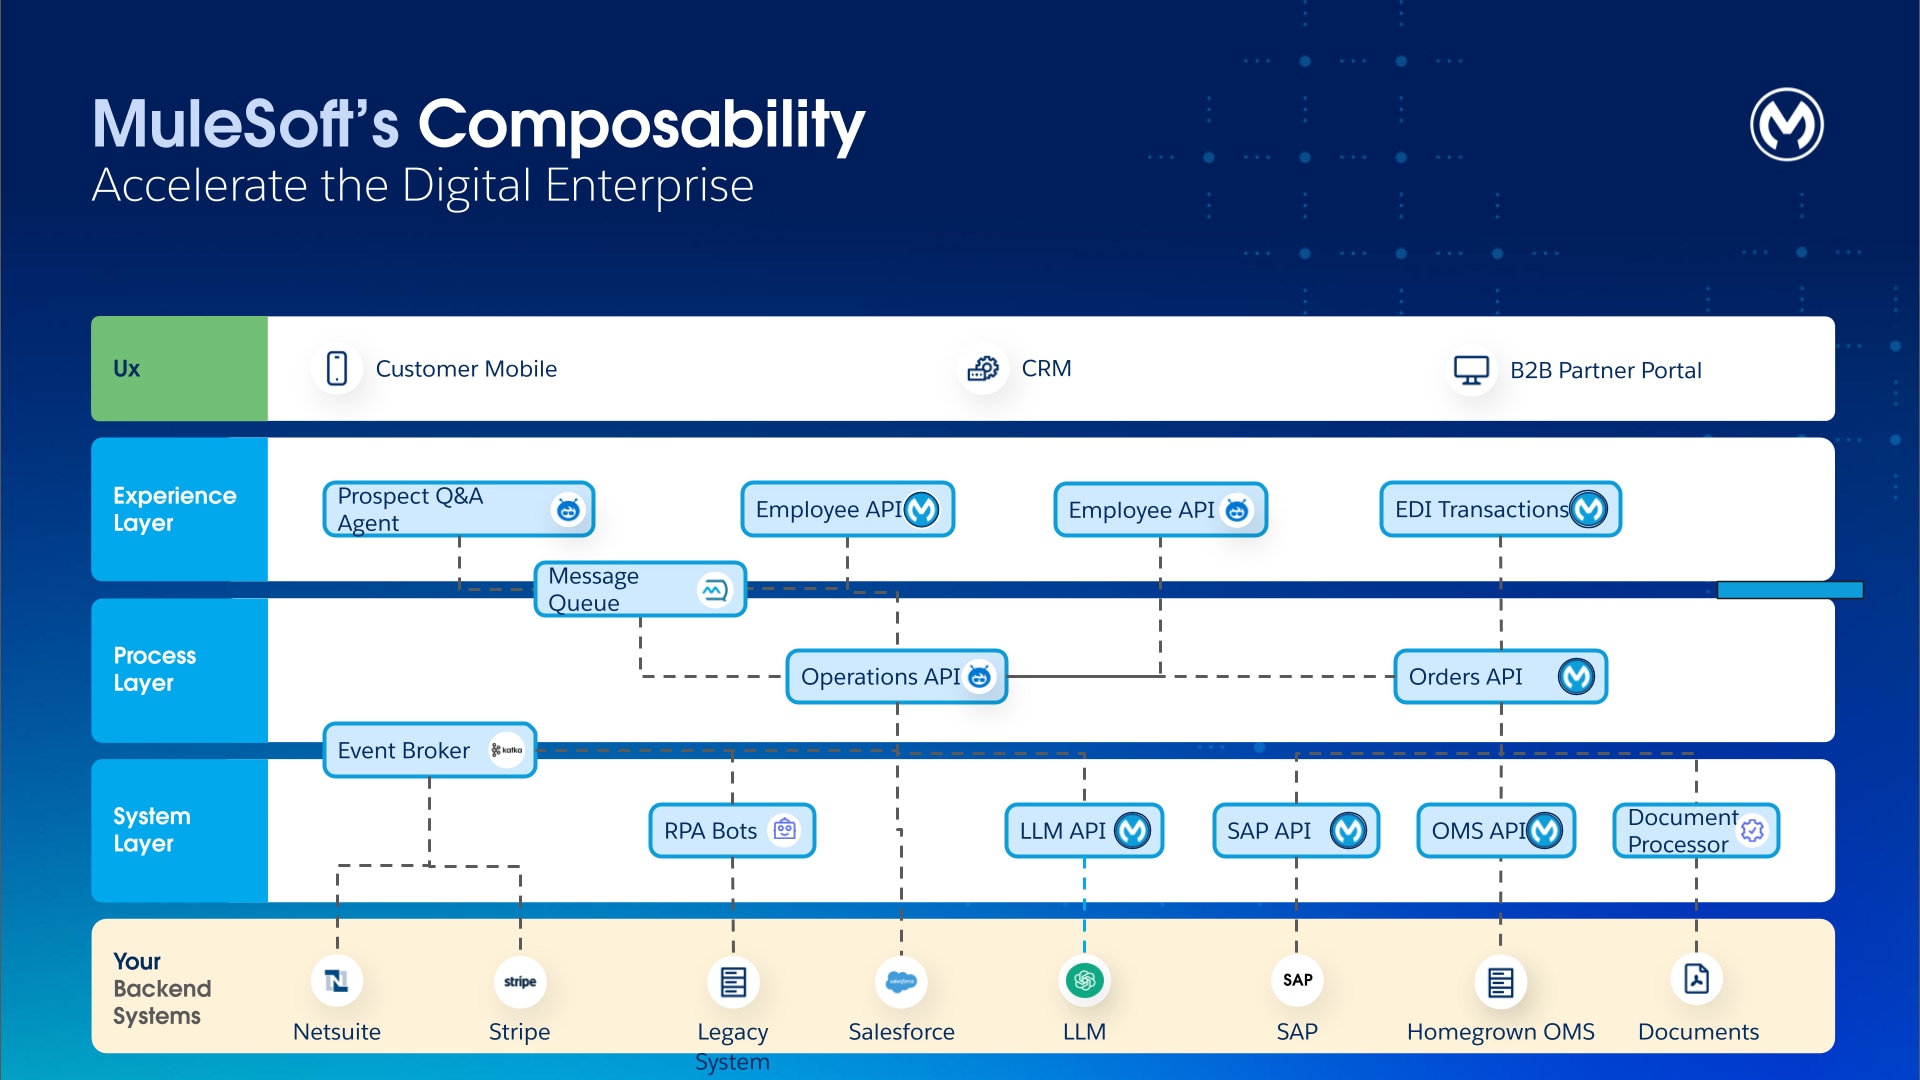 Der etablierte dreischichtige Ansatz der API-geführten Konnektivität – System-, Prozess- und Erfahrungs-APIs – bietet ein leistungsstarkes Framework zur Strukturierung der Handlungsfähigkeit von Agenten.
- **System-APIs** bieten eine konsistente, sichere und abstrahierte Schnittstelle zu zugrunde liegenden Datensatzsystemen. Sie entkoppeln Agenten von der Komplexität von Backend-Protokollen und -Datenmodellen, wodurch sichergestellt wird, dass alle Agentenaktionen an geregelten, zuverlässigen Endpunkten ausgeführt werden.
- **Prozess-APIs** enthalten eine komplexe Geschäftslogik aus mehreren Schritten. Agenten müssen die komplizierte Orchestrierung, die sich hinter dem Erstellen von Vertriebsaufträgen, dem Überprüfen des Inventars oder dem Initiieren von Versandvorgängen verbirgt, nicht verstehen. Sie können Prozess-APIs (z. B. "Prozessreihenfolge") verwenden, ohne sich um die zugrunde liegenden Komplexitäten kümmern zu müssen. Prozess-APIs bieten Agenten einen sicheren, transaktionalen und überprüfbaren Mechanismus zum Ausführen von Geschäftsprozessen. Dadurch wird die erforderliche Argumentation der Agenten erheblich reduziert und sichergestellt, dass Geschäftsregeln einheitlich durchgesetzt werden.
- **Erfahrungs-APIs** wurden traditionell für bestimmte Benutzeroberflächenanwendungen (z. B. Auftragsverwaltungsanwendung) entwickelt. Sie können jedoch auch als kontextreiche Aktionen für Agenten verwendet werden. Dadurch erhalten Agenten wichtige Informationen, damit sie eine bestimmte Aufgabe ausführen können, ohne mehrere Aufrufe an nachgelagerte Systeme vornehmen zu müssen.
## 1\. Generative Erstellung: Beschleunigen der Entwicklung von für Agenten geeigneten Vermögenswerten
Unternehmen müssen die Entwicklung der APIs und Integrationen beschleunigen, die die zusammengesetzte Grundlage bilden, um der steigenden Nachfrage nach agentenfähigen Tools und Funktionen gerecht zu werden. _MuleSoft_ meistert diese Herausforderung, indem es generative AI direkt in den Entwicklungslebenszyklus einbettet. Dadurch entsteht ein virtuoser Zyklus, der mithilfe von AI die hochwertigen Vermögenswerte erstellt, die andere Agenten verbrauchen.
### **1.1 MuleSoft Vibes**
Für Entwickler fungiert [MuleSoft Vibes](https://www.mulesoft.com/platform/api/anypoint-code-builder/announcing-mulesoft-vibes) als intelligenter Partner, da es die sich wiederholendsten Aspekte der Integrationsentwicklung automatisiert und eine einheitliche, agentenbasierte Oberfläche für den gesamten Softwareentwicklungslebenszyklus bereitstellt. Über MuleSoft Vibes im [Anypoint Code Builder](https://docs.mulesoft.com/anypoint-code-builder/) interagieren Entwickler mit generativen Funktionen, die auf den [vertrauenswürdigen _Einstein AI Pipelines_](https://blogs.mulesoft.com/automation/how-mulesoft-turns-generative-output-into-value/) basieren, was den AI-gestützten Entwicklungsprozess reibungslos und effizient gestaltet. Bei dieser Pipeline – dem _Inference Graph Execution Service (IGES)_ – handelt es sich um einen mehrstufigen Prozess, mit dem hochwertige Ergebnisse erzielt werden. Sie besteht aus Kontextbildung, Validierung, Fehlerkorrektur und strenger Auswertung.
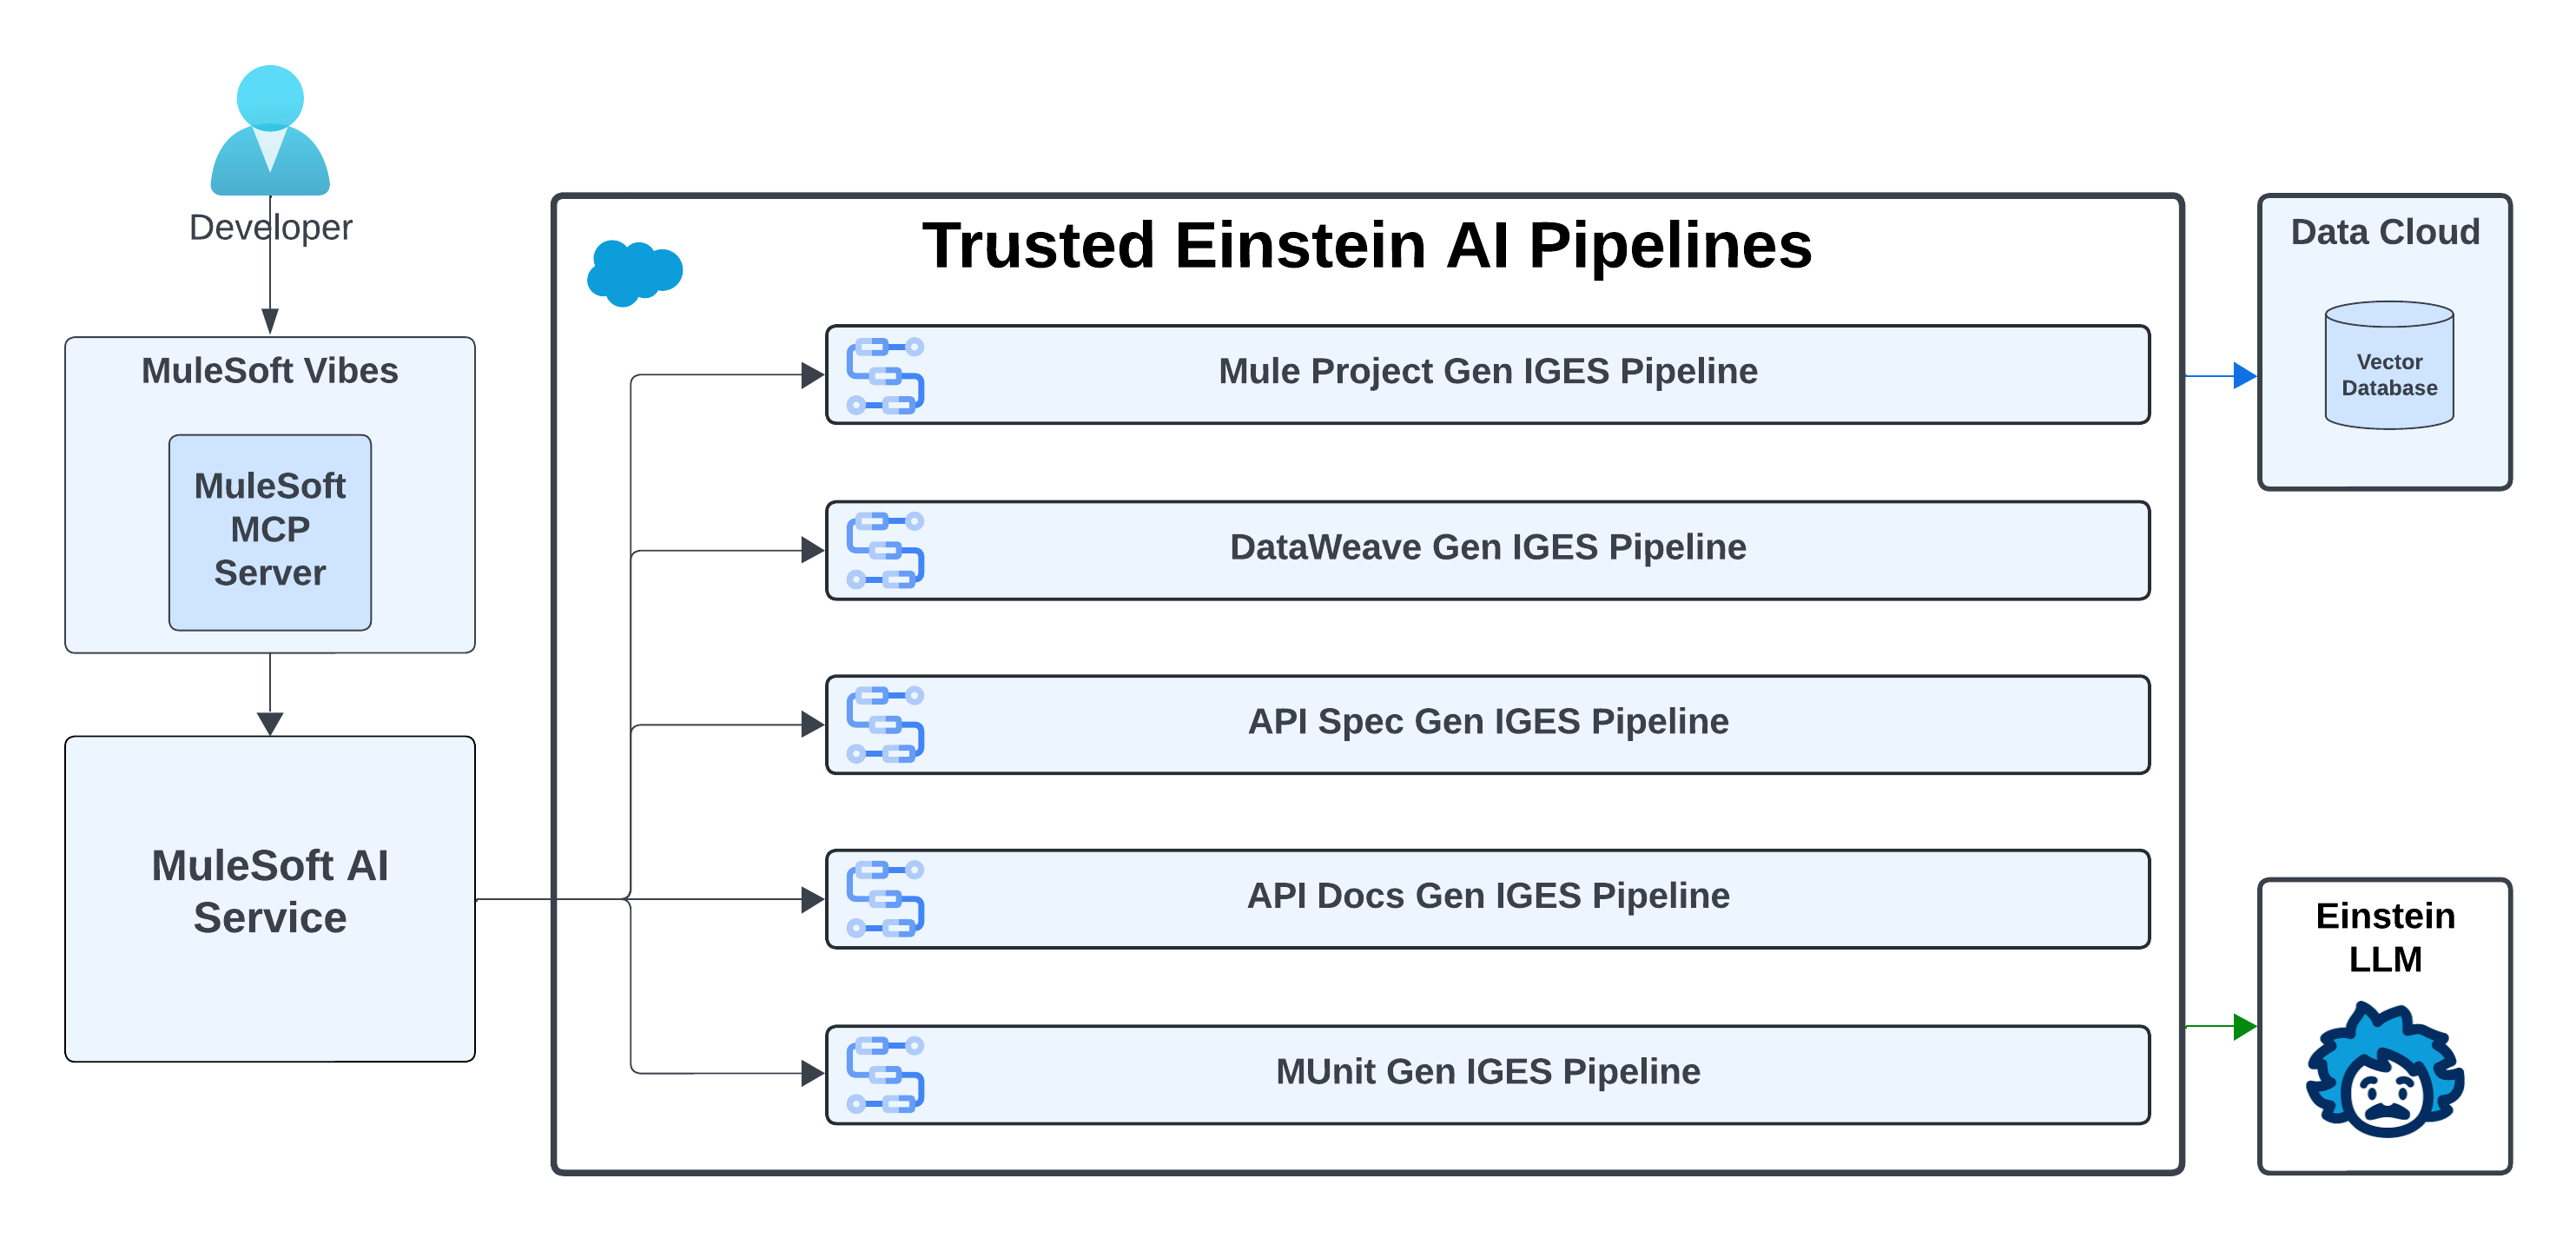 - Die Funktion [**"Generative Flows**](https://blogs.mulesoft.com/dev-guides/einstein-for-acb/)" in _MuleSoft Vibes_ basiert auf dem _Agentforce AI_ Framework. Sie wandelt Geschäftslogik mit natürlicher Sprache (Benutzeraufforderungen) in funktionale Mule-Anwendungen um. Die _IGES-Pipeline_ besteht aus folgenden Schritten:
- **Zusammenfassung des Unterhaltungsverlaufs:** Der LLM analysiert die aktuelle Aufforderung und die vorherigen Nachrichten des Benutzers, um eine zusammengefasste Aufforderung zu erstellen, die den Benutzer-Intent und den Unterhaltungsverlauf erfasst. Diese konsolidierte Aufforderung erhöht die Genauigkeit nachfolgender Schritte zum Abrufen und Generieren von Daten.
- **Semantisches Abrufen von Flows aus einer Vektordatenbank:** Das System verwendet die zusammengefasste Eingabeaufforderung aus dem vorherigen Schritt und führt eine semantische Suche anhand einer Vektordatenbank aus, die 200+ Konnektoren, 7.000+ Konnektorvorgänge und 7.000+ Beispielcodeauszüge enthält. Sie ruft die relevantesten Konnektoren, Vorgänge und Codebeispiele ab, um den Generierungsprozess anhand genauer Daten zu ergründen, und stellt sicher, dass die Ausgaben mit dem umfangreichen Konnektor-Ökosystem von MuleSoft übereinstimmen. Da MuleSoft der Branchenstandard für Konnektoren und Vorgänge ist, bietet diese Kontextbildung dem Modell eine umfassende Kontext- und Domänengenauigkeit, die generischen LLMs fehlt.
- **Vergrößerung:** Die abgerufenen Inhalte und Unterhaltungsverlaufsmeldungen werden dann mit der zusammengefassten Aufforderung kombiniert. Diese erweiterte Eingabeaufforderung leitet die LLM an, Halluzinationen zu reduzieren. Sie enthält auch Anweisungen zum Verhindern der Generierung toxischer Inhalte.
- **Flow-Generierung:** Bei diesem Schritt wird das _Einstein AI LLM_-Modell verwendet, um XML-Rohcode zu generieren, der auf dem Kontext und den angegebenen Beispielen basiert. Dies ist der Kernschritt der Generierungs-Pipeline.
- **Nachbearbeitung und Validierung:** Der Postprozessor und Validierer überprüft den Code, um die richtige Syntax und die Verwendung gültiger Konnektorvorgänge sicherzustellen, während eine separate Toxizitätsprüfung schädliche Inhalte kennzeichnet.
- **Fehlerkorrektur in mehreren Schritten:** Wenn alle anfänglichen Generierungen ungültig sind, analysiert der automatisierte Fehlerkorrekturmechanismus die Fehlermeldungen, um Muster zu erkennen. Anschließend wird die Eingabeaufforderung zusammen mit angereicherten Fehlermeldungen und korrigierenden Metadaten erneut an das LLM gesendet.
- **Generierung von Konfigurationsdateien:** Dieser Schritt extrahiert relevante Konnektor-Metadaten, erweitert die Eingabeaufforderung und sendet sie an das LLM, um genaue Konnektorkonfigurationen zu generieren. Schließlich werden alle POM- und XML-Namespaces deterministisch mit der neuesten Version jeder Abhängigkeit generiert, was Halluzinationen beseitigt und Konsistenz gewährleistet.
- Die Datentransformation [**der DataWeave-Transformationsgenerierung**](https://blogs.mulesoft.com/dev-guides/dataweave-generative-transformation/)**:** ist oft der zeitaufwendigste Teil der Integrationsentwicklung. _MuleSoft Vibes_ greift diesen Prozess mithilfe des Ansatzes aus mehreren Schritten auf, der der Generierung von _MuleFlow-XML_ ähnelt.
- **Intention Reasoning (Intentionsgründe):** Das LLM analysiert Benutzereingabe- und Ausgabedatenbeispiele, um Transformationslogik auf hoher Ebene in natürlicher Sprache abzuleiten und zu artikulieren. Dieser Schritt trennt das Ziel des Benutzers von den Literaldatenwerten, die in der Eingabeaufforderung angegeben wurden.
- **Semantisches Abrufen von DataWeave:** Um die semantisch relevanteste DataWeave-Funktionsdokumentation und vollständige Transformationsbeispiele zu finden, verwendet das System die generierte Eingabeaufforderung aus dem vorherigen Schritt als Abfrage an die Vektordatenbank. Dadurch basiert der Generierungsprozess auf hochwertigen, überprüften Informationen.
- **Vergrößerung:** Die abgerufenen Funktionen und Beispiele werden mit der ursprünglichen Benutzeraufforderung kombiniert, um eine kontextbezogene Reihe von Anweisungen für den nachfolgenden LLM-Aufruf zu erstellen, die das Verhalten des LLM zur Reduzierung von Halluzinationen beeinflusst.
- **Datenwebgenerierung:** In diesem Schritt wird das LLM-Modell verwendet, um ein DataWeave-Transformationsskript und eine zugehörige Erläuterung zu generieren, die auf dem bereitgestellten Kontext und den Beispielen basiert. Dies ist der Kernschritt der Generierungs-Pipeline.
- **Nachbearbeitung und Validierung** Das generierte Skript wird anhand zweier spezifischer Kennzahlen ausgewertet: Gültigkeit und Richtigkeit. Das Skript muss ohne Syntaxfehler kompiliert werden (Gültigkeit) und die erwartete Ausgabe erzeugen, wenn es mit der Beispieleingabe ausgeführt wird (Korrektheit).
- **Fehlerkorrektur in mehreren Schritten:** Wenn die anfängliche Validierung fehlschlägt, identifiziert dieses Plugin die Fehlerkategorien und behebt die Probleme im generierten Skript. Diese Optimierung trägt zur Verbesserung der Gesamterfolgsrate und -genauigkeit des Systems bei.
- **Abschließende Nachbearbeitung und Validierung** Das korrigierte Skript aus dem Fehlerkorrekturmodul wird einem erneuten Validierungsprozess unterzogen, um sicherzustellen, dass es syntaktisch gültig und funktionsgerecht ist. Dieses endgültige Qualitäts-Gate stellt sicher, dass die Ausgabe genau und zuverlässig ist, bevor sie an den Benutzer zurückgesendet wird.
- Entwickler von [**API-Spezifikationen**](https://docs.mulesoft.com/anypoint-code-builder/api-ai-create-spec) **und der [Dokumentationsgenerierung](https://docs.mulesoft.com/exchange/generating-documentation-with-ai):** können vollständig validierte _OpenAPI-_ oder _RAML-_Spezifikationen generieren, indem sie die gewünschte API in natürlicher Sprache beschreiben. _MuleSoft Vibes_ nimmt die Eingabeaufforderung auf (die Details zu Ressourcen, Methoden, Sicherheitsschemas und Parametern enthält) und erstellt eine gültige, syntaktisch richtige API-Definition. Nach der Generierung kann eine Dokumentation für die API in _Anypoint Exchange_ erstellt werden, die von der Authentifizierung über Endpunktdetails bis hin zur Fehlerbehandlung reicht und Entwickler von diesen mühsamen Aufgaben befreit.
- **AI-gestützte MUnit-Generierung:** Die Qualitätssicherung ist für Vermögenswerte, die von autonomen Agenten verbraucht werden, von entscheidender Bedeutung. Mit _MuleSoft Vibes_ können Sie MUnit-Testfälle direkt über den Mule-Flow-Code generieren. Dadurch können externe Abhängigkeiten und Behauptungen simuliert und allgemeine Testlücken identifiziert werden, was den manuellen Aufwand, der erforderlich ist, um eine hohe Testabdeckung zu erreichen und die Zuverlässigkeit der Integrationslogik sicherzustellen, drastisch reduziert.
### **1.2 MuleSoft auf Ihre Weise**
Entwickler profitieren in ihren bevorzugten Umgebungen. Daher trifft _MuleSoft_ Entwickler dort, wo sie sich befinden, und ermöglicht ihnen die Erstellung von Integrationen in ihre gewünschte AI-IDE. [Der MuleSoft-Server](https://www.npmjs.com/package/@mulesoft/mcp-server) für das Modellkontextprotokoll (Model Context Protocol, MCP) stellt Entwicklungs-, Bereitstellungs- und Verwaltungsfunktionen als MCP-Tools bereit, die von jeder nativen AI-IDE auf VS-Code-Basis (z. B. Cursor, Windsurf oder Trae) verwendet werden können, um mit der _Anypoint Platform_ mithilfe natürlicher Sprache zu interagieren.
Indem _MuleSoft_ seine Kern-IDE-Funktionen in eine [Standard-VS Code](https://marketplace.visualstudio.com/items?itemName=salesforce.mule-dx-extension-pack)-Erweiterung bündelt, entkoppelt es seine Tools von einer IDE-Shell mit Branding, wodurch Entwicklungstools IDE-unabhängig sind. Anstatt mit der rasanten Entwicklung von IDEs zu konkurrieren, ermöglicht diese Architekturentscheidung, dass die Entwicklungstools von MuleSoft im wachsenden Ökosystem moderner AI-gestützter IDEs kompatibel und zugänglich bleiben.
## 2\. Aktivieren der Handlungsfähigkeit: Umwandeln von APIs in Tools für Agenten
In einem Agentic Enterprise ist eine solide Grundlage für zusammengesetzte APIs erforderlich, aber unzureichend. Der nächste wichtige Schritt besteht darin, sicherzustellen, dass diese Vermögenswerte auffindbar, verständlich und für AI-Agenten aufrufbar sind. Dies erfordert eine "Handlungsebene", die auf offenen Standards basiert, die speziell für die Kommunikation mit Agenten entwickelt wurden. _MuleSoft_ bietet Tools auf Unternehmensebene für die beiden dominanten neuen Protokolle:
- **MCP** für Interaktionen zwischen Agenten und Systemen
- **A2A** für Interaktionen zwischen Agenten
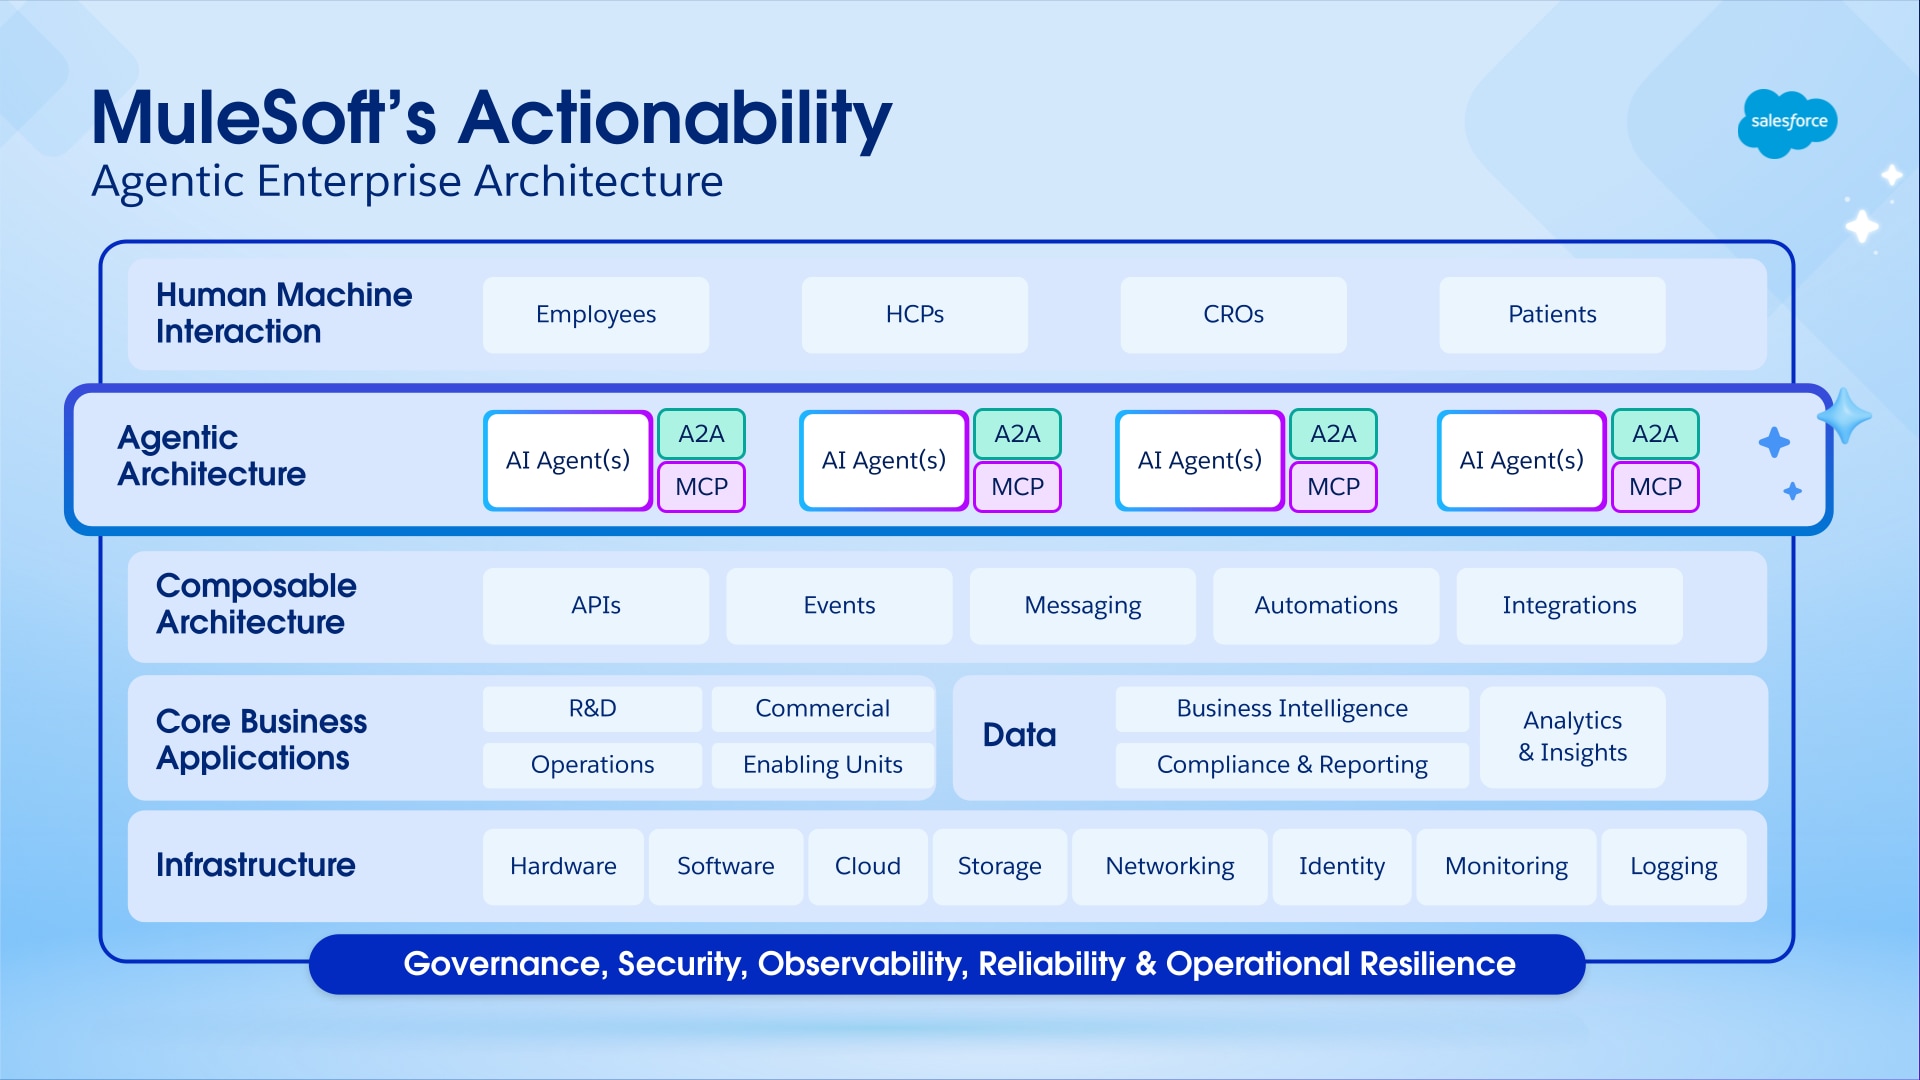 ### **2.1 Modellkontextprotokoll (MCP)**
_MCP_ hat sich schnell als Branchenstandard für die Kommunikation zwischen Agenten und Tools etabliert, was dem entspricht, was _REST_ für Webservices geworden ist. Mit _MCP_ können AI-Agenten die Funktionen eines Systems dynamisch entdecken, seine Ein- und Ausgaben verstehen und es aufrufen, um eine Aktion auszuführen, ohne vorprogrammierte oder hartcodierte Logik zu benötigen.
Mit dem [MuleSoft-MCP-Konnektor](https://docs.mulesoft.com/mcp-connector/latest/) können alle als Mule-Anwendung implementierten APIs als MCP-Server veröffentlicht werden. Da _MuleSoft_ Hunderte vordefinierter Konnektoren für nahezu jedes wichtige Unternehmenssystem (z. B. SaaS, veraltete Systeme und Datenbanken) bereitstellt, werden die APIs und Anwendungen einer Organisation sofort in eine Reihe agentenfähiger Tools umgewandelt. Eine API zum Überprüfen des Inventars in SAP, ein Flow zum Verarbeiten eines neuen Leads in Salesforce oder eine benutzerdefinierte Anwendung, die über _MuleSoft_ verbunden ist, können AI-Agenten mithilfe des _MCP-Konnektors_ als atomare, gesteuerte Tools zur Verfügung gestellt werden.
### **2.2 Protokoll zwischen Agenten (A2A)**
Obwohl der _MCP_ bei hierarchischen Interaktionen zwischen Agenten und Tools zum Aufrufen von Tools hervorragend ist, erfordern komplexe Geschäftsprozesse oft die Zusammenarbeit mehrerer spezialisierter Agenten. Das Protokoll _Agent-zu-Agent (A2A)_ ist der neue offene Standard, der die Kommunikation zwischen gleichrangigen Personen erleichtern soll und komplexe Workflows mit mehreren Agenten ermöglicht.
Die Unterstützung von A2A durch MuleSoft ermöglicht es Unternehmen, erweiterte Systeme mit demselben Maß an Governance und Zuverlässigkeit zu entwerfen und zu erstellen, das sie für ihre APIs erwarten. Mit dem [MuleSoft A2A-Konnektor](https://docs.mulesoft.com/a2a-connector/latest/) können Entwickler beliebige Agenten einfach als A2A-Server bereitstellen oder A2A-kompatible Agenten aus einer Mule-Anwendung aufrufen. Beispielsweise kann ein Hypothekenantragsprozess zwischen einem "Agenten für die Kreditprüfung", einem "Agenten für die Dokumentsignatur" und einem "Agenten für die Einhaltung gesetzlicher Vorschriften" orchestriert werden, wobei jeder Agent die Fähigkeiten der anderen erkennt und (bei Bedarf) aufruft, um den Antrag voranzutreiben.
MuleSoft bietet zuverlässige Tools auf Unternehmensebene für MCP und A2A und unterstützt so den Aufbau eines flexiblen Ökosystems, das aus direkten Interaktionen zwischen Agenten (über MCP-Tools) und Agenten (A2A) besteht. Unabhängig davon, wie sich die AI-Landschaft entwickelt, positioniert dieser Ansatz _MuleSoft_ als die zugrunde liegende Grundlage, die alle Formen der Agentenkommunikation verbindet.
## 3\. MuleSoft-Agentengewebe: Das zentrale Nervensystem des Agentenunternehmens
Da Unternehmen die Agenten-AI einsetzen, stehen sie zwangsläufig vor der Herausforderung der Zersiedelung von Agenten. Um zu verhindern, dass dies zu Chaos führt, ist eine spezielle Orchestrierungsebene erforderlich. [MuleSoft Agent Fabric](https://docs.mulesoft.com/agent-fabric/) ([Demo](https://www.youtube.com/watch?v=GAqwPie16ic)) ist eine umfassende architektonische Lösung, die speziell für diese Herausforderung entwickelt wurde. Sie bietet eine zentrale Verwaltungsebene, um das gesamte Netzwerk von AI-Agenten zu ermitteln, zu steuern, zu orchestrieren und zu beobachten, unabhängig davon, wo sie sich befinden oder wie sie arbeiten. _MuleSoft Agent Fabric_ fungiert als "Fluglotse" für die digitale Belegschaft des Unternehmens und wandelt eine Sammlung fragmentierter isolierter Agenten in ein zusammenhängendes, sicheres und leistungsstarkes Geheimdienstnetzwerk um.
_MuleSoft Agent Fabric_ basiert auf vier integrierten Säulen, die die gesamte Lebenszyklusverwaltung für Agenten als erstklassige Unternehmensvermögenswerte abdecken.
### **3.1 Agentenregister (Erkunden)**
Die Grundlage jedes verwalteten Ökosystems ist die Auffindbarkeit. Die _Agentenregistrierung_ dient als universeller zentraler Katalog für jeden Agentenvermögenswert im Unternehmen. Dies umfasst benutzerdefinierte Agenten, Agenten, die in SaaS-Anwendungen eingebettet sind, MCP-Server, die veraltete Systeme bereitstellen, und A2A-Endpunkte für die Zusammenarbeit zwischen Agenten. Die _Agentenregistrierung_ löst das Problem der kritischen Erkennung, indem sie verhindert, dass Teams redundante Funktionen erstellen, und es menschlichen Entwicklern und anderen AI-Agenten ermöglicht, vorhandene Vermögenswerte dynamisch zu finden und wiederzuverwenden.
 Die _Agentenregistrierung_ basiert auf _Anypoint Exchange_ und fügt drei neue Vermögenswerttypen hinzu: Agenten, MCP-Server und LLMs. Er erfasst Informationen zu diesen Datenbeständen, einschließlich MCP-Tools, Transportprotokollen und Agentenkarten, sowie die Abhängigkeiten zwischen Agenten und den von ihnen verwendeten MCP-Servern und -Tools. Entwickler können Vermögenswerte direkt in der Registrierung erstellen und verwalten. Außerdem können sie vorhandene Datenbestände in MuleSoft Vibes (über das Tool search_asset des _MuleSoft MCP-Servers_) beim Erstellen neuer Orchestrierungen programmgesteuert erkennen und wiederverwenden. Dadurch erhalten Entwickler alle Informationen, die sie benötigen, um diese Datenbestände zu verstehen und zu nutzen.
### **3.2 Agentenmakler (Orchestrat)**
Sobald Vermögenswerte gefunden werden können, müssen sie orchestriert werden, um nützliche Arbeit zu leisten. Der _Agentenmakler_ ist ein Orchestrierungsservice, der Geschäftsprozesse in mehreren Schritten ausführt. Es verwendet eine konfigurierbare LLM, um allgemeine Aufgaben zu interpretieren und entsprechende Workflows zu generieren. Der _Agentenmakler_ erkennt, sequenziert und ruft dynamisch die erforderlichen Agenten und Tools auf, um diese Prozesse abzuschließen.
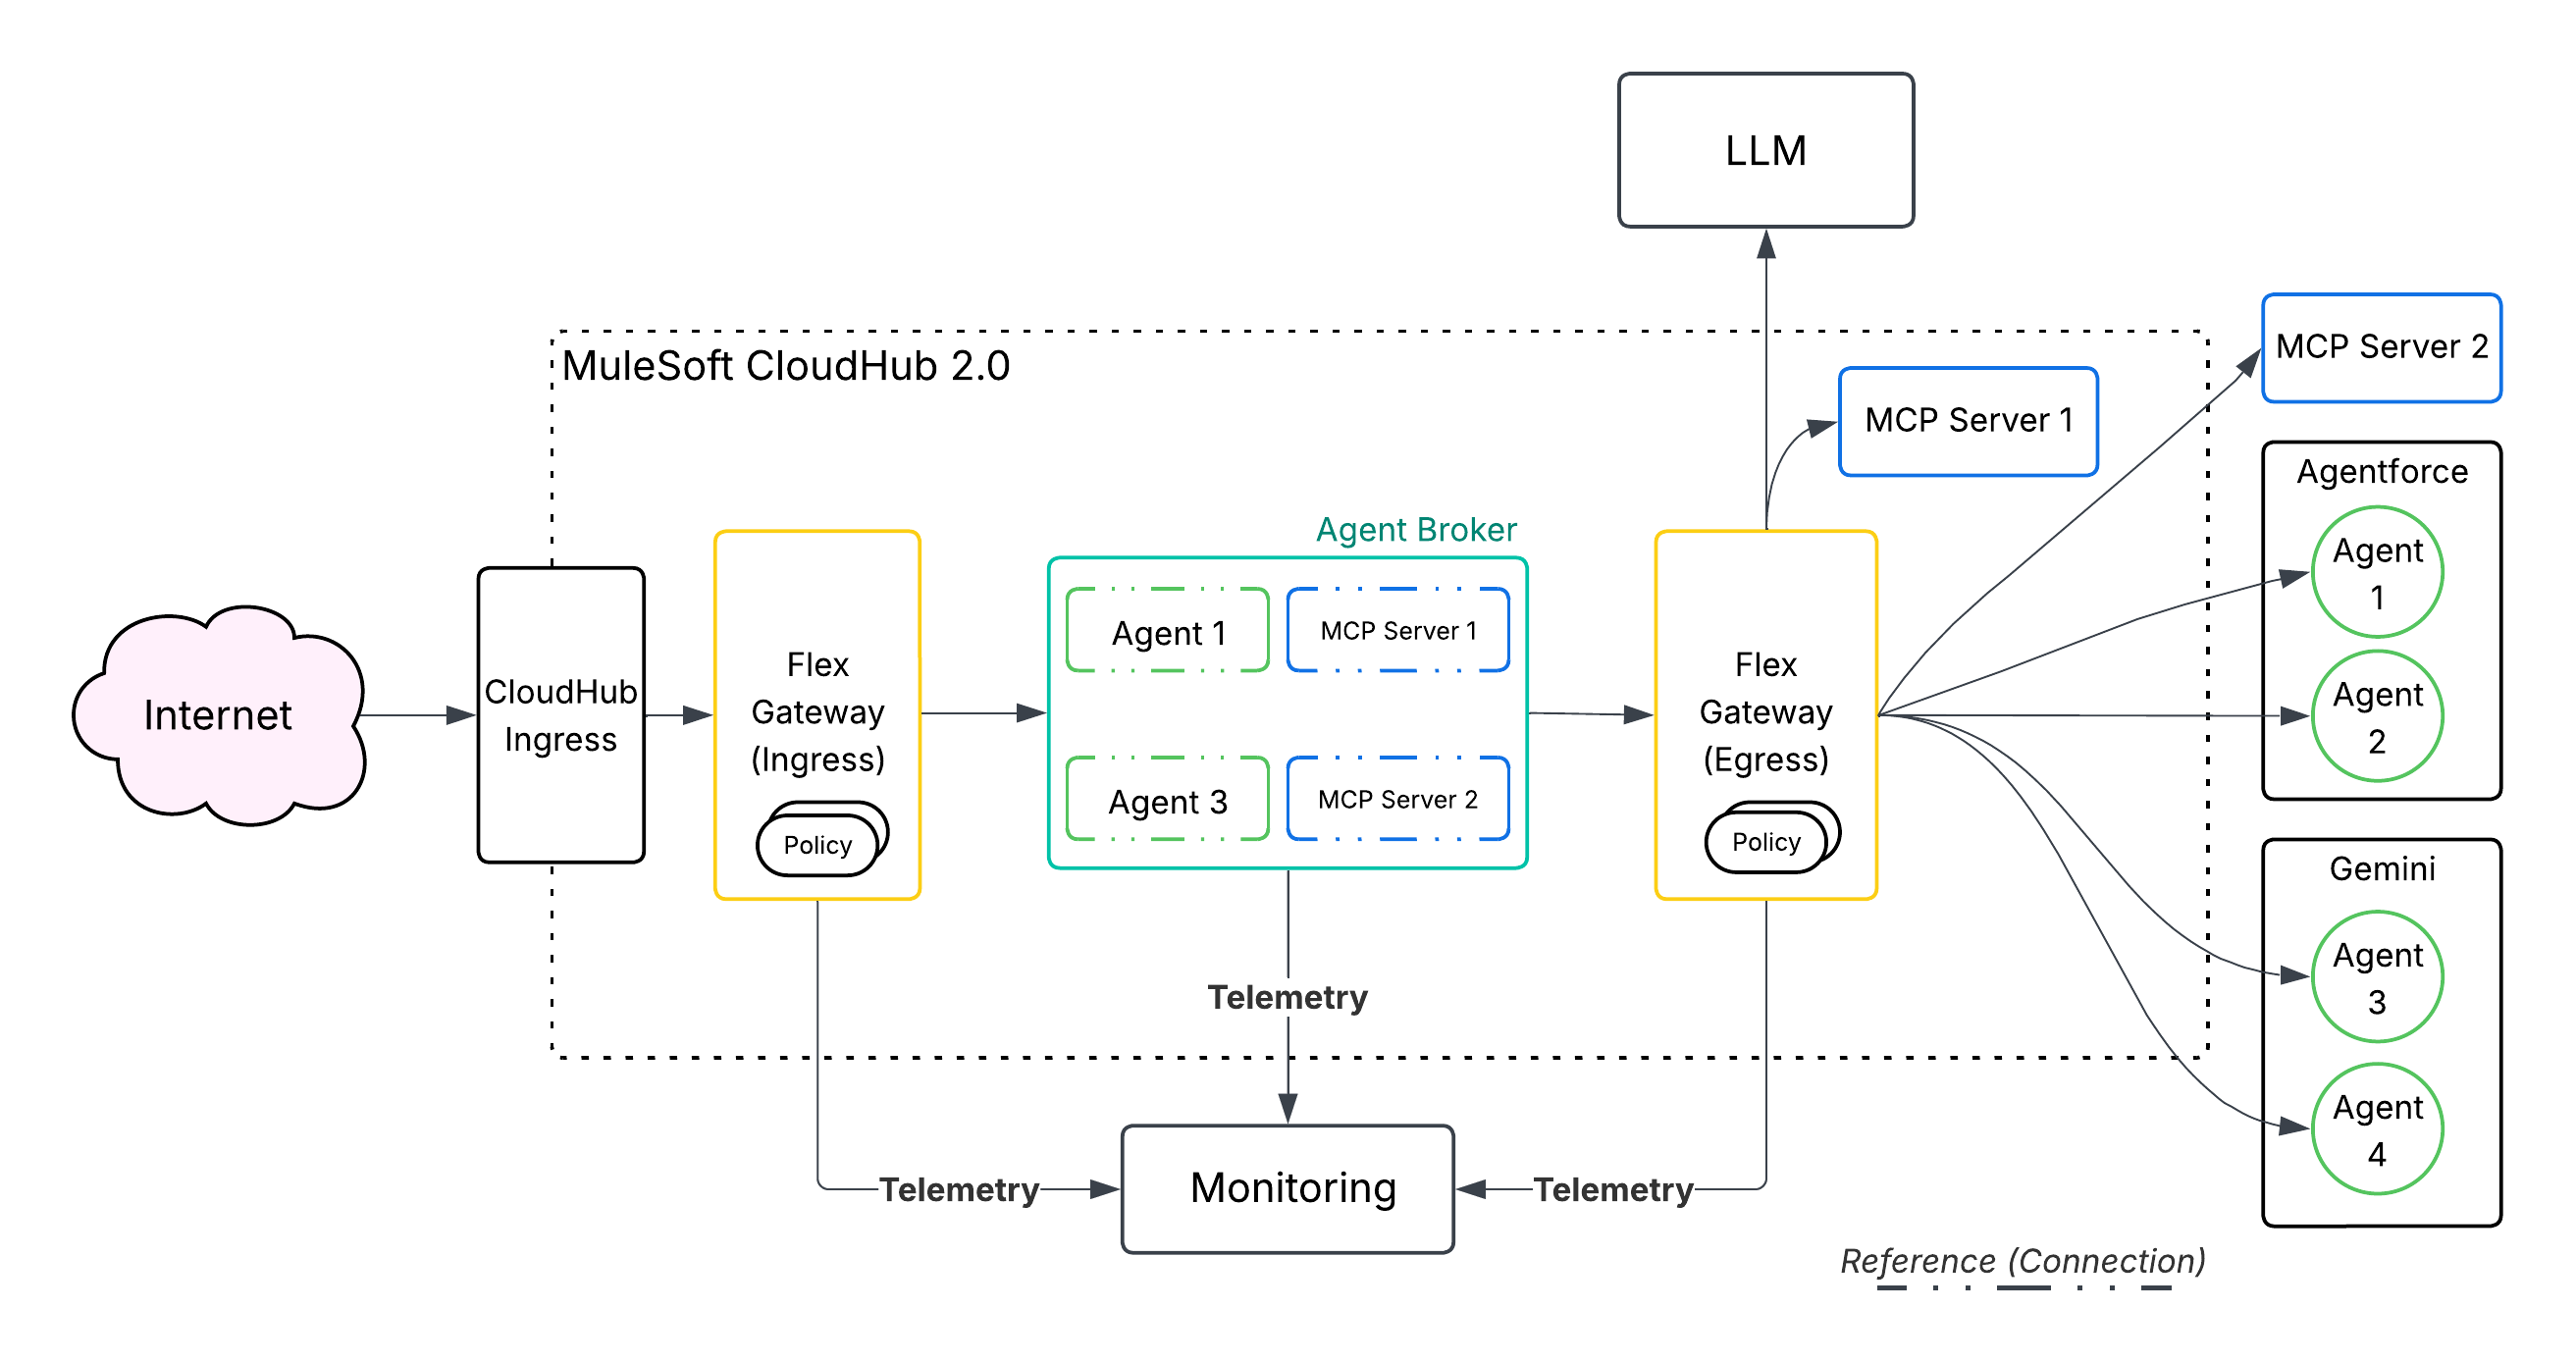 Die Konnektivität wird über das _MCP_ für Tools und ein _A2A-_Protokoll für Agenten verwaltet. Dadurch kann das System Agenten in unternehmensspezifischen Domänen organisieren (z. B. Lieferkette oder Finanzen) und Aufgaben an alle weiterleiten. Eine einzelne Aufforderung in natürlicher Sprache (z. B. "Einarbeitung eines Mitarbeiters") wird in eine Sequenz diskreter Aktionen zerlegt, die von verschiedenen Agenten oder Tools in mehreren Backend-Systemen ausgeführt werden. Die Agentenbroker-Orchestrierung umfasst Folgendes:
- **Dynamisches Orchestrierungsmuster:** Hierbei handelt es sich um ein Agentenschleifenmuster, das Teilaufgaben bestimmt und sie über die am besten geeigneten Agenten und Tools orchestriert, um das Gesamtziel zu erreichen. Mithilfe dieses Musters können [Mitarbeiter](/docs/architect/de-de/fundamentals/guide/agentic-patterns#15-gemeinschaftliche-agenten-agentenbearbeitung) erstellt werden, um komplexe Anwendungsfälle zu lösen (z. B. [Bearbeitung einer komplexen Serviceeskalation](/docs/architect/de-de/fundamentals/guide/agentic-patterns#35-anwendungsfall-gemeinschaftlicher-agent-komplexe-serviceeskalation)).
- **LLM-gestützte Argumentation:** Verwendet ein LLM, um Ziele mit natürlicher Sprache zu interpretieren und Ausführungspläne zu generieren, wodurch hartcodierte, starre Workflow-Logik nicht mehr erforderlich ist.
- **Konfigurierbares LLM-Modell:** Ermöglicht es Entwicklern, anzugeben, welches LLM-Modell verwendet werden soll, wodurch Kosten, Leistung und Funktionen gesteuert werden.
- **Natürliche Sprachentwicklung:** Die Logik _des Agentenmaklers_ kann mithilfe natürlicher Sprache über _MuleSoft Vibes_ definiert werden.
- **Beobachtbarkeit:** Die _Anypoint-Überwachung_ bietet Protokollierung und Verfolgung bei der Bereitstellung, damit Benutzer die Argumentation und Interaktionen von Agent Broker mit _MCP-_Tools und _A2A-_Agenten verstehen und debuggen können.
- **Verwaltete Bereitstellung:** Bei _Agent Broker_ handelt es sich um eine containerisierte Anwendung, die durch _die Maultierlaufzeit_ unterstützt wird, die die Verfügbarkeit und Skalierbarkeit der Bereitstellung verwaltet.
### **3.3 Flex Gateway für MCP und A2A (Govern)**
Das _Anypoint Flex Gateway_ ist der Mechanismus, über den bestimmte Richtlinien technisch erzwungen werden. _MuleSoft Agent Fabric_ nutzt das _Anypoint Flex Gateway_ zum [Sichern, Untersuchen und Verwalten](https://docs.mulesoft.com/gateway/latest/flex-agent-secure) aller über _MCP-_ und _A2A-_Protokolle stattfindenden Agenteninteraktionen. Auf diese Weise können Organisationen eine umfangreiche [Reihe von Unternehmensrichtlinien](https://docs.mulesoft.com/gateway/latest/flex-agent-policies) auf den gesamten Datenverkehr mit Agenten anwenden, um sicherzustellen, dass jede Aktion vor ihrer Ausführung sicher, konform und überprüfbar ist. Für eine sichere und verantwortungsvolle Skalierung der AI-Akzeptanz sind diese Leitplanken entscheidend.
| Policenname | Protokoll(e) | Beschreibung |
| :----------------------------------------------------- | :---------- | :-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **JWT-Validierungsrichtlinie/Erzwingungsrichtlinie für Client-IDs** | A2A, MCP | Die **JWT-Validierungsrichtlinie/Client-ID-Erzwingungsrichtlinie** schützt _A2A-_Agenten und _MCP-_Server, indem der Zugriff nur auf authentifizierte Anrufer eingeschränkt wird. |
| **Schemavalidierung** | A2A, MCP | Durch die **Schemavalidierung wird** sichergestellt, dass eingehende Agentenanforderungen mit der _A2A-_ oder _MCP-_Spezifikation übereinstimmen, wodurch missbräuchlicher Datenverkehr verhindert wird. |
| **A2A PII-Detektor** | A2A | **A2A PII Detector** identifiziert _personenbezogene Daten_ in Anforderungen und Antworten und ermöglicht die Protokollierung oder Blockierung, um die Compliance-Anforderungen zu erfüllen. |
| **A2A-Aufforderungsdekorator** | A2A | **A2A Prompt Decorator** fügt benutzerdefinierten Kontext oder Anweisungen in Aufforderungen ein, die an Agenten gesendet werden, um ihr Verhalten zu steuern und Schutzmaßnahmen durchzusetzen. |
| **Attributbasierte MCP-Zugriffssteuerung** | MCP | Die **attributbasierte MCP-Zugriffssteuerung** regelt den Zugriff auf bestimmte Tools und Ressourcen, die von einem _MCP-_Server auf der Grundlage von Benutzerattributen (z. B. Stufen, IP oder JWT-Claims) bereitgestellt werden. |
| **SSE-Protokollierung** | A2A, MCP | Die **SSE-Protokollierung** zeichnet den Inhalt von _Server-Sent Events (SSE)_-Streams auf, die von Agentenprotokollen für eine umfassende Überprüfung und Rückverfolgbarkeit verwendet werden. |
| **Ratenbegrenzung und Spitzensteuerung** | A2A, MCP | Die **Ratenbegrenzung und Spitzensteuerung** schützt Backend-Agenten und -Systeme vor Datenverkehrsüberflutungen und Denial-of-Service-Angriffen, indem Anforderungsobergrenzen erzwungen werden. |
| **A2A-Agentenkarte** | A2A | Die **A2A-Agentenkarte** schreibt den Agentenkarten-URL um, um sicherzustellen, dass der gesamte Datenverkehr ordnungsgemäß über die regulierte Flex Gateway-Instanz weitergeleitet wird. |
**Unternehmensführungsrichtlinien für Agentenprotokolle**
Das _Anypoint Flex Gateway_ verwaltet nicht nur eingehende Anforderungen, sondern auch alle ausgehenden Verbindungen und Anforderungen eines Agenten an externe Services (z. B. _MCP_-Server und -Tools oder andere Agenten). Dazu zählen:
- **Protokollierung:** Bietet einen zentralen Beobachtungspunkt, um alle ausgehenden Agentenanforderungen zur Überprüfung und Fehlerbehebung zu überwachen und zu protokollieren.
- **Sicherheit:** Verhindert das Lecken vertraulicher Daten, indem der ausgehende Datenverkehr überprüft wird.
- **Authentifizierung:** Verwaltet Anmeldeinformationen für externe Systeme, indem ausgehende Authentifizierungsmechanismen, einschließlich API-Schlüsseln, OAuth und ClientId/ClientSecret, von einem einzigen Punkt aus angewendet werden.
Mit dem _Anypoint Flex Gateway_ [**Policy Development Kit (PDK**)](https://docs.mulesoft.com/pdk/latest/policies-pdk-overview) können Benutzer benutzerdefinierte Richtlinien erstellen, wenn vorkonfigurierte Richtlinien bestimmte Anforderungen nicht erfüllen. Mithilfe der _PDK_ können Entwickler Richtlinienlogik in der Programmiersprache _Rust_ schreiben und zu einem _WASM-_Modul kompilieren. Anschließend wird das eigenständige Modul in das _Anypoint Flex Gateway_ geladen, um eindeutige Sicherheitsregeln, benutzerdefinierte Datentransformationen oder spezielle Integrationslogik direkt am API-Rand zu erzwingen. Dies bietet eine leistungsstarke und leistungsstarke Möglichkeit, die Gateway-Funktionen für einzelne oder komplexe Anwendungsfälle zu erweitern.
Die vier wichtigsten Komponenten der _PDK_:
- **PDK-Plugin für Anypoint CLI:** Dieses Plugin erstellt das _PDK-_Projekt und lädt die kompilierte Richtlinie in _Exchange_ hoch. Außerdem wird eine _Makefile_ generiert, die den Entwicklungsprozess vereinfacht, indem ein klarer Satz an Befehlen zum Erstellen und Verwalten der Richtlinie bereitgestellt wird.
- **Richtlinienvorlage:** Wenn ein neues Projekt erstellt wird, generiert die _PDK_ ein grundlegendes Gerüst oder eine Vorlage. Diese Struktur enthält alle erforderlichen Dateien und Konfigurationen, die zum erfolgreichen Kompilieren der Richtlinie erforderlich sind, was Entwicklern einen Ausgangspunkt für benutzerdefinierte Logik bietet.
- **SDK-Erstellungstools:** Diese Tools abstrahieren die komplexe, ereignisgesteuerte Architektur des zugrunde liegenden _Envoy-_Proxys. Durch die Verwendung von Reaktor- und Ausführungsmustern bietet das _SDK_ eine einfache, lineare Codierungsmethode. Dies hilft, die Komplexität zu reduzieren, das Debugging zu verbessern und die Lernkurve für Entwickler zu senken.
- **Richtlinienverwaltung:** Der [MuleSoft-MCP-Server](https://docs.mulesoft.com/mulesoft-mcp-server/reference-mcp-tools) bietet _MCP-_Tools, mit denen Benutzer den Lebenszyklus benutzerdefinierter Richtlinien verwalten können. Beispiele für diese Tools:
- get_flex_gateway_policy_example
- manage_api_instance_policy
- manage_flex_gateway_policy_project
### **3.4 Agent Visualizer (Beobachten)**
 Der _Agentenvisualisierer_ bietet eine dynamische Echtzeitkarte des gesamten Agentennetzwerks und verwandelt eine Blackbox von AI-Interaktionen in ein vollständig beobachtbares System. Architekten und Betriebsteams können mit dem _Agent Visualizer_ überprüfen, wie Agenten verbunden sind, ihre Entscheidungs-Flows verfolgen, ihren Zustand und ihre Leistung überwachen und Abhängigkeiten identifizieren. Diese Sichtbarkeit ist entscheidend, um die Leistung zu optimieren, Fehler effizient zu beheben, Engpässe zu erkennen und Vertrauen in bereitgestellte Agenten aufzubauen.
## **4\. Salesforce Platform-Zusammenführung**
### **4.1 API-Katalog- und Themencenter**
Der _MuleSoft-API-Katalog_ und das _Themencenter_ sollen die Erkennung, Verwendung und Verwaltung von APIs verbessern, insbesondere in Verbindung mit _Agentforce_.
Alle _MuleSoft_-APIs, die entworfen und veröffentlicht wurden, können über den [API-Katalog](https://help.salesforce.com/s/articleView?id=platform.api_catalog.htm&type=5) in der _Salesforce Platform_ auffindbar und verbrauchbar gemacht werden. Der _API-Katalog_ fungiert als zentralisiertes Repository und vereinheitlicht alle APIs einer Organisation aus _MuleSoft_, _Salesforce_, _Heroku_ und anderen Clouds in einer einzigen Ansicht. Dadurch können Entwickler und Administratoren vorhandene APIs leichter erkennen, verstehen und wiederverwenden, indem sie in Automatisierungen verwendet werden können (z. B. _Agentforce_, _Flow_ und _Apex_).
[MuleSoft für Agentforce: Mit dem Themencenter](https://blogs.mulesoft.com/news/mulesoft-for-agentforce-topic-center/) können Entwickler ihre APIs anhand bestimmter Geschäftsanwendungsfälle strukturieren, indem sie Metadaten zu Agentforce **Themen** und **Aktionen** zum Zeitpunkt des Entwurfs selbst definieren. Dazu zählen:
- **Aktionen**, bei denen es sich um die Aufgaben handelt, die ein Agent ausführen kann
- **Anweisungen**, die den Agenten bei der Anwendung bestimmter Aktionen unterstützen
Durch das [Hinzufügen dieser semantischen Ebene](https://docs.mulesoft.com/anypoint-code-builder/ai-enabling-api-project-topic-center) macht das _Themencenter_ APIs für _Agentforce_ verständlich und verbrauchbar, wodurch sichergestellt wird, dass es effektiv mit Unternehmenssystemen interagieren kann.
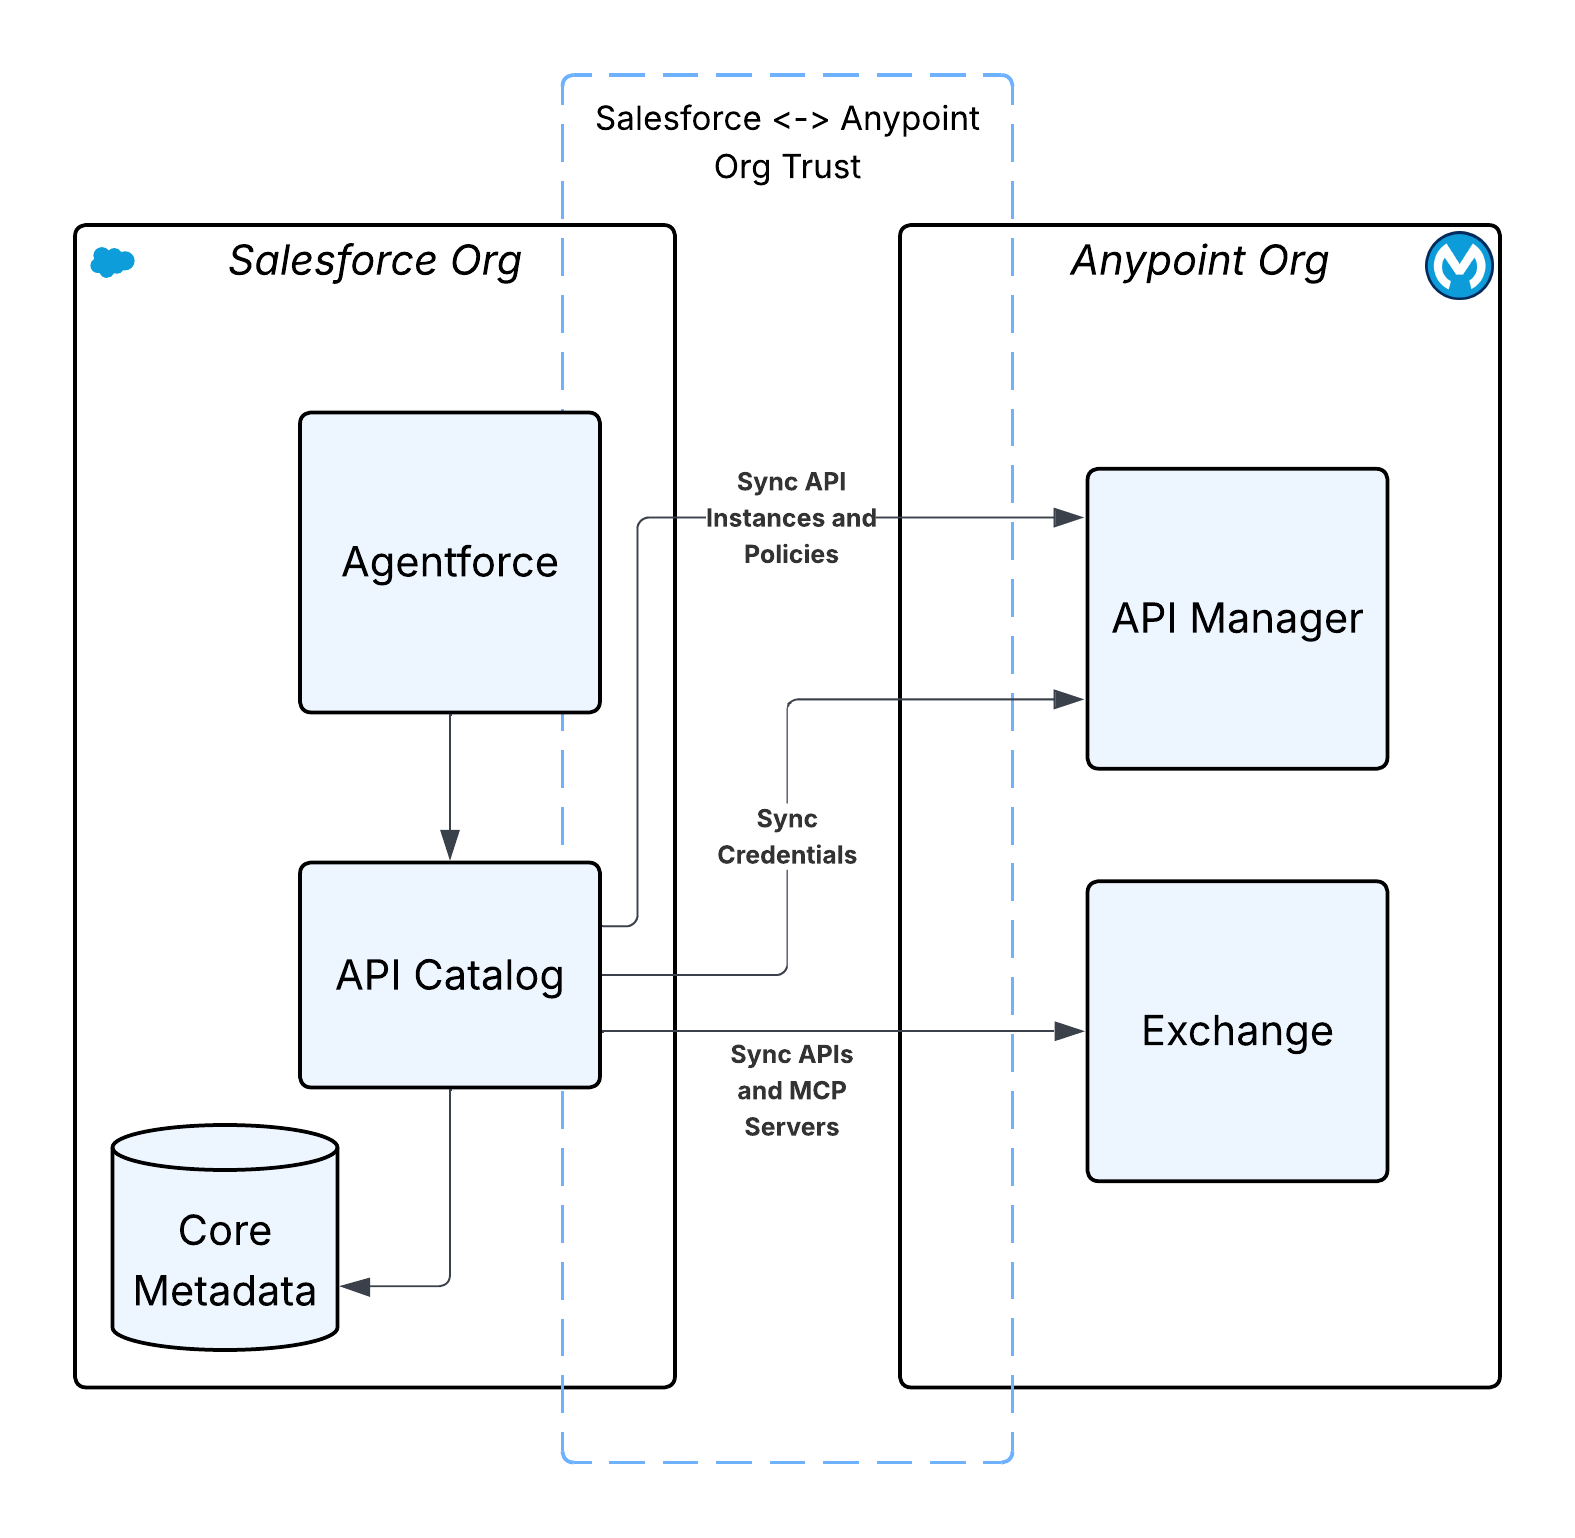 ### **4.2 Agentforce Gateway**
Bei dem _Agentforce Gateway_ handelt es sich um eine zentralisierte Governance-Ebene, mit der Interaktionen im wachsenden Ökosystem von _Agentforce_ verwaltet und geschützt werden sollen. Da _Agentforce_ über Protokolle wie _MCP_ in zusätzliche Drittanbieter-APIs und -Tools integriert wird, besteht die primäre Funktion des _Agentforce Gateway_ darin, Richtlinien (beispielsweise Ratenobergrenzen und Tooleinschränkungen) für den gesamten ausgehenden Datenverkehr, der von _Agentforce_ initiiert wird, zu erzwingen und alle ausgehenden Anforderungen zu prüfen.
Das _Agentforce Gateway_ nutzt das vorhandene _MuleSoft_-API-Governance-Richtlinienmodul, das nativ in die _Salesforce Platform_ integriert ist. Dieses _Beauftragten_-basierte Richtlinienmodul fängt den Agentenverkehr ab, wendet konfigurierte Richtlinien an (z. B. die attributbasierte Zugriffssteuerung und Quotenbegrenzungen) und verwaltet die Authentifizierung und Autorisierung, ohne dass Kunden eine zusätzliche Gateway-Infrastruktur installieren müssen.
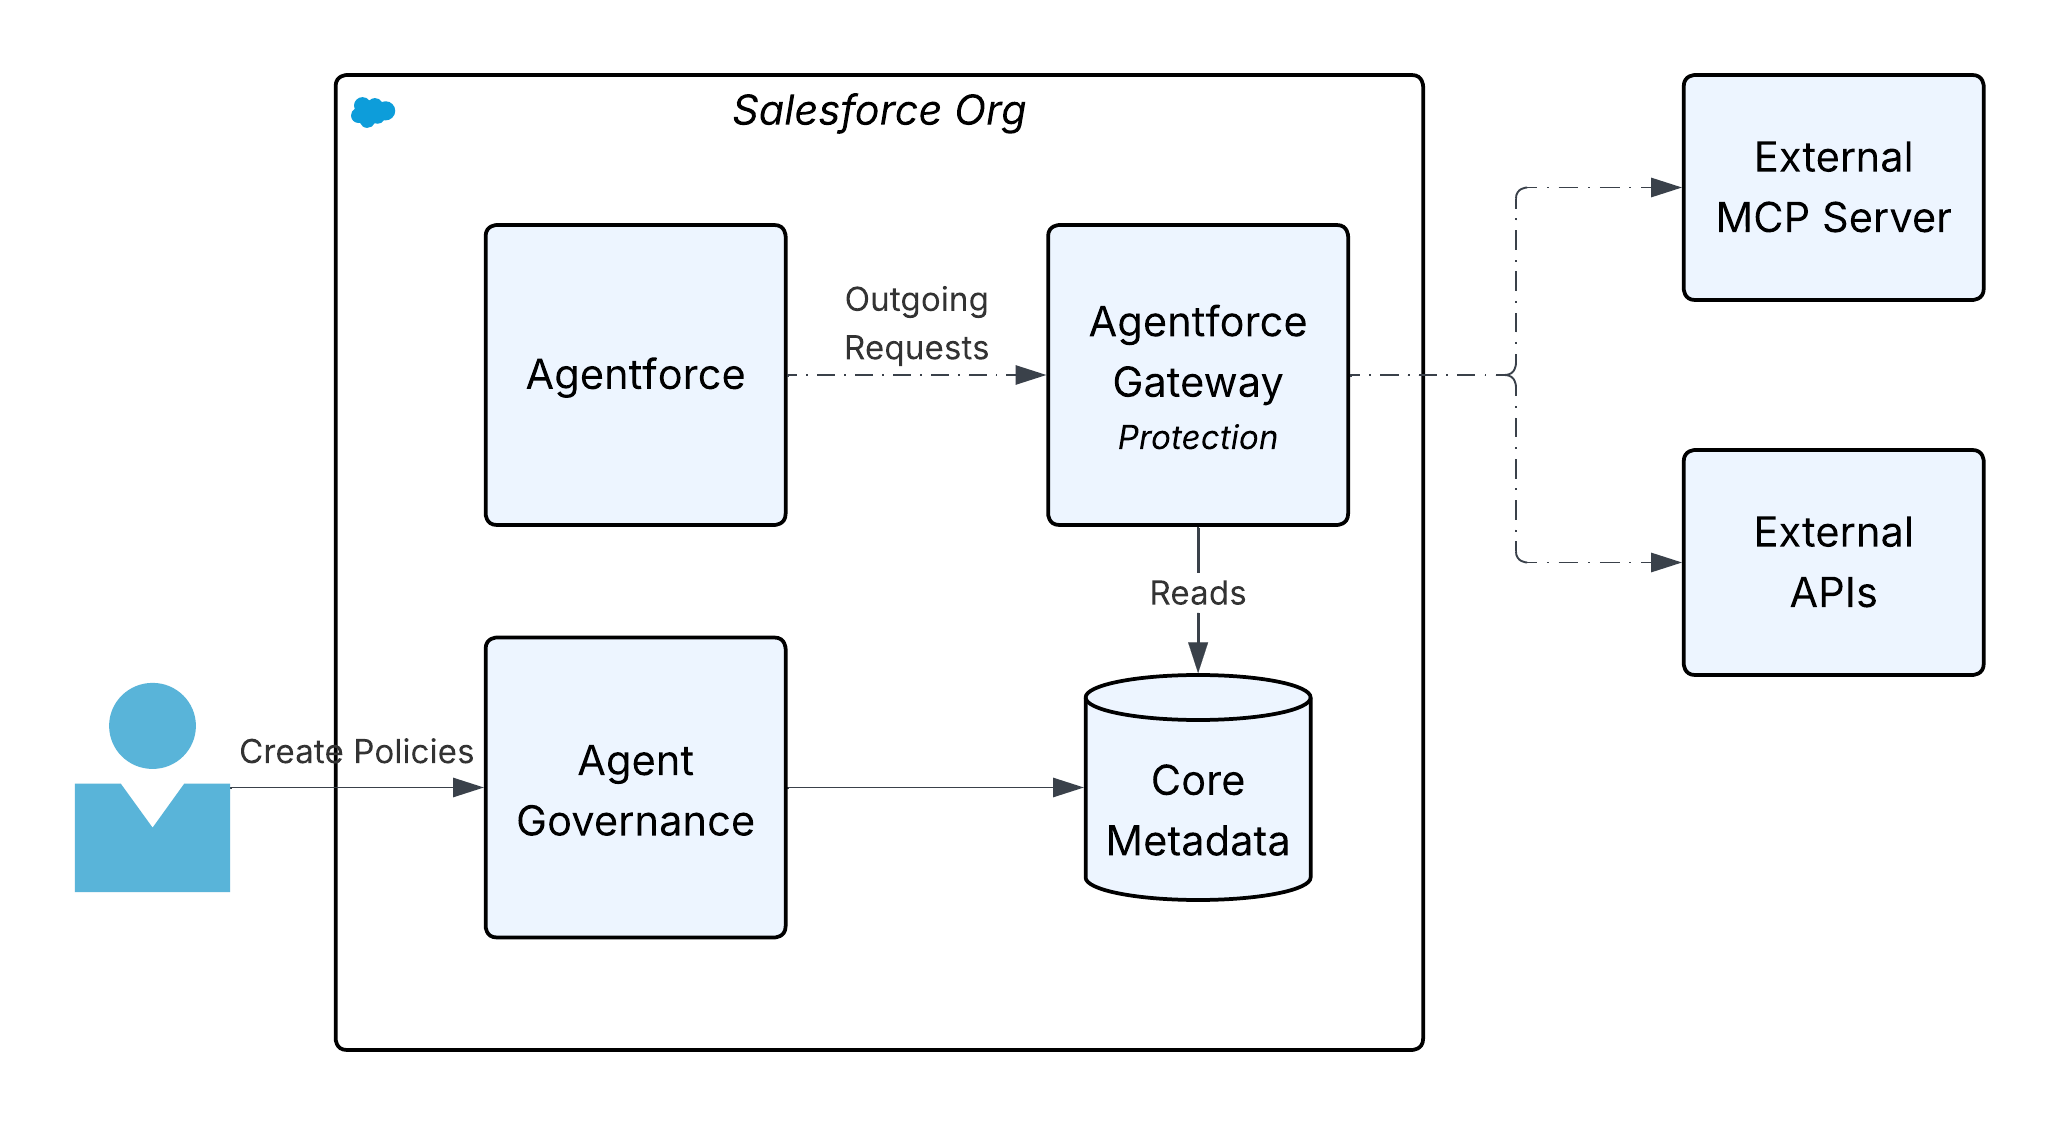 ### **4.3 Integrationsintelligenz**
Die Bereitstellung eines geregelten Agentennetzwerks ist eine wichtige Leistung. Es werden jedoch neue betriebliche Herausforderungen für "Tag 2" eingeführt. Sie erfordert eine verbesserte operative Intelligenz, um ein dynamisches, verteiltes System autonomer Akteure überwachen, messen und beheben zu können. Die ultimative architektonische Vision ist ein System, in dem KI nicht nur zur Ausführung von Geschäftsprozessen verwendet wird, sondern auch zur Überwachung, Verwaltung und Heilung der Infrastruktur, auf der sie ausgeführt wird.
_MuleSofts_ Vision für Integrationsintelligenz nutzt die Leistungsfähigkeit des breiteren _Salesforce_-Ökosystems, um umfassende, anpassbare Statistiken zur Leistung der Integrationsstruktur und des Agentennetzwerks bereitzustellen. Durch das Erfassen und Speichern [von OpenTelemetry-konformen](https://opentelemetry.io/) Daten (dem neuen Standard für die Beobachtbarkeit) in **Salesforce Data 360** können Organisationen ein einheitliches Repository für Protokolle, Kennzahlen und Verfolgungen in ihrer gesamten Landschaft erstellen. Diese Daten können in **Tableau** über vorgefertigte Dashboards und benutzerdefinierte Visualisierungen angezeigt werden, um detaillierte Statistiken zur API-Leistung, zu Agenteninteraktionsmustern und zum allgemeinen Systemzustand zu erhalten.
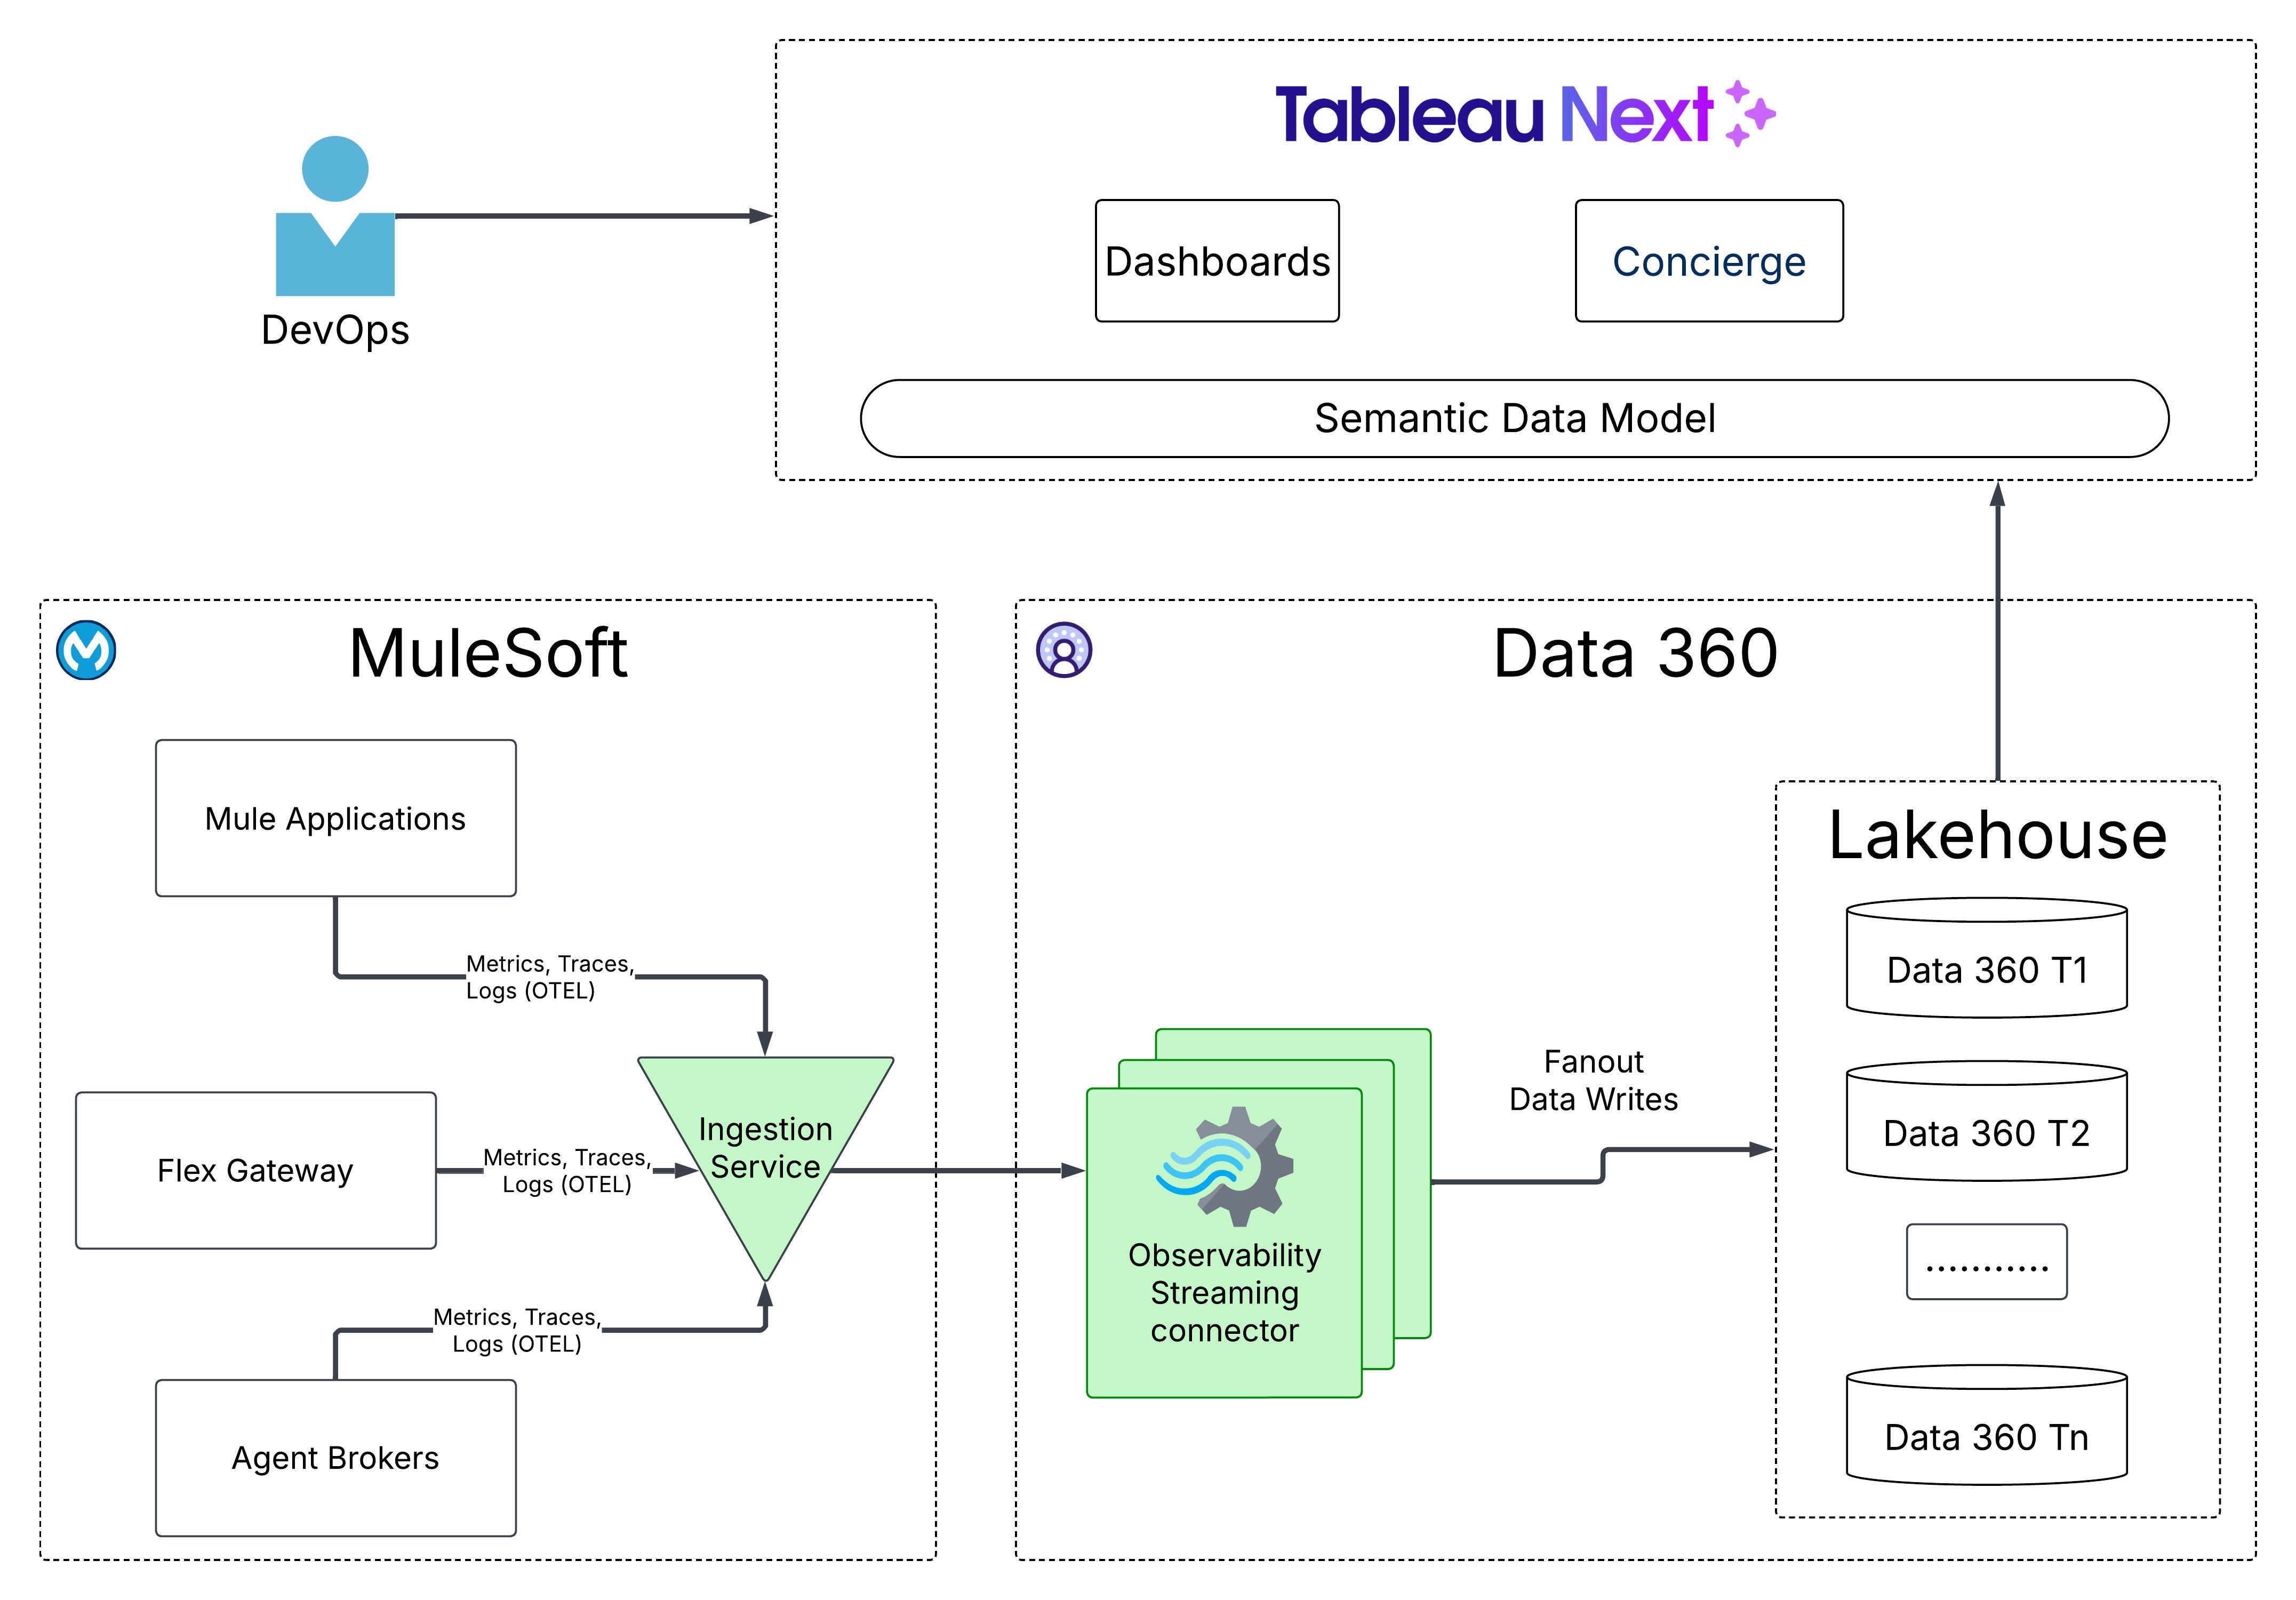 Dieses System verfügt über drei Schlüsselkomponenten:
1. **Aufnahme:** Der Aufnahmeservice ist der zentrale Einstiegspunkt für das Sammeln und Verarbeiten von Telemetriedaten aus verschiedenen _Mule-_Anwendungen, _Agentenmaklern_ und _Flex-Gateways_. Sie führt Schemavalidierung, Datennormalisierung und Filterung durch, um die Datenqualität und Konsistenz in verschiedenen Anwendungen aufrechtzuerhalten. Darüber hinaus werden Kontrollen (z. B. Authentifizierung, Verschlüsselung, Mandantengerechtigkeit und Ratenbegrenzung) in der Aufnahme-Pipeline erzwungen.
2. **Speicher:** In _Data 360_ wird ein Streamingauftrag mit hohem Durchsatz ausgeführt, der Daten aus _Kafka-_Themen mit mehreren Mandanten liest und in das _OTEL-_Format umwandelt. OTEL-Daten werden dann in den _DMOs TelemetryTraceSpan_, _TelemetryLogs_ und _TelemetryMetrics_ im _Lakehouse_ in die _Data 360_ des Mandanten übernommen.
3. **Visualisierung/Verbrauch:** Mit den in _Data 360_ verfügbaren Telemetriedaten können Kunden den Systemstatus überprüfen und Statistiken abrufen, indem sie vorgefertigte oder benutzerdefinierte Dashboards über _Tableau Next_ verwenden. Kunden können auch [Tableau Concierge](https://help.salesforce.com/s/articleView?id=analytics.tua_metric_questions.htm&type=5) verwenden, eine vorgefertigte Agentenanalyse-Fertigkeit in _Tableau Next_, mit der Benutzer Fragen zu Telemetriedaten in natürlicher Sprache stellen und vertrauenswürdige, handlungsrelevante Antworten mit Visualisierungen erhalten können. Kunden können die Daten auch in vorhandene _APM-_Systeme (z. B. _DynaTrace_, _Datadog_, _Splunk_ usw.) exportieren.
## **Schlussfolgerung**
Der Wechsel zu einem Agentic Enterprise ist nicht nur ein IT-Upgrade, sondern ein grundlegender architektonischer Wendepunkt. Eine fragmentierte, isolierte Bereitstellung von AI-Agenten ist ein direkter Weg zu betrieblichem Chaos, Schatten-IT und nicht überschaubarer technischer Verschuldung. Der einzige nachhaltige Weg nach vorn führt über eine einheitliche, komponierbare Architektur. Die _MuleSoft Agent Fabric_ baut auf der bewährten Grundlage der API-geführten Konnektivität auf und bietet das "zentrale Nervensystem", das für die Verwaltung dieser neuen digitalen Belegschaft erforderlich ist. Sie bietet wichtige Funktionen für die Erkennung, Orchestrierung, Unternehmensführung und durchgängige Beobachtbarkeit. Auf diese Weise gehen wir über das Experimentieren mit KI hinaus und beginnen, ein wirklich intelligentes, automatisiertes und sicheres Unternehmen zu entwickeln, das autonome Potenziale in konkrete, gesteuerte Geschäftsergebnisse umwandelt.
## **Technische Anleitungen und Referenzen**
- [Erste Schritte mit dem Anypoint-Codegenerator](https://docs.mulesoft.com/anypoint-code-builder/start-acb)
- [Technischer Leitfaden zu Einstein für den Anypoint-Codegenerator: Generative Flows](https://blogs.mulesoft.com/dev-guides/einstein-for-acb/)
- [DataWeave Generative Transformation Deep Dive: AI-Innovation für die schnelle Datentransformation](https://blogs.mulesoft.com/dev-guides/dataweave-generative-transformation/)
- [Erstellen von API-Spezifikationen mit MuleSoft Dev Agent](https://docs.mulesoft.com/anypoint-code-builder/api-ai-create-spec)
- [Generieren von API-Dokumentation mit generativer AI von Einstein](https://docs.mulesoft.com/exchange/generating-documentation-with-ai)
- [MuleSoft MCP Server – Übersicht](https://docs.mulesoft.com/mulesoft-mcp-server/)
- [MuleSoft MCP Server-Tools](https://docs.mulesoft.com/mulesoft-mcp-server/reference-mcp-tools)
- [MCP-Konnektor](https://docs.mulesoft.com/mcp-connector/latest/)
- [A2A-Konnektor](https://docs.mulesoft.com/a2a-connector/latest/)
- [Erste Schritte mit Agentengewebe](https://docs.mulesoft.com/agent-fabric/learning-map-agent-fabric)
- [Sichern von Agenteninteraktionen mit Flex Gateway](https://docs.mulesoft.com/gateway/latest/flex-agent-secure)
- [Flex-Gateway-Agentenrichtlinien](https://docs.mulesoft.com/gateway/latest/flex-agent-policies)
- [Übersicht über das Flex Gateway Policy Development Kit (PDK)](https://docs.mulesoft.com/pdk/latest/policies-pdk-overview)
- [MuleSoft-API-Katalog für Salesforce](https://help.salesforce.com/s/articleView?id=platform.api_catalog.htm&type=5)
- [Aktivieren eines API-Projekts für Themen und Agentenaktionen](https://docs.mulesoft.com/anypoint-code-builder/ai-enabling-api-project-topic-center)
- [Arbeiten mit Tableau Next](https://help.salesforce.com/s/articleView?id=analytics.tua_consume.htm&type=5)
- [OpenTelemetry](https://opentelemetry.io/)
- [Modellkontextprotokoll](https://modelcontextprotocol.io/docs/getting-started/intro)
- [Agent2Agent (A2A)-Protokoll](https://a2a-protocol.org/latest/)
## Informationen zum Autor
Nikhil Aggarwal ist Principal Architect bei Salesforce, wo er die Architektur für MuleSoft und Salesforce Automation Clouds leitet. Nikhil verfügt über mehr als 18 Jahre Erfahrung in der Bereitstellung von Produkten im großen Stil und ist begeistert von skalierbarer Architektur, intuitiven Entwicklererfahrungen und dem Aufbau leistungsstarker Teams. Vor Salesforce leitete er mehrere Initiativen in Microsoft Power Platform, Dataverse und Office 365 vom Konzept bis zur Einführung. Seine Arbeit prägt weiterhin, wie moderne Unternehmen Systeme verbinden, Workflows automatisieren und Geschäftswerte im Zeitalter der AI-Ersten nutzen.
# Erste Schritte mit Agentforce
In diesem Abschnitt finden Sie praktische Anleitungen für die Erstellung intelligenter AI-Agenten auf der Agentforce Platform von Salesforce, die Agentenmuster, die Implementierung, die Unternehmensarchitektur und den gesamten Entwicklungslebenszyklus abdecken und Ihnen beim Entwerfen und Bereitstellen effektiver agentischer Lösungen helfen.
## Agentenmuster und Implementierung mit Agentforce
[Agentic Patterns and Implementation with Agentforce](/docs/architect/de-de/fundamentals/guide/agentic-patterns) bietet eine technische Erkundung der primären Typen von AI-Agenten und ihrer Erstellung. Dieses Whitepaper behandelt Folgendes:
- **Agententaxonomie**: Die fünf zentralen AI-Agententypen – "Unterhaltung", "Proaktiv", "Umgebung", "Autonom" und "Gemeinschaftlich" – sind den Kundenvorgangsanforderungen zugeordnet.
- **CRM-Anwendungsfälle**: Szenarien der Kundenbeziehungsverwaltung für jeden Agententyp mit Beispielen für reale Geschäftsprozesse.
- **Architekturpläne**: Agentforce Platform-Referenzarchitekturen mit technischen Beispielen zu Flow, Apex, Data 360, A2A-Kommunikation und MCP-Interoperabilität (Model Context Protocol).
- **Implementierungsanleitung**: Der Wechsel von der direkten Manipulation zur zielorientierten Delegierung mit Mustern für Agenten, die in der Lage sind, im Namen der Benutzer zu verstehen, zu argumentieren und zu handeln.
Dieses Whitepaper richtet sich an Entwickler und Architekten, die sich mit den verschiedenen verfügbaren Agententypen vertraut machen möchten und wissen möchten, wie sie effektiv auf der Agentforce Platform implementiert werden können.
## Agentische Architektur und Designmuster für Unternehmen
[Enterprise Agentic Architecture and Design Patterns](/docs/architect/de-de/fundamentals/guide/enterprise-agentic-architecture) (Enterprise Agentische Architektur und Designmuster) bringt Struktur in Architekturen mit mehreren Agenten mithilfe einer musterbasierten Methode. In diesem Dokument wird Folgendes bereitgestellt:
- **Entwurfsmusteransatz**: Entwerfen Sie Musterprinzipien für agentische Lösungen, die auf objektorientierte Musterkonzepte abgestimmt sind und sich auf zuverlässige, wiederholbare, skalierbare und verwaltbare Architekturen konzentrieren.
- **Multi-Agent Rationale**: Die Gründe für Architekturen mit mehreren Agenten, einschließlich Herausforderungen und Opportunities für Unternehmen.
- **Musterkatalog**: Eine Sammlung von Agentenmustern, die von natürlichen sprachgesteuerten Intent-Mustern bis hin zu komplexen Multi-Agenten-Mustern mit getrennten Bedenken und UX-orientierten Agentenmustern für die Argumentation in Präsentations- und Interaktionsebenen reichen.
- **Musterkomponenten**: Standardmusterelemente, einschließlich Komponentendiagrammen, Nutzungsempfehlungen und repräsentativer Anwendungsfälle.
In diesem Whitepaper können Sie Agenten als Komponenten, Komponisten, Schauspieler und Mitwirkende in einer größeren Architektur betrachten. So können Sie umfassende agentische Lösungen entwickeln, die sich auf Benutzer-Journeys erstrecken und Erfahrungen schaffen, die zuvor nicht möglich waren.
## Der Lebenszyklus der Agentenentwicklung: Von der Konzeption bis zur Produktion
[Der Lebenszyklus der Agentenentwicklung: Von der Konzeption bis zur Produktion](/docs/architect/de-de/fundamentals/guide/agent-development-lifecycle) bietet eine umfassende Anleitung zum Agent Development Lifecycle (ADLC), einer auf die Erstellung autonomer Agenten zugeschnittenen Methode. Dieses Dokument behandelt Folgendes:
- **ADLC-Framework**: Der Agent Development Lifecycle (Lebenszyklus der Agentenentwicklung) im Gegensatz zu traditionellen Methoden des Software Development Lifecycle (SDLC), mit Fokus auf autonomen Agenten und nicht deterministischem Verhalten.
- **Fünf Phasen**: Die fünf ADLC-Kernphasen – Idee und Design, Entwicklung (innere Schleife), Test und Validierung, Bereitstellung und kontinuierliche Überwachung und Optimierung (äußere Schleife).
- **Agentforce Platform**: Agentforce-Funktionen über den gesamten Agentenentwicklungslebenszyklus hinweg, einschließlich Agentendesign, Datenverarbeitung, Bereitstellung und kontinuierlicher Überwachung.
- **Pro-Code-Implementierung**: Pro-Code-Workflows und reale Beispiele für die Agentenentwicklung in Agentforce, einschließlich Prototyping, Funktionsentwicklung, Modellbereitstellung, Leistungsoptimierung und Wartung.
Dieses Dokument richtet sich an Entwickler und Enterprise-Architekten, die mit SDLC vertraut sind und ihr Fachwissen auf agentenbasierte Systeme erweitern möchten. Es vermittelt theoretisches Knowledge und praktische Fertigkeiten für die Erstellung von Agenten, die für die Produktion geeignet sind.
## IT-Architektur für das AI-gestützte Agentenunternehmen
[Die](/docs/architect/de-de/fundamentals/guide/agentic-enterprise-it-architecture) IT-Architektur für die AI-gestützte Zukunft ist ein strategischer Leitfaden für CIOs, CDOs und IT-Führungskräfte, die ihre Reise zum Agentenunternehmen planen. Dieses Dokument behandelt Folgendes:
- **IT-Transformation**: IT-Architektur für Unternehmen für die nächsten 3–5 Jahre mit Anforderungen für die Bereitstellung einer Agentenbelegschaft im großen Umfang.
- **Geschäftsfunktionen**: Neue Unternehmensfunktionen, die durch Agentensysteme ermöglicht werden, einschließlich erhöhter menschlicher Produktivität, Anpassungsverbesserung und Organisationsresistenz.
- **Referenzarchitektur**: Strategische Anleitung und Referenzarchitektur für die Integration einer digitalen Belegschaft intelligenter AI-Agenten in menschliche Mitarbeiter.
- **Strategische Planung**: Ansätze für die Unternehmenstransformation, die Informationssilos, manuelle Prozesse und falsch ausgerichtete Anreize für agentische Lösungen angehen.
Dieses Dokument ist wichtig für Führungskräfte, die die strategischen Implikationen und IT-Architekturanforderungen für den Aufbau eines Agentic Enterprise verstehen müssen.
## Entwerfen des Agentenunternehmens mit MuleSoft
Die [Architektur des Agentic Enterprise mit MuleSoft](/docs/architect/de-de/fundamentals/guide/mulesoft-architecting-agentic-enterprise) bietet einen Blickwinkel für die Architektur des intelligenten Unternehmens mit der Integrationsplattform von MuleSoft. Dieses Dokument behandelt Folgendes:
- **Grundlage für Composable Integration**: Das dreischichtige API-geführte Konnektivitätsmodell von MuleSoft – System-, Prozess- und Erfahrungs-APIs – bildet die Grundlage für die Handlungsfähigkeit von Agenten.
- **Agentengewebe**: Funktionen von MuleSoft Agent Fabric für die Agentenerkennung, -orchestrierung, -verwaltung und -beobachtbarkeit im gesamten Agenten-Ökosystem.
- **Unterstützung offener Standards**: Unterstützung für offene Standards wie das Modellkontextprotokoll (Model Context Protocol, MCP) und Agent2Agent (A2A), wodurch einfache Befehle und komplexe Zusammenarbeit mit mehreren Agenten ermöglicht werden.
- **Governance und Sicherheit**: Integration und Governance des vereinheitlichten Agenten für reduzierte Silos, verbesserten Sicherheitsstatus und geringere betriebliche Komplexität.
Dieses Dokument ist nützlich für Architekten, die Agenten in vorhandene Unternehmenssysteme integrieren und eine ordnungsgemäße Verwaltung, Sicherheit und Beobachtbarkeit in ihrem gesamten Agenten-Ökosystem sicherstellen müssen.
## MuleSoft Agent Fabric – Deep Dive
[MuleSoft Agent Fabric - Deep Dive](/docs/architect/de-de/fundamentals/guide/mulesoft-agent-fabric-deep-dive) bietet eine umfassende Übersicht über die Verwendung von MuleSoft Agent Fabric. Sie umfasst Folgendes:
- **Agent Fabric Vision (Vision des Agentengewebes)**: Eine vereinheitlichte Plattform zum Verwalten der Agentenausbreitung und zum Ermöglichen eines geregelten, koordinierten Unternehmensagentennetzwerks über heterogene Agenten und Tools hinweg.
- **Vier zentrale Säulen**: Zentrale Erkennung (Agentenregister), intelligente Orchestrierung (Agentenmakler), Unternehmensführung und -sicherheit (Flex Gateway) und durchgängige Beobachtbarkeit (Agent Visualizer).
- **Spezifikationsbasierte Architektur**: Deklarative, YAML-basierte Agentennetzwerkdefinitionen, die von der Ausführung entkoppelt sind und Übertragbarkeit, Wiederverwendung, Versionierung und Lifecycle Governance ermöglichen.
- **Skalierbare Orchestrierungsmuster**: Hierarchische und domänengesteuerte Agentennetzwerk-Designs für verbesserte Rückverfolgbarkeit, kontrollierte Kontextgröße, Zuverlässigkeit und Vorgänge im Unternehmensbereich.
Dieses Dokument ist nützlich für Architekten und Entwickler, die skalierbare Multi-Agent-Netzwerke entwerfen, orchestrieren und steuern müssen und gleichzeitig Sicherheit, Beobachtbarkeit und nahtlose Integration in Unternehmenssysteme gewährleisten.
# Erste Schritte mit Data 360 und Integration
In diesem Abschnitt wird erläutert, wie Sie Datenplattformen erstellen und Salesforce in Unternehmenssysteme integrieren. In diesen Artikeln erhalten Sie grundlegendes Knowledge zum Erstellen von Architekturen für vereinheitlichte Daten und zum Verbinden von Salesforce mit Ihrem breiteren Technologie-Ökosystem.
## Data 360-Architektur
[Data 360 Architecture](/docs/architect/de-de/fundamentals/guide/data-360-architecture) stellt die Datenplattform der nächsten Generation von Salesforce vor, die für die KI-gestützte Zukunft konzipiert ist. Dieser umfassende Leitfaden behandelt Folgendes:
- **Moderne Datenplattformarchitektur**: Data 360 integriert AI/ML, dezentrale Daten, Cloud-Lakehouses, unstrukturierte Daten, Knowledge Management und Echtzeitverarbeitung.
- **Designprinzipien**: Offenheit, Interoperabilität, Multi-Modell-Speicher, metadatengesteuertes Design, Echtzeit-Hybridverarbeitung, intelligente Daten, Governance und Eins-zu-Viele-Miete.
- **Wichtige Differenzierer**: Verbindet sich mit Snowflake, Databricks, BigQuery und Redshift und erweitert Customer 360, ohne vorhandene Investitionen zu duplizieren.
- **Anwendungsfälle und Funktionen**: Ermöglicht Echtzeitstatistiken, autonome Entscheidungsfindung und vereinheitlichten Zugriff auf strukturierte und unstrukturierte Daten.
Dieses Dokument ist wichtig für Unternehmensarchitekten und CTOs, die ihre Datenstrategie für das Zeitalter des Agentenunternehmens planen, und bietet sowohl strategische Anleitungen als auch technische Einblicke in die Architektur von Data 360.
## Integrationsmuster
[Integrationsmuster](/docs/architect/de-de/fundamentals/guide/integration-patterns) bieten eine umfassende Anleitung zur Integration der Salesforce Platform in andere Anwendungen in Ihrem Unternehmen. Dieses Dokument bietet Folgendes:
- **Musterbasierter Ansatz**: Integrationsmuster für allgemeine Szenarien, die aus erfolgreichen Salesforce-Implementierungen destilliert wurden.
- **Musterauswahlhandbuch**: Eine Matrix zur Auswahl des richtigen Musters für Ihr spezifisches Integrationsszenario.
- **Bewährte Vorgehensweisen für die Integration**: Tipps zum schnellen Erstellen stabiler, skalierbarer und wartbarer Integrationen.
- **Umfassende Abdeckung**: Muster für Echtzeitsynchronisierung, Batchverarbeitung, Datenmigration und ereignisgesteuerte Architekturen.
Dieses Dokument richtet sich an Architekten und Entwickler, die Salesforce in andere Unternehmensanwendungen integrieren müssen. Salesforce-eigene Consulting-Architekten verwenden diese Muster als Referenzpunkte bei Architekturüberprüfungen, was sie zu einer maßgeblichen Anleitung für die Integrationsarchitektur macht.
---
Diese beiden Artikel helfen Ihnen, zu verstehen, wie Sie moderne Datenplattformen mit Data 360 erstellen und Salesforce effektiv in Ihre vorhandenen Unternehmenssysteme integrieren können. Beginnen Sie mit Data 360 Architecture, um die Funktionen der Datenplattform zu verstehen, und erkunden Sie dann Integrationsmuster, um zu erfahren, wie Sie Salesforce mit Ihrem breiteren Technologie-Ökosystem verbinden können.
# Erste Schritte mit Grundlagen
In diesem Abschnitt erhalten Sie grundlegendes Knowledge zum Verständnis der Funktionsweise der Salesforce Platform. Unabhängig davon, ob Sie mit der Salesforce-Architektur noch nicht vertraut sind oder Ihr Verständnis vertiefen möchten, helfen Ihnen diese grundlegenden Artikel, eine solide architektonische Grundlage zu schaffen.
## Salesforce Platform-Architektur
[Architekturgrundlagen](/docs/architect/de-de/fundamentals/guide/architecture-basics) sind der Ausgangspunkt für das Erstellen von Lösungen auf Salesforce Platform. Dieser Artikel behandelt drei wesentliche Bereiche, die jeder Architekt beherrschen muss:
- **Transaktionen**: Erfahren Sie, wie Salesforce Transaktionen über Obergrenzen und Ausführungskontexte definiert und steuert. Machen Sie sich mit der Ausführungsreihenfolge der Plattform vertraut und damit, wie die Datenintegrität über alle Datenbankvorgänge hinweg gewährleistet wird.
- **Metadaten im Vergleich zu Daten**: Erfahren Sie mehr über die wichtige Unterscheidung zwischen Metadaten und Daten und darüber, wie sich dies auf Ihren Anwendungslebenszyklus auswirkt – von der Sandbox-Entwicklung über die Produktionsbereitstellung bis hin zur Paketverwaltung.
- **Plattform-APIs**: Erkunden Sie die verschiedenen verfügbaren Salesforce Platform-APIs, erfahren Sie, wann Sie die einzelnen APIs verwenden sollten, und erfahren Sie, wie Sie die API-Versionierung und -Wartung planen.
Beginnen Sie mit diesem Artikel, um ein grundlegendes Verständnis davon zu vermitteln, wie die Plattform Ressourcen verwaltet, Obergrenzen durchsetzt und APIs für die Anwendungsentwicklung bereitstellt.
## Salesforce Platform – Transformation für morgen
[Die Salesforce Platform – Transformed for Tomorrow](/docs/architect/de-de/fundamentals/guide/platform-transformation) dokumentiert die umfassende Transformation, die die Plattformarchitektur von Salesforce verändert hat. In diesem ausführlichen Whitepaper wird Folgendes erläutert:
- **Moderne Plattformarchitektur**: Erfahren Sie, wie sich Salesforce von einer monolithischen Architektur zu einer Struktur mit unabhängigen Services entwickelt hat, die AI-gestützte Anwendungen und Agentenerfahrungen unterstützt.
- **Hyperforce Infrastruktur**: Erfahren Sie mehr über die Infrastruktur der nächsten Generation von Salesforce, die über mehrere Public Cloud-Anbieter hinweg funktioniert und verbesserte Skalierbarkeit, Compliance und Datenresidenzfunktionen bietet.
- **Architekturprinzipien**: Machen Sie sich mit den sechs Kernprinzipien vertraut, die die Plattformentwicklung steuern: "Enterprise-Grade Trust", "Multitenant Design", "Metadaten-gesteuerte Architektur", "API First" (API First), "Offene und interoperable Systeme" und "Agentische Funktionen".
- **Plattformebenen**: Erkunden Sie die miteinander verbundenen Ebenen, aus denen die moderne Salesforce Platform besteht, von der Infrastruktur bis zur Benutzererfahrung und wie sie zusammenarbeiten, um umfassende Geschäftsfunktionen bereitzustellen.
Dieser Artikel ist eine wichtige Lektüre, um zu verstehen, wie Salesforce sich für die Zukunft von Unternehmensanwendungen positioniert hat, insbesondere im Zeitalter der AI und Cloud-nativen Architekturen.
## Plattform-Mandantenarchitektur
Die [Plattform-Mandantenarchitektur](/docs/architect/de-de/fundamentals/guide/platform-multitenant-architecture) bietet einen detaillierten technischen Einblick in die Bereitstellung zuverlässiger, skalierbarer und anpassbarer Erfahrungen. In diesem Artikel wird erläutert:
- **Mandantendesign**: Erfahren Sie, wie eine einzelne freigegebene Datenbank und ein Schema Mandantenspezifische Daten, Metadaten und Geschäftslogik für Hunderttausende von Organisationen sicher isolieren.
- **Die Plattformdatenebene**: Erkunden Sie das Universal Data Dictionary (UDD), flexible Spalten, Indizierungssysteme und wie die Plattform Metadaten und Daten effizient speichert.
- **Anwendungsentwicklung**: Erfahren Sie mehr über die Unterstützung von No-Code-, Low-Code- und Pro-Code-Entwicklungsansätzen, einschließlich browserbasierter Tools, APIs, Abfragesprachen und Apex.
- **Interne Verarbeitung**: Erfahren Sie, wie die Plattform Abfragen, Suchvorgänge, Massenvorgänge, Schemaänderungen und die Isolierung mehrerer Mandanten verarbeitet, um optimale Leistung und Sicherheit zu gewährleisten.
Diese technische Zusammenfassung ist von unschätzbarem Wert für Architekten, die die zugrunde liegenden Mechanismen verstehen müssen, die Salesforce Platform skalierbar, sicher und anpassbar machen.
## Plattformfreigabearchitektur
Die [Plattformfreigabearchitektur](/docs/architect/de-de/fundamentals/guide/platform-sharing-architecture) ist Ihr umfassender Leitfaden zum Entwerfen sicherer Datenzugriffsmodelle. Dieses Dokument behandelt Folgendes:
- **Freigabekomponenten**: Erfahren Sie mehr über alle Komponenten, aus denen das Freigabemodell besteht, einschließlich Profilen, Berechtigungssätzen, Rollenhierarchien, organisationsweiten Standardeinstellungen, Freigaberegeln, Teams, Regionen und mehr.
- **Implementierungsszenarien**: Erkunden Sie reale Kundenszenarien und erfahren Sie, wie verschiedene Freigabekomponenten zusammenarbeiten, um komplexe Anforderungen an den Datenzugriff zu erfüllen.
- **Bewährte Vorgehensweisen**: Machen Sie sich mit den Überlegungen zu großen Datenmengen, Verzerrungen bei der Inhaberschaft, der Regionsverwaltung und der Planung von Organisationsänderungen vertraut.
- **Fehlerbehebung**: Führen Sie einen systematischen Ansatz aus, um zu diagnostizieren, warum Benutzer auf Datensätze zugreifen können oder nicht, und erfahren Sie, wie Sie allgemeine Probleme mit Freigabemodellen lösen können.
Unabhängig davon, ob Sie ein neues Freigabemodell entwerfen oder ein vorhandenes optimieren, bietet dieses Handbuch das Knowledge, das Sie zum Erstellen sicherer, flexibler und wartungsfreundlicher Datenzugriffsarchitekturen benötigen.
---
Diese vier Artikel bilden die Grundlage für Knowledge der Salesforce Platform-Architektur. Es wird empfohlen, sie zu lesen, um Ihr Verständnis schrittweise von grundlegenden Konzepten zu erweiterten Architekturmustern aufzubauen.
# Erste Schritte mit zusätzlichen Ressourcen
In diesem Abschnitt erfahren Sie, wie Sie bewährte Vorgehensweisen und Designmuster auf alle Salesforce Platform-Funktionen anwenden, einschließlich Flows, Apex und zugehöriger Tools.
## Schrittbasiertes asynchrones Framework
## Zusätzliche Ressourcen
Das [schrittbasierte Aysnc-Framework](/docs/architect/de-de/fundamentals/guide/step-based-async-framework) ist ein Verarbeitungs-Framework zum Ausführen asynchroner Aufträge mit einer beliebigen Anzahl von Schritten. Dieser Artikel behandelt drei wesentliche Bereiche, die jeder Architekt beherrschen muss:
- **Planung und Aufruf**: Verwendet "Geplanter Flow" und "Aufrufbarer Apex", um die Ausführung mit Umgebungsprüfungen und Fehlerbehandlung zu orchestrieren, auszulösen und zu steuern.
- **Schrittdesign und Flexibilität**: Definiert eine wiederverwendbare Schrittoberfläche mit Unterstützung für Apex, Flow, cursorbasierte Verarbeitung und konfigurierbare Muster wie Funktionskennzeichnungen und Schritte ohne Op.
- **Orchestrierungs- und Ausführungsmodul**: Nutzt einen Schrittprozessor zum Sequenzieren, Ausführen, Wiederholen und Verwalten von Schritten mit zentraler Protokollierung und Lebenszyklussteuerung.
Dieser Artikel bietet ein skalierbares, schrittbasiertes asynchrones Framework für Salesforce, das komplexe Prozesse in modulare, unabhängig ausführbare Schritte mit zentraler Orchestrierung, Protokollierung und Leistung bei hohem Volumen aufschlüsselt.
## Salesforce-Datensynchronisierung
Das [schrittbasierte Aysnc-Framework](/docs/architect/de-de/fundamentals/guide/data-synchronization) ist der zentrale Funktionsteil von Salesfore CRM Analytics. Es ist die native Business Intelligence-Plattform des Ökosystems für interaktive Dashboards und AI-gestützte Statistiken und ermöglicht die nahtlose bidirektionale Datenbewegung mit externen Systemen durch zwei zentrale Funktionen: SyncOut und SyncIn. CRM Analytics SyncOut überträgt Salesforce-Objektdaten an externe Plattformen und unterstützt sowohl die vollständige als auch die inkrementelle Datenerfassung (CDC) sowie die integrierte Verfolgung der endgültigen Löschung, um die absolute Datenintegrität nachgelagert zu gewährleisten. Nach Abschluss der Schleife ruft CRM Analytics SyncIn externe Daten zurück in Salesforce-Objekte und nutzt die Bulk-API 2.0, um Datensets mit hohem Volumen zuverlässig und effizient aufzunehmen und sofort einsatzbereit zu sein. In diesem Dokument wird am Beispiel von Snowflake erläutert, wie das Muster funktioniert, wann es verwendet werden soll und wie Sie loslegen.
## Salesforce-Datenvirtualisierung
Das [schrittbasierte Aysnc-Framework](/docs/architect/de-de/fundamentals/guide/data-virtualization) ist ein Integrationsarchitekturmuster, mit dem Salesforce Daten zur Laufzeit direkt aus externen Systemen abfragen kann, ohne diese Daten in den Salesforce-Speicher kopieren oder replizieren zu müssen.Statt Daten in Salesforce zu verschieben, kann Salesforce Daten direkt an der Quelle zur Laufzeit abfragen, ohne Abgleich. Benutzern werden externe Live-Daten über Salesforce-Standardoberflächen angezeigt. Die Daten verlassen niemals ihren maßgeblichen Speicherort. In diesem Dokument wird erläutert, wie das Muster funktioniert, wann es verwendet werden soll und wie Sie loslegen können, indem Sie Snowflake als konkretes Beispiel verwenden.
## Architekturmuster für Field Service: Optimieren der Freigabe und Sichtbarkeit von Vertragsnehmern im richtigen Maßstab
[Architekturmuster für Field Service: Bei der Optimierung der Freigabe und Sichtbarkeit von Vertragsnehmern im richtigen Maßstab](/docs/architect/de-de/fundamentals/guide/field-service-contractor-sharing-patterns) werden zwei Architekturmuster für die Verwaltung externer Vertragsnehmernetzwerke in Salesforce Field Service verglichen: **regionsbasierte Freigabe** und **accountbasierte Freigabe**. Dieser Leitfaden behandelt Folgendes:
- **Personas des Vertragsnehmers**: "Benannte Vertragsnehmer", "Vertragsnehmerunternehmen" und "Gelegenheitsarbeiter" und wie jede Persona die entsprechende Freigabearchitektur formt.
- **Regionsbasierte Freigabe**: Verwenden von dedizierten Serviceregionen als primäre Sicherheitsgrenze und der Kompromisse bei der Skalierbarkeit dieses Ansatzes im richtigen Maßstab.
- **Accountbasierte Freigabe**: Trennen Sie die Sichtbarkeit von der geografischen Region mithilfe von kriterienbasierten Freigaberegeln, um einen einheitlichen Ressourcenpool zwischen Vertragsnehmern und internen Technikern zu ermöglichen.
- **Beschlussrahmen**: Eine Entscheidungsstruktur und Vergleichsmatrix für die Auswahl des richtigen Musters auf der Grundlage von Wettbewerbsüberschneidungen und geografischer Exklusivität.
Hilft Architekten, die Plattformsicherheit mit der Planungsleistung in Einklang zu bringen, und schafft gleichzeitig eine Grundlage, die mit Agentforce und Data Cloud skaliert werden kann.
# Einführung
_Hinweis: "Themen" wurden in diesem Artikel gemäß unseren neuesten Produktbenennungskonventionen in "Nachhaltige" umbenannt._
Sie können einen Agenten erstellen, der in einer Testumgebung gut funktioniert, nur damit er beim zweimaligen Verarbeiten desselben Workflows völlig unterschiedliche Routen beschreitet. Diese grundlegende Einschränkung zeigt, wie das vorherige Agentforce Modell die Ausführung verarbeitet hat: Jede Entscheidung – von der Intent-Interpretation bis zur Aktionsauswahl – wurde vom LLM in Echtzeit getroffen, ohne dass ein garantierter Pfad durch den Workflow vorhanden war.
LLMs können als Reaktion auf identische Eingaben zu inkonsistenten Ergebnissen führen. Subtile Variationen des Kontexts, der Systemaufforderungen oder der Tokengenerierung reichen aus, um einen Agenten auf eine andere Route zu schicken. Für viele Interaktionen ist diese Variabilität akzeptabel. Bei mehrstufigen Workflows, die Überprüfbarkeit, Reproduzierbarkeit und Rückverfolgbarkeit erfordern, ist dies jedoch nicht der Fall. Eine Darlehensgenehmigung, eine Inventarübertragung oder ein Patientenprobeprozess kann nicht von einem Agenten abhängen, der sich jedes Mal anders durch die Schritte schleicht.
Der neue Agentforce Builder und das Agentenskript lösen dieses Problem, indem sie die deterministische Ausführung von der LLM-Überlegung trennen. Das Hybridmodell von Agentforce stellt sicher, dass der Agent bei jeder Workflow-Ausführung einer genau definierten Struktur folgt, während er dennoch LLM-Überlegungen verwendet, bei denen Urteilsvermögen, natürliches Sprachverständnis oder Kontextinterpretation wirklich erforderlich sind.
## Vorherige Einschränkungen für Agentforce
In der vorherigen Version von Agentforce funktionierte ein Agent als einfache reaktive Schleife. Jede Entscheidung – von der Interpretation des Intents bis zur Auswahl der nächsten Aktion – wurde in Echtzeit von der LLM ausschließlich anhand der neuesten Eingaben des Benutzers getroffen. Es gab keinen garantierten Ausführungspfad, keinen persistenten Status und keinen Mechanismus zum Erzwingen einer Sequenz von Schritten.
**Ausführungspfade konnten nicht garantiert werden**
Da jede Entscheidung von der Echtzeitüberlegungen des LLM abhing, führten geringfügige Variationen in der Eingabe, der Systemaufforderung oder der Modellversion zu unterschiedlichen Aktionsauswahlen für identische Anforderungen. Dadurch war das Vorgängermodell schwer zu testen: Ein in der Staging-Phase übergebener Workflow konnte sich in der Produktion anders verhalten und es gab keine zuverlässige Möglichkeit, einen bestimmten Ausführungspfad zu Debugging- oder Überwachungszwecken zu reproduzieren.
**Jede Interaktion hat die vollen LLM-Kosten bezahlt**
Selbst für einfache Unterhaltungsszenarien waren mindestens drei LLM-Zyklen erforderlich: Auswahl des Unteragenten, Aktionsauswahl und Generierung der endgültigen Antwort. Aufgaben mit mehreren Schritten, die auf fünf oder mehr Zyklen erweitert wurden. Für Architekten, die Workflows mit hohem Volumen oder Latenzempfindlichkeit entwerfen, war dies nicht nur ein Leistungsproblem. Das bedeutete, dass Sie die Argumentationsschleife für Schritte, die kein Urteil erfordern, nicht kurzschließen konnten, da die Architektur keinen Mechanismus zum Unterscheiden zwischen beiden hatte.
**Nicht deterministische Ausführung führte zu einer Überprüfungslücke**
In regulierten Branchen bedeutet Überprüfbarkeit, nachweisen zu können, dass ein bestimmter Prozess für eine bestimmte Transaktion auf eine bestimmte Weise befolgt wurde. Ein rein nichtdeterministisches Modell kann diese Garantie nicht bieten. Wenn der Ausführungspfad zwischen Ausführungen variiert, variiert auch der Überprüfungspfad und "der Agent hat entschieden" ist keine vertretbare Antwort in einer Konformitätsüberprüfung.
**Das Bundesland hat die Unterhaltung nicht überlebt**
Wenn der Agent sich auf die Single-Turn-Verarbeitung verließ, hatte er keine persistente Erinnerung an frühere Schritte. Wenn die Unterhaltung auch nur geringfügig abweicht, kann der Agent zuvor erfassten Kontext verwerfen und den Benutzer zwingen, neu zu starten. Bei mehrstufigen Transaktions-Workflows wurde dadurch eine Zuverlässigkeitsobergrenze festgelegt: Je mehr Schritte im Prozess, desto höher ist die Wahrscheinlichkeit eines Kontextverlusts vor Abschluss.
**Abgeschlossene Schritte wurden nicht gespeichert**
Ohne die Staatsverwaltung hatten Agenten keine Aufzeichnungen darüber, welche obligatorischen Schritte ein Benutzer bereits abgeschlossen hatte. Dies führte zu einer unvorhersehbaren Schleife, bei der ein Agent zu einem Schritt zurückkehrte, den der Benutzer bereits abgeschlossen hatte. Neben den Auswirkungen auf die Benutzererfahrung führte dies zu einem tieferen architektonischen Problem: Das Entwerfen eines zuverlässigen sequenziellen Workflows war unmöglich, da der Agent die Sequenz nicht erzwingen konnte.
## Funktionsweise der neuen Agentforce Architektur
Die neue Agentforce, die seit Februar 2026 allgemein verfügbar ist, wechselt von rein probabilistischen LLM-Überlegungen zu einem Hybridmodell. Statt jede Entscheidung durch das LLM weiterzuleiten, wird die deterministische Ausführung von der LLM-Überlegung getrennt und jeder kann nur das verarbeiten, wofür er geeignet ist. Zur Unterstützung hat Agentforce zwei Erstellungstools eingeführt: Agentenskript für die codebasierte Entwicklung und Agentforce Studio, eine Umgebung ohne Code.
**Agentforce Builder**
Agentforce Builder ist die empfohlene Umgebung für die Entwicklung neuer Agenten. Sie wird in Agentforce Studio gehostet und ersetzt die alte Setup-Erfahrung, die weiterhin verfügbar ist, aber nicht mehr der primäre Erstellungspfad ist. Im Generator arbeiten Sie entweder in einer visuellen Zeichenbereichsansicht oder direkt in der Skriptansicht und bearbeiten das Agentenskript, das das Verhalten Ihres Agenten definiert.
**Agentenskript**
Agentenskript ist eine deklarative, domänenspezifische Sprache (DSL), die alles über das Verhalten eines Agenten definiert: Konfiguration, Geschäftslogik und Aufforderung. Sie ist als Schlüssel-Wert-Paare strukturiert, die sich über mehrere Zeilen erstrecken oder verschachtelte Untereigenschaften enthalten können, und ist so konzipiert, dass sie für Menschen lesbar ist, ohne Knowledge über die zugrunde liegende Diagrammarchitektur zu benötigen.
Mit Agentenskript können Sie zwei grundlegend unterschiedliche Arten von Anweisungen im selben Agenten ausdrücken: Anweisungen zur deterministischen Logik und Aufforderungsanweisungen. Deterministische Logikanweisungen definieren Bedingungen und Aktionssequenzen, die als Code ohne LLM-Beteiligung ausgeführt werden. Eingabeaufforderungsanweisungen definieren die Hilfestellung für natürliche Sprachen, die von der LLM zur Laufzeit interpretiert wird. Die Grenze zwischen beiden ist explizit und bewusst. Wenn Sie wissen, wo diese Grenze platziert werden soll, ist dies eine der wichtigsten Designentscheidungen, die Sie beim Erstellen mit der neuen Agentforce treffen werden.
**Deterministische Logik in der Praxis**
Wenn Anweisungen deterministisch sind, folgt der Agent einem definierten Ausführungspfad, unabhängig davon, wie der Benutzer seine Eingabe formuliert. Im folgenden Beispiel wird ein Unteragent gezeigt, der ein Dashboard für Kundenintelligenzen lädt. Sie sucht nach einer Kunden-ID, ruft Profildaten, den Auftragsverlauf und Support-Tickets ab und berechnet dann den Kundenlebenszeitwert und das Abwanderungsrisiko. Für keinen dieser Schritte ist eine LLM-Überlegung erforderlich.
Diese Logik ruft Aktionen in einer festen Reihenfolge auf, sobald bestimmte Bedingungen erfüllt sind.
```
instructions: ->
# Ask for user_id if we don't have it
if @variables.user_id=="":
| Ask the user for customer ID to view personalized insights. Do not proceed until you have the customer ID.
Use {!@actions.set_user_id} to update the user_id variable and set context.
# Fetch customer data if we have user_id
if @variables.user_id!="":
run @actions.fetch_user_profile
with user_id=@variables.user_id
set @variables.user_profile = @outputs.profile
# Chain additional data fetches
run @actions.fetch_account_data
with user_id=@variables.user_id
set @variables.account_data = @outputs.account
run @actions.fetch_order_history
with user_id=@variables.user_id
with limit=10
set @variables.recent_orders = @outputs.orders
run @actions.fetch_support_history
with user_id=@variables.user_id
set @variables.support_history = @outputs.tickets
# Compute insights
run @actions.calculate_customer_value
with user_id=@variables.user_id
with orders=@variables.recent_orders
set @variables.customer_lifetime_value = @outputs.clv
set @variables.loyalty_status = @outputs.loyalty_tier
run @actions.assess_churn_risk
with account=@variables.account_data
with orders=@variables.recent_orders
with support_tickets=@variables.support_history
set @variables.churn_risk_score = @outputs.risk_score
run @actions.generate_recommendations
with profile=@variables.user_profile
with clv=@variables.customer_lifetime_value
with churn_risk=@variables.churn_risk_score
set @variables.recommended_actions = @outputs.recommendations
```
**Aufforderungsanweisungen und bewusste LLM-Übergabe**
Wenn deterministische Logik Bedingungen und Sequenzen verarbeitet, die als Code ausgedrückt werden können, verarbeiten Aufforderungsanweisungen alles, was Urteilsvermögen, Interpretation oder die Generierung natürlicher Sprache erfordert. Wenn das Atlas Reasoning Engine auf einen Knoten mit Aufforderungsanweisungen stößt, wird ein LLM-Aufruf ausgelöst. Andernfalls wird er deterministisch ausgeführt.
Das folgende Beispiel zeigt einen Unteragenten für Produkte und Services. Bei den Anweisungen handelt es sich um eine mehrzeilige Eingabeaufforderung, mit der die LLM informiert wird, wie sie antworten, wann sie Informationen nachschlagen und wie sie mit Mehrdeutigkeiten umgehen soll. Dies ist das richtige Muster, wenn der Bereich der möglichen Benutzereingaben zu breit ist, um sie mit bedingter Logik zu antizipieren, oder wenn die Qualität der Antwort von der Fähigkeit des LLM abhängt, den Kontext zu interpretieren und eine natürliche Antwort zu generieren.
Die Aufforderungsanweisungen für einen Knoten lösen den LLM-Aufruf aus. Das ist kein Zufall – es ist der Mechanismus, mit dem das Agentenskript die LLM-Grenze explizit und erzwingbar macht, statt sie der Laufzeitableitung zu überlassen.
Dieser Unteragent zeigt deterministische Logik und LLM-Übergabe in Aktion.
```
instructions:->
| Answer the user's questions about products and services clearly and accurately.
When the user asks about a specific product, use {!@actions.get_product_info}
to look up current information.
When answering:
- Be specific and provide helpful details
- If the question is unclear, ask for clarification
- Stay focused on product-related subagents
- Use {!@actions.get_product_info} to get accurate, up-to-date information
Subagents you can help with:
- Product features and specifications
- Pricing and packages
- Availability and delivery
- Comparisons between products
```
**Die dreistufige Ausführungs-Pipeline**
Der Agentforce Builder und das Agentenskript sind die Erstellungsebene, das Agentendiagramm und das Atlas Reasoning Engine führen Ihren Agenten jedoch tatsächlich aus. Designbedingt ist keine dieser Komponenten für Sie direkt zugänglich. Durch die Trennung von Erstellung und Ausführung kann die Plattform deterministisches Verhalten unabhängig davon erzwingen, wie das Skript geschrieben wurde.
Die Pipeline durchläuft drei Phasen.
1. Beim **Autorisieren** arbeiten Sie. Das Agentenskript ist für Menschen lesbar und kann in der Zeichenbereichsansicht oder in der Skriptansicht im Agentforce Builder bearbeitet werden. Dies ist die einzige Ebene, mit der Sie direkt interagieren.
2. Bei der **Kompilierung** wandelt der Salesforce-Compiler Ihr Agentenskript in ein Agentendiagramm um, einen serialisierten Ausführungsplan, der für die maschinelle Ausführung optimiert ist und nicht für die menschliche Lesbarkeit. Sie debuggen nicht auf dieser Ebene. Durch die Kompilierung wird eine Darstellung erstellt, die die Laufzeit effizient durchlaufen kann.
3. Bei der **Laufzeitausführung** übernimmt das Atlas Reasoning Engine. Er liest das Agentendiagramm, traversiert es anhand des aktuellen Sitzungsstatus und entscheidet bei jedem Knoten, ob er deterministisch ausgeführt werden soll oder ob er das LLM aufruft. Das Modul erzwingt hier explizit Guard-Klauseln und die bedingte Weiterleitung, statt daraus zu schließen.
**Agentendiagramm**
Das Agentendiagramm ist die Zwischendarstellung zwischen Ihrem für Menschen lesbaren Skript und der tatsächlichen Laufzeitausführung. Seine Struktur ist für die State Machine optimiert, die es verwendet, nicht für den Architekten, der das Skript erstellt hat. Das Verständnis, dass es vorhanden ist und was es darstellt, ist wichtig, da es das Artefakt ist, das das Argumentationsmodul zum Erzwingen des Ausführungsplans verwendet, den Ihr Skript definiert.
**Atlas-Urteilsmodul**
Das Atlas Reasoning Engine ist ein State Machine Executor. In jedem Zug wird das Agentendiagramm anhand des Sitzungsstatus traversiert, deterministische Knoten werden als Code ausgeführt und LLM-Aufrufe werden nur ausgelöst, wenn Aufforderungsanweisungen vorhanden sind. Außerdem werden Schutzklauseln erzwungen und die bedingte Weiterleitung verarbeitet. Das Argumentationsmodul ist der Ort, an dem das hybride Argumentationsmodell tatsächlich implementiert ist. Das Skript definiert die Grenze und das Modul berücksichtigt sie.
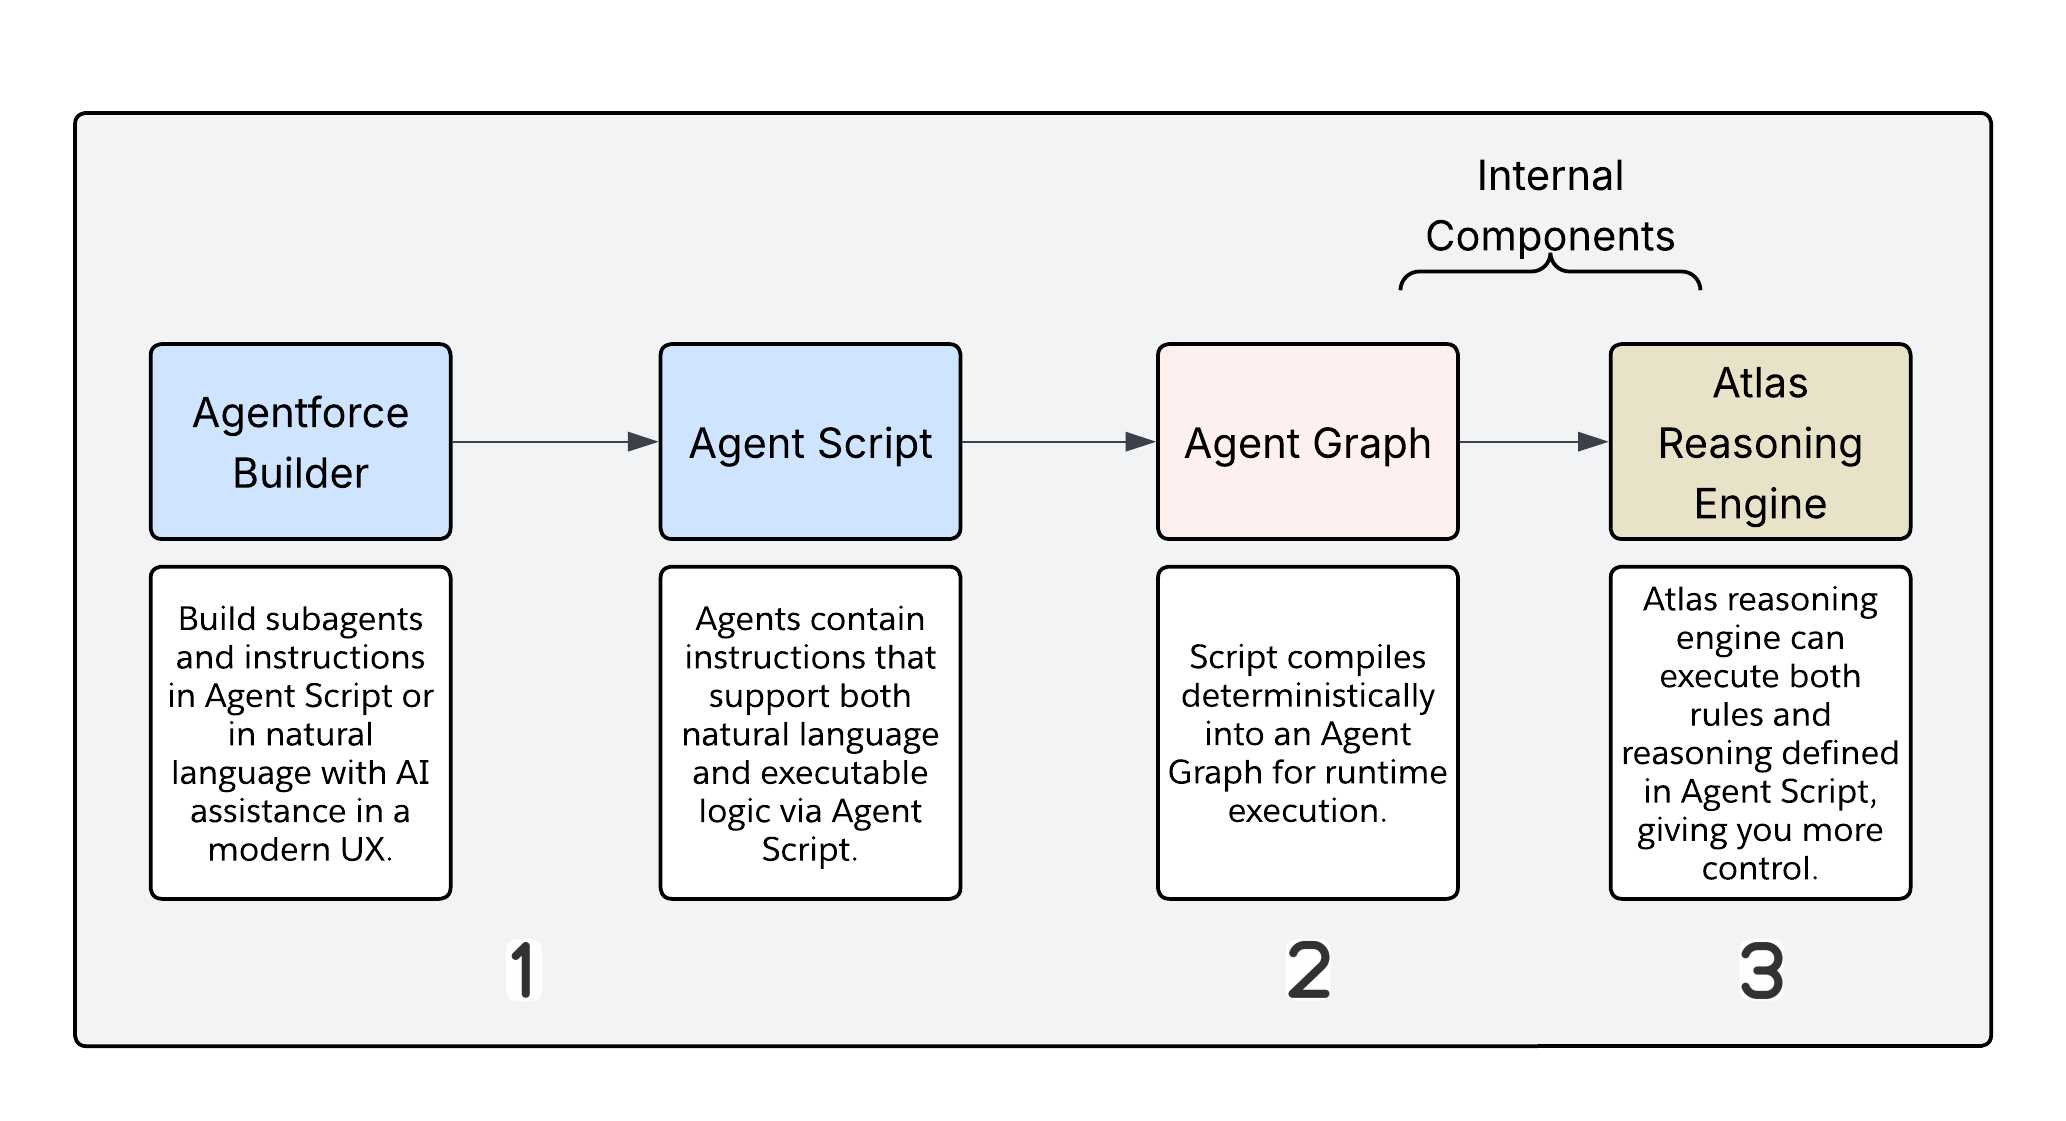
## Die LLM-Grenze: Wo das Urteil endet und Code beginnt
Das Agentendiagramm ist kein LLM-Wrapper. Es ist ein hybrides Argumentationsmodul, das die deterministische Ausführung von der probabilistischen Argumentation trennt. Die Regel ist einfach: Wenn Sie eine Entscheidung als Code ausdrücken können, sollte sie als Logik geschrieben werden. Wenn für die Entscheidung Urteile, Interpretationen oder die Generierung natürlicher Sprache erforderlich sind, sollte das LLM dies übernehmen. Diese Entwurfsentscheidung ist die wichtigste architektonische Entscheidung im neuen Agentforce Modell. Wo die LLM-Grenze fällt, wirkt sich direkt auf die Kosten, die Latenz, die Überprüfbarkeit und die Zuverlässigkeit Ihrer Lösung aus.
Das Atlas Reasoning Engine wertet jeden eingehenden Benutzerzug aus und leitet ihn über einen von zwei Pfaden weiter.
**Pfad A: Deterministische Ausführung**
Dieser Pfad weist keine LLM-Belastung auf. Er verhält sich wie kompilierter Code zur Laufzeit. Das Argumentationsmodul klassifiziert den Intent des Benutzers und bestimmt, ob eine Logikanweisung übereinstimmt, wobei das LLM vollständig umgangen wird. Das kompilierte Agentenskript wird von oben nach unten ausgeführt, wobei If-else-Regeln bei jedem Zug bedingungslos ausgeführt werden. Flow-, Apex- oder API-Aktionen werden mit deterministischen Parametern aufgerufen, ohne dass eine Aufforderungszusammenstellung oder ein Modellaufruf erforderlich ist. Das Ergebnis wird mit vollständiger Überprüfungsprotokollierung durch die Trust Layer zurückgegeben.
**Pfad B: LLM-Überlegungen**
Das Argumentationsmodul geht diesen Weg, wenn es Intent nicht allein mit Logikanweisungen auflösen kann. Sie durchläuft das Agentendiagramm und wertet jeden Knoten aus. Knoten mit Aufforderungsanweisungen lösen einen LLM-Aufruf aus. Knoten ohne sie werden deterministisch ausgeführt. Das Vorhandensein einer Aufforderungsanweisung ist der Auslöser und wird im Skript explizit angegeben und nicht zur Laufzeit abgeleitet.
**Was einen LLM-Aufruf auslöst**
Es gibt acht Punkte im Ausführungslebenszyklus, an denen die LLM aufgerufen wird. Die Subagent-Klassifizierung oder die Entscheidung, welcher Subagent mit der Anforderung des Benutzers übereinstimmt, ist eine, obwohl ein Kurzschlusspfad den vollständigen LLM-Aufruf umgehen kann, wenn die Klassifizierung eindeutig ist. Die Agentenüberlegungen, bei denen der Agent entscheidet, welche Aktion als Nächstes ausgeführt werden soll, werden immer durch die LLM geleitet. Ebenso die Generierung von Antworten, bei denen die endgültige Antwort aus einer Eingabeaufforderung mit Hydratisierung zusammengesetzt wird.
Die restlichen Auslöser sind funktionsfähiger: Die Integritätsvalidierung bestätigt, dass die Ausgabe auf abgerufenen Daten basiert. Die Aktionssimulation emuliert Antworten in der Umgebung "Vorschau" und "Simulieren", statt sie live auszuführen. Die strukturierte Ausgabegenerierung verarbeitet Fälle, in denen die Antwort einem definierten Schema entsprechen muss.
**Was bleibt deterministisch**
Die Diagrammtraversierung und Statusumstellungen beinhalten niemals die LLM. Die Lebenszyklusblöcke `before_reasoning` und `after_reasoning` werden deterministisch ausgeführt, solange sie nur Aktionsknoten ohne Aufforderungsanweisungen enthalten. Mathematik, Datenabruf, Validierung und bedingte Logik gehören alle in Code. Alle Aktionen, die Flow, Apex oder eine REST-API ausführen, bleiben direkt auf dem deterministischen Pfad. Alle Knoten ohne Aufforderungsanweisungen werden ohne LLM-Aufruf ausgeführt.
Es ist wichtig, dass Sie diese Grenze zu Ihrem Team explizit festlegen. Jeder unnötige LLM-Aufruf erhöht Latenz, Kosten und Variabilität. Architekten sollten standardmäßig deterministische Logik übertragen und die LLM für Kundenvorgänge reservieren, bei denen die Aufgabe tatsächlich ihre Argumentationsfunktion erfordert.
**Gestaltungsanleitung: Push-Logik standardmäßig auf Code**
Verwenden Sie Anweisungen zur Logik des Agentenskripts, wenn Sie Aufforderungsanweisungen schreiben, die als Bedingung, Variablenzuweisung oder Aktionsfilter ausgedrückt werden könnten. Jeder unnötige LLM-Aufruf erhöht Latenz, Kosten und Variabilität.
Die Standardposition sollte deterministisch sein. Isolieren Sie jedes Agentenverhalten, das in der Regel kodiert werden kann, und verschieben Sie es in das Agentenskript. Die verbleibenden Aufgaben, die eine Synthese natürlicher Sprache, kontextbezogene Beurteilung oder komplexe Interpretation erfordern, gehören zu Knoten mit Eingabeaufforderungen. Das ist keine Einschränkung, sondern die Grenze funktioniert wie vorgesehen. Der LLM verarbeitet, wofür er am besten geeignet ist, und alles andere wird als Code ausgeführt.
## Die Parsergrenze: `before_reasoning`, `reasoning` und `after_reasoning`
Die primäre Ausführungseinheit im Agentenskript ist nicht der Benutzerzug. Es ist die Parse: einen einzelnen vollständigen Zyklus durch die drei Lebenszyklusblöcke eines Unteragenten. Das Atlas Reasoning Engine initiiert jedes Mal eine Analyse, wenn ein Unteragent etwas verarbeiten muss. Dies geschieht in drei Situationen: bei der ersten Eingabe im Unteragenten, nach jedem Tool-Aufruf, wenn eine Aktion abgeschlossen ist und ein Ergebnis zurückgibt, und bei jedem neuen Benutzer innerhalb desselben Unteragenten.
Das Verständnis der Parse-Grenze ist wichtig, da sie bestimmt, wie oft jeder Block ausgeführt wird und wo Sie sich daher darauf verlassen können, dass ein bestimmter Teil der Logik genau einmal ausgeführt wird.
Jeder Unteragent definiert drei Ausführungszonen:
| Blockieren | Wenn sie ausgeführt wird | LLM-Beteiligung |
| ------------------ | --------------------------------------------------------- | ----------------------------- |
| `before_reasoning` | Zu Beginn jeder Analyse, bevor die LLM etwas sieht | Keine |
| `reasoning` | Während der deterministischen Auflösung vor LLM-Aufrufen | Gemischt |
| `after_reasoning` | Nach Abschluss der Argumentation und Antwort des LLM | Keine (mit kritischen Einschränkungen) |
`before_reasoning` und `after_reasoning` sind vollständig deterministisch. Sie führen Aktionen aus, legen Variablen fest und wenden bedingte Logik an, ohne die LLM einzubeziehen. Dadurch sind sie die zuverlässigen, kostengünstigen Blöcke im Skript.
**Anwendungszeitpunkt `before_reasoning`**
`before_reasoning` wird ausnahmslos am Anfang jeder Analyse ausgeführt. Sie wird beim ersten Eingeben in den Unteragenten und erneut ausgeführt, nachdem sich jeder Tool-Aufruf oder jeder neue Benutzer innerhalb dieses Unteragenten gedreht hat. Ein `run @actions.X` in `before_reasoning` ist code. Im Gegensatz zu einer Anweisung innerhalb eines Aufforderungsblocks, der der LLM folgen kann, wird `before_reasoning` bedingungslos ausgeführt.
Verwenden Sie diesen Block für die Sitzungsinitialisierung: Abrufen von Kontextdatensätzen und Festlegen von Sitzungsvariablen aus Apex oder Flow. Hier gehören auch Authentifizierung und Anspruchsprüfungen hin, da Sie diese überprüfen möchten, bevor die LLM Tools sieht. Die Kontexthydrierung passt auch hier: Aufrufen einer Datenabrufaktion, damit der LLM vorab ausgefüllte Variablen empfängt, statt sie anfordern zu müssen. Alle Zähler- oder Überwachungsvariablen, die bei jeder Parse inkrementiert werden müssen, sollten hier festgelegt werden, da die `before_reasoning` `set`-Direktive so gewährleistet ist, dass dies bei einer Pipeline-Anweisung nicht der Fall ist.
Was hier nicht hingehört, ist Logik, die nur einmal pro Sitzung ausgeführt werden sollte, da `before_reasoning` bei jeder Parse und nicht nur beim ersten Eintrag ausgeführt wird. Alles, was von der Benutzereingabe aus dem aktuellen Zug abhängt, gehört ebenfalls nicht hierher, da diese Eingabe noch nicht verarbeitet wurde. Und Umstellungen sollten nie `before_reasoning`: sein Eine `transition to`-Anweisung löst hier bei jeder Parse bedingungslos aus und erstellt Schleifen.
Wenn Sie die Initialisierung einmal pro Sitzung benötigen, sollten Sie sie explizit schützen:
```
before_reasoning:
if @variables.sessionInitialized == False:
run @actions.InitializeSession
set @variables.sessionInitialized = True
```
Ein Benutzerzug kann mehrere Parses auslösen: einmal bei der Eingabe, dann erneut nach jedem Tool-Aufruf. Diese Funktion hat drei praktische Konsequenzen: Initialisierungsaktionen in `before_reasoning` werden in Flows mit mehreren Aktionen mehrmals pro Benutzerzug ausgeführt, die hier inkrementierten Zählervariablen geben die Anzahl der Parses wieder, nicht die Anzahl der Parses, und Aktionen mit Nebenwirkungen, externen API-Aufrufen oder Datensatzschreibvorgängen sollten nicht in `before_reasoning` bleiben, es sei denn, die erneute Ausführung für jede Parses ist explizit zulässig.
`before_reasoning` ist kein Konstruktor. Es handelt sich um eine Vorabprüfung, die bei jeder Analyse ausgeführt wird. Gestalten Sie sie entsprechend.
**Anwendungszeitpunkt `after_reasoning`**
Die `after_reasoning` wird ausgeführt, sobald die Argumentationsschleife abgeschlossen ist, nachdem der LLM geantwortet hat und Aktionsausgaben erfasst wurden. Hier gehören deterministische Prüfungen nach der Aktion: Auswerten von Aktionsausgaben und Verzweigen anhand von Ergebnissen. Deterministische Übergänge oder das Wechseln zum nächsten Unteragenten auf der Grundlage des Variablenstatus statt des LLM-Urteils finden Sie hier. Ebenso die Variablenbereinigung vor dem nächsten Zug und die Orchestrierungssequenzierung, wenn Sie Unteragenten in einer vorhersehbaren Reihenfolge ohne LLM-Weiterleitungsentscheidung verketten müssen.
Behandeln Sie `after_reasoning` als Leitplankenebene. Hier erzwingen Sie Geschäftsregeln und die Verwaltung von Bundesstaaten, nachdem die LLM ihre Arbeit erledigt hat, und stellen sicher, dass wichtige Prozess-Flows vorhersehbar bleiben, unabhängig davon, was die LLM generiert hat.
**`is_displayable: True` mit Bedacht verwenden**
Jeder Architekt, der Orchestrierungs-Flows entwirft, muss dieses Plattformverhalten verstehen. Wenn `is_displayable: True` für eine Aktion festgelegt ist, verlässt die Plattform die Argumentationsschleife, sobald die LLM diese Ausgabe anzeigt. Diese Beendigung erfolgt sofort, d. h., `after_reasoning` wird nie ausgeführt.
Dies ist ein bekanntes Plattformverhalten, hat jedoch eine direkte Konsequenz für die Orchestrierung: Alle Logiken, die Sie in `after_reasoning` platziert haben, werden übersprungen, wenn eine anzeigbare Aktion Teil des Flows ist.
Die Antwort ist einfach. Verschieben Sie die Logik, die zuverlässig **ausgeführt werden muss**, in den `before_reasoning` des nachfolgenden Unteragenten und nicht in den `after_reasoning` des aktuellen.
**Gestaltungsanleitung: Ort der Platzierung der Initialisierungslogik**
Die Entscheidung, wo Logik platziert werden soll, ist beim Entwerfen eines Unteragenten von entscheidender Bedeutung. Dieses Framework deckt die häufigsten Szenarien ab:
| Szenario | Wohin damit? |
| ------------------------------------------------------------------------------- | --------------------------------------------------------- |
| Muss ausgeführt werden, bevor der LLM Kontext angezeigt wird | `before_reasoning` |
| Führt jede Parse aus, einschließlich der erneuten Eingabe bei neuen Benutzern | `before_reasoning` |
| Hängt von der Aktionsausgabe in diesem Zug ab | Bedingter `if` in `reasoning` |
| Erfordert deterministische Umstellung auf Subagenten basierend auf dem Ergebnis | `after_reasoning` (siehe `is_displayable` unten) |
| Erfordert Orchestrierungslogik, wenn die nachgelagerte Aktion `is_displayable: True` verwendet | `before_reasoning` des nächsten Unteragenten |
| Verwendet Logik, die Urteils- oder Benutzerkontext erfordert | `reasoning` mit Aufforderungsanweisungen |
Das zugrunde liegende Prinzip ist einfach. Wenn Sie eine Aufforderungsanweisung schreiben, in der die LLM angewiesen wird, eine Aktion "immer auszuführen", ist dies ein Vorschlag. Die LLM kann ihr je nach Kontext folgen, aber nicht. Wenn Sie eine `run`-Direktive in `before_reasoning` platzieren, ist dies Code. Sie wird ausnahmslos bei jeder Parse ausgeführt.
## Bedingtes Bereitstellen von Aktionen für LLMs
Bei der Verfügbarkeit von bedingten Aktionen handelt es sich um den Mechanismus, mit dem das Agentenskript Aktionen basierend auf dem Status der Laufzeitvariablen im LLM ein- oder ausblendet. Wenn die `available when` als `false` ausgewertet wird, wird die Aktion vollständig aus der Toolliste entfernt, die dem LLM angezeigt wird. Falsche Werte, einschließlich `None`, `False`, `0` oder einer leeren Zeichenfolge, unterdrücken die Aktion.
Dies ist keine Aufforderungsanweisung, die dem LLM sagt "Noch nicht aufrufen", es ist ein hartes Gate auf Plattformebene. Der LLM kann keine Aktion aufrufen, auf die er nicht zugreifen kann.
```
actions:
execute_transfer: @actions.execute_transfer
available when @variables.validation_passed
with from_account=@variables.source_account
with to_account=@variables.destination_account
with amount=@variables.transfer_amount
```
In diesem Beispiel ist die `execute_transfer` für die LLM unsichtbar, bis die `validation_passed` als `true` ausgewertet wird. Das Gate wird von der Plattform erzwungen, nicht per Anweisung.
**Gestaltungsanleitung: Legen Sie die Gate-Variable** niemals über das LLM fest
Geben Sie jeder Variablen in einer `available when` einen deterministischen Codepfad an, der die Variable vor der Ausführung der zugeordneten Aktion festlegt. Verwenden Sie `before_reasoning` oder einen deterministischen `run`\- und `set`, `reasoning` die Variable in einem bekannten Zustand zu halten. Wenn Sie sich beim Festlegen der Gate-Variablen auf die LLM verlassen, haben Sie die Variabilität, die das Gate verhindern soll, wieder eingeführt. Abhängig von der Unterhaltung kann die LLM sie festlegen, aber nicht, d. h., das Gate kann geöffnet werden oder nicht.
**Das Problem der Aktionsschleife**
Eine Aktionsschleife tritt auf, wenn der LLM dieselbe Aktion wiederholt aufruft, ohne jemals einen Endstatus zu erreichen. Dies geschieht, wenn zwei Bedingungen gleichzeitig wahr sind: die `available when`-Bedingung nach der Ausführung der Aktion weiterhin erfüllt ist und die Argumentationsanweisungen den LLM nicht explizit auffordern, den Aufruf einzustellen.
Die Plattform unterdrückt eine Aktion nicht automatisch, nachdem sie aufgerufen wurde. Wenn das Gate geöffnet bleibt und die Argumentationsanweisungen mehrdeutig sind, ruft das LLM unbegrenzt dieselbe Aktion für jede Parse auf.
Sehen Sie sich `available when @variables.interest != ""` als Beispiel an. Wenn die Aktion ausgeführt wird, die Interessenvariable jedoch nicht leer ist, bleibt das Gate bei der nächsten Analyse geöffnet. Der LLM sieht die Aktion als verfügbar an, hat keine Anweisung zum Anhalten und ruft sie erneut auf.
Es gibt zwei zuverlässige Möglichkeiten, die Schleife zu durchbrechen. Die erste besteht darin, die Gate-Variable als Teil der Logik nach der Ausführung der Aktion auf einen geschlossenen Zustand zu setzen, damit `available when` bei der nächsten Analyse als `false` ausgewertet wird. Die zweite besteht darin, einen separaten booleschen `has_run` zu verwenden, der das Gate nach der ersten Ausführung schließt. Beide Ansätze verleihen dem Gate einen deterministischen geschlossenen Zustand, d. h. die Bedingung, die die Plattform benötigt, um die Aktion zu unterdrücken.
## Festlegen einer deterministischen Agentenüberweisung
Eine Banküberweisung ist eine nützliche Linse, um zu verstehen, wie diese Muster in der Praxis funktionieren. Der Workflow sieht von außen einfach aus: Geld von einem Konto auf ein anderes verschieben. Die Implementierung erfordert mehrere komplexe Schritte. Bevor die Übertragung ausgeführt wird, muss der Agent Accountdetails erfassen, den Betrag validieren, Übertragungsobergrenzen überprüfen, den verfügbaren Saldo bestätigen und erst dann die Übertragungsaktion offenlegen. Jeder Schritt hängt von den vorherigen Schritten ab. Keiner von ihnen sollte dem LLM-Urteil überlassen werden.
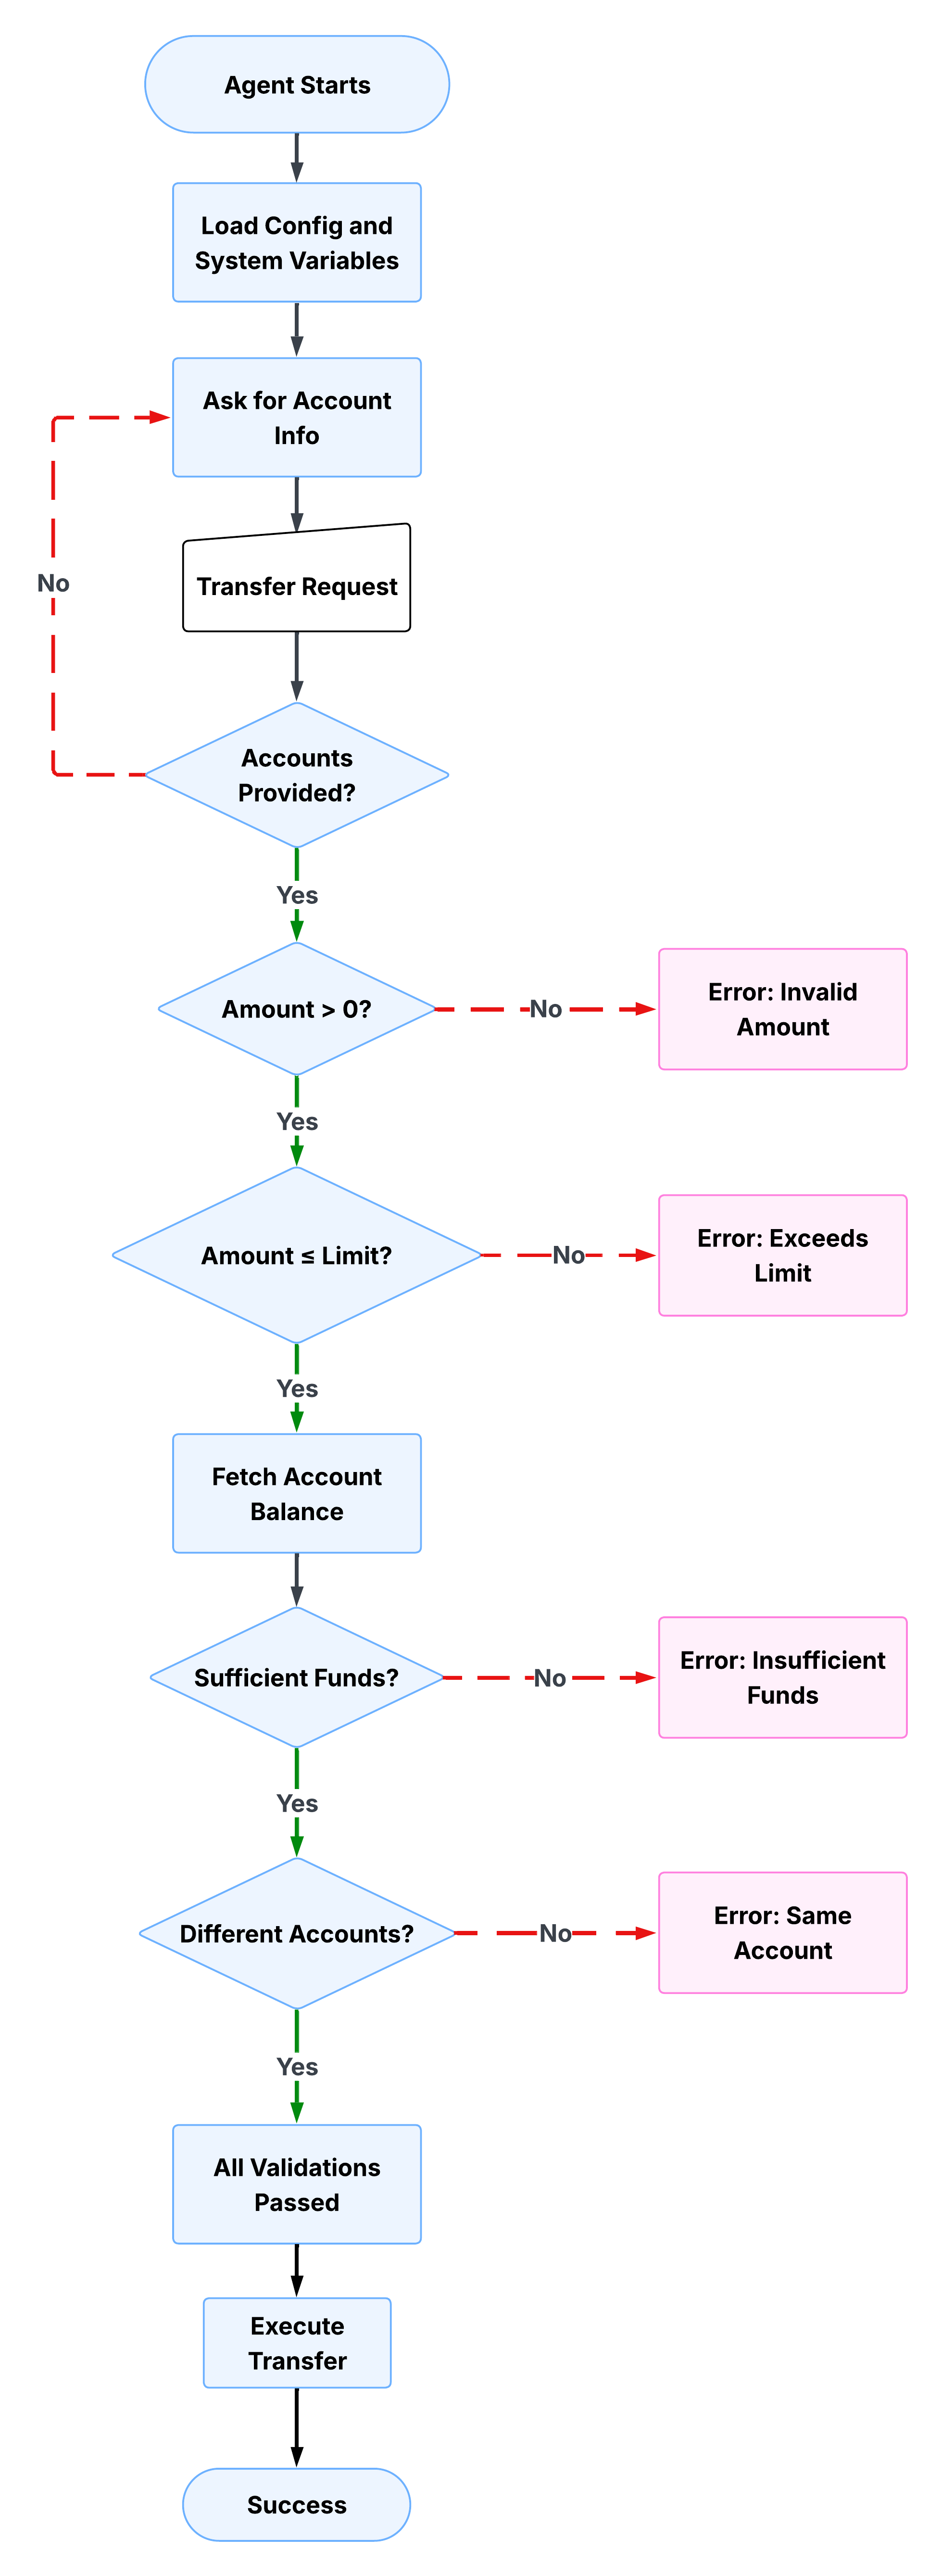 **Erfassen und Validieren von Eingaben**
Der erste Unteragent erfasst den Quellaccount, den Zielaccount und den Übertragungsbetrag vom Benutzer. Sie wird erst fortgesetzt, wenn alle drei vorhanden und gültig sind. Das Agentenskript überprüft jedes Feld in der Reihenfolge: Wenn der Quellaccount fehlt, wird gefragt. Wenn das Ziel fehlt, wird danach gefragt. Wenn der Betrag null oder negativ ist, wird gefragt. Die Variable `validation_passed` wird erst dann auf `true` festgelegt, wenn alle Prüfungen eindeutig sind.
Das folgende Skript zeigt dies in der Praxis. Beachten Sie, dass "`validation_passed`" an jedem Fehlerpunkt explizit auf "`false`" festgelegt ist und die LLM angewiesen wird, nicht fortzufahren. Die deterministischen Überprüfungen werden bedingungslos ausgeführt, während die Aufforderungsanweisungen die benutzerseitige Antwort verarbeiten.
```
instructions:->
| Always ensure to request the following data from the user, and to store it using {!@actions.store_details}
- source account number
- destination account number
- amount to transfer
Only after you have all the data, you can proceed with the next steps.
if not @variables.source_account:
set @variables.validation_information = "Missing source account"
set @variables.validation_passed = False
| You need the source account number before proceeding.
Ask the customer for the source account number.
else:
set @variables.validation_passed = True
if @variables.source_account and not @variables.destination_account:
set @variables.validation_information = "Missing destination account"
set @variables.validation_passed = False
| You need the destination account number before proceeding.
Ask the customer for the destination account number.
else:
set @variables.validation_passed = True
if not @variables.source_account or not @variables.destination_account:
| Do NOT proceed with the transfer yet.
if @variables.transfer_amount <= 0:
set @variables.validation_information = "Invalid transfer amount"
set @variables.validation_passed = False
| The transfer amount must be greater than zero. Ask the customer
how much they want to transfer.
Do NOT proceed with the transfer yet.
else:
set @variables.validation_passed = True
```
**Geschäftsregeln erzwingen**
Nachdem der Agent Eingaben validiert hat, wird überprüft, ob der Übertragungsbetrag die konfigurierte Übertragungsobergrenze überschreitet. Hier werden Geschäftsregeln zu Code und nicht zu Anweisungen. Die Obergrenze ist nicht etwas, was die LLM begründet. Sie ist ein harter Schwellenwert, der im Skript definiert und bei jeder Analyse deterministisch überprüft wird.
Wenn der Betrag die Obergrenze überschreitet, wird `validation_passed` wieder auf `false` zurückgesetzt und der Benutzer hat drei Optionen: Übertragen Sie den maximal zulässigen Betrag, teilen Sie ihn in mehrere Übertragungen auf oder wenden Sie sich an den Support, um höhere Obergrenzen zu erhalten. Der Agent kann erst fortfahren, nachdem der Benutzer die Ausnahme behoben hat. Beachten Sie, dass die Aufforderungsanweisung hier genau das tut, wofür sich die LLM-Überlegungen eignen: Anzeigen von Optionen in einer Unterhaltung und Verarbeiten der Antwort des Benutzers. Die Geschäftsregel selbst ist deterministisch, die Unterhaltung darum jedoch nicht.
Das folgende Skript zeigt, wie die Obergrenzenüberprüfung funktioniert. Die deterministische Bedingung wertet den Übertragungsbetrag anhand der Obergrenzenvariablen aus, legt die `validation_passed` auf `false` fest, wenn der Schwellenwert überschritten wird, und delegiert sie an eine Aufforderung, die benutzerseitige Antwort zu verarbeiten.
```
instructions:->
if @variables.transfer_amount > @variables.transfer_limit:
set @variables.validation_information = "Amount exceeds transfer limit"
set @variables.validation_passed = False
| ⚠️ STOP: The requested amount (${!@variables.transfer_amount}) exceeds
the maximum transfer limit of ${!@variables.transfer_limit}.
Inform the customer and ask if they'd like to:
1. Transfer the maximum allowed amount (${!@variables.transfer_limit})
2. Split into multiple transfers
3. Contact support for higher limits
Do NOT proceed with the transfer.
```
**Anwenden von Schutzklauseln**
Nach Abschluss der Betrags- und Obergrenzenüberprüfungen ruft der Agent den Quellaccountsaldo ab und bestätigt, dass genügend Mittel verfügbar sind. Schutzklauseln verhindern, dass der Agent Vorgänge ausführt, wenn die Voraussetzungen nicht erfüllt sind. Im Gegensatz zu einer Aufforderungsanweisung, die die LLM anweist, den Saldo zu überprüfen, wird die Prüfung durch eine Guard-Klausel im Agentenskript bedingungslos. Der LLM entscheidet nicht, ob er ausgeführt werden soll.
Wenn der Saldo nicht ausreicht, berechnet der Agent den Engpass und stellt dem Benutzer eine konkrete Alternative bereit. "`validation_passed`" ist auf "`false`" festgelegt, bis diese Überprüfung bestanden ist, d. h., die Übertragungsaktion bleibt gegatet.
Das folgende Skript zeigt einen Aufruf der deterministischen Aktion, der den Saldo abruft, gefolgt von einer bedingten Überprüfung, die ihn auswertet. Der Abruf wird nur ausgeführt, wenn der Saldo noch nicht abgerufen wurde, wodurch redundante API-Aufrufe bei nachfolgenden Parsen vermieden werden.
```
instructions:->
# Fetch balance if needed
if @variables.source_account and not @variables.source_balance:
run @actions.get_account_balance
with account_number = @variables.source_account
set @variables.source_balance = @outputs.balance
# Validate sufficient funds
if @variables.source_balance < @variables.transfer_amount:
set @variables.validation_information = "Insufficient funds"
set @variables.validation_passed = False
| ⚠️ STOP: Insufficient funds in the source account.
- Available balance: ${!@variables.source_balance}
- Requested transfer: ${!@variables.transfer_amount}
- Shortfall: ${!@variables.transfer_amount-@variables.source_balance}
Ask if they'd like to transfer a smaller amount.
Do NOT proceed with the transfer.
```
**Oberflächenfehler deutlich**
Schutzklauseln legen den Status fest. Fehlermeldungen kommunizieren dies. Wenn es sich bei `validation_passed` um `false` handelt, muss der Agent dem Benutzer genügend Informationen bereitstellen, um das Problem ohne Neustart zu beheben. Vage Fehlermeldungen verursachen Reibung, strukturierte schließen die Schleife schneller.
Im folgenden Skript wird die Fehlermeldung "Nicht ausreichende Mittel" in der Praxis angezeigt. Dadurch wird dem Benutzer nicht nur mitgeteilt, dass die Übertragung fehlgeschlagen ist. Sie zeigt den verfügbaren Saldo, den angeforderten Betrag und den berechneten Fehlbetrag an und bietet einen konkreten nächsten Schritt, der alle aus Sitzungsvariablen zusammengesetzt und nicht durch die LLM generiert wird.
```
| ⚠️ STOP: Insufficient funds.
- Available: ${!@variables.source_balance}
- Requested: ${!@variables.transfer_amount}
- Short by: ${!@variables.transfer_amount - @variables.source_balance}
Would you like to transfer ${!@variables.source_balance} instead?
```
Die Berechnung des Engpasses erfolgt im Skript, nicht im LLM. Die vorgeschlagene Alternative, die Übertragung des verfügbaren Saldos, wird deterministisch aus dem Sitzungsstatus abgeleitet. Die Rolle des LLM ist hier rein präsentativ: es stellt eine Nachricht bereit, die das Skript bereits strukturiert hat.
**Gate der Übertragungsaktion**
Bei jeder Validierungsprüfung in den vorhergehenden Schritten wird dieselbe Variable festgelegt oder gelöscht: `validation_passed`. Diese Variable erledigt nun ihre wichtigste Aufgabe. Die `execute_transfer` ist bedingt verfügbar, d. h., sie wird nur in der Toolliste des LLM angezeigt, wenn `validation_passed` `true` ist. Die Aktion ist aus der Perspektive des LLM erst vorhanden, nachdem jede vorherige Prüfung bestanden und diese Variable festgelegt wurde.
Dies ist das Muster aus dem früheren Gate-Abschnitt, das auf einen Produktions-Workflow angewendet wurde. Die Übertragungsaktion wird nicht durch eine Aufforderungsanweisung ausgeblendet. Sie wird von der Plattform ausgeblendet. Kein großer Unterhaltungsdruck oder eine mehrdeutige Formulierung kann dazu führen, dass der LLM ihn aufruft, bevor die Voraussetzungen erfüllt sind.
Das folgende Skript zeigt, wie das Gate konfiguriert ist. Die `available when`-Klausel verweist direkt auf `validation_passed` und die Aktionsparameter sind an die in den vorherigen Schritten erfassten und validierten Sitzungsvariablen gebunden.
```
actions:
execute_transfer: @actions.execute_transfer
available when @variables.validation_passed
with from_account=@variables.source_account
with to_account=@variables.destination_account
with amount=@variables.transfer_amount
```
Alle drei Parameter `from_account`, `to_account` und `amount` werden deterministisch aus Sitzungsvariablen übergeben. Wenn diese Aktion verfügbar ist, wurde jeder Wert validiert. Der LLM stellt die Parameter nicht aus dem Unterhaltungskontext zusammen, sondern liest sie aus dem Status.
**Verfolgen des Status im gesamten Workflow**
Die Muster in den vorherigen Abschnitten funktionieren nur, da der Sitzungsstatus über den gesamten Workflow hinweg beibehalten wird. Die im ersten Schritt erfassten Accountnummern sind im vierten Schritt verfügbar. Validierungsergebnisse, die in einer Check-Gate-Aktion in einer anderen festgelegt sind. Die Unterhaltung kann abweichen, der Benutzer kann Folgefragen stellen und der Agent weiß weiterhin genau, wo er sich im Prozess befindet.
Der Variablenblock unten zeigt den vollständigen Sitzungsstatus für diesen Workflow an. Jede Variable verfügt über einen definierten Typ, einen Standardwert und eine Beschreibung. Zwei Variablen übernehmen den Großteil der Orchestrierungsarbeit: `validation_passed` steuert die Aktionsverfügbarkeit bei jedem Gate und `validation_information` enthält einen für Menschen lesbaren Kontext darüber, warum eine Überprüfung fehlgeschlagen ist. Dieser kann dem Benutzer angezeigt werden, ohne dass er sich über den zugrunde liegenden Zustand Gedanken machen muss.
```
variables:
source_account: mutable string = ""
description: "Account to transfer from"
destination_account: mutable string = ""
description: "Account to transfer to"
transfer_amount: mutable number = 0
description: "Amount to transfer"
source_balance: mutable number = 0
description: "Balance of source account"
transfer_limit: mutable number = 10000
description: "Maximum allowed transfer amount"
validation_passed: mutable boolean = False
description: "Whether all validations passed"
validation_information: mutable string = ""
description: "Human readable validation information"
```
Jede Variable beginnt in einem bekannten Standardstatus. Zeichenfolgen sind standardmäßig leer, Zahlen auf null und `validation_passed` boolesch auf `false`. Das bedeutet, dass das Gate standardmäßig geschlossen ist. Der Workflow muss sich das Recht verdienen, bei jedem Schritt aktiv fortzufahren, statt das Tor zu öffnen und sich auf Prüfungen zum Schließen zu verlassen.
## Einsatzmöglichkeiten der deterministischen Logik
Das Beispiel für eine Banküberweisung zeigt, wo deterministische Logik das richtige Tool ist, aber nicht immer die beste Wahl. Das Verständnis der Grenze ist ebenso wichtig wie das Verständnis der Muster.
Deterministische Logik ist die richtige Wahl, wenn für den Workflow eine garantierte Ausführungsreihenfolge erforderlich ist, wenn Fehler erhebliche Folgen haben, wenn der Prozess einen reproduzierbaren Überprüfungsprotokoll erstellen muss oder wenn Geschäftsregeln gut genug definiert sind, um als Bedingungen und Schwellenwerte ausgedrückt zu werden. Finanz-, Gesundheits- und Versicherungs-Workflows fallen im Allgemeinen in diese Kategorie.
Reine LLM-Überlegungen ohne strenge deterministische Einschränkungen sind sinnvoller, wenn der Wert der Interaktion in Flexibilität und nicht in Präzision liegt. Offener Kundensupport, Produkte in der Anfangsphase, bei denen sich Geschäftsprozesse noch weiterentwickeln, und Informationsabfragen mit geringer Beteiligung sind allesamt Fälle, in denen die Variabilität der LLM-Überlegungen ein Merkmal und kein Problem ist.
In der Praxis benötigen die meisten Produktionsagenten beides. Die Entscheidung, wo die Grenze liegt, ist keine binäre Entscheidung zwischen deterministisch und probabilistisch, sondern eine Designentscheidung, die Sie auf Knotenebene für jeden Teil des Workflows Ihres Agenten treffen.
| Deterministische Logik verwenden für | Verwenden von LLM-Überlegungen für |
| ------------------------------------------- | --------------------------------------------------- |
| Eingabevalidierung und -bereinigung | Natürliches Sprachverständnis und Intent-Erkennung |
| Durchsetzung von Geschäftsregeln | Generieren von gesprächigen, einfühlsamen Antworten |
| Sequenzielle Prozessorchestrierung | Umgang mit mehrdeutigen oder unerwarteten Eingaben |
| Bundesstaatsverwaltung und Kontexterhaltung | Bereitstellen von Erläuterungen und Klarstellungen |
| Schutzklauseln, die ungültige Vorgänge verhindern | Anpassen von Ton und Messaging an den Benutzerkontext |
**Die Grenze ist die Designentscheidung**
Das Beispiel für eine Banküberweisung veranschaulicht eine Designphilosophie: dass die Grenze zwischen deterministischer Ausführung und LLM-Überlegungen die folgenreichste architektonische Entscheidung ist, die Sie beim Erstellen eines Produktionsagenten treffen.
Platzieren Sie eine Grenze, die zu starr ist, und Sie erhalten einen Agenten, der starr, teuer in der Wartung und nicht in der Lage ist, die natürliche Variation realer Unterhaltungen zu verarbeiten. Wenn Sie die Grenze in die andere Richtung verfehlen, entsteht ein Agent, der flexibel, aber unvorhersehbar ist, bei Tests gut abschneidet, sich in der Produktion jedoch anders verhält und keinen zuverlässigen Prüfpfad erstellen kann oder bei einer Transaktion mit hohem Einsatz vertrauen kann.
Das neue Agentforce Modell bietet Ihnen die Tools, um diese Grenze bewusst zu platzieren. Mit Agentenskript können Sie deterministische Logik und Aufforderungsanweisungen in derselben Datei ausdrücken, mit einer expliziten Syntax, um die Grenze sichtbar zu machen. Das Atlas Reasoning Engine erzwingt Logik und Aufforderungen zur Laufzeit. Die Blöcke `before_reasoning` und `after_reasoning` bieten Ihnen garantierte Ausführungszonen auf beiden Seiten des LLM-Aufrufs. Die Verfügbarkeit von bedingten Aktionen stellt sicher, dass die LLM nur dann handeln kann, wenn die Voraussetzungen erfüllt sind.
Keine dieser Funktionen ist isoliert. Gemeinsam entwickeln sie eine kohärente Architektur für die Erstellung von Agenten, denen Unternehmen bei geschäftskritischen Workflows Trust schenken können. Das hybride Argumentationsmodell erkennt, dass Determinismus und Flexibilität in Ihrer Architektur eine Rolle spielen. Es ist die Aufgabe des Architekten, genau zu entscheiden, wo die einzelnen Elemente gelten.
## Verweise
[Agentenskript-Rezepte](https://developer.salesforce.com/sample-apps/agent-script-recipes)
[Agentforce Developer Guides](https://developer.salesforce.com/docs/ai/agentforce/guide/agent-script.html)
Agentendiagramm [von Agentforce: Hin zu geführtem Determinismus mit hybrider Argumentation](https://engineering.salesforce.com/agentforces-agent-graph-toward-guided-determinism-with-hybrid-reasoning/)
## Über die Autoren
Gulal Kumar ist Software-Entwickler bei Salesforce und verfügt über mehr als 20 Jahre Erfahrung. Seine Expertise erstreckt sich auf AI, Integration, APIs und Unternehmensarchitektur, wobei er sich darauf konzentriert, die Geschäftstransformation durch sichere, belastbare und innovative AI-Lösungen voranzutreiben. Verbinden Sie sich mit ihm über [LinkedIn](https://www.linkedin.com/in/gulal/).
Miriam McCabe ist Senior Director und Leiter des Teams "Architekt Evangelisation". Ihre Arbeit konzentriert sich darauf, die globale Salesforce-Architekten-Community durch fundierte technische Inhalte, Live-Programmierung und Community-Engagement in die Lage zu versetzen, im Zeitalter der Agenten führend zu sein. Folgen Sie ihr auf [LinkedIn](https://www.linkedin.com/in/miriammccabe/).
# Integration Patterns Overview (Übersicht über Integrationsmuster)
Wenn Sie Salesforce implementieren, müssen Sie es in der Regel in andere Anwendungen integrieren. Obwohl jedes Integrationsszenario einzigartig ist, müssen Entwickler und Architekten gemeinsame Anforderungen und Probleme lösen.
In diesem Dokument werden Strategien (in Form von Mustern) für diese gängigen Integrationsszenarien beschrieben. Jedes Muster beschreibt das Design und den Ansatz für ein bestimmtes Szenario, statt eine bestimmte Implementierung zu beschreiben. In diesem Dokument finden Sie Folgendes:
- Eine Reihe von Mustern, die wichtige Integrationsszenarien vom Typ "Archetyp" ansprechen
- Eine Auswahlmatrix, mit der bestimmt werden kann, welches Muster am besten zu Ihrem Szenario passt
- Integrationstipps und bewährte Vorgehensweisen
**Zweck und Umfang**
Dieses Dokument richtet sich an Designer und Architekten, die Salesforce Platform in andere Anwendungen in ihrem Unternehmen integrieren müssen. Wir haben diese Inhalte aus vielen erfolgreichen Implementierungen destilliert.
Wenn Sie sich mit den Integrationsfunktionen und -optionen vertraut machen möchten, die für die umfassende Akzeptanz von Salesforce-basierten Anwendungen verfügbar sind, lesen Sie den Leitfaden zur Musterzusammenfassung und Musterauswahl. Architekten und Entwickler sollten diese Musterdetails und bewährten Vorgehensweisen während der Entwurfs- und Implementierungsphase eines Salesforce-Integrationsprojekts anwenden.
Wenn diese Muster ordnungsgemäß implementiert werden, können Sie so schnell wie möglich zur Produktion gelangen und über die stabilsten, skalierbarsten und wartungsfreien Anwendungen verfügen. Die eigenen beratenden Architekten von Salesforce verwenden diese Muster als Referenzpunkte bei Architekturüberprüfungen und pflegen und verbessern sie aktiv.
Wie bei allen Mustern deckt dieser Inhalt die meisten Integrationsszenarien ab, jedoch nicht alle. Salesforce ermöglicht zwar die Integration der Benutzeroberfläche (UI), Mashups, aber diese Integration fällt nicht in den Geltungsbereich dieses Dokuments.
**Mustervorlage**
Jedes Integrationsmuster folgt einer konsistenten Struktur. Durch diese Struktur können Muster einfacher verglichen und relevante Informationen gefunden werden.
_Name_
Der Musterkennzeichner, der auch den im Muster enthaltenen Integrationstyp angibt.
_Context_
Das allgemeine Integrationsszenario, auf das sich das Muster bezieht. Kontext enthält Informationen darüber, was Benutzer erreichen möchten und wie sich die Anwendung verhalten wird, um die Anforderungen zu erfüllen.
_Problem_
Das Szenario oder Problem (ausgedrückt als Frage), das bzw. das durch das Muster gelöst werden soll. Lesen Sie beim Überprüfen der Muster diesen Abschnitt, um schnell zu verstehen, ob das Muster für Ihr Integrationsszenario geeignet ist.
_Kräfte_
Die Einschränkungen und Umstände, die die Lösung des angegebenen Szenarios erschweren.
_Lösung_
Die empfohlene Lösung für das Integrationsszenario.
_Skizze_
Ein UML-Sequenzdiagramm, das Ihnen zeigt, wie die Lösung das Szenario angeht.
_Ergebnisse_
Erläutert, wie die Lösung auf Ihr Integrationsszenario angewendet wird und wie die mit diesem Szenario verbundenen Kräfte aufgelöst werden. Dieser Abschnitt enthält auch neue Herausforderungen, die durch die Anwendung des Musters auftreten können.
_Randleisten_
Zusätzliche Abschnitte zum Muster, die wichtige technische Probleme, Variationen des Musters, musterspezifische Bedenken usw. enthalten.
_Beispiel_
Ein durchgängiges Szenario, das beschreibt, wie das Designmuster in einem realen Salesforce-Szenario verwendet wird. Im Beispiel werden die Integrationsziele erläutert und erläutert, wie das Muster implementiert wird, um diese Ziele zu erreichen.
**Musterübersicht**
In der folgenden Tabelle sind die in diesem Dokument enthaltenen Integrationsmuster aufgeführt.
**Liste der Muster**
| Muster | Szenario |
| :------------------------------------------------------------------------------------------------------------------------------------------------------- | :--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| [Remote-Prozessaufruf – Anforderung und Antwort](/docs/architect/de-de/fundamentals/guide/integration-patterns.html#remote-process-invocation--request-and-reply) | Salesforce ruft einen Prozess auf einem Remote-System auf, wartet auf den Abschluss dieses Prozesses und verfolgt dann den Status anhand der Antwort des Remote-Systems. |
| [Remote-Prozessaufruf – Feuer und Vergessen](/docs/architect/de-de/fundamentals/guide/integration-patterns.html#remote-process-invocation--fire-and-forget) | Salesforce ruft einen Prozess in einem Remote-System auf, wartet jedoch nicht auf den Abschluss des Prozesses. Stattdessen empfängt und bestätigt der Remote-Prozess die Anforderung und übergibt dann die Kontrolle wieder an Salesforce. |
| [Batch-Datensynchronisierung](/docs/architect/de-de/fundamentals/guide/integration-patterns.html#batch-data-synchronization) | In Salesforce Platform gespeicherte Daten werden erstellt oder aktualisiert, um Aktualisierungen aus einem externen System widerzuspiegeln und wenn Änderungen von Salesforce Platform an ein externes System gesendet werden. Aktualisierungen in beide Richtungen erfolgen in Batch-Manier. |
| [Remote-Anruf](/docs/architect/de-de/fundamentals/guide/integration-patterns.html#remote-call-in) | In Salesforce Platform gespeicherte Daten werden von einem Remote-System erstellt, abgerufen, aktualisiert oder gelöscht. |
| [Benutzeroberflächenaktualisierung anhand von Datenänderungen](/docs/architect/de-de/fundamentals/guide/integration-patterns.html#ui-update-based-on-data-changes) | Die Salesforce-Benutzeroberfläche muss aufgrund von Änderungen an Salesforce-Daten automatisch aktualisiert werden. |
| [Datenvirtualisierung](/docs/architect/de-de/fundamentals/guide/integration-patterns.html#data-virtualization) | Salesforce greift in Echtzeit auf externe Daten zu. Dadurch müssen die Daten nicht mehr in Salesforce gespeichert und dann zwischen Salesforce und dem externen System abgeglichen werden. |
**Musteransatz**
Die Integrationsmuster in diesem Dokument werden in drei Kategorien unterteilt:
- Datenintegration: Diese Muster erfüllen die Anforderung, Daten zu synchronisieren, die sich in zwei oder mehr Systemen befinden, sodass beide Systeme immer aktuelle und aussagekräftige Daten enthalten. Die Datenintegration ist oft die am einfachsten zu implementierende Art der Integration, erfordert jedoch geeignete Informationsverwaltungstechniken, um die Lösung nachhaltig und kosteneffizient zu gestalten. Solche Techniken umfassen oft Aspekte der Masterdatenverwaltung (Master Data Management, MDM), der Datenverwaltung, des Mastering, der Duplizierung, des Datenflussdesigns und andere.
- Prozessintegration: Die Muster in dieser Kategorie berücksichtigen die Notwendigkeit, dass ein Geschäftsprozess zwei oder mehr Anwendungen nutzen muss, um seine Aufgabe zu erledigen. Wenn Sie eine Lösung für diesen Integrationstyp implementieren, muss die auslösende Anwendung über Prozessgrenzen hinweg zu anderen Anwendungen aufrufen. In der Regel umfassen diese Muster auch sowohl die Orchestrierung (wobei eine Anwendung das zentrale "Steuerfeld" ist) als auch die Choreografie (wobei Anwendungen mehrere Teilnehmer sind und es kein zentrales "Steuerfeld" gibt). Diese Integrationen erfordern oft komplexe Anforderungen an Design, Tests und die Verarbeitung von Ausnahmen. Darüber hinaus sind solche zusammengesetzten Anwendungen in der Regel anspruchsvoller für die zugrunde liegenden Systeme, da sie oft langfristige Transaktionen unterstützen und Berichte zum Prozessstatus erstellen oder verwalten können.
- Virtuelle Integration: Die Muster in dieser Kategorie berücksichtigen die Notwendigkeit, dass ein Benutzer Daten anzeigen, suchen und ändern muss, die in einem externen System gespeichert sind. Wenn Sie eine Lösung für diesen Integrationstyp implementieren, muss die auslösende Anwendung andere Anwendungen aufrufen und in Echtzeit mit ihren Daten interagieren. Durch diese Art der Integration müssen Daten nicht mehr systemübergreifend repliziert werden, sodass Benutzer immer mit den neuesten Daten interagieren.
Die Auswahl der besten Integrationsstrategie für Ihr System ist nicht trivial. Es gibt viele Aspekte zu berücksichtigen und viele Tools, die verwendet werden können, wobei einige Tools für bestimmte Aufgaben besser geeignet sind als andere. Jedes Muster richtet sich an bestimmte kritische Bereiche, einschließlich der Funktionen der einzelnen Systeme, des Datenvolumens, der Fehlerverarbeitung und der Transaktionalität.
**Musterauswahlhandbuch**
In den Auswahlmatrixtabellen werden die Muster und ihre wichtigsten Aspekte aufgeführt, damit Sie bestimmen können, welches Muster Ihren Integrationsanforderungen am besten entspricht. Die Muster werden anhand dieser Dimensionen kategorisiert.
| Aspekt | Beschreibung |
| :----- | :-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Typ | Gibt den Integrationsstil an: **Prozess**, **Daten** oder **Virtuell**.
| Anrufmechanismus | Beschreibung |
|---|---|
| Erweiterter externer Service, der in einen Flow eingebettet ist, oder Lightning-Komponente oder Apex Steuerfelder |
Wird verwendet, wenn der Remote-Prozess im Rahmen eines durchgängigen Prozesses mit der Benutzeroberfläche ausgelöst wird und das Ergebnis in einem Salesforce-Datensatz angezeigt oder aktualisiert werden muss. Beispielsweise werden die Zahlungsergebnisse sofort zurückgegeben und dem Benutzer angezeigt, wenn eine Kreditkartenzahlung an ein externes Zahlungs-Gateway gesendet wird. |
| Apex Auslöser | Wird hauptsächlich zum Aufrufen von Remote-Prozessen mithilfe von Apex Callouts aus DML-initiierten Ereignissen verwendet. Weitere Informationen zu diesem Aufrufmechanismus finden Sie unter Muster Remote Process Invocation – Fire and Forget (Remote-Prozessaufruf – ausgelöst und vergessen). |
| Apex Batchklassen | Wird zum Aufrufen von Remote-Prozessen im Batch verwendet. Weitere Informationen zu diesem Aufrufmechanismus finden Sie unter Muster Remote Process Invocation – Fire and Forget (Remote-Prozessaufruf – ausgelöst und vergessen). |
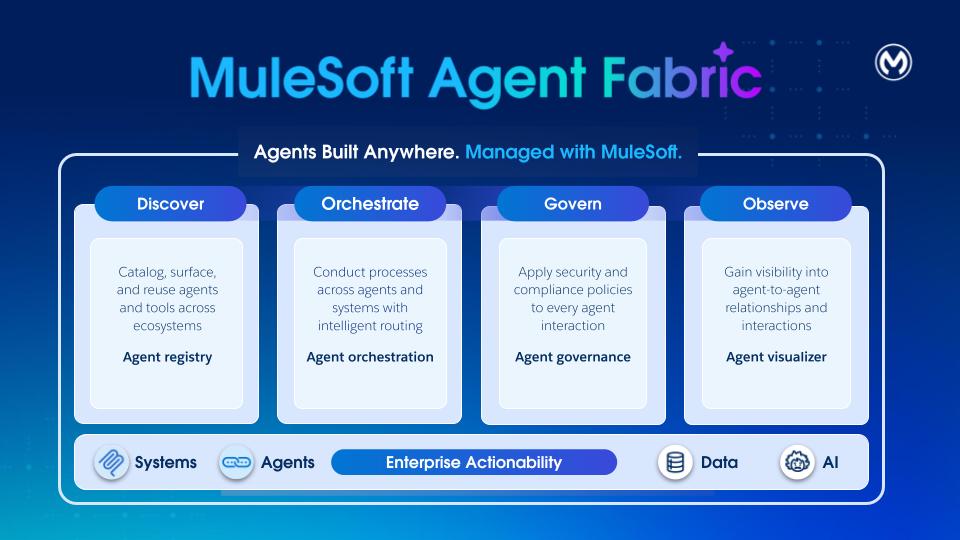 **Entdecken:** Die Agentenregistrierung bietet einen zentralen Katalog aller AI-Agenten und -Tools in der gesamten Organisation. Sie ermöglicht die Erkennung und Wiederverwendung intern erstellter, in SaaS eingebetteter und externer Datenbestände. Durch die Bereitstellung einer einzigen Informationsquelle für alle Agenten-Datenbestände beseitigt die Agentenregistrierung Redundanz und stellt sicher, dass Entwickler vorhandene Funktionen im richtigen Maßstab nutzen können.
**Orchestrieren:** MuleSoft Agent Broker ist eine intelligente Weiterleitungslösung, die Aufgaben dynamisch mit dem am besten geeigneten Agenten oder Tool abgleicht. Unterstützt von einem LLM Ihrer Wahl koordiniert es Agenten und Tools, um sicherzustellen, dass komplexe Anforderungen und Geschäftsprozesse mit mehreren Schritten mit hoher Zuverlässigkeit und nachvollziehbaren Ergebnissen ausgeführt werden.
**Regieren:** [MuleSoft Agent Governance](https://www.mulesoft.com/platform/ai/ai-agent-governance) verwendet Flex Gateway und unterstützt das [Modellkontextprotokoll (Model Context Protocol, MCP)](https://www.mulesoft.com/platform/ai/model-context-protocol) und das [Agent2Agent-Protokoll](https://www.mulesoft.com/platform/ai/a2a-support). Mit Flex Gateway können Unternehmen Sicherheits- und Compliance-Richtlinien für jede Agent-Agent- und Agent-Tool-Interaktion durchsetzen.
**Beobachten:** Agent Visualizer bietet Echtzeit-Beobachtbarkeit durch eine dynamische, interaktive Karte von Agenteninteraktionen. Sie verfolgt Entscheidungen, überwacht den Systemzustand und ermöglicht so eine kontinuierliche Optimierung und eine zuverlässige Überwachung des gesamten Agentenökosystems.
Agent Fabric setzt sich für einen Spezifikation-zuerst-Ansatz ein, bei dem Benutzer Agentennetzwerke über einen Metadatendeskriptor (die "YAML-Datei") definieren. Diese YAML-Datei ist für MuleSoft agnostiziert und entkoppelt die Definition des Agentennetzwerks von seiner Ausführung.
## Agentennetzwerkspezifikation (Metadatendeskriptor)
Jedes Agentennetzwerk definiert einen bestimmten Funktionsbereich mit seinen Agentenvermögenswerten, einschließlich seiner betrieblichen Regeln und Richtlinien. Die YAML wird verwendet, um die vier Säulen des Agentengewebes zu aktivieren:
1. Entdecken Sie: Füllen Sie die Agentenregistrierung mit vorhandenen Agentenvermögenswerten aus, beispielsweise:
1. Agenten, die auf verschiedenen Plattformen bereitgestellt werden (MuleSoft oder andere)
2. MCP-Server
3. LLM-Anbieter
2. Orchestrieren: Erstellen von Agentenmaklern für die Orchestrierung
3. Govern: Anwenden von Richtlinien auf Vermögenswerte für Sicherheit und Governance
4. Beobachten: Definieren und verwenden Sie Verbindungen zu den definierten Vermögenswerten erneut. Darüber hinaus sind Beobachtungs- und Überwachungsfunktionen für Agentennetzwerke verfügbar.
### Erstellung
Die Benutzer-Journey beginnt im Anypoint Code Builder. Verwenden Sie den neuen Befehl "MuleSoft: Erstellen eines Agentennetzwerkprojekts" zum Erstellen eines neuen Projekts. Mit diesem Befehl wird ein neues Projekt ("Agentennetzwerk") erstellt, das zwei Dateien enthält.
- **agent-network.yaml:** Diese Datei definiert die Konfiguration für das Multi-Agenten-System und ermöglicht die Orchestrierung von AI-Agenten mit externen Tools (über MCP) und Agenten (über A2A-Protokoll). Dieses Format bietet eine deklarative Möglichkeit, Agentenfunktionen, Abhängigkeiten und Integrationen zu definieren.
- **exchange.json:** Alle Agentennetzwerkprojekte verfügen zudem über eine Datei exchange.json. Diese Datei enthält Vermögenswert-Metadaten, die nach der Veröffentlichung Ihrer Agentennetzwerk-Datenbestände in Anypoint Exchange verfügbar sind.
Die Entwicklung Ihres Agentennetzwerks folgt einem standardmäßigen Software Development Lifecycle (SDLC), der vier Hauptphasen umfasst:
1. **Umgebungs-Setup:** Setup-Laufzeitumgebung und Gateways
2. **Projekterstellung und -design**: Erstellen einer Agentennetzwerk-Projektspezifikation
3. **Erstellung und Veröffentlichung:** Erstellen und Veröffentlichen von Datenbeständen in der Agentenregistrierung
4. **Bereitstellung:** Bereitstellen oder Höherstufen des Agentennetzwerks in einer bestimmten Umgebung
Nachdem Sie das Projekt erstellt und die erforderliche MuleSoft-Anwendung und die erforderlichen Datenbestände generiert haben, machen Sie sie in Exchange verfügbar. Lösen Sie den Erstellungs- und Veröffentlichungsprozess im Anypoint Code Builder mithilfe von **_"MuleSoft: Der Befehl "Projekt für Agentenmakler in Exchange veröffentlichen"_** ist über die Befehlspalette verfügbar.
Der Veröffentlichungsschritt wandelt jeden Agenten-Datenbestand in der YAML-Datei in eine A2A-, MCP- oder LLM-Spezifikation um und veröffentlicht ihn in Exchange.
Zusätzlich **veröffentlicht** das System die YAML mithilfe eines neuen Vermögenswerttyps vom Typ "Agent-Netzwerk" in Exchange. Sie können diesen Datenbestand auf der Benutzeroberfläche der Agentenregistrierung **anzeigen** und über die Exchange-API danach **suchen**.
### Beispiel
Verweisen Sie auf eine [Agentennetzwerkdatei,](https://docs.mulesoft.com/anypoint-code-builder/af-project-files) die ein Agentennetzwerk für ein Unternehmen definiert. Dieses Agentennetzwerk aktiviert das Netzwerk für die Auftragsabwicklung in Salesforce, Stripe, einem anderen Auftragsabwicklungsagenten und Inventar-MCP-Server mit einer einzigen richtliniengesteuerten Erfahrung.
- **Entdecken**
Veröffentlichen Sie vorhandene Agenten und Tools (wie Salesforce, Stripe, Auftragsabwicklung und Inventar) als Exchange-Datenbestände zur Wiederverwendung. Darüber hinaus die Auftragsabwicklungsdefinition (YAML), die versioniert und freigegeben werden kann und eine schnelle Anpassung für Rollen, Regionen oder Tochtergesellschaften ermöglicht, ohne Flows neu erstellen zu müssen.
- **Orchestrieren**
Ein Agentenmakler verwendet eine LLM, um den Auftragsabwicklungsprozess in eine Reihe von Aufgaben zu unterteilen, beispielsweise die Überprüfung von Kundendetails, die Zuteilung von Inventar und die Berechnung von Versandkosten. Anschließend wird dieser Workflow ausgeführt, indem MCP- und A2A-Agenten angerufen werden, um sicherzustellen, dass Genehmigungen jederzeit angefordert werden.
- **Regieren**
Anypoint Flex Gateway erzwingt die Authentifizierung, den Zugriff mit den geringsten Berechtigungen und Schutzmaßnahmen. API-Manager-Richtlinien stellen konsistente Kontrollen für alle Aufrufe und Datenaustausche sicher.
- **Beobachten**
Überwachung und Verfolgungen bieten durchgängige Einblicke in Fortschritt, Fehler und Latenz. Die Visualisierung zeigt, welche Agenten interagiert haben und wo Engpässe aufgetreten sind.
- **Trust und Compliance**
Zentralisierte Anmeldeinformationen, Prüfprotokolle und Richtlinienübernahme unterstützen Sicherheits-, Datenschutz- und behördliche Anforderungen (Handhabung personenbezogener Daten, Genehmigungen und Aufgabentrennung).
Das Diagramm zeigt die verschiedenen Knoten des im YAML definierten Agentennetzwerks (Metadaten).
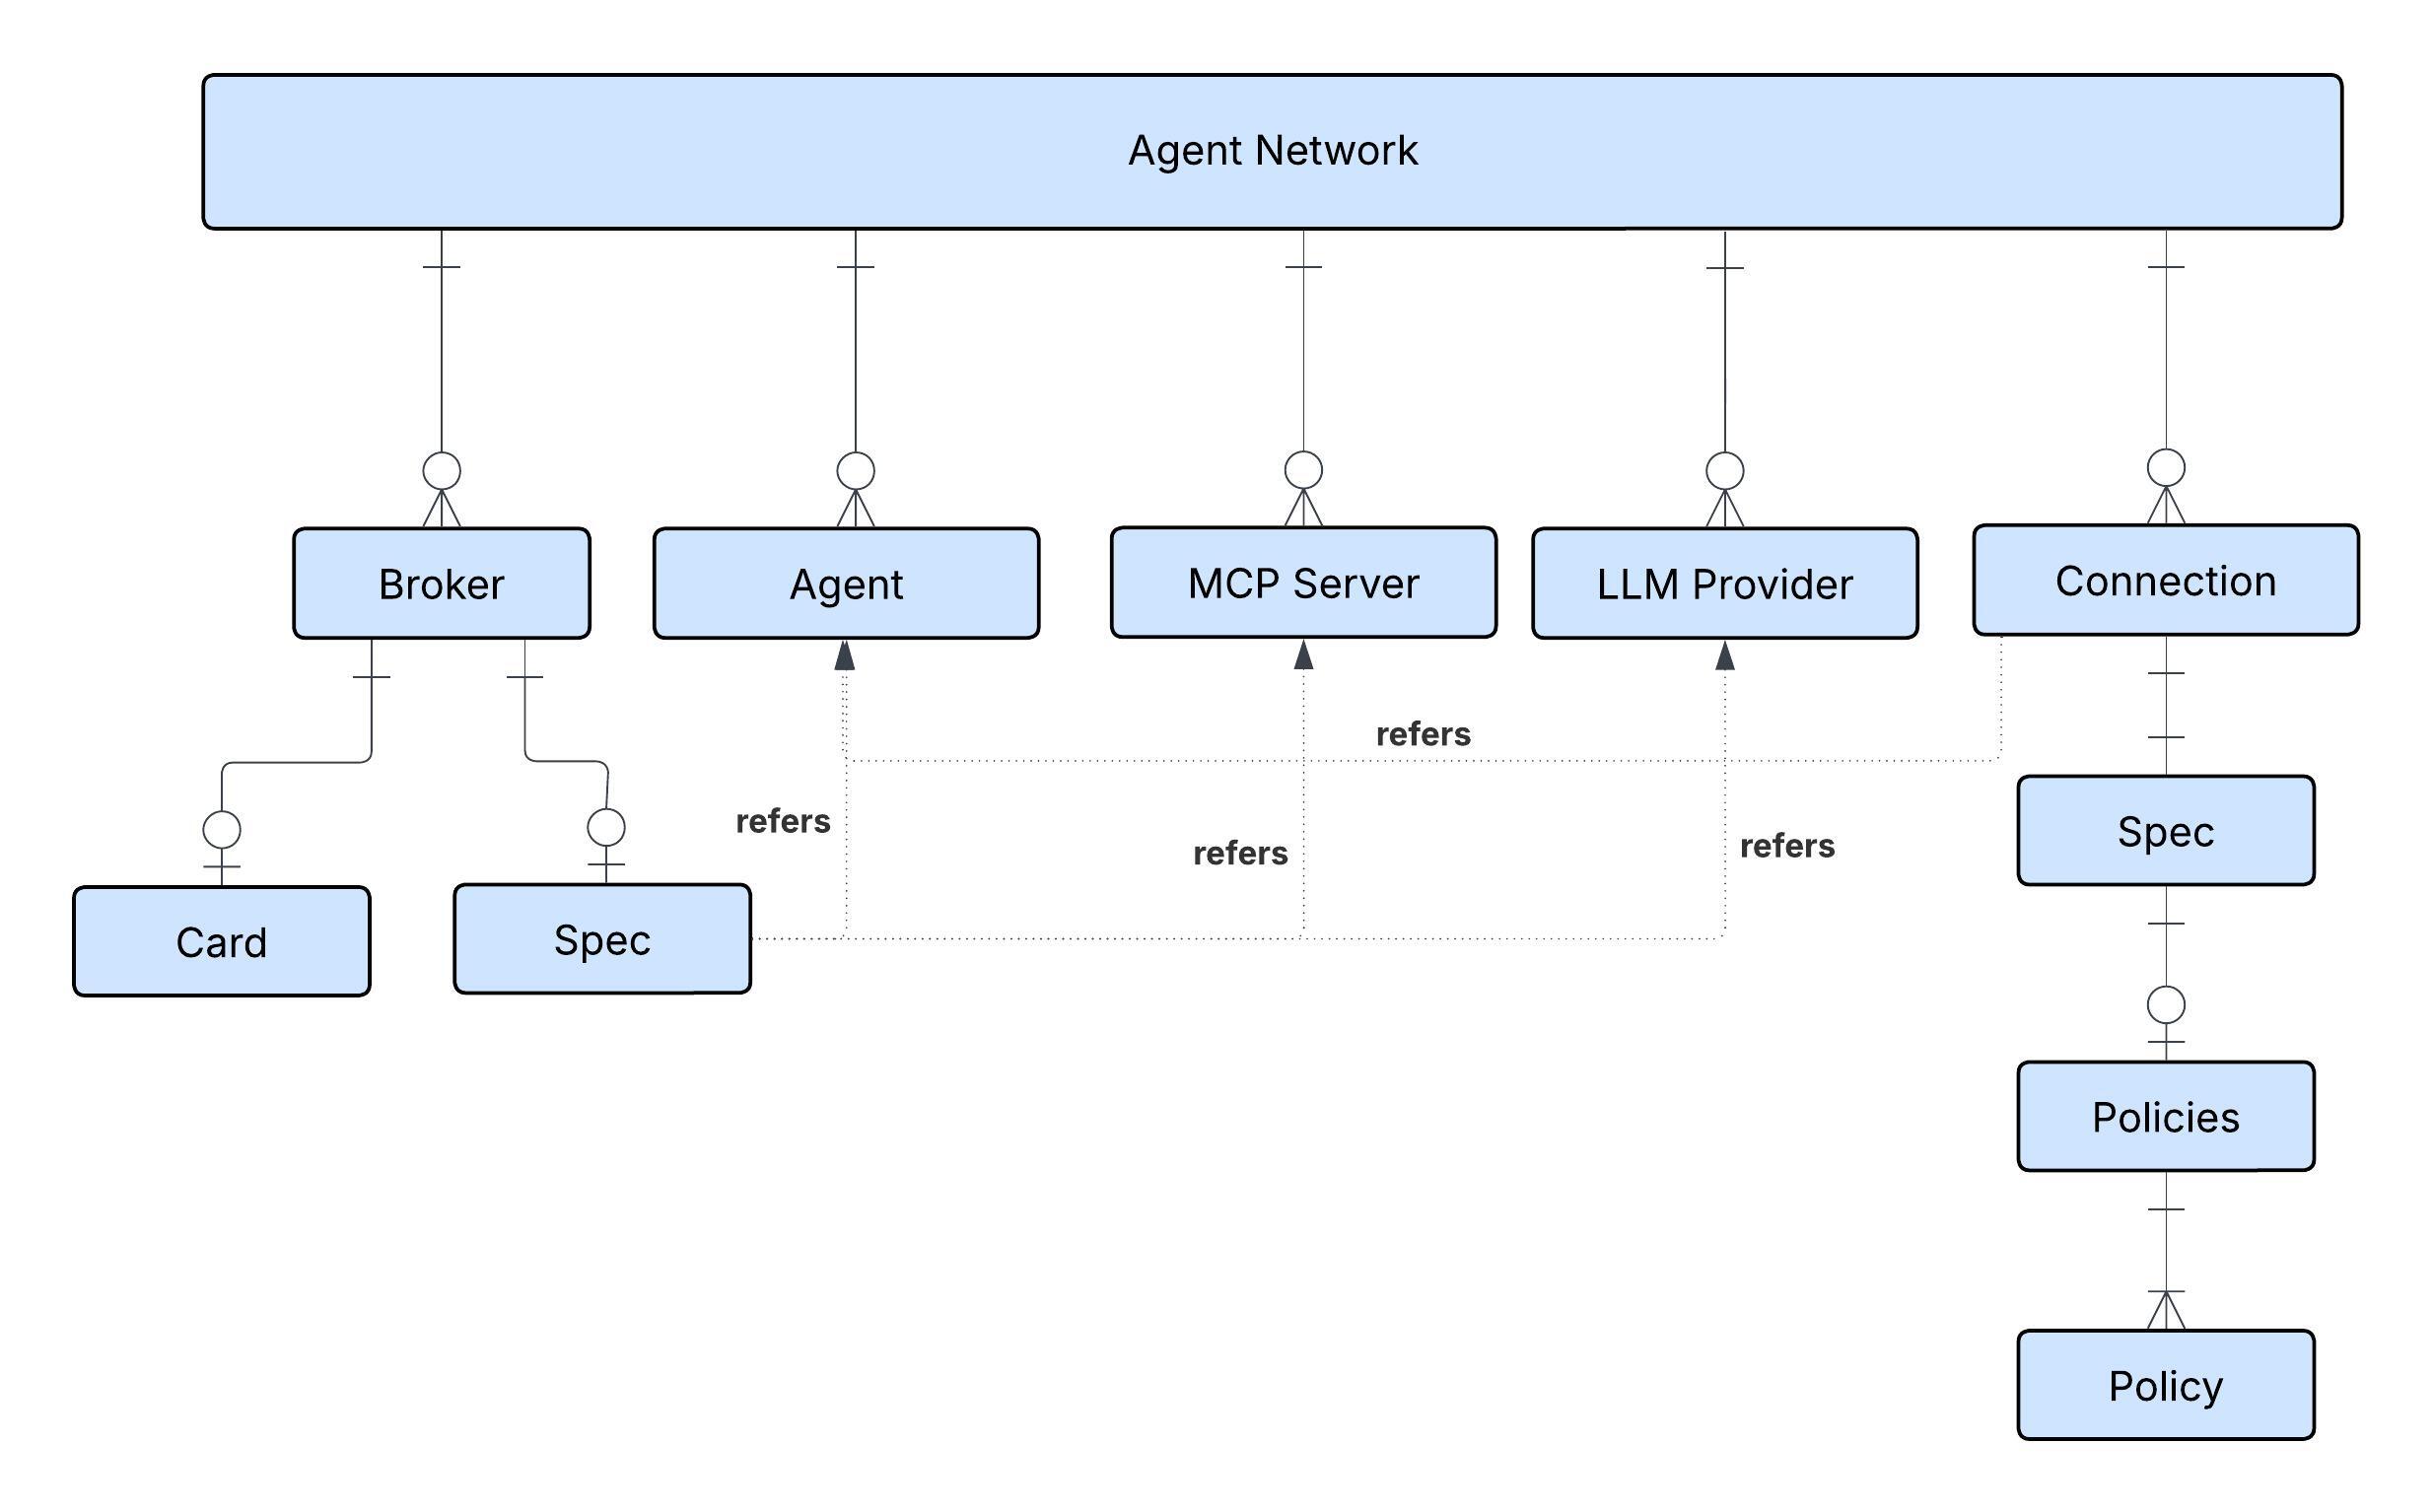 ## Agentenregister (Ermitteln)
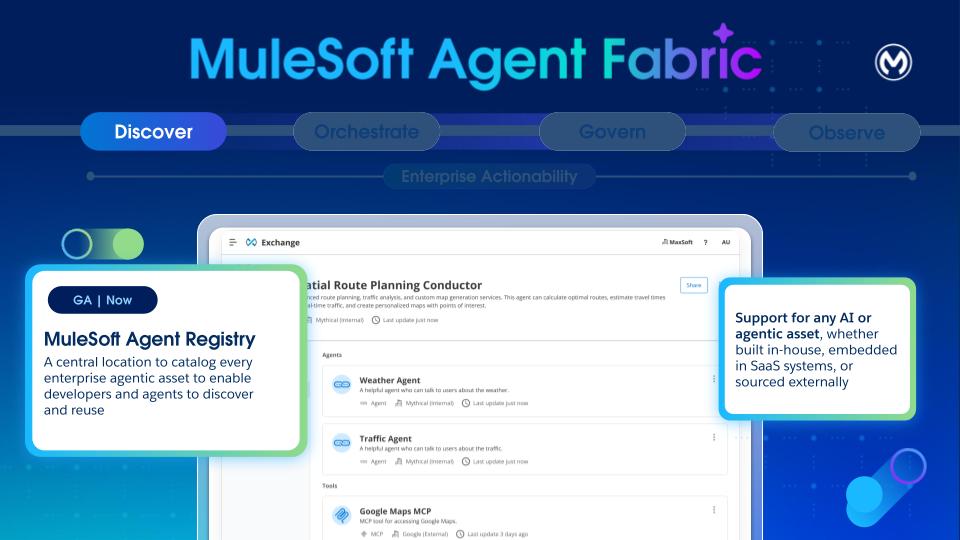 - **Zweck**: Exchange ist der Katalog für Agenten, Tools und andere Vermögenswerte. Ihr primäres Ziel ist es, die "Agentenverbreitung" zu lösen, indem ein einziger, geregelter Katalog für die Entdeckung, Pflege und Lebenszyklusverwaltung heterogener Agenten bereitgestellt wird. Dadurch können Entwickler Agenten finden und wiederverwenden, Plattforminhaber die Sichtbarkeit wahren und Orchestrierer die Funktionen entdecken.
- **Heterogen nach Design**: Anypoint Exchange unterstützt nun drei neue Datenbestände: Agenten, MCPs und LLMs. Exchange ist als universeller Katalog zur Registrierung und Verwaltung beliebiger Agententypen konzipiert. Sie unterstützt A2A-kompatible Agenten, MCP-Server und LLM-Anbieter aus allen Quellen, einschließlich Drittanbietern, Agentforce und benutzerdefinierten MuleSoft-Agenten.
- **Kernmetadaten**: Jeder registrierte Vermögenswert verfügt über einen Basissatz unveränderlicher Metadaten, einschließlich eines eindeutigen Namens und einer eindeutigen Version, Inhaberschaft und Herausgeber. Lebenszyklusstatus (Entwicklung, Staging, Produktion, veraltet) werden ebenfalls verfolgt.
- **Discovery**:
- **Design-Time**: Entwickler können registrierte Agenten entweder über die vorhandene Exchange-Benutzeroberfläche oder über die Suche mit natürlicher Sprache mit Vibes im Anypoint-Codegenerator finden.
- **Tagging und Klassifizierung**: Vermögenswerte können nach Typ (Agent, MCP, LLM, Makler) und Domäne (z. B. HR, Wetter) klassifiziert werden, indem ein grundlegendes Schlüssel-Wert-Tagging-System verwendet wird, das dynamische Verknüpfungs-, Such- und Auswahlrichtlinien ermöglicht.
- **Katalog**: Das Repository unterstützt private und interne Katalogmodelle für Freigabeagenten in einer Organisation.
- **Visualisierung**: Bietet ein visuelles Tool zur Unterstützung von Netzwerkansichten, das Verbindungen für einzelne Datenbestände oder die gesamte Karte der Knoten und Links in der gesamten Organisation mit Filterfunktionen anzeigt.
Makler in einem Agentennetzwerk können auf registrierte Agenten, MCP-Server und LLM-Anbieter verweisen, die in Anypoint Exchange gespeichert sind. Wenn sie jedoch noch nicht registriert sind, können sie in den Metadaten des Agentennetzwerks (YAML) deklariert werden und werden automatisch registriert. Im Beispiel werden mehrere Agenten, MCP-Server und LLM-Anbieter in Anypoint Exchange deklariert und registriert.
```
agents:
orders-agent:
label: Order Fulfilment Agent
metadata:
protocol: a2a
platform: OpenAI
salesforce-agent:
label: Salesforce Agent
metadata:
protocol: a2a
platform: OpenAI
stripe-agent:
label: Stripe Payment Agent
metadata:
protocol: a2a
platform: OpenAI
mcpServers:
inventory:
label: Inventory MCP
metadata:
transport:
kind: streamableHttp
path: /mcp
llmProviders:
open-ai:
label: OpenAI
description: OpenAI LLM Provider
metadata:
platform: OpenAI
```
## Agentenmakler (Orchestrat)
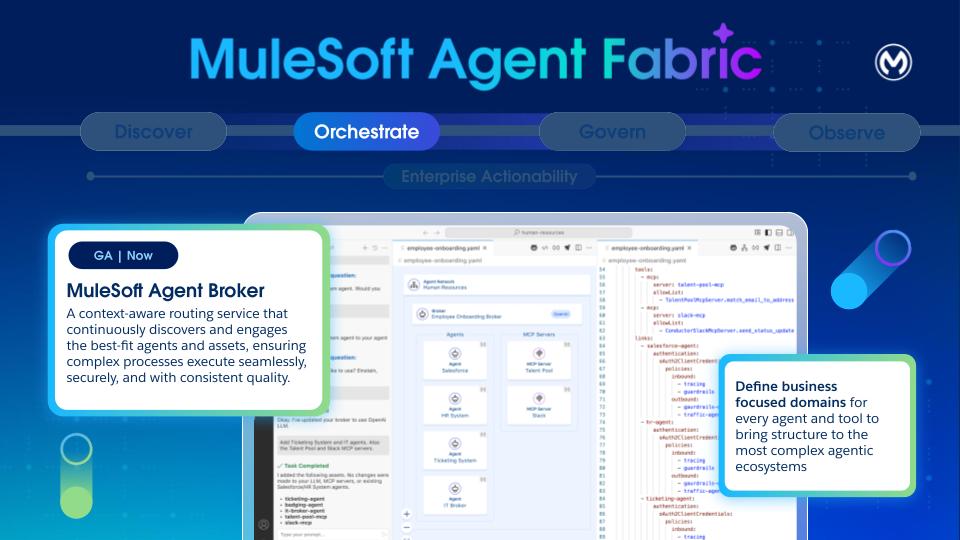 Ein Agentenmakler ist ein intelligenter Weiterleitungsagent, der die Aufgabenübertragung zwischen spezialisierten Agenten in einem Unternehmen koordiniert. Sie wird durch die Agenten und MCP-Server definiert, die sie zum Ausführen von Aufgaben verwendet.
Ein Makler ist ein spezialisierter Agent, der in Anypoint Exchange angezeigt wird, nachdem ein Agentennetzwerk-Vermögenswert veröffentlicht und von anderen Maklern wiederverwendet wurde.
Makler werden im Abschnitt "_Brokers_" (Makler) des YAML definiert. Die definierten Makler werden transparent in eine Anwendung "kompiliert", ohne dass Knowledge über Mule erforderlich sind. Diese generierte Anwendung wird in CloudHub 2.0 (CH2) bereitgestellt und nutzt die robuste CH2-Infrastruktur.
Das bedeutet, dass Agentenmakler von den bewährten Leistungsmerkmalen von CloudHub 2.0 profitieren, einschließlich der Protokollierungs- und Kennzahlenfunktionen. Operative Aspekte wie "Betriebskosten" und "Überwachung/Warnung/Tooling" sind mit allen anderen Arbeitslasten identisch.
In Szenarien, in denen ein menschliches Eingreifen erforderlich ist (Human-in-the-Loop), wird der Status jeder Interaktion mithilfe des MuleSoft Object Store beibehalten, einer verteilten Lösung, die für eine effektive Zustandsverwaltung in hochgradig gleichzeitigen Umgebungen entwickelt wurde.
Eine Maklerdefinition besteht aus zwei Abschnitten: card und spec.
### Karte
Der Kartenabschnitt folgt der [Agent-zu-Agent-Spezifikation](https://a2a-protocol.org/v0.2.5/specification/). Darin werden unter anderem der Vertrag, die Fertigkeiten und die Fähigkeiten des Makleragenten beschrieben. Der Karten-URL wird automatisch mit dem Wert ${ingressgw.url}/broker-name ausgefüllt. Bei der Bereitstellung wird der Platzhalter ${ingressgw.url} automatisch durch den URL des Anypoint Flex Gateway ersetzt, der den eingehenden Anforderungen des Agenten vorangestellt ist.
### Spezifikation
Im Abschnitt "Spezifikation" wird der "Quellcode" des Maklers konfiguriert. Hier kann der Entwickler das zu verwendende LLM, Anweisungen, verfügbare Tools, Fehlerbehandlung und vor allem die verschiedenen Agenten und MCP-Tools angeben, die diesem Makler zur Verfügung stehen.
**LLM-Anbieter**
Dieser Abschnitt ist Teil der Spezifikation in jedem Broker. Dies ist ein Verweis auf eine der im Abschnitt "Services" definierten LLMs. Wir können auswählen, ob ein LLM für alle Makler freigegeben werden soll oder ob bei Bedarf verschiedene Makler das LLM verwenden sollen, das besser zu ihren Aufgaben passt.
Makler können auf LLM-Anbieter verweisen. Je nach Bedarf können wir Modelle dieser Anbieter auswählen.
```
llmProviders:
open-ai:
label: OpenAI
description: OpenAI LLM Provider
metadata:
platform: OpenAI
```
**Anweisungen**
Dieser Abschnitt ist optional und Sie können ihn verwenden, um Anweisungen speziell für diesen Makleragenten anzugeben. Diese Anweisungen konzentrieren sich oft auf bestimmte geschäftsorientierte Anliegen. Stellen Sie sich beispielsweise einen Kundendienstagenten vor, der die Verwaltung für vom Kunden gemeldete Vorfälle koordiniert:
```
instructions:
- |
You are an Incident Management Orchestrator Agent. Your primary responsibility is to coordinate the resolution of incidents reported by customers.
The process for incident management is:
1. Fetch Salesforce Case Details: Retrieve the latest critical case details for the given customer.
2. Fetch Entitlement Details: Obtain the customer's entitlement information.
3. Fetch On-Call Engineer: Identify the current on-call engineer for the incident.
4. Create Slack War Room and invite on-call engineer: Set up a Slack war room channel and invite the on-call engineer.
5. Summarize Actions: Provide a clear, human-readable summary of the steps performed, including information about the created slack channel and the on-call engineer assigned
```
Beachten Sie, dass es keine expliziten Anweisungen wie **"Aufteilung der Eingabeaufforderung in Aufgaben" oder "Auswahl des besten Tools"** gibt, da der Makler dies selbst erledigt. Diese Anweisungen sind nur bei der Beschreibung bestimmter Geschäftsprozesse erforderlich.
**Konfiguration der Tools**
Tools bieten Agenten externe Funktionen. Wenn ein Makler auf ein externes System zugreifen muss (d. h. nicht auf einen anderen Agenten, beispielsweise eine vorhandene API oder einen SaaS-Service), wendet er sich an einen MCP-Server (Model Context Protocol):
```
tools:
- mcp:
server: collaboration-mcp # MCP server reference
allowed: # Allowlist specific tools
- create_channel
- invite_user
```
Auf den MCP-Server verweist der Name des Exchange-Vermögenswerts. Die Konnektivitätsdetails dazu sind im Abschnitt "Services" angegeben.
Standardmäßig hat der Makler Zugriff auf alle Tools, die auf dem MCP-Server verfügbar sind. Nach unserer Beobachtung können die modernsten LLMs nur etwa 20 - 25 Tools pro Kontext verarbeiten, bevor sie Ungenauigkeiten generieren (oder den Kontext verlieren). Aus diesem Grund empfiehlt es sich in der Regel, die verfügbaren Tools auf das erforderliche Minimum zu beschränken. Sie können diese Filterung über die zulässigen Listen anwenden.
**Agentenlinks**
Dieser Abschnitt ist der wichtigste Teil der gesamten Definition. Der Abschnitt "Links" ermöglicht die Kommunikation und Orchestrierung zwischen Agenten. Das bedeutet, dass dieser Makler bei der Ausführung der entsprechenden Aktionen auf die hier verlinkten Agenten angewiesen ist, um das Ziel des Benutzers zu erreichen.
```
links:
- agent:
ref:
name: orders-agent
- agent:
ref:
name: salesforce-agent
- agent:
ref:
name: stripe-agent
```
Tatsächlich definiert dieser Abschnitt ein Agentennetzwerk für die Zusammenarbeit.
## Flex Gateway (Verwalten)
 Die Agenten-Governance ist eine wichtige Säule für die Agenten-Fabrik, die für den Aufbau eines vertrauenswürdigen Agentennetzwerks und die Gewährleistung von Sicherheit und Compliance unerlässlich ist.
Für die Verwaltung sind insgesamt zwei Flex Gateways (1 Eingang und 1 Ausgang) in Ihrem privaten Bereich erforderlich.
Die Governance schafft die erforderlichen Strukturen, Kontrollen und Nachweise, um den gesamten Lebenszyklus der Agentenentwicklung sicher zu skalieren. Insbesondere implementiert die Governance wichtige Prozesse wie die Agentenzertifizierung, die Katalogisierung, Lebenszyklusentscheidungen und die Erzwingung von Laufzeitrichtlinien.
- **Katalogisierung:**
- Exchange: Unterstützt die Aufzeichnung von Agentenzwecken, Inhabern, Umgebungen sowie Daten- und Klassifizierungsgrenzen. Außerdem werden Funktionen, Tools, Ressourcen, Aufforderungen und externe Abhängigkeiten mit Versionen registriert.
- **Versionierung und Lebenszyklus:**
- Dokumentieren und verwalten Sie die semantische Versionierung von Agenten, Tools und Vermögenswerten während des gesamten Agentenentwicklungslebenszyklus.
- Die Versionsverwaltung hilft Ihnen bei der Verwaltung der Zeitachsen für die Agentenabschreibung und unterstützt (sofern möglich) Dual-Run, um reibungslose Migrationen zu gewährleisten.
- **Policenerzwingung**:
- Die Architektur der Agenten-AI erweitert die Angriffsfläche (Unterhaltungsoberfläche, Eingabeaufforderungen und neue Protokolle wie MCP). Jeder Kompromiss an Komponenten kann zu kaskadierenden Effekten für mehrere Systeme führen, die Komponenten wie Protokoll, Aufforderung, API oder Tool bereitstellen.
- Die Sicherung von Bereitstellungen mit agentischer AI für Unternehmen erfordert einen speziellen Ansatz, da diese autonomen und unvorhersehbaren Umgebungen die Angriffsfläche durch Interaktionen zwischen Agenten erweitern. Vorhandene Sicherheitstools für statische Systeme sind zwar unerlässlich, reichen jedoch allein nicht mehr aus. Unternehmen müssen vier spezifische Sicherheitslösungen proaktiv planen und implementieren, die jeweils direkt auf ein kritisches Geschäftsrisiko im Zusammenhang mit der Agenten-AI eingehen.
- Flex Gateway: Der gesamte A2A- und MCP-Datenverkehr wird über Flex Gateway weitergeleitet, selbst wenn das Zielsystem nicht sicher ist, um sicherzustellen, dass Richtlinien auf jeden Endpunkt angewendet werden. Diese Weiterleitung ist entscheidend für die Sicherung der Agentenkommunikation und die Integration in Autorisierungsserver.
- Policenpakete: Benutzer können Pakete vordefinierter Richtlinien vor der Ausführung definieren und auf Workflows anwenden, um einen einheitlichen Satz an Sicherheits- und Betriebsrichtlinien zu erzwingen.
- Policentypen: Die Plattform unterstützt verschiedene eingehende und ausgehende Richtlinien, darunter:
- A2A-Richtlinien: Agentenkarte, PII-Detektor, Aufforderungsdekorator, Schemavalidierung.
- MCP-Richtlinien: Attributbasierte Zugriffssteuerung, Schemavalidierung, MCP-Unterstützung.
- LLM/AI-Richtlinien: AI Prompt Decorator, AI Prompt Guard (Filtern schädlicher Inhalte), AI Prompt Template (Anwendung vordefinierter Vorlagen), AI Basic Token Rate Limiting (AI Basic Token Rate Limiting).
- Telemetrierichtlinien: A2A- und MCP-Telemetrie zur Erweiterung der Open Telemetry-Lösungen für die Erfassung und den Export von Protokolldaten.
- **Protokollierung**: Dank der automatischen Verfolgung sind Protokolle im gesamten Agentennetzwerk verfügbar, um jede Agenteninteraktion zu verfolgen, Verhaltensweisen zu erläutern und Trust aufzubauen.
Das Beispiel zeigt eine Richtlinie für die Nachrichtenprotokollierung, die mithilfe der Agentennetzwerk-Metadaten konfiguriert wird. Der Broker für die Auftragsabwicklung bezieht sich auf einen vorhandenen Agenten namens Salesforce-Agent und die Richtlinie für das Messaging wird mithilfe der Metadaten konfiguriert. Beachten Sie, dass Agent Fabric automatisch alle Richtlinien konfiguriert, die im Abschnitt "Spezifikation" für Flex Gateway erwähnt werden. Sie benötigen keine zusätzlichen Schritte.
```
salesforce-agent-connection:
kind: agent
ref:
name: salesforce-agent
spec:
url: ${salesforce-agent.cardUrl}
policies:
- ref:
name: message-logging
namespace: 68ef9520-24e9-4cf2-b2f5-620025690913
configuration:
loggingConfiguration:
- itemName: "Payload"
itemData:
message: "#[payload]"
firstSection: true
secondSection: true
level: "INFO"
- itemName: "Headers"
itemData:
message: "#[attributes.headers]"
firstSection: true
secondSection: true
level: "INFO"
```
## Agent Visualizer (Beobachten)
 Angesichts des nichtdeterministischen Charakters und der Komplexität von LLM-Agenten und Bereitstellungen mit mehreren Agenten sind Beobachtbarkeit und Überwachung entscheidend.
- **Grundlegende Protokolle und Verfolgungen**: Die Argumentation und die Toolausführungsverfolgung werden über Protokolle bereitgestellt. Protokolle und Verfolgungen aus Workflow-Ausführungen können nach der Ausführung im Laufzeit-Manager angezeigt werden.
- **Kennzahlen**: In der Anfangsphase veröffentlicht die Plattform a2a_total_calls und mcp_total_calls als Zähler mit Bezeichnungen (z. B. Pfad, Status, Methode, Tool), um die Gesamtzahl der erfolgreichen und fehlgeschlagenen Aufrufe zu ermitteln. Diese Kennzahlen werden über den Richtliniencode mithilfe der nativen Statistikschnittstelle von Envoy (Flex Gateway) veröffentlicht, vorzugsweise über vorhandene Richtlinien wie mcp_support_policy und a2a_agent_card_policy.
- **Erweiterte Beobachtbarkeit (Zukunft)**: Die Pläne beinhalten die Verwendung der offenen Telemetrie für die verteilte Verfolgung in künftigen Versionen. Die erweiterte Beobachtbarkeit umfasst Folgendes:
- **Detaillierte Anforderungsverfolgung**: Erhalten durchgängiger Einblicke in Anforderungen, einschließlich Aufforderungen, Planerprozessen, aufgerufenen Aktionen und Interaktionen mit Unteragenten.
- **Agentenintegritätsüberwachung**: Überwachen der Agentenverfügbarkeit, der Antwortlatenz, des Durchsatzes, der Fehlerraten und der zugrunde liegenden Ressourcenauslastung (CPU, Speicher, Netzwerk, GPU).
- **Überwachung der Koordination mehrerer Agenten**: Erfassen von Erfolgs- und Fehlerraten von Interaktionen zwischen Agenten, Erkennen von kreisförmigen Aufrufmustern (Schleifen) und Verfolgen von Kennzahlen pro Agent, beispielsweise Aufgabenabschluss und Aufrufanzahl.
- **Kostenverfolgung**: Verfolgen der Tokennutzung und der damit verbundenen Kosten für jeden LLM-Aufruf, idealerweise pro Agent, mit Dashboards und Benachrichtigungen.
- **Kognitive Verfolgung**: Erfassen und Anzeigen einer detaillierten Verfolgung der Sitzung eines Agenten, einschließlich interner Denkprozesse und aller Tool-Aufrufe, als unveränderlicher Überwachungspfad.
- **Agentensitzungswiedergabe**: Eine Benutzeroberfläche, die es ermöglicht, die kognitive Verfolgung eines Agenten Schritt für Schritt visuell für Deep Debugging "wiederzugeben".
- **DAG-Visualisierung**: Bereitstellen einer Visualisierung des gerichteten azyklischen Diagramms (DAG) der Agenten-Workflow-Ausführung für komplexe Interaktionen mit mehreren Agenten.
Der Agentenvisualisierer wird verwendet, um die Teile Ihres Agentennetzwerks zu identifizieren und zu sehen, wie sie zusammenarbeiten.
- Unterscheiden Sie Knotentypen (Agenten und MCP-Server).
- Zeigen Sie die Ränder an, um deklarierte und Laufzeitinteraktionen anzuzeigen.
- Verwenden von Ebenen zum Fokussieren von Ansichten auf bestimmte Umgebungen
- Öffnen von Detailkarten zum Untersuchen von Metadaten und Kennzahlen für Knoten und zum Zugreifen auf Protokolle und Verfolgungen
- Überprüfen Sie Governance-Indikatoren wie den Flex Gateway-Schutz und die angewendeten Richtlinien.
Details zu den Komponenten von Agent Visualizer finden Sie [hier](https://docs.mulesoft.com/agent-visualizer/agent-visualizer-components).
## Agentengewebe: Vier Säulen zusammen
Mit diesen vier Säulen zusammen erweitert MuleSoft Agent Fabric die Sicherheit und Kontrolle auf alle Agenten mit integrierter Governance. Sie ermöglicht Agenten, überall zu handeln, indem sie neue Protokolle wie A2A (Agent to Agent) und MCP (Model Context Protocol) verwenden, um Geschäftsprozesse zu erstellen und zu erweitern. Wir verbinden alles – Anwendungen, Daten und Systeme –, um Agenten zu unterstützen und zu steuern, während sie im gesamten Unternehmen agieren. Intelligentes Tooling unterstützt die Erstellung und Erweiterung von Geschäftsprozessen oder APIs, indem AI nativ verwendet wird oder indem AI-Tools von Drittanbietern bereitgestellt werden.
Die Verwendung aller vier Säulen zusammen ist nicht erforderlich, wird jedoch empfohlen. Sie können Säulen nach Bedarf unabhängig voneinander auswählen. Beispielsweise können Sie "Agent Fabric" für die Registrierung und Verwaltung nutzen, ohne die Orchestrierungsebene zu verwenden. Ebenso können Sie den Makler verwenden, um Agenten zu orchestrieren, die über eine andere Plattform verwaltet werden.
Das Diagramm zeigt, wie alle vier Komponenten miteinander interagieren:
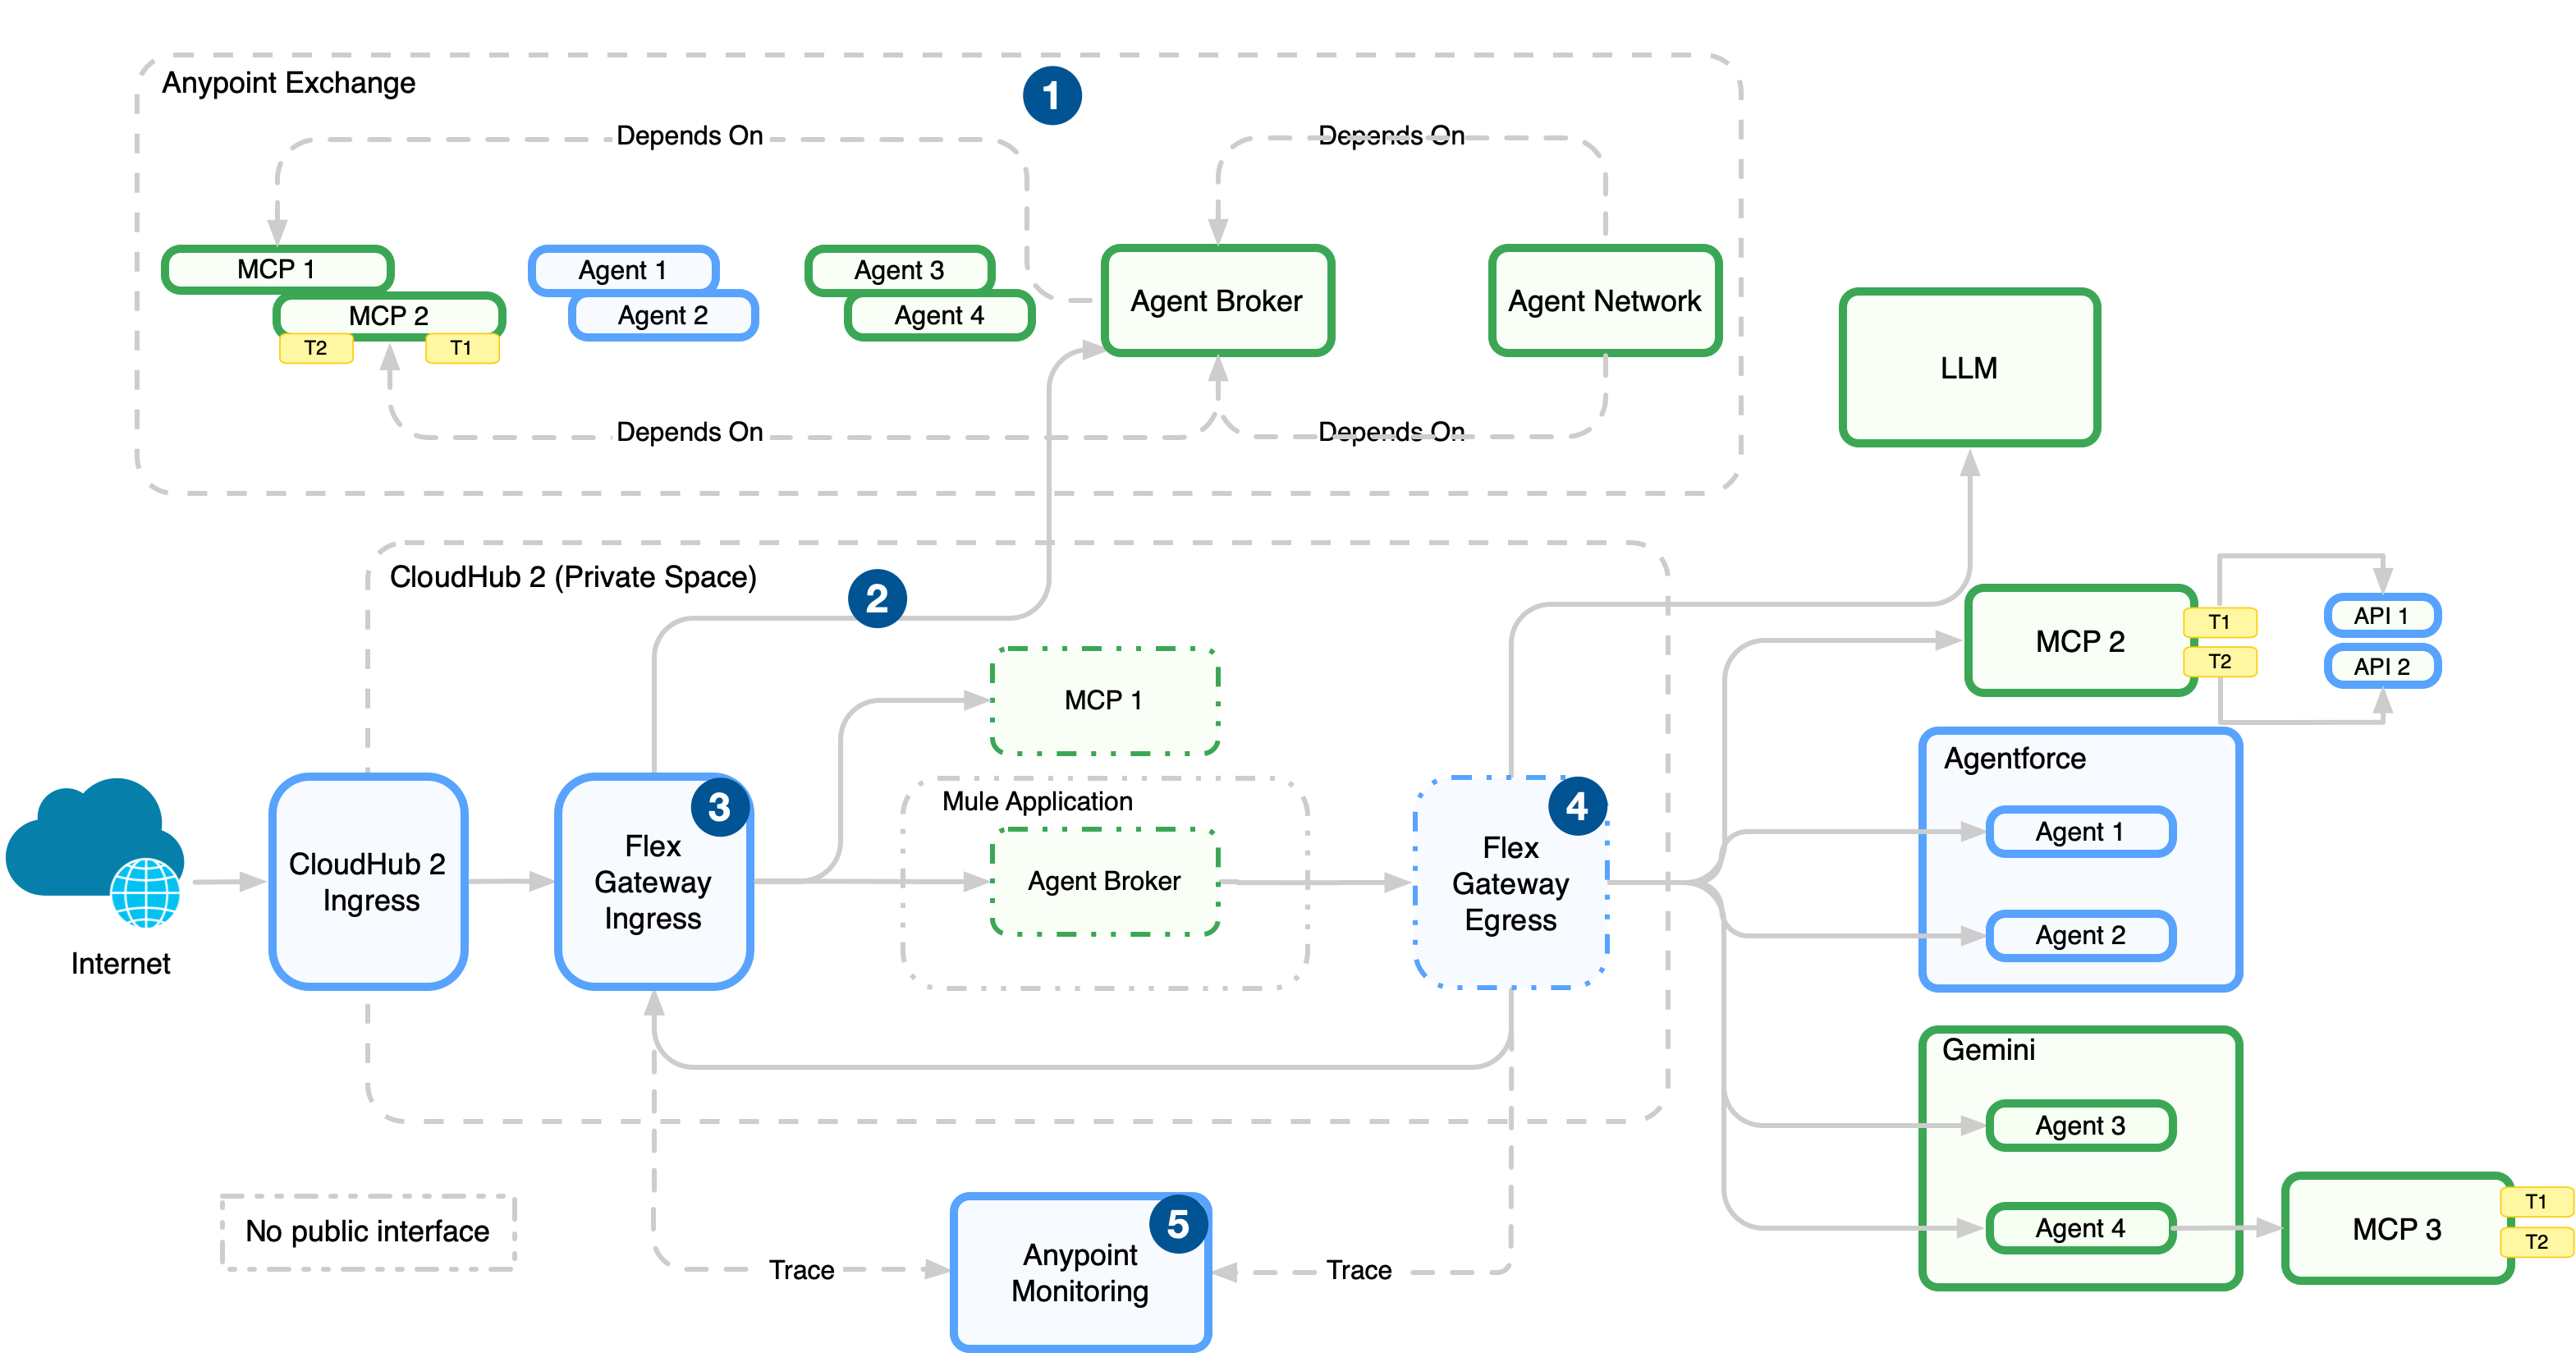 1. Veröffentlichen Sie die agentischen Datenbestände in Anypoint Exchange zur Erkennung und Wiederverwendung, nachdem Sie das Agentennetzwerk (Broker, Agenten, MCP-Server) im Agentennetzwerk-YAML im Anypoint Code Builder definiert haben.
2. Stellen Sie die Agenten-Datenbestände in CloudHub 2.0 (verwaltet im Laufzeit-Manager) bereit.
3. Erzwingen Sie Richtlinien für eingehenden Datenverkehr im Netzwerk mit einem eingehenden Flex-Gateway, das sich vor Broker- und API-Endpunkten befindet.
4. Erzwingen Sie Richtlinien, verwalten Sie Verbindungen und senden Sie Telemetriedaten mit einem ausgehenden Flex Gateway. Dieses Gateway befindet sich auf ausgehenden Pfaden von Maklern und Agenten zu externen Services.
5. Erfassen Sie Protokolle, Kennzahlen und Verfolgungen aus Flex Gateway und Laufzeiten in Anypoint Monitoring.
## Designmuster der Agentenorchestrierung
Es ist verlockend, jeden spezialisierten Agenten sofort in einer flachen, uneingeschränkten Architektur zugänglich zu machen, mit einem einzigen Orchestrierer, der jede Aufgabe bewältigen kann, indem er auf alle verfügbaren AI-Datenbestände zugreifen kann. Dieser Ansatz erweist sich jedoch schnell als schädlich für die Effizienz und Zuverlässigkeit des Gesamtsystems. Ähnlich wie das Prinzip, das auf einen Überschuss an einzelnen Tools angewendet wird, führen viele Agentenoptionen zu erheblichen Störungen und Komplexität für den zentralen **Makleragenten** (oder Orchestrierer). Diese erhöhte Komplexität führt direkt zu einem spürbaren Rückgang sowohl der Genauigkeit der Entscheidungsfindung des Maklers (Auswahl des richtigen Agenten für den Auftrag) als auch des Determinismus der Antwort des Systems (vorhersehbare, konsistente Ergebnisse für ähnliche Abfragen). Der Makleragent leidet effektiv an einer Optionslähmung, was zu einer langsameren und weniger zuverlässigen Weiterleitung führt.
Statt einer flachen Struktur wird dringend ein **mehrstufiger hierarchischer Ansatz** zur Strukturierung des Agentennetzwerks befürwortet. Dieses Organisationsprinzip bietet zahlreiche entscheidende Vorteile. Erstens begünstigt sie von Natur aus die **Verfolgbarkeit und Verwaltung**. Eine hierarchische Struktur spiegelt die bewährten Vorgehensweisen der Organisation wider, sodass Sie den Flow einer Anforderung leichter überprüfen, Probleme durch die Identifizierung der Fehlerebene debuggen und die Bereitstellung und Einstellung bestimmter Agenten oder Subnetzwerke verwalten können.
Zweitens hilft eine Hierarchie im Kontext von großen Sprachmodellen (LLMs), die diese Agenten unterstützen, dabei, die **Kontextgrößen in Schach** zu halten. Durch die Segmentierung der Agentenlandschaft berücksichtigt der Makleragent auf einer bestimmten Ebene nur den begrenzten Satz an Agenten oder Untermaklern, der sich direkt darunter befindet. Durch diese Struktur wird verhindert, dass der primäre Orchestrierer die Beschreibung, die Funktionen und den historischen Kontext _jedes Agenten_ in seinen Arbeitsspeicher lädt, was das Risiko **vermeidet**, dass die Kontextfenstergrenzen des LLM schnell **überschritten** werden und unerschwingliche Kosten und Latenzen **entstehen**.
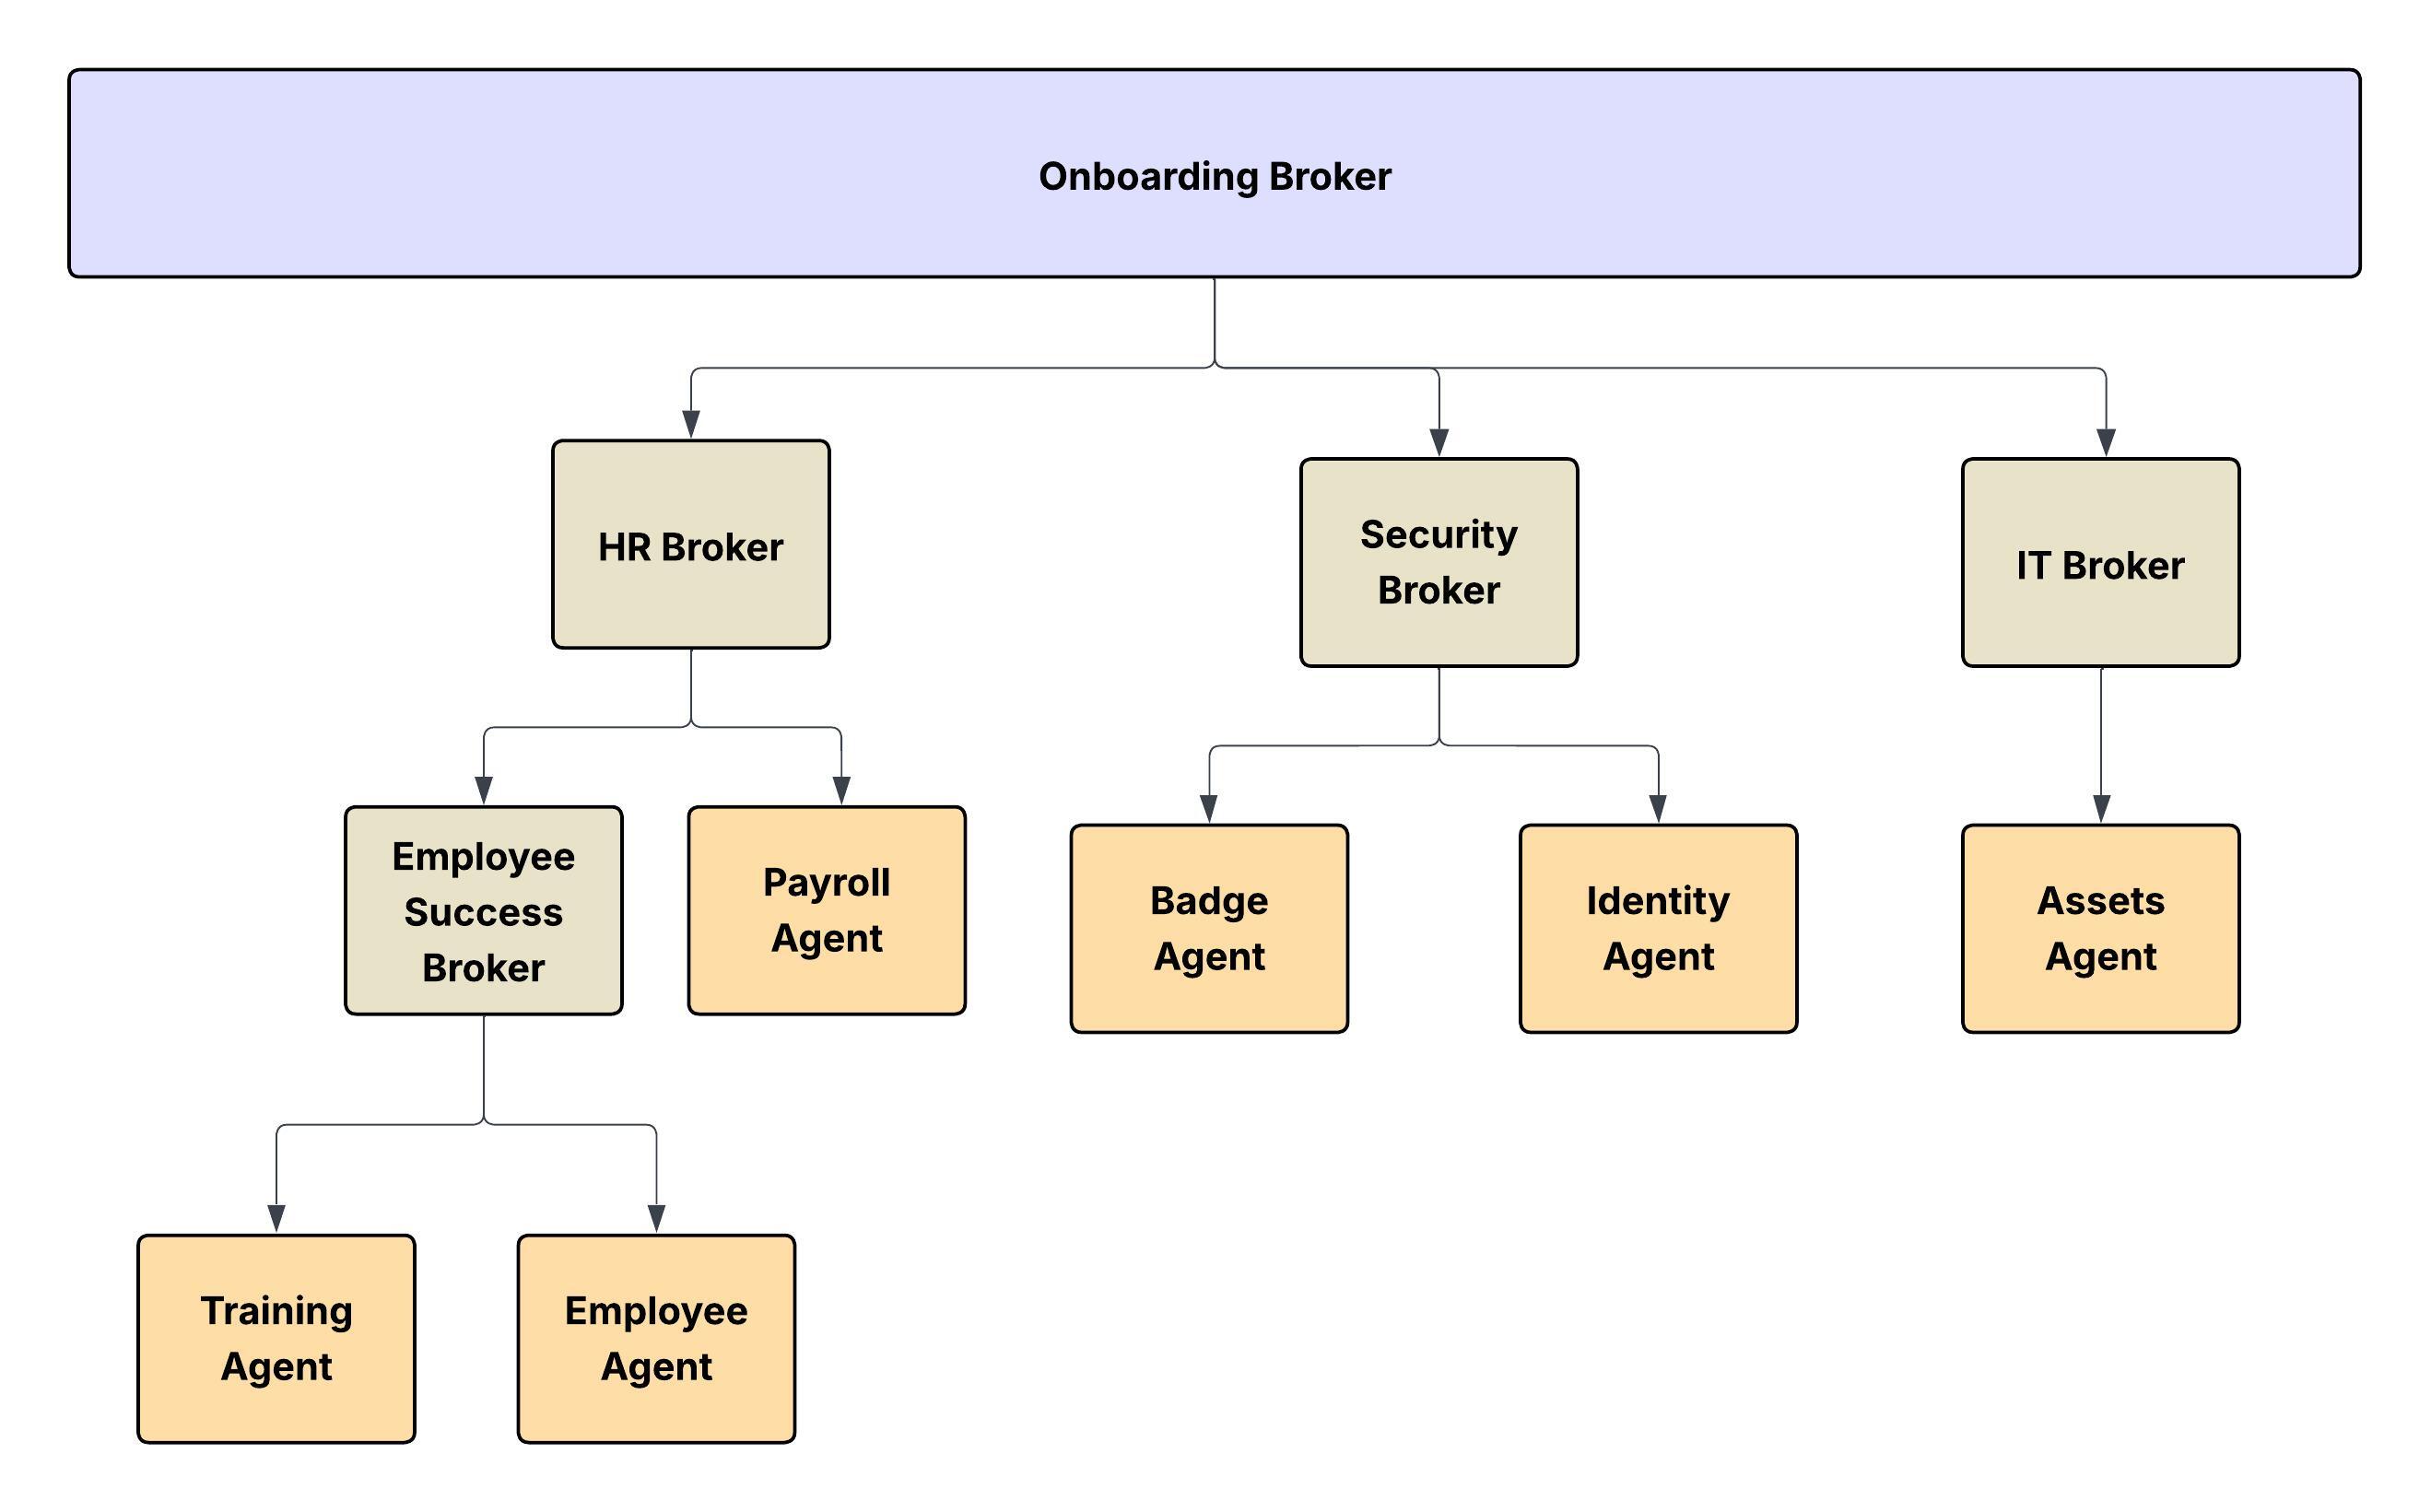 Das Agentennetzwerk kann auf mehrere Arten implementiert werden. Zwei davon sind:
1. Conway's Law (Conway-Gesetz): Intuitive Möglichkeit, es der realen hierarchischen Struktur zuzuordnen.
2. Domänengesteuertes Design – Fokussierter auf Geschäftsdomänen
## Option 1: Zuordnung mit realer hierarchischer Struktur
In einer hierarchischen Organisation erfolgt die Kommunikation vertikal – von Managern bis hin zu nachgeordneten Positionen – und Entscheidungen werden oft zentralisiert. Gemäß dem Conway-Gesetz:
- Die von solchen Organisationen erstellten Systeme oder Softwarearchitekturen sind in der Regel mehrschichtig und hierarchisch.
- Jedes Team neigt dazu, Subsysteme zu entwerfen, die seine eigenen Grenzen und Autoritäten widerspiegeln.
- Die Schnittstellen zwischen den Systemen spiegeln die Kommunikationskanäle zwischen den Abteilungen wider.
Das Agentennetzwerk kann auch intuitiv der **realen hierarchischen Struktur eines großen Unternehmens** entsprechend dem Conway'schen Gesetz zugeordnet werden.
- **Das Konzeptmodell:** So wie ein Unternehmen über unterschiedliche Unternehmensbereiche, Abteilungen und Verwaltungsebenen verfügt (z. B. C-Suite, VPs, Directors, Manager), kann ein Agentennetzwerk, das in einer bestimmten Domäne arbeitet, als paralleles Organigramm modelliert werden.
- **Die Knoten und Blätter:** In dieser Hierarchie:
- **Die Blätter** der Struktur sind die **Fachagenten** oder **MCPs**. Sie sind die Funktionseinheiten, die die eigentliche Arbeit ausführen (beispielsweise ein "Datenbankabfrageagent", ein "Kundenauthentifizierungsagent", ein "Stimmungsanalyseagent"). Sie stellen die einzelnen Beitragenden oder Arbeitseinheiten der Organisation dar.
- **Alle anderen Knoten** in der Hierarchie, einschließlich der Stamm- und Zwischenebenen, sind **Makleragenten** (oder Unterorchestratoren). Diese Agenten führen nicht die letzte Aufgabe aus, sondern sind für die Weiterleitung, Delegierung, Aggregation und Konfliktlösung innerhalb ihrer spezifischen Domäne oder Ebene verantwortlich. Ein Makler auf hoher Ebene delegiert eine Aufgabe an einen "Vertriebsdomänenmakler", der wiederum an einen "Opportunity-Verwaltungsmakler" delegiert, der die Aufgabe über einen "Agenten für die Aktualisierung des Opportunity-Status" (das Blatt) ausführt.
Diese Struktur stellt sicher, dass die Komplexität lokal verwaltet wird, der Kontext enthalten ist und das System vorhersehbar und zuverlässig skaliert wird. Sie können neue spezialisierte Agenten in bestimmte, geeignete Zweige der Organisationsstruktur einführen.
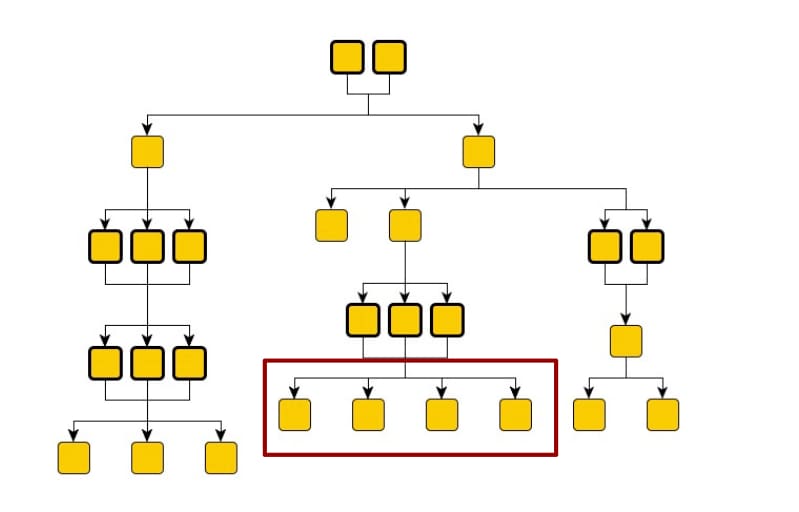 Betrachten Sie die Analogie eines Organigramms für digitale Arbeit. Jede YAML-Datei stellt jede der internen Organisationen (Mitarbeitererfolg, Sicherheit, Finanzen usw.) dar. In jeder Organisation (Agentennetzwerk) verfügen Sie möglicherweise über eine hierarchische Struktur, über die Akteure zusammenarbeiten, Aufträge werden in Aufgaben aufgeteilt und zugewiesen. Im vorherigen Diagramm verläuft die Kommunikation von oben nach unten. Und die Blätter können nicht nur von einer Reihe von Maklern verwendet werden.
## Option 2: Domänengesteuertes Design und Implementierung von Agenten-AI
Die Modellierung von Agentennetzwerken auf der Grundlage des menschlichen Organigramms birgt das Risiko, dass eine häufige Neuarchitektur erforderlich ist, insbesondere in Unternehmen, die häufige Neuorganisationen durchlaufen. Ein alternativer Ansatz besteht darin, Agenten nach Funktionsdomäne zu organisieren. Für diese Gruppierung müssen möglicherweise die traditionellen menschlichen Organisationsgrenzen überschritten werden. Beispielsweise umfasst die Einarbeitung neuer Mitarbeiter IT-Vorgänge für die Hardware- und Benutzerbereitstellung, während eine Vertriebsbewegung sowohl Vorgänge als auch Marketing erfordert.
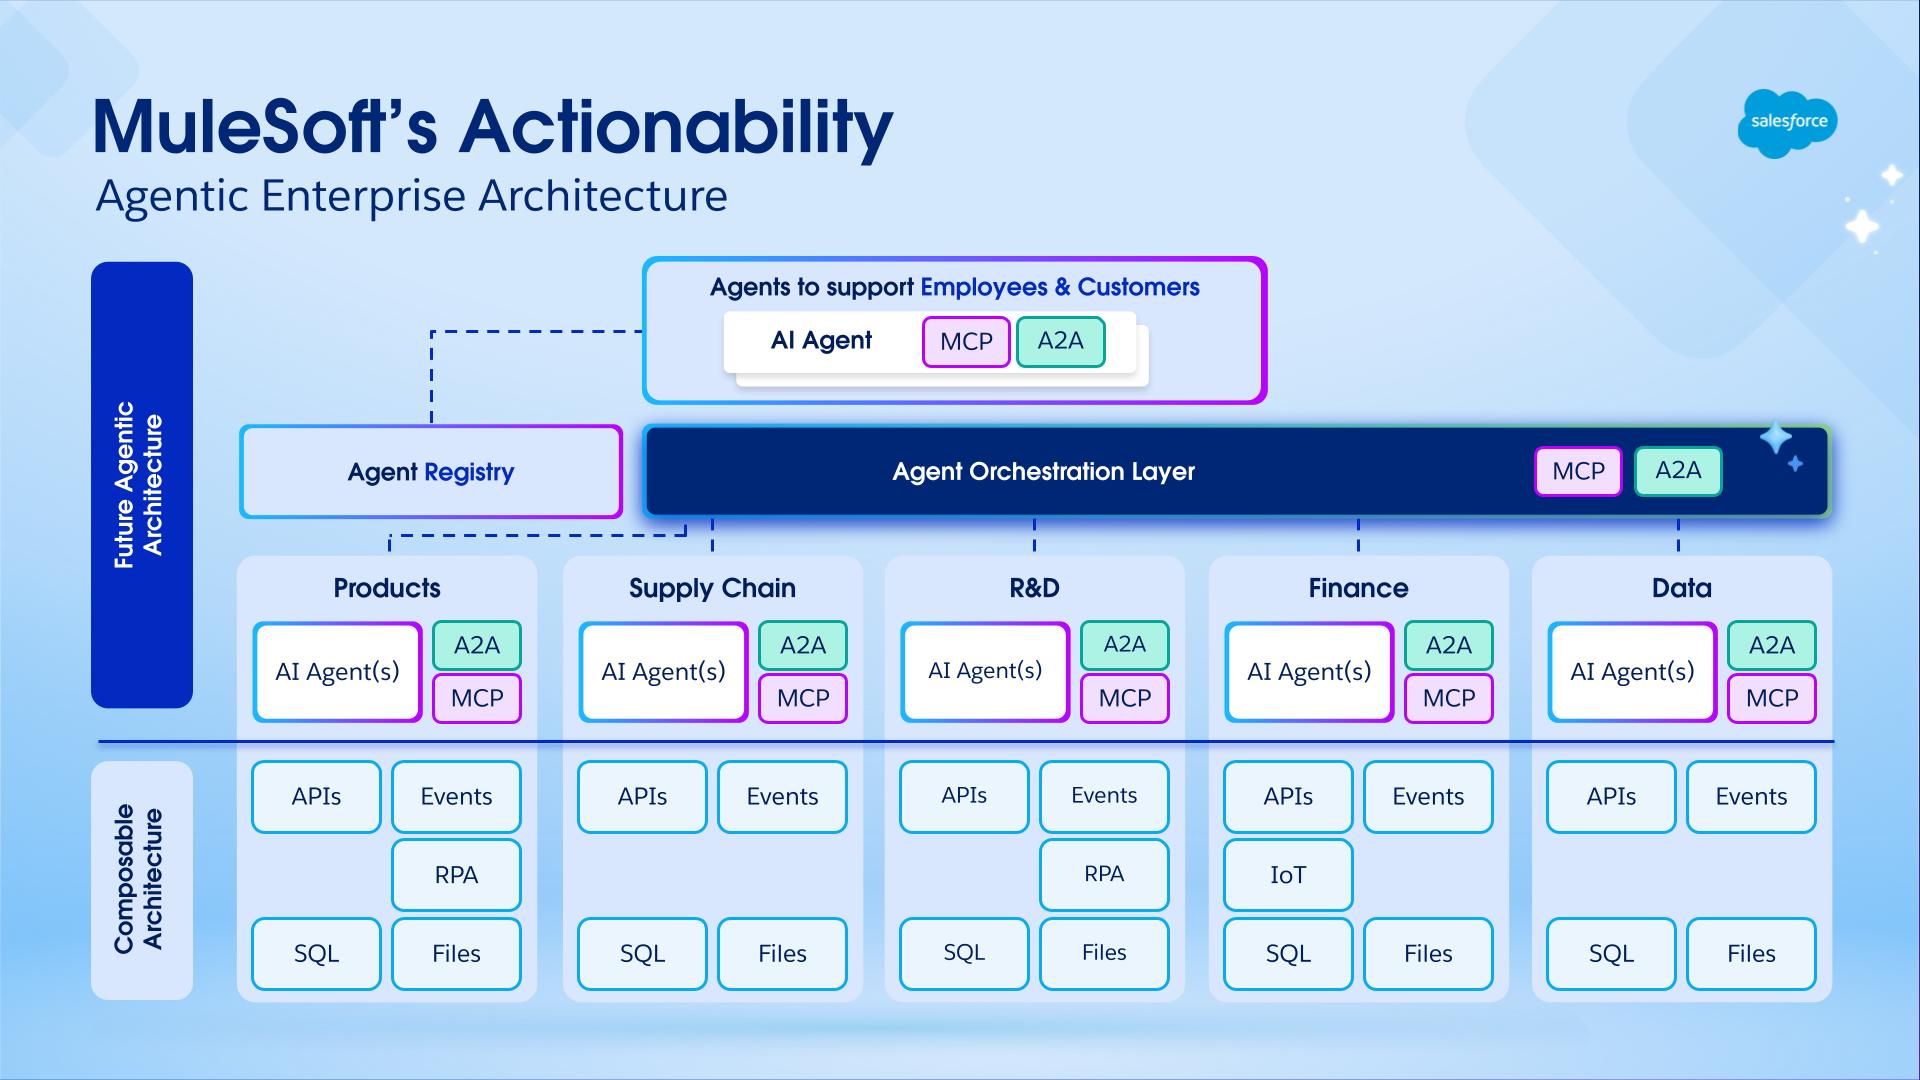 ## Über die Autoren
Nikhil Aggarwal ist Principal Architect bei Salesforce, wo er die Architektur für MuleSoft und Salesforce Automation Clouds leitet. Nikhil verfügt über mehr als 18 Jahre Erfahrung in der Bereitstellung von Produkten im großen Stil und ist begeistert von skalierbarer Architektur, intuitiven Entwicklererfahrungen und dem Aufbau leistungsstarker Teams. Vor Salesforce leitete er mehrere Initiativen in Microsoft Power Platform, Dataverse und Office 365 vom Konzept bis zur Einführung. Seine Arbeit prägt weiterhin, wie moderne Unternehmen Systeme verbinden, Workflows automatisieren und Geschäftswerte im Zeitalter der AI-Ersten nutzen.
Mariano Gonzalez ist seit 2011 bei MuleSoft tätig und hat sich auf geschäftskritische verteilte Systeme, Integration, PaaS und Cloud Computing spezialisiert. Heute liegt der Fokus von Mariano auf der Weiterentwicklung von AI-Plattformen mit besonderem Augenmerk auf Governance, Orchestrierung, Entdeckung und Beobachtbarkeit. Mit über 20 Jahren in der IT-Branche hat Mariano als Softwarearchitekt und Teamleiter BPM-, ERP- und Integrationslösungen in den Sektoren Landwirtschaft, Energie, Regierung, IT, Telekommunikation und Inhaltsverwaltung entwickelt und bereitgestellt.
Pedro Colunga ist Software Engineer Architect bei Salesforce und spezialisiert sich auf API und Metadatenarchitektur. Pedro konzentriert sich auf den gesamten Plattformlebenszyklus und spielt eine Schlüsselrolle bei der Gestaltung der Interaktion von Organisationen mit Systemintelligenz, Semantik und metadatengestützten Lösungen. Pedros 20-jährige Karriere, die unternehmerische Erfahrung umfasst, umfasst Unternehmen wie Fuego, BEA Systems, Oracle und TekGenesis, ein Unternehmen, das später von MuleSoft übernommen wurde. Dort hat er die plattformbezogene Architektur konsequent vorangetrieben und umfassende Expertise in Bereichen wie BPM, RAD und Integrationen bereitgestellt.
Gulal Kumar ist Software-Engineering-Architekt bei Salesforce mit Schwerpunkt auf Daten- und Integrationsarchitektur. Mit über 20 Jahren Erfahrung in Integration und APIs, Modernisierungsprogrammen, Sicherheit und AIML-Initiativen bringt er eine Fülle von Expertise mit. Gulal hat sich verpflichtet, Initiativen zur Geschäftstransformation voranzutreiben, Sicherheit und Widerstandsfähigkeit zu erhöhen, Architekturexzellenz zu fördern und AIML-Initiativen in verschiedenen Bereichen voranzutreiben.
Täglich betreiben [Hunderttausende Unternehmen und Millionen von Benutzern](https://www.salesforce.com/customer-stories/) ihre Geschäfte in der Cloud mithilfe von Salesforce Platform-gestützten Anwendungen. Warum ist die Plattform so erfolgreich? Warum können Sie Trusts zur Unterstützung Ihres Unternehmens vertrauen? Welche einzigartigen Vorteile bietet die Plattform Unternehmen wie Ihnen?
In dieser technischen Zusammenfassung wird erläutert, wie die Salesforce Platform mithilfe ihrer einzigartigen Softwarearchitektur für Cloud Computing zuverlässige, skalierbare und einfach anzupassende Endbenutzererfahrungen bereitstellt. Nachdem Sie diese Kurzbeschreibung gelesen haben, werden Sie die zugrunde liegende Technologie besser verstehen, die Salesforce Platform zu einer überzeugenden Wahl für Ihre Geschäftsanwendungen macht.
# Plattformübersicht
Die Salesforce Platform ist das herausragende Beispiel für eine erfolgreiche Cloud Computing-Plattform und ein entsprechendes Ökosystem von Anwendungen. Seit der Jahrtausendwende ist die Plattform die Grundlage für Folgendes:
- Viele beliebte [Geschäftsanwendungen](http://www.salesforce.com/products/) für häufige Anwendungsfälle wie Vertrieb und Kundenservice
- [Branchenspezifische Anwendungen](https://www.salesforce.com/solutions/industries/) für spezialisiertere Anwendungsfälle wie Finanzen und Gesundheitswesen
- Millionen von [benutzerdefinierten Anwendungen und Anwendungserweiterungen](https://www.salesforce.com/products/platform/overview/) für individuelle Anwendungsfälle
Die Salesforce Platform ist zum großen Teil deshalb so erfolgreich und beliebt, weil ihre einzigartige Softwarearchitektur Anwendungen unterstützt, die einfach zu erstellen, zu verwenden, anzupassen und zu erweitern sind und eine außergewöhnliche [Leistung und Zuverlässigkeit](http://trust.salesforce.com/trust/) bieten. Das Herzstück der Softwarearchitektur der Plattform ist das mandantenfähige, metadatengesteuerte Design.
| Messungen der Selektivität vor der Abfrage | Schreiben Sie eine Abfrage für den endgültigen Datenbankzugriff und erzwingen... | |
| Benutzer | Filter | |
| Niedrig | Niedrig | ... Verschachtelte Schleifen verknüpfen, Laufwerk mit Ansicht der Zeilen, die der Benutzer sehen kann |
| Niedrig | Hoch | ... Verwendung des mit dem Filter verbundenen Index |
| Hoch | Niedrig | ... Geordnete Hash-Verknüpfung, Laufwerk mit MT_DATA |
| Hoch | Hoch | ... Verwendung des indexbezogenen Filters |
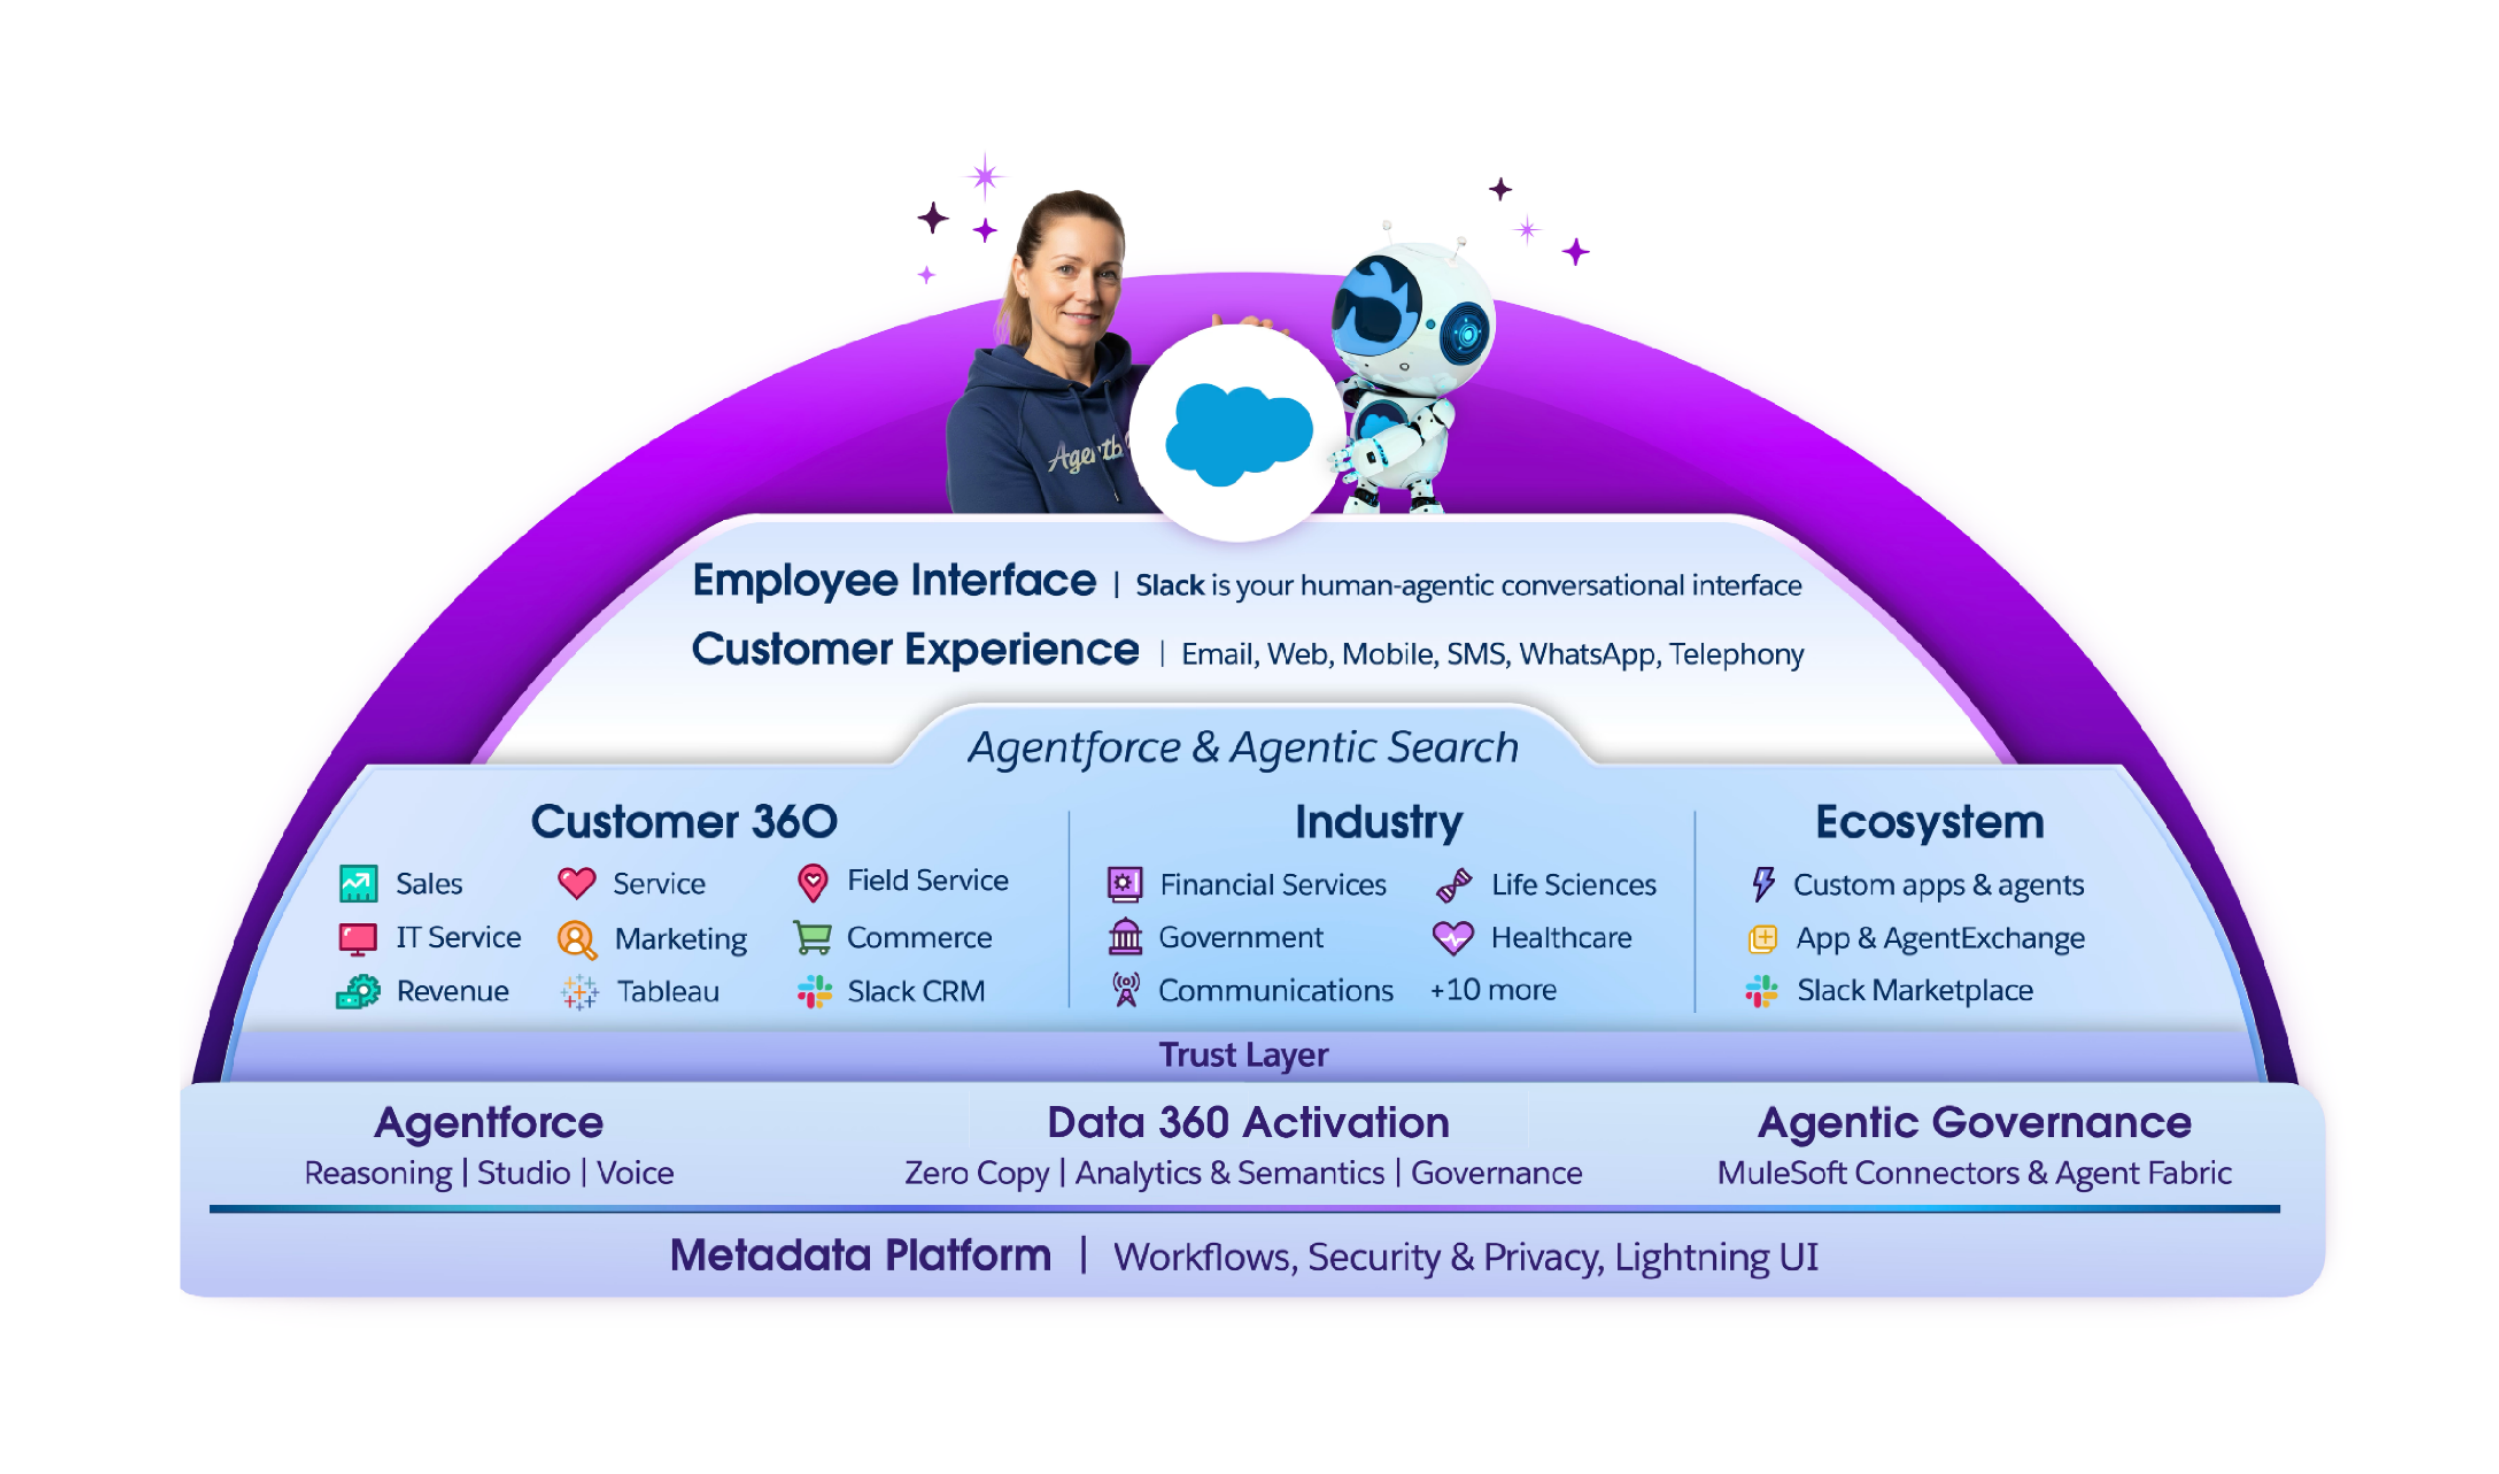 ## 2\. Architekturübersicht
Die Architekturprinzipien der folgenden Salesforce Platform bilden die Grundlage und die Differenzierung für die Entwicklung von Funktionen und Funktionen:
- **Enterprise-Grade Trust**: Trust ist Salesforces wichtigster Wert. Wir legen nicht nur Wert auf Verfügbarkeit und Sicherheit unserer Services, sondern entwickeln auch die Funktionen für Zugriffskontrolle, Compliance und Sicherheit, damit unsere Kunden ihre Compliance- und Sicherheitsstandards mit Salesforce Platform erfüllen können.
- **Mandant**: Alle Services und Infrastrukturen wurden für das Hosten mehrerer Kunden entwickelt. Dies bietet ein strategisches Muster für die Skalierung mit Nutzung sowie die Standardisierung auf einen gemeinsamen hohen Grad an Verfügbarkeit und Sicherheit unabhängig von der Größe unserer Kunden.
- **Metadatengesteuert**: Metadaten sind das Herzstück der Anpassbarkeit unserer Mandantenservices. Unsere Metadaten sind erweiterbar, sodass Administratoren und Entwickler auf vorhandenen Arbeiten aufbauen und von künftigen Produktaktualisierungen von Salesforce und Ökosystempartnern profitieren können.
- **API zuerst:** Die Salesforce Platform priorisiert ein umfassendes und kohärentes API-Portfolio, das alles abdeckt, was über native Salesforce-Benutzeroberflächen möglich ist. Dadurch können Entwickler und Partner die Funktionen der Plattform nutzen und neu zusammenstellen, um Systeme zu integrieren oder neue Benutzererfahrungen zu erstellen.
- **Offen und interoperabel**: Die Salesforce Platform kann in jede Unternehmensarchitektur unserer Kunden integriert werden. Die Salesforce Platform wurde für die Verwendung mit anderen Cloud-basierten und lokalen Systemen entwickelt und bietet APIs, Tools und Integrationsstandards für externe Systeme zur Integration in die Salesforce Platform.
- **Agent:** Die Salesforce Platform entwickelt sich schnell weiter und steht in der gesamten Anwendungssuite an erster Stelle. Wir möchten, dass Benutzer über umfassende Agentenunterhaltungserfahrungen mit Salesforce interagieren können, die es ihnen ermöglichen, Arbeit zu erledigen und auf immer natürlichere Weise mit ihren Daten zu interagieren.
Die aktuelle Salesforce Platform stellt die neueste Phase in der Entwicklung der Salesforce-Funktionen seit der Einführung der Force.com Platform im Jahr 2008 dar. Zu den letzten Schlüsseltransformationen zählen:
- Einführung von Hyperforce und Umstellung auf Cloud-basierte Architekturen.
- Entwicklung von einer monolithischen Architektur zu einer Struktur mit unabhängigen Services.
- Einführung der Data 360- und Lakehouse-Technologien zusammen mit traditionellen relationalen Datenspeichern.
- Tiefe Integration von AI-Technologien, generativem und maschinellem Lernen und eine Weiterentwicklung zu agentenbasierten Erfahrungen auf der gesamten Plattform.
Diese Änderungen haben die Funktionen der Plattform ohne erhebliche Unterbrechungen erweitert und verfeinert, dank zuverlässiger Abstraktionen, die es Salesforce-Technikern ermöglichen, unsere Technologien nahtlos und mit minimalen Unterbrechungen durch Kunden voranzutreiben. Die robuste Abstraktion ist auch weiterhin der Schlüssel zum Nutzen der Salesforce Platform, da sie die technischen Komplexitäten von Software auf Unternehmensebene wie Sicherheit, Verfügbarkeit und Technologiekonventionen vereinfacht, sodass sich Anwendungsentwickler auf die Lösung ihrer individuellen Herausforderungen konzentrieren können. Die Funktionen der Salesforce Platform sind im Folgenden hervorgehoben:
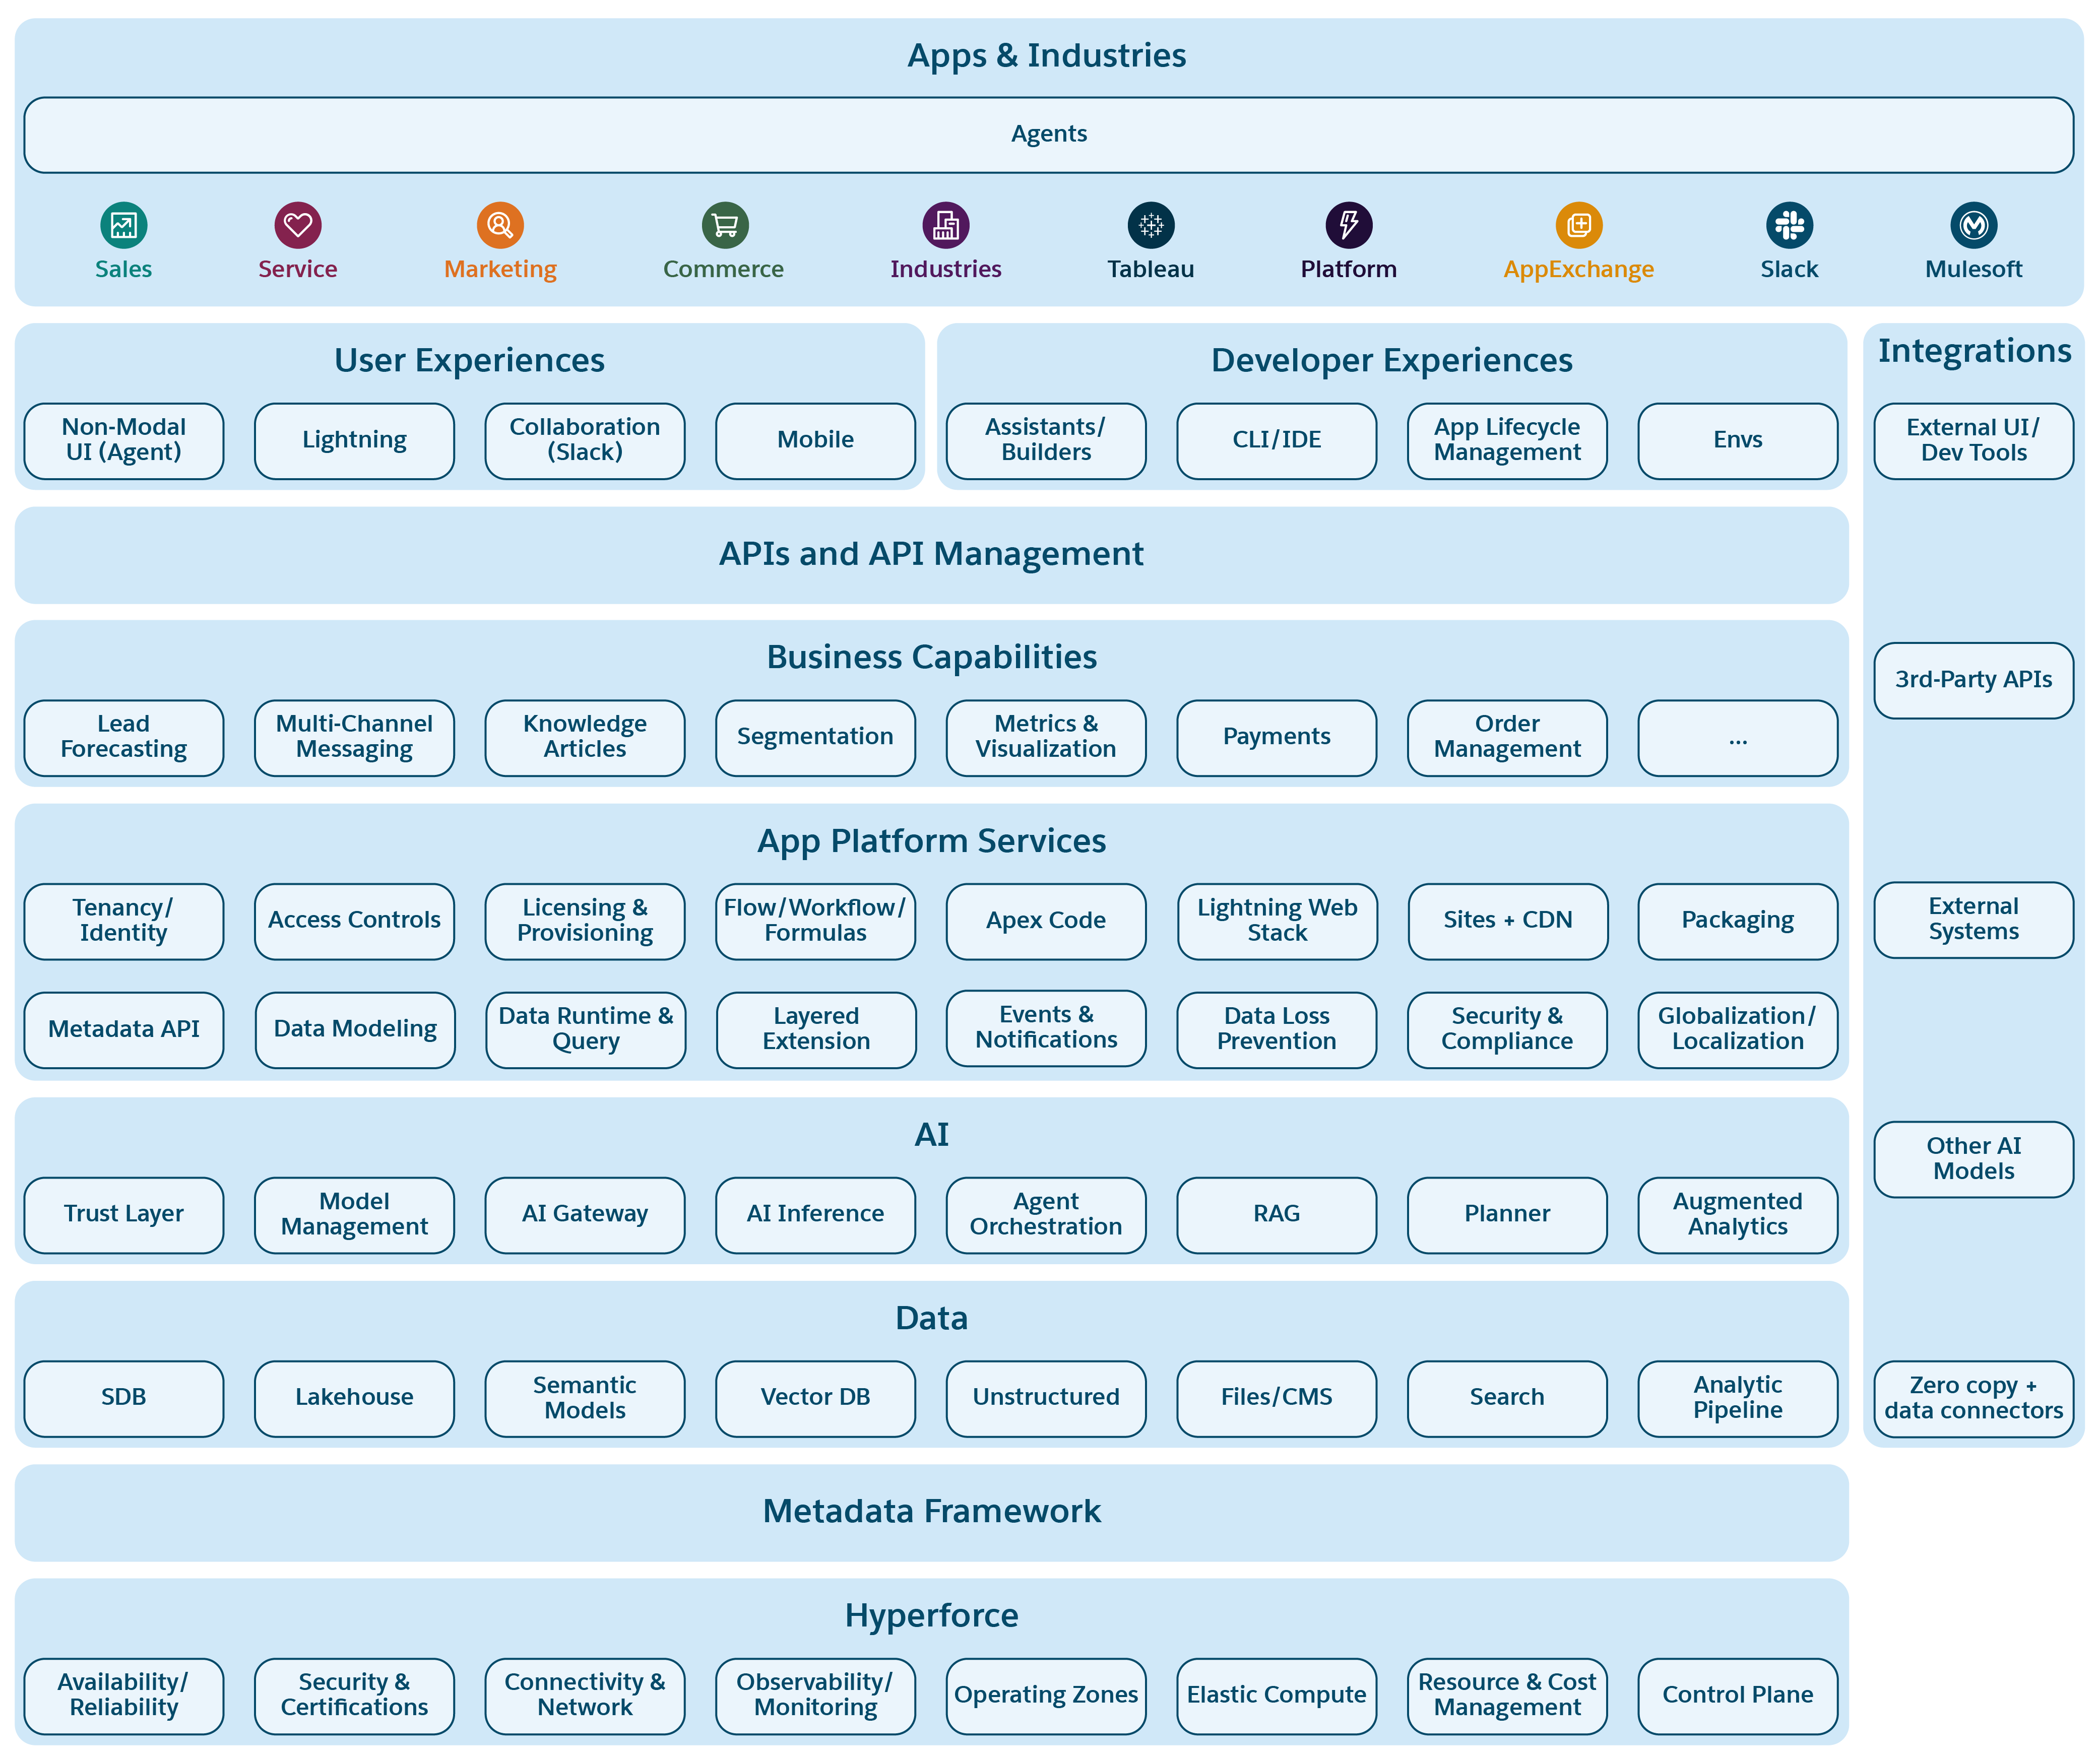 Die Salesforce Platform wird als eine Reihe von Ebenen angezeigt, aus denen das System besteht. Jede Ebene stellt eine Gruppe verwandter Funktionen dar, die für auf der Plattform basierende Anwendungen wichtig sind. Die Unterfelder in jeder Ebene bieten anschauliche Beispiele für diese Funktionen. Die Funktionen der einzelnen unteren Ebenen sind in alle oben genannten Ebenen integriert und gewährleisten eine konsistente und kohärente Erfahrung in der gesamten Salesforce-Anwendungssuite.
Die Salesforce Platform verkörpert umfassende technische Transformationen auf allen Ebenen einer ausgereiften Technologieplattform, die in den letzten 20 Jahren entwickelt wurde. Diese Änderungen ermöglichen, getrieben durch sich ändernde Kundenanforderungen und neue Technologien, die Unterstützung für neue Anwendungstypen und -lösungen. Die Transformationen sind miteinander verbunden, wobei Änderungen in unteren Ebenen die Entwicklung aller nachfolgenden Ebenen beeinflussen.
Die Salesforce Platform ist in mehrere Ebenen unterteilt, die jeweils zu ihren umfassenden Funktionen beitragen:
- **Hyperforce**: Die grundlegende Infrastruktur hat sich von Erstanbieter-Rechenzentren zu öffentlichen Cloud-Anbietern entwickelt, die durch Salesforce-Technologien für sicheres, konformes, hochverfügbares und kosteneffizientes Hosting erweitert wurden.
- **Metadaten-Framework**: Bietet eine stabile Abstraktion für Anwendungen, auf der sie aufbauen können, auch wenn sich die Technologien, die wir haben und verwenden, weiterentwickeln. Enthält eine objektbezogene Zuordnung, eine präskriptive Ausführungsreihenfolge und eine "Kern"-Laufzeit, die die Metadatendefinitionen mit den metadatengesteuerten Laufzeiten verbindet.
- **Daten**: Enthält eine relationale Datenbank mit mehreren Mandanten und ein Lakehouse auf Petabyte-Skala zum Verwalten von Salesforce- und Nicht-Salesforce-Daten und unterstützt die Verwaltung unstrukturierter Daten und Inhalte, erweiterte Such-, Governance- und Analysefunktionen.
- **AI**: Basiert auf der Datenebene mit grundlegenden, Vertrauenswürdigen AI Technologien, die prädiktive und generative AI nutzen, um Agentenerfahrungen zu unterstützen.
- **Anwendungsplattformservices:** Bietet IT-Administratoren, Entwicklern und Anbietern Tools zum Erstellen und Anpassen von Anwendungen und bietet eine Abstraktion mit Meinungen, um allgemeine und komplexe Aufgaben zu vereinfachen.
- **Geschäftsfunktionen**: Bietet eine Reihe von Funktionen, um verschiedene Geschäftsanforderungen zu erfüllen, sodass Entwickler Anwendungen nach Bedarf anpassen können.
- **APIs und API-Verwaltung**: Stellt sicher, dass über gut ausgebildete APIs auf alle Plattformfunktionen zugegriffen werden kann, was Service- und Schichtabhängigkeiten erleichtert.
- **Benutzer- und Entwicklererfahrung**: Enthält benutzerfreundliche Oberflächen für Endbenutzer und eine Reihe von Entwicklungstools von Low-Code bis Pro-Code für die Anwendungsentwicklung und -anpassung mit Unterstützung für die moderne AI-gestützte Entwicklung.
- **Integration**: Kann in jede Unternehmensarchitektur integriert werden und ermöglicht die Kompatibilität mit Salesforce- und Nicht-Salesforce-Systemen über Datenkonnektoren, Zero-Copy-Datenintegration und andere Tools.
- **Anwendungen und Branchen**: Bietet eine Reihe an anpassbaren Anwendungen und branchenspezifischen Lösungen, die auf den integrierten Funktionen der Plattform basieren und die gesamte Palette an Funktionen untergeordneter Ebenen sowie tief integrierte AI-Agenten nutzen.
## 3\. Hyperforce
Salesforce entwickelt seit fast 25 Jahren die globale Rechenzentrumsinfrastruktur, die vielen aktuellen Hyperskalierern und IaaS-Anbietern vorausgeht. Hyperforce, die aktuelle Generation der Salesforce-Infrastrukturentwicklung, wurde für den Betrieb über mehrere Public Cloud-Anbieter hinweg entwickelt.
Sie ist auf die Anforderungen der Kunden hinsichtlich elastischer B2C-Skalierung, globaler Datenresidenz, erhöhter Verfügbarkeit, erstklassiger Sicherheit und Einhaltung gesetzlicher Vorschriften zugeschnitten. Hyperforce standardisiert die Infrastruktur in allen Salesforce-Produkten und ermöglicht so die schnelle Integration von Neuerwerbungen.
Hyperforce stellt die Bereitstellung der Salesforce Platform sicher und ermöglicht so die schnelle Bereitstellung neuer Funktionen und Anwendungen, um die Anforderungen an die Datenresidenz und die Einhaltung gesetzlicher Vorschriften in mehr als 20 Regionen weltweit zu erfüllen.
### 3.1 Architekturprinzipien
Während der Umstellung von Salesforce auf Hyperforce wurden erhebliche Unterschiede in Bezug auf Services, Schnittstellen und Compliance-Ebenen zwischen Hyperskalierern festgestellt. Zum Erstellen einer robusten und tragbaren Grundlage für Salesforce Platform wurden die folgenden architektonischen Prinzipien übernommen:
- **Infrastruktur als Code**: Bei Verwendung einer domänengesteuerten Architektur umfasst dieses Prinzip die deklarative Codierung für die Infrastruktur, die Erstellung unveränderlicher Artefakte und die Automatisierung der Infrastruktur bei Bedarf mit Standards wie Kubernetes und Service Mesh.
- **Zero-Trust Security**: Implementierung eines Zero Trust Sicherheitsmodells mit umfassenden Verteidigungsstrategien, einschließlich Identitätsverwaltung, Authentifizierung, Autorisierung, Netzwerkisolation, Richtlinien für die Sicherheit mit den geringsten Berechtigungen und Verschlüsselung von Daten bei der Übertragung und im Leerlauf.
- **Verwaltete Services**: Durch die Hervorhebung der Verwendung von Mandanten- und Multi-Cloud-Services verbessert dieses Prinzip die Übertragbarkeit auf verschiedene Infrastrukturen und Umgebungen wie kommerzielle, staatliche und luftgestützte Systeme.
- **Integrierte Widerstandsfähigkeit**: Geschäftskritische Services sind auf mehrere Verfügbarkeitszonen verteilt, um eine hohe Verfügbarkeit zu gewährleisten. Die Daten werden regionsübergreifend repliziert. Services werden auch mit einer Verfügbarkeitsstufe gekennzeichnet, um Servicestufenziele und die Resilienzplanung zu verwalten.
- **Vollständig beobachtbar**: Integration aller Services in eine standardmäßige Observability-Plattform für eine effiziente Überwachung, einschließlich Protokollerfassung, Kennzahlenerfassung, Warnung, verteilter Verfolgung und Verfolgung von Servicevorgängen wie Datenverkehrsvolumen, Fehlerraten und Ressourcenauslastung.
- **Automatische Vorgänge**: Dies umfasst die automatisierte Verwaltung des Infrastrukturlebenszyklus und prädiktive AIOps (AI for Operations) für die Aufrechterhaltung der Servicequalität, die Erkennung und Behebung von Servicebeeinträchtigungen und die Fehlererkennung.
- **Automatische Skalierung**: Dieses Prinzip konzentriert sich auf Skalierbarkeit und Kosteneffizienz und ermöglicht betriebliche Flexibilität über verschiedene Skalen hinweg, ohne die betrieblichen Risiken zu erhöhen, wodurch spezifische Accountobergrenzen in Bezug auf den Cloud-Anbieter abstrahiert werden.
- **FinOps bewusst**: Public Cloud bietet Infrastrukturagilität, jedoch mit dem Risiko erhöhter Kosten. Während des gesamten Servicelebenszyklus verfolgen wir eine effizienzorientierte Engineering-Kultur, ohne Kompromisse bei Verfügbarkeit, Sicherheit und Customer Trust einzugehen.
Diese Grundsätze leiten die Entwicklung und den Betrieb der Hyperforce Platform von Salesforce und stellen sicher, dass sie in verschiedenen Umgebungen anpassungsfähig, sicher und effizient bleibt.
### 3.2 Infrastrukturkonzepte
Die Salesforce Platform und ihre unterstützenden Services werden auf der Hyperforce Foundation ausgeführt, die mehrere Hyperforce Instanzen umfasst. Diese Instanzen sind strategisch auf verschiedene Länder verteilt, um den Kundenpräferenzen in Bezug auf Geografie und Verfügbarkeit gerecht zu werden. Um die strengen Anforderungen an die Datenresidenz und den Betrieb zu erfüllen, können eine oder mehrere Hyperforce Instanzen optional gruppiert und als Betriebszone festgelegt werden. Jede Instanz wird regelmäßig aktualisiert, um Sicherheit, Skalierbarkeit und die Einhaltung lokaler und gesetzlicher Standards zu gewährleisten.
Hyperforce Instances bestehen aus mehreren Hyperforce Functional Domain-Instanzen, bei denen es sich um Service-Cluster handelt, die bestimmte Funktionen bereitstellen. Grundlegende Funktionsdomänen bieten wichtige Services wie Sicherheit, Authentifizierung, Protokollierung und Überwachung, die für andere Hyperforce-Services unerlässlich sind. Geschäftsfunktionale Domänen unterstützen verschiedene Salesforce-Produkte wie Sales Cloud, Service Cloud und andere, was ihre Produktfunktionalität erleichtert.
Services in einer Funktionsdomäne können in Zellen organisiert sein, bei denen es sich um skalierbare und wiederholbare Einheiten der Servicebereitstellung handelt. Die Hyperforce Zelle entspricht einer sogenannten Salesforce-Instanz, in der sich eine oder mehrere Salesforce-Organisationen (Organisationen) befinden. Eine Zelle ist eine Skalierungseinheit und eine starke Strahlradiusgrenze. Superzellen bieten eine logische Gruppierung mehrerer Zellen, um einen größeren Explosionsradius durch gemeinsame Services zwischen Zellen zu definieren. In einer Funktionsdomäne können mehrere Superzellen vorhanden sein. Mit Zellen und Superzellen kann Hyperforce horizontal innerhalb einer Funktionsdomäne skalieren und gleichzeitig die Größe des Strahlradius genau steuern.
Jede Hyperforce Instance ist einer Availability Region zugeordnet, einem Konzept, das in allen öffentlichen Cloud-Infrastrukturen vorhanden ist, und kann unabhängig von allen anderen Hyperforce Instances verwendet werden. Alle geschäftskritischen Services und Daten in der Hyperforce Instance werden auf mindestens drei Verfügbarkeitszonen verteilt und repliziert, um Fehlertoleranz und Stabilität zu erreichen. Darüber hinaus werden Datensicherungen in andere geeignete Hyperforce Instanzen kopiert, um die Geschäftskontinuität und die Einhaltung gesetzlicher Vorschriften zu gewährleisten.
Die Hyperforce Infrastruktur wird kontinuierlich weiterentwickelt, da neue Hyperforce Instanzen und Zellen erstellt oder aktualisiert werden. Kunden sind vor Änderungen an den physischen Details von Hyperforce geschützt. Auf alle extern sichtbaren Kundenendpunkte wird über stabile und sichere Salesforce My Domains (z. B. acme.my.salesforce.com) zugegriffen, die den Datenverkehr sicher an den aktuellen Daten- und Servicestandort weiterleiten. Ausgehender Datenverkehr (z. B. E-Mail, Web-Callouts) lässt sich am besten mit sicheren Mechanismen wie "Domain Keys Identified Mail" (DKIM) und "mTLS" implementieren, um sicherzustellen, dass die lokale Infrastruktur der Kunden die physischen Details der Salesforce-Infrastruktur nicht hartcodiert, beispielsweise IP-Adressen, die sich im Laufe der Zeit ändern können.
 ### 3.3 Netzwerksicherheit
Hyperforce Functional Domains sind mit robusten Sicherheitsmaßnahmen ausgestattet. Jede Domäne ist peripher geschützt und isoliert, wobei Services innerhalb einer Domäne für zusätzliche Sicherheit in dedizierte Accounts getrennt sind. Die Kommunikation zwischen Services wird über Service Mesh oder ähnliche Protokolle sicher erleichtert. Die Datenverkehrsverwaltung wird von Ein- und Ausgangs-Gateways verwaltet, die den gesamten eingehenden und ausgehenden Datenverkehr überprüfen, weiterleiten und die erforderlichen Kontrollen wie Leistungsschalter oder Ratenbegrenzungen anwenden.
Services in einer Hyperforce Functional Domain werden in Sicherheitsgruppen gruppiert, wobei nur die Services in der Edge-Gruppe für das öffentliche Internet verfügbar sind. Laufzeitsicherheitsrichtlinien erzwingen Kommunikationsregeln zwischen unterschiedlichen Sicherheitsgruppen unter Einhaltung des Prinzips der geringsten Berechtigung, um sicherzustellen, dass Services nur über den erforderlichen Zugriff verfügen.
Jede geografische Region verfügt über eine funktionale Hyperforce Edge-Domäne, die die Sicherheit von Transportebenen beendet und Firewall-Richtlinien für programmierbare Webanwendungen verwendet, um Bedrohungen präventiv zu begegnen. Dadurch wird sichergestellt, dass nur legitimer Datenverkehr Hyperforce-Endpunkte erreicht und gleichzeitig eine sichere und effiziente Kundenerfahrung gewährleistet wird. Darüber hinaus werden interne Netzwerkverbindungen zwischen Hyperforce Instances streng kontrolliert und alle Protokolldaten, die personenbezogene Daten enthalten, werden anonymisiert, um die DSGVO-Standards einzuhalten.
### 3.4 Hyperforce-Rastersteuerungsebene
Ein Hyperforce-Raster besteht aus mehreren Hyperforce Instanzen, die dieselbe Steuerungsebene verwenden, um sensible Arbeitslasten gegebenenfalls zu isolieren. Sie stellt sicher, dass keine Kunden- oder Systemdaten, Plattformmetadaten oder Überwachungsdaten über mehrere Raster hinweg verloren gehen. Die Steuerungsebene besteht aus redundanten Hyperforce Instances, die wichtige Services zum Erstellen, Verwalten und Überwachen kundenorientierter Hyperforce Instances hosten.
Der Service- und Infrastrukturcode für alle Hyperforce Services wird sicher in einer speziellen Funktionsdomäne der Steuerebene entwickelt und nutzt die Services für die Quellcodeverwaltung, die kontinuierliche Integration, Tests und die Artefakterstellung. Der generierte Code wird auf Bedrohungen und Schwachstellen überprüft, bevor er in standardisierte, digital signierte Container gepackt und in Bildregistrierungen gespeichert wird. Die Codebereitstellung wird über autorisierte Pipelines im Hyperforce Continuous Delivery-System abgewickelt, wobei die Bereitstellungsberechtigungen auf autorisierte Teams und Operatoren beschränkt sind. Ein Airgapped Control Plane übernimmt zusätzliche Schutzmaßnahmen, die in solchen Umgebungen erforderlich sind.
Die IAM-Services (Identity and Access Management) erzwingen die Just-in-Time-Genehmigung, um die Zugriffsdauer und die Zugriffsaktionen zu begrenzen, während die Überwachungsprotokolle alle Aktivitäten überwachen und in Echtzeiterkennungssysteme einfließen, um verdächtige Aktivitäten zu identifizieren und zu warnen.
### 3.5 Hyperforce Kostenverwaltung
Da Salesforce seine Services über seine Erstanbieter-Rechenzentren auf Hyperforce in öffentlichen Clouds umstellt, ist es wichtig, die Strategien zur Erstellung von Budgets, zur Kostenvisualisierung und zur Ressourcenoptimierung zu überarbeiten.
Bei unserem Kostenmanagement-Ansatz geht es nicht nur darum, Kosten zu senken, sondern es handelt sich um einen strategischen Prozess, der zwischen Produkten, die auf Wachstum abzielen, und Produkten, die stabil sind, unterscheidet. Sie plant verbrauchsbasierte Preise und Margen, die die Produktverfügbarkeit aufrechterhalten, und entspricht unserem Kernwert Trust. Public Cloud-Accounts sind hierarchisch organisiert und mit bestimmten Produkten und Führungskräften verknüpft. Detailliertes Tagging von Ressourcen auf Serviceebene, angereichert mit Organisationsmetadaten, hilft, die Kosten für einzelne Microservices zu ermitteln. Tools wie Tableau und Slack sowie erweiterte Prognosetools werden verwendet, um Führungskräften und Teams Echtzeitdaten zu Kosten, Prognosen und Budgetanalysen bereitzustellen und so Vertrauen in die zukünftige Finanzplanung zu gewinnen.
Um ein optimales Kostenmanagement zu gewährleisten, verwendet Salesforce eine Kombination aus Compute Savings Plans (Einsparungspläne berechnen), Spot Capacity (Spot-Kapazität) und On-Demand Capacity Reservations (ODCR), um die erforderliche Kapazität zu gewährleisten. Diese Reservierungen werden über erweiterte Zeitreihenprognosen und benutzerdefinierte Dashboards verwaltet, wodurch die menschliche Aufsicht und Entscheidungsfindung gewährleistet sind. Das Festlegen erreichbarer Ziele für die Reduzierung der Transaktionsstückkosten (der Kosten für die Verarbeitung eines definierten Volumens an Geschäftstransaktionen) ist eine effektive Strategie, um Verbesserungen voranzutreiben. Mit dem Tool "Hyperforce Unit Cost Explorer" (Explorer für Hyperforce-Stückkosten) können Teams Stückkostentrends analysieren und verwalten, Kosten bestimmten Services zuordnen und neue Verbesserungsmöglichkeiten identifizieren. Der Salesforce Cloud-Optimierungsindex (COIN) bewertet Services anhand einer dynamischen Liste von Einspar-Opportunities und motiviert Serviceteams, eine optimale Ressourceneffizienz zu gewährleisten.
Im Rahmen unseres unerschütterlichen Engagements für Nachhaltigkeit verfolgen wir aktiv die Reduzierung unserer CO2-Bilanz und setzen uns spezifische Ziele, um unsere Einheit "CO2 to Serve" (CO2 zur Bereitstellung) zu reduzieren, eine Maßeinheit für die Emissionen im Verhältnis zur geleisteten Arbeit.
## 4\. Enterprise-Grade Trust
Sicherheit und Verfügbarkeit sind grundlegende Aspekte unserer Enterprise-Plattform, die für den Erhalt des Customer Trust unerlässlich sind. Bei Salesforce sind diese Steuerelemente integraler Bestandteil der Salesforce Platform, die automatisch über freigegebene Services und Software-Frameworks erzwungen werden. Dieser integrierte Ansatz stellt sicher, dass einzelne Systeme ohne zusätzlichen Aufwand profitieren.
Die Verwaltung und kontinuierliche Verbesserung dieser umfangreichen Reihe von Sicherheits- und Verfügbarkeitskontrollen für Tausende von Services und Hunderte von Teams stellt eine erhebliche Herausforderung dar. Dies ist jedoch wichtig, da das Übersehen selbst kleiner Details zu einer Sicherheitsverletzung oder einem Systemausfall führen kann.
### 4.1 Sicherheit
Hyperforce ist eine sichere und kompatible Infrastrukturplattform, die die Entwicklung und Bereitstellung von Services mit erweiterten Sicherheitsfunktionen unterstützt. Sie bietet eine sichere Zugriffskontrolle, Datenverschlüsselung und die Einhaltung von Sicherheitsstandards. Salesforce hält über 40 Sicherheits- und Compliance-Standards wie PCI/DSS, DSGVO, HIPAA, FedRamp und mehr ein.
Zu den wichtigsten Sicherheitsprinzipien zählen die Zero Trust Architecture (ZTA) und die durchgängige Verschlüsselung, um den Schutz der Kundendaten in allen Verarbeitungsphasen zu gewährleisten. Salesforce hält sich an Sicherheitsstandards und bewährte Vorgehensweisen vom sicheren Softwareentwicklungslebenszyklus bis hin zum Produktionsvorgang sowie an zuverlässige Sicherheitspraktiken auf Anwendungsebene, um potenzielle Bedrohungen zu vermeiden.
#### Zero Trust Architecture (ZTA)
Das ZTA-Cybersicherheitsparadigma stellt sicher, dass alle Benutzer, Geräte und Serviceverbindungen unabhängig vom Standort einer Authentifizierung, Autorisierung und kontinuierlichen Validierung unterzogen werden. ZTA und die Public Key Infrastructure (PKI) sind für die moderne Cybersicherheit unerlässlich, da sie Trust Grenzen und sichere Kommunikation schaffen, ohne auf die Perimetersicherheit angewiesen zu sein.
Bei PKI-Bereitstellungen wird jedoch oft übersehen, wie wichtig der Widerruf von Zertifikaten und die Verwaltung von Stammzertifikaten gegenüber Behörden sind. Die Implementierung des Zertifikatswiderrufs durch Salesforce ist robust und skalierbar und unterstützt die durchgängige PKI-Sicherheit.
Darüber hinaus erzwingt Hyperforce ZTA durch die gegenseitige Sicherheit auf Transportebenen zwischen Services, indem kurze private Schlüssel und Just-in-Time-Zugriff für Benutzer mit rollenbasierter Zugriffssteuerung verwendet werden.
#### Durchgängige Verschlüsselung
Die Salesforce Platform gewährleistet den Schutz von Daten bei der Übertragung durch die Verwendung von TLS mit perfekten Suiten für die Weiterleitungsgeheimnisse, die Daten während der Übertragung zwischen Benutzergeräten und Salesforce-Services sowie innerhalb der Salesforce-Infrastrukturdomänen schützen.
Bei Daten im Leerlauf verwendet die Salesforce Platform ein Schlüsselverwaltungssystem, das von Hardware-Sicherheitsmodulen unterstützt wird. Auf seiner Mandantenplattform wird jedem Mandanten ein eindeutiger Verschlüsselungsschlüssel zugewiesen, wodurch verhindert wird, dass sich Schlüssel zwischen Mandanten kreuzen.
Die Sicherheit der Kommunikation und Verschlüsselung hängt stark von der Entropie zum Generieren von Schlüsseln oder Zufallsdaten ab. Da kryptografische Protokolle aufgrund der prognostizierbaren Schlüsselgenerierung anfällig für Angriffe sind, mindert Salesforce Platform dieses Risiko, indem Entropie aus mehreren Quellen für alle Schlüsselgenerierungsprozesse bezogen wird. Die in verschiedenen Prozessoren verfügbare Speicherverschlüsselungsfunktion, die von einem Cloud-Serviceanbieter aktiviert wird, verbessert den Schutz vor Cold-Boot-Angriffen.
#### Sicherer Softwareentwicklungslebenszyklus
Salesforce verfügt über ein angepasstes JDK, das viele Compliance-Standards wie den Federal Information Processing Standard (FIPS) erfüllt. Dadurch wird der Prozess für Entwickler und Betreiber vereinfacht, da sie keine Compliance-Arbeit mehr selbst ausführen müssen. Diese Anpassung hilft nicht nur dabei, Risiken wie die Injektion externer XML-Einheiten (XXE) zu vermeiden, sondern verbessert auch die Kryptografieagilität von Salesforce und die Möglichkeit, Kryptografiestrategien nach Bedarf auszutauschen. Sie ermöglicht die Umwandlung von nicht konformem Code – unabhängig davon, ob er intern entwickelt oder aus offenen Repositorys bezogen wurde – in FIPS-kompatiblen Code, ohne dass eine vollständige Überarbeitung erforderlich ist. Dadurch wird die Arbeitslast für Entwicklungsteams reduziert und die Einhaltung der Prinzipien des sicheren Designs nach Standard gewährleistet.
Darüber hinaus hat Salesforce Frameworks zur Bekämpfung von Schwachstellen wie Cross-Site-Scripting (XSS), Anforderungsfälschung (CSRF) und SQL-Injection integriert, indem Schutzmaßnahmen in den sicheren Software Development Lifecycle (SSDL) integriert werden.
Ein zentralisiertes Geheimnisverwaltungssystem, das durch rollenbasierte Zugriffssteuerungen (RBAC) unterstützt wird, wird implementiert, um sowohl Services als auch den Benutzerzugriff zu schützen. Darüber hinaus werden Code-Scan-Tools verwendet, um die versehentliche Offenlegung von Geheimnissen in Produktionsumgebungen durch Quellcodeverwaltungssysteme zu verhindern.
#### Funktionen für die betriebliche Hyperforce-Sicherheit
Phishing stellt nach wie vor eine erhebliche Bedrohung für Unternehmen dar und führt dazu, dass Salesforce die Phishing-resistente Multi-Faktor-Authentifizierung (MFA) gemäß einer Reihe bewährter Vorgehensweisen der Branche implementiert, einschließlich der Zero Trust Prinzipien der CISA (Cybersecurity and Infrastructure Security Agency). Dies beinhaltet hardwaregestützte Schlüssel für Mitarbeiter mit Produktionszugriff und einen sicheren Kernel für den kontrollierten Zugriff auf Cloud-Serviceanbieteraccounts.
Salesforce verfügt über standardisierte Sicherheitssteuerungen und integrierte Cloud-native Sicherheitsservices in Hyperforce, um die Sichtbarkeit, die Erkennung von Bedrohungen und die Durchsetzung von Richtlinien zu verbessern. Für die Echtzeitüberwachung, -warnung und -berichterstattung ist ein umfassendes Sicherheitsinformations- und Ereignisverwaltungssystem vorhanden, das durch ein umfassendes Schwachstellenverwaltungsprogramm und Cloud-Sicherheitsstatusverwaltungstools unterstützt wird, um Schwachstellen kontinuierlich zu identifizieren, zu bewerten und zu beheben.
Darüber hinaus filtert und überwacht eine Webanwendungs-Firewall den HTTP-Datenverkehr, um sich vor verschiedenen Angriffen zu schützen, und eine Reihe von Netzwerksicherheitstools, einschließlich Firewalls, Eindringlingserkennungs- und -verhinderungssystemen, virtuellen privaten Netzwerken sowie Endpunkterkennungs- und -reaktionsagenten, werden verwendet, um eine kontinuierliche Überwachung und Bedrohungserkennung bereitzustellen. Netzwerksegmentierung und Mikrosegmentierung werden implementiert, um die Angriffsfläche zu minimieren und potenzielle Verstöße einzudämmen.
Salesforce hat zudem einen zuverlässigen Plan für die Reaktion auf Vorfälle entwickelt und implementiert, der auf die individuellen Herausforderungen von Hyperforce zugeschnitten ist und vordefinierte Verfahren zum Identifizieren, Eindämmen und Eindämmen von Sicherheitsvorfällen enthält, um eine schnelle und effektive Reaktion auf potenzielle Sicherheitsbedrohungen zu gewährleisten.
### 4.2 Verfügbarkeit
Salesforce verwaltet geschäftskritische Kundenarbeitslasten, die eine hohe Verfügbarkeit erfordern. Unsere Strategie für Hochverfügbarkeit umfasst verschiedene organisatorische Aspekte wie unser Serviceinhaberschaftsmodell, das Vorfallsmanagement und die operativen Überprüfungen. Zu den wichtigsten technischen Elementen unserer Strategie zählen unsere Überwachungsarchitektur, die Automatisierung AI-gestützter Vorgänge und automatisierte Sicherheitsmechanismen für Produktionsänderungen.
#### Verfügbarkeitsarchitekturstandards
Um eine konsistente Hochverfügbarkeit über Tausende von Services hinweg zu erreichen, werden technische Risiken durch einen aus drei Schritten bestehenden Ansatz im richtigen Maßstab gesteuert.
Zunächst werden Standards für die Verfügbarkeitsarchitektur festgelegt, die bewährte Vorgehensweisen definieren, beispielsweise:
- **Redundanz mit automatisiertem Failover**. Salesforce entwickelt seine Services mit einem hohen Maß an Redundanz, vollautomatischer Fehlererkennung und nahtloser automatisierter Wiederherstellung für vollständige und Teilfehler, um die ständigen Fehler zu verarbeiten, die ein großes Cloud-basiertes System aufweist.
- **Explosionsradius begrenzen**. Es _werden_ Fehler auftreten. Daher konzipiert das Team alle seine Services mit absichtlichen Maximalwerten für den Sprengradius, um die Auswirkungen von Fehlern zu begrenzen. Das klassischste und sichtbarste Beispiel ist das der Hyperforce Cell (fka Pod).
- **Kompartimentieren Sie Fehler**. Verhindert, dass sich Fehler über unabhängige Einheiten des Systems ausbreiten und verdichten. Fehlertolerante API-Aufrufe zwischen Services sind ein Schlüsselmuster, das eine Kaskade von Fehlern im verteilten System verhindert. Dabei gleicht das Team sorgfältig die Kompartimentierung und die Redundanz ab.
- **Automatische Skalierung**. Wenn Sie unvorhersehbare Lasten ohne Leistungseinbußen bereitstellen möchten, skalieren Sie automatisch schnell und langsam, ohne auf langsame, fehlbare menschliche Operatoren angewiesen zu sein, ausgelöst durch Sättigungspunkte von Ressourcen wie CPU, Speicher oder Warteschlangentiefen.
- **Schnelle Rollbacks**. Die Wiederherstellungsziele werden in Minuten für alle Services festgelegt und die Wiederherstellung wird automatisch in Vorproduktionsumgebungen getestet, indem das Vorwärts-, Zurück- und Wiedervorwärtsfahren als Standardvorgang festgelegt wird. Das Team nutzt umfangreiche Funktionskennzeichnungen für noch schnellere und detailliertere Notfallumstellungen und Einführungen.
- **Schützen Sie alle Services, die API-Aufrufe erhalten**. Lastabwurf, Obergrenzen für Mandantenmessen, Webanwendungs-Firewalls und komplexe Schutzmaßnahmen auf Ebene sieben werden auf allen Ebenen des Systems bereitgestellt, von den Services in äußerster Randlage, die direkt mit dem Internet verbunden sind, bis hin zu den tiefsten internen Services des Teams, die versehentlich durch Fehler in Anrufservices der übergeordneten Ebene angegriffen werden können.
- **Häufig Abhängigkeiten**. Abhängigkeiten zwischen Services sind so konzipiert, dass sie möglichst weich sind, damit sie unabhängig fehlschlagen oder erfolgreich sind. Die Zwischenspeicherung ist hier eines der häufigsten Muster – oft ist ein veraltetes Ergebnis aus einer nachgelagerten Abhängigkeit ausreichend für die weitere Funktion.
- **Bevorzugte asynchrone Kommunikation**. Die asynchrone, vermittelte Kommunikation zwischen Services entkoppelt diese Services voneinander und puffert Lastspitzen zwischen ihnen.
- **Machen Sie API-Aufrufe fehlertolerant**. Zur Toleranz gegenüber Teilausfällen und vorübergehenden Netzwerkproblemen werden verschiedene Muster verwendet: Zeitüberschreitungen und Fristen, Stromkreisunterbrechungen und Wiederholungen mit Backoff. Es wird empfohlen, Anrufe, bei denen keine Blockierung erfolgt, nach Möglichkeit nicht zu blockieren, um den Ressourcenverbrauch und die Blockierung zu begrenzen. Die Rückwärts- und Vorwärtskompatibilität wird mit Linting auf Schemaebene bei der Erstellung und Integrationstests erzwungen.
- **Servicekontingente und Einschränkungen verwalten**. Das Team legt Quoten und Einschränkungen für seine Serviceflotte fest, beispielsweise IP-Adressen, Datenträger-IOps oder die Kapazität eines bestimmten Kubernetes-Clusters. Das Team aggregiert, überwacht und warnt zentral vor der Nutzung dieser Quoten und Einschränkungen, um zu vermeiden, dass sich eine nahende Obergrenze zur Laufzeit auf das System auswirkt.
Zweitens stellt ein mehrschichtiges Inspektionsmodell sicher, dass Services diese Standards erfüllen. Dazu zählen automatisierte Chaostests, Scans und Linting auf Anti-Patterns sowie Architekturüberprüfungen mit erfahrenen Architekten, um Probleme zu erkennen, die nicht durch Automatisierung behoben werden.
Drittens sind Lösungen in Hyperforce integriert, um die Einhaltung dieser Standards zu vereinfachen. Dazu zählen die automatische Telemetrieerfassung, standardmäßige Redundanz- und Failover-Mechanismen sowie integrierte Schutzmechanismen wie Lastabwurf und DDoS-Abwehr, die standardmäßig für einzelne Services aktiviert sind.
#### Überwachung und Beobachtbarkeit
Salesforce verarbeitet ein immenses Volumen an Telemetriedaten, einschließlich Kennzahlen, Protokollen, Ereignissen und Verfolgungen, die von herkömmlichen Überwachungslösungen nicht immer effektiv verwaltet werden können.
Um diesem Problem Rechnung zu tragen, hat Salesforce ein umfassendes Beobachtbarkeitssystem entwickelt, das in seinen Softwareentwicklungslebenszyklus, seine Vorgänge und seine Supportfunktionen integriert ist. Dieses System bietet eine einheitliche Erfahrung für Technik- und Kundensupportteams, erfüllt gleichzeitig die Anforderungen an die Skalierung und reduziert die Lizenzkosten für Drittanbietersoftware.
Die auf OpenTSDB und HBase basierende Kennzahleninfrastruktur bei Salesforce unterstützt die umfangreiche Erfassung, Speicherung und Echtzeitabfrage von Zeitreihendaten. Nicht-Echtzeit-Anwendungsfälle verwenden Trino und Iceberg und verarbeiten mehr als 2 Milliarden Kennzahlen pro Minute, um Statistiken zur CPU-Auslastung, Speicherauslastung und Anforderungsraten bereitzustellen. Für die Protokollverwaltung verwendet Salesforce Splunk für seine leistungsstarken Indizierungs- und Suchfunktionen. Apache Druid unterstützt die Echtzeiterfassung und -analyse von umfangreichen Ereignisdaten, die für das Verständnis von Benutzerinteraktionen und Systemereignissen entscheidend sind. Die verteilte Verfolgung über Microservices hinweg wird mit OpenTelemetry und ElasticSearch verwaltet, wodurch bestimmte Latenz- und Fehlerpunkte identifiziert werden können.
Salesforce implementierte zudem eine API-Infrastruktur (Application Performance Monitoring), die in seine Technologiestapel für Datenerfassungs- und Telemetriespeicher integriert werden kann. Durch diese automatische Instrumentierung von Anwendungen wird die Datenerfassung vereinfacht und eine konsistente Telemetrie zwischen Services gewährleistet. Das vereinheitlichte Dashboard von APM korreliert mit verschiedenen Datentypen und verbessert die Möglichkeit für Ingenieure, die Leistung zu überwachen, Probleme zu diagnostizieren und Systeme über eine zusammenhängende Oberfläche zu optimieren.
Durch die Standardisierung von Tools für die Beobachtbarkeit verknüpft Salesforce verschiedene Telemetrietypen mithilfe der verteilten Verfolgung. Dadurch wird ein umfassendes Diagramm zur Serviceabhängigkeit erstellt, das das gesamte Service-Ökosystem visualisiert und Anforderungen detailliert verfolgt. Diese Funktion ist wichtig, um Probleme zu erkennen, Engpässe zu identifizieren und AI-gestützte Funktionen wie Anomalieerkennung, Prognoseanalysen und automatische Behebung zu unterstützen.
#### AIOps-Agent
Um die Lösungszeiten für Vorfälle zu verkürzen, wurde ein Agent für AI-Vorgänge (AI Operations, AIOps) entwickelt, der Vorfälle automatisch erkennt, triagiert und behebt, wobei nur in einer Minderheit der Fälle eingegriffen wird. Der AIOps-Agent ist ein skalierbares Toolkit für reaktive Agenten, das die Entwicklung komplexer, reaktiver Agenten-basierter Systeme erleichtern soll. Sie ist hochgradig modular und kann mit verschiedenen Tools erweitert werden, um ihre Funktionalität zu erweitern. Es wurde entwickelt, um mit zunehmender Anzahl von Agenten effizient zu skalieren. Zu den wichtigsten Funktionen zählen eine reaktive Architektur, mit der Agenten dynamisch auf Änderungen in ihrer Umgebung reagieren können, eine Toolerweiterung, die eine einfache Integration von Tools zur Erweiterung der Agentenfunktionen ermöglicht, und ein steckbares Planungsmodul, das die Anpassung der Planungsstrategien von Agenten durch das Einfügen verschiedener Planungsmodule ermöglicht.
Die schnelle proaktive Erkennung erfolgt bei 91 % (zum Zeitpunkt der Erstellung) unserer zentralen CRM-Produktvorfälle mit Modellen für erweitertes maschinelles Lernen aus unserer Merlion-Bibliothek, einer öffentlich verfügbaren Open-Source-Bibliothek, die von unserem AI-Forschungsteam entwickelt wurde. Merlion ist ein Ensemble von Modellen für maschinelles Lernen wie Isolation Forests, Stats, Random Forests und Long Short-Term Memory (LSTM), die die umfangreichen Telemetriedaten, die von unseren Systemen generiert werden, nahezu in Echtzeit verarbeiten.
79 % der Vorfälle (zum Zeitpunkt des Schreibens) werden automatisch durch die Aktionen des Agenten gelöst. Unser AIOps-Agent kann Datenvektoren wie Protokolle, Profilerstellung, Diagnose, Zeitreihen und servicespezifische Artefakte verarbeiten und triagieren, um Korrekturaktionen zu empfehlen. Das Steuerfeld und der Planer für AIOps-Agenten wählen einen Agenten mit bestimmten Fertigkeiten aus, um Aktionen in der Produktion auszuführen.
Bei den verbleibenden Vorfällen, die eine menschliche Beteiligung erfordern, leitet der AIOps-Agent ungelöste Probleme effizient an die entsprechenden Serviceteams weiter. Dies geschieht durch intelligentes Verständnis der Art und des Kontexts jedes Vorfalls mithilfe des hausinternen, optimierten Modells XGenOps, das an operativen Datensets wie Problemdatensätzen, Vorfällen, JFRs und Protokollen trainiert wird, um sicherzustellen, dass es an das Team mit der erforderlichen Expertise weitergeleitet wird. Dadurch werden mehr als 2800 Stunden Planungszeit pro Woche eingespart, sodass Ingenieure ungelöste Probleme nicht mehr lösen müssen.
#### Kontinuierliche Bereitstellung
Um das Risiko von Ausfällen durch fast 250.000 wöchentlich vorgenommene Produktionsänderungen zu verwalten, werden vollautomatische Bereitstellungssysteme verwendet, um sichere Änderungspraktiken zu erzwingen und menschliche Fehler zu vermeiden. Standardmäßige Systeme waren nicht skalierbar oder anpassbar genug, was zur Entwicklung maßgeschneiderter Lösungen führte.
Das benutzerdefinierte System für die kontinuierliche Bereitstellung gewährleistet die Sicherheit durch mehrere Ebenen und folgt den branchenüblichen Bereitstellungsstrategien für Blau/Grün:
- Obligatorische Testnachweise für jede Änderung.
- Anfängliche Kanarienvogeltests von Änderungen.
- Gestaffelte Bereitstellung mit kontrolliertem Sprengradius.
- Einweichen und Integritätsprüfungen zwischen Bereitstellungsphasen.
- Abmildern von Konflikten mit bestehenden Moratorien und Vorfällen.
Darüber hinaus wurden kontinuierliche Integrationssysteme für die Ausführung von Millionen von AI-ausgewählten Tests optimiert, um schnelle Versionen zu ermöglichen und gleichzeitig Regressionsrisiken zu minimieren.
## 5\. Metadaten-Framework
Das zentrale architektonische Prinzip der Salesforce Platform ist ihr metadatengestütztes Design. Salesforce-Techniker erstellen Mandantenservices und Datenspeicher. Jede Anwendung auf der Plattform ist im Wesentlichen eine Sammlung von Metadaten, die anpasst, wie diese Mandantenservices von einzelnen Kunden genutzt werden. Daher lautet ein allgemeiner Marketingausdruck für Salesforce Platform: "Auf alles wird mit Metadaten zugegriffen".
Die Plattform betont strukturierte und stark typisierte Metadaten. Diese Metadaten dienen als Abstraktionsebene zwischen der Kundenerfahrung und der zugrunde liegenden Salesforce-Infrastruktur und -Implementierungen. Dieser Ansatz verbessert sowohl die Benutzerfreundlichkeit als auch die Qualität von Anwendungen. Anstatt beispielsweise SQL-Schemadefinitionen und -Abfragen zu verwenden, interagieren Kunden über Salesforce Object-APIs mit strukturierten Metadaten wie Einheiten, Feldern und Datensätzen. Dieses Design ermöglicht es der Plattform, neue Datenspeichertechnologien zu integrieren oder vorhandene zu ändern, ohne dass Anwendungsänderungen erforderlich sind, und unterstützt so bewährte Vorgehensweisen für die kontinuierliche Entwicklung.
 Die Salesforce Platform-Architektur verfügt über einen Ansatz der "Schichterweiterung", der vier wichtige Personas beim Erstellen und Erweitern von Anwendungen unterstützt:
- **Salesforce Engineering:** Teams entwickeln native Anwendungen wie Sales Cloud und Service Cloud, die über einen umfangreichen Versionsprozess für alle Services und Laufzeiten bereitgestellt werden. Diese Anwendungen werden allen Mandanten über Lizenzierungs- und Bereitstellungsmechanismen zur Verfügung gestellt.
- **Externe Partner**: Unabhängige Softwareanbieter (ISVs) und andere Partner können die von Salesforce erstellten Metadaten erweitern, um Mehrwertlösungen zu erstellen, beispielsweise Schemaerweiterungen für Sales Cloud-Datenmodelle oder zusätzliche Validierungsregeln für Service Cloud-Kundenvorgangsdatensätze. Sie können diese Lösungen für die Verteilung an mehrere Kunden als Paket erstellen.
- **Organisationsspezifische IT-Administratoren und -Entwickler**: Sie können ihre Anwendungen über das Angebot von ISVs hinaus anpassen und so Lösungen an die individuellen geschäftlichen Herausforderungen wie proprietäre oder regionsspezifische Prozesse anpassen.
- **Einzelne Endbenutzer**: Endbenutzer können ihre Anwendungserfahrung personalisieren, beispielsweise die Spaltenreihenfolge in einer Listenansicht ändern oder eine Standardregisterkarte festlegen.
Jede Persona kann unabhängig voneinander dieselbe Anwendung durchlaufen, indem sichergestellt wird, dass untere Ebenen nicht von Änderungen an Personas in den höheren Ebenen abhängen, und indem starke Versions- und Abwärtskompatibilitätsverträge beibehalten werden.
Eine Funktion, die das Konzept der "Schichterweiterung" hervorhebt, ist die Ausführungsreihenfolge für die Datensatzspeicherung, die sicherstellt, dass Geschäftslogik aus allen vier Ebenen in einer vorhersehbaren Reihenfolge angewendet wird. Dadurch können spezifischere Geschäftslogiken mit höherer Ebene, die vom Organisationsadministrator oder IT-Entwickler bestimmt werden, während der Datensatzspeicherung Logiken mit niedrigerer Ebene, die möglicherweise von Salesforce oder einem externen Partner bereitgestellt werden, entsprechend überschreiben.
Darüber hinaus verwenden die Metadaten-Frameworks der Plattform eine "Core"-Laufzeit und ein proprietäres objektbezogenes Zuordnungsprogramm (Object-Relational Mapper, ORM) mit integriertem Mandantenzugriff, das mit einer relationalen Datenbank verbunden ist. Diese Core-Laufzeit ermöglicht den freigegebenen Speicherstatus, referenzielle Integritätsvalidierungen und transaktionale Commits, wodurch die Anwendungsstabilität priorisiert und die Zuverlässigkeit von Anwendungsbereitstellungen erhöht wird. Die Architektur wurde kontinuierlich weiterentwickelt, um die wachsende Komplexität der Anwendungen zu unterstützen. Zum Beispiel gibt es seit Oktober 2025 über 85.000 Einheiten, die von Salesforce definiert wurden, und über 300 Millionen benutzerdefinierte Einheiten, die von unseren Kunden definiert wurden.
In der Vergangenheit hostete die Core-Laufzeit den Großteil der Plattform- und Anwendungsfunktionen. Die aktuelle Architektur der Salesforce Platform umfasst nun Hunderte unabhängige, metadatengestützte Services. Die Core-Laufzeit bleibt das einzige Datensatzsystem für Anwendungsmetadaten und nutzt die einzigartigen Vorteile einer monolithischen Architektur für die Metadatenverwaltung. Die relevanten Metadaten werden in unabhängigen Services mit lokalen Caches synchronisiert, wodurch die vielfältigen skalierbaren Services für die Anwendungslaufzeiten unterstützt werden.
## 6\. Daten
Daten sind für Unternehmen ein wichtiger Vermögenswert. Hyperforce bietet eine zuverlässige Grundlage für die Speicherung bei Salesforce. Die größte Herausforderung besteht darin, Daten so zu speichern, dass ihr Dienstprogramm für Anwendungen optimiert wird. Die Salesforce Platform hat die Datenebene durch die Berücksichtigung verschiedener Speicher- und Zugriffsanforderungen umgestaltet. Sie gleicht Kosten, Lese-/Schreibgeschwindigkeiten, Speicherkapazität und Datentypen effektiv aus, um unterschiedlichen Anforderungen gerecht zu werden.
Da AI und Analysen zunehmend Unternehmensanwendungen prägen, haben sich Daten als zentrales Element etabliert. Ihre Bedeutung liegt in ihrer Fähigkeit, KI und Analysen zu ermöglichen, Prozesse zu lernen, zu analysieren, Entscheidungen zu treffen und zu automatisieren.
Die Daten stammen aus System of Record (SOR)-Datenbanken und erfüllen die betrieblichen Anforderungen von Unternehmen. Anschließend werden verschiedene Transformationen zu Big Data-Plattformen durchgeführt, die für die Bereitstellung von AI und analysegestützten Anwendungen unerlässlich sind.
Eine effektive Verwaltung von Daten, von Transaktionsinformationen bis hin zu analytischen Statistiken, ist entscheidend für die Wertschöpfung und die Unterstützung komplexer Anwendungen. Salesforce Database (SalesforceDB) ist eine führende Transaktionsdatenbank für die Verwaltung von SOR-Daten, während Data 360 als robuste Big Data-Plattform fungiert, die die AI- und Analysefunktionen verbessert.
### 6.1 Transaktionsdatenbank
Transaktionsdaten und Metadaten sind für Salesforce Platform von entscheidender Bedeutung. SalesforceDB ist eine moderne, Cloud-native relationale Datenbank, die speziell für die Multi-Mandanten-Arbeitslasten von Salesforce entwickelt wurde, ähnlich wie andere Cloud-Datenbanken wichtiger Anbieter, jedoch mit benutzerdefinierten Funktionen für die Salesforce-Architektur. Sie erweitert PostgreSQL, trennt Berechnung und Speicher und nutzt Kubernetes und Cloud-Speicher und erweitert Vorgänge um mandantenspezifische Funktionen wie Verschlüsselung und Sandbox-Instanzen.
SalesforceDB verarbeitet alle transaktionalen CRM-Daten ab 1,1 Billionen Transaktionen pro Monat sowie Metadaten für Data 360 und zugehörige Services. Das Hauptziel besteht darin, Trust durch Langlebigkeit, Verfügbarkeit, Leistung und Sicherheit zu gewährleisten, die Skalierung für Großkunden zu ermöglichen und vereinfachte und zuverlässige Cloud-Vorgänge zu ermöglichen. Diese Ziele werden durch ein Design erreicht, das Rechen- und Speicherebenen, ein unveränderliches verteiltes Speichersystem und den protokollstrukturierten Zugriff auf Briefvorlagendaten voneinander trennt. Dies ermöglicht erweiterte Funktionen wie die mandantenbasierte Verschlüsselung von Daten im Speicher und effiziente Sandbox-Instanzen und Migrationen.
#### Architekturübersicht
Die SalesforceDB-Servicearchitektur wird in drei Verfügbarkeitszonen ausgeführt, wobei Berechnung und Speicher in diesen Zonen repliziert werden, um sicherzustellen, dass das System auch dann verfügbar bleibt, wenn ein Knoten oder eine gesamte Zone verloren geht. Alle Services werden in Kubernetes ausgeführt, um die automatische Fehlerbehebung und Servicebereitstellungen zu ermöglichen.
Um eine hohe Haltbarkeit und Verfügbarkeit zu gewährleisten, ist das ultimative Datensatzsystem für SalesforceDB Cloud-Speicher wie S3 von AWS. Vorgänge wie die Archivierung und der regionsübergreifende Abgleich werden auf dieser Cloud-Speicherebene verwaltet. Speicherobjekte sind unveränderlich und verbessern die Datenverteilung und den Abgleich für eine hohe Verfügbarkeit.
Aufgrund der hohen Latenz im Cloud-Speicher verwendet SalesforceDB Speicher-Caches für den Zugriff auf Daten. Bei diesen Caches handelt es sich um verteilte Speichersysteme, die temporäre Kopien von Speicherobjekten in einem Knoten-Cluster verwalten und so den Abgleich und die Haltbarkeit nach Bedarf der Datenbank gewährleisten. Für die Speicherung von Transaktionsprotokollen und Datendateien werden separate Caches verwendet.
Die SQL-Berechnungsebene besteht aus einem primären Datenbank-Cluster und zwei Standby-Clustern in drei verschiedenen Verfügbarkeitszonen. Der primäre Cluster verarbeitet alle Datenbankänderungen, während die Standby-Cluster nur Abfragevorgänge verarbeiten.
 #### LSM-Speicher und -Zugriff
SalesforceDB verwendet eine LSM-Datenstruktur (Log-structured merge tree), bei der Änderungen zunächst in einem Transaktionsprotokoll aufgezeichnet und im Speicher akkumuliert werden. Die übernommenen Änderungen werden dann gemeinsam in schlüsselgeordneten Datendateien ausgeschrieben, die regelmäßig zusammengeführt und kompaktiert werden, um die Speichereffizienz zu optimieren.
Durch diese Struktur werden Probleme bei gleichzeitigen Aktualisierungen, die in Datenbanken, die den Speicher direkt aktualisieren, häufig auftreten, effektiv beseitigt. Mithilfe des LSM-Ansatzes unterstützt SalesforceDB wichtige Funktionen wie unveränderlichen Speicher und ist somit eine robuste Lösung für die Verwaltung von Salesforce-Arbeitslasten.
#### Unveränderlicher Speicher
Daten im Speicher sind unveränderlich. Sobald Datendateien geschrieben und sichtbar gemacht wurden, werden sie nicht mehr geändert. Transaktionsprotokolle sind nur angehängt, was Datenzugriffsmuster vereinfacht und die Zuverlässigkeit erhöht. Diese Struktur unterstützt nicht koordinierte Lesevorgänge, vereinfacht Sicherungen, erhöht die Skalierbarkeit und erleichtert die Speichervirtualisierung, wodurch sie sich gut für Cloud-Umgebungen eignet.
#### Verfügbarkeit und Haltbarkeit
Transaktionen in SalesforceDB werden über mehrere Verfügbarkeitszonen hinweg übernommen, wodurch sichergestellt wird, dass auch bei einem Knoten oder einer Zone kein Datenverlust auftritt. Wenn ein Fehler auftritt, werden Transaktionen während des Betriebs abgebrochen und übernommene Transaktionen erfolgreich wiederhergestellt. Da bei Fehlern keine übernommenen Daten verloren gehen, wird das Failover auf neue Knoten automatisiert.
Die Clusterverwaltungssoftware verarbeitet Failover automatisch, indem sie die Quorums überwacht und Inhaberschaftsübertragungen verwaltet. Dieser Prozess wird nicht nur in Notfällen, sondern auch routinemäßig bei regelmäßigen Patches verwendet, um die Zuverlässigkeit des Systems durch ständige Nutzung zu erhöhen. Kurze Datenbank-Neustarts werden von Endbenutzern in der Regel nicht bemerkt, was eine nahtlose Benutzererfahrung gewährleistet.
Salesforce nimmt drei wichtige Schemaaktualisierungen pro Jahr vor, wobei wöchentlich kleinere Schemaaktualisierungen vorgenommen werden. SalesforceDB bietet Zero-Downtime-Schemavorgänge, mit denen diese Aktualisierungen ohne Auswirkungen auf die Kunden durchgeführt werden können.
#### Datensatzsystem
Unsere Transaktionsdatenbank dient als primäres Repository für Kundendaten, die über mehrere Verfügbarkeitszonen hinweg zwischengespeichert und in der Cloud gespeichert werden. Jeder Datenblock ist mit einer unveränderlichen Prüfsumme geschützt, die sowohl von der Speicherebene als auch vom Datenbankmodul überprüft wird. Die Datenbank führt die Abstammungsverfolgung durch, um alle nicht ordnungsgemäßen Änderungen oder verpassten Versionen zu erkennen, und führt fortlaufende Konsistenzprüfungen zwischen Indizes und Basistabellen aus.
Zum Schutz vor Ransomware werden Datenbanken in separatem Speicher unter einem anderen Account archiviert, einschließlich vollständiger und inkrementeller Transaktionsprotokoll-Sicherungen. Diese Sicherungen werden regelmäßig durch einen Wiederherstellungstestprozess validiert. Darüber hinaus ist die Cloud-Infrastruktur vorkonfiguriert, aber nicht aktiviert und kann Datenwiederherstellungsanforderungen nach Bedarf verwalten.
#### Skalierung
Jede Salesforce-Organisation befindet sich in einer Hyperforce-Zelle, die den SalesforceDB-Service enthält. Dieses Setup ermöglicht eine schnelle globale Skalierung durch die Erstellung neuer Zellen über die Hyperforce Architektur. Zudem kann der Datenverkehr einfach zwischen Zellen verschoben werden, um die Auslastung zu verwalten. Da jedoch die Arbeitslasten und Geschäftsanforderungen der Kunden steigen, kann die Kapazität einer einzelnen Datenbankinstanz nicht ausreichen.
SalesforceDB verwendet dazu eine horizontale Skalierungsarchitektur für die Speicher- und Rechenebenen. Der Cloud-Speicher ist nahezu unbegrenzt und die Cache-Ebenen werden automatisch an die Nachfrage angepasst. Darüber hinaus kann die Berechnungsebene erweitert werden, indem mehr Datenbank-Berechnungsknoten hinzugefügt werden, die effizient aus freigegebenem unveränderlichem Speicher gelesen werden, ohne koordiniert werden zu müssen. Durch diesen Ansatz kann SalesforceDB eine Skalierbarkeit erreichen, die mit der von führenden kommerziellen Cluster-Datenbankarchitekturen übereinstimmt oder übereinstimmt, ohne dass eine spezielle Vernetzung oder Hardware erforderlich ist.
#### Mandantschaft
Salesforce ist eine mandantenfähige Anwendung, bei der eine einzelne Datenbank mehrere Mandanten hostet. Jeder Tabellendatensatz enthält eine Mandanten-ID, um seine Inhaberschaft zu unterscheiden, und die Mandantenisolation wird durch automatische Abfrageprädikate beibehalten, die von der Anwendungsebene von Salesforce hinzugefügt werden.
SalesforceDB ist auf dieses Modell zugeschnitten und unterstützt mandantenspezifische DDL-, Metadaten- und Laufzeitprozesse, was Zuverlässigkeit, Leistung und Sicherheit erhöht. Es kombiniert den geringen Overhead eines Mandanten-pro-Zeile-Modells mit der Effizienz eines Mandanten-pro-Datenbank-Schemas.
In SalesforceDB sind Mandanten-IDs Teil des Primärschlüssels in mandantenfähigen Tabellen, die Daten nach Mandant in der LSM-Datenstruktur gruppieren und so die Zugriffseffizienz erhöhen. Diese Einrichtung erleichtert nicht nur den effizienten Datenzugriff und die mandantenbasierte Verschlüsselung, sondern vereinfacht auch die Mandantendatenverwaltung. Mandanten können dank der kompakten Metadatenstruktur ohne Weiteres kopiert oder verschoben werden.
### 6.2 Data 360 und Data Lake
AI, Analysen und Datenfunktionen sind in modernen Unternehmen unerlässlich. Unternehmen investieren bereits in ausgereifte Big Data-Plattformen wie Snowflake, Databricks, BigQuery und Redshift. Viele jedoch
Kunden leiten aufgrund von Datensilos, fehlender AI-Verarbeitung, veralteter Daten oder Inaktivität innerhalb eines vorhandenen Geschäftsprozesses keinen Geschäftswert aus ihren Daten ab. Die Zentralisierung von Kundendaten in einer einzigen Informationsquelle mit einer einzigen Ansicht des Kundenengagements ist für ein Unternehmen entscheidend und aufgrund der Datenfragmentierung und der Komplexität der Systemverwaltung eine Herausforderung. Salesforce ist führend bei der Vereinfachung einer ganzheitlichen Sicht auf einen Kunden, indem Daten, AI und CRM in einen tugendhaften Kreislauf integriert werden, der auf Statistiken zur generativen AI und zum maschinellen Lernen basiert und auf Daten basiert.
SalesforceDB ist für leistungsstarke transaktionale Arbeitslasten für strukturierte Daten optimiert, während AI- und Analytics-Arbeitslasten die Verarbeitung großer Mengen unstrukturierter Daten aus verschiedenen Quellen und die Durchführung komplexer Abfragen und Batch-Verarbeitungen erfordern. Um diesen Anforderungen gerecht zu werden, hat Salesforce Data 360 entwickelt, eine Plattform, mit der Datensilos abgebaut, vereinheitlicht, gespeichert und effizient verarbeitet werden können, AI- und Analyseanforderungen unterstützt und Unternehmensvorgänge in Echtzeit ermöglicht werden.
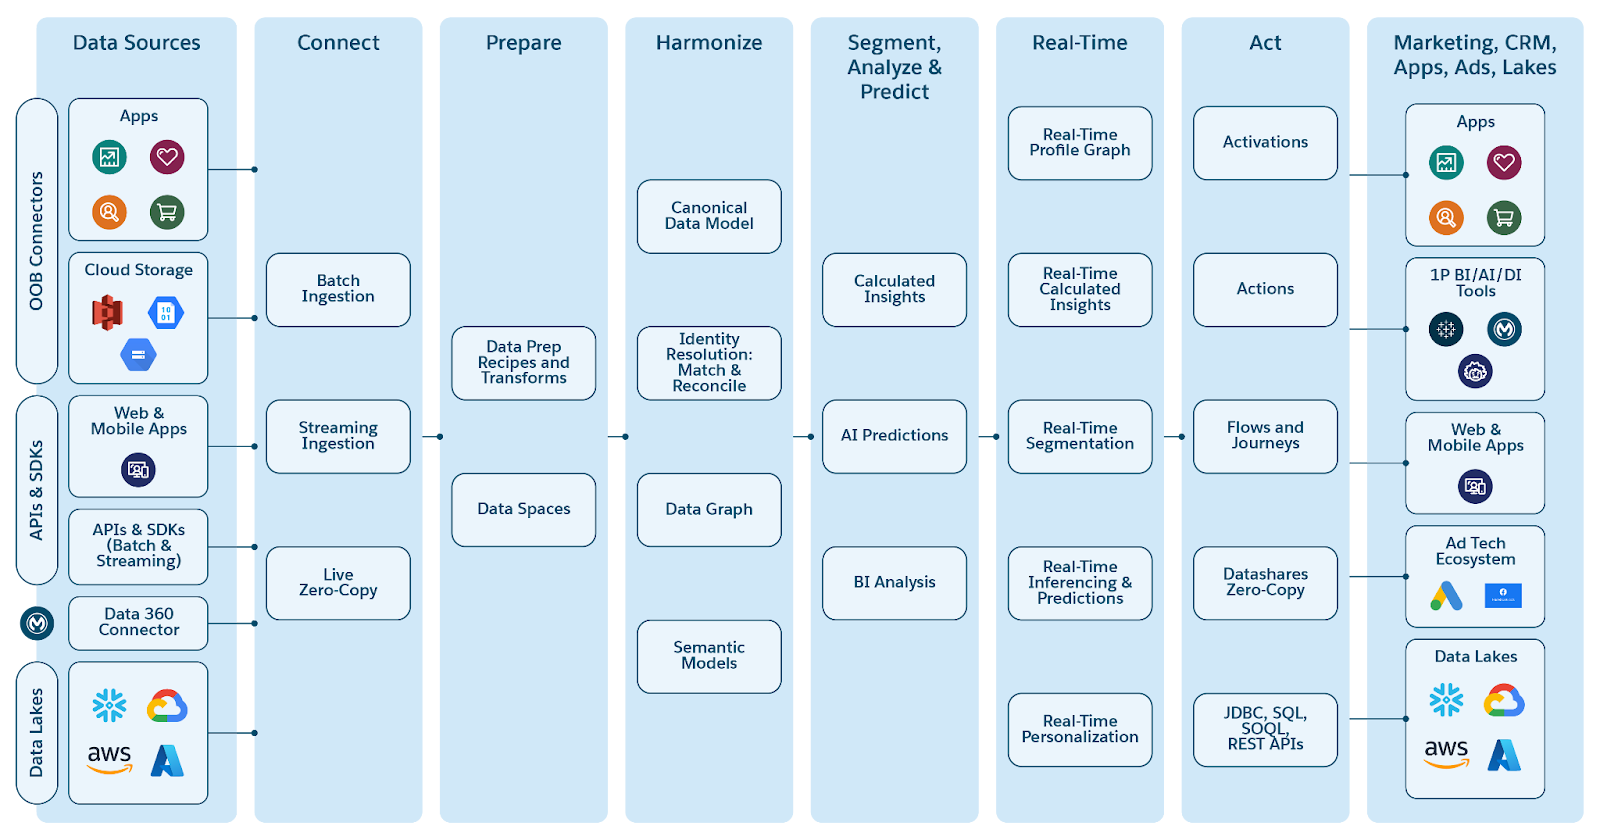 Data 360, das auf Hyperforce basiert, dient als Grundlage für AI und Analytics und bietet Folgendes:
- Integrierte Infrastruktur und eine No-Code-Plattform zum Konsolidieren von Datensilos über Verbindungen
- Datenaufnahme in Echtzeit und nahezu in Echtzeit
- Zero-Copy-Verbund
- Datenbereinigung, -vorbereitung und -formung für die Verarbeitung
- Vereinheitlichter Abfrageservice für strukturierte und unstrukturierte Daten
- Entwicklung von Analyse- und AI/ML-Modellen zur Statistikgenerierung
- Durch Daten ausgelöste Aktionen und Aktivierungen
- Unterstützung für die generative AI Retrieval Augmented Generation (RAG)
- Umfassende richtlinienbasierte Unternehmensführung
Data 360-Architektur unterstützt eine Reihe von Komponenten und Funktionen, die im Folgenden beschrieben werden.
#### Konnektivität, Transformation und Harmonisierung
Data 360 unterstützt effiziente Aufnahme-Pipelines aus verschiedenen strukturierten und unstrukturierten Datenquellen für die Batch-, Nahezu-Echtzeit- und Echtzeit-Datenverarbeitung. Der Aufnahmeservice von Data 360 funktioniert nach dem Muster "Extract-Load-Transformation (ELT)" und ist für geringe Latenz konzipiert und für die B2C-Skalierung geeignet. Die Echtzeitaufnahme umfasst APIs und interaktive Streams, während Quellen nahezu in Echtzeit eine detaillierte Produktnutzung abdecken. Nach der Aufnahme werden Daten umfassend umgewandelt, um sie vorzubereiten, zu harmonisieren (z. B. durch Vereinheitlichung verschiedener Kontakttypen) und für effektive Abfrage-, Analyse- und AI-Anwendungen zu modellieren. Die Plattform enthält zudem eine Vielzahl einsatzbereiter harmonisierter Datenmodelle.
Data 360 lässt sich nahtlos in Salesforce-Anwendungen wie Sales Cloud, Service Cloud, Marketing Cloud und Commerce Cloud integrieren. Darüber hinaus bietet er Hunderte von Konnektoren für externe Datenquellen, was eine reibungslose Datenintegration gewährleistet.
#### Lakehouse für Big Data
Data 360 verfügt über eine native Lakehouse-Architektur, die auf Iceberg/Parquet basiert und für die Verwaltung und Verarbeitung umfangreicher Daten für Batch-, Streaming- und Echtzeitszenarien konzipiert wurde. Diese Architektur unterstützt strukturierte und unstrukturierte Daten, die für AI- und Analyseanwendungen entscheidend sind.
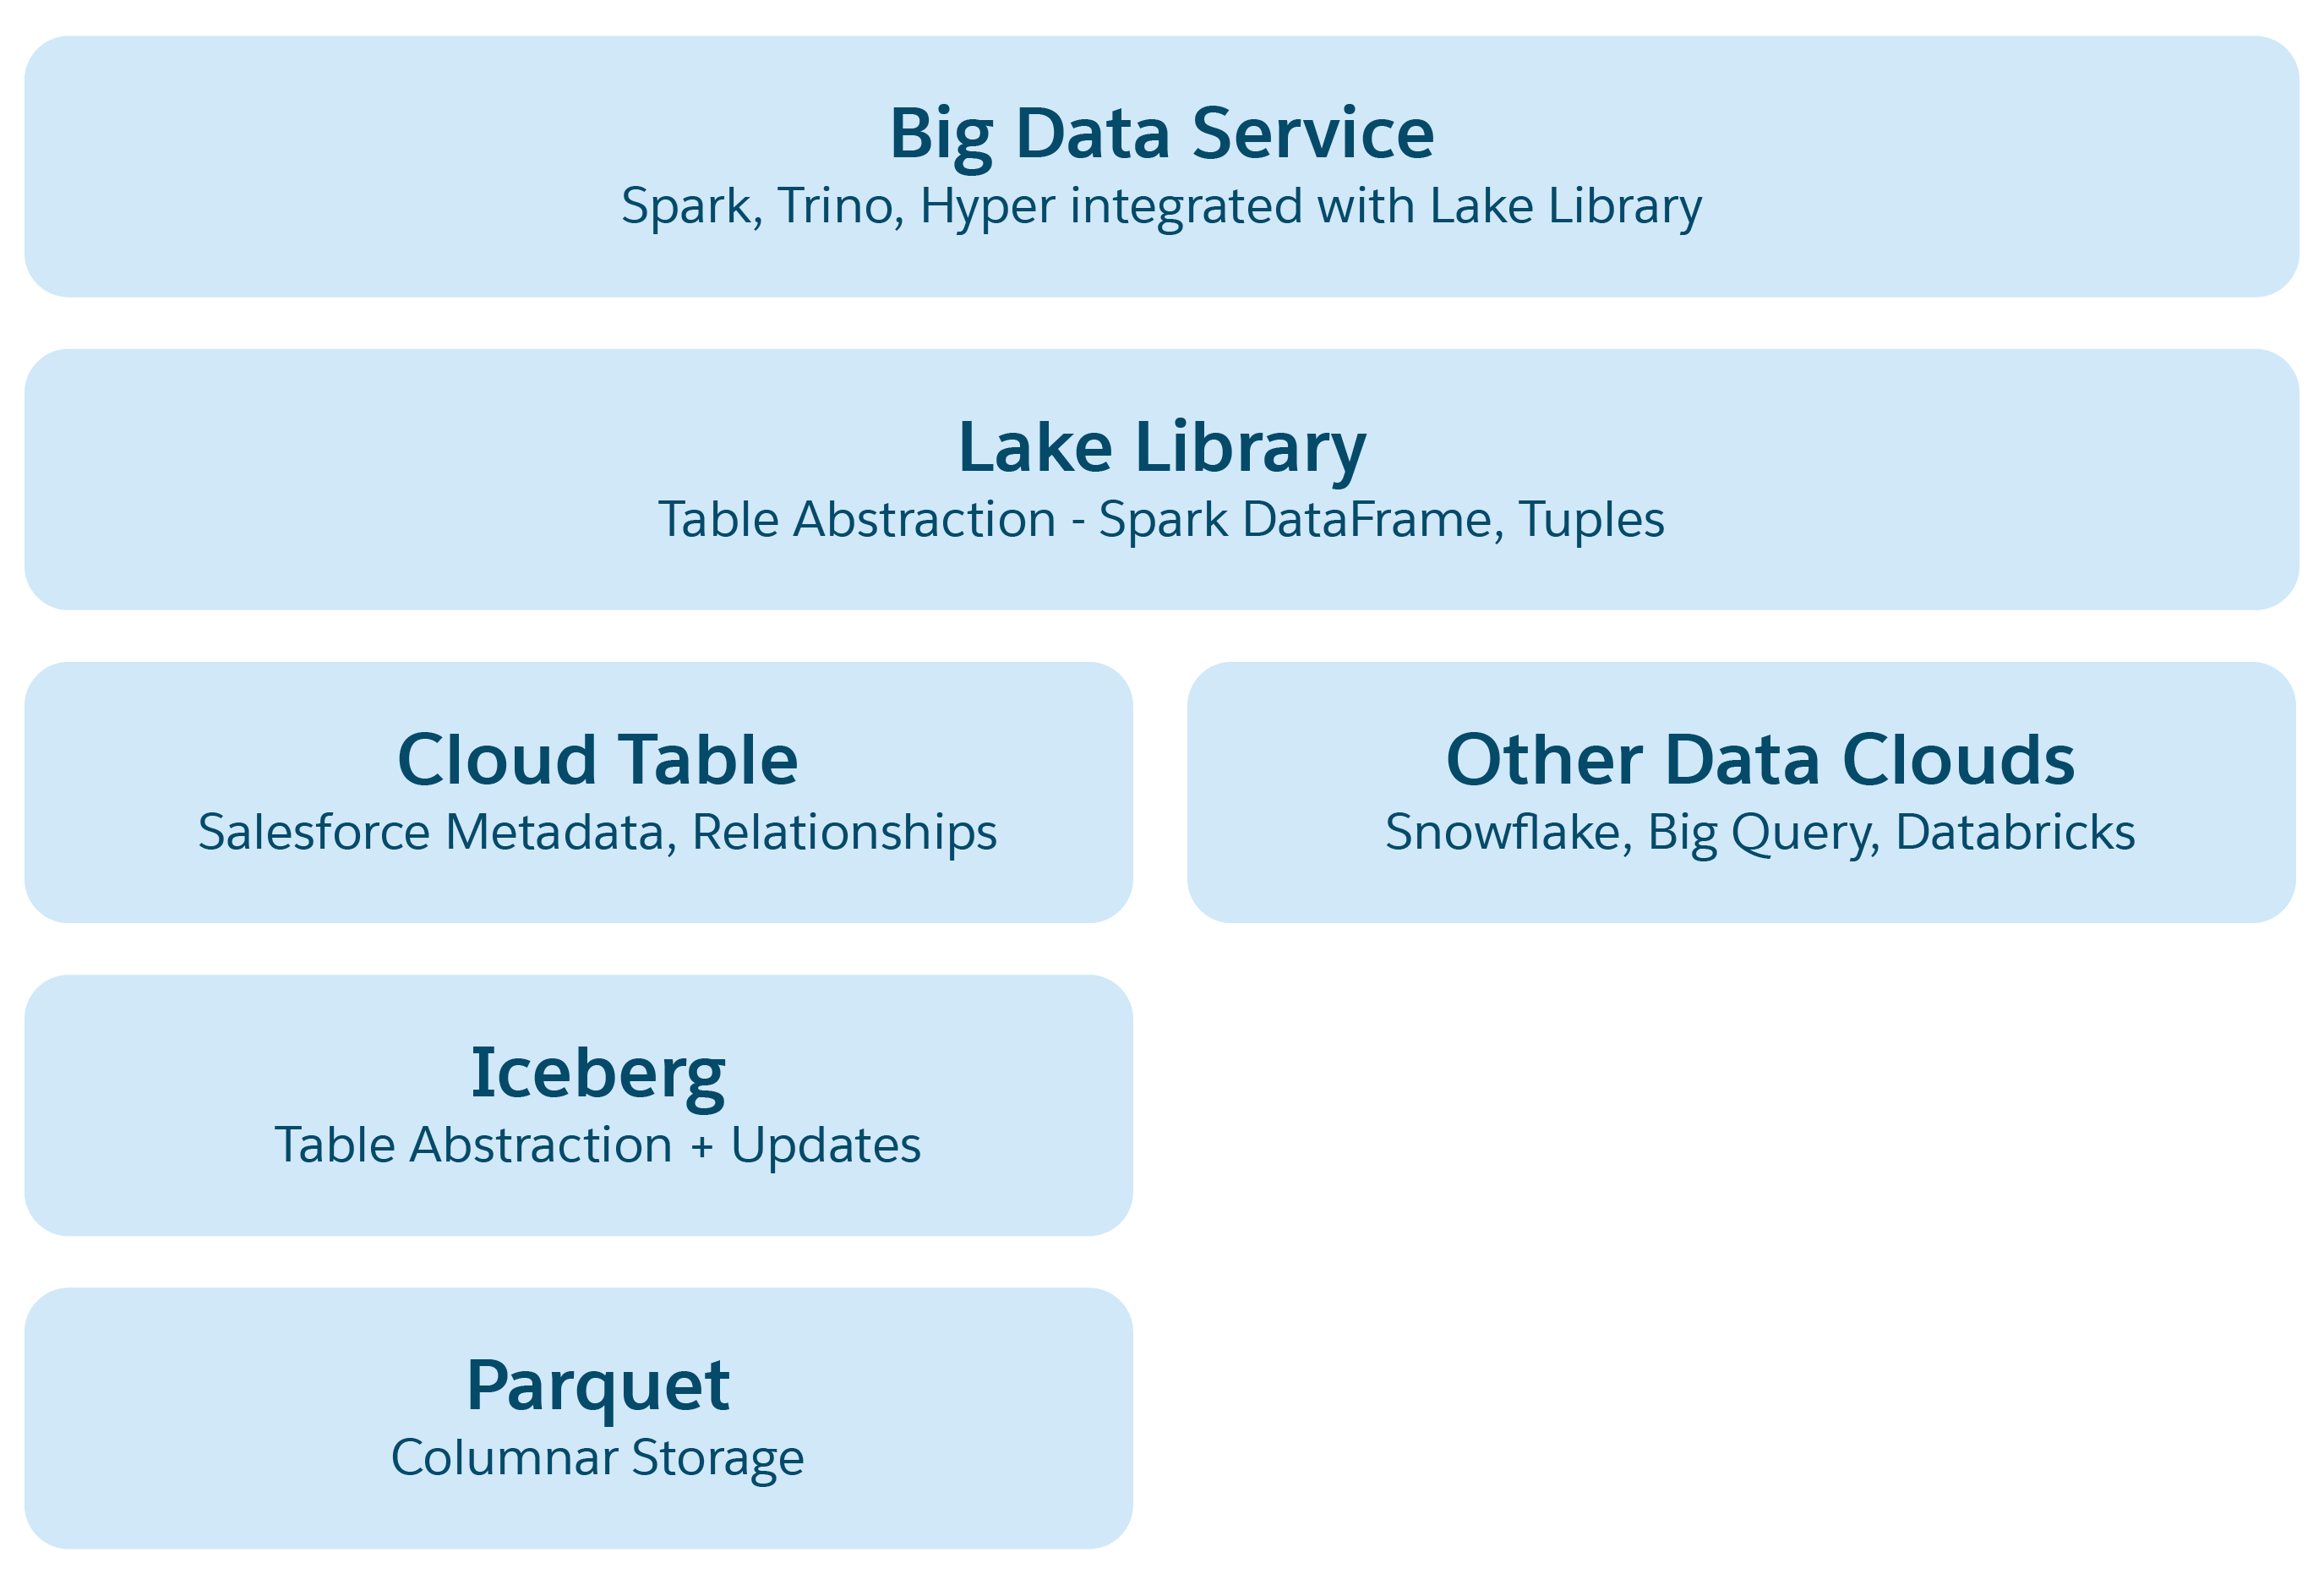 In Cloud-basierten Data Lakes wie Azure, AWS oder GCP ist die grundlegende Speichereinheit eine Datei, die in der Regel in Ordnern und Hierarchien organisiert ist. Dieses Lakehouse erweitert diese Struktur durch die Einführung struktureller und semantischer Abstraktionen auf übergeordneter Ebene, um Vorgänge wie Abfragen und die AI/ML-Verarbeitung zu vereinfachen. Bei der primären Abstraktion handelt es sich um eine Tabelle mit Metadaten, die ihre Struktur und Semantik definiert und Elemente aus Open-Source-Projekten wie Iceberg oder Delta Lake mit zusätzlichen semantischen Ebenen enthält, die durch Data 360 hinzugefügt wurden.
Abstraktionsebenen im Seehaus:
- **Parquet File Abstract (Parquet-Dateiabstraktion)**: Auf der Basis besteht der Speicher aus Data-Lake-Dateien (z. B. S3 in AWS oder Blob in Azure) im Parquet-Format. Daten für eine Quelltabelle werden in mehreren Partitionen als Parquet-Dateien gespeichert, wobei jede Tabelle eine Sammlung dieser Dateien ist.
- **Iceberg-Tabellenabstraktion**: Tabellen sind als Ordner organisiert, wobei Datenpartitionen in diesen Ordnern als Parquet-Dateien gespeichert sind. Änderungen an einer Partition führen zu neuen Parquet-Dateien als Snapshots. Iceberg verwaltet eine Metadatendatei für jede Tabelle mit detaillierten Schemas, Partitionsspezifikationen und Snapshots.
- **Salesforce Cloud-Tabellenabstraktion**: Aufbauend auf Iceberg fügt diese Ebene semantische Metadaten wie Spaltennamen und Beziehungen sowie Konfigurationen wie die Zieldateigröße und die Komprimierung hinzu. Sie abstrahiert Tabellen auf verschiedenen Plattformen wie Snowflake und Databricks und schützt Data 360-Anwendungen vor den zugrunde liegenden Besonderheiten der Speicherplattform.
- **Bibliothek für Seezugriff**: Diese Bibliothek bietet Zugriff auf die Salesforce Cloud-Tabelle, verarbeitet Daten und Metadaten und abstrahiert die zugrunde liegenden Speichermechanismen für Anwendungsentwickler.
- **Big Data-Service-Abstraktion**: Dies umfasst Verarbeitungs-Frameworks wie Trino und Hyper für Abfragen und Spark für die Verarbeitung auf jeder Cloud-Tabellenplattform.
Data 360 Lakehouse unterstützt die B2C-Skalierung, die Echtzeitaufnahme, die Verarbeitung, die Erzwingung und Evolution von Schemas, Snapshots und verwendet offene Speicherformate.
#### Echtzeitspeicher
Data 360 erweitert den Big Data-Speicher eines Lakehouse um einen zusätzlichen Low Latency Store (LLS), um Echtzeitanalysen und agentische Anwendungen zu unterstützen. Die Echtzeitverarbeitungsebene von Data 360 analysiert Echtzeitsignale und Interaktionsdaten im Arbeitsspeicher. Da die speicherbasierte Speicherkapazität begrenzt ist, können nicht alle Daten gleichzeitig verarbeitet werden. Data 360 fügt diese LLS hinzu, um solche Einschränkungen zu entfernen und eine skalierbare Echtzeitverarbeitung zu ermöglichen.
Der Low Latency Store ist eine NVMe-Speicherschicht (SSD) im Petabyte-Format im Lakehouse. Es handelt sich um einen dauerhaften Cache – die meisten Daten gelangen schließlich zur langfristigen Aufbewahrung ins Lakehouse. Sitzungsdaten in der Echtzeitebene können in den Speicher mit niedriger Latenz gefiltert werden, um anschließend schnell darauf zugreifen zu können. In einer Agentenunterhaltung können beispielsweise aktuelle Nachrichten im Arbeitsspeicher verarbeitet werden. Ältere Nachrichten können in die LLS geleert werden. Wenn eine vorherige Unterhaltung erforderlich ist, kann innerhalb weniger Millisekunden über das LLS darauf zugegriffen werden. Mit NVMe-basiertem Speicher können große Datenmengen gespeichert und mit Latenzen von Millisekunden aufgerufen werden. Daten können zur langfristigen Aufbewahrung in das Lakehouse gelangen.
Darüber hinaus werden Daten aus dem Lakehouse abgerufen und im LLS gespeichert, die für die Echtzeitverarbeitung oder zur Erweiterung von Echtzeiterfahrungen erforderlich sind. Beispielsweise wird der Kundenprofilkontext vorab abgerufen oder aus dem Lakehouse geholt und im LLS zwischengespeichert. Außerdem können alle Lakehouse-Objekte und anderen Objekte, die für die Echtzeitverarbeitung während der Verarbeitung in der Sitzung erforderlich sind, ebenfalls im LLS zwischengespeichert werden. Das LLS ermöglicht eine Echtzeitebene in einer echten Speicherhierarchie mit Speicher-, SSD- und Lakehouse-Speicherebenen, wobei die Daten nahtlos zwischen den einzelnen Ebenen migriert werden.
Data 360 bietet zudem zuverlässige Unterstützung für Sicherheit, einschließlich der Verschlüsselung auf Mandantenebene mit vom Kunden verwalteten Schlüsseln sowie Datenschutz und Compliance durch seine Governance-Technologien. Im Mittelpunkt steht die Unterstützung der attributbasierten Zugriffssteuerung (ABAC), die den Zugriff dynamisch anhand von Attributen in Bezug auf Einheiten, Vorgänge und Umweltfaktoren auswertet. Dieses System unterstützt sowohl nach Ermessen als auch obligatorische Zugriffssteuerungen.
Ergänzend zu ABAC kategorisiert ein detailliertes Datenklassifizierungssystem Daten nach Sensibilität und Zweck und verbessert so die Compliance, das Risikomanagement und die Reaktion auf Vorfälle. Zusammen bieten ABAC und dieses Klassifizierungssystem eine umfassende Datenverwaltung und stellen sicher, dass Daten in Data 360 sicher und effizient verwaltet werden.
#### Metadata-driven
Data 360 ist für Metadaten, Paketerstellung, Erweiterbarkeit, Benutzererfahrung und Anwendungsverteilung über AppExchange tief in Salesforce Platform integriert. Kunden können die Metadaten für Lakehouse-Streams und -Tabellen genau wie andere Salesforce-Metadaten definieren und verwalten. Jedes Datenobjekt (einschließlich Verbund- oder externer Tabellen) wird als Salesforce-Objekt dargestellt und als virtuelle Einheiten modelliert, die durch Datenspeicher in Data 360 unterstützt werden. Sie können von Entwicklern zum Erstellen von Anwendungen auf der Salesforce Platform verwendet werden.
#### Zero-Copy-Verbund und Erweiterbarkeit
Data 360 bietet umfangreiche Unterstützung für Zero-Copy-Verbunde, sodass Benutzer in externe Data Warehouses wie Snowflake und Redshift, Lakehouses wie Google BigQuery, Databricks und Azure Fabric sowie SQL-Datenbanken und verschiedene Dateitypen, einschließlich Excel, integriert werden können. Data 360 unterstützt die datei- und abfragebasierte Zuordnung mit Live-Abfrage und Zugriffsbeschleunigung, wie in der Abbildung gezeigt. Die Bezeichnungen (1) und (2) veranschaulichen die Abfrage von Data 360 (einschließlich Pushdowns für Live-Abfragen) und die dateibasierte Zuordnung für den Zugriff auf Daten aus externen Data Lakes/Warehouses/Datenquellen. Die Bezeichnung (3) hebt die Beschleunigung des Verbundzugriffs aus externen Data Lakes/Datenquellen hervor. Die Bezeichnungen (4) und (5) veranschaulichen die abfrage- und dateibasierte Freigabe von Daten aus Data 360 für externe Data Lakes/Warehouses. Die Funktion erstreckt sich auch auf unstrukturierte Datenquellen wie Slack und Google Drive, auf die über die unstrukturierten Verarbeitungspipelines von Data 360 zugegriffen werden kann. Darüber hinaus erleichtert Data 360 die Abstraktion von Salesforce-Objekten und den Datenzugriff für Daten, die aus externen Quellen verknüpft werden, und ermöglicht so den Zugriff auf diese Daten über die Salesforce Platform und die Salesforce-Anwendungen hinweg.
#### Customer Data Platform (CDP)
Data 360 integriert eine CDP, die erweiterte Funktionen zur Identitätsbestimmung bietet, wodurch Kennzeichner und Profile für zusammengeführte Einzelpersonen sowie umfassende Interaktionsverläufe erstellt werden. Diese Plattform ist in der Handhabung von Business-to-Business-Frameworks (B2B) und Business-to-Consumer-Frameworks (B2C) bestens geübt, da sie Identitätsdiagramme unterstützt, die sowohl exakte als auch Fuzzy-Abgleichsregeln verwenden. Diese Identitätsdiagramme werden mit Interaktionsdaten aus verschiedenen Kanälen angereichert, wodurch detaillierte Profildiagramme mit wertvollen analytischen Statistiken und Segmenten erstellt werden können.
Darüber hinaus ermöglicht das CDP eine effektive Segmentierung und Aktivierung auf verschiedenen Plattformen wie Marketing Cloud, Facebook und Google. Es verarbeitet Kundenprofile in Batch-, nahezu Echtzeit- und Echtzeit, was eine sofortige Entscheidungsfindung und Personalisierung ermöglicht. Diese Funktion verbessert die Interaktionen in B2C- und B2B-Szenarien und stellt sicher, dass Unternehmen schnell und genau auf Kundenanforderungen und -verhalten reagieren können.
#### Datendiagramme
Data 360 bietet ein Unternehmensdatendiagramm im JSON-Format, bei dem es sich um ein denormalisiertes Objekt handelt, das aus verschiedenen Lakehouse-Tabellen und ihren Beziehungen abgeleitet wurde. Dies beinhaltet ein von CDP erstelltes "Profil"-Datendiagramm, das den Kauf- und Browserverlauf einer Person, den Kundenvorgangsverlauf, die Produktnutzung und andere berechnete Statistiken umfasst und von Kunden und Partnern erweitert werden kann. Diese Datendiagramme sind auf bestimmte Anwendungen zugeschnitten und verbessern die Genauigkeit der Eingabeaufforderungen mit generativer AI, indem sie relevanten Kunden- oder Benutzerkontext bereitstellen.
Außerdem ist geplant, diese Datendiagramme um Knowledge Diagramme zu erweitern, die abgeleitetes Knowledge erfassen und modellieren, beispielsweise extrahierte Einheiten und Beziehungen aus unstrukturierten Daten. Die Echtzeitebene von Data 360 verwendet das Profildiagramm für die Echtzeitpersonalisierung und -segmentierung.
#### Echtzeitebene
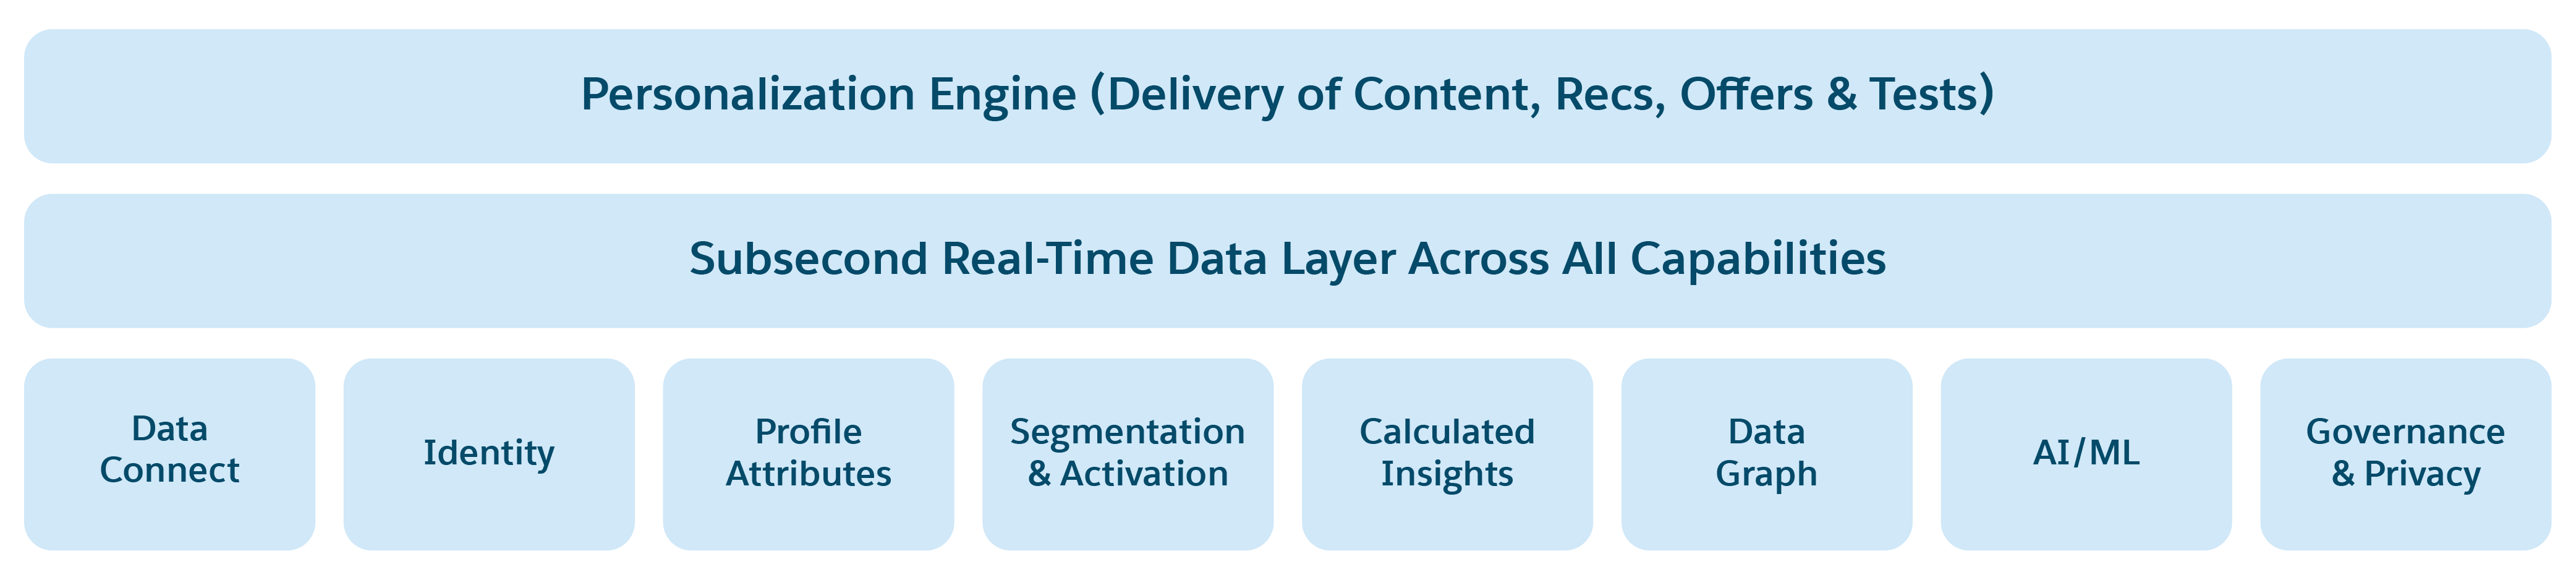 Die Echtzeitebene von Data 360 wurde entwickelt, um Ereignisse wie Web- und mobile Clickstreams, Besuche, Einkaufswagendaten und Checkouts mit Latenzen von Millisekunden zu verarbeiten und so die Personalisierung der Kundenerfahrung zu verbessern. Es überwacht kontinuierlich das Kundenengagement und aktualisiert das Kundenprofil von CDP mit Echtzeit-Interaktionsdaten, -Segmenten und -Berechnungen für die sofortige Personalisierung.
Wenn ein Verbraucher beispielsweise einen Artikel auf einer Einkaufswebsite kauft, erkennt und erfasst die Echtzeitebene dieses Ereignis schnell, identifiziert den Verbraucher und reichert sein Profil mit aktualisierten Informationen zu Lebenszeitausgaben an. Dies ermöglicht die Personalisierung ihrer Erfahrung auf der Site in Sekundenschnelle. Darüber hinaus enthält diese Ebene Funktionen für Echtzeitauslöser und -antworten, die sofortige Aktionen basierend auf Kundeninteraktionen ermöglichen.
#### Personalisierung
Die Personalisierung besteht darin, zu wissen, welche Persona wann und wo relevante Inhalte und Empfehlungen bereitgestellt werden sollen, was zu sagen ist und in welcher Häufigkeit. Die Funktion "Personalisierungsservices-Plattform" von Data 360 ist der Orchestrierer, dessen Entscheidungen getroffen werden, um die Zielerreichung durch personalisierte Erfahrungen zu optimieren. Diese Plattform bietet die folgenden Funktionen:
- Konsistenter Satz an Modellen und Möglichkeiten zur Interpretation von Profil-, Aktivitäts- und Vermögenswertdaten in Data 360.
- Plattformintegrierte Experimente (z. B. A/B/n- oder mehrarmige Banditenentscheidung).
- Integration von Zielen zur Entwurfszeit über Konfiguration, ML-Trainingszeit und Laufzeit (ML-Rückschluss).
- Unterstützung für B2C-Skalierung, Echtzeit und Batchinteraktion (anonyme Benutzer, Echtzeit/interaktiver externer Batch mit hohem Volumen, interner Batch mit hohem Volumen).
- Analytics wird über Data 360 gesteuert.
- Muster zur Integration von AI-Modellen und Services anderer Parteien (intern und extern).
- OOTB-Implementierungen hochwertiger AI-gestützter Anwendungsfälle (Empfehlungen und Entscheidungen mit verschiedenen ML-Algorithmen, einschließlich Kontextbanditen für Sonderangebote/Inhaltsauswahl, Produktempfehlungen und Preisentscheidungen).
#### Datenaktionen
Data 360 ist eine aktive Plattform, die die Aktivierung von Pipelines als Reaktion auf Datenereignisse unterstützt. Beispielsweise kann ein wichtiges Ereignis, beispielsweise ein Rückgang des Accountsaldos eines Kunden, einen Salesforce-Flow auslösen, um eine entsprechende Aktion zu orchestrieren. Ebenso können Aktualisierungen an wichtigen Kennzahlen wie Lebenszeitausgaben automatisch in relevante Anwendungen übernommen werden.
#### Datenberechnungsgewebe
Data 360 verfügt über Berechnungscluster mit elastischer Skalierung, die Verarbeitungsaufgaben effizient verarbeiten. Sie bietet eine zuverlässige Verwaltung für mehrere Mandanten und dedizierte Rechenumgebungen. Darüber hinaus bietet es verwaltete Unterstützung für Spark und SQL. BYOC-Funktionen (Bring Your Own Compute/Code) unterstützen mehrere Programmiersprachen, einschließlich Java, Python und Spark, was die Integration benutzerdefinierter Transformationen, Modelle (einschließlich LLMs) und Funktionen ermöglicht und die Erweiterbarkeit verbessert.
Data 360 Compute Fabric bietet eine vereinheitlichte Ebene namens "Data Processing Controller (DPC)" zum Verwalten und Ausführen aller Big Data-Arbeitslasten. DPC ist ein umfassender Orchestrierungsservice für die Datenverarbeitung mit mehreren Arbeitslasten, der JaaS-Funktionen (Job-as-a-Service) in verschiedenen Cloud-Rechenumgebungen bereitstellt. Sie abstrahiert die Infrastrukturkomplexität und vereinheitlicht die Auftragsausführung für Frameworks wie Spark (EMR in EC2 und EMR in EKS) und Kubernetes Resource Controller (KRC). Durch die Verwendung als zentrales Gateway für Steuerungsebenen orchestriert, plant und überwacht DPC Aufträge über mehrere Datenebenen hinweg und gewährleistet so Zuverlässigkeit, Skalierbarkeit, Kosteneffizienz und eine konsistente Entwicklererfahrung.
#### Vereinheitlichte Abfragen
Der Abfrageservice von Data 360 bietet erweiterte Abfragefunktionen und bietet umfangreiche SQL-Unterstützung für strukturierte und unstrukturierte Daten über Trino und Hyper. Sie erweitert die Funktionen durch die Erweiterbarkeit des Operators durch Tabellenfunktionen und ermöglicht so verschiedene Suchvorgänge über Text-, Bild-, räumliche und andere unstrukturierte Datentypen hinweg. Diese Funktionen sind nahtlos in relationale Vorgänge integriert, beispielsweise in die Auswahl von Kundendatensätzen. Dieser einheitliche Ansatz ermöglicht die Generierung zielgerichteter und personalisierter Ergebnisse und ermöglicht so präzisere LLM-Antworten mithilfe von RAG.
#### Unstrukturierte Datenverarbeitung
Data 360 unterstützt die Speicherung und Verwaltung von strukturierten (Tabellen), halbstrukturierten (JSON) und unstrukturierten Daten nahtlos über die Mechanismen der Datenaufnahme, -verarbeitung, -indizierung und -abfrage hinweg. Data 360 unterstützt verschiedene unstrukturierte Datentypen über Text hinaus, einschließlich Audio, Video und Bildern, was den Umfang der Datenverarbeitung und -analyse erweitert. Die folgende Abbildung veranschaulicht die beiden Seiten der Erdung (Aufnahme und Abruf).
Data 360 verwaltet unstrukturierte Daten, indem es sie in Spalten als Text oder in Dateien für größere Datensets speichert. Sie unterstützt die Datenzuordnung für unstrukturierte Inhalte, wodurch Daten aus mehreren Quellen integriert und verwaltet werden können.
Die unstrukturierte Datenindizierungs-Pipeline von Data 360 ist als modulare, erweiterbare Architektur mit fünf Kernphasen konzipiert: Analysieren, Vorverarbeiten, Chunking, Nachverarbeiten und Einbetten. Anschließend folgen Stichwort- und Vektorindizierung. Beispiele für die Vorverarbeitung sind Vorgänge wie Rauschentfernung, Sprachnormalisierung und Bildverständnis (Optische Zeichenerkennung), während Phasen nach der Verarbeitung Metadatenanreicherung, semantische Gruppierung oder erweiterte Techniken wie das Blockieren umfassen können.
Data 360 bietet mehrere vorkonfigurierte und steckbare Modelle für die Generierung von Blöcken und Einbettungen. Datenpipelines in Data 360 unterstützen Codeerweiterungen vollständig, sodass Kunden und interne Teams in jeder Phase benutzerdefinierte Logik einbinden können. Diese Phasen unterstützen auch die LLM-basierte Verarbeitung, wodurch Kunden nach Bedarf ihre eigenen Eingabeaufforderungen definieren können.
Bei der Indizierung unterstützt Data 360 die Stichwortindizierung mithilfe von Suchservices und die Vektorindizierung mithilfe von Milvus, einem nativen Open-Source-Vektorindex. Data 360 nutzt die Kontextindizierung zum Einrichten von RAGs mit unstrukturierter Verarbeitung, um eine schnelle Iteration und Validierung mithilfe von Beispieltestabfragen zu ermöglichen, wobei personaspezifische Inhalte so konfiguriert sind, dass sie an die Persona oder den Benutzer angepasst werden.
Die Dokument-AI-Funktion von Data 360 unterstützt das Lesen und Importieren von unstrukturierten oder halbstrukturierten Daten aus Dokumenten wie Rechnungen, Lebensläufen, Laborberichten und Bestellungen. Diese Funktion unterstützt die interaktive Ad-hoc-Verarbeitung sowie die Verarbeitung von Massen-Batchs. Dies ist eine Schlüsselfunktion, die die Automatisierung von Geschäftsprozessen für unsere Kunden ermöglicht.
#### Semantische Ebene
Data 360 verfügt über eine Headless-Semantikebene mit APIs, die die Geschäftssemantik und AI/ML-gestützte Analysen verbessern sollen, ähnlich wie Tableau Next. Diese Ebene enthält einen semantischen Datenmodellierungsservice, der traditionelle Analysemodelle mit Unternehmenstaxonomie wie Maßeinheiten und Kennzahlen anreichert.
Der semantische Abfrageservice verwendet eine deklarative Sprache für die Interaktion mit diesen Modellen und übersetzt Abfragen in SQL für den Zugriff auf Daten aus nativen und Verbunddatenquellen in Data 360.
Diese Integration ermöglicht skalierbare und interaktive analytische Erkundungen, Berichte und Dashboards, die mit Visualisierungstools von Drittanbietern kompatibel sind.
#### Datenverwaltung
Data 360 fungiert als zentralisiertes Governance-Zentrum und stellt sicher, dass alle Daten – von der Roherfassung bis hin zu aktivierten Statistiken – integritätssicher und kontrolliert verwaltet werden. Data 360 hat die attributbasierte Zugriffssteuerung als zentrales Autorisierungsmodell übernommen. Mit ABAC können Zugriffsentscheidungen auf Attributen des Benutzers (Abteilung, Rolle, Standort), Daten (persönliche Informationen, Sensibilität, Datenbereich) und Umgebung (z. B. Tageszeit) basieren und nicht auf vordefinierten Rollen. Dadurch werden sehr detaillierte und kontextbezogene Zugriffsrichtlinien ermöglicht, die an sich ändernde Daten und Benutzerattribute angepasst werden. Das Herzstück der ABAC-Implementierung von Data 360 ist die Verwendung der CEDAR-Richtliniensprache. Diese speziell entwickelte, Open-Source-Formularsprache für Policen bietet eine präzise und überprüfbare Möglichkeit, komplexe Autorisierungsregeln zu definieren, wodurch sichergestellt wird, dass Policen eindeutig sind und einheitlich im richtigen Maßstab ausgewertet werden können.
Der Governance-Lebenszyklus umfasst wichtige Funktionen in Bezug auf Richtlinieninformationen, Durchsetzung und Entscheidungspunkte:
- **Tagging und Klassifizierung (Policy Information Point):** Daten werden identifiziert und mit wichtigen Attributen angereichert. Data 360 bietet automatisierte Tagging- und Klassifizierungsmechanismen, nutzt Discovery, LLMs und maschinelles Lernen, um sensible Datenkategorien (beispielsweise personenbezogene Daten wie E-Mail, Telefon, Name) in strukturierten und unstrukturierten Daten zu identifizieren.
- **Autorisierungsservice (Policy Enforcement Point):** Dieser Service fängt alle Datenzugriffsanforderungen von verschiedenen Verbrauchsebenen ab (strukturierte/unstrukturierte hybride Abfragen, RAG-Abrufer und -Aufforderungen sowie CRM-Anreicherung) und konsultiert den Richtlinienentscheidungspunkt, um zu bestimmen, ob der Zugriff zulässig ist.
- **Modul für die Richtlinienevaluierung (Richtlinienentscheidungspunkt):** Dieses Modul verwendet den Zugriffsanforderungskontext aus dem Richtliniendurchsetzungspunkt zusammen mit Richtliniendefinitionen (in CEDAR) und Attributen aus dem Richtlinieninformationspunkt, um eine autorisierende Zugriffsentscheidung zu treffen.
Das ABAC-Framework mit CEDAR-Richtlinien bietet Kontrolle und Flexibilität und stellt sicher, dass Kundendaten nicht nur handlungsrelevant, sondern auch unternehmensweit sicher, konform und vertrauenswürdig sind.
### 6.3 Datenzwischenspeicherung
Caches sind wichtig für den schnellen Zugriff auf häufig verwendete Daten. Salesforce verwendet viele Caches auf der gesamten Salesforce Platform, einschließlich auf zentralen Anwendungsservern, SalesforceDB und Edge. Salesforce Platform und Anwendungen benötigen eine skalierbare, mandantenorientierte Zwischenspeicherlösung mit geringer Latenz und hohem Durchsatz. Diese Lösung muss es Salesforce-Technikern ermöglichen, zu steuern, was und wie lange zwischengespeichert wird, um sicherzustellen, dass ihre Daten nicht durch Systemrauschen oder die Daten anderer Kunden verloren gehen. Vegacache, ein von Salesforce verwalteter Cache-Service, der auf Redis basiert, ist auf eine polyglotte, mandantenfähige und Public Cloud-Umgebung zugeschnitten. Sie wird häufig von Salesforce-Services verwendet und ist für Plattformentwickler über APIs für Apex-Programmiersprachen zugänglich. Vegacache arbeitet in Hyperforce und verarbeitet täglich über 2 Billionen Anforderungen mit Antwortzeiten von weniger als Millisekunden.
Vegacache-Instanzen, die in Kubernetes-Containern ausgeführt werden, auf die über Service Mesh zugegriffen wird, werden in mehreren Verfügbarkeitszonen bereitgestellt, um die Datenverfügbarkeit und die Latenz auszugleichen. Sie wird automatisch anhand der Systemlast skaliert, wodurch die Datenverfügbarkeit und die Bewahrung der Zeitfensterreihenfolge gewährleistet werden. Vegacache bietet eine garantierte Cache-Größe pro Kunde und bietet Schutz vor lauten Nachbarn, wobei Infrastrukturausfälle durch replizierten Datenspeicher vermieden werden.
Für Salesforce Platform-Entwickler ermöglicht Vegacache es Entwicklern, Ergebnisse von Apex Objects und SOQL-Datenbankabfragen zwischenzuspeichern, wodurch die CPU-Auslastung und die Latenz reduziert werden, da unnötige Datenabrufe aus SalesforceDB vermieden werden. Es unterstützt Put(), Get() und Delete() Vorgänge, sodass häufig verwendete Objekte leicht zugänglich bleiben.
### 6.4 Asynchrone Datenverarbeitung
Salesforce unterstützt asynchrone Datenprozesse und -architekturen nativ für mehr Flexibilität, Widerstandsfähigkeit und Skalierbarkeit bei Workflows.
Salesforce-Ingenieure nutzten zunächst Nachrichtenwarteschlangen, um Massen- und große Datenprozesse zu entkoppeln und Prozesse zwischen unabhängigen Systemen zu koordinieren. Diese Nachrichtenwarteschlangen wurden über Plattformfunktionen wie Bulk-API-Abfragen oder asynchrones Apex vom externen Entwickler abstrahiert. Anschließend führte Salesforce Platform protokollierte Ereignisströme ein, die auf einer robusten Messaging-Infrastruktur intern verwalteter Apache-Kafka-Cluster basieren. Dadurch wurde eine ereignisbasierte Architektur mit einem Veröffentlichungs-/Abonnementinteraktionsmodell ermöglicht und für externe Entwickler als Plattformereignisse produktivisiert.
Sowohl Nachrichtenwarteschlangen als auch Ereignis-Streams sind weiterhin Technologien, die von Anwendungen und Lösungen, die auf der Plattform basieren, besonders stark genutzt werden, da sie mehr Funktionen, Clouds und externe Systeme nutzen, die während unabhängiger Laufzeiten gehostet werden. Die Kommunikation über versionierte Ereignisschemas ermöglicht unabhängige Softwareentwicklungslebenszyklen für die verschiedenen Laufzeiten. Die Entkopplung von Systemen über Ereignisse hilft auch bei der Verwaltung von Lastspitzen und der Elastizität/Skalierung einzelner Laufzeiten, um eine höhere Gesamtresilienz und Verfügbarkeit einer Anwendung zu unterstützen.
### 6.5 Unternehmenssuche
Suchfunktionen bei Salesforce, die für Anwendungen von der globalen Suche bis zur generativen AI entscheidend sind, stehen vor einzigartigen Herausforderungen, die unseren architektonischen Ansatz prägen:
- **Skala**: Unsere Cloud-native Suchlösung unterstützt Hunderttausende von Kunden und Millionen von Mandanten und ist auf eine massive Skalierung ausgelegt, während sie kosteneffizient bleibt.
- **Kundenvielfalt**: Die vielfältige Kundenbasis von Salesforce in verschiedenen Branchen weist aufgrund der umfangreichen Anpassung der Plattform, die zahlreiche Objekttypen und Felder umfasst, einzigartige und komplexe Suchanforderungen auf.
- **Operabilität**: Die Suchlösung muss belastbar und hochverfügbar sein, die Datenresidenz, Mandantenlebenszyklusvorgänge wie regionale Migrationen und Sandbox-Instanzen unterstützen und die Latenz bei niedriger Indexierung sowie Fairness zwischen Mandanten gewährleisten.
- **Relevanz im Maßstab**: Die Relevanz von Suchergebnissen zu verbessern, um verschiedene Benutzerabfragen zu erfüllen, ist entscheidend, insbesondere da Relevanzalgorithmen auf verschiedene Mandanten, Datentypen und Suchszenarien skaliert werden.
- **AI und semantische Funktionen**: Die Suche unterstützt maschinelles Lernen und generative AI, insbesondere für die abruferweiterte Generierung (RAG) und die Agentensuche.
- **Nahtlose Integration**: Um eine einheitliche Benutzererfahrung zu gewährleisten, ist die Suchtechnologie von Salesforce tief in die breitere Salesforce Platform integriert, einschließlich Metadatenmodellen und AI/Datenservices.
Die Cloud-native Lösung von Salesforce, SeaS (Search as a Service), basiert auf Solr, einer Open-Source-verteilten Suchmaschine. Salesforce hat Solr erheblich erweitert und optimiert, um unsere einzigartigen Herausforderungen zu erfüllen, und es tief in Salesforce-Anwendungen und -Plattformen integriert, wobei semantische Technologien integriert wurden, um AI-Anwendungen und die Suchrelevanz zu verbessern.
SeaS verwendet eine Architektur für die Berechnung/Speichertrennung, die eine skalierbare Verteilung von Indizes über Knoten hinweg und einen Neuausgleich von Lasten und Verfügbarkeit zwischen Zonen bei Fehlern ermöglicht. Sie bietet automatisches Sharding und Größenanpassung von Shards, Upgrades ohne Ausfallzeiten und Optimierungen wie das Laden und Archivieren von Replikaten mit Faulheit, um selten verwendete Indizes zu berücksichtigen.
Die Architektur enthält auch eine Indeximplementierung auf niedriger Ebene, die für eine große Anzahl von Feldern optimiert ist, automatische Vervollständigung, Rechtschreibprüfung und Verschlüsselung mit eigenem Schlüssel. Die Hyperforce-Suchinfrastruktur verwaltet weltweit etwa 6.000 Solr-Knoten und verwendet mehrere unabhängige Cluster (Hyperforce) in jeder Region, um Kosten und Kontrolle auszugleichen und Client-Indizes automatisch anhand von Last, Domäne und Typ zu platzieren.
Die Pipeline für die Suchrelevanz von Salesforce verwendet Techniken zum Erlernen des Rangs, um sich an die vielfältigen Anforderungen unserer Kunden anzupassen und Funktionen wie das Ergebnisranking zu unterstützen. Sie enthält auch Einheitenprognosen aus Benutzerabfragen und vergangenen Interaktionen. Relevanzmodelle werden kontinuierlich optimiert, indem aus Benutzerinteraktionen gelernt und durch A/B-Tests ausgewertet wird, was die Genauigkeit der Suchergebnisse erhöht. Dieser Prozess unterstützt auch das Bootstrapping von Modellen für AI-Anwendungen über Knowledge Transfer.
Der Stapel enthält eine Vektorsuchmaschine für semantische Suche und AI-Anwendungen, die in Data 360 für Funktionen der generativen AI integriert ist. Dies beinhaltet eine umfassende Pipeline für die Datentransformation, Unterstützung für hybride Suchvorgänge, einen Katalog konfigurierbarer Ranger wie Deep Fusion Ranker und Autodrop zum Herausfiltern von Suchergebnissen mit geringer Relevanz.
Da die generative AI den primären Verbraucher von Suchservices von menschlichen Benutzern auf die Verwendung von LLMs verschiebt, passt sich der Salesforce-Suchstapel an, um für diesen programmgesteuerten Verbrauch optimierte Ergebnisse zu finden und zurückzugeben, wobei längere und komplexere Abfragen verarbeitet werden und aussagekräftigere Ergebnisse wie Blöcke zurückgegeben werden. Dadurch werden neue Funktionen für die Agentensuche unterstützt, bei denen Agentforce-Agenten die Suche mit einer Argumentationsschleife nutzen, um komplexe Aufgaben zu erledigen.
Die Suchfunktionen von Salesforce umfassen verschiedene Kontexte, darunter die globale Suche, Nachschlagevorgänge, Suchantworten, Community-Suche, Themenlisten, Setup, mobile und generative AI-Anwendungen. Diese umfassende Funktionalität wird durch die enge Integration des Suchstapels in das Metadatensystem und das Benutzeroberflächen-Ökosystem von Salesforce erreicht, was eine nahtlose Unterstützung für standardmäßige und benutzerdefinierte Objekte ermöglicht.
Darüber hinaus erweitert die Integration in Data 360 die Suchfunktionen für Datenobjekte durch Konfigurationen ohne Code und ermöglicht die Zusammensetzung von Suchfunktionen in Datenpipelines, beispielsweise das Einschließen von Suchanweisungen in SQL-Abfragen. Der Suchstapel nutzt das Ökosystem der umfangreichen Data 360-Konnektoren, beispielsweise den Google Drive-Konnektor mit Berechtigungsbewusstsein, um eine vollständige Unternehmenssuche bereitzustellen. Die Integration erstreckt sich auf die AI-Plattform, wodurch Suchabfragen im Eingabeaufforderungsgenerator für die Kontextbildung und in der Agentensuche als Abrufer verwendet werden können.
## 7\. AI und Agentforce
AI hat die Technologielandschaft neu gestaltet und die Salesforce Platform mit ihrer integrierten und umfangreichen Datenebene positioniert Salesforce in der Lage, Kunden effektive AI-Erfahrungen bereitzustellen. Salesforce hat seine AI-Transformation vor fast einem Jahrzehnt begonnen und ist seit 2013 führend in diesem Bereich. Der Fokus liegt auf Forschung, Ethik und Produktentwicklung, um Unternehmen in die Lage zu versetzen, komplexe Probleme zu lösen und das Wachstum anzukurbeln.
Salesforce nutzt den Kernwert von Innovationen und hat die prädiktive AI von Einstein eingeführt, mit der Unternehmen Daten analysieren, Prozesse automatisieren, Kunden verstehen und Vorgänge mit einer umfassenden Suite AI-gestützter Tools wie dem Einstein-Prognosegenerator und AI-Bots optimieren können. Mit der Einführung der generativen AI hat Salesforce Agentforce eingeführt, eine Plattform, die Prognose- und generative Modelle zusammenführt, um erweiterte AI-Funktionen zu bieten und gleichzeitig den Datenschutz zu priorisieren.
Mit der neuesten Einführung von Agentforce 3.0, die auf Python mit einem ereignisgesteuerten Framework basiert, bietet Salesforce mehr Flexibilität durch Funktionen wie integrierten Unterhaltungsverlauf, durchgängige Sitzungsverfolgung, Sprachunterstützung und benutzerdefinierte Argumentationsmodule (Bring Your Own Planner).
### 7.1 Kern-AI-Prinzipien
Agentforce folgt den folgenden Kernprinzipien:
- **Datensicherheit und Ethik**: Priorisiert Datenschutz, Compliance und ethische AI-Prinzipien.
- **Transparenz und Erklärbarkeit**: Bietet klares Verständnis und Validierung von AI-generierten Ausgaben.
- **Flexibilität und Anpassung**: Passt AI-Anwendungen an bestimmte Anforderungen und Branchen an.
- **Nahtlose Integration**: Kann in Salesforce CRM und andere Systeme integriert werden.
- **Skalierbarkeit**: Verarbeitet umfangreiche Bereitstellungen und bietet AI-Erfahrungen in Echtzeit.
- **Intelligente und konsistente Erfahrungen**: Bietet personalisierte, erweiterte und automatisierte Erfahrungen durch verbundene Daten und Kontextverständnisse.
- **Umfassende Beobachtbarkeit:** Bietet einen umfassenden Überblick über AI-Agenteninteraktionen und ermöglicht eine proaktive Optimierung und Feinabstimmung von Agenten mit dem Agentforce Interaction Explorer.
### 7.2 Architekturübersicht
 Der AI-Stack besteht aus mehreren Schlüsselkomponenten:
- **AI-Plattform**: Diese Plattformebene ist für die Verwaltung, Schulung und Feinabstimmung von AI-Modellen verantwortlich, die in Prognose- und generativen Anwendungen verwendet werden. Es bietet vorkonfigurierte Services, Trust Services und grundlegende Modelle für Schulungen, Tests und Rückschlüsse auf Modelle. Darüber hinaus unterstützt sie die Integration Ihrer eigenen prädiktiven und generativen Modelle, sodass Sie benutzerdefinierte Modelle in die Plattform integrieren können.
- **Grundlegende AI-Services**: Dazu gehören die Services "AI Gateway", "Feedback Framework", "RAG", "Agentic Orchestration" (Agentenorchestrierung), "Agent Evaluation" (Agentenauswertung) und " Reasoning" (Begründung), die die Integration von Geschäftsanwendungen in den AI-Stack erleichtern.
- **AI-gestützte Benutzer- und Agentenerfahrungen**: Salesforce stellt spezielle AI-gestützte Anwendungen über seine Cloud-Services bereit. Kunden können auch benutzerdefinierte Erfahrungen erstellen, die beliebige Komponenten der Plattform wie Flow, Apex oder sogar Lightning Web Components (LWC) nutzen, um AI-gestützte Erfahrungen zu erstellen, die nahtlos in ihre Workflows und Geschäftsprozesse integriert sind.
- **Agentforce Studio**: Diese Komponente verfügt über Tools wie Agentengenerator, Eingabeaufforderungsgenerator, Testcenter und Modellgenerator, mit denen Sie generative und prädiktive AI-Erfahrungen erstellen können. Es bietet durchgängige Unterstützung für die Entwicklung/Schulung, Tests und Optimierung von AI-Modellen. Die Next Gen Authoring erweitert diese Funktionen, um die Erstellung von AI-Agenten durch verbesserte Benutzerfreundlichkeit und Kompatibilität mit SFDX zu vereinfachen und zu beschleunigen.
### 7.3 Grundlegende Komponenten
#### Agentforce Trust Layer
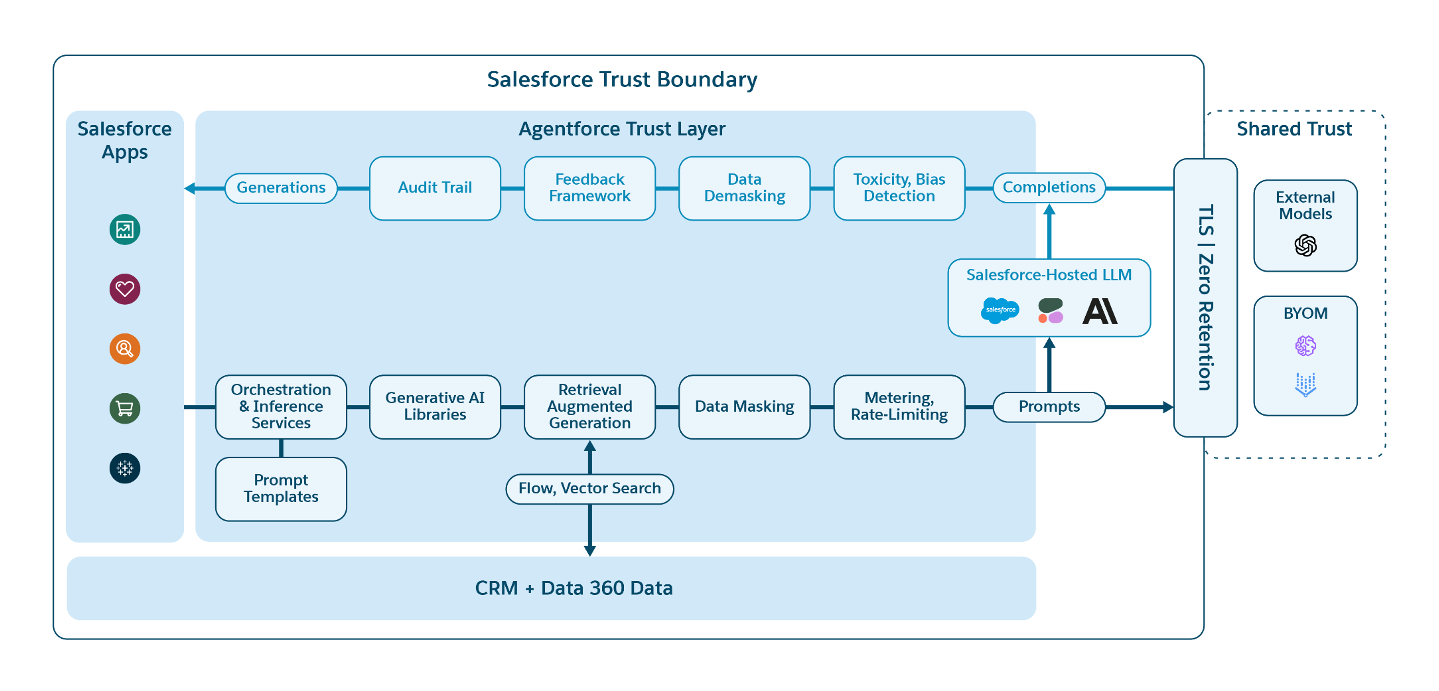 Die Agentforce Trust Layer ist in ausgewählten Anwendungsfällen verfügbar, um Kundendaten in generativen AI-Anwendungen zu schützen, indem sie zuverlässige Funktionen bietet:
- **Datenschutz**: Starke Maskierungs- und Datenschutzkontrollen schützen sensible Informationen vor dem Zugriff durch externe AI-Modelle.
- **Sicherheit**: Gewährleistet eine sichere Datenverarbeitungsumgebung und verhindert unbefugten Zugriff.
- **Trust**: Behält die Kundenkontrolle über Daten, ohne AI-Speicher oder Drittanbieternutzung.
- **Guardrails:** Erzwingen Sie Verhaltensstandards für Agenten und mildern Sie den inhärenten Nichtdeterminismus von LLMs. Überprüfen Sie, ob Agenten vordefinierte Anweisungen und Workflows konsequent befolgen.
- **Genauigkeit**: Erweitert die AI-Ausgaben, indem relevante Salesforce-Daten für Eingabeaufforderungen verwendet werden.
- **Inhaltsmoderation**: Bietet Moderation vor und nach dem Inhalt, anpassbare Datenmaskierung für sensible Informationen (PII/PCI/PHI) und Toxizitätsklassifizierung für Antworten mit großem Sprachmodell (LLM).
#### Agentforce AI Gateway
Das AI-Gateway bietet eine einheitliche Schnittstelle für den Zugriff auf und die Verwaltung verschiedener LLMs und Prognosemodelle. Es fungiert als Brücke zwischen Salesforce und der Welt der LLMs und abstrahiert die Komplexitäten verschiedener LLM-Anbieter und der eigenen Prognose-AI-Modelle der Kunden und bietet eine konsistente Möglichkeit, mit ihnen zu interagieren. Das AI-Gateway von Agentforce kann in mehrere LLM-Anbieter integriert werden, sodass Kunden das beste Modell für ihre Anforderungen auswählen können. Zudem enthält es zuverlässige Datensicherheitsmaßnahmen, um die mit der Verwendung verschiedener LLMs verbundenen Kosten zu verwalten.
Der Feedbackservice ist eine Komponente, die Benutzerfeedback erfasst, analysiert, misst und nutzt, um AI-Modelle neu zu trainieren und zu verfeinern. Sie spielt eine entscheidende Rolle bei der kontinuierlichen Verbesserung der AI-gestützten Funktionen und Funktionen in Salesforce Platform.
#### Abrufen der erweiterten Generierung (RAG)
RAG ist eine wichtige Technik, die die Suchfunktionen mit generativer AI erweitert und zu aussagekräftigeren und genaueren Antworten führt. Mithilfe der umfangreichen Salesforce Data 360 und der integrierten Vector Database ruft die Agentforce Platform schnell die relevanten Daten für die Abfrage eines Benutzers ab. Diese Daten werden dann als Grundlage für LLMs verwendet, um optimale Antworten zu generieren.
Darüber hinaus erhöht diese Methode die Antwortgeschwindigkeit und das Trust der Benutzer, indem Quelldaten in Antworten aufgenommen werden. RAG wird in der Agentforce Platform umfassend eingesetzt, insbesondere für Anwendungen wie Agentforce für Service und Agentforce für den Vertrieb, und zeigt, wie relevante Informationen für diese Anwendungsfälle angezeigt werden.
### 7.4 Agentforce Platform
Im Zuge der Weiterentwicklung von AI-Modellen ist die Entwicklung von Agenten zur Automatisierung von Aufgaben, die Überlegungen erfordern, der nächste Schritt. Diese Agenten dienen als intelligente Assistenten, die in der Lage sind, Abfragen in natürlicher Sprache zu verstehen und zu beantworten, sodass Benutzer sie entwerfen, testen und für verschiedene Aufgaben bereitstellen können. Eine wichtige Komponente dieses Systems ist der Planerservice, der wie folgt funktioniert:
- **Interpretiert Benutzeranforderung**: Es analysiert die Eingaben des Benutzers, um den Intent zu bestimmen.
- **Erstellt einen Plan**: Sie formuliert einen strukturierten Plan, der auf die Anforderungen des Benutzers zugeschnitten ist.
- **Startet Aktionen**: Der Plan wird ausgeführt, indem Aktionen direkt oder über andere Services initiiert werden.
Der Planerservice orchestriert den Prozess und stellt sicher, dass der Agent Benutzeranforderungen effizient erfüllt, indem er die erforderlichen Schritte verwaltet und ausführt.
#### Agentforce
Agentforce stellt eine Plattform zum Erstellen von Agenten dar, mit der Kunden und ISVs automatisierte AI-Agenten für Anwendungen wie Serviceagenten und Vertriebsagenten erstellen können. Diese Agenten können Kundenanfragen auf natürliche und menschliche Weise verarbeiten und beantworten, ein breites Spektrum an Geschäftsaufgaben bearbeiten und sowohl Unternehmen als auch ihren Kunden erhebliche Vorteile bieten.
Der Workflow eines Agenten umfasst Folgendes:
- **Aktivierung**: Der Agent wird durch vordefinierte Kriterien wie die Anforderung eines Kunden über verschiedene Kanäle hinweg ausgelöst.
- **Grundlegendes und Antworten**: Sie verwendet die natürliche Sprachverarbeitung, um die Abfrage, den Intent und die Stimmung des Kunden zu erfassen, und konsultiert dann die Knowledge Base oder andere Datenquellen von Salesforce, um eine geeignete Antwort zu erstellen.
- **Umgang mit Komplexitäten**: Wenn der Agent mit einem komplexen Problem konfrontiert ist oder eine menschliche Aufsicht benötigt, kann er die Interaktion problemlos an einen menschlichen Agenten übergeben.
- **Kontinuierliches Lernen**: Der Agent lernt aus jeder Interaktion und verbessert kontinuierlich seine Antworten und die Gesamtleistung.
#### Agentforce Studio
Agentforce Studio bietet eine Low-Code-Plattform, mit der Kunden KI in ihre Salesforce-Anwendungen und -Workflows integrieren können, wodurch KI-Technologien über Datenwissenschaftler hinaus zugänglich werden.
Zu den wichtigsten Funktionen des Studios zählen:
- **Modellgenerator**: Ermöglicht das Erstellen oder Importieren von AI-Modellen, die auf bestimmte Geschäftsanforderungen zugeschnitten sind.
- **Eingabeaufforderungsgenerator**: Ein Tool ohne Code/Low-Code, das die Erstellung und Verwaltung von Eingabeaufforderungen mit generativer AI erleichtert und die Benutzererfahrung mit einer einfachen Oberfläche zum Erstellen, Testen und Bereitstellen von Eingabeaufforderungen verbessert.
- **Agentengenerator**: Ermöglicht es Kunden und ISVs, benutzerdefinierte Unterhaltungs- und autonome Agenten zu entwickeln.
- **Testcenter**: Unterstützt das Testen von Modellen, Aufforderungen und Agenten, was entscheidend ist, um hochwertige AI-Anwendungen sicherzustellen und die Leistung und Kosteneffizienz zu optimieren, während gleichzeitig deterministische Antworten und die Qualität der Benutzererfahrung verbessert werden.
Agentforce kombiniert prädiktive und generative AI und nutzt das vereinheitlichte Metadaten-Framework von Salesforce Platform und Data 360, um intelligente, personalisierte und effektive Geschäftslösungen bereitzustellen.
### 7.5 Die nächste Evolution: Agentforce 3.0
Salesforce entwickelt seine Architektur mit Agentforce 3.0 weiter, um den steigenden Anforderungen des Marktes für generative AI gerecht zu werden – einschließlich schneller Fortschritte bei der Argumentation, der Notwendigkeit skalierbarer Multiagentensysteme und der Umstellung auf multimodale Schnittstellen.
- **Asynchrone, ereignisgesteuerte Architektur:** Agentforce 3.0 basiert auf einer Python-Grundlage mit einem erweiterten ereignisgesteuerten Framework. Dies ermöglicht eine asynchrone und hochgradig skalierbare Agentenimplementierung, verbessert die Leistung und schafft die Grundlage für komplexe Anwendungsfälle mit mehreren Agenten, in denen Agenten über Ereignisse kommunizieren können.
- **Multimodale Voice-Funktionen:** Agentforce 3.0 geht über textbasierte Interaktionen hinaus und bietet Voice-Unterstützung als primäre Modalität. Die Architektur lässt sich in Telefonieanbieter und WebRTC-Gateways integrieren, um Audio-Streaming in Echtzeit zu verarbeiten. Neue Services verwalten die Konvertierung von Audio in Text (ASR) und Text zurück in Audio (TTS) und ermöglichen so natürliche Unterhaltungs-Voice-Erfahrungen für Anwendungsfälle wie automatisierte Kontaktcenter.
- **Agentforce Skript und Determinismus:** Ein zustandsmaschinenbasierter Abhörmechanismus, der das Agentenverhalten innerhalb einer explizit definierten Struktur einschränkt und so konsistente Ausführungspfade gewährleistet. Dies ermöglicht deterministische Diagramme, bietet eine zuverlässige Statusverwaltung, um Speicherverluste zu vermeiden, und erleichtert bedingte und LLM-bestimmte Übergaben, wodurch vorhersehbare und konsistente Agentenaktionen für wichtige Geschäftsprozesse gewährleistet werden.
## 8\. Application Platform Services (Anwendungsplattformservices)
Das Anwendungsökosystem der Salesforce Platform zeichnet sich durch die Integration von Funktionen auf den Ebenen "App Platform Services", "API", "User Experience" und "Developer Experience" aus. App Platform Services sind allgemeine Funktionen, die zum Erstellen und Anpassen der meisten Anwendungen auf der Salesforce Platform verwendet werden, während Geschäftsfunktionen im Allgemeinen lösungsspezifischer sind.
### 8.1 Wichtige Funktionen
Das Anwendungsökosystem basiert auf fünf wichtigen Funktionen, die den Anwendungsentwicklungsprozess steuern.
- **Mandant**: Dies beinhaltet die logische Trennung von Daten und Metadaten innerhalb eines Mandantenservice, wodurch authentifizierte Benutzer auf bestimmte Daten und Funktionen zugreifen können. Dies ist für Kunden am sichtbarsten, wenn sie bei der Registrierung eine Salesforce-Organisation erhalten.
- **Einheiten**: Einheiten, die Datenbanktabellen darstellen, bestehen aus Feldern, die Tabellenspalten ähneln. Einheiten- und Feldmetadaten enthalten Attribute für die Datenmodellierung wie Datentypen und API-Namen sowie Funktionsattribute, beispielsweise wenn die Einheit abfrage- oder schreibfähig ist. Durch diese Abstraktion und nicht durch direkte Manipulationen am Datenspeicher selbst kann Salesforce nahtlos Speichertechnologien einführen und umstellen, ohne dass Aktualisierungen von IT-Entwicklern erforderlich sind, wodurch eine kontinuierliche Anwendungsfunktion gewährleistet wird.
- **Zugriffssteuerungen**: Diese Steuerelemente regeln den Benutzerzugriff auf Daten und Funktionen, hauptsächlich basierend auf der Benutzeridentität und bestimmten Richtlinien. Richtlinien bestehen aus Regeln und Funktionsumschaltern und regeln die Einheiten, Felder und Funktionen, auf die zugegriffen werden kann. Die Richtlinien und Berechtigungen werden in "Berechtigungssätzen" erfasst und der Zugriff wird durch Zuweisen von Berechtigungssätzen zu Benutzeridentitäten gewährt.
- **Ebenenerweiterung**: Wie bereits erwähnt, unterstützt dies die unabhängige Entwicklung von Metadaten und Anwendungen durch unterschiedliche Rollen, einschließlich Salesforce-Ingenieuren, externer Partner, IT-Administratoren und Endbenutzern. Dies wird durch strukturierte Speicheraufträge und Metadaten-Namespaces erleichtert.
- **Verpackung**: Diese Funktion ermöglicht die Paketerstellung und Verteilung von Metadaten zwischen Salesforce-Mandanten, wodurch der Aktualisierungs- und Verteilungsprozess von Anwendungen optimiert wird, ohne dass eine Neuerstellung erforderlich ist.
Neben diesen wichtigen Funktionen umfassen die App Platform Services auch Folgendes:
- **Datenlaufzeit und Abfrage**: Unterstützt Vorgänge wie das Erstellen, Aktualisieren, Löschen und Abfragen von Daten in mehreren spezialisierten Datenspeichern. Ein Spektrum an Datenskalierung und -leistung wird durch eine Architektur unterstützt, die die Ausführung von Datenvorgängen direkt im Datenspeicher ermöglicht, über eine interne Abstraktion, die von Salesforce-Technikern verwendet werden kann, oder über die kundenorientierte "Salesforce Object"- oder sObject-Konvention.
- **Flow / Workflow / Formeln**: Definition und Ausführung von Geschäftslogik und Validierungsregeln mit Low-Code-Tools.
- **Apex Code**: Pro-Code-Sprache für Anwendungslogik, die nativ in Plattformdatenlaufzeiten und APIs integriert ist.
- **Cloud-native Infrastrukturservices:** Heroku bietet eine robuste Umgebung für Entwickler, die Programmiersprachen und Frameworks für Branchen verwenden, um Anwendungen zu erstellen, bereitzustellen und zu verwalten, die in Plattformdaten und -ereignisse integriert sind.
- **Ereignisse und Benachrichtigungen**: Verwaltet Auslöser und ereignisbasierte Orchestrierung.
- **Globalisierung**: Bietet Unterstützung für mehrsprachige und multinationale Anwendungen.
- **Lizenzierung und Bereitstellung**: Behandelt den Kauf und die Verwaltung des Zugriffs auf Plattformfunktionen und Anwendungen.
- **Lightning Web Stack**: Ermöglicht die Anpassung von visuellen Oberflächen mithilfe strukturierter Metadaten wie Layouts und standardmäßiger Webtechnologien.
- **Sites + CDN**: Stellt Weberfahrungen mit geringer Latenz und hohem Datenverkehr sicher, auch für nicht authentifizierte Benutzer.
- **Sicherheit und Compliance**: Bietet Tools und Steuerelemente zum Erfüllen spezifischer Sicherheits- und Compliance-Anforderungen der Organisation.
- **Vermeidung von Datenverlust**: Enthält Funktionen für die Datensicherung, -wiederherstellung und -archivierung.
### 8.2 Cloud-Anwendungsplattform
Die Salesforce Platform bietet über Heroku eine Reihe von Tools und Funktionen, mit denen Entwickler Anwendungen in der Cloud mit den Programmiersprachen und Frameworks ihrer Wahl erstellen, ausführen und verwalten können. Die verwaltete Cloud-Anwendungsplattform von Heroku bietet Anwendungslaufzeiten, Datenspeicher, Messaging-Warteschlangen und Eventing-Systeme als skalierbare Services zum Erstellen von Erweiterungen für Salesforce-Anwendungen.
Anwendungen, die auf Heroku ausgeführt werden, haben Zugriff auf die vollständige Suite der Salesforce-Funktionen, Kundendaten und Geschäftslogik sowie die Möglichkeit, eine Verbindung mit Drittanbietersystemen und -services herzustellen. Mit Heroku können sich Entwickler darauf konzentrieren, einen Mehrwert zu bieten, ohne durch zugrunde liegende Infrastrukturbelange belastet zu werden.
## 9\. Automatisierung
Automatisierung macht eine Anwendung dynamisch und ist entscheidend für die digitale Transformation wesentlicher Geschäftsprozesse.
Die Salesforce-Prozessautomatisierung wurde entwickelt, um die wichtigsten Herausforderungen anzugehen, mit denen Kunden konfrontiert sind, einschließlich der Notwendigkeit optimierter und effizienter Geschäftsprozesse, die sich aus der Skalierung von Organisationen ergeben. Diese Herausforderungen beinhalten oft Workflows, die einen übermäßigen manuellen Aufwand erfordern, was zu Ineffizienzen und höheren Betriebskosten führt. Kunden suchen nach einer Lösung, die diese Prozesse automatisieren, manuelle Arbeit minimieren und Konsistenz und Genauigkeit gewährleisten kann.
Ein wichtiges Problem war das Fehlen eines benutzerfreundlichen Tools, mit dem nicht technische Benutzer Geschäftsprozesse ohne umfangreiche Programmierkenntnisse entwerfen und implementieren konnten. Darüber hinaus bestand Bedarf an einer Lösung, die sich sicher, skalierbar und nahtlos in vorhandene automatisierte Salesforce-Aufgaben wie Dateneingabe, Genehmigungen, Benachrichtigungen und komplexe Prozesse mit mehreren Schritten integrieren lässt.
Die Salesforce-Prozessautomatisierung erfüllt diese Anforderungen, indem sie eine robuste und dennoch intuitive Plattform zum Erstellen automatisierter Workflows bietet. Sie ermöglicht es Benutzern, Flows über eine visuelle Oberfläche zu erstellen und anzupassen, auf die sowohl technische als auch nicht technische Benutzer zugreifen können, wodurch sich wiederholende Aufgaben automatisiert, Geschäftsregeln durchgesetzt und Prozesse im Salesforce-Ökosystem optimiert werden.
Salesforce bietet Apex als Pro-Code-Sprache zum Schreiben von Geschäftslogik an, um Automatisierungen zu ermöglichen, die eine komplexe Orchestrierung erfordern, die mit Transaktionsdaten interagieren.
### 9.1 Prozessautomatisierungsarchitektur und -funktionen
**Generator für visuelle Logik**: Kunden und ISVs verwenden Flow Builder, eine Ziehen-und-Ablegen-Oberfläche, um Prozessautomatisierungs-Flows ohne Codierung zu erstellen. Dieses visuelle Tool ist für alle technischen Ebenen benutzerfreundlich und ermöglicht es Geschäftsanalysten und Administratoren, komplexe Automatisierungen einfach zu entwerfen.
Mit Flow Builder können Kunden vielseitige Flows erstellen, die in verschiedenen Kontexten funktionieren und vom Core Flow Engine unterstützt werden:
- **Datensatzauslöser**: Flows werden bei Datensatzaktualisierungen oder Formularsendungen aktiviert und ermöglichen Datenänderungen, Validierungen und Workflow-Initiierungen anhand von Kundenaktionen.
- **Geplante oder ereignisgesteuerte Flows**: Diese Flows können nach einem vorgegebenen Zeitplan ausgeführt werden oder nach bestimmten Ereignissen ausgelöst werden und Callouts an externe Services senden.
- **Bildschirm-Flows**: Stellen Sie eine Benutzeroberfläche für geführte schrittweise Prozesse mit Formularen, Bildschirmen und anderen interaktiven Elementen bereit, die für Aufgaben wie die Dateneingabe, Fehlerbehebung oder Einarbeitung nützlich sind.
- **Orchestrator-Flows**: Verwalten und integrieren Sie Prozesse mit mehreren Schritten und erleichtern Sie so die Handhabung komplexer Vorgänge.
Das Offline-Flow-Modul kann ohne Verbindung zum Salesforce-Anwendungsserver ausgeführt werden. Der Offline-Flow unterstützt die Automatisierung von Field Service Mobile-Anwendungsfällen. Das High-Scale-Flow-Modul unterstützt Marketing-Flows. Es bietet eine B2C-Skalierung für die gleichzeitige Verarbeitung eines hohen Volumens an langfristigen Flows.
Alle Anwendungsfälle und Umgebungen werden durch ein vereinheitlichtes Metadatenmodell in Flow Builder erweitert, das eine Vielzahl leistungsstarker Logikelemente unterstützt, die für alle Prozessautomatisierungs-Flows gelten:
- **Erweiterte Logik und Bedingungen**: Benutzer können komplexe Logik wie Entscheidungselemente, Schleifen und Wartebedingungen in ihre Workflows integrieren und so komplexe Geschäftsszenarien verarbeiten.
- **Datenverwaltung und -transformation**: Flow Builder ermöglicht die Datenaufnahme, -transformation und -verwaltung aus verschiedenen Quellen, einschließlich Webservices, Salesforce-Organisationen und Data 360\. Es unterstützt umfassende Datenvorgänge wie das Erstellen, Aktualisieren, Löschen und Abfragen von Datensätzen.
### 9.2 Automatisierung auf der gesamten Salesforce Platform
Die Salesforce-Prozessautomatisierung bietet eine nahtlose Integration in andere Salesforce-Produkte und Drittanbietersysteme und gewährleistet so einen reibungslosen Datenfluss zwischen Anwendungen für eine einheitliche Ansicht der Geschäftsprozesse und Kundeninteraktionen. Es unterstützt verschiedene Integrationsmethoden wie APIs, Web-Callouts und MuleSoft-Konnektoren.
Externe Services und die MuleSoft-Konnektivität in Salesforce ermöglichen Verbindungen zu externen APIs und die Nutzung ihrer Daten in der Salesforce-Prozessautomatisierung. Durch die Registrierung des API-Schemas können aufrufbare Aktionen erstellt werden, die sich nahtlos in Flows integrieren lassen, was die Automatisierung von Prozessen mit externen Datenquellen erleichtert. Die robusten Integrationsfunktionen von MuleSoft gewährleisten einen nahtlosen Datenfluss zwischen Salesforce und anderen Anwendungen, wodurch Datensilos beseitigt werden und eine einheitliche Ansicht der Geschäftsprozesse bereitgestellt wird.
**Agentforce Integration**: Die Salesforce-Prozessautomatisierung nutzt Agentforce, um Workflows durch intelligente Entscheidungsfindung zu verbessern. Mithilfe von AI-Statistiken können Leads automatisch an geeignete Vertriebsmitarbeiter weitergeleitet oder maßgeschneiderte Marketingkampagnen basierend auf dem Kundenverhalten initiiert werden, wodurch die Effektivität der Automatisierung durch zusätzliche Intelligenz gesteigert wird.
**Plattformsynergie**: Die Salesforce-Prozessautomatisierung lässt sich nahtlos in andere Salesforce-Produkte wie Sales Cloud, Service Cloud, Commerce Cloud und Marketing Cloud integrieren. Durch diese Integration können Organisationen Prozesse über verschiedene Abteilungen hinweg automatisieren und so die betriebliche Effizienz steigern. Beispielsweise kann ein Workflow automatisch einen Support-Kundenvorgang in Service Cloud generieren, wenn eine Kundenbeschwerde über ein Marketing Cloud-Formular gesendet wird.
### 9.3 Pro-Code-Automatisierung mit Apex
Apex ist eine leistungsstarke, objektorientierte Programmiersprache, mit der Entwickler benutzerdefinierte Geschäftslogik schreiben und komplexe Vorgänge auf der Salesforce Platform ausführen können. Die Plattform ist seit Oktober 2025 eine tragende Säule unserer Plattform und verarbeitet derzeit über 350 Milliarden Apex Transaktionen pro Monat.
Apex wird verwendet, um eine Vielzahl von benutzerdefinierten Funktionen und tiefgreifenden Integrationen in Salesforce Platform zu entwickeln. Dazu zählen:
- **Auslöserbasierte Automatisierung**: Implementieren Sie eine komplexe Automatisierung, die ausgeführt wird, bevor oder nachdem Datensätze eingefügt, aktualisiert oder gelöscht wurden. Dies ermöglicht eine komplizierte Datenvalidierung, zugehörige Datensatzaktualisierungen und den Aufruf anderer Prozesse anhand spezifischer Datenänderungen.
- **Web Services:** Erstellen Sie benutzerdefinierte Integrationen in externe Systeme und rufen Sie REST- oder SOAP-APIs über Apex auf.
- **Benutzerdefinierte Benutzeroberflächen**: Erstellen Sie mithilfe von Visualforce und Lightning Web Components (LWC) hochgradig angepasste Benutzeroberflächen und -erfahrungen, wobei Apex als Backend-Steuerfeld für Datenmanipulationen und Geschäftslogik fungiert.
- **Benutzerdefinierte APIs:** Entwickler können benutzerdefinierte Logik mithilfe von Apex REST und Apex SOAP als APIs bereitstellen, sodass externe Systeme programmgesteuert mit Salesforce-Daten und -Prozessen interagieren können.
- **Asynchrone Verarbeitung**: Führen Sie langfristige oder ressourcenintensive Aufgaben asynchron durch künftige Methoden, warteschlangenfähigen Apex und geplanten Apex aus. Dadurch können langfristige Vorgänge im Hintergrund ausgeladen und verarbeitet werden, was die Benutzererfahrung und die Systemleistung verbessert.
- **Geplanter Apex:** Entwickler können Apex Klassen so planen, dass sie zu bestimmten Zeiten ausgeführt werden, indem sie den Apex Scheduler für regelmäßige Aufgaben wie die nächtliche Datensynchronisierung, die Berichtserstellung und Wartungsaktivitäten verwenden.
## 10\. Benutzererfahrungen
Mit den Funktionen für Benutzererfahrungen auf der Salesforce Platform können Endbenutzer über verschiedene Bereitstellungsoptionen in browserbasierten Lightning-Anwendungen, Erfahrungs-Sites, nativen mobilen, AI-orientierten, gemeinschaftlichen Benutzeroberflächen oder eingebetteten Komponenten mit Lightning Out mit Anwendungen interagieren.
### 10.1 Lightning Design System
Das Salesforce Lightning Design System (SLDS) ist ein umfassendes Design-Framework, das die Erstellung konsistenter und barrierefreier Benutzeroberflächen mit den Designprinzipien von Salesforce fördert, um eine einheitliche Benutzererfahrung über alle Produkte hinweg zu gewährleisten. Damit können Salesforce-Ingenieure, -Kunden und -Partner Anwendungen erstellen, die im gesamten Salesforce-Ökosystem heimisch sind.
Zu den wichtigsten Merkmalen des Designsystems zählen:
- **Designmuster**: Bewährte Lösungen für häufige Designherausforderungen, die Richtlinien für Layout, Datenpräsentation und Benutzerinteraktionen bieten, um eine konsistente Benutzererfahrung zu gewährleisten.
- **Stylinghaken**: CSS-Variablen, die Designentscheidungen darstellen, beispielsweise Farben, Typografie, Abstände und Größen, wodurch Konsistenz zwischen Anwendungen gewährleistet wird.
- **Lightning Base-Komponentenbibliothek**: Eine Sammlung wiederverwendbarer Benutzeroberflächenkomponenten wie Schaltflächen, Formularelemente und Navigationselemente, die den Designprinzipien von Salesforce entsprechen und eine schnelle und effiziente Entwicklung ermöglichen.
- **Barrierefreiheit**: Integrierte Funktionen und Richtlinien für den barrierefreien Zugriff, um sicherzustellen, dass alle Komponenten von Personen mit Behinderungen verwendet werden können und Standards wie Web Content Accessibility Guidelines (WCAG) eingehalten werden.
- **Anpassbare Layouts**: Ein flexibles Rastersystem und Layoutrichtlinien, mit denen sich Anwendungen nahtlos an verschiedene Geräte und Bildschirmgrößen anpassen lassen.
- **Tooling**: Eine Sammlung von Tools, Ressourcen und Technologien, die die Komponentenhygiene, die Reduzierung von Mustern und die Gestaltung der Systemverwaltung unterstützen.
Das SLDS Framework wird ständig weiterentwickelt, um umfangreichere Gestaltungs-Hooks und umfassendere Anpassungsfunktionen zu unterstützen, sodass Komponenten wiederverwendet werden können, während sie weiterhin an die individuellen Branding- und Themenanforderungen angepasst werden. Unser Anspruch an das Designsystem besteht darin, Salesforce schnell, einfach und überzeugend für die Verwendung mit AI zu gestalten.
### 10.2 Lightning Web Stack
Die browserbasierte Oberfläche von Salesforce, die als Lightning bezeichnet wird, bietet Salesforce-Ingenieuren, IT-Administratoren, Entwicklern und Partnern ein einheitliches Benutzeroberflächen-Container und ein metadatengesteuertes Benutzeroberflächen-Framework sowie eine Sammlung von Technologien für die schnelle Entwicklung der Benutzeroberfläche mit einer einheitlichen Salesforce-Ästhetik sowie Erweiterungspunkte für die vollständige Kontrolle über das Ändern des Stils und Re-Branding. Der Lightning Web Stack enthält verschiedene Technologien:
- **Lightning Web Components**: Benutzerdefinierte Webkomponenten, die mit HTML und JavaScript erstellt wurden und den W3C-Webstandards entsprechen.
- **Lightning Web Security**: Ein Virtualisierungsmodul, das JavaScript-Code im Browser verwaltet und so die Einhaltung der Salesforce-Sicherheitsstandards für Drittanbietercode sicherstellt.
- **Lightning Data Services**: Ein Framework für eine effiziente Interaktion mit serverseitigen Daten.
- **Lightning Web Runtime**: Stellt ein leistungsfähiges und konsistentes Benutzeroberflächen-Rendering für verschiedene Clients sicher.
Salesforce Engineering hat Erfahrungen aus früheren Benutzeroberflächentechnologien integriert und in Webstandardsgremien mitgewirkt, was die Entwicklung standardbasierter Komponentenimplementierungen beeinflusst hat. Salesforce ist beispielsweise weiterhin Mitglied von etwa 20 W3C-Arbeitsgruppen. Die Lightning Web Components und Lightning Web Stack entsprechen diesen Branchenstandards, was die Komplexität für Entwickler reduziert.
### 10.3 Mobile
Mobile ist weiterhin eine wachsende und wichtige Benutzeroberfläche für die Interaktion mit Salesforce-Anwendungen.
Salesforce stellt eine native mobile Anwendung bereit, sodass alle browserbasierten Lightning-Anwendungen zu mobilen Anwendungen werden können, ohne neuen Code schreiben zu müssen. Salesforce bietet auch eine Reihe von Tools, SDKs und Funktionen zum Erstellen vollständig benutzerdefinierter nativer Anwendungen, die für Geräte optimiert sind. Dazu zählen:
- **Mobiles SDK**: Pro-Code-Schnittstelle für Entwickler in mobilen Betriebssystemen, die die Integration in Authentifizierung, Sitzungs-/Tokenverwaltung, Salesforce-APIs und vieles mehr vereinfacht.
- **Native mobile Laufzeit**: Ermöglicht es Entwicklern, metadatengesteuerte native Erfahrungen zu erstellen, die zur Laufzeit dynamisch mit iOS- und Android-Technologien gerendert werden, die auch Funktionen auf Geräten nutzen.
- **Branding**: Ermöglicht die Anpassung der Ästhetik mobiler Anwendungen über die Mobile Publisher Pipeline zum Konvertieren mobiler Salesforce-Anwendungen in Anwendungen mit Kunden-Branding.
- **Offline-Funktionen**: Stellt eine nahtlose Anwendungsfunktion mit inkonsistenter oder fehlender Internetverbindung sicher.
Das Mobile Customization Framework (MCF) verbessert die Entwicklung nativer mobiler Salesforce-Anwendungen erheblich, da es eine einfache Bedienung und umfangreiche Anpassungsoptionen bietet. Zu den wichtigsten Vorteilen zählen:
- **Metadatengestützter Ansatz**: Die MCF verwendet Metadaten, die aus visuellen Generatoren, gängigen Repositorys und von Salesforce gehosteten Ressourcen stammen können, um dynamische und anpassbare Benutzererfahrungen zu erstellen, die auf bestimmte Anforderungen zugeschnitten sind.
- **Experimentieren und Optimieren**: Das Framework unterstützt Laufzeitexperimente mit unterschiedlichen Layouts, was die fortlaufende Engagementoptimierung und die Optimierung der Benutzererfahrung erleichtert.
- **Erweiterbarkeit**: Die auf Flexibilität ausgelegte MCF ermöglicht die Integration benutzerdefinierter Komponenten in das zentrale Metadaten-Framework und verbessert so die Funktionalität und Vielseitigkeit.
- **Komponierbare Benutzererfahrungen**: Mithilfe der neuesten iOS- und Android-Technologien unterstützt MCF die Zusammenstellung wiederverwendbarer Komponenten wie Schaltflächen, Listen und Karten, um komplexe Benutzeroberflächen zu erstellen.
- **Laufzeitanpassung**: Die MCF ermöglicht die Echtzeitanpassung der Benutzeroberfläche und -experimentierung, was eine personalisiertere und ansprechendere Benutzererfahrung ermöglicht.
Offline-Szenarien und Szenarien mit geringer Konnektivität sind bei der Verwendung von Anwendungen auf Mobilgeräten ein erhöhtes Problem. Der mobile Technologiestapel priorisiert die Erstellung von Anwendungen, die offline sein können. Zu den wichtigsten Funktionen zählen:
- **Erste Erfahrung zwischenspeichern**: Konzentriert sich auf das Zwischenspeichern von Daten für die Offline-Nutzung, um eine hohe Leistung und Sicherheit zu gewährleisten. Die Benutzerinteraktion wurde auch unter Berücksichtigung der Offline-Rendering-Prinzipien konzipiert.
- **Cache-Verwaltung**: Hält den Cache relevant und aktualisiert, auch wenn er offline ist.
- **Freigegebener Cache**: Verwendet einen einzelnen Cache für native und hybride Bildschirme und ermöglicht so nahtlose Offline-Erfahrungen.
Nimbus ist die produktionsfähige Lösung der Plattform, die Entwicklern von Hybridanwendungen den Zugriff auf Gerätefunktionen vereinfacht. Bisher war das Überbrücken der Lücke zwischen JavaScript und nativem Code für mobile Geräte eine komplexe Aufgabe. Mit Nimbus können Entwickler nun jedoch das volle Potenzial von Mobilgeräten nutzen, ohne sich auf die Low-Level-Codierung zu konzentrieren. Zu den wichtigsten Funktionen zählen:
- **Breiter Zugriff**: Bietet eine nahtlose Integration in eine Vielzahl von Gerätefunktionen wie Kamera, Mikrofon, Geotargeting und LiDAR.
- **Standardisierte Schnittstelle**: Bietet eine einheitliche Methode für den Zugriff auf Gerätefunktionen.
- **Hybridanwendungsintegration**: Ermöglicht hybriden Anwendungen die vollständige Nutzung der Gerätefunktionen.
- **Effiziente Entwicklung**: Optimiert den Anwendungsentwicklungsprozess und reduziert so die Komplexität.
Da die KI die Möglichkeiten von Salesforce-Anwendungen ständig verändert, bietet Salesforce auch eine differenzierte Benutzererfahrung, indem es gerätespezifische AI-Modelle und Cloud-basierte Lösungen nutzt:
- **Small Language Models (SLM):** Diese können auf Mobilgeräten effizient und kostengünstig ausgeführt werden.
- **Datenschutz und Sicherheit:** Gewährleistet Datenschutz für Benutzer und gewährleistet Trust und Sicherheit auf einem Niveau, das mit serverbasierten Modellen vergleichbar ist.
- **Offline-Funktion:** Funktioniert effektiv in Umgebungen mit geringer Konnektivität und ermöglicht Offline-Anwendungsfälle.
- **Voice:** Modernste Modelle für die Sprachausgabe, die natürliche Text-zu-Sprache und die Sprecher-Diarisierung werden nun nativ auf Geräten ausgeführt und bieten hochpräzise Sprachinteraktionen mit vollständiger Privatsphäre und latenzfreier Wiedergabe.
### 10.4 AI und Zusammenarbeit
Die Nicht-Modell-Benutzeroberfläche für natürliche Sprache und Multiturn-Interaktionen mit unserer Anwendung wird weiter zunehmen. Es wird erwartet, dass künftige Entwicklungen die Integration zwischen Modellen, Gerätefunktionen und Anwendungen verbessern und die Benutzerinteraktionen durch intuitivere Sprach- und Textoberflächen verbessern. Die On-Device-Kennzahlenerfassung ermöglicht zudem personalisierte Anpassungen anhand der Benutzerpräferenzen.
Die Zusammenarbeit zwischen allen Benutzern, einschließlich Mensch und Agent, ist wichtig, um die kombinierten Stärken der Automatisierung und menschlichen Überwachung zu nutzen. Diese Zusammenarbeit ist besonders wichtig für komplexe Geschäftsinteraktionen, an denen die Mitarbeiter und Kunden einer Organisation beteiligt sind. Slack dient als primäres Tool innerhalb der Salesforce Platform und erleichtert diese Interaktion durch Direktnachrichten und Kanäle mit mehreren Benutzern, die auf bestimmte Diskussionsthemen zugeschnitten sind. Diese Diskussionen können von spontanen, vom Benutzer erstellten Unterhaltungen bis hin zu strukturierteren Dialogen reichen, bei denen es um bestimmte Daten im Workflow eines Benutzers geht, beispielsweise einem detaillierten Slack-Nachrichten-Thread, der ein wichtiges Kundenproblem anspricht.
In Zukunft plant die Salesforce Platform, die derzeit von Slack bereitgestellte gemeinschaftliche Erfahrung zu verbessern. Diese Erweiterung zielt darauf ab, die umfangreichen Funktionen der Plattform vollständig zu nutzen und so die Art und Weise zu verbessern, wie Benutzer innerhalb der digitalen Arbeitsumgebung interagieren und zusammenarbeiten.
## 11\. Entwicklererfahrung
Die Developer Experience-Funktionen auf der Plattform bieten Tools zum Erstellen, Anpassen, Testen und Bereitstellen von Anwendungen und konzentrieren sich auf das Spektrum von Low-Code durch Pro-Code-Ansätze, um die Chancengleichheit für Entwickler aller Fertigkeitsstufen zu gewährleisten.
- **Low-Code-Tools**: Dazu zählen der Schemagenerator für Datenmodelle, der Flow für Geschäftsregeln und der AppBuilder für die Benutzeroberflächenanpassung, die den Entwicklungsprozess durch Ändern strukturierter Metadaten vereinfachen und in der Sprache der Geschäftslösung statt in technischen Konzepten und Jargon arbeiten.
- **Pro-Code-Tools**: Entwicklern, die eine umfassendere und komplexere Anpassung benötigen, bietet die Plattform Tools wie den Salesforce Code Builder, eine Cloud-basierte IDE, sowie eine Befehlszeilenschnittstelle (Command Line Interface, CLI) und APIs für die erweiterte Codierung und Komponentenerstellung. Entwickler können Code in der Sprache ihrer Wahl erstellen, indem sie Lösungen für die Bereitstellung, Verwaltung und Optimierung von Anwendungen mit Heroku nutzen.
- **Integrierte Entwicklungsumgebung**: Das Salesforce-Ökosystem unterstützt die nahtlose Integration zwischen Low-Code- und Pro-Code-Tools sowie die kohärente Entwicklung in der Cloud und lokal mit branchenüblichen Tools.
- **Anwendungslebenszyklus-Verwaltung**: Enthält eine Reihe von Sandbox-Organisationen für die Entwicklung, die von der Produktionsumgebung getrennt sind, einschließlich Testorganisationen für die Erstentwicklung und Vollständige Sandbox-Organisationen für Tests anhand von produktionsähnlichen Daten und Skalierung.
### 11.1 AI für Entwickler
AI und "Entwicklerassistenten" revolutionieren die Entwicklererfahrung, indem sie die Erstellung effizienter und hochwertiger Anwendungen vereinfachen und beschleunigen. Bei Salesforce arbeiten unsere AI-Forschungs- und Developer Experience-Teams kontinuierlich daran, herauszufinden, wie prädiktive und generative AI mit agentischer Argumentation in leistungsstarke Entwickleragenten umgewandelt werden können. Diese Entwickleragenten sind nativ in Tools integriert, die von Entwicklern bereits verwendet werden, beispielsweise VS Code, Code Builder, Befehlszeile, DevOps Center und Code Analyzer.
Bei der Codeanalyse wurden erhebliche Fortschritte erzielt, um Anti-Patterns und Hotspots im Apex Code zu identifizieren und dann wichtige Empfehlungen zur Verbesserung ihrer Implementierung zu geben. Die identifizierten Probleme verschwenden in der Regel Rechenressourcen und führen oft zu Vorfällen in großem Umfang. Diese wurde im Januar 2024 als ApexGuru-Statistiken gestartet.
Im ersten Jahr nach der Einführung verwendeten über 2.800 Salesforce-Organisationen ApexGuru, um ihre Salesforce-Implementierung zu analysieren und zu verbessern. Mehr als 22.000 Empfehlungen wurden erfolgreich umgesetzt, was zu einer Einsparung von 28.000 CPU-Stunden pro Woche führte. Diese Verbesserung steigert nicht nur die Leistung, sondern trägt auch zur ökologischen Nachhaltigkeit bei, indem sie die CO2-Emissionen wöchentlich um 135 kg reduziert. Dies entspricht unserem Kernwert „Nachhaltigkeit“ und unserem Engagement für weniger CO2-Emissionen.
Darüber hinaus integrieren wir KI in Pro-Code-Entwicklertools und -funktionen, um die Developer Productivity zu verbessern. Entwickler, die 2024 als "Agentforce für Entwickler" bezeichnet wurden, können in Visual Studio-Code und Codegenerator auf diese neuen Funktionen in den Salesforce-Erweiterungspaketen zugreifen. Diese Erweiterungen ermöglichen Folgendes:
- Inline-Codevorschläge beim Schreiben durch den Entwickler und Generieren von Code für Apex und Lightning Webkomponenten (JavaScript, CSS, HTML).
- Codeerklärung und Dokumentationserstellung für Apex und Lightning Webkomponenten.
- Generierung von Apex-Testcodes für Einheiten.
- Eine eindeutige Multi-Turn-Chat-Erfahrung in der IDE, die für die Generierung, Erläuterung und Dokumentation von Code für mehrere Antworten verwendet werden kann.
- Lightning-Webkomponenten-Optimierungen.
- Agentengenerierung mit für Menschen lesbaren YAML-Metadaten, einschließlich Agententests und Debugging-Funktionen.
Seit Oktober 2025 verwenden monatlich über 42.000 Entwickler diese Technologie, wobei 17,6 Millionen Codezeilen akzeptiert werden. Diese umfassende Suite gewährleistet eine flexible, integrierte und effiziente Entwicklungsumgebung, die auf ein breites Spektrum von Entwicklungsanforderungen innerhalb der Salesforce Platform eingeht. Die AI-Entwicklertools wurden zudem um eine Architektur erweitert, die über mehrere externe und von Salesforce entwickelte Modelle hinweg funktioniert, um das effektivste und effizienteste Modell für einen bestimmten Anwendungsfall auszuwählen.
### 11.2 MCP-Unterstützung und AI-gestützte Codierung
Das Modellkontextprotokoll (Model Context Protocol, MCP) ist ein neuer offener Standard, der es AI-Agenten ermöglicht, sicher und konsistent mit beliebigen Tools oder Datenquellen zu interagieren. Salesforce integriert die MCP-Unterstützung nativ in das Salesforce-Entwickler-Toolkit, um Entwickleragenten zu unterstützen, die auf Funktionen und Tools in ihrem gesamten Unternehmen zugreifen können. Dazu zählen:
- **Lokaler MCP-Server:** Ein lokaler MCP-Server ermöglicht es Entwicklern, ihre Agentenintegrationen einfach in ihrer lokalen IDE zu erstellen, zu testen und zu debuggen, bevor sie sie in der Produktion bereitstellen, was die Produktivität erheblich verbessert. Der lokale MCP-Server bietet spezielle Tools für Organisationsinteraktionen und Entwicklungs-Workflows wie mobile Entwicklung, Barrierefreiheitstests, Aura-zu-LWC-Migration und agentische DevOps. Der lokale MCP-Server enthält auch die Integration in agentische Argumentation und LLMs, damit Entwickler ihre Anwendung iterativ und in natürlicher Sprache besser "vibe coden" können.
- **Benutzerdefinierter MCP-Server für Salesforce-APIs:** Entwickler können Salesforce-APIs, Data 360-Objekte und Automatisierungs-Flows nun sicher als MCP-"Tools" bereitstellen. Dadurch wird die gesamte Salesforce Platform zu einem umfassenden, vertrauenswürdigen und auffindbaren Satz an Funktionen für externe AI-Agenten oder -Anwendungen, der eine genaue Zugriffssteuerung und das Potenzial neuer verbrauchsbasierter Monetarisierungsmodelle bietet.
- **Native externe MCP-Konnektivität:** Entwickler können auch die Verbindung zu externen Servern, die dem MCP-Standard entsprechen, sicher verwalten. Dadurch können Entwickler Agenten erstellen, die in ihrem gesamten Unternehmen arbeiten können.
## 12\. Anwendungssuite
Unsere Anwendungs-Clouds, einschließlich Sales Cloud, Service Cloud, Marketing Cloud, Revenue Cloud und Commerce Cloud, basieren auf der Salesforce Platform und bieten führende Geschäftsfunktionen. Zu den wichtigsten Funktionen zählen:
- **Nahtlose Integration**: Tief integriert und so konzipiert, dass sie über die gesamte Kunden-Journey hinweg kohärent arbeiten und einen reibungslosen Daten- und Prozessfluss über Kundenkontaktpunkte hinweg gewährleisten, was die Kundenerfahrung verbessert.
- **Durchgängige Anpassbarkeit**: Unsere auf unserer Plattform basierenden Anwendungen bieten umfangreiche Anpassungsoptionen von No-Code bis Pro-Code, was eine präzise Anpassung an Kundenanforderungen ermöglicht.
- **Erweiterte AI-Funktionen**: Stellen Sie mit unseren Agentforce Agenten agentengestützte und agentenautonome kanalbasierte Workflows bereit. Enthält prädiktive und generative AI, um die Effizienz durch Automatisierung, Prognoseanalysen und personalisierte Benutzererfahrungen zu steigern und handlungsrelevante Statistiken und Empfehlungen bereitzustellen.
- **Echtzeit-Datenverarbeitung**: Verwendet Data 360 für Echtzeit-Datenzugriff und -analysen und unterstützt so eine zeitnahe und fundierte Entscheidungsfindung auf der Grundlage der neuesten Informationen. Dies verbessert die Reaktionsfähigkeit und Agilität in schnelllebigen Umgebungen.
- **Zusammengeführte Daten und Analytics**: Integriert verschiedene Datenquellen in eine zentralisierte Plattform für konsistente und umfassende Datenansichten, um genaue Analysen bereitzustellen und die Entscheidungsfindung zu verbessern.
- **Erhöhte Sicherheit und Compliance**: Enthält zuverlässige Sicherheits- und Compliance-Tools zum Schutz vertraulicher Daten und zur Einhaltung gesetzlicher Standards.
- **Verbraucherfreundliche Benutzererfahrung**: Bietet intuitive, benutzerfreundliche Oberflächen, die Anwendungen über Geräte, Kanäle und Modalitäten hinweg zugänglich und effektiv machen.
- **Zuverlässigkeit**: Stellt minimale Ausfallzeiten und Skalierbarkeit sicher, um geschäftskritische und lebenskritische Vorgänge, einschließlich Notfallservices und wichtiger Transportsysteme, zu unterstützen.
- **Elastische Skalierbarkeit**: Basiert auf Hyperforce, das die Erhöhung des Daten- und Benutzerinteraktionsvolumens unterstützt, ohne die Leistung oder die Bereitstellungskosten zu beeinträchtigen.
- **Kontinuierliche Verbesserung**: Integriert regelmäßig Innovationen, um die Funktionen zu verbessern, ohne bestehende Vorgänge zu unterbrechen.
Salesforce ist bestrebt, seine Anwendungen weiterzuentwickeln, indem die Funktionen auf seiner gesamten Plattform vereinheitlicht werden, wobei auf den in diesem Whitepaper beschriebenen grundlegenden Technologien aufgebaut wird. Diese Transformation wird von einer Reihe wichtiger Prioritäten geleitet, die das Design und die Entwicklung der Salesforce-Anwendungssuite prägen.
### 12.1 Skalierung und Leistung
Unsere Anwendungsteams sind auf Leistung und Skalierbarkeit spezialisiert und verwenden fortschrittliche Leistungslabore, um genaue Abgleiche unserer Produktionsumgebungen mit synthetischen Daten zu erstellen. Dieses Setup ermöglicht eine umfassende Simulation paralleler Benutzer-Journeys, um sicherzustellen, dass jede neue Funktion gründlich auf ihre Leistung getestet und ihre Auswirkungen bewertet werden. Wenn Laufzeitengpässe identifiziert werden, werden Ratenobergrenzen und andere Maßnahmen dynamisch angepasst, um die Systemintegrität zu schützen, und gleichzeitig Daten gesammelt, um die Lösung zu verbessern.
Unsere Systeme sind auf horizontale Skalierung ausgelegt, um die Flexibilität der Public Cloud effektiv zu nutzen. Automatisierte Prüfungen stellen sicher, dass Aktualisierungen oder Verbesserungen die Leistung nicht beeinträchtigen. Es werden automatische Prognoseskalierer eingesetzt, die die Systemlast proaktiv verwalten und nicht nur auf die erhöhte Nachfrage reagieren, sondern auch im Voraus antizipieren und anpassen.
Die automatische Skalierung ist entscheidend für die Minimierung der Bereitstellungskosten, da die ungenutzte Kapazität reduziert wird. Wir überwachen die laufenden Systemkosten genau und identifizieren und beheben Ineffizienzen bei der automatischen Skalierung oder Ressourcennutzung. Obwohl Kosteneffizienz wichtig ist, wird die zuverlässige Anwendungszustellung priorisiert und es werden automatische Skalierer verwendet, die schnell und langsam hoch- und herunterskaliert werden, um das Trust der Kunden aufrechtzuerhalten, selbst wenn dadurch höhere Kosten entstehen.
### 12.2 Nahtlose Integration
#### Allgemeines Datenmodell
Datenmodelle sind grundlegend für alle Geschäftsvorgänge bei Salesforce und beeinflussen Geschäftsfunktionen, APIs, Navigation, Benutzeroberflächenanzeigen und die Berichte, die erstellt werden können. Sie sind integraler Bestandteil der Funktionen der Plattform.
Unsere Anwendungssuite verwendet ein gemeinsames Datenmodell für Sales Cloud, Service Cloud, Revenue Cloud, Commerce Cloud, Marketing Cloud und Industries Cloud. Dies trägt zu unserer integrierten Suite bei und bietet ein konsistentes Verhalten und Interoperabilität sowie klare Pfade für Upgrades und Erweiterungen.
Beispielsweise können Benutzer in Marketing Cloud und Sales Cloud durch die Freigabe von Account- und Produkteinheiten Daten, Metadaten, Benutzeroberflächenkomponenten und Geschäftslogik austauschen. Diese Integration hilft beim Abbau von Silos und fördert die funktionsübergreifende Zusammenarbeit.
#### Plattform für virtuelle Daten
Ein gemeinsames Datenmodell für alle Salesforce Clouds verbessert die Integration erheblich, erfüllt jedoch möglicherweise nicht alle komplexen Anforderungen an die Partnerintegration. Das Data 360 Common Data Model erweitert dies, indem die Vorteile des freigegebenen Datenmodells über die typischen Datengrenzen von Salesforce hinaus erweitert werden und umfangreichere Integrationsszenarien berücksichtigt werden.
#### Erweiterbarkeit auf Ebenen
Mit dem Metadaten-Framework von Salesforce können verschiedene Gruppen wie Entwicklungsteams, ISVs, Partner, Administratoren und Endbenutzer ihre Anwendungen innerhalb unterschiedlicher Erweiterbarkeitsebenen anpassen und erweitern, ohne sich gegenseitig zu beeinträchtigen. Diese Struktur unterstützt eine skalierbare Umgebung, in der Änderungen durch eine Gruppe andere nicht stören und die Systemintegrität gewahrt bleibt.
Ein Paradebeispiel für das Framework in Aktion ist das Produkt Vereinheitlichtes Knowledge, das alle Knowledge Quellen in einen Data Lake integriert. Dieses Setup enthält eine semantische Ebene und Abrufer, die die Funktionen für die prädiktive und generative AI in Sales Cloud, Service Cloud, Revenue Cloud, Marketing Cloud und Commerce Cloud verbessern. Es enthält ein Datenmodell für unstrukturiertes und halbstrukturiertes Knowledge, das mit dem vorhandenen strukturierten Knowledge Modell verknüpft ist.
Darüber hinaus verwendet das Framework Metadaten, um benutzerdefinierte Beziehungen zwischen Datentypen zu definieren, was die erweiterte Abfragegenerierung erleichtert. Auf diese Weise können Anwendungsteams anpassbare Anwendungen erstellen, die diese umfassende Knowledge Base nutzen. ISVs, Partner und Kunden können die Anwendungsfunktionen weiter verbessern, indem sie Metadatenbeziehungen ändern oder benutzerdefinierte Abrufer für bestimmte Geschäftsanwendungsfälle entwickeln.
#### Verbessern der Common Data Platform
Kundendaten werden auf verschiedenen Plattformen wie SalesforceDB und Data 360 sicher gespeichert und unabhängig von ihrem strukturierten oder unstrukturierten Format standardisiert und normalisiert. Dadurch wird eine konsistente Datenverarbeitung durch ein vereinheitlichtes Format, das als sObject bezeichnet wird und eine zusammenhängende Datenplattform für alle Kundendaten unterstützt, gewährleistet.
Diese Standardisierung ermöglicht eine einzige API für alle Datenvorgänge, eine einheitliche Oberfläche für Auslöser in Apex und die Erstellung benutzerdefinierter Workflows mit Flow. Tableau Next wird ebenfalls unterstützt und ermöglicht benutzerdefinierte Datenansichten sowie die Integration in Tools der generativen AI wie den Eingabeaufforderungsgenerator zur intelligenten Antwortgenerierung auf der Grundlage von Kundendaten.
Darüber hinaus können Salesforce-Anwendungen in verschiedene Datenspeicher integriert werden, um die Flexibilität von Geschäftsprozessen in Produkten zu erhöhen. In Marketing Cloud wird Flow beispielsweise zum Verwalten von Multitouch-Kundenerfahrungen mit Optionen zum Verwenden vordefinierter Vorlagen oder zum Erstellen benutzerdefinierter Flows verwendet, die Marketing in andere Geschäftsprozesse integrieren – alles basierend auf zugrunde liegenden Kundendaten.
### 12.3 Gemeinsame Geschäftsfunktionen
Anwendungen nutzen und verbessern gemeinsam genutzte Services wie Identitätsbestimmung, Inhaltsorchestrierung, Personalisierung, Analysen, LLM Gateway und Reasoning Services und ermöglichen so eine schnelle Innovation und Bereitstellung. Diese Services unterstützen die Echtzeit-Datenverarbeitung, AI-gestützte Statistiken und erweiterte Benutzererfahrungen und bieten eine umfassende 360-Grad-Kundenansicht.
Zu den Vorteilen zählen eine verbesserte Effizienz durch intelligente Automatisierung und Prognoseanalysen, Skalierbarkeit für mehr Daten- und Benutzerinteraktionen sowie zuverlässige Sicherheit und Compliance. Die Anpassungsfunktionen der Plattform ermöglichen es Organisationen, sich schnell an sich ändernde Anforderungen anzupassen, was Wachstum und operative Spitzenleistungen fördert.
Die Innovation auf Anwendungsebene wird durch die Salesforce Platform und einzelne Anwendungen vorangetrieben, wodurch das Salesforce-Ökosystem verbessert und Anwendungen als Branchenführer etabliert werden.
### 12.4 Multikanal- und kanaloptimiert
Salesforce-Anwendungen wurden entwickelt, um Benutzer auf einer Vielzahl von Plattformen zu treffen, einschließlich Web, Mobilgeräten, E-Mails, SMS, WhatsApp und anderen Kanälen. Sie optimieren die nativen Funktionen jedes Kanals, um die Benutzererfahrung und die Effizienz zu verbessern.
Zu den Funktionen zählen mehrmonatige Offline-Funktionen für Salesforce Field Service-Benutzer, Push-Benachrichtigungen für Browser und Breitbildlayouts für Serviceagenten in Lightning Service Console sowie leistungsstarke Storefronts und Co-Pilot-Funktionen für Commerce-Käufer.
Die Metadatenplattform stellt sicher, dass Salesforce, seine Partner und Kunden sofort von diesen Funktionen profitieren können.
### 12.5 Schnelle Bereitstellung von Innovationen
Die Funktionen "Grundlagenservices", "Plattform" und "Gemeinsame Geschäftstätigkeiten" von Salesforce ermöglichen es Anwendungen, sich schnell an Marktveränderungen und technologische Trends anzupassen, was eine schnelle Bereitstellung von Innovationen ermöglicht. Mit der Einführung der generativen AI nutzte Salesforce beispielsweise schnell vorhandene AI-Services wie die NLP Trust Layer und die Intent-Erkennung, um Aufforderungsvorlagen in die Universal Communications Platform zu integrieren. Durch diese Integration werden die Messaging- und Telefonfunktionen produktübergreifend verbessert und persönlichere Client-Verbindungen ermöglicht.
Im Zuge des Trends zur autonomen AI hat Salesforce Agentforce eingeführt, eine Lösung, die diese vorhandenen Investitionen nutzt, um Geschäftsanwendungsfälle mit Agenten effizient zu automatisieren, ohne dass Sie von Grund auf neu erstellen müssen.
### 12.6 Pfad zur Anwendungssuite
Marketing Cloud, Revenue Cloud und Commerce Cloud wurden auf der Salesforce Platform neu erstellt. Dadurch können diese Clouds dieselbe Infrastruktur, dieselbe Plattform, dieselben Metadaten, dieselben Daten, dieselbe AI, dieselben Benutzeroberflächenkomponenten und dieselbe Geschäftslogik verwenden und gleichzeitig von der vollen Leistungsfähigkeit der Salesforce Platform profitieren. Beispielsweise wurden Funktionen aus Revenue Cloud und eingebettete Kernfunktionen wie der auf Einschränkungen basierende Konfigurator, Preisgestaltungsmodule und die Katalogverwaltung übernommen, wodurch sie zu grundlegenden Services werden, die in der gesamten Suite verfügbar sind. Dies ermöglicht uns auch eine nahtlose Integration in alle unsere Clouds und die Funktionen, die Commerce Cloud und Marketing Cloud bereitstellen, werden Teil der gemeinsamen Geschäftsfunktionen, die von anderen Anwendungen genutzt werden können. Dies ist die Vision unserer integrierten Anwendungssuite.
Die Salesforce Platform hat eine integrierte Anwendungssuite entwickelt, die Sales Cloud, Service Cloud, Marketing Cloud, Revenue Cloud und Commerce Cloud zu einer einheitlichen Lösung vereint. Diese Suite ist ab der Salesforce Starter Edition verfügbar und bietet Mehrkanal-Kontaktaufnahme, Kundenbeziehungsverwaltung und Geschäftsstatistiken in einem zusammenhängenden Paket. Unabhängig von der ausgewählten Edition können Benutzer auf die Kernfunktionen von Sales Cloud, Service Cloud, Marketing Cloud und Commerce Cloud zugreifen und so eine konsistente Erfahrung auf allen Ebenen gewährleisten.
## 13\. Branchenspezifische Lösungen
Salesforce Industries-Produkte für Finanzdienste, Gesundheit, Biowissenschaften, Medien, Energie und Versorgungsunternehmen, Fertigung, Auto, Konsumgüter, Einzelhandel, Net Zero, Öffentlicher Sektor, Bildung und gemeinnützige Organisationen erweitern unsere Anwendungsprodukte und -plattform, um maßgeschneiderte Lösungen für die individuellen Herausforderungen der Branche bereitzustellen. Sie optimieren Vorgänge und steigern die Produktivität, indem sie branchenspezifische Workflows, Compliance-Maßnahmen und Datenmodelle integrieren.
Das Portfolio "Branchen" wurde auf der Salesforce Platform neu erstellt, um die Verwendbarkeit in vertikalen Bereichen zu ermöglichen. Kunden können nun eine oder mehrere Branchenfunktionen zu maßgeschneiderten Lösungen zusammenstellen und dabei gemeinsam genutzte Metadaten, APIs und Geschäftsservices nutzen. Dieser Ansatz gleicht vertikale Differenzierung mit Plattformkonsistenz aus und gewährleistet Anpassungsfähigkeit und Skalierbarkeit in verschiedenen regulatorischen und geschäftlichen Kontexten.
### 13.1 Ansatz der mehrschichtigen Architektur
Unsere Produkte verwenden eine mehrschichtige Architektur. Die Basis bilden die Salesforce Platform und horizontale Anwendungen wie Sales Cloud und Service Cloud, die als Grundlage für alle Branchenlösungen dienen. Salesforce bietet zusätzliche allgemeine Services, die wiederverwendbare Komponenten verbessern, die in die meisten Branchen eingebettet sind. Beispiele hierfür sind Funktionen für die digitale Automatisierung, Zeitachsen, Aktionspläne und mehr. Über dieser Ebene befindet sich eine wiederverwendbare Geschäftslogikebene, die horizontale Funktionen wie Feedbackverwaltung, CPQ (Konfiguration, Preis, Angebot) und Serviceverwaltung umfasst.
Die oberste Ebene verfügt über domänenspezifische Anpassungen, die auf bestimmte Branchenanforderungen zugeschnitten sind, und nutzt die zugrunde liegende Plattform für mehr Skalierbarkeit und Effizienz. In der Fertigungsvertikalen optimiert dieses Setup beispielsweise die Produktionsplanung durch genaue Prognosen. Im Life Sciences-Sektor bietet es Pharma-Vertriebsteams mobile Offline-Lösungen, die Workflows und die Probenhandhabung effizient verwalten und gleichzeitig verschiedene geografische behördliche Anforderungen erfüllen.
### 13.2 Branchenspezifische Funktionen
**Vertrauenswürdige AI Excellence**: Unsere vertrauenswürdigen Lösungen für generative AI bieten branchenspezifische AI-Funktionen. Dazu zählen Agenten und Aufforderungs-Engineering, die eine Low-Code-/No-Code-Automatisierung und -Digitalisierung in Branchen wie Gesundheitswesen, Biowissenschaften und Finanzdienstleistungen ermöglichen. Darüber hinaus sind Funktionen wie Dokument-/Textanalyse und -zusammenfassung auf Branchen zugeschnitten, die große Datenmengen verarbeiten, was die Informationsextraktion und die Erfassung von Statistiken erleichtert.
Angepasste Agenten verbessern die bidirektionale Kommunikation zwischen Agenten und Kunden, was zu schnelleren Lösungen führt. Die Trust Layer der Salesforce Platform erleichtert die Einhaltung aller Compliance- und behördlichen Standards in allen Branchen.
**Daten, Statistiken und Informationen mit Compliance und Sicherheit**: Salesforce Industries bietet eine umfassende 360-Grad-Ansicht mit strengen Datenschutz-, Freigabe- und Sicherheitsmaßnahmen, die auf spezifische Branchenvorschriften wie DSGVO, HIPAA und FedRamp zugeschnitten sind. Salesforce integriert Daten aus verschiedenen Quellen, um Compliance und Sicherheit zu ermöglichen, und erweitert diese Lösungen um zusätzliche Funktionen wie die Shield-Verschlüsselung BYOK (Bring Your Own Keys) für die Mandantendatenverschlüsselung.
**Erhöhte Benutzererfahrung**: Salesforce Industries betont eine nahtlose Benutzererfahrung, die auf branchenspezifische Anforderungen zugeschnitten ist, um die Benutzer-Journey zu verbessern. Dazu zählen Tools wie das Center für handlungsrelevante Ressourcen, Experience Cloud-Vorlagen und OmniStudio-basierte Lösungen.
**Digitalisierung, Integration und Einarbeitung**: Salesforce Industries bietet Digitalisierung, Integration und Onboarding über Low-Code- bis hin zu No-Code-Lösungen, nutzt Tools wie Flows und OmniStudio für neue Kunden und bietet Migrationslösungen für vorhandene CRM-Systeme. Die Integration in externe Systeme und Daten wird über die von MuleSoft angebotenen Konnektoren optimiert. Salesforce umfasst auch branchenspezifische Serviceprozesse, beispielsweise die Streitbeilegung für Retail Banking.
**Mobil und Offline**: Salesforce Industries bietet zuverlässige domänenspezifische Unterstützung für die mobile Salesforce-Anwendung und die Field Service Mobile-Anwendung. Für hochspezialisierte Domänen, die erweiterte Offline-Unterstützung benötigen, bietet Branchen maßgeschneiderte mobile Anwendungen, die auf mobilen Salesforce-SDKs basieren.
**Allgemeine Geschäftsfunktionen**: Salesforce Industries baut auf der Grundlage gemeinsamer Geschäftsfunktionen auf, die Konsistenz und Produktivität ermöglichen und gleichzeitig Lösungen an die individuellen Branchenanforderungen anpassen, beispielsweise unterschiedliche Terminbuchungssysteme für Banken und Krankenhäuser. Salesforce ist in das gesamte Salesforce-Ökosystem integriert und bietet eine ganzheitliche Customer 360-Ansicht, wodurch es ein wichtiger Bestandteil der Salesforce-Produktsuite ist.
## 14\. Analysen
Seit Jahren fördert der Markt für Analytics- und Business Intelligence-Plattformen (BI) visuelle Self-Service- und AI-gestützte automatisierte Statistiken für Endbenutzer, damit sie schnellere und datengesteuertere Entscheidungen treffen können. Wir wissen jedoch, dass dies nicht jeder aufgrund mehrerer Herausforderungen realisiert hat:
- **Nicht verbundene Statistiken**: Statistiken sind nicht in die Workflows der Benutzer integriert, was es schwierig macht, Maßnahmen für die Statistiken zu ergreifen, obwohl sie die Entscheidungsfindung beeinflussen können.
- **Datenüberlastung und Silos**: Die Daten wachsen weiterhin schnell und bleiben abgeschottet, was zu Desorganisation und Sicherheitsrisiken führt. Organisationen stehen vor einem Dilemma zwischen einer chaotischen Self-Service-Datenumgebung und einer restriktiven, gut verwalteten Datenumgebung.
- **Mißtrauen in Daten**: Die Erweiterung und Fragmentierung von Daten hat das Trust der Benutzer in die Statistiken aus Unternehmensdaten erodiert.
- **Mangelnde Composability**: In Arbeitsprozessen gibt es keine Möglichkeit zur Zusammenstellung und Wiederverwendung, was Benutzer zwingt, Aufgaben zu wiederholen, und keine klaren Möglichkeiten für die Monetarisierung bietet.
Tableau Next wurde entwickelt, um den Zyklus visueller Analysen zu erweitern, indem Geschäftsbenutzer und Datenexperten auf neue, gemeinschaftliche Arten zusammengebracht werden. Sie bietet zeitnahe, vertrauenswürdige Kennzahlen und Statistiken über die Salesforce Platform und erleichtert so den allgegenwärtigen Zugriff auf handlungsrelevante Statistiken.
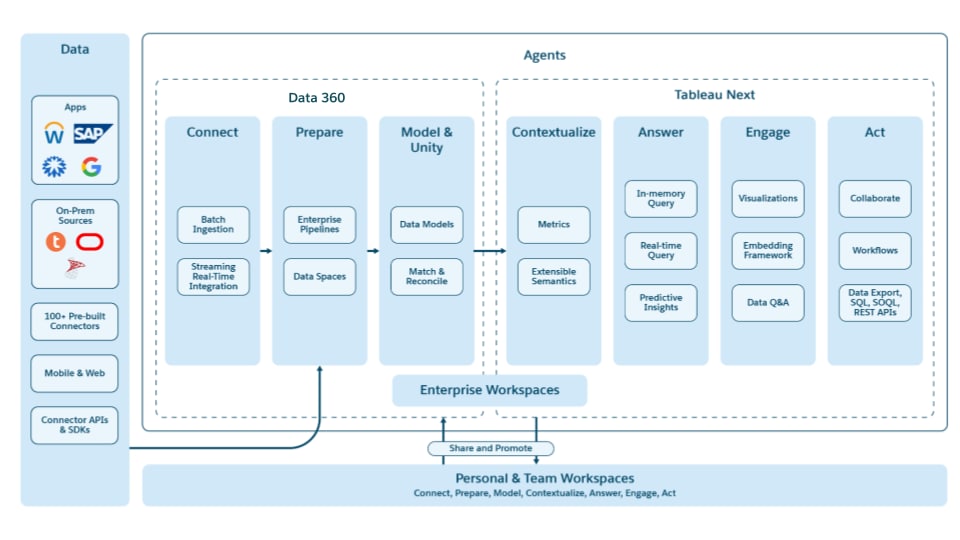 Tableau Next meistert diese Herausforderungen durch Folgendes:
- Erstellen einer offenen, zusammensetzbaren API-First-Plattform für verbundene Erfahrungen von der Datenverbindung bis zur Aktion. Bereitstellung von Tools für die Entwicklung, zusammengesetzten Komponenten für umfangreiche Analyseanwendungen und Funktionen zum Verwalten ihrer Paketerstellung und Verteilung.
- Erstellen mit KI im Mittelpunkt und Bereitstellen von kontextbezogenen und relevanten Statistiken mit Tools, die Datenexperten effizient überprüfen und validieren können, um Trust sicherzustellen.
- Aufbauend auf Tableau Semantics als universelle semantische Ebene für schnelle Self-Service- und kontrollierte Datenanalysen in einem kontrollierten und gleichzeitig flexiblen Ökosystem.
- Bietet Cloud-basierte Datenfunktionen in Echtzeit über Data 360 für vertrauenswürdigen, skalierbaren und geregelten Datenzugriff.
- Bereitstellen einer umfangreichen Umgebung und eines Marktplatzes für Entwickler zum Erstellen und Monetarisieren von Anwendungen.
- Integrieren Sie die Intelligenz im Kern und bringen Sie den Agenten, die Sie unterstützen, die Leistungsfähigkeit der Semantik und Knowledge Ihrer Organisation näher.
- Priorisieren von Trust, damit Sie durch direkte Kontrolle und Einblicke in ihre Aktivitäten und ihre Effektivität auf Ihre Daten, Analysen und die Arbeitslasten und Bereitstellung von Agenten vertrauen können.
- Nutzen Sie die Zusammenarbeit als erstklassiges Designprinzip mit tiefen und umfassenden Integrationen in Slack sowie alle anderen Tools für die Zusammenarbeit in Ihrer Organisation.
### 14.1 Best-of-Class Analytics-Erfahrungen
Tableau Next baut auf der Führungsrolle von Tableau bei Datenanalysetools auf und bietet eine offene Plattform, die die Funktionen erweitert und Erfahrungen integriert. Zu den wichtigsten Funktionen zählen:
- **Rich-Data-Visualisierung**: Nutzt die VizQL-Technologie von Tableau für erweiterte visuelle Analysen.
- **Gemeinschaftliche, gesteuerte Arbeitsumgebungen**: Bietet eine einheitliche Oberfläche für Analyseaufgaben und ist in Slack für die Zusammenarbeit in Echtzeit integriert.
- **Vertrauenswürdige, gesteuerte Daten**: Unterstützt Self-Service-Analysen mit strukturierten Sonderangebotspfaden für die globale Verwaltung in einer sicheren Umgebung.
- **Erweiterte Kennzahlenerstellung**: Ermöglicht es Analysten, KPIs effizient in Ihrer Organisation zu erstellen und wiederzuverwenden, was Konsistenz und Zuverlässigkeit ermöglicht.
### 14.2 Agentic Analytics
Tableau Next wurde grundlegend mit Agentforce als grundlegendem Architekturkonstrukt entwickelt und verbessert die Fähigkeit von Tableau Next, hochgradig verbundene, vertrauenswürdige und gemeinschaftliche AI-gestützte Datentools bereitzustellen.
- **BI-Tools**: Verbessert die Effizienz bei der Self-Service-Analyse für Datenmitarbeiter, wobei der Fokus auf der Datenvorbereitung und der Pflege visueller und semantischer Metadaten liegt.
- **Kontexterfahrungen**: Bringt Datenstatistiken, Erfahrungen und transparente AI in den Kontext der Arbeitsumgebung der meisten Organisationen (z. B. Slack).
- **Agentforce Architektur**: Basiert auf dem Agentforce-Stapel und bietet Tableau Next umfangreichen Kontext auf einer erweiterten Agentenarchitektur.
- **Semantischer Katalog**: Bietet ein zentralisiertes System zum Verwalten von Metadaten, Abstammung und Suche und ermöglicht so gemeinsame Erfahrungen für Tableau Next-Benutzer.
- **Freigegebene und generierte Metadaten**: Ermöglicht nahtlose Workflows zwischen Self-Service-Analysen und geregelten Inhalten in einem umfassenden Ökosystem.
- **Aktions-Framework**: Ermöglicht die Umsetzung von Statistiken über vorgefertigte, von Menschen zusammengestellte oder generierte Workflows.
- **Personalisierte Statistiken**. Lernt Ihre Datenvoreinstellungen, Ihre Rolle und vieles mehr kennen (in dem Maße, in dem Sie dies zulassen), um Ihnen sofort hochgradig kontextbezogene und personalisierte Datenstatistiken bereitzustellen.
- **Proaktive Statistiken**. Erkundet Ihr Datenökosystem auf intelligente Weise und sucht nach Orten, die für Sie von statistischem Interesse sind. Während Sie die Ursachen der Änderung proaktiv verstehen, erfahren Sie, was Sie dagegen tun sollten, und empfehlen, als nächste Schritte Maßnahmen zu ergreifen.
- **Vertrauenswürdige Datenagenten**. Bietet Ihnen als Treiber Ihrer Datenagenten die Möglichkeit, die Anwendung über integrierte Erfahrungen zu erstellen und zu optimieren. Außerdem erhalten Sie Testtools, mit denen Sie Ihre Datenänderungen und deren Auswirkungen auf die Genauigkeit und Wirksamkeit Ihrer Agenten vorab auswerten können.
### 14.3 Integrierte lösungsgesteuerte Geschäftsbenutzererfahrungen
Tableau Next verbessert die Benutzererfahrung für Geschäftsbenutzer auf verschiedenen Plattformen wie Slack und Salesforce und durch neue Analysefunktionen wie Tableau Pulse, auf die über Agentenerfahrungen zugegriffen werden kann, um das Analytics-Engagement zu vereinfachen. Zu den wichtigsten Aspekten zählen:
- **Zusammenarbeit**: Sie ist für vertrauenswürdige Analysen von zentraler Bedeutung und erleichtert die Interaktion zwischen verschiedenen Analysekomponenten und integriert Validierungstools in den Workflow der Benutzer.
- **Pulskennzahlen**: Bietet zusammengestellte und automatisierte Statistiken effizienter als herkömmliche von Analysten erstellte Dashboards.
- **AI-gestützte Erfahrungen**: Setzt KI ein, um den Bedarf an technischem Fachwissen in erweiterten Analysen zu reduzieren und so die Zuverlässigkeit mit deterministischen Metadaten und geregelten Daten zu gewährleisten.
- **Zustellung von Statistiken für mehrere Spieler**: Ermöglicht es Geschäftsbenutzern, gemeinsam mit Analysten Knowledge und Trust in die vom System bereitgestellten Statistiken zu gewinnen.
- **Tiefe Integration**: Basiert auf einer freigegebenen Metadaten- und Datenplattform, die die Zusammenstellung über verschiedene Systeme und Erfahrungen hinweg ermöglicht, um die Zusammenstellung für Höherstufung, Datenfluss und für unterschiedliche Personas zu ermöglichen, die einander bei der Überprüfung und Ausführung von Arbeit helfen.
### 14.4 Tableau-Semantik
Die semantische Tableau-Ebene dient als wichtige Brücke zwischen Rohdaten und Benutzerinterpretation, vereinfacht die Datenanalyse, die Entscheidungsfindung und die Anwendungsentwicklung und verbessert den AI-gestützten Kontext und Abruf. Zu den wichtigsten Funktionen zählen:
- **Integrierte Metadatenverwaltung**: Unterstützt Self-Service- und verwaltete Metadaten und ermöglicht Ad-hoc-Analysen mit strukturierten Pfaden zur zentralen Informationsquelle für Organisationen.
- **Best-of-Breed-Funktionen von Tableau**: Einschließlich Unterstützung für mehrere logische Objekte, Modellzusammenstellung, gemeinsam genutzte Dimensionen, komplexe georäumliche Hierarchie und zeitliche Modellierung.
- **Diverse Daten und Analysen**: Hilft beim Verknüpfen von unstrukturierten und strukturierten Daten, beispielsweise beim Korrelieren von bildbasierten Produktkategorien mit strukturierten Vertriebsdaten, und beim Integrieren von Stimmungsanalysen aus halbstrukturierten Produktbewertungen.
- **Salesforce Platform-Integration**: Etabliert eine einheitliche Quelle der Wahrheit, die eine konsistente Geschäftssemantik und eine nahtlose Integration zwischen Anwendungen sowie ein zusammenhängendes Metadatenmodell ermöglicht, das verschiedene Benutzererfahrungen und Anwendungsfälle unterstützt.
- **Agentische Intelligenz**: Die semantische Ebene ist einer der Schlüsselbereiche, in denen Agenten Informationen gewinnen, indem sie nicht nur die Daten und Metadaten verstehen, die Ihr Unternehmen unterstützen, sondern auch die Semantik, die es definiert, einschließlich ausführlicherer Beschreibungen und Präferenzen, die auf Ihre Organisation zugeschnitten sind.
### 14.5 Integrierte Workflows und handlungsrelevante Statistiken
Tableau Next bietet integrierte Lösungen, die die datengesteuerte Entscheidungsfindung und die vertrauenswürdige Automatisierung verbessern, mit einfachen Aktionen, vordefinierten Flows, Planung und API-Integrationen. Zu den wichtigsten Komponenten zählen:
- **Standardisierte intelligente Geschäftsaktionen**: Ermöglicht dringende und kontextspezifische Kommunikation innerhalb von Unternehmen, die wichtig und dennoch komplex sind.
- **Vordefinierte und generierte Flow-Pläne**: Aktiviert Ad-hoc- und geplante Aktionen über statische und dynamisch generierte Flows, die vertrauenswürdig und dennoch überprüfbar sind.
- **Agentforce**: Unterstützt AI-gestützte Datenunterhaltungen und -interaktionen, wodurch Benutzer mit Statistiken interagieren und Aktionen ausführen können, die denen auf einer traditionellen Benutzeroberfläche ähneln, sowohl innerhalb als auch außerhalb ihrer Geschäftsanwendungen und durch Unterhaltung vereinfacht werden.
### 14.6 Composable Developer Platform
Tableau Next bietet eine zusammengesetzte Entwicklerplattform mit Optionen für die Anwendungsentwicklung ohne Code, Low-Code und Pro-Code, die alle Tableau Semantics in Data 360 verwenden.
- **Branche/Intelligente Anwendungen im Fertigpaket**: Bietet vorlagenbasierte und anpassbare Analyseanwendungen, die auf spezifische Branchenanforderungen zugeschnitten sind.
- **Drittanbieter- und ISV-Anwendungen**: Unterstützt die Erstellung dynamischer und interaktiver Anwendungen für analytische, branchenspezifische und benutzerdefinierte Zwecke.
- **Markt und Börse**: Ermöglicht es ISVs und Entwicklern, ihre Anwendungen im größten und vertrauenswürdigsten Ökosystem für die Entwicklung von Geschäftsanwendungen zu bündeln und zu verteilen.
### 14.7 Tiefgreifende Zusammenarbeit
Tableau Next wurde für Geschäftsbenutzer und Datenexperten entwickelt und unterstützt einen gemeinschaftlichen Ansatz für das Datenverständnis. Ob technisch oder nicht technisch, alle Teammitglieder, vom Geschäftsbenutzer bis zum Datenexperten, können die Datenstatistiken des jeweils anderen überprüfen. Darüber hinaus sind diese Statistiken nicht auf eine Browserregisterkarte innerhalb einer BI-Plattform beschränkt.
Als BI-Plattform ist Tableau Next wie folgt:
- **Plattformübergreifend komponierbar**. Statistiken werden unabhängig von der Plattform, auf der Sie sie anzeigen, auf dieselbe Weise dargestellt. Diese Konsistenz ist ein Säulendesignprinzip bei der visuellen Verarbeitung von Daten.
- **Tief in Slack** integriert. Die Integrationsentwicklung mit Slack hat eine der intuitivsten und umfassendsten Erfahrungen für gemeinschaftliche Daten auf dem heutigen Markt gewährleistet.
- **Geöffnet für alle Tools**. Die Anwendung unseres API-first-Prinzips auf unserer tief vereinheitlichten Plattform stellt sicher, dass die Integration auf andere Tools für die Zusammenarbeit und Drittanbieter ausgeweitet werden kann, wobei die Fülle durchgängig erhalten bleibt.
## 15\. Integration
Die Salesforce Platform bietet eine umfassende Suite von Integrationsfunktionen, um eine Vielzahl digitaler Herausforderungen zu bewältigen. Viele Kunden arbeiten jedoch in Unternehmensarchitekturen, die sich im Laufe der Zeit durch die Verwendung verschiedener Anbieter und Technologien entwickelt haben.
Moderne Unternehmen stehen vor Herausforderungen bei der Systemintegration und Automatisierung von Geschäftsprozessen, was oft zu Datensilos und Ineffizienzen führt. Die Salesforce-Integrationsplattform, die die Leistungsfähigkeit von MuleSoft nutzt, behebt diese Probleme, indem sie die schnelle Entwicklung und Verbesserung automatisierter Prozesse ermöglicht. Sie gewährleistet eine nahtlose Systemkonnektivität, verbessert den Informationsfluss und unterstützt die Entscheidungsfindung auf verschiedenen Plattformen und reduziert so die Arbeitskosten und Automatisierungskosten. Diese Ebene ist entscheidend für die Erstellung, Verwaltung, Steuerung und Überwachung von Integrationen zwischen Salesforce-Services und anderen benutzerdefinierten Services oder Drittanbieterservices.
Systeme werden über APIs definiert, die Folgendes ermöglichen:
- Greifen Sie auf Daten aus wichtigen Systemen wie ERP, Kunden- und Abrechnungssystemen und proprietären Datenbanken zu.
- Erleichtern Sie die Dateninteraktion und -integration und beseitigen Sie so Datensilos.
- Fügen Sie den über System- und Prozess-APIs verwalteten Daten und Prozessen Geschäftskontext hinzu.
Für eine effektive Kommunikation werden APIs wie folgt beschrieben:
- OpenAPI Specification (OAS) für sofortigen synchronen Austausch
- Asynchrone API für asynchrone, ereignisgesteuerte Kommunikation
- Modellkontextprotokoll (Model Context Protocol, MCP) für strukturierte Modellkontextinteraktionen
- Agent-zu-Agent-Protokoll (A2A) für direkte Agent-zu-Agent-Integrationen.
Die Salesforce-Integrationsebene bietet zuverlässige Funktionen zum Integrieren und Verwalten beliebiger Systeme und verbessert die Konnektivität mit den Daten-, AI- und Anwendungsfunktionen von Salesforce, unabhängig davon, ob die Systeme nativ in Salesforce oder von anderen Anbietern sind.
Komplexe Integrationen erfordern erweiterte Transformationen und zuverlässige Tools, einschließlich universeller Konnektivität, API-Verwaltung und -Governance, einer integrierten Entwicklungsumgebung (IDE) zum Erstellen von Integrationsarbeitslasten, einer Laufzeitplattform zum Bereitstellen, Verwalten und Überwachen dieser Integrationen und einer Plattform für die Beobachtbarkeit, die einen durchgängigen Einblick in diese Integrationen bietet.
Um den Integrationsprozess weiter zu beschleunigen, bieten wir Acceleratoren und branchenspezifische Vorlagen an, die allgemeine Integrationsmuster und -anforderungen codieren.
### 15.1 Integrationsmuster in Salesforce
Zwei primäre Integrationsmuster richten sich an den Daten- und Prozessfluss zwischen Salesforce und dem gesamten Ökosystem: ausgehende Integration und eingehende Integration.
**Verbinden von Salesforce mit externen Systemen (Ausgehend):** Bei diesem Muster handelt es sich um Prozesse, die aus Salesforce stammen und auf Daten zugreifen oder Aktionen in externen Systemen auslösen.
- **Sichere Endpunktverwaltung (Anmeldeinformationen mit Namen):** Anmeldeinformationen mit Namen bieten einen sicheren, zentralen Ort zum Speichern von Endpunkt- und Authentifizierungsdetails. Anwendungen und Automatisierungen verweisen auf einen logischen Namen, während die Plattform die Komplexitäten des Authentifizierungslebenszyklus verarbeitet.
- **Deklarative Integration (externe Services):** Bei externen Systemen, die eine OpenAPI-Standardspezifikation bieten, kann ein Administrator externe Services verwenden, um die API deklarativ zu registrieren. Anschließend verarbeitet die Plattform die Spezifikation und stellt die Vorgänge des Service automatisch als native Aktionen in Tools wie Flow oder als native Objekte in Apex zur Verfügung.
- **Komplexe Systemintegration (MuleSoft)**: Für Systeme ohne moderne Schnittstellen erstellt MuleSoft eine standardmäßige wiederverwendbare API-Ebene. Dadurch wird die veraltete Komplexität abstrahiert und lokale Daten und Prozesse werden in das Salesforce-Ökosystem integriert.
- **Echtzeit-Datenzugriff (externe Objekte):** Stellt Tabellen aus externen Systemen als virtuelle Objekte im Salesforce-Datenmodell dar, wodurch externe Daten über Standardabfragen und Benutzeroberflächenkomponenten ohne Abgleich zugänglich werden.
- **Zentrale Funktionsverwaltung (vereinheitlichter API-Katalog):** Der vereinheitlichte API-Katalog ist ein zentralisiertes Repository und die einzige Quelle der Wahrheit für alle API-Spezifikationen und ihre zugehörigen Metadaten, beispielsweise ihren Standort und ihre Sicherheitsprotokolle. Sie stellt sicher, dass Daten oder Geschäftslogik unabhängig davon, wo sie sich befinden, erkannt, sicher mit ihnen verbunden und zu leistungsstarken neuen Anwendungen und Automatisierungen im gesamten Salesforce-Ökosystem zusammengestellt werden können.
- **Benutzerdefinierte Pro-Code-Logik (Apex REST):** Entwickler können benutzerdefinierte Geschäftslogik, die in Apex geschrieben wurde, als REST-API und -Aktion bereitstellen. Die Aktion ist dann als Schritt in einem Flow oder als Tool für einen AI-Agenten verfügbar.
**Verbinden externer Systeme mit Salesforce (Eingehend):** Durch dieses Muster können externe Systeme und Anwendungen eine Verbindung mit Salesforce Platform herstellen, um auf Daten zuzugreifen, Geschäftslogik auszulösen und Prozesse zu orchestrieren. Diese Funktion basiert auf bewährten APIs auf Unternehmensebene, die in großem Umfang funktionieren. Stand Oktober 2025:
- Die Abfrage-API (SOQL) verarbeitet täglich über 50 Milliarden Anforderungen.
- Die REST-API stellt täglich fast 5 Milliarden Aufrufe über externe Systeme bereit, wobei die Nutzung im Jahresvergleich um 30 % wächst.
- Die Bulk-API verarbeitet täglich Hunderte von Milliarden Datensätzen für umfangreiche Datenvorgänge.
Diese bewährte Zuverlässigkeit und Skalierung untermauert die folgenden Funktionen:
- **Eine einheitliche API-Erfahrung:** Der Zugriff auf alle Salesforce-Funktionen wird über eine konsistente Endpunktstruktur (api.salesforce.com) vereinheitlicht, sodass Entwickler keine unterschiedlichen Muster oder Authentifizierungs-Flows für jedes Produkt erlernen müssen.
- **Umfassendes API-Portfolio für bestimmte Zwecke:** Die Plattform bietet eine Vielzahl von APIs, die auf bestimmte Anforderungen zugeschnitten sind. Dazu zählen REST- und SOAP-APIs für Transaktionsvorgänge, die Bulk-API für die Verarbeitung großer Datenmengen, die Pub/Sub-API für ereignisgesteuerte Anwendungen und spezielle Produkt- oder benutzerdefinierte Apex APIs.
- **Zukunftsbereit für die Agentenintegration:** Über Standards wie MCP können Kunden ihre Salesforce-Daten und -Aktionen sicher als "Tools" für externe AI-Agenten bereitstellen und so eine Salesforce-Instanz in eine erweiterbare Menge an Fertigkeiten für eine digitale Belegschaft verwandeln.
### 15.2 Agentenintegration mit MCP
Über die etablierten Muster für eingehende und ausgehende Daten und Prozessintegrationen hinaus zeichnet sich ein neues Muster für das Zeitalter der Agenten ab. Die Salesforce Platform implementiert eine umfassende MCP-Strategie und positioniert sie sowohl als Verbraucher als auch als Anbieter von AI-gestützten Services. Dieser bidirektionale Ansatz ermöglicht die Agenteninteroperabilität und ermöglicht es Unternehmen, Salesforce-Daten und -Funktionen nahtlos in das sich ständig weiterentwickelnde Ökosystem von AI-Agenten und -Tools zu integrieren und gleichzeitig Sicherheit und Unternehmensführung aufrechtzuerhalten.
**Salesforce als MCP-Client:** Agenten können als MCP-Client fungieren, indem sie externe Systeme und APIs intelligent und dynamisch nutzen. Mit dieser Funktion können Organisationen die Reichweite von Agentforce über Salesforce-Grenzen hinaus erweitern und Aktionen für jedes beliebige System orchestrieren, unabhängig davon, ob es über eine moderne API verfügt oder eine Verbindung über MuleSoft mit veralteten Systemen oder RPA-Bots erfordert. Die Konfiguration erfolgt über eine vertraute deklarative, themenbasierte Setup-Erfahrung, die eine schnelle Integration ohne benutzerdefinierte Entwicklung ermöglicht. Ein vereinfachter Erkennungsmechanismus für von Partnern bereitgestellte MCP-Server optimiert die Integration externer Funktionen weiter. Unternehmen können Agentforce schnell in ihre breitere Technologielandschaft integrieren, indem sie die Komplexität der externen Konnektivität über einen umfangreichen Stapel abstrahieren.
**Salesforce als MCP-Server:** Als MCP-Server stellt die Plattform ihre Logik und Datenbestände, einschließlich standardmäßiger REST-APIs, benutzerdefinierter Endpunkte, aufrufbarer Aktionen und Flows, als erkennbare "Tools" für externe Agenten bereit. Über eine deklarative Oberfläche können Kunden und ISVs ihre eigenen benutzerdefinierten MCP-Server erstellen und konfigurieren und so Funktionen zu Sammlungen von Tools zusammenstellen, die auf individuelle Geschäftsprozesse zugeschnitten sind. Dies gilt auch für MCP-Eingabeaufforderungen, wodurch natürliche Synergien mit den Funktionen der Aufforderungsvorlage der Plattform geschaffen werden und Organisationen ihre Investition in die Eingabeaufforderungstechnik für jedes externe AI-System zugänglich machen können.
Diese Funktion wird durch ein mehrschichtiges Sicherheitsmodell gesteuert:
- **Anwendungssteuerung:** Mit dem Konstrukt "Externe Client-Anwendung" können Administratoren zuverlässig steuern, welche externen Agentenanwendungen auf ihre Salesforce-Organisation zugreifen können.
- **Umfangreiche Berechtigungen:** Die Authentifizierung wird durch eine detaillierte OAuth-Einteilung erweitert, die eine genaue Verfolgung und Erzwingung von Aktionen ermöglicht, die ein authentifizierter Agent ausführen darf.
- **Kernplattformautorisierung:** Diese neuen Steuerelemente basieren auf dem robusten Autorisierungsmodell von Salesforce. Dazu zählen Steuerelemente für den Datensatzzugriff, Berechtigungen auf Einheiten- und Feldebene sowie andere in "Profile" und "Berechtigungssätze" definierte Berechtigungen.
ISVs und Partner können auch MCP-Serverkonfigurationen in Pakete aufnehmen und verteilen, um die schnelle Bereitstellung von AI-fähigen Integrationen im gesamten Salesforce-Ökosystem zu ermöglichen.
### 15.3 Universelle Konnektivität
Der moderne Ansatz von Salesforce für die universelle Konnektivität besteht in der _interpretierten Konnektivität_. Hierbei handelt es sich um einen metadatenzentrierten Ansatz zur Entwicklung von Konnektoren, die auf jeder beliebigen Plattform (MuleSoft, Flow oder Data 360) für jeden Anwendungsfall ohne Programmierung ausgeführt werden können. Die Metadatenmodelle enthalten Informationen dazu, wie Sie eine Verbindung zu Remote-Services herstellen können, um eine Anforderung zu authentifizieren, die zurückgegebenen Daten zu modellieren, Abfragen zu erstellen, Ergebnisse zu durchsuchen und Ereignisse (Auslöser) zu empfangen, um einen Prozess zu automatisieren.
Für Systeme, die keine HTTP-basierten APIs verwenden, bietet Salesforce Hunderte vordefinierter Konnektoren und ein vollständiges SDK zum Erstellen benutzerdefinierter Konnektoren. Für Systeme ohne API-Zugriff bietet Salesforce die automatische Prozessautomatisierung (Robotic Process Automation, RPA), die Agenten verwendet, um sich wiederholende, regelbasierte Aufgaben zu automatisieren, die in der Regel von Menschen ausgeführt werden. Diese Aufgaben können die Dateneingabe, die Transaktionsverarbeitung und das Beantworten einfacher Kundendienstabfragen umfassen. Zum Extrahieren von Informationen aus Dokumenten bietet Salesforce die intelligente Dokumentverarbeitung (IDP) an, die mithilfe von KI Daten aus verschiedenen Dokumenttypen wie Rechnungen, Verträgen und Formularen automatisch extrahiert, klassifiziert und verarbeitet. Salesforce bietet jedoch eine automatisierte Möglichkeit, Informationen abzurufen und zu ändern.
Mit den jüngsten Verbesserungen der AI bietet Salesforce Bausteine zum schnellen Aktivieren von Agentenfunktionen in der Organisation:
- Mit **dem Modellkontextprotokoll-Konnektor** können Organisationen ihre API schnell als MCP-Tools bereitstellen und die Suche nach APIs und Ressourcen für die Verwendung durch Agenten vereinfachen.
- Mit dem **Agent-zu-Agent-Konnektor** können Organisationen die Kommunikation zwischen Agenten standardisieren, indem sie Agenten A2A-Protokollunterstützung bereitstellen. Jeder Agent (ein funktionaler Experte in der Domäne) kann die Anfrage eines Kunden ermitteln und an den für die Domäne am besten geeigneten Agenten delegieren.
- Der **Rückschluss-Konnektor** bietet Bausteine zum Erstellen eines Agenten von Grund auf, indem er LLM-Aufrufe, Vektoreinbettungen und -Suche, RAG-Abruf und MCP-Tools unterstützt.
### 15.4 API-Verwaltung
Die über den Anypoint-API-Manager bereitgestellte API-Verwaltung von MuleSoft bietet eine umfassende Plattform zum Entwerfen, Schützen, Regeln, Überwachen und Skalieren von APIs und Microservices in jeder Bereitstellungsumgebung. Organisationen können ihre APIs und Microservices mit konsistenten Steuerelementen und Statistiken auf Unternehmensebene unabhängig von der Plattform zentral verwalten. Zu den wichtigsten Funktionen zählen:
- **Anypoint Flex Gateway** ist ein API-Gateway auf Anwendungsebene zum Verwalten und Sichern von APIs und wendet Richtlinien zur Ratenbegrenzung, Zwischenspeicherung, Authentifizierung, Autorisierung, Bedrohungsschutz, Überwachung und Protokollierung auf HTTP/S-Ebene an. Es ist ein kompaktes, leistungsstarkes, Envoy-basiertes Gateway, das für Microservices-basierte verteilte Umgebungen entwickelt wurde und nahtlos in DevOps- und CI/CD-Workflows integriert werden kann, während es Unternehmenssicherheit und Verwaltbarkeit in jeder Umgebung bietet und eingehende und ausgehende Richtlinien unterstützt.
- Mit **API-Benachrichtigungen** können Organisationen bestimmte Schwellenwerte oder Bedingungen für ihre APIs definieren und überwachen, um ungewöhnliches oder unerwünschtes Verhalten zu erkennen. Beispiele sind Benachrichtigungen, wenn die Antwortzeit eine Obergrenze überschreitet (beispielsweise 60 Sekunden), wenn die Anzahl der Anforderungen in einem Zeitfenster zu hoch ist, wenn bestimmte HTTP-Antwortcodes zurückgegeben werden oder wenn Richtlinienverstöße auftreten.
- **API Analytics** bietet Einblicke in die Verwendung und Leistung von APIs. Mit dem Analytics-Dashboard können Organisationen allgemeine Kennzahlen verfolgen und anzeigen, Diagramme aufrufen, Dashboards und Berichte erstellen und anpassen, um Nutzungstrends, Richtlinienverstöße, Antwortzeiten, Anforderungs-/Antwortcodes und mehr nachzuvollziehen.
### 15.5 Integrationsentwicklungsumgebung der nächsten Generation
MuleSoft Anypoint Code Builder (ACB) ist unsere nächste Generation der IDE für die API- und Integrationsentwicklung und bietet eine moderne, einheitliche Erfahrung mit VS Code als Backend.
- **Zusammengeführte Entwicklungsumgebung:** Konsolidiert den gesamten API- und Integrationsentwicklungsprozess in einem Tool und unterstützt AsyncAPI-, OAS- und RAML-APIs, Governance-Regelsätze, einen Flow-Zeichenbereich mit geringem Code, vorgefertigte Konnektoren sowie integrierte Test- und Bereitstellungsoptionen. Darüber hinaus unterstützt ACB das Debugging, die Fehlerbehebung und die laufende Wartung mit intelligenten kontextbezogenen Vorschlägen.
- **Erfahrung bei der Agentenentwicklung:** Stellt Agentenerfahrungen über den gesamten Anwendungsentwicklungslebenszyklus hinweg bereit. Kernstück ist der MuleSoft-MCP-Server, der die Entwicklung der Agentenintegration ermöglicht. MuleSoft MCP Server bietet leistungsstarke Tools zum Generieren von API-Spezifikationen und -Integrationen aus natürlicher Sprache, Erstellen von Datentransformationen, Verwalten von Datenbeständen in MuleSoft Exchange und Verwalten von Anwendungen und API-Richtlinien. Die MuleSoft MCP Server-Tools treiben die API-Spezifikation und Integrationsentwicklung von Benutzern in allen VS Code-basierten AI-Code-Editoren voran, einschließlich Cursor, Windsurf und vielen mehr.
- **AI-Integrationen:** MuleSoft erweitert die Integrationsentwicklung mit Agentenfunktionen mithilfe des MuleSoft-Themencenters, das API-Aufrufe für den Zugriff auf das Unternehmenssystem in Agentforce-Aktionen umwandelt. Der Agentforce Connector bettet die Automatisierung natürlicher Sprache in Integrationen ein. Der Rückschluss-Konnektor integriert externe LLM-Anbieter sicher und ermöglicht AI-gesteuerte Logik in MuleSoft-Anwendungen. Organisationen können diese kombinierten Funktionen verwenden, um intelligente, adaptive Integrationen zu erstellen.
### 15.6 Laufzeitplattform
Die Laufzeitplattform von MuleSoft bietet flexible Bereitstellungsoptionen zum Ausführen von MuleSoft-Anwendungen, -APIs und -Integrationen in verschiedenen Umgebungen. Organisationen können das Laufzeitmodell auswählen, das ihren betrieblichen, Compliance- und Skalierbarkeitsanforderungen am besten entspricht, während gleichzeitig eine einheitliche Verwaltung und Governance über die Anypoint Platform gewährleistet ist. Durch diese Flexibilität wird sichergestellt, dass Anwendungen nahezu datennah ausgeführt werden können, regionale Vorschriften eingehalten werden und bedarfsgerecht nahtlos skaliert werden können.
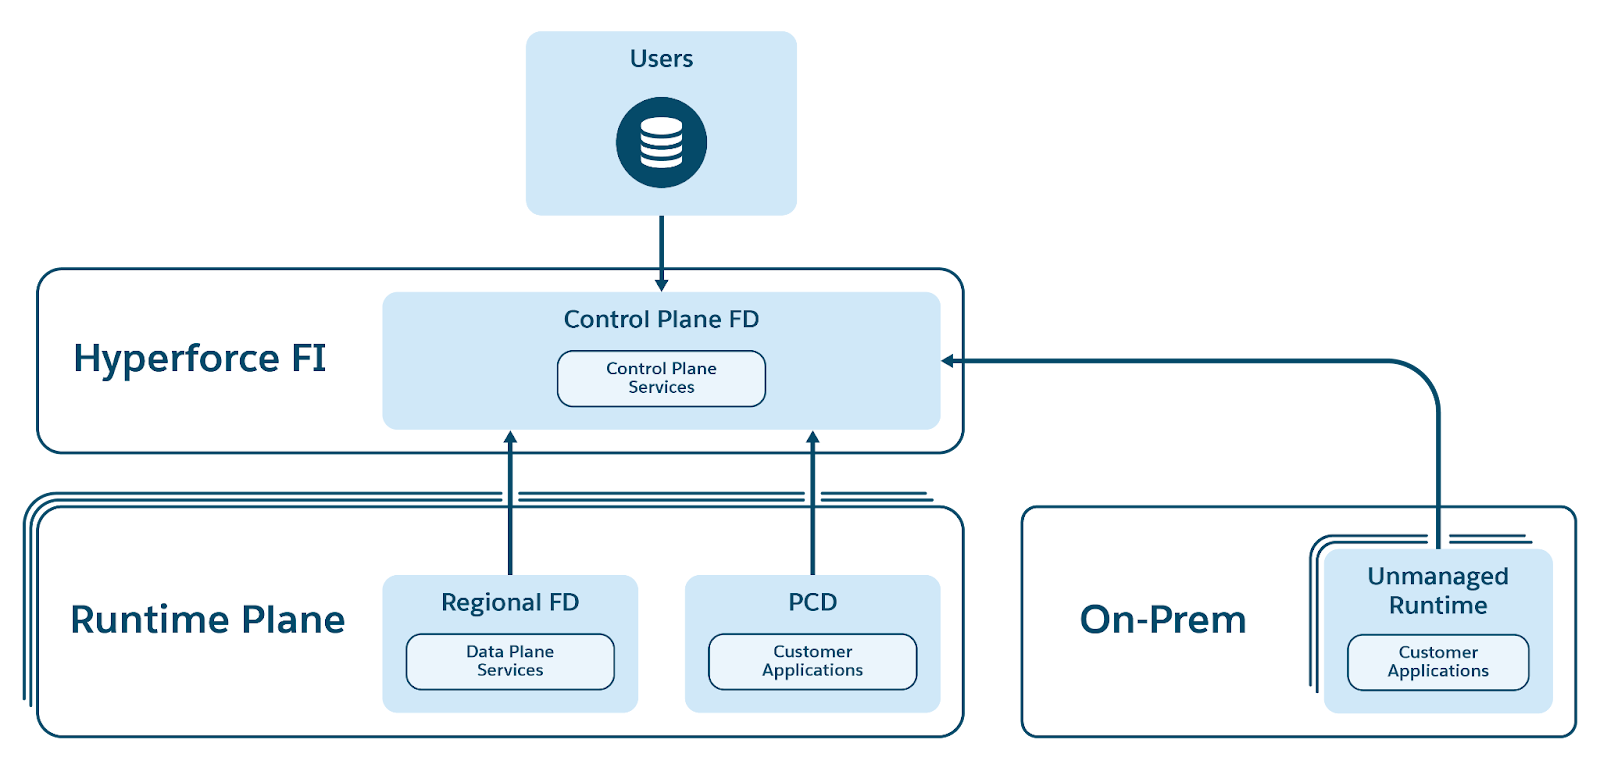 Zu den wichtigsten Hosting-Optionen zählen:
- **Cloud:** MuleSofts vollständig verwaltete Multi-Mandanten-Integration Platform-as-a-Service (iPaaS), die den Aufwand für die Infrastrukturverwaltung eliminiert. CloudHub 2.0 bietet elastische Skalierung, Hochverfügbarkeit und Bereitstellungen/Upgrades ohne Ausfallzeiten mit integrierten Anforderungen an die Beobachtbarkeit und Compliance-Zertifizierungen. Entwickler können sich auf die Erstellung von APIs und Integrationen konzentrieren, während MuleSoft die Laufzeitinfrastruktur verwaltet und so Sicherheit, Zuverlässigkeit und Hochverfügbarkeit auf Unternehmensebene gewährleistet.
- **Hybrid:** Für Organisationen, die ihre Anwendungen selbst hosten müssen, um mehr Kontrolle zu erhalten, bietet MuleSoft Runtime Fabric an, einen Containerservice, der die Bereitstellung und Orchestrierung von MuleSoft-Laufzeiten in Kubernetes oder virtuellen Maschinen automatisiert. Sie unterstützt horizontale Skalierung, Bereitstellungen ohne Ausfallzeiten, integrierte Sicherheitssteuerungen und vereinfachte Clusterverwaltung.
- **Private Cloud Edition (PCE):** Die Private Cloud Edition von MuleSoft bietet eine vollständig selbstverwaltete, lokale Version der Anypoint Platform (einschließlich Steuerfeld- und Laufzeitebenen), mit der Organisationen strenge behördliche, Datenresidenz- und Sicherheitsanforderungen erfüllen können. Sie ermöglicht es großen Unternehmen, die vollständige Kontrolle über die Infrastruktur zu behalten und gleichzeitig von den Funktionen der einheitlichen Integration und API-Verwaltung der Anypoint Platform zu profitieren.
### 15.7 Beobachtbarkeit
MuleSoft bietet umfassende Lösungen für die Beobachtbarkeit, die einen durchgängigen Überblick über APIs, Integrationen und Anwendungen in jedem Bereitstellungsmodell bieten. Die Beobachtbarkeitsfunktionen sind unabhängig davon, wo Arbeitslasten ausgeführt werden, konsistent und bieten eine einheitliche Ansicht der Umgebungen. Durch die Erfassung von Echtzeit- und historischen Telemetriedaten ermöglicht MuleSoft es Organisationen, Produktionsprobleme im gesamten Anwendungsnetzwerk schneller zu erkennen, zu analysieren und zu lösen. Die Beobachtbarkeitsdaten können nativ auf der Anypoint Platform angezeigt oder über OpenTelemetry in das bevorzugte APM eines Kunden exportiert werden, was eine nahtlose Integration in vorhandene Überwachungsökosysteme ermöglicht. Dadurch können Organisationen die Widerstandsfähigkeit der Infrastruktur proaktiv stärken und die Zuverlässigkeit geschäftskritischer Anwendungen verbessern.
MuleSoft bietet Beobachtbarkeit durch zwei primäre Angebote:
- Bei **der Anypoint-Überwachung** handelt es sich um die aktuelle in der Anypoint Platform integrierte Lösung für die Beobachtbarkeit im Markt. Es bietet vorkonfigurierte und anpassbare Dashboards zur Überwachung des Anwendungsstatus, erweiterte Protokollsuche für die Protokollverwaltung und Warnfunktionen, die Teams benachrichtigen, wenn definierte Schwellenwerte oder Anomalien auftreten.
- **Integrationsintelligenz** ist die erste AI-Beobachtbarkeitsplattform der nächsten Generation für MuleSoft, die nativ auf der Salesforce Platform neu konzipiert wurde. Dieses Angebot verwendet Data 360 als vereinheitlichte Datenebene für die Telemetriedaten, Tableau Semantics als vertrauenswürdige semantische Ebene, um intelligente, handlungsrelevante Statistiken zu ermöglichen, Tableau Concierge zur AI-gestützten Fehlerbehebung und Tableau Next-Dashboards, um interaktive visuelle Schnittstellen bereitzustellen, die mehrere Visualisierungen umfangreicher Daten in einer einzigen, zusammenhängenden Ansicht zusammenführen. Tableau Next bietet Kunden zudem die Möglichkeit, benutzerdefinierte Dashboards auf der Grundlage des mit Beobachtungsfunktionen ausgelieferten semantischen Datenmodells zu erstellen.
Dieser Stapel unterstützt auch die agentenzentrierte Verfolgung, die Kunden vollständige Transparenz über den nicht deterministischen Pfad des durchgängigen Agentenaufrufs bietet, sodass sie den Agenten bei jedem Zwischenschritt beobachten können, wodurch Benutzer die Ursache von Fehlern schneller finden und Leistungsengpässe identifizieren können.
## 16\. Ökosystem und AppExchange
Das Salesforce-Ökosystem zeigt beispielhaft die Leistungsfähigkeit der Plattform. Systemintegratoren (SIs) und Beratungspartner unterstützen Kunden durch die Entwicklung, Konfiguration und Optimierung komplexer Salesforce-Lösungen. Unabhängige Softwareanbieter erstellen innovative Anwendungen und Lösungen auf der Plattform, die Kunden dann in ihren Salesforce-Organisationen installieren können. Diese ISV-Anwendungen sind auf AppExchange verfügbar, dem 2006 gestarteten Anwendungs-Store von Salesforce, der nun über 10.000 Anwendungen mit mehr als 14,3 Millionen Installationen (Stand Oktober 2025) enthält.
Die AppExchange-Sucherfahrung wurde 2025 neu gestaltet, um Data 360 zu nutzen. Die Vektorsuchfunktionen von Salesforce Data 360 funktionieren in Verbindung mit der traditionellen Stichwortübereinstimmung, um semantisch relevantere Ergebnisse zu liefern, indem der Intent eines Benutzers in natürlicher Sprache verstanden wird. Die ultimative Vision besteht darin, diese Grundlage weiterzuentwickeln, indem sie in die Agentforce Platform integriert wird und eine vollständig agentenbasierte Oberfläche ermöglicht, auf der Kunden ihre geschäftlichen Herausforderungen konversativ beschreiben können, um hochgradig personalisierte Lösungsempfehlungen zu erhalten.
AppExchange gewährleistet in enger Zusammenarbeit mit Salesforce hochwertige Lösungen durch einen strengen Überprüfungsprozess, der Codeanalysen, Sicherheitsscanner und Referenzimplementierungsleitfäden umfasst. Diese Plattform bietet ISVs auch Lizenzverwaltungstools, um die Lizenzierung und Monetarisierung von Anwendungen anzupassen und verschiedene Preismodelle, einschließlich benutzerbasierter und verbrauchsbasierter Optionen, zu unterstützen.
Mit den "metadatengesteuerten Plattform"-Prinzipien können ISVs die nativen Anwendungen und Metadaten von Salesforce erweitern und so die Entwicklung von Datenmodellen, Geschäftslogik und Benutzeroberflächen vereinfachen. Von branchenspezifischen Anwendungen bis hin zu hochgradig angepassten Anwendungen mit Branding, die Technologien wie Lightning Web Components für die Benutzeroberfläche und Apex Code für die Geschäftslogik verwenden, unterstützt die Salesforce Platform eine breite Palette von Lösungen.
Das Konzept der Paketerstellung ist entscheidend für die Verteilung dieser Anwendungen auf verschiedene Salesforce-Organisationen. Die Paketerstellung umfasst die Serialisierung von Metadaten in ein Artefakt, das von jedem Salesforce-Kunden mithilfe der zugrunde liegenden Technologien für die Metadatenverwaltung in verschiedenen Umgebungen installiert werden kann. Eine Besonderheit der Paketerstellung besteht darin, dass sie Installationen in Umgebungen ermöglicht, die dem Entwickler unbekannt sind.
Um die Kontrolle und Sicherheit zu erhöhen, können ISVs Teile einer Anwendung sicher aktualisieren, da sich andere nicht auf diese Teile verlassen können, während Kunden andere Teile besitzen und verwalten können. Beispielsweise können ISVs bestimmte Metadaten, beispielsweise benutzerdefinierte Einstellungen, auf "verwaltet" festlegen, sodass sie für den Kunden unsichtbar und nicht bearbeitbar sind, was Unterbrechungen in der Umgebung des Kunden verhindert. Verwaltete Pakete enthalten diese Steuerelemente für die Verwaltbarkeit, während nicht verwaltete Pakete bereitgestellte Metadaten als vom Kunden erstellt behandeln, die nach der Bereitstellung nicht aktualisiert werden können.
Seit der Einführung von AppExchange und Salesforce Platform ist die Anzahl und Komplexität der Pakete, die erstellt und installiert werden, deutlich gestiegen. Als Reaktion auf diese Anforderungen hat die Plattform im Jahr 2020 die Paketerstellungsarchitektur der zweiten Generation eingeführt. Diese neue Architektur verbessert die Modularität verwalteter Pakete, verbessert die Versionierungsflexibilität, ermöglicht die Freigabe von Namespaces und unterstützt deklarative Abhängigkeiten u. a. im Softwareentwicklungslebenszyklus. Die Paketbereitstellungsarchitektur verfügte zudem über mehrere erhebliche Verbesserungen für mehr Effizienz und Skalierbarkeit, beispielsweise die Bestimmung der geänderten Metadaten und nur die Bereitstellung der Deltas.
Eine wichtige Maßeinheit für die Entwicklung neuer Produkte und Funktionen ist die Kompatibilität mit der Verpackung und die Bereitschaft zum ISV-Einsatz. Die Plattform betont die schnelle Verfügbarkeit ihrer Funktionen für Partner, wodurch das Salesforce-Ökosystem das Innovationspotenzial der Salesforce Platform effektiv und über die vorkonfigurierten Angebote von Salesforce hinaus nutzen kann. Dies ist jedoch ein Bereich der laufenden Investitionen, um sicherzustellen, dass alle in diesem Dokument beschriebenen Funktionen, die internen Salesforce-Entwicklern zur Verfügung stehen, auch für unsere ISV-Entwickler verfügbar sind.
Darüber hinaus bieten der Heroku Marketplace und der Slack Marketplace eine Vielzahl von Drittanbieterintegrationen und -Add-Ons, die die Funktionalität von Salesforce-Anwendungen verbessern können. Heroku Marketplace bietet Tools und Services für zusätzliche Anwendungsfunktionen und verbessert die Art und Weise, wie Entwickler Anwendungen erstellen, bereitstellen und verwalten. Slack Marketplace bietet Integrationen, die Workflows optimieren und die Zusammenarbeit in Salesforce-Umgebungen verbessern können.
## 17\. Salesforce in Salesforce
Im Sinne unseres Kernwerts "Kundenerfolg" fungiert Salesforce als "Customer Zero" für alle Anwendungen und Services auf der Salesforce Platform und nutzt kundenorientierte Produkte nach Möglichkeit intern. Dies bietet erhebliche Vorteile:
- **Rigorose Produkttests**: Durch die tägliche Verwendung der Produkt-Suite stellen sich Salesforce-Mitarbeiter den Herausforderungen der Praxis, verbessern die Produktqualität und identifizieren Verbesserungsbereiche.
- **Verfeinerte Produkte**: Das sofortige Feedback aus der internen Verwendung ermöglicht eine schnelle Optimierung der Funktionen und der Benutzerfreundlichkeit sowie die schnelle Identifizierung und Behebung von Fehlern, was zu Produkten führt, die die Kundenanforderungen nach der Veröffentlichung besser erfüllen.
- **Vertiefte Branchenexpertise**: Die interne Verwendung über verschiedene Funktionen hinweg bietet Salesforce wertvolle Statistiken zu spezifischen Produkt- und Branchenherausforderungen, insbesondere in Hightech-Sektoren.
- **Verbessertes Kundeneinfühlungsvermögen**: Die Erfahrung aus erster Hand mit der Plattform ermöglicht es Mitarbeitern, die Schwachstellen der Kunden besser zu verstehen und zu beheben.
- **Marketing- und Vertriebsstatistiken**: Die tägliche Produktnutzung fließt in Vertriebs- und Marketingstrategien ein und hilft so, die Plattform an die Kundenanforderungen anzupassen.
- **Strengere Markteinführungsstrategie**: Durch die erfolgreiche interne Implementierung kann Salesforce die Suite sicher als bewährte Lösung vermarkten.
Darüber hinaus werden alle für die Produktion vorgesehenen Softwareaktualisierungen im Rahmen eines gestaffelten Bereitstellungsprozesses zunächst in einer speziellen Salesforce on Salesforce Hyperforce-Instanz bereitgestellt. Seit August 2020 hostet diese Instanz erfolgreich GUS, die Salesforce-Organisation für Entwicklungsteams, sowie die CRM-Vorgänge von Salesforce, was die Robustheit und Bereitschaft von Hyperforce für jeden Kunden zeigt. Mit dieser Strategie können interne Teams Probleme lange vor Produktionsbereitstellungen für externe Kunden testen und feststellen.
Die Salesforce Technology-Organisation hat Agentforce als interne Plattform für mehr Produktivität und Qualität im gesamten SDLC vollständig übernommen. Dadurch konnten wir nicht nur die Qualität des gesendeten Codes für unsere Kunden verbessern, indem wir Fehler frühzeitig erkannt und behoben haben, sondern auch die Agentenerfahrungen anhand interner Rückmeldungen aus erster Hand schnell durchlaufen.
## 18\. Bereitstellung der Transformation im großen Maßstab
Seit der Gründung im Jahr 1999 hat Salesforce mehrere Technologietransformationen durchlaufen. Die Transformation der Salesforce Platform war jedoch aufgrund ihres Umfangs und der schnellen Implementierung von Änderungen besonders bedeutsam. Diese Transformation erforderte eine gleichzeitige Weiterentwicklung aller wichtigen Architekturkomponenten, um eine integrierte Plattform zu erreichen. Um sicherzustellen, dass diese Transformation iterativ und minimal störend für Beteiligte und Vorreiter war, musste die Salesforce Technology-Organisation auch ihre Entwicklungs- und Produktzustellungspraktiken weiterentwickeln.
Die Salesforce Technology-Organisation ist ein großes und vielfältiges Team, das aus über 2500 Teams an mehr als 20 Standorten in 14 verschiedenen Ländern besteht. Diese Gruppe arbeitet in großem Umfang, stellt mehr als 200 Produktversionen bereit und implementiert jede Woche 250.000 Systemänderungen. Entsprechend dem allgemeinen Unternehmensethos orientiert sich der Technologiekonzern an fünf Kernwerten: Trust, Kundenerfolg, Innovation, Gleichberechtigung und Nachhaltigkeit. Diese Werte sind wesentlich für die Gestaltung der Strategie der Gruppe, die Steuerung ihrer Ausführung und die Beeinflussung täglicher Entscheidungen.
Im Einklang mit unseren Grundwerten bietet das Salesforce Engineering 360-Framework Ingenieurteams handlungsorientierte Dashboards und umfassende Statistiken zu ihren Vorgängen, wodurch klare Erwartungen an Standards und bewährte Vorgehensweisen innerhalb der Organisation gestellt werden. Diese ganzheitliche Ansicht umfasst verschiedene wichtige Bereiche wie Verfügbarkeit, Sicherheit, Compliance, Qualität, Barrierefreiheit, Developer Productivity, agile Produktentwicklung und Kosteneffizienz. Das Framework verarbeitet Milliarden von Datensätzen aus Hunderten von internen Engineering-Systemen, beispielsweise Sicherheitssystemen, Produktionsintegritätsprotokollen, Code-Repositorys, Entwicklungsumgebungen, CI/CD-Systemen sowie Systemen zur Versions-/Arbeitsplanung und -verfolgung, die auf der Salesforce Platform basieren und die neuesten Innovationen von Agentforce, Data 360, Tableau und Slack nutzen.
Die Salesforce Technology-Organisation basiert auf diesen und anderen Daten und nutzt KI und Agententechnologien, um die Produktivität zu steigern. Wir haben täglich über 10.000 aktive Benutzer interner AI-Tools und über 100 AI-Agenten erstellt, die Teil unseres internen AgentExchange-Programms sind, um die Produktivität in der gesamten Organisation voranzutreiben.
Dank unseres Top-Werts Trust ist die Serviceinhaberschaft tief in unserer Ingenieurskultur verankert. Jeder Service und jedes Produkt ist so konzipiert, dass sie seine Service Level Objectives (SLOs) in Bezug auf Verfügbarkeit und Vorfallsmanagementkennzahlen wie Time To Detect (TTD) und Time To Restore (TTR) nicht nur erfüllen, sondern übertreffen. Unser Ansatz für die Änderungsverwaltung, die Versionsbereitschaft und das Problemmanagement entspricht hohen Standards. Die Sicherheit ist in jede Phase unseres sicheren Entwicklungslebenszyklus integriert und folgt dem Prinzip der Sicherheit nach Standard. Qualität und Leistung werden durch die agile Testmethode priorisiert, die Millionen automatisierter Tests für Einheiten-, Funktions-, Integrations- und Last-/Skalierungstests in unseren CI/CD-Pipelines umfasst.
Architektonisch konzentrieren wir uns auf die Entwicklung gemeinsamer Funktionen, um Hebelwirkung und Effizienz zu steigern und so die Qualität zu verbessern. Beispielsweise haben wir verwaltete Services in Hyperforce entwickelt, um verschiedene Anforderungen wie Rechen- und Datenverwaltung zu erfüllen. So können sich Produktteams auf Produktinnovationen konzentrieren, während zentrale Teams diese Services hinsichtlich Sicherheit, Verfügbarkeit und Kosteneffizienz verbessern.
Unsere Abläufe sind agil und fördern die Innovation für Kunden. Jedes der über 3.000 Teams verfügt über die Autonomie bei der Implementierung des agilen Frameworks mit Scrum oder Kanban. Die Produktentwicklungsplanung in der gesamten Organisation ist mit verschiedenen Zeitachsen strukturiert, einschließlich eines 3-Jahres-Langstreckenplans für die strategische Ausrichtung, gefolgt von jährlichen Ausführungsplänen und weiter unterteilt in 4-monatige Produktveröffentlichungspläne, die alle zwei Wochen Sprintpläne enthalten. Produkte, Funktionen und Fehlerbehebungen werden über mehrere Versionsfahrzeuge bereitgestellt, um verschiedenen Kundenanforderungen gerecht zu werden. Dazu zählen drei Hauptversionen pro Jahr, zweiwöchentliche Versionen und tägliche Versionen.
Produktivität ist angesichts unserer Skalierung von entscheidender Bedeutung. Das SPACE-Framework wird verwendet, um die Produktivität effektiv zu messen, unterstützt durch einen umfassenden Satz an Kennzahlen, die vom Engineering 360-System bereitgestellt werden. Darüber hinaus konzentrieren wir uns auf die Verbesserung der Tools und Erfahrungen für unsere internen Entwickler, um den Entwicklungslebenszyklus zu optimieren, wobei Investitionen in Agentenerfahrungen und AI, Workflow, Erstellungstools, Entwicklungs-Setups, sicherere Versionen und Sicherheitsservices erhebliche Vorteile bringen.
## 19\. Fazit
Zusammenfassend lässt sich sagen, dass die Salesforce Platform in den letzten fünf Jahren eine bemerkenswerte Transformation durchlaufen hat, die sich von der wegweisenden Multi-Mandanten-Cloud-Plattform zu einer vertrauenswürdigen, integrierten, agentenbasierten und datengestützten Plattform entwickelt hat, die eine Reihe von Anwendungen und Services in ihrer gewünschten Region unterstützt. Diese Entwicklung wurde durch die Notwendigkeit vorangetrieben, sich neuen Herausforderungen zu stellen, wie dem Aufstieg von Public Cloud-Anbietern, steigenden regulatorischen Anforderungen und Fortschritten bei generativer AI und maschinellem Lernen.
Durch die Einführung von Hyperforce, Data 360 und Agentforce wurden die Funktionen der Plattform erheblich erweitert, sodass sie bei gleichzeitiger Wahrung von Trust und Zuverlässigkeit an der Spitze der Innovationen steht. Die erfolgreiche Migration der Mehrheit unserer Kunden auf diese neue Plattform unterstreicht den Einfallsreichtum und das Engagement unserer Ingenieure.
Da wir weiterhin innovativ sind und uns an die sich ändernden Marktanforderungen anpassen, ist die Salesforce Platform gut positioniert, um die nächste Generation von Anwendungen und Kundenanwendungsfällen zu unterstützen, was unser Engagement für Kundenerfolg und technologische Spitzenleistungen bekräftigt.
## Übersicht
Enterprise-Datenarchitekturen befinden sich selten in einem System. Salesforce verwaltet Kundenengagement-, Pipeline- und Serviceinteraktionen. Analyseplattformen wie Snowflake enthalten historische Transaktionen, Finanzdatensätze, Nutzungsdaten und betriebliche Kennzahlen. Traditionell bedeutete die Überbrückung dieser beiden Welten das Erstellen und Pflegen von ETL-Pipelines: geplante Aufträge, die Daten aus der Quelle extrahieren, umwandeln und Kopien in Salesforce laden. Aufgrund dieser Pipelines erhalten die Daten Verzögerungen, die Governance-Richtlinien vervielfachen sich systemübergreifend und Pipelines erfordern eine kontinuierliche betriebliche Versorgung.
Die Salesforce-Datenvirtualisierung bietet ein anderes Modell. Anstatt Daten in Salesforce zu verschieben, ermöglicht sie Salesforce die Abfrage von Daten direkt an der Quelle zur Laufzeit ohne Abgleich. Benutzern werden externe Live-Daten über Salesforce-Standardoberflächen angezeigt. Die Daten verlassen niemals ihren maßgeblichen Speicherort. In diesem Dokument wird am Beispiel von Snowflake erläutert, wie das Muster funktioniert, wann es verwendet werden soll und wie Sie loslegen.
## Was ist die Datenvirtualisierung?
Bei der Salesforce-Datenvirtualisierung handelt es sich um ein Integrationsarchitekturmuster, mit dem Salesforce Daten zur Laufzeit direkt aus externen Systemen abfragen kann, ohne diese Daten in den Salesforce-Speicher kopieren oder replizieren zu müssen. Statt Daten einzugeben, sendet die Plattform die Abfrage aus.
Daher interagieren Salesforce-Benutzer über vertraute Salesforce-Oberflächen (wie Seitenlayouts, Themenlisten, Berichte oder Flows) mit externen Daten, während die Daten im zugehörigen Quellsystem verbleiben. Governance, Zugriffssteuerung und Datenresidenz bleiben dort, wo sie hingehören.
Dieses Muster basiert auf einem einzigen Architekturprinzip: Daten verbleiben an der Quelle. Die Berechnung wird in die Daten verschoben.
## Warum es wichtig ist
Die meisten Salesforce-Bereitstellungen in Unternehmen können über Abgleichspipelines in externe Datenplattformen (wie Data Warehouses, betriebliche Datenbanken oder Analyse-Shops) integriert werden. Pipelines extrahieren, transformieren und laden Daten nach Plan in Salesforce. Dieser Ansatz funktioniert, aber die Replikation führt zu strukturellen Kompromissen:
* Abgeglichene Daten werden immer verzögert. Pipelines führen zu Verzögerungen und veraltete Daten führen zu schlechten Entscheidungen.
* Jede Kopie der Daten erweitert den Compliance-Geltungsbereich. Für sensible Daten (wie personenbezogene Daten, Finanzdatensätze oder Gesundheitsdaten) in mehreren Systemen müssen mehrere Governance-Richtlinien verwaltet werden.
* Pipelines erfordern laufende betriebliche Investitionen, Überwachung, Fehlerbehandlung, Schemadrift-Verwaltung und Wiederverarbeitungslogik.
Die Datenvirtualisierung behebt diese Kompromisse direkt. Sie entfernt die Pipeline vollständig für schreibgeschützte Anwendungsfälle, behält die Daten an ihrem maßgeblichen Speicherort bei und bietet Salesforce-Benutzern eine kontrollierte Echtzeitansicht der externen Daten ohne den Aufwand für den Abgleich.
## Produkte im Umfang
 |
Salesforce Connect ist die Plattformfunktion, die die Datenvirtualisierung in Salesforce ermöglicht. Es stellt das Adapter-Framework bereit, das SOQL-Abfragen in die Abfragesprache eines externen Systems übersetzt, authentifizierte Callouts verwaltet und Ergebnissätze wieder Salesforce-Feldtypen zuordnet. Es unterstützt externe Objekte, das Salesforce-Metadatenkonstrukt, das externe Daten als abfragbare, plattformeigene Einheiten anzeigt, ohne Daten in den Salesforce-Speicher zu replizieren. Externe Objekte verhalten sich wie Salesforce-Standardobjekte, die in Seitenlayouts, Themenlisten und Berichten sichtbar sind und über SOQL und Standard-APIs aufgerufen werden können, enthalten jedoch keine Daten. Externe Objekte sind eine Schemaprojektion über das Quellsystem. |
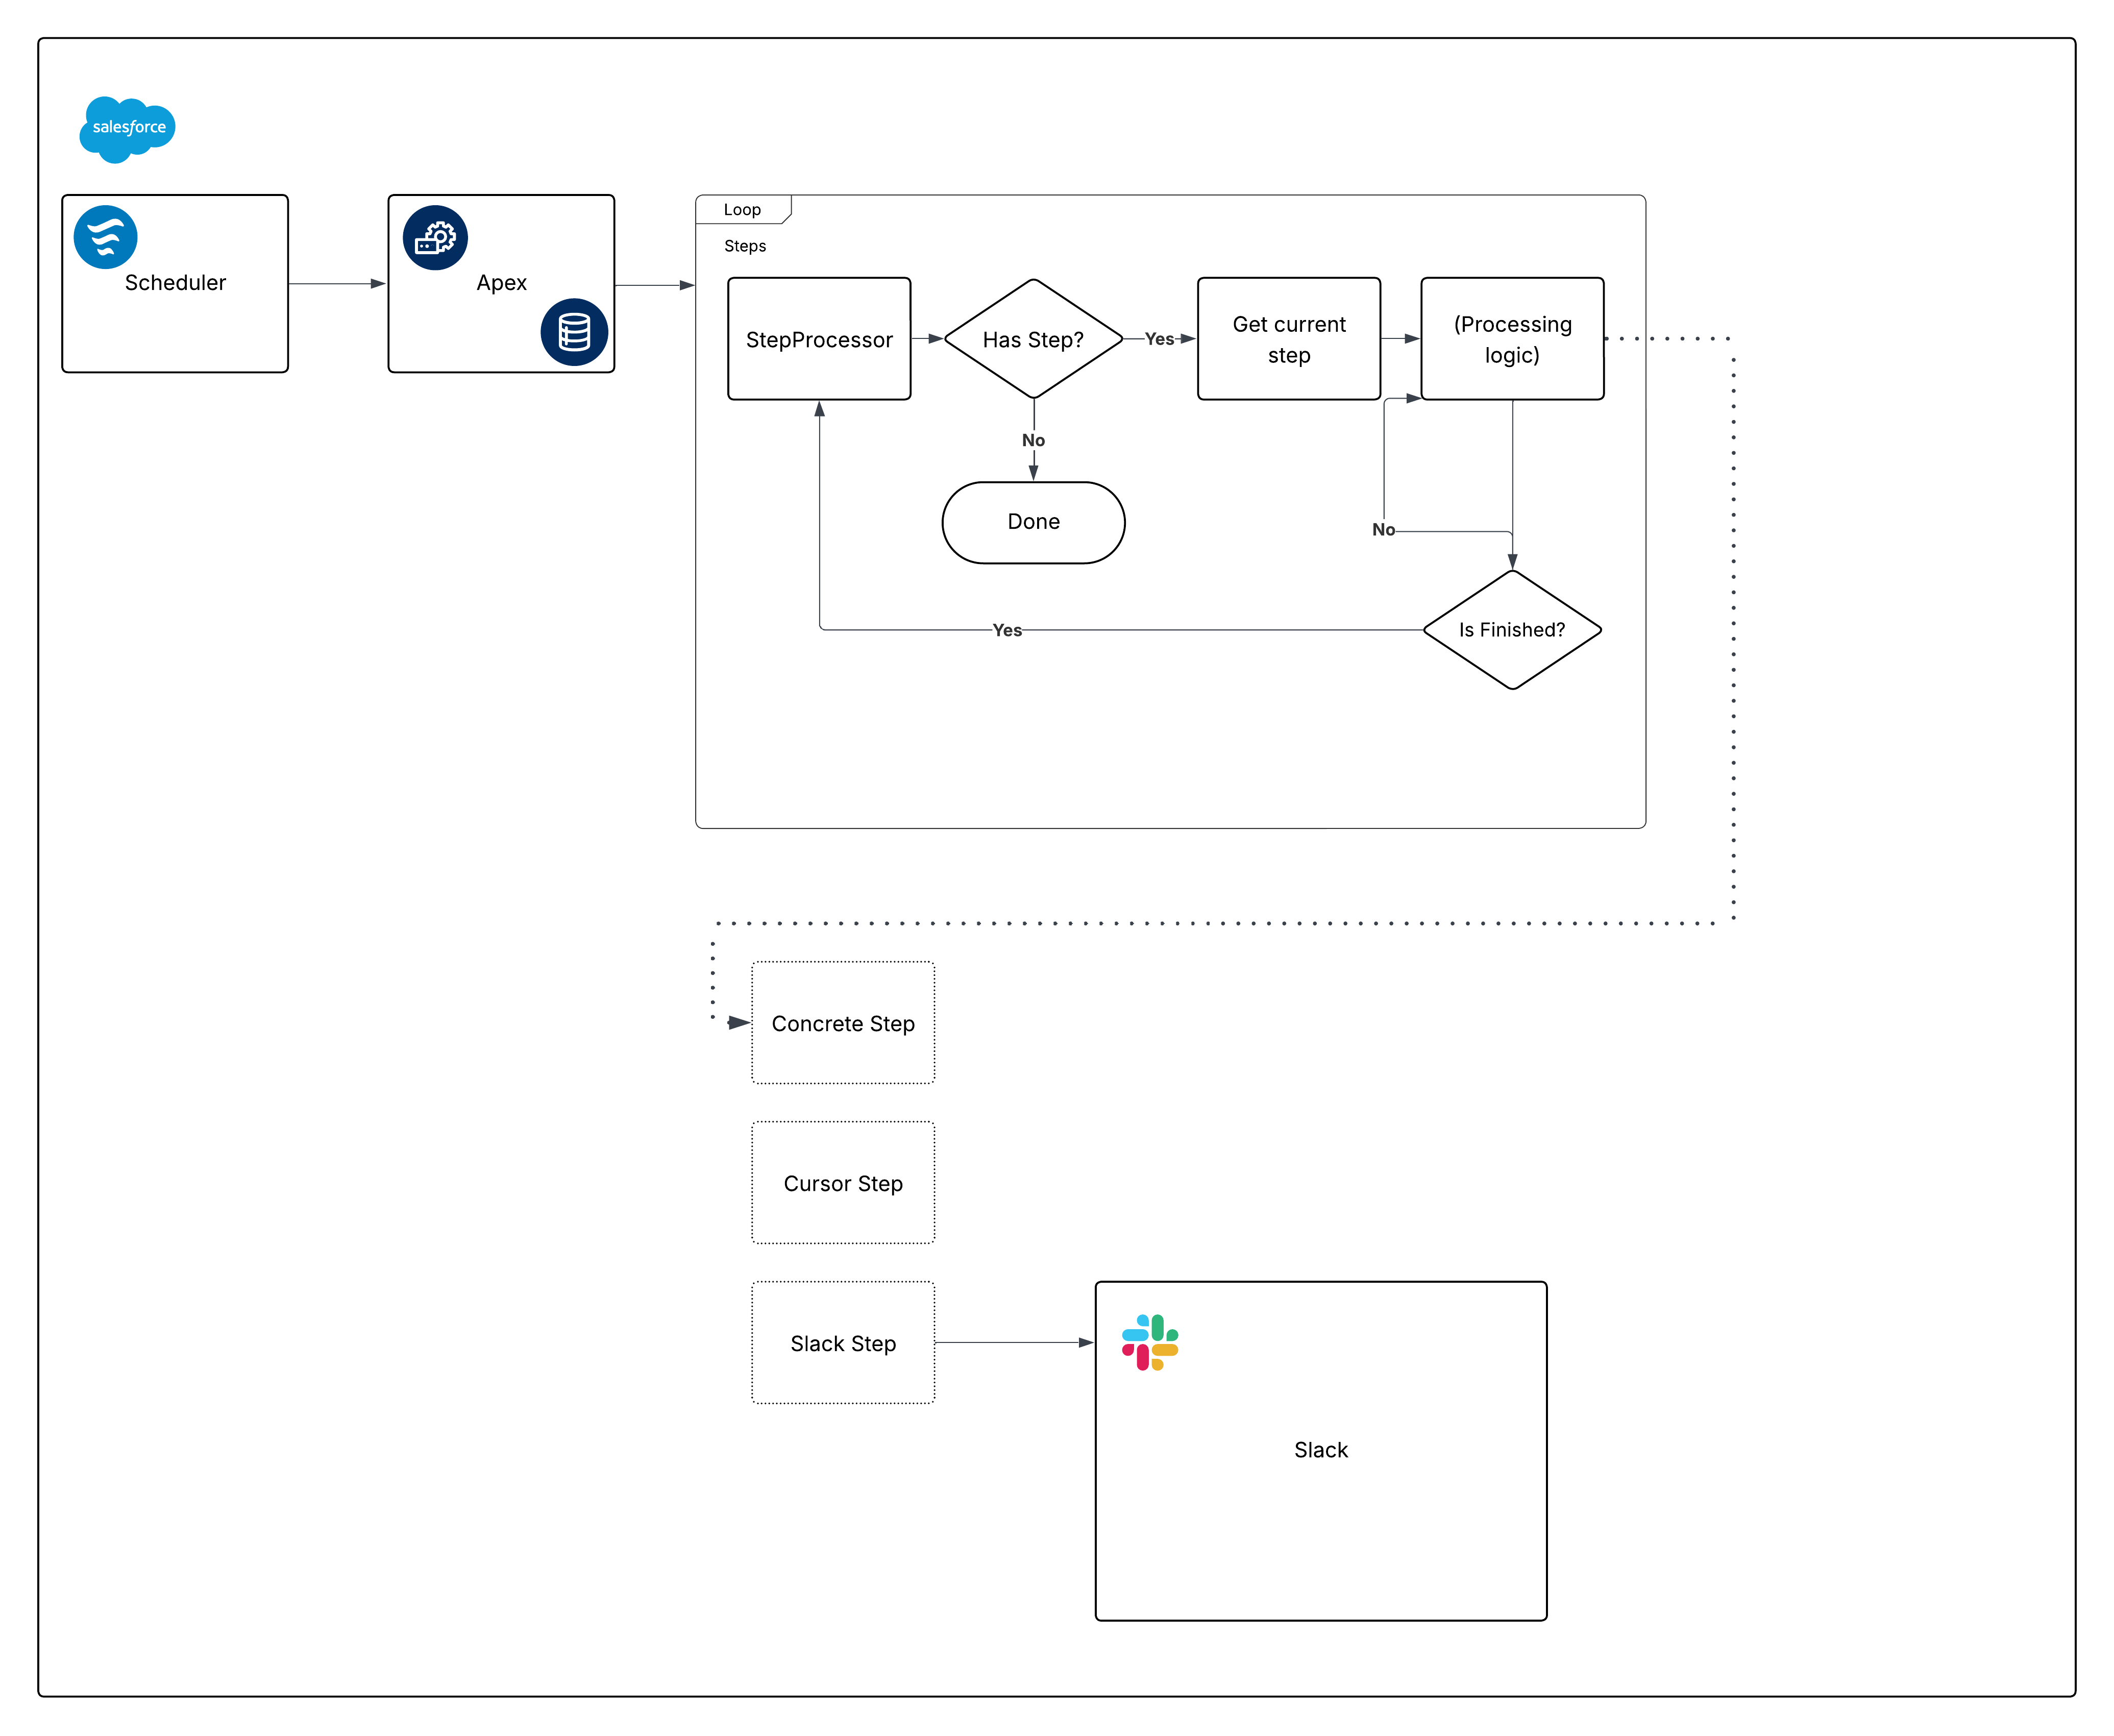 Nun schlüsseln Sie das Diagramm auf und erstellen Sie die Teile.
## Planung mit geplantem Flow
Der geplante Flow bietet als Planungsmechanismus mehrere Vorteile:
- Geplante Flows können als Metadaten in Pakete aufgenommen und bereitgestellt werden. Dies gilt nicht für Aufträge, die über Apex (oder über die Seite "Geplante Aufträge") geplant werden.
- Das Warteelement ist wichtig für Frameworks, die Callouts erfordern. Durch die Verwendung in Flow sind Callouts im Teil "Aufrufbar" des Frameworks nicht erforderlich.
- Die Planungsgranularität erfüllt die folgenden Anforderungen: Das Mindestintervall für geplante Flows beträgt täglich. Wenn Sie eine höhere Häufigkeit benötigen (z. B. stündlich), sollten Sie den geplanten Flow für diese Anforderung überdenken.
Eine weitere Überlegung beim Konfigurieren des geplanten Flows ist das Umgebungs-Gating. Fügen Sie vor dem Aufrufen der Apex-Aktion ein Entscheidungselement hinzu, das die `{!$Api.Enterprise_Server_URL_100}` auswertet. Dadurch wird sichergestellt, dass der Auftrag nur in den vorgesehenen Umgebungen ausgeführt wird, z. B. in UAT und Production. Dieses Muster ist wichtig, da Sandbox-Instanzen während des SDLC häufig aktualisiert oder neu erstellt werden und ein geplanter Flow ohne explizite Umgebungsprüfung versehentlich in Umgebungen ausgeführt werden könnte, in denen das Framework nicht ausgeführt werden soll. Durch die Verwendung des `contains`-Operators im Entscheidungselement wird das Setup widerstandsfähig gegen künftige Sandbox-Erstellungen oder URL-Änderungen.
Überlegen Sie abschließend, wie das Framework Fehler erfassen soll. Fügen Sie immer einen Fehlerpfad hinzu, wenn Flow eine beliebige Aktion aufruft. Beispielsweise können Sie Fehler mit [der](https://www.nebulalogger.com/) Aktion "Protokolleintrag hinzufügen" verdrahten. Der Nebelprotokollierer schreibt Protokolle in benutzerdefinierte Objekte. Daher sollten sich Kunden bewusst sein, dass Protokolldaten den Speicherplatz in der Organisation belegen. Protokolle werden standardmäßig 14 Tage in einer Organisation gespeichert und dann bereinigt. Dieser Aufbewahrungszeitraum kann konfiguriert werden. Der Nebelprotokollierer verwendet auch Plattformereignisse zum Veröffentlichen von Protokollen, sodass Protokolleinträge unabhängig von der Hauptdatenverarbeitungstransaktion gespeichert werden. Auf diese Weise wird sichergestellt, dass Fehler auch dann erfasst werden, wenn die primäre Flow- oder Apex-Aktion zurückgesetzt wird. Kunden sollten das erwartete Protokollvolumen und die Aufbewahrungsanforderungen auswerten, wenn sie das Hinzufügen eines Protokollierungs-Frameworks in Erwägung ziehen.
So sieht der Flow aus:
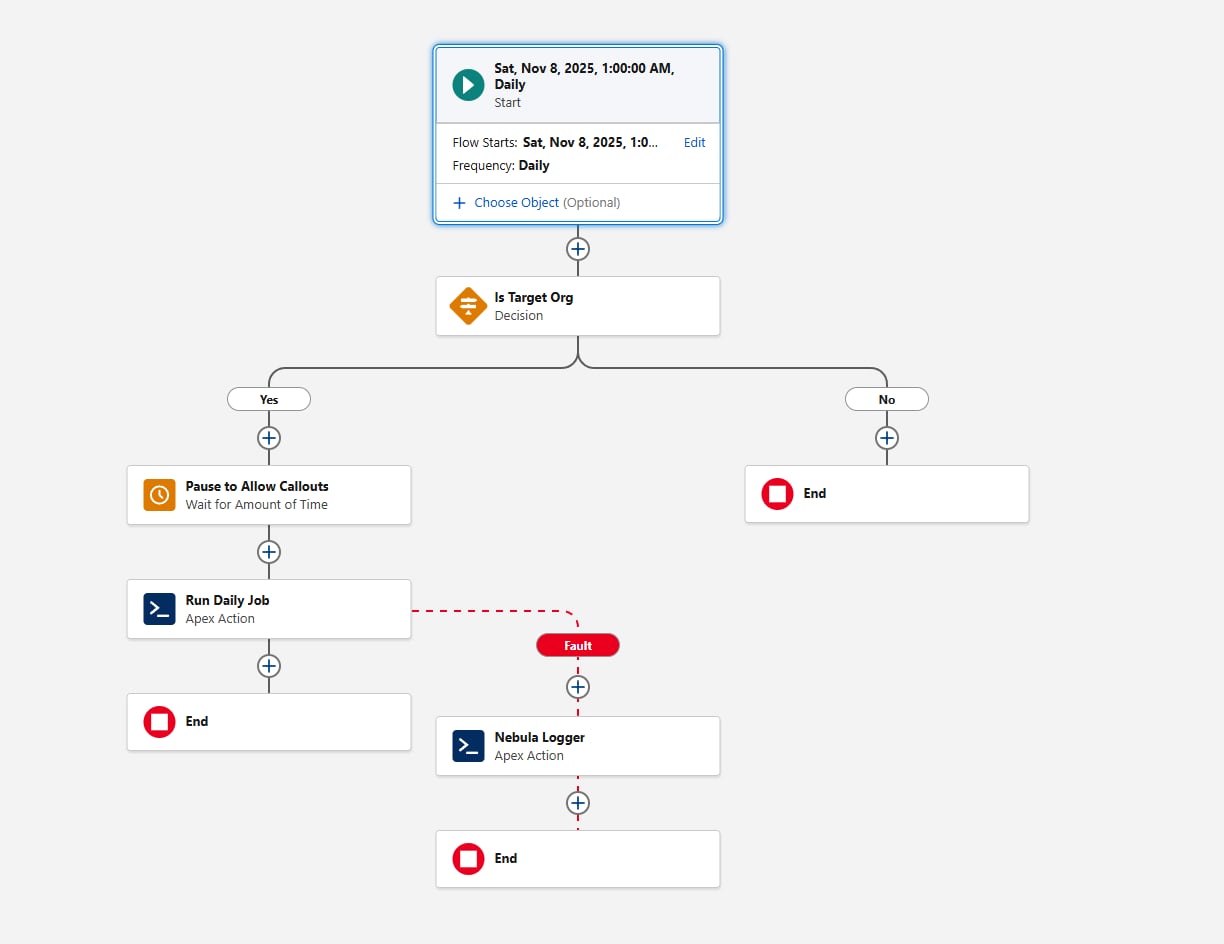 Gehen wir nun zu den ersten Teilen des Apex Codes über, wobei die Planungsanforderung nun erfüllt ist.
## Erstellen einer Schrittoberfläche
Definieren einer `Step`:
```java
public interface Step {
void execute();
void finalize();
String getName();
Boolean shouldRestart();
}
```
In diesem Artikel wird die `step` der Übersichtlichkeit halber als äußere Klasse angezeigt. Das Framework selbst ist flexibel. Teams können die Oberfläche und ihre Implementierungen mithilfe eines beliebigen Apex-Paketerstellungsmusters organisieren, sofern alle Schrittklassen auf dieselbe Oberfläche verweisen.
Zu den auf unserer Oberfläche definierten Methoden gibt es einige Hinweise:
- Die `execute` wird verbessert, wenn eine `State` (oder Schnittstelle) übergeben wird, um Daten zwischen Schritten zu orchestrieren, wenn es auf die Reihenfolge ankommt.
- `getName` kann anstelle eines `String` einen `System.Type` zurückgeben. Ziel ist es, der Orchestrierungsebene eine Möglichkeit zu geben, Schrittnamen zu protokollieren, ohne andere Eigenschaften offenzulegen.
Im Folgenden finden Sie die erste konkrete Implementierung, die zeigt, wie diese Teile zusammenpassen. Mit einer Ausnahme später wird empfohlen, warteschlangenfähigen Apex zu verwenden, um eine asynchrone Verarbeitung in Apex zu implementieren; Batch Apex ist in der Regel nicht erforderlich (und `@future` werden abgeraten). Warteschlangenfähiger Apex startet schnell und bietet mit Apex Cursors viele Vorteile gegenüber Batch Apex.
### Eine Apex Cursor-ähnliche Implementierung
[Apex Cursors](https://developer.salesforce.com/docs/atlas.en-us.apexcode.meta/apexcode/apex_cursors.htm) bieten eine moderne Alternative zum herkömmlichen Batch Apex Modell. Ähnlich wie bei der Batch-Verarbeitung kann eine Cursor-Implementierung Datensätze in Blöcken abrufen (bis zu 2.000 pro Batch). Cursors ermöglichen jedoch mehrere Abrufe innerhalb einer einzelnen Transaktion und ermöglichen so einen deutlich höheren Durchsatz für Vorgänge mit großem Volumen.
Wenn Teams Cursors als Teil dieses Frameworks übernehmen, sollten sie die aktuellen Einschränkungen bei Tests und der Mockability beachten. Das Cursorverhalten in Tests kann sich vom Produktionsverhalten unterscheiden. Daher ist es wichtig, Teststrategien zu entwerfen, die vermeiden, dass sich Cursorinterna auf sie verlassen, und stattdessen die Orchestrierungslogik an den Grenzen zu validieren. Im Zuge der Weiterentwicklung der Plattform werden sich diese Bereiche weiter verbessern, die zentrale Anleitung bleibt jedoch: Cursors bieten im Vergleich zu Batch Apex in vielen Anwendungsfällen eine höhere Leistung und einen geringeren Orchestrierungsaufwand.
Wenn Sie eine klare Grenze zwischen dem vom System bereitgestellten Cursor und Ihrem eigenen Code definieren möchten, sollten Sie beim Implementieren der `Step` eine Cursor-ähnliche Darstellung erstellen. Beachten Sie diesen Code:
```java
public inherited sharing abstract class CursorStep implements Step {
private static final Integer MAX_CHUNK_SIZE = 2000;
protected Cursor cursor;
private Integer chunkSize = System.Limits.getLimitDMLRows();
private Integer position = 0;
protected abstract Cursor getCursor();
protected abstract void innerExecute(List