
|
Bei der Salesforce Lightning Platform handelt es sich um eine umfassende AI-gestützte Plattform, die Mitarbeiter, autonome AI-Agenten, Unternehmensdaten und Anwendungen in einem einzigen, vertrauenswürdigen System zusammenführt, um die Produktivität und die Kundenerfahrung zu steigern. Durch die Verbindung von Customer 360-Anwendungen, Data Cloud und Slack für eine durchgängige Automatisierung kann ein "Agentenunternehmen" erstellt werden. |
| Ansatz | Beschreibung | Erforderliche Fertigkeiten | Lizenzen und Obergrenzen |
|---|---|---|---|
| Queueable Apex | Wird für Prozesse verwendet, die langfristige Datenbankvorgänge oder Callouts für externe Webservices beinhalten. Der warteschlangenfähige Apex bietet Funktionen wie Auftrags-IDs, Unterstützung für nicht primitive Typen und Auftragsverkettung. | Pro-Code | Die Anzahl der Lizenzen kann die Obergrenzen erhöhen. |
| Batch Apex | Erstellen Sie komplexe, langfristige Prozesse, die Millionen von Datensätzen umfassen, indem Sie Ihren Datensatz aufteilen und in überschaubare Blöcke verarbeiten. | Pro-Code | Die Anzahl der Lizenzen kann die Obergrenzen erhöhen. |
| Geplantes Apex | Führen Sie Apex zu einem geplanten Zeitpunkt aus, der durch einen Cron-Ausdruck definiert ist. Obwohl es sich bei der Planung von Apex über den Ausdruck cron um einen asynchronen Prozess handelt, wird der zugrunde liegende Code synchron ausgeführt, wenn der Auftrag gestartet wird. | Pro-Code | Die Anzahl der Lizenzen kann die Obergrenzen erhöhen. |
| Apex-Fortsetzungs-Callouts | Führen Sie Callouts aus Apex-Methoden aus, die in einem synchronen Transaktionskontext ausgeführt werden. | Pro-Code | Nein |
| Asynchroner Pfad (durch Datensätze ausgelöste Flows) | Führen Sie einen Vorgang aus, den Sie selbst ausführen möchten. Vermeiden Sie gemischte DML-Fehler, die auftreten, wenn Sie einen Wert in einem verwandten Datensatz aktualisieren, der nicht Teil des Datensatzes ist, der einen Flow ausgelöst hat. | Low-Code | Anzahl und Typ der Lizenzen können die Obergrenzen erhöhen. |
| Geplanter Pfad (nach Commit-Flows) | Ausführen zu einem dynamisch geplanten Zeitpunkt nach einem auslösenden Ereignis, beispielsweise wenn ein Datensatz erstellt, aktualisiert oder gelöscht wird. | Low-Code | Anzahl und Typ der Lizenzen können die Obergrenzen erhöhen. |
| Geplante Flows | Führen Sie einen Flow im Hintergrund zu einer angegebenen Zeit und mit wiederholter Häufigkeit (täglich, wöchentlich oder einmal) aus, um Aktionen für einen Datensatzbatch auszuführen. | Low-Code | Anzahl und Typ der Lizenzen können die Obergrenzen erhöhen. |
| Plattformereignisauslöser | Koppeln Sie Salesforce lose mit externen Systemen und kommunizieren Sie zwischen asynchronen Komponenten innerhalb der Salesforce Platform. | Low-Code + Pro-Code | Für Anwendungsfälle von Plattformereignissen mit hohem Volumen ist eine Add-On-Lizenz erforderlich |
| Datenerfassung ändern | Erfassen und verarbeiten Sie Änderungsereignisse asynchron, nachdem die Datenbanktransaktion übernommen wurde. | Pro-Code | Für die Skalierung oberhalb der Basiszuteilung ist eine Add-On-Lizenz erforderlich. |
| Bulk API | Fügen Sie viele Datensätze asynchron ein, aktualisieren, aktualisieren, einfügen, abfragen oder löschen Sie sie und verarbeiten Sie die Ergebnisse später. | Pro-Code | Es gibt Obergrenzen. |
| Lightning Aktionen | Ermöglichen Sie es Lightning-Seiten, mit dem Server zu interagieren, ohne Benutzer zu zwingen, die Seite vollständig zu aktualisieren. | Low-Code | Nein |
| Erforderliche Fertigkeiten | Einige der in diesem Handbuch beschriebenen Tools erfordern Code, während andere deklarativ konfiguriert werden können. Überlegen Sie sich bei Ihren Optionen, über welche Fertigkeiten Ihre Teammitglieder verfügen. Beachten Sie, dass Sie Ihre Lösungen in Zukunft möglicherweise ändern müssen, selbst wenn Entwickler für Ihre erste Implementierung verfügbar sind (beispielsweise über einen Implementierungspartner). Wenn Ihrem Wartungsteam Entwickler fehlen, kann eine Low-Code-Option besser passen. |
| Typ der erzwungenen Plattformobergrenzen | Legen Sie fest, welche Obergrenzen für die Ausführung gelten. Überlegen Sie beim Entwerfen Ihrer Lösungen genau, wie das Volumen und die Häufigkeit von Transaktionen auf die Obergrenzen für den gewählten Ansatz pro Tag angerechnet werden. Berechnen Sie die Anzahl der Hinrichtungen, die jeden Tag erfolgen. Stellen Sie sicher, dass die berechneten Werte innerhalb der mit Ihren ausgewählten Tools verknüpften Obergrenzen liegen. |
| Latenz | Bestimmen Sie, wie schnell die Verarbeitungsergebnisse auf der Plattform verfügbar sein sollen. Bei einigen Ansätzen sind die Änderungen nahezu sofort, bei anderen hingegen in Minuten oder Stunden. |
| Anwendungsfall | Beschreibung | Ansatz der ersten Wahl | Begründung |
|---|---|---|---|
| Hochleistungsfähige Batchverarbeitung | Jede Automatisierung, die Tausende oder Millionen von Datensätzen effizient verarbeiten muss | Batch-Apex | Batch Apex bietet umfangreiche APIs für die Anbindung an die Plattform und für die Rohgeschwindigkeit. |
| Datenbereinigungsauftrag | Ein Auftrag, der routinemäßig oder nach Bedarf ausgeführt wird und Daten bereinigt. Beispiele hierfür sind die Duplizierung, die Adressüberprüfung oder die Datenkonsolidierung. | Batch-Apex | Batch Apex bietet umfangreiche APIs für die Anbindung an die Plattform und für die Rohgeschwindigkeit. |
| Nächtlicher Rollup-Auftrag | Auftrag, der Rollup-Daten am Ende eines Geschäftstags berechnet. | Batch-Apex | Batch Apex bietet umfangreiche APIs für die Anbindung an die Plattform und für die Rohgeschwindigkeit. |
| Durch Datensatz ausgelöste Logik | Führen Sie Logik als Reaktion auf eine Datensatzaktualisierung aus. | Variiert | Lesen Sie unseren Leitfaden zur begleitenden Entscheidung, Record Triggered Events Automation. Sie enthält eine Entscheidungsstruktur für asynchrone Anwendungsfälle, einschließlich warteschlangenfähigen Apex, Batch Apex, geplanten Apex, geplanten Flows, asynchronen Pfad-Flows und Datenerfassung ändern. |
| Eskadierende Aktualisierungen durch ein Objektdiagramm | Ermöglicht es einem Benutzer, die Speicheraktion schnell abzuschließen, indem kaskadierende Aktualisierungen an anderen Objekten zurückgestellt werden, um sie asynchron auszuführen. | Warteschlangenfähiger Apex | Der warteschlangenfähige Apex verfügt über leistungsstarke Verkettungsfunktionen, mit denen eine Aktualisierungskette durch Logik in eine Reihe asynchroner Transaktionen unterteilt werden kann. |
| Datensatzspezifische geplante Verarbeitung | Automatisierung zu einem zukünftigen dynamischen Datum, das für den Datensatz spezifisch ist (z. B. 3 Tage vor einem Schlusstermin). | Flow mit einem geplanten Pfad | Geplante Pfade bieten Flow eine einzigartige Stärke, da die Plattform automatisch die Planung, Stornierung und Neuplanung dieser Pfade übernimmt, wenn sich die Daten des Datensatzes ändern. |
| Mehrere langsame externe Services parallel aufrufen | Während einer synchronen Ausführung werden mehrere externe Services parallel aufgerufen, um die Gesamtausführungszeit zu optimieren. | Callouts für Apex-Fortsetzungen | Wenn Sie zulassen, dass mehrere langsam ausgeführte Callouts parallel ausgeführt werden, wird die Gesamtzeit zum Abschließen der Arbeit minimiert. |
| Datenmigration von Datensätzen aus einem externen System | Verschieben Sie große Datensatzmengen aus einem externen System in die Salesforce Platform. Entweder einmalig oder regelmäßig geplant. | Bulk- API | Dies ist der effizienteste und grenzenschonendste Ansatz für die Datenmigration. |
| Ausführen zusätzlicher Logik auf einem externen System | Feuer-und-Vergessen-Muster, bei dem ein externes System über ein Ereignis auf der Plattform benachrichtigt wird und dieses System dann das Ereignis asynchron verarbeiten kann. | Plattformereignisse oder Datenerfassung ändern | Ein Pub-Sub-Modell funktioniert hier am besten und ermöglicht es dem externen System, das Ereignis zu verarbeiten, wenn es bereit ist. Weitere Details zu diesem Muster finden Sie unter Ereignisgesteuerte Architektur. |
| Agentforce | Traditionelle Automatisierung | Integration |
|---|---|---|
 |
Salesforce Data 360 ist die hyperskalierbare Echtzeit-Datenplattform von Salesforce, die Daten aus beliebigen Quellen (CRM, Web, Mobilgeräten oder externen Data Lakes) in einem einzigen handlungsrelevanten Kundenprofil harmonisiert und vereinheitlicht. Als wichtige Komponente der Customer 360 Platform unterstützt sie AI, Analysen und personalisierte Erfahrungen in Vertrieb, Service und Marketing. |
| Überlegung | Warum es wichtig ist | Beispielszenarien |
|---|---|---|
| Datenresidenz und Compliance | Legt fest, wo Daten gespeichert und verarbeitet werden. Regulatorische Regeln können bestimmte Regionen oder mehrere Instanzen erfordern. | Eine globale Bank stellt einen Data 360-Mandanten in einer Salesforce-Organisation mit Standort in Frankfurt zur Einhaltung der DSGVO bereit. Sie stellen einen weiteren Mandanten in einer Organisation in Virginia für ihre US-Division bereit. |
| Governance und Sicherheit | Identifizieren Sie einen Administrator und die Inhaberschaft von Data 360, einschließlich Richtlinienverwaltung und Delegierungsstrategien. | Ein multinationaler Konzern mit starker zentraler IT erstellt eine dedizierte Heimorganisation, die von einem Exzellenzzentrum verwaltet wird. |
| Autonomie vs. Zentralisierung | Unterschiedliche Führungskräfte wünschen sich möglicherweise eine separate Inhaberschaft der Daten. Die Autonomie bevorzugt mehrere Data 360-Organisationen. Die Zentralisierung bevorzugt Data Cloud One. | Eine Holdinggesellschaft mit unabhängigen Tochtergesellschaften ermöglicht es jedem BU, seine eigenen Data 360-Daten auszuführen. |
| Latenz und Leistung | Wirkt sich auf die Abfragegeschwindigkeit und -erfahrung aus, insbesondere für Begleitorganisationen, die regionsübergreifend mit einem Data 360-Mandanten verbunden sind. | Ein Vertriebsteam in London, das Daten von einem Data 360-Mandanten in den USA abfragt, sieht möglicherweise eine höhere Latenz. |
| Integrationskomplexität | Mehr Data 360-Mandanten = mehr Pipelines, APIs und Middleware. Die Konsolidierung vereinfacht die Integration. | Ein Händler vermeidet das Erstellen von 10 ETL-Pipelines, indem er sie in einer Data Cloud One-Konfiguration konsolidiert. |
| Zero Copy Data Source Region (Zero Copy-Datenquellenregion) | Die regionsübergreifenden Zugriffsanforderungen für einige Konnektoren können die Region oder den Standort Ihrer Data 360-Organisation einschränken. | Ein Unternehmen verfügt über eine Snowflake-Instanz in der Region AWS eu-west-1. Sie können Zero Copy verwenden, um Daten mit einer Data 360 in ihrer Region zu verknüpfen, Zero Copy jedoch nicht, um eine Data 360 in der Region der USA zu verknüpfen. |
| Regionsübergreifende Private Connect-Kompatibilität | Manchmal hängt die Unterstützung von Private Connect davon ab, ob sich die Datenquelle in derselben Region wie der Data 360-Mandant befindet. | Ein Unternehmen verfügt über eine Snowflake-Instanz in der Region aws-east-1, die per Zero-Copy mit Data 360 verbunden werden soll. Sie können nur dann eine Private Connect-Netzwerkverbindung herstellen, wenn sich die Data 360-Startorganisation in derselben Region befindet. |
| Kosten und Lizenzierung | Jeder Data 360-Mandant hat zusätzliche Kosten. Die Konsolidierung in weniger Instanzen optimiert die Ausgaben. | Ein Gesundheitsanbieter reduziert die Lizenzkosten, indem er Data Cloud One anstelle mehrerer unabhängiger Data 360-Instanzen verwendet. |
| Künftige Skalierbarkeit | Bereitstellungsentscheidungen schaffen heute die Grundlage für Wachstum. | Ein SaaS-Unternehmen beginnt mit einer einzelnen Data 360-Instanz, plant jedoch, mit der Übernahme von Tochtergesellschaften mit Salesforce-Organisationen auf Data Cloud One zu expandieren. |
| Unternehmensweite AI-Bereitschaft | Für AI-Funktionen und Agentforce ist in jeder Organisation ein verbundener Data 360-Mandant erforderlich. Bereitstellungsentscheidungen wirken sich darauf aus, wie AI-Modelle im gesamten Unternehmen trainiert und aktiviert werden. | Ein Finanzdienstleistungsunternehmen vereinheitlicht Daten in Data Cloud One, sodass seine Einstein AI-Modelle auf unternehmensweite Kundendaten zugreifen können. |
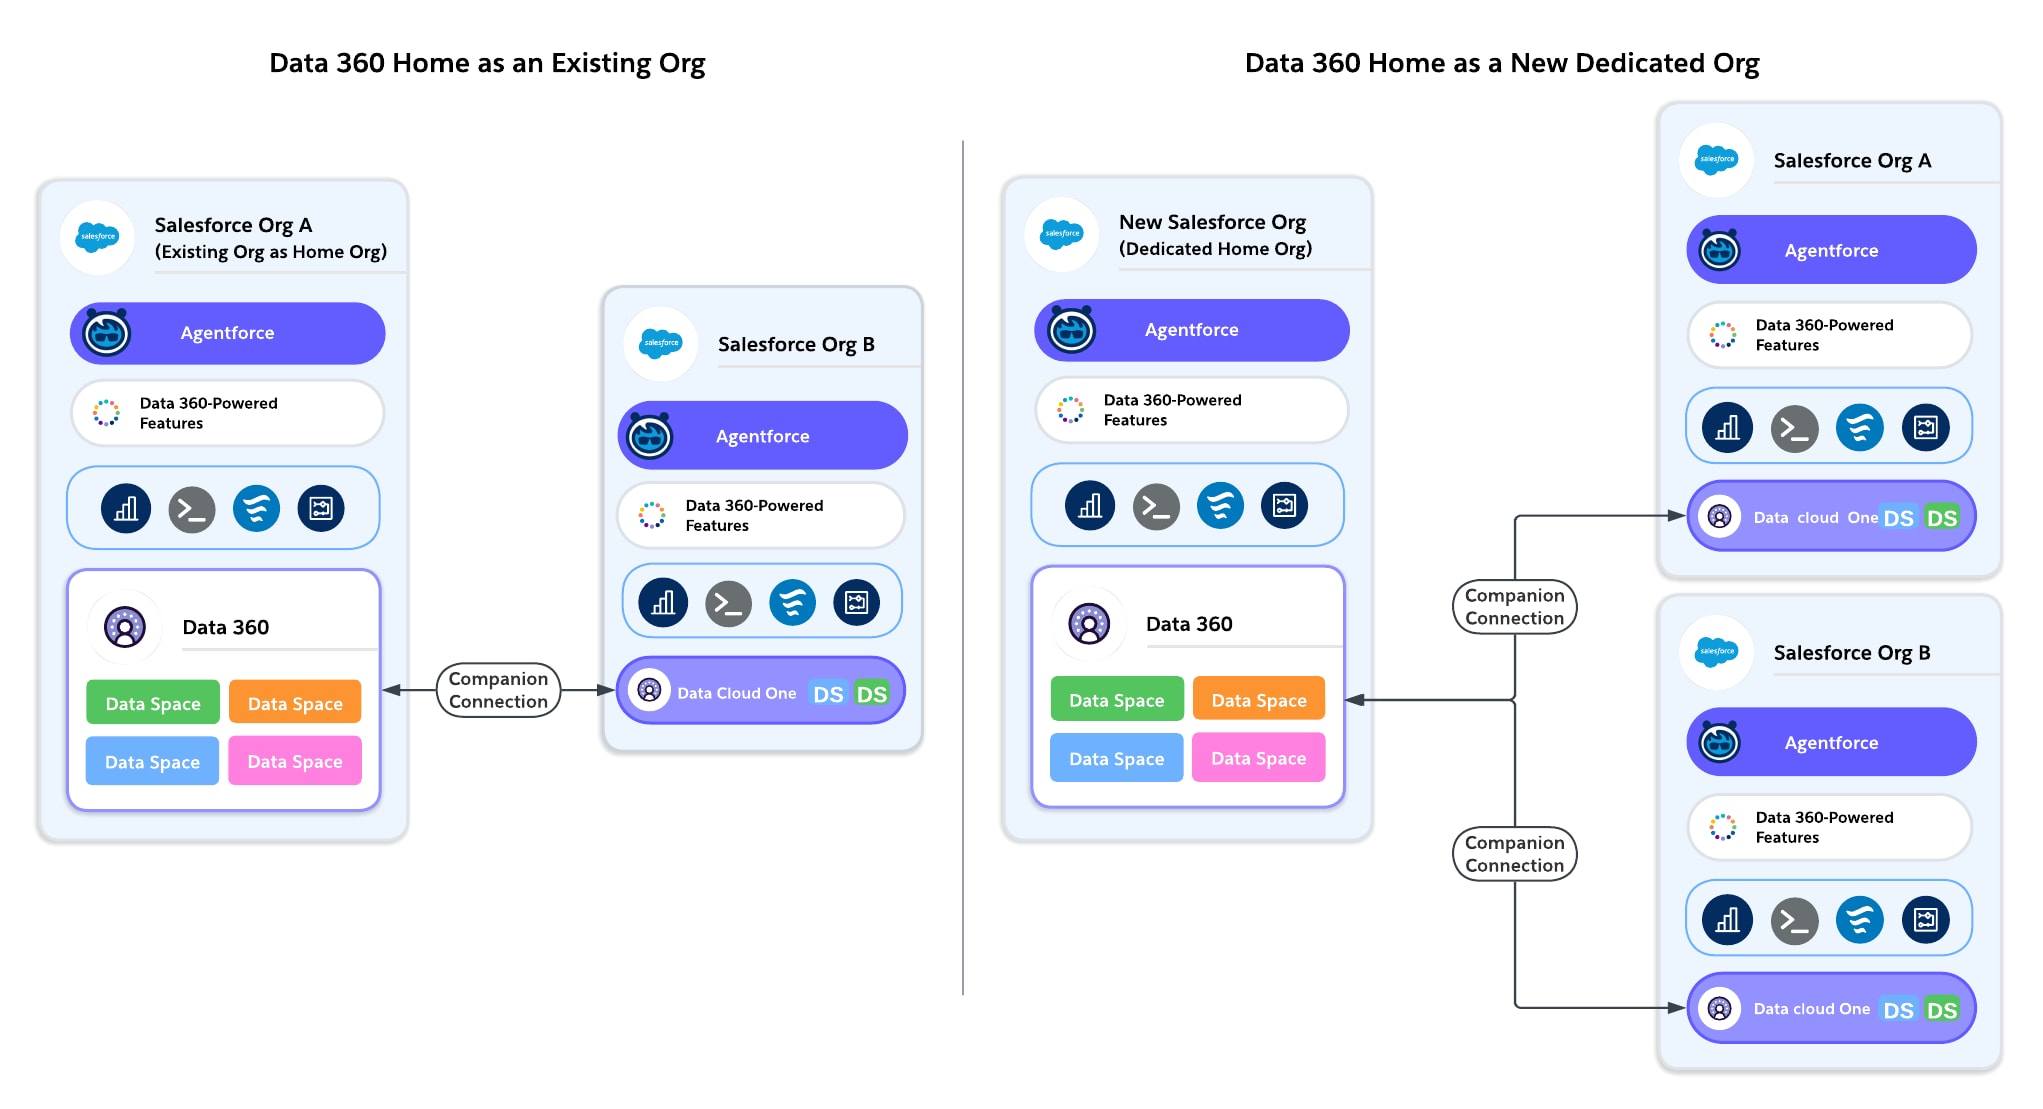 **Option A: Bereitstellen von Daten 360 in einer vorhandenen Organisation**
**Funktioniert am besten für:** Kunden mit einer einzelnen Salesforce-Organisation oder Kunden mit mehreren Organisationen, die bereits über eine zentrale Organisation verfügen, in der die meisten Geschäftsprozesse ausgeführt werden.
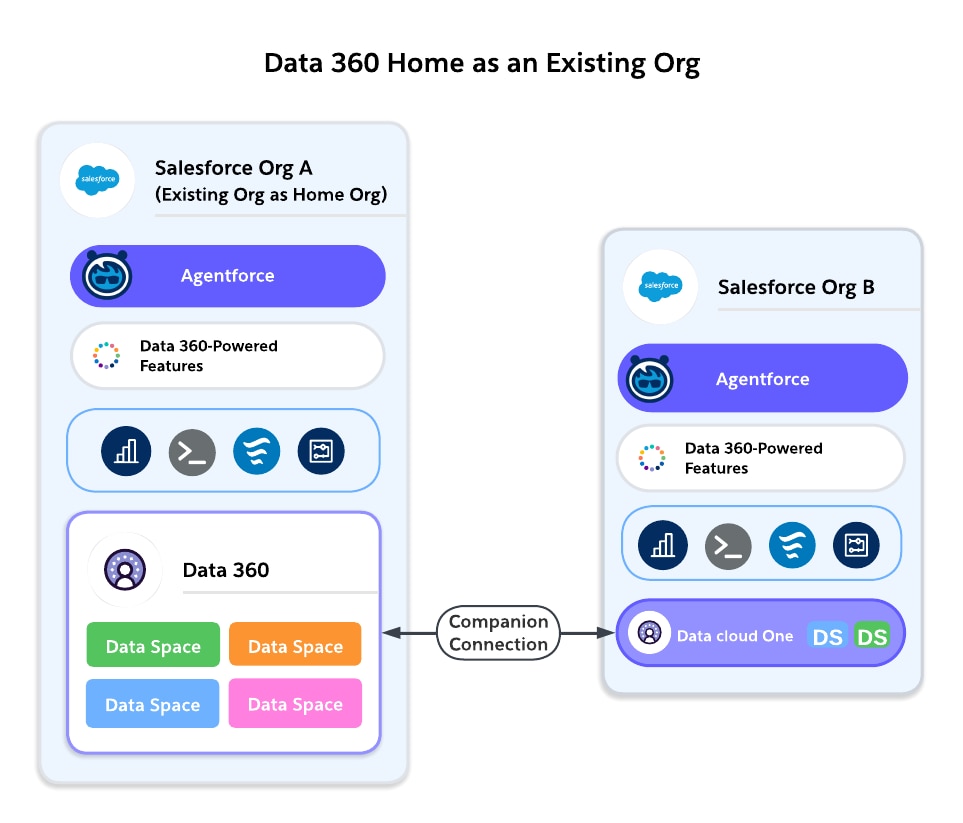 - **Positiv:**
- Einfachster Pfad: Data 360 wird dort bereitgestellt, wo sich Ihre CRM-Daten befinden.
- Sofortiger Zugriff auf lokale Vertriebs-, Service- und Marketingdaten.
- Es ist keine zusätzliche Integration erforderlich.
- Weniger zu verwaltende Lizenzen und Umgebungen.
- Beschleunigt die frühzeitige Akzeptanz, Pilotprogramme und Produktionsanwendungsfälle.
- **Kontra:**
- Kann die Governance oder die technischen Schulden einer vorhandenen Organisation übernehmen.
- Wenn keine einzelne "Hauptorganisation" vorhanden ist, kann die Auswahl einer solchen Organisation zu Inhaberschaftsdebatten führen.
- Die Leistung ist an den Standort der Organisation gebunden und entspricht möglicherweise nicht den Anforderungen der unternehmensweiten Residenz.
- Wenn mehrere Geschäftseinheiten unterschiedliche Organisationen verwenden, kann die lokale Bereitstellung zu einer Fragmentierung führen, wenn sie nicht mit Data Cloud One gekoppelt ist.
**Beispiel:**
Ein SaaS-Unternehmen mit einer Salesforce-Organisation stellt Data 360 in dieser Organisation bereit, um Kundenabonnement- und Supportdaten zu vereinheitlichen.
**Option B: Bereitstellen von Daten 360 in einer neuen, dedizierten Organisation**
**Funktioniert am besten für:** Kunden mit mehreren Salesforce-Organisationen, die sich nicht auf eine einzelne Hauptorganisation ausrichten können, oder Unternehmen mit einem starken Center of Excellence-Modell.
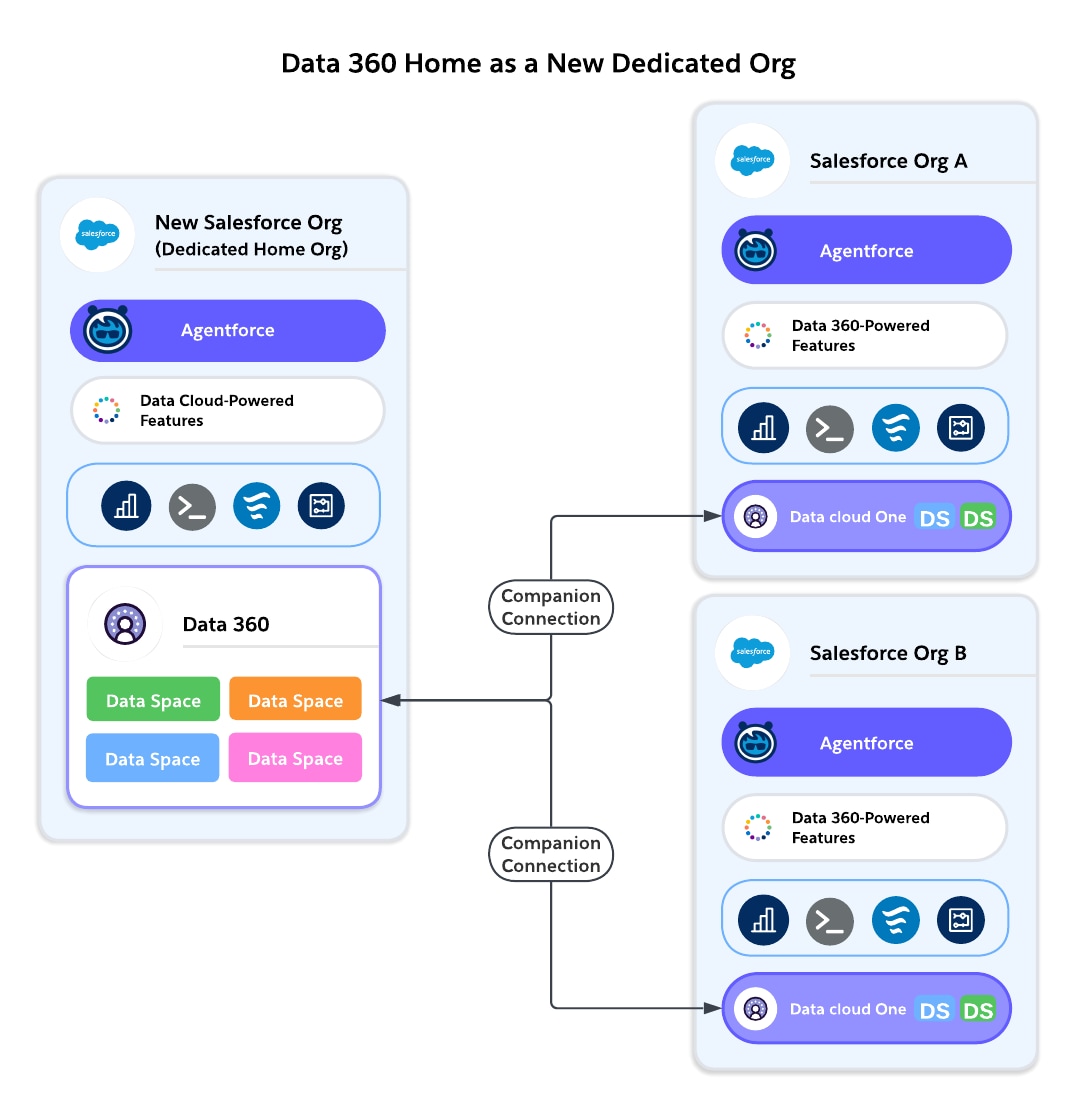 - **Positiv:**
- Sauberes Design für die Unternehmensführung ohne übernommene Organisationskomplexitäten.
- Zentrale Steuerung über mehrere Geschäftsbereiche hinweg.
- Flexibilität bei der Auswahl einer Region anhand der Compliance-Anforderungen.
- Funktioniert als neutrale "Shared Service"-Organisation, die nicht an eine Geschäftseinheit gebunden ist.
- Einrichten für die künftige Data Cloud One-Architektur (Startorganisation mit mehreren Begleitorganisationen).
- **Kontra:**
- Kunden müssen eine neue Salesforce-Organisation lizenzieren, in der Data 360 bereitgestellt werden soll.
- Zusätzliche Integration erforderlich, um die Organisation über eine Data Cloud One-Begleitverbindung mit einer Data 360 zu verbinden.
- Kann Verwaltungsaufwand verursachen (Benutzerverwaltung, Sicherheit, Identität).
- Verlangsamte Wertschöpfungszeit im Vergleich zur Bereitstellung in einer vorhandenen Produktionsorganisation.
**Beispiel:**
Ein multinationales Finanzdienstleistungsunternehmen erstellt eine dedizierte Startseitenorganisation zur Bereitstellung von Data 360\. Alle Organisationen der Geschäftseinheit (Einzelhandel, Vermögen, Geschäftsbankwesen) verbinden sich als Begleitorganisationen über Data Cloud One.
**Entscheidungskriterien**
| Überlegung | Vorhandene Organisation als Startorganisation (bevorzugte Standardeinstellung) | Neue Organisation als Heimatorganisation (Alternative) |
|---|---|---|
| Einfachheit | Aufbauend auf der vorhandenen Benutzer- und Datenstruktur für eine schnellere Einrichtung. Data 360 ist standardmäßig in die Startseite integriert. |
Erfordert die Lizenzierung und Einrichtung einer neuen Salesforce-Organisation sowie zusätzlichen Verwaltungsaufwand für ihre Verwaltung |
| Time-to-Value (Zeit bis zum Wert) | Sofortige Verwendung lokaler CRM-Daten | Eine langsamere Steigerung und Integration ist erforderlich. |
| Governance | Übernimmt das grundlegende Governance-Modell der vorhandenen Organisation – vorhandene Benutzer und Berechtigungssätze (möglicherweise akzeptabel, wenn die Organisation bereits zentral ist). | Sauberes Blatt für die Unternehmensführung. Ideal für COE-geführte Modelle. |
| Compliance | Residenz, die an die Region der vorhandenen Organisation gebunden ist | Flexibilität bei der Auswahl einer Region unabhängig von vorhandenen Organisationen |
| Leistung | Beste Leistung für lokale CRM-Abfragen | Abhängig von der Konnektivität der Begleitorganisation, unabhängig davon, ob es sich um dieselbe Region oder eine Region mit den anderen Organisationen handelt |
| Künftige Skalierbarkeit | Funktioniert gut in Kombination mit Data Cloud One. Schwerer zu verschieben, wenn die falsche Organisation ausgewählt wurde | Einfache Skalierung mit Data Cloud One. Entwickelt für Neutralität. |
| Kosten | Geringere inkrementelle Kosten | Höherer Overhead durch zusätzliche Umgebungen |
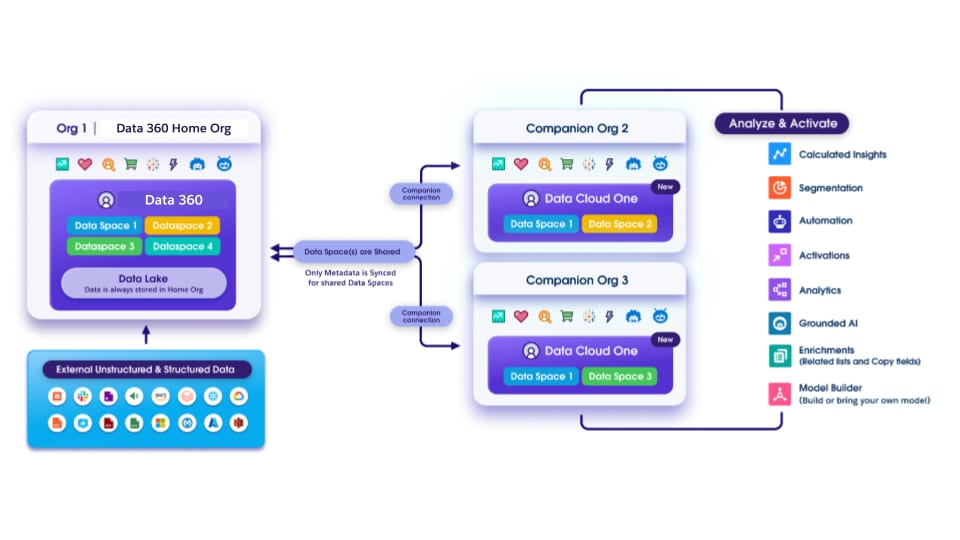 **Funktionsweise von Data Cloud One**
- **Datenaufnahme und -vereinheitlichung (Startorganisation)**
- Die gesamte Konfiguration der Datenaufnahme (Salesforce CRM, externe Quellen, Streaming, Batch) erfolgt nur über die Startseite.
- Der Data 360-Mandant, der an die Startseitenorganisation gebunden ist, führt die Identitätsbestimmung, Harmonisierung, Modellierung und Vereinheitlichung in vertrauenswürdigen Kundenprofilen aus.
- Data 360-Verwaltung, Governance-Richtlinien, Tagging und Maskierung werden zentral über die Startseitenorganisation angewendet.
- **Datenbereichsarchitektur**
- In der Startseite werden Daten in Datenbereichen organisiert, die als logische Container für Daten, Metadaten und Prozesse fungieren.
- Unternehmen können Datenbereiche für Marken, Regionen oder Geschäftsbereiche erstellen.
- Freigabe von Datenbereichen: In der Startseite werden bestimmte Datenbereiche selektiv für Begleitorganisationen freigegeben. Dadurch wird sichergestellt, dass nur die relevanten Daten (und die zugehörigen Metadaten) in die richtigen Organisationen fließen.
- **Metadatenfreigabe**
Begleitorganisationen erhalten Metadatendefinitionen von der Startseite, einschließlich Datenmodellobjekten (DMOs), vereinheitlichtem Profilschema, berechneten Statistiken, Segmenten [und mehr](https://help.salesforce.com/s/articleView?id=data.c360_a_companion_org_data_cloud_features.htm&type=5). Diese werden nativ in der Begleitorganisation angezeigt, als ob es sich um lokale Vermögenswerte handelte, sie sind jedoch mit der Startseite verknüpft.
- **Funktionen in Organisationen vom Typ "Startorganisation" im Vergleich zu Begleitorganisationen**
Der Funktionszugriff unterscheidet sich je nach Startseite und Begleitorganisation. Begleitorganisationen können keine Daten aufnehmen oder vereinheitlichen und sind bei der Aufnahme, Modellierung und Vereinheitlichung auf die Startseite angewiesen. Begleitorganisationen können auf Data 360-Daten zugreifen, um Data 360-gestützte Plattformfunktionen bereitzustellen, und sie können lokale Statistiken, Segmente und Flows auf der Grundlage der freigegebenen, vertrauenswürdigen Daten erstellen. In der Zukunftsvision können sie auch auf Aktivierungsfunktionen zugreifen.
| Kapazität | Home Org (Startorganisation) | Begleitorganisation |
|---|---|---|
| Konnektoren konfigurieren, Datenströme erstellen, Daten aufnehmen oder Verbunddaten erstellen | ✅ | ❌ |
| Harmonisieren und Vereinheitlichen Erstellen und Ausführen von Datentransformationen und Identitätsbestimmung | ✅ | ❌ |
| Steuern von sicheren Daten mit Datenbereichen und Berechtigungen | ✅ | ✅ |
| Erstellen von Segmenten und Prognosen für Einstein Studio-Modelle | ✅ | ✅ |
| Aktivierungen von Everywhere, Datenaktionen | ✅ | ✅ |
| Plattformfunktionen: Eingabeaufforderungsgenerator, Flows, Berichte, Anreicherung [und mehr](https://help.salesforce.com/s/articleView?id=data.c360_a_companion_org_data_cloud_features.htm&type=5) | ✅ | ✅ |
| Data 360-gestützte Funktionen: Prospecting Center, Sales- und Service Cloud-Funktionen, Agentforce und mehr | ✅ | ✅ |
| Überlegung | Mehrere unabhängige Data 360-Organisationen | One Shared Data 360 (Data Cloud One) |
|---|---|---|
| Autonomie | Hohe Autonomie für jede Organisation oder Geschäftseinheit | Zentralisierte Verwaltung, weniger Autonomie pro Organisation |
| Compliance | Nützlich, wenn eine strenge Trennung erforderlich ist (z. B. regionale Gesetze) | Funktioniert am besten, wenn die Residenz die Zentralisierung zulässt |
| Kosten | Höhere Lizenzierungs- und Administratorkosten | Kosteneffizienter; eine Lizenz für viele Organisationen |
| Governance | Fragmentiert; Richtlinien unterscheiden sich je nach Organisation | Zentralisierte, organisationsübergreifend konsistente Richtlinien |
| Datensilos | Jede Organisation mit eigener Ansicht Kein Unternehmen 360 | Vereinheitlichtes Datenset, keine Duplizierung |
| AI/Analysen | Beschränkt auf die Daten der einzelnen Organisationen | Unternehmensweite Modelle mit höherer Genauigkeit |
| Komplexität | Mehr zu verwaltende Instanzen, mehr Integrationen | Einfachere Architektur, weniger bewegliche Teile |
| Leistung | Bestens geeignet für Anwendungsfälle innerhalb der Organisation | Potenzielle Erhöhung der Latenz mit Zugriff auf Begleitorganisationen |
| Faktor | Pros | Nachteile |
|---|---|---|
| Datenresidenz | Unterstützt die regionale Trennung und ermöglicht gleichzeitig die Zusammenarbeit. | Die Verwaltung mehrerer Data 360-Organisationen entfällt nicht. |
| Datenduplizierung | Nullkopie; keine Duplizierung von Objekten. | Erfordert eine bewusste Auswahl von Objekten für die Aufnahme in jede Datenfreigabe. |
| Governance | Die Freigabe erfolgt explizit und bewusst (Objektebene). | Es werden keine Tags oder Richtlinien verwendet. Die Zielorganisation muss die Governance erneut anwenden. |
| Komplexität | Ermöglicht die selektive Zusammenarbeit ohne Zentralisierung. | Erfordert die Verwaltung mehrerer Data 360-Organisationen und Datenfreigaben. |
| **AI/Analytics** | Regionale AI/Analysen möglich; Statistiken können organisationsübergreifend freigegeben werden. | Keine unternehmensweite AI, es sei denn, Daten werden bewusst freigegeben. |
| **Plattformfunktionen** | Die Data 360-gestützten Funktionen jeder Organisation werden unabhängig ausgeführt. | Keine automatische Freigabe. Duplizierungsrisiko, wenn nicht sorgfältig geplant. |
| Kosten | Kann den Bedarf an ETL-Pipelines reduzieren. | Für mehrere Data 360-Organisationen fallen weiterhin Kosten an. Verbraucht Gutschriften für Datenabfragen und die Datenfreigabe. |
| Überlegung | Data Cloud One (für mehrere Organisationen bevorzugt) | Datenfreigabe zwischen Data 360-Organisationen |
|---|---|---|
| Single Source of Truth (Einzelne Quelle der Wahrheit) | Ja, alle Organisationen verwenden ein gemeinsames Datenmodell. | Nein, jede Data 360 verfügt über ein eigenes Datenmodell. |
| Compliance | Funktioniert nur, wenn die Residenz die Zentralisierung zulässt. | Wird benötigt, wenn Residenzgesetze die Zentralisierung verhindern. |
| Governance | Zentralisiert, konsistent. | Verbunden; bewusste Freigaben auf Objektebene. |
| Komplexität | Weniger bewegliche Teile, einfacher. | Komplexer: Erfordert Konfigurationsdatenfreigaben und mehrere Datenorganisationen. |
| AI/Analysen | Unternehmensweite AI-Modelle. | Regionale AI. Geben Sie Statistiken selektiv frei. |
| Plattformfunktionen | "Shared Data 360" bedeutet, dass alle Funktionen konsistent zu Hause + Begleiter funktionieren. | Funktionen werden in jeder Data 360 unabhängig ausgeführt. Die Freigabe muss explizit sein. |
| Mustertyp | Modus/Tool | Vorteile | Überlegungen | Ergebnisse |
|---|---|---|---|---|
| Datenaufnahme |
Echtzeit:
|
|
|
Agentforce:
|
Streaming:
|
|
|
Agentforce:
|
|
Batch:
|
|
|
Agentforce:
|
|
| Zero Copy |
Live-Abfrage:
|
|
|
Agentforce:
|
Beschleunigte Abfrage (Zwischenspeicherung):
|
|
|
Agentforce:
|
|
Dateiverbund:
|
|
|
Agentforce:
|
 #### Methoden zur Datenaufnahme
Die Methoden zur _Datenaufnahme_ können variieren, je nachdem, welchen Konnektor Sie zur Aufnahme Ihrer Daten verwenden. Einige Konnektoren bieten eine Vielzahl von Aufnahmemethoden, während andere nur im Batch- oder Streaming-Modus arbeiten. Eine vollständige Liste der _Data 360-_Konnektoren und verfügbaren Methoden finden Sie unter [Data 360: Integrationen und Konnektoren](https://help.salesforce.com/s/articleView?id=data.c360_a_sources_targets.htm&type=5).
- **Echtzeit:**
- Ermöglicht die Aufnahme im Sekundenbereich mithilfe der _Datenerfassung (CDC)_
- Geeignet für zeitkritische Workflows (z. B. Betrugserkennung, Personalisierung und betriebliche Dashboards)
- Verfügt über Push-Transformationen und Aggregationen in _Data 360_, wodurch die nachgelagerten Ein- und Ausgänge reduziert und die Berechnungsnutzung optimiert wird
- Unterstützt die Verwendung von inkrementeller CDC zum Minimieren der Datenvermischung
- **Streaming:**
- Bietet Aufnahme alle 1–3 Minuten in kleinen Schritten
- Wägt Frische und Kosten ab
- Geeignet für die Kampagnenorchestrierung, die Interaktion beinahe live und für operative Berichte
- Unterstützt die Verwendung von Micro-Batchs zum Steuern von E/A-Spitzen
- Aggregiert Daten an der Quelle (sofern möglich), um Übertragungsvolumen zu reduzieren und den Speicher zu optimieren
- **Batch (Geplante Lasten):**
- Stellt die regelmäßige Aufnahme großer Datensets bereit (z. B. stündlich, täglich und wöchentlich)
- Bietet Kosteneffizienz und Zuverlässigkeit für historische Datensets, behördliche Berichte und Compliance-Anwendungsfälle
- Stellt sicher, dass sich das Gebietsschema in derselben Region wie der Quellspeicher befindet, um die Leistung zu steigern und die Kosten zu optimieren
#### Architect Playbook (Playbook für Architekten)
- **Anwendungsfälle für die Datenaufnahme:**
- **Generieren von zusammengeführten Customer 360-Profilen.** Erstellen Sie eine einzige Datenquelle für Kundenidentitäten und -attribute.
- **Verwalten Sie Datensets zur Einhaltung gesetzlicher Vorschriften.** Erzwingen Sie die Verwaltung, Abstammung und Überprüfbarkeit für sensible Daten.
- **Kampagnenorchestrierung zentralisieren.** Stellen Sie sicher, dass Marketing, Vertrieb und Service alle über konsistente, vertrauenswürdige Datensets funktionieren.
- **Gestaltungspraxis:**
- Passen Sie die Batch-Aufnahme für historische oder latenzarme Anforderungen an (z. B. Archivberichte oder regelmäßige Snapshots).
- Verwenden Sie CDC- oder Streaming-APIs, um die Aktualität für Betriebs- und Personalisierungs-Workflows aufrechtzuerhalten und Aktualisierungen nahezu in Echtzeit sicherzustellen.
- Steuern Sie das Speicher- und Berechnungswachstum, indem Sie inkrementelle Lasten anwenden, um Kosten und Effizienz zu optimieren (anstatt ganze Datensets neu zu laden).
- Passen Sie Aufnahme-Pipelines an die Rechenlokalität und die inkrementelle Verarbeitung an, um die Netzwerk-I/O zu reduzieren.
- Wenden Sie Transformationen in _Data 360 an_, um unnötige Verschiebungen von Rohdaten zu vermeiden.
- **Überlegungen zu Kosten:**
- Die **Echtzeitaufnahme** weist die höchsten Rechen- und Pipeline-Kosten auf, was für hochwertige, zeitkritische Workflows (z. B. Personalisierung, operative Dashboards oder Agentforce-gesteuerte Aktionen) gerechtfertigt sein kann.
- Die **Streaming-Aufnahme** weist moderate Rechen- und Speicherkosten auf, die für häufige Aktualisierungen geeignet sein können, die leichte Verzögerungen vertragen (z. B. Kampagnenorchestrierung oder Betriebsberichte).
- Die **Batch-Aufnahme** hat geringere Rechenkosten und einen vorhersehbaren Speicherplatz, der für historische Datensets oder Aktualisierungen mit geringer Häufigkeit geeignet ist. Die Aufnahme von Batch-Daten aus Salesforce-Organisationen mit bestimmten Konnektoren ist kostenlos.
- **Aktualisierungsmodus** Ermöglicht Ihnen die Auswahl des Modus _"Inkrementelle Aktualisierung_", der die Gesamtaufnahme- und Berechnungskosten reduziert. Bei Salesforce wird empfohlen, nach Möglichkeit _eine inkrementelle Aktualisierung_ zu verwenden, um die Effizienz über alle Aufnahmetypen hinweg zu optimieren.
- Die **Kosten** werden auch durch das E/A-Volumen von der Quelle zu _Data 360_ beeinflusst. Die Optimierung von Batchgrößen, Partitionen und regionaler Ausrichtung reduziert die Übertragungskosten und verbessert die Leistung.
- **Branchenszenarien:**
- **Finanzen:** Aufnahme-Datensets sind erforderlich, um _Ihren Kunden zu_ _kennen_, Geldwäsche zu bekämpfen und Betrug zu erkennen, wenn Überprüfbarkeit und Compliance nicht verhandelbar sind.
- **Gesundheitswesen:** Verwenden Sie die Aufnahme für die Patientenidentitätsbestimmung und HIPAA-konforme Datensätze, wodurch sichere, vereinheitlichte Ansichten ermöglicht werden.
- **Einzelhandel:** Konsolidieren Sie _POS-_, E-Commerce- und Treueprogrammdaten in vereinheitlichten Profilen für die Segmentierung und Personalisierung.
- **Telecom:** Unterstützen Sie Abwanderungsprävention und Nutzungsanalysen mit kanonischen, geregelten Abonnentendaten.
#### Entscheidungskriterien für die Datenaufnahmemethode
| Funktion | Echtzeitaufnahme | Streaming-Aufnahme | Batchaufnahme |
| :----------------------------------- | :------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------ | :------------------------------------------------------------------------------------------------------------------------------------------------------------ | :----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Latenz und Frische** | Enthält die Aufnahme von Latenzzeiten im Sekundenbereich über Aufnahme-APIs mit Unterstützung der _Datenerfassung (CDC)_. Bietet kontinuierliche Streaming-Pipelines. Geeignet für operative Anwendungsfälle mit geringer Latenz. | Enthält die Aufnahme von Micro-Batch alle 1–3 Minuten über native Konnektoren. Unterstützt inkrementelle Aktualisierungen. Es wird eine leichte Latenz erwartet. | Es wird eine Datenlatenz erwartet. Lässt geplante Ladevorgänge mit großem Volumen zu. Bietet regelmäßige Aufnahme (stündlich, täglich und wöchentlich). Nicht für zeitkritische Vorgänge geeignet. |
| **Primäre Anwendungsfälle** | Ideal für Anwendungsfälle mit geringer Latenz und Personalisierung. Wird für zeitkritische Workflows verwendet. Unterstützt ereignisgesteuerte Workflows. Wird für Echtzeitbetrugswarnungen und operative Warnungen verwendet. | Geeignet für mäßig dringende Prozesse. Wird für die Kampagnenorchestrierung, die Interaktion beinahe live und für operative Berichte verwendet. Wird für zeitnahe Kampagnenauslöser verwendet. | Kosteneffizient für massive Datensets. Zuverlässig für historische Analysen. Wird für historische Aggregations- oder regulierte Berichts-Workflows verwendet. Geeignet für historische oder Low-Velocity-Datensets. |
| **Architekturkomplexität und I/O** | Enthält hohe Kosten und komplexe Architektur. Erfordert Quellsysteme mit geringer Latenz. I/O-intensiv. Quellen mit hohem Volumen können zu gesättigten Pipelines führen. | Verfügt über eine einfachere Architektur als in Echtzeit. I/O ist moderat. Geeignet für vorhersehbare, wiederholte Aktualisierungsmuster. Die Batchgröße wirkt sich auf den Speicher und die Berechnung aus. | Einfach zu implementieren. I/O-intensiv bei Lastfenstern. Der Netzwerkdurchsatz kann bei großen Batches zu einem Engpass werden. |
| **Überlegungen zu Kosten** | Enthält die höchsten Rechen- und Pipeline-Kosten. Nur für hochwertige zeitkritische Workflows geeignet. | Enthält moderate Berechnungs- und Speicherkosten. Bietet einen ausgewogenen Ansatz für Kosten und Frische. Geeignet für häufige Aktualisierungen, die leichte Verzögerungen vertragen. | Niedrigere Rechenkosten und vorhersehbarer Speicher. Empfohlen für historische Datensets oder Aktualisierungen mit geringer Häufigkeit. Die Aufnahme über interne Salesforce-Pipelines ist kostenlos. |
| **Designpraktiken** | Verwenden Sie die inkrementelle CDC, um die Datenvermischung zu minimieren. Filtern und verwenden Sie selektive Felder, um den Overhead zu reduzieren. | Verwenden Sie Micro-Batchs zum Steuern von E/A-Spitzen. Ziehen Sie die Aggregation mit Fenstern in Betracht, um die Verarbeitungslast zu reduzieren. | Wird für Archivberichte oder regelmäßige Snapshots verwendet. Stellen Sie zur Kostenoptimierung sicher, dass sich die Berechnungslokalität in derselben Region wie der Quellspeicher befindet. |
### Zero Copy Data Federation (Zero Copy-Datenverbund)
#### Zero Copy-Anwendungsfälle
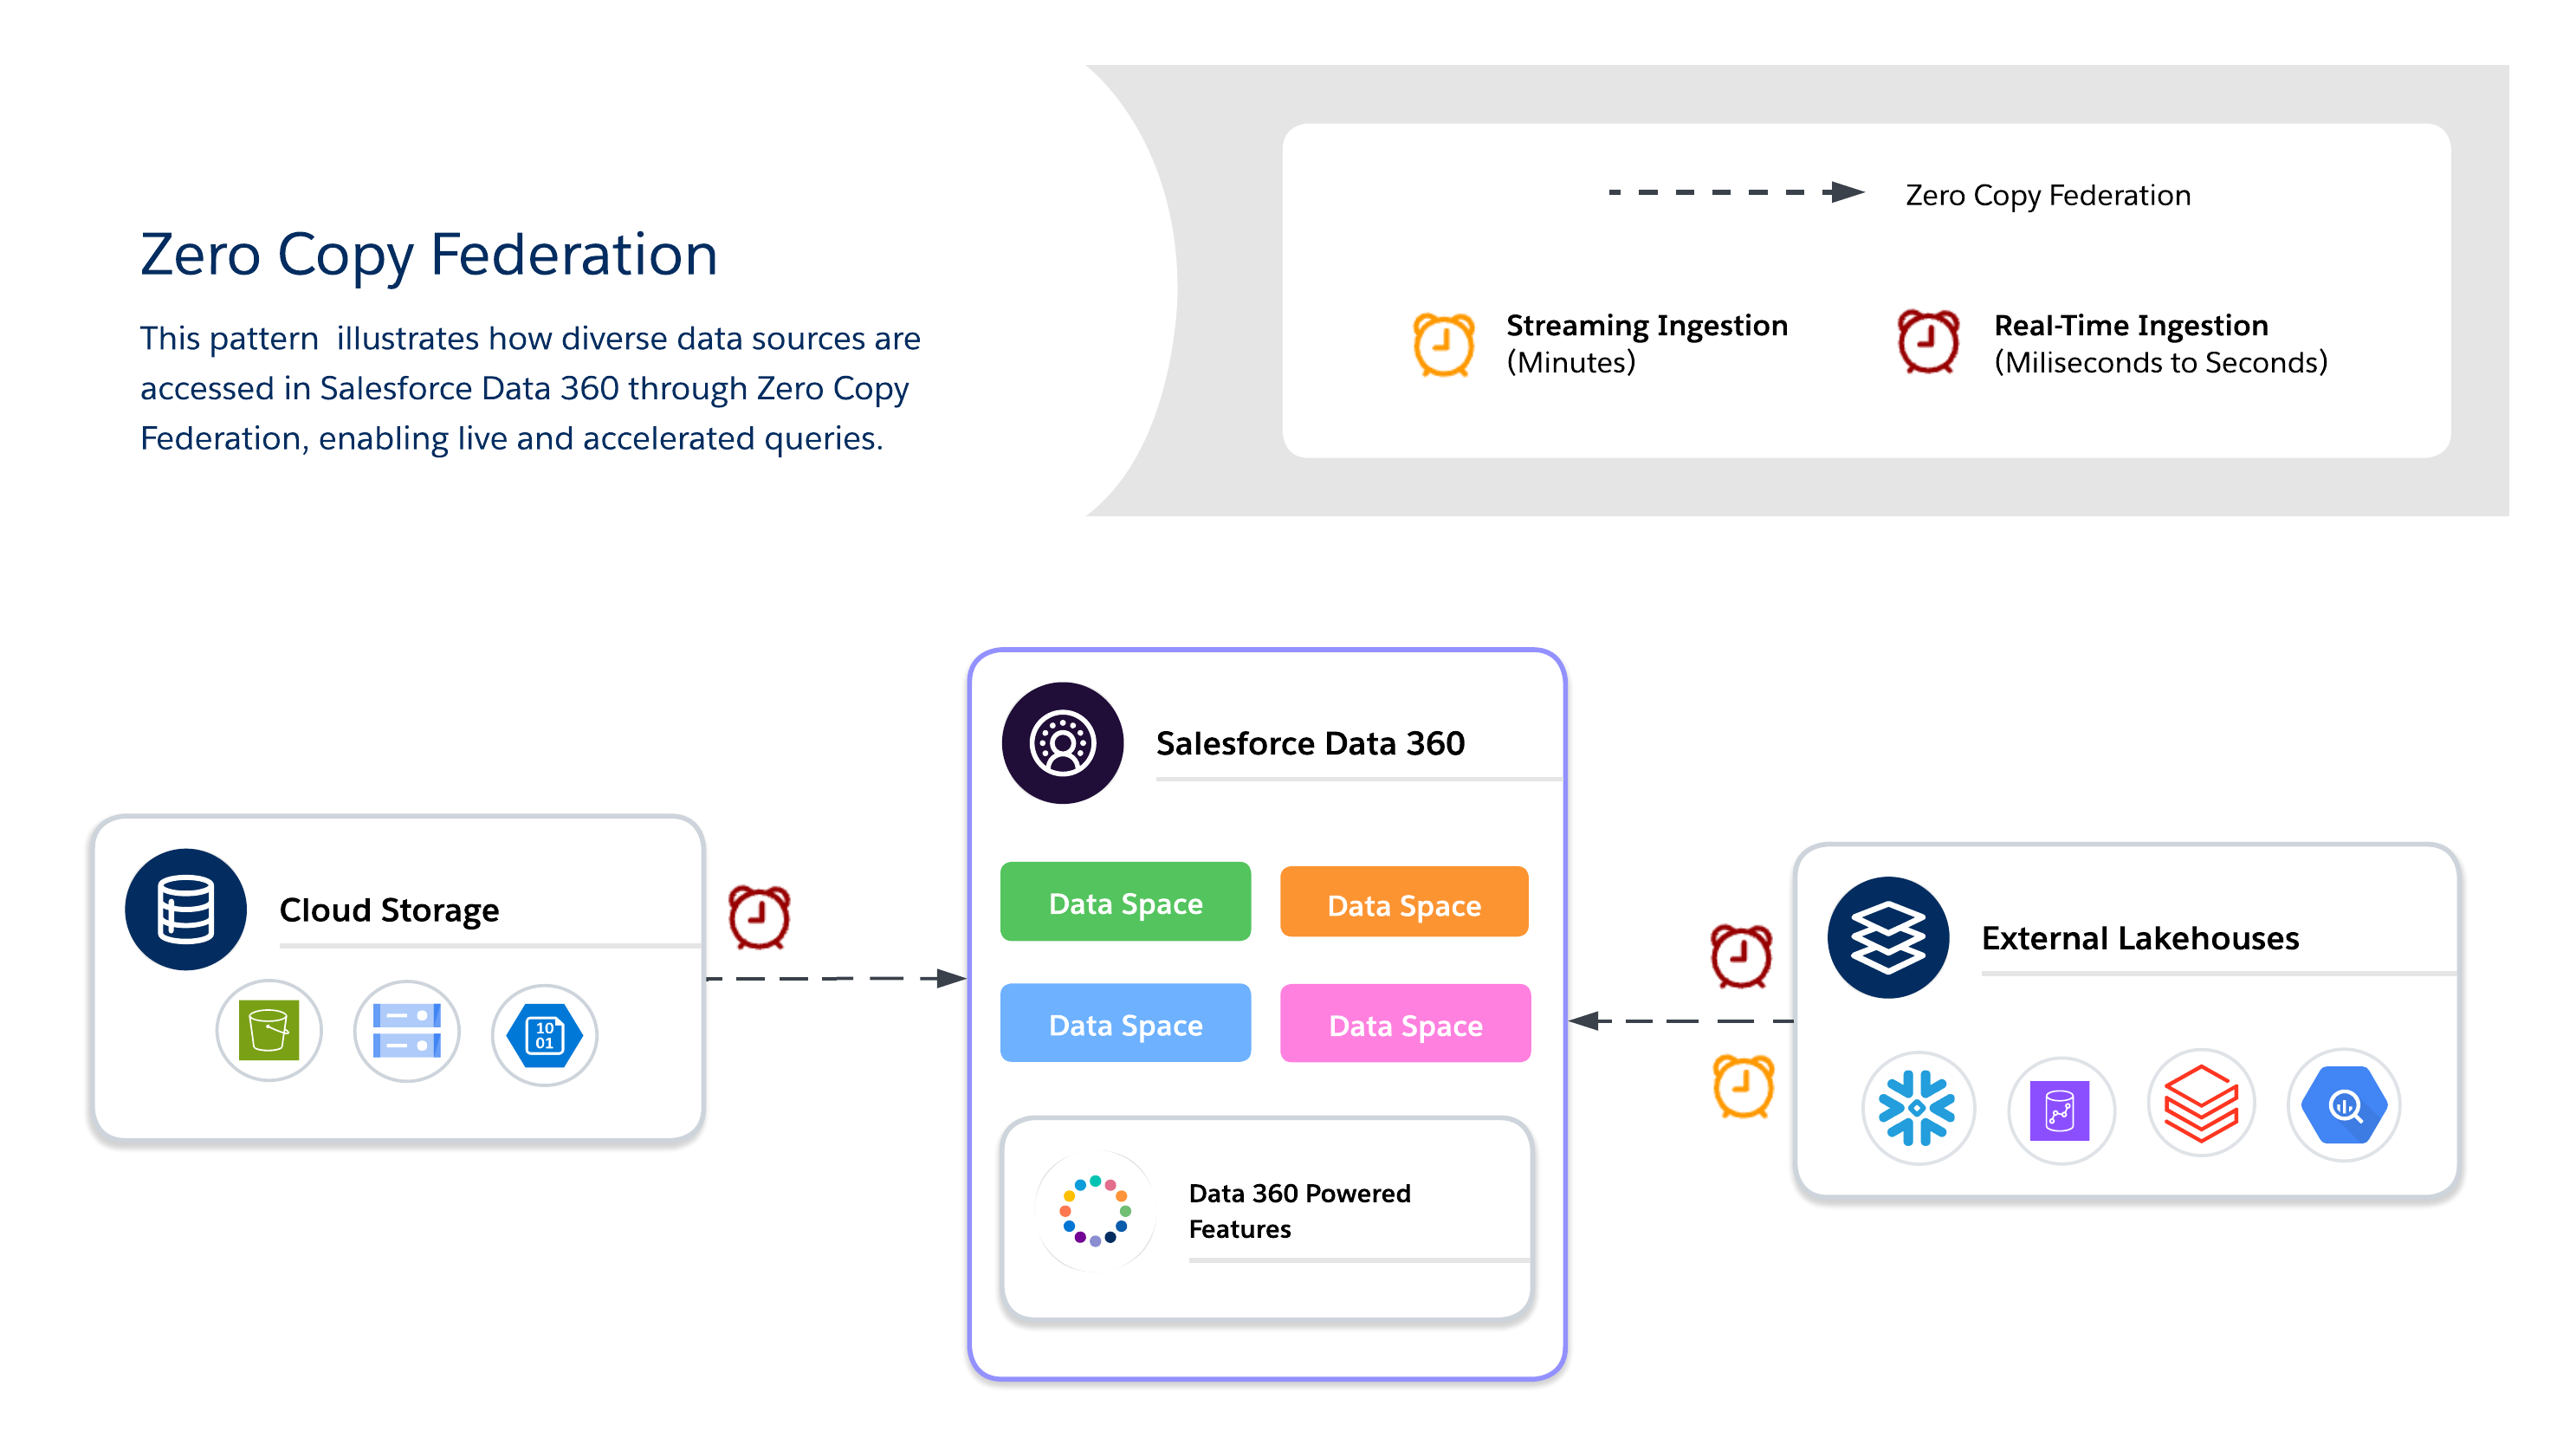
Verwenden Sie _Nullkopie_ für Echtzeitabfragen externer Systeme ohne Datenduplizierung, um Agilität, Aktualität und skalierbaren Zugriff auf große oder vorübergehende Datensets zu ermöglichen. Sie eignet sich für Live-Dashboards, explorative Analysen, AI/ML-Modellschulungen und Echtzeit-Kundenengagement direkt über Salesforce _Data 360_.
 #### Nullkopiemethoden
Bei Verwendung von _Nullkopie_ müssen Architekten zwischen drei verfügbaren Datenverbundmethoden wählen, von denen jede ihre eigenen Kompromisse zwischen Aktualität, Leistung und Kosten bietet.
- **Live-Abfrage**
- Führt Abfragen direkt gegen externe Systeme (z. B. _Snowflake_, _Google BigQuery_, _Redshift_, _Databricks_ usw.) ohne Datenduplizierung aus.
- Minimiert die Datenbewegung über das Netzwerk und reduziert die Ein- und Ausgänge bei der Salesforce _Data 360_-Berechnung. Dies ist optimal, wenn Prädikate und Aggregationen nach unten verschoben werden können.
- Geeignet für Echtzeitstatistiken und betriebliche Dashboards mit geringer Latenz.
- Abhängig von der Leistung des externen Systems.
- **Zwischenspeicherung (beschleunigte Abfrage)**
- Speichert temporär zwischengespeicherte Kopien von Verbunddaten in Salesforce _Data 360_.
- Reduziert wiederholte Abfragekosten und Latenz für häufig aufgerufene Datensets mit konfigurierbarer Dauer (Minuten bis Tage).
- Die Daten werden nicht dauerhaft kopiert oder vollständig verwaltet. Daher wird die Aktualisierung über geplante Aktualisierungen aus der Quelle verwaltet.
- _Die inkrementelle Aktualisierung_ unterstützt nur das Einfügen von Aktualisierungen. Gelöschte Datensätze werden nicht aus dem Cache entfernt.
- Führen Sie regelmäßig eine vollständige Aktualisierung aus, um sicherzustellen, dass der Cache mit der Quelle synchron bleibt.
- **Hinweis:** Der _Snowflake-_Konnektor unterstützt die Funktion _Entladen_, die die Beschleunigungsraten durch Verwendung eines von Snowflake initiierten Staging-Buckets erhöht. Dies ist standardmäßig aktiviert, kann jedoch durch Bearbeiten der Verbindung deaktiviert werden.
- **Dateiverbund**
- Bietet direkten schreibgeschützten Zugriff auf umfangreiche Datensets in Objektspeichern (z. B. _S3_ und _GCS_ mit _Iceberg_).
- Geeignet für AI/ML-Arbeitslasten, historische Analysen und Berichte auf Petabyte-Skala, ohne Daten verschieben zu müssen.
- Die Abfrageleistung hängt stark vom Objektformat, der Partitionierung und der Netzwerk-I/O ab. Große Scans können erhebliche E/A-Werte generieren, wenn sie nicht optimiert sind.
#### Architect Playbook (Playbook für Architekten)
- **Anwendungsfälle**
- **Echtzeitpersonalisierung und adaptive Workflows** bieten dynamische Angebote, Empfehlungen und Next-Best-Aktionen, wenn sich das Kundenverhalten ändert.
- **Live-Dashboards und operative Analysen** unterstützen geschäftskritische Dashboards und KPIs direkt aus externen Lagerhäusern.
- **AI/ML-Modelltraining mit großen externen Datensets** nutzt Daten im Petabyte-Bereich aus Data Lakes und Lagerhäusern, ohne sie per Dateiverbund zu verschieben.
- **Branchenszenarien**
- **Einzelhandel/Medien:** Aktivieren Sie personalisierte Empfehlungen und Kundenengagement in Echtzeit, indem Sie Clickstream- oder Inhaltsinteraktionsdaten verknüpfen.
- **Finanzen:** Führen Sie Betrugserkennung und Risikobewertung nahezu in Echtzeit aus, indem Sie externe Lagerhäuser abfragen, ohne sensible Daten zu duplizieren.
- **Tech/Enterprise:** Unterstützen Sie cloudübergreifende Berichte, IT-Service-Dashboards und betriebliche Analysen, wenn sich Datensets in mehreren Systemen befinden.
- **Designpraktiken**
- **Live-Abfrage**
- Wird für Abfragen mit hoher QPS und geringer Latenz verwendet, wenn die Aktualisierung wichtig ist.
- Übertragen Sie Prädikate und Aggregationen an das externe System, um die Datenverlagerung über das Netzwerk zu reduzieren.
- Vermeiden Sie Abfragen, die unnötig große Datenvolumen scannen.
- Ziehen Sie stattdessen den Partitionszuschnitt und Filter in Betracht.
- **Dateiverbund**
- Greifen Sie ohne Aufnahme auf Datensets im Petabyte-Bereich in Objektspeichern zu.
- Minimieren Sie Latenz- und Ausgangskosten, indem Sie den Objektspeicher in derselben Cloud-Region wie die Salesforce-Berechnung aufbewahren.
- Verwenden Sie partitionierte Spaltenformate (Parquet/ORC) und Pushdown-Filter, um die E/A- und Netzwerkübertragung zu reduzieren.
- Nutzen Sie den Pushdown für Abfragen und Prädikate, um Daten an der Quelle zu filtern und zu aggregieren, wodurch die Datenbewegung reduziert wird.
- Vermeiden Sie regionsübergreifenden Datenzugriff – es sei denn, er ist unbedingt erforderlich –, da er I/O, Latenz und Kosten erhöht.
- **Zwischenspeicherung (beschleunigte Abfrage)**
- Zwischenspeichern häufig aufgerufener Datensets, um Kosten und Leistung in Einklang zu bringen.
- Konfigurieren Sie Aktualisierungsintervalle, um die Frische im Vergleich zu den Abfragekosten auszugleichen.
- **Compliance:** Erzwingen Sie die Governance an der Quelle, indem Sie Richtlinien zur _Sicherheit auf Zeilenebene_ und Maskierung direkt in Verbundsystemen nutzen.
- Im Folgenden finden Sie einige bewährte Vorgehensweisen für einheitliches RLS und Maskierung über Plattformen hinweg:
- **Verwenden Sie eine zentralisierte Unternehmens-ID.** Ordnen Sie Benutzer und Einheiten in Salesforce _Data 360_ einer eindeutigen, zentralisierten Unternehmenskennung zu, die Identitäten in externen Systemen entspricht.
- **Angleichen von Sicherheitsrichtlinien.** Stellen Sie sicher, dass die Richtlinien für die Sprachausgabe und Maskierung in Verbundsystemen basierend auf der zugeordneten Identität angewendet werden. Dadurch wird die Compliance beim Abfragen externer Daten beibehalten.
- **Standardisieren Sie Identitätsschemas.** Verwalten Sie konsistente Identitätsattribute (E-Mail, Benutzer-ID, Kunden-ID usw.) über alle Datenquellen hinweg, um Inkonsistenzen und Zugriffsverletzungen zu vermeiden.
- **Überlegungen zu Kosten**
- **Live-Abfrage:** Im Pay-per-Query-Modell fallen bei der Berechnung des externen Lake House Kosten an, die zu Spitzen mit hohem QPS führen können. Dies eignet sich für frischigkeitskritische Anwendungsfälle, in denen der Wert größer als die Kostenvariabilität ist.
- **Beschleunigte Abfrage (Zwischenspeicherung):** Diese Methode senkt die Abfragekosten (im Vergleich zur _Live-Abfrage)_, indem Treffer im Quellsystem reduziert werden. Sie erhöht jedoch die Kosten für die Aufnahme von Batch-Daten beim Füllen und Aktualisieren des Cache. Dies eignet sich für häufig aufgerufene Datensets.
- **Dateiverbund:** Dies ist die günstigste Speicheroption als Daten im Objektspeicher. Die Abfragekosten hängen jedoch von der Dateigröße, der Partitionierung und dem Zuschnitt ab. Dies eignet sich für historische oder Massendaten im Petabyte-Maßstab.
#### Entscheidungskriterien für Nullkopiemethode
| Entscheidungspunkt | Live-Abfrage | Zwischenspeicherung (beschleunigte Abfrage) | Dateiverbund |
| :----------------------- | :---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | :--------------------------------------------------------------------------------------------------------------------------------------------------------- | :------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Datenquellenstandort** | Externe Data-Lake-Häuser (z. B. _Snowflake_, _Google BigQuery_, _Redshift_ und _Databricks_) | Externe Data-Lake-Häuser (z. B. _Snowflake_, _Google BigQuery_, _Redshift_ und _Databricks_) | Objektspeicher oder Cloud-Data-Lakes (z. B. _S3_, _ADLS_ und _GCS_), die häufig Open-Table-Formate wie _Iceberg_ verwenden. |
| **Zweck/Anwendungsfall** | Geeignet für interaktive Analysen und Echtzeit-Dashboards. Geeignet für Echtzeitpersonalisierung und dynamische Workflows. | Geeignet für häufige Abfragen, aber leicht veraltete Ergebnisse sind akzeptabel. Geeignet für BI-Dashboards und Segmentierung. | Geeignet für die Batchverarbeitung im großen Umfang und für AI/ML-Modellschulungen. Geeignet für historische Analysen und Berichte auf Petabyte-Skala. |
| **Frisch/Latenz** | Bietet maximale Aktualität Führt Abfragen direkt in Echtzeit aus. Unterstützt Entscheidungen innerhalb von Sekunden, wenn das Quellsystem für Abfragen mit geringer Latenz und effektivem Pushdown für Prädikate optimiert ist. | Wird verwendet, wenn leicht veraltete Ergebnisse akzeptabel sind. Die Aktualisierung hängt vom Cache-Intervall ab, das zwischen 15 Minuten und 7 Tagen konfiguriert werden kann. | Geeignet für chargenintensive, durchsatzintensive Aufträge. Nicht für Echtzeit-Dashboards geeignet. |
| **Zugriffsmuster** | Geeignet für seltene oder Ad-hoc-Abfragen, bei denen die Aktualität entscheidend ist und das Abfragevolumen gering ist. Die Kosten steigen bei hoher QPS erheblich an. Daher ist es wichtig, die Zwischenspeicherung (beschleunigte Abfrage) auszuwerten, wenn die Abfragehäufigkeit hoch ist. | Geeignet für Szenarien mit hoher Lesehäufigkeit. Verbessert die Leistung bei häufigen Zugriffsmustern. | Bietet *nur Lesezugriff*. Geeignet für Datensets im Petabyte-Bereich ohne Aufnahme. |
| **Leistungstreiber** | Stark von der Leistung des externen Quellsystems abhängig. Geeignet für den Fall, dass Prädikate und Aggregationen an die Quelle übertragen werden können. | Verringert die Latenz im Vergleich zu wiederholten Live-Abfragen. Die Leistung hängt von der Cache-Verwaltung und den Intervallen ab. | Die Leistung hängt stark vom Objektformat, der Partitionierung und dem externen Systemdurchsatz ab. Verwenden Sie partitionierte, spaltenförmige Formate (Parquet/ORC). |
| **Kostenauswirkungen** | Hierbei handelt es sich um ein Pay-per-Query-Modell. Daher fallen bei externen Lake House-Berechnungen Kosten an. Dies ist für seltene Abfragen kosteneffektiv, kann jedoch bei hohem QPS-Volumen zu hohen Ausgaben führen. | Die Kosten sind niedriger als bei wiederholten Live-Abfragen. Dadurch müssen die externen Quellen nicht mehr wiederholt abgefragt werden, es werden jedoch Cache-Speicher und Aktualisierungs-Overhead hinzugefügt. | Dies ist die günstigste Speicheroption. Bei AWS-Setups mit derselben Region (z. B. _S3_ in US-Ost-1 mit einem _Data Cloud-_Mandanten, der sich ebenfalls in US-Ost-1 befindet) werden die Gutschriften für die Zeilen, auf die zugegriffen wird, nicht verbraucht. Regions- oder Cloud-übergreifende Konfigurationen (z. B. _Azurblau_, _GCS_ oder verschiedene _AWS-_Regionen) führen zu einem Gutschriftsverbrauch für die Zeilen, auf die zugegriffen wird. Die Abfragekosten hängen auch von der Dateigröße, der Partitionierung und der Optimierung des Prädikat-Pushdowns ab. |
| **Wichtige Überlegungen** | Vermeiden Sie ungefilterte Abfragen, die unnötig große Datenvolumen scannen. | Für diesen Ansatz ist eine Cache-Verwaltung erforderlich. Nicht für Entscheidungen im Sekundenbereich geeignet. | Die Abfrageleistung hängt stark von der Optimierung über Partitionierung und Pushdown-Prädikate ab. |
### Hybridansatz
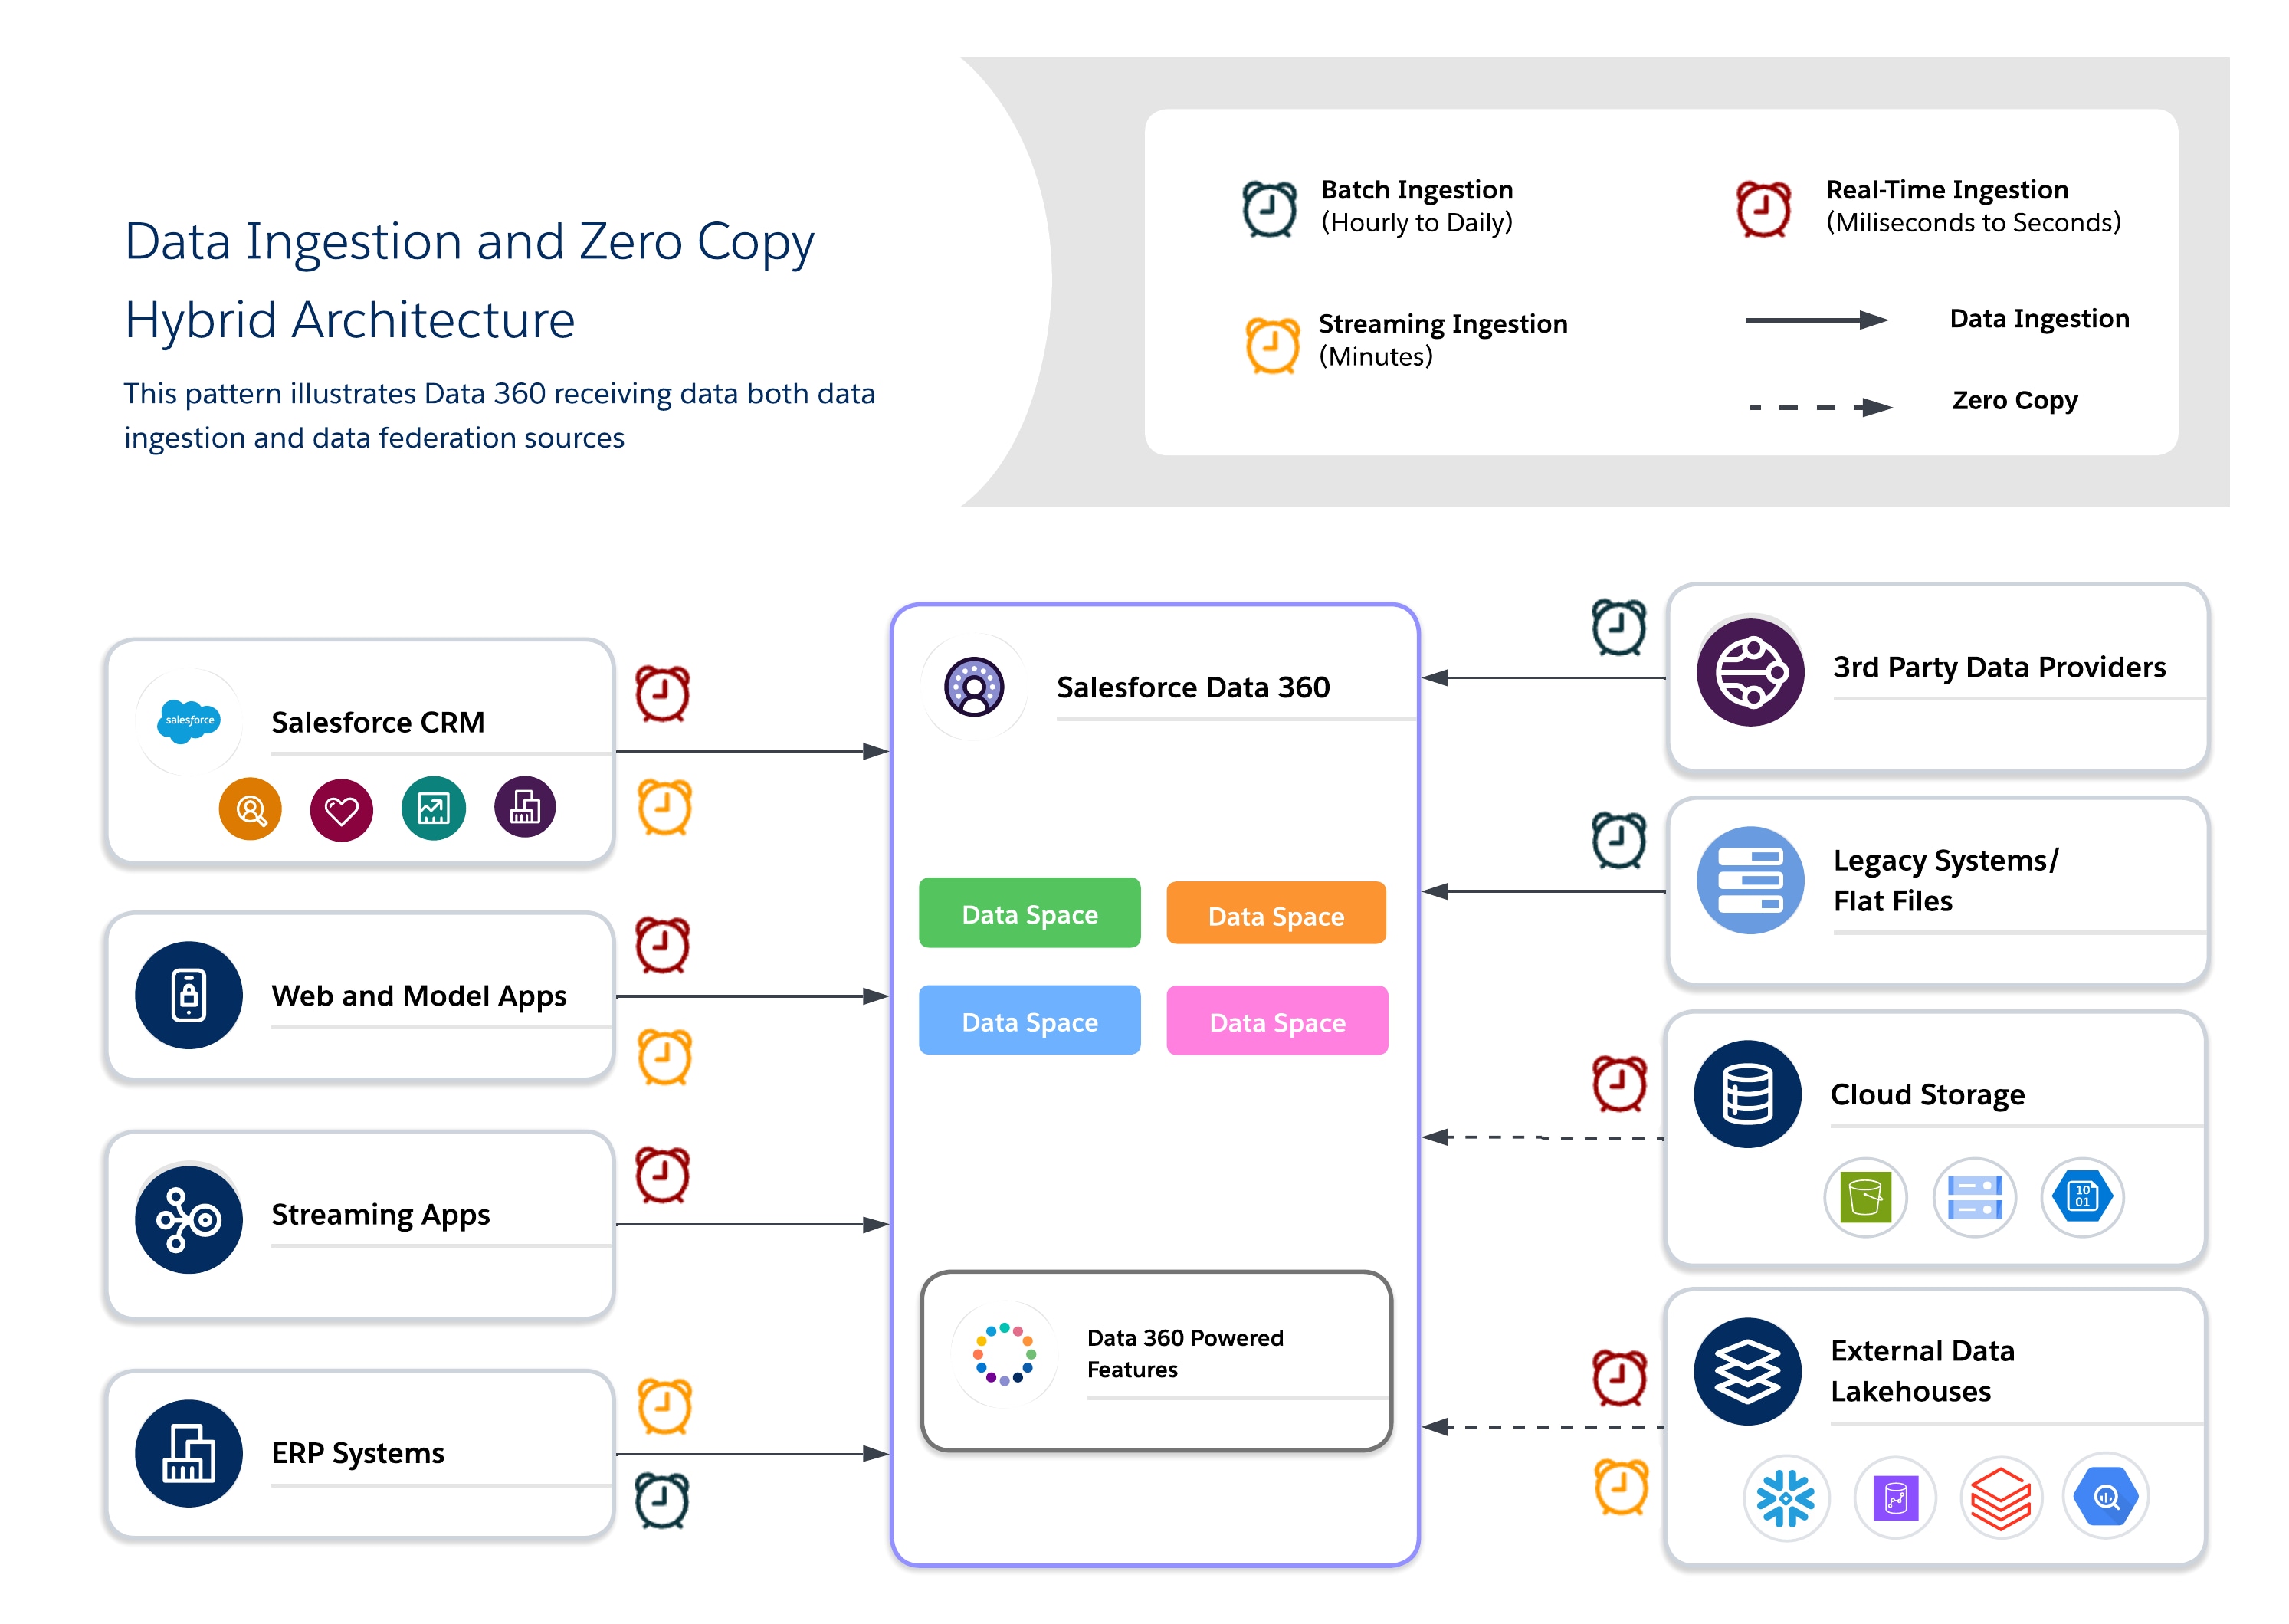
Mit hybriden Architekturen können Architekten wichtige Datensets in _Data 360_ verankern und gleichzeitig Verbundabfragen für Aktualität, reduzierte Duplikate und skalierbaren Zugriff auf große externe Datensets nutzen. Bei diesem Ansatz werden die Anforderungen an E/A, Berechnungslokalität, Kosten und Compliance abgewogen.
#### Hybride Anwendungsfälle
Verwenden Sie einen hybriden Ansatz für ausgewogene Verwaltung, Aktualität und betriebliche Effizienz, indem Sie Datenaufnahme und Nullkopie kombinieren, um handlungsrelevante Statistiken in Echtzeit bereitzustellen. Verwenden Sie die Aufnahme für hochwertige, regulierte Datensets, bei denen Rückverfolgbarkeit, RLS und Maskierung erforderlich sind, und die Zuordnung für vorübergehende Datensets oder Datensets mit hohem Volumen, bei denen Aktualität und Leistung entscheidend sind.
 #### Architect Playbook (Playbook für Architekten)
- **Anwendungsfälle**
- **Omnikanal-Engagement:** Kombinieren Sie historische Kundendaten mit Echtzeitverhalten, um konsistente, kontextbezogene Erfahrungen bereitzustellen.
- **AI/ML-Pipelines:** Trainieren Sie Modelle für zusammengestellte kanonische Datensets und reichern Sie sie mit Roh- oder Echtzeitsignalen aus externen Quellen an.
- **Kombinierte Compliance- und Agilitätsanforderungen:** Wenden Sie strenge Governance-Vorschriften für sensible Daten an und eine Verbundorganisation für betriebliche Agilität.
- **Branchenszenarien**
- **Einzelhandel:** Verwenden Sie die _Integration_ für die Identitätsbestimmung und die Profilvereinheitlichung und _die Zuordnung_ für Echtzeitangebote und Personalisierung.
- **Gesundheitswesen:** Verwalten Sie goldene Patientenakten per _Integration_, während Sie _eine Verbundverbindung für_ IoT-Geräteströme und Sensordaten verwenden, um einen unmittelbaren Kontext zu erhalten.
- **Financial Services:** Nehmen Sie regulierte Daten in einen konformitätsgesteuerten See auf, während Sie _den Verbund_ für externe Abfragen zur Betrugserkennung und Risikoüberwachung verwenden.
- **Designpraktiken**
- **Anker-Governance mit Aufnahme:** Nehmen Sie hochwertige oder regulierte Daten in kanonische Modelle auf, um Trust und Compliance zu gewährleisten.
- **Verbund für Frische verwenden:** Ermöglicht es externen Lake Houses, Datenzugriff in Echtzeit oder in großem Umfang ohne Duplikate bereitzustellen.
- **Balance Cost vs Performance (Saldokosten im Vergleich zur Leistung):** Profilarbeitslasten, um zu bestimmen, wann _die Aufnahme_ im Vergleich zum _Verbund_ verwendet werden soll, wodurch unnötige Speicher- und Abfragekosten minimiert werden.
- **Anwenden der mehrschichtigen Unternehmensführung:** Erzwingen Sie die zentralisierte Verwaltung für aufgenommene Daten und nutzen Sie gleichzeitig die Sicherheitssteuerungen für Verbundsysteme (z. B. RLS und Maskierung).
- **Hinweis:** Wenn Sie hybride Pipelines entwerfen, ist es wichtig, die inkrementelle Aufnahme historischer Datensets sicherzustellen und Aggregationen oder Filter an Verbundquellen zu übertragen, um die E/A- und Berechnungsnutzung zu optimieren.
- **Überlegungen zu Kosten**
- Wägen Sie die Gesamtkosten im Vergleich zur Leistung ab, indem Sie die _Aufnahme_ für Compliance- oder wichtige Daten mit dem _Verbund_ kombinieren, wenn eine Aktualisierung erforderlich ist.
- Berücksichtigen Sie die E/A- und Berechnungsverteilung beim Mischen von _Aufnahme_ und _Verbund_. Verwenden Sie die Zwischenspeicherung (beschleunigte Abfrage) für Verbunddatensets mit hohem Lesezugriff, um die Rechenkosten für wiederholte Abfragen in Quellsystemen zu reduzieren.
- Verwenden Sie diese Regel, um die Entscheidung über die Aufnahme im Vergleich zum Verbund festzulegen: Wenn häufig auf Daten zugegriffen wird, sich diese jedoch selten ändern, ist die _beschleunigte Abfrage_ in der Regel kostengünstiger. Wenn sich die Daten jedoch häufig ändern (bezogen auf die Zugriffshäufigkeit), ist die _Live-Abfrage_ oder -_Aufnahme_ besser geeignet. Hier einige Kostenbeispiele:
- **Beschleunigungsgewinne:** Ein Dashboard, das aus 1 Million Datensätzen erstellt und täglich mit etwa 10.000 Änderungen aktualisiert wird, wird 20 Mal pro Tag angezeigt. Die _Beschleunigungskosten_ belaufen sich auf etwa 600 Gutschriften/Monat im Vergleich zu 4.200 Gutschriften/Monat für _Live-Abfragen_.
- **Live-Abfrage gewinnt:** Segmente, die 20 Mal pro Tag veröffentlicht werden und Daten verwenden, die sich alle 30 Minuten ändern. _Live-Abfragen_ kosten etwa ~4.200 Credits/Monat im Vergleich zu ~28.800 Credits/Monat für die _Beschleunigung_ bei dieser Aktualisierungshäufigkeit.
## Leitfaden zur Anwendungsfallentscheidung
Sehen wir uns einige gängige Archetypen genauer an, die die Anwendung dieser Logik veranschaulichen.
- **Der Archetyp "Single Source of Truth" (Einzelne Datenquelle): Zentralisieren und Verwalten**
- **Szenario:** Sie müssen kompatible, vereinheitlichte _Customer 360_ Profile für Ihr gesamtes globales Unternehmen erstellen. Die Daten stammen aus einem Dutzend verschiedener Systeme, müssen strenge _DSGVO-_ und _CCPA-_Vorschriften einhalten und dienen als Quelle der Wahrheit für alle Marketing- und Serviceinteraktionen.
- **Empfohlenes Muster:** **Datenaufnahme.** Hier stehen Governance, Trust und Kontrolle im Vordergrund. Die Aufnahme der Daten in _Data 360_ ist die einzige Möglichkeit, ein vollständig überprüfbares, kanonisches Profil zu erstellen, das von den Quellsystemen isoliert ist.
- **Der Archetyp "Echtzeitstatistiken": Analysieren ohne Verschieben**
- **Szenario:** Ihr Data Science-Team muss Erkundungsabfragen für eine massive, ständig aktualisierte Transaktionstabelle in _Snowflake_ ausführen. Gleichzeitig möchte Ihr Führungsteam ein Live-_BI-_Dashboard, das auf denselben Daten basiert. Das tägliche Verschieben von Petabyte Daten ist langsam und teuer.
- **Empfohlenes Muster:** **Zero Copy Federation.** Die Priorität liegt dabei auf Geschwindigkeit, Agilität und Kosteneffizienz im richtigen Maßstab. Mit _Zero Copy_ können Sie die Leistungsfähigkeit Ihres vorhandenen Data Warehouse für Echtzeitabfragen nutzen, ohne den Aufwand und die Latenz der Datenduplizierung zu erhöhen.
- **Der Archetyp "Hybridintelligenz": Verwalten des Kerns, Zusammenführen des Kerns**
- **Szenario:** Sie möchten Ihre verwalteten, aufgenommenen Kundenprofile mit Echtzeit-Verhaltenssignalen (z. B. Website-Klicks) aus einem Data Lake anreichern. Sie benötigen die Stabilität des Kernprofils, aber die Unmittelbarkeit der Live-Daten, um die sofortige Personalisierung zu unterstützen.
- **Empfohlenes Muster:** **Ein hybrider Ansatz.** Verwenden Sie die _Datenaufnahme_, um einen stabilen, geregelten Kern für Ihre Kundendaten zu erstellen. Verwenden Sie _Nullkopie_, um die volatilen Echtzeit-"Edge"-Daten zu verknüpfen und dann zur Abfragezeit miteinander zu verknüpfen, um eine vollständige, sekundengenaue Ansicht zu erhalten.
## Der Weg nach vorn
Bei der Unternehmensdatenstrategie geht es nicht mehr darum, ein einzelnes Integrationsmuster auszuwählen, sondern darum, kontrollierte Flexibilität in einem interoperablen Datenökosystem zu entwickeln. Der richtige Ansatz ordnet jedes Quellsystem dem Muster zu, das seinen Anforderungen an Aktualität, Verwaltung, Kosten und Zugriff am besten entspricht:
- Nehmen Sie geschäftskritische, regulierte Datensets in Salesforce _Data Cloud_ auf, um Compliance, Identitätsbestimmung und betriebliche Workflows zu gewährleisten.
- Verbinden Sie Daten über _Nullkopie_ für Live-, explorative und AI-gestützte Analysen, ohne Speicher zu duplizieren.
- Anwenden von _Caching (beschleunigte Abfrage)_ zum Reduzieren der Quellsystemlast und des Guthabenverbrauchs bei hoher Abfragehäufigkeit und niedriger Datenänderungshäufigkeit
Salesforce _Data 360_ in _Hyperforce_ bietet Widerstandsfähigkeit und Skalierbarkeit für mehrere Regionen. Das offene Lake House mit _Iceberg-_Tabellen ermöglicht die Berechnungstrennung und Interoperabilität mit Plattformen wie _Snowflake_, _Databricks_ und _S3 Iceberg, die_ das Rückgrat eines wirklich interoperablen Multi-Cloud-Datenökosystems bilden.
Während sich Datenökosysteme weiterentwickeln, müssen wir kontinuierlich zwischen Aktualität, Kosten, Leistung und Compliance abwägen, um die architektonische Agilität aufrechtzuerhalten. Daher ist es wichtig, Ihre Plattform zukunftssicher zu gestalten, indem erfasste, geregelte Daten mit Verbundzugriff vereinheitlicht werden. Dies ermöglicht Echtzeitintelligenz, AI-Aktivierung und Personalisierung im Unternehmensbereich über Clouds, Regionen und Geschäftsdomänen hinweg.
Beachten Sie, dass Lösungen für die einheitliche Größe für die meisten Unternehmen nicht geeignet sind. Die optimale Strategie ordnet das richtige Muster dem richtigen Geschäftstreiber zu.
## Über die Autoren
**Yugandhar Bora** ist Software-Entwickler bei Salesforce und hat sich auf die Datenarchitektur innerhalb der Plattform für Daten- und Intelligenzanwendungen spezialisiert. Er leitet Initiativen des _Enterprise Architecture Review Board (EARB)_, die sich auf Datenverwaltung und vereinheitlichte Datenmodelle konzentrieren und gleichzeitig zu automatisierten Plattformbereitstellungslösungen beitragen.
**Jan Fernando** ist Principal Architect im _Office of the Chief Architect (OCA)_ bei Salesforce und seit 2012 bei Salesforce tätig. Vor seiner Tätigkeit beim OCA war er über ein Jahrzehnt in der _Plattformorganisation_ tätig, wo er mehrere wichtige Technologietransformationen leitete.
# Datenintegration in Salesforce
Es gibt eine Vielzahl von Möglichkeiten, auf Daten zwischen Salesforce und externen Systemen zuzugreifen, sie zu synchronisieren und freizugeben. Aber nicht jedes Tool ist für Ihr jeweiliges Projekt geeignet. Dieser Leitfaden führt Sie durch die Landschaft der Datenintegrationstools, die von Salesforce verfügbar sind. Sie bietet auch Empfehlungen für die Tools (oder Kombinationen von Tools), die für einen bestimmten Anwendungsfall am besten geeignet sind, sowie Anleitungen zu Tools, die für bestimmte Szenarien vermieden werden sollten.
## Leitfadenübersicht
Dieser Entscheidungsleitfaden konzentriert sich auf Integrationen auf Datenebene, die Salesforce betreffen. Insbesondere deckt sie die folgenden Datenintegrationsanwendungsfälle ab:
- Salesforce für externe Systeme
- Externe Systeme für Salesforce
- Salesforce-Organisation zu Salesforce-Organisation
Dies ist nur ein Teil der Integrationsherausforderungen, mit denen Salesforce-Architekten konfrontiert sind. Daher planen wir, weitere Entscheidungsleitfäden hinzuzufügen, die sich auf die ereignisgesteuerte Integration konzentrieren, effektive Workflows für Kunden oder Mitarbeiter mithilfe der Prozessintegration erstellen usw. Schließlich ist es wichtig zu beachten, dass viele der hier beschriebenen Tools und Ansätze verwendet werden können, um Integrationsherausforderungen im gesamten Unternehmen zu lösen. Solche Anwendungen sprengen jedoch den Umfang dieses Leitfadens.
## Takeaways
- **Vermeiden Sie unnötige Datenreplikationen.** Sofern sich die Daten nicht unbedingt in Salesforce befinden müssen, sollten Sie stattdessen die Datenvirtualisierung mit Salesforce Connect in Erwägung ziehen. Mehr Daten in Ihrer Organisation führen letztlich zu größeren Datenvolumen, was sich negativ auf [die Leistung](/docs/architect/de-de/well-architected/guide/reliability.html#scalability-and-capacity-planning) auswirken und zu höheren technischen Schulden führen kann. Wenn sich Ihre Daten bereits in Salesforce befinden und Sie sie in einem externen System benötigen, sollten Sie vermeiden, sie in ein externes System zu kopieren, sofern dies nicht unbedingt erforderlich ist. Lassen Sie das externe System stattdessen über die Salesforce-APIs auf die Daten zugreifen.
- **Verwenden Sie MuleSoft oder andere Enterprise Service Bus-Lösungen (ESB) oder ETL-Lösungen (Extract-Transform-Load), sofern verfügbar und Teil Ihrer vorhandenen Landschaft.** Da diese Tools entwickelt wurden, um die Datenmigration und -transformation zu unterstützen, verfügen sie oft über leistungsstarke Funktionen, mit denen Sie Integrationen im gesamten Unternehmen wiederverwenden, eine stärkere Unternehmensführung aufrechterhalten und die Verwaltung von Integrationen zentralisieren können. Überlegen Sie in dieser Anleitung, wo immer MuleSoft Anypoint empfohlen wird, ob Ihre vorhandene ESB/ETL-Lösung ausreicht.
- **Harmonisieren Sie Daten aus verschiedenen Quellen mit Data 360 und Data Cloud One.** Über das Customer 360-Datenmodell, die Identitätsbestimmung, den Datenverbund und andere Funktionen konsolidiert Data 360 Daten aus Salesforce und anderen externen Systemen in einer einheitlichen Ansicht Ihres Kunden. Mit [Data Cloud One](/docs/architect/de-de/fundamentals/guide/data360_integration_patterns_and_practices.html#unified-multi-org-data-platform-with-data-cloud-one) können Benutzer in anderen Salesforce-Organisationen sicher über Datenbereiche auf Daten zugreifen, die virtuell aus Data 360 freigegeben wurden.
- Verschieben Sie Daten zwischen Organisationen mithilfe von **Data 360-Aktionen und -Aktivierungen.** Nachdem Daten aus verschiedenen Organisationen in Data 360 aufgenommen wurden, können Datenaktionen [und Aktivierungen](/docs/architect/de-de/fundamentals/guide/data360_integration_patterns_and_practices.html#data-activation-patterns--data-outbound) die Daten mit einer anderen Organisation synchronisieren. Dieser Ansatz kann für Integrationen in Marketing Cloud-Organisationen sehr nützlich sein.
- Extrahieren und verschieben Sie Daten mit **MuleSoft Anypoint.** MuleSoft Anypoint kann verwendet werden, um Daten aus Data 360 mithilfe der Connect-API und der Datendiagramm-API zu extrahieren und in eine andere Salesforce-Organisation zu verschieben. Ohne Data 360 kann MuleSoft Anypoint auch verwendet werden, wenn Daten zwischen Organisationen verschoben werden müssen, ohne dass sie in Data 360 repliziert werden.
- **Gehen Sie mit Bedacht vor, wenn Sie sich für die Erstellung mit ausgehendem Messaging entscheiden.** Salesforce wird ausgehendes Messaging im Rahmen der aktuellen Funktionskapazitäten weiterhin unterstützen, plant jedoch keine weiteren Investitionen in diese Technologie.
- **Für alle Integrationen wird immer die Integrationsbenutzerlizenz mit dem Profil "Nur API" empfohlen.** Salesforce empfiehlt zudem die Verwendung von externen Client-Anwendungen (zugunsten verbundener Anwendungen oder SOAP-Anmeldung) als ordnungsgemäß autorisierte AuthN- und AuthZ-Muster für alle Integrationen.
## Allgemeine Überlegungen zur Auswahl von Datenintegrationstools
Bevor Sie sich mit den verfügbaren Datenintegrationstools vertraut machen, sollten Sie bei der Auswahl eines Tools einige allgemeine Überlegungen berücksichtigen. Wie bei der Architektur üblich, gibt es nicht jede präskriptive Antwort auf jede geschäftliche Herausforderung. Wenn Sie bei Integrationsentscheidungen die Worte "es kommt darauf an" ausgesprochen haben, sind Sie an der richtigen Stelle.
| Zu berücksichtigender Bereich | Allgemeine Fragen |
|---|---|
| Vorhandene Tools und Landschaft | Gibt es eine vorhandene ESB- oder ETL-Lösung? Verfügen die beteiligten Daten über gesetzliche oder Compliance-Anforderungen? Wo befinden sich die Systeme, die Sie integrieren möchten (in der Cloud oder vor Ort)? |
| Datenfluss (Zeiteinteilung, erwartete Benutzererfahrung, Richtung) | Müssen die Daten synchron oder asynchron verschoben werden oder können sie als Batch oder Plan erstellt werden? Ist ein Datenabgleich erforderlich? Welches System sollte die Quelle der Wahrheit sein? Was ist die Datenquelle? Was ist das Ziel? Ist eine Benutzerinteraktion erforderlich? Muss der Benutzer das Ergebnis der Integration sehen? Was sind die Anforderungen an die Verarbeitung von Ausnahmen (Wiederholen, Benachrichtigen, Fehlschlagen)? Wie eng sollten Systeme gekoppelt sein? |
| Implementierung | Wie hoch ist der Aufwand für Nicht-Salesforce-Systeme? Welche Teams sind für die Bereitstellung von Integrationen verantwortlich? Welche Tools verwenden sie bevorzugt? |
| Wartbarkeit | Von welchen Teams wird erwartet, dass sie die Integration pflegen? Welche Fertigkeiten verfügen sie derzeit? Welche Fertigkeiten benötigen sie in Zukunft? Wie hoch sind die Gesamtbetriebskosten im Laufe der Zeit? Wie wichtig ist die Fähigkeit zum Testen, Debuggen und zur Fehlerbehebung mit Low- oder Pro-Code-Tools? |
| Datenvolumen | Wie viele Daten sind an der Integration beteiligt? Arbeiten Sie mit Large Data Volumes (LDV)? Wie häufig werden Änderungen per Massenvorgang vorgenommen? Welche Auswirkungen haben Singleton-Aktualisierungen? Wie oft werden sie auftreten? |
| Obergrenzen | Müssen die Daten einer komplexen Transformation unterzogen werden? Müssen die Daten aus mehreren Quellsystemen kombiniert werden? Wie oft erfolgt eine Integration pro Benutzer? Wie viele Benutzer insgesamt? Haben Sie für Massendatenladungen im Voraus geplant (Beispiel: anfängliches Laden von Daten für eine neue Instanz)? |
| Von Salesforce zum externen System | Vom externen System zu Salesforce | Ausführung | Zusätzliche Lizenz erforderlich | |
|---|---|---|---|---|
| Apex Aktionen | Verfügbar | Verfügbar | Serverseitig | Nein |
| Datenerfassung ändern | Verfügbar | Nicht verfügbar | Serverseitig | Nein* |
| Benutzerdefiniertes Apex (REST- und SOAP-Webservices) | Verfügbar | Verfügbar | Serverseitig | Nein |
| Externe Services | Verfügbar | Nicht verfügbar | Serverseitig | Nein |
| Heroku Connect | Verfügbar | Verfügbar | Serverseitig | Ja |
| Daten 360 | Verfügbar | Verfügbar | Serverseitig | Ja |
| MuleSoft Anypoint | Verfügbar | Verfügbar | Serverseitig | Ja |
| Native Salesforce-APIs | Nicht verfügbar | Verfügbar | Serverseitig | Nein |
| OmniScript | Verfügbar | Verfügbar | Clientseitig*** | Ja |
| OmniStudio-Integrationsverfahren | Verfügbar | Verfügbar | Serverseitig | Ja |
| Ausgehendes Messaging | Nicht ideal | Nicht verfügbar | Serverseitig | Nein |
| Plattformereignisse | Verfügbar | Verfügbar | Serverseitig | Nein** |
| Salesforce Connect / Externe Objekte | Verfügbar | Verfügbar | Serverseitig | Ja |
| Anleitung | Lizenzierung | Zeitpunkt | Volumen und Skalierung | Lieferung & Wartung | Datenschutz und Sicherheit | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Anwendungszeitpunkt | Zusätzliche Lizenz | Synchronisierung (Anforderung/Antwort) oder Asynchronisierung (Auslösen/Vergessen) | Unterstützung von mehreren Objekten | LDV/Masse | Testen und Bereitstellen** | Debugging | Eingebautes Fehlerverarbeitungs-/Wiederholungsverhalten | Kann mit im Leerlauf verschlüsselten Daten verwendet werden | Authentifizierungsprotokoll | |
| Datenerfassung ändern | Wenn Sie in Salesforce vorgenommene Änderungen auf Datensatzebene in einem externen System veröffentlichen müssen und keine benutzerdefinierte Nutzlast benötigen. | Erforderlich | Asynchron | Nein | Nein | Ja | Mit Pro-Code-Tools | Ja | Ja | OAuth |
| Externe Services | Wenn Sie einen Prozess mit Flow, Apex, Einstein Bots oder OmniStudio orchestrieren, werden die APIs des externen Systems mit OpenAPI-Spezifikationen beschrieben. | Nicht erforderlich | Sync | Ja | Nein | Ja | Mit Pro-Code-Tools | Nein | N/A | Anmeldeinformationen mit Namen |
| Heroku Connect | Wenn Sie Ihre Daten mit bidirektionaler Synchronisierung erweitern möchten, um mobile und andere Anwendungen in Heroku zu aktivieren, und Sie möchten, dass die Daten auch in Salesforce repliziert werden. | Erforderlich | Asynchron | Ja | Ja | Nein | Mit Proficode-Tools | Ja | Ja, über Shield Connect | OAuth |
| OmniStudio-Integrationsverfahren | Wenn Sie Daten ohne Benutzerinteraktion umwandeln und die Leistung durch Verarbeitung auf dem Server statt im Browser verbessern müssen. | Erforderlich | Beides | Ja | Ja | Ja | Deklarative Unterstützung | Ja | Ja | Anmeldeinformationen mit Namen |
| Salesforce Connect / Externe Objekte | Wenn Daten auf der Salesforce-Benutzeroberfläche angezeigt werden sollen, die Daten jedoch in einem externen System gespeichert werden sollen. Daten werden nicht in Salesforce repliziert. | Erforderlich | Sync | Nein | Ja* | Ja | Mit Pro-Code-Tools und deklarativer Verfolgung | Nein | N/A | Anmeldeinformationen mit Namen |
| * Für Odata Adapter, die älter als Version 4.01 sind, gelten Callout-Obergrenzen. Weitere Details finden Sie unter Überlegungen zur Odata Callout Rate Limit (Obergrenze für Odata-Callouts). ** Testen und Bereitstellen bezieht sich auf die Möglichkeit, in einer niedrigeren Umgebung zu erstellen und über die Metadaten-API, Pakete oder Änderungssets in der Produktion bereitzustellen. | ||||||||||
| Anleitung | Lizenzierung | Zeitpunkt | Volumen und Skalierung | Lieferung & Wartung | Datenschutz und Sicherheit | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Anwendungszeitpunkt | Zusätzliche Lizenz | Synchronisierung (Anforderung/Antwort) oder Asynchronisierung (Auslösen/Vergessen) | Unterstützung von mehreren Objekten | LDV/Masse | Testen und Bereitstellen** | Debugging | Eingebautes Fehlerverarbeitungs-/Wiederholungsverhalten | Kann mit im Leerlauf verschlüsselten Daten verwendet werden | Authentifizierungsprotokoll | |
| Apex Aktionen | Wenn Sie Callouts an ein anderes System über den Salesforce-Flow automatisieren möchten. Ein Entwickler kann eine Apex-Klasse schreiben, die ein Flow aufrufen kann, oder Sie können eine vordefinierte Lösung aus AppExchange herunterladen. | Nicht erforderlich | Beides | Ja | Nein | Ja | Mit Pro-Code-Tools | Nein | Ja | Mehrere |
| Ereignisweiterleitungen | Wenn Sie Plattformereignisse und Ereignisse der Datenerfassung über Salesforce an Amazon EventBridge senden müssen. Ereignisweiterleitungen stellen nur eine Verbindung mit AWS Eventbridge her | Nein | Asynchron | Ja | Nein | Ja | Ja | Ja | Ja | HTTP/1.1 mit TLS |
| Ausgehendes Messaging | Wenn Sie SOAP-Nachrichten über HTTP(S) an einen angegebenen Endpunkt mit garantiertem Empfang senden müssen, wenn er durch eine Workflow-Regel ausgelöst wird. | Nicht erforderlich | Asynchron | Nein | Nein | Ja | Deklarative Unterstützung | Ja | Ja | Bidirektionales TLS |
| Plattformereignisse | Wenn Sie eine benutzerdefinierte, strukturierte Nutzlast für Änderungen nahezu in Echtzeit in Salesforce oder einem externen System benötigen. | Nicht erforderlich* | Asynchron | Ja | Nein | Ja | Mit Pro-Code-Tools | Ja | Ja | OAuth |
| Salesforce Connect / Externe Objekte (mit benutzerdefinierten Apex Adaptern) | Wenn Daten auf der Salesforce-Benutzeroberfläche angezeigt werden sollen, die Daten jedoch in einem externen System gespeichert werden sollen, das keine Standardprotokolle wie Odata oder GraphQL verwenden kann. | Erforderlich | Beides | Ja | Ja | Ja | Mit Pro-Code-Tools | Nein | N/A | Mehrere |
| Daten 360 | Wenn Sie harmonisierte Daten aus verschiedenen Quellen in einem Datenspeicher wünschen oder Ihre Daten in andere Salesforce-Organisationen oder andere externe Systeme replizieren möchten. | Erforderlich | Beides | Ja | Ja | Ja | Ja | Ja | Ja | Mehrere |
| Anleitung | Lizenzierung | Zeitpunkt | Volumen und Skalierung | Lieferung & Wartung | Datenschutz und Sicherheit | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Anwendungszeitpunkt | Zusätzliche Lizenz | Synchronisierung (Anforderung/Antwort) oder Asynchronisierung (Auslösen/Vergessen) | Unterstützung von mehreren Objekten | LDV/Masse | Testen und Bereitstellen** | Debugging | Eingebautes Fehlerverarbeitungs-/Wiederholungsverhalten | Kann mit im Leerlauf verschlüsselten Daten verwendet werden | Authentifizierungsprotokoll | |
| Benutzerdefinierter Apex | Wenn Sie mehr Funktionen benötigen, als in Low-Code-Tools verfügbar sind. | Nicht erforderlich | Beides | Ja | Ja | Ja | Mit Pro-Code-Tools | Nein | Ja* | Mehrere |
| Externe Services | Die Integration aus Code in externe System-APIs wird mit OpenAPI-Spezifikationen beschrieben. | Nicht erforderlich | Sync | Ja | Nein | Ja | Mit Pro-Code-Tools | Nein | N/A | Mehrere |
| MuleSoft Anypoint | Wenn Sie eine einzelne einheitliche Lösung auf Unternehmensebene zum Erstellen, Orchestrieren und Verwalten Ihrer Integrationen benötigen, wenn Sie eine veraltete Punkt-zu-Punkt-Architektur ersetzen müssen oder wenn Sie API-Verwaltungsunterstützung benötigen. | Erforderlich | Beides | Ja | Ja | Ja | Mit Pro-Code-Tools | Nein | Ja* | Mehrere |
| Anleitung | Lizenzierung | Zeitpunkt | Volumen und Skalierung | Lieferung & Wartung | Datenschutz und Sicherheit | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Wann zu verwenden | Zusätzliche Lizenz | Synchronisierung (Anforderung/Antwort) oder Asynchronisierung (Auslösen/Vergessen) | Unterstützung für mehrere Objekte | LDV/Bulk | Testen und Bereitstellen* | Debugging | Integriertes Fehlerverarbeitungs-/Wiederholungsverhalten | Kann mit im Leerlauf verschlüsselten Daten verwendet werden | Authentifizierungsprotokoll | |
| Heroku Connect | Wenn Sie Ihre Daten mit bidirektionaler Synchronisierung erweitern möchten, um mobile und andere Anwendungen in Heroku zu aktivieren, und Sie möchten, dass die Daten auch in Salesforce repliziert werden. | Erforderlich | Asynchron | Ja | Ja | Nein | Mit Pro-Code-Tools | Ja | Ja, über Shield Connect | OAuth |
| OmniStudio-Integrationsverfahren | Wenn Sie Daten aus Drittanbieterquellen ohne Benutzerinteraktion importieren und umwandeln müssen. | Erforderlich | Beides | Ja | Ja | Ja | Deklarative Unterstützung | Nein | Ja | Anmeldeinformationen mit Namen |
| Salesforce Connect / Externe Objekte | Wenn Daten auf der Salesforce-Benutzeroberfläche angezeigt werden sollen, die Daten jedoch in einem externen System gespeichert werden sollen, das Standardprotokolle wie Odata oder GraphQL verwenden kann. | Erforderlich | Sync | Ja | Ja | Ja | Mit Pro-Code-Tools | Nein | N/A | Mehrere |
| Anleitung | Lizenzierung | Zeitpunkt | Volumen und Skalierung | Lieferung & Wartung | Datenschutz und Sicherheit | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Wann zu verwenden | Zusätzliche Lizenz | Synchronisierung (Anforderung/Antwort) oder Asynchronisierung (Auslösen/Vergessen) | Unterstützung für mehrere Objekte | LDV/Bulk | Testen und Bereitstellen** | Debugging | Integriertes Fehlerverarbeitungs-/Wiederholungsverhalten | Kann mit im Leerlauf verschlüsselten Daten verwendet werden | Authentifizierungsprotokoll | |
| Plattformereignisse | Wenn Sie eine benutzerdefinierte, strukturierte Nutzlast für Änderungen nahezu in Echtzeit in Salesforce oder einem externen System benötigen. | Nicht erforderlich* | Asynchron | Ja | Nein | Ja | Mit Pro-Code-Tools | Ja | Ja | OAuth |
| Salesforce Connect / Externe Objekte (mit benutzerdefinierten Apex Adaptern) | Wenn Daten auf der Salesforce-Benutzeroberfläche angezeigt werden sollen, die Daten jedoch in einem externen System gespeichert werden sollen, das keine Odata 2.0/4.0-Protokolle verwenden kann. | Erforderlich | Beides | Ja | Ja | Ja | Mit Pro-Code-Tools | Nein | N/A | Mehrere |
| Daten 360 | Wenn Sie harmonisierte Daten aus verschiedenen Quellen in einem Datenspeicher wünschen oder Ihre Daten aus anderen Salesforce-Organisationen oder anderen externen Systemen replizieren möchten. Data 360 unterstützt auch die Virtualisierung für einige Plattformen. | Erforderlich | Beides | Ja | Ja | Ja | Nein | Ja | Ja | Mehrere |
| Anleitung | Lizenzierung | Zeitpunkt | Volumen und Skalierung | Lieferung & Wartung | Datenschutz und Sicherheit | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| Wann zu verwenden | Zusätzliche Lizenz | Synchronisierung (Anforderung/Antwort) oder Asynchronisierung (Auslösen/Vergessen) | Unterstützung für mehrere Objekte | LDV/Bulk | Testen und Bereitstellen**** | Debugging | Integriertes Fehlerverarbeitungs-/Wiederholungsverhalten | Kann mit im Leerlauf verschlüsselten Daten verwendet werden | Authentifizierungsprotokoll | |
| Benutzerdefinierte Apex REST & SOAP Web Services | Wenn Sie mehr Funktionen benötigen, als von den nativen API-Endpunkten bereitgestellt werden, beispielsweise die objektübergreifende Verarbeitung oder andere komplexe Logik. | Nicht erforderlich | Beides | Ja | Ja | Ja | Mit Pro-Code-Tools | Nein | Ja*** | Mehrere |
| MuleSoft Anypoint | Wenn Sie eine einzelne einheitliche Lösung auf Unternehmensebene zum Erstellen, Orchestrieren und Verwalten Ihrer Integrationen benötigen, wenn Sie eine veraltete Punkt-zu-Punkt-Architektur ersetzen müssen oder wenn Sie API-Verwaltungsunterstützung benötigen. | Erforderlich | Beides | Ja | Ja | Ja | Mit Pro-Code-Tools | Nein | Ja*** | Mehrere |
| Native Salesforce-APIs | Wenn Sie mehr Kontrolle benötigen oder über eine Pro-Code-Fertigkeit verfügen, um Integrationen über die REST-API, die SOAP-API, die Bulk-API oder GraphQL-APIs oder gRPC zu erstellen. | Nicht erforderlich* | Beides | Ja***** | Ja | Ja | Mit Pro-Code-Tools | Ja** | Ja*** | Mehrere |
| Anleitung | Kosten | Zeitpunkt | Volumen und Skalierung | Lieferung & Wartung | Datenschutz und Sicherheit | Zu implementierende Tools | |||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| Anwendungszeitpunkt | Zusätzliche Lizenz | Synchronisierung (Anforderung/Antwort) oder Asynchronisierung (Auslösen/Vergessen) | Unterstützung von mehreren Objekten | LDV/Masse | Testen und Bereitstellen* | Debugging | Eingebautes Fehlerverarbeitungs-/Wiederholungsverhalten | Kann mit im Leerlauf verschlüsselten Daten verwendet werden | Authentifizierungsprotokoll | Niedriger Code → Pro Code | |
| Heroku Connect | Wenn Sie Ihre Daten mit bidirektionaler Synchronisierung über Salesforce-Organisationen hinweg erweitern und auch den Zugriff auf die Daten über mobile und andere Anwendungen aktivieren möchten, die auf Heroku ausgeführt werden | Erforderlich | Asynchron | Ja | Ja | Nein | Mit Pro-Code-Tools | Ja | Ja, über Shield Connect | OAuth | Low Code (Niedriger Code) |
| MuleSoft Anypoint | Wenn Sie eine einzelne einheitliche Lösung für Unternehmen zum Erstellen, Orchestrieren und Verwalten Ihrer Integrationen benötigen, wenn Sie eine veraltete Punkt-zu-Punkt-Architektur ersetzen müssen oder wenn Sie API-Verwaltungsunterstützung benötigen | Erforderlich | Beides | Ja | Ja | Ja | Mit Pro-Code-Tools | Nein | Ja** | Mehrere | Pro-Code |
| Native Salesforce-APIs | Wenn Salesforce oder Heroku Connect keine Option sind oder Sie eine komplexere Verarbeitung benötigen | Nicht erforderlich | Beides | Nein | Ja | Ja | Mit Pro-Code-Tools | Nein | Ja** | Mehrere | Pro-Code |
| Datenerfassung ändern | Wenn Sie in Salesforce vorgenommene Änderungen auf Datensatzebene in einem externen System veröffentlichen müssen und keine benutzerdefinierte Nutzlast benötigen. | Erforderlich | Asynchron | Nein | Nein | Ja | Mit Pro-Code-Tools | Ja | Ja | OAuth | |
| Salesforce Connect mit organisationsübergreifendem Adapter | Wenn Benutzer in einer Organisation Datensätze in einer anderen Organisation ohne Datenreplikation anzeigen oder bearbeiten sollen | Erforderlich | Asynchron | Ja | Ja | Ja | Mit Pro-Code-Tools | N/A | N/A | Mehrere | Low Code (Niedriger Code) |
| Daten 360 | Wenn Sie möchten, dass Benutzer in einer Organisation Datensätze in einer anderen Organisation mit in Data 360 abgeglichenen Daten anzeigen oder bearbeiten können. | Erforderlich | Beides | Ja | Ja | Ja | Mit Pro-Code-Tools | Ja | Ja | Mehrere | Hybrid |
| Flow | Salesforce Flow ist ein leistungsstarkes Zeigen-und-Klicken-Automatisierungstool, mit dem Benutzer komplexe Geschäftsprozesse, Bildschirme und Logik visuell mit Flow Builder erstellen können, ohne Code schreiben zu müssen. Sie automatisiert Aufgaben wie Datenaktualisierungen, das Senden von E-Mails und das Führen von Benutzern und bietet Flexibilität durch Typen wie Bildschirm-Flows (Benutzerinteraktion) und Ausgelöste Flows (Datensatz-/geplante Ereignisse). |
| Apex | Salesforce Apex ist eine proprietäre, objektorientierte Programmiersprache für die Salesforce Platform, die ähnlich wie Java zum Erstellen von benutzerdefinierter Geschäftslogik, Automatisieren von Prozessen und Erweitern der zentralen CRM-Funktionen über deklarative Tools hinaus verwendet wird. |
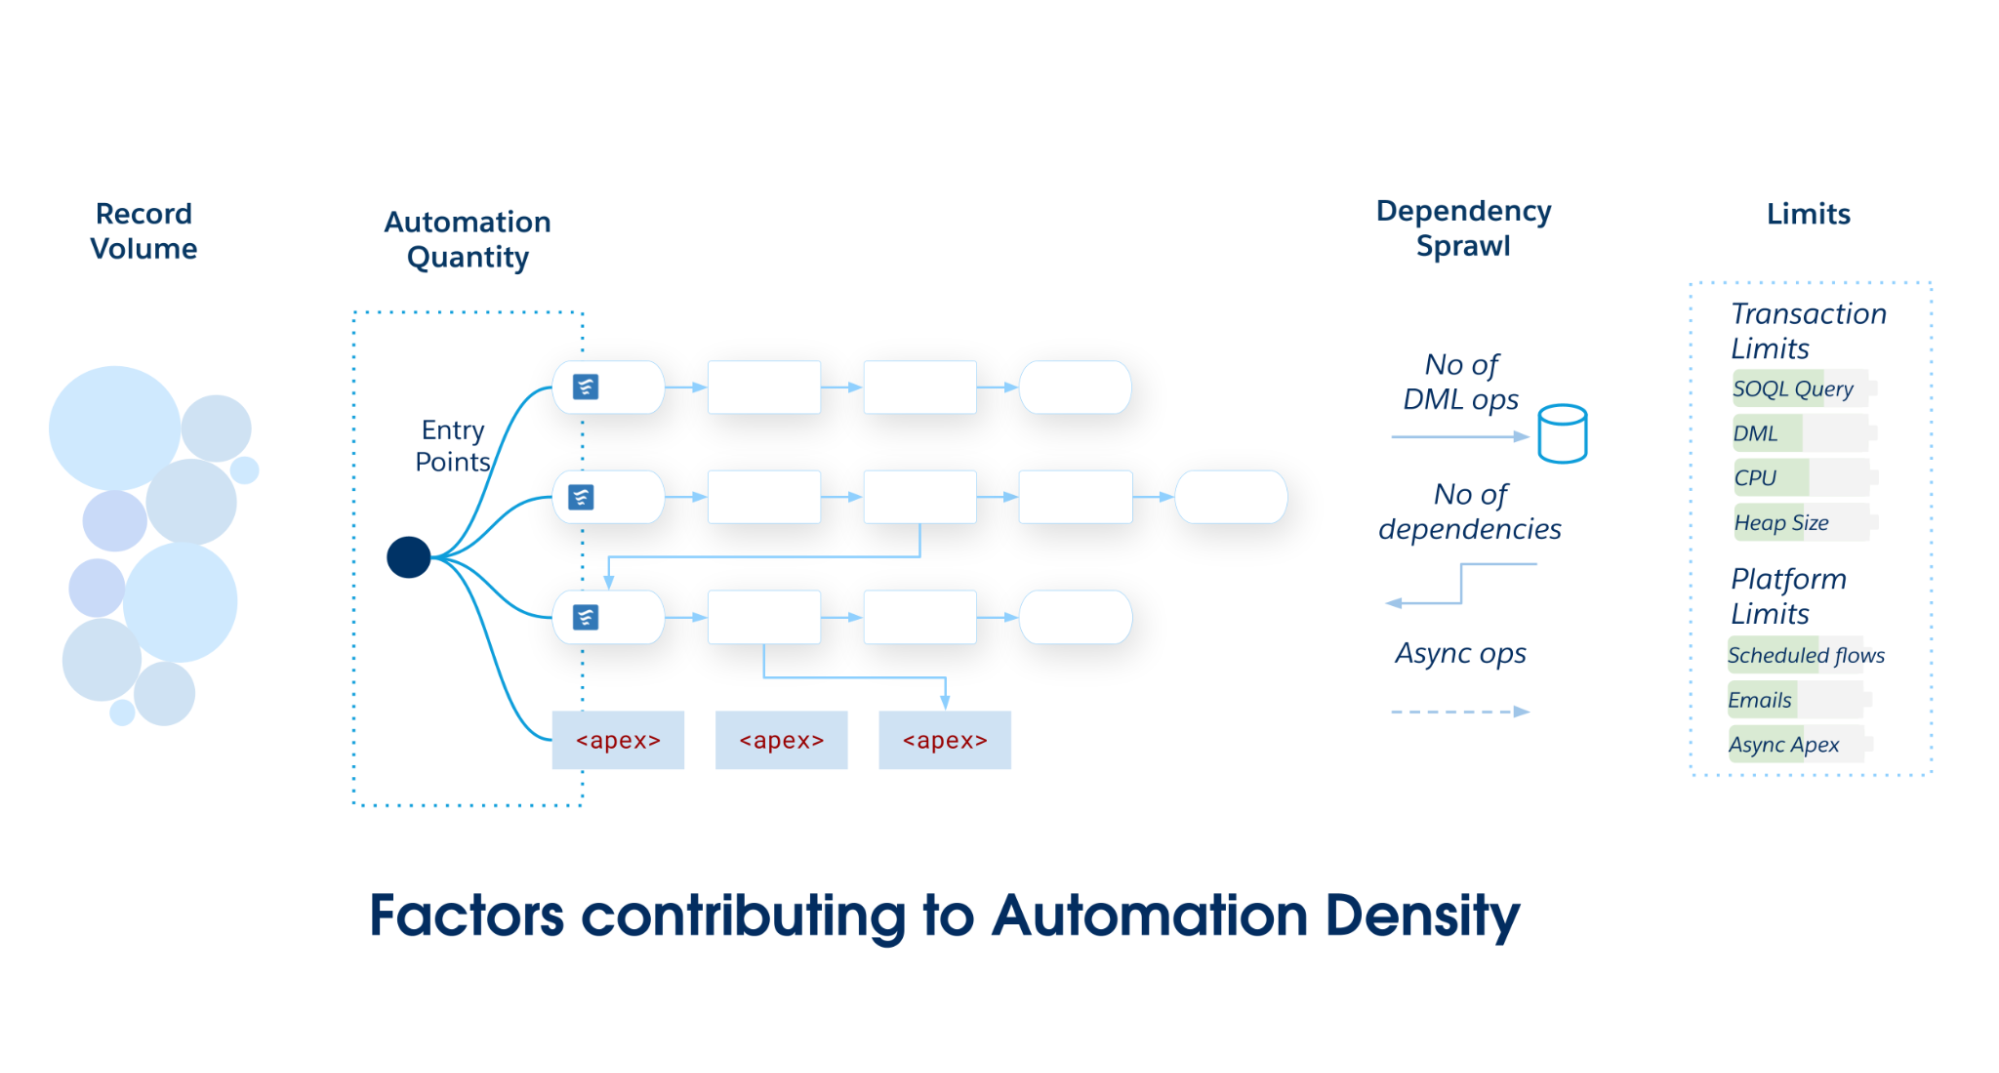 Wenn der Umfang und die Komplexität Ihrer Salesforce-Anwendung zunehmen, können Sie sich für einen einzigen primären Einstiegspunkt entscheiden – entweder durch Datensätze ausgelöster Flow oder Apex Triggers. Vermeiden Sie die Partitionierung von Automatisierungen über mehrere Mechanismen in einem einzelnen Salesforce-Objekt, da dies zu einer schlechten Wartungsfähigkeit und einer fragmentierten Verwaltung führt.
### Die Dichteauswahlmatrix
Verwenden Sie diese Matrix, um den erforderlichen Architekturstandard für Ihr Salesforce-Objekt zu bestimmen.
- **Durch Datensätze ausgelöster Flow** ist die bevorzugte Lösung für eine niedrige Automatisierungsdichte. Sie bietet ein ausgewogenes Verhältnis zwischen Leistung und Zugänglichkeit, das sich ideal für einfache und voneinander unabhängige Automatisierungen eignet.
- **Das Hybridmuster (Record-Triggered Flow with Invocable Apex)** ist eine leistungsstarke und wartbare Wahl für Automatisierungen mittlerer Dichte mit steigender Komplexität. Durch dieses Muster können Teams die geordnete Choreografie im deklarativen Flow beibehalten und gleichzeitig rechenintensive Vorgänge an Apex delegieren, um den barrierefreien Zugriff mit der Leistung abzugleichen.
- **Apex Auslöser** bieten die notwendigen Bausteine für eine solide architektonische Grundlage, um Automatisierungen mit hoher Dichte zu unterstützen. Die Leistung, die granulare Steuerung sowie die objektorientierte Abstraktion und Polymorphie von Apex eignen sich besser, um die Komplexität und den Umfang dieser Szenarien zu bewältigen.
| Dichtestufe | Automatisierungsmenge | Datenvolumen (Batchgröße) | Abhängigkeitszersiedelung | Architektonischer Standard |
|---|---|---|---|---|
| Niedrig | < 15 Automatisierungen |
Standard Benutzergesteuerte Benutzeroberflächeninteraktionen oder kleine API-Lastungen (1–200 Datensätze) |
Diskret In sich geschlossene Logik. 0–1 nachgelagerte DML-Vorgänge für dasselbe Objekt oder ein verwandtes Objekt. |
Durch einen Datensatz ausgelöster Flow |
| Mittel | 15–30 Automatisierungen |
Mittel Standardmäßige Batchverarbeitung (mit Logik, die eine sorgfältige Massenverarbeitung erfordert) |
Gekoppelt "Übergeordnet/Untergeordnet" aktualisiert 2–4 nachgelagerte DML-Vorgänge. Rekursionsrisiko |
Hybridmuster Flow + aufrufbares Apex |
| Hoch | > 30 Automatisierungen |
Hoch Große Datenvolumen mit Massen-API-Last (2.000 – 10.000+ Datensätze) |
Komplex und rekursiv Diagramm mit tiefer Abhängigkeit (5+ nachgelagerte DML-Vorgänge). Risiko von Dreiecksrekursionsschleifen |
Apex-Auslöser-Metadaten-Framework |
| Kapazität | Durch einen Datensatz ausgelöster Flow | Apex Trigger |
|---|---|---|
| Liefer- und Wartungsgeschwindigkeit | Empfohlen Über die visuelle Benutzeroberfläche von Flow Builder können Administratoren und andere deklarative Generatoren Automatisierungen schneller erstellen und ändern als Apex Code schreiben, testen und bereitstellen. Diese Oberfläche ermöglicht es einem breiteren Spektrum von Teammitgliedern, Geschäftswerte zu liefern, und reduziert die Abhängigkeit von spezialisierten Entwicklerressourcen für einfache Aufgaben. |
Fachwissen erforderlich Für die Implementierung, den Test und die Wartung des Codes benötigt Apex entsprechend qualifizierte Softwareentwickler. |
| Modularität | Verfügbar Durch Datensätze ausgelöste Flows sind standardmäßig modular. Statt monolithischer Logik erstellen Teams diskrete Flows für bestimmte Anforderungen und choreographieren sie zusammen mit dem Flow-Auslöser-Explorer. Diese Modularität ermöglicht eine isolierte Änderung und einfache Erweiterung, wodurch die langfristigen Betriebskosten erheblich reduziert werden. |
Verfügbar Apex ist nach Design in Funktionsmodule unterteilt. Jede Apex-Klasse soll ein einzelnes Funktionsmodul implementieren. |
| Sichtbarkeit und Governance | Empfohlen Der visuelle Charakter von Flow bietet eine intuitive Darstellung der Geschäftslogik. Der Flow-Auslöser-Explorer bietet eine konsolidierte Ansicht aller Flows in einem Objekt, sodass Architekten und Administratoren einfacher verstehen, steuern und Fehler beheben können, ohne Code lesen zu müssen. |
Fachwissen erforderlich Die Verwendung eines Metadaten-Frameworks zum Organisieren von Auslösern ist vorteilhaft. Apex erfordert jedoch ein diszipliniertes Entwicklungsteam, um den Code organisiert und wartbar zu halten. |
| Hochleistungsfähige Massendatenverarbeitung | Nicht empfohlen Bei komplexen Logiken oder großen Datenmengen besteht ein erhöhtes Risiko, dass Obergrenzen erreicht werden. |
Empfohlen Apex Code wird näher an den Kernservices der Plattform ausgeführt und bietet Entwicklern mehr Kontrolle über die Abfrageoptimierung, die Datenverarbeitung und die algorithmische Effizienz. Dies führt zu mehr Leistung und Skalierbarkeit, insbesondere in komplexen Szenarien mit großen Datenmengen. |
| Robuste Logik und Datenstrukturen | Verfügbar Das Element "Flowtransformation" kann bei einigen komplexen Verarbeitungsaufgaben hilfreich sein. Dem Flow fehlen jedoch native Zuordnungs- und Set-Datenstrukturen, was die komplexe Datenverarbeitung umständlich und rechenineffizient macht. |
Empfohlen Apex bietet vollständigen Zugriff auf Karten-, Satz- und Programmschleifen für hocheffiziente und sichere Datenbearbeitungen. Als Programmiersprache mit vollem Funktionsumfang bietet Apex zudem Zugriff auf komplexe logische Konstrukte, Datenstrukturen und Designmuster, mit denen komplexe Geschäftsprobleme wartungsfreundlich und effizient gelöst werden können. Apex enthält eine umfangreiche Standardbibliothek mit erweiterten Funktionen (z. B. BusinessHours, Crypto), die derzeit in deklarativen Tools nicht verfügbar sind. |
| Transaktionssteuerung | Nicht verfügbar Der Flow bietet keinen Zugriff auf "Database.savepoint", "Database.rollback" oder teilweise erfolgreiche DML-Vorgänge für teilweise Transaktions-Commits oder -Rollbacks. |
Verfügbar Apex bietet vollständige und detaillierte Kontrolle über die Transaktionsintegrität und komplexe Fehlerbehebungsszenarien. |
| E-Mail-Verteilung | Empfohlen Das Senden vorkonfigurierter E-Mail-Benachrichtigungen über einen durch einen Datensatz ausgelösten Flow ist einfach und skalierbar. Benutzerdefinierte E-Mail-Benachrichtigungen können zur Laufzeit erstellt und verteilt werden. Für benutzerdefinierte E-Mails gelten die täglichen Obergrenzen für den Versand von E-Mails. |
Verfügbar Apex kann benutzerdefinierte E-Mail-Nachrichten generieren und senden. Für alle über Apex gesendeten E-Mails gelten die täglichen Obergrenzen für den E-Mail-Versand. |
| Anwendung von Plattformsicherungen | Empfohlen Der Flow enthält integrierte Schutzmaßnahmen wie automatische Massenverarbeitung und automatische Wiederholungen. Diese Sicherungen erhöhen die Bewertungsgeschwindigkeit und verhindern Leistungseinbußen, die andernfalls eine komplexe manuelle Codierung erfordern. |
Manuelle Implementierung erforderlich Schutzmaßnahmen wie die Massenverarbeitung müssen explizit codiert werden (beispielsweise das Verwalten von Sammlungen und das Vermeiden von SOQL in Schleifen). Automatische Wiederholungen sind nicht nativ für Auslöser und erfordern eine komplexe benutzerdefinierte Logik. |
| Asynchrone Verarbeitung | Verfügbar Flow bietet einfache Mechanismen für Automatisierungen, die eine separate Transaktion in einem asynchronen Pfad erfordern. Für diese Automatisierungen gelten tägliche Obergrenzen. |
Verfügbar Apex ermöglicht die vollständige Kontrolle über die Datenerfassung ändern und warteschlangenfähige Ereignisse, die von einem entkoppelten Auslöserabonnenten verarbeitet werden. |
| Geplante Verarbeitung | Empfohlen Die geplanten Pfade des Flows bieten eine einzigartige und leistungsstarke Planungsfunktion (z. B. "3 Tage vor Schlusstermin auslösen"). Diese Funktion beinhaltet die automatische Stornierung und Neuplanung, wenn sich die Daten des Datensatzes ändern. Für diese Automatisierungen gelten tägliche Obergrenzen. |
Nicht verfügbar Ein Apex Auslöser kann ein zeitliches, datensatzspezifisches Ereignis mit automatischer Stornierung nicht nativ planen. Geplantes Apex ist zwar vorhanden, es handelt sich jedoch um einen grundlegend anderen Mechanismus, der zu einem bestimmten Zeitpunkt ausgeführt wird und nicht während der Verarbeitung eines einzelnen Datensatzes als Teil eines Auslösers geplant wird. |
| Ordnung und Choreografie | Verfügbar Mit dem Flow-Auslöser-Explorer können Administratoren eine relative Ausführungsreihenfolge für mehrere Flows desselben Objekts definieren. |
Verfügbar Ein Auslöser-Framework bietet genaue Kontrolle über die genaue Reihenfolge der Automatisierungen. |
| Aktualisierungen desselben Datensatzfelds | Verfügbar (vor dem Speichern) Durch einen Datensatz ausgelöster Flow ist die leistungsfähigste deklarative Option zum Aktualisieren des auslösenden Datensatzes vor dem anfänglichen DML-Commit. |
Verfügbar (vor dem Speichern) Apex bietet das leistungsstärkste Angebot mit minimalem Overhead. |
| Objektübergreifende CRUD | Verfügbar (nach dem Speichern) Flow eignet sich für einfache objektübergreifende DML-Vorgänge mit geringer Komplexität. |
Verfügbar (nach dem Speichern) Apex bietet eine überlegene Kontrolle über die Deduplizierung, Fehlerbehandlung und Leistung für objektübergreifende DML-Vorgänge. |
| Duplizierung teurer Berechnungen | Verfügbar Flow zeichnet sich durch die Beseitigung redundanter Abfragen und DML-Anweisungen durch automatische Massenverarbeitung aus. Der Status kann jedoch nicht zwischen verschiedenen Flow-Auslösern oder über mehrere Aufrufe desselben Flows innerhalb einer Transaktion zwischengespeichert oder freigegeben werden. Diese Einschränkung kann in extremen Leistungsszenarien wichtig werden. |
Empfohlen Apex bietet Mechanismen zum Deduplizieren teurer Vorgänge. Entwickler können die transaktionale Zwischenspeicherung mithilfe statischer Eigenschaften und Variablen und die Zwischenspeicherung auf Plattformebene mithilfe des Plattform-Cache nutzen, um Daten zu speichern und wiederzuverwenden. Diese Techniken sind wichtig, um den Verbrauch von Obergrenzen für Transaktionen wie SOQL-Abfragen zu reduzieren und eine hohe Leistung und Skalierbarkeit zu gewährleisten. |
| Benutzerdefinierte Fehlerverarbeitung | Verfügbar Das Element CustomError kann einen Speichervorgang blockieren und dem Benutzer eine Meldung anzeigen. |
Empfohlen Die Methode addError() bietet flexible Fehlermeldungen auf Feldebene und bedingte Fehlermeldungen. |
| Anwendungsfall | Beschreibung | Best-Fit | Begründung |
|---|---|---|---|
| Hochleistungsfähige Batchverarbeitung | Jede Automatisierung, die Tausende von Datensätzen effizient verarbeiten muss | Apex | Apex bietet umfangreiche APIs für die Anbindung an die Plattform und für die Rohgeschwindigkeit. |
| Komplexe Datenverarbeitung | Szenarien, in denen erweiterte Datenmanipulationen erforderlich sind | Apex | Apex stellt Datenstrukturen wie "Karte" und "Satz" bereit, die in Flow nicht nativ verfügbar sind und für das Schreiben von performantem Code mit Massensicherheit entscheidend sein können. |
| Transaktionssteuerung | Kontrollmechanismen wie Speicherpunkte, Rollbacks und Teil-Commits | Apex | Apex bietet Zugriff auf Mechanismen wie Database.savepoint und Database.rollback und kann teilweise erfolgreiche DML-Vorgänge verarbeiten. |
| Hochentwickelte benutzerdefinierte Validierung | Datenvalidierung über mehrere Felder in einem Datensatz hinweg | Apex | Flow kann zwar mit dem Element "CustomError" ein Speichern verhindern, ist jedoch nicht in allen Flow-Typen verfügbar, einschließlich Subflows. Die Apex addError()-Methode stellt mehrere feldspezifische Fehlermeldungen bereit, die einem Datensatz jederzeit während der Auslöserverarbeitung hinzugefügt werden können. |
| Mittelkomplexe Logik in einem einfachen Prozess | Logik- und Datenmanipulation mit moderater Komplexität, vereinfacht durch eine Standardbibliothek erweiterter Funktionen, die als Teil eines unkomplizierten Prozesses erfolgt | Flow + Apex | Durch einen Datensatz ausgelöster Flow fungiert als Orchestrierungsebene, während hochkomplexe Vorgänge in aufrufbarem Apex gekapselt sind. |
| Einfache bis mittelkomplexe Logik | Datenmanipulation mit geringer bis mittlerer Komplexität mit Auslöseraktualisierungen an den primären und verwandten Datenobjekten | Flow | Flow ist in der Regel die Option, die aufgerufen werden kann, da er auf einem deklarativen Modell basiert, das sowohl für Administratoren als auch für Entwickler zugänglich ist. |
| Benachrichtigungen und ausgehende Nachrichten | Senden von ausgehenden E-Mails und Nachrichten | Flow | Mit Flow können E-Mail-Benachrichtigungen und ausgehende Nachrichten zu Datensatzänderungen einfach und hochgradig skaliert werden. |
| Geplante Verarbeitung | Automatisierung zu einem zukünftigen dynamischen Datum (z. B. 3 Tage vor einem Schlusstermin) | Flow | Geplante Pfade bieten Flow eine einzigartige Stärke, da die Plattform automatisch die Planung, Stornierung und Neuplanung dieser Pfade übernimmt, wenn sich die Daten des Datensatzes ändern. |
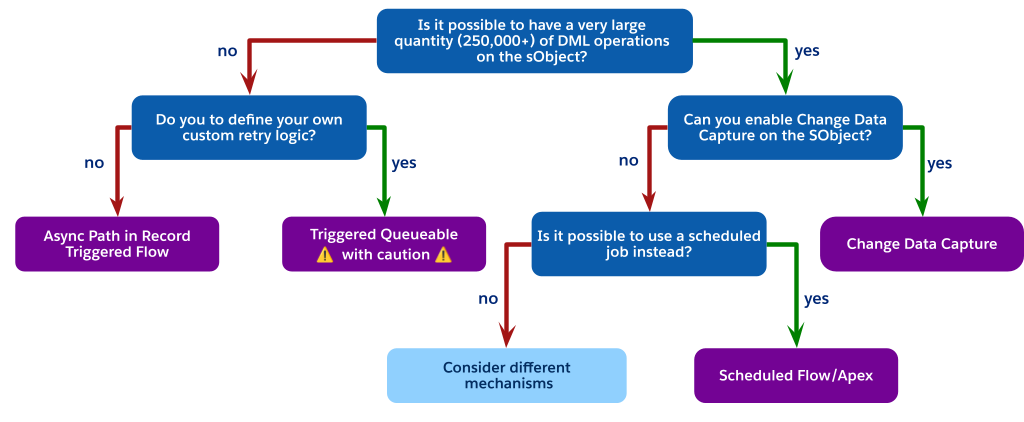 ### Die Alternative für geplante Aufträge
Wie aus dem Diagramm hervorgeht, besteht die beste architektonische Wahl oft darin, einen durch einen Auslöser aufgerufenen Prozess vollständig zu vermeiden, wenn Sie mit DML-Vorgängen mit hohem Volumen konfrontiert sind, die Datenerfassung jedoch nicht verwenden können (möglicherweise aufgrund von Objektobergrenzen).
Verwenden Sie stattdessen einen geplanten Prozess. Dies kann entweder ein geplanter Flow oder geplanter Apex sein. Erforderliche Schritte sind:
1. Führen Sie eine einfache kostengünstige Aktualisierung im synchronen Auslöser aus. Legen Sie beispielsweise ein `Status__c`-Feld auf "Verarbeitung ausstehend" fest oder fügen Sie einen verwandten Datensatz mit niedrigen Kosten ein, beispielsweise einen Chatter Post, um anzugeben, dass der Datensatz verarbeitet werden muss.
2. Erstellen Sie einen geplanten Auftrag, entweder einen geplanten Flow oder geplanten Apex, der regelmäßig ausgeführt wird, beispielsweise alle 15 Minuten oder stündlich.
3. Lassen Sie den geplanten Auftrag für alle Datensätze im Status "Ausstehend" abfragen, führen Sie die komplexe Logik in einem kontrollierten Kontext mit hohem Volumen aus und aktualisieren Sie dann die verarbeiteten Datensätze.
Dieses Muster entkoppelt die schwere Verarbeitung vollständig vom synchronen Speichern des Benutzers, unterliegt nicht der Obergrenze von einem Auftrag pro Transaktion eines ausgelösten Batches und bietet eine hochgradig skalierbare und regelbare Lösung für Nicht-Echtzeitanforderungen.
Wenn die Latenz eines geplanten Auftrags für die Geschäftsanforderungen nicht akzeptabel ist und Sie weiterhin CDC oder eine ausgelöste Warteschlange nicht verwenden können, deutet dies auf eine erhebliche architektonische Inkongruenz hin. An dieser Stelle müssen verschiedene Mechanismen in Betracht gezogen werden. Die erneute Bewertung des Designs der Kernanwendung kann zu bestimmten Schlussfolgerungen führen, beispielsweise:
- Erwerb des Add-Ons zum Entfernen der CDC-Objektobergrenzen.
- Die geschäftliche Anforderung, festzustellen, ob die Verarbeitung nahezu in Echtzeit wirklich ein "Must-have" ist oder ob die Latenz eines geplanten Auftrags ein akzeptabler Kompromiss für die Plattformstabilität ist, wird grundlegend herausgefordert.
## Nicht funktionale Überlegungen
Zusätzlich zu den Entscheidungspunkten müssen Sie nicht funktionale Überlegungen wie Komplexität und Standards berücksichtigen.
### Komplexität
Der Komplexitätsgrad einer Implementierung ist Teil der Gesamtbetriebskosten einer Lösung und ihrer Fähigkeit, sich an sich ändernde Geschäftsanforderungen anzupassen. Komplexität kann sich auf jede Implementierung auswirken, wenn bewährte Vorgehensweisen nicht befolgt werden. Im Abschnitt "_Verwandte bewährte Vorgehensweisen_" dieses Dokuments finden Sie Empfehlungen zur Reduzierung der Komplexität Ihrer Lösung, einschließlich der folgenden Muster:
- Hybridmuster: Aufrufbares Apex für komplexe Logik im Flow
- Verwenden eines Metadaten-Frameworks für Apex-Auslöser
- Mega-Flows im Vergleich zu mehreren Flows
### Prozesse und Standards
Die Dokumentation ist so wichtig wie die Automatisierung selbst. Sie gewährleistet nicht nur die Wartbarkeit, sondern ist auch für AI und agentenbasierte Tools entscheidend. Mithilfe der Dokumentation können Sie Ihre Geschäftsprozesse verstehen und verwalten.
**Im Flow**
- Richten Sie eine konsistente Benennungskonvention für alle Elemente und Variablen ein.
- Verwenden Sie das Feld "Beschreibung" für den Flow, um seinen allgemeinen Zweck, seine Auslösekriterien und sein beabsichtigtes Ergebnis zu erläutern.
- Verwenden Sie das Feld Beschreibung für jedes einzelne Element (z. B. `Get Records`, `Action`, `Transform`). Diese Vorgehensweise ist die beste Möglichkeit, Intent zu vermitteln. Dies ist besonders wichtig für aufrufbare Aktionen und Subflows, bei denen die Beschreibung der primäre Ort ist, um die komplexe Logik zu erklären, die von der Aktion ausgeführt wird.
**In Apex**
- Kommentieren Sie Ihren Code deutlich, um zu erklären, _warum_ Ihre Logik dahintersteckt, und nicht nur, _was_.
- Stellen Sie bei Verwendung eines metadatengesteuerten Frameworks sicher, dass Ihre Metadatensätze ein für Menschen lesbares Beschreibungsfeld enthalten und ausfüllen, um zu erläutern, was jede Handler-Klasse vornimmt und wann sie ausgeführt werden soll.
DevOps- und Quellcodeverwaltung ist Teil eines ausgereiften Entwicklungslebenszyklus. Verwenden Sie immer ein Quellcodeverwaltungstool wie Git für Salesforce-Projekte. Sowohl Apex-Klassen als auch Salesforce-Flows sind Metadaten, die Ihre Geschäftslogik definieren. Sie müssen versioniert und verwaltet werden.
Im Kontext der Verwaltung von durch Datensätze ausgelösten Automatisierungen bietet eine moderne DevOps-Pipeline wesentliche Vorteile.
- **Automatische Qualitätsprüfungen:** Tools wie [Salesforce Code Analyzer](https://developer.salesforce.com/docs/platform/salesforce-code-analyzer/overview) können so konfiguriert werden, dass sie automatisch in Ihrer Pipeline ausgeführt werden. Statische Analysen können problematische Muster in beiden Automatisierungstools erkennen, bevor sie höhergestuft werden, und Probleme wie ineffiziente `Get Records` in einer Flow-Schleife oder `SOQL` in einer Apex-Schleife kennzeichnen, die häufige Ursachen für Leistungseinbußen sind.
- **Regressionsprävention:** Wenn Ihre Automatisierungsdichte steigt, kann eine Änderung an einer Flow- oder Apex-Klasse unbeabsichtigte Konsequenzen für andere Automatisierungen im selben Objekt haben. Eine zuverlässige DevOps-Teststrategie, bei der automatisierte Apex-Tests anhand vorgeschlagener Änderungen ausgeführt werden, ist die zuverlässigste Methode, um sicherzustellen, dass eine neue Flow-Version die vorhandene Apex-Logik nicht beschädigt (und umgekehrt).
- **Zusammenarbeit und Sichtbarkeit:** Die Quellcodeverwaltung ist die "einzige Quelle der Wahrheit". Dadurch können Administratoren und Entwickler parallel an der Automatisierung für dasselbe Objekt arbeiten. Es bietet auch einen unschätzbaren Prüfpfad: Wenn ein Produktionsprozess fehlschlägt, können Sie sofort sehen, _wer_ die Automatisierung geändert hat, _wann_ sie geändert wurde und – über Commit-Meldungen –, _warum_ sie geändert wurde.
Teams mit einer Mischung aus Administratoren und Entwicklern bietet das [DevOps Center](https://help.salesforce.com/s/articleView?id=platform.devops_center_overview.htm&type=5) eine vereinheitlichte Oberfläche, mit der alle diese Schritte choreographiert werden können, sodass jeder im Team auf einen skalierbaren, auf Quellcodeverwaltung basierenden Entwicklungsprozess zugreifen kann.
Diese kombinierte Disziplin der Dokumentation und DevOps gewährleistet die langfristige Integrität und Wartungsfähigkeit Ihrer Organisation, was jedem Architekten und Administrator zugute kommt, der Ihnen folgt.
## Verwandte bewährte Vorgehensweisen
Die oben stehende Entscheidungsanleitung wird am besten vor der Planung Ihrer Implementierung verwendet. Es soll Ihnen bei der Auswahl des besten Produkts für Ihre Anwendungsfälle helfen. Nach der Produktauswahl ist es wichtig, die vorhandenen bewährten Vorgehensweisen für Ihre Implementierung zu verstehen.
### Ausnutzen des Hybridmusters: Aufrufbares Apex für komplexe Logik im Flow
Das Prinzip _"Ein Tool pro Objekt_" ist für die Verwaltung der Automatisierung mit hoher Dichte wichtig. Sie sollten es jedoch nicht als binäre Auswahl zwischen einem rein deklarativen oder einem rein programmgesteuerten Stapel interpretieren. Ein effektiveres und pflegeleichteres Architekturmuster nutzt ein Hybridmodell: Positionieren Sie "Durch Datensatz ausgelöster Flow" als Orchestrierungsebene, während Sie hochkomplexe Vorgänge in "Aufrufbarer Apex" kapseln.
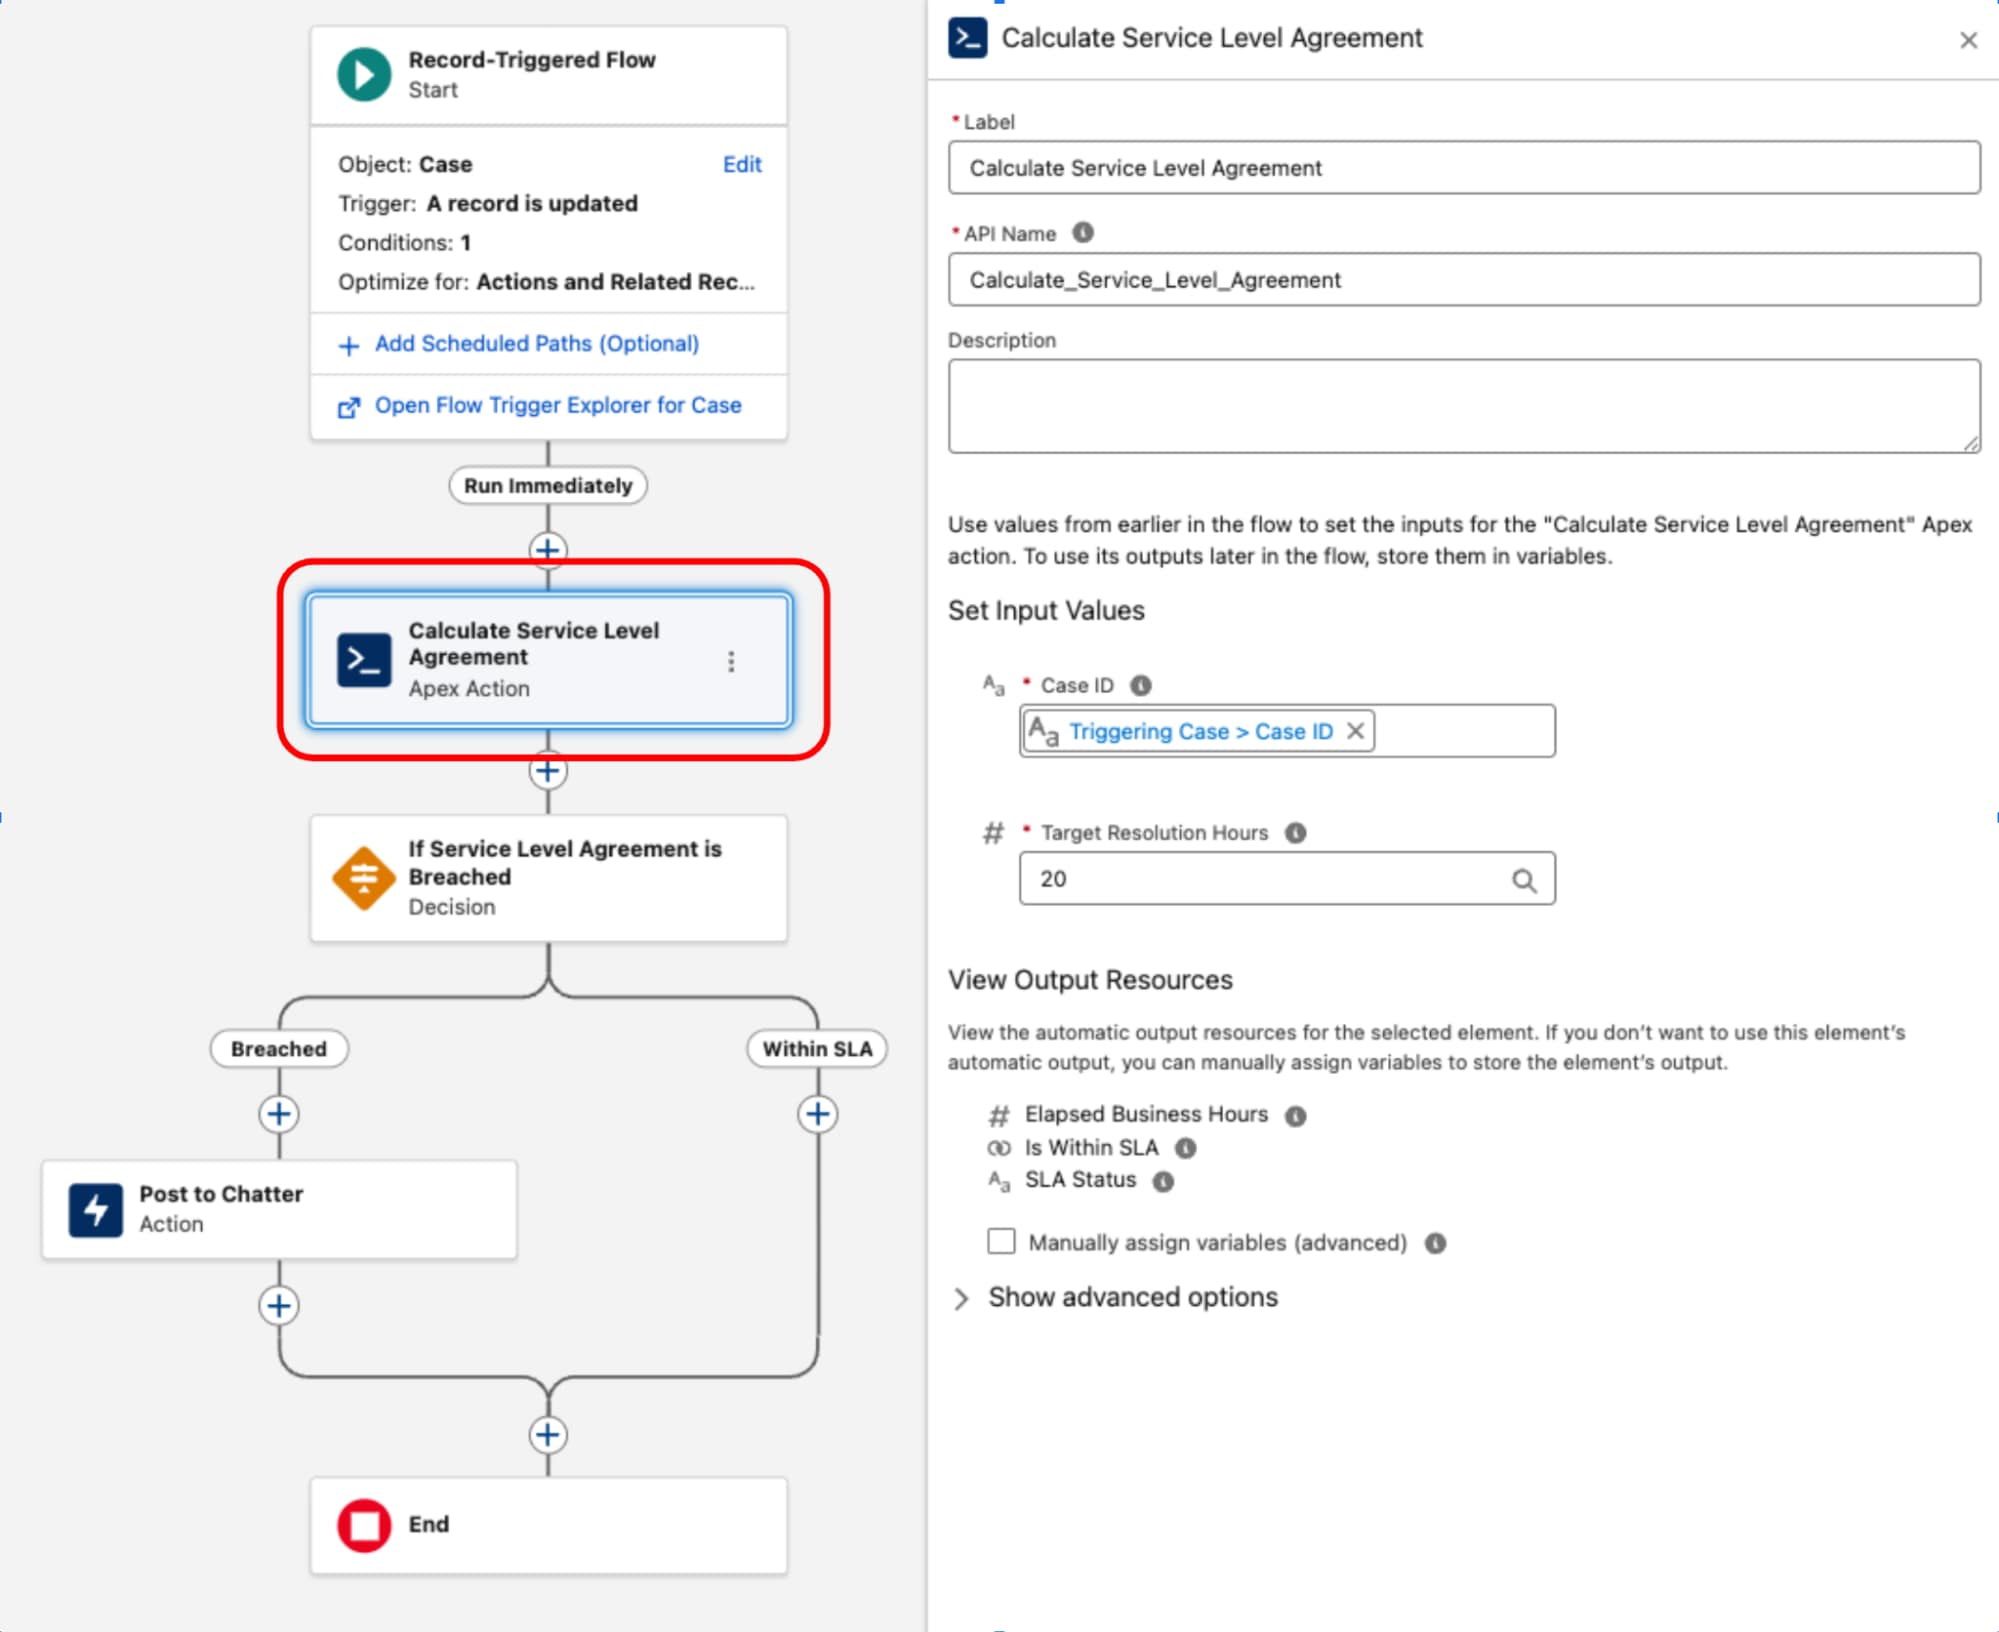 #### Orchestrierungsebene: Flow
Durch einen Datensatz ausgelöster Flow dient als Orchestrierungsebene für den Geschäftsprozess. Er ist Inhaber der Eingabekriterien und des Ausführungskontexts (das _Was_ und _Wann_). Durch Beibehaltung der Entscheidungslogik und der Weiterleitung innerhalb dieser Ebene bleibt die Prozesstopologie der Architektur transparent und kann über den Flow-Auslöser-Explorer verwaltet werden, wodurch verhindert wird, dass wichtige Geschäftslogik im Code verdeckt wird.
#### Die komplexe Komponente: Aufrufbares Apex
Ein häufiges Beispiel für eine komplexe Komponente ist die Implementierung von Service Level Agreement-Berechnungen (SLA) für Kundenvorgangsdatensätze. Da das Objekt "BusinessHours" und die zugehörige Logik, die für genaue Berechnungen ohne Arbeitszeiten und Feiertage wichtig sind, in Flow nicht nativ zugänglich sind, wird eine spezielle Apex-Klasse verwendet. Diese Klasse, die oft als `ServiceLevelAgreementCalculator` bezeichnet wird, wurde mit einer einzigen statischen Methode entwickelt, die mit `@InvocableMethod` gekennzeichnet ist, um die verstrichenen Geschäftszeiten zu berechnen, zu bestimmen, ob das SLA "Innerhalb des Ziels" oder "Verletzt" lautet, und eine strukturierte Ausgabe zurückzugeben. Dieser Ansatz fasst die komplexe Hochleistungslogik in Apex zusammen und ermöglicht ihre nahtlose Ausführung und Integration in die deklarative Orchestrierungsebene eines durch einen Datensatz ausgelösten Flows.
Sobald die Apex `ServiceLevelAgreementCalculator` definiert ist, kann sie in einem durch einen Datensatz ausgelösten Flow verwendet werden:
Dieses Muster zeigt eine strikte Trennung der Bedenken. Die deklarative Ebene wird zum Verwalten des Transaktionslebenszyklus und der Orchestrierung verwendet, während Code für die Ausführung mit hoher Komplexität verwendet wird. Indem Code als funktionales Dienstprogramm und nicht als Grundlage behandelt wird, halten wir Leistung und Wartungsfreundlichkeit in Einklang.
#### Wichtige Gewinne mit dem Hybridmuster
**Modularität**: Die Entscheidung weicht von der Besonderheit der Verwendung von Apex oder Flow für den gesamten Prozess ab. Stattdessen kapselt die Architektur komplexe Logik in diskrete, massensichere und unabhängig testbare Einheiten. Diese Einheiten fungieren als wiederverwendbare Komponenten, die von der deklarativen Ebene verbraucht werden, und stellen sicher, dass die Automatisierung skaliert wird, ohne dass die architektonische Planung kompliziert wird.
**Wiederverwendbarkeit**: Die Logik ist vom Auslöserereignis getrennt. Eine gut gestaltete Code-Einheit (z. B. ein `InvocableMethod`) wird einmal geschrieben, jedoch über mehrere Eingangspunkte hinweg verwendet: Durch Datensätze ausgelöste Flows, Bildschirm-Flows oder externe Integrationen. Durch diese Code-Wiederverwendung entfällt die redundante Entwicklung.
**Wartbarkeit**: Die Prozess-Flow-Logik bleibt im deklarativen Flow sichtbar und verwaltbar. Durch diese Zentralisierung wird der Debugging-Overhead drastisch reduziert und sichergestellt, dass die Ausführungsreihenfolge des Systems deterministisch und transparent ist.
#### Einschränkungen und Kompromisse des Hybridmusters
Das hybride Modell der Verwendung von aufrufbarem Apex aus Flow ist zwar leistungsfähig, aber kein Ansatz für alle. Architekten müssen sich der spezifischen Einschränkungen und Kompromisse bewusst sein, bevor sie sich auf eine Hybridlösung festlegen.
- **Keine Unterstützung vor dem Speichern**: Dies ist die wichtigste Einschränkung. Aufrufbare Aktionen sind nur im Kontext nach dem Speichern verfügbar (Flows für Aktionen und verwandte Datensätze). Sie können nicht im leistungsstarken Kontext vor dem Speichern verwendet werden (Flows für schnelle Feldaktualisierungen). Daher kann dieses Muster nicht zum Delegieren von Feldaktualisierungen desselben Datensatzes verwendet werden. Erledigen Sie diese leistungsstarke Arbeit mit nativen Flow-Elementen in einem Flow vor dem Speichern oder in einem Apex-Auslöser vor dem Kontext.
- **Keine Unterstützung nach dem Rückgängigmachen der Löschung:** Der durch einen Datensatz ausgelöste Flow unterstützt derzeit den Kontext nach dem Rückgängigmachen des Löschens nicht. Wenn für ein Salesforce-Objekt eine geschäftliche Anforderung besteht, die Automatisierung auszuführen, wenn ein Datensatz aus dem Papierkorb wiederhergestellt wird, ist ein Apex-Auslöser die einzige Lösung.
- **Leistungs-Overhead in Szenarien mit hohem Volumen:** Der Übergang von der Flow-Laufzeit zur Apex-Laufzeit ist kein Nullkostenvorgang. Obwohl sie im Allgemeinen schnell ist, ist der Vorgang, bei dem Sie von der Laufzeit des Flows aus in eine aufrufbare Aktion wechseln, nicht so rechenschnell wie die native Ausführung, die vollständig in einem Apex Auslöser verbleibt. Für die meisten Automatisierungen mittlerer Dichte ist dieser Micro-Overhead ein vernachlässigbarer und lohnender Kompromiss für die verbesserte Barrierefreiheit. Bei extrem leistungsstarken Szenarien mit hohem Volumen bietet ein reines Apex-Framework jedoch einen Vorteil bei der Berechnungsgeschwindigkeit.
### Strategien für die veraltete Automatisierung
Während die Heuristik der Automatisierungsdichte eine definitive Orientierungshilfe für neuere Greenfield-Architekturen bietet, ist die Realität in Salesforce-Unternehmensumgebungen oft differenzierter. In ausgereiften Organisationen finden sich häufig durch Datensätze ausgelöste Flows und Apex-Auslöser, die mit demselben Salesforce-Objekt arbeiten. Dieses Szenario unterscheidet sich von dem zuvor erläuterten hybriden Muster: Dabei sind die Flows und Apex Auslöser weder gekoppelt noch für die Zusammenarbeit ausgelegt.
Diese Koexistenz ist oft das Ergebnis sich entwickelnder Plattformfunktionen oder veralteter technischer Schulden. Obwohl dies ein tolerierter Betriebszustand ist, müssen Architekten ihn als berechneten Kompromiss und nicht als Endzustand behandeln.
Die fragmentierte Orchestrierung verursacht einen erheblichen Verwaltungs- und Wartungsaufwand, wodurch Entwicklungs-, Test- und Vorfallsbearbeitungsaktivitäten uneinheitlich und umständlich werden. Dies führt zu einer erhöhten Time to Resolution (TTR) und betrieblichen Komplexität.
- Halten Sie sich bei neuen Salesforce-Objekten an das Prinzip der Automatisierungsdichte als primäre Anleitung.
- Bewerten Sie bei vorhandenen Salesforce-Objekten mit hybrider Bilanz und doppeltem Apex-Auslöser und durch einen Datensatz ausgelösten Flow-Eingangspunkten die Dichte und konzipieren Sie dann den Refaktor in einen aufrechterhaltenswerten Hybridzustand.
- Bei geringer Dichte werden durch Refaktor-Apex ausgelöste Flows durch einen Datensatz ausgelöst und die Ausführungsreihenfolge angegeben, wodurch sie an einen einzigen Automatisierungs-Eingangspunkt gelangen.
- Bei mittlerer Dichte fließen komplexe Mega-Flows in eine Teilmenge von Flows mit der richtigen Ausführungsreihenfolge ein. Führen Sie Apex-Auslöser nur dann ein, wenn dies unbedingt erforderlich ist, z. B. zur Unterstützung nach dem Rückgängigmachen des Kontexts.
- Bei hoher Dichte bevorzugen Sie die Implementierung von Apex Auslösern.
### Verwenden eines Metadaten-Frameworks für Apex-Auslöser
Wenn die Geschäftsprozesse einer Organisation auf der Salesforce Platform reifen, steigen zwangsläufig das Volumen und die Komplexität der durch Datensätze ausgelösten Automatisierung. Eine grundlegende bewährte Vorgehensweise besteht darin, _einen Apex-Auslöser pro Salesforce-Objekt_ beizubehalten. Diese Regel ist wichtig, da die Plattform die Ausführungsreihenfolge mehrerer Auslöser für dasselbe Objekt für dasselbe Ereignis nicht garantiert. Diese Einschränkung kann zu nicht deterministischem Verhalten, Rassenbedingungen und schwierig zu debuggenden Problemen führen.
Die Einhaltung des Prinzips _eines Auslösers_ stellt jedoch eine architektonische Herausforderung dar: wie Sie alle Geschäftslogiken, die über diesen zentralen Einstiegspunkt aufgerufen werden, verwalten und orchestrieren können, und zwar auf eine wartungsfreundliche und skalierbare Weise.
#### Die Einschränkungen von Classic-Auslöser-Handlern
Die erste Entwicklung dieser Architektur war das Classic-Auslöser-Handler-Muster. Bei diesem Ansatz delegiert der einzelne Apex-Auslöser seine gesamte Logik an eine entsprechende Handler-Klasse (beispielsweise `OpportunityTriggerHandler`). Diese Methode trennt die Logik von der Auslöserdatei und bietet Entwicklern deterministische Kontrolle über die Ausführungsreihenfolge innerhalb der Methoden der Handler-Klasse (z. B. `afterInsert()`).
Obwohl dieses Muster eine Verbesserung darstellt, führt es häufig zu monolithischen Handler-Klassen. Im Laufe der Zeit wird die Klasse groß, schwer zu verwalten und schwer isoliert zu testen, da mehr Geschäftsanforderungen hinzugefügt werden. Die Ausführungsreihenfolge aller einzelnen Prozesse ist innerhalb einer einzelnen Methode hartcodiert, wodurch die Klasse anfällig für Zusammenführungskonflikte ist, was den Verwaltungs- und Wartungsaufwand in einer großen Unternehmensumgebung drastisch erhöht.
#### Die Lösung: Ein metadatengesteuertes Auslöser-Framework
Architekten wechseln zum **Metadaten-gesteuerten Auslöser-Framework**, um die Kernprobleme der Modularität und Orchestrierung zu lösen. Dies ist ein bedeutender architektonischer Sprung, der die Automatisierungslogik selbst von der Konfiguration _der Art_ und _Weise der_ Ausführung entkoppelt.
Dieses Framework basiert auf drei wichtigen Vorteilen:
- **Partitionierung:** Anstelle einer einzigen Handler-Klasse wird die Kerngeschäftslogik in kleine, atomare Apex-Klassen (beispielsweise eine `RecalculateAccountValues`-Klasse oder eine `NotifySalesLeads`-Klasse) unterteilt, wobei jede Klasse dem _Prinzip der einzelnen Verantwortung_ folgt. Durch diese Modularität können Logik einfacher isoliert getestet, debuggt und verstanden werden.
- **Auftrag und Choreografie:** Der Ausführungsauftrag ist in Apex nicht mehr hartcodiert. Stattdessen wird er deklarativ durch Konfigurationsdatensätze definiert, die in der Regel in einem benutzerdefinierten Metadatentyp (z. B. `TriggerAction__mdt`) gespeichert sind. Dadurch können Administratoren Automatisierungsaktionen einfach neu anordnen, hinzufügen oder entfernen, indem sie einen Metadatensatz ändern, was keine Bereitstellung oder Codeänderung erfordert.
- **Bypass-Funktion:** Das Framework bietet standardisierte, granulare Bypass-Funktionen. Jede Automatisierungsaktion kann über ihren Metadatensatz so konfiguriert werden, dass sie global deaktiviert oder für bestimmte Verwaltungsbenutzer durch Verweisen auf eine benutzerdefinierte Berechtigung umgangen wird.
Der einzelne Apex-Auslöser für das Objekt fungiert dann nur noch als dynamischer Disponent. Sie enthält keine Geschäftslogik, sondern instanziiert stattdessen eine zentrale `MetadataTriggerHandler`. Dieser Handler fragt die benutzerdefinierten Metadatensätze ab, um die Ausführungsreihenfolge dynamisch zu bestimmen und die richtigen atomaren Apex-Klassen in der vorgegebenen Reihenfolge aufzurufen. Die Automatisierung wird unter einer einzigen, transparenten und regelbaren Ebene vereinheitlicht.
### Duplizieren teurer Vorgänge in der Transaktion
Ein wichtiger Vorteil der Verwendung von Apex in einem robusten Framework ist die Möglichkeit, den Transaktionsstatus zu verwalten und die Leistung zu optimieren, da redundante Arbeit entfällt. Wenn sich Logik ansammelt, ist es üblich, dass unterschiedliche Automatisierungen innerhalb des Speicherauftrags dieselben teuren Vorgänge unabhängig ausführen, wodurch wertvolle Obergrenzen verbraucht und die DML-Vorgangszeit erhöht wird.
Das Framework ist so konzipiert, dass es diesem Problem mit zwei primären Strategien begegnet:
- **Gemeinsame Bundesstaatsverwaltung:** Im Rahmen einer einzelnen Apex-Transaktion werden statische Eigenschaften und Variablen zum Zwischenspeichern von Daten verwendet. Dadurch wird sichergestellt, dass ein teurer Vorgang wie eine `SOQL` für eine Konfigurationseinstellung nur einmal ausgeführt wird, selbst wenn die Automatisierungslogik mehrfach über verschiedene Datensätze oder Phasen des Auslösers hinweg aufgerufen wird. Der Verbrauch von Transaktionsobergrenzen wird erheblich reduziert.
- **Plattform-Cache-Auslastung:** Verwenden Sie den Plattform-Cache, um zu vermeiden, dass die gesamte Datenbank nach bestimmten Daten abgefragt wird, um über die einfache Zwischenspeicherung innerhalb der Transaktion hinauszugehen. Dieser verwaltete Speicher-Cache eignet sich ideal zum Abrufen von Daten, die nicht primitiv sind, häufig in der Codebasis gelesen werden und im Laufe einer Transaktion unveränderlich sind (z. B. Profile, Rollen, Geschäftszeiten). Über die `Cache.CacheBuilder` überprüft das System zunächst den Cache und führt die Datenbankabfrage nur aus, wenn die Daten nicht vorhanden sind, was die Leistung und Skalierbarkeit maximiert.
### Verwenden vor dem Speichern für Aktualisierungen desselben Datensatzes
Verwenden Sie immer eine Aktualisierung vor dem Speichern, wenn Ihre Automatisierung nur Feldwerte für den Datensatz ändern muss, der die Transaktion startet. Dies gilt für Schnellfeldaktualisierungen in Flow (die vor dem Speichern ausgeführt werden) und für Vor-Kontext-Logik in Apex Triggers (vor dem Einfügen, vor der Aktualisierung).
Dieses Muster ist unabhängig vom verwendeten Tool leistungsfähig, da ein zweiter DML-Vorgang und ein rekursiver Speicherzyklus vermieden werden. Die Änderungen werden am Datensatz im Arbeitsspeicher vorgenommen, _bevor_ er in die Datenbank übernommen wird, und als Teil der ursprünglichen Transaktion gespeichert. Der Overhead eines zweiten Speichervorgangs, der andernfalls den gesamten Speicherauftrag erneut ausführen und die gesamte Automatisierung erneut auslösen würde, entfällt.
### Verhindern unkontrollierter Rekursionen
Unkontrollierte Rekursion ist ein häufiger Fallstrick bei Auslösern nach der Aktualisierung, bei denen die Logik eines Auslösers eine DML-Aktualisierung ausführt, die wiederum dazu führt, dass derselbe Auslöser erneut ausgelöst wird. Dadurch wird eine Endlosschleife erstellt, die schließlich mit einer Ausnahme der Obergrenze endet. Obwohl statische boolesche Kennzeichnungen oder Sammlungen verarbeiteter Datensatz-IDs in der Vergangenheit verwendet wurden, um eine solche Rekursion zu verhindern, besteht ein genaueres und zuverlässigeres Muster darin, die Logik durch Vergleich von Feldwerten zwischen der neuen und der alten Version des Datensatzes selbst zu verbinden.
Führen Sie die Logik nur dann aus, wenn sich ein bestimmtes interessierendes Feld tatsächlich geändert hat. Dadurch wird verhindert, dass der Auslöser seine Logik bei nachfolgenden DML-Vorgängen innerhalb derselben Transaktion ausführt, bei denen die wichtigen Daten unverändert bleiben.
#### Steuern der Rekursion im durch einen Datensatz ausgelösten Flow
Verhindern Sie in einem durch einen Datensatz ausgelösten Flow eine unkontrollierte Rekursion, indem Sie den Flow so festlegen, dass er nur ausgeführt wird, wenn der Datensatz aktualisiert wird, um die Bedingungsanforderungen zu erfüllen:
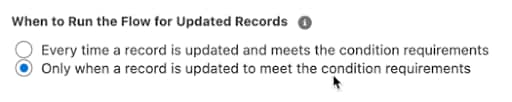 Wenn Sie eine Eingabekriterienformel in Ihrem Flow verwenden, können Sie eine Rekursion verhindern, indem Sie die globale Variable `$Record` (die die neuen Werte darstellt) mit der globalen Variable `$RecordPrior` (die die ursprünglichen Werte vor dem Speichern darstellt) vergleichen. Wenn Sie beispielsweise sicherstellen möchten, dass ein Flow nur ausgeführt wird, wenn sich das Feld "Betrag" für eine Opportunity geändert hat, verwenden Sie dies in den Eingabekriterien:
```
$Record.Amount != $Record__Prior.Amount
```
#### Steuern der Rekursion in Apex
Vergleichen Sie Feldwerte aus der neuen Version des Datensatzes `Trigger.new` mit den Feldwerten aus der alten Version des Datensatzes `Trigger.oldMap`, um festzustellen, ob die gewünschte Änderung stattgefunden hat. Durch diesen Ansatz wird sichergestellt, dass die Automatisierung idempotent ist und nur bei Bedarf ausgeführt wird, wodurch das System effizienter wird und katastrophale rekursive Schleifen verhindert werden.
### Automatisierung umgehen
Eine gut strukturierte Salesforce-Organisation erfordert einen konsistenten und zuverlässigen Mechanismus zur Umgehung der Automatisierung. Dies ist keine optionale Funktion, sondern eine zentrale betriebliche Voraussetzung für die Aufrechterhaltung der Datenintegrität und die Aktivierung von Verwaltungsaufgaben.
Ein Bypass-Framework ist für einige Szenarien unerlässlich:
- Beim Laden großer Datenmengen kann das Auslösen von Auslösern für jeden Datensatz den Prozess drastisch verlangsamen, zu Obergrenzenausnahmen führen und fehlerhafte zugehörige Datensätze und Benachrichtigungen erstellen. Über eine Umgehung können die Daten sauber und effizient eingefügt werden.
- Ein Integrationsbenutzer muss möglicherweise Daten aus einem externen Datensatzsystem synchronisieren. Die Automatisierung, die normalerweise für eine vom Benutzer initiierte Änderung ausgelöst wird (z. B. Senden einer E-Mail oder Erstellen einer Aufgabe), kann unerwünscht oder redundant sein, wenn die Änderung von einem anderen System stammt.
- Administratoren oder Supportmitarbeiter müssen möglicherweise Korrekturaktualisierungen an Datensätzen vornehmen. Mithilfe eines Bypass-Mechanismus können sie diese Änderungen vornehmen, ohne die standardmäßige Geschäftsautomatisierung auszulösen, was unbeabsichtigte Folgen haben könnte.
**Benutzerdefinierte Berechtigungen**: Der moderne, skalierbare Standard zum Implementieren der Umgehungslogik sind benutzerdefinierte Berechtigungen. Diese sind älteren Methoden aus mehreren Gründen überlegen:
- **Flexibilität:** Benutzerdefinierte Berechtigungen können Benutzern über Berechtigungssätze zugewiesen werden. Diese Vorgehensweise entspricht dem modernen Salesforce-Sicherheits- und -Zugriffsmodell und ermöglicht eine detaillierte und flexible Zuweisung. Eine Umgehung kann einem bestimmten Benutzer oder sogar vorübergehend mit einem bestimmten Ablaufdatum/einer bestimmten Ablaufzeit gewährt werden.
- **Wartbarkeit:** Durch die Verwendung benutzerdefinierter Berechtigungen wird vermieden, dass Profile oder Benutzer hartcodiert werden. Wenn sich die Rolle eines Benutzers ändert oder ein neues Profil Umgehungszugriff benötigt, handelt es sich bei der Änderung um eine einfache Berechtigungssatzzuweisung und nicht um eine Code- oder Flow-Änderung, die eine Bereitstellung erfordert.
- **Skalierbarkeit:** Benutzerdefinierte Berechtigungen bieten ein skalierbares Framework zum Verwalten von Ausnahmen in einer komplexen Benutzerbasis. Sie können Benutzern über Berechtigungssätze, Berechtigungssatzgruppen oder Profile zugewiesen werden. Ihre Zuordnung zu einem Berechtigungssatz oder Profil kann auch in Quellmetadaten dargestellt werden.
**Implementierungsmuster**: Wenden Sie ein konsistentes Umgehungsmuster auf alle durch einen Datensatz ausgelösten Automatisierungen in der Organisation an.
**Umgehen eines durch einen Datensatz ausgelösten Flows**: Die effizienteste Möglichkeit, einen Flow zu umgehen, besteht darin, zu verhindern, dass er überhaupt ausgeführt wird. Dies wird erreicht, indem den Eingabekriterien des Flows eine Bedingung hinzugefügt wird.
- Legen Sie im Startelement des durch einen Datensatz ausgelösten Flows "Bedingungsanforderungen" auf "Formel wird ausgewertet" auf "Wahr" fest.
- Integrieren Sie eine Überprüfung auf die benutzerdefinierte Berechtigung mithilfe der globalen Variablen `$Permission` in den Formelgenerator. Kombinieren Sie die Prüfung mit Ihren vorhandenen Eingabekriterien.
- Formelmuster:
```
( ) && NOT($Permission.Bypass_This_Flow)
```
- Durch dieses Muster wird sichergestellt, dass der Flow nur ausgeführt wird, wenn dem Benutzer die angegebene benutzerdefinierte Berechtigung _nicht_ zugewiesen ist. Diese Überprüfung wird durchgeführt, bevor das Flow-Interview überhaupt erstellt wird, was es zum leistungsfähigsten Ansatz macht.
**Umgehen eines Apex Trigger Framework**: Integrieren Sie die Bypass-Logik in Apex direkt in das metadatengesteuerte Auslöser-Framework, um eine genaue Steuerung zu ermöglichen.
- Der benutzerdefinierte Metadatentyp "`TriggerAction__mdt`" sollte ein Textfeld enthalten, beispielsweise "`BypassPermission__c`".
- In der `MetadataTriggerHandler`-Klasse sollte der Code vor dem dynamischen Ausführen einer Aktion den Wert aus diesem Feld lesen.
- Wenn das Feld ausgefüllt ist, verwendet der Handler die `FeatureManagement.checkPermission()`-Methode, um festzustellen, ob der aktuelle aktuelle Benutzer über die angegebene benutzerdefinierte Berechtigung verfügt.
- Wenn `checkPermission()` true zurückgibt, überspringt der Handler diese spezifische Aktion und fährt mit der nächsten in der Sequenz fort.
- Dieses Muster ist leistungsstark, da es sowohl eine globale Umgehung (wenn alle `TriggerAction__mdt` auf dieselbe Berechtigung verweisen) als auch eine detaillierte Umgehung pro Aktion (wenn unterschiedliche Datensätze auf unterschiedliche Berechtigungen verweisen oder einige gar keine Umgehungsberechtigung haben) ermöglicht.
### Mega-Flows im Vergleich zu mehreren Flows
Es ist ein Anti-Pattern, um die gesamte Automatisierung eines Objekts in einem einzigen, massiven Mega-Flow zu konsolidieren. Die Konsolidierung in einem Flow im Vergleich zur Aufteilung der Logik in mehrere gut konditionierte Flows hat keine großen Auswirkungen auf die Leistung. Die wichtigsten Leistungssteigerungen stammen aus:
- Verwenden von Flows vor dem Speichern für Feldaktualisierungen desselben Datensatzes.
- Schreiben genauer Eintrittsbedingungen, um sicherzustellen, dass Flows nicht für Änderungen ausgeführt werden, die sich nicht auf ihren jeweiligen Anwendungsfall auswirken.
Mit [dem Flow-Auslöser-Explorer](https://trailhead.salesforce.com/content/learn/modules/record-triggered-flows/meet-flow-trigger-explorer) können Sie jedem Flow für ein Objekt einen Auftragswert zuweisen, um eine sequenzielle Ausführungsreihenfolge zu gewährleisten.
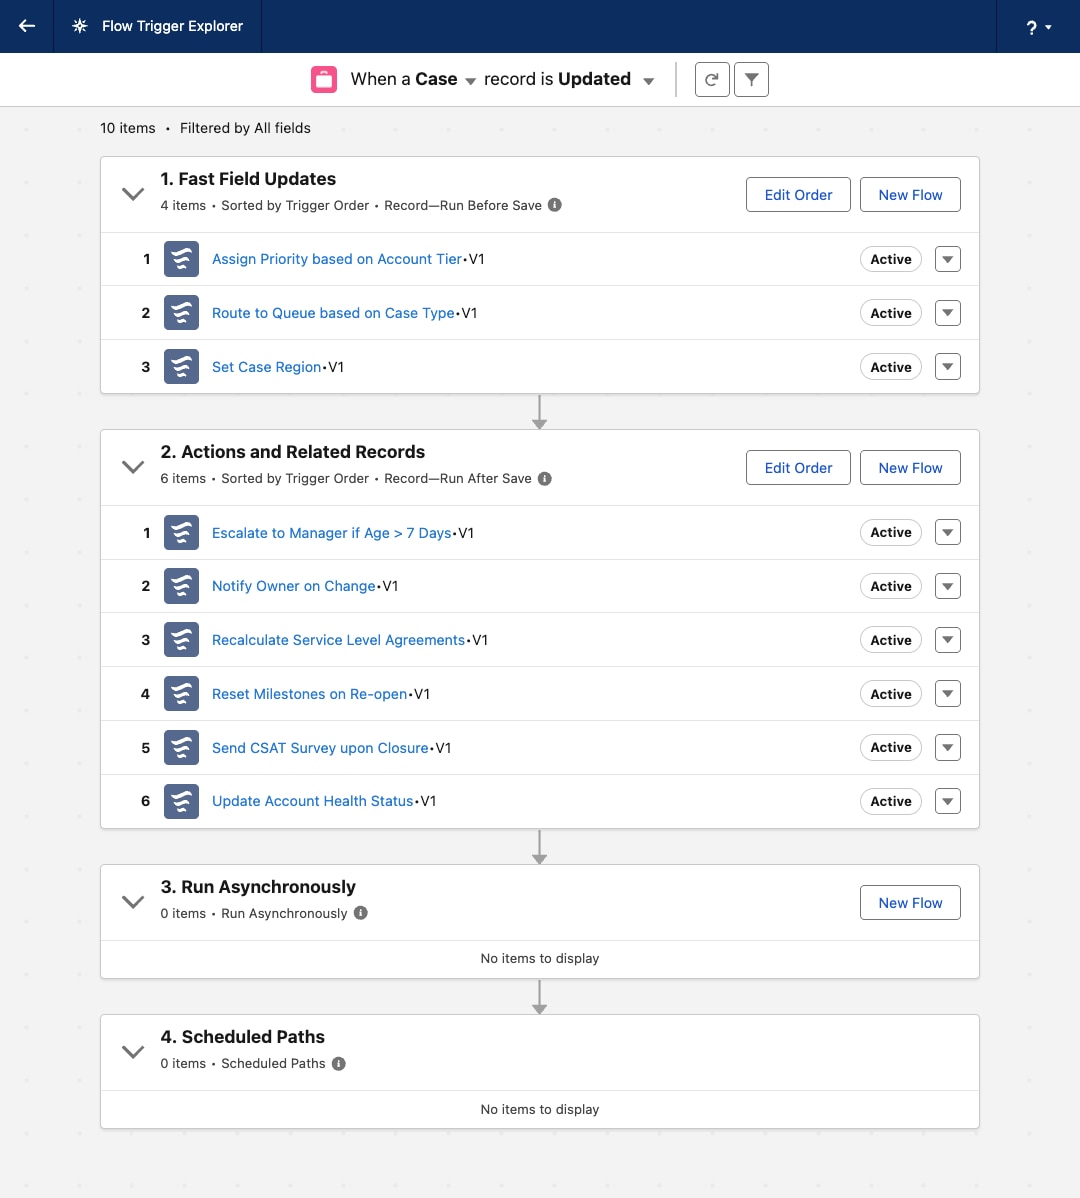 ## Ressourcen
| Apex | Flow | Vorgänge |
|---|---|---|
|
Bei der Salesforce Platform handelt es sich um eine umfassende AI-gestützte Plattform, die Mitarbeiter, autonome AI-Agenten, Unternehmensdaten und Anwendungen in einem einzigen, vertrauenswürdigen System zusammenführt, um die Produktivität und die Kundenerfahrung zu steigern. Durch die Verbindung von Customer 360-Anwendungen, Data Cloud und Slack für eine durchgängige Automatisierung kann ein "Agentenunternehmen" erstellt werden. |
 |
MuleSoft ist die führende Integrationsplattform von Salesforce, mit der Organisationen Anwendungen, Daten und Geräte lokal und Cloud-Umgebungen miteinander verbinden können. MuleSoft ist eine Plattform, die der IT die Plattformen bietet, um Daten systemübergreifend freizugeben, skalierbare Integrations- und Automatisierungs-Frameworks zu entwickeln und differenzierte, verbundene Erfahrungen zu schaffen – und zwar schnell. |
| Entscheidungspunkt | Anleitung |
|---|---|
| Benachrichtigungen nahezu in Echtzeit | Ereignisgesteuerte Architekturmuster wie Veröffentlichen/Abonnieren, Fanout und Streaming funktionieren in der Regel gut in Szenarien, in denen mehrere Anwendungen nahezu in Echtzeit über Statusänderungen oder Datensatzaktualisierungen benachrichtigt werden müssen. |
| Parallelverarbeitung | Muster wie Veröffentlichen/Abonnieren funktionieren in der Regel gut in Szenarien, in denen große Datenmengen oder hochkomplexe Nachrichten die Verarbeitungslast auf mehrere Systeme verteilen müssen. |
| Lesevorgänge mit hohem Volumen | Die Muster "Übergebene Nachrichten" und "Warteschlange" werden häufig in Szenarien verwendet, in denen Organisationen Anstiege verzeichnen und das Volumen der produzierten Nachrichten die Fähigkeit der Abonnenten übersteigen kann, sie sofort zu verarbeiten. |
| Schreibvorgänge mit hohem Volumen | Die Streaming- und Warteschlangenmuster funktionieren gut in vielen Szenarien, in denen Organisationen einen Anstieg der Anzahl der produzierten Nachrichten feststellen. |
| Senden derselben Daten an unterschiedliche Systeme | Während das Veröffentlichen/Abonnieren für Organisationen, die dieselben Daten an mehrere Systeme senden müssen, tendenziell eine recht häufige Lösung ist, können die meisten hier behandelten Muster darauf reagieren. Überprüfen Sie sie im Detail, um die beste Passform zu finden. |
| Häufige Einführung neuer Systeme oder Geräte | Die Muster "Veröffentlichen/Abonnieren", "Streamen" und "Warteschlange" funktionieren in der Regel gut in Szenarien, in denen sich die gesamte Landschaft in einem Wandel befindet und regelmäßig neue Systeme und Geräte hinzugefügt werden. In diesem Szenario muss ein neues System oder Gerät lediglich Abonnent des Ereignis-Busses werden oder einer Warteschlange zugeordnet werden, um Nachrichten zu empfangen, statt eine benutzerdefinierte Punkt-zu-Punkt-Integration erforderlich zu machen. |
| IoT-Geräte | Da IoT-Geräte in der Regel häufige Aktualisierungen bereitstellen und in einigen Szenarien auch eine Welle von Nachrichten generieren können, funktionieren die Streaming- und Warteschlangenmuster in der Regel gut, wenn sie in eine IT-Landschaft integriert werden. |
| Mobilgeräte und -systeme im Offline-Modus | Mobilgeräte, die in Bereichen mit minderwertigem oder nicht vorhandenem Internetzugang arbeiten müssen, oder Systeme, die zum Zeitpunkt der Nachrichtenzustellung offline sein können, profitieren vom Warteschlangenmuster, mit dem sie eine Verbindung zu ihren Warteschlangen herstellen und alle relevanten Nachrichten abrufen können, sobald sie wieder online sind. |
| Entscheidungspunkt | Anleitung/Fragen |
|---|---|
| Geschäftsanforderungen | Besteht ein echter Geschäftsbedarf für eine der Funktionen, die im Abschnitt [When-to-use an event-driven-architecture] (#when-to-use-an-event-driven-architecture) beschrieben sind? |
| Technische Anforderungen | Passt die Integration, die Sie entwerfen, offensichtlich zu einem anderen Muster, beispielsweise Datenvirtualisierung, Batch oder Anforderung/Antwort? Mit anderen Worten, versuchen Sie, einen Vierkantzapfen in ein rundes Loch zu passen? |
| Prozesse, bei denen Menschen auf Antworten warten müssen | Jede Integration, bei der ein Mensch auf eine Antwort vom Zielsystem wartet, eignet sich nicht für ereignisgesteuerte Architekturen, da sie für die asynchrone Ausführung konzipiert sind und keine Antwortzeit garantieren können. Überlegen Sie, ob solche Prozesse für Ihre Organisation optimal sind, bevor Sie technische Lösungen implementieren. Weitere Informationen finden Sie unter [Well-Architected – Operational Excellence](/docs/architect/de-de/well-architected/guide/operational-excellence.html). |
| Häufig geänderte Quelldaten | Wenn sich die Daten in Ihrem Quellsystem so selten ändern, dass regelmäßige Aktualisierungen ausreichend sind, können Sie Ihre Architektur wahrscheinlich vereinfachen, indem Sie [batch patterns] (https://developer.salesforce.com/docs/atlas.en-us.integration_patterns_and_practices.meta/integration_patterns_and_practices/integ_pat_batch_data_sync.htm) anstelle von ereignisgesteuerten Mustern verwenden. |
| Implementierungsanforderungen | Unterstützen die meisten an Ihrer Lösung beteiligten Systeme ereignisgesteuerte Architekturen? Was wäre erforderlich, um ereignisgesteuerte Architekturen mit Systemen zu verwenden, die sie nicht unterstützen (z. B. Upgrades, Anpassungen oder Middleware)? Welcher Aufwand wäre erforderlich, um diese Anforderungen zu erfüllen? |
| Messaging-Strukturstabilität | Wie oft müssen sich Ihre Nachrichtenstrukturen ändern? Welche Systeme sind von einer solchen Änderung betroffen und wie sieht der Sanierungsprozess aus? |
| Organisationsführung | Verfügen Sie über eine Governance-Struktur, um sicherzustellen, dass alle Beteiligten über Änderungen an Nachrichtenstrukturen, Auslösern und anderen architektur- und prozessbezogenen Entscheidungen informiert sind und Einfluss darauf haben? |
| Erforderliche Fertigkeiten | Verfügen Ihre Mitarbeiter über Erfahrung mit ereignisgesteuerten Architekturen und wissen sie, wie sie sie unterstützen können? |
| Muster | Nahezu in Echtzeit | Kopie einer eindeutigen Nachricht | Garantiezustellung | Reduzieren der Nachrichtengröße | Umwandeln von Daten |
|---|---|---|---|---|---|
| Veröffentlichen/Abonnieren | ✓ | ✓ | ✓ | ||
| Fanout | ✓ | ✓ | ✓ | ||
| Übergebene Nachrichten | ✓ | ✓ | ✓ | ✓ | |
| Streaming | ✓ | ✓ | ✓ | ||
| Warteschlange | ✓ | ✓ | ✓ |
| Tool | Beschreibung | Erforderliche Fertigkeiten | |
|---|---|---|---|
| MuleSoft | Beliebige Punktplattform | Plattform, die die Datenintegration mithilfe von API-Ebenen ermöglicht. | Pro-Code |
| Salesforce Pub/Sub-Konnektor | Konnektor für die Pub/Sub-API, der eine einzige Oberfläche für die Veröffentlichung und Abonnierung von Plattformereignissen, Ereignissen der Echtzeit-Ereignisüberwachung und Ereignissen der Datenerfassung von Änderungen bietet. | Pro-Code | |
| MuleSoft Anypoint JMS Connector | Konnektor, der das Senden und Empfangen von Nachrichten an Warteschlangen und Themen für jeden Nachrichtenservice ermöglicht, der die Java Message Service-Spezifikation (JMS) implementiert. | Pro-Code | |
| MuleSoft Anypoint Apache Kafka Connector | Konnektor zum Verschieben von Daten zwischen Apache Kafka und Unternehmensanwendungen und -services. | Pro-Code | |
| MuleSoft Anypoint Solace-Konnektor | Konnektor für Solace PubSub+-Ereignisbroker mit nativer API-Integration mithilfe des JCSMP Java-SDK | Pro-Code | |
| MuleSoft Anypoint MQ-Konnektor | Ein mandantenübergreifender Cloud-Messaging-Service, mit dem Kunden erweiterte asynchrone Nachrichten zwischen ihren Anwendungen ausführen können. | Pro-Code | |
| MuleSoft Anypoint-MQTT-Konnektor | Eine MuleSoft-Erweiterung, die mit dem Protokoll MQTT (Message Queuing Telemetry Transport) v3.x kompatibel ist. | Pro-Code | |
| MuleSoft Anypoint AMQP-Konnektor | Ein Konnektor, mit dem Ihre Anwendung Nachrichten mithilfe eines AMQP 0.9.1-kompatiblen Brokers veröffentlichen und konsumieren kann. | Pro-Code | |
| MuleSoft Anypoint Event-Driven (ASync)-API | Branchenunabhängige Sprache, die die Veröffentlichung von ereignisgesteuerten APIs unterstützt, indem sie in Ereignis-, Kanal- und Transportebenen unterteilt werden. | Pro-Code | |
| MuleSoft Anypoint MQ | Messaging-Service für mehrere Mandanten, mit dem Kunden erweiterte asynchrone Nachrichten zwischen ihren Anwendungen ausführen können. | Pro-Code | |
| MuleSoft Anypoint-Datenströme | Das in MuleSoft Anypoint verfügbare Framework zum Veröffentlichen und Abonnieren von Streaming-Daten. | Pro-Code | |
| Salesforce Platform | Apache Kafka auf Heroku | Heroku-Add-On, das Apache Kafka als Service mit vollständiger Plattformintegration in die Heroku-Plattform bereitstellt. | Pro-Code |
| Datenerfassung ändern | Änderungsereignisprotokoll, das Änderungen an Salesforce-Datensätzen veröffentlicht. Zu den Änderungen zählen die Erstellung eines neuen Datensatzes, Aktualisierungen an einem vorhandenen Datensatz, das Löschen eines Datensatzes und das Rückgängigmachen der Löschung eines Datensatzes. | Low-Code zu Pro-Code | |
| Ausgehende Nachrichten | Aktionen, die XML-Nachrichten an externe Endpunkte senden, wenn Feldwerte in Salesforce aktualisiert werden. | Low-Code | |
| Plattformereignisse | Sichere und skalierbare Nachrichten, die benutzerdefinierte Ereignisdaten enthalten. | Low-Code zu Pro-Code | |
| Pub/Sub API | API, die Abonnements für Plattformereignisse, Ereignisse der Datenerfassung ändern und/oder Ereignisse der Echtzeit-Ereignisüberwachung aktiviert. | Pro-Code | |
| Ereignisweiterleitungen | Ermöglicht die Übertragung von Plattformereignissen und Ereignissen der Datenerfassung von Salesforce an Amazon EventBridge. Beachten Sie, dass Ereignisweiterleitungen nur eine Verbindung mit AWS Eventbridge herstellen. | Low-Code | |
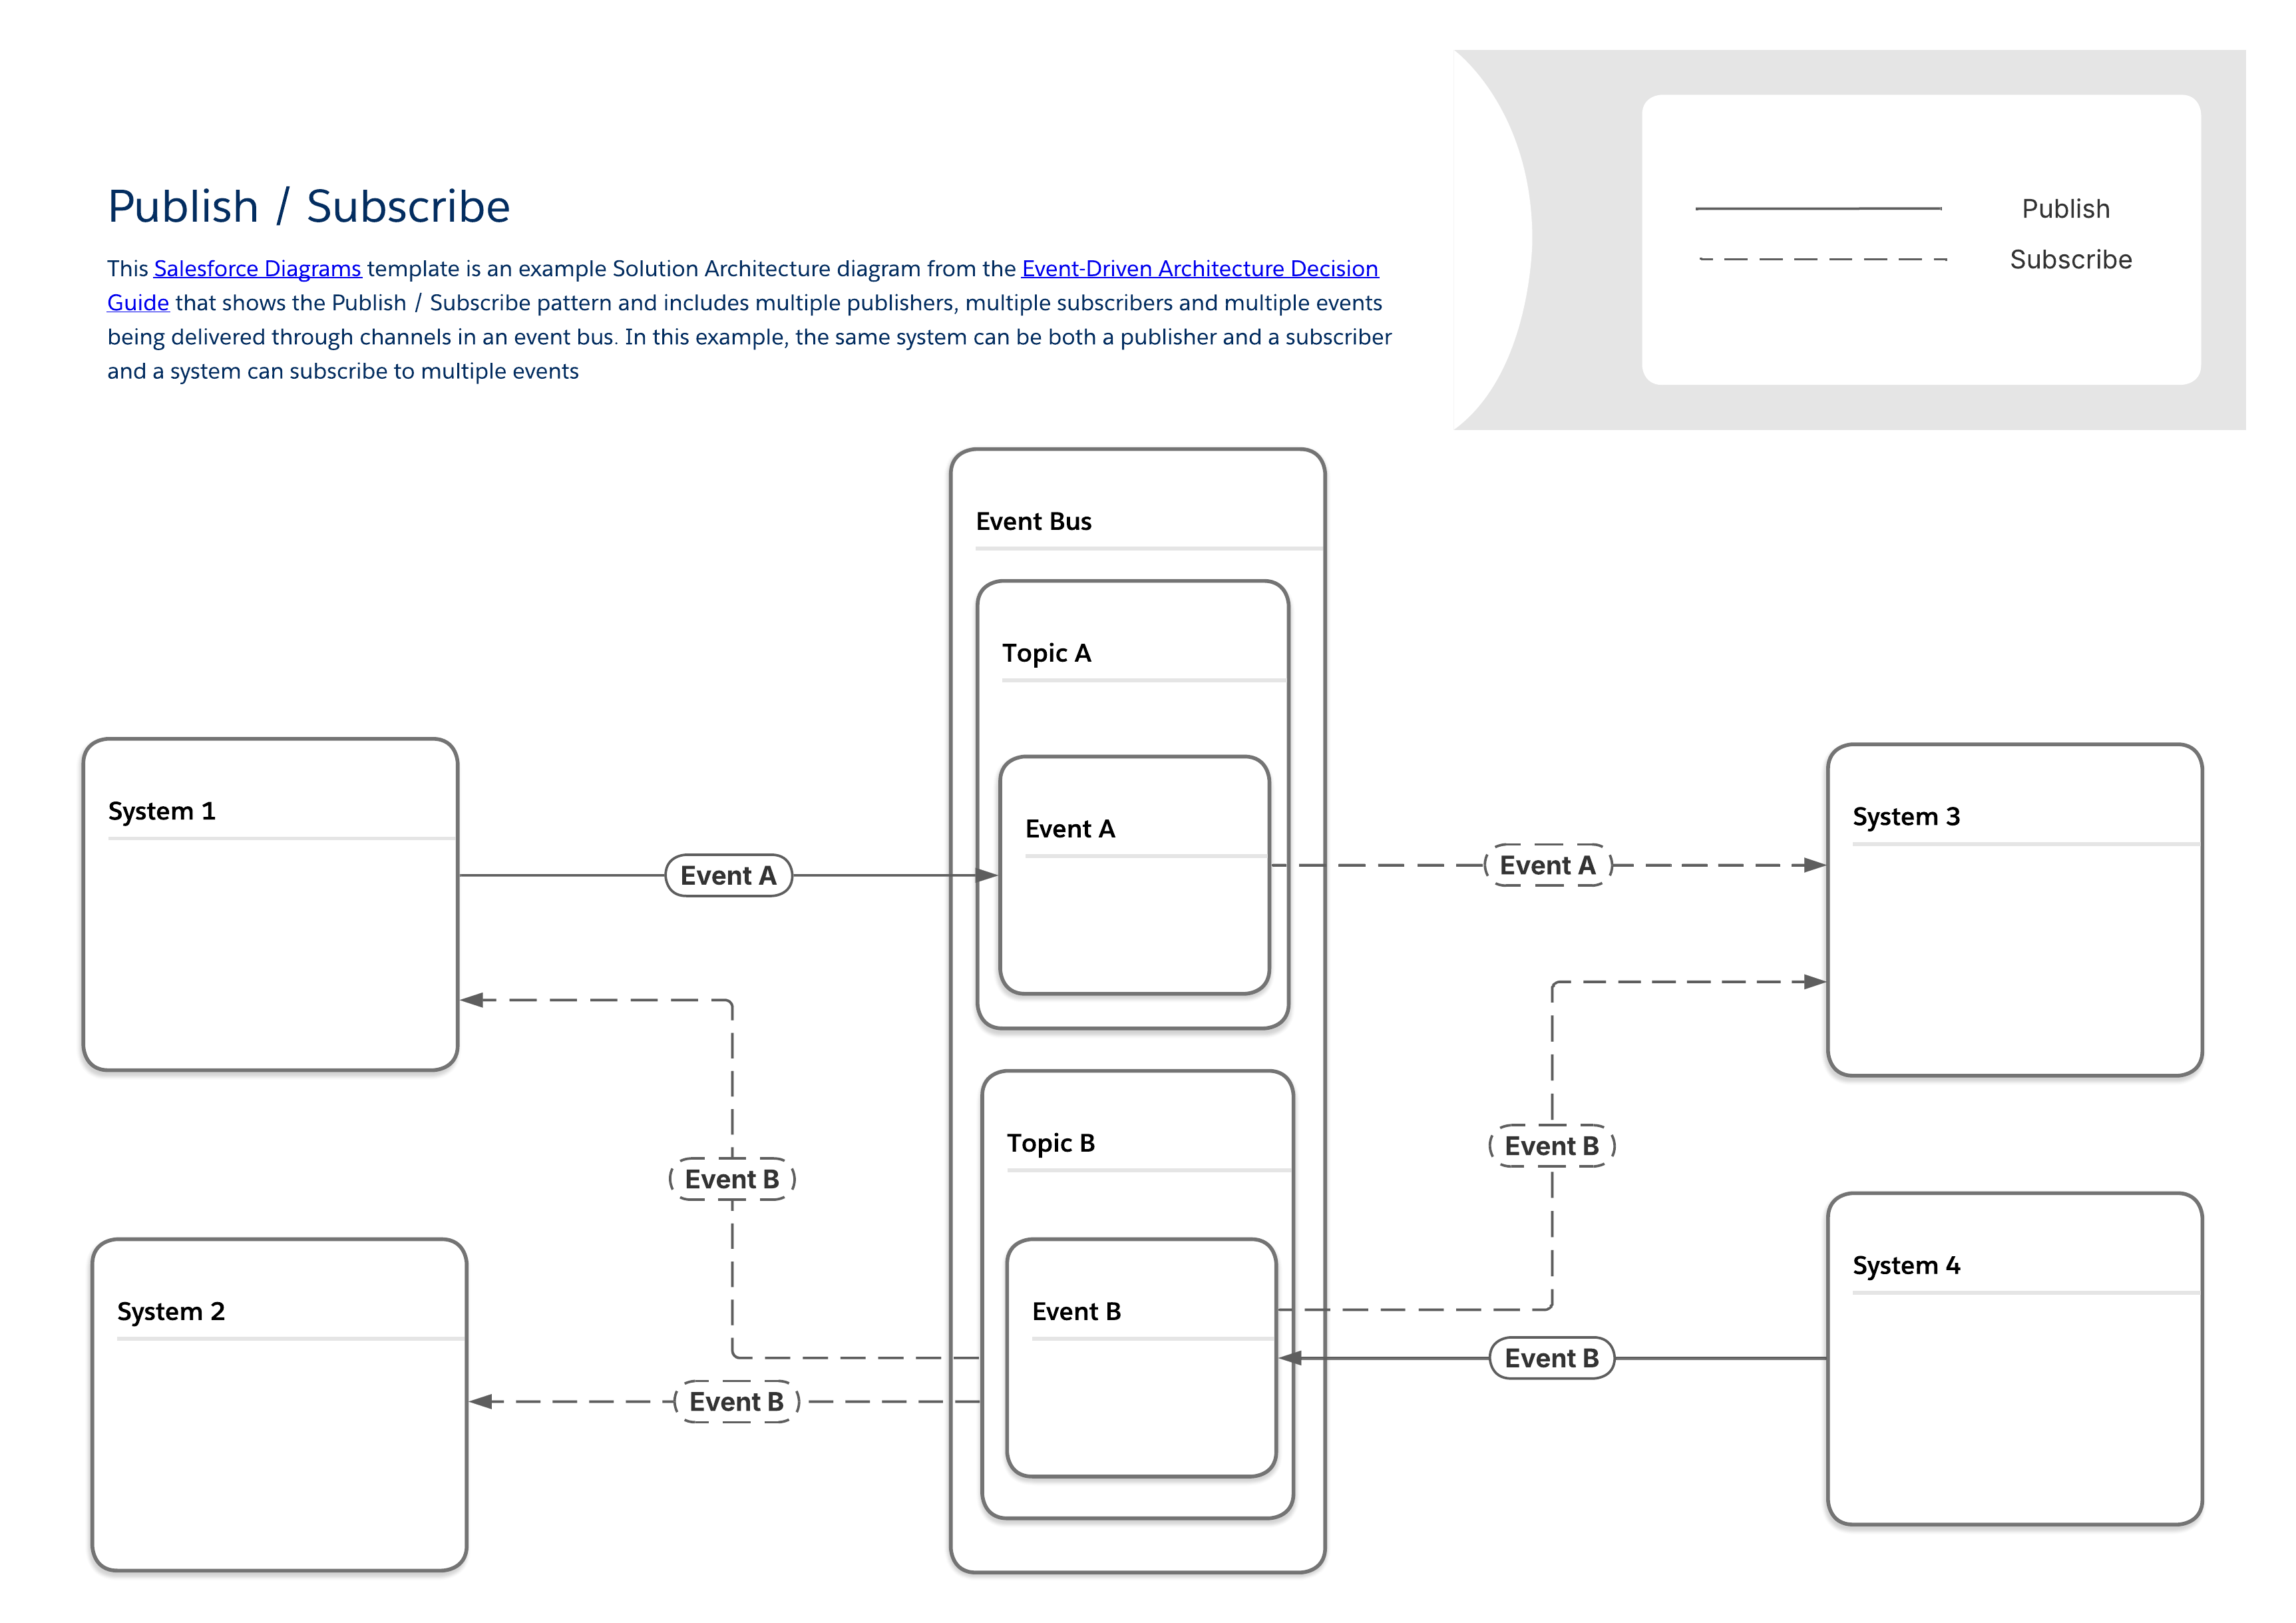 #### Für das Veröffentlichungs-/Abonnementmuster relevante Tools
| Ereignis-Flow und -Verhalten | Überlegungen zur Nutzlast | ||||||
|---|---|---|---|---|---|---|---|
| Verfügbare Tools | Erforderliche Fertigkeiten | Veröffentlichen über | Abonnieren über | Wiederholungszeitraum | Nutzlaststruktur | Nutzlastobergrenzen | |
| MuleSoft | Beliebige Punktplattform | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine |
| Salesforce Pub/Sub-Konnektor | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| MuleSoft Anypoint JMS Connector | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| MuleSoft Anypoint Apache Kafka Connector | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| MuleSoft Anypoint Solace-Konnektor | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| MuleSoft Anypoint MQ-Konnektor | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| MuleSoft Anypoint-MQTT-Konnektor | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| MuleSoft Anypoint AMQP-Konnektor | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| MuleSoft Anypoint Event-Driven (ASync)-API | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| MuleSoft Anypoint MQ | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| Salesforce Platform | Apache Kafka auf Heroku | Pro-Code | APIs, Datensatzänderungen in Heroku Postgres | N/A | 1-6 Wochen | Vom Benutzer definiert | Vom Benutzer definiert |
| Datenerfassung ändern | Low-Code zu Pro-Code | Datensatzänderungen | Apex, APIs, Lightning Web Components (LWC) | 3 Tage | Vordefiniert | 1 MB | |
| Ausgehende Nachrichten* | Low-Code | Flow- und Workflow-Regeln | N/A | 24 Stunden | Vom Benutzer definiert | 100 Benachrichtigungen pro Nachricht | |
| Plattformereignisse | Low-Code zu Pro-Code | APIs, Apex, Flow | Apex, APIs, Flow, LWC | 3 Tage | Vom Benutzer definiert | 1 MB | |
| Pub/Sub API | Pro-Code | Pub/Sub API oder APIs, Apex, Flow | Pub/Sub-API | 3 Tage | Vom Benutzer definiert | 1 MB | |
| Ereignisweiterleitungen** | Low-Code | Plattformereignisse, Datenerfassung ändern | API | 3 Tage | Vom Benutzer definiert | 1 MB | |
| * Salesforce wird ausgehende Nachrichten weiterhin im Rahmen der aktuellen Funktionsfunktionen unterstützen, plant jedoch keine weiteren Investitionen in diese Technologie. **Ereignisweiterleitungen stellen nur eine Verbindung mit AWS Eventbridge her | |||||||
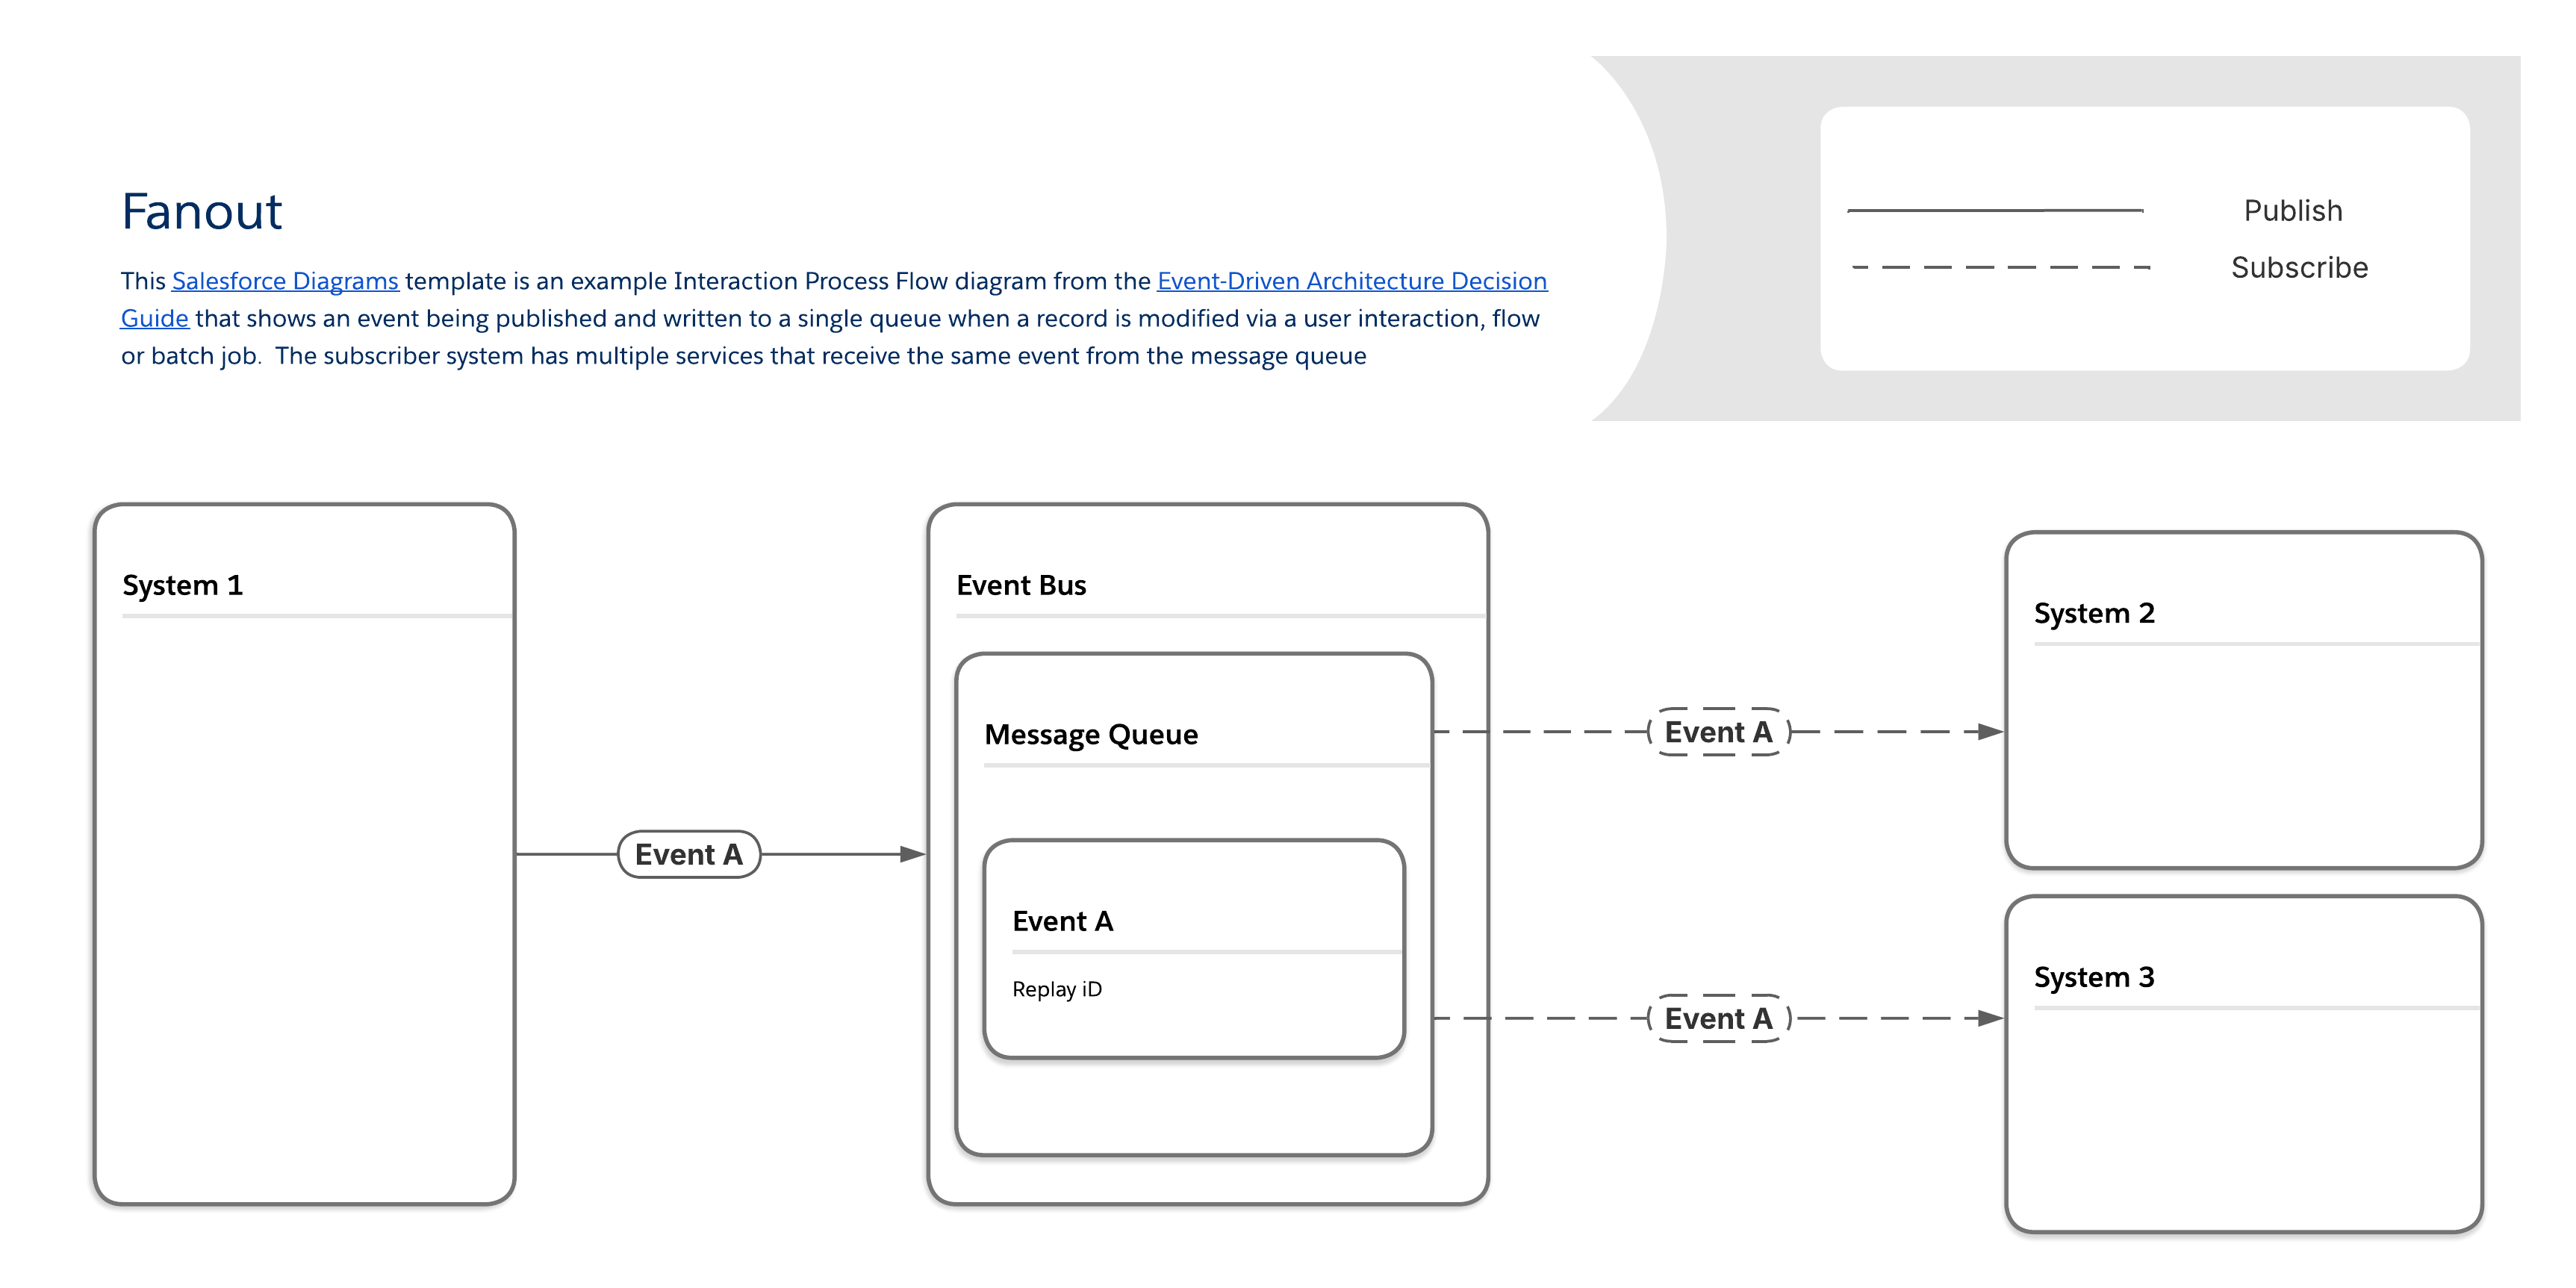 #### Für das Fanout-Muster relevante Tools
| Ereignis-Flow und -Verhalten | Überlegungen zur Nutzlast | ||||||
|---|---|---|---|---|---|---|---|
| Verfügbare Tools | Erforderliche Fertigkeiten | Veröffentlichen über | Abonnieren über | Wiederholungszeitraum | Nutzlaststruktur | Nutzlastobergrenzen | |
| MuleSoft | MuleSoft Anypoint JMS Connector | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine |
| Salesforce Pub/Sub-Konnektor | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| MuleSoft Anypoint Apache Kafka Connector | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| MuleSoft Anypoint Solace-Konnektor | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| MuleSoft Anypoint MQ-Konnektor | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| MuleSoft Anypoint-MQTT-Konnektor | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| MuleSoft Anypoint AMQP-Konnektor | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| MuleSoft Anypoint MQ | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| Salesforce Platform | Apache Kafka auf Heroku | Pro-Code | APIs, Datensatzänderungen in Heroku Postgres | N/A | 1-6 Wochen | Vom Benutzer definiert | Vom Benutzer definiert |
| Datenerfassung ändern | Low-Code zu Pro-Code | Datensatzänderungen | Apex, APIs, Lightning Web Components (LWC) | 3 Tage | Vordefiniert | 1 MB | |
| Plattformereignisse | Low-Code zu Pro-Code | APIs, Apex, Flow | Apex, APIs, Flow, LWC | 3 Tage | Vom Benutzer definiert | 1 MB | |
| Pub/Sub API | Pro-Code | Pub/Sub API oder Apex, APIs, Flow | Pub/Sub-API | 3 Tage | Vom Benutzer definiert | 1 MB | |
| Ereignisweiterleitungen* | Low-Code | Plattformereignisse, Datenerfassung ändern | API | 3 Tage | Vom Benutzer definiert | 1 MB | |
| * Ereignisweiterleitungen senden nur Daten an AWS Eventbridge | |||||||
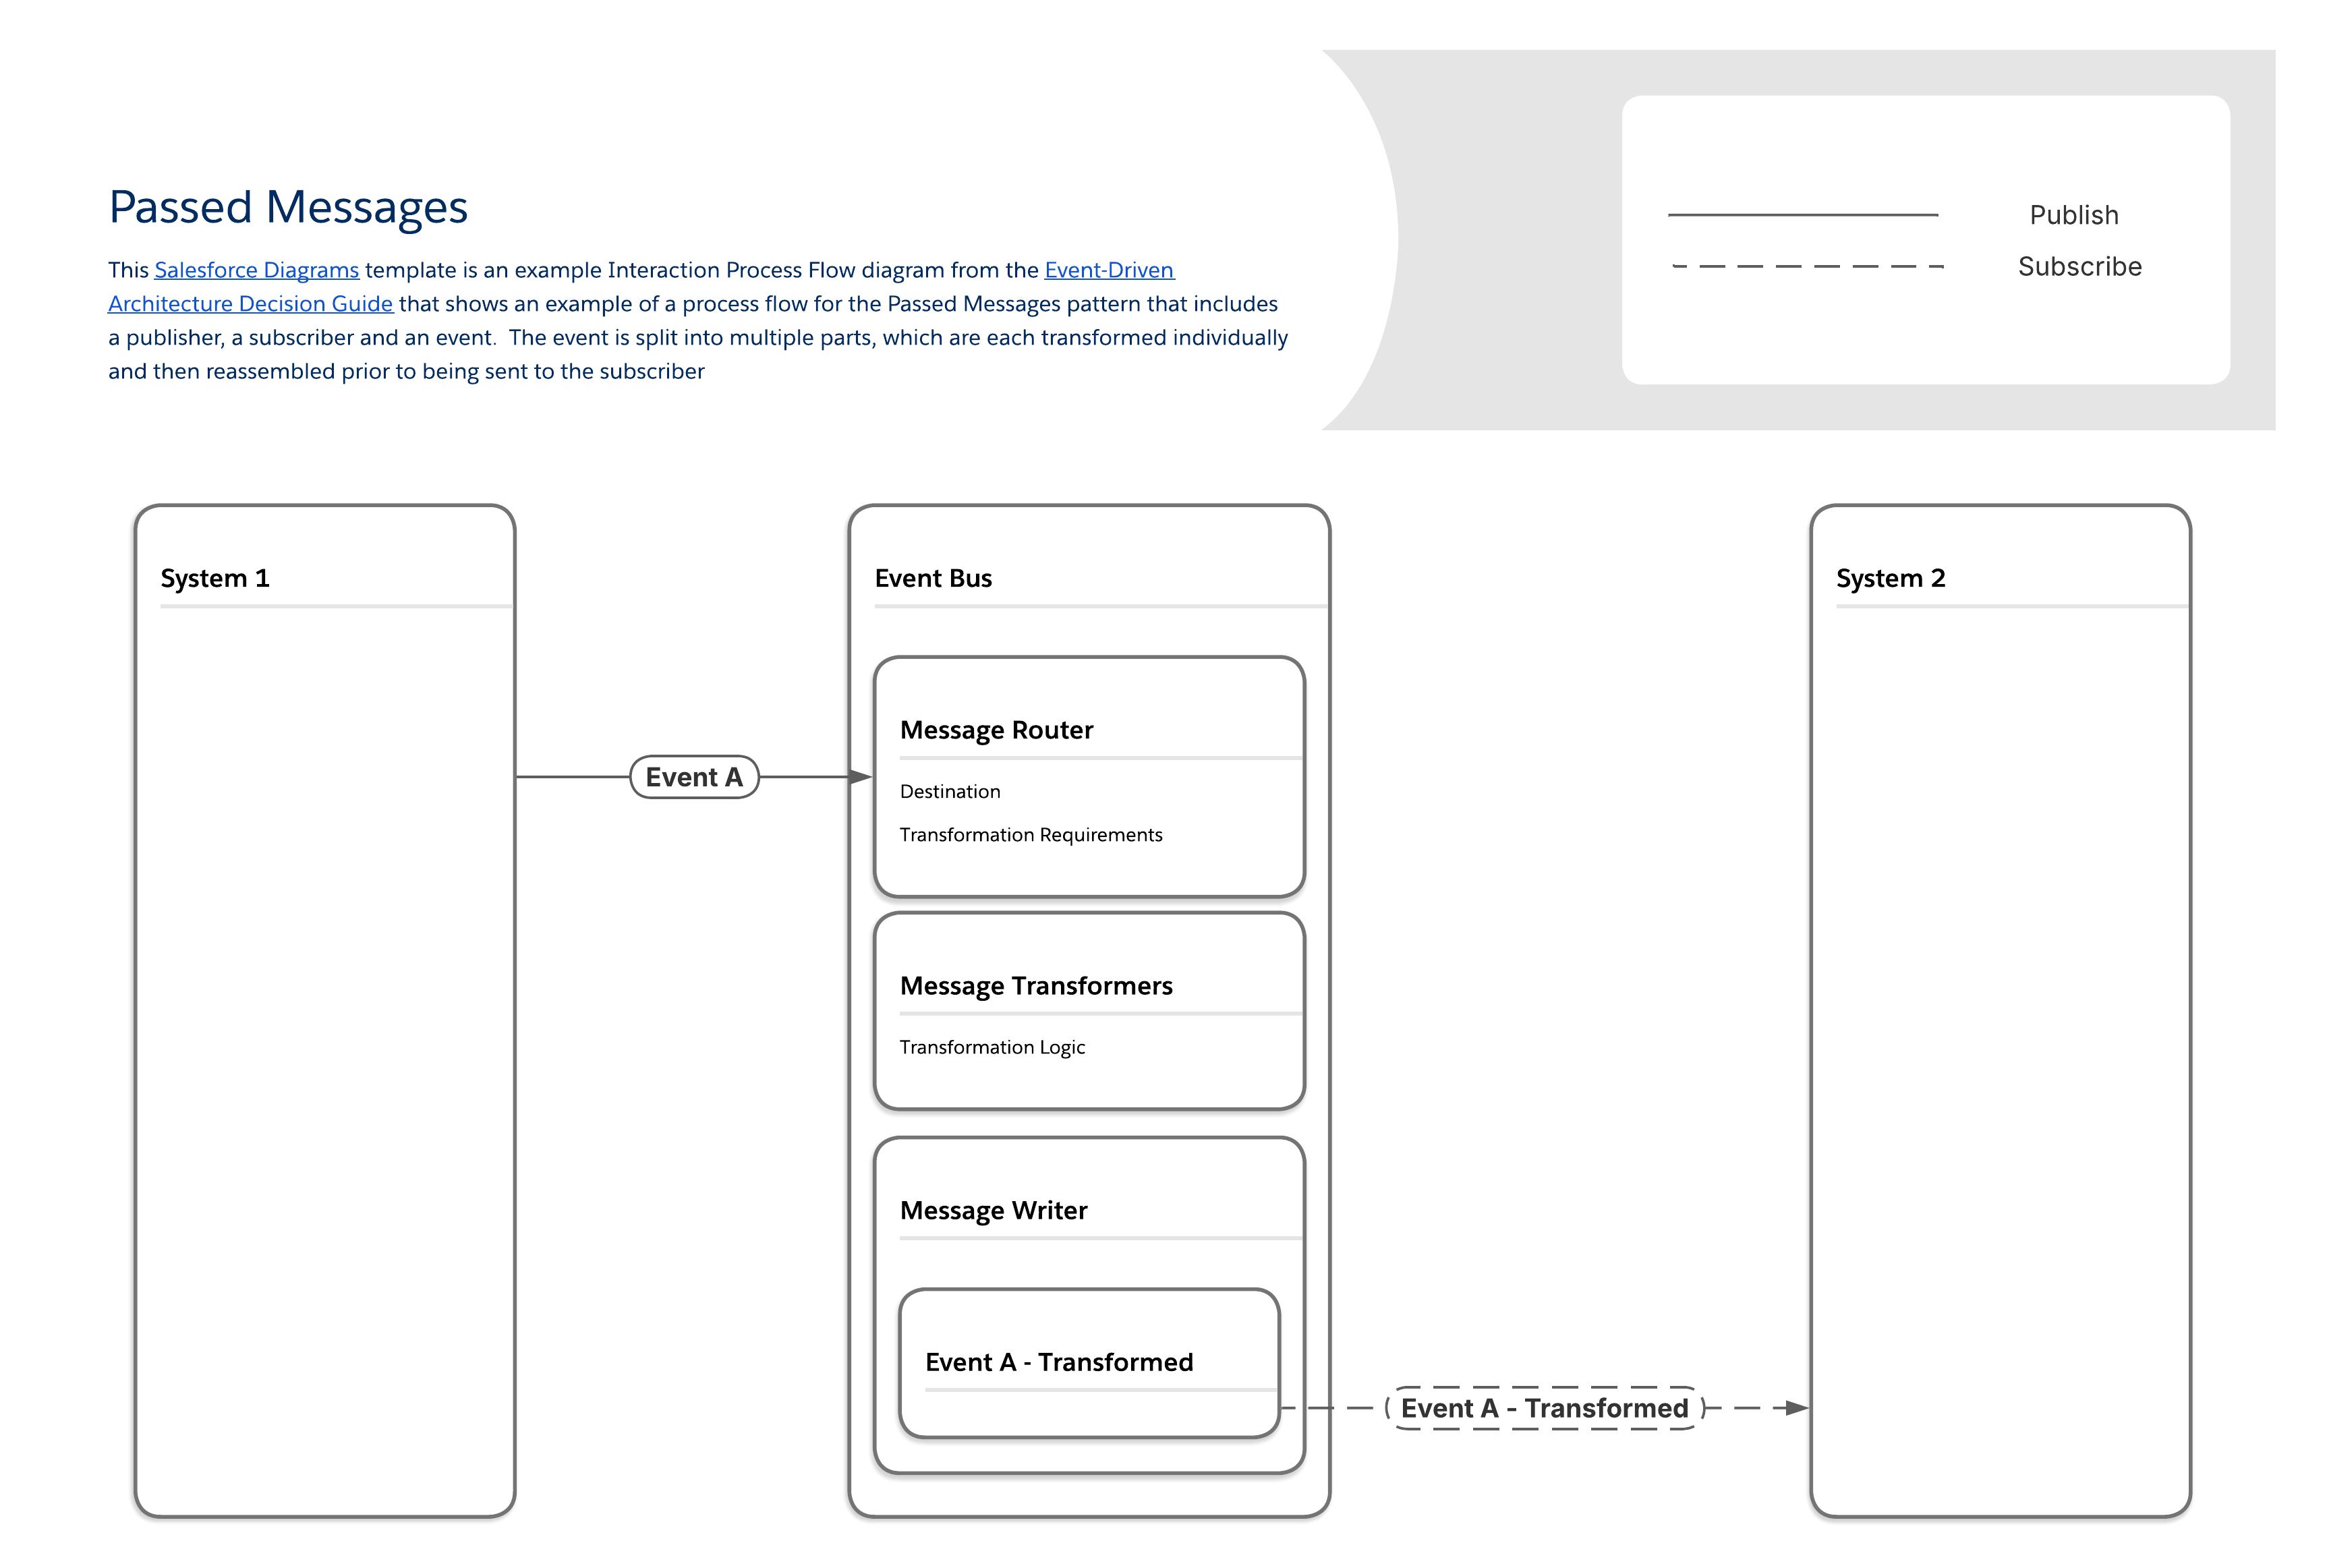 #### Für das Muster der übergebenen Nachrichten relevante Tools
| Ereignis-Flow und -Verhalten | Überlegungen zur Nutzlast | ||||||
|---|---|---|---|---|---|---|---|
| Verfügbare Tools | Erforderliche Fertigkeiten | Veröffentlichen über | Abonnieren über | Wiederholungszeitraum | Nutzlaststruktur | Nutzlastobergrenzen | |
| MuleSoft | MuleSoft Anypoint Apache Kafka Connector | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine |
| Salesforce Pub/Sub-Konnektor | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| Salesforce Platform | Apache Kafka auf Heroku | Pro-Code | APIs, Datensatzänderungen in Heroku Postgres | N/A | 1-6 Wochen | Vom Benutzer definiert | Vom Benutzer definiert |
| Datenerfassung ändern | Low-Code zu Pro-Code | Datensatzänderungen | Apex, APIs, Lightning Web Components (LWC) | 3 Tage | Vordefiniert | 1 MB | |
| Plattformereignisse | Low-Code zu Pro-Code | APIs, Apex, Flow | Apex, APIs, Flow, LWC | 3 Tage | Vom Benutzer definiert | 1 MB | |
| Pub/Sub API | Pro-Code | Pub/Sub API oder APIs, Apex Flow | Pub/Sub-API | 3 Tage | Vom Benutzer definiert | 1 MB | |
| Ereignisweiterleitungen* | Low-Code | Plattformereignisse, Datenerfassung ändern | API | 3 Tage | Vom Benutzer definiert | 1 MB | |
| * Ereignisweiterleitungen senden nur Daten an AWS Eventbridge | |||||||
 #### Für das Streaming-Muster relevante Tools
| Ereignis-Flow und -Verhalten | Überlegungen zur Nutzlast | ||||||
|---|---|---|---|---|---|---|---|
| Verfügbare Tools | Erforderliche Fertigkeiten | Veröffentlichen über | Abonnieren über | Wiederholungszeitraum | Nutzlaststruktur | Nutzlastobergrenzen | |
| MuleSoft | MuleSoft Anypoint-Datenströme | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine |
| Salesforce Pub/Sub-Konnektor | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| MuleSoft Anypoint Apache Kafka Connector | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| Salesforce Platform | Apache Kafka auf Heroku | Pro-Code | APIs, Datensatzänderungen in Heroku Postgres | N/A | 1-6 Wochen | Vom Benutzer definiert | Vom Benutzer definiert |
| Pub/Sub API | Pro-Code | Pub/Sub API oder APIs, Apex Flow | Pub/Sub-API | 3 Tage | Vom Benutzer definiert | 1 MB | |
 #### Für das Warteschlangenmuster relevante Tools
| Ereignis-Flow und -Verhalten | Überlegungen zur Nutzlast | ||||||
|---|---|---|---|---|---|---|---|
| Verfügbare Tools | Erforderliche Fertigkeiten | Veröffentlichen über | Abonnieren über | Wiederholungszeitraum | Nutzlaststruktur | Nutzlastobergrenzen | |
| MuleSoft | MuleSoft Anypoint MQ | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine |
| Salesforce Pub/Sub-Konnektor | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| MuleSoft Anypoint Apache Kafka Connector | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| MuleSoft Anypoint MQ-Konnektor | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| MuleSoft Anypoint-MQTT-Konnektor | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| MuleSoft Anypoint AMQP-Konnektor | Pro-Code | APIs | APIs | Wie konfiguriert | Vom Benutzer definiert | Keine | |
| Salesforce Platform | Apache Kafka auf Heroku | Pro-Code | APIs, Datensatzänderungen in Heroku Postgres | N/A | 1-6 Wochen | Vom Benutzer definiert | Vom Benutzer definiert |
| Datenerfassung ändern | Low-Code zu Pro-Code | Datensatzänderungen | Apex, APIs, Lightning Web Components (LWC) | 3 Tage | Vordefiniert | 1 MB | |
| Plattformereignisse | Low-Code zu Pro-Code | APIs, Apex, Flow | Apex, APIs, Flow, LWC | 3 Tage | Vom Benutzer definiert | 1 MB | |
| Pub/Sub API | Pro-Code | Pub/Sub API oder APIs, Apex, Flow | Pub/Sub-API | 3 Tage | Vom Benutzer definiert | 1 MB | |
| Ereignisweiterleitungen* | Low-Code | Plattformereignisse, Datenerfassung ändern | API | 3 Tage | Vom Benutzer definiert | 1 MB | |
| * Ereignisweiterleitungen senden nur Daten an AWS Eventbridge | |||||||
| Dynamische Formulare | Dynamische Formulare im Salesforce Lightning App Builder unterteilen monolithische Datensatzdetailkomponenten in einzelne konfigurierbare Felder und Abschnitte. Mit dieser Funktion können Administratoren flexible und leistungsstarke Seiten erstellen, indem sie Felder an einer beliebigen Stelle platzieren und Sichtbarkeitsregeln verwenden, um Komponenten basierend auf Benutzerprofilen, Geräten oder Daten anzuzeigen oder auszublenden, was die Übersichtlichkeit der Seiten reduziert. |
|---|---|
| Bildschirm-Flow | Bei einem Salesforce-Bildschirm-Flow handelt es sich um ein interaktives Automatisierungstool in Flow Builder, das Benutzereingaben erfordert, um benutzerdefinierte schrittweise Geschäftsprozesse zu durchlaufen. Im Gegensatz zu automatisierten Hintergrund-Flows bieten Bildschirm-Flows eine assistentenähnliche Benutzeroberfläche, um Daten zu erfassen, Informationen anzuzeigen oder Aktionen über Lightning-Seiten, Schaltflächen oder benutzerdefinierte Anwendungen auszuführen, ohne Code schreiben zu müssen. |
| OmniStudio | Salesforce OmniStudio ist eine Low-Code-Suite mit Tools, die für die schnelle Erstellung geführter, branchenspezifischer digitaler Erfahrungen und komplexer Geschäftsprozesse konzipiert wurden. Damit können Entwickler mithilfe von Komponenten zum Ziehen und Ablegen wie FlexCards und OmniScripts pixelgenaue Benutzeroberflächen erstellen (z. B. geführte Workflows und dynamische Dashboards). Mit OmniStudio können Sie deklarativ LWCs erstellen. |
| Lightning Web Components | Bei Salesforce Lightning Web Components handelt es sich um leichte benutzerdefinierte HTML-Elemente, die mit HTML, CSS und modernem JavaScript erstellt wurden und für die native Ausführung in Browsern konzipiert wurden, um die Leistung der Salesforce-Benutzeroberfläche zu verbessern. Sie ermöglichen es Entwicklern, benutzerdefinierte Benutzeroberflächen zu erstellen, die zusammen mit Aura-Komponenten vorhanden sind, was die Entwicklung durch Branchenstandards und ein detailliertes Komponenten-Ökosystem erhöht. |
| Konfiguration | Zusätzliche Lizenzanforderungen | |
|---|---|---|
| Dynamische Formulare | Low Code (Niedriger Code) | Keine |
| Bildschirm-Flow | Low Code (Niedriger Code) | Keine |
| OmniStudio | Low Code + Pro Code | Branchenpaket |
| Bildschirm-Flow plus Lightning Web Components | Low Code + Pro Code | Keine |
| Lightning Web Components | Pro-Code | Keine |
| Entscheidungspunkt | Anleitung |
|---|---|
| Anwendungsfallkategorien für die Laufzeit | |
| Formularumfang und Navigation | Legen Sie fest, ob alle Felder in Ihrem Formular logisch auf einen einzelnen Bildschirm passen oder ob Benutzer zwischen mehreren Bildschirmen navigieren können müssen. |
| Standort | Geben Sie die Position(en) an, an der bzw. den Sie das Formular einbetten möchten. Dies kann von einer Salesforce-Anwendung über eine mobile Anwendung bis hin zu einer externen Website reichen. |
| Steuerfeld | Identifizieren Sie die Aktionen oder Logik, die im Hintergrund ausgeführt werden müssen, während Benutzer mit Ihrem Formular interagieren, einschließlich Datentransformationen und Integrationen in externe Systeme. |
| Validierung | Ermitteln Sie, ob Sie zusätzliche Eingabevalidierungsanforderungen haben, die über die von Salesforce bereitgestellte Standardvalidierung auf Systemebene hinausgehen. |
| Interaktionsdesign | Identifizieren Sie die Arten von Interaktionen oder Bedingungen, die dynamische Antworten in Ihrem Formular auslösen sollen. |
| Stil | Bestimmen Sie den Grad der Komplexität, der für Ihren gewünschten Stil und Ihre CSS-Anforderungen erforderlich ist. |
| Layout | Identifizieren Sie die Layoutanforderungen Ihres Formulars (beispielsweise die erforderliche Anzahl an Spalten, Registerkarten und Akkordeons) und die Möglichkeit, sich wiederholende Datenblöcke anzuzeigen. |
| Übersetzung | Legen Sie fest, ob Ihr Formular für andere Sprachen lokalisiert werden muss. |
| Nicht funktionale Überlegungen | |
| Sicherheit | Legen Sie fest, ob Ihr Formular den Zugriff des Benutzers vor der Ausführung bestimmter Vorgänge überprüfen soll, ob Sie steuern möchten, wer auf das Formular zugreifen kann und ob Sie steuern möchten, wo das Formular eingebettet werden kann. |
| Objektauswirkung | Legen Sie fest, ob Ihr Formular für ein einzelnes Objekt oder für mehrere Objekte verwendet werden soll. |
| Benutzeroberflächentestautomatisierung | Legen Sie fest, ob Ihr Formular für Ihre DevOps-Prozesse automatisierten Einheitentests oder automatisierten durchgängigen Tests unterzogen werden muss. |
| Kennzahlen | Legen Sie fest, wie Sie die Nutzung Ihres Formulars verfolgen möchten, einschließlich Seitenaufrufen, der für das Formular aufgewendeten Zeit, Abschlussraten und Erfolgsraten. |
| Paketerstellung und Bereitstellung | Legen Sie fest, wie Sie Ihr Formular verteilen oder bereitstellen möchten, nachdem es erstellt wurde. |
| Einzelbildschirm | Formular mit mehreren Bildschirmen | Fortschrittsindikatoren | Schnellnavigation zwischen Schritten/Bildschirmen | |
|---|---|---|---|---|
| Dynamische Formulare | Verfügbar | Nicht verfügbar | Verfügbar | Nicht verfügbar |
| Bildschirm-Flow | Verfügbar | Verfügbar | Verfügbar | Nicht verfügbar |
| OmniStudio | Verfügbar | Verfügbar | Verfügbar | Verfügbar |
| Bildschirm-Flow + LWC | Verfügbar | Verfügbar | Verfügbar | Verfügbar |
| LWC | Verfügbar | Nicht ideal | Nicht ideal | Nicht ideal |
| Lightning-Datensatzseite | Lightning-Startseite oder -Anwendungsseite | Aura Experience Cloud-Sites | LWR Experience Cloud-Sites | Eingebettete Snap | Dienstprogrammleiste | Objektspezifische Aktion | Globale Aktion | Mobile Salesforce-Anwendung* | Field Service Mobile | Mobiles SDK | Externe Sites und Anwendungen | Benutzerdefinierte LWC | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Dynamische Formulare | Verfügbar | Nicht verfügbar | Nicht verfügbar | Nicht verfügbar | Nicht verfügbar | Nicht verfügbar | Nicht verfügbar | Nicht verfügbar | Verfügbar | Nicht verfügbar | Nicht verfügbar | Nicht verfügbar | Nicht verfügbar |
| Bildschirm-Flow | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Nicht verfügbar | Verfügbar | Verfügbar** | Nicht verfügbar | Nicht verfügbar | Verfügbar |
| OmniStudio | Verfügbar | Verfügbar | Verfügbar | Nicht verfügbar | Nicht verfügbar | Verfügbar | Nicht verfügbar | Nicht verfügbar | Verfügbar | Nicht verfügbar | Nicht verfügbar | Verfügbar | Verfügbar |
| Bildschirm-Flow + LWC | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Nicht verfügbar | Verfügbar | Nicht verfügbar | Nicht verfügbar | Nicht ideal | Verfügbar |
| LWC | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Nicht verfügbar | Nicht verfügbar | Verfügbar | Nicht verfügbar | Nicht verfügbar | Verfügbar | Verfügbar |
| * Flows und Lightning-Webkomponenten werden in der mobilen Salesforce-Anwendung unterstützt, jedoch nicht alle Möglichkeiten zum Einbetten von Flows und Lightning-Webkomponenten (z. B. werden objektspezifische Aktionen auf Mobilgeräten unterstützt, Dienstprogrammleistenelemente jedoch nicht). **Die mobile Salesforce Field Service-Anwendung enthält die Datenerfassung – eine auf dem Flow-Modul basierende Lösung für die Offline-Erstverarbeitung mit einer dedizierten Offline-Laufzeit, die die neuesten Flow-Funktionen unterstützt. Die Anwendung enthält auch die alten Field Service Mobile-Flows, die auf einem älteren benutzerdefinierten Offline-Modul ausgeführt werden und viele der neuesten Flow-Funktionen nicht unterstützen. | |||||||||||||
| Protokoll und Aktionen | Hierarchische Datenverwaltung | Arbeiten innerhalb einer Transaktion | Transaktionsübergreifendes Arbeiten | Integration | Modulares Design und Wiederverwendung | Verpackung | |
|---|---|---|---|---|---|---|---|
| Dynamische Formulare | Nicht verfügbar | Nicht verfügbar | Nicht verfügbar | Nicht verfügbar | Nicht verfügbar | Nicht verfügbar | Verfügbar |
| Bildschirm-Flow | Verfügbar | Nicht verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar |
| OmniStudio | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Nicht verfügbar |
| Bildschirm-Flow + LWC | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar |
| LWC | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar |
| Berücksichtigen der Validierung auf Systemebene | Benutzerdefinierte Validierung auf Feldebene speziell für dieses Formular | Validierung auf benutzerdefinierter Feldebene | |
|---|---|---|---|
| Dynamische Formulare | Verfügbar | Nicht verfügbar | Nicht verfügbar |
| Bildschirm-Flow | Verfügbar | Nicht verfügbar | Nicht verfügbar |
| OmniStudio | Verfügbar | Verfügbar | Verfügbar |
| Bildschirm-Flow + LWC | Verfügbar | Verfügbar | Verfügbar |
| LWC | Verfügbar | Verfügbar | Verfügbar |
| Ausführen von Off-Screen-Datenvorgängen | Bedingte Werte und Berechnungen | Bedingte Sichtbarkeit | Bedingte Anforderung | Bedingte Formatierung | Bedingter schreibgeschützter Status | Bedingter deaktivierter Status | |
|---|---|---|---|---|---|---|---|
| Dynamische Formulare | Nicht verfügbar | Nicht verfügbar | Verfügbar | Nicht verfügbar | Verfügbar | Nicht verfügbar | Nicht verfügbar |
| Bildschirm-Flow | Verfügbar | Verfügbar* | Verfügbar | Verfügbar | Nicht verfügbar | Verfügbar | Verfügbar |
| OmniStudio | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar |
| Bildschirm-Flow + LWC | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar |
| LWC | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar |
| * Beschränkt auf Komponenten, die eine Ressourcenauswahl und kein statisches Kontrollkästchen verwenden | |||||||
| Standardmäßige Ereignisverarbeitung(Unschärfe, Fokus) | Benutzerdefinierte Ereignisverarbeitung | |
|---|---|---|
| Dynamische Formulare | Nicht verfügbar | Nicht verfügbar |
| Bildschirm-Flow | Nicht verfügbar | Nicht verfügbar |
| OmniStudio | Nicht verfügbar | Verfügbar* |
| Bildschirm-Flow + LWC | Verfügbar | Verfügbar |
| LWC | Verfügbar | Verfügbar |
| * Die OmniStudio-Standardlaufzeit unterstützt Pub/Sub nicht, Windows postMessage jedoch nicht | ||
| Direkter Stil | Organisations- und Erfahrungsgeneratorthemen | Pixel-perfekter Stil | |
|---|---|---|---|
| Dynamische Formulare | Nicht verfügbar | Verfügbar | Nicht verfügbar |
| Bildschirm-Flow | Nicht verfügbar | Verfügbar | Verfügbar** |
| OmniStudio | Verfügbar* | Nicht verfügbar | Verfügbar |
| Bildschirm-Flow + LWC | Nicht verfügbar | Verfügbar | Verfügbar |
| LWC | Nicht verfügbar | Verfügbar | Verfügbar |
| * Nur FlexCards ** Bestimmte Stilattribute können für Bildschirmkomponenten konfiguriert werden, jedoch nicht für CSS-Überschreibungen. | |||
| 2 Spalten | 4 Spalten | Jenseits von 4 Spalten | Wiederholen von Datenblöcken | Registerkartencontainer | Akkordeonbehälter | |
|---|---|---|---|---|---|---|
| Dynamische Formulare | Verfügbar | Nicht verfügbar | Nicht verfügbar | Nicht verfügbar | Verfügbar | Verfügbar |
| Bildschirm-Flow | Verfügbar | Verfügbar | Nicht verfügbar | Verfügbar | Nicht verfügbar | Verfügbar |
| OmniStudio | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar* | Verfügbar |
| Bildschirm-Flow + LWC | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar |
| LWC | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar |
| * Registerkarten können verwendet werden, wenn Daten in eine FlexCard in ein OmniScript eingebettet werden | ||||||
| Im Generator eingegebene Bezeichnungen | Bezeichnungen im Code | |
|---|---|---|
| Dynamische Formulare | Verfügbar* | Nicht verfügbar |
| Bildschirm-Flow | Verfügbar | Verfügbar |
| OmniStudio | Verfügbar | Verfügbar |
| Bildschirm-Flow + LWC | Verfügbar | Verfügbar |
| LWC | Nicht anwendbar | Verfügbar |
| * Nur Feldabschnittsüberschriften | ||
| Erhöhen von Benutzerberechtigungen | Steuern, wer Zugriff hat | Zulässige Standorte einschränken | |
|---|---|---|---|
| Dynamische Formulare | Nicht verfügbar | Verfügbar | Nicht verfügbar |
| Bildschirm-Flow | Verfügbar | Verfügbar | Nicht verfügbar |
| OmniStudio | Nicht verfügbar | Verfügbar | Nicht verfügbar** |
| Bildschirm-Flow + LWC | Verfügbar | Verfügbar | Nicht verfügbar |
| LWC | Verfügbar* | Verfügbar | Verfügbar |
| * Erfordert Apex **OmniScripts können zwar keine angegebenen Zielstandorte aufweisen, FlexCards jedoch schon. | |||
| Einheitentests | Durchgängige Automatisierung | |
|---|---|---|
| Dynamische Formulare | Nicht verfügbar | Verfügbar* |
| Bildschirm-Flow | Nicht verfügbar | Verfügbar* |
| OmniStudio | Verfügbar* | Verfügbar* |
| Bildschirm-Flow + LWC | Verfügbar* | Verfügbar* |
| LWC | Verfügbar | Verfügbar |
| * Erfordert Code | ||
| Seitenaufrufe | Zeitaufwand für Formular | Verfolgen des Formularabschlusses | Verfolgen der Erfolgsrate | |
|---|---|---|---|---|
| Dynamische Formulare | Verfügbar** | Nicht verfügbar | Nicht verfügbar | Nicht verfügbar |
| Bildschirm-Flow | Verfügbar | Verfügbar* | Verfügbar | Verfügbar |
| OmniStudio | Verfügbar | Verfügbar* | Verfügbar | Verfügbar |
| Bildschirm-Flow + LWC | Verfügbar | Verfügbar* | Verfügbar | Verfügbar |
| LWC | Verfügbar** | Verfügbar* | Verfügbar | Verfügbar |
| *Verfügbar, wenn die paketbasierte OmniStudio-Laufzeit aktiviert ist** Verfügbar durch Verfolgen der Nutzung übergeordneter Lightning-Seiten | ||||
| Verwaltete Pakete der ersten Generation (1GP) | Verwaltete Pakete der zweiten Generation (2GP) | Entsperrte Pakete | Änderungssets | DevOps Center | |
|---|---|---|---|---|---|
| Dynamische Formulare | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar |
| Bildschirm-Flow | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar |
| OmniStudio | Nicht verfügbar | Nicht verfügbar | Nicht verfügbar | Nicht verfügbar* | Nicht verfügbar* |
| Bildschirm-Flow + LWC | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar |
| LWC | Verfügbar | Verfügbar | Verfügbar | Verfügbar | Verfügbar |
| * Verwenden Sie die IDX-Workbench, um OmniStudio-Lösungen in anderen Organisationen bereitzustellen. | |||||