| Mustertyp | Modus/Tool | Vorteile | Überlegungen | Ergebnisse |
|---|---|---|---|---|
| Datenaufnahme |
Echtzeit:
|
|
|
Agentforce:
|
Streaming:
|
|
|
Agentforce:
|
|
Batch:
|
|
|
Agentforce:
|
|
| Zero Copy |
Live-Abfrage:
|
|
|
Agentforce:
|
Beschleunigte Abfrage (Zwischenspeicherung):
|
|
|
Agentforce:
|
|
Dateiverbund:
|
|
|
Agentforce:
|
 #### Methoden zur Datenaufnahme
Die Methoden zur _Datenaufnahme_ können variieren, je nachdem, welchen Konnektor Sie zur Aufnahme Ihrer Daten verwenden. Einige Konnektoren bieten eine Vielzahl von Aufnahmemethoden, während andere nur im Batch- oder Streaming-Modus arbeiten. Eine vollständige Liste der _Data 360-_Konnektoren und verfügbaren Methoden finden Sie unter [Data 360: Integrationen und Konnektoren](https://help.salesforce.com/s/articleView?id=data.c360_a_sources_targets.htm&type=5).
- **Echtzeit:**
- Ermöglicht die Aufnahme im Sekundenbereich mithilfe der _Datenerfassung (CDC)_
- Geeignet für zeitkritische Workflows (z. B. Betrugserkennung, Personalisierung und betriebliche Dashboards)
- Verfügt über Push-Transformationen und Aggregationen in _Data 360_, wodurch die nachgelagerten Ein- und Ausgänge reduziert und die Berechnungsnutzung optimiert wird
- Unterstützt die Verwendung von inkrementeller CDC zum Minimieren der Datenvermischung
- **Streaming:**
- Bietet Aufnahme alle 1–3 Minuten in kleinen Schritten
- Wägt Frische und Kosten ab
- Geeignet für die Kampagnenorchestrierung, die Interaktion beinahe live und für operative Berichte
- Unterstützt die Verwendung von Micro-Batchs zum Steuern von E/A-Spitzen
- Aggregiert Daten an der Quelle (sofern möglich), um Übertragungsvolumen zu reduzieren und den Speicher zu optimieren
- **Batch (Geplante Lasten):**
- Stellt die regelmäßige Aufnahme großer Datensets bereit (z. B. stündlich, täglich und wöchentlich)
- Bietet Kosteneffizienz und Zuverlässigkeit für historische Datensets, behördliche Berichte und Compliance-Anwendungsfälle
- Stellt sicher, dass sich das Gebietsschema in derselben Region wie der Quellspeicher befindet, um die Leistung zu steigern und die Kosten zu optimieren
#### Architect Playbook (Playbook für Architekten)
- **Anwendungsfälle für die Datenaufnahme:**
- **Generieren von zusammengeführten Customer 360-Profilen.** Erstellen Sie eine einzige Datenquelle für Kundenidentitäten und -attribute.
- **Verwalten Sie Datensets zur Einhaltung gesetzlicher Vorschriften.** Erzwingen Sie die Verwaltung, Abstammung und Überprüfbarkeit für sensible Daten.
- **Kampagnenorchestrierung zentralisieren.** Stellen Sie sicher, dass Marketing, Vertrieb und Service alle über konsistente, vertrauenswürdige Datensets funktionieren.
- **Gestaltungspraxis:**
- Passen Sie die Batch-Aufnahme für historische oder latenzarme Anforderungen an (z. B. Archivberichte oder regelmäßige Snapshots).
- Verwenden Sie CDC- oder Streaming-APIs, um die Aktualität für Betriebs- und Personalisierungs-Workflows aufrechtzuerhalten und Aktualisierungen nahezu in Echtzeit sicherzustellen.
- Steuern Sie das Speicher- und Berechnungswachstum, indem Sie inkrementelle Lasten anwenden, um Kosten und Effizienz zu optimieren (anstatt ganze Datensets neu zu laden).
- Passen Sie Aufnahme-Pipelines an die Rechenlokalität und die inkrementelle Verarbeitung an, um die Netzwerk-I/O zu reduzieren.
- Wenden Sie Transformationen in _Data 360 an_, um unnötige Verschiebungen von Rohdaten zu vermeiden.
- **Überlegungen zu Kosten:**
- Die **Echtzeitaufnahme** weist die höchsten Rechen- und Pipeline-Kosten auf, was für hochwertige, zeitkritische Workflows (z. B. Personalisierung, operative Dashboards oder Agentforce-gesteuerte Aktionen) gerechtfertigt sein kann.
- Die **Streaming-Aufnahme** weist moderate Rechen- und Speicherkosten auf, die für häufige Aktualisierungen geeignet sein können, die leichte Verzögerungen vertragen (z. B. Kampagnenorchestrierung oder Betriebsberichte).
- Die **Batch-Aufnahme** hat geringere Rechenkosten und einen vorhersehbaren Speicherplatz, der für historische Datensets oder Aktualisierungen mit geringer Häufigkeit geeignet ist. Die Aufnahme von Batch-Daten aus Salesforce-Organisationen mit bestimmten Konnektoren ist kostenlos.
- **Aktualisierungsmodus** Ermöglicht Ihnen die Auswahl des Modus _"Inkrementelle Aktualisierung_", der die Gesamtaufnahme- und Berechnungskosten reduziert. Bei Salesforce wird empfohlen, nach Möglichkeit _eine inkrementelle Aktualisierung_ zu verwenden, um die Effizienz über alle Aufnahmetypen hinweg zu optimieren.
- Die **Kosten** werden auch durch das E/A-Volumen von der Quelle zu _Data 360_ beeinflusst. Die Optimierung von Batchgrößen, Partitionen und regionaler Ausrichtung reduziert die Übertragungskosten und verbessert die Leistung.
- **Branchenszenarien:**
- **Finanzen:** Aufnahme-Datensets sind erforderlich, um _Ihren Kunden zu_ _kennen_, Geldwäsche zu bekämpfen und Betrug zu erkennen, wenn Überprüfbarkeit und Compliance nicht verhandelbar sind.
- **Gesundheitswesen:** Verwenden Sie die Aufnahme für die Patientenidentitätsbestimmung und HIPAA-konforme Datensätze, wodurch sichere, vereinheitlichte Ansichten ermöglicht werden.
- **Einzelhandel:** Konsolidieren Sie _POS-_, E-Commerce- und Treueprogrammdaten in vereinheitlichten Profilen für die Segmentierung und Personalisierung.
- **Telecom:** Unterstützen Sie Abwanderungsprävention und Nutzungsanalysen mit kanonischen, geregelten Abonnentendaten.
#### Entscheidungskriterien für die Datenaufnahmemethode
| Funktion | Echtzeitaufnahme | Streaming-Aufnahme | Batchaufnahme |
| :----------------------------------- | :------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------ | :------------------------------------------------------------------------------------------------------------------------------------------------------------ | :----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Latenz und Frische** | Enthält die Aufnahme von Latenzzeiten im Sekundenbereich über Aufnahme-APIs mit Unterstützung der _Datenerfassung (CDC)_. Bietet kontinuierliche Streaming-Pipelines. Geeignet für operative Anwendungsfälle mit geringer Latenz. | Enthält die Aufnahme von Micro-Batch alle 1–3 Minuten über native Konnektoren. Unterstützt inkrementelle Aktualisierungen. Es wird eine leichte Latenz erwartet. | Es wird eine Datenlatenz erwartet. Lässt geplante Ladevorgänge mit großem Volumen zu. Bietet regelmäßige Aufnahme (stündlich, täglich und wöchentlich). Nicht für zeitkritische Vorgänge geeignet. |
| **Primäre Anwendungsfälle** | Ideal für Anwendungsfälle mit geringer Latenz und Personalisierung. Wird für zeitkritische Workflows verwendet. Unterstützt ereignisgesteuerte Workflows. Wird für Echtzeitbetrugswarnungen und operative Warnungen verwendet. | Geeignet für mäßig dringende Prozesse. Wird für die Kampagnenorchestrierung, die Interaktion beinahe live und für operative Berichte verwendet. Wird für zeitnahe Kampagnenauslöser verwendet. | Kosteneffizient für massive Datensets. Zuverlässig für historische Analysen. Wird für historische Aggregations- oder regulierte Berichts-Workflows verwendet. Geeignet für historische oder Low-Velocity-Datensets. |
| **Architekturkomplexität und I/O** | Enthält hohe Kosten und komplexe Architektur. Erfordert Quellsysteme mit geringer Latenz. I/O-intensiv. Quellen mit hohem Volumen können zu gesättigten Pipelines führen. | Verfügt über eine einfachere Architektur als in Echtzeit. I/O ist moderat. Geeignet für vorhersehbare, wiederholte Aktualisierungsmuster. Die Batchgröße wirkt sich auf den Speicher und die Berechnung aus. | Einfach zu implementieren. I/O-intensiv bei Lastfenstern. Der Netzwerkdurchsatz kann bei großen Batches zu einem Engpass werden. |
| **Überlegungen zu Kosten** | Enthält die höchsten Rechen- und Pipeline-Kosten. Nur für hochwertige zeitkritische Workflows geeignet. | Enthält moderate Berechnungs- und Speicherkosten. Bietet einen ausgewogenen Ansatz für Kosten und Frische. Geeignet für häufige Aktualisierungen, die leichte Verzögerungen vertragen. | Niedrigere Rechenkosten und vorhersehbarer Speicher. Empfohlen für historische Datensets oder Aktualisierungen mit geringer Häufigkeit. Die Aufnahme über interne Salesforce-Pipelines ist kostenlos. |
| **Designpraktiken** | Verwenden Sie die inkrementelle CDC, um die Datenvermischung zu minimieren. Filtern und verwenden Sie selektive Felder, um den Overhead zu reduzieren. | Verwenden Sie Micro-Batchs zum Steuern von E/A-Spitzen. Ziehen Sie die Aggregation mit Fenstern in Betracht, um die Verarbeitungslast zu reduzieren. | Wird für Archivberichte oder regelmäßige Snapshots verwendet. Stellen Sie zur Kostenoptimierung sicher, dass sich die Berechnungslokalität in derselben Region wie der Quellspeicher befindet. |
### Zero Copy Data Federation (Zero Copy-Datenverbund)
#### Zero Copy-Anwendungsfälle
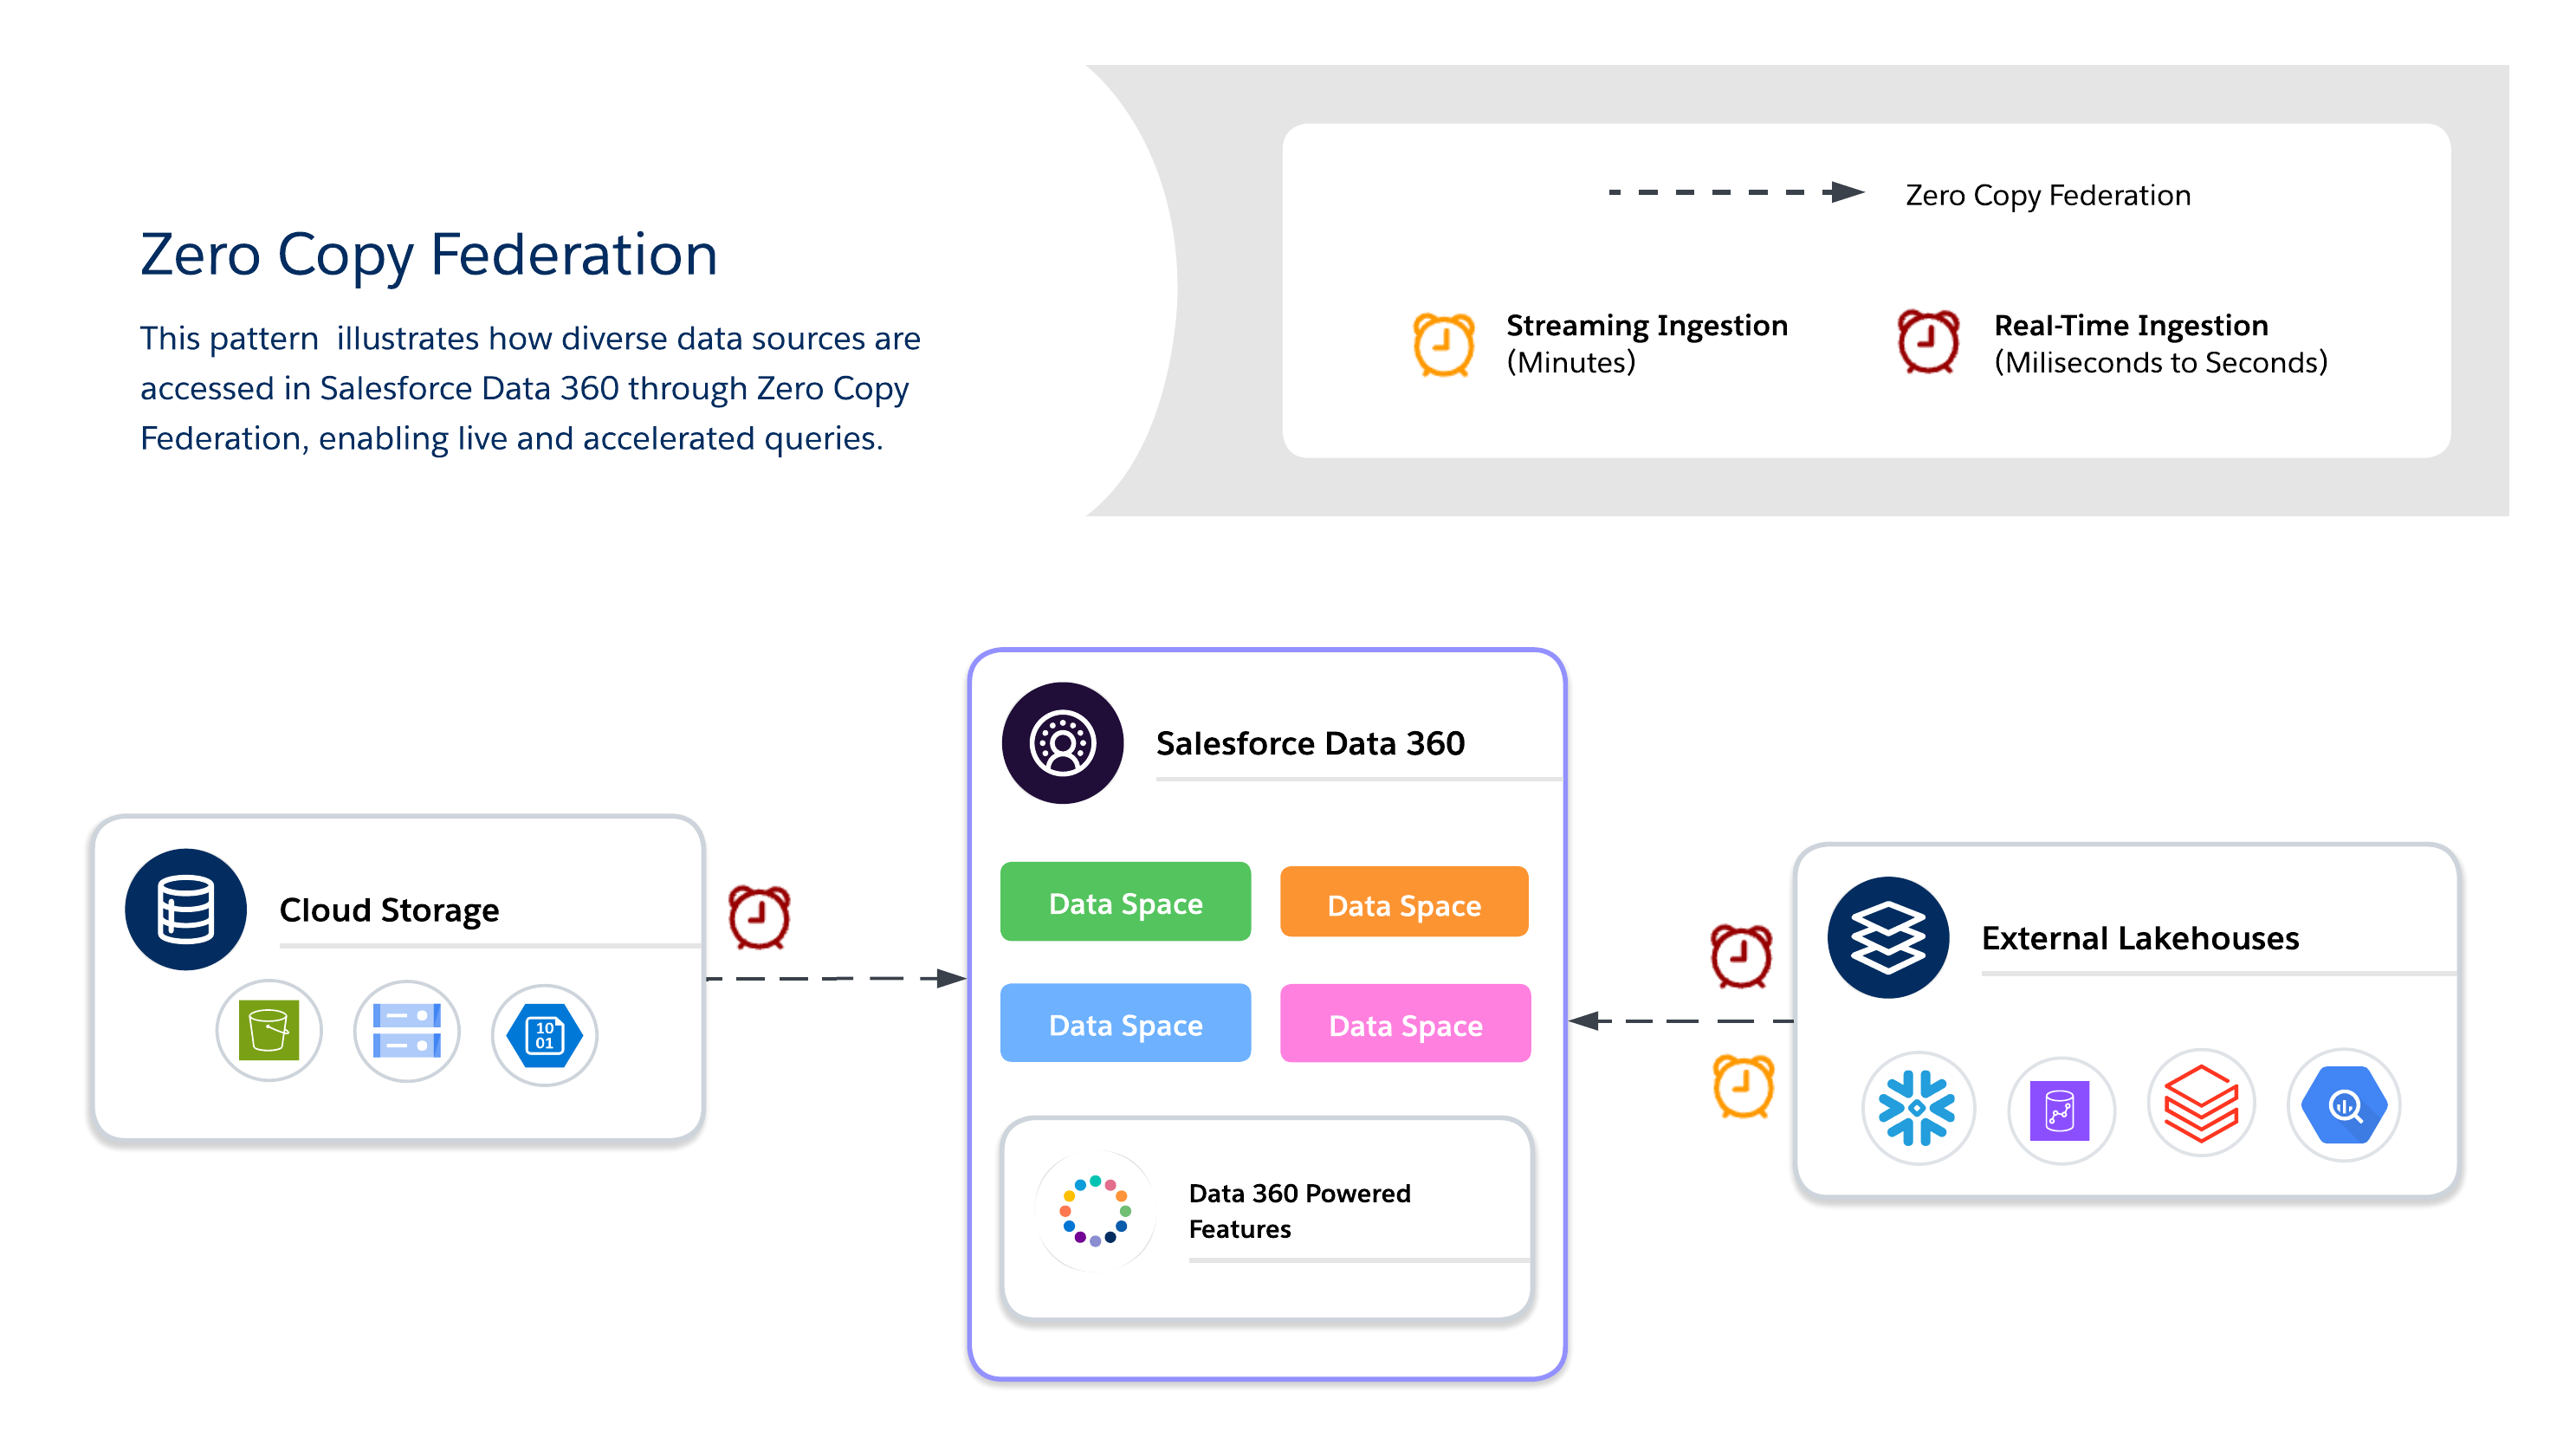
Verwenden Sie _Nullkopie_ für Echtzeitabfragen externer Systeme ohne Datenduplizierung, um Agilität, Aktualität und skalierbaren Zugriff auf große oder vorübergehende Datensets zu ermöglichen. Sie eignet sich für Live-Dashboards, explorative Analysen, AI/ML-Modellschulungen und Echtzeit-Kundenengagement direkt über Salesforce _Data 360_.
 #### Nullkopiemethoden
Bei Verwendung von _Nullkopie_ müssen Architekten zwischen drei verfügbaren Datenverbundmethoden wählen, von denen jede ihre eigenen Kompromisse zwischen Aktualität, Leistung und Kosten bietet.
- **Live-Abfrage**
- Führt Abfragen direkt gegen externe Systeme (z. B. _Snowflake_, _Google BigQuery_, _Redshift_, _Databricks_ usw.) ohne Datenduplizierung aus.
- Minimiert die Datenbewegung über das Netzwerk und reduziert die Ein- und Ausgänge bei der Salesforce _Data 360_-Berechnung. Dies ist optimal, wenn Prädikate und Aggregationen nach unten verschoben werden können.
- Geeignet für Echtzeitstatistiken und betriebliche Dashboards mit geringer Latenz.
- Abhängig von der Leistung des externen Systems.
- **Zwischenspeicherung (beschleunigte Abfrage)**
- Speichert temporär zwischengespeicherte Kopien von Verbunddaten in Salesforce _Data 360_.
- Reduziert wiederholte Abfragekosten und Latenz für häufig aufgerufene Datensets mit konfigurierbarer Dauer (Minuten bis Tage).
- Die Daten werden nicht dauerhaft kopiert oder vollständig verwaltet. Daher wird die Aktualisierung über geplante Aktualisierungen aus der Quelle verwaltet.
- _Die inkrementelle Aktualisierung_ unterstützt nur das Einfügen von Aktualisierungen. Gelöschte Datensätze werden nicht aus dem Cache entfernt.
- Führen Sie regelmäßig eine vollständige Aktualisierung aus, um sicherzustellen, dass der Cache mit der Quelle synchron bleibt.
- **Hinweis:** Der _Snowflake-_Konnektor unterstützt die Funktion _Entladen_, die die Beschleunigungsraten durch Verwendung eines von Snowflake initiierten Staging-Buckets erhöht. Dies ist standardmäßig aktiviert, kann jedoch durch Bearbeiten der Verbindung deaktiviert werden.
- **Dateiverbund**
- Bietet direkten schreibgeschützten Zugriff auf umfangreiche Datensets in Objektspeichern (z. B. _S3_ und _GCS_ mit _Iceberg_).
- Geeignet für AI/ML-Arbeitslasten, historische Analysen und Berichte auf Petabyte-Skala, ohne Daten verschieben zu müssen.
- Die Abfrageleistung hängt stark vom Objektformat, der Partitionierung und der Netzwerk-I/O ab. Große Scans können erhebliche E/A-Werte generieren, wenn sie nicht optimiert sind.
#### Architect Playbook (Playbook für Architekten)
- **Anwendungsfälle**
- **Echtzeitpersonalisierung und adaptive Workflows** bieten dynamische Angebote, Empfehlungen und Next-Best-Aktionen, wenn sich das Kundenverhalten ändert.
- **Live-Dashboards und operative Analysen** unterstützen geschäftskritische Dashboards und KPIs direkt aus externen Lagerhäusern.
- **AI/ML-Modelltraining mit großen externen Datensets** nutzt Daten im Petabyte-Bereich aus Data Lakes und Lagerhäusern, ohne sie per Dateiverbund zu verschieben.
- **Branchenszenarien**
- **Einzelhandel/Medien:** Aktivieren Sie personalisierte Empfehlungen und Kundenengagement in Echtzeit, indem Sie Clickstream- oder Inhaltsinteraktionsdaten verknüpfen.
- **Finanzen:** Führen Sie Betrugserkennung und Risikobewertung nahezu in Echtzeit aus, indem Sie externe Lagerhäuser abfragen, ohne sensible Daten zu duplizieren.
- **Tech/Enterprise:** Unterstützen Sie cloudübergreifende Berichte, IT-Service-Dashboards und betriebliche Analysen, wenn sich Datensets in mehreren Systemen befinden.
- **Designpraktiken**
- **Live-Abfrage**
- Wird für Abfragen mit hoher QPS und geringer Latenz verwendet, wenn die Aktualisierung wichtig ist.
- Übertragen Sie Prädikate und Aggregationen an das externe System, um die Datenverlagerung über das Netzwerk zu reduzieren.
- Vermeiden Sie Abfragen, die unnötig große Datenvolumen scannen.
- Ziehen Sie stattdessen den Partitionszuschnitt und Filter in Betracht.
- **Dateiverbund**
- Greifen Sie ohne Aufnahme auf Datensets im Petabyte-Bereich in Objektspeichern zu.
- Minimieren Sie Latenz- und Ausgangskosten, indem Sie den Objektspeicher in derselben Cloud-Region wie die Salesforce-Berechnung aufbewahren.
- Verwenden Sie partitionierte Spaltenformate (Parquet/ORC) und Pushdown-Filter, um die E/A- und Netzwerkübertragung zu reduzieren.
- Nutzen Sie den Pushdown für Abfragen und Prädikate, um Daten an der Quelle zu filtern und zu aggregieren, wodurch die Datenbewegung reduziert wird.
- Vermeiden Sie regionsübergreifenden Datenzugriff – es sei denn, er ist unbedingt erforderlich –, da er I/O, Latenz und Kosten erhöht.
- **Zwischenspeicherung (beschleunigte Abfrage)**
- Zwischenspeichern häufig aufgerufener Datensets, um Kosten und Leistung in Einklang zu bringen.
- Konfigurieren Sie Aktualisierungsintervalle, um die Frische im Vergleich zu den Abfragekosten auszugleichen.
- **Compliance:** Erzwingen Sie die Governance an der Quelle, indem Sie Richtlinien zur _Sicherheit auf Zeilenebene_ und Maskierung direkt in Verbundsystemen nutzen.
- Im Folgenden finden Sie einige bewährte Vorgehensweisen für einheitliches RLS und Maskierung über Plattformen hinweg:
- **Verwenden Sie eine zentralisierte Unternehmens-ID.** Ordnen Sie Benutzer und Einheiten in Salesforce _Data 360_ einer eindeutigen, zentralisierten Unternehmenskennung zu, die Identitäten in externen Systemen entspricht.
- **Angleichen von Sicherheitsrichtlinien.** Stellen Sie sicher, dass die Richtlinien für die Sprachausgabe und Maskierung in Verbundsystemen basierend auf der zugeordneten Identität angewendet werden. Dadurch wird die Compliance beim Abfragen externer Daten beibehalten.
- **Standardisieren Sie Identitätsschemas.** Verwalten Sie konsistente Identitätsattribute (E-Mail, Benutzer-ID, Kunden-ID usw.) über alle Datenquellen hinweg, um Inkonsistenzen und Zugriffsverletzungen zu vermeiden.
- **Überlegungen zu Kosten**
- **Live-Abfrage:** Im Pay-per-Query-Modell fallen bei der Berechnung des externen Lake House Kosten an, die zu Spitzen mit hohem QPS führen können. Dies eignet sich für frischigkeitskritische Anwendungsfälle, in denen der Wert größer als die Kostenvariabilität ist.
- **Beschleunigte Abfrage (Zwischenspeicherung):** Diese Methode senkt die Abfragekosten (im Vergleich zur _Live-Abfrage)_, indem Treffer im Quellsystem reduziert werden. Sie erhöht jedoch die Kosten für die Aufnahme von Batch-Daten beim Füllen und Aktualisieren des Cache. Dies eignet sich für häufig aufgerufene Datensets.
- **Dateiverbund:** Dies ist die günstigste Speicheroption als Daten im Objektspeicher. Die Abfragekosten hängen jedoch von der Dateigröße, der Partitionierung und dem Zuschnitt ab. Dies eignet sich für historische oder Massendaten im Petabyte-Maßstab.
#### Entscheidungskriterien für Nullkopiemethode
| Entscheidungspunkt | Live-Abfrage | Zwischenspeicherung (beschleunigte Abfrage) | Dateiverbund |
| :----------------------- | :---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | :--------------------------------------------------------------------------------------------------------------------------------------------------------- | :------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Datenquellenstandort** | Externe Data-Lake-Häuser (z. B. _Snowflake_, _Google BigQuery_, _Redshift_ und _Databricks_) | Externe Data-Lake-Häuser (z. B. _Snowflake_, _Google BigQuery_, _Redshift_ und _Databricks_) | Objektspeicher oder Cloud-Data-Lakes (z. B. _S3_, _ADLS_ und _GCS_), die häufig Open-Table-Formate wie _Iceberg_ verwenden. |
| **Zweck/Anwendungsfall** | Geeignet für interaktive Analysen und Echtzeit-Dashboards. Geeignet für Echtzeitpersonalisierung und dynamische Workflows. | Geeignet für häufige Abfragen, aber leicht veraltete Ergebnisse sind akzeptabel. Geeignet für BI-Dashboards und Segmentierung. | Geeignet für die Batchverarbeitung im großen Umfang und für AI/ML-Modellschulungen. Geeignet für historische Analysen und Berichte auf Petabyte-Skala. |
| **Frisch/Latenz** | Bietet maximale Aktualität Führt Abfragen direkt in Echtzeit aus. Unterstützt Entscheidungen innerhalb von Sekunden, wenn das Quellsystem für Abfragen mit geringer Latenz und effektivem Pushdown für Prädikate optimiert ist. | Wird verwendet, wenn leicht veraltete Ergebnisse akzeptabel sind. Die Aktualisierung hängt vom Cache-Intervall ab, das zwischen 15 Minuten und 7 Tagen konfiguriert werden kann. | Geeignet für chargenintensive, durchsatzintensive Aufträge. Nicht für Echtzeit-Dashboards geeignet. |
| **Zugriffsmuster** | Geeignet für seltene oder Ad-hoc-Abfragen, bei denen die Aktualität entscheidend ist und das Abfragevolumen gering ist. Die Kosten steigen bei hoher QPS erheblich an. Daher ist es wichtig, die Zwischenspeicherung (beschleunigte Abfrage) auszuwerten, wenn die Abfragehäufigkeit hoch ist. | Geeignet für Szenarien mit hoher Lesehäufigkeit. Verbessert die Leistung bei häufigen Zugriffsmustern. | Bietet *nur Lesezugriff*. Geeignet für Datensets im Petabyte-Bereich ohne Aufnahme. |
| **Leistungstreiber** | Stark von der Leistung des externen Quellsystems abhängig. Geeignet für den Fall, dass Prädikate und Aggregationen an die Quelle übertragen werden können. | Verringert die Latenz im Vergleich zu wiederholten Live-Abfragen. Die Leistung hängt von der Cache-Verwaltung und den Intervallen ab. | Die Leistung hängt stark vom Objektformat, der Partitionierung und dem externen Systemdurchsatz ab. Verwenden Sie partitionierte, spaltenförmige Formate (Parquet/ORC). |
| **Kostenauswirkungen** | Hierbei handelt es sich um ein Pay-per-Query-Modell. Daher fallen bei externen Lake House-Berechnungen Kosten an. Dies ist für seltene Abfragen kosteneffektiv, kann jedoch bei hohem QPS-Volumen zu hohen Ausgaben führen. | Die Kosten sind niedriger als bei wiederholten Live-Abfragen. Dadurch müssen die externen Quellen nicht mehr wiederholt abgefragt werden, es werden jedoch Cache-Speicher und Aktualisierungs-Overhead hinzugefügt. | Dies ist die günstigste Speicheroption. Bei AWS-Setups mit derselben Region (z. B. _S3_ in US-Ost-1 mit einem _Data Cloud-_Mandanten, der sich ebenfalls in US-Ost-1 befindet) werden die Gutschriften für die Zeilen, auf die zugegriffen wird, nicht verbraucht. Regions- oder Cloud-übergreifende Konfigurationen (z. B. _Azurblau_, _GCS_ oder verschiedene _AWS-_Regionen) führen zu einem Gutschriftsverbrauch für die Zeilen, auf die zugegriffen wird. Die Abfragekosten hängen auch von der Dateigröße, der Partitionierung und der Optimierung des Prädikat-Pushdowns ab. |
| **Wichtige Überlegungen** | Vermeiden Sie ungefilterte Abfragen, die unnötig große Datenvolumen scannen. | Für diesen Ansatz ist eine Cache-Verwaltung erforderlich. Nicht für Entscheidungen im Sekundenbereich geeignet. | Die Abfrageleistung hängt stark von der Optimierung über Partitionierung und Pushdown-Prädikate ab. |
### Hybridansatz
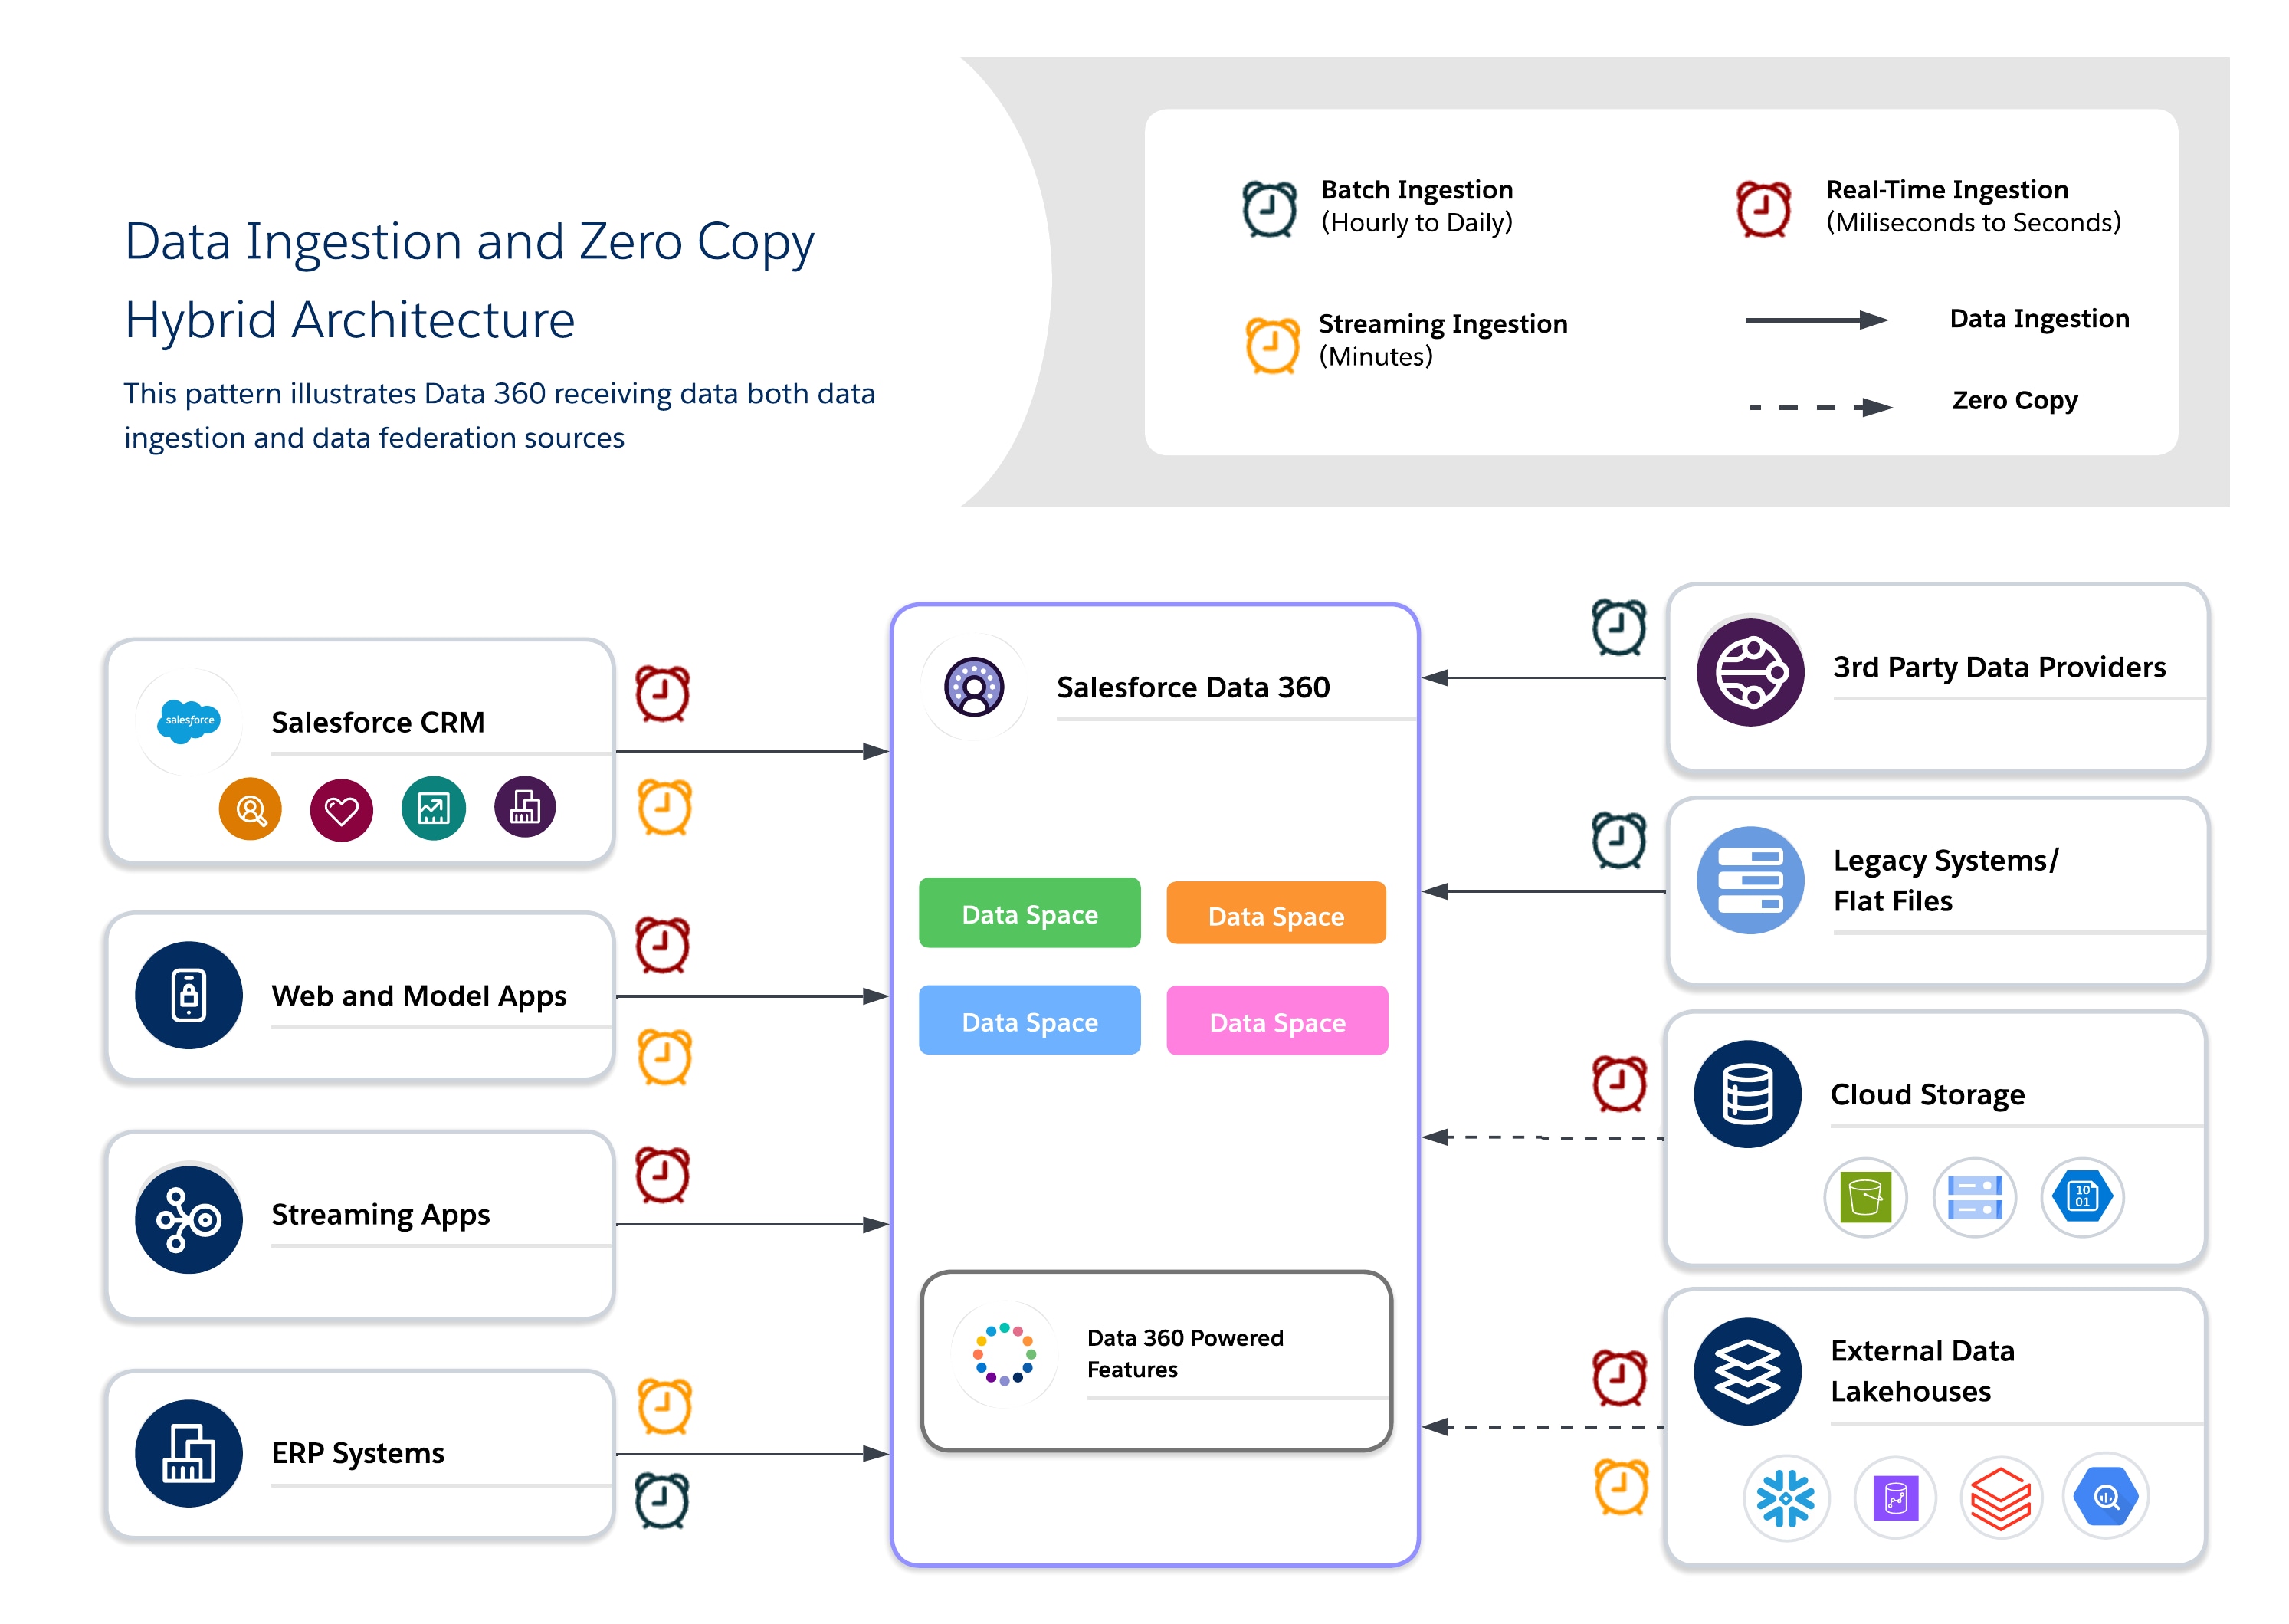
Mit hybriden Architekturen können Architekten wichtige Datensets in _Data 360_ verankern und gleichzeitig Verbundabfragen für Aktualität, reduzierte Duplikate und skalierbaren Zugriff auf große externe Datensets nutzen. Bei diesem Ansatz werden die Anforderungen an E/A, Berechnungslokalität, Kosten und Compliance abgewogen.
#### Hybride Anwendungsfälle
Verwenden Sie einen hybriden Ansatz für ausgewogene Verwaltung, Aktualität und betriebliche Effizienz, indem Sie Datenaufnahme und Nullkopie kombinieren, um handlungsrelevante Statistiken in Echtzeit bereitzustellen. Verwenden Sie die Aufnahme für hochwertige, regulierte Datensets, bei denen Rückverfolgbarkeit, RLS und Maskierung erforderlich sind, und die Zuordnung für vorübergehende Datensets oder Datensets mit hohem Volumen, bei denen Aktualität und Leistung entscheidend sind.
 #### Architect Playbook (Playbook für Architekten)
- **Anwendungsfälle**
- **Omnikanal-Engagement:** Kombinieren Sie historische Kundendaten mit Echtzeitverhalten, um konsistente, kontextbezogene Erfahrungen bereitzustellen.
- **AI/ML-Pipelines:** Trainieren Sie Modelle für zusammengestellte kanonische Datensets und reichern Sie sie mit Roh- oder Echtzeitsignalen aus externen Quellen an.
- **Kombinierte Compliance- und Agilitätsanforderungen:** Wenden Sie strenge Governance-Vorschriften für sensible Daten an und eine Verbundorganisation für betriebliche Agilität.
- **Branchenszenarien**
- **Einzelhandel:** Verwenden Sie die _Integration_ für die Identitätsbestimmung und die Profilvereinheitlichung und _die Zuordnung_ für Echtzeitangebote und Personalisierung.
- **Gesundheitswesen:** Verwalten Sie goldene Patientenakten per _Integration_, während Sie _eine Verbundverbindung für_ IoT-Geräteströme und Sensordaten verwenden, um einen unmittelbaren Kontext zu erhalten.
- **Financial Services:** Nehmen Sie regulierte Daten in einen konformitätsgesteuerten See auf, während Sie _den Verbund_ für externe Abfragen zur Betrugserkennung und Risikoüberwachung verwenden.
- **Designpraktiken**
- **Anker-Governance mit Aufnahme:** Nehmen Sie hochwertige oder regulierte Daten in kanonische Modelle auf, um Trust und Compliance zu gewährleisten.
- **Verbund für Frische verwenden:** Ermöglicht es externen Lake Houses, Datenzugriff in Echtzeit oder in großem Umfang ohne Duplikate bereitzustellen.
- **Balance Cost vs Performance (Saldokosten im Vergleich zur Leistung):** Profilarbeitslasten, um zu bestimmen, wann _die Aufnahme_ im Vergleich zum _Verbund_ verwendet werden soll, wodurch unnötige Speicher- und Abfragekosten minimiert werden.
- **Anwenden der mehrschichtigen Unternehmensführung:** Erzwingen Sie die zentralisierte Verwaltung für aufgenommene Daten und nutzen Sie gleichzeitig die Sicherheitssteuerungen für Verbundsysteme (z. B. RLS und Maskierung).
- **Hinweis:** Wenn Sie hybride Pipelines entwerfen, ist es wichtig, die inkrementelle Aufnahme historischer Datensets sicherzustellen und Aggregationen oder Filter an Verbundquellen zu übertragen, um die E/A- und Berechnungsnutzung zu optimieren.
- **Überlegungen zu Kosten**
- Wägen Sie die Gesamtkosten im Vergleich zur Leistung ab, indem Sie die _Aufnahme_ für Compliance- oder wichtige Daten mit dem _Verbund_ kombinieren, wenn eine Aktualisierung erforderlich ist.
- Berücksichtigen Sie die E/A- und Berechnungsverteilung beim Mischen von _Aufnahme_ und _Verbund_. Verwenden Sie die Zwischenspeicherung (beschleunigte Abfrage) für Verbunddatensets mit hohem Lesezugriff, um die Rechenkosten für wiederholte Abfragen in Quellsystemen zu reduzieren.
- Verwenden Sie diese Regel, um die Entscheidung über die Aufnahme im Vergleich zum Verbund festzulegen: Wenn häufig auf Daten zugegriffen wird, sich diese jedoch selten ändern, ist die _beschleunigte Abfrage_ in der Regel kostengünstiger. Wenn sich die Daten jedoch häufig ändern (bezogen auf die Zugriffshäufigkeit), ist die _Live-Abfrage_ oder -_Aufnahme_ besser geeignet. Hier einige Kostenbeispiele:
- **Beschleunigungsgewinne:** Ein Dashboard, das aus 1 Million Datensätzen erstellt und täglich mit etwa 10.000 Änderungen aktualisiert wird, wird 20 Mal pro Tag angezeigt. Die _Beschleunigungskosten_ belaufen sich auf etwa 600 Gutschriften/Monat im Vergleich zu 4.200 Gutschriften/Monat für _Live-Abfragen_.
- **Live-Abfrage gewinnt:** Segmente, die 20 Mal pro Tag veröffentlicht werden und Daten verwenden, die sich alle 30 Minuten ändern. _Live-Abfragen_ kosten etwa ~4.200 Credits/Monat im Vergleich zu ~28.800 Credits/Monat für die _Beschleunigung_ bei dieser Aktualisierungshäufigkeit.
## Leitfaden zur Anwendungsfallentscheidung
Sehen wir uns einige gängige Archetypen genauer an, die die Anwendung dieser Logik veranschaulichen.
- **Der Archetyp "Single Source of Truth" (Einzelne Datenquelle): Zentralisieren und Verwalten**
- **Szenario:** Sie müssen kompatible, vereinheitlichte _Customer 360_ Profile für Ihr gesamtes globales Unternehmen erstellen. Die Daten stammen aus einem Dutzend verschiedener Systeme, müssen strenge _DSGVO-_ und _CCPA-_Vorschriften einhalten und dienen als Quelle der Wahrheit für alle Marketing- und Serviceinteraktionen.
- **Empfohlenes Muster:** **Datenaufnahme.** Hier stehen Governance, Trust und Kontrolle im Vordergrund. Die Aufnahme der Daten in _Data 360_ ist die einzige Möglichkeit, ein vollständig überprüfbares, kanonisches Profil zu erstellen, das von den Quellsystemen isoliert ist.
- **Der Archetyp "Echtzeitstatistiken": Analysieren ohne Verschieben**
- **Szenario:** Ihr Data Science-Team muss Erkundungsabfragen für eine massive, ständig aktualisierte Transaktionstabelle in _Snowflake_ ausführen. Gleichzeitig möchte Ihr Führungsteam ein Live-_BI-_Dashboard, das auf denselben Daten basiert. Das tägliche Verschieben von Petabyte Daten ist langsam und teuer.
- **Empfohlenes Muster:** **Zero Copy Federation.** Die Priorität liegt dabei auf Geschwindigkeit, Agilität und Kosteneffizienz im richtigen Maßstab. Mit _Zero Copy_ können Sie die Leistungsfähigkeit Ihres vorhandenen Data Warehouse für Echtzeitabfragen nutzen, ohne den Aufwand und die Latenz der Datenduplizierung zu erhöhen.
- **Der Archetyp "Hybridintelligenz": Verwalten des Kerns, Zusammenführen des Kerns**
- **Szenario:** Sie möchten Ihre verwalteten, aufgenommenen Kundenprofile mit Echtzeit-Verhaltenssignalen (z. B. Website-Klicks) aus einem Data Lake anreichern. Sie benötigen die Stabilität des Kernprofils, aber die Unmittelbarkeit der Live-Daten, um die sofortige Personalisierung zu unterstützen.
- **Empfohlenes Muster:** **Ein hybrider Ansatz.** Verwenden Sie die _Datenaufnahme_, um einen stabilen, geregelten Kern für Ihre Kundendaten zu erstellen. Verwenden Sie _Nullkopie_, um die volatilen Echtzeit-"Edge"-Daten zu verknüpfen und dann zur Abfragezeit miteinander zu verknüpfen, um eine vollständige, sekundengenaue Ansicht zu erhalten.
## Der Weg nach vorn
Bei der Unternehmensdatenstrategie geht es nicht mehr darum, ein einzelnes Integrationsmuster auszuwählen, sondern darum, kontrollierte Flexibilität in einem interoperablen Datenökosystem zu entwickeln. Der richtige Ansatz ordnet jedes Quellsystem dem Muster zu, das seinen Anforderungen an Aktualität, Verwaltung, Kosten und Zugriff am besten entspricht:
- Nehmen Sie geschäftskritische, regulierte Datensets in Salesforce _Data Cloud_ auf, um Compliance, Identitätsbestimmung und betriebliche Workflows zu gewährleisten.
- Verbinden Sie Daten über _Nullkopie_ für Live-, explorative und AI-gestützte Analysen, ohne Speicher zu duplizieren.
- Anwenden von _Caching (beschleunigte Abfrage)_ zum Reduzieren der Quellsystemlast und des Guthabenverbrauchs bei hoher Abfragehäufigkeit und niedriger Datenänderungshäufigkeit
Salesforce _Data 360_ in _Hyperforce_ bietet Widerstandsfähigkeit und Skalierbarkeit für mehrere Regionen. Das offene Lake House mit _Iceberg-_Tabellen ermöglicht die Berechnungstrennung und Interoperabilität mit Plattformen wie _Snowflake_, _Databricks_ und _S3 Iceberg, die_ das Rückgrat eines wirklich interoperablen Multi-Cloud-Datenökosystems bilden.
Während sich Datenökosysteme weiterentwickeln, müssen wir kontinuierlich zwischen Aktualität, Kosten, Leistung und Compliance abwägen, um die architektonische Agilität aufrechtzuerhalten. Daher ist es wichtig, Ihre Plattform zukunftssicher zu gestalten, indem erfasste, geregelte Daten mit Verbundzugriff vereinheitlicht werden. Dies ermöglicht Echtzeitintelligenz, AI-Aktivierung und Personalisierung im Unternehmensbereich über Clouds, Regionen und Geschäftsdomänen hinweg.
Beachten Sie, dass Lösungen für die einheitliche Größe für die meisten Unternehmen nicht geeignet sind. Die optimale Strategie ordnet das richtige Muster dem richtigen Geschäftstreiber zu.
## Über die Autoren
**Yugandhar Bora** ist Software-Entwickler bei Salesforce und hat sich auf die Datenarchitektur innerhalb der Plattform für Daten- und Intelligenzanwendungen spezialisiert. Er leitet Initiativen des _Enterprise Architecture Review Board (EARB)_, die sich auf Datenverwaltung und vereinheitlichte Datenmodelle konzentrieren und gleichzeitig zu automatisierten Plattformbereitstellungslösungen beitragen.
**Jan Fernando** ist Principal Architect im _Office of the Chief Architect (OCA)_ bei Salesforce und seit 2012 bei Salesforce tätig. Vor seiner Tätigkeit beim OCA war er über ein Jahrzehnt in der _Plattformorganisation_ tätig, wo er mehrere wichtige Technologietransformationen leitete.